搜索到
38
篇与
AIGC Fundamentals
的结果
-
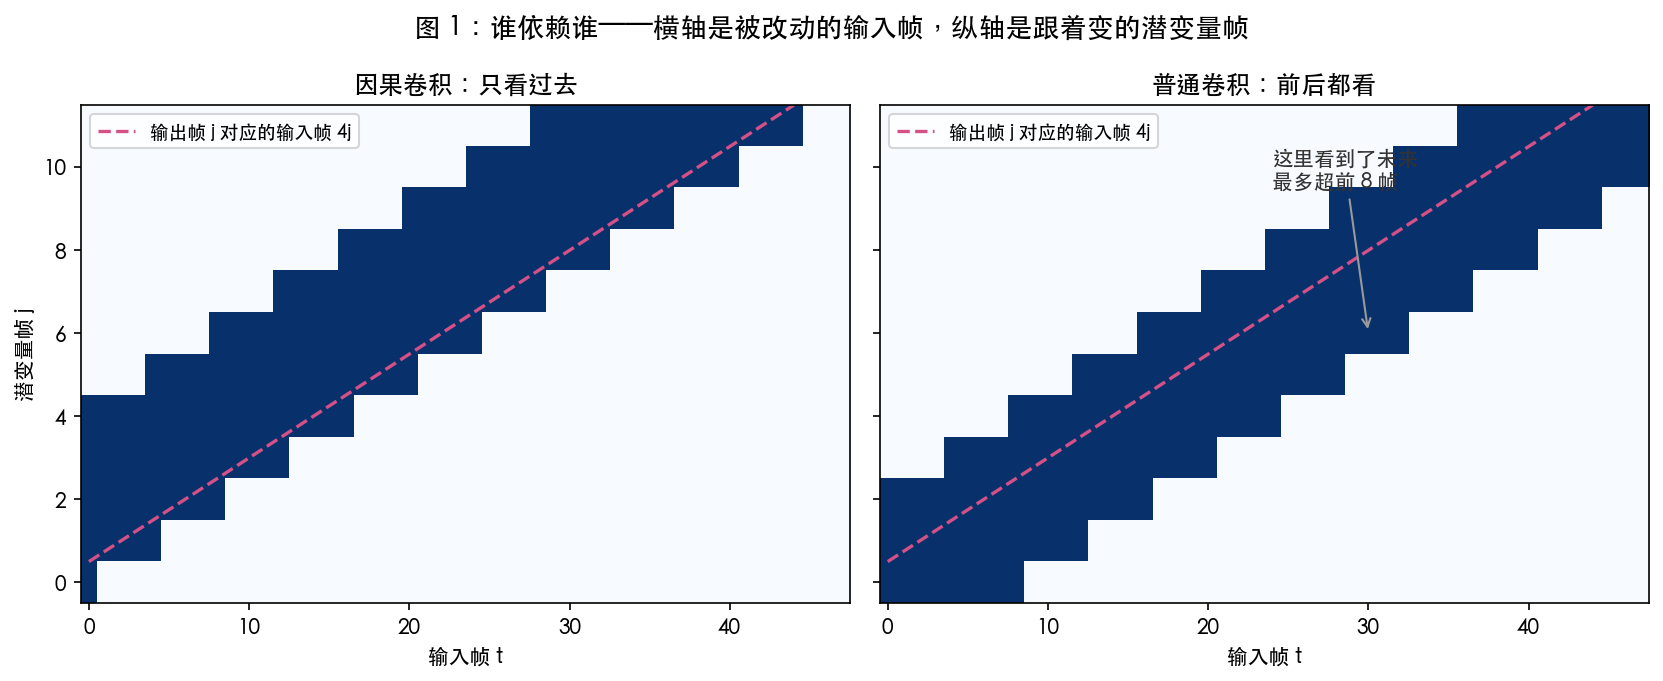
 AIGC 基本功|视频 VAE 的时空压缩结构-VideoVAE 视频 VAE 的时空压缩结构 所属方向:表征与压缩 | 难度:进阶 | 前置知识:VAE 结构与训练目标(vae_basics) 关键词:视频VAE、3D因果卷积、时间压缩、分块推理、闪烁伪影、潜变量 token 01. 为什么需要它 先给四个数字,全部来自文末附录里能直接跑的脚本。 数字一:不压时间维,潜变量序列会长到做不了全注意力。 同样一段 121 帧、768×512 的视频,用逐帧图像 VAE(空间 8×8、4 通道)编码出来是 743,424 个 token;改成 4×8×8(时间再压 4 倍、16 通道,CogVideoX / Wan / HunyuanVideo 这一档)是 190,464 个;再激进一点到 8×32×32(LTX-Video 这一档)只剩 6,144 个。自注意力的代价是 $O(N^2)$,所以相对第一档,注意力分别便宜 15.2 倍和 14641 倍(04 节算账,图 4 画出来)。这个差距决定了视频 DiT 能不能做「全时空自注意力」——做不了就只能在空间上做注意力、时间维另想办法,而「时间维另想办法」正是早期视频模型帧间闪烁的根源之一。 数字二:对称时间卷积可能读取未来,本 toy 的每个输出都有这种依赖。 把编码器里的时间填充从「只补前面」换成「前后对称补」,实测 12 个潜变量帧全部都依赖未来帧,最多超前 8 帧。这意味着你没法一边生成一边往外吐——潜变量位置 $j$ 最多要等到输入位置 $4j+8$(与本 toy 总步距 4 对齐),而不是把两侧帧索引直接相加。因果卷积把这个数字压到 0(03 节证明,图 1 左右两栏对比)。 数字三:分块解码不补够上下文,一整块都是错的,不是只有接缝那一帧。 把 24 个潜变量帧切成 3 块、每块 8 帧逐块解码:上下文带 0 帧时,两块合计 64 个输出帧里有 48 帧和整段解码的结果对不上;每块每多带 1 帧上下文,就少错 4 个输出帧(两块合计 8 帧);带到 6 帧时误差精确归零(不是变小,是浮点意义上完全相等)。6 这个数字不是经验值,它等于解码器的时间感受野减 1(03 节推导,图 3 是整条曲线)。 数字四:时间压缩的额度取决于画面运动有多快。 把一个匀速移动的高斯斑点压 8 倍时间再还原,运动速度 0.25 像素/帧时重建 PSNR 是 40.81 dB,速度提到 4 像素/帧掉到 24.92 dB,差 15.9 dB。而且会交叉:压时间 2 倍的曲线在约 2 像素/帧处掉到「压空间 2 倍」这条与速度无关的基线之下——过了这个点,继续压时间不如改压空间(06 节展开,图 5)。 所以这篇文章回答四件事:时间维到底怎么压、何时需要因果卷积、逐块推理要带多少上下文才不接缝、以及时间压缩比能推到多大。 02. 最小可用理解 三句话讲完: 视频 VAE 相对图像 VAE 只多一件事:在时间轴上再压 $s_T$ 倍。 潜变量形状从 $T \times H' \times W' \times C$ 变成 $T' \times H' \times W' \times C$,其中 $T' = \lfloor (T-1)/s_T \rfloor + 1$。token 数直接除以 $s_T$,注意力代价除以 $s_T^2$。 需要严格流式处理时,时间运算应满足因果性。 无膨胀、核长 $k_t$ 的卷积可只在前面补 $k_t-1$ 帧,边界可补零或复制首帧。离线视频 VAE 也可以采用非因果结构;卷积因果还不够,归一化、注意力、池化等其他时间运算也须检查。 代价有两笔,都要记账。 一是时间压缩等价于给运动物体糊上一条长度 $(s_T - 1) \cdot v$ 像素的运动模糊($v$ 是运动速度);二是因果卷积的感受野有限,逐块推理时每块必须额外带「感受野 − 1」帧上下文,带不够就不是接缝难看,是整块算错。 这张图要看什么:横轴是被人为改动的输入帧,纵轴是跟着发生变化的潜变量帧,蓝点表示「这一对有依赖关系」。左图所有蓝点都落在虚线(输入帧 $= 4j$)左边或线上——没有任何一个潜变量帧看到未来;右图蓝点越过虚线,右侧那团就是泄漏的未来信息,实测最多超前 8 帧。两张图除了时间填充方式,其余完全相同。 03. 数学推导 3.1 输出帧数:为什么是 $\lfloor (T-1)/s_T \rfloor + 1$ 而不是 $\lfloor T/s_T \rfloor$ 一维卷积(时间轴)在输入长度 $T_{\text{in}}$、核 $k_t$、步距 $s_t$、两端填充 $p_{\text{front}}$ 和 $p_{\text{back}}$ 下的输出长度是 $$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} + p_{\text{front}} + p_{\text{back}} - k_t}{s_t} \right\rfloor + 1$$ 每个符号:$T_{\text{in}}$ 是进入这一层的帧数,$p_{\text{front}}$ 是时间轴前面补的帧数,$p_{\text{back}}$ 是后面补的,$k_t$ 是时间维核长,$s_t$ 是时间步距。 因果卷积取 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$,代进去: $$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} - 1}{s_t} \right\rfloor + 1$$ 减 1 加 1 这一对不是凑出来的,它有物理含义:首帧被单独保留下来了。 前面补的那 $k_t - 1$ 帧全是零,所以第一个输出位置看到的是「$k_t - 1$ 个零 + 第 0 帧」,它天生就是第 0 帧的专属输出位。剩下 $T_{\text{in}} - 1$ 帧才按步距 $s_t$ 分组。 许多视频模型约定输入帧数为 $1+k s_T$,但要以完整实现为准。 本文 stride-conv toy 两次时间步距 2 时,49 帧的链路为: $$49 \to \lfloor 48/2 \rfloor + 1 = 25 \to \lfloor 24/2 \rfloor + 1 = 13$$ 得到 13 个 latent 帧。对本 toy,100 帧得到 25 个,最后输出所对齐的输入位置为 96,因此尾部 97—99 没被覆盖;真实模型也可能通过补帧、裁剪或专门的池化分支处理。下面引用的 CogVideoX 对奇偶长度有不同池化逻辑,不能把单层 stride-conv 公式不加条件地替代完整模型。 3.2 因果性:为什么前补零就够了 设时间填充后第 $i$ 个输入帧落在下标 $i + k_t - 1$ 上。步距为 $s_t$ 的第 $j$ 个输出取的是填充后区间 $[j s_t,\; j s_t + k_t - 1]$,对应原始输入下标 $$[j s_t - (k_t - 1),\; j s_t]$$ 上界恰好是 $j s_t$——第 $j$ 个输出能用到的最新输入帧就是第 $j s_t$ 帧,未来的帧一个都进不来。这就是因果性的全部证明,它只依赖「$p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$」这一条。 堆多层时把每层的时间步距连乘,记到第 $l$ 层输入为止的累积步距为 $S_l = \prod_{m<l} s_m$,则最终第 $j$ 个潜变量帧能用到的最新输入帧是 $S_{\text{total}} \cdot j$。脚本 causality_check() 用扰动法验过:把第 $t$ 帧之后的所有输入都改掉,凡是满足 $S_{\text{total}} \cdot j < t$ 的潜变量帧,变化量精确等于 0——不是小,是零,因为根本没连过来。 换成对称填充($p_{\text{front}} = p_{\text{back}} = (k_t - 1)/2$),上界变成 $j s_t + \lfloor (k_t - 1)/2 \rfloor$,未来的帧就漏进来了。实测 12 个潜变量帧全部泄漏,最多超前 8 帧。 3.3 时间感受野:为什么越靠后的层越值钱 $t$ 时刻的输出能看到多长的历史,叫时间感受野。标准公式是 $$\mathrm{RF} = 1 + \sum_l (k_l - 1) \cdot S_l,\qquad S_l = \prod_{m<l} s_m$$ 每个符号:$k_l$ 是第 $l$ 层的时间核长,$S_l$ 是走到第 $l$ 层输入时已经累积的时间步距。关键点在 $S_l$:第 $l$ 层的一个核长 $k_l$,在原始输入上跨的是 $k_l \times S_l$ 帧,因为它的每一个位置本身就代表了 $S_l$ 个原始帧。 本工程的 toy 编码器是 4 层 $k = 3$、步距 $[1, 2, 2, 1]$: $$\mathrm{RF} = 1 + 2\cdot 1 + 2\cdot 1 + 2\cdot 2 + 2\cdot 4 = 17$$ 注意最后两项:同样一个 $k = 3$ 的核,在第 3 层贡献 4 帧,到第 4 层就贡献 8 帧——因为前面已经把时间压了 4 倍。这就是「层数不变、压缩比一上去感受野暴涨」的原因,也是下面那条上下文公式的来源。 这张图要看什么:四根柱子的核长全都是 3,但贡献从 2 帧一路涨到 8 帧,涨的唯一原因是柱底标注的「累积步距」从 1 变成 4。要控制感受野和分块开销,就要一起考虑各层的核长与累计步距。 脚本 receptive_field() 用逐帧扰动实测了同一个数:最大跨度 17 帧,与公式逐项吻合;同时验了因果上界(潜变量帧 $j$ 能看到的最新输入帧 $\le 4j$)零次违反。 3.4 逐块推理:需要的上下文帧数恰好是 $\mathrm{RF} - 1$ 由 3.3,输出(或潜变量)帧 $j$ 依赖的输入区间长度是 $\mathrm{RF}$,右端点是 $S_{\text{total}} \cdot j$,所以左端点是 $S_{\text{total}} \cdot j - \mathrm{RF} + 1$。 现在做分块:要正确算出第 $j_0$ 块,就必须拿到它左端点往前的全部输入。缺掉的部分在普通卷积里是被零填充替掉的——零不是正确的值,于是结果错。所以: $$\text{所需上下文} = \mathrm{RF} - 1 \quad \text{(以该侧的时间单位为帧)}$$ 注意单位随你在哪一侧算: 解码侧:单位是潜变量帧。本 toy 解码器的感受野实测是 7 个潜变量帧(两次最近邻上采样会把间距缩小,所以按「潜变量帧」计只有 7 而不是几十),于是需要 6 帧上下文。 编码侧:单位是输入帧。编码器感受野 17 帧,于是需要 16 帧输入上下文。 两条都被脚本验到了:解码侧 ctx 从 0 加到 6,误差在 6 处精确归零;编码侧 ctx 从 0 加到 16,误差在 16 处精确归零。这不是调参调出来的,是感受野直接算出来的。 3.5 时间压缩等价于一条多长的运动模糊 把时间下采样简化成最朴素的「$s$ 帧取平均」(CogVideoX 的下采样层真的就是 avg_pool1d,见 05 节)。一个以速度 $v$ 像素/帧平移的物体,在 $s$ 帧内走过的距离是 $(s-1)v$,所以 $s$ 帧平均等价于把它和一条长度 $L = (s-1)v$ 的盒式核做卷积。 这实际上是 $s$ 个离散平移位置的均匀平均,位移取 $0,v,\ldots,(s-1)v$,其方差为 $v^2(s^2-1)/12$。不是把端点距离直接代入连续盒核的 $L^2/12$。因此,无限画布上按二阶矩定义的宽度满足 $$\sigma_{\text{new}} = \sqrt{\sigma^2 + \frac{v^2(s^2-1)}{12}}$$ 当 $s=8,v=4,\sigma=3$ 时,解析宽度是 $\sqrt{9+84}=\sqrt{93}\approx9.644$ 像素;带微噪声并截去噪声底的代码测得约 9.640。差别来自有限画布和阈值测宽,而不是神经网络实验。这只是“时间平均 + 最近邻还原”的模型,不是学习型视频 VAE 的必然误差或压缩下界。 04. 代码实现 环境只要 numpy。全部脚本在文末附录,这里放最核心的三段。 4.1 因果卷积:时间只补前面 def causal_pad(x, k_t): """时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。""" if k_t <= 1: return x pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype) return np.concatenate([pad, x], axis=1) def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"): """3D 卷积,时间填充方式可选: time_pad="causal" 前面补 k_t-1 帧、后面不补(只看过去) time_pad="symmetric" 前后各补 (k_t-1)//2 帧(会看到未来) """ kt, kh, kw = w.shape[2], w.shape[3], w.shape[4] if time_pad == "causal": x = causal_pad(x, kt) else: pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0)) x = np.pad(x, pad, mode="constant") x = sym_pad_hw(x, kh, kw) return conv3d_valid(x, w, stride) def out_frames(t_in, k_t=3, s_t=1): """因果卷积的时间输出帧数。注意不是 floor(T_in / s_t)。""" return (t_in - 1) // s_t + 1 toy 使用无 batch 的 [C,T,H,W];PyTorch Conv3d 常用带 batch 的 [B,C,T,H,W],也支持无 batch 输入。真实输出: T_in= 49 -> s_t=1: 预测 49 / 实测 49 OK s_t=2: 预测 25 / 实测 25 OK s_t=4: 预测 13 / 实测 13 OK 两级时间压缩 2(CogVideoX 口径):49 帧 -> 25 -> 13 潜变量帧 4.2 因果性检验:改未来,看过去 def causality_check(): """改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。""" net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) worst = 0.0 for t_edit in range(0, 48, 4): v2 = v.copy() v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动 z2 = net.encode(v2) # 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j for j in range(z2.shape[1]): if 4 * j < t_edit: diff = np.abs(z2[:, j] - z_ref[:, j]).max() worst = max(worst, diff) print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}") 真实输出: 应该完全不受影响的潜变量帧上,最大变化量 = 0.000e+00 把 ToyVideoVAE() 换成 ToyVideoVAE(time_pad="symmetric") 再跑一次 dependency_matrix,会得到「12 个潜变量帧全部泄漏、最多超前 8 帧」——这是 09 节留给读者的第一个动手验证。 4.3 分块解码:接缝是算出来的,不是看出来的 def decode_chunked(net, z, chunk=CHUNK, ctx=0): """按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。""" nz = z.shape[1] pieces, starts = [], [] n_chunks = (nz + chunk - 1) // chunk for i in range(n_chunks): lo = i * chunk hi = min(lo + chunk, nz) lo_in = max(0, lo - ctx) out = net.decode(z[:, lo_in:hi]) keep = (hi - lo) * T_STRIDE # 上下文部分的输出要丢掉 pieces.append(out[:, -keep:]) starts.append(lo * T_STRIDE) return np.concatenate(pieces, axis=1), starts 96 帧输入 $\to$ 24 个潜变量帧 $\to$ 切 3 块,真实输出(误差按输出标准差归一): ctx | 块头误差 | 块尾误差 | 块内被污染帧数 | 边界跳变放大 ----+---------+---------+----------------+------------ 0 | 2.550e+00 | 3.206e+00 | 48 | 1.90x 1 | 2.094e+00 | 1.814e+00 | 40 | 2.19x 2 | 1.658e+00 | 1.399e+00 | 32 | 1.88x 3 | 1.313e+00 | 8.267e-01 | 24 | 2.19x 4 | 8.700e-01 | 4.549e-01 | 16 | 1.15x 5 | 4.051e-01 | 0.000e+00 | 8 | 1.07x 6 | 0.000e+00 | 0.000e+00 | 0 | 1.00x 三件事要读出来: 误差在 ctx = 6 处精确归零,不是渐近变小。少 1 帧(ctx = 5)还剩 8 个输出帧是错的。 每块每少带 1 帧上下文,就多错 4 个输出帧(表中两块合计 8 帧),正好等于 1 个潜变量帧的输出跨度($s_T = 4$)。所以「接缝」根本不是一条线,是一段区域。 块尾误差比块头误差先归零(ctx = 5 时块尾已经是 0 而块头还有 0.405)。这符合感受野的形状:越靠块尾,缺的上下文越少。 编码侧同理,真实输出(每块 32 个输入帧,误差按潜变量标准差归一): ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数 ----+----------------+----------------+-------------- 0 | 3.245e+00 | 2.984e+00 | 4 8 | 1.297e+00 | 0.000e+00 | 2 12 | 6.090e-01 | 0.000e+00 | 1 16 | 0.000e+00 | 0.000e+00 | 0 阈值 16,正是编码器感受野 $17 - 1$。 这张图要看什么:左图两条线(块头、块尾)在 ctx = 6 处一起掉到 0,纵坐标是对数轴——前面那段下降看着平缓,其实是从「两个标准差」这种肉眼可见的错误降到零。右图的阶梯更直白:被污染帧数每块减少 4 帧、图中两块合计减少 8 帧,斜率就是 $s_T$。 4.4 token 账本 def latent_frames(t_in, s_t): """因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。""" return (t_in - 1) // s_t + 1 121 帧 / 768×512 / RGB 的真实输出: 配置 | 潜变量形状 (T'xH'xW'xC) | token 数 N | N^2 相对代价 | 便宜倍数 | 每 token 覆盖像素 图像 VAE 逐帧(SVD / AnimateDiff 口径)| 121 x 64 x 96 x 4 | 743,424 | 1.000e+00 | 1.0x | 192 CogVideoX / Wan / HunyuanVideo(4x8x8)| 31 x 64 x 96 x 16 | 190,464 | 6.564e-02 | 15.2x | 768 LTX-Video(8x32x32) | 16 x 16 x 24 x 128 | 6,144 | 6.830e-05 | 14641.0x | 24,576 只动时间维的对照(固定空间 8×8、通道 16):时间压缩 1→2→4→8,token 数 743,424→374,784→190,464→98,304,长序列下近似每翻一倍注意力代价降到 1/4,首帧保留会带来取整差异。 这张图要看什么:左图是序列长度(对数轴),右图是注意力的相对代价——右图的差距比左图大得多,因为代价是 $N^2$。6,144 个 token 意味着 LTX-Video 可以在这个分辨率上直接做全时空自注意力,而 743,424 个 token 连存 attention map 都存不下。 05. 工业级实现对照 最小实现只有一条时间前补零,生产代码多了五处,每处都有原因。以下均以 huggingface/diffusers 2026-09 的实现为准(上游会重构,引用时请对照 repo/path#symbol): src/diffusers/models/autoencoders/autoencoder_kl_cogvideox.py#CogVideoXCausalConv3d src/diffusers/models/autoencoders/autoencoder_kl_wan.py#WanCausalConv3d src/diffusers/models/downsampling.py#CogVideoXDownsample3D src/diffusers/models/upsampling.py#CogVideoXUpsample3D 5.1 填充元组:时间只补前面 src/diffusers/models/autoencoders/autoencoder_kl_cogvideox.py#CogVideoXCausalConv3d: time_pad = time_kernel_size - 1 self.time_causal_padding = (width_pad, width_pad, height_pad, height_pad, time_pad, 0) F.pad 的元组是从最后一维往前写的,所以这六个数的含义是 $(W_{\text{left}}, W_{\text{right}}, H_{\text{left}}, H_{\text{right}}, T_{\text{left}}, T_{\text{right}})$。最后两个是 $(k_t - 1,\ 0)$——和 3.2 节推导的 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$ 完全一致。空间两维是对称的,只有时间轴不对称。 Wan 的 WanCausalConv3d(autoencoder_kl_wan.py)写成另一种形式: self._padding = (self.padding[2], self.padding[2], self.padding[1], self.padding[1], 2 * self.padding[0], 0) self.padding = (0, 0, 0) 它先把 nn.Conv3d 自带的 padding 清零,改成自己手动 pad。$k_t = 3$ 时 padding[0] = 1,于是 $2 \cdot 1 = 2 = k_t - 1$,和 CogVideoX 殊途同归。 5.2 上下文缓存:分块推理靠它 CogVideoX 的 fake_context_parallel_forward: kernel_size = self.time_kernel_size if kernel_size > 1: cached_inputs = [conv_cache] if conv_cache is not None else [inputs[:, :, :1]] * (kernel_size - 1) inputs = torch.cat(cached_inputs + [inputs], dim=2) return inputs 读法:有缓存就把上一块最后 $k_t - 1$ 帧拼到前面;是第一块(没缓存)就把第 0 帧复制 $k_t - 1$ 次。这正好对应 3.4 节的两种情形——「缺上下文就用别的东西填」,而复制首帧比补零更合理(这是 pad_mode 的一个选项)。紧接着: conv_cache = inputs[:, :, -self.time_kernel_size + 1:].clone() 把拼接后输入的最后 $k_t - 1$ 帧存起来,给下一块用。整个编码器把这些缓存收进一个以层名索引的字典(conv_in、down_block_0……)逐层传递。Wan 的对应逻辑更紧凑,直接把缓存长度从待补的填充里减掉: if cache_x is not None and self._padding[4] > 0: x = torch.cat([cache_x, x], dim=2) padding[4] -= cache_x.shape[2] 这就是 04 节那个 ctx 在生产代码里的样子。 这里有个容易看错的地方:工业实现每层只缓存 $k_t - 1 = 2$ 帧,而 04 节实测需要 6 帧,直觉上会觉得「2 帧不够」。其实够——因为每层缓存的是该层自己输入分辨率下的帧,越往后的层分辨率越高,同样 2 帧折回潜变量帧单位就越小。把解码器 d0…d4 逐层折算后累加: 层 输入相对潜变量的帧间距 缓存 $(k_t - 1)$ 帧折回潜变量帧 d0 1.00 2.00 d1 1.00 2.00 d2 0.50 1.00 d3 0.25 0.50 d4 0.25 0.50 合计 6.00 逐层累加 = 6.00,和 04 节实测需要的 6 帧完全吻合——逐层缓存本来就等价于整条链路的感受野减 1,前提是每一层都缓存。真正的陷阱是只在网络入口缓存一次,那样只有 2 帧,接缝一定在。 5.3 时间下采样:CogVideoX 用的是平均池化,不是学习出来的卷积 src/diffusers/models/downsampling.py#CogVideoXDownsample3D: x = x.permute(0, 3, 4, 1, 2).reshape(batch_size * height * width, channels, frames) if x.shape[-1] % 2 == 1: x_first, x_rest = x[..., 0], x[..., 1:] x_rest = F.avg_pool1d(x_rest, kernel_size=2, stride=2) x = torch.cat([x_first[..., None], x_rest], dim=-1) else: x = F.avg_pool1d(x, kernel_size=2, stride=2) 两个细节值得记住: 时间维是 avg_pool1d,不是 stride 卷积。 空间维倒是用 nn.Conv2d(stride=2)(注意它把 (B, T, C, H, W) 折叠成 (B*T, C, H, W) 后用 2D 卷积做的,目的是省 Conv3d 的显存)。所以 3.5 节把时间下采样建模成平均池化不是偷懒,它就是这个实现。 帧数为奇数时首帧单独保留,不参与池化——和 3.1 节「首帧单独占一个输出位」是同一件事的两种写法。 上采样端(upsampling.py#CogVideoXUpsample3D)对称地用 F.interpolate 做时间 2 倍、空间 2 倍,并且同样对首帧单独处理。 另外编码器里有一行决定「在哪几层压时间」: temporal_compress_level = int(np.log2(temporal_compression_ratio)) compress_time = i < temporal_compress_level 压缩比 4 → level = 2 → 只有前两个下采样块压时间。这也解释了图 2 那件事:压缩集中在前段时,后段的层会以更大的累积步距去看历史,感受野涨得最快。 5.4 与最小实现的五处差距 差距 生产代码 为什么 归一化 GroupNorm / CogVideoXSpatialNorm3D 调节中间激活的尺度;不能代替 KL,也不保证 latent 标准正态。若统计量跨时间,还须单独检查因果性 激活与结构 ResNet block + SiLU,不是单层卷积 单层卷积的表达能力撑不起 8×8 的空间压缩 卷积实现 CogVideoXSafeConv3d(分块跑的 Conv3d) 避免长视频上 Conv3d 一次性分配大显存 缓存粒度 每层一个 key 的字典 分块推理要逐层续接,不是只在入口续接 精度与缓存 dtype 由模型配置决定;缓存可 .clone() bf16 降低存储,clone 控制缓存所有权;二者是不同问题 06. 代价与边界 数值个数、序列长度与信息量是三件事。 这张表最容易看错: 配置 | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值) 图像 VAE 逐帧(SVD / AnimateDiff 口径)| 2,973,696 | 48.0 : 1 CogVideoX / Wan / HunyuanVideo(4x8x8)| 3,047,424 | 46.8 : 1 LTX-Video(8x32x32) | 786,432 | 181.5 : 1 4×8×8 这一档的数值元素压缩比和逐帧图像 VAE 几乎一样(46.8 vs 48.0)。它在这个数值元素口径下没有更小,但并非无损重排:学习型编码器把 743,424 个 token 重排成 190,464 个更「厚」的 token(通道 4 → 16)。数值个数接近不代表信息容量相同;这张表直接说明的是序列长度。 真正开始省容量的是 8×32×32 这一档,代价是 LTX-Video 摘要里自己写的那句:"the high compression inherently limits the representation of fine details"(高压缩本质上限制了细节的表达)。 时间压缩的额度由运动速度决定。 图 5 的三组曲线: 这张图要看什么:实线是压时间,虚线是压空间(与速度无关,当基线用)。同一颜色实线往下掉、虚线不动,交叉之后「再压时间」就不如「改压空间」。实测交叉点:压 2 倍和 4 倍在约 2 像素/帧处,压 8 倍在约 4 像素/帧处。 速度 v | 时间 2x / 空间 2x 时间 4x / 空间 4x 时间 8x / 空间 8x 0.25 | 53.49 / 39.00 46.87 / 32.35 40.81 / 26.58 1.00 | 41.97 / 39.00 35.28 / 32.35 30.05 / 26.58 2.00 | 36.15 / 39.00 30.18 / 32.35 26.62 / 26.58 4.00 | 30.83 / 39.00 26.69 / 32.29 24.92 / 26.57 这些交叉点只属于本实验的斑点、尺寸、噪声和滤波器。尤其“时间 s 倍”减少 s 倍元素,而“空间两轴各 s 倍”减少 s² 倍元素,并非等码率比较,不能据此给出“超过 2 像素/帧就不能压缩”的部署阈值。真实 VAE 需在相同码率、动作数据和感知/时序指标下做验证。 首帧总是吃亏的。 因果卷积前面补的是零(或复制首帧),第一个输出位置天然只能看到 1 帧输入。图 1 左图第 0 行只有一个蓝点就是这个意思。所以「图生视频」任务里把首帧单独处理、或者编码时多给一帧,是常见做法。 上下文是纯开销。 带够 $\mathrm{RF} - 1$ 帧上下文,意味着每块要多算: 解码块大小 | 需要上下文 | 额外算力占比 8 潜变量帧 | 6 帧 | 42.9% 16 潜变量帧 | 6 帧 | 27.3% 24 潜变量帧 | 6 帧 | 20.0% 编码块大小 | 需要上下文 | 额外算力占比 32 输入帧 | 16 帧 | 33.3% 128 输入帧 | 16 帧 | 11.1% 上下文的绝对量是固定的,块越大摊得越薄。这就是「块不能切太小」的定量理由:块切成 8 帧,42.9% 的算力花在重复计算上,此时「分块省显存」的收益已经被吃掉了三分之一。 离线场景可以考虑非因果结构。 它能使用前后帧,但是否提高质量要由实验决定。非因果网络也能分块,只是需要左右上下文或接受输出延迟。因果性本身不保证无闪烁,也不保证完整模型严格流式:跨时间归一化或全局注意力仍可能破坏性质。 07. 经典论文脉络 五篇,每篇一句话说清它对「时间维怎么处理」的贡献: VQ-VAE(arXiv:1711.00937,2017) — 提出「先压成离散 token 再建模」的范式。它本身是图像的,但整套 video tokenizer 都是从它长出来的。 MAGVIT(arXiv:2212.05199,2022) — 把 3D 卷积 + 时间下采样正式带进视频 tokenizer,用 masked modeling 训练,是这一方向的一项代表工作。(更早的 VideoGPT,arXiv:2104.10157,是另一条路:VQ-VAE + 自回归 Transformer。) MAGVIT-v2(arXiv:2310.05737,2023) — 换掉矢量量化,用 lookup-free 量化把词表做大,让离散视频 token 的质量第一次追上扩散。标题那句 "Tokenizer is Key" 就是这一支的纲领。 CogVideoX(arXiv:2408.06072,2024) — 本文的锚点。把 3D 因果 VAE 和 Expert Transformer 绑在一起,明确以「提高压缩率同时保住保真度」为目标;它也是这套因果缓存实现被广泛复用的起点。同期的 HunyuanVideo(arXiv:2412.03603)与 Wan(arXiv:2503.20314)都走 4×8×8 这一档。 LTX-Video(arXiv:2501.00103,2025) — 把压缩比推到 8×32×32(摘要自述 1:192),代价是细节;它的解法是让解码器顺手把最后一步去噪也做了,直接在像素空间出结果。 还有一条不压时间的路线:Stable Video Diffusion 使用空间压缩的图像自编码器并加入时序解码层;Align your Latents 是较早的 Video LDM 工作,不能把两个标题和论文 ID 混在一起。逐帧 latent 的长度更大,但生成器是否采用全时空、分离式注意力或其他结构会改变真实成本。 08. 常见误解 误解一:「时间压缩 4 倍时,48 帧一定输出 13 帧。」 本文单侧填充 stride-conv 公式给出 $\lfloor47/4\rfloor+1=12$,49 帧才给 13。许多真实模型限定 $1+k s_T$ 帧,其他输入长度会经过补齐、裁剪或不同池化分支,必须核对代码,不能把帧数规则泛化。 误解二:「只要卷积前补零,整个 VAE 就严格因果。」 单层卷积的因果范围可以逐项证明,但还要检查膨胀、池化对齐、归一化和注意力的时间依赖。分块既可逐层缓存中间特征,也可在入口重叠足够大的上下文后裁剪;后者在本 toy 需要 6 个 latent 帧,而不是只缓存 2 帧。两种方式都可正确,只是计算和内存开销不同。 误解三:「分块解码只要重叠 1 帧就够,接缝最多难看一点点。」 实测:缺上下文时不是接缝那一帧错,是整块错。块大小 8 个潜变量帧、上下文 0 帧时,32 个输出帧里 24 帧是错的;每少带 1 帧上下文多错 4 个输出帧。而且这个错误不是「视觉上略糊」,是数值上完全跑偏(相对标准差 2.55 倍)。 误解四:「压缩比越高越好,反正都是 VAE 重建。」 4×8×8 相对逐帧图像 VAE 的数值元素压缩比几乎没变(46.8:1 vs 48.0:1),它省的是序列长度(06 节第一张表)。真正省容量的是 8×32×32 那一档,而论文自己承认细节受限。所以「压缩比」这个词在这件事上有两个含义,混着用会得出完全相反的结论。 误解五:「视频 VAE 就是把图像 VAE 的 2D 卷积换成 3D 卷积。」 三处不一样:(a)CogVideoX 的时间池化本身没有可学习参数,但其前后的 3D 时间卷积有;(b)空间卷积被折叠成 2D 卷积做,为的是省 Conv3d 的显存;(c)temporal_compress_level = int(log2(ratio)) 决定只有前几层压时间,不是每层都压。想从图像 VAE 权重 inflate 一个视频 VAE,这三处都得单独处理。 09. 动手验证 五个脚本都在文末附录;数值实验依赖 numpy,make_figures.py 还依赖 matplotlib。运行时间取决于机器。 python causal_conv3d.py # 形状公式 + 因果性 + 感受野(约 11 秒) python chunk_decode.py # 分块编解码的接缝(约 8 秒) python temporal_budget.py # 运动速度 vs 时间压缩 python token_ledger.py # token 账本 python make_figures.py # 重画本文 5 张图 预期结果: causal_conv3d.py:形状公式 6 组输入、3 组步距预测值全部等于实测值;49 -> 25 -> 13;因果性违反量 0.000e+00;感受野公式 17 = 实测 17,因果上界 0 次违反。 chunk_decode.py:解码侧 ctx = 6 时误差 0.000e+00;编码侧 ctx = 16 时误差 0.000e+00;被污染帧数随 ctx 每 +1 减 8(两块合计)。 temporal_budget.py:s=8 那一列 PSNR 从 40.81 dB 掉到 24.92 dB;宽度增幅实测约 3.24 倍,修正离散方差后的解析值也约 3.24 倍;交叉点报在 2 / 2 / 4 像素/帧。 三个可以自己改的小实验: 把因果改成非因果:dependency_matrix(t_in=48, time_pad="symmetric"),看所有 12 个潜变量帧都越过 $4j$ 那条线,最多超前 8 帧。 把解码器的 latent 级卷积从 2 层加到 4 层:感受野会变成 11 个潜变量帧,所需上下文从 6 涨到 10,重跑 chunk_decode.py 会看到阈值跟着移动。这条最能验证「上下文 = 感受野 − 1」不是巧合。 把 toy 编码器的时间步距从 $[1,2,2,1]$ 改成 $[1,1,2,2]$:总压缩比不变(还是 4),但累积步距的分布变了,感受野从 17 变成 $1+2+2+2+4=11$。压缩比相同,上下文开销不同——这就是选架构时真正该看的量。 10. 延伸阅读 按依赖顺序: vae_basics(VAE 结构与训练目标) — 本文默认你已经知道 KL 项和重参数化在干什么。若要接着问「潜变量为什么要近似标准正态」,看它。 vae_losses(视频 VAE 的常见 loss 组合) — 本文只讲了结构没讲训练目标。L1 + KL + LPIPS + GAN 四项权重怎么配、谁在管伪影,是那篇的话题;帧间闪烁的根因有一半在那儿,不在本文的因果性里。 latent_diffusion(潜空间扩散) — 潜变量一旦定了,扩散过程就全在它上面做,包括那个 scaling factor。 dit(DiT:用 Transformer 替掉 UNet) — 01 节那个 $N^2$ 账单最后是要 DiT 来付的,token 数直接决定它能不能做全时空注意力。 autoregressive_video(自回归视频生成与 Forcing 范式) — 本文讲的是「逐块解码不接缝」;那篇讲的是更进一步:干脆按帧自回归地生成,因果性从 VAE 一路贯穿到生成模型。 附录:完整代码 09 节用到的脚本全文如下(make_figures.py、causal_conv3d.py、chunk_decode.py、temporal_budget.py、token_ledger.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 make_figures.py # -*- coding: utf-8 -*- """画配图。所有数字都来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] 标签一律用 Unicode(σ、×)而不是 mathtext,省得反斜杠踩到转义检查。 """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) import causal_conv3d as cc # noqa: E402 import chunk_decode as cd # noqa: E402 import token_ledger as tl # noqa: E402 import temporal_budget as tb # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Heiti TC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:因果 vs 非因果的依赖矩阵 ─────────────── def fig_dependency(): dep_c = cc.dependency_matrix(t_in=48, time_pad="causal") dep_n = cc.dependency_matrix(t_in=48, time_pad="symmetric") fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.6), sharey=True) for ax, dep, title in ((axes[0], dep_c, "因果卷积:只看过去"), (axes[1], dep_n, "普通卷积:前后都看")): ax.imshow(dep.T, aspect="auto", cmap="Blues", interpolation="nearest", origin="lower") nz = dep.shape[1] jj = np.arange(nz) ax.plot(4 * jj, jj + 0.5, color=C1, lw=1.6, ls="--", label="输出帧 j 对应的输入帧 4j") ax.set_xlabel("输入帧 t") ax.set_title(title, fontsize=12) ax.legend(loc="upper left", fontsize=9) axes[0].set_ylabel("潜变量帧 j") # 标一处「未来泄漏」 leak = [] for j in range(dep_n.shape[1]): idx = np.where(dep_n[:, j])[0] if len(idx) and idx.max() > 4 * j: leak.append(int(idx.max()) - 4 * j) if leak: axes[1].annotate(f"这里看到了未来\n最多超前 {max(leak)} 帧", xy=(30, 6), xytext=(24, 9.5), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#999999", lw=1)) fig.suptitle("图 1:谁依赖谁——横轴是被改动的输入帧,纵轴是跟着变的潜变量帧", fontsize=13) fig.tight_layout() _save(fig, "fig1_dependency.png") return dep_c, dep_n # ─────────────── 图 2:感受野为什么会被步距放大 ─────────────── def fig_rf(): kernels = [3, 3, 3, 3] strides = [1, 2, 2, 1] contrib, cum = [], [] c = 1 for k, s in zip(kernels, strides): contrib.append((k - 1) * c) cum.append(c) c *= s rf = 1 + sum(contrib) fig, ax = plt.subplots(figsize=(7.6, 4.4)) x = np.arange(len(kernels)) ax.bar(x, contrib, color=[C0, C0, C2, C1], width=0.62) for i, (v, cu) in enumerate(zip(contrib, cum)): ax.text(i, v + 0.25, f"+{v}", ha="center", fontsize=10) ax.text(i, -0.9, f"累积步距 {cu}", ha="center", fontsize=9, color="#555555") ax.axhline(0, color="#333333", lw=0.8) ax.set_xticks(x) ax.set_xticklabels([f"第 {i + 1} 层\nk={k}, s={s}" for i, (k, s) in enumerate(zip(kernels, strides))]) ax.set_ylabel("这一层给感受野贡献的帧数") ax.set_ylim(-1.6, max(contrib) + 1.6) ax.set_title(f"图 2:同样的 k=3,越靠后的层贡献越大(总感受野 = 1 + 各项 = {rf} 帧)", fontsize=12) ax.grid(alpha=0.25, axis="y") fig.tight_layout() _save(fig, "fig2_rf.png") return contrib, rf # ─────────────── 图 3:分块解码的接缝 ─────────────── def fig_chunk(): net, v, z, ref = cd.build() scale = float(ref.std()) ctxs = list(range(0, 9)) head, tail, contam = [], [], [] for ctx in ctxs: got, starts = cd.decode_chunked(net, z, cd.CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale hi, ti, cn = [], [], 0 for s in starts[1:]: hi += list(range(s, s + cd.T_STRIDE)) ti += list(range(s + cd.T_STRIDE, s + cd.CHUNK * cd.T_STRIDE)) cn += int((diff[s:s + cd.CHUNK * cd.T_STRIDE] > 1e-9).sum()) head.append(float(diff[hi].max())) tail.append(float(diff[ti].max())) contam.append(cn) fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5)) ax = axes[0] ax.plot(ctxs, head, "o-", color=C1, lw=2.2, label="块头误差(块的前 4 个输出帧)") ax.plot(ctxs, tail, "s--", color=C0, lw=2.0, label="块尾误差(其余输出帧)") ax.set_yscale("symlog", linthresh=1e-3) ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx") ax.set_ylabel("相对整段解码的最大误差(按输出标准差归一)") ax.axvline(6, color=C3, lw=1.6, ls=":") ax.annotate("ctx=6 起误差精确归零", xy=(6, 1e-1), xytext=(6.4, 4e-1), fontsize=10, color=C3, arrowprops=dict(arrowstyle="->", color=C3, lw=1)) ax.set_title("左:误差随上下文帧数的变化", fontsize=12) ax.legend(fontsize=9) ax.grid(alpha=0.25) ax = axes[1] ax.plot(ctxs, contam, "o-", color=C2, lw=2.2) ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx") ax.set_ylabel("被污染的块内输出帧数(两块合计)") for i, c in enumerate(contam): ax.annotate(str(c), (ctxs[i], c), textcoords="offset points", xytext=(0, 7), ha="center", fontsize=9) ax.set_title("右:少带一帧上下文,就多错 4 个输出帧", fontsize=12) ax.grid(alpha=0.25) fig.suptitle("图 3:分块解码的接缝——上下文不是越多越好,而是有个精确阈值", fontsize=13) fig.tight_layout() _save(fig, "fig3_chunk.png") return ctxs, head, tail, contam # ─────────────── 图 4:token 账本 ─────────────── def fig_ledger(): rows = [tl._row(n, a, b, c) for n, a, b, c in tl.REAL] labels = ["逐帧图像 VAE\n(1x8x8)", "4x8x8\n(CogVideoX/Wan)", "8x32x32\n(LTX-Video)"] ns = [r["n"] for r in rows] rel = [(r["n"] / ns[0]) ** 2 for r in rows] fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5)) ax = axes[0] bars = ax.bar(labels, ns, color=[CGREY, C0, C3], width=0.58) ax.set_yscale("log") ax.set_ylabel("潜变量 token 数 N(对数轴)") for b, n in zip(bars, ns): ax.text(b.get_x() + b.get_width() / 2, n * 1.15, f"{n:,}", ha="center", fontsize=9) ax.set_ylim(1e3, 3e6) ax.set_title("左:序列长度", fontsize=12) ax.grid(alpha=0.25, axis="y") ax = axes[1] bars = ax.bar(labels, [1.0 / r for r in rel], color=[CGREY, C0, C3], width=0.58) ax.set_yscale("log") ax.set_ylabel("注意力代价相对「逐帧图像 VAE」便宜多少倍") for b, r in zip(bars, rel): ax.text(b.get_x() + b.get_width() / 2, (1.0 / r) * 1.15, f"{1.0 / r:.0f}x", ha="center", fontsize=9) ax.set_ylim(0.8, 6e4) ax.set_title("右:因为代价是 N 的平方,差距被放大", fontsize=12) ax.grid(alpha=0.25, axis="y") fig.suptitle("图 4:同一个 121 帧 768x512 输入,压缩比决定了 DiT 能不能做全注意力", fontsize=13) fig.tight_layout() _save(fig, "fig4_ledger.png") return ns, rel # ─────────────── 图 5:运动速度 vs 时间压缩 ─────────────── def fig_motion(): speeds = tb.SPEEDS p_t = {2: [], 4: [], 8: []} p_s = {2: [], 4: [], 8: []} for v in speeds: x = tb.moving_blob(v) for s in (2, 4, 8): p_t[s].append(tb.psnr(x, tb.repeat_time(tb.avg_pool_time(x, s), s))) p_s[s].append(tb.psnr(x, tb.repeat_space(tb.avg_pool_space(x, s), s))) fig, ax = plt.subplots(figsize=(8.2, 5.0)) colors = {2: C0, 4: C2, 8: C1} for s in (2, 4, 8): ax.plot(speeds, p_t[s], "o-", color=colors[s], lw=2.2, label=f"压时间 {s} 倍") for s in (2, 4, 8): ax.plot(speeds, p_s[s], ls="--", color=colors[s], lw=1.6, alpha=0.75, label=f"空间两轴各 {s} 倍(元素压 {s*s} 倍)") ax.set_xscale("log") ax.set_xticks(speeds) ax.set_xticklabels([str(v) for v in speeds]) ax.set_xlabel("运动速度(像素 / 帧,对数轴)") ax.set_ylabel("重建 PSNR(dB)") ax.set_title("图 5:时间平均与空间平均的教学对照(并非等码率)", fontsize=12) ax.legend(fontsize=9, ncol=2) ax.grid(alpha=0.25) fig.tight_layout() _save(fig, "fig5_motion.png") return p_t, p_s if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None jobs = { "dependency": fig_dependency, "rf": fig_rf, "chunk": fig_chunk, "ledger": fig_ledger, "motion": fig_motion, } for k, fn in jobs.items(): if only and k != only: continue print(f"[draw] {k}") fn() print("done") causal_conv3d.py # -*- coding: utf-8 -*- """3D 因果卷积的 numpy 最小实现,以及形状公式、因果性、感受野的实测。 运行: python causal_conv3d.py 约定张量布局 [C, T, H, W](通道优先,和 torch 的 Conv3d 一致)。 因果卷积的全部秘密只有一条:时间轴**只在前面**补 k_t - 1 帧,后面一帧都不补。 """ import numpy as np def base_rng(seed=20260930): """全工程的种子入口。所有随机权重都从这里分叉,保证数字可复现。""" return np.random.default_rng(seed) # ─────────────── 基本算子 ─────────────── def causal_pad(x, k_t): """时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。""" if k_t <= 1: return x pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype) return np.concatenate([pad, x], axis=1) def sym_pad_hw(x, k_h, k_w): """空间轴对称补零,和 torch 的 Conv3d 默认行为一致。""" pad = ((0, 0), (0, 0), ((k_h - 1) // 2, k_h // 2), ((k_w - 1) // 2, k_w // 2)) return np.pad(x, pad, mode="constant") def conv3d_valid(x, w, stride=(1, 1, 1)): """x [C_in,T,H,W] × w [C_out,C_in,kT,kH,kW] -> [C_out,To,Ho,Wo],只做 valid 部分。""" c_in, t, h, wd = x.shape c_out, c_in2, kt, kh, kw = w.shape assert c_in == c_in2, "通道数对不上" st, sh, sw = stride to = (t - kt) // st + 1 ho = (h - kh) // sh + 1 wo = (wd - kw) // sw + 1 out = np.zeros((c_out, to, ho, wo), dtype=np.float64) for o in range(c_out): wo_kernel = w[o] for i in range(to): for j in range(ho): for k in range(wo): patch = x[:, i * st:i * st + kt, j * sh:j * sh + kh, k * sw:k * sw + kw] out[o, i, j, k] = np.sum(patch * wo_kernel) return out def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"): """3D 卷积,时间填充方式可选: time_pad="causal" 前面补 k_t-1 帧、后面不补(只看过去) time_pad="symmetric" 前后各补 (k_t-1)//2 帧(会看到未来) """ kt, kh, kw = w.shape[2], w.shape[3], w.shape[4] if time_pad == "causal": x = causal_pad(x, kt) else: pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0)) x = np.pad(x, pad, mode="constant") x = sym_pad_hw(x, kh, kw) return conv3d_valid(x, w, stride) def out_frames(t_in, k_t=3, s_t=1): """因果卷积的时间输出帧数。 T_out = floor((T_in - 1) / s_t) + 1 注意不是 floor(T_in / s_t):因为首帧被保留下来单独占了一个输出位。 """ return (t_in - 1) // s_t + 1 # ─────────────── 一个可复用的 toy 视频 VAE ─────────────── class CausalConv3d: """带激活的因果卷积层。权重由 base_rng 派生,fix 住后所有实验共用。 act 默认用 tanh 而不是 ReLU:随机权重下 ReLU 会把一大半通道关死, 实测感受野会被「死通道」削小,接缝误差也随之小到 1e-7 量级,看不出问题。 真实 VAE 里有 GroupNorm 兜着,绝大多数通道是活的,tanh 更接近那个状态。 """ def __init__(self, c_in, c_out, k=(3, 3, 3), s=(1, 1, 1), seed=0, act="tanh", time_pad="causal"): rng = base_rng(1000 + seed) scale = 0.9 / np.sqrt(c_in * k[0] * k[1] * k[2]) self.w = rng.normal(0.0, scale, size=(c_out, c_in) + tuple(k)) self.b = rng.normal(0.0, 0.02, size=c_out) self.k = tuple(k) self.s = tuple(s) self.act = act self.time_pad = time_pad def __call__(self, x): y = conv3d_causal(x, self.w, self.s, time_pad=self.time_pad) y = y + self.b.reshape(-1, 1, 1, 1) if self.act == "tanh": y = np.tanh(y) elif self.act is True or self.act == "relu": y = np.maximum(y, 0.0) return y def time_upsample(x, factor=2): """时间维最近邻上采样:每个潜变量帧重复 factor 次。 这是纯复制,不引入新的时间依赖,所以不改感受野的「帧数」, 只改感受野在输出帧单位下的跨度。 """ return np.repeat(x, factor, axis=1) class ToyVideoVAE: """一个能跑的因果视频自编码器(权重是随机的,不追求重建质量)。 编码器把时间压 4 倍、空间压 4 倍;解码器用最近邻上采样还原。 它的唯一用途是让「谁依赖谁」这件事可以被实测。 """ def __init__(self, time_pad="causal"): self.e0 = CausalConv3d(1, 4, k=(3, 3, 3), s=(1, 1, 1), seed=1, time_pad=time_pad) self.e1 = CausalConv3d(4, 8, k=(3, 3, 3), s=(2, 2, 2), seed=2, time_pad=time_pad) self.e2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(2, 2, 2), seed=3, time_pad=time_pad) self.e3 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=4, time_pad=time_pad) self.d0 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=5) self.d1 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=6) self.d2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=7) self.d3 = CausalConv3d(8, 4, k=(3, 3, 3), s=(1, 1, 1), seed=8) self.d4 = CausalConv3d(4, 1, k=(3, 3, 3), s=(1, 1, 1), seed=9, act=None) def encode(self, x): x = self.e0(x) x = self.e1(x) x = self.e2(x) return self.e3(x) def decode(self, z): x = self.d0(z) x = self.d1(x) x = time_upsample(x, 2) x = self.d2(x) x = time_upsample(x, 2) x = self.d3(x) return self.d4(x) def __call__(self, x): return self.decode(self.encode(x)) def make_video(t=48, h=16, w=16, seed=7): """一段有运动的合成视频:一个高斯斑点匀速横移 + 缓慢明暗变化。""" rng = base_rng(seed) ys, xs = np.mgrid[0:h, 0:w] frames = [] speed = 0.6 cy = h / 2.0 + rng.normal(0, 0.3) for ti in range(t): cx = (w / 4.0 + speed * ti) % w blob = np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / 6.0)) bg = 0.15 * np.sin(2 * np.pi * ti / 24.0) * np.ones_like(blob) frames.append(blob + bg + 0.02 * rng.normal(size=blob.shape)) v = np.stack(frames)[None] # [1, T, H, W] return v.astype(np.float64) # ─────────────── 实验 1:形状公式 ─────────────── def shape_table(): print("── 实验 1:因果卷积的时间帧数公式 ──") print("公式:T_out = floor((T_in - 1) / s_t) + 1 (因果,前补 k_t-1)") rows = [] for t_in in (16, 17, 32, 48, 49, 121): row = [t_in] for s_t in (1, 2, 4): pred = out_frames(t_in, s_t=s_t) w = np.zeros((2, 1, 3, 3, 3)) w[:] = 0.1 x = np.zeros((1, t_in, 8, 8)) got = conv3d_causal(x, w, stride=(s_t, 1, 1)).shape[1] row.append((s_t, pred, got)) rows.append(row) print(f" T_in={t_in:4d} -> " + " ".join(f"s_t={s}: 预测 {p:3d} / 实测 {g:3d} {'OK' if p == g else 'FAIL'}" for s, p, g in row[1:])) # CogVideoX 的真实数字:49 帧进,两级时间压缩 2 t = 49 t1 = out_frames(t, s_t=2) t2 = out_frames(t1, s_t=2) print(f" 两级时间压缩 2(CogVideoX 口径):49 帧 -> {t1} -> {t2} 潜变量帧") return rows, (t, t1, t2) # ─────────────── 实验 2:因果性 ─────────────── def causality_check(): """改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。""" print("\n── 实验 2:因果性检验(改未来,看过去)──") net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) worst = 0.0 for t_edit in range(0, 48, 4): v2 = v.copy() v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动 z2 = net.encode(v2) # 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j for j in range(z2.shape[1]): if 4 * j < t_edit: # 这个潜变量帧不该看到第 t_edit 帧及之后 diff = np.abs(z2[:, j] - z_ref[:, j]).max() worst = max(worst, diff) print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}") print(f" 判据:等于 0 则因果性成立(浮点意义上 < 1e-12 即通过)") return worst # ─────────────── 实验 3:感受野 ─────────────── def encoder_rf_formula(kernels, strides): """RF = 1 + sum_l (k_l - 1) * prod_{m<l} s_m prod_{m<l} s_m 是「到第 l 层输入为止累积的时间步距」, 所以越靠后的层,一个 kernel 覆盖的原始帧数越多。 """ rf = 1 cum = 1 for k, s in zip(kernels, strides): rf += (k - 1) * cum cum *= s return rf, cum def encoder_rf_measured(): """扰动法实测:逐帧加扰动,看哪些潜变量帧跟着动。""" net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) nz = z_ref.shape[1] depends = np.zeros((48, nz), dtype=bool) for t_edit in range(48): v2 = v.copy() v2[:, t_edit:t_edit + 1] += 2.0 z2 = net.encode(v2) depends[t_edit] = np.abs(z2 - z_ref).max(axis=(0, 2, 3)) > 1e-12 return depends, z_ref def receptive_field(): kernels = [3, 3, 3, 3] strides = [1, 2, 2, 1] rf_pred, cum = encoder_rf_formula(kernels, strides) print("\n── 实验 3:编码器的时间感受野 ──") print(f" 公式:RF = 1 + sum (k_l - 1) * prod_(m<l) s_m") print(f" 本 toy 的层配置 k={kernels}, s={strides}") print(f" 公式预测 RF = {rf_pred} 帧,累积时间步距 = {cum}") depends, z_ref = encoder_rf_measured() nz = z_ref.shape[1] spans = [] for j in range(nz): idx = np.where(depends[:, j])[0] if len(idx) == 0: spans.append((j, None, None, 0)) continue spans.append((j, int(idx.min()), int(idx.max()), int(idx.max()) - int(idx.min()) + 1)) print(" 实测(逐帧扰动):潜变量帧 j -> 受影响的输入帧区间") for j, lo, hi, sp in spans[:6]: if lo is None: print(f" j={j:2d}: 无任何输入帧影响它(权重恰好全被 ReLU 关掉)") else: print(f" j={j:2d}: 输入帧 [{lo:2d}, {hi:2d}],跨度 {sp:2d} 帧") # 因果性上界:潜变量帧 j 能看到的最新输入帧 print(" 因果性上界检查:潜变量帧 j 能看到的最新输入帧应当 <= 步距 * j") bad = 0 for j, lo, hi, sp in spans: if hi is not None and hi > cum * j: bad += 1 print(f" 违反次数 = {bad}(0 表示因果性严格成立)") max_span = max(s for _, _, _, s in spans) print(f" 实测最大跨度 = {max_span} 帧,公式预测 = {rf_pred} 帧") return rf_pred, cum, spans, max_span def dependency_matrix(t_in=48, time_pad="causal"): """扰动法得到「输入帧 t 是否影响潜变量帧 j」的布尔矩阵 [T_in, n_z]。 这张矩阵就是因果性的可视化:因果卷积下它必须落在 j*s_t 这条对角线以下。 """ net = ToyVideoVAE(time_pad=time_pad) v = make_video(t=t_in) z_ref = net.encode(v) dep = np.zeros((t_in, z_ref.shape[1]), dtype=bool) for t_edit in range(t_in): v2 = v.copy() v2[:, t_edit:t_edit + 1] += 2.0 dep[t_edit] = np.abs(net.encode(v2) - z_ref).max(axis=(0, 2, 3)) > 1e-12 return dep if __name__ == "__main__": shape_table() causality_check() receptive_field() chunk_decode.py # -*- coding: utf-8 -*- """分块编解码的接缝实验:到底要带多少帧上下文,逐块跑才能和整段跑一模一样。 运行: python chunk_decode.py 这是整篇文章最核心的一个实验。设置: - 96 帧输入 -> 编码器压成 24 个潜变量帧(时间步距 4) - 整段编解码得到参考输出 - 然后把潜变量切成 3 块,每块前面额外喂 ctx 个潜变量帧当上下文, 解码后把上下文那部分输出丢掉,只留本块 - 比较「分块结果」与「整段结果」在每个位置的差 编码侧同样要分块(长视频不可能一次装进显存),所以下面两件事都测: 1. 解码侧:需要几个潜变量帧上下文 2. 编码侧:需要几个输入帧上下文 """ import numpy as np from causal_conv3d import ToyVideoVAE, make_video T_FRAMES = 96 # 输入帧数 T_STRIDE = 4 # 编码器总时间步距:1 个潜变量帧对应 4 个输出帧 CHUNK = 8 # 每块 8 个潜变量帧 = 32 个输出帧 def build(): net = ToyVideoVAE() v = make_video(t=T_FRAMES) z = net.encode(v) # [8, 24, 4, 4] ref = net.decode(z) # [1, 96, 16, 16] return net, v, z, ref # ─────────────── 解码侧 ─────────────── def decode_chunked(net, z, chunk=CHUNK, ctx=0): """按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。""" nz = z.shape[1] pieces, starts = [], [] n_chunks = (nz + chunk - 1) // chunk for i in range(n_chunks): lo = i * chunk hi = min(lo + chunk, nz) lo_in = max(0, lo - ctx) out = net.decode(z[:, lo_in:hi]) keep = (hi - lo) * T_STRIDE # 上下文部分的输出要丢掉 pieces.append(out[:, -keep:]) starts.append(lo * T_STRIDE) return np.concatenate(pieces, axis=1), starts def decode_sweep(): net, v, z, ref = build() scale = float(ref.std()) print("── 解码侧:上下文帧数 vs 接缝误差 ──") print(f" {T_FRAMES} 帧输入 -> {z.shape[1]} 个潜变量帧(时间步距 {T_STRIDE})" f" -> {ref.shape[1]} 帧输出") print(f" 误差已按输出标准差归一化(std = {scale:.4f})") print("") print(" ctx | 块头误差 | 块尾误差 | 块内被污染帧数 | 边界跳变放大") print(" ----+---------+---------+----------------+------------") table = [] for ctx in range(0, 9): got, starts = decode_chunked(net, z, CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale head_idx, tail_idx, contam = [], [], 0 for s in starts[1:]: head_idx += list(range(s, s + T_STRIDE)) tail_idx += list(range(s + T_STRIDE, s + CHUNK * T_STRIDE)) contam += int((diff[s:s + CHUNK * T_STRIDE] > 1e-9).sum()) head = float(diff[head_idx].max()) tail = float(diff[tail_idx].max()) jump = boundary_jump(ref, got, starts) table.append((ctx, head, tail, contam, jump)) print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d} | {jump:.2f}x") return table def boundary_jump(ref, got, starts): """同一位置处,分块结果的帧间跳变相对整段结果放大了多少倍。 分母取「整段解码在同一帧的跳变」而不是全场平均——视频在某些帧本来就变化快, 拿全场平均当分母会把正常内容误判成接缝。 """ ratios = [] for s in starts[1:]: j_got = float(np.abs(got[:, s] - got[:, s - 1]).max()) j_ref = float(np.abs(ref[:, s] - ref[:, s - 1]).max()) if j_ref > 1e-12: ratios.append(j_got / j_ref) return max(ratios) if ratios else float("nan") def decode_profile(): """误差在块内是怎么衰减的:看第 2 块前 24 个输出帧。""" net, v, z, ref = build() scale = float(ref.std()) print("") print("── 第 2 块内的误差衰减(输出帧 32 起,取前 12 帧,按 std 归一)──") out = {} for ctx in (0, 2, 4, 6): got, starts = decode_chunked(net, z, CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale seg = diff[32:32 + 24] out[ctx] = seg print(f" ctx={ctx}: " + " ".join(f"{x:.1e}" for x in seg[:12])) return out # ─────────────── 编码侧 ─────────────── def encode_chunked(net, v, chunk_in=32, ctx=0): """按 chunk_in 个输入帧一块编码,每块前面带 ctx 个输入帧上下文。""" t = v.shape[1] pieces = [] n_chunks = (t + chunk_in - 1) // chunk_in for i in range(n_chunks): lo = i * chunk_in hi = min(lo + chunk_in, t) lo_in = max(0, lo - ctx) z_i = net.encode(v[:, lo_in:hi]) keep = (hi - lo) // T_STRIDE # 上下文换来的多余潜变量帧要丢掉 pieces.append(z_i[:, -keep:] if keep > 0 else z_i[:, :0]) return np.concatenate(pieces, axis=1) def encode_sweep(): net, v, z, ref = build() scale = float(z.std()) print("") print("── 编码侧:上下文帧数 vs 潜变量误差 ──") print(f" 每块 32 个输入帧(= 8 个潜变量帧),误差按潜变量标准差归一" f"(std = {scale:.4f})") print("") print(" ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数") print(" ----+----------------+----------------+--------------") table = [] for ctx in (0, 4, 8, 12, 16, 20, 24): zh = encode_chunked(net, v, 32, ctx) if zh.shape[1] != z.shape[1]: print(f" ctx={ctx}: 潜变量帧数对不上 {zh.shape[1]} vs {z.shape[1]},跳过") continue d = np.abs(zh - z).max(axis=(0, 2, 3)) / scale head = float(d[8:10].max()) tail = float(d[10:16].max()) contam = int((d[8:16] > 1e-9).sum()) table.append((ctx, head, tail, contam)) print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d}") return table # ─────────────── 直接问:谁依赖谁 ─────────────── def dependency_table(): """扰动法:直接问「输出帧 o 依赖哪些潜变量帧」,从而算出必需的上下文帧数。""" net, v, z, ref = build() nz = z.shape[1] z_ref = net.decode(z) dep = np.zeros((nz, z_ref.shape[1]), dtype=bool) for j in range(nz): z2 = z.copy() z2[:, j] += 1.0 dep[j] = np.abs(net.decode(z2) - z_ref).max(axis=(0, 2, 3)) > 1e-12 print("") print("── 直接问:块头输出帧依赖哪些潜变量帧 ──") print(" 块起点(输出帧) | 依赖的最早潜变量帧 | 需要的上下文帧数") need = [] n_chunks = (nz + CHUNK - 1) // CHUNK for i in range(1, n_chunks): j0 = i * CHUNK o0 = j0 * T_STRIDE idx = np.where(dep[:, o0])[0] if len(idx) == 0: continue need.append((o0, int(idx.min()), j0 - int(idx.min()))) print(f" {o0:3d} | {int(idx.min()):3d} | {j0 - int(idx.min())}") widths = [] for o in range(z_ref.shape[1]): idx = np.where(dep[:, o])[0] widths.append(int(idx.max()) - int(idx.min()) + 1 if len(idx) else 0) rf_dec = max(widths) print(f" 解码器时间感受野(潜变量帧数,取所有输出帧的最大值)= {rf_dec}") print(f" 推论:所需上下文 = 感受野 - 1 = {rf_dec - 1} 个潜变量帧") return need, rf_dec def context_decomposition(): """逐层只缓存 (k_t - 1) 帧,折算回潜变量帧单位后累加起来等于什么? 这是检验「工业实现里每层只缓存 k_t-1 帧够不够」的关键一笔: 够不够取决于你把缓存折算回哪一级的单位。逐层缓存时,第 l 层的 k_t-1 = 2 帧是该层输入分辨率下的 2 帧,折回潜变量帧要乘上该层 相对潜变量的帧间距(上采样会把间距缩小)。 """ # 解码器 d0..d4 的输入相对潜变量的时间帧间距 spacing = {"d0": 1.0, "d1": 1.0, "d2": 0.5, "d3": 0.25, "d4": 0.25} k_t = 3 print("") print("── 逐层缓存 (k_t - 1) 帧,累加起来是多少 ──") print("") print(" 层 | 输入相对潜变量的帧间距 | 缓存 (k_t-1) 帧折回潜变量帧") print(" ----+------------------------+----------------------------") total = 0.0 for name, sp in spacing.items(): c = (k_t - 1) * sp total += c print(f" {name} | {sp:22.2f} | {c:12.2f}") print(f" 合计 | {'':22} | {total:12.2f}") print("") print(f" 实测需要的上下文(dependency_table)= 6 个潜变量帧") print(f" 逐层缓存累加 = {total:.2f} 个潜变量帧 -> " f"{'完全吻合' if abs(total - 6) < 1e-9 else '不吻合'}") print("") print(" 结论:工业实现里「每层只缓存 k_t-1 帧」是**正确的**,因为逐层") print(" 累加后恰好等于感受野 - 1。真正的陷阱是只在网络入口缓存一次——") print(" 那样只有 (k_t-1) = 2 帧,差得远。") return total def overhead(rf_dec=7, rf_enc=17): """带上下文要多算多少:额外算的量占本块的比例。""" print("") print("── 上下文的开销 ──") print(" 解码块大小 | 需要上下文 | 额外算力占比") rows = [] for chunk in (8, 12, 16, 24): ctx = rf_dec - 1 frac = ctx / (chunk + ctx) rows.append(("decode", chunk, ctx, frac)) print(f" {chunk:3d} 潜变量帧 | {ctx:3d} 帧 | {frac * 100:.1f}%") print(" 编码块大小 | 需要上下文 | 额外算力占比") for chunk in (32, 64, 128): ctx = rf_enc - 1 frac = ctx / (chunk + ctx) rows.append(("encode", chunk, ctx, frac)) print(f" {chunk:3d} 输入帧 | {ctx:3d} 帧 | {frac * 100:.1f}%") return rows def state(): net, v, z, ref = build() return dict(z=z, ref=ref) if __name__ == "__main__": decode_sweep() decode_profile() dependency_table() context_decomposition() encode_sweep() overhead() temporal_budget.py # -*- coding: utf-8 -*- """时间压缩比的预算:运动多快的时候,压 s 倍时间就开始糊。 运行: python temporal_budget.py 把「时间下采样」简化成最朴素的 s 帧平均 + 最近邻还原(CogVideoX 的下采样层 真的就是 avg_pool1d,见 05 节)。学习到的时间卷积会比平均聪明,但这个教学模型 只演示量级和规律,不是神经 VAE 的误差下界,而且它有一条可以验的解析预期: 平均 s 帧 == 给运动物体糊上一条长度 (s-1) * v 像素的运动模糊 """ import numpy as np from causal_conv3d import base_rng # 画布要够宽:最快的斑点(4 px/帧 x 32 帧 = 128 px)必须全程留在画面内, # 否则斑点在后面几帧整个飘出去,加权宽度会因为分母趋于 0 而算成 nan。 T, H, W = 32, 32, 192 SIGMA = 3.0 # 斑点的高斯半径(像素) SPEEDS = [0.25, 0.5, 1.0, 2.0, 4.0] FACTORS = [1, 2, 4, 8] def moving_blob(speed, t=T, h=H, w=W, sigma=SIGMA, seed=11): """一个匀速横移的高斯斑点。不环绕,避免边界跳变污染 PSNR。""" rng = base_rng(seed) ys, xs = np.mgrid[0:h, 0:w] cy = h / 2.0 cx0 = w * 0.25 frames = [] for ti in range(t): cx = cx0 + speed * ti frames.append(np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / (2 * sigma ** 2)))) v = np.stack(frames)[None] # [1, T, H, W] return v + 0.001 * rng.normal(size=v.shape) # 微量噪声,避免除零 def avg_pool_time(x, s): """每 s 帧平均成 1 帧(非重叠分组)。""" n = x.shape[1] // s return x[:, :n * s].reshape(x.shape[0], n, s, H, W).mean(axis=2) def repeat_time(z, s, t_out=T): """最近邻还原:每个潜变量帧重复 s 次。""" return np.repeat(z, s, axis=1)[:, :t_out] def avg_pool_space(x, s): """空间 sxs 块平均。""" n_h, n_w = H // s, W // s y = x[:, :, :n_h * s, :n_w * s] y = y.reshape(x.shape[0], T, n_h, s, n_w, s) return y.mean(axis=(3, 5)) def repeat_space(z, s): """空间最近邻还原。""" return np.repeat(np.repeat(z, s, axis=2), s, axis=3) def psnr(a, b, peak=1.0): mse = float(np.mean((a - b) ** 2)) return 99.0 if mse <= 1e-20 else 10.0 * np.log10(peak ** 2 / mse) def width_along_x(x): """斑点沿运动方向的强度加权标准差,用来量「被糊成多宽」。 两个坑都踩过: 1. 只能在空间维度上归约(沿 y 求和、保留 x)。把所有轴一起归约会把 x 也压掉,得到一个不随压缩变化的常数。 2. 要先掐掉噪声底。加权方差里 (x - mean)^2 是杠杆,画面远端一个 -0.026 的噪声像素能贡献 -9 的「方差」,把真实值直接打成负数。 """ xs = np.arange(W)[None, None, :] # [1, 1, W] prof = x.sum(axis=2) # [1, T, W],沿 y 归约 prof = np.clip(prof, 0.0, None) thr = 0.005 * prof.max(axis=2, keepdims=True) # 掐掉噪声底,保留斑点 prof = np.where(prof < thr, 0.0, prof) wsum = prof.sum(axis=2, keepdims=True) + 1e-12 # [1, T, 1] mx = (prof * xs).sum(axis=2, keepdims=True) / wsum var = (prof * (xs - mx) ** 2).sum(axis=2, keepdims=True) / wsum return float(np.sqrt(var).mean()) def psnr_table(): print("── 时间压缩 s 倍之后,运动速度 vs 重建 PSNR(dB)──") print("") print(" 速度 v |" + "".join(f" s={s:<2d} " for s in FACTORS)) print(" --------+" + "".join("---------------" for _ in FACTORS)) table = {} for v in SPEEDS: x = moving_blob(v) row = [] for s in FACTORS: row.append(psnr(x, repeat_time(avg_pool_time(x, s), s))) table[v] = row print(f" {v:5.2f} |" + "".join(f" {p:8.2f} dB " for p in row)) print("") print(" 读法:s=1 是原图(噪声极小,PSNR 到顶);同一列往下看,运动越快越糊。") print(f" s=8 那一列从最慢到最快掉了 " f"{table[SPEEDS[0]][-1] - table[SPEEDS[-1]][-1]:.1f} dB。") return table def blur_law(): """验那条解析规律:糊掉的长度应该是 (s-1) * v。""" print("") print("── 验规律:平均 s 帧 ≈ 加一条长度 (s-1)*v 的运动模糊 ──") print("") print(" 速度 v | s | 斑点宽度 原图 -> 压缩后 | 实测增幅 | 解析预期") print(" --------+-----+-------------------------+----------+----------") rows = [] for v in (1.0, 2.0, 4.0): x = moving_blob(v) w0 = width_along_x(x) for s in (2, 4, 8): r = repeat_time(avg_pool_time(x, s), s) w1 = width_along_x(r) pred = np.sqrt(SIGMA ** 2 + v ** 2 * (s ** 2 - 1) / 12.0) rows.append((v, s, w0, w1, w1 / w0, pred / w0)) print(f" {v:5.2f} | {s:2d} | {w0:7.3f} -> {w1:7.3f} " f"| {w1 / w0:7.3f}x | {pred / w0:7.3f}x") print("") print(" 解析预期 = sqrt(sigma^2 + v^2*(s^2-1)/12) / 实测原宽度:") print(" 平均 s 个等间隔平移量,其离散方差是 v^2*(s^2-1)/12。") return rows def time_vs_space(): """时间压 s 倍与空间两轴各压 s 倍(总 s^2 倍),并非等码率对照。""" print("") print("── 不同元素压缩率:时间 s 倍 vs 空间 s^2 倍(PSNR,dB)──") print("") print(" 速度 v |" + "".join(f" 时间 {s}x / 空间 {s}x " for s in (2, 4, 8))) print(" --------+" + "".join("-----------------------" for _ in (2, 4, 8))) rows = [] for v in SPEEDS: x = moving_blob(v) cells = [] for s in (2, 4, 8): p_t = psnr(x, repeat_time(avg_pool_time(x, s), s)) p_s = psnr(x, repeat_space(avg_pool_space(x, s), s)) cells.append((p_t, p_s)) rows.append((v, cells)) line = " {:5.2f} |".format(v) for p_t, p_s in cells: line += f" {p_t:6.2f} / {p_s:6.2f} " print(line) print("") print(" 读法:空间那一列基本与速度无关(压空间就是把细节磨掉,一视同仁);") print(" 时间那一列随运动变快而下降。两条线会交叉,交叉之后") print(" 这只比较两种滤波失真,不能从非等码率交叉点推出实际压缩策略。") crossings = [] for si, s in enumerate((2, 4, 8)): prev_sign = None for v, cells in rows: p_t, p_s = cells[si] sign = p_t > p_s if prev_sign is not None and sign != prev_sign: crossings.append((s, v)) prev_sign = sign if crossings: print("") print(" 交叉点(压时间开始不如压空间的速度):") for s, v in crossings: print(f" s={s}x:约 {v} px/帧 附近") return rows def state(): return dict(psnr=psnr_table(), blur=blur_law(), ts=time_vs_space()) if __name__ == "__main__": psnr_table() blur_law() time_vs_space() token_ledger.py # -*- coding: utf-8 -*- """潜变量 token 账本:不同的时空压缩比,到底把 Transformer 的序列变成多长。 运行: python token_ledger.py 自注意力的代价是 O(N^2),所以真正决定「视频 DiT 能不能做全时空注意力」的 不是像素总量,而是**潜变量 token 数 N**。这个脚本只做算术,但它是选压缩比的依据。 """ # 统一的输入:121 帧(5 秒 @ 24fps)、768 x 512、RGB T_IN, H_IN, W_IN, C_IN = 121, 512, 768, 3 # 表一:真实模型在用的配置(通道数取各模型公开权重的值) REAL = [ ("图像 VAE 逐帧(SVD / AnimateDiff 口径)", 1, 8, 4), ("CogVideoX / Wan / HunyuanVideo(4x8x8)", 4, 8, 16), ("LTX-Video(8x32x32)", 8, 32, 128), ] # 表二:固定空间 8x8、通道 16,只扫时间压缩比——把时间这一维的贡献单独拎出来 TIME_SWEEP = [(s_t, 8, 16) for s_t in (1, 2, 4, 8)] def latent_frames(t_in, s_t): """因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。""" return (t_in - 1) // s_t + 1 def _row(name, s_t, s_h, s_c): t_out = latent_frames(T_IN, s_t) h_out = H_IN // s_h w_out = W_IN // s_h n = t_out * h_out * w_out return dict(name=name, s_t=s_t, s_h=s_h, ch=s_c, shape=(t_out, h_out, w_out), n=n, vals=n * s_c, cover=s_t * s_h * s_h * C_IN) def table_real(): pix = T_IN * H_IN * W_IN * C_IN print(f"输入:{T_IN} 帧(5 秒 @ 24fps)、{W_IN} x {H_IN}、RGB," f"像素值总数 = {pix:,}") rows = [_row(n, a, b, c) for n, a, b, c in REAL] base = rows[0]["n"] print("") print("── 表一:三个真实档位 ──") print("") print(" 配置 | 潜变量形状 (T'xH'xW'xC) " "| token 数 N | N^2 相对代价 | 便宜倍数 | 每 token 覆盖像素") print(" --------------------------------------+-----------------------" "+------------+-------------+---------+----------------") for r in rows: rel = (r["n"] / base) ** 2 r["rel"] = rel t, h, w = r["shape"] print(f" {r['name']:<38} | {t:3d} x {h:3d} x {w:3d} x {r['ch']:3d} " f"| {r['n']:10,d} | {rel:11.3e} | {1 / rel:7.1f}x | {r['cover']:8,d}") return rows def table_time_sweep(): print("") print("── 表二:固定空间 8x8 / 通道 16,只动时间压缩比 ──") print("") print(" 时间压缩 | 潜变量帧数 | token 数 N | 相对上一步便宜 | 相对 1x 累计") print(" ---------+------------+------------+----------------+-------------") rows = [] base = None for s_t, s_h, s_c in TIME_SWEEP: r = _row(f"s_t={s_t}", s_t, s_h, s_c) if base is None: base = r["n"] r["rel"] = (r["n"] / base) ** 2 rows.append(r) for i, r in enumerate(rows): step = (rows[i - 1]["n"] / r["n"]) ** 2 if i > 0 else 1.0 print(f" {r['s_t']:3d} x | {r['shape'][0]:10d} | {r['n']:10,d} " f"| {step:13.1f}x | {1 / r['rel']:11.1f}x") print("") print(" 规律:时间压缩每翻一倍,token 数减半,注意力代价降到 1/4。") return rows def why_channels_grow(): """压缩的是序列长度,不是信息量——通道数必须补回来。""" pix = T_IN * H_IN * W_IN * C_IN print("") print("── 为什么压缩比上去了,潜变量通道数也要跟着涨 ──") print("") print(" 配置 | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值)") print(" --------------------------------------+----------------+----------------------------") for name, s_t, s_h, s_c in REAL: r = _row(name, s_t, s_h, s_c) print(f" {name:<38} | {r['vals']:14,d} | {pix / r['vals']:8.1f} : 1") print("") print(" 数字要看懂:4x8x8 那一行和「逐帧图像 VAE」的压缩比几乎一样(46.8 vs 48.0),") print(" 它省下的不是信息量,而是**序列长度**——190464 个 token 变成能做注意力的规模。") print(" LTX-Video 摘要里自述总压缩比 1:192,和上表最后一行的 181.5:1 是同一量级") print(" (差别来自它把 patchify 挪进 VAE 的口径)。") def frame_count_rule(): """帧数必须满足什么条件,才能整除不被裁掉。""" print("") print("── 帧数该怎么选:T = 1 + k * s_T ──") for s_t in (4, 8): print(f" 时间压缩 {s_t}x:合法帧数 1, {1 + s_t}, {1 + 2 * s_t}, ... 即 T = 1 + k*{s_t}") print(f" 例:121 帧 -> {latent_frames(121, s_t)} 个潜变量帧" f"({'整除,不丢帧' if (121 - 1) % s_t == 0 else '不整除,会向下取整'})") print(f" 例:100 帧 -> {latent_frames(100, s_t)} 个潜变量帧" f"({'整除,不丢帧' if (100 - 1) % s_t == 0 else '不整除,会向下取整'})") def state(): return dict(real=table_real(), sweep=table_time_sweep()) if __name__ == "__main__": table_real() table_time_sweep() why_channels_grow() frame_count_rule()
-
AIGC 基本功|自回归视频生成与 Forcing 范式-Forcing 自回归视频生成与 Forcing 范式:流式出帧的账,和曝光偏差的坑 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 训练目标与采样流程($\bar{\alpha}$ 记号、DDIM 单步更新直接沿用)、DiT 架构拆解(潜空间 patch 化成 token 的约定) 关键词:自回归视频、Diffusion Forcing、Self-Forcing、teacher forcing、曝光偏差、KV cache、流式生成 01. 为什么需要它 你盯着一个视频生成产品等了 3 秒,第一帧才出来——不是网速问题,是范式问题。 本文先以全序列双向扩散为对照:21 个潜帧(对应约 5 秒成片)拼成一条 3 万多 token 的序列,帧和帧之间双向可见,整段一起降噪。代价是「流式」这个词跟它彻底无缘——最后一帧没去噪完,第一帧就不能给你看。这不是工程优化能修的:双向注意力在数学上要求未来帧也参与当前帧的去噪,未来帧不存在,这一步就算不了。 我按 Wan2.1-T2V-1.3B 的真实拓扑和 Self-Forcing 的默认配置,把这笔账算成了 MAC 数(第 06 节有完整过程):在假设有效算力 400 TFLOPS、只计 Transformer 的理想算术估算中,5 秒视频的全序列扩散首帧约 2.83 秒;换成因果自回归加 KV cache,0.20 秒就能吐出第一帧——账本中的 13.98 倍差距(不是实测 GPU 延迟)。而总算力几乎没变(比值 0.875,自回归反而略省)。 但把「一帧一帧往后生成」这条路走通,会立刻撞上一个语言模型社区早就算过的老账:训练时模型看的上下文是真值帧(teacher forcing),推理时上下文只能换成模型自己的输出。这两件事不是一回事,误差会顺着自回归链条滚雪球——这就是曝光偏差(exposure bias)。 Forcing 系列就是围着这两个问题打转的:Diffusion Forcing 把「下一帧预测」和「扩散去噪」缝成一个目标,让每帧带独立噪声级;Self-Forcing 干脆在训练时就用模型自己的 rollout 当上下文,把训练分布直接掰成测试分布。这篇把两个问题都算成数:流式的账用真实拓扑算,曝光偏差的坑用一个能完整复现的玩具实验拆开看。 02. 最小可用理解 把三种范式并排放,差别其实只有一句话:每一帧被允许看什么、以什么噪声级被看到。 这张图要看什么:上行是全序列扩散——所有帧共用同一个噪声级、一起降、双向注意力互相可见,代价是 4 步全部算完才有第一帧;中行是 teacher forcing——只有当前帧带噪声,上下文全是浅色真值帧,而推理时真值帧不存在,误差就从这里的「换上下文」进来;下行是因果自回归采样;训练时使用自身 rollout 对应 Self-Forcing,而独立噪声的 Diffusion Forcing 训练上下文仍来自数据——历史帧干净地躺在 KV cache 里,当前 block 从高噪声一路降到干净,其中“训练用自身 rollout”是 Self-Forcing 的额外设计。 三个要点: 全序列扩散:质量上限高(未来帧参与去噪),双向联合去噪通常须整块完成才能交付;可变长度、滑窗或块间生成需要额外设计,不能称为所有此类模型永远不能流式。 Diffusion Forcing:给每帧分配独立的噪声级 $k^{(t)}$。训练目标退化成「对每一帧做条件去噪」,采样时可以逐帧(逐 block)从高噪声降到干净再吐出去——这就是「next-token prediction 与全序列扩散的合流」这句话的数学含义。 Self-Forcing:承认上下文永远是模型自己的输出,于是在训练时就真的 rollout——上一帧生成完、进 KV cache、下一帧从它出发,整段视频算一个整体损失,而不是逐帧各自算。 顺带把「Forcing」这个词的出处交代掉。它来自语言模型的 teacher forcing:训练 RNN 语言模型时,每一步的输入都用数据集里的真值 token「强行喂入」(force),而不是模型上一步的输出。这个约定让训练可以并行、梯度稳定,但也埋下了训练-测试分布错位的种子——语言模型社区管它叫 exposure bias,几十年里试过 scheduled sampling、DAgger 各种解法。Forcing 系列的谱系就是围绕这个错位逐步收紧的过程:Diffusion Forcing 先把「下一帧预测」的接口扩展成「每帧带独立噪声级的条件去噪」,让自回归的骨架里能塞进扩散的表达力;Self-Forcing 再把训练时的上下文从真值换成模型自己的 rollout,直接对齐两个分布。视频把这个问题变得更尖锐:语言模型一步错一个 token,视频一步错的是一整帧,而且帧与帧之间还有时间维度上的积分效应(下一节的主角)。 03. 数学推导 3.1 训练目标与推理目标的错位 为展示上下文错位,可用一个简化的逐帧去噪回归目标: $$\mathcal L_{TF}=E_{x,k,\epsilon}\sum_t\|x_t-f_\theta(z_t(k_t),k_t,x_{<t}^{gt})\|^2.$$ 推理时把真值历史换成模型生成历史 $\hat x_{<t}$,但通常不在推理现场优化损失。用同样的去噪回归在生成历史上评测,只是本文的受控诊断量,不是视频生成质量的完整定义;任意生成视频与某条真值逐帧 MSE 也不是 Self-Forcing 的训练目标。 训练和评测使用同一个 $f_\theta$ 时,上下文从数据历史换成模型历史即可造成分布偏移。充分容量下精确学习每个条件分布可得到正确联合分布;现实中的估计误差、有限容量和长时 rollout 会放大这一差异。 3.2 曝光偏差为什么会滚雪球:慢变量与快变量 把误差沿着自回归链条往前传一步。设第 $t$ 帧的上下文误差是 $e_t$,对很多动力系统可以近似成线性递推 $e_t = A e_{t-1} + \delta_t$,其中 $\delta_t$ 是本帧新引入的误差。下面标量方差式假设初始误差为零、增量独立同分布且零均值;一般矩阵非正规性、相关误差和模型偏差会改变增长。关键量是传递矩阵的谱半径。按谱半径把状态拆成两块看: 慢变量(谱半径 $\lambda_{\text{slow}}$ 接近 1,近似积分环节): $$e_t = \lambda_{\text{slow}} e_{t-1} + \delta_t \quad \Rightarrow \quad \mathrm{Var}[e_T] = \mathrm{Var}[\delta] \cdot \frac{1 - \lambda_{\text{slow}}^{2T}}{1 - \lambda_{\text{slow}}^{2}} \quad \xrightarrow{T \to \infty} \quad \frac{\mathrm{Var}[\delta]}{1 - \lambda_{\text{slow}}^{2}}$$ $\lambda_{\text{slow}} = 0.97$ 时系数是 $1 / (1 - 0.9409) \approx 16.9$,误差方差被放大约 17 倍,而且随长度单调增长——这就是「滚雪球」的数学形态。 快变量(谱半径 $\rho_{\text{fast}}$ 明显小于 1,收缩映射): $$e_t = \rho_{\text{fast}} e_{t-1} + \eta_t \quad \Rightarrow \quad \mathrm{Var}[e^{\text{fast}}] \approx \frac{\mathrm{Var}[\eta]}{1 - \rho_{\text{fast}}^{2}}, \quad \rho_{\text{fast}} < 1$$ 这是一个有界的常数抬升:旧误差每帧被乘上 $\rho_{\text{fast}}$ 衰减掉,只有本帧新增的误差活着。$\rho_{\text{fast}} = 0.85$ 时系数约 3.6 倍,早期仍随长度增大,但更快接近上界。 所以「曝光偏差有多严重」这个问题没有单一答案:在 $|\lambda|<1$ 的独立增量模型中,两者都有界,只是慢变量更晚饱和;$\lambda=1$ 方差才线性增长,$|\lambda|>1$ 才可能指数发散。这也是为什么第 08 节的误解二里,光看「平均误差涨了几倍」会得出错误结论。 3.3 Diffusion Forcing:每帧一个独立噪声级 标准全序列噪声训练通常共享 $k$;Diffusion Forcing 对各帧独立采噪声级,并把带噪历史一起作为条件。例如噪声预测形式为: $$\mathcal L_{DF}=E_{x,k_{1:T},\epsilon_{1:T}}\sum_t w(k_t)\|\epsilon_t-\epsilon_\theta(z_{\le t},k_{\le t})\|^2,$$ 其中 $z_t=\sqrt{\bar\alpha_{k_t}}x_t+\sqrt{1-\bar\alpha_{k_t}}\epsilon_t$;也可等价改写成带相应权重的 $x_0$ 预测。历史 $z_{<t}$ 通常也带各自的噪声,不能只在公式里写干净的 $x_{<t}$。 统一噪声级可恢复共享噪声训练形式,但不会自动把因果遮罩变成双向注意力;把历史噪声降到 0、仅对当前块去噪,则给出自回归采样接口。当前块仍从高噪声逐步降噪,不是“把当前噪声取最小就等于 next-token prediction”。 3.4 Self-Forcing:在训练时就把分布掰过来 Self-Forcing 第 3.3 节 用自身自回归 rollout 产生整段视频,再做视频级分布匹配。以 DMD 为例,目标可写为 $$\mathcal L_{SF}=E_k\big[D_{KL}(p_{\theta,k}(x^{1:T})\|p_{data,k}(x^{1:T}))\big].$$ 这里比较生成与数据的加噪联合分布,借助教师/学生 score 估计更新;论文还考察 SiD、GAN 损失。它不是逐帧配对 MSE,也不是 DAgger 的同义词。二者都关注自生成上下文,但经典 DAgger 需要专家对学习器访问状态提供标签,Self-Forcing 不以这种标签循环定义。 本文下面的线性回归 toy 只诊断上下文分布错位,并做 DAgger 风格重拟合;它没有实现 DMD,不能用它的失败证明 Self-Forcing 失败。 3.5 梯度怎么穿过 rollout Self-Forcing 为控制显存,每个序列随机选一个去噪退出步,只保留最终被选步骤的反传,并阻断先前帧 KV cache 的梯度;这比笼统说“回传最近几帧”更准确。普通一阶反传并不自动产生 Hessian 的二阶交叉项。 本文 toy 的重拟合则是收集自身 rollout 特征,再做岭回归并用 line search 混合权重;它不对 rollout 链做可微反传。line search 和发散保护只约束这个实验,不能外推成 Self-Forcing 的固有不稳定性。 04. 代码实现 完整实验在 forcing_lab.py(附录有全文,numpy 单文件可跑)。设计原则是让三种范式唯一的差别就是特征函数: 动力系统:3 维慢变量 $u_t = \Lambda u_{t-1} + G w_{t-1} + 0.02 \xi$(谱半径 0.97)+ 3 维快变量 $w_t = \tanh(A_w w_{t-1} + B_w c) + 0.1 \xi$(谱半径 0.85),再加一个每条序列固定、模型可见的条件向量 $c$(类比文本 embedding——没有它第一帧不可预测,实验就没法做)。 去噪:4 步 DDIM(eta=0),噪声步 $[1000, 750, 500, 250]$,线性 beta 表。特征维数两范式完全相同($F = 3D + 4 + 1 = 23$),线性回归头(岭回归闭式解)——给定数据可求确定的回归解,但数据、噪声、特征和模型假设仍决定结果,不能把差异全部归因于范式。 训练集 6000 条 × 72 帧,测试集 1500 条;训练视野 24 帧,外推到 72 帧。 公平性是这么保证的:同一个回归头 $W$ 拟合三版——全序列版用双向特征整段拟合;teacher forcing 版用因果特征、上下文取真值;自回归评测用的模型与 teacher forcing 版共享同一组参数,差别只在评测时喂什么上下文。所以下表里 rollout 和 teacher forcing 之间 8.3 倍的差距里没有任何训练差异的成分,全部来自「上下文是谁生成的」。 核心代码(节选自 forcing_lab.py,去掉 Q4 受控实验分支): def feat_causal(z_t, hist, c): if len(hist) == 0: prev = np.zeros(D) past_mean = np.zeros(D) else: prev = hist[-1] past_mean = np.asarray(hist[-4:]).mean(axis=0) return np.concatenate([z_t, prev, past_mean, c, np.ones(1)]) def feat_bidir(z_seq, t, c): zp = z_seq[t - 1] if t > 0 else np.zeros(D) zn = z_seq[t + 1] if t + 1 < len(z_seq) else np.zeros(D) return np.concatenate([z_seq[t], zp, zn, c, np.ones(1)]) def sample_causal(W, rng, T_out, c, steps=STEPS, ctx_ts=0, hist_true=None): """ctx_ts: 把刚生成的帧按这个时间步加噪后才写进历史。 hist_true 给定时上下文永远取真值 = teacher forcing 评测。""" out = np.empty((T_out, D)) hist = [] for t in range(T_out): a0 = abar_of(steps[0]) z = np.sqrt(1.0 - a0) * rng.standard_normal(D) for i, ts in enumerate(steps): if hist_true is not None: ctx = hist_true[:t] else: ctx = np.array(hist) if len(hist) else np.zeros((0, D)) xhat = feat_causal(z, ctx, c) @ W if i + 1 < len(steps): z = ddim_step(z, xhat, abar_of(ts), abar_of(steps[i + 1])) out[t] = xhat hist.append(xhat.copy()) return out 这张图要看什么:左图三条曲线在训练视野边界(第 24 帧,竖虚线)附近的分叉——teacher forcing 平在 0.01 附近,但它测试时不可得;自回归 rollout 从第 1 帧起就比 teacher forcing 高一截,越过视野后继续单调上爬。右图把 rollout 的误差拆成快慢两块:慢变量(红)在所测 72 帧窗口内继续增大,不能据此证明无限长度发散,快变量(绿)基本是平的——3.2 节的预测被数据证实。 真实输出(逐帧 MSE,每维平均平方误差): 帧号 全序列扩散 teacher forcing 自回归 rollout 0 0.36699 0.32465 0.32471 1 0.33968 0.02699 0.27550 11 0.20119 0.01126 0.17954 23(视野边界前最后一帧) 0.24698 0.01152 0.22402 47 —(非流式) 0.01152 0.41608 71 — 0.01152 0.60288 三个范式在视野内的总账:全序列扩散 0.23990,teacher forcing 0.02536,自回归 rollout 0.20941。teacher forcing 比 rollout 低 8.3 倍,这 8.3 倍全是曝光偏差——同一个模型、同一套参数,只是上下文来源不同。 把 rollout 的误差按 3.2 节拆开: teacher forcing rollout 放大倍数 行为 快变量 w 0.03208 0.13269 4.14× 恒定抬升,不随长度涨 慢变量 u 0.01864 0.28614 15.35× 积累,理论预测约 16.9× 慢变量 15.35 倍对上理论值 16.9 倍,量级和方向都对得上(实测略低是因为有限长度截断了增长:“翻倍长度”若来自有限区间拟合,不能当成有界理论模型的渐近性质)。越过训练视野后慢变量误差是视野内的 2.45 倍,快变量只有 1.01 倍——扩散模型 rollout 的伤害是有结构的,不是均匀糊在所有维度上。 DAgger 轮次(Q3)的实现细节值得交代:每轮用当前权重 rollout 出上下文,重新收集特征-标签对,在岭回归闭式解上以步长 $\alpha = 0.3$ 混合新权重;然后做步长折半的 line search——实际输出若为 $\alpha=0.01875$,对应从 0.3 连续减半四次;应以脚本打印的接受步长为准,说明更新方向已接近退化;外推末帧超过 round0 的 50 倍触发发散保护。Q5 的训练上下文噪声扫描是同一套循环的外层:给训练时的真值上下文按 $k \in [0, 400]$ 个噪声步加噪(用 3.3 节同一个 $\bar{\alpha}$ 表映射),再在 TF 与 rollout 两端评测——06 节的精度换稳定性曲线就是这么来的。 05. 工业级实现对照 玩具里的一切,在 Self-Forcing 的官方实现(pipeline/causal_inference.py 的 CausalInferencePipeline,以 2026-09 时的代码为准)里都有对应物,而且配置文件里每一条都能对上: 玩具实验 Self-Forcing 真实配置(configs/self_forcing_dmd.yaml) 4 步去噪 $[1000, 750, 500, 250]$ denoising_step_list: [1000, 750, 500, 250] 每个 block 3 帧 num_frame_per_block: 3 条件向量 $c$ conditional_dict(文本编码,cross-attention 消费) 训练用自己 rollout 的上下文 训练管线 rollout + KV cache,distribution_loss: dmd 底座 Wan2.1-T2V-14B,学习率 2.0e-06 推理循环的骨架是按 block 走的,每个 block 3 帧,5 次前向: Step 3.1 空间去噪:当前 block 的帧从噪声步 1000 开始,沿 denoising_step_list 降到 250,共 4 次前向。每次前向都通过 KV cache 读到全部历史 token,当前帧的 key/value 也写进缓存。 Step 3.2 记录去噪输出 denoised_pred。 Step 3.3 刷缓存:这是整个管线最值得盯的一步——前 4 次前向里写进 KV cache 的是带噪声输入的 key/value,和「历史是干净的」这个推理前提不符。所以代码用干净的 denoised_pred 在 context_noise 时间步上重跑一次前向,把缓存里这个 block 的条目覆盖掉。这就是 Q5 实验里「训练上下文噪声」在推理侧的镜像:缓存里的历史按多脏的口径存,下游就按什么口径消费。 Step 3.4 起始帧号前移 3 帧潜帧,进入下一个 block。 底座 Wan2.1-T2V-1.3B 的拓扑是账本的地基:dim=1536、30 层、12 头(head_dim=128)、FFN 8960、patch (1,2,2)、VAE stride (4,8,8)。Self-Forcing 默认视频形状 [1, 21, 16, 60, 104]——21 个潜帧,每帧 $(60/2)\times(104/2)=1560$ 个 token;16 是通道数,进入每个 patch 的特征维度,不再乘进 token 数(60、104 是潜空间宽高,空间 patch 是 $2 \times 2$),整段 32760 个 token,约 81 个像素帧,16 fps 下 5.06 秒。训练侧的规模感:基于 CausVid 蒸馏,600 次迭代、64 张 H100、2 小时以内。 双向底座怎么改成因果的? Wan2.1 的 DiT 本来是双向注意力,改造没有动预训练权重的语义:把 self-attention 换成「空间维双向 + 时间维因果」的混合遮罩,rollout 时每个 block 的 token 先以 query 身份读完整个缓存,再把自己的 key/value 写进去;第 0 帧没有历史,等价于一次图像生成。文本条件走 cross-attention——它的 K/V 只有 512 个 T5 token,缓存恒定 0.088 GB,一次算好全程复用,跟帧数无关。训练侧在 rollout 前向之上叠 DMD 蒸馏损失(distribution_loss: dmd),让少步学生的分布对齐教师——这就是 600 次迭代能收敛的原因:监督信号来自蒸馏,不是从零拟合数据分布。 为什么缓存刷新那一步不能省? 4 步去噪的每次前向都会把「带噪声输入」的 key/value 写进缓存,而下游 block 读缓存时的前提是「历史是干净的」。Step 3.3 用干净输出在 context_noise 时间步重刷一遍,本质是把「缓存里的历史有多脏」从「去噪过程的残留」变成一个显式超参——第 06 节 Q4 实验会证明模型对这个超参极其敏感:干净上下文训练的模型,推理时给上下文加 50 步噪声,误差就从 0.025 涨到 0.047。 06. 代价与边界 流式不是免费的,把账算干净。 这张图要看什么:左图的台阶是每个 block 算完才吐 12 个像素帧(3 潜帧),出帧节奏整体贴着 16 fps 的实时线走,橙色竖线是全序列扩散一次性交付的时刻;中图和右图是一对警告——不滚动缓存时显存和单 block 时间都随长度线性涨,9 帧滚动窗口把两者同时钉成常数。 口径先交代清楚(逐项对齐公开配置,代码在附录 streaming_ledger.py):每层每 token 的 MAC = 注意力分数(对每个可见 key 做两次内积,$2 \times n_{\text{key}} \times d$)+ 四个注意力投影($4 d^2$)+ FFN($2 \times d \times 8960$)+ 一次 cross-attention(对 512 个文本 token 的分数与投影)。KV cache 每潜帧的字节数是 $2 \times 30 \times 1560 \times 1536 \times 2 \text{ B} \approx 0.268$ GB——K、V 两份,乘 30 层、每帧 1560 token、$d = 1536$、bf16 两字节——21 帧合计 5.624 GB。时间按 H100 bf16 有效 400 TFLOPS 折算(1 MAC = 2 FLOP),只算 transformer 主体,不含 VAE 解码与文本编码。 算力账(400 TFLOPS 有效算力折算,MAC 计入注意力 QKV 与投影): 全序列扩散 因果 + KV cache 单步去噪 MAC 1.4142e+14 首块 8.09e+12 → 末块 2.02e+13 4 步总 MAC 5.6567e+14 4.9514e+14(比值 0.875) 总时间 2.828 s 2.476 s 首帧延迟 2.828 s 0.202 s(13.98×) 稳态节奏 一次性交付 每块 505.1 ms,实时预算 750 ms,余量 1.48× 两点容易被误读:其一,自回归并不显著省总算力(0.875 倍,注意力遮罩少算的钱被 KV cache 刷新的额外前向花掉了大半),它买到的是首帧延迟和出帧节奏;其二,若每层稠密保存 32760×32760×12 个 bf16 分数,约 25.76 GB(24.0 GiB)(32760 token 的平方 × 12 头 × bf16),所以 FlashAttention 不是优化项是必需品(前置阅读见那篇)。 显存账(bf16 KV cache,30 层全量):21 帧全量 5.624 GB,9 帧滚动窗口 2.410 GB(43%)。不滚动的话,生成到 336 潜帧(336 个潜帧按 4 倍时间解码约 1341 帧,在 16 fps 下约 83.8 秒)时单 block 要 5.8 秒、缓存 89.98 GB——两头都爆炸;9 帧滚动窗口下恒定 303.2 ms、2.41 GB。「越生成越慢」不是自回归的本质属性,是「不滚动」这个实现选择的属性。 质量与稳定性的账,用两个受控实验说: 这张图要看什么:左图是曝光偏差的「单位换算」——把 rollout 的误差水平放到「干净模型 + 给真值上下文加噪」的曲线上插值,等效于给上下文加了约 160 个噪声步($\bar{\alpha}$ 约 0.76);右图是精度换稳定性的折中——训练时给上下文加的噪声从 0 加到 250,外推末帧误差先降后平,但视野内精度从 0.025 恶化到 0.096。 等效噪声级 ≈ 160 步:自回归 rollout 的伤害,等价于把干净的真值上下文往里掺这么多噪声。这给了当前模型、当前噪声表与误差指标下的诊断刻度,不能不经校准跨模型比较,而不是一句「会变差」。 训练上下文加噪的最优点很小:扫描 $k \in [0, 400]$,视野内误差在 $k=50$ 处最优(0.20516,对照 $k=0$ 的 0.20914),$k=250$ 时视野内恶化到 0.34373 但外推末帧确实最稳(0.49690 对 0.60284)。加噪换来的鲁棒性是真的,但精度代价涨得比稳定性收益快,别一上来就拉满。 训练噪声级和推理噪声级必须配套(Q4 受控实验):干净上下文训练的模型,推理时给上下文加 50 步噪声,误差就从 0.025 涨到 0.047——模型对「上下文多脏」这件事的敏感性是训练时铸死的,这也解释了 Step 3.3 为什么非刷缓存不可。 一个诚实说明:这个玩具里全序列扩散的逐帧误差(0.24)反而比自回归 rollout(0.21)高——线性回归头太弱,双向注意力没占到便宜。真实系统的质量取决于架构、训练与蒸馏,双向上下文本身不构成质量必胜保证,所以这条不能外推成「因果不亏质量」,只能说质量差不是自回归路线的主要障碍,曝光偏差和工程复杂度才是。 07. 经典论文脉络 先把「为什么不用更老的解法」说掉。Scheduled sampling(按概率把训练输入从真值换成模型自己的输出)在语言模型上就有分布畸变的老毛病:混着喂会让模型面对一个训练里从未出现过的「半真半假」分布;搬到扩散模型上问题更糟,因为上下文还带着噪声级这个第二维度——真值帧和自生成帧在不同的 $k$ 下混在一起,畸变是二维的。GAN 式判别器(让判别器区分真值轨迹和 rollout 轨迹)能补分布层面的监督,但训练不稳、和扩散目标叠加的工程成本高。DAgger 路线的好处是监督信号始终来自真值(专家),模型只是把「自己会走到的地方」纳入训练分布,不需要引入新网络。Self-Forcing 采用自 rollout 的视频分布匹配,与 DAgger 共享关注分布偏移的动机,但目标与监督信号不同。 Diffusion Forcing(arXiv 2407.01392,NeurIPS 2024):把下一帧预测和全序列扩散统一成「每帧独立噪声级的条件去噪」,证明了两者是同一个目标的两个端点。后续的流式视频模型(含游戏引擎式的实时生成)基本都沿用「逐 block 从噪声降干净 + 历史进缓存」的采样骨架。 CausVid:把双向扩散模型蒸馏成因果自回归的 few-step 生成器,证明「因果化 + 步数蒸馏」可以叠加。Self-Forcing 的训练基建直接继承自它。 Self-Forcing(arXiv 2506.08009):指出曝光偏差在视频扩散上的具体形态,给出「训练时 rollout + KV cache + 视频级整体损失」的解法。600 次迭代、64 H100、2 小时以内,这是这条路线「能用普通实验室的预算续命」的直接证据。 同方向的中文篇目:DDIM 采样器(本文的 4 步去噪就是它)、流匹配(另一条「少步数化」的路线)、潜空间扩散(21 潜帧从哪来)。 08. 常见误解 误解一:「自回归省算力。」 总 MAC 比值 0.875——基本不省。注意力遮罩省下的 FLOPs,被 Step 3.3 的缓存刷新前向(每块 5 次前向对 4 次)吃掉了大半。自回归买到的是 13.98 倍的首帧延迟和贴着实时线的出帧节奏,把「省算力」当卖点去汇报会翻车。 误解二:「曝光偏差就是误差随长度无限涨。」 本例慢变量系数 0.97 仍小于 1,理想独立增量模型有界;快变量更快饱和。实际学习器可因模型偏差或不稳定闭环继续增长,需另测有效误差传播,不能把快慢直接等同于有界/发散。看「平均逐帧误差涨了几倍」会把 15.35 倍和 4.14 倍混成一个数,既高估也低估——先拆维度再下结论。 误解三:「在自生成上下文上逐帧重拟合,轮次越多就越稳。」 看 DAgger 循环只盯视野内逐帧损失时发生了什么: 这张图要看什么:蓝色柱(训练视野内 MSE)从 0.209 逐轮降到 0.187,看起来一路向好;红色柱(外推第 72 帧 MSE,对数轴)从 0.60 涨到 0.83 再爆到 97.15——第 2 轮的外推末帧是第 0 轮的 161 倍。视野内的改进是真的,但把权重推离了能外推的区域。这说明本 toy 的视野内回归目标不能保证长时稳定;Self-Forcing 用联合分布匹配,不能把本 toy 当作论文算法消融或 DAgger 的普遍反例。我的实验里第 2 轮被发散保护停掉;换成对整段(含外推段)算损失的变体,两轮内慢变量降 11.9%、快变量降 8.5%,外推同步受控。 误解四:「训练时给上下文加噪越多越鲁棒。」 右图(06 节)的折中曲线明确说不是,Q5 的原始数据在这里: 训练上下文噪声步 $k$ TF 评测 自回归视野内 外推 t=71 0 0.02536 0.20914 0.60284 50 0.02792 0.20516 0.51928 150 0.05050 0.27835 0.51929 250 0.09561 0.34373 0.49690 400 0.15762 0.29314 0.54894 本次扫描中 $k=250$ 的末帧 MSE 最低,但 rollout 视野内 MSE 0.34373 是 $k=50$ 的约 1.68 倍、$k=0$ 的约 1.64 倍;另一个指标 TF MSE 为 0.09561,较 $k=0$ 的 0.02536 恶化约 3.77 倍。两列不能混算——加噪不是只影响 rollout 端。结合 Q4(模型对上下文噪声级的敏感度在训练时铸死),「加噪」本身是一种要配套的契约,不是免费的保险。 误解五:「因果注意力必须丢质量。」 在这个玩具里没有丢(见 06 节诚实说明);真实系统里质量损失主要来自曝光偏差与蒸馏误差,而不是「看不见未来」本身——CausVid 与 Self-Forcing 的生成质量支撑这一点。 09. 动手验证 三个脚本都在本文附录,numpy 单文件,无 GPU 依赖: # 主实验:三种范式 + 快慢拆解 + DAgger 轮次 + 上下文噪声扫描(约 3~5 分钟) python forcing_lab.py # 流式账本:按 Wan2.1-1.3B 真实拓扑算 MAC / 显存 / 出帧节奏(纯算术,秒级) python streaming_ledger.py # 复现本文全部 5 张图 python make_figures.py 对着输出核对三件事: forcing_lab.py 的 Q1 表里,teacher forcing 视野内均值应为 0.02536,自回归 rollout 应为 0.20941(比值约 8.3);Q3 应打印「外推末帧已发散」并停止。 streaming_ledger.py 的首帧延迟比应为 13.98,KV cache 全量应为 5.624 GB。改任何拓扑参数(层数、头数、潜帧数)都应按比例传导——比如把潜帧数从 21 改成 42,全量缓存应精确翻倍到 11.25 GB。 去 Self-Forcing 仓库打开 configs/self_forcing_dmd.yaml,核对 denoising_step_list 与 num_frame_per_block 是否与本文 05 节的表一致(上游若重构,以仓库为准)。 把 forcing_lab.py 里的 LAM_SLOW 从 0.97 调到 0.85 重跑:慢变量的放大倍数应从 15.35 回落到 4 倍上下(理论值 $1/(1 - 0.85^2) \approx 3.6$),快变量几乎不动——这是 3.2 节「谱半径决定一切」最直接的验证。 把 streaming_ledger.py 的 LAT_FRAMES 从 21 改成 42:全量 KV cache 应精确翻倍到 11.25 GB,首块延迟不变——「流式成本与已生成长度解耦」在代码里就是这么体现的。 10. 延伸阅读 Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion(arXiv 2407.01392,NeurIPS 2024) Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion(arXiv 2506.08009) 代码:guandeh17/Self-Forcing(pipeline/causal_inference.py、configs/self_forcing_dmd.yaml) 本系列相关篇目:KV cache、FlashAttention、DDIM 采样器、流匹配 下一篇自然是「少步数蒸馏」(DMD / 蒸馏到 1~4 步)——Forcing 解决了「怎么流式地生成」,蒸馏解决「每块少算几步」,两者拼起来才是实时视频生成的完整拼图。 读原论文的建议顺序:先读 Self-Forcing 的第 3 节(推理管线那五步,对照本文 05 节的表),再回头读 Diffusion Forcing 的第 3 节(目标函数的统一形式,对照本文 3.3 节)——反过来读会被「每帧独立噪声级」的抽象描述卡住,先看到具体的采样循环再回头抽象,会顺很多。玩具实验(04 节)建议在读论文之前跑一遍,数字先在手里,论文里每一句关于 exposure bias 的表述都能对号入座。 附录:完整代码 09 节用到的脚本全文如下(forcing_lab.py、streaming_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 forcing_lab.py # -*- coding: utf-8 -*- """ forcing_lab.py —— 自回归视频生成 / Forcing 范式的玩具实验(只依赖 numpy) 跑法: python forcing_lab.py # 全量 python forcing_lab.py --fast # 小样本快速迭代 python forcing_lab.py --rounds 4 # 多做几轮 DAgger 风格 toy 重拟合 python forcing_lab.py --ctx 0 100 250 # 只扫这几个上下文噪声级 数据是一段"带条件的 6 维视频",分成两块,故意让它们的时间尺度不同: u(前 3 维)慢变量:u_t = Lam u_{t-1} + G w_{t-1} + 噪声,Lam 的谱半径 0.97 —— 一条会被积分记住的轨迹,误差会累积(相机轨迹、主体位置) w(后 3 维)快变量:w_t = tanh(Aw w_{t-1} + Bw c) + 噪声 —— 收缩模态,误差会被动力学忘掉(纹理、局部细节) 输出顺序与正文表格一一对应: Q1 三种范式的逐帧误差:全序列扩散 / teacher forcing / 自回归 rollout Q2 曝光偏差拆成两块看:快变量是恒定抬升,慢变量是随帧号累积 Q3 DAgger 风格线性重拟合;不是 Self-Forcing 的 DMD 实现 Q4 上下文噪声 context_noise:训练时用什么噪声级,推理时就得用什么噪声级 """ import argparse import os import numpy as np # ═══════════════════════════════ 0. 配置 ═══════════════════════════════ DU = 3 # 慢变量 u 的维度(会被积分记住的分量) DW = 3 # 快变量 w 的维度(收缩的分量) D = DU + DW # 每帧"潜向量"的总维度 DC = 4 # 条件向量维度(类比文本 embedding) T_TRAIN = 24 # 训练时的序列长度(horizon) T_ROLL = 72 # 推理外推到 3 倍长度 N_STEPS_DIFF = 1000 STEPS = [1000, 750, 500, 250] # 对齐 Self-Forcing 的 4 步去噪 LAM_SLOW = 0.97 # 慢变量的自回归系数(谱半径) RHO_FAST = 0.85 # 快变量转移矩阵的谱半径 G_SCALE = 0.09 # 快变量驱动慢变量的耦合强度 SIG_U = 0.02 # 慢变量的过程噪声 SIG_W = 0.10 # 快变量的过程噪声 LAMBDA = 3e-3 # ridge 系数(压住上下文权重,防止 rollout 重训时正反馈发散) ALPHA = 0.3 # toy 重拟合 每轮的权重更新步长(1.0 = 完全换成新解) SEED_SYS = 20250608 CACHE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "forcing_lab_cache.npz") # ═══════════════════════ 1. 噪声表:线性 beta 调度(DDPM 原版)═══════════════════════ def build_schedule(n_steps=N_STEPS_DIFF, beta0=1e-4, beta1=0.02): beta = np.linspace(beta0, beta1, n_steps) return np.concatenate([[1.0], np.cumprod(1.0 - beta)]) # 下标 = 时间步 t ABAR = build_schedule() def abar_of(timestep): t = min(max(int(round(timestep)), 0), N_STEPS_DIFF) return float(ABAR[t]) # ═══════════════════════ 2. 数据:慢变量 + 快变量 + 条件 ═══════════════════════ def _ortho(rng, n, rho): q, _ = np.linalg.qr(rng.standard_normal((n, n))) return rho * q def make_system(): rng = np.random.default_rng(SEED_SYS) return dict( Lam=_ortho(rng, DU, LAM_SLOW), G=rng.standard_normal((DU, DW)) * G_SCALE, Aw=_ortho(rng, DW, RHO_FAST), Bw=rng.standard_normal((DW, DC)) * 0.9, H=rng.standard_normal((DU, DC)) * 0.9, ) def sample_sequences(rng, S, n, T): """采样 n 条长度为 T 的序列。c 是每条序列固定、模型可见的条件(类比文本)。""" c = rng.standard_normal((n, DC)) cb = c @ S["Bw"].T # (n, DW) hb = c @ S["H"].T # (n, DU) u = np.tanh(hb) + SIG_U * rng.standard_normal((n, DU)) w = np.tanh(cb) + SIG_W * rng.standard_normal((n, DW)) out = np.empty((n, T, D)) for t in range(T): out[:, t, :DU] = u out[:, t, DU:] = w w_new = np.tanh(w @ S["Aw"].T + cb) + SIG_W * rng.standard_normal((n, DW)) u_new = u @ S["Lam"].T + w @ S["G"].T + SIG_U * rng.standard_normal((n, DU)) u, w = u_new, w_new return out, c # ═══════════════════════════ 3. 两种特征(因果 / 双向)═══════════════════════════ # # 两边都是"自己的观测 + 两个邻居/汇总向量 + 条件 + 偏置",维数完全相同 = 3D+DC+1。 # 差别只在"能看哪几帧"——这个差别就是两种范式的全部定义: # 因果 causal:上一帧的上下文 + 过去 4 帧均值(只看过去) # 双向 bidir :前一帧 + 后一帧的噪声观测(能看未来) F_DIM = 3 * D + DC + 1 def feat_causal(z_t, hist, c): if len(hist) == 0: prev = np.zeros(D) past_mean = np.zeros(D) else: prev = hist[-1] past_mean = np.asarray(hist[-4:]).mean(axis=0) return np.concatenate([z_t, prev, past_mean, c, np.ones(1)]) def feat_bidir(z_seq, t, c): zp = z_seq[t - 1] if t > 0 else np.zeros(D) zn = z_seq[t + 1] if t + 1 < len(z_seq) else np.zeros(D) return np.concatenate([z_seq[t], zp, zn, c, np.ones(1)]) def fit_ridge(X, Y, lam=LAMBDA): F = X.shape[1] return np.linalg.solve(X.T @ X + lam * np.eye(F), X.T @ Y) # ═══════════════════════════ 4. 采样器 ════════════════════════════ def ddim_step(z, xhat, a, a_next): """DDIM (eta=0):固定噪声估计,只把噪声水平降到下一档。""" eps = (z - np.sqrt(a) * xhat) / np.sqrt(max(1e-12, 1.0 - a)) return np.sqrt(a_next) * xhat + np.sqrt(1.0 - a_next) * eps def sample_bidir(W, z_init, c, steps=STEPS): """全序列扩散:整条序列一起走 4 步,每步所有帧互相可见。非流式。""" T = z_init.shape[0] z = z_init.copy() xhat = np.zeros_like(z) for i, ts in enumerate(steps): a = abar_of(ts) xhat = np.stack([feat_bidir(z, t, c) for t in range(T)]) @ W if i + 1 < len(steps): z = ddim_step(z, xhat, a, abar_of(steps[i + 1])) return xhat def sample_causal(W, rng, T_out, c, steps=STEPS, ctx_ts=0, hist_true=None, ctx_rng=None, collect=False, x_true=None): """因果自回归 rollout。 ctx_ts 把刚生成的帧按这个时间步加噪后才写进历史(对应 Self-Forcing 里 用 context_noise 刷新 KV cache 那一步)。0 = 干净上下文。 hist_true 给定时上下文永远取真值 —— teacher forcing 评测(测试时不可得)。 ctx_rng 给定时,连真值上下文也按 ctx_ts 加噪(Q4 用的受控实验)。 """ a_ctx = abar_of(ctx_ts) out = np.empty((T_out, D)) hist = [] rows_X, rows_Y = [], [] for t in range(T_out): a0 = abar_of(steps[0]) z = rng.standard_normal(D) if a0 < 1e-8 else ( np.sqrt(a0) * (x_true[t] if x_true is not None else np.zeros(D)) + np.sqrt(1.0 - a0) * rng.standard_normal(D)) for i, ts in enumerate(steps): a = abar_of(ts) if hist_true is not None: ctx = hist_true[:t] if ctx_rng is not None and a_ctx < 1.0 - 1e-12 and len(ctx): ctx = (np.sqrt(a_ctx) * ctx + np.sqrt(1 - a_ctx) * ctx_rng.standard_normal(ctx.shape)) else: ctx = np.array(hist) if len(hist) else np.zeros((0, D)) feat = feat_causal(z, ctx, c) xhat = feat @ W if collect and x_true is not None: rows_X.append(feat.copy()) rows_Y.append(x_true[t].copy()) if i + 1 < len(steps): z = ddim_step(z, xhat, a, abar_of(steps[i + 1])) out[t] = xhat if hist_true is None: if a_ctx >= 1.0 - 1e-12: hist.append(xhat.copy()) else: hist.append(np.sqrt(a_ctx) * xhat + np.sqrt(1.0 - a_ctx) * rng.standard_normal(D)) if collect: return out, np.array(rows_X), np.array(rows_Y) return out # ═══════════════════════════ 5. 数据集构造 ════════════════════════════ def build_gt_dataset(seqs, conds, rng, levels=STEPS, ctx_ts=0): """teacher forcing 数据集:上下文用真值帧(可按 ctx_ts 加噪)。""" n, T, _ = seqs.shape a_ctx = abar_of(ctx_ts) Xs, Ys = [], [] for t in range(T): if t == 0: prev, pm = np.zeros((n, D)), np.zeros((n, D)) else: prev = seqs[:, t - 1, :] pm = seqs[:, max(0, t - 4):t, :].mean(axis=1) if a_ctx < 1.0 - 1e-12: prev = np.sqrt(a_ctx) * prev + np.sqrt(1 - a_ctx) * rng.standard_normal((n, D)) pm = np.sqrt(a_ctx) * pm + np.sqrt(1 - a_ctx) * rng.standard_normal((n, D)) for ts in levels: a = abar_of(ts) z = np.sqrt(a) * seqs[:, t, :] + np.sqrt(1.0 - a) * rng.standard_normal((n, D)) Xs.append(np.concatenate([z, prev, pm, conds, np.ones((n, 1))], axis=1)) Ys.append(seqs[:, t, :]) return np.concatenate(Xs, 0), np.concatenate(Ys, 0) def build_bidir_dataset(seqs, conds, rng, levels=STEPS): n, T, _ = seqs.shape Xs, Ys = [], [] for ts in levels: a = abar_of(ts) z = np.sqrt(a) * seqs + np.sqrt(1.0 - a) * rng.standard_normal((n, T, D)) for t in range(T): zp = z[:, t - 1, :] if t > 0 else np.zeros((n, D)) zn = z[:, t + 1, :] if t + 1 < T else np.zeros((n, D)) Xs.append(np.concatenate([z[:, t, :], zp, zn, conds, np.ones((n, 1))], axis=1)) Ys.append(seqs[:, t, :]) return np.concatenate(Xs, 0), np.concatenate(Ys, 0) # ═══════════════════════════ 6. 度量 ════════════════════════════ def mse_curve(pred, truth, sl=None): """每帧每维的平均平方误差。sl 是维度切片,用来把快慢变量分开看。""" e = (pred - truth) if sl is None else (pred[..., sl] - truth[..., sl]) return (e ** 2).mean(axis=(0, -1)) USL, WSL = slice(0, DU), slice(DU, D) def ctx_gain(W): """模型对上下文的依赖强度:上下文两块特征对应权重的 Frobenius 范数。""" return float(np.linalg.norm(W[D:3 * D, :])) def doubling_length(curve, t0=2, t1=None): t1 = t1 or len(curve) - 1 y = np.log(np.maximum(curve[t0:t1 + 1], 1e-12)) b = np.polyfit(np.arange(t0, t1 + 1), y, 1)[0] return float(np.log(2.0) / b) if b > 0 else float("inf") def fmt_row(tag, cur, cur_u, cur_w, T=T_TRAIN): return (f" {tag:<12}{cur[:T].mean():>12.5f}{cur_u[:T].mean():>12.5f}" f"{cur_w[:T].mean():>12.5f}{cur[min(23, len(cur) - 1)]:>12.5f}" f"{cur[min(47, len(cur) - 1)]:>12.5f}{cur[-1]:>12.5f}") # ═══════════════════════════ 7. 主流程 ════════════════════════════ def main(): ap = argparse.ArgumentParser() ap.add_argument("--rounds", type=int, default=3) ap.add_argument("--n-train", type=int, default=6000) ap.add_argument("--n-test", type=int, default=1500) ap.add_argument("--alpha", type=float, default=ALPHA) ap.add_argument("--fast", action="store_true") ap.add_argument("--ctx", type=int, nargs="*", default=[0, 50, 100, 150, 200, 250, 300, 400]) args = ap.parse_args() if args.fast: args.n_train, args.n_test = 2500, 500 S = make_system() seqs_train, c_train = sample_sequences(np.random.default_rng(11), S, args.n_train, max(T_TRAIN, T_ROLL)) seqs_test, c_test = sample_sequences(np.random.default_rng(12), S, args.n_test, max(T_TRAIN, T_ROLL)) var_u = seqs_test[..., USL].var(axis=(0, 1)).mean() var_w = seqs_test[..., WSL].var(axis=(0, 1)).mean() print("=" * 78) print(f"数据:u_t = Lam u_{{t-1}} + G w_{{t-1}} + {SIG_U} xi (慢变量,谱半径 {LAM_SLOW})") print(f" w_t = tanh(Aw w_{{t-1}} + Bw c) + {SIG_W} xi (快变量,谱半径 {RHO_FAST})") print(f"D={D}(u:{DU} + w:{DW}) DC={DC} 训练集 {seqs_train.shape} 测试集 {seqs_test.shape}") print(f"慢变量边缘方差 {var_u:.4f} 快变量边缘方差 {var_w:.4f}") print(f"训练视野 T={T_TRAIN},外推到 T={T_ROLL};去噪步 {STEPS}") print(f"特征维数 F = 3D+DC+1 = {F_DIM}(因果与双向完全相同)") print(f"最后一步的输入噪声级 abar({STEPS[-1]}) = {abar_of(STEPS[-1]):.4f}") print("=" * 78) # ── 基线 0:全序列扩散(非因果,整段一起解)───────────────────── Xb, Yb = build_bidir_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(21)) Wb = fit_ridge(Xb, Yb) rng_b = np.random.default_rng(31) pred_bi = np.stack([sample_bidir(Wb, rng_b.standard_normal((T_TRAIN, D)), c_test[i]) for i in range(args.n_test)]) cur_bi = mse_curve(pred_bi, seqs_test[:, :T_TRAIN]) cur_bi_u = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], USL) cur_bi_w = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], WSL) # ── 基线 1:teacher forcing(上下文用真值帧)──────────────────── Xg, Yg = build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(22)) W_tf = fit_ridge(Xg, Yg) rng_tf = np.random.default_rng(32) pred_tf = np.stack([sample_causal(W_tf, rng_tf, T_TRAIN, c_test[i], hist_true=seqs_test[i, :T_TRAIN]) for i in range(args.n_test)]) cur_tf = mse_curve(pred_tf, seqs_test[:, :T_TRAIN]) cur_tf_u = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], USL) cur_tf_w = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], WSL) # ── 基线 2:同一个权重做自回归 rollout ────────────────────────── rng_sf = np.random.default_rng(33) pred_sf0 = np.stack([sample_causal(W_tf, rng_sf, T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) cur_sf0 = mse_curve(pred_sf0, seqs_test[:, :T_ROLL]) cur_sf0_u = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], USL) cur_sf0_w = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], WSL) print("\n【Q1】三种范式的逐帧 MSE(每维平均平方误差)") print(f"{'帧号':>6}{'全序列扩散':>14}{'teacher forcing':>16}{'自回归 rollout':>16}") for t in [0, 1, 2, 3, 5, 7, 11, 15, 19, 23]: print(f"{t:>6}{cur_bi[t]:>14.5f}{cur_tf[t]:>16.5f}{cur_sf0[t]:>16.5f}") print("\n【Q2】曝光偏差拆成快慢两块看") print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w) + " 非流式,长度固定") print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w) + " 上下文用真值,测试时不可得") print(fmt_row("rollout0", cur_sf0, cur_sf0_u, cur_sf0_w)) print(f"\n 快变量 w:teacher {cur_tf_w[:T_TRAIN].mean():.5f} -> " f"rollout {cur_sf0_w[:T_TRAIN].mean():.5f} " f"放大 {cur_sf0_w[:T_TRAIN].mean() / cur_tf_w[:T_TRAIN].mean():.2f} 倍(恒定抬升)") print(f" 慢变量 u:teacher {cur_tf_u[:T_TRAIN].mean():.5f} -> " f"rollout {cur_sf0_u[:T_TRAIN].mean():.5f} " f"放大 {cur_sf0_u[:T_TRAIN].mean() / cur_tf_u[:T_TRAIN].mean():.2f} 倍") print(f" 慢变量误差 t=1 -> t=23 增长 " f"{cur_sf0_u[23] / max(cur_sf0_u[1], 1e-12):.2f} 倍," f"翻倍长度 {doubling_length(cur_sf0_u, 1, T_TRAIN - 1):.2f} 帧") print(f" 快变量误差 t=1 -> t=23 变化 " f"{cur_sf0_w[23] / max(cur_sf0_w[1], 1e-12):.3f} 倍(不累积)") print(f" 越过训练视野(t>={T_TRAIN})后:慢变量是视野内的 " f"{cur_sf0_u[T_TRAIN:].mean() / cur_sf0_u[:T_TRAIN].mean():.2f} 倍," f"快变量 {cur_sf0_w[T_TRAIN:].mean() / cur_sf0_w[:T_TRAIN].mean():.2f} 倍") print(f" 模型对上下文的依赖强度 |W_ctx| = {ctx_gain(W_tf):.4f}") # ── Q3:Self-Forcing 轮次 ───────────────────────────────────── print(f"\n【Q3】Self-Forcing 轮次(每轮用自己 rollout 的上下文重训,步长 alpha={args.alpha})") print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") W = W_tf.copy() curves, us, ws = {"round0": cur_sf0}, {"round0": cur_sf0_u}, {"round0": cur_sf0_w} rng_roll = np.random.default_rng(41) rng_eval = np.random.default_rng(61) n_sub = min(3000, args.n_train) def eval_rollout(Wm, rng): p = np.stack([sample_causal(Wm, rng, T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) return p, mse_curve(p, seqs_test[:, :T_ROLL]) # 注意:这里故意只按训练视野内的指标接受更新。Self-Forcing 的论文强调用 # "视频级整体损失",下面会看到只盯视野内会发生什么。 best_score = cur_sf0[:T_TRAIN].mean() tail0 = cur_sf0[-1] for r in range(1, args.rounds + 1): Xs, Ys = [], [] for i in range(n_sub): _, Xr, Yr = sample_causal(W, rng_roll, T_TRAIN, c_train[i], ctx_ts=0, collect=True, x_true=seqs_train[i, :T_TRAIN]) Xs.append(Xr) Ys.append(Yr) W_new = fit_ridge(np.concatenate(Xs, 0), np.concatenate(Ys, 0)) # 折半线搜索:rollout 重训容易形成正反馈,只接受真的变好的更新 picked = None a = args.alpha for _ in range(5): W_try = (1.0 - a) * W + a * W_new rng_try = np.random.default_rng(900 + r * 10 + int(a * 100)) p_try, c_try = eval_rollout(W_try, rng_try) sc = c_try[:T_TRAIN].mean() if np.isfinite(sc) and sc < best_score: picked = (W_try, p_try, c_try, sc, a) best_score = sc break a *= 0.5 if picked is None: print(f" round {r}: 折半线搜索到 alpha={a:.4f} 仍没有变好的更新,提前停止") break if picked[2][-1] > 50.0 * tail0: print(f" round {r}: 外推末帧已发散到 {picked[2][-1]:.3g}(round0 的 " f"{picked[2][-1] / tail0:.1f} 倍),停止") curves[f"round{r}"] = picked[2] us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL) ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL) break W = picked[0] curves[f"round{r}"] = picked[2] us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL) ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL) print(fmt_row(f"round{r}", curves[f"round{r}"], us[f"round{r}"], ws[f"round{r}"]) + f" alpha={picked[3]:.4f}") print(f"\n {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w)) print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w)) keys = ["round0"] + [k for k in curves if k != "round0"] for k in keys: print(fmt_row(k, curves[k], us[k], ws[k])) best = min(keys, key=lambda k: curves[k][:T_TRAIN].mean()) print(f"\n 最好一轮 {best}:快变量 {ws['round0'][:T_TRAIN].mean():.5f} -> " f"{ws[best][:T_TRAIN].mean():.5f}" f"(降 {100 * (1 - ws[best][:T_TRAIN].mean() / ws['round0'][:T_TRAIN].mean()):.1f}%)," f"慢变量 {us['round0'][:T_TRAIN].mean():.5f} -> " f"{us[best][:T_TRAIN].mean():.5f}" f"(降 {100 * (1 - us[best][:T_TRAIN].mean() / us['round0'][:T_TRAIN].mean()):.1f}%)") # ── Q4:上下文噪声必须与训练对齐 ────────────────────────────── print("\n【Q4】上下文噪声 context_noise:训练用什么级,推理就得用什么级") print(" (受控实验:上下文一律取真值帧,只改加噪级别,把曝光偏差排除掉)") W_noisy = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(23), ctx_ts=250)) print(f" {'训练噪声步':<12}{'推理噪声步':<12}{'abar':>8}{'视野内MSE':>12}{'慢变量u':>12}") ctx_rows = {} for tag, Wm in [("clean(0)", W_tf), ("noisy(250)", W_noisy)]: row = {} for cts in args.ctx: rng_e = np.random.default_rng(70) p = np.stack([sample_causal(Wm, rng_e, T_TRAIN, c_test[i], ctx_ts=cts, hist_true=seqs_test[i, :T_TRAIN], ctx_rng=rng_e) for i in range(args.n_test)]) cc = mse_curve(p, seqs_test[:, :T_TRAIN]) cu = mse_curve(p, seqs_test[:, :T_TRAIN], USL) row[cts] = cc print(f" {tag:<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}{cu.mean():>12.5f}") ctx_rows[tag] = row print(f" -> {tag} 的最优推理噪声步 = {min(row, key=lambda k: row[k].mean())}") print("\n 同样的扫描放到自回归 rollout 上(此时上下文是模型自己的输出)") row_sf = {} for cts in args.ctx: rng_e = np.random.default_rng(80) p = np.stack([sample_causal(W, rng_e, T_TRAIN, c_test[i], ctx_ts=cts) for i in range(args.n_test)]) cc = mse_curve(p, seqs_test[:, :T_TRAIN]) row_sf[cts] = cc print(f" {'selfroll':<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}" f"{mse_curve(p, seqs_test[:, :T_TRAIN], USL).mean():>12.5f}") print(f" -> 自回归 rollout 的最优推理噪声步 = {min(row_sf, key=lambda k: row_sf[k].mean())}") # ── Q5:等效噪声级 + 训练时给上下文加噪换鲁棒性 ────────────────── print("\n【Q5】曝光偏差的等效噪声级,以及训练时给上下文加噪能不能换来自回归的鲁棒性") line_tf = np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx]) target = cur_sf0[:T_TRAIN].mean() grid = np.array(args.ctx, dtype=float) eq = float(np.interp(target, line_tf, grid)) if line_tf[-1] > target else float("nan") print(f" 自回归 rollout 的视野内 MSE = {target:.5f}") if np.isfinite(eq): print(f" 在 Q4 那条『干净模型 + 加噪上下文』曲线上插值,它等效于给真值上下文加 " f"{eq:.1f} 个时间步的噪声(abar 约 {abar_of(eq):.4f})") else: print(" 超出 Q4 的扫描范围,无法插值出等效噪声级") print(f"\n {'训练ctx噪声':<14}{'TF评测':>12}{'自回归(视野内)':>16}{'自回归t=71':>14}{'慢变量u':>12}") q5 = {} for k in args.ctx: Wk = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(24), ctx_ts=k)) rng_a = np.random.default_rng(90) p_tf = np.stack([sample_causal(Wk, rng_a, T_TRAIN, c_test[i], hist_true=seqs_test[i, :T_TRAIN]) for i in range(args.n_test)]) rng_b2 = np.random.default_rng(91) p_sf = np.stack([sample_causal(Wk, rng_b2, T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) c_tfk = mse_curve(p_tf, seqs_test[:, :T_TRAIN]).mean() c_sfk = mse_curve(p_sf, seqs_test[:, :T_ROLL]) c_sfu = mse_curve(p_sf, seqs_test[:, :T_ROLL], USL) q5[k] = (c_tfk, c_sfk[:T_TRAIN].mean(), c_sfk[-1], c_sfu[:T_TRAIN].mean()) print(f" {k:<14}{c_tfk:>12.5f}{c_sfk[:T_TRAIN].mean():>16.5f}" f"{c_sfk[-1]:>14.5f}{c_sfu[:T_TRAIN].mean():>12.5f}") best_k = min(q5, key=lambda k: q5[k][1]) print(f" -> 自回归 rollout 最好的训练上下文噪声步 = {best_k}" f"(视野内 {q5[best_k][1]:.5f},对照 k=0 的 {q5[args.ctx[0]][1]:.5f})") cache_path = CACHE.replace(".npz", "_fast.npz") if args.fast else CACHE np.savez(cache_path, cur_bi=cur_bi, cur_bi_u=cur_bi_u, cur_bi_w=cur_bi_w, cur_tf=cur_tf, cur_tf_u=cur_tf_u, cur_tf_w=cur_tf_w, var_u=np.array([var_u]), var_w=np.array([var_w]), **{f"cur_{k}": v for k, v in curves.items()}, **{f"u_{k}": v for k, v in us.items()}, **{f"w_{k}": v for k, v in ws.items()}, ctx_clean=np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx]), ctx_noisy=np.array([ctx_rows["noisy(250)"][k].mean() for k in args.ctx]), ctx_sf=np.array([row_sf[k].mean() for k in args.ctx]), ctx_list=np.array(args.ctx), q5_tf=np.array([q5[k][0] for k in args.ctx]), q5_sf=np.array([q5[k][1] for k in args.ctx]), q5_sf_end=np.array([q5[k][2] for k in args.ctx]), q5_sf_u=np.array([q5[k][3] for k in args.ctx]), eq_noise=np.array([eq])) print(f"\n[cached] {cache_path}") if __name__ == "__main__": main() streaming_ledger.py # -*- coding: utf-8 -*- """ streaming_ledger.py —— 流式生成 vs 全序列扩散的算力 / 显存账本(纯算术,numpy 只用来算) 跑法: python streaming_ledger.py 拓扑全部取自公开配置,不是估的: Wan2.1-T2V-1.3B(wan/configs/wan_t2v_1_3B.py): dim=1536, ffn=8960, num_heads=12, num_layers=30, patch_size=(1,2,2), vae_stride=(4,8,8) Self-Forcing(configs/self_forcing_dmd.yaml): image_or_video_shape=[1,21,16,60,104] denoising_step_list=[1000,750,500,250] # 4 步 num_frame_per_block=3 Self-Forcing(pipeline/causal_inference.py): 每个 block 走完 4 步之后,还要用 context_noise 时间步再跑一次 forward 刷新 KV cache 口径:MAC = 一次乘加(1 MAC = 2 FLOP)。时间按 H100 bf16 有效算力 400 TFLOPS 折算, 只算 transformer 主体,不含 VAE 解码与文本编码。 """ import numpy as np # ── 拓扑 ────────────────────────────────────────────────────────── D = 1536 # dim FFN = 8960 # ffn_dim LAYERS = 30 HEADS = 12 D_HEAD = D // HEADS N_TEXT = 512 # T5 文本 token 数(cross-attn 的 K/V 长度) LAT_FRAMES = 21 # 潜空间帧数 LAT_H, LAT_W = 60, 104 PATCH = (1, 2, 2) TOK_PER_FRAME = (LAT_H // PATCH[1]) * (LAT_W // PATCH[2]) # 1560 N_TOK = LAT_FRAMES * TOK_PER_FRAME # 32760 BLOCK = 3 # num_frame_per_block N_STEPS = 4 # len(denoising_step_list) EXTRA_KV_REFRESH = 1 # 每个 block 结束后刷新 KV cache 的那次 forward PIXEL_PER_LATENT = 4 # vae_stride[0],21 潜帧 ≈ 81 像素帧 FPS = 16 BYTES = 2 # bf16 EFF_TFLOPS = 400e12 def mac_per_layer(n_new, n_key): """一层 transformer 的 MAC。n_new = 本次参与计算的 token 数,n_key = 可见的 key 数。""" attn = 2.0 * n_new * n_key * D # QK^T + AV proj = 4.0 * n_new * D * D # q, k, v, o ffn = 2.0 * n_new * D * FFN cross = 2.0 * n_new * N_TEXT * D + 2.0 * n_new * D * D # 注意力 + q/o 投影 return attn + proj + ffn + cross def gbyte(x_bytes): return x_bytes / 1024.0 ** 3 def sec(mac): return 2.0 * mac / EFF_TFLOPS def main(): print("=" * 78) print("拓扑:Wan2.1-T2V-1.3B + Self-Forcing 默认配置") print(f" dim={D} ffn={FFN} layers={LAYERS} heads={HEADS} head_dim={D_HEAD}") print(f" 潜空间 {LAT_FRAMES}x16x{LAT_H}x{LAT_W} patch={PATCH} -> " f"每帧 {TOK_PER_FRAME} token,整段 {N_TOK} token") print(f" block={BLOCK} 帧,每 block {N_STEPS} 步去噪 + {EXTRA_KV_REFRESH} 次 KV cache 刷新") print(f" 21 潜帧 ≈ {LAT_FRAMES * PIXEL_PER_LATENT - 3} 像素帧 @ {FPS}fps ≈ " f"{(LAT_FRAMES * PIXEL_PER_LATENT - 3) / FPS:.2f} 秒") print(f" 时间按 {EFF_TFLOPS/1e12:.0f} TFLOPS 有效算力折算(1 MAC = 2 FLOP)") print("=" * 78) # ── A. 全序列扩散:4 步,每步整段双向 ──────────────────────────── mac_full_step = LAYERS * mac_per_layer(N_TOK, N_TOK) mac_full = N_STEPS * mac_full_step print("\n【A】全序列扩散(非流式,整段一起解)") print(f" 单步 MAC {mac_full_step:.4e} 时间 {sec(mac_full_step)*1000:.1f} ms") print(f" 4 步合计 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s") print(f" 第一帧延迟 必须等 {N_STEPS} 步全部算完 = {sec(mac_full):.3f} s") attn_bytes_full = HEADS * N_TOK * N_TOK * BYTES print(f" 注意力矩阵要是真存下来:{HEADS} 头 x {N_TOK}^2 x {BYTES}B = " f"{gbyte(attn_bytes_full):.1f} GB(所以必须 FlashAttention)") # ── B. 因果自回归 + KV cache ──────────────────────────────────── n_blocks = LAT_FRAMES // BLOCK print(f"\n【B】因果自回归 + KV cache({n_blocks} 个 block,每 block {BLOCK} 帧)") print(f" {'block':>6}{'新token':>9}{'可见key':>9}{'单步MAC':>14}{'block合计MAC':>16}{'时间(ms)':>11}") mac_blocks = [] for i in range(n_blocks): n_new = BLOCK * TOK_PER_FRAME n_key = (i + 1) * BLOCK * TOK_PER_FRAME m_step = LAYERS * mac_per_layer(n_new, n_key) n_fwd = N_STEPS + EXTRA_KV_REFRESH # 4 步去噪:每步的 key 数就是 n_key(含当前 block 内部的因果可见部分) m_block = n_fwd * m_step mac_blocks.append(m_block) print(f" {i:>6}{n_new:>9}{n_key:>9}{m_step:>14.4e}{m_block:>16.4e}" f"{sec(m_block)*1000:>11.1f}") mac_blocks = np.array(mac_blocks) mac_causal = mac_blocks.sum() print(f" 合计 MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s") print(f" 第一帧延迟 = 第 0 个 block = {sec(mac_blocks[0])*1000:.1f} ms" f"(比全序列快 {sec(mac_full)/sec(mac_blocks[0]):.1f} 倍)") print(f" 稳态每个 block {sec(mac_blocks[-1])*1000:.1f} ms," f"实时预算 {BLOCK * PIXEL_PER_LATENT / FPS * 1000:.0f} ms " f"-> 余量 {BLOCK * PIXEL_PER_LATENT / FPS / sec(mac_blocks[-1]):.2f} 倍") # ── C. 总账对比 ──────────────────────────────────────────────── print(f"\n【C】总账({LAT_FRAMES} 潜帧)") print(f" 全序列扩散 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s " f"首帧延迟 {sec(mac_full):.3f} s") print(f" 因果+KVcache MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s " f"首帧延迟 {sec(mac_blocks[0]):.3f} s") print(f" 总算力比 因果 / 全序列 = {mac_causal / mac_full:.3f}") print(f" 首帧延迟比 全序列 / 因果 = {sec(mac_full) / sec(mac_blocks[0]):.2f}") # ── D. KV cache 显存 ─────────────────────────────────────────── print("\n【D】KV cache 显存(bf16)") kv_all = 2 * LAYERS * N_TOK * D * BYTES print(f" 完整 21 帧 2 x {LAYERS} x {N_TOK} x {D} x {BYTES}B = {gbyte(kv_all):.3f} GB") for w in [3, 6, 9, 12, 21]: kv_w = 2 * LAYERS * w * TOK_PER_FRAME * D * BYTES print(f" 滚动窗口 {w:>2} 帧 {gbyte(kv_w):.3f} GB (占完整缓存 {w/LAT_FRAMES*100:.0f}%)") cross_cache = 2 * LAYERS * N_TEXT * D * BYTES print(f" cross-attn 缓存(文本 {N_TEXT} token,只算一次){gbyte(cross_cache):.3f} GB") # ── E. 无限长:不滚动缓存会怎样 ───────────────────────────────── print("\n【E】继续往下生成(不滚动缓存 vs 滚动窗口 9 帧)") print(f" {'已生成潜帧':>10}{'无滚动:单block时间(ms)':>24}{'滚动9帧(ms)':>16}{'无滚动:累计GB':>16}") cum = 0.0 for nlat in [21, 42, 84, 168, 336]: i = nlat // BLOCK - 1 n_new = BLOCK * TOK_PER_FRAME n_key = (i + 1) * BLOCK * TOK_PER_FRAME m_noroll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key) m_roll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer( n_new, min(n_key, 9 * TOK_PER_FRAME)) cum = 2 * LAYERS * nlat * TOK_PER_FRAME * D * BYTES print(f" {nlat:>10}{sec(m_noroll)*1000:>24.1f}{sec(m_roll)*1000:>16.1f}" f"{gbyte(cum):>16.3f}") # ── F. 出帧节奏 ──────────────────────────────────────────────── print("\n【F】出帧节奏(每 block 出 3 潜帧 = 12 像素帧)") t_full = sec(mac_full) t_blocks = np.cumsum(sec(mac_blocks)) print(f" 全序列:t={t_full:.3f} s 时一次性拿到全部 {LAT_FRAMES * PIXEL_PER_LATENT - 3} 帧") for i, tb in enumerate(t_blocks): print(f" 因果 :t={tb:.3f} s 时拿到第 {(i+1)*BLOCK*PIXEL_PER_LATENT-3:>3} 像素帧") print(f" 实时预算:{FPS} fps 下应该在 " f"{np.arange(1, n_blocks+1)*BLOCK*PIXEL_PER_LATENT/FPS} 秒处出帧") print("\n[cached] 数值直接被 make_figures.py 引用(本文件被 import 时用函数取)") def ledger_numbers(): """给 make_figures.py 用的结构化数值。""" n_blocks = LAT_FRAMES // BLOCK mac_blocks = [] for i in range(n_blocks): n_new = BLOCK * TOK_PER_FRAME n_key = (i + 1) * BLOCK * TOK_PER_FRAME mac_blocks.append((N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key)) mac_blocks = np.array(mac_blocks, dtype=float) mac_full = N_STEPS * LAYERS * mac_per_layer(N_TOK, N_TOK) return dict( mac_full=float(mac_full), mac_causal=float(mac_blocks.sum()), mac_blocks=mac_blocks, t_full=sec(mac_full), t_blocks=np.cumsum(sec(mac_blocks)), kv_all_gb=gbyte(2 * LAYERS * N_TOK * D * BYTES), kv_per_frame_gb=gbyte(2 * LAYERS * TOK_PER_FRAME * D * BYTES), n_blocks=n_blocks, block=BLOCK, lat_frames=LAT_FRAMES, tok_per_frame=TOK_PER_FRAME, n_tok=N_TOK, attn_gb_if_materialized=gbyte(HEADS * N_TOK * N_TOK * BYTES), pixel_frames=LAT_FRAMES * PIXEL_PER_LATENT - 3, fps=FPS, ) if __name__ == "__main__": main() print() for k, v in ledger_numbers().items(): if not isinstance(v, np.ndarray): print(f" {k:>28} = {v}") make_figures.py # -*- coding: utf-8 -*- """ make_figures.py —— 本文配图(matplotlib,中文字体 PingFang SC) 跑法: python make_figures.py 所有数字都从 forcing_lab_cache.npz(forcing_lab.py 实跑产出)和 streaming_ledger.ledger_numbers() 里取,不手写,避免图文漂移。 注意:matplotlib 的 mathtext 标签一律写 raw 字符串,且反斜杠后只跟字母 (beta 这种字母命令没问题,逗号、百分号等非字母不要跟在反斜杠后面)。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt from matplotlib.patches import Rectangle, FancyArrow HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") CACHE = os.path.join(HERE, "forcing_lab_cache.npz") import forcing_lab as FL import streaming_ledger as SL plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "Heiti TC"] plt.rcParams["axes.unicode_minus"] = False # 颜色常量(写图注前先对照这里,别凭印象写颜色) C_BLUE = "#1f6feb" # 自回归 rollout C_TEAL = "#0f9b8e" # teacher forcing C_ORANGE = "#e07b00" # 全序列扩散 C_RED = "#c0392b" # 慢变量 u / 恶化 C_GREEN = "#2d8a4e" # 快变量 w / 改善 C_GRAY = "#8a8a8a" # 参照线、未生成 C_DARK = "#3a3a3a" # 噪声最重的格子 C_LIGHT = "#f2f2f2" # 干净的格子 def load(): return dict(np.load(CACHE, allow_pickle=True)) # ══════════════════════════ 图 1:三种范式的噪声级与因果结构 ══════════════════════════ def _box(ax, x, y, w, h, level, edge=C_GRAY, lw=0.8, ls="-"): """level: 1 = 干净(浅),0 = 纯噪声(深)""" facecolor = str(max(0.0, min(1.0, float(level)))) ax.add_patch(Rectangle((x, y), w, h, facecolor=facecolor, edgecolor=edge, linewidth=lw, linestyle=ls, zorder=2)) def fig_paradigm(path): n = 12 bw, bh = 0.86, 0.62 fig, axes = plt.subplots(3, 1, figsize=(11.0, 6.6)) fig.subplots_adjust(left=0.06, right=0.97, top=0.93, bottom=0.07, hspace=0.34) # (a) 全序列扩散:整段一起降噪,帧与帧之间双向可见 ax = axes[0] steps_lv = [0.06, 0.30, 0.62, 0.92] for r, lv in enumerate(steps_lv): y = (len(steps_lv) - 1 - r) * 1.0 for i in range(n): _box(ax, i * 1.07, y, bw, bh, lv) ax.annotate("", xy=(n * 1.07 - 0.1, y + bh / 2), xytext=(0.05, y + bh / 2), arrowprops=dict(arrowstyle="<->", color=C_ORANGE, lw=1.8)) ax.text(-0.35, y + bh / 2, r"去噪步 %d" % (r + 1), ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, len(steps_lv) + 0.15, "所有帧同一个噪声级,一起降;双向注意力,帧间互相可见", ha="center", fontsize=11, color=C_ORANGE) ax.text(n * 1.07 / 2, -0.55, "代价:本图需 4 步整段去噪才交付第一帧;可用长度由架构与训练共同限制", ha="center", fontsize=10, color=C_GRAY) # (b) teacher forcing:真值上下文,只看过去 ax = axes[1] y = 0.0 cur = 7 for i in range(n): if i < cur: _box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_TEAL, lw=1.2) elif i == cur: _box(ax, i * 1.07, y, bw, bh, 0.10) else: _box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--") for i in range(cur): ax.annotate("", xy=(cur * 1.07 + bw * 0.5, y + bh * 0.45), xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45), arrowprops=dict(arrowstyle="->", color=C_TEAL, lw=1.2, connectionstyle="arc3,rad=-0.25")) ax.text(-0.35, y + bh / 2, "训练时", ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, y + 1.15, "上下文永远取真值帧(浅色),只有当前帧(深色)带噪声", ha="center", fontsize=11, color=C_TEAL) ax.text(n * 1.07 / 2, y - 0.52, "代价:推理时真值帧不存在,上下文换成模型自己的输出 —— 这就是曝光偏差", ha="center", fontsize=10, color=C_GRAY) # (c) Self-Forcing 风格的生成上下文:自己的输出进 KV cache,逐 block 走 ax = axes[2] done, blk = 6, 3 for i in range(n): if i < done: _box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_BLUE, lw=1.2) elif i < done + blk: _box(ax, i * 1.07, y, bw, bh, 0.10, edge=C_BLUE, lw=1.2) else: _box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--") for i in range(done): ax.annotate("", xy=(done * 1.07 + bw * 0.5, y + bh * 0.45), xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45), arrowprops=dict(arrowstyle="->", color=C_BLUE, lw=1.2, connectionstyle="arc3,rad=-0.25")) ax.add_patch(Rectangle((-0.05, y - 0.42), done * 1.07 + 0.05, 0.26, facecolor=C_BLUE, alpha=0.15, edgecolor=C_BLUE, lw=1.0)) ax.text(done * 1.07 / 2, y - 0.29, "KV cache(已生成的帧,不再重算)", ha="center", va="center", fontsize=9.5, color=C_BLUE) ax.text(-0.35, y + bh / 2, "推理时", ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, y + 1.15, "自回归推理:历史为已生成的干净帧,当前 block 从噪声降到干净", ha="center", fontsize=11, color=C_BLUE) ax.text(n * 1.07 / 2, y - 0.82, "Self-Forcing 训练也用自己的 rollout 上下文,减轻训练与推理的分布差异", ha="center", fontsize=10, color=C_GRAY) for ax in axes: ax.set_xlim(-2.4, n * 1.07 + 0.3) ax.set_ylim(-1.05, len(steps_lv) + 0.45 if ax is axes[0] else 1.55) ax.axis("off") axes[0].set_title("三种上下文组织示意:可见范围、噪声级与历史来源", fontsize=13, pad=10) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 2:误差随帧号怎么长 ══════════════════════════ def fig_rollout(d, path): T = FL.T_TRAIN fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7)) ax = axes[0] xs = np.arange(T) ax.plot(xs, d["cur_bi"][:T], color=C_ORANGE, lw=2.0, label="全序列扩散(非流式)") ax.plot(xs, d["cur_tf"][:T], color=C_TEAL, lw=2.0, label="teacher forcing(真值上下文)") xr = np.arange(len(d["cur_round0"])) ax.plot(xr, d["cur_round0"], color=C_BLUE, lw=2.0, label="自回归 rollout(自己的输出)") ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2) ax.text(T - 0.4, ax.get_ylim()[1] * 0.55, "训练视野\nT=24", fontsize=9.5, color=C_GRAY) ax.set_yscale("log") ax.set_xlabel("帧号 t") ax.set_ylabel("每维平均平方误差(对数轴)") ax.set_title("(a) 三种范式的逐帧误差", fontsize=12) ax.legend(fontsize=9.5, loc="lower right") ax.grid(alpha=0.25, ls=":") ax = axes[1] ax.plot(xr, d["u_round0"], color=C_RED, lw=2.0, label=r"慢变量 u(会被积分记住)") ax.plot(xr, d["w_round0"], color=C_GREEN, lw=2.0, label=r"快变量 w(收缩模态)") ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2) ax.text(T - 0.4, 0.10, "训练视野\nT=24", fontsize=9.5, color=C_GRAY) ax.set_yscale("log") ax.set_xlabel("帧号 t") ax.set_ylabel("每维平均平方误差(对数轴)") ax.set_title("(b) 自回归 rollout 拆成快慢两块", fontsize=12) ax.legend(fontsize=9.5, loc="upper left") ax.grid(alpha=0.25, ls=":") fig.suptitle("本玩具系统中,慢变量的误差在越过训练视野后明显增长", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.94]) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 3:Self-Forcing 轮次的取舍 ══════════════════════════ def fig_rounds(d, path): keys = sorted([k[4:] for k in d if k.startswith("cur_round")], key=lambda s: int(s.replace("round", ""))) lbl = [("round0" if k == "round0" else k) for k in keys] inh = [float(d[f"cur_{k}"][:FL.T_TRAIN].mean()) for k in keys] tail = [float(d[f"cur_{k}"][-1]) for k in keys] x = np.arange(len(keys)) fig, ax = plt.subplots(figsize=(9.6, 4.6)) ax2 = ax.twinx() b1 = ax.bar(x - 0.19, inh, 0.36, color=C_BLUE, label="训练视野内 MSE(左轴)") b2 = ax2.bar(x + 0.19, tail, 0.36, color=C_RED, label="外推第 72 帧 MSE(右轴,对数)") for b in b1: ax.text(b.get_x() + b.get_width() / 2, b.get_height(), f"{b.get_height():.3f}", ha="center", va="bottom", fontsize=9) for b in b2: ax2.text(b.get_x() + b.get_width() / 2, b.get_height(), f"{b.get_height():.2f}", ha="center", va="bottom", fontsize=9, color=C_RED) ax.set_xticks(x) ax.set_xticklabels([k.replace("round", "第 ") + " 轮" if k != "round0" else "第 0 轮" for k in keys]) ax.set_ylabel("训练视野内 MSE", color=C_BLUE) ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED) ax2.set_yscale("log") ax.set_ylim(0, max(inh) * 1.35) ax2.set_ylim(min(tail) * 0.5, max(tail) * 3.0) ax.grid(alpha=0.25, ls=":", axis="y") ax.set_title("玩具 DAgger 式重训:视野内改善,长程误差增加(非论文 Self-Forcing)", fontsize=13) h1, l1 = ax.get_legend_handles_labels() h2, l2 = ax2.get_legend_handles_labels() ax.legend(h1 + h2, l1 + l2, fontsize=10, loc="upper left") fig.tight_layout() fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 4:上下文噪声的取舍 ══════════════════════════ def fig_context(d, path): ks = [int(v) for v in d["ctx_list"]] ab = [FL.abar_of(k) for k in ks] tf = [float(v) for v in d["q5_tf"]] end = [float(v) for v in d["q5_sf_end"]] inh = [float(v) for v in d["q5_sf"]] fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7)) ax = axes[0] ax.plot(ks, d["ctx_clean"], "o-", color=C_TEAL, lw=2.0, label="干净模型 + 推理时给上下文加噪") ax.axhline(float(d["cur_round0"][:FL.T_TRAIN].mean()), color=C_BLUE, ls="--", lw=1.6, label="自回归 rollout 的实际水平") ax.axvline(float(d["eq_noise"][0]), color=C_RED, ls=":", lw=1.8) ax.text(float(d["eq_noise"][0]) + 8, ax.get_ylim()[1] * 0.62, f"等效噪声级\n约 {float(d['eq_noise'][0]):.0f} 步", fontsize=9.5, color=C_RED) ax.set_xlabel("上下文噪声时间步") ax.set_ylabel("视野内 MSE") ax.set_title("(a) 曝光偏差有多大:换算成等效噪声级", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") ax = axes[1] ax.plot(ks, inh, "o-", color=C_BLUE, lw=2.0, label="训练视野内 MSE(精度)") ax.set_xlabel("训练时给上下文加的噪声时间步 k") ax.set_ylabel("训练视野内 MSE", color=C_BLUE) ax2 = ax.twinx() ax2.plot(ks, end, "s-", color=C_RED, lw=2.0, label="外推第 72 帧 MSE(稳定性)") ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED) ax.set_title("(b) 训练时给上下文加噪:精度换稳定性", fontsize=12) h1, l1 = ax.get_legend_handles_labels() h2, l2 = ax2.get_legend_handles_labels() ax.legend(h1 + h2, l1 + l2, fontsize=9.5, loc="center right") ax.grid(alpha=0.25, ls=":") fig.suptitle(f"上下文噪声:abar 从 {ab[0]:.2f} 降到 {ab[-1]:.2f}," f"本实验中增加上下文噪声可降低长程误差,但影响视野内精度", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.93]) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 5:流式账本 ══════════════════════════ def fig_ledger(path): L = SL.ledger_numbers() fig, axes = plt.subplots(1, 3, figsize=(15.6, 4.6)) # (a) 出帧节奏 ax = axes[0] pix = (np.arange(1, L["n_blocks"] + 1) * L["block"] * 4 - 3) ax.step(np.concatenate([[0], L["t_blocks"]]), np.concatenate([[0], pix]), where="post", color=C_BLUE, lw=2.2, label="因果自回归 + KV cache") ax.plot([L["t_full"], L["t_full"]], [0, L["pixel_frames"]], color=C_ORANGE, lw=2.2, label="全序列扩散(一次性出全部帧)") tt = np.linspace(0, L["pixel_frames"] / L["fps"], 50) ax.plot(tt, tt * L["fps"], color=C_GRAY, ls="--", lw=1.4, label="实时预算 16 fps") ax.set_xlabel("时间 (s)") ax.set_ylabel("已生成的像素帧") ax.set_title("(a) 出帧节奏", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") ax.set_ylim(0, L["pixel_frames"] * 1.05) # (b) KV cache 显存 ax = axes[1] nf = np.arange(1, 169) ax.plot(nf, nf * L["kv_per_frame_gb"], color=C_BLUE, lw=2.2, label="KV cache(不滚动)") ax.axhline(9 * L["kv_per_frame_gb"], color=C_GREEN, ls="--", lw=1.6, label="滚动窗口 9 帧的上限") ax.axhline(L["kv_all_gb"], color=C_GRAY, ls=":", lw=1.4, label="21 帧整段") ax.set_xlabel("已生成的潜帧数") ax.set_ylabel("KV cache 显存 (GB)") ax.set_title("(b) 不滚动缓存,显存线性涨", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") # (c) 单 block 计算时间 ax = axes[2] nkey = np.arange(1, 169) * SL.TOK_PER_FRAME t_noroll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array( [SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME, k) for k in nkey]) / SL.EFF_TFLOPS t_roll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array( [SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME, min(k, 9 * SL.TOK_PER_FRAME)) for k in nkey]) / SL.EFF_TFLOPS ax.plot(np.arange(1, 169), t_noroll * 1000, color=C_RED, lw=2.2, label="不滚动(线性变慢)") ax.plot(np.arange(1, 169), t_roll * 1000, color=C_GREEN, lw=2.2, label="滚动窗口 9 帧(恒定)") ax.axhline(SL.BLOCK * 4 / SL.FPS * 1000, color=C_GRAY, ls="--", lw=1.4, label="实时预算 750 ms / block") ax.set_xlabel("已生成的潜帧数") ax.set_ylabel("单个 block 的计算时间 (ms)") ax.set_title("(c) 不滚动缓存,每个 block 越来越慢", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") fig.suptitle("400 TFLOPS 假设下的算术估算:首帧交付更早;缓存与历史计算仍有代价", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.93]) fig.savefig(path, dpi=140) plt.close(fig) def main(): os.makedirs(FIGDIR, exist_ok=True) d = load() fig_paradigm(os.path.join(FIGDIR, "paradigm.png")) fig_rollout(d, os.path.join(FIGDIR, "rollout_error.png")) fig_rounds(d, os.path.join(FIGDIR, "selfforcing_rounds.png")) fig_context(d, os.path.join(FIGDIR, "context_noise.png")) fig_ledger(os.path.join(FIGDIR, "streaming_ledger.png")) for f in sorted(os.listdir(FIGDIR)): p = os.path.join(FIGDIR, f) print(f" {f:<28} {os.path.getsize(p)/1024:.0f} KB") if __name__ == "__main__": main()
-
AIGC 基本功|DiT:用 Transformer 替掉 UNet-DiT AIGC 基本功|DiT:用 Transformer 替掉 UNet-DiT 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(ddpm)、潜空间扩散(latent_diffusion)、自注意力(attention_basics) 关键词:DiT、Diffusion Transformer、adaLN-Zero、patchify、Gflops 缩放、条件注入 01. 为什么需要它 读者先掌握 DDPM 的加噪与噪声预测目标、潜空间压缩和多头注意力即可。本文把 $z_t$ 记作加噪后的 VAE 潜变量;$T$ 是空间 token 数,时间步用 $t$,二者不要混淆。LayerNorm 对每个 token 的特征维归一化,后文给出其条件调制。MAC 是乘加次数;一次乘加常按 2 FLOPs 折算,既不是耗时也不是吞吐。 先给三组数字。论文结果来自 DiT 原文 Table 4:256×256 ImageNet、400K 训练步、batch 256、EMA 权重、无 CFG、50K 样本 FID、250 步 DDPM、ft-MSE VAE 解码器;不包含 VAE 的参数和前向成本。本文没有重训该 ImageNet 实验。文中 NumPy toy 与解析账本另有完整可运行脚本。 第一组:参数量相差约 4 倍的两个模型,FID 几乎相同;第三个大模型却差得多。 DiT-S/2 用 33M 参数、6.06 Gflops 得到 FID 68.40,DiT-B/4 用 130M、5.56 Gflops 得到 68.38;DiT-L/8 用 459M、5.01 Gflops 得到 118.87。三者的预算只是接近,并非严格相等。图 1 虚线连接的是这三种配置,第三点并未与前两点重合。它说明参数量不足以预测这些配置的质量;更小 patch 可以让小模型增加 token 计算,得到有竞争力的结果。三个点同时改变宽度、深度和 patch,不能单独证明“买 token 永远优于买宽度”。UNet 也能调整通道、层数或下采样设计,DiT 的优势在于用统一 block 更方便地组织这些缩放实验。 第二组:DiT-XL/2 的主要矩阵 MAC 中,注意力两次矩阵乘约占 3.57%。 对 $T=256,d=1152$,qkv、输出投影和 MLP 合计是 $12Td^2$,注意力分数与加权是 $2T^2d$。线性项占这两类主项的约 96.43%;若以包含调制、输入和输出等简化项的 118.646 G 账本为分母,则分别约 96.21% 与 3.56%。不要混用分母。两类主项相等时 $T=6d$,即 XL 的 6912。这个算式解释运算量分配;实际瓶颈仍受访存、kernel 和硬件影响,注意力的二次存储也不能从 MAC 比例中排除。论文在指定配置网格和训练预算中观察到更多 Gflops 与更低 FID 的相关性,不是对任意任务的单调保证。 第三组:同样 118.6 Gflops,只换条件注入方式,FID 从 25.21 掉到 19.47。 论文 Table 4 中四种 block 的 400K 步对照是同一个 DiT-XL/2 骨架:in-context 35.24、cross-attention 26.14、vanilla adaLN 25.21、adaLN-Zero 19.47。其中 vanilla adaLN 与 adaLN-Zero 的 Gflops 只差 0.08,差别包括新增残差门控与零初始化,不能把整个增益归因于初始化一个因素。这组 5.74 分差距对应门控与初始化等结构选择的联合比较,不能视为只改一个初始化变量的因果效应。下文逐行说明其前向和梯度路径。 这张图要看什么:左图使用论文 Table 4 的预算和 FID,虚线只是连接预算接近的配置。S/2 与 B/4 的 FID 接近,L/8 明显更高,不能读成三者等高。右图只比较注意力矩阵 MAC 与主干线性 MAC,竖线为 T=256;随 token 增加,二次项逐渐变得重要。 所以这篇文章回答三个问题:DiT 的算力账本是怎么记的、adaLN-Zero 的「恒等初始化」在数学上意味着什么、以及它换来的到底是什么。 02. 最小可用理解 三句话讲完: 把潜变量切成 patch 序列,再接条件化的 ViT 风格骨干。 32×32×4 的潜变量按 p=2 切成 (32/2)²=256 个 token,每个 token 原始 16 维,线性嵌入到 d 维,加固定的 2D sin-cos 位置编码,过 N 个 block,最后一层线性投回 p²×2C 维(原始 learn_sigma=True,同时输出噪声与方差参数)再拼回空间形状。patch size p 是 DiT 沿用 ViT 的缩放旋钮:p 减半,token 数翻四倍,主干线性 MAC 翻四倍、注意力矩阵 MAC 翻十六倍;总预算还含每样本固定项,参数量近似不变。 条件(时间步 + 类别)不进序列,而是变成每个 block 的 LayerNorm 参数。 具体做法是调制:先算出 $c = t_{\text{emb}} + y_{\text{emb}}$,再用一个 $\text{SiLU} \to \text{Linear}(d, 6d)$ 把它变成 6 段 d 维向量,分别是注意力分支与 MLP 分支的 $(\beta_1, \gamma_1, \alpha_1)$ 与 $(\beta_2, \gamma_2, \alpha_2)$。前两个做 shift/scale,第三个是残差门控:$x \leftarrow x + \alpha \odot f(\cdot)$。 Zero 指的是整个调制层零初始化,于是每个 block 在初始化时是恒等函数。 关键点在 DiT 的 modulate 写法:它是 $x(1 + \gamma_{\text{out}}) + \beta_{\text{out}}$ 而不是 $x\gamma_{\text{out}} + \beta_{\text{out}}$。调制层输出全零时,$\gamma_{out}=0$(有效缩放为 $1+\gamma_{out}=1$)、$\beta = 0$、$\alpha = 0$,三件事同时成立,整个 block 变成 $x \mapsto x$。实测:28 层叠完之后 $\|x_{28} - x_0\|_\infty = 0$(图 2 左)。 代价也很清楚:门关着的时候,block 内部除门控之外的参数梯度精确为零——在独立 block 接非零上游梯度时,门控可能先获得梯度;完整 DiT 的输出头也为零,第一步首先更新输出头。 03. 数学推导 3.1 patchify:从空间表示到 token 序列 记潜变量 $z \in \mathbb{R}^{I \times I \times C}$(256×256 图像过 VAE 后是 $I=32, C=4$)。patchify 把每个 $p \times p \times C$ 的方块摊平成一个 $p^2C$ 维向量,共 $$T = (I/p)^2$$ 个,再用一个线性层 $\mathbb{R}^{p^2C} \to \mathbb{R}^d$ 嵌入。实测的形状(附录 dit_flops.py): 输入潜变量 z: (2, 32, 32, 4) p=8: patchify -> (2, 16, 256) T=16, 每 token 256 维 p=4: patchify -> (2, 64, 64) T=64, 每 token 64 维 p=2: patchify -> (2, 256, 16) T=256, 每 token 16 维 $T$ 之外的一切($d$、block 数、头数)都与 $p$ 无关,所以在其余配置固定时,$p$ 主要改变 token 运算量,但输入和输出投影的参数也随之改变:$p$ 从 8 减到 2,DiT-S 的 Gflops 从 0.36 涨到 6.06(17 倍),论文取整均为 33M,并非每个参数完全相同。 3.2 算力账本:主导项是 $O(Td^2)$ 数一个 block 的主要矩阵乘加次数(MAC,一次 $ab+c$ 记 1)。这一口径能近似解释论文的 Gflops;论文没有给出足以完全复现所有逐元素算子的统一 profiler 定义,本文不声称逐 FLOP 完全一致。 部件 每个 token 的 MAC 说明 qkv 投影 $3d^2$ $d \to 3d$ 注意力分数 $QK^\top$ $Td$ 每个 token 对 T 个位置各做 d 次乘加 注意力加权 $AV$ $Td$ 同上 输出投影 $d^2$ $d \to d$ MLP($d \to 4d \to d$) $8d^2$ 两层各 $4d^2$ adaLN 调制 $6d^2$ / 样本 + $3d$ / token 每个样本只算一次;3d 是简化的逐元素计数,未穷尽两分支全部操作 忽略调制与逐元素项,一个 block 的算力是 $$\mathrm{MAC}_{\text{block}} \approx T(12d^2 + 2Td)$$ 其中 $12d^2=3d^2+d^2+8d^2$。仅乘 $N=28,T=256,d=1152$ 的两类主项得到 118.380 G MAC;再加每层 $6d^2$ 的条件投影、输入/输出和时间嵌入以及简化逐元素项,脚本得到 118.646194176 G,论文报告 118.64 G。两者很接近,但不是同一个精确计数。LayerNorm、softmax、SiLU/GELU 的实际算子成本与偏置操作未完整计入。一次乘加按 2 FLOPs 折算时,主矩阵项可约乘二,不能把所有逐元素项也机械当成两次运算。 参数账本则可以精确核对:原始源码的两个 block LayerNorm 和最终 LayerNorm 均无仿射参数;类别表含 1000 个类别与 1 个 null 行;输出头含 $2C$ 通道。因此每块可训练参数为 $18d^2+15d$,XL/2 的可训练参数共 674,834,720,冻结位置编码另有 294,912 个数;将冻结参数也算入模型 Parameter,总数是 675,129,632。下面表格的“本篇参数量”统一取可训练参数。12 种配置均已用固定官方 DiT 类在 PyTorch meta 设备上逐参数数目核对,不执行这些大模型的前向或训练。 这张对账表本身就是文章的一半结论,值得整张贴出来: 模型 N / d / T 本篇 GMAC 论文 Gflops 可训练 M 论文 FID DiT-S/8 12 / 384 / 16 0.358 0.36 33.142 153.60 DiT-S/4 12 / 384 / 64 1.413 1.41 32.920 100.41 DiT-S/2 12 / 384 / 256 6.059 6.06 32.865 68.40 DiT-B/8 12 / 768 / 16 1.418 1.42 130.869 122.74 DiT-B/4 12 / 768 / 64 5.567 5.56 130.426 68.38 DiT-B/2 12 / 768 / 256 23.012 23.01 130.316 43.47 DiT-L/8 24 / 1024 / 16 5.013 5.01 458.578 118.87 DiT-L/4 24 / 1024 / 64 19.700 19.70 457.988 45.64 DiT-L/2 24 / 1024 / 256 80.716 80.71 457.841 23.33 DiT-XL/8 28 / 1152 / 16 7.394 7.39 675.665 106.41 DiT-XL/4 28 / 1152 / 64 29.050 29.05 675.001 43.01 DiT-XL/2 28 / 1152 / 256 118.646 118.64 674.835 19.47 横着读这张表,三个旋钮的作用各不相同: 深度 N:固定 d、T 时,block 的参数和 MAC 随 N 线性增加。表中 L/2 与 B/2 也同时改变 d 和头数,不能把两者的 FID 差单独归因于加深。 宽度 d:固定 N、T 时,主干线性参数与 MAC 近似按 d² 增加,注意力矩阵项按 d 增加。表中 XL/4 与 S/4 还同时改变 N,不能视为纯宽度消融。 减小 patch(p: 8→2):算力涨 4 倍一档(线性项按 T 涨),总参数量近似不变(patch 投影和输出头会随 p 改变);S/8 → S/2 贵 17 倍算力,FID 从 153.60 到 68.40。 值得注意的是「同样算力下单块算力都是 12d² 主导」这件事在表里也看得出来:DiT-S/2 与 DiT-B/4 的算力(6.06 / 5.56 G)落在同一档,说明一个 12 层 384 宽、切到 p=2 的小模型,和 12 层 768 宽、切到 p=4 的大模型,在算力上是可以互换的;两者的 FID 也确实只差 0.02。这条「算力等价」的直觉,是后面理解缩放实验的前提。 注意力占比是两种项的比值: $$\frac{2Td}{12d^2 + 2Td} = \frac{2T}{12d + 2T}$$ 代入 $T=256, d=1152$ 得 3.57%。令两者相等解出临界点 $T = 6d$:固定 T 时,d 越大,注意力矩阵 MAC 在这两类主项中的占比越小;这不判定实际延迟或显存占比。图 1 右图画的是各档模型在 $T$ 从 64 到 16384 上扫过的这条曲线。 3.3 adaLN:把条件变成 LayerNorm 的参数 标准 LayerNorm 之后接仿射变换: $$h = \gamma \odot \mathrm{LN}(x) + \beta$$ 其中 $\mathrm{LN}$ 对最后一维做归一化(DiT 里 elementwise_affine=False,仿射参数不是 LN 自带的)。 具体对一个 d 维 token,均值 $\mu=d^{-1}\sum_jx_j$,方差 $v=d^{-1}\sum_j(x_j-\mu)^2$,使用总体方差而非无偏样本方差: $$\mathrm{LN}(x)_j=\frac{x_j-\mu}{\sqrt{v+\epsilon_{LN}}},\qquad \epsilon_{LN}=10^{-6}$$ 其中稳定常数防止零方差时除零;它与扩散噪声 $\varepsilon$ 是两个不同量。adaLN 的做法是把 $\gamma, \beta$ 变成条件的函数: $$(\beta_1, \gamma_1, \alpha_1, \beta_2, \gamma_2, \alpha_2) = \mathrm{Linear}_{d \to 6d}\big(\mathrm{SiLU}(c)\big), \qquad c = t_{\text{emb}} + y_{\text{emb}}$$ DiT 源码里的 modulate 是这样写的: $$\mathrm{modulate}(x, \beta, \gamma) = x \odot (1 + \gamma) + \beta$$ 用 $1+\gamma$ 时,调制层输出 $\gamma=0$ 对应有效缩放为 1,$\beta=0$ 对应不平移。注意“调制输出”与“有效缩放”是两个量,不能把同一个 $\gamma$ 同时写成 0 与 1。没有这项偏移未必数学上完全无法学习,但会改变初始特征与梯度路径。 3.4 门控与恒等初始化 DiT block 的两条残差分支都带门: $$x' = x + \alpha_1 \odot \mathrm{Attn}\big(\mathrm{modulate}(\mathrm{LN}_1(x), \beta_1, \gamma_1)\big)$$ $$x'' = x' + \alpha_2 \odot \mathrm{MLP}\big(\mathrm{modulate}(\mathrm{LN}_2(x'), \beta_2, \gamma_2)\big)$$ 调制层零初始化时 $\beta=0$、$\gamma=0$(有效缩放 $1+\gamma=1$)、$\alpha=0$。只要两个门控为零且分支输出有限,block 就是恒等映射,即使 shift/scale 非零也成立。把整层调制器置零进一步让分支内部从不平移、单位缩放开始,但这不是恒等的必要条件。 实测(附录 adaln_zero.py,DiT-XL 宽度 d=1152、T=256、16 头;随机 float64 教学 block,不是预训练模型): adaln_zero 单块 |out - x| 最大值 = 0.000e+00 叠 28 层后 |out - x| 最大值 = 0.000e+00 adaln 单块 |out - x| 最大值 = 2.985e+00 单块相对扰动 std(out-x)/std(x) = 0.6105 叠 28 层后残差流漂移 std(x_28 - x_0) = 4.3497 对照组 vanilla adaLN(无门控且调制层非零初始化):单块就给残差流叠上 std 为 0.61 的随机扰动,28 层随机游走之后漂移达到 4.35——该 seed 下输出相对输入有较大扰动;漂移标准差不能证明输入信息已经丢失。零初始化这一侧,漂移严格是 0,连浮点误差都没有。图 2 左图画的就是这两条曲线。 这张图要看什么:左图比较相同深度宽度的两种 block;差别包含门控及调制初始化——蓝线恒等于 0,粉线一路爬到 4.35。右图是初始化那一刻各部件的梯度大小(对数轴):蓝柱的主干部分趴在底部,真实值就是精确的 0(画在 1e-12 只是为了让 log 轴显示得出),只有最后一组「调制层 gate 段」立起来;粉柱则所有部件都有梯度。注意最右一组的对比是不对称的:vanilla adaLN 结构里压根没有 gate 这一项,所以那条柱子是空的——零初始化不只是「让某些梯度变成 0」,它同时给网络装上了一组原本不存在的门。 3.5 初始化那一刻,谁拿到了梯度 先看单条残差分支 $y=x+\alpha\odot f(h;\theta_f)$,其中 $h=(1+\gamma)\odot\mathrm{LN}(x)+\beta$。对每个样本 b,三个调制向量均为 d 维,并广播到所有 token;$g=\partial L/\partial y$ 与 x 同形状。令 $J_f$ 是 f 对其输入的完整雅可比,$J_{\theta_f}$ 是对分支参数的雅可比,链式法则给出: $$\frac{\partial L}{\partial\alpha_{bj}}=\sum_{t=1}^{T}g_{btj}f(h)_{btj}$$ $$r=J_f(h)^\top(\alpha\odot g),\qquad \frac{\partial L}{\partial\theta_f}=J_{\theta_f}^\top(\alpha\odot g)$$ $$\frac{\partial L}{\partial\beta_{bj}}=\sum_t r_{btj},\qquad \frac{\partial L}{\partial\gamma_{bj}}=\sum_t r_{btj}\mathrm{LN}(x)_{btj}$$ 这里 $\alpha\odot g$ 隐含 token 广播,雅可比转置乘向量是完整矩阵运算,不能把它写成没有收缩指标的逐元素乘积。于是有限分支值且 gate=0 时,分支参数、shift 和 scale 的梯度为零;gate 的梯度可以非零,但若上游 g 为零或求和抵消,它也可能为零。共享调制线性层的权重和偏置还须对样本 b 累加。残差输入 x 的梯度仍可通过恒等路径传播,并不是整个 block 的所有梯度都为零。 下面独立 block 的线性损失实际为 mean(out*w),w 是固定随机数组,均值归一化已包含在 g 中: adaLN-Zero: W_qkv=0.000000e+00, W_o=0.000000e+00, W_1=0.000000e+00, W_2=0.000000e+00 调制层各段: shift_msa=0.000000e+00, scale_msa=0.000000e+00, gate_msa=6.521017e-05, shift_mlp=0.000000e+00, scale_mlp=0.000000e+00, gate_mlp=4.136085e-04 vanilla adaLN: W_qkv=3.751596e-04, W_o=1.960228e-04, W_1=2.736421e-04, W_2=2.435175e-04 调制层各段: shift_msa=6.434247e-04, scale_msa=7.563427e-05, shift_mlp=3.578871e-04, scale_mlp=3.251636e-04 完整 DiT 还将最终输出线性层置零。写成 $o=W_{out}h+b_{out}$,首次反传的上游为 $W_{out}^\top\partial L/\partial o=0$,所以更早的 block gates 暂时也没有损失梯度。固定官方小模型的真实 CPU 实验(输入 2×4×8×8、输出 2×8×8×8、两块 d=32、SGD 学习率 0.1)得到: step 0: 输出 max=0;输出头 grad max=0.0414984;首块调制/注意力 grad=0/0 step 1: 首块调制 grad max=9.09985e-5;注意力 grad=0 step 2: 首块注意力 grad max=1.65495e-9 这是一个具体更新过程的验证,不是保证任意优化器和数据都按固定步数打开门。权重衰减、显式正则或其他损失会另添更新路径。 零输出头的初始 MSE 等于当前这批样本噪声平方的平均值,不保证恰为总体期望 1;learned-variance 的完整训练损失还含另一项,不能只报噪声 MSE 就称完整训练 loss。NumPy 小模型的实跑见下一段: 当前批 mean(eps²)=1.0083085178;零头 MSE=1.0083085178;输出 max=0.0 随机打开输出头后 MSE=3.1357716071;输出 max=4.954960 3.6 四种条件注入:先在自己的玩具任务上排一遍序 论文那组数字(DiT-XL/2、400K 步、ImageNet)在本机复现不了——没有 ImageNet,也没有 TPU。但同一个问题可以搬到跑得完的 toy 上:8 个朝向的二维条纹、潜变量 8×8×2、patch p=2 得到 $T=16$、$d=64$、6 层,各方案使用相同宽度、深度、训练样本流、优化器、学习率计划与步数,每种跑 3 个 seed。结构、参数量、初始化规则及随机数消费顺序不同,不能称为只改初始化的配对消融。脚本就是附录里的 cond_ablation.py。 结果以最终代码真实重跑,训练统计是最后 200 步各 batch MSE 的均值;“±”是 3 次结果的总体标准差(ddof=0),只作描述性统计。另在每次训练结束后,用新噪声和新时间采样的 256 个样本计算评估 MSE;8 类条纹模板仍与训练相同,不是新语义类别的泛化评估。 方案 参数量 训练 MSE 均值 ± std 新加噪评估 MSE 均值 ± std adaLN-Zero 464,328 0.031844 ± 0.002636 0.022255 ± 0.003168 vanilla adaLN 414,408 0.073483 ± 0.001623 0.068328 ± 0.000756 in-context 307,912 0.073493 ± 0.002453 0.064545 ± 0.003234 cross-attention 408,520 0.071401 ± 0.001369 0.067276 ± 0.006353 三个 seed 各自的最后200步训练 MSE: adaLN-Zero:0.028939 / 0.035319 / 0.031276 vanilla adaLN:0.075761 / 0.072582 / 0.072105 in-context:0.071173 / 0.076887 / 0.072419 cross-attention:0.070053 / 0.073279 / 0.070870 这张图要看什么:左图仅画 seed=0 的训练曲线,右图画三个 seed 的最终训练 MSE 和离散点。曲线及数值均来自本轮完整档缓存;完整参数与代码哈希绑定在缓存元数据中,修改代码或 batch/depth/seed 后不会沿用旧结果。 在这一次完整重跑中,按平均训练 MSE 从低到高依次为:adaLN-Zero、cross-attention、vanilla adaLN、in-context。这是此教学结构、8 个固定条纹模板和三个训练 seed 的结果,不是对所有条件注入方法的排序定理。新加噪评估值不必等于最后 200 步训练均值:两者既使用不同噪声,也对应不同阶段的参数。 这个实验保留了自注意力、条件注入与噪声预测的机制,但不含 VAE、learned variance、CFG 或图像 FID。评估只检查同一组条纹模板下新的加噪样本;三 seed 的区间或排序不能证明不存在随机波动,也不能解释 ImageNet 上其他方案的排序为何不同。in-context 多两个 token 的成本、条件交互的难度都可能随任务变化;本文没有用这个实验分别识别这些原因。vanilla adaLN 与 adaLN-Zero 的每层参数差为 2d²+2d,d=64、6 层时差 49,920,来自多出的两个调制门段;这个参数差可以精确解释,质量差不能据此单因归因。 3.7 四种方案到底差在哪(回到论文的数字) 论文比较了四种把条件塞进 Transformer 的办法,它们的差别全部集中在「条件从哪里进入 block」这一件事上: 方案 条件怎么进去 代价 in-context 把 $t_{\text{emb}}, y_{\text{emb}}$ 当成两个额外 token 加入序列(本教学实现拼在末尾),走的还是同一套 self-attention 序列变长,token 数从 $T$ 变 $T+2$;每个 block 都要为这两个 token 做一次全量 attention cross-attention 主干只放图像 token,另加一层交叉注意力,条件 token 当 key/value 多一套 $d \to d$ 的注意力参数,算力上涨最多 vanilla adaLN 条件不进序列,变成 LayerNorm 的 shift/scale($\gamma, \beta$),没有门 每层另加约 4d² 的条件投影参数,MAC 只对每样本算一次;无额外 gate adaLN-Zero 同上,再多两个门 $\alpha_1, \alpha_2$,并把整个调制层零初始化 每层比 vanilla adaLN 多 $2d^2+2d$ 的调制参数(含偏置) 这张图要看什么:三根柱子分别是算力、参数量、FID,四组从左到右对应上表的四种方案。先看中间那张参数量图:in-context 参数最少(449M,因为它没有额外的注意力参数,只是把序列变长),cross-attention 为约 598M 总参数,不能把它与另一方案的 600M 相加,adaLN-Zero 是 675M,比 vanilla adaLN 多了 75M——近似差来自每块新增的 $2d^2+2d$ 个调制参数。再看右边那张 FID 图:参数最少的 in-context 质量最差(35.24),参数最多的 adaLN-Zero 质量最好(19.47)。最后看左边的算力:四种方案的算力其实都挤在 118~138 G 这个窄区间里(in-context 因为序列长了一点反而是 119.37,cross-attention 因为多一套注意力到 137.62),这约 16 分的差距出现在相近但并不完全相同的前向预算下,表明这个训练设置对条件结构选择敏感;它不把算力、参数量与初始化的因果贡献完全拆开。 一个容易看漏的对照:vanilla adaLN 与 adaLN-Zero 的算力只差 0.08 G(118.56 vs 118.64),参数量差 75M,FID 差 5.74 分。门取常数 1 时可包含无门控的行为,但条件相关门控也增加了函数自由度;该对照同时改变参数与初始化,不能证明函数类完全相同,更不能把 5.74 分全部归因为优化路径。 04. 代码实现 完整脚本在文末附录,这里放三段核心代码与它们的真实输出。 4.1 patchify 与它的逆 def patchify(z, p): """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]""" B, I, _, C = z.shape g = I // p z = z.reshape(B, g, p, g, p, C) z = z.transpose(0, 1, 3, 2, 4, 5) # [B, g, g, p, p, C] return z.reshape(B, g * g, p * p * C) 跑一遍(batch=2、32×32×4):p=8 -> (2, 16, 256)、p=4 -> (2, 64, 64)、p=2 -> (2, 256, 16),逆变换的最大误差 0.00e+00。 4.2 一个 DiT block def modulate(h, shift, scale): """DiT 源码的 modulate: x * (1 + scale) + shift""" sh = tg.reshape(shift, (shift.v.shape[0], 1, -1)) sc = tg.reshape(scale, (scale.v.shape[0], 1, -1)) return tg.add(tg.add(h, tg.mul(h, sc)), sh) class DiTBlock: def __call__(self, x, c, store, ctx=None): B, T, d = x.v.shape sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last( self.w_mod(tg.silu(c), store), 6) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a)) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u)) 逐项对一下变量名与 03 节的符号:sh_a/sc_a/gate_a 就是 $(\beta_1, \gamma_1, \alpha_1)$,w_mod 是那个 $\text{Linear}(d, 6d)$,注意它前面接的是 silu 而不是别的激活。w_mod 在 mode="adaln_zero" 时用 zero=True 初始化——weight 和 bias 全是 0,另外 vanilla adaLN 调制四段且没有残差门控;两者并非只差初始化。 4.3 账本对账与非平凡反向检查 dit_flops.py 的真实输出中,XL/2 的可训练参数为: patch 嵌入 19,584 时间嵌入 1,624,320 类别嵌入(含 null) 1,153,152 28 × 23,905,152 669,344,256 FinalLayer(含方差输出) 2,693,408 合计 674,834,720 冻结位置编码另计 294,912 近似主矩阵账本中,逐 token 线性项是 114.152177664 G,注意力两次乘法为 4.227858432 G,完整简化账本 118.646194176 G。所有 12 个配置与论文 Gflops 的偏差小于 1%,但这只是计数模型接近论文,不是测出了相同 GPU 延迟。参数数目则与官方类的真实注册参数精确相等。 手写自动微分不能在零输出头下检验主干:那样主干梯度全为零,错误的反向也可能“通过”。本次修正 gradcheck_report,在中心差分前把输出头设为非零,真正让 LayerNorm、注意力、MLP 和条件路径接到梯度。另把同一套 NumPy block 权重复制给固定官方 DiTBlock 与 timm Attention/Mlp,打开非零调制,比较输出、输入/条件及全部五组线性层的权重和偏置梯度;float64 的最大误差见第 09 节。官方完整小模型还验证了第 3.5 节的分阶段梯度路径。 05. 工业级实现对照 对照官方 固定提交的 models.py,提交为 ed81ce2(完整提交链接可点开核查)。本文实际执行原始 AST 类与方法,依赖选用 timm v0.6.12 的原始 Attention/Mlp/PatchEmbed;官方 environment.yml 并未固定 timm 版本。两项简单辅助函数提供等价的 tuple 转换和断言,未改写这些类的数学实现。使用 PyTorch 2.10 CPU,未声称复现原 JAX/TPU 训练或 GPU 性能。 modulate 就是那个 $1+\gamma$。 源码原样: def modulate(x, shift, scale): return x * (1 + scale.unsqueeze(1)) + shift.unsqueeze(1) 每个 block 内用一层 SiLU + Linear,一次算 6 段再 chunk;不同 block 的调制器不共享权重。 不是给六个分支各配一个线性层: self.adaLN_modulation = nn.Sequential(nn.SiLU(), nn.Linear(hidden_size, 6 * hidden_size, bias=True)) # 上面这个 Sequential 的输出一次是 6d 维,再切成六段 shift_msa, scale_msa, gate_msa, shift_mlp, scale_mlp, gate_mlp = self.adaLN_modulation(c).chunk(6, dim=1) 初始化分三步,顺序不能乱。 先 xavier_uniform_ 初始化所有 Linear,再把每个 block 的调制层整体置零,最后把 FinalLayer 的调制层和输出线性层置零: self.apply(_basic_init) # 1. 全模型 xavier_uniform for block in self.blocks: # 2. 每个 block 的 adaLN 调制层归零 nn.init.constant_(block.adaLN_modulation[-1].weight, 0) nn.init.constant_(block.adaLN_modulation[-1].bias, 0) nn.init.constant_(self.final_layer.adaLN_modulation[-1].weight, 0) # 3. 输出层归零 nn.init.constant_(self.final_layer.adaLN_modulation[-1].bias, 0) nn.init.constant_(self.final_layer.linear.weight, 0) nn.init.constant_(self.final_layer.linear.bias, 0) 注意第 2 步是整层置零,不是只置零 gate 那两段——这就是 3.4 节说的「一次拿到 $\gamma=0$(有效缩放为 1)、$\beta=0, \alpha=0$ 三件事」。 与最小实现的差异,以及为什么: 差异 源码里的做法 为什么 位置编码 2D sin-cos,requires_grad=False 冻结 沿用 MAE 风格;冻结的是位置 Parameter,仍占存储,不能由此推得所有任务质量或外推优势 时间步编码 256 维正弦 → Linear → SiLU → Linear 原始 DiT 采用该频率嵌入,不是所有扩散模型的唯一选择;toy 使用归一化时间且 t_freq=32 类别嵌入 nn.Embedding(1000 + 1, d),多一个位置 多出来的那一行是 CFG 的 null token,token_drop 把标签换成它 输出通道 learn_sigma=True 时输出 $2 \times 4 = 8$ 通道 一半预测噪声、一半预测方差(可学习的 $\Sigma_\theta$),采样时用后者做各时间步的方差 CFG 的作用范围 forward_with_cfg 只把引导作用在前 3 个通道 该固定代码注释说明这是为了精确复现做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推;这是复现 DiT 数值时最容易踩的坑之一 激活函数 nn.GELU(approximate="tanh") 固定代码采用此近似;本文不以它推出跨硬件速度或 FID 不变的保证 还有一个容易被忽略的点:unpatchify 用的是 torch.einsum('nhwpqc->nchpwq', x),不是简单的 reshape。它要把 token 里的 $p \times p \times C$ 重新摆回空间位置,通道维要提到最前面。 整条前向的调用顺序(DiT.forward)值得记住,因为后面拆视频版 DiT 时这几步会变成瓶颈点: x = self.x_embedder(x) + self.pos_embed # 1. patchify + 位置 t = self.t_embedder(t) # 2. 时间步 → 256 → d y = self.y_embedder(y, self.training) # 3. 类别 → d(training 时才做 label dropout) c = t + y # 4. 两个条件相加,不是拼接 for block in self.blocks: x = block(x, c) # 5. N 个 block,条件从 c 进来 x = self.final_layer(x, c) # 6. 也是调制出来的 shift/scale x = self.unpatchify(x) # 7. 回到空间形状 第 4 步相加后 c 仍为 d 维,每个 block 的调制参数沿 token 广播;这是条件注入的形式约束,不是对含位置编码和注意力的整个网络表达能力给出绝对上界。 分类器无关引导(CFG)是在 forward 外面拼的。 forward_with_cfg 复制输入 batch 的前半份为两份,但不会替调用者改标签。调用者需传入偶数 batch、成对一致的时间步,以及前半条件标签、后半 null 标签,最后再合成: half = x[: len(x) // 2] combined = torch.cat([half, half], dim=0) # 前半、后半的条件由调用者传入的 y 决定 model_out = self.forward(combined, t, y) eps, rest = model_out[:, :3], model_out[:, 3:] cond_eps, uncond_eps = torch.split(eps, len(eps) // 2, dim=0) half_eps = uncond_eps + cfg_scale * (cond_eps - uncond_eps) eps = torch.cat([half_eps, half_eps], dim=0) return torch.cat([eps, rest], dim=1) # 其余通道原样保留 这里有两个复现时必须知道的细节:其一,引导公式用无条件分支做基准(uncond + w·(cond − uncond)),不是把有条件分支当基准;其二,eps, rest 的拆分把引导限制在前 3 个通道,返回时仍拼回其余通道(含方差),该固定代码注释说这是为了精确复现而做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推。照着论文数值复现时如果忘了这一条,采样协议会改变;本文没有测出这个修改会令 FID 改变多少。 learn_sigma 是输出通道翻倍的原因。 当它为真时 out_channels = 2 * in_channels,网络一半预测噪声 $\varepsilon$、另一半预测 learned-range 的方差插值参数,经同提交扩散代码映射为对数方差。该映射不自动将插值参数裁到 [-1,1],网络超出该区间时也可能发生外插。采样时前者进 DDPM/DDIM 的更新公式,后者可用于学习方差的 DDPM 更新;DDIM 的随机方差由其调度与 η 决定,通常不使用该头。这也是为什么 DiT 的输出头看起来比「预测噪声」该有的形状大一号。 06. 代价与边界 代价一:$O(T^2)$ 迟早会来找你。 T=256 时注意力只占 3.6%,那是 256×256 图像。512×512 的 DiT-XL/2 有 T=1024,一次前向 524.6 Gflops(是 256 分辨率的 4.4 倍);再往视频走,时间维一加,token 数轻易上万。长视频常采用序列并行、稀疏/窗口或时空分解等方案,但不是由该公式得出的唯一必选实现。T 远小于 6d 只说明 MAC 主项中线性层更大,不能据此保证注意力不是实际瓶颈。 代价二:adaLN 对所有 token 施加同一个函数。 论文原话:adaLN 是四种方案里唯一「被限制成对所有 token 应用同一个函数」的。$\beta, \gamma, \alpha$ 是 d 维向量,在整个序列上广播,没有空间维度。所以凡是条件本身带空间结构的任务——局部编辑、inpainting 的 mask、逐区域控制——单靠一个广播的全局调制向量不便保留空间对应关系,通常还需空间输入、条件 token 或 cross-attention;不能据此断言整体网络表达不了局部任务。SD3 的 MM-DiT 为图像和文本保留不同权重并做联合注意力;它给出另一种条件交互设计,本文不将其历史动机归因于单一原因。 代价三:patch size 减半,主要 token 算力约四倍起,参数仅小幅变化。 这是好事也是陷阱:在论文所测配置中,小模型 + 小 patch 可获得接近某些大模型的 FID(01 节);不保证任意模型可互换;坏消息是部署成本还取决于硬件、batch、访存和采样步数;Gflops 是其中一项,论文前向 Gflops 约相差 17 倍,参数取整相同;这不是测得 17 倍延迟,部署时容易误判。 代价四:丢掉了 UNet 的多尺度归纳偏置。 UNet 的下采样-上采样结构天然假设「图像有局部性、有尺度层次」,这个先验在小数据集上是白送的。原始 DiT 用平铺 token 网格和全局注意力,也有 patch 结构和固定位置编码;不能说完全没有空间归纳偏置。论文的结论主要来自 ImageNet 规模;它没有给出这里所说“几万张图”场景的普遍收敛比较,因此小数据集需另做受控验证。 代价五:初始化决定最初的梯度路径。 独立 block 实验验证门控阻断分支梯度;完整模型还需先打开零输出头。不能据此指定“前几步只有门在动”的固定持续时间,或无依据地推荐给调制器更大学习率。 论文中的 ADM 1983 Gflops 与 DiT-XL/2 118.64 Gflops 是像素空间 UNet 与潜空间 Transformer 的跨系统比较,分辨率、表示和训练预算都不同。它说明整套 DiT 系统有竞争力,不能把约 16.7 倍单次前向差全归因于更换骨干,也不包含完整采样步数与 VAE 成本。 07. 经典论文脉络 论文 原文 在本文中的作用 ADM 2105.05233 UNet 扩散与引导的强基线;跨像素/潜空间预算不能全归因于骨干 LDM 2112.10752 在压缩潜空间训练扩散,为 DiT 的 32×32×4 输入提供表示基础 U-ViT 2209.12152 探索带长跳连的 ViT 扩散骨干,将时间和条件作为 token;整体结构不等于 DiT 的 in-context 变体 DiT 2212.09748 在指定 ImageNet 配置网格研究深度、宽度、patch 和条件注入,adaLN-Zero 在所测对照中较优 PixArt-α 2310.00426 结合文本 cross-attention 与时间调制;文中训练预算比较绑定其数据与训练方案 SD3 2403.03206 用图文不同权重的 MM-DiT 和 rectified flow,不能等同于只改原始类别嵌入 Latte 2401.03048 探索视频潜空间 Transformer 的四种时空建模设计,不代表所有视频骨干都采用同一结构 这条阅读线把潜空间表示、Transformer 骨干、文本交互与时间建模分开理解:ADM/LDM 提供扩散与潜空间背景,U-ViT/DiT 探索骨干,PixArt-α/SD3 研究文本交互,Latte 研究视频。它是按问题组织的阅读顺序,不是所有后继工作的一条单向继承史。可以从固定 DiT 代码确认时间/类别调制与恒等残差这套设计;不能把“后继几乎都沿用零初始化”当成已逐模型验证的事实。 08. 常见误解 误解一:adaLN-Zero 只是把 scale 零初始化。 实现把整个调制线性层置零;调制输出 scale=0,而有效缩放为 1。残差恒等主要由 gate=0 保证,单独关门已经足够。 误解二:注意力 MAC 比例小,就不会成为瓶颈。 XL/2、T=256 的两类主矩阵 MAC 中注意力约占 3.57%,但实际耗时取决于算子效率与访存;显式注意力矩阵存储仍是二次项。长视频的 T 可远大于图像,不能把几百 token 的结论泛化。$T=6d$ 只是两类 MAC 主项相等的点。 误解三:patch size 只影响 token 数,是个「免费的」结构选择。 参数量只是近似不变(DiT-S 三档取整都是 33M),对算力一点也不免费(0.36 → 1.41 → 6.06 G,17 倍)。论文里那句「changing $p$ has no meaningful impact on downstream parameter counts」说的是参数,别顺手读成「没有代价」。 误解四:Gflops、GMAC 和实测速度可以互换。 论文预算数值接近按一次乘加计 1 的主要矩阵账本。若按乘、加各计一次,主矩阵 FLOPs 约是 MAC 的两倍;逐元素函数仍需自己的计数规则。本文明确给出近似项和遗漏,不把接近 118.64 写成逐 FLOP 复现,更不从预算直接推出硬件速度。 误解五:零初始化让整个模型不能训练。 零输出头仍能先收到非零梯度;随后 gate 和主干逐步接到信号。独立 block 的梯度实验不能替代完整 DiT 首次反传的检查。 误解六:DiT 就是「把 UNet 换成 ViT」,拿一个标准 ViT 直接接上就行。 差的不是一点:DiT 没有 [CLS] token、没有分类头、位置编码是冻结的 2D sin-cos(这是原始实现的选择,不能由此保证所有任务中都优于可学习编码);最关键的是它的 block 不是标准 ViT block——多了一条 adaLN 调制支路和两个门,FinalLayer 也是「调制 + 线性」而不是「LN + 线性」。把 torchvision 里的 ViT 拿来改,能跑起来,但那不是 DiT,也复现不出 19.47 的 FID。 09. 动手验证 附录保留六个完整脚本,其中 dit_core.py、tiny_grad.py 是公共件,另四个是实验入口。只需 NumPy、matplotlib;主体脚本与绘图实跑环境是 Windows、Python 3.11.9、NumPy 2.4.3、matplotlib 3.10.7;官方 CPU 参考使用已有局部运行依赖,确切版本见实跑证据。进程内 OpenBLAS/OMP 各 1 线程。官方参考另用 PyTorch 2.10.0+cpu,不安装系统包,不将 CPU 结果外推为 GPU、TPU 性能。 python dit_flops.py:打印 patchify 与逆变换的真实形状、可训练参数和近似 MAC;预期 XL/2 为 674,834,720 可训练参数、约 118.646 G 简化预算。冻结位置编码另计 294,912,12 配置与官方注册参数精确一致。 python adaln_zero.py:真实执行 d=1152、T=256 的单块/28 层前向和独立 block 梯度,恒等误差为 0。非零输出头下中心差分检查实际激活的主干梯度,最大相对误差 1.110e-03(分母下限 1e-8;近零梯度的相对值受消减误差放大)。另以三步长独立检查 702 个参数探点,步长 1e-6 时最大绝对差为 3.217e-10,步长从 1e-4 降低时的误差收敛与独立官方对照支持反向实现;同权重官方 block 的 float64 前向最大差 2.220e-16,输入/条件/所有参数梯度最大差 1.388e-17。 python cond_ablation.py:快速档为 150 步、1 seed,只检查这套小实验的训练行为。python cond_ablation.py --full --rerun 强制重跑 800 步 × 3 seed × 4 方案;正常 --full 仅在源码哈希、NumPy、seed、batch、depth 与完整元数据均一致时复用缓存。学习率从 0.003 按 0.25**(step/steps) 衰减,batch=32,训练时间均匀取 [0.05,0.95],用余弦加噪。完整档耗时随机器而异,以本机运行证据为准。 python make_figures.py:生成四张原图;图 3 使用完整档缓存,若缺失则触发完整训练。图 1/4 的 FID 来自原论文,不是本机测得;图 2/3 的数值是本文实跑。 想验证零 gate 的边界,可在 adaln_zero.py 中分别换随机 c、给 shift/scale 非零值但保持两个 gate=0,有限分支下仍为恒等。反例是分支出现 NaN 或无穷时,浮点的零乘它并不保证有限输出。再把输出头随机打开后做梯度检查,便能避免“全零梯度让错误反向看似正确”的假通过。 10. 延伸阅读 往回走:潜空间扩散与 Stable Diffusion 的整体结构(latent_diffusion)、DDPM 的训练目标(ddpm)、自注意力的计算细节(attention_basics) 往两侧走:分类器无关引导的代价(cfg)、流匹配与 Rectified Flow——SD3 之后的新一代训练目标(flow_matching) 往工程走:DiT 上到长视频后 token 数增长,可结合注意力设计与并行方案处理预算,见序列并行(sequence_parallel)、张量/流水线并行(tensor_pipeline_parallel)、混合精度(mixed_precision) 往采样走:同样的骨干,采样步数怎么省,见从 DDIM 到高阶采样器(ddim_samplers) 直接后继:自回归视频生成、跨步缓存复用。本篇不改变这些节点。 附录:完整代码 09 节用到的脚本全文如下(dit_flops.py、adaln_zero.py、cond_ablation.py、dit_core.py、tiny_grad.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 dit_flops.py # -*- coding: utf-8 -*- """DiT 账本(一):patchify 的形状、参数量与 Gflops,逐项对账。 DiT 这篇论文最反直觉的一点是:**它把「模型大小」和「一次前向的算力」拆开了**。 改 patch size p 几乎不动参数量,却能让 Gflops 翻四倍;改 hidden size d 不动 token 数,参数量与逐 token 线性 MAC 都近似按 d² 增长。 这个脚本做三件事: 1. 真的做一次 patchify,打印每一步的形状(不是嘴上说 T=(I/p)^2); 2. 按 DiT 的实际结构逐项数参数,与论文 Table 4 的 Params(M) 对账; 3. 用同一套结构数 Gflops,与论文 Table 4 的 Flops(G) 对账。 计数说明:主要矩阵乘法按一次乘加记 1 的 MAC 口径;另含简化逐元素项。 该预算接近论文 Gflops,未完整计数 LN/softmax/非线性,不是逐 FLOP 或延迟复现。 """ import numpy as np # ─────────────── 论文 Table 1 的四档配置:(深度 N, hidden d, 头数) ─────────────── DIT_CONFIGS = { "S": (12, 384, 6), "B": (12, 768, 12), "L": (24, 1024, 16), "XL": (28, 1152, 16), } # 论文 Table 4 的真实数字,用来对账:(Gflops, 参数量 M, FID-50K 无引导) PAPER_TABLE4_256 = { ("S", 8): (0.36, 33, 153.60), ("S", 4): (1.41, 33, 100.41), ("S", 2): (6.06, 33, 68.40), ("B", 8): (1.42, 131, 122.74), ("B", 4): (5.56, 130, 68.38), ("B", 2): (23.01, 130, 43.47), ("L", 8): (5.01, 459, 118.87), ("L", 4): (19.70, 458, 45.64), ("L", 2): (80.71, 458, 23.33), ("XL", 8): (7.39, 676, 106.41), ("XL", 4): (29.05, 675, 43.01), ("XL", 2): (118.64, 675, 19.47), } # 四种条件注入在 DiT-XL/2 上的对照:论文 Table 4 的四种 block 在 400K 步时的行 PAPER_BLOCK_DESIGN = { # 名字: (Gflops, Params M, FID) "in-context": (119.37, 449, 35.24), "cross-attention": (137.62, 598, 26.14), "adaLN": (118.56, 600, 25.21), "adaLN-Zero": (118.64, 675, 19.47), } # ─────────────── 1. patchify:真的做一遍 ─────────────── def patchify(z, p): """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]。 把 I×I 切成 (I/p)×(I/p) 个格子,每个格子里的 p*p*C 个数直接摊平成 一个 token 的原始特征。论文里这一步是一个 nn.Linear(p*p*C, d)。 """ B, I, _, C = z.shape assert I % p == 0, f"I={I} 必须被 p={p} 整除" g = I // p z = z.reshape(B, g, p, g, p, C) z = z.transpose(0, 1, 3, 2, 4, 5) # [B, g, g, p, p, C] return z.reshape(B, g * g, p * p * C) def unpatchify(x, p, I, C): """patchify 的逆:[B, T, p*p*C] -> [B, I, I, C]。""" B = x.shape[0] g = I // p x = x.reshape(B, g, g, p, p, C) x = x.transpose(0, 1, 3, 2, 4, 5) # [B, g, p, g, p, C] return x.reshape(B, I, I, C) # ─────────────── 2. 参数账本 ─────────────── def count_params(cfg="XL", p=2, C=4, n_classes=1000, t_freq=256, I=32, learn_sigma=True, class_dropout=True, include_frozen=False): """固定官方 DiT 参数;默认统计可训练参数,冻结位置编码另计。""" N, d, _ = DIT_CONFIGS[cfg] out_C = 2 * C if learn_sigma else C items = {"patch 嵌入": p*p*C*d+d, "时间嵌入": t_freq*d+d+d*d+d, "类别嵌入(含 null 行)": (n_classes+int(class_dropout))*d} # 两个 LN 均 elementwise_affine=False,不含任何可训练 scale/bias。 per_block = 18*d*d + 15*d items[f"{N} 个 block × {per_block:,}"] = N*per_block items["FinalLayer(含方差输出)"] = 2*d*d+2*d+d*p*p*out_C+p*p*out_C if include_frozen: items["冻结 2D 位置编码"] = (I//p)**2*d return sum(items.values()), items, per_block # ─────────────── 3. 近似 MAC 账本(不等同实际 FLOP 或延迟)─────────────── def count_gflops(cfg="XL", p=2, I=32, C=4, t_freq=256, learn_sigma=True): """一次前向(batch=1)的主要矩阵 MAC + 简化逐元素计数;非完整 profiler。""" N, d, _ = DIT_CONFIGS[cfg] T = (I // p) ** 2 # 每个 block:qkv 3d²、attn 分数 T²d、attn 加权 T²d、out d²、mlp 8d² # 调制层对整条样本只算一次(6d²),逐 token 的 γ/β/α 逐元素乘加记 3Td per_block_token = 12 * d * d # 3(qkv) + 1(out) + 8(mlp) per_block_attn = 2 * T * d # 摊到每个 token 上是 2*T*d per_block_elem = 3 * d # γ⊙h、+β、α⊙Δ block_macs = T * (per_block_token + per_block_attn + per_block_elem) + 6 * d * d patch_macs = T * (p * p * C) * d # patchify 的线性嵌入 final_macs = T * d * (p * p * C * (2 if learn_sigma else 1)) + 2 * d * d cond_macs = t_freq * d + d * d # t 嵌入 MLP,算一次 total = N * block_macs + patch_macs + final_macs + cond_macs return total / 1e9, { "T": T, "block 内逐 token 线性(12d²)": N * T * per_block_token / 1e9, "block 内注意力(2T²d)": N * T * per_block_attn / 1e9, "调制与逐元素(3Td + 6d²)": N * (T * per_block_elem + 6 * d * d) / 1e9, "patchify + FinalLayer": (patch_macs + final_macs) / 1e9, "t 嵌入": cond_macs / 1e9, } def scaling_ledger(): """把 12 个模型的解析账本与论文数字并排打印。""" rows = [] for cfg in ["S", "B", "L", "XL"]: for p in [8, 4, 2]: g, _ = count_gflops(cfg, p) tot, _, _ = count_params(cfg, p) pg, pm, fid = PAPER_TABLE4_256[(cfg, p)] rows.append((f"DiT-{cfg}/{p}", DIT_CONFIGS[cfg][0], DIT_CONFIGS[cfg][1], (32 // p) ** 2, g, pg, tot / 1e6, pm, fid)) return rows def main(): rng = np.random.default_rng(0) print("=" * 78) print("1. patchify 的真实形状(256×256 图像 → 32×32×4 潜变量,batch=2)") print("=" * 78) z = rng.standard_normal((2, 32, 32, 4)) print(f" 输入潜变量 z: {z.shape}") for p in [8, 4, 2]: x = patchify(z, p) back = unpatchify(x, p, 32, 4) ok = np.abs(back - z).max() print(f" p={p}: patchify -> {x.shape}" f" (T={(32//p)**2}, 每个 token 原始维度 {p*p*4})" f" 逆变换最大误差 {ok:.2e}") print() print("=" * 78) print("2. 参数账本(DiT-XL/2 逐项)") print("=" * 78) tot, items, per_block = count_params("XL", 2) for k, v in items.items(): print(f" {k:<34s} {v:>14,d} ({v/tot*100:5.1f}%)") print(f" {'合计':<34s} {tot:>14,d} = {tot/1e6:.1f} M" f" (论文 Table 4: 675 M)") print() print("=" * 78) print("3. Gflops 账本(DiT-XL/2,按 MAC 记)") print("=" * 78) g, parts = count_gflops("XL", 2) for k, v in parts.items(): if k == "T": print(f" token 数 T {v:>10d}") else: print(f" {k:<38s} {v:>10.2f} G ({v/g*100:5.1f}%)") print(f" {'合计':<38s} {g:>10.2f} G (论文 Table 4: 118.64 G)") print() print("=" * 78) print("4. 12 个模型:解析账本 vs 论文数字") print("=" * 78) hdr = f"{'模型':<12s}{'N':>4s}{'d':>6s}{'T':>6s}{'Gflops算':>10s}{'Gflops论文':>11s}{'差':>8s}{'M算':>8s}{'M论文':>7s}{'FID':>8s}" print(hdr) for name, N, d, T, g, pg, m, pm, fid in scaling_ledger(): print(f"{name:<12s}{N:>4d}{d:>6d}{T:>6d}{g:>10.2f}{pg:>11.2f}{(g-pg)/pg*100:>7.1f}%" f"{m:>8.1f}{pm:>7d}{fid:>8.2f}") print() print("=" * 78) print("5. 同算力下:把预算花在 token 上还是花在宽度/深度上?") print("=" * 78) print(" 取自论文 Table 4,挑 Gflops 接近的组:") for tag, keys in [("~5-6 G", [("S", 2), ("B", 4), ("L", 8)]), ("~20-29 G", [("B", 2), ("L", 4), ("XL", 4)]), ("~80-119 G", [("L", 2), ("XL", 2)])]: print(f" {tag}:") for k in keys: pg, pm, fid = PAPER_TABLE4_256[k] print(f" DiT-{k[0]}/{k[1]}: {pg:6.2f} G {pm:4d} M FID {fid:6.2f}") if __name__ == "__main__": main() adaln_zero.py # -*- coding: utf-8 -*- """DiT 账本(二):adaLN-Zero 的初始化到底做了什么,逐个数出来。 adaLN-Zero 通常被一句话带过——「把每个 block 初始化成恒等函数」。 这句话里有三个可以量出来的事实,本脚本一个一个验: A. 恒等是真的恒等:out - x 的最大绝对误差是 0.0,不是「很小」。 B. 门控关着的时候,block 里除门控之外的参数梯度**精确为 0**; 连 shift/scale 那两段的梯度也是 0——只有 gate 那两段有梯度。 这是独立 block 接非零上游梯度的实验;完整零输出头模型第一步先更新输出头。 C. 不零初始化会怎样:block 在初始化时给残差流叠上一层随机扰动, 28 层叠下来 std 会漂。零初始化则一层都不漂。 D. 输出层也零初始化:模型第一天的预测是全 0,初始 loss 就是噪声的 二阶矩,可以被事先算出来,而不是一个随机的数。 另有一个 gradcheck,用中心差分核对手写 autograd,正文里报的最大相对误差来自它。 """ import numpy as np import tiny_grad as tg from dit_core import DiTBlock, MicroDiT, COND_MODES D_BIG = 1152 # DiT-XL 的 hidden size T_BIG = 256 # 32×32 潜变量、p=2 时的 token 数 DEPTH = 28 # DiT-XL 的深度 def _fresh_block(mode, seed=0, d=D_BIG, n_heads=16): rng = np.random.default_rng(seed) return DiTBlock(d, n_heads, rng, mode=mode) # ─────────────── A + C:恒等性与深度漂移 ─────────────── def identity_and_drift(depth=DEPTH, seed=0, d=D_BIG, T=T_BIG, n_heads=16): rng = np.random.default_rng(seed) x0 = rng.standard_normal((1, T, d)) c = rng.standard_normal((1, d)) out = {} for mode in ("adaln_zero", "adaln"): x = tg.leaf(x0.copy()) drift = [] for i in range(depth): blk = _fresh_block(mode, seed=seed + i, d=d, n_heads=n_heads) x = blk(x, tg.leaf(c), []) tg.reset() drift.append(float(np.std(x.v - x0))) out[mode] = { "identity_err": float(np.abs(x.v - x0).max()), "drift": drift, "std_ratio": [float(np.std(x.v) / np.std(x0))], } # 单块的恒等性单独再报一次(28 层叠完还是 0 才说明真的恒等) blk = _fresh_block("adaln_zero", seed=3, d=d, n_heads=n_heads) tg.reset() y = blk(tg.leaf(x0.copy()), tg.leaf(c), []) out["adaln_zero"]["single_block_err"] = float(np.abs(y.v - x0).max()) blk = _fresh_block("adaln", seed=3, d=d, n_heads=n_heads) tg.reset() y = blk(tg.leaf(x0.copy()), tg.leaf(c), []) out["adaln"]["single_block_err"] = float(np.abs(y.v - x0).max()) out["adaln"]["single_block_rel"] = float(np.std(y.v - x0) / np.std(x0)) tg.reset() return out # ─────────────── B:初始化那一刻的梯度结构 ─────────────── def grad_at_init(mode="adaln_zero", seed=0, d=D_BIG, T=T_BIG, n_heads=16): rng = np.random.default_rng(seed) x0 = rng.standard_normal((1, T, d)) c = rng.standard_normal((1, d)) w = rng.standard_normal((1, T, d)) # 线性损失 L = mean(out*w) blk = _fresh_block(mode, seed=seed, d=d, n_heads=n_heads) store = [] tg.reset() out = blk(tg.leaf(x0), tg.leaf(c), store, ctx=None) loss = tg.mean_all(tg.mul(out, tg.leaf(w))) tg.backward(loss) names = { "W_qkv": blk.w_qkv.W, "W_o": blk.w_o.W, "W_1": blk.w_1.W, "W_2": blk.w_2.W, } res = {} for k, arr in names.items(): node = [n for n in store if n.v is arr] res[k] = float(np.abs(node[0].g).max()) if node else 0.0 # 调制层按 6 段(或 4 段)拆开看:哪几段真的拿到了梯度 mod_node = [n for n in store if n.v is blk.w_mod.W][0] g = mod_node.g # [d, n_mod*d] n_mod = 6 if mode == "adaln_zero" else 4 cols = [float(np.abs(g[:, i * d:(i + 1) * d]).max()) for i in range(n_mod)] res["mod_chunks"] = cols res["mod_name"] = (["shift_msa", "scale_msa", "gate_msa", "shift_mlp", "scale_mlp", "gate_mlp"] if n_mod == 6 else ["shift_msa", "scale_msa", "shift_mlp", "scale_mlp"]) tg.reset() return res # ─────────────── D:初始 loss 是不是可预测的 ─────────────── def init_loss(mode="adaln_zero", seed=0, B=32): rng = np.random.default_rng(seed) m = MicroDiT(mode=mode, seed=seed) z = rng.standard_normal((B, m.T, 8)) t = rng.uniform(0.05, 0.95, B) y = rng.integers(0, m.n_classes, B) oh = np.zeros((B, m.n_classes)) oh[np.arange(B), y] = 1.0 eps = rng.standard_normal((B, m.T, 8)) store = [] tg.reset() pred = m.forward(z, t, oh, store) mse_zero = float(((pred.v - eps) ** 2).mean()) pmax_zero = float(np.abs(pred.v).max()) # 把输出层换成正常 xavier 初始化再测一次 lim = np.sqrt(6.0 / (m.d + 8)) m.w_out.W = rng.uniform(-lim, lim, m.w_out.W.shape) store = [] tg.reset() pred = m.forward(z, t, oh, store) mse_rand = float(((pred.v - eps) ** 2).mean()) pmax_rand = float(np.abs(pred.v).max()) tg.reset() return float((eps ** 2).mean()), mse_zero, mse_rand, pmax_zero, pmax_rand # ─────────────── autograd 自检 ─────────────── def gradcheck_report(seed=0): """手写 autograd 对不对:拿中心差分逐个参数核。 adaln_zero 初始化下大部分参数梯度恒为 0(B 节已证),核不出东西, 所以核 adaln 与 cross_attn 两种结构——它们把所有算子都走到了。 """ rng = np.random.default_rng(seed + 7) z = rng.standard_normal((4, 16, 8)) t = rng.uniform(0.05, 0.95, 4) oh = np.zeros((4, 8)) oh[np.arange(4), rng.integers(0, 8, 4)] = 1.0 tgt = rng.standard_normal((4, 16, 8)) worst = 0.0 for mode in ("adaln", "cross_attn", "in_context"): mm = MicroDiT(d=32, n_heads=4, depth=2, mode=mode, seed=seed) # 必须打开输出头,否则上游全为零,无法检验主干的反向。 mm.w_out.W[:] = rng.normal(0, 0.1, mm.w_out.W.shape) def build(mm=mm): s = [] p = mm.forward(z, t, oh, s) diff = tg.sub(p, tg.leaf(tgt)) return tg.mean_all(tg.mul(diff, diff)), s tg.reset() worst = max(worst, tg.gradcheck(build, seed=seed)) return worst def main(): print("=" * 78) print("A. 恒等性:DiT-XL 配置(d=1152, 16 头, T=256)") print("=" * 78) r = identity_and_drift() for mode in ("adaln_zero", "adaln"): d = r[mode] print(f" {mode:<12s} 单块 |out - x| 最大值 = {d['single_block_err']:.3e}") if mode == "adaln": print(f" {'':<12s} 单块相对扰动 std(out-x)/std(x) = {d['single_block_rel']:.4f}") print(f" {'':<12s} 叠 {DEPTH} 层后 |out - x| 最大值 = {d['identity_err']:.3e}") dr = d["drift"] pick = [0, 6, 13, 20, 27] print(f" {'':<12s} 残差流漂移 std(x_k - x_0):" + " ".join(f"k={k+1}:{dr[k]:.4f}" for k in pick)) print() print("=" * 78) print("B. 初始化那一刻,block 里谁拿到了梯度(L = mean(out*w),w 固定随机)") print("=" * 78) for mode in ("adaln_zero", "adaln"): g = grad_at_init(mode) nz = [g[k] for k in ("W_qkv", "W_o", "W_1", "W_2")] print(f" {mode:<12s} 主干参数 |grad|max: " + " ".join(f"{k}={v:.3e}" for k, v in zip(("W_qkv", "W_o", "W_1", "W_2"), nz))) print(f" {'':<12s} 调制层各段 |grad|max: " + " ".join(f"{n}={v:.3e}" for n, v in zip(g["mod_name"], g["mod_chunks"]))) print() print("=" * 78) print("D. 初始 loss 能不能事先算出来(FinalLayer 零初始化 vs 正常初始化)") print("=" * 78) e2, mse_z, mse_r, pz, pr = init_loss() print(f" 样本噪声平方均值 mean(eps^2) = {e2:.4f} <- 理论上就是初始 loss") print(f" 零初始化输出层,实测初始 MSE = {mse_z:.4f}") print(f" 零初始化时模型输出的最大绝对值 = {pz:.3e} (就是全 0)") print(f" 正常初始化输出层,实测初始 MSE = {mse_r:.4f} <- 高出 {mse_r/mse_z:.2f} 倍") print(f" 正常初始化时模型输出的最大绝对值 = {pr:.3e}") print() print("=" * 78) print("自检:非零输出头下 autograd vs 中心差分(三种非门控结构)") print("=" * 78) print(f" 最大相对误差 = {gradcheck_report():.2e}") if __name__ == "__main__": main() cond_ablation.py # -*- coding: utf-8 -*- """四种条件注入的 NumPy toy 对照;不是 ImageNet FID 复现。 8 个固定条纹模板,8×8×2 潜变量,p=2、T=16、d=64、4 头、6 层。 各方案共享采样流和训练超参数,结构、参数数目与初始化不同。 默认150步×1seed;--full为800步×3seed,--rerun强制重算,实际耗时依机器。 源码哈希及完整元数据一致时才复用缓存;同时评估256个新加噪样本。 """ import json import hashlib import tempfile import os import sys import numpy as np import tiny_grad as tg from dit_core import (MicroDiT, Adam, COND_MODES, make_patterns, patchify_imgs, alpha_bar_cosine) SIDE, P, C = 8, 2, 2 PATCH_DIM = P * P * C # 8 T = (SIDE // P) ** 2 # 16 K = 8 # 类别数 DEPTH = 6 HERE = os.path.dirname(os.path.abspath(__file__)) NODE_DIR = os.path.dirname(HERE) # 完整档的参数(文章里的数字就是这一组) STEPS_FULL, SEEDS_FULL = 800, (0, 1, 2) # 快速档:只为「脚本能跑通」而存在(体检会真的执行每个脚本), # 结果同样会缓存,不会覆盖完整档。 STEPS_QUICK, SEEDS_QUICK = 150, (0,) def _cache_path(steps, seeds): return os.path.join(NODE_DIR, "_cache", f"cond_results_s{steps}_n{len(seeds)}.json") CACHE = _cache_path(STEPS_FULL, SEEDS_FULL) def sample_batch(rng, pats, B): """采一批 (z_t, t, y_onehot, eps)。""" y = rng.integers(0, K, B) x0 = pats[y] # [B,8,8,2] eps = rng.standard_normal((B, SIDE, SIDE, C)) t = rng.uniform(0.05, 0.95, B) ab = alpha_bar_cosine(t)[:, None, None, None] z = np.sqrt(ab) * x0 + np.sqrt(1.0 - ab) * eps oh = np.zeros((B, K)) oh[np.arange(B), y] = 1.0 return patchify_imgs(z, P), t, oh, patchify_imgs(eps, P) def make_model(mode, seed, depth=DEPTH): return MicroDiT(d=64, n_heads=4, depth=depth, n_classes=K, patch_dim=PATCH_DIM, T=T, mode=mode, seed=seed, out_dim=PATCH_DIM) def train_one(mode, seed=0, steps=800, batch=32, lr=3e-3, log_every=50, depth=DEPTH): rng = np.random.default_rng(seed) pats = make_patterns(SIDE, C, K) m = make_model(mode, seed, depth) opt = Adam(m.arrays()) curve, gnorms, losses = [], [], [] for s in range(1, steps + 1): z, t, oh, eps = sample_batch(rng, pats, batch) store = [] tg.reset() pred = m.forward(z, t, oh, store) diff = tg.sub(pred, tg.leaf(eps)) loss = tg.mean_all(tg.mul(diff, diff)) tg.backward(loss) gn = opt.step(store, lr * (0.25 ** (s / steps)), s) losses.append(float(loss.v)) gnorms.append(gn) if s % log_every == 0: curve.append([s, float(np.mean(losses[-log_every:]))]) # 新噪声/时间采样;同 seed 各方案使用相同 256 个评估样本。 eval_rng = np.random.default_rng(10000 + seed) vals = [] for _ in range(8): z,t,oh,eps = sample_batch(eval_rng,pats,32) tg.reset() pred = m.forward(z,t,oh,[]) vals.append(float(np.mean((pred.v-eps)**2))) tg.reset() return { "evaluation_mse": float(np.mean(vals)), "evaluation_examples": 256, "mode": mode, "curve": curve, "final": float(np.mean(losses[-200:])), "grad1": gnorms[0], "grad10": float(np.mean(gnorms[:10])), "gradmax": float(np.max(gnorms)), "params": int(sum(a.size for a in m.arrays())), } def _meta(steps,seeds,batch,depth): names = ["cond_ablation.py","dit_core.py","tiny_grad.py"] return dict(steps=steps,seeds=list(seeds),batch=batch,depth=depth, code_sha256={n:hashlib.sha256(open(os.path.join(HERE,n),"rb").read()).hexdigest() for n in names}, numpy=np.__version__,schema=2,lr=3e-3,evaluation_examples=256) def _write_cache(data, path=CACHE): """原子保存,防止中断留下半份 JSON。""" os.makedirs(os.path.dirname(path), exist_ok=True) fd,tmp=tempfile.mkstemp(dir=os.path.dirname(path),suffix=".tmp") try: with os.fdopen(fd,"w",encoding="utf8") as stream: json.dump(data,stream,ensure_ascii=False,indent=1) stream.flush();os.fsync(stream.fileno()) os.replace(tmp,path) finally: if os.path.exists(tmp):os.unlink(tmp) def run_all(seeds=(0, 1, 2), steps=800, batch=32, depth=DEPTH, resume=True): """跑四种条件注入的对照。resume=True 时复用缓存里已经跑完的模式。""" cache = _cache_path(steps, seeds) out = {} if resume and os.path.exists(cache): try: with open(cache, encoding="utf-8") as f: old = json.load(f) if old.get("_meta") == _meta(steps,seeds,batch,depth): out = {k: v for k, v in old.items() if not k.startswith("_")} if "_sweep" in old: out["_sweep"] = old["_sweep"] except Exception: out = {} for mode in COND_MODES: if mode in out: print(f" [skip] {mode}(缓存里已有,跳过)", file=sys.stdout) continue rs = [train_one(mode, seed=sd, steps=steps, batch=batch, depth=depth) for sd in seeds] fin = [r["final"] for r in rs] out[mode] = { "final_mean": float(np.mean(fin)), "final_std": float(np.std(fin)), "finals": fin, "evaluation_mses": [r["evaluation_mse"] for r in rs], "evaluation_mean": float(np.mean([r["evaluation_mse"] for r in rs])), "evaluation_std": float(np.std([r["evaluation_mse"] for r in rs])), "curve": rs[0]["curve"], "grad1": rs[0]["grad1"], "grad10": rs[0]["grad10"], "gradmax": rs[0]["gradmax"], "params": rs[0]["params"], } out["_meta"] = _meta(steps,seeds,batch,depth) _write_cache(out, cache) print(f" [done] {mode}", file=sys.stdout) out["_meta"] = _meta(steps,seeds,batch,depth) return out def sweep_depth(modes=("adaln_zero", "adaln"), depths=(2, 4, 6, 8, 10), steps=400, seed=0, batch=32): """深度变化时,两种 adaLN 的差距怎么变。""" res = {} for mode in modes: row = [] for dep in depths: rng = np.random.default_rng(seed) pats = make_patterns(SIDE, C, K) m = make_model(mode, seed, dep) opt = Adam(m.arrays()) losses = [] for s in range(1, steps + 1): z, t, oh, eps = sample_batch(rng, pats, batch) store = [] tg.reset() pred = m.forward(z, t, oh, store) diff = tg.sub(pred, tg.leaf(eps)) loss = tg.mean_all(tg.mul(diff, diff)) tg.backward(loss) opt.step(store, 3e-3 * (0.25 ** (s / steps)), s) losses.append(float(loss.v)) row.append([dep, float(np.mean(losses[-200:]))]) print(f" [done] {mode} depth={dep}", file=sys.stdout) res[mode] = row return res def load_or_run(seeds=SEEDS_FULL, steps=STEPS_FULL, batch=32, depth=DEPTH, sweep=False): """缓存优先(完整档)。sweep=True 时才额外跑深度扫描(很慢,默认不跑)。""" cache = _cache_path(steps, seeds) data = None if os.path.exists(cache): try: with open(cache, encoding="utf-8") as f: data = json.load(f) except Exception: data = None if data and data.get("_meta") == _meta(steps,seeds,batch,depth) \ and all(m in data for m in COND_MODES): if sweep and "_sweep" not in data: data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch) _write_cache(data, cache) return data data = run_all(seeds=seeds, steps=steps, batch=batch, depth=depth) if sweep: data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch) _write_cache(data, cache) return data def _show(res, steps, n_seeds): print(f"{'mode':<14s}{'参数量':>10s}{'最终 loss(均值±std)':>24s}" f"{'首步梯度范数':>14s}{'峰值梯度':>12s}") for mode in COND_MODES: r = res[mode] print(f"{mode:<14s}{r['params']:>10d}" f"{r['final_mean']:>16.4f} ± {r['final_std']:<7.4f}" f"{r['grad1']:>14.3e}{r['gradmax']:>12.3e}") print() print(f" loss 曲线(seed=0,{steps} 步,每 {max(1, steps // 20)} 步取一次均值):") for mode in COND_MODES: c = res[mode]["curve"] picks = [c[i] for i in range(0, len(c), max(1, len(c) // 6))] print(f" {mode:<14s} " + " ".join(f"{s}:{v:.4f}" for s, v in picks)) if n_seeds > 1: print() print(" 每个 seed 的最终 loss(看排序稳不稳):") for mode in COND_MODES: print(f" {mode:<14s} " + " ".join(f"{v:.4f}" for v in res[mode]["finals"])) if res.get("_sweep"): print() print("=" * 78) print("深度扫描:两种 adaLN 在不同深度下的最终 loss") print("=" * 78) for mode, row in res["_sweep"].items(): print(f" {mode:<12s} " + " ".join(f"d={d}:{v:.4f}" for d, v in row)) if __name__ == "__main__": full = "--full" in sys.argv steps, seeds = (STEPS_FULL, SEEDS_FULL) if full else (STEPS_QUICK, SEEDS_QUICK) tag = "完整档" if full else "快速档" print("=" * 78) print(f"四种条件注入在 toy 任务上的训练对照({tag}:{steps} 步 × " f"{len(seeds)} 个 seed)") print("=" * 78) res = (run_all(seeds=seeds,steps=steps,resume=False) if "--rerun" in sys.argv else load_or_run(seeds=seeds, steps=steps, sweep="--sweep" in sys.argv)) _write_cache(res,_cache_path(steps,seeds)) _show(res, steps, len(seeds)) if not full: print() print(f" 想复现文章里的那组数字:python cond_ablation.py --full" f"({STEPS_FULL} 步 × {len(SEEDS_FULL)} 个 seed,约十分钟)") dit_core.py # -*- coding: utf-8 -*- """DiT 的最小可运行复刻(numpy):一个 block、四种条件注入方式、一个 toy 训练集。 教学结构参考 facebookresearch/DiT;不复现完整方差头、CFG、VAE 或训练配方。models.py: modulate(x, shift, scale) = x * (1 + scale) + shift block: x = x + gate_msa * attn(modulate(norm1(x), shift_msa, scale_msa)) x = x + gate_mlp * mlp(modulate(norm2(x), shift_mlp, scale_mlp)) 初始化采用同类规则(随机数消费顺序与官方不同)::所有 Linear 走 xavier_uniform,然后把每个 block 的 adaLN 调制层 (SiLU → Linear(d, 6d))的 weight 与 bias 整个置零;FinalLayer 的调制层与输出 线性层同样置零。 四种条件注入(对应论文 Figure 3 与 Table 4 末尾四行): adaln_zero : adaLN-Zero,调制层零初始化 adaln : 无门控、四段调制,调制层用 xavier 初始化(vanilla adaLN 教学版) in_context : t 与 y 当作两个额外 token 塞进序列,标准 ViT block cross_attn : 标准 ViT block + 一层对条件向量的 cross-attention """ import numpy as np import tiny_grad as tg COND_MODES = ("adaln_zero", "adaln", "in_context", "cross_attn") # ─────────────── 线性层 ─────────────── class Linear: def __init__(self, fan_in, fan_out, rng, zero=False, std=None): if zero: self.W = np.zeros((fan_in, fan_out)) elif std is not None: self.W = rng.normal(0.0, std, (fan_in, fan_out)) else: lim = np.sqrt(6.0 / (fan_in + fan_out)) # xavier_uniform self.W = rng.uniform(-lim, lim, (fan_in, fan_out)) self.b = np.zeros(fan_out) def __call__(self, x, store=None): Wn = tg.leaf(self.W) bn = tg.leaf(self.b) if store is not None: store.append(Wn) store.append(bn) return tg.add(tg.matmul(x, Wn), bn) def _to_heads(a, B, T, n_heads, dh): return tg.transpose(tg.reshape(a, (B, T, n_heads, dh)), 0, 2, 1, 3) def _attend(q, k, v, scale): s = tg.scale(tg.matmul(q, tg.transpose(k, 0, 1, 3, 2)), scale) return tg.matmul(tg.softmax(s, axis=-1), v) def mh_self_attention(x, n_heads, w_qkv, w_o, store): B, T, d = x.v.shape dh = d // n_heads q, k, v = tg.chunk_last(w_qkv(x, store), 3) q = _to_heads(q, B, T, n_heads, dh) k = _to_heads(k, B, T, n_heads, dh) v = _to_heads(v, B, T, n_heads, dh) y = _attend(q, k, v, 1.0 / np.sqrt(dh)) # [B,H,T,dh] y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d)) return w_o(y, store) def mh_cross_attention(x, ctx, n_heads, w_q, w_kv, w_o, store): B, T, d = x.v.shape Tc = ctx.v.shape[1] dh = d // n_heads q = w_q(x, store) k, v = tg.chunk_last(w_kv(ctx, store), 2) q = _to_heads(q, B, T, n_heads, dh) k = _to_heads(k, B, Tc, n_heads, dh) v = _to_heads(v, B, Tc, n_heads, dh) y = _attend(q, k, v, 1.0 / np.sqrt(dh)) y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d)) return w_o(y, store) # ─────────────── DiT block ─────────────── class DiTBlock: def __init__(self, d, n_heads, rng, mode="adaln_zero", mlp_ratio=4): assert mode in COND_MODES, mode assert d % n_heads == 0 self.mode = mode self.d = d self.n_heads = n_heads self.w_qkv = Linear(d, 3 * d, rng) self.w_o = Linear(d, d, rng) hid = int(d * mlp_ratio) self.w_1 = Linear(d, hid, rng) self.w_2 = Linear(hid, d, rng) if mode == "cross_attn": self.w_cq = Linear(d, d, rng) self.w_ckv = Linear(d, 2 * d, rng) self.w_co = Linear(d, d, rng) if mode == "adaln_zero": self.w_mod = Linear(d, 6 * d, rng, zero=True) elif mode == "adaln": self.w_mod = Linear(d, 4 * d, rng) else: # 标准 ViT block:LayerNorm 带仿射参数,初始化成 γ=1、β=0 self.ln1_g, self.ln1_b = np.ones(d), np.zeros(d) self.ln2_g, self.ln2_b = np.ones(d), np.zeros(d) self.ln3_g, self.ln3_b = np.ones(d), np.zeros(d) def _modulate(self, h, shift, scale): """DiT 源码的 modulate: x * (1 + scale) + shift,展平成 [B,1,d] 再广播。""" sh = tg.reshape(shift, (shift.v.shape[0], 1, -1)) sc = tg.reshape(scale, (scale.v.shape[0], 1, -1)) return tg.add(tg.add(h, tg.mul(h, sc)), sh) def _vi_norm(self, x, g, b, store): gn, bn = tg.leaf(g), tg.leaf(b) store.append(gn) store.append(bn) return tg.add(tg.mul(tg.layernorm(x), gn), bn) def __call__(self, x, c, store, ctx=None): B, T, d = x.v.shape if self.mode == "adaln_zero": sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last( self.w_mod(tg.silu(c), store), 6) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a)) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u)) if self.mode == "adaln": sh_a, sc_a, sh_m, sc_m = tg.chunk_last(self.w_mod(tg.silu(c), store), 4) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, a) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, u) # ── 标准 ViT block(in-context / cross-attn)── h = self._vi_norm(x, self.ln1_g, self.ln1_b, store) x = tg.add(x, mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store)) if self.mode == "cross_attn": h2 = self._vi_norm(x, self.ln2_g, self.ln2_b, store) x = tg.add(x, mh_cross_attention(h2, ctx, self.n_heads, self.w_cq, self.w_ckv, self.w_co, store)) h3 = self._vi_norm(x, self.ln3_g, self.ln3_b, store) else: h3 = self._vi_norm(x, self.ln2_g, self.ln2_b, store) u = self.w_2(tg.gelu_tanh(self.w_1(h3, store)), store) return tg.add(x, u) def arrays(self): out = [self.w_qkv.W, self.w_qkv.b, self.w_o.W, self.w_o.b, self.w_1.W, self.w_1.b, self.w_2.W, self.w_2.b] if self.mode in ("adaln_zero", "adaln"): out += [self.w_mod.W, self.w_mod.b] else: out += [self.ln1_g, self.ln1_b, self.ln2_g, self.ln2_b] if self.mode == "cross_attn": out += [self.ln3_g, self.ln3_b, self.w_cq.W, self.w_cq.b, self.w_ckv.W, self.w_ckv.b, self.w_co.W, self.w_co.b] return out # ─────────────── 位置编码与时间步编码 ─────────────── def sincos_pos_embed(side, d): """2D sin-cos 位置编码(DiT 直接抄 MAE 的,固定不可学习)。 两个空间轴各占一半维度:每轴的 d/2 维里再对半分成 sin 与 cos。 """ assert d % 4 == 0, "d 必须是 4 的倍数才能两轴对半分" def emb1d(pos, dim): half = dim // 2 omega = 1.0 / (10000 ** (np.arange(half, dtype=np.float64) / half)) out = np.asarray(pos, dtype=np.float64).reshape(-1, 1) * omega[None] return np.concatenate([np.sin(out), np.cos(out)], axis=-1) gy, gx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij") emb = np.concatenate([emb1d(gy.reshape(-1), d // 2), emb1d(gx.reshape(-1), d // 2)], axis=-1) return emb[None, :, :] def timestep_embedding(t, dim, max_period=10000): """DiT 抄 GLIDE 的正弦时间步编码。t: [B] -> [B, dim]。""" half = dim // 2 freqs = np.exp(-np.log(max_period) * np.arange(half, dtype=np.float64) / half) args = np.asarray(t, dtype=np.float64)[:, None] * freqs[None] return np.concatenate([np.cos(args), np.sin(args)], axis=-1) # ─────────────── 一个能训的小 DiT ─────────────── class MicroDiT: def __init__(self, d=64, n_heads=4, depth=8, n_classes=8, patch_dim=8, T=16, t_freq=32, mode="adaln_zero", seed=0, out_dim=8): rng = np.random.default_rng(seed) self.mode = mode self.d, self.T, self.n_classes = d, T, n_classes self.w_in = Linear(patch_dim, d, rng) self.pos = sincos_pos_embed(int(round(np.sqrt(T))), d) self.w_t0 = Linear(t_freq, d, rng, std=0.02) self.w_t1 = Linear(d, d, rng, std=0.02) self.y_emb = rng.normal(0.0, 0.02, (n_classes, d)) self.blocks = [DiTBlock(d, n_heads, rng, mode=mode) for _ in range(depth)] # FinalLayer:adaLN 调制(零初始化)+ 输出线性层(零初始化) if mode in ("adaln_zero", "adaln"): self.w_fmod = Linear(d, 2 * d, rng, zero=True) self.fin_g, self.fin_b = np.ones(d), np.zeros(d) self.w_out = Linear(d, out_dim, rng, zero=True) def forward(self, z, t, y_onehot, store): """z:[B,T,patch_dim] t:[B] y_onehot:[B,K] -> pred:[B,T,out_dim]""" B = z.shape[0] d = self.d x = tg.add(self.w_in(tg.leaf(z), store), tg.leaf(self.pos)) tf = timestep_embedding(t, self.w_t0.W.shape[0]) tv = self.w_t1(tg.silu(self.w_t0(tg.leaf(tf), store)), store) ytab = tg.leaf(self.y_emb) store.append(ytab) yv = tg.matmul(tg.leaf(y_onehot), ytab) c = tg.add(tv, yv) t_tok = tg.reshape(tv, (B, 1, d)) y_tok = tg.reshape(yv, (B, 1, d)) if self.mode == "in_context": x = tg.concat_tokens(x, tg.concat_tokens(t_tok, y_tok)) ctx = tg.concat_tokens(t_tok, y_tok) for blk in self.blocks: x = blk(x, c, store, ctx=ctx) if self.mode == "in_context": x = tg.take_tokens(x, self.T) if self.mode in ("adaln_zero", "adaln"): sh, sc = tg.chunk_last(self.w_fmod(tg.silu(c), store), 2) hn = tg.layernorm(x) h = tg.add(tg.add(hn, tg.mul(hn, tg.reshape(sc, (B, 1, d)))), tg.reshape(sh, (B, 1, d))) else: g, b = tg.leaf(self.fin_g), tg.leaf(self.fin_b) store.append(g) store.append(b) h = tg.add(tg.mul(tg.layernorm(x), g), b) return self.w_out(h, store) def arrays(self): out = [self.w_in.W, self.w_in.b, self.w_t0.W, self.w_t0.b, self.w_t1.W, self.w_t1.b, self.y_emb, self.w_out.W, self.w_out.b] if self.mode in ("adaln_zero", "adaln"): out += [self.w_fmod.W, self.w_fmod.b] else: out += [self.fin_g, self.fin_b] for blk in self.blocks: out += blk.arrays() return out # ─────────────── Adam ─────────────── class Adam: def __init__(self, arrays): self.idx = {id(a): i for i, a in enumerate(arrays)} self.m = [np.zeros_like(a) for a in arrays] self.v = [np.zeros_like(a) for a in arrays] def step(self, nodes, lr, step, b1=0.9, b2=0.999, eps=1e-8): gnorm = 0.0 for n in nodes: i = self.idx.get(id(n.v)) if i is None or n.g is None: continue g = n.g gnorm += float((g * g).sum()) self.m[i] = b1 * self.m[i] + (1 - b1) * g self.v[i] = b2 * self.v[i] + (1 - b2) * g * g mh = self.m[i] / (1 - b1 ** step) vh = self.v[i] / (1 - b2 ** step) n.v -= lr * mh / (np.sqrt(vh) + eps) return float(np.sqrt(gnorm)) # ─────────────── toy 训练数据:8 个方向的条纹 ─────────────── def make_patterns(side=8, C=2, K=8): """K 个不同朝向的二维条纹,当作 K 类「图像」。""" yy, xx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij") pats = np.zeros((K, side, side, C)) for k in range(K): th = k * np.pi / K phase = 2 * np.pi * 2.0 * (xx * np.cos(th) + yy * np.sin(th)) / side pats[k, :, :, 0] = np.cos(phase) pats[k, :, :, 1] = np.sin(phase) return pats / np.std(pats) def patchify_imgs(imgs, p): """imgs:[B,I,I,C] -> [B,(I/p)^2,p*p*C]""" B, I, _, C = imgs.shape g = I // p z = imgs.reshape(B, g, p, g, p, C).transpose(0, 1, 3, 2, 4, 5) return z.reshape(B, g * g, p * p * C) def alpha_bar_cosine(t): """余弦 schedule 的 ᾱ_t:t=0 时 1(干净),t=1 时 0(纯噪声)。""" return np.cos(np.pi * np.asarray(t, dtype=np.float64) / 2.0) ** 2 tiny_grad.py # -*- coding: utf-8 -*- """NumPy reverse-mode 自动微分,仅供本文小型实验。 训练使用解析反向;中心差分在非零输出头下检查实际活跃的主干, 近零梯度需同时报告绝对误差和相对误差,不能以旧零输出头检查推断全部反向正确。 """ import numpy as np _TAPE = [] class Node: __slots__ = ("v", "g", "ins", "bwd") def __init__(self, v, ins=(), bwd=None): self.v = np.asarray(v, dtype=np.float64) self.g = None self.ins = ins self.bwd = bwd _TAPE.append(self) @property def shape(self): return self.v.shape def reset(): _TAPE.clear() def leaf(v): return Node(v) def _unbc(g, shape): """把广播出去的梯度还原成 shape(求和 + 去掉被广播的轴)。""" if g.shape == shape: return g while g.ndim > len(shape): g = g.sum(axis=0) for ax, s in enumerate(shape): if s == 1 and g.shape[ax] != 1: g = g.sum(axis=ax, keepdims=True) return g.reshape(shape) def _mk(v, ins, fn): def bwd(g, a=ins, f=fn): for node, gv in zip(a, f(g)): if node.g is None: node.g = np.zeros_like(node.v) node.g += _unbc(gv, node.v.shape) return Node(v, ins, bwd) def add(a, b): return _mk(a.v + b.v, (a, b), lambda g: (g, g)) def sub(a, b): return _mk(a.v - b.v, (a, b), lambda g: (g, -g)) def mul(a, b): return _mk(a.v * b.v, (a, b), lambda g: (g * b.v, g * a.v)) def neg(a): return _mk(-a.v, (a,), lambda g: (-g,)) def matmul(a, b): """支持 [m,k]@[k,n]、[... ,m,k]@[k,n]、[m,k]@[B,k,n]、[... ,m,k]@[... ,k,n]。""" av, bv = a.v, b.v v = av @ bv def f(g): # 一律走 BLAS 的 batched matmul:比 einsum 快一个量级 if av.ndim <= 2 and bv.ndim <= 2: return (g @ bv.T, av.T @ g) if bv.ndim == 2: # [..., m,k] @ [k,n] da = g @ bv.T p = int(np.prod(av.shape[:-2])) a2 = av.reshape(p, *av.shape[-2:]).swapaxes(-1, -2) # [p,k,m] g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n] return (da, (a2 @ g2).sum(axis=0)) if av.ndim == 2: # [m,k] @ [..., k,n] p = int(np.prod(bv.shape[:-2])) b2 = bv.reshape(p, *bv.shape[-2:]).swapaxes(-1, -2) # [p,n,k] g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n] return ((g2 @ b2).sum(axis=0), av.T @ g) return (g @ bv.swapaxes(-1, -2), av.swapaxes(-1, -2) @ g) return _mk(v, (a, b), f) def transpose(a, *axes): inv = np.argsort(axes) return _mk(a.v.transpose(axes), (a,), lambda g: (g.transpose(inv),)) def reshape(a, shape): return _mk(a.v.reshape(shape), (a,), lambda g: (g.reshape(a.v.shape),)) def scale(a, c): return _mk(a.v * c, (a,), lambda g: (g * c,)) def chunk_last(a, n): """把最后一维等分成 n 份(adaLN 的 6 路调制输出就是这么切的)。""" k = a.v.shape[-1] // n out = [] for i in range(n): v = a.v[..., i * k:(i + 1) * k] def f(g, i=i, k=k): full = np.zeros_like(a.v) full[..., i * k:(i + 1) * k] = g return (full,) out.append(_mk(v, (a,), f)) return out def split3(a): """把最后一维等分三份(qkv)。""" d = a.v.shape[-1] // 3 out = [] for i in range(3): v = a.v[..., i * d:(i + 1) * d] def f(g, i=i, d=d): full = np.zeros_like(a.v) full[..., i * d:(i + 1) * d] = g return (full,) out.append(_mk(v, (a,), f)) return out def take_tokens(a, n): """取前 n 个 token,其余位置梯度补零(in-context 读回图像 token 用)。""" v = a.v[:, :n, :] def f(g): full = np.zeros_like(a.v) full[:, :n, :] = g return (full,) return _mk(v, (a,), f) def concat_tokens(a, b): """沿 token 维拼接(in-context 把条件 token 接在序列末尾)。""" v = np.concatenate([a.v, b.v], axis=1) def f(g): return (g[:, :a.v.shape[1], :], g[:, a.v.shape[1]:, :]) return _mk(v, (a, b), f) def tanh(a): t = np.tanh(a.v) return _mk(t, (a,), lambda g: (g * (1.0 - t * t),)) def sigmoid(a): s = 1.0 / (1.0 + np.exp(-a.v)) return _mk(s, (a,), lambda g: (g * s * (1.0 - s),)) def silu(a): s = 1.0 / (1.0 + np.exp(-a.v)) v = a.v * s return _mk(v, (a,), lambda g: (g * (s + v * (1.0 - s)),)) def gelu_tanh(a): """GELU 的 tanh 近似,DiT 源码里用的就是这个(nn.GELU(approximate='tanh'))。""" k = np.sqrt(2.0 / np.pi) s = a.v * a.v inner = k * (a.v + 0.044715 * a.v * s) t = np.tanh(inner) v = 0.5 * a.v * (1.0 + t) dv = 0.5 * (1.0 + t) + 0.5 * a.v * (1.0 - t * t) * k * (1.0 + 0.134145 * s) return _mk(v, (a,), lambda g: (g * dv,)) def softmax(a, axis=-1): e = np.exp(a.v - a.v.max(axis=axis, keepdims=True)) p = e / e.sum(axis=axis, keepdims=True) def f(g): s = (g * p).sum(axis=axis, keepdims=True) return (p * (g - s),) return _mk(p, (a,), f) def layernorm(a, eps=1e-6): """对最后一维做归一化,无仿射参数(DiT 的缩放/平移由 adaLN 给出)。""" mu = a.v.mean(axis=-1, keepdims=True) xc = a.v - mu var = (xc * xc).mean(axis=-1, keepdims=True) inv = 1.0 / np.sqrt(var + eps) v = xc * inv def f(g): gm = g.mean(axis=-1, keepdims=True) gv = (g * v).mean(axis=-1, keepdims=True) return (inv * (g - gm - v * gv),) return _mk(v, (a,), f) def mean_all(a): n = a.v.size return _mk(a.v.mean(), (a,), lambda g: (np.full(a.v.shape, g / n),)) def backward(loss): for node in _TAPE: node.g = np.zeros_like(node.v) loss.g = np.ones_like(loss.v) for node in reversed(_TAPE): if node.bwd is not None: node.bwd(node.g) return loss def gradcheck(build, eps=1e-5, seed=0, n_probe=6): """中心差分逐参数核对,返回最大相对误差。 build() 每次调用要返回 (loss Node, 参数 Node 列表)。差分直接扰动 Node 底层 的 ndarray——Node.v 与模型里那块内存是同一块,所以扰动后重新 forward 就能拿到扰动后的 loss。 """ rng = np.random.default_rng(seed) worst = 0.0 _, store = build() for node in store: flat = node.v.reshape(-1) idx = rng.choice(flat.size, size=min(n_probe, flat.size), replace=False) for i in idx: old = flat[i] flat[i] = old + eps reset() lp = float(build()[0].v) flat[i] = old - eps reset() lm = float(build()[0].v) flat[i] = old num = (lp - lm) / (2 * eps) reset() loss, s2 = build() backward(loss) cur = [n for n in s2 if n.v is node.v] ana = cur[0].g.reshape(-1)[i] if cur and cur[0].g is not None else 0.0 denom = max(abs(num), abs(ana), 1e-8) worst = max(worst, abs(num - ana) / denom) reset() return worst make_figures.py # -*- coding: utf-8 -*- """画配图。数字全部来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) import dit_flops as F # noqa: E402 import adaln_zero as AZ # noqa: E402 import cond_ablation as CA # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:算力账本 ─────────────── def fig_ledger(): fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.8)) # 左:相近 Gflops 的三个配置,FID 并不都相等 ax = axes[0] marks = {8: "o", 4: "s", 2: "^"} cols = {8: CGREY, 4: C2, 2: C1} # 手工微调标号偏移,避免同算力组里三个点叠在一起看不清 offs = {("S", 2): (7, -15), ("B", 4): (1, 9), ("L", 8): (8, 5), ("S", 4): (8, 5), ("B", 8): (8, 5), ("B", 2): (7, -15), ("L", 4): (-4, 10), ("XL", 4): (8, 6), ("L", 2): (8, 5), ("XL", 2): (8, 5), ("S", 8): (8, 5), ("XL", 8): (8, 5)} for cfg in ["S", "B", "L", "XL"]: for p in [8, 4, 2]: g, pm, fid = F.PAPER_TABLE4_256[(cfg, p)] ax.scatter(g, fid, marker=marks[p], s=95, color=cols[p], zorder=3, edgecolor="white", linewidth=1.3) ax.annotate(f"{cfg}/{p}", (g, fid), textcoords="offset points", xytext=offs[(cfg, p)], fontsize=9, color="#333333", bbox=dict(boxstyle="round,pad=0.15", fc="white", ec="none", alpha=0.75)) ax.set_xscale("log") ax.set_xlim(0.25, 320) ax.set_ylim(0, 175) ax.set_xlabel("一次前向的算力 Gflops(对数轴,论文 Table 4)") ax.set_ylabel("FID-50K(无 CFG,越低越好)") ax.set_title("论文配置对比:相近 MAC 不保证相同 FID") ax.grid(alpha=0.25, ls=":") for tag, keys, col, tx, ty in [ ("约 5~6 G", [("S", 2), ("B", 4), ("L", 8)], C3, 1.05, 152), ("约 20~29 G", [("B", 2), ("L", 4), ("XL", 4)], C0, 36, 60)]: xs = [F.PAPER_TABLE4_256[k][0] for k in keys] ys = [F.PAPER_TABLE4_256[k][2] for k in keys] ax.plot(xs, ys, ls="--", lw=1.3, color=col, alpha=0.75, zorder=1) ax.text(tx, ty, tag, color=col, fontsize=9.5, ha="left", bbox=dict(boxstyle="round,pad=0.25", fc="white", ec=col, alpha=0.85, lw=0.8)) ax.annotate("这两个点参数量差 4 倍\n(33M / 130M),FID 几乎重合", xy=(6.06, 68.40), xytext=(0.42, 26), fontsize=9, color="#333333", ha="left", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) # 右:注意力占多少算力,随 token 数怎么变 ax = axes[1] Ts = np.array([64, 256, 1024, 4096, 16384]) ds = {"DiT-S (d=384)": 384, "DiT-B (d=768)": 768, "DiT-L (d=1024)": 1024, "DiT-XL (d=1152)": 1152} for name, d in ds.items(): lin = 12 * d * d # 每 token 的线性部分(qkv+out+mlp) attn = 2 * Ts * d # 每 token 摊到的注意力部分 ax.plot(Ts, attn / (lin + attn) * 100, marker="o", lw=2, ms=4, label=name) ax.set_xscale("log") ax.set_ylim(0, 100) ax.set_xlabel("token 数 T(对数轴)") ax.set_ylabel("注意力占主矩阵 MAC 的百分比") ax.set_title("T=256 时注意力只占 3.6%,要到 T 上千才成为大头") ax.grid(alpha=0.25, ls=":") ax.legend(fontsize=9, loc="upper left") ax.axvline(256, color="#cccccc", lw=1.2, ls=":", zorder=0) ax.annotate("256×256 图像、p=2:3.6%", xy=(256, 3.6), xytext=(330, 8), fontsize=9, color="#555555") ax.text(900, 2.5, "同样 T 下,网络越宽(d 越大)注意力占比越低", fontsize=9, color="#555555") fig.suptitle("图 1:DiT 的算力账本——矩阵乘加分配与论文配置对比", fontsize=12) fig.tight_layout() _save(fig, "fig1_compute_ledger.png") # ─────────────── 图 2:初始化恒等 ─────────────── def fig_identity(): r = AZ.identity_and_drift() drift_zero = r["adaln_zero"]["drift"] drift_plain = r["adaln"]["drift"] ks = np.arange(1, len(drift_plain) + 1) fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.4)) ax = axes[0] ax.plot(ks, drift_plain, color=C1, lw=2.4, marker="o", ms=3, label="vanilla adaLN(调制层正常初始化)") ax.plot(ks, drift_zero, color=C0, lw=2.4, label="adaLN-Zero(调制层零初始化)") ax.set_xlabel("第 k 个 block 之后") ax.set_ylabel(r"残差流漂移 std(x_k - x_0)") ax.set_title("零初始化:叠 28 层,漂移严格是 0") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":") ax.annotate(f"第 28 层:{drift_plain[-1]:.2f} vs {drift_zero[-1]:.2f}", xy=(28, drift_plain[-1]), xytext=(13, 3.4), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) ax = axes[1] labels = ["W_qkv", "W_o", "W_1", "W_2", "调制层\nshift/scale 段", "调制层\ngate 段"] gz = AZ.grad_at_init("adaln_zero") gp = AZ.grad_at_init("adaln") def pick(r, kind): """按名字取,避免把 vanilla adaLN 的 shift_mlp 误当成 gate。""" vals = [v for nm, v in zip(r["mod_name"], r["mod_chunks"]) if (("gate" in nm) if kind == "gate" else ("shift" in nm or "scale" in nm))] return max(vals) if vals else None v_zero = [gz["W_qkv"], gz["W_o"], gz["W_1"], gz["W_2"], pick(gz, "ss"), pick(gz, "gate")] v_plain = [gp["W_qkv"], gp["W_o"], gp["W_1"], gp["W_2"], pick(gp, "ss"), pick(gp, "gate")] # vanilla adaLN 结构里没有 gate:画在最底部,并单独标注 FLOOR = 1e-12 v_plain = [FLOOR if v is None else v for v in v_plain] v_zero = [FLOOR if v is None else v for v in v_zero] x = np.arange(len(labels)) w = 0.38 ax.bar(x - w / 2, np.array(v_plain) + FLOOR, w, color=C2, label="vanilla adaLN") ax.bar(x + w / 2, np.array(v_zero) + FLOOR, w, color=C0, label="adaLN-Zero") ax.set_yscale("log") ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9) ax.set_ylabel("初始化时刻的 |grad| 最大值(对数轴)") ax.set_title("门关着的时候,独立 block:门梯度可非零,主干梯度为零") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":", axis="y") ax.annotate("adaLN-Zero 的主干参数梯度精确为 0\n(0 画在 1e-12,否则 log 轴显示不出来)", xy=(x[0] + w / 2, FLOOR), xytext=(0.35, 1e-9), fontsize=9, color="#333333") ax.annotate("vanilla adaLN 结构里\n根本没有 gate 这一项", xy=(x[-1] - w / 2, FLOOR), xytext=(3.35, 1e-7), fontsize=9, color="#555555", ha="center", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) fig.suptitle("图 2:adaLN-Zero 的初始化——恒等是怎么来的,代价是什么", fontsize=12) fig.tight_layout() _save(fig, "fig2_identity.png") # ─────────────── 图 3:四种条件注入的 toy 训练对照 ─────────────── def fig_ablation(): res = CA.load_or_run() fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.6)) cols = {"adaln_zero": C0, "adaln": C2, "in_context": C1, "cross_attn": C3} names = {"adaln_zero": "adaLN-Zero", "adaln": "vanilla adaLN", "in_context": "in-context", "cross_attn": "cross-attention"} ax = axes[0] for mode in CA.COND_MODES: c = res[mode]["curve"] ax.plot([p[0] for p in c], [p[1] for p in c], lw=2.2, color=cols[mode], label=names[mode]) ax.set_xlabel("训练步数") ax.set_ylabel("噪声预测 MSE(每 50 步取均值)") ax.set_title("同一个 toy 任务,四种条件注入的训练曲线") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":") ax = axes[1] x = np.arange(len(CA.COND_MODES)) means = [res[m]["final_mean"] for m in CA.COND_MODES] stds = [res[m]["final_std"] for m in CA.COND_MODES] ax.bar(x, means, yerr=stds, capsize=4, color=[cols[m] for m in CA.COND_MODES], alpha=0.9) # 把 3 个 seed 的最终 loss 直接点到柱子上:看排序有没有重叠 for i, m in enumerate(CA.COND_MODES): vals = res[m]["finals"] ax.scatter([i] * len(vals), vals, s=20, color="white", edgecolor="#333333", linewidth=0.8, zorder=4) ax.set_xticks(x) ax.set_xticklabels([names[m] for m in CA.COND_MODES], fontsize=9) ax.set_ylabel("最后 200 步的平均 loss(3 个 seed)") ax.set_title("训练 MSE:三次 seed 的描述性统计") ax.grid(alpha=0.25, ls=":", axis="y") top = max(means) + max(stds) * 3 ax.set_ylim(0, top) for i, (m, s) in enumerate(zip(means, stds)): ax.text(i, m + s + top * 0.02, f"{m:.4f}", ha="center", fontsize=9, color="#333333") ax.annotate("白点 = 每个 seed 单独的结果\n(仅此 toy 配方,不作显著性推断)", xy=(0, means[0]), xytext=(1.15, top * 0.62), fontsize=9, color="#333333", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) fig.suptitle("图 3:条件注入方式的 toy 对照(6 层 d=64、T=16,800 步 × 3 seed)", fontsize=12) fig.tight_layout() _save(fig, "fig3_cond_ablation.png") # ─────────────── 图 4:四种 block design 的算力-质量对照 ─────────────── def fig_design(): order = ["in-context", "cross-attention", "adaLN", "adaLN-Zero"] names = ["in-context", "cross-attention", "vanilla adaLN", "adaLN-Zero"] g = [F.PAPER_BLOCK_DESIGN[k][0] for k in order] pm = [F.PAPER_BLOCK_DESIGN[k][1] for k in order] fid = [F.PAPER_BLOCK_DESIGN[k][2] for k in order] fig, axes = plt.subplots(1, 3, figsize=(13.2, 4.0)) cols = [C1, C2, CGREY, C0] for ax, vals, title, ylab, fmt in [ (axes[0], g, "一次前向 Gflops", "Gflops", "{:.1f}"), (axes[1], pm, "参数量", "M", "{:d}"), (axes[2], fid, "FID-50K(越低越好)", "FID", "{:.2f}"), ]: bars = ax.bar(np.arange(4), vals, color=cols, alpha=0.92) ax.set_xticks(np.arange(4)) ax.set_xticklabels(names, fontsize=8.5, rotation=18) ax.set_title(title) ax.set_ylabel(ylab) ax.grid(alpha=0.25, ls=":", axis="y") for b, v in zip(bars, vals): ax.text(b.get_x() + b.get_width() / 2, v, fmt.format(v), ha="center", va="bottom", fontsize=9, color="#333333") if title.startswith("FID"): ax.set_ylim(0, max(vals) * 1.25) else: ax.set_ylim(0, max(vals) * 1.22) fig.suptitle("图 4:DiT-XL/2 骨架下四种 block design(论文 Table 4,400K 步)", fontsize=12) fig.tight_layout() _save(fig, "fig4_block_design.png") FIGURES = { "ledger": fig_ledger, "identity": fig_identity, "ablation": fig_ablation, "design": fig_design, } if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None for name, fn in FIGURES.items(): if only and name != only: continue print(f"[draw] {name}") fn()
-
AIGC 基本功|潜空间扩散与 Stable Diffusion 架构-LDM AIGC 基本功|潜空间扩散与 Stable Diffusion 架构-LDM 所属方向:生成范式 | 难度:进阶 | 前置知识:VAE 结构与 0.18215、DDPM 训练目标与采样流程(先掌握累计信号系数与噪声预测;DDIM 的完整更新另见文末采样器链接) 关键词:潜空间扩散、LDM、Stable Diffusion、UNet、交叉注意力、scale factor 01. 为什么需要它 潜空间扩散的主要收益是降低生成网络处理的空间位置数。下面把一个 SD1.5 风格 UNet 原样放大到像素空间做静态对照;这不是所有像素扩散的成本,也不是实际 GPU 显存或延迟测试。 账本依据 SD1.5 固定配置和 Diffusers v0.35.1 构造逻辑(附录 unet_ledger.py)。历史命名 attention_head_dim=8 在这里实际指定 8 个头,320 通道对应每头 40 维。本轮用官方类在 meta 设备构造完整拓扑,参数为 859,520,964,与账本完全一致;旧文“官方 859,522,604”的参照值有误。meta 构造只核验结构,不运行真实权重,也不测显存或速度。若朴素实现显式保存注意力矩阵,512² 像素上的首层需要 $$512^2\times512^2\times8\times2\ \text{bytes}=2^{40}\ \text{bytes}=1\ \text{TiB}$$ 这里按二进制单位计算为 1 TiB;同层 64² latent 需要 256 MiB,矩阵元素数相差 4096 倍。SDPA / FlashAttention 可以不保存完整矩阵,所以这些是朴素物化成本,不是现代实现的必然显存占用。 把像素模型 attention 只放最深层,静态账本得到单步约 $1.4455\times10^{13}$ MAC;latent 版本约 $4.0164\times10^{11}$ MAC,相差 36.0 倍;该变体参数量也变了,不是同一个模型。若像素版保留 SD 的全部 attention 位置,则约为 $2.7256\times10^{14}$ MAC,比例 678.6。两种对照不能混用。深层 attention 变体与 latent 版对应的逐层张量累计约 12.94 GiB 与 2.04 GiB,尚未模拟张量生命周期、重计算、优化器或融合内核。VAE 编解码是额外开销,占比随采样步数、分辨率和实现改变,本实验没有测量它。 压缩也引入信息取舍。latent_lab.py 用一张样例图做块 DCT,只保留 192 个系数中的 4 个,得到 94.91% 能量和约 22.06 dB PSNR。能量不是语义信息量,高频中的文字笔画、边缘、细小物体仍可能很重要;该单图线性实验不能证明 VAE 只删除“人眼不关心”的内容。 实际 LDM 用学习到的感知压缩来减小扩散的工作空间,并同时权衡重建质量、生成质量和成本。像素扩散、级联超分也能实现高分辨率生成,潜空间是有用路线而非唯一可行路线。 02. 最小可用理解 三句话: 机制:先训练并冻结感知自编码器,再在它的潜表示上训练扩散模型。SD1.5 的 KL 自编码器将 512×512×3 图像变成 64×64×4 的后验样本,经配套缩放后交给 UNet;文本主要通过交叉注意力注入。 成本:固定通道与卷积核时,卷积 MAC 随空间位置数线性变化,self-attention 的矩阵乘随位置数平方变化。同拓扑静态账本在 512px 得到 678.6 倍 MAC 比;卷积部分约 63.993 倍,四舍五入为 64.0,因输入/输出通道从 3 变成 4 而非严格 64。端到端加速仍需实测。 效果与代价:扩散模型不再直接对像素负责,可还原的细节受 VAE 限制——VAE 解不回来的细节,扩散模型画得再好也出不来。这是潜空间模型的一项误差来源,不能单独解释文字或手指等全部生成错误。 这张图看静态 MAC 随边长变化的趋势:在本扫描区间,像素同拓扑约为边长的 3.87 次方,latent 约为 2.61 次方。512px 处约相差 679 倍。右图是朴素实现的逐层张量累计,不是实测峰值;使用融合注意力时,红色矩阵项会显著改变。 03. 数学推导 3.1 两阶段目标 LDM 是两阶段训练,不是给同一个联合损失设置一个任意 λ: $$\text{阶段一:}\min_{\phi,\psi}L_{\text{AE}}(\phi,\psi),\qquad\text{阶段二:固定 }(\phi,\psi)\text{ 后 }\min_\theta L_{\text{LDM}}(\theta)$$ 第一阶段优化自编码器的重建、正则与感知/对抗目标;第二阶段冻结编码器与解码器,只优化 latent 扩散目标。这样扩散训练所见的 latent 分布保持固定。联合训练是另一类研究方案,需要额外处理两侧变化。 3.2 感知压缩:压缩率从哪来 VAE 的编码器把 $x\in\mathbb{R}^{H\times W\times 3}$ 映到 $z\in\mathbb{R}^{h\times w\times C}$,其中 $h=H/f$、$w=W/f$。定义张量元素数量比 $$r=\frac{3\,f^{2}}{C}$$ $f$ 是空间下采样倍数,$C$ 是潜通道数。SD 用 $f=8$、$C=4$,所以 $r=48$。它不是文件码率:若原图为 uint8、latent 为 FP16,未计元数据的字节比只有 24;若还保存后验均值与方差,存储又不同。实际编码还需量化、熵编码和解码约定。这个式子值得停一下:$f$ 和 $C$ 是两个独立的旋钮,$f$ 控制空间上省多少(直接决定 UNet 卷积部分省多少,因为卷积算力正比 $h\times w$),$C$ 控制每个位置带多少信息。附录表 [A] 里扫了这两个旋钮的交叉组合:$f=8,C=4$ 时线性重建只有 22.06 dB,把 $C$ 从 4 提到 16 能到 27.56 dB,把 $f$ 从 8 降到 4 也能到 26.09 dB——增大 $C$ 或减小 $f$ 都可能改善这个替身的重建,但改变的维度不同。固定骨干时,$f$ 加倍使空间位置数除以 4;self-attention 的矩阵项约除以 16,首尾卷积还随 $C$ 改变,不能把全部算力统称除以 4。LDM 论文比较了多种压缩因子和 KL/VQ 正则;SD1.5 的 $f=8,C=4$ 是具体模型的选择,不是这张单图 DCT 曲线推出的最优解。 图中星号只是与 SD 相同张量尺寸的 DCT 教学替身,不是实测 SD VAE 的 PSNR。不同曲线来自同一张图的不同块大小与保留系数数目;右侧能量比例依赖图像和基底,不代表感知信息保留率。此处保留的是整张输入图上平均能量最大的固定 DCT 索引,不保证都属于最低频率;它使用待测图自身选择索引,重建端还需知道这些索引。该图展示单图适配,不是固定编码器的留出泛化或完整码率评估。 感知压缩通常结合像素重建、LPIPS 和对抗目标。逐像素 L2 在重建不确定时倾向条件均值,可能使细节变模糊;感知项约束特征而非逐像素对应。但 L2 不会因为“高频系数数量多”就被低能量项支配:正交变换下 Parseval 等式保持总平方误差。是否使用某项应看具体配方与消融。 在 SD1.5 的 KL 路径中,编码器实际给出对角高斯后验,而非一个天然确定的向量。用 $u$ 区分原始自编码器 latent 与扩散所见的 $z$: $$q_\phi(u\mid x)=\mathcal N(\mu_\phi(x),\operatorname{diag}(\sigma_\phi^2(x))),\quad u=\mu_\phi(x)+\sigma_\phi(x)\odot\eta,\quad\eta\sim\mathcal N(0,I),\quad z_0=su.$$ $\phi,\psi$ 分别是编码器与解码器参数,$s$ 是配套全局缩放系数,$\odot$ 是逐元素乘;批量布局通常为 $[B,4,H/8,W/8]$。重建若取后验均值,和训练时取随机后验样本并非同一输入分布。采样结束后先还原 $u=z_0/s$,再由 $\mathcal D_\psi(u)$ 解码,不能漏除或除两遍。纯文生图推理从噪声出发,本身不必先编码一张输入图。 原始 LDM 还研究 VQ-reg. 路线,将量化放进解码侧;“LDM 都等于 SD1.5 的四通道高斯 VAE”过于狭窄。本文后面的具体尺寸、CLIP 长度和配置均限定到 SD1.5。 3.3 潜空间扩散目标 VAE 冻结之后,扩散这一半就是把 DDPM 的每个符号里的 $x$ 换成 $z$。前向过程: $$z_t=\sqrt{\bar\alpha_t}\,z_0+\sqrt{1-\bar\alpha_t}\,\varepsilon,\qquad \varepsilon\sim\mathcal{N}(0,1)$$ 训练时独立采样数据图像及后验噪声得到 $z_0$,再采样离散时间 $t$ 和同形状标准高斯噪声 $\varepsilon$;$\bar\alpha_t$ 是预先约定的累计信号系数,$\theta$ 是 UNet 参数。SD1.5 采用噪声预测,条件 $c$ 是文本编码器输出,通过 UNet 的交叉注意力进入: $$L_{\text{LDM}}=\mathbb{E}_{z_0,\,\varepsilon,\,t}\Big[\big\|\varepsilon-\varepsilon_\theta(z_t,t,c)\big\|_2^2\Big]$$ 损失形式沿用 DDPM 的噪声回归,但训练数据分布已换成缩放后的后验样本,调度、预测目标和条件接口仍须匹配模型。CFG 和 DDIM 可以在这里使用,不能将像素模型的训练权重直接当作 latent 模型权重。上述标准目标也没有覆盖额外 noise offset 等训练变体。 3.4 scale factor:为什么必须有 扩散训练需要固定 latent 的尺度约定。单位数据方差时,SNR 是 $\bar\alpha_t/(1-\bar\alpha_t)$,不是 $\bar\alpha_t$ 本身。SD1.x 常用乘数 $s=0.18215$;若把缩放后全局标准差约定为 1,它隐含参考原始标准差约 5.49、方差约 30.14,这不是本轮测得的训练集统计。固定 AutoencoderKL 源码默认使用该值;本次下载的 SD1.5 VAE 旧配置未显式列出它,加载时继承默认值,不能假称配置文件中一定写了这一键。编码后乘 s、解码前除 s,由训练脚本与 pipeline 完成,encode 本身不会自动做这步。 把 $z$ 整体乘 $k$ 倍,信噪比就乘 $k^2$: $$\mathrm{SNR}_{\text{eff}}(t)=\frac{\bar\alpha_t\,(k\sigma_z)^2}{1-\bar\alpha_t}$$ 也就是说,网络在时间步 $t$ 实际体验到的难度,可对应到单位方差参考调度里另一个时间步 $t'$ 的相同标量 SNR。附录脚本 [B2] 把这个对应关系算了出来(连续归一化 cosine 调度、$T=1000$、参考 $t=500$):scale 错 2 倍,等效于把 t=500 映射到约 t′=292.8(差 −207.2 步);错 4 倍是 −348.7 步;错 0.5 倍是 +205.6 步。这是参考时刻的等效 SNR 变化,不是固定的全局时间平移。按原论文定义,先定义连续函数: $$F(t)=\cos^2\left[\frac{(t/T+0.008)\pi}{2\times1.008}\right].$$ 再取 $\bar\alpha(t)=F(t)/F(0)$,保证 $\bar\alpha(0)=1$;旧代码漏了分母,本次修正后数字有约 0.1 步的变化。连续曲线还不同于离散 beta 上限裁剪后的累乘表。 相同标量 SNR 不等于两个网络调用等效:数据幅度、时间 embedding、后验分布及训练约定仍可能不同。这个对应关系用于诊断尺度,不能靠把错误 latent 配上 $t'$ 就保证恢复预训练模型。 这张图在固定参考 t=500 上比较尺度倍数 k 与等效时间 t′,曲线经过 k=1、t′=500。这种映射是非线性的,不是把整条时间表平移固定步数;−207.2 只是本调度在这个参考时刻、k=2 的差值。 还有一层:全局缩放只解决「整体方差」的问题,解决不了「通道之间」。附录 [B] 用样例照片的 DCT 特征实测(不是 VAE 权重输出):8 个通道的标准差从 8.0681 一直掉到 0.5386,相差 14.98 倍。为单独理解方差效应,另设第 $j$ 通道是均值 $\mu_j$、方差 $\sigma_j^2$ 的高斯变量,独立于加噪噪声;此时预测噪声的最优残差是 $$\mathrm{MSE}_j(t)=\frac{\bar\alpha_t\,\sigma_j^2}{\bar\alpha_t\,\sigma_j^2+1-\bar\alpha_t}$$ 推导来自高斯条件分布。记 $a=\bar\alpha_t$、$y=\sqrt a z+\sqrt{1-a}\varepsilon$,则 $\operatorname{Var}(y)=a\sigma_j^2+1-a$,$\operatorname{Cov}(\varepsilon,y)=\sqrt{1-a}$。因此 $$\mathbb E[\varepsilon\mid y]=\frac{\sqrt{1-a}}{a\sigma_j^2+1-a}(y-\sqrt a\mu_j),\quad\operatorname{Var}(\varepsilon\mid y)=1-\frac{1-a}{a\sigma_j^2+1-a}=\frac{a\sigma_j^2}{a\sigma_j^2+1-a}.$$ 有限方差变量即使不是高斯,这个系数仍给出最佳仿射预测器,残差却不能再称任意非线性预测器的 Bayes 下界。只有独立高斯通道时,逐通道残差之和才等于联合 Bayes 损失;通道相关时,联合预测还可能利用跨通道信息进一步降低误差。DCT 通道一般非高斯、也未证明独立;这里仅把实测通道方差代入高斯替身,未缩放时 $a=0.1$ 的最大通道残差份额约 51.28%。逐通道求和或求平均也要按损失约定区分。这不是参数梯度份额,更不能解释真实 SD 的细节质量。独立脚本以三组高斯各 40 万样本核对解析均值和 Monte Carlo 标准误。 这张图要看什么:左图是 8 个通道各自的 std(对数刻度),橙色虚线是通道方差均值的平方根(3.0457,不含通道均值之间的差异)——它的倒数 0.3283 就是 SD 那个 0.18215 的类比物,注意全局缩放之后通道之间的 15 倍跨度原封不动。右图是以实测方差构造高斯替身后,三条 $\bar\alpha_t$ 下各通道的最优残差份额:三条曲线都从左往右掉,灰色虚线是「逐通道缩放后」的均摊线 12.5%。$\bar\alpha_t$ 越小(噪声越大),失衡越严重。 3.5 交叉注意力:条件怎么进来 文本 $y$ 先过 CLIP 文本编码器得到 $\tau_\theta(y)\in\mathbb{R}^{77\times 768}$,然后进 UNet 内部的 Transformer 块。每个 Transformer 块有两个注意力,分工不同: $$\mathrm{attn}_1=\mathrm{softmax}\Big(\frac{QK^\top}{\sqrt d}\Big)V,\quad Q,K,V\ \text{都来自图像 token}\qquad\qquad\mathrm{attn}_2=\mathrm{softmax}\Big(\frac{QK^\top}{\sqrt d}\Big)V,\quad Q\ \text{来自图像 token},\ K,V\ \text{来自文本}$$ $\mathrm{attn}_1$ 是 self-attention,管图像内部的空间关系;$\mathrm{attn}_2$ 是 cross-attention,管「这段话在这个位置要什么」。关键在成本结构:图像 token 数 $N=h\times w$,文本 token 数固定 $T=77$,所以 $$\mathrm{attn}_1\ \text{的注意力矩阵是}\ N\times N,\qquad \mathrm{attn}_2\ \text{的是}\ N\times 77$$ 对 token 数 N,self-attention 的矩阵计算二次增长,cross-attention 在固定文本长度下近似线性增长。修正账本后,cross-attention 的 MAC 占比从 64² latent 的 4.00% 降到 256² 的 1.11%;绝对 MAC 仍从约 $1.60\times10^{10}$ 升到 $2.35\times10^{11}$,占比下降不能说它“不涨钱”。 单头注意力输出 $AV$ 满足 $\mathrm{rank}(AV)\le\min(T,d_{\text{head}})$,这里 T=77。附录单头、d=320 的随机矩阵实验得到秩 77。真实 SD 是多头:各头拼接后秩上界可达 $\min(C,H_{\text{heads}}T)$,再加残差、非线性与多层处理,不能声称整个 UNet 只有 77 个自由度。文本与细粒度空间控制仍是不同接口,但这个单头秩实验不能单独证明 ControlNet 的必要性。 左图是修正后的静态 MAC 占比。右图只是人为设定的“许多等 logit 位置”在 softmax 中累加概率质量的示意:真实 CLIP 即使使用相同 padding token ID,各位置经过位置编码与上下文注意力后的向量也不相同,不能把它们当成一个相同 EOS embedding 集团。是否传 mask 应核对具体 pipeline。 04. 代码实现 保留原有三份脚本,补一份独立校验。实验用 NumPy 与 Pillow,配图另需 matplotlib;本轮实跑为 Windows / Python 3.11.9 / NumPy 2.4.3。完整代码在文末附录,图像可用仓库样例,也可通过 --image 传入自己的图片。 4.1 块正交编码器(VAE 的替身) 为了隔离张量尺寸与数值因素,这里不加载预训练权重,而用一个线性正交编码器当 VAE 的替身:切成 $f\times f\times 3$ 的块、做三维可分离 DCT、只留能量最大的 $C$ 个系数。它与该 VAE 的张量形状及元素压缩率对应——潜特征形状就是 $(h, w, C)$,压缩率就是 $\frac{3f^2}{C}$,变量名和 3.2 节的符号一一对应。用它做替身的好处是把「压缩率」这一个变量单独隔离出来了。 def block_basis(f): """f x f x 3 块的可分离正交基,展平顺序 (channel, row, col)。""" df = dct_matrix(f) return np.kron(dct_matrix(3), np.kron(df, df)) def encode_decode(img, f, c_keep): """img: [H, W, 3],值域 [-1, 1]。返回潜特征、重建图、能量占比。""" h, w, _ = img.shape patches = to_blocks(img, f) # [h*w/f^2, 3*f*f] b = block_basis(f) coef = patches @ b.T # 正交变换,能量不变 energy = np.mean(coef ** 2, axis=0) # 每个基函数的平均能量 keep = np.sort(np.argsort(energy)[::-1][:c_keep]) latent = coef[:, keep].reshape(h // f, w // f, c_keep) rec = from_blocks(coef[:, keep] @ b[keep, :], h, w, f) frac = float(energy[keep].sum() / energy.sum()) return latent, np.clip(rec, -1.0, 1.0), frac 真实输出(一张 512×512 照片): encode_decode(img, 8, 4) latent.shape = (64, 64, 4) # 与 SD 的潜特征形状完全一致 压缩率 = 48.0x # 3*8^2/4 PSNR = 22.06 dB # 本样例、本次索引和裁剪策略的结果 保留能量 = 94.9081% # 扔掉的 98% 系数只占 5.09% 的能量 22.06 dB 是这一张图在该 DCT 选择和裁剪策略下的结果,不是所有线性编码器的上限,也不是 SD VAE 的重建质量。真实非线性编码器可能学到不同的特征表示;没有跑权重就不能量化它比这个替身好多少。 4.2 UNet 账本(参数量对拍) 记账模型按 SD 1.5 的拓扑走一遍:4 个分辨率、每层 2 个 ResNet(上采样路径 3 个)、attention 放在下采样路径的第 0/1/2 层和上采样路径对应的层、中段是 ResNet-Transformer-ResNet。 def resnet(self, res, cin, cout): """ResnetBlock2D:GroupNorm-Conv-GroupNorm-Conv + timestep 注入 + shortcut。""" n = res * res self.group_norm(n, cin) self.conv2d(3, cin, cout, res, res) self.group_norm(n, cout) self.conv2d(3, cout, cout, res, res) self.linear(1, TEMB_CH, cout) # time_emb_proj: [1280] -> [cout] if cin != cout: self.conv2d(1, cin, cout, res, res) # conv_shortcut(上采样路径必带) def attention_scores(self, n_q, n_kv, ch, kind): macs = 2.0 * n_q * n_kv * ch self.macs += macs self.kinds[kind] += macs matrix_bytes = n_q * n_kv * NUM_HEADS * self.bpe self.attn_matrix += matrix_bytes self.act += matrix_bytes return macs 真实输出: build_unet(64, 64, 4, 4) # 潜空间 params = 859,520,964 # 与固定配置官方类的结构计数一致 MAC = 4.0164e+11 构成 = conv 52.1% self_attn 21.6% cross_attn 4.0% ffn 19.1% proj 3.2% build_unet(512, 512, 3, 3) # 同一拓扑搬回像素空间 MAC = 2.7256e+14 # 是潜空间的 678.6 倍 账本中 FFN 占约 19.1% MAC、cross-attention 约 4.0%,需要同时考虑投影、卷积和注意力矩阵乘。上采样 ResNet 拼接当前特征与 skip,其通道数是两者相加,跨层时并不总等于输出通道的两倍;修正版按 skip 栈逐项消费。 4.3 交叉注意力(10 行,含秩的验证) def cross_attn_demo(rng, d=320, side=64, ctx_len=77): n_img = side * side q = rng.standard_normal((n_img, d)) / np.sqrt(d) # 图像 token k_txt = rng.standard_normal((ctx_len, d)) / np.sqrt(d) # 文本 token v_txt = rng.standard_normal((ctx_len, d)) / np.sqrt(d) a = softmax((q @ k_txt.T) / np.sqrt(d), axis=-1) # [4096, 77] out = a @ v_txt # [4096, 320] rank = int(np.sum(np.linalg.svd(out, compute_uv=False) > np.linalg.svd(out, compute_uv=False)[0] * 1e-8)) print(a.shape, out.shape, rank) 真实输出: (4096, 77) (4096, 320) 77 这个单头教学例子的秩为 77,验证的是单次矩阵乘积的秩界。独立校验另构造两个各秩至多 2 的头,拼接后秩为 3,直接反驳“多头仍只有 T 个自由度”;加入残差后秩还可以恢复满秩。多头、残差与深层非线性不受同一个“77 维全局瓶颈”约束。 05. 工业级实现对照 对照 diffusers 的 UNet2DConditionModel(huggingface/diffusers · unet_2d_condition.py,symbol UNet2DConditionModel.forward;固定 Diffusers v0.35.1,核对日期为本次精修日;上游其他版本可能不同): 时间步通过 ResBlock 注入。 SD1.5 常见实现把时间 embedding 投影后加到特征上;原始 DDPM 实现也有加性注入,不能说原版 DDPM 使用 AdaGN、到 SD 才改成加法。scale-shift norm 等方式属于其他配置选择,比较时应指出具体模型。 SD1.5 的文本通常通过 cross-attention 注入。 通用 UNet2DConditionModel 还支持 class embedding、附加条件以及 only_cross_attention 等配置,不能把 SD1.5 的一条路径说成这个类的永恒约束。SDXL 还有 pooled 文本、尺寸和裁剪条件;SD2.x 并不是这里所有额外条件接口的来源。 attention 后端影响实际显存。 UNet 构造实现 为历史兼容设置 num_attention_heads = num_attention_heads or attention_head_dim,SD1.5 因而是 8 头。64² latent 的单层显式矩阵约 256 MiB;SDPA / FlashAttention 可避免完整物化,是否使用取决于设备、版本和配置。 scale factor 放在 VAE 的配置里,不在 UNet 里。 这个旧模型配置未显式带该键,AutoencoderKL 构造默认值为 scaling_factor=0.18215,pipeline 在 vae.encode(...).latent_dist.sample() 之后乘上它、在 vae.decode 之前除回来。UNet 见到的是训练约定缩放后的潜特征。替换 VAE 要核对它与扩散主干共同训练的尺度、偏移和 latent 语义;仅修改 scaling_factor 不保证兼容,见 3.4 节的等效时间映射。 本轮对固定原类做了两类验证:完整 SD1.5 拓扑只在 meta 设备数参数;随机初始化的小 UNet 在 CPU 上执行带文本/时间的前向和反向,输出与输入均为 [2,4,8,8]。另外将官方四头 attention 与 NumPy 显式 QK/softmax/AV/输出投影对照,并作输入梯度有限差分;小 VAE 实跑后验采样和外部缩放/解码。这些验证覆盖接口和代数,没有测预训练 SD1.5 图像质量、完整模型 CPU 速度或 GPU 显存。 64² latent 的中段在 8²。 三次下采样后到达 8²;skip 栈包含 conv_in、每个 ResNet/attention 组合的输出与下采样输出,attention 不是在同一 ResNet 之外额外再存一条独立 skip。上采样块依次消费这些特征,所以输入通道必须逐项记账。 06. 代价与边界 代价一:解码器与瓶颈限制重建和生成。 被编码过程丢掉的信息无法保证按原样还原,固定解码器也限制可生成的图像集合。但手指、文字错误还可能来自生成模型和数据,不能把一类生成错误全部归因于 VAE。输入重建误差也不是生成样本误差的严格上限。 代价二:尺度约定要成对维护。 toy 的通道跨度说明一个全局标量不能独立归一化每个通道。真实 VAE 是否需要逐通道处理必须测量;使用预训练扩散模型时还要保持它训练时的 latent 语义和配置,不能只改系数。 代价三:文本不直接指定每个空间位置。 更精确的姿态、深度、边缘控制常加入空间条件分支,但原因涉及任务表示与训练,不是整个 UNet 输出秩只能为 77。多头注意力的秩上界见 3.5 节。 选择时看保真需求与实测成本。 严格像素保真的编辑、文档和重建任务需要评估 VAE 引入的误差,可能选择更低压缩、多尺度或像素方案。超高分辨率并不自动排除 latent 模型:分块、融合注意力、不同生成骨干都会改变成本。本文 2048px 对照的朴素逐层累计约 352.53 GiB,既不是实测峰值,也不是 SDXL 的数字。 07. 经典论文脉络 Taming Transformers for High-Resolution Image Synthesis:VQGAN 将感知压缩与离散 token 自回归生成结合,LDM 沿用并比较了相关感知压缩设计。 Denoising Diffusion Probabilistic Models:提供噪声预测训练与逆扩散的基础。 High-Resolution Image Synthesis with Latent Diffusion Models:在学习的潜空间训练扩散,比较 KL/VQ 正则、不同压缩因子,并用交叉注意力接受一般条件;SD1.5 是后续具体模型实例。 Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding(Imagen):采用像素空间级联扩散和冻结的大文本编码器,展示另一条高分辨率生成路线;文中对文本编码器规模与质量的观察限于其比较设置。 SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis:增加 UNet 与文本条件容量,加入尺寸/裁剪条件、多宽高比训练及 refinement 阶段,说明潜空间路线还有多种工程选择。 它们分别讨论压缩、扩散、条件建模和尺度化设计;不能把跨论文的不同模型视为同一控制变量实验。 08. 常见误解 「潜空间扩散等价于像素扩散加一个 VAE。」 VAE 改变了数据表示、尺度与可还原的信息,训练好的两个去噪器不能无成本互换;差异不能简单归结为“高频全部被删掉”。 「保留 95% 能量就等于保留 95% 信息。」 能量是特定数值空间的平方和,不是感知信息量;小字等低能量结构可能极为重要。本文单图 DCT 只展示能量集中性,真实 VAE 必须另做重建与感知评估。 「0.18215 可以任意改,或是所有图像逐通道标准差的精确倒数。」 它是具体模型约定的全局乘数,不会保证每张图、每个通道都精确单位方差。错 2 倍会改变 SNR;本文连续参考表在 t=500 映射到约早 207 步,但没有实际重排采样预算,也不意味着网络等效。新模型可以重新训练尺度约定,预训练模型使用时则需成对维护。 「静态 MAC 占比就等于延迟占比。」 本账本在 64×64 latent 将 cross-attention 的 Q/K/V/输出投影与矩阵乘合计为约 4.00%,self-attention 21.6%、卷积 52.1%;另有 Transformer 外层投影单独归类。融合内核、访存、文本 K/V 跨步缓存与设备利用率都会改变实际延迟;因此不能仅凭这个比例排除交叉注意力优化。 「SD 的 UNet 只需按通道翻倍估一下。」 跨层 skip、Transformer 外层投影、不同 attention 配置都会影响账本。尤其 SD1.x 配置中的 attention_head_dim=8 是历史头数命名,不能据此算成 40 个头。 09. 动手验证 四份脚本都在附录,unet_ledger.py 仅用标准库,latent_lab.py 需要 numpy 与 Pillow,并需要通过 --image 提供图片或在仓库中使用默认样例(不需要 torch): python unet_ledger.py --sweep python latent_lab.py --image your_image.jpg python ldm_checks.py python make_figures.py 我实跑的关键输出,你可以对: unet_ledger.py 潜空间 params = 859,520,964(官方配置实际构造计数一致) 潜空间单步 MAC = 4.0164e+11;像素空间 = 2.7256e+14,678.6 倍 只看卷积部分 = 64.0 倍(约为 f^2,首尾通道不同产生小差异) cross-attn 占比:64x64 4.00% -> 256x256 1.11% 分辨率扫描加速比:256px 234.3x,512px 678.6x,1024px 1754.7x latent_lab.py f=8, C=4:PSNR 22.06 dB,保留能量 94.9081% 能量最大的 1% 系数(2 个)携带 91.01% 的总能量 8 个通道 std 相差 14.98 倍;alpha_bar=0.1 时 top1 通道占 51.28% 的 loss scale 错 2 倍 -> 等效时间步偏移 -207.2 步 cross-attn 输出的秩 = 77(self-attn 对照 = 320) 人工logit实验在 delta=0 时零logit组约占 84.38%(不是CLIP测量) 注意 84.38% 来自八个带随机波动的 logit 与 69 个零 logit;若 77 个位置严格同分,后者占比应是 $69/77=89.61\%$。这两个模型不同,不能拿前者当作同分组公式的验证。 独立校验还覆盖块拆装、DCT 正交性与 Parseval、满系数重建、投影误差等式、零能量输入、六类非法图像参数、SNR 连续反解及逐行注意力计算。 两个练习:把 --image 换成自己的图,比较 DCT 能量集中度与重建质量;把 NUM_HEADS 从 8 改为 4,在通道宽度不变时,注意力矩阵存储减半,而 QK/AV 的总 MAC 基本不变。该配置实验演示公式,不代表修改预训练模型后可直接使用。 10. 延伸阅读 按知识树的依赖链走: DDPM 训练目标与采样流程:本文 3.3 节那行目标的完整推导。 VAE 结构与 0.18215:VAE 一侧的全部细节,包括那个数字的来历。 分类器无关引导 CFG 的代价与调法:cross-attention 这条条件通路在采样时怎么被外推。 从 DDIM 到高阶采样器:潜空间里怎么把 1000 步压到 20 步。 FlashAttention 为什么不需要存下注意力矩阵:图 1b 那根红柱子怎么消掉。 已发布相邻节点:DiT(Transformer 生成骨干,具体条件方式依模型而异)、流匹配(另一种连续生成路径)。VQ-VAE 与 VQGAN 专题也已发布,可对照离散编码器。 附录:完整代码 09 节用到的脚本全文如下(unet_ledger.py、latent_lab.py、ldm_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 unet_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """SD 系 UNet 的算力 / 显存账本:像素空间 vs 潜空间。 这个脚本不跑真正的卷积,而是按 SD 1.5 UNet2DConditionModel 的公开配置把每一层的形状、参数量、MAC 数、需要保存的 激活字节数逐一累加出来。数字是静态算子账本,不是实测显存或延迟;激活量不含优化器、内核临时区,且不模拟张量生命周期。 记账模型的可靠性用一件事来校准:参数量。官方 SD 1.5 的 UNet 是 参数量由官方配置构造的模型另行核对;参数量逐项对齐后仍需区分静态账本与实测峰值。 用法: python unet_ledger.py # 潜空间 vs 像素空间的主对比 python unet_ledger.py --sweep # 分辨率扫描(看缩放指数) """ from __future__ import annotations import argparse import math # ── 记账口径 ────────────────────────────────────────────────────────────── BYTES_PER_ELEM = 2 # 激活按 bf16/fp16 记,训练时主干激活就是这个精度 # ── SD 1.5 UNet2DConditionModel 的公开配置(v1-5/config.json)───────────── BASE_CH = 320 CH_MULT = (1, 2, 4, 4) LAYERS_PER_BLOCK = 2 # 每个分辨率上的 ResNet 个数(下采样路径) DOWN_ATTN_LEVELS = (0, 1, 2) # 下采样路径里带 self+cross attention 的层 UP_ATTN_LEVELS = (0, 1, 2) # 上采样路径里带 attention 的层 TEMB_CH = 1280 # timestep embedding 的宽度 CTX_DIM = 768 # 文本编码器(CLIP ViT-L)的隐藏维 NUM_HEADS = 8 # SD1.x 历史配置 attention_head_dim 实际指定头数 N_LEVELS = len(CH_MULT) def fmt_bytes(b: float) -> str: """字节数转人类可读字符串。""" for unit in ("B", "KiB", "MiB", "GiB", "TiB", "PiB"): if abs(b) < 1024.0: return "%.2f %s" % (b, unit) b /= 1024.0 return "%.2f PiB" % b def fmt_sci(x: float) -> str: return "%.4e" % x class Ledger: """逐层累加 MAC / 参数 / 激活字节。""" def __init__(self, name: str, bytes_per_elem: int = BYTES_PER_ELEM): self.name = name self.bpe = bytes_per_elem self.macs = 0.0 self.params = 0.0 self.act = 0.0 # 选定算子输出的逐层累计,不模拟活跃期 self.attn_matrix = 0.0 # 注意力矩阵单独统计(它是最容易爆的那一项) self.kinds = {"conv": 0.0, "self_attn": 0.0, "cross_attn": 0.0, "ffn": 0.0, "proj": 0.0} # ── 基本算子 ────────────────────────────────────────────────────── def conv2d(self, k, cin, cout, h, w, kind="conv", save=True): macs = k * k * cin * cout * h * w self.macs += macs self.params += k * k * cin * cout + cout self.kinds[kind] += macs if save: self.act += h * w * cout * self.bpe return macs def linear(self, n_tok, cin, cout, kind="proj", save=True, bias=True): macs = n_tok * cin * cout self.macs += macs self.params += cin * cout + (cout if bias else 0) self.kinds[kind] += macs if save: self.act += n_tok * cout * self.bpe return macs def geglu(self, n_tok, ch): """diffusers 的 GEGLU:Linear(ch, 8*ch) -> GELU -> 逐元素乘 -> Linear(4*ch, ch)。""" m = self.linear(n_tok, ch, 8 * ch, kind="ffn") m += self.linear(n_tok, 4 * ch, ch, kind="ffn") return m def group_norm(self, n_tok, ch): self.params += 2 * ch self.act += n_tok * ch * self.bpe def attention_scores(self, n_q, n_kv, ch, kind): """Q K^T 与 A V 两次矩阵乘,外加注意力矩阵本身的显存。""" heads = NUM_HEADS macs = 2.0 * n_q * n_kv * ch # d_head * n_heads == ch self.macs += macs self.kinds[kind] += macs # 注意力矩阵是 [heads, n_q, n_kv] self.attn_matrix += n_q * n_kv * heads * self.bpe self.act += n_q * n_kv * heads * self.bpe return macs # ── 复合模块 ────────────────────────────────────────────────────── def resnet(self, res, cin, cout): """ResnetBlock2D:GroupNorm-Conv-GroupNorm-Conv + timestep 注入 + shortcut。""" n = res * res self.group_norm(n, cin) self.conv2d(3, cin, cout, res, res) self.group_norm(n, cout) self.conv2d(3, cout, cout, res, res) # timestep embedding 的投影:对每个样本做一次 [1280] -> [cout] self.linear(1, TEMB_CH, cout, kind="proj", save=True) if cin != cout: self.conv2d(1, cin, cout, res, res) # conv_shortcut self.act += n * cout * self.bpe # 残差输出要给上采样路径留着 def transformer_block(self, res, ch, ctx_len): """BasicTransformerBlock:self-attn -> cross-attn -> FFN。""" n = res * res heads = NUM_HEADS # Transformer2DModel 的外层归一化和输入投影 self.group_norm(n, ch) self.conv2d(1, ch, ch, res, res, kind="proj") # (1) self-attention self.group_norm(n, ch) self.linear(n, ch, ch, kind="self_attn", bias=False) self.linear(n, ch, ch, kind="self_attn", bias=False) self.linear(n, ch, ch, kind="self_attn", bias=False) self.attention_scores(n, n, ch, "self_attn") self.linear(n, ch, ch, kind="self_attn") self.act += n * ch * self.bpe # (2) cross-attention:Q 来自图像 token,K/V 来自文本 token self.group_norm(n, ch) self.linear(n, ch, ch, kind="cross_attn", bias=False) self.linear(ctx_len, CTX_DIM, ch, kind="cross_attn", bias=False) self.linear(ctx_len, CTX_DIM, ch, kind="cross_attn", bias=False) self.attention_scores(n, ctx_len, ch, "cross_attn") self.linear(n, ch, ch, kind="cross_attn") self.act += n * ch * self.bpe # (3) FFN self.group_norm(n, ch) self.geglu(n, ch) self.act += n * ch * self.bpe self.conv2d(1, ch, ch, res, res, kind="proj") return heads def build_unet(h, w, in_ch, out_ch, ctx_len=77, name="unet", down_attn=DOWN_ATTN_LEVELS, up_attn=UP_ATTN_LEVELS): """按 SD 1.5 的拓扑跑一遍记账。 h, w : 输入特征图的空间尺寸(潜空间是 64x64,像素空间是 512x512) in_ch : 输入通道(潜空间 4,像素空间 3) out_ch : 输出通道(同上) ctx_len : 文本 token 数(CLIP 固定 77) down_attn/up_attn : 哪些层级带 attention。默认是 SD 的配置; 像素空间可以用 deep 变体把 attention 只留在最深层。 """ if any(isinstance(v, bool) or not isinstance(v, int) or v <= 0 for v in (h,w,in_ch,out_ch,ctx_len)): raise ValueError("尺寸、通道和文本长度必须是正整数") if h != w or h % 8 != 0: raise ValueError("本账本仅支持边长为8的倍数的正方形输入") L = Ledger(name) chs = [BASE_CH * m for m in CH_MULT] # timestep 的 MLP:sinusoidal -> Linear(320, 1280) -> Linear(1280, 1280) L.linear(1, BASE_CH, TEMB_CH, save=True) L.linear(1, TEMB_CH, TEMB_CH, save=True) # conv_in res = h L.conv2d(3, in_ch, chs[0], res, res) # ── 下采样路径 ─────────────────────────────────────────────────── skips = [(res, chs[0])] # conv_in 输出也是 skip current_ch = chs[0] for lv in range(N_LEVELS): cout = chs[lv] for _ in range(LAYERS_PER_BLOCK): L.resnet(res, current_ch, cout) current_ch = cout if lv in down_attn: L.transformer_block(res, cout, ctx_len) skips.append((res, cout)) if lv < N_LEVELS - 1: res //= 2 L.conv2d(3, cout, cout, res, res) skips.append((res, cout)) # ── 中段:ResNet -> Transformer -> ResNet ───────────────────────── mid_ch = chs[-1] L.resnet(res, mid_ch, mid_ch) L.transformer_block(res, mid_ch, ctx_len) L.resnet(res, mid_ch, mid_ch) # ── 上采样路径 ─────────────────────────────────────────────────── current_ch = mid_ch for lv in reversed(range(N_LEVELS)): cout = chs[lv] for _ in range(LAYERS_PER_BLOCK + 1): skip_res, skip_ch = skips.pop() assert skip_res == res L.resnet(res, current_ch + skip_ch, cout) current_ch = cout if lv in up_attn: L.transformer_block(res, cout, ctx_len) if lv > 0: res *= 2 L.conv2d(3, cout, cout, res, res) assert not skips # conv_out L.group_norm(res * res, chs[0]) L.conv2d(3, chs[0], out_ch, res, res) return L def report(L: Ledger, note=""): tot = L.macs print(" %-22s params=%s MAC=%s 激活=%s 其中注意力矩阵=%s" % (L.name + note, "{:,}".format(int(L.params)), fmt_sci(L.macs), fmt_bytes(L.act), fmt_bytes(L.attn_matrix))) if tot > 0: parts = " ".join("%s %.1f%%" % (k, 100.0 * v / tot) for k, v in L.kinds.items() if v > 0) print(" MAC 构成: " + parts) def main(): ap = argparse.ArgumentParser() ap.add_argument("--sweep", action="store_true", help="跑分辨率扫描") args = ap.parse_args() print("=" * 78) print("SD 1.5 UNet 记账(激活按 %d 字节/元素,文本 token 数 77)" % BYTES_PER_ELEM) print("=" * 78) # ── 主对比 ─────────────────────────────────────────────────────── lat = build_unet(64, 64, 4, 4, ctx_len=77, name="latent-64x64x4") pix = build_unet(512, 512, 3, 3, ctx_len=77, name="pixel-512x512x3") # 另一个教学拓扑:attention仅在最深层,参数和算子位置也改变。 pixd = build_unet(512, 512, 3, 3, ctx_len=77, name="pixel-deep-attn", down_attn=(3,), up_attn=(3,)) print("\n[1] 潜空间 vs 像素空间(同一次前向,batch=1)") report(lat, "") report(pix, "") report(pixd, "") print("\n SD 1.5 风格静态参数量 = %s;官方结构的独立核对见质量证据" % "{:,}".format(int(lat.params))) print("\n 比值(像素 / 潜):") print(" 总 MAC %.1fx 只看卷积部分 %.1fx" % (pix.macs / lat.macs, pix.kinds["conv"] / lat.kinds["conv"])) print(" 深层attention变体总MAC %.1fx 只看卷积部分 %.1fx" % (pixd.macs / lat.macs, pixd.kinds["conv"] / lat.kinds["conv"])) print(" 激活 %.1fx 注意力矩阵 %.1fx" % (pix.act / lat.act, pix.attn_matrix / lat.attn_matrix)) print(" 像素空间 512x512 上单个 self-attn 层的注意力矩阵 = %s(8 头)" % fmt_bytes(512 * 512 * 512 * 512 * NUM_HEADS * BYTES_PER_ELEM)) print(" 潜空间 64x64 上单个 self-attn 层的注意力矩阵 = %s(8 头)" % fmt_bytes(64 * 64 * 64 * 64 * NUM_HEADS * BYTES_PER_ELEM)) print(" 潜空间 UNet 朴素实现注意力矩阵逐层累计(非峰值) = %s" % fmt_bytes(lat.attn_matrix)) # ── 交叉注意力的占比 ───────────────────────────────────────────── print("\n[2] 交叉注意力在不同分辨率下的占比(潜空间 UNet,ctx=77)") print(" %-10s %-14s %-12s %-12s" % ("latent", "总 MAC", "cross MAC", "占比")) for r in (32, 64, 96, 128, 192, 256): L = build_unet(r, r, 4, 4, ctx_len=77, name="r%d" % r) cr = L.kinds["cross_attn"] print(" %-10s %-14s %-12s %-12s" % ("%dx%d" % (r, r), fmt_sci(L.macs), fmt_sci(cr), "%.2f%%" % (100.0 * cr / L.macs))) if not args.sweep: return # ── 分辨率扫描:看缩放指数 ─────────────────────────────────────── print("\n[3] 分辨率扫描:图像边长 -> 潜空间边长(f=8)") print(" %-10s %-16s %-16s %-10s %-12s" % ("图像", "像素空间 MAC", "潜空间 MAC", "加速比", "潜空间激活")) rows = [] for side in (256, 384, 512, 768, 1024, 2048): lp = build_unet(side // 8, side // 8, 4, 4, ctx_len=77, name="lp") px = build_unet(side, side, 3, 3, ctx_len=77, name="px") rows.append((side, px.macs, lp.macs, px.macs / lp.macs, lp.act)) print(" %-10s %-16s %-16s %-10s %-12s" % ("%d px" % side, fmt_sci(px.macs), fmt_sci(lp.macs), "%.1fx" % (px.macs / lp.macs), fmt_bytes(lp.act))) # 拟合 log-log 斜率 = 缩放指数 xs = [math.log(r[0]) for r in rows] for idx, tag in ((1, "像素空间"), (2, "潜空间")): ys = [math.log(r[idx]) for r in rows] n = len(xs) mx = sum(xs) / n my = sum(ys) / n sl = sum((a - mx) * (b - my) for a, b in zip(xs, ys)) / \ sum((a - mx) ** 2 for a in xs) print(" %s 的缩放指数 ~ 边长^%.3f" % (tag, sl)) if __name__ == "__main__": main() latent_lab.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """潜空间到底丢了多少东西:块正交变换替身 + 通道尺度 + 交叉注意力。 本实验不加载真实 VAE 权重,使用一个**线性正交编码器** 当 VAE 的替身:把图像切成 f x f x 3 的块,做三维可分离 DCT,只保留能量最大的 C 个系数。它和选定 VAE 的张量尺寸对应——潜特征形状就是 (H/f, W/f, C), 压缩率就是 3*f*f / C。差别在于真实 VAE 是非线性、端到端训练的,重建表现须运行具体权重比较。 用它做替身的好处是:**压缩率这一个变量被单独隔离出来了**。 三件事: A. 压缩率 vs 重建质量 vs 能量集中度 B. 潜特征各通道的方差跨度,以及 scale factor 为什么要存在 C. 交叉注意力:形状、秩瓶颈、padding token 抢走的注意力质量 用法: python latent_lab.py python latent_lab.py --image /path/to/xxx.jpg --size 512 """ from __future__ import annotations import argparse import math import os import numpy as np from PIL import Image SEED = 20260929 HERE = os.path.dirname(os.path.abspath(__file__)) def _find_image() -> str: """向上找 asserts/AIGC.jpg,找不到就退回 outputs/../asserts。""" cur = HERE for _ in range(8): cand = os.path.join(cur, "asserts", "AIGC.jpg") if os.path.exists(cand): return cand cur = os.path.dirname(cur) return os.path.normpath(os.path.join(HERE, "..", "..", "..", "..", "asserts", "AIGC.jpg")) DEFAULT_IMAGE = _find_image() # ───────────────────────────────────────────────────────────────────────── # 基础工具 # ───────────────────────────────────────────────────────────────────────── def dct_matrix(n: int) -> np.ndarray: """正交归一的 DCT-II 矩阵(第 k 行是第 k 个基)。""" if isinstance(n,bool) or not isinstance(n,int) or n <= 0: raise ValueError("DCT长度必须是正整数") k = np.arange(n).reshape(n, 1) i = np.arange(n).reshape(1, n) M = np.cos(math.pi * (i + 0.5) * k / n) M[0] *= math.sqrt(1.0 / n) M[1:] *= math.sqrt(2.0 / n) return M def block_basis(f: int) -> np.ndarray: """f x f x 3 块的可分离正交基,形状 [3*f*f, 3*f*f]。 展平顺序是 (channel, row, col),所以基矩阵是 D_c ⊗ D_row ⊗ D_col。 """ dc = dct_matrix(3) df = dct_matrix(f) return np.kron(dc, np.kron(df, df)) def load_image(path: str, size: int) -> np.ndarray: """读图 -> 居中裁剪成正方形 -> resize -> 归一化到 [-1, 1]。""" if isinstance(size,bool) or not isinstance(size,int) or size <= 0: raise ValueError("size必须是正整数") with Image.open(path) as source: im = source.convert("RGB") w, h = im.size s = min(w, h) im = im.crop(((w - s) // 2, (h - s) // 2, (w - s) // 2 + s, (h - s) // 2 + s)) im = im.resize((size, size), Image.LANCZOS) a = np.asarray(im, dtype=np.float64) / 127.5 - 1.0 return a def to_blocks(img: np.ndarray, f: int) -> np.ndarray: """[H, W, 3] -> [Nb, 3*f*f],Nb = (H/f)*(W/f)。""" if isinstance(f,bool) or not isinstance(f,int) or f <= 0: raise ValueError("f必须是正整数") if img.ndim != 3 or img.shape[-1] != 3 or not np.isfinite(img).all(): raise ValueError("图像必须是有限值的[H,W,3]张量") h, w, c = img.shape if h <= 0 or w <= 0 or h % f or w % f: raise ValueError("H和W必须是f的正整数倍") x = img.reshape(h // f, f, w // f, f, c) x = x.transpose(0, 2, 4, 1, 3) # [H/f, W/f, c, f, f] return x.reshape(-1, c * f * f) def from_blocks(patches: np.ndarray, h: int, w: int, f: int, c: int = 3) -> np.ndarray: x = patches.reshape(h // f, w // f, c, f, f) x = x.transpose(0, 3, 1, 4, 2) # [H/f, f, W/f, f, c] return x.reshape(h, w, c) def psnr(a: np.ndarray, b: np.ndarray) -> float: """a, b 都在 [-1, 1],峰值是 1,所以满量程平方是 4。""" mse = float(np.mean((a - b) ** 2)) return math.inf if mse == 0 else 10.0 * math.log10(4.0 / mse) # ───────────────────────────────────────────────────────────────────────── # A. 压缩率 vs 重建 vs 能量 # ───────────────────────────────────────────────────────────────────────── def encode_decode(img: np.ndarray, f: int, c_keep: int): """保留能量最大的 c_keep 个系数,返回 (潜特征, 重建图, 能量占比)。""" patches = to_blocks(img, f) h, w, _ = img.shape if isinstance(c_keep,bool) or not isinstance(c_keep,int) or not 1 <= c_keep <= 3*f*f: raise ValueError("c_keep必须在1到3*f*f之间") b = block_basis(f) coef = patches @ b.T # [Nb, 3*f*f] energy = np.mean(coef ** 2, axis=0) # 每个基函数的平均能量 order = np.argsort(energy)[::-1] keep = np.sort(order[:c_keep]) latent = coef[:, keep].reshape(h // f, w // f, c_keep) rec = (coef[:, keep] @ b[keep, :]) rec = from_blocks(rec, h, w, f) total = float(energy.sum()) frac = float(energy[keep].sum() / total) if total else 1.0 return latent, np.clip(rec, -1.0, 1.0), frac def part_a(img: np.ndarray): print("\n[A] 元素比 vs 重建质量(输入样例,逐图自适应DCT子集;非VAE)") print(" %-6s %-5s %-16s %-9s %-9s %-9s" % ("f", "C", "潜特征形状", "压缩率", "PSNR dB", "保留能量")) out = [] for f in (2, 4, 8, 16): for c_keep in (3, 4, 8, 16): if c_keep > 3 * f * f: continue lat, rec, frac = encode_decode(img, f, c_keep) ratio = (3.0 * f * f) / c_keep p = psnr(img, rec) out.append((f, c_keep, ratio, p, frac)) print(" %-6d %-5d %-16s %-9s %-9s %-9s" % (f, c_keep, "%dx%dx%d" % lat.shape, "%.1fx" % ratio, "%.2f" % p, "%.4f%%" % (100 * frac))) return out def sweep_c(img: np.ndarray, f: int = 8): print("\n[A2] 固定 f=%d,扫 C(SD 用的是 C=4)" % f) print(" %-5s %-9s %-9s %-9s" % ("C", "压缩率", "PSNR dB", "保留能量")) rows = [] for c_keep in (1, 2, 3, 4, 6, 8, 12, 16, 24, 32, 48, 64, 96, 128): if c_keep > 3 * f * f: continue _, rec, frac = encode_decode(img, f, c_keep) rows.append((c_keep, (3.0 * f * f) / c_keep, psnr(img, rec), frac)) print(" %-5d %-9s %-9s %-9s" % (c_keep, "%.1fx" % ((3.0 * f * f) / c_keep), "%.2f" % psnr(img, rec), "%.4f%%" % (100 * frac))) return rows # ───────────────────────────────────────────────────────────────────────── # B. 通道方差跨度与 scale factor # ───────────────────────────────────────────────────────────────────────── def cosine_abar(t: np.ndarray, big_t: int = 1000, s: float = 0.008) -> np.ndarray: """连续cosine alpha_bar=f(t)/f(0),非离散beta裁剪后的累乘。""" x = (t / big_t + s) / (1.0 + s) return np.cos(x * math.pi / 2.0) ** 2 / math.cos(s/(1+s)*math.pi/2)**2 def part_b(img: np.ndarray, f: int = 8, c_keep: int = 8): print("\n[B] 潜特征各通道的方差跨度(f=%d, C=%d)" % (f, c_keep)) lat, _, _ = encode_decode(img, f, c_keep) sig = lat.reshape(-1, c_keep).std(axis=0) order = np.argsort(sig)[::-1] print(" 各通道 std(从大到小): " + ", ".join("%.4f" % v for v in sig[order])) print(" 最大 / 最小 = %.2f 倍" % (sig.max() / sig.min())) gstd = float(np.sqrt(np.mean(sig ** 2))) print(" 通道方差均值的平方根 = %.4f,它的倒数(SD 的 scale factor 类比)= %.4f" % (gstd, 1.0 / gstd)) # 未缩放时,epsilon 预测的最优残差 MSE 逐通道 = a*sigma^2 / (a*sigma^2 + 1-a) print("\n [B1] 各通道对训练 loss 的贡献(最优线性-高斯去噪器的残差)") print(" %-10s %-12s %-12s %-12s" % ("alpha_bar", "未缩放 top1 占比", "全局缩放后", "逐通道缩放后")) for abar in (0.9, 0.5, 0.1): raw = abar * sig ** 2 / (abar * sig ** 2 + 1.0 - abar) sg = sig / gstd gsc = abar * sg ** 2 / (abar * sg ** 2 + 1.0 - abar) pc = np.ones_like(sig) psc = abar * pc ** 2 / (abar * pc ** 2 + 1.0 - abar) print(" %-10s %-12s %-12s %-12s" % ("%.2f" % abar, "%.2f%%" % (100 * raw.max() / raw.sum()), "%.2f%%" % (100 * gsc.max() / gsc.sum()), "%.2f%%" % (100 * psc.max() / psc.sum()))) # [B2] scale factor 用错会怎样:等效时间步偏移 print("\n [B2] scale factor 用错 k 倍时,等效时间步偏移多少(cosine 调度,T=1000)") ts = np.arange(1, 1001, dtype=np.float64) ab = cosine_abar(ts) snr = ab / (1.0 - ab) # 单调递减 print(" %-10s %-16s %-16s %-12s" % ("k", "参考 t=500", "等效 t'", "偏移")) rows = [] for k in (0.25, 0.5, 1.0, 2.0, 4.0): # k 倍缩放 -> 潜特征整体方差变 k^2 倍 -> 有效信噪比变 k^2 倍 target = (k ** 2) * snr[499] tp = float(np.interp(-target, -snr, ts)) # -snr 单调递增,可以插值 rows.append((k, tp, tp - 500.0)) print(" %-10s %-16s %-16s %-12s" % ("%.2fx" % k, "500", "%.1f" % tp, "%+.1f 步" % (tp - 500.0))) return sig, gstd, rows # ───────────────────────────────────────────────────────────────────────── # C. 交叉注意力 # ───────────────────────────────────────────────────────────────────────── def softmax(x: np.ndarray, axis=-1) -> np.ndarray: e = np.exp(x - x.max(axis=axis, keepdims=True)) return e / e.sum(axis=axis, keepdims=True) def part_c(rng: np.random.Generator, d: int = 320, side: int = 64, ctx_len: int = 77, n_content: int = 8): print("\n[C] 交叉注意力:形状、秩瓶颈、padding 抢走的质量") n_img = side * side # Q 来自图像 token,K/V 来自文本 token q = rng.standard_normal((n_img, d)) / math.sqrt(d) k_txt = rng.standard_normal((ctx_len, d)) / math.sqrt(d) v_txt = rng.standard_normal((ctx_len, d)) / math.sqrt(d) scale = 1.0 / math.sqrt(d) a = softmax((q @ k_txt.T) * scale, axis=-1) out = a @ v_txt print(" Q [%d, %d] x K^T [%d, %d] -> 注意力 [%d, %d] -> 输出 [%d, %d]" % (q.shape[0], q.shape[1], k_txt.shape[1], k_txt.shape[0], a.shape[0], a.shape[1], out.shape[0], out.shape[1])) print(" 注意力矩阵固定为 %d 列(文本 token 数),行数等于图像token数" % ctx_len) # 秩瓶颈:输出一定落在 v_txt 张成的子空间里 sv = np.linalg.svd(out, compute_uv=False) rank = int(np.sum(sv > sv[0] * 1e-8)) print(" cross-attn 输出的秩 = %d(<= 文本 token 数 %d,图像 token 有 %d 个)" % (rank, ctx_len, n_img)) # 对照:self-attn 的 K/V 也来自图像 token,秩可以撑满 k_img = rng.standard_normal((n_img, d)) / math.sqrt(d) v_img = rng.standard_normal((n_img, d)) / math.sqrt(d) out_self = softmax((q @ k_img.T) * scale, axis=-1) @ v_img sv2 = np.linalg.svd(out_self, compute_uv=False) rank2 = int(np.sum(sv2 > sv2[0] * 1e-8)) print(" 对照:self-attn 输出的秩 = %d(K/V 也来自 %d 个图像 token)" % (rank2, n_img)) print(" 该秩界仅约束本次单头矩阵乘积,不约束多头、残差及整个UNet") # 合成演示:设置69个相同logit位置;不模拟真实CLIP上下文化的padding特征 print("\n [C2] 人工分组logit的概率质量(随机组 %d 个 + 零logit组 %d 个)" % (n_content, ctx_len - n_content)) print(" %-20s %-22s %-22s" % ("内容 token 分数优势", "padding 组质量占比", "内容 token 质量占比")) rows = [] n_pad = ctx_len - n_content n_query = 40000 for delta in (0.0, 1.0, 2.0, 3.0, 5.0, 8.0): # 此处人为设相同 logit,真实 CLIP 特征受位置和上下文影响; # 内容 token 的 logit 建模为 padding 基准 + delta + N(0,1) 的波动 s_c = delta + rng.standard_normal((n_query, n_content)) s_p = np.zeros((n_query, 1)) logits = np.concatenate([s_c, np.repeat(s_p, n_pad, axis=1)], axis=1) w = softmax(logits, axis=-1) pad_share = float(w[:, n_content:].sum(axis=1).mean()) rows.append((delta, pad_share)) print(" %-20s %-22s %-22s" % ("+%.1f" % delta, "%.2f%%" % (100 * pad_share), "%.2f%%" % (100 * (1 - pad_share)))) return rows def main(): ap = argparse.ArgumentParser() ap.add_argument("--image", default=DEFAULT_IMAGE) ap.add_argument("--size", type=int, default=512) args = ap.parse_args() rng = np.random.default_rng(SEED) img = load_image(args.image, args.size) print("=" * 78) print("潜空间扩散实验 图像=%s 裁剪后 %dx%d 像素值域 [-1, 1]" % (os.path.basename(args.image), args.size, args.size)) print("图像本身的标准差 = %.4f" % img.std()) print("=" * 78) part_a(img) sweep_c(img, f=8) part_b(img, f=8, c_keep=8) part_c(rng) # 顺便给一张「整图 DCT 能量谱」的斜率,说明高频有多穷 print("\n[D] 输入样例的块DCT能量集中度(按能量排序,不按频率半径分桶)") b = block_basis(8) patches = to_blocks(img, 8) coef = patches @ b.T energy = np.mean(coef ** 2, axis=0) order = np.argsort(energy)[::-1] tot = energy.sum() for frac in (0.01, 0.02, 0.05, 0.1, 0.25): n = max(1, int(round(frac * energy.size))) print(" 能量最大的 %.0f%% 系数(%d 个)携带 %.4f%% 的总能量" % (100 * frac, n, 100 * energy[order[:n]].sum() / tot)) if __name__ == "__main__": main() ldm_checks.py """Independent checks for the article's algebra and NumPy examples; no weights.""" import hashlib import json from pathlib import Path import numpy as np from latent_lab import (block_basis, cosine_abar, encode_decode, from_blocks, psnr, softmax, to_blocks) from unet_ledger import build_unet, fmt_bytes def main(): rng = np.random.default_rng(20261025) errors = {} for f in (1, 2, 4, 8): b = block_basis(f) errors[f'orthogonal_{f}'] = float(np.max(np.abs(b@b.T-np.eye(len(b))))) x = rng.uniform(-1, 1, (16, 24, 3)) patches = to_blocks(x, f) errors[f'blocks_{f}'] = float(np.max(np.abs(from_blocks(patches,16,24,f)-x))) coef = patches@b.T errors[f'parseval_{f}'] = float(abs(np.sum(coef**2)/np.sum(x**2)-1)) _, rec, energy = encode_decode(x, f, 3*f*f) errors[f'full_reconstruction_{f}'] = float(np.max(np.abs(rec-x))) assert abs(energy-1) < 1e-14 c = max(1, f) keep = np.argsort(np.mean(coef**2,axis=0))[-c:] projected = coef[:,keep]@b[keep] removed = np.delete(coef,keep,axis=1) errors[f'projection_error_{f}'] = float(abs(np.sum((patches-projected)**2)-np.sum(removed**2))/max(1,np.sum(patches**2))) assert max(errors.values()) < 1e-12 _, zero, frac = encode_decode(np.zeros((8,8,3)),8,4) assert frac==1 and np.isinf(psnr(zero,zero)) rejected=0 for x,f,c in [(np.zeros((8,8,3)),0,4),(np.zeros((9,8,3)),8,4), (np.zeros((8,8,1)),8,4),(np.full((8,8,3),np.nan),8,4), (np.zeros((8,8,3)),8,0),(np.zeros((8,8,3)),8,193)]: try: encode_decode(x,f,c) except ValueError: rejected+=1 assert rejected==6 assert cosine_abar(np.array([0.]))[0]==1 ts=np.arange(1,1001,dtype=float);a=cosine_abar(ts);snr=a/(1-a) shifts=[] for k in (.25,.5,1.,2.,4.): target=k*k*snr[499];tp=float(np.interp(-target,-snr,ts)) f0=np.cos(.008/1.008*np.pi/2)**2 exact=1000*(1.008*2/np.pi*np.arccos(np.sqrt(target/(1+target)*f0))-.008) assert abs(tp-exact)<.01 shifts.append(dict(k=k,t=tp,shift=tp-500,continuous_t=float(exact))) # Conditional Gaussian epsilon mean derived from covariance, then Monte Carlo. gaussian=[] for a,sigma,mu in [(.1,.5,2.),(.5,2.,-1.),(.9,8.,.3)]: n=400000;z=mu+sigma*rng.standard_normal(n);eps=rng.standard_normal(n) y=np.sqrt(a)*z+np.sqrt(1-a)*eps var=a*sigma*sigma+1-a pred=np.sqrt(1-a)/var*(y-np.sqrt(a)*mu) residual=(eps-pred)**2;theory=a*sigma*sigma/var se=float(residual.std(ddof=1)/np.sqrt(n)) assert abs(residual.mean()-theory)<6*se gaussian.append(dict(alpha=a,sigma=sigma,expected=theory,observed=float(residual.mean()),standard_error=se)) # Direct row-wise computation, equivariance and a multihead/residual counterexample. q=rng.normal(size=(16,8));k=rng.normal(size=(7,8));v=rng.normal(size=(7,8)) out=softmax(q@k.T/np.sqrt(8))@v direct=np.empty_like(out) for i,row in enumerate(q): scores=np.exp(k@row/np.sqrt(8)-np.max(k@row/np.sqrt(8))) direct[i]=np.sum(scores[:,None]*v,axis=0)/sum(scores) errors['attention_rows']=float(np.max(np.abs(direct-out))) perm=rng.permutation(7) errors['text_permutation']=float(np.max(np.abs(softmax(q@k[perm].T/np.sqrt(8))@v[perm]-out))) assert max(errors.values())<1e-12 and np.linalg.matrix_rank(out)<=7 head1=np.array([[1.,0],[0,1],[1,0],[0,1]]) head2=np.array([[1.,0],[1,0],[0,1],[0,1]]) concatenated=np.concatenate([head1,head2],axis=1) assert np.linalg.matrix_rank(concatenated)==3>2 assert np.linalg.matrix_rank(head1@np.ones((2,4))+np.eye(4))==4 equal_mass=float(softmax(np.zeros(77))[8:].sum()) assert abs(equal_mass-69/77)<1e-14 lat=build_unet(64,64,4,4);pix=build_unet(512,512,3,3) deep=build_unet(512,512,3,3,down_attn=(3,),up_attn=(3,)) assert fmt_bytes(2**40)=='1.00 TiB' and fmt_bytes(2**28)=='256.00 MiB' ledger=dict(parameters=int(lat.params),latent_mac=lat.macs,pixel_mac=pix.macs,deep_mac=deep.macs, same_topology_ratio=pix.macs/lat.macs,deep_ratio=deep.macs/lat.macs, conv_ratio=pix.kinds['conv']/lat.kinds['conv'],latent_cumulative_bytes=lat.act, deep_cumulative_bytes=deep.act,parts={k:v/lat.macs for k,v in lat.kinds.items()}) for dims in [(0,0,4,4),(7,7,4,4),(8,8,0,4)]: try: build_unet(*dims) except ValueError: continue raise AssertionError(dims) result=dict(passed=True,errors=[],warnings=[],max_errors=errors,invalid_images_rejected=rejected, gaussian=gaussian,scale_shifts=shifts,equal_logit_group_mass=equal_mass, multihead_rank=int(np.linalg.matrix_rank(concatenated)),ledger=ledger, source_hashes={p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in Path(__file__).parent.glob('*.py')}) dest=Path(__file__).with_name('validation_results.json') dest.write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8') print(json.dumps(result,ensure_ascii=False,indent=2)) if __name__=='__main__': main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """画四张配图,数据源全部来自 unet_ledger.py / latent_lab.py 的真实输出。 改了那两个脚本之后必须重跑本脚本,否则图上的数字会和正文对不上。 用法: python make_figures.py """ from __future__ import annotations import math import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image from latent_lab import (block_basis, cosine_abar, encode_decode, load_image, psnr, softmax, to_blocks, DEFAULT_IMAGE) from unet_ledger import build_unet, fmt_bytes HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["font.size"] = 10.5 C_MAIN = "#2E5C8A" C_GREEN = "#2E8B57" C_RED = "#C0392B" C_PURPLE = "#7B4B94" C_GRAY = "#8A8A8A" C_ALT = "#D68910" def _save(fig, name): os.makedirs(FIGDIR, exist_ok=True) p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=130, bbox_inches="tight", facecolor="white") plt.close(fig) print(" %s" % name) # ───────────────────────────────────────────────────────────────────────── # 图 1:算力 / 显存账本 # ───────────────────────────────────────────────────────────────────────── def fig_ledger(): sides = [256, 384, 512, 768, 1024, 2048] lat = [build_unet(s // 8, s // 8, 4, 4, name="l%d" % s) for s in sides] pix = [build_unet(s, s, 3, 3, name="p%d" % s) for s in sides] pixd = [build_unet(s, s, 3, 3, name="d%d" % s, down_attn=(3,), up_attn=(3,)) for s in sides] fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) MAC 随分辨率的缩放(log-log) ax = axes[0] ax.plot(sides, [p.macs for p in pix], "o-", color=C_RED, lw=2.2, ms=6, label=r"像素空间 UNet(attention 位置同 SD)") ax.plot(sides, [p.macs for p in pixd], "s--", color=C_ALT, lw=2.0, ms=6, label=r"像素空间 UNet(attention 只放最深层)") ax.plot(sides, [l.macs for l in lat], "^-", color=C_MAIN, lw=2.2, ms=6, label=r"潜空间 UNet($f$=8)") ax.set_yscale("log") ax.set_xscale("log") ax.set_xticks(sides) ax.set_xticklabels([str(s) for s in sides]) ax.xaxis.set_minor_formatter(plt.NullFormatter()) ax.set_xlabel("输出图像边长(像素)") ax.set_ylabel(r"单步前向的乘加次数(MAC)") def _slope(vals): lx = [math.log(s) for s in sides] ly = [math.log(v) for v in vals] n = len(lx) mx, my = sum(lx) / n, sum(ly) / n return (sum((a - mx) * (b - my) for a, b in zip(lx, ly)) / sum((a - mx) ** 2 for a in lx)) ax.set_title("(a) 算力:缩放指数从 %.1f 压到 %.1f" % (_slope([p.macs for p in pix]), _slope([l.macs for l in lat])), fontsize=11.5) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) # 标注 512 处的比值 i = sides.index(512) ax.annotate(r"512 px 处相差 %.0f 倍" % (pix[i].macs / lat[i].macs), xy=(512, pix[i].macs), xytext=(650, 3e14), fontsize=9, color=C_RED, arrowprops=dict(arrowstyle="->", color=C_RED, lw=1.2)) # (b) 激活显存账本的构成 ax = axes[1] labels = ["潜空间 64x64x4", "像素空间 512x512x3\n(attention 放最深层)", "像素空间 512x512x3\n(attention 位置同 SD)"] attn = [lat[i].attn_matrix, pixd[i].attn_matrix, pix[i].attn_matrix] rest = [lat[i].act - lat[i].attn_matrix, pixd[i].act - pixd[i].attn_matrix, pix[i].act - pix[i].attn_matrix] x = np.arange(3) ax.bar(x, attn, 0.55, color=C_RED, label=r"注意力矩阵(softmax 那张表)") ax.bar(x, rest, 0.55, bottom=attn, color=C_MAIN, label=r"其余层间激活") ax.set_yscale("log") ax.set_ylim(1e8, 2e14) ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9) ax.set_ylabel(r"朴素张量逐层累计(非实测峰值)(字节,$\log$ 刻度)") ax.set_title("(b) 静态累计:融合注意力会改变矩阵项", fontsize=11.5) for xi, a, r in zip(x, attn, rest): ax.text(xi, a + r, " %s" % fmt_bytes(a + r), ha="center", va="bottom", fontsize=9) ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") fig.tight_layout() _save(fig, "fig_ledger.png") print(" 潜/像 MAC 比 %.1f;卷积部分比 %.1f" % (pix[i].macs / lat[i].macs, pix[i].kinds["conv"] / lat[i].kinds["conv"])) # ───────────────────────────────────────────────────────────────────────── # 图 2:压缩率的帕累托前沿 + 能量集中度 # ───────────────────────────────────────────────────────────────────────── def fig_compression(): img = load_image(DEFAULT_IMAGE, 512) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 压缩率 vs PSNR ax = axes[0] for f, col, mk in ((2, C_GREEN, "o"), (4, C_MAIN, "s"), (8, C_RED, "^"), (16, C_PURPLE, "D")): cs = [c for c in (3, 4, 8, 16, 32, 64) if c <= 3 * f * f] rs, ps = [], [] for c in cs: _, rec, _ = encode_decode(img, f, c) rs.append(3.0 * f * f / c) ps.append(psnr(img, rec)) ax.plot(rs, ps, "-%s" % mk, color=col, lw=2.0, ms=5, label=r"$f$=%d" % f) _, rec4, frac4 = encode_decode(img, 8, 4) ax.plot([48.0], [psnr(img, rec4)], "*", color=C_ALT, ms=20, markeredgecolor="black", markeredgewidth=0.8, label=r"DCT 替身的尺寸:$f$=8, $C$=4") ax.set_xscale("log") ax.set_xlabel(r"张量元素数比 $= 3 f^2 / C$(对数刻度)") ax.set_ylabel(r"重建 PSNR(dB,值域 $[-1,1]$)") ax.set_title("(a) 单图 DCT 压缩实验", fontsize=11.5) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax.annotate(r"元素数比48,本样例重建 %.2f dB" % psnr(img, rec4), xy=(48.0, psnr(img, rec4)), xytext=(12, 34), fontsize=9, color=C_ALT, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) # (b) 能量集中度 ax = axes[1] b = block_basis(8) coef = to_blocks(img, 8) @ b.T energy = np.mean(coef ** 2, axis=0) order = np.argsort(energy)[::-1] tot = energy.sum() ks = np.arange(1, energy.size + 1) cum = np.cumsum(energy[order]) / tot ax.plot(100.0 * ks / energy.size, 100.0 * cum, "-", color=C_MAIN, lw=2.4) ax.axvline(100.0 * 4 / 192, color=C_RED, ls="--", lw=1.6) ax.axhline(100 * cum[3], color=C_GRAY, ls=":", lw=1.2) ax.plot([100.0 * 4 / 192], [100 * cum[3]], "o", color=C_RED, ms=8) ax.annotate(r"保留 %.2f%% 的系数" % (100.0 * 4 / 192) + "\n" + r"拿回 %.2f%% 的能量" % (100 * cum[3]), xy=(100.0 * 4 / 192, 100 * cum[3]), xytext=(14, 88), fontsize=9.5, color=C_RED, arrowprops=dict(arrowstyle="->", color=C_RED, lw=1.2)) ax.set_xlabel(r"保留的系数比例(按能量从大到小,%)") ax.set_ylabel(r"累计能量占比(%)") ax.set_title("(b) 样例图在该基底下的能量集中度", fontsize=11.5) ax.grid(alpha=0.25) ax.set_ylim(80, 100.2) fig.tight_layout() _save(fig, "fig_compression.png") print(" f=8,C=4: PSNR %.2f dB,保留能量 %.4f%%" % (psnr(img, rec4), 100 * frac4)) # ───────────────────────────────────────────────────────────────────────── # 图 3:通道方差跨度与 loss 份额 # ───────────────────────────────────────────────────────────────────────── def fig_latent_scale(): img = load_image(DEFAULT_IMAGE, 512) lat, _, _ = encode_decode(img, 8, 8) sig = lat.reshape(-1, 8).std(axis=0) order = np.argsort(sig)[::-1] sig = sig[order] gstd = float(np.sqrt(np.mean(sig ** 2))) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 各通道 std ax = axes[0] x = np.arange(8) ax.bar(x, sig, 0.6, color=C_MAIN) ax.axhline(gstd, color=C_ALT, ls="--", lw=1.8, label=r"通道方差 RMS 尺度 $=%.4f$,其倒数 $=%.4f$" % (gstd, 1.0 / gstd)) ax.set_yscale("log") ax.set_xticks(x) ax.set_xticklabels([r"通道 %d" % (i + 1) for i in range(8)], fontsize=9) ax.set_ylabel(r"该通道在整张图上取值的标准差($\log$ 刻度)") ax.set_title("(a) DCT通道标准差跨度 %.1f 倍" % (sig.max() / sig.min()), fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") # (b) loss 份额 ax = axes[1] for abar, col, mk in ((0.9, C_GREEN, "o"), (0.5, C_MAIN, "s"), (0.1, C_RED, "^")): raw = abar * sig ** 2 / (abar * sig ** 2 + 1.0 - abar) share = 100.0 * raw / raw.sum() ax.plot(x, share, "-%s" % mk, color=col, lw=2.0, ms=5, label=r"$\bar\alpha_t=%.2f$" % abar) ax.axhline(12.5, color=C_GRAY, ls="--", lw=1.5, label=r"逐通道缩放后(均摊 $=100/8$)") ax.set_xticks(x) ax.set_xticklabels([r"通道 %d" % (i + 1) for i in range(8)], fontsize=9) ax.set_xlabel("潜特征通道(按 std 从大到小排)") ax.set_ylabel(r"高斯替身的最优残差份额(%)") ax.set_title("(b) 仅用实测方差构造独立高斯替身", fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25) fig.tight_layout() _save(fig, "fig_latent_scale.png") # 顺带画出 scale factor 用错的时间步偏移 ts = np.arange(1, 1001, dtype=np.float64) snr = cosine_abar(ts) / (1.0 - cosine_abar(ts)) ks = np.array([0.25, 0.5, 1.0, 2.0, 4.0]) tps = [] for k in ks: tps.append(float(np.interp(-(k ** 2) * snr[499], -snr, ts))) tps = np.array(tps) fig2, ax2 = plt.subplots(figsize=(6.6, 4.2)) ax2.plot(ks, tps, "o-", color=C_PURPLE, lw=2.2, ms=7) for k, t in zip(ks, tps): ax2.annotate(r"$t^\prime$=%.0f" % t, (k, t), textcoords="offset points", xytext=(8, -4), fontsize=9) ax2.axhline(500, color=C_GRAY, ls=":", lw=1.2) ax2.axvline(1.0, color=C_GRAY, ls=":", lw=1.2) ax2.set_xscale("log") ax2.set_xticks(list(ks)) ax2.set_xticklabels([r"%.2f$\times$" % k for k in ks]) ax2.set_xlabel(r"scale factor 用错的倍数 $k$") ax2.set_ylabel(r"等效时间步 $t^\prime$(参考 $t=500$)") ax2.set_title(r"scale factor 错 $k$ 倍,改变参考时刻的等效 SNR", fontsize=11.5) ax2.grid(alpha=0.25) fig2.tight_layout() _save(fig2, "fig_scale_shift.png") # ───────────────────────────────────────────────────────────────────────── # 图 4:交叉注意力 # ───────────────────────────────────────────────────────────────────────── def fig_cross_attn(): sides = [32, 48, 64, 96, 128, 192, 256] cross, selfa, conv = [], [], [] for s in sides: L = build_unet(s, s, 4, 4, name="c%d" % s) cross.append(100.0 * L.kinds["cross_attn"] / L.macs) selfa.append(100.0 * L.kinds["self_attn"] / L.macs) conv.append(100.0 * L.kinds["conv"] / L.macs) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 三种算子的占比随分辨率变化 ax = axes[0] ax.plot(sides, cross, "o-", color=C_GREEN, lw=2.2, ms=6, label=r"cross-attn($O(N \cdot T \cdot d)$)") ax.plot(sides, selfa, "s-", color=C_RED, lw=2.2, ms=6, label=r"self-attn($O(N^2 \cdot d)$)") ax.plot(sides, conv, "^-", color=C_MAIN, lw=2.0, ms=6, label=r"卷积($O(N \cdot k^2 c^2)$)") ax.set_xlabel(r"潜特征边长($N=$ 边长的平方个 token)") ax.set_ylabel(r"占单步 MAC 的比例(%)") ax.set_title("(a) 交叉注意力的份额随分辨率反而下降", fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25) ax.annotate(r"64x64 时只占 %.2f%%" % cross[2], xy=(64, cross[2]), xytext=(75, 8), fontsize=9.5, color=C_GREEN, arrowprops=dict(arrowstyle="->", color=C_GREEN, lw=1.2)) # (b) padding 抢走的注意力质量 ax = axes[1] rng = np.random.default_rng(20260929) n_content, n_pad, n_query = 8, 69, 40000 deltas = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 5.0, 6.0, 8.0]) shares = [] for d in deltas: s_c = d + rng.standard_normal((n_query, n_content)) s_p = np.zeros((n_query, 1)) logits = np.concatenate([s_c, np.repeat(s_p, n_pad, axis=1)], axis=1) w = softmax(logits, axis=-1) shares.append(100.0 * float(w[:, n_content:].sum(axis=1).mean())) shares = np.array(shares) ax.plot(deltas, shares, "o-", color=C_PURPLE, lw=2.4, ms=6) ax.axhline(50, color=C_GRAY, ls=":", lw=1.2) i5 = int(np.argmin(np.abs(deltas - 5.0))) ax.plot([deltas[i5]], [shares[i5]], "*", color=C_ALT, ms=18, markeredgecolor="black", markeredgewidth=0.8) ax.annotate(r"设 $\Delta=%.1f$ 时零logit组约占 %.1f%%" % (deltas[i5], shares[i5]), xy=(deltas[i5], shares[i5]), xytext=(0.6, 70), fontsize=9.5, color=C_ALT, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax.set_xlabel(r"另8个随机logit的分布均值 $\Delta$(标准差1)") ax.set_ylabel(r"69个零logit位置分到的概率质量(%)") ax.set_title(r"(b) 人工分组logit实验,非CLIP测量", fontsize=11.5) ax.grid(alpha=0.25) ax.set_ylim(-2, 102) fig.tight_layout() _save(fig, "fig_cross_attn.png") print(" cross-attn 占比:64x64 %.2f%% -> 256x256 %.2f%%" % (cross[2], cross[-1])) def main(): print("画配图(数据源:unet_ledger.py / latent_lab.py 的真实输出)") fig_ledger() fig_compression() fig_latent_scale() fig_cross_attn() print("输出目录:%s" % os.path.abspath(FIGDIR)) if __name__ == "__main__": main()
-
AIGC 基本功|流匹配与 Rectified Flow-FlowMatching AIGC 基本功|流匹配与 Rectified Flow-FlowMatching 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练与采样、扩散过程与 score 关键词:流匹配、flow matching、rectified flow、速度场、直线路径、reflow、NFE 01. 为什么需要它 先给三个数字,全部来自文末附录里能直接跑的脚本。 数字一:换个回归目标,预测误差幅度系数差 100 倍,对应平方损失权重差 10000 倍。 把「干净图估计」上的误差记为 $\delta$,在 $t=0.99$(几乎纯噪声)这一时刻:如果模型输出的是噪声 $\epsilon$,loss 看到的误差是 $0.0101\,\delta$;如果输出的是速度 $v$,loss 看到的是 $1.0101\,\delta$。在固定干净图误差的比较下,速度目标给予高噪声端更大的相对权重。 这是速度参数化与噪声参数化的一个权重差异;采用何种目标还取决于路径、预条件、训练时间分布与架构,不能把所有模型选择归因为这一个系数(03 节推导,图 1 画出整条曲线)。 数字二:「直线路径」的 ODE 轨迹一点都不直。 Rectified Flow 最常被转述成"路径是直的,所以快"。实测:把二维八模高斯混合推到数据端,用附录 reflow_lab.py 的 10 万个起点、64 步 RK2(128 NFE)轨迹账本,精确场的弧长/弦长均值为 1.6499(图 2 另用 300 步 RK4 示意)——轨迹比两点连线多走了 65% 的路。训练时那条 $(1-t)x+t\epsilon$ 插值线确实是直线,但模型实际采样走的是边缘速度场的积分曲线,两者不是一回事(02 节的图 2 把这件事画出来了)。 数字三:reflow 一轮,2 步采样的误差降 11.1 倍。 用第 1 轮训好的模型把噪声推到数据端、拿得到的配对重训一轮,配对插值上的归一化回归残差 $S_{pair}$ 从 $0.6229$ 掉到 $0.0027$(前者用精确场,后者用训练模型;对应不同耦合,也包含学习误差,不能据此声称不可约误差降低 231 倍),NFE=2 的终点偏差从 $0.04469$ 降到 $0.00402$,已经低于方差保持路径 2 步的 $0.0105$。但高 NFE 下的终点偏差没有因此继续下降:生成质量仍受教师分布、重训误差和有限样本评估影响,06 节展开。 所以这篇文章要回答三个问题:流匹配到底在训练什么、它和 DDPM 是不是两个东西、以及"直线路径"这个卖点真实兑现了多少。 02. 最小可用理解 三句话讲完: 流匹配训练的是一个速度场,不是噪声。 采样是解一条 ODE:从噪声端 $t=1$ 出发,跟着 $v_\theta$ 走到数据端 $t=0$。训练只是回归:给定当前点 $z_t$,预测条件速度 $u_t$;在线性 Rectified Flow 路径上,它就是这一对端点的相对位移。最优解是条件期望 $E[u_t \mid z_t = z]$,而由连续性方程,在可积性、正则性及解唯一性成立、场学习与积分均精确时(03 节证),这个期望场把 $p_1$ 运到 $p_0$——所以不需要知道任何密度,样本对就够。 高斯路径提供了统一描述,但不同路径不等于同一个模型。 把路径统一写成 $z_t=\alpha_t x+\sigma_t\epsilon$:DDPM 的单时刻加噪边缘可对应 $\alpha_t=\sqrt{\bar\alpha_t}$、$\sigma_t=\sqrt{1-\bar\alpha_t}$;这里需将离散噪声表连续化,Rectified Flow 取 $\alpha_t=1-t$、$\sigma_t=t$。两者可以使用相同的网络架构。三种预测目标(干净图 $x$、噪声 $\epsilon$、速度 $v$)在同一条已知路径及非退化时间内可以代数换算输出(无需重训网络);不同路径的模型不能仅换公式就变成彼此,04 节把换算残差验到 $10^{-15}$。 "直"的是训练插值线,不是采样轨迹。 在本文独立配对的平滑数据分布上,线性路径边缘场满足 $v(z,0)=-z$、$v(z,1)=z-\mu$,其中 $\mu=E[x]$。采样从 1 积分到 0,时间步为负,因此噪声端先朝数据均值走,数据端局部向外走;中间还有模式分流。实际积分轨迹可以弯曲,reflow 用模型生成的端点配对重训,可在理想条件下改善速度沿轨迹的恒定程度。本文以下采用数据 $t=0$、噪声 $t=1$;RF 原论文常用噪声到数据的正向时间。令 $s=1-t$ 后,速度也要变号,不能只倒置时间标签。 这张图要看什么:在这 14 个共同起点上,左图(直线路径)出现明显回转,右图(VP 余弦路径)较平缓。灰点是 8 个数据模式,蓝圆是噪声起点,绿方是生成终点。两图使用相同的精确场计算方式和 300 步 RK4,只改变路径;其形状是本分布上的实验结果。VP 数据端速度为零,但由于数据均值不为零,噪声端速度并不为零,见 3.4 节。 03. 数学推导 3.1 高斯路径与条件速度 把常见高斯插值类扩散/流方法统一成一条路径。取数据样本 $x\sim p_{\text{data}}$、独立噪声 $\epsilon\sim N(0,I)$,令 $$z_t=\alpha_t x+\sigma_t\epsilon,\qquad t\in[0,1]$$ 约定 $t=0$ 是数据端、$t=1$ 是噪声端,即 $\alpha_0=1,\sigma_0=0$、$\alpha_1=0,\sigma_1=1$。各符号的含义:$\alpha_t$ 是数据分量的幅度,$\sigma_t$ 是噪声分量的幅度,两者是标量函数,选不同的曲线就得到不同的方法: 方法 $\alpha_t$ $\sigma_t$ 备注 VP / DDPM $\sqrt{\bar\alpha_t}$ $\sqrt{1-\bar\alpha_t}$ 满足 $\alpha_t^2+\sigma_t^2=1$,当数据协方差也为单位阵时保持单位方差;一般数据协方差仍随 t 改变 Rectified Flow $1-t$ $t$ 线性插值,中间分布方差会缩水(06 节) 对固定的一对 $(x,\epsilon)$,$z_t$ 是一条确定的曲线,它对时间的导数是 $$u_t=\dot\alpha_t x+\dot\sigma_t\epsilon$$ 每个符号:$\dot\alpha_t$、$\dot\sigma_t$ 是两条幅度曲线的导数;$u_t$ 叫条件速度——它说的是"这一对端点对应的粒子此刻在往哪走"。直线路径下 $\dot\alpha_t=-1$、$\dot\sigma_t=1$,所以 $u_t=\epsilon-x$,与 $t$ 无关:整条插值线是匀速直线。这就是"直线"的全部含义,它只说了这条以 $(x,\epsilon)$ 为参数的曲线,没说采样时走的那条。 这里的“高斯”指给定数据后的加噪分布。单时刻边缘并不指定随机过程的联合分布:固定一份 $\epsilon$ 画出的插值曲线,与 DDPM 每步注入新噪声的马尔可夫链可以有相应的单时刻边缘,却有不同的路径联合分布与采样器。本文积分的是确定性 ODE;不能把它称为原 DDPM 逆链的逐路径复现。有限 DDPM 噪声表的最后时刻一般也只是接近标准高斯;本文的纯噪声端是连续路径的理想端点。 后文 reflow 改变端点耦合(coupling,即两个端点的联合分布),不改变线性插值公式。3.2 节的条件期望证明允许相关端点;本节的独立高斯条件式、4.1 节的 GMM 精确场以及 3.4 节独立配对的端点公式,只用于第 1 轮。第 2 轮端点由教师相关配对,不能继续套用同一 GMM 闭式。 3.2 边缘速度场:为什么样本对就够训练 采样时我们手里没有那对 $(x,\epsilon)$,只有 $z_t$。所以要用的是边缘速度场: $$v^{\star}(z,t)=E\left[u_t \mid z_t=z\right]$$ 读法:在所有"此刻恰好经过 $z$ 的粒子对"里,平均下来往哪走。要证它是"对的场",也就是用它解 ODE 确实把 $p_1$ 运到 $p_0$。对任意光滑测试函数 $\phi$,沿条件路径求导再取期望: $$\frac{d}{dt}E\left[\phi(z_t)\right]=E\left[\nabla\phi(z_t)\cdot u_t\right]=E\left[\nabla\phi(z_t)\cdot E[u_t\mid z_t]\right]=\int \nabla\phi(z)\cdot v^{\star}(z,t)\,p_t(z)\,dz$$ 第二步是把里层的条件期望提出来(塔性质)。最后那个积分正是连续性方程 $\partial_t p_t+\nabla\cdot(v^{\star}p_t)=0$ 的弱形式,在速度场和密度满足适当正则性、相应 ODE 与连续性方程有唯一解的条件下,$v^{\star}$ 生成的流在每个时刻匹配既定的 $p_t$,从 $p_1$ 走到 $p_0$。这里 $p_t$ 本身随时间变化,并不是保持某个固定分布不变。这一步就是"marginalization trick":条件场逐对可得,边缘场取个条件期望就行。 于是在线性路径下,训练目标可以完全绕开密度(一般路径把目标换成 $u_t$): $$\min_\theta\;E_{t,x,\epsilon}\left\|v_\theta(z_t,t)-(\epsilon-x)\right\|^2$$ 这里 $t$ 在训练时按指定密度采样,本文 toy 使用均匀分布;$E$ 表示对时间和端点配对取期望。对每个有正训练密度的 $t$,平方回归的逐点最优解是 $v^{\star}(z,t)$;改变时间采样而不补重要性权重,会改变有限容量模型的误差分配。没有任何一项需要 $p_t$ 的表达式——这是流匹配在工程上能起飞的根本原因:它把"学分布"变成了"学一个回归"。 3.3 同一路径的三种预测输出如何换算 设 $m(z,t)=E[x\mid z_t=z]$(干净图估计)、$e(z,t)=E[\epsilon\mid z_t=z]$(噪声估计)。对 $z_t=\alpha_t x+\sigma_t\epsilon$ 两边取条件期望(条件期望是线性的,$z_t$ 在条件下是常数): $$z=\alpha_t m+\sigma_t e$$ 这是贯穿全文的恒等式,$\alpha m+\sigma e=z$。再配合速度的定义 $v=\dot\alpha_t m+\dot\sigma_t e$,两个方程、两个未知数,解出 $$m=\frac{\sigma_t v-\dot\sigma_t z}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t},\qquad e=\frac{\dot\alpha_t z-\alpha_t v}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t}$$ 分母 $\Delta_t=\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t$ 是个行列式;一般路径必须满足 $\Delta_t\ne0$ 才能从 $(z,v)$ 唯一恢复两个估计。若数据与噪声幅度以同一比例变化,两行方程相关,换算就不可逆。直线路径下它恒等于 $-1$($(-1)\cdot t-1\cdot(1-t)=-1$),于是换算干净得没有任何除法: 已知 求 $m$(干净图) 求 $e$(噪声) 速度 $v$ $m=z-t\,v$ $e=z+(1-t)\,v$ 噪声 $\epsilon$ $m=(z-t\,e)/(1-t)$ — 干净图 $m$ — $e=(z-(1-t)m)/t$ 第一行值得盯一眼:从速度换算到干净图和噪声都不需要除以 $\alpha$ 或 $\sigma$,而第二、三行各有一个会趋奇的除法。这说明线性路径下由速度到两个端点估计的系数有界;并不保证网络误差、训练梯度或完整采样算法都更稳定。该线性换算在端点仍有定义,但从噪声反推干净图要求 $1-t\ne0$,从干净图反推噪声要求 $t\ne0$。 那为什么不能说"三种参数化完全等价"? 真值层面等价(上表),loss 层面不等价。假设模型在 $m$ 上有误差 $\delta$,把它代入三种目标的误差: $$\text{x0 目标:}\ \|\delta\|,\qquad \text{噪声目标:}\ \frac{\alpha_t}{\sigma_t}\|\delta\|,\qquad \text{速度目标:}\ \left|\dot\alpha_t-\frac{\dot\sigma_t\alpha_t}{\sigma_t}\right|\|\delta\|$$ 来历:$e=(z-\alpha_t m)/\sigma_t$ 对 $m$ 求导得 $-\alpha_t/\sigma_t$;$v=\dot\alpha_t m+\dot\sigma_t e$ 对 $m$ 求导得 $\dot\alpha_t-\dot\sigma_t\alpha_t/\sigma_t$。直线路径代入,得到三条曲线 $$\text{x0:}1,\qquad \text{噪声:}\frac{1-t}{t},\qquad \text{速度:}\frac{1}{t}$$ 这张图要看什么:横轴是时间 $t$,纵轴是对数刻度的放大倍数。$t=0.99$(接近纯噪声端)噪声参数化的曲线是 $0.0101$——在高噪声端,噪声目标对"你把干净图猜错了"几乎无感,因为 $z$ 里本来就几乎没有 $x$ 的信息;而速度目标的系数是 $1.0101$;真正取 $t\to1$ 的极限时,二者分别趋于 0 和 1。反过来在 $t\to 0$(数据端)二者对固定干净图误差的换算系数都增大,速度系数比噪声系数加法上大 1;这不等于直接 velocity 训练的目标或梯度必然发散。这里能直接推出的是高噪声端对干净图估计误差的相对损失权重不同,不能单凭它保证真实网络的梯度大小或学习效率。 还可以把这条链接回先修中的 score。仅在独立高斯加噪、$\sigma_t>0$ 时,对加噪密度求空间导数给出 $\nabla\log p_t(z)=-e(z,t)/\sigma_t$。再在 $\alpha_t>0$ 时用 $m=(z-\sigma_t e)/\alpha_t$ 消元: $$v^{\star}(z,t)=\frac{\dot\alpha_t}{\alpha_t}z+\left(\frac{\dot\alpha_t}{\alpha_t}\sigma_t^2-\dot\sigma_t\sigma_t\right)\nabla\log p_t(z).$$ 这就是与同边缘扩散的概率流 ODE 对接的一种写法;在可构造相应扩散的条件下,它与随机反向采样共享边缘目标,轨迹不必相同。式中除法的非退化条件不能省略;直线路径的 $v=\epsilon-x$ 监督本身不需要计算 score,也不需要在退化端点执行这些除法。相关端点的 reflow 不具有上述独立加噪条件,不能直接照搬此 score 恒等式。原始推导讨论了概率路径、条件场与边缘场的关系。 3.4 直的是插值线,不是轨迹 先看端点行为。本文数据是平滑的高斯混合,数据与噪声独立;因此在数据端,$m(z,0)=z$、$e(z,0)=E[\epsilon\mid x=z]=0$;在噪声端,$m(z,1)=\mu=E[x]$、$e(z,1)=z$。这些关系来自端点的条件独立性,不能用 $(z-\alpha m)/\sigma$ 中的“分子趋零”来推断一个 $0/0$ 极限。 make_data 的 8 个分量权重与 $1+0.35\cos(\cdot)$ 成正比,并不均匀。精确加权均值为 $$\mu=(0.294464,\,-0.248024).$$ 线性路径 $\dot\alpha=-1,\dot\sigma=1$ 的端点速度是 $$v(z,0)=-z,\qquad v(z,1)=z-\mu.$$ 采样沿负时间方向积分,所以噪声端局部朝 $\mu$ 走,数据端局部沿 $z$ 向外走。中间的模式分流也会影响轨迹,端点公式本身不能决定全程弯曲程度;01 节的弧长比是实际积分测得的结果,不是由端点方向推出的普遍定理。 VP 余弦路径取 $\alpha=\cos(\pi t/2)$、$\sigma=\sin(\pi t/2)$,因此 $$v_{\rm VP}(z,0)=0,\qquad v_{\rm VP}(z,1)=-\frac{\pi}{2}\mu=(-0.462543,\,0.389595).$$ 只有数据均值为零时,这条 VP 路径的两个端点速度才都为零。本实验不满足该条件。 需要区分两个诊断量。本文脚本 straightness_of 实际计算的是原始端点配对插值上的归一化回归残差: $$S_{pair}=\frac{\int_0^1 E\|v((1-t)z_0+t z_1,t)-(z_1-z_0)\|^2dt}{E\|z_1-z_0\|^2}.$$ 当 $v=v^{\star}$ 时,分子是条件回归的不可约误差。下式的期望同时包含均匀时间与端点配对,并且 $S_{pair}$ 用 $v^{\star}$ 计算: $$E\|v_\theta-u\|^2=E\|v_\theta-v^{\star}\|^2+S_{pair}E\|z_1-z_0\|^2.$$ Rectified Flow 论文沿实际 ODE 轨迹 $Z_t$ 定义的 straightness 则比较 $v(Z_t,t)$ 与 $Z_1-Z_0$。这不是在独立原始配对插值线上评估,不能直接把本文 $S_{pair}$ 当成论文的同名量。本文另用实际积分轨迹的弧长/弦长检测几何变直,两个指标应分别报告。论文的零 straightness 要求速度沿轨迹恒定,比“几何上落在一条直线”更强:标量轨迹 $Z_t=t^2$ 的弧长/弦长是 1,但 $\int_0^1(2t-1)^2dt=1/3$;从 0 到 1 用一步 Euler 得到 0,精确终点却是 1。几何直线仍可能需要更好的时间参数化或积分格式。弧长的离散计算必须是 $\sum_j\|Z_{t_{j+1}}-Z_{t_j}\|_2$,不能先分别累加坐标上的绝对位移再取范数。 path_lab.py 另取 1500 个起点、400 步 RK4(1600 NFE):线性路径的平均弧长/弦长为 1.6232,VP 为 1.2915。沿实际轨迹的速度偏差再除以平均弦长平方,得到归一化 $S_{traj}$ 分别为 1.2293、0.5317。这与原始配对插值上的 $S_{pair}$ 不同。01 节的 1.6499 来自 reflow_lab.py 的另一批 10 万个起点和 64 步 RK2;样本与积分精度不同,诊断数值也会不同。 04. 代码实现 全部代码在文末附录,保留原有五个实验脚本,另补一份独立校验脚本;数值实验依赖 numpy、画图另需 matplotlib:fm_oracle.py(实验台与精确场)、param_lab.py(三种参数化)、path_lab.py(路径对比与 NFE)、reflow_lab.py(reflow 两轮)、make_figures.py(配图)。实验台是一个二维八模高斯混合,噪声是 $N(0,I)$。选它的原因是:高斯混合经过任何高斯路径之后仍是高斯混合,于是 $m$、$e$、$v^{\star}$ 全都有闭式解,不用训练也不用采样近似。 4.1 精确场:后验责任与条件均值 分量 $k$ 的中间方差是 $V_k(t)=\alpha_t^2 s_k^2+\sigma_t^2$($s_k$ 是该分量的标准差),后验责任是给定当前点后属于分量 $k$ 的概率,贝叶斯公式给出未归一化权重: $$r_k(z,t)\propto w_k V_k(t)^{-d/2}\exp\left[-\frac{\|z-\alpha_t\mu_k\|^2}{2V_k(t)}\right].$$ 最后对 $k$ 归一化;本文维数 $d=2$。三个量都是"责任加权的条件均值": def m(self, z, t): # E[x | z_t = z] a = self.path.alpha(t) r, V, diff = self._post(z, t) ex = self.data.mu[None,:,:] + (a * self.data.s**2 / V)[None,:,None] * diff return (r[:,:,None] * ex).sum(1) def e(self, z, t): # E[eps | z_t = z] sg = self.path.sigma(t) r, V, diff = self._post(z, t) ee = (sg / V)[None,:,None] * diff return (r[:,:,None] * ee).sum(1) def v(self, z, t): # 边缘速度场 return self.path.dalpha(t) * self.m(z, t) + self.path.dsigma(t) * self.e(z, t) 先验两个恒等式。第一个是 3.3 节的 $\alpha m+\sigma e=z$,第二个是把 $v^{\star}$ 用另一种方式算一遍——直线路径下 3.3 节的表给出 $v^{\star}=(z-m)/t$: === 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)=== path t |a*m+s*e-z| |v-(da*m+ds*e)| linear 0.05 2.66e-15 0.00e+00 linear 0.95 1.78e-15 0.00e+00 cosine_vp 0.05 1.78e-15 0.00e+00 cosine_vp 0.95 1.78e-15 0.00e+00 === 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e === t=0.1 最大绝对差 = 1.332e-14 t=0.9 最大绝对差 = 1.776e-15 第一条验证了条件均值的一致性;第二条直接复用了 v() 的定义,只能作接口检查,不能算独立证明。新增 fm_checks.py 直接对混合密度有限差分核验 score 和连续性方程,并用单高斯的均值/方差导数另算速度;还检查 MLP 梯度及积分器实际 NFE。数值残差验证具体实现,推导正确性仍依赖 03 节的假设与证明。 4.2 换算表与放大倍数 把 3.3 节的换算写成代码并逐点验真值(注意残差随 $t\to 1$ 变大——那是除以 $(1-t)$ 的数值放大,不是推导错): def v_to_me(z, v, path, t): a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) det = da * sg - ds * a # 直线路径恒等于 -1 m = (sg * v - ds * z) / det e = (da * z - a * v) / det return m, e path t v->m v->e eps->m eps->v linear 0.10 1.78e-15 1.33e-15 1.78e-15 1.78e-15 linear 0.90 1.22e-15 8.88e-16 1.30e-14 1.29e-14 linear 0.99 1.78e-15 1.78e-15 2.04e-13 2.03e-13 放大倍数不靠公式背,用数值扰动直接量:给 $m$ 加一个长度固定为 $0.01$ 的随机扰动,看三种预测误差范数各被放大多少;平方损失对应这些系数的平方。实测与解析式在小数点后四位完全一致($t=0.1$ 时噪声目标 $9.0000$ 对 $9.0000$、速度目标 $10.0000$ 对 $10.0000$),整条曲线就是图 1。 4.3 路径对比:NFE-误差曲线 误差尺子值得单独说一句。常用做法是"拿一条很高步数的参考解当真值",但那条参考解自己也有截断误差。这里利用 $p_t$ 仍是高斯混合这一点,取一组中心为 $c$、带宽为 $h>0$ 的 RBF 特征: $$\phi_c(z)=\exp\left(-\frac{\|z-c\|^2}{2h^2}\right).$$ 它在高斯下的期望有闭式,于是参照侧没有任何采样噪声。生成样本一侧仍有有限样本误差:一批 4000 个真实样本对精确 $p_{\text{data}}$ 的偏差是 $0.00211$,这里只把它画成参考线,既不是误差下限,也不是显著性阈值。更换随机种子后,这个参考偏差也会变化。要判断小差异是否稳定,应对方法使用共同起点并重复多个种子。有限组 RBF 特征只是分布诊断,特征偏差小不能证明两个分布相同。 NFE 统计实际速度场评估次数:Euler 每步 1 次,RK2 每步 2 次。所以 NFE=8 时分别运行 8 步 Euler 或 4 步 RK2,表中按这一预算公平比较。 === NFE-误差:直线路径 vs VP 余弦路径(同一批起点、同一批随机数)=== NFE linear/euler linear/rk2 vp/euler vp/rk2 2 0.04074 0.04113 0.01047 0.04603 4 0.01491 0.00736 0.00562 0.00318 8 0.00802 0.00202 0.00329 0.00236 16 0.00466 0.00183 0.00234 0.00194 32 0.00307 0.00184 0.00199 0.00186 256 0.00194 0.00183 0.00184 0.00183 这张图要看什么:高 NFE 时,四条线都接近同一量级的小偏差,与有限样本误差并存;这不能单独证明场正确。低 NFE 的差异依赖路径和积分器:在 Euler、NFE=8 这一点,线性路径误差是 VP 的约 2.4 倍($0.00802$ 对 $0.00329$),不是“需要 2.4 倍步数”。要比较所需步数,应先规定相同误差阈值。RK2 在 NFE=2 时只有一个积分步,误差甚至大于 Euler;较高阶也不保证每个极低预算下都更好。 数值积分误差受速度场的空间与时间变化、时间网格和积分器共同影响,不能仅用“曲线弯”或错误的“两端速度为零”解释。时间 shift 也可能改变弯曲轨迹的积分精度;这里只能报告本次测试:Euler、NFE=8 时,shift=1、3、6 的误差分别为 $0.00802$、$0.00864$、$0.01843$,这两个非均匀网格没有带来改善。 4.4 Reflow:把弯的轨迹拉直 reflow 的实现出奇地短:用第 1 轮模型从噪声端积分到数据端,得到新配对,再训一轮。 def round1_pairs(n, seed=0): rng = base_rng(seed) data = make_data() z0 = data.sample(n, rng) # 数据端(t=0) z1 = rng.standard_normal((n, D)) # 噪声端(t=1),独立配对 return z0, z1 def generate_pairs(model, z1, n_steps=100): sched = make_schedule(n_steps) # RK2:100 步 = 200 次场评估 z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2") return z0 # 新配对就是 (z0, z1) 模型是 NumPy 实现的两个 128 宽 tanh 隐层 MLP,两轮各 6000 次更新、batch=512、训练 seed=0。第 1 轮从 10 万个固定数据样本有放回抽取,并每步重采独立噪声和时间;这仍是有限经验数据池,不等于每步重新抽总体数据。第 2 轮拟合 10 万个数值教师配对;教师使用 100 步 RK2,即每条配对 200 NFE。第 1 轮在 10 万条独立配对上训练(每步从数据样本池抽样并重采独立噪声),末 200 个训练 minibatch 的逐坐标 MSE 均值为 $2.1853$——按样本平方范数是 $4.3706$,而估计的不可约回归误差 $S_{pair}\cdot E\|z_1-z_0\|^2\approx4.3702$(未舍入计算;两个因子分别约为 $0.6229$、$7.0162$)。训练 minibatch 均值与配对池上 32 时刻求积的估计口径不同;还含有限数据/时间采样误差,略低或略高都可能发生,不能证明模型已达精确最优;在分布内查询点上它与精确场的相对均方误差是 $1.28\%$。 然后是关键的一步——量两轮的归一化配对残差和 NFE: === 归一化配对回归残差(另用弧长/弦长量轨迹)=== 第 1 轮配对 + 精确场 S_pair = 0.6229 第 1 轮配对 + 第1轮模型 S_pair = 0.6289 第 2 轮配对 + 第2轮模型 S_pair = 0.0027 弧长/弦长:精确场 1.6499 | 第1轮 1.6463 | 第2轮 1.0027 === NFE-误差(直线路径;精确场 / 第1轮模型 / 第2轮模型)=== NFE 精确场 第1轮 第2轮 2 0.04012 0.04469 0.00402 4 0.01469 0.01789 0.00401 8 0.00785 0.00927 0.00402 16 0.00427 0.00563 0.00402 64 0.00182 0.00389 0.00403 这张图要看什么:左图是三条 NFE-误差曲线,绿色(reflow 后)从 NFE=2 起就是一条平线——步数不再是瓶颈;右图分别比较配对回归残差与实际轨迹弧长/弦长:配对残差第 1 轮用精确场、第 2 轮用重训模型;弧长柱均用对应训练模型。第 2 轮的弧长/弦长 $1.0027$,这批数值轨迹在几何上接近两点连线;速度是否均匀还需另看沿轨迹的诊断。第 1 轮配对残差用精确场(估计不可约误差),第 2 轮用训练模型(包含不可约误差与学习误差),而且耦合不同,不能用二者比值定量声称不可约误差降低多少倍。两者均以 32 等距时刻近似时间积分。另外注意第 2 轮配对的弦长平方从 $7.0162$ 掉到 $1.2410$:reflow 之后噪声端和数据端被强相关地配对了,这种配对改变也体现在实际轨迹变直上;不能把较小的配对残差本身称为曲率。 本次在同一对训练模型上新增独立评估:留出 4000 个新噪声,经同一 100 步 RK2 教师生成配对,第 2 轮模型的配对残差为 0.002772(训练配对池为 0.002749)。再固定模型,仅更换五个噪声 seed;每个 seed 两轮共享 4000 个起点,均用 NFE=2 的 Euler: 评估 seed 第 1 轮偏差 第 2 轮偏差 999 0.04469 0.00402 1000 0.04497 0.00584 1001 0.04399 0.00307 1002 0.04504 0.00519 1003 0.04461 0.00553 五次均观察到第 2 轮偏差更低,但数值随评估采样变化;这只支持这两个固定 toy 模型的少步结果,不是五次独立训练,也不是图像质量或所有数据分布的保证。完整训练配置、源码 SHA256、结果与权重写入同目录快照。 05. 工业级实现对照 以 Diffusers v0.35.1 的 调度器源码为准。对照的是标量时间、默认确定性分支,关闭 inverted sigma、终点拉伸及其他 sigma 重排;逐 token 等分支不在这里的公式覆盖范围。model_output 是模型输出的本文方向速度 $\epsilon-x$,不是 VP 路径中另有定义的 $v$ 目标。网络时间标签通常是 $1000\sigma$,积分步长仍使用 $\sigma$,两者不可混用。 Euler 更新。 原类的 step() 在该分支执行: dt = sigma_next - sigma prev_sample = sample + dt * model_output $\sigma$ 就是本文线性路径的 $t$,表从 1 递减到 0,因此负步长负责从噪声生成数据。函数先把 sample 升到 FP32,再按模型输出 dtype 返回;不要从文档中的泛称“预测噪声”反推这条分支的实际参数化。本文对原类 AST 做 18 次 CPU step 对照,覆盖 FP32、FP16、BF16 和 shift=1/3,结果与同精度更新逐位一致;这是调度器公式验证,没有运行完整文生图模型或 GPU 性能测试。 干净图估计与随机分支。 stochastic_sampling=True 时,源码先算 $\widehat x_0=z-\sigma v_\theta$,再以新噪声 $\eta\sim N(0,I)$ 构造下一状态: $$z_{next}=(1-\sigma_{next})\widehat x_0+\sigma_{next}\eta.$$ 干净图公式正是 3.3 节第一格,但整个随机更新并非默认 Euler ODE 步;不能只摘第一行就说两条采样路径等价。本文固定随机种子实跑这一分支,与完整式逐位核对。 最后评估点与最终落点。 shift=1 的默认 1000 训练时间表,最后非零模型评估点为约 0.001,set_timesteps 另在 sigma 表末尾追加 0。最后一步从正 sigma 积分到 0,不在 0 再评估网络;其他配置/自定义表应查看实际 sigmas。网络调用所需的是表内时间值,不能把 enumerate 的整数索引传进 step()。 静态与动态 shift。 静态变换是 $t'=st/[1+(s-1)t]$,其中 $s>0$ 是配置中的 shift。它重新安排模型评估时刻;本文未将位移速度换成 $dz/dt'$ 后再统一网格求解,而是在改变后的原时间点上用其差值积分。动态指数分支使用 $$t'=\frac{\exp(\mu)}{\exp(\mu)+(1/t-1)}.$$ 序列长度到 $\mu$ 的线性插值发生在 pipeline 调用者中:FLUX 调用代码、SD3 调用代码先由实际 token 数 $L$ 计算 $$\mu(L)=\mu_b+\frac{L-L_b}{L_m-L_b}(\mu_m-\mu_b),$$ 再传给调度器;调度器在启用动态 shift 却没收到 $\mu$ 时会报错。以显式配置 $L_b=256$、$L_m=4096$、$\mu_b=0.5$、$\mu_m=1.15$ 为例,中点 $L=2176$ 得 $\mu=0.825$。它不自动截断,$L=8192$ 会外推到约 1.8433;默认值需以具体模型配置为准,不能把所有 SD3/FLUX 模型概括成同一策略。SD3 原论文第 5.3.2 节用常量图像与分辨率相关的信噪比作动机,这不是“每张真实图都按像素数精确缩放信息”的定理。04 节的 toy shift 测试也只报告该分布上的数值结果。 训练时间分布。 SD3 原论文第 3.1 节比较多种时间采样,包含 logit-normal:先采 $a\sim N(m,s^2)$,再取 $t=1/(1+\exp(-a))$;本文关注的 $m=0,s=1$ 在中间时刻权重较大。该形状依赖参数,不能说所有 logit-normal 都只有一个居中众数。固定训练辅助函数按此变换实现,CPU 实跑与同 seed 的 normal→sigmoid 逐位相同。改变时间密度相当于改变有限模型的训练权重;这与推理侧改变离散时间网格是两个设计选择,也不能用噪声目标在高噪声端的系数直接解释 velocity 模型选择这一密度。 06. 代价与边界 直线路径不是免费的午餐。 在这组实验的 Euler、NFE=8 处,线性路径的误差约为 VP 余弦路径的 2.4 倍;这个误差比不等于达到同一质量所需的步数比。需要诚实标注边界:这是一个二维、数据尺度(标准差 1.56)与噪声尺度(1)不匹配的 toy,不能据此断言"VP 路径普遍更省步数";但至少说明直线插值不保证少步积分准确。实际轨迹接近直线有助于理解 reflow 的效果,积分难度仍取决于沿轨迹的速度变化与数值格式。真实模型里路径选择还和训练分布、模型容量、蒸馏方案纠缠在一起,单独归因很难。 reflow 仍受教师分布与学习误差限制。 本次第 2 轮的高 NFE 偏差约为 $0.00403$;第 1 轮模型用于训练的 10 万个生成端点偏差为 $0.00328$。二者评估样本量不同,不能据此定量断言“误差几乎全部继承自教师”。在理论条件满足、回归和积分精确的理想 reflow 中,端点边缘分布保持为教师的分布;有限模型还会增加重训和积分误差。图 4 显示的是少步曲线被压平,不能当作重训自动改善真实数据拟合的证据。 reflow 的账单。 它需要用第 1 轮模型做一次全量生成,生成量要够训第 2 轮。其成本由配对生成量、教师步数和重训步数共同决定,不能固定说成翻倍,所以工程上要么只在最后的精调阶段做,要么直接换成少步蒸馏(已发布的少步蒸馏)。 $\sigma\to0$ 的数值边界。 需要避免在端点进行会除以零的参数化转换;速度场 Euler 更新自身不含该除法。最后从 $\sigma>0$ 到 0 的 Euler 步正是 $x_0=x-\sigma v$,两种说法在直线路径下是同一操作。 07. 经典论文脉络 Lipman et al., 2022,Flow Matching for Generative Modeling:用 simulation-free 条件回归训练速度场,避免训练期间反复数值求解 ODE;不是从 O(1) 复杂度降到 1,提出条件路径 + marginalization trick,是"用回归训速度场"的源头。 Liu et al., 2022,Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow:从线性插值回归出发构造流,并提出 reflow。在论文的理想化条件下,reflow 具有直线度和凸运输成本的相关保证;本文 4.4 节的有限样本、有限模型实验用于观察趋势,不能替代理论条件。 Albergo & Vanden-Eijnden, 2022,Building Normalizing Flows with Stochastic Interpolants:通过随机端点的插值和回归目标构造确定性概率流。 Albergo, Boffi & Vanden-Eijnden, 2023,Stochastic Interpolants: A Unifying Framework for Flows and Diffusions:进一步引入可调噪声项,建立流与扩散过程的统一框架;应与上一项区分引用。 Karras et al., 2022,Elucidating the Design Space of Diffusion-Based Generative Models(EDM):不谈"流",把预条件(参数化)和时间调度当成独立的自由度来调。它把输出预条件、损失权重与采样调度分开设计;本文 3.3 节涉及其中的输出换算与相对权重,不能把换算恒等式当作训练行为完全等价。 Esser et al., 2024,Scaling Rectified Flow Transformers for High-Resolution Image Synthesis(SD3):把 rectified flow 推到大规模文生图,给出 logit-normal 时间采样与分辨率相关 shift——大规模采用该路径的一项代表性工作,不据此断言整个工业界已统一迁移。 08. 常见误解 误解一:"流匹配与扩散完全相同,或完全无关。" Flow Matching 是训练速度场的框架,可以采用扩散的连续高斯边缘路径,也可以采用其他插值路径。DDPM 另有离散马尔可夫链和随机逆过程;同边缘概率流 ODE 不等于相同的随机路径。相同架构和可换算输出不意味着训练损失、模型分布及采样器完全等价。Rectified Flow 在本文取 $\alpha=1-t,\sigma=t$,还需指定端点耦合、时间采样和数值求解器。 误解二:"路径是直的,所以一两步就能出图。" 直的是训练时的插值线;采样走的是边缘场的积分曲线。实测 1-rectified 的弧长/弦长是 $1.65$,NFE=2 误差 $0.04469$。要两步出图,靠的是 reflow 之后的第 2 轮($0.00402$),不是第 1 轮的"直线路径"。 误解三:"reflow 之后质量和速度都变好了。" 只对了一半。步数-精度曲线确实被压平(NFE=2 就到位),但精度仍受教师样本分布与重训误差限制:第 2 轮在本次实验中停在约 $0.00403$,教师生成端点的参考偏差为 $0.00328$。理想 reflow 保持教师端点边缘,有限训练下则需另外评估分布偏差,不能保证质量自动提高。 误解四:"velocity 预测只是把回归目标换了个写法。" 真值层面是,loss 层面不是。$t=0.99$ 处噪声目标对干净图误差的放大倍数是 $0.0101$,速度目标是 $1.0101$,幅度系数差 100 倍、平方权重差 10000 倍;这只描述固定干净图误差的相对权重,不代表高噪声端一半训练样本都无用。 误解五:"流匹配需要知道边缘密度或 score。" 3.2 节的推导全程只用了条件期望和塔性质,训练目标里没有任何一项含 $p_t$。若评估 NLL,需要概率密度或其可计算表示;沿可逆 ODE 跟踪散度是一种做法,并不要求已知数据密度。本文的 RBF 指标之所以有解析参照,是因为选了可计算的 GMM;真实图像任务通常没有这个条件。 09. 动手验证 三个可以自己跑的小实验,按顺序: 恒等式链:python fm_oracle.py。应该看到 $\alpha m+\sigma e=z$ 的残差在 $10^{-15}$ 量级,$v^{\star}$ 的两种算法差约 $10^{-14}$。这些是 float64 和本例尺度下的数值,不是所有 dtype 的固定门槛。较大残差也可能来自精度、端点除法或索引错误;应定位原因,不能仅凭残差认定缺 log-sum-exp。 放大倍数:python param_lab.py。看解析式与数值扰动两列是否完全一致,再看 $t=0.99$ 那一行——噪声目标 $0.0101$ 对速度目标 $1.0101$。 reflow 的残差与采样曲线:python reflow_lab.py(完整两轮 6000 步和十万配对,纯 NumPy;耗时取决于 CPU、BLAS 与线程数)。确认三件事:第 1 轮逐坐标平均 loss 乘以维数 2 后,接近估计的 $S_{pair}\cdot E\|z_1-z_0\|^2$;第 2 轮弧长/弦长 $\approx 1.00$;第 2 轮 NFE 曲线近乎平坦,但仍存在相对真实数据的偏差。 另跑 python fm_checks.py,可复核密度有限差分、连续性、MLP 梯度、真实 NFE 和几何直但非匀速的反例。make_figures.py 复用本次 reflow 实跑结果;快照绑定源码 SHA256、模型权重哈希与训练配置,缺失或过期就完整重算。它不是拿旧图上的数字反填正文。 想改实验设置的话:make_data 里的 radius 控制数据尺度(默认 2.2)。改变它后重新运行 path_lab.py,比较不同路径在相同实际 NFE 下的误差。半径改变会同时影响数据协方差、模式间距和路径难度;不要把某一次误差比当作固定的步数收益。 10. 延伸阅读 前置:DDPM、扩散过程与 score;若想对照另一类生成目标,可读 VAE 的 ELBO。 相邻:采样器与 NFE、CFG。引导形式可对照,场的方向和参数化仍要与具体模型一致。 后继:少步蒸馏、视频生成强化学习。reflow 与蒸馏是相关的加速选择,训练目标和保证不应混称。 附录:完整代码 09 节用到的脚本全文如下(reflow_lab.py、path_lab.py、fm_oracle.py、param_lab.py、make_figures.py、fm_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 reflow_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(四):Reflow —— 用模型自己造的配对再训一轮。 Rectified Flow 最容易被转述错的一句话是「它的路径是直的」。 真的是直的,但直的是**训练时那条插值线** (1-t)x + t*eps; ODE 真正走出来的轨迹是边缘速度场 v*(z,t) = E[eps - x | z_t = z] 的积分曲线, 本例的积分轨迹会弯曲,弧长须把每一小段的欧式长度相加后再与弦长比较。 Reflow 做的事是:用第 1 轮训好的模型把噪声推到数据端,得到一批**配对** (z_1, z_0) = (起点噪声, 模型生成的终点),再拿这批配对重训一轮。 理想化 reflow 的性质有理论条件;本实验另外测量有限模型的轨迹长度比和采样误差。 这一份用 numpy 手搓一个小 MLP 当"模型",分别报告配对插值上的归一化回归残差 S_pair、实际 ODE 轨迹弧长/弦长和 NFE-误差。 """ import hashlib import json import os import platform from pathlib import Path import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, OracleFlow, make_rbf_centers, discrepancy, make_schedule, integrate, ) C, BW = make_rbf_centers() PATH = LinearPath() # ─────────────────── 一个小 MLP(numpy 手写) ─────────────────── class MLP: def __init__(self, sizes, rng): self.W, self.b = [], [] for i in range(len(sizes) - 1): lim = np.sqrt(6.0 / (sizes[i] + sizes[i + 1])) self.W.append(rng.uniform(-lim, lim, (sizes[i], sizes[i + 1]))) self.b.append(np.zeros(sizes[i + 1])) self.m = [np.zeros_like(w) for w in self.W] self.v = [np.zeros_like(w) for w in self.W] self.mb = [np.zeros_like(x) for x in self.b] self.vb = [np.zeros_like(x) for x in self.b] def forward(self, X): A = [X] H = X for i in range(len(self.W) - 1): H = np.tanh(H @ self.W[i] + self.b[i]) A.append(H) A.append(H @ self.W[-1] + self.b[-1]) return A[-1], A def step(self, X, Y, lr, tstep, beta1=0.9, beta2=0.999, eps=1e-8): pred, A = self.forward(X) g = 2.0 * (pred - Y) / pred.size for i in range(len(self.W) - 1, -1, -1): gW = A[i].T @ g gb = g.sum(0) self.m[i] = beta1 * self.m[i] + (1 - beta1) * gW self.v[i] = beta2 * self.v[i] + (1 - beta2) * (gW * gW) self.mb[i] = beta1 * self.mb[i] + (1 - beta1) * gb self.vb[i] = beta2 * self.vb[i] + (1 - beta2) * (gb * gb) mh = self.m[i] / (1 - beta1 ** tstep) vh = self.v[i] / (1 - beta2 ** tstep) # 先用本次前向的旧权重传播梯度,再更新参数。 g_prev = (g @ self.W[i].T) * (1 - A[i] ** 2) if i > 0 else None self.W[i] -= lr * mh / (np.sqrt(vh) + eps) bmh = self.mb[i] / (1 - beta1 ** tstep) bvh = self.vb[i] / (1 - beta2 ** tstep) self.b[i] -= lr * bmh / (np.sqrt(bvh) + eps) if i > 0: g = g_prev return float(((pred - Y) ** 2).mean()) def __call__(self, z, t): tt = np.full((z.shape[0], 1), float(t)) return self.forward(np.concatenate([z, tt], axis=1))[0] def train(pairs_z0, pairs_z1, n_step=4000, batch=512, lr=3e-3, seed=0, fresh=False): """在给定配对上训练速度场:目标 u = z_1 - z_0,z_t = (1-t) z_0 + t z_1。 fresh=True 时重采噪声和时间,数据仍从有限样本池有放回抽取。 这不是每步重新抽取总体数据;独立留出样本用于检查泛化。 """ rng = base_rng(seed) net = MLP([D + 1, 128, 128, D], np.random.default_rng(seed + 1)) n = pairs_z0.shape[0] losses = [] for s in range(1, n_step + 1): if fresh: idx = rng.integers(0, n, batch) z1 = rng.standard_normal((batch, D)) z0 = pairs_z0[idx] # 有限经验数据池,不能当作总体新样本 else: idx = rng.integers(0, n, batch) z0 = pairs_z0[idx] z1 = pairs_z1[idx] t = rng.uniform(0.0, 1.0, (batch, 1)) zt = (1 - t) * z0 + t * z1 u = z1 - z0 X = np.concatenate([zt, t], axis=1) cur_lr = lr * (0.3 ** (s / n_step)) # 余弦退火换成简单指数退火 l = net.step(X, u, cur_lr, s) losses.append(l) return net, float(np.mean(losses[-200:])) # ─────────────────── 两轮的配对 ─────────────────── def round1_pairs(n, seed=0): """第 1 轮:数据与噪声独立配对(这就是 Rectified Flow 原始的训练配对)。""" rng = base_rng(seed) data = make_data() z0 = data.sample(n, rng) # 数据端(t=0) z1 = rng.standard_normal((n, D)) # 噪声端(t=1) return z0, z1 def generate_pairs(model, z1, n_steps=100): """用 RK2 的 n_steps 个积分步生成配对,实际场评估次数为 2*n_steps。""" sched = make_schedule(n_steps) z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2") return z0 # ─────────────────── 评价指标 ─────────────────── def straightness_of(pairs_z0, pairs_z1, vfun, nstep=32): """配对插值上的归一化回归残差;不是论文沿实际 ODE 轨迹定义的 straightness。""" ts = np.linspace(1.0, 0.0, nstep + 1)[:-1] dev = 0.0 for t in ts: zt = (1 - t) * pairs_z0 + t * pairs_z1 dev += float(np.mean(np.sum((vfun(zt, t) - (pairs_z1 - pairs_z0)) ** 2, axis=1))) dev /= len(ts) return dev / float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1))) def arc_over_chord(pairs_z1, vfun, nstep=64): """真走一遍:从 z_1 出发积分到 t=0,量轨迹弧长与端点弦长之比。""" sched = make_schedule(nstep) z0, traj = integrate(vfun, pairs_z1, sched, "rk2") seg = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(0) chord = np.linalg.norm(z0 - pairs_z1, axis=1) return float(np.mean(seg / np.maximum(chord, 1e-12))), z0 def nfe_curve(pairs_z1, vfun, nfe_list, data): flow = OracleFlow(data, PATH) out = [] for nfe in nfe_list: sched = make_schedule(nfe) z0, _ = integrate(vfun, pairs_z1, sched, "euler") out.append(discrepancy(z0, 0.0, flow, C, BW)) return np.array(out) def field_error(model, flow, n=4000, seed=3): """训练出来的场与精确场差多少(相对均方)。 查询点取自真实边缘 p_t(与第 1 轮训练分布一致),并在五个时刻汇总平方误差。 """ rng = base_rng(seed) data = make_data() num = 0.0 den = 0.0 for t in (0.1, 0.3, 0.5, 0.7, 0.9): x = data.sample(n, rng) eps = rng.standard_normal((n, D)) zt = (1 - t) * x + t * eps v = flow.v(zt, t) num += float(np.mean(np.sum((model(zt, t) - v) ** 2, axis=1))) den += float(np.mean(np.sum(v ** 2, axis=1))) return num / den def chord_scale(pairs_z0, pairs_z1): """E||z_1 - z_0||^2,配对残差 S_pair 的分母。""" return float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1))) def state(): data = make_data() flow = OracleFlow(data, PATH) z0_1, z1 = round1_pairs(100000, seed=0) net1, loss1 = train(z0_1, z1, n_step=6000, seed=0, fresh=True) z0_2 = generate_pairs(net1, z1, n_steps=100) net2, loss2 = train(z0_2, z1, n_step=6000, seed=0) nfe_list = [2, 4, 8, 16, 32, 64] eval_z1 = base_rng(999).standard_normal((4000, D)) out = { "nfe": np.array(nfe_list), "loss1": loss1, "loss2": loss2, "ferr1": field_error(net1, flow), "ferr2": field_error(net2, flow), "S1_oracle": straightness_of(z0_1, z1, lambda z, t: flow.v(z, t)), "S1_learned": straightness_of(z0_1, z1, lambda z, t: net1(z, t)), "S2_learned": straightness_of(z0_2, z1, lambda z, t: net2(z, t)), "arc1_oracle": arc_over_chord(z1, lambda z, t: flow.v(z, t))[0], "arc1_learned": arc_over_chord(z1, lambda z, t: net1(z, t))[0], "arc2_learned": arc_over_chord(z1, lambda z, t: net2(z, t))[0], "nfe_oracle": nfe_curve(eval_z1, lambda z, t: flow.v(z, t), nfe_list, data), "nfe_learned1": nfe_curve(eval_z1, lambda z, t: net1(z, t), nfe_list, data), "nfe_learned2": nfe_curve(eval_z1, lambda z, t: net2(z, t), nfe_list, data), "chord1": chord_scale(z0_1, z1), "chord2": chord_scale(z0_2, z1), "teacher_discrepancy": discrepancy(z0_2, 0.0, flow, C, BW), } # 留出噪声经同一教师生成配对;只量回归/数值教师,不假称精确 reflow。 held_z1 = base_rng(1234).standard_normal((4000, D)) held_z0 = generate_pairs(net1, held_z1, n_steps=100) out["S2_heldout"] = straightness_of(held_z0, held_z1, net2) out["evaluation_seeds"] = [] for seed in [999, 1000, 1001, 1002, 1003]: z = base_rng(seed).standard_normal((4000, D)) vals = [float(nfe_curve(z, net, [2], data)[0]) for net in [net1, net2]] out["evaluation_seeds"].append({"seed": seed, "round1_nfe2": vals[0], "round2_nfe2": vals[1]}) arrays = {} for name, net in [("net1", net1), ("net2", net2)]: for i, (w, b) in enumerate(zip(net.W, net.b)): arrays[f"{name}_W{i}"] = w arrays[f"{name}_b{i}"] = b here = Path(__file__).resolve().parent tmp = here / '_reflow_models.tmp.npz' np.savez(tmp, **arrays) os.replace(tmp, here / '_reflow_models.npz') def serial(v): if isinstance(v, np.ndarray): return v.tolist() if isinstance(v, dict): return {k: serial(x) for k, x in v.items()} if isinstance(v, list): return [serial(x) for x in v] return v payload = {"results": serial(out), "inputs": snapshot_inputs(), "numpy": np.__version__, "python": platform.python_version(), "models_sha256": hashlib.sha256((here / '_reflow_models.npz').read_bytes()).hexdigest(), "config": {"pairs": 100000, "steps_per_round": 6000, "batch": 512, "hidden": [128, 128], "teacher_steps": 100, "teacher_method": "rk2", "training_seed": 0, "evaluation_particles": 4000, "S_pair_quadrature": "32 equal intervals, right endpoints in increasing time"}} tmp = here / '_reflow_results.tmp.json' tmp.write_text(json.dumps(payload, ensure_ascii=False, indent=2), encoding='utf8') os.replace(tmp, here / '_reflow_results.json') return out def snapshot_inputs(): here = Path(__file__).resolve().parent return {n: hashlib.sha256((here / n).read_bytes()).hexdigest() for n in ['fm_oracle.py', 'reflow_lab.py']} def reviewed_state(): """配图复用当前代码的真实实跑;缺失/过期时完整重算,不接受旧实验缓存。""" here = Path(__file__).resolve().parent p = here / '_reflow_results.json' if p.exists(): obj = json.loads(p.read_text('utf8')) if obj['inputs'] == snapshot_inputs() and obj['models_sha256'] == hashlib.sha256((here / '_reflow_models.npz').read_bytes()).hexdigest(): return obj['results'] return state() if __name__ == "__main__": result = state() print(json.dumps(result, default=lambda v: v.tolist(), ensure_ascii=False, indent=2)) path_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(三):路径的选择到底值多少 NFE。 直线路径(Rectified Flow)和 VP 余弦路径(DDPM 那一路)通向**同一个**目标分布, 中间分布不同,ODE 的轨迹与时间参数化也会不同。这一份把这件事量成三条曲线: 1. NFE-误差曲线:同一批起点,比较路径和积分器;Euler/RK2/RK4 每步分别评估 1/2/4 次场。 2. 欧式弧长 / 弦长,以及沿实际 ODE 轨迹的归一化速度偏差 S_traj; 后者对 Rectified Flow 的轨迹 straightness 再除以 E||Z_1-Z_0||^2, 不等于 reflow_lab 在原始配对插值上计算的 S_pair。 3. 时间 shift(SD3/FLUX 的做法)在直线路径上到底省不省步数。 误差尺子是 fm_oracle.discrepancy:拿精确边缘 p_t 的 RBF 特征矩当参照, 参照侧没有采样噪声,生成粒子一侧仍有有限样本误差。共享起点可减轻比较方差, 小差异是否稳定仍应更换随机种子验证;单次真实样本偏差不是硬下限。 """ import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, make_rbf_centers, discrepancy, make_schedule, integrate, ) NPART = 4000 C, BW = make_rbf_centers() def start_particles(n, rng): """t=1 端的粒子:精确就是 N(0, I)。""" return rng.standard_normal((n, D)) def sampling_reference(data, n=NPART): """固定一次真实样本与精确 p_data 的偏差,仅作有限采样参考,不是误差下限。""" rng = base_rng(12345) x = data.sample(n, rng) flow = OracleFlow(data, LinearPath()) return discrepancy(x, 0.0, flow, C, BW) def run_sweep(path, method, nfe_list, npart=NPART): rng = base_rng() z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) out = [] calls_per_step = {"euler": 1, "rk2": 2, "rk4": 4}[method] for nfe in nfe_list: if nfe < calls_per_step or nfe % calls_per_step: raise ValueError(f"{method}: NFE must be a positive multiple of {calls_per_step}") sched = make_schedule(nfe // calls_per_step) z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, method) out.append(discrepancy(z0, 0.0, flow, C, BW)) return np.array(out) def straightness(path, npart=1500, nstep=400): """细步长积分出真实轨迹,量它离弦有多远。""" rng = base_rng(777) z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) sched = make_schedule(nstep) z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4") # traj: [nstep+1, npart, 2],index 0 是 t=1 arc = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(axis=0) # [npart],各段欧式长度相加 chord = np.linalg.norm(z0 - z1, axis=1) ratio = float(np.mean(arc / np.maximum(chord, 1e-12))) # S_traj = mean_t ||v(z_t,t) - (z_1 - z_0)||^2 / mean ||z_1 - z_0||^2 chord_dir = (z1 - z0)[None, :, :] # [1,npart,2] ts = sched[:-1] dev = 0.0 for i, t in enumerate(ts): v = flow.v(traj[i], t) dev += float(np.mean(np.sum((v - chord_dir[0]) ** 2, axis=1))) dev /= len(ts) scale = float(np.mean(np.sum((z1 - z0) ** 2, axis=1))) return ratio, dev / scale def shift_sweep(path, nfe_list, shifts, npart=NPART): rng = base_rng() z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) res = {} for sh in shifts: errs = [] for nfe in nfe_list: sched = make_schedule(nfe, shift=sh) z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, "euler") errs.append(discrepancy(z0, 0.0, flow, C, BW)) res[sh] = np.array(errs) return res def state(): """给画图脚本复用:返回与上面打印完全一致的数字。""" data = make_data() nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] out = { "nfe": np.array(nfe_list), "sampling_reference": sampling_reference(data), "sweep": {}, "straight": {}, "shift": {}, } for path in (LinearPath(), CosineVPPath()): for method in ("euler", "rk2"): out["sweep"][(path.name, method)] = run_sweep(path, method, nfe_list) out["straight"][path.name] = straightness(path) out["shift"] = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0]) out["shift_nfe"] = np.array([4, 8, 16, 32, 64]) return out if __name__ == "__main__": data = make_data() print(f"=== 单次采样参考:{NPART} 个真实样本 vs 精确 p_data 的偏差 = " f"{sampling_reference(data):.5f} ===") print("(这不是硬下限或显著性阈值;评估小差异需重复采样)") print() nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] print("=== NFE-误差:直线路径 vs VP 余弦路径 ===") print(" NFE linear/euler linear/rk2 vp/euler vp/rk2") lin_e = run_sweep(LinearPath(), "euler", nfe_list) lin_r = run_sweep(LinearPath(), "rk2", nfe_list) vp_e = run_sweep(CosineVPPath(), "euler", nfe_list) vp_r = run_sweep(CosineVPPath(), "rk2", nfe_list) for i, n in enumerate(nfe_list): print(f"{n:>5}{lin_e[i]:>14.5f}{lin_r[i]:>13.5f}{vp_e[i]:>12.5f}{vp_r[i]:>11.5f}") print() print("=== 轨迹指标(400 步 RK4,即 1600 NFE;数值近似 ODE 轨迹)===") for path in (LinearPath(), CosineVPPath()): ratio, s = straightness(path) print(f" {path.label:<28} 弧长/弦长 = {ratio:.4f} 归一化 S_traj = {s:.4f}") print() print("=== 时间 shift(仅直线路径,Euler)===") res = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0]) print(" NFE shift=1 shift=3 shift=6") for i, n in enumerate([4, 8, 16, 32, 64]): print(f"{n:>5}{res[1.0][i]:>11.5f}{res[3.0][i]:>11.5f}{res[6.0][i]:>11.5f}") fm_oracle.py # -*- coding: utf-8 -*- """flow_matching 实验台(一):任意高斯路径下的精确速度场。 这一份是整个文章所有数字的来源。思想是: 数据分布取二维高斯混合 p_data(K 个各向同性分量),噪声取 N(0, I)。 对任意「高斯路径」 z_t = alpha_t * x + sigma_t * eps(t=1 是纯噪声,t=0 是数据), p_t 仍然是高斯混合(分量均值 alpha*mu_k,方差 alpha^2 s_k^2 + sigma^2), 于是下面四样东西全都有闭式解,不需要训练、不需要采样近似: m(z,t) = E[x | z_t = z] 去噪均值(x0 预测的真值) e(z,t) = E[eps | z_t = z] 噪声均值(epsilon 预测的真值) v(z,t) = alpha' m + sigma' e 边缘速度场(速度预测的真值) score = grad log p_t(z) 有了这些,三种参数化(x0 / eps / v)可以逐点互相换算并验到浮点误差, ODE 的 NFE-误差曲线可以用「精确边缘 p_t」当尺子,不需要跑一条高精参考解。 误差尺子:取一组 RBF 特征 phi_c(z) = exp(-||z-c||^2 / (2h^2)), 它在高斯分布下的期望有闭式,于是 disc(粒子云, t) = mean_c | (1/N) sum_i phi_c(z_i) - E_{p_t}[phi_c] | 经验侧仍有有限样本误差,解析侧不额外引入采样噪声。单次真实样本参考值既不是硬地板, 也不是统计显著性阈值;有限组 RBF 特征矩一致也不能证明两个分布完全一致。 """ import numpy as np D = 2 # 二维,画图方便;公式与代码对任意维都成立 # ─────────────────────────── 随机流 ─────────────────────────── def base_rng(seed=20260928): """所有脚本与画图共用同一条随机流,保证正文数字与图上的数字一致。""" return np.random.default_rng(seed) # ─────────────────────────── 数据分布 ─────────────────────────── class GMM2D: """二维各向同性高斯混合。""" def __init__(self, means, stds, weights=None): self.mu = np.asarray(means, dtype=float) # [K, 2] self.s = np.asarray(stds, dtype=float) # [K] K = self.mu.shape[0] if weights is None: self.w = np.full(K, 1.0 / K) else: self.w = np.asarray(weights, dtype=float) self.w = self.w / self.w.sum() @property def K(self): return self.mu.shape[0] def sample(self, n, rng): k = rng.choice(self.K, size=n, p=self.w) return self.mu[k] + self.s[k][:, None] * rng.standard_normal((n, D)) def mean_cov(self): m = (self.w[:, None] * self.mu).sum(0) c = (self.w[:, None, None] * ( (self.s ** 2)[:, None, None] * np.eye(D)[None] + (self.mu - m)[:, :, None] * (self.mu - m)[:, None, :] )).sum(0) return m, c def make_data(K=8, radius=2.2, std=0.28): """8 个分量摆在半径 2.2 的圆上,每个分量标准差 0.28。""" ang = np.arange(K) * 2 * np.pi / K mu = np.stack([radius * np.cos(ang), radius * np.sin(ang)], axis=1) s = np.full(K, std) # 权重做成确定性的非均匀(1 + 0.35 cos),让混合更不像"一圈一样的点" w = 1.0 + 0.35 * np.cos(ang + 0.7) return GMM2D(mu, s, w / w.sum()) # ─────────────────────────── 路径 ─────────────────────────── class LinearPath: """Rectified Flow 的直线插值路径:z_t = (1-t) x + t eps。""" name = "linear" label = "直线路径(Rectified Flow)" def alpha(self, t): return 1.0 - t def sigma(self, t): return t def dalpha(self, t): return -1.0 def dsigma(self, t): return 1.0 class CosineVPPath: """方差保持(VP)路径:z_t = cos(pi t/2) x + sin(pi t/2) eps。 alpha^2 + sigma^2 = 1,也就是 DDPM 那一路 cosine schedule 的连续化版本。 """ name = "cosine_vp" label = "VP 余弦路径(DDPM 那一路)" def alpha(self, t): return np.cos(0.5 * np.pi * t) def sigma(self, t): return np.sin(0.5 * np.pi * t) def dalpha(self, t): return -0.5 * np.pi * np.sin(0.5 * np.pi * t) def dsigma(self, t): return 0.5 * np.pi * np.cos(0.5 * np.pi * t) # ─────────────────────────── 精确场 ─────────────────────────── class OracleFlow: """给定数据与路径后的精确边缘速度场。""" def __init__(self, data: GMM2D, path): self.data = data self.path = path # 后验responsibility r_k(z,t) 与分量方差 V_k(t) def _post(self, z, t): a = self.path.alpha(t) sg = self.path.sigma(t) V = a * a * self.data.s ** 2 + sg * sg # [K] diff = z[:, None, :] - a * self.data.mu[None, :, :] # [N,K,2] d2 = (diff ** 2).sum(-1) # [N,K] logp = -0.5 * d2 / V[None, :] - np.log(V)[None, :] + np.log(self.data.w)[None, :] logp = logp - logp.max(1, keepdims=True) r = np.exp(logp) r = r / r.sum(1, keepdims=True) return r, V, diff def m(self, z, t): """E[x | z_t = z],也就是 x0 预测的真值。""" a = self.path.alpha(t) r, V, diff = self._post(z, t) ex = self.data.mu[None, :, :] + (a * self.data.s ** 2 / V)[None, :, None] * diff return (r[:, :, None] * ex).sum(1) def e(self, z, t): """E[eps | z_t = z],也就是 epsilon 预测的真值。""" sg = self.path.sigma(t) r, V, diff = self._post(z, t) ee = (sg / V)[None, :, None] * diff return (r[:, :, None] * ee).sum(1) def v(self, z, t): """边缘速度场 v*(z,t) = alpha' m + sigma' e。""" da = self.path.dalpha(t) ds = self.path.dsigma(t) return da * self.m(z, t) + ds * self.e(z, t) def score(self, z, t): """grad log p_t(z)。""" r, V, diff = self._post(z, t) return -(r[:, :, None] * diff / V[None, :, None]).sum(1) def marginal(self, t): """p_t 的分量参数(仍是 GMM):均值 [K,2]、标准差 [K]、权重 [K]。""" a = self.path.alpha(t) sg = self.path.sigma(t) return a * self.data.mu, np.sqrt(a * a * self.data.s ** 2 + sg * sg), self.data.w # ─────────────────────────── 误差尺子 ─────────────────────────── def make_rbf_centers(n=9, extent=3.6, bw=0.9): g = np.linspace(-extent, extent, n) C = np.stack(np.meshgrid(g, g, indexing="ij"), axis=-1).reshape(-1, D) return C, bw def rbf_expectation(means, sds, weights, C, bw): """E_{p_t}[phi_c],phi_c(z)=exp(-||z-c||^2/(2 bw^2)),p_t 为各向同性 GMM。 单个高斯分量 N(m, v I) 下:E[phi_c] = (bw^2/(bw^2+v))^{d/2} * exp(-||m-c||^2/(2(bw^2+v))) """ v = sds ** 2 # [K] coef = (bw ** 2 / (bw ** 2 + v)) ** (D / 2.0) # [K] d2 = ((means[:, None, :] - C[None, :, :]) ** 2).sum(-1) # [K, M] val = coef[:, None] * np.exp(-0.5 * d2 / (bw ** 2 + v)[:, None]) return (weights[:, None] * val).sum(0) # [M] def discrepancy(z, t, flow: OracleFlow, C, bw): """粒子云 z 与精确边缘 p_t 的 RBF 特征矩偏差(越小越好)。""" mu_t, sd_t, w_t = flow.marginal(t) exact = rbf_expectation(mu_t, sd_t, w_t, C, bw) d2 = ((z[:, None, :] - C[None, :, :]) ** 2).sum(-1) emp = np.exp(-0.5 * d2 / bw ** 2).mean(0) return float(np.abs(emp - exact).mean()) # ─────────────────────────── 积分器 ─────────────────────────── def make_schedule(n_steps, shift=1.0): """含 n_steps 个积分区间(不是统一 NFE 预算)的时刻表。shift>1 是 SD3/FLUX 那套把时间往高噪声端推的做法。""" t = np.linspace(1.0, 0.0, n_steps + 1) if shift != 1.0: t = shift * t / (1.0 + (shift - 1.0) * t) return t def integrate(vfun, z, schedule, method="euler"): """从 t=1 走到 t=0。vfun(z, t) 返回对递增时间定义的 dz/dt;负步长负责反向积分。""" z = z.copy() traj = [z.copy()] for i in range(len(schedule) - 1): t = schedule[i] h = schedule[i] - schedule[i + 1] # >0 if method == "euler": dz = vfun(z, t) elif method == "rk2": zm = z - 0.5 * h * vfun(z, t) dz = vfun(zm, t - 0.5 * h) elif method == "rk4": k1 = vfun(z, t) k2 = vfun(z - 0.5 * h * k1, t - 0.5 * h) k3 = vfun(z - 0.5 * h * k2, t - 0.5 * h) k4 = vfun(z - h * k3, t - h) dz = (k1 + 2 * k2 + 2 * k3 + k4) / 6.0 else: raise ValueError(method) z = z - h * dz traj.append(z.copy()) return z, np.stack(traj) # traj: [S+1, N, 2] # ─────────────────────────── 自测 ─────────────────────────── def selfcheck(): rng = base_rng() data = make_data() out = [] for path in (LinearPath(), CosineVPPath()): flow = OracleFlow(data, path) z = rng.standard_normal((4000, D)) * 1.6 for t in (0.05, 0.25, 0.5, 0.75, 0.95): a = path.alpha(t) sg = path.sigma(t) m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) # 恒等式 1:alpha*m + sigma*e == z r1 = float(np.abs(a * m + sg * e - z).max()) # 恒等式 2:v == alpha' m + sigma' e(定义,顺手确认没写反导数) r2 = float(np.abs(v - (path.dalpha(t) * m + path.dsigma(t) * e)).max()) out.append((path.name, t, r1, r2)) return out if __name__ == "__main__": print("=== 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)===") hdr = "path t |a*m+s*e-z| |v-(da*m+ds*e)|" print(hdr) for name, t, r1, r2 in selfcheck(): print(f"{name:<12}{t:>6.2f}{r1:>16.2e}{r2:>18.2e}") rng = base_rng() data = make_data() flow = OracleFlow(data, LinearPath()) print() print("=== 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e ===") for t in (0.1, 0.3, 0.5, 0.7, 0.9): z = rng.standard_normal((2000, D)) * 1.6 lhs = (z - flow.m(z, t)) / t rhs = flow.v(z, t) print(f" t={t:.1f} 最大绝对差 = {np.abs(lhs - rhs).max():.3e}") param_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(二):三种参数化(x0 / eps / v)的换算与 loss 权重。 要回答两个问题: 1. 固定同一条高斯路径和非退化时间,eps / x0 / v 输出能否代数换算? 可以换算同一路径上的输出,但不能据此把 VP 模型直接变成另一条 RF 路径的模型。 三种参数化的真值来自同一个去噪均值 m: z = alpha*m + sigma*e (路径定义,恒等) v = alpha'*m + sigma'*e (速度定义) 两式联立解出 m、e,就得到「速度 -> 噪声/干净图」的换算; 反过来也成立。下面把这些换算逐点验到 1e-14。 2. 输出可换算,为什么不同训练目标仍会产生差异? 因为「等价」指的是**真值**等价,**loss 不等价**:同一个 m 上的误差 delta, 在三种 loss 里被放大的倍数不同: x0 : 1 eps : alpha / sigma v : |alpha' - sigma' * alpha / sigma| 这里列的是误差幅度系数,平方损失权重还需平方。直线路径 t→1 时, eps 系数趋于 0,v 系数趋于 1;这比较固定 m 误差的相对权重, 不等于真实网络的所有梯度或质量。t=1 的 eps->m 换算本身退化。 """ import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, ) # ─────────────────── 换算表的通用形式 ─────────────────── def v_to_me(z, v, path, t): """由 (z, v) 反解 (m, e)。 解 [[alpha', sigma'], [alpha, sigma]] @ [m, e] = [v, z] 行列式 det = alpha'*sigma - sigma'*alpha """ a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) det = da * sg - ds * a m = (sg * v - ds * z) / det e = (da * z - a * v) / det return m, e def eps_to_me(z, eps_hat, path, t): """由 eps 预测反解 (m, e)。""" a, sg = path.alpha(t), path.sigma(t) m = (z - sg * eps_hat) / a return m, np.broadcast_to(eps_hat, m.shape).copy() def me_to_v(m, e, path, t): return path.dalpha(t) * m + path.dsigma(t) * e def check_conversions(): """真值层面三种参数化互转,误差应到浮点量级。""" rng = base_rng() data = make_data() rows = [] for path in (LinearPath(), CosineVPPath()): flow = OracleFlow(data, path) z = rng.standard_normal((3000, D)) * 1.6 for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99): m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) # 真值 v -> (m,e) m2, e2 = v_to_me(z, v, path, t) # 真值 eps -> m -> v m3, _ = eps_to_me(z, e, path, t) v3 = me_to_v(m3, e, path, t) rows.append(( path.name, t, float(np.abs(m2 - m).max()), float(np.abs(e2 - e).max()), float(np.abs(m3 - m).max()), float(np.abs(v3 - v).max()), )) return rows # ─────────────────── 放大倍数 ─────────────────── def weights(path, ts): """返回三种参数化下「m 上的单位误差」被放大的倍数(振幅,非平方)。""" wx = np.ones_like(ts) we, wv = [], [] for t in ts: a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) we.append(a / sg) wv.append(abs(da - ds * a / sg)) return wx, np.array(we), np.array(wv) def numeric_weight_check(): """不靠公式,直接用数值扰动验证放大倍数:给 m 加一个固定扰动,看 loss 变化。""" rng = base_rng() data = make_data() flow = OracleFlow(data, LinearPath()) path = LinearPath() z = rng.standard_normal((4000, D)) * 1.6 out = [] for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99): m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) delta = rng.standard_normal((4000, D)) delta = delta / np.linalg.norm(delta) * 0.01 # 固定长度 0.01 的扰动 mp = m + delta ep = (z - path.alpha(t) * mp) / path.sigma(t) vp = me_to_v(mp, ep, path, t) r_eps = np.linalg.norm(ep - e) / np.linalg.norm(delta) r_v = np.linalg.norm(vp - v) / np.linalg.norm(delta) _, we, wv = weights(path, np.array([t])) out.append((t, r_eps, float(we[0]), r_v, float(wv[0]))) return out if __name__ == "__main__": print("=== 换算残差(真值层面互转,应为 1e-14 量级)===") print("path t v->m v->e eps->m eps->v") for name, t, r1, r2, r3, r4 in check_conversions(): print(f"{name:<11}{t:>5.2f}{r1:>12.2e}{r2:>12.2e}{r3:>12.2e}{r4:>12.2e}") print() print("=== 放大倍数:解析式 vs 数值扰动(直线路径)===") print(" t eps实测 eps解析 v实测 v解析") for t, re_, we_, rv_, wv_ in numeric_weight_check(): print(f"{t:>5.2f}{re_:>10.4f}{we_:>10.4f}{rv_:>10.4f}{wv_:>10.4f}") print() print("=== 放大倍数随 t 的变化(直线路径 vs VP 余弦路径)===") ts = np.array([0.01, 0.05, 0.1, 0.2, 0.4, 0.6, 0.8, 0.9, 0.95, 0.99]) for path in (LinearPath(), CosineVPPath()): wx, we, wv = weights(path, ts) print(f"-- {path.label}") print(" t x0 eps v") for i, t in enumerate(ts): print(f"{t:>7.2f}{wx[i]:>8.3f}{we[i]:>10.3f}{wv[i]:>10.3f}") make_figures.py # -*- coding: utf-8 -*- """画配图。数字全部来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) from fm_oracle import ( # noqa: E402 D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, make_schedule, integrate, ) from param_lab import weights # noqa: E402 import path_lab # noqa: E402 import reflow_lab # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:三种参数化的放大倍数 ─────────────── def fig_weights(): ts = np.linspace(0.01, 0.999, 400) wx, we, wv = weights(LinearPath(), ts) fig, ax = plt.subplots(figsize=(7.4, 4.2)) ax.plot(ts, wv, color=C1, lw=2.4, label="velocity 参数化 v") ax.plot(ts, we, color=C0, lw=2.4, label="噪声参数化 eps") ax.plot(ts, wx, color=CGREY, lw=1.8, ls="--", label="干净图参数化 x0") ax.set_yscale("log") ax.set_xlabel("时间 t(0 = 数据端,1 = 纯噪声端)") ax.set_ylabel("同一份误差被放大的倍数(对数轴)") ax.set_title("图 1:预测误差幅度系数(平方损失权重为其平方)") ax.axvline(0.99, color="#cccccc", lw=1, ls=":") ax.annotate("t=0.99 处 eps 系数为 0.010,\nvelocity 还有 1.010", xy=(0.99, 1.0), xytext=(0.55, 0.35), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#999999", lw=1)) ax.legend(loc="upper right", fontsize=10) ax.grid(alpha=0.25) _save(fig, "fig1_param_weights.png") # ─────────────── 图 2:两条路径的真实 ODE 轨迹 ─────────────── def fig_trajectories(): data = make_data() rng = base_rng(4242) z1 = rng.standard_normal((600, D)) xs = data.sample(1200, base_rng(11)) fig, axes = plt.subplots(1, 2, figsize=(12.0, 5.4), sharex=True, sharey=True) sched = make_schedule(300) for ax, path in zip(axes, (LinearPath(), CosineVPPath())): flow = OracleFlow(data, path) z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4") ax.scatter(xs[:, 0], xs[:, 1], s=8, color="#dddddd", label="数据样本(8 个模式)") for i in range(14): ax.plot(traj[:, i, 0], traj[:, i, 1], color=C1, lw=1.3, alpha=0.9) ax.scatter(z1[:14, 0], z1[:14, 1], s=34, color=C0, zorder=5, label="起点(纯噪声)") ax.scatter(z0[:14, 0], z0[:14, 1], s=34, color=C3, marker="s", zorder=5, label="终点(生成)") ax.set_title(path.label) ax.set_xlabel("dim 1") ax.grid(alpha=0.2) axes[0].set_ylabel("dim 2") axes[0].legend(fontsize=9, loc="upper left") fig.suptitle("图 2:同一批起点,两条路径走出来的 ODE 轨迹(300 步 RK4)", fontsize=13) fig.tight_layout() _save(fig, "fig2_trajectories.png") # ─────────────── 图 3:NFE-误差 ─────────────── def fig_nfe(): nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] floor = path_lab.sampling_reference(make_data()) cur = { "linear/euler": path_lab.run_sweep(LinearPath(), "euler", nfe_list), "linear/rk2": path_lab.run_sweep(LinearPath(), "rk2", nfe_list), "vp/euler": path_lab.run_sweep(CosineVPPath(), "euler", nfe_list), "vp/rk2": path_lab.run_sweep(CosineVPPath(), "rk2", nfe_list), } fig, ax = plt.subplots(figsize=(7.6, 4.6)) for (k, v), col, mk in zip(cur.items(), [C1, C0, C2, C3], ["o", "o", "s", "s"]): ax.loglog(nfe_list, v, marker=mk, color=col, lw=2, label=k) ax.loglog(nfe_list, [floor] * len(nfe_list), color=CGREY, ls="--", lw=1.6, label="单次采样参考(4000 个真实样本)") ax.set_xlabel("NFE(模型评估次数)") ax.set_ylabel("终点分布与精确 p_data 的偏差") ax.set_title("图 3:1-rectified 的直线路径 vs VP 余弦路径") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=10) _save(fig, "fig3_nfe_paths.png") return {"nfe": nfe_list, "curves": {k: v.tolist() for k, v in cur.items()}} # ─────────────── 图 4:Reflow ─────────────── def fig_reflow(): snapshot = reflow_lab.reviewed_state() nfe_list = snapshot['nfe'] o = np.asarray(snapshot['nfe_oracle']) a = np.asarray(snapshot['nfe_learned1']) b = np.asarray(snapshot['nfe_learned2']) floor = path_lab.sampling_reference(make_data()) arc1, arc2 = snapshot['arc1_learned'], snapshot['arc2_learned'] s1, s2 = snapshot['S1_oracle'], snapshot['S2_learned'] fig, axes = plt.subplots(1, 2, figsize=(12.0, 4.8)) ax = axes[0] ax.loglog(nfe_list, o, marker="o", color=CGREY, lw=2, label="精确场(数值积分对照)") ax.loglog(nfe_list, a, marker="o", color=C1, lw=2, label="第 1 轮模型") ax.loglog(nfe_list, b, marker="s", color=C3, lw=2, label="第 2 轮模型(reflow 后)") ax.loglog(nfe_list, [floor] * len(nfe_list), color="#bbbbbb", ls="--", lw=1.5, label="单次采样参考(非下限)") ax.set_xlabel("NFE") ax.set_ylabel("终点偏差") ax.set_title("本实验 reflow 后:NFE≥2 的偏差变化很小") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax = axes[1] names = ["第 1 轮", "第 2 轮"] x = np.arange(2) ax.bar(x - 0.18, [arc1, arc2], width=0.34, color=C0, label="弧长/弦长(1 = 几何直线)") ax.bar(x + 0.18, [s1, s2], width=0.34, color=C2, label="配对残差(第1轮精确场/第2轮模型)") ax.set_xticks(x) ax.set_xticklabels(names) ax.set_yscale("log") ax.set_ylabel("配对残差与轨迹长度比(对数轴)") ax.set_title("第 2 轮:几何轨迹接近直线") ax.grid(alpha=0.25, axis="y") ax.legend(fontsize=9) for i, (av, sv) in enumerate([(arc1, s1), (arc2, s2)]): ax.text(i - 0.18, av * 1.08, f"{av:.4f}", ha="center", fontsize=9) ax.text(i + 0.18, sv * 1.08, f"{sv:.4f}", ha="center", fontsize=9) fig.suptitle("图 4:Reflow 的两轮对比(同一个直线路径、同一批起点)", fontsize=13) fig.tight_layout() _save(fig, "fig4_reflow.png") return {"nfe1": a.tolist(), "nfe2": b.tolist(), "S1": s1, "S2": s2, "arc1": arc1, "arc2": arc2} if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None jobs = { "weights": fig_weights, "trajectories": fig_trajectories, "nfe": fig_nfe, "reflow": fig_reflow, } for k, fn in jobs.items(): if only and k != only: continue print(f"[draw] {k}") fn() print("done") fm_checks.py """Independent numerical checks of the article's mathematics and NumPy MLP.""" import json from pathlib import Path import numpy as np from fm_oracle import (GMM2D, make_data, OracleFlow, LinearPath, CosineVPPath, make_schedule, integrate) from reflow_lab import MLP def density(z, t, data, path): # Direct mixture density, independent of OracleFlow._post/score. var = path.alpha(t)**2 * data.s**2 + path.sigma(t)**2 d = z[:, None, :] - path.alpha(t) * data.mu[None] return (data.w[None] * np.exp(-np.sum(d*d, axis=2)/(2*var[None])) / (2*np.pi*var[None])).sum(1) def main(): rng = np.random.default_rng(7) data = make_data() points = rng.normal(size=(32, 2)) score_error = continuity_error = gaussian_error = 0.0 step = 1e-5 for path in [LinearPath(), CosineVPPath()]: flow = OracleFlow(data, path) for t in [.05, .2, .5, .8, .95]: p = density(points, t, data, path) fd = np.zeros_like(points) div = np.zeros(len(points)) for j in range(2): dz = np.zeros_like(points); dz[:, j] = step pp = density(points+dz, t, data, path) pm = density(points-dz, t, data, path) fd[:, j] = (np.log(pp)-np.log(pm))/(2*step) div += (pp*flow.v(points+dz, t)[:, j] - pm*flow.v(points-dz, t)[:, j])/(2*step) score_error = max(score_error, float(np.max(abs(fd-flow.score(points, t))))) pt = (density(points, t+step, data, path)-density(points, t-step, data, path))/(2*step) continuity_error = max(continuity_error, float(np.max(abs(pt+div)))) gaussian = GMM2D([[.3, -.8]], [.7]) gf = OracleFlow(gaussian, path) a, s, da, ds = path.alpha(t), path.sigma(t), path.dalpha(t), path.dsigma(t) var = a*a*.7**2+s*s exact = da*gaussian.mu[0]+(a*da*.7**2+s*ds)/var*(points-a*gaussian.mu[0]) gaussian_error = max(gaussian_error, float(np.max(abs(gf.v(points, t)-exact)))) assert score_error < 2e-7 and continuity_error < 2e-8 and gaussian_error < 1e-12 # Numerical gradients versus moment buffers from one real Adam update. net = MLP([3, 4, 2], np.random.default_rng(11)) x = rng.normal(size=(5, 3)); y = rng.normal(size=(5, 2)) fdw = []; fdb = [] for params, target in [(net.W, fdw), (net.b, fdb)]: for param in params: g = np.empty_like(param) for idx in np.ndindex(param.shape): old = param[idx]; param[idx] = old+1e-6 lp = ((net.forward(x)[0]-y)**2).mean() param[idx] = old-1e-6 lm = ((net.forward(x)[0]-y)**2).mean() param[idx] = old; g[idx] = (lp-lm)/2e-6 target.append(g) net.step(x, y, .001, 1) grad_error = max(float(np.max(abs(g-m/.1))) for g,m in zip(fdw+fdb,net.m+net.mb)) assert grad_error < 2e-9 orders = []; nfe = [] for method, calls in [('euler',1),('rk2',2),('rk4',4)]: errs = [] for n in [8,16]: counter = [0] def velocity(z,t): counter[0] += 1 return z z,_ = integrate(velocity,np.ones((1,2)),make_schedule(n),method) assert counter[0] == n*calls errs.append(float(abs(z[0,0]-np.exp(-1)))) nfe.append(dict(method=method,steps=n,calls=counter[0])) orders.append(dict(method=method,errors=errs,observed_order=float(np.log2(errs[0]/errs[1])))) assert all(r['observed_order'] > k-.15 for r,k in zip(orders,[1,2,4])) # One geometric line can have nonuniform velocity: z_t=t^2, z'_t=2t. ts = np.linspace(0,1,10001) nonuniform = float(np.trapezoid((2*ts-1)**2,ts)) assert abs(nonuniform-1/3) < 1e-8 report = dict(passed=True,score_fd_max_error=score_error,continuity_max_residual=continuity_error, gaussian_closed_form_error=gaussian_error,mlp_gradient_fd_error=grad_error, integrator_orders=orders,nfe_counts=nfe, straight_line_nonuniform_speed=dict(arc_over_chord=1,velocity_residual=nonuniform,one_step_euler_endpoint=0,exact_endpoint=1), dependent_coupling_counterexample='x=epsilon implies z_t=x and v=0; independent endpoint formulas do not apply', errors=[],warnings=[]) Path(__file__).with_name('validation_results.json').write_text(json.dumps(report,indent=2),encoding='utf8') print(json.dumps(report,indent=2)) if __name__ == '__main__': main()
-
AIGC 基本功|分类器无关引导 CFG 的代价与调法-CFG AIGC 基本功|分类器无关引导 CFG 的代价与调法-CFG 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 训练目标与采样流程($\varepsilon$ 预测器、$\bar\alpha_t$ 与 DDIM 那一步怎么走都在那篇推过,这里直接用结论) 关键词:CFG、guidance scale、噪声预测外推、倾斜分布、guidance interval、guidance rescale、autoguidance 01. 为什么需要它 CFG 经常被说成「不增加参数,所以是免费的」。共享权重的常规实现仍需要条件和参考两支预测:可以串行调用两次,也可以把 batch 合并后调用一次。相对同形状的单条件分支,样本级前向算术量约翻倍;调用次数、延迟和峰值显存各有不同口径,后面分别算。 我搭了一个二维高斯混合的玩具:4 个高斯分量,2 个类别,两类故意重叠(类心只差 1.3,标准差 0.6~1.0),每个类里一个紧分量(方差 0.36)一个松分量(方差 1.00)。选它的理由是:高斯混合的 MMSE 去噪器 $E[x_0|x_t]$ 有闭式解,条件分支和无条件分支都是精确的。也就是说,这个玩具里没有任何训练误差,可把训练误差排除,但仍要控制有限步采样、有限样本与数值积分误差。 然后换上一个可控的弱去噪器:把混合分布近似成各向同性高斯,匹配均值和每维平均方差。它有解析的模型偏差,便于单独观察误差与引导如何相互作用;它不能代表真实 UNet 的误差结构。下面各表采用固定种子20260928、200步DDIM、20000个生成样本和40000个真实条件参照样本,方差比的分母也是样本估计。 $w$ 生成方差 / 真实条件方差 软纯度 1.0 0.9856 0.7035 2.0 0.7754 0.8488 3.0 0.6098 0.9211 5.0 0.3768 0.9621 7.5 0.2061 0.9794 15.0 0.0334 0.9930 修正矩匹配后,$w=1$ 方差比为 0.9856,$w=15$ 为 0.0334,软纯度由 0.7035 变为 0.9930。这个单高斯近似保留总方差,却丢失多模态结构;强引导在本例中进一步改变了分布。它不能证明所有弱模型都会同样塌缩,也没有测量真实图像的颜色或结构。 再换回精确条件/无条件去噪器,观察采样分布: $w$ 软纯度 硬纯度 多样性比 典型度 (nats) 类心偏移 真实条件样本(参照) 0.7388 0.7834 1.0000 +0.0000 0.0000 0.0 0.5001 0.5008 1.2512 +0.0081 0.6651 1.0 0.7409 0.7852 0.9876 +0.0030 0.0075 2.0 0.8770 0.9545 0.8596 −0.1995 0.4546 3.0 0.9245 0.9969 0.8193 −0.4974 0.7721 5.0 0.9503 1.0000 0.8042 −1.2480 1.2615 7.5 0.9636 1.0000 0.7933 −2.3042 1.7809 10.0 0.9744 1.0000 0.7603 −3.3963 2.2545 15.0 0.9905 1.0000 0.6716 −5.5530 3.0681 25.0 0.9985 1.0000 0.6033 −9.7613 4.2532 真实参照与 $w=1$ 的软纯度为0.7388对0.7409,平均对数密度差为0对+0.0030,均值偏移为0对0.0075;它们在这些统计上接近。精确score、正确终端分布和精确反向积分的理想条件下,$w=1$ 对应条件采样;这里仍有有限DDIM步数、纯噪声近似起点与有限样本偏差,不能由表格证明完全同分布。 本例 $w=7.5$ 软纯度为0.9636,但平均对数数据密度差为−2.3042 nats、均值偏移为1.7809。这里沿用「典型度」作该密度差的简称,它不是FID、感知质量或分布距离。高斯混合的支撑是整个空间;较低平均密度不能直接翻译成图像过饱和,较高密度也可能来自模式坍缩,仍须结合方差和覆盖判断。 本文关注两支预测的成本、误差组合与幅度统计,以及强度、区间和rescale分别如何干预它们。二维解析实验帮助核对机制;图像观感与参数选择须回到具体模型验证。 指标先对齐。 软纯度为真实后验的样本平均 $E[p(c|x)]$;硬纯度是马氏最近分量标签属于目标类的比例,并非贝叶斯最优分类准确率。多样性比是每维方差平均值之比,不能衡量全部模式覆盖;类心偏移实际是生成均值与参照样本均值的欧氏距离。代码运行于Windows、Python3.11.9、NumPy2.4.3、matplotlib3.10.7,BLAS/OMP单线程;仅官方参考使用已有局部PyTorch2.10 CPU环境,未做GPU或真实图像质量复现。 02. 最小可用理解 三句话: 机制:常规双分支分别预测条件 $c$ 与空条件,然后把无条件预测沿「条件减无条件」的方向外推 $w$ 倍:$e_{\text{guided}}=e_{\text{un}}+w(e_{\text{c}}-e_{\text{un}})$。 成本:固定网络形状时,两支的样本级算术量约为一支的两倍。保留的示意卷积表给出 $1.898\times10^{11}\to3.796\times10^{11}$ MAC与0.126→0.251 GiB逐层输入输出字节和;它不是实际SD-v1-5 UNet逐层测量,也不是峰值显存。 效果:精确模型在固定噪声时刻的组合score是相应倾斜密度的score,但这些密度通常不是某个共同初始密度的前向边际。本文公式 $w=1$ 是条件分支,$w=0$ 是无条件分支;具体pipeline可能对 $w\le1$ 直接关闭双分支。 图中比较软纯度、方差比、平均对数密度差和均值偏移。纯度在较小强度处增长较快,其后放缓;其他变化不必线性。$w=7.5$ 是本实验参照点,也是固定Diffusers v0.35.1 StableDiffusionPipeline接口默认值,不能推广至整个SD系列或视频模型。 03. 数学推导 3.1 符号与定义 DDPM 的前向过程写成 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\,\varepsilon$,训练以本次噪声 $\varepsilon$ 作回归目标,平方损失的最优预测是 $E[\varepsilon|x_t,c]$。记 $$e_{\text{c}}=\varepsilon_\theta(x_t,t,c),\qquad e_{\text{un}}=\varepsilon_\theta(x_t,t,\varnothing)$$ 其中 $\varnothing$ 是空条件(训练时按一定概率丢弃条件,让同一个权重同时充当两个分支)。CFG 的输出是 $$e_{\text{guided}}=e_{\text{un}}+w\,(e_{\text{c}}-e_{\text{un}})=w\,e_{\text{c}}+(1-w)\,e_{\text{un}}$$ 这个改写值得停一下:它是两支预测的仿射组合,系数和为1;在 $w>1$ 时无条件系数为负。$w=1$ 时退化成纯条件分支,$w=0$ 时退化成纯无条件分支,$w>1$ 时无条件分支的系数 $1-w\lt 0$,也就是把「条件相对无条件的优势」往远处推。 常用实现以随机丢弃条件让同一主干学习两支预测;也可分别训练条件与无条件模型。原CFG论文比较过0.1、0.2、0.5的条件丢弃概率,不能当作文生图全系列配置。共享主干通常避免再存一整套网络,空条件embedding是否有额外参数取决于架构;训练仍需分配容量学习空条件任务。原论文写 $(1+w_{\mathrm{paper}})e_{\mathrm{c}}-w_{\mathrm{paper}}e_{\mathrm{un}}$,本文采用Diffusers的 $w=1+w_{\mathrm{paper}}$,引用强度前先统一约定。 3.2 它和「倾斜分布」是什么关系 先明确精确关系。令 $p_t(x_t|c)$ 为前向加噪后的条件边际,$m_t=E[x_0|x_t,c]$ 为平方损失下最优干净样本预测,$\sigma_t=\sqrt{1-\bar\alpha_t}$。对高斯核求导,再用后验期望提出积分,得到 $$s_t(x_t|c)=\nabla_{x_t}\log p_t(x_t|c)=-\frac{x_t-\sqrt{\bar\alpha_t}m_t}{\sigma_t^2}=-\frac{E[\varepsilon|x_t,c]}{\sigma_t}$$ 最优噪声预测器与真实score只差缩放;一般训练网络只有近似关系,向量场也不必恰好是归一化密度的梯度。下面先在精确模型下讨论: $$\tilde{s}(x_t|c)=\nabla\log p(x_t|\varnothing)+w\big(\nabla\log p(x_t|c)-\nabla\log p(x_t|\varnothing)\big)=(1-w)\nabla\log p(x_t)+w\,\nabla\log p(x_t|c)$$ 每个固定噪声时刻定义 $$q_t(z|c)=Z_t^{-1}p_t(z|c)^w p_t(z)^{1-w}$$ $z$ 为该时刻样本,$Z_t$ 为积分归一化常数,不随 $z$ 变化。对真实离散类别,贝叶斯公式给出 $q_t\propto p_t(z)p_t(c|z)^w$;$w\ge0$ 且类别先验非零时,后验有界保证可归一化。任意两个独立模型或负向prompt的密度比需另行检查。其score为 $$\nabla_z\log q_t(z|c)=w\nabla_z\log p_t(z|c)+(1-w)\nabla_z\log p_t(z)$$ 两式的梯度相同,但这只是固定时刻的恒等式,不保证所有 $q_t$ 能由同一个 $q_0$ 加噪得到。 关键是时间相容性:「先倾斜再加噪」通常不同于「分别加噪再倾斜」。一个可手算反例是 $p(z|c)=N(0,1)$、$p(z)=N(0,2)$、$w=2$。取 $P(c)=1/2$ 时后验最大为 $\sqrt2/2$,另一类密度取 $2p(z)-p(z|c)$ 非负且积分为1,可构成合法条件/边际对。初始倾斜方差为 $(2-1/2)^{-1}=2/3$;再做 $\bar\alpha_t=1/2$ 的前向加噪,方差为 $5/6$。若先分别加噪,两支方差为1与 $3/2$,再倾斜得到 $(2-2/3)^{-1}=3/4$。两种边际不同,说明score恒等式不能直接推出终点分布;特殊模型可能相等,偏差也未必随强度单调增加。 本toy另从归一化倾斜密度作网格近似采样:$w=7.5$ 时CFG样本与倾斜样本的固定目标交叉熵为3.6926与2.2258 nats,结合均值/方差给出数值反证。交叉熵差不是KL,仍需检查网格与抽样误差,见第08节。 几何上看得更直接: 三图为条件密度、归一化倾斜密度和DDIM样本平滑直方图。灰线共用无条件密度标尺,蓝点为真实条件样本均值,右图红点为生成均值,偏移约1.78。窗口仅 $[-4.2,4.2]^2$;直方图丢弃窗外点再在窗口内归一化,不能用颜色比较全部尾部质量,也不能据此量化图像过曝。 3.3 误差放大:为什么最坏上界是 $2w-1$ 设真实的条件/无条件预测为 $e^\star_{\text{c}}$ 与 $e^\star_{\text{un}}$,模型误差为 $\delta_{\text{c}}=e_{\text{c}}-e^\star_{\text{c}}$、$\delta_{\text{un}}=e_{\text{un}}-e^\star_{\text{un}}$。引导后预测相对「同样加权过的真值」$w e^\star_{\text{c}}+(1-w)e^\star_{\text{un}}$ 的误差是 $$\delta_{\text{guided}}=w\,\delta_{\text{c}}+(1-w)\,\delta_{\text{un}}$$ 取范数并放缩: $$\|\delta_{\text{guided}}\|\le w\|\delta_{\text{c}}\|+(w-1)\|\delta_{\text{un}}\|\le(2w-1)\max\big(\|\delta_{\text{c}}\|,\|\delta_{\text{un}}\|\big)$$ 这里限定 $w\ge1$,故 $|1-w|=w-1$;一般强度的系数界为 $|w|+|1-w|$。该界比较引导预测相对同样加权真值的误差,不是相对条件预测的误差,也不是端到端分布或画质界。共同误差 $\delta_{\mathrm{c}}=\delta_{\mathrm{un}}$ 会原样保留;相反误差可达到上界;取 $\delta_{\mathrm{un}}=2\delta_{\mathrm{c}}$、$w=2$ 又能完全抵消。实际误差不必随强度单调放大。 3.4 幅度统计与图像过曝的区别 外推可能增大预测幅度,但并非必然。中心化逐元素方差满足 $$\operatorname{Var}(e_g)=w^2\operatorname{Var}(e_c)+(1-w)^2\operatorname{Var}(e_u)+2w(1-w)\operatorname{Cov}(e_c,e_u)$$ 相关性一个数不足以决定趋势。重建 $\hat x_0=(x_t-\sigma_t e_g)/\sqrt{\bar\alpha_t}$ 还依赖向量方向和噪声档位;标准差大不能直接推出样本远离中心或图像过曝。本文固定探测点上确有幅度增长,作为数值现象报告,Lin等人的图像rescale实验是另一类证据。 04. 代码实现 核心是「精确去噪器 + DDIM」。高斯混合下 $E[x_0|x_t]$ 有闭式解:分量内部是高斯的,所以 $$E[x_0|x_t,k]=\mu_k+\frac{\bar\alpha_t^{1/2}\,\sigma_k^2}{\bar\alpha_t\sigma_k^2+(1-\bar\alpha_t)}\big(x_t-\bar\alpha_t^{1/2}\mu_k\big)$$ 再按分量后验 $r_k=p(k|x_t)$ 加权。代码就是这一行公式: def x0_hat(X, a_bar, logw): s = np.sqrt(a_bar) v = a_bar * VAR + (1.0 - a_bar) gain = VAR * s / v r = posterior(X, a_bar, logw) per = MU[None, :, :] + gain[None, :, None] * (X[:, None, :] - s * MU[None, :, :]) return (r[:, :, None] * per).sum(axis=1) 其中 $k$ 是分量索引,$\mu_k$ 是二维均值,$\sigma_k^2$ 是各向同性方差,$a=\bar\alpha_t$。在分量k内部,高斯条件均值增益是交叉协方差乘观测协方差的逆;各向同性化后其标量系数为 $$g_k=\frac{\sqrt a\sigma_k^2}{a\sigma_k^2+1-a}$$ 因此分量后验为 $$r_k=\frac{\pi_k N(x_t;\sqrt a\mu_k,(a\sigma_k^2+1-a)I)}{\sum_j\pi_j N(x_t;\sqrt a\mu_j,(a\sigma_j^2+1-a)I)}$$ 再用全期望公式加权。条件分支只把 $\pi_k$ 换成类内归一化先验;这是解析计算,不是训练了一个神经网络。弱分支的各向同性矩匹配应为 $$m=\sum_k\pi_k\mu_k,\qquad v=\frac{1}{d}\sum_k\pi_k\left(d\sigma_k^2+\|\mu_k-m\|^2\right)$$ $d=2$,分量内方差必须先乘维数再平均。条件 $v=0.84$、无条件 $v=1.06625$;它只匹配协方差的迹,不能匹配完整协方差和多模态结构。 这里有个实现上的坑值得单独说:类内重新归一化之后,类外分量的先验变成 0,$\log 0$ 会直接炸。所以所有先验都要先过一遍 safe_log,把非正的权重映到 $-\infty$ 而不是让 numpy 抛 RuntimeWarning。这个坑在写倾斜分布那段还会再咬一次——$\log p_{\text{tilde}}$ 的归一化常数要在网格上做数值积分,网格范围取窄了(比如只取 $\pm3.6$)会把分布的尾巴切掉,归一化常数偏小,后面所有交叉熵都跟着错。本文用的是 $\pm9$ 的 420 点网格。 $\varepsilon$ 预测和 DDIM 的一步: def eps_hat(X, t, logw): a = abar(t) return (X - np.sqrt(a) * x0_hat(X, a, logw)) / np.sqrt(1.0 - a) # DDIM (eta=0) 的一步,含 CFG 与引导区间 e_un = fn(X, t, LOGW_UNCOND) e_c = fn(X, t, LOGW_COND) w_eff = w if (lo <= t / T <= hi) else 1.0 e_g = e_un + w_eff * (e_c - e_un) x0 = (X - np.sqrt(1.0 - a) * e_g) / np.sqrt(a) X = np.sqrt(a_prev) * x0 + np.sqrt(max(1.0 - a_prev, 0.0)) * e_g 五行里三个细节值得说: w_eff 那一行的 t / T 是归一化时间索引,区间外直接退回 $w=1$(不是 $w=0$)。这是本教学实现的区间开关;是否跳过参考支另见第06节。 e_g 可以写成 w_eff * e_c + (1 - w_eff) * e_un,两者数值等价但后者在 $w$ 很大时更容易看出负系数——建议保留后者以免误读。 DDIM 的更新里 $x_0$ 和 $e_g$ 用的是同一个 $e_g$,所以缩放 $e_g$ 会同时改变 $x_0$ 和噪声项,不是单向的。这一点在第 06 节 rescale 那一段会咬人。 先验证去噪器本身是对的。做法是数值积分对拍:固定 20 万真实样本,对每个探测点 $x_t$ 按 $q(x_t|x_0)$ 加权求样本平均,跟闭式解比。 [Q1] 精确去噪器 E[x0|xt] 的数值积分对拍 t alpha_bar 闭式解 E[x0] 数值积分 E[x0] 最大绝对差 1 9.999000e-01 [-0.80383,-0.00497] [-0.80352,-0.00542] 3.00e-02 50 9.710157e-01 [+0.33377,-0.32706] [+0.33434,-0.32566] 1.13e-02 200 6.590385e-01 [-1.63345,-1.01052] [-1.62640,-1.00988] 1.32e-02 500 7.858724e-02 [-0.03520,+0.23795] [-0.03229,+0.24075] 1.03e-02 900 2.752059e-04 [+0.01798,-0.00712] [+0.02195,-0.00467] 4.12e-03 1000 4.035830e-05 [+0.00501,-0.00579] [+0.00899,-0.00330] 4.03e-03 这些重要性采样结果与闭式解相容,但误差随噪声变化不能证明公式正确:低噪声时权重可能集中到极少数样本。闭式解的依据是上述高斯条件公式;独立对数密度有限差分验证score/MMSE关系,最大绝对差约 $1.17\times10^{-10}$。附录cfg_checks.py也核对矩匹配、倾斜归一化和实际步数。 再验证采样器步数够不够($w=7.5$): steps 软纯度 多样性比 典型度 类心偏移 50 0.9640 0.7490 -2.2718 1.7794 100 0.9637 0.7782 -2.2930 1.7803 200 0.9636 0.7933 -2.3042 1.7809 400 0.9635 0.8006 -2.3101 1.7814 1000 0.9635 0.8055 -2.3136 1.7815 这些是同一批起点、不同积分网格的敏感性检查;400步现恰好执行400步,原先整除步长会误执行500步。1000步仍不是连续时间真值。后文保留200步口径;不能用单项变化小来声称整个采样器已精确收敛。 05. 工业级实现对照 参考实现: Diffusers固定版本SD pipeline源码 → StableDiffusionPipeline.__call__ 以固定Diffusers v0.35.1源码为准,去噪循环里的核心是这几行: # expand the latents if we are doing classifier free guidance latent_model_input = torch.cat([latents] * 2) if self.do_classifier_free_guidance else latents if hasattr(self.scheduler, "scale_model_input"): latent_model_input = self.scheduler.scale_model_input(latent_model_input, t) noise_pred = self.unet(latent_model_input, t, encoder_hidden_states=prompt_embeds, timestep_cond=timestep_cond, cross_attention_kwargs=self.cross_attention_kwargs, added_cond_kwargs=added_cond_kwargs, return_dict=False)[0] if self.do_classifier_free_guidance: noise_pred_uncond, noise_pred_text = noise_pred.chunk(2) noise_pred = noise_pred_uncond + self.guidance_scale * (noise_pred_text - noise_pred_uncond) if self.do_classifier_free_guidance and self.guidance_rescale > 0.0: noise_pred = rescale_noise_cfg(noise_pred, noise_pred_text, guidance_rescale=self.guidance_rescale) latents = self.scheduler.step(noise_pred, t, latents, **extra_step_kwargs, return_dict=False)[0] 和我的最小实现比,有四处差异,每一处都有理由: 第一,合批不等于只启动一个 kernel。 torch.cat 让一次 UNet 调用同时处理两分支,但网络仍包含很多算子、kernel 和临时张量。理论算术量约翻倍;实际延迟与吞吐取决于 batch、显存、并行和硬件,不能直接断言延迟只涨 30%~60% 或吞吐必然减半。 第二,do_classifier_free_guidance 是一个属性而不是参数: @property def do_classifier_free_guidance(self): return self._guidance_scale > 1 and self.unet.config.time_cond_proj_dim is None 固定实现对 $w\le1$(包括0)都关闭双分支,输出普通条件预测;不能靠把该接口设0复现本文公式的无条件端点。负向embedding也可由调用者预先准备,不能说它在一切情况下从未构造。第二个条件说明带guidance embedding的配置另有路径;LCM、LCM-LoRA和其他少步模型应按实际配置判断。 第三,rescale_noise_cfg 把缩放做成了插值而不是替换: std_text = noise_pred_text.std(dim=list(range(1, noise_pred_text.ndim)), keepdim=True) std_cfg = noise_cfg.std(dim=list(range(1, noise_cfg.ndim)), keepdim=True) noise_pred_rescaled = noise_cfg * (std_text / std_cfg) noise_cfg = guidance_rescale * noise_pred_rescaled + (1 - guidance_rescale) * noise_cfg Lin等人原论文3.4节已包含标准差重缩放与 $\phi$ 插值,并报告其配置下 $w=7.5,\phi=0.7$ 效果较好;插值不是Diffusers额外发明的机制。固定SD和SDXL接口的guidance_rescale默认均为0。统计按每样本跨通道/空间维度求,PyTorch std默认作样本方差校正;缩放整个向量,并未先去均值。原函数无分母下界:常量预测可产生0/0或非有限值,移植时须明确跳过/夹紧策略,并记录该策略改变了退化输入定义。 原rescale函数、属性及原 __call__ 中的CFG算术块已在CPU执行,和独立参考误差为 $4.44\times10^{-16}$ 与 $7.11\times10^{-15}$;没有运行完整pipeline或图像checkpoint。 第四,负向prompt走同一个条件通道。 参考支可由空文本换成负向文本,此时它是另一条件预测,不是真正无条件边际的score。组合公式保留,前述贝叶斯后验的密度解释需改写;「不要什么」是操作意图,公式不保证指定语义必被删除。 06. 代价与边界 6.1 算力账:样本级当量、调用次数与峰值显存 保留受SD通道尺度启发的简化卷积表来说明固定计算图上batch翻倍。它合并了不同残差块的通道、省略真实上下采样细节,不是实际UNet清单,绝对量不能称为真实模型的MAC下限或参数量。 示意表,64×64潜空间、每元素2字节 单分支:MAC 1.898e11;逐层输入输出字节和0.126 GiB 双分支:MAC 3.796e11;逐层输入输出字节和0.251 GiB 示意卷积权重约517.0 M,权重不因batch翻倍 单层公式为 $\mathrm{MAC}=B H_o W_o C_i C_o k^2$,$H_o,W_o$ 为输出高宽,$C_i,C_o$ 为输入输出通道,$k$ 为方形核边长;一次乘加计一个MAC,按乘法和加法分别计FLOPs时主体约为两倍MAC。逐层字节和不是峰值显存或DRAM流量的上下界:权重共享、串行分支复用、残差暂存、工作区和融合都会影响真实占用。1 GiB为 $2^{30}$ 字节。 修正im2col先把窗口转成 $(B,H,W,C,k_h,k_w)$,再展平每位置的卷积核;直接reshape会混淆空间与核维度。逐索引卷积及PyTorch conv2d均对拍通过。下为本机float32、64×64×320→320、3×3卷积计时,预热一次、5次取最小,包括展平和分配: batch=1 : 0.1469 s batch=2 : 0.2883 s 时间比 : 1.9630 串行是两次网络调用,合批是一次batch翻倍的调用;两者均为两个样本级前向当量。50步对应50对100个当量,合批仍是50次UNet调用。CPU/GPU延迟、吞吐和峰值显存须实测,单个卷积时间比不构成完整模型瓶颈证明。 左图倍数只来自示意账本;中图分母为逐点两支误差较大范数的平均,与 $2w-1$ 界一致;右图是在固定探测点上的预测幅度统计。不同图使用各自记录的探测随机流,不应强行对齐最后几位。 6.2 误差组合:同一分母下核对上界 探测点固定为「真实数据前向扩散到 $t$」,与 $w$ 无关,这样排除轨迹漂移的干扰: $t$ $w=1$ $w=2$ $w=3$ $w=5$ $w=7.5$ $w=15$ 1000 1.000 2.411 3.824 6.651 10.186 20.791 700 1.000 2.403 3.808 6.620 10.136 20.685 400 0.986 2.198 3.429 5.899 8.991 18.271 200 0.952 1.915 2.925 4.974 7.551 15.302 50 0.896 1.666 2.518 4.276 6.502 13.217 10 0.890 1.639 2.473 4.198 6.384 12.983 所有列现使用同一分母 $E[\max(\|\delta_c\|,\|\delta_u\|)]$,因此可与对应界1、3、5、9、14、29直接比较。表格只报告此toy探测批结果,不把预测相关系数当作误差相关系数,也不由小t的趋势推导所有模型更易失稳。相反/共同误差与完全抵消反例见第03节和附录。 6.3 幅度膨胀与 rescale 的边界 $t=300$ 处,探测点来自真实条件样本: $w$ 标准差比 0.0 0.9110 1.0 1.0000 2.0 1.1009 3.0 1.2109 5.0 1.4493 7.5 1.7690 10.0 2.1026 15.0 2.7914 25.0 4.2052 本探测批的标准差比由0.9110升至4.2052;它是整批二维坐标的统计,不是图像逐样本统计。不能仅凭无条件分支覆盖更多分量就推导其幅度更小,均值、协方差与探测分布共同决定结果。 下面只做二维 toy 的 batch 标准差线性 rescale,在 $w=15$ 下扫系数 $\phi$。真实图像实现按每个样本的 C/H/W 统计;二维向量只有两个坐标,不能把此处整批统计量当成原论文的逐样本实现: $\phi$ 多样性比 典型度 软纯度 0.0 0.6716 −5.5530 0.9905 0.3 0.8274 −6.1435 0.9910 0.5 0.9513 −6.5778 0.9913 0.7 1.0944 −7.0504 0.9914 1.0 1.3521 −7.8447 0.9916 本toy方差比上升,但平均对数密度差更负;它不能替代真实图像的逐样本rescale实验。若预测乘 $k$,重建改变量为 $$\Delta\hat x_0=(1-k)\frac{\sigma_t}{\sqrt{\bar\alpha_t}}e_g$$ 方向由 $e_g$ 决定,取相反预测就得到相反改变量,不能一般说成「把样本往噪声推」。本实验也无像素或感知指标,不能据此声称已修复过曝。 6.4 引导区间:指标取舍与计算成本 把 $w=7.5$ 只开在归一化噪声档位 $t/T$ 的某个区间内(区间外退回 $w=1$): 区间($t/T$) 软纯度 多样性比 典型度 类心偏移 说明 $[0.0,1.0]$ 0.9636 0.7933 −2.3042 1.7809 全程开 $[0.5,1.0]$ 0.9126 0.9571 −0.8896 0.9365 只在高噪声段(链首) $[0.2,0.8]$ 0.9594 0.8167 −2.0693 1.6609 只在中段 $[0.0,0.5]$ 0.9519 0.7672 −1.1345 1.2251 只在低噪声段(链尾) $[0.0,0.2]$ 0.9042 0.8172 −0.0831 0.4222 只在极低噪声段 $[0.0,0.0]$ 0.7409 0.9876 +0.0030 0.0075 全程不开($w=1$ 基线) 再细扫两族区间,用「纯度增益 / 典型度代价」当性价比: 细扫 A:只开链尾(区间 = [0, hi]) 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比 [0.0,0.1] +0.0829 0.0099 8.345 0.1649 0.8899 [0.0,0.2] +0.1632 0.0861 1.896 0.4222 0.8172 [0.0,0.3] +0.1921 0.3080 0.624 0.6888 0.7890 [0.0,0.4] +0.2040 0.6816 0.299 0.9630 0.7737 [0.0,0.5] +0.2110 1.1375 0.185 1.2251 0.7672 [0.0,0.8] +0.2211 2.1335 0.104 1.7045 0.7862 [0.0,1.0] +0.2226 2.3072 0.097 1.7809 0.7933 细扫 B:只开链首(区间 = [lo, 1.0]) 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比 [0.0,1.0] +0.2226 2.3072 0.097 1.7809 0.7933 [0.3,1.0] +0.2154 2.0350 0.106 1.6224 0.8669 [0.5,1.0] +0.1716 0.8926 0.192 0.9365 0.9571 [0.7,1.0] +0.0674 0.1837 0.367 0.2866 0.9813 [0.9,1.0] +0.0101 0.0209 0.481 0.0438 0.9868 本toy只开链尾10%时纯度增益约0.0829、平均对数密度损失约0.0099,比值约8.345。比值带每nat单位,分母近零时敏感;它不是统一质量指标或计算效率。比值最低的点未必被其他点帕累托支配,因为它可能同时取得最高纯度。区间效果不可简单相加,沿途轨迹会改变。 横轴为相对无引导基线的平均对数密度损失,纵轴为软纯度增益,虚线只是固定比值线。两族仅描述本toy的离散候选,不证明完整帕累托前沿。换模型后若增益或代价非正、接近零,双对数图与比值都需调整。 原论文的图像实验发现高噪声引导可能有害、低噪声多余、中段更有用;本toy的指标偏好链尾,不能直接对齐。这里只说明区间值得检验,不能推出所有模型全程引导必非最优。当前教学代码在区间外仍计算两支再设 $w=1$,只改区间并未省算力;生产实现若跳过参考支,$S$步仅 $G$步引导可由 $2S$ 降至 $S+G$ 个当量。$t/T$ 是时间索引比例,不等于标准差或SNR比例,也不是原论文噪声区间的直接坐标。 6.5 什么时候应先核对实现 guidance embedding或蒸馏模型先核对训练目标与推理接口,避免未经训练支持就叠加双分支。 多样性、覆盖和条件一致性分别测量,不能只凭软纯度上涨继续加大强度。 弱模型效果取决于误差方向,本toy不是一般模型失效定理。 要省算力时检查参考支是否真正跳过,再量目标硬件的延迟与显存。 07. 经典论文脉络 Classifier-Free Diffusion Guidance(原论文):联合学习条件/无条件预测,研究保真度与多样性取舍。其引导强度约定比本文少1,也讨论条件丢弃与推理成本,不应说完全没量化代价。 Common Diffusion Noise Schedules and Sample Steps are Flawed(arXiv:2305.08891)——Lin 等人。其中两项建议是训练端的 zero-terminal-SNR 调度(让最后一步真的能走到纯噪声)与推理端的 guidance rescale(3.4 节)。Rescale 直接对着「$w$ 大了会过曝」这个现象下刀,是 rescale 方法的来源;6.3 节数值由本文二维 batch 统计 toy 实测,并非论文原表。 Applying Guidance in a Limited Interval Improves Sample and Distribution Quality in Diffusion Models(arXiv:2404.07724)——Kynkäänniemi 等人(NeurIPS 2024)。指出引导在链首有害、链尾基本没必要、只有中段有用,把引导限制在噪声水平的某个区间内,ImageNet-512 的 FID 从 1.81 降到 1.40,并建议在所有用引导的扩散模型里把区间作为超参暴露出来。 Guiding a Diffusion Model with a Bad Version of Itself(原论文):用容量较小、训练较少的模型作参考支,保持条件任务一致,研究质量与条件对齐的分离控制;也适用于无条件生成。不能把较差模型简单解释为只保留低频,也不能由负系数推出更语义化方向。 Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference(arXiv:2310.04378)——Luo 等人。把「带引导的反向过程」看成一个增广的概率流 ODE,直接蒸馏它的解。这一步之后 $w$ 变成网络的一个输入,每步只需一次前向——这是「干掉 CFG 那 2×」最彻底的一条路,也是知识树里 step_distillation 那篇要展开的内容。 这些工作分别处理引导组合、噪声日程与rescale、引导区间、参考模型选择及引导蒸馏,并非所有模型必经的单一替代链。专门训练可减少推理步骤/分支,但会增加训练与适用范围上的约束,不能说所有少步模型都把同一个w作为输入。 08. 常见误解 误解一:「CFG 就是在采样 $p(x|c)^w p(x)^{1-w}$。」 精确score在固定时刻恒等,最终分布层面不能由此保证。参考统计量是交叉熵 $-E_{X\sim Q}[\log P(X)]$。不同列目标不同,不能横向比较“越小越像”;即使固定 $P$,较低交叉熵也可能来自模式坍缩,需与均值、方差或分布距离联读: 下表 $H_c,H_t,H_u$ 分别为以条件、倾斜和无条件密度作目标的交叉熵,单位nats;后表保留同一批样本的矩统计。 强度/来源 $H_c$ $H_t$ $H_u$ 真实条件 2.5757 — 2.8562 1.0/CFG 2.5670 2.5670 2.8532 1.0/倾斜 2.5891 2.5891 2.8706 3.0/CFG 2.7405 2.4039 3.3536 3.0/倾斜 2.4824 2.3227 3.0070 7.5/CFG 4.5048 3.6926 5.1605 7.5/倾斜 2.6350 2.2258 3.2287 15.0/CFG 7.7257 6.1882 8.4092 15.0/倾斜 2.9792 2.2782 3.6030 强度/来源 方差比 均值偏移 真实条件 1.0000 0.0000 1.0/CFG 0.9876 0.0075 1.0/倾斜 1.0090 0.0096 3.0/CFG 0.8193 0.7721 3.0/倾斜 0.8944 0.3546 7.5/CFG 0.7933 1.7809 7.5/倾斜 0.9077 0.6028 15.0/CFG 0.6716 3.0681 15.0/倾斜 1.0059 0.8828 $w=1$ 两行有限统计接近,不证明同分布。$w=7.5$ 固定目标交叉熵差约1.47 nats,结合均值偏移1.78对0.60支持本设定中分布不同。log-sum-exp保留归一化偏移;420与840网格的log常数差小于 $1.3\times10^{-14}$,$w=1$ 对数密度恒等误差约 $3.1\times10^{-14}$。这是指定窗口内的数值敏感性检查,不是尾部误差严格界;第03节的解析方差反例不依赖本表抽样。 误解二:「w越大越准。」 必须先定义「准」是条件一致性、覆盖、概率拟合还是观感,不能用一列替代所有目标。 误解三:「没有第二套主干参数,就没有推理成本。」 两支增加样本级当量;示意表MAC由 $1.898\times10^{11}$ 增至 $3.796\times10^{11}$,不等于实际延迟或显存必翻倍。 误解四:「w调小一点就省算力。」 固定双分支配置中由30改成1.01不减少当量;真正关闭参考支或跳过部分步骤才会减少计算,条件计算模型还须检查实际路径。 误解五:「rescale修好了分布,可以无限加w。」 它匹配一种标准差并插值,不保证拟合真实分布;本toy不能替代原论文图像实验。 误解六:「w小于1就是条件采样变弱。」 公式中 $0\lt w\lt 1$ 为预测插值,不是分布混合;固定SD接口对 $w\le1$ 关闭双分支,不能靠把接口设0复现toy的无条件端点。 09. 动手验证 五个小实验,脚本在附录里,全部只依赖 numpy 与 matplotlib。 实验一:独立验证。 先跑cfg_checks.py,以高斯矩、密度有限差分和逐索引卷积核对公式/代码;再看Q1重要性采样,理解小t权重退化,不把误差趋势当正确性证明。 实验二:扫自己的w。 修改SPECS,保持方差为正并归一化权重,比较同一起点的Q2统计。必要时换seed并增加样本,分别观察条件一致性、方差和密度,不要求新模型复现本文曲线。 实验三:扫引导区间。 记录Q5增益与代价的绝对量,检查近零分母;要量计算收益,须真正跳过区间外参考支并核对调用数,指标比值不能替代吞吐。 实验四:算真实模型。 CONVS只演示固定图随batch的变化。实际UNet账本应由真实模块形状导出,区分权重、同时活跃张量、工作区与硬件计时;修改示意表几行不保证得到模型下限。 实验五:构造反例。 cfg_checks.py检查先倾斜/先加噪的5/6与3/4方差、误差保持/达到界/抵消,以及rescale改变量方向可相反。先核对边界,再在真实模型评估画质。 10. 延伸阅读 读这篇之前建议先看: DDPM 训练目标与采样流程——$\varepsilon$ 预测器、$L_{\text{simple}}$、以及采样循环怎么写。本文 04 节的 DDIM 一步直接用了那篇的结论。 扩散过程的前向与反向推导——$\bar\alpha_t$、后验方差、以及 $\varepsilon$ 与 score 的换算关系(3.2 节那一步在那篇推过)。 从 DDIM 到高阶采样器——本文全部实验用 DDIM $\eta=0$,换采样器会改变引导误差累积的方式。 VAE的ELBO——可补读条件期望与训练目标;VAE不是本文CFG的必要前提。 读完之后: 少步蒸馏——继续讨论带引导过程如何进入蒸馏目标。 回到知识树:本文是「生成范式」方向的一级节点,往上接 DDPM,往下接少步蒸馏。 附录:完整代码 09 节用到的脚本全文如下(cfg_checks.py、cfg_gmm.py、cfg_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 cfg_checks.py """Independent CFG algebra, moment, convolution and numerical-boundary checks (NumPy only).""" import json from pathlib import Path import numpy as np import cfg_gmm as G import cfg_lab as L def validate(): rng = np.random.default_rng(20261020) moment_errors = [] for logw in [G.LOGW_COND, G.LOGW_UNCOND]: w = np.exp(logw); w /= w.sum() mean = w @ G.MU cov = sum(w[k]*(G.VAR[k]*np.eye(G.DIM)+np.outer(G.MU[k]-mean,G.MU[k]-mean)) for k in range(G.K)) m,v = G.single_gauss(logw) moment_errors += [float(np.max(np.abs(m-mean))),float(abs(v-np.trace(cov)/G.DIM))] # Direct index convolution checks avoid reproducing im2col's axis order. x = rng.normal(size=(2,2,4,5)); w = rng.normal(size=(3,2,3,3)) padded = np.pad(x,((0,0),(0,0),(1,1),(1,1))) expected = np.zeros((2,3,4,5)) for n in range(2): for co in range(3): for h in range(4): for j in range(5): expected[n,co,h,j] = np.sum(padded[n,:,h:h+3,j:j+3]*w[co]) conv_error = float(np.max(np.abs(L.conv3x3(x,w)-expected))) # Finite-difference log-mixture gradients independently verify MMSE-score identity. X = rng.normal(size=(30,2)); score_errors=[] for t in [1,200,900]: a = G.abar(t); h = 1e-5 for logw in [G.LOGW_COND,G.LOGW_UNCOND]: def lp(q):return G.logsumexp_rows(G.logpdf_comps(q,a)+logw[None,:]) grad = np.column_stack([(lp(X+h*np.eye(2)[i])-lp(X-h*np.eye(2)[i]))/(2*h) for i in range(2)]) pred = -G.eps_hat(X,t,logw)/np.sqrt(1-a) score_errors.append(float(np.max(np.abs(pred-grad)))) # p_u=N(0,2), p_c=N(0,1) can be genuine marginals: prior p(c)=1/2 bounds p(c|x)<=sqrt(2)/2. # w=2 gives tilted variance 2/3 at t=0; alpha_bar=1/2 yields 5/6 after forward noise, # whereas tilting the separately noised branches gives 3/4. tilted0 = 1/(2/1-1/2); forward = 0.5*tilted0+0.5 tilted_t = 1/(2/(0.5*1+0.5)-1/(0.5*2+0.5)) # Error cancellation and tightness do not require Monte Carlo or trained models. dc,du = np.array([1.,-2.]), np.array([-1.,2.]) tight_error = abs(np.linalg.norm(3*dc-2*du)-5*np.linalg.norm(dc)) cancel = 2*np.array([1.,0.])-np.array([2.,0.]) # Rescaling epsilon by k changes x0 by +(1-k)*sqrt((1-a)/a)*epsilon, whose direction is not fixed. a,k = 0.5,0.5 delta = [float((1-k)*np.sqrt((1-a)/a)*eps) for eps in [-2.,2.]] grid = {} for wval in [1.,7.5,15.]: values=[] for n in [420,840]: G.logp_tilt_norm(np.zeros((1,2)),wval,n=n) values.append(G._TILT_CACHE[(wval,-9.,9.,n)]) grid[str(wval)] = dict(logZ=values,absolute_difference=abs(values[0]-values[1])) identity = float(np.max(np.abs(G.logp_tilt_norm(X,1.)-G.logp_cond(X)))) counts={str(s):len(G.ddim_timesteps(s)) for s in [1,50,200,400,1000]} assert max(moment_errors)<1e-12 and conv_error<1e-12 and max(score_errors)<1e-7 assert abs(forward-5/6)<1e-12 and abs(tilted_t-3/4)<1e-12 and tight_error<1e-12 assert np.linalg.norm(cancel)==0 and identity<1e-10 assert all(int(k)==v for k,v in counts.items()) result=dict(passed=True,moment_max_error=max(moment_errors),conditional_isotropic_variance=G.single_gauss(G.LOGW_COND)[1], unconditional_isotropic_variance=G.single_gauss(G.LOGW_UNCOND)[1],convolution_max_error=conv_error, score_finite_difference_max_error=max(score_errors),time_compatibility_counterexample=dict(initial_tilt_variance=tilted0,forward_tilt_variance=forward,tilt_noised_variance=tilted_t), error_bound_tightness_error=tight_error,error_cancellation_norm=float(np.linalg.norm(cancel)),rescale_x0_delta_opposite_signs=delta, tilt_grid_convergence=grid,w1_normalization_error=identity,timestep_counts=counts,errors=[],warnings=[]) return result if __name__ == '__main__': result=validate() Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2),encoding='utf-8') print(json.dumps(result,ensure_ascii=False,indent=2)) cfg_gmm.py # -*- coding: utf-8 -*- """cfg_gmm.py —— 在一个「去噪器可解析求解」的高斯混合模型上把 CFG 做实。 为什么非要用 GMM: CFG 需要一支条件去噪器和一支无条件去噪器。用真网络的话两支都有训练误差, 观察到的形变会混入模型误差。而 GMM 的 MMSE 去噪器 E[x0|xt] 有闭式解,两支都是**精确**的,但采样仍有有限步、起点和有限样本误差。 另外 p_t(x_t|c) 也有解析式,可以直接验证「CFG 是不是在从倾斜分布 p(x|c)^w p(x)^{1-w} 里采样」这个命题。 本脚本回答六个问题(全部是实跑数字,不是推测): Q1 精确去噪器对不对?(数值积分对拍) Q2 w 扫描:条件纯度 / 多样性 / 典型度 怎么变? Q3 CFG 采出来的分布,是不是那个倾斜分布? Q4 w 把去噪器的**误差**放大了多少倍?(最坏上界 2w-1) Q5 只在某个噪声区间开引导,比全程开好吗? Q6 引导后的预测幅度膨胀多少?rescale 能不能压回去? 运行: /usr/local/bin/python3 cfg_gmm.py 依赖: numpy(无 torch,全部闭式解 + 向量化) """ import numpy as np # ═════════════════════════════ 1. 数据:两组、四个高斯分量 ═════════════════════════════ # (均值, 各向同性方差, 无条件权重, 类别标签) # 设计意图:两类故意重叠(类心相距约 1.3,分量标准差 0.6~1.0), # 这样 w=1 时条件采样仍会「漏」到对面,给 CFG 留出可观测的改善空间。 # 两类各有一个「紧」分量和一个「松」分量 —— 方差不齐是后面「模式漂进尾巴」的关键。 SPECS = [ ((-0.90, -0.05), 0.36, 0.25, 0), ((-0.10, -0.85), 1.00, 0.25, 0), ((0.90, 0.05), 0.36, 0.25, 1), ((0.10, 0.85), 1.00, 0.25, 1), ] MU = np.array([s[0] for s in SPECS], dtype=float) # [K, 2] VAR = np.array([s[1] for s in SPECS], dtype=float) # [K] PI = np.array([s[2] for s in SPECS], dtype=float) # [K] CLS = np.array([s[3] for s in SPECS], dtype=int) # [K] K = len(SPECS) DIM = 2 TARGET_CLS = 1 # 本文统一用「条件 = 类别 1」做演示 # ── 调度:DDPM 线性 beta,T=1000(与 ddpm 那篇同一套口径)── T = 1000 BETAS = np.linspace(1e-4, 0.02, T) ALPHAS = 1.0 - BETAS ABAR = np.cumprod(ALPHAS) # alpha_bar,下标 0 对应 t=1 def abar(t): """alpha_bar_t,t 从 1 开始(与论文记号一致)。""" return ABAR[t - 1] def safe_log(w): """对数,0 分量记为 -inf 而不报警告。""" w = np.asarray(w, dtype=float) out = np.full_like(w, -np.inf) m = w > 0 out[m] = np.log(w[m]) return out # ═════════════════════════════ 2. 精确去噪器 ═════════════════════════════ def logpdf_comps(X, a_bar): """每个分量对 x_t 的对数密度:x_t|k ~ N(sqrt(a) mu_k, a var_k + (1-a))。""" s = np.sqrt(a_bar) m = s * MU # [K, 2] v = a_bar * VAR + (1.0 - a_bar) # [K] d2 = ((X[:, None, :] - m[None, :, :]) ** 2).sum(-1) # [N, K] return -0.5 * (d2 / v[None, :] + DIM * np.log(2 * np.pi * v)[None, :]) def posterior(X, a_bar, logw): """分量后验权重 r_k = p(k | x_t)。logw 是分量的对数先验。""" lp = logpdf_comps(X, a_bar) + logw[None, :] lp -= lp.max(axis=1, keepdims=True) r = np.exp(lp) return r / r.sum(axis=1, keepdims=True) def x0_hat(X, a_bar, logw): """MMSE 估计 E[x0 | x_t](精确闭式解)。 分量内部是高斯的,所以 E[x0|x_t,k] 有闭式解: mu_k + S_k sqrt(a) (a S_k + (1-a) I)^{-1} (x_t - sqrt(a) mu_k) 再按后验权重 r_k 加权。S_k = var_k * I,所以增益是个标量。 """ s = np.sqrt(a_bar) v = a_bar * VAR + (1.0 - a_bar) gain = VAR * s / v # [K] r = posterior(X, a_bar, logw) # [N, K] per = MU[None, :, :] + gain[None, :, None] * (X[:, None, :] - s * MU[None, :, :]) return (r[:, :, None] * per).sum(axis=1) # [N, 2] def eps_hat(X, t, logw): """epsilon 预测:eps = (x_t - sqrt(a) x0_hat) / sqrt(1-a)。""" a = abar(t) return (X - np.sqrt(a) * x0_hat(X, a, logw)) / np.sqrt(1.0 - a) def cond_logw(cls): """条件分支的分量对数先验:只保留该类内部分量,类内权重重新归一化。""" w = np.where(CLS == cls, PI, 0.0) w = w / w.sum() return safe_log(w) LOGW_UNCOND = safe_log(PI) # 无条件:全混合 LOGW_COND = cond_logw(TARGET_CLS) # 条件:类别 TARGET_CLS # ── 弱去噪器:把整簇拟合成「一个高斯」之后的线性维纳滤波 ── # 给 Q4 用的「不完美模型」:它是该高斯下的最优线性去噪器,但真实数据是混合体, # 所以误差非零、且随 t 变化 —— 正好用来看 w 的放大倍数。 def single_gauss(logw): """按分量权重算出混合体的均值与平均方差。""" w = np.exp(logw) w = w / w.sum() mu = (w[:, None] * MU).sum(0) var = (w * (DIM * VAR + (MU ** 2).sum(1))).sum() - (mu ** 2).sum() return mu, var / DIM def weak_eps_hat(X, t, logw): """单高斯近似的线性去噪器(有误差)。""" a = abar(t) mu, var = single_gauss(logw) s = np.sqrt(a) v = a * var + (1.0 - a) gain = var * s / v x0 = mu[None, :] + gain * (X - s * mu[None, :]) return (X - s * x0) / np.sqrt(1.0 - a) # ═════════════════════════════ 3. 采样器(DDIM, eta=0) ═════════════════════════════ def ddim_timesteps(steps): """均匀步长的 DDIM 时间步序列,从 T 递减;末次直接到干净端,调用数恰为 steps。""" if not isinstance(steps, int) or not 1 <= steps <= T: raise ValueError("steps must be an integer in [1,T]") if T % steps == 0: return list(range(T, 0, -(T // steps))) return np.linspace(T, 1, steps).round().astype(int).tolist() def ddim_sample(x_T, steps=200, w=1.0, interval=(0.0, 1.0), weak=False, rescale=0.0): """确定性 DDIM 采样(eta=0),带 CFG。 x_T : [N, 2] 纯噪声起点 w : 引导强度(w=1 即纯条件,w=0 即纯无条件) interval : 引导生效的 t/T 区间 (lo, hi)。区间外退化为 w=1。 weak : True 则用单高斯弱去噪器(Q4/Q6 用) rescale : 二维玩具的 batch 标准差线性 rescale 系数 phi;不等于图像逐样本 rescale """ fn = weak_eps_hat if weak else eps_hat ts = ddim_timesteps(steps) X = x_T.copy() lo, hi = interval for i, t in enumerate(ts): a = abar(t) a_prev = abar(ts[i + 1]) if i + 1 < len(ts) else 1.0 e_un = fn(X, t, LOGW_UNCOND) e_c = fn(X, t, LOGW_COND) frac = t / T w_eff = w if (lo <= frac <= hi) else 1.0 e_g = e_un + w_eff * (e_c - e_un) # = w_eff*e_c + (1-w_eff)*e_un if rescale > 0.0: # 二维 toy 用整批统计量;图像实现应按样本跨 C/H/W 统计。 # 沿用线性插值,而不是把标准差比取 phi 次幂。 s_g, s_c = e_g.std(), e_c.std() if s_g > 1e-12: e_g = (1.0 - rescale) * e_g + rescale * e_g * (s_c / s_g) x0 = (X - np.sqrt(1.0 - a) * e_g) / np.sqrt(a) X = np.sqrt(a_prev) * x0 + np.sqrt(max(1.0 - a_prev, 0.0)) * e_g return X # ═════════════════════════════ 4. 度量 ═════════════════════════════ def logsumexp_rows(lp): m = lp.max(axis=1, keepdims=True) return m[:, 0] + np.log(np.exp(lp - m).sum(axis=1)) def logp_data(X): """真实数据分布(无条件 GMM)的对数密度。""" return logsumexp_rows(logpdf_comps(X, 1.0) + safe_log(PI)[None, :]) def logp_cond(X): """真实条件分布 p(x|c=TARGET_CLS) 的对数密度。""" return logsumexp_rows(logpdf_comps(X, 1.0) + LOGW_COND[None, :]) def class_posterior(X): """p(类别=TARGET_CLS | x) —— 用真实 GMM 算,作为「软纯度」。""" lp = logpdf_comps(X, 1.0) + safe_log(PI)[None, :] m = lp.max(axis=1, keepdims=True) r = np.exp(lp - m) r /= r.sum(axis=1, keepdims=True) return (r * (CLS[None, :] == TARGET_CLS)).sum(axis=1) def spread(X): """分布的「宽度」:每维方差的平均。""" return float(np.mean(X.var(axis=0))) def summarize(X, Xref, tag=""): """一组样本的核心指标。Xref 是真实条件分布 p(x|c) 的样本,作为基准。""" d2 = ((X[:, None, :] - MU[None, :, :]) ** 2).sum(-1) / VAR[None, :] return dict( tag=tag, purity=float(class_posterior(X).mean()), hard=float((CLS[np.argmin(d2, axis=1)] == TARGET_CLS).mean()), div=float(spread(X) / spread(Xref)), typicality=float(logp_data(X).mean() - logp_data(Xref).mean()), bias=float(np.linalg.norm(X.mean(0) - Xref.mean(0))), ) def sample_data(rng, n, cls=None): """从真实 GMM 采 n 个样本;cls 非空则只采该类的样本。""" w = PI.copy() if cls is not None: w = np.where(CLS == cls, PI, 0.0) w = w / w.sum() k = rng.choice(K, size=n, p=w) return MU[k] + np.sqrt(VAR[k])[:, None] * rng.standard_normal((n, DIM)) # ═══════════════════════ 5. 倾斜分布 p(x|c)^w p(x)^{1-w} ═══════════════════════ def tilted_logpdf(X, w): """未归一化的倾斜对数密度:w*log p(x|c) + (1-w)*log p(x)。""" return w * logp_cond(X) + (1.0 - w) * logp_data(X) def _tilt_grid(w, lo=-9.0, hi=9.0, n=420): """在方格上算归一化后的倾斜密度,返回 (xs, P[ny, nx]),P 求和为 1。""" xs = np.linspace(lo, hi, n) GX, GY = np.meshgrid(xs, xs) P = np.column_stack([GX.ravel(), GY.ravel()]) lp = tilted_logpdf(P, w) lp -= lp.max() d = np.exp(lp).reshape(n, n) return xs, d / d.sum() _TILT_CACHE = {} def logp_tilt_norm(X, w, lo=-9.0, hi=9.0, n=420): """归一化后的 log p_tilde(x)(归一化常数由方格数值积分得到)。""" key = (float(w), float(lo), float(hi), int(n)) if key not in _TILT_CACHE: xs = np.linspace(lo, hi, n) GX, GY = np.meshgrid(xs, xs) lp = tilted_logpdf(np.column_stack([GX.ravel(), GY.ravel()]), w) offset = lp.max() d = np.exp(lp - offset).reshape(n, n) Z = d.sum() * (xs[1] - xs[0]) ** 2 _TILT_CACHE[key] = offset + np.log(Z) return tilted_logpdf(X, w) - _TILT_CACHE[key] def sample_tilted(rng, w, n): """从倾斜分布 p(x|c)^w p(x)^{1-w} 采样(方格离散近似 + 格内抖动)。""" xs, d = _tilt_grid(w) flat = d.ravel() idx = rng.choice(len(flat), size=n, p=flat / flat.sum()) iy, ix = np.unravel_index(idx, d.shape) step = xs[1] - xs[0] return np.column_stack([xs[ix] + (rng.random(n) - 0.5) * step, xs[iy] + (rng.random(n) - 0.5) * step]) # ═════════════════════════════ 6. 主流程 ═════════════════════════════ def base_rng(): """主实验与画图共用的随机流起点。 两边必须 draw 相同次数、相同顺序,否则图上的数字和正文表格会对不上。 """ rng = np.random.default_rng(20260928) Xref = sample_data(rng, 40000, cls=TARGET_CLS) return rng, Xref def main(): rng, Xref = base_rng() q0_rows = {}; q1_rows = []; weak_rows = {}; rescale_rows = {} N = 20000 STEPS = 200 print("=" * 78) print("CFG 实跑账本 —— 数据:2D 高斯混合,4 分量 / 2 类,条件 = 类别 %d" % TARGET_CLS) print("=" * 78) # ── Q1:精确去噪器对拍(数值积分) ── print("\n[Q1] 精确去噪器 E[x0|xt] 的数值积分对拍") print(" 做法:固定 20 万真实样本,对每个探测点 xt 按 q(xt|x0) 加权求样本平均。") print(" t alpha_bar 闭式解 E[x0] 数值积分 E[x0] 最大绝对差") mc_rng = np.random.default_rng(7) X0 = sample_data(mc_rng, 200000) for t in (1, 50, 200, 500, 900, 1000): a = abar(t) Xt = np.sqrt(a) * X0 + np.sqrt(1 - a) * mc_rng.standard_normal(X0.shape) idx = mc_rng.integers(0, len(X0), size=60) xt_probe = Xt[idx] mc = np.empty_like(xt_probe) s = np.sqrt(a) for j, xp in enumerate(xt_probe): # 逐点算,避免大临时矩阵 # 权重就是 q(xt|x0) ∝ exp(-||xt - sqrt(a) x0||^2 / (2(1-a))) d2 = ((xp[None, :] - s * X0) ** 2).sum(-1) ww = np.exp(-0.5 * (d2 - d2.min()) / (1 - a)) # 减最小值防下溢 ww /= ww.sum() mc[j] = (X0 * ww[:, None]).sum(0) q1_rows.append(dict(t=t, min_ess=float(1.0/(ww@ww)))) cf = x0_hat(xt_probe, a, LOGW_UNCOND) # 探测数据来自全混合,故用无条件先验 print(" %4d %.6e [%+.5f,%+.5f] [%+.5f,%+.5f] %.2e" % (t, a, cf[0, 0], cf[0, 1], mc[0, 0], mc[0, 1], np.abs(mc - cf).max())) print(" → MC差异不能独立证明闭式解正确;小t的重要性权重会退化。独立验证见cfg_checks.py。") # 基准 print("\n基准:真实条件分布 p(x|c=%d)" % TARGET_CLS) print(" 每维方差 %.4f | 均值 [%+.4f,%+.4f] | 平均 log p_data %.4f | 软纯度 %.4f" % (spread(Xref), Xref.mean(0)[0], Xref.mean(0)[1], logp_data(Xref).mean(), class_posterior(Xref).mean())) x_T0 = rng.standard_normal((N, DIM)) # ── 步长收敛检查 ── print("\n[Q0] DDIM 步数收敛检查(w=7.5,看 200 步够不够;1000 步 = 全量 T)") print(" steps 软纯度 多样性比 典型度 类心偏移") for st in (50, 100, 200, 400, 1000): X = ddim_sample(x_T0, steps=st, w=7.5) m = summarize(X, Xref) q0_rows[st] = dict(actual_steps=len(ddim_timesteps(st)), **m) print(" %4d %.4f %.4f %+.4f %.4f" % (st, m["purity"], m["div"], m["typicality"], m["bias"])) # ── Q2:w 扫描 ── print("\n[Q2] 引导强度 w 扫描(精确去噪器,DDIM %d 步,N=%d)" % (STEPS, N)) print(" w 软纯度 硬纯度 多样性比 典型度(nats) 类心偏移") r0 = summarize(Xref, Xref, tag="真实条件") print(" 真实条件样本(参照) %.4f %.4f %.4f %+.4f %.4f" % (r0["purity"], r0["hard"], r0["div"], r0["typicality"], r0["bias"])) sweep = {} for w in (0.0, 1.0, 2.0, 3.0, 5.0, 7.5, 10.0, 15.0, 25.0): X = ddim_sample(x_T0, steps=STEPS, w=w) m = summarize(X, Xref) sweep[w] = m print(" %5.1f %.4f %.4f %.4f %+.4f %.4f" % (w, m["purity"], m["hard"], m["div"], m["typicality"], m["bias"])) print(" 软纯度 = E[p(c|x)](真实后验);硬纯度 = 马氏最近分量属于目标类的比例;") print(" 多样性比 = 生成样本每维方差 / 真实条件方差;") print(" 典型度 = 生成样本与真实样本的平均 log p_data 之差(负 = 平均落在较低密度区,不代表支撑之外)。") # ── Q3:CFG 采的是不是倾斜分布 ── print("\n[Q3] CFG 采出的分布 vs 倾斜目标 p(x|c)^w p(x)^{1-w}") print(" 统计量:固定目标的交叉熵差可否定同分布;更小不保证更像目标") print(" w 样本来源 -E[log p(x|c)] -E[log p_tilde] -E[log p(x)] 方差比 类心偏移") tilt_rows = {} # 参照行:真实条件分布自己的交叉熵(作为「完美拟合」的刻度) print(" ---- 真实条件样本 %10.4f %10s %10.4f %6.4f %6.4f" % (-float(logp_cond(Xref).mean()), "(w=1 时同)", -float(logp_data(Xref).mean()), spread(Xref) / spread(Xref), float(np.linalg.norm(Xref.mean(0) - Xref.mean(0))))) for w in (1.0, 3.0, 7.5, 15.0): Xg = ddim_sample(x_T0, steps=STEPS, w=w) Xt = sample_tilted(rng, w, 20000) for name, X in (("CFG 生成", Xg), ("倾斜目标", Xt)): row = dict( ce_cond=-float(logp_cond(X).mean()), ce_tilt=-float(logp_tilt_norm(X, w).mean()), ce_data=-float(logp_data(X).mean()), div=float(spread(X) / spread(Xref)), bias=float(np.linalg.norm(X.mean(0) - Xref.mean(0))), ) tilt_rows[(w, name)] = row print(" %4.1f %-11s %10.4f %10.4f %10.4f %6.4f %6.4f" % (w, name, row["ce_cond"], row["ce_tilt"], row["ce_data"], row["div"], row["bias"])) print(" ↑ 结合均值和方差判断;仅交叉熵接近不能证明同分布") # ── Q4:误差放大(固定探测分布) ── print("\n[Q4] 弱去噪器(单高斯近似)下,w 把误差放大了多少倍") print(" 探测点固定为「真实数据前向扩散到 t」,与 w 无关,排除轨迹漂移的干扰。") ws4 = (1.0, 2.0, 3.0, 5.0, 7.5, 15.0) print(" t " + " ".join("w=%-4g" % w for w in ws4) + " 最坏上界 2w-1(同序)") probe = sample_data(rng, 20000) amp_by_t = {} for t in (1000, 700, 400, 200, 50, 10): a = abar(t) Xt = np.sqrt(a) * probe + np.sqrt(1 - a) * rng.standard_normal(probe.shape) ec = weak_eps_hat(Xt, t, LOGW_COND) - eps_hat(Xt, t, LOGW_COND) eu = weak_eps_hat(Xt, t, LOGW_UNCOND) - eps_hat(Xt, t, LOGW_UNCOND) base = np.maximum(np.linalg.norm(ec, axis=1), np.linalg.norm(eu, axis=1)).mean() row = [] for w in ws4: amp = np.linalg.norm(w * ec + (1.0 - w) * eu, axis=1).mean() row.append(amp / max(base, 1e-12)) amp_by_t[t] = row print(" %4d " % t + " ".join("%6.3f" % v for v in row) + " " + " ".join("%.0f" % (2 * w - 1) for w in ws4)) print(" → 分母为逐点两支较大误差范数的平均,与2w-1界一致;相关误差可放大也可抵消。") print("\n 各向同性矩匹配弱去噪器下端到端效果(仅本toy):") print(" w 生成方差/真条件 软纯度") for w in ws4: X = ddim_sample(x_T0, steps=STEPS, w=w, weak=True) m = summarize(X, Xref) weak_rows[w] = m print(" %5.1f %.4f %.4f" % (w, m["div"], m["purity"])) # ── Q5:引导区间 ── print("\n[Q5] 只在某个噪声区间开引导(w=7.5,精确去噪器,DDIM %d 步)" % STEPS) print(" 区间(t/T) 软纯度 多样性比 典型度 类心偏移 说明") intervals = [ ((0.0, 1.0), "全程开"), ((0.5, 1.0), "只在高噪声段(链的前半)"), ((0.2, 0.8), "只在中段"), ((0.0, 0.5), "只在低噪声段(链的后半)"), ((0.0, 0.2), "只在极低噪声段"), ((0.0, 0.0), "全程不开(w=1 基线)"), ] interval_rows = {} base = None for (lo, hi), name in intervals: if (lo, hi) == (0.0, 0.0): X = ddim_sample(x_T0, steps=STEPS, w=1.0) else: X = ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(lo, hi)) m = summarize(X, Xref) interval_rows[(lo, hi)] = dict(name=name, **m) if (lo, hi) == (0.0, 0.0): base = m print(" [%.1f,%.1f] %.4f %.4f %+.4f %.4f %s" % (lo, hi, m["purity"], m["div"], m["typicality"], m["bias"], name)) # 细扫:把「区间末端从哪切」和「区间起点从哪切」分别扫一遍,看帕累托前沿 print("\n 细扫 A:只看链的后半段(区间 = [0, hi]),hi 从 0.1 扫到 1.0") print(" 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比") fine_a = {} for hi in (0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0): X = ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(0.0, hi)) m = summarize(X, Xref) g = m["purity"] - base["purity"] c = -(m["typicality"] - base["typicality"]) fine_a[hi] = dict(gain=g, cost=c, ratio=g / c, **m) print(" [0.0,%.1f] %+.4f %.4f %6.3f %.4f %.4f" % (hi, g, c, g / c, m["bias"], m["div"])) print("\n 细扫 B:只看链的前半段(区间 = [lo, 1.0]),lo 从 0.0 扫到 0.9") print(" 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比") fine_b = {} for lo in (0.0, 0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9): X = ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(lo, 1.0)) m = summarize(X, Xref) g = m["purity"] - base["purity"] c = -(m["typicality"] - base["typicality"]) fine_b[lo] = dict(gain=g, cost=c, ratio=g / c, **m) print(" [%.1f,1.0] %+.4f %.4f %6.3f %.4f %.4f" % (lo, g, c, g / c, m["bias"], m["div"])) # ── Q6:幅度膨胀 + rescale ── print("\n[Q6] 引导后预测的幅度膨胀(t=300,探测点来自真实条件样本)") Xp_base = sample_data(rng, 8000, cls=TARGET_CLS) a300 = abar(300) Xp = np.sqrt(a300) * Xp_base + np.sqrt(1 - a300) * rng.standard_normal(Xp_base.shape) e_c = eps_hat(Xp, 300, LOGW_COND) e_u = eps_hat(Xp, 300, LOGW_UNCOND) rho = float(np.corrcoef(e_c.ravel(), e_u.ravel())[0, 1]) print(" 两分支预测的相关系数 rho = %.4f(不等于误差相关性或幅度单调性证明)" % rho) print(" w std(eps_guided)/std(eps_cond)") infl = {} for w in (0.0, 1.0, 2.0, 3.0, 5.0, 7.5, 10.0, 15.0, 25.0): e_g = e_u + w * (e_c - e_u) infl[w] = float(e_g.std() / e_c.std()) print(" %5.1f %.4f" % (w, infl[w])) print("\n guidance rescale 的效果(w=15):") print(" phi 多样性比 典型度 软纯度") for phi in (0.0, 0.3, 0.5, 0.7, 1.0): X = ddim_sample(x_T0, steps=STEPS, w=15.0, rescale=phi) m = summarize(X, Xref) rescale_rows[phi] = m print(" %.1f %.4f %+.4f %.4f" % (phi, m["div"], m["typicality"], m["purity"])) print(" → 本设定(精确去噪器 + DDIM eta=0)下 rescale 把多样性拉回来了,") print(" 但典型度更差:它缩放的是 eps 的幅度,而 x0 是 eps 的仿射函数,") print(" x0的改变量依赖eps向量方向,不可一般解释为往噪声推。") print("\n" + "=" * 78) import json from pathlib import Path result = dict(seed=20260928, N=N, steps=STEPS, q0=q0_rows, q1_last_probe_ess=q1_rows, sweep=sweep, weak=weak_rows, error_amplification=amp_by_t, tilt={str(k):v for k,v in tilt_rows.items()}, intervals={str(k):v for k,v in interval_rows.items()}, fine_a=fine_a, fine_b=fine_b, inflation=infl, rescale=rescale_rows, rho=rho, reference=summarize(Xref,Xref)) Path(__file__).with_name("experiment_results.json").write_text(json.dumps(result,ensure_ascii=False,indent=2),encoding="utf-8") print("全部数字由本脚本实跑产生,结构化结果 experiment_results.json。") print("=" * 78) if __name__ == "__main__": main() cfg_lab.py # -*- coding: utf-8 -*- """cfg_lab.py —— CFG 的代价账本:算术量、逐层输入输出字节和、实测耗时。 这一篇的立论是「CFG 让每步算两遍,是推理成本里最容易被忽视的 2×」。 这句话里「2×」是**在固定示意账本口径下精确**的(batch 维翻倍、权重不变), 但读者真正想知道的是:这个 2× 在真机上兑现成多少墙钟时间。 本脚本做三件事: L1 按 stable-diffusion-v1-5 的 UNet 配置手算一份示意卷积表的算术与张量字节和(fp16), 给出「单步张量字节和」和「单步 MAC」这两个绝对量级。 L2 用 numpy 真跑一个 64x64x320 的 3x3 卷积,实测 batch=1 与 batch=2 的时间比。 (CPU + BLAS,只用于说明算术量翻倍在时间上兑现的程度;GPU 上数字会不同。) L3 把「每步两遍」换算成端到端:50 步采样一共多了多少次前向。 运行: /usr/local/bin/python3 cfg_lab.py 依赖: numpy """ import time import numpy as np # ───────────────────────── L1. UNet 配置与账本 ───────────────────────── # 受SD1.5通道尺度启发的简化示意表,不是实际模型结构清单: # block_out_channels = [320, 640, 1280, 1280],潜空间 64x64(对应 512x512 图) # 下面只列卷积:ResBlock 内部是 GroupNorm-SiLU-Conv3x3-GroupNorm-SiLU-Conv3x3。 # 注意力模块的 QKV / 输出投影、时间嵌入 MLP 都不在表里 —— 它们参数不少, # 原表合并了不同resnet的通道与下采样,不能推作真实UNet的MAC或参数下限。 CONVS = [ # (阶段名, 空间尺寸, in_ch, out_ch, 重复次数) ("conv_in", 64, 4, 320, 1), ("down0.resnet", 64, 320, 320, 4), # 2 个 ResBlock x 2 个 conv ("down0.downsample", 64, 320, 320, 1), ("down1.resnet", 32, 320, 640, 2), ("down1.resnet", 32, 640, 640, 2), ("down1.downsample", 32, 640, 640, 1), ("down2.resnet", 16, 640, 1280, 2), ("down2.resnet", 16, 1280, 1280, 2), ("down2.downsample", 16, 1280, 1280, 1), ("down3.resnet", 8, 1280, 1280, 4), ("mid.resnet", 8, 1280, 1280, 4), ("up0.resnet", 8, 2560, 1280, 3), ("up0.resnet", 8, 1280, 1280, 3), ("up1.resnet", 16, 2560, 1280, 3), ("up1.resnet", 16, 1280, 1280, 3), ("up2.resnet", 32, 1920, 640, 3), ("up2.resnet", 32, 640, 640, 3), ("up3.resnet", 64, 960, 320, 3), ("up3.resnet", 64, 320, 320, 3), ("conv_out", 64, 320, 4, 1), ] def ledger(dtype_bytes=2, batch=1, with_cfg=False): """算一份示意卷积表的算术与张量字节和。 dtype_bytes : fp16 = 2 字节 batch : 一次前向同时处理的样本数 with_cfg : True 则 batch 翻倍(无条件分支拼在 batch 维里) 返回 (总 MAC, 层间张量字节总和, 参数量) """ b = batch * (2 if with_cfg else 1) mac = 0 act = 0 params = 0 for _, hw, cin, cout, rep in CONVS: n = hw * hw mac += b * n * cin * 9 * cout * rep # 一个卷积要留着输入、要写出输出,两块都算层间张量 act += b * n * (cin + cout) * dtype_bytes * rep params += cin * 9 * cout * rep return mac, act, params # ───────────────────────── L2. 实测:一个 3x3 卷积,batch 1 vs 2 ───────────────────────── def conv3x3(X, W): """X: [B, C, H, W],W: [Co, C, 3, 3] —— im2col + 一次大矩阵乘。""" B, C, H, Wd = X.shape Co = W.shape[0] Xp = np.pad(X, ((0, 0), (0, 0), (1, 1), (1, 1))) win = np.lib.stride_tricks.sliding_window_view(Xp, (3, 3), axis=(2, 3)) cols = win.transpose(0, 2, 3, 1, 4, 5).reshape(B * H * Wd, C * 9) out = cols @ W.reshape(Co, C * 9).T return out.reshape(B, H, Wd, Co).transpose(0, 3, 1, 2) def time_conv(hw=64, cin=320, cout=320, batch=1, repeat=5): """对一个具体尺寸的 3x3 卷积计时,取 repeat 次的最小值。""" rng = np.random.default_rng(11) X = rng.standard_normal((batch, cin, hw, hw), dtype=np.float32) W = (rng.standard_normal((cout, cin, 3, 3), dtype=np.float32) / np.sqrt(cin * 9)) conv3x3(X, W) # 预热 best = float("inf") for _ in range(repeat): t0 = time.perf_counter() conv3x3(X, W) best = min(best, time.perf_counter() - t0) return best def main(): print("=" * 78) print("CFG 的代价账本") print("=" * 78) print("\n[L1] SD形状启发的示意卷积表,非真实UNet计数,512x512图(潜空间 64x64),fp16,batch=1") print(" (只算上表列出的卷积;注意力矩阵与 autograd 临时缓冲不计)") print(" ──────────────────────────────────────────────────────────────") print(" %-14s %18s %18s" % ("配置", "示意 MAC", "张量字节和")) for tag, cfg in (("CFG off", False), ("CFG on (w>1)", True)): mac, act, par = ledger(with_cfg=cfg) print(" %-14s %18.3e %18s" % (tag, mac, "%.3f GiB" % (act / 1024 ** 3))) mac0, act0, par0 = ledger(with_cfg=False) mac1, act1, _ = ledger(with_cfg=True) print(" ──────────────────────────────────────────────────────────────") print(" 倍率:MAC %.4f | 激活 %.4f ← 这两个 2 是在固定示意账本口径下精确的" % (mac1 / mac0, act1 / act0)) print(" 示意口径说明:上表只列了卷积,每个卷积只算 1 份输入 + 1 份输出。") print(" 注意力投影、GroupNorm/SiLU 的中间张量、残差分支都没计进去,") print(" 它不是峰值显存的上下界:层间张量可复用,权重、工作区、残差另计。本文只用它给量级,结论只依赖「翻倍」这个比值。") print(" 上表示意卷积权重数 %.1f M(非真实模型参数量," "不作生产UNet差额归因)" % (par0 / 1e6)) print("\n[L2] 实测:一个 64x64x320 -> 320 的 3x3 卷积(SD常见卷积形状,仅测本算子)") print(" CPU + numpy BLAS,取 5 次最小值。用来看算术量翻倍兑现成多少墙钟。") t1 = time_conv(batch=1) t2 = time_conv(batch=2) print(" batch=1 : %.4f s" % t1) print(" batch=2 : %.4f s" % t2) print(" 时间比 : %.4f" % (t2 / t1)) print(" → 此CPU/im2col计时包含展平与分配;比值只描述本次运行;") print(" GPU的延迟、吞吐、峰值显存需要在目标硬件另测,") print(" 理论样本算术量约翻倍;吞吐与峰值显存应在实际硬件测量。") print("\n[L3] 换算成端到端") for steps in (20, 30, 50): print(" %2d 步 DDIM:CFG off 共 %2d 个样本级前向当量 | CFG on 共 %2d 个样本级前向当量" % (steps, steps, 2 * steps)) print(" 部分guidance条件蒸馏模型把w作为输入;其他少步模型配置不同,") print(" 只跑一遍前向 —— 是否使用双分支应核对checkpoint与pipeline。") print("\n" + "=" * 78) if __name__ == "__main__": main() make_figures.py # -*- coding: utf-8 -*- """画本文的四张图。数据源全部来自 cfg_gmm.py / cfg_lab.py 的真实输出,不另造数。 cfg_geometry.png 引导把样本推到了哪:真条件 / 倾斜目标 / CFG 实际生成 w_sweep.png 纯度涨了多少、代价涨了多少(双轴) interval.png 引导只在某个噪声区间开,性价比差多少 cost_ledger.png 那个 2x 的账本,以及 w 对误差的放大 运行: /usr/local/bin/python3 make_figures.py 依赖: numpy, matplotlib(Windows字体Microsoft YaHei;可替换为本机中文字体) 注意:matplotlib 的 mathtext 标签一律用 raw 字符串,且反斜杠后面只能跟字母 ——源码会被 sync-code 原样搬进文章附录,反斜杠后面跟非字母会被体检器判成转义污染。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import cfg_gmm as G import cfg_lab as L plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.facecolor"] = "white" plt.rcParams["axes.facecolor"] = "white" plt.rcParams["savefig.facecolor"] = "white" plt.rcParams["font.size"] = 11 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C_MAIN, C_ALT, C_GREEN, C_GRAY, C_PURPLE = ("#2563eb", "#dc2626", "#059669", "#6b7280", "#7c3aed") STEPS = 200 N = 20000 def smooth(H, sigma=1.6): """可分离高斯平滑(不依赖 scipy)。""" r = int(3 * sigma) xs = np.arange(-r, r + 1) k = np.exp(-0.5 * (xs / sigma) ** 2) k /= k.sum() H = np.apply_along_axis(lambda m: np.convolve(m, k, mode="same"), 0, H) H = np.apply_along_axis(lambda m: np.convolve(m, k, mode="same"), 1, H) return H def kde_on_grid(X, xs, sigma=2.0): """样本 -> 与 grid 同坐标的平滑密度(积分归一)。""" n = len(xs) lo, hi = xs[0], xs[-1] X = X[(X[:,0]>=lo)&(X[:,0]<=hi)&(X[:,1]>=lo)&(X[:,1]<=hi)] idx = np.clip(((X[:, 0] - lo) / (hi - lo) * n).astype(int), 0, n - 1) idy = np.clip(((X[:, 1] - lo) / (hi - lo) * n).astype(int), 0, n - 1) H = np.zeros((n, n)) np.add.at(H, (idy, idx), 1.0) H = smooth(H, sigma) return H / H.sum() def fig_geometry(): """三张等高线:真实条件 / 倾斜目标 / CFG 实际生成。""" rng, Xref = G.base_rng() # 与 cfg_gmm.main 同一条随机流 xs = np.linspace(-4.2, 4.2, 200) GX, GY = np.meshgrid(xs, xs) P = np.column_stack([GX.ravel(), GY.ravel()]) def dens(fn): d = np.exp(fn(P)) d = d.reshape(len(xs), len(xs)) return d / d.sum() D_cond = dens(lambda X: G.logp_cond(X)) D_un = dens(lambda X: G.logp_data(X)) w = 7.5 lp_t = G.tilted_logpdf(P, w) lp_t = lp_t - lp_t.max() D_tilt = np.exp(lp_t).reshape(len(xs), len(xs)) D_tilt /= D_tilt.sum() Xg = G.ddim_sample(rng.standard_normal((N, 2)), steps=STEPS, w=w) D_cfg = kde_on_grid(Xg, xs, sigma=2.2) mean_ref = Xref.mean(0) mean_cfg = Xg.mean(0) lvl_un = np.geomspace(D_un.max() * 1e-4, D_un.max(), 6) fig, axes = plt.subplots(1, 3, figsize=(15.2, 5.0)) panels = [ ("真实条件分布 $p(x|c)$", D_cond, mean_ref, C_MAIN), ("倾斜目标 $p(x|c)^{w}p(x)^{1-w}$", D_tilt, None, C_PURPLE), ("CFG 实际采出的分布", D_cfg, mean_cfg, C_ALT), ] for ax, (title, D, mean, col) in zip(axes, panels): ax.contour(xs, xs, D_un, levels=lvl_un, colors=[C_GRAY], linewidths=0.7, alpha=0.55) lvl = np.geomspace(D.max() * 2e-3, D.max(), 8) ax.contourf(xs, xs, D, levels=lvl, cmap="Blues", alpha=0.85) ax.contour(xs, xs, D, levels=lvl, colors=[col], linewidths=1.1) ax.plot(G.MU[:, 0], G.MU[:, 1], "k+", ms=11, mew=1.8) ax.plot(mean_ref[0], mean_ref[1], "o", color=C_MAIN, ms=9, markeredgecolor="white", mew=1.6) if mean is not None and not np.allclose(mean, mean_ref): ax.plot(mean[0], mean[1], "D", color=C_ALT, ms=8, markeredgecolor="white", mew=1.6) ax.annotate("", xy=mean, xytext=mean_ref, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=2.0)) ax.set_title(title, fontsize=12) ax.set_xlim(xs[0], xs[-1]) ax.set_ylim(xs[0], xs[-1]) ax.set_aspect("equal") ax.grid(alpha=0.15) ax.set_xlabel("$x_1$") ax.set_ylabel("$x_2$") axes[0].text(0.02, 0.03, "灰色细线 = 无条件数据密度\n蓝色圆点 = 真实条件均值", transform=axes[0].transAxes, fontsize=8.5, color=C_GRAY, va="bottom") d_bias = float(np.linalg.norm(mean_cfg - mean_ref)) axes[2].text(0.02, 0.03, "红色菱形 = 生成分布均值\n离真实条件均值 %.2f(本图只显示指定窗口)" % d_bias, transform=axes[2].transAxes, fontsize=8.5, color=C_ALT, va="bottom") fig.suptitle(r"引导强度 $w=7.5$:样本被推到了哪(同一坐标系,网格 $[-4.2,4.2]^2$)", fontsize=13) fig.tight_layout(rect=[0, 0, 1, 0.94]) fig.savefig(os.path.join(FIGDIR, "cfg_geometry.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" cfg_geometry.png 类心偏移 %.4f" % d_bias) def fig_w_sweep(): """纯度涨了多少、代价涨了多少。""" rng, Xref = G.base_rng() # 与 cfg_gmm.main 同一条随机流 ws = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 5.0, 7.5, 10.0, 15.0, 20.0, 25.0]) x_T0 = rng.standard_normal((N, 2)) rows = [G.summarize(G.ddim_sample(x_T0, steps=STEPS, w=float(w)), Xref) for w in ws] pur = np.array([r["purity"] for r in rows]) div = np.array([r["div"] for r in rows]) typ = np.array([r["typicality"] for r in rows]) bias = np.array([r["bias"] for r in rows]) fig, ax = plt.subplots(figsize=(9.6, 5.6)) ax.plot(ws, pur, "o-", color=C_MAIN, lw=2.2, ms=5, label="软纯度 $E[p(c|x)]$") ax.plot(ws, div, "s-", color=C_GREEN, lw=2.2, ms=5, label="多样性比(生成方差/真条件)") ax.axhline(0.7388, color=C_GRAY, ls=":", lw=1.2) ax.text(0.6, 0.752, "真实条件样本 0.7388", color=C_GRAY, fontsize=9) ax.set_xlabel(r"引导强度 $w$") ax.set_ylabel("纯度 / 多样性比", color="black") ax.set_ylim(0.35, 1.35) ax.grid(alpha=0.25) ax.legend(loc="center left", fontsize=9.5) ax2 = ax.twinx() ax2.plot(ws, typ, "^--", color=C_ALT, lw=2.2, ms=5, label=r"典型度 $\Delta\log p_{\mathrm{data}}$(nats)") ax2.plot(ws, bias, "v--", color=C_PURPLE, lw=2.0, ms=5, label="类心偏移") ax2.set_ylabel("典型度 / 类心偏移(越负/越大越糟)") ax2.legend(loc="center right", fontsize=9.5) ax.axvline(1.0, color=C_GRAY, lw=1.0, alpha=0.6) ax.axvline(7.5, color=C_ALT, lw=1.2, ls="-.", alpha=0.8) ax.text(7.9, 1.30, "本实验参照 $w=7.5$", color=C_ALT, fontsize=9.5) ax.text(1.1, 1.28, "$w=1$ 就是纯条件模型", color=C_GRAY, fontsize=9) fig.suptitle("本toy的纯度、方差与平均对数密度变化(DDIM %d 步,N=%d)" % (STEPS, N), fontsize=12.5) fig.tight_layout(rect=[0, 0, 1, 0.95]) fig.savefig(os.path.join(FIGDIR, "w_sweep.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" w_sweep.png w=7.5: 纯度 %.4f / 多样性 %.4f / 典型度 %.4f / 偏移 %.4f" % (rows[8]["purity"], rows[8]["div"], rows[8]["typicality"], rows[8]["bias"])) def fig_interval(): """本toy两个统计指标的离散取舍,不是分布距离或完整帕累托前沿。""" rng, Xref = G.base_rng() # 与 cfg_gmm.main 同一条随机流 x_T0 = rng.standard_normal((N, 2)) base = G.summarize(G.ddim_sample(x_T0, steps=STEPS, w=1.0), Xref) def run(lo, hi): m = G.summarize(G.ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(lo, hi)), Xref) gain = m["purity"] - base["purity"] cost = -(m["typicality"] - base["typicality"]) return gain, cost, m fig, ax = plt.subplots(figsize=(9.8, 6.6)) # 等性价比参考线(双对数坐标下是斜率 1 的直线);标签放在可见范围内 xr = np.logspace(-2.4, 0.6, 60) for k in (0.1, 0.5, 1.0, 5.0): ax.plot(xr, k * xr, "--", color=C_GRAY, lw=0.8, alpha=0.65) x_lab = 0.22 / k if 6e-3 <= x_lab <= 3.0: ax.text(x_lab, k * x_lab * 1.1, "性价比 %.1f" % k, fontsize=8, color=C_GRAY, ha="center", va="bottom", clip_on=True) # A 族:区间 = [0, hi],即只在链的后半(低噪声)开 his = (0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0) pts_a = [run(0.0, hi) for hi in his] ax.plot([p[1] for p in pts_a], [p[0] for p in pts_a], "-o", color=C_GREEN, lw=2.2, ms=8, markeredgecolor="white", mew=1.4, label=r"只在低噪声段开:区间 $[0,h]$") for hi, (g, c, m) in zip(his, pts_a): if hi in (0.1, 0.2, 0.5, 1.0): ax.annotate("$h$=%.1f\n性价比 %.2f" % (hi, g / c), (c, g), textcoords="offset points", xytext=(10, 6) if hi < 0.2 else (-64, 6), fontsize=9, color=C_GREEN) print(" 区间 [0.0,%.1f] 纯度增益 %+.4f 典型度代价 %.4f 性价比 %.3f" % (hi, g, c, g / c)) # B 族:区间 = [lo, 1],即只在链的前半(高噪声)开 los = (0.9, 0.8, 0.7, 0.6, 0.5, 0.4, 0.3, 0.2, 0.1, 0.0) pts_b = [run(lo, 1.0) for lo in los] ax.plot([p[1] for p in pts_b], [p[0] for p in pts_b], "-s", color=C_MAIN, lw=2.2, ms=7, markeredgecolor="white", mew=1.4, label=r"只在高噪声段开:区间 $[l,1]$") for lo, (g, c, m) in zip(los, pts_b): if lo in (0.9, 0.5, 0.0): ax.annotate("$l$=%.1f\n性价比 %.2f" % (lo, g / c), (c, g), textcoords="offset points", xytext=(-68, -22) if lo < 0.1 else (10, -14), fontsize=9, color=C_MAIN) print(" 区间 [%.1f,1.0] 纯度增益 %+.4f 典型度代价 %.4f 性价比 %.3f" % (lo, g, c, g / c)) ax.set_xscale("log") ax.set_yscale("log") ax.set_xlabel(r"代价:典型度损失 $-\Delta\log p_{\mathrm{data}}$(nats)") ax.set_ylabel(r"收益:软纯度增益") ax.set_xlim(6e-3, 4.0) ax.set_ylim(6e-3, 0.4) ax.grid(alpha=0.25, which="both") ax.legend(loc="lower right", fontsize=10) fig.suptitle(r"引导区间的双指标取舍($w=7.5$,DDIM %d 步)" % STEPS, fontsize=12.5) fig.tight_layout(rect=[0, 0, 1, 0.955]) fig.savefig(os.path.join(FIGDIR, "interval.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" interval.png") def fig_cost_ledger(): """2x 账本 + w 对误差的放大。""" rng, _ = G.base_rng() # 与 cfg_gmm.main 同一条随机流 mac0, act0, _ = L.ledger(with_cfg=False) mac1, act1, _ = L.ledger(with_cfg=True) fig, axes = plt.subplots(1, 3, figsize=(15.0, 4.6)) # (a) 账本 ax = axes[0] labels = ["单步 MAC", "层间张量\n(fp16)", "50 步的样本级前向\n次数"] v0 = [mac0 / 1e11, act0 / 1024 ** 3, 50.0] v1 = [mac1 / 1e11, act1 / 1024 ** 3, 100.0] x = np.arange(3) ax.bar(x - 0.19, v0, 0.36, color=C_MAIN, label="CFG off") ax.bar(x + 0.19, v1, 0.36, color=C_ALT, label=r"CFG on($w>1$)") for i, (a, b) in enumerate(zip(v0, v1)): ax.text(i - 0.19, a, "%.2f" % a, ha="center", va="bottom", fontsize=8.5) ax.text(i + 0.19, b, "%.2f" % b, ha="center", va="bottom", fontsize=8.5) ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9.5) ax.set_yscale("log") ax.set_ylabel("(MAC 单位 1e11,张量字节和单位 GiB)") ax.set_title("示意算术表的 2 倍", fontsize=12) ax.legend(fontsize=9) ax.grid(alpha=0.2, axis="y") # (b) 误差放大 ax = axes[1] ws = np.array([1.0, 2.0, 3.0, 5.0, 7.5, 10.0, 15.0, 20.0]) probe = G.sample_data(rng, 20000) for t, col in ((1000, C_MAIN), (200, C_GREEN), (10, C_ALT)): a = G.abar(t) Xt = np.sqrt(a) * probe + np.sqrt(1 - a) * rng.standard_normal(probe.shape) ec = G.weak_eps_hat(Xt, t, G.LOGW_COND) - G.eps_hat(Xt, t, G.LOGW_COND) eu = G.weak_eps_hat(Xt, t, G.LOGW_UNCOND) - G.eps_hat(Xt, t, G.LOGW_UNCOND) base = np.maximum(np.linalg.norm(ec, axis=1), np.linalg.norm(eu, axis=1)).mean() rat = [np.linalg.norm(w * ec + (1 - w) * eu, axis=1).mean() / base for w in ws] ax.plot(ws, rat, "o-", color=col, lw=2.0, ms=5, label="实测 $t=%d$" % t) ax.plot(ws, 2 * ws - 1, "k--", lw=1.6, label=r"最坏上界 $2w-1$") ax.set_xlabel(r"引导强度 $w$") ax.set_ylabel("去噪误差被放大的倍数") ax.set_title("本toy两支误差的组合", fontsize=12) ax.legend(fontsize=9) ax.grid(alpha=0.25) # (c) 幅度膨胀 ax = axes[2] Xb = G.sample_data(rng, 8000, cls=G.TARGET_CLS) a = G.abar(300) Xp = np.sqrt(a) * Xb + np.sqrt(1 - a) * rng.standard_normal(Xb.shape) e_c = G.eps_hat(Xp, 300, G.LOGW_COND) e_u = G.eps_hat(Xp, 300, G.LOGW_UNCOND) wgrid = np.linspace(0, 25, 120) infl = np.array([(e_u + w * (e_c - e_u)).std() / e_c.std() for w in wgrid]) ax.plot(wgrid, infl, "-", color=C_PURPLE, lw=2.4) for w in (1.0, 7.5, 15.0): v = float((e_u + w * (e_c - e_u)).std() / e_c.std()) ax.plot([w], [v], "o", color=C_ALT, ms=7) ax.annotate("$w$=%.1f:%.2f 倍" % (w, v), (w, v), textcoords="offset points", xytext=(8, -12), fontsize=9) ax.axhline(1.0, color=C_GRAY, ls=":", lw=1.2) ax.set_xlabel(r"引导强度 $w$") ax.set_ylabel(r"$\mathrm{std}(\varepsilon_{\mathrm{guided}})/\mathrm{std}(\varepsilon_{\mathrm{cond}})$") ax.set_title("预测幅度膨胀(本toy幅度统计)", fontsize=12) ax.grid(alpha=0.25) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "cost_ledger.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" cost_ledger.png MAC %.3e -> %.3e" % (mac0, mac1)) def main(): print("画图(数据源:cfg_gmm.py / cfg_lab.py 的真实输出)") fig_geometry() fig_w_sweep() fig_interval() fig_cost_ledger() print("输出目录:%s" % FIGDIR) if __name__ == "__main__": main()
-
AIGC 基本功|从 DDIM 到高阶采样器-DDIM AIGC 基本功|从 DDIM 到高阶采样器-DDIM 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(ddpm)、扩散过程的前向与反向推导(diffusion_math) 关键词:DDIM、DPM-Solver、确定性采样、二阶采样、步数、NFE 01. 为什么需要它 先给两个数字,都来自文末附录里能直接跑的脚本。 数字一:本例达到相同终点 RMS 阈值,扫描得到的评估预算相差 12.8 倍。 在二维八分量高斯混合上,score 有闭式解;配对相同初始噪声,比较同一有限区间概率流 ODE 的数值终点,并使用相同的末端 $\hat x_0$ 投影。这里的“精度”是到参考轨迹终点的距离,不能直接换算成图像质量、FID 或运行时间。 采样器 压到 1e-2 需要的模型评估次数 压到 1e-3 DDIM(时间步等间隔) 256 > 384 数据预测指数中点法(教学单步二阶) 63 255 DPM-Solver++ 2M(多步二阶) 40 128 3M(固定 v0.35.1 多步系数) 20 64 3M(二次插值指数积分对照) 20 48 DDIM 首次在扫描点 256 次评估达标,v0.35.1 系数版本在 20 次达标;比例为 12.8。扫描只检查指定预算,不证明整数 NFE 的全局最小值。中点法有限步每步两次评估、收尾一次,所以预算是 $2S-1$。少一次模型调用也不等于少同样比例的墙钟时间;真实网络还要计入算子、调度与引导的成本。 数字二:换采样器后,应重新核验缓存配置。 跨步复用特征依赖相邻去噪计算的冗余,但并非都通过输入位移阈值决定。DeepCache 的官方示例 使用更新间隔,TeaCache 则以时间嵌入相关变化估计模型输出差异。这里先固定同一模型、50 步网格与配对起点,分别跑 η=0/0.5/1,量最后十步“模型输入相对变化”: 采样器 最后 10 步输入相对变化 DDIM(η=0) 0.0197 η=0.5 0.0667 跳步 DDIM 家族祖采样(η=1) 0.1294 η=1 的最后十步平均输入位移代理是 η=0 的 6.6 倍。这提示换采样器后应重新校准缓存判据,但均值不能推出逐步命中率。例如十个变化量中九个为 0.01、一个为 1.21,均值是 0.13,2% 阈值仍会接受九步。实际复用间隔或变化判据也不等于此处的输入位移;本文没有实现特征缓存,没有测缓存命中率、缓存加速或画质退化。 所以这篇文章沿着“更新式 → 概率流 ODE → 指数积分 → 实际评估预算”来解释采样器。η=0 的 DDIM 对应一阶确定性格式,η>0 的同族更新带随机项;随机采样不能全部归为 ODE 积分。比较时要分别报告阶数、时间网格、终端处理和 NFE(number of function evaluations),再用适合任务的质量指标验收。 02. 最小可用理解 三句话讲完: DDIM 给出了可复用同一噪声预测模型的采样族。 它用非马尔可夫联合前向过程保持条件边缘 $q(x_t\mid x_0)$,对应回归项仍在同一加噪边缘上计算。改变联合过程并不等于所有 ELBO 权重都不变;实践复用的是 DDPM 常用的共享简化噪声目标。η 控制随机项,η=0 是确定性的特殊情形。参见 DDIM 第 3–4 节。 η=0 的更新可以放进概率流 ODE 的数值积分框架。 对精确 score、正确初始边缘和精确连续求解,SDE 与概率流 ODE 共享边缘分布;给定一个初值,ODE 轨迹确定。有限步误差、模型误差和起始先验误差仍会改变生成分布。下面用配对初值观察两类离散路径。 这张图要看的是:蓝色的 η=0 轨迹是一条平滑曲线,橙色 η=1 轨迹在同一份随机数下走成了折线——每一步都被注入的方向改变。"同一个采样器家族"的两种极端,轨迹的几何性质完全不同,缓存类加速盯的正是这个几何性质。 选择确定性 ODE 后,可以讨论积分阶数。 用 $\lambda=\log(\alpha/\sigma)$(半 log-SNR)分离可精确积分的线性部分,在光滑性、稳定性、启动及终端误差满足条件时,一、二、三阶的全局误差分别按最大步长的一、二、三次方收敛。指数积分提供了高效格式,但高阶方法能省多少评估,仍需测量。 03. 数学推导 3.1 把 DDIM 的一步拆开 DDPM 的 fixed-small 祖先采样先估干净图,再缩放,再加后验噪声。这里用 $a_t=1-\beta_t$ 表示离散单步信号方差系数,$\bar\alpha_t=\prod_{i=1}^{t}a_i$ 表示累积系数,$\tilde\beta_t$ 是给定 $x_0,x_t$ 的后验方差,$z\sim\mathcal N(0,I)$ 是独立标准高斯噪声;终步不加噪声。后文连续振幅 $\alpha(t)=\sqrt{\bar\alpha(t)}$ 与 $a_t$ 区分。 $$x_{t-1} = \frac{1}{\sqrt{a_t}}\Big(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t,t)\Big) + \sqrt{\tilde\beta_t}z$$ DDIM 论文式 (12) 换了一个组织方式。令 $\hat x_0$ 是这一时刻对干净图的估计、$\epsilon_\theta$ 是模型输出的噪声预测,两者由 $\hat x_0 = (x_t-\sqrt{1-\bar\alpha_t}\epsilon_\theta)/\sqrt{\bar\alpha_t}$ 相互确定,则一步写成三项: $$x_{t-1} = \underbrace{\sqrt{\bar\alpha_{t-1}}\hat x_0}_{\text{回数据的方向}} + \underbrace{\sqrt{1-\bar\alpha_{t-1}-\tilde\sigma_t^2}\epsilon_\theta}_{\text{沿当前噪声方向}} + \underbrace{\tilde\sigma_t z}_{\text{新掷的噪声}}$$ 这里第二项必须使用目标时刻的总噪声方差 $1-\bar\alpha_{t-1}$,新注入噪声为 $$\tilde\sigma_t = \eta\sqrt{\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}}\sqrt{1-\frac{\bar\alpha_t}{\bar\alpha_{t-1}}}$$ 每一项在干什么。 第一项是"这一时刻认为的干净图"乘上新时刻的 $\sqrt{\bar\alpha}$,也就是把估计值放到目标噪声水平上。第二项补偿两者的差额:前向过程是 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon$,要从 $x_t$ 走到 $x_{t-1}$,得把噪声幅度从 $\sqrt{1-\bar\alpha_t}$ 缩到 $\sqrt{1-\bar\alpha_{t-1}}$,这个缩放只能沿着"当前噪声方向"做——$\sqrt{1-\bar\alpha_{t-1}-\tilde\sigma_t^2}$ 正好是这两者的勾股差。第三项才是唯一带随机性的部分。 $\eta$ 是那个旋钮。 $\eta=0$ 时第三项消失,$\tilde\sigma_t=0$,迭代完全确定;$\eta=1$ 时 $\tilde\sigma_t$ 恰好等于 DDPM 的后验标准差,第二、三项合起来正好还原 DDPM 的加噪——在相同的完整时间表、fixed-small 方差、预测器及随机数下,$\eta=1$ 与该 DDPM 更新代数等价;跳步时应比较对应重排时间表的祖先采样,而不是原始 1000 步链。04 节会把这两条都量到浮点误差量级。 为什么可以有这个旋钮。 DDIM 从 $q_\eta(x_{t-1}\mid x_t,x_0)$ 与终点边缘构造非马尔可夫联合过程,保留每个条件边缘 $q(x_t\mid x_0)$。噪声回归仍使用这些边缘,所以同一简化目标训练出的模型能用于不同 η;不要把它说成任意联合过程的完整变分目标、最优解及训练权重都完全相同。η=0 的退化过程还应理解为确定性极限。 3.2 换成 ODE 视角 $\eta=0$ 时迭代没有随机项,它可以被看成一条 ODE 的离散格式。连续时间下,前向过程是 $dx = -\frac{1}{2}\beta(t)x\mathrm{d}t + \sqrt{\beta(t)}\mathrm{d}w$(第一项把 $x$ 往 0 拉,第二项持续注入白噪声),对应的概率流 ODE(与 SDE 共享所有边缘分布的那个确定性方程)是 $$\frac{dx}{dt} = -\frac{1}{2}\beta(t)\Big(x + \nabla_x\log p_t(x)\Big)$$ 这个 score 漂移不是“噪声均值”(布朗增量的均值为零)。设前向漂移 $f=-\beta(t)x/2$、扩散强度平方 $g^2=\beta(t)$,其 Fokker–Planck 方程为 $\partial_t p=-\nabla\cdot(fp)+g^2\Delta p/2$。利用 $\Delta p=\nabla\cdot(p\nabla\log p)$,可改写为 $\partial_t p=-\nabla\cdot[(f-g^2\nabla\log p/2)p]$,正是上述 ODE 的连续性方程。该等价要求足够正则的密度、精确 score 与匹配初始分布;网络近似和有限步求解不自动保留精确边缘。原始 SDE 论文第 4.3 节 给出了这一概率流解释。 对平方损失的最优噪声预测,score 满足 $\nabla_x\log p_t(x)=-\epsilon_*(x,t)/\sigma(t)$;训练网络 $\epsilon_\theta$ 只是其近似。这里 $\alpha(t)=\sqrt{\bar\alpha(t)}$、$\sigma(t)=\sqrt{1-\bar\alpha(t)}$,两者是振幅,且 $\alpha^2+\sigma^2=1$。换坐标令 $\lambda=\log(\alpha/\sigma)=\tfrac12\log[\bar\alpha/(1-\bar\alpha)]$,后文记 $\alpha_s,\sigma_s$ 为当前噪声水平的振幅,$\alpha_t,\sigma_t$ 为目标的振幅;从噪声到数据时 $h=\lambda_t-\lambda_s>0$。 “半”来自 $\mathrm{SNR}=\alpha^2/\sigma^2$,所以 $\lambda=\tfrac12\log\mathrm{SNR}$。本线性 1000 步调度在最吵端 $\bar\alpha_T\approx4.036\times10^{-5}$、$\lambda_T\approx-5.06$,最早训练噪声端 $\bar\alpha_1=0.9999$、$\lambda_1\approx4.61$。两个坐标跨度的数字受单位选择影响,不能用“10 对 1000”直接证明哪一段更难。真正有用的是 $\lambda$ 能让线性部分被解析处理,并显式显示噪声尺度变化。 沿概率流解令 $m(\lambda)=\hat x_0(x(\lambda),\lambda)$。由 $d\lambda/dt=-\beta(t)/(2\sigma^2)$ 和 score 关系,得到 $dx/d\lambda=-\alpha^2x+\alpha m$。又有 $d\log\sigma/d\lambda=-\alpha^2$,故乘积分因子后 $d(x/\sigma)/d\lambda=(\alpha/\sigma)m=e^\lambda m$。把它从 $\lambda_s$ 积到 $\lambda_t$,利用 $\sigma_t e^{\lambda_t}=\alpha_t$,便得到下面的精确积分式。这里的“精确”指该 ODE 的积分恒等式;数值方法还要近似沿未知轨迹的 $m$。参见 DPM-Solver 的指数积分推导 与 DPM-Solver++ 的数据预测形式。 $$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t\int_{0}^{h} e^{-(h-u)}\hat x_0(\lambda_s+u)du$$ 这个式子值得停一下:它说明整步的解由"$\hat x_0$ 沿着 $\lambda$ 的变化曲线"加权积分决定,权重是 $e^{-(h-u)}$——越靠近区间右端(越干净的那端)权重越大。验证一下:如果 $\hat x_0$ 是常数,积分给出 $\alpha_t(1-e^{-h})\hat x_0$,加上第一项正好是 $\alpha_t \hat x_0+\sigma_t \epsilon$,也就是"一步跳到位"的精确解。所以步法阶数的本质,就是用多少个点上的 $\hat x_0$ 去逼近这条曲线。 3.3 阶数从哪来:泰勒展开 把沿解轨迹的 $m(\lambda_s+u)$ 在 $u=0$ 展开;下式 $\hat x_0,\hat x_0',\hat x_0''$ 分别指当前 $m,m',m''$。导数是总导数,例如 $m'=\partial_\lambda\hat x_0+(\nabla_x\hat x_0)(dx/d\lambda)$,包含输入状态随轨迹变化,不能只对时间标签求偏导。泰勒展开需相应光滑性;逐项积分给出: $$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t\Big[J_0\hat x_0 + J_1\hat x_0' + J_2\hat x_0'' + \cdots\Big]$$ $$J_0 = 1-e^{-h},\qquad J_1 = e^{-h}-1+h,\qquad J_2 = \frac{h^2-2h+2-2e^{-h}}{2}$$ 小 $h$ 展开看数量级:$J_0\approx h$、$J_1\approx h^2/2$、$J_2\approx h^3/6$。所以导数项每高一阶,整步误差就多一个 $h$。 一阶格式:只留 $J_0$,把 $\hat x_0$ 当成整步不变。局部误差 $O(h^2)$,全局 $O(h)$。 二阶格式:再加 $J_1\hat x_0'$,系数 $\varphi_2 = J_1/h$,用一次评估估出 $\hat x_0'$ 就行。 三阶格式:再加 $J_2\hat x_0''$,系数 $\varphi_3 = J_2/h^2$。 多步法用历史模型输出估计这些总导数。当前点为 $\lambda_0$,两个历史点满足 $\lambda_2\lt\lambda_1\lt\lambda_0$,目标点为 $\lambda_t=\lambda_0+h$。令 $m_j=\hat x_0(x(\lambda_j),\lambda_j)$,$h_0=\lambda_0-\lambda_1$、$h_1=\lambda_1-\lambda_2$,归一化步长比 $r_0=h_0/h$、$r_1=h_1/h$。这样全部差商都有明确单位: $$D_{1,0}=(m_0-m_1)/r_0,\qquad D_{1,1}=(m_1-m_2)/r_1$$ $$D_1=D_{1,0}+\frac{r_0}{r_0+r_1}(D_{1,0}-D_{1,1}),\qquad D_2=\frac{D_{1,0}-D_{1,1}}{r_0+r_1}$$ 在步长同比缩小、$r_0,r_1$ 为正且有界的条件下,在当前点展开,$D_{1,0}=hm'-hh_0m''/2+O(h^3)$,$D_{1,1}=hm'-h(h_0+h_1/2)m''+O(h^3)$;两者相减为 $h(h_0+h_1)m''/2+O(h^3)$。代回可见 $D_1=hm'+O(h^3)$、$D_2=h^2m''/2+O(h^3)$。因此用三点二次插值并精确做上述指数积分时,导数项为 $(J_1/h)D_1+(2J_2/h^2)D_2$。这个 2 来自二次项的归一化,而非随意调参。 这里必须区分两种实现:本地 d2_scale=1.0 复刻固定 diffusers v0.35.1 的多步数据预测更新;d2_scale=2.0 是二次插值指数积分对照版本。05 节直接执行原始上游方法并做外部二次函数检验,报告这两个具体公式的差异,不据此断言整个框架、其他分支或所有名义三阶方法都相同。一般三阶 ODE 求解器也不必对这种强迫函数一步精确。 3.4 DDIM 就是一阶格式 把 03.1 的 DDIM 迭代($\eta=0$)和"只留 $J_0$"的一阶格式对照:$\eta=0$ 时第二项系数为 $\sqrt{1-\bar\alpha_{t-1}}$,第三项为 0,代入 $\hat x_0$ 的定义整理,得到 $$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t(1-e^{-h})\hat x_0(\lambda_s)$$ 与一阶格式逐项相同。所以"DDIM 是一阶方法"不是比喻,是恒等式——04 节用两套独立实现的代码把它验到约 $1.4\times10^{-14}$。 04. 代码实现 全部代码在文末附录,五个脚本:数值实验依赖 NumPy 2.x,配图另需 matplotlib:oracle_gmm.py(实验台与尺子)、ddim_family.py(η 家族)、dpm_solver_lab.py(λ 坐标与高阶格式)、spacing_lab.py(步数摆法)、make_figures.py(配图)。下面的数字是它们的真实输出。 4.1 先造一把可靠的尺子 要在二维上分离模型误差与数值误差,用八个各向异性高斯分量摆成环。权重 $w_k=1/8$、中心 $\mu_k$ 半径 1.8、局部径向/切向方差分别为 0.30/0.05(不是标准差)。加噪后中心变成 $\alpha\mu_k$、协方差变成 $\alpha^2\Sigma_k+\sigma^2I$;令 $\pi_k(x)$ 为观察到 $x$ 后的分量后验权重,则 score 为 $-\sum_k\pi_k(x)(\alpha^2\Sigma_k+\sigma^2I)^{-1}(x-\alpha\mu_k)$。附录按稳定 log-sum-exp 计算权重,并用有限差分验证。解析 score 消除了网络拟合误差,仍保留离散化、终端先验、收尾投影和浮点误差。 A. Oracle 自检:解析 score vs 有限差分 t= 1 abar=0.999900 max|解析 - 差分| = 1.57e-08 t= 200 abar=0.659039 max|解析 - 差分| = 4.99e-11 t= 1000 abar=0.000040 max|解析 - 差分| = 3.10e-11 B. 端点检查:t=T 时协方差与 I 的最大差 = 3.834e-05 C. 尺子的噪声地板:SW1 真vs真 ×8 = 0.03055 ± 0.00452 D. 天花板:真样本当生成样本送进去 SW1 = 0.000000 有限差分只是自检解析公式与代码的一致性。第二项量的是每个分量协方差与 $I$ 的差,不是整个混合分布到标准高斯的完整距离;分量均值仍约有 0.0114 的模长。第三项是当前 4000 样本、512 个固定投影方向下的真对真抽样基线;基线大小不等于方法比较的显著性阈值。第四项为同一经验样本对自身的恒等零值,不能证明分布距离估计无偏。 4.2 最小实现:DDIM 的一步 ddim_family.py 的核心就是下面这个函数,变量名与 3.1 节一一对应: def ddim_step(x, abar_cur, abar_tgt, eps, z, eta): """从 abar_cur 走到 abar_tgt(噪声变小)。返回 (x_tgt, x0_hat)。""" a_c, s_c = alpha_sigma(abar_cur) # 当前时刻的 alpha_t / sigma_t a_t, s_t = alpha_sigma(abar_tgt) # 目标时刻的 alpha_t / sigma_t x0 = (x - s_c * eps) / a_c # 第一项用的 x0_hat var = (1 - abar_tgt) / (1 - abar_cur) * (1 - abar_cur / abar_tgt) sig_tilde = eta * np.sqrt(max(var, 0.0)) # 第三项:新掷噪声的幅度 direc = np.sqrt(max(s_t ** 2 - sig_tilde ** 2, 0.0)) # 第二项:勾股差 return a_t * x0 + direc * eps + sig_tilde * z, x0 最后一行就是 3.1 节那三项,一次加法写完,没有任何按时刻分支的特判。跑个小验证,看 $\tilde\sigma_t$ 在轨迹两端各占多少: _, ABAR = linear_schedule() ts, grid = uniform_t_grid(50) # 51 个 abar,grid[0] 最吵、grid[-1] = 1.0 x, zs = paired_noise(50, n=4, seed=4321) # 起点 + 每一步要用的随机数 print("x.shape =", x.shape, "| grid 长度 =", len(grid)) for i in (0, 25, 48): for eta in (0.0, 1.0): a_c, s_c = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) var = (1 - grid[i+1]) / (1 - grid[i]) * (1 - grid[i] / grid[i+1]) sig_tilde = eta * np.sqrt(var) print(f"step {i:2d} eta={eta:.1f} sigma_tilde = {sig_tilde:.6f}" f" (该步总噪声幅度 {s_t:.4f})") 真实输出: x.shape = (4, 2) | grid 长度 = 51 step 0 eta=0.0 sigma_tilde = 0.000000 (该步总噪声幅度 1.0000) step 0 eta=1.0 sigma_tilde = 0.574284 (该步总噪声幅度 1.0000) step 25 eta=0.0 sigma_tilde = 0.000000 (该步总噪声幅度 0.9509) step 25 eta=1.0 sigma_tilde = 0.419845 (该步总噪声幅度 0.9509) step 48 eta=0.0 sigma_tilde = 0.000000 (该步总噪声幅度 0.0760) step 48 eta=1.0 sigma_tilde = 0.063819 (该步总噪声幅度 0.0760) η=1 时,注入标准差占目标总噪声幅度的比例在示例起点约为 57%,第 48 步约为 84%。这描述三项分解中随机项的比例;它不能单独解释哪种采样器更好,因为漂移、方差、离散化和模型误差都会影响终点分布。 再看 η=1 的第 25 步:ddim_family.py D 节使用 4000 个配对起点、seed=1234,打印每项的 Euclidean RMS,即先求二维平方范数再对样本平均开根号: eta=1 第 25 步三项 RMS: 回数据 0.2119 | 沿噪声方向 1.1114 | 新掷噪声 0.5924 三个向量项的 RMS 描述该批样本的更新组成,既不能推出网络算力花在哪里,也不能单独证明加噪声有害。积分阶数衡量的是确定性更新对连续轨迹的逼近能力,分布质量要另测。 4.3 两次交叉验证 ddim_family.py 里故意写了两套互不相干的代码:一套照 DDPM Algorithm 2 的原式走 1000 步(一步不能跳),一套照 DDIM 式 (12) 走。喂同样的随机数: A. 终点逐元素最大差 = 3.203e-14 终点 RMS = 1.3520 3.2e-14 是本次浮点累加误差的量级。这验证同一完整时间表、fixed-small 方差、同一噪声预测、没有额外裁剪及配对随机数下的代数等价;不涵盖 learned variance、不同终步处理或任意跳步实现。 dpm_solver_lab.py 里同样对待 DDIM 与一阶指数积分器: A. max|DDIM(eta=0) - DPM-Solver-1| S= 20 uniform-t 1.399e-14 uniform-lambda 6.439e-15 S= 50 uniform-t 1.144e-14 uniform-lambda 1.110e-14 两套记号、两套时间网格,输出差在 1e-14。DDIM 是一阶指数积分器,这句到这里可以当结论用了。 4.4 量阶数:误差 vs NFE 4000 次评估的二次插值版本与 2000 次版本在 1000 个配对初值上相差 1.162×10⁻⁸;这是参考解的自检尺度,不是严格误差上界。独立 RK4 直接积分 $dx/d\lambda=\sigma^2(x+\mathrm{score})$,在 128 个另取初值上,2000 与 4000 步相差 1.71×10⁻¹²,4000 步 RK4 与指数积分参考的 RMS 差为 1.11×10⁻⁹;两者使用同一有限端点和最后的 $\hat x_0$ 投影。横轴逐方法由 Counter 实计,包含额外启动评估,不能把各方法 NFE 平均后共用。 这张图要看的是斜率:DDIM 的误差衰减阶约 1,二阶方法约 2,二次插值系数对照接近 3;误差更小的曲线位于图的下方。纵轴量同一 ODE 路径的终点误差,不量模型学到的分布是否正确。 拟合出来: 采样器 实测拟合斜率 p 备注 DDIM(时间步等间隔) 0.98 一阶格式,整数网格与收尾策略同时变化 DDIM(λ 等间隔) 1.01 一阶格式 数据预测指数中点法(单步) 1.91 连续中点,有限步两次、收尾一次 DPM-Solver++ 2M(多步) 2.01 每步一次评估 3M(v0.35.1 多步系数) 2.10 本实验区间呈二阶趋势 3M(二次插值指数积分版本) 2.89 本实验接近三阶趋势 拟合只取真实 NFE≥24、误差大于参考自检尺度三倍的点,中点法为六点、其他方法七点。有限区间斜率不是普适阶数证明;网格量化、启动和末端投影都会影响它。图和正文重用相同随机数消耗顺序与初值,05 节补充系数的独立验证。 4.5 步数与质量的实测表 路径 RMS 与分布距离回答不同问题。SW1 在 512 个固定单位方向投影后计算等样本数的一维经验 Wasserstein-1,再对方向平均;4000 个生成样本与固定的 4000 个参考真样本比较。下表为更换生成起点的五次均值±总体标准差(NumPy std(ddof=0)),不是置信区间;参考样本与投影方向没更换。中点法的真实 NFE 分别是 9、19、49,其余方法为列中预算。 方法 / 名义预算 10 20 50 DDIM(t) 0.1292±0.006 0.0741±0.004 0.0420±0.007 DDIM(λ) 0.2180±0.006 0.1122±0.004 0.0516±0.007 指数中点法 0.1910±0.007 0.0569±0.004 0.0335±0.006 2M 0.0731±0.006 0.0317±0.006 0.0328±0.005 3M 0.0680±0.006 0.0277±0.005 0.0327±0.005 二次插值对照 0.0428±0.005 0.0279±0.004 0.0327±0.005 这里 3M 使用固定 v0.35.1 系数;中点法真实 NFE 为预算减一。 真对真八次基线是 0.0301±0.0026。20 次预算下 DDIM 与多步方法的差距明显,而 2M 与两种 3M 的近邻差别远小于该批重复的波动。50 次下 2M/3M/中点法的估计接近基线;DDIM(λ) 的 0.0516 不能被笼统说成与 0.033 完全一样。更多样本、投影和独立重复能提高分辨能力。RMS 可揭示路径误差,但两条不同耦合路径也可能产生相同边缘分布,所以它不能替代分布质量指标。 4.6 η 到底该调多大 ddim_family.py 在 oracle 下扫一遍 η,再在欠拟合模型下扫一遍。所谓欠拟合是让模型以为数据是单个高斯(用真均值真协方差拟合),它在高噪声区几乎是对的、在低噪声区错得离谱——这是人为选择的一种误差结构,并不代表所有真实网络(也正好对应"训练时看到的是加噪数据分布"这件事)。 图中固定种子下多数格子 η=0 的 SW1 较低,但并不单调或全部最优。oracle 的 N=20 时 η=0.25 得 0.0719,低于 η=0 的 0.0746;单高斯近似在 N=20 也有 0.2124 对 0.2152,在 N=100 时 η=0.75 得 0.1828,低于 η=0 的 0.1845。这些小差别没有独立多种子置信区间,不能据此排名。这个例子能反驳“少步必然应调大 η”,也不能建立“确定性采样必胜”的新定律。 4.7 输入位移能提示什么缓存风险 图量的是 $r_i=\sqrt{\mathbb E\|x_{i+1}-x_i\|^2}/\sqrt{\mathbb E\|x_i\|^2}$ 的逐步值,以及最后十步的均值;它不是逐样本相对误差的平均,也不是特征变化。有限网格最后一步直接投影,不能由图说步长趋于零。最后十步输入代理均值相差 6.6 倍;$\hat x_0$ 位移的平均绝对 RMS 为 0.0371 对 0.2407,约 6.5 倍,单位与数据相同。缓存判据若使用相应代理,应检查整条序列的分布与失败步,真实特征缓存则需另测。 4.8 评估预算 图中柱子为已扫描预算中首次达到指定路径 RMS 阈值的真实 NFE。solve_dpm2s 这个历史函数名保留,但它实现的是数据预测指数中点教学方法,不能写成对原始噪声预测 DPM-Solver-2 的逐项复现。有限步两次评估,$\sigma=0$ 的投影一步一次,故 $S$ 步实际为 $2S-1$ 次。未达标表示扫描到最大预算仍未达到,不是完整最优预算搜索。 4.9 步数该摆在哪:收尾步不是免费的 阶数回答的是"步数变多时误差掉多快",没回答"步数摆在哪"。spacing_lab.py 固定 NFE=20、只改摆法,终点误差如下: 摆法 DDIM(一阶) 2M(二阶) 在 $t$ 上等间隔(本文的时间网格) 1.107e-01 5.285e-02 在 $\lambda$ 上等间隔 1.713e-01 2.897e-02 在 $\lambda$ 上等间隔、落回整数 $t$ 1.712e-01 2.894e-02 Karras / EDM($\rho=7$) 1.873e-01 7.038e-02 Karras($\rho=3$) 2.655e-01 3.397e-01 本例的阶数、网格和收尾点要一起看。 固定 NFE=20,一阶方法在所测 $t$ 网格中的路径误差最低,2M 在所测 λ 网格中最低。Karras 网格这里也使用完全相同的 VP 振幅比 $\sigma/\alpha$ 端点约 158→0.01,并没有直接照搬 EDM 的 80→0.002;差别是内点密度。ρ=7 的最大有限 λ 间隔 1.019,ρ=3 为 2.455,λ 均匀网格为 0.509。ρ=7 也并非表里最差(ρ=3 更差);它在此误差指标上表现较差,不能解释成 EDM 的通用失败或只归因于单段步长。EDM 还包含预条件、Heun 更新、噪声注入等设计,本例只比较网格。EDM 原文。 uniform-t 为什么赢,值得追问一层。 它把 $\lambda$ 的上界截在了 +1.76(NFE=20 时),剩下的干净端交给最后那一步"直接输出 $\hat x_0$"。这条捷径是不是免费的?不是。沿高精度参考轨迹量"在 $\lambda$ 处直接输出 $\hat x_0$ 会偏多少": $\lambda$ −0.23 +0.74 +1.71 +2.67 +3.64 提前收尾的偏差 5.234e-01 1.400e-01 4.398e-02 9.416e-03 1.280e-03 截得越早白送的偏差越大,而且这份偏差不随步数下降——它只取决于截在哪个 $\lambda$。在本例的候选截断点中,可观察到较低的总误差(2M,NFE=20,只改截断点): $\lambda_{max}$ 1.0 2.0 2.5 3.0 4.61(走到底) 终点误差 9.82e-02 2.80e-02 1.71e-02 1.81e-02 2.90e-02 这五个候选呈 U 形,最低点在 2.5,比"走到底"低约 1.7 倍;未证明连续截断范围的全局最优。这条也解释了 uniform-t 的行为为什么还不错:它的截断点随步数自动往右挪(NFE=20 时 1.76、50 时 2.55、100 时 3.1),等于一个廉价的自适应策略——但它是巧合,不是设计。 局部难度代理也有边界。 把一阶缺失项写成 $\delta_i\approx\alpha_{t_i}h^2m'/2$,可观察 $\alpha\|m'\|$ 的变化。本例在 λ<0 与 λ≥0 区间的平均分别约 0.1024、0.1000,峰值约 0.4417,出现在 λ≈−0.19 的中间段;两个区间均值接近不等于全区间难度均匀。该代理没有包含误差传播矩阵、末端投影或实际模型扰动,不能单独算出最优步数排布。 05. 工业级实现对照 本节固定在 diffusers v0.35.1 的 DPMSolverMultistepScheduler,也回查 v0.30.0 多步源文件。结论限定到所读版本与分支;不能把浮动 main 链接当版本证据。 第一处:训练输出、积分参数化与随机过程是三个开关。 prediction_type 指网络输出的 ε / sample / v 等,convert_model_output 再转换成更新需要的数据或噪声预测;algorithm_type="dpmsolver++" 用数据预测积分,dpmsolver 用噪声预测。sde-dpmsolver 与 sde-dpmsolver++ 还改变漂移和随机项,不能说只是往同一条 ODE 原封不动加回噪声。某些新分支处理 flow sigmas,本例不覆盖它们。数据预测能改善某些引导问题,不能由参数化名称推断所有预测曲线都更光滑。 第二处:启动与终端需要单独处理。 历史不足时调度器按 lower_order_nums 降阶;lower_order_final 在低步数等条件下控制最后几步降阶,final_sigmas_type="zero" 让最后目标 σ=0。我们的循环明确在最后一步输出当前 $\hat x_0$;这是收尾近似,并非把高阶项带到 $h=\infty$ 就能无误差地处理整个剩余区间。以固定系数版本测试 warm2s=True,额外一次启动评估后拟合斜率为 2.13,默认为 2.10;影响不大,不能证明启动误差在其他配置中永远无关。 第三处:网格不是坐标变换本身。 源码提供 leading、trailing、默认 linspace 和其他 sigma 排布选项。本文 uniform_t_grid 先取 T→0 的整数节点,而 uniform_lambda_grid 保留 S 个有限模型评估点再附加完全干净目标,两者末端的有限评估位置不同。不能称为“只换内点、其他都一样”的比较。NFE=192 时,DDIM(t) RMS 为 1.245e−02,DDIM(λ) 为 1.775e−02;在扫描预算中分别于 256 和 384 次达到 1e−2。λ 坐标方便指数积分,并不自动证明 λ 均匀网格对所有方法最佳。离散训练时间标签是否可插值也要按网络核对,本文 oracle 接受任意累积系数。 第四处:把三阶系数差异验证到具体公式。 03.3 的 $D_2$ 表示 $h^2m''/2$;二次插值指数积分的末项需要 $2J_2D_2/h^2$。固定 v0.35.1 多步 dpmsolver++ 分支的代码则使用: D2 = (D1_0 - D1_1) / (r0 + r1) x_t = ((sigma_t / sigma_s0) * sample - alpha_t * (exp(-h) - 1) * D0 + alpha_t * ((exp(-h) - 1) / h + 1) * D1 - alpha_t * ((exp(-h) - 1 + h) / h**2 - 0.5) * D2) 上式与附录都采用括号组织赋值。最后一个系数正好为 $J_2/h^2$。另一方面,同版本单步源码 的三阶 heun 数据预测分支写的是 D2 = 2.0 * (D1_1 - D1_0) / (r0 - r1);它的节点及差商方向不同,所以不能只看一个 2 就断定两种算法完全等价。 本轮提取原始文件中的一、二、三阶方法及 _sigma_to_alpha_sigma_t,保持函数 AST 不变,以 PyTorch CPU float64 真执行。均匀和非均匀有限步、12 组噪声/步长组合的上游更新与本地 d2_scale=1.0 对照,最大差 1.24×10⁻¹⁴。调用不走弃用位置参数,使用 algorithm_type="dpmsolver++"、use_flow_sigmas=False;二阶设 midpoint。这验证实际更新分支,不是完整 diffusers 包、生产 scheduler 的所有配置或 GPU 图像生成复现。 再用外部指定的二次函数 $m(\lambda)=A+B\lambda+C\lambda^2/2$,切断模型输出对状态的依赖。指数积分的原函数为 $e^\lambda[A+B(\lambda-1)+C(\lambda^2-2\lambda+2)/2]$,所以不需要高分辨率梯形积分当“真值”。在 λ=0.3 起步、h 从 0.4 缩到 0.025,真实最大绝对误差为: 一阶: 4.17e-02 1.04e-02 2.57e-03 6.39e-04 1.59e-04 二阶midpoint: 8.16e-03 1.05e-03 1.32e-04 1.65e-05 2.07e-06 v0.35.1多步系数: 1.96e-03 2.46e-04 3.06e-05 3.81e-06 4.75e-07 二次插值版本: 6.66e-16 7.77e-16 7.77e-16 4.44e-16 6.11e-16 这里一阶局部误差按 h²、midpoint 按 h³,固定多步系数在该受控函数上也留下 h³ 项;二次插值版本到浮点量级。非均匀历史点同样核对。对二次插值做精确指数积分应具备这一精确性,一般名义三阶 ODE 方法却不必如此。结论是这两个具体指数更新在该归一化下不同,以及本地 GMM 的拟合趋势为 2.10 与 2.89;不把自行修改的系数称为经过真实图像验证的生产补丁,也不推断上游作者意图。 06. 代价与边界 省了什么。 η=0 省掉每步随机噪声生成,固定初始状态时更新确定;本例轨迹位移较平滑,提供了校准缓存判据的动机。主要大幅减少神经网络调用的机制是重新选择过程、网格与更新格式,而不是高维采样中噪声生成本身必然很贵。本例路径误差的预算表不能直接当成生产提速或图像质量证明。 赔了什么。 少了路径噪声这个自由度。 更换初始噪声仍可产生多样性;确定性不等于没有分布覆盖。精确 score 和正确初始分布下,概率流 ODE 本来就能匹配对应 SDE 的边缘,所以不能说它先天必然过平滑。真实模型中的误差与有限步积分可能让随机/确定性方法各有优势,需在同一质量和成本口径下比较。 高阶方法需要历史、稳定性和启动精度。 多步法低预算时历史不够,差商在极短或重复时间点还会失稳。显式高阶不自动比低阶稳;强 CFG、阈值化或不光滑网络输出可能放大局部误差。midpoint / heun 是所读多步实现的二阶选项,不能与作者其他 API 的 solver 选项混用。默认低步数降阶是一种实际稳定化处理,不是自动的最优方案。 理论阶数包含正则性条件。 本例 oracle 是平滑解析函数,仍要考虑网格、启动和末端投影。对真实网络,不应先断言阶数一定打折;应固定连续区间与端点,测多个渐近预算,并检查是否被模型误差或离散标签量化限制。高阶曲线偏离理论时,先分开这些来源。 最后一次投影有代价。 $\sigma=0$ 是 λ=∞,有限训练端点直接输出 $\hat x_0$ 的偏差与求解器阶数不同。4.9 的截断点扫描展示二者的权衡;固定收尾噪声会限制误差继续下降,不能把更多步数误当成能修复所有误差。 什么时候保留随机过程。 如果任务定义本身要求随机转移、训练/蒸馏的路径分布或噪声注入,应先保证过程匹配。若目的是提高真实图像的覆盖与质量,则同时实测 ODE/SDE、η、引导强度和预算,而非套用此二维例子。本文的单高斯近似只代表一种人为误差结构。 什么时候值得上高阶。 本例约 20 次预算时多步方法已显著降低路径误差;预算极低时二次插值版本也可能不稳定(NFE=6 时误差约 0.8445,而 2M 约 0.1460)。这是高阶并非总优的具体反例。预算几百次时高阶仍可能更省达到同一路径阈值的评估次数,不能改口断言一阶必然更好;生产选择还要测单步成本、质量和可靠性。 07. 经典论文脉络 Denoising Diffusion Implicit Models(2020,DDIM):重构非马尔可夫联合前向过程、保持条件边缘,复用简化噪声预测目标,并给出包括确定性极限的采样族。它的反向生成链仍按条件转移逐步执行,不应被称为“非马尔可夫反向”。 Score-Based Generative Modeling through Stochastic Differential Equations(2020):统一 score 与反向 SDE,并给出共享边缘的概率流 ODE,是解释随机过程与确定性流关系的基础。 DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 Steps(2022):解析处理线性部分,并在半 log-SNR 坐标构造指数积分高阶格式。标题中的 Around 10 Steps 是论文所测任务的结果,不是每个模型的预算保证。 DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic Models(2022):用数据预测及多步变体改善引导采样中的数值稳定性,算法、阈值化和适用空间要分别核对。 Elucidating the Design Space of Diffusion-Based Generative Models(2022,EDM):把噪声调度、求解器、预条件等设计拆开比较,提供 Heun 与噪声水平排布等方案。把其网格搬到 VP oracle 上并不等于复现整套 EDM。 Consistency Models 与 Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference(2023):学习沿概率流轨迹的一致映射,支持一/少步生成;多步推理仍可带重新加噪与调度,不能简单说“从此不需要采样器”。 这条脉络区分过程、数值更新和学习映射:它们可以组合,但对训练目标、初始分布与成本的要求不同。 08. 常见误解 误解一:DDIM 只是把 DDPM 步幅放大。 非马尔可夫前向族与可选随机项给出了额外自由度;η=0 也能走 1000 步,仍然是确定性更新。η=1 只有在完整时间表、fixed-small 方差、相同预测与终步处理时才有前文的 DDPM 等价关系。 误解二:少步必调大 η,或 η=0 必胜。 两个绝对判断都不成立。本例 N=10 的 η=0 比 η=1 的 SW1 低,但 N=20 的 η=0.25 又略低于 η=0;这些单次小差别不能外推。随机标准差占比或平均轨迹位移也不能单独推导质量排序。 误解三:名义阶数越高,任何预算都更省。 NFE=6 的二次插值版本比 2M 更差,启动和稳定性不可省。名义三阶与本文 2.10 的拟合斜率也不矛盾:应检查具体系数、网格、终端及渐近区,而非只读选项名字。03.3 的差商推导与 05 的原始方法实跑给出了可查的局部证据。 误解四:SW1 贴近真对真基线就失效了。 同一分布的两个经验样本仍有非零距离,它是有限样本效应;近邻差别需要更高分辨率的实验。对自身为零不证明估计无偏。配对路径 RMS 可以暴露求解误差,却不能给不同随机耦合的边缘分布作通用质量排名。 误解五:半 log-SNR 坐标、λ 均匀网格、Karras 网格是一件事。 第一项是推导坐标,后两项是评估点排布。本文同端点 Karras 只改内点密度,而 $t$ 网格还改变最后有限评估点;比较要写全这些条件。 误解六:平均输入变化大于阈值,缓存就零命中。 平均数不约束每一步,输入变化又不等于中间特征或残差变化。要证明缓存收益,必须真的实现缓存并量命中率、误差、速度和验收质量,本篇只提供输入位移代理。 09. 动手验证 在 Python 3.11、NumPy 2.4.6、matplotlib 3.10.7 的 Windows CPU 环境下,五个完整脚本全部 exit 0、stderr 为空。图示依赖 matplotlib;数值脚本依赖 NumPy 2.x。NumPy 的随机种子固定,主要实验种子 20260927,η 对照使用 paired_noise 的 1234,投影方向 7。实跑证据另用 PyTorch 2.10.0+cpu 核验原始更新方法;没有 GPU、训练权重或图像质量测试。安装依赖后按以下顺序运行;输出时间随 CPU 与线程设置变化。 cd outputs/fundamentals_files/ddim_samplers/code python oracle_gmm.py # ① 标定尺子(先量地板) python ddim_family.py # ② η 旋钮与缓存抖动 python dpm_solver_lab.py # ③ 阶数、预算、三阶项的受控检验 python spacing_lab.py # ④ 步数摆法与收尾点 python make_figures.py # ⑤ 画图 四个具体的改动实验: 改 ddim_family.py η 扫描点,先看固定种子表,再更换多组种子。本例最后十步输入代理均值为 0.0197、0.0667、0.1294(η=0/0.5/1);记录逐步曲线,不用均值替代缓存命中率。 比较 dpm_solver_lab.py 已列出的 d2_scale=1.0 和 2.0 两种版本。真实 NFE 拟合为 2.10 与 2.89;二次强迫函数最后一个 h 的误差为 4.75e−07 与 6.11e−16。保留上游系数对照,别把教学版本直接当生产补丁。 比较 uniform_t_grid 与 uniform_lambda_grid:DDIM 拟合约 0.98/1.01,扫描到 1e−2 的 NFE 为 256/384。打印最后一个有限 λ,就会看到这不是只有内点密度不同的实验。量化网格可能因重复整数节点而缩短,预算必须读 Counter。 在 spacing_lab.py 里比较 NFE=20、λ 上界 4.61 与 2.5。2M 路径 RMS 为 2.90e−02 与 1.71e−02;沿同一参考路径的提前投影误差也要一起记录。这展示固定预算内截断与积分误差的权衡,不保证 λ=2.5 对其他数据最优。 10. 延伸阅读 DDPM 的训练目标与采样流程:本篇必要先修,定义噪声回归、后验方差与累计调度。 扩散过程的前向与反向推导:补读 SDE/ODE 与参数化;即使只学过 DDPM,03.2 已补充读懂本文所需的连续性方程背景。 变分下界与重参数化:理解条件边缘、联合分布与训练权重的区分。 分类器无关引导:引导改变向量场与数值稳定性,要和求解预算一起测。 流匹配与 Rectified Flow:学习速度场的另一条路径,勿把所有流直接套成 VP 噪声调度。 附录:完整代码 09 节用到的脚本全文如下(oracle_gmm.py、ddim_family.py、dpm_solver_lab.py、spacing_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 oracle_gmm.py # -*- coding: utf-8 -*- """采样器实验的地基:一个 score 有闭式解的二维高斯混合 + 一把「尺子」。 为什么必须先把这两件事钉死: 1. 比较采样器时,最大的干扰项是**模型误差**。同一个噪声网络,在 t=1 和 t=1000 上的误差可以差两个数量级,你根本分不清「这个采样器好」和「这个时间步好学」。 用闭式 score(oracle),模型误差恒为 0,仍有终端先验偏差、收尾投影、离散化和浮点误差。 2. 比较采样器时,第二大的干扰项是**尺子本身的噪声**。切片 Wasserstein 距离 是用有限样本估的,两个「都对」的分布之间也能量出一个正数。这个正数就是 抽样基线;近邻差别需增加样本和重复,而非一律判成运气。 所以这个脚本干三件事:给出 oracle、给出尺子、量出地板。后面三个脚本全部 import 它,保证四处用到的目标分布、指标、随机数是同一套。 python oracle_gmm.py 依赖:numpy, matplotlib(画图时才需要) """ import numpy as np T = 1000 # 训练时的扩散步数 D = 2 # 数据维度(二维才画得出轨迹,也才跑得起闭式 score) N_EVAL = 4000 # 评价用的样本数 N_DIRS = 512 # 切片 Wasserstein 的投影方向数 # ══════════════════════════════════════════════════════════════════ # 1. 噪声调度 # ══════════════════════════════════════════════════════════════════ def linear_schedule(T: int = T, b0: float = 1e-4, b1: float = 0.02): """DDPM / diffusers 默认的线性 beta 调度。 返回 abar 的长度是 T+1:abar[t] = prod_{s<=t} (1 - beta_s), abar[0] = 1 表示「完全干净」。这样下标和论文里的 t 直接对齐, 不用在 0-based / 1-based 之间来回换算。 """ betas = np.linspace(b0, b1, T) abar = np.concatenate([[1.0], np.cumprod(1.0 - betas)]) return betas, abar def alpha_sigma(abar_t: float): """给定 abar_t,返回 (alpha_t, sigma_t) = (sqrt(abar), sqrt(1-abar))。 这是全文唯一的「坐标」:x_t = alpha_t * x_0 + sigma_t * eps。 注意 alpha 是**信号尺度**,不是 DDPM 论文里的 alpha_t = 1 - beta_t。 """ return np.sqrt(abar_t), np.sqrt(1.0 - abar_t) # ══════════════════════════════════════════════════════════════════ # 2. 目标分布:8 个切向拉长的高斯,摆成一个环 # ══════════════════════════════════════════════════════════════════ def make_target(K: int = 8, radius: float = 1.8, radial_var: float = 0.30, tangential_var: float = 0.05): """K 个分量均匀摆在一个半径 radius 的环上,每个分量沿径向拉长。 为什么不用各向同性:各向同性的高斯混合,加噪之后很快变成一个圆球, 各向同性混合的score仍可非线性;这里选各向异性来构造具体实验。 径向拉长之后,环上的 score 场有明显曲率,离散化误差才显出来。 """ ang = np.linspace(0.0, 2.0 * np.pi, K, endpoint=False) mu = np.stack([radius * np.cos(ang), radius * np.sin(ang)], axis=1) Sig = np.zeros((K, D, D)) for k, a in enumerate(ang): R = np.array([[np.cos(a), -np.sin(a)], [np.sin(a), np.cos(a)]]) Sig[k] = R @ np.diag([radial_var, tangential_var]) @ R.T w = np.ones(K) / K return w, mu, Sig def sample_true(n: int, w, mu, Sig, rng): """从目标分布抽样。""" k = rng.choice(len(w), size=n, p=w) L = np.linalg.cholesky(Sig[k]) # (n, D, D) z = rng.standard_normal((n, D)) return mu[k] + np.einsum("nij,nj->ni", L, z) # ══════════════════════════════════════════════════════════════════ # 3. Oracle:加噪后分布的闭式 score,以及最优的 eps 预测 # ══════════════════════════════════════════════════════════════════ def _cov_at(abar_t: float, Sig): """q(x_t) 的第 k 个分量协方差:C_k = abar * Sig_k + (1 - abar) * I。""" return abar_t * Sig + (1.0 - abar_t) * np.eye(D) def logp_and_score(x, abar_t: float, w, mu, Sig): """返回 (log q_t(x), score_t(x)),x 形状 (n, D)。 q_t 是 K 个高斯的混合:第 k 个分量的均值是 sqrt(abar) * mu_k, 协方差是 abar * Sig_k + (1 - abar) * I。score 是这个混合分布的 对数梯度 = 各分量 score 的后验加权平均。 """ C = _cov_at(abar_t, Sig) # (K, D, D) inv = np.linalg.inv(C) ld = np.log(np.linalg.det(C)) r = x[:, None, :] - np.sqrt(abar_t) * mu[None] # (n, K, D) quad = np.einsum("nki,kij,nkj->nk", r, inv, r) lg = np.log(w)[None, :] - 0.5 * quad - 0.5 * ld[None, :] m = lg.max(axis=1, keepdims=True) p = np.exp(lg - m) Z = p.sum(axis=1, keepdims=True) logp = (m[:, 0] + np.log(Z[:, 0])) pi = p / Z # 后验分量权重 comp = -np.einsum("kij,nkj->nki", inv, r) # 每个分量的 score score = np.einsum("nk,nki->ni", pi, comp) return logp, score def eps_star(x, abar_t: float, w, mu, Sig): """MMSE 意义下最优的 eps 预测:eps* = -sigma_t * score_t(x)。 因为 x_t = alpha x_0 + sigma * eps,对 x_t 求 log 梯度会得到 grad log q_t = -E[eps | x_t] / sigma,所以最优的噪声预测就是 score 乘一个 -sigma。后面所有采样器都拿它当「模型」。 """ _, s = logp_and_score(x, abar_t, w, mu, Sig) return -np.sqrt(1.0 - abar_t) * s def x0_from_eps(x, abar_t: float, eps): """由 x_t 和 eps 反解 x_0:x_0 = (x_t - sigma_t * eps) / alpha_t。""" a, sg = alpha_sigma(abar_t) return (x - sg * eps) / a # ══════════════════════════════════════════════════════════════════ # 4. 尺子:切片 Wasserstein-1 + 平均对数密度 # ══════════════════════════════════════════════════════════════════ def make_dirs(n_dirs: int = N_DIRS, seed: int = 7): """预先抽好投影方向,全篇共用同一组。 这一条很重要:每次评价都重新抽方向的话,两组「同样好」的样本也会因为 方向不同量出不同的数,这部分方差完全是无谓的。方向固定之后, A 和 B 的差别就只来自样本本身。 """ th = np.random.default_rng(seed).standard_normal((n_dirs, D)) th /= np.linalg.norm(th, axis=1, keepdims=True) return th def sliced_w1(X, Y, TH=None, n_dirs: int = N_DIRS, rng=None): """切片 W1:在 n_dirs 个随机方向上算一维 W1,再取平均。 一维 W1 有闭式解:把两个样本集投影后排序,逐位相减取绝对值平均。 单位和数据同单位(这里是「平均要挪多远」),比 MMD^2 好解释。 """ if TH is None: TH = make_dirs(n_dirs) if rng is None else None if TH is None: th = rng.standard_normal((n_dirs, X.shape[1])) th /= np.linalg.norm(th, axis=1, keepdims=True) else: th = TH a = np.sort(X @ th.T, axis=0) b = np.sort(Y @ th.T, axis=0) return float(np.abs(a - b).mean()) def mean_logp(X, w, mu, Sig): """生成样本在真实分布下的平均对数密度。""" lp, _ = logp_and_score(X, 1.0, w, mu, Sig) return float(lp.mean()) def evaluate(X, Xref, w, mu, Sig, lp_ref, TH): """一次评价,返回 (SW1, dlogp)。 dlogp = 生成样本的平均 log 密度 − 真实样本的平均 log 密度。 0仅表示平均log密度相同,不证明分布相同;正数也不等于质量更好。 """ return sliced_w1(X, Xref, TH=TH), mean_logp(X, w, mu, Sig) - lp_ref # ══════════════════════════════════════════════════════════════════ # 5. 主流程:验 oracle、量尺子的噪声地板 # ══════════════════════════════════════════════════════════════════ def main(): rng = np.random.default_rng(20260927) betas, abar = linear_schedule() w, mu, Sig = make_target() print("=" * 68) print("A. Oracle 自检:解析 score vs 有限差分") print("=" * 68) for t in (1, 50, 200, 500, 1000): x = sample_true(8, w, mu, Sig, rng) _, s = logp_and_score(x, abar[t], w, mu, Sig) h = 1e-5 fd = np.zeros_like(s) for i in range(D): e = np.zeros(D) e[i] = h lp_p, _ = logp_and_score(x + e, abar[t], w, mu, Sig) lp_m, _ = logp_and_score(x - e, abar[t], w, mu, Sig) fd[:, i] = (lp_p - lp_m) / (2 * h) err = np.abs(fd - s).max() print(f" t={t:5d} abar={abar[t]:.6f} max|解析 - 差分| = {err:.2e}") print(" 有限差分与解析 score 数值一致;该自检不证明整体生成误差为零") # 顺便看一眼:oracle eps 在 t=1000 处还剩多少信息 print() print("=" * 68) print("B. 端点检查:t=T 时分布离标准正态有多远") print("=" * 68) for t in (200, 500, 800, 1000): C = _cov_at(abar[t], Sig) dev = np.abs(C - np.eye(D)).max() print(f" t={t:5d} abar={abar[t]:.3e} " f"各分量协方差与 I 的最大差 = {dev:.3e}") print(" 越接近 t=T,加噪后的混合越接近一个标准正态球") # ── 尺子的噪声地板 ── print() print("=" * 68) print("C. 尺子的噪声地板:两批「都对」的样本之间也能量出距离") print("=" * 68) Xref = sample_true(N_EVAL, w, mu, Sig, rng) lp_ref = mean_logp(Xref, w, mu, Sig) print(f" 参考样本: {Xref.shape}, 真实样本自己的平均 logp = {lp_ref:.4f}") TH = make_dirs() sw_floor, lp_floor = [], [] for r in range(8): Y = sample_true(N_EVAL, w, mu, Sig, np.random.default_rng(1000 + r)) sw_floor.append(sliced_w1(Y, Xref, TH=TH)) lp_floor.append(mean_logp(Y, w, mu, Sig)) print(f" SW1 真vs真 ×8: 均值 {np.mean(sw_floor):.5f} " f"标准差 {np.std(sw_floor):.5f} 最大 {np.max(sw_floor):.5f}") print(f" dlogp 真vs真 ×8: 均值 {np.mean(lp_floor) - lp_ref:+.4f} " f"标准差 {np.std(lp_floor):.4f}") print(" → 当前抽样基线不能直接当作显著性阈值;近邻差别需更多重复") # ── 一个有参照的好答案长什么样 ── print() print("=" * 68) print("D. 天花板:把真样本直接当生成样本送进去") print("=" * 68) print(f" SW1 = {sliced_w1(Xref, Xref, TH=TH):.6f}" f" dlogp = {mean_logp(Xref, w, mu, Sig) - lp_ref:+.4f}") print(" (同一经验样本对自身为0;不说明有限样本分布估计无偏)") if __name__ == "__main__": main() ddim_family.py # -*- coding: utf-8 -*- """DDIM 家族:一个 eta 旋钮,把 DDPM 祖采样和 DDIM 串成一条线。 这个脚本回答三个问题: 1. **eta=1 的 DDIM 是不是就是 DDPM 祖采样?** 用两套独立的代码(一套写 DDPM Algorithm 2 的原式,一套写 DDIM 论文式 (12)),喂同样的随机数和 同样的起点,看输出能不能对到最后一位。能,那这条家族关系就不是传说。 2. **eta 到底该调多大?** 在 oracle score 下扫一遍:步数少的时候是不是 「加噪声更好」?在欠拟合模型下再扫一遍,看结论翻不翻。 3. **换采样器为什么缓存策略得重调?** 量每步「模型输入变了多少」: 确定性采样器的轨迹是光滑的,随机采样器每一步都往里砸一份新噪声。 python ddim_family.py 依赖:numpy(+ 同目录的 oracle_gmm.py) """ import numpy as np from oracle_gmm import (T, linear_schedule, make_target, sample_true, eps_star, x0_from_eps, alpha_sigma, sliced_w1, mean_logp, make_dirs, N_EVAL, N_DIRS) # ══════════════════════════════════════════════════════════════════ # 0. 时间步网格与模型 # ══════════════════════════════════════════════════════════════════ def uniform_t_grid(S: int, T: int = T): """本文在 t 上取整数等间隔节点;不宣称复刻 diffusers leading 端点。 返回 S+1 个 abar:起点 abar[T],终点 1.0(完全干净)。 """ ts = np.round(np.linspace(0.0, T, S + 1)).astype(int)[::-1] grid = np.array([1.0 if t == 0 else _ABAR[t] for t in ts], dtype=float) return ts, grid def paired_noise(S: int, n: int, seed: int = 1234): """给所有采样器**同一份**起点和同一批随机数。 这是整套实验最要紧的一条:如果每个配置各抽各的起点,配置之间就多了一份 抽样方差,量出来的差别里有多少是采样器的功劳根本说不清。配对之后, eta=0 和 eta=1 的终点之差只能来自算法本身。 """ r = np.random.default_rng(seed + S) x_init = r.standard_normal((n, 2)) zs = [r.standard_normal((n, 2)) for _ in range(S)] return x_init, zs def make_model(kind: str, w, mu, Sig): """两种「模型」,用来分离离散化误差和模型误差。 oracle : 用的就是真 score,没有网络拟合误差;仍有离散化、终端先验、收尾与浮点误差。 gauss : 模型以为数据是一个单高斯(用真均值真协方差拟合), 也就是「容量不足以表达多峰」。高噪声区它几乎是对的, 低噪声区偏差较大;这只是一种人工误差结构,不代表所有网络。 """ if kind == "oracle": return lambda x, abar: eps_star(x, abar, w, mu, Sig) if kind == "gauss": m = (w[:, None] * mu).sum(axis=0) S = ((w[:, None, None] * (Sig + np.einsum("ki,kj->kij", mu, mu))).sum(axis=0) - np.outer(m, m)) w1, mu1, S1 = np.array([1.0]), m[None, :], S[None, :, :] return lambda x, abar: eps_star(x, abar, w1, mu1, S1) raise ValueError(kind) # ══════════════════════════════════════════════════════════════════ # 1. DDIM 的一步(论文式 12,与 diffusers DDIMScheduler.step 逐项对齐) # ══════════════════════════════════════════════════════════════════ def ddim_step(x, abar_cur, abar_tgt, eps, z, eta): """从 abar_cur 走到 abar_tgt(abar_tgt > abar_cur,噪声变小)。 x_tgt = sqrt(abar_tgt) * x0_hat + sqrt(sigma_tgt^2 - sigma_tilde^2) * eps ← 指向 x_t 的方向项 + sigma_tilde * z ← 随机项 sigma_tilde = eta * sqrt( (1-abar_tgt)/(1-abar_cur) * (1 - abar_cur/abar_tgt) ) eta = 0 → 完全没有随机项,DDIM; eta = 1 → 完整时间表时等于 fixed-small DDPM 后验标准差。 """ if not (0 < abar_cur < abar_tgt <= 1 and 0 <= eta <= 1): raise ValueError("要求0<abar_cur<abar_tgt<=1且0<=eta<=1") a_c, s_c = alpha_sigma(abar_cur) a_t, s_t = alpha_sigma(abar_tgt) x0 = (x - s_c * eps) / a_c var = (1.0 - abar_tgt) / (1.0 - abar_cur) * (1.0 - abar_cur / abar_tgt) sig_tilde = eta * np.sqrt(max(var, 0.0)) direc = np.sqrt(max(s_t ** 2 - sig_tilde ** 2, 0.0)) return a_t * x0 + direc * eps + sig_tilde * z, x0 def ddpm_step(x, abar_cur, abar_tgt, eps, z, betas): """DDPM Algorithm 2 的原式,故意写成「另一套代码」用来交叉验证。 x_{t-1} = (x_t - beta_t / sqrt(1 - abar_t) * eps) / sqrt(alpha_t) + sqrt(beta_tilde_t) * z 只在相邻步(stride = 1)上成立,不能跳步。 """ abar_prev = abar_tgt beta_t = 1.0 - abar_cur / max(abar_prev, 1e-12) # = 1 - alpha_t beta_tilde = (1.0 - abar_prev) / (1.0 - abar_cur) * beta_t a_t = np.sqrt(max(abar_cur / max(abar_prev, 1e-12), 1e-12)) mean = (x - beta_t / np.sqrt(1.0 - abar_cur) * eps) / a_t return mean + np.sqrt(max(beta_tilde, 0.0)) * z def run_ddim(x, grid, model, eta, zs, track=False): """沿 grid 走一遍。grid[0] 最吵,grid[-1] = 1.0。 track=True 时额外返回每一步的 (x, x0_hat),D 节量「轨迹抖动」要用。 """ xs, x0s = [x.copy()], [] for i in range(len(grid) - 1): eps = model(x, grid[i]) z = zs[i] if zs is not None else 0.0 x, x0 = ddim_step(x, grid[i], grid[i + 1], eps, z, eta) if track: xs.append(x.copy()) x0s.append(x0.copy()) return x, (xs, x0s) if track else x0s # ══════════════════════════════════════════════════════════════════ # 2. 主流程 # ══════════════════════════════════════════════════════════════════ _BETAS, _ABAR = linear_schedule() def main(): rng = np.random.default_rng(20260927) w, mu, Sig = make_target() Xref = sample_true(N_EVAL, w, mu, Sig, rng) lp_ref = mean_logp(Xref, w, mu, Sig) ev_rng = np.random.default_rng(7) model = make_model("oracle", w, mu, Sig) # ── A. eta=1 的 DDIM 是不是 DDPM 祖采样 ── print("=" * 70) print("A. 交叉验证:DDIM(eta=1, stride=1) 是否等于 DDPM Algorithm 2") print("=" * 70) S = 1000 ts, grid = uniform_t_grid(S) n = 400 x_init = rng.standard_normal((n, 2)) zs = [rng.standard_normal((n, 2)) for _ in range(S)] x_ddpm = x_init.copy() for i in range(S): # 原式,一步步走完 1000 步 t = ts[i] x_ddpm = ddpm_step(x_ddpm, grid[i], grid[i + 1], model(x_ddpm, grid[i]), zs[i], _BETAS) x_ddim, _ = run_ddim(x_init.copy(), grid, model, eta=1.0, zs=zs) d = np.abs(x_ddpm - x_ddim).max() print(f" 两条独立实现,喂同样的 {S} 份随机数") print(f" 终点逐元素最大差 = {d:.3e} 终点 RMS = {np.sqrt((x_ddim**2).mean()):.4f}") print(f" → 差 {d:.1e},是浮点累加误差量级:eta=1 就是 DDPM 祖采样,不是「近似」") # ── B. eta 扫描(oracle score)── print() print("=" * 70) print("B. eta 扫描:步数越少,是不是越该加噪声?(oracle score,配对起点)") print("=" * 70) TH = make_dirs() floors = [sliced_w1(sample_true(N_EVAL, w, mu, Sig, np.random.default_rng(1000 + r)), Xref, TH=TH) for r in range(6)] print(f" 噪声地板 SW1 = {np.mean(floors):.4f} ± {np.std(floors):.4f}" f"(真实样本对真实样本),仅作当前估计量的抽样基线") NS = (10, 20, 50, 100) print(f" {'eta':>5} " + " ".join(f"{'N=' + str(s):>10}" for s in NS)) for eta in (0.0, 0.25, 0.5, 0.75, 1.0): row = [] for S in NS: ts, grid = uniform_t_grid(S) x_init, zs = paired_noise(S, N_EVAL) x, _ = run_ddim(x_init, grid, model, eta, zs) row.append(sliced_w1(x, Xref, TH=TH)) print(f" {eta:5.2f} " + " ".join(f"{v:10.4f}" for v in row)) # ── C. 换个欠拟合的模型,结论翻不翻 ── print() print("=" * 70) print("C. 同样的扫描,但把模型换成「以为数据是单高斯」") print("=" * 70) gm = make_model("gauss", w, mu, Sig) print(f" {'eta':>5} " + " ".join(f"{'N=' + str(s):>10}" for s in NS)) for eta in (0.0, 0.25, 0.5, 0.75, 1.0): row = [] for S in NS: ts, grid = uniform_t_grid(S) x_init, zs = paired_noise(S, N_EVAL) x, _ = run_ddim(x_init, grid, gm, eta, zs) row.append(sliced_w1(x, Xref, TH=TH)) print(f" {eta:5.2f} " + " ".join(f"{v:10.4f}" for v in row)) # ── D. 每步「模型输入变了多少」:缓存友好度 ── print() print("=" * 70) print("D. 轨迹抖动:每步「模型输入」变了百分之几(缓存相关的一个输入代理量)") print("=" * 70) print(" 缓存类加速(按『这一步的输入和上一步差不多就复用上一步的特征』决策)") print(" 这里只量输入位移代理;没有特征缓存/命中率/画质实测。") print(f" {'eta':>5} {'最后10步 输入相对变化':>22} {'最后10步 x0_hat位移':>22}") S = 50 ts, grid = uniform_t_grid(S) x_init, zs = paired_noise(S, N_EVAL) out = {} for eta in (0.0, 0.5, 1.0): _, (xs, x0s) = run_ddim(x_init.copy(), grid, model, eta, zs, track=True) rel_x = [float(np.sqrt((((xs[i + 1] - xs[i]) ** 2).sum(1)).mean()) / np.sqrt(((xs[i] ** 2).sum(1)).mean())) for i in range(len(xs) - 1)] d_x0 = [float(np.sqrt((((x0s[i] - x0s[i - 1]) ** 2).sum(1)).mean())) for i in range(1, len(x0s))] out[eta] = (rel_x, d_x0) print(f" {eta:5.1f} {np.mean(rel_x[-10:]):22.4f} {np.mean(d_x0[-10:]):22.4f}") i = 25 _, (xs, _) = run_ddim(x_init.copy(), grid, model, 1.0, zs, track=True) xcur = xs[i] ac, sc = alpha_sigma(grid[i]); at, st = alpha_sigma(grid[i + 1]) eps = model(xcur, grid[i]); m = (xcur - sc * eps) / ac var = (1 - grid[i + 1]) / (1 - grid[i]) * (1 - grid[i] / grid[i + 1]) rms = lambda v: float(np.sqrt(np.sum(v * v, axis=1).mean())) print(" eta=1 第25步三项 Euclidean RMS:", f"回数据={rms(at*m):.4f} 沿噪声方向={rms(np.sqrt(st*st-var)*eps):.4f}", f"新掷噪声={rms(np.sqrt(var)*zs[i]):.4f}") r0, r1 = out[0.0][0][-10:], out[1.0][0][-10:] print(f" → eta=1 的输入抖动是 eta=0 的 {np.mean(r1) / np.mean(r0):.1f} 倍;" f"按 eta=0 调出来的缓存阈值,换个采样器就完全不是一回事") if __name__ == "__main__": main() dpm_solver_lab.py # -*- coding: utf-8 -*- """从 DDIM 走到高阶:把时间轴换成 lambda,阶数就变成可以直接量出来的东西。 这个脚本做四件事: 1. **验证 DDIM 就是一阶 DPM-Solver。** 两套完全不同的代码(一套写 DDIM 论文式 12,一套写 lambda 空间的一阶指数积分器),同样的时间网格、 同样的模型,看输出是不是同一个数。是,那「DDIM 是一阶方法」就不是比喻。 2. **把阶数量出来。** 拿一条超高精度的参考解当真值,量各采样器终点到它的 距离。这个距离没有抽样噪声(起点配对、采样器确定),能干净地跨几个数量级, 于是「误差 ~ NFE^(-p)」里的 p 可以直接拟合出来。 3. **给出实用的步数-质量表。** 阶数是数值分析的语言,产品要的是 「20 步够不够」,所以再给一张 SW1 表(含抽样基线)。 4. **看高阶方法省下的评估次数到底落在哪。** python dpm_solver_lab.py 依赖:numpy(+ 同目录的 oracle_gmm.py / ddim_family.py) """ import numpy as np from oracle_gmm import (T, linear_schedule, make_target, sample_true, eps_star, alpha_sigma, sliced_w1, make_dirs, N_EVAL) from ddim_family import uniform_t_grid, make_model, ddim_step _BETAS, _ABAR = linear_schedule() _LAM = 0.5 * np.log(np.maximum(_ABAR, 1e-300) / np.maximum(1.0 - _ABAR, 1e-300)) # ══════════════════════════════════════════════════════════════════ # 0. lambda 坐标与网格 # ══════════════════════════════════════════════════════════════════ def lam_of_abar(abar): """half log-SNR:lambda = log(alpha) - log(sigma) = 0.5 * log(abar/(1-abar))。""" return 0.5 * np.log(np.maximum(abar, 1e-300) / np.maximum(1.0 - abar, 1e-300)) def abar_of_lam(lam): """lambda 的反函数:abar = e^(2 lam) / (1 + e^(2 lam))。""" e = np.exp(2.0 * lam) return e / (1.0 + e) def nearest_t(abar): """把连续的 abar 落到最近的训练时间步上(离散训练网络需按具体实现处理时间标签)。 注意 abar 是**递减**的,不能用 searchsorted(它只认递增数组), 老老实实找绝对值最小的那个下标。 """ return int(np.clip(int(np.argmin(np.abs(_ABAR - abar))), 1, T)) def uniform_lambda_grid(S: int, quantize: bool = False): """在 lambda 上等间隔取 S 个点,再落回训练网格。 返回 S+1 个 abar:前 S 个是「要评估模型」的位置,最后一个是 1.0 (完全干净,sigma = 0,对应 lambda = +inf,只能用一阶收尾)。 quantize=True 会把每个 lambda 落回整数时间步。落回去之后可能撞车 (两个 lambda 落到同一个 t),撞车会让多步法的差商分母变成 0, 所以强制 t 严格递减。参考解要更细的分辨率,用 quantize=False 直接 吃连续的 abar —— oracle 认得任意 abar;真实模型的时间插值/标签须查训练约定。 """ l0, l1 = _LAM[T], _LAM[1] # 从最吵到最干净 lams = np.linspace(l0, l1, S) if not quantize: return None, np.concatenate([abar_of_lam(lams), [1.0]]) ts = [] for l in lams: t = nearest_t(abar_of_lam(l)) if ts and t >= ts[-1]: t = ts[-1] - 1 # 强制严格递减,避免差商分母为 0 if t < 1: break # 干净端训练网格已无分辨率,到此为止 ts.append(t) ts = np.array(ts, dtype=int) return ts, np.concatenate([_ABAR[ts], [1.0]]) class Counter: """包一层模型,数一下到底调了几次。NFE 不能靠嘴算。""" def __init__(self, model): self.m = model self.n = 0 def __call__(self, x, abar): self.n += 1 return self.m(x, abar) # ══════════════════════════════════════════════════════════════════ # 1. 一阶指数积分器(DPM-Solver-1 / dpmsolver++ 的一阶更新) # ══════════════════════════════════════════════════════════════════ def dpm_pp_first(x, m0, a_s, s_s, a_t, s_t): """x_t = (sigma_t/sigma_s) * x_s - alpha_t * (e^{-h} - 1) * x0_hat h = lambda_t - lambda_s。sigma_t = 0 时 lambda_t = +inf,e^{-h} = 0, 整条式子退化成 x_t = x0_hat —— 最后一步自动正确,不用特判。 """ if s_t <= 0.0: return m0 h = (np.log(a_t) - np.log(s_t)) - (np.log(a_s) - np.log(s_s)) return (s_t / s_s) * x - a_t * (np.exp(-h) - 1.0) * m0 def dpm_pp_second(x, hist, a_s, s_s, a_t, s_t, solver_type="midpoint"): """diffusers multistep_dpm_solver_second_order_update 的逐项复刻。 D1 是用上一步的 x0_hat 做差商估出来的导数:D1 ~ h * dx0/dlambda。 midpoint 和 heun 的区别只在 D1 前面的系数,两者都是二阶。 """ lam_t = np.log(a_t) - np.log(s_t) lam_s0, m0 = hist[-1] lam_s1, m1 = hist[-2] h = lam_t - lam_s0 h0 = lam_s0 - lam_s1 r0 = h0 / h D0, D1 = m0, (m0 - m1) / r0 emh = np.exp(-h) if solver_type == "midpoint": return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0 - 0.5 * a_t * (emh - 1.0) * D1) return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0 + a_t * ((emh - 1.0) / h + 1.0) * D1) def dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=2.0): """三阶多步更新。 d2_scale=1.0 是 diffusers v0.35.1 的 dpmsolver++ 分支(也核对 v0.30.0)`multistep_dpm_solver_third_order_update` 的逐项复刻;d2_scale=2.0 是本文的二次插值指数积分对照版本。 两者的差别见 F 节的受控检验 —— 差的就是这一个 2。 """ lam_t = np.log(a_t) - np.log(s_t) lam_s0, m0 = hist[-1] lam_s1, m1 = hist[-2] lam_s2, m2 = hist[-3] h = lam_t - lam_s0 h0, h1 = lam_s0 - lam_s1, lam_s1 - lam_s2 r0, r1 = h0 / h, h1 / h D0 = m0 D1_0, D1_1 = (m0 - m1) / r0, (m1 - m2) / r1 D1 = D1_0 + (r0 / (r0 + r1)) * (D1_0 - D1_1) D2 = d2_scale * (D1_0 - D1_1) / (r0 + r1) emh = np.exp(-h) return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0 + a_t * ((emh - 1.0) / h + 1.0) * D1 - a_t * ((emh - 1.0 + h) / h ** 2 - 0.5) * D2) # ══════════════════════════════════════════════════════════════════ # 2. 五个采样器 # ══════════════════════════════════════════════════════════════════ def solve_ddim(grid, model, x): """DDIM(eta=0):论文式 12,完全不碰 lambda。""" for i in range(len(grid) - 1): eps = model(x, grid[i]) x, _ = ddim_step(x, grid[i], grid[i + 1], eps, 0.0, 0.0) return x def solve_dpm1(grid, model, x): """一阶指数积分器。理论上应该和 DDIM 逐位相同 —— A 节去验。""" for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t) return x def solve_dpm2s(grid, model, x): """数据预测指数中点法:每步先在 lambda 中点落一脚,用中点的 x0 走完。 有限目标一步两次评估,sigma=0 收尾仅一次。中点的 x0 对积分的「加权平均」是二阶准确的, 所以整步的局部误差是 O(h^3),全局 O(h^2)。 """ for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s lam_s, lam_t = np.log(a_s) - np.log(s_s), None if s_t <= 0.0: # 收尾:lambda_t = +inf,中点无从谈起 x = m0 continue lam_t = np.log(a_t) - np.log(s_t) lam_m = 0.5 * (lam_s + lam_t) abar_m = abar_of_lam(lam_m) # oracle 用连续中点;整数标签版本需独立分析 a_m, s_m = alpha_sigma(abar_m) x_m = dpm_pp_first(x, m0, a_s, s_s, a_m, s_m) # 先跳到中点 eps_m = model(x_m, abar_m) m_m = (x_m - s_m * eps_m) / a_m # 中点处的 x0 x = dpm_pp_first(x, m_m, a_s, s_s, a_t, s_t) # 用中点 x0 走完整步 return x def _midpoint_x0(x, m0, a_s, s_s, a_t, s_t, model): """在 lambda 的中点补一次评估,拿中点的 x0 走完整步(局部二阶)。 多步法开头那一步没有历史可用,只能降成一阶,而一阶在长度为 h 的区间上 局部误差是 O(h^2),这个误差会一路传到终点 —— 这可能影响全局阶数 的潜在来源之一。给第一步多花一次评估可对照,但不证明其他误差项不存在。 """ lam_s, lam_t = np.log(a_s) - np.log(s_s), np.log(a_t) - np.log(s_t) abar_m = abar_of_lam(0.5 * (lam_s + lam_t)) a_m, s_m = alpha_sigma(abar_m) x_m = dpm_pp_first(x, m0, a_s, s_s, a_m, s_m) eps_m = model(x_m, abar_m) return (x_m - s_m * eps_m) / a_m def solve_multistep(grid, model, x, order=2, solver_type="midpoint", warm2s=False, d2_scale=2.0): """多步法(DPM-Solver++ 2M / 3M):一步一次评估,导数是拿历史 x0 做差商。 开头几步历史不够,自动降阶(和 diffusers 的 lower_order_nums 一样); 最后一步 sigma=0 强制降成一阶(和 final_sigmas_type="zero" 一样)。 warm2s=True 时,第一步改用中点法(多花一次评估)把局部精度提到二阶。 """ hist = [] for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s hist.append((np.log(a_s) - np.log(s_s), m0)) last = (i == len(grid) - 2) if i == 0 and warm2s and s_t > 0.0: x = dpm_pp_first(x, _midpoint_x0(x, m0, a_s, s_s, a_t, s_t, model), a_s, s_s, a_t, s_t) elif s_t <= 0.0 or len(hist) < 2 or last: x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t) elif order >= 3 and len(hist) >= 3: x = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=d2_scale) else: x = dpm_pp_second(x, hist, a_s, s_s, a_t, s_t, solver_type) return x # ══════════════════════════════════════════════════════════════════ # 3. 主流程 # ══════════════════════════════════════════════════════════════════ def rms_err(x, xref): return float(np.sqrt(((x - xref) ** 2).sum(1).mean())) def fit_slope(ns, errs, res, nfe_min=24): """在双对数上拟合 err ~ N^(-p),返回 p。 只取渐近段:NFE 太小的时候高阶方法还在「攒历史」(前几步被迫降阶), 这一段量出来的斜率既不是 1 也不是 3,什么都不说明;误差接近参考解 自检差值的点可能受参考误差影响,同样不能要。 """ xs, ys = [], [] for n, e in zip(ns, errs): if n >= nfe_min and e > 3.0 * res and np.isfinite(e) and e > 0: xs.append(np.log(n)) ys.append(np.log(e)) if len(xs) < 3: return float("nan"), 0 p = -np.polyfit(xs, ys, 1)[0] return float(p), len(xs) def local_err_test(): """受控检验:规定 x0_hat(lambda) 是二次多项式,看各阶更新的局部误差阶。 本文要检验的是对二次插值函数做精确指数积分的系数归一化。 这类构造应对外部指定的二次函数精确;一般三阶ODE求解器不必有此性质。 这个检验把「公式对不对」和「轨迹好不好」彻底分开,谁也赖不着谁。 """ rng = np.random.default_rng(3) A, Bc, Cc = rng.standard_normal(2), rng.standard_normal(2), rng.standard_normal(2) g = lambda lam: A + Bc * lam + 0.5 * Cc * lam ** 2 def exact_inc(lam_s, lam_t): def primitive(lam): return np.exp(lam) * (A + Bc * (lam - 1) + 0.5 * Cc * (lam * lam - 2 * lam + 2)) return primitive(lam_t) - primitive(lam_s) hs = [0.4, 0.2, 0.1, 0.05, 0.025] lam_s = 0.3 out = {} for name in ("一阶", "二阶", "三阶-D2原式", "三阶-D2乘2"): errs = [] for h in hs: lam_t = lam_s + h a_s, s_s = alpha_sigma(abar_of_lam(lam_s)) a_t, s_t = alpha_sigma(abar_of_lam(lam_t)) x = np.array([0.7, -0.4]) hist = [(lam_s - j * h, g(lam_s - j * h)) for j in (2, 1, 0)] # 老→新 if name == "一阶": got = dpm_pp_first(x, g(lam_s), a_s, s_s, a_t, s_t) elif name == "二阶": got = dpm_pp_second(x, hist, a_s, s_s, a_t, s_t) elif name == "三阶-D2原式": got = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=1.0) else: got = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=2.0) want = (s_t / s_s) * x + s_t * exact_inc(lam_s, lam_t) errs.append(float(np.abs(got - want).max())) out[name] = errs print(f" {name:>12}: " + " ".join(f"{e:.2e}" for e in errs)) print(" (h 从 0.4 缩到 0.025)") print(" → 一阶 h^2、二阶 h^3 都对;三阶原式只有 h^3(等于二阶),") print(" D2 乘 2 之后直接掉到 1e-14 —— 二次 x0_hat 下它一步就算准了") def main(): rng = np.random.default_rng(20260927) w, mu, Sig = make_target() TH = make_dirs() Xref = sample_true(N_EVAL, w, mu, Sig, rng) model = make_model("oracle", w, mu, Sig) # ── A. DDIM == 一阶 DPM-Solver ? ── print("=" * 72) print("A. 交叉验证:DDIM(eta=0) 与 lambda 空间一阶指数积分器是不是同一个东西") print("=" * 72) n = 500 for S in (20, 50): _, grid_l = uniform_lambda_grid(S) _, grid_t = uniform_t_grid(S) for name, grid in (("uniform-t", grid_t), ("uniform-lambda", grid_l)): x0 = rng.standard_normal((n, 2)) xa = solve_ddim(grid, model, x0.copy()) xb = solve_dpm1(grid, model, x0.copy()) print(f" S={S:3d} {name:>14} max|DDIM - DPM-Solver-1| = " f"{np.abs(xa - xb).max():.3e}") print(" → 两套代码、两套记号,输出差在浮点误差量级:DDIM 就是一阶方法") # ── B. 参考解 ── print() print("=" * 72) print("B. 参考解:3M 跑 4000 步当真值,再自查一下它自己收敛到哪") print("=" * 72) n_ref = 1000 x_init = rng.standard_normal((n_ref, 2)) _, g_fine = uniform_lambda_grid(4000, quantize=False) _, g_mid = uniform_lambda_grid(2000, quantize=False) xref = solve_multistep(g_fine, model, x_init.copy(), order=3) xchk = solve_multistep(g_mid, model, x_init.copy(), order=3) res = rms_err(xref, xchk) print(f" 4000 步 vs 2000 步参考解的差 = {res:.3e}") print(f" → 这个差值是当前参考解的自检尺度,比它小的差别不可信") # ── C. 阶数 ── print() print("=" * 72) print("C. 把阶数量出来:终点到参考解的 RMS 距离 vs 真实 NFE") print("=" * 72) NS = [6, 8, 12, 16, 24, 32, 48, 64, 96, 128, 192] solvers = { "DDIM (uniform-t)": lambda S: (uniform_t_grid(S)[1], solve_ddim, {}), "DDIM (=DPM-1, lambda)": lambda S: (uniform_lambda_grid(S)[1], solve_ddim, {}), "数据预测中点(单步)": lambda S: (uniform_lambda_grid(max(S // 2, 2))[1], solve_dpm2s, {}), "DPM-Solver++ 2M": lambda S: (uniform_lambda_grid(S)[1], solve_multistep, {"order": 2}), "3M(v0.35.1系数)": lambda S: (uniform_lambda_grid(S)[1], solve_multistep, {"order": 3, "d2_scale": 1.0}), "3M(二次插值版本)": lambda S: (uniform_lambda_grid(S)[1], solve_multistep, {"order": 3, "d2_scale": 2.0}), } print(f" {'NFE':>5} " + " ".join(f"{k:>14}" for k in solvers)) table = {k: [] for k in solvers} nfes = {k: [] for k in solvers} for S in NS: row, real_n = [], [] for k, build in solvers.items(): grid, fn, kw = build(S) c = Counter(model) x = fn(grid, c, x_init.copy(), **kw) row.append(rms_err(x, xref)) real_n.append(c.n) for k, n in zip(solvers, real_n): nfes[k].append(n) table_k = list(solvers) for k, v in zip(table_k, row): table[k].append(v) print(f" nominal={S:3d} " + " ".join(f"{n:3d}:{v:.3e}" for n,v in zip(real_n,row))) print() print(f" 拟合误差 ~ NFE^(-p)(只取 NFE>=24 且误差高于分辨率 {res:.1e}×3 的渐近段):") for k in solvers: p, m = fit_slope(nfes[k], table[k], res) print(f" {k:>24} p = {p:.2f} (用了 {m} 个点)") # ── D. SW1 走到哪一步就分不出高下了 ── print() print("=" * 72) print("D. 分布层面SW1:换起点估计均值和标准差,参考样本固定") print("=" * 72) floors = [sliced_w1(sample_true(N_EVAL, w, mu, Sig, np.random.default_rng(2000 + r)), Xref, TH=TH) for r in range(8)] print(f" 真样本 vs 真样本(8 次):{np.mean(floors):.4f} ± {np.std(floors):.4f}" f" ← 当前样本量/投影/固定参考样本的抽样基线") PS = [10, 20, 50] print(f" {'NFE':>5} " + " ".join(f"{k:>14}" for k in solvers)) for S in PS: row = [] for k, build in solvers.items(): grid, fn, kw = build(S) vs = [] for r in range(5): # 换几份起点,量出估计量的抖动 c = Counter(model) x = fn(grid, c, np.random.default_rng(900 + S * 100 + r) .standard_normal((N_EVAL, 2)), **kw) vs.append(sliced_w1(x, Xref, TH=TH)) row.append((c.n, np.mean(vs), np.std(vs))) print(f" nominal={S:3d} " + " ".join(f"{v[0]}:{v[1]:.4f}±{v[2]:.3f}" for v in row)) print(" → 20 步时各采样器的差别还大于抖动;到 50 步大家都贴着地板,") print(" SW1的近邻差别需更多样本/重复;C节RMS量的是同一路径误差,不能代替分布质量") # ── E. 同一个精度,省多少次评估 ── print() print("=" * 72) print("E. 把终点误差压到 1e-2 / 1e-3,最少要几次模型评估(实测扫描)") print("=" * 72) scan = [4, 6, 8, 10, 12, 16, 20, 24, 32, 40, 48, 64, 80, 96, 128, 160, 192, 256, 384] for k, build in solvers.items(): got = {} for S in scan: if len(got) == 2: break grid, fn, kw = build(S) c = Counter(model) e = rms_err(fn(grid, c, x_init.copy(), **kw), xref) for tol in (1e-2, 1e-3): if tol not in got and e <= tol: got[tol] = c.n s1 = got.get(1e-2, None) s2 = got.get(1e-3, None) f1 = f"NFE={s1:3d}" if s1 else f"未达标(max NFE={c.n})" f2 = f"NFE={s2:3d}" if s2 else f"未达标(max NFE={c.n})" print(f" {k:>24} 1e-2: {f1} 1e-3: {f2}") # ── F. 受控检验:三阶更新到底几阶 ── print() print("=" * 72) print("F. 受控检验:规定一条解析的 x0_hat(lambda),直接量局部误差") print("=" * 72) print(" 做法:不让 x0_hat 由 x 决定,而是规定它是 lambda 的二次多项式") print(" g(lambda)。此时精确解就是 (sigma_t/sigma_s) x + sigma_t * 积分 e^lambda g。") print(" 对二次插值做精确指数积分的版本应一步算准;一般三阶方法不要求这一性质。") local_err_test() # ── G. 卡住 3M 的不是开头那一步 ── print() print("=" * 72) print("G. 是不是「第一步被迫降阶」拖累的?给第一步多花一次评估试试") print("=" * 72) for tag, kw in (("第一步一阶(默认)", {}), ("第一步改中点法(多 1 次评估)", {"warm2s": True})): ns, es = [], [] for S in (24, 32, 48, 64, 96, 128, 192): grid = uniform_lambda_grid(S)[1] c = Counter(model) got = solve_multistep(grid, c, x_init.copy(), order=3, d2_scale=1.0, **kw) ns.append(c.n) es.append(rms_err(got, xref)) p, _ = fit_slope(ns, es, res, nfe_min=24) print(f" 3M(D2 原式)+ {tag:<22} 实测阶数 p = {p:.2f}") print(" → 此对照只量起步处理对本组斜率的影响;系数检验见F节。") if __name__ == "__main__": main() spacing_lab.py # -*- coding: utf-8 -*- """步数该往哪放:同样 20 次评估,换个摆法能差出一个数量级。 阶数(dpm_solver_lab.py 里量出来的 p)说的是「步数变多时误差掉多快」, 但没说「步数摆在哪」。这一篇的主角是**时间步的摆法**: - 在 t 上等间隔(本文取 T 到 0 的整数节点) - 在 lambda 上等间隔(DPM-Solver 的建议) - 在 lambda 上等间隔但落回整数 t(整数标签需按实际网络处理) - 在 log sigma 上等间隔 - Karras / EDM 的 rho=7 摆法(只移植网格,不复现整套 EDM) 判断标准是两条:确定性误差(终点到参考解的距离)和「难度曲线」—— 沿着一条高精度参考轨迹量 |dx0_hat / d lambda|,看哪一段 lambda 上 x0_hat 变得最快;这是局部代理,不单独决定最优网格。 python spacing_lab.py 依赖:numpy(+ 同目录的 oracle_gmm.py / ddim_family.py / dpm_solver_lab.py) """ import numpy as np from oracle_gmm import (T, linear_schedule, make_target, sample_true, alpha_sigma, sliced_w1, make_dirs, N_EVAL) from ddim_family import uniform_t_grid, make_model, ddim_step from dpm_solver_lab import (uniform_lambda_grid, solve_ddim, solve_multistep, solve_dpm2s, lam_of_abar, abar_of_lam, nearest_t, Counter, rms_err, dpm_pp_first, dpm_pp_second, dpm_pp_third) _BETAS, _ABAR = linear_schedule() _LAM = lam_of_abar(_ABAR) # ══════════════════════════════════════════════════════════════════ # 1. 五种摆法 # ══════════════════════════════════════════════════════════════════ def grid_uniform_t(S: int): """本文在 t 上取整数等间隔节点,端点与 leading 选项需分别核对。""" return uniform_t_grid(S)[1] def grid_uniform_lambda(S: int): """在 lambda 上等间隔,连续 abar(DPM-Solver 理论里的标准摆法)。""" return uniform_lambda_grid(S, quantize=False)[1] def grid_uniform_lambda_q(S: int): """在 lambda 上等间隔,但落回整数时间步(标签量化需按具体网络核对)。""" return uniform_lambda_grid(S, quantize=True)[1] def _ratio(abar): """EDM / diffusers 语境里的 sigma:sigma_t / alpha_t = e^{-lambda}。 注意这不是 sqrt(1-abar)。VP 调度下 lambda 就是 -log 这个量, 所以「在 log sigma 上等间隔」等于「在 lambda 上等间隔」——两者是同一个东西, 表里因此只留一种。 """ return np.sqrt(np.maximum(1.0 - abar, 1e-300) / np.maximum(abar, 1e-300)) def grid_uniform_lambda_capped(S: int, lam_max: float): """在 lambda 上等间隔,但只走到 lam_max 就收尾。 为什么要这个变体:uniform-t 天然把 lambda 的上界截在某个值(NFE=20 时 是 +1.76),剩下的干净端交给最后那个「直接输出 x0_hat」的一阶收尾步。 如果 uniform-t 赢的原因是「截得早」而不是「t 本身特别」,那么把 uniform-lambda 截到同一个上界,两者就该差不多。 """ l0 = _LAM[T] lams = np.linspace(l0, lam_max, S) return np.concatenate([abar_of_lam(lams), [1.0]]) def grid_karras(S: int, rho: float = 7.0): """Karras / EDM 的摆法:在 sigma^(1/rho) 上等间隔,EDM 原文取 rho=7。 sigma 用的是 EDM 的那个 sigma(= sigma_t/alpha_t),VP 下等于 e^{-lambda}, 区间是 [_ratio(abar_T), _ratio(abar_1)] ≈ [158, 0.01]。 """ r_hi, r_lo = _ratio(_ABAR[T]), _ratio(_ABAR[1]) r = (r_hi ** (1.0 / rho) + np.arange(S) / (S - 1) * (r_lo ** (1.0 / rho) - r_hi ** (1.0 / rho))) ** rho return np.concatenate([1.0 / (1.0 + r ** 2), [1.0]]) GRIDS = { "uniform-t": grid_uniform_t, "uniform-lambda": grid_uniform_lambda, "uniform-lambda(整数t)": grid_uniform_lambda_q, "lambda截到1.8": lambda S: grid_uniform_lambda_capped(S, 1.8), "lambda截到3.0": lambda S: grid_uniform_lambda_capped(S, 3.0), "karras(rho=7)": grid_karras, "karras(rho=3)": lambda S: grid_karras(S, rho=3.0), } # ══════════════════════════════════════════════════════════════════ # 2. 难度曲线:沿着参考轨迹看 x0_hat 在哪一段变得最快 # ══════════════════════════════════════════════════════════════════ def difficulty_profile(model, n=400, steps=1500, seed=5): """返回 (lam_mid, weight):一阶方法每一步的误差贡献权重。 推导:第 i 步的局部误差(在 x 的单位里)是 delta_i = sigma_{t_i} * ∫ e^lambda [x0(lam) - x0(lam_i)] d lambda ≈ sigma_{t_i} * e^{lam_i} * (h^2/2) * x0'(lam_i) = alpha_{t_i} * e^{-h} * (h^2/2) * x0'(lam_i) 局部代理带 alpha_t 因子,还要同时观察沿轨迹的 x0 导数。 不能只由 alpha 小推出轨迹不动或误差无害;这也未计入传播与末端投影。 返回 alpha(lambda) * |dx0_hat / d lambda|,不是完整误差界。 """ x = np.random.default_rng(seed).standard_normal((n, 2)) grid = uniform_lambda_grid(steps, quantize=False)[1] lams, x0s, alphas = [], [], [] for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s lams.append(lam_of_abar(grid[i])) alphas.append(a_s) x0s.append(m0.copy()) x = (s_t / s_s) * x - a_t * (np.exp(-(lam_of_abar(grid[i + 1]) - lam_of_abar(grid[i]))) - 1.0) * m0 if s_t <= 0: break lams = np.array(lams) alphas = np.array(alphas) x0s = np.array(x0s) # (steps, n, 2) dx = np.sqrt(((np.diff(x0s, axis=0)) ** 2).sum(-1).mean(-1)) speed = dx / np.abs(np.diff(lams)) lam_mid = 0.5 * (lams[1:] + lams[:-1]) a_mid = 0.5 * (alphas[1:] + alphas[:-1]) return lam_mid, a_mid * speed, speed # ══════════════════════════════════════════════════════════════════ # 3. 主流程 # ══════════════════════════════════════════════════════════════════ def main(): rng = np.random.default_rng(20260927) w, mu, Sig = make_target() model = make_model("oracle", w, mu, Sig) TH = make_dirs() Xref = sample_true(N_EVAL, w, mu, Sig, rng) n_ref = 1000 x_init = rng.standard_normal((n_ref, 2)) g_ref = uniform_lambda_grid(3000, quantize=False)[1] xref = solve_multistep(g_ref, model, x_init.copy(), order=3) g_chk = uniform_lambda_grid(1500, quantize=False)[1] res = rms_err(xref, solve_multistep(g_chk, model, x_init.copy(), order=3)) print("=" * 72) print("A. 参考解分辨率") print("=" * 72) print(f" 3000 步 vs 1500 步 = {res:.2e}(误差表只能信到这个量级)") # ── B. 摆法对比(确定性误差)── print() print("=" * 72) print("B. 同样 NFE,步数摆在哪:终点到参考解的 RMS 距离") print("=" * 72) print(f" {'摆法':>22} " + " ".join(f"{'N=' + str(s):>9}" for s in (10, 20, 50)) + " | " + " ".join(f"{'N=' + str(s):>9}" for s in (10, 20, 50))) print(f" {'':>22} " + " ".join(f"{'DDIM':>9}" for _ in range(3)) + " | " + " ".join(f"{'2M':>9}" for _ in range(3))) for name, build in GRIDS.items(): row_a, row_b = [], [] for S in (10, 20, 50): grid = build(S) row_a.append(rms_err(solve_ddim(grid, model, x_init.copy()), xref)) row_b.append(rms_err(solve_multistep(grid, model, x_init.copy(), order=2), xref)) print(f" {name:>22} " + " ".join(f"{v:9.3e}" for v in row_a) + " | " + " ".join(f"{v:9.3e}" for v in row_b)) # ── C. 摆法对比(分布层面)── print() print("=" * 72) print("C. 同样的比较,换成 SW1(地板约 0.030,重复换起点看抖动)") print("=" * 72) print(f" {'摆法':>22} " + " ".join(f"{'N=' + str(s):>16}" for s in (10, 20))) for name, build in GRIDS.items(): row = [] for S in (10, 20): grid = build(S) vs = [] for r in range(5): x0 = np.random.default_rng(700 + S * 10 + r).standard_normal( (N_EVAL, 2)) vs.append(sliced_w1(solve_multistep(grid, model, x0, order=2), Xref, TH=TH)) row.append((np.mean(vs), np.std(vs))) print(f" {name:>22} " + " ".join(f"{v[0]:.4f}±{v[1]:.3f}" for v in row)) # ── D. 难度曲线 ── print() print("=" * 72) print("D. 难度曲线:x0_hat 在哪一段 lambda 上变化最快") print("=" * 72) lams, weight, raw = difficulty_profile(model) lo = lams < 0 print(f" 只看 |dx0/dlambda|(不带 alpha 因子):" f"噪声端 {raw[lo].mean():.3e} vs 干净端 {raw[~lo].mean():.3e}") print(f" 乘上 alpha_t 之后的**误差权重**: " f"噪声端 {weight[lo].mean():.3e} vs 干净端 {weight[~lo].mean():.3e}" f" ← 干净端重 {weight[~lo].mean() / weight[lo].mean():.1f} 倍") top = np.argsort(weight)[-5:][::-1] print(" 权重最大的 5 段:") for i in top: print(f" lambda = {lams[i]:+6.2f} 权重 = {weight[i]:.3e}") print(" → 本例噪声端/干净端平均局部代理权重接近,中段峰值更高。") print(" 这是局部估计,未包含误差传播,不能单独证明最优网格。") # ── E2. 收尾步不是免费的 ── print() print("=" * 72) print("E2. 收尾步的代价:在 lambda_max 处直接输出 x0_hat,到底偏了多少") print("=" * 72) print(" 沿高精度参考轨迹取快照,对每个 lambda 量") print(" || x0_hat(x_lambda, lambda) - 轨迹终点 || —— 这就是提前收尾的偏差。") g_fine = uniform_lambda_grid(3000, quantize=False)[1] x = x_init.copy() snaps = [] history = [] for i in range(len(g_fine) - 1): a_s, s_s = alpha_sigma(g_fine[i]) a_t, s_t = alpha_sigma(g_fine[i + 1]) eps = model(x, g_fine[i]) m0 = (x - s_s * eps) / a_s if i % 60 == 0: snaps.append((lam_of_abar(g_fine[i]), float(np.sqrt(((m0 - xref[:n_ref]) ** 2).sum(1).mean())))) history.append((lam_of_abar(g_fine[i]), m0)) if s_t <= 0 or len(history) < 2: x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t) elif len(history) < 3: x = dpm_pp_second(x, history, a_s, s_s, a_t, s_t) else: x = dpm_pp_third(x, history, a_s, s_s, a_t, s_t, d2_scale=2.0) if s_t <= 0: break for lam, d in snaps[::5]: print(f" lambda = {lam:+6.2f} 提前收尾的偏差 = {d:.3e}") print(" → 偏差随 lambda 单调下降:截得越早,这一步白送的误差越大,") print(" 而且它**不随步数下降**(只取决于截在哪个 lambda)") print() print(" 于是 lambda_max 有个最优值(2M, N=20,只改截断点):") for cap in (1.0, 1.5, 2.0, 2.5, 3.0, 3.5, 4.0, 4.61): grid = grid_uniform_lambda_capped(20, cap) e = rms_err(solve_multistep(grid, model, x_init.copy(), order=2), xref) print(f" lambda_max = {cap:4.2f} 终点误差 = {e:.3e}") print(" → 两头都变差:截太早是收尾偏差,截太晚是每步的 h 变大") # ── E. 20 步时各摆法的落脚点 ── print() print("=" * 72) print("E. NFE=20 时各摆法把步子落在 lambda 的哪几个位置") print("=" * 72) for name, build in GRIDS.items(): grid = build(20) lam = np.array([lam_of_abar(g) if g < 1.0 else np.inf for g in grid]) lam_f = lam[np.isfinite(lam)] print(f" {name:>22}: lambda 从 {lam_f[0]:+.2f} 到 {lam_f[-1]:+.2f}," f"相邻间隔 min {np.diff(lam_f).min():.3f} / max {np.diff(lam_f).max():.3f}") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """给「从 DDIM 到高阶采样器」画五张图。 所有数字都是现场重算的:这里 import ddim_family / dpm_solver_lab 里的 采样器,重新跑一遍实验再画,不抄任何手打的表格。改了那边的实现,重跑 这个脚本图就会跟着变,不会出现「图上是旧数字、正文是新数字」。 五张图分别回答: 1. eta=0 和 eta=1 走的是两条什么样的路(同一份随机数,二维真轨迹) 2. eta 该调多大?oracle 模型下扫一遍,欠拟合模型下再扫一遍 3. 为什么换采样器缓存就得重调:模型输入每步变多少 4. 阶数:误差 vs NFE 的双对数斜率 5. 达到 1e-2 / 1e-3 到底要花几次模型评估 只依赖 numpy + matplotlib。跑法:python make_figures.py """ from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np import oracle_gmm as OG import ddim_family as DF import dpm_solver_lab as DL ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 RNG_SEED = 20260927 # ══════════════════════════════════════════════════════════════════ # 公共:目标分布、参考解、评估尺子 # ═════════════════════════════════════════════════════════════════= def build_world(): rng = np.random.default_rng(RNG_SEED) w, mu, Sig = OG.make_target() Xref = OG.sample_true(OG.N_EVAL, w, mu, Sig, rng) TH = OG.make_dirs() return w, mu, Sig, Xref, TH def floors(TH, Xref, w, mu, Sig, n=8, base=2000): """尺子的分辨率:真样本对真样本,量 n 次。""" v = [OG.sliced_w1(OG.sample_true(OG.N_EVAL, w, mu, Sig, np.random.default_rng(base + r)), Xref, TH=TH) for r in range(n)] return float(np.mean(v)), float(np.std(v)) # ══════════════════════════════════════════════════════════════════ # 图 1:两条轨迹 # ═════════════════════════════════════════════════════════════════= def fig_traj(w, mu, Sig, Xref): model = DF.make_model("oracle", w, mu, Sig) S = 20 ts, grid = DF.uniform_t_grid(S) n_show = 4 x_init, zs = DF.paired_noise(S, n_show, seed=4321) fig, ax = plt.subplots(figsize=(6.4, 5.4)) ax.scatter(Xref[:, 0], Xref[:, 1], s=3, c="#C9CDD4", alpha=0.45, label="真实样本(目标分布)") styles = {1.0: ("#D2691E", 0.9, 5, r"$\eta=1$(DDPM 祖采样式):每步都重掷噪声"), 0.0: ("#2F6FB3", 1.7, 8, r"$\eta=0$(DDIM,确定性):一条光滑的路")} for eta, (c, lw, ms, lab) in styles.items(): _, (xs, _) = DF.run_ddim(x_init.copy(), grid, model, eta, zs, track=True) P = np.stack(xs, axis=1) # (n, S+1, 2) for k in range(n_show): ax.plot(P[k, :, 0], P[k, :, 1], "-", color=c, lw=lw, alpha=0.85 if eta == 0.0 else 0.55, zorder=4 if eta == 0.0 else 3, label=lab if k == 0 else None) ax.scatter(P[k, 1:-1, 0], P[k, 1:-1, 1], s=ms, color=c, alpha=0.85 if eta == 0.0 else 0.5, zorder=4) ax.scatter(x_init[:, 0], x_init[:, 1], s=110, marker="*", c="#111111", zorder=6, label="起点(两边共用,只有 4 个)") ax.set_xlabel(r"$x_1$") ax.set_ylabel(r"$x_2$") ax.set_title("同一份起点、同一份随机数:N=20 步走出的两条路") ax.legend(loc="upper right", fontsize=8, framealpha=0.9) ax.set_aspect("equal", adjustable="box") fig.tight_layout() p = OUT / "traj_eta.png" fig.savefig(p) plt.close(fig) print(f" [1] {p.name} 轨迹 {n_show} 条 × 2 种 eta") # ══════════════════════════════════════════════════════════════════ # 图 2:eta 扫描(oracle + 欠拟合) # ═════════════════════════════════════════════════════════════════= def fig_eta_sweep(w, mu, Sig, Xref, TH): NS = (10, 20, 50, 100) etas = (0.0, 0.25, 0.5, 0.75, 1.0) flo, flo_sd = floors(TH, Xref, w, mu, Sig) panels = {} for tag, kind in (("oracle(真 score,模型误差=0)", "oracle"), ("欠拟合(模型以为数据是单高斯)", "gauss")): model = DF.make_model(kind, w, mu, Sig) panels[tag] = {e: [] for e in etas} for e in etas: for S in NS: _, grid = DF.uniform_t_grid(S) xi, zs = DF.paired_noise(S, OG.N_EVAL) x, _ = DF.run_ddim(xi, grid, model, e, zs) panels[tag][e].append(OG.sliced_w1(x, Xref, TH=TH)) fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.4), sharey=True) cmap = plt.get_cmap("viridis") for ax, (tag, tab) in zip(axes, panels.items()): for i, e in enumerate(etas): ax.plot(NS, tab[e], "o-", color=cmap(0.15 + 0.7 * i / (len(etas) - 1)), lw=1.6, ms=5, label=r"$\eta=" + f"{e:g}" + r"$") ax.axhline(flo, ls="--", c="#999999", lw=1.2, label=f"噪声地板 {flo:.4f}") ax.set_xscale("log") ax.set_xticks(list(NS)) ax.set_xticklabels([str(s) for s in NS]) ax.set_xlabel("采样步数 N") ax.set_title(tag) ax.grid(alpha=0.25) axes[0].set_ylabel("SW1(越小越好)") axes[0].legend(fontsize=8) axes[1].legend(fontsize=8) fig.suptitle("固定玩具模型的 eta 扫描(不代表所有网络)", fontsize=12) fig.tight_layout() p = OUT / "eta_sweep.png" fig.savefig(p) plt.close(fig) print(f" [2] {p.name} 地板 {flo:.4f}±{flo_sd:.4f};" f"oracle N=10: eta0={panels['oracle(真 score,模型误差=0)'][0.0][0]:.4f}" f" eta1={panels['oracle(真 score,模型误差=0)'][1.0][0]:.4f}") # ══════════════════════════════════════════════════════════════════ # 图 3:每步「模型输入变了多少」 # ═════════════════════════════════════════════════════════════════= def fig_cache_jitter(w, mu, Sig): model = DF.make_model("oracle", w, mu, Sig) S = 50 _, grid = DF.uniform_t_grid(S) x_init, zs = DF.paired_noise(S, OG.N_EVAL) fig, ax = plt.subplots(figsize=(6.6, 4.4)) cols = {0.0: "#2F6FB3", 0.5: "#7A7A7A", 1.0: "#D2691E"} last10 = {} for eta, c in cols.items(): _, (xs, _) = DF.run_ddim(x_init.copy(), grid, model, eta, zs, track=True) rel = [float(np.sqrt((((xs[i + 1] - xs[i]) ** 2).sum(1)).mean()) / np.sqrt(((xs[i] ** 2).sum(1)).mean())) for i in range(len(xs) - 1)] last10[eta] = float(np.mean(rel[-10:])) ax.plot(range(1, len(rel) + 1), rel, "-", color=c, lw=1.6, label=r"$\eta=" + f"{eta:g}" + r"$") ax.plot([len(rel) - 9, len(rel)], [last10[eta], last10[eta]], lw=3.2, color=c, alpha=0.35) ax.set_xlabel("步序号(越往右越接近干净端)") ax.set_ylabel(r"模型输入相对变化 $\Delta x_i / x_i$(长度之比,无量纲)") ax.set_title("输入位移代理:本例 eta 改变轨迹变化量") ax.legend(fontsize=9) ax.grid(alpha=0.25) ratio = last10[1.0] / last10[0.0] ax.annotate(f"最后 10 步:eta=1 是 eta=0 的 {ratio:.1f} 倍", xy=(0.42, 0.86), xycoords="axes fraction", fontsize=9, bbox=dict(boxstyle="round,pad=0.35", fc="#FFF6E5", ec="#D2691E")) fig.tight_layout() p = OUT / "cache_jitter.png" fig.savefig(p) plt.close(fig) print(f" [3] {p.name} 最后10步 eta0={last10[0.0]:.4f} " f"eta0.5={last10[0.5]:.4f} eta1={last10[1.0]:.4f} 倍数 {ratio:.1f}") # ══════════════════════════════════════════════════════════════════ # 图 4 + 图 5:阶数与评估预算 # ═════════════════════════════════════════════════════════════════= def build_reference(w, mu, Sig): """超高分辨率参考解;顺手用 2000 步自查它的收敛精度。 随机数的取法与 dpm_solver_lab.py 的 B 节一模一样(同一个种子、同样的 消耗顺序:先抽一批真样本、再抽初始噪声),所以这里打印的分辨率和那边 是同一个数,图上和正文不会对不上。 """ model = DF.make_model("oracle", w, mu, Sig) rng = np.random.default_rng(RNG_SEED) OG.sample_true(OG.N_EVAL, w, mu, Sig, rng) for _ in range(4): rng.standard_normal((500, 2)) # 与 dpm_solver_lab A节消耗一致 x_init = rng.standard_normal((1000, 2)) _, gf = DL.uniform_lambda_grid(4000, quantize=False) _, gm = DL.uniform_lambda_grid(2000, quantize=False) xref = DL.solve_multistep(gf, model, x_init.copy(), order=3, d2_scale=2.0) xchk = DL.solve_multistep(gm, model, x_init.copy(), order=3, d2_scale=2.0) return model, x_init, xref, DL.rms_err(xref, xchk) def fig_order_and_budget(w, mu, Sig): model, x_init, xref, res = build_reference(w, mu, Sig) NS = [6, 8, 12, 16, 24, 32, 48, 64, 96, 128, 192] solvers = { "DDIM(uniform-t)": lambda S: (DF.uniform_t_grid(S)[1], DL.solve_ddim, {}), "DDIM(=DPM-1, lambda)": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_ddim, {}), "数据预测中点(单步)": lambda S: (DL.uniform_lambda_grid(max(S // 2, 2))[1], DL.solve_dpm2s, {}), "DPM-Solver++ 2M": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_multistep, {"order": 2}), "3M(v0.35.1系数)": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_multistep, {"order": 3, "d2_scale": 1.0}), "3M(二次插值版本)": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_multistep, {"order": 3, "d2_scale": 2.0}), } cols = ["#2F6FB3", "#6FA8DC", "#7A7A7A", "#3E8E41", "#D2691E", "#B03060"] tab = {k: [] for k in solvers} nfes = {k: [] for k in solvers} for S in NS: cn = [] for k, build in solvers.items(): grid, fn, kw = build(S) c = DL.Counter(model) tab[k].append(DL.rms_err(fn(grid, c, x_init.copy(), **kw), xref)) cn.append(c.n) for k, n in zip(solvers, cn): nfes[k].append(n) # ── 图 4:阶数 ── fig, ax = plt.subplots(figsize=(7.0, 5.0)) for (k, errs), c in zip(tab.items(), cols): p, _ = DL.fit_slope(nfes[k], errs, res) ax.plot(nfes[k], errs, "o-", color=c, lw=1.5, ms=4.5, label=f"{k} " + r"$p=" + f"{p:.2f}" + r"$") ax.axhline(res, ls="--", c="#BBBBBB", lw=1.2) ax.text(max(n[-1] for n in nfes.values()), res * 1.15, f"参考解分辨率 {res:.1e}", fontsize=8, color="#888888", ha="right") ax.set_xscale("log") ax.set_yscale("log") ax.set_xlabel("NFE(真实模型评估次数,数出来的)") ax.set_ylabel("终点到参考解的 RMS 距离") ax.set_title("本例误差对各方法实际 NFE 的拟合斜率") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=8, loc="lower left") fig.tight_layout() p4 = OUT / "order_nfe.png" fig.savefig(p4) plt.close(fig) # ── 图 5:评估预算 ── scan = [4, 6, 8, 10, 12, 16, 20, 24, 32, 40, 48, 64, 80, 96, 128, 160, 192, 256, 384] got = {} for k, build in solvers.items(): row = {} for S in scan: grid, fn, kw = build(S) c = DL.Counter(model) e = DL.rms_err(fn(grid, c, x_init.copy(), **kw), xref) for tol in (1e-2, 1e-3): if tol not in row and e <= tol: row[tol] = c.n got[k] = row fig, ax = plt.subplots(figsize=(7.4, 4.6)) names = list(solvers) xs = np.arange(len(names)) for j, (tol, lab) in enumerate(((1e-2, r"压到 $10^{-2}$ 所需 NFE"), (1e-3, r"压到 $10^{-3}$ 所需 NFE"))): vals, txt = [], [] for k in names: v = got[k].get(tol) vals.append(v if v else 0) txt.append(str(v) if v else "未达扫描阈值") bars = ax.bar(xs + (j - 0.5) * 0.38, vals, width=0.36, color=["#8FB8DE", "#1F4E79"][j], label=lab) for b, t in zip(bars, txt): ax.text(b.get_x() + b.get_width() / 2, b.get_height() + 4, t, ha="center", fontsize=8) ax.set_xticks(xs) ax.set_xticklabels(names, rotation=18, ha="right", fontsize=8) ax.set_ylabel("NFE") ax.set_title("同一个精度,高阶方法省下的评估次数(柱子顶上标的是实测值)") ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") fig.tight_layout() p5 = OUT / "nfe_budget.png" fig.savefig(p5) plt.close(fig) print(f" [4] {p4.name} 参考解分辨率 {res:.3e}") print(f" [5] {p5.name} 1e-2 所需 NFE: " + " ".join(f"{k}={got[k].get(1e-2, '>384')}" for k in names)) print(f" 1e-3 所需 NFE: " + " ".join(f"{k}={got[k].get(1e-3, '>384')}" for k in names)) def main(): print("生成配图(数值全部现场重算)") w, mu, Sig, Xref, TH = build_world() fig_traj(w, mu, Sig, Xref) fig_eta_sweep(w, mu, Sig, Xref, TH) fig_cache_jitter(w, mu, Sig) fig_order_and_budget(w, mu, Sig) print("完成,输出目录:", OUT) if __name__ == "__main__": main()
-
AIGC 基本功|DDPM 训练目标与采样流程-DDPM AIGC 基本功|DDPM 训练目标与采样流程-DDPM 所属方向:生成范式 | 难度:进阶 | 前置知识:扩散过程的前向与反向推导(前向闭式解、反向后验、以及 ELBO 化简到「预测噪声」的那一步都在那篇推过,这里直接用结论) 关键词:DDPM、L_simple、ELBO 每步权重、采样方差、Algorithm 1/2、fixed_small / fixed_large 01. 为什么需要它 我第一次照着 DDPM 论文的公式老老实实实现训练目标,结果比「偷懒版」更差。 实验是这样的:数据是二维高斯,调度用原文的线性 $T=1000$,模型是一个跨时间步共享参数的仿射预测器(18 个可学参数),三种目标各拟合一份,然后算生成分布的精确负对数似然。结果是: 训练目标 期望 NLL(nats,越小越好) 等权 $L_{\text{simple}}$ 1.898760 真 ELBO 每步权重 1.922295 差了 0.0235 nats。而 Ho 等人在原文里就明说了:他们把 ELBO 里那一串只跟 $t$ 有关的系数扔掉,直接等权,反而「sample quality 更好」。我当时以为这只是工程上的凑巧,这组玩具实验给出的线索是:权重与有限模型容量共同影响各时段的拟合误差。把同一个仿射预测器的时间基从 3 项加到 5 项(30 个参数),结论立刻反过来:真 ELBO 权重 1.880952,等权 1.881758,真 ELBO 反超。 第二个坑是采样方差。我一直把 $\tilde\beta_t$ 当成「真实后验方差」。实测把方差换成真正的后验协方差之后,生成分布的期望 NLL 从 1.881015 降到 1.880914,差的 0.000101 nats 全部来自把方差钉死成 $\tilde\beta_t$;生成协方差与真值的比值从 $[0.98946,\ 0.98713]$ 变成 $[1.0,\ 1.0]$。准确地说:$\tilde\beta_t I$ 是已知 $x_0$ 的条件后验协方差;对边缘反向 $q(x_{t-1}\mid x_t)$,它是全协方差分解中的下界。本例用它生成的分布偏窄,不能把数值幅度推广到所有数据。 第三个观察是权重分配。$t\ge2$ 的 ELBO KL 权重跨 120.4 倍,而低噪声端的噪声预测有很高的不可约误差。不可约误差不产生期望梯度;真正被权重重新分配的是可学习的超额误差及随机梯度噪声。后文的容量对照说明“加权在哪种模型上更合适”需要实测,不能把某个时间段断言成无用功。 这里的 NLL 是二维连续高斯数据上的交叉熵,不是图像 FID,也不是论文表格的复现。数据固定为 $\mu_0=(1,-0.5)$、$S_0=\begin{pmatrix}0.60&0.25\\0.25&0.35\end{pmatrix}$,种子为 20260927;时间基、拟合样本数和终步方差约定见第 04 节。这样限定后,数字才能比较。 这三个坑合起来就是这一篇要讲的事:DDPM 的训练目标和采样循环是两件独立的东西,前者管误差权重,后者管转移;在 $L_{simple}$ 下可以分别选择,但 ELBO 权重显式依赖反向方差,并非完全独立。把这两件事分开看,后面所有改进(DDIM、CFG、flow matching)才读得懂。 02. 最小可用理解 先统一符号:$x_0\in\mathbb{R}^{D}$ 是数据,$x_t$ 是第 $t$ 个噪声档,$T$ 是总档数;$\beta_t$ 是前向增量噪声方差,$\alpha_t=1-\beta_t$,$\bar\alpha_t=\prod_{s=1}^{t}\alpha_s$,$\bar\alpha_0=1$。$\varepsilon\sim\mathcal{N}(0,I)$ 与 $x_0$ 独立,$\varepsilon_\theta$ 是预测器,$\sigma_t^2$ 是反向模型方差。$q$ 表示数据与固定前向过程,$p_\theta$ 表示生成链;$I$ 是 $D$ 维单位矩阵。只需先修篇的这一条闭式式子: $$x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon$$ 三句话: 训练:每一步都是一个「从 $x_t$ 猜刚才加了什么噪声 $\varepsilon$」的回归问题。DDPM 把它做成等权均方误差 $L_{\text{simple}}$,故意不理 ELBO 给每步分配的系数。 权重:本例 KL 权重 $w_t$ 跨 120 倍。等权是改写目标;是否改善生成质量取决于误差分布、优化、容量和评测目标。 采样:反向一步的均值由 $\varepsilon$ 预测器决定,方差可取固定 $\tilde\beta_t$、$\beta_t$ 或学习值;固定方差不进入 $L_{simple}$,却进入 ELBO,学习方差还需要相应训练项。 这张图要看什么:左轴的两条线是真 ELBO 权重(蓝实线 $\sigma^2=\tilde\beta_t$,红虚线 $\sigma^2=\beta_t$),灰色点线是「等权」压平到 1 的位置。右轴绿线是这一时刻噪声里能学出来的比例 $R^2$。两条曲线正好反向:权重在 $t$ 很小的地方冲到 0.6,而那里的 $R^2$ 几乎是 0;权重最低的 $t\approx350$,反而是 $R^2$ 爬到一半的地方。低噪声端权重大、可预测噪声占比小;右端并不遵循这个反向关系。这提示检查容量分配,不足以单独证明等权必然更优。 03. 数学推导 3.1 ELBO 拆成每步的 KL 下面的 $L$ 是负 ELBO,即期望负对数似然的上界:$\mathbb{E}_{q(x_0)}[-\log p_\theta(x_0)]\le L$。最大化 ELBO 等价于最小化 $L$,符号方向不要混淆。按 DDPM 原文 Eq.5 展开为 $$L = \mathbb{E}_q\Big[-\log p_\theta(x_0|x_1) + \sum_{t=2}^{T} D_{\mathrm{KL}}\big(q(x_{t-1}|x_t,x_0)\,\|\,p_\theta(x_{t-1}|x_t)\big) + D_{\mathrm{KL}}\big(q(x_T|x_0)\,\|\,p(x_T)\big)\Big]$$ 最后一项在固定前向过程与先验时没有可学参数;$L_0=-\log p_\theta(x_0|x_1)$ 也是训练目标的一部分。DDPM 为离散像素采用离散化高斯解码似然,连续数据可选连续密度;中间那一长串是下面推导的 KL 项。把它记为 $L_{t-1}$(下标是 $t-1$ 因为它监督的是「从 $t$ 走到 $t-1$」这一步)。 为什么这一项好算?因为 $q$ 和 $p_\theta$ 都是高斯,两个高斯的 KL 有闭式解。而 $q(x_{t-1}|x_t,x_0)$ 在后验那篇已经推过:$q=\mathcal{N}(\tilde\mu_t,\ \tilde\beta_t I)$,其中 $\tilde\beta_t$ 是一个不依赖 $x_t$ 的常数,$\tilde\mu_t$ 是 $x_t$ 与 $x_0$ 的线性组合。在反向方差固定、不由模型学习的前提下,KL 里唯一依赖模型的部分是均值之差: $$L_{t-1} = \mathbb{E}_q\Big[\tfrac{1}{2\sigma_t^{2}}\big\|\tilde\mu_t(x_t,x_0)-\mu_\theta(x_t,t)\big\|^{2}\Big] + C$$ $C$ 是与参数无关的常数,$\sigma_t^2$ 是反向链在这一步选的方差。 3.2 把均值之差换成噪声之差 $\tilde\mu_t$ 和 $\mu_\theta$ 用同一组系数线性组合,前者组合的是真 $x_0$,后者组合的是模型猜的 $\hat x_0$。把 $x_0=\frac{1}{\sqrt{\bar\alpha_t}}(x_t-\sqrt{1-\bar\alpha_t}\,\varepsilon)$ 和 $\hat x_0=\frac{1}{\sqrt{\bar\alpha_t}}(x_t-\sqrt{1-\bar\alpha_t}\,\varepsilon_\theta)$ 代进去,$x_t$ 那一项整整齐齐地消掉,剩下 $$\tilde\mu_t-\mu_\theta = -\frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}}\big(\varepsilon-\varepsilon_\theta\big)$$ 注意这里出现的 $\sqrt{\bar\alpha_{t-1}}/\sqrt{\bar\alpha_t}=1/\sqrt{\alpha_t}$——这是整个化简能成立的关键一步,两个系数只差一个 $\sqrt{\alpha_t}$,所以差值是干净的单项。 平方之后: $$L_{t-1} = \mathbb{E}\Big[w_t\big\|\varepsilon-\varepsilon_\theta\big\|^{2}\Big] + C,\qquad w_t=\frac{\beta_t^{2}}{2\sigma_t^{2}\alpha_t(1-\bar\alpha_t)}$$ 这就是那个「只跟 $t$ 有关的系数」。固定方差时由调度和方差选择决定;若学习方差,就不能把相关项都视为与参数无关的常数。 代入两种方差选择,还能再化简一层: $$w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_{t-1})}\ \ (\sigma_t^{2}=\tilde\beta_t),\qquad w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_t)}\ \ (\sigma_t^{2}=\beta_t)$$ 两条式子的分母只差一个下标。附录 ddpm_lab.py 里解析式和化简式两条都算了,最大相对差 3.93×10⁻¹⁶($\tilde\beta$)和 4.13×10⁻¹⁶($\beta$),就是浮点误差级别。 $t=1$ 时 $\tilde\beta_1=0$,上述固定小方差高斯 KL 权重分母为零、分子非零,不能使用。它不是 $0/0$。ELBO 此时对应重建似然 $L_0$,需另行定义;不是“所有最后一步都不准有高斯密度”。本实验用 $\beta_1>0$ 的连续高斯重建权重补这一点,因此表中的 elbo_tilde 是这一连续数据约定,不是逐字复现离散像素 ELBO。 3.3 $w_t$ 长什么样 线性调度 $T=1000$、$\beta$ 从 $10^{-4}$ 到 $0.02$(原文 CIFAR-10 的配置),$\bar\alpha_T=4.0358\times10^{-5}$。实跑出来: $t$ $\bar\alpha_t$ $\beta_t$ $w_t$($\sigma^2=\tilde\beta_t$) $w_t$($\sigma^2=\beta_t$) 相对 $t=500$ 2 9.998e-01 0.00012 5.9967e-01 2.7269e-01 108.87 10 9.981e-01 0.00028 8.6437e-02 7.3717e-02 15.69 50 9.710e-01 0.00108 1.9279e-02 1.8583e-02 3.50 100 8.970e-01 0.00207 1.0267e-02 1.0081e-02 1.86 250 5.241e-01 0.00506 5.3733e-03 5.3432e-03 0.98 500 7.859e-02 0.01004 5.5082e-03 5.5034e-03 1.00 750 3.351e-03 0.01502 7.6506e-03 7.6502e-03 1.39 900 2.752e-04 0.01801 9.1717e-03 9.1716e-03 1.67 1000 4.036e-05 0.02000 1.0205e-02 1.0204e-02 1.85 最后一列是「相对 $t=500$ 的倍数」,等权相当于把这一列全压成 1.00。 形状是两端高、中间平的一个碗。$\tilde\beta$ 版本的最大值是最小值的 120.4 倍;$\beta$ 版本因为分母用的是 $1-\bar\alpha_t$ 而不是 $1-\bar\alpha_{t-1}$,在 $t$ 很小的地方发散得温和些,动态范围小很多。 左端 $1-\bar\alpha_{t-1}$ 很小,使权重大;中段分母增长与线性增大的 $\beta_t$ 互相抵消;右端 $1-\bar\alpha_t$ 趋近 1 后,$w_t\approx\beta_t/(2\alpha_t)$ 随 $\beta_t$ 上升。不能说 $t=250$ 时分母已饱和:表中此时 $1-\bar\alpha_t\approx0.476$。 这个式子不是我拍脑袋的,脚本里用两个高斯的 KL 数值核了一遍:随机取 $x_0$ 和 $\varepsilon$,令 $\varepsilon_\theta=\varepsilon+\delta$($\delta$ 是一个固定的小扰动),比较「数值算的 KL」与「$w_t\|\delta\|^2$」: t KL(数值) w_t*||delta||^2 相对差 2 1.416848e-02 1.416848e-02 2.89e-13 100 1.612712e-03 1.612712e-03 4.17e-14 500 5.035556e-04 5.035556e-04 1.72e-15 1000 2.188401e-03 2.188401e-03 1.61e-14 相对差在 $10^{-13}$ 量级,推导和代码对上了。 3.4 先分清不可约地板和可学习误差 $w_t$ 只说明「这一步的误差在 ELBO 里值多少钱」,没说明这一步的误差能不能被压下去。真正该看的是贝叶斯地板:给定 $x_t$ 后 $\varepsilon$ 还剩多少不确定性。 数据是 $\mathcal{N}(\mu_0,S_0)$ 时,$x_t$ 的协方差是 $\bar\alpha_t S_0+(1-\bar\alpha_t)I$,条件方差有闭式解,地板就是 $$\mathrm{floor}(t)=\frac{1}{D}\,\mathrm{tr}\Big[\mathrm{Var}(\varepsilon\,|\,x_t)\Big]=\frac{D-(1-\bar\alpha_t)\,\mathrm{tr}\big[(\bar\alpha_tS_0+(1-\bar\alpha_t)I)^{-1}\big]}{D}$$ 定义可学占比 $R^2(t)=1-\mathrm{floor}(t)$($\varepsilon$ 每维先验方差是 1)。实测:$t=1$ 时 $R^2=3.22\times10^{-4}$,$t=500$ 时 0.9616,$t=1000$ 时 1.0000。 在 $t=1$,噪声系数是 $\sqrt{1-\bar\alpha_1}=0.01$,$R^2=3.22\times10^{-4}$ 即约 0.0322%。这说明噪声有很大的条件方差,不说明最优预测毫无用途:生成所需 score 正由小的条件均值决定。$t=2$ 的 108.87 倍权重与 $t=1$ 的 $R^2$ 不能混为同一个时间步。 为什么地板不能用来判断某一步“没用”?记最优预测器 $\varepsilon^{\star}(x_t,t)=\mathbb{E}[\varepsilon\mid x_t]$。把 $\varepsilon-\varepsilon_\theta=(\varepsilon-\varepsilon^{\star})+(\varepsilon^{\star}-\varepsilon_\theta)$ 平方展开;交叉项的条件期望为零,因为 $\mathbb{E}[\varepsilon-\varepsilon^{\star}\mid x_t]=0$,所以 $$\frac{1}{D}\mathbb{E}\|\varepsilon-\varepsilon_\theta\|^2=\frac{1}{D}\mathbb{E}\,\mathrm{tr}\,\mathrm{Var}(\varepsilon\mid x_t)+\frac{1}{D}\mathbb{E}\|\varepsilon^{\star}-\varepsilon_\theta\|^2$$ 第一项是地板,第二项才是超额误差。给它乘 $w_t$ 后,地板依然不产生参数的期望梯度;它会参与有限样本损失和梯度噪声的统计,却不能证明低噪声拟合不重要。高斯加噪还给出 $\nabla_{x_t}\log q_t(x_t)=-\varepsilon^{\star}(x_t,t)/\sqrt{1-\bar\alpha_t}$,其中 $q_t$ 是 $x_t$ 的边缘密度:小的噪声均值经小分母缩放后,仍可对应有限且重要的 score。 因此,有限容量如何分配超额误差、优化噪声多大,以及误差如何沿采样链传播,需要分别验证。不能只凭 $R^2$ 或权重曲线推出生成质量。 3.5 采样方差不是后验方差 $\tilde\beta_t$ 是 $q(x_{t-1}|x_t,x_0)$ 的方差,条件是「已知 $x_0$」。边缘反向 $q(x_{t-1}\mid x_t)$ 要对未知的 $x_0$ 积分。令 $c_0=\sqrt{\bar\alpha_{t-1}}\beta_t/(1-\bar\alpha_t)$、$c_t=\sqrt{\alpha_t}(1-\bar\alpha_{t-1})/(1-\bar\alpha_t)$。对 $q(x_{t-1}\mid x_t,x_0)$ 使用全协方差公式,第一项是条件协方差的期望,第二项是条件均值的协方差: $$\Sigma_t(x_t)=\mathrm{Cov}(x_{t-1}\mid x_t)=\tilde\beta_t I+c_0^2\mathrm{Cov}(x_0\mid x_t)$$ 这是数据的条件不确定性,即使模型恰好输出最优条件均值,也仍然存在;它不等于模型的均值预测偏差。$\hat x_0$ 若是 $x_t$ 的确定函数,$\mathrm{Cov}(x_0-\hat x_0\mid x_t)=\mathrm{Cov}(x_0\mid x_t)$,但误差的二阶矩还会包含偏差项,不能混称。第二项半正定,因此 $\tilde\beta_t I$ 是协方差意义的下界。一般数据的边缘反向分布是高斯的混合,协方差可以依赖 $x_t$;即使匹配其均值与协方差,也不保证高斯转移等于该分布。本节只有在高斯数据下,边缘反向本身才是高斯且协方差与 $x_t$ 无关。实测:用最优 $\varepsilon$ 预测器配 $\tilde\beta_t$,生成协方差只有真值的 $[0.98946,\ 0.98713]$;换成真实后验协方差,比值精确回到 $[1.0,\ 1.0]$,NLL 差 $3.56\times10^{-10}$ nats——在本例中极接近数据分布;仍有有限终点先验与数值误差。 这一节的结论对后面很重要:反向链的均值和方差是两件事。均值决定你往哪走,方差决定你抖多厉害;在这个高斯实验中,固定 $\tilde\beta_t$ 使协方差特征值约偏小 1.1%~1.3%;该数值不是通用结论。 04. 代码实现 4.1 调度、$\tilde\beta_t$、$w_t$(20 行) def linear_beta(T=1000, b1=1e-4, bT=0.02): """DDPM 原文 CIFAR-10 用的线性调度。""" return np.linspace(b1, bT, T) class Sched: """下标约定:abar[t]、bt[t] 的 t 取 0..T;beta[t-1]、alpha[t-1] 对应数学时间步 t。""" def __init__(self, beta): self.T = len(beta) self.beta = beta self.alpha = 1.0 - beta self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)]) # 长度 T+1 self.bt = np.empty(self.T + 1) self.bt[0] = 0.0 self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta def weight(self, which="tilde"): s2 = self.bt[1:] if which == "tilde" else self.beta with np.errstate(divide="ignore", invalid="ignore"): w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:])) if which == "tilde": # t=1 时 tilde_beta_1=0,分母为零。DDPM 把这一步交给 L_0 单独处理, # 这里退化地用 fixed_large 的权重顶上,只为让训练能跑。 w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1])) return w np.errstate 那一行不是装饰:\tilde\beta_1=0 会触发除零,不包起来的话 w/w.mean() 之后整条权重变成 nan,训练静悄悄地训出一个废模型。 4.2 三种目标:共享参数的带权最小二乘 要让「权重决定容量往哪搬」这件事看得见,模型必须跨时间步共享参数——否则每一步各自拟合,权重只影响每一步自己的收敛速度,看不出搬移效果。所以用一个仿射 $\varepsilon$ 预测器加固定时间基: $$\varepsilon_\theta(x_t,t)=W\,\big[x_t\otimes\psi(t),\;\psi(t)\big],\qquad \psi(t)=\big[1,\ (t/T)^{0.5},\ t/T\big]$$ (指数取 $[0,0.5,1]$ 而不是 $[0,1,2]$:因为 $\sqrt{1-\bar\alpha_t}$ 在 $t$ 小的时候像 $\sqrt{t}$,纯整数次幂的多项式基在这一段拟合不出来,曲线会剧烈振荡。这是踩过的坑。) 训练集 $M=120000$ 条 $(x_0,t,\varepsilon)$,特征维度 9,可学参数 18 个。三种权重都归一化到均值 1(无正则时整体缩放不改变解;这里另有 $\lambda=10^{-6}$ 的岭项,归一化使正则强度口径一致)。用带权岭回归一步算出闭式解,不做迭代。 4.3 高斯生成链的精确 NLL 一开始我用采样算 NLL,三种目标差 0.002~0.005 nats,而 2 万样本的蒙特卡洛误差就有 ±0.007——结论完全淹没在噪声里。改走闭式解:仿射模型下 $p_\theta(x_0)$ 仍是高斯,把密度沿反向链往前传,最后 $$\mathbb{E}\big[-\log p_\theta(x_0)\big]=H\big[\mathcal{N}(\mu_0,S_0)\big]+D_{\mathrm{KL}}\big(\mathcal{N}(\mu_0,S_0)\,\|\,\mathcal{N}(m,S)\big)$$ 这里 $m,S$ 是生成链终点的均值和协方差,$H$ 是数据分布微分熵。注意两份代码的终步约定:ddpm_lab.py 的 large 与线性插值在 $t=1$ 仍加入相应高斯方差;tilde 的终步方差为零,exact 保留高斯数据的真实条件协方差。ddpm_train.py 则遵循 Algorithm 2,所有固定方差分支的 $t=1$ 都不加噪声。因此下面是各自明确约定下的实验,不能当作同一个终步采样器的横向排名。 用 40 万样本复核,闭式解 1.880914 对蒙特卡洛 1.880890,差 $2.38\times10^{-5}$。两种独立实现(密度前向传播 / 线性映射复合)的均值差 $8.88\times10^{-16}$、协方差差 $5.00\times10^{-16}$。 三种目标 × 两种采样方差: 训练目标 $\sigma^2=\tilde\beta_t$ $\sigma^2=\beta_t$ 差 生成 std / 真 std uniform(等权) 1.898760 1.895815 −0.002945 0.9659 elbo_tilde 1.922295 1.924692 +0.002396 1.0392 elbo_large 1.914947 1.917129 +0.002181 1.0322 (最后一列是生成分布标准差与真分布标准差的比值,1 表示胖瘦刚好对上。等权明显偏窄,真 ELBO 权重的两个版本反而偏宽。) 4.4 权重把超额误差搬到了哪 「超额」= 实际 MSE − 贝叶斯地板,包括容量、有限样本、正则化与优化误差: $t$ 可学占比 $R^2$ 地板 等权超额 真 ELBO 超额 1 0.0003 0.9997 1.516e-01 1.017e-02 5 0.0022 0.9978 1.120e-01 6.824e-03 20 0.0182 0.9818 5.295e-02 3.897e-03 50 0.0853 0.9147 9.778e-03 7.323e-03 100 0.2510 0.7490 4.271e-03 2.560e-02 200 0.5663 0.4337 1.324e-02 2.820e-02 400 0.9000 0.1000 1.067e-03 4.463e-03 600 0.9876 0.0124 5.375e-03 1.349e-02 800 0.9993 0.0007 3.118e-04 1.082e-03 1000 1.0000 0.0000 1.337e-02 2.345e-02 分档汇总:低噪声档 $t\le50$,等权超额 5.140e-02,真 ELBO 5.137e-03(比值 0.10,好 10 倍);高噪声档 $t\ge400$,等权 3.459e-03,真 ELBO 8.060e-03(比值 2.33,差一倍多)。 这张图要看什么:(a) 两条曲线的交叉点大约在 $t=70$——交叉点左边真 ELBO 权重更准,右边等权更准;(b) 取比值后看得更清楚,灰色填充区(比值 <1)是真 ELBO 占优的低噪声段,红色填充区(比值 >1)是等权占优的中高噪声段。这个容量档的加权结果是一部分时段变好、另一部分变差。表格支持这一观察,却不能凭“超额误差相对地板很小”解释哪一段赔得起:地板不参与最优均值的期望梯度,且各时段预测误差对终点分布的影响不同。本例等权 NLL 更低,是反向链传播后由 4.3 实际算出的结果;4.5 的容量反例说明它不是普遍规律。 4.5 换个容量档,结论反过来 时间基从 3 项加到 5 项($[0,0.5,1,1.5,2]$,30 个参数),其他完全不动: 容量档 时间基项数 可学参数 NLL(等权) NLL(真 ELBO) 谁更好 低噪声档超额比 高噪声档超额比 loose 5 30 1.881758 1.880952 真 ELBO 0.71 3.91 tight 3 18 1.898760 1.922295 等权 0.10 2.33 这张表说明两档容量的排序不同,不能推出“容量足够时 ELBO 自然赢”。ELBO、生成 NLL 和感知质量也不是同一个目标;EDM、Min-SNR 同时涉及预条件、噪声分布或多任务梯度冲突,不应仅归因为模型变大。 4.6 真网络版:Algorithm 1 与 Algorithm 2 闭式解毕竟是玩具。附录 ddpm_train.py 给了一份 numpy 手写版:两个隐藏层、三个线性层的 MLP($10\to64\to64\to2$,输入为二维 $x_t$ 加八维时间嵌入,共 4994 个参数),手写反向传播 + Adam,batch 256,20000 步,数据是 7 个高斯的混合(一个中心 + 六个环)。 梯度先对:手写反向传播 vs 有限差分,最大相对差 4.42×10⁻⁹。Algorithm 1(训练) 保留原文的均匀抽 $t$、一步加噪、预测噪声流程;网络、优化器与玩具数据是教学选择,加权分支额外乘 $w_t$。等权目标显式为 $$L_{\mathrm{simple}}=\mathbb{E}_{t\sim U\{1,\ldots,T\},\,x_0\sim q,\,\varepsilon\sim\mathcal{N}(0,I)}\|\varepsilon-\varepsilon_\theta(\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon,t)\|^2$$ 只关心相对训练权重时可省整体常数;若要无偏估计 ELBO 的逐步求和,则均匀采样还需乘相应项数,并单独处理 $L_0$。代码是: def train(sc, w_full, steps, batch, rng, lr=1e-3): p = init_params(rng) opt = Adam(p, lr=lr) for _ in range(steps): # 1: t ~ Uniform({1, ..., T}) 2: x_0 ~ q(x_0) 3: eps ~ N(0, I) t_idx = rng.integers(1, T + 1, size=batch) # (256,) x0 = sample_mix(batch, rng) # (256, 2) eps = rng.standard_normal((batch, D)) # (256, 2) # 4: 一步加噪(闭式解,不需要真的走 t 步) a = sc.abar[t_idx] # (256,) xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps # 5: 梯度下降一步 Z = np.concatenate([xt, time_embed(t_idx)], axis=1) # (256, 10) h1, h2, out = forward(p, Z) # (256,64) (256,64) (256,2) opt.step(p, backward(p, Z, h1, h2, out, eps, w_full[t_idx - 1])) return p 三个 shape 值得停下来看一眼。第一,t_idx 是一个长度为 batch 的随机整数向量,不是标量——每个样本走不同的时间步,这是 $L_{\text{simple}}$ 里那个 $\mathbb{E}_t$ 的实现方式,也是「等权」的字面含义:每个 $t$ 被抽中的概率相同。第二,Z 的第二维是 $10 = 2 + 8$,其中 8 维来自 TIME_FREQ = (1,2,4,8) 的 cos/sin 时间嵌入;不把 $t$ 喂进去的话,网络不知道当前噪声档位,$L_{\text{simple}}$ 根本学不动。第三,w_full[t_idx - 1] 这个减一是全文最容易写错的地方:时间步 $t$ 从 1 数到 $T$,而数组下标从 0 开始。写反了整条权重会整体错位一步,$t$ 很小的地方拿到的是 $t+1$ 的权重——在动态范围 120 倍的曲线上,错位一步就能让训练目标面目全非。 Algorithm 2(采样) 是完整 1000 步链: def sample_chain(sc, p, n, which="tilde", rng=None): x = rng.standard_normal((n, D)) # x_T ~ N(0, I) for t in range(T, 0, -1): eps_hat = predict_eps(p, x, t) a, a_prev = sc.abar[t], sc.abar[t - 1] alpha_t, beta_t = sc.alpha[t - 1], sc.beta[t - 1] mu = (x - beta_t / np.sqrt(1.0 - a) * eps_hat) / np.sqrt(alpha_t) sigma = np.sqrt(sc.bt[t]) if which == "tilde" else np.sqrt(beta_t) z = rng.standard_normal((n, D)) x = mu + (sigma * z if t > 1 else 0.0) # t == 1 时不加噪声 return x 最后那行 if t > 1 else 0.0 就是 diffusers 里 if t > 0 的同一个判断(下标约定差 1):最后一步不加噪声。均值那一行是 $\tilde\mu_t$ 的另一种写法——把 $x_0$ 用 Tweedie 公式替掉之后 $\tilde\mu_t=\frac{1}{\sqrt{\alpha_t}}\big(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\varepsilon_\theta\big)$,比 3.2 节那个两项组合的形式更紧凑,也是 diffusers 之外大多数实现采用的写法。 采样之后用三个教学指标打分,先明确它们不是 4.3 的生成模型 NLL。这里的 $\Delta\log p_0=\mathbb{E}_{p_\theta}[\log p_{\mathrm{data}}]-\mathbb{E}_{p_{\mathrm{data}}}[\log p_{\mathrm{data}}]$ 把生成样本代入已知数据密度,积分分布和打分密度都与 NLL 不同。 采样之后用三个指标打分:$\log p_0$ 相对真样本、到最近模式中心的距离比、模式覆盖数(某个分量占比超过 2% 才算被覆盖)。这三个指标是互补的——$\log p_0$ 只衡量落在高密度区,模式覆盖才告诉你有没有整个丢掉某个模式;这次两个网络都是 7/7,但仅靠覆盖数与平均中心距离,不能断言模式内的分布已拟合正确。一个反例是按真实分量权重只输出七个中心:它没有分量内方差,却能获得很高密度评分和 7/7 覆盖。完整脚本新增这一反例供实跑:密度评分 +0.9580、中心距离比 0、覆盖 7/7,尽管分量内方差为零。 训练目标 $\log p_0$ 相对真样本 到最近中心距离 / 真样本 模式覆盖 uniform −0.2208 ± 0.0195 1.0857 7/7 elbo_tilde −0.4212 ± 0.0062 1.1997 7/7 在这次固定训练种子的运行中,等权分支在上述两个评分上更接近真样本基线。表内 ± 是同一个已训练模型的三个采样种子间标准差,不是重复训练标准差或置信区间;两个分支用了不同初始化与训练随机序列,故不能把差距全归因于权重,也不能和高斯 NLL 的差值比较。每步 MSE 剖面中,$t=1$ 两个网络都约 1.0,说明低噪声档的噪声条件方差大;$t=1000$ 为 0.0016 与 0.0026。这不意味着低噪声 score 无需精确学习。 只换采样方差、不动网络: 方差选择 $\log p_0$ 相对真样本 到最近中心距离 / 真样本 $\tilde\beta_t$(fixed_small) −0.2363 ± 0.0123 1.0968 $\beta_t$(fixed_large) −0.2640 ± 0.0129 1.1099 这里和 4.3 的高斯实验结论相反:高斯闭式解里 $\beta_t$ 把偏窄补回来了(std 比 0.9659 → 0.9720),多峰数据上 $\tilde\beta_t$ 反而更好。两个方差在低噪声段的相对差较大,高噪声段很接近;本次 large 分支的平均中心距离更大。这是可观察结果,尚未隔离方差、预测误差与多步传播各自的贡献。方差选择取决于数据、预测误差、调度与评价指标,不能只按是否多峰判断,别把一维高斯的结论直接搬。 05. 工业级实现对照 对照 huggingface/diffusers v0.35.1 的固定版本源码:DDPMScheduler.step、_get_variance 和 previous_timestep,于 2026-10-09 逐项核对。本文讨论默认完整训练时间网格;推理若跳步,应使用当前与目标步的累计 $\bar\alpha$ 重新组合转移系数。这一份源码就是知识树里给这个节点配的 code_refs。 第一处差异:方差有六个分支,不是一个数。 我 4.1 节只写了 $\tilde\beta_t$ 和 $\beta_t$ 两种,框架里是 _get_variance() 的六个 variance_type: if variance_type == "fixed_small": # 默认:后验方差的下界 variance = variance elif variance_type == "fixed_small_log": # 取 log 再 exp(0.5*log),代数上等价 variance = torch.log(variance); variance = torch.exp(0.5 * variance) elif variance_type == "fixed_large": # 直接上 beta_t variance = current_beta_t elif variance_type == "fixed_large_log": variance = torch.log(current_beta_t) elif variance_type == "learned": # 网络自己输出 return predicted_variance elif variance_type == "learned_range": # 在 [tilde_beta, beta] 之间插值 min_log = torch.log(variance); max_log = torch.log(current_beta_t) frac = (predicted_variance + 1) / 2 variance = frac * max_log + (1 - frac) * min_log 值得注意的是 learned_range:两个端点是固定小方差与大方差的对数,与 4.3/第 06 节线性方差扫描采用相同端点,但插值空间不同。公式 $f=(v+1)/2$ 只有在网络输出 $v\in[-1,1]$ 时才把结果限制于端点之间;这个版本的 scheduler 不 clamp $v$,越界时是外插。学习方差还需要配套的训练损失,不能只把输出通道翻倍。 第二处差异:最后一步不加噪声。 源码里 variance = 0; if t > 0: ...,t=0 对应本文的 $t=1$。这是 Algorithm 2 和该 scheduler 的终步约定;即使选 fixed_large 也跳过终步噪声,不能仅由 $\tilde\beta_1=0$ 推出所有方差分支都必须如此。连续密度模型可另定义有非零方差的终步分布,如本篇高斯账本;须明确自己评估的是哪条链。 第三处差异:累计噪声表预先计算,转移系数在 step 内由当前与目标时间步组合。 step() 里那两行: pred_original_sample_coeff = (alpha_prod_t_prev ** 0.5 * current_beta_t) / beta_prod_t current_sample_coeff = current_alpha_t ** 0.5 * beta_prod_t_prev / beta_prod_t pred_prev_sample = pred_original_sample_coeff * pred_original_sample + current_sample_coeff * sample 展开就是 3.2 节的 $\tilde\mu_t$,$c_0=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}$、$c_x=\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}$,一字不差。 这张图要看什么:三条线是反向一步的三个配料随 $t$ 的变化——蓝线是「拉向 $\hat x_0$ 的系数」$c_0$,灰虚线是「保留 $x_t$ 的系数」$c_x$,红线是注入噪声的标准差 $\sqrt{\tilde\beta_t}$。较多时间步的 $c_0$ 在 1e-4 ~ 1e-2 量级,低噪声端会增大。系数大小不是实际位移大小:$\mu_\theta-x_t=c_0\hat x_0+(c_t-1)x_t$ 还取决于两个向量,且 $c_0+c_t$ 一般不等于 1;因此不能把 $c_0=0.003$ 直接解释成“挪了千分之三”,也不能据此断言图像在哪些步才成形。这是完整 1000 步离散表下的系数,不意味着采样必须走满 1000 步。重排噪声表或换求解器后,模型可用更少的评估次数采样。 第四处差异:prediction_type 有三个选项。 epsilon(默认)、sample(直接预测 $x_0$)、v_prediction(预测 $v$)。源码把三者统一先转成 pred_original_sample,再走同一套系数——参数化只是换了个入口,反向一步的代数完全一样。参数化之间的权重差异在那篇《扩散过程的前向与反向推导》里算过(本线性调度下,以等权噪声误差换算:$v$ 的系数是 $\bar\alpha_t$,$x_0$ 的系数是 $\bar\alpha_t/(1-\bar\alpha_t)$;系数动态范围分别约 2.5×10⁴ 与 2.5×10⁸)。 第五处:clip_sample=True 是默认开的。 默认 clip_sample_range=1.0,把 pred_original_sample 夹到 $[-1,1]$。这适合相应归一化像素设定,不能直接套给任意潜空间——潜变量即使经过模型约定的尺度归一化,也不因此具有 $[-1,1]$ 的有界支撑。因此不能照搬像素裁剪,是否关闭或采用其他限幅应遵循具体模型配置。 06. 代价与边界 等权省了什么:不用管 $\tilde\beta_1=0$ 的退化,不用管 $L_0$ 的离散解码器,没有显式时间权重,但不保证每步的梯度范数一致(这点很重要——那篇前向反向推导里算过,$x_0$ 参数化跨 2.5×10⁸ 倍,不同时间档的梯度大小可能差异很大,实际范数还受网络雅可比和数据影响)。 等权赔了什么:三档实测摆在一起看—— 场景 等权 真 ELBO 权重 谁赢 容量宽裕(30 参数,高斯) 1.881758 1.880952 真 ELBO 容量吃紧(18 参数,高斯) 1.898760 1.922295 等权 容量吃紧(MLP,7 峰混合) −0.2208 −0.4212 等权 怎么选择权重:若关注低噪声重建精度,应在任务数据上测量各时段超额误差与最终质量,比较等权与加权;本例的 10 倍误差比不能直接推出超分、修复都不该用等权。 采样方差的边界:高斯数据上 $\beta_t$ 把偏窄从 3.4% 补到 2.8%(补回 0.6 个百分点,还没补满);多峰数据上 $\beta_t$ 反而更差。所以别把「fixed_large 更大更对」当成通例——应按相同终步约定,控制训练随机性,再比较目标任务的质量、覆盖和方差指标。是否多峰只是数据特征之一。 这张图要看什么:(a) 三条线是本高斯实验每步的方差——$\tilde\beta_t$(蓝)、$\beta_t$(红虚)、真实后验方差(绿)。绿线与蓝线的差异取决于时间步,较低噪声端尤其需关注,这个差值是 3.5 节的条件不确定性项。最优高斯预测器下,加入真实条件协方差后,NLL 缺口从约 0.000101 降到 3.56e-10 nats;仍保留有限终点先验与数值误差,不宣称精确等于零。(b) 在 $\tilde\beta_t$ 与 $\beta_t$ 之间插值扫一遍:蓝线(左轴)是生成分布标准差与真分布之比,从 0.9659 单调爬到 0.9720;红线(右轴)是期望 NLL,几乎是一条平线。标准差之比是敏感指标,NLL 对这件事几乎不动——想判断方差选得对不对,同时检查 NLL 与协方差,不要只看一个指标。 采样成本要按同一口径计数:4000 样本 × 1000 步是 $4\times10^6$ 次样本级前向;训练 20000 步 × batch 256 是 $5.12\times10^6$ 次样本级前向,另有反向计算。不能拿样本级采样前向数除以训练优化器步数,声称采样贵 200 倍。批量大小与硬件利用率还会改变墙钟时间。 最后一个容易搞混的地方:训练目标(等权还是加权)和采样器(DDPM 随机链还是 DDIM 确定链)在等权噪声回归设定下可以分别比较。本篇始终使用逐步高斯反向转移,但既比较训练权重,也比较固定/真实协方差和终步约定。等权噪声回归可以配合 DDIM 等其他采样构造;完整 ELBO 的具体形式仍与所定义的生成链有关。换了训练目标不影响你能不能换采样器,反过来也一样——DDIM 那篇最关键的观察就是:DDPM 的训练目标根本没有约束反向链必须是一阶 Markov 的。把这两件事当成一件事,是读扩散模型文献时最普遍的混线。 07. 经典论文脉络 arXiv:1503.03585(Sohl-Dickstein et al., 2015)——扩散的雏形。 定义了前向 Markov 链和反向链,用前向扩散与变分目标训练反向过程,样本质量也远不够看。贡献是「这个方向存在」。 Denoising Diffusion Probabilistic Models(Ho et al., 2020)——DDPM,本篇的锚点。 三件事:把 $\tilde\mu_t$ 参数化成预测 $\varepsilon$;指出 ELBO 里那串只跟 $t$ 有关的系数可以扔掉、等权反而更好;给出 $\tilde\beta_t/\tilde\mu_t$ 的闭式解并配上线性调度。上述参数化与简化目标是该论文实验选择的一部分,采样质量改善还依赖网络、调度和训练配置。 Improved Denoising Diffusion Probabilistic Models(Nichol & Dhariwal, 2021)。 两件事直接对着本篇的洞:一是学方差(对应 learned_range,在 $\tilde\beta_t$ 与 $\beta_t$ 之间让网络选位置,且在 log 空间插值);二是余弦调度,改善低分辨率设置下线性噪声调度过快破坏信号、后段接近纯噪声的问题。 Denoising Diffusion Implicit Models(Song et al., 2020)——DDIM。 指出 DDPM 的训练目标其实没有约束反向链必须是 Markov 的,于是可以推一个非 Markov 的确定性问题,一步跨很多步。训练和采样在这里正式解耦。 Elucidating the Design Space of Diffusion-Based Generative Models(Karras et al., 2022)——EDM。 从「每步该加权多少」重新出发,把加权、预处理、调度统一成一套设计空间,并用二阶求解器把步数压到几十步。它分析采样器、噪声分布与预条件等独立设计因素,不能称为本文“容量排序翻转”的真实模型复现。 08. 常见误解 ①「$L_{\text{simple}}$ 就是 ELBO。」 不是。它丢掉了两样东西:每步的 $w_t$,以及 $L_0$ 那一项的离散解码器。它是一个设计选择,不是近似——丢掉的部分在数学上并不小($w_t$ 跨 120 倍),本文的一个小容量档出现等权优势,另一个容量档相反;这些实验不能给所有容量受限模型下结论。 ②「$\tilde\beta_t$ 是真实后验方差。」 不是,它是已知 $x_0$ 时的后验方差。边缘反向还要计入 $x_0\mid x_t$ 的条件不确定性;即使预测均值完全正确,该项也不消失。本高斯例的协方差两个对角元分别约偏低 1.1% 和 1.3%;这是方差口径,不能写成标准差也下降相同比例,更不能推广到所有时间步或数据。 ③「权重大意味着更容易学。」 权重衡量误差在目标中的代价,条件方差衡量不可约误差;两者不是同一个量。低噪声端 $R^2$ 小不意味着该步 score 不重要。 ④「采样方差是训出来的。」 默认不是。fixed_small 是硬编码的 $\tilde\beta_t$,跟训练毫无关系;只有 learned / learned_range 才让网络参与,而且此时模型输出通道要翻倍(step() 里 model_output.shape[1] == sample.shape[1] * 2 那个判断就是干这个的)。 ⑤「换方差只影响采样,不影响训练。」 一半对。方差确实不参与 $L_{\text{simple}}$ 的计算,但 $w_t$ 的公式里有 $\sigma_t^2$——所以用真 ELBO 权重训练时,你选的方差会通过 $w_t$ 反过来改变训练目标(表 3 里 elbo_tilde 和 elbo_large 是两种不同的训练目标,不只是两种采样方式)。 ⑥「等权赢,所以加权分析没用了。」 本文两个容量档已经出现排序翻转;权重还与噪声调度、预条件、数据与优化相互作用。应在同一评测口径下选择,不能把一次玩具胜负当成普遍结论。 ⑦「$T=1000$ 是个需要调的超参。」 不完全是。$T$ 决定了 $w_t$ 的动态范围,也决定了每步要挪多远;但它同时被 $\beta$ 调度绑住——改 $T$ 不改 $\beta$ 的端点,等于改了整条噪声表的形状。Improved DDPM 同时研究余弦调度,并将默认训练扩散步数由 1000 增至 4000;它也研究减少推理步数。训练噪声网格与推理评估次数是不同的超参数,比较前要一起交代。 09. 动手验证 两个数值实验脚本都在附录,只依赖 NumPy;配图脚本另需 matplotlib。原种子下的数值表保留,本轮在 Windows/CPU 上完整复跑并核对,训练与采样种子的统计限制见 4.6: python ddpm_lab.py # 闭式解实验室,几秒跑完 python ddpm_train.py --steps 20000 --n-gen 4000 # 真网络版,几分钟 ddpm_lab.py 会依次打印六段(真实输出摘要,不是预期值): A 段:两种方差下的 $w_t$ 表格,解析式与化简式的最大相对差 3.93e-16;用两个高斯的 KL 数值核对,相对差 2.89e-13;并明确打印 t=1 的 tilde_beta_1 = 0.000e+00。 B 段:训练集规模(120000 条、时间基 3 项、18 个参数)与权重动态范围 120.4。 C 段:真分布熵 1.880914 nats;「最优 $\varepsilon$ 预测器 + $\tilde\beta_t$」1.881015(差 +0.000101);「最优 $\varepsilon$ 预测器 + 真实后验方差」1.880914(差 +3.56e-10)。三种目标 × 两种方差的 NLL 表。 D 段:每步超额误差剖面,低噪声档比值 0.10、高噪声档比值 2.33。 E 段:$\lambda$ 插值扫描,NLL 1.898760 → 1.895815,生成 std 比 0.9659 → 0.9720。 F 段:两档容量对照,loose 真 ELBO 赢(1.880952 vs 1.881758)、tight 等权赢(1.898760 vs 1.922295)。 ddpm_train.py 的 A 段是梯度检查(有限差分相对差 4.42e-09),C 段是三种指标打分(uniform −0.2208±0.0195 / elbo_tilde −0.4212±0.0062),D 段只换采样方差($\tilde\beta_t$ −0.2363±0.0123 / $\beta_t$ −0.2640±0.0129)。 想自己动手改的话,三个地方最值得试:把 BASIS 从 3 项换成 5 项看结论翻转(F 段已经在做);把 T 从 1000 降到 100 看 $w_t$ 的动态范围怎么变;把数据从高斯换成 ddpm_train.py 的 7 峰混合,看方差选择的结论会不会反过来。 10. 延伸阅读 前置:扩散过程的前向与反向推导(前向闭式解、反向后验、ELBO→$\varepsilon$ 的化简)、变分下界与重参数化(ELBO 这个工具本身从哪来)。 已发布后继:DDIM 与高阶采样器、CFG、潜空间扩散、流匹配。 往上一层:把 RL 用到扩散模型上(训练目标被换成奖励之后,$w_t$ 这套分析还成不成立)。 附录:完整代码 09 节用到的脚本全文如下(ddpm_lab.py、ddpm_train.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 ddpm_lab.py # -*- coding: utf-8 -*- """DDPM 训练目标的最小实验室(闭式解版,只依赖 numpy,无 torch)。 这个脚本回答四个只能用数字回答的问题: A. ELBO 里那一串「只跟 t 有关的系数」到底是什么形状。 解析式 w_t = beta_t^2 / (2 sigma_t^2 alpha_t (1 - abar_t)), 用两个高斯的 KL 数值核一遍,确认没推导错。 B. 用带权最小二乘训练一个**跨时间步共享参数**的 epsilon 网络 (仿射 + 固定时间基),比较三种目标: uniform —— DDPM 的 L_simple,等权 elbo_tilde —— 真 ELBO 权重,sigma^2 = tilde_beta_t(diffusers 的 fixed_small) elbo_large —— 真 ELBO 权重,sigma^2 = beta_t(diffusers 的 fixed_large) 模型容量故意给小(3 个时间基、9 维特征、18 个参数),所以权重真的会决定容量往哪搬。 C. 仿射模型下 p_theta(x_0) 是一个高斯,可以算出**精确 NLL**。 用「密度沿链前向传播」算,再用「线性映射复合」交叉验证一遍。 D. 反向链的方差 sigma^2 到底该取 tilde_beta_t 还是 beta_t。 在 beta_tilde 与 beta 之间插值扫一遍,看 NLL 与生成分布的胖瘦怎么变。 运行: /usr/local/bin/python3 ddpm_lab.py 依赖: numpy(无 GPU、无 torch) """ import os import numpy as np RNG_SEED = 20260927 T = 1000 D = 2 # ══════════════════════════════════════════════════════════════════ # 0. 噪声调度与前向过程的闭式量 # ══════════════════════════════════════════════════════════════════ def linear_beta(T=1000, b1=1e-4, bT=0.02): """DDPM 原文 CIFAR-10 用的线性调度。""" return np.linspace(b1, bT, T) def cosine_beta(T=1000, s=0.008, clip=0.999): """Improved DDPM 的余弦调度:先定 abar(t) 再反解 beta。""" u = np.arange(1, T + 1) / T f = np.cos(((u + s) / (1 + s)) * np.pi / 2) ** 2 f0 = np.cos((s / (1 + s)) * np.pi / 2) ** 2 abar = f / f0 beta = 1.0 - abar / np.concatenate([[1.0], abar[:-1]]) return np.clip(beta, 1e-8, clip) class Sched: """下标约定:abar[t]、bt[t] 的 t 取 0..T;beta[t-1]、alpha[t-1] 对应数学时间步 t。""" def __init__(self, beta): self.T = len(beta) self.beta = beta self.alpha = 1.0 - beta self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)]) # 长度 T+1 # tilde_beta_t = (1 - abar_{t-1}) / (1 - abar_t) * beta_t self.bt = np.empty(self.T + 1) self.bt[0] = 0.0 self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta def weight(self, which="tilde"): """ELBO 第 t 项里 ||eps - eps_theta||^2 前面的系数(长度 T,下标 0 对应 t=1)。 which="tilde" -> sigma^2 = tilde_beta_t (fixed_small) which="large" -> sigma^2 = beta_t (fixed_large) t=1 时 tilde_beta_1 = 0,权重分母为零(分子非零)。DDPM 把这一项交给 L_0(离散解码器) 单独处理;这里为了让训练能跑,退化地用 fixed_large 的权重顶上。 """ s2 = self.bt[1:] if which == "tilde" else self.beta with np.errstate(divide="ignore", invalid="ignore"): w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:])) if which == "tilde": w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1])) return w def weight_simplified(self, which="tilde"): """上面那条式子化简之后的样子,用来核对代数没推错。""" denom = 1.0 - (self.abar[:-1] if which == "tilde" else self.abar[1:]) with np.errstate(divide="ignore", invalid="ignore"): return self.beta / (2.0 * self.alpha * denom) def q_sample(x0, t_idx, abar, rng): """x_t = sqrt(abar_t) x_0 + sqrt(1 - abar_t) eps,一步到位。""" a = abar[t_idx] if np.isscalar(a): a = np.full(len(x0), a) eps = rng.standard_normal(x0.shape) return np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps, eps # ══════════════════════════════════════════════════════════════════ # 1. 数据:一个二维高斯(NLL 能算到机器精度) # ══════════════════════════════════════════════════════════════════ MU0 = np.array([1.0, -0.5]) S0 = np.array([[0.60, 0.25], [0.25, 0.35]]) def sample_gauss(n, rng): L = np.linalg.cholesky(S0) return MU0 + rng.standard_normal((n, D)) @ L.T def entropy_gauss(S): """高斯熵(nats)。""" _, ld = np.linalg.slogdet(S) return 0.5 * (D * np.log(2 * np.pi * np.e) + ld) def kl_gauss(m0, S0_, m1, S1_): """KL( N(m0, S0_) || N(m1, S1_) ),闭式解。""" L = np.linalg.cholesky(S1_) y = np.linalg.solve(L, m1 - m0) Sinv_S0 = np.linalg.solve(S1_, S0_) _, ld1 = np.linalg.slogdet(S1_) _, ld0 = np.linalg.slogdet(S0_) return 0.5 * (np.trace(Sinv_S0) + y @ y - D + ld1 - ld0) def expected_nll(m, S): """E_{x ~ p_data}[-log p_theta(x)] 的**精确值**。 = 数据分布的熵 + KL(p_data || p_theta),两个高斯之间全是闭式解, 没有蒙特卡洛噪声——用固定测试集估 NLL 时,2 万样本的波动有 ±0.007 nats, 比我们要比的 0.002~0.004 nats 还大,所以这里必须用闭式解。 """ return entropy_gauss(S0) + kl_gauss(MU0, S0, m, S) def gauss_nll(X, m, S): """多元高斯负对数似然(nats)。协方差病态时加抖动兜底。""" jitter = 0.0 for _ in range(8): try: L = np.linalg.cholesky(S + jitter * np.eye(D)) y = np.linalg.solve(L, (X - m).T) return 0.5 * (np.sum(y * y, axis=0) + 2 * np.sum(np.log(np.diag(L))) + D * np.log(2 * np.pi)) except np.linalg.LinAlgError: jitter = 1e-12 if jitter == 0.0 else jitter * 100.0 raise RuntimeError("协方差矩阵无法正定化,说明反向链已经数值发散") # ══════════════════════════════════════════════════════════════════ # 2. 模型:eps_theta(x, t) = B(psi_t) x + c(psi_t),参数跨 t 共享 # psi 是固定的幂函数时间基,只有 B、c 的系数是可学的 # ══════════════════════════════════════════════════════════════════ # 时间基故意取得很小:让「容量」成为真正的约束,权重才会决定容量往哪搬。 # 指数里出现 0.5,是因为最优的 B_t 与 sqrt(1 - abar_t) 成正比, # 在 t 很小时它按 sqrt(t) 走 —— 用纯多项式去拟合会在开头剧烈震荡。 BASIS = { "loose": [0.0, 0.5, 1.0, 1.5, 2.0], # 5 项:较高容量档,不代表一般容量充分 "tight": [0.0, 0.5, 1.0], # 3 项:容量真的成了瓶颈 } BASIS_EXP = BASIS["tight"] # 默认用容量吃紧那一档,机制看得最清楚 K = len(BASIS_EXP) def set_basis(name): global BASIS_EXP, K BASIS_EXP = BASIS[name] K = len(BASIS_EXP) return K def psi_basis(t_arr): """t (1..T) -> (n, K) 的固定时间基,u = t / T in (0, 1]。""" u = np.asarray(t_arr, dtype=float) / T return np.stack([u ** e for e in BASIS_EXP], axis=-1) def feats(x, psi): """拼特征:[x ⊗ psi, psi],最后一维长度 D*K + K。""" px = x[:, :, None] * psi[:, None, :] # (n, D, K) return np.concatenate([px.reshape(len(x), -1), psi], axis=1) def fit_weighted_ridge(Phi, E, w, lam): """最小化 sum_i w_i ||W phi_i - eps_i||^2 + lam ||W||^2。""" P = Phi.shape[1] A = np.einsum("n,np,nq->pq", w, Phi, Phi) + lam * np.eye(P) Bmat = np.einsum("n,np,nd->pd", w, Phi, E) return np.linalg.solve(A, Bmat) def model_Bc(W, psi_t): """把共享权重在某个时刻 t 上展开成 eps = B x + c。""" Wx = W[: D * K, :].reshape(D, K, D) # Wx[i, k, j] Bmat = np.einsum("ikj,k->ji", Wx, psi_t) cvec = psi_t @ W[D * K:, :] return Bmat, cvec def optimal_Bc(sc, t): """高斯数据下 eps 的最优预测器(后验均值),用来做参考与验算。""" a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) Bmat = np.sqrt(1.0 - a) * np.linalg.inv(C) cvec = -np.sqrt(a) * (Bmat @ MU0) return Bmat, cvec def mse_analytic(Bmat, cvec, sc, t): """E||B x_t + c - eps||^2 的闭式解(对 D 维取了平均)。 (x_t, eps) 是联合高斯:Var(x_t) = C_t = abar_t S0 + (1-abar_t) I, Cov(x_t, eps) = sqrt(1-abar_t) I,E[x_t] = sqrt(abar_t) mu0,E[eps] = 0。 展开 ||B x_t + c - eps||^2 的期望即得下式,不用蒙特卡洛,没有抽样噪声。 """ a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) m = np.sqrt(a) * MU0 quad = np.trace(Bmat @ C @ Bmat.T) # Var(B x_t) bias = np.sum((Bmat @ m + cvec) ** 2) # 均值没对上的部分 cross = 2.0 * np.sqrt(1.0 - a) * np.trace(Bmat) # -2 Cov(B x_t, eps) return float((quad + bias - cross + D) / D) def mse_floor(sc, t): """贝叶斯最优的 MSE 地板:Var(eps | x_t) 的迹除以 D。""" a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) return float((D - (1.0 - a) * np.trace(np.linalg.inv(C))) / D) def learnability(sc, t): """这一时刻的 eps 里,有多大比例是能从 x_t 里看出来的。 R^2 = 1 - 地板 / Var(eps),Var(eps) 的每维是 1。 """ return 1.0 - mse_floor(sc, t) # ══════════════════════════════════════════════════════════════════ # 3. 精确 NLL:把高斯密度沿反向链往前传 # ══════════════════════════════════════════════════════════════════ def _s2_mat(sigma2, t): """每步注入的噪声协方差:既接受标量(各向同性),也接受 (T+1, D, D)。""" if sigma2.ndim == 1: return sigma2[t] * np.eye(D) return sigma2[t] def chain_moments_prop(sc, Bcfun, sigma2): """写法一:密度传播。x_{t-1} = M_t x_t + v_t + noise。""" m = np.zeros(D) S = np.eye(D) sig = np.atleast_1d(sigma2) for t in range(T, 0, -1): Bmat, cvec = Bcfun(t) kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t]) M = (np.eye(D) - kk * Bmat) / np.sqrt(sc.alpha[t - 1]) v = -kk * cvec / np.sqrt(sc.alpha[t - 1]) m = M @ m + v S = M @ S @ M.T + _s2_mat(sig, t) return m, S def chain_moments_comp(sc, Bcfun, sigma2): """写法二:把整条链复合成一个仿射映射,再累加各步噪声。独立实现,用于交叉验证。""" m = np.zeros(D) S = np.zeros((D, D)) Pprev = np.eye(D) for t in range(1, T + 1): Bmat, cvec = Bcfun(t) kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t]) M = (np.eye(D) - kk * Bmat) / np.sqrt(sc.alpha[t - 1]) v = -kk * cvec / np.sqrt(sc.alpha[t - 1]) m = m + Pprev @ v S = S + Pprev @ _s2_mat(sigma2, t) @ Pprev.T Pprev = Pprev @ M S = S + Pprev @ Pprev.T # x_T ~ N(0, I) 的那一坨 return m, S def sigma2_exact_posterior(sc): """真实后验 q(x_{t-1}|x_t) 的协方差(高斯数据下可算)。 = tilde_beta_t I + Var(mu_t | x_t) = tilde_beta_t I + (beta_t^2 / (alpha_t (1 - abar_t))) Var(eps | x_t) 第二项就是 DDPM 反向链扔掉的那部分:真实后验比 beta_tilde 更胖。 """ out = np.zeros((T + 1, D, D)) for t in range(1, T + 1): a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) var_eps = np.eye(D) - (1.0 - a) * np.linalg.inv(C) kk2 = sc.beta[t - 1] ** 2 / (sc.alpha[t - 1] * (1.0 - a)) out[t] = sc.bt[t] * np.eye(D) + kk2 * var_eps return out def sigma2_from_choice(sc, which="tilde", lam_mix=0.0): """反向链每步注入的方差。lam_mix 在 tilde_beta 与 beta 之间插值。""" if which == "tilde": base = sc.bt.copy() other = np.concatenate([[0.0], sc.beta]) else: base = np.concatenate([[0.0], sc.beta]) other = sc.bt.copy() return (1.0 - lam_mix) * base + lam_mix * other # ══════════════════════════════════════════════════════════════════ # 4. 主流程 # ══════════════════════════════════════════════════════════════════ def section_A(sc): print("=" * 74) print("A. ELBO 每步权重:解析式 vs 两个高斯的 KL") print("=" * 74) w_tilde = sc.weight("tilde") w_large = sc.weight("large") ws_tilde = sc.weight_simplified("tilde") ws_large = sc.weight_simplified("large") ok = np.isfinite(ws_tilde) & (ws_tilde > 0) rel = np.max(np.abs(w_tilde[ok] - ws_tilde[ok]) / ws_tilde[ok]) print(f" 化简式与原始式的最大相对差(tilde):{rel:.3e}") rel2 = np.max(np.abs(w_large - ws_large) / ws_large) print(f" 化简式与原始式的最大相对差(large):{rel2:.3e}") print(f" t=1 的 tilde_beta_1 = {sc.bt[1]:.3e}(后验方差为 0 => 权重发散," f"这就是 DDPM 要把 L_0 单独拿出来的原因)") print() print(" t abar_t beta_t w_t(sigma^2=bt) w_t(sigma^2=beta) 相对等权") for t in [2, 10, 50, 100, 250, 500, 750, 900, 1000]: print(f" {t:<6d}{sc.abar[t]:<12.3e}{sc.beta[t-1]:<10.5f}" f"{w_tilde[t-1]:<18.4e}{w_large[t-1]:<20.4e}" f"{w_tilde[t-1] / w_tilde[499]:<10.2f}") print() span = w_tilde[1] / w_tilde.min() print(f" sigma^2=tilde_beta 时,权重最大值(t=2)是最小值(t={int(np.argmin(w_tilde))+1})的 " f"{span:.1f} 倍") print(f" 等权 L_simple 相当于把这条曲线整体压平到 1") print() # 数值核对:KL( q(x_{t-1}|x_t,x_0) || p_theta(x_{t-1}|x_t) ) == w_t * ||delta_eps||^2 rng = np.random.default_rng(RNG_SEED) print(" —— KL 数值核对(随机取 x_0, eps,令 eps_theta = eps + delta)——") print(" t KL(数值) w_t*||delta||^2 相对差") for t in [2, 100, 500, 1000]: x0 = sample_gauss(1, rng)[0] a = sc.abar[t] eps = rng.standard_normal(D) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps delta = rng.standard_normal(D) * 0.3 eps_hat = eps + delta kk = sc.beta[t - 1] / np.sqrt(1 - a) mu_tilde = (xt - kk * eps) / np.sqrt(sc.alpha[t - 1]) mu_theta = (xt - kk * eps_hat) / np.sqrt(sc.alpha[t - 1]) s2 = sc.bt[t] kl = np.sum((mu_tilde - mu_theta) ** 2) / (2 * s2) pred = w_tilde[t - 1] * np.sum(delta ** 2) print(f" {t:<7d}{kl:<18.6e}{pred:<20.6e}{abs(kl-pred)/kl:<12.2e}") print() return w_tilde, w_large def fit_three(sc, w_tilde, w_large, lam=1e-6): """三种权重各解一遍带权最小二乘。不打印任何东西,供 section_B / section_F 共用。""" rng = np.random.default_rng(RNG_SEED + 1) M = 120_000 t_idx = rng.integers(1, T + 1, size=M) x0 = sample_gauss(M, rng) a = sc.abar[t_idx] eps = rng.standard_normal((M, D)) xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1 - a)[:, None] * eps psi = psi_basis(t_idx) Phi = feats(xt, psi) # 三种权重都归一化到均值 1(整体缩放不改变无正则时的解, # 归一化只是为了让正则强度在三种目标下可比) schemes = { "uniform": np.ones(T), "elbo_tilde": w_tilde / w_tilde.mean(), "elbo_large": w_large / w_large.mean(), } W = {} for name, w_full in schemes.items(): w = w_full[t_idx - 1] W[name] = fit_weighted_ridge(Phi, eps, w, lam) return W, schemes def section_B(sc, w_tilde, w_large): print("=" * 74) print("B. 带权最小二乘训练:三种目标,共享参数,容量有限") print("=" * 74) W, schemes = fit_three(sc, w_tilde, w_large) print(f" 训练集:M=120000 条 (x_0, t, eps),时间基 {K} 项,特征维度 {K * (D + 1)}," f"可学参数 {K * (D + 1) * D} 个") print(f" 三种权重都归一化到均值 1(无正则时整体缩放不改变解;归一化使正则强度口径一致)") print(f" 权重动态范围:elbo_tilde 的 max/min = {w_tilde.max()/w_tilde.min():.1f}") print() return W, schemes def model_moments(sc, Wm, which="tilde"): """把训练好的共享权重展开成整条反向链→生成分布的均值与协方差。""" s2 = sigma2_from_choice(sc, which) return chain_moments_prop( sc, lambda t: model_Bc(Wm, psi_basis(np.array([t]))[0]), s2) def excess_bands(sc, W): """低噪声档 / 高噪声档的超额误差均值,以及 elbo 相对 uniform 的比值。""" lo = np.arange(1, 51) hi = np.arange(400, 1001) out = {} for band, idx in [("lo", lo), ("hi", hi)]: e = {} for name in ["uniform", "elbo_tilde"]: e[name] = float(np.mean([ mse_analytic(*model_Bc(W[name], psi_basis(np.array([t]))[0]), sc, t) - mse_floor(sc, t) for t in idx])) out[band] = (e["uniform"], e["elbo_tilde"], e["elbo_tilde"] / e["uniform"]) return out def section_C(sc, W, schemes): print("=" * 74) print("C. 仿射模型下的精确 NLL(密度前向传播)") print("=" * 74) rng = np.random.default_rng(RNG_SEED + 2) Xtest = sample_gauss(400_000, rng) nll_true = expected_nll(MU0, S0) print(f" 参考:真分布 N(mu_0, S_0) 的熵 = {nll_true:.6f} nats" f"({nll_true / np.log(2) / D:.4f} bits/dim)") print(f" 蒙特卡洛复核(40 万样本):{gauss_nll(Xtest, MU0, S0).mean():.6f} nats" f",与闭式解差 {abs(gauss_nll(Xtest, MU0, S0).mean()-nll_true):.2e}") # 交叉验证两种写法 m1, S1 = chain_moments_prop(sc, lambda t: optimal_Bc(sc, t), sigma2_from_choice(sc, "tilde")) m2, S2 = chain_moments_comp(sc, lambda t: optimal_Bc(sc, t), sigma2_from_choice(sc, "tilde")) print(f" 两种写法的差异:均值 {np.max(np.abs(m1-m2)):.2e},协方差 {np.max(np.abs(S1-S2)):.2e}") # 蒙特卡洛复核:真跑 20 万条链,比对经验均值/协方差 rng3 = np.random.default_rng(RNG_SEED + 3) xs = rng3.standard_normal((200_000, D)) for t in range(T, 0, -1): Bmat, cvec = optimal_Bc(sc, t) kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t]) mu = (xs - kk * (xs @ Bmat.T + cvec)) / np.sqrt(sc.alpha[t - 1]) xs = mu + np.sqrt(sc.bt[t]) * rng3.standard_normal((200_000, D)) print(f" 蒙特卡洛复核:均值差 {np.max(np.abs(xs.mean(0)-m1)):.2e}," f"协方差差 {np.max(np.abs(np.cov(xs.T)-S1)):.2e}") nll_opt = expected_nll(m1, S1) print(f" 「最优 eps 预测器 + sigma^2=tilde_beta」的期望 NLL = {nll_opt:.6f} nats," f"比真分布差 {nll_opt - nll_true:+.6f} nats") print(f" 蒙特卡洛复核(同上 40 万样本):{gauss_nll(Xtest, m1, S1).mean():.6f} nats," f"差 {abs(gauss_nll(Xtest, m1, S1).mean()-nll_opt):.2e}") print(f" 生成分布的协方差 diag = {np.diag(S1)},真值 diag = {np.diag(S0)} " f"=> 比值 {np.diag(S1)/np.diag(S0)}") # 把真实后验方差(而不是 tilde_beta)灌回反向链:在本高斯实验中接近数据分布,仍有有限终点先验误差 s2_exact = sigma2_exact_posterior(sc) m3, S3 = chain_moments_prop(sc, lambda t: optimal_Bc(sc, t), s2_exact) nll_exact = expected_nll(m3, S3) print(f" 「最优 eps 预测器 + 真实后验方差」的期望 NLL = {nll_exact:.6f} nats," f"比真分布差 {nll_exact - nll_true:+.2e} nats") print(f" 此时生成协方差 diag / 真值 = {np.diag(S3)/np.diag(S0)}," f"均值差 {np.max(np.abs(m3 - MU0)):.2e}") print(" => reverse 链的均值用最优 eps 预测器、方差用真实后验方差," "在本高斯实验中极接近数据分布;仍有有限终点先验与数值误差;") print(" 约 0.0001 nats 的缺口主要来自固定 tilde_beta;对照的残差如上,不视为严格零。") print() print(" 三种训练目标 × 两种采样方差的期望 NLL(nats,越小越好):") print(" 训练目标 sigma^2=tilde_beta sigma^2=beta 差 生成std/真std") rows = {} for name in ["uniform", "elbo_tilde", "elbo_large"]: Wm = W[name] out = {} for which in ["tilde", "large"]: m, S = model_moments(sc, Wm, which) out[which] = expected_nll(m, S) out[which + "_std"] = float(np.mean(np.sqrt(np.diag(S)) / np.sqrt(np.diag(S0)))) rows[name] = out print(f" {name:<16}{out['tilde']:<22.6f}{out['large']:<18.6f}" f"{out['large']-out['tilde']:<+12.6f}{out['tilde_std']:.4f}") print() return rows, nll_true, nll_opt def section_D(sc, W): print("=" * 74) print("D. 每步误差剖面:权重把「超额误差」搬到了哪") print("=" * 74) grid = list(range(1, 1001)) floor = np.array([mse_floor(sc, t) for t in grid]) learn = np.array([learnability(sc, t) for t in grid]) prof = {} for name, Wm in W.items(): mse = [] for t in grid: Bmat, cvec = model_Bc(Wm, psi_basis(np.array([t]))[0]) mse.append(mse_analytic(Bmat, cvec, sc, t)) prof[name] = np.array(mse) print(" 闭式解算的,没有蒙特卡洛噪声。『超额』= MSE − 贝叶斯地板。") print(" t 可学占比R^2 地板 uniform超额 elbo_tilde超额 elbo_large超额") for t in [1, 5, 20, 50, 100, 200, 400, 600, 800, 950, 1000]: i = t - 1 print(f" {t:<6d}{learn[i]:<12.4f}{floor[i]:<9.4f}" f"{prof['uniform'][i]-floor[i]:<14.3e}{prof['elbo_tilde'][i]-floor[i]:<16.3e}" f"{prof['elbo_large'][i]-floor[i]:.3e}") print() lo = slice(0, 50) # t = 1..50 hi = slice(399, 1000) # t = 400..1000 eu_u, eu_e = prof["uniform"] - floor, prof["elbo_tilde"] - floor print(f" 低噪声档 t<=50 :uniform 超额均值 {eu_u[lo].mean():.3e}," f"elbo_tilde {eu_e[lo].mean():.3e}(比值 {eu_e[lo].mean()/eu_u[lo].mean():.2f})") print(f" 高噪声档 t>=400 :uniform 超额均值 {eu_u[hi].mean():.3e}," f"elbo_tilde {eu_e[hi].mean():.3e}(比值 {eu_e[hi].mean()/eu_u[hi].mean():.2f})") print() print(f" 可学占比 R^2:t=1 时 {learn[0]:.2e},t=500 时 {learn[499]:.4f}," f"t=1000 时 {learn[999]:.4f}") print() return grid, prof, floor, learn def section_E(sc, W): print("=" * 74) print("E. 采样方差该取 tilde_beta 还是 beta:在两者之间插值扫一遍") print("=" * 74) nll_true = expected_nll(MU0, S0) print(" lam 是插值系数:sigma^2 = (1-lam)*tilde_beta + lam*beta") print(" lam NLL(uniform训练) NLL(elbo_tilde训练) 生成 std / 真 std") out = {"lam": [], "nll_uniform": [], "nll_elbo": [], "std_ratio": []} for lam in [0.0, 0.25, 0.5, 0.75, 1.0]: s2 = sigma2_from_choice(sc, "tilde", lam_mix=lam) row, sr = [], 0.0 for name in ["uniform", "elbo_tilde"]: m, S = chain_moments_prop( sc, lambda t: model_Bc(W[name], psi_basis(np.array([t]))[0]), s2) row.append(expected_nll(m, S)) if name == "uniform": sr = float(np.mean(np.sqrt(np.diag(S)) / np.sqrt(np.diag(S0)))) out["lam"].append(lam) out["nll_uniform"].append(row[0]) out["nll_elbo"].append(row[1]) out["std_ratio"].append(sr) print(f" {lam:<7.2f}{row[0]:<19.6f}{row[1]:<22.6f}{sr:.4f}") best = out["lam"][int(np.argmin(np.abs(np.array(out["std_ratio"]) - 1.0)))] print(f" 扫描范围内标准差比最接近 1 的 lam ≈ {best:.2f}(这一列是最敏感的指标," f"NLL 对 lam 几乎不动)") print(f" 参考:真分布熵 = {nll_true:.6f}") print() return out def section_F(sc, w_tilde, w_large): """容量充足 vs 容量吃紧:『该不该扔掉系数』的答案会不会反过来。""" print("=" * 74) print("F. 同样两个目标,换一档模型容量:结论会反过来") print("=" * 74) print(" 两档时间基都只动特征个数,训练数据、种子、正则强度完全一样。") print() print(" 容量档 时间基项数 可学参数 NLL(等权) NLL(真ELBO) 谁更好 低噪声档超额比 高噪声档超额比") out = {} for regime in ["loose", "tight"]: k = set_basis(regime) Wf, _ = fit_three(sc, w_tilde, w_large) n_u = expected_nll(*model_moments(sc, Wf["uniform"])) n_e = expected_nll(*model_moments(sc, Wf["elbo_tilde"])) bands = excess_bands(sc, Wf) better = "等权" if n_u < n_e else "真ELBO" n_par = k * (D + 1) * D out[regime] = dict(K=k, nll_uniform=n_u, nll_elbo=n_e, bands=bands, W=Wf) print(f" {regime:<8}{k:<12}{n_par:<11}{n_u:<12.6f}{n_e:<14.6f}" f"{better:<9}{bands['lo'][2]:<16.2f}{bands['hi'][2]:.2f}") set_basis("tight") print() print(" 列『超额比』= 真 ELBO 权重的超额误差 / 等权的超额误差,小于 1 表示更好。") print(" => 本实验较高容量档 ELBO 权重略胜,较低容量档等权胜;不推广到任意容量或模型。") print() return out def main(): sc = Sched(linear_beta(T)) print(f"调度:线性 T={T},beta 从 {sc.beta[0]:.1e} 到 {sc.beta[-1]:.3f}," f"abar_T = {sc.abar[T]:.4e}") print() w_tilde, w_large = section_A(sc) W, schemes = section_B(sc, w_tilde, w_large) print() rows, nll_true, nll_opt = section_C(sc, W, schemes) print() grid, prof, floor, learn = section_D(sc, W) print() mix = section_E(sc, W) print() regimes = section_F(sc, w_tilde, w_large) return dict(sched=sc, w_tilde=w_tilde, w_large=w_large, W=W, nll_rows=rows, nll_true=nll_true, nll_opt=nll_opt, grid=grid, prof=prof, floor=floor, learn=learn, mix=mix, regimes=regimes) if __name__ == "__main__": main() ddpm_train.py # -*- coding: utf-8 -*- """照着 DDPM 原文 Algorithm 1 / Algorithm 2 写的最小实现(纯 numpy,无 torch)。 为什么还要写一遍神经网络版:ddpm_lab.py 用带权最小二乘的闭式解把「优化算法」 这个变量消掉了,代价是模型只能仿射。这里补上手写反向传播的两层 MLP, 在**多模态**的目标分布上跑完整的一千步采样,看训练目标的权重到底怎么影响 最后生成出来的东西。 A. 梯度核对:手写反向传播 vs 有限差分 B. Algorithm 1:按两种权重(等权 / ELBO-tilde)各训练一个网络 C. Algorithm 2:一千步采样,三种指标打分 D. 反向链方差 sigma^2 = tilde_beta 还是 beta 运行: /usr/local/bin/python3 ddpm_train.py # 默认 20000 步 /usr/local/bin/python3 ddpm_train.py --steps 40000 依赖: numpy """ import argparse import os import numpy as np RNG_SEED = 20260927 T = 1000 D = 2 # ══════════════════════════════════════════════════════════════════ # 0. 调度(与 ddpm_lab.py 同一套,下标约定:t 取 1..T) # ══════════════════════════════════════════════════════════════════ def linear_beta(T=1000, b1=1e-4, bT=0.02): return np.linspace(b1, bT, T) class Sched: def __init__(self, beta): self.beta = beta self.alpha = 1.0 - beta self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)]) self.bt = np.empty(len(beta) + 1) self.bt[0] = 0.0 self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta def weight(self, which="tilde"): """ELBO 第 t 项里 ||eps - eps_theta||^2 的系数。""" s2 = self.bt[1:] if which == "tilde" else self.beta with np.errstate(divide="ignore", invalid="ignore"): w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:])) if which == "tilde": # t=1 分母为零、分子非零;用连续重建方差 beta_1 的权重 w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1])) return w # ══════════════════════════════════════════════════════════════════ # 1. 目标分布:7 个分量的二维高斯混合(环状 + 一个中心) # ══════════════════════════════════════════════════════════════════ RING_R = 1.15 N_RING = 6 CENTERS = np.array( [[RING_R * np.cos(2 * np.pi * k / N_RING), RING_R * np.sin(2 * np.pi * k / N_RING)] for k in range(N_RING)] + [[0.0, 0.0]] ) SCALES = np.array([0.17, 0.20, 0.16, 0.22, 0.18, 0.19, 0.28]) WEIGHTS = SCALES ** 2 # 分量越大越容易被采到,制造不均匀 WEIGHTS = WEIGHTS / WEIGHTS.sum() def sample_mix(n, rng): kk = rng.choice(len(WEIGHTS), size=n, p=WEIGHTS) return CENTERS[kk] + SCALES[kk][:, None] * rng.standard_normal((n, D)) def logp_mix(X): """混合分布在 X 处的对数密度(各分量都是各向同性高斯)。""" d2 = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1) # (n, K) comp = np.log(WEIGHTS)[None, :] - 0.5 * d2 / SCALES[None, :] ** 2 \ - D * np.log(SCALES[None, :]) - 0.5 * D * np.log(2 * np.pi) m = comp.max(axis=1, keepdims=True) return (m[:, 0] + np.log(np.exp(comp - m).sum(axis=1))) def nearest_center_dist(X): d2 = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1) return np.sqrt(d2.min(axis=1)) # ══════════════════════════════════════════════════════════════════ # 2. 时间嵌入 + 两层 MLP + 手写 Adam # ══════════════════════════════════════════════════════════════════ TIME_FREQ = (1, 2, 4, 8) # 8 维时间基 def time_embed(t_arr): u = np.asarray(t_arr, dtype=float) / T cols = [] for w in TIME_FREQ: cols.append(np.cos(w * np.pi * u)) cols.append(np.sin(w * np.pi * u)) return np.stack(cols, axis=-1) N_IN = D + 2 * len(TIME_FREQ) H = 64 def init_params(rng): def he(fan_in, fan_out): return rng.standard_normal((fan_in, fan_out)) * np.sqrt(2.0 / fan_in) return { "W1": he(N_IN, H), "b1": np.zeros(H), "W2": he(H, H), "b2": np.zeros(H), "W3": he(H, D), "b3": np.zeros(D), } def forward(p, Z): h1 = np.maximum(Z @ p["W1"] + p["b1"], 0.0) h2 = np.maximum(h1 @ p["W2"] + p["b2"], 0.0) return h1, h2, h2 @ p["W3"] + p["b3"] def backward(p, Z, h1, h2, out, eps, w): """d/d(theta) of mean_i w_i ||out_i - eps_i||^2。""" n = len(Z) dout = 2.0 * (w[:, None] * (out - eps)) / n g = {} g["W3"] = h2.T @ dout g["b3"] = dout.sum(0) dh2 = dout @ p["W3"].T dh2[h2 <= 0] = 0.0 g["W2"] = h1.T @ dh2 g["b2"] = dh2.sum(0) dh1 = dh2 @ p["W2"].T dh1[h1 <= 0] = 0.0 g["W1"] = Z.T @ dh1 g["b1"] = dh1.sum(0) return g class Adam: def __init__(self, p, lr=1e-3, b1=0.9, b2=0.999, eps=1e-8): self.m = {k: np.zeros_like(v) for k, v in p.items()} self.v = {k: np.zeros_like(v) for k, v in p.items()} self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps self.i = 0 def step(self, p, g): self.i += 1 for k in p: self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * g[k] self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * g[k] ** 2 mh = self.m[k] / (1 - self.b1 ** self.i) vh = self.v[k] / (1 - self.b2 ** self.i) p[k] -= self.lr * mh / (np.sqrt(vh) + self.eps) def predict_eps(p, x, t_idx): Z = np.concatenate([x, time_embed(np.full(len(x), t_idx))], axis=1) _, _, out = forward(p, Z) return out # ══════════════════════════════════════════════════════════════════ # 3. Algorithm 1(训练)与 Algorithm 2(采样) # ══════════════════════════════════════════════════════════════════ def train(sc, w_full, steps, batch, rng, lr=1e-3): """保留 DDPM Algorithm 1 的抽样与加噪流程,另允许教学用时间权重。""" p = init_params(rng) opt = Adam(p, lr=lr) for _ in range(steps): # 1: t ~ Uniform({1, ..., T}) 2: x_0 ~ q(x_0) 3: eps ~ N(0, I) t_idx = rng.integers(1, T + 1, size=batch) x0 = sample_mix(batch, rng) eps = rng.standard_normal((batch, D)) # 4: 一步加噪(闭式解,不需要真的走 t 步) a = sc.abar[t_idx] xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps # 5: 梯度下降一步 Z = np.concatenate([xt, time_embed(t_idx)], axis=1) h1, h2, out = forward(p, Z) opt.step(p, backward(p, Z, h1, h2, out, eps, w_full[t_idx - 1])) return p def sample_chain(sc, p, n, which="tilde", rng=None): """DDPM 原文 Algorithm 2。which 决定 sigma^2 取 tilde_beta 还是 beta。""" x = rng.standard_normal((n, D)) # x_T ~ N(0, I) for t in range(T, 0, -1): eps_hat = predict_eps(p, x, t) a, a_prev = sc.abar[t], sc.abar[t - 1] alpha_t, beta_t = sc.alpha[t - 1], sc.beta[t - 1] # mu_tilde = (x_t - beta_t/sqrt(1-abar_t) * eps_hat) / sqrt(alpha_t) mu = (x - beta_t / np.sqrt(1.0 - a) * eps_hat) / np.sqrt(alpha_t) if which == "tilde": sigma = np.sqrt(sc.bt[t]) else: sigma = np.sqrt(beta_t) z = rng.standard_normal((n, D)) x = mu + (sigma * z if t > 1 else 0.0) # t == 1 时不加噪声 return x # ══════════════════════════════════════════════════════════════════ # 4. 主流程 # ══════════════════════════════════════════════════════════════════ def section_A(): print("=" * 74) print("A. 手写反向传播 vs 有限差分") print("=" * 74) rng = np.random.default_rng(RNG_SEED) sc = Sched(linear_beta(T)) p = init_params(rng) n = 32 t_idx = rng.integers(1, T + 1, size=n) x0 = sample_mix(n, rng) eps = rng.standard_normal((n, D)) a = sc.abar[t_idx] xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1 - a)[:, None] * eps Z = np.concatenate([xt, time_embed(t_idx)], axis=1) w = np.ones(n) h1, h2, out = forward(p, Z) g = backward(p, Z, h1, h2, out, eps, w) def loss(): _, _, o = forward(p, Z) return float(np.mean(np.sum((o - eps) ** 2, axis=1))) print(" 参数 解析梯度 有限差分 相对差") worst = 0.0 for key in ["W1", "b1", "W2", "b2", "W3", "b3"]: idx = tuple(0 for _ in p[key].shape) h = 1e-6 orig = p[key][idx] p[key][idx] = orig + h lp = loss() p[key][idx] = orig - h lm = loss() p[key][idx] = orig num = (lp - lm) / (2 * h) ana = g[key][idx] rel = abs(num - ana) / max(abs(num), 1e-12) worst = max(worst, rel) print(f" {key:<8}{ana:<16.8e}{num:<16.8e}{rel:.2e}") print(f" => 最大相对差 {worst:.2e}(有限差分自己的精度极限在 1e-6 量级)") print() return sc def section_B(sc, steps): print("=" * 74) print("B. Algorithm 1:两种权重各训一个网络") print("=" * 74) w_tilde, w_large = sc.weight("tilde"), sc.weight("large") schemes = { "uniform": np.ones(T), "elbo_tilde": w_tilde / w_tilde.mean(), } print(f" 步数 {steps},batch 256,两层 MLP({N_IN} -> {H} -> {H} -> {D}),Adam lr=1e-3") print(f" elbo 权重的动态范围:max/min = {w_tilde.max()/w_tilde.min():.1f}") models = {} # 注意:不能用 hash(name)——Python 的字符串 hash 每次进程都变,结果会不可复现。 seed_of = {"uniform": 11, "elbo_tilde": 22, "elbo_large": 33} for name, w in schemes.items(): rng = np.random.default_rng(RNG_SEED + seed_of.get(name, 44)) models[name] = train(sc, w, steps, 256, rng) print(f" [{name}] 训练完成") print() return models def _score(X, base_logp, base_dist): """三个指标:log p0 相对真样本、到最近模式中心的距离比、模式覆盖数。""" dlogp = logp_mix(X).mean() - base_logp dratio = nearest_center_dist(X).mean() / base_dist assign = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1).argmin(1) frac = np.bincount(assign, minlength=len(CENTERS)) / len(X) return dlogp, dratio, int((frac > 0.02).sum()) def section_C(sc, models, n_gen, n_seed=3): print("=" * 74) print("C. Algorithm 2:一千步采样,三个指标打分") print("=" * 74) rng0 = np.random.default_rng(RNG_SEED + 77) Xtrue = sample_mix(20_000, rng0) base_logp = logp_mix(Xtrue).mean() base_dist = nearest_center_dist(Xtrue).mean() print(f" 基线(2 万真样本):log p0 均值 {base_logp:.4f}," f"到最近模式中心距离均值 {base_dist:.4f}") print(f" 每组用 {n_seed} 个不同的采样种子重复,报告采样间均值 ± 标准差;训练每分支仅一个独立固定种子") print() print(" 训练目标 log p0 相对真样本 到最近中心距离/真样本 模式覆盖") res = {} for name, p in models.items(): dl, dr, cov = [], [], [] for s in range(n_seed): rng = np.random.default_rng(RNG_SEED + 88 + s) a, b, c = _score(sample_chain(sc, p, n_gen, "tilde", rng), base_logp, base_dist) dl.append(a) dr.append(b) cov.append(c) res[name] = dict(dlogp=float(np.mean(dl)), dlogp_std=float(np.std(dl, ddof=1)), dratio=float(np.mean(dr)), frac=cov[0]) print(f" {name:<14}{np.mean(dl):<+10.4f} ± {np.std(dl, ddof=1):<10.4f}" f"{np.mean(dr):<22.4f}{cov[0]}/7") print() return res, base_logp, base_dist def section_D(sc, models, n_gen, n_seed=3): print("=" * 74) print("D. 反向链方差:tilde_beta(fixed_small)还是 beta(fixed_large)") print("=" * 74) rng0 = np.random.default_rng(RNG_SEED + 77) Xtrue = sample_mix(20_000, rng0) base_logp = logp_mix(Xtrue).mean() base_dist = nearest_center_dist(Xtrue).mean() p = models["uniform"] print(" 用 uniform(L_simple)训出来的那个网络,只换每步注入的方差:") print(" 方差选择 log p0 相对真样本 到最近中心距离/真样本") out = {} for which in ["tilde", "large"]: dl, dr = [], [] for s in range(n_seed): rng = np.random.default_rng(RNG_SEED + 99 + s) a, b, _ = _score(sample_chain(sc, p, n_gen, which, rng), base_logp, base_dist) dl.append(a) dr.append(b) out[which] = dict(dlogp=float(np.mean(dl)), dlogp_std=float(np.std(dl, ddof=1)), dratio=float(np.mean(dr))) print(f" {which:<14}{np.mean(dl):<+10.4f} ± {np.std(dl, ddof=1):<10.4f}{np.mean(dr):.4f}") print() return out def mse_profile(sc, models, rng_seed=RNG_SEED + 123): """每个时刻的 eps 预测误差(蒙特卡洛,用来画图)。""" rng = np.random.default_rng(rng_seed) grid = np.array([1, 2, 5, 10, 20, 50, 100, 200, 400, 600, 800, 950, 1000]) n = 6000 prof = {} for name, p in models.items(): vals = [] for t in grid: x0 = sample_mix(n, rng) a = sc.abar[t] eps = rng.standard_normal((n, D)) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps vals.append(float(np.mean((predict_eps(p, xt, t) - eps) ** 2))) prof[name] = np.array(vals) return grid, prof def score_counterexample(): """七个中心按真实分量权重重复输出;覆盖完整,但分量内方差为零。""" rng = np.random.default_rng(RNG_SEED + 777) true = sample_mix(20_000, rng) idx = rng.choice(len(WEIGHTS), size=20_000, p=WEIGHTS) centers_only = CENTERS[idx] result = _score(centers_only, logp_mix(true).mean(), nearest_center_dist(true).mean()) print("F. 密度评分反例:只输出七个模式中心(分量内方差为零)") print(f" delta_logp={result[0]:+.4f}, center_distance_ratio={result[1]:.4f}, coverage={result[2]}/7") print(" 高密度与全覆盖仍不能证明分量内分布正确;这不是模型NLL。") return result def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=20000) ap.add_argument("--n-gen", type=int, default=4000) args = ap.parse_args() sc = section_A() models = section_B(sc, args.steps) res, base_logp, base_dist = section_C(sc, models, args.n_gen) dres = section_D(sc, models, args.n_gen) grid, prof = mse_profile(sc, models) print("=" * 74) print("E. 每步预测误差(MSE,真 eps 的每维方差是 1)") print("=" * 74) print(" t uniform elbo_tilde") for i, t in enumerate(grid): print(f" {t:<7d}{prof['uniform'][i]:<12.4f}{prof['elbo_tilde'][i]:.4f}") counterexample = score_counterexample() return dict(sched=sc, models=models, res=res, dres=dres, grid=grid, prof=prof, counterexample=counterexample) if __name__ == "__main__": main() make_figures.py # -*- coding: utf-8 -*- """画本文的四张图。数据源全部来自 ddpm_lab.py 的真实输出,不另造数。 weight_profile.png ELBO 每步权重 vs 这个时刻真正可学的信号占比 excess_error.png 两种训练目标把「超额误差」搬到了哪 variance_ledger.png 反向链每步注入的噪声:beta_tilde / beta / 真实后验 step_anatomy.png 反向一步的三个配料怎么随 t 变 运行: /usr/local/bin/python3 make_figures.py 依赖: numpy, matplotlib(字体 PingFang SC) 注意:matplotlib 的 mathtext 标签一律用 raw 字符串,且反斜杠后面只能跟字母 ——源码会被 sync-code 原样搬进文章附录,反斜杠后面跟非字母会被体检器判成转义污染。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import ddpm_lab as LAB plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "PingFang SC", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.facecolor"] = "white" plt.rcParams["axes.facecolor"] = "white" plt.rcParams["savefig.facecolor"] = "white" plt.rcParams["font.size"] = 11 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C_MAIN, C_ALT, C_GREEN, C_GRAY = "#2563eb", "#dc2626", "#059669", "#6b7280" T = LAB.T D = LAB.D # ─────────────────────────── 图 1:权重 vs 可学占比 ─────────────────────────── def fig_weight_profile(sc, w_tilde, w_large, learn): fig, ax = plt.subplots(figsize=(9.2, 5.4)) tt = np.arange(1, T + 1) ax.semilogy(tt, w_tilde, color=C_MAIN, lw=2.0, label=r"真 ELBO 权重 $w_t$($\sigma^2=\tilde\beta_t$)") ax.semilogy(tt, w_large, color=C_ALT, lw=1.6, ls="--", label=r"真 ELBO 权重 $w_t$($\sigma^2=\beta_t$)") ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":") ax.text(620, 1.15, "等权 $L_{\mathrm{simple}}$ 就压在这条 1 上", color=C_GRAY, fontsize=9) ax.set_xlabel(r"时间步 $t$") ax.set_ylabel(r"预测误差平方前面的系数 $w_t$") ax.set_ylim(3e-3, 3.0) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9, loc="lower left") ax2 = ax.twinx() ax2.plot(tt, learn, color=C_GREEN, lw=2.0) ax2.set_ylabel(r"这一时刻能学出来的噪声占比 $R^2$", color=C_GREEN) ax2.set_ylim(-0.05, 1.05) ax2.tick_params(axis="y", labelcolor=C_GREEN) ax2.set_title("(a) 权重与可预测比例:低噪声地板大,不代表 score 无用", fontsize=11) span = w_tilde.max() / w_tilde.min() ax.annotate(rf"权重跨 {span:.0f} 倍", xy=(2, w_tilde[0]), xytext=(70, 0.35), fontsize=9, color=C_MAIN, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) ax.annotate(rf"$t=1$ 时 $R^2$只有 {learn[0]:.1e}", xy=(1, 0.02), xytext=(120, 0.012), fontsize=9, color=C_GREEN, arrowprops=dict(arrowstyle="->", color=C_GREEN, lw=1.2)) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "weight_profile.png"), dpi=130) plt.close(fig) # ──────────────────────── 图 2:超额误差被搬到哪 ──────────────────────── def fig_excess(sc, grid, prof, floor, learn): fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.0)) tt = np.asarray(grid) ax = axes[0] ax.semilogy(tt, prof["uniform"] - floor, color=C_MAIN, lw=2.0, label=r"等权($L_{\mathrm{simple}}$)") ax.semilogy(tt, prof["elbo_tilde"] - floor, color=C_ALT, lw=2.0, label="真 ELBO 权重") ax.set_xlabel(r"时间步 $t$") ax.set_ylabel(r"超额误差 MSE $-$ 贝叶斯地板") ax.set_title("(a) 本容量档:低噪声超额误差改善,部分后段变差") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax.set_xlim(0, 1000) ax = axes[1] ratio = (prof["elbo_tilde"] - floor) / (prof["uniform"] - floor) ax.semilogy(tt, ratio, color=C_GREEN, lw=2.0) ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":") ax.fill_between(tt, 1e-3, ratio, where=(ratio < 1.0), color=C_MAIN, alpha=0.13) ax.fill_between(tt, 1.0, ratio, where=(ratio > 1.0), color=C_ALT, alpha=0.13) ax.set_xlabel(r"时间步 $t$") ax.set_ylabel("真 ELBO 权重 / 等权 的超额误差之比") ax.set_title("(b) 同一条曲线取比值:1 以下变好,1 以上变差") ax.grid(alpha=0.25, which="both") ax.set_xlim(0, 1000) ax.set_ylim(1e-2, 1e2) ax.text(60, 0.022, "低噪声档平均:约改善 10 倍", color=C_MAIN, fontsize=9) ax.text(430, 4.5, "中高噪声档:差 2~6 倍", color=C_ALT, fontsize=9) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "excess_error.png"), dpi=130) plt.close(fig) # ───────────────────── 图 3:每步注入的噪声账本 ───────────────────── def fig_variance(sc, mix): s2_exact = LAB.sigma2_exact_posterior(sc) tt = np.arange(1, T + 1) tr_exact = np.array([np.trace(s2_exact[t]) / D for t in range(1, T + 1)]) fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.0)) ax = axes[0] ax.semilogy(tt, sc.bt[1:], color=C_MAIN, lw=2.0, label=r"$\tilde\beta_t$(DDPM 反向链用的,fixed_small)") ax.semilogy(tt, sc.beta, color=C_ALT, lw=1.8, ls="--", label=r"$\beta_t$(fixed_large)") ax.semilogy(tt, tr_exact, color=C_GREEN, lw=2.0, label=r"高斯数据的条件方差(含未知数据的条件不确定性)") ax.set_xlabel(r"时间步 $t$") ax.set_ylabel("每步注入噪声的方差") ax.set_title(r"(a) 本高斯数据的条件方差不小于 $\tilde\beta_t$") ax.set_ylim(1e-6, 1e0) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax = axes[1] lam = np.asarray(mix["lam"]) sr = np.asarray(mix["std_ratio"]) nn = np.asarray(mix["nll_uniform"]) ax.plot(lam, sr, "o-", color=C_MAIN, lw=2.0, label="生成分布的标准差 / 真分布") ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":") ax.set_xlabel(r"插值系数 $\lambda$:$\sigma^2=(1-\lambda)\tilde\beta_t+\lambda\beta_t$") ax.set_ylabel("标准差之比(1 表示胖瘦刚好对上)") ax.set_ylim(0.960, 0.978) ax2 = ax.twinx() ax2.plot(lam, nn, "s--", color=C_ALT, lw=1.8, label="期望 NLL") ax2.set_ylabel("期望 NLL(nats)", color=C_ALT) ax2.tick_params(axis="y", labelcolor=C_ALT) ax.set_title(r"(b) 换成 $\beta_t$ 把 3.4% 的偏窄补回 0.6 个点(没补满)", fontsize=11) ax.grid(alpha=0.25) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "variance_ledger.png"), dpi=130) plt.close(fig) # ──────────────────── 图 4:反向一步的三个配料 ──────────────────── def fig_step(sc): tt = np.arange(1, T + 1) abar_prev = sc.abar[:-1] abar_cur = sc.abar[1:] beta = sc.beta # x_{t-1} = c_x * x_t + c_0 * x_hat0 + sigma_t * z c_x = np.sqrt(sc.alpha) * (1.0 - abar_prev) / (1.0 - abar_cur) c_0 = np.sqrt(abar_prev) * beta / (1.0 - abar_cur) sigma = np.sqrt(sc.bt[1:]) fig, ax = plt.subplots(figsize=(9.2, 5.4)) ax.semilogy(tt, c_0, color=C_MAIN, lw=2.2, label=r"均值中 $\hat x_0$ 的系数(不是位移比例)") ax.semilogy(tt, c_x, color=C_GRAY, lw=1.8, ls="--", label=r"保留 $x_t$ 的系数") ax.semilogy(tt, sigma, color=C_ALT, lw=2.0, label=r"注入噪声的标准差 $\sqrt{\tilde\beta_t}$") ax.set_xlabel(r"时间步 $t$") ax.set_ylabel("系数 / 标准差(绝对值)") ax.set_title("反向一步的两个均值系数与噪声标准差") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax.set_ylim(1e-6, 3.0) ax.annotate(rf"$t=500$:$c_0$={c_0[499]:.2e}", xy=(500, c_0[499]), xytext=(560, 2e-5), fontsize=9, color=C_MAIN, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) ax.annotate(rf"$t=2$:$c_0$={c_0[1]:.2f}", xy=(2, c_0[1]), xytext=(90, 0.9), fontsize=9, color=C_MAIN, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "step_anatomy.png"), dpi=130) plt.close(fig) def main(): sc = LAB.Sched(LAB.linear_beta(T)) w_tilde = sc.weight("tilde") w_large = sc.weight("large") grid = list(range(1, T + 1)) floor = np.array([LAB.mse_floor(sc, t) for t in grid]) learn = np.array([LAB.learnability(sc, t) for t in grid]) print(" 重新训练三份闭式解权重(与 ddpm_lab.py 同一套种子)...") W, _ = LAB.section_B(sc, w_tilde, w_large) prof = {} for name, Wm in W.items(): prof[name] = np.array([ LAB.mse_analytic(*LAB.model_Bc(Wm, LAB.psi_basis(np.array([t]))[0]), sc, t) for t in grid]) mix = LAB.section_E(sc, W) fig_weight_profile(sc, w_tilde, w_large, learn) fig_excess(sc, grid, prof, floor, learn) fig_variance(sc, mix) fig_step(sc) print(" 四张图已写入 figures/") return dict(sc=sc, W=W, prof=prof, floor=floor, learn=learn, mix=mix) if __name__ == "__main__": main()
-
AIGC 基本功|扩散过程的前向与反向推导-SDE AIGC 基本功|扩散过程的前向与反向推导-SDE 所属方向:数学基础 | 难度:入门 | 前置知识:变分下界与重参数化(KL、重参数化技巧、重参数化梯度) 关键词:马尔可夫链、前向扩散、反向去噪、随机微分方程、score matching、DDPM、DDIM、DPM-Solver 01. 为什么需要它 先摆四组数字,全部来自文末附录里六个能直接跑的脚本。 第一组:同一个 score 下比较不同采样器。 在 2D 七分量高斯混合上,score 有闭式解,可以排除神经网络拟合误差。下表记录一次固定种子实验的 dlogp,即生成样本与参考样本的平均 $\log p_0(x)$ 之差。它只是一个分布统计量:0 只说明这一个均值相同,不代表分布完全相同;正值也不是“生成得更好”。 配置 score 评估次数 dlogp DDPM 祖采样 N=1000 1000 −0.032 DDPM 祖采样 N=200 200 +0.089 DDIM(η=0)N=50 50 +0.090 Heun 二阶 N=50 100 +0.019 DDIM@50 与 DDPM@200 在这次运行中的 dlogp 接近,但不能据此得出通用的“4 倍提速”。Heun@50 的 +0.019 与 DDPM@1000 的 −0.032 也不足以证明谁更准确:还需重复随机种子、估计差值的不确定性,并结合模式占比和模式内半径等指标。比较成本时要按 score 调用次数 NFE 计,Heun 每步调用两次。 不把这件事算清楚,调 num_inference_steps 就是盲猜:既不知道收益的量级,也分不清收益里哪部分来自「换了算法的阶数」、哪部分来自「少走了冤枉路」。 第二组:调度改变了各噪声水平上的计算分配。 本实验把线性调度换成余弦,DDIM@50 的单次 dlogp 从 0.090 变到 0.050。线性调度有 74.1% 的离散步处在单位方差参考下 SNR<1 的区域,这描述了噪声水平分配,并不证明这些步骤“没有用”;高噪声阶段也负责形成全局结构。0.040 的差值需要重复实验确认,不能称为已经验证的 1.8 倍质量提升。 这张图要看什么:左图是信号方差系数,右图是在数据方差为 1 的约定下的信噪比。虚线标出 $\bar\alpha=0.5$ 的位置;低于这条线仍可能保留有用语义,不能把阴影区直接标成无效计算。 第三组:换个参数化(ε / v / x₀),等于给每个时间步换了 8 个数量级的权重。 三种参数化描述的是同一个量,但作为最小二乘目标并不等价。把它们的损失都折算回「对 ε 误差的权重」:ε 参数化恒为 1;v 参数化跨 2.5×10⁴ 倍;x₀ 参数化跨 2.5×10⁸ 倍(t=1 时 1.0×10⁻⁴,t=1000 时 2.5×10⁴)。这表明改变参数化会改变隐式时间权重。DDPM 的简化目标是经样本质量实验支持的重新加权,不能仅由此表推出其唯一理由。 第四组:验证手段本身有个坑。 我第一版是用 MMD² 给采样器排序的,跑出来的表看着非常漂亮:Heun 在 N≥10 就顶到「噪声地板」,其余采样器一路降到 0 以下。问题是那个「地板」是单次抽样的运气值——拿真实样本去对真实样本、重复 8 次,MMD² 的标准差是 ±3.6×10⁻⁴,比 N≥100 时各采样器之间的差别还大。发现它的办法很笨:做一次噪声标定。附录里的 mmd_noise_check.py 就是干这个的。分布距离的估计量本身有方差,用它排序前先量一下噪声。 02. 最小可用理解 三句话。 第一句:前向是一串手工设好的加噪,能一步算出来。 它形式上是一条 1000 步的马尔可夫链,但因为每步加的都是高斯,累乘之后仍然是高斯,所以 $q(x_t|x_0)$ 有闭式解,不需要真的跑 1000 次。 第二句:固定前向过程下,反向漂移由边缘 score 决定。 给定 $x_t$ 预测本次噪声,均方误差最优答案是噪声的条件均值,等于 score 的一个时间相关倍率,通常不等于本次实际噪声。精确 score、正确终端分布和连续过程下,生成可归结为数值求解;有限步反向核的近似及模型误差还要分别检查。 第三句:采样器既选择过程,也选择离散化。 DDPM / 反向 SDE、DDIM / 概率流 ODE 的随机性与漂移不同;求解器还要选择参数化、时间网格、阶数、方差和预测后处理,不能只把它们看作同一个更新式改几个系数。 这张图要看什么:左图叠加各时刻独立抽样的边缘快照,展示模式逐渐被噪声混合;它不是同一批样本的连续前向路径。右图记录 40 条初始噪声的 Heun 轨迹,展示本例如何回到模式附近,不能据此推断自然图像的布局、细节或可省步数。 03. 数学推导 3.1 前向链:为什么能一步到位 设原始数据 $x_0 \sim p_0$。前向过程每一步只做一件事:往上加一点高斯噪声。 $$q(x_t|x_{t-1}) = \mathcal{N}(x_t; \sqrt{\alpha_t}\,x_{t-1},\ \beta_t I)$$ 这里 $\alpha_t = 1 - \beta_t$,而 $\beta_t$ 是方差而不是标准差——这个记号是 DDPM 原文定的,容易看错。写成重参数化形式就是 $x_t = \sqrt{\alpha_t}\,x_{t-1} + \sqrt{\beta_t}\,\varepsilon$。 现在把两步接起来看: $$x_t = \sqrt{\alpha_t\alpha_{t-1}}\,x_{t-2} + \sqrt{\alpha_t\beta_{t-1}}\,\varepsilon_1 + \sqrt{\beta_t}\,\varepsilon_2$$ 两个独立高斯的线性组合仍是高斯,噪声方差为 $(\alpha_t\beta_{t-1}+\beta_t)I$。代入 $\beta_{t-1}=1-\alpha_{t-1}$、$\beta_t=1-\alpha_t$,得到 $\alpha_t(1-\alpha_{t-1})+(1-\alpha_t)=1-\alpha_t\alpha_{t-1}$。这才是两步方差的正确化简。 于是归纳下去,任意步数都能一步算出来。记 $\bar\alpha_t = \prod_{s\le t}\alpha_s$: $$q(x_t|x_0) = \mathcal{N}\big(x_t;\ \sqrt{\bar\alpha_t}\,x_0,\ (1-\bar\alpha_t)I\big)$$ 这就是整个扩散模型里唯一一条「白送」的公式,训练时要多少步的加噪样本都能直接算。这里使用独立、零均值、各向同性高斯噪声,因而协方差简化成标量乘 $I$。各向同性不是高斯闭式解的必要条件:若第 $t$ 步噪声协方差为 $Q_t$,则 $\Sigma_t=\alpha_t\Sigma_{t-1}+Q_t$,仍为高斯条件分布;若改用非高斯噪声,本文这条高斯密度式一般不再成立。$p_t(x_t)=\int q(x_t\mid x_0)p_0(x_0)dx_0$ 是边缘密度,未必高斯,须与 $q(x_t\mid x_0)$ 分清。 附录里的 forward_diffusion.py 拿 20 万样本对着验了一遍:用「逐步迭代 1000 次」和「一步闭式」两条路分别算 $x_t$ 的均值与方差,误差量级都在 $10^{-3}$,正好是 20 万样本的蒙特卡洛噪声水平(t=1000 时闭式方差误差 6.20×10⁻³,逐步方差误差 6.19×10⁻³,两者接近是统计核对,不能替代上面的代数证明;两条路径使用独立噪声,不逐样本比对)。 3.2 反向链:条件后验与边缘后验要分开 我们需要 $q(x_{t-1}\mid x_t)$;先求已知 $x_0$ 的条件后验。令 $y=x_{t-1}$,利用前向马尔可夫性: $$q(y\mid x_t,x_0)\propto q(x_t\mid y)q(y\mid x_0)$$ 把两个高斯的指数展开,丢掉与 $y$ 无关的项: $$\log q(y\mid x_t,x_0)= -\frac12 A_t\|y\|^2+b_t^\top y+C$$ $$A_t=\frac{\alpha_t}{\beta_t}+\frac{1}{1-\bar\alpha_{t-1}},\qquad b_t=\frac{\sqrt{\alpha_t}}{\beta_t}x_t+\frac{\sqrt{\bar\alpha_{t-1}}}{1-\bar\alpha_{t-1}}x_0$$ $A_t$ 是标量精度,$b_t$ 是线性项,$C$ 为常数;配方成 $-A_t\|y-A_t^{-1}b_t\|^2/2$。使用 $\bar\alpha_t=\alpha_t\bar\alpha_{t-1}$ 化简,就得到 DDPM 式 (6)、(7): $$q(x_{t-1}\mid x_t,x_0)=\mathcal N(\tilde\mu_t,\tilde\beta_t I)$$ $$\tilde\beta_t=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t$$ $$\tilde\mu_t=c_t x_0+d_t x_t,\quad c_t=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t},\quad d_t=\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}$$ 上面的精度配方用于 $t\ge2$;$t=1$ 时 $x_{t-1}=x_0$ 已知,是点质量,不能在精度表达式里除以零。此时闭式系数的极限给出 $\tilde\beta_1=0$。 采样时 $x_0$ 未知,要对 $q(x_0\mid x_t)$ 积分。全期望与全协方差给出: $$\mathbb E[x_{t-1}\mid x_t]=c_t\mathbb E[x_0\mid x_t]+d_t x_t$$ $$\operatorname{Cov}(x_{t-1}\mid x_t)=\tilde\beta_t I+c_t^2\operatorname{Cov}(x_0\mid x_t)$$ 所以把 $x_0$ 替换为最优均值可得到真实反向均值,却不能同时得到真实反向协方差。一般数据下真实逆核还是混合分布。反例:一维等权双峰 $x_0\sim\tfrac12\mathcal N(-2,0.04)+\tfrac12\mathcal N(2,0.04)$,观测 $x_t=0$、$\bar\alpha_t=0.9$,后验均值为 0,但方差约为 2.19;用零方差均值回到 0 会丢掉两个峰。diffusion_checks.py 独立算出分量均值、分量方差及总方差。有限步 DDPM 高斯核与最后的均值去噪属于近似,不能因 score 精确就宣称逆核精确。 3.3 从 ELBO 到「只预测噪声」 以前向链 $q(x_{1:T}\mid x_0)$ 为变分分布,生成链为 $p_\theta(x_{0:T})$。Jensen 不等式给出 $\mathrm{ELBO}\le\log p_\theta(x_0)$,因此负 ELBO 是负对数似然的上界: $$-\log p_\theta(x_0)\le -\mathrm{ELBO}=L_T+\sum_{t=2}^T\mathbb E_q L_{t-1}+\mathbb E_q L_0$$ $L_T=\mathrm{KL}(q(x_T\mid x_0)\Vert p(x_T))$ 是条件终端先验项。固定调度下不依赖去噪网络;本文数据取期望后,线性调度为 $1.065154\times10^{-4}$ nats,余弦为 $6.410060\times10^{-9}$ nats。它与边缘终端 KL 相差 $I(x_0;x_T)$,不能混用。忽略固定项不改变网络梯度,报告似然界时仍须计入。 去噪匹配项比较条件后验与模型反向核: $$L_{t-1}=\mathrm{KL}(q(x_{t-1}\mid x_t,x_0)\Vert p_\theta(x_{t-1}\mid x_t))$$ $L_0=-\log p_\theta(x_0\mid x_1)$ 是最终解码项。离散像素须用离散化似然,连续数据也不能未经评估便认定它很小。 设模型方差为固定的 $\sigma_t^2 I$。高斯 KL 展开为: $$L_{t-1}=\frac{\|\tilde\mu_t-\mu_\theta\|^2}{2\sigma_t^2}+\frac D2\left(\frac{\tilde\beta_t}{\sigma_t^2}-1+\log\frac{\sigma_t^2}{\tilde\beta_t}\right)$$ $D$ 是数据维数。若方差固定,第二项对均值网络是常数;只有 $\sigma_t^2=\tilde\beta_t$ 时它才为零,不能把“同协方差”当成所有 DDPM 的前提。若方差可学习,这一项参与优化。 由 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon$ 解出 $x_0$ 再代回均值: $$\tilde\mu_t=\frac1{\sqrt{\alpha_t}}\left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\varepsilon\right)$$ 把实际噪声 $\varepsilon$ 换成网络输出 $\varepsilon_\theta(x_t,t)$ 得到 $\mu_\theta$。两均值之差是一个确定倍率乘噪声残差,所以固定方差下与网络有关的项为: $$w_t\|\varepsilon-\varepsilon_\theta(x_t,t)\|^2,\qquad w_t=\frac{\beta_t^2}{2\sigma_t^2\alpha_t(1-\bar\alpha_t)}$$ DDPM 式 (12)、(14) 改用均匀抽取 $t$ 的简化目标: $$L_{\text{simple}}=\mathbb E_{t,x_0,\varepsilon}\|\varepsilon-\varepsilon_\theta(\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon,t)\|^2$$ 这是依据样本质量实验选择的重新加权目标,通常不等于原 ELBO。对每个噪声时刻,理想无限容量的 MSE 最优解是条件均值;有限共享网络的梯度和训练结果仍会随权重变化。06 节将另一类“输出参数化的代数权重”换算到噪声残差空间,它与这里的 ELBO 权重 $w_t$ 是不同概念。 3.4 连续化:分布方程、时间方向和积分变量 离散步号是 $t=0,\ldots,T$,连续时间是 $u=t/T\in[0,1]$,步长 $\Delta u=1/T$。离散 $\beta_t$ 是无量纲方差,连续 $\beta(u)$ 是每单位时间的噪声率。令 $\beta_t\approx\beta(u)\Delta u$ 并展开 $\sqrt{1-\beta_t}\approx1-\beta_t/2$,得到 VP-SDE: $$dx=-\tfrac12\beta(u)x\,du+\sqrt{\beta(u)}\,dw_u$$ $w_u$ 为标准布朗运动,正向增量协方差为 $du\,I$。记 $a(u)=\exp(-\int_0^u\beta(v)dv)$,边缘协方差为 $a(u)\operatorname{Cov}(x_0)+(1-a(u))I$;只有初始单位协方差才严格保持单位协方差。 有限离散表与指定连续率是两个设计。 本实验将线性表端点乘 $T$ 得到连续线性率 0.1 到 20;在 $u=1$,其 $a(u)$ 与离散乘积相差约 7.01%。这个差包含 $\log(1-\beta_t)\ne-\beta_t$ 的有限步效应及率插值/求积约定,不能称为所有连续化不可避免的固定误差。更直接的精确嵌入是每个区间取: $$\beta_{\text{exact}}(u)=-T\log(1-\beta_t),\qquad (t-1)/T\lt u\le t/T$$ 此时区间积分为 $-\log(1-\beta_t)$,边界处 $a(t/T)=\prod_{j=1}^t(1-\beta_j)=\bar\alpha_t$,前向转移也完全对应。附录独立核对该等式。本文采样器使用 $L=\log(a_{\text{prev}}/a_{\text{cur}})$,等于使用累计噪声钟作为积分变量。 为解释 score 系数,写一般标量扩散 $dx=f(x,u)du+g(u)dw_u$ 的 Fokker–Planck 方程: $$\partial_u p=-\nabla\cdot(fp)+\tfrac12 g^2\Delta p$$ 定义边缘 score $s=\nabla\log p$,有 $ps=\nabla p$,从而 $\Delta p=\nabla\cdot(ps)$。代入得连续性方程: $$\partial_u p=-\nabla\cdot\left[(f-\tfrac12 g^2s)p\right]$$ 所以速度 $f-\tfrac12g^2s$ 的确定性 ODE 与正向 SDE 具有同一系列边缘分布。反向 SDE 定理及概率流推导 给出: $$dx=\left[-\tfrac12\beta x-\beta s(x,u)\right]du+\sqrt\beta\,d\bar w_u\quad\text{(反向 SDE)}$$ $$dx=\left[-\tfrac12\beta x-\tfrac12\beta s(x,u)\right]du\quad\text{(概率流 ODE)}$$ 这里反向求解 $du\lt0$;反向布朗增量协方差是 $|du|I$,不是负的 $du I$。为消除实现歧义,可用递增反向时间 $\tau=1-u$:SDE 漂移为 $\beta(x/2+s)$,噪声增量为 $\sqrt{\beta\Delta\tau}z$;ODE 漂移为 $\beta(x+s)/2$。它们从同一正确终端分布出发、使用精确 score 并满足正则性条件时,才有相同目标边缘;路径联合分布不同,有限求解器也不同。 记一次反向区间的积分: $$L=\int_{u_{\text{prev}}}^{u_{\text{cur}}}\beta(u)du=\log\frac{a_{\text{prev}}}{a_{\text{cur}}}>0$$ 在累计噪声钟中冻结当前 $x,s$,Euler 漂移更新为 $x\leftarrow x+L(x/2+c s)$,$c=1$ 对应 SDE,$c=1/2$ 对应 ODE;前者另加 $\sqrt Lz$。不能只删 SDE 的噪声而保留完整 score 系数。反例:稳态 $p=\mathcal N(0,I)$ 的 score 为 $-x$,概率流速度恰为 0;删噪声后的 SDE 漂移却是 $-\beta x/2$,会错误收缩方差。diffusion_checks.py 在 $L=0.1$ 给出删噪声方差 0.9025、Euler–Maruyama 方差 1.0025、精确 ODE 方差 1;EM 的 0.0025 是有限步误差。 3.5 四种参数化:实际 target 与条件均值 令 $a=\bar\alpha_t$、$b=\sqrt{1-a}$。实际训练样本满足 $x_t=\sqrt a x_0+b\varepsilon$。条件高斯的 score 为 $\nabla_{x_t}\log q(x_t\mid x_0)=-\varepsilon/b$。对 $x_0$ 的后验取平均,并把求导移入积分(需可微及可积条件),得到边缘 score 的恒等式: $$s_t(x_t)=\mathbb E\left[\nabla_{x_t}\log q(x_t\mid x_0)\mid x_t\right]=-\frac{\mathbb E[\varepsilon\mid x_t]}{\sqrt{1-a}}$$ 因此应写 $\hat\varepsilon_{\text{MMSE}}=\mathbb E[\varepsilon\mid x_t]=-\sqrt{1-a}s_t(x_t)$。网络只看到 $x_t,t$,不同 $x_0,\varepsilon$ 能形成同一观测,不能恢复每次真实噪声。MSE 的条件分解说明其不可约误差: $$\mathbb E[\|\varepsilon-h(x_t)\|^2\mid x_t]=\operatorname{tr}\operatorname{Cov}(\varepsilon\mid x_t)+\|\mathbb E[\varepsilon\mid x_t]-h(x_t)\|^2$$ 把 $\mathbb E[\varepsilon\mid x_t]$ 代回加噪等式,得 Tweedie 公式: $$\mathbb E[x_0\mid x_t]=\frac{x_t+(1-a)s_t(x_t)}{\sqrt a}$$ 高斯先验反例:$x_0,\varepsilon$ 独立且皆标准正态,此时 $x_t$ 也为标准正态,$\mathbb E[\varepsilon\mid x_t]=\sqrt{1-a}x_t$,但条件噪声协方差为 $aI$。本文 $D=2,a=0.25$ 的最优期望平方误差为 0.5,并非 0。零预测器的向量 RMSE 基线是 $\sqrt D$;只有独立标准高斯“瞎猜”才是 $\sqrt{2D}$。 v 参数化 定义实际 target 为 $v=\sqrt a\varepsilon-\sqrt{1-a}x_0$。联合变换及逆变换是: $$\begin{pmatrix}x_t\\v\end{pmatrix}=\begin{pmatrix}\sqrt a&\sqrt{1-a}\\-\sqrt{1-a}&\sqrt a\end{pmatrix}\begin{pmatrix}x_0\\\varepsilon\end{pmatrix}$$ $$x_0=\sqrt a x_t-\sqrt{1-a}v,\qquad \varepsilon=\sqrt{1-a}x_t+\sqrt a v$$ 矩阵转置乘自身等于单位阵,保持联合向量范数;这一性质不保证所有单输出预测或反解都不会放大误差。固定 $x_t$ 时,$\delta\varepsilon=\sqrt a\delta v$、$\delta x_0=-\sqrt{1-a}\delta v$;反解 $v$ 从噪声残差会除以 $\sqrt a$,高噪声时仍可能放大。对条件均值取同一线性变换也成立,网络的 MSE 最优 $v$ 输出是 $\mathbb E[v\mid x_t]$。 score_bridges.py 保留所有数值核对:Tweedie 对精确混合后验均值最大差约 $10^{-15}\sim10^{-13}$,两种 MMSE 噪声算法差约 $10^{-16}\sim10^{-15}$,实际 $(x_0,\varepsilon)$ 用实际 $v$ 重建差约 $10^{-15}$。100 万样本的自归一化重要性采样提供独立后验均值核对,有限样本有偏且有抽样误差,ESS 仅诊断权重集中程度,不是误差保证。 04. 代码实现 4.1 实验设计:把「模型误差」这个变量消掉 真实扩散模型的采样误差来自两处:score 估计得不准,以及数值积分不准。想把第二处单独看清楚,就得让第一处等于零——用一个 score 有闭式解的目标分布。 办法是选高斯混合:$p_0 = \sum_k w_k\mathcal{N}(\mu_k, s_k^2 I)$。前向加噪之后,第 $k$ 个分量的均值缩到 $\sqrt{\bar\alpha_t}\mu_k$、方差变成 $\bar\alpha_t s_k^2 + (1-\bar\alpha_t)$,仍然是各向同性高斯,所以 $p_t$ 还是高斯混合,且 $$\nabla_x\log p_t(x) = -\sum_k r_k(x)\frac{x - \sqrt{\bar\alpha_t}\mu_k}{\bar\alpha_t s_k^2 + (1-\bar\alpha_t)},\qquad r_k(x) = \frac{w_k\mathcal{N}_k(x)}{\sum_j w_j\mathcal{N}_j(x)}$$ $r_k$ 就是「这个样本属于第 $k$ 个分量」的责任度,是标准的软分配。由此排除 score 拟合误差;剩下的差异还包含有限终端高斯近似、逆核与终步去噪近似、积分误差及样本统计误差。 这里有个调参坑值得记一下:我第一版用了 3 个很宽的分量(标准差 0.45/0.35/0.55),结果五种采样器全部顶到 MMD 噪声地板上,分不出高下。换成 7 个紧分量(标准差 0.16~0.30)之后差距才显出来——目标太光滑,分辨不出采样器的差别。这是本 toy 的分辨力调整;自然图像的误差可能同时影响布局、模式覆盖和细节,不能从低维混合外推唯一成因。 4.2 前向:闭式解核对 核心就几行,除了算 $\bar\alpha$ 之外没有任何魔法: def linear_beta(T=1000, beta_1=1e-4, beta_T=0.02): return np.linspace(beta_1, beta_T, T) def alpha_bar_from_beta(beta): return np.cumprod(1.0 - beta) def q_sample(x0, t_idx, alpha_bar, rng): a = alpha_bar[t_idx] eps = rng.standard_normal(x0.shape) return np.sqrt(a) * x0 + np.sqrt(1.0 - a) * eps, eps q_sample 就是 3.1 节那个闭式解。余弦调度多两行——按 $\bar\alpha_t$ 定义式算完之后要把 β 截到 0.999 以内,因为 $t=T$ 时 $\cos(\pi/2)=0$ 会让最后一步 $\beta=1$,实操直接炸: def cosine_beta(T=1000, s=0.008, clip=0.999): t = np.arange(1, T + 1) / T f = np.cos(((t + s) / (1 + s)) * np.pi / 2) ** 2 f0 = (np.cos((s / (1 + s)) * np.pi / 2)) ** 2 beta = beta_from_alpha_bar(f / f0) # 反解出每步的 beta return np.clip(beta, None, clip) 4.3 反向:五个采样器 DDPM 祖采样——用高斯核近似反向转移。对一般数据,即使均值来自精确 score,有限步高斯核也不等于真实反向条件分布。把 3.2 节的 $\tilde\mu_t$ 和 $\tilde\beta_t$ 抄进来,再把 $\hat x_0$ 换成 Tweedie 公式: def run_ddpm(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) alpha_j = a_cur / a_prev # 跨 k 步的等效 alpha beta_j = 1.0 - alpha_j s = score_at(x, alpha_bar, t_cur) mean = (x + beta_j * s) / np.sqrt(alpha_j) var = beta_j * (1.0 - a_prev) / (1.0 - a_cur) x = mean + np.sqrt(var) * rng.standard_normal(x.shape) return x Euler-Maruyama(反向 SDE)——把 $L$ 和 $c=1$ 代进 3.4 节的结果: def run_em(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) s = score_at(x, alpha_bar, taus[j]) x = x + L * (0.5 * x + s) + np.sqrt(L) * rng.standard_normal(x.shape) return x 概率流 ODE——唯一的改动是 score 系数减半、噪声项删掉: def run_ode(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) s = score_at(x, alpha_bar, taus[j]) x = x + 0.5 * L * (x + s) return x Heun 二阶——Euler 预测一步,再用终点的 score 校正一次。每步两次评估: def run_heun(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) s0 = score_at(x, alpha_bar, taus[j]) d0 = 0.5 * L * (x + s0) x1 = x + d0 # Euler 预测 s1 = score_at(x1, alpha_bar, taus[j + 1]) # 终点再评估一次 d1 = 0.5 * L * (x1 + s1) x = x + 0.5 * (d0 + d1) return x DDIM 单独说,因为它长得不像上面四个。它先把样本一步跳到 $\hat x_0$,再按目标时刻的 $\bar\alpha$ 重新加回噪声: $$x_{t-1} = \sqrt{\bar\alpha_{t-1}}\,\hat x_0 + \sqrt{1-\bar\alpha_{t-1}}\,\hat\varepsilon$$ $\hat x_0$ 用 Tweedie 公式算、$\hat\varepsilon$ 用 $\varepsilon=-\sqrt{1-\bar\alpha_t}s$ 算。η=0 的 DDIM 在小步长极限对应概率流 ODE,其 score 漂移系数为反向 SDE 的一半;DDPM 的均值更新对应后者,两者并不在代数上相同。 4.4 结果 七个分量、每档生成 4000 个样本、参照集 8000 个真实样本。三个统计量扣除参照样本的估计值;0 仅表示该统计量相同,不能保证模式比例、半径或整个分布正确: 采样器 N=10 N=25 N=50 DDPM −0.365 +0.266 +0.249 DDIM −0.248 +0.124 +0.090 EM(SDE) −2.725 −0.756 −0.347 Euler(ODE) −2.340 −0.792 −0.348 Heun +0.546 +0.084 +0.019 采样器 N=100 N=200 N=1000 DDPM +0.174 +0.089 −0.032 DDIM +0.057 +0.032 +0.007 EM(SDE) −0.189 −0.100 −0.081 Euler(ODE) −0.159 −0.074 −0.014 Heun +0.005 +0.002 +0.001 上表是单次实验的 dlogp。两批独立真实样本在这次运行中的差值约 0.053;这不是经重复估计的标准差或置信区间。表格主要帮助识别量级很大的离散化偏差,微小差异不做显著性排序。三点读法: DDPM / DDIM 在 N=10 还能看,Euler 系直接崩(−2.3 ~ −2.7,说明样本散在低密度区根本没收敛)。这里最大单步跨约 1.92 的积分量;网格、非线性 score 与数值方法共同影响结果,不能把所有误差唯一归因到第一步。 误差变号可作为线索。 正的 dlogp 表示生成样本的平均目标密度较高,负的表示较低;本实验结合半径诊断观察到聚拢或散开的倾向。单个密度均值也可能受分量占比变化影响,不能独立确定失败原因。 本次 Heun 在 N≥20 的 dlogp 较小,但差异接近采样波动时不作排名;接近0也不足以证明整个分布正确。 补充两个不同统计量:按模式归属估算的分量占比 TV,以及模式内均方半径的相对误差。在 N=50 的本次运行中,Heun 为 0.011 / 0.066,DDIM 为 0.014 / 0.155,DDPM 为 0.019 / 0.340,Euler-ODE 为 0.017 / 0.358。这里数值分别为占比误差偏移 dTV 与半径误差偏移 dspread,并非未经扣基线的绝对误差;它们分别检查模式比例与分散程度,排序并非处处一致,也要估计采样误差。 这张图要看什么:左图画的是单个诊断统计量的偏差,参考虚线只表示一次真实样本对照差值,不是置信区间。右图比较线性漂移项的指数因子和 Euler 近似,解释大步长为何可能困难;完整 score 场同时参与更新,不能仅用这一项定量归因全部误差。 按相同 NFE 复核。 新增 diffusion_checks.py 每种方法做五个独立种子,每次生成 4000 个、参考 8000 个样本;Heun 用 25 步,其他方法 50 步,实际计数都为 50 次 score 调用。下面报告跨种子的均值和样本标准差(ddof=1),标准差不是置信区间,也不是对单次抽样标准误的替代。 方法 步数 NFE 平均 dlogp 跨种子 SD ddpm 50 50 +0.2751 0.0081 ddim 50 50 +0.0840 0.0129 em 50 50 -0.3231 0.0233 ode 50 50 -0.3707 0.0270 heun 25 50 +0.0775 0.0141 每次独立生成与参考样本的密度均值差,还可估计 iid 标准误 $\sqrt{s_g^2/n_g+s_r^2/n_r}$,两批样本独立时方差相加;完整数值由脚本打印。少量重复只帮助观察稳健性,不代表真实图像模型上的方法排名。 dlogp 等于 0 的反例。 在二维标准高斯目标下,把所有样本放到半径 $\sqrt2$ 的圆上,期望 $\log p$ 与真实高斯完全相同;但半径四次矩是 4,真实高斯为 8,径向分布显然不同。该解析反例说明单个均值相同也可严重失真,不能把密度偏移当作完整分布距离。 固定带宽的 MMD 平方 U 统计量可能为负,而总体 MMD 平方非负;8 次真实样本对照中约 $3.6\times10^{-4}$ 是用 ddof=0 计算的这一组经验散布,既不是通用噪声下界,也不是置信区间。mmd2 默认用待比较样本选带宽,此时数据自适应值不能直接套固定核的无偏性;严谨评测应以独立数据固定带宽。模式归属使用最近均值,重叠分量可能错分;缺少某模式样本时半径误差置 1 是教学约定,不能视作准确总体 TV 或缺失模式的半径估计。MMD 原始论文 给出固定核估计的定义。 4.5 为什么朴素 Euler 在大步长下会崩 把上面第 1 点挖到底。概率流 ODE 里线性部分 $\tfrac12\beta x$ 的精确解是 $e^{L/2}$,而 Euler 用的是它的一阶展开 $1+L/2$。线性子问题的相对误差为 $1-(1+L/2)e^{-L/2}$,随正 $L$ 增大而趋近 1: 采样步数 N 每步最大积分量 $L_{\max}$ $e^{L/2}$ 与 $1+L/2$ 的相对误差 10 1.9197 24.95% 20 0.9852 8.80% 50 0.4002 1.75% 100 0.2011 0.47% 200 0.1008 0.12% 1000 0.0202 0.01% DDPM 与 DDIM 的更新含精确线性指数因子。 从当前到前一时刻,因子为 $\sqrt{a_{\text{prev}}/a_{\text{cur}}}=e^{L/2}$,不是孤立的 $\sqrt{a}$。DDIM 还近似积分剩余噪声预测项;DDPM 仍使用近似高斯逆核。因此该表仅解释线性子项,不能单独证明完整误差大小或工业选择。DPM-Solver 系统利用半线性结构构造积分器,反向 SDE 的 Euler–Maruyama 与 predictor–corrector 也有实际用途。 高阶方法也需要合适的步长。 本次 Heun@10 的 dlogp 为 +0.546,DDIM@10 为 −0.248,说明这个网格上的 Heun 出现明显偏聚拢。原因可能包括稳定域、非线性 score 与步长的相互作用;不能说二阶校正必然放大线性项误差,更不能推广为 DPM-Solver 高阶算法在所有少步数任务上都更差。 05. 工业级实现对照 以下以 diffusers v0.35.1 / scheduling_ddpm.py 的 DDPMScheduler.add_noise、step 和 _get_variance 为准;已获取固定版本原始源码并执行原方法,核验日为 2026-10-15。 add_noise 就是 3.1 节的闭式解,一字不差: sqrt_alpha_prod = alphas_cumprod[timesteps] ** 0.5 sqrt_one_minus_alpha_prod = (1 - alphas_cumprod[timesteps]) ** 0.5 noisy_samples = sqrt_alpha_prod * original_samples + sqrt_one_minus_alpha_prod * noise 第一个值得注意的细节:noise 是从外面传进来的,不是在函数里采的。因为训练时需要知道「这次加的是哪个 ε」才能算损失——如果接口内部采样且不返回噪声,就无法直接取得 target;接口当然也可以选择同时返回噪声。该实现还把累计表移到样本设备,系数转为样本 dtype,先展平 timestep 系数再逐维增加尾轴,支持批量样本广播。整数 timestep 是从 0 开始的数组下标,本文理论 $t=1$ 对应源码 timestep 0。 第二个细节:alphas_cumprod 在 __init__ 里用 torch.cumprod(1 - betas) 一次算好并缓存。1000 个数,每个训练步都要按 timestep 取,重新累乘显然不划算。这就是 3.1 节那条「白送」的公式在工程上的直接体现。 step 的均值在对齐配置时与本文等价。 它写的是 DDPM 原文公式 (7) 的系数形式: current_alpha_t = alpha_prod_t / alpha_prod_t_prev current_beta_t = 1 - current_alpha_t pred_original_sample = (sample - beta_prod_t ** 0.5 * model_output) / alpha_prod_t ** 0.5 # 即 Tweedie pred_original_sample_coeff = (alpha_prod_t_prev ** 0.5 * current_beta_t) / beta_prod_t current_sample_coeff = current_alpha_t ** 0.5 * beta_prod_t_prev / beta_prod_t pred_prev_sample = pred_original_sample_coeff * pred_original_sample + current_sample_coeff * sample 把 pred_original_sample_coeff 和 current_sample_coeff 代进 3.2 节的 $\tilde\mu_t$ 表达式展开,$x_t$ 的系数会化简成 $1/\sqrt{\alpha_j}$、$\varepsilon$ 的系数化简成 $-\beta_j/(\sqrt{\alpha_j}\sqrt{1-\bar\alpha_{\text{cur}}})$,也就是 $\tilde\mu = (x_t + \beta_j s)/\sqrt{\alpha_j}$——和我 4.3 节那个「一行 DDPM」完全一样。current_alpha_t = alpha_prod_t / alpha_prod_t_prev 对应的正是我的 alpha_j,所以 diffusers 支持跳步(strided)采样;这里只在相同 prediction_type、方差与不启用 clipping/thresholding 的条件下和最小实现等价。 三处工程实现要额外核对的差异: 第一,调度不是自由参数,是分类的。beta_schedule 有 linear / scaled_linear / squaredcos_cap_v2 / sigmoid 几个分支;我 4.2 节实现的余弦调度在它这里叫 squaredcos_cap_v2,走的是通用函数 betas_for_alpha_bar——先给定 $\bar\alpha(t)$ 的解析式,再按 $1 - \bar\alpha(t_2)/\bar\alpha(t_1)$ 反解出每步 β,并且硬编码 max_beta=0.999。这正好对上我 cosine_beta 里那句 clip,不是巧合:$t=T$ 时 $\cos(\pi/2)=0$ 会给出 $\beta_T=1$,必须截。 第二,有限终端 SNR 会引入起点分布近似。线性表的 $\bar\alpha_T=4.0358\times10^{-5}$,仍保留少量数据成分;推理却常从标准高斯开始。diffusers 的 rescale_betas_zero_snr 对应 Lin 等,2023 的修正,但要与训练的参数化、时刻采样和起点设置一起核对。对已有 epsilon checkpoint 不能只开一个开关就假定兼容,零 SNR 下若仍用除以 $\sqrt{\bar\alpha_T}$ 的公式还会遇到奇异点。 第三,参数化是可切换的输出头。prediction_type 支持 epsilon / sample / v_prediction 三选一,step 开头那个 if-elif 就干这件事。三种模式对 pred_original_sample 的算法不同,但固定方差的后续均值系数计算共用——这正是 3.5 节「它们描述同一个量」在工程上的样子。也正因如此,采样端转换形式可由配置选择,但 checkpoint 的训练目标必须匹配,不能把 epsilon 权重仅改一行配置就当作 v 预测器,代价藏在 06 节的权重表里。 固定官方方法的真实对照。 将 v0.35.1 中原始 add_noise、get_velocity、step、_get_variance、previous_timestep 的函数体按 AST 原样取出,在 PyTorch 2.10.0+cpu 上执行。对 float32/float64 以及 [2,3]、[2,1,3,4]、[2,1,2,3,4] 六组加噪/速度广播核对,差为 0;自定义 timestep [999,799,399,49,0] 与三个 prediction_type 共 15 组均值/方差对照,最大误差小于 $10^{-10}$。独立后验配方及 KL 权重最大误差约 $9.68\times10^{-14}$。为了单独检查均值,实跑用零噪声适配器替代随机数入口;原函数体未改,这不等于完整 diffusers 包或 GPU 模型复现。 注意默认 clip_sample=True 会裁剪预测的 $x_0$ 到约定范围,教学等价对照关闭它;另有实际裁剪分支对照。fixed_small 方差会被数值下界截到 $10^{-20}$。当源码 timestep 为 0 时不调用随机数;若自定义最后时刻大于 0、previous_timestep 为 −1,它仍会走噪声分支,加一个极小噪声,与本文严格零方差最终均值略有差别。若使用 learned 方差,还要核对双通道输出及 _get_variance 分支,本文的固定方差核不能代表它们。 06. 代价与边界 代价一:换参数化不是改记号,是改损失权重。 把三种参数化都折算回「对 $\varepsilon$ 误差的权重」(推导见 score_bridges.py 的文档串:x₀ 的损失 $\|\delta x_0\|^2$ 折成 $\varepsilon$ 误差要乘倍率,v 的误差因为 $\delta\varepsilon = \sqrt{\bar\alpha_t}\,\delta v$ 也要乘): t $\bar\alpha_t$ ε 参数化的权重 v 参数化的权重 x₀ 参数化的权重 1 9.999×10⁻¹ 1.0000 1.0001 1.0001×10⁻⁴ 100 8.970×10⁻¹ 1.0000 1.1148 1.1480×10⁻¹ 500 7.859×10⁻² 1.0000 1.2725×10¹ 1.1725×10¹ 900 2.752×10⁻⁴ 1.0000 3.6336×10³ 3.6326×10³ 1000 4.036×10⁻⁵ 1.0000 2.4778×10⁴ 2.4777×10⁴ 这张表是等价残差之间的代数权重,不是网络参数梯度的实测值。 ε、v、x₀ 三种目标的输出尺度、网络雅可比以及时间采样方式都会影响梯度。等权 ε 损失在这里对应 ε 残差权重恒为 1;不能据此断言各时刻梯度相同,也不能仅凭该表断言 x₀ 目标一定被高噪声支配或无法训练。 这张图要看什么:把不同输出误差换算到 ε 误差时,各自带上不同时间权重。曲线说明训练目标不等价,不是实测梯度图;实际训练还要连同参数化和时间采样权重一起分析。 代价二:阶数更高也要选择合适的网格。 Heun@10 的表现说明本实验的大步长不合适,不是对所有高阶求解器的否定。DPM-Solver 专门利用扩散 ODE 的半线性结构,不能从朴素 Heun 的结果推导它的少步数表现。 代价三:随机项改变有限步采样的误差与方差。 DDIM 的 η 从 0 到 1,本次 N=50 的 dlogp 为 0.090、0.065、0.092、0.169、0.249。这里 η=1 配上相同时间网格和方差选择可恢复所实现的 DDPM 更新,但不能把单次结果概括为“噪声没有用”。在精确 score、连续时间和正确初始分布下,反向 SDE 与概率流 ODE 都能得到相同边缘分布;有限步误差的优劣取决于具体离散化。 边界:这套实验测不到模型误差。 oracle score 排除了训练误差,却仍有有限终端分布近似、离散化和样本统计误差;它不是现实图像模型误差的严格下界。真实网络的误差还会与采样轨迹交互,必须在目标 checkpoint 上另做实验。 边界:高斯混合不是自然图像。 这里的数据维数、模态结构、score 光滑性和引导强度都很简单。表格适合验证公式与数值方法,不能当作真实模型加速倍率或通用采样器排名。 ODE 也能生成多样样本与估计似然。 确定性只意味着固定初始噪声对应固定轨迹;不同随机初值仍可覆盖整个数据分布。原始 score-SDE 论文 就利用概率流 ODE 计算似然。在向量场满足正则条件时精确流可逆,但有限步 DDIM / ODE 数值求解一般不能无误差反演。 按任务给一张实验决策表(密度偏移绝对值仅衡量一个统计量,须结合覆盖、半径和抽样波动): 步数预算 该选谁 实测依据 8~10 步 在目标模型上比较合适的少步采样器 本 toy 的 Heun@10 偏聚拢,不能推出其他高阶方法的排名 20~50 步 Heun 是本实验可考虑的方案 Heun@50 的 dlogp 为 0.019,需结合其他指标和重复试验 100~200 步 同 NFE 比较,避免只按步数选 N=200:Heun 0.002、DDIM 0.032、DDPM 0.089 要多样性 ODE / SDE 都可,比较分布覆盖 ODE 的多样性来自随机初值;SDE 还增加路径随机性 要反演 / 要编辑 可考虑概率流 ODE / DDIM 理想流可逆;有限步反演仍有数值和模型误差 表格只总结当前教学实验能支持的选择。没有实测的 PNDM / DPM-Solver 不参与排名;真实模型应以同等 NFE、重复种子与多个质量指标比较。 07. 经典论文脉络 ① 1503.03585(Sohl-Dickstein et al., 2015)——把扩散搬进生成模型。 用非平衡热力学里的一个想法:先定义一个把数据逐步破坏成噪声的正向过程,再学它的反向过程。贡献是框架本身,同时研究了高斯与二项扩散等设置,展示了可训练的生成扩散框架;这里不对其所有应用的实用性作统一判断。 ② 2006.11239(Ho et al., 2020)——DDPM,把目标改成「预测噪声」。 三件事:把 $\tilde\mu_t$ 参数化成预测 $\varepsilon$;指出把 ELBO 里那一串只跟 t 有关的系数扔掉、直接用等权的 $L_{\text{simple}}$ 反而效果更好;给出 3.2 节那套 $\tilde\beta_t / \tilde\mu_t$ 的闭式解。该参数化与经验重新加权推动了图像扩散质量;早期工作已有可训练目标,不能把历史概括为此前无法训练。 ③ 2011.13456(Song et al., 2021)——把离散和连续统一起来。 这篇是本节点的锚点。它做了两件大事:把 DDPM(VP-SDE)和它自己那套 score matching(VE-SDE)统一到同一个 SDE 框架下,把它们写成不同漂移与扩散系数下的 SDE,并由相应 Fokker–Planck 方程构造边缘等价的概率流 ODE;以及提出了概率流 ODE——同一个边缘分布、确定性求解、还能用现成的 ODE 求解器(原文使用自适应 RK45 / Dormand–Prince,见附录 D.2、D.4)。3.4 节那两条式子就出自这里。 ④ 2010.02502(Song et al., 2021)——DDIM,确定性采样。 把反向链改成不含随机项的确定性映射:样本轨迹只由 $x_T$ 决定,跳步采样不再需要「一步一小步」的假设。两篇作者不同:DDIM 的第一作者是 Jiaming Song,score-SDE 的第一作者是 Yang Song——DDIM 本质上就是概率流 ODE 的一个(指数积分器风格的)离散化。原文在特定模型与数据上展示少步生成及显著采样加速;具体质量取决于模型、步数与指标,不能称所有任务 50 步等于 1000 步。 ⑤ 2102.09672(Nichol & Dhariwal, 2021)——余弦调度。 指出线性调度把信噪比压得太快(就是 01 节第二组数字里那 74%),改成 $\bar\alpha_t = \cos^2(\cdot)$ 之后低步数下的质量明显更好。这篇的价值在于它把「调度」从工程细节变成了有图像解释的设计问题:$\bar\alpha_t$ 的形状决定了「每个时刻还剩多少信息量」,而余弦的形状让信息量的衰减更均匀。 在这五篇之外还有两条重要支线:v 参数化与渐进蒸馏 探讨不同预测目标和低步数训练;零终端 SNR 分析特定训练/推理噪声设置的不一致。前者不是对所有尺度问题的自动修复,后者也不意味着每个有限时间非零 SNR 过程都定义错误。它们都是在这条主线已经跑通之后,针对具体失效模式的补丁。 08. 常见误解 误解一:「DDPM 和 DDIM 是同一条 ODE 的两种离散化。」 DDPM 是带噪声的高斯反向马尔可夫链,连续极限对应反向 SDE;η=0 的 DDIM 是确定性路径,可联系到概率流 ODE。二者的连续边缘分布可一致,但漂移中的 score 系数不同:SDE 是 1,ODE 是 1/2,不能只把 DDPM 的噪声删除就得到 DDIM。 误解二:「反向过程就是把噪声一步步减掉。」 方向反了。反向 drift 是 $+\tfrac12\beta x + \beta s$,$x$ 那一项是往外推的。前向把分布压向原点,score 与线性项合起来才决定方向;对稳态标准高斯,反向 SDE 的总漂移向内,概率流速度为零,不能把每个样本都理解成向外吹。我按「减掉」实现了三个采样器,全部崩掉(4.3 节那个符号坑),而错误版本跑起来并不报错、只是数值不对——这类 bug 只能靠对着闭式解核对来抓。 误解三:「换个参数化只是记号问题,等价就是等价。」 描述的对象等价,作为训练目标不等价。权重表跨 8 个数量级(06 节),这不是小差异。代数转换对任意兼容输出都成立,不要求网络先收敛;不同的未加权训练目标、共享参数及时间采样通常产生不同优化过程。 误解四:「换成 mean log p 就能可靠排序。」 MMD / FID 需要估计不确定性,mean log p 同样需要,而且单个均值不能刻画完整分布。对两批真实样本只算一次差值,不能据此画置信区间;必须重复抽样或用适当的标准误 / bootstrap 分析。 误解五:「ODE 无随机项,所以没有多样性;SDE 多走几步只会累积坏噪声。」 随机性可以来自初始噪声,也可以来自路径。精确连续过程下两者都可得到正确分布;更多步数通常减少相应数值方法的离散误差,但有限模型、引导、网格与算力约束下仍应实测。 误解六:「$\bar\alpha_t$ 和 $1-\bar\alpha_t$ 加起来是 1,所以信噪比就是 $\bar\alpha_t$。」 信噪比是 $\bar\alpha_t/(1-\bar\alpha_t)$,不是 $\bar\alpha_t$。以单位数据方差为参考,t=500 时线性调度 $\bar\alpha_{500}=7.86\times10^{-2}$,看着还有 7.9% 的信号,但信噪比只有 0.085(−10.7 dB)——信号和噪声的幅度比已经掉到 1:3.4 以下。只看 $\bar\alpha$ 会严重高估「还剩多少信息」。 09. 动手验证 六个脚本都在文末完整附录里,保存到同一目录后用 Python 3 运行。除绘图脚本外只依赖 NumPy,绘图另需 matplotlib。本次实际环境为 Windows、Python 3.11.9、NumPy 2.4.6、matplotlib 3.10.7;BLAS 单线程。主实验种子 20260926 保持,新增核对种子见脚本,未测试 GPU 或真实图像吞吐。 python forward_diffusion.py # 前向闭式解核对 + 两种调度对比 + 终端 SNR python reverse_sampling.py # 五种采样器 × 七档步数的主实验 python score_bridges.py # Tweedie / ε / v 四条恒等式核对 + 权重表 python mmd_noise_check.py # 先量一下 MMD² 自己的噪声 python make_figures.py # 生成四张图 python diffusion_checks.py # 条件target/后验/精确嵌入/同NFE五种子反例 值得自己动手改着看的四处: 第一,把 N 设成 10,看 DDIM 和 Euler 谁先崩。 预期:DDIM 的 dlogp 是 −0.248(偏散、没收敛完),Euler 是 −2.340(散得离谱)。对照 4.5 节的最大积分量与线性子项误差,并检查覆盖和半径;它们提供诊断线索,不能独立解释全部误差。 第二,给 run_ode 加一个符号。 把 x + 0.5 * L * (x + s) 改成 x - 0.5 * L * (x + s) 再跑,观察分布是否继续被收缩,并记录实际统计量,勿把旧试跑数字当作本环境必然输出。稳态高斯的解析方差反例可先由 diffusion_checks.py 验证。这就是 3.4 节那个 $du<0$ 的坑。 第三,把目标分布的 SCALES 从 0.16~0.24 改成 0.45 附近。 检查估计噪声是否遮住方法差异;结果依赖分量、种子、带宽与样本量,不预设所有方法必然相同。这是 4.1 节那个「目标太光滑就分不出来」的第二遍确认。 第四,改 forward_diffusion.py 里的 linear_beta,把 beta_T 从 0.02 降到 0.01。 预期:$\bar\alpha_T$ 变大(终端残留信号变多),t=500 的 SNR 也跟着变。可以顺着看 05 节说的那个「非零终端 SNR」到底有多敏感。 10. 延伸阅读 前置:变分下界与重参数化。先掌握 Jensen 不等式、KL 与条件期望;本文补全后验配方、负 ELBO 方向与固定方差权重,不要求预先学会随机微积分。 下一步:DDPM 训练目标与采样流程。把本文数学对象接到训练网络、方差选择和完整采样循环。 下一步:从 DDIM 到高阶采样器。进一步研究累计噪声钟、半线性积分、网格与 NFE。 下一步:流匹配与 Rectified Flow。比较速度场训练与 score 漂移的联系及不同路径选择。 评测:FID / CLIP Score 到底测了什么。延续本文的统计量反例;低维解析分布上的均值匹配不替代图像评测。 原始来源:2015 扩散框架、DDPM、score-SDE、DDIM、Improved DDPM、渐进蒸馏、DPM-Solver、零终端 SNR、MMD 原始论文。工业源码固定到 diffusers v0.35.1。 附录:完整代码 09 节用到的脚本全文如下(mmd_noise_check.py、forward_diffusion.py、diffusion_checks.py、score_bridges.py、reverse_sampling.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 mmd_noise_check.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """MMD^2 估计噪声核对:本样本量和带宽下,微小差异不足以可靠排序。 写这篇的时候第一版主指标就是 MMD^2,跑出来的表看着很漂亮(Heun 在 N>=10 就顶到"噪声地板",其余采样器数值一路降到 0 以下)。问题是那个 "噪声地板"是单次抽样的运气值:把真实样本对真实样本重复 8 次,MMD^2 的标准差是 3.6e-4,比 N>=100 时各采样器之间的差别还大。 所以正文改用三个可直接计算但仍有抽样波动的统计量(mean log p_0 / 分量占比 TV / 模式内半径),MMD^2 只留作低步数区间的旁证。 跑法:python mmd_noise_check.py """ import numpy as np from forward_diffusion import sample_data from reverse_sampling import mmd2, run_ddpm, make_stride from forward_diffusion import alpha_bar_from_beta, linear_beta, T, D ab = alpha_bar_from_beta(linear_beta(T)) print("A. 真实样本 vs 真实样本(应当 ~0),重复 8 次,看估计量的散布") for bw in [None, 1.9, 1.0, 0.5]: vals = [] for k in range(8): a = sample_data(2000, np.random.default_rng(1000 + k)) b = sample_data(2000, np.random.default_rng(5000 + k)) v, used = mmd2(a, b, bw=bw) vals.append(v) vals = np.array(vals) print(f" bw={str(bw):>5} (实取{used:.2f}) mean={vals.mean():+.3e} " f"std={vals.std():.3e} min={vals.min():+.3e} max={vals.max():+.3e}") print() print("B. ddpm@1000 换 8 个不同的初始噪声种子") for bw in [None, 1.0, 0.5]: ref = sample_data(4000, np.random.default_rng(7)) vals = [] for k in range(8): rng = np.random.default_rng(3000 + k) x = rng.standard_normal((2000, D)) x = run_ddpm(x, ab, make_stride(1000, T), rng) v, used = mmd2(x, ref, bw=bw) vals.append(v) vals = np.array(vals) print(f" bw={str(bw):>5} (实取{used:.2f}) mean={vals.mean():+.3e} " f"std={vals.std():.3e}") print(f" -> {np.array2string(vals, precision=3, formatter={'float': lambda v: f'{v:+.2e}'})}") print() print("C. 极端对照:把样本整体平移 0.5,看各带宽的分辨力") ref = sample_data(4000, np.random.default_rng(7)) for shift in [0.05, 0.1, 0.2, 0.5]: y = sample_data(2000, np.random.default_rng(11)) + shift row = f" shift={shift:.2f} " for bw in [1.9, 1.0, 0.5, 0.25]: v, _ = mmd2(y, ref, bw=bw) row += f"bw={bw}:{v:+.2e} " print(row) forward_diffusion.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """扩散前向过程:闭式解、噪声调度、信噪比。 只依赖 numpy。正文里出现的每一个数字都由本脚本打印,不手填。 要回答三个问题: 1. q(x_t | x_0) 的闭式解是不是真的成立(蒙特卡洛对着验) 2. 线性调度和余弦调度把"难度"分配得有多不一样(看 alpha_bar / SNR) 3. 前向终点的分布离标准正态到底差多少(决定了 L_T 那一项有多大) 运行: python forward_diffusion.py """ import numpy as np SEED = 20260926 T = 1000 # 总步数,与 DDPM 原文一致 D = 2 # 玩具数据维度 # ── 玩具数据:2D 七分量各向同性高斯混合(环状 + 一个中心分量)────────── # 分量故意取紧(标准差 0.16~0.30):score 场的曲率大,离散化误差才显出来。 # 换成 3 个宽分量(标准差 ~0.5)的话,oracle score 下所有采样器都会直接顶到 # MMD 噪声地板上,分不出高下——这是调这个玩具问题时踩的第一个坑。 WEIGHTS = np.array([0.14, 0.13, 0.15, 0.12, 0.14, 0.13, 0.19]) MEANS = np.array([[-2.6, -1.0], [-1.0, -2.2], [1.4, -2.0], [2.6, -0.4], [1.6, 1.8], [-0.6, 2.4], [0.0, 0.0]]) SCALES = np.array([0.22, 0.18, 0.20, 0.16, 0.24, 0.20, 0.30]) def sample_data(n, rng): """从 p_0 采 n 个样本。""" k = rng.choice(len(WEIGHTS), size=n, p=WEIGHTS) return MEANS[k] + SCALES[k][:, None] * rng.standard_normal((n, D)) # ── 噪声调度 ────────────────────────────────────────────────────────── def linear_beta(T=T, beta_1=1e-4, beta_T=0.02): """DDPM 原文的线性调度,beta 从 1e-4 均匀涨到 0.02。""" return np.linspace(beta_1, beta_T, T) def cosine_beta(T=T, s=0.008, clip=0.999): """Nichol & Dhariwal 的余弦调度,返回 beta_t。 alpha_bar_t = cos^2(((t/T + s)/(1+s)) * pi/2) / cos^2((s/(1+s)) * pi/2) 分母只是为了让 t=0 时 alpha_bar=1。 按 t=T 代入会得到 alpha_bar_T = 0(cos(pi/2)=0),也就是最后一步 beta=1, 实操上会炸。原文和 diffusers 都会把 beta 截到 0.999 以内,这里照做。 """ t = np.arange(1, T + 1) / T f = np.cos(((t + s) / (1 + s)) * np.pi / 2) ** 2 f0 = (np.cos((s / (1 + s)) * np.pi / 2)) ** 2 a_bar = f / f0 beta = beta_from_alpha_bar(a_bar) return np.clip(beta, None, clip) def cosine_alpha_bar(T=T, s=0.008, clip=0.999): """截尾之后的余弦调度的 alpha_bar,与 cosine_beta 一致。""" return alpha_bar_from_beta(cosine_beta(T, s, clip)) def alpha_bar_from_beta(beta): """alpha_bar_t = prod_{s<=t} (1 - beta_s),t = 1..T。""" return np.cumprod(1.0 - beta) def beta_from_alpha_bar(alpha_bar): """反解出每步的 beta_t = 1 - alpha_bar_t / alpha_bar_{t-1}。""" prev = np.concatenate([[1.0], alpha_bar[:-1]]) return 1.0 - alpha_bar / prev def snr_db(alpha_bar): """信噪比 alpha_bar/(1-alpha_bar),取 10*log10。""" return 10.0 * np.log10(alpha_bar / (1.0 - alpha_bar)) def q_sample(x0, t_idx, alpha_bar, rng): """x_t = sqrt(alpha_bar_t) * x_0 + sqrt(1 - alpha_bar_t) * eps。 t_idx 是 0-based 的数组下标,对应 alpha_bar[t_idx]。 """ a = alpha_bar[t_idx] eps = rng.standard_normal(x0.shape) return np.sqrt(a) * x0 + np.sqrt(1.0 - a) * eps, eps # ── 加噪后分布的解析形式(反向采样要用 oracle score)────────────────── def noised_mixture(alpha_bar_t): """p_t 仍是高斯混合:第 k 个分量的均值缩到 sqrt(a)*mu_k, 协方差变成 a*Sigma_k + (1-a)*I。因为 Sigma_k = s_k^2 I,结果仍是各向同性。 """ a = alpha_bar_t means = np.sqrt(a) * MEANS var = a * SCALES ** 2 + (1.0 - a) # 每个分量的方差(标量) return WEIGHTS, means, var def log_density(x, weights, means, var): """各向同性高斯混合的 log 密度,x: [n, 2]。""" n, d = x.shape # [n, K] sq = ((x[:, None, :] - means[None, :, :]) ** 2).sum(-1) comp = -0.5 * (sq / var[None, :] + d * np.log(2 * np.pi * var)[None, :]) mx = comp.max(axis=1, keepdims=True) e = np.exp(comp - mx) mix = (weights[None, :] * e).sum(1) return (np.log(mix) + mx[:, 0]) def score_fn(x, alpha_bar_t): """nabla_x log p_t(x) 的闭式解。混合权重用 log-sum-exp 稳住数值。""" w, m, v = noised_mixture(alpha_bar_t) n, d = x.shape sq = ((x[:, None, :] - m[None, :, :]) ** 2).sum(-1) comp = -0.5 * (sq / v[None, :] + d * np.log(2 * np.pi * v)[None, :]) mx = comp.max(axis=1, keepdims=True) e = np.exp(comp - mx) resp = w[None, :] * e resp = resp / resp.sum(1, keepdims=True) # [n, K] 责任度 # grad log N(x; m_k, v_k I) = -(x - m_k)/v_k return -(resp[:, :, None] * (x[:, None, :] - m[None, :, :]) / v[None, :, None]).sum(1) # ────────────────────────────────────────────────────────────────────── # A. 闭式解核对 # ────────────────────────────────────────────────────────────────────── def check_closed_form(rng, alpha_bar, n=200_000): """一步一步加噪 1000 次,和闭式解 x_t = sqrt(a) x_0 + sqrt(1-a) eps 对着验。""" x0 = sample_data(n, rng) out = [] for t_idx in [49, 199, 499, 999]: a = alpha_bar[t_idx] # 路径 1:逐步迭代 x = x0.copy() beta = beta_from_alpha_bar(alpha_bar) for i in range(t_idx + 1): x = np.sqrt(1.0 - beta[i]) * x + np.sqrt(beta[i]) * rng.standard_normal(x.shape) # 路径 2:独立噪声闭式抽样;只比较边缘统计量,不逐样本配对 xt_cf, _ = q_sample(x0, t_idx, alpha_bar, rng) # 逐样本比不了(噪声不同),比统计量 out.append({ "t": t_idx + 1, "alpha_bar": a, "mean_step": np.abs(x.mean(0) - np.sqrt(a) * x0.mean(0)).max(), "var_step": np.abs(x.var(0) - (a * x0.var(0) + (1 - a))).max(), "var_cf": np.abs(xt_cf.var(0) - (a * x0.var(0) + (1 - a))).max(), }) return out # ────────────────────────────────────────────────────────────────────── # B. 调度对比 # ────────────────────────────────────────────────────────────────────── def schedule_report(): lin_b = linear_beta(T) lin_a = alpha_bar_from_beta(lin_b) cos_b = cosine_beta(T) cos_a = alpha_bar_from_beta(cos_b) rows = [] for t in [1, 50, 100, 250, 500, 750, 900, 1000]: rows.append({ "t": t, "lin_a": lin_a[t - 1], "cos_a": cos_a[t - 1], "lin_snr": snr_db(lin_a[t - 1]), "cos_snr": snr_db(cos_a[t - 1]), "lin_b": lin_b[t - 1], "cos_b": cos_b[t - 1], }) return lin_b, lin_a, cos_b, cos_a, rows def half_life(alpha_bar): """alpha_bar 掉到 0.5 是第几步——一半的采样步数花在这之后。""" idx = np.argmax(alpha_bar < 0.5) return int(idx) + 1 if alpha_bar[idx] < 0.5 else T # ────────────────────────────────────────────────────────────────────── # C. 区分边缘终端 KL 与 ELBO 的条件终端 KL # ────────────────────────────────────────────────────────────────────── def terminal_kl(alpha_bar_T): """KL( q(x_T) || N(0,I) ),q(x_T) 是七分量高斯混合。 没有闭式解,用蒙特卡洛:E_{q(x_T)}[ log q(x_T) - log N(0,I) ] """ rng = np.random.default_rng(SEED + 7) x = sample_data(400_000, rng) w, m, v = noised_mixture(alpha_bar_T) eps = rng.standard_normal(x.shape) xt = np.sqrt(alpha_bar_T) * x + np.sqrt(1.0 - alpha_bar_T) * eps lq = log_density(xt, w, m, v) ln = -0.5 * ((xt ** 2).sum(1) + D * np.log(2 * np.pi)) return float((lq - ln).mean()), float((lq - ln).std() / np.sqrt(len(xt))) def terminal_elbo_kl(alpha_bar_T): """E_data KL(q(x_T|x_0) || N(0,I)) 的闭式值。""" if not 0 <= alpha_bar_T < 1: raise ValueError("alpha_bar_T must lie in [0,1)") second_moment = np.sum(WEIGHTS * (np.sum(MEANS ** 2, axis=1) + D * SCALES ** 2)) return 0.5 * (alpha_bar_T * second_moment - D * alpha_bar_T - D * np.log1p(-alpha_bar_T)) def main(): rng = np.random.default_rng(SEED) print("=" * 68) print("A. 闭式解核对:逐步迭代 vs 一步闭式(20 万样本,2D)") print("=" * 68) lin_b, lin_a, cos_b, cos_a, _rows = schedule_report() for r in check_closed_form(rng, lin_a): print(f" t={r['t']:>4} alpha_bar={r['alpha_bar']:.6e} " f"|均值差|={r['mean_step']:.2e} 逐步方差误={r['var_step']:.2e} " f"闭式方差误={r['var_cf']:.2e}") print() print("=" * 68) print("B. 两种调度把信息怎么抹掉的") print("=" * 68) print(f" {'t':>5} {'alpha_bar(linear)':>18} {'alpha_bar(cosine)':>18} " f"{'SNR_dB(lin)':>12} {'SNR_dB(cos)':>12}") for r in _rows: print(f" {r['t']:>5} {r['lin_a']:>18.6e} {r['cos_a']:>18.6e} " f"{r['lin_snr']:>12.2f} {r['cos_snr']:>12.2f}") print(f"\n alpha_bar 掉到 0.5 的步数:linear = {half_life(lin_a)}," f"cosine = {half_life(cos_a)}") print(f" 也就是说 linear 调度下,{100 * np.mean(lin_a < 0.5):.1f}% 的步数" f"花在信噪比已经低于 0 dB 的区域") print() print("=" * 68) print("C. 边缘终端 KL 和 ELBO 条件终端 KL(不同对象)") print("=" * 68) for name, aT in [("linear", lin_a[-1]), ("cosine", cos_a[-1])]: kl, se = terminal_kl(aT) print(f" {name:>7}: E_data KL(q(x_T|x_0)||N(0,I)) = {terminal_elbo_kl(aT):.6e} nats") print(f" {name:>7}: alpha_bar_T={aT:.6e} KL(q(x_T)||N(0,I)) = {kl:.6e} nats" f" (±{se:.1e})") print() print("=" * 68) print("D. 连续时间对账:beta(t) = T * beta_i,积分出来的 alpha_bar 对不对") print("=" * 68) b_min, b_max = T * float(lin_b[0]), T * float(lin_b[-1]) print(f" beta_min = {b_min:.4f}(Song et al. VP-SDE 默认 0.1)" f" beta_max = {b_max:.4f}(默认 20)") for t in [0.25, 0.5, 0.75, 1.0]: i = int(round(t * T)) - 1 a_cont = np.exp(-(b_min * t + 0.5 * (b_max - b_min) * t * t)) print(f" t={t:.2f} 离散 alpha_bar={lin_a[i]:.6e} " f"连续 exp(-int beta)={a_cont:.6e} 相对差={abs(lin_a[i] - a_cont) / lin_a[i]:.2e}") print() print("=" * 68) print("E. 终点还剩多少原始信号(非零终端 SNR 问题)") print("=" * 68) for name, aT in [("linear", lin_a[-1]), ("cosine", cos_a[-1])]: amp = np.sqrt(aT) snr_T = aT / (1.0 - aT) print(f" {name:>7}: alpha_bar_T={aT:.6e} sqrt(alpha_bar_T)={amp:.6e}" f" => x_T 里原始信号的振幅占比 {amp * 100:.4f}%") print(f" 终端 SNR = {snr_T:.4e}(= {snr_db(aT):.2f} dB)," f"若设计为纯高斯终端则应为 0;有限时间允许非零值") if __name__ == "__main__": main() diffusion_checks.py """NumPy checks for conditional targets, posterior uncertainty and sampling statistics. Run: python diffusion_checks.py. No model weights or GPU are required. """ import json from pathlib import Path import numpy as np import forward_diffusion as fd import reverse_sampling as rs def main(): rng = np.random.default_rng(20261015) ab = fd.alpha_bar_from_beta(fd.linear_beta()) x = rng.normal(size=(30, fd.D)) h = 1e-5 score_errors = [] for t in [1, 50, 500, 1000]: a = ab[t - 1] w, m, v = fd.noised_mixture(a) finite_diff = np.empty_like(x) for d in range(fd.D): step = np.zeros_like(x) step[:, d] = h finite_diff[:, d] = (fd.log_density(x + step, w, m, v) - fd.log_density(x - step, w, m, v)) / (2 * h) score_errors.append(float(np.max(np.abs(finite_diff - fd.score_fn(x, a))))) assert max(score_errors) < 1e-7 # Conditioning a standard Gaussian prior leaves nonzero target uncertainty. a = 0.25 x0 = rng.normal(size=(100000, fd.D)) eps = rng.normal(size=x0.shape) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps eps_mean = np.sqrt(1 - a) * xt # marginal score is -xt mmse = float(np.mean(np.sum((eps - eps_mean) ** 2, axis=1))) assert abs(mmse - fd.D * a) < 0.006 target_example = dict(empirical_mmse=mmse,analytic_mmse=fd.D*a, zero_predictor_rmse=np.sqrt(fd.D), independent_gaussian_predictor_rmse=np.sqrt(2*fd.D)) # q(x0|xt=0) for a symmetric two-mode prior: mean=0 hides both modes. a, s2, mu = 0.9, 0.04, 2.0 vt = a * s2 + 1 - a posterior_component_mean = (1 - a) * mu / vt posterior_component_var = s2 * (1 - a) / vt posterior_var = posterior_component_var + posterior_component_mean ** 2 posterior_example = dict(component_means=[-posterior_component_mean, posterior_component_mean], within_component_variance=posterior_component_var, true_variance=posterior_var, plugin_final_variance=0.0,plugin_final_mean=0.0) assert posterior_var > 2 # Exact finite-interval embedding: exp(-int rate)=prod(1-beta). b = fd.linear_beta() rates = -fd.T * np.log1p(-b) embedded = np.exp(-np.cumsum(rates) / fd.T) embedding_error = float(np.max(np.abs(embedded - ab))) assert embedding_error < 2e-14 # Stationary N(0,I): reverse SDE needs the full score, ODE drift is zero. L = 0.1 correct_em_variance = (1 - L/2)**2 + L deleted_noise_variance = (1 - L/2)**2 ode_variance = 1.0 assert abs(correct_em_variance - 1) < 0.003 assert deleted_noise_variance < 0.91 # A radius-sqrt(D) sphere has the Gaussian's exact expected log-density, # but different radial fourth moment. This is a distribution counterexample. gaussian_logp = -fd.D/2 * (1 + np.log(2*np.pi)) sphere_logp = -0.5 * (fd.D + fd.D*np.log(2*np.pi)) counterexample = dict(dlogp=sphere_logp-gaussian_logp, sphere_radius_fourth_moment=fd.D**2, gaussian_radius_fourth_moment=fd.D*(fd.D+2)) assert abs(counterexample['dlogp']) < 1e-14 # Same NFE=50 for all methods; five independent runs, not a confidence band. configs = [('ddpm',50),('ddim',50),('em',50),('ode',50),('heun',25)] repeated = [] for name, n in configs: vals, ses = [], [] for k in range(5): seed = 70000 + 100*k ref = fd.sample_data(8000,np.random.default_rng(seed)) gen_rng = np.random.default_rng(seed+1) initial = gen_rng.standard_normal((4000,fd.D)) before = rs.SCORE_CALLS generated = rs.SAMPLERS[name][0](initial,ab,rs.make_stride(n),gen_rng) nfe = rs.SCORE_CALLS-before assert nfe == 50 and np.isfinite(generated).all() lg = fd.log_density(generated,fd.WEIGHTS,fd.MEANS,fd.SCALES**2) lr = fd.log_density(ref,fd.WEIGHTS,fd.MEANS,fd.SCALES**2) vals.append(float(lg.mean()-lr.mean())) ses.append(float(np.sqrt(lg.var(ddof=1)/len(lg)+lr.var(ddof=1)/len(lr)))) repeated.append(dict(method=name,steps=n,nfe=nfe,seeds=5,dlogp_runs=vals, dlogp_mean=float(np.mean(vals)), across_seed_sd=float(np.std(vals,ddof=1)), iid_standard_errors=ses)) results = dict(passed=True,score_gradient_max_abs=max(score_errors), conditional_target=target_example,posterior=posterior_example, exact_embedding_max_abs=embedding_error, stationary_gaussian=dict(correct_em_variance=correct_em_variance, delete_noise_variance=deleted_noise_variance, probability_flow_variance=ode_variance), density_counterexample=counterexample,repeated_sampling=repeated, errors=[],warnings=[]) target = Path(__file__).with_name('validation_results.json') target.write_text(json.dumps(results,ensure_ascii=False,indent=2)+'\n',encoding='utf8') print(json.dumps(results,ensure_ascii=False,indent=2)) if __name__ == '__main__': main() score_bridges.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """把 score / epsilon / x_0 / v 四种参数化钉死在同一组恒等式上。 扩散模型的代码里同一个东西有四种写法,换参数化是家常便饭(SD 2.x 用 v, 不同checkpoint分别采用epsilon、v或x_0,必须检查训练目标配置)。这篇要说的是: 它们描述的是同一个量,但**作为训练目标并不等价**——换参数化等于给每个 时间步偷偷换了一个权重。 跑法:python score_bridges.py """ import numpy as np from forward_diffusion import ( D, SEED, T, MEANS, SCALES, WEIGHTS, alpha_bar_from_beta, linear_beta, noised_mixture, sample_data, score_fn, ) ALPHA_BAR = alpha_bar_from_beta(linear_beta(T)) def abar(t): """t 是 1-based 步号。""" return 1.0 if t == 0 else float(ALPHA_BAR[t - 1]) def score_at(x, t): return score_fn(x, abar(t)) # ────────────────────────────────────────────────────────────────────── # A. 精确后验均值 E[x_0 | x_t] # ────────────────────────────────────────────────────────────────────── def posterior_mean_exact(x, t): """q(x_0 | x_t) 仍是高斯混合,第 k 个分量: 后验权重 r_k = 与 score 里用的是同一份责任度 后验方差 C_k = (1/s_k^2 + alpha_bar/(1-alpha_bar))^{-1} 后验均值 m_k = C_k * (mu_k / s_k^2 + sqrt(alpha_bar) * x_t / (1-alpha_bar)) """ a = abar(t) if a >= 1.0: return x.copy() _, m_t, v_t = noised_mixture(a) # 加噪后各分量的均值 / 方差 n = x.shape[0] sq = ((x[:, None, :] - m_t[None, :, :]) ** 2).sum(-1) logc = -0.5 * (sq / v_t[None, :] + D * np.log(2 * np.pi * v_t)[None, :]) mx = logc.max(1, keepdims=True) resp = WEIGHTS[None, :] * np.exp(logc - mx) resp = resp / resp.sum(1, keepdims=True) # [n, K] s2 = SCALES ** 2 C = 1.0 / (1.0 / s2 + a / (1.0 - a)) # [K] mk = C[None, :, None] * (MEANS[None, :, :] / s2[None, :, None] + np.sqrt(a) * x[:, None, :] / (1.0 - a)) return (resp[:, :, None] * mk).sum(1) def tweedie_mean(x, t): """Tweedie:E[x_0 | x_t] = (x_t + (1 - alpha_bar_t) * score) / sqrt(alpha_bar_t)。""" a = abar(t) if a >= 1.0: return x.copy() return (x + (1.0 - a) * score_at(x, t)) / np.sqrt(a) def eps_from_score(x, t): """E[eps|x_t] = -sqrt(1 - alpha_bar_t) * marginal score。""" a = abar(t) return -np.sqrt(1.0 - a) * score_at(x, t) def eps_from_x0(x, x0_hat, t): """反解:eps = (x_t - sqrt(alpha_bar_t) * x_0) / sqrt(1 - alpha_bar_t)。""" a = abar(t) return (x - np.sqrt(a) * x0_hat) / np.sqrt(1.0 - a) def v_target(x0, eps, t): """v = sqrt(alpha_bar) * eps - sqrt(1 - alpha_bar) * x_0。""" a = abar(t) return np.sqrt(a) * eps - np.sqrt(1.0 - a) * x0 def recover_from_v(x, v, t): """v 和 x_t 之间是一个旋转:x_0 = a*x_t - b*v,eps = b*x_t + a*v。 变换矩阵 [[a, b], [-b, a]] 行列式为 a^2+b^2=1,所以它是正交的—— 这也保证联合向量范数;固定 x_t 时 eps 误差为 sqrt(a)*delta_v,不能推成任意误差无放大。 """ a, b = np.sqrt(abar(t)), np.sqrt(1.0 - abar(t)) return a * x - b * v, b * x + a * v # ────────────────────────────────────────────────────────────────────── # B. 蒙特卡洛交叉验证(不靠闭式解,纯重要性采样) # ────────────────────────────────────────────────────────────────────── def is_posterior_mean(xi, t, n=1_000_000, seed=SEED + 11): """E[x_0 | x_t = xi] 的自归一化重要性采样估计。 x_0^i 就是从 p_0 里采的,所以权重直接取 q(xi | x_0^i) 即可, 不需要知道归一化常数。 """ rng = np.random.default_rng(seed) x0 = sample_data(n, rng) a = abar(t) b2 = 1.0 - a sq = ((xi[None, :] - np.sqrt(a) * x0) ** 2).sum(1) logw = -0.5 * sq / b2 logw -= logw.max() w = np.exp(logw) ess = w.sum() ** 2 / (w ** 2).sum() return (w[:, None] * x0).sum(0) / w.sum(), ess # ────────────────────────────────────────────────────────────────────── # C. 三种参数化在 epsilon 空间下的每步权重 # ────────────────────────────────────────────────────────────────────── def loss_weights(t): """把三种参数化的训练损失都换算回"相当于给 eps 误差加了多大权重"。 - eps 参数化:delta_eps = delta_u -> 权重 1 - x_0 参数化:eps = (x_t - sqrt(a) x_0)/sqrt(1-a) delta_eps = -sqrt(a/(1-a)) * delta_u -> 权重 a/(1-a) = SNR 反过来,x_0 的损失 ||delta_u||^2 折算成 eps 误差是 ||delta_eps||^2 = SNR * ||delta_x0||^2, 即 x_0 损失对 eps 误差的权重是 1/SNR - v 参数化 :eps = sqrt(1-a)*x_t + sqrt(a)*v,delta_eps = sqrt(a) * delta_v -> v 损失折算成 eps 误差的权重是 1/a = 1/alpha_bar 返回 (权重_eps, 权重_v, 权重_x0),都是"乘在 ||delta_eps||^2 上的系数"。 """ a = abar(t) if t > 0 else 1.0 snr = a / (1.0 - a) return 1.0, 1.0 / a, 1.0 / snr def main(): rng = np.random.default_rng(SEED) print("=" * 72) print("A. Tweedie 恒等式核对:闭式后验均值 vs 公式 (x_t + (1-a) s)/sqrt(a)") print("=" * 72) print(f" {'t':>5} {'alpha_bar':>14} {'最大绝对误差':>16} {'x_t 范数均值':>14}") for t in [1, 50, 100, 250, 500, 750, 1000]: x = sample_data(2000, rng) xt, _ = (np.sqrt(abar(t)) * x + np.sqrt(1 - abar(t)) * rng.standard_normal(x.shape), None) e1 = posterior_mean_exact(xt, t) e2 = tweedie_mean(xt, t) err = np.abs(e1 - e2).max() print(f" {t:>5} {abar(t):>14.6e} {err:>16.3e} " f"{np.linalg.norm(xt, axis=1).mean():>14.4f}") print() print("=" * 72) print("B. MMSE eps 与边缘 score 的换算:两条路算条件均值是否一致") print("=" * 72) print(f" {'t':>5} {'|eps(score) - eps(x_0)| 最大':>28}") for t in [50, 250, 500, 1000]: x0 = sample_data(2000, rng) eps_true = rng.standard_normal(x0.shape) a = abar(t) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps_true # 路线 1:从 score e_s = eps_from_score(xt, t) # 路线 2:从 Tweedie 反解出的 x_0 e_x = eps_from_x0(xt, tweedie_mean(xt, t), t) print(f" {t:>5} {np.abs(e_s - e_x).max():>28.3e}") # 顺便看看 MMSE 估计量离真实 eps 有多远(这是"复原不了"的那部分) print(f" (MMSE 估计量与本次真实 eps 的 RMSE = " f"{np.sqrt(((e_s - eps_true) ** 2).sum(1).mean()):.4f}," f"零预测基线 sqrt(D)={np.sqrt(D):.4f};独立标准高斯猜测基线 sqrt(2D)={np.sqrt(2 * D):.4f})") print() print("=" * 72) print("C. v 参数化:它与 (x_t, eps, x_0) 之间是一个旋转") print("=" * 72) for t in [50, 500, 1000]: x0 = sample_data(2000, rng) eps = rng.standard_normal(x0.shape) a = abar(t) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps v = v_target(x0, eps, t) x0_rec, eps_rec = recover_from_v(xt, v, t) print(f" t={t:>5} 重建 x_0 误差={np.abs(x0_rec - x0).max():.3e} " f"重建 eps 误差={np.abs(eps_rec - eps).max():.3e} " f"v 的范数均值={np.linalg.norm(v, axis=1).mean():.4f}") print() print("=" * 72) print("D. 蒙特卡洛交叉验证(100 万样本的重要性采样,不依赖上面的闭式解)") print("=" * 72) print(f" {'t':>5} {'Tweedie':>22} {'重要性采样':>22} {'有效样本数':>12}") for t in [50, 250, 500, 1000]: xi = sample_data(1, rng)[0] xi = np.sqrt(abar(t)) * xi + np.sqrt(1 - abar(t)) * rng.standard_normal(2) tm = tweedie_mean(xi[None, :], t)[0] im, ess = is_posterior_mean(xi, t) print(f" {t:>5} {np.array2string(tm, precision=4):>22} " f"{np.array2string(im, precision=4):>22} {ess:>12.0f}") print() print("=" * 72) print("E. 换参数化 = 给每个时间步换权重(折算回 eps 空间的系数)") print("=" * 72) print(f" {'t':>5} {'alpha_bar':>13} {'w_eps':>12} {'w_v':>14} {'w_x0':>14}") for t in [1, 10, 50, 100, 250, 500, 750, 900, 1000]: we, wv, wx = loss_weights(t) print(f" {t:>5} {abar(t):>13.6e} {we:>12.4f} {wv:>14.4e} {wx:>14.4e}") wes, wvs, wxs = zip(*[loss_weights(t) for t in range(1, T + 1)]) print(f"\n eps 参数化: 权重恒为 1,动态范围 {max(wes) / min(wes):.1f}") print(f" v 参数化: 权重 {min(wvs):.4e} ~ {max(wvs):.4e}," f"动态范围 {max(wvs) / min(wvs):.3e}") print(f" x_0 参数化: 权重 {min(wxs):.4e} ~ {max(wxs):.4e}," f"动态范围 {max(wxs) / min(wxs):.3e}") if __name__ == "__main__": main() reverse_sampling.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """反向采样:五种采样器在"同一个 oracle score"下的正面对比。 这一节要回答的是:反向 SDE 与概率流 ODE 的漂移不同,为什么工业界 能搞出 DDPM / DDIM / DPM-Solver / Euler / Heun 这么多种采样器?差别到底 在哪里? 关键设计:目标分布用 2D 高斯混合,加噪之后仍然是高斯混合,所以 nabla_x log p_t(x) 有闭式解。也就是说这里的 score 是**理论最优**的, 不掺任何网络拟合误差——差异来自离散化、有限终端噪声近似以及蒙特卡洛波动。 五种采样器: ddpm DDPM 祖采样(ancestral),高斯反向核近似,每步注噪声 ddim DDIM,eta=0,确定性 em Euler-Maruyama 解反向 SDE,一阶,注噪声 ode Euler 解概率流 ODE,一阶,确定性 heun Heun 二阶解概率流 ODE,每步两次 score 评估 运行: python reverse_sampling.py """ import numpy as np from forward_diffusion import ( D, SEED, T, MEANS, SCALES, WEIGHTS, alpha_bar_from_beta, cosine_beta, linear_beta, log_density, sample_data, score_fn, ) # ────────────────────────────────────────────────────────────────────── # 时间步工具 # ────────────────────────────────────────────────────────────────────── def make_stride(n_steps, T=T): """把 0..T 均匀切成 n_steps 段,返回 1-based 的 t 序列(含 T 与 0)。 例:n_steps=50, T=1000 -> [1000, 980, 960, ..., 20, 0] """ idx = np.linspace(T, 0, n_steps + 1).astype(int) # 保证严格递减且唯一 idx = np.unique(idx)[::-1] return list(idx) def abar_at(alpha_bar, t): """t 是 1-based 步号;t=0 时 alpha_bar=1(即 x_0 本身)。""" return 1.0 if t == 0 else float(alpha_bar[t - 1]) SCORE_CALLS = 0 def score_at(x, alpha_bar, t): global SCORE_CALLS SCORE_CALLS += 1 return score_fn(x, abar_at(alpha_bar, t)) # ────────────────────────────────────────────────────────────────────── # 五种采样器 # ────────────────────────────────────────────────────────────────────── def _tweedie_x0(x, s, a_cur): """Tweedie 公式:E[x_0 | x_t] = (x_t + (1-a_t) * score) / sqrt(a_t)。""" return (x + (1.0 - a_cur) * s) / np.sqrt(a_cur) def _eps_from_score(s, a_cur): """epsilon 与 score 的换算:E[epsilon | x_t] = -sqrt(1 - a_t) * marginal score。""" return -np.sqrt(1.0 - a_cur) * s def run_ddpm(x, alpha_bar, taus, rng, **kw): """DDPM 祖采样:用精确反向均值配固定高斯方差,有限步并非精确逆核。 x_{t-1} = (x_t + beta_t * s) / sqrt(alpha_t) + sigma_t * z sigma_t^2 = beta_t * (1 - abar_{t-1}) / (1 - abar_t) """ for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) alpha_j = a_cur / a_prev beta_j = 1.0 - alpha_j if beta_j < 1e-12: continue s = score_at(x, alpha_bar, t_cur) mean = (x + beta_j * s) / np.sqrt(alpha_j) var = beta_j * (1.0 - a_prev) / (1.0 - a_cur) x = mean + np.sqrt(max(var, 0.0)) * rng.standard_normal(x.shape) return x def run_ddim(x, alpha_bar, taus, rng, **kw): """DDIM,eta=0:先跳到去噪后的 x_0,再重新加回 target 时刻的噪声。 x_{t-1} = sqrt(abar_{t-1}) * xhat_0 + sqrt(1 - abar_{t-1}) * eps_hat """ for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) s = score_at(x, alpha_bar, t_cur) xhat0 = _tweedie_x0(x, s, a_cur) eps_hat = _eps_from_score(s, a_cur) x = np.sqrt(a_prev) * xhat0 + np.sqrt(max(1.0 - a_prev, 0.0)) * eps_hat return x def _log_step(alpha_bar, t_cur, t_prev): """跨一步"累积"起来的积分量 L = int beta du = log(alpha_bar_{prev}/alpha_bar_{cur}) > 0。 这一步很关键:正向 SDE 的时间是 u = t/T,从 0 涨到 1;反向采样是让 u **往回走**,所以 du 是负的。改用递增反向时间后,drift 符号整体翻转; 完整score与线性项共同决定方向,稳态高斯的ODE速度为零。 用 L 记这段区间上 beta 的积分,Euler 步就写成: dx = +L * (0.5 x + c * s) (c=1 是 SDE,c=1/2 是 ODE) """ a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) return float(np.log(a_prev / a_cur)) def run_em(x, alpha_bar, taus, rng, **kw): """Euler-Maruyama 解反向 SDE:全量 score + 注入噪声。 反向 SDE 的 drift 里 score 的系数是 **1 倍**(不是 ODE 的半倍), 另外每步还要加 sqrt(L) 的噪声。 """ for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) if L < 1e-12: continue s = score_at(x, alpha_bar, taus[j]) x = x + L * (0.5 * x + s) + np.sqrt(L) * rng.standard_normal(x.shape) return x def run_ode(x, alpha_bar, taus, rng, **kw): """Euler 解概率流 ODE:半倍 score,无噪声。 和 EM 只差两处:score 系数从 1 减到 0.5,噪声项整个去掉。 """ for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) if L < 1e-12: continue s = score_at(x, alpha_bar, taus[j]) x = x + 0.5 * L * (x + s) return x def run_heun(x, alpha_bar, taus, rng, **kw): """Heun 二阶解概率流 ODE:Euler 预测一步,再用终点的 score 校正一次。 每步两次 score 评估(NFE = 2 * n_steps)。 """ for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) if L < 1e-12: continue s0 = score_at(x, alpha_bar, taus[j]) d0 = 0.5 * L * (x + s0) x1 = x + d0 # Euler 预测 s1 = score_at(x1, alpha_bar, taus[j + 1]) # 在目标时刻再评估一次 d1 = 0.5 * L * (x1 + s1) x = x + 0.5 * (d0 + d1) return x SAMPLERS = { "ddpm": (run_ddpm, 1), "ddim": (run_ddim, 1), "em": (run_em, 1), "ode": (run_ode, 1), "heun": (run_heun, 2), } # ────────────────────────────────────────────────────────────────────── # 评价:MMD^2(RBF 核,median heuristic) # ────────────────────────────────────────────────────────────────────── def _rbf_kernels(a, b, bw): sa = (a ** 2).sum(1) sb = (b ** 2).sum(1) d2 = sa[:, None] + sb[None, :] - 2.0 * a @ b.T return np.exp(-d2 / (2.0 * bw ** 2)) def mmd2(x, y, bw=None, n_cap=1500): """固定且独立于待评估样本的带宽下是MMD^2无偏估计;自动带宽为数据自适应诊断。""" rng = np.random.default_rng(0) if len(x) > n_cap: x = x[rng.choice(len(x), n_cap, replace=False)] if len(y) > n_cap: y = y[rng.choice(len(y), n_cap, replace=False)] if bw is None: allp = np.vstack([x[:800], y[:800]]) d2 = ((allp[:, None, :] - allp[None, :, :]) ** 2).sum(-1) bw = float(np.sqrt(np.median(d2) / 2.0)) bw = max(bw, 1e-3) kxx = _rbf_kernels(x, x, bw) kyy = _rbf_kernels(y, y, bw) kxy = _rbf_kernels(x, y, bw) n, m = len(x), len(y) # 去掉对角线才无偏 t1 = (kxx.sum() - np.trace(kxx)) / (n * (n - 1)) t2 = (kyy.sum() - np.trace(kyy)) / (m * (m - 1)) t3 = kxy.mean() return float(t1 + t2 - 2 * t3), bw def mean_logp(x): """生成样本在真实 p_0 下的平均 log 密度。 比 MMD 更能抓一种特定的失败:采样器把样本堆到高密度区(过聚拢), 或者样本飘到分量之间的低密度地带。 """ return float(log_density(x, WEIGHTS, MEANS, SCALES ** 2).mean()) def assign_components(x): """按最近的均值把样本归到混合分量上(分量标准差同量级,够用)。""" d = ((x[:, None, :] - MEANS[None, :, :]) ** 2).sum(-1) return d.argmin(1) def tv_weights(x): """经验分量占比与真实权重之间的全变差距离。 抓的是"各模式的比例对不对"——模式丢了一个、或者某个模式被过度采样, 这个数会涨,而 mean log p 未必涨(甚至可能更漂亮)。 """ idx = assign_components(x) n = len(x) hist = np.bincount(idx, minlength=len(WEIGHTS)) / n return float(0.5 * np.abs(hist - WEIGHTS).sum()) def mode_spread_err(x): """每个分量内部样本的均方半径,与理论值 D*s_k^2 的相对误差(取各分量最大)。 抓的是"样本落在模式的中心但挤成一团"或者"散得太开"。 """ idx = assign_components(x) errs = [] for k in range(len(WEIGHTS)): sel = x[idx == k] if len(sel) < 30: errs.append(1.0) continue r2 = ((sel - MEANS[k]) ** 2).sum(1).mean() errs.append(abs(r2 / (D * SCALES[k] ** 2) - 1.0)) return float(max(errs)) def moment_err(x, y): """均值与协方差的绝对误差(作为 MMD 之外的直观补充)。""" return float(np.abs(x.mean(0) - y.mean(0)).max()), \ float(np.abs(np.cov(x.T) - np.cov(y.T)).max()) # ────────────────────────────────────────────────────────────────────── # 主实验 # ────────────────────────────────────────────────────────────────────── def sweep(n_list=(10, 20, 25, 50, 100, 200, 1000), n_samples=4000, schedule="linear", seed=SEED): """固定一份真实样本做参照,扫采样器 × 步数。""" alpha_bar = (alpha_bar_from_beta(linear_beta(T)) if schedule == "linear" else alpha_bar_from_beta(cosine_beta(T))) ref = sample_data(8000, np.random.default_rng(seed)) # 噪声地板:两份**独立**真实样本之间的 MMD^2。 # 单次值不是置信区间;细微差异需要重复抽样评估。 ref_b = sample_data(4000, np.random.default_rng(seed + 999)) floor, bw = mmd2(ref[:4000], ref_b) # 三个主指标都先在大样本真实数据上算一遍当基线,后面一律报"相对基线的偏移", # 理想期望下匹配的统计量差为0,有限样本仍有波动,0也不保证整个分布匹配。 base = { "logp": mean_logp(ref), "tv": tv_weights(ref), "spread": mode_spread_err(ref), } # 一次对照差值(不是标准误或置信区间) noise = { "logp": mean_logp(ref_b) - base["logp"], "tv": tv_weights(ref_b) - base["tv"], "spread": mode_spread_err(ref_b) - base["spread"], } results = {"_floor": floor, "_bw": bw, "_base": base, "_noise": noise} for name, (fn, mult) in SAMPLERS.items(): for n in n_list: rng = np.random.default_rng(seed + 1) x = rng.standard_normal((n_samples, D)) taus = make_stride(n, T) before_nfe = SCORE_CALLS x = fn(x, alpha_bar, taus, rng) actual_nfe = SCORE_CALLS - before_nfe assert actual_nfe == (len(taus) - 1) * mult m2, _ = mmd2(x, ref, bw=bw) me, ce = moment_err(x, ref) results[(name, n)] = { "mmd2": m2, "nfe": actual_nfe, "mean_err": me, "cov_err": ce, "dlogp": mean_logp(x) - base["logp"], "dtv": tv_weights(x) - base["tv"], "dspread": mode_spread_err(x) - base["spread"], "finite": bool(np.isfinite(x).all()), } return results, bw def stride_stats(n_list=(10, 20, 50, 100, 200, 1000), T=T): """每一步跨过的"积分量" L = int beta du,以及 Euler 近似 e^{L/2} 会错多少。 DDPM / DDIM 的更新里线性部分是**精确**解掉的(直接乘 sqrt(alpha_bar)), Euler 却把它展开成一阶:e^{L/2} ≈ 1 + L/2。步长越大这两个差得越远, 这是一个线性子项的诊断,不能单独归因非线性完整采样误差。 """ alpha_bar = alpha_bar_from_beta(linear_beta(T)) out = [] for n in n_list: taus = make_stride(n, T) Ls = np.array([_log_step(alpha_bar, taus[j], taus[j + 1]) for j in range(len(taus) - 1)]) lm = float(Ls.max()) err = float(np.abs(np.exp(lm / 2) - (1 + lm / 2)) / np.exp(lm / 2)) out.append({"n": n, "L_max": lm, "L_mean": float(Ls.mean()), "euler_err": err}) return out def ablation_noise(n=50, n_samples=4000, seed=SEED): """把 DDIM 的 eta 从 0 拉到 1,看"注入噪声"这一项单独值多少钱。 eta=0 -> DDIM(确定性);eta=1 -> 等价 DDPM 祖采样。 sigma_t = eta * sqrt(beta_t * (1 - abar_{t-1}) / (1 - abar_t)) """ alpha_bar = alpha_bar_from_beta(linear_beta(T)) ref = sample_data(8000, np.random.default_rng(seed)) base_logp, base_tv, bw0 = _ablation_baseline(seed) out = [] taus = make_stride(n, T) for eta in [0.0, 0.25, 0.5, 0.75, 1.0]: rng = np.random.default_rng(seed + 1) x = rng.standard_normal((n_samples, D)) for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) alpha_j = a_cur / a_prev beta_j = 1.0 - alpha_j if beta_j < 1e-12: continue s = score_at(x, alpha_bar, t_cur) xhat0 = _tweedie_x0(x, s, a_cur) eps_hat = _eps_from_score(s, a_cur) var = beta_j * (1.0 - a_prev) / (1.0 - a_cur) sig = eta * np.sqrt(max(var, 0.0)) coeff = np.sqrt(max(1.0 - a_prev - sig ** 2, 0.0)) x = np.sqrt(a_prev) * xhat0 + coeff * eps_hat + sig * rng.standard_normal(x.shape) m2, _ = mmd2(x, ref, bw=bw0) out.append({"eta": eta, "mmd2": m2, "dlogp": mean_logp(x) - base_logp, "dtv": tv_weights(x) - base_tv}) return out def _ablation_baseline(seed=SEED): ref = sample_data(8000, np.random.default_rng(seed)) _, bw0 = mmd2(ref[:2000], sample_data(2000, np.random.default_rng(seed + 3))) return mean_logp(ref), tv_weights(ref), bw0 def main(): print("=" * 74) print("主实验:同一个 oracle score,五种采样器 × 七档步数") print(f"目标:2D 七分量高斯混合;参照集 8000 真实样本;每档生成 {4000} 个") print("主指标是 dlogp / dTV / dspread 三个(都扣掉了真实样本自己的基线," "0 = 仅该统计量匹配)") print("MMD^2 只列出来做旁证——它自身的噪声有 ±3.6e-4,见 mmd_noise_check.py") print("=" * 74) res, bw = sweep() floor = res["_floor"] base, noise = res["_base"], res["_noise"] n_list = [10, 20, 25, 50, 100, 200, 1000] print(f" MMD^2(噪声 ±3.6e-4,所以微小差异需重复抽样确认):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['mmd2']:>13.2e}" print(row) print() print(" 主指标 1 —— mean log p_0 相对真实样本的偏移(nats,0 = 仅该统计量匹配):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['dlogp']:>13.3f}" print(row) print() print(" 主指标 2 —— 分量占比的全变差距离偏移(0 = 与参照占比误差相同):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['dtv']:>13.4f}" print(row) print() print(" 主指标 3 —— 模式内均方半径的相对误差(0 = 与参照半径误差相同):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['dspread']:>13.4f}" print(row) print() print("=" * 74) print("为什么 DDIM 大步长扛得住、Euler 扛不住:看每步跨过的 L 有多大") print("=" * 74) print(f" {'N':>6} {'L_max':>10} {'L_mean':>10} {'e^(L/2) 与 1+L/2 的相对误差':>30}") for r in stride_stats(): print(f" {r['n']:>6} {r['L_max']:>10.4f} {r['L_mean']:>10.4f} " f"{r['euler_err'] * 100:>27.2f}%") print(f"\n 基线:真实样本 mean log p_0 = {base['logp']:.4f}," f"TV = {base['tv']:.4f},spread err = {base['spread']:.4f}") print(f" 指标自身噪声(另一份独立真实样本对基线的偏移):" f"logp {noise['logp']:+.4f} / TV {noise['tv']:+.4f} / " f"spread {noise['spread']:+.4f}") print() print(" 按 NFE(score 评估次数)对齐再看一遍——Heun 每步算两次:") print(f" {'采样器':<8} {'N':>6} {'NFE':>6} {'dlogp':>11} {'dspread':>11}") for name, n in [("ddpm", 1000), ("ddpm", 200), ("ddim", 50), ("ddim", 100), ("em", 50), ("ode", 50), ("heun", 25), ("heun", 50), ("ode", 200)]: r = res[(name, n)] print(f" {name:<8} {n:>6} {r['nfe']:>6} {r['dlogp']:>11.4f} " f"{r['dspread']:>11.4f}") print() print("=" * 74) print("关键对照:50 步能追上 1000 步吗(主指标看 dlogp,0 = 仅mean log p统计量一致)") print("=" * 74) for name, n in [("ddpm", 1000), ("ddim", 50), ("heun", 50), ("ode", 50), ("em", 50), ("ddpm", 50)]: r = res[(name, n)] print(f" {name:<6} N={n:<5} NFE={r['nfe']:<5} " f"dlogp={r['dlogp']:+.4f} dTV={r['dtv']:+.4f} " f"dspread={r['dspread']:+.4f} MMD^2={r['mmd2']:+.2e}") print() print("=" * 74) print("消融:只改 eta(注入多少噪声),其余完全不动,N=50") print("=" * 74) print(f" {'eta':>6} {'dlogp':>12} {'dTV':>12} {'MMD^2':>13}") for r in ablation_noise(): print(f" {r['eta']:>6.2f} {r['dlogp']:>12.4f} {r['dtv']:>12.4f} " f"{r['mmd2']:>13.2e}") print() print("=" * 74) print("换余弦调度再跑一遍(N=50)") print("=" * 74) res_c, _ = sweep(n_list=(50,), schedule="cosine") print(f" {'采样器':<8} {'dlogp(linear)':>15} {'dlogp(cosine)':>15}") for name in ["ddpm", "ddim", "em", "ode", "heun"]: print(f" {name:<8} {res[(name, 50)]['dlogp']:>15.4f} " f"{res_c[(name, 50)]['dlogp']:>15.4f}") print() print(f" (参照:MMD^2 噪声地板 = {floor:.3e},RBF 带宽 = {bw:.3f};" f"真实样本 mean log p_0 = {base['logp']:.4f})") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「扩散过程的前向与反向推导」的四张解释图。 数值一律从同目录的三个脚本里取(forward_diffusion / reverse_sampling / score_bridges),这里只负责画——改了那边这里要重跑,免得图和正文数字打架。 四张图分别回答: 1. 噪声调度到底把"难度"怎么分配到 1000 步上的 2. 五种采样器的误差随步数怎么降,以及每步跨过的积分量有多大 3. 前向把数据流推成球、反向沿轨迹走回七个模式,长什么样 4. 换参数化等价于给每个时间步换了多大权重(跨 10 个数量级) 只依赖 numpy + matplotlib。跑法:python make_figures.py """ import textwrap from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from matplotlib.collections import LineCollection import forward_diffusion as FD import reverse_sampling as RS import score_bridges as SB ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.bbox": "tight", }) INK = "#1f2937" MUTE = "#6b7280" C_LIN = "#d1495b" # 线性调度 / 差的一侧:红 C_COS = "#2f6fb0" # 余弦调度:蓝 C_DDPM = "#e0a03c" C_DDIM = "#2f9e6f" C_EM = "#8b5cf6" C_ODE = "#d1495b" C_HEUN = "#1f6feb" C_OK = "#2f9e6f" C_BAD = "#d1495b" def sci(v): """2.48e+08 -> 2.5e8,读起来省事。""" return f"{v:.1e}".replace("e+0", "e").replace("e+", "e").replace("e-0", "e-") def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left") if xlabel: ax.set_xlabel(xlabel, fontsize=10, color=MUTE) if ylabel: ax.set_ylabel(ylabel, fontsize=10, color=MUTE) ax.tick_params(colors=MUTE, labelsize=9) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#d1d5db") ax.grid(alpha=0.25, linewidth=0.6) ax.set_axisbelow(True) def footer(fig, text, width=72): """把「这张图要看什么」放到坐标轴下方。 必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来, 放在 0~0.05 之间的话会和 x 轴标签叠在一起。 """ wrapped = "\n".join(textwrap.wrap(text, width=width)) fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE, va="top", ha="left", linespacing=1.6) # ────────────────────────────────────────────────────────────────────── # 图 1:噪声调度怎么分配难度 # ────────────────────────────────────────────────────────────────────── def fig_schedule(): lin_b, lin_a, cos_b, cos_a, rows = FD.schedule_report() ts = np.arange(1, FD.T + 1) snr_lin = FD.snr_db(lin_a) snr_cos = FD.snr_db(cos_a) fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.1)) ax = axes[0] ax.plot(ts, lin_a, color=C_LIN, lw=2.0, label=r"linear $\beta$ 调度") ax.plot(ts, cos_a, color=C_COS, lw=2.0, label="余弦调度") ax.set_yscale("log") ax.axhline(0.5, color=MUTE, ls=":", lw=1.0) for x, c, lbl in [(FD.half_life(lin_a), C_LIN, f"linear 跌破 0.5:第 {FD.half_life(lin_a)} 步"), (FD.half_life(cos_a), C_COS, f"余弦跌破 0.5:第 {FD.half_life(cos_a)} 步")]: ax.axvline(x, color=c, ls="--", lw=1.0, alpha=0.8) ax.legend(fontsize=8.5, frameon=False, loc="lower left") style(ax, r"$\bar\alpha_t$:还剩下多少原始信号", "步数 t", r"$\bar\alpha_t$(对数轴)") ax = axes[1] ax.plot(ts, snr_lin, color=C_LIN, lw=2.0, label="linear") ax.plot(ts, snr_cos, color=C_COS, lw=2.0, label="余弦") ax.axhline(0.0, color=INK, lw=1.0) ax.fill_between(ts, snr_lin.min(), 0.0, where=(snr_lin < 0), color=C_LIN, alpha=0.10) i500 = 499 ax.annotate(f"t=500\nlinear {snr_lin[i500]:.1f} dB\n余弦 {snr_cos[i500]:.1f} dB", xy=(500, snr_lin[i500]), xytext=(620, -6), fontsize=8.5, color=INK, arrowprops=dict(arrowstyle="->", color=MUTE, lw=0.9)) ax.legend(fontsize=8.5, frameon=False, loc="upper right") style(ax, "信噪比:低于 0 dB 时信号已经被噪声淹没", "步数 t", "SNR (dB)") fig.suptitle("图 1 线性调度把 74% 的步数花在了信噪比已经低于 0 dB 的区域", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图是「还剩多少信号」,右图是「信噪比」。线性调度第 260 步的单位参照信号方差系数跌破 0.5," "后续处在较低 SNR 区间,但不等于无效计算;图中 SNR 以数据方差为 1 作参考。") fig.savefig(OUT / "schedule_snr.png") plt.close(fig) # ────────────────────────────────────────────────────────────────────── # 图 2:采样器误差随步数怎么降 + 每步跨过的积分量 # ────────────────────────────────────────────────────────────────────── def fig_samplers(res=None): if res is None: res, _ = RS.sweep() n_list = [10, 20, 25, 50, 100, 200, 1000] cols = {"ddpm": C_DDPM, "ddim": C_DDIM, "em": C_EM, "ode": C_ODE, "heun": C_HEUN} names = {"ddpm": "DDPM 祖采样", "ddim": "DDIM (η=0)", "em": "Euler–Maruyama (SDE)", "ode": "Euler (概率流 ODE)", "heun": "Heun 二阶 (ODE)"} fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.3)) ax = axes[0] for name in ["ddpm", "ddim", "em", "ode", "heun"]: y = [abs(res[(name, n)]["dlogp"]) for n in n_list] ax.plot(n_list, y, marker="o", ms=4.5, lw=1.9, color=cols[name], label=names[name]) ax.set_xscale("log") ax.set_yscale("log") ax.axhline(0.0528, color=MUTE, ls="--", lw=1.0) ax.text(11, 0.062, "一次真实样本对照差值 0.053", fontsize=8, color=MUTE) ax.legend(fontsize=8, frameon=False, loc="upper right") style(ax, "单一统计量偏差(不能独立确认分布正确)", "采样步数 N(对数轴)", r"$|$mean log $p_0$ 偏移$|$(nats)") ax = axes[1] st = RS.stride_stats() ns = [r["n"] for r in st] ax.plot(ns, [r["L_max"] for r in st], marker="s", ms=4.5, lw=1.9, color=C_ODE, label=r"每步跨过的积分量 $L=\int\beta(u)du$(最大)") ax.plot(ns, [r["euler_err"] * 100 for r in st], marker="^", ms=4.5, lw=1.9, color=C_HEUN, label=r"Euler 近似 $e^{L/2}\approx 1+L/2$ 的相对误差") ax.set_xscale("log") ax.set_yscale("log") for r in st: if r["n"] in (10, 50): ax.annotate(f"{r['euler_err'] * 100:.1f}%", xy=(r["n"], r["euler_err"] * 100), xytext=(r["n"] * 1.15, r["euler_err"] * 100 * 1.6), fontsize=8.5, color=C_HEUN) ax.legend(fontsize=8, frameon=False, loc="upper right") style(ax, "为什么朴素 Euler 在大步长下会崩", "采样步数 N(对数轴)", "数值(对数轴,% 按数值读)") fig.suptitle("图 2 采样器诊断统计量与线性漂移的离散误差", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图为单次实验,近零差异不作显著性排名;右图只比较线性漂移项的数值近似。DDPM/DDIM 把线性部分" "精确解掉了(包含精确线性指数因子),Euler 却把它展开成一阶,N=10 时每步误差就有 25%。") fig.savefig(OUT / "sampler_scaling.png") plt.close(fig) return res # ────────────────────────────────────────────────────────────────────── # 图 3:前向流形被推成球,反向轨迹走回七个模式 # ────────────────────────────────────────────────────────────────────── def fig_trajectories(): rng = np.random.default_rng(FD.SEED) ab = FD.alpha_bar_from_beta(FD.linear_beta(FD.T)) x0 = FD.sample_data(600, rng) snaps = [0, 60, 200, 500, 1000] cols_f = plt.cm.viridis(np.linspace(0.05, 0.85, len(snaps))) # 反向:从同一批噪声出发,用 Heun 走 50 步,记录轨迹 x = rng.standard_normal((40, FD.D)) taus = RS.make_stride(50, FD.T) paths = [x.copy()] for j in range(len(taus) - 1): L = RS._log_step(ab, taus[j], taus[j + 1]) if L < 1e-12: continue s0 = RS.score_at(x, ab, taus[j]) d0 = 0.5 * L * (x + s0) x1 = x + d0 s1 = RS.score_at(x1, ab, taus[j + 1]) x = x + 0.5 * (d0 + 0.5 * L * (x1 + s1)) paths.append(x.copy()) fig, axes = plt.subplots(1, 2, figsize=(11.4, 4.9)) ax = axes[0] for t, c in zip(snaps, cols_f): a = 1.0 if t == 0 else float(ab[t - 1]) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * rng.standard_normal(x0.shape) ax.scatter(xt[:, 0], xt[:, 1], s=7, color=c, alpha=0.65, label=f"t={t}") ax.scatter(FD.MEANS[:, 0], FD.MEANS[:, 1], marker="x", s=70, color=INK, linewidths=1.6, label="分量中心") ax.legend(fontsize=8, frameon=False, loc="upper left", ncol=2) style(ax, "前向:七个模式逐步趋近高斯云", r"$x_1$", r"$x_2$") ax.set_aspect("equal") ax = axes[1] # 背景:p_0 的密度等高线 g = np.linspace(-4.6, 4.6, 220) GX, GY = np.meshgrid(g, g) grid = np.stack([GX.ravel(), GY.ravel()], 1) lp = FD.log_density(grid, FD.WEIGHTS, FD.MEANS, FD.SCALES ** 2) dens = np.exp(lp - lp.max()).reshape(GX.shape) ax.contourf(GX, GY, dens, levels=np.linspace(0.02, 1.0, 12), cmap="Blues", alpha=0.9, vmin=0.0, vmax=1.6) ax.contour(GX, GY, dens, levels=[0.05, 0.2, 0.5], colors="#1d4ed8", linewidths=0.7, alpha=0.55) P = np.stack(paths, 1) # [n, steps, 2] for i in range(P.shape[0]): seg = P[i] ax.add_collection(LineCollection( [seg[k:k + 2] for k in range(len(seg) - 1)], colors="#1f6feb", linewidths=0.8, alpha=0.5)) ax.scatter(P[:, 0, 0], P[:, 0, 1], s=14, color=MUTE, label="起点 x_T ~ N(0,I)") ax.scatter(P[:, -1, 0], P[:, -1, 1], s=16, color=C_OK, label="终点 x_0") ax.scatter(FD.MEANS[:, 0], FD.MEANS[:, 1], marker="x", s=70, color=INK, linewidths=1.6) ax.legend(fontsize=8, frameon=False, loc="upper left") style(ax, "反向:50 步 Heun,40 条轨迹从噪声回到模式", r"$x_1$", r"$x_2$") ax.set_aspect("equal") fig.suptitle("图 3 前向是「加水搅匀」,反向是「沿着 score 场把水滤掉」", fontsize=12, color=INK, x=0.012, ha="left", y=1.0) footer(fig, "要看什么:左图叠加的是各时刻独立边缘快照,不是同一条前向路径;右图是同批初始噪声的Heun轨迹。" "它展示本例分布变化,不证明自然图像的细节成因,也不证明全局步数可省。") fig.savefig(OUT / "trajectories.png") plt.close(fig) # ────────────────────────────────────────────────────────────────────── # 图 4:换参数化 = 换每步权重 # ────────────────────────────────────────────────────────────────────── def fig_param_weights(): ts = np.arange(1, FD.T + 1) w = np.array([SB.loss_weights(t) for t in ts]) # [T, 3] fig, ax = plt.subplots(figsize=(7.6, 4.5)) ax.plot(ts, w[:, 0], color=C_OK, lw=2.4, label=r"$\varepsilon$ 参数化:恒为 1") ax.plot(ts, w[:, 1], color=C_DDPM, lw=2.0, label=r"$v$ 参数化:$1/\bar\alpha_t$") ax.plot(ts, w[:, 2], color=C_BAD, lw=2.0, label=r"$x_0$ 参数化:$1/\mathrm{SNR}_t$") ax.set_yscale("log") ax.axhline(1.0, color=MUTE, ls=":", lw=1.0) ax.annotate(rf"$x_0$ 跨 {sci(w[-1, 2] / w[0, 2])} 倍(1.0e-4 → 2.5e4)", xy=(1000, w[-1, 2]), xytext=(300, 6e2), fontsize=9, color=C_BAD, arrowprops=dict(arrowstyle="->", color=C_BAD, lw=0.9)) ax.annotate(rf"$v$ 跨 {sci(w[-1, 1] / w[0, 1])} 倍(1.0 → 2.5e4)", xy=(1000, w[-1, 1]), xytext=(300, 1.6e0), fontsize=9, color=C_DDPM, arrowprops=dict(arrowstyle="->", color=C_DDPM, lw=0.9)) ax.set_ylim(5e-5, 1e5) ax.legend(fontsize=9, frameon=False, loc="lower right") style(ax, "同一个模型,换参数化等于给每个时间步换权重", "步数 t", r"折算到 $\varepsilon$ 空间后的权重(对数轴)") fig.suptitle(r"图 4 $\varepsilon$ 参数化的权重恒为 1,$x_0$ 参数化跨了 8 个数量级", fontsize=12, color=INK, x=0.012, ha="left", y=1.03) footer(fig, "要看什么:三种参数化描述的是同一个量,但作为训练目标并不等价。$x_0$ 参数化在 t=1 处权重只有" " 1e-4、在 t=1000 处却有 2.5e4。这些是代数残差权重,不是实测参数梯度;不能据此单独判断 " "训练稳定性或最终质量。") fig.savefig(OUT / "param_weights.png") plt.close(fig) def main(): fig_schedule() res = fig_samplers() fig_trajectories() fig_param_weights() print(f"[OK] 四张图已写入 {OUT}") for f in sorted(OUT.glob("*.png")): print(f" {f.name} {f.stat().st_size / 1024:.0f} KB") if __name__ == "__main__": main()
-
AIGC 基本功|VAE 结构与训练目标-VAE AIGC 基本功|VAE 结构与训练目标-VAE 所属方向:表征与压缩 | 难度:进阶 | 前置知识:变分下界与重参数化(本篇是它的直接后继,ELBO 与重参数化在那里推过,这里只用结论) 关键词:VAE、编码器、解码器、潜空间、KL 权重、后验坍缩、scaling factor 01. 为什么需要它 先看一个可复现的尺度错误:预训练扩散模型要求 VAE latent 乘以 vae.config.scaling_factor,却把原始 latent 直接送进去。张量形状仍正确,但它已经偏离训练分布。下面用一维高斯去噪器量化这个误差;这些数字来自教学模型,不是 Stable Diffusion 图像质量实验,不能据此断言真实图像一定发灰或过曝。 这不是玄学,可以精确算出来。设潜空间真实标准差是 $\sigma$,扩散模型的噪声表却是按「数据方差为 1」标定的。在完全干净那一端($\bar{\alpha}\to1$)两种估计相同;噪声增加时它们的均值系数比会偏离 1,但绝对误差差距在两端都趋零。MMSE 指最小均方误差估计。用高斯模型可以算出,单位方差假设的后验均值系数是匹配真实方差系数的 $$r(\bar{\alpha}) = \bar{\alpha} + \frac{1 - \bar{\alpha}}{\sigma^{2}}$$ 倍。$\sigma = 5.49$(这是由 SD1.x 常用配置系数反推的尺度,第 03.4 节会讲为什么)时,$\bar{\alpha} = 0.5$ 处 $r = 0.5166$——幅度只剩一半。实测的均方误差从本该有的 0.9682 涨到 7.8154,恶化 8.07 倍。这是高斯教学模型的估计误差,不是图像实测。 反着错也一样疼。如果你的 VAE 是规规矩矩训的(潜空间方差约等于 1),却照抄 Stable Diffusion 的 0.18215,那么 $\sigma$ 变成 0.18215,同一个 $\bar{\alpha}=0.5$ 处 $r = 15.5699$——幅度被放大 15.6 倍,教学去噪器的后验均值幅度被高估。这仍是一维教学类比,不是换 VAE 后图像表现的预测。 还有第三种错法:训练扩散模型时没有统一 latent 与噪声调度的尺度。LDM 原文 D.1 与附录 G观察到,论文中的 KL 正则自编码器具有较高 latent 方差,这会改变给定噪声调度的信噪比并影响高分辨率卷积采样;作者据此对 latent 做缩放。 这段观察针对 LDM 论文中具体的 KL / VQ 自编码器:KL latent 的高方差改变了给定噪声调度下的信噪比,影响高分辨率卷积采样;论文所用 VQ latent 的方差接近 1。它不表示所有 VQ 码本天然归一化,也不表示尺度错误一定对应某一种视觉伪影。 最后是 KL 权重本身的坑。在我的最小实验里,把 KL 权重 $\beta$ 从 0.1 调到 1,重建 MSE 从 0.2119 跳到 1.0000——1.0000 就是「什么都不学、直接输出均值」的分数(数据逐维方差已被归一化成 1)。八维都低于本文的 KL 诊断阈值,平均 KL 很小但非精确零,提示近似后验坍缩。 这一篇就把这三件事串起来:VAE 的结构决定了潜空间里有什么,KL 权重决定了还剩下什么,而潜变量尺度的使用约定解释为何要遵守 0.18215 这类配置。 02. 最小可用理解 三句话: 结构:编码器把 $x$ 压成 $2d$ 个数($d$ 个均值 $\mu$、$d$ 个对数方差 $\log\sigma^{2}$),重参数化采出一个 $z$,解码器从 $z$ 重建 $x$。训练目标是 ELBO——本质上是「重建质量」减「每个潜变量维度花掉的 KL 预算」。 KL 项既是正则,也可以看作信息预算。一维潜变量要花掉多少 KL,就必须换回足够的重建收益,否则最优解就是关掉这一维。实测里 $\beta = 10^{-3}$ 时模型正好活 4 个维度(合成数据的真实因子数就是 4),$\beta$ 收到 0.3 只剩 3 个,$\beta = 1$ 一个不剩。这里的“活”只是逐维平均 KL 超过 0.05 nat 的诊断计数,不能证明各维是独立开关,也不能直接视为有效因子数。 潜空间的尺度要与扩散模型的训练约定一致。本实验无衰减、$\beta=10^{-3}$ 时跨维边际标准差 RMS 为 1.0067;固定 seed、加 L2 梯度且 $\beta=10^{-6}$ 时为 2.7174。它们描述特定优化结果。LDM 的 KL 自编码器用很弱的正则(附录 G 写约 $10^{-6}$),但不能仅从这个系数推出 SD1.x latent 的实际方差或训练过程。SD1.x 的 0.18215 对应倒数约 5.49 的标定尺度,必须从具体配置读取。 这张图要看什么:四张子图连起来读。(a) 重建 MSE 在 $\beta$ 超过 0.1 后逐渐上升到 1.0 那条虚线,提示本实验的重建已接近均值预测基线;(b) 总 KL 随权重增大趋近零,提示近似后验接近先验;(c) 潜空间边际标准差:蓝线(无权重衰减)在较大 $\beta$ 下接近 1,红线是同 seed 加 L2 梯度的对照;横轴是不同训练任务的超参数,不是同一次训练的时间轨迹,绿虚线是由 SD1.x 系数倒数构造的 5.49 参照;(d) 还活着的维度数从 8 一路掉到 0,中间在 4 这个地方有个明显的台阶——数值上与合成数据的驱动因子数相同,但不能证明解耦。 03. 数学推导 3.1 一次编码到底出了什么 设数据 $x \in \mathbb{R}^{D}$,潜变量 $z \in \mathbb{R}^{d}$。VAE 的编码器不输出一个 $z$,它输出一个分布: $$q_{\phi}(z \mid x) = \mathcal{N}\!\left(z;\ \mu_{\phi}(x),\ \text{diag}\left(\sigma_{\phi}^{2}(x)\right)\right)$$ 网络实际算出来的是 $\mu$ 和对数方差 $\text{logvar}$ 两组数,各 $d$ 个。为什么是 logvar 而不是方差:网络输出可取任意实数,而方差必须为正。在精确算术下,$\sigma^2=\exp(\text{logvar})$ 保证正值;用对数参数表达很小的方差也方便。浮点计算仍可能溢出或下溢,因此要同时核对截断和 dtype,不能说取对数自动解决数值问题。本实验 $\beta=10^{-6}$ 时跨维后验噪声标准差 RMS 约 0.009,描述的是各维方差平均后开方,不是每个样本统一的方差。 如果只调用不记录参数依赖的普通采样接口,自动微分通常无法得到通过该样本的路径梯度;也可使用 score-function 估计。这里采用 AEVB 的重参数化,把参数依赖写成: $$z = \mu + \sigma \odot \epsilon, \qquad \epsilon \sim \mathcal{N}(0, I)$$ $\odot$ 是逐元素乘。随机性全部塞进 $\epsilon$ 里,$\mu$ 和 $\sigma$ 变成普通可导函数。这使本实现可以对固定噪声样本直接反向传播;它不是唯一可用的梯度估计方法。 解码器给的是似然,取对角高斯: $$p_{\theta}(x \mid z) = \mathcal{N}\!\left(x;\ \text{dec}_{\theta}(z),\ \sigma_{\text{dec}}^{2} I\right)$$ 取对数: $$\log p_{\theta}(x \mid z) = -\frac{\lVert x - \text{dec}_{\theta}(z) \rVert^{2}}{2\sigma_{\text{dec}}^{2}} - \frac{D}{2}\log\left(2\pi\sigma_{\text{dec}}^{2}\right)$$ 当 $\sigma_{\text{dec}}>0$ 固定时,第二项与 $z$ 和解码器均值参数无关,是训练中的常数;若学习这个方差,就不能丢掉它。所以重建项就是平方误差之和除以 $2\sigma_{\text{dec}}^{2}$——「重建用 MSE」不是拍脑袋定的,它是高斯似然的必然结果,而 $\sigma_{\text{dec}}$ 就是重建项的隐式权重。日志里那种 recon + beta * kl 的写法,还要明确 reduction:若 recon 是逐元素均值,则标准负 ELBO 按同尺度缩放后的 KL 系数为 $2\sigma_{\text{dec}}^{2}/D$。 把两件事拼起来,ELBO 给出下面的不等式: $$\log p(x) \ge \mathbb{E}_{q}\left[\log p_{\theta}(x|z)\right] - \text{KL}\!\left(q_{\phi}(z|x)\,\Vert\,p(z)\right)$$ 先验取标准正态 $p(z)=\mathcal{N}(0,I)$。加入可调权重后,我们最小化以下目标;$\beta=1$ 时才是上述负 ELBO 去掉固定常数: $$J = \frac{\mathbb{E}_{q}\left[\lVert x - \text{dec}_{\theta}(z) \rVert^{2}\right]}{2\sigma_{\text{dec}}^{2}} + \beta \sum_{j=1}^{d} \text{KL}_{j}, \qquad \text{KL}_{j} = \text{KL}\!\left(\mathcal{N}(\mu_{j}, \sigma_{j}^{2})\,\Vert\,\mathcal{N}(0,1)\right)$$ $\beta$ 是我们插进去的旋钮:$\beta = 1$ 是标准 ELBO,$\beta>1$ 是 $\beta$-VAE 采用的权衡路线,但是否解耦取决于数据、模型和优化,没有普遍保证。本文后面的数值脚本使用逐元素 MSE,因此其 $\beta_{\text{toy}}$ 与本式 $\beta$ 的关系为 $\beta_{\text{toy}}=2\sigma_{\text{dec}}^2\beta/D$;不能把脚本的 1 自动叫作标准 ELBO。注意 KL 是对维度求和而不是求平均,这一点第 05 节还会回来算账。 3.2 KL 的闭式解,逐项推 两个对角高斯之间的 KL 有闭式解。按定义 $\text{KL}(q \Vert p) = \mathbb{E}_{q}[\log q] - \mathbb{E}_{q}[\log p]$ 分头算。因为逐维独立,下面只看第 $j$ 维。 先算 $\mathbb{E}_{q}[\log q]$。$q_{j} = \mathcal{N}(\mu_{j}, \sigma_{j}^{2})$,所以 $$\log q_{j}(z_{j}) = -\frac{1}{2}\log(2\pi\sigma_{j}^{2}) - \frac{(z_{j} - \mu_{j})^{2}}{2\sigma_{j}^{2}}$$ 对 $q_{j}$ 取期望时,右边第二项的期望是 $\sigma_{j}^{2} / (2\sigma_{j}^{2}) = 1/2$,于是 $$\mathbb{E}_{q_{j}}\left[\log q_{j}\right] = -\frac{1}{2}\left(1 + \log 2\pi + \log \sigma_{j}^{2}\right)$$ 只有三项,和 $\mu_{j}$ 无关——这一点值得停一下:在 $\mu_{j}$ 上平移一个高斯分布,它的熵不变。 再算 $\mathbb{E}_{q}[\log p]$。先验 $p_{j} = \mathcal{N}(0,1)$,同样展开 $$\mathbb{E}_{q_{j}}\left[\log p_{j}\right] = -\frac{1}{2}\log 2\pi - \frac{\mathbb{E}_{q_{j}}\left[z_{j}^{2}\right]}{2}$$ 这里用到 $z_{j} = \mu_{j} + \sigma_{j}\epsilon$,所以 $\mathbb{E}_{q_{j}}[z_{j}^{2}] = \mu_{j}^{2} + \sigma_{j}^{2}$——这就是 $z$ 的二阶矩,它才是把 $\mu$ 拉进公式的那一项。 两者相减,$-\frac{1}{2}\log 2\pi$ 正好抵消: $$\text{KL}_{j} = \frac{1}{2}\left(\mu_{j}^{2} + \sigma_{j}^{2} - \log \sigma_{j}^{2} - 1\right)$$ 对 $j$ 求和即得总 KL。这个式子里每一块都有明确的物理含义,逐项读: $\mu_{j}^{2}$ 是均值偏离先验中心的成本。 不同输入的均值发生变化可以传递信息,但这一项不是互信息本身。即使所有输入的均值都是 0,只要方差仍依赖输入,潜变量也可能携带信息;只有整个条件分布都与输入无关时,这一维才不传信息。逐维 KL 同时包含信息代价与聚合后验偏离先验的代价,不能把 8~12 nats 直接叫作有效信息量。 $\sigma_j^2$ 与 $-\log\sigma_j^2$ 共同约束方差:函数 $t-\log t-1$ 对 $t>0$ 非负,唯一最小点在 $t=1$。连同 $\mu_j^2$,单样本 KL 为零恰好要求均值 0、方差 1。 要把 KL 叫作信息预算,还要区分数据分布 $p_{\text{data}}(x)$ 与生成模型 $p_\theta(x)$,并定义联合分布 $q(x,z)=p_{\text{data}}(x)q_\phi(z\mid x)$。在对数中插入聚合后验 $q(z)$: $$\mathbb E_{p_{\text{data}}}\mathrm{KL}(q_\phi(z\mid x)\Vert p(z))=I_q(X;Z)+\mathrm{KL}(q(z)\Vert p(z))$$ 第一项是 $\mathbb E_q\log[q_\phi(z\mid x)/q(z)]$,表示输入与潜变量的互信息;第二项是聚合后验偏离先验的成本。这个恒等式来自把对数比拆成两项并分别积分,不要求神经网络近似。平均 KL 约束两项总和,不能把每个 KL 数值都叫有效信息。 两个反例帮助区分统计对象。若所有输入都得到 $q(z\mid x)=\mathcal N(3,1)$,平均 KL 为 4.5 nats,但 $I_q(X;Z)=0$,没有输入信息。在线性模型未坍缩解中,$m^2v+s^2=1$,所以聚合后验恰好等于先验;取 $\lambda=0.2$ 时互信息为 $-\tfrac12\log0.2\approx0.8047$ nats,仍在传信息。二者分别说明“KL 大”与“边际像先验”都不能单独判断信息或坍缩。 3.3 权重到底在权衡什么:一维线性 VAE 的闭式解 上面的直觉可以算到精确解。把模型简化到最狠:一维数据 $x \sim \mathcal{N}(0, v)$,线性编码器 $q(z|x) = \mathcal{N}(mx, s^{2})$($m$ 是缩放系数,$s^{2}$ 是固定的后验方差),线性解码器 $p(x|z) = \mathcal{N}(wz, \sigma_{\text{dec}}^{2})$。这里要求 $v>0$、$\sigma_{\text{dec}}>0$、$\beta>0$、$s>0$,观测噪声固定。目标函数展开成 $$J(w, m, s) = \frac{v(1 - wm)^{2} + w^{2} s^{2}}{2\sigma_{\text{dec}}^{2}} + \frac{\beta}{2}\left(m^{2} v + s^{2} - \log s^{2} - 1\right)$$ 第一项里的 $v(1-wm)^{2}$ 是「编码-解码这条路的增益偏离 1 有多远」,$w^{2}s^{2}$ 是「采样噪声被放大 $w$ 倍后落在输出上的方差」;第二项就是上一节的 KL。三个未知数各求一次偏导并置零: $$\frac{\partial J}{\partial w} = \frac{-v m(1 - wm) + w s^{2}}{\sigma_{\text{dec}}^{2}} = 0, \qquad \frac{\partial J}{\partial m} = \frac{-v w(1 - wm)}{\sigma_{\text{dec}}^{2}} + \beta m v = 0, \qquad \frac{\partial J}{\partial s} = \frac{w^{2} s}{\sigma_{\text{dec}}^{2}} + \beta\left(s - \frac{1}{s}\right) = 0$$ 记路增益 $u := wm$(它就是「潜变量被真正使用的程度」),把 $\partial_m$ 的式子两边乘 $w$ 换成 $u$,可以整理出 $w^{2}(1-u) = \beta \sigma_{\text{dec}}^{2} u$;再从 $\partial_w$ 得到 $w^{2} s^{2} = v u (1-u)$;从 $\partial_s$ 得到 $s^{2}\left(\beta + w^{2}/\sigma_{\text{dec}}^{2}\right) = \beta$。三式联立,令 $$\lambda := \frac{\beta \sigma_{\text{dec}}^{2}}{v}$$ 解出来是一组非常干净的东西: $$u = 1 - \lambda, \qquad s^{2} = \lambda, \qquad w^{2} = v(1 - \lambda)$$ 代回验一遍:$\partial_m$ 要求 $w(1-u)/\sigma_{\text{dec}}^{2}=\beta m$。乘以 $w$,代入 $w^2=v(1-\lambda)$ 和 $1-u=\lambda$,得到 $v(1-\lambda)\lambda/\sigma_{\text{dec}}^{2}=\beta(1-\lambda)$。在未坍缩区间约去 $1-\lambda$,正好得到 $\lambda=\beta\sigma_{\text{dec}}^{2}/v$。第 04.2 节的数值优化与此吻合。 $\lambda$ 的读法:它是 KL 权重乘观测噪声方差,再除以数据方差的无量纲比值。这个比例决定一切: $u = 1-\lambda$ 随 $\lambda$ 线性下降。$\lambda \to 0$ 时 $u \to 1$、$s^{2} \to 0$,退化成确定性自编码器——潜变量满负荷工作,采样噪声归零。 $s^{2}=\lambda$ 随权重变化;$\beta=1$ 时等于这个线性高斯模型的真实后验方差,其他权重一般对应不同的变分目标。 当 $\lambda>1$ 时上述分支要求 $w^2<0$,不存在实数解;$\lambda=1$ 时它连续接到坍缩点,最优解退化成坍缩点 $(w, m, s) = (0, 0, 1)$。坍缩阈值是 $\beta^{\ast} = v / \sigma_{\text{dec}}^{2}$:数据方差越大、或者解码器的观测噪声越小,需要的 $\beta$ 就越大。这是线性高斯模型的阈值,不是神经 VAE 的通用保证。 附带一个值得记住的事实:$(0,0,1)$ 在任意 $\beta$ 下都是驻点(数值验证梯度恒等于 0)。它只是当 $\lambda < 1$ 时不是最小值。所以「后验坍缩」不是数值 bug、不是训练不充分——在本线性模型的阈值以上,它是该目标的最优解;一般神经模型也可能因局部最优和优化动力学而坍缩。 仅检验驻点不足以证明全局阈值。先固定 $w$,目标对 $m$ 是凸二次、对 $s^2>0$ 严格凸。令 $b=\beta\sigma_{\text{dec}}^2$,分别求极小得 $m=w/(w^2+b)$ 与 $s^2=b/(w^2+b)$。代回后令 $t=b/(w^2+b)\in(0,1]$: $$J(t)=\frac{v}{2\sigma_{\text{dec}}^2}t-\frac{\beta}{2}\log t$$ 其导数在 $t=\lambda$ 为零,二阶导数为 $\beta/(2t^2)>0$,所以全局最小点为 $t=\min(\lambda,1)$。这补足上面阈值的证明。$\beta\to0^+$ 是极限,恰好 $\beta=0$ 时方差可趋零但不满足我们要求的严格正方差,不能直接套用内部驻点。 3.4 潜空间的统计性质,和那个 0.18215 现在把「编码器」反过来看会得到什么分布。训练完之后,把所有 $x$ 编码一遍,潜变量的边际分布是 $$q(z) = \int q_{\phi}(z \mid x)\, p_{\text{data}}(x)\, \mathrm{d}x$$ 这是个混合分布。对每一维分别算方差,用全方差公式: $$\text{Var}(z_{j}) = \underbrace{\text{Var}_{p_{\text{data}}}\!\left[\mu_{j}(x)\right]}_{\text{均值变化}} + \underbrace{\mathbb{E}_{p_{\text{data}}}\!\left[\sigma_{j}^{2}(x)\right]}_{\text{采样噪声}}$$ 左边是 scaling_factor 要归一化的东西,右边两项来源完全不同:前一项是「不同样本被编码到不同位置」,后一项是「每个样本自己抖多少」。下表先对每维方差取平均再开方,不能先平均标准差再平方,也不能把两项标准差直接相加。方差占比不是互信息。实测拆账($\beta$ 从小到大): $\beta$ 均值变化 std RMS 后验噪声 std RMS 边际 std RMS 均值变化方差占比 1e-06 2.060 0.009 2.060 100% 1e-05 1.411 0.014 1.411 100% 0.0001 1.004 0.355 1.065 89% 0.001 0.726 0.697 1.007 52% 0.01 0.705 0.717 1.005 49% 0.1 0.620 0.779 0.995 39% 0.3 0.406 0.914 1.000 16% 1 0.003 1.000 1.000 0% $\beta = 10^{-3}$ 附近有个交叉点:总方差中的均值变化与平均后验方差约各占一半。较小权重处均值变化贡献更大,较大权重处平均后验方差贡献更大——$\beta = 1$ 时 $z$ 就是一坨噪声,$\text{std}_x(\mu)$ 只剩 0.003。 那么 scaling_factor 是什么?在 LDM 的 std-rescaling 分支,它是首个训练 batch 后验样本展平标准差的倒数;使用预训练模型则遵守保存的配置,不能在当前 batch 上重新标定。LDM 的 固定版本原始标定代码 使用 1. / z.flatten().std();diffusers 文档中的标准差描述要结合实际乘法方向理解。本文 toy 的跨维 RMS 也不等于一般的展平标准差:设 $\bar\mu_j=\mathbb E_x\mu_j(x)$,把通道视作均匀随机索引,则展平方差还多出 $\mathrm{Var}_j(\bar\mu_j)$。本次 $\beta=10^{-6}$ 无 L2 的 RMS 为 2.0596,按总体方差估计的展平 std 为 2.0617。LDM 代码 torch.std() 还使用样本方差修正;它是单 batch 后验样本的估计量,不是对整个数据分布的精确标准差。 $$z_{\text{scaled}} = s \cdot z, \qquad s = \frac{1}{\text{std}(z)}$$ SD1.x 的 官方推理配置取 $s=0.18215$;diffusers v0.35.1 的 AutoencoderKL 默认也为此值,具体 checkpoint 可能覆盖默认,倒过来就是 $\text{std}(z) = 5.4900$、$\text{Var}(z) = 30.1399$。为什么需要这一步,LDM D.1 用信噪比的语言回答了:扩散模型的噪声表 $\sigma_t$ 是相对数据尺度标定的,把这个比值写出来 $$\text{SNR} = \frac{\text{Var}(z)\,\bar{\alpha}}{1 - \bar{\alpha}}$$ 单位数据方差假设对应 $\bar{\alpha}/(1-\bar{\alpha})$;本高斯模型的实际 SNR 是它的 30.14 倍,即约 14.79 dB。噪声方差仍为 $1-\bar{\alpha}$,变的是信号方差,不能说实际噪声被缩小了 30 倍。 接下来用一维高斯后验均值说明尺度不匹配怎样造成估计偏差,不能把它翻译成真实图像发灰或过曝。假设扩散模型是在单位方差潜空间上训好的,那它的去噪器就是一个高斯 MMSE 估计:先验 $z_{0} \sim \mathcal{N}(0, \sigma_{p}^{2} I)$,观测 $z_{t} = \sqrt{\bar{\alpha}}\,z_{0} + \sqrt{1-\bar{\alpha}}\,\epsilon$,后验均值是 $$\hat{z}_{0} = \frac{\sigma_{p}^{2}\sqrt{\bar{\alpha}}}{\sigma_{p}^{2}\bar{\alpha} + 1 - \bar{\alpha}}\, z_{t}$$ 代入 $\sigma_{p}^{2} = 1$ 得 $\hat{z}_{0} = \sqrt{\bar{\alpha}}\, z_{t}$;而真实潜空间的标准差是 $\sigma$,正确的 MMSE 估计要用 $\sigma_{p}^{2} = \sigma^{2}$。两者相除就是第 01 节那个 $r(\bar{\alpha}) = \bar{\alpha} + (1-\bar{\alpha})/\sigma^{2}$。$\sigma = 5.49$ 时它在 $\bar{\alpha} \to 0$ 处趋于 $1/\sigma^{2} = 0.033$,这是两个均值系数之比的极限。在 $\bar{\alpha}=0$ 时两种后验均值都为零,输出比本身是 $0/0$,两种 MSE 均为 $\sigma^2$;不能据极限比值认为纯噪声端的绝对误差差距最大。 对同一观察过程还可精确算错假设估计器的 MSE: $$M_{\text{bad}}=(1-\bar{\alpha})^2\sigma^2+\bar{\alpha}(1-\bar{\alpha})$$ 匹配该尺度的理论最小 MSE 为 $M_{\text{good}}=\sigma^2(1-\bar{\alpha})/(\sigma^2\bar{\alpha}+1-\bar{\alpha})$,相减得到: $$M_{\text{bad}}-M_{\text{good}}=\frac{\bar{\alpha}(1-\bar{\alpha})^2(\sigma^2-1)^2}{\sigma^2\bar{\alpha}+1-\bar{\alpha}}$$ 差距非负,在两端都趋零。若先缩放原数据并维持原噪声表,SNR 也随之改变;因此表中的匹配估计器与“正确缩放后同一步”不是同一个观察问题。 04. 代码实现 完整脚本在文末附录(vae_minimal.py、collapse_closed_form.py、latent_scaling.py、make_figures.py),依赖 NumPy 与 matplotlib。2026-10-13 在 Windows CPU 上完整重跑;Python 3.11.9、NumPy 2.4.6、matplotlib 3.10.7,BLAS 使用单线程。训练脚本默认优先读同目录缓存,--full 才重新训练;复制附录到空目录时会从头计算。下面是实跑输出,运行时间受机器影响,不能保证两分钟完成。反向传播手写,另以 PyTorch CPU 自动微分与固定噪声中心差分核验。 4.1 最小 VAE 与两轮对照实验 模型就是 3.1 节那套,符号一一对应: def forward(self, x, eps): p = self.p h1 = np.maximum(x @ p["W1"] + p["b1"], 0.0) mu = h1 @ p["Wmu"] + p["bmu"] # 后验均值 lv_raw = h1 @ p["Wlv"] + p["blv"] lv = np.clip(lv_raw, LOGVAR_MIN, LOGVAR_MAX) # logvar 截断,防 exp 溢出 sig = np.exp(0.5 * lv) # 后验标准差 sigma z = mu + sig * eps # 重参数化 g1 = np.maximum(z @ p["V1"] + p["c1"], 0.0) xhat = g1 @ p["V2"] + p["c2"] return xhat, dict(x=x, h1=h1, mu=mu, lv=lv, lv_raw=lv_raw, sig=sig, z=z, g1=g1, xhat=xhat, eps=eps) @staticmethod def losses(x, xhat, mu, lv, sig): recon = float(np.mean((xhat - x) ** 2)) # 重建:MSE kl_dim = 0.5 * np.mean(mu ** 2 + sig ** 2 - lv - 1.0, axis=0) # 逐维 KL(3.2 节那个式子) return recon, kl_dim, float(np.sum(kl_dim)) # 对维度求和 数据是合成的:64 个观测维度由 4 个高斯因子线性混合而成,再除以训练集逐维标准差使方差为 1,未减样本均值。输出逐维训练均值的 MSE 精确为 1;输出零还会含样本均值平方。潜变量给了 8 维,故意比真实因子数多一倍,看模型怎么选。编码器/解码器各一层 128 宽的隐藏层,Adam,250 epoch,把逐维平均 KL 大于 0.05 nat 计为“超过 KL 阈值”。这不是另一种按后验均值方差定义的 active units 指标,也不是互信息测试。数据/初始化/批次与训练噪声/评估噪声种子分别为 0/1/2/3;4096 个样本训练后仍在同一训练集评估,每样本采 8 次取平均,因此这里展示训练拟合而非测试泛化。 跑两轮:一组不加重衰减,一组给权重加上 $10^{-3}$ 的衰减。结果: weight_decay beta 重建MSE 总KL std(z) 1/std KL阈值计数 ----------------------------------------------------------------------------------- 0 1e-06 0.0030 76.958 2.0596 0.4855 8/8 0 1e-05 0.0031 39.861 1.4107 0.7088 8/8 0 0.0001 0.0038 23.512 1.0651 0.9389 7/8 0 0.001 0.0062 12.454 1.0067 0.9934 4/8 0 0.01 0.0247 7.843 1.0055 0.9946 4/8 0 0.1 0.2119 3.092 0.9952 1.0048 4/8 0 0.3 0.6206 0.884 1.0000 1.0000 3/8 0 1 1.0000 0.000 1.0001 0.9999 0/8 0 3 1.0001 0.000 1.0000 1.0000 0/8 0.001 1e-06 0.0046 55.983 2.7174 0.3680 8/8 0.001 1e-05 0.0046 49.327 2.5978 0.3849 6/8 0.001 0.0001 0.0049 28.672 2.0580 0.4859 5/8 0.001 0.001 0.0075 13.409 1.3082 0.7644 4/8 0.001 0.01 0.0259 7.917 1.0689 0.9355 4/8 0.001 0.1 0.2148 3.107 1.0051 0.9949 4/8 0.001 0.3 0.6302 0.858 1.0017 0.9983 3/8 0.001 1 1.0000 0.000 1.0000 1.0000 0/8 0.001 3 1.0000 0.000 1.0000 1.0000 0/8 三件事一眼可见: 第一,重建误差逐渐上升,而阈值计数呈台阶。 $\beta$ 从 $10^{-2}$ 到 0.1、0.3、1,MSE 是 $0.0247\to0.2119\to0.6206\to1.0000$;超过 KL 阈值的维度数为 $4\to4\to3\to0$。总 KL 打印到三位小数为 0.000 不代表数学上精确为零,应连同逐维均值和方差判断近似坍缩。 第二,计数与因子数相等是一项观察。 $\beta=10^{-3}$ 时逐维 KL 约为 [2.96, 0.002, 3.19, 0.004, 3.12, 3.18, 0.001, 0.001]。超过阈值的四维与合成数据四个驱动因子的数量相同;不能据此证明一维对应一个因子、模型发现了真实因子,或冗余维度一定关闭。 第三,相同训练算法在不同正则下产生不同尺度。 无 L2 时从 1.0067($\beta=10^{-3}$)到 2.0596($\beta=10^{-6}$);L2 系数 $10^{-3}$、$\beta=10^{-6}$ 时为 2.7174,对应 RMS 倒数 0.3680。这是有限训练的配对观察,不能证明 SD 的 5.49 来自同一机制。 代码把 wd * W 加入 Adam 的梯度,作用于五组编码器/解码器矩阵,是耦合 L2 正则,不是 AdamW。单看解码器,放大 latent 可以缩小相应权重;但编码器权重与后验方差也会同时变化,所以完整正则不能只归因为“小解码器偏好”。本实验固定单个 seed,没有跨 seed 统计,不能推出一般尺度漂移机制。 4.2 换条路验一遍:一维闭式解 3.3 节那组闭式解值得单独验,因为「后验坍缩阈值 $\lambda = 1$」这个结论如果错了,整篇文章的框架就错了。做法是直接对 $(w, m, \log s)$ 做梯度下降。 def closed_form(beta, v=V, sigma_x=SIGMA_X): lam = beta * sigma_x ** 2 / v if lam >= 1.0: # lambda >= 1:坍缩 return dict(lam=lam, u=0.0, s2=1.0, w2=0.0, collapsed=True) u = 1.0 - lam return dict(lam=lam, u=u, s2=lam, w2=v * u, collapsed=False) ($v = 1$、$\sigma_{\text{dec}} = 1$,所以 $\lambda = \beta$、坍缩阈值 $\beta^{\ast} = 1$。)对照结果: beta lambda | u=wm 预测 拟合 | s^2 预测 拟合 | w^2 预测 拟合 | 坍缩 0.05 0.050 | 0.9500 0.9500 | 0.0500 0.0500 | 0.9500 0.9500 | 否 0.1 0.100 | 0.9000 0.9000 | 0.1000 0.1000 | 0.9000 0.9000 | 否 0.2 0.200 | 0.8000 0.8000 | 0.2000 0.2000 | 0.8000 0.8000 | 否 0.4 0.400 | 0.6000 0.6000 | 0.4000 0.4000 | 0.6000 0.6000 | 否 0.6 0.600 | 0.4000 0.4000 | 0.6000 0.6000 | 0.4000 0.4000 | 否 0.8 0.800 | 0.2000 0.2000 | 0.8000 0.8000 | 0.2000 0.2000 | 否 0.95 0.950 | 0.0500 0.0500 | 0.9500 0.9500 | 0.0500 0.0500 | 否 1 1.000 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 1.2 1.200 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 2 2.000 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 5 5.000 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 未坍缩区间内,闭式解与数值拟合的最大偏差:5.91e-06 坍缩点 (w, m, s) = (0, 0, 1) 处的梯度(应当恒为 0): beta=0.05 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 beta=0.5 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 beta=1 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 beta=5 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 坍缩点 vs 解析解的目标函数值(谁小谁是最优): beta=0.05 J(解析解)= 0.09989 J(坍缩点)= 0.50000 beta=0.5 J(解析解)= 0.42329 J(坍缩点)= 0.50000 beta=0.9 J(解析解)= 0.49741 J(坍缩点)= 0.50000 beta=1 J(解析解)= 0.50000 J(坍缩点)= — beta=2 J(解析解)= 0.50000 J(坍缩点)= — 三处细节值得留意。偏差 5.91e-06 是有限步优化与闭式解的一致性检查,全局正确性来自 3.3 节的消元证明。梯度恒等于 0 说明坍缩点在任意 $\beta$ 下都是驻点——它一直「在那儿」,$\lambda \ge 1$ 时它只是终于变成了最小值。$\beta = 0.9$ 时两者的目标值只差 0.0026,只说明本线性目标的最优值接近坍缩值;不是势垒或坍缩速度的测量,不能据此推断真实网络的训练动力学。 4.3 后验坍缩长什么样 这张图要看什么:三张子图是三档 $\beta$ 下逐维 KL 的柱状图,蓝色是超过 0.05 nat 阈值的维度,灰色是低于阈值的维度。注意三张图的纵轴量级完全不同(3.19 / 0.39 / 0.00001 nats,差五个数量级),各图保留至少 0.35 nat 的纵轴范围以显示阈值线,并标注本组 KL 最大值而非纵轴上限——如果共享纵轴,后两张会被压成一条线,看不出结构。$\beta = 10^{-3}$ 时是 4 根高柱加 4 根贴地;$\beta = 0.3$ 时只剩 3 根矮柱,重建 MSE 已经涨到 0.6206;$\beta = 1$ 时一根都没有。 4.4 潜尺度漂移:从 1.0067 到 2.7174 这张图左侧按全方差公式堆叠两项方差:跨样本后验均值方差、平均后验方差;右侧显示第一项占总方差的比例。两项方差相加后开方才得到边际标准差,标准差本身不能直接堆叠。这个分解描述二阶统计,不能等同于信息与噪声的互信息分解。 这张图帮助理解尺度与信息的区别:相同的边际方差可以来自不同的均值/条件方差组合。缩放只调整统计尺度,不保证 latent 的语义分布匹配,也不能单凭 std 判断是否坍缩。 4.5 忘掉 scaling_factor 的代价,量化 这张图要看什么:左图的纵轴是对数的,三条线分别是三种潜空间尺度下的去噪幅度比 $r$。绿线 $\sigma = 1.0$ 平在 $r = 1$ 上(正确);蓝线是按 SD1.x 配置倒数构造的教学情形 $\sigma = 5.49$,$\bar{\alpha}$ 越小掉得越狠,最左端贴在 $1/\sigma^{2} = 0.033$,也就是幅度只剩 3.3%(后验均值幅度偏小);红线是反向错误——潜空间其实是单位方差却照抄了 0.18215,$\sigma$ 变成 0.182,$r$ 冲到 30 倍(后验均值幅度偏大)。右图是同一个前向过程下两种去噪器的均方误差,中段拉开 8 倍,两端收敛($\bar{\alpha} \to 1$ 时都没噪声要除,$\bar{\alpha} \to 0$ 时都没信息可用——误差差距最大的地方在中间,这跟直觉不太一样)。 alpha_bar | 错假设 MSE 正确 MSE 理论后验方差 恶化倍数 0.999 | 0.0010 0.0010 0.0010 1.03x 0.99 | 0.0130 0.0101 0.0101 1.28x 0.9 | 0.3933 0.1106 0.1107 3.55x 0.5 | 7.8154 0.9682 0.9679 8.07x 0.1 | 24.5816 6.9502 6.9305 3.54x 0.01 | 29.6359 23.2187 23.1056 1.28x 「理论后验方差」一列是和蒙特卡洛结果并排校核的:$\bar{\alpha}=0.5$ 处 0.9679 对 0.9682,这一格的差值约 $3\times10^{-4}$;其他格的采样波动会更大,不能把单个差值当作整张表的误差保证。 05. 工业级实现对照 以下核对固定 diffusers v0.35.1 的 AutoencoderKL 与 DiagonalGaussianDistribution,以及 LDM 固定提交 a506df5756472e2ebaf9078affdde2c4f1502cd4 的标定和训练损失。源码版本固定于链接;2026-10-13 执行了原分布类与 retrieve_latents 函数的 CPU 最小对照,未运行预训练权重或整条生成管线。 编码链路(AutoencoderKL._encode / encode):encoder(x) → quant_conv → 把结果塞进 DiagonalGaussianDistribution。和最小实现的差异有四处: 用卷积而不是全连接。最小实现里 x 是一个 64 维向量,一层矩阵乘就够;图像要保留空间结构,所以编码器是卷积堆栈,以 SD1.x 的 $f=8$ 配置为例,输出 [B, 2*z_channels, H/8, W/8],每个 latent 空间位置各出一组 $(\mu, \text{logvar})$。KL 也因此对每个元素都算一次。 *quant_conv 是 1×1 卷积,默认从 `2latent_channels映到同样的通道数**。编码器已经输出均值与 logvar 所需的双倍通道;这里做通道混合,随后torch.chunk(parameters, 2, dim=1)` 分成两组,不是在 quant_conv 这一步翻倍。 logvar 被硬截断到 $[-30, 20]$,这一行是 self.logvar = torch.clamp(self.logvar, -30.0, 20.0)。别小看它:$\exp(20) = 4.85\times10^{8}$,$\exp(-30) = 9.36\times10^{-14}$。我的最小实现里也照抄了这个阈值。不加截断,很大的 logvar 会增大 KL,极小值会压低采样标准差;exp(20) 在 float16 中仍会溢出,截断不能替代 dtype 控制。手写实现对截断外的 logvar 原始输出置零梯度;边界处不可微,验证避开端点。 encode 返回的是后验分布,不乘 scaling factor。这一步由调用方负责——pipeline 里显式写 latents = vae.encode(image).latent_dist.sample() * vae.config.scaling_factor。这个设计是个典型的「容易漏」:它不在 encode 里面,所以复制粘贴半段代码就会丢掉。 推理时用 sample() 还是 mode():两者都合法,必须与具体管线的约定一致。mode() 返回均值,适合需要确定性编码的实验;sample(generator=...) 返回后验样本,固定随机生成器也能复现。diffusers 的 Stable Diffusion img2img 中 retrieve_latents 默认走 sample,所以不能说图生图、修补必须用 mode()。deterministic=True 是把分布对象的方差与标准差置零的特殊模式,不等于重新训练过的普通自编码器。 KL 的实现细节:kl() 里写的是 0.5 * torch.sum(torch.pow(self.mean, 2) + self.var - 1.0 - self.logvar, dim=[1, 2, 3])。跟 3.2 节那个式子逐字对上(var 就是 $\sigma^{2}$,logvar 就是 $\log\sigma^{2}$),只是求和范围从「8 个潜变量维度」变成「$4 \times 64 \times 64 = 16384$ 个元素」,对四维图像 latent 返回每个样本一个标量。此方法默认只求和第 1、2、3 维,把五维视频张量直接传入会留下最后一维;本次 CPU 实跑时参数张量形状如下,分成均值和 logvar 后,KL 返回 [2,4]。参数张量与默认输出的对应关系: parameters: [2, 8, 2, 3, 4] mean/logvar: [2, 4, 2, 3, 4] kl() default: [2, 4] 所以视频模型必须核对专用实现或显式归约全部非 batch 维,不能把图像接口原样套上去。这一点是全文最容易被忽略的工程事实:KL 是逐元素求和的,所以潜变量个数一变,同一个 $\beta$ 数值的含义完全不同。LDM 用 $10^{-6}$、我的实验用 $10^{-3}\sim1$,这两个数不能直接比较。LDM 的 原损失实现把重建/感知项按 batch 平均的元素和计算,KL 也先求元素和再按 batch 平均;本脚本重建却按元素平均。比较 $\beta$ 必须同时记录形状、归约、似然尺度以及感知/对抗项。 视频 VAE 上这条线怎么延伸:时间维一起下采样,例如一种时空压缩约定下为 [B, C, T/4, H/8, W/8];实际首帧/因果边界及倍率依模型而定,KL 求和范围又大了一个量级。KL 虽逐元素求和,但编码器、解码器会耦合各维,不能保证各维独立开关。元素数增大时还要同时看重建项如何归约,不能仅凭维度数断言同一 β 必然关闭更多维度——这也是为什么视频 VAE 的 loss 配比需要单开一篇(见 视频 VAE 的常见 loss 组合)。 带 shift 的 VAE 要区分编码和解码方向:例如 diffusers 的 SD3 管线 在解码前使用 $z_{\text{raw}}=z_{\text{diffusion}}/\text{scale}+\text{shift}$;对应的正向变换才是 $z_{\text{diffusion}}=(z_{\text{raw}}-\text{shift})\cdot\text{scale}$。读取具体 checkpoint 的配置和管线,不把 SD1.x 的常数套到 SD3 / FLUX。 06. 代价与边界 VAE 是有损压缩,需要先量重建误差。 以 $f=8$、4 latent 通道为例,512×512 RGB 图变成 $4\times64\times64=16384$ 个 latent 元素,元素数比为 48。这不是文件字节压缩比,也不是 FLOPs 加速比,后者还取决于 dtype、网络通道和实现。细纹理、文字等是否损失要通过具体 VAE 重建验证;生成先验可以猜出合理细节,却不能保证恢复压缩前同一张图的真实细节。 减小 $\beta$ 可能改善拟合,却不能保证全局性能单调。 本 toy 展示重建与正则的权衡,实际网络还受优化、结构与其他损失影响。更大的平均 KL 既可能承载信息,也可能表示聚合后验偏离先验。换 VAE 时核对语义、通道、尺度、shift 和扩散模型训练约定,一个标量缩放不能保证兼容。 增大 $\beta$ 会提高信息代价,但阈值来自指定模型。 在线性闭式模型中,未坍缩区 MSE 为 $\beta\sigma_{\text{dec}}^2$,到阈值后连续接到 $v$;逐维 KL 连续趋零。本文神经 toy 在脚本 $\beta=1$ 附近拟合接近均值基线,不能把 1 称为所有 VAE 的坍缩阈值。 保真任务要实测而非一律排除 latent。 超分、医学或文档生成需要核对细节保真和任务指标,可比较像素空间、低压缩倍率或多尺度方案。LDM 原文本身也展示了超分模型,所以“超分不能用 latent”不成立。算力收益与压缩误差需要一起评估。 另一条路线:VQ。 用有限码本替换连续高斯,带来量化误差、码本容量与使用率等另一组权衡。LDM 论文观察到它所用的 VQ latent 方差接近 1;这不是离散化的数学保证,码本仍然可以整体缩放,是否需要归一化要看实际训练分布。 07. 经典论文脉络 Kingma & Welling, 2013, Auto-Encoding Variational Bayes(arXiv:1312.6114) — VAE 本体。两个贡献撑起了后面所有工作:重参数化技巧(把采样挪出计算图)和对角高斯近似后验与标准高斯先验的 KL 闭式项(3.2 节那个式子)。 Higgins 等, ICLR 2017, β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework — 把 KL 权重从固定的 1 变成可调旋钮,$\beta>1$ 换解耦表征。作者讨论了增大 $\beta$ 时的重建与解耦权衡;其结果不是所有模型的坍缩保证。原始 OpenReview 入口保留;本次该站返回挑战页,因此定义与权衡另据 同作者后续解释。 van den Oord 等, 2017, Neural Discrete Representation Learning(arXiv:1711.00937) — VQ-VAE。用码本查表替换连续高斯采样,潜空间变成离散索引,训练自编码器时若取均匀离散先验,确定性索引的 KL 是常数,因此可从该阶段的优化目标中省掉;随后仍要学习索引先验。不是概率模型中的 KL 数学上不存在。 Esser 等, CVPR 2021, Taming Transformers for High-Resolution Image Synthesis(arXiv:2012.09841) — VQGAN。给 VQ 自编码器加上感知损失和对抗损失,研究感知压缩与潜空间自回归生成的组合,展示高分辨率合成;本文不据此给出商用质量保证或历史首次判断。 Rombach 等, CVPR 2022, High-Resolution Image Synthesis with Latent Diffusion Models(arXiv:2112.10752) — LDM / Stable Diffusion。它把「KL 权重、潜空间方差、信噪比、scaling factor」这四件事的关系写进了 4.3.2 与 D.1 两节,附录 G 列出标定估计量;0.18215 则是 SD1.x 的具体配置,不能推广到全部后续 VAE。 顺着这条线看,故事其实是「潜空间的统计性质从哪儿来」在被一步步讲清楚:2013 年给了目标函数,2017 年研究权重与表征的权衡,2017—2021 年发展离散化和感知训练路线,2022 年把压缩与 latent 尺度约定纳入扩散模型设计。各路线有不同目标,不能概括为前者被后者彻底替代。 08. 常见误解 误解一:KL 既然是正则项,越大越好。 KL 确实可以看作正则,也可用信息预算解释,但增强它会牺牲重建。第 09 节的密集扫描显示 MSE 从 $0.0650$ 到 $0.8881$ 逐步上升;台阶出现在人为设阈值的存活维度计数,不能把稀疏扫描误读为“中间没有过渡”。 误解二:任意 KL 权重下都在拟合原模型的真实后验。 当 $\beta=1$ 且变分族足够时,最优 $q$ 可以等于该生成模型的真实后验;本文线性高斯模型就是例子。$\beta\ne1$ 则改变权衡,存活区 $s^2=\beta\sigma_{\text{dec}}^2/v$ 同时依赖权重、观测噪声和数据方差 $v$,不能说与数据无关。 误解三:聚合后验等于先验就意味着坍缩。 逐样本 $q(z\mid x)$ 和聚合后验 $q(z)=\int q(z\mid x)p_{\text{data}}(x)\,dx$ 是两个对象。本文未坍缩线性解满足 $m^2v+s^2=(1-\lambda)+\lambda=1$,因而 $q(z)=\mathcal N(0,1)$,但 $m\ne0$,仍然传递信息。真正的完全坍缩要求几乎所有输入的整个 $q(z\mid x)$ 都等于同一个先验。 误解四:scaling factor 是固定的魔法常数。 LDM 的标定实现使用首个训练 batch 的 latent 展平后的标准差,令缩放因子为其倒数;这不是逐通道独立归一化。使用预训练模型时应遵守 checkpoint 保存的系数,不能随手在一张新图上重估并替换。换 VAE 还可能改变 latent 的语义和通道分布,重算一个标量不保证与原扩散模型兼容。 误解五:后验采样只在训练时用。 官方 img2img 管线默认也会采样;固定 generator 可以控制随机性。mode() 是去掉编码采样噪声的一种选择,必须核对训练与推理的分布约定,不能统一替换所有管线。 误解六:截断范围等于所有精度下的安全范围。 [-30,20] 是实现中的防护范围,但 exp(20) 超过 fp16 最大有限值,实际还要看计算 dtype 和 VAE 是否上转 fp32。实验中的 logvar 约 −9.4 离 −30 很远,不能仅凭这个数断言已接近数值崩溃。 09. 动手验证 三个小实验,训练扫描较慢,时间取决于 CPU/BLAS;缓存输出不等于本次训练。建议保存 stdout 并核对种子与配置。 实验一:确认坍缩是「跳」还是「滑」。 一行命令: python vae_minimal.py --betas=0.03,0.05,0.1,0.2,0.5 --wd=0 实测($\text{weight\_decay} = 0$,$250$ epoch,随机种子固定,可复现): $\beta$ $0.03$ $0.05$ $0.1$ $0.2$ $0.5$ 重建 MSE $0.0650$ $0.1057$ $0.2119$ $0.4200$ $0.8881$ 总 KL $5.580$ $4.554$ $3.092$ $1.677$ $0.196$ 存活维度 $4/8$ $4/8$ $4/8$ $4/8$ $1/8$ 结论:重建误差逐渐增加,存活维度的计数呈台阶。 这里把每维 KL 超过 0.05 nat 计为存活,所以计数天然离散。在线性模型中,每维 KL 为 $-\tfrac12\log\lambda$(未坍缩时),连续趋向 0,并不会从 3 直接跳到 0;应同时观察逐维 KL、重建与均值/方差统计。 实验二:比较耦合 L2 系数对固定 seed 的影响。 把权重衰减单独开到 $10^{-2}$: python vae_minimal.py --wd=0.01 三档权重衰减下 $\text{std}(z)$ 的对照(同一批 $\beta$,小权重处的统计尺度变化更明显): $\beta$ $\text{wd} = 0$ $\text{wd} = 10^{-3}$ $\text{wd} = 10^{-2}$ $10^{-6}$ $2.0596$ $2.7174$ $2.6747$ $10^{-5}$ $1.4107$ $2.5978$ $2.6385$ $10^{-4}$ $1.0651$ $2.0580$ $2.5400$ $10^{-3}$ $1.0067$ $1.3082$ $2.0464$ $10^{-2}$ $1.0055$ $1.0689$ $1.3657$ $10^{-1}$ $0.9952$ $1.0051$ $1.0523$ $3\times10^{-1}$ $1.0000$ $1.0018$ $1.0000$ 看这张表的方式是看「回到 1.00 的那个拐点」在往右挪:$\text{wd} = 0$ 时 $\beta \ge 10^{-3}$ 就已经归位;$\text{wd} = 10^{-3}$ 时要到 $\beta \ge 10^{-2}$;$\text{wd} = 10^{-2}$ 时要一路推到 $\beta \ge 0.3$。权重衰减把「潜尺度失控」的区间往大 $\beta$ 方向整整推了两个数量级。一个诚实的补充:$10^{-6}$ 那一档 $10^{-2}$ 的 $2.6747$ 反而略低于 $10^{-3}$ 的 $2.7174$,说明这三个有限训练结果不严格单调;单 seed、三个档位不足以证明饱和或一般因果机制。 实验三:反向验证 scaling factor。 指定另外两个标定系数各跑一次;这个参数通过 $\sigma=1/s$ 构造不同数据方差,不是在同一个 SD latent 上分别应用 0.5 和 2.0(--sf 会把整张表按新系数重算): python latent_scaling.py --sf=0.5 python latent_scaling.py --sf=2.0 实际结果: $\text{scaling factor}$ $\text{std}(z)$ $r$ 在 $\bar{\alpha}=0.999$ $r$ 在 $\bar{\alpha}=0.01$ $\bar{\alpha}=0.5$ 处 MSE 比值 $0.18215$(SD1.x 系数对应 toy) $5.4900$ $0.9990$ $0.0428$ $8.07\times$ $0.5$(另一标定系数) $2.0000$ $0.9992$ $0.2575$ $1.57\times$ $2.0$(另一标定系数) $0.5000$ $1.0030$ $3.9700$ $1.56\times$ $\sigma = 2$ 时 $r$ 全程在 1 以下(最低 $0.2575$,正是 $1/\sigma^{2} = 0.25$ 加上 $\bar{\alpha}$ 那一项),该高斯估计器的幅度偏小;$\sigma = 0.5$ 时 $r$ 全程在 1 以上(最高 $3.97$,趋近 $1/\sigma^{2} = 4$),该高斯估计器的幅度偏大。在这个高斯模型中:$r$ 是大于还是小于 1,只取决于 $\sigma$ 是大于还是小于 1;当 $\bar{\alpha}\to0$ 时系数比趋向 $1/\sigma^2$,但两个后验均值本身趋零、MSE 差也趋零。表中 8.07 倍是 $\bar{\alpha}=0.5$ 的有限 Monte Carlo 误差比,不能与噪声端 0.0428 的系数比混为一项指标。它说明与预训练模型尺度约定一致的重要性,不提供真实图像质量或完整采样链的性能保证。 10. 延伸阅读 前置:变分下界与重参数化 —— ELBO 的完整推导和重参数化为什么可导,本篇只用结论。 同方向:视频 VAE 的常见 loss 组合 —— 真实训练里 $\beta$ 不是单独出现的,它要和 L1、LPIPS、GAN 四项一起配比。 数值细节:混合精度与数值稳定性 —— logvar 截断那类技巧在 fp16 下会变得更关键。 下一步:潜空间扩散与 Stable Diffusion 架构会讲 $\text{Var}(z)$ 和信噪比这条线在 UNet 采样里怎么具体表现出来;离散化表征:VQ-VAE 与 VQGAN讲离散码本与使用率问题;视频 VAE 的时空压缩结构继续核对时间压缩与归约约定。 附录:完整代码 09 节用到的脚本全文如下(vae_minimal.py、collapse_closed_form.py、latent_scaling.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 vae_minimal.py """最小 VAE:numpy 手写反向传播,扫 KL 权重 beta,观察潜空间统计量怎么变。 这篇文章要回答的问题是:KL 权重 beta 调大调小,到底改变了什么? 本脚本做两轮对照实验: 条件 A(无权重衰减):观察不同 beta 下的潜尺度,不能预设所有 beta 都接近 1。 条件 B(权重衰减 1e-3):对五组编码/解码权重同时加入 L2 梯度; 与条件 A 比较固定 seed 的训练结果,不能单独归因解码器。 两轮对照展示本模型在有限优化下的尺度变化。平均 KL 同时惩罚信息与 聚合后验偏离先验,不能保证每个 beta 的边际尺度精确等于 1。 固定 seed 的结果不能反推 Stable Diffusion 的训练轨迹或一般因果机制。 运行: python vae_minimal.py 依赖: numpy """ import os import json import numpy as np # ── 固定随机性,保证正文里贴的每个数字都能复现 ───────────────────────── DATA_SEED = 0 INIT_SEED = 1 BATCH_SEED = 2 EVAL_SEED = 3 N_TRAIN = 4096 # 训练样本数 D_OBS = 64 # 观测维度(类比一张图的像素数) H_HID = 128 # 编码器/解码器隐藏层 D_LAT = 8 # 潜变量维度 K_FAC = 4 # 合成数据的真实因子数(< D_LAT,故意留出冗余维度) EPOCHS = 250 BATCH = 256 LR = 3e-3 LOGVAR_MIN, LOGVAR_MAX = -30.0, 20.0 # 与 diffusers DiagonalGaussianDistribution 一致 BETAS = [1e-6, 1e-5, 1e-4, 1e-3, 1e-2, 1e-1, 3e-1, 1.0, 3.0] WD_LIST = [0.0, 1e-3] # 两轮对照:无权重衰减 / 有权重衰减 # ─────────────────────────── 合成数据 ─────────────────────────── def make_data(n=N_TRAIN, d=D_OBS, k=K_FAC, seed=DATA_SEED): """x = A u + 观测噪声,u 是 k 维高斯因子。 教学数据由 k=4 个高斯因子驱动,并带观测噪声;不宣称真实图像只有四因子。 潜变量维度 D_LAT=8 > 4,留出冗余以便比较逐维 KL;后验坍缩不要求冗余维度。 最后仅除以训练集逐维标准差,不减样本均值。输出逐维训练均值时 MSE 精确为 1; 输出零时会额外含样本均值平方。下文 evaluate 也使用同一训练集,不是泛化测试。 """ rng = np.random.default_rng(seed) A = rng.normal(size=(d, k)) / np.sqrt(k) U = rng.normal(size=(n, k)) X = U @ A.T + 0.05 * rng.normal(size=(n, d)) X = X / X.std(axis=0, keepdims=True) # 逐维方差 = 1 return X # ─────────────────────────── 模型 ─────────────────────────── class VAE: """编码器 x -> h -> (mu, logvar),解码器 z -> g -> x_hat。 符号与正文第 03 节一致: h = relu(x W1 + b1) 编码器隐藏层 mu = h Wmu + bmu 后验均值 logvar = h Wlv + blv 后验对数方差(网络出的是 log sigma^2) z = mu + exp(0.5 logvar) * eps 重参数化 x_hat = relu(z V1 + c1) V2 + c2 解码器 """ def __init__(self, d_obs=D_OBS, h=H_HID, d_lat=D_LAT, seed=INIT_SEED): rng = np.random.default_rng(seed) sc = lambda fan_in, fan_out: rng.normal( scale=np.sqrt(2.0 / (fan_in + fan_out)), size=(fan_in, fan_out) ) self.p = {} self.p["W1"] = sc(d_obs, h) self.p["b1"] = np.zeros(h) self.p["Wmu"] = sc(h, d_lat) self.p["bmu"] = np.zeros(d_lat) self.p["Wlv"] = sc(h, d_lat) self.p["blv"] = np.zeros(d_lat) self.p["V1"] = sc(d_lat, h) self.p["c1"] = np.zeros(h) self.p["V2"] = sc(h, d_obs) self.p["c2"] = np.zeros(d_obs) self.d_obs, self.h, self.d_lat = d_obs, h, d_lat def forward(self, x, eps): p = self.p h1 = np.maximum(x @ p["W1"] + p["b1"], 0.0) mu = h1 @ p["Wmu"] + p["bmu"] lv_raw = h1 @ p["Wlv"] + p["blv"] lv = np.clip(lv_raw, LOGVAR_MIN, LOGVAR_MAX) # 防 exp 溢出,见第 05 节 sig = np.exp(0.5 * lv) z = mu + sig * eps g1 = np.maximum(z @ p["V1"] + p["c1"], 0.0) xhat = g1 @ p["V2"] + p["c2"] cache = dict(x=x, h1=h1, mu=mu, lv=lv, lv_raw=lv_raw, sig=sig, z=z, g1=g1, xhat=xhat, eps=eps) return xhat, cache @staticmethod def losses(x, xhat, mu, lv, sig): """recon = 逐元素均方误差;kl = 0.5 * sum_d(mu^2 + var - 1 - logvar)。 注意 kl 是对潜变量维度「求和」而不是求平均——这是标准写法, 比较 beta 还需同时记录重建归约和张量形状,不能仅按潜维数推断最优行为。 """ recon = float(np.mean((xhat - x) ** 2)) kl_dim = 0.5 * np.mean(mu ** 2 + sig ** 2 - lv - 1.0, axis=0) # [d] return recon, kl_dim, float(np.sum(kl_dim)) def backward(self, cache, beta): """全部手推。grad 的形状与 self.p 一一对应。""" p = self.p x, h1, mu, lv, lv_raw, sig, z, g1, xhat, eps = ( cache[k] for k in ["x", "h1", "mu", "lv", "lv_raw", "sig", "z", "g1", "xhat", "eps"] ) B, D = x.shape[0], self.d_obs g = {k: np.zeros_like(v) for k, v in p.items()} # 重建项:recon = mean((xhat - x)^2),d/d(xhat) = 2 (xhat - x) / (B*D) dxhat = 2.0 * (xhat - x) / (B * D) g["V2"] += g1.T @ dxhat g["c2"] += dxhat.sum(axis=0) dg1 = (dxhat @ p["V2"].T) * (g1 > 0) # relu g["V1"] += z.T @ dg1 g["c1"] += dg1.sum(axis=0) dz = dg1 @ p["V1"].T # [B, d] # 重参数化:dz 同时流回 mu 与 logvar 两条支路 dmu = dz + beta * mu / B # KL 对 mu 的导数 = beta * mu dlv = dz * (0.5 * sig * eps) + beta * 0.5 * (sig ** 2 - 1.0) / B # 被 clamp 的位置梯度必须截断,否则会用未截断的 logvar 继续更新 dlv = dlv * ((lv_raw > LOGVAR_MIN) & (lv_raw < LOGVAR_MAX)) g["Wmu"] += h1.T @ dmu g["bmu"] += dmu.sum(axis=0) g["Wlv"] += h1.T @ dlv g["blv"] += dlv.sum(axis=0) dh1 = (dmu @ p["Wmu"].T + dlv @ p["Wlv"].T) * (h1 > 0) g["W1"] += x.T @ dh1 g["b1"] += dh1.sum(axis=0) return g # ─────────────────────────── Adam ─────────────────────────── class Adam: def __init__(self, params, lr=LR, b1=0.9, b2=0.999, eps=1e-8): self.m = {k: np.zeros_like(v) for k, v in params.items()} self.v = {k: np.zeros_like(v) for k, v in params.items()} self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps self.t = 0 def step(self, params, grads): self.t += 1 for k in params: self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * grads[k] self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * grads[k] ** 2 mhat = self.m[k] / (1 - self.b1 ** self.t) vhat = self.v[k] / (1 - self.b2 ** self.t) params[k] -= self.lr * mhat / (np.sqrt(vhat) + self.eps) def train(beta, X, weight_decay=0.0, epochs=EPOCHS, batch=BATCH, seed=BATCH_SEED): """训练一个 VAE。weight_decay 是本次实验的关键对照变量。""" rng = np.random.default_rng(seed) model = VAE() opt = Adam(model.p) n = X.shape[0] for _ in range(epochs): perm = rng.permutation(n) for s in range(0, n, batch): xb = X[perm[s:s + batch]] eps = rng.normal(size=(xb.shape[0], D_LAT)) xhat, cache = model.forward(xb, eps) model.losses(xb, xhat, cache["mu"], cache["lv"], cache["sig"]) grads = model.backward(cache, beta) if weight_decay > 0: # 只对权重做衰减,偏置不管 for k in ["W1", "Wmu", "Wlv", "V1", "V2"]: grads[k] += weight_decay * model.p[k] opt.step(model.p, grads) return model def evaluate(model, X, beta, weight_decay=0.0, n_repeat=8): """统计潜空间性质,并把边际标准差拆成两半: Var(z_j) = Var_x(mu_j(x)) + E_x[sigma_j(x)^2] 前一半是「不同样本被编码到不同位置」,后一半是「每个样本自己抖多少」。 scaling_factor 要归一化的是两者之和的开方。 """ rng = np.random.default_rng(EVAL_SEED) n, d = X.shape[0], D_LAT mu_all = np.empty((n, d)) var_all = np.empty((n, d)) recon_all = 0.0 kl_dim_all = np.zeros(d) for s in range(0, n, 512): xb = X[s:s + 512] B = xb.shape[0] h1 = np.maximum(xb @ model.p["W1"] + model.p["b1"], 0.0) mu = h1 @ model.p["Wmu"] + model.p["bmu"] lv = np.clip(h1 @ model.p["Wlv"] + model.p["blv"], LOGVAR_MIN, LOGVAR_MAX) var = np.exp(lv) sig = np.sqrt(var) mu_all[s:s + B] = mu var_all[s:s + B] = var # 逐维 KL:先对 batch 求和,最后统一除以总样本数 kl_dim_all += 0.5 * np.sum(mu ** 2 + var - lv - 1.0, axis=0) / n # 用同一个 mu 重复采样 n_repeat 次,估计解码器实际看到的抖动有多大 eps = rng.normal(size=(B, n_repeat, d)) z = mu[:, None, :] + sig[:, None, :] * eps z_flat = z.reshape(-1, d) h1d = np.maximum(z_flat @ model.p["V1"] + model.p["c1"], 0.0) xhat = (h1d @ model.p["V2"] + model.p["c2"]).reshape(B, n_repeat, D_OBS) recon_all += np.sum((xhat - xb[:, None, :]) ** 2) / (n * n_repeat * D_OBS) std_mu = mu_all.std(axis=0) # [d] mean_sig = np.sqrt(var_all.mean(axis=0)) # [d] marginal_std = np.sqrt(std_mu ** 2 + var_all.mean(axis=0)) # [d] overall_std = float(np.sqrt(np.mean(marginal_std ** 2))) return dict( beta=beta, weight_decay=weight_decay, recon=float(recon_all), kl=float(np.sum(kl_dim_all)), kl_dim=kl_dim_all.tolist(), std_mu=std_mu.tolist(), mean_sig=mean_sig.tolist(), marginal_std=marginal_std.tolist(), overall_std=overall_std, scaling_factor=1.0 / overall_std, active_dims=int(np.sum(kl_dim_all > 0.05)), # 仅为本实验 KL 阈值计数,不是互信息/AU mean_mu=mu_all.mean(axis=0).tolist(), flat_std=float(np.sqrt(np.mean(marginal_std ** 2) + np.var(mu_all.mean(axis=0)))), data_mean_mse=float(np.mean((X-X.mean(axis=0)) ** 2)), data_zero_mse=float(np.mean(X ** 2)), ) def sweep(wd_list=None, betas=None, verbose=True): wd_list = WD_LIST if wd_list is None else wd_list betas = BETAS if betas is None else betas X = make_data() out = {} for wd in wd_list: rows = [] for beta in betas: model = train(beta, X, weight_decay=wd) rows.append(evaluate(model, X, beta, weight_decay=wd)) out[f"wd={wd:g}"] = rows if verbose: print(f"--- weight_decay = {wd:g} ---") for m in rows: print(f" beta={m['beta']:<8g} recon={m['recon']:.4f} " f"kl={m['kl']:9.3f} std(z)={m['overall_std']:7.4f} " f"1/std={m['scaling_factor']:7.4f} active={m['active_dims']}/{D_LAT}") return out CACHE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "beta_sweep.json") def load_or_sweep(path=CACHE): """图与正文共用同一份结果,避免图文数字漂移。""" if os.path.exists(path): with open(path) as f: rows=json.load(f) if set(rows) != {f"wd={wd:g}" for wd in WD_LIST}: raise ValueError("Figure cache does not contain the two default paired sweeps") return rows res = sweep() with open(path, "w") as f: json.dump(res, f, indent=2) return res def _parse_cli(argv): """正文 09 节的两个实验就是靠这两个参数复现的: python vae_minimal.py --betas 0.03,0.05,0.1,0.2,0.5 --wd 0 python vae_minimal.py --wd 0.01 """ wd_list, betas, full = None, None, False for a in argv: if a.startswith("--betas="): betas = [float(t) for t in a.split("=", 1)[1].split(",")] elif a.startswith("--wd="): wd_list = [float(t) for t in a.split("=", 1)[1].split(",")] elif a == "--full": full = True return wd_list, betas, full if __name__ == "__main__": import sys wd_list, betas, force = _parse_cli(sys.argv[1:]) custom = wd_list is not None or betas is not None if os.path.exists(CACHE) and not force and not custom: # 扫描要跑 9 x 2 x 250 = 4500 个 epoch,读缓存是为了让「跑一遍就有输出」 # 这句话成立;想从头算就加 --full。指定了自定义参数就不走缓存。 with open(CACHE) as f: res = json.load(f) print(f"[缓存] 读 {os.path.basename(CACHE)};加 --full 可重跑约 5 分钟的完整扫描") else: if custom: print(f"自定义扫描:wd={wd_list or WD_LIST} beta={betas or BETAS}") else: print("开始完整扫描(9 个 beta x 2 组权重衰减 x 250 epoch,约 5 分钟)...") res = sweep(wd_list, betas) if not custom: with open(CACHE, "w") as f: json.dump(res, f, indent=2) print(f"\n{'='*84}") print(f"{'weight_decay':>14} {'beta':>9} {'重建MSE':>10} {'总KL':>10} " f"{'std(z)':>9} {'1/std':>8} {'存活维度':>8}") print(f"{'-'*84}") for key, rows in res.items(): for m in rows: print(f"{key:>14} {m['beta']:>9g} {m['recon']:>10.4f} {m['kl']:>10.3f} " f"{m['overall_std']:>9.4f} {m['scaling_factor']:>8.4f} " f"{m['active_dims']:>5}/{D_LAT}") print("\n潜尺度拆账(std_mu = 跨维均值变化标准差 RMS;mean_sig = 跨维采样噪声标准差 RMS):") for key, rows in res.items(): print(f" {key}") for m in rows: frac = np.mean(np.array(m["std_mu"]) ** 2) / ( np.mean(np.array(m["std_mu"]) ** 2) + np.mean(np.array(m["mean_sig"]) ** 2)) print(f" beta={m['beta']:<8g} std_mu={np.sqrt(np.mean(np.array(m['std_mu']) ** 2)):6.3f} " f"mean_sig={np.sqrt(np.mean(np.array(m['mean_sig']) ** 2)):6.3f} std(z)={m['overall_std']:6.3f} " f"均值变化方差占比={frac:5.1%}") collapse_closed_form.py """一维线性 VAE 的闭式解:后验坍缩的阈值到底在哪。 第 03 节推了这么一个结论: 设 数据 x ~ N(0, v),编码器 q(z|x) = N(m x, s^2), 解码器 p(x|z) = N(w z, sigma_x^2)(sigma_x 固定,等价于重建项的权重), 目标 J = [v(1-wm)^2 + w^2 s^2] / (2 sigma_x^2) + beta * 0.5 * (m^2 v + s^2 - log s^2 - 1) 令 lambda = beta * sigma_x^2 / v,则驻点为 u := w m = 1 - lambda (潜变量被真正使用的程度) s^2 = lambda (后验方差) w^2 = v (1 - lambda) (解码器权重) 当 lambda > 1 时此分支要求 w^2 < 0,不存在实数解;lambda = 1 接到坍缩点,最优解退化为坍缩点 (w, m, s) = (0, 0, 1)。 这个脚本用数值优化去拟合 (w, m, s),逐项对照闭式解, 顺便验证「坍缩点永远是一个驻点」这件事。 运行: python collapse_closed_form.py 依赖: numpy """ import numpy as np V = 1.0 # 数据方差 SIGMA_X = 1.0 # 解码器的观测噪声标准差,固定(它就是重建项的隐式权重) # ─────────────────────────── 目标函数与梯度 ─────────────────────────── def objective(w, m, s, beta, v=V, sigma_x=SIGMA_X): recon = (v * (1.0 - w * m) ** 2 + w ** 2 * s ** 2) / (2.0 * sigma_x ** 2) kl = 0.5 * beta * (m ** 2 * v + s ** 2 - np.log(s ** 2) - 1.0) return recon + kl def grad(w, m, s, beta, v=V, sigma_x=SIGMA_X): dJ_dw = (-v * m * (1.0 - w * m) + w * s ** 2) / sigma_x ** 2 dJ_dm = -v * w * (1.0 - w * m) / sigma_x ** 2 + beta * m * v dJ_ds = w ** 2 * s / sigma_x ** 2 + beta * (s - 1.0 / s) return dJ_dw, dJ_dm, dJ_ds def fit(beta, v=V, sigma_x=SIGMA_X, steps=20000, lr=0.02, seed=0): """对 (w, m, log s) 做梯度下降。用 log s 参数化保证 s > 0。""" rng = np.random.default_rng(seed) w = rng.normal() * 0.5 m = rng.normal() * 0.5 t = rng.normal() * 0.5 # s = exp(t) for i in range(steps): s = np.exp(t) gw, gm, gs = grad(w, m, s, beta, v, sigma_x) # 对 t 的梯度要过一次链式法则 w -= lr * gw m -= lr * gm t -= lr * gs * s return w, m, np.exp(t) def closed_form(beta, v=V, sigma_x=SIGMA_X): if beta <= 0 or v <= 0 or sigma_x <= 0: raise ValueError("beta, v and sigma_x must be positive") lam = beta * sigma_x ** 2 / v if lam >= 1.0: # 坍缩 return dict(lam=lam, u=0.0, s2=1.0, w2=0.0, collapsed=True) u = 1.0 - lam return dict(lam=lam, u=u, s2=lam, w2=v * u, collapsed=False) # ─────────────────────────── 主流程 ─────────────────────────── if __name__ == "__main__": betas = [0.05, 0.1, 0.2, 0.4, 0.6, 0.8, 0.95, 1.0, 1.2, 2.0, 5.0] print(f"v = {V}, sigma_x = {SIGMA_X}, lambda = beta * sigma_x^2 / v = {SIGMA_X**2/V} * beta") print(f"闭式预测:坍缩阈值 beta* = v / sigma_x^2 = {V / SIGMA_X**2:g}\n") print(f"{'beta':>6} {'lambda':>8} | {'u=wm 预测':>10} {'拟合':>9} " f"| {'s^2 预测':>9} {'拟合':>9} | {'w^2 预测':>9} {'拟合':>9} | 坍缩") max_err = 0.0 for beta in betas: cf = closed_form(beta) w, m, s = fit(beta) u_fit = w * m err = max(abs(u_fit - cf["u"]), abs(s ** 2 - cf["s2"]), abs(w ** 2 - cf["w2"])) max_err = max(max_err, err) if not cf["collapsed"] else max_err print(f"{beta:>6g} {cf['lam']:>8.3f} | {cf['u']:>10.4f} {u_fit:>9.4f} " f"| {cf['s2']:>9.4f} {s**2:>9.4f} | {cf['w2']:>9.4f} {w**2:>9.4f} " f"| {'是' if cf['collapsed'] else '否'}") print(f"\n未坍缩区间内,闭式解与数值拟合的最大偏差:{max_err:.2e}") # 坍缩点是不是永远的驻点? print("\n坍缩点 (w, m, s) = (0, 0, 1) 处的梯度(应当恒为 0):") for beta in [0.05, 0.5, 1.0, 5.0]: gw, gm, gs = grad(0.0, 0.0, 1.0, beta) print(f" beta={beta:<6g} dJ/dw={gw:+.2e} dJ/dm={gm:+.2e} dJ/ds={gs:+.2e}") # 坍缩点在不同 beta 下到底是不是最优?比一下目标函数值 print("\n坍缩点 vs 解析解的目标函数值(谁小谁是最优):") for beta in [0.05, 0.5, 0.9, 1.0, 2.0]: cf = closed_form(beta) if cf["collapsed"]: j_star = objective(0.0, 0.0, 1.0, beta) j_alt = None else: w2 = cf["w2"] w = np.sqrt(w2) m = cf["u"] / w j_star = objective(w, m, np.sqrt(cf["s2"]), beta) j_alt = objective(0.0, 0.0, 1.0, beta) alt = " —" if j_alt is None else f"{j_alt:9.5f}" print(f" beta={beta:<6g} J(解析解)={j_star:9.5f} J(坍缩点)={alt}") latent_scaling.py """scaling_factor 到底在补什么:把「潜空间标准差」翻译成「信噪比」。 Stable Diffusion 的 VAE 有个著名常数 0.18215。它是这么用的: 编码: z_scaled = z * 0.18215 (交给扩散模型之前) 解码: z = z_scaled / 0.18215 (交给解码器之前) 核对 checkpoint 配置与实际乘除方向。LDM 原始实现 std-rescaling 分支 用首个 batch 后验样本的展平标准差倒数,并非逐通道独立归一化。 0.18215 是 SD1.x 配置中的缩放系数,1/s 只是它对应的标定尺度, 不表示本脚本实测了该预训练 VAE 的当前输出统计。 本脚本把这段话变成可算的数。核心结论是两条: 1. 若扩散模型是在单位方差潜空间上训练的,它对 z_0 的后验均值估计就是 z_hat_0 = sqrt(alpha_bar) * z_t (高斯先验 N(0, I) 下的 MMSE 估计)。而真实潜空间标准差是 sigma 时, 正确的 MMSE 估计是 z_hat_0 = sigma^2 sqrt(alpha_bar) / (sigma^2 alpha_bar + 1 - alpha_bar) * z_t 两者之比 r = alpha_bar + (1 - alpha_bar) / sigma^2。 r 是后验均值系数之比;不能由一维高斯结果推断真实图像亮度或伪影。 2. 每一层的真实信噪比是 sigma^2 * alpha_bar / (1 - alpha_bar), 模型以为的是 alpha_bar / (1 - alpha_bar),整整差 sigma^2 倍 (20*log10(sigma) 分贝)。 运行: python latent_scaling.py 依赖: numpy """ import numpy as np SD_SCALING_FACTOR = 0.18215 # diffusers AutoencoderKL 的默认值 ABARS = [0.999, 0.99, 0.9, 0.5, 0.1, 0.01] def latent_std_from_scaling(s): """scaling_factor 是潜空间边际标准差的倒数。""" if not np.isfinite(s) or s <= 0: raise ValueError("scaling factor must be finite and positive") return 1.0 / s def mmse_model(z_t, abar): """在「潜空间方差 = 1」的假设下训练出来的高斯 MMSE 去噪器。""" return np.sqrt(abar) * z_t def mmse_true(z_t, abar, sigma): """潜空间真实标准差为 sigma 时的高斯 MMSE 去噪器。""" return sigma ** 2 * np.sqrt(abar) / (sigma ** 2 * abar + 1.0 - abar) * z_t def amplitude_ratio(abar, sigma): """模型输出 / 正确输出 = alpha_bar + (1 - alpha_bar) / sigma^2。""" return abar + (1.0 - abar) / sigma ** 2 def snr(abar, sigma): """真实信噪比 Var(z_0 的信号成分) / Var(噪声成分) = sigma^2 * abar / (1 - abar)。""" return sigma ** 2 * abar / (1.0 - abar) def mmse_mse(abar, sigma): """高斯 MMSE 估计的理论误差,就是后验方差。""" return sigma ** 2 * (1.0 - abar) / (sigma ** 2 * abar + 1.0 - abar) def demo_step(abar, sigma, n=400000, seed=0): """蒙特卡洛:固定同一个前向过程,比较两个去噪器。 est_model:按「潜空间方差 = 1」训练出来的理想去噪器,用在方差为 sigma^2 的 潜空间上,是忘缩放的一种教学类比。 est_true :同一前向过程就该 sigma 匹配的理想估计器。对原始 z0 缩放但保持 原噪声表,会改变观察到的 SNR;所以它不等价于正确缩放的同一步 MSE。 """ rng = np.random.default_rng(seed) z0 = sigma * rng.normal(size=n) eps = rng.normal(size=n) z_t = np.sqrt(abar) * z0 + np.sqrt(1.0 - abar) * eps est_model = mmse_model(z_t, abar) est_true = mmse_true(z_t, abar, sigma) return (float(np.mean((est_model - z0) ** 2)), float(np.mean((est_true - z0) ** 2))) if __name__ == "__main__": import sys # 正文 09 节实验三:换一个反事实的 scaling_factor 重算整张表 # python latent_scaling.py --sf=0.5 # python latent_scaling.py --sf=2.0 for a in sys.argv[1:]: if a.startswith("--sf="): SD_SCALING_FACTOR = float(a.split("=", 1)[1]) sigma_sd = latent_std_from_scaling(SD_SCALING_FACTOR) print("=" * 72) print("一、0.18215 意味着什么") print("=" * 72) print(f" scaling_factor = {SD_SCALING_FACTOR}") print(f" 潜空间边际标准差 sigma = 1 / {SD_SCALING_FACTOR} = {sigma_sd:.4f}") print(f" 潜空间边际方差 Var(z) = {sigma_sd**2:.4f}") print(f" 信噪比偏移 = {20*np.log10(sigma_sd):.2f} dB") print() print(" 对照:若某个 VAE 的潜空间方差真的接近 1(LDM 说 VQ 版就是如此),") print(" scaling_factor 就应当接近 1,完全不需要 rescale。") print() print("=" * 72) print("二、忘掉 scaling factor,去噪幅度错多少") print("=" * 72) print(" r = 模型输出 / 正确输出;r=1 才是正确的") print(f" {'alpha_bar':>10} | " + " | ".join(f"sigma={s:<7.4g}" for s in [sigma_sd, 1.0, SD_SCALING_FACTOR])) for abar in ABARS: rs = [amplitude_ratio(abar, s) for s in [sigma_sd, 1.0, SD_SCALING_FACTOR]] print(f" {abar:>10g} | " + " | ".join(f"{r:>13.4f}" for r in rs)) print() print("=" * 72) print("三、蒙特卡洛实测:单步去噪的均方误差(n=400000)") print("=" * 72) print(f" {'alpha_bar':>10} | {'错假设 MSE':>12} {'正确 MSE':>12} {'理论后验方差':>14} {'恶化倍数':>10}") for abar in ABARS: m_bad, m_good = demo_step(abar, sigma_sd) print(f" {abar:>10g} | {m_bad:>12.4f} {m_good:>12.4f} {mmse_mse(abar, sigma_sd):>14.4f} " f"{m_bad/m_good:>10.2f}x") print() print(" 读法:固定同一个前向过程 z_t = sqrt(alpha_bar) z_0 + sqrt(1-alpha_bar) eps,") print(" 「错假设」是拿了按单位方差潜空间训好的去噪器却喂未缩放的 latent,") print(" 「正确」是同一观察过程就该 sigma 匹配的估计器;不是正确缩放的同一步实测。") print(f" 「理论后验方差」= sigma^2 (1-alpha_bar) / (sigma^2 alpha_bar + 1 - alpha_bar),") print(f" 与蒙特卡洛的「正确」一列应当吻合(校核 alpha_bar=0.5:" f"{mmse_mse(0.5, sigma_sd):.4f} vs 实测 {demo_step(0.5, sigma_sd)[1]:.4f})") print() print("=" * 72) print("四、反向的错误:换了个方差接近 1 的 VAE,却照抄 0.18215") print("=" * 72) print(f" {'alpha_bar':>10} | {'r(幅度被放大的倍数)':>24}") for abar in ABARS: print(f" {abar:>10g} | {amplitude_ratio(abar, SD_SCALING_FACTOR):>24.4f}") print() print(" r >> 1:高斯后验均值系数偏大;不能推断生成图过曝或结构模糊。") print() print("=" * 72) print("五、信噪比视角(LDM D.1 的定义 Var(z) / sigma_t^2)") print("=" * 72) print(f" {'alpha_bar':>10} | {'模型以为的 SNR':>16} {'真实 SNR':>16} {'倍数':>10}") for abar in ABARS: a = abar / (1.0 - abar) b = snr(abar, sigma_sd) print(f" {abar:>10g} | {a:>16.4f} {b:>16.4f} {b/a:>10.2f}x") make_figures.py """画本文的四张图。数据源全部来自 vae_minimal.py / latent_scaling.py 的真实输出, 不另造数,避免图文数字漂移。 beta_sweep.png beta 扫描全景:重建 / KL / 潜尺度 / KL 阈值计数 latent_scale_split.png 潜尺度的拆账:编码位置 vs 采样噪声 scaling_snr.png 忘掉 scaling_factor 的后果:幅度比 + 单步去噪 MSE collapse_profile.png 后验坍缩的指纹:逐维 KL 怎么一个个死掉 运行: python make_figures.py 依赖: numpy, matplotlib(Windows 优先 Microsoft YaHei,其他平台需中文字体) """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import vae_minimal as VM import latent_scaling as LS plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.facecolor"] = "white" plt.rcParams["axes.facecolor"] = "white" plt.rcParams["savefig.facecolor"] = "white" plt.rcParams["font.size"] = 11 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) # exist_ok 必须带,否则目录已存在会 PermissionError C_MAIN, C_ALT = "#2563eb", "#dc2626" C_GRAY = "#6b7280" def _b(rows): return np.array([r["beta"] for r in rows]) # ─────────────────────────── 图 1:beta 扫描全景 ─────────────────────────── def fig_beta_sweep(res): rows0 = res["wd=0"] rows1 = res["wd=0.001"] fig, axes = plt.subplots(2, 2, figsize=(13.5, 8.6)) ax = axes[0][0] ax.plot(_b(rows0), [r["recon"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["recon"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.set_xscale("log") ax.set_yscale("log") ax.axhline(1.0, color=C_GRAY, lw=1, ls=":") ax.text(1.1e-6, 1.05, "重建 MSE = 1:训练均值预测基线", color=C_GRAY, fontsize=9) ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("重建 MSE($D$ 维平均)") ax.set_title("(a) 重建误差随 β 变化") ax.legend(fontsize=9) ax.grid(alpha=0.25) ax = axes[0][1] ax.plot(_b(rows0), [r["kl"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["kl"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.set_xscale("log") ax.set_yscale("symlog", linthresh=1e-1) ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("总 KL(nats,8 维求和)") ax.set_title("(b) KL:β 越大越贴先验,坍缩时归零") ax.legend(fontsize=9) ax.grid(alpha=0.25) ax = axes[1][0] ax.plot(_b(rows0), [r["overall_std"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["overall_std"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.axhline(1.0, color=C_GRAY, lw=1, ls=":") ax.text(1.1e-6, 1.03, "std(z) = 1:单位尺度参照", color=C_GRAY, fontsize=9) ax.axhline(LS.latent_std_from_scaling(LS.SD_SCALING_FACTOR), color="#059669", lw=1, ls="--") ax.text(1.1e-6, 5.62, "std(z) = 5.49:由 SD1.x 配置系数反推", color="#059669", fontsize=9) ax.set_xscale("log") ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("潜空间边际标准差 std(z)") ax.set_ylim(0.9, 6.2) ax.set_title("(c) 有限训练后的潜尺度统计") ax.legend(fontsize=9, loc="upper right") ax.grid(alpha=0.25) reciprocal = lambda x: np.divide(1.0, x, out=np.full_like(x, np.inf, dtype=float), where=x != 0) ax2 = ax.secondary_yaxis("right", functions=(reciprocal, reciprocal)) ax2.set_ylabel("对应的 scaling_factor = 1 / std(z)") ax = axes[1][1] ax.plot(_b(rows0), [r["active_dims"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["active_dims"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.axhline(4, color="#059669", lw=1, ls="--") ax.text(1.1e-6, 4.2, "真实因子数 = 4", color="#059669", fontsize=9) ax.set_xscale("log") ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("超过阈值的维度数(逐维 KL > 0.05 nat)") ax.set_ylim(-0.3, 8.6) ax.set_title("(d) 不同权重下的 KL 阈值计数") ax.legend(fontsize=9, loc="lower left") ax.grid(alpha=0.25) fig.suptitle("KL 权重扫描:重建、KL、潜尺度、KL 阈值计数(潜变量 8 维,真实因子 4 个)", fontsize=13, y=0.98) fig.tight_layout(rect=[0, 0, 1, 0.96]) out = os.path.join(FIGDIR, "beta_sweep.png") fig.savefig(out, dpi=150) plt.close(fig) return out # ─────────────────────────── 图 2:潜尺度拆账 ─────────────────────────── def fig_scale_split(res): rows = res["wd=0"] betas = _b(rows) std_mu = np.array([np.mean(np.array(r["std_mu"]) ** 2) for r in rows]) # 编码位置的跨样本波动 mean_sig = np.array([np.mean(np.array(r["mean_sig"]) ** 2) for r in rows]) # 采样噪声 RMS x = np.arange(len(betas)) fig, axes = plt.subplots(1, 2, figsize=(13.5, 4.6)) ax = axes[0] ax.bar(x, std_mu, 0.62, label=r"后验均值的跨样本方差", color=C_MAIN) ax.bar(x, mean_sig, 0.62, bottom=std_mu, label=r"平均后验方差", color="#f59e0b") ax.set_xticks(x) ax.set_xticklabels([f"{b:g}" for b in betas]) ax.set_xlabel(r"KL 权重 $\beta$(离散档位)") ax.set_ylabel("Var(z) 的构成(各维平均)") ax.set_title("(a) 方差拆账:后验均值变化与后验噪声") ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") ax = axes[1] frac = std_mu / (std_mu + mean_sig) ax.plot(x, frac, "o-", color=C_MAIN, lw=2) ax.axhline(0.5, color=C_GRAY, lw=1, ls=":") ax.set_xticks(x) ax.set_xticklabels([f"{b:g}" for b in betas]) ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("方差里来自编码位置的比例") ax.set_ylim(-0.03, 1.06) ax.set_title("(b) 总方差中均值变化的占比") ax.grid(alpha=0.25) for i, (xi, fi) in enumerate(zip(x, frac)): ax.annotate(f"{fi:.2f}", (xi, fi), textcoords="offset points", xytext=(0, 8), ha="center", fontsize=9, color=C_MAIN) fig.suptitle("全方差公式:两项方差相加;方差占比不等于互信息", fontsize=12.5, y=1.0) fig.tight_layout(rect=[0, 0, 1, 0.95]) out = os.path.join(FIGDIR, "latent_scale_split.png") fig.savefig(out, dpi=150) plt.close(fig) return out # ─────────────────────────── 图 3:scaling factor 的后果 ─────────────────────────── def fig_scaling_snr(): sigma_sd = LS.latent_std_from_scaling(LS.SD_SCALING_FACTOR) abar = np.logspace(-3, np.log10(0.9999), 400) fig, axes = plt.subplots(1, 2, figsize=(13.5, 4.8)) ax = axes[0] for sigma, lab, col in [(sigma_sd, rf"$\sigma$={sigma_sd:.2f}(由 SD1.x 配置反推)", C_MAIN), (1.0, r"$\sigma$=1.0(单位尺度参照)", "#059669"), (LS.SD_SCALING_FACTOR, rf"$\sigma$={LS.SD_SCALING_FACTOR:.3f}(照抄 0.18215 用错 VAE)", C_ALT)]: ax.plot(abar, LS.amplitude_ratio(abar, sigma), "-", color=col, lw=2, label=lab) ax.axhline(1.0, color=C_GRAY, lw=1, ls=":") ax.text(5e-2, 1.35, "$r=1$:单位尺度参照", color=C_GRAY, fontsize=9) ax.text(2e-3, 0.025, r"噪声端系数比极限 $1/\sigma^2=0.033$,两种均值都趋零", color=C_MAIN, fontsize=9) ax.set_xscale("log") ax.set_yscale("log") ax.set_ylim(2e-2, 6e1) ax.set_xlabel(r"$\bar{\alpha}$(1 = 完全干净,0 = 纯噪声)") ax.set_ylabel("去噪幅度比 $r$ = 模型输出 / 正确输出") ax.set_title("(a) 高斯 MMSE 教学模型的后验均值幅度比") ax.legend(fontsize=9, loc="center left") ax.grid(alpha=0.25, which="both") ax = axes[1] abars = np.array(LS.ABARS) bad, good = [], [] for a in abars: b_, g_ = LS.demo_step(a, sigma_sd, n=400000) bad.append(b_) good.append(g_) ax.plot(abars, bad, "o-", color=C_ALT, lw=2, label=r"错假设去噪器(按 $\sigma$=1 训练)") ax.plot(abars, good, "s-", color=C_MAIN, lw=2, label=r"正确去噪器(就该 $\sigma$ 训练)") ax.set_xscale("log") ax.set_yscale("log") ax.set_xlabel(r"$\bar{\alpha}$") ax.set_ylabel("单步去噪均方误差") ax.set_title("(b) 同一个前向过程下的 MSE 差距") ax.legend(fontsize=9) ax.grid(alpha=0.25) i5 = int(np.argmin(np.abs(abars - 0.5))) ax.annotate(f"{bad[i5]/good[i5]:.1f}×", (abars[i5], bad[i5]), textcoords="offset points", xytext=(12, -6), color=C_ALT, fontsize=11) fig.suptitle(r"忘掉 scaling_factor 的代价:实际信噪比高于单位尺度假设 $\sigma^2$ = 30.1 倍(14.8 dB)", fontsize=12.5, y=1.0) fig.tight_layout(rect=[0, 0, 1, 0.94]) out = os.path.join(FIGDIR, "scaling_snr.png") fig.savefig(out, dpi=150) plt.close(fig) return out # ─────────────────────────── 图 4:坍缩指纹 ─────────────────────────── def fig_collapse_profile(res): rows = res["wd=0"] picks = [1e-3, 3e-1, 1.0] # 三档:够用 / 正在坍缩 / 完全坍缩 # 每张子图各自缩放:三档之间差 20 倍,共享 y 轴会把另两张压成一条线 fig, axes = plt.subplots(1, 3, figsize=(13.5, 4.2)) d = len(rows[0]["kl_dim"]) for ax, beta in zip(axes, picks): row = min(rows, key=lambda r: abs(r["beta"] - beta)) kl = np.array(row["kl_dim"]) colors = [C_MAIN if v > 0.05 else "#d1d5db" for v in kl] ax.bar(np.arange(d), kl, 0.68, color=colors) ax.axhline(0.05, color=C_GRAY, lw=1, ls=":") ax.set_xticks(np.arange(d)) ax.set_xticklabels([f"$z_{j+1}$" for j in range(d)], fontsize=9) ax.set_xlabel("潜变量维度") ax.set_ylim(0, max(0.35, kl.max() * 1.18)) ax.set_title(rf"$\beta$={row['beta']:g} 阈值计数 {row['active_dims']}/{d} " f"重建 MSE={row['recon']:.4f}") ax.grid(alpha=0.25, axis="y") ax.text(0.99, 0.92, f"本组 KL 最大 {kl.max():.2g} nats", transform=ax.transAxes, ha="right", fontsize=8.5, color=C_GRAY) axes[0].set_ylabel("逐维 KL(nats)") axes[1].set_ylabel("逐维 KL(nats)") axes[2].set_ylabel("逐维 KL(nats)") fig.suptitle("逐维 KL:阈值计数仅供诊断(注意三张图的纵轴范围不同)", fontsize=12.5, y=0.99) fig.tight_layout(rect=[0, 0, 1, 0.91]) out = os.path.join(FIGDIR, "collapse_profile.png") fig.savefig(out, dpi=150) plt.close(fig) return out if __name__ == "__main__": res = VM.load_or_sweep() for fn in [fig_beta_sweep, fig_scale_split, fig_collapse_profile]: print("写出", fn(res)) print("写出", fig_scaling_snr())
-
AIGC 基本功|变分下界与重参数化-ELBO AIGC 基本功|变分下界与重参数化-ELBO 所属方向:数学基础 | 难度:入门 | 前置知识:无知识树先修节点;需了解条件概率、概率密度、期望、矩阵乘法与链式求导 关键词:变分推断、ELBO、重参数化、KL 散度、后验坍缩、β-VAE、IWAE、得分函数估计量 01. 为什么需要它 先摆三组可复现的数字,全部出自文末四份完整脚本。本轮在 Windows CPU、Python 3.11.9、NumPy 2.4.6 实跑;固定 float64 与随机种子。前三份脚本做数学实验,第四份还依赖 matplotlib 3.10.7 生成三图。表中的“最优”来自第 4.3 节的线性高斯闭式,不是训练真实图像模型得到的性能。 第一组:KL 项掉到 0,潜变量整条死掉。 固定解码器噪声 σ²=0.25,让四个独立数据方向分别具有方差 λ=4.0、1.0、0.25、0.0625,只改 KL 项的权重 β,看看最优解长什么样: 数据方向方差 λ β=0.5 β=1.0 β=2.0 β=4.0 死亡阈值 β* 4.0 MSE 0.125 存活 MSE 0.250 存活 MSE 0.500 存活 MSE 1.000 存活 16.00 1.0 MSE 0.125 存活 MSE 0.250 存活 MSE 0.500 存活 MSE 1.000 死亡 4.00 0.25 MSE 0.125 存活 MSE 0.250 死亡 死亡 死亡 1.00 0.0625 死亡 死亡 死亡 死亡 0.25 死亡那一格的具体解是 a=0、s=1、KL=0:编码器把均值直接输出 0、方差输出 1,等于彻底放弃这个维度。此时重建误差精确等于 λ——也就是把 x 全猜成 0 的水平,这个维度一点信息都没传。问题在于看 loss 曲线你只会看到「KL 顺利降到 0,总损失还在降」,很难意识到这是失败而不是收敛。 第二组:把 ELBO 当成似然来监控,会被方差骗。 在一个 D=6、K=3 的高斯线性模型上,真实 log p(x) = -5.434331,解析 ELBO = -7.419767,两者差 1.985436。但用训练时真正用的那个单样本蒙特卡洛估计量去估 ELBO,重复 4000 次,标准差是 4.308——比它和 log p(x) 之间的差距还大一倍多,结果有 40.7% 的采样值直接越过了 -5.434 这条「上界」。如果把单样本曲线直接当成精确似然或模型排序,可能被波动误导;重复评估与报告不确定性才有助于比较。 第三组:不用重参数化,梯度方差能大到没法训练。 同一个模型上估 ∇ E_q[log p(x|z)],重参数化的梯度方差和是 377.55,得分函数估计量是 3043.11,差 8.1 倍。听起来还能忍?把数据维度 D 从 8 拉到 2048: D 重参数化方差 得分函数方差 比值 8 2.08 2 469 1 188× 64 1.98 104 328 52 630× 512 1.84 7 579 291 4 121 907× 2048 1.84 114 230 222 61 916 893× 重参数化的方差几乎不随 D 动,得分函数估计量按 D² 往上冲,到 D=2048(约 45×45 个标量)比值是 6191 万倍。这是本教学扫描中一个很大的方差差距,足以说明原始得分函数估计量可能难用;它不证明所有高维模型都无法用得分函数训练。这里固定 K=3、归一化 W 的列范数、s=0.6、每个 D 用 4000 次采样,并未训练 2048 维图像模型。2048 只是观测维度,约等于 45×45 个标量的数量。 这三组数字背后是同一件事:我们想最大化的是 log p(x),但它算不动,只能换成它的一个下界 ELBO 来优化;而换成下界之后,「换掉了什么」「这个下界的估计量有多吵」「梯度怎么穿过采样」这三笔账必须自己算清楚。不搞清楚 KL 项的价,你就不知道 β 该往哪调;不搞清楚下界的松紧,你就不知道扩散模型的训练目标从哪来。 02. 最小可用理解 三句话讲完核心: 算不动的边际似然换成一个能算的下界:$p_\theta(x)$ 要对所有 z 积分,算不动,于是引入一个我们自己挑的分布 $q_\phi(z \mid x)$,用 Jensen 不等式把优化目标换成 ELBO,它只需要在 q 下求期望,采样就能算。 下界和真值之间差的那一坨,正好是 q 和真实后验的 KL:固定生成模型时,对数边际密度等于 ELBO 加上后验 KL(完整公式见 3.3)。所以「下界有多松」等价于「q 离真后验有多远」,而不是「q 离先验有多远」——后者的 KL 在 ELBO 中被减去,是另一回事。 要让这个下界能被反向传播,就把随机性从梯度路径上挪走:写成 $z = m_\phi + s_\phi \odot \epsilon$,$\epsilon$ 与参数无关,固定一份噪声后,z 是参数的确定性函数,梯度沿它传回 $m_\phi$ 和 $s_\phi$;在可交换微分与期望等正则条件下,这给出有效的路径梯度估计。 03. 数学推导 先统一符号:$x\in\mathbb R^D$ 是一个观测,$z\in\mathbb R^K$ 是隐变量;$\theta$ 控制生成模型,$\phi$ 控制编码器;$m_\phi(x),s_\phi(x)\in\mathbb R^K$ 分别是均值和逐维标准差,$s_j>0$。$\odot$ 表示逐元素乘,$\ell=\log s$,工业代码的 logvar 则是 $2\ell$。$I_D,I_K$ 是相应单位矩阵,$\mathrm{tr}$ 是迹。本文对数为自然对数,KL 和对数密度的单位是 nats;连续密度可以大于 1,对数密度也可以为正。 3.1 边际似然为什么算不动 生成模型的设定很简单:先从一个固定先验里采隐变量 $z \sim p(z)$(通常是标准正态),再用解码器生成观测 $x \sim p_\theta(x \mid z)$。要拟合数据,目标是对数边际似然: $$\log p_\theta(x) = \log \int p_\theta(x \mid z) \, p(z) \, dz$$ 麻烦全在这个积分上。$p_\theta(x \mid z)$ 是由神经网络给出参数的条件概率分布,一般非线性解码器的边际积分没有可用闭式解;本文第 4 节的线性高斯模型是特意选出的可解特例。用数值积分的话,z 是 K 维,网格点数随 K 指数爆炸,K=32 就已经不可能。而 K 小了模型表达能力又不够——这正是我们不愿意接受的取舍。 3.2 换个能算的目标 既然积分算不动,就绕开它。引入在目标分布支撑上为正、满足相关可积条件的以 x 为条件的分布 $q_\phi(z \mid x)$(后面简称 $q$),把被积函数乘一个 $q/q$: $$\log p_\theta(x) = \log \int q_\phi(z \mid x) \, \frac{p_\theta(x, z)}{q_\phi(z \mid x)} \, dz = \log \mathbb{E}_{q_\phi}\!\left[\frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right]$$ log 是凹函数,Jensen 不等式给出 $\log \mathbb{E}[Y] \ge \mathbb{E}[\log Y]$,于是 $$\log p_\theta(x) \ge \mathbb{E}_{q_\phi}\!\left[\log \frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right] \equiv \mathcal{L}(\theta, \phi)$$ 右边就是 ELBO(Evidence Lower Bound)。它好算:$\log p_\theta(x, z) = \log p_\theta(x \mid z) + \log p(z)$ 两项都能直接求值,期望用采样估计就行。代价是我们不再直接优化 log p(x),而是优化它的一个下界。 3.3 差的那一项到底是什么 这是全文最关键的一步,也是最容易被跳过的一步。把 $\log p_\theta(x)$ 写成对 q 的期望(它和 z 无关,所以这么写是恒等的),再硬塞一个 $\log \frac{q}{q}$ 进去: $$\log p_\theta(x) = \mathbb{E}_{q}\!\left[\log p_\theta(x)\right] = \mathbb{E}_{q}\!\left[\log \frac{p_\theta(x, z)}{p_\theta(z \mid x)}\right] = \mathbb{E}_{q}\!\left[\log \frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right] + \mathbb{E}_{q}\!\left[\log \frac{q_\phi(z \mid x)}{p_\theta(z \mid x)}\right]$$ 第一项正是 ELBO,第二项按定义就是 KL 散度。合起来: $$\log p_\theta(x) = \mathcal{L}(\theta, \phi) + \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p_\theta(z \mid x)\big)$$ KL 恒非负,所以 $\mathcal{L} \le \log p_\theta(x)$,和 Jensen 的结论一致——但这一版多给了一个信息:等号成立当且仅当 q 等于真实后验。这里固定 x 和生成模型 θ,缝隙才完全等于 q 到该模型真实后验的 KL;联合训练改变 θ 时,后验与 log pθ(x) 本身也会改变。“q 等于后验”指概率分布几乎处处相同,并要求式中的量有定义。 3.4 把 ELBO 拆成两项看 把 $\log p_\theta(x, z)$ 展开,ELBO 可以写成更有物理含义的形式: $$\mathcal{L}(\theta, \phi) = \mathbb{E}_{q_\phi}\!\left[\log p_\theta(x \mid z)\right] - \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p(z)\big)$$ 第一项是重建项:从 q 里采 z,解码器能不能还原出 x。第二项是先验对齐项:q 别离先验太远——因为生成时我们是从先验采 z 的,标准高斯先验具有全空间支撑,“覆盖不到”应理解为采到的概率很小,而非严格为零。这个惩罚逐个 x 约束 q;仅让汇总后验 q(z)=E数据[q(z|x)] 接近先验,不能保证每个条件后验都接近先验。 这里有个必须记住的区分,后面第 08 节还会回到它: $\mathrm{KL}(q \,\|\, p(z))$ —— 出现在 ELBO 里,是要被最小化的一项,物理含义是「编码分布别跑太偏」。 $\mathrm{KL}(q \,\|\, p(z \mid x))$ —— 不出现在 ELBO 里,是下界的缝隙,物理含义是「q 离真后验还差多少」。 在我们那个 D=6 的例子里,这两个数是 3.364364 和 1.985436,不是一回事,也不是简单的包含关系。β-VAE 显式改的是先验 KL 的权重,但重新训练后 q 与生成模型都会变化,所以真实后验差距也会变化,且不保证变小。 顺带一个很容易漏掉的推论:把 KL 乘上 β 之后得到的目标 $$\mathcal{L}_\beta = \mathbb{E}_{q_\phi}\!\left[\log p_\theta(x \mid z)\right] - \beta \cdot \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p(z)\big)$$ 当 $\beta\ge1$,仍有 $\mathcal L_\beta=\mathcal L-(\beta-1)\mathrm{KL}(q\Vert p)\le\mathcal L\le\log p_\theta(x)$,所以它仍是下界,只是更松;$0<\beta<1$ 时则不再保证下界。不同 β 的目标包含不同惩罚,不能直接当成同一种似然估计比较。 3.5 梯度怎么穿过采样 ELBO 对解码器参数 $\theta$ 的梯度没问题,重建项直接可导。麻烦在对 $\phi$ 的梯度:期望的分布本身依赖于 $\phi$,而采样操作不可导。设 $f(z) = \log p_\theta(x \mid z)$,要估的是 $\nabla_\phi \mathbb{E}_{q_\phi}[f(z)]$。 方法一:得分函数估计量(REINFORCE)。 直接把导数挪进期望: $$\nabla_\phi \mathbb{E}_{q_\phi}[f(z)] = \mathbb{E}_{q_\phi}\!\left[f(z) \, \nabla_\phi \log q_\phi(z \mid x)\right]$$ 在可交换微分与积分、分布支持集不随参数变化等常见正则条件下,这个式子成立;它不要求 f 对 z 可导,也可用于离散 z;方差可能较大,因为整个 f 都被乘进梯度里。此处 f 不显含 φ;若 f 也依赖 φ,另需加上 E_q[∇φ f]。下面两种估计量只比较重建项梯度,先验 KL 的解析梯度另算。对高斯先验,KL 对 m 的梯度是 m,对 ℓ 的梯度是 s²−1;最大化 ELBO 时从重建梯度里减去它们。 方法二:重参数化。 把 z 写成参数的确定性函数外加一个与参数无关的噪声: $$z = m_\phi(x) + s_\phi(x) \odot \epsilon, \quad \epsilon \sim \mathcal{N}(0, I)$$ 于是期望可以改写成对 $\epsilon$ 的期望,导数直接进去: $$\nabla_\phi \mathbb{E}_{q_\phi}[f(z)] = \mathbb{E}_{\epsilon}\!\left[\nabla_\phi f\big(m_\phi(x) + s_\phi(x) \odot \epsilon\big)\right] = \mathbb{E}_{\epsilon}\!\left[\nabla_z f(z) \cdot \nabla_\phi z\right]$$ 关键在于 $\nabla_z f$ 用到了 f 对 z 的局部形状,相当于「知道往哪个方向挪 z 会让 f 变大」,这是方法一完全没有利用的信息。 方差为什么差这么多——把与 z 无关的部分拆开。 高斯解码器 $p(x|z)=\mathcal N(Wz+b,\sigma^2 I_D)$ 中,$W\in\mathbb R^{D\times K}$、$b\in\mathbb R^D$、$\sigma^2>0$ 固定。令 $d=x-b$: $$f(z)=-\frac D2\log(2\pi\sigma^2)-\frac{\|d-Wz\|^2}{2\sigma^2}=c_0+\frac{d^\top Wz}{\sigma^2}-\frac{z^\top W^\top Wz}{2\sigma^2},\quad c_0=-\frac D2\log(2\pi\sigma^2)-\frac{d^\top d}{2\sigma^2}$$ 路径梯度对 $c_0$ 求导为零;得分函数把它乘上 $S(z)=\nabla_\phi\log q(z|x)$,虽然 E_q[S]=0,不改变梯度期望,却可能造成很大的方差。归一化常数和固定观测残差都在 c₀ 中,仅凭 D 扫描不能把全部差距归因于前者。本实验同时把 W 列范数固定,避免梯度尺度随 D 自然增长,故 D² 趋势是这组设置的观测,不是普适定律。 用与当前采样 z 无关的 baseline c,E_q[(f-c)S]=E_q[fS]。脚本用解析 E_q[f] 作预言机 baseline,D=2048 的方差比从 61 916 893× 降至约 5.3×;它不是通用最优 baseline。若按梯度各分量的总方差选一个标量,最优常数为 E[f‖S‖²]/E[‖S‖²],通常并非 E[f]。实际可用历史批次或独立样本估计 c,并在这个梯度估计里停止对 c 求导;直接减去同批样本均值会引入相关性,在独立同分布 n 个样本的简单情形把期望缩成 (1−1/n) 倍。 一个反例说明边界。 固定 q=N(m,1),在 m=0 估计 f(z)=sin(10z) 的均值梯度,pathwise 是 10cos(10z),score 是 z sin(10z)。200000 个共同噪声样本实跑,方差分别 50.062 与 0.499,后者更低。两者理论均值均为 10exp(−50)。因此重参数化在本文高斯重建中明显有利,并不保证任何可微 f 上都方差更小。反例与推导核验见第 09 节。 3.6 下界能有多紧:IWAE 单样本 ELBO 的缝是 $\mathrm{KL}(q \,\|\, p(z \mid x))$。要缩缝有两条路:把 q 变强(换更灵活的后验族),或者换一个更紧的界。后者的经典做法是 IWAE 的 k 样本界: $$L_k = \mathbb{E}_{z_1 \dots z_k \sim q_\phi}\!\left[\log \frac{1}{k} \sum_{l=1}^{k} \frac{p_\theta(x, z_l)}{q_\phi(z_l \mid x)}\right]$$ 注意顺序:先对 k 个重要性权重取平均,再取 log。单样本 ELBO 是「log 再取平均」(每个样本的 log 比值取期望),IWAE 是「平均再 log」,Jensen 保证后者更紧。可以证明 $\log p_\theta(x) \ge L_{k+1} \ge L_k \ge L_1 = \mathcal{L}$,收敛还需要更强的尾部与可积条件,具体充分条件见下文。 这里 $\widehat L_k=\log(k^{-1}\sum_l w_l)$ 是随机结果,而 $L_k=\mathbb E[\widehat L_k]$ 才是下界,$w_l=p(x,z_l)/q(z_l|x)>0$。支持覆盖使 E_q[w]=p(x),Jensen 给出 Lk≤log p(x)。单调性也能一步看清:k+1 个权重的均值等于所有“删去一个权重”的 k 样本均值的平均;先应用 log 的凹性,再取期望,就得到 L{k+1}≥L_k。这个论证针对同一固定模型与 q 下的独立同分布采样,并要求相应期望存在。 IWAE 原文定理 1 给出重要性权重有界时趋近真值的充分条件。一般讨论极限还须保证期望可随极限交换,例如相关 log 估计量的均匀可积性;只有支持覆盖和 E[w] 有限不足以直接交换 log 与期望。即便界更紧,单次结果以及有限重复的均值仍可越过 log p(x),也不保证逐次单调。 明确反例:离散真实后验为 (0.5,0.5),q=(0.9,0.1),设 p(x)=1,则权重为 (5/9,5)。一条先采到 5、再采到两次 5/9 的路径,其 log 平均权重依次为 1.6094、1.0217、0.7115,全高于真实 log p(x)=0 且连续下降;对全部路径取期望得到的 L₁、L₂、L₃ 则是 −0.3681、−0.2761、−0.2200,保持下界与单调性。多采样平均 log 权重只降低同一 ELBO 估计的方差;改成 log 平均权重才改变期望目标及其偏差。 代价是:梯度不再是对单个样本的简单求和,k 个权重互相耦合(每个权重的梯度都带上了其他权重的归一化因子),总计算量随 k 线性上涨;编码器梯度的信噪比还可能随 k 增大而下降(见 Rainforth 等,2018),这反而不利于训练编码器——工程上这是个明确的取舍,不是免费的午餐。 这张图要看什么:左图四根柱子——ELBO(-7.420)加 KL(q‖p(z|x))(1.985)正好等于 log p(x)(-5.434),而 KL(q‖p(z))(3.364)是另一根完全不同的柱子,别混。中图是单样本蒙特卡洛 ELBO 的 4000 次采样分布,标准差 4.31,虚线是真实上界 -5.434,40.7% 的样本落在它右边。右图是 IWAE 的 k 扫描,k 从 1 涨到 500,6000 次重复的平均缝隙从 2.049 缩到 0.00262,标准误分别为 0.04643 和 0.00080;这是有限重复的估计,不能当成解析界。k=1、5、50、500 时单次越过 log p(x) 的比例分别为 34.7%、43.5%、47.7%、48.2%。标准误描述均值的不确定性,不是严格置信界。 04. 代码实现 4.1 恒等式核对:先造一个能算到机器精度的模型 要验证「差的那一项到底是什么」,必须三样东西都有解析解:边际似然、真实后验、ELBO。高斯线性模型满足这一点。将联合 log 密度中的 z 项配方: $$\log p(x,z)=\text{const}-\frac12z^\top Pz+h^\top z=\text{const}-\frac12(z-\mu)^\top P(z-\mu),\quad P=I_K+\frac{W^\top W}{\sigma^2},\quad h=\frac{W^\top(x-b)}{\sigma^2},\quad\mu=P^{-1}h$$ 所以后验 p(z|x)=N(μ,P⁻¹),边际 p(x)=N(b,WWᵀ+σ²I_D)。P 正定,实际计算可用 solve/Cholesky;这里 K=3,为便于展示保留显式逆。我们的模型为:$z \sim \mathcal{N}(0, I_K)$,$x \mid z \sim \mathcal{N}(Wz + b, \sigma^2 I_D)$。边际仍是高斯,后验是共轭高斯,ELBO 也能闭式算。 import numpy as np D, K, SIGMA2 = 6, 3, 0.35 ** 2 rng_model = np.random.default_rng(20260925) W = rng_model.normal(0, 1, size=(D, K)) * 0.9 b = rng_model.normal(0, 0.3, size=(D,)) def true_posterior(x): """p(z|x) 的闭式解:precision = I + W^T W / sigma^2。""" prec = np.eye(K) + W.T @ W / SIGMA2 cov = np.linalg.inv(prec) return cov @ (W.T @ (x - b) / SIGMA2), cov def elbo_analytic(x, m, s): """ELBO 的解析值。注意 ||x - Wz - b||^2 对 q 求期望会多出一项 trace。""" var = s ** 2 resid = x - (W @ m + b) recon = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + (resid @ resid + np.trace(W.T @ W @ np.diag(var))) / SIGMA2) kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var)) return float(recon - kl), float(recon), float(kl) def kl_gauss_gauss(m, s, mean2, cov2): """KL(N(m, diag(s^2)) || N(mean2, cov2)),两个高斯的闭式。""" var, diff = s ** 2, mean2 - m cov2_inv = np.linalg.inv(cov2) _, logdet2 = np.linalg.slogdet(cov2) return 0.5 * (np.trace(cov2_inv @ np.diag(var)) + diff @ cov2_inv @ diff - K + logdet2 - np.sum(np.log(var))) 重建项里那个 np.trace(W.T @ W @ np.diag(var)) 是最容易漏掉的一项:对 $z$ 求期望时,$\|x - Wz - b\|^2$ 里的 $Wz$ 项会因为 z 的随机性多出一份方差贡献。漏了它,ELBO 就不是下界了。 关键一步是故意把 q 指定错:取真实后验的均值再加扰动,协方差只留对角线,再乘 0.8 并加 0.05。在固定状态下,真实边际方差为 [0.21735,0.04503,0.04927],q 方差为 [0.22388,0.08602,0.08942],三个都更大,不能称为“更自信”。这份 q 同时有均值偏移、方差失配和缺失相关性。这样 KL(q‖p(z|x)) 严格大于 0,缝才看得见。跑起来: [1] 解析三项 E_q[log p(x|z)] = -4.055403 KL(q || p(z)) = 3.364364 ELBO = -7.419767 KL(q || p(z|x)) = 1.985436 ELBO + KL(q||p(z|x)) = -5.434331 log p(x) = -5.434331 |误差| = 1.776e-15 恒等式对到 2e-15 以内。同时注意:KL(q‖p(z))=3.364 比 KL(q‖p(z|x))=1.985 还大——这两个量的大小关系没有必然规律,别用其中一个去猜另一个。 均值正确时,“把协方差的非对角项丢掉”仍不是 reverse KL 意义下的最优对角近似。设 q=N(m,diag(v)),真实后验精度为 P,KL 中依赖 v_j 的项为 (P_jj v_j−log v_j)/2,对它求导得到 v_j=1/P_jj,均值最优为 m=μ。于是: $$\min_{m,v}\mathrm{KL}(q\Vert p(z|x))=\frac12\log\frac{\prod_j P_{jj}}{\det P}$$ 本例直接使用真实边际方差 diag(P⁻¹) 时,残留缝隙为 0.79398;使用 1/diag(P) 时为 0.40038。这才是在固定生成模型下该对角族的近似误差;原来 1.98544 还包含人为指定 q 的额外误差。满协方差 q 等于后验时,缝才为零。 4.2 两种梯度估计量,方差实测 同一个模型上,$\nabla_m$ 和 $\nabla_\ell$($\ell = \log s$)的解析梯度都能写出来,所以「谁对谁错」有标准答案,剩下的差别纯粹是方差: def sample_reparam(x, m, s, W, b, sigma2, rng, n): """重参数化:z = m + s ⊙ ε,梯度经 z 反传。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps score_z = (x - (z @ W.T + b)) @ W / sigma2 # ∇_z log p(x|z) return score_z, score_z * s * eps # ∂z/∂m = 1, ∂z/∂ℓ = s ⊙ ε def sample_score(x, m, s, W, b, D, sigma2, rng, n, baseline=None): """得分函数:∇ E[f] = E[f · ∇ log q],f = log p(x|z)。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps r = x - (z @ W.T + b) f = -0.5 * (D * np.log(2 * np.pi * sigma2) + np.einsum("nd,nd->n", r, r) / sigma2) if baseline is not None: f = f - baseline return f[:, None] * (eps / s), f[:, None] * (eps ** 2 - 1.0) 两行代码的差别就是全部:重参数化用的是 $\nabla_z f$,得分函数用的是 $f$ 本身。跑 40000 次独立采样: 真实梯度(解析) ∇_m = [ 0.4228 4.9273 -0.6448] ∇_ℓ = [-1.9319 -2.4426 -3.8296] 估计量对比(40000 次独立采样,方差 = 6 个参数分量方差之和) 重参数化 方差和= 377.55 均值相对误差= 0.41% 5%相对RMS需 n≈3068 得分函数(无 baseline) 方差和= 3043.11 均值相对误差= 3.95% 5%相对RMS需 n≈24722 得分函数(预言机 baseline) 方差和= 1586.45 均值相对误差= 3.09% 5%相对RMS需 n≈12889 方差比:得分函数 / 重参数化 = 8.1× 加 baseline 之后 = 4.2× 在上述正则条件与独立 baseline 下,三个估计量理论上无偏;有限样本均值仍有误差。表中的样本数是按相对均方根误差计算的估计:设单样本梯度协方差为 V、真实梯度为 g,则 n 个独立样本均值满足 E‖ĝ−g‖²=tr(V)/n,所以 n≈tr(V)/(0.05²‖g‖²)。3068 与 24722 不是“95% 概率落在 5% 内”的保证。方差和是 6 个参数分量方差之和,正文表取总体式 ddof=0 的样本估计。 这张图要看什么:左图是 $\nabla_m$ 第 0 个分量(真值 0.4228)在三种估计量下的分布——均值都压在真值附近,标准差分别是 5.7、16.9、12.0,尾巴长度差一个量级。右图的双对数坐标里,重参数化那条线几乎是平的(方差 2.08 → 1.84),得分函数曲线在本设置中近似呈 D² 增长;而把蓝色点(加了 baseline)和橙色点对比,比值从 1188× 一路到 6191 万×,加完 baseline 却稳定在 5~7×——说明减去完整均值能显著降低本组 score 方差;归一化常数与固定残差都参与,不能由此隔离各自的贡献。 4.3 β 加权:把维度死掉的过程解出来 这一节的目标是要一个能解到全局最优的玩具模型,这样「维度死了」是解析结论而不是训练运气。构造:每个坐标独立,$x_j \sim \mathcal{N}(0, \lambda_j)$,$q(z_j \mid x_j) = \mathcal{N}(a_j x_j, s_j^2)$,$p(x_j \mid z_j) = \mathcal{N}(b_j z_j, \sigma^2)$。每个维度就是一份独立副本,逐个维度单独求最优即可: SIGMA2 = 0.25 # 解码器观测噪声方差 def kl_of(a, lam, s): return 0.5 * (a ** 2 * lam + s ** 2 - 1.0 - np.log(s ** 2)) def recon_mse(a, b, lam, s): """E_{x,z}[(x - b z)^2],重建误差的期望。""" return lam * (1.0 - b * a) ** 2 + b ** 2 * s ** 2 def objective(p, lam, beta): a, b, ell = p s = np.exp(ell) return -recon_mse(a, b, lam, s) / (2 * SIGMA2) - beta * kl_of(a, lam, s) 目标对 $(a, b, \ell)$ 的梯度全部解析,脚本里再用中心差分核对一遍(实测最大偏差 5.5e-10),避免推错。数值梯度上升保留多起点作对照:a=b=0 是一个驻点,单起点可能停住;它不构成全局最优证明。下面直接把三变量问题降成一变量,给出全局解。 先固定 a,s 对 b 求导,得到 b*=aλ/(a²λ+s²)。令 r=a²λ+s²>0、t=s²/r∈(0,1],代回重建 MSE=λt,数据平均 KL=(r−1−log r−log t)/2。r−1−log r≥0,在 r=1 取到最小;其余目标为: $$J(t)=-\frac{\lambda t}{2\sigma^2}+\frac\beta2\log t,\quad J'(t)=-\frac\lambda{2\sigma^2}+\frac\beta{2t},\quad J''(t)=-\frac\beta{2t^2}<0$$ 因此 β>0、λ>0 时唯一最优 t=min(βσ²/λ,1)。选正号的一组解为 s²=t、a=√((1−t)/λ)、b=√(λ(1−t));a,b 同时取负也是同一重建解。t=1 时 a=b=0、s=1,MSE=λ;否则 MSE=βσ²、平均 KL=−log(t)/2。阈值 β*=λ/σ² 与连续的 MSE=min(βσ²,λ) 就这样推出来,等号处也关闭。λ 是数据方差,不是以 nats 衡量的信息量。 本轮扫描和配图采用这份闭式。独立多起点优化在 (λ,β)=(4,0.25) 仍有目标差 1.51×10⁻⁵,MSE 0.0627248 对闭式 0.0625,说明有限迭代会留下误差;原文 5.53×10⁻³ 的偏差也不应当作精确最优证明。闭式内部一致性误差 8.88×10⁻¹⁶;另以原三变量目标的随机扰动与一变量网格核对,均未发现更优值。 跑完 β 扫描,把最优解和闭式预测放在一起对: λ β s²闭式 βσ²/λ a²λ闭式 1-s² MSE闭式 βσ² 1.0000 1.00 0.25000 0.25000 0.75000 0.75000 0.25000 0.25000 1.0000 2.00 0.50000 0.50000 0.50000 0.50000 0.50000 0.50000 1.0000 3.00 0.75000 0.75000 0.25000 0.25000 0.75000 0.75000 0.2500 0.50 0.50000 0.50000 0.50000 0.50000 0.12500 0.12500 最大内部一致性偏差 = 8.88e-16;独立数值优化误差另列 λ=4.0000 理论死亡阈值 β* = λ/σ² = 16.00 λ=1.0000 理论死亡阈值 β* = λ/σ² = 4.00 λ=0.2500 理论死亡阈值 β* = λ/σ² = 1.00 λ=0.0625 理论死亡阈值 β* = λ/σ² = 0.25 存活时最优解落在闭式 $s^2 = \beta\sigma^2/\lambda$、$a^2\lambda = 1 - s^2$、$\mathrm{MSE} = \beta\sigma^2$ 上。这个闭式有个反直觉的推论:存活时的重建误差只由 β 和解码器噪声决定,跟这个维度携带多少信息 λ 无关——λ 只决定「这个维度值不值得用」。 05. 工业级实现对照 最小实现里 KL 是两个高斯的闭式,官方示例也是闭式,但分布、归约和 dtype 必须对齐。本节固定 diffusers v0.35.1 与 pytorch/examples 提交 acc295dc7b90,以 2026-10-12 的核对为准;主分支后续可变化。已从原始源码 AST 原样提取相关方法,在 PyTorch 2.10.0+cpu 上真实执行;没有下载权重、MNIST 或运行整个生成管线。 1. 官方最小实现:pytorch/examples。 pytorch/examples 的 vae/main.py 里,loss_function 就是标准的 BCE 重建加闭式 KL,没有任何 β(以本轮核对的固定源码为准): def loss_function(recon_x, x, mu, logvar): BCE = F.binary_cross_entropy(recon_x, x.view(-1, 784), reduction='sum') # 0.5 * sum(1 + log(sigma^2) - mu^2 - sigma^2) KLD = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp()) return BCE + KLD 和本文 3.4 节那一项完全对得上:$\mathrm{KL} = \frac{1}{2}\sum(\mu^2 + s^2 - 1 - \log s^2)$,代码里写成 -0.5 * sum(1 + logvar - mu^2 - exp(logvar)),logvar 就是 $\log s^2$。要加 β 得自己动手,官方示例没有。 2. 为什么参数化 logvar 而不是 s。 方差必须为正,直接学 s 要加约束;学 $\log s^2$ 则值域是全体实数,网络怎么输出都合法。diffusers 的 DiagonalGaussianDistribution 还额外做了截断(以本轮核对的固定源码为准): self.mean, self.logvar = torch.chunk(parameters, 2, dim=1) self.logvar = torch.clamp(self.logvar, -30.0, 20.0) self.std = torch.exp(0.5 * self.logvar) self.var = torch.exp(self.logvar) clamp 到 [-30, 20] 限制指数输入,但不等于所有精度安全:$\exp(20)$ 约为 4.85 亿,fp32 可表示但 fp16 已无法表示;下界 -30 避免过小方差与过大负 logvar。还需核对计算 dtype,截断本身不是所有精度下的安全保证。 3. 采样就是重参数化,一行代码。 同一个类里: def sample(self, generator=None): sample = randn_tensor(self.mean.shape, generator=generator, device=self.parameters.device, dtype=self.parameters.dtype) x = self.mean + self.std * sample return x 就是本文 3.5 的 $z = m + s \odot \epsilon$。mode() 直接返回均值——一些确定性编码场景使用 mode(),但 diffusers img2img 默认使用后验 sample(generator=...),训练和推理均可采样。 4. KL 的求和维度与归一化。 diffusers 里 kl() 写成(以本轮核对的固定源码为准): return 0.5 * torch.sum(torch.pow(self.mean, 2) + self.var - 1.0 - self.logvar, dim=[1, 2, 3]) 对通道、高、宽三个维度求和,得到的是每个样本一个标量,得到 [B] 后,训练侧可按其目标再取 batch 平均。这里源码固定求和 dim=[1,2,3],该结论只适用于 [B,C,H,W];若直接输入五维 [B,C,T,H,W],返回 [B,W],本轮实跑形状为 [2,4],不能据类名假定它已归约全部视频维度。应核对具体视频 VAE 类与外部 loss,不能直接复用此四维示例。这个区别很实际:若重建归约保持不变,却仅把每样本的 KL 再除以 $C \times H \times W$,其相对权重就会相应变小;若两个 loss 一同同比缩放,其相对权重则不变。单独把 KL 改成逐元素平均时,潜变量维度越多,其相对权重越小,可能使先验对齐变弱、尺度漂移;过强 KL 才更直接推动后验坍缩。 5. 训练时 KL 根本不在模型里。 值得注意的是 AutoencoderKL 的模型文件里没有 kl_loss 这个东西,它只通过 encode() 返回 DiagonalGaussianDistribution 后验,KL 由外部训练脚本算。这是工程上的职责划分:模型只负责给出分布,损失函数怎么组合(KL 权重、perceptual loss、对抗损失)交给训练配置。 6. 潜空间的缩放。 SD1.x 常见 scaling_factor=0.18215 是乘到原始 latent 上的系数,按缩放后目标标准差为 1 的约定,对应原始标准差约 $1/0.18215\approx5.49$,缩放后才接近 1,不能把 0.18 当成原始潜空间尺度。它来自特定 VAE 与扩散训练的尺度约定,不由 ELBO 唯一决定。 7. 最小实现和工业实现的差异。 工业代码增加 logvar 截断、dtype 控制、分布采样接口及 latent 尺度约定。KL 逐维求和来自概率定义,batch 平均来自训练目标;它们不是任意工程细节。sample() 与 mode() 都有推理用途,要依具体管线选择。 06. 代价与边界 省了什么。 把一个对 K 维积分的不可解问题,变成了「采样 + 两个可导项」,梯度能用标准反向传播算。这是 VAE、扩散模型、以及一大票潜变量模型能训练起来的全部前提。 赔了什么,四条。 一是下界不是似然。 优化 ELBO 不等于优化 log p(x),中间隔着 KL(q‖p(z|x))。在固定生成模型下,这个缝受 q 族表达能力与实际优化结果共同影响:均值场对角高斯拟合不了有相关性的真实后验,缝就永远在。本例里缝是 1.985 nats,在一个 log p(x) 只有 -5.43 的小模型上,数值上差约 36%,但连续对数密度受坐标单位影响,不宜把这个比例当作通用误差尺度。 二是 KL 的方向有偏好。 $\mathrm{KL}(q\Vert p(z\mid x))$ 是 reverse KL:当 $q$ 把概率放到真实后验很低的地方,代价很大,因此在受限的单峰近似族下常表现为 mode-seeking,可能只覆盖一个峰;反向的 $\mathrm{KL}(p\Vert q)$ 则倾向覆盖目标的质量,即 mass-covering。VAE 的模糊不能单归因于这个方向,逐像素重建目标、解码器分布与压缩瓶颈都有关。 三是推断被参数化摊平(amortized)之后又多了一层误差。 经典变分推断对每个 x 单独优化一组变分参数;VAE 用一个共享的编码器网络去输出所有 x 的 $m_\phi(x)$ 和 $s_\phi(x)$。这一步是为了快——测试时一次前向就得到近似后验参数,不用重新迭代——但共享映射还增加了约束。即便每个 x 单独看,最优的对角高斯后验就在那儿,共享编码器也可能一辈子到不了。Cremer 等的分析 区分近似差距与摊销差距。若再把实际优化单独列账,固定 θ 与 x,可写成 log p(x)−L实际=(log p(x)−L族最优)+(L族最优−L共享最优)+(L共享最优−L实际),分别对应近似、共享约束、优化差距。在 L实际属于该共享模型族等前提下各项非负。当前实验直接指定一份 x 的 q,没有训练共享编码器,不能测出摊销差距。这也解释了为什么给编码器加容量在有些任务上能明显提 ELBO——在固定生成模型时,这改善的是近似推断。 四是加权 KL 会直接杀死维度。 这是第 4.3 节那张表的完整结论: λ=4.0000 在 β≤12.0 内都存活 λ=1.0000 从 β=4.0 起死亡(β=1 时 KL=0.6931) λ=0.2500 从 β=1.0 起死亡 λ=0.0625 从 β=0.25 起死亡 死亡阈值是 $\beta^\ast = \lambda / \sigma^2$。读出这个式子的含义:一个维度要活下来,数据方差 λ 必须盖过「KL 的价」β 乘上「解码器噪声」σ²。β 翻倍,能活下来的维度门槛就翻倍;解码器越准(σ² 越小),越多的维度能活。这仅解释线性高斯模型的阈值。强大的自回归解码器可通过其他条件预测数据而忽略 z,不能简单等同于把固定高斯观测方差 σ² 调小。 这张图要看什么:左图四条曲线是不同 λ 下重建 MSE 随 β 的变化,实心点表示维度存活、空心方块表示已死——注意存活段的 MSE 就是 $\beta\sigma^2$ 这条直线,跟 λ 无关;而死掉的段 MSE 平在 λ 上不再变化。右图是 $(\lambda, \beta)$ 平面上的相图,斜线是 $\beta = \lambda/\sigma^2$,横轴是 λ/σ²、纵轴是 β,线的上方关闭、下方存活。调 β 之前先看一眼这个平面:你真正要判断的是「在当前 β 下,哪些数据方向位于存活区域」。 缓解手段:free bits。 归约顺序对应 IAF 原文附录 C.8、公式 15 的分组平均后截断;本文另加 β 作教学对照。 在本脚本中,先对数据取每维平均 KL,再换成 $\max(\mathbb E_{\mathrm{data}}[\mathrm{KL}],C)$,是在 KL 小于 C 时去掉进一步压低它的梯度,给重建项使用这部分容量的机会;这不是保证至少传 C nats 的硬约束。下面的线性实验确实在边界附近找到更好的重建,但一般神经网络不保证被救活。这个“先平均再截断”的目标与“每个样本先截断再平均”通常不同,数值和全局解也不同。本模型 r=1 时记 R=−log(t)/2≥0,MSE=λexp(−2R),目标为 −λexp(−2R)/(2σ²)−βmax(R,C),所以 R*=max(C,0.5log(λ/(βσ²)),0)。这个特例确实用到 C 附近,但普遍神经网络无此保证。闭式结果(β=4): λ C=0(纯 β) C=0.05 C=0.2 1.0000 a=0.000 KL=0.000 MSE=1.000 a=0.308 KL=0.050 MSE=0.905 a=0.574 KL=0.200 MSE=0.670 0.2500 a=0.000 KL=0.000 MSE=0.250 a=0.617 KL=0.050 MSE=0.226 a=1.148 KL=0.200 MSE=0.168 λ=1.0 的维度被救回来了(MSE 1.000 → 0.670),λ=0.25 的也从 0.250 降到 0.168。代价是放松了对先验 KL 的惩罚;是否改善或损害解耦需要独立评估——这是一笔明码标价的交易。 什么时候不该用。 归一化流和自回归模型在相应建模假设下可计算精确似然,不一定需要变分下界;VQ 模型可精确计算离散 token 序列的自回归概率,但一般仍不能精确边缘化得到像素似然。ELBO 也不是训练高维生成模型的唯一途径,score matching、流匹配和对抗训练是其他路线。同一数据、同一似然约定下标准 ELBO 可比较为下界,但 q 的质量影响松紧,不能直接据此断言真实似然或感知质量的排序。 07. 经典论文脉络 Kingma & Welling, 1312.6114(2013)——VAE 原文。贡献是把「变分推断 + 重参数化 + 神经网络编码器」拼成一个能用 SGD 训的东西,并给出 SGVB 估计量。它同时确立了沿用至今的 loss 形式:重建项减 KL。本文 3.2~3.5 节基本是这篇的复述。 Rezende, Mohamed & Wierstra, 1401.4082(2014)——几乎同期独立提出的重参数化,论文里叫 stochastic backpropagation。贡献是把这个方法从「VAE 的一个技巧」推广到论文所讨论的可微潜变量模型与分布族,仍需可用的噪声变换和正则条件,并系统讨论了高斯之外的分布族怎么处理。想理解重参数化的适用边界(哪些分布能做、哪些只能退回得分函数),这篇比 VAE 原文讲得更清楚。 Burda, Grosse & Salakhutdinov, 1509.00519(2015)——IWAE。贡献就是本文 3.6 那个 $L_k$:把「log 再平均」换成「平均再 log」,得到一个随 k 单调变紧的界,并证明了收敛性。它澄清了一个当时普遍的误解——「多采几个样本只是降方差」,实际上换的是界本身。 Higgins et al., ICLR 2017——β-VAE。给 KL 项加权重 β > 1,旨在增强因子化与解耦表征,效果须独立评测;目标与重建取舍可对照同组作者的 2018 原论文。本文第 4.3 节给出线性高斯教学特例的代价面:只在存活区域,MSE 随 β 成正比;到阈值后饱和。它不是该论文非线性模型的通用定理,也未在本实验测量解耦指标。 Bowman et al., 1511.06349(2015)——讨论句子 VAE 后验坍缩的代表性工作。用 VAE 做句子生成,强大的自回归解码器会直接忽略潜变量,KL 掉到 0。这篇提出的 KL annealing(训练初期把 β 从 0 慢慢涨到 1)是可尝试的缓解手段之一,效果依赖具体模型和优化过程,并非保证解决坍缩。 补充两篇:Kingma et al. 的 IAF(1606.04934)走的是另一条路——不改界,改 q,用可逆变换把后验族变强来直接缩小那个缝;Kingma & Welling 的综述(1906.02691)适合把上述脉络串起来通读。 08. 常见误解 误解一:「ELBO 里的 KL 就是 q 和真实后验的差距」。 ELBO 里减去的是 $\mathrm{KL}(q\Vert p(z))$;下界的差距是 $\mathrm{KL}(q\Vert p(z\mid x))$。调整 β 会通过训练改变 q 和生成模型,后者也可能变化,只是没有保证随前者一起下降。 误解二:「ELBO 是下界,所以蒙特卡洛估计值不会超过 log p(x)」。 下界性质是对期望成立的,不是对每个样本成立。本例单样本估计的标准差是 4.308,而缝只有 1.985,结果 40.7% 的样本越过了真实上界。若有限样本估计越过 log p(x),采样波动是一种解释;仍应核对归约、似然常数与实现,不能仅凭越界认定程序正确。 误解三:「重参数化是为了让采样可微」。 准确说法是把参数相关的随机变量表示为固定噪声上的可导变换,从而得到路径梯度。采样「不可微」这个表述本身就有问题:得分函数估计量里 $\nabla_\phi \log q_\phi$ 是对参数求导,完全可微,它对 f 连可导性都不要求。路径估计用上了 ∇z f,在本文高斯重建实验中方差较低;第 3.5 节的正弦反例说明排序可反转。其首要机制是把参数相关采样表示成固定噪声的可导映射,方差降低是有条件的好处。 误解四:「KL 掉到 0 说明 KL 项优化到位了」。 这是后验坍缩的典型症状。本例 λ=1.0、β=4 时最优解就是 a=0、s=1、KL=0、MSE=1.000(正好等于 λ),编码器彻底放弃了这个维度。看数据平均 KL 为零可推出几乎所有 x 的 q(z|x)=p(z),说明潜变量不携带 x 信息;非零 KL 也未必等于有用信息。辅助统计量 A=Var数据(E_q[z|x])=a²λ 只检查均值活动度。active_unit() 使用 IWAE 第 5.2 节 的经验阈值 A>0.01;它不等价于理论 a≠0,方差编码的信息也可能被它漏掉。临近阈值时仍存活但 A≤0.01 的方向会被统计判为 inactive。 误解五:「β 越大解耦越好,重建变差只是小代价」。 在线性模型中,最优 MSE 为 $\min(\beta\sigma^2,\lambda)$,连续增加后饱和;每维 KL 也连续趋零。离散的存活计数会出现台阶,但不意味着误差发生跳变。更强的 KL 约束还可能让所有维度关闭,不能只用 β 大小判断解耦质量。 09. 动手验证 前三个实验只依赖 numpy,配图脚本还需 matplotlib;完整四脚本均在附录。把它们保存到同一个目录运行,reparam_gradients.py 和 make_figures.py 会导入相邻脚本: python -B elbo_identity.py python -B reparam_gradients.py python -B beta_kl_weight.py python -B make_figures.py 本轮 CPU 实跑约 1.7、0.7、1.0、6.7 秒,仅供环境对照,不承诺其他机器的耗时。模型生成与状态种子 20260925,MC 种子 7,IWAE 种子 13,梯度小模型种子 11,维度扫描种子 23。matplotlib 字体选 Microsoft YaHei/SimHei/DejaVu Sans;其他平台请换成已安装的中文字体。计算线程在本轮进程中设为 1。 实验一:比较三份 q。 把 make_q 的均值设成真实后验均值,分别用 np.diag(cov) 与 1 / np.diag(np.linalg.solve(cov,np.eye(K))) 作方差。预期 KL 缝隙为 0.79398 与 0.40038;原指定 q 为 1.98544。要到零还需完整协方差,不只是换均值或对角方差。 实验二:换独立 baseline 并查无偏条件。 用独立 pilot 样本或上一批 f 的均值作当前批次 c,比较方差与均值误差。不要直接对当前批次减自身均值后声称严格无偏;可用 leave-one-out 排除当前样本。方差改善依 f、score 与 baseline 的关系决定,不承诺一定到 4.2×。 实验三:比较 free bits 的两种归约顺序。 运行: from beta_kl_weight import closed_form_optimal print(closed_form_optimal(lam=0.25, beta=4.0, free_bits=0.5)) 这里对应数据平均 KL 外取 max,低方差方向在这个解析模型中会使用 latent;若改为逐样本 max 后求期望,须重新计算目标与最优解,不能沿用这里的闭式。 实验四:重现两个反例。 离散 IWAE 权重路径与正弦梯度的最小实验如下;第二个种子固定 73、20 万共同噪声,独立运行的方差应约为 50 与 0.5,具体有限样本数值允许变化。 import numpy as np weights = np.array([5.0, 5.0/9.0, 5.0/9.0]) print(np.log(np.cumsum(weights)/np.arange(1,4))) z = np.random.default_rng(73).normal(size=200000) print(np.var(10*np.cos(10*z)), np.var(z*np.sin(10*z))) 第一行输出 [1.60943791, 1.02165125, 0.71149632];这条可发生的路径同时反驳“单次一定是下界”和“单次随 k 单调”。它不反驳对全部路径取期望的定理。 10. 延伸阅读 按知识树的依赖关系,从这篇出发有三个方向: 往下(直接依赖本文):扩散过程的前向与反向推导——离散潜变量链的变分界与连续 SDE/score 视角怎样联系;SDE 训练并非只有 ELBO 一条路线。另一个直接后继是 VAE 结构与训练目标。 往旁(同一个估计量,另一副马甲):策略梯度与 PPO 基础——本文 3.5 的得分函数估计量在 RL 里叫 REINFORCE,方差问题一模一样,baseline 的作用也一模一样。读过这篇再去看 PPO,会省掉一次重新理解。 已发布的相关篇目:视频 VAE 的常见 loss 组合——KL 之外还有哪些 loss 会加进来,以及它们各自的量级;FlashAttention 为什么不需要存下注意力矩阵 与 性能建模与 Profiling——本文没碰的工程侧。 完整的知识树见博客目录页 AIGC 基本功知识树,按依赖顺序排好了先修课。 附录:完整代码 09 节用到的脚本全文如下(reparam_gradients.py、make_figures.py、elbo_identity.py、beta_kl_weight.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 reparam_gradients.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """重参数化 vs 得分函数(REINFORCE)梯度估计量,方差实测。 要估的量:∇_φ E_{q_φ}[log p(x|z)],φ = (m, ℓ),ℓ = log s。 这一项没法解析求的时候只能采样,两种采样方式的方差差好几个数量级。 真实梯度在这个高斯线性模型里能解析算出来,所以「谁对谁错」有标准答案, 剩下的差别就纯粹是方差。 两部分实验: A. 固定一个小模型(D=6),看三种估计量的分布 B. 扫数据维度 D,看方差比怎么长——这里才是重参数化真正救命的地方 只依赖 numpy,直接 `python reparam_gradients.py` 即可运行。 """ import numpy as np import elbo_identity as EI from elbo_identity import ( D, K, SIGMA2, W, b, elbo_analytic, make_one_x, make_q, ) N_TRIAL = 40000 # ══════════════════════════════════════════════════════════════ # A. 小模型:三种估计量的分布 # ══════════════════════════════════════════════════════════════ def true_grad(x, m, s, Wm, bm, sigma2): """∇_m 与 ∇_ℓ 的解析梯度,ℓ = log s。""" g_m = Wm.T @ (x - (Wm @ m + bm)) / sigma2 g_ell = -(s ** 2) * np.diag(Wm.T @ Wm) / sigma2 return g_m, g_ell def log_lik_rows(x, z, Wm, bm, Dm, sigma2): """批量算 log p(x|z),z: [n, K]。""" r = x - (z @ Wm.T + bm) return -0.5 * (Dm * np.log(2 * np.pi * sigma2) + np.einsum("nd,nd->n", r, r) / sigma2) def sample_reparam(x, m, s, Wm, bm, sigma2, rng, n): """重参数化:z = m + s ⊙ ε,梯度经 z 反传。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps score_z = (x - (z @ Wm.T + bm)) @ Wm / sigma2 # ∇_z log p(x|z) return score_z, score_z * s * eps # ∂z/∂m=1, ∂z/∂ℓ=s⊙ε def sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n, baseline=None): """得分函数:∇ E[f] = E[f · ∇ log q],f = log p(x|z)。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps f = log_lik_rows(x, z, Wm, bm, Dm, sigma2) if baseline is not None: f = f - baseline return f[:, None] * (eps / s), f[:, None] * (eps ** 2 - 1.0) def summarize(name, gm_hat, ge_hat, g_m, g_ell): var = float(np.var(gm_hat, axis=0).sum() + np.var(ge_hat, axis=0).sum()) gnorm = float(np.linalg.norm(np.concatenate([g_m, g_ell]))) err = float(np.linalg.norm(np.concatenate([gm_hat.mean(0) - g_m, ge_hat.mean(0) - g_ell]))) / gnorm n_needed = int(np.ceil((var ** 0.5 / (0.05 * gnorm)) ** 2)) print(f" {name:<24s} 方差和={var:11.2f} 均值相对误差={err:6.2%} " f"5%相对RMS需 n≈{n_needed}") return var def part_a(): print("=" * 68) print("A. 小模型(D=6, σ=0.35):三种估计量的分布") print("=" * 68) # 与 elbo_identity.state() 同一颗种子 => 同一个 x、同一个 q rng_state = np.random.default_rng(EI.STATE_SEED) x, _ = make_one_x(rng_state) m, s = make_q(x, rng_state) g_m, g_ell = true_grad(x, m, s, W, b, SIGMA2) _, recon, kl = elbo_analytic(x, m, s) print(f"\n真实梯度(解析)") print(f" ∇_m = {np.array2string(g_m, precision=4)}") print(f" ∇_ℓ = {np.array2string(g_ell, precision=4)}") print(f" E_q[log p(x|z)] = {recon:.4f},KL(q||p(z)) = {kl:.4f}") rng = np.random.default_rng(11) n = N_TRIAL print(f"\n估计量对比({n} 次独立采样,方差 = 6 个参数分量方差之和)") gm_r, ge_r = sample_reparam(x, m, s, W, b, SIGMA2, rng, n) gm_s, ge_s = sample_score(x, m, s, W, b, D, SIGMA2, rng, n) gm_sb, ge_sb = sample_score(x, m, s, W, b, D, SIGMA2, rng, n, baseline=recon) v_r = summarize("重参数化", gm_r, ge_r, g_m, g_ell) v_s = summarize("得分函数(无 baseline)", gm_s, ge_s, g_m, g_ell) v_sb = summarize("得分函数(预言机 baseline)", gm_sb, ge_sb, g_m, g_ell) print(f"\n 方差比:得分函数 / 重参数化 = {v_s / v_r:.1f}×") print(f" 加 baseline 之后 = {v_sb / v_r:.1f}×") print(f"\n∇_m 第 0 个分量(真值 {g_m[0]:.4f})的估计分布") for name, g in (("重参数化", gm_r[:, 0]), ("得分函数", gm_s[:, 0]), ("得分函数+baseline", gm_sb[:, 0])): print(f" {name:<20s} mean={g.mean():9.4f} std={g.std():8.3f} " f"min={g.min():9.2f} max={g.max():9.2f}") print(f"\n均值误差随样本数的收敛(∇_m 第 0 个分量)") print(f" {'n':>7s} {'重参数化':>12s} {'得分函数':>12s}") for n2 in (10, 100, 1000, 10000, N_TRIAL): print(f" {n2:7d} {abs(gm_r[:n2, 0].mean() - g_m[0]):12.5f} " f"{abs(gm_s[:n2, 0].mean() - g_m[0]):12.5f}") return dict(g_m0=g_m[0], gm_r=gm_r[:, 0], gm_s=gm_s[:, 0], gm_sb=gm_sb[:, 0], var_r=v_r, var_s=v_s, var_sb=v_sb) # ══════════════════════════════════════════════════════════════ # B. 方差比随数据维度 D 怎么长 # ══════════════════════════════════════════════════════════════ def build_model(Dm, Km, seed): """构造一个 decoder 列范数归一化的线性高斯模型,让梯度尺度不随 D 漂。""" rng = np.random.default_rng(seed) Wm = rng.normal(size=(Dm, Km)) Wm /= np.linalg.norm(Wm, axis=0, keepdims=True) # 每列范数 = 1 bm = rng.normal(0.0, 0.3, size=(Dm,)) return Wm, bm def part_b(): print("\n" + "=" * 68) print("B. 方差比随数据维度 D 的变化(σ²=1,decoder 列范数归一化)") print("=" * 68) rng = np.random.default_rng(23) rows = [] print(f"\n {'D':>6s} {'重参数化':>12s} {'得分函数':>14s} {'比值':>10s} " f"{'+baseline 方差':>14s} {'比值':>10s}") for Dm in (8, 64, 512, 2048): Wm, bm = build_model(Dm, K, seed=1000 + Dm) z_true = rng.normal(size=(K,)) x = Wm @ z_true + bm + rng.normal(size=(Dm,)) # σ² = 1 m = Wm.T @ (x - bm) # 一个合理的变分均值 s = np.full((K,), 0.6) sigma2 = 1.0 n = 4000 gm_r, ge_r = sample_reparam(x, m, s, Wm, bm, sigma2, rng, n) gm_s, ge_s = sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n) # 预言机 baseline:E_q[log p(x|z)] 的解析值 resid = x - (Wm @ m + bm) recon = -0.5 * (Dm * np.log(2 * np.pi * sigma2) + (resid @ resid + np.trace(Wm.T @ Wm @ np.diag(s ** 2))) / sigma2) gm_sb, ge_sb = sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n, baseline=recon) v_r = float(np.var(gm_r, axis=0).sum() + np.var(ge_r, axis=0).sum()) v_s = float(np.var(gm_s, axis=0).sum() + np.var(ge_s, axis=0).sum()) v_sb = float(np.var(gm_sb, axis=0).sum() + np.var(ge_sb, axis=0).sum()) rows.append((Dm, v_r, v_s, v_sb)) print(f" {Dm:6d} {v_r:12.2f} {v_s:14.2f} {v_s / v_r:9.1f}× " f"{v_sb:14.2f} {v_sb / v_r:9.1f}×") print("\n 为什么长这么快:f = log p(x|z) 的均值里有一大坨与参数无关的") print(" 与 z 无关的归一化常数和残差均值。它们乘到 score 中会增加方差;") print(" 本扫描固定 K=3、归一化 W 列范数、s=0.6,非一般维度定律。") print(" baseline 减去完整 E[f];pathwise 不一定在所有问题上都更低方差。") return rows if __name__ == "__main__": a = part_a() rows = part_b() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「变分下界与重参数化」的三张解释图。 数值全部来自同目录的三个脚本(elbo_identity / reparam_gradients / beta_kl_weight),这里只负责把它们画出来——改了那几个脚本这里要重跑, 避免图与正文数字不一致。 三张图分别回答: 1. ELBO 离真实目标差多少,差的那一项是什么,多采样能不能补上 2. 重参数化到底省了多少方差,以及这个差距随数据维度怎么长 3. KL 项加权的 β 是怎么把潜变量维度一刀一刀切掉的 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from matplotlib.patches import Rectangle import beta_kl_weight as BK import elbo_identity as EI import reparam_gradients as RG ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) INK = "#1f2937" C_ELBO = "#2f6fb0" # ELBO:蓝 C_GAP = "#e0a03c" # 缺口:橙 C_BAD = "#d1495b" # 越界 / 死亡:红 C_OK = "#2f9e6f" # 收紧 / 存活:绿 C_SCORE = "#8b5cf6" # 得分函数:紫 def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=13.0, weight="bold", color=INK, pad=10) if xlabel: ax.set_xlabel(xlabel, fontsize=11, color="#475569") if ylabel: ax.set_ylabel(ylabel, fontsize=11, color="#475569") ax.tick_params(labelsize=10, colors="#64748b") for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#cbd5e1") ax.grid(axis="y", color="#eef2f7", lw=1.0) ax.set_axisbelow(True) # ══════════════════════════════════════════════════════════════ # 图 1:ELBO 离 log p(x) 差多少 # ══════════════════════════════════════════════════════════════ def fig_elbo_gap(): st = EI.state() mc = EI.mc_table(st) iw = EI.iwae_table(st) log_px, elbo, gap, kl_prior = st["log_px"], st["elbo"], st["gap"], st["kl"] fig, axes = plt.subplots(1, 3, figsize=(16.2, 4.9)) fig.patch.set_facecolor("white") # ── (a) 分解:两条横向长条 ── ax = axes[0] style(ax, "(a) log p(x) 拆成两截", "nats(对数似然,0 在右边)") rows = [ ("ELBO(能算,优化它)", elbo, C_ELBO, "white"), ("log p(x)(本例闭式真值)", log_px, C_BAD, "white"), ("KL(q‖p(z)):loss 里那一项", -kl_prior, "#94a3b8", "white"), ("KL(q‖p(z|x)):上面两条的差", -gap, C_GAP, "white"), ] for i, (name, v, color, tc) in enumerate(rows): y = len(rows) - 1 - i ax.barh(y, -v, left=v, height=0.52, color=color) ax.text(v + 0.18, y, f"{v if i < 2 else abs(v):.3f}", ha="left", va="center", fontsize=10, color=INK, weight="bold") ax.axvline(log_px, color=C_BAD, ls="--", lw=1.3) ax.axvline(elbo, color=C_ELBO, ls="--", lw=1.3) ax.annotate("", xy=(elbo, 3.28), xytext=(log_px, 3.28), arrowprops=dict(arrowstyle="<->", color="#a16207", lw=1.8)) ax.text((elbo + log_px) / 2, 3.75, "差 = 1.985", ha="center", va="bottom", fontsize=10.5, color="#a16207", weight="bold", bbox=dict(fc="white", ec="none", alpha=0.9, pad=1.0)) ax.text(-9.35, 0.68, "上面两条之差 = 下面橙色那条,\n不是灰色那条——这两个 KL 常被混为一谈", ha="left", va="center", fontsize=9, color="#64748b", linespacing=1.5) ax.set_yticks(range(len(rows))) ax.set_yticklabels([r[0] for r in rows][::-1], fontsize=9.5) ax.set_xlim(-9.6, 1.5) ax.set_ylim(-0.6, 3.9) ax.grid(axis="x", color="#eef2f7", lw=1.0) ax.grid(axis="y", visible=False) # ── (b) 单样本 MC 会越过上界 ── ax = axes[1] style(ax, f"(b) L=1 的 MC 估计({EI.MC_REP} 次)", "单次估计值", "频数") vals = mc[1]["vals"] ax.hist(vals, bins=70, color="#cbd5e1", edgecolor="white", lw=0.4) over = vals[vals > log_px] ax.hist(over, bins=70, color=C_BAD, alpha=0.85, label=f"{mc[1]['frac']:.1%} 越过了 log p(x)") ax.axvline(elbo, color=C_ELBO, lw=2.0, label=f"ELBO = {elbo:.3f}") ax.axvline(log_px, color=C_BAD, lw=2.0, ls="--", label=f"log p(x) = {log_px:.3f}") ax.set_xlim(-26, 7) ax.legend(fontsize=9, frameon=False, loc="upper left") ax.set_yscale("log") ax.set_ylim(0.7, 900) ax.text(0.03, 0.05, "估计量是无偏的:它在 ELBO 周围晃,\n不是「恒小于 log p(x)」", transform=ax.transAxes, ha="left", va="bottom", fontsize=9.5, color="#64748b", linespacing=1.5) # ── (c) IWAE 收紧 ── ax = axes[2] style(ax, f"(c) 多采样收紧(每项 {EI.IW_REP} 次)", "k(每次采几个 z)", "nats") ks = np.array(EI.IW_KS, dtype=float) means = np.array([iw[k]["mean"] for k in EI.IW_KS]) stds = np.array([iw[k]["std"] for k in EI.IW_KS]) ax.errorbar(ks, means, yerr=stds, fmt="o-", color=C_OK, lw=2.0, capsize=4, markersize=6) ax.axhline(log_px, color=C_BAD, ls="--", lw=1.6, label=f"log p(x) = {log_px:.3f}") ax.axhline(elbo, color=C_ELBO, ls=":", lw=1.6, label=f"ELBO = {elbo:.3f}") ax.set_xscale("log") ax.set_ylim(-9.4, -4.7) ax.set_xlim(0.7, 900) for k, m in zip(ks, means): ax.annotate(f"还差 {log_px - m:.3f}", (k, m), textcoords="offset points", xytext=(8, 12 if k > 1 else -18), fontsize=9, color="#64748b", bbox=dict(fc="white", ec="none", alpha=0.85, pad=0.6)) ax.legend(fontsize=9, frameon=False, loc="lower right") ax.text(0.03, 0.06, "期望界更紧;误差棒是单次标准差", transform=ax.transAxes, fontsize=9.5, color="#64748b") fig.suptitle("这张图要看什么:ELBO 与真实目标之间那道缝," "固定 q 的 KL 缝隙与采样波动是两件事", fontsize=11.5, color="#64748b", y=1.02) fig.tight_layout() p = OUT / "elbo_gap.png" fig.savefig(p, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" ✓ {p.name}") # ══════════════════════════════════════════════════════════════ # 图 2:重参数化省了多少方差 # ══════════════════════════════════════════════════════════════ def fig_grad_variance(): a = RG.part_a() rows = RG.part_b() fig, axes = plt.subplots(1, 2, figsize=(13.4, 5.0)) fig.patch.set_facecolor("white") # ── (a) 估计分布 ── ax = axes[0] style(ax, "(a) ∂L/∂m 第 0 个分量的估计分布", "估计值", "频数") bins = np.linspace(-70, 70, 90) for vals, color, name in ((a["gm_r"], C_ELBO, "重参数化"), (a["gm_s"], C_SCORE, "得分函数"), (a["gm_sb"], C_GAP, "得分函数+baseline")): ax.hist(vals, bins=bins, histtype="step", lw=1.8, color=color, label=f"{name} std={vals.std():.1f}") ax.axvline(a["g_m0"], color=C_OK, lw=2.2, label=f"真值 = {a['g_m0']:.3f}") ax.set_xlim(-70, 70) ax.set_yscale("log") ax.legend(fontsize=9.5, frameon=False, loc="upper left") ax.text(0.98, 0.05, "理论均值相同,有限样本均值有误差:\n" f"std = {a['gm_r'].std():.1f} / {a['gm_s'].std():.1f} / " f"{a['gm_sb'].std():.1f}", transform=ax.transAxes, ha="right", va="bottom", fontsize=9.5, color="#64748b", linespacing=1.5) # ── (b) 随维度怎么长 ── ax = axes[1] style(ax, "(b) 方差随数据维度 D 怎么长", "D(数据维度)", "梯度方差(6 个分量之和)") Ds = np.array([r[0] for r in rows], dtype=float) vr = np.array([r[1] for r in rows]) vs = np.array([r[2] for r in rows]) vsb = np.array([r[3] for r in rows]) ax.loglog(Ds, vs, "o-", color=C_SCORE, lw=2.0, markersize=7, label="得分函数(无 baseline)") ax.loglog(Ds, vsb, "s--", color=C_GAP, lw=2.0, markersize=6, label="得分函数 + baseline") ax.loglog(Ds, vr, "o-", color=C_ELBO, lw=2.0, markersize=7, label="重参数化") # 斜率 2 的参考线 ref = vs[0] * (Ds / Ds[0]) ** 2 ax.loglog(Ds, ref, ":", color="#cbd5e1", lw=2.0, label="∝ D² 参考线") for d, v, r in zip(Ds, vs, vr): ratio = v / r txt = f"{ratio:,.0f}×" if ratio < 1e4 else f"{ratio:.1e}×" ax.annotate(txt, (d, v), textcoords="offset points", xytext=(8, -14), fontsize=9.5, color=C_SCORE, weight="bold", bbox=dict(fc="white", ec="none", alpha=0.85, pad=0.6)) ax.set_ylim(2e-1, 1e10) ax.legend(fontsize=9.5, frameon=False, loc="upper left") ax.text(0.97, 0.03, "本归一化扫描中 pathwise 方差近似稳定", transform=ax.transAxes, fontsize=9.5, color=C_ELBO, ha="right", va="bottom", weight="bold") fig.suptitle("这张图要看什么:重参数化不是「更准」,是「腰围更小」——" "本实验分布更集中;方差排序不是普遍定理", fontsize=11.5, color="#64748b", y=1.02) fig.tight_layout() p = OUT / "grad_variance.png" fig.savefig(p, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" ✓ {p.name}") # ══════════════════════════════════════════════════════════════ # 图 3:β 怎么把潜变量维度切掉 # ══════════════════════════════════════════════════════════════ def fig_beta_tradeoff(): table = BK.sweep(BK.LAMS, BK.BETAS, verbose=False) s2 = BK.SIGMA2 fig, axes = plt.subplots(1, 2, figsize=(13.4, 5.0)) fig.patch.set_facecolor("white") # ── (a) 重建误差 vs β ── ax = axes[0] style(ax, "(a) β 越大,重建越差——直到某一维被直接放弃", "β(KL 项的权重)", "该维的重建 MSE") colors = ["#2f6fb0", "#2f9e6f", "#e0a03c", "#d1495b"] bgrid = np.linspace(0.2, 14, 100) ax.plot(bgrid, bgrid * s2, ":", color="#94a3b8", lw=1.8, label="理论:MSE = βσ²(还活着)") for lam, c in zip(BK.LAMS, colors): betas, mses, alive = [], [], [] for beta in BK.BETAS: a, b, s, mse, kl, au = table[(lam, beta)] betas.append(beta) mses.append(mse) alive.append(BK.active_unit(a, lam)) betas = np.array(betas) mses = np.array(mses) alive = np.array(alive) ax.plot(betas[alive], mses[alive], "o-", color=c, lw=2.0, markersize=6, label=f"λ={lam}") if (~alive).any(): ax.plot(betas[~alive], mses[~alive], "s", color=c, markersize=7, mfc="white", mew=1.8) ax.axhline(mses[~alive][0], color=c, ls="--", lw=1.0, alpha=0.45) ax.set_xscale("log") ax.set_yscale("log") ax.set_ylim(0.028, 7.0) ax.legend(fontsize=9, frameon=False, loc="upper left", ncol=2) ax.text(0.5, 0.012, "实心圆 = 该维还活着(MSE 贴着 βσ² 往上走);" "空心方块 = 该维已死,MSE 停在 λ", transform=ax.transAxes, ha="center", va="bottom", fontsize=9.5, color="#64748b") # ── (b) 相图 ── ax = axes[1] style(ax, "(b) 存活 / 死亡的相图", "λ / σ²(该维的信噪比)", "β") snr = np.array(BK.LAMS) / s2 grid = np.logspace(-1, 1.6, 60) ax.loglog(grid, grid, "-", color="#94a3b8", lw=2.2, label="理论分界:β = λ/σ²") ax.fill_between(grid, grid, 1e3, color=C_BAD, alpha=0.06) ax.fill_between(grid, 1e-3, grid, color=C_OK, alpha=0.06) for lam in BK.LAMS: for beta in BK.BETAS: a, b, s, mse, kl, au = table[(lam, beta)] ok = BK.active_unit(a, lam) ax.plot(lam / s2, beta, "o" if ok else "s", color=C_OK if ok else C_BAD, markersize=7, mfc=C_OK if ok else "white", mew=1.6) ax.text(0.05, 0.93, "上方:KL 太贵,维度被关掉", transform=ax.transAxes, fontsize=10, color=C_BAD, weight="bold") ax.text(0.05, 0.06, "下方:数据方差信噪比盖过 KL 的价,维度存活", transform=ax.transAxes, fontsize=10, color=C_OK, weight="bold") ax.set_xlim(0.1, 40) ax.set_ylim(0.15, 20) ax.legend(fontsize=9.5, frameon=False, loc="center right") ax.grid(axis="y", color="#eef2f7", lw=1.0) fig.suptitle("这张图要看什么:线性高斯特例:β 给 KL 加权," "等于给每个潜变量维度标一个价——信噪比不够的维度直接归零", fontsize=11.5, color="#64748b", y=1.02) fig.tight_layout() p = OUT / "beta_tradeoff.png" fig.savefig(p, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" ✓ {p.name}") if __name__ == "__main__": print("生成配图 →", OUT) fig_elbo_gap() fig_grad_variance() fig_beta_tradeoff() print("完成:3 张") elbo_identity.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ELBO 恒等式核对:log p(x) = ELBO + KL(q || p(z|x))。 构造一个「后验有解析解」的模型,这样三样东西都能算到机器精度: * 边际似然 log p(x) —— 高斯线性模型,边际仍是高斯 * 真实后验 p(z|x) —— 共轭高斯,闭式解 * ELBO —— 重建项对 q 可解析求期望,KL 两项都是高斯闭式 有解析解才能验证「差的那一项到底是什么」,靠采样是验不出来的。 只依赖 numpy,直接 `python elbo_identity.py` 即可运行。 """ import numpy as np RNG = np.random.default_rng(20260925) # ── 模型:z ~ N(0, I_K),x|z ~ N(W z + b, sigma^2 I_D) ── D, K = 6, 3 SIGMA = 0.35 # 解码器观测噪声标准差 SIGMA2 = SIGMA ** 2 W = RNG.normal(0.0, 1.0, size=(D, K)) * 0.9 # 解码器权重 b = RNG.normal(0.0, 0.3, size=(D,)) # 解码器偏置 def make_one_x(rng=None): """从真实的边际分布里采一个 x,并返回它的解析 log p(x)。 rng 可显式传入:这样 reparam_gradients / make_figures 拿到的是同一个 x, 不会因为模块级 RNG 被别人消耗过而对不上数字。 """ if rng is None: rng = RNG z = rng.normal(size=(K,)) x = W @ z + b + SIGMA * rng.normal(size=(D,)) cov = W @ W.T + SIGMA2 * np.eye(D) sign, logdet = np.linalg.slogdet(cov) d = x - b quad = d @ np.linalg.solve(cov, d) log_px = -0.5 * (D * np.log(2 * np.pi) + logdet + quad) return x, log_px def true_posterior(x): """p(z|x) 的闭式解:precision = I + W^T W / sigma^2。""" prec = np.eye(K) + W.T @ W / SIGMA2 cov = np.linalg.inv(prec) mean = cov @ (W.T @ (x - b) / SIGMA2) return mean, cov # ── 变分后验 q(z|x) = N(m, diag(s^2)):故意用「对角」错误指定 ── def make_q(x, rng=None): """取真实后验的均值,协方差只留对角线,再乘 0.8 并加 0.05。 真实后验是有相关性的(cov 非对角),q 强行对角 => KL(q||p(z|x)) > 0, 这正是我们要留出来的那条缝。 """ if rng is None: rng = RNG mean, cov = true_posterior(x) m = mean + 0.15 * rng.normal(size=(K,)) # 均值也偏一点 var = np.diag(cov).copy() * 0.8 + 0.05 # 与原方差大小须逐项比较 return m, np.sqrt(var) def log_gauss_diag(z, mean, var, ): """log N(z; mean, diag(var))(省略常数也行,但这里算全)。""" return float(-0.5 * np.sum(np.log(2 * np.pi * var) + (z - mean) ** 2 / var)) def log_joint(x, z): """log p(x, z) = log p(x|z) + log p(z)。""" r = x - (W @ z + b) log_lik = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + r @ r / SIGMA2) log_prior = -0.5 * (K * np.log(2 * np.pi) + z @ z) return log_lik + log_prior def elbo_analytic(x, m, s): """ELBO 的解析值。 E_q[log p(x|z)] 里 ||x - Wz - b||^2 对 q 求期望: ||x - Wm - b||^2 + tr(W^T W diag(s^2)) 第二项是采样噪声经过解码器放大出来的那部分,容易被漏掉。 """ var = s ** 2 resid = x - (W @ m + b) recon = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + (resid @ resid + np.trace(W.T @ W @ np.diag(var))) / SIGMA2) kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var)) return float(recon - kl), float(recon), float(kl) def kl_gauss_gauss(m, s, mean2, cov2): """KL(N(m, diag(s^2)) || N(mean2, cov2)),两个高斯的闭式。""" var = s ** 2 diff = mean2 - m cov2_inv = np.linalg.inv(cov2) trace = float(np.trace(cov2_inv @ np.diag(var))) quad = float(diff @ cov2_inv @ diff) _, logdet2 = np.linalg.slogdet(cov2) return 0.5 * (trace + quad - K + logdet2 - np.sum(np.log(var))) def mc_elbo(x, m, s, L, rng): """蒙特卡洛 ELBO:L 个样本取平均(L=1 就是训练时实际用的那个)。""" eps = rng.normal(size=(L, K)) z = m + s * eps residual = x - (z @ W.T + b) log_lik = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + np.sum(residual ** 2, axis=1) / SIGMA2) var = s ** 2 kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var)) return float(log_lik.mean() - kl) def iwae_log_bound(x, m, s, k, rng): """IWAE 的 k 样本界:log (1/k) sum_l p(x,z_l)/q(z_l),用 logsumexp 稳算。""" eps = rng.normal(size=(k, K)) z = m + s * eps var = s ** 2 residual = x - (z @ W.T + b) log_lik = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + np.sum(residual ** 2, axis=1) / SIGMA2) log_prior = -0.5 * (K * np.log(2 * np.pi) + np.sum(z ** 2, axis=1)) log_q = -0.5 * np.sum(np.log(2 * np.pi * var) + (z - m) ** 2 / var, axis=1) logw = log_lik + log_prior - log_q mx = logw.max() return float(mx + np.log(np.mean(np.exp(logw - mx)))) # ── 下面两个表被 main 与 make_figures 共用,种子固定 => 数字永远一致 ── MC_LS = (1, 4, 16, 64) MC_REP = 4000 IW_KS = (1, 5, 50, 500) IW_REP = 6000 STATE_SEED = 20260925 def state(): """文章与配图共用的那一份状态:同一个 x、同一个 q。 用固定种子重放,保证单独跑本脚本与跑 make_figures 拿到同一组数字。 """ rng = np.random.default_rng(STATE_SEED) x, log_px = make_one_x(rng) m, s = make_q(x, rng) post_mean, post_cov = true_posterior(x) elbo, recon, kl = elbo_analytic(x, m, s) gap = kl_gauss_gauss(m, s, post_mean, post_cov) return dict(x=x, log_px=log_px, m=m, s=s, elbo=elbo, recon=recon, kl=kl, gap=gap) def mc_table(st): """蒙特卡洛 ELBO 的均值 / 标准差 / 越过 log p(x) 的比例。""" rng = np.random.default_rng(7) out = {} for L in MC_LS: vals = np.array([mc_elbo(st["x"], st["m"], st["s"], L, rng) for _ in range(MC_REP)]) out[L] = dict(mean=float(vals.mean()), std=float(vals.std()), frac=float(np.mean(vals > st["log_px"])), vals=vals) return out def iwae_table(st): """IWAE 的 k 样本界。""" rng = np.random.default_rng(13) out = {} for k in IW_KS: vals = np.array([iwae_log_bound(st["x"], st["m"], st["s"], k, rng) for _ in range(IW_REP)]) out[k] = dict(mean=float(vals.mean()), std=float(vals.std()), gap=float(st["log_px"] - vals.mean()), se=float(vals.std(ddof=1) / np.sqrt(IW_REP)), frac=float(np.mean(vals > st["log_px"])), vals=vals) return out def main(): print("=" * 68) print("ELBO 恒等式核对 log p(x) = ELBO + KL(q || p(z|x))") print("=" * 68) print(f"模型: D={D}, K={K}, sigma={SIGMA}") st = state() x, log_px, m, s = st["x"], st["log_px"], st["m"], st["s"] elbo, recon, kl, gap = st["elbo"], st["recon"], st["kl"], st["gap"] print(f"\n[1] 解析三项") print(f" E_q[log p(x|z)] = {recon: .6f}") print(f" KL(q || p(z)) = {kl: .6f}") print(f" ELBO = {elbo: .6f}") print(f" KL(q || p(z|x)) = {gap: .6f}") print(f" ELBO + KL(q||p(z|x)) = {elbo + gap: .6f}") print(f" log p(x) = {log_px: .6f}") print(f" |误差| = {abs(elbo + gap - log_px): .3e}") # ── 蒙特卡洛波动:ELBO 的估计量是无偏的,不是恒小于 log p(x) ── print(f"\n[2] 蒙特卡洛估计的波动(每项 {MC_REP} 次重复)") print(f" {'L':>5s} {'mean':>12s} {'std':>10s} {'超过 log p(x) 的比例':>22s}") mc = mc_table(st) for L in MC_LS: r = mc[L] print(f" {L:5d} {r['mean']:12.5f} {r['std']:10.5f} {r['frac']:21.1%}") print(f" log p(x) = {log_px:.5f}(上界本身),ELBO(解析) = {elbo:.5f}") # ── IWAE:k 越大越紧 ── print(f"\n[3] IWAE 的 k 样本界(每项 {IW_REP} 次重复)") print(f" {'k':>5s} {'mean L_k':>12s} {'std':>9s} {'log p(x) - L_k':>16s}") iw = iwae_table(st) for k in IW_KS: r = iw[k] print(f" {k:5d} {r['mean']:12.5f} {r['std']:9.5f} {r['gap']:16.5f} SE={r['se']:.5f} 越界={r['frac']:.1%}") print(f" 参考:单样本 MC ELBO 的均值 = {elbo:.5f}(= ELBO 解析值,不随 k 变)") print("\n结论:期望下界 L_k 随 k 单调;单次结果和有限重复均值可以越界或不单调;" "而「取平均再 log」和「log 再取平均」是两件事。") if __name__ == "__main__": main() beta_kl_weight.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """β-VAE 的 KL 加权:一个能解到最优的玩具模型,看潜变量维度怎么死掉。 构造:数据每个坐标独立,x_j ~ N(0, λ_j),潜变量每个坐标也独立, q(z_j | x_j) = N(a_j x_j, s_j²),p(x_j | z_j) = N(b_j z_j, σ²) 这样每个维度就是一份独立副本,最优解可由闭式得到;保留多起点梯度上升用于独立数值对照。 单维目标(要最大化),把 λ 与 σ² 都当作常数: L(a, b, ℓ) = -[λ(1 - b a)² + b² s²] / (2σ²) - β · KL KL = 0.5 · (a² λ + s² - 1 - log s²), s = exp(ℓ) 梯度全部解析,脚本里再用有限差分核对一遍,避免推错。 只依赖 numpy,直接 `python beta_kl_weight.py` 即可运行。 """ import numpy as np SIGMA2 = 0.25 # 解码器观测噪声方差 def kl_of(a, lam, s): """KL(N(a x, s²) || N(0, 1)),对 x ~ N(0, λ) 取期望后的形式。""" return 0.5 * (a ** 2 * lam + s ** 2 - 1.0 - np.log(s ** 2)) def recon_mse(a, b, lam, s): """E_{x,z}[(x - b z)²],重建误差的期望。""" return lam * (1.0 - b * a) ** 2 + b ** 2 * s ** 2 def objective(p, lam, beta, free_bits=None): """目标函数值(越大越好)。free_bits=C 时 KL 项取 max(KL, C)。""" a, b, ell = p s = np.exp(ell) kl = kl_of(a, lam, s) kl_eff = max(kl, free_bits) if free_bits is not None else kl return -(recon_mse(a, b, lam, s)) / (2 * SIGMA2) - beta * kl_eff def grad(p, lam, beta, free_bits=None): """解析梯度 ∇(∂L/∂a, ∂L/∂b, ∂L/∂ℓ)。""" a, b, ell = p s2 = np.exp(2 * ell) g = np.zeros(3) g[0] = lam * b * (1.0 - b * a) / SIGMA2 g[1] = (lam * a * (1.0 - b * a) - b * s2) / SIGMA2 g[2] = -b ** 2 * s2 / SIGMA2 if free_bits is None or kl_of(a, lam, np.exp(ell)) > free_bits: # KL 项对 (a, b, ℓ) 的梯度 g[0] -= beta * a * lam g[2] -= beta * (s2 - 1.0) return g def grad_fd(p, lam, beta, free_bits=None, h=1e-6): """中心差分梯度,用来核对解析梯度有没有推错。""" g = np.zeros(3) for i in range(3): e = np.zeros(3) e[i] = h g[i] = (objective(p + e, lam, beta, free_bits) - objective(p - e, lam, beta, free_bits)) / (2 * h) return g def optimize(lam, beta, free_bits=None, n_init=9, n_iter=12000, seed=0): """多起点梯度上升,返回最好的 (a, b, s)。 必须多起点:(a, b) = (0, 0) 是「维度死亡」解,单起点容易掉进去出不来。 """ rng = np.random.default_rng(seed) best_p, best_v = None, -np.inf for k in range(n_init): if k == 0: p = np.array([0.9, 0.9, np.log(0.6)]) elif k == 1: p = np.array([0.0, 0.0, 0.0]) # 死亡解,也让它试试 else: p = np.array([rng.uniform(-1.5, 1.5), rng.uniform(-1.5, 1.5), rng.uniform(-1.2, 0.5)]) lr = 0.02 for t in range(n_iter): g = grad(p, lam, beta, free_bits) g = np.clip(g, -50.0, 50.0) # 梯度裁剪:b²s²/σ² 那一项能把参数炸飞 p = p + lr * g # 数值保护,别让 exp(ℓ) 或 (a, b) 爆掉 p[0] = float(np.clip(p[0], -8.0, 8.0)) p[1] = float(np.clip(p[1], -8.0, 8.0)) p[2] = float(np.clip(p[2], -4.0, 1.0)) if t % 1000 == 999: lr *= 0.6 # 收尾再磨一遍:β 很小的时候收敛慢,不磨的话 s² 会差到 1e-3 lr = 1e-4 for t in range(6000): g = np.clip(grad(p, lam, beta, free_bits), -50.0, 50.0) p = p + lr * g v = objective(p, lam, beta, free_bits) if v > best_v: best_v, best_p = v, p a, b, ell = best_p return float(a), float(b), float(np.exp(ell)), float(best_v) def closed_form_optimal(lam, beta, free_bits=None): """数据期望 KL 外取 max(KL,C) 的闭式全局最优(省略似然常数)。""" if lam <= 0 or beta <= 0 or (free_bits is not None and free_bits < 0): raise ValueError("lam and beta must be positive; C must be nonnegative") rate = max(0.0, 0.5 * np.log(lam / (beta * SIGMA2))) if free_bits is not None: rate = max(rate, free_bits) t = np.exp(-2 * rate) a, b, s = np.sqrt((1 - t) / lam), np.sqrt(lam * (1 - t)), np.sqrt(t) return float(a), float(b), float(s), float(objective(np.array([a,b,np.log(s)]),lam,beta,free_bits)) def active_unit(a, lam, thr=0.01): """IWAE 5.2 节的 active unit 经验判据:Cov_x(E_q[z]) = a²λ 是否超过阈值。""" return a ** 2 * lam > thr # 文章与配图共用的扫描范围 LAMS = [4.0, 1.0, 0.25, 0.0625] BETAS = [0.25, 0.5, 1.0, 2.0, 3.0, 4.0, 6.0, 8.0, 12.0] def sweep(lams, betas, verbose=True): """扫 (λ, β) 网格,返回 {(λ, β): (a, b, s, MSE, KL, a²λ)}。""" table = {} if verbose: print("\n[1] β 扫描:每个 (λ, β) 的最优解") print(f"\n {'λ':>7s} {'β':>5s} {'a':>8s} {'b':>8s} {'s':>8s} " f"{'重建MSE':>9s} {'KL':>8s} {'a²λ':>8s} {'存活':>5s}") for lam in lams: for beta in betas: a, b, s, _ = closed_form_optimal(lam, beta) kl = kl_of(a, lam, s) mse = recon_mse(a, b, lam, s) au = a ** 2 * lam table[(lam, beta)] = (a, b, s, mse, kl, au) if verbose: print(f" {lam:7.4f} {beta:5.2f} {a:8.4f} {b:8.4f} {s:8.4f} " f"{mse:9.4f} {kl:8.4f} {au:8.4f} " f"{'是' if active_unit(a, lam) else '死':>5s}") return table def main(): print("=" * 72) print("β-VAE 的 KL 加权:潜变量维度怎么死掉") print(f"σ² = {SIGMA2}(解码器噪声),单维独立副本,闭式全局最优;多起点梯度上升独立对照") print("=" * 72) # ── 先核对解析梯度 ── print("\n[0] 解析梯度 vs 有限差分") for lam, beta in ((4.0, 1.0), (0.25, 4.0)): p = np.array([0.7, -0.4, np.log(0.8)]) ga, gf = grad(p, lam, beta), grad_fd(p, lam, beta) print(f" λ={lam:<5} β={beta:<4} 解析={np.array2string(ga, precision=5)} " f"差分={np.array2string(gf, precision=5)} 最大偏差={np.abs(ga - gf).max():.2e}") print("\n[0b] 独立多起点梯度上升 vs 闭式(数值误差,不当成全局证明)") for lam,beta in [(1.0,1.0),(0.25,4.0),(4.0,0.25)]: numeric=optimize(lam,beta,n_init=3,n_iter=3000,seed=17) exact=closed_form_optimal(lam,beta) print(f" lambda={lam} beta={beta} objective_gap={exact[3]-numeric[3]:.6g} " f"MSE_numeric={recon_mse(*numeric[:2],lam,numeric[2]):.6g} MSE_exact={min(beta*SIGMA2,lam):.6g}") table = sweep(LAMS, BETAS) print("\n[2] 每个 λ 的「死亡阈值」:β 到多大时这个维度不再被用") for lam in LAMS: dead = [beta for beta in BETAS if not active_unit(table[(lam, beta)][0], lam)] if dead: print(f" λ={lam:<7.4f} 从 β={min(dead)} 起死亡" f"(β=1 时 KL={table[(lam, 1.0)][4]:.4f})") else: print(f" λ={lam:<7.4f} 在 β≤{max(BETAS)} 内都存活") # ── 闭式解核对:存活时 s² = βσ²/λ,a²λ = 1 - s²,重建 MSE = βσ² ── print("\n[2b] 闭式解核对(存活的格子才成立)") print(f" {'λ':>7s} {'β':>5s} {'s²闭式':>9s} {'βσ²/λ':>9s} " f"{'a²λ闭式':>9s} {'1-s²':>9s} {'MSE闭式':>9s} {'βσ²':>9s}") worst = 0.0 for lam in LAMS: for beta in BETAS: a, b, s, _, kl, au = table[(lam, beta)] if not active_unit(a, lam): continue s2_pred = beta * SIGMA2 / lam rows = (s ** 2, s2_pred, au, 1 - s ** 2, recon_mse(a, b, lam, s), beta * SIGMA2) print(f" {lam:7.4f} {beta:5.2f} " + " ".join(f"{v:9.5f}" for v in rows)) worst = max(worst, abs(s ** 2 - s2_pred), abs(au - (1 - s ** 2)), abs(recon_mse(a, b, lam, s) - beta * SIGMA2)) print(f" 最大偏差 = {worst:.2e} → 存活时闭式内部一致性(不代替独立数值核验)") print(f" 推论:维度存活条件 s² < 1 ⟺ β < λ/σ²,即该维的信噪比要盖过 KL 的价") for lam in LAMS: print(f" λ={lam:<7.4f} 理论死亡阈值 β* = λ/σ² = {lam / SIGMA2:.2f}") # ── free bits:数据期望KL外的截断惩罚;非信息下限保证 ── print("\n[3] free bits 对照(β=4,KL 项取 max(KL, C))") print(f" {'λ':>7s} {'C=0(纯 β)':>22s} {'C=0.05':>22s} {'C=0.2':>22s}") for lam in LAMS: cells = [] for C in (None, 0.05, 0.2): a, b, s, _ = closed_form_optimal(lam, 4.0, free_bits=C) cells.append(f"a={a:5.3f} KL={kl_of(a, lam, s):5.3f} " f"MSE={recon_mse(a, b, lam, s):5.3f}") print(f" {lam:7.4f} " + " ".join(f"{c:>22s}" for c in cells)) print("\n[4] 一个直觉:β 大了以后,模型宁可不要这个维度") print(" λ=0.0625 时这个坐标的数据方差本来就小于解码器噪声 σ²=0.25,") print(" 用它换来的重建收益抵不上 KL 的代价,最优解就是把它整条关掉。") if __name__ == "__main__": main()
-
AIGC 基本功|FlashAttention 为什么不需要存下注意力矩阵-FlashAttn AIGC 基本功|FlashAttention 为什么不需要存下注意力矩阵-FlashAttn 所属方向:注意力与位置编码 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本(本篇是它的直接后继) 关键词:FlashAttention、online softmax、tiling、IO感知、显存优化 01. 为什么需要它 上一篇《自注意力机制的计算与显存账本》结尾留了一个没解的结:N=4096 的视频 DiT,按保守教学分配模型计,单层注意力为 2.39 GiB 激活,无重算训练时按同一假设累加 32 层就是 76.5 GiB,尚未包含权重、梯度、优化器与 FFN。推理的临时激活则不能直接乘层数。当时摆出了两条出路:稀疏化(算得少,但要看清赔的是什么质量)和 FlashAttention。这一篇把后者讲透。 先把一个流传很广的说法钉死:FlashAttention 不是近似注意力。它算出来的就是标准的 softmax 注意力,在实数算术下等价,浮点下允许舍入差异(第 04 节有实测:本次 float64 实验最大绝对误差不超过 8.9e-16;这组输入的舍入量级,非通用误差保证)。它快的理由也不神秘——附录 io_ledger.py 给出的同类型元素教学账本,单头 d=64、N=4096 时: 朴素实现要在 HBM(显存)上搬 130 MiB:分数矩阵 S 写一次读一次,softmax 权重 P 写一次读一次,4N² 次元素搬运; FlashAttention 只搬 17.8 MiB,少了 7.3 倍。 两种实现的主导矩阵乘 FLOPs 相同,但重算和归一化开销不同。在这组 A100 参数的 roofline 模型中,朴素实现算术强度为 31.5 FLOP/byte,低于约 200 的平衡点;这支持优先优化 IO 的方向,不证明所有序列、硬件或近似注意力方法都必然更慢。本文 130 MiB、17.8 MiB 是脚本估算值,不是 GPU 访存计数器实测。 另一个结论更值钱:显式保存概率矩阵 P 的朴素实现仍需二次存储,S 本身通常不必一并保留,该显式物化实现的主导存储随 N 二次增长;FlashAttention 把这两个矩阵整个从显存里删掉了,训练激活从 O(N²) 降到 O(N)——在统一采用六份线性张量、忽略小的 LSE 与工作区的教学预算中,上面那个 76.5 GiB 降为 4.5 GiB。N=32768 的长视频任务,本文教学模型的朴素实现要约 4.54 TiB 激活,超过这里对比的单卡教学预算;融合侧同一账本为 36 GiB,仍未计 FFN、权重、优化器和完整工作区。FlashAttention 为长序列精确注意力减少了重要的容量障碍;具体模型能否训练还受其他层、并行策略和硬件影响。 02. 最小可用理解 三句话讲完核心思想: softmax attention 每行需要两个标量和一个 d 维向量:这行的最大值 m、指数和 l、未归一化加权和 U。把分数按块流进来,每块用一条递推式把这三个量修正一次,全流完之后 U÷l 就是精确的 softmax 注意力输出——中间任何一步都不需要把整行摆在内存里。这叫 online softmax。 显式物化 N×N 经常造成较低的算术强度;受限类型取决于维度、硬件与实现。朴素实现把 N×N 的 S、P 写回显存再读回来;FlashAttention 用 tiling(分块)把它们关在片上 片上存储里算完就扔,在原论文两级存储模型及 d≤M≤Nd 的范围内,HBM 读写量由 Θ(Nd+N²) 变为 Θ(N²d²/M);M 按可存的同类型元素数计,实际 kernel 的混合精度预算另算。 反向传播要用的 S、P 全部重算。除 Q/K/V(或它们的重算来源)外,前向存输出 O 和每行的 logsumexp(都是 O(N)),反向时拿 Q、K 重新过一遍分块流程,把需要的局部 P 重新算出来——用重复计算换显存,这是整个方法里最「敢」的一步。 这张图要看什么:左边朴素实现的 S、P 两个 N×N 是该前向示意中的主要中间量,它们必须写回 HBM 再读回来;右边是同一个 N×N 被切成 B_r×B_c 的小块,K/V 块进 SRAM 常驻、Q 块逐行流过,跨块只有 O_i、l_i、m_i 三个 O(N) 的量一直活着。 03. 数学推导 3.1 出发点:safe softmax 为什么需要先看全一行 设一行分数为 $s_1, \dots, s_N$,softmax 的定义是 $$p_i = \frac{\exp(s_i)}{\sum_{j=1}^{N} \exp(s_j)}$$ 先修要求是矩阵乘、逐行 softmax 和链式法则;这里补齐指数换参考系与 softmax 雅可比,不需要先懂 CUDA。本文先讨论有限分数、至少一个未遮 key、无 dropout 的单头自注意力,$Q,K,V\in\mathbb R^{N\times d}$,$S=QK^\top/\sqrt d$;d 为头宽度。直接计算 $\exp(s)$ 会溢出,fp32 的阈值约为 $\log(\mathrm{finfo}(\mathrm{float32}).\mathrm{max})\approx88.72$。常用 safe softmax——先求这行的最大值 m,再算平移后的指数: $$p_i = \frac{\exp(s_i - m)}{\sum_{j=1}^{N} \exp(s_j - m)}, \qquad m = \max_{1 \le j \le N} s_j$$ 把指数共同平移 -m(数学上等价于分子分母同乘 $\exp(-m)$,实现不真的计算这个乘子),结果不变,但指数的输入全部落在 $(-\infty, 0]$,永不溢出。问题就出在这个 m 上:m 是对整行取的 max。你必须先把 N 个分数全部看过一遍才知道 m 是多少,然后才能开始算 exp——这解释了常见实现先保存分数再做 softmax 的流程;算法并不强制保存整个 N×N,也可重算分数或逐行处理,只是 IO 和效率不同。 而注意力输出对这一行还要再多两个量:分母 $l = \sum_j \exp(s_j - m)$,以及未归一化加权和 $U = \sum_j \exp(s_j - m)\, v_j$($v_j$ 是第 j 个 token 的 Value 向量)。最终输出 O 就是 $U / l$。 所以真正要回答的问题是:如果分数是一块一块到来的(事先不知道后面块里有什么),这三个量还能算吗? 3.2 online softmax 递推式(全文核心) 能。做法是把「以 m 为参考系」改成「以当前的 m 为参考系,m 变了就整体换算」。 设 $J_t$ 为前 t 块中未被遮住的 key 下标集合,至少含一个有限分数;维护三个量:参考系最大值 $m^{(t)}$、分母 $l^{(t)}$、未归一化加权和 $U^{(t)}$,它们满足不变式 $$U^{(t)} = \sum_{j \in J_t} \exp(s_j - m^{(t)})\, v_j, \qquad l^{(t)} = \sum_{j \in J_t} \exp(s_j - m^{(t)})$$ U 表示未归一化加权和,最终输出才记作 O;这样不把中途累加器与归一化结果混为同一量。现在第 $t+1$ 块到了,块内最大值是 $m_{\text{blk}}$。新的全局最大值是 $$m^{(t+1)} = \max(m^{(t)},\ m_{\text{blk}})$$ 关键一步来了:旧累积量是按 $m^{(t)}$ 为参考系记的,而新的不变式要求参考系换成 $m^{(t+1)}$。把不变式里的 $\exp(s_j - m^{(t)})$ 拆成 $\exp(s_j - m^{(t+1)}) \cdot \exp(m^{(t+1)} - m^{(t)})$,旧量的换算系数就是 $\exp(m^{(t)} - m^{(t+1)})$: $$l^{(t+1)} = \exp(m^{(t)} - m^{(t+1)})\, l^{(t)} + \sum_{j \in \text{blk}} \exp(s_j - m^{(t+1)})$$ $$U^{(t+1)} = \exp(m^{(t)} - m^{(t+1)})\, U^{(t)} + \sum_{j \in \text{blk}} \exp(s_j - m^{(t+1)})\, v_j$$ 每一步只是把指数拆成两项相乘再重新合并,等价性是代入即可验证的恒等式;所有块流完后 $U^{(T)}/l^{(T)}$ 与朴素 softmax 在实数算术下相同(差在浮点舍入,第 04 节实测 1e-16 量级)。这个「换参考系」的系数在论文和代码里叫 rescale,跨块最大值、求和与 rescale 都会带来额外的标量操作;它们不改变主导矩阵乘次数。 严谨一点可以正向验证不变式:假设第 t 步的不变式成立,那么 $$U^{(t+1)} = e^{m^{(t)} - m^{(t+1)}} \sum_{j \in J_t} e^{s_j - m^{(t)}} v_j + \sum_{j \in \text{blk}} e^{s_j - m^{(t+1)}} v_j = \sum_{j \in J_{t+1}} e^{s_j - m^{(t+1)}} v_j$$ (第一个等号就是递推式,第二个等号把 $e^{m^{(t)} - m^{(t+1)}}$ 乘进求和号里、指数相加后正好变回 $e^{s_j - m^{(t+1)}}$。)旧块和新块在同一个参考系下合并,不变式保持。$l$ 的证明一字不差,把 $v_j$ 去掉就行。归纳基础是初始状态 $m^{(0)} = -\infty$、$l^{(0)} = 0$、$U^{(0)} = 0$:第一个含有效 key 的块到来时换算系数按 0 处理(代码只在旧最大值有限的位置做减法,避免提前计算未定义差值),三个量直接等于该块的局部值。 三个细节值得停一下: 这个递推对任意分块都成立,块大小可以是 1(一个 key 一个 key 地流),也可以是 128 行。块大小只影响效率,不影响结果。 $\exp(m^{(t)} - m^{(t+1)}) \le 1$ 恒成立(因为 $m$ 单调不减),rescale 永远是在把旧量缩小,不会因正指数而溢出,但有限精度下可能下溢到零、求和也有舍入误差;点积溢出必须另外处理。 $m^{(t)} + \log l^{(t)}$ 就是 logsumexp(LSE)。它是反向传播唯一需要额外记录的东西——记住这个,第 3.3 节要用。 掩码把被遮分数设为 $-\infty$。若此前最大值有限,它的指数贡献为零。若一整行截至当前全被遮住,不能直接算 $-\infty-(-\infty)$;本文约定该行累计量为零,最终全遮行返回零输出、LSE 为 $-\infty$。这是接口约定,全遮行本身没有概率归一化定义。实现用带 where= 的 np.subtract 跳过未定义减法;普通 np.where 会先求值两个分支,不能保证避免 NaN 警告。更进一步,如果一整块都被遮住(Q 块整体在 K 块之前),这块连算都不用算,直接跳过。第 04 节实测这个「整块跳过」在 N=4096、块 64 时省掉 49.2% 的块。 3.3 反向传播:重算换显存 这里的 $O=PV$ 指最终归一化输出,$G=\partial L/\partial O\in\mathbb R^{N\times d}$ 是上游梯度,$A=GV^\top=\partial L/\partial P\in\mathbb R^{N\times N}$。先对一行 softmax 求导,$\delta_{jk}$ 表示 j=k 时为 1、否则为 0: $$\frac{\partial p_j}{\partial s_k}=p_j(\delta_{jk}-p_k)$$ 把损失对各 $p_j$ 的导数 $A_j$ 代入链式法则,得到 $$\frac{\partial L}{\partial s_k}=\sum_j A_jp_j(\delta_{jk}-p_k)=p_k\left(A_k-\sum_j A_jp_j\right)$$ 因此矩阵形式为 $$dS=P\odot\left(A-\operatorname{rowsum}(A\odot P)\right)$$ 行和是 $N\times1$,沿 key 轴广播。继续对 $S=QK^\top/\sqrt d$ 与 $O=PV$ 求导: $$dQ=dS\,K/\sqrt d,\qquad dK=dS^\top Q/\sqrt d,\qquad dV=P^\top G$$ 反向真正巧的一步是先把行和算出来。对第 i 行,用内积线性性可得 $$\delta_i=\sum_j P_{ij}\langle G_i,V_j\rangle=\left\langle G_i,\sum_j P_{ij}V_j\right\rangle=\langle G_i,O_i\rangle$$ 所以 $\delta=\operatorname{rowsum}(G\odot O)$,仅为 N 个数,无需为这项先构造完整 A/P。前向额外保存 O 和 $\mathrm{LSE}_i=m_i+\log l_i$;反向从 Q/K 重算局部分数,再用 $$P_{ij}=\exp(S_{ij}-\mathrm{LSE}_i)$$ 恢复局部概率,把它和局部 $G_iV_j^\top-\delta_i$ 相乘得到 dS,立即累加到 dQ/dK/dV 后丢弃。Q/K/V、输出和梯度仍是 $O(Nd)$,局部 tile 为 $O(B_rB_c)$;只有在 d 与块大小固定时才能简称 O(N)。原论文附录 B 给出分块反向;附录 attention_backward 把上述步骤完整实现,第 4.6 节实际核验梯度。 以上推导无 dropout。若训练使用概率 dropout,令随机乘子为 $R/(1-p)$,p 为丢弃率;dV 和 dP 都要使用同一随机掩码重放,不能直接照抄本教学函数。LSE 仍对应 dropout 之前的 softmax。生产实现还需保留随机生成器状态,见第 05 节。 用重复计算换显存——这笔交易的换算率是:每层每个头多算一遍 QK^T 和一次 exp(具体比例取决于前后向统计口径与实现),对本文保守教学账本,这对应去掉 S、P、浮点 dropout 乘子三项;真实朴素反向通常不用同时保存 S,具体减少几份取决于实现。N=4096、本文简化模型上,单层激活 2.39 GiB → 0.141 GiB,17 倍。 3.4 IO 账:搬运量到底差多少 设单头维度 d,片上存储预算为 M 个元素(不是字节);fp16 下 192 KiB 对应 M=98304。SRAM 里要同时放下 K 块、V 块(各 $B_c \times d$)和 Q 块、输出块(各 $B_r \times d$),论文 Algorithm 1 取(脚本对整数块大小向下取整) $$B_c = \frac{M}{4d}, \qquad B_r = \min(B_c,\ d)$$ NVIDIA Ampere 文档 给出 A100 每个 SM 的 192 KiB 统一 L1/共享内存空间及共享内存配额;它不是全部可用于单个 block 的任意数组。以这一数量级作为教学预算,fp16 下 d=64 时 $B_c = 384$、$B_r = 64$——这是论文 IO 模型的粗略分块预算;真实 kernel 还受 score tile、累加器、寄存器、共享内存配额与 occupancy 约束,192 KiB 也不是每个 block 可独占的共享内存。 朴素实现的搬运量(单位:元素个数):QK^T 读 Q、K 各 Nd、写 S 一次 N²;softmax 读 S 写 P 各 N²;PV 读 P 一次 N²、读 V 写 O 各 Nd。合计 $4Nd + 4N^2$,主导项 4N²。 FlashAttention 的搬运量:K、V 各进 SRAM 一次($2Nd$);Q 块每换一个 K/V 块就要重读一遍,共 $T_c \cdot Nd$($T_c = \lceil N/B_c\rceil$ 是 K/V 块数);输出 O 同理要读出写回各一遍($2 T_c Nd$);l、m 两个 O(N) 的运行量共 $4T_c N$。合计约 $2Nd + 3T_cNd + 4T_cN$,代进去: $$\text{HBM 搬运量} \;\approx\; 3 \cdot \frac{N}{B_c} \cdot Nd \;=\; \Theta\!\left(\frac{N^2 d^2}{M}\right)$$ 两个量级一比:朴素是 $\Theta(N^2)$,Flash 是 $\Theta(N^2 d^2/M)$,比值 $d^2/M$ 在 d=64、fp16、M=98304 个元素(192 KiB) 时约等于 0.04——大 O 比例省略了常数,不能直接当作 25 倍的实际收益;脚本计入 Q/O 反复读写后的模型比值为 7.3 倍。原论文 Theorem 2 的前提为 $d\le M\le Nd$;其中线性项可被主导项吸收。若整份输入已能驻留片上,不能继续把 $N^2d^2/M$ 往下外推到低于读写输入输出的 $\Omega(Nd)$。小 N 时仍应保留线性项与取整。本文计数也忽略初始化、最终归一化、LSE 写回及多级缓存,提供对照账本而非 GPU 字节计数器。 一个预算反例:d=64、Bc=384、Br=64,若 Q/K/V 用 2 字节,而输出累加器、分数 tile 和统计量用 4 字节,仅这些数组就需 221696 字节,超过 192 KiB;这还未算额外概率 tile。因而同类型元素模型推得的 384 不能作为实际混合精度 kernel 的可用配置。真实实现会重用存储、分配寄存器并选不同 tile。 按本文简化模型,朴素注意力的算术强度在 N 远大于 d 时约为 d/2 FLOP/byte(fp16),所以固定 d=64 时接近 32;它会随 d 改变,并非与头维度无关。A100 示例的约 200 FLOP/byte 是 NVIDIA A100 白皮书 中 dense FP16 Tensor Core 峰值312 TFLOP/s与HBM带宽1555 GB/s之比,真实 softmax 的非矩阵乘指令、缓存与调度仍会影响性能。 这张图要看什么:固定 d 与 SRAM 大小时,左图两者的大 N 主导项均为 N²,比值渐近趋于常数;线性项和取整会让有限 N 的比值变化;右图斜率不同(N² 对 N),N 越大两条线离得越远,朴素教学激活曲线越过示例 80 GiB 预算线的位置,FlashAttention 还有几百倍余量。 04. 代码实现 完整脚本在文末附录(flash_online_softmax.py、io_ledger.py、attention_checks.py、make_figures.py)。前三项数值/账本实验主要用 NumPy,梯度对拍还需 PyTorch,配图需 matplotlib。本次 2026-10-14 在 Windows、Python 3.11.9、NumPy 2.4.6、PyTorch 2.10.0+cpu、matplotlib 3.10.7 实跑;BLAS/OMP 线程设为 1。下面表格来自同一次完整运行,不是 GPU 性能复现。 4.1 递推式长什么样:逐块打印 先看一个能盯着看的例子(N=8、D=4、K/V 块大小 B_c=2,Q 整行一起处理): # 局部Sij已设置掩码;m_old/l/O是已见块的累计量。 m_new = np.maximum(m_old, Sij.max(axis=-1)) shifted = np.full_like(Sij, -np.inf) np.subtract(Sij, m_new[:, None], out=shifted, where=np.isfinite(m_new)[:, None]) Pij = np.exp(shifted) delta = np.full_like(m_old, -np.inf) np.subtract(m_old, m_new, out=delta, where=np.isfinite(m_old)) corr = np.exp(delta) l[i0:i1] = l[i0:i1] * corr + Pij.sum(axis=-1) O[i0:i1] = O[i0:i1] * corr[:, None] + Pij @ Vj m[i0:i1] = m_new 和第 3.2 节逐符号对上:m_new 是 $m^{(t+1)}$,corr 是换参考系系数,Pij.sum 是块内指数和,Pij @ Vj 是块内加权和。代码内部 O 保存的是数学记号 U,函数最后才除以 l 得到归一化输出。全遮行不做除法,保持零输出。函数要求相同非空形状 [N,D] 与有限浮点输入;支持尾块、一维 key_valid 和等长因果掩码。float16 输入提升到 float32 累加并输出 float32;float64 保持 float64。它未实现非等长、GQA 或 dropout,不能当作完整 CUDA API 替代品。 实跑的逐块轨迹(第 0 号 query): j= 0 m=+0.2968 l=1.7748 corr=0.0000 j= 2 m=+0.6071 l=3.0317 corr=0.7333 j= 4 m=+0.6071 l=3.9732 corr=1.0000 j= 6 m=+0.6071 l=5.3007 corr=1.0000 看两点:j=2 时新块里出现了更大的分数,m 被抬高、旧累积量被打了个 0.733 的折扣;j=4 之后 m 没再变,corr 恒为 1,rescale 白做——此时乘子在数学上为 1;具体 GPU kernel 是否跳过这些操作要核对实现,不能仅由轨迹推断。最大的单个临时矩阵只有 16 个元素([8, 2]),而 N×N 是 64;这里不等于同时存活临时数组的总元素数;代码对尾块和全遮行的额外检查也占临时空间。 4.2 等价性:和朴素实现在实数算术下等价,浮点下允许舍入差异 attention_naive 是上一篇的标准实现(S、P 都落地),两者对拍: N D causal 最大绝对误差 相对误差 256 64 False 5.551e-16 1.192e-15 256 64 True 8.882e-16 3.520e-16 1024 64 False 2.082e-16 8.962e-16 1024 64 True 6.661e-16 2.332e-16 2048 64 False 3.053e-16 1.205e-15 2048 64 True 6.661e-16 2.856e-16 4096 64 False 1.249e-16 9.209e-16 4096 64 True 7.772e-16 2.426e-16 本次表的最大绝对误差为 1.2e-16 到 8.9e-16;这是此输入、规模与 float64 运算顺序下的结果。这就是「精确注意力」四个字的实测含义:不是「误差很小」,是算法本身和朴素 softmax 完全等价。 4.3 峰值内存:O(N²) 对 O(N),实测 用 tracemalloc 量函数内新分配的峰值内存(float64、D=64、块 64×64;Q/K/V 已提前分配,不计入本表): N naive 实测 naive 理论 2N²·8 flash 实测 比值 1024 16.5 MiB 16.0 MiB 1.2 MiB 13.9x 2048 65.0 MiB 64.0 MiB 2.2 MiB 29.4x 4096 258.0 MiB 256.0 MiB 4.3 MiB 60.0x 8192 1028.0 MiB 1024.0 MiB 8.5 MiB 121.0x 理论列只计 S/P;tracemalloc 表还包含输出、运行量和局部临时数组。NumPy 在此环境向 Python 跟踪器登记数组分配,这些数值与主导项一致;tracemalloc 不等于进程 RSS,也不覆盖所有 BLAS 内部缓冲,更不是 GPU 显存峰值。最后那行是阶数的直接证据:N 翻倍,naive 峰值 ×4(二次),flash 峰值 ×2(线性)。 4.4 时间:CPU 教学循环的实测口径 N naive flash(B=64) flash/naive 1024 13.6 ms 16.2 ms 1.2x 2048 57.5 ms 65.4 ms 1.1x 4096 230.0 ms 266.1 ms 1.2x 每个方法先预热一次,再量 5 次取墙钟中位数,包含 Python 循环与 NumPy分配,不计输入生成。这里 flash 教学循环慢约 1.1–1.2 倍;不同机器或本机再次运行可能变化。可能原因包括:乘加次数一样还多了 rescale 和逐块 exp;一次大矩阵乘被拆成 (N/64)² 个 64×64 小矩阵乘,BLAS 跑不满小块,Python 循环开销也进来了;CPU 也有 SRAM 缓存,但这里的 Python/NumPy 分块没有实现专门的缓存与线程优化,不能把它当作 GPU 内核速度的预测。第三张图展示 IO 模型为何支持在 GPU 上尝试这一优化。 4.5 因果掩码:跳块比例与真实算力要分开 本脚本朴素路径先计算全分数,再遮住未来 key,因此该路径不因掩码节省矩阵乘;这是所测实现的选择,不是所有精确算法的限制。FlashAttention 按「Q 块整体在 K 块之前就整块跳过」处理,N=4096、块 64 时实测: 块总数(非因果) : 4096 块总数(因果跳过): 2080 跳过的块占比 : 49.2% 保留的是含对角线的下三角,块数是 $T(T+1)/2$,占比 $(T+1)/2T$,T 大时趋近一半。对齐、等长且等块时,49.2% 是跳过的 tile 数比例;对角 tile 中仍有被遮元素,softmax/调度还有开销,所以不等于总 FLOPs 或延迟精确减半。时序因果视频注意力还须明确 token 排序与掩码定义。 4.6 反向与边界:实际梯度对拍 attention_checks.py 对 N=1/7/17、float64/float32/float16 输入、因果/非因果、正常/全遮及部分遮 key、三组包含尾块的块大小组合,总计 108 组前向结果与 PyTorch 2.10 的 CPU math SDPA(float64 参考)对拍;最大绝对差为 2.33e-7。float16 输入先提升到 float32,并非模拟 GPU 的每一处精度行为。float64 分块反向对 autograd 最大差为 1.33e-15。另对 N=7、d=5 的 Q/K/V 共 105 个参数做中心差分,步长 1e-5,最大差为 8.74e-11;全遮行零输出约定也参与检验。 还实际提取并执行 FlashAttention v2.8.3 官方测试的 attention_ref 与 construct_local_mask 原函数 AST,CPU float64、不做默认 float32 upcast,对三种长度及两种因果设置核对输出与梯度。这是原始参考函数的检查,未安装或执行 CUDA kernel,不能据此声称 GPU 速度/低精度训练已复现。独立对拍支持实现正确性;第 03 节的恒等式才说明算法为何等价。 05. 工业级实现对照 最小实现讲清了原理,但生产 kernel 和它有四处本质差异,每处都值得知道为什么: 第一,理论 tile 和工程配置要分清。 本次固定核对 flash-attention v2.8.3,入口为 flash_attn_func。flash_fwd_launch_template.h 中有基于头维度、架构、dropout/因果等条件的编译配置分支;Python _get_block_size_n 也说明应匹配 CUDA 块尺寸。静态分支选配置不等于每次运行都在线 autotune。$B_c=M/(4d)$ 只为 IO 分析提供同阶预算,实际还要计 score tile、寄存器、共享内存和 occupancy。本文不判断更新版本的 kernel 细节。 第二,减少非矩阵乘操作。 FlashAttention-2 使用未归一化输出累计,减少 rescale、除法等非矩阵乘工作。corr=1 时数学上无需改变旧值,但不能笼统声称所有 kernel 都按每行最大值是否变化来分支跳过。 第三,前向的结构是「外层 Q、内层 K/V」。 我们按论文 v1 的写法外层遍历 K/V 块;FlashAttention-2 把循环反过来(外层 Q 块),好处是输出 O 常驻寄存器不用反复读写、且不同 Q 块之间天然并行,能吃满更多 SM。论文 v1 的伪代码适合理解递推,v2 的循环结构才是现在 kernel 的样子。 第四,dropout 要重放随机过程。 固定接口保存 rng_state,反向从同一状态重建概率 dropout;flash_bwd_kernel.h 中可核对 Philox seed/offset 与块坐标。仅口头说“种子一样”仍不够:并行划分与计数器映射也必须一致。无需保存完整二次掩码,是特定 kernel 的实现能力,不代表所有朴素框架必定保存浮点掩码。 另一个易错边界是非等长因果对齐。 v2.8.3 接口明确对齐右下角;Nq=5、Nk=2 的保留矩阵为下面五行,前 3 行全遮时输出零。本文 NumPy函数只支持等长,因此不暗中把一种对齐当作另一种。PyTorch 2.10 SDPA 文档 的 is_causal 在非方形时定义左上对齐;跨 API 迁移要显式核对。 0 0 0 0 0 0 1 0 1 1 PyTorch SDPA 可以按环境选优化后端,也有 CPU/math 路径;调用该 API 本身不能证明使用了 CUDA FlashAttention。评估时还要把 dropout_p 显式设为 0,该函数不会因模型切换 eval 就自动关闭传入的 dropout。 原 FlashAttention 论文分别在 BERT-large/MLPerf、GPT-2/HuggingFace、Long Range Arena 上报告 15%、3 倍、2.4 倍端到端收益。这些模型、基线与任务不同,不能把三组数字当作只改变 N 的对照实验,更不能由它们证明收益严格随 N 单调增加。 排查问题时你会想知道「此刻到底在用哪个后端」。PyTorch 留了一个官方口子: import torch from torch.nn import functional as F from torch.nn.attention import sdpa_kernel, SDPBackend # CUDA环境使用;形状[B,H,N,D],输入half,关闭dropout。 q = k = v = torch.randn(1, 2, 128, 64, device="cuda", dtype=torch.float16) with sdpa_kernel(SDPBackend.FLASH_ATTENTION): out = F.scaled_dot_product_attention(q, k, v, is_causal=True, dropout_p=0.0) # 强制走 flash;如果这个头维度/掩码组合它不支持,应按官方后端约束排查告警或错误;本文CPU实跑明确选择MATH, # 而不是悄悄退回 math 后端——「悄悄降级」正是性能莫名掉一半时最该先查的事 这张图要看什么:横轴是 N,纵轴是「每搬 1 字节做多少次运算」,灰色虚线是机器平衡点(201 FLOP/byte)。本模型中朴素实现的强度渐近接近 32;FlashAttention 的估计从 N=2048 起超过平衡点。这是按矩阵乘峰值做的模型分类,真实瓶颈还受非矩阵乘指令、缓存、并行度和调度影响。 06. 代价与边界 FlashAttention 省下了 HBM 搬运和 N² 显存,赔进去的和没管住的也要说清楚。 代价:重计算和额外归一化操作。 反向要重算局部分数及概率,其中包含矩阵乘和逐元素运算,不能统称为固定 30% 的额外非矩阵乘开销。小序列的收益取决于 kernel、调度和硬件,没有统一的“序列短于512就亏损”阈值。 数值边界:实数算术等价不保证浮点逐位一致。 kernel 内部用 fp16/bf16 存储、fp32 累加,块内的归一化和朴素实现的一次性归一化在浮点上不同。对训练的影响需要结合 dtype、输入尺度与误差测试判断,但如果你在做数值敏感的分析(比如逐 token 概率对比),应建立与输入尺度、dtype 和应用需求匹配的容差,并检查遮罩及非有限值;不能仅凭“精确算法”就把所有数值差异判为正常舍入。 边界的核心一条:它改变存储阶数,但不消除精确稠密注意力的二次计算。 显存从 $O(N^2)$ 降到 $O(N)$,但算力还是 $\Theta(N^2 d)$、在第 3.4 节限定模型中,HBM 搬运为 $\Theta(N^2 d^2/M)$。N=32768 时 FlashAttention 的单头搬运是 1061 MiB——比朴素实现的 8.2 GiB 好得多,但随 N 继续平方增长这一点没变。上下文再往上涨(1M token),可以考虑稀疏注意力、线性注意力、状态空间模型或并行方案;它们各有建模或系统代价,是否合适须按任务验证。FlashAttention 的块结构恰恰是它们的底座:把注意力切成块之后,「整块跳过」才成为可能,第 4.5 节那个 49.2% 推广到任意稀疏模式就是块稀疏注意力。 不该用的场景:需要拿到完整注意力权重做分析或可视化的(P 从头到尾没存在过,想看它就得回到朴素实现);自定义的任意注意力偏置如果 kernel 不支持,绕过去的方法可能把优势吃掉;以及缺乏适配内核的环境;CPU 也有 SRAM 缓存,但本文 NumPy 循环没有实现专门的 CPU cache 优化(第 4.4 节的 CPU 实测就是例子)。 07. 经典论文脉络 这条线的演进关系一句话各说清: Milakov & Gimelshein, 2018(arXiv:1805.02867)Online normalizer calculation for softmax——给出 softmax 的 online normalizer 算法:流式更新 max 和指数和。从原文可核对其减少内存访问的 softmax/TopK 实验;不从这篇论文推断此前所有研究的范围。 Rabe & Staats, 2021(arXiv:2112.05682)Self-attention Does Not Need O(n²) Memory——讨论单 query 的常数额外空间方案,并给出分块的低内存自注意力实现及速度/内存实验;不能把单 query 的额外空间结论写成整段输出总存储 O(1),也不能概括为没有实用价值。 Dao et al., 2022(arXiv:2205.14135)FlashAttention——本篇锚点。补上缺失的一环:把流式更新从「逐 token」改成「逐块」(tiling),配上 IO 复杂度分析和 GPU kernel,报告精确注意力在其测试 GPU/模型上的速度和内存收益。 Dao, 2023(arXiv:2307.08691)FlashAttention-2——循环重排(外层 Q)、削减非矩阵乘 FLOPs、更好的并行度,把 v1 大约 25-40% 的峰值算力利用率推向 50-73%。 这条阅读线从流式归一化、低内存自注意力到 IO 与 GPU 调度,逐步解释同一数学操作为何能有不同的存储和运行代价。它是选定论文的演进关系,不是对所有先行工作或产品的首次性判断。 08. 常见误解 以下几条都值得单独记住,前两条我当初也信过: 「FlashAttention 是近似注意力,所以有精度损失」。错。它是精确算法,和朴素 softmax 数学等价(第 4.2 节实测 1e-16)。真正近似的是 Linformer、Performer 那一族。两者经常被并列讨论,但一个在改算法,一个在改数据的搬运方式。 「它快是因为算了更少的 FLOPs」。反了,它的 FLOPs 略多于朴素实现(第 4.4 节本次CPU教学循环约慢 1.1–1.2 倍)。主要收益来自减少 IO,也来自更好的并行划分与调度——这正是它给所有做系统优化的人的启示:先问数据在哪,再问算了多少。 「显存优化只对前向有用」。训练反向同样受益:除 Q/K/V 外额外存 O 和 LSE(固定 d 时为 O(N)),反向重算 P。本文三份二次张量是教学分配假设,真实反向不一定保存三份;可靠结论是分块重算避免显式保留完整 P。 「块开得越大越快」。块大小受 SRAM 硬约束:超过每个 block 的资源上限可能无法启动或编译;寄存器 spill 等情况也会引入额外访存,整个方法的根基(中间结果不落 HBM)就塌了。真实 kernel 的块大小是约束内的调优问题,不是越大越好。 「有了它就不用再关心 N²」。它改变了激活存储阶数;固定 d/M、在本文模型内,稠密计算与搬运的主导项仍随 N 平方增长。能继续走的长上下文路线是稀疏化(改算力阶数)和状态空间/线性注意力(改注意力本身),FlashAttention 的块结构是它们的载体,不是替代品。 09. 动手验证 跑文末附录的 flash_online_softmax.py(只依赖 numpy),预期输出与正文一致: 第 2 节等价性表:本次非因果最大误差 1.2e-16 到 5.6e-16,因果 6.7e-16 到 8.9e-16——全是舍入级别; 第 3 节内存表:naive 峰值和理论值 $2N^2 \times 8$ 字节吻合,N 翻倍时 naive ×4.0、flash ×2.0。 再运行附录 attention_checks.py,它用 seed=1024、N=1024、d=64、块 64×64,故意把正确函数的 corr = np.exp(delta) 替换成 corr = np.ones_like(delta);这是自动构造的错误反例。最大差实测为 0.275658、平均差为 0.013599。这项对比把“丢掉换参考系会出错”变成可重复实验,不让读者误把旧代码里的 np.where 当作必要写法。 最后改 io_ledger.py 开头的硬件常数(比如把 SRAM_PER_SM 调到 48 KiB,作为更小片上预算的假设,不能据此代表某款消费级卡),重跑看块大小和搬运量比值怎么变——你会看到 SRAM 越小,FlashAttention 相对朴素实现的搬运量优势越小,$d^2/M$ 里的 M 直接控制这一切。 10. 延伸阅读 按知识树的依赖关系,建议按这个顺序继续走: 前置:自注意力机制的计算与显存账本——本篇所有显存账本的出处(2.39 GiB、94% 那几笔账都在那篇里);旋转位置编码 RoPE 与 视频 DiT 里的 3D RoPE——注意力的另外两个必备零件,本篇刻意没有碰位置编码。 后继:视频生成里的稀疏注意力——FlashAttention 的块结构是稀疏模式的执行底座,「整块跳过」从因果掩码推广到任意稀疏图;算子融合与 CUDA Graph——把「少搬内存」推到极端就是融合,FlashAttention 是这个思路最成功的案例;KV Cache 与自回归视频生成——推理时的另一本显存账。 延伸到知识树之外:想读 kernel 源码,从 Dao-AILab/flash-attention 的 flash_attn/flash_attn_interface.py 进,先读 forward 再读 backward;想读原始推导,Milakov & Gimelshein(1805.02867)给出了独立 softmax 在线归一化的直接推导。 附录:完整代码 09 节用到的脚本全文如下(io_ledger.py、flash_online_softmax.py、attention_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 io_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """IO 账本:朴素注意力和 FlashAttention 在 HBM 上到底搬了多少字节。 这篇讲的是「为什么快」。答案不在 FLOPs 上——两者的乘加次数几乎一样—— 而在于 GPU 有两级内存: HBM(显存) 带宽约 1.5 TB/s,容量 40~80 GB SRAM(片上) 带宽约 19 TB/s,但每个 SM 只有 192 KB 朴素实现把 N×N 的分数矩阵写回 HBM 再读出来,等于把数据在这条 13 倍带宽差的 通道上来回搬;FlashAttention 用 tiling 让这些中间结果根本不落 HBM。 下面的模型把每一笔读写都点清楚,参数是可调的,读者可以改硬件常数重算。 硬件数量级取自 FlashAttention 论文第2节与NVIDIA A100白皮书(40GB、非稀疏Tensor Core峰值)。 只依赖 numpy。直接 `python io_ledger.py` 即可运行。 """ import numpy as np # ── 硬件常数(A100 40GB 量级,论文第2节/NVIDIA白皮书)──────────────────── HBM_BW = 1.555e12 # HBM 带宽,字节/秒 SRAM_BW = 19.0e12 # 片上 SRAM 带宽,字节/秒 SRAM_PER_SM = 192 * 1024 # 每个 SM 的片上 SRAM,字节 FLOPS_PEAK = 312e12 # fp16 tensor core 峰值,FLOP/秒 GIB = 1024 ** 3 MIB = 1024 ** 2 # ──────────────────────────────────────────────────────────── # 块大小:SRAM 里能同时放下什么 # ──────────────────────────────────────────────────────────── def block_sizes(d, sram_bytes=SRAM_PER_SM, dtype_bytes=2): """返回 (B_r, B_c):Q 块行数与 K/V 块行数。 SRAM 里要同时放下 K_j、V_j 两个 [B_c, d] 和 Q_i、O_i 两个 [B_r, d]。 论文的取法是 B_c = M / (4d)、B_r = min(B_c, d),这里取整近似: 先让 K_j+V_j 占掉一半 SRAM,Q 块则不超过 d 行(与分数tile的存储预算同阶)。 """ if d <= 0 or dtype_bytes <= 0 or sram_bytes < 4*d*dtype_bytes: raise ValueError("存储预算不足或参数非正") elems = sram_bytes / dtype_bytes B_c = max(1, int(elems // (4 * d))) B_r = min(B_c, d) return B_r, B_c # ──────────────────────────────────────────────────────────── # HBM 读写量(单位:元素个数,乘 dtype_bytes 得字节) # ──────────────────────────────────────────────────────────── def hbm_elems_naive(N, d): """朴素实现:S 和 P 都要落地。 QK^T: 读 Q(Nd) + 读 K(Nd) + 写 S(N²) softmax: 读 S(N²) + 写 P(N²) PV: 读 P(N²) + 读 V(Nd) + 写 O(Nd) """ return 4 * N * d + 4 * N * N def hbm_elems_flash(N, d, B_r, B_c): """FlashAttention:外层遍历 K/V 块,内层遍历 Q 块。 K、V 各读一遍(每个 j 块进 SRAM 后,内层 i 循环里一直复用) Q 每个 j 都要重读一遍:T_c · N·d O 每个 (j,i) 都要读出来再写回去(累加器跨 j 迭代):2 · T_c · N·d l、m 两个 O(N) 的运行量同理:4 · T_c · N """ T_c = int(np.ceil(N / B_c)) return 2 * N * d + 3 * T_c * N * d + 4 * T_c * N def flops_attention(N, d): """两个 N×N 矩阵乘,一次 [M,K]×[K,N] 算 2MKN 个浮点运算。""" return 4 * N * N * d def activation_bytes(N, d, H, B=1, dtype_bytes=2): """单层注意力的训练激活(反向要用的中间张量)。 保守教学模型:6 个 [B,N,d_model] 线性项 + S/P/浮点乘子 3 个 [B,H,N,N]。 此函数 d 是总宽度 d_model,不是其他 IO 函数中的头宽度。 融合侧保留同样六份线性预算,忽略小的 LSE 与工作区;不是框架峰值测量。 """ lin = 6 * B * N * d * dtype_bytes quad = 3 * B * H * N * N * dtype_bytes return lin + quad, lin def roofline(bytes_moved, flops): """算术强度(FLOP/byte)与两个理想下界时间。返回 (强度, 内存时间, 算力时间, 瓶颈)。""" intensity = flops / bytes_moved t_mem = bytes_moved / HBM_BW t_comp = flops / FLOPS_PEAK bound = "内存受限" if t_mem > t_comp else "算力受限" return intensity, t_mem, t_comp, bound # ──────────────────────────────────────────────────────────── # 报表 # ──────────────────────────────────────────────────────────── def report_io(): d, b = 64, 2 # 单头维度 64,fp16 B_r, B_c = block_sizes(d) print("=" * 74) print("1. SRAM 块大小与 HBM 读写量(单头,d=64,fp16)") print("=" * 74) print(f" SRAM {SRAM_PER_SM / 1024:.0f} KB / SM,fp16 下能放 " f"{SRAM_PER_SM / b:.0f} 个元素") print(f" → B_c = M/(4d) = {B_c},B_r = min(B_c, d) = {B_r}\n") print(f"{'N':>7} {'naive HBM':>12} {'flash HBM':>12} {'比值':>8} " f"{'naive 强度':>11} {'flash 强度':>11}") rows = [] for N in (1024, 2048, 4096, 8192, 16384, 32768): nb = hbm_elems_naive(N, d) * b fb = hbm_elems_flash(N, d, B_r, B_c) * b fl = flops_attention(N, d) i_n, _, _, bound_n = roofline(nb, fl) i_f, _, _, bound_f = roofline(fb, fl) rows.append((N, nb, fb, i_n, i_f, bound_n, bound_f)) print(f"{N:>7} {nb / MIB:>10.1f} MiB {fb / MIB:>10.1f} MiB " f"{nb / fb:>7.1f}x {i_n:>9.1f} {i_f:>9.1f} ") print(f"\n 机器平衡点(峰值算力/带宽)= {FLOPS_PEAK / HBM_BW:.0f} FLOP/byte") print(" 仅本理想模型:强度低于平衡点由HBM项主导,高于时由计算项主导。\n") print(f"{'N':>7} {'naive 瓶颈':>12} {'flash 瓶颈':>12}") for N, nb, fb, i_n, i_f, bn, bf in rows: print(f"{N:>7} {bn:>12} {bf:>12}") print("\n 注意:flash 的强度在 N 大时越过平衡点,模型说它变成算力受限了。") print(" 但真实 kernel 达不到峰值——softmax 的 exp 走的是特殊函数单元,") print(" 不走 tensor core,这个「非矩阵乘开销」正是 FlashAttention-2 之后") print(" 继续优化的地方。峰值资源模型给出理想时间下界,不是实测速度承诺。") def report_activation(): d, H, B, b = 3072, 24, 1, 2 print("\n" + "=" * 74) print("2. 教学激活存储模型(简化 Transformer:d=3072, H=24, B=1, 32 层, bf16)") print("=" * 74) print(f"{'N':>7} {'朴素/层':>12} {'Flash/层':>12} {'比值':>8} " f"{'朴素 32 层':>12} {'Flash 32 层':>13}") for N in (1024, 4096, 8192, 32768): naive, flash = activation_bytes(N, d, H, B, b) print(f"{N:>7} {naive / GIB:>10.2f} GiB {flash / GIB:>10.3f} GiB " f"{naive / flash:>7.0f}x {32 * naive / GIB:>10.1f} GiB " f"{32 * flash / GIB:>11.2f} GiB") n4096, f4096 = activation_bytes(4096, d, H, B, b) print(f"\n N=4096 时,朴素实现单层 {n4096 / GIB:.2f} GiB,其中二次项占 " f"{100 * (1 - f4096 / n4096):.1f}%——") print(" 这正是 attention_basics 那篇里「三个 N×N 吃掉 94%」的那一格。") print(" FlashAttention 删掉的就是这一格,剩下的是 O(N) 的线性项。") def report_speed_limit(): d, b = 64, 2 B_r, B_c = block_sizes(d) print("\n" + "=" * 74) print("3. 理想时间下界:如果只受 HBM 带宽限制,两者各要多久(单头,d=64)") print("=" * 74) print(f"{'N':>7} {'FLOPs':>10} {'naive 内存时间':>16} {'flash 内存时间':>16} " f"{'纯带宽模型比':>9}") for N in (1024, 4096, 16384): nb = hbm_elems_naive(N, d) * b fb = hbm_elems_flash(N, d, B_r, B_c) * b fl = flops_attention(N, d) print(f"{N:>7} {fl / 1e9:>8.2f} G {nb / HBM_BW * 1e3:>14.3f} ms " f"{fb / HBM_BW * 1e3:>14.3f} ms {nb / fb:>8.1f}x") print("\n 此列只比较理想 HBM 时间,并非完整模型训练或实际 kernel 加速上界。") print(" 论文的端到端训练加速与此处单头 IO 模型口径不同,不能直接相比。") if __name__ == "__main__": report_io() report_activation() report_speed_limit() flash_online_softmax.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """online softmax 的正确性与显存代价实测(FlashAttention 的核心那一步)。 对比两种实现: naive —— 先算出完整的 N×N 分数矩阵 S,再逐行 softmax 得到 P,最后算 O = P V flash —— 按块流过 K/V,只维护三个 O(N) 的运行量:输出累加器 O、分母 l、 运行最大值 m(第 03 节递推式的直接实现) 无dropout且同一掩码时两者在实数算术下等价;求和顺序、dtype及临时数组不同。 这份脚本回答三个问题: 1. 递推式写出来的结果,和朴素 softmax 数学等价、数值误差多大?(1.1 节) 2. 峰值内存真的差一个 N 吗?(用 tracemalloc 量,不是估的) 3. 那算力呢?——在 CPU + numpy 上速度由实际运行环境决定,这一点必须诚实讲清楚 只依赖 numpy。直接 `python flash_online_softmax.py` 即可运行。 """ import time import tracemalloc import numpy as np NEG = -np.inf # ──────────────────────────────────────────────────────────── # 两个被测实现 # ──────────────────────────────────────────────────────────── def attention_naive(Q, K, V, causal=False): """标准实现:S 和 P 都是完整的 N×N 常驻张量。""" D = Q.shape[-1] S = (Q @ K.T) / np.sqrt(D) # [N, N] ← 第一块 N×N if causal: S = np.where(np.triu(np.ones((Q.shape[0], K.shape[0])), 1) > 0, NEG, S) S -= S.max(axis=-1, keepdims=True) # safe softmax,不改变结果 P = np.exp(S) # [N, N] ← 第二块 N×N P /= P.sum(axis=-1, keepdims=True) return P @ V def attention_flash(Q, K, V, B_r, B_c, causal=False, trace=False, key_valid=None): """等长单头自注意力;输入有限,float16提升到float32累加。 key_valid是一维key保留掩码;全遮行按本文约定返回零输出、LSE=-inf。 支持尾块,不实现dropout、GQA、非等长因果对齐或GPU kernel。 """ Q, K, V = (np.asarray(x) for x in (Q, K, V)) if Q.ndim != 2 or Q.shape != K.shape or Q.shape != V.shape or min(Q.shape) <= 0: raise ValueError("Q/K/V必须为相同非空[N,D]浮点矩阵") if not all(np.issubdtype(x.dtype, np.floating) and np.isfinite(x).all() for x in (Q,K,V)): raise ValueError("仅支持有限浮点输入") if any(not isinstance(b, (int, np.integer)) or isinstance(b, bool) or b <= 0 for b in (B_r,B_c)): raise ValueError("块大小必须为正整数") N, D = Q.shape dtype = np.result_type(Q.dtype, K.dtype, V.dtype, np.float32) Q, K, V = (x.astype(dtype, copy=False) for x in (Q,K,V)) valid = np.ones(N, dtype=bool) if key_valid is None else np.asarray(key_valid) if valid.shape != (N,) or valid.dtype != bool: raise ValueError("key_valid必须为[N]布尔数组") scale = 1.0 / np.sqrt(D) O = np.zeros((N, D), dtype=dtype) l = np.zeros(N, dtype=dtype) m = np.full(N, NEG, dtype=dtype) peak_tmp = 0 for j0 in range(0, N, B_c): Kj, Vj = K[j0:j0+B_c], V[j0:j0+B_c] for i0 in range(0, N, B_r): i1 = min(i0+B_r, N) if causal and i1 <= j0: continue Qi = Q[i0:i1] Sij = (Qi @ Kj.T) * scale if not np.isfinite(Sij).all(): raise ValueError("点积溢出;需缩小输入或使用更高精度") keep = np.broadcast_to(valid[j0:j0+B_c], Sij.shape).copy() if causal: keep &= (j0+np.arange(Sij.shape[1]))[None,:] <= np.arange(i0,i1)[:,None] Sij = np.where(keep, Sij, NEG) peak_tmp = max(peak_tmp, Sij.size) m_old = m[i0:i1] m_new = np.maximum(m_old, Sij.max(axis=-1)) # 对全遮行不计算-inf-(-inf),避免np.where提前求值导致NaN/警告。 shifted = np.full_like(Sij, NEG) np.subtract(Sij, m_new[:,None], out=shifted, where=np.isfinite(m_new)[:,None]) Pij = np.exp(shifted) delta = np.full_like(m_old, NEG) np.subtract(m_old, m_new, out=delta, where=np.isfinite(m_old)) corr = np.exp(delta) l[i0:i1] = l_old = l[i0:i1] * corr + Pij.sum(axis=-1) O[i0:i1] = O[i0:i1] * corr[:,None] + Pij @ Vj m[i0:i1] = m_new if trace: print(f" j={j0:>2} i={i0:>2} m={m_new[0]:+.4f} l={l_old[0]:.4f} corr={corr[0]:.4f}") out = np.zeros_like(O) np.divide(O, l[:,None], out=out, where=l[:,None]>0) LSE = np.full_like(l, NEG) active = l>0 LSE[active] = m[active]+np.log(l[active]) return out, LSE, peak_tmp def attention_backward(Q, K, V, G, B_r=64, B_c=64, causal=False, key_valid=None): """无dropout的分块反向:从O/LSE重算局部P,不存完整P。""" O, LSE, _ = attention_flash(Q,K,V,B_r,B_c,causal=causal,key_valid=key_valid) Q,K,V,G = (np.asarray(x,dtype=O.dtype) for x in (Q,K,V,G)) if G.shape != O.shape or not np.isfinite(G).all(): raise ValueError("G必须为有限[N,D]梯度") N,D=Q.shape valid=np.ones(N,dtype=bool) if key_valid is None else np.asarray(key_valid) dQ,dK,dV = (np.zeros_like(x) for x in (Q,K,V)) row_delta=(G*O).sum(axis=-1) for i0 in range(0,N,B_r): i1=min(i0+B_r,N) for j0 in range(0,N,B_c): j1=min(j0+B_c,N) keep=np.broadcast_to(valid[j0:j1],(i1-i0,j1-j0)).copy() if causal: keep &= np.arange(j0,j1)[None,:] <= np.arange(i0,i1)[:,None] S=(Q[i0:i1]@K[j0:j1].T)/np.sqrt(D) logP=np.full_like(S,NEG) np.subtract(S,LSE[i0:i1,None],out=logP,where=keep & np.isfinite(LSE[i0:i1,None])) P=np.exp(logP) dP=G[i0:i1]@V[j0:j1].T dS=P*(dP-row_delta[i0:i1,None]) dQ[i0:i1] += dS@K[j0:j1]/np.sqrt(D) dK[j0:j1] += dS.T@Q[i0:i1]/np.sqrt(D) dV[j0:j1] += P.T@G[i0:i1] return dQ,dK,dV def peak_bytes(fn, *args, **kwargs): """跑一次 fn,返回 (结果, 峰值字节数)。用 tracemalloc 实测。""" tracemalloc.start() tracemalloc.reset_peak() out = fn(*args, **kwargs) _, peak = tracemalloc.get_traced_memory() tracemalloc.stop() return out, peak def timed(fn, *args, repeat=5, **kwargs): durations = [] fn(*args, **kwargs) # 预热一次,不计入统计 out = None for _ in range(repeat): t0 = time.perf_counter() out = fn(*args, **kwargs) durations.append(time.perf_counter() - t0) return out, float(np.median(durations)) # ──────────────────────────────────────────────────────────── # 1. 递推式长什么样:一个能逐块打印的最小例子 # ──────────────────────────────────────────────────────────── def demo_recurrence(): rng = np.random.default_rng(0) N, D, B_c = 8, 4, 2 Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) print("=" * 68) print("1. online softmax 的递推过程(N=8, D=4, K/V 块大小 B_c=2)") print("=" * 68) print(" Q 块固定为整行(B_r=N),K/V 分成 4 块依次流过;") print(" 每个K/V块打印第 0 号 query 的 m / l / corr,看它们怎么被逐次修正:\n") _, _, peak = attention_flash(Q, K, V, B_r=N, B_c=B_c, trace=True) print(f"\n 最大的单个临时矩阵只有 {peak} 个元素(并非临时内存总和) = [{N}, {B_c}],而 N×N = {N * N}") # ──────────────────────────────────────────────────────────── # 2. 等价性:和朴素 softmax 逐位对得上吗 # ──────────────────────────────────────────────────────────── def demo_exactness(): print("\n" + "=" * 68) print("2. 数值等价性(float64,非因果 / 因果两种掩码)") print("=" * 68) print(f"{'N':>6} {'D':>4} {'causal':>7} {'最大绝对误差':>14} {'相对误差':>12}") for N in (256, 1024, 2048, 4096): D = 64 rng = np.random.default_rng(N) Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) for causal in (False, True): ref = attention_naive(Q, K, V, causal) got, _, _ = attention_flash(Q, K, V, B_r=64, B_c=64, causal=causal) diff = np.abs(ref - got).max() rel = diff / np.abs(ref).max() print(f"{N:>6} {D:>4} {str(causal):>7} {diff:>14.3e} {rel:>12.3e}") print("\n 误差量级是浮点舍入(1e-15),不是近似——FlashAttention 是精确算法。") # ──────────────────────────────────────────────────────────── # 3. 峰值内存:是不是真的差一个 N # ──────────────────────────────────────────────────────────── def demo_memory(): print("\n" + "=" * 68) print("3. 峰值内存实测(tracemalloc,float64,D=64,B_r=B_c=64)") print("=" * 68) print(f"{'N':>6} {'naive 实测':>12} {'naive 理论 2N²·8':>18} " f"{'flash 实测':>12} {'比值':>8}") peaks = {} for N in (1024, 2048, 4096, 8192): D = 64 rng = np.random.default_rng(N) Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) _, p_naive = peak_bytes(attention_naive, Q, K, V) _, p_flash = peak_bytes(attention_flash, Q, K, V, 64, 64) peaks[N] = (p_naive, p_flash) print(f"{N:>6} {p_naive / 2**20:>10.1f} MiB " f"{2 * N * N * 8 / 2**20:>16.1f} MiB " f"{p_flash / 2**20:>10.1f} MiB {p_naive / p_flash:>7.1f}x") g_n = peaks[8192][0] / peaks[4096][0] g_f = peaks[8192][1] / peaks[4096][1] print(f"\n N 从 4096 翻到 8192:naive 峰值 ×{g_n:.1f},flash 峰值 ×{g_f:.1f}") print(" 这就是 O(N²) 和 O(N) 的区别:前者翻两倍(4×),后者跟着翻倍(2×)。") print(" 朴素实现要同时留住 S 和 P 两个 N×N(理论列就是 2N²·8 字节,和实测对得上);") print(" flash 只留 B_r×B_c 的块,剩下的是 O(N·D) 的输出累加器。") # ──────────────────────────────────────────────────────────── # 4. 时间:CPU教学循环的实际耗时 # ──────────────────────────────────────────────────────────── def demo_time(): print("\n" + "=" * 68) print("4. 墙钟时间(CPU + numpy,线程配置以运行环境为准;预热1次+5次中位数)——反直觉的一项是这个") print("=" * 68) print(f"{'N':>6} {'naive':>10} {'flash(B=64)':>13} {'flash/naive':>12}") for N in (1024, 2048, 4096): D = 64 rng = np.random.default_rng(N) Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) _, t_naive = timed(attention_naive, Q, K, V) _, t_flash = timed(attention_flash, Q, K, V, 64, 64) print(f"{N:>6} {t_naive * 1e3:>9.1f} ms {t_flash * 1e3:>12.1f} ms " f"{t_flash / t_naive:>11.1f}x") print("\n 以上比值是本机本次计时,不能据此预测 GPU;可能影响速度的因素包括:") print(" 1. 乘加次数一模一样,还额外多了每块的 rescale 和逐元素 exp;") print(" 2. 一次大矩阵乘被拆成 (N/B)² 次 64×64 的小矩阵乘,") print(" BLAS 在小块上根本跑不满,Python 循环开销也进来了;") print(" 3. 最关键的:它省的是**内存搬运**,不是 FLOPs,") print(" CPU 同样有 SRAM 缓存,但本示例没有专门优化缓存和线程,") print(" 因此分块可能省容量,却被 Python 循环与小 GEMM 开销抵消。") print(" 第 05 节讲GPU实现如何优化IO与调度,本文不实测GPU性能。") # ──────────────────────────────────────────────────────────── # 5. 因果掩码:统计本实现跳过的全遮块比例 # ──────────────────────────────────────────────────────────── def demo_causal_blocks(): print("\n" + "=" * 68) print("5. 因果掩码下实际算了多少块(N=4096, B_r=B_c=64)") print("=" * 68) N, B = 4096, 64 T_r = T_c = N // B total = 0 for j in range(T_c): for i in range(T_r): if i * B + B <= j * B: # 整个 Q 块都在 K 块之前 → 全遮,跳过 continue total += 1 print(f" 块总数(非因果) : {T_r * T_c}") print(f" 块总数(因果跳过): {total}") print(f" 跳过的块占比 : {100.0 * (1 - total / (T_r * T_c)):.1f}%") print("\n 朴素实现就算加了因果掩码,N×N 的矩阵照样得整块算完再遮,") print(" 本脚本朴素路径不跳块;flash省去全遮块,但并非精确减半(严格说是") print(" (T²+T)/2 / T² ≈ 一半多一点的对角块保留)。") if __name__ == "__main__": np.set_printoptions(precision=4, suppress=True) demo_recurrence() demo_exactness() demo_memory() demo_time() demo_causal_blocks() attention_checks.py """CPU数学对拍与反例;依赖numpy和torch。与GPU速度复现无关。""" import inspect import json from pathlib import Path import numpy as np import torch from torch.nn import functional as F from torch.nn.attention import sdpa_kernel, SDPBackend from flash_online_softmax import attention_flash, attention_backward def main(): torch.set_num_threads(1) rng=np.random.default_rng(42) rows=[];grad_errors=[] for N in (1,7,17): D=5 for dtype in (np.float64,np.float32,np.float16): Q,K,V=(rng.normal(size=(N,D)).astype(dtype) for _ in range(3)) for causal in (False,True): for masked in (False,True): valid=np.ones(N,dtype=bool) if masked: valid[:min(3,N)]=False keep=np.broadcast_to(valid,(N,N)).copy() if causal: keep &= np.arange(N)[None,:] <= np.arange(N)[:,None] # Math后端、float64参考用于隔离输入量化和分块舍入。 ts=[torch.tensor(x.astype(np.float64)[None,None],requires_grad=True) for x in (Q,K,V)] with sdpa_kernel(SDPBackend.MATH): ref=F.scaled_dot_product_attention(*ts,attn_mask=torch.tensor(keep),dropout_p=0.0) G=rng.normal(size=(N,D));expected=torch.autograd.grad((ref*torch.tensor(G[None,None])).sum(),ts) for br,bc in ((1,1),(3,2),(8,11)): out,lse,_=attention_flash(Q,K,V,br,bc,causal=causal,key_valid=valid) error=float(np.max(np.abs(out-ref.detach().numpy()[0,0]))) assert error < (2e-12 if dtype==np.float64 else 2e-6) assert np.all(out[~keep.any(-1)]==0) and np.isneginf(lse[~keep.any(-1)]).all() rows.append(dict(N=N,dtype=str(np.dtype(dtype)),causal=causal,masked=masked,block=[br,bc],max_abs=error)) if dtype==np.float64: gs=attention_backward(Q,K,V,G,br,bc,causal=causal,key_valid=valid) err=max(float(np.max(np.abs(g-e.numpy()[0,0]))) for g,e in zip(gs,expected)) assert err<2e-12;grad_errors.append(err) Q,K,V=(rng.normal(size=(7,5)) for _ in range(3));G=rng.normal(size=(7,5));valid=np.array([False,False,True,True,False,True,True]) grads=attention_backward(Q,K,V,G,3,2,causal=True,key_valid=valid) fd_errors=[];step=1e-5 for x,g in zip((Q,K,V),grads): for idx in np.ndindex(x.shape): old=x[idx];x[idx]=old+step;plus=np.sum(attention_flash(Q,K,V,3,2,causal=True,key_valid=valid)[0]*G) x[idx]=old-step;minus=np.sum(attention_flash(Q,K,V,3,2,causal=True,key_valid=valid)[0]*G);x[idx]=old fd_errors.append(abs((plus-minus)/(2*step)-g[idx])) assert max(fd_errors)<1e-8 # 仅为展示错误:删除rescale,其他代码保持一致。不要用于计算正确注意力。 src=inspect.getsource(attention_flash).replace('corr = np.exp(delta)','corr = np.ones_like(delta)') ns=dict(np=np,NEG=-np.inf);exec(src,ns) rng=np.random.default_rng(1024);Q,K,V=(rng.normal(size=(1024,64)) for _ in range(3)) correct=attention_flash(Q,K,V,64,64)[0];bad=ns['attention_flash'](Q,K,V,64,64)[0];diff=np.abs(correct-bad) res=dict(passed=True,environment=dict(torch=torch.__version__,numpy=np.__version__,device='CPU',threads=1),forward_cases=rows, forward_max_abs=max(x['max_abs'] for x in rows),autograd_max_abs=max(grad_errors),finite_difference_parameters=len(fd_errors),finite_difference_max_abs=max(fd_errors), broken_rescale=dict(seed=1024,N=1024,D=64,max_abs=float(diff.max()),mean_abs=float(diff.mean())),errors=[],warnings=[]) Path(__file__).with_name('validation_results.json').write_text(json.dumps(res,indent=2),encoding='utf8') print(json.dumps({k:v for k,v in res.items() if k!='forward_cases'},indent=2)) if __name__=='__main__': with np.errstate(all='raise'): main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「FlashAttention」的三张解释图。 数值全部来自同目录下的 io_ledger.py(HBM 读写量、激活显存、算术强度), 改了那个脚本的话这里要跟着重跑,避免图与正文数字不一致。 三张图分别回答: 1. tiling 到底怎么切、什么留在 SRAM、什么留在 HBM 2. 两本账随 N 怎么长(HBM 读写量、教学激活存储模型) 3. 为什么说是「内存受限」变的「不那么受限」(算术强度对机器平衡点) 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from matplotlib.patches import FancyArrowPatch, FancyBboxPatch, Rectangle from io_ledger import ( FLOPS_PEAK, HBM_BW, activation_bytes, block_sizes, flops_attention, hbm_elems_flash, hbm_elems_naive, ) ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) C_NAIVE = "#e05263" # 朴素实现:红 C_FLASH = "#2f9e6f" # FlashAttention:绿 C_SRAM = "#f0a03c" # SRAM 高亮:橙 C_GREY = "#94a3b8" C_SKIP = "#e4e9f0" INK = "#182238" MIB = 1024 ** 2 GIB = 1024 ** 3 def _style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=13.5, weight="bold", color=INK, pad=10) if xlabel: ax.set_xlabel(xlabel, fontsize=11, color="#475569") if ylabel: ax.set_ylabel(ylabel, fontsize=11, color="#475569") ax.tick_params(colors="#475569", labelsize=10) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#cbd5e1") ax.set_axisbelow(True) def _box(ax, x, y, w, h, text, fc, fs=10.5, tc="white"): ax.add_patch(FancyBboxPatch( (x, y), w, h, boxstyle="round,pad=0.02,rounding_size=0.12", linewidth=0, facecolor=fc, edgecolor="none")) ax.text(x + w / 2, y + h / 2, text, ha="center", va="center", fontsize=fs, color=tc, weight="bold", linespacing=1.5) def _arrow(ax, x1, y1, x2, y2, label=None, color="#475569"): ax.add_patch(FancyArrowPatch( (x1, y1), (x2, y2), arrowstyle="-|>", mutation_scale=13, linewidth=1.4, color=color, shrinkA=2, shrinkB=2)) if label: ax.text((x1 + x2) / 2, max(y1, y2) + 0.22, label, ha="center", fontsize=9, color=color) def _caption(fig, text): fig.text(0.5, 0.012, text, ha="center", fontsize=9.5, color="#94a3b8") # ──────────────────────────────────────────────────────────── # 图 1:tiling 怎么切 # ──────────────────────────────────────────────────────────── def fig_tiling(): fig = plt.figure(figsize=(13.6, 6.0), facecolor="#fbfcfe") # ── 左:朴素实现 ── ax = fig.add_axes([0.03, 0.09, 0.46, 0.80]) ax.set_xlim(0, 10); ax.set_ylim(0, 7.4); ax.axis("off") ax.text(0, 7.05, "本例朴素前向:物化 S 与 P", fontsize=13.5, weight="bold", color=C_NAIVE) _box(ax, 0.1, 5.1, 1.5, 1.1, "Q, K, V\n[N, d]", "#64748b", fs=10) _box(ax, 2.4, 4.8, 2.0, 1.7, "S = QK^T / √d\n[N, N]", C_NAIVE, fs=11) _box(ax, 5.3, 4.8, 2.0, 1.7, "P = softmax(S)\n[N, N]", C_NAIVE, fs=11) _box(ax, 8.2, 5.1, 1.6, 1.1, "O = PV\n[N, d]", "#64748b", fs=10) _arrow(ax, 1.65, 5.65, 2.35, 5.65) _arrow(ax, 4.45, 5.65, 5.25, 5.65, "读 S 写 P") _arrow(ax, 7.35, 5.65, 8.15, 5.65, "读 P") ax.text(4.4, 4.25, "N=4096, d=64, fp16:S 和 P 各 32 MiB", ha="center", fontsize=9.5, color="#475569") ax.add_patch(Rectangle((0.1, 2.2), 9.7, 1.35, facecolor="#eef2f7", edgecolor="#cbd5e1", linewidth=1.2)) ax.text(4.95, 3.2, "HBM 带宽 1.5 TB/s", ha="center", fontsize=10.5, color="#475569", weight="bold") ax.text(4.95, 2.5, "S 写一次读一次,P 写一次读一次 → 简化计数 4N² 次元素搬运", ha="center", fontsize=9.5, color="#64748b") _arrow(ax, 3.4, 4.75, 3.4, 3.6, color=C_NAIVE) _arrow(ax, 6.3, 4.75, 6.3, 3.6, color=C_NAIVE) ax.text(0.1, 1.35, "代价:数据在这条通道上来回两趟,", fontsize=10.5, color=C_NAIVE, weight="bold") ax.text(0.1, 0.75, "表中带宽数量级不同,非延迟之比", fontsize=10.5, color=C_NAIVE, weight="bold") # ── 右:FlashAttention ── ax2 = fig.add_axes([0.53, 0.09, 0.44, 0.80]) ax2.set_xlim(0, 10); ax2.set_ylim(0, 7.4); ax2.axis("off") ax2.text(0, 7.05, "FlashAttention:按块流过,只留 O(N)", fontsize=13.5, weight="bold", color=C_FLASH) T = 8 gx0, gy0, cell = 1.05, 3.1, 0.46 for i in range(T): for j in range(T): if i + 1 <= j: # 因果掩码下整块跳过(先判,优先级最高) fc, ec = C_SKIP, "#c3ccd8" elif j == 3: # 当前正在处理的 K/V 块列 fc, ec = "#cdeadb", C_SRAM elif i == 5: # 当前 Q 块行 fc, ec = "#dfeaf6", "#94a3b8" else: fc, ec = "#f7fafc", "#dde3ea" ax2.add_patch(Rectangle( (gx0 + j * cell, gy0 + (T - 1 - i) * cell), cell * 0.90, cell * 0.90, facecolor=fc, edgecolor=ec, linewidth=1.1)) gtop = gy0 + T * cell ax2.text(gx0 - 0.42, gy0 + T * cell / 2, "Q 块逐行流过", fontsize=9.5, color="#475569", ha="center", va="center", rotation=90) ax2.add_patch(FancyBboxPatch( (gx0 + 3 * cell - 0.06, gy0 - 0.06), cell * 1.02, T * cell + 0.12, boxstyle="round,pad=0.03,rounding_size=0.1", linewidth=1.6, edgecolor=C_SRAM, facecolor="none", linestyle="--")) ax2.text(gx0 + 3.5 * cell, gy0 - 0.42, "K_j, V_j 常驻 SRAM", ha="center", fontsize=9.5, color=C_SRAM, weight="bold") ax2.text(gx0 + T * cell + 0.45, gtop - 0.35, "一块 = [B_r, B_c]\n= [64, 64]", fontsize=9.5, color="#475569", va="top", linespacing=1.5) ax2.text(gx0 + T * cell + 0.45, gtop - 1.55, "灰色块:因果掩码下\n整块跳过,连算都不算", fontsize=9, color="#94a3b8", va="top", linespacing=1.5) ax2.text(gx0 + T * cell + 0.45, gtop - 2.95, "片上空间受限:\n驻留 K/V 与 Q/O 块,\n还要容纳分数和统计量", fontsize=9, color=C_SRAM, va="top", linespacing=1.5) by = 1.85 ax2.text(0.15, by + 0.52, "跨 K/V 块一直复用的三个量:", fontsize=10.5, color=INK, weight="bold") for k, (label, color) in enumerate([ ("O_i 未归一化累加器 [N, d]", C_FLASH), ("l_i 分母 [N]", "#7fb3d5"), ("m_i 运行最大值 [N]", "#c9a227")]): ax2.add_patch(Rectangle((0.15, by - k * 0.46), 4.6, 0.28, facecolor=color, edgecolor="none")) ax2.text(4.9, by - k * 0.46 + 0.14, label, fontsize=9.5, color="#475569", va="center") ax2.text(0.15, 0.12, "每来一块就 rescale 一次(乘 e^{m旧−m新}),最后 O/l 收尾", fontsize=9.5, color="#64748b") _caption(fig, "图 1:切的是「K/V 块 × Q 块」这两层循环,不是把注意力切开。" "左边突出两份二次中间量,右边只维护线性的累加量(固定 d)。") fig.savefig(OUT / "tiling.png", facecolor="#fbfcfe") plt.close(fig) print(" figures/tiling.png") # ──────────────────────────────────────────────────────────── # 图 2:两本账随 N 怎么长 # ──────────────────────────────────────────────────────────── def fig_curves(): d, b = 64, 2 B_r, B_c = block_sizes(d) Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768]) naive_io = np.array([hbm_elems_naive(N, d) * b for N in Ns]) / MIB flash_io = np.array([hbm_elems_flash(N, d, B_r, B_c) * b for N in Ns]) / MIB fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.1), facecolor="#fbfcfe") fig.subplots_adjust(bottom=0.20, top=0.86, wspace=0.25) ax = axes[0] ax.loglog(Ns, naive_io, "o-", color=C_NAIVE, lw=2.2, ms=6, label="朴素实现(∝N²)") ax.loglog(Ns, flash_io, "s-", color=C_FLASH, lw=2.2, ms=6, label="FlashAttention(∝N²/M)") ax.annotate(f"{naive_io[2] / flash_io[2]:.1f}×", xy=(Ns[2], naive_io[2]), xytext=(Ns[2] * 1.6, naive_io[2] * 3.0), fontsize=11, color=C_NAIVE, weight="bold", arrowprops=dict(arrowstyle="->", color=C_NAIVE, lw=1.3)) ax.legend(fontsize=10, frameon=False, loc="upper left") ax.grid(True, which="both", color="#eef2f7", lw=0.9) _style(ax, "HBM 读写量(单头 d=64, fp16)", "序列长度 N", "MiB") ax = axes[1] d2, H, B = 3072, 24, 1 lay = 32 naive_act = np.array( [activation_bytes(N, d2, H, B)[0] * lay for N in Ns]) / GIB flash_act = np.array( [activation_bytes(N, d2, H, B)[1] * lay for N in Ns]) / GIB ax.loglog(Ns, naive_act, "o-", color=C_NAIVE, lw=2.2, ms=6, label="朴素实现(∝N²)") ax.loglog(Ns, flash_act, "s-", color=C_FLASH, lw=2.2, ms=6, label="FlashAttention(∝N)") ax.axhline(80, color="#64748b", ls="--", lw=1.4) ax.text(Ns[0] * 1.15, 92, "示例预算:80 GiB(非硬件规格)", fontsize=9.5, color="#64748b") ax.annotate("76.5 GiB", xy=(4096, naive_act[2]), xytext=(4096 * 1.8, naive_act[2] * 2.2), fontsize=10.5, color=C_NAIVE, weight="bold", arrowprops=dict(arrowstyle="->", color=C_NAIVE, lw=1.3)) ax.annotate("4.5 GiB", xy=(4096, flash_act[2]), xytext=(4096 * 0.55, flash_act[2] * 6.0), fontsize=10.5, color=C_FLASH, weight="bold", arrowprops=dict(arrowstyle="->", color=C_FLASH, lw=1.3)) ax.legend(fontsize=10, frameon=False, loc="upper left") ax.grid(True, which="both", color="#eef2f7", lw=0.9) _style(ax, "教学激活存储模型(简化视频 DiT,32 层)", "序列长度 N", "GiB") _caption(fig, "图 2:两张都是对数轴,斜率就是复杂度阶数。" "左图的大 N 主导项均为 N²,有限 N 时比例受线性项和取整影响;" "右图斜率不同(N² 对 N),N 越大差距越离谱。") fig.savefig(OUT / "io_curve.png", facecolor="#fbfcfe") plt.close(fig) print(" figures/io_curve.png") # ──────────────────────────────────────────────────────────── # 图 3:算术强度 vs 机器平衡点 # ──────────────────────────────────────────────────────────── def fig_intensity(): d, b = 64, 2 B_r, B_c = block_sizes(d) Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768]) naive_i = np.array([flops_attention(N, d) / (hbm_elems_naive(N, d) * b) for N in Ns]) flash_i = np.array([flops_attention(N, d) / (hbm_elems_flash(N, d, B_r, B_c) * b) for N in Ns]) balance = FLOPS_PEAK / HBM_BW fig, ax = plt.subplots(figsize=(11.4, 5.0), facecolor="#fbfcfe") fig.subplots_adjust(bottom=0.22, top=0.86) ax.axhspan(0, balance, color="#fdf1f2", zorder=0) ax.axhline(balance, color="#64748b", ls="--", lw=1.6, zorder=3) ax.text(Ns[-1] * 2.1, balance * 0.70, f"机器平衡点 {balance:.0f} FLOP/byte\n(峰值算力 ÷ HBM 带宽)", fontsize=10, color="#475569", va="center", linespacing=1.5) ax.text(Ns[0] * 1.02, balance * 0.40, "线下:本 roofline 模型由 HBM 项主导(实际瓶颈需测量)", fontsize=10, color=C_NAIVE) ax.text(Ns[0] * 1.02, balance * 1.32, "线上:本模型计算项主导", fontsize=10, color=C_FLASH) ax.semilogx(Ns, naive_i, "o-", color=C_NAIVE, lw=2.4, ms=7, label="朴素实现", zorder=4) ax.semilogx(Ns, flash_i, "s-", color=C_FLASH, lw=2.4, ms=7, label="FlashAttention", zorder=4) for x, v in zip(Ns, naive_i): ax.annotate(f"{v:.0f}", (x, v), textcoords="offset points", xytext=(0, -16), ha="center", fontsize=9, color=C_NAIVE) for x, v in zip(Ns, flash_i): ax.annotate(f"{v:.0f}", (x, v), textcoords="offset points", xytext=(0, 9), ha="center", fontsize=9, color=C_FLASH) ax.set_xticks(Ns) ax.set_xticklabels([f"{n // 1024}K" for n in Ns]) ax.set_xlim(Ns[0] * 0.75, Ns[-1] * 4.5) ax.set_ylim(0, balance * 1.85) ax.legend(fontsize=10.5, frameon=False, loc="center right") ax.grid(axis="y", color="#eef2f7", lw=0.9) _style(ax, "算术强度:每搬 1 字节能做多少次运算(单头 d=64, fp16)", "序列长度 N", "FLOP / byte") _caption(fig, "图 3:朴素实现的强度几乎不随 N 变(一直贴在 32 附近)," "在此模型中由 HBM 项主导;FlashAttention 的估计抬过平衡点," "并不单独证明实际 kernel 已充分利用计算单元。") fig.savefig(OUT / "intensity.png", facecolor="#fbfcfe") plt.close(fig) print(" figures/intensity.png") if __name__ == "__main__": print("生成配图:") fig_tiling() fig_curves() fig_intensity()