
搜索到
240
篇与
人工智能炼丹君
的结果
-
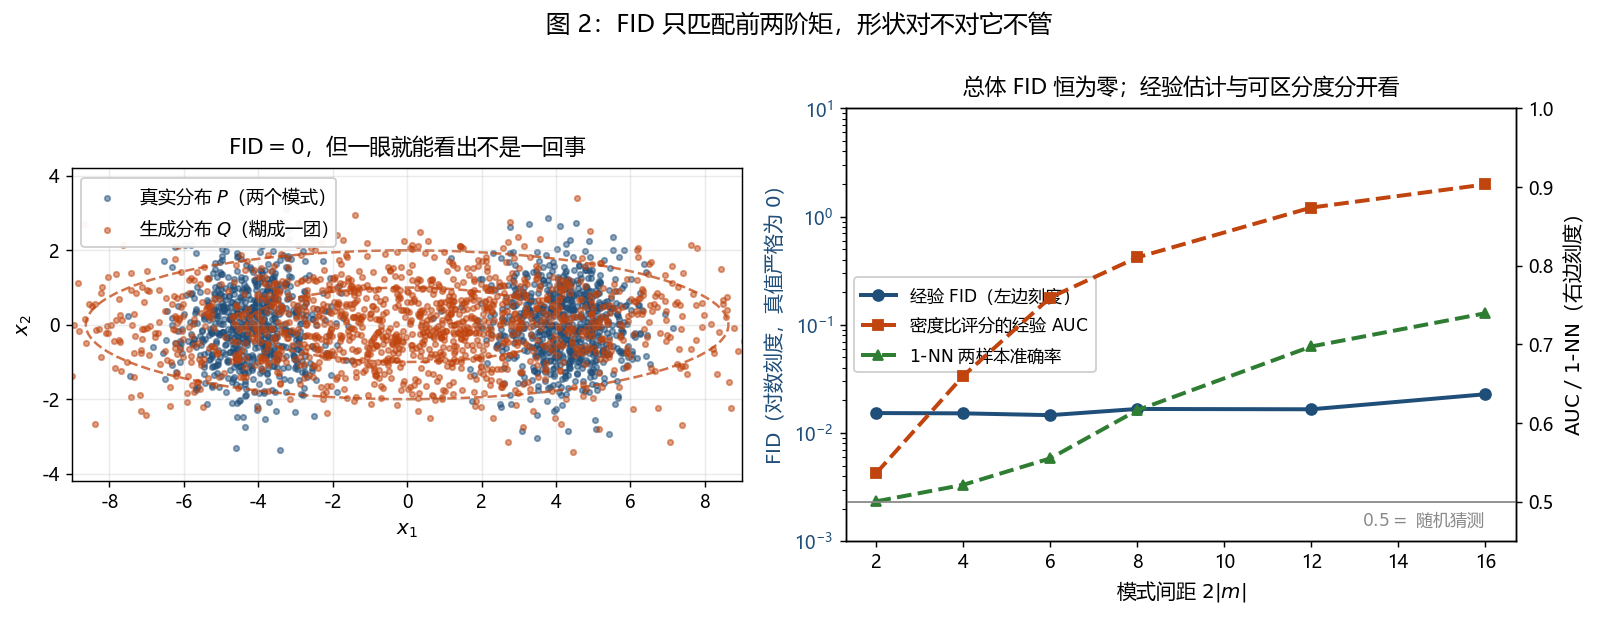
 AIGC 基本功|FID / CLIP Score 到底测了什么-FID AIGC 基本功|FID / CLIP Score 到底测了什么-FID 所属方向:评测 | 难度:进阶 | 前置知识:无(先补均值、协方差和余弦相似度的最小背景,再进入推导) 关键词:FID、Inception Score、CLIP Score、2-Wasserstein 距离、样本量偏差、指标失效 01. 为什么需要它 先给一个我自己跑出来的数字,它比任何论述都更能说明问题。 我从同一个分布里抽两组样本:真实组和生成组来自同一个人工构造的 2048 维多元高斯:协方差特征值按 $1/k$ 衰减,迹归一化为 2048。总体的高斯距离为 0,但两组有限样本的估计值不必为 0。每组 10000 个样本时,实测 FID = 71.20;每组加到 50000 个样本,实测 FID = 14.21。两组的总体分布相同,但具体抽样不同。这里改变样本量并重复抽样取平均;不是对真实 Inception 图像特征的测量。 这不是实现写错了,而是 FID 的固有性质:有限样本估计的期望会偏离总体值;本例总体值为零、估计非负,因此表现为正偏差。这不等于每一次非同分布估计都比真值大。偏差来自哪里?Inception-v3 的 pool3 特征是 2048 维,一个 2048×2048 的协方差矩阵有 $2048 \times 2049 / 2 \approx 2.10 \times 10^{6}$ 个自由参数,全靠有限样本去填。有限样本让均值与协方差发生波动,经非线性距离公式后产生估计偏差。同分布基线的期望非负,但不能把自由参数数量直接当作最低样本量。我做过分解(附录 fid_bias_lab.py 的 [A2] 段):在 $d=512$、$n=40000$ 时,把均值换成真值只能消掉 1.4% 的偏差,把协方差换成真值能消掉 98.6%——在这组谱和尺度下,偏差主要来自协方差估计。 这些数字展示了样本量可以显著改变同分布基线,但不能把 71 或 57 分推广为所有真实模型的偏差。特征整体乘 $c$,距离就乘 $c^2$;谱结构、参考集是否固定、两个分布的差异也会影响偏差。因此跨论文比较前必须核对特征器、数据集和样本量等协议。Chong 与 Forsyth 的研究 还说明偏差依赖生成器,同样的样本量并不能自动消除排序偏差。 第二个坑在另一头。FID 只比较分布,不比较单张图。例如,若只是把同一组图像与 prompt 重新错配,图像集合不变,FID 就完全不变;但把所有橘猫换成黑猫可能改变图像分布,不能保证 FID 不变。因此文生图评测常配合 CLIP 相似度或其他条件一致性指标——在文生图迁移中,它不需要配对真值图,能逐样本给图文兼容性分;原始 caption 任务的 reference-free 是指无需人工参考描述。但 CLIP Score 有自己的洞:它先给每个图文对打分,常见的数据集均值会丢失分布信息,好样本和坏样本可以互相平均掉。在合成共享空间里,可以构造汇总分数近似相同、逐样本分布却不同的两组输出。第 6.3 节列出四组例子;标准差比最大约 17.55 倍对应 $p=0.9$,并非 $p=0.3$ 那一行。分数一样,产品体验完全不同。 本文的数值实验全部使用明确指定分布的人工特征;表中简称 FID 的数值是沿用 FID 公式的高斯矩距离,没有加载 Inception 或 CLIP 权重,也没有测真实图像质量。真实 FID 还由固定的图像特征器与预处理协议共同定义。 所以这篇要讲清楚的是三件事:FID 的闭式解是怎么推出来的、它的偏差有多大且怎么补救、以及 FID 和 CLIP Score 各自测的是哪一半。 02. 最小可用理解 三句话: 机制:把真实图和生成图都过一遍 Inception-v3,取 pool3 层的 2048 维特征;对两组特征各拟合一个多元高斯 $\mathcal{N}(\mu_{\text{real}}, \Sigma_{\text{real}})$ 和 $\mathcal{N}(\mu_{\text{gen}}, \Sigma_{\text{gen}})$;然后算这两个高斯之间的 Fréchet 距离(也就是 2-Wasserstein 距离的平方)。全部闭式,几行代码。 成本:只需要一阶矩和二阶矩,不需要知道分布的形状,也不需要先训一个判别器。代价是它只看得见前两阶矩,有限样本协方差可以计算,但估计误差会进入 FID;大样本区间常用 $1/n$ 展开描述偏差,系数依赖具体分布。 效果与代价:FID 对改变前两阶矩的分布变化敏感,也可能漏掉矩匹配的模式变化;CLIPScore 提供逐图文对相似度,但不等于综合质量。本文合成例子说明两个目标可能冲突,不能据此断言真实 FID 与 CLIPScore 永远相反。 03. 数学推导 先约定符号:特征向量有 $d$ 个分量,均值描述中心,协方差描述各方向的方差及共同变化: $$\mu=\mathbb{E}X,\qquad \Sigma=\mathbb{E}[(X-\mu)(X-\mu)^\top].$$ 其中,$\mathrm{Tr}$ 是对角线之和,$\succeq0$ 表示二次型非负。余弦相似度是两个非零向量的内积除以各自范数,只比较方向。下文用总体矩定义目标,用带帽子的样本矩估计它。 3.1 为什么不能逐图打分 生成模型的评测有一个结构性困难:无条件生成或自由文生图评测通常没有逐图配对的真值。你拿不到「这张生成图对应的真值图」,因此 MSE、PSNR、SSIM 等有参考指标不能直接用于这种非配对比较——它们要求两张图逐像素对齐。 一个自然的替代是「只给生成图打分」,这就是 Inception Score(IS)的思路:把生成图送进 Inception-v3,看分类分布 $p(y \mid x)$ 是不是既尖锐又有多样性。但它有一个致命缺陷:它根本不看真实图片。记忆训练集也可能得到高 IS,因为 IS 不检查是否抄袭,也不比较目标数据分布。高 IS 还要求预测类别清晰且类别边缘分布有多样性,并非真实图片自动「满分」。FID 同样不直接检验记忆训练集。 把 IS 写开就更清楚了。令 $p(y)$ 为生成图分类概率的平均,$H$ 为离散熵,则原始 IS 论文 的定义等价于 $$\mathrm{IS}=\exp\!\left(\mathbb{E}_{\mathrm{img}}\mathrm{KL}(p(y\mid x)\Vert p(y))\right)=\exp\!\left(H(p(y))-\mathbb{E}_{\mathrm{img}}H(p(y\mid x))\right).$$ 所以它鼓励分类边缘分布分散、单图分类明确;同一类别里只反复输出一张原型图,也可能保留高分。分类器标签之外的多样性、条件匹配和记忆训练集都不能由这个数保证。 FID 的出发点就是要补上这一半:把真实分布也纳入比较,比较两个分布之间的距离,而不是给单张图打分。 3.2 为什么是高斯 图像在 Inception 特征空间(2048 维)里的分布形状未知,而且在这个维度上你没法可靠地估计它的形状。FID 选择用一阶矩和二阶矩近似描述,估计质量仍依赖样本量。 那么问题变成:在只知道均值和协方差的条件下,应该假设什么分布?一种常见选择是高斯:在协方差正定、具有密度且熵定义适当的分布中,它在固定均值和协方差下最大化微分熵。奇异情形应在其支撑子空间上理解。这个性质解释了矩近似的动机,并不证明真实 Inception 特征服从高斯。这个选择的物理含义是:FID 只承诺比较前两阶矩,不承诺比较形状。后面 3.5 节会看到,这个妥协是有代价的。 3.3 Fréchet 距离的闭式解 设 $X \sim \mathcal{N}(\mu_1, \Sigma_1)$、$Y \sim \mathcal{N}(\mu_2, \Sigma_2)$。2-Wasserstein 距离的平方定义为所有耦合(joint distribution)中传输代价的最小值: $$W_2^2 = \min_{\text{coupling}} \mathbb{E} \big[ \| X - Y \|^2 \big]$$ 先看任意一个耦合的代价是多少。设交叉协方差 $C = \mathrm{Cov}(X, Y)$,把 $\|X - Y\|^2$ 展开成三项并分别取期望:第一项 $\mathbb{E}\|X\|^2 = \|\mu_1\|^2 + \mathrm{Tr}(\Sigma_1)$(因为 $\mathrm{Tr}(\Sigma_1)$ 就是 $X$ 各维方差之和);第二项同理;第三项交叉项 $\mathbb{E}[X^\top Y] = \mu_1^\top \mu_2 + \mathrm{Tr}(C)$。三项合并,$\|\mu_1\|^2 + \|\mu_2\|^2 - 2\mu_1^\top\mu_2$ 正好凑成 $\|\mu_1 - \mu_2\|^2$,于是 $$\mathbb{E} \big[ \| X - Y \|^2 \big] = \| \mu_1 - \mu_2 \|^2 + \mathrm{Tr}(\Sigma_1) + \mathrm{Tr}(\Sigma_2) - 2\,\mathrm{Tr}(C)$$ 前三项由边缘分布决定,动不了。所以要让传输代价最小,等价于让 $\mathrm{Tr}(C)$ 最大。约束是联合协方差矩阵必须半正定: $$\begin{pmatrix} \Sigma_1 & C \\ C^\top & \Sigma_2 \end{pmatrix} \succeq 0$$ 为什么这个最大值可求?先假设两协方差正定。将联合协方差分别按两边的逆平方根归一化,再用 Schur 补,可把约束等价写成 $$C=\Sigma_1^{1/2}K\Sigma_2^{1/2},\qquad \|K\|_{\mathrm{op}}\le1.$$ $K$ 是两个标准化随机向量的交叉协方差,算子范数上界 1 表示任何方向的相关性不能超出允许范围。对下面的矩阵做奇异值分解: $$\Sigma_2^{1/2}\Sigma_1^{1/2}=U\,\mathrm{diag}(s_i)\,V^\top.$$ 利用迹的循环性质,$\mathrm{Tr}(C)$ 等于下式;中间矩阵仍是收缩矩阵,每个对角元至多为 1: $$\mathrm{Tr}(C)=\sum_i s_i(V^\top K U)_{ii}\le\sum_i s_i.$$ 取 $K=VU^\top$ 达到上界。奇异值的平方正是半正定夹心矩阵的特征值,因此上界等于该矩阵平方根的迹。这也对应 Bhatia、Jain 与 Lim 的矩阵分析。 上界不是只有形式的矩阵解。令 $X$ 为给定高斯,取对称线性映射 $$A=\Sigma_1^{-1/2}(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2})^{1/2}\Sigma_1^{-1/2},\qquad Y=\mu_2+A(X-\mu_1).$$ 可直接相乘验证 $A\Sigma_1A^\top=\Sigma_2$;因此 $Y$ 确实具有要求的高斯边缘,交叉协方差 $C=\Sigma_1A^\top$ 达到上界。由此最优解为 $$C^\star = \Sigma_1^{1/2} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)^{1/2} \Sigma_1^{-1/2}$$ 代回去,利用迹的循环性质把外面的 $\Sigma_1^{1/2}$ 和 $\Sigma_1^{-1/2}$ 抵消掉,得到 $$\mathrm{Tr}(C^\star) = \mathrm{Tr} \Big( \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)^{1/2} \Big) = \mathrm{Tr} \Big( \big( \Sigma_1 \Sigma_2 \big)^{1/2} \Big)$$ 最后一个等号值得停一下,因为它是实现环节最容易写错的地方。$\Sigma_1 \Sigma_2$ 两个对称矩阵的乘积一般不是对称矩阵,不能直接交给对称特征值求解器。当 $\Sigma_1$ 正定时,$\Sigma_1 \Sigma_2$ 与 $\Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2}$ 相似: $$\Sigma_1^{1/2} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big) \Sigma_1^{-1/2} = \Sigma_1 \Sigma_2$$ 而后者 $\Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2}$ 是对称半正定的(对任意 $v$ 有 $$v^\top \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} v = (\Sigma_1^{1/2} v)^\top \Sigma_2 (\Sigma_1^{1/2} v) \ge 0$$ )。相似矩阵特征值相同,而主平方根与相似变换可交换,所以两者的平方根迹相等: $$\mathrm{Tr} \big( (\Sigma_1 \Sigma_2)^{1/2} \big) = \sum_i \sqrt{\lambda_i}, \quad \lambda_i = \text{eig} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)$$ 奇异协方差可由连续性取极限,实际计算仍使用半正定夹心矩阵而无需显式求逆。 把所有项拼起来,就是 FID 的完整定义: $$\mathrm{FID} = \| \mu_{\text{real}} - \mu_{\text{gen}} \|^2 + \mathrm{Tr}(\Sigma_{\text{real}}) + \mathrm{Tr}(\Sigma_{\text{gen}}) - 2\,\mathrm{Tr} \Big( \big( \Sigma_{\text{real}} \Sigma_{\text{gen}} \big)^{1/2} \Big)$$ 这里的数值是 $W_2^2$,开平方后才是高斯空间的 $W_2$ 距离。平方量本身不满足三角不等式,例如一维点质量在 0、1、2 时,端点代价 4 大于两个相邻代价之和 2。FID 这个惯用名称不改变这一点。 三项的物理含义分别是:均值项管「两组图的平均特征偏了多远」(表示该特征空间的整体偏移,不能逐项等同于某种视觉属性),两个迹项管「各自铺开得多宽」(对应多样性),交叉项管「两者铺开的形状有多重合」。注意如果两组分布只是整体缩放 $c$ 倍,那么 $\mu$ 变 $c$ 倍、$\Sigma$ 变 $c^2$ 倍,四项一起变 $c^2$ 倍——FID 不是尺度不变的,这一点后面会用到。 3.4 对称求解器必须使用对称半正定输入 上面那个「最后一个等号」在实现里就是一道坎。看看三种写法差多少(附录 fid_core.py 的 [2][3] 段,随机生成的对称正定 $\Sigma_1, \Sigma_2$): $d$ 对称化路线(正确) eigh(Σ1Σ2)(错误) 通用特征值参考 8 11.5957639872 10.8132126304 11.5957639872 32 41.7985007127 40.2403835447 41.7985007127 128 173.3801162800 165.4519506579 173.3801162800 本表里错误写法偏小,且绝对误差随所选维度增加;这不是任意矩阵都成立的单调律。原因很具体:np.linalg.eigh 是专供对称矩阵的求解器,它只读矩阵的上三角(或下三角)并假设输入对称。按 NumPy 官方文档,默认 UPLO="L" 只读下三角并按其镜像解释上三角,并不是计算 $(A+A^\top)/2$。它与半正定夹心矩阵不是一回事。 误差会原样传进 FID。同一对 128 维特征($n=4096$),正确路线算出 FID = 45.584468,错误路线算出 50.484178,差 +4.899711。这个量级足以让你以为模型退化了。 3.5 FID 只看前两阶矩,所以有结构性盲区 3.2 节的高斯假设现在来收账了。构造一个极端例子: 真实分布 $P = \frac{1}{2}\mathcal{N}(+m, I) + \frac{1}{2}\mathcal{N}(-m, I)$——两个分离的模式; 生成分布 $Q = \mathcal{N}(0, I + m m^\top)$——把两个模式糊成一团的单个高斯。 两者的均值都是 0,协方差都是 $I + m m^\top$。前两阶矩完全一样,所以 FID 的真值严格等于 0,不管两个模式离多远。 但人(或者一个简单的分类器)一眼就能看出区别。实测(附录 fid_bias_lab.py 的 [D] 段,$d=32$、$n=40000$;记 $a = \|m\|$,横轴是两个模式中心的间距 $2a$): 间距 $2a$ 总体目标 经验距离 密度比 AUC 2 0 0.0153 0.5365 4 0 0.0152 0.6601 6 0 0.0146 0.7596 8 0 0.0167 0.8106 12 0 0.0165 0.8739 16 0 0.0228 0.9033 间距 $2a$ 1-NN 同组比例 二次 ridge AUC 2 0.5006 0.5039 4 0.5216 0.5004 6 0.5552 0.5013 8 0.6164 0.4991 12 0.6974 0.4990 16 0.7396 0.5003 总体目标精确为零;直接矩阵运算的零值残差最大约 $7.2\times10^{-13}$,不能当信号。密度比评分使用真实分布的密度(常数项不影响排序),但表中 AUC 仍是有限样本的经验统计。1-NN 在每组前 2500 个点上排除自身找近邻;ridge 用每类 8000 个训练、32000 个测试样本。这里没有报告置换校准的 p 值,也没有把单次统计当成置信区间。 FID 从头到尾是 0(那 0.015~0.023 是前面说的有限样本估计误差,不是信号),而贝叶斯最优判别器的 AUC 已经到了 0.9033,1-NN 双样本检验准确率到了 0.7396(0.5 是这个统计的随机基线,并不能单独证明两个分布相同)。两个模式明明越离越远,FID 一动不动。 更值得玩味的是第二张表里的二次特征上的 ridge 分类器 AUC 也一直是 0.50。这不是巧合——这里的平方损失 ridge 在类平衡、矩匹配时缺少均值层面的监督信号。不能推广为所有二次判别器都只看前两阶矩:例如对 $x^2$ 设阈值也可以利用平方值分布的尾部差异。为了确认这一点我做了对照实验:固定模式间距 $2a=16$,改成把 $Q$ 的协方差整体放大 $s$ 倍(破坏矩匹配),这次扫描中,总体矩距离持续增加,二次 ridge AUC 在较大倍数时明显上升: 协方差倍数 $s$ 总体矩距离 二次 ridge AUC 1.0 0.0000 0.5037 1.05 0.0585 0.5008 1.2 0.8745 0.5216 1.5 4.8490 0.6003 2.0 16.4710 0.7794 本实验中,矩匹配使总体 FID 为零,二次特征 ridge 的测试 AUC 接近随机水平 0.5;改变协方差后两者均发生变化。 1-NN 那种基于局部密度的判别器则不吃这一套——它看的是密度本身的形状,不是矩。 这张图要看什么:左图是 $P$(蓝)和 $Q$(橙)在二维上的真实散点,连同两者共享的理论协方差 1σ/2σ 椭圆(重合后只画一套)——注意形状信息不在这套椭圆里,这就是「前两阶矩完全一样」的几何含义:二阶统计量把两个分离的团和一个糊在一起的团画成了同一个椭圆。右图是同一个实验扫过模式间距的结果,蓝线画的是经验矩距离(左轴对数刻度,约 0.015 到 0.023),其总体目标严格为零;没有把总体浮点残差画成这条线,橙线(贝叶斯最优 AUC)和绿线(1-NN 准确率,右轴)一路爬到 0.90 / 0.74。两条线之间的那片空白,就是 FID 用高斯假设换来的盲区。 04. 代码实现 核心只有三件事:对称矩阵的平方根、$\mathrm{Tr}((\Sigma_1\Sigma_2)^{1/2})$ 的对称化路线、以及协方差怎么估。下面这段演示 fid_core.py 的接口与非法输入边界(完整版见附录)。 import numpy as np from fid_core import frechet_distance, trace_sqrt_product mu = np.zeros(2) sigma1 = np.diag([1.0, 0.0]) sigma2 = np.diag([4.0, 0.0]) print(trace_sqrt_product(sigma1, sigma2)) # 2.0 print(frechet_distance(mu, sigma1, mu, sigma2)) # 1.0 try: frechet_distance(mu, sigma1, mu, np.diag([4.0, -0.1])) except ValueError as exc: print(type(exc).__name__) # ValueError 先将文末完整的 fid_core.py 保存到同目录,再运行这段。第一行交叉项为 2,第二行距离为 1,第三次调用明确拒绝第二组协方差中的负方差。完整实现会校验两边的维度、有限值、对称性和半正定性;只有相对容差内的微小负特征值才投影到零。不能只检查第一组,再把第二组的错误靠对称化和截零藏起来。 四个符号和 3.3 节的推导一一对应:mu1/mu2 是 $\mu_1/\mu_2$,sigma1/sigma2 是 $\Sigma_1/\Sigma_2$,trace_sqrt_product 就是 $\mathrm{Tr}((\Sigma_1\Sigma_2)^{1/2})$,eps 是判定负特征值是否属于舍入误差的相对容差,不是把所有小特征值抬高的正则项。 跑 python fid_core.py 的自检输出(这些数字全部是实跑结果): [1] 恒等性:FID(P, P) 必须为 0 FID(P,P) = 0.000e+00 (本次运行;按尺度相关容差验收) [2] 对称化路线 vs 错误写法 vs 一般特征值参考实现 d sym(正确) naive(错误) eigvals(参考) 8 11.5957639872 10.8132126304 11.5957639872 32 41.7985007127 40.2403835447 41.7985007127 128 173.3801162800 165.4519506579 173.3801162800 [3] 这个差异会传进 FID:同一对特征,两种写法差多少 FID(sym) = 45.584468 FID(naive) = 50.484178 (差值 +4.899711) [4] 尺度不是不变的:特征整体乘 c,FID 变 c^2 倍 c=0.5 FID= 11.396117 期望 c^2*base= 11.396117 c=2.0 FID= 182.337871 期望 c^2*base= 182.337871 c=4.0 FID= 729.351482 期望 c^2*base= 729.351482 [5] 有偏 vs 无偏协方差(n 越小差得越多) n unbiased biased 差值 256 43.932626 43.765931 -0.166696 1024 10.959338 10.948996 -0.010341 8192 1.518005 1.517825 -0.000180 逐条对一下这几个数为什么要看: [1] 按绝对值和尺度相关容差检查恒等性;0.0、极小正值和极小负值都可能正确。明显超出容差才需要排查。附录还验证奇异、小尺度协方差与非 PSD 输入。 [4] 验证 3.3 节末尾那个推论:$c=2$ 时 $4 \times 45.584468 = 182.337871$,完全吻合。这意味着任何改变特征尺度的预处理都会改变 FID,而且不是线性地改。 [5] 本例两组样本数相同,用 $1/n$ 会把双方协方差一起缩小,因此表中的有偏协方差版本距离略小。协方差无偏不代表 FID 无偏;不同样本量时不能直接套这个单调结论。$n=8192$ 时差 0.00018 可以忽略,$n=256$ 时差 0.167 就不能忽略了。工业实现和手写实现在这上面分叉,跨实现比较时要注意。 05. 工业级实现对照 生产里大家用的是 mseitzer/pytorch-fid(本文固定 v0.3.0 源码,不将其称为最新版本),核心函数在 固定版数值函数,函数名为 calculate_frechet_distance。和上面的最小实现有五处差异,每一处都有原因: 1. 矩阵平方根用的是 scipy 而不是 eigh。 官方写的是 covmean, _ = linalg.sqrtm(sigma1.dot(sigma2), disp=False) if not np.isfinite(covmean).all(): offset = np.eye(sigma1.shape[0]) * eps covmean = linalg.sqrtm((sigma1 + offset).dot(sigma2 + offset)) if np.iscomplexobj(covmean): if not np.allclose(np.diagonal(covmean).imag, 0, atol=1e-3): raise ValueError("Imaginary component {}".format(np.max(np.abs(covmean.imag)))) covmean = covmean.real scipy.linalg.sqrtm 是通用矩阵的主平方根求解器,不假设输入对称,所以直接喂 $\Sigma_1\Sigma_2$ 是对的——这跟我的对称化路线在数学上等价,只是浮点路径不同。代价是结果可能带极小的虚部(数值误差),所以有了那段 .real 兜底:先看对角线虚部是不是都在 $10^{-3}$ 以内,超了就报错而不是默默取实部。本文实现先验证两组协方差,再对半正定夹心矩阵使用 eigvalsh,不产生复数。代价是额外的谱检查与矩阵乘法;随意对称化非法输入不能视为修复。真正的坑是有人为了去掉 scipy 依赖把它换成 np.linalg.eigh——那就是 3.4 节那个 +4.9 的错误。 2. 数值容差与正则化不同。 本文只截掉容差内的负特征值并保留零值,以便奇异或小尺度协方差仍满足恒等性;不能无条件把所有特征值抬到 eps。pytorch-fid 在 sqrtm 失败时给协方差加 eps*I 重试,这是改变问题的正则化兜底,应记录是否触发。 3. 协方差用 np.cov(act, rowvar=False),默认无偏。 也就是 04 节 [5] 那张表的第一列。这一点在 $n$ 小的时候会造成跨实现的系统差异。 4. 特征提取有一整套约定。 src/pytorch_fid/inception.py 里的 InceptionV3 取的是第 3 个 block(最终平均池化之后)的 2048 维;resize_input=True 会先把输入双线性缩放到 299×299;use_fid_inception=True 用的是与 TensorFlow 版对齐的 FID 专用权重,而不是 torchvision 默认的 ImageNet 权重。命令行还有 --dims,可以选 64 / 192 / 768 / 2048——换了 dims 就是换了另一个指标,数字不可比,这是跨论文比较时最常被忽略的一项。 5. 保留数值诊断。 该实现返回原始结果,不自动截零。生产实现也可以先验证误差在容差内再截零,但不能不加检查地掩盖大负值;正好为 0 并不说明出错。 本次独立校验还真实执行了该固定源码中未经改写的数值函数,并与本文实现及对角闭式解比较;环境固定为 SciPy 1.15.3。该版本的 sqrtm(..., disp=False) 返回矩阵与误差估计二元组(官方文档)。这是数值核对,没有加载完整 Inception 网络或重现真实图像 FID。固定源码将输入缩放到 299×299、采用 bilinear/align_corners=False,再从 [0,1] 转为 [-1,1];这些选择也属于协议。 还有一个实现之外、必须统一记录的事:预处理的一致性。Parmar 等的 On Aliased Resizing and Surprising Subtleties in GAN Evaluation 指出,resize 是否抗锯齿、图片是否被 JPEG 量化,都会显著改变 FID 的数值——大到足以改变两篇论文的排序。所以在比对任何两个 FID 之前,先确认两边的 Inception 权重、dims、resize 方式、量化流程、样本量、协方差是否有偏,这六项是不是一致。这些是最小核对项,还需对齐参考数据的版本、划分与去重规则、生成条件分布及解码实现。协议不一致时,观察到的差异不能直接归因于模型。不同随机样本量影响估计误差,不代表总体目标必然不同。 06. 代价与边界 6.1 偏差有多大:随 $1/n$ 衰减,随维度放大 先拆出一项可以精确计算的偏差。两组独立同分布样本各来自各自总体,样本数为 $n_r,n_g$,样本均值记为 $\widehat\mu_r,\widehat\mu_g$。零均值估计误差的交叉项期望为零,所以 $$\mathbb{E}\|\widehat\mu_r-\widehat\mu_g\|^2=\|\mu_r-\mu_g\|^2+\frac{\mathrm{Tr}(\Sigma_r)}{n_r}+\frac{\mathrm{Tr}(\Sigma_g)}{n_g}.$$ 这一步只需独立抽样与有限二阶矩,不需高斯。协方差项再叠加平方根非线性的估计影响;无偏样本协方差也不能令整个距离估计无偏。样本协方差秩至多为 $\min(d,n-1)$,$n\le d$ 时可奇异,但夹心公式无需求逆,仍然可以计算,不能把“能计算”当成“估得准”。 下面 A、A2、B、C 每点做 3 次独立重复;A 括号中的 std 是重复值的总体型标准差(ddof=0),不是均值标准误。A/B/C 都同时重采参考和生成特征,不是固定真实参考集的实图评测。谱、迹归一化和各部分随机种子在完整代码中给出;不同部分相近数值来自各自独立随机流。 把 01 节那个实验做全(附录 fid_bias_lab.py 的 [A] 段,$P$ 和 $Q$ 是同一个分布,所以真值是 0): 每组 $n$ 距离:512 维 距离:2048 维 50 431.54 2131.57 1000 53.85 640.65 10000 5.39 71.20 50000 1.09 14.21 两个观察: 双对数坐标下这些点近乎落在一条直线上,斜率接近 $-1$,也就是偏差按 $\sim 1/n$ 衰减。在本实验的大样本区间,样本量翻倍时平均偏差约减半。 维度从 512 涨到 2048(4 倍),$n=10000$ 处的偏差从 5.40 涨到 71.14(13 倍)。把 $d$ 从 64 扫到 2048,以首尾点估计对数斜率([B] 段,固定 $n=10000$),这组扫描的首尾对数斜率约为 1.814: 维度 $d$ 经验距离 64 0.1326 128 0.4517 256 1.5584 512 5.3967 1024 19.5333 2048 71.1371 这里约 $d^{1.8}$ 的拟合只适用于所选的 $1/k$ 协方差谱、迹归一化与扫描范围。真实 Inception 的谱和尺度不同,不能把这个指数当作通用样本量定律。 这张图要看什么:左图是 $P=Q$(真值 0)时 FID 随样本量的变化,双对数刻度,蓝线 $d=512$、橙线 $d=2048$,灰色虚线是斜率 $-1$ 的参考——大样本端接近这条参考线;小样本、秩亏的区间明显偏离,不能称整条曲线都服从 $1/n$;注意橙线在 $n=50000$ 时还有 14.21,远没有收敛到 0。右图固定 $n=10000$ 扫维度,同样是对数刻度,首尾点的对数斜率约 1.814,意味着维度翻一倍偏差涨约 3.5 倍;最右端采用了与 Inception pool3 相同的维度,但使用的是合成高斯特征,并非实际图像嵌入。 6.2 能不能把偏差外推掉 在偏差近似服从 $1/n$ 展开的样本区间,可以尝试外推;需检验拟合稳定性。Chong 与 Forsyth 将真实参考集固定、改变生成样本数,拟合无限生成样本的截距。原文 4.3 节用同一 50k 池有放回抽样得到 15 个点,还比较了取点与采样方案。 本文 C 是另一个教学实验:用 $n=N,N/2,N/4,N/8$ 四个规模,每点独立重采两边并重复 3 次,再对 $1/n$ 线性拟合。它演示两端同时趋于总体矩的外推思想,不是原论文完整协议或真实图像实验的复现。 实测([C] 段,$d=512$): $P = Q$(真值 0):$n=40000$ 估 1.3473、$n=5000$ 估 10.8717,外推得 $F_{\infty} = -0.0121$。直接报 $n=40000$ 的数字(1.35)比外推差得多。 $P \neq Q$(真值 0.3635):$n=40000$ 直接估 1.7430,误差 +1.3795;外推得 0.4845,误差 +0.1210。 本次这个非同分布例子中,绝对误差之比约为 11;只有一个已知总体的合成实例,不能据此保证一般改进倍数。若从大池复用子集,可以减少特征提取开销,但各点相关,不能把拟合残差或独立重复的标准误直接套上去。 新增 metric_checks.py 则把 16 维参考特征固定为 5000 个样本,生成侧在 500/1000/2000/4000 四规模各独立重复 8 次,并同时输出总体目标、冻结参考矩对应的目标和拟合截距。即使生成侧无限多,也仍在比较有限参考矩,参考集误差不会随生成样本数自动消失。 固定参考补充实验的真实输出如下;SD 是 8 次独立生成重复的样本标准差(ddof=1),与前面 3 次扫描的 std 口径不同。 生成数 $n$ 距离均值 SD 500 0.301612 0.024609 1000 0.177233 0.023732 2000 0.145395 0.018082 4000 0.130410 0.008297 总体目标 0.105947,冻结参考矩的目标 0.108259,拟合截距 0.095651。三者不同,说明生成侧外推既不会消除参考误差,也不保证截距恰好等于目标。 报告时同时给参考/生成样本数、原始 FID 和完整协议;使用外推还要报告拟合点、重复采样与不确定性。负截距反映估计误差,不是负的总体距离;外推不保证每个有限样本实验都更准。 6.3 FID 和 CLIP Score 在给不同的东西打高分 Hessel 等的 CLIPScore 原为图像描述评价提出。原文采用 ViT-B/32 的 512 维嵌入,并建议在候选描述前加 A photo depicts 前缀;本文只复现打分公式: $$\mathrm{CLIP\text{-}S} = w \cdot \max \big( \cos(f_{\text{img}}, f_{\text{txt}}), 0 \big), \quad w = 2.5$$ 其中 $f_{\text{img}}$ 和 $f_{\text{txt}}$ 是 CLIP 的图像/文本编码,$w=2.5$ 将原文通常约 0 到 0.4 的相似度范围拉伸;它不把分数变成概率。公式的数学范围是 [0,2.5],并非严格归一到 [0,1]。原始 CLIPScore 为图像描述评价提出,reference-free 指不需要人工参考描述;它仍需要待评图像和文本。迁移到文生图时不需要配对真值图。这里按原论文 $w=2.5$,其他实现可能采用不同的缩放约定,必须注明模型和约定。 下面的人工共享空间反例中,两者最优点不同(附录 clip_alignment_lab.py 的 [A] 段:一个结构化的 CLIP 替身,共享表示空间 $d_s=64$、$K=24$ 个概念,真实数据的多样性固定为 $\sigma_{\text{real}}=0.5$,$n=20000$): $\sigma_g$ 矩距离 CLIPScore 0.05 10.966 2.323 0.1 8.926 1.953 0.2 5.237 1.323 0.3 2.393 0.958 0.4 0.627 0.744 0.5 0.029 0.607 0.6 0.650 0.515 0.8 5.652 0.399 1.0 15.609 0.335 FID 在 $\sigma_g = 0.5$(真实数据的多样性)处取最小 0.029,呈 U 形;CLIP Score 单调递减,在 $\sigma_g = 0.05$(几乎退化成确定性输出)处取最大 2.323。该构造下,相似度奖励靠近概念中心,分布距离奖励匹配设定的方差;不能解释为所有 CLIP 模型都偏好确定性。 顺带一提,真实数据自己的 CLIP Score 是 0.6082,而 $\sigma_g=0.5$ 那个「FID 最优」的模型是 0.6073——跟真实数据几乎一样。也就是说在这个实验里,FID 最优点才对应「和真实数据一致」,CLIP Score 的最优点对应的是「模式收敛」。 而且 CLIPScore 的逐样本分数本身保留个体差异,只报告均值才会掩盖分布。构造两个模型([B] 段):$M_1$ 以概率 $p$ 输出完美匹配的图、以 $1-p$ 输出纯噪声;$M_2$ 每张图都中等匹配(二分调 $\sigma$ 让它的 CLIP Score 与 $M_1$ 相同): $p$ $M_1$ 分数 $M_2$ 分数 0.3 0.8330 0.8332 0.5 1.3039 1.3016 0.7 1.7896 1.7895 0.9 2.2681 2.2688 $p$ $M_1$ 余弦 SD $M_2$ 余弦 SD 0.3 0.4695 0.1078 0.5 0.5078 0.0847 0.7 0.4627 0.0536 0.9 0.2992 0.0171 $p$ $M_1$ 矩距离 $M_2$ 的 $\sigma$ $M_2$ 矩距离 0.3 9.920 0.353 1.323 0.5 10.191 0.204 5.112 0.7 10.677 0.122 8.079 0.9 11.584 0.058 10.663 $p$ $M_1$ 余弦超 0.5 比例 $M_2$ 余弦超 0.5 比例 0.3 0.2980 0.0520 0.5 0.4966 0.6168 0.7 0.7012 0.9993 0.9 0.9023 1.0000 两组 CLIP Score 的最大差距约 0.0023:二分只在固定种子的校准探针上匹配,最终表格使用另一条独立随机流评价,所以不是最终样本精确同分,但 $M_1$ 的逐样本原始余弦标准差是 $M_2$ 的 17.55 倍($p=0.9$ 时 0.2992 对 0.0171)。同一个分数,一个是「九成图完美、一成完全不沾边」,另一个是相似度更集中的输出($p=0.9$ 时均值也很高,不能称为勉强沾边)。例如 $p=0.9$ 时,真正分数的标准差为 0.7070/0.0426,分数 10% 分位数为 2.5000/2.2127。分数标准差不能直接拿原始余弦标准差乘 2.5 代替,因为先发生了截零。本例低分样本略少于 10%,所以 10% 分位数也可能已到满分;一个分位数同样不能代替完整直方图。 表中的标准差对应截零之前的余弦,不是乘 2.5 后的分数;新版代码同时输出真正 CLIPScore 标准差与 10% 分位数。“好图占比”也只是余弦大于 0.5 的比例,没有真人质量标签。汇总均值看不见这个区别,逐样本分数直方图或分位数可以。 这张图要看什么:左图是同一个 $\sigma_g$ 扫描下两个指标的走向,蓝线(FID,左轴,越低越好)呈 U 形、在 $\sigma_g=0.5$ 处触底,橙线(CLIP Score,右轴,越高越好)单调下降、在最左端 $\sigma_g=0.05$ 处封顶——两条线的最优点不同,说明这组构造下两个目标存在冲突;0.5 并不是横轴右端,也不能据此断言现实模型的普遍走势;灰色竖虚线标出的是真实数据的多样性 $\sigma_{\text{real}}=0.5$。右图是 $p=0.5$ 那一行两个模型的逐样本相似度分布:橙色的 $M_1$ 是明显的双峰(一半堆在接近 1 的位置、一半堆在 0 附近),蓝色的 $M_2$ 是一根集中在 0.5 附近的单峰,图中直方图直接来自附录实际实验数据,橙/蓝虚线分别是原始余弦均值。CLIPScore 先对每个相似度截零,分数接近不保证原始余弦均值相同;汇总分数仍可能掩盖两种很不一样的样本分布。 6.4 什么时候不该用 FID 样本量小的时候:估计偏差可能淹没模型差异,具体量级取决于数据与特征器。先做同分布基线和重复抽样,再判断是否增样本或尝试外推;没有通用的「10k 以下偏差大于 70」门槛。 要评价单张图的时候:FID 根本没有「单张图」这个概念。需要逐样本打分就上 CLIP Score / ImageReward,但要区分逐样本评分与数据集均值,要配着直方图或者分位数一起看。 要区分「质量」和「覆盖」的时候:FID 把两者压成一个数。一个只生成 10 张高质量图的模型和一个生成 10000 张中等质量图的模型,FID 可能很接近,但产品含义完全不同。这种情况应该用 Improved Precision & Recall(arXiv:1904.06991)拆成两个数。 两个分布形状不同但矩相同的时候:3.5 节的实验——总体矩距离严格为 0,而本例 1-NN 的同组近邻比例约 0.74;这还不是带显著性校准的检验 p 值。 要跨论文比较的时候:除非核实了 05 节末尾那六项完全一致,否则请把数字当成「同一篇论文内部的相对量」,不要当成绝对值。 07. 经典论文脉络 Inception Score(arXiv:1606.03498,Improved Techniques for Training GANs)——早期广泛采用的自动指标之一:用 Inception 的分类分布衡量「单图是否清晰可辨」+「整体是否有多样性」。贡献是提供了可自动重复计算的比较工具;根本缺陷是完全不看真实分布,所以无法检测记忆训练集,也无法检测 mode collapse 的另一种形式。 FID(arXiv:1706.08500,TTUR 那篇)——把真实分布拉进比较,用 Inception pool3 特征上的 2-Wasserstein 距离平方评价分布差异。贡献是「两个分布之间的距离」这个范式,在论文实验中展示了对若干退化的敏感性,后来成为常用指标;这种表现不保证覆盖所有退化。 Improved Precision and Recall Metric for Assessing Generative Models(2019)——指出单个标量无法同时表达「生成质量」和「分布覆盖」,拆成 P(生成样本落在真实流形内的比例)和 R(真实样本能被生成覆盖的比例)。贡献是提供了 FID 缺失的那个维度:FID 相同的一对模型,可以在 P/R 平面上处于完全不同、甚至此消彼长的位置。 Effectively Unbiased FID(arXiv:1911.07023)——把 FID 当成一个统计估计量来审视,指出它是有偏的、偏差随 $1/n$ 衰减,并给出用多个样本量外推到 $F_{\infty}$ 的方法。6.2 节演示其外推思想,并区分了两端重采与固定参考;没有声称完整复现原文协议。它解释了有限样本偏差为何会影响模型排序。 CLIPScore(arXiv:2104.08718)——把评测从「分布 vs 分布」拉回「图 vs 文」,提出无需人工参考描述的图像描述指标;迁移到文生图后可用 prompt 与生成图评价兼容性,但不是原论文对所有文生图条件的保证。局限是相似度不能覆盖全部质量维度,汇总均值也会丢失样本分布;与 FID 的关系依赖实际模型。 补充一条横向的:Borji 的 Pros and Cons of GAN Evaluation Measures(arXiv:1802.03446)系统比较了十几种指标的失效模式,结论是没有任何单一指标能在所有场景下胜出——这也是本篇反复强调「两个指标一起看、连同它们的盲区一起看」的依据。 08. 常见误解 误解 1:「FID 越低,生成的图越好。」 FID 只比较两个分布的前两阶矩,不比较单张图。实测证据:把两个模式越拉越远,FID 一动不动(3.5 节,FID 恒为 0,1-NN 判别率 0.7396)。反过来的方向也成立——FID 很低但每张图都文不对题,是完全可能的。 误解 2:「FID = 0 说明两个分布一样。」 3.5 节整节都在反驳这一点。前两阶矩匹配就够了,形状随便怎么不同都行。高斯假设换来的就是这个。 误解 3:「两篇论文的 FID 可以直接比大小。」 我自己踩过最狠的一个。至少六项要对齐:Inception 权重、特征维度 dims、resize 方式与是否抗锯齿、量化流程、样本量、协方差是否有偏。实测的敏感度:$d=2048$ 时样本量从 10k 到 50k,本文特定人工高斯模型的估计距离从 71.20 变 14.21(差 57);特征整体乘 $c$ 倍,FID 乘 $c^2$ 倍($c=2$ 时 45.58 → 182.34)。这些数字说明 FID 更像一个有单位的物理量,不是一个无量纲分数。 误解 4:「FID 与 CLIP Score 必然反向变化。」 两者测的内容不同,可能同好同坏,也可能冲突。本文合成实验给出冲突的一个例子,不是普遍定律。CFG 的变化也不能精确等同于给合成嵌入加某个固定高斯噪声。 误解 5:「平均 CLIP Score 高,说明每张图都对。」 数据集均值会掩盖尾部。实测两个 CLIP Score 差 0.0023 的模型,逐样本相似度标准差差 17.55 倍(0.2992 对 0.0171)。要看单张图的质量分布,得看直方图或者低分位数,不能只看均值。 误解 6:「FID 非负,所以所有负输出都直接夹为 0。」 应先确认输入和平方根实现,再检查负值是否在尺度相关容差内。小负数可以记录后截零,明显负数必须报错;恰好输出 0 本身既不能证明正确,也不能证明有错。 09. 动手验证 四个数值脚本在文末附录,依赖 numpy;配图另需 matplotlib,不使用真实 Inception/CLIP 权重: python fid_core.py # 约 1 秒:FID 最小实现 + 5 组自检 python fid_bias_lab.py ALL # 高维完整扫描:耗时和内存取决于机器 python clip_alignment_lab.py ALL # 人工空间中的不同最优点 python metric_checks.py # 耦合、数值输入、AUC、近邻、固定参考外推 python make_figures.py # 从上两项实验JSON重新画三张图 预期结果(这些数字是实跑输出,可以直接对): fid_core.py 会按尺度相关容差断言恒等性,包括奇异和小尺度 PSD 输入。数值可以恰好为 0;不要要求固定尾数或符号。明显超出容差时再查矩阵平方根与输入。 fid_bias_lab.py 的 [A] 段,$d=2048$ 那一列:n=10000 应约 71.20、n=50000 应约 14.21($P=Q$,真值 0)。[D] 段最后一行的贝叶斯 AUC 应约 0.9033、1-NN 准确率应约 0.7396,而总体 FID 的数值实现应在零附近的浮点容差内。 clip_alignment_lab.py 的 [A] 段,最优 $\sigma_g$:FID 是 0.5、CLIP Score 是 0.05。[B] 段最后打印的「CLIP Score 最大差距」应约 0.0023、「标准差比值」应约 17.55 倍。 完整高维实验同时持有两组 50000×2048 的 float64 特征时,仅这两数组约占 1.53 GiB,还需协方差、分解与临时工作区。1-NN 已改为每批 128 行的距离矩阵,5000 点时该矩阵约 4.88 MiB,避免旧广播写法约 5.96 GiB 的三维临时数组;仍是二次时间复杂度。不同 BLAS 与线程数会改变耗时和末位浮点数。 想自己造一个「FID 失效」的例子?改 fid_bias_lab.py 的 [D] 段里那个 a(模式间距的一半)就行:把 $a$ 从 1 扫到 8(中心间距从 2 到 16),总体 FID 保持 0;本例 1-NN 准确率从约 0.50 增至 0.74。 10. 延伸阅读 音频质量评测:MOS、PESQ 与 FAD 各测什么(本系列已发布)——里面的 FAD(Fréchet Audio Distance)就是 FID 换了个特征提取器,高斯矩估计的风险同样存在,但偏差系数与特征器、尺度和样本相关性有关。 视频生成评测:VBench 与人工验收(本系列已发布)——VBench 是多维度视频评测框架,不是简单把 FID 升维;FVD 才是采用视频特征的相关高斯距离指标。两者都不能直接套本文合成模型的 $d^{1.8}$ 指数。 DDPM 训练目标与采样流程、Classifier-Free Guidance(本系列已发布)——CFG 会影响条件一致性与多样性,但不是 6.3 节 $\sigma_g$ 的严格等价参数。实际趋势需要在具体模型上测量。 附录:完整代码 09 节用到的脚本全文如下(fid_bias_lab.py、fid_core.py、metric_checks.py、clip_alignment_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 fid_bias_lab.py """ fid_bias_lab.py —— FID 的样本量偏差实验。 回答三个问题: [A] 两个分布**完全一样**时,FID 是多少?(答:不是 0,而且 n 越小越离谱) [B] 这个偏差随维度 d、样本量 n 怎么变? [C] 能不能把它外推掉?(Chong & Forsyth, arXiv:1911.07023 的做法) [D] FID 只看前两阶矩,那「前两阶矩完全一样、分布完全不同」能骗过去吗? 运行: python fid_bias_lab.py # 全跑 python fid_bias_lab.py A # 只跑 A 段 """ from __future__ import annotations import json import os import sys import numpy as np from fid_core import fid_from_features, frechet_distance, covariance HERE = os.path.dirname(os.path.abspath(__file__)) OUT_JSON = os.path.join(HERE, "_fid_bias_results.json") # ────────────────────────────────────────────────────────────── # 造一个明确指定谱与尺度的合成协方差:特征值按 1/k 衰减,迹归一到 d # ────────────────────────────────────────────────────────────── def spectrum_cov(d: int, trace: float | None = None, alpha: float = 1.0) -> np.ndarray: r"""对角协方差,特征值 λ_k ∝ k^{-alpha},归一化到 Tr(Σ)=trace。 这是人为选择的谱衰减模型,并非对 Inception pool3 的实测拟合: 少数几个方向撑着大部分方差,长尾方向方差很小。 trace 默认取 d,也就是「每个维度平均方差为 1」。 """ k = np.arange(1, d + 1, dtype=np.float64) lam = k.astype(np.float64) ** (-alpha) if trace is None: trace = float(d) lam = lam * (trace / lam.sum()) return np.diag(lam) def sample_gaussian(mean: np.ndarray, cov_diag: np.ndarray, n: int, rng: np.random.Generator) -> np.ndarray: """从对角协方差的高斯里采样(对角阵直接按列缩放,不用 Cholesky)。""" d = mean.shape[0] lam = np.diag(cov_diag) if cov_diag.ndim == 2 else cov_diag z = rng.standard_normal((n, d)) return mean[None, :] + z * np.sqrt(lam)[None, :] # ────────────────────────────────────────────────────────────── # [A] P == Q 时的 FID # ────────────────────────────────────────────────────────────── def section_a(d_list=(512, 2048), reps=3, verbose=True): print("=" * 74) print("[A] 两个分布完全一样时,FID 不是 0") print(" 真实分布 = 生成分布,理论上 FID = 0。实测:") print("=" * 74) n_list = [50, 100, 200, 500, 1000, 2000, 5000, 10000, 20000, 50000] out = {} for d in d_list: rng = np.random.default_rng(20261001 + d) cov = spectrum_cov(d) mu = np.zeros(d) rows = [] for n in n_list: vals = [] for r in range(reps): x1 = sample_gaussian(mu, cov, n, rng) x2 = sample_gaussian(mu, cov, n, rng) vals.append(fid_from_features(x1, x2)) m = float(np.mean(vals)) s = float(np.std(vals)) rows.append((n, m, s)) if verbose: print(f" d={d:>5} n={n:>6} FID = {m:>10.4f} (std {s:.4f})") out[d] = rows if verbose: print() return {"n_list": n_list, "by_d": {str(k): v for k, v in out.items()}} # ────────────────────────────────────────────────────────────── # [A2] 偏差到底来自均值还是协方差 # ────────────────────────────────────────────────────────────── def section_a2(d=512, n=40000, reps=3, verbose=True): print("=" * 74) print("[A2] 偏差来自哪里:均值还是协方差?(P == Q,真值 0)") print("=" * 74) rng = np.random.default_rng(556677) cov = spectrum_cov(d) mu = np.zeros(d) full, mean_known, cov_known = [], [], [] for _ in range(reps): x1 = sample_gaussian(mu, cov, n, rng) x2 = sample_gaussian(mu, cov, n, rng) m1, s1 = x1.mean(0), covariance(x1) m2, s2 = x2.mean(0), covariance(x2) full.append(frechet_distance(m1, s1, m2, s2)) # 假设均值已知(用真实 mu=0),只估协方差 mean_known.append(frechet_distance(mu, s1, mu, s2)) # 假设协方差已知(用真实 cov),只估均值 cov_known.append(frechet_distance(m1, cov, m2, cov)) f, mk, ck = float(np.mean(full)), float(np.mean(mean_known)), float(np.mean(cov_known)) theory_mean = 2.0 * np.trace(cov) / n if verbose: print(f" d={d} n={n}") print(f" 两个都估(正常做法) FID = {f:>10.4f}") print(f" 均值已知、只估协方差 FID = {mk:>10.4f} " f"占全部偏差的 {mk / f * 100:5.1f}%") print(f" 协方差已知、只估均值 FID = {ck:>10.4f} " f"占全部偏差的 {ck / f * 100:5.1f}%") print(f" 理论值 2*Tr(Sigma)/n = {theory_mean:.6f}(对照上一行)") print() print(" -> 偏差几乎全部来自**协方差估计**。均值那一项理论上就是") print(" 2*Tr(Sigma)/n,小到可以忽略;麻烦的是 d x d 个协方差元素。") print() return {"d": d, "n": n, "full": f, "mean_known": mk, "cov_known": ck, "theory_mean": float(theory_mean)} # ────────────────────────────────────────────────────────────── # [B] 偏差随 d 与 n 的缩放 # ────────────────────────────────────────────────────────────── def section_b(verbose=True): print("=" * 74) print("[B] 偏差随维度 d 怎么长(固定 n=10000)") print("=" * 74) n = 10000 rows = [] for d in (64, 128, 256, 512, 1024, 2048): rng = np.random.default_rng(777000 + d) cov = spectrum_cov(d) mu = np.zeros(d) vals = [] for r in range(3): x1 = sample_gaussian(mu, cov, n, rng) x2 = sample_gaussian(mu, cov, n, rng) vals.append(fid_from_features(x1, x2)) m = float(np.mean(vals)) rows.append((d, m, d / n)) if verbose: print(f" d={d:>5} n={n} d/n={d / n:>7.4f} FID = {m:>10.4f}") print() return {"n": n, "rows": rows} # ────────────────────────────────────────────────────────────── # [C] 外推:FID(n) ≈ F_inf + beta / n # ────────────────────────────────────────────────────────────── def section_c(verbose=True): print("=" * 74) print("[C] 能不能把偏差外推掉?(arXiv:1911.07023 的做法)") print(" 用 n = N, N/2, N/4, N/8 四个点,对 1/n 做线性拟合,截距即 F_inf") print("=" * 74) d = 512 rng = np.random.default_rng(31337) cov = spectrum_cov(d) # C1: P == Q,真值 0 N = 40000 sizes = [N, N // 2, N // 4, N // 8] est = [] for n in sizes: v = [] for r in range(3): x1 = sample_gaussian(np.zeros(d), cov, n, rng) x2 = sample_gaussian(np.zeros(d), cov, n, rng) v.append(fid_from_features(x1, x2)) est.append(float(np.mean(v))) inv_n = np.array([1.0 / n for n in sizes]) beta, a0 = np.polyfit(inv_n, np.array(est), 1) if verbose: for n, e in zip(sizes, est): print(f" P==Q n={n:>6} FID = {e:>9.4f}") print(f" 外推 F_inf = {a0:>9.4f} (真值 0.0000, 斜率 beta={beta:.2f})") c1 = {"sizes": sizes, "est": est, "extrap": float(a0), "slope": float(beta)} # C2: P != Q,真值可以直接从矩算出来 print() shift = np.zeros(d) shift[0] = 0.5 # 只在第 0 维上挪一点 mu_q = shift cov_q = cov * 1.03 # 协方差整体放大 3% true_fid = frechet_distance(np.zeros(d), cov, mu_q, cov_q) est2 = [] for n in sizes: v = [] for r in range(3): x1 = sample_gaussian(np.zeros(d), cov, n, rng) x2 = sample_gaussian(mu_q, cov_q, n, rng) v.append(fid_from_features(x1, x2)) est2.append(float(np.mean(v))) beta2, a02 = np.polyfit(inv_n, np.array(est2), 1) if verbose: for n, e in zip(sizes, est2): print(f" P!=Q n={n:>6} FID = {e:>9.4f}") print(f" 真值 FID = {true_fid:>9.4f}") print(f" 外推 F_inf = {a02:>9.4f} (斜率 beta={beta2:.2f})") print(f" 直接用 n={N} 的估计误差 = {est2[0] - true_fid:+.4f}") print(f" 外推后的误差 = {a02 - true_fid:+.4f}") print() return {"c1": c1, "c2": {"sizes": sizes, "est": est2, "true": float(true_fid), "extrap": float(a02), "slope": float(beta2)}} # ────────────────────────────────────────────────────────────── # [D] 前两阶矩一样、分布完全不同 # ────────────────────────────────────────────────────────────── def _auc(scores_pos: np.ndarray, scores_neg: np.ndarray) -> float: """Mann-Whitney AUC, assigning half credit to equal scores.""" a = np.sort(scores_pos) b = np.sort(scores_neg) # 对每个 b,统计有多少 a 严格大于它 right = np.searchsorted(a, b, side="right") left = np.searchsorted(a, b, side="left") return float((a.size - right + 0.5 * (right - left)).sum() / (a.size * b.size)) def _quad_features(X: np.ndarray) -> np.ndarray: """二次特征展开:[x_i, x_i x_j (i<=j)]。""" n, d = X.shape iu = np.triu_indices(d) quad = X[:, iu[0]] * X[:, iu[1]] return np.concatenate([X, quad], axis=1) def _gauss_logpdf(X: np.ndarray, mean: np.ndarray, cov: np.ndarray) -> np.ndarray: """对角/一般协方差下的高斯 log 密度。""" d = X.shape[1] Xc = X - mean[None, :] if cov.ndim == 2 and cov.shape[0] == cov.shape[1]: lam, V = np.linalg.eigh(cov) lam = np.clip(lam, 1e-12, None) proj = Xc @ V quad = (proj ** 2 / lam[None, :]).sum(axis=1) logdet = np.log(lam).sum() else: lam = np.asarray(cov).ravel() quad = (Xc ** 2 / lam[None, :]).sum(axis=1) logdet = np.log(lam).sum() return -0.5 * (quad + logdet + d * np.log(2 * np.pi)) def _nn_two_sample(Xa: np.ndarray, Xb: np.ndarray, m: int = 2500) -> float: """1-近邻两样本检验的准确率。 把两组样本混在一起,对每个点找它的最近邻,看这个邻居是不是同组的。 P == Q 时这个比例趋近 0.5(纯随机),分布有差别时会明显大于 0.5。 """ A, B = Xa[:m], Xb[:m] P = np.concatenate([A, B], axis=0) sizes = (len(A), len(B)) lab = np.concatenate([np.zeros(sizes[0]), np.ones(sizes[1])]) norm = (P * P).sum(1) idx = np.empty(len(P), dtype=np.int64) for start in range(0, len(P), 128): stop = min(start + 128, len(P)) D = norm[start:stop, None] + norm[None, :] - 2 * (P[start:stop] @ P.T) D[np.arange(stop-start), np.arange(start, stop)] = np.inf idx[start:stop] = np.argmin(D, axis=1) return float((lab[idx] == lab).mean()) def _ridge_auc(Xp: np.ndarray, Xq: np.ndarray, feat, ntr: int, lam: float, rng: np.random.Generator) -> float: """在给定特征映射上训一个 ridge 二分类器,返回测试集 AUC。""" Fp, Fq = feat(Xp), feat(Xq) n = Xp.shape[0] Xtr = np.concatenate([Fp[:ntr], Fq[:ntr]], axis=0) ytr = np.concatenate([np.ones(ntr), -np.ones(ntr)]) Xte = np.concatenate([Fp[ntr:], Fq[ntr:]], axis=0) yte = np.concatenate([np.ones(n - ntr), -np.ones(n - ntr)]) sd = Xtr.std(axis=0) sd[sd < 1e-12] = 1.0 Xtr, Xte = Xtr / sd, Xte / sd Phi = Xtr.T @ Xtr w = np.linalg.solve(Phi + lam * np.eye(Phi.shape[0]), Xtr.T @ ytr) sc = Xte @ w return _auc(sc[yte > 0], sc[yte < 0]) def section_d(verbose=True): print("=" * 74) print("[D] 前两阶矩完全一样、分布完全不同 —— FID 看得见吗") print(" 真实 P = 0.5*N(+m, I) + 0.5*N(-m, I) (两个分离的模式)") print(" 生成 Q = N(0, I + m m^T) (一个把两个模式糊在一起的团)") print(" 两者均值都是 0、协方差都是 I + m m^T => FID 真值严格等于 0") print("=" * 74) d = 32 n = 40000 rng = np.random.default_rng(24680) u = rng.standard_normal(d) u /= np.linalg.norm(u) if verbose: print(f" {'模式间距 2|m|':>12} {'FID(总体)':>12} {'FID(经验)':>10} " f"{'最优AUC':>9} {'1NN':>7} {'二次AUC':>8} {'线性AUC':>8}") rows = [] for a in (1, 2, 3, 4, 6, 8): m = a * u sign = rng.integers(0, 2, size=n) * 2 - 1 Xp = rng.standard_normal((n, d)) + sign[:, None] * m[None, :] cov_q = np.eye(d) + np.outer(m, m) Xq = rng.multivariate_normal(np.zeros(d), cov_q, size=n) # 总体 FID:直接用矩算,理论值 0 cov_p = np.eye(d) + np.outer(m, m) fid_pop = frechet_distance(np.zeros(d), cov_p, np.zeros(d), cov_q) # 经验 FID fid_emp = frechet_distance(Xp.mean(0), covariance(Xp), Xq.mean(0), covariance(Xq)) # 最优判别(log 密度比) inv_q = np.linalg.inv(cov_q) def logp_mix(X): return np.logaddexp(-0.5 * ((X - m) ** 2).sum(1), -0.5 * ((X + m) ** 2).sum(1)) def logq(X): return -0.5 * (X @ inv_q * X).sum(1) auc_bayes = _auc(logp_mix(Xp) - logq(Xp), logp_mix(Xq) - logq(Xq)) # 1-NN 两样本检验 acc_nn = _nn_two_sample(Xp, Xq) # 二次特征 / 线性特征的 ridge 分类器 auc_quad = _ridge_auc(Xp, Xq, _quad_features, 8000, 1.0, rng) auc_lin = _ridge_auc(Xp, Xq, lambda X: X, 8000, 1.0, rng) rows.append((2 * a, float(fid_pop), float(fid_emp), auc_bayes, acc_nn, auc_quad, auc_lin)) if verbose: print(f" {2 * a:>12} {fid_pop:>12.2e} {fid_emp:>10.4f} " f"{auc_bayes:>9.4f} {acc_nn:>7.4f} {auc_quad:>8.4f} {auc_lin:>8.4f}") # 对照组:把 Q 的协方差整体放大 s 倍(破坏矩匹配),FID 与二次判别一起醒过来 print() print(" 对照组(2|m|=16):把 Q 的协方差整体放大 s 倍,破坏矩匹配") print(f" {'s':>6} {'FID':>10} {'二次特征 ridge AUC':>20}") m = 8 * u sign = rng.integers(0, 2, size=n) * 2 - 1 Xp = rng.standard_normal((n, d)) + sign[:, None] * m[None, :] cov_p = np.eye(d) + np.outer(m, m) ctrl = [] for s in (1.0, 1.05, 1.2, 1.5, 2.0): cov_q_s = cov_p * s Xq_s = rng.multivariate_normal(np.zeros(d), cov_q_s, size=n) fid_s = frechet_distance(np.zeros(d), cov_p, np.zeros(d), cov_q_s) auc_s = _ridge_auc(Xp, Xq_s, _quad_features, 8000, 1.0, rng) ctrl.append((s, float(fid_s), auc_s)) print(f" {s:>6} {fid_s:>10.4f} {auc_s:>20.4f}") print(" -> 本例矩匹配时总体 FID 为 0,平方损失 ridge 的 AUC 近 0.5。") print(" 这不代表任意二次分类器都无法区分两组分布。") print() return {"d": d, "n": n, "rows": rows, "control": ctrl} # ────────────────────────────────────────────────────────────── def main(): which = sys.argv[1].upper() if len(sys.argv) > 1 else "ALL" res = {} if which in ("ALL", "A"): res["A"] = section_a() if which in ("ALL", "A2"): res["A2"] = section_a2() if which in ("ALL", "B"): res["B"] = section_b() if which in ("ALL", "C"): res["C"] = section_c() if which in ("ALL", "D"): res["D"] = section_d() if which == "ALL": with open(OUT_JSON, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=1) print(f"结果已写入 {OUT_JSON}") if __name__ == "__main__": main() fid_core.py """ fid_core.py —— FID(Fréchet Inception Distance)的最小可用实现。 本脚本只依赖 NumPy;与 scipy.linalg.sqrtm 官方路线的独立对照见 metric_checks.py。 矩阵平方根采用 NumPy 的对称特征分解。 好处是每一步都看得见,也正好能把「手写实现最容易踩的那个坑」暴露出来。 运行: python fid_core.py """ from __future__ import annotations import numpy as np # ────────────────────────────────────────────────────────────── # 1. 对称 PSD 矩阵的平方根 # ────────────────────────────────────────────────────────────── def _psd_eigh(C: np.ndarray, eps: float): """Validate both covariance inputs; project only tolerance-level negative eigenvalues.""" if not np.isfinite(eps) or not 0 <= eps < 1: raise ValueError("eps must be finite and in [0, 1)") C = np.asarray(C, dtype=np.float64) if C.ndim != 2 or not C.shape[0] or C.shape[0] != C.shape[1] or not np.isfinite(C).all(): raise ValueError("C must be a nonempty finite square matrix") scale = max(np.linalg.norm(C, ord=np.inf), np.finfo(float).tiny) if not np.allclose(C, C.T, rtol=0.0, atol=eps * scale): raise ValueError("C must be symmetric") C = (C + C.T) / 2 w, V = np.linalg.eigh(C) if w.min() < -eps * max(np.abs(w).max(), np.finfo(float).tiny): raise ValueError("C must be positive semidefinite") if w.min() < 0: w = np.maximum(w, 0.0) C = (V * w) @ V.T return C, w, V def sqrtm_sym(C: np.ndarray, eps: float = 1e-6) -> np.ndarray: r"""对称半正定矩阵的平方根。 对 C = V diag(w) V^T,有 C^{1/2} = V diag(sqrt(w)) V^T。 eps 是相对谱尺度的负特征值容差,不是给正特征值设置下限。 明显非半正定输入报错;容差内负值截到 0,保留真正的零特征值。 """ _, w, V = _psd_eigh(C, eps) w = np.sqrt(np.clip(w, 0.0, None)) return (V * w) @ V.T def sqrtm_naive(A: np.ndarray, eps: float = 1e-6) -> np.ndarray: """「把 A 直接当对称矩阵开方」。 np.linalg.eigh 只读矩阵的上/下三角并**假设输入对称**, 默认 UPLO="L",以 A 的下三角及其镜像构造对称矩阵, 并不等于 (A + A^T)/2。 很多手写 FID 就是这么写的,而 A = Σ1 Σ2 恰恰不是对称矩阵。 """ w, V = np.linalg.eigh(A) w = np.sqrt(np.clip(w, eps, None)) return (V * w) @ V.T # ────────────────────────────────────────────────────────────── # 2. Tr((Σ1 Σ2)^{1/2}) # ────────────────────────────────────────────────────────────── def trace_sqrt_product(sigma1: np.ndarray, sigma2: np.ndarray, eps: float = 1e-6) -> float: r"""计算 Tr((Σ1 Σ2)^{1/2}),走对称化路线。 Σ1 正定时,Σ1 Σ2 与 Σ1^{1/2} Σ2 Σ1^{1/2} 相似: Σ1^{1/2} (Σ1^{1/2} Σ2 Σ1^{1/2}) Σ1^{-1/2} = Σ1 Σ2 二者特征值相同,而后者是**对称半正定**的,可以安全用 eigh。 主平方根与相似变换可交换,所以迹也相同: Tr((Σ1 Σ2)^{1/2}) = Σ_i sqrt(λ_i) """ _, w1, V1 = _psd_eigh(sigma1, eps) sigma2, _, _ = _psd_eigh(sigma2, eps) if sigma2.shape != (len(w1), len(w1)): raise ValueError("covariance dimensions differ") s1 = (V1 * np.sqrt(w1)) @ V1.T return _trace_sandwich(s1, sigma2, eps) def _trace_sandwich(s1: np.ndarray, sigma2: np.ndarray, eps: float) -> float: """Both inputs have already been validated; reject substantial PSD loss.""" M = s1 @ sigma2 @ s1 M = 0.5 * (M + M.T) # 强制对称,压掉浮点不对称 w = np.linalg.eigvalsh(M) tolerance = max(eps, 64 * np.finfo(float).eps * len(w)) * max(np.abs(w).max(), np.finfo(float).tiny) if w.min() < -tolerance: raise ValueError("sandwich lost positive semidefiniteness") return float(np.sqrt(np.clip(w, 0.0, None)).sum()) def trace_sqrt_product_naive(sigma1: np.ndarray, sigma2: np.ndarray, eps: float = 1e-6) -> float: """对照用的错误写法:直接对 Σ1 Σ2 调 eigh。""" return float(np.trace(sqrtm_naive(sigma1 @ sigma2, eps))) def trace_sqrt_product_ref(sigma1: np.ndarray, sigma2: np.ndarray) -> float: """参考实现:用一般矩阵的特征值求解器 eigvals(不假设对称)。""" ev = np.linalg.eigvals(sigma1 @ sigma2) return float(np.sqrt(np.clip(ev.real, 0.0, None)).sum()) # ────────────────────────────────────────────────────────────── # 3. FID 本体 # ────────────────────────────────────────────────────────────── def frechet_distance(mu1: np.ndarray, sigma1: np.ndarray, mu2: np.ndarray, sigma2: np.ndarray, eps: float = 1e-6, mode: str = "sym") -> float: r"""两个多元高斯之间的 Fréchet 距离(= 2-Wasserstein 距离的平方)。 FID = ||μ1 - μ2||^2 + Tr(Σ1) + Tr(Σ2) - 2 Tr((Σ1 Σ2)^{1/2}) mode="sym" 用对称化路线(正确) mode="naive" 用 eigh(Σ1 Σ2)(错误,保留它只为对照) """ mu1, mu2 = np.asarray(mu1, dtype=np.float64), np.asarray(mu2, dtype=np.float64) if mu1.ndim != 1 or mu2.shape != mu1.shape or not mu1.size or not np.isfinite(mu1).all() or not np.isfinite(mu2).all(): raise ValueError("means must be matching finite nonempty vectors") sigma1, w1, V1 = _psd_eigh(sigma1, eps) sigma2, w2, _ = _psd_eigh(sigma2, eps) if sigma1.shape != sigma2.shape or sigma1.shape[0] != mu1.size: raise ValueError("mean and covariance dimensions differ") diff = mu1 - mu2 if mode == "sym": s1 = (V1 * np.sqrt(w1)) @ V1.T tr = _trace_sandwich(s1, sigma2, eps) elif mode == "naive": tr = trace_sqrt_product_naive(sigma1, sigma2, eps) else: raise ValueError(f"unknown mode: {mode}") # 注意:这里**不做** max(val, 0)。浮点误差确实会让 FID(P,P) 变成 -1e-9 量级, # 但把负数夹成 0 会把真正的实现 bug(比如开方写错)一起藏掉—— # 我自己第一版就是因为夹了 0,测试全绿而结果是错的。 return float(diff @ diff + w1.sum() + w2.sum() - 2.0 * tr) def covariance(X: np.ndarray, unbiased: bool = True) -> np.ndarray: r"""样本协方差。unbiased=True 用 1/(n-1)(np.cov 默认), False 用 1/n(高斯最大似然估计的常见约定)。""" X = np.asarray(X, dtype=np.float64) if X.ndim != 2 or not X.shape[1] or not np.isfinite(X).all(): raise ValueError("X must be a finite [n, d] array") n = X.shape[0] if n < (2 if unbiased else 1): raise ValueError("not enough samples for covariance") Xc = X - X.mean(axis=0, keepdims=True) denom = (n - 1) if unbiased else n return (Xc.T @ Xc) / denom def fid_from_features(X1: np.ndarray, X2: np.ndarray, unbiased: bool = True, eps: float = 1e-6, mode: str = "sym") -> float: """直接从两组特征算 FID。X1: 真实 [n1, d],X2: 生成 [n2, d]。""" X1, X2 = np.asarray(X1, dtype=np.float64), np.asarray(X2, dtype=np.float64) sig1 = covariance(X1, unbiased=unbiased) sig2 = covariance(X2, unbiased=unbiased) if X1.shape[1] != X2.shape[1]: raise ValueError("feature dimensions differ") mu1, mu2 = X1.mean(axis=0), X2.mean(axis=0) return frechet_distance(mu1, sig1, mu2, sig2, eps=eps, mode=mode) # ────────────────────────────────────────────────────────────── # 4. 自检 # ────────────────────────────────────────────────────────────── def _rand_psd(d: int, rng: np.random.Generator, k: int | None = None) -> np.ndarray: """随机对称正定矩阵:A A^T/k + 0.5 I;加单位阵后满秩。""" k = k or d A = rng.standard_normal((d, k)) return A @ A.T / k + 0.5 * np.eye(d) def self_test() -> None: rng = np.random.default_rng(20261001) print("=" * 68) print("[1] 恒等性:FID(P, P) 必须为 0") d = 32 mu = rng.standard_normal(d) sig = _rand_psd(d, rng) identity = frechet_distance(mu, sig, mu, sig) assert abs(identity) < 1e-10 * np.trace(sig) print(f" FID(P,P) = {identity:.3e} (按容差判断,不要求固定符号或尾数)") for scale in (1.0, 1e-12): singular = np.diag([scale, 0.0, 2 * scale]) z = np.zeros(3) got = frechet_distance(z, singular, z, singular) assert abs(got) < 1e-10 * np.trace(singular) try: sqrtm_sym(np.diag([1.0, -0.1])) except ValueError: pass else: raise AssertionError("non-PSD input was accepted") print(" 奇异/小尺度 PSD 恒等性、非 PSD 拒绝:通过") print() print("[2] 对称化路线 vs 错误写法 vs 一般特征值参考实现") print(f" {'d':>6} {'sym(正确)':>16} {'naive(错误)':>16} {'eigvals(参考)':>16}") for d in (8, 32, 128): s1 = _rand_psd(d, rng) s2 = _rand_psd(d, rng) a = trace_sqrt_product(s1, s2) b = trace_sqrt_product_naive(s1, s2) c = trace_sqrt_product_ref(s1, s2) assert np.isclose(a, c, rtol=1e-9) print(f" {d:>6} {a:>16.10f} {b:>16.10f} {c:>16.10f}") print() print("[3] 这个差异会传进 FID:同一对特征,两种写法差多少") d = 128 n = 4096 mu_a = rng.standard_normal(d) * 0.3 sa = _rand_psd(d, rng) sb = sa + 0.05 * np.eye(d) xa = rng.multivariate_normal(mu_a, sa, size=n) xb = rng.multivariate_normal(-mu_a, sb, size=n) fa = fid_from_features(xa, xb, mode="sym") fb = fid_from_features(xa, xb, mode="naive") print(f" FID(sym) = {fa:.6f}") print(f" FID(naive) = {fb:.6f} (差值 {fb - fa:+.6f})") print() print("[4] 尺度不是不变的:特征整体乘 c,FID 变 c^2 倍") base = fid_from_features(xa, xb, mode="sym") for c in (0.5, 2.0, 4.0): got = fid_from_features(xa * c, xb * c, mode="sym") assert np.isclose(got, c * c * base, rtol=1e-9) print(f" c={c:<4} FID={got:>12.6f} 期望 c^2*base={c * c * base:>12.6f}") print() print("[5] 有偏 vs 无偏协方差(n 越小差得越多)") d = 128 truth_a = _rand_psd(d, rng) truth_b = truth_a + 0.08 * np.eye(d) print(f" {'n':>7} {'unbiased':>13} {'biased':>13} {'差值':>12}") for n in (256, 1024, 8192): pa = rng.multivariate_normal(np.zeros(d), truth_a, size=n) pb = rng.multivariate_normal(np.zeros(d), truth_b, size=n) fu = fid_from_features(pa, pb, unbiased=True) fb2 = fid_from_features(pa, pb, unbiased=False) print(f" {n:>7} {fu:>13.6f} {fb2:>13.6f} {fb2 - fu:>+12.6f}") print() print("=" * 68) if __name__ == "__main__": self_test() metric_checks.py """Independent NumPy checks and fixed-reference extrapolation example. Run: python metric_checks.py No Inception/CLIP weights, image quality or GPU performance measurements. """ from __future__ import annotations import json from pathlib import Path import numpy as np from fid_core import frechet_distance, fid_from_features, sqrtm_sym, covariance from fid_bias_lab import _auc, _nn_two_sample from clip_alignment_lab import clip_score def main(): rng = np.random.default_rng(20261022) errors = [] diagonal_errors, coupling_errors, nuclear_errors = [], [], [] for d in (1, 3, 8, 16): for _ in range(4): a, b = np.exp(rng.normal(size=d)), np.exp(rng.normal(size=d)) m1, m2 = rng.normal(size=d), rng.normal(size=d) target = float(((m1-m2)**2).sum() + ((np.sqrt(a)-np.sqrt(b))**2).sum()) diagonal_errors.append(abs(frechet_distance(m1,np.diag(a),m2,np.diag(b))-target)) U, V = rng.normal(size=(d,d)), rng.normal(size=(d,d)) s1, s2 = U@U.T+np.eye(d), V@V.T+np.eye(d) r1, r2 = sqrtm_sym(s1), sqrtm_sym(s2) inv1 = np.linalg.inv(r1) B = sqrtm_sym(r1@s2@r1) A = inv1@B@inv1 C = s1@A.T coupling_errors.append(float(np.max(np.abs(A@s1@A.T-s2)))) joint = np.block([[s1,C],[C.T,s2]]) assert np.linalg.eigvalsh(joint).min() > -1e-9 cost = float(((m1-m2)**2).sum()+np.trace(s1)+np.trace(s2)-2*np.trace(C)) assert abs(cost-frechet_distance(m1,s1,m2,s2)) < 1e-8 nuclear = np.linalg.svd(r2@r1,compute_uv=False).sum() nuclear_errors.append(abs(np.trace(B)-nuclear)) invalid = [np.diag([1.,-.1]),np.array([[1.,.4],[0.,1.]]),np.array([[1.,np.nan],[0.,1.]])] rejected = 0 for bad in invalid: for first in (True,False): try: frechet_distance(np.zeros(2),bad if first else np.eye(2),np.zeros(2),np.eye(2) if first else bad) except ValueError: rejected += 1 else: raise AssertionError('invalid covariance accepted') for scale in (1.,1e-12,1e12): S=np.diag([scale,0.,2*scale]);z=np.zeros(3) assert abs(frechet_distance(z,S,z,S)) < 1e-10*max(np.trace(S),1e-30) X,Y=rng.normal(size=(50,5)),rng.normal(size=(47,5)) P=np.concatenate([X,Y]);D=((P[:,None,:]-P[None,:,:])**2).sum(-1);np.fill_diagonal(D,np.inf) labels=np.r_[np.zeros(len(X)),np.ones(len(Y))] brute=float(np.mean(labels[np.argmin(D,axis=1)]==labels)) block=_nn_two_sample(X,Y,m=100) assert brute==block assert _auc(np.ones(4),np.ones(5))==.5 assert _auc(np.array([1.,2.]),np.array([0.,1.]))==.875 img=rng.normal(size=(1000,8));txt=rng.normal(size=(1000,8)) cs=clip_score(img,txt); scaled=clip_score(img*7,txt*.3) assert abs(cs['score']-scaled['score']) < 1e-14 assert abs(cs['score_std']-2.5*np.maximum(cs['cos'],0).std()) < 1e-14 # A single empirical estimate may fall below a positive population distance. small=rng.normal(size=(20,1));other=rng.normal(size=(20,1))+1 empirical=fid_from_features(small,other) probe=np.random.default_rng(314159) attempts=0 while empirical >= 1.0 and attempts < 100: empirical=fid_from_features(probe.normal(size=(20,1)),probe.normal(size=(20,1))+1) attempts += 1 assert empirical < 1.0 # Freeze reference features; this limit targets a fixed empirical Gaussian. d=16;nref=5000;ref=rng.normal(size=(nref,d)) mr,sr=ref.mean(0),covariance(ref) mg=np.full(d,.08);sg=np.eye(d)*1.03 fixed_target=frechet_distance(mr,sr,mg,sg) true_target=frechet_distance(np.zeros(d),np.eye(d),mg,sg) rows=[] for n in (500,1000,2000,4000): vals=[fid_from_features(ref,rng.normal(size=(n,d))*np.sqrt(1.03)+mg) for _ in range(8)] rows.append(dict(n=n,mean=float(np.mean(vals)),sd=float(np.std(vals,ddof=1)),repeats=8)) slope,intercept=np.polyfit([1/r['n'] for r in rows],[r['mean'] for r in rows],1) # Exact expected squared sample-mean error for two independent sample sets. exact_mean_bias=2*512/40000 result=dict(passed=True,errors=errors,warnings=[],seed=20261022, diagonal_max_error=max(diagonal_errors),coupling_covariance_max_error=max(coupling_errors), nuclear_trace_max_error=max(nuclear_errors),invalid_covariances_rejected=rejected, nn_block=block,nn_broadcast=brute,auc_all_ties=.5,clip_scale_invariance_error=abs(cs['score']-scaled['score']), exact_mean_bias_d512_n40000=exact_mean_bias, one_empirical_mean_shift_case=dict(population=1.,estimate=empirical,search_attempts=attempts,note='Searched counterexample, not a typical-error estimate'), fixed_reference=dict(d=d,nref=nref,rows=rows,population_target=true_target, frozen_reference_target=fixed_target,intercept=float(intercept),slope=float(slope), note='Fixed empirical reference retains reference-set error; eight repeats, sample SD ddof=1.')) assert result['diagonal_max_error'] < 1e-10 and result['coupling_covariance_max_error'] < 1e-9 Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2),encoding='utf8') print(json.dumps(result,ensure_ascii=False,indent=2)) if __name__=='__main__': main() clip_alignment_lab.py """ clip_alignment_lab.py —— CLIP Score 与 FID 到底在给谁打高分。 这里不加载真实 CLIP 权重,而是搭一个**人工共享空间**: - 两个编码器把图像和文本投到同一个共享空间(真 CLIP 就是这么干的) - 打分用余弦相似度,并且照抄 CLIPScore 论文的定义 CLIP-S = w * max(cos(image, text), 0),w = 2.5(arXiv:2104.08718) - 相似度用归一化向量,高斯矩距离用未归一化的同一组人工特征 这不是 Inception FID 或真实 CLIP 测量。 [A] 仅本构造的扫描中,两个目标最优点不同;不是相似度结构的普遍定理。 [B] 汇总均值可以隐藏逐样本分布;标准差字段为原始余弦的标准差。 运行: python clip_alignment_lab.py """ from __future__ import annotations import json import os import sys import numpy as np from fid_core import fid_from_features HERE = os.path.dirname(os.path.abspath(__file__)) OUT_JSON = os.path.join(HERE, "_clip_results.json") W = 2.5 # CLIPScore 论文的缩放系数 # ────────────────────────────────────────────────────────────── # 共享空间与两个(替身)编码器 # ────────────────────────────────────────────────────────────── def build_concepts(K: int, ds: int, rng: np.random.Generator) -> np.ndarray: """K 个语义概念的类心,单位范数。ds >> K 时它们近似两两正交。""" C = rng.standard_normal((K, ds)) C /= np.linalg.norm(C, axis=1, keepdims=True) return C def encode_image(C: np.ndarray, idx: np.ndarray, sigma: float, rng: np.random.Generator) -> np.ndarray: """「图像编码器」:类心 + 各向同性噪声。sigma 就是生成多样性。""" Z = rng.standard_normal((idx.shape[0], C.shape[1])) return C[idx] + sigma * Z def encode_text(C: np.ndarray, idx: np.ndarray) -> np.ndarray: """「文本编码器」:prompt 直接就是类心本身。""" return C[idx] def clip_score(images: np.ndarray, texts: np.ndarray, w: float = W) -> dict: """CLIP-S = w * max(cos(image, text), 0),逐样本取均值。""" images,texts=np.asarray(images,dtype=np.float64),np.asarray(texts,dtype=np.float64) if images.ndim!=2 or images.shape!=texts.shape or not images.size or not np.isfinite(images).all() or not np.isfinite(texts).all(): raise ValueError("matching nonempty finite [n,d] inputs required") if not np.isfinite(w) or w<0 or np.any(np.linalg.norm(images,axis=1)==0) or np.any(np.linalg.norm(texts,axis=1)==0): raise ValueError("nonzero vectors and finite nonnegative w required") a = images / np.linalg.norm(images, axis=1, keepdims=True) b = texts / np.linalg.norm(texts, axis=1, keepdims=True) cos = (a * b).sum(axis=1) scores = w * np.maximum(cos, 0.0) return { "score": float(scores.mean()), "score_std": float(scores.std()), "score_p10": float(np.quantile(scores, 0.1)), "score_p50": float(np.quantile(scores, 0.5)), "cos_mean": float(cos.mean()), "cos_std": float(cos.std()), "cos_frac_gt_half": float((cos > 0.5).mean()), "cos": cos, } # ────────────────────────────────────────────────────────────── # [A] 多样性扫描:FID 与 CLIP Score 的最优解不在一起 # ────────────────────────────────────────────────────────────── def section_a(K=24, ds=64, n=20000, verbose=True): print("=" * 76) print("[A] 生成多样性 sigma_g 扫描:FID 与 CLIP Score 分别给谁打高分") print(f" 真实数据 sigma_real = 0.5,K={K} 个概念,共享空间维度 ds={ds}") print("=" * 76) rng = np.random.default_rng(90210) C = build_concepts(K, ds, rng) idx = rng.integers(0, K, size=n) real_img = encode_image(C, idx, 0.5, rng) real_txt = encode_text(C, idx) ref = clip_score(real_img, real_txt) if verbose: print(f" 真实数据自己的 CLIP Score = {ref['score']:.4f} " f"(cos 均值 {ref['cos_mean']:.4f})") print() print(f" {'sigma_g':>8} {'FID':>10} {'CLIPScore':>11} " f"{'cos均值':>9} {'cos标准差':>10}") rows = [] for sg in (0.05, 0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0): idx2 = rng.integers(0, K, size=n) gen_img = encode_image(C, idx2, sg, rng) gen_txt = encode_text(C, idx2) fid = fid_from_features(real_img, gen_img) cs = clip_score(gen_img, gen_txt) rows.append((sg, float(fid), cs["score"], cs["cos_mean"], cs["cos_std"])) if verbose: mark = " <- 真实值" if abs(sg - 0.5) < 1e-9 else "" print(f" {sg:>8} {fid:>10.4f} {cs['score']:>11.4f} " f"{cs['cos_mean']:>9.4f} {cs['cos_std']:>10.4f}{mark}") fids = [r[1] for r in rows] scores = [r[2] for r in rows] best_fid = rows[int(np.argmin(fids))][0] best_cs = rows[int(np.argmax(scores))][0] if verbose: print() print(f" FID 最小时 sigma_g = {best_fid}") print(f" CLIP Score 最大时 sigma_g = {best_cs}") print(" -> 在本合成实验中,FID 偏好的方差与 CLIPScore 不同;") print(" 不能据此把真实模型中的多样性与文本对齐视为必然冲突。") print() return {"K": K, "ds": ds, "n": n, "rows": rows, "real_score": ref["score"], "best_fid_sigma": best_fid, "best_clip_sigma": best_cs} # ────────────────────────────────────────────────────────────── # [B] 同一个均值,完全不同的现实 # ────────────────────────────────────────────────────────────── def _score_for_sigma(C, idx, sigma) -> float: """用固定种子探一次,避免二分过程本身消耗主随机流。""" probe = np.random.default_rng(4242) img = encode_image(C, idx, sigma, probe) return clip_score(img, encode_text(C, idx))["score"] def section_b(K=24, ds=64, n=20000, verbose=True): print("=" * 76) print("[B] 汇总 CLIP Score 是均值:好样本和坏样本可以互相平均掉") print(" 模型 M1:p 的概率输出完美匹配,1-p 的概率输出纯噪声") print(" 模型 M2:各样本相似度较集中(调 sigma 让截断后的 CLIPScore 与 M1 相同)") print(" 探针上匹配均值,独立评价近似同分;逐样本分布不同。") print("=" * 76) rng = np.random.default_rng(1357) C = build_concepts(K, ds, rng) idx = rng.integers(0, K, size=n) real_img = encode_image(C, idx, 0.5, rng) if verbose: print(f" {'p':>6} {'M1 CLIP':>9} {'M1 cos标准差':>13} {'M1 好图占比':>12} " f"{'M1 FID':>10} | {'M2 sigma':>9} {'M2 CLIP':>9} {'M2 cos标准差':>13} " f"{'M2 好图占比':>12} {'M2 FID':>10}") rows = [] for p in (0.3, 0.5, 0.7, 0.9): # M1: 混合 good = rng.random(n) < p img1 = np.where(good[:, None], C[idx], 0.0) # 完美命中类心 noise = rng.standard_normal((n, ds)) noise /= np.linalg.norm(noise, axis=1, keepdims=True) img1 = img1 + np.where(good[:, None], 0.0, noise) # 否则是随机方向 cs1 = clip_score(img1, encode_text(C, idx)) fid1 = fid_from_features(real_img, img1) # M2: 固定探针校准sigma,再用独立主随机流评价;不声称最终样本精确同分。 # 注意要对齐的是 score(含 max(cos, 0) 截断),不是裸的 cos 均值 target = cs1["score"] lo, hi = 1e-3, 50.0 for _ in range(60): mid = 0.5 * (lo + hi) if _score_for_sigma(C, idx, mid) > target: lo = mid else: hi = mid sg2 = 0.5 * (lo + hi) img2 = encode_image(C, idx, sg2, rng) cs2 = clip_score(img2, encode_text(C, idx)) fid2 = fid_from_features(real_img, img2) rows.append({"p": p, "m1_clip": cs1["score"], "m1_std": cs1["cos_std"], "m1_score_std": cs1["score_std"], "m1_score_p10": cs1["score_p10"], "m2_score_std": cs2["score_std"], "m2_score_p10": cs2["score_p10"], "m1_good": cs1["cos_frac_gt_half"], "m1_fid": float(fid1), "m2_sigma": float(sg2), "m2_clip": cs2["score"], "m2_std": cs2["cos_std"], "m2_good": cs2["cos_frac_gt_half"], "m2_fid": float(fid2)}) bins = np.linspace(-1.0, 1.0, 51) rows[-1].update(hist_bins=bins.tolist(), hist1=np.histogram(np.clip(cs1["cos"], -1, 1), bins)[0].tolist(), hist2=np.histogram(np.clip(cs2["cos"], -1, 1), bins)[0].tolist(), m1_cos_mean=cs1["cos_mean"], m2_cos_mean=cs2["cos_mean"]) if verbose: print(f" {p:>6} {cs1['score']:>9.4f} {cs1['cos_std']:>13.4f} " f"{cs1['cos_frac_gt_half']:>12.4f} {fid1:>10.3f} | " f"{sg2:>9.3f} {cs2['score']:>9.4f} {cs2['cos_std']:>13.4f} " f"{cs2['cos_frac_gt_half']:>12.4f} {fid2:>10.3f}") if verbose: print() d_clip = max(abs(r["m1_clip"] - r["m2_clip"]) for r in rows) d_std = max(r["m1_std"] / max(r["m2_std"], 1e-9) for r in rows) print(f" CLIP Score 最大差距 = {d_clip:.4f} (探针校准后的独立评价差异)") print(f" 逐样本相似度标准差的比值最大 = {d_std:.2f} 倍") print(" -> 同一个 CLIP Score 背后,可以是「p 的图完美、其余完全不沾边」,") print(" 也可以是「各样本有相近的相似度」。汇总均值看不见这个区别,逐样本分数分布可以。") print() return {"K": K, "ds": ds, "n": n, "rows": rows} def main(): which = sys.argv[1].upper() if len(sys.argv) > 1 else "ALL" res = {} if which in ("ALL", "A"): res["A"] = section_a() if which in ("ALL", "B"): res["B"] = section_b() if which == "ALL": with open(OUT_JSON, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=1) print(f"结果已写入 {OUT_JSON}") if __name__ == "__main__": main() make_figures.py """ make_figures.py —— 画本文的配图。 数据来源都是已经跑完的实验(_fid_bias_results.json / _clip_results.json), 不在这里重新算,避免图上的数字和正文漂移。 运行: python make_figures.py """ from __future__ import annotations import json import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") os.makedirs(FIGDIR, exist_ok=True) # 配色(正文里写「这张图要看什么」时按这六个名字来描述) C_MAIN = "#1f4e79" # 深蓝:主曲线 C_ALT = "#c1440e" # 橙红:对照曲线 C_GREEN = "#2e7d32" # 绿:第三组 C_PURPLE = "#7b1fa2" # 紫:标注线 C_GRAY = "#8a8a8a" # 灰:参考线 C_LIGHT = "#bcd7ee" # 浅蓝:填充 plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 plt.rcParams["savefig.dpi"] = 130 def _load(name): p = os.path.join(HERE, name) if not os.path.exists(p): return None with open(p, encoding="utf-8") as f: return json.load(f) # ────────────────────────────────────────────────────────────── # 图 1:FID 的样本量偏差 # ────────────────────────────────────────────────────────────── def fig_bias(res): rows512 = res["A"]["by_d"]["512"] rows2048 = res["A"]["by_d"]["2048"] rows_b = res["B"]["rows"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7)) # ── 左:偏差 vs n ── n5 = [r[0] for r in rows512] f5 = [r[1] for r in rows512] n2 = [r[0] for r in rows2048] f2 = [r[1] for r in rows2048] ax1.loglog(n5, f5, "o-", color=C_MAIN, lw=2, ms=5, label=r"$d=512$") ax1.loglog(n2, f2, "s-", color=C_ALT, lw=2, ms=5, label=r"$d=2048$") # 参考斜率 1/n ref_n = np.array([n2[3], n2[-1]], dtype=float) ref_y = f2[-1] * (ref_n / n2[-1]) ** (-1.0) ax1.loglog(ref_n, ref_y, "--", color=C_GRAY, lw=1.6, label=r"$\mathrm{slope}=-1$") ax1.axvline(2048, color=C_PURPLE, ls=":", lw=1.6) ax1.annotate(r"$n=d=2048$", xy=(2048, 1.0), xytext=(2600, 1.6), color=C_PURPLE, fontsize=10) ax1.annotate(r"$n=50000$ 时仍有 $14.21$", xy=(n2[-1], f2[-1]), xytext=(9000, 30), color=C_ALT, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax1.set_xlabel("样本量 $n$(两组各 $n$ 个特征)", fontsize=11) ax1.set_ylabel(r"$\mathrm{FID}$(真值 $0$)", fontsize=11) ax1.set_title("大样本区间接近 $1/n$,不是所有区间定律", fontsize=12, pad=8) ax1.legend(loc="upper right", fontsize=10, framealpha=0.95) ax1.grid(True, which="both", alpha=0.25) # ── 右:偏差 vs d ── dd = [r[0] for r in rows_b] bb = [r[1] for r in rows_b] ax2.loglog(dd, bb, "o-", color=C_MAIN, lw=2, ms=6) lo, hi = np.log(dd[0]), np.log(dd[-1]) slope = (np.log(bb[-1]) - np.log(bb[0])) / (hi - lo) ax2.annotate(r"$\mathrm{slope}\approx %.2f$" % slope, xy=(dd[2], bb[2]), xytext=(90, 20), fontsize=11.5, color=C_PURPLE, arrowprops=dict(arrowstyle="->", color=C_PURPLE, lw=1.2)) ax2.scatter([2048], [bb[-1]], s=90, facecolors="none", edgecolors=C_ALT, lw=2, zorder=5) ax2.annotate(r"$d=2048$ 时 $71.14$", xy=(2048, bb[-1]), xytext=(600, 40), color=C_ALT, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax2.set_xlabel("特征维度 $d$", fontsize=11) ax2.set_ylabel(r"$\mathrm{FID}$(真值 $0$)", fontsize=11) ax2.set_title(r"固定 $n=10000$,偏差随维度暴涨", fontsize=12, pad=8) ax2.grid(True, which="both", alpha=0.25) fig.suptitle("图 1:人工高斯同分布,有限样本估计仍有偏差", fontsize=13.5, y=1.0) fig.tight_layout() out = os.path.join(FIGDIR, "fig_fid_bias.png") fig.savefig(out, bbox_inches="tight", facecolor="white") plt.close(fig) print("wrote", out, f"slope={slope:.3f}") # ────────────────────────────────────────────────────────────── # 图 2:前两阶矩一样、分布完全不同 # ────────────────────────────────────────────────────────────── def fig_moment_blind(res): rows = res["D"]["rows"] sep = [r[0] for r in rows] fpop = [abs(r[1]) for r in rows] femp = [r[2] for r in rows] aucb = [r[3] for r in rows] nn = [r[4] for r in rows] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7)) # ── 左:二维示意 ── rng = np.random.default_rng(20261001) a = 4.2 # 二维示意里把模式拉开一点,让「两个团」一眼可见 n = 1400 sgn = rng.integers(0, 2, size=n) * 2 - 1 P = rng.standard_normal((n, 2)) + np.stack([sgn * a, np.zeros(n)], axis=1) covq = np.eye(2) + np.array([[a * a, 0.0], [0.0, 0.0]]) Q = rng.multivariate_normal(np.zeros(2), covq, size=n) ax1.scatter(P[:, 0], P[:, 1], s=9, alpha=0.5, color=C_MAIN, label="真实分布 $P$(两个模式)") ax1.scatter(Q[:, 0], Q[:, 1], s=9, alpha=0.5, color=C_ALT, label="生成分布 $Q$(糊成一团)") # 画 Q 的 1 个标准差椭圆 w, V = np.linalg.eigh(covq) ang = np.degrees(np.arctan2(V[1, -1], V[0, -1])) from matplotlib.patches import Ellipse for k, col in ((1, C_ALT), (2, C_ALT)): e = Ellipse((0, 0), 2 * k * np.sqrt(w[-1]), 2 * k * np.sqrt(w[0]), angle=ang, fill=False, ls="--", lw=1.4, edgecolor=col, alpha=0.75) ax1.add_patch(e) ax1.set_xlim(-9, 9) ax1.set_ylim(-4.2, 4.2) ax1.set_aspect("equal", adjustable="box") ax1.set_xlabel(r"$x_1$", fontsize=11) ax1.set_ylabel(r"$x_2$", fontsize=11) ax1.set_title(r"$\mathrm{FID}=0$,但一眼就能看出不是一回事", fontsize=12, pad=8) ax1.legend(loc="upper left", fontsize=10, framealpha=0.95) ax1.grid(True, alpha=0.25) # ── 右:FID 与可区分度 ── ax2.plot(sep, femp, "o-", color=C_MAIN, lw=2.2, ms=6, label=r"经验 $\mathrm{FID}$(左边刻度)") ax2.set_yscale("log") ax2.set_ylim(1e-3, 1e1) ax2.set_xlabel("模式间距 $2|m|$", fontsize=11) ax2.set_ylabel(r"$\mathrm{FID}$(对数刻度,真值严格为 $0$)", fontsize=11, color=C_MAIN) ax2.tick_params(axis="y", labelcolor=C_MAIN) ax3 = ax2.twinx() ax3.plot(sep, aucb, "s--", color=C_ALT, lw=2.2, ms=6, label=r"密度比评分的经验 $\mathrm{AUC}$") ax3.plot(sep, nn, "^--", color=C_GREEN, lw=2.2, ms=6, label=r"$1$-$\mathrm{NN}$ 两样本准确率") ax3.axhline(0.5, color=C_GRAY, ls="-", lw=1.0) ax3.set_ylim(0.45, 1.0) ax3.set_ylabel(r"$\mathrm{AUC}$ / $1$-$\mathrm{NN}$(右边刻度)", fontsize=11) ax3.text(sep[-1], 0.47, r"$0.5=$ 随机猜测", color=C_GRAY, fontsize=9.5, ha="right") h1, l1 = ax2.get_legend_handles_labels() h2, l2 = ax3.get_legend_handles_labels() ax2.legend(h1 + h2, l1 + l2, loc="center left", fontsize=9.5, framealpha=0.95) ax2.set_title("总体 FID 恒为零;经验估计与可区分度分开看", fontsize=12, pad=8) fig.suptitle("图 2:FID 只匹配前两阶矩,形状对不对它不管", fontsize=13.5, y=1.0) fig.tight_layout() out = os.path.join(FIGDIR, "fig_moment_blind.png") fig.savefig(out, bbox_inches="tight", facecolor="white") plt.close(fig) print("wrote", out) # ────────────────────────────────────────────────────────────── # 图 3:FID 与 CLIP Score 的最优解不在一起 # ────────────────────────────────────────────────────────────── def fig_clip_vs_fid(cres): rows = cres["A"]["rows"] sg = [r[0] for r in rows] fid = [r[1] for r in rows] cs = [r[2] for r in rows] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7)) # ── 左:sigma 扫描 ── ax1.plot(sg, fid, "o-", color=C_MAIN, lw=2.4, ms=6) ax1.set_xlabel(r"生成多样性 $\sigma_g$", fontsize=11) ax1.set_ylabel("FID(越低越好)", fontsize=11, color=C_MAIN) ax1.tick_params(axis="y", labelcolor=C_MAIN) ax1.set_ylim(-1.0, 19.5) imin = int(np.argmin(fid)) ax1.scatter([sg[imin]], [fid[imin]], s=170, facecolors="none", edgecolors=C_MAIN, lw=2.2, zorder=5) ax1.annotate(r"FID 最小,$\sigma_g=%.2f$" % sg[imin], xy=(sg[imin], fid[imin]), xytext=(0.58, 9.6), color=C_MAIN, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) ax3 = ax1.twinx() ax3.plot(sg, cs, "s--", color=C_ALT, lw=2.4, ms=6) ax3.set_ylabel("CLIP Score(越高越好)", fontsize=11, color=C_ALT) ax3.tick_params(axis="y", labelcolor=C_ALT) ax3.set_ylim(0.15, 2.85) imax = int(np.argmax(cs)) ax3.scatter([sg[imax]], [cs[imax]], s=170, facecolors="none", edgecolors=C_ALT, lw=2.2, zorder=5) ax3.annotate(r"CLIP Score 最大,$\sigma_g=%.2f$" % sg[imax], xy=(sg[imax], cs[imax]), xytext=(0.21, 1.85), color=C_ALT, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax1.axvline(0.5, color=C_GRAY, ls=":", lw=1.4) ax1.text(0.31, 2.4, r"$\sigma_{\mathrm{real}}=0.5$", color=C_GRAY, fontsize=10) ax1.set_title("合成共享空间:两个目标的最优点不同", fontsize=12, pad=8) ax1.grid(True, alpha=0.22) # ── 右:同一个 CLIP Score 的两种现实 ── brows = cres["B"]["rows"] target = [r for r in brows if abs(r["p"] - 0.5) < 1e-9][0] # 直接读取实验的真实 cos 直方图;不重新捏造近似分布。 bins = np.asarray(target["hist_bins"]) ax2.stairs(target["hist1"], bins, fill=True, alpha=0.72, color=C_ALT, label=r"$M_1$:半数精确对齐,半数随机方向") ax2.stairs(target["hist2"], bins, fill=True, alpha=0.72, color=C_MAIN, label=r"$M_2$:相似度较集中") for key, color in [("m1_cos_mean", C_ALT), ("m2_cos_mean", C_MAIN)]: ax2.axvline(target[key], color=color, ls="--", lw=1.3) ax2.text(0.03, 0.74, "虚线为各自原始 cos 均值\n分数含截断,等分不等于 cos 均值相同", transform=ax2.transAxes, color="#444444", fontsize=8.5) ax2.set_xlabel(r"单张样本的相似度 $\cos(f_{\mathrm{img}}, f_{\mathrm{txt}})$", fontsize=11) ax2.set_ylabel(r"$\mathrm{count}$", fontsize=11) ax2.set_title(r"余弦标准差:$M_1$ 为 $%.2f$,$M_2$ 为 $%.2f$" % (target["m1_std"], target["m2_std"]), fontsize=12, pad=8) ax2.legend(loc="upper center", fontsize=9.5, framealpha=0.95) ax2.grid(True, alpha=0.22) fig.suptitle("图 3:合成替身实验,不是真实 CLIP 或 Inception 测评", fontsize=13.5, y=1.0) fig.tight_layout() out = os.path.join(FIGDIR, "fig_clip_vs_fid.png") fig.savefig(out, bbox_inches="tight", facecolor="white") plt.close(fig) print("wrote", out) # ────────────────────────────────────────────────────────────── def main(): res = _load("_fid_bias_results.json") cres = _load("_clip_results.json") made = [] if res: fig_bias(res) fig_moment_blind(res) made += ["fig_fid_bias.png", "fig_moment_blind.png"] if cres: fig_clip_vs_fid(cres) made.append("fig_clip_vs_fid.png") print("figures:", made) if __name__ == "__main__": main()
-
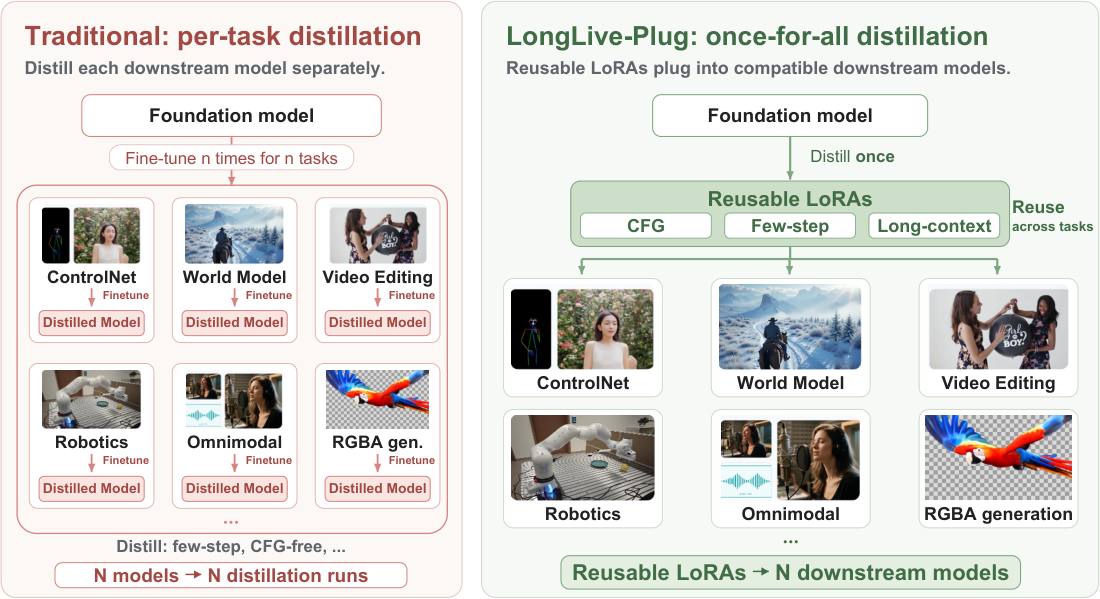
AIGC 每日速读|2026-10-01|一次蒸馏插遍54个模型,LongLive-Plug 今日 AIGC 论文速览 今日共 10 篇 · 视频与图像生成模型 5 篇 · 世界模型与音视频联合生成 1 篇 · 推理加速与模型压缩 2 篇 · 生成理解一体化与奖励模型 2 篇 重点论文标题列表 LongLive-Plug(NVIDIA):蒸馏一次,插遍54个模型 SplitMoE(国科大):专家拆两拨,人像涨9分 HelixWorld(港科大):24帧实时出声的世界 LDM-is-AE(港理工):不用分词器,FID 1.80 NesTok(华北电力大学):变长 token,gFID 1.46 今日论文速览 1. LongLive-Plug:蒸馏一次,插遍54个模型 LongLive-Plug: Once-for-All Distillation for Video Generation | NVIDIA | arXiv:2609.38154 关键词:视频生成, 扩散蒸馏, LoRA 复用, 少步采样, 免训练部署 前序问题:视频扩散模型每做一次下游特化就要重跑一遍蒸馏:要么为少步采样,要么为长视频补误差修正。论文在 Wan2.2-TI2V-5B 上算了账——四个任务各自的专用蒸馏再花 83.9、150.0、86.8、56.1 H100 卡时,合计 376.8,加上一次性底座蒸馏约 80 卡时,总共 456.8 卡时。能力是通用的,钱被重复付了四遍。 本文贡献:把「单遍 CFG」「少步采样」「自回归长时误差修正」各蒸馏成一个 LoRA 挂在底座上,之后插到任何结构兼容的下游模型即可用,下游不再重训。CFG LoRA 只在 w=5 的固定引导强度下训练,推理时靠调 LoRA 权重换引导强度;与少步 LoRA 叠加,下游同时保住少步生成和 CFG 可控。作者称下游新增条件分支、扩展输出通道后适配器仍可复用。 Once-for-all distillation: reusable LoRAs plug into compatible downstream models. 实验效果:在 Wan2.1-14B、Wan2.2-TI2V-5B、MiniMax-H3 三个底座家族、八个任务类别共 54 个下游模型上验证免训练部署。世界模型 SCOPE 上把朴素四步的 FVD 从 805.5 拉回 478.7,优于专用蒸馏的 502.1;ControlNet 上六项全优于朴素四步,深度 si-RMSE 从 2.135 降到 1.641、DOVER 从 8.90 升到 10.11;原生 20–50 步调度降到 1/5–1/12.5。 Downstream distillation cost: task-specific distillation accumulates while LongLive-Plug stays flat. 批判点评:省的是专用蒸馏的钱,80 卡时的一次性底座蒸馏照付,且只对同一底座家族有效。更关键的取舍藏在正文一句「相对任务专用蒸馏存在按指标而异的取舍」——插拔版不是全面反超,而是用 80 卡时换一个接近 456.8 卡时的结果。CFG LoRA 的引导控制是推理权重外推出来的,训练只见过 w=5 这一个点。 2. SplitMoE:专家拆两拨,人像涨9分 Breaking the Uniformity Trap: Scaling Video Diffusion Model via SplitMoE | 中国科学院大学;字节跳动;Canva Research;北京科技大学 | arXiv:2609.38140 关键词:视频生成, 混合专家, 稀疏路由, DiT 规模化, 负载均衡 前序问题:MoE 从 LLM 搬到视频生成上一直水土不服:token 级路由各自为政,再用负载均衡损失把使用率往均匀方向压,结果语义连贯的一块画面被拆到互不相关的专家里,作者称之为「均匀性陷阱」。视频数据时空冗余、语义长尾,本来就不该被均匀分配。 本文贡献:把专家池显式劈成两拨:语义专家抓高层语义抽象,通用专家兜住残差视觉信息和生成自由度。路由用原型引导,配合 pull-push 正则——pull 把原型锚在有意义的视觉语义上,push 防止原型塌缩冗余。两条 sigmoid 独立打分,一个 token 可以同时选中一个语义专家和一个通用专家,不必在所有专家间做全局 softmax 竞争。 Pipeline of SplitMoE: each Video MoE layer splits into Semantic and Generic branches with VAE-prototype induced semantic routing. 实验效果:在同等激活参数预算(A14B)下对比 Wan2.2 系列:Creativity 58.46%、Human Fidelity 84.47%、T2V-CompBench 属性一致性 84.63% 三项拿到全场第一,人像保真比 Wan2.2 的 75.33% 高出 9 个多点。对比同数据微调的密集 Wan2.2-FT 全维领先,且收敛更快——约 70% 训练步数就达到可比的验证扩散损失。 Qualitative comparison with baseline methods. 批判点评:「打破均匀性陷阱」的措辞比结果激进。它自己的表里 Physics 69.41% 输给 LTX-2 的 76.71%,Interaction 69.98% 输给 Wan2.2 的 73.29% 和 OmniWeaving 的 73.94%,Commonsense 64.89% 离 LongCat-Video 的 70.94% 差 6 个点。消融也显示去掉原型引导的 w/o PG 版本在 Commonsense 上 63.22% 与完整版 64.89% 差距很小,语义路由的主要收益其实集中在物理和人像两项。 3. HelixWorld:24帧实时出声的世界 HelixWorld: A Real-time Interactive Audio-Visual World Model | 香港科技大学;Noiz AI | arXiv:2609.38123 关键词:世界模型, 音视频生成, 实时交互, 空间音频, 因果蒸馏 前序问题:主流交互式世界模型全是哑巴:只管画面渲染和操控,声音这一维整个缺失。级联的视频转音频模型拿不到相机轨迹和用户动作,声场对不上自运动,串行延迟也谈不上实时;而把它们硬改成因果自回归,历史误差会迅速累积成灾难性多模态漂移。训练数据同样缺——现有世界模型数据集基本无声,视频语料里的音轨又常被后期配乐和旁白污染。 本文贡献:先用一个双向教师模型在自建的高保真空间音视频数据(真立体声 + 度量级相机位姿)上学 6-DoF 轨迹与动作条件,再用在线轨迹蒸馏把它压成少步因果学生,配合长程流式微调压掉曝光偏差。块内注意力保持双向以维持音视频交互,跨块注意力严格因果并配滑动 KV 缓存。同时提出 HelixBench,首次把空间声学一致性纳入世界模型评测。 Causal distillation pipeline: self-forcing rollout, online trajectory distillation, DMD, and long-horizon tuning. 实验效果:单张 NVIDIA H800 上稳态 RTF 0.77,768×512、24 FPS,含视频与音频解码。HelixBench 上因果学生 KL 1.3934、FAD 2.3872、IB 0.2987、Spatial 41.7583 全部第一;级联配音路线(HelixWorld+AudioX / ThinkSound / PrismAudio)的空间分甚至是负的,说明分离式生成根本抓不住声源位置。 Visual comparison under interactive control. 批判点评:WBench 导航榜上它平均 79.9 只排第 4,落后 Alaya-EVOKE-Turbo 82.0、EchoWM 81.0、Zing-0.5 81.0——「比肩 SOTA 无声世界模型」是有选择的比法。更反直觉的是音画同步:学生的 DeSync 0.5867 秒反而差于 LTX-2.3 base 的 0.4042 秒,CLAP 0.3016 也略低于级联的 HelixWorld+AudioX 0.3094,联合生成在语义对齐上没打赢「先出画面再配音」。 4. LDM-is-AE:不用分词器,FID 1.80 LDM-is-AE: Latent Diffusion Model is an Auto-Encoder for End-to-End Image Generation | 香港理工大学;OPPO 研究院 | arXiv:2609.37080 关键词:图像生成, 潜在扩散, 自编码器, 一阶段训练, 表示学习 前序问题:LDM 的两段式流程先训一个自编码器定住 latent 空间,再在里面训扩散。问题在于这个空间是为重建优化的,训练扩散时它是冻住的,天然与去噪动力学不匹配。而两阶段里最强的那批又几乎都挂着 DINOv2 这类外部视觉基础模型做监督,等于把表示学习的成本挪到表外。 本文贡献:核心观察是:LDM 骨干每一步去噪其实都在做 latent→feature→latent 的变换,这本身就是一次内部「解码—编码」。于是把 DiT 劈成互逆的两半 DiT-D 与 DiT-E,在中间特征上加一个轻量 MLP 头对齐到像素空间并施加图像域监督,把这条 latent→image→latent 路径显式化;零噪声时它自然等价于一次自编码。另配时间感知的辅助特征混合,避免对齐吃掉去噪容量。 Architecture and training design of LDM-is-AE: (a) network architecture and training pipeline; (b) time-aware auxiliary feature mixing. 实验效果:ImageNet 256×256 上 FID 1.80、IS 314,512×512 上 FID 1.90、IS 320——512 这一档超过了 JiT-H/32 的 1.94、REPA-SiT-XL/2 的 2.08。生成器训练 FLOPs 7.02,低于 JiT-H/16 的 14.0。自编码路径上 PSNR 27.57 高于 VAVAE 的 26.59 和 SDVAE 的 25.94。 Class-conditional ImageNet samples generated by LDM-is-AE at 256x256 resolution. 批判点评:FID 1.80 这个数得放在「不用 VFM 的一阶段方法」这个限定里看:两阶段挂 DINOv2 的 LightningDiT、REPA-SiT 仍然更好。更值得玩味的是它自己的重建口径——rFID 0.7879 明显差于 VAVAE 的 0.2650 和 REPA-E 的 0.4980,PSNR 最高却 rFID 最差,说明这个 latent 是奔着自然图像分布去的,压根不为「还原输入」负责,论文把这叫 diffusion-native,换个说法就是不忠于输入。 5. NesTok:变长 token,gFID 1.46 NesTok: Nested Self-Aligned 1D Tokenizer for Autoregressive Image Generation | 华北电力大学;中国科学技术大学;斯坦福大学 | arXiv:2609.36756 关键词:图像生成, 视觉分词器, 变长 token, 自回归生成, 嵌套对齐 前序问题:变长 1D 分词器想用一个 tokenizer 覆盖不同算力预算,主流做法是嵌套 dropout——随机截断 latent 序列并保留前缀,逼着前面的 token 装下最重要的信息。但「长度灵活」不等于「token 用得好」:已有工作发现序列加长后下游 AR 生成质量收益递减甚至倒退,尾部 token 基本成了摆设。 本文贡献:提出嵌套自对齐:跨长度联合优化重建,同时用全长序列去指导短序列,让短前缀逼近全长的重建质量,而不是只让前缀独立地「更重要」。配套的动机实验很直白——嵌套 dropout 训出来的码本在靠后位置归一化熵很低,码本多样性塌了,gFID 只有 2.46。 Overview of the nested self-aligned training pipeline. 实验效果:ImageNet 上 rFID 0.98,下游 AR 生成 gFID 1.46(带引导)、IS 295.9,在变长自回归图像生成这一档里是当前最好,优于 ReTok 的 2.27、One-D-Piece 的 2.35、DetailFlow-32 的 2.75,也远好于嵌套 dropout 基线的 2.46。 gFID with and without classifier-free guidance across different methods, model sizes, and token lengths. 批判点评:1.46 这个 SOTA 是「变长自回归」这个小池子里的 SOTA:同一张表上扩散路线的 Lightning-DiT-XL 带引导 gFID 1.35、REPA-XL/2 1.42 都更好。而重建口径更尴尬——rFID 0.98 远差于 LightningDiT 用的 KL tokenizer 0.28 和 SD-VAE 的 0.62,等于用重建质量换了生成质量。另外它仍是 VQ 分词器,390M 参数不算轻。 6. PixelDiff-GAN:加判别器,FID 降到28.6 Adversarial Training for Pixel Diffusion | Adobe Research;加州大学圣地亚哥分校;加州大学默塞德分校 | arXiv:2609.38170 关键词:图像生成, 像素扩散, 对抗训练, 后训练, 频谱分析 前序问题:像素扩散直接在 RGB 上出图,绕开了自编码器这个瓶颈,但产出的图像在细尺度自然图像统计上系统性偏低——说白了就是高频细节不够。这是个老问题,却一直没人系统性地验证对抗训练能不能补。 本文贡献:保留预训练模型原来的扩散/流匹配目标不动,只在非高噪声时间步上对预测输出额外加一个对抗损失,架构和采样流程一行不改。作者还做了归因:频带与幂律分析显示原模型系统性地欠产高频,对抗后训练正好把这部分谱功率补回来。 Noise-gate rationale: structure settles early, detail settles late. 实验效果:两个像素骨干上同时改善分布保真、覆盖率、提示对齐和感知质量。DeCo 上 FID 从 33.27 降到 28.59、pFID 27.9→24.4、CMMD 0.836→0.736、recall 0.361→0.406、DPG 81.6→83.3、TOPIQ 0.71→0.77、MANIQA 0.64→0.71;PixelGen 上 DPG 从 78.4 提到 80.8。1065 组配对样本的胜率也明显高于 latent 扩散的同类做法。 Pixel radial-profile band share over 30,000 images per model; gray = no-GAN, green = +GAN. 批判点评:FID 28.59 的绝对值放在今天并不好看,它赢的是「相对自己」这一档。真正有价值的是边界实验:同样的流程搬到 latent 扩散(PixArt / SANA)上没有可比增益,也几乎没加回解码后的高频功率——作者据此认为「能否直接触达被修正的图像统计」才是对抗后训练成不成立的关键。另外论文自己提到真实照片在 TOPIQ 上只拿 0.57,比生成的还低,等于承认无参考指标不足以单独作证。 7. DIET:砍半专家,57GB 变 30GB DIET: Deletion-response Expert Trimming for Video Diffusion Transformers | 西安交通大学;上海交通大学;阿里巴巴 Token Hub;阿里云 | arXiv:2609.37829 关键词:视频生成, MoE 剪枝, 专家裁剪, 免微调压缩, 推理加速 前序问题:MoE 的稀疏激活只省算力不省显存——所有专家的参数一个不少地躺在 checkpoint 里。整块删掉专家是最直接的瘦身办法,但现有一次性剪枝判据靠静态激活或路由频率打分,看不见「删掉某个专家、token 重新路由之后」这一层到底发生什么。而在这个规模上穷举多种删除组合,代价根本付不起。 本文贡献:用一次 all-expert 标定把条件/无条件 token 下所有专家输出和 router 状态全部录下来,之后重放任何单专家删除及其成组重路由,退化成对缓存状态的张量运算,零额外前向。在此基础上把「保留哪些专家」写成整体多样性损失:每个被删专家匹配到最近的保留专家,求和最近邻余弦距离作集合级覆盖损失。求解分两层——层内贪心+单交换+模拟退火,层间用回归指导的预算分配。 DIET overview: grouped MoE capture, replay-to-signature, intra-layer ODL, and inter-layer budget search. 实验效果:在 LingBot-Video 30B-A3B 上免微调剪掉 50% 专家(6144→3072),checkpoint 从 57GB 降到 30GB,48GB 单卡可部署;284 条固定用例上 VBench Total 反而从 0.7941 升到 0.8115。层间非均匀预算分配比均匀分配多拿 1.2 个点。所有保留预算下都优于从 LLM 移植过来的剪枝基线。 Primary evaluation and routing dynamics across candidate retention budgets. 批判点评:VBench 从 0.7941 涨到 0.8115 是这条工作最抓眼的数字,但幅度只有 1.7 个百分点,且出自自家固定的 284 条协议,更像「没掉点」而不是「变好了」。省下的是 27GB 存储,激活算力并没少——稀疏激活本来就只算一部分。另外这套标定缓存的前提是条件/无条件 token 可配对,CFG 之外的采样路径能否同样成立没有验证。 8. SoL-Refiner:一步上 4K,快 8.91 倍 SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video | NVIDIA | arXiv:2609.37969 关键词:视频生成, 超分辨率精修, 一步蒸馏, 强化学习后训练, 推理加速 前序问题:高分辨率视频生成的代价随时空 token 数暴涨。实用做法是先在低分辨率出片再用 refiner 精修,但常规 refiner 本身要跑好几个目标分辨率的去噪步,等于引入第二个采样瓶颈。而且多数 refiner 只针对自家基模型开发,换一个生成器还灵不灵几乎没人测。 本文贡献:从 LTX-2.3 出发走三步:高分辨率续训学精修映射、帧级奖励模型做 RL 后训练提升感知质量、最后一步蒸馏压成单步。推理侧配 TAE 小自编码器降低编解码开销,用 latent 上采样初始化,再由 Sol Video Inference Engine 执行单次 NFE。同时建了 Refiner-Bench——150 条对齐视频、统一输入协议,专门横向比 refiner。 Training and inference pipeline of SoL-Refiner. 实验效果:一步版在 Refiner-Bench 上 VBench 均值 0.81048、UniPercept 均值 60.4150,超过同为一档步数的 SEEDVR2 和三步的 LTX-2.3 Refiner。4K 上相对三步 LTX-2.3 Refiner,VBench 与 UniPercept 均值分别提升 3.86% 和 22.79%。叠满加速栈后 2K 延迟档精修提速 8.91 倍;配四步 MiniMax H3 基模型,整条两级流水线比直接全分辨率生成快 27 倍。 Performance across output resolutions: three-step LTX-2.3 Refiner vs one-step SoL-Refiner. 批判点评:一步版输给自家多步版——0.81048 对 23 步的 0.81691,主体一致性 0.92191、动态度 0.71333 都被多步版和 LTX-2.0 Refiner 压过。8.91 倍是「精修阶段」的加速,不是端到端;27 倍那个数则是把基模型也换成低分辨率四步 H3 之后的联合结果。另外 Refiner-Bench 是自建集,起点又是 LTX-2.3,公平性靠 shared-input 协议兜着。 9. OmniTaskonomy:19个生成任务换25项能力 OmniTaskonomy: When Does Visual Generation Improve Visual Understanding? | 加州大学伯克利分校;杜克大学;卡内基梅隆大学;华盛顿大学;Elorian;Impossible Research | arXiv:2609.38079 关键词:统一多模态, 生成理解一体化, 任务迁移, 梯度对齐, 训练课程 前序问题:生成能给理解带来多少好处,一直是笔糊涂账:已有工作普遍认为理解反哺生成容易,反过来收益微弱。但这在直觉上说不通——生成提供的是像素级稠密监督,覆盖外观、空间关系、几何,而这些恰恰也是识别、计数、空间推理、3D 感知需要的。 本文贡献:用「同一个底层视觉问题、两种输出模态」的受控配对来做因果分离:I2I 生成任务和 I2T 理解任务表达同一个问题,只换监督形式。再搭一个覆盖 19 个 I2I 生成任务与 25 项 I2T 理解能力的统一分类法 OmniTaskonomy(按识别、重建、重组三个基础问题组织),画出完整的迁移图谱。机制上用梯度对齐解释:生成与理解在理解分支 pre-attention RMSNorm 参数上的梯度对齐越强,迁移增益越大。 OmniTaskonomy: a unified taxonomy of I2I tasks and understanding capabilities under the three Rs. 实验效果:先做 I2I 再做 I2T 的课程能稳定提升理解表现,且增益随 I2I 数据量单调增长;混合训练则没有一致的规模收益。I2I 训练还能减少达到同一理解水平所需的 I2T 监督量,在 I2T 数据稀缺时收益最大。迁移图谱里既有直觉对应的组合(深度预测→度量 3D 推理、物体指向→计数、拼图重建→2D 排序),也有反直觉的(2.5D 分割→类别识别、Z-depth 预测→定位)。 Generation-to-understanding transfer across visual capabilities. 批判点评:结论的成立高度依赖课程顺序——先 I2I 后 I2T 才有效,混合训练就没有一致的规模收益,这更像是「课程设计」而非「生成天然有益」。迁移图谱是选择性的:作者自己也说收益 task-dependent,图里有多少格子是负增益论文没有全列。梯度对齐目前只是相关性分析,拿它做任务选择的先验还缺因果验证。 10. ThinkRM:先定评分表,9B 超 GPT-4.1 Think Before You Score: Thinking Reward Model for Visual Generation | 杭州电子科技大学;中国科学院自动化研究所;北京大学;商汤科技;复旦大学;西北工业大学;南洋理工大学;清华大学 | arXiv:2609.37372 关键词:奖励模型, 视觉生成评测, 评分细则, 偏好优化, 强化学习 前序问题:视觉奖励模型通常把任务条件和候选输出直接映射成一个标量分数,至于「这个 case 到底该评什么」完全隐在黑箱里。图像生成和图像编辑的评判标准差异极大,用一套固定标准硬套,细粒度区分能力必然上不去。 本文贡献:提出「先想清楚再打分」:为每个 case 先自适应地生成评分细则(rubric),再按细则做逐条评估,最后产出细粒度 pointwise 分数。训练上先做结构化 SFT 冷启动,再用成对偏好优化;作者发现常规成对偏好优化会引起分数极化,于是提出 Pairwise Dual-Group Relative Policy Optimization,在保留细粒度打分能力的同时提升判别力。 Thinking Reward Model (TRM) follows the Think-Before-You-Score paradigm, with RM and RL performance. 实验效果:9B 模型在 GenAI-T2I 上从基线的 58.9% 提到 71.2%、MMRB2-T2I 从 59.4% 提到 67.9%,两个榜上都超过 GPT-4.1;编辑侧 EditScore-ERB 0.750/0.639/0.743、EditReward-ERB 67.8%、MMRB2 从 53.0% 提到 58.2%。用它做奖励去优化 BAGEL、FLUX.1-dev、SD3.5-M 等多个生成模型,跨架构跨规模一致有提升。 Qualitative comparison of SenseNova-U1.5 before and after RL fine-tuning with TRM. 批判点评:「超过 GPT-4.1」是在特定榜单和特定打分协议下的结果,且作者明说 pointwise 模型只统计非平局预测的准确率,平局样本另算——这个口径会显著抬高数字。冷启动 SFT 已经把 58.9% 拉到 70.1%,后面的成对优化只再加 1.1 个点,说明真正吃重的是 rubric 监督数据本身。另外 8 家单位联合、训练只用约 4000 条偏好对,规模偏小。 趋势观察 蒸馏的计价单位从「每个模型」变成「每个底座家族」 LongLive-Plug 把少步采样、单遍 CFG、长时误差修正各做成一只 LoRA,一次 80 卡时的底座蒸馏换掉四个任务 376.8 卡时的专用蒸馏;SoL-Refiner 把多步精修压成一步再叠 TAE 与推理引擎拿到 8.91 倍;DIET 直接免微调砍掉一半专家把 57GB 压到 30GB。三篇下手的地方完全不同——一只 LoRA、一次 NFE、一半专家——但都在问同一个问题:这份能力到底要不要为每个落点重付一遍钱。 生成与理解之间的账开始被逐项结算 OmniTaskonomy 用 19 个生成任务对 25 项理解能力画出迁移图谱,结论是收益 selective 且强依赖「先 I2I 后 I2T」的课程;Think Before You Score 则反过来问评估侧——给每个 case 先拟一份评分细则再打分,9B 模型在两个榜上压过 GPT-4.1。前者说明「生成有益理解」不能当口号用,后者说明奖励模型缺的不是参数量而是「该评什么」这一步显式化。 人工智能炼丹君 整理 | 2026-10-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
深度解读|字节Seed×UCSD VSA2|砍掉95%注意力计算 720p端到端快4.62倍 VSA2 深度解读:字节 Seed 与 UCSD 把视频稀疏注意力推到 95%,720p 端到端快 4.62 倍 论文:Improving Video Sparse Attention with Fine-grained Router and Sparse Rebasing 机构:UC San Diego · 字节跳动 Seed · UC Berkeley · Georgia Tech 作者:Peiyuan Zhang、Guoqiang Wei、Yilong Zhao、Zixiang Zhang、Wei Zhou、Will Lin、Heng Zhang、Xiaonan Nie、Yan Zeng、Hao Zhang(Peiyuan Zhang 与 Yilong Zhao 的工作完成于字节 Seed 实习期间) 日期:2026-09-26(arXiv 2609.32882) 代码:截至发稿未见 VSA2 的代码与权重;前代 VSA、STA 的 kernel 在 FastVideo 仓库(hao-ai-lab/FastVideo)开源 论文状态:arXiv 预印本,comment 字段为空,暂无接收信息 01 先说说这东西是干嘛用的 视频 DiT 越做越长、越做越清晰,最先扛不住的是注意力。 论文开头给了一个量级:一段 5 秒的高清视频,展开成 token 就超过 10 万个。3D 全注意力的计算量随序列长度平方增长,训练和推理的大头都落在注意力上。作者后面测速用的 720p、10 秒视频,是 22 万 token。 UCSD 这个组在更早的 STA 论文里给过一个更直观的数:HunyuanVideo 生成一段 5 秒 720P 视频总共要 945 秒,其中注意力就占了 800 秒。 大家早就知道注意力矩阵里大部分元素贡献很小,于是有了一大批稀疏注意力方法。但这里有一道分水岭: 只在推理时稀疏(Sparse VideoGen、SpargeAttn 这一类):模型还是用全注意力训出来的,最贵的预训练阶段一点没省; 训练时就稀疏(VSA、SLA、SLA2 这一类):理论上预训练也能省。但按作者的说法,这类方法在 post-training 阶段大约能稀疏掉 80%,再往上就碰到天花板;真正拿去做预训练的工作规模都偏小,评价主要只看 loss。 VSA2 想做的是后一类的"完整版":一个能从预训练中途接入、一路用到 RL 和推理的可训练稀疏注意力。它在前代 VSA 的基础上改了两处结构,外加一套训练配方: 细粒度 router:选块时的池化粒度不再和 GPU 友好的块大小绑定,而是先用小得多的池化算注意力分数,softmax 之后再合并成块级分数; per-sequence TopK:总计算预算固定,但不再要求每个 query 分到一样多的 KV 块,难的 query 可以多拿; Sparse Rebasing:低分辨率阶段照旧用全注意力 checkpoint,到 480p/720p 这种最烧算力的阶段才切换成 VSA2;配合 Hard-to-Easy Curriculum,训练时稀疏度高、推理时放宽。 结果是这样的(论文 Table 2 与 Figure 8): 设置 注意力稀疏度 加速 质量 480p 预训练,训练/推理都用 top64 90% 端到端 2.09× 人评与全注意力互有胜负 720p 预训练,训练/推理都用 top64 95% 端到端 4.62× 人评与全注意力基本持平 注意力算子,22 万 token(单卡 H800,对比 FlashAttention-3) top64 注意力 8.9× — 作者团队也值得一提。UCSD 这边是 Hao Zhang 组,STA、VSA 和 FastVideo 都出自这里,一作 Peiyuan Zhang 同时是 STA 和 VSA 的一作;另一半作者来自字节 Seed。所以这篇可以看成 VSA 这条路线第一次在完整的视频 DiT 训练流程里走通——从预训练、RL 到推理。 (图片来源:论文 Figure 3。样本来自 Table 2 中 Exp 6 的 checkpoint,每组上行是全注意力、下行是 VSA2;第一组和第三组是图生视频,中间一组是文生视频) 02 主要亮点,以及需要冷静看的地方 值得关注的地方: 全流程验证。480p 预训练、720p 预训练、RL、推理四个环节都换成了稀疏注意力,并且和同数据、同超参、同步数训出来的全注意力模型逐项对比。按作者的说法,这是第一个在视频 DiT 开发各阶段都端到端验证过的可训练稀疏注意力; "router 不需要学"有实验支撑。几组对照实验显示,让 router 接收梯度(不管是 NSA 式借道 coarse branch,还是 MoE 式直接反传),都不如完全不给梯度(Figure 7(c)(d)),结构因此更简单; 选块粒度和硬件块大小解耦。细粒度 router 配 top64,loss 比粗粒度 router 配 top128 还低(Figure 7(e)),fine branch 的计算量直接砍半; 稀疏预算按整条序列分配。per-sequence TopK 让每个 query block 拿到的 KV 块数可变,loss 比传统的 per-token TopK 低(Figure 7(f)); 不用从头训。Sparse Rebasing 只在高分辨率阶段切换,新增参数只有一个零初始化的门控投影; "训难测易"换来更好的运动。用 top64 训、top128 推,文生视频运动质量的人评净胜率达到 22.1%(Table 2 Exp 2); kernel 是认真做过的。router 的 GEMM、softmax、池化融合成一个 CuTe DSL kernel,fine branch 用 ThunderKittens 实现 block-sparse attention,22 万 token 下注意力比 FlashAttention-3 快 8.9 倍。 需要冷静看的地方: 人评的分辨率很粗。分数是(更好 − 更差)/ 149,每 0.67% 就是一条 prompt。720p 那一行"运动 +6.71%、指令跟随 −2.01%",换算过来是净多赢 10 条、净少 3 条,多数格子都在统计噪声范围内(详见第 09 段); "计算量减半"只算了 fine branch。把 router 自身的开销算进去,720p 下相对 VSA 的 top128,实际省下的注意力时间大约是三分之一(我按论文给的 router 耗时占比粗算,见第 10 段); 没有外部 baseline。没有和 SLA、SLA2、VMoBA、Sparse VideoGen 在同一个模型上比,也没有 VBench 这类公开 benchmark,对比对象只有全注意力和 VSA/NSA 的设计变体; 模型、数据、代码都不公开。参数量、数据集、VAE 配置论文都没写,外部无法复现; 训练省了多少没给数。论文动机是降低预训练成本,但给出的加速全在推理侧,没有训练吞吐或 GPU 小时的对比; Hard-to-Easy 有代价。运动变好了,指令跟随和美学却下降(Exp 3 的文生视频指令跟随净输 15.4%),需要再做一轮更高 top-K 的 RL 才能拉回来; 30 秒长视频只有抽帧展示,没有全注意力对照,也没有量化指标; 扩展性有两个已知隐患:router 的相对开销固定在全注意力的 $1/R^2$ 左右,序列更长时会变成瓶颈;动态稀疏模式和 Ring-Attention 序列并行不好配合。这两点作者在附录里自己承认了。 03 视频稀疏注意力这条赛道现在什么样 先把 VSA2 放回坐标系里。视频 DiT 的稀疏注意力大致分三拨。 第一拨:免训练,只管推理。 拿一个用全注意力训好的模型,推理时找出不重要的注意力块跳过。代表是 Sparse VideoGen(在线判断每个头是"空间头"还是"时间头",在 CogVideoX-v1.5 和 HunyuanVideo 上端到端最高 2.28 倍和 2.33 倍),以及 SpargeAttn、XAttention、Radial Attention 等。STA 算半只脚在这里:它用固定的 3D 滑动 tile 窗口,免训练时 HunyuanVideo 从 945 秒降到 685 秒,允许微调后降到 268 秒。 这一拨的共同问题是模型没见过稀疏,稀疏度一高就容易掉质量,而且预训练成本一分没省。 第二拨:微调之后稀疏。 在已有模型上用少量步数把稀疏注意力"训进去"。清华的 SLA 把注意力权重分成关键、边缘、可忽略三类,关键部分走稀疏注意力、边缘部分走线性注意力,在 Wan2.1-1.3B 上注意力计算省 95%,端到端 2.2 倍;后续的 SLA2 加上可学习 router 和量化感知训练,把稀疏度推到 97%。VSA 也做过类似的改造:把 Wan-2.1 换成稀疏注意力后,注意力提速 6 倍,端到端从 31 秒降到 18 秒。 第三拨:预训练就稀疏。 DSV、VSA 都尝试过从预训练阶段就用稀疏注意力。VSA 当时从 6000 万参数一路做到 14 亿参数的 scaling 实验,找到一个训练 FLOPs 降 2.53 倍、diffusion loss 不掉的点。但正如 VSA2 自己指出的,这些实验规模偏小,评价主要看 loss,没有人评和视觉对比。 LLM 那边的两条线也是 VSA2 的直接参照: DeepSeek 的 NSA:压缩、选择、滑窗三路注意力,同一 GQA 组内的 query 头共享稀疏模式,选块分数借用压缩分支; Moonshot 的 MoBA:对 key 块做均值池化当门控,不带可训练参数。 VSA2 的不少消融实验,就是在回答"LLM 这套设计搬到视频上还成不成立"。 所以 VSA2 的位置很清楚:沿着 VSA 的 coarse-to-fine 框架,把"预训练就稀疏"推进到完整的视频 DiT 训练流程里,并重新设计了 router。 04 旧 router 卡在哪:两个结构性天花板 先把 coarse-to-fine 框架讲清楚,VSA2 的改动都在它上面动刀。 以 VSA 为例,一层稀疏注意力分两步: coarse branch(粗粒度支路):把相邻的 B 个 token(在视频里是一个 $B_t\times B_h\times B_w$ 的小立方体,下面叫 cube)的 Q、K、V 各求平均,得到长度为 $L/B$ 的短序列,在上面做一次全注意力。这一步既产出一份粗粒度的注意力输出,又得到一张 cube 与 cube 之间的亲和度分数图; 选块 + fine branch(细粒度支路):每个 query cube 在分数图里挑 TopK 个最相关的 key cube,然后只在这些 cube 对里做逐 token 的 block-sparse attention。 为了让 GPU 算得快,block-sparse attention 的块大小 B 通常取 64 或 128,这是硬件决定的。问题在于,以往的 router 顺手把池化步长也设成了 B——一个 cube 的 128 个 token 被压成一个向量去算分数。 作者认为这带来两个结构性天花板。 天花板一:池化太粗,看不清关键 token。 128 个 token 的平均值会把 $\mathbf{QK}^\top$ 里的细节抹平。长视频、高分辨率下,这种"混叠"要么让真正关键的 token 漏选、质量下降,要么逼着你多选块、稀疏度上不去。 天花板二:每个 query 分到的预算一样多。 标准的 per-token TopK 要求每个 query 看同样数量的 KV。简单的 query 浪费算力,难的 query 又吃不饱。稀疏度一往上推,最先饿着的恰恰是最需要上下文的那些 query。 从公式上看更清楚。假如算力无限,最理想的选块分数应该是先算完整的 token 级注意力 $\mathbf{A}$,再按块求平均: $$\mathbf{A}=\mathrm{Softmax}\big(\mathbf{Q}\mathbf{K}^\top/\sqrt{D}\big)$$ $$\mathbf{P}_{oracle}=\mathrm{MeanPool}_{B\times B}(\mathbf{A})$$ VSA 的 coarse branch 则是把池化挪到了 softmax 前面,先按整个 cube 池化出 $\mathbf{Q}_c=\mathrm{MeanPool}_B(\mathbf{Q})$、$\mathbf{K}_c=\mathrm{MeanPool}_B(\mathbf{K})$,再算注意力: $$\mathbf{P}_c=\mathrm{Softmax}\big(\mathbf{Q}_c\mathbf{K}_c^\top/\sqrt{D}\big)$$ 如果注意力是线性的,两者相等;但 softmax 是非线性的,所以这只是近似,精度取决于"cube 内部的 token 足够相似"这个局部性假设。cube 越大,这个假设越站不住。 VSA2 的解法,一句话就是:只在 router 里把 cube 切得更细。下图左边是以往的 router,右边是 VSA2 的细粒度 router,细节放到第 07 段讲。 (图片来源:论文 Figure 1。左:VSA 等方法使用的常规 router,Q、K 都按整个 cube 池化,softmax 之后直接 TopK;右:VSA2 的细粒度 router,先按小得多的尺寸 R 池化 Q、K,softmax 之后再按 G×G 做分数池化,最后 TopK) 05 router 要不要学?作者先做了一组拆解实验 (05~07 三段偏技术,只想看结果的可以直接跳到 08。) 改 router 之前,作者先回答了一个更根本的问题:router 的选块能力到底从哪来? 这件事在 MoE 里很明确:router 的打分会乘到专家输出上,梯度能流回来,router 是学出来的。但在稀疏注意力里,TopK 选出的是一张布尔 mask,fine branch 的梯度流不回 router。VSA 的 coarse branch 虽然有梯度(来自它自己的输出 $\mathbf{O}_c$),但这份梯度并不来自选块结果。 于是有两种假说: 局部性启发:相邻 token 本来就相似,均值池化出来的 cube 特征已经够用,router 根本不需要参数和梯度。MoBA、Quest 是这个思路; 辅助监督:router 和 coarse branch 共享参数,coarse branch 的梯度虽然不直接针对选块,但顺带把 router 也练好了。NSA 属于这种。 作者设计了几组参数量对齐的消融: (图片来源:论文 Figure 7。(a) 全注意力设置下 GQA(4 组)与 MHA 的训练 loss;(b) "按头分组 + 按邻域分组"的混合方案与纯"按邻域分组"对比;(c) router 的 QKV 绑定 coarse branch 还是 fine branch;(d) MoE 式可反传 router 与 VSA 对比;(e) 有无细粒度 router、top64 与 top128 对比;(f) per-token 与 per-sequence TopK 对比。除 (f) 从 256p 视频 checkpoint 初始化外,其余都从头训练;(b)(e)(f) 的放大插图是训练末段) 先看 router 相关的两组: (c) router 绑谁:把 coarse branch 和 fine branch 的 QKV 投影拆开,让 router 跟 coarse branch 共用 QKV(能收到 $\mathbf{O}_c$ 的梯度),或者跟 fine branch 共用(相当于 MoBA 式的无梯度 router)。结果后者 loss 更低; (d) 直接给 router 梯度:仿照 FFN 里的 MoE,coarse、router、fine 各用一套独立的 QKV,fine branch 的输出再乘上 router 的打分,让 router 直接拿到梯度。结果这种 MoE 式反传并不比原版 VSA 好。 结论是:在视频扩散模型里,复杂的可学习 router 没必要,无梯度 router 就够了,效果还更好。 既然 router 不学,能改进的就只剩"无梯度 router 本身的精度",这就引出了细粒度 router。 同一张图里还有两组是针对 NSA 设计的: (a) GQA vs MHA:全注意力下,MHA 的训练 loss 明显低于 4 组的 GQA。LLM 用 GQA 主要是为了解码时省 KV cache,视频 DiT 是双向、整段去噪,没有这个约束; (b) 按头分组 vs 按邻域分组:NSA 让同一 GQA 组内的 query 头共享稀疏模式(group head);VSA2 让时空上相邻的 query token 共享(group neighbour)。有效组大小相同时,纯 group neighbour 更好。 我的看法:这组实验的结论很干脆,但有两点要留个心眼。一是 (a)~(d) 和 (f) 都只训了 1 万步,(e) 也只有 3 万步,全是单次运行,没给多随机种子的方差;二是 (e)(f) 两组的差距要靠放大插图才分得清,曲线大部分时候是重叠的。结论的方向我倾向于相信,但"显著更低"的说法要打个折。 另一个有意思的对照是 SLA2。SLA2 的核心卖点恰恰是可学习 router,VSA2 却说 router 不用学,两篇结论看似相反。不过场景不同:SLA2 是在训好的 Wan2.1 上做短程微调,router 要在很少的步数里适配一个现成的全注意力模型;VSA2 是数万步的预训练,网络的其他部分有足够时间去适应一个固定的 router。我的理解是,在预训练尺度上,与其让 router 学会挑块,不如让模型学会适应 router。 06 VSA2 的整体结构:两条支路、一个 router、一扇门 (图片来源:论文 Figure 2。左侧 coarse branch 把 Q、K、V 按 cube 池化后做 cube 级全注意力,再 Repeat 回原分辨率,乘上由 Gate 投影经 Tanh 得到的门控值;右侧细粒度 router 产出块级 mask M,交给 BlockSparseAttn 计算 fine branch;两路输出相加得到最终结果) 按数据流走一遍。 第 0 步:重排。 把 token 从逐行扫描的顺序重排成逐 cube 的顺序,让同一个 cube 里的 token 在内存里挨着。注意力是整个 Transformer 里唯一依赖 token 顺序的算子,所以这个重排只需在网络开头做一次,RoPE 位置编码跟着一起重排即可。 coarse branch:和 VSA 一样。 按 cube 做均值池化,在 $L/B$ 长度的序列上做全注意力,再把输出复制回每个 token。作者也试过 NSA 式的池化和基于注意力的池化,都没比简单的均值池化更好。 fine branch:只算选中的块。 用 router 给出的 mask 做 block-sparse attention。文本条件部分照 MMDiT 的做法处理:视频到文本、文本到视频的注意力保持完整,不做稀疏。 门控合并: $$\mathbf{O}=\tanh(\mathbf{X}\mathbf{W}_g)\odot\mathbf{O}_c+\mathbf{O}_f$$ $\mathbf{X}$ 是这一层的隐状态,$\mathbf{W}_g$ 是一个单通道投影,每个 token、每个头算出一个门控值,用来调节 coarse branch 的贡献;fine branch 的输出直接加上去。 这扇门的初始化很关键,第 08 段会讲到:$\mathbf{W}_g$ 是 VSA2 唯一新增的参数,初始化为零。 router 是 VSA2 相对 VSA 真正动刀的地方,单独拿出来讲。 07 细粒度 router:先小池化,softmax 之后再合并 VSA2 把 router 从 coarse branch 里拆了出来,单独用一个小得多的池化尺寸 R(见第 04 段的 Figure 1 右图)。记 $\mathbf{Q}_r=\mathrm{MeanPool}_R(\mathbf{Q})$、$\mathbf{K}_r=\mathrm{MeanPool}_R(\mathbf{K})$,router 的块级分数是: $$\hat{\mathbf{P}}=\mathrm{Softmax}\big(\mathbf{Q}_r\mathbf{K}_r^\top/\sqrt{D}\big)$$ $$\mathbf{P}_r=\mathrm{MeanPool}_{G\times G}(\hat{\mathbf{P}})$$ 拆开是三步,作者叫它 pool-softmax-pool: 小池化:每 R 个相邻 token 求平均(R 远小于 B),序列长度从 L 缩到 L/R; softmax:在这个"半粗粒度"的序列上算注意力分数; 再池化:把一对 cube 之间的 G×G 个分数求平均(G = B/R),得到 N×N 的块级分数。 它夹在两个极端之间:比 oracle 便宜得多(序列只有 L/R 长),又比 VSA 的 coarse branch 保留了更多 cube 内部的差异。换个说法,池化有一部分挪到了 softmax 之后,非线性造成的失真就小一部分。 论文没给具体的 B 和 R,但可以反推。 附录给了稀疏度的估算公式: $$\text{Sparsity}\approx 1-\Big(\frac{1}{R^2}+\frac{KB}{L}\Big)$$ 其中 $1/R^2$ 是 router 的开销(相对全注意力),$KB/L$ 是 fine branch 的开销(平均每个 query block 看 K 个 KV block),coarse branch 的 $1/B^2$ 小到可以忽略。 把 Table 2 的三组数代进去:480p(约 9.9 万 token)top64 时稀疏度 0.90、top128 时 0.82,720p(约 22 万 token)top64 时 0.95。两个 480p 的数一减,$64B/99\text{K}\approx0.08$,B 应该是 128;再代回去,R 取 8 时三个数都能对上(算出来是 0.902、0.819、0.947),取 4 或 16 都对不上。所以我推断 VSA2 用的是 B = 128、R = 8、G = 16——这是我的推算,论文正文没有写。 这组参数能说明几件事: router 的开销恒定在全注意力的 1/64,约 1.6%,跟序列长度无关; 720p 下约有 1719 个块,每个 query block 平均只看其中 64 个,也就是 3.7%; fine branch 的相对开销随序列变长而下降,所以同样的 top64,分辨率越高稀疏度越高。这正是作者强调的"从 480p 到 720p 不需要调大 top-K"。 per-sequence TopK:预算按整条序列分。 传统做法是每个 query block 各挑 K 个;VSA2 把 N×N 的分数矩阵拉平,在整条序列上一次挑出 N×K 个块对,各个头的预算相同。总计算量不变,但每个 query block 分到的 KV 块数可以差很多。Figure 7(f) 显示这样做的 loss 比 per-token 低一点;作者也试过按累计概率截断的 top-p 类方法,没有正向结果。 下面是按论文公式写的示意代码,方便对照理解(不是官方实现,真实 kernel 不会物化中间的注意力矩阵): import torch @torch.no_grad() # router 不接收梯度 def fine_grained_router(q, k, R, topk): # q, k: [H, N, B, D],已按 cube-major 重排; # 假设每个 block 内按 G 个大小为 R 的子立方体连续存放 H, N, B, D = q.shape G = B // R # MeanPool_R -> [H, L/R, D] qr = q.reshape(H, N * G, R, D).mean(dim=2) kr = k.reshape(H, N * G, R, D).mean(dim=2) # softmax -> [H, L/R, L/R] scores = qr @ kr.transpose(-1, -2) / D ** 0.5 p_hat = scores.softmax(dim=-1) # MeanPool_{GxG} -> [H, N, N] p = p_hat.reshape(H, N, G, N, G).mean(dim=(2, 4)) # per-sequence TopK:整条序列一起挑 N * topk 个块对 idx = p.reshape(H, N * N).topk(N * topk, dim=-1).indices mask = torch.zeros(H, N * N, dtype=torch.bool, device=q.device) mask.scatter_(1, idx, True) # 每行(query block)选中的块数可以不同 return mask.reshape(H, N, N) 融合 kernel:中间矩阵不能写出来。 上面代码里的 p_hat 是 (L/R)×(L/R) 大小。按我反推的 R = 8,22 万 token 时每个头约有 7.6 亿个元素,BF16 下约 1.5 GB,20 个头就是约 30 GB,物化出来显存和带宽都扛不住。 所以作者用 CuTe DSL 写了一个融合 kernel,把 GEMM、softmax 和 G×G 池化合在一起: (图片来源:论文 Figure 5。Q、K 先按 R 池化成 Qr、Kr;第一遍在 SRAM 上逐块计算 softmax 之前的注意力分数并累积 log-sum-exp;第二遍重新计算注意力块、做 softmax,并直接在 SRAM 上完成 G×G 池化,只把 L/B × L/B 的块级分数写回 HBM) $\mathbf{Q}_r\mathbf{K}_r^\top$ 要算两遍,多了一次计算,但换来 I/O 大幅减少。作者称比不融合的版本明显更快,但没给具体倍数。这是典型的用计算换访存,和 FlashAttention 的思路一脉相承。 08 训练配方:Sparse Rebasing 与 Hard-to-Easy 结构讲完,再看怎么训。对想在自家训练流程里用的人来说,这部分可能比结构本身更有参考价值。 先交代训练设置。 模型结构大体沿用 MMDiT,目标是 flow matching(预测速度),文生视频和图生视频联合训练;时间步采样用 logit-normal 分布,并按分辨率做偏移;工程上用了 FSDP、序列并行、激活重计算和 torch.compile。训练分三段:480p 预训练、720p 预训练,以及从 480p checkpoint 出发的 RL。所有阶段的训练片段都是 5~12 秒、多种长宽比。参数量、数据集、VAE 配置,论文都没有写。 Sparse Rebasing:只在最贵的阶段切换。 现在的视频 DiT 普遍走渐进式训练:先图像,再低分辨率短视频,最后高分辨率长视频。VSA2 从一个用全注意力训到 256p 的视频 checkpoint 出发,到 480p、720p 预训练和 RL 阶段才换成 VSA2。 切换之所以平滑,靠的是那扇门:$\mathbf{W}_g$ 零初始化,刚切换时 $\mathbf{O}=\mathbf{O}_f$,输出只来自 fine branch,也就是用同一套 Q、K、V 做的稀疏注意力,对原模型的扰动最小。coarse branch 的贡献之后再慢慢学出来。 这个思路和 MoE 从稠密模型 upcycling 很像(这是我的类比)。好处有两个:一是可以直接复用全注意力训好的文生图、低分辨率视频 checkpoint;二是低分辨率阶段序列本来就短,稀疏注意力省不了多少,没必要在那里折腾。 Hard-to-Easy Curriculum:训得难,测得松。 训练时用更激进的稀疏度(top-K 小),推理时放宽(top-K 大)。Table 2 的 Exp 1~4 对比了 top32/top64 训练与 top64/top128 推理的几种组合,规律很一致:推理时的 top-K 比训练时大,运动质量就更好。 最突出的是 Exp 2(top64 训、top128 推),文生视频运动质量人评净胜 22.1%。 但代价也很一致:指令跟随和美学变差。 Exp 3(top32 训、top128 推)的文生视频指令跟随净输 15.4%。 作者对这两个现象的解释是: 运动变好,是类似结构化 dropout 的正则效果; 指令跟随变差,是训练与推理不一致造成的。MMDiT 里视频和文本 token 共用一个注意力空间,推理时多看了视频 token,分给文本 token 的注意力就被稀释了。 对应的补救办法是:拿 top64 预训练好的 checkpoint,在 RL 阶段改用 top128 再训一轮(Exp 6)。结果文生视频的指令跟随和美学基本拉回持平(−2.01%、0.00%),运动质量仍然保持优势(文生 +7.38%、图生 +8.05%)。 RL 用的是 reward feedback learning,不是 GRPO 或 DPO。 模型直接预测干净视频 $x_0$,由一个基于 VLM 的奖励模型和一个基于 CLIP 的奖励模型打分,梯度直接穿过奖励模型回传给 DiT。一个值得肯定的细节:奖励权重是在全注意力 checkpoint 上调的,VSA2 直接沿用、不做任何调整。这对 VSA2 来说是偏保守的比较方式。 (图片来源:论文 Figure 4。(a) 480p 预训练和 (b) 720p 预训练的训练 loss,VSA2(蓝)整体略低于全注意力(绿),放大插图里才看得清差距;(c) 480p RL 阶段的美学 reward 与运动 reward,两种注意力的曲线基本重合) 90%~95% 稀疏度下 loss 反而略低于全注意力,这一点值得多想一下。我的一个猜测是:VSA2 并不是全注意力的"子集",coarse branch 额外提供了一条带门控的全局汇总通路,相当于多了一点结构上的归纳偏置。论文没有做去掉 coarse branch 的消融,这个问题目前没有答案。 09 人评表怎么读:每 0.67% 就是一条 prompt VSA2 的质量评估主要靠两样:训练 loss(作者引用 Movie Gen 的结论,认为它和人类偏好相关性好),以及 149 条人工挑选的高难度 prompt 上的成对人评。 人评规则是:同一条 prompt 下 VSA2 和全注意力各生成一个 10 秒视频,评分员判"更好、一样、更差",最后报告(更好 − 更差)/ 149。评测分辨率是 480×864(约 9.9 万 token)和 720×1280(约 22 万 token),用的是 EMA checkpoint。 这意味着表里的每个百分比都能换算回"净多赢了几条":1/149 ≈ 0.67%。先看七组实验的配置: Exp 阶段 训练 / 推理 top-K 注意力稀疏度 端到端加速 1 480p 64 / 64 0.90 2.09× 2 480p 64 / 128 0.82 1.92× 3 480p 32 / 128 0.82 1.92× 4 480p 32 / 64 0.90 2.09× 5 480p RL 64 / 64 0.90 2.09× 6 480p RL 64+128 / 128 0.82 1.92× 7 720p 64 / 64 0.95 4.62× 再看人评结果,括号里是我按 ×149 换算的净条数: Exp 文生·运动 文生·指令跟随 文生·美学 图生·运动 图生·指令跟随 1 −1.34%(−2) +1.34%(+2) −0.67%(−1) +8.72%(+13) +1.34%(+2) 2 +22.1%(+33) −3.36%(−5) −4.7%(−7) +6.71%(+10) −8.72%(−13) 3 +7.38%(+11) −15.4%(−23) −4.7%(−7) +11.4%(+17) −9.4%(−14) 4 +12.1%(+18) −10.1%(−15) −7.38%(−11) +4.03%(+6) −4.03%(−6) 5 −4.03%(−6) +1.34%(+2) −2.01%(−3) +8.05%(+12) −4.7%(−7) 6 +7.38%(+11) −2.01%(−3) 0.00%(0) +8.05%(+12) −2.69%(−4) 7 +6.71%(+10) −2.01%(−3) +1.34%(+2) +0.67%(+1) −1.34%(−2) (数据来源:论文 Table 2,正数表示 VSA2 优于同阶段的全注意力模型;括号内的净条数是我的换算) 几个读法: 第一,720p 那一行才是标题数字对应的质量。 95% 稀疏、端到端 4.62 倍的情况下,五项指标里净差最大的是文生视频运动 +10 条,其余都在 3 条以内。说"与全注意力基本持平"是站得住的。 第二,多数格子在噪声范围内。 论文没报告平票比例。我粗算了一下:假如 VSA2 和全注意力其实一样好,且有一半是平票,那么净胜条数的标准差约为 8.6 条,也就是 ±5.8%。按这把尺子量,超出两个标准差的只有 Exp 2 的文生运动(+22.1%)和 Exp 3 的文生指令跟随(−15.4%),Exp 4 的文生运动(+12.1%)刚好擦线。也就是说,Hard-to-Easy 对运动的提升和对指令跟随的损害是可信的信号,其余的正负差别大多分辨不出来。 第三,正文有一处表述不严谨。 论文说 Exp 2 中"评分员认为 22.1% 的 VSA2 文生视频样本运动更好",但按它自己的计分规则,22.1% 是净胜率(更好减更差),不是"更好"的比例。实际被判为更好的比例只会更高。 第四,图生视频的运动几乎全线为正。 7 组实验里只有 Exp 7 接近 0,其余都在 +4%~+11.4%。单看每格都不算显著,但方向一致,值得后续验证。 作者还做了一个挺有说服力的分析:把 Exp 1 里两个分别训练的 checkpoint(一个 VSA2、一个全注意力)的注意力图并排对比,训练 6 万步之后两者的注意力模式仍然高度相似(论文 Figure 6)。以往的分析一般是拿全注意力模型推理时的注意力图做 profiling,这里是两个独立训练的模型直接对比,更能说明稀疏训练没有把模型带偏。 10 速度到底从哪来 (图片来源:论文 Figure 8。单张 H800、batch 1、20 个头、head dim 128、top64;统计的是 Figure 2 中除 QKV 投影之外所有算子的总耗时。橙线是 FlashAttention-3,蓝线是 VSA2,虚线是 VSA2 的 router、fine branch、coarse branch 分项耗时) 算子层面:22 万 token(对应 720p、10 秒)时,VSA2 的注意力比 FlashAttention-3 快 8.9 倍。序列越长差距越大,图里 43.6 万 token 处 FA3 已经超过 3000 毫秒,VSA2 仍在几百毫秒以内。 router 的开销不小:22 万 token 时占注意力总耗时的 22%,43.6 万 token 时升到 30%。 理想与实测之间还有空间。 95% 稀疏意味着计算量只剩约 5%,按 FLOPs 算理想加速接近 20 倍,实测是 8.9 倍。差出来的部分,一块是 router 自己(22%),另一块我推测来自 block-sparse 的访存开销,以及每个 query block 选中块数不等带来的负载不均。论文没有给 fine branch 单独的 MFU,没法细拆。 端到端层面:720p 端到端 4.62 倍,比注意力的 8.9 倍低一截,因为 DiT 里还有线性层、归一化,以及文本编码、VAE 解码等开销。论文没有说明端到端计时具体包含哪些环节、用了几张卡、多少步。 用 Amdahl 定律倒推一下(我的粗算,假设 8.9 倍对端到端里的所有注意力都成立):全注意力时,注意力约占 720p 端到端时间的 88%;换成 VSA2 之后,注意力只剩端到端时间的 46% 左右,非注意力部分反而占了一半以上。 这有一个直接推论:在 720p 这个量级,继续压注意力的边际收益已经在变小,下一步的大头在步数蒸馏、特征缓存、量化这些手段上。论文也提到,稀疏注意力和这些方法基本正交。 "计算量减半"要打个折。 摘要说 VSA2 比 VSA "注意力计算减半、loss 还更低",依据是 Figure 7(e):细粒度 router 配 top64 优于粗粒度 router 配 top128,fine branch 的计算量确实减半。但 router 本身不是免费的。 按论文给的 22% router 耗时占比粗算:VSA2 的注意力耗时里,fine branch(连同很小的 coarse branch)约占 78%;换成 VSA 的 top128,这部分翻倍,总耗时约为 VSA2 的 1.56 倍。也就是说,VSA2 相对 VSA 实际省下的注意力时间约 36%,大约三分之一。如果改按附录的 FLOPs 公式和我反推的参数算,720p 省 29%、480p 省 41%。数字依然可观,但不是一半。 router 的开销会越来越显眼。 按稀疏度公式,router 的相对开销固定在 $1/R^2$,fine branch 的相对开销 $KB/L$ 随序列变长而下降。按我反推的 B = 128、R = 8、K = 64,两者在 $L=KBR^2\approx52$ 万 token 时持平。作为参照,1080p、10 秒视频按 720p 的 22 万 token 等比例换算约 49.5 万 token,已经贴着这个拐点,而 1080p 正是作者在附录里写的下一步。到那时,要么把 R 调大(router 更便宜,但也更粗),要么就得换一种分层的 router。 11 30 秒长视频:是个信号,还不是结论 (图片来源:论文 Figure 11,附录。样本来自 Exp 6 的 checkpoint,四组 30 秒视频的抽帧:雪山滑雪、水中追球的小狗、乡间土路上开旧卡车的男人、客厅里弹钢琴的男人) 论文附录展示了一组 30 秒视频:训练数据最长只有 12 秒,模型直接生成了 30 秒,作者称"没有明显退化",并把它当作 VSA2 能往分钟级视频扩展的早期证据。 这组结果值得看,但证据力度有限: 没有全注意力对照。30 秒这组只有 VSA2 自己的样本,分不清长度泛化能力来自稀疏注意力还是模型本身; 没有量化指标,也没说明生成分辨率和 token 数; 抽帧看不出时序问题。比如第二行最后一帧,小狗和水花已经糊成一团,是剧烈运动的正常模糊还是长时退化,单凭抽帧判断不了。作者提到补充材料里附了视频文件。 不过有一点是确定的:30 秒视频的 token 数是 10 秒的三倍左右,全注意力的计算量就是九倍。越是这种长度,稀疏注意力的收益越大。 作者在附录里写了两个后续方向:一是做 1080p,二是和 Self-Forcing 这类自回归视频生成方法结合。后者逐块生成视频,天然需要高效的长上下文注意力。 12 想自己用要注意什么 现状:截至发稿,VSA2 的代码和权重都没有公开。前代 VSA、STA 的 kernel 在 FastVideo 仓库里开源,VSA2 的 fine branch 和 VSA 一样用 ThunderKittens 实现 block-sparse attention,复现有现成的起点;需要自己补的是细粒度 router 的融合 kernel,以及支持每个 query block 选中块数不等的调度。 如果想照着复现,关键配置是这些(B、R 为我的反推): 块大小 B = 128(cube 的三维切法论文没给),router 池化尺寸 R = 8,G = B/R = 16; 平均每个 query block 选 64 个 KV block,用 per-sequence TopK,各个头预算相同; router 不接收梯度,Q、K 直接用 fine branch 的投影结果; 门控 $\mathbf{W}_g$ 零初始化,coarse branch 的输出乘 tanh 门控后与 fine branch 相加; 与文本相关的注意力保持完整。 训练配方上的建议: 不要从头训。低分辨率阶段保留全注意力,到 480p 以上再切换; 如果想用 Hard-to-Easy 换运动质量,最后记得用推理时的 top-K 再做一轮 RL 或微调,否则指令跟随会掉; 序列并行优先用 Ulysses(按头切分)。VSA2 每个头的计算量相同,Ulysses 下负载天然均衡;Ring-Attention 按序列切分,而 per-sequence TopK 选中的 KV 块可能集中在少数分片上,GPU 之间会负载不均。这是作者在附录里承认的限制。 如果你手上是开源模型、只想加速推理:VSA2 需要训练,不是即插即用的方案。在 Wan2.1 这类开源模型上,SLA、VSA 这类微调方案,或者 Sparse VideoGen 这类免训练方案,代码都已经开源,现在就能用。 硬件:测速只在 H800 上做过,kernel 依赖 ThunderKittens 和 CuTe DSL,换到其他架构的卡上需要重新评估。 13 需要留意的限制 前面零散提过,这里集中说。 1. 人评样本少、粒度粗。 149 条 prompt,每格的分辨率是 0.67%。论文没报告评分员人数、是否盲评、平票比例和评分一致性。除了 Hard-to-Easy 带来的运动提升和指令跟随下降,其余多数差异都在统计噪声以内。"与全注意力持平"的结论站得住,"部分场景超过全注意力"需要更大的评测集来确认。 2. 没有外部 baseline,没有公开 benchmark。 对比对象只有同条件训练的全注意力,以及 VSA/NSA 的设计变体。没有在同一个模型上比 SLA、SLA2、VMoBA、Sparse VideoGen,也没有 VBench 之类的公开指标。 3. 无法复现。 模型参数量、数据集、VAE、训练算力都没公开,代码和权重也没放出,外部读者只能相信内部实验。 4. 训练加速没有量化。 论文的出发点是预训练成本,但所有加速数字都来自推理。Sparse Rebasing 到底省了多少 GPU 小时、训练吞吐提升多少,没有给。 5. "计算量减半"没算 router。 算上 router,720p 下相对 VSA 实际省下约三分之一(见第 10 段)。 6. 消融的统计强度一般。 Figure 7 的消融是 1 万到 3 万步的单次运行,(e)(f) 的差距要靠放大插图才看得见,没有多随机种子。 7. Hard-to-Easy 的代价要靠额外训练来补。 运动质量的提升伴随着指令跟随和美学的下降,要再做一轮更高 top-K 的 RL 才能恢复。工程上意味着训练和推理要维护两套 top-K 配置。 8. 扩展性隐患。 router 的相对开销固定在 $1/R^2$,按反推参数在约 52 万 token(接近 1080p、10 秒)时会追平 fine branch;动态稀疏和 Ring-Attention 不好配合。这两点作者都在附录里承认了。 9. 长视频证据薄弱。 30 秒生成只有抽帧展示,没有全注意力对照和量化指标。 10. 端到端测速条件不透明。 端到端加速用的硬件、GPU 数、采样步数、是否包含文本编码与 VAE 解码,论文都没交代。 14 横向对比表格 下面这张表是我按各论文公开信息整理的,不是论文原表。各方法的模型、硬件、分辨率、baseline 都不同,加速倍率跨行不能直接比较。 方案 何时引入稀疏 怎么选块 选块器是否学习 报告的稀疏度 论文报告的加速 VSA2(2026.09) 预训练中途接入,覆盖 RL 与推理 细粒度 pool-softmax-pool,per-sequence TopK 否,无梯度 90%~95% 注意力 8.9×(H800,对比 FA3);720p 端到端 4.62× VSA(2025.05,NeurIPS 2025) 从头预训练,或改造已有模型 cube 级 coarse attention 的分数,逐 query block TopK 与 coarse branch 共享参数 — 训练 FLOPs 降 2.53×;Wan-2.1 注意力 6×,端到端 31 秒→18 秒 SLA(2025.09) 微调 按注意力权重分关键、边缘、可忽略,边缘部分走线性注意力 启发式划分 注意力计算省 95% 注意力 13.7×;Wan2.1-1.3B 端到端 2.2× SLA2(2026.02) 微调 + 量化感知训练 可学习 router 决定走稀疏还是线性 是 97% 注意力约 18.6×;Wan2.1-14B-720P 端到端 4.35×(RTX 5090,排除 CPU offload 开销) STA(2025.02,ICML 2025) 免训练或微调 固定的 3D 滑动 tile 窗口 无选块器 — HunyuanVideo 端到端 945 秒→685 秒(免训练)、268 秒(微调) Sparse VideoGen(2025.02) 仅推理 在线 profiling,把头分成空间头和时间头 不需要训练 — 端到端最高 2.28×(CogVideoX-v1.5)、2.33×(HunyuanVideo) NSA / MoBA(2025.02,LLM) 预训练 NSA:压缩分支打分,GQA 组内共享;MoBA:key 块均值池化做门控 NSA 借道压缩分支获得梯度;MoBA 无参数 — 语言模型,不直接可比 几点解读: VSA2 真正的差异化不在倍率,而在"何时引入稀疏"那一列。 表里其他视频方法要么只管推理,要么在现成模型上微调,VSA2 是唯一在完整的视频 DiT 训练流程里(预训练 + RL + 推理)端到端验证过的; "router 要不要学",各家答案不同。 SLA2 押注可学习 router,VSA2 的消融说不用学。两者一个是微调、一个是预训练,场景不同,目前还谈不上谁对谁错; 单看倍率,SLA2 在 Wan2.1-14B-720P 上的 4.35 倍和 VSA2 的 4.62 倍量级相当,但模型、硬件、测速条件都不同,不能据此排高下。更实际的差别是门槛:SLA2 可以拿开源模型直接微调,VSA2 得从预训练阶段就改,对大多数团队来说前者容易得多。 15 总结感受 我觉得这篇论文最大的价值,是把"可训练稀疏注意力"从一个小规模、只看 loss 的研究结论,变成了一个在完整视频 DiT 训练流程里走通的工程方案。预训练、RL、推理都换成 90%~95% 稀疏的注意力,人评还能和全注意力打平,这件事本身就是一个很强的信号。 具体的技术结论里,有三条我认为会被后续工作反复引用: router 不需要学,但需要比硬件块更细的粒度。 选块能力来自数据本身的局部性,而不是梯度;真正限制精度的,是把 128 个 token 压成一个向量的那一步; 稀疏预算应该按序列分,而不是按 query 均分。 固定总预算、让难的 query 多拿,是一种简单有效的自适应计算; 稀疏注意力可以在训练中途接入。 "要不要用稀疏注意力"从一个预训练开始前就得拍板的架构决策,变成了一个可以到高分辨率阶段再做的工程决策,采用门槛低了很多。 但也要清醒地看到,这篇论文的证据几乎全是内部的:内部模型、内部数据、149 条 prompt 的人评、没有外部 baseline,也没有代码。它更像一份高质量的工业实践报告,而不是一篇可以被独立验证的方法论文。 给不同读者的建议: 如果你在训练自己的视频 DiT:这篇是目前最值得参考的稀疏注意力训练配方。Sparse Rebasing 和"高分辨率阶段才切换"的思路可以直接借鉴;Hard-to-Easy 能换来运动质量,但要为指令跟随留一轮 RL。 如果你做推理部署、用的是开源模型:VSA2 暂时用不上,SLA、VSA 改造版或 Sparse VideoGen 这些有代码的方案更现实。另外记住,在 720p 量级上注意力被砍掉之后,非注意力部分就成了大头,步数蒸馏和缓存可能比继续压注意力更划算。 如果你是研究者:有几个问题这篇论文没有回答。稀疏训练为什么能让 loss 低于全注意力,是 coarse branch 带来的额外通路,还是正则效应?router 在 1080p 以上怎么扩展?每个 query 选中的块数不等时,序列并行的负载怎么均衡? VSA2 把视频稀疏注意力的讨论,从"推理时怎么少算"推进到了"训练时就不算"。它能不能撑到 1080p 和分钟级视频,取决于 router 开销和序列并行这两个问题怎么解决,这也是这条路线接下来最值得期待的地方。 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|视频 VAE 的时空压缩结构-VideoVAE AIGC 基本功|视频 VAE 的时空压缩结构-VideoVAE 所属方向:表征与压缩 | 难度:进阶 | 前置知识:VAE 结构与训练目标 关键词:视频VAE、3D因果卷积、时间压缩、分块推理、闪烁伪影、潜变量 token 01. 为什么需要它 先给四个数字,全部来自文末附录里能直接跑的脚本。 数字一:时间压缩显著减少 VAE 网格,但实际注意力成本还要看 patch 和宽度。 同样一段 121 帧、768×512 的视频,用逐帧图像 VAE(空间 8×8、4 通道)编码出来是 743,424 个 token;改成 4×8×8(时间再压 4 倍、16 通道,CogVideoX / Wan / HunyuanVideo 这一档)是 190,464 个;再激进一点到 8×32×32(LTX-Video 这一档)只剩 6,144 个。自注意力的代价是 $O(N^2)$,所以在相同隐藏宽度、相同 patch 划分且只比较稠密注意力矩阵乘法时,$N^2$ 代理量分别减少 15.2 倍和 14641 倍(04 节算账,图 4 画出来)。这里的 $N$ 是 latent 网格点数,未做 DiT patch;计算可行性还取决于层数、宽度、显存与 kernel。它不能单独证明某模型能否做全注意力,也不能据此归因帧间闪烁。 数字二:对称时间卷积可能读取未来,本 toy 的每个输出都有这种依赖。 把编码器里的时间填充从「只补前面」换成「前后对称补」,实测 12 个潜变量帧全部都依赖未来帧,最多超前 8 帧。这意味着你没法一边生成一边往外吐——潜变量位置 $j$ 最多要等到输入位置 $4j+8$(与本 toy 总步距 4 对齐),而不是把两侧帧索引直接相加。因果卷积把这个数字压到 0(03 节证明,图 1 左右两栏对比)。 数字三:分块解码不补够上下文,一段输出会错,不是只有接缝那一帧。 把 24 个潜变量帧切成 3 块、每块 8 帧逐块解码:上下文带 0 帧时,两块合计 64 个输出帧里有 48 帧和整段解码的结果对不上;每块每多带 1 帧上下文,就少错 4 个输出帧(两块合计 8 帧);带到 6 帧时误差精确归零(不是变小,是浮点意义上完全相等)。6 来自本 toy 每个输出相位的依赖区间,恰好等于其最大潜变量感受野减 1(03 节推导,图 3 是整条曲线)。 数字四:时间压缩的额度取决于画面运动有多快。 把一个匀速移动的高斯斑点压 8 倍时间再还原,运动速度 0.25 像素/帧时重建 PSNR 是 40.81 dB,速度提到 4 像素/帧掉到 24.92 dB,差 15.9 dB。而且会交叉:压时间 2 倍的曲线在约 2 像素/帧处掉到「压空间 2 倍」这条与速度无关的基线之下——这个交叉只比较两种滤波失真,空间两轴各压 2 倍减少 4 倍元素,时间压 2 倍只减少 2 倍元素,不能直接推出等码率方案优劣(06 节展开,图 5)。 所以这篇文章回答四件事:时间维到底怎么压、何时需要因果卷积、逐块推理要带多少上下文才不接缝、以及时间压缩比能推到多大。 02. 最小可用理解 三句话讲完: 本文先抓住视频 VAE 的一个结构变化:在时间轴上再压 $s_T$ 倍。 潜变量形状从 $T \times H' \times W' \times C$ 变成 $T' \times H' \times W' \times C$,其中 $T' = \lfloor (T-1)/s_T \rfloor + 1$。长序列忽略首帧取整、固定空间网格与 patch 后,序列长度近似除以 $s_T$;同宽稠密注意力的二次项近似除以 $s_T^2$。 需要严格流式处理时,时间运算应满足因果性。 无膨胀、核长 $k_t$ 的卷积可只在前面补 $k_t-1$ 帧,边界可补零或复制首帧。离线视频 VAE 也可以采用非因果结构;卷积因果还不够,归一化、注意力、池化等其他时间运算也须检查。 代价有两笔,都要记账。 一是本教学平均滤波器会把速度为 $v$ 像素/帧的物体在 $(s_T-1)v$ 像素范围内的离散平移叠加,不是学习型 VAE 的必然模糊量;二是分块必须覆盖依赖、保持采样相位与边界规则。本文 toy 的入口重叠量为编码 16 个输入帧、解码 6 个 latent 帧,真实模型需重新计算。 这张图要看什么:横轴是被人为改动的输入帧,纵轴是跟着发生变化的潜变量帧,蓝点表示「这一对有依赖关系」。左图所有蓝点都落在虚线(输入帧 $= 4j$)左边或线上——没有任何一个潜变量帧看到未来;右图蓝点越过虚线,右侧那团就是泄漏的未来信息,实测最多超前 8 帧。两张图除了时间填充方式,其余完全相同。 03. 数学推导 先补三个背景。$x$ 表示输入视频,$z$ 表示潜变量,$C$ 表示通道数;$T,H,W$ 分别为时间、垂直和水平方向长度。真正的 VAE 编码器输出后验分布参数,再采样或取均值;解码器重建视频,训练还包含重建与 KL 等目标。本文 ToyVideoVAE 是随机权重的确定性卷积自编码器,没有后验头、采样或 KL 训练,只验证布局与依赖,不能用它的重建评价 VAE 质量。以下先假设无膨胀、没有跨时间归一化或全局注意力,坐标从 0 开始。 3.1 输出帧数:为什么是 $\lfloor (T-1)/s_T \rfloor + 1$ 而不是 $\lfloor T/s_T \rfloor$ 一维卷积(时间轴)在输入长度 $T_{\text{in}}$、核 $k_t$、步距 $s_t$、两端填充 $p_{\text{front}}$ 和 $p_{\text{back}}$ 下的输出长度是 $$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} + p_{\text{front}} + p_{\text{back}} - k_t}{s_t} \right\rfloor + 1$$ 这里暂取 dilation 为 1;若时间膨胀率为 $d_t$,公式中的核长需替换为有效核长 $d_t(k_t-1)+1$,因果前填充也需改为 $d_t(k_t-1)$。每个符号:$T_{\text{in}}$ 是进入这一层的帧数,$p_{\text{front}}$ 是时间轴前面补的帧数,$p_{\text{back}}$ 是后面补的,$k_t$ 是时间维核长,$s_t$ 是时间步距。 因果卷积取 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$,代进去: $$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} - 1}{s_t} \right\rfloor + 1$$ 减 1 加 1 说明这个输出网格包含对齐输入 0 的位置,并非保证保留原始首帧像素。 前面补的那 $k_t - 1$ 帧全是零,所以第一个输出位置看到的是「$k_t - 1$ 个零 + 第 0 帧」,它只依赖第 0 帧的空间邻域,但权重、bias 和激活仍会改变数值。剩下 $T_{\text{in}} - 1$ 帧才按步距 $s_t$ 分组。 许多视频模型约定输入帧数为 $1+k s_T$,但要以完整实现为准。 本文 stride-conv toy 两次时间步距 2 时,49 帧的链路为: $$49 \to \lfloor 48/2 \rfloor + 1 = 25 \to \lfloor 24/2 \rfloor + 1 = 13$$ 得到 13 个 latent 帧。对本 toy,100 帧得到 25 个,最后输出所对齐的输入位置为 96,因此尾部 97—99 没被覆盖;真实模型也可能通过补帧、裁剪或专门的池化分支处理。下面引用的 CogVideoX 对奇偶长度有不同池化逻辑,不能把单层 stride-conv 公式不加条件地替代完整模型。 3.2 因果性:为什么前补零就够了 设时间填充后第 $i$ 个输入帧落在下标 $i + k_t - 1$ 上。步距为 $s_t$ 的第 $j$ 个输出取的是填充后区间 $[j s_t,\; j s_t + k_t - 1]$,对应原始输入下标 $$[j s_t - (k_t - 1),\; j s_t]$$ 上界恰好是 $j s_t$——第 $j$ 个输出能用到的最新输入帧就是第 $j s_t$ 帧,未来的帧一个都进不来。这是本单层、无膨胀卷积的完整证明;完整网络还需逐项检查其他运算。 堆多层时把每层的时间步距连乘,记到第 $l$ 层输入为止的累积步距为 $S_l = \prod_{m\lt l} s_m$,则最终第 $j$ 个潜变量帧能用到的最新输入帧是 $S_{\text{total}} \cdot j$。脚本 causality_check() 用扰动法验过:把第 $t$ 帧之后的所有输入都改掉,凡是满足 $S_{\text{total}} \cdot j \lt t$ 的潜变量帧,变化量精确等于 0——不是小,是零,因为根本没连过来。 换成对称填充($p_{\text{front}} = p_{\text{back}} = (k_t - 1)/2$),上界变成 $j s_t + \lfloor (k_t - 1)/2 \rfloor$,未来的帧就漏进来了。实测 12 个潜变量帧全部泄漏,最多超前 8 帧。 3.3 时间感受野:为什么越靠后的层越值钱 $t$ 时刻的输出能看到多长的历史,叫时间感受野。标准公式是 $$\mathrm{RF} = 1 + \sum_l (k_l - 1) \cdot S_l,\qquad S_l = \prod_{m\lt l} s_m$$ 每个符号:$k_l$ 是第 $l$ 层的时间核长,$S_l$ 是走到第 $l$ 层输入时已经累积的时间步距。关键点在 $S_l$:第 $l$ 层相邻核位置在原始输入上相隔 $S_l$ 帧,因此新增跨度是 $(k_l-1)S_l$,加上已有跨度后才是总感受野,因为它的每一个位置本身就代表了 $S_l$ 个原始帧。 本工程的 toy 编码器是 4 层 $k = 3$、步距 $[1, 2, 2, 1]$: $$\mathrm{RF} = 1 + 2\cdot 1 + 2\cdot 1 + 2\cdot 2 + 2\cdot 4 = 17$$ 注意最后两项:同样一个 $k = 3$ 的核,在第 3 层贡献 4 帧,到第 4 层就贡献 8 帧——因为前面已经把时间压了 4 倍。这就是「层数不变、压缩比一上去感受野暴涨」的原因,也是下面那条上下文公式的来源。 这张图要看什么:四根柱子的核长全都是 3,但贡献从 2 帧一路涨到 8 帧,涨的唯一原因是柱底标注的「累积步距」从 1 变成 4。要控制感受野和分块开销,就要一起考虑各层的核长与累计步距。 脚本 receptive_field() 用逐帧扰动实测了同一个数:最大跨度 17 帧,与公式逐项吻合;同时验了因果上界(潜变量帧 $j$ 能看到的最新输入帧 $\le 4j$)零次违反。 3.4 逐块推理:先算依赖区间,再对齐采样网格 由 3.3,输出(或潜变量)帧 $j$ 依赖的输入区间长度是 $\mathrm{RF}$,右端点是 $S_{\text{total}} \cdot j$,所以左端点是 $S_{\text{total}} \cdot j - \mathrm{RF} + 1$。 现在做分块:要正确算出首个目标锚点为 $j_0$ 的块,就必须拿到它左端点往前的全部输入。缺掉的部分在普通卷积里是被零填充替掉的——零不是正确的值,于是结果错。所以: $$\text{本因果卷积链的充分历史长度}=\mathrm{RF}-1$$ 注意单位随你在哪一侧算: 解码侧:单位是潜变量帧。本 toy 解码器的感受野实测是 7 个潜变量帧(两次最近邻上采样会把间距缩小,所以按「潜变量帧」计只有 7 而不是几十),于是需要 6 帧上下文。 编码侧:单位是输入帧。编码器感受野 17 帧,于是需要 16 帧输入上下文。 两条都被脚本验到了:解码侧 ctx 从 0 加到 6,误差在 6 处精确归零;编码侧 ctx 从 0 加到 16,误差在 16 处精确归零。这不是调参得到的,但还需满足下面的对齐与局部算子条件。 编码时还必须保留全局采样网格:第 $j$ 个 latent 对齐输入 $4j$。若每块从任意 lo_in 重新编码,本地网格变为 lo_in+4j;上下文加得更多也可能错。旧代码对 seed=7 的 [1,48,4,4] 输入、每块 16 帧、ctx=17 时最大绝对偏差 0.077592。修订代码把 lo_in 向左对齐到 4 的倍数,再只保留全局锚点落在 [lo,hi) 的 latent;请求 17 帧历史可能实际读取 17—20 帧。尾块也用向上取整的采样点索引,不再因整除截断而丢 latent。60 组不同长度、块大小和上下文的整段/分块对照逐元素一致。 解码器有最近邻上采样,不能只套编码器的 stride 乘积公式。把输出坐标写为 $o=4j+r$,其中 $r=0,1,2,3$;反向经过卷积时依赖向左扩 2,反向经过两倍最近邻时把下标取整除 2。本 toy 的最早输入下标为 $$a(o)=\left\lfloor\frac{\left\lfloor(o-4)/2\right\rfloor-2}{2}\right\rfloor-4=j-6$$ 最晚为 $j$,四个相位都依赖 $[j-6,j]$,故完整的后续块需要前 6 个 latent;视频起点以零边界截断负下标。独立整数脉冲传播逐项验证了这个区间。对本固定非零权重实验,少一帧仍测到差异;一般网络的零权重、抵消或激活饱和可能缩小实际依赖,所以 RF 给出的结构范围不总是最小必需量。 以上等价性还要求:块内使用同一权重与确定性局部运算、上采样相位一致、真正视频起点沿用全段的边界填充、最终裁剪按全局坐标。跨块 GroupNorm、全局 attention、随机层及非因果池化可能破坏条件。缓存必须保存该层真实需要的状态,不能仅凭卷积名字推断整个 VAE 等价。 3.5 时间平均的离散运动模糊模型 把时间下采样简化成最朴素的「$s$ 帧取平均」(CogVideoX 的下采样层真的就是 avg_pool1d,见 05 节)。一个以速度 $v$ 像素/帧平移的物体,在 $s$ 帧内走过的距离是 $(s-1)v$,因此它叠加了覆盖长度 $L=(s-1)v$ 内的 $s$ 个离散位移;这是等权脉冲核,不能直接当连续盒式核。这里的平均作用于合成斑点,官方池化作用于已学习的中间特征,两者的图像失真不能等同。 这实际上是 $s$ 个离散平移位置的均匀平均,位移取 $0,v,\ldots,(s-1)v$,其方差为 $v^2(s^2-1)/12$。不是把端点距离直接代入连续盒核的 $L^2/12$。因此,无限画布上按二阶矩定义的宽度满足 $$\sigma_{\text{new}} = \sqrt{\sigma^2 + \frac{v^2(s^2-1)}{12}}$$ 当 $s=8,v=4,\sigma=3$ 时,解析宽度是 $\sqrt{9+84}=\sqrt{93}\approx9.644$ 像素;带微噪声并截去噪声底的代码测得约 9.640。差别来自有限画布和阈值测宽,而不是神经网络实验。这只是“时间平均 + 最近邻还原”的模型,不是学习型视频 VAE 的必然误差或压缩下界。 04. 代码实现 数值实验只需 NumPy;重绘还需 matplotlib。本轮实跑为 Windows、Python 3.11.9、NumPy 2.4.3、matplotlib 3.10.7,固定种子保存在脚本。全部脚本在文末附录,这里保留核心片段。 4.1 因果卷积:时间只补前面 def causal_pad(x, k_t): """时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。""" if k_t <= 1: return x pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype) return np.concatenate([pad, x], axis=1) def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"): """3D 卷积,时间填充方式可选: time_pad="causal" 前面补 k_t-1 帧、后面不补(只看过去) time_pad="symmetric" 前后各补 (k_t-1)//2 帧(会看到未来) """ if x.ndim != 4 or w.ndim != 5 or min(x.shape) <= 0 or min(w.shape) <= 0: raise ValueError("expected nonempty x[C,T,H,W], w[O,C,kT,kH,kW]") if x.shape[0] != w.shape[1] or len(stride) != 3 or any(not isinstance(v, int) or v <= 0 for v in stride): raise ValueError("incompatible channels or invalid strides") if time_pad not in ("causal", "symmetric"): raise ValueError("unknown time_pad") kt, kh, kw = w.shape[2], w.shape[3], w.shape[4] if time_pad == "symmetric" and kt % 2 == 0: raise ValueError("symmetric teaching mode requires an odd time kernel") if time_pad == "causal": x = causal_pad(x, kt) else: pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0)) x = np.pad(x, pad, mode="constant") x = sym_pad_hw(x, kh, kw) return conv3d_valid(x, w, stride) def out_frames(t_in, k_t=3, s_t=1): """因果卷积的时间输出帧数。 T_out = floor((T_in - 1) / s_t) + 1 注意不是 floor(T_in / s_t):因为首帧被保留下来单独占了一个输出位。 """ return (t_in - 1) // s_t + 1 toy 使用无 batch 的 [C,T,H,W];PyTorch Conv3d 常用带 batch 的 [B,C,T,H,W],也支持无 batch 输入。真实输出: T_in= 49 -> s_t=1: 预测 49 / 实测 49 OK s_t=2: 预测 25 / 实测 25 OK s_t=4: 预测 13 / 实测 13 OK 两级时间压缩 2(stride-conv toy):49 帧 -> 25 -> 13 潜变量帧 4.2 因果性检验:改未来,看过去 def causality_check(): """改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。""" net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) worst = 0.0 for t_edit in range(0, 48, 4): v2 = v.copy() v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动 z2 = net.encode(v2) # 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j for j in range(z2.shape[1]): if 4 * j < t_edit: diff = np.abs(z2[:, j] - z_ref[:, j]).max() worst = max(worst, diff) print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}") 真实输出: 应该完全不受影响的潜变量帧上,最大变化量 = 0.000e+00 把 ToyVideoVAE() 换成 ToyVideoVAE(time_pad="symmetric") 再跑一次 dependency_matrix,会得到「12 个潜变量帧全部泄漏、最多超前 8 帧」——这是 09 节留给读者的第一个动手验证。 4.3 分块解码:接缝是算出来的,不是看出来的 def decode_chunked(net, z, chunk=CHUNK, ctx=0): """按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。""" if not isinstance(chunk, int) or chunk <= 0 or not isinstance(ctx, int) or ctx < 0: raise ValueError("chunk must be positive and ctx nonnegative integers") if z.ndim != 4 or min(z.shape) <= 0: raise ValueError("z must be nonempty [C,T,H,W]") nz = z.shape[1] pieces, starts = [], [] n_chunks = (nz + chunk - 1) // chunk for i in range(n_chunks): lo = i * chunk hi = min(lo + chunk, nz) lo_in = max(0, lo - ctx) out = net.decode(z[:, lo_in:hi]) keep = (hi - lo) * T_STRIDE # 上下文部分的输出要丢掉 pieces.append(out[:, -keep:]) starts.append(lo * T_STRIDE) return np.concatenate(pieces, axis=1), starts 96 帧输入 $\to$ 24 个潜变量帧 $\to$ 切 3 块,真实输出(误差按输出标准差归一): ctx | 块头误差 | 块内后段误差 | 块内被污染帧数 | 边界跳变放大 ----+---------+---------+----------------+------------ 0 | 2.550e+00 | 3.206e+00 | 48 | 1.90x 1 | 2.094e+00 | 1.814e+00 | 40 | 2.19x 2 | 1.658e+00 | 1.399e+00 | 32 | 1.88x 3 | 1.313e+00 | 8.267e-01 | 24 | 2.19x 4 | 8.700e-01 | 4.549e-01 | 16 | 1.15x 5 | 4.051e-01 | 0.000e+00 | 8 | 1.07x 6 | 0.000e+00 | 0.000e+00 | 0 | 1.00x 三件事要读出来: 误差在 ctx = 6 处精确归零,不是渐近变小。少 1 帧(ctx = 5)还剩 8 个输出帧是错的。 每块每少带 1 帧上下文,就多错 4 个输出帧(表中两块合计 8 帧),正好等于 1 个潜变量帧的输出跨度($s_T = 4$)。所以「接缝」根本不是一条线,是一段区域。 块内后段误差比块头误差先归零(ctx = 5 时块尾已经是 0 而块头还有 0.405)。这符合感受野的形状:这里“后段”是每块第 5—32 个输出位置的最大值,并非单独最后一帧;越靠后,缺的历史影响可逐渐消失。 编码侧同理,真实输出(每块 32 个输入帧,误差按潜变量标准差归一): ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数 ----+----------------+----------------+-------------- 0 | 3.245e+00 | 2.984e+00 | 4 8 | 1.297e+00 | 0.000e+00 | 2 12 | 6.090e-01 | 0.000e+00 | 1 16 | 0.000e+00 | 0.000e+00 | 0 阈值 16,正是编码器感受野 $17 - 1$。 这张图要看什么:左图两条线(块头、块内后段)在 ctx = 6 处一起掉到 0,纵坐标是 symlog 轴,在零附近是线性区——前面那段下降看着平缓,其实是从「两个标准差」这种肉眼可见的错误降到零。右图的阶梯更直白:被污染帧数每块减少 4 帧、图中两块合计减少 8 帧,斜率就是 $s_T$。 4.4 token 账本:先区分 VAE 网格和 DiT patch def latent_frames(t_in, s_t): """因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。""" return (t_in - 1) // s_t + 1 121 帧 / 768×512 / RGB 的真实输出: 配置 | 潜变量形状 (T'xH'xW'xC) | token 数 N | N^2 相对代价 | 平方比倍数 | 名义 RGB 数值/格点 图像 VAE 逐帧(SVD / AnimateDiff 口径)| 121 x 64 x 96 x 4 | 743,424 | 1.000e+00 | 1.0x | 192 CogVideoX / Wan / HunyuanVideo(4x8x8)| 31 x 64 x 96 x 16 | 190,464 | 6.564e-02 | 15.2x | 768 LTX-Video(8x32x32) | 16 x 16 x 24 x 128 | 6,144 | 6.830e-05 | 14641.0x | 24,576 只动时间维的对照(固定空间 8×8、通道 16):时间压缩 1→2→4→8,token 数 743,424→374,784→190,464→98,304,长序列下近似每翻一倍注意力代价降到 1/4,首帧保留会带来取整差异。 这张图要看什么:左图是序列长度(对数轴),右图是注意力的相对代价——右图的差距比左图大得多,因为代价是 $N^2$。表中 $N$ 还不是通用的 Transformer token 数:若后续用 $p_T,p_H,p_W$ 大小的非重叠 patch 且各维整除,序列长度是 $N/(p_Tp_Hp_W)$。宽度为 $d$ 时,稠密 attention 两次矩阵乘法的量级为 $N^2d$,投影还有 $Nd^2$ 项;这些平方比不等于整个模型的加速比。显式存每头 fp16 分数矩阵需约 $2N^2$ 字节,而 FlashAttention 类实现可避免完整物化它,算术二次项仍在。真实部署必须测量具体模型与 kernel。 05. 工业级实现对照 最小实现只有一条时间前补零,生产代码多了五处,每处都有原因。以下逐项核对 Diffusers v0.35.1 的固定源码(上游会重构,引用时请对照 repo/path#symbol): CogVideoXCausalConv3d WanCausalConv3d CogVideoXDownsample3D CogVideoXUpsample3D 5.1 填充元组:时间只补前面 CogVideoXCausalConv3d: time_pad = time_kernel_size - 1 self.time_causal_padding = (width_pad, width_pad, height_pad, height_pad, time_pad, 0) F.pad 的元组是从最后一维往前写的,所以这六个数的含义是 $(W_{\text{left}}, W_{\text{right}}, H_{\text{left}}, H_{\text{right}}, T_{\text{left}}, T_{\text{right}})$。最后两个是 $(k_t - 1,\ 0)$——和 3.2 节推导的 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$ 完全一致。空间两维是对称的,只有时间轴不对称。 Wan 的 WanCausalConv3d(autoencoder_kl_wan.py)写成另一种形式: self._padding = (self.padding[2], self.padding[2], self.padding[1], self.padding[1], 2 * self.padding[0], 0) self.padding = (0, 0, 0) 它先把 nn.Conv3d 自带的 padding 清零,改成自己手动 pad。$k_t = 3$ 时 padding[0] = 1,于是 $2 \cdot 1 = 2 = k_t - 1$,和 CogVideoX 殊途同归。 5.2 上下文缓存:分块推理靠它 CogVideoX 的 fake_context_parallel_forward: kernel_size = self.time_kernel_size if kernel_size > 1: cached_inputs = [conv_cache] if conv_cache is not None else [inputs[:, :, :1]] * (kernel_size - 1) inputs = torch.cat(cached_inputs + [inputs], dim=2) return inputs 读法:在该版非 replicate 分支,有缓存时直接拼入缓存,无缓存时复制第 0 帧 $k_t-1$ 次。不要被默认名 constant 误导成时间补零。replicate 分支每次调用 F.pad 并返回空缓存,不适合把它当同一种续接协议。这正好对应 3.4 节的两种情形——「缺上下文就用别的东西填」,而首帧复制与补零产生不同边界值,需要与训练时规则一致,不能单凭形式判定哪种质量更好。紧接着: conv_cache = inputs[:, :, -self.time_kernel_size + 1:].clone() 把拼接后输入的最后 $k_t - 1$ 帧存起来,给下一块用。整个编码器把这些缓存收进一个以层名索引的字典(conv_in、down_block_0……)逐层传递。Wan 的对应逻辑更紧凑,直接把缓存长度从待补的填充里减掉: if cache_x is not None and self._padding[4] > 0: x = torch.cat([cache_x, x], dim=2) padding[4] -= cache_x.shape[2] 这就是 04 节那个 ctx 在生产代码里的样子。 这里有个容易看错的地方:工业实现每层只缓存 $k_t - 1 = 2$ 帧,而 04 节实测需要 6 帧,直觉上会觉得「2 帧不够」。其实够——因为每层缓存的是该层自己输入分辨率下的帧,越往后的层分辨率越高,同样 2 帧折回潜变量帧单位就越小。把解码器 d0…d4 逐层折算后累加: 层 输入相对潜变量的帧间距 缓存 $(k_t - 1)$ 帧折回潜变量帧 d0 1.00 2.00 d1 1.00 2.00 d2 0.50 1.00 d3 0.25 0.50 d4 0.25 0.50 合计 6.00 这里的 6.00 是本 toy 的层间距账本,与 3.4 的逐相位整数依赖推导相符;不能把分数缓存单位相加当成任意网络的最小上下文证明。官方缓存的是每层中间特征,入口重叠法则重算历史,二者占用不同。对本 toy 只在入口给 2 个 latent 帧确实不足,但真实模型还要核对归一化、池化、padding 和采样相位。 卷积缓存并不证明整模型流式等价。 固定版编码器的 GroupNorm 和解码器的 CogVideoXSpatialNorm3D 会在 5D 张量的各通道组内跨时间、空间计算均值与方差;未来帧变动能改变早期输出。小 CPU 夹具中,改变第 3 帧让第 1 帧的 GroupNorm 输出变化 0.735271;原 SpatialNorm 类的变化为 0.782046。它们是确定的反例,不是重建质量测试。官方整 VAE 也有指定的帧批次协议:编码首批可为 9 帧、随后 8 帧,解码首批可为 3 个 latent、随后 2 个;不能把任意“全段一次调用”和任意块长的运行宣称数值等价。 5.3 时间下采样:CogVideoX 用的是平均池化,不是学习出来的卷积 CogVideoXDownsample3D: x = x.permute(0, 3, 4, 1, 2).reshape(batch_size * height * width, channels, frames) if x.shape[-1] % 2 == 1: x_first, x_rest = x[..., 0], x[..., 1:] x_rest = F.avg_pool1d(x_rest, kernel_size=2, stride=2) x = torch.cat([x_first[..., None], x_rest], dim=-1) else: x = F.avg_pool1d(x, kernel_size=2, stride=2) 两个细节值得记住: 时间维是 avg_pool1d,不是 stride 卷积。 空间维倒是用 nn.Conv2d(stride=2)(注意它把 (B, T, C, H, W) 折叠成 (B*T, C, H, W) 后用 2D 卷积做的,这使该层只在单帧空间上学习权重;实际峰值显存还取决于布局复制、kernel 和输入形状,源码本身不足以量化收益)。因此 3.5 的平均算子有结构参照,但真实中间特征已被前面的卷积变换,不能把合成图像平均的 PSNR 迁移到 VAE。 帧数为奇数时首帧单独保留,不参与池化——其索引语义与 stride-conv toy 不同:奇数 $T$ 的第 $j\gt 0$ 个输出平均输入 $2j-1,2j$;偶数 $T$ 的第 $j$ 个输出平均 $2j,2j+1$。偶数分支若仍对齐 $2j$ 就读了下一帧,若定义为在 $2j+1$ 时刻可用,则有一帧延迟。必须先定义时间戳再讨论因果。 上采样端(upsampling.py#CogVideoXUpsample3D)对称地用 F.interpolate 做时间 2 倍、空间 2 倍,并按长度分支:大于 1 的奇数长度保首帧,输出 $2T-1$;偶数长度输出 $2T$;单帧仍为 1。因此它们不是所有长度下的互逆形状变换。例如原下采样层把 [0,1,2] 变成 [0,1.5],上采样得到 4 帧,而不是还原 3 帧;合法的 $49\to25\to13\to25\to49$ 两级链则能匹配。 另外编码器里有一行决定「在哪几层压时间」: temporal_compress_level = int(np.log2(temporal_compression_ratio)) compress_time = i < temporal_compress_level 在本配置有足够下采样块时,压缩比 4 → level = 2 → 前两个下采样块压时间。不要把 int(log2(ratio)) 当作对任意非 2 次幂参数的正确压缩承诺。这也解释了图 2 那件事:压缩集中在前段时,后段的层会以更大的累积步距去看历史,感受野涨得最快。 5.4 与最小实现的五处差距 差距 生产代码 为什么 归一化 GroupNorm / CogVideoXSpatialNorm3D 调节中间激活的尺度;不能代替 KL,也不保证 latent 标准正态。若统计量跨时间,还须单独检查因果性 激活与结构 ResNet block + SiLU,不是单层卷积 单层卷积的表达能力撑不起 8×8 的空间压缩 卷积实现 CogVideoXSafeConv3d(分块跑的 Conv3d) 避免长视频上 Conv3d 一次性分配大显存 缓存粒度 每层一个 key 的字典 分块推理要逐层续接,不是只在入口续接 精度与缓存 dtype 由模型配置决定;缓存可 .clone() bf16 降低存储,clone 控制缓存所有权;二者是不同问题 06. 代价与边界 数值个数、字节存储、序列长度与信息量是不同口径。 这张表最容易看错: 配置 | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值) 图像 VAE 逐帧(SVD / AnimateDiff 口径)| 2,973,696 | 48.0 : 1 CogVideoX / Wan / HunyuanVideo(4x8x8)| 3,047,424 | 46.8 : 1 LTX-Video(8x32x32) | 786,432 | 181.5 : 1 4×8×8 这一档的数值元素压缩比和逐帧图像 VAE 几乎一样(46.8 vs 48.0)。它在这个数值元素口径下没有更小,但并非无损重排:学习型编码器把 743,424 个 token 重排成 190,464 个更「厚」的 token(通道 4 → 16)。数值个数接近不代表信息容量相同;这张表直接说明的是序列长度。 在相同 dtype、仅比较这些张量时,8×32×32 这一档的数值总数也更少,代价是 LTX-Video 摘要里自己写的那句:"the high compression inherently limits the representation of fine details"(高压缩本质上限制了细节的表达)。 元素压缩比为 $THWC/(T'H'W'C')$,字节比还需乘输入与 latent 的每元素字节数之比;原 RGB 若存 uint8 而 latent 存 fp16,字节比是表中一半。LTX 这一组的名义 192:1 来自 $8\cdot32^2\cdot3/128$;有限 121 帧按首帧规则得到 16 个 latent 帧,故实际为 $192\cdot121/(8\cdot16)=181.5$。差异来自有限长度的首帧取整,不是把 patchify 挪进 VAE 所产生的新误差。通道数增加是架构选择,不能从元素个数推出信息量守恒或必然需要增通道。 本平均滤波实验的失真随运动速度改变。 图 5 的三组曲线: 这张图要看什么:实线是压时间,虚线是压空间(与速度无关,当基线用)。同一颜色实线往下掉、虚线不动,交叉后时间平均的 PSNR 低于该空间平均基线,但二者压缩的元素比例不同。实测交叉点:压 2 倍和 4 倍在约 2 像素/帧处,压 8 倍在约 4 像素/帧处。 速度 v | 时间 2x / 空间 2x 时间 4x / 空间 4x 时间 8x / 空间 8x 0.25 | 53.49 / 39.00 46.87 / 32.35 40.81 / 26.58 1.00 | 41.97 / 39.00 35.28 / 32.35 30.05 / 26.58 2.00 | 36.15 / 39.00 30.18 / 32.35 26.62 / 26.58 4.00 | 30.83 / 39.00 26.69 / 32.29 24.92 / 26.57 这些交叉点只属于本实验的斑点、尺寸、噪声和滤波器。尤其“时间 s 倍”减少 s 倍元素,而“空间两轴各 s 倍”减少 s² 倍元素,并非等码率比较,不能据此给出“超过 2 像素/帧就不能压缩”的部署阈值。真实 VAE 需在相同码率、动作数据和感知/时序指标下做验证。 首帧可用历史更少,但不等于质量必然更差。 因果卷积前面补的是零(或复制首帧),第一个输出位置天然只能看到 1 帧输入。图 1 左图第 0 行只有一个蓝点就是这个意思。复制首帧也只能补边界值,不能凭空增加过去观测;图生视频的条件注入与重建质量还要单独核验。 入口重叠法会重算历史,逐层缓存的账本不同。 带够 $\mathrm{RF} - 1$ 帧上下文,意味着每块要多算: 解码块大小 | 需要上下文 | 重算时间位置/总时间位置 8 潜变量帧 | 6 帧 | 42.9% 16 潜变量帧 | 6 帧 | 27.3% 24 潜变量帧 | 6 帧 | 20.0% 编码块大小 | 需要上下文 | 重算时间位置/总时间位置 32 输入帧 | 16 帧 | 33.3% 128 输入帧 | 16 帧 | 11.1% 这里百分比是 ctx/(chunk+ctx),仅按远离首块的输入时间位置计数。若问“比不重叠多读多少”,分母应为 chunk:8+6 对 8 是 75%,其中重叠部分占总位置的 42.9%;16+6 的两种比例为 37.5% 与 27.3%。首块无左侧重叠、尾块可更短,整段需逐块求和。由于中间分辨率、padding 和计算量不同,这些都不是精确 FLOP、耗时或显存比例,更不能从重复计算比例扣减显存收益。 离线场景可以考虑非因果结构。 它能使用前后帧,但是否提高质量要由实验决定。非因果网络也能分块,只是需要左右上下文或接受输出延迟。因果性本身不保证无闪烁,也不保证完整模型严格流式:跨时间归一化或全局注意力仍可能破坏性质。 07. 经典论文脉络 五篇,每篇一句话说清它对「时间维怎么处理」的贡献: Neural Discrete Representation Learning(VQ-VAE,2017)— 学习离散潜变量,并在潜变量上学习先验;与本文连续高斯后验 VAE 属于不同表征选择,不能把所有视频 tokenizer 归为同一条起源。 MAGVIT: Masked Generative Video Transformer(arXiv 首发 2022) — 使用 3D 卷积与时空压缩的离散视频 tokenizer,用 masked modeling 训练,是这一方向的一项代表工作。这与在离散 token 上自回归建模是可比较的另一种生成器设计。 Language Model Beats Diffusion -- Tokenizer is Key to Visual Generation(MAGVIT-v2,2023)— 用 lookup-free quantization 设计视觉 tokenizer,并在论文指定的图像/视频生成评测中与扩散比较;不能把具体结果推广为所有任务的首次超越。 CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer(2024) — 本文的锚点。把 3D 因果 VAE 和 Expert Transformer 绑在一起,明确以「提高压缩率同时保住保真度」为目标;后续的 HunyuanVideo: A Systematic Framework For Large Video Generative Models 与 Wan: Open and Advanced Large-Scale Video Generative Models 也给出 4×8×8 的 VAE 方案;这里比较代表性配置,不声称代码起源或所有版本一致。 LTX-Video: Realtime Video Latent Diffusion(arXiv 首发 2024-12-30,编号归入 2025-01) — 把压缩比推到 8×32×32(摘要自述 1:192),代价是细节;它的解法是让解码器顺手把最后一步去噪也做了,直接在像素空间出结果。 还有一条不压时间的路线:Stable Video Diffusion 使用空间压缩的图像自编码器并加入时序解码层;Align your Latents 是较早的 Video LDM 工作,不能把两个标题和论文 ID 混在一起。逐帧 latent 的长度更大,但生成器是否采用全时空、分离式注意力或其他结构会改变真实成本。 08. 常见误解 误解一:「时间压缩 4 倍时,48 帧一定输出 13 帧。」 本文单侧填充 stride-conv 公式给出 $\lfloor47/4\rfloor+1=12$,49 帧才给 13。许多真实模型限定 $1+k s_T$ 帧,其他输入长度会经过补齐、裁剪或不同池化分支,必须核对代码,不能把帧数规则泛化。 误解二:「只要卷积前补零,整个 VAE 就严格因果。」 单层卷积的因果范围可以逐项证明,但还要检查膨胀、池化对齐、归一化和注意力的时间依赖。分块既可逐层缓存中间特征,也可在入口重叠足够大的上下文后裁剪;后者在本 toy 需要 6 个 latent 帧,而不是只缓存 2 帧。两种方式都可正确,只是计算和内存开销不同。 误解三:「分块解码只要重叠 1 帧就够,接缝最多难看一点点。」 实测:缺上下文时不是接缝那一帧错,是一段区域错。块大小 8 个潜变量帧、上下文 0 帧时,32 个输出帧里 24 帧是错的;每少带 1 帧上下文多错 4 个输出帧。而且这个错误不是「视觉上略糊」,是数值上完全跑偏(相对标准差 2.55 倍)。 误解四:「压缩比越高越好,反正都是 VAE 重建。」 4×8×8 相对逐帧图像 VAE 的数值元素压缩比几乎没变(46.8:1 vs 48.0:1),它主要减少本账本中的网格长度(06 节第一张表)。在相同 dtype 下,8×32×32 这一档的数值存储更少,而论文自己承认细节受限。所以「压缩比」这个词在这件事上有两个含义,混着用会得出完全相反的结论。 误解五:「视频 VAE 就是把图像 VAE 的 2D 卷积换成 3D 卷积。」 三处不一样:(a)CogVideoX 的时间池化本身没有可学习参数,但其前后的 3D 时间卷积有;(b)空间卷积被折叠成 2D 卷积做,该层独立处理各帧的空间运算,具体显存收益需实测;(c)temporal_compress_level = int(log2(ratio)) 决定只有前几层压时间,不是每层都压。想从图像 VAE 权重 inflate 一个视频 VAE,这三处都得单独处理。 09. 动手验证 六个脚本都在文末附录;数值实验依赖 numpy,make_figures.py 还依赖 matplotlib。运行时间取决于机器。 python causal_conv3d.py # 形状公式 + 因果性 + 感受野(约 11 秒) python chunk_decode.py # 分块编解码的接缝(约 8 秒) python temporal_budget.py # 运动速度 vs 时间压缩 python token_ledger.py # token 账本 python video_vae_checks.py # 网格对齐、整数依赖、离散方差与账本 python make_figures.py # 重画本文 5 张图 预期结果: causal_conv3d.py:形状公式 6 组输入、3 组步距预测值全部等于实测值;49 -> 25 -> 13;因果性违反量 0.000e+00;感受野公式 17 = 实测 17,因果上界 0 次违反。 chunk_decode.py:解码侧 ctx = 6 时误差 0.000e+00;编码侧 ctx = 16 时误差 0.000e+00;被污染帧数随 ctx 每 +1 减 8(两块合计)。 temporal_budget.py:s=8 那一列 PSNR 从 40.81 dB 掉到 24.92 dB;宽度增幅实测约 3.24 倍,修正离散方差后的解析值也约 3.24 倍;交叉点报在 2 / 2 / 4 像素/帧。 video_vae_checks.py 还验证 297 组卷积形状、60 组任意块长/尾块编码对照、112 个解码相位和 9 组无噪声离散混合方差;另用原始 PyTorch/Diffusers CPU 类验证卷积前后向、三种 padding 分支、奇偶采样与 GroupNorm 未来依赖。它们没有运行完整预训练 VAE、CUDA 或感知质量评测。 三个可以自己改的小实验: 把因果改成非因果:dependency_matrix(t_in=48, time_pad="symmetric"),看所有 12 个潜变量帧都越过 $4j$ 那条线,最多超前 8 帧。 把解码器的 latent 级卷积从 2 层加到 4 层:感受野会变成 11 个潜变量帧,所需上下文从 6 涨到 10,重跑 chunk_decode.py 会看到阈值跟着移动。这条最能验证「上下文 = 感受野 − 1」不是巧合。 把 toy 编码器的时间步距从 $[1,2,2,1]$ 改成 $[1,1,2,2]$:总压缩比不变(还是 4),但累积步距的分布变了,感受野从 17 变成 $1+2+2+2+4=11$。压缩比相同,上下文开销不同——这就是选架构时真正该看的量。 10. 延伸阅读 按依赖顺序: VAE 结构与训练目标 — 本文默认你已经知道 KL 项和重参数化在干什么。若要接着问「潜变量为什么要近似标准正态」,看它。 视频 VAE 的常见 loss 组合 — 本文只讲了结构没讲训练目标。L1 + KL + LPIPS + GAN 四项权重怎么配、谁在管伪影,是那篇的话题;结构、训练数据与目标、latent 生成过程都可能影响闪烁;本文没有实验分离各自贡献,不能给出“一半”这样的比例。 潜空间扩散 — 潜变量一旦定了,扩散过程就全在它上面做,包括那个 scaling factor。 DiT:用 Transformer 替掉 UNet — 01 节那个 $N^2$ 账单最后是要 DiT 来付的,token 数直接决定它能不能做全时空注意力。 自回归视频生成与 Forcing 范式 — 本文讲的是「逐块解码不接缝」;那篇讲的是更进一步:干脆按帧自回归地生成,因果性从 VAE 一路贯穿到生成模型。附录:完整代码 09 节用到的脚本全文如下(make_figures.py、causal_conv3d.py、chunk_decode.py、temporal_budget.py、token_ledger.py、video_vae_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 make_figures.py # -*- coding: utf-8 -*- """画配图。所有数字都来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] 标签一律用 Unicode(σ、×)而不是 mathtext,省得反斜杠踩到转义检查。 """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) import causal_conv3d as cc # noqa: E402 import chunk_decode as cd # noqa: E402 import token_ledger as tl # noqa: E402 import temporal_budget as tb # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:因果 vs 非因果的依赖矩阵 ─────────────── def fig_dependency(): dep_c = cc.dependency_matrix(t_in=48, time_pad="causal") dep_n = cc.dependency_matrix(t_in=48, time_pad="symmetric") fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.6), sharey=True) for ax, dep, title in ((axes[0], dep_c, "因果卷积:只看过去"), (axes[1], dep_n, "普通卷积:前后都看")): ax.imshow(dep.T, aspect="auto", cmap="Blues", interpolation="nearest", origin="lower") nz = dep.shape[1] jj = np.arange(nz) ax.plot(4 * jj, jj, color=C1, lw=1.6, ls="--", label="输出帧 j 对应的输入帧 4j") ax.set_xlabel("输入帧 t") ax.set_title(title, fontsize=12) ax.legend(loc="upper left", fontsize=9) axes[0].set_ylabel("潜变量帧 j") # 标一处「未来泄漏」 leak = [] for j in range(dep_n.shape[1]): idx = np.where(dep_n[:, j])[0] if len(idx) and idx.max() > 4 * j: leak.append(int(idx.max()) - 4 * j) if leak: axes[1].annotate(f"这里看到了未来\n最多超前 {max(leak)} 帧", xy=(30, 6), xytext=(24, 9.5), fontsize=10, color="#333333", bbox=dict(facecolor="white", alpha=0.9, edgecolor="none"), arrowprops=dict(arrowstyle="->", color="#999999", lw=1)) fig.suptitle("图 1:谁依赖谁——横轴是被改动的输入帧,纵轴是跟着变的潜变量帧", fontsize=13) fig.tight_layout() _save(fig, "fig1_dependency.png") return dep_c, dep_n # ─────────────── 图 2:感受野为什么会被步距放大 ─────────────── def fig_rf(): kernels = [3, 3, 3, 3] strides = [1, 2, 2, 1] contrib, cum = [], [] c = 1 for k, s in zip(kernels, strides): contrib.append((k - 1) * c) cum.append(c) c *= s rf = 1 + sum(contrib) fig, ax = plt.subplots(figsize=(7.6, 4.4)) x = np.arange(len(kernels)) ax.bar(x, contrib, color=[C0, C0, C2, C1], width=0.62) for i, (v, cu) in enumerate(zip(contrib, cum)): ax.text(i, v + 0.25, f"+{v}", ha="center", fontsize=10) ax.text(i, -0.9, f"累积步距 {cu}", ha="center", fontsize=9, color="#555555") ax.axhline(0, color="#333333", lw=0.8) ax.set_xticks(x) ax.set_xticklabels([f"第 {i + 1} 层\nk={k}, s={s}" for i, (k, s) in enumerate(zip(kernels, strides))]) ax.set_ylabel("这一层给感受野贡献的帧数") ax.set_ylim(-1.6, max(contrib) + 1.6) ax.set_title(f"图 2:同样的 k=3,越靠后的层贡献越大(总感受野 = 1 + 各项 = {rf} 帧)", fontsize=12) ax.grid(alpha=0.25, axis="y") fig.tight_layout() _save(fig, "fig2_rf.png") return contrib, rf # ─────────────── 图 3:分块解码的接缝 ─────────────── def fig_chunk(): net, v, z, ref = cd.build() scale = float(ref.std()) ctxs = list(range(0, 9)) head, tail, contam = [], [], [] for ctx in ctxs: got, starts = cd.decode_chunked(net, z, cd.CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale hi, ti, cn = [], [], 0 for s in starts[1:]: hi += list(range(s, s + cd.T_STRIDE)) ti += list(range(s + cd.T_STRIDE, s + cd.CHUNK * cd.T_STRIDE)) cn += int((diff[s:s + cd.CHUNK * cd.T_STRIDE] > 1e-9).sum()) head.append(float(diff[hi].max())) tail.append(float(diff[ti].max())) contam.append(cn) fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5)) ax = axes[0] ax.plot(ctxs, head, "o-", color=C1, lw=2.2, label="块头误差(块的前 4 个输出帧)") ax.plot(ctxs, tail, "s--", color=C0, lw=2.0, label="块内后段误差(其余 28 帧)") ax.set_yscale("symlog", linthresh=1e-3) ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx") ax.set_ylabel("相对整段解码的最大误差(按输出标准差归一)") ax.axvline(6, color=C3, lw=1.6, ls=":") ax.annotate("ctx=6 起误差精确归零", xy=(6, 1e-1), xytext=(6.4, 4e-1), fontsize=10, color=C3, arrowprops=dict(arrowstyle="->", color=C3, lw=1)) ax.set_title("左:误差随上下文帧数的变化", fontsize=12) ax.legend(fontsize=9) ax.grid(alpha=0.25) ax = axes[1] ax.plot(ctxs, contam, "o-", color=C2, lw=2.2) ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx") ax.set_ylabel("被污染的块内输出帧数(两块合计)") for i, c in enumerate(contam): ax.annotate(str(c), (ctxs[i], c), textcoords="offset points", xytext=(0, 7), ha="center", fontsize=9) ax.set_title("右:每块少带 1 帧,两块合计多错 8 帧", fontsize=12) ax.grid(alpha=0.25) fig.suptitle("图 3:本 toy 的分块解码在 ctx=6 起与整段计算一致", fontsize=13) fig.tight_layout() _save(fig, "fig3_chunk.png") return ctxs, head, tail, contam # ─────────────── 图 4:token 账本 ─────────────── def fig_ledger(): rows = [tl._row(n, a, b, c) for n, a, b, c in tl.REAL] labels = ["逐帧图像 VAE\n(1x8x8)", "4x8x8\n(CogVideoX/Wan)", "8x32x32\n(LTX-Video)"] ns = [r["n"] for r in rows] rel = [(r["n"] / ns[0]) ** 2 for r in rows] fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5)) ax = axes[0] bars = ax.bar(labels, ns, color=[CGREY, C0, C3], width=0.58) ax.set_yscale("log") ax.set_ylabel("VAE 网格数 N(尚未做 Transformer patch)") for b, n in zip(bars, ns): ax.text(b.get_x() + b.get_width() / 2, n * 1.15, f"{n:,}", ha="center", fontsize=9) ax.set_ylim(1e3, 3e6) ax.set_title("左:序列长度", fontsize=12) ax.grid(alpha=0.25, axis="y") ax = axes[1] bars = ax.bar(labels, [1.0 / r for r in rel], color=[CGREY, C0, C3], width=0.58) ax.set_yscale("log") ax.set_ylabel("同宽同 patch 的 N 平方比(非实测加速)") for b, r in zip(bars, rel): ax.text(b.get_x() + b.get_width() / 2, (1.0 / r) * 1.15, f"{1.0 / r:.0f}x", ha="center", fontsize=9) ax.set_ylim(0.8, 6e4) ax.set_title("右:因为代价是 N 的平方,差距被放大", fontsize=12) ax.grid(alpha=0.25, axis="y") fig.suptitle("图 4:同一个 121 帧 768x512 输入,比较 VAE 网格长度及其平方", fontsize=13) fig.tight_layout() _save(fig, "fig4_ledger.png") return ns, rel # ─────────────── 图 5:运动速度 vs 时间压缩 ─────────────── def fig_motion(): speeds = tb.SPEEDS p_t = {2: [], 4: [], 8: []} p_s = {2: [], 4: [], 8: []} for v in speeds: x = tb.moving_blob(v) for s in (2, 4, 8): p_t[s].append(tb.psnr(x, tb.repeat_time(tb.avg_pool_time(x, s), s))) p_s[s].append(tb.psnr(x, tb.repeat_space(tb.avg_pool_space(x, s), s))) fig, ax = plt.subplots(figsize=(8.2, 5.0)) colors = {2: C0, 4: C2, 8: C1} for s in (2, 4, 8): ax.plot(speeds, p_t[s], "o-", color=colors[s], lw=2.2, label=f"压时间 {s} 倍") for s in (2, 4, 8): ax.plot(speeds, p_s[s], ls="--", color=colors[s], lw=1.6, alpha=0.75, label=f"空间两轴各 {s} 倍(元素压 {s*s} 倍)") ax.set_xscale("log") ax.set_xticks(speeds) ax.set_xticklabels([str(v) for v in speeds]) ax.set_xlabel("运动速度(像素 / 帧,对数轴)") ax.set_ylabel("重建 PSNR(dB)") ax.set_title("图 5:时间平均与空间平均的教学对照(并非等码率)", fontsize=12) ax.legend(fontsize=9, ncol=2) ax.grid(alpha=0.25) fig.tight_layout() _save(fig, "fig5_motion.png") return p_t, p_s if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None jobs = { "dependency": fig_dependency, "rf": fig_rf, "chunk": fig_chunk, "ledger": fig_ledger, "motion": fig_motion, } for k, fn in jobs.items(): if only and k != only: continue print(f"[draw] {k}") fn() print("done") causal_conv3d.py # -*- coding: utf-8 -*- """3D 因果卷积的 numpy 最小实现,以及形状公式、因果性、感受野的实测。 运行: python causal_conv3d.py 约定张量布局 [C, T, H, W](通道优先,和 torch 的 Conv3d 一致)。 因果卷积的全部秘密只有一条:时间轴**只在前面**补 k_t - 1 帧,后面一帧都不补。 """ import numpy as np def base_rng(seed=20260930): """全工程的种子入口。所有随机权重都从这里分叉,保证数字可复现。""" return np.random.default_rng(seed) # ─────────────── 基本算子 ─────────────── def causal_pad(x, k_t): """时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。""" if k_t <= 1: return x pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype) return np.concatenate([pad, x], axis=1) def sym_pad_hw(x, k_h, k_w): """空间轴对称补零,和 torch 的 Conv3d 默认行为一致。""" pad = ((0, 0), (0, 0), ((k_h - 1) // 2, k_h // 2), ((k_w - 1) // 2, k_w // 2)) return np.pad(x, pad, mode="constant") def conv3d_valid(x, w, stride=(1, 1, 1)): """x [C_in,T,H,W] × w [C_out,C_in,kT,kH,kW] -> [C_out,To,Ho,Wo],只做 valid 部分。""" c_in, t, h, wd = x.shape c_out, c_in2, kt, kh, kw = w.shape assert c_in == c_in2, "通道数对不上" st, sh, sw = stride to = (t - kt) // st + 1 ho = (h - kh) // sh + 1 wo = (wd - kw) // sw + 1 out = np.zeros((c_out, to, ho, wo), dtype=np.float64) for o in range(c_out): wo_kernel = w[o] for i in range(to): for j in range(ho): for k in range(wo): patch = x[:, i * st:i * st + kt, j * sh:j * sh + kh, k * sw:k * sw + kw] out[o, i, j, k] = np.sum(patch * wo_kernel) return out def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"): """3D 卷积,时间填充方式可选: time_pad="causal" 前面补 k_t-1 帧、后面不补(只看过去) time_pad="symmetric" 前后各补 (k_t-1)//2 帧(会看到未来) """ if x.ndim != 4 or w.ndim != 5 or min(x.shape) <= 0 or min(w.shape) <= 0: raise ValueError("expected nonempty x[C,T,H,W], w[O,C,kT,kH,kW]") if x.shape[0] != w.shape[1] or len(stride) != 3 or any(not isinstance(v, int) or v <= 0 for v in stride): raise ValueError("incompatible channels or invalid strides") if time_pad not in ("causal", "symmetric"): raise ValueError("unknown time_pad") kt, kh, kw = w.shape[2], w.shape[3], w.shape[4] if time_pad == "symmetric" and kt % 2 == 0: raise ValueError("symmetric teaching mode requires an odd time kernel") if time_pad == "causal": x = causal_pad(x, kt) else: pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0)) x = np.pad(x, pad, mode="constant") x = sym_pad_hw(x, kh, kw) return conv3d_valid(x, w, stride) def out_frames(t_in, k_t=3, s_t=1): """因果卷积的时间输出帧数。 T_out = floor((T_in - 1) / s_t) + 1 注意不是 floor(T_in / s_t):因为首帧被保留下来单独占了一个输出位。 """ return (t_in - 1) // s_t + 1 # ─────────────── 一个可复用的 toy 视频 VAE ─────────────── class CausalConv3d: """带激活的因果卷积层。权重由 base_rng 派生,fix 住后所有实验共用。 act 默认用 tanh 而不是 ReLU:随机权重下 ReLU 会把一大半通道关死, 实测感受野会被「死通道」削小,接缝误差也随之小到 1e-7 量级,看不出问题。 tanh 只用于减少本扰动探针的死通道,不代表真实 VAE 的激活分布。 """ def __init__(self, c_in, c_out, k=(3, 3, 3), s=(1, 1, 1), seed=0, act="tanh", time_pad="causal"): rng = base_rng(1000 + seed) scale = 0.9 / np.sqrt(c_in * k[0] * k[1] * k[2]) self.w = rng.normal(0.0, scale, size=(c_out, c_in) + tuple(k)) self.b = rng.normal(0.0, 0.02, size=c_out) self.k = tuple(k) self.s = tuple(s) self.act = act self.time_pad = time_pad def __call__(self, x): y = conv3d_causal(x, self.w, self.s, time_pad=self.time_pad) y = y + self.b.reshape(-1, 1, 1, 1) if self.act == "tanh": y = np.tanh(y) elif self.act is True or self.act == "relu": y = np.maximum(y, 0.0) return y def time_upsample(x, factor=2): """时间维最近邻上采样:每个潜变量帧重复 factor 次。 输出时刻 o 对应输入 floor(o/factor),不混合相邻输入。 串联后续卷积时仍须按这个整数映射逐相位计算依赖。 """ return np.repeat(x, factor, axis=1) class ToyVideoVAE: """一个能跑的因果视频自编码器(权重是随机的,不追求重建质量)。 编码器把时间压 4 倍、空间压 4 倍;解码器用最近邻上采样还原。 它的唯一用途是让「谁依赖谁」这件事可以被实测。 """ def __init__(self, time_pad="causal"): self.e0 = CausalConv3d(1, 4, k=(3, 3, 3), s=(1, 1, 1), seed=1, time_pad=time_pad) self.e1 = CausalConv3d(4, 8, k=(3, 3, 3), s=(2, 2, 2), seed=2, time_pad=time_pad) self.e2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(2, 2, 2), seed=3, time_pad=time_pad) self.e3 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=4, time_pad=time_pad) self.d0 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=5) self.d1 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=6) self.d2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=7) self.d3 = CausalConv3d(8, 4, k=(3, 3, 3), s=(1, 1, 1), seed=8) self.d4 = CausalConv3d(4, 1, k=(3, 3, 3), s=(1, 1, 1), seed=9, act=None) def encode(self, x): x = self.e0(x) x = self.e1(x) x = self.e2(x) return self.e3(x) def decode(self, z): x = self.d0(z) x = self.d1(x) x = time_upsample(x, 2) x = self.d2(x) x = time_upsample(x, 2) x = self.d3(x) return self.d4(x) def __call__(self, x): return self.decode(self.encode(x)) def make_video(t=48, h=16, w=16, seed=7): """一段有运动的合成视频:一个高斯斑点匀速横移 + 缓慢明暗变化。""" rng = base_rng(seed) ys, xs = np.mgrid[0:h, 0:w] frames = [] speed = 0.6 cy = h / 2.0 + rng.normal(0, 0.3) for ti in range(t): cx = (w / 4.0 + speed * ti) % w blob = np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / 6.0)) bg = 0.15 * np.sin(2 * np.pi * ti / 24.0) * np.ones_like(blob) frames.append(blob + bg + 0.02 * rng.normal(size=blob.shape)) v = np.stack(frames)[None] # [1, T, H, W] return v.astype(np.float64) # ─────────────── 实验 1:形状公式 ─────────────── def shape_table(): print("── 实验 1:因果卷积的时间帧数公式 ──") print("公式:T_out = floor((T_in - 1) / s_t) + 1 (因果,前补 k_t-1)") rows = [] for t_in in (16, 17, 32, 48, 49, 121): row = [t_in] for s_t in (1, 2, 4): pred = out_frames(t_in, s_t=s_t) w = np.zeros((2, 1, 3, 3, 3)) w[:] = 0.1 x = np.zeros((1, t_in, 8, 8)) got = conv3d_causal(x, w, stride=(s_t, 1, 1)).shape[1] row.append((s_t, pred, got)) rows.append(row) print(f" T_in={t_in:4d} -> " + " ".join(f"s_t={s}: 预测 {p:3d} / 实测 {g:3d} {'OK' if p == g else 'FAIL'}" for s, p, g in row[1:])) # 本 stride-conv toy:49 帧进,两级时间压缩 2 t = 49 t1 = out_frames(t, s_t=2) t2 = out_frames(t1, s_t=2) print(f" 两级时间压缩 2(stride-conv toy):49 帧 -> {t1} -> {t2} 潜变量帧") return rows, (t, t1, t2) # ─────────────── 实验 2:因果性 ─────────────── def causality_check(): """改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。""" print("\n── 实验 2:因果性检验(改未来,看过去)──") net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) worst = 0.0 for t_edit in range(0, 48, 4): v2 = v.copy() v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动 z2 = net.encode(v2) # 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j for j in range(z2.shape[1]): if 4 * j < t_edit: # 这个潜变量帧不该看到第 t_edit 帧及之后 diff = np.abs(z2[:, j] - z_ref[:, j]).max() worst = max(worst, diff) print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}") print(f" 判据:等于 0 则因果性成立(浮点意义上 < 1e-12 即通过)") return worst # ─────────────── 实验 3:感受野 ─────────────── def encoder_rf_formula(kernels, strides): """RF = 1 + sum_l (k_l - 1) * prod_{m<l} s_m prod_{m<l} s_m 是「到第 l 层输入为止累积的时间步距」, 所以越靠后的层,一个 kernel 覆盖的原始帧数越多。 """ rf = 1 cum = 1 for k, s in zip(kernels, strides): rf += (k - 1) * cum cum *= s return rf, cum def encoder_rf_measured(): """扰动法实测:逐帧加扰动,看哪些潜变量帧跟着动。""" net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) nz = z_ref.shape[1] depends = np.zeros((48, nz), dtype=bool) for t_edit in range(48): v2 = v.copy() v2[:, t_edit:t_edit + 1] += 2.0 z2 = net.encode(v2) depends[t_edit] = np.abs(z2 - z_ref).max(axis=(0, 2, 3)) > 1e-12 return depends, z_ref def receptive_field(): kernels = [3, 3, 3, 3] strides = [1, 2, 2, 1] rf_pred, cum = encoder_rf_formula(kernels, strides) print("\n── 实验 3:编码器的时间感受野 ──") print(f" 公式:RF = 1 + sum (k_l - 1) * prod_(m<l) s_m") print(f" 本 toy 的层配置 k={kernels}, s={strides}") print(f" 公式预测 RF = {rf_pred} 帧,累积时间步距 = {cum}") depends, z_ref = encoder_rf_measured() nz = z_ref.shape[1] spans = [] for j in range(nz): idx = np.where(depends[:, j])[0] if len(idx) == 0: spans.append((j, None, None, 0)) continue spans.append((j, int(idx.min()), int(idx.max()), int(idx.max()) - int(idx.min()) + 1)) print(" 实测(逐帧扰动):潜变量帧 j -> 受影响的输入帧区间") for j, lo, hi, sp in spans[:6]: if lo is None: print(f" j={j:2d}: 无任何输入帧影响它(权重恰好全被 ReLU 关掉)") else: print(f" j={j:2d}: 输入帧 [{lo:2d}, {hi:2d}],跨度 {sp:2d} 帧") # 因果性上界:潜变量帧 j 能看到的最新输入帧 print(" 因果性上界检查:潜变量帧 j 能看到的最新输入帧应当 <= 步距 * j") bad = 0 for j, lo, hi, sp in spans: if hi is not None and hi > cum * j: bad += 1 print(f" 违反次数 = {bad}(0 表示因果性严格成立)") max_span = max(s for _, _, _, s in spans) print(f" 实测最大跨度 = {max_span} 帧,公式预测 = {rf_pred} 帧") return rf_pred, cum, spans, max_span def dependency_matrix(t_in=48, time_pad="causal"): """扰动法得到「输入帧 t 是否影响潜变量帧 j」的布尔矩阵 [T_in, n_z]。 这张矩阵就是因果性的可视化:因果卷积下它必须落在 j*s_t 这条对角线以下。 """ net = ToyVideoVAE(time_pad=time_pad) v = make_video(t=t_in) z_ref = net.encode(v) dep = np.zeros((t_in, z_ref.shape[1]), dtype=bool) for t_edit in range(t_in): v2 = v.copy() v2[:, t_edit:t_edit + 1] += 2.0 dep[t_edit] = np.abs(net.encode(v2) - z_ref).max(axis=(0, 2, 3)) > 1e-12 return dep if __name__ == "__main__": shape_table() causality_check() receptive_field() chunk_decode.py # -*- coding: utf-8 -*- """分块编解码的接缝实验:到底要带多少帧上下文,逐块跑才能和整段跑一模一样。 运行: python chunk_decode.py 这是整篇文章最核心的一个实验。设置: - 96 帧输入 -> 编码器压成 24 个潜变量帧(时间步距 4) - 整段编解码得到参考输出 - 然后把潜变量切成 3 块,每块前面额外喂 ctx 个潜变量帧当上下文, 解码后把上下文那部分输出丢掉,只留本块 - 比较「分块结果」与「整段结果」在每个位置的差 编码侧同样要分块(长视频不可能一次装进显存),所以下面两件事都测: 1. 解码侧:需要几个潜变量帧上下文 2. 编码侧:需要几个输入帧上下文 """ import numpy as np from causal_conv3d import ToyVideoVAE, make_video T_FRAMES = 96 # 输入帧数 T_STRIDE = 4 # 编码器总时间步距:1 个潜变量帧对应 4 个输出帧 CHUNK = 8 # 每块 8 个潜变量帧 = 32 个输出帧 def build(): net = ToyVideoVAE() v = make_video(t=T_FRAMES) z = net.encode(v) # [8, 24, 4, 4] ref = net.decode(z) # [1, 96, 16, 16] return net, v, z, ref # ─────────────── 解码侧 ─────────────── def decode_chunked(net, z, chunk=CHUNK, ctx=0): """按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。""" if not isinstance(chunk, int) or chunk <= 0 or not isinstance(ctx, int) or ctx < 0: raise ValueError("chunk must be positive and ctx nonnegative integers") if z.ndim != 4 or min(z.shape) <= 0: raise ValueError("z must be nonempty [C,T,H,W]") nz = z.shape[1] pieces, starts = [], [] n_chunks = (nz + chunk - 1) // chunk for i in range(n_chunks): lo = i * chunk hi = min(lo + chunk, nz) lo_in = max(0, lo - ctx) out = net.decode(z[:, lo_in:hi]) keep = (hi - lo) * T_STRIDE # 上下文部分的输出要丢掉 pieces.append(out[:, -keep:]) starts.append(lo * T_STRIDE) return np.concatenate(pieces, axis=1), starts def decode_sweep(): net, v, z, ref = build() scale = float(ref.std()) print("── 解码侧:上下文帧数 vs 接缝误差 ──") print(f" {T_FRAMES} 帧输入 -> {z.shape[1]} 个潜变量帧(时间步距 {T_STRIDE})" f" -> {ref.shape[1]} 帧输出") print(f" 误差已按输出标准差归一化(std = {scale:.4f})") print("") print(" ctx | 块头误差 | 块尾误差 | 块内被污染帧数 | 边界跳变放大") print(" ----+---------+---------+----------------+------------") table = [] for ctx in range(0, 9): got, starts = decode_chunked(net, z, CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale head_idx, tail_idx, contam = [], [], 0 for s in starts[1:]: head_idx += list(range(s, s + T_STRIDE)) tail_idx += list(range(s + T_STRIDE, s + CHUNK * T_STRIDE)) contam += int((diff[s:s + CHUNK * T_STRIDE] > 1e-9).sum()) head = float(diff[head_idx].max()) tail = float(diff[tail_idx].max()) jump = boundary_jump(ref, got, starts) table.append((ctx, head, tail, contam, jump)) print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d} | {jump:.2f}x") return table def boundary_jump(ref, got, starts): """同一位置处,分块结果的帧间跳变相对整段结果放大了多少倍。 分母取「整段解码在同一帧的跳变」而不是全场平均——视频在某些帧本来就变化快, 拿全场平均当分母会把正常内容误判成接缝。 """ ratios = [] for s in starts[1:]: j_got = float(np.abs(got[:, s] - got[:, s - 1]).max()) j_ref = float(np.abs(ref[:, s] - ref[:, s - 1]).max()) if j_ref > 1e-12: ratios.append(j_got / j_ref) return max(ratios) if ratios else float("nan") def decode_profile(): """误差在块内是怎么衰减的:看第 2 块前 24 个输出帧。""" net, v, z, ref = build() scale = float(ref.std()) print("") print("── 第 2 块内的误差衰减(输出帧 32 起,取前 12 帧,按 std 归一)──") out = {} for ctx in (0, 2, 4, 6): got, starts = decode_chunked(net, z, CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale seg = diff[32:32 + 24] out[ctx] = seg print(f" ctx={ctx}: " + " ".join(f"{x:.1e}" for x in seg[:12])) return out # ─────────────── 编码侧 ─────────────── def encode_chunked(net, v, chunk_in=32, ctx=0): """在全局 stride=4 网格上切块;ctx 是最少请求的历史帧数。 向左对齐会实际再多取 0..3 帧;最后不足整块时也保留所有全局采样点。 仅用于本文无时间归一化、零前填充、总步距4的因果 toy。 """ if not isinstance(chunk_in, int) or chunk_in <= 0 or not isinstance(ctx, int) or ctx < 0: raise ValueError("chunk_in must be positive and ctx nonnegative integers") if v.ndim != 4 or min(v.shape) <= 0: raise ValueError("v must be nonempty [C,T,H,W]") if any(layer.time_pad != "causal" for layer in (net.e0, net.e1, net.e2, net.e3)): raise ValueError("this chunker requires the causal toy encoder") pieces = [] for lo in range(0, v.shape[1], chunk_in): hi = min(lo + chunk_in, v.shape[1]) lo_in = max(0, lo - ctx) // T_STRIDE * T_STRIDE z_i = net.encode(v[:, lo_in:hi]) first = (lo + T_STRIDE - 1) // T_STRIDE - lo_in // T_STRIDE stop = (hi + T_STRIDE - 1) // T_STRIDE - lo_in // T_STRIDE pieces.append(z_i[:, first:stop]) return np.concatenate(pieces, axis=1) def encode_sweep(): net, v, z, ref = build() scale = float(z.std()) print("") print("── 编码侧:上下文帧数 vs 潜变量误差 ──") print(f" 每块 32 个输入帧(= 8 个潜变量帧),误差按潜变量标准差归一" f"(std = {scale:.4f})") print("") print(" ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数") print(" ----+----------------+----------------+--------------") table = [] for ctx in (0, 4, 8, 12, 16, 20, 24): zh = encode_chunked(net, v, 32, ctx) if zh.shape[1] != z.shape[1]: print(f" ctx={ctx}: 潜变量帧数对不上 {zh.shape[1]} vs {z.shape[1]},跳过") continue d = np.abs(zh - z).max(axis=(0, 2, 3)) / scale head = float(d[8:10].max()) tail = float(d[10:16].max()) contam = int((d[8:16] > 1e-9).sum()) table.append((ctx, head, tail, contam)) print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d}") return table # ─────────────── 直接问:谁依赖谁 ─────────────── def dependency_table(): """扰动法:直接问「输出帧 o 依赖哪些潜变量帧」,从而算出必需的上下文帧数。""" net, v, z, ref = build() nz = z.shape[1] z_ref = net.decode(z) dep = np.zeros((nz, z_ref.shape[1]), dtype=bool) for j in range(nz): z2 = z.copy() z2[:, j] += 1.0 dep[j] = np.abs(net.decode(z2) - z_ref).max(axis=(0, 2, 3)) > 1e-12 print("") print("── 直接问:块头输出帧依赖哪些潜变量帧 ──") print(" 块起点(输出帧) | 依赖的最早潜变量帧 | 需要的上下文帧数") need = [] n_chunks = (nz + CHUNK - 1) // CHUNK for i in range(1, n_chunks): j0 = i * CHUNK o0 = j0 * T_STRIDE idx = np.where(dep[:, o0])[0] if len(idx) == 0: continue need.append((o0, int(idx.min()), j0 - int(idx.min()))) print(f" {o0:3d} | {int(idx.min()):3d} | {j0 - int(idx.min())}") widths = [] for o in range(z_ref.shape[1]): idx = np.where(dep[:, o])[0] widths.append(int(idx.max()) - int(idx.min()) + 1 if len(idx) else 0) rf_dec = max(widths) print(f" 解码器时间感受野(潜变量帧数,取所有输出帧的最大值)= {rf_dec}") print(f" 推论:所需上下文 = 感受野 - 1 = {rf_dec - 1} 个潜变量帧") return need, rf_dec def context_decomposition(): """逐层只缓存 (k_t - 1) 帧,折算回潜变量帧单位后累加起来等于什么? 这是检验「工业实现里每层只缓存 k_t-1 帧够不够」的关键一笔: 够不够取决于你把缓存折算回哪一级的单位。逐层缓存时,第 l 层的 k_t-1 = 2 帧是该层输入分辨率下的 2 帧,折回潜变量帧要乘上该层 相对潜变量的帧间距(上采样会把间距缩小)。 """ # 解码器 d0..d4 的输入相对潜变量的时间帧间距 spacing = {"d0": 1.0, "d1": 1.0, "d2": 0.5, "d3": 0.25, "d4": 0.25} k_t = 3 print("") print("── 逐层缓存 (k_t - 1) 帧,累加起来是多少 ──") print("") print(" 层 | 输入相对潜变量的帧间距 | 缓存 (k_t-1) 帧折回潜变量帧") print(" ----+------------------------+----------------------------") total = 0.0 for name, sp in spacing.items(): c = (k_t - 1) * sp total += c print(f" {name} | {sp:22.2f} | {c:12.2f}") print(f" 合计 | {'':22} | {total:12.2f}") print("") print(f" 实测需要的上下文(dependency_table)= 6 个潜变量帧") print(f" 逐层缓存累加 = {total:.2f} 个潜变量帧 -> " f"{'完全吻合' if abs(total - 6) < 1e-9 else '不吻合'}") print("") print(" 结论:本 toy 无时间归一化且上采样相位一致;逐层") print(" 此处折算与入口所需历史相符;真实模型还需检查其他算子和相位。若只在网络入口缓存一次——") print(" 那样只有 (k_t-1) = 2 帧,差得远。") return total def overhead(rf_dec=7, rf_enc=17): """带上下文要多算多少:ctx/(chunk+ctx),相对基线为ctx/chunk;均不是实测FLOP或显存比例。""" print("") print("── 上下文的开销 ──") print(" 解码块大小 | 需要上下文 | 重算时间位置比例") rows = [] for chunk in (8, 12, 16, 24): ctx = rf_dec - 1 frac = ctx / (chunk + ctx) rows.append(("decode", chunk, ctx, frac)) print(f" {chunk:3d} 潜变量帧 | {ctx:3d} 帧 | {frac * 100:.1f}%") print(" 编码块大小 | 需要上下文 | 重算时间位置比例") for chunk in (32, 64, 128): ctx = rf_enc - 1 frac = ctx / (chunk + ctx) rows.append(("encode", chunk, ctx, frac)) print(f" {chunk:3d} 输入帧 | {ctx:3d} 帧 | {frac * 100:.1f}%") return rows def state(): net, v, z, ref = build() return dict(z=z, ref=ref) if __name__ == "__main__": decode_sweep() decode_profile() dependency_table() context_decomposition() encode_sweep() overhead() temporal_budget.py # -*- coding: utf-8 -*- """时间压缩比的预算:运动多快的时候,压 s 倍时间就开始糊。 运行: python temporal_budget.py 把「时间下采样」简化成最朴素的 s 帧平均 + 最近邻还原(CogVideoX 的下采样层 真的就是 avg_pool1d,见 05 节)。学习型编码器可以重新分配表征预算,但这个教学模型 只演示量级和规律,不是神经 VAE 的误差下界,而且它有一条可以验的解析预期: 平均 s 帧 == 给运动物体糊上一条长度 (s-1) * v 像素的运动模糊 """ import numpy as np from causal_conv3d import base_rng # 画布要够宽:最快的斑点(4 px/帧 x 32 帧 = 128 px)必须全程留在画面内, # 否则斑点在后面几帧整个飘出去,加权宽度会因为分母趋于 0 而算成 nan。 T, H, W = 32, 32, 192 SIGMA = 3.0 # 斑点的高斯半径(像素) SPEEDS = [0.25, 0.5, 1.0, 2.0, 4.0] FACTORS = [1, 2, 4, 8] def moving_blob(speed, t=T, h=H, w=W, sigma=SIGMA, seed=11): """一个匀速横移的高斯斑点。不环绕,避免边界跳变污染 PSNR。""" rng = base_rng(seed) ys, xs = np.mgrid[0:h, 0:w] cy = h / 2.0 cx0 = w * 0.25 frames = [] for ti in range(t): cx = cx0 + speed * ti frames.append(np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / (2 * sigma ** 2)))) v = np.stack(frames)[None] # [1, T, H, W] return v + 0.001 * rng.normal(size=v.shape) # 微量噪声,避免除零 def avg_pool_time(x, s): """每 s 帧平均成 1 帧(非重叠分组)。""" n = x.shape[1] // s return x[:, :n * s].reshape(x.shape[0], n, s, *x.shape[2:]).mean(axis=2) def repeat_time(z, s, t_out=T): """最近邻还原:每个潜变量帧重复 s 次。""" return np.repeat(z, s, axis=1)[:, :t_out] def avg_pool_space(x, s): """空间 sxs 块平均。""" n_h, n_w = x.shape[2] // s, x.shape[3] // s y = x[:, :, :n_h * s, :n_w * s] y = y.reshape(x.shape[0], x.shape[1], n_h, s, n_w, s) return y.mean(axis=(3, 5)) def repeat_space(z, s): """空间最近邻还原。""" return np.repeat(np.repeat(z, s, axis=2), s, axis=3) def psnr(a, b, peak=1.0): mse = float(np.mean((a - b) ** 2)) return float("inf") if mse == 0 else 10.0 * np.log10(peak ** 2 / mse) def width_along_x(x): """斑点沿运动方向的强度加权标准差,用来量「被糊成多宽」。 两个坑都踩过: 1. 只能在空间维度上归约(沿 y 求和、保留 x)。把所有轴一起归约会把 x 也压掉,得到一个不随压缩变化的常数。 2. 要先掐掉噪声底。加权方差里 (x - mean)^2 是杠杆,画面远端一个 -0.026 的噪声像素能贡献 -9 的「方差」,把真实值直接打成负数。 """ xs = np.arange(x.shape[3])[None, None, :] # [1, 1, W] prof = x.sum(axis=2) # [1, T, W],沿 y 归约 prof = np.clip(prof, 0.0, None) thr = 0.005 * prof.max(axis=2, keepdims=True) # 掐掉噪声底,保留斑点 prof = np.where(prof < thr, 0.0, prof) wsum = prof.sum(axis=2, keepdims=True) + 1e-12 # [1, T, 1] mx = (prof * xs).sum(axis=2, keepdims=True) / wsum var = (prof * (xs - mx) ** 2).sum(axis=2, keepdims=True) / wsum return float(np.sqrt(var).mean()) def psnr_table(): print("── 时间压缩 s 倍之后,运动速度 vs 重建 PSNR(dB)──") print("") print(" 速度 v |" + "".join(f" s={s:<2d} " for s in FACTORS)) print(" --------+" + "".join("---------------" for _ in FACTORS)) table = {} for v in SPEEDS: x = moving_blob(v) row = [] for s in FACTORS: row.append(psnr(x, repeat_time(avg_pool_time(x, s), s))) table[v] = row print(f" {v:5.2f} |" + "".join(f" {p:8.2f} dB " for p in row)) print("") print(" 读法:s=1 是逐元素相同的原图(MSE=0,PSNR=inf);同一列往下看,运动越快越糊。") print(f" s=8 那一列从最慢到最快掉了 " f"{table[SPEEDS[0]][-1] - table[SPEEDS[-1]][-1]:.1f} dB。") return table def blur_law(): """验那条解析规律:糊掉的长度应该是 (s-1) * v。""" print("") print("── 验规律:平均 s 帧 ≈ 加一条长度 (s-1)*v 的运动模糊 ──") print("") print(" 速度 v | s | 斑点宽度 原图 -> 压缩后 | 实测增幅 | 解析预期") print(" --------+-----+-------------------------+----------+----------") rows = [] for v in (1.0, 2.0, 4.0): x = moving_blob(v) w0 = width_along_x(x) for s in (2, 4, 8): r = repeat_time(avg_pool_time(x, s), s) w1 = width_along_x(r) pred = np.sqrt(SIGMA ** 2 + v ** 2 * (s ** 2 - 1) / 12.0) rows.append((v, s, w0, w1, w1 / w0, pred / w0)) print(f" {v:5.2f} | {s:2d} | {w0:7.3f} -> {w1:7.3f} " f"| {w1 / w0:7.3f}x | {pred / w0:7.3f}x") print("") print(" 解析预期 = sqrt(sigma^2 + v^2*(s^2-1)/12) / 实测原宽度:") print(" 平均 s 个等间隔平移量,其离散方差是 v^2*(s^2-1)/12。") return rows def time_vs_space(): """时间压 s 倍与空间两轴各压 s 倍(总 s^2 倍),并非等码率对照。""" print("") print("── 不同元素压缩率:时间 s 倍 vs 空间 s^2 倍(PSNR,dB)──") print("") print(" 速度 v |" + "".join(f" 时间 {s}x / 空间 {s}x " for s in (2, 4, 8))) print(" --------+" + "".join("-----------------------" for _ in (2, 4, 8))) rows = [] for v in SPEEDS: x = moving_blob(v) cells = [] for s in (2, 4, 8): p_t = psnr(x, repeat_time(avg_pool_time(x, s), s)) p_s = psnr(x, repeat_space(avg_pool_space(x, s), s)) cells.append((p_t, p_s)) rows.append((v, cells)) line = " {:5.2f} |".format(v) for p_t, p_s in cells: line += f" {p_t:6.2f} / {p_s:6.2f} " print(line) print("") print(" 读法:空间那一列基本与速度无关(压空间就是把细节磨掉,一视同仁);") print(" 时间那一列随运动变快而下降。两条线会交叉,交叉之后") print(" 这只比较两种滤波失真,不能从非等码率交叉点推出实际压缩策略。") crossings = [] for si, s in enumerate((2, 4, 8)): prev_sign = None for v, cells in rows: p_t, p_s = cells[si] sign = p_t > p_s if prev_sign is not None and sign != prev_sign: crossings.append((s, v)) prev_sign = sign if crossings: print("") print(" 交叉点(压时间开始不如压空间的速度):") for s, v in crossings: print(f" s={s}x:约 {v} px/帧 附近") return rows def state(): return dict(psnr=psnr_table(), blur=blur_law(), ts=time_vs_space()) if __name__ == "__main__": psnr_table() blur_law() time_vs_space() token_ledger.py # -*- coding: utf-8 -*- """潜变量 token 账本:不同的时空压缩比,到底把 Transformer 的序列变成多长。 运行: python token_ledger.py 自注意力的代价是 O(N^2),所以真正决定「视频 DiT 能不能做全时空注意力」的 取决于patch后序列长度、宽度和kernel。这里N只是VAE网格数,N平方仅为同宽稠密attention的算术代理。 """ # 统一的输入:121 帧(5 秒 @ 24fps)、768 x 512、RGB T_IN, H_IN, W_IN, C_IN = 121, 512, 768, 3 # 表一:代表性VAE网格配置;不等于模型patch后的Transformer token数 REAL = [ ("图像 VAE 逐帧(SVD / AnimateDiff 口径)", 1, 8, 4), ("CogVideoX / Wan / HunyuanVideo(4x8x8)", 4, 8, 16), ("LTX-Video(8x32x32)", 8, 32, 128), ] # 表二:固定空间 8x8、通道 16,只扫时间压缩比——把时间这一维的贡献单独拎出来 TIME_SWEEP = [(s_t, 8, 16) for s_t in (1, 2, 4, 8)] def latent_frames(t_in, s_t): """因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。""" return (t_in - 1) // s_t + 1 def _row(name, s_t, s_h, s_c): t_out = latent_frames(T_IN, s_t) h_out = H_IN // s_h w_out = W_IN // s_h n = t_out * h_out * w_out return dict(name=name, s_t=s_t, s_h=s_h, ch=s_c, shape=(t_out, h_out, w_out), n=n, vals=n * s_c, cover=s_t * s_h * s_h * C_IN) def table_real(): pix = T_IN * H_IN * W_IN * C_IN print(f"输入:{T_IN} 帧(5 秒 @ 24fps)、{W_IN} x {H_IN}、RGB," f"像素值总数 = {pix:,}") rows = [_row(n, a, b, c) for n, a, b, c in REAL] base = rows[0]["n"] print("") print("── 表一:三个真实档位 ──") print("") print(" 配置 | 潜变量形状 (T'xH'xW'xC) " "| token 数 N | N^2 相对代价 | 平方比倍数 | 名义RGB数值/格点") print(" --------------------------------------+-----------------------" "+------------+-------------+---------+----------------") for r in rows: rel = (r["n"] / base) ** 2 r["rel"] = rel t, h, w = r["shape"] print(f" {r['name']:<38} | {t:3d} x {h:3d} x {w:3d} x {r['ch']:3d} " f"| {r['n']:10,d} | {rel:11.3e} | {1 / rel:7.1f}x | {r['cover']:8,d}") return rows def table_time_sweep(): print("") print("── 表二:固定空间 8x8 / 通道 16,只动时间压缩比 ──") print("") print(" 时间压缩 | 潜变量帧数 | token 数 N | 相对上一步便宜 | 相对 1x 累计") print(" ---------+------------+------------+----------------+-------------") rows = [] base = None for s_t, s_h, s_c in TIME_SWEEP: r = _row(f"s_t={s_t}", s_t, s_h, s_c) if base is None: base = r["n"] r["rel"] = (r["n"] / base) ** 2 rows.append(r) for i, r in enumerate(rows): step = (rows[i - 1]["n"] / r["n"]) ** 2 if i > 0 else 1.0 print(f" {r['s_t']:3d} x | {r['shape'][0]:10d} | {r['n']:10,d} " f"| {step:13.1f}x | {1 / r['rel']:11.1f}x") print("") print(" 规律:忽略首帧取整且同宽同patch时,时间比翻倍使N近似减半,N平方近似降至1/4。") return rows def why_channels_grow(): """压缩的是序列长度,不是信息量——通道数必须补回来。""" pix = T_IN * H_IN * W_IN * C_IN print("") print("── 为什么压缩比上去了,潜变量通道数也要跟着涨 ──") print("") print(" 配置 | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值)") print(" --------------------------------------+----------------+----------------------------") for name, s_t, s_h, s_c in REAL: r = _row(name, s_t, s_h, s_c) print(f" {name:<38} | {r['vals']:14,d} | {pix / r['vals']:8.1f} : 1") print("") print(" 数字要看懂:4x8x8 那一行和「逐帧图像 VAE」的压缩比几乎一样(46.8 vs 48.0),") print(" 它减少VAE网格数;数值个数不能衡量信息量——是否能计算 attention 仍取决于patch、宽度和kernel。") print(" LTX-Video 摘要里自述总压缩比 1:192,和上表最后一行的 181.5:1 是同一量级") print(" (这里差别完全来自首帧规则:192 * 121 / (8*16) = 181.5)。") def frame_count_rule(): """帧数必须满足什么条件,才能整除不被裁掉。""" print("") print("── 帧数该怎么选:T = 1 + k * s_T ──") for s_t in (4, 8): print(f" 时间压缩 {s_t}x:合法帧数 1, {1 + s_t}, {1 + 2 * s_t}, ... 即 T = 1 + k*{s_t}") print(f" 例:121 帧 -> {latent_frames(121, s_t)} 个潜变量帧" f"({'整除,不丢帧' if (121 - 1) % s_t == 0 else '不整除,会向下取整'})") print(f" 例:100 帧 -> {latent_frames(100, s_t)} 个潜变量帧" f"({'整除,不丢帧' if (100 - 1) % s_t == 0 else '不整除,会向下取整'})") def state(): return dict(real=table_real(), sweep=table_time_sweep()) if __name__ == "__main__": table_real() table_time_sweep() why_channels_grow() frame_count_rule() video_vae_checks.py """Independent temporal dependency, chunk alignment and accounting checks (NumPy only).""" import json from pathlib import Path from fractions import Fraction import numpy as np from causal_conv3d import ToyVideoVAE, make_video, conv3d_causal from chunk_decode import encode_chunked, decode_chunked from temporal_budget import psnr def decoder_support(o): indices = {o} for operation in ("conv", "conv", "up", "conv", "up", "conv", "conv"): if operation == "conv": indices = {i - d for i in indices for d in range(3)} else: indices = {i // 2 for i in indices} return indices def main(): rng = np.random.default_rng(20261028) net = ToyVideoVAE() shapes = 0 for t in range(1, 34): for s in (1, 2, 4): for k in (1, 3, 5): x = rng.normal(size=(1, t, 2, 2)) w = rng.normal(size=(1, 1, k, 1, 1)) y = conv3d_causal(x, w, (s, 1, 1)) assert y.shape[1] == (t-1)//s+1 shapes += 1 chunks = [] for t in (1, 7, 17, 25, 33): v = make_video(t=t, h=4, w=4) ref = net.encode(v) for chunk in (1, 5, 8, 11): for ctx in (16, 17, 19): got = encode_chunked(net, v, chunk, ctx) err = float(np.max(np.abs(got-ref))) assert got.shape == ref.shape and err == 0 chunks.append(dict(t=t, chunk=chunk, ctx=ctx, max_error=err)) v = make_video(t=48, h=4, w=4) ref = net.encode(v) old_pieces = [] for lo in range(0, 48, 16): hi = min(lo+16, 48) old_pieces.append(net.encode(v[:, max(0, lo-17):hi])[:, -(hi-lo)//4:]) old = np.concatenate(old_pieces, axis=1) old_error = float(np.max(np.abs(old-ref))) assert old_error > 1e-8 supports = [] for o in range(16, 128): j = o//4 support = decoder_support(o) assert support == set(range(j-6, j+1)) supports.append(dict(output=o, latent_min=min(support), latent_max=max(support))) # Nonnegative linear temporal chain independently probes each input impulse. impulse = np.eye(32, dtype=np.int64) def conv(a): pad = np.pad(a, ((0, 0), (2, 0))) return pad[:, :-2]+pad[:, 1:-1]+pad[:, 2:] y = conv(conv(impulse)) y = conv(np.repeat(y, 2, axis=1)) y = conv(conv(np.repeat(y, 2, axis=1))) for o in range(128): got = set(np.flatnonzero(y[:, o])) expected = decoder_support(o) & set(range(32)) assert got == expected z = rng.normal(size=(8, 15, 1, 1)) dr = net.decode(z) decode_errors = [] for chunk in (1, 3, 8): got, _ = decode_chunked(net, z, chunk, 6) err = float(np.max(np.abs(got-dr)));assert err == 0 decode_errors.append(dict(chunk=chunk, max_error=err)) blur = [] xs = np.arange(-128, 129, dtype=np.float64) for v in (.25, 1., 4.): for s in (2, 4, 8): mixture = sum(np.exp(-(xs-v*i)**2/18) for i in range(s)) / s mixture /= mixture.sum() mean = float(mixture@xs) variance = float(mixture@((xs-mean)**2)) expected = 9+v*v*(s*s-1)/12 error = abs(variance-expected);assert error < 1e-10 blur.append(dict(v=v,s=s,variance=variance,theory=expected,error=error)) assert psnr(np.ones(2),np.ones(2)) == float('inf') finite_ratio = Fraction(192*121, 8*16) assert finite_ratio == Fraction(363, 2) assert Fraction(6,8) == Fraction(3,4) and Fraction(6,14) == Fraction(3,7) result = dict(passed=True,shape_cases=shapes,chunk_cases=chunks,old_phase_error=old_error, decoder_supports=supports,independent_impulse_support_exact=True, decode_errors=decode_errors,blur_variance=blur,finite_ltx_ratio=str(finite_ratio), repetition_fraction=str(Fraction(6,14)),extra_over_baseline=str(Fraction(6,8)), errors=[],warnings=[]) Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,indent=2),encoding='utf8') print('PASS', shapes, 'shapes;', len(chunks), 'aligned encoding cases;', len(supports), 'decoder phases') print('Old unaligned ctx=17 encoder max error:', old_error) print('Exact finite ratio:', finite_ratio, '; extra/baseline=3/4; repeated/all=3/7') if __name__ == '__main__': main()
-
AIGC 基本功|自回归视频生成与 Forcing 范式-Forcing AIGC 基本功|自回归视频生成与 Forcing 范式-Forcing 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 训练目标与采样流程($\bar{\alpha}$ 记号、DDIM 单步更新直接沿用)、DiT 架构拆解(潜空间 patch 化成 token 的约定) 关键词:自回归视频、Diffusion Forcing、Self-Forcing、teacher forcing、曝光偏差、KV cache、流式生成 01. 为什么需要它 设想一个采用固定整段去噪的视频产品,等了3秒才出第一帧。若主要耗时来自采样循环,就需要先检查范式的交付粒度。 本文先以全序列双向扩散为对照:21 个潜帧(对应约 5 秒成片)拼成一条 3 万多 token 的序列,帧和帧之间双向可见,整段一起降噪。在这个循环里,最后一帧没去噪完,第一帧就不交付。这描述的是固定整段、无额外交付机制的采样循环:未来帧作为带噪状态已在张量里,并非“不存在”;当前帧依赖这些状态,须等当前整块完成。滑窗、分块或因果化会改变交互方式。 我按 Wan2.1-T2V-1.3B 的真实拓扑和 Self-Forcing 的默认配置,把这笔账算成了 MAC 数(第 06 节有完整过程):在假设有效算力 400 TFLOPS、只计 Transformer 的理想算术估算中,5 秒视频的全序列扩散整段 latent 就绪约 2.83 秒;换成因果自回归加 KV cache,首块去噪加缓存刷新折算 0.20 秒——账本中的 13.98 倍差距(不是实测 GPU 延迟)。而总算力几乎没变(比值 0.875,自回归反而略省)。 但把「一帧一帧往后生成」这条路走通,会立刻撞上一个语言模型社区早就算过的老账:训练时模型看的上下文是真值帧(teacher forcing),推理时上下文只能换成模型自己的输出。这两件事不是一回事,误差会顺着自回归链条滚雪球——这就是曝光偏差(exposure bias)。 Forcing 系列就是围着这两个问题打转的:Diffusion Forcing 把「下一帧预测」和「扩散去噪」缝成一个目标,让每帧带独立噪声级;Self-Forcing 干脆在训练时就用模型自己的 rollout 当上下文,缩小训练与推理的上下文分布差异。这篇把两个问题都算成数:流式的账用真实拓扑算,曝光偏差的坑用一个能完整复现的玩具实验拆开看。 02. 最小可用理解 把三种范式并排放,差别其实只有一句话:每一帧能看什么、历史从哪里来、以什么噪声级被看到。 这张图要看什么:上行是全序列扩散——所有帧共用同一个噪声级、一起降、双向注意力互相可见,代价是 4 步全部算完才有第一帧;中行是 teacher forcing——只有当前帧带噪声,上下文全是浅色真值帧,而推理时真值帧不存在,误差就从这里的「换上下文」进来;下行是因果自回归采样;训练时使用自身 rollout 对应 Self-Forcing,而独立噪声的 Diffusion Forcing 训练上下文仍来自数据——图示的历史帧以干净预测构建缓存(真实刷新路径见05节),当前 block 从高噪声一路降到干净,其中“训练用自身 rollout”是 Self-Forcing 的额外设计。 这里的帧指潜帧,block是一次生成的潜帧组;KV缓存保存历史各层key/value向量,并非原视频帧。03节需用到条件概率、均值与方差,额外假设将逐项说明。 三个要点: 全序列扩散:未来帧参与联合去噪,双向联合去噪通常须整块完成才能交付;可变长度、滑窗或块间生成需要额外设计,不能称为所有此类模型永远不能流式。 Diffusion Forcing:给每帧分配独立的噪声级 $k^{(t)}$。训练目标退化成「对每一帧做条件去噪」,采样时可以逐帧(逐 block)从高噪声降到干净再吐出去——这就是「next-token prediction 与全序列扩散的合流」这句话的数学含义。 Self-Forcing:承认上下文永远是模型自己的输出,于是在训练时就真的 rollout——上一帧生成完、进 KV cache、下一帧从它出发,整段视频算一个整体损失,而不是逐帧各自算。 顺带把「Forcing」这个词的出处交代掉。它来自语言模型的 teacher forcing:训练 RNN 语言模型时,每一步的输入都用数据集里的真值 token「强行喂入」(force),而不是模型上一步的输出。在采用因果掩码的Transformer中,这允许训练位置并行;RNN本身仍按时间递推,但也埋下了训练-测试分布错位的种子——语言模型社区管它叫 exposure bias,几十年里试过 scheduled sampling、DAgger 各种解法。Forcing 系列的谱系就是围绕这个错位逐步收紧的过程:Diffusion Forcing 先把「下一帧预测」的接口扩展成「每帧带独立噪声级的条件去噪」,让自回归的骨架里能塞进扩散的表达力;Self-Forcing 再把训练时的上下文从真值换成模型自己的 rollout,缩小这项错位(截断梯度、长度与采样设定仍有差异)。视频把这个问题变得更尖锐:语言模型一步错一个 token,视频一步错的是一整帧,而且帧与帧之间还有时间维度上的积分效应(下一节的主角)。 03. 数学推导 3.1 训练目标与推理目标的错位 为展示上下文错位,令x_t为第t个干净潜帧、k_t为噪声步、epsilon_t为独立标准高斯,z_t(k_t)为按3.3节加噪的输入;f_theta为参数theta的干净帧预测器,gt是真值历史,向量范数对潜帧全部分量求平方和。期望覆盖数据、噪声步和噪声,可用简化目标: $$\mathcal L_{TF}=E_{x,k,\epsilon}\sum_t\|x_t-f_\theta(z_t(k_t),k_t,x_{\lt t}^{gt})\|^2.$$ 推理时把真值历史换成模型生成历史 $\hat x_{\lt t}$,但通常不在推理现场优化损失。用同样的去噪回归在生成历史上评测,只是本文的受控诊断量,不是视频生成质量的完整定义;任意生成视频与某条真值逐帧 MSE 也不是 Self-Forcing 的训练目标。 训练和评测使用同一个 $f_\theta$ 时,上下文从数据历史换成模型历史即可造成分布偏移。充分容量下精确学习每个条件分布可得到正确联合分布;现实中的估计误差、有限容量和长时 rollout 会放大这一差异。 3.2 误差如何传播:有限和、偏差与快慢 令 $e_t$ 是第 $t$ 步的标量误差,$a$ 是有效传递系数,$\delta_t$ 是本步新增误差。先假设 $e_0=0$,增量独立、零均值、方差为 $v$。展开递推 $e_t=ae_{t-1}+\delta_t$ 得 $e_T=\sum_{j=0}^{T-1}a^j\delta_{T-j}$;独立性令交叉协方差消失,所以 $$\operatorname{Var}(e_T)=v\sum_{j=0}^{T-1}a^{2j}=v\frac{1-a^{2T}}{1-a^2},\qquad a^2\ne1.$$ 最后一步是等比数列求和。$a=1$ 或 $a=-1$ 时直接用有限和得到 $Tv$;$|a|\lt1$ 时极限为 $v/(1-a^2)$;$|a|\gt1$ 才有指数增长。$a=0.97$ 与0.85的极限放大系数约16.9和3.60,前者更晚饱和:慢和快在这里都是有界的。 若增量均值为 $m$,均值误差还含 $m\sum_j a^j$,MSE是方差加均值平方;相关增量还带交叉协方差。矩阵情形需检查 $A^j$ 的范数,不能只报谱半径。例如 $A=\begin{pmatrix}0.5&10\\0&0.5\end{pmatrix}$ 的谱半径只有0.5,却把单位向量 $(0,1)$ 一步放大到范数10.0125。 toy数据慢矩阵是0.97倍正交矩阵、快矩阵是0.85倍正交矩阵再过tanh;它们不等于学习器闭环误差的传递系数。耦合、非线性、初始误差与估计偏差会改变结果。下文只报告快慢分量曲线,不把实测倍数接近16.9当作上述公式的证明。forcing_checks.py 独立检查30个有限和与非正规矩阵反例。 3.3 Diffusion Forcing:每帧一个独立噪声级 标准全序列噪声训练通常共享 $k$;Diffusion Forcing 对各帧独立采噪声级,并把带噪历史一起作为条件。例如噪声预测形式为: $$\mathcal L_{DF}=E_{x,k_{1:T},\epsilon_{1:T}}\sum_t w(k_t)\|\epsilon_t-\epsilon_\theta(z_{\le t},k_{\le t})\|^2,$$ w(k_t)是非负时间权重,epsilon_theta是噪声预测器;此目标显式输入噪声级,与toy不同。其中 $z_t=\sqrt{\bar\alpha_{k_t}}x_t+\sqrt{1-\bar\alpha_{k_t}}\epsilon_t$;也可等价改写成带相应权重的 $x_0$ 预测。历史 $z_{\lt t}$ 通常也带各自的噪声,不能只在公式里写干净的 $x_{\lt t}$。 统一噪声级可恢复共享噪声训练形式,但不会自动把因果遮罩变成双向注意力;把历史噪声降到 0、仅对当前块去噪,则给出自回归采样接口。当前块仍从高噪声逐步降噪,不是“把当前噪声取最小就等于 next-token prediction”。 3.4 Self-Forcing:在训练时就把分布掰过来 Self-Forcing 第 3.3 节 用自身自回归 rollout 产生整段视频,再做视频级分布匹配。以 DMD 为例,目标可写为 $$\mathcal L_{SF}=E_k\big[D_{KL}(p_{\theta,k}(x^{1:T})\|p_{data,k}(x^{1:T}))\big].$$ 这里k是对整段视频施加的评估噪声级,p_theta,k与p_data,k分别是生成/数据经该加噪核后的联合密度。这里比较生成与数据的加噪联合分布,借助教师/学生 score 估计更新;论文还考察 SiD、GAN 损失。它不是逐帧配对 MSE,也不是 DAgger 的同义词。二者都关注自生成上下文,但经典 DAgger 需要专家对学习器访问状态提供标签,Self-Forcing 不以这种标签循环定义。 本文下面的线性回归 toy 诊断历史替换,并在自身历史特征上做配对标签重拟合。目标仍是原配对轨迹下一帧;既没有DAgger的访问状态专家重标注,也没有累计数据集,因此只借用了“收集自身历史”的想法。它没有实现DMD,不能用它的失败证明Self-Forcing失败。 3.5 梯度怎么穿过 rollout Self-Forcing 为控制显存,每个序列随机选一个去噪退出步,只保留最终被选步骤的反传,并阻断先前帧 KV cache 的梯度;这比笼统说“回传最近几帧”更准确。普通一阶反传并不自动产生 Hessian 的二阶交叉项。 本文toy不对rollout链反传。岭回归后从0.3起最多五次折半,按独立验证集前24帧MSE选步;外推测试末帧超过初始50倍的保护仅是探索性停止规则,故不声称选择后的长时测试有无偏泛化保证。日志现打印真正接受的alpha。 04. 代码实现 完整实验在 forcing_lab.py(附录有全文,numpy 单文件可跑)。比较两种局部特征模型,以及同一因果模型替换历史后的表现: 动力系统:3 维慢变量 $u_t = \Lambda u_{t-1} + G w_{t-1} + 0.02 \xi$(谱半径 0.97)+ 3 维快变量 $w_t=\tanh(h_t)+0.1\eta_t$,其中 $h_t=A_ww_{t-1}+B_wc$(线性部分为0.85倍正交矩阵;tanh再改变局部雅可比),xi与eta为独立标准高斯增量;再加一个每条序列固定、模型可见的条件向量 $c$(类比文本 embedding——没有它第一帧不可预测,实验就没法做)。 去噪:教学用4次预测、确定性DDIM更新(eta=0),噪声步 $[1000, 750, 500, 250]$,线性 beta 表。特征维数两范式完全相同($F = 3D + 4 + 1 = 23$),线性回归头(岭回归闭式解)——给定数据可求确定的回归解,但数据、噪声、特征和模型假设仍决定结果,不能把差异全部归因于范式。 训练集形状[6000,72,6]、测试集[1500,72,6],只用前24帧拟合,外推到72帧;种子13另生成300条验证序列选步。回归头不显式输入噪声步、混合拟合各步,限制了模型能力。VP末端alpha_bar约0.00004036,以标准高斯启动只是有限终端近似。 双向与因果模型的信息分布、特征定义和采样过程不同,等维数不保证公平架构比较。更窄的干预是:同一个TF权重分别读真值历史与自身历史,测试样本i两端均重置种子32000+i,每帧初始噪声配对,因此无历史的第0帧应逐元素相同。x_true只作标签,不再泄漏进生成初始状态。TF是使用测试真值的oracle诊断;逐帧MSE还含不可预测过程噪声,不是视频分布质量。 核心特征函数如下;完整采样器和训练循环保留在附录: def feat_causal(z_t, hist, c): if len(hist) == 0: prev = np.zeros(D) past_mean = np.zeros(D) else: prev = hist[-1] past_mean = np.asarray(hist[-4:]).mean(axis=0) return np.concatenate([z_t, prev, past_mean, c, np.ones(1)]) 这张图要看什么:左图三条曲线在训练视野边界(第 24 帧,竖虚线)附近的分叉——teacher forcing 平在 0.01 附近,但它测试时不可得;自身历史曲线与TF分开,越过视野后慢分量误差明显增大,曲线并非处处单调。右图把 rollout 的误差拆成快慢两块:慢变量(红)在所测 72 帧窗口内继续增大,不能据此证明无限长度发散,快变量(绿)基本是平的——这仅描述当前模型与有限长度,不验证独立增量方差假设。 真实输出(逐帧 MSE,每维平均平方误差): 零起始帧号 双向局部特征 TF真值历史 自身历史rollout 0 0.36699 0.32436 0.32436 1 0.33968 0.02699 0.27516 11 0.20119 0.01125 0.17958 23 0.24698 0.01149 0.22396 47 —(本次只采24帧) — 0.41614 71 —(本次只采24帧) — 0.60306 本次视野内MSE分别为0.23990、0.02535、0.20947;同权重历史替换对应约8.26倍误差比。它诊断当前弱模型的上下文依赖,不能换算成真实视频质量降低多少。 把 rollout 的误差按 3.2 节拆开: 状态分量 TF视野内 rollout视野内 二者比值 rollout视野外/内 慢变量u 0.01863 0.28621 15.36 2.45 快变量w 0.03207 0.13272 4.14 1.01 这些倍数仅是当前拟合器的分量统计;数据转移系数、误差相关和配对过程噪声不同,不能把它们与16.9或3.6做一一理论拟合。有限区间内增长也不是无限长度发散证据。 Q3现在称“配对标签重拟合”:自身历史配原序列标签,独立验证集选混合步长;没有专家重新标注、数据聚合或DMD。Q4固定真值历史只改加噪,Q5改训练历史的噪声级,再用干净真值/自身历史评测。 训练先对每条历史帧独立加噪,再用同一组帧构造prev和past_mean;评测同样只加一次,并在四次当前帧去噪之间保持历史固定。空历史仍为零。四帧均值噪声方差、prev与均值的噪声协方差都为 $(1-\bar\alpha_k)/4$,分别给两个汇总特征加独立同方差噪声会破坏这两项。此toy只用一个全局历史噪声级且未显式输入网络,不等于独立逐帧噪声的Diffusion Forcing。 05. 工业级实现对照 固定到官方Self-Forcing提交 33593df3e81fa3ec10239271dd2c100facac6de1,检查日期2026-10-29。锚点为 CausalInferencePipeline、SelfForcingTrainingPipeline、self_forcing_dmd.yaml、default_config.yaml、WanDiffusionWrapper与FlowMatchScheduler。 学生和教师必须分开。 包装器默认 model_name="Wan2.1-T2V-1.3B";配置中的 real_name: Wan2.1-T2V-14B 是real score教师,并非生成器尺寸。生成器学习率2e-6,DMD目标,形状[1,21,16,60,104]、每块3潜帧,默认不单独生成首帧。四步列表[1000,750,500,250]开启warp。本文账本只数学生生成,不含教师/critic训练。 同提交Wan 1.3B配置给出宽1536、FFN8960、30层、12头,每头128;patch=(1,2,2),VAE stride=(4,8,8)。60×104是潜空间宽高,每帧(60/2)(104/2)=1560个token,通道16进入patch特征,不再乘token数。21潜帧对应1+4(21-1)=81像素帧,16fps约5.06秒;首块3潜帧对应9像素帧,之后每块增加12帧。 四次预测加一次刷新,但不是四步确定性DDIM。 官方相邻预测之间调用flow加噪器,使用新标准高斯重新污染预测的干净结果,而非沿用同一个噪声估计。形式 $z=(1-\sigma)x+\sigma\epsilon$ 不等于toy VP的 $\sqrt{\bar\alpha}x+\sqrt{1-\bar\alpha}\epsilon$。warp用shift=5的1000点表,通过1000-step索引映射,因此名义750不是线性beta表的第750步。 四次后,普通推理用干净的 denoised_pred 输入、context_noise时间标签再跑一次,覆盖当前块K/V;刷新前没有再加噪。训练管线则先scheduler.add_noise,再在no_grad内刷新。表设置sigma_min=0且extra_one_step=True,排除了精确零;时间步0的最近点sigma约0.00498008,所以固定版本的训练刷新仍有小量污染。不能把toy“上下文多少VP噪声”当作通用官方参数契约。 缓存的实际分配不同于理想动态账本。 K/V每层形状[B,capacity,12,128];普通推理无局部窗时一开始预分配32760容量,局部窗时为local_attn_size×1560。30层bf16共5.623627GiB,非逐帧从零分配。文本K/V每层[B,512,12,128],合计0.087891GiB;512是固定文本槽位数。块内彼此可见、块间因果,不是块内逐token三角遮罩。滚动窗口还受sink token、位置编码和训练局部注意力影响,不能无条件截断。 普通 inference() 最后才调用以下解码,再返回整段: vae.decode_to_pixel(output, use_cache=False) 它可以逐块算latent,调用这个函数仍不能逐块收到像素帧;流式产品还需要分块VAE、交付接口和传输。本文MAC不含这些成本。 梯度和实跑边界。 训练随机选退出去噪步,之前步不记录梯度、退出步反传、缓存刷新不反传;same_step_across_blocks控制共享索引,超过21帧时更早块也关闭梯度。它是截断估计,不是完整BPTT。DMD用整段加噪分布的score差,非配对MSE。 本次未经改写执行原始完整方法AST:CPU四种退出位置均验证前步无梯度/退出步有梯度/刷新无梯度;两块推理共10次前向,刷新输入等于干净预测。原始分配方法在meta设备核对真实shape与字节;flow加噪float32/64四组输入通过。生成器、文本、VAE用小张量回调,退出索引由夹具指定,未加载权重、未跑真实CUDA/NCCL/完整DMD或视频质量。论文第4节与附录A报告DMD约1.5小时/64张H100,属于原论文训练预算;本机CPU核验不支持推断训练收敛或GPU吞吐。 06. 代价与边界 流式不是免费的,把账算干净。 这张图要看什么:左图台阶是按顺序完成预测与刷新的latent就绪点,像素轴按压缩率理论换算:首块9帧、之后每块12帧;没有计入解码或实际GPU时间,橙色竖线是全序列扩散一次性交付的时刻;中图和右图是一对警告——不滚动缓存时显存和单 block 时间都随长度线性涨,无sink的理想9潜帧有效窗口限制这两项;非官方整应用显存测量。 口径先交代清楚(逐项对齐公开配置,代码在附录 streaming_ledger.py):每层每 token 的 MAC = 注意力分数(对每个可见 key 做两次内积,$2 \times n_{\text{key}} \times d$)+ 四个注意力投影($4 d^2$)+ FFN($2 \times d \times 8960$)+ 一次 cross-attention(对 512 个文本 token 的分数与投影)。KV cache 每潜帧的字节数按以下乘积计算,折合0.267792GiB: $$2 \times30\times1560\times1536\times2=287539200\text{ B}.$$ (十进制0.287539GB)——K、V 两份,乘 30 层、每帧 1560 token、$d = 1536$、bf16 两字节——21帧合计5.623627GiB,即6.0383232GB。时间按假设有效400 TFLOPS折算(1 MAC = 2 FLOP),只算 transformer 主体,不含 VAE 解码与文本编码。 算力账(400 TFLOPS 有效算力折算,MAC 计入注意力 QKV 与投影): 全序列扩散 因果 + KV cache 单步去噪 MAC 1.4142e+14 首块 8.09e+12 → 末块 2.02e+13 四次全序列 / 每块四次加刷新总MAC 5.6567e+14 4.9514e+14(比值 0.875) 总时间 2.828 s 2.476 s 首块含刷新折算(非像素交付) 2.828 s 0.202 s(13.98×) 末块算术节奏 一次性交付 末块505.1ms,实时预算 750 ms,余量 1.48× 首块四次预测完成即有干净latent,算术折算约0.162秒;表中0.202秒额外计一次刷新,二者对应整段/首块比约17.48与13.98。四步后最后块的刷新也按原循环计入。norm、激活、调制、patch输入输出、文本K/V首次投影、VAE、随机数、数据搬移与kernel launch均未计入。固定400TFLOPS速率未随shape或瓶颈变化,不能推断实际实时。 两点容易被误读:其一,自回归并不显著省总算力(0.875 倍,注意力遮罩少算的钱被 KV cache 刷新的额外前向花掉了大半),它主要改变latent交付粒度和后续块节奏;其二,若每层稠密保存 32760×32760×12 个 bf16 分数,约 25.76 GB(24.0 GiB)(32760 token 的平方 × 12 头 × bf16),精确IO优化注意力可避免物化这项;并不减少全部二次算术(前置阅读见那篇)。 显存账(bf16 KV cache,30 层全量):21帧有效容量5.624GiB,理想9帧窗口2.410GiB(43%)。不滚动的话,生成到 336 潜帧(336 个潜帧按 4 倍时间解码约 1341 帧,在 16 fps 下约 83.8 秒)时单 block 要 5.8 秒、缓存89.98GiB——两头都爆炸;9 帧滚动窗口下恒定 303.2ms、2.41GiB(仅理想有效注意力窗口)。固定可见窗口可限制这两项工作量,但会丢弃远程直接信息。官方普通函数预分配缓存并保存整段latent,所以不能据此宣称整个应用空间恒定或长时语义稳定。 质量与稳定性的账,用两个受控实验说: 这张图左侧以一个MSE坐标校准历史扰动,右侧给不同训练历史加噪的视野内与末帧测试误差;曲线和标注来自本次统一加噪方式后的完整实跑, 等效噪声级约160.4:仅令两个实验的一个MSE相等,对应toy alpha_bar约0.7636。先确认Q4曲线严格递增且目标被上下端夹住,才插值;它不说明rollout误差真是高斯,也不能跨模型比较。 不同指标偏好不同训练扰动:Q5完整八点见08节;TF用真值历史、自回归用自身历史。末帧MSE下降不等于长时稳定被证明,须连同视野内精度和多种时长检验。 历史加噪是要验证的设计条件:Q4固定真值历史,Q5训练历史加噪后测试干净或生成历史。统一了逐帧加噪与求均值的联合分布,但这个回归头没有噪声级输入,不能外推成官方context_noise契约。 双向与因果局部特征模型的MSE比较不能证明真实因果生成必然不损质量,也不能分解真实系统曝光偏差和蒸馏各占多少。模型信息、特征、目标和采样条件均需一起比较。 07. 经典论文脉络 Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks:在训练历史中逐步引入自身预测;不能仅凭混合历史就断言所有任务必然变差。 A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning:DAgger为学习器访问状态取专家标签并聚合数据;本文配对标签重拟合不满足这两个完整条件。 Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion:独立逐token噪声级与因果序列模型支持多种采样日程。原始方法含循环隐状态,不要求所有实现都用Transformer KV缓存;统一噪声也不会把因果遮罩变双向。 From Slow Bidirectional to Fast Autoregressive Video Diffusion Models(CausVid):从双向教师蒸馏因果少步学生;因果化和步数蒸馏是两个设计维度。 Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion:自身rollout与视频级分布匹配,结合截断梯度及滚动缓存。论文预算、质量和速度属于其模型与硬件条件。 这条脉络同时改变历史来源、噪声条件、后训练目标和采样成本,不能压成“加噪后再做DAgger”。相关推导见DDIM、流匹配与潜空间扩散。 08. 常见误解 误解一:“自回归必然省总算力,0.20秒就是产品首帧。” 当前0.875倍只属于该shape、可见范围及每块四次预测加刷新;0.20秒是含刷新算术折算,VAE、接口和传输未计入。官方普通函数还在末尾整段解码。 误解二:“谱半径决定一切,0.97意味着无限发散。” 理想独立零均值标量模型在绝对系数小于1时有界;偏置、相关增量和非正规矩阵另查。数据转移0.97不等于学习器误差闭环0.97。 误解三:「在自生成上下文上逐帧重拟合,轮次越多就越稳。」 看配对标签重拟合用验证集视野内误差选步时发生了什么: 蓝柱读左轴视野内MSE,红柱读右侧对数轴末帧MSE。Q3按独立验证集选步,真值不参与生成初始状态;它既不是完整DAgger,也不是Self-Forcing消融。以下给本次完整实跑: 轮次 测试视野内MSE 测试t=71MSE round0 0.20947 0.60306 round1 0.18767 0.82679 round2 0.17684 4.70642 round3 0.17357 11.66893 误解四:「训练时给上下文加噪越多越鲁棒。」 右图(06 节)的折中曲线明确说不是,Q5 的原始数据在这里: 训练历史噪声步 TF诊断 rollout视野内 rollout末帧t=71 0 0.02535 0.20909 0.60274 50 0.02723 0.21259 0.59302 100 0.03301 0.21712 1.23368 150 0.04476 0.26883 2.38543 200 0.06276 0.40246 3.12273 250 0.08539 0.57413 2.58114 300 0.11001 0.67454 1.52668 400 0.15310 0.54038 0.58389 Q5用训练噪声种子24重新拟合,测试初始噪声按90000+i配对;Q1用训练种子22、测试种子32000+i,因此两个k=0基线略有差异。 本次八点只展示这个弱模型的精度取舍,视野内和末帧可以偏好不同超参。不要混算TF与rollout列,也不能把单条MSE下降解释为长时稳定性证明;这里没有实现独立逐帧噪声且输入噪声级的Diffusion Forcing。 误解五:“因果注意力必须丢质量,或一定不丢质量。” 本toy不支持任何一项普遍结论。双向信息、架构容量、后训练与采样误差都需真实模型实验,不能用配对MSE替代视频分布评测。 09. 动手验证 四脚本全文见附录;教学实验依赖NumPy,制图另需matplotlib,无权重或GPU要求。快速版样本较少,写独立fast缓存,不能拿其数字配完整实验图。 python forcing_lab.py --fast python forcing_lab.py python streaming_ledger.py python forcing_checks.py python make_figures.py 完整Q1第0帧TF与rollout应逐元素相同;视野内均值约0.02535与0.20947。Q3接受步长须对照当前日志,不能沿用旧发散表。 forcing_checks.py 独立检查30个误差有限和、DDIM约2.22e-16误差、非正规矩阵一步10.0125放大;传标签不改变生成、同随机数首帧相等。10万条历史夹具验证均值方差与prev/mean协方差,理论值0.118979。 账本全量应5.623627GiB,即6.0383232GB;将21潜帧改42,理想缓存翻倍,总算术量不按同一倍数增长。支持非整块尾块。首块条件不变时首块折算不变,后块仍读更长历史。 改慢变量系数后须重新生成数据、训练并更新缓存;不要预设学习器误差比必然变成3.6。理论3.6属于独立增量标量方差模型,用有限和单独验证。 源码先分学生model_name与教师real_name,再查warp、add_noise和刷新路径。CPU原方法夹具验证控制流和算术,不支持宣称真实Wan视频质量或GPU速度。 10. 延伸阅读 Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion(arXiv 2407.01392,NeurIPS 2024) Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion(arXiv 2506.08009) 代码:guandeh17/Self-Forcing(pipeline/causal_inference.py、configs/self_forcing_dmd.yaml) 本系列相关篇目:KV cache、FlashAttention、DDIM 采样器、流匹配 互补阅读是少步蒸馏与下游世界模型;流式出帧不自动等于可交互环境。少步数蒸馏(DMD / 蒸馏到 1~4 步)——Forcing 解决了「怎么流式地生成」,蒸馏解决「每块少算几步」,两者拼起来才是实时视频生成的完整拼图。 读原论文的建议顺序:先读 Self-Forcing 的第 3 节(推理管线那五步,对照本文 05 节的表),再回头读 Diffusion Forcing 的第 3 节(目标函数的统一形式,对照本文 3.3 节)——反过来读会被「每帧独立噪声级」的抽象描述卡住,先看到具体的采样循环再回头抽象,会顺很多。玩具实验(04 节)建议在读论文之前跑一遍,数字先在手里,论文里每一句关于 exposure bias 的表述都能对号入座。 附录:完整代码 09 节用到的脚本全文如下(forcing_checks.py、forcing_lab.py、streaming_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 forcing_checks.py """Independent arithmetic checks for the article (NumPy only).""" import json from pathlib import Path import numpy as np import forcing_lab as f import streaming_ledger as s def main(): rng = np.random.default_rng(77) errors = [] for a in [0.0, 0.85, 0.97, 1.0, -1.0, 1.02]: for length in [1, 2, 24, 72, 200]: # Independent impulse response versus iterated covariance. v = 0.0 for _ in range(length): v = a*a*v + 0.04 direct = 0.04 * sum(a**(2*j) for j in range(length)) errors.append(abs(v-direct)) assert max(errors) < 1e-9 transient = np.array([[0.5, 10.0], [0.0, 0.5]]) assert max(abs(np.linalg.eigvals(transient))) == 0.5 assert np.linalg.norm(transient @ [0., 1.]) > 10 # DDIM: exact x0 and shared epsilon reproduce every intermediate. x, noise = rng.normal(size=(2, 6)), rng.normal(size=(2, 6)) ddim_errors = [] for t, u in [(1000, 750), (750, 500), (500, 250), (250, 0)]: a, b = f.abar_of(t), f.abar_of(u) z = np.sqrt(a)*x + np.sqrt(1-a)*noise expected = np.sqrt(b)*x + np.sqrt(1-b)*noise ddim_errors.append(float(np.max(abs(f.ddim_step(z, x, a, b)-expected)))) assert max(ddim_errors) < 1e-14 W = rng.normal(0, 0.02, size=(f.F_DIM, f.D)) truth, cond = f.sample_sequences(rng, f.make_system(), 2, 8) free = f.sample_causal(W, np.random.default_rng(9), 8, cond[0]) labelled, features, labels = f.sample_causal( W, np.random.default_rng(9), 8, cond[0], collect=True, x_true=truth[0]) assert np.array_equal(free, labelled) # labels cannot leak into generation teacher = f.sample_causal(W, np.random.default_rng(9), 8, cond[0], hist_true=truth[0]) assert np.array_equal(free[0], teacher[0]) # Correct joint history covariance, rather than two independently noised features. level = 250 data = np.tile(truth[:1], (100000, 1, 1)) X, Y = f.build_gt_dataset(data, np.tile(cond[:1], (len(data), 1)), np.random.default_rng(17), levels=[500], ctx_ts=level) n = len(data) assert not X[:n, f.D:3*f.D].any() # empty history remains exactly zero t = 4 prev = X[t*n:(t+1)*n, f.D:2*f.D] mean = X[t*n:(t+1)*n, 2*f.D:3*f.D] covariance = float(np.cov(prev[:, 0], mean[:, 0], ddof=0)[0, 1]) variance = float(mean[:, 0].var()) expected = (1-f.abar_of(level))/4 assert abs(covariance-expected) < 0.002 assert abs(variance-expected) < 0.002 # Enumerate visible token pairs independently from the algebraic ledger. pairs = sum((min(i+3,21)-i)*min(i+3,21) for i in range(0,21,3)) expected_pairs = 3*3*sum(range(1,8)) assert pairs == expected_pairs == 252 ledger = s.ledger_numbers() bytes_per_latent = 2*30*1560*1536*2 assert ledger['kv_all_gb']*2**30 == bytes_per_latent*21 assert s.gbyte(bytes_per_latent*42) == 2*ledger['kv_all_gb'] assert [4*(3*i-1)+1 for i in range(1,8)] == [9,21,33,45,57,69,81] result = dict(passed=True, recurrence_cases=len(errors), recurrence_max_error=max(errors), nonnormal_spectral_radius=.5, nonnormal_one_step_norm=float(np.linalg.norm(transient@[0.,1.])), ddim_max_error=max(ddim_errors), labels_do_not_change_generation=True, first_frame_paired_exact=True, noisy_history_covariance=covariance, noisy_mean_variance=variance, covariance_theory=expected, block_pairs=pairs, kv_bytes_per_latent=bytes_per_latent, kv_21_gib=ledger['kv_all_gb'], latency_ratio=ledger['t_full']/ledger['t_blocks'][0], toy_vp_terminal_alpha=f.abar_of(1000), errors=[], warnings=[]) Path(__file__).with_name('validation_results.json').write_text( json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8') print(json.dumps(result,ensure_ascii=False,indent=2)) if __name__ == '__main__': main() forcing_lab.py # -*- coding: utf-8 -*- """ forcing_lab.py —— 自回归视频生成 / Forcing 范式的玩具实验(只依赖 numpy) 跑法: python forcing_lab.py # 全量 python forcing_lab.py --fast # 小样本快速迭代 python forcing_lab.py --rounds 4 # 多做几轮配对标签重拟合 python forcing_lab.py --ctx 0 100 250 # 只扫这几个上下文噪声级 数据是一段"带条件的 6 维视频",分成两块,故意让它们的时间尺度不同: u(前 3 维)慢变量:u_t = Lam u_{t-1} + G w_{t-1} + 噪声,Lam 的谱半径 0.97 —— 一条会被积分记住的轨迹,误差会累积(相机轨迹、主体位置) w(后 3 维)快变量:w_t = tanh(Aw w_{t-1} + Bw c) + 噪声 —— 收缩模态,误差会被动力学忘掉(纹理、局部细节) 输出顺序与正文表格一一对应: Q1 三种范式的逐帧误差:全序列扩散 / teacher forcing / 自回归 rollout Q2 当前拟合器的误差分量;不把数据生成谱半径当闭环误差的系数 Q3 配对标签线性重拟合;不是 Self-Forcing 的 DMD 实现 Q4 历史加噪扫描;与官方flow context_noise不是相同接口 """ import argparse import os import numpy as np # ═══════════════════════════════ 0. 配置 ═══════════════════════════════ DU = 3 # 慢变量 u 的维度(会被积分记住的分量) DW = 3 # 快变量 w 的维度(收缩的分量) D = DU + DW # 每帧"潜向量"的总维度 DC = 4 # 条件向量维度(类比文本 embedding) T_TRAIN = 24 # 训练时的序列长度(horizon) T_ROLL = 72 # 推理外推到 3 倍长度 N_STEPS_DIFF = 1000 STEPS = [1000, 750, 500, 250] # 对齐 Self-Forcing 的 4 步去噪 LAM_SLOW = 0.97 # 慢变量的自回归系数(谱半径) RHO_FAST = 0.85 # 快变量转移矩阵的谱半径 G_SCALE = 0.09 # 快变量驱动慢变量的耦合强度 SIG_U = 0.02 # 慢变量的过程噪声 SIG_W = 0.10 # 快变量的过程噪声 LAMBDA = 3e-3 # ridge 系数(压住上下文权重,防止 rollout 重训时正反馈发散) ALPHA = 0.3 # toy 重拟合 每轮的权重更新步长(1.0 = 完全换成新解) SEED_SYS = 20250608 CACHE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "forcing_lab_cache.npz") # ═══════════════════════ 1. 噪声表:线性 beta 调度(DDPM 原版)═══════════════════════ def build_schedule(n_steps=N_STEPS_DIFF, beta0=1e-4, beta1=0.02): beta = np.linspace(beta0, beta1, n_steps) return np.concatenate([[1.0], np.cumprod(1.0 - beta)]) # 下标 = 时间步 t ABAR = build_schedule() def abar_of(timestep): t = min(max(int(round(timestep)), 0), N_STEPS_DIFF) return float(ABAR[t]) # ═══════════════════════ 2. 数据:慢变量 + 快变量 + 条件 ═══════════════════════ def _ortho(rng, n, rho): q, _ = np.linalg.qr(rng.standard_normal((n, n))) return rho * q def make_system(): rng = np.random.default_rng(SEED_SYS) return dict( Lam=_ortho(rng, DU, LAM_SLOW), G=rng.standard_normal((DU, DW)) * G_SCALE, Aw=_ortho(rng, DW, RHO_FAST), Bw=rng.standard_normal((DW, DC)) * 0.9, H=rng.standard_normal((DU, DC)) * 0.9, ) def sample_sequences(rng, S, n, T): """采样 n 条长度为 T 的序列。c 是每条序列固定、模型可见的条件(类比文本)。""" c = rng.standard_normal((n, DC)) cb = c @ S["Bw"].T # (n, DW) hb = c @ S["H"].T # (n, DU) u = np.tanh(hb) + SIG_U * rng.standard_normal((n, DU)) w = np.tanh(cb) + SIG_W * rng.standard_normal((n, DW)) out = np.empty((n, T, D)) for t in range(T): out[:, t, :DU] = u out[:, t, DU:] = w w_new = np.tanh(w @ S["Aw"].T + cb) + SIG_W * rng.standard_normal((n, DW)) u_new = u @ S["Lam"].T + w @ S["G"].T + SIG_U * rng.standard_normal((n, DU)) u, w = u_new, w_new return out, c # ═══════════════════════════ 3. 两种特征(因果 / 双向)═══════════════════════════ # # 两边都是"自己的观测 + 两个邻居/汇总向量 + 条件 + 偏置",维数完全相同 = 3D+DC+1。 # 两个受控特征构造不同;不是完整视频范式之间的性能比较: # 因果 causal:上一帧的上下文 + 过去 4 帧均值(只看过去) # 双向 bidir :前一帧 + 后一帧的噪声观测(能看未来) F_DIM = 3 * D + DC + 1 def feat_causal(z_t, hist, c): if len(hist) == 0: prev = np.zeros(D) past_mean = np.zeros(D) else: prev = hist[-1] past_mean = np.asarray(hist[-4:]).mean(axis=0) return np.concatenate([z_t, prev, past_mean, c, np.ones(1)]) def feat_bidir(z_seq, t, c): zp = z_seq[t - 1] if t > 0 else np.zeros(D) zn = z_seq[t + 1] if t + 1 < len(z_seq) else np.zeros(D) return np.concatenate([z_seq[t], zp, zn, c, np.ones(1)]) def fit_ridge(X, Y, lam=LAMBDA): F = X.shape[1] return np.linalg.solve(X.T @ X + lam * np.eye(F), X.T @ Y) # ═══════════════════════════ 4. 采样器 ════════════════════════════ def ddim_step(z, xhat, a, a_next): """DDIM (eta=0):固定噪声估计,只把噪声水平降到下一档。""" eps = (z - np.sqrt(a) * xhat) / np.sqrt(max(1e-12, 1.0 - a)) return np.sqrt(a_next) * xhat + np.sqrt(1.0 - a_next) * eps def sample_bidir(W, z_init, c, steps=STEPS): """全序列扩散:整条序列一起走 4 步,每步所有帧互相可见。非流式。""" T = z_init.shape[0] z = z_init.copy() xhat = np.zeros_like(z) for i, ts in enumerate(steps): a = abar_of(ts) xhat = np.stack([feat_bidir(z, t, c) for t in range(T)]) @ W if i + 1 < len(steps): z = ddim_step(z, xhat, a, abar_of(steps[i + 1])) return xhat def sample_causal(W, rng, T_out, c, steps=STEPS, ctx_ts=0, hist_true=None, ctx_rng=None, collect=False, x_true=None): """因果自回归 rollout。 ctx_ts VP教学加噪级;历史帧各自加噪一次后固定,0为干净。 官方flow缓存刷新另见实现对照,二者不是相同的调度器。 hist_true 给定时上下文永远取真值 —— teacher forcing 评测(测试时不可得)。 ctx_rng 给定时,连真值上下文也按 ctx_ts 加噪(Q4 用的受控实验)。 """ a_ctx = abar_of(ctx_ts) if T_out < 1 or hist_true is not None and len(hist_true) < T_out: raise ValueError("Invalid output/history length") # 固定一次每条历史帧的噪声;求均值时保留与prev的协方差。 history_source = None if hist_true is not None: history_source = np.asarray(hist_true[:T_out]).copy() if ctx_rng is not None and a_ctx < 1.0: history_source = (np.sqrt(a_ctx) * history_source + np.sqrt(1-a_ctx) * ctx_rng.standard_normal(history_source.shape)) out = np.empty((T_out, D)) hist = [] rows_X, rows_Y = [], [] for t in range(T_out): # 生成初始噪声不依赖真值标签;VP末端仍近似N(0,I)。 z = rng.standard_normal(D) for i, ts in enumerate(steps): a = abar_of(ts) if hist_true is not None: ctx = history_source[:t] else: ctx = np.array(hist) if len(hist) else np.zeros((0, D)) feat = feat_causal(z, ctx, c) xhat = feat @ W if collect and x_true is not None: rows_X.append(feat.copy()) rows_Y.append(x_true[t].copy()) if i + 1 < len(steps): z = ddim_step(z, xhat, a, abar_of(steps[i + 1])) out[t] = xhat if hist_true is None: if a_ctx >= 1.0 - 1e-12: hist.append(xhat.copy()) else: hist.append(np.sqrt(a_ctx) * xhat + np.sqrt(1.0 - a_ctx) * rng.standard_normal(D)) if collect: return out, np.array(rows_X), np.array(rows_Y) return out # ═══════════════════════════ 5. 数据集构造 ════════════════════════════ def build_gt_dataset(seqs, conds, rng, levels=STEPS, ctx_ts=0): """teacher forcing 数据集:上下文用真值帧(可按 ctx_ts 加噪)。""" n, T, _ = seqs.shape a_ctx = abar_of(ctx_ts) Xs, Ys = [], [] context = seqs if a_ctx < 1.0: context = np.sqrt(a_ctx) * seqs + np.sqrt(1-a_ctx) * rng.standard_normal(seqs.shape) for t in range(T): if t == 0: prev, pm = np.zeros((n, D)), np.zeros((n, D)) else: prev = context[:, t-1, :] pm = context[:, max(0,t-4):t, :].mean(axis=1) for ts in levels: a = abar_of(ts) z = np.sqrt(a) * seqs[:, t, :] + np.sqrt(1.0 - a) * rng.standard_normal((n, D)) Xs.append(np.concatenate([z, prev, pm, conds, np.ones((n, 1))], axis=1)) Ys.append(seqs[:, t, :]) return np.concatenate(Xs, 0), np.concatenate(Ys, 0) def build_bidir_dataset(seqs, conds, rng, levels=STEPS): n, T, _ = seqs.shape Xs, Ys = [], [] for ts in levels: a = abar_of(ts) z = np.sqrt(a) * seqs + np.sqrt(1.0 - a) * rng.standard_normal((n, T, D)) for t in range(T): zp = z[:, t - 1, :] if t > 0 else np.zeros((n, D)) zn = z[:, t + 1, :] if t + 1 < T else np.zeros((n, D)) Xs.append(np.concatenate([z[:, t, :], zp, zn, conds, np.ones((n, 1))], axis=1)) Ys.append(seqs[:, t, :]) return np.concatenate(Xs, 0), np.concatenate(Ys, 0) # ═══════════════════════════ 6. 度量 ════════════════════════════ def mse_curve(pred, truth, sl=None): """每帧每维的平均平方误差。sl 是维度切片,用来把快慢变量分开看。""" e = (pred - truth) if sl is None else (pred[..., sl] - truth[..., sl]) return (e ** 2).mean(axis=(0, -1)) USL, WSL = slice(0, DU), slice(DU, D) def ctx_gain(W): """模型对上下文的依赖强度:上下文两块特征对应权重的 Frobenius 范数。""" return float(np.linalg.norm(W[D:3 * D, :])) def doubling_length(curve, t0=2, t1=None): t1 = t1 or len(curve) - 1 y = np.log(np.maximum(curve[t0:t1 + 1], 1e-12)) b = np.polyfit(np.arange(t0, t1 + 1), y, 1)[0] return float(np.log(2.0) / b) if b > 0 else float("inf") def fmt_row(tag, cur, cur_u, cur_w, T=T_TRAIN): return (f" {tag:<12}{cur[:T].mean():>12.5f}{cur_u[:T].mean():>12.5f}" f"{cur_w[:T].mean():>12.5f}{cur[min(23, len(cur) - 1)]:>12.5f}" f"{cur[min(47, len(cur) - 1)]:>12.5f}{cur[-1]:>12.5f}") # ═══════════════════════════ 7. 主流程 ════════════════════════════ def main(): ap = argparse.ArgumentParser() ap.add_argument("--rounds", type=int, default=3) ap.add_argument("--n-train", type=int, default=6000) ap.add_argument("--n-test", type=int, default=1500) ap.add_argument("--alpha", type=float, default=ALPHA) ap.add_argument("--fast", action="store_true") ap.add_argument("--ctx", type=int, nargs="*", default=[0, 50, 100, 150, 200, 250, 300, 400]) args = ap.parse_args() if args.fast: args.n_train, args.n_test = 2500, 500 S = make_system() seqs_train, c_train = sample_sequences(np.random.default_rng(11), S, args.n_train, max(T_TRAIN, T_ROLL)) seqs_test, c_test = sample_sequences(np.random.default_rng(12), S, args.n_test, max(T_TRAIN, T_ROLL)) var_u = seqs_test[..., USL].var(axis=(0, 1)).mean() var_w = seqs_test[..., WSL].var(axis=(0, 1)).mean() print("=" * 78) print(f"数据:u_t = Lam u_{{t-1}} + G w_{{t-1}} + {SIG_U} xi (慢变量,谱半径 {LAM_SLOW})") print(f" w_t = tanh(Aw w_{{t-1}} + Bw c) + {SIG_W} xi (快变量,谱半径 {RHO_FAST})") print(f"D={D}(u:{DU} + w:{DW}) DC={DC} 训练集 {seqs_train.shape} 测试集 {seqs_test.shape}") print(f"慢变量边缘方差 {var_u:.4f} 快变量边缘方差 {var_w:.4f}") print(f"训练视野 T={T_TRAIN},外推到 T={T_ROLL};去噪步 {STEPS}") print(f"特征维数 F = 3D+DC+1 = {F_DIM}(因果与双向完全相同)") print(f"最后一步的输入噪声级 abar({STEPS[-1]}) = {abar_of(STEPS[-1]):.4f}") print("=" * 78) # ── 基线 0:全序列扩散(非因果,整段一起解)───────────────────── Xb, Yb = build_bidir_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(21)) Wb = fit_ridge(Xb, Yb) rng_b = np.random.default_rng(31) pred_bi = np.stack([sample_bidir(Wb, rng_b.standard_normal((T_TRAIN, D)), c_test[i]) for i in range(args.n_test)]) cur_bi = mse_curve(pred_bi, seqs_test[:, :T_TRAIN]) cur_bi_u = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], USL) cur_bi_w = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], WSL) # ── 基线 1:teacher forcing(上下文用真值帧)──────────────────── Xg, Yg = build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(22)) W_tf = fit_ridge(Xg, Yg) rng_tf = np.random.default_rng(32) pred_tf = np.stack([sample_causal(W_tf, np.random.default_rng(32000+i), T_TRAIN, c_test[i], hist_true=seqs_test[i, :T_TRAIN]) for i in range(args.n_test)]) cur_tf = mse_curve(pred_tf, seqs_test[:, :T_TRAIN]) cur_tf_u = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], USL) cur_tf_w = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], WSL) # ── 基线 2:同一个权重做自回归 rollout ────────────────────────── rng_sf = np.random.default_rng(33) pred_sf0 = np.stack([sample_causal(W_tf, np.random.default_rng(32000+i), T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) cur_sf0 = mse_curve(pred_sf0, seqs_test[:, :T_ROLL]) cur_sf0_u = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], USL) cur_sf0_w = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], WSL) print("\n【Q1】三种范式的逐帧 MSE(每维平均平方误差)") print(f"{'帧号':>6}{'全序列扩散':>14}{'teacher forcing':>16}{'自回归 rollout':>16}") for t in [0, 1, 2, 3, 5, 7, 11, 15, 19, 23]: print(f"{t:>6}{cur_bi[t]:>14.5f}{cur_tf[t]:>16.5f}{cur_sf0[t]:>16.5f}") print("\n【Q2】曝光偏差拆成快慢两块看") print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w) + " 非流式,长度固定") print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w) + " 上下文用真值,测试时不可得") print(fmt_row("rollout0", cur_sf0, cur_sf0_u, cur_sf0_w)) print(f"\n 快变量 w:teacher {cur_tf_w[:T_TRAIN].mean():.5f} -> " f"rollout {cur_sf0_w[:T_TRAIN].mean():.5f} " f"放大 {cur_sf0_w[:T_TRAIN].mean() / cur_tf_w[:T_TRAIN].mean():.2f} 倍(有限窗口统计)") print(f" 慢变量 u:teacher {cur_tf_u[:T_TRAIN].mean():.5f} -> " f"rollout {cur_sf0_u[:T_TRAIN].mean():.5f} " f"放大 {cur_sf0_u[:T_TRAIN].mean() / cur_tf_u[:T_TRAIN].mean():.2f} 倍") print(f" 慢变量误差 t=1 -> t=23 增长 " f"{cur_sf0_u[23] / max(cur_sf0_u[1], 1e-12):.2f} 倍," f"翻倍长度 {doubling_length(cur_sf0_u, 1, T_TRAIN - 1):.2f} 帧") print(f" 快变量误差 t=1 -> t=23 变化 " f"{cur_sf0_w[23] / max(cur_sf0_w[1], 1e-12):.3f} 倍(有限窗口统计)") print(f" 越过训练视野(t>={T_TRAIN})后:慢变量是视野内的 " f"{cur_sf0_u[T_TRAIN:].mean() / cur_sf0_u[:T_TRAIN].mean():.2f} 倍," f"快变量 {cur_sf0_w[T_TRAIN:].mean() / cur_sf0_w[:T_TRAIN].mean():.2f} 倍") print(f" 模型对上下文的依赖强度 |W_ctx| = {ctx_gain(W_tf):.4f}") # ── Q3:Self-Forcing 轮次 ───────────────────────────────────── print(f"\n【Q3】配对标签重拟合(非Self-Forcing/完整DAgger)轮次(每轮用自己 rollout 的上下文重训,步长 alpha={args.alpha})") print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") W = W_tf.copy() curves, us, ws = {"round0": cur_sf0}, {"round0": cur_sf0_u}, {"round0": cur_sf0_w} rng_roll = np.random.default_rng(41) rng_eval = np.random.default_rng(61) n_sub = min(3000, args.n_train) def eval_rollout(Wm, rng): p = np.stack([sample_causal(Wm, rng, T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) return p, mse_curve(p, seqs_test[:, :T_ROLL]) # 注意:这里故意只按训练视野内的指标接受更新。Self-Forcing 的论文强调用 # "视频级整体损失",下面会看到只盯视野内会发生什么。 seqs_val, c_val = sample_sequences(np.random.default_rng(13), S, min(300,args.n_test), T_ROLL) def validation_score(Wm): pv = np.stack([sample_causal(Wm,np.random.default_rng(44000+i),T_TRAIN,c_val[i]) for i in range(len(c_val))]) return float(mse_curve(pv,seqs_val[:,:T_TRAIN]).mean()) best_score = validation_score(W) tail0 = cur_sf0[-1] for r in range(1, args.rounds + 1): Xs, Ys = [], [] for i in range(n_sub): _, Xr, Yr = sample_causal(W, rng_roll, T_TRAIN, c_train[i], ctx_ts=0, collect=True, x_true=seqs_train[i, :T_TRAIN]) Xs.append(Xr) Ys.append(Yr) W_new = fit_ridge(np.concatenate(Xs, 0), np.concatenate(Ys, 0)) # 折半线搜索:rollout 重训容易形成正反馈,只接受真的变好的更新 picked = None a = args.alpha for _ in range(5): W_try = (1.0 - a) * W + a * W_new rng_try = np.random.default_rng(61) p_try, c_try = eval_rollout(W_try, rng_try) sc = validation_score(W_try) if np.isfinite(sc) and sc < best_score: picked = (W_try, p_try, c_try, sc, a) best_score = sc break a *= 0.5 if picked is None: print(f" round {r}: 折半线搜索到 alpha={a:.4f} 仍没有变好的更新,提前停止") break if picked[2][-1] > 50.0 * tail0: print(f" round {r}: 外推末帧已发散到 {picked[2][-1]:.3g}(round0 的 " f"{picked[2][-1] / tail0:.1f} 倍),停止") curves[f"round{r}"] = picked[2] us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL) ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL) break W = picked[0] curves[f"round{r}"] = picked[2] us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL) ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL) print(fmt_row(f"round{r}", curves[f"round{r}"], us[f"round{r}"], ws[f"round{r}"]) + f" alpha={picked[4]:.5f}") print(f"\n {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w)) print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w)) keys = ["round0"] + [k for k in curves if k != "round0"] for k in keys: print(fmt_row(k, curves[k], us[k], ws[k])) best = min(keys, key=lambda k: curves[k][:T_TRAIN].mean()) print(f"\n 最好一轮 {best}:快变量 {ws['round0'][:T_TRAIN].mean():.5f} -> " f"{ws[best][:T_TRAIN].mean():.5f}" f"(降 {100 * (1 - ws[best][:T_TRAIN].mean() / ws['round0'][:T_TRAIN].mean()):.1f}%)," f"慢变量 {us['round0'][:T_TRAIN].mean():.5f} -> " f"{us[best][:T_TRAIN].mean():.5f}" f"(降 {100 * (1 - us[best][:T_TRAIN].mean() / us['round0'][:T_TRAIN].mean()):.1f}%)") # ── Q4:上下文噪声必须与训练对齐 ────────────────────────────── print("\n【Q4】固定历史来源,只扫描历史加噪级") print(" (受控实验:上下文一律取真值帧,只改加噪级别,把曝光偏差排除掉)") W_noisy = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(23), ctx_ts=250)) print(f" {'训练噪声步':<12}{'推理噪声步':<12}{'abar':>8}{'视野内MSE':>12}{'慢变量u':>12}") ctx_rows = {} for tag, Wm in [("clean(0)", W_tf), ("noisy(250)", W_noisy)]: row = {} for cts in args.ctx: rng_e = np.random.default_rng(70) p = np.stack([sample_causal(Wm, rng_e, T_TRAIN, c_test[i], ctx_ts=cts, hist_true=seqs_test[i, :T_TRAIN], ctx_rng=rng_e) for i in range(args.n_test)]) cc = mse_curve(p, seqs_test[:, :T_TRAIN]) cu = mse_curve(p, seqs_test[:, :T_TRAIN], USL) row[cts] = cc print(f" {tag:<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}{cu.mean():>12.5f}") ctx_rows[tag] = row print(f" -> {tag} 的最优推理噪声步 = {min(row, key=lambda k: row[k].mean())}") print("\n 同样的扫描放到自回归 rollout 上(此时上下文是模型自己的输出)") row_sf = {} for cts in args.ctx: rng_e = np.random.default_rng(80) p = np.stack([sample_causal(W, rng_e, T_TRAIN, c_test[i], ctx_ts=cts) for i in range(args.n_test)]) cc = mse_curve(p, seqs_test[:, :T_TRAIN]) row_sf[cts] = cc print(f" {'selfroll':<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}" f"{mse_curve(p, seqs_test[:, :T_TRAIN], USL).mean():>12.5f}") print(f" -> 自回归 rollout 的最优推理噪声步 = {min(row_sf, key=lambda k: row_sf[k].mean())}") # ── Q5:等效噪声级 + 训练时给上下文加噪换鲁棒性 ────────────────── print("\n【Q5】曝光偏差的等效噪声级,以及训练时给上下文加噪能不能换来自回归的鲁棒性") line_tf = np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx]) if not np.all(np.diff(line_tf) > 0): raise ValueError("Equivalent-noise interpolation requires a strictly increasing measured curve") target = cur_sf0[:T_TRAIN].mean() grid = np.array(args.ctx, dtype=float) eq = float(np.interp(target, line_tf, grid)) if line_tf[0] <= target <= line_tf[-1] else float("nan") print(f" 自回归 rollout 的视野内 MSE = {target:.5f}") if np.isfinite(eq): print(f" 在 Q4 那条『干净模型 + 加噪上下文』曲线上插值,它等效于给真值上下文加 " f"{eq:.1f} 个时间步的噪声(abar 约 {abar_of(eq):.4f})") else: print(" 超出 Q4 的扫描范围,无法插值出等效噪声级") print(f"\n {'训练ctx噪声':<14}{'TF评测':>12}{'自回归(视野内)':>16}{'自回归t=71':>14}{'慢变量u':>12}") q5 = {} for k in args.ctx: Wk = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(24), ctx_ts=k)) rng_a = np.random.default_rng(90) p_tf = np.stack([sample_causal(Wk, np.random.default_rng(90000+i), T_TRAIN, c_test[i], hist_true=seqs_test[i, :T_TRAIN]) for i in range(args.n_test)]) rng_b2 = np.random.default_rng(91) p_sf = np.stack([sample_causal(Wk, np.random.default_rng(90000+i), T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) c_tfk = mse_curve(p_tf, seqs_test[:, :T_TRAIN]).mean() c_sfk = mse_curve(p_sf, seqs_test[:, :T_ROLL]) c_sfu = mse_curve(p_sf, seqs_test[:, :T_ROLL], USL) q5[k] = (c_tfk, c_sfk[:T_TRAIN].mean(), c_sfk[-1], c_sfu[:T_TRAIN].mean()) print(f" {k:<14}{c_tfk:>12.5f}{c_sfk[:T_TRAIN].mean():>16.5f}" f"{c_sfk[-1]:>14.5f}{c_sfu[:T_TRAIN].mean():>12.5f}") best_k = min(q5, key=lambda k: q5[k][1]) print(f" -> 自回归 rollout 最好的训练上下文噪声步 = {best_k}" f"(视野内 {q5[best_k][1]:.5f},对照 k=0 的 {q5[args.ctx[0]][1]:.5f})") cache_path = CACHE.replace(".npz", "_fast.npz") if args.fast else CACHE np.savez(cache_path, cur_bi=cur_bi, cur_bi_u=cur_bi_u, cur_bi_w=cur_bi_w, cur_tf=cur_tf, cur_tf_u=cur_tf_u, cur_tf_w=cur_tf_w, var_u=np.array([var_u]), var_w=np.array([var_w]), **{f"cur_{k}": v for k, v in curves.items()}, **{f"u_{k}": v for k, v in us.items()}, **{f"w_{k}": v for k, v in ws.items()}, ctx_clean=np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx]), ctx_noisy=np.array([ctx_rows["noisy(250)"][k].mean() for k in args.ctx]), ctx_sf=np.array([row_sf[k].mean() for k in args.ctx]), ctx_list=np.array(args.ctx), q5_tf=np.array([q5[k][0] for k in args.ctx]), q5_sf=np.array([q5[k][1] for k in args.ctx]), q5_sf_end=np.array([q5[k][2] for k in args.ctx]), q5_sf_u=np.array([q5[k][3] for k in args.ctx]), eq_noise=np.array([eq])) print(f"\n[cached] {cache_path}") if __name__ == "__main__": main() streaming_ledger.py # -*- coding: utf-8 -*- """ streaming_ledger.py —— 流式生成 vs 全序列扩散的算力 / 显存账本(纯算术,numpy 只用来算) 跑法: python streaming_ledger.py 拓扑全部取自公开配置,不是估的: Wan2.1-T2V-1.3B(wan/configs/wan_t2v_1_3B.py): dim=1536, ffn=8960, num_heads=12, num_layers=30, patch_size=(1,2,2), vae_stride=(4,8,8) Self-Forcing(configs/self_forcing_dmd.yaml): image_or_video_shape=[1,21,16,60,104] denoising_step_list=[1000,750,500,250] # 4 步 num_frame_per_block=3 Self-Forcing(pipeline/causal_inference.py): 每个 block 走完 4 步之后,还要用 context_noise 时间步再跑一次 forward 刷新 KV cache 口径:MAC = 一次乘加(1 MAC = 2 FLOP)。时间按 假设有效算力 400 TFLOPS 折算, 只算 transformer 主体,不含 VAE 解码与文本编码。 """ import numpy as np # ── 拓扑 ────────────────────────────────────────────────────────── D = 1536 # dim FFN = 8960 # ffn_dim LAYERS = 30 HEADS = 12 D_HEAD = D // HEADS N_TEXT = 512 # T5 文本 token 数(cross-attn 的 K/V 长度) LAT_FRAMES = 21 # 潜空间帧数 LAT_H, LAT_W = 60, 104 PATCH = (1, 2, 2) TOK_PER_FRAME = (LAT_H // PATCH[1]) * (LAT_W // PATCH[2]) # 1560 N_TOK = LAT_FRAMES * TOK_PER_FRAME # 32760 BLOCK = 3 # num_frame_per_block N_STEPS = 4 # len(denoising_step_list) EXTRA_KV_REFRESH = 1 # 每个 block 结束后刷新 KV cache 的那次 forward PIXEL_PER_LATENT = 4 # vae_stride[0],潜帧映射: 81 像素帧 FPS = 16 BYTES = 2 # bf16 EFF_TFLOPS = 400e12 def mac_per_layer(n_new, n_key): """一层 transformer 的 MAC。n_new = 本次参与计算的 token 数,n_key = 可见的 key 数。""" attn = 2.0 * n_new * n_key * D # QK^T + AV proj = 4.0 * n_new * D * D # q, k, v, o ffn = 2.0 * n_new * D * FFN cross = 2.0 * n_new * N_TEXT * D + 2.0 * n_new * D * D # 注意力 + q/o 投影 return attn + proj + ffn + cross def gbyte(x_bytes): return x_bytes / 1024.0 ** 3 def sec(mac): return 2.0 * mac / EFF_TFLOPS def main(): print("=" * 78) print("拓扑:Wan2.1-T2V-1.3B + Self-Forcing 默认配置") print(f" dim={D} ffn={FFN} layers={LAYERS} heads={HEADS} head_dim={D_HEAD}") print(f" 潜空间 {LAT_FRAMES}x16x{LAT_H}x{LAT_W} patch={PATCH} -> " f"每帧 {TOK_PER_FRAME} token,整段 {N_TOK} token") print(f" block={BLOCK} 帧,每 block {N_STEPS} 步去噪 + {EXTRA_KV_REFRESH} 次 KV cache 刷新") print(f" 潜帧映射: {LAT_FRAMES * PIXEL_PER_LATENT - 3} 像素帧 @ {FPS}fps ≈ " f"{(LAT_FRAMES * PIXEL_PER_LATENT - 3) / FPS:.2f} 秒") print(f" 时间按 {EFF_TFLOPS/1e12:.0f} TFLOPS 有效算力折算(1 MAC = 2 FLOP)") print("=" * 78) # ── A. 全序列扩散:4 步,每步整段双向 ──────────────────────────── mac_full_step = LAYERS * mac_per_layer(N_TOK, N_TOK) mac_full = N_STEPS * mac_full_step print("\n【A】全序列扩散(非流式,整段一起解)") print(f" 单步 MAC {mac_full_step:.4e} 时间 {sec(mac_full_step)*1000:.1f} ms") print(f" 4 步合计 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s") print(f" 第一帧延迟 必须等 {N_STEPS} 步全部算完 = {sec(mac_full):.3f} s") attn_bytes_full = HEADS * N_TOK * N_TOK * BYTES print(f" 注意力矩阵要是真存下来:{HEADS} 头 x {N_TOK}^2 x {BYTES}B = " f"{gbyte(attn_bytes_full):.1f} GiB(稠密物化很贵;精确IO优化可避免物化)") # ── B. 因果自回归 + KV cache ──────────────────────────────────── n_blocks = (LAT_FRAMES + BLOCK - 1) // BLOCK print(f"\n【B】因果自回归 + KV cache({n_blocks} 个 block,每 block {BLOCK} 帧)") print(f" {'block':>6}{'新token':>9}{'可见key':>9}{'单步MAC':>14}{'block合计MAC':>16}{'时间(ms)':>11}") mac_blocks = [] for i in range(n_blocks): n_new = min(BLOCK, LAT_FRAMES-i*BLOCK) * TOK_PER_FRAME n_key = min((i+1)*BLOCK,LAT_FRAMES) * TOK_PER_FRAME m_step = LAYERS * mac_per_layer(n_new, n_key) n_fwd = N_STEPS + EXTRA_KV_REFRESH # 4 步去噪:每步的 key 数就是 n_key(含当前 block 内部的因果可见部分) m_block = n_fwd * m_step mac_blocks.append(m_block) print(f" {i:>6}{n_new:>9}{n_key:>9}{m_step:>14.4e}{m_block:>16.4e}" f"{sec(m_block)*1000:>11.1f}") mac_blocks = np.array(mac_blocks) mac_causal = mac_blocks.sum() print(f" 合计 MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s") print(f" 第一帧延迟 = 第 0 个 block = {sec(mac_blocks[0])*1000:.1f} ms" f"(比全序列快 {sec(mac_full)/sec(mac_blocks[0]):.1f} 倍)") print(f" 稳态每个 block {sec(mac_blocks[-1])*1000:.1f} ms," f"实时预算 {BLOCK * PIXEL_PER_LATENT / FPS * 1000:.0f} ms " f"-> 余量 {BLOCK * PIXEL_PER_LATENT / FPS / sec(mac_blocks[-1]):.2f} 倍") # ── C. 总账对比 ──────────────────────────────────────────────── print(f"\n【C】总账({LAT_FRAMES} 潜帧)") print(f" 全序列扩散 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s " f"首帧延迟 {sec(mac_full):.3f} s") print(f" 因果+KVcache MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s " f"首帧延迟 {sec(mac_blocks[0]):.3f} s") print(f" 总算力比 因果 / 全序列 = {mac_causal / mac_full:.3f}") print(f" 首帧延迟比 全序列 / 因果 = {sec(mac_full) / sec(mac_blocks[0]):.2f}") # ── D. KV cache 显存 ─────────────────────────────────────────── print("\n【D】KV cache 显存(bf16)") kv_all = 2 * LAYERS * N_TOK * D * BYTES print(f" 完整 21 帧 2 x {LAYERS} x {N_TOK} x {D} x {BYTES}B = {gbyte(kv_all):.3f} GiB") for w in [3, 6, 9, 12, 21]: kv_w = 2 * LAYERS * w * TOK_PER_FRAME * D * BYTES print(f" 滚动窗口 {w:>2} 帧 {gbyte(kv_w):.3f} GiB (占完整缓存 {w/LAT_FRAMES*100:.0f}%)") cross_cache = 2 * LAYERS * N_TEXT * D * BYTES print(f" cross-attn 缓存(文本 {N_TEXT} token,只算一次){gbyte(cross_cache):.3f} GiB") # ── E. 无限长:不滚动缓存会怎样 ───────────────────────────────── print("\n【E】继续往下生成(不滚动缓存 vs 滚动窗口 9 帧)") print(f" {'已生成潜帧':>10}{'无滚动:单block时间(ms)':>24}{'滚动9帧(ms)':>16}{'无滚动:累计GB':>16}") cum = 0.0 for nlat in [21, 42, 84, 168, 336]: i = nlat // BLOCK - 1 n_new = min(BLOCK, LAT_FRAMES-i*BLOCK) * TOK_PER_FRAME n_key = min((i+1)*BLOCK,LAT_FRAMES) * TOK_PER_FRAME m_noroll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key) m_roll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer( n_new, min(n_key, 9 * TOK_PER_FRAME)) cum = 2 * LAYERS * nlat * TOK_PER_FRAME * D * BYTES print(f" {nlat:>10}{sec(m_noroll)*1000:>24.1f}{sec(m_roll)*1000:>16.1f}" f"{gbyte(cum):>16.3f}") # ── F. 出帧节奏 ──────────────────────────────────────────────── print("\n【F】出帧节奏(首块3潜帧对应9像素帧,后续每块增加12帧;仅latent就绪,不含解码)") t_full = sec(mac_full) t_blocks = np.cumsum(sec(mac_blocks)) print(f" 全序列:t={t_full:.3f} s 时一次性拿到全部 {LAT_FRAMES * PIXEL_PER_LATENT - 3} 帧") for i, tb in enumerate(t_blocks): print(f" 因果 :t={tb:.3f} s 时拿到第 {(i+1)*BLOCK*PIXEL_PER_LATENT-3:>3} 像素帧") print(f" 实时预算:{FPS} fps 下应该在 " f"{np.arange(1, n_blocks+1)*BLOCK*PIXEL_PER_LATENT/FPS} 秒处出帧") print("\n[cached] 数值直接被 make_figures.py 引用(本文件被 import 时用函数取)") def ledger_numbers(): """给 make_figures.py 用的结构化数值。""" n_blocks = (LAT_FRAMES + BLOCK - 1) // BLOCK mac_blocks = [] for i in range(n_blocks): n_new = min(BLOCK, LAT_FRAMES-i*BLOCK) * TOK_PER_FRAME n_key = min((i+1)*BLOCK,LAT_FRAMES) * TOK_PER_FRAME mac_blocks.append((N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key)) mac_blocks = np.array(mac_blocks, dtype=float) mac_full = N_STEPS * LAYERS * mac_per_layer(N_TOK, N_TOK) return dict( mac_full=float(mac_full), mac_causal=float(mac_blocks.sum()), mac_blocks=mac_blocks, t_full=sec(mac_full), t_blocks=np.cumsum(sec(mac_blocks)), kv_all_gb=gbyte(2 * LAYERS * N_TOK * D * BYTES), kv_per_frame_gb=gbyte(2 * LAYERS * TOK_PER_FRAME * D * BYTES), n_blocks=n_blocks, block=BLOCK, lat_frames=LAT_FRAMES, tok_per_frame=TOK_PER_FRAME, n_tok=N_TOK, attn_gb_if_materialized=gbyte(HEADS * N_TOK * N_TOK * BYTES), pixel_frames=LAT_FRAMES * PIXEL_PER_LATENT - 3, fps=FPS, ) if __name__ == "__main__": main() print() for k, v in ledger_numbers().items(): if not isinstance(v, np.ndarray): print(f" {k:>28} = {v}") make_figures.py # -*- coding: utf-8 -*- """ make_figures.py —— 本文配图(matplotlib,中文字体 PingFang SC) 跑法: python make_figures.py 所有数字都从 forcing_lab_cache.npz(forcing_lab.py 实跑产出)和 streaming_ledger.ledger_numbers() 里取,不手写,避免图文漂移。 注意:matplotlib 的 mathtext 标签一律写 raw 字符串,且反斜杠后只跟字母 (beta 这种字母命令没问题,逗号、百分号等非字母不要跟在反斜杠后面)。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt from matplotlib.patches import Rectangle, FancyArrow HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") CACHE = os.path.join(HERE, "forcing_lab_cache.npz") import forcing_lab as FL import streaming_ledger as SL plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False # 颜色常量(写图注前先对照这里,别凭印象写颜色) C_BLUE = "#1f6feb" # 自回归 rollout C_TEAL = "#0f9b8e" # teacher forcing C_ORANGE = "#e07b00" # 全序列扩散 C_RED = "#c0392b" # 慢变量 u / 恶化 C_GREEN = "#2d8a4e" # 快变量 w / 改善 C_GRAY = "#8a8a8a" # 参照线、未生成 C_DARK = "#3a3a3a" # 噪声最重的格子 C_LIGHT = "#f2f2f2" # 干净的格子 def load(): return dict(np.load(CACHE, allow_pickle=True)) # ══════════════════════════ 图 1:三种范式的噪声级与因果结构 ══════════════════════════ def _box(ax, x, y, w, h, level, edge=C_GRAY, lw=0.8, ls="-"): """level: 1 = 干净(浅),0 = 纯噪声(深)""" facecolor = str(max(0.0, min(1.0, float(level)))) ax.add_patch(Rectangle((x, y), w, h, facecolor=facecolor, edgecolor=edge, linewidth=lw, linestyle=ls, zorder=2)) def fig_paradigm(path): n = 12 bw, bh = 0.86, 0.62 fig, axes = plt.subplots(3, 1, figsize=(11.0, 6.6)) fig.subplots_adjust(left=0.06, right=0.97, top=0.93, bottom=0.07, hspace=0.34) # (a) 全序列扩散:整段一起降噪,帧与帧之间双向可见 ax = axes[0] steps_lv = [0.06, 0.30, 0.62, 0.92] for r, lv in enumerate(steps_lv): y = (len(steps_lv) - 1 - r) * 1.0 for i in range(n): _box(ax, i * 1.07, y, bw, bh, lv) ax.annotate("", xy=(n * 1.07 - 0.1, y + bh / 2), xytext=(0.05, y + bh / 2), arrowprops=dict(arrowstyle="<->", color=C_ORANGE, lw=1.8)) ax.text(-0.35, y + bh / 2, r"去噪步 %d" % (r + 1), ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, len(steps_lv) + 0.15, "所有帧同一个噪声级,一起降;双向注意力,帧间互相可见", ha="center", fontsize=11, color=C_ORANGE) ax.text(n * 1.07 / 2, -0.55, "代价:本图需 4 步整段去噪才交付第一帧;可用长度由架构与训练共同限制", ha="center", fontsize=10, color=C_GRAY) # (b) teacher forcing:真值上下文,只看过去 ax = axes[1] y = 0.0 cur = 7 for i in range(n): if i < cur: _box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_TEAL, lw=1.2) elif i == cur: _box(ax, i * 1.07, y, bw, bh, 0.10) else: _box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--") for i in range(cur): ax.annotate("", xy=(cur * 1.07 + bw * 0.5, y + bh * 0.45), xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45), arrowprops=dict(arrowstyle="->", color=C_TEAL, lw=1.2, connectionstyle="arc3,rad=-0.25")) ax.text(-0.35, y + bh / 2, "训练时", ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, y + 1.50, "上下文永远取真值帧(浅色),只有当前帧(深色)带噪声", ha="center", fontsize=11, color=C_TEAL) ax.text(n * 1.07 / 2, y - 0.52, "代价:推理时真值帧不存在,上下文换成模型自己的输出 —— 这就是曝光偏差", ha="center", fontsize=10, color=C_GRAY) # (c) Self-Forcing 风格的生成上下文:自己的输出进 KV cache,逐 block 走 ax = axes[2] done, blk = 6, 3 for i in range(n): if i < done: _box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_BLUE, lw=1.2) elif i < done + blk: _box(ax, i * 1.07, y, bw, bh, 0.10, edge=C_BLUE, lw=1.2) else: _box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--") for i in range(done): ax.annotate("", xy=(done * 1.07 + bw * 0.5, y + bh * 0.45), xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45), arrowprops=dict(arrowstyle="->", color=C_BLUE, lw=1.2, connectionstyle="arc3,rad=-0.25")) ax.add_patch(Rectangle((-0.05, y - 0.42), done * 1.07 + 0.05, 0.26, facecolor=C_BLUE, alpha=0.15, edgecolor=C_BLUE, lw=1.0)) ax.text(done * 1.07 / 2, y - 0.29, "KV cache(已生成的帧,不再重算)", ha="center", va="center", fontsize=9.5, color=C_BLUE) ax.text(-0.35, y + bh / 2, "推理时", ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, y + 1.50, "自回归推理:历史为已生成的干净帧,当前 block 从噪声降到干净", ha="center", fontsize=11, color=C_BLUE) ax.text(n * 1.07 / 2, y - 0.82, "Self-Forcing 训练也用自己的 rollout 上下文,减轻训练与推理的分布差异", ha="center", fontsize=10, color=C_GRAY) for ax in axes: ax.set_xlim(-2.4, n * 1.07 + 0.3) ax.set_ylim(-1.05, len(steps_lv) + 0.45 if ax is axes[0] else 1.95) ax.axis("off") axes[0].set_title("三种上下文组织示意:可见范围、噪声级与历史来源", fontsize=13, pad=10) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 2:误差随帧号怎么长 ══════════════════════════ def fig_rollout(d, path): T = FL.T_TRAIN fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7)) ax = axes[0] xs = np.arange(T) ax.plot(xs, d["cur_bi"][:T], color=C_ORANGE, lw=2.0, label="全序列扩散(非流式)") ax.plot(xs, d["cur_tf"][:T], color=C_TEAL, lw=2.0, label="teacher forcing(真值上下文)") xr = np.arange(len(d["cur_round0"])) ax.plot(xr, d["cur_round0"], color=C_BLUE, lw=2.0, label="自回归 rollout(自己的输出)") ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2) ax.text(T - 0.4, ax.get_ylim()[1] * 0.55, "训练视野\nT=24", fontsize=9.5, color=C_GRAY) ax.set_yscale("log") ax.set_xlabel("帧号 t") ax.set_ylabel("每维平均平方误差(对数轴)") ax.set_title("(a) 三种范式的逐帧误差", fontsize=12) ax.legend(fontsize=9.5, loc="lower right") ax.grid(alpha=0.25, ls=":") ax = axes[1] ax.plot(xr, d["u_round0"], color=C_RED, lw=2.0, label=r"慢变量 u(会被积分记住)") ax.plot(xr, d["w_round0"], color=C_GREEN, lw=2.0, label=r"快变量 w(收缩模态)") ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2) ax.text(T - 0.4, 0.22, "训练视野\nT=24", fontsize=9.5, color=C_GRAY) ax.set_yscale("log") ax.set_xlabel("帧号 t") ax.set_ylabel("每维平均平方误差(对数轴)") ax.set_title("(b) 自回归 rollout 拆成快慢两块", fontsize=12) ax.legend(fontsize=9.5, loc="upper left") ax.grid(alpha=0.25, ls=":") fig.suptitle("本玩具系统中,慢变量的误差在越过训练视野后明显增长", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.94]) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 3:Self-Forcing 轮次的取舍 ══════════════════════════ def fig_rounds(d, path): keys = sorted([k[4:] for k in d if k.startswith("cur_round")], key=lambda s: int(s.replace("round", ""))) lbl = [("round0" if k == "round0" else k) for k in keys] inh = [float(d[f"cur_{k}"][:FL.T_TRAIN].mean()) for k in keys] tail = [float(d[f"cur_{k}"][-1]) for k in keys] x = np.arange(len(keys)) fig, ax = plt.subplots(figsize=(9.6, 4.6)) ax2 = ax.twinx() b1 = ax.bar(x - 0.19, inh, 0.36, color=C_BLUE, label="测试集视野内 MSE(左轴)") b2 = ax2.bar(x + 0.19, tail, 0.36, color=C_RED, label="外推第 72 帧 MSE(右轴,对数)") for b in b1: ax.text(b.get_x() + b.get_width() / 2, b.get_height(), f"{b.get_height():.3f}", ha="center", va="bottom", fontsize=9) for b in b2: ax2.text(b.get_x() + b.get_width() / 2, b.get_height(), f"{b.get_height():.2f}", ha="center", va="bottom", fontsize=9, color=C_RED) ax.set_xticks(x) ax.set_xticklabels([k.replace("round", "第 ") + " 轮" if k != "round0" else "第 0 轮" for k in keys]) ax.set_ylabel("视野内测试 MSE", color=C_BLUE) ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED) ax2.set_yscale("log") ax.set_ylim(0, max(inh) * 1.35) ax2.set_ylim(min(tail) * 0.5, max(tail) * 3.0) ax.grid(alpha=0.25, ls=":", axis="y") ax.set_title("配对标签重拟合(验证集选步):视野内改善,长程误差增加(非论文 Self-Forcing)", fontsize=13) h1, l1 = ax.get_legend_handles_labels() h2, l2 = ax2.get_legend_handles_labels() ax.legend(h1 + h2, l1 + l2, fontsize=10, loc="upper left") fig.tight_layout() fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 4:上下文噪声的取舍 ══════════════════════════ def fig_context(d, path): ks = [int(v) for v in d["ctx_list"]] ab = [FL.abar_of(k) for k in ks] tf = [float(v) for v in d["q5_tf"]] end = [float(v) for v in d["q5_sf_end"]] inh = [float(v) for v in d["q5_sf"]] fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7)) ax = axes[0] ax.plot(ks, d["ctx_clean"], "o-", color=C_TEAL, lw=2.0, label="干净模型 + 推理时给上下文加噪") ax.axhline(float(d["cur_round0"][:FL.T_TRAIN].mean()), color=C_BLUE, ls="--", lw=1.6, label="自回归 rollout 的实际水平") ax.axvline(float(d["eq_noise"][0]), color=C_RED, ls=":", lw=1.8) ax.text(float(d["eq_noise"][0]) + 8, ax.get_ylim()[1] * 0.62, f"等效噪声级\n约 {float(d['eq_noise'][0]):.0f} 步", fontsize=9.5, color=C_RED) ax.set_xlabel("上下文噪声时间步") ax.set_ylabel("视野内 MSE") ax.set_title("(a) 同MSE的历史扰动坐标", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") ax = axes[1] ax.plot(ks, inh, "o-", color=C_BLUE, lw=2.0, label="视野内测试 MSE(精度)") ax.set_xlabel("训练时给上下文加的噪声时间步 k") ax.set_ylabel("视野内测试 MSE", color=C_BLUE) ax2 = ax.twinx() ax2.plot(ks, end, "s-", color=C_RED, lw=2.0, label="外推第 72 帧 MSE(单点误差)") ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED) ax.set_title("(b) 训练历史扰动与测试误差", fontsize=12) h1, l1 = ax.get_legend_handles_labels() h2, l2 = ax2.get_legend_handles_labels() ax.legend(h1 + h2, l1 + l2, fontsize=9.5, loc="center right") ax.grid(alpha=0.25, ls=":") fig.suptitle(f"上下文噪声:abar 从 {ab[0]:.2f} 降到 {ab[-1]:.2f}," f"视野内与末帧误差的偏好不同;不代表稳定性证明", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.93]) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 5:流式账本 ══════════════════════════ def fig_ledger(path): L = SL.ledger_numbers() fig, axes = plt.subplots(1, 3, figsize=(15.6, 4.6)) # (a) 出帧节奏 ax = axes[0] pix = (np.arange(1, L["n_blocks"] + 1) * L["block"] * 4 - 3) ax.step(np.concatenate([[0], L["t_blocks"]]), np.concatenate([[0], pix]), where="post", color=C_BLUE, lw=2.2, label="因果自回归 + KV cache") ax.plot([L["t_full"], L["t_full"]], [0, L["pixel_frames"]], color=C_ORANGE, lw=2.2, label="全序列扩散(一次性出全部帧)") tt = np.linspace(0, L["pixel_frames"] / L["fps"], 50) ax.plot(tt, tt * L["fps"], color=C_GRAY, ls="--", lw=1.4, label="实时预算 16 fps") ax.set_xlabel("算术折算时间 (s)") ax.set_ylabel("累计latent的理论像素帧数(未计解码)") ax.set_title("(a) 出帧节奏", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") ax.set_ylim(0, L["pixel_frames"] * 1.05) # (b) KV cache 显存 ax = axes[1] nf = np.arange(1, 169) ax.plot(nf, nf * L["kv_per_frame_gb"], color=C_BLUE, lw=2.2, label="KV cache(不滚动)") ax.axhline(9 * L["kv_per_frame_gb"], color=C_GREEN, ls="--", lw=1.6, label="滚动窗口 9 帧的上限") ax.axhline(L["kv_all_gb"], color=C_GRAY, ls=":", lw=1.4, label="21 帧整段") ax.set_xlabel("已生成的潜帧数") ax.set_ylabel("KV cache 显存 (GiB)") ax.set_title("(b) 不滚动缓存,显存线性涨", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") # (c) 单 block 计算时间 ax = axes[2] nkey = np.arange(1, 169) * SL.TOK_PER_FRAME t_noroll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array( [SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME, k) for k in nkey]) / SL.EFF_TFLOPS t_roll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array( [SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME, min(k, 9 * SL.TOK_PER_FRAME)) for k in nkey]) / SL.EFF_TFLOPS ax.plot(np.arange(1, 169), t_noroll * 1000, color=C_RED, lw=2.2, label="不滚动(线性变慢)") ax.plot(np.arange(1, 169), t_roll * 1000, color=C_GREEN, lw=2.2, label="滚动窗口 9 帧(恒定)") ax.axhline(SL.BLOCK * 4 / SL.FPS * 1000, color=C_GRAY, ls="--", lw=1.4, label="实时预算 750 ms / block") ax.set_xlabel("已生成的潜帧数") ax.set_ylabel("单个 block 的计算时间 (ms)") ax.set_title("(c) 不滚动缓存,每个 block 越来越慢", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") fig.suptitle("400 TFLOPS假设:首块latent更早就绪;未计像素解码与传输", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.93]) fig.savefig(path, dpi=140) plt.close(fig) def main(): os.makedirs(FIGDIR, exist_ok=True) d = load() fig_paradigm(os.path.join(FIGDIR, "paradigm.png")) fig_rollout(d, os.path.join(FIGDIR, "rollout_error.png")) fig_rounds(d, os.path.join(FIGDIR, "selfforcing_rounds.png")) fig_context(d, os.path.join(FIGDIR, "context_noise.png")) fig_ledger(os.path.join(FIGDIR, "streaming_ledger.png")) for f in sorted(os.listdir(FIGDIR)): p = os.path.join(FIGDIR, f) print(f" {f:<28} {os.path.getsize(p)/1024:.0f} KB") if __name__ == "__main__": main()
-
AIGC 每日速读|2026-09-30|港科大先写谱再唱,YuE2 逼近 Suno 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 蒸馏与一步生成 3 篇 · 统一模型与自我反思 1 篇 · 音乐与音频生成 1 篇 · 数据集与评测 1 篇 重点论文标题列表 YuE2(港科大):先写谱再唱出来,49.3%胜 WorldAttention(阿里巴巴达摩院):单卡22帧,内核快14倍 PDMD(加州大学圣迭戈分校):一行代码,VBench 涨 1.03 GeoShrink(香港科技大学(广州)):两行代码换五倍,PSNR+3.10 MGFlow(清华大学):一步打赢四步,FDr 1.45 今日论文速览 1. YuE2:先写谱再唱出来,49.3%胜 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality | 香港科技大学;M-A-P;HKGAI;Tokenwave.AI;纽约大学;斯坦福大学;MBZUAI;Noiz;ACE Studio | arXiv:2609.33757 关键词:音乐生成, 符号音乐, 音频生成, 可控创作, 多模态 前序问题:符号音乐模型把旋律、和声、节奏、曲式写得很清楚,但通常停在「谱」这一步,出不了成品录音;音频模型能吐出完整歌曲,作曲过程却完全隐式,用户没法改。真正可用的创作工具要的是「先看懂谱、再决定怎么唱」。更麻烦的是训练数据:现成录音没有对齐的乐谱,符号监督和语义监督双双缺失。 本文贡献:用一个 AR-NAR 混合的 Mixture-of-Transformers 把两件事接成一条链:先写出可读的乐谱(指定旋律与和声),展开成 25 Hz 语义音乐 token,最后落成 25 Hz 连续声学 latent,由 48 kHz 立体声 VAE 解码成整首歌。为从「没有对齐乐谱的录音」里学会这套流程,配套提出 MERT2 提供语义监督、SheetSage2 提供符号监督。由于中间产物是人类可读的乐谱,同一 checkpoint 能跟着谱面编辑改动并保住未改动部分,还能零样本翻唱,外部大模型也可把反馈译成谱面修订,实现 agentic 改曲。 Composing in symbols, performing in audio. 实验效果:同一 checkpoint 下,专家对「带符号规划」的整体偏好为 49.3%,不规划只有 34.6%。WildSongBench 上 SongBench Global Avg 得 6.73,超过所有受评公开基线;best-of-8 取 6.96,是全部受评系统中的最高均值。专家听测中 best-of-8 优于 Suno v4.5,对 v5 接近持平。MERT2 在 MARBLE 的 15 项指标中 14 项刷新最佳;SheetSage2 在 lead-sheet 转录对比的 15 组指标对中 12 组领先。 Expert preferences for YuE2 versus six proprietary song generators across all six criteria. 批判点评:49.3% 对 34.6% 看着是压倒性优势,其实只是同一套系统的两种采样策略互相比,净增益不到 15 个百分点。真正硬的对标是 Suno v6:论文自己给的专家偏好里对 v6 的 overall 胜率只有 31.6%、败率 59.3%,是明显劣势——「frontier quality」只在 v4.5 / v5 这一档站得住。另外 best-of-8 的 6.96 需要 8 倍采样成本,56 页技术报告也没有同行评审背书。 2. WorldAttention:单卡22帧,内核快14倍 WorldAttention: An Efficient Attention Architecture for Interactive Video World Models | 阿里巴巴达摩院;浙江大学;香港科技大学;湖畔实验室;阿里巴巴 TRE | arXiv:2609.34606 关键词:视频世界模型, 稀疏注意力, KV 缓存, 推理加速, 长视频生成 前序问题:交互式视频世界模型要按文本指令持续生成长时间、时间连贯的视频。滑动窗口能把计算量封住,代价是历史上下文被直接砍掉,长程交互能力塌掉;而保留全历史 KV 缓存在计算和显存上都不可行——注意力的二次复杂度让开销爆掉,KV 缓存的线性增长迟早把显存吃满。两条路都不通,问题落在「既要长历史,又要低延迟」上。 本文贡献:提出系统级协同设计的注意力架构,两手一起改:一是 Hybrid Sparse Attention(HSA),把线性全局注意力和头自适应稀疏注意力并在双分支里,按注意力头动态决定稀疏度;二是 Hierarchical KV Cache(HKV),把历史 KV 组织成跨多层存储的语义索引页,先做 prompt 级检索再做 page 级检索,粗到细地把需要的页取回并控制 GPU 驻留量。两项设计都配了定制 kernel,把理论上的效率真正落到硬件上。 Overall architecture of WorldAttention. 实验效果:定制 kernel 相对 FlashAttention-3 带来 14.02 倍 kernel 级加速,叠加 HKV 后端到端加速 2.21 倍;单张 NVIDIA H100 上维持 22.0 FPS。VBench-Long 上质量得分 86.55 且吞吐最快,主体一致性 0.9472;InterVBench 上主体一致性 0.9668。B200 上跨模型规模与分辨率的端到端加速为 2.06 到 2.46 倍。 Attention kernel speedup. 批判点评:14.02 倍是 attention kernel 这一层的数字,端到端只剩 2.21 倍,落差本身就是论文的自我交代:HSA 单次执行 633 微秒里,稀疏 block 注意力 kernel 只占 11.78 微秒(1.86%),大头是 KV 连续拷贝(31.00%)和线性分支(39.78%)。也就是说 kernel 做得再快,杠杆也被内存搬运和线性分支吃掉。另外质量侧的「超越此前 SOTA」只给了主体一致性等少数几项,没有给出相对最强基线的完整指标表。 3. PDMD:一行代码,VBench 涨 1.03 PDMD: Projected Distribution Matching Distillation for Video Diffusion Models | 加州大学圣迭戈分校;字节跳动 | arXiv:2609.35768 关键词:视频生成, 扩散蒸馏, 分布匹配, 少步生成, 批评者误差 前序问题:视频扩散模型动辄要几十次去噪评估,DMD 能把 NFE 压到个位数,但蒸馏出来的样本会在训练过程中逐步退化:画面越来越过饱和、纹理出现不自然的伪影。作者把根因定位到 critic 误差——它混进学生更新之后会随训练步数累积,而 DMD 本身没有任何机制把这个误差拦下来。 本文贡献:提出 PDMD:把 DMD 更新中「与学生-critic 端点残差平行」的那个分量投影掉。作者证明,在固定噪声查询点上,这个残差正是 critic 端点误差的无偏估计;在高维假设下,投影能移除恒定比例的 critic 误差,同时只丢掉可忽略比例的 ideal DMD 信号。整个改动对 DMD 只动一行代码,不引入额外损失、额外网络、额外数据、额外模型前向,也不需要多阶段训练。 2D comparison of projection directions (20-point moving average). 实验效果:Wan2.1 上 4 NFE 取得 VBench 总分 83.73,比对齐设置的 DMD 高 1.03 分。MiniMax-H3 音视频联合生成上,VideoGen-Eval 视觉总分 83.17,比最强蒸馏基线高 0.41 分,且在受评的 4-NFE 模型中 6 项音频指标全部拿到最好成绩。定性对比与用户研究在视觉质量、运动、音频质量上都偏向 PDMD。 Quality, semantic, and total scores on the 387 VideoGen-Eval prompts. 批判点评:1.03 和 0.41 都是小数点后两位的量级提升,放在 VBench 总分 80 多的量级上更像「修退化」而不是「提上限」——它的价值本来就在于 DMD 已经开始崩的那段区间,基线越健康收益越小。MiniMax-H3 的 0.41 分是相对「最强蒸馏基线」而非 teacher,论文没给与未蒸馏模型的差距。另外投影只保证移除「恒定比例」误差,这个结论建立在高维假设之上,实际有限维下的常数有多大并未量化。 4. GeoShrink:两行代码换五倍,PSNR+3.10 GeoShrink: Accelerating Diffusion Transformers with Two Lines of Code | 香港科技大学(广州);格里菲斯大学;CSIRO Data61;JITRI 深度感知研究所 | arXiv:2609.33723 关键词:推理加速, 扩散Transformer, 免训练, 采样求解器, 特征预测 前序问题:扩散 Transformer 的推理成本几乎全部来自沿采样轨迹反复调用模型。已有的免训练加速多走特征缓存路线,在不同去噪步之间复用或预测中间表示;但这类方法动的是模型内部结构,接入成本高,而且缓存什么、什么时候更新都要重新调。能不能完全不碰模型,只在求解器接口上做文章。 本文贡献:提出 GeoShrink:保留原始求解器网格,只在预先规定的一组锚点上真正调用模型。被跳过的阶段,它把「最近一次观测到的增量」按几何保留比例加回最近的精确输出,作为求解器要的那个场。这个规则从弦切线传输和往返线投影推出来,并给出一条几何锚间距原则:在固定覆盖率和首段跨度下,让相邻最大间隔的扩张最小。误差分析刻画了预测误差的几何闭合与传播,全程不假设能拿到未来模型输出。改动只需两行代码。 Overview of GeoShrink. 实验效果:在约 5 倍加速下,FLUX 的 PSNR 比所列最强基线高 3.10 dB。HunyuanVideo 上报告 4.99 倍加速,ChronoMagic-Bench-150 的 PSNR 比最强保真基线高 5.44 dB。在固定评估预算下对比,运动、音频、音乐、3D 生成上也都有明显增益,实验覆盖图像、视频、动作、音频以及适配后的 3D 后端。 Speed-quality trade-off: GeoShrink yields a better Pareto frontier on SD3.5 Medium. 批判点评:全文主打指标是 PSNR,这是保真度指标而不是感知质量指标——5.44 dB 的 PSNR 增益可以对应肉眼几乎无差别的画面,也可以对应明显更糊的结果,论文没有补 FID 或人类偏好。另外「比所列最强基线高」里的基线集合是作者自选的,到底是跟哪些缓存类方法比、有没有包含最新的同类工作,从摘要看不出来。锚间距原则也只在给定覆盖率和首段跨度这组约束下最优。 5. MGFlow:一步打赢四步,FDr 1.45 Unifying Distributional Training for One-Step Visual Generation | 清华大学;复旦大学;西安交通大学;北京大学;浙江大学;DeepSeek;字节跳动 Seed;加州大学伯克利分校;智源研究院 | arXiv:2609.35763 关键词:一步生成, 分布匹配, 高斯混合, Wasserstein梯度流, 文生图 前序问题:一步生成器的分布训练有很多条彼此看起来不相干的路线:FD-Loss 用高斯矩匹配,Drifting 用核密度做 KL 匹配,各自都能work,但没人说清楚它们之间的关系是什么,也说不清「分布建模」和「匹配差异」这两件事哪一件在起作用。缺少统一视角的直接后果是,新方法只能靠试,无法判断某一处改动到底改的是哪一环。 本文贡献:给出一个统一的理论框架:把「分布建模」与「匹配差异度」拆开,再用 Wasserstein 梯度流把全局目标和逐点特征更新连起来。在这个框架下,FD-Loss 和 Gaussian-kernel Drifting 分别被还原为高斯最优传输和基于核密度的 KL 匹配两个特例。框架进一步催生 MGFlow:用高斯混合来建模特征分布,粒度可调,介于全局矩和逐样本表示之间;它同时支持最优传输和基于分数的匹配,并用带质量约束的样本分配配成对分量更新,专门解决「混合模型表达力提升」本身解决不了的 mode collapse。 A unified view of distributional training. 实验效果:ImageNet 256×256 上大幅超过 FD-Loss 基线,pMF-H 取得 FDr⁶ 1.45、JiT-H 取得 1.64,均为当前最佳。文生图方面,把 FLUX.2 [klein] 4B 后训练成一步生成器,在 GenEval 和 PickScore 两个指标上都超过了原始的四步模型。 One-step text-to-image samples from FLUX.2 [klein] 4B post-trained with MGFlow. 批判点评:FDr⁶ 是论文自报指标,对比表里的基线也是作者自己跑的,跨论文可比性存疑;ImageNet-256 是类条件生成的老基准,没有在更大规模或更高分辨率上验证。文生图部分只报了 GenEval 和 PickScore 两个自动指标,没给人类偏好,而「一步超过四步」这种反直觉结论恰恰最需要人工评测背书。另外九家机构联合署名,真正的方法贡献集中在统一框架和高斯混合这两点上,工程验证面其实偏窄。 6. REPI:16万步追平700万步 Scaffold Then Internalize: Representation Injection for Diffusion Transformers | 中山大学;Video Rebirth;香港理工大学 | arXiv:2609.35292 关键词:扩散Transformer, 表示对齐, 训练加速, 表示注入, 图像生成 前序问题:REPA 类方法靠「把扩散 Transformer 的隐状态投影到预训练视觉编码器空间」来加速训练,方向是单向的:扩散模型被迫去迎合编码器。反过来那条路没人走过——让编码器表示直接参与去噪过程。问题在于直接注入会破坏扩散模型自身的表示结构,注入之后模型到底学到了什么、推理时还要不要带着编码器,都没人回答。 本文贡献:提出 REPI(REPresentation Injection),走 scaffold-then-internalize 两段式:第一阶段「搭脚手架」,用投影后的编码器 K/V 临时替换扩散 Transformer 原生的 K/V,只保留它自己的 Query,让外部表示先替模型把去噪这件事撑起来;第二阶段「内化」,模型恢复到使用自己的 K/V,同时用一个内化目标把自身 K/V 对齐到投影后的编码器表示。推理时编码器和投影层全部丢掉,不留下任何额外开销。 Overview of REPI. (a) Scaffold. (b) Internalization. 实验效果:在 SiT-B、SiT-L、SiT-XL 等多种骨干上一致优于 REPA,且两者高度互补——叠加后收益远超任一单独使用。SiT-XL 上,REPI + REPA 训练 200K 步就已经超过 REPA 训练 400K 步的结果。最亮眼的是:仅用 160K 步,REPI + REPA 就能匹配 vanilla SiT 训练 7M 步的效果,相当于 43.5 倍以上的提速。 REPI accelerates diffusion transformer training across model scales. 批判点评:43.5 倍的对照物是「什么都不加的 vanilla SiT」,这个基线本身不含任何加速手段,比值因此被放大;更有信息量的是和 REPA 的等步数对比,那部分增益要小得多。另外从 FID-步数曲线看,REPI 做的是把曲线「提前」,并没有把收敛上限抬高——训练足够久之后差距会收窄。论文也明确指出最大收益来自与 REPA 叠加,单独用 REPI 的绝对提升要看主表才清楚。代码目前标注为即将开源。 7. UMM-Reflection:自己改自己图,GenEval+12 Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning | 南洋理工大学;上海交通大学;东京大学 | arXiv:2609.35767 关键词:统一多模态模型, 强化学习, 自我反思, 图像编辑, 文生图 前序问题:统一多模态模型既能看图又能画图,理论上应该能自己修自己的输出:先诊断这张图错在哪,再改,看着改完的结果继续诊断。但「这次修改到底有没有用」只有渲染出来才知道,所以反思文本和图像生成必须沿着整条回路联合学习。SFT 冷启动能学会走流程却找不到高成功率的修复路径;而只优化渲染器或只优化某一个头的朴素 RL,又把大部分收益留在桌上。 本文贡献:提出 UMM-Reflection,在同一个统一模型内部对完整反思轨迹做 RL。关键设计是 sibling trajectories 共享同一张初始图像,这样 group-relative advantage 比较的就是不同「反思策略」而不是不同起点;再用一个轨迹级 advantage 同时更新反思 token 和基于 flow 的修订,避免逐轮信用分配带来的组合爆炸。信用跨轮次流动、同时流向同一模型的两种角色,推理时不需要任何 verifier。 UMM-Reflection RL. 实验效果:在 BAGEL 上相对 SFT 把 GenEval 提升 12.05 分,且增益能迁移到训练中完全没用过的 WISE(+10.97)、OneIG-Bench(+3.48)、T2I-CompBench++(+4.63)。 Learning dynamics of the 1,000-update RL run. 批判点评:+12.05 分是相对 SFT 冷启动版本,不是相对原始 BAGEL 或当前 SOTA 生成模型,绝对值要在主表里才看得清。整套实验只在一个统一模型(BAGEL)上做,换骨干是否成立未知。训练侧每条轨迹最多三轮反思、每组 16 条 rollout,为了拿到稳定的 group-relative advantage 开销不小;而三轮上限本身就意味着更长链条的迭代修复能力没有被验证——尽管推理免 verifier 是实打实的优势。 8. Elastic Forcing:扔掉两个打分模型,84.64 From Scores to Samples: Elastic Forcing for Autoregressive Video Generation | 清华大学人工智能学院;西安交通大学 IAIR;复旦大学相辉研究院;北京大学 | arXiv:2609.35491 关键词:视频生成, 自回归生成, 蒸馏, MMD, 后训练 前序问题:少步自回归视频生成基本都挂在 DMD 上,而 DMD 需要两样重资产:一个双向扩散 teacher,和一个在线更新的 fake-score 模型。前者限制了「能学什么」——必须有一个现成的目标分布 teacher;后者让后训练的内存和计算开销居高不下,模型一大就跑不动。两者的存在使得「直接向参考视频学」这条路一直没走通。 本文贡献:提出 Elastic Forcing:不学 teacher 给出的真假分数,而是直接从参考视频学 rollout 分布,后训练阶段两个 score model 全部去掉。做法是在冻结的自监督视频表示空间里最小化 MMD(最大均值差异),并用 Nyström–Monte Carlo 混合估计器在近似偏差与采样方差之间取平衡;再配合省内存的 replay 和梯度子采样让这个目标变得可训练。移除辅助 score model 之后,14B 后训练可以放进 8 张 H200。 Demonstration of Elastic Forcing. 实验效果:在与 Self-Forcing 完全相同的架构和初始化下,1.3B 模型把 VBench 总分从 83.80 提到 84.64,同时保持 17 FPS。去掉辅助 score model 使 14B 规模的后训练在 8 张 H200 GPU 上成为可能。除了蒸馏,直接从参考视频学习还能在没有目标专用扩散 teacher 的情况下习得新的视觉风格、语义概念和空间先验。 Additional demonstrations of our 14B model. 批判点评:83.80 到 84.64 只有 0.84 分,而且这个对照是与 Self-Forcing 同架构同初始化的自体基线,不是与当前最强少步方法比。14B 那部分论文只说「使后训练成为可能」,没有给出 14B 的量化评测结果,也没有和带 score model 的同等规模方案做效率对比——省下来的显存到底换来多少质量,读者看不到。MMD 估计器本身还需要在 Nyström 近似偏差和 Monte Carlo 方差之间调参,这个权衡的敏感度没在摘要里交代。 9. GEAR:几何只当地址,12项全第一 Geometry as Address: Routing Attention to Visual Memory for Long-Horizon Camera-Controlled Video Generation | 浙江大学 CAD&CG 国家重点实验室;香港科技大学(广州);LIGHTSPEED | arXiv:2609.34722 关键词:视频生成, 相机控制, 长程记忆, 几何先验, 记忆检索 前序问题:长程相机可控视频生成要从不断膨胀的视觉历史里把之前看过的内容取回来。现有做法要么在历史上下文里隐式检索,要么把历史重建成持久的 3D 记忆:前者检索低效、token 越堆越多,后者会因为全局融合不断累积几何误差,跑几十秒之后画面就漂了。矛盾在于几何信息到底该被用来「解释场景」还是只用来「定位」。 本文贡献:核心洞察是:几何不需要解释场景,它只需要决定「视觉记忆该从哪里读」,而「该恢复什么」交给注意力去判断。GEAR 据此把几何当作视觉记忆的显式 token 级地址——不把历史观测融进一个持久的全局 3D 表示,而是保留为逐帧 latent,只用逐帧几何与目标视角建立 token 级对应关系,从而避开全局融合的误差累积。由这些对应关系引导,Geometric Correspondence Attention(GCA)在去噪时把几何匹配上的历史特征选择性注入到噪声目标 patch。另外用 Invisible Octree 累积可见性证据,把几何上合理但实际被遮挡的对应关系剔掉。 System overview. 实验效果:在 DL3DV 与 WorldScore 的全部 12 项指标上取得最佳:SSIM 0.3645、LPIPS 0.4459、FVD 837.59、TransErr 0.0116、RotErr 0.1228、ATE 0.0436、Content Alignment 0.7423、Photo Consistency 0.9732、Style Consistency 0.8700、主观分 0.5018、Revisit SSIM 0.6489、Revisit LPIPS 0.2019。支持沿高难度轨迹生成分钟级视频。 Out-of-domain qualitative comparison for minute-long generation. 批判点评:主观分只有 0.5018,刚过一半,说明「12 项全第一」里最贴近人的那一项优势最薄。FVD 837.59 的绝对值也谈不上低。对比集合是「带 memory 机制的近期方法」,没有与不带记忆的强基线在同等时长下对照,因此无法判断这套地址机制相对「干脆不记忆」的净收益。此外整套方法依赖每帧几何(位姿与深度)可用,相机轨迹是外部给定的,几何估计本身的误差如何传导到地址精度只做了定性讨论。 10. ORAV:380题9种角色,人机86% ORAV: Benchmarking Audio-Video Generation from Multimodal Contexts | 清华大学人工智能学院;腾讯混元 | arXiv:2609.34843 关键词:音视频生成, 多模态参考, 基准评测, 组合式生成, 评测协议 前序问题:用异构多模态参考(图、视频、音频混着给)去生成音视频成了一个新课题,它同时要求两件事:对生成结果有组合式控制,对多模态上下文有 grounded 理解。但现有基准基本只覆盖单参考或同构参考,评测协议也沿用通用视频质量指标,无法判断「模型有没有照着指令把指定参考里的指定内容取出来并正确组合」。没有基准,就没法追踪这一方向的进展。 本文贡献:提出 ORAV Bench,包含 380 个任务实例,每个实例带 2 到 10 个参考,覆盖 9 种语义角色和 30 种角色组合;指令负责说明各参考之间的关系,媒体本身提供要被落实的身份、动态和音频特征。评测上设计了一套参考感知的成对比较协议:先分别准备视觉和听觉证据,再逐个比较每个参考「本应贡献什么」,最后在两种呈现顺序下核对总体裁决,以消解顺序偏差。 Omni-reference audio-video generation requires selectively composing information from heterogeneous references. 实验效果:在留出实例上,该协议与人类判断的有效一致率达到 86.08%。对 5 个前沿系统的评测显示,总体排名掩盖了各系统在不同参考组合上的能力差异;暴露出的一个反复出现的失败模式是:模型生成了与某个参考高度相似、但并非指令所要求的内容。可复现的逐点诊断在质量、参考亲和度、语音三个维度上揭示出彼此独立的行为差异。 Performance across composition signatures. 批判点评:86.08% 是「有效一致率」,已经剔除了不可用判断和顺序冲突的样本,分母比全部配对要小,实际一致性更接近的下界没有给出。5 个受评系统在摘要里被匿名处理为 frontier systems,读者无法核对评测对象;380 个实例摊到 30 种角色组合后每种只剩十几个,论文也承认只有共享实例数不少于 8 个的 14 个 signature 才重拟合了胜率。作为纯基准工作,它不提供任何模型或训练方案,落地价值取决于社区是否跟进。 趋势观察 加速的战场从算法层下移到系统层 今天十篇里有三篇在跟计算成本较劲,但下手的层级完全不同:WorldAttention 直接写定制 kernel 并重排 KV 的内存层级,GeoShrink 干脆绕开模型、只在求解器接口上抠掉五分之四的调用,Elastic Forcing 则是把两个 score model 整个删掉换来 14B 后训练的可行性。共同点是单纯改注意力数学已经不够,谁把内存搬运和调用次数一起管起来谁才拿到真实收益。 「先搭脚手架再拆掉」成了训练范式的共识动作 REPI 用编码器 K/V 临时替换扩散 Transformer 的原生 K/V,等模型内化之后在推理时把编码器整体丢弃;PDMD 只对 DMD 动一行代码、不加任何额外网络或损失;UMM-Reflection 在训练时用冻结 verifier 打分、推理时一个 verifier 都不需要。三篇方向毫不相干,却都在做同一件事:把复杂度全部留在训练期,交付一个结构不变、开销不增的推理模型。 人工智能炼丹君 整理 | 2026-09-30 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|DiT:用 Transformer 替掉 UNet-DiT AIGC 基本功|DiT:用 Transformer 替掉 UNet-DiT 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(ddpm)、潜空间扩散(latent_diffusion)、自注意力(attention_basics) 关键词:DiT、Diffusion Transformer、adaLN-Zero、patchify、Gflops 缩放、条件注入 01. 为什么需要它 读者先掌握 DDPM 的加噪与噪声预测目标、潜空间压缩和多头注意力即可。本文把 $z_t$ 记作加噪后的 VAE 潜变量;$T$ 是空间 token 数,时间步用 $t$,二者不要混淆。LayerNorm 对每个 token 的特征维归一化,后文给出其条件调制。MAC 是乘加次数;一次乘加常按 2 FLOPs 折算,既不是耗时也不是吞吐。 先给三组数字。论文结果来自 DiT 原文 Table 4:256×256 ImageNet、400K 训练步、batch 256、EMA 权重、无 CFG、50K 样本 FID、250 步 DDPM、ft-MSE VAE 解码器;不包含 VAE 的参数和前向成本。本文没有重训该 ImageNet 实验。文中 NumPy toy 与解析账本另有完整可运行脚本。 第一组:参数量相差约 4 倍的两个模型,FID 几乎相同;第三个大模型却差得多。 DiT-S/2 用 33M 参数、6.06 Gflops 得到 FID 68.40,DiT-B/4 用 130M、5.56 Gflops 得到 68.38;DiT-L/8 用 459M、5.01 Gflops 得到 118.87。三者的预算只是接近,并非严格相等。图 1 虚线连接的是这三种配置,第三点并未与前两点重合。它说明参数量不足以预测这些配置的质量;更小 patch 可以让小模型增加 token 计算,得到有竞争力的结果。三个点同时改变宽度、深度和 patch,不能单独证明“买 token 永远优于买宽度”。UNet 也能调整通道、层数或下采样设计,DiT 的优势在于用统一 block 更方便地组织这些缩放实验。 第二组:DiT-XL/2 的主要矩阵 MAC 中,注意力两次矩阵乘约占 3.57%。 对 $T=256,d=1152$,qkv、输出投影和 MLP 合计是 $12Td^2$,注意力分数与加权是 $2T^2d$。线性项占这两类主项的约 96.43%;若以包含调制、输入和输出等简化项的 118.646 G 账本为分母,则分别约 96.21% 与 3.56%。不要混用分母。两类主项相等时 $T=6d$,即 XL 的 6912。这个算式解释运算量分配;实际瓶颈仍受访存、kernel 和硬件影响,注意力的二次存储也不能从 MAC 比例中排除。论文在指定配置网格和训练预算中观察到更多 Gflops 与更低 FID 的相关性,不是对任意任务的单调保证。 第三组:同样 118.6 Gflops,只换条件注入方式,FID 从 25.21 掉到 19.47。 论文 Table 4 中四种 block 的 400K 步对照是同一个 DiT-XL/2 骨架:in-context 35.24、cross-attention 26.14、vanilla adaLN 25.21、adaLN-Zero 19.47。其中 vanilla adaLN 与 adaLN-Zero 的 Gflops 只差 0.08,差别包括新增残差门控与零初始化,不能把整个增益归因于初始化一个因素。这组 5.74 分差距对应门控与初始化等结构选择的联合比较,不能视为只改一个初始化变量的因果效应。下文逐行说明其前向和梯度路径。 这张图要看什么:左图使用论文 Table 4 的预算和 FID,虚线只是连接预算接近的配置。S/2 与 B/4 的 FID 接近,L/8 明显更高,不能读成三者等高。右图只比较注意力矩阵 MAC 与主干线性 MAC,竖线为 T=256;随 token 增加,二次项逐渐变得重要。 所以这篇文章回答三个问题:DiT 的算力账本是怎么记的、adaLN-Zero 的「恒等初始化」在数学上意味着什么、以及它换来的到底是什么。 02. 最小可用理解 三句话讲完: 把潜变量切成 patch 序列,再接条件化的 ViT 风格骨干。 32×32×4 的潜变量按 p=2 切成 (32/2)²=256 个 token,每个 token 原始 16 维,线性嵌入到 d 维,加固定的 2D sin-cos 位置编码,过 N 个 block,最后一层线性投回 p²×2C 维(原始 learn_sigma=True,同时输出噪声与方差参数)再拼回空间形状。patch size p 是 DiT 沿用 ViT 的缩放旋钮:p 减半,token 数翻四倍,主干线性 MAC 翻四倍、注意力矩阵 MAC 翻十六倍;总预算还含每样本固定项,参数量近似不变。 条件(时间步 + 类别)不进序列,而是变成每个 block 的 LayerNorm 参数。 具体做法是调制:先算出 $c = t_{\text{emb}} + y_{\text{emb}}$,再用一个 $\text{SiLU} \to \text{Linear}(d, 6d)$ 把它变成 6 段 d 维向量,分别是注意力分支与 MLP 分支的 $(\beta_1, \gamma_1, \alpha_1)$ 与 $(\beta_2, \gamma_2, \alpha_2)$。前两个做 shift/scale,第三个是残差门控:$x \leftarrow x + \alpha \odot f(\cdot)$。 Zero 指的是整个调制层零初始化,于是每个 block 在初始化时是恒等函数。 关键点在 DiT 的 modulate 写法:它是 $x(1 + \gamma_{\text{out}}) + \beta_{\text{out}}$ 而不是 $x\gamma_{\text{out}} + \beta_{\text{out}}$。调制层输出全零时,$\gamma_{out}=0$(有效缩放为 $1+\gamma_{out}=1$)、$\beta = 0$、$\alpha = 0$,三件事同时成立,整个 block 变成 $x \mapsto x$。实测:28 层叠完之后 $\|x_{28} - x_0\|_\infty = 0$(图 2 左)。 代价也很清楚:门关着的时候,block 内部除门控之外的参数梯度精确为零——在独立 block 接非零上游梯度时,门控可能先获得梯度;完整 DiT 的输出头也为零,第一步首先更新输出头。 03. 数学推导 3.1 patchify:从空间表示到 token 序列 记潜变量 $z \in \mathbb{R}^{I \times I \times C}$(256×256 图像过 VAE 后是 $I=32, C=4$)。patchify 把每个 $p \times p \times C$ 的方块摊平成一个 $p^2C$ 维向量,共 $$T = (I/p)^2$$ 个,再用一个线性层 $\mathbb{R}^{p^2C} \to \mathbb{R}^d$ 嵌入。实测的形状(附录 dit_flops.py): 输入潜变量 z: (2, 32, 32, 4) p=8: patchify -> (2, 16, 256) T=16, 每 token 256 维 p=4: patchify -> (2, 64, 64) T=64, 每 token 64 维 p=2: patchify -> (2, 256, 16) T=256, 每 token 16 维 $T$ 之外的一切($d$、block 数、头数)都与 $p$ 无关,所以在其余配置固定时,$p$ 主要改变 token 运算量,但输入和输出投影的参数也随之改变:$p$ 从 8 减到 2,DiT-S 的 Gflops 从 0.36 涨到 6.06(17 倍),论文取整均为 33M,并非每个参数完全相同。 3.2 算力账本:主导项是 $O(Td^2)$ 数一个 block 的主要矩阵乘加次数(MAC,一次 $ab+c$ 记 1)。这一口径能近似解释论文的 Gflops;论文没有给出足以完全复现所有逐元素算子的统一 profiler 定义,本文不声称逐 FLOP 完全一致。 部件 每个 token 的 MAC 说明 qkv 投影 $3d^2$ $d \to 3d$ 注意力分数 $QK^\top$ $Td$ 每个 token 对 T 个位置各做 d 次乘加 注意力加权 $AV$ $Td$ 同上 输出投影 $d^2$ $d \to d$ MLP($d \to 4d \to d$) $8d^2$ 两层各 $4d^2$ adaLN 调制 $6d^2$ / 样本 + $3d$ / token 每个样本只算一次;3d 是简化的逐元素计数,未穷尽两分支全部操作 忽略调制与逐元素项,一个 block 的算力是 $$\mathrm{MAC}_{\text{block}} \approx T(12d^2 + 2Td)$$ 其中 $12d^2=3d^2+d^2+8d^2$。仅乘 $N=28,T=256,d=1152$ 的两类主项得到 118.380 G MAC;再加每层 $6d^2$ 的条件投影、输入/输出和时间嵌入以及简化逐元素项,脚本得到 118.646194176 G,论文报告 118.64 G。两者很接近,但不是同一个精确计数。LayerNorm、softmax、SiLU/GELU 的实际算子成本与偏置操作未完整计入。一次乘加按 2 FLOPs 折算时,主矩阵项可约乘二,不能把所有逐元素项也机械当成两次运算。 参数账本则可以精确核对:原始源码的两个 block LayerNorm 和最终 LayerNorm 均无仿射参数;类别表含 1000 个类别与 1 个 null 行;输出头含 $2C$ 通道。因此每块可训练参数为 $18d^2+15d$,XL/2 的可训练参数共 674,834,720,冻结位置编码另有 294,912 个数;将冻结参数也算入模型 Parameter,总数是 675,129,632。下面表格的“本篇参数量”统一取可训练参数。12 种配置均已用固定官方 DiT 类在 PyTorch meta 设备上逐参数数目核对,不执行这些大模型的前向或训练。 这张对账表本身就是文章的一半结论,值得整张贴出来: 模型 N / d / T 本篇 GMAC 论文 Gflops 可训练 M 论文 FID DiT-S/8 12 / 384 / 16 0.358 0.36 33.142 153.60 DiT-S/4 12 / 384 / 64 1.413 1.41 32.920 100.41 DiT-S/2 12 / 384 / 256 6.059 6.06 32.865 68.40 DiT-B/8 12 / 768 / 16 1.418 1.42 130.869 122.74 DiT-B/4 12 / 768 / 64 5.567 5.56 130.426 68.38 DiT-B/2 12 / 768 / 256 23.012 23.01 130.316 43.47 DiT-L/8 24 / 1024 / 16 5.013 5.01 458.578 118.87 DiT-L/4 24 / 1024 / 64 19.700 19.70 457.988 45.64 DiT-L/2 24 / 1024 / 256 80.716 80.71 457.841 23.33 DiT-XL/8 28 / 1152 / 16 7.394 7.39 675.665 106.41 DiT-XL/4 28 / 1152 / 64 29.050 29.05 675.001 43.01 DiT-XL/2 28 / 1152 / 256 118.646 118.64 674.835 19.47 横着读这张表,三个旋钮的作用各不相同: 深度 N:固定 d、T 时,block 的参数和 MAC 随 N 线性增加。表中 L/2 与 B/2 也同时改变 d 和头数,不能把两者的 FID 差单独归因于加深。 宽度 d:固定 N、T 时,主干线性参数与 MAC 近似按 d² 增加,注意力矩阵项按 d 增加。表中 XL/4 与 S/4 还同时改变 N,不能视为纯宽度消融。 减小 patch(p: 8→2):算力涨 4 倍一档(线性项按 T 涨),总参数量近似不变(patch 投影和输出头会随 p 改变);S/8 → S/2 贵 17 倍算力,FID 从 153.60 到 68.40。 值得注意的是「同样算力下单块算力都是 12d² 主导」这件事在表里也看得出来:DiT-S/2 与 DiT-B/4 的算力(6.06 / 5.56 G)落在同一档,说明一个 12 层 384 宽、切到 p=2 的小模型,和 12 层 768 宽、切到 p=4 的大模型,在算力上是可以互换的;两者的 FID 也确实只差 0.02。这条「算力等价」的直觉,是后面理解缩放实验的前提。 注意力占比是两种项的比值: $$\frac{2Td}{12d^2 + 2Td} = \frac{2T}{12d + 2T}$$ 代入 $T=256, d=1152$ 得 3.57%。令两者相等解出临界点 $T = 6d$:固定 T 时,d 越大,注意力矩阵 MAC 在这两类主项中的占比越小;这不判定实际延迟或显存占比。图 1 右图画的是各档模型在 $T$ 从 64 到 16384 上扫过的这条曲线。 3.3 adaLN:把条件变成 LayerNorm 的参数 标准 LayerNorm 之后接仿射变换: $$h = \gamma \odot \mathrm{LN}(x) + \beta$$ 其中 $\mathrm{LN}$ 对最后一维做归一化(DiT 里 elementwise_affine=False,仿射参数不是 LN 自带的)。 具体对一个 d 维 token,均值 $\mu=d^{-1}\sum_jx_j$,方差 $v=d^{-1}\sum_j(x_j-\mu)^2$,使用总体方差而非无偏样本方差: $$\mathrm{LN}(x)_j=\frac{x_j-\mu}{\sqrt{v+\epsilon_{LN}}},\qquad \epsilon_{LN}=10^{-6}$$ 其中稳定常数防止零方差时除零;它与扩散噪声 $\varepsilon$ 是两个不同量。adaLN 的做法是把 $\gamma, \beta$ 变成条件的函数: $$(\beta_1, \gamma_1, \alpha_1, \beta_2, \gamma_2, \alpha_2) = \mathrm{Linear}_{d \to 6d}\big(\mathrm{SiLU}(c)\big), \qquad c = t_{\text{emb}} + y_{\text{emb}}$$ DiT 源码里的 modulate 是这样写的: $$\mathrm{modulate}(x, \beta, \gamma) = x \odot (1 + \gamma) + \beta$$ 用 $1+\gamma$ 时,调制层输出 $\gamma=0$ 对应有效缩放为 1,$\beta=0$ 对应不平移。注意“调制输出”与“有效缩放”是两个量,不能把同一个 $\gamma$ 同时写成 0 与 1。没有这项偏移未必数学上完全无法学习,但会改变初始特征与梯度路径。 3.4 门控与恒等初始化 DiT block 的两条残差分支都带门: $$x' = x + \alpha_1 \odot \mathrm{Attn}\big(\mathrm{modulate}(\mathrm{LN}_1(x), \beta_1, \gamma_1)\big)$$ $$x'' = x' + \alpha_2 \odot \mathrm{MLP}\big(\mathrm{modulate}(\mathrm{LN}_2(x'), \beta_2, \gamma_2)\big)$$ 调制层零初始化时 $\beta=0$、$\gamma=0$(有效缩放 $1+\gamma=1$)、$\alpha=0$。只要两个门控为零且分支输出有限,block 就是恒等映射,即使 shift/scale 非零也成立。把整层调制器置零进一步让分支内部从不平移、单位缩放开始,但这不是恒等的必要条件。 实测(附录 adaln_zero.py,DiT-XL 宽度 d=1152、T=256、16 头;随机 float64 教学 block,不是预训练模型): adaln_zero 单块 |out - x| 最大值 = 0.000e+00 叠 28 层后 |out - x| 最大值 = 0.000e+00 adaln 单块 |out - x| 最大值 = 2.985e+00 单块相对扰动 std(out-x)/std(x) = 0.6105 叠 28 层后残差流漂移 std(x_28 - x_0) = 4.3497 对照组 vanilla adaLN(无门控且调制层非零初始化):单块就给残差流叠上 std 为 0.61 的随机扰动,28 层随机游走之后漂移达到 4.35——该 seed 下输出相对输入有较大扰动;漂移标准差不能证明输入信息已经丢失。零初始化这一侧,漂移严格是 0,连浮点误差都没有。图 2 左图画的就是这两条曲线。 这张图要看什么:左图比较相同深度宽度的两种 block;差别包含门控及调制初始化——蓝线恒等于 0,粉线一路爬到 4.35。右图是初始化那一刻各部件的梯度大小(对数轴):蓝柱的主干部分趴在底部,真实值就是精确的 0(画在 1e-12 只是为了让 log 轴显示得出),只有最后一组「调制层 gate 段」立起来;粉柱则所有部件都有梯度。注意最右一组的对比是不对称的:vanilla adaLN 结构里压根没有 gate 这一项,所以那条柱子是空的——零初始化不只是「让某些梯度变成 0」,它同时给网络装上了一组原本不存在的门。 3.5 初始化那一刻,谁拿到了梯度 先看单条残差分支 $y=x+\alpha\odot f(h;\theta_f)$,其中 $h=(1+\gamma)\odot\mathrm{LN}(x)+\beta$。对每个样本 b,三个调制向量均为 d 维,并广播到所有 token;$g=\partial L/\partial y$ 与 x 同形状。令 $J_f$ 是 f 对其输入的完整雅可比,$J_{\theta_f}$ 是对分支参数的雅可比,链式法则给出: $$\frac{\partial L}{\partial\alpha_{bj}}=\sum_{t=1}^{T}g_{btj}f(h)_{btj}$$ $$r=J_f(h)^\top(\alpha\odot g),\qquad \frac{\partial L}{\partial\theta_f}=J_{\theta_f}^\top(\alpha\odot g)$$ $$\frac{\partial L}{\partial\beta_{bj}}=\sum_t r_{btj},\qquad \frac{\partial L}{\partial\gamma_{bj}}=\sum_t r_{btj}\mathrm{LN}(x)_{btj}$$ 这里 $\alpha\odot g$ 隐含 token 广播,雅可比转置乘向量是完整矩阵运算,不能把它写成没有收缩指标的逐元素乘积。于是有限分支值且 gate=0 时,分支参数、shift 和 scale 的梯度为零;gate 的梯度可以非零,但若上游 g 为零或求和抵消,它也可能为零。共享调制线性层的权重和偏置还须对样本 b 累加。残差输入 x 的梯度仍可通过恒等路径传播,并不是整个 block 的所有梯度都为零。 下面独立 block 的线性损失实际为 mean(out*w),w 是固定随机数组,均值归一化已包含在 g 中: adaLN-Zero: W_qkv=0.000000e+00, W_o=0.000000e+00, W_1=0.000000e+00, W_2=0.000000e+00 调制层各段: shift_msa=0.000000e+00, scale_msa=0.000000e+00, gate_msa=6.521017e-05, shift_mlp=0.000000e+00, scale_mlp=0.000000e+00, gate_mlp=4.136085e-04 vanilla adaLN: W_qkv=3.751596e-04, W_o=1.960228e-04, W_1=2.736421e-04, W_2=2.435175e-04 调制层各段: shift_msa=6.434247e-04, scale_msa=7.563427e-05, shift_mlp=3.578871e-04, scale_mlp=3.251636e-04 完整 DiT 还将最终输出线性层置零。写成 $o=W_{out}h+b_{out}$,首次反传的上游为 $W_{out}^\top\partial L/\partial o=0$,所以更早的 block gates 暂时也没有损失梯度。固定官方小模型的真实 CPU 实验(输入 2×4×8×8、输出 2×8×8×8、两块 d=32、SGD 学习率 0.1)得到: step 0: 输出 max=0;输出头 grad max=0.0414984;首块调制/注意力 grad=0/0 step 1: 首块调制 grad max=9.09985e-5;注意力 grad=0 step 2: 首块注意力 grad max=1.65495e-9 这是一个具体更新过程的验证,不是保证任意优化器和数据都按固定步数打开门。权重衰减、显式正则或其他损失会另添更新路径。 零输出头的初始 MSE 等于当前这批样本噪声平方的平均值,不保证恰为总体期望 1;learned-variance 的完整训练损失还含另一项,不能只报噪声 MSE 就称完整训练 loss。NumPy 小模型的实跑见下一段: 当前批 mean(eps²)=1.0083085178;零头 MSE=1.0083085178;输出 max=0.0 随机打开输出头后 MSE=3.1357716071;输出 max=4.954960 3.6 四种条件注入:先在自己的玩具任务上排一遍序 论文那组数字(DiT-XL/2、400K 步、ImageNet)在本机复现不了——没有 ImageNet,也没有 TPU。但同一个问题可以搬到跑得完的 toy 上:8 个朝向的二维条纹、潜变量 8×8×2、patch p=2 得到 $T=16$、$d=64$、6 层,各方案使用相同宽度、深度、训练样本流、优化器、学习率计划与步数,每种跑 3 个 seed。结构、参数量、初始化规则及随机数消费顺序不同,不能称为只改初始化的配对消融。脚本就是附录里的 cond_ablation.py。 结果以最终代码真实重跑,训练统计是最后 200 步各 batch MSE 的均值;“±”是 3 次结果的总体标准差(ddof=0),只作描述性统计。另在每次训练结束后,用新噪声和新时间采样的 256 个样本计算评估 MSE;8 类条纹模板仍与训练相同,不是新语义类别的泛化评估。 方案 参数量 训练 MSE 均值 ± std 新加噪评估 MSE 均值 ± std adaLN-Zero 464,328 0.031844 ± 0.002636 0.022255 ± 0.003168 vanilla adaLN 414,408 0.073483 ± 0.001623 0.068328 ± 0.000756 in-context 307,912 0.073493 ± 0.002453 0.064545 ± 0.003234 cross-attention 408,520 0.071401 ± 0.001369 0.067276 ± 0.006353 三个 seed 各自的最后200步训练 MSE: adaLN-Zero:0.028939 / 0.035319 / 0.031276 vanilla adaLN:0.075761 / 0.072582 / 0.072105 in-context:0.071173 / 0.076887 / 0.072419 cross-attention:0.070053 / 0.073279 / 0.070870 这张图要看什么:左图仅画 seed=0 的训练曲线,右图画三个 seed 的最终训练 MSE 和离散点。曲线及数值均来自本轮完整档缓存;完整参数与代码哈希绑定在缓存元数据中,修改代码或 batch/depth/seed 后不会沿用旧结果。 在这一次完整重跑中,按平均训练 MSE 从低到高依次为:adaLN-Zero、cross-attention、vanilla adaLN、in-context。这是此教学结构、8 个固定条纹模板和三个训练 seed 的结果,不是对所有条件注入方法的排序定理。新加噪评估值不必等于最后 200 步训练均值:两者既使用不同噪声,也对应不同阶段的参数。 这个实验保留了自注意力、条件注入与噪声预测的机制,但不含 VAE、learned variance、CFG 或图像 FID。评估只检查同一组条纹模板下新的加噪样本;三 seed 的区间或排序不能证明不存在随机波动,也不能解释 ImageNet 上其他方案的排序为何不同。in-context 多两个 token 的成本、条件交互的难度都可能随任务变化;本文没有用这个实验分别识别这些原因。vanilla adaLN 与 adaLN-Zero 的每层参数差为 2d²+2d,d=64、6 层时差 49,920,来自多出的两个调制门段;这个参数差可以精确解释,质量差不能据此单因归因。 3.7 四种方案到底差在哪(回到论文的数字) 论文比较了四种把条件塞进 Transformer 的办法,它们的差别全部集中在「条件从哪里进入 block」这一件事上: 方案 条件怎么进去 代价 in-context 把 $t_{\text{emb}}, y_{\text{emb}}$ 当成两个额外 token 加入序列(本教学实现拼在末尾),走的还是同一套 self-attention 序列变长,token 数从 $T$ 变 $T+2$;每个 block 都要为这两个 token 做一次全量 attention cross-attention 主干只放图像 token,另加一层交叉注意力,条件 token 当 key/value 多一套 $d \to d$ 的注意力参数,算力上涨最多 vanilla adaLN 条件不进序列,变成 LayerNorm 的 shift/scale($\gamma, \beta$),没有门 每层另加约 4d² 的条件投影参数,MAC 只对每样本算一次;无额外 gate adaLN-Zero 同上,再多两个门 $\alpha_1, \alpha_2$,并把整个调制层零初始化 每层比 vanilla adaLN 多 $2d^2+2d$ 的调制参数(含偏置) 这张图要看什么:三根柱子分别是算力、参数量、FID,四组从左到右对应上表的四种方案。先看中间那张参数量图:in-context 参数最少(449M,因为它没有额外的注意力参数,只是把序列变长),cross-attention 为约 598M 总参数,不能把它与另一方案的 600M 相加,adaLN-Zero 是 675M,比 vanilla adaLN 多了 75M——近似差来自每块新增的 $2d^2+2d$ 个调制参数。再看右边那张 FID 图:参数最少的 in-context 质量最差(35.24),参数最多的 adaLN-Zero 质量最好(19.47)。最后看左边的算力:四种方案的算力其实都挤在 118~138 G 这个窄区间里(in-context 因为序列长了一点反而是 119.37,cross-attention 因为多一套注意力到 137.62),这约 16 分的差距出现在相近但并不完全相同的前向预算下,表明这个训练设置对条件结构选择敏感;它不把算力、参数量与初始化的因果贡献完全拆开。 一个容易看漏的对照:vanilla adaLN 与 adaLN-Zero 的算力只差 0.08 G(118.56 vs 118.64),参数量差 75M,FID 差 5.74 分。门取常数 1 时可包含无门控的行为,但条件相关门控也增加了函数自由度;该对照同时改变参数与初始化,不能证明函数类完全相同,更不能把 5.74 分全部归因为优化路径。 04. 代码实现 完整脚本在文末附录,这里放三段核心代码与它们的真实输出。 4.1 patchify 与它的逆 def patchify(z, p): """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]""" B, I, _, C = z.shape g = I // p z = z.reshape(B, g, p, g, p, C) z = z.transpose(0, 1, 3, 2, 4, 5) # [B, g, g, p, p, C] return z.reshape(B, g * g, p * p * C) 跑一遍(batch=2、32×32×4):p=8 -> (2, 16, 256)、p=4 -> (2, 64, 64)、p=2 -> (2, 256, 16),逆变换的最大误差 0.00e+00。 4.2 一个 DiT block def modulate(h, shift, scale): """DiT 源码的 modulate: x * (1 + scale) + shift""" sh = tg.reshape(shift, (shift.v.shape[0], 1, -1)) sc = tg.reshape(scale, (scale.v.shape[0], 1, -1)) return tg.add(tg.add(h, tg.mul(h, sc)), sh) class DiTBlock: def __call__(self, x, c, store, ctx=None): B, T, d = x.v.shape sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last( self.w_mod(tg.silu(c), store), 6) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a)) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u)) 逐项对一下变量名与 03 节的符号:sh_a/sc_a/gate_a 就是 $(\beta_1, \gamma_1, \alpha_1)$,w_mod 是那个 $\text{Linear}(d, 6d)$,注意它前面接的是 silu 而不是别的激活。w_mod 在 mode="adaln_zero" 时用 zero=True 初始化——weight 和 bias 全是 0,另外 vanilla adaLN 调制四段且没有残差门控;两者并非只差初始化。 4.3 账本对账与非平凡反向检查 dit_flops.py 的真实输出中,XL/2 的可训练参数为: patch 嵌入 19,584 时间嵌入 1,624,320 类别嵌入(含 null) 1,153,152 28 × 23,905,152 669,344,256 FinalLayer(含方差输出) 2,693,408 合计 674,834,720 冻结位置编码另计 294,912 近似主矩阵账本中,逐 token 线性项是 114.152177664 G,注意力两次乘法为 4.227858432 G,完整简化账本 118.646194176 G。所有 12 个配置与论文 Gflops 的偏差小于 1%,但这只是计数模型接近论文,不是测出了相同 GPU 延迟。参数数目则与官方类的真实注册参数精确相等。 手写自动微分不能在零输出头下检验主干:那样主干梯度全为零,错误的反向也可能“通过”。本次修正 gradcheck_report,在中心差分前把输出头设为非零,真正让 LayerNorm、注意力、MLP 和条件路径接到梯度。另把同一套 NumPy block 权重复制给固定官方 DiTBlock 与 timm Attention/Mlp,打开非零调制,比较输出、输入/条件及全部五组线性层的权重和偏置梯度;float64 的最大误差见第 09 节。官方完整小模型还验证了第 3.5 节的分阶段梯度路径。 05. 工业级实现对照 对照官方 固定提交的 models.py,提交为 ed81ce2(完整提交链接可点开核查)。本文实际执行原始 AST 类与方法,依赖选用 timm v0.6.12 的原始 Attention/Mlp/PatchEmbed;官方 environment.yml 并未固定 timm 版本。两项简单辅助函数提供等价的 tuple 转换和断言,未改写这些类的数学实现。使用 PyTorch 2.10 CPU,未声称复现原 JAX/TPU 训练或 GPU 性能。 modulate 就是那个 $1+\gamma$。 源码原样: def modulate(x, shift, scale): return x * (1 + scale.unsqueeze(1)) + shift.unsqueeze(1) 每个 block 内用一层 SiLU + Linear,一次算 6 段再 chunk;不同 block 的调制器不共享权重。 不是给六个分支各配一个线性层: self.adaLN_modulation = nn.Sequential(nn.SiLU(), nn.Linear(hidden_size, 6 * hidden_size, bias=True)) # 上面这个 Sequential 的输出一次是 6d 维,再切成六段 shift_msa, scale_msa, gate_msa, shift_mlp, scale_mlp, gate_mlp = self.adaLN_modulation(c).chunk(6, dim=1) 初始化分三步,顺序不能乱。 先 xavier_uniform_ 初始化所有 Linear,再把每个 block 的调制层整体置零,最后把 FinalLayer 的调制层和输出线性层置零: self.apply(_basic_init) # 1. 全模型 xavier_uniform for block in self.blocks: # 2. 每个 block 的 adaLN 调制层归零 nn.init.constant_(block.adaLN_modulation[-1].weight, 0) nn.init.constant_(block.adaLN_modulation[-1].bias, 0) nn.init.constant_(self.final_layer.adaLN_modulation[-1].weight, 0) # 3. 输出层归零 nn.init.constant_(self.final_layer.adaLN_modulation[-1].bias, 0) nn.init.constant_(self.final_layer.linear.weight, 0) nn.init.constant_(self.final_layer.linear.bias, 0) 注意第 2 步是整层置零,不是只置零 gate 那两段——这就是 3.4 节说的「一次拿到 $\gamma=0$(有效缩放为 1)、$\beta=0, \alpha=0$ 三件事」。 与最小实现的差异,以及为什么: 差异 源码里的做法 为什么 位置编码 2D sin-cos,requires_grad=False 冻结 沿用 MAE 风格;冻结的是位置 Parameter,仍占存储,不能由此推得所有任务质量或外推优势 时间步编码 256 维正弦 → Linear → SiLU → Linear 原始 DiT 采用该频率嵌入,不是所有扩散模型的唯一选择;toy 使用归一化时间且 t_freq=32 类别嵌入 nn.Embedding(1000 + 1, d),多一个位置 多出来的那一行是 CFG 的 null token,token_drop 把标签换成它 输出通道 learn_sigma=True 时输出 $2 \times 4 = 8$ 通道 一半预测噪声、一半预测方差(可学习的 $\Sigma_\theta$),采样时用后者做各时间步的方差 CFG 的作用范围 forward_with_cfg 只把引导作用在前 3 个通道 该固定代码注释说明这是为了精确复现做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推;这是复现 DiT 数值时最容易踩的坑之一 激活函数 nn.GELU(approximate="tanh") 固定代码采用此近似;本文不以它推出跨硬件速度或 FID 不变的保证 还有一个容易被忽略的点:unpatchify 用的是 torch.einsum('nhwpqc->nchpwq', x),不是简单的 reshape。它要把 token 里的 $p \times p \times C$ 重新摆回空间位置,通道维要提到最前面。 整条前向的调用顺序(DiT.forward)值得记住,因为后面拆视频版 DiT 时这几步会变成瓶颈点: x = self.x_embedder(x) + self.pos_embed # 1. patchify + 位置 t = self.t_embedder(t) # 2. 时间步 → 256 → d y = self.y_embedder(y, self.training) # 3. 类别 → d(training 时才做 label dropout) c = t + y # 4. 两个条件相加,不是拼接 for block in self.blocks: x = block(x, c) # 5. N 个 block,条件从 c 进来 x = self.final_layer(x, c) # 6. 也是调制出来的 shift/scale x = self.unpatchify(x) # 7. 回到空间形状 第 4 步相加后 c 仍为 d 维,每个 block 的调制参数沿 token 广播;这是条件注入的形式约束,不是对含位置编码和注意力的整个网络表达能力给出绝对上界。 分类器无关引导(CFG)是在 forward 外面拼的。 forward_with_cfg 复制输入 batch 的前半份为两份,但不会替调用者改标签。调用者需传入偶数 batch、成对一致的时间步,以及前半条件标签、后半 null 标签,最后再合成: half = x[: len(x) // 2] combined = torch.cat([half, half], dim=0) # 前半、后半的条件由调用者传入的 y 决定 model_out = self.forward(combined, t, y) eps, rest = model_out[:, :3], model_out[:, 3:] cond_eps, uncond_eps = torch.split(eps, len(eps) // 2, dim=0) half_eps = uncond_eps + cfg_scale * (cond_eps - uncond_eps) eps = torch.cat([half_eps, half_eps], dim=0) return torch.cat([eps, rest], dim=1) # 其余通道原样保留 这里有两个复现时必须知道的细节:其一,引导公式用无条件分支做基准(uncond + w·(cond − uncond)),不是把有条件分支当基准;其二,eps, rest 的拆分把引导限制在前 3 个通道,返回时仍拼回其余通道(含方差),该固定代码注释说这是为了精确复现而做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推。照着论文数值复现时如果忘了这一条,采样协议会改变;本文没有测出这个修改会令 FID 改变多少。 learn_sigma 是输出通道翻倍的原因。 当它为真时 out_channels = 2 * in_channels,网络一半预测噪声 $\varepsilon$、另一半预测 learned-range 的方差插值参数,经同提交扩散代码映射为对数方差。该映射不自动将插值参数裁到 [-1,1],网络超出该区间时也可能发生外插。采样时前者进 DDPM/DDIM 的更新公式,后者可用于学习方差的 DDPM 更新;DDIM 的随机方差由其调度与 η 决定,通常不使用该头。这也是为什么 DiT 的输出头看起来比「预测噪声」该有的形状大一号。 06. 代价与边界 代价一:$O(T^2)$ 迟早会来找你。 T=256 时注意力只占 3.6%,那是 256×256 图像。512×512 的 DiT-XL/2 有 T=1024,一次前向 524.6 Gflops(是 256 分辨率的 4.4 倍);再往视频走,时间维一加,token 数轻易上万。长视频常采用序列并行、稀疏/窗口或时空分解等方案,但不是由该公式得出的唯一必选实现。T 远小于 6d 只说明 MAC 主项中线性层更大,不能据此保证注意力不是实际瓶颈。 代价二:adaLN 对所有 token 施加同一个函数。 论文原话:adaLN 是四种方案里唯一「被限制成对所有 token 应用同一个函数」的。$\beta, \gamma, \alpha$ 是 d 维向量,在整个序列上广播,没有空间维度。所以凡是条件本身带空间结构的任务——局部编辑、inpainting 的 mask、逐区域控制——单靠一个广播的全局调制向量不便保留空间对应关系,通常还需空间输入、条件 token 或 cross-attention;不能据此断言整体网络表达不了局部任务。SD3 的 MM-DiT 为图像和文本保留不同权重并做联合注意力;它给出另一种条件交互设计,本文不将其历史动机归因于单一原因。 代价三:patch size 减半,主要 token 算力约四倍起,参数仅小幅变化。 这是好事也是陷阱:在论文所测配置中,小模型 + 小 patch 可获得接近某些大模型的 FID(01 节);不保证任意模型可互换;坏消息是部署成本还取决于硬件、batch、访存和采样步数;Gflops 是其中一项,论文前向 Gflops 约相差 17 倍,参数取整相同;这不是测得 17 倍延迟,部署时容易误判。 代价四:丢掉了 UNet 的多尺度归纳偏置。 UNet 的下采样-上采样结构天然假设「图像有局部性、有尺度层次」,这个先验在小数据集上是白送的。原始 DiT 用平铺 token 网格和全局注意力,也有 patch 结构和固定位置编码;不能说完全没有空间归纳偏置。论文的结论主要来自 ImageNet 规模;它没有给出这里所说“几万张图”场景的普遍收敛比较,因此小数据集需另做受控验证。 代价五:初始化决定最初的梯度路径。 独立 block 实验验证门控阻断分支梯度;完整模型还需先打开零输出头。不能据此指定“前几步只有门在动”的固定持续时间,或无依据地推荐给调制器更大学习率。 论文中的 ADM 1983 Gflops 与 DiT-XL/2 118.64 Gflops 是像素空间 UNet 与潜空间 Transformer 的跨系统比较,分辨率、表示和训练预算都不同。它说明整套 DiT 系统有竞争力,不能把约 16.7 倍单次前向差全归因于更换骨干,也不包含完整采样步数与 VAE 成本。 07. 经典论文脉络 论文 原文 在本文中的作用 ADM 2105.05233 UNet 扩散与引导的强基线;跨像素/潜空间预算不能全归因于骨干 LDM 2112.10752 在压缩潜空间训练扩散,为 DiT 的 32×32×4 输入提供表示基础 U-ViT 2209.12152 探索带长跳连的 ViT 扩散骨干,将时间和条件作为 token;整体结构不等于 DiT 的 in-context 变体 DiT 2212.09748 在指定 ImageNet 配置网格研究深度、宽度、patch 和条件注入,adaLN-Zero 在所测对照中较优 PixArt-α 2310.00426 结合文本 cross-attention 与时间调制;文中训练预算比较绑定其数据与训练方案 SD3 2403.03206 用图文不同权重的 MM-DiT 和 rectified flow,不能等同于只改原始类别嵌入 Latte 2401.03048 探索视频潜空间 Transformer 的四种时空建模设计,不代表所有视频骨干都采用同一结构 这条阅读线把潜空间表示、Transformer 骨干、文本交互与时间建模分开理解:ADM/LDM 提供扩散与潜空间背景,U-ViT/DiT 探索骨干,PixArt-α/SD3 研究文本交互,Latte 研究视频。它是按问题组织的阅读顺序,不是所有后继工作的一条单向继承史。可以从固定 DiT 代码确认时间/类别调制与恒等残差这套设计;不能把“后继几乎都沿用零初始化”当成已逐模型验证的事实。 08. 常见误解 误解一:adaLN-Zero 只是把 scale 零初始化。 实现把整个调制线性层置零;调制输出 scale=0,而有效缩放为 1。残差恒等主要由 gate=0 保证,单独关门已经足够。 误解二:注意力 MAC 比例小,就不会成为瓶颈。 XL/2、T=256 的两类主矩阵 MAC 中注意力约占 3.57%,但实际耗时取决于算子效率与访存;显式注意力矩阵存储仍是二次项。长视频的 T 可远大于图像,不能把几百 token 的结论泛化。$T=6d$ 只是两类 MAC 主项相等的点。 误解三:patch size 只影响 token 数,是个「免费的」结构选择。 参数量只是近似不变(DiT-S 三档取整都是 33M),对算力一点也不免费(0.36 → 1.41 → 6.06 G,17 倍)。论文里那句「changing $p$ has no meaningful impact on downstream parameter counts」说的是参数,别顺手读成「没有代价」。 误解四:Gflops、GMAC 和实测速度可以互换。 论文预算数值接近按一次乘加计 1 的主要矩阵账本。若按乘、加各计一次,主矩阵 FLOPs 约是 MAC 的两倍;逐元素函数仍需自己的计数规则。本文明确给出近似项和遗漏,不把接近 118.64 写成逐 FLOP 复现,更不从预算直接推出硬件速度。 误解五:零初始化让整个模型不能训练。 零输出头仍能先收到非零梯度;随后 gate 和主干逐步接到信号。独立 block 的梯度实验不能替代完整 DiT 首次反传的检查。 误解六:DiT 就是「把 UNet 换成 ViT」,拿一个标准 ViT 直接接上就行。 差的不是一点:DiT 没有 [CLS] token、没有分类头、位置编码是冻结的 2D sin-cos(这是原始实现的选择,不能由此保证所有任务中都优于可学习编码);最关键的是它的 block 不是标准 ViT block——多了一条 adaLN 调制支路和两个门,FinalLayer 也是「调制 + 线性」而不是「LN + 线性」。把 torchvision 里的 ViT 拿来改,能跑起来,但那不是 DiT,也复现不出 19.47 的 FID。 09. 动手验证 附录保留六个完整脚本,其中 dit_core.py、tiny_grad.py 是公共件,另四个是实验入口。只需 NumPy、matplotlib;主体脚本与绘图实跑环境是 Windows、Python 3.11.9、NumPy 2.4.3、matplotlib 3.10.7;官方 CPU 参考使用已有局部运行依赖,确切版本见实跑证据。进程内 OpenBLAS/OMP 各 1 线程。官方参考另用 PyTorch 2.10.0+cpu,不安装系统包,不将 CPU 结果外推为 GPU、TPU 性能。 python dit_flops.py:打印 patchify 与逆变换的真实形状、可训练参数和近似 MAC;预期 XL/2 为 674,834,720 可训练参数、约 118.646 G 简化预算。冻结位置编码另计 294,912,12 配置与官方注册参数精确一致。 python adaln_zero.py:真实执行 d=1152、T=256 的单块/28 层前向和独立 block 梯度,恒等误差为 0。非零输出头下中心差分检查实际激活的主干梯度,最大相对误差 1.110e-03(分母下限 1e-8;近零梯度的相对值受消减误差放大)。另以三步长独立检查 702 个参数探点,步长 1e-6 时最大绝对差为 3.217e-10,步长从 1e-4 降低时的误差收敛与独立官方对照支持反向实现;同权重官方 block 的 float64 前向最大差 2.220e-16,输入/条件/所有参数梯度最大差 1.388e-17。 python cond_ablation.py:快速档为 150 步、1 seed,只检查这套小实验的训练行为。python cond_ablation.py --full --rerun 强制重跑 800 步 × 3 seed × 4 方案;正常 --full 仅在源码哈希、NumPy、seed、batch、depth 与完整元数据均一致时复用缓存。学习率从 0.003 按 0.25**(step/steps) 衰减,batch=32,训练时间均匀取 [0.05,0.95],用余弦加噪。完整档耗时随机器而异,以本机运行证据为准。 python make_figures.py:生成四张原图;图 3 使用完整档缓存,若缺失则触发完整训练。图 1/4 的 FID 来自原论文,不是本机测得;图 2/3 的数值是本文实跑。 想验证零 gate 的边界,可在 adaln_zero.py 中分别换随机 c、给 shift/scale 非零值但保持两个 gate=0,有限分支下仍为恒等。反例是分支出现 NaN 或无穷时,浮点的零乘它并不保证有限输出。再把输出头随机打开后做梯度检查,便能避免“全零梯度让错误反向看似正确”的假通过。 10. 延伸阅读 往回走:潜空间扩散与 Stable Diffusion 的整体结构(latent_diffusion)、DDPM 的训练目标(ddpm)、自注意力的计算细节(attention_basics) 往两侧走:分类器无关引导的代价(cfg)、流匹配与 Rectified Flow——SD3 之后的新一代训练目标(flow_matching) 往工程走:DiT 上到长视频后 token 数增长,可结合注意力设计与并行方案处理预算,见序列并行(sequence_parallel)、张量/流水线并行(tensor_pipeline_parallel)、混合精度(mixed_precision) 往采样走:同样的骨干,采样步数怎么省,见从 DDIM 到高阶采样器(ddim_samplers) 直接后继:自回归视频生成、跨步缓存复用。本篇不改变这些节点。 附录:完整代码 09 节用到的脚本全文如下(dit_flops.py、adaln_zero.py、cond_ablation.py、dit_core.py、tiny_grad.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 dit_flops.py # -*- coding: utf-8 -*- """DiT 账本(一):patchify 的形状、参数量与 Gflops,逐项对账。 DiT 这篇论文最反直觉的一点是:**它把「模型大小」和「一次前向的算力」拆开了**。 改 patch size p 几乎不动参数量,却能让 Gflops 翻四倍;改 hidden size d 不动 token 数,参数量与逐 token 线性 MAC 都近似按 d² 增长。 这个脚本做三件事: 1. 真的做一次 patchify,打印每一步的形状(不是嘴上说 T=(I/p)^2); 2. 按 DiT 的实际结构逐项数参数,与论文 Table 4 的 Params(M) 对账; 3. 用同一套结构数 Gflops,与论文 Table 4 的 Flops(G) 对账。 计数说明:主要矩阵乘法按一次乘加记 1 的 MAC 口径;另含简化逐元素项。 该预算接近论文 Gflops,未完整计数 LN/softmax/非线性,不是逐 FLOP 或延迟复现。 """ import numpy as np # ─────────────── 论文 Table 1 的四档配置:(深度 N, hidden d, 头数) ─────────────── DIT_CONFIGS = { "S": (12, 384, 6), "B": (12, 768, 12), "L": (24, 1024, 16), "XL": (28, 1152, 16), } # 论文 Table 4 的真实数字,用来对账:(Gflops, 参数量 M, FID-50K 无引导) PAPER_TABLE4_256 = { ("S", 8): (0.36, 33, 153.60), ("S", 4): (1.41, 33, 100.41), ("S", 2): (6.06, 33, 68.40), ("B", 8): (1.42, 131, 122.74), ("B", 4): (5.56, 130, 68.38), ("B", 2): (23.01, 130, 43.47), ("L", 8): (5.01, 459, 118.87), ("L", 4): (19.70, 458, 45.64), ("L", 2): (80.71, 458, 23.33), ("XL", 8): (7.39, 676, 106.41), ("XL", 4): (29.05, 675, 43.01), ("XL", 2): (118.64, 675, 19.47), } # 四种条件注入在 DiT-XL/2 上的对照:论文 Table 4 的四种 block 在 400K 步时的行 PAPER_BLOCK_DESIGN = { # 名字: (Gflops, Params M, FID) "in-context": (119.37, 449, 35.24), "cross-attention": (137.62, 598, 26.14), "adaLN": (118.56, 600, 25.21), "adaLN-Zero": (118.64, 675, 19.47), } # ─────────────── 1. patchify:真的做一遍 ─────────────── def patchify(z, p): """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]。 把 I×I 切成 (I/p)×(I/p) 个格子,每个格子里的 p*p*C 个数直接摊平成 一个 token 的原始特征。论文里这一步是一个 nn.Linear(p*p*C, d)。 """ B, I, _, C = z.shape assert I % p == 0, f"I={I} 必须被 p={p} 整除" g = I // p z = z.reshape(B, g, p, g, p, C) z = z.transpose(0, 1, 3, 2, 4, 5) # [B, g, g, p, p, C] return z.reshape(B, g * g, p * p * C) def unpatchify(x, p, I, C): """patchify 的逆:[B, T, p*p*C] -> [B, I, I, C]。""" B = x.shape[0] g = I // p x = x.reshape(B, g, g, p, p, C) x = x.transpose(0, 1, 3, 2, 4, 5) # [B, g, p, g, p, C] return x.reshape(B, I, I, C) # ─────────────── 2. 参数账本 ─────────────── def count_params(cfg="XL", p=2, C=4, n_classes=1000, t_freq=256, I=32, learn_sigma=True, class_dropout=True, include_frozen=False): """固定官方 DiT 参数;默认统计可训练参数,冻结位置编码另计。""" N, d, _ = DIT_CONFIGS[cfg] out_C = 2 * C if learn_sigma else C items = {"patch 嵌入": p*p*C*d+d, "时间嵌入": t_freq*d+d+d*d+d, "类别嵌入(含 null 行)": (n_classes+int(class_dropout))*d} # 两个 LN 均 elementwise_affine=False,不含任何可训练 scale/bias。 per_block = 18*d*d + 15*d items[f"{N} 个 block × {per_block:,}"] = N*per_block items["FinalLayer(含方差输出)"] = 2*d*d+2*d+d*p*p*out_C+p*p*out_C if include_frozen: items["冻结 2D 位置编码"] = (I//p)**2*d return sum(items.values()), items, per_block # ─────────────── 3. 近似 MAC 账本(不等同实际 FLOP 或延迟)─────────────── def count_gflops(cfg="XL", p=2, I=32, C=4, t_freq=256, learn_sigma=True): """一次前向(batch=1)的主要矩阵 MAC + 简化逐元素计数;非完整 profiler。""" N, d, _ = DIT_CONFIGS[cfg] T = (I // p) ** 2 # 每个 block:qkv 3d²、attn 分数 T²d、attn 加权 T²d、out d²、mlp 8d² # 调制层对整条样本只算一次(6d²),逐 token 的 γ/β/α 逐元素乘加记 3Td per_block_token = 12 * d * d # 3(qkv) + 1(out) + 8(mlp) per_block_attn = 2 * T * d # 摊到每个 token 上是 2*T*d per_block_elem = 3 * d # γ⊙h、+β、α⊙Δ block_macs = T * (per_block_token + per_block_attn + per_block_elem) + 6 * d * d patch_macs = T * (p * p * C) * d # patchify 的线性嵌入 final_macs = T * d * (p * p * C * (2 if learn_sigma else 1)) + 2 * d * d cond_macs = t_freq * d + d * d # t 嵌入 MLP,算一次 total = N * block_macs + patch_macs + final_macs + cond_macs return total / 1e9, { "T": T, "block 内逐 token 线性(12d²)": N * T * per_block_token / 1e9, "block 内注意力(2T²d)": N * T * per_block_attn / 1e9, "调制与逐元素(3Td + 6d²)": N * (T * per_block_elem + 6 * d * d) / 1e9, "patchify + FinalLayer": (patch_macs + final_macs) / 1e9, "t 嵌入": cond_macs / 1e9, } def scaling_ledger(): """把 12 个模型的解析账本与论文数字并排打印。""" rows = [] for cfg in ["S", "B", "L", "XL"]: for p in [8, 4, 2]: g, _ = count_gflops(cfg, p) tot, _, _ = count_params(cfg, p) pg, pm, fid = PAPER_TABLE4_256[(cfg, p)] rows.append((f"DiT-{cfg}/{p}", DIT_CONFIGS[cfg][0], DIT_CONFIGS[cfg][1], (32 // p) ** 2, g, pg, tot / 1e6, pm, fid)) return rows def main(): rng = np.random.default_rng(0) print("=" * 78) print("1. patchify 的真实形状(256×256 图像 → 32×32×4 潜变量,batch=2)") print("=" * 78) z = rng.standard_normal((2, 32, 32, 4)) print(f" 输入潜变量 z: {z.shape}") for p in [8, 4, 2]: x = patchify(z, p) back = unpatchify(x, p, 32, 4) ok = np.abs(back - z).max() print(f" p={p}: patchify -> {x.shape}" f" (T={(32//p)**2}, 每个 token 原始维度 {p*p*4})" f" 逆变换最大误差 {ok:.2e}") print() print("=" * 78) print("2. 参数账本(DiT-XL/2 逐项)") print("=" * 78) tot, items, per_block = count_params("XL", 2) for k, v in items.items(): print(f" {k:<34s} {v:>14,d} ({v/tot*100:5.1f}%)") print(f" {'合计':<34s} {tot:>14,d} = {tot/1e6:.1f} M" f" (论文 Table 4: 675 M)") print() print("=" * 78) print("3. Gflops 账本(DiT-XL/2,按 MAC 记)") print("=" * 78) g, parts = count_gflops("XL", 2) for k, v in parts.items(): if k == "T": print(f" token 数 T {v:>10d}") else: print(f" {k:<38s} {v:>10.2f} G ({v/g*100:5.1f}%)") print(f" {'合计':<38s} {g:>10.2f} G (论文 Table 4: 118.64 G)") print() print("=" * 78) print("4. 12 个模型:解析账本 vs 论文数字") print("=" * 78) hdr = f"{'模型':<12s}{'N':>4s}{'d':>6s}{'T':>6s}{'Gflops算':>10s}{'Gflops论文':>11s}{'差':>8s}{'M算':>8s}{'M论文':>7s}{'FID':>8s}" print(hdr) for name, N, d, T, g, pg, m, pm, fid in scaling_ledger(): print(f"{name:<12s}{N:>4d}{d:>6d}{T:>6d}{g:>10.2f}{pg:>11.2f}{(g-pg)/pg*100:>7.1f}%" f"{m:>8.1f}{pm:>7d}{fid:>8.2f}") print() print("=" * 78) print("5. 同算力下:把预算花在 token 上还是花在宽度/深度上?") print("=" * 78) print(" 取自论文 Table 4,挑 Gflops 接近的组:") for tag, keys in [("~5-6 G", [("S", 2), ("B", 4), ("L", 8)]), ("~20-29 G", [("B", 2), ("L", 4), ("XL", 4)]), ("~80-119 G", [("L", 2), ("XL", 2)])]: print(f" {tag}:") for k in keys: pg, pm, fid = PAPER_TABLE4_256[k] print(f" DiT-{k[0]}/{k[1]}: {pg:6.2f} G {pm:4d} M FID {fid:6.2f}") if __name__ == "__main__": main() adaln_zero.py # -*- coding: utf-8 -*- """DiT 账本(二):adaLN-Zero 的初始化到底做了什么,逐个数出来。 adaLN-Zero 通常被一句话带过——「把每个 block 初始化成恒等函数」。 这句话里有三个可以量出来的事实,本脚本一个一个验: A. 恒等是真的恒等:out - x 的最大绝对误差是 0.0,不是「很小」。 B. 门控关着的时候,block 里除门控之外的参数梯度**精确为 0**; 连 shift/scale 那两段的梯度也是 0——只有 gate 那两段有梯度。 这是独立 block 接非零上游梯度的实验;完整零输出头模型第一步先更新输出头。 C. 不零初始化会怎样:block 在初始化时给残差流叠上一层随机扰动, 28 层叠下来 std 会漂。零初始化则一层都不漂。 D. 输出层也零初始化:模型第一天的预测是全 0,初始 loss 就是噪声的 二阶矩,可以被事先算出来,而不是一个随机的数。 另有一个 gradcheck,用中心差分核对手写 autograd,正文里报的最大相对误差来自它。 """ import numpy as np import tiny_grad as tg from dit_core import DiTBlock, MicroDiT, COND_MODES D_BIG = 1152 # DiT-XL 的 hidden size T_BIG = 256 # 32×32 潜变量、p=2 时的 token 数 DEPTH = 28 # DiT-XL 的深度 def _fresh_block(mode, seed=0, d=D_BIG, n_heads=16): rng = np.random.default_rng(seed) return DiTBlock(d, n_heads, rng, mode=mode) # ─────────────── A + C:恒等性与深度漂移 ─────────────── def identity_and_drift(depth=DEPTH, seed=0, d=D_BIG, T=T_BIG, n_heads=16): rng = np.random.default_rng(seed) x0 = rng.standard_normal((1, T, d)) c = rng.standard_normal((1, d)) out = {} for mode in ("adaln_zero", "adaln"): x = tg.leaf(x0.copy()) drift = [] for i in range(depth): blk = _fresh_block(mode, seed=seed + i, d=d, n_heads=n_heads) x = blk(x, tg.leaf(c), []) tg.reset() drift.append(float(np.std(x.v - x0))) out[mode] = { "identity_err": float(np.abs(x.v - x0).max()), "drift": drift, "std_ratio": [float(np.std(x.v) / np.std(x0))], } # 单块的恒等性单独再报一次(28 层叠完还是 0 才说明真的恒等) blk = _fresh_block("adaln_zero", seed=3, d=d, n_heads=n_heads) tg.reset() y = blk(tg.leaf(x0.copy()), tg.leaf(c), []) out["adaln_zero"]["single_block_err"] = float(np.abs(y.v - x0).max()) blk = _fresh_block("adaln", seed=3, d=d, n_heads=n_heads) tg.reset() y = blk(tg.leaf(x0.copy()), tg.leaf(c), []) out["adaln"]["single_block_err"] = float(np.abs(y.v - x0).max()) out["adaln"]["single_block_rel"] = float(np.std(y.v - x0) / np.std(x0)) tg.reset() return out # ─────────────── B:初始化那一刻的梯度结构 ─────────────── def grad_at_init(mode="adaln_zero", seed=0, d=D_BIG, T=T_BIG, n_heads=16): rng = np.random.default_rng(seed) x0 = rng.standard_normal((1, T, d)) c = rng.standard_normal((1, d)) w = rng.standard_normal((1, T, d)) # 线性损失 L = mean(out*w) blk = _fresh_block(mode, seed=seed, d=d, n_heads=n_heads) store = [] tg.reset() out = blk(tg.leaf(x0), tg.leaf(c), store, ctx=None) loss = tg.mean_all(tg.mul(out, tg.leaf(w))) tg.backward(loss) names = { "W_qkv": blk.w_qkv.W, "W_o": blk.w_o.W, "W_1": blk.w_1.W, "W_2": blk.w_2.W, } res = {} for k, arr in names.items(): node = [n for n in store if n.v is arr] res[k] = float(np.abs(node[0].g).max()) if node else 0.0 # 调制层按 6 段(或 4 段)拆开看:哪几段真的拿到了梯度 mod_node = [n for n in store if n.v is blk.w_mod.W][0] g = mod_node.g # [d, n_mod*d] n_mod = 6 if mode == "adaln_zero" else 4 cols = [float(np.abs(g[:, i * d:(i + 1) * d]).max()) for i in range(n_mod)] res["mod_chunks"] = cols res["mod_name"] = (["shift_msa", "scale_msa", "gate_msa", "shift_mlp", "scale_mlp", "gate_mlp"] if n_mod == 6 else ["shift_msa", "scale_msa", "shift_mlp", "scale_mlp"]) tg.reset() return res # ─────────────── D:初始 loss 是不是可预测的 ─────────────── def init_loss(mode="adaln_zero", seed=0, B=32): rng = np.random.default_rng(seed) m = MicroDiT(mode=mode, seed=seed) z = rng.standard_normal((B, m.T, 8)) t = rng.uniform(0.05, 0.95, B) y = rng.integers(0, m.n_classes, B) oh = np.zeros((B, m.n_classes)) oh[np.arange(B), y] = 1.0 eps = rng.standard_normal((B, m.T, 8)) store = [] tg.reset() pred = m.forward(z, t, oh, store) mse_zero = float(((pred.v - eps) ** 2).mean()) pmax_zero = float(np.abs(pred.v).max()) # 把输出层换成正常 xavier 初始化再测一次 lim = np.sqrt(6.0 / (m.d + 8)) m.w_out.W = rng.uniform(-lim, lim, m.w_out.W.shape) store = [] tg.reset() pred = m.forward(z, t, oh, store) mse_rand = float(((pred.v - eps) ** 2).mean()) pmax_rand = float(np.abs(pred.v).max()) tg.reset() return float((eps ** 2).mean()), mse_zero, mse_rand, pmax_zero, pmax_rand # ─────────────── autograd 自检 ─────────────── def gradcheck_report(seed=0): """手写 autograd 对不对:拿中心差分逐个参数核。 adaln_zero 初始化下大部分参数梯度恒为 0(B 节已证),核不出东西, 所以核 adaln 与 cross_attn 两种结构——它们把所有算子都走到了。 """ rng = np.random.default_rng(seed + 7) z = rng.standard_normal((4, 16, 8)) t = rng.uniform(0.05, 0.95, 4) oh = np.zeros((4, 8)) oh[np.arange(4), rng.integers(0, 8, 4)] = 1.0 tgt = rng.standard_normal((4, 16, 8)) worst = 0.0 for mode in ("adaln", "cross_attn", "in_context"): mm = MicroDiT(d=32, n_heads=4, depth=2, mode=mode, seed=seed) # 必须打开输出头,否则上游全为零,无法检验主干的反向。 mm.w_out.W[:] = rng.normal(0, 0.1, mm.w_out.W.shape) def build(mm=mm): s = [] p = mm.forward(z, t, oh, s) diff = tg.sub(p, tg.leaf(tgt)) return tg.mean_all(tg.mul(diff, diff)), s tg.reset() worst = max(worst, tg.gradcheck(build, seed=seed)) return worst def main(): print("=" * 78) print("A. 恒等性:DiT-XL 配置(d=1152, 16 头, T=256)") print("=" * 78) r = identity_and_drift() for mode in ("adaln_zero", "adaln"): d = r[mode] print(f" {mode:<12s} 单块 |out - x| 最大值 = {d['single_block_err']:.3e}") if mode == "adaln": print(f" {'':<12s} 单块相对扰动 std(out-x)/std(x) = {d['single_block_rel']:.4f}") print(f" {'':<12s} 叠 {DEPTH} 层后 |out - x| 最大值 = {d['identity_err']:.3e}") dr = d["drift"] pick = [0, 6, 13, 20, 27] print(f" {'':<12s} 残差流漂移 std(x_k - x_0):" + " ".join(f"k={k+1}:{dr[k]:.4f}" for k in pick)) print() print("=" * 78) print("B. 初始化那一刻,block 里谁拿到了梯度(L = mean(out*w),w 固定随机)") print("=" * 78) for mode in ("adaln_zero", "adaln"): g = grad_at_init(mode) nz = [g[k] for k in ("W_qkv", "W_o", "W_1", "W_2")] print(f" {mode:<12s} 主干参数 |grad|max: " + " ".join(f"{k}={v:.3e}" for k, v in zip(("W_qkv", "W_o", "W_1", "W_2"), nz))) print(f" {'':<12s} 调制层各段 |grad|max: " + " ".join(f"{n}={v:.3e}" for n, v in zip(g["mod_name"], g["mod_chunks"]))) print() print("=" * 78) print("D. 初始 loss 能不能事先算出来(FinalLayer 零初始化 vs 正常初始化)") print("=" * 78) e2, mse_z, mse_r, pz, pr = init_loss() print(f" 样本噪声平方均值 mean(eps^2) = {e2:.4f} <- 理论上就是初始 loss") print(f" 零初始化输出层,实测初始 MSE = {mse_z:.4f}") print(f" 零初始化时模型输出的最大绝对值 = {pz:.3e} (就是全 0)") print(f" 正常初始化输出层,实测初始 MSE = {mse_r:.4f} <- 高出 {mse_r/mse_z:.2f} 倍") print(f" 正常初始化时模型输出的最大绝对值 = {pr:.3e}") print() print("=" * 78) print("自检:非零输出头下 autograd vs 中心差分(三种非门控结构)") print("=" * 78) print(f" 最大相对误差 = {gradcheck_report():.2e}") if __name__ == "__main__": main() cond_ablation.py # -*- coding: utf-8 -*- """四种条件注入的 NumPy toy 对照;不是 ImageNet FID 复现。 8 个固定条纹模板,8×8×2 潜变量,p=2、T=16、d=64、4 头、6 层。 各方案共享采样流和训练超参数,结构、参数数目与初始化不同。 默认150步×1seed;--full为800步×3seed,--rerun强制重算,实际耗时依机器。 源码哈希及完整元数据一致时才复用缓存;同时评估256个新加噪样本。 """ import json import hashlib import tempfile import os import sys import numpy as np import tiny_grad as tg from dit_core import (MicroDiT, Adam, COND_MODES, make_patterns, patchify_imgs, alpha_bar_cosine) SIDE, P, C = 8, 2, 2 PATCH_DIM = P * P * C # 8 T = (SIDE // P) ** 2 # 16 K = 8 # 类别数 DEPTH = 6 HERE = os.path.dirname(os.path.abspath(__file__)) NODE_DIR = os.path.dirname(HERE) # 完整档的参数(文章里的数字就是这一组) STEPS_FULL, SEEDS_FULL = 800, (0, 1, 2) # 快速档:只为「脚本能跑通」而存在(体检会真的执行每个脚本), # 结果同样会缓存,不会覆盖完整档。 STEPS_QUICK, SEEDS_QUICK = 150, (0,) def _cache_path(steps, seeds): return os.path.join(NODE_DIR, "_cache", f"cond_results_s{steps}_n{len(seeds)}.json") CACHE = _cache_path(STEPS_FULL, SEEDS_FULL) def sample_batch(rng, pats, B): """采一批 (z_t, t, y_onehot, eps)。""" y = rng.integers(0, K, B) x0 = pats[y] # [B,8,8,2] eps = rng.standard_normal((B, SIDE, SIDE, C)) t = rng.uniform(0.05, 0.95, B) ab = alpha_bar_cosine(t)[:, None, None, None] z = np.sqrt(ab) * x0 + np.sqrt(1.0 - ab) * eps oh = np.zeros((B, K)) oh[np.arange(B), y] = 1.0 return patchify_imgs(z, P), t, oh, patchify_imgs(eps, P) def make_model(mode, seed, depth=DEPTH): return MicroDiT(d=64, n_heads=4, depth=depth, n_classes=K, patch_dim=PATCH_DIM, T=T, mode=mode, seed=seed, out_dim=PATCH_DIM) def train_one(mode, seed=0, steps=800, batch=32, lr=3e-3, log_every=50, depth=DEPTH): rng = np.random.default_rng(seed) pats = make_patterns(SIDE, C, K) m = make_model(mode, seed, depth) opt = Adam(m.arrays()) curve, gnorms, losses = [], [], [] for s in range(1, steps + 1): z, t, oh, eps = sample_batch(rng, pats, batch) store = [] tg.reset() pred = m.forward(z, t, oh, store) diff = tg.sub(pred, tg.leaf(eps)) loss = tg.mean_all(tg.mul(diff, diff)) tg.backward(loss) gn = opt.step(store, lr * (0.25 ** (s / steps)), s) losses.append(float(loss.v)) gnorms.append(gn) if s % log_every == 0: curve.append([s, float(np.mean(losses[-log_every:]))]) # 新噪声/时间采样;同 seed 各方案使用相同 256 个评估样本。 eval_rng = np.random.default_rng(10000 + seed) vals = [] for _ in range(8): z,t,oh,eps = sample_batch(eval_rng,pats,32) tg.reset() pred = m.forward(z,t,oh,[]) vals.append(float(np.mean((pred.v-eps)**2))) tg.reset() return { "evaluation_mse": float(np.mean(vals)), "evaluation_examples": 256, "mode": mode, "curve": curve, "final": float(np.mean(losses[-200:])), "grad1": gnorms[0], "grad10": float(np.mean(gnorms[:10])), "gradmax": float(np.max(gnorms)), "params": int(sum(a.size for a in m.arrays())), } def _meta(steps,seeds,batch,depth): names = ["cond_ablation.py","dit_core.py","tiny_grad.py"] return dict(steps=steps,seeds=list(seeds),batch=batch,depth=depth, code_sha256={n:hashlib.sha256(open(os.path.join(HERE,n),"rb").read()).hexdigest() for n in names}, numpy=np.__version__,schema=2,lr=3e-3,evaluation_examples=256) def _write_cache(data, path=CACHE): """原子保存,防止中断留下半份 JSON。""" os.makedirs(os.path.dirname(path), exist_ok=True) fd,tmp=tempfile.mkstemp(dir=os.path.dirname(path),suffix=".tmp") try: with os.fdopen(fd,"w",encoding="utf8") as stream: json.dump(data,stream,ensure_ascii=False,indent=1) stream.flush();os.fsync(stream.fileno()) os.replace(tmp,path) finally: if os.path.exists(tmp):os.unlink(tmp) def run_all(seeds=(0, 1, 2), steps=800, batch=32, depth=DEPTH, resume=True): """跑四种条件注入的对照。resume=True 时复用缓存里已经跑完的模式。""" cache = _cache_path(steps, seeds) out = {} if resume and os.path.exists(cache): try: with open(cache, encoding="utf-8") as f: old = json.load(f) if old.get("_meta") == _meta(steps,seeds,batch,depth): out = {k: v for k, v in old.items() if not k.startswith("_")} if "_sweep" in old: out["_sweep"] = old["_sweep"] except Exception: out = {} for mode in COND_MODES: if mode in out: print(f" [skip] {mode}(缓存里已有,跳过)", file=sys.stdout) continue rs = [train_one(mode, seed=sd, steps=steps, batch=batch, depth=depth) for sd in seeds] fin = [r["final"] for r in rs] out[mode] = { "final_mean": float(np.mean(fin)), "final_std": float(np.std(fin)), "finals": fin, "evaluation_mses": [r["evaluation_mse"] for r in rs], "evaluation_mean": float(np.mean([r["evaluation_mse"] for r in rs])), "evaluation_std": float(np.std([r["evaluation_mse"] for r in rs])), "curve": rs[0]["curve"], "grad1": rs[0]["grad1"], "grad10": rs[0]["grad10"], "gradmax": rs[0]["gradmax"], "params": rs[0]["params"], } out["_meta"] = _meta(steps,seeds,batch,depth) _write_cache(out, cache) print(f" [done] {mode}", file=sys.stdout) out["_meta"] = _meta(steps,seeds,batch,depth) return out def sweep_depth(modes=("adaln_zero", "adaln"), depths=(2, 4, 6, 8, 10), steps=400, seed=0, batch=32): """深度变化时,两种 adaLN 的差距怎么变。""" res = {} for mode in modes: row = [] for dep in depths: rng = np.random.default_rng(seed) pats = make_patterns(SIDE, C, K) m = make_model(mode, seed, dep) opt = Adam(m.arrays()) losses = [] for s in range(1, steps + 1): z, t, oh, eps = sample_batch(rng, pats, batch) store = [] tg.reset() pred = m.forward(z, t, oh, store) diff = tg.sub(pred, tg.leaf(eps)) loss = tg.mean_all(tg.mul(diff, diff)) tg.backward(loss) opt.step(store, 3e-3 * (0.25 ** (s / steps)), s) losses.append(float(loss.v)) row.append([dep, float(np.mean(losses[-200:]))]) print(f" [done] {mode} depth={dep}", file=sys.stdout) res[mode] = row return res def load_or_run(seeds=SEEDS_FULL, steps=STEPS_FULL, batch=32, depth=DEPTH, sweep=False): """缓存优先(完整档)。sweep=True 时才额外跑深度扫描(很慢,默认不跑)。""" cache = _cache_path(steps, seeds) data = None if os.path.exists(cache): try: with open(cache, encoding="utf-8") as f: data = json.load(f) except Exception: data = None if data and data.get("_meta") == _meta(steps,seeds,batch,depth) \ and all(m in data for m in COND_MODES): if sweep and "_sweep" not in data: data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch) _write_cache(data, cache) return data data = run_all(seeds=seeds, steps=steps, batch=batch, depth=depth) if sweep: data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch) _write_cache(data, cache) return data def _show(res, steps, n_seeds): print(f"{'mode':<14s}{'参数量':>10s}{'最终 loss(均值±std)':>24s}" f"{'首步梯度范数':>14s}{'峰值梯度':>12s}") for mode in COND_MODES: r = res[mode] print(f"{mode:<14s}{r['params']:>10d}" f"{r['final_mean']:>16.4f} ± {r['final_std']:<7.4f}" f"{r['grad1']:>14.3e}{r['gradmax']:>12.3e}") print() print(f" loss 曲线(seed=0,{steps} 步,每 {max(1, steps // 20)} 步取一次均值):") for mode in COND_MODES: c = res[mode]["curve"] picks = [c[i] for i in range(0, len(c), max(1, len(c) // 6))] print(f" {mode:<14s} " + " ".join(f"{s}:{v:.4f}" for s, v in picks)) if n_seeds > 1: print() print(" 每个 seed 的最终 loss(看排序稳不稳):") for mode in COND_MODES: print(f" {mode:<14s} " + " ".join(f"{v:.4f}" for v in res[mode]["finals"])) if res.get("_sweep"): print() print("=" * 78) print("深度扫描:两种 adaLN 在不同深度下的最终 loss") print("=" * 78) for mode, row in res["_sweep"].items(): print(f" {mode:<12s} " + " ".join(f"d={d}:{v:.4f}" for d, v in row)) if __name__ == "__main__": full = "--full" in sys.argv steps, seeds = (STEPS_FULL, SEEDS_FULL) if full else (STEPS_QUICK, SEEDS_QUICK) tag = "完整档" if full else "快速档" print("=" * 78) print(f"四种条件注入在 toy 任务上的训练对照({tag}:{steps} 步 × " f"{len(seeds)} 个 seed)") print("=" * 78) res = (run_all(seeds=seeds,steps=steps,resume=False) if "--rerun" in sys.argv else load_or_run(seeds=seeds, steps=steps, sweep="--sweep" in sys.argv)) _write_cache(res,_cache_path(steps,seeds)) _show(res, steps, len(seeds)) if not full: print() print(f" 想复现文章里的那组数字:python cond_ablation.py --full" f"({STEPS_FULL} 步 × {len(SEEDS_FULL)} 个 seed,约十分钟)") dit_core.py # -*- coding: utf-8 -*- """DiT 的最小可运行复刻(numpy):一个 block、四种条件注入方式、一个 toy 训练集。 教学结构参考 facebookresearch/DiT;不复现完整方差头、CFG、VAE 或训练配方。models.py: modulate(x, shift, scale) = x * (1 + scale) + shift block: x = x + gate_msa * attn(modulate(norm1(x), shift_msa, scale_msa)) x = x + gate_mlp * mlp(modulate(norm2(x), shift_mlp, scale_mlp)) 初始化采用同类规则(随机数消费顺序与官方不同)::所有 Linear 走 xavier_uniform,然后把每个 block 的 adaLN 调制层 (SiLU → Linear(d, 6d))的 weight 与 bias 整个置零;FinalLayer 的调制层与输出 线性层同样置零。 四种条件注入(对应论文 Figure 3 与 Table 4 末尾四行): adaln_zero : adaLN-Zero,调制层零初始化 adaln : 无门控、四段调制,调制层用 xavier 初始化(vanilla adaLN 教学版) in_context : t 与 y 当作两个额外 token 塞进序列,标准 ViT block cross_attn : 标准 ViT block + 一层对条件向量的 cross-attention """ import numpy as np import tiny_grad as tg COND_MODES = ("adaln_zero", "adaln", "in_context", "cross_attn") # ─────────────── 线性层 ─────────────── class Linear: def __init__(self, fan_in, fan_out, rng, zero=False, std=None): if zero: self.W = np.zeros((fan_in, fan_out)) elif std is not None: self.W = rng.normal(0.0, std, (fan_in, fan_out)) else: lim = np.sqrt(6.0 / (fan_in + fan_out)) # xavier_uniform self.W = rng.uniform(-lim, lim, (fan_in, fan_out)) self.b = np.zeros(fan_out) def __call__(self, x, store=None): Wn = tg.leaf(self.W) bn = tg.leaf(self.b) if store is not None: store.append(Wn) store.append(bn) return tg.add(tg.matmul(x, Wn), bn) def _to_heads(a, B, T, n_heads, dh): return tg.transpose(tg.reshape(a, (B, T, n_heads, dh)), 0, 2, 1, 3) def _attend(q, k, v, scale): s = tg.scale(tg.matmul(q, tg.transpose(k, 0, 1, 3, 2)), scale) return tg.matmul(tg.softmax(s, axis=-1), v) def mh_self_attention(x, n_heads, w_qkv, w_o, store): B, T, d = x.v.shape dh = d // n_heads q, k, v = tg.chunk_last(w_qkv(x, store), 3) q = _to_heads(q, B, T, n_heads, dh) k = _to_heads(k, B, T, n_heads, dh) v = _to_heads(v, B, T, n_heads, dh) y = _attend(q, k, v, 1.0 / np.sqrt(dh)) # [B,H,T,dh] y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d)) return w_o(y, store) def mh_cross_attention(x, ctx, n_heads, w_q, w_kv, w_o, store): B, T, d = x.v.shape Tc = ctx.v.shape[1] dh = d // n_heads q = w_q(x, store) k, v = tg.chunk_last(w_kv(ctx, store), 2) q = _to_heads(q, B, T, n_heads, dh) k = _to_heads(k, B, Tc, n_heads, dh) v = _to_heads(v, B, Tc, n_heads, dh) y = _attend(q, k, v, 1.0 / np.sqrt(dh)) y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d)) return w_o(y, store) # ─────────────── DiT block ─────────────── class DiTBlock: def __init__(self, d, n_heads, rng, mode="adaln_zero", mlp_ratio=4): assert mode in COND_MODES, mode assert d % n_heads == 0 self.mode = mode self.d = d self.n_heads = n_heads self.w_qkv = Linear(d, 3 * d, rng) self.w_o = Linear(d, d, rng) hid = int(d * mlp_ratio) self.w_1 = Linear(d, hid, rng) self.w_2 = Linear(hid, d, rng) if mode == "cross_attn": self.w_cq = Linear(d, d, rng) self.w_ckv = Linear(d, 2 * d, rng) self.w_co = Linear(d, d, rng) if mode == "adaln_zero": self.w_mod = Linear(d, 6 * d, rng, zero=True) elif mode == "adaln": self.w_mod = Linear(d, 4 * d, rng) else: # 标准 ViT block:LayerNorm 带仿射参数,初始化成 γ=1、β=0 self.ln1_g, self.ln1_b = np.ones(d), np.zeros(d) self.ln2_g, self.ln2_b = np.ones(d), np.zeros(d) self.ln3_g, self.ln3_b = np.ones(d), np.zeros(d) def _modulate(self, h, shift, scale): """DiT 源码的 modulate: x * (1 + scale) + shift,展平成 [B,1,d] 再广播。""" sh = tg.reshape(shift, (shift.v.shape[0], 1, -1)) sc = tg.reshape(scale, (scale.v.shape[0], 1, -1)) return tg.add(tg.add(h, tg.mul(h, sc)), sh) def _vi_norm(self, x, g, b, store): gn, bn = tg.leaf(g), tg.leaf(b) store.append(gn) store.append(bn) return tg.add(tg.mul(tg.layernorm(x), gn), bn) def __call__(self, x, c, store, ctx=None): B, T, d = x.v.shape if self.mode == "adaln_zero": sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last( self.w_mod(tg.silu(c), store), 6) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a)) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u)) if self.mode == "adaln": sh_a, sc_a, sh_m, sc_m = tg.chunk_last(self.w_mod(tg.silu(c), store), 4) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, a) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, u) # ── 标准 ViT block(in-context / cross-attn)── h = self._vi_norm(x, self.ln1_g, self.ln1_b, store) x = tg.add(x, mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store)) if self.mode == "cross_attn": h2 = self._vi_norm(x, self.ln2_g, self.ln2_b, store) x = tg.add(x, mh_cross_attention(h2, ctx, self.n_heads, self.w_cq, self.w_ckv, self.w_co, store)) h3 = self._vi_norm(x, self.ln3_g, self.ln3_b, store) else: h3 = self._vi_norm(x, self.ln2_g, self.ln2_b, store) u = self.w_2(tg.gelu_tanh(self.w_1(h3, store)), store) return tg.add(x, u) def arrays(self): out = [self.w_qkv.W, self.w_qkv.b, self.w_o.W, self.w_o.b, self.w_1.W, self.w_1.b, self.w_2.W, self.w_2.b] if self.mode in ("adaln_zero", "adaln"): out += [self.w_mod.W, self.w_mod.b] else: out += [self.ln1_g, self.ln1_b, self.ln2_g, self.ln2_b] if self.mode == "cross_attn": out += [self.ln3_g, self.ln3_b, self.w_cq.W, self.w_cq.b, self.w_ckv.W, self.w_ckv.b, self.w_co.W, self.w_co.b] return out # ─────────────── 位置编码与时间步编码 ─────────────── def sincos_pos_embed(side, d): """2D sin-cos 位置编码(DiT 直接抄 MAE 的,固定不可学习)。 两个空间轴各占一半维度:每轴的 d/2 维里再对半分成 sin 与 cos。 """ assert d % 4 == 0, "d 必须是 4 的倍数才能两轴对半分" def emb1d(pos, dim): half = dim // 2 omega = 1.0 / (10000 ** (np.arange(half, dtype=np.float64) / half)) out = np.asarray(pos, dtype=np.float64).reshape(-1, 1) * omega[None] return np.concatenate([np.sin(out), np.cos(out)], axis=-1) gy, gx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij") emb = np.concatenate([emb1d(gy.reshape(-1), d // 2), emb1d(gx.reshape(-1), d // 2)], axis=-1) return emb[None, :, :] def timestep_embedding(t, dim, max_period=10000): """DiT 抄 GLIDE 的正弦时间步编码。t: [B] -> [B, dim]。""" half = dim // 2 freqs = np.exp(-np.log(max_period) * np.arange(half, dtype=np.float64) / half) args = np.asarray(t, dtype=np.float64)[:, None] * freqs[None] return np.concatenate([np.cos(args), np.sin(args)], axis=-1) # ─────────────── 一个能训的小 DiT ─────────────── class MicroDiT: def __init__(self, d=64, n_heads=4, depth=8, n_classes=8, patch_dim=8, T=16, t_freq=32, mode="adaln_zero", seed=0, out_dim=8): rng = np.random.default_rng(seed) self.mode = mode self.d, self.T, self.n_classes = d, T, n_classes self.w_in = Linear(patch_dim, d, rng) self.pos = sincos_pos_embed(int(round(np.sqrt(T))), d) self.w_t0 = Linear(t_freq, d, rng, std=0.02) self.w_t1 = Linear(d, d, rng, std=0.02) self.y_emb = rng.normal(0.0, 0.02, (n_classes, d)) self.blocks = [DiTBlock(d, n_heads, rng, mode=mode) for _ in range(depth)] # FinalLayer:adaLN 调制(零初始化)+ 输出线性层(零初始化) if mode in ("adaln_zero", "adaln"): self.w_fmod = Linear(d, 2 * d, rng, zero=True) self.fin_g, self.fin_b = np.ones(d), np.zeros(d) self.w_out = Linear(d, out_dim, rng, zero=True) def forward(self, z, t, y_onehot, store): """z:[B,T,patch_dim] t:[B] y_onehot:[B,K] -> pred:[B,T,out_dim]""" B = z.shape[0] d = self.d x = tg.add(self.w_in(tg.leaf(z), store), tg.leaf(self.pos)) tf = timestep_embedding(t, self.w_t0.W.shape[0]) tv = self.w_t1(tg.silu(self.w_t0(tg.leaf(tf), store)), store) ytab = tg.leaf(self.y_emb) store.append(ytab) yv = tg.matmul(tg.leaf(y_onehot), ytab) c = tg.add(tv, yv) t_tok = tg.reshape(tv, (B, 1, d)) y_tok = tg.reshape(yv, (B, 1, d)) if self.mode == "in_context": x = tg.concat_tokens(x, tg.concat_tokens(t_tok, y_tok)) ctx = tg.concat_tokens(t_tok, y_tok) for blk in self.blocks: x = blk(x, c, store, ctx=ctx) if self.mode == "in_context": x = tg.take_tokens(x, self.T) if self.mode in ("adaln_zero", "adaln"): sh, sc = tg.chunk_last(self.w_fmod(tg.silu(c), store), 2) hn = tg.layernorm(x) h = tg.add(tg.add(hn, tg.mul(hn, tg.reshape(sc, (B, 1, d)))), tg.reshape(sh, (B, 1, d))) else: g, b = tg.leaf(self.fin_g), tg.leaf(self.fin_b) store.append(g) store.append(b) h = tg.add(tg.mul(tg.layernorm(x), g), b) return self.w_out(h, store) def arrays(self): out = [self.w_in.W, self.w_in.b, self.w_t0.W, self.w_t0.b, self.w_t1.W, self.w_t1.b, self.y_emb, self.w_out.W, self.w_out.b] if self.mode in ("adaln_zero", "adaln"): out += [self.w_fmod.W, self.w_fmod.b] else: out += [self.fin_g, self.fin_b] for blk in self.blocks: out += blk.arrays() return out # ─────────────── Adam ─────────────── class Adam: def __init__(self, arrays): self.idx = {id(a): i for i, a in enumerate(arrays)} self.m = [np.zeros_like(a) for a in arrays] self.v = [np.zeros_like(a) for a in arrays] def step(self, nodes, lr, step, b1=0.9, b2=0.999, eps=1e-8): gnorm = 0.0 for n in nodes: i = self.idx.get(id(n.v)) if i is None or n.g is None: continue g = n.g gnorm += float((g * g).sum()) self.m[i] = b1 * self.m[i] + (1 - b1) * g self.v[i] = b2 * self.v[i] + (1 - b2) * g * g mh = self.m[i] / (1 - b1 ** step) vh = self.v[i] / (1 - b2 ** step) n.v -= lr * mh / (np.sqrt(vh) + eps) return float(np.sqrt(gnorm)) # ─────────────── toy 训练数据:8 个方向的条纹 ─────────────── def make_patterns(side=8, C=2, K=8): """K 个不同朝向的二维条纹,当作 K 类「图像」。""" yy, xx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij") pats = np.zeros((K, side, side, C)) for k in range(K): th = k * np.pi / K phase = 2 * np.pi * 2.0 * (xx * np.cos(th) + yy * np.sin(th)) / side pats[k, :, :, 0] = np.cos(phase) pats[k, :, :, 1] = np.sin(phase) return pats / np.std(pats) def patchify_imgs(imgs, p): """imgs:[B,I,I,C] -> [B,(I/p)^2,p*p*C]""" B, I, _, C = imgs.shape g = I // p z = imgs.reshape(B, g, p, g, p, C).transpose(0, 1, 3, 2, 4, 5) return z.reshape(B, g * g, p * p * C) def alpha_bar_cosine(t): """余弦 schedule 的 ᾱ_t:t=0 时 1(干净),t=1 时 0(纯噪声)。""" return np.cos(np.pi * np.asarray(t, dtype=np.float64) / 2.0) ** 2 tiny_grad.py # -*- coding: utf-8 -*- """NumPy reverse-mode 自动微分,仅供本文小型实验。 训练使用解析反向;中心差分在非零输出头下检查实际活跃的主干, 近零梯度需同时报告绝对误差和相对误差,不能以旧零输出头检查推断全部反向正确。 """ import numpy as np _TAPE = [] class Node: __slots__ = ("v", "g", "ins", "bwd") def __init__(self, v, ins=(), bwd=None): self.v = np.asarray(v, dtype=np.float64) self.g = None self.ins = ins self.bwd = bwd _TAPE.append(self) @property def shape(self): return self.v.shape def reset(): _TAPE.clear() def leaf(v): return Node(v) def _unbc(g, shape): """把广播出去的梯度还原成 shape(求和 + 去掉被广播的轴)。""" if g.shape == shape: return g while g.ndim > len(shape): g = g.sum(axis=0) for ax, s in enumerate(shape): if s == 1 and g.shape[ax] != 1: g = g.sum(axis=ax, keepdims=True) return g.reshape(shape) def _mk(v, ins, fn): def bwd(g, a=ins, f=fn): for node, gv in zip(a, f(g)): if node.g is None: node.g = np.zeros_like(node.v) node.g += _unbc(gv, node.v.shape) return Node(v, ins, bwd) def add(a, b): return _mk(a.v + b.v, (a, b), lambda g: (g, g)) def sub(a, b): return _mk(a.v - b.v, (a, b), lambda g: (g, -g)) def mul(a, b): return _mk(a.v * b.v, (a, b), lambda g: (g * b.v, g * a.v)) def neg(a): return _mk(-a.v, (a,), lambda g: (-g,)) def matmul(a, b): """支持 [m,k]@[k,n]、[... ,m,k]@[k,n]、[m,k]@[B,k,n]、[... ,m,k]@[... ,k,n]。""" av, bv = a.v, b.v v = av @ bv def f(g): # 一律走 BLAS 的 batched matmul:比 einsum 快一个量级 if av.ndim <= 2 and bv.ndim <= 2: return (g @ bv.T, av.T @ g) if bv.ndim == 2: # [..., m,k] @ [k,n] da = g @ bv.T p = int(np.prod(av.shape[:-2])) a2 = av.reshape(p, *av.shape[-2:]).swapaxes(-1, -2) # [p,k,m] g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n] return (da, (a2 @ g2).sum(axis=0)) if av.ndim == 2: # [m,k] @ [..., k,n] p = int(np.prod(bv.shape[:-2])) b2 = bv.reshape(p, *bv.shape[-2:]).swapaxes(-1, -2) # [p,n,k] g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n] return ((g2 @ b2).sum(axis=0), av.T @ g) return (g @ bv.swapaxes(-1, -2), av.swapaxes(-1, -2) @ g) return _mk(v, (a, b), f) def transpose(a, *axes): inv = np.argsort(axes) return _mk(a.v.transpose(axes), (a,), lambda g: (g.transpose(inv),)) def reshape(a, shape): return _mk(a.v.reshape(shape), (a,), lambda g: (g.reshape(a.v.shape),)) def scale(a, c): return _mk(a.v * c, (a,), lambda g: (g * c,)) def chunk_last(a, n): """把最后一维等分成 n 份(adaLN 的 6 路调制输出就是这么切的)。""" k = a.v.shape[-1] // n out = [] for i in range(n): v = a.v[..., i * k:(i + 1) * k] def f(g, i=i, k=k): full = np.zeros_like(a.v) full[..., i * k:(i + 1) * k] = g return (full,) out.append(_mk(v, (a,), f)) return out def split3(a): """把最后一维等分三份(qkv)。""" d = a.v.shape[-1] // 3 out = [] for i in range(3): v = a.v[..., i * d:(i + 1) * d] def f(g, i=i, d=d): full = np.zeros_like(a.v) full[..., i * d:(i + 1) * d] = g return (full,) out.append(_mk(v, (a,), f)) return out def take_tokens(a, n): """取前 n 个 token,其余位置梯度补零(in-context 读回图像 token 用)。""" v = a.v[:, :n, :] def f(g): full = np.zeros_like(a.v) full[:, :n, :] = g return (full,) return _mk(v, (a,), f) def concat_tokens(a, b): """沿 token 维拼接(in-context 把条件 token 接在序列末尾)。""" v = np.concatenate([a.v, b.v], axis=1) def f(g): return (g[:, :a.v.shape[1], :], g[:, a.v.shape[1]:, :]) return _mk(v, (a, b), f) def tanh(a): t = np.tanh(a.v) return _mk(t, (a,), lambda g: (g * (1.0 - t * t),)) def sigmoid(a): s = 1.0 / (1.0 + np.exp(-a.v)) return _mk(s, (a,), lambda g: (g * s * (1.0 - s),)) def silu(a): s = 1.0 / (1.0 + np.exp(-a.v)) v = a.v * s return _mk(v, (a,), lambda g: (g * (s + v * (1.0 - s)),)) def gelu_tanh(a): """GELU 的 tanh 近似,DiT 源码里用的就是这个(nn.GELU(approximate='tanh'))。""" k = np.sqrt(2.0 / np.pi) s = a.v * a.v inner = k * (a.v + 0.044715 * a.v * s) t = np.tanh(inner) v = 0.5 * a.v * (1.0 + t) dv = 0.5 * (1.0 + t) + 0.5 * a.v * (1.0 - t * t) * k * (1.0 + 0.134145 * s) return _mk(v, (a,), lambda g: (g * dv,)) def softmax(a, axis=-1): e = np.exp(a.v - a.v.max(axis=axis, keepdims=True)) p = e / e.sum(axis=axis, keepdims=True) def f(g): s = (g * p).sum(axis=axis, keepdims=True) return (p * (g - s),) return _mk(p, (a,), f) def layernorm(a, eps=1e-6): """对最后一维做归一化,无仿射参数(DiT 的缩放/平移由 adaLN 给出)。""" mu = a.v.mean(axis=-1, keepdims=True) xc = a.v - mu var = (xc * xc).mean(axis=-1, keepdims=True) inv = 1.0 / np.sqrt(var + eps) v = xc * inv def f(g): gm = g.mean(axis=-1, keepdims=True) gv = (g * v).mean(axis=-1, keepdims=True) return (inv * (g - gm - v * gv),) return _mk(v, (a,), f) def mean_all(a): n = a.v.size return _mk(a.v.mean(), (a,), lambda g: (np.full(a.v.shape, g / n),)) def backward(loss): for node in _TAPE: node.g = np.zeros_like(node.v) loss.g = np.ones_like(loss.v) for node in reversed(_TAPE): if node.bwd is not None: node.bwd(node.g) return loss def gradcheck(build, eps=1e-5, seed=0, n_probe=6): """中心差分逐参数核对,返回最大相对误差。 build() 每次调用要返回 (loss Node, 参数 Node 列表)。差分直接扰动 Node 底层 的 ndarray——Node.v 与模型里那块内存是同一块,所以扰动后重新 forward 就能拿到扰动后的 loss。 """ rng = np.random.default_rng(seed) worst = 0.0 _, store = build() for node in store: flat = node.v.reshape(-1) idx = rng.choice(flat.size, size=min(n_probe, flat.size), replace=False) for i in idx: old = flat[i] flat[i] = old + eps reset() lp = float(build()[0].v) flat[i] = old - eps reset() lm = float(build()[0].v) flat[i] = old num = (lp - lm) / (2 * eps) reset() loss, s2 = build() backward(loss) cur = [n for n in s2 if n.v is node.v] ana = cur[0].g.reshape(-1)[i] if cur and cur[0].g is not None else 0.0 denom = max(abs(num), abs(ana), 1e-8) worst = max(worst, abs(num - ana) / denom) reset() return worst make_figures.py # -*- coding: utf-8 -*- """画配图。数字全部来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) import dit_flops as F # noqa: E402 import adaln_zero as AZ # noqa: E402 import cond_ablation as CA # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:算力账本 ─────────────── def fig_ledger(): fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.8)) # 左:相近 Gflops 的三个配置,FID 并不都相等 ax = axes[0] marks = {8: "o", 4: "s", 2: "^"} cols = {8: CGREY, 4: C2, 2: C1} # 手工微调标号偏移,避免同算力组里三个点叠在一起看不清 offs = {("S", 2): (7, -15), ("B", 4): (1, 9), ("L", 8): (8, 5), ("S", 4): (8, 5), ("B", 8): (8, 5), ("B", 2): (7, -15), ("L", 4): (-4, 10), ("XL", 4): (8, 6), ("L", 2): (8, 5), ("XL", 2): (8, 5), ("S", 8): (8, 5), ("XL", 8): (8, 5)} for cfg in ["S", "B", "L", "XL"]: for p in [8, 4, 2]: g, pm, fid = F.PAPER_TABLE4_256[(cfg, p)] ax.scatter(g, fid, marker=marks[p], s=95, color=cols[p], zorder=3, edgecolor="white", linewidth=1.3) ax.annotate(f"{cfg}/{p}", (g, fid), textcoords="offset points", xytext=offs[(cfg, p)], fontsize=9, color="#333333", bbox=dict(boxstyle="round,pad=0.15", fc="white", ec="none", alpha=0.75)) ax.set_xscale("log") ax.set_xlim(0.25, 320) ax.set_ylim(0, 175) ax.set_xlabel("一次前向的算力 Gflops(对数轴,论文 Table 4)") ax.set_ylabel("FID-50K(无 CFG,越低越好)") ax.set_title("论文配置对比:相近 MAC 不保证相同 FID") ax.grid(alpha=0.25, ls=":") for tag, keys, col, tx, ty in [ ("约 5~6 G", [("S", 2), ("B", 4), ("L", 8)], C3, 1.05, 152), ("约 20~29 G", [("B", 2), ("L", 4), ("XL", 4)], C0, 36, 60)]: xs = [F.PAPER_TABLE4_256[k][0] for k in keys] ys = [F.PAPER_TABLE4_256[k][2] for k in keys] ax.plot(xs, ys, ls="--", lw=1.3, color=col, alpha=0.75, zorder=1) ax.text(tx, ty, tag, color=col, fontsize=9.5, ha="left", bbox=dict(boxstyle="round,pad=0.25", fc="white", ec=col, alpha=0.85, lw=0.8)) ax.annotate("这两个点参数量差 4 倍\n(33M / 130M),FID 几乎重合", xy=(6.06, 68.40), xytext=(0.42, 26), fontsize=9, color="#333333", ha="left", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) # 右:注意力占多少算力,随 token 数怎么变 ax = axes[1] Ts = np.array([64, 256, 1024, 4096, 16384]) ds = {"DiT-S (d=384)": 384, "DiT-B (d=768)": 768, "DiT-L (d=1024)": 1024, "DiT-XL (d=1152)": 1152} for name, d in ds.items(): lin = 12 * d * d # 每 token 的线性部分(qkv+out+mlp) attn = 2 * Ts * d # 每 token 摊到的注意力部分 ax.plot(Ts, attn / (lin + attn) * 100, marker="o", lw=2, ms=4, label=name) ax.set_xscale("log") ax.set_ylim(0, 100) ax.set_xlabel("token 数 T(对数轴)") ax.set_ylabel("注意力占主矩阵 MAC 的百分比") ax.set_title("T=256 时注意力只占 3.6%,要到 T 上千才成为大头") ax.grid(alpha=0.25, ls=":") ax.legend(fontsize=9, loc="upper left") ax.axvline(256, color="#cccccc", lw=1.2, ls=":", zorder=0) ax.annotate("256×256 图像、p=2:3.6%", xy=(256, 3.6), xytext=(330, 8), fontsize=9, color="#555555") ax.text(900, 2.5, "同样 T 下,网络越宽(d 越大)注意力占比越低", fontsize=9, color="#555555") fig.suptitle("图 1:DiT 的算力账本——矩阵乘加分配与论文配置对比", fontsize=12) fig.tight_layout() _save(fig, "fig1_compute_ledger.png") # ─────────────── 图 2:初始化恒等 ─────────────── def fig_identity(): r = AZ.identity_and_drift() drift_zero = r["adaln_zero"]["drift"] drift_plain = r["adaln"]["drift"] ks = np.arange(1, len(drift_plain) + 1) fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.4)) ax = axes[0] ax.plot(ks, drift_plain, color=C1, lw=2.4, marker="o", ms=3, label="vanilla adaLN(调制层正常初始化)") ax.plot(ks, drift_zero, color=C0, lw=2.4, label="adaLN-Zero(调制层零初始化)") ax.set_xlabel("第 k 个 block 之后") ax.set_ylabel(r"残差流漂移 std(x_k - x_0)") ax.set_title("零初始化:叠 28 层,漂移严格是 0") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":") ax.annotate(f"第 28 层:{drift_plain[-1]:.2f} vs {drift_zero[-1]:.2f}", xy=(28, drift_plain[-1]), xytext=(13, 3.4), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) ax = axes[1] labels = ["W_qkv", "W_o", "W_1", "W_2", "调制层\nshift/scale 段", "调制层\ngate 段"] gz = AZ.grad_at_init("adaln_zero") gp = AZ.grad_at_init("adaln") def pick(r, kind): """按名字取,避免把 vanilla adaLN 的 shift_mlp 误当成 gate。""" vals = [v for nm, v in zip(r["mod_name"], r["mod_chunks"]) if (("gate" in nm) if kind == "gate" else ("shift" in nm or "scale" in nm))] return max(vals) if vals else None v_zero = [gz["W_qkv"], gz["W_o"], gz["W_1"], gz["W_2"], pick(gz, "ss"), pick(gz, "gate")] v_plain = [gp["W_qkv"], gp["W_o"], gp["W_1"], gp["W_2"], pick(gp, "ss"), pick(gp, "gate")] # vanilla adaLN 结构里没有 gate:画在最底部,并单独标注 FLOOR = 1e-12 v_plain = [FLOOR if v is None else v for v in v_plain] v_zero = [FLOOR if v is None else v for v in v_zero] x = np.arange(len(labels)) w = 0.38 ax.bar(x - w / 2, np.array(v_plain) + FLOOR, w, color=C2, label="vanilla adaLN") ax.bar(x + w / 2, np.array(v_zero) + FLOOR, w, color=C0, label="adaLN-Zero") ax.set_yscale("log") ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9) ax.set_ylabel("初始化时刻的 |grad| 最大值(对数轴)") ax.set_title("门关着的时候,独立 block:门梯度可非零,主干梯度为零") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":", axis="y") ax.annotate("adaLN-Zero 的主干参数梯度精确为 0\n(0 画在 1e-12,否则 log 轴显示不出来)", xy=(x[0] + w / 2, FLOOR), xytext=(0.35, 1e-9), fontsize=9, color="#333333") ax.annotate("vanilla adaLN 结构里\n根本没有 gate 这一项", xy=(x[-1] - w / 2, FLOOR), xytext=(3.35, 1e-7), fontsize=9, color="#555555", ha="center", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) fig.suptitle("图 2:adaLN-Zero 的初始化——恒等是怎么来的,代价是什么", fontsize=12) fig.tight_layout() _save(fig, "fig2_identity.png") # ─────────────── 图 3:四种条件注入的 toy 训练对照 ─────────────── def fig_ablation(): res = CA.load_or_run() fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.6)) cols = {"adaln_zero": C0, "adaln": C2, "in_context": C1, "cross_attn": C3} names = {"adaln_zero": "adaLN-Zero", "adaln": "vanilla adaLN", "in_context": "in-context", "cross_attn": "cross-attention"} ax = axes[0] for mode in CA.COND_MODES: c = res[mode]["curve"] ax.plot([p[0] for p in c], [p[1] for p in c], lw=2.2, color=cols[mode], label=names[mode]) ax.set_xlabel("训练步数") ax.set_ylabel("噪声预测 MSE(每 50 步取均值)") ax.set_title("同一个 toy 任务,四种条件注入的训练曲线") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":") ax = axes[1] x = np.arange(len(CA.COND_MODES)) means = [res[m]["final_mean"] for m in CA.COND_MODES] stds = [res[m]["final_std"] for m in CA.COND_MODES] ax.bar(x, means, yerr=stds, capsize=4, color=[cols[m] for m in CA.COND_MODES], alpha=0.9) # 把 3 个 seed 的最终 loss 直接点到柱子上:看排序有没有重叠 for i, m in enumerate(CA.COND_MODES): vals = res[m]["finals"] ax.scatter([i] * len(vals), vals, s=20, color="white", edgecolor="#333333", linewidth=0.8, zorder=4) ax.set_xticks(x) ax.set_xticklabels([names[m] for m in CA.COND_MODES], fontsize=9) ax.set_ylabel("最后 200 步的平均 loss(3 个 seed)") ax.set_title("训练 MSE:三次 seed 的描述性统计") ax.grid(alpha=0.25, ls=":", axis="y") top = max(means) + max(stds) * 3 ax.set_ylim(0, top) for i, (m, s) in enumerate(zip(means, stds)): ax.text(i, m + s + top * 0.02, f"{m:.4f}", ha="center", fontsize=9, color="#333333") ax.annotate("白点 = 每个 seed 单独的结果\n(仅此 toy 配方,不作显著性推断)", xy=(0, means[0]), xytext=(1.15, top * 0.62), fontsize=9, color="#333333", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) fig.suptitle("图 3:条件注入方式的 toy 对照(6 层 d=64、T=16,800 步 × 3 seed)", fontsize=12) fig.tight_layout() _save(fig, "fig3_cond_ablation.png") # ─────────────── 图 4:四种 block design 的算力-质量对照 ─────────────── def fig_design(): order = ["in-context", "cross-attention", "adaLN", "adaLN-Zero"] names = ["in-context", "cross-attention", "vanilla adaLN", "adaLN-Zero"] g = [F.PAPER_BLOCK_DESIGN[k][0] for k in order] pm = [F.PAPER_BLOCK_DESIGN[k][1] for k in order] fid = [F.PAPER_BLOCK_DESIGN[k][2] for k in order] fig, axes = plt.subplots(1, 3, figsize=(13.2, 4.0)) cols = [C1, C2, CGREY, C0] for ax, vals, title, ylab, fmt in [ (axes[0], g, "一次前向 Gflops", "Gflops", "{:.1f}"), (axes[1], pm, "参数量", "M", "{:d}"), (axes[2], fid, "FID-50K(越低越好)", "FID", "{:.2f}"), ]: bars = ax.bar(np.arange(4), vals, color=cols, alpha=0.92) ax.set_xticks(np.arange(4)) ax.set_xticklabels(names, fontsize=8.5, rotation=18) ax.set_title(title) ax.set_ylabel(ylab) ax.grid(alpha=0.25, ls=":", axis="y") for b, v in zip(bars, vals): ax.text(b.get_x() + b.get_width() / 2, v, fmt.format(v), ha="center", va="bottom", fontsize=9, color="#333333") if title.startswith("FID"): ax.set_ylim(0, max(vals) * 1.25) else: ax.set_ylim(0, max(vals) * 1.22) fig.suptitle("图 4:DiT-XL/2 骨架下四种 block design(论文 Table 4,400K 步)", fontsize=12) fig.tight_layout() _save(fig, "fig4_block_design.png") FIGURES = { "ledger": fig_ledger, "identity": fig_identity, "ablation": fig_ablation, "design": fig_design, } if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None for name, fn in FIGURES.items(): if only and name != only: continue print(f"[draw] {name}") fn()
-
AIGC 基本功|潜空间扩散与 Stable Diffusion 架构-LDM AIGC 基本功|潜空间扩散与 Stable Diffusion 架构-LDM 所属方向:生成范式 | 难度:进阶 | 前置知识:VAE 结构与 0.18215、DDPM 训练目标与采样流程(先掌握累计信号系数与噪声预测;DDIM 的完整更新另见文末采样器链接) 关键词:潜空间扩散、LDM、Stable Diffusion、UNet、交叉注意力、scale factor 01. 为什么需要它 潜空间扩散的主要收益是降低生成网络处理的空间位置数。下面把一个 SD1.5 风格 UNet 原样放大到像素空间做静态对照;这不是所有像素扩散的成本,也不是实际 GPU 显存或延迟测试。 账本依据 SD1.5 固定配置和 Diffusers v0.35.1 构造逻辑(附录 unet_ledger.py)。历史命名 attention_head_dim=8 在这里实际指定 8 个头,320 通道对应每头 40 维。本轮用官方类在 meta 设备构造完整拓扑,参数为 859,520,964,与账本完全一致;旧文“官方 859,522,604”的参照值有误。meta 构造只核验结构,不运行真实权重,也不测显存或速度。若朴素实现显式保存注意力矩阵,512² 像素上的首层需要 $$512^2\times512^2\times8\times2\ \text{bytes}=2^{40}\ \text{bytes}=1\ \text{TiB}$$ 这里按二进制单位计算为 1 TiB;同层 64² latent 需要 256 MiB,矩阵元素数相差 4096 倍。SDPA / FlashAttention 可以不保存完整矩阵,所以这些是朴素物化成本,不是现代实现的必然显存占用。 把像素模型 attention 只放最深层,静态账本得到单步约 $1.4455\times10^{13}$ MAC;latent 版本约 $4.0164\times10^{11}$ MAC,相差 36.0 倍;该变体参数量也变了,不是同一个模型。若像素版保留 SD 的全部 attention 位置,则约为 $2.7256\times10^{14}$ MAC,比例 678.6。两种对照不能混用。深层 attention 变体与 latent 版对应的逐层张量累计约 12.94 GiB 与 2.04 GiB,尚未模拟张量生命周期、重计算、优化器或融合内核。VAE 编解码是额外开销,占比随采样步数、分辨率和实现改变,本实验没有测量它。 压缩也引入信息取舍。latent_lab.py 用一张样例图做块 DCT,只保留 192 个系数中的 4 个,得到 94.91% 能量和约 22.06 dB PSNR。能量不是语义信息量,高频中的文字笔画、边缘、细小物体仍可能很重要;该单图线性实验不能证明 VAE 只删除“人眼不关心”的内容。 实际 LDM 用学习到的感知压缩来减小扩散的工作空间,并同时权衡重建质量、生成质量和成本。像素扩散、级联超分也能实现高分辨率生成,潜空间是有用路线而非唯一可行路线。 02. 最小可用理解 三句话: 机制:先训练并冻结感知自编码器,再在它的潜表示上训练扩散模型。SD1.5 的 KL 自编码器将 512×512×3 图像变成 64×64×4 的后验样本,经配套缩放后交给 UNet;文本主要通过交叉注意力注入。 成本:固定通道与卷积核时,卷积 MAC 随空间位置数线性变化,self-attention 的矩阵乘随位置数平方变化。同拓扑静态账本在 512px 得到 678.6 倍 MAC 比;卷积部分约 63.993 倍,四舍五入为 64.0,因输入/输出通道从 3 变成 4 而非严格 64。端到端加速仍需实测。 效果与代价:扩散模型不再直接对像素负责,可还原的细节受 VAE 限制——VAE 解不回来的细节,扩散模型画得再好也出不来。这是潜空间模型的一项误差来源,不能单独解释文字或手指等全部生成错误。 这张图看静态 MAC 随边长变化的趋势:在本扫描区间,像素同拓扑约为边长的 3.87 次方,latent 约为 2.61 次方。512px 处约相差 679 倍。右图是朴素实现的逐层张量累计,不是实测峰值;使用融合注意力时,红色矩阵项会显著改变。 03. 数学推导 3.1 两阶段目标 LDM 是两阶段训练,不是给同一个联合损失设置一个任意 λ: $$\text{阶段一:}\min_{\phi,\psi}L_{\text{AE}}(\phi,\psi),\qquad\text{阶段二:固定 }(\phi,\psi)\text{ 后 }\min_\theta L_{\text{LDM}}(\theta)$$ 第一阶段优化自编码器的重建、正则与感知/对抗目标;第二阶段冻结编码器与解码器,只优化 latent 扩散目标。这样扩散训练所见的 latent 分布保持固定。联合训练是另一类研究方案,需要额外处理两侧变化。 3.2 感知压缩:压缩率从哪来 VAE 的编码器把 $x\in\mathbb{R}^{H\times W\times 3}$ 映到 $z\in\mathbb{R}^{h\times w\times C}$,其中 $h=H/f$、$w=W/f$。定义张量元素数量比 $$r=\frac{3\,f^{2}}{C}$$ $f$ 是空间下采样倍数,$C$ 是潜通道数。SD 用 $f=8$、$C=4$,所以 $r=48$。它不是文件码率:若原图为 uint8、latent 为 FP16,未计元数据的字节比只有 24;若还保存后验均值与方差,存储又不同。实际编码还需量化、熵编码和解码约定。这个式子值得停一下:$f$ 和 $C$ 是两个独立的旋钮,$f$ 控制空间上省多少(直接决定 UNet 卷积部分省多少,因为卷积算力正比 $h\times w$),$C$ 控制每个位置带多少信息。附录表 [A] 里扫了这两个旋钮的交叉组合:$f=8,C=4$ 时线性重建只有 22.06 dB,把 $C$ 从 4 提到 16 能到 27.56 dB,把 $f$ 从 8 降到 4 也能到 26.09 dB——增大 $C$ 或减小 $f$ 都可能改善这个替身的重建,但改变的维度不同。固定骨干时,$f$ 加倍使空间位置数除以 4;self-attention 的矩阵项约除以 16,首尾卷积还随 $C$ 改变,不能把全部算力统称除以 4。LDM 论文比较了多种压缩因子和 KL/VQ 正则;SD1.5 的 $f=8,C=4$ 是具体模型的选择,不是这张单图 DCT 曲线推出的最优解。 图中星号只是与 SD 相同张量尺寸的 DCT 教学替身,不是实测 SD VAE 的 PSNR。不同曲线来自同一张图的不同块大小与保留系数数目;右侧能量比例依赖图像和基底,不代表感知信息保留率。此处保留的是整张输入图上平均能量最大的固定 DCT 索引,不保证都属于最低频率;它使用待测图自身选择索引,重建端还需知道这些索引。该图展示单图适配,不是固定编码器的留出泛化或完整码率评估。 感知压缩通常结合像素重建、LPIPS 和对抗目标。逐像素 L2 在重建不确定时倾向条件均值,可能使细节变模糊;感知项约束特征而非逐像素对应。但 L2 不会因为“高频系数数量多”就被低能量项支配:正交变换下 Parseval 等式保持总平方误差。是否使用某项应看具体配方与消融。 在 SD1.5 的 KL 路径中,编码器实际给出对角高斯后验,而非一个天然确定的向量。用 $u$ 区分原始自编码器 latent 与扩散所见的 $z$: $$q_\phi(u\mid x)=\mathcal N(\mu_\phi(x),\operatorname{diag}(\sigma_\phi^2(x))),\quad u=\mu_\phi(x)+\sigma_\phi(x)\odot\eta,\quad\eta\sim\mathcal N(0,I),\quad z_0=su.$$ $\phi,\psi$ 分别是编码器与解码器参数,$s$ 是配套全局缩放系数,$\odot$ 是逐元素乘;批量布局通常为 $[B,4,H/8,W/8]$。重建若取后验均值,和训练时取随机后验样本并非同一输入分布。采样结束后先还原 $u=z_0/s$,再由 $\mathcal D_\psi(u)$ 解码,不能漏除或除两遍。纯文生图推理从噪声出发,本身不必先编码一张输入图。 原始 LDM 还研究 VQ-reg. 路线,将量化放进解码侧;“LDM 都等于 SD1.5 的四通道高斯 VAE”过于狭窄。本文后面的具体尺寸、CLIP 长度和配置均限定到 SD1.5。 3.3 潜空间扩散目标 VAE 冻结之后,扩散这一半就是把 DDPM 的每个符号里的 $x$ 换成 $z$。前向过程: $$z_t=\sqrt{\bar\alpha_t}\,z_0+\sqrt{1-\bar\alpha_t}\,\varepsilon,\qquad \varepsilon\sim\mathcal{N}(0,1)$$ 训练时独立采样数据图像及后验噪声得到 $z_0$,再采样离散时间 $t$ 和同形状标准高斯噪声 $\varepsilon$;$\bar\alpha_t$ 是预先约定的累计信号系数,$\theta$ 是 UNet 参数。SD1.5 采用噪声预测,条件 $c$ 是文本编码器输出,通过 UNet 的交叉注意力进入: $$L_{\text{LDM}}=\mathbb{E}_{z_0,\,\varepsilon,\,t}\Big[\big\|\varepsilon-\varepsilon_\theta(z_t,t,c)\big\|_2^2\Big]$$ 损失形式沿用 DDPM 的噪声回归,但训练数据分布已换成缩放后的后验样本,调度、预测目标和条件接口仍须匹配模型。CFG 和 DDIM 可以在这里使用,不能将像素模型的训练权重直接当作 latent 模型权重。上述标准目标也没有覆盖额外 noise offset 等训练变体。 3.4 scale factor:为什么必须有 扩散训练需要固定 latent 的尺度约定。单位数据方差时,SNR 是 $\bar\alpha_t/(1-\bar\alpha_t)$,不是 $\bar\alpha_t$ 本身。SD1.x 常用乘数 $s=0.18215$;若把缩放后全局标准差约定为 1,它隐含参考原始标准差约 5.49、方差约 30.14,这不是本轮测得的训练集统计。固定 AutoencoderKL 源码默认使用该值;本次下载的 SD1.5 VAE 旧配置未显式列出它,加载时继承默认值,不能假称配置文件中一定写了这一键。编码后乘 s、解码前除 s,由训练脚本与 pipeline 完成,encode 本身不会自动做这步。 把 $z$ 整体乘 $k$ 倍,信噪比就乘 $k^2$: $$\mathrm{SNR}_{\text{eff}}(t)=\frac{\bar\alpha_t\,(k\sigma_z)^2}{1-\bar\alpha_t}$$ 也就是说,网络在时间步 $t$ 实际体验到的难度,可对应到单位方差参考调度里另一个时间步 $t'$ 的相同标量 SNR。附录脚本 [B2] 把这个对应关系算了出来(连续归一化 cosine 调度、$T=1000$、参考 $t=500$):scale 错 2 倍,等效于把 t=500 映射到约 t′=292.8(差 −207.2 步);错 4 倍是 −348.7 步;错 0.5 倍是 +205.6 步。这是参考时刻的等效 SNR 变化,不是固定的全局时间平移。按原论文定义,先定义连续函数: $$F(t)=\cos^2\left[\frac{(t/T+0.008)\pi}{2\times1.008}\right].$$ 再取 $\bar\alpha(t)=F(t)/F(0)$,保证 $\bar\alpha(0)=1$;旧代码漏了分母,本次修正后数字有约 0.1 步的变化。连续曲线还不同于离散 beta 上限裁剪后的累乘表。 相同标量 SNR 不等于两个网络调用等效:数据幅度、时间 embedding、后验分布及训练约定仍可能不同。这个对应关系用于诊断尺度,不能靠把错误 latent 配上 $t'$ 就保证恢复预训练模型。 这张图在固定参考 t=500 上比较尺度倍数 k 与等效时间 t′,曲线经过 k=1、t′=500。这种映射是非线性的,不是把整条时间表平移固定步数;−207.2 只是本调度在这个参考时刻、k=2 的差值。 还有一层:全局缩放只解决「整体方差」的问题,解决不了「通道之间」。附录 [B] 用样例照片的 DCT 特征实测(不是 VAE 权重输出):8 个通道的标准差从 8.0681 一直掉到 0.5386,相差 14.98 倍。为单独理解方差效应,另设第 $j$ 通道是均值 $\mu_j$、方差 $\sigma_j^2$ 的高斯变量,独立于加噪噪声;此时预测噪声的最优残差是 $$\mathrm{MSE}_j(t)=\frac{\bar\alpha_t\,\sigma_j^2}{\bar\alpha_t\,\sigma_j^2+1-\bar\alpha_t}$$ 推导来自高斯条件分布。记 $a=\bar\alpha_t$、$y=\sqrt a z+\sqrt{1-a}\varepsilon$,则 $\operatorname{Var}(y)=a\sigma_j^2+1-a$,$\operatorname{Cov}(\varepsilon,y)=\sqrt{1-a}$。因此 $$\mathbb E[\varepsilon\mid y]=\frac{\sqrt{1-a}}{a\sigma_j^2+1-a}(y-\sqrt a\mu_j),\quad\operatorname{Var}(\varepsilon\mid y)=1-\frac{1-a}{a\sigma_j^2+1-a}=\frac{a\sigma_j^2}{a\sigma_j^2+1-a}.$$ 有限方差变量即使不是高斯,这个系数仍给出最佳仿射预测器,残差却不能再称任意非线性预测器的 Bayes 下界。只有独立高斯通道时,逐通道残差之和才等于联合 Bayes 损失;通道相关时,联合预测还可能利用跨通道信息进一步降低误差。DCT 通道一般非高斯、也未证明独立;这里仅把实测通道方差代入高斯替身,未缩放时 $a=0.1$ 的最大通道残差份额约 51.28%。逐通道求和或求平均也要按损失约定区分。这不是参数梯度份额,更不能解释真实 SD 的细节质量。独立脚本以三组高斯各 40 万样本核对解析均值和 Monte Carlo 标准误。 这张图要看什么:左图是 8 个通道各自的 std(对数刻度),橙色虚线是通道方差均值的平方根(3.0457,不含通道均值之间的差异)——它的倒数 0.3283 就是 SD 那个 0.18215 的类比物,注意全局缩放之后通道之间的 15 倍跨度原封不动。右图是以实测方差构造高斯替身后,三条 $\bar\alpha_t$ 下各通道的最优残差份额:三条曲线都从左往右掉,灰色虚线是「逐通道缩放后」的均摊线 12.5%。$\bar\alpha_t$ 越小(噪声越大),失衡越严重。 3.5 交叉注意力:条件怎么进来 文本 $y$ 先过 CLIP 文本编码器得到 $\tau_\theta(y)\in\mathbb{R}^{77\times 768}$,然后进 UNet 内部的 Transformer 块。每个 Transformer 块有两个注意力,分工不同: $$\mathrm{attn}_1=\mathrm{softmax}\Big(\frac{QK^\top}{\sqrt d}\Big)V,\quad Q,K,V\ \text{都来自图像 token}\qquad\qquad\mathrm{attn}_2=\mathrm{softmax}\Big(\frac{QK^\top}{\sqrt d}\Big)V,\quad Q\ \text{来自图像 token},\ K,V\ \text{来自文本}$$ $\mathrm{attn}_1$ 是 self-attention,管图像内部的空间关系;$\mathrm{attn}_2$ 是 cross-attention,管「这段话在这个位置要什么」。关键在成本结构:图像 token 数 $N=h\times w$,文本 token 数固定 $T=77$,所以 $$\mathrm{attn}_1\ \text{的注意力矩阵是}\ N\times N,\qquad \mathrm{attn}_2\ \text{的是}\ N\times 77$$ 对 token 数 N,self-attention 的矩阵计算二次增长,cross-attention 在固定文本长度下近似线性增长。修正账本后,cross-attention 的 MAC 占比从 64² latent 的 4.00% 降到 256² 的 1.11%;绝对 MAC 仍从约 $1.60\times10^{10}$ 升到 $2.35\times10^{11}$,占比下降不能说它“不涨钱”。 单头注意力输出 $AV$ 满足 $\mathrm{rank}(AV)\le\min(T,d_{\text{head}})$,这里 T=77。附录单头、d=320 的随机矩阵实验得到秩 77。真实 SD 是多头:各头拼接后秩上界可达 $\min(C,H_{\text{heads}}T)$,再加残差、非线性与多层处理,不能声称整个 UNet 只有 77 个自由度。文本与细粒度空间控制仍是不同接口,但这个单头秩实验不能单独证明 ControlNet 的必要性。 左图是修正后的静态 MAC 占比。右图只是人为设定的“许多等 logit 位置”在 softmax 中累加概率质量的示意:真实 CLIP 即使使用相同 padding token ID,各位置经过位置编码与上下文注意力后的向量也不相同,不能把它们当成一个相同 EOS embedding 集团。是否传 mask 应核对具体 pipeline。 04. 代码实现 保留原有三份脚本,补一份独立校验。实验用 NumPy 与 Pillow,配图另需 matplotlib;本轮实跑为 Windows / Python 3.11.9 / NumPy 2.4.3。完整代码在文末附录,图像可用仓库样例,也可通过 --image 传入自己的图片。 4.1 块正交编码器(VAE 的替身) 为了隔离张量尺寸与数值因素,这里不加载预训练权重,而用一个线性正交编码器当 VAE 的替身:切成 $f\times f\times 3$ 的块、做三维可分离 DCT、只留能量最大的 $C$ 个系数。它与该 VAE 的张量形状及元素压缩率对应——潜特征形状就是 $(h, w, C)$,压缩率就是 $\frac{3f^2}{C}$,变量名和 3.2 节的符号一一对应。用它做替身的好处是把「压缩率」这一个变量单独隔离出来了。 def block_basis(f): """f x f x 3 块的可分离正交基,展平顺序 (channel, row, col)。""" df = dct_matrix(f) return np.kron(dct_matrix(3), np.kron(df, df)) def encode_decode(img, f, c_keep): """img: [H, W, 3],值域 [-1, 1]。返回潜特征、重建图、能量占比。""" h, w, _ = img.shape patches = to_blocks(img, f) # [h*w/f^2, 3*f*f] b = block_basis(f) coef = patches @ b.T # 正交变换,能量不变 energy = np.mean(coef ** 2, axis=0) # 每个基函数的平均能量 keep = np.sort(np.argsort(energy)[::-1][:c_keep]) latent = coef[:, keep].reshape(h // f, w // f, c_keep) rec = from_blocks(coef[:, keep] @ b[keep, :], h, w, f) frac = float(energy[keep].sum() / energy.sum()) return latent, np.clip(rec, -1.0, 1.0), frac 真实输出(一张 512×512 照片): encode_decode(img, 8, 4) latent.shape = (64, 64, 4) # 与 SD 的潜特征形状完全一致 压缩率 = 48.0x # 3*8^2/4 PSNR = 22.06 dB # 本样例、本次索引和裁剪策略的结果 保留能量 = 94.9081% # 扔掉的 98% 系数只占 5.09% 的能量 22.06 dB 是这一张图在该 DCT 选择和裁剪策略下的结果,不是所有线性编码器的上限,也不是 SD VAE 的重建质量。真实非线性编码器可能学到不同的特征表示;没有跑权重就不能量化它比这个替身好多少。 4.2 UNet 账本(参数量对拍) 记账模型按 SD 1.5 的拓扑走一遍:4 个分辨率、每层 2 个 ResNet(上采样路径 3 个)、attention 放在下采样路径的第 0/1/2 层和上采样路径对应的层、中段是 ResNet-Transformer-ResNet。 def resnet(self, res, cin, cout): """ResnetBlock2D:GroupNorm-Conv-GroupNorm-Conv + timestep 注入 + shortcut。""" n = res * res self.group_norm(n, cin) self.conv2d(3, cin, cout, res, res) self.group_norm(n, cout) self.conv2d(3, cout, cout, res, res) self.linear(1, TEMB_CH, cout) # time_emb_proj: [1280] -> [cout] if cin != cout: self.conv2d(1, cin, cout, res, res) # conv_shortcut(上采样路径必带) def attention_scores(self, n_q, n_kv, ch, kind): macs = 2.0 * n_q * n_kv * ch self.macs += macs self.kinds[kind] += macs matrix_bytes = n_q * n_kv * NUM_HEADS * self.bpe self.attn_matrix += matrix_bytes self.act += matrix_bytes return macs 真实输出: build_unet(64, 64, 4, 4) # 潜空间 params = 859,520,964 # 与固定配置官方类的结构计数一致 MAC = 4.0164e+11 构成 = conv 52.1% self_attn 21.6% cross_attn 4.0% ffn 19.1% proj 3.2% build_unet(512, 512, 3, 3) # 同一拓扑搬回像素空间 MAC = 2.7256e+14 # 是潜空间的 678.6 倍 账本中 FFN 占约 19.1% MAC、cross-attention 约 4.0%,需要同时考虑投影、卷积和注意力矩阵乘。上采样 ResNet 拼接当前特征与 skip,其通道数是两者相加,跨层时并不总等于输出通道的两倍;修正版按 skip 栈逐项消费。 4.3 交叉注意力(10 行,含秩的验证) def cross_attn_demo(rng, d=320, side=64, ctx_len=77): n_img = side * side q = rng.standard_normal((n_img, d)) / np.sqrt(d) # 图像 token k_txt = rng.standard_normal((ctx_len, d)) / np.sqrt(d) # 文本 token v_txt = rng.standard_normal((ctx_len, d)) / np.sqrt(d) a = softmax((q @ k_txt.T) / np.sqrt(d), axis=-1) # [4096, 77] out = a @ v_txt # [4096, 320] rank = int(np.sum(np.linalg.svd(out, compute_uv=False) > np.linalg.svd(out, compute_uv=False)[0] * 1e-8)) print(a.shape, out.shape, rank) 真实输出: (4096, 77) (4096, 320) 77 这个单头教学例子的秩为 77,验证的是单次矩阵乘积的秩界。独立校验另构造两个各秩至多 2 的头,拼接后秩为 3,直接反驳“多头仍只有 T 个自由度”;加入残差后秩还可以恢复满秩。多头、残差与深层非线性不受同一个“77 维全局瓶颈”约束。 05. 工业级实现对照 对照 diffusers 的 UNet2DConditionModel(huggingface/diffusers · unet_2d_condition.py,symbol UNet2DConditionModel.forward;固定 Diffusers v0.35.1,核对日期为本次精修日;上游其他版本可能不同): 时间步通过 ResBlock 注入。 SD1.5 常见实现把时间 embedding 投影后加到特征上;原始 DDPM 实现也有加性注入,不能说原版 DDPM 使用 AdaGN、到 SD 才改成加法。scale-shift norm 等方式属于其他配置选择,比较时应指出具体模型。 SD1.5 的文本通常通过 cross-attention 注入。 通用 UNet2DConditionModel 还支持 class embedding、附加条件以及 only_cross_attention 等配置,不能把 SD1.5 的一条路径说成这个类的永恒约束。SDXL 还有 pooled 文本、尺寸和裁剪条件;SD2.x 并不是这里所有额外条件接口的来源。 attention 后端影响实际显存。 UNet 构造实现 为历史兼容设置 num_attention_heads = num_attention_heads or attention_head_dim,SD1.5 因而是 8 头。64² latent 的单层显式矩阵约 256 MiB;SDPA / FlashAttention 可避免完整物化,是否使用取决于设备、版本和配置。 scale factor 放在 VAE 的配置里,不在 UNet 里。 这个旧模型配置未显式带该键,AutoencoderKL 构造默认值为 scaling_factor=0.18215,pipeline 在 vae.encode(...).latent_dist.sample() 之后乘上它、在 vae.decode 之前除回来。UNet 见到的是训练约定缩放后的潜特征。替换 VAE 要核对它与扩散主干共同训练的尺度、偏移和 latent 语义;仅修改 scaling_factor 不保证兼容,见 3.4 节的等效时间映射。 本轮对固定原类做了两类验证:完整 SD1.5 拓扑只在 meta 设备数参数;随机初始化的小 UNet 在 CPU 上执行带文本/时间的前向和反向,输出与输入均为 [2,4,8,8]。另外将官方四头 attention 与 NumPy 显式 QK/softmax/AV/输出投影对照,并作输入梯度有限差分;小 VAE 实跑后验采样和外部缩放/解码。这些验证覆盖接口和代数,没有测预训练 SD1.5 图像质量、完整模型 CPU 速度或 GPU 显存。 64² latent 的中段在 8²。 三次下采样后到达 8²;skip 栈包含 conv_in、每个 ResNet/attention 组合的输出与下采样输出,attention 不是在同一 ResNet 之外额外再存一条独立 skip。上采样块依次消费这些特征,所以输入通道必须逐项记账。 06. 代价与边界 代价一:解码器与瓶颈限制重建和生成。 被编码过程丢掉的信息无法保证按原样还原,固定解码器也限制可生成的图像集合。但手指、文字错误还可能来自生成模型和数据,不能把一类生成错误全部归因于 VAE。输入重建误差也不是生成样本误差的严格上限。 代价二:尺度约定要成对维护。 toy 的通道跨度说明一个全局标量不能独立归一化每个通道。真实 VAE 是否需要逐通道处理必须测量;使用预训练扩散模型时还要保持它训练时的 latent 语义和配置,不能只改系数。 代价三:文本不直接指定每个空间位置。 更精确的姿态、深度、边缘控制常加入空间条件分支,但原因涉及任务表示与训练,不是整个 UNet 输出秩只能为 77。多头注意力的秩上界见 3.5 节。 选择时看保真需求与实测成本。 严格像素保真的编辑、文档和重建任务需要评估 VAE 引入的误差,可能选择更低压缩、多尺度或像素方案。超高分辨率并不自动排除 latent 模型:分块、融合注意力、不同生成骨干都会改变成本。本文 2048px 对照的朴素逐层累计约 352.53 GiB,既不是实测峰值,也不是 SDXL 的数字。 07. 经典论文脉络 Taming Transformers for High-Resolution Image Synthesis:VQGAN 将感知压缩与离散 token 自回归生成结合,LDM 沿用并比较了相关感知压缩设计。 Denoising Diffusion Probabilistic Models:提供噪声预测训练与逆扩散的基础。 High-Resolution Image Synthesis with Latent Diffusion Models:在学习的潜空间训练扩散,比较 KL/VQ 正则、不同压缩因子,并用交叉注意力接受一般条件;SD1.5 是后续具体模型实例。 Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding(Imagen):采用像素空间级联扩散和冻结的大文本编码器,展示另一条高分辨率生成路线;文中对文本编码器规模与质量的观察限于其比较设置。 SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis:增加 UNet 与文本条件容量,加入尺寸/裁剪条件、多宽高比训练及 refinement 阶段,说明潜空间路线还有多种工程选择。 它们分别讨论压缩、扩散、条件建模和尺度化设计;不能把跨论文的不同模型视为同一控制变量实验。 08. 常见误解 「潜空间扩散等价于像素扩散加一个 VAE。」 VAE 改变了数据表示、尺度与可还原的信息,训练好的两个去噪器不能无成本互换;差异不能简单归结为“高频全部被删掉”。 「保留 95% 能量就等于保留 95% 信息。」 能量是特定数值空间的平方和,不是感知信息量;小字等低能量结构可能极为重要。本文单图 DCT 只展示能量集中性,真实 VAE 必须另做重建与感知评估。 「0.18215 可以任意改,或是所有图像逐通道标准差的精确倒数。」 它是具体模型约定的全局乘数,不会保证每张图、每个通道都精确单位方差。错 2 倍会改变 SNR;本文连续参考表在 t=500 映射到约早 207 步,但没有实际重排采样预算,也不意味着网络等效。新模型可以重新训练尺度约定,预训练模型使用时则需成对维护。 「静态 MAC 占比就等于延迟占比。」 本账本在 64×64 latent 将 cross-attention 的 Q/K/V/输出投影与矩阵乘合计为约 4.00%,self-attention 21.6%、卷积 52.1%;另有 Transformer 外层投影单独归类。融合内核、访存、文本 K/V 跨步缓存与设备利用率都会改变实际延迟;因此不能仅凭这个比例排除交叉注意力优化。 「SD 的 UNet 只需按通道翻倍估一下。」 跨层 skip、Transformer 外层投影、不同 attention 配置都会影响账本。尤其 SD1.x 配置中的 attention_head_dim=8 是历史头数命名,不能据此算成 40 个头。 09. 动手验证 四份脚本都在附录,unet_ledger.py 仅用标准库,latent_lab.py 需要 numpy 与 Pillow,并需要通过 --image 提供图片或在仓库中使用默认样例(不需要 torch): python unet_ledger.py --sweep python latent_lab.py --image your_image.jpg python ldm_checks.py python make_figures.py 我实跑的关键输出,你可以对: unet_ledger.py 潜空间 params = 859,520,964(官方配置实际构造计数一致) 潜空间单步 MAC = 4.0164e+11;像素空间 = 2.7256e+14,678.6 倍 只看卷积部分 = 64.0 倍(约为 f^2,首尾通道不同产生小差异) cross-attn 占比:64x64 4.00% -> 256x256 1.11% 分辨率扫描加速比:256px 234.3x,512px 678.6x,1024px 1754.7x latent_lab.py f=8, C=4:PSNR 22.06 dB,保留能量 94.9081% 能量最大的 1% 系数(2 个)携带 91.01% 的总能量 8 个通道 std 相差 14.98 倍;alpha_bar=0.1 时 top1 通道占 51.28% 的 loss scale 错 2 倍 -> 等效时间步偏移 -207.2 步 cross-attn 输出的秩 = 77(self-attn 对照 = 320) 人工logit实验在 delta=0 时零logit组约占 84.38%(不是CLIP测量) 注意 84.38% 来自八个带随机波动的 logit 与 69 个零 logit;若 77 个位置严格同分,后者占比应是 $69/77=89.61\%$。这两个模型不同,不能拿前者当作同分组公式的验证。 独立校验还覆盖块拆装、DCT 正交性与 Parseval、满系数重建、投影误差等式、零能量输入、六类非法图像参数、SNR 连续反解及逐行注意力计算。 两个练习:把 --image 换成自己的图,比较 DCT 能量集中度与重建质量;把 NUM_HEADS 从 8 改为 4,在通道宽度不变时,注意力矩阵存储减半,而 QK/AV 的总 MAC 基本不变。该配置实验演示公式,不代表修改预训练模型后可直接使用。 10. 延伸阅读 按知识树的依赖链走: DDPM 训练目标与采样流程:本文 3.3 节那行目标的完整推导。 VAE 结构与 0.18215:VAE 一侧的全部细节,包括那个数字的来历。 分类器无关引导 CFG 的代价与调法:cross-attention 这条条件通路在采样时怎么被外推。 从 DDIM 到高阶采样器:潜空间里怎么把 1000 步压到 20 步。 FlashAttention 为什么不需要存下注意力矩阵:图 1b 那根红柱子怎么消掉。 已发布相邻节点:DiT(Transformer 生成骨干,具体条件方式依模型而异)、流匹配(另一种连续生成路径)。VQ-VAE 与 VQGAN 专题也已发布,可对照离散编码器。 附录:完整代码 09 节用到的脚本全文如下(unet_ledger.py、latent_lab.py、ldm_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 unet_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """SD 系 UNet 的算力 / 显存账本:像素空间 vs 潜空间。 这个脚本不跑真正的卷积,而是按 SD 1.5 UNet2DConditionModel 的公开配置把每一层的形状、参数量、MAC 数、需要保存的 激活字节数逐一累加出来。数字是静态算子账本,不是实测显存或延迟;激活量不含优化器、内核临时区,且不模拟张量生命周期。 记账模型的可靠性用一件事来校准:参数量。官方 SD 1.5 的 UNet 是 参数量由官方配置构造的模型另行核对;参数量逐项对齐后仍需区分静态账本与实测峰值。 用法: python unet_ledger.py # 潜空间 vs 像素空间的主对比 python unet_ledger.py --sweep # 分辨率扫描(看缩放指数) """ from __future__ import annotations import argparse import math # ── 记账口径 ────────────────────────────────────────────────────────────── BYTES_PER_ELEM = 2 # 激活按 bf16/fp16 记,训练时主干激活就是这个精度 # ── SD 1.5 UNet2DConditionModel 的公开配置(v1-5/config.json)───────────── BASE_CH = 320 CH_MULT = (1, 2, 4, 4) LAYERS_PER_BLOCK = 2 # 每个分辨率上的 ResNet 个数(下采样路径) DOWN_ATTN_LEVELS = (0, 1, 2) # 下采样路径里带 self+cross attention 的层 UP_ATTN_LEVELS = (0, 1, 2) # 上采样路径里带 attention 的层 TEMB_CH = 1280 # timestep embedding 的宽度 CTX_DIM = 768 # 文本编码器(CLIP ViT-L)的隐藏维 NUM_HEADS = 8 # SD1.x 历史配置 attention_head_dim 实际指定头数 N_LEVELS = len(CH_MULT) def fmt_bytes(b: float) -> str: """字节数转人类可读字符串。""" for unit in ("B", "KiB", "MiB", "GiB", "TiB", "PiB"): if abs(b) < 1024.0: return "%.2f %s" % (b, unit) b /= 1024.0 return "%.2f PiB" % b def fmt_sci(x: float) -> str: return "%.4e" % x class Ledger: """逐层累加 MAC / 参数 / 激活字节。""" def __init__(self, name: str, bytes_per_elem: int = BYTES_PER_ELEM): self.name = name self.bpe = bytes_per_elem self.macs = 0.0 self.params = 0.0 self.act = 0.0 # 选定算子输出的逐层累计,不模拟活跃期 self.attn_matrix = 0.0 # 注意力矩阵单独统计(它是最容易爆的那一项) self.kinds = {"conv": 0.0, "self_attn": 0.0, "cross_attn": 0.0, "ffn": 0.0, "proj": 0.0} # ── 基本算子 ────────────────────────────────────────────────────── def conv2d(self, k, cin, cout, h, w, kind="conv", save=True): macs = k * k * cin * cout * h * w self.macs += macs self.params += k * k * cin * cout + cout self.kinds[kind] += macs if save: self.act += h * w * cout * self.bpe return macs def linear(self, n_tok, cin, cout, kind="proj", save=True, bias=True): macs = n_tok * cin * cout self.macs += macs self.params += cin * cout + (cout if bias else 0) self.kinds[kind] += macs if save: self.act += n_tok * cout * self.bpe return macs def geglu(self, n_tok, ch): """diffusers 的 GEGLU:Linear(ch, 8*ch) -> GELU -> 逐元素乘 -> Linear(4*ch, ch)。""" m = self.linear(n_tok, ch, 8 * ch, kind="ffn") m += self.linear(n_tok, 4 * ch, ch, kind="ffn") return m def group_norm(self, n_tok, ch): self.params += 2 * ch self.act += n_tok * ch * self.bpe def attention_scores(self, n_q, n_kv, ch, kind): """Q K^T 与 A V 两次矩阵乘,外加注意力矩阵本身的显存。""" heads = NUM_HEADS macs = 2.0 * n_q * n_kv * ch # d_head * n_heads == ch self.macs += macs self.kinds[kind] += macs # 注意力矩阵是 [heads, n_q, n_kv] self.attn_matrix += n_q * n_kv * heads * self.bpe self.act += n_q * n_kv * heads * self.bpe return macs # ── 复合模块 ────────────────────────────────────────────────────── def resnet(self, res, cin, cout): """ResnetBlock2D:GroupNorm-Conv-GroupNorm-Conv + timestep 注入 + shortcut。""" n = res * res self.group_norm(n, cin) self.conv2d(3, cin, cout, res, res) self.group_norm(n, cout) self.conv2d(3, cout, cout, res, res) # timestep embedding 的投影:对每个样本做一次 [1280] -> [cout] self.linear(1, TEMB_CH, cout, kind="proj", save=True) if cin != cout: self.conv2d(1, cin, cout, res, res) # conv_shortcut self.act += n * cout * self.bpe # 残差输出要给上采样路径留着 def transformer_block(self, res, ch, ctx_len): """BasicTransformerBlock:self-attn -> cross-attn -> FFN。""" n = res * res heads = NUM_HEADS # Transformer2DModel 的外层归一化和输入投影 self.group_norm(n, ch) self.conv2d(1, ch, ch, res, res, kind="proj") # (1) self-attention self.group_norm(n, ch) self.linear(n, ch, ch, kind="self_attn", bias=False) self.linear(n, ch, ch, kind="self_attn", bias=False) self.linear(n, ch, ch, kind="self_attn", bias=False) self.attention_scores(n, n, ch, "self_attn") self.linear(n, ch, ch, kind="self_attn") self.act += n * ch * self.bpe # (2) cross-attention:Q 来自图像 token,K/V 来自文本 token self.group_norm(n, ch) self.linear(n, ch, ch, kind="cross_attn", bias=False) self.linear(ctx_len, CTX_DIM, ch, kind="cross_attn", bias=False) self.linear(ctx_len, CTX_DIM, ch, kind="cross_attn", bias=False) self.attention_scores(n, ctx_len, ch, "cross_attn") self.linear(n, ch, ch, kind="cross_attn") self.act += n * ch * self.bpe # (3) FFN self.group_norm(n, ch) self.geglu(n, ch) self.act += n * ch * self.bpe self.conv2d(1, ch, ch, res, res, kind="proj") return heads def build_unet(h, w, in_ch, out_ch, ctx_len=77, name="unet", down_attn=DOWN_ATTN_LEVELS, up_attn=UP_ATTN_LEVELS): """按 SD 1.5 的拓扑跑一遍记账。 h, w : 输入特征图的空间尺寸(潜空间是 64x64,像素空间是 512x512) in_ch : 输入通道(潜空间 4,像素空间 3) out_ch : 输出通道(同上) ctx_len : 文本 token 数(CLIP 固定 77) down_attn/up_attn : 哪些层级带 attention。默认是 SD 的配置; 像素空间可以用 deep 变体把 attention 只留在最深层。 """ if any(isinstance(v, bool) or not isinstance(v, int) or v <= 0 for v in (h,w,in_ch,out_ch,ctx_len)): raise ValueError("尺寸、通道和文本长度必须是正整数") if h != w or h % 8 != 0: raise ValueError("本账本仅支持边长为8的倍数的正方形输入") L = Ledger(name) chs = [BASE_CH * m for m in CH_MULT] # timestep 的 MLP:sinusoidal -> Linear(320, 1280) -> Linear(1280, 1280) L.linear(1, BASE_CH, TEMB_CH, save=True) L.linear(1, TEMB_CH, TEMB_CH, save=True) # conv_in res = h L.conv2d(3, in_ch, chs[0], res, res) # ── 下采样路径 ─────────────────────────────────────────────────── skips = [(res, chs[0])] # conv_in 输出也是 skip current_ch = chs[0] for lv in range(N_LEVELS): cout = chs[lv] for _ in range(LAYERS_PER_BLOCK): L.resnet(res, current_ch, cout) current_ch = cout if lv in down_attn: L.transformer_block(res, cout, ctx_len) skips.append((res, cout)) if lv < N_LEVELS - 1: res //= 2 L.conv2d(3, cout, cout, res, res) skips.append((res, cout)) # ── 中段:ResNet -> Transformer -> ResNet ───────────────────────── mid_ch = chs[-1] L.resnet(res, mid_ch, mid_ch) L.transformer_block(res, mid_ch, ctx_len) L.resnet(res, mid_ch, mid_ch) # ── 上采样路径 ─────────────────────────────────────────────────── current_ch = mid_ch for lv in reversed(range(N_LEVELS)): cout = chs[lv] for _ in range(LAYERS_PER_BLOCK + 1): skip_res, skip_ch = skips.pop() assert skip_res == res L.resnet(res, current_ch + skip_ch, cout) current_ch = cout if lv in up_attn: L.transformer_block(res, cout, ctx_len) if lv > 0: res *= 2 L.conv2d(3, cout, cout, res, res) assert not skips # conv_out L.group_norm(res * res, chs[0]) L.conv2d(3, chs[0], out_ch, res, res) return L def report(L: Ledger, note=""): tot = L.macs print(" %-22s params=%s MAC=%s 激活=%s 其中注意力矩阵=%s" % (L.name + note, "{:,}".format(int(L.params)), fmt_sci(L.macs), fmt_bytes(L.act), fmt_bytes(L.attn_matrix))) if tot > 0: parts = " ".join("%s %.1f%%" % (k, 100.0 * v / tot) for k, v in L.kinds.items() if v > 0) print(" MAC 构成: " + parts) def main(): ap = argparse.ArgumentParser() ap.add_argument("--sweep", action="store_true", help="跑分辨率扫描") args = ap.parse_args() print("=" * 78) print("SD 1.5 UNet 记账(激活按 %d 字节/元素,文本 token 数 77)" % BYTES_PER_ELEM) print("=" * 78) # ── 主对比 ─────────────────────────────────────────────────────── lat = build_unet(64, 64, 4, 4, ctx_len=77, name="latent-64x64x4") pix = build_unet(512, 512, 3, 3, ctx_len=77, name="pixel-512x512x3") # 另一个教学拓扑:attention仅在最深层,参数和算子位置也改变。 pixd = build_unet(512, 512, 3, 3, ctx_len=77, name="pixel-deep-attn", down_attn=(3,), up_attn=(3,)) print("\n[1] 潜空间 vs 像素空间(同一次前向,batch=1)") report(lat, "") report(pix, "") report(pixd, "") print("\n SD 1.5 风格静态参数量 = %s;官方结构的独立核对见质量证据" % "{:,}".format(int(lat.params))) print("\n 比值(像素 / 潜):") print(" 总 MAC %.1fx 只看卷积部分 %.1fx" % (pix.macs / lat.macs, pix.kinds["conv"] / lat.kinds["conv"])) print(" 深层attention变体总MAC %.1fx 只看卷积部分 %.1fx" % (pixd.macs / lat.macs, pixd.kinds["conv"] / lat.kinds["conv"])) print(" 激活 %.1fx 注意力矩阵 %.1fx" % (pix.act / lat.act, pix.attn_matrix / lat.attn_matrix)) print(" 像素空间 512x512 上单个 self-attn 层的注意力矩阵 = %s(8 头)" % fmt_bytes(512 * 512 * 512 * 512 * NUM_HEADS * BYTES_PER_ELEM)) print(" 潜空间 64x64 上单个 self-attn 层的注意力矩阵 = %s(8 头)" % fmt_bytes(64 * 64 * 64 * 64 * NUM_HEADS * BYTES_PER_ELEM)) print(" 潜空间 UNet 朴素实现注意力矩阵逐层累计(非峰值) = %s" % fmt_bytes(lat.attn_matrix)) # ── 交叉注意力的占比 ───────────────────────────────────────────── print("\n[2] 交叉注意力在不同分辨率下的占比(潜空间 UNet,ctx=77)") print(" %-10s %-14s %-12s %-12s" % ("latent", "总 MAC", "cross MAC", "占比")) for r in (32, 64, 96, 128, 192, 256): L = build_unet(r, r, 4, 4, ctx_len=77, name="r%d" % r) cr = L.kinds["cross_attn"] print(" %-10s %-14s %-12s %-12s" % ("%dx%d" % (r, r), fmt_sci(L.macs), fmt_sci(cr), "%.2f%%" % (100.0 * cr / L.macs))) if not args.sweep: return # ── 分辨率扫描:看缩放指数 ─────────────────────────────────────── print("\n[3] 分辨率扫描:图像边长 -> 潜空间边长(f=8)") print(" %-10s %-16s %-16s %-10s %-12s" % ("图像", "像素空间 MAC", "潜空间 MAC", "加速比", "潜空间激活")) rows = [] for side in (256, 384, 512, 768, 1024, 2048): lp = build_unet(side // 8, side // 8, 4, 4, ctx_len=77, name="lp") px = build_unet(side, side, 3, 3, ctx_len=77, name="px") rows.append((side, px.macs, lp.macs, px.macs / lp.macs, lp.act)) print(" %-10s %-16s %-16s %-10s %-12s" % ("%d px" % side, fmt_sci(px.macs), fmt_sci(lp.macs), "%.1fx" % (px.macs / lp.macs), fmt_bytes(lp.act))) # 拟合 log-log 斜率 = 缩放指数 xs = [math.log(r[0]) for r in rows] for idx, tag in ((1, "像素空间"), (2, "潜空间")): ys = [math.log(r[idx]) for r in rows] n = len(xs) mx = sum(xs) / n my = sum(ys) / n sl = sum((a - mx) * (b - my) for a, b in zip(xs, ys)) / \ sum((a - mx) ** 2 for a in xs) print(" %s 的缩放指数 ~ 边长^%.3f" % (tag, sl)) if __name__ == "__main__": main() latent_lab.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """潜空间到底丢了多少东西:块正交变换替身 + 通道尺度 + 交叉注意力。 本实验不加载真实 VAE 权重,使用一个**线性正交编码器** 当 VAE 的替身:把图像切成 f x f x 3 的块,做三维可分离 DCT,只保留能量最大的 C 个系数。它和选定 VAE 的张量尺寸对应——潜特征形状就是 (H/f, W/f, C), 压缩率就是 3*f*f / C。差别在于真实 VAE 是非线性、端到端训练的,重建表现须运行具体权重比较。 用它做替身的好处是:**压缩率这一个变量被单独隔离出来了**。 三件事: A. 压缩率 vs 重建质量 vs 能量集中度 B. 潜特征各通道的方差跨度,以及 scale factor 为什么要存在 C. 交叉注意力:形状、秩瓶颈、padding token 抢走的注意力质量 用法: python latent_lab.py python latent_lab.py --image /path/to/xxx.jpg --size 512 """ from __future__ import annotations import argparse import math import os import numpy as np from PIL import Image SEED = 20260929 HERE = os.path.dirname(os.path.abspath(__file__)) def _find_image() -> str: """向上找 asserts/AIGC.jpg,找不到就退回 outputs/../asserts。""" cur = HERE for _ in range(8): cand = os.path.join(cur, "asserts", "AIGC.jpg") if os.path.exists(cand): return cand cur = os.path.dirname(cur) return os.path.normpath(os.path.join(HERE, "..", "..", "..", "..", "asserts", "AIGC.jpg")) DEFAULT_IMAGE = _find_image() # ───────────────────────────────────────────────────────────────────────── # 基础工具 # ───────────────────────────────────────────────────────────────────────── def dct_matrix(n: int) -> np.ndarray: """正交归一的 DCT-II 矩阵(第 k 行是第 k 个基)。""" if isinstance(n,bool) or not isinstance(n,int) or n <= 0: raise ValueError("DCT长度必须是正整数") k = np.arange(n).reshape(n, 1) i = np.arange(n).reshape(1, n) M = np.cos(math.pi * (i + 0.5) * k / n) M[0] *= math.sqrt(1.0 / n) M[1:] *= math.sqrt(2.0 / n) return M def block_basis(f: int) -> np.ndarray: """f x f x 3 块的可分离正交基,形状 [3*f*f, 3*f*f]。 展平顺序是 (channel, row, col),所以基矩阵是 D_c ⊗ D_row ⊗ D_col。 """ dc = dct_matrix(3) df = dct_matrix(f) return np.kron(dc, np.kron(df, df)) def load_image(path: str, size: int) -> np.ndarray: """读图 -> 居中裁剪成正方形 -> resize -> 归一化到 [-1, 1]。""" if isinstance(size,bool) or not isinstance(size,int) or size <= 0: raise ValueError("size必须是正整数") with Image.open(path) as source: im = source.convert("RGB") w, h = im.size s = min(w, h) im = im.crop(((w - s) // 2, (h - s) // 2, (w - s) // 2 + s, (h - s) // 2 + s)) im = im.resize((size, size), Image.LANCZOS) a = np.asarray(im, dtype=np.float64) / 127.5 - 1.0 return a def to_blocks(img: np.ndarray, f: int) -> np.ndarray: """[H, W, 3] -> [Nb, 3*f*f],Nb = (H/f)*(W/f)。""" if isinstance(f,bool) or not isinstance(f,int) or f <= 0: raise ValueError("f必须是正整数") if img.ndim != 3 or img.shape[-1] != 3 or not np.isfinite(img).all(): raise ValueError("图像必须是有限值的[H,W,3]张量") h, w, c = img.shape if h <= 0 or w <= 0 or h % f or w % f: raise ValueError("H和W必须是f的正整数倍") x = img.reshape(h // f, f, w // f, f, c) x = x.transpose(0, 2, 4, 1, 3) # [H/f, W/f, c, f, f] return x.reshape(-1, c * f * f) def from_blocks(patches: np.ndarray, h: int, w: int, f: int, c: int = 3) -> np.ndarray: x = patches.reshape(h // f, w // f, c, f, f) x = x.transpose(0, 3, 1, 4, 2) # [H/f, f, W/f, f, c] return x.reshape(h, w, c) def psnr(a: np.ndarray, b: np.ndarray) -> float: """a, b 都在 [-1, 1],峰值是 1,所以满量程平方是 4。""" mse = float(np.mean((a - b) ** 2)) return math.inf if mse == 0 else 10.0 * math.log10(4.0 / mse) # ───────────────────────────────────────────────────────────────────────── # A. 压缩率 vs 重建 vs 能量 # ───────────────────────────────────────────────────────────────────────── def encode_decode(img: np.ndarray, f: int, c_keep: int): """保留能量最大的 c_keep 个系数,返回 (潜特征, 重建图, 能量占比)。""" patches = to_blocks(img, f) h, w, _ = img.shape if isinstance(c_keep,bool) or not isinstance(c_keep,int) or not 1 <= c_keep <= 3*f*f: raise ValueError("c_keep必须在1到3*f*f之间") b = block_basis(f) coef = patches @ b.T # [Nb, 3*f*f] energy = np.mean(coef ** 2, axis=0) # 每个基函数的平均能量 order = np.argsort(energy)[::-1] keep = np.sort(order[:c_keep]) latent = coef[:, keep].reshape(h // f, w // f, c_keep) rec = (coef[:, keep] @ b[keep, :]) rec = from_blocks(rec, h, w, f) total = float(energy.sum()) frac = float(energy[keep].sum() / total) if total else 1.0 return latent, np.clip(rec, -1.0, 1.0), frac def part_a(img: np.ndarray): print("\n[A] 元素比 vs 重建质量(输入样例,逐图自适应DCT子集;非VAE)") print(" %-6s %-5s %-16s %-9s %-9s %-9s" % ("f", "C", "潜特征形状", "压缩率", "PSNR dB", "保留能量")) out = [] for f in (2, 4, 8, 16): for c_keep in (3, 4, 8, 16): if c_keep > 3 * f * f: continue lat, rec, frac = encode_decode(img, f, c_keep) ratio = (3.0 * f * f) / c_keep p = psnr(img, rec) out.append((f, c_keep, ratio, p, frac)) print(" %-6d %-5d %-16s %-9s %-9s %-9s" % (f, c_keep, "%dx%dx%d" % lat.shape, "%.1fx" % ratio, "%.2f" % p, "%.4f%%" % (100 * frac))) return out def sweep_c(img: np.ndarray, f: int = 8): print("\n[A2] 固定 f=%d,扫 C(SD 用的是 C=4)" % f) print(" %-5s %-9s %-9s %-9s" % ("C", "压缩率", "PSNR dB", "保留能量")) rows = [] for c_keep in (1, 2, 3, 4, 6, 8, 12, 16, 24, 32, 48, 64, 96, 128): if c_keep > 3 * f * f: continue _, rec, frac = encode_decode(img, f, c_keep) rows.append((c_keep, (3.0 * f * f) / c_keep, psnr(img, rec), frac)) print(" %-5d %-9s %-9s %-9s" % (c_keep, "%.1fx" % ((3.0 * f * f) / c_keep), "%.2f" % psnr(img, rec), "%.4f%%" % (100 * frac))) return rows # ───────────────────────────────────────────────────────────────────────── # B. 通道方差跨度与 scale factor # ───────────────────────────────────────────────────────────────────────── def cosine_abar(t: np.ndarray, big_t: int = 1000, s: float = 0.008) -> np.ndarray: """连续cosine alpha_bar=f(t)/f(0),非离散beta裁剪后的累乘。""" x = (t / big_t + s) / (1.0 + s) return np.cos(x * math.pi / 2.0) ** 2 / math.cos(s/(1+s)*math.pi/2)**2 def part_b(img: np.ndarray, f: int = 8, c_keep: int = 8): print("\n[B] 潜特征各通道的方差跨度(f=%d, C=%d)" % (f, c_keep)) lat, _, _ = encode_decode(img, f, c_keep) sig = lat.reshape(-1, c_keep).std(axis=0) order = np.argsort(sig)[::-1] print(" 各通道 std(从大到小): " + ", ".join("%.4f" % v for v in sig[order])) print(" 最大 / 最小 = %.2f 倍" % (sig.max() / sig.min())) gstd = float(np.sqrt(np.mean(sig ** 2))) print(" 通道方差均值的平方根 = %.4f,它的倒数(SD 的 scale factor 类比)= %.4f" % (gstd, 1.0 / gstd)) # 未缩放时,epsilon 预测的最优残差 MSE 逐通道 = a*sigma^2 / (a*sigma^2 + 1-a) print("\n [B1] 各通道对训练 loss 的贡献(最优线性-高斯去噪器的残差)") print(" %-10s %-12s %-12s %-12s" % ("alpha_bar", "未缩放 top1 占比", "全局缩放后", "逐通道缩放后")) for abar in (0.9, 0.5, 0.1): raw = abar * sig ** 2 / (abar * sig ** 2 + 1.0 - abar) sg = sig / gstd gsc = abar * sg ** 2 / (abar * sg ** 2 + 1.0 - abar) pc = np.ones_like(sig) psc = abar * pc ** 2 / (abar * pc ** 2 + 1.0 - abar) print(" %-10s %-12s %-12s %-12s" % ("%.2f" % abar, "%.2f%%" % (100 * raw.max() / raw.sum()), "%.2f%%" % (100 * gsc.max() / gsc.sum()), "%.2f%%" % (100 * psc.max() / psc.sum()))) # [B2] scale factor 用错会怎样:等效时间步偏移 print("\n [B2] scale factor 用错 k 倍时,等效时间步偏移多少(cosine 调度,T=1000)") ts = np.arange(1, 1001, dtype=np.float64) ab = cosine_abar(ts) snr = ab / (1.0 - ab) # 单调递减 print(" %-10s %-16s %-16s %-12s" % ("k", "参考 t=500", "等效 t'", "偏移")) rows = [] for k in (0.25, 0.5, 1.0, 2.0, 4.0): # k 倍缩放 -> 潜特征整体方差变 k^2 倍 -> 有效信噪比变 k^2 倍 target = (k ** 2) * snr[499] tp = float(np.interp(-target, -snr, ts)) # -snr 单调递增,可以插值 rows.append((k, tp, tp - 500.0)) print(" %-10s %-16s %-16s %-12s" % ("%.2fx" % k, "500", "%.1f" % tp, "%+.1f 步" % (tp - 500.0))) return sig, gstd, rows # ───────────────────────────────────────────────────────────────────────── # C. 交叉注意力 # ───────────────────────────────────────────────────────────────────────── def softmax(x: np.ndarray, axis=-1) -> np.ndarray: e = np.exp(x - x.max(axis=axis, keepdims=True)) return e / e.sum(axis=axis, keepdims=True) def part_c(rng: np.random.Generator, d: int = 320, side: int = 64, ctx_len: int = 77, n_content: int = 8): print("\n[C] 交叉注意力:形状、秩瓶颈、padding 抢走的质量") n_img = side * side # Q 来自图像 token,K/V 来自文本 token q = rng.standard_normal((n_img, d)) / math.sqrt(d) k_txt = rng.standard_normal((ctx_len, d)) / math.sqrt(d) v_txt = rng.standard_normal((ctx_len, d)) / math.sqrt(d) scale = 1.0 / math.sqrt(d) a = softmax((q @ k_txt.T) * scale, axis=-1) out = a @ v_txt print(" Q [%d, %d] x K^T [%d, %d] -> 注意力 [%d, %d] -> 输出 [%d, %d]" % (q.shape[0], q.shape[1], k_txt.shape[1], k_txt.shape[0], a.shape[0], a.shape[1], out.shape[0], out.shape[1])) print(" 注意力矩阵固定为 %d 列(文本 token 数),行数等于图像token数" % ctx_len) # 秩瓶颈:输出一定落在 v_txt 张成的子空间里 sv = np.linalg.svd(out, compute_uv=False) rank = int(np.sum(sv > sv[0] * 1e-8)) print(" cross-attn 输出的秩 = %d(<= 文本 token 数 %d,图像 token 有 %d 个)" % (rank, ctx_len, n_img)) # 对照:self-attn 的 K/V 也来自图像 token,秩可以撑满 k_img = rng.standard_normal((n_img, d)) / math.sqrt(d) v_img = rng.standard_normal((n_img, d)) / math.sqrt(d) out_self = softmax((q @ k_img.T) * scale, axis=-1) @ v_img sv2 = np.linalg.svd(out_self, compute_uv=False) rank2 = int(np.sum(sv2 > sv2[0] * 1e-8)) print(" 对照:self-attn 输出的秩 = %d(K/V 也来自 %d 个图像 token)" % (rank2, n_img)) print(" 该秩界仅约束本次单头矩阵乘积,不约束多头、残差及整个UNet") # 合成演示:设置69个相同logit位置;不模拟真实CLIP上下文化的padding特征 print("\n [C2] 人工分组logit的概率质量(随机组 %d 个 + 零logit组 %d 个)" % (n_content, ctx_len - n_content)) print(" %-20s %-22s %-22s" % ("内容 token 分数优势", "padding 组质量占比", "内容 token 质量占比")) rows = [] n_pad = ctx_len - n_content n_query = 40000 for delta in (0.0, 1.0, 2.0, 3.0, 5.0, 8.0): # 此处人为设相同 logit,真实 CLIP 特征受位置和上下文影响; # 内容 token 的 logit 建模为 padding 基准 + delta + N(0,1) 的波动 s_c = delta + rng.standard_normal((n_query, n_content)) s_p = np.zeros((n_query, 1)) logits = np.concatenate([s_c, np.repeat(s_p, n_pad, axis=1)], axis=1) w = softmax(logits, axis=-1) pad_share = float(w[:, n_content:].sum(axis=1).mean()) rows.append((delta, pad_share)) print(" %-20s %-22s %-22s" % ("+%.1f" % delta, "%.2f%%" % (100 * pad_share), "%.2f%%" % (100 * (1 - pad_share)))) return rows def main(): ap = argparse.ArgumentParser() ap.add_argument("--image", default=DEFAULT_IMAGE) ap.add_argument("--size", type=int, default=512) args = ap.parse_args() rng = np.random.default_rng(SEED) img = load_image(args.image, args.size) print("=" * 78) print("潜空间扩散实验 图像=%s 裁剪后 %dx%d 像素值域 [-1, 1]" % (os.path.basename(args.image), args.size, args.size)) print("图像本身的标准差 = %.4f" % img.std()) print("=" * 78) part_a(img) sweep_c(img, f=8) part_b(img, f=8, c_keep=8) part_c(rng) # 顺便给一张「整图 DCT 能量谱」的斜率,说明高频有多穷 print("\n[D] 输入样例的块DCT能量集中度(按能量排序,不按频率半径分桶)") b = block_basis(8) patches = to_blocks(img, 8) coef = patches @ b.T energy = np.mean(coef ** 2, axis=0) order = np.argsort(energy)[::-1] tot = energy.sum() for frac in (0.01, 0.02, 0.05, 0.1, 0.25): n = max(1, int(round(frac * energy.size))) print(" 能量最大的 %.0f%% 系数(%d 个)携带 %.4f%% 的总能量" % (100 * frac, n, 100 * energy[order[:n]].sum() / tot)) if __name__ == "__main__": main() ldm_checks.py """Independent checks for the article's algebra and NumPy examples; no weights.""" import hashlib import json from pathlib import Path import numpy as np from latent_lab import (block_basis, cosine_abar, encode_decode, from_blocks, psnr, softmax, to_blocks) from unet_ledger import build_unet, fmt_bytes def main(): rng = np.random.default_rng(20261025) errors = {} for f in (1, 2, 4, 8): b = block_basis(f) errors[f'orthogonal_{f}'] = float(np.max(np.abs(b@b.T-np.eye(len(b))))) x = rng.uniform(-1, 1, (16, 24, 3)) patches = to_blocks(x, f) errors[f'blocks_{f}'] = float(np.max(np.abs(from_blocks(patches,16,24,f)-x))) coef = patches@b.T errors[f'parseval_{f}'] = float(abs(np.sum(coef**2)/np.sum(x**2)-1)) _, rec, energy = encode_decode(x, f, 3*f*f) errors[f'full_reconstruction_{f}'] = float(np.max(np.abs(rec-x))) assert abs(energy-1) < 1e-14 c = max(1, f) keep = np.argsort(np.mean(coef**2,axis=0))[-c:] projected = coef[:,keep]@b[keep] removed = np.delete(coef,keep,axis=1) errors[f'projection_error_{f}'] = float(abs(np.sum((patches-projected)**2)-np.sum(removed**2))/max(1,np.sum(patches**2))) assert max(errors.values()) < 1e-12 _, zero, frac = encode_decode(np.zeros((8,8,3)),8,4) assert frac==1 and np.isinf(psnr(zero,zero)) rejected=0 for x,f,c in [(np.zeros((8,8,3)),0,4),(np.zeros((9,8,3)),8,4), (np.zeros((8,8,1)),8,4),(np.full((8,8,3),np.nan),8,4), (np.zeros((8,8,3)),8,0),(np.zeros((8,8,3)),8,193)]: try: encode_decode(x,f,c) except ValueError: rejected+=1 assert rejected==6 assert cosine_abar(np.array([0.]))[0]==1 ts=np.arange(1,1001,dtype=float);a=cosine_abar(ts);snr=a/(1-a) shifts=[] for k in (.25,.5,1.,2.,4.): target=k*k*snr[499];tp=float(np.interp(-target,-snr,ts)) f0=np.cos(.008/1.008*np.pi/2)**2 exact=1000*(1.008*2/np.pi*np.arccos(np.sqrt(target/(1+target)*f0))-.008) assert abs(tp-exact)<.01 shifts.append(dict(k=k,t=tp,shift=tp-500,continuous_t=float(exact))) # Conditional Gaussian epsilon mean derived from covariance, then Monte Carlo. gaussian=[] for a,sigma,mu in [(.1,.5,2.),(.5,2.,-1.),(.9,8.,.3)]: n=400000;z=mu+sigma*rng.standard_normal(n);eps=rng.standard_normal(n) y=np.sqrt(a)*z+np.sqrt(1-a)*eps var=a*sigma*sigma+1-a pred=np.sqrt(1-a)/var*(y-np.sqrt(a)*mu) residual=(eps-pred)**2;theory=a*sigma*sigma/var se=float(residual.std(ddof=1)/np.sqrt(n)) assert abs(residual.mean()-theory)<6*se gaussian.append(dict(alpha=a,sigma=sigma,expected=theory,observed=float(residual.mean()),standard_error=se)) # Direct row-wise computation, equivariance and a multihead/residual counterexample. q=rng.normal(size=(16,8));k=rng.normal(size=(7,8));v=rng.normal(size=(7,8)) out=softmax(q@k.T/np.sqrt(8))@v direct=np.empty_like(out) for i,row in enumerate(q): scores=np.exp(k@row/np.sqrt(8)-np.max(k@row/np.sqrt(8))) direct[i]=np.sum(scores[:,None]*v,axis=0)/sum(scores) errors['attention_rows']=float(np.max(np.abs(direct-out))) perm=rng.permutation(7) errors['text_permutation']=float(np.max(np.abs(softmax(q@k[perm].T/np.sqrt(8))@v[perm]-out))) assert max(errors.values())<1e-12 and np.linalg.matrix_rank(out)<=7 head1=np.array([[1.,0],[0,1],[1,0],[0,1]]) head2=np.array([[1.,0],[1,0],[0,1],[0,1]]) concatenated=np.concatenate([head1,head2],axis=1) assert np.linalg.matrix_rank(concatenated)==3>2 assert np.linalg.matrix_rank(head1@np.ones((2,4))+np.eye(4))==4 equal_mass=float(softmax(np.zeros(77))[8:].sum()) assert abs(equal_mass-69/77)<1e-14 lat=build_unet(64,64,4,4);pix=build_unet(512,512,3,3) deep=build_unet(512,512,3,3,down_attn=(3,),up_attn=(3,)) assert fmt_bytes(2**40)=='1.00 TiB' and fmt_bytes(2**28)=='256.00 MiB' ledger=dict(parameters=int(lat.params),latent_mac=lat.macs,pixel_mac=pix.macs,deep_mac=deep.macs, same_topology_ratio=pix.macs/lat.macs,deep_ratio=deep.macs/lat.macs, conv_ratio=pix.kinds['conv']/lat.kinds['conv'],latent_cumulative_bytes=lat.act, deep_cumulative_bytes=deep.act,parts={k:v/lat.macs for k,v in lat.kinds.items()}) for dims in [(0,0,4,4),(7,7,4,4),(8,8,0,4)]: try: build_unet(*dims) except ValueError: continue raise AssertionError(dims) result=dict(passed=True,errors=[],warnings=[],max_errors=errors,invalid_images_rejected=rejected, gaussian=gaussian,scale_shifts=shifts,equal_logit_group_mass=equal_mass, multihead_rank=int(np.linalg.matrix_rank(concatenated)),ledger=ledger, source_hashes={p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in Path(__file__).parent.glob('*.py')}) dest=Path(__file__).with_name('validation_results.json') dest.write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8') print(json.dumps(result,ensure_ascii=False,indent=2)) if __name__=='__main__': main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """画四张配图,数据源全部来自 unet_ledger.py / latent_lab.py 的真实输出。 改了那两个脚本之后必须重跑本脚本,否则图上的数字会和正文对不上。 用法: python make_figures.py """ from __future__ import annotations import math import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image from latent_lab import (block_basis, cosine_abar, encode_decode, load_image, psnr, softmax, to_blocks, DEFAULT_IMAGE) from unet_ledger import build_unet, fmt_bytes HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["font.size"] = 10.5 C_MAIN = "#2E5C8A" C_GREEN = "#2E8B57" C_RED = "#C0392B" C_PURPLE = "#7B4B94" C_GRAY = "#8A8A8A" C_ALT = "#D68910" def _save(fig, name): os.makedirs(FIGDIR, exist_ok=True) p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=130, bbox_inches="tight", facecolor="white") plt.close(fig) print(" %s" % name) # ───────────────────────────────────────────────────────────────────────── # 图 1:算力 / 显存账本 # ───────────────────────────────────────────────────────────────────────── def fig_ledger(): sides = [256, 384, 512, 768, 1024, 2048] lat = [build_unet(s // 8, s // 8, 4, 4, name="l%d" % s) for s in sides] pix = [build_unet(s, s, 3, 3, name="p%d" % s) for s in sides] pixd = [build_unet(s, s, 3, 3, name="d%d" % s, down_attn=(3,), up_attn=(3,)) for s in sides] fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) MAC 随分辨率的缩放(log-log) ax = axes[0] ax.plot(sides, [p.macs for p in pix], "o-", color=C_RED, lw=2.2, ms=6, label=r"像素空间 UNet(attention 位置同 SD)") ax.plot(sides, [p.macs for p in pixd], "s--", color=C_ALT, lw=2.0, ms=6, label=r"像素空间 UNet(attention 只放最深层)") ax.plot(sides, [l.macs for l in lat], "^-", color=C_MAIN, lw=2.2, ms=6, label=r"潜空间 UNet($f$=8)") ax.set_yscale("log") ax.set_xscale("log") ax.set_xticks(sides) ax.set_xticklabels([str(s) for s in sides]) ax.xaxis.set_minor_formatter(plt.NullFormatter()) ax.set_xlabel("输出图像边长(像素)") ax.set_ylabel(r"单步前向的乘加次数(MAC)") def _slope(vals): lx = [math.log(s) for s in sides] ly = [math.log(v) for v in vals] n = len(lx) mx, my = sum(lx) / n, sum(ly) / n return (sum((a - mx) * (b - my) for a, b in zip(lx, ly)) / sum((a - mx) ** 2 for a in lx)) ax.set_title("(a) 算力:缩放指数从 %.1f 压到 %.1f" % (_slope([p.macs for p in pix]), _slope([l.macs for l in lat])), fontsize=11.5) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) # 标注 512 处的比值 i = sides.index(512) ax.annotate(r"512 px 处相差 %.0f 倍" % (pix[i].macs / lat[i].macs), xy=(512, pix[i].macs), xytext=(650, 3e14), fontsize=9, color=C_RED, arrowprops=dict(arrowstyle="->", color=C_RED, lw=1.2)) # (b) 激活显存账本的构成 ax = axes[1] labels = ["潜空间 64x64x4", "像素空间 512x512x3\n(attention 放最深层)", "像素空间 512x512x3\n(attention 位置同 SD)"] attn = [lat[i].attn_matrix, pixd[i].attn_matrix, pix[i].attn_matrix] rest = [lat[i].act - lat[i].attn_matrix, pixd[i].act - pixd[i].attn_matrix, pix[i].act - pix[i].attn_matrix] x = np.arange(3) ax.bar(x, attn, 0.55, color=C_RED, label=r"注意力矩阵(softmax 那张表)") ax.bar(x, rest, 0.55, bottom=attn, color=C_MAIN, label=r"其余层间激活") ax.set_yscale("log") ax.set_ylim(1e8, 2e14) ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9) ax.set_ylabel(r"朴素张量逐层累计(非实测峰值)(字节,$\log$ 刻度)") ax.set_title("(b) 静态累计:融合注意力会改变矩阵项", fontsize=11.5) for xi, a, r in zip(x, attn, rest): ax.text(xi, a + r, " %s" % fmt_bytes(a + r), ha="center", va="bottom", fontsize=9) ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") fig.tight_layout() _save(fig, "fig_ledger.png") print(" 潜/像 MAC 比 %.1f;卷积部分比 %.1f" % (pix[i].macs / lat[i].macs, pix[i].kinds["conv"] / lat[i].kinds["conv"])) # ───────────────────────────────────────────────────────────────────────── # 图 2:压缩率的帕累托前沿 + 能量集中度 # ───────────────────────────────────────────────────────────────────────── def fig_compression(): img = load_image(DEFAULT_IMAGE, 512) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 压缩率 vs PSNR ax = axes[0] for f, col, mk in ((2, C_GREEN, "o"), (4, C_MAIN, "s"), (8, C_RED, "^"), (16, C_PURPLE, "D")): cs = [c for c in (3, 4, 8, 16, 32, 64) if c <= 3 * f * f] rs, ps = [], [] for c in cs: _, rec, _ = encode_decode(img, f, c) rs.append(3.0 * f * f / c) ps.append(psnr(img, rec)) ax.plot(rs, ps, "-%s" % mk, color=col, lw=2.0, ms=5, label=r"$f$=%d" % f) _, rec4, frac4 = encode_decode(img, 8, 4) ax.plot([48.0], [psnr(img, rec4)], "*", color=C_ALT, ms=20, markeredgecolor="black", markeredgewidth=0.8, label=r"DCT 替身的尺寸:$f$=8, $C$=4") ax.set_xscale("log") ax.set_xlabel(r"张量元素数比 $= 3 f^2 / C$(对数刻度)") ax.set_ylabel(r"重建 PSNR(dB,值域 $[-1,1]$)") ax.set_title("(a) 单图 DCT 压缩实验", fontsize=11.5) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax.annotate(r"元素数比48,本样例重建 %.2f dB" % psnr(img, rec4), xy=(48.0, psnr(img, rec4)), xytext=(12, 34), fontsize=9, color=C_ALT, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) # (b) 能量集中度 ax = axes[1] b = block_basis(8) coef = to_blocks(img, 8) @ b.T energy = np.mean(coef ** 2, axis=0) order = np.argsort(energy)[::-1] tot = energy.sum() ks = np.arange(1, energy.size + 1) cum = np.cumsum(energy[order]) / tot ax.plot(100.0 * ks / energy.size, 100.0 * cum, "-", color=C_MAIN, lw=2.4) ax.axvline(100.0 * 4 / 192, color=C_RED, ls="--", lw=1.6) ax.axhline(100 * cum[3], color=C_GRAY, ls=":", lw=1.2) ax.plot([100.0 * 4 / 192], [100 * cum[3]], "o", color=C_RED, ms=8) ax.annotate(r"保留 %.2f%% 的系数" % (100.0 * 4 / 192) + "\n" + r"拿回 %.2f%% 的能量" % (100 * cum[3]), xy=(100.0 * 4 / 192, 100 * cum[3]), xytext=(14, 88), fontsize=9.5, color=C_RED, arrowprops=dict(arrowstyle="->", color=C_RED, lw=1.2)) ax.set_xlabel(r"保留的系数比例(按能量从大到小,%)") ax.set_ylabel(r"累计能量占比(%)") ax.set_title("(b) 样例图在该基底下的能量集中度", fontsize=11.5) ax.grid(alpha=0.25) ax.set_ylim(80, 100.2) fig.tight_layout() _save(fig, "fig_compression.png") print(" f=8,C=4: PSNR %.2f dB,保留能量 %.4f%%" % (psnr(img, rec4), 100 * frac4)) # ───────────────────────────────────────────────────────────────────────── # 图 3:通道方差跨度与 loss 份额 # ───────────────────────────────────────────────────────────────────────── def fig_latent_scale(): img = load_image(DEFAULT_IMAGE, 512) lat, _, _ = encode_decode(img, 8, 8) sig = lat.reshape(-1, 8).std(axis=0) order = np.argsort(sig)[::-1] sig = sig[order] gstd = float(np.sqrt(np.mean(sig ** 2))) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 各通道 std ax = axes[0] x = np.arange(8) ax.bar(x, sig, 0.6, color=C_MAIN) ax.axhline(gstd, color=C_ALT, ls="--", lw=1.8, label=r"通道方差 RMS 尺度 $=%.4f$,其倒数 $=%.4f$" % (gstd, 1.0 / gstd)) ax.set_yscale("log") ax.set_xticks(x) ax.set_xticklabels([r"通道 %d" % (i + 1) for i in range(8)], fontsize=9) ax.set_ylabel(r"该通道在整张图上取值的标准差($\log$ 刻度)") ax.set_title("(a) DCT通道标准差跨度 %.1f 倍" % (sig.max() / sig.min()), fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") # (b) loss 份额 ax = axes[1] for abar, col, mk in ((0.9, C_GREEN, "o"), (0.5, C_MAIN, "s"), (0.1, C_RED, "^")): raw = abar * sig ** 2 / (abar * sig ** 2 + 1.0 - abar) share = 100.0 * raw / raw.sum() ax.plot(x, share, "-%s" % mk, color=col, lw=2.0, ms=5, label=r"$\bar\alpha_t=%.2f$" % abar) ax.axhline(12.5, color=C_GRAY, ls="--", lw=1.5, label=r"逐通道缩放后(均摊 $=100/8$)") ax.set_xticks(x) ax.set_xticklabels([r"通道 %d" % (i + 1) for i in range(8)], fontsize=9) ax.set_xlabel("潜特征通道(按 std 从大到小排)") ax.set_ylabel(r"高斯替身的最优残差份额(%)") ax.set_title("(b) 仅用实测方差构造独立高斯替身", fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25) fig.tight_layout() _save(fig, "fig_latent_scale.png") # 顺带画出 scale factor 用错的时间步偏移 ts = np.arange(1, 1001, dtype=np.float64) snr = cosine_abar(ts) / (1.0 - cosine_abar(ts)) ks = np.array([0.25, 0.5, 1.0, 2.0, 4.0]) tps = [] for k in ks: tps.append(float(np.interp(-(k ** 2) * snr[499], -snr, ts))) tps = np.array(tps) fig2, ax2 = plt.subplots(figsize=(6.6, 4.2)) ax2.plot(ks, tps, "o-", color=C_PURPLE, lw=2.2, ms=7) for k, t in zip(ks, tps): ax2.annotate(r"$t^\prime$=%.0f" % t, (k, t), textcoords="offset points", xytext=(8, -4), fontsize=9) ax2.axhline(500, color=C_GRAY, ls=":", lw=1.2) ax2.axvline(1.0, color=C_GRAY, ls=":", lw=1.2) ax2.set_xscale("log") ax2.set_xticks(list(ks)) ax2.set_xticklabels([r"%.2f$\times$" % k for k in ks]) ax2.set_xlabel(r"scale factor 用错的倍数 $k$") ax2.set_ylabel(r"等效时间步 $t^\prime$(参考 $t=500$)") ax2.set_title(r"scale factor 错 $k$ 倍,改变参考时刻的等效 SNR", fontsize=11.5) ax2.grid(alpha=0.25) fig2.tight_layout() _save(fig2, "fig_scale_shift.png") # ───────────────────────────────────────────────────────────────────────── # 图 4:交叉注意力 # ───────────────────────────────────────────────────────────────────────── def fig_cross_attn(): sides = [32, 48, 64, 96, 128, 192, 256] cross, selfa, conv = [], [], [] for s in sides: L = build_unet(s, s, 4, 4, name="c%d" % s) cross.append(100.0 * L.kinds["cross_attn"] / L.macs) selfa.append(100.0 * L.kinds["self_attn"] / L.macs) conv.append(100.0 * L.kinds["conv"] / L.macs) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 三种算子的占比随分辨率变化 ax = axes[0] ax.plot(sides, cross, "o-", color=C_GREEN, lw=2.2, ms=6, label=r"cross-attn($O(N \cdot T \cdot d)$)") ax.plot(sides, selfa, "s-", color=C_RED, lw=2.2, ms=6, label=r"self-attn($O(N^2 \cdot d)$)") ax.plot(sides, conv, "^-", color=C_MAIN, lw=2.0, ms=6, label=r"卷积($O(N \cdot k^2 c^2)$)") ax.set_xlabel(r"潜特征边长($N=$ 边长的平方个 token)") ax.set_ylabel(r"占单步 MAC 的比例(%)") ax.set_title("(a) 交叉注意力的份额随分辨率反而下降", fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25) ax.annotate(r"64x64 时只占 %.2f%%" % cross[2], xy=(64, cross[2]), xytext=(75, 8), fontsize=9.5, color=C_GREEN, arrowprops=dict(arrowstyle="->", color=C_GREEN, lw=1.2)) # (b) padding 抢走的注意力质量 ax = axes[1] rng = np.random.default_rng(20260929) n_content, n_pad, n_query = 8, 69, 40000 deltas = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 5.0, 6.0, 8.0]) shares = [] for d in deltas: s_c = d + rng.standard_normal((n_query, n_content)) s_p = np.zeros((n_query, 1)) logits = np.concatenate([s_c, np.repeat(s_p, n_pad, axis=1)], axis=1) w = softmax(logits, axis=-1) shares.append(100.0 * float(w[:, n_content:].sum(axis=1).mean())) shares = np.array(shares) ax.plot(deltas, shares, "o-", color=C_PURPLE, lw=2.4, ms=6) ax.axhline(50, color=C_GRAY, ls=":", lw=1.2) i5 = int(np.argmin(np.abs(deltas - 5.0))) ax.plot([deltas[i5]], [shares[i5]], "*", color=C_ALT, ms=18, markeredgecolor="black", markeredgewidth=0.8) ax.annotate(r"设 $\Delta=%.1f$ 时零logit组约占 %.1f%%" % (deltas[i5], shares[i5]), xy=(deltas[i5], shares[i5]), xytext=(0.6, 70), fontsize=9.5, color=C_ALT, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax.set_xlabel(r"另8个随机logit的分布均值 $\Delta$(标准差1)") ax.set_ylabel(r"69个零logit位置分到的概率质量(%)") ax.set_title(r"(b) 人工分组logit实验,非CLIP测量", fontsize=11.5) ax.grid(alpha=0.25) ax.set_ylim(-2, 102) fig.tight_layout() _save(fig, "fig_cross_attn.png") print(" cross-attn 占比:64x64 %.2f%% -> 256x256 %.2f%%" % (cross[2], cross[-1])) def main(): print("画配图(数据源:unet_ledger.py / latent_lab.py 的真实输出)") fig_ledger() fig_compression() fig_latent_scale() fig_cross_attn() print("输出目录:%s" % os.path.abspath(FIGDIR)) if __name__ == "__main__": main()
-
AIGC 每日速读|2026-09-29|阿里双Agent语音涨10.4分,Qwen-Audio 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 图像生成与编辑 3 篇 · 语音与动作生成 2 篇 · 数据集与评测 1 篇 重点论文标题列表 Qwen-Audio-Agent(阿里巴巴 Token Foundry):双Agent并行,座舱91.04% DyMD(北航):14B 压成 1.3B 四步 HetA-DiT(高通 AI 研究院):两成 token 走全注意力 Routed Forcing(清华大学):动力学+45%,嘴部不动 RWTD(字节跳动 Seed):一步模型 GenEval 0.80 今日论文速览 1. Qwen-Audio-Agent:双Agent并行,座舱91.04% Qwen-Audio-Agent Technical Report | 阿里巴巴 Token Foundry | arXiv:2609.25195 关键词:全双工语音, 智能体架构, 任务委派, 语音助手, 异步执行 前序问题:全双工语音助手要一边聊天一边干活,但一段对话里既混着「马上能答」的即时操作,也混着「要跑好几步」的长任务。现有做法要么让前台模型自己把工具全调完(长任务把对话卡死),要么整段委托给后台(用户干等,中途插一句还会把任务一起取消)。语音打断与任务取消、执行完成与结果回传被绑成一根绳,是这套系统要解决的核心矛盾。 本文贡献:提出前后台双 Agent 架构:Frontend Agent 只负责对话,并判断这一步是直接调工具还是委派出去;Backend Agent 在独立上下文里跑被委派的任务;Orchestration Runtime 负责维护任务状态、协调向用户要授权,并把结果排回对话。关键设计是把「语音打断」和「任务取消」解耦,把「执行完成」和「结果投递」解耦,所以后台在跑的时候对话还能继续往下聊。独立适配器让前台模型、后台 Agent、客户端可以分别替换,已在桌面助手、智能座舱、语音客服三类场景落地。 Foreground-background architecture of Qwen-Audio-Agent. 实验效果:内部座舱基准 134 个用例上,混合执行的任务成功率 91.04%,直接执行 72.39%、全部委派 80.60%。另在「三种配置都成功」的同一批轮次上做延迟评测,混合执行的平均任务执行延迟比这两个基线分别低 26.73% 和 30.91%。 Illustrative timeline of a delegated task. 批判点评:两个数字其实来自两个不同的评测集合:成功率是 134 个座舱用例,延迟只统计三种配置都跑成功的轮次——也就是说最难的那批(只有混合执行成功、基线直接失败)根本没进延迟统计,26.73% 的降幅是在对自己有利的子集上算出来的。另外 91.04% 比的是同一套系统的两种退化配置,没有跟任何外部语音智能体对照,报告也没给后台任务的绝对耗时。 2. DyMD:14B 压成 1.3B 四步 DyMD: Preserving Interaction Dynamics through Distribution Matching Distillation in Few-Step Video World Models | 北京航空航天大学;京东未来学院 | arXiv:2609.31349 关键词:视频世界模型, 分布匹配蒸馏, 少步生成, 具身智能, 交互动力学 前序问题:大视频扩散模型是很强的具身预测先验,但多步采样对交互式下游太贵。DMD 能把采样压到几步,代价却是机器人与物体之间的交互运动被抹掉:画面看着没问题,机械臂却基本不动,生成出来的世界对规划毫无用处。 本文贡献:从 teacher 信号和 fake-score 信号两头定位问题:弱重加噪让 teacher 后验一直集中在「没动作」的 rollout 附近,而动作更强的 rollout 又带来更大的 fake-score 拟合误差,反过来拖住生成器学动力学。DyMD 给两个自适应机制——temporal affinity 条件下的重加噪采样,按每条 rollout 当前交互保真度混合基础时间步表与 teacher 先验;dynamics-guided fake-score tracking,用噪声条件预测器估计每条 rollout 的拟合难度并上调其 critic 权重。14B teacher 蒸成 4 步 1.3B 学生,推理时不加任何辅助模块。 Overview of DyMD. 实验效果:具身视频基准上,相对 Base DMD 把 R-Bench 任务遵循度提 9.6 个百分点、PAI-Bench-G 的 Domain 分提 5.1 分,视觉质量基本持平。作为下游动作规划骨干,在两个 WorldArena 任务上平均成功率 34%,Base DMD 为 16%。 Visual comparison of interaction dynamics between Base DMD and DyMD at four NFE. 批判点评:34% 对 16% 看着翻倍,但绝对值仍只有三分之一,而且只在两个任务上测;全文反复验证的其实是主表那两个更朴素的数(9.6 / 5.1)。另外整套收益建立在「先用 V-JEPA 类特征算 temporal affinity」之上,这个额外前向的开销并没有计进推理成本。 3. HetA-DiT:两成 token 走全注意力 Where Compute Matters: Heterogeneous Attention for Efficient Video Diffusion | 高通 AI 研究院;波恩大学 | arXiv:2609.31050 关键词:视频扩散, 稀疏注意力, 推理加速, token 路由, DMD 前序问题:视频扩散的自注意力在长时空 token 序列上是二次开销。现有高效注意力基本对所有 token 一视同仁,但去噪难度在不同视频区域、不同时间步上差异极大,均匀省算力必然在最难的地方翻车。 本文贡献:提出 HetA-DiT:一个轻量不确定度分支预测每个 token 的去噪难度,据此把不确定的 token 送进稠密全局注意力、把更可信的 token 交给便宜的局部注意力。路由同时随内容和时间步自适应,并保留全局上下文,还留了一个参数控制质量-效率权衡。关键工程点是推理时不新增 Transformer 前向——不确定度估计直接复用上一个去噪步的结果,也因此能和少步 DMD 蒸馏兼容。 HetA-DiT. Heterogeneous self-attention computation assigned to tokens with different denoising complexities. 实验效果:在 DMD 蒸馏后的 Wan2.2-5B 与 Wan2.1-1.3B 上评测,VBench、VBench-2.0 和人工偏好上质量与基线可比,但只有约 20% 的 token 走稠密注意力。 Qualitative comparison of HetA-DiT to baseline DMD. 批判点评:摘要只说「维持可比质量」,没给 VBench 总分的具体差值;而「约 20% 走稠密」是路由比例、不是端到端加速比,局部注意力在真实硬件上能兑现多少要看实现,论文里也没有 wall-clock 延迟表。此外不确定度复用上一步估计,意味着第一个去噪步的路由其实是盲的。 4. Routed Forcing:动力学+45%,嘴部不动 Where and When to Force: Routed Forcing for Streaming Avatars | 清华大学;京东未来学院;东南大学 | arXiv:2609.30963 关键词:流式数字人, 蒸馏, DMD, 多样性塌缩, 区域路由 前序问题:Self Forcing 用 DMD 把双向视频扩散模型蒸成因果、少步的流式生成器,但 DMD 最小化的是 reverse KL,本质是 mode-seeking:学生会丢掉高动态模态、塌到静止输出上,把生成视频的动态和多样性一起压扁。 本文贡献:先把这种塌缩量化成一张区域异质图:人物区域(姿态、手势)多样性损失最大,音频驱动的嘴部损失很小,背景几乎不变。据此提出两维路由——Where:人物区域改用 Data-Forcing Distillation(拿真实视频当监督),嘴部与背景保留 DMD 以保口型和场景稳定;When:高噪声阶段开 DFD 注入真实动态,低噪声阶段切回 DMD 修细节,避免真实视频与学生 rollout 的空间差异带来模糊与伪影。 Routed Forcing routes distillation by semantic region and noise stage. 实验效果:相对 Self Forcing,动态最高提升 45%,多样性提升 7–25%,视频质量与口型同步基本保持。 Qualitative comparison of different training strategies. 批判点评:45% 是「最高」值,7–25% 的多样性区间跨了不同指标,主表里并不是每项都赢。更重要的是整套方法依赖先用分割模型对学生 rollout 抽人物 mask、用面部关键点抽嘴部 mask,这些前处理在流式实时场景里的开销没有被计入收益。 5. RWTD:一步模型 GenEval 0.80 Aligning One-Step Generative Models with Reward-Weighted Transport Distillation | 字节跳动 Seed;加州大学伯克利分校 | arXiv:2609.30840 关键词:一步生成, 奖励对齐, 最优传输, 蒸馏, 后训练 前序问题:一步生成器推理便宜,但后训练极难:通用隐式生成器既没有可算的似然,也没有去噪轨迹可借,而 GenEval、HPSv2 这类奖励往往根本不可导,梯度类方法又容易把图改得过度风格化。 本文贡献:提出 Reward-Weighted Transport Distillation,只要采样和标量奖励分数。它没有直接对齐常规的 reward-tilted 参考分布,而是构造自适应目标:把「当前分布」与「参考分布」分别倾斜后再混合——当前项吸收训练中已发现的改进,参考项把目标锚回预训练生成器。实现上用特征空间最优传输加不动点回归完成对齐。理论分析表明其不动点分布在 off-policy 倾斜参考与 on-policy 倾斜当前模型之间插值,给出了「适应奖励」与「保留先验」的权衡解释。 SANA Sprint 1.6B comparisons. RWTD improves alignment on difficult position prompts. 实验效果:把一步模型 SANA Sprint 1.6B 的 GenEval 从 0.73 提到 0.80;单独的偏好对齐实验显示跨奖励泛化良好,HPSv2 后训练在涨分的同时基本保住了组合能力与真实感。 Effect of mixed reward tilting on GenEval and held-out PickScore / diversity. 批判点评:0.73→0.80 是 GenEval 单项,摘要没说明其他指标是否同步变好。论文自己指出梯度类基线 FAV、DRaFT 在 HPSv2 上出现明显风格化、属于奖励过优化,而 RWTD 只是「大体保留真实感」——这说明 RWTD 同样在往奖励方向偏,只是偏得慢。另外最优传输做在特征空间,编码器选谁会直接影响结论。 6. SAP-DMD:两步采样救回高频细节 Spectral Amplitude Purification in Distribution Matching for Diffusion Distillation | 浙江大学;加州大学伯克利分校 | arXiv:2609.29116 关键词:扩散蒸馏, DMD, 频域分析, 一步生成, 细节恢复 前序问题:DMD 能让扩散模型几步出图,但优化动态长期被低频信号主导:方向误差的幅度谱高度集中在低频,弱的中高频信号被压住,细结构和纹理迟迟回不来。 本文贡献:提出 SAP-DMD,一个即插即用模块:自适应地调制 DMD 方向场的幅度谱,压掉幅度谱的支配性长尾,削弱低频主导,让中高频结构更快恢复。改动只在方向场上做,不替换骨干、不加参数。 2-step performance evolution during training on SD3.5 Medium. 实验效果:在 PixArt-α、SD3、SD3.5 上,2 步与 4 步采样下都更快收敛、生成质量更好。 Qualitative comparison of 4-step (top) and 2-step (bottom) generation. 批判点评:摘要通篇是定性表述——「更快收敛」「质量更好」,没有给任何一个具体数字,FID/CLIP 的实际对比全在正文表里。所谓「即插即用」也只在这三个文生图模型上验过,视频与编辑类任务没测。另外压低频本身是经验操作,压到什么程度靠阈值超参,论文没有给出选参依据。 7. FuseReg:换解码器 gFID 降 27% FuseReg: Regularizing Layer Fusion Mitigates the Reconstruction-Generation Gap in Representation Autoencoders | 布朗大学;南加州大学;莱斯大学;阿伯丁大学;圣母大学;马里兰大学;宾夕法尼亚大学 | arXiv:2609.31620 关键词:表征自编码器, 层融合, 正则化, 图像生成, 重建生成鸿沟 前序问题:表征自编码器(RAE)直接把预训练视觉编码器的特征当重建与扩散潜变量用。但要选哪些编码器层组成这个共享潜空间是个两难:浅层保像素细节更好,深层生成指标更好。固定启发式的层融合把两个本该分开优化的目标硬绑在了一起。 本文贡献:提出 FuseReg:不挑层,改为在随机采样的编码器层子集上训练。理论分析给出机制解释——子集采样显式惩罚了对跨层不一致的敏感性。结果是同一个解码器可以不重训地同时处理完整、稀疏、单层三种融合方式。 Cosine-similarity maps of decoder intermediate-block features under different layer fusions. 实验效果:ImageNet-256 + DINOv3-L 上,单个 FuseReg 解码器在三种融合下的 PSNR 都高于为固定融合专门训的解码器;只换解码器、生成器完全不动,RAEv2 DiT-XL 的无引导 gFID 降 27%;生成与扩散两阶段一起正则化,DiT-Base 的 gFID 降 29%。 One FuseReg decoder supports both sparse and single-layer fusions. 批判点评:27% 和 29% 都是相对自身基线的相对降幅,不是 gFID 绝对值,也没跟非 RAE 路线(如 SD-VAE)的潜空间横向比。另外随机子集训练要求训练时多跑几种融合,成本靠「一次训练多处可用」摊平——这个账只在论文自己的设定下成立。 8. Timo:40K 动作片段六维评测 Timo: $\textbf{T}$aming Mult$\textbf{i}$modal Diffusion Transformer for Human $\textbf{Mo}$tion Generation | 逐际动力 | arXiv:2609.30761 关键词:人体动作生成, MMDiT, flow matching, 运动学监督, 评测基准 前序问题:现有人体动作生成大多用 cross-attention 注入文本语义,忽略了动作与文本 token 之间的双向建模。直接把视觉生成里好用的 MMDiT 搬过来也不行:关节运动时间上连贯、跨关节相关性却很弱,MMDiT 配 flow matching 直接上会产出不协调、抖动严重的动作。 本文贡献:提出 kinematics-aware 的 MMDiT 框架 Timo:用全共享的多模态注意力做文本-动作双向建模,配合 flow matching、几何与旋转运动学监督(直接比较真实旋转及其随时间的变化),以及从「广泛动作学习」到「细节字幕对齐」的两阶段课程。同时构建了 6 个公开数据集、40,025 条留出片段的基准,在同一评测器与评分协议下测六个互补维度。 Kinematics-aware multimodal generation with a shared 24-block stack. 实验效果:定量与定性均明显超过现有方法,在六个维度中的五个上超过 Kimodo,基准平均分相对提升 40.8%。并在 LimX Luna、LimX Oli 两台实体人形机器人上完成重定向与跟踪执行。 Qualitative comparison across models and prompts. 批判点评:40.8% 是「基准平均分」的相对提升,而这个基准的作者就是本论文自己:六个维度、统一评测器都是他们定的,被比较的四个系统是「重新评测而非引用原文数字」,训练数据与表示各不相同,文中也承认自家数据含内部采集。机器人演示只做到重定向跟踪,没有闭环控制指标。 9. HyperErase:超网络一次前向出 LoRA HyperErase: Scale-Calibrated Hypernetwork for Multi-Concept Erasure in Text-to-Image Models | 哈尔滨工业大学(深圳);清华大学深圳国际研究生院;吉林大学;鹏城实验室;华南理工大学 | arXiv:2609.31154 关键词:概念擦除, 超网络, LoRA, 文生图, 模型安全 前序问题:概念擦除的主流做法是静态权重:训一个冻结的 adapter,遇到不同 prompt 变体就不好使,多概念叠加时还会发生参数互相干扰。 本文贡献:把概念擦除重构成「prompt 条件的参数摊销」:训一个超网络,把文本描述直接映射为该 prompt 专属的 LoRA 更新,不需要逐 prompt 做梯度优化,也免去手工合并 LoRA。为了让合成出的 adapter 稳且准,又提出 decoupled rectification——把 LoRA token 拆成 pattern 与 scale 两个子空间,对 scale 用平方根变换抑制乘性过缩放,并在推理时用教师给出的规范先验做校正。 Overview of HyperErase: hypernetwork-driven prompt-conditioned parameter synthesis. 实验效果:在主要概念类别上,擦除有效性、图像质量、语义对齐三者的权衡全面改善,性能接近「金标准」的单概念基线;一次前向就能为每个 prompt 变体产出专属 LoRA,推理期无需梯度更新。 Visual results of artist style erasure. 批判点评:摘要里「接近金标准单概念基线」是自我定位,实际是在 I2P / NudeNet 这类检测指标上逼近,而 FID、CLIP 的对比分散在不同概念类别的表里,没有一张表把三个维度同时摆在一起。另外超网络本身要先跑完 gold baseline 的擦除流程、收集 checkpoint-prompt 对,这个前置成本并没有被算进「免优化」的收益里。 10. TrafficImag:31K 样本的反事实路口 TrafficImag: A Benchmark for Counterfactual Roadside Traffic Video Generation | 德克萨斯大学奥斯汀分校;杜克大学 | arXiv:2609.30722 关键词:反事实生成, 路侧交通, 视频生成, 评测基准, 世界模型 前序问题:现成路侧交通数据集支持感知、预测和视觉问答,但不评「反事实视频生成」:改掉某一个交通参与者的行为之后,生成的未来既要符合道路拓扑,又不能扰动其余交通参与者。 本文贡献:TrafficImag 把大规模路侧数据(9,022 张标注图、7,043 段去重视频、31,145 条以参与者为中心的历史-未来样本)和一套可执行协议绑在一起,覆盖行为推理、干预感知的图像编辑、条件视频生成三类任务。每次干预都用「参与者级程序」来描述:目标参与者、意图行为、合法路线、交互顺序、时间约束,从而给异构基础模型提供统一评测接口。评测四个互补的有效性维度,端到端反事实只有四项全过才算成功。 Overview of the TrafficImag benchmark. 实验效果:在多个 SOTA 基础模型上,最强推理器的 macro F1 为 80.4%;完整条件接口把最好生成器的端到端成功率从 23.3% 拉到 55.0%。Oracle 研究显示条件视频执行仍是剩余的主要瓶颈。 Matched 8-second rollouts for a programmed left-turn counterfactual. 批判点评:55.0% 已经是最好的数,意味着接口给全后仍有近一半反事实做不成;而 20 个场景 × 3 次重复对百分比类指标来说置信区间很宽。论文自己也承认瓶颈在视频执行,也就是说这个基准当下更多是在给生成器记分,还没真正定位到路侧场景的语义难题。 趋势观察 少步蒸馏开始为「丢掉的东西」买单 今天十篇里有四篇在修蒸馏的副作用:DyMD 修的是机器人不再和物体交互,Routed Forcing 修的是数字人塌成静态,SAP-DMD 修的是低频把高频细节吃掉,RWTD 则换了个方向——先承认一步生成器的后训练很难做,再用最优传输把奖励塞进去。共同点是 NFE 已经不是瓶颈,蒸馏完之后「还剩什么」才是。 「对所有东西一视同仁」正在被放弃 HetA-DiT 只让约两成 token 走稠密注意力,Routed Forcing 按人物、嘴部、背景分区域换监督信号,FuseReg 干脆不挑层而是在随机层子集上训练。三篇方法毫不相干,但都在拒绝均匀处理——按 token、按区域、按层做差异化分配,成了这一批论文共享的默认动作。 人工智能炼丹君 整理 | 2026-09-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|流匹配与 Rectified Flow-FlowMatching AIGC 基本功|流匹配与 Rectified Flow-FlowMatching 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练与采样、扩散过程与 score 关键词:流匹配、flow matching、rectified flow、速度场、直线路径、reflow、NFE 01. 为什么需要它 先给三个数字,全部来自文末附录里能直接跑的脚本。 数字一:换个回归目标,预测误差幅度系数差 100 倍,对应平方损失权重差 10000 倍。 把「干净图估计」上的误差记为 $\delta$,在 $t=0.99$(几乎纯噪声)这一时刻:如果模型输出的是噪声 $\epsilon$,loss 看到的误差是 $0.0101\,\delta$;如果输出的是速度 $v$,loss 看到的是 $1.0101\,\delta$。在固定干净图误差的比较下,速度目标给予高噪声端更大的相对权重。 这是速度参数化与噪声参数化的一个权重差异;采用何种目标还取决于路径、预条件、训练时间分布与架构,不能把所有模型选择归因为这一个系数(03 节推导,图 1 画出整条曲线)。 数字二:「直线路径」的 ODE 轨迹一点都不直。 Rectified Flow 最常被转述成"路径是直的,所以快"。实测:把二维八模高斯混合推到数据端,用附录 reflow_lab.py 的 10 万个起点、64 步 RK2(128 NFE)轨迹账本,精确场的弧长/弦长均值为 1.6499(图 2 另用 300 步 RK4 示意)——轨迹比两点连线多走了 65% 的路。训练时那条 $(1-t)x+t\epsilon$ 插值线确实是直线,但模型实际采样走的是边缘速度场的积分曲线,两者不是一回事(02 节的图 2 把这件事画出来了)。 数字三:reflow 一轮,2 步采样的误差降 11.1 倍。 用第 1 轮训好的模型把噪声推到数据端、拿得到的配对重训一轮,配对插值上的归一化回归残差 $S_{pair}$ 从 $0.6229$ 掉到 $0.0027$(前者用精确场,后者用训练模型;对应不同耦合,也包含学习误差,不能据此声称不可约误差降低 231 倍),NFE=2 的终点偏差从 $0.04469$ 降到 $0.00402$,已经低于方差保持路径 2 步的 $0.0105$。但高 NFE 下的终点偏差没有因此继续下降:生成质量仍受教师分布、重训误差和有限样本评估影响,06 节展开。 所以这篇文章要回答三个问题:流匹配到底在训练什么、它和 DDPM 是不是两个东西、以及"直线路径"这个卖点真实兑现了多少。 02. 最小可用理解 三句话讲完: 流匹配训练的是一个速度场,不是噪声。 采样是解一条 ODE:从噪声端 $t=1$ 出发,跟着 $v_\theta$ 走到数据端 $t=0$。训练只是回归:给定当前点 $z_t$,预测条件速度 $u_t$;在线性 Rectified Flow 路径上,它就是这一对端点的相对位移。最优解是条件期望 $E[u_t \mid z_t = z]$,而由连续性方程,在可积性、正则性及解唯一性成立、场学习与积分均精确时(03 节证),这个期望场把 $p_1$ 运到 $p_0$——所以不需要知道任何密度,样本对就够。 高斯路径提供了统一描述,但不同路径不等于同一个模型。 把路径统一写成 $z_t=\alpha_t x+\sigma_t\epsilon$:DDPM 的单时刻加噪边缘可对应 $\alpha_t=\sqrt{\bar\alpha_t}$、$\sigma_t=\sqrt{1-\bar\alpha_t}$;这里需将离散噪声表连续化,Rectified Flow 取 $\alpha_t=1-t$、$\sigma_t=t$。两者可以使用相同的网络架构。三种预测目标(干净图 $x$、噪声 $\epsilon$、速度 $v$)在同一条已知路径及非退化时间内可以代数换算输出(无需重训网络);不同路径的模型不能仅换公式就变成彼此,04 节把换算残差验到 $10^{-15}$。 "直"的是训练插值线,不是采样轨迹。 在本文独立配对的平滑数据分布上,线性路径边缘场满足 $v(z,0)=-z$、$v(z,1)=z-\mu$,其中 $\mu=E[x]$。采样从 1 积分到 0,时间步为负,因此噪声端先朝数据均值走,数据端局部向外走;中间还有模式分流。实际积分轨迹可以弯曲,reflow 用模型生成的端点配对重训,可在理想条件下改善速度沿轨迹的恒定程度。本文以下采用数据 $t=0$、噪声 $t=1$;RF 原论文常用噪声到数据的正向时间。令 $s=1-t$ 后,速度也要变号,不能只倒置时间标签。 这张图要看什么:在这 14 个共同起点上,左图(直线路径)出现明显回转,右图(VP 余弦路径)较平缓。灰点是 8 个数据模式,蓝圆是噪声起点,绿方是生成终点。两图使用相同的精确场计算方式和 300 步 RK4,只改变路径;其形状是本分布上的实验结果。VP 数据端速度为零,但由于数据均值不为零,噪声端速度并不为零,见 3.4 节。 03. 数学推导 3.1 高斯路径与条件速度 把常见高斯插值类扩散/流方法统一成一条路径。取数据样本 $x\sim p_{\text{data}}$、独立噪声 $\epsilon\sim N(0,I)$,令 $$z_t=\alpha_t x+\sigma_t\epsilon,\qquad t\in[0,1]$$ 约定 $t=0$ 是数据端、$t=1$ 是噪声端,即 $\alpha_0=1,\sigma_0=0$、$\alpha_1=0,\sigma_1=1$。各符号的含义:$\alpha_t$ 是数据分量的幅度,$\sigma_t$ 是噪声分量的幅度,两者是标量函数,选不同的曲线就得到不同的方法: 方法 $\alpha_t$ $\sigma_t$ 备注 VP / DDPM $\sqrt{\bar\alpha_t}$ $\sqrt{1-\bar\alpha_t}$ 满足 $\alpha_t^2+\sigma_t^2=1$,当数据协方差也为单位阵时保持单位方差;一般数据协方差仍随 t 改变 Rectified Flow $1-t$ $t$ 线性插值,中间分布方差会缩水(06 节) 对固定的一对 $(x,\epsilon)$,$z_t$ 是一条确定的曲线,它对时间的导数是 $$u_t=\dot\alpha_t x+\dot\sigma_t\epsilon$$ 每个符号:$\dot\alpha_t$、$\dot\sigma_t$ 是两条幅度曲线的导数;$u_t$ 叫条件速度——它说的是"这一对端点对应的粒子此刻在往哪走"。直线路径下 $\dot\alpha_t=-1$、$\dot\sigma_t=1$,所以 $u_t=\epsilon-x$,与 $t$ 无关:整条插值线是匀速直线。这就是"直线"的全部含义,它只说了这条以 $(x,\epsilon)$ 为参数的曲线,没说采样时走的那条。 这里的“高斯”指给定数据后的加噪分布。单时刻边缘并不指定随机过程的联合分布:固定一份 $\epsilon$ 画出的插值曲线,与 DDPM 每步注入新噪声的马尔可夫链可以有相应的单时刻边缘,却有不同的路径联合分布与采样器。本文积分的是确定性 ODE;不能把它称为原 DDPM 逆链的逐路径复现。有限 DDPM 噪声表的最后时刻一般也只是接近标准高斯;本文的纯噪声端是连续路径的理想端点。 后文 reflow 改变端点耦合(coupling,即两个端点的联合分布),不改变线性插值公式。3.2 节的条件期望证明允许相关端点;本节的独立高斯条件式、4.1 节的 GMM 精确场以及 3.4 节独立配对的端点公式,只用于第 1 轮。第 2 轮端点由教师相关配对,不能继续套用同一 GMM 闭式。 3.2 边缘速度场:为什么样本对就够训练 采样时我们手里没有那对 $(x,\epsilon)$,只有 $z_t$。所以要用的是边缘速度场: $$v^{\star}(z,t)=E\left[u_t \mid z_t=z\right]$$ 读法:在所有"此刻恰好经过 $z$ 的粒子对"里,平均下来往哪走。要证它是"对的场",也就是用它解 ODE 确实把 $p_1$ 运到 $p_0$。对任意光滑测试函数 $\phi$,沿条件路径求导再取期望: $$\frac{d}{dt}E\left[\phi(z_t)\right]=E\left[\nabla\phi(z_t)\cdot u_t\right]=E\left[\nabla\phi(z_t)\cdot E[u_t\mid z_t]\right]=\int \nabla\phi(z)\cdot v^{\star}(z,t)\,p_t(z)\,dz$$ 第二步是把里层的条件期望提出来(塔性质)。最后那个积分正是连续性方程 $\partial_t p_t+\nabla\cdot(v^{\star}p_t)=0$ 的弱形式,在速度场和密度满足适当正则性、相应 ODE 与连续性方程有唯一解的条件下,$v^{\star}$ 生成的流在每个时刻匹配既定的 $p_t$,从 $p_1$ 走到 $p_0$。这里 $p_t$ 本身随时间变化,并不是保持某个固定分布不变。这一步就是"marginalization trick":条件场逐对可得,边缘场取个条件期望就行。 于是在线性路径下,训练目标可以完全绕开密度(一般路径把目标换成 $u_t$): $$\min_\theta\;E_{t,x,\epsilon}\left\|v_\theta(z_t,t)-(\epsilon-x)\right\|^2$$ 这里 $t$ 在训练时按指定密度采样,本文 toy 使用均匀分布;$E$ 表示对时间和端点配对取期望。对每个有正训练密度的 $t$,平方回归的逐点最优解是 $v^{\star}(z,t)$;改变时间采样而不补重要性权重,会改变有限容量模型的误差分配。没有任何一项需要 $p_t$ 的表达式——这是流匹配在工程上能起飞的根本原因:它把"学分布"变成了"学一个回归"。 3.3 同一路径的三种预测输出如何换算 设 $m(z,t)=E[x\mid z_t=z]$(干净图估计)、$e(z,t)=E[\epsilon\mid z_t=z]$(噪声估计)。对 $z_t=\alpha_t x+\sigma_t\epsilon$ 两边取条件期望(条件期望是线性的,$z_t$ 在条件下是常数): $$z=\alpha_t m+\sigma_t e$$ 这是贯穿全文的恒等式,$\alpha m+\sigma e=z$。再配合速度的定义 $v=\dot\alpha_t m+\dot\sigma_t e$,两个方程、两个未知数,解出 $$m=\frac{\sigma_t v-\dot\sigma_t z}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t},\qquad e=\frac{\dot\alpha_t z-\alpha_t v}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t}$$ 分母 $\Delta_t=\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t$ 是个行列式;一般路径必须满足 $\Delta_t\ne0$ 才能从 $(z,v)$ 唯一恢复两个估计。若数据与噪声幅度以同一比例变化,两行方程相关,换算就不可逆。直线路径下它恒等于 $-1$($(-1)\cdot t-1\cdot(1-t)=-1$),于是换算干净得没有任何除法: 已知 求 $m$(干净图) 求 $e$(噪声) 速度 $v$ $m=z-t\,v$ $e=z+(1-t)\,v$ 噪声 $\epsilon$ $m=(z-t\,e)/(1-t)$ — 干净图 $m$ — $e=(z-(1-t)m)/t$ 第一行值得盯一眼:从速度换算到干净图和噪声都不需要除以 $\alpha$ 或 $\sigma$,而第二、三行各有一个会趋奇的除法。这说明线性路径下由速度到两个端点估计的系数有界;并不保证网络误差、训练梯度或完整采样算法都更稳定。该线性换算在端点仍有定义,但从噪声反推干净图要求 $1-t\ne0$,从干净图反推噪声要求 $t\ne0$。 那为什么不能说"三种参数化完全等价"? 真值层面等价(上表),loss 层面不等价。假设模型在 $m$ 上有误差 $\delta$,把它代入三种目标的误差: $$\text{x0 目标:}\ \|\delta\|,\qquad \text{噪声目标:}\ \frac{\alpha_t}{\sigma_t}\|\delta\|,\qquad \text{速度目标:}\ \left|\dot\alpha_t-\frac{\dot\sigma_t\alpha_t}{\sigma_t}\right|\|\delta\|$$ 来历:$e=(z-\alpha_t m)/\sigma_t$ 对 $m$ 求导得 $-\alpha_t/\sigma_t$;$v=\dot\alpha_t m+\dot\sigma_t e$ 对 $m$ 求导得 $\dot\alpha_t-\dot\sigma_t\alpha_t/\sigma_t$。直线路径代入,得到三条曲线 $$\text{x0:}1,\qquad \text{噪声:}\frac{1-t}{t},\qquad \text{速度:}\frac{1}{t}$$ 这张图要看什么:横轴是时间 $t$,纵轴是对数刻度的放大倍数。$t=0.99$(接近纯噪声端)噪声参数化的曲线是 $0.0101$——在高噪声端,噪声目标对"你把干净图猜错了"几乎无感,因为 $z$ 里本来就几乎没有 $x$ 的信息;而速度目标的系数是 $1.0101$;真正取 $t\to1$ 的极限时,二者分别趋于 0 和 1。反过来在 $t\to 0$(数据端)二者对固定干净图误差的换算系数都增大,速度系数比噪声系数加法上大 1;这不等于直接 velocity 训练的目标或梯度必然发散。这里能直接推出的是高噪声端对干净图估计误差的相对损失权重不同,不能单凭它保证真实网络的梯度大小或学习效率。 还可以把这条链接回先修中的 score。仅在独立高斯加噪、$\sigma_t>0$ 时,对加噪密度求空间导数给出 $\nabla\log p_t(z)=-e(z,t)/\sigma_t$。再在 $\alpha_t>0$ 时用 $m=(z-\sigma_t e)/\alpha_t$ 消元: $$v^{\star}(z,t)=\frac{\dot\alpha_t}{\alpha_t}z+\left(\frac{\dot\alpha_t}{\alpha_t}\sigma_t^2-\dot\sigma_t\sigma_t\right)\nabla\log p_t(z).$$ 这就是与同边缘扩散的概率流 ODE 对接的一种写法;在可构造相应扩散的条件下,它与随机反向采样共享边缘目标,轨迹不必相同。式中除法的非退化条件不能省略;直线路径的 $v=\epsilon-x$ 监督本身不需要计算 score,也不需要在退化端点执行这些除法。相关端点的 reflow 不具有上述独立加噪条件,不能直接照搬此 score 恒等式。原始推导讨论了概率路径、条件场与边缘场的关系。 3.4 直的是插值线,不是轨迹 先看端点行为。本文数据是平滑的高斯混合,数据与噪声独立;因此在数据端,$m(z,0)=z$、$e(z,0)=E[\epsilon\mid x=z]=0$;在噪声端,$m(z,1)=\mu=E[x]$、$e(z,1)=z$。这些关系来自端点的条件独立性,不能用 $(z-\alpha m)/\sigma$ 中的“分子趋零”来推断一个 $0/0$ 极限。 make_data 的 8 个分量权重与 $1+0.35\cos(\cdot)$ 成正比,并不均匀。精确加权均值为 $$\mu=(0.294464,\,-0.248024).$$ 线性路径 $\dot\alpha=-1,\dot\sigma=1$ 的端点速度是 $$v(z,0)=-z,\qquad v(z,1)=z-\mu.$$ 采样沿负时间方向积分,所以噪声端局部朝 $\mu$ 走,数据端局部沿 $z$ 向外走。中间的模式分流也会影响轨迹,端点公式本身不能决定全程弯曲程度;01 节的弧长比是实际积分测得的结果,不是由端点方向推出的普遍定理。 VP 余弦路径取 $\alpha=\cos(\pi t/2)$、$\sigma=\sin(\pi t/2)$,因此 $$v_{\rm VP}(z,0)=0,\qquad v_{\rm VP}(z,1)=-\frac{\pi}{2}\mu=(-0.462543,\,0.389595).$$ 只有数据均值为零时,这条 VP 路径的两个端点速度才都为零。本实验不满足该条件。 需要区分两个诊断量。本文脚本 straightness_of 实际计算的是原始端点配对插值上的归一化回归残差: $$S_{pair}=\frac{\int_0^1 E\|v((1-t)z_0+t z_1,t)-(z_1-z_0)\|^2dt}{E\|z_1-z_0\|^2}.$$ 当 $v=v^{\star}$ 时,分子是条件回归的不可约误差。下式的期望同时包含均匀时间与端点配对,并且 $S_{pair}$ 用 $v^{\star}$ 计算: $$E\|v_\theta-u\|^2=E\|v_\theta-v^{\star}\|^2+S_{pair}E\|z_1-z_0\|^2.$$ Rectified Flow 论文沿实际 ODE 轨迹 $Z_t$ 定义的 straightness 则比较 $v(Z_t,t)$ 与 $Z_1-Z_0$。这不是在独立原始配对插值线上评估,不能直接把本文 $S_{pair}$ 当成论文的同名量。本文另用实际积分轨迹的弧长/弦长检测几何变直,两个指标应分别报告。论文的零 straightness 要求速度沿轨迹恒定,比“几何上落在一条直线”更强:标量轨迹 $Z_t=t^2$ 的弧长/弦长是 1,但 $\int_0^1(2t-1)^2dt=1/3$;从 0 到 1 用一步 Euler 得到 0,精确终点却是 1。几何直线仍可能需要更好的时间参数化或积分格式。弧长的离散计算必须是 $\sum_j\|Z_{t_{j+1}}-Z_{t_j}\|_2$,不能先分别累加坐标上的绝对位移再取范数。 path_lab.py 另取 1500 个起点、400 步 RK4(1600 NFE):线性路径的平均弧长/弦长为 1.6232,VP 为 1.2915。沿实际轨迹的速度偏差再除以平均弦长平方,得到归一化 $S_{traj}$ 分别为 1.2293、0.5317。这与原始配对插值上的 $S_{pair}$ 不同。01 节的 1.6499 来自 reflow_lab.py 的另一批 10 万个起点和 64 步 RK2;样本与积分精度不同,诊断数值也会不同。 04. 代码实现 全部代码在文末附录,保留原有五个实验脚本,另补一份独立校验脚本;数值实验依赖 numpy、画图另需 matplotlib:fm_oracle.py(实验台与精确场)、param_lab.py(三种参数化)、path_lab.py(路径对比与 NFE)、reflow_lab.py(reflow 两轮)、make_figures.py(配图)。实验台是一个二维八模高斯混合,噪声是 $N(0,I)$。选它的原因是:高斯混合经过任何高斯路径之后仍是高斯混合,于是 $m$、$e$、$v^{\star}$ 全都有闭式解,不用训练也不用采样近似。 4.1 精确场:后验责任与条件均值 分量 $k$ 的中间方差是 $V_k(t)=\alpha_t^2 s_k^2+\sigma_t^2$($s_k$ 是该分量的标准差),后验责任是给定当前点后属于分量 $k$ 的概率,贝叶斯公式给出未归一化权重: $$r_k(z,t)\propto w_k V_k(t)^{-d/2}\exp\left[-\frac{\|z-\alpha_t\mu_k\|^2}{2V_k(t)}\right].$$ 最后对 $k$ 归一化;本文维数 $d=2$。三个量都是"责任加权的条件均值": def m(self, z, t): # E[x | z_t = z] a = self.path.alpha(t) r, V, diff = self._post(z, t) ex = self.data.mu[None,:,:] + (a * self.data.s**2 / V)[None,:,None] * diff return (r[:,:,None] * ex).sum(1) def e(self, z, t): # E[eps | z_t = z] sg = self.path.sigma(t) r, V, diff = self._post(z, t) ee = (sg / V)[None,:,None] * diff return (r[:,:,None] * ee).sum(1) def v(self, z, t): # 边缘速度场 return self.path.dalpha(t) * self.m(z, t) + self.path.dsigma(t) * self.e(z, t) 先验两个恒等式。第一个是 3.3 节的 $\alpha m+\sigma e=z$,第二个是把 $v^{\star}$ 用另一种方式算一遍——直线路径下 3.3 节的表给出 $v^{\star}=(z-m)/t$: === 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)=== path t |a*m+s*e-z| |v-(da*m+ds*e)| linear 0.05 2.66e-15 0.00e+00 linear 0.95 1.78e-15 0.00e+00 cosine_vp 0.05 1.78e-15 0.00e+00 cosine_vp 0.95 1.78e-15 0.00e+00 === 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e === t=0.1 最大绝对差 = 1.332e-14 t=0.9 最大绝对差 = 1.776e-15 第一条验证了条件均值的一致性;第二条直接复用了 v() 的定义,只能作接口检查,不能算独立证明。新增 fm_checks.py 直接对混合密度有限差分核验 score 和连续性方程,并用单高斯的均值/方差导数另算速度;还检查 MLP 梯度及积分器实际 NFE。数值残差验证具体实现,推导正确性仍依赖 03 节的假设与证明。 4.2 换算表与放大倍数 把 3.3 节的换算写成代码并逐点验真值(注意残差随 $t\to 1$ 变大——那是除以 $(1-t)$ 的数值放大,不是推导错): def v_to_me(z, v, path, t): a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) det = da * sg - ds * a # 直线路径恒等于 -1 m = (sg * v - ds * z) / det e = (da * z - a * v) / det return m, e path t v->m v->e eps->m eps->v linear 0.10 1.78e-15 1.33e-15 1.78e-15 1.78e-15 linear 0.90 1.22e-15 8.88e-16 1.30e-14 1.29e-14 linear 0.99 1.78e-15 1.78e-15 2.04e-13 2.03e-13 放大倍数不靠公式背,用数值扰动直接量:给 $m$ 加一个长度固定为 $0.01$ 的随机扰动,看三种预测误差范数各被放大多少;平方损失对应这些系数的平方。实测与解析式在小数点后四位完全一致($t=0.1$ 时噪声目标 $9.0000$ 对 $9.0000$、速度目标 $10.0000$ 对 $10.0000$),整条曲线就是图 1。 4.3 路径对比:NFE-误差曲线 误差尺子值得单独说一句。常用做法是"拿一条很高步数的参考解当真值",但那条参考解自己也有截断误差。这里利用 $p_t$ 仍是高斯混合这一点,取一组中心为 $c$、带宽为 $h>0$ 的 RBF 特征: $$\phi_c(z)=\exp\left(-\frac{\|z-c\|^2}{2h^2}\right).$$ 它在高斯下的期望有闭式,于是参照侧没有任何采样噪声。生成样本一侧仍有有限样本误差:一批 4000 个真实样本对精确 $p_{\text{data}}$ 的偏差是 $0.00211$,这里只把它画成参考线,既不是误差下限,也不是显著性阈值。更换随机种子后,这个参考偏差也会变化。要判断小差异是否稳定,应对方法使用共同起点并重复多个种子。有限组 RBF 特征只是分布诊断,特征偏差小不能证明两个分布相同。 NFE 统计实际速度场评估次数:Euler 每步 1 次,RK2 每步 2 次。所以 NFE=8 时分别运行 8 步 Euler 或 4 步 RK2,表中按这一预算公平比较。 === NFE-误差:直线路径 vs VP 余弦路径(同一批起点、同一批随机数)=== NFE linear/euler linear/rk2 vp/euler vp/rk2 2 0.04074 0.04113 0.01047 0.04603 4 0.01491 0.00736 0.00562 0.00318 8 0.00802 0.00202 0.00329 0.00236 16 0.00466 0.00183 0.00234 0.00194 32 0.00307 0.00184 0.00199 0.00186 256 0.00194 0.00183 0.00184 0.00183 这张图要看什么:高 NFE 时,四条线都接近同一量级的小偏差,与有限样本误差并存;这不能单独证明场正确。低 NFE 的差异依赖路径和积分器:在 Euler、NFE=8 这一点,线性路径误差是 VP 的约 2.4 倍($0.00802$ 对 $0.00329$),不是“需要 2.4 倍步数”。要比较所需步数,应先规定相同误差阈值。RK2 在 NFE=2 时只有一个积分步,误差甚至大于 Euler;较高阶也不保证每个极低预算下都更好。 数值积分误差受速度场的空间与时间变化、时间网格和积分器共同影响,不能仅用“曲线弯”或错误的“两端速度为零”解释。时间 shift 也可能改变弯曲轨迹的积分精度;这里只能报告本次测试:Euler、NFE=8 时,shift=1、3、6 的误差分别为 $0.00802$、$0.00864$、$0.01843$,这两个非均匀网格没有带来改善。 4.4 Reflow:把弯的轨迹拉直 reflow 的实现出奇地短:用第 1 轮模型从噪声端积分到数据端,得到新配对,再训一轮。 def round1_pairs(n, seed=0): rng = base_rng(seed) data = make_data() z0 = data.sample(n, rng) # 数据端(t=0) z1 = rng.standard_normal((n, D)) # 噪声端(t=1),独立配对 return z0, z1 def generate_pairs(model, z1, n_steps=100): sched = make_schedule(n_steps) # RK2:100 步 = 200 次场评估 z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2") return z0 # 新配对就是 (z0, z1) 模型是 NumPy 实现的两个 128 宽 tanh 隐层 MLP,两轮各 6000 次更新、batch=512、训练 seed=0。第 1 轮从 10 万个固定数据样本有放回抽取,并每步重采独立噪声和时间;这仍是有限经验数据池,不等于每步重新抽总体数据。第 2 轮拟合 10 万个数值教师配对;教师使用 100 步 RK2,即每条配对 200 NFE。第 1 轮在 10 万条独立配对上训练(每步从数据样本池抽样并重采独立噪声),末 200 个训练 minibatch 的逐坐标 MSE 均值为 $2.1853$——按样本平方范数是 $4.3706$,而估计的不可约回归误差 $S_{pair}\cdot E\|z_1-z_0\|^2\approx4.3702$(未舍入计算;两个因子分别约为 $0.6229$、$7.0162$)。训练 minibatch 均值与配对池上 32 时刻求积的估计口径不同;还含有限数据/时间采样误差,略低或略高都可能发生,不能证明模型已达精确最优;在分布内查询点上它与精确场的相对均方误差是 $1.28\%$。 然后是关键的一步——量两轮的归一化配对残差和 NFE: === 归一化配对回归残差(另用弧长/弦长量轨迹)=== 第 1 轮配对 + 精确场 S_pair = 0.6229 第 1 轮配对 + 第1轮模型 S_pair = 0.6289 第 2 轮配对 + 第2轮模型 S_pair = 0.0027 弧长/弦长:精确场 1.6499 | 第1轮 1.6463 | 第2轮 1.0027 === NFE-误差(直线路径;精确场 / 第1轮模型 / 第2轮模型)=== NFE 精确场 第1轮 第2轮 2 0.04012 0.04469 0.00402 4 0.01469 0.01789 0.00401 8 0.00785 0.00927 0.00402 16 0.00427 0.00563 0.00402 64 0.00182 0.00389 0.00403 这张图要看什么:左图是三条 NFE-误差曲线,绿色(reflow 后)从 NFE=2 起就是一条平线——步数不再是瓶颈;右图分别比较配对回归残差与实际轨迹弧长/弦长:配对残差第 1 轮用精确场、第 2 轮用重训模型;弧长柱均用对应训练模型。第 2 轮的弧长/弦长 $1.0027$,这批数值轨迹在几何上接近两点连线;速度是否均匀还需另看沿轨迹的诊断。第 1 轮配对残差用精确场(估计不可约误差),第 2 轮用训练模型(包含不可约误差与学习误差),而且耦合不同,不能用二者比值定量声称不可约误差降低多少倍。两者均以 32 等距时刻近似时间积分。另外注意第 2 轮配对的弦长平方从 $7.0162$ 掉到 $1.2410$:reflow 之后噪声端和数据端被强相关地配对了,这种配对改变也体现在实际轨迹变直上;不能把较小的配对残差本身称为曲率。 本次在同一对训练模型上新增独立评估:留出 4000 个新噪声,经同一 100 步 RK2 教师生成配对,第 2 轮模型的配对残差为 0.002772(训练配对池为 0.002749)。再固定模型,仅更换五个噪声 seed;每个 seed 两轮共享 4000 个起点,均用 NFE=2 的 Euler: 评估 seed 第 1 轮偏差 第 2 轮偏差 999 0.04469 0.00402 1000 0.04497 0.00584 1001 0.04399 0.00307 1002 0.04504 0.00519 1003 0.04461 0.00553 五次均观察到第 2 轮偏差更低,但数值随评估采样变化;这只支持这两个固定 toy 模型的少步结果,不是五次独立训练,也不是图像质量或所有数据分布的保证。完整训练配置、源码 SHA256、结果与权重写入同目录快照。 05. 工业级实现对照 以 Diffusers v0.35.1 的 调度器源码为准。对照的是标量时间、默认确定性分支,关闭 inverted sigma、终点拉伸及其他 sigma 重排;逐 token 等分支不在这里的公式覆盖范围。model_output 是模型输出的本文方向速度 $\epsilon-x$,不是 VP 路径中另有定义的 $v$ 目标。网络时间标签通常是 $1000\sigma$,积分步长仍使用 $\sigma$,两者不可混用。 Euler 更新。 原类的 step() 在该分支执行: dt = sigma_next - sigma prev_sample = sample + dt * model_output $\sigma$ 就是本文线性路径的 $t$,表从 1 递减到 0,因此负步长负责从噪声生成数据。函数先把 sample 升到 FP32,再按模型输出 dtype 返回;不要从文档中的泛称“预测噪声”反推这条分支的实际参数化。本文对原类 AST 做 18 次 CPU step 对照,覆盖 FP32、FP16、BF16 和 shift=1/3,结果与同精度更新逐位一致;这是调度器公式验证,没有运行完整文生图模型或 GPU 性能测试。 干净图估计与随机分支。 stochastic_sampling=True 时,源码先算 $\widehat x_0=z-\sigma v_\theta$,再以新噪声 $\eta\sim N(0,I)$ 构造下一状态: $$z_{next}=(1-\sigma_{next})\widehat x_0+\sigma_{next}\eta.$$ 干净图公式正是 3.3 节第一格,但整个随机更新并非默认 Euler ODE 步;不能只摘第一行就说两条采样路径等价。本文固定随机种子实跑这一分支,与完整式逐位核对。 最后评估点与最终落点。 shift=1 的默认 1000 训练时间表,最后非零模型评估点为约 0.001,set_timesteps 另在 sigma 表末尾追加 0。最后一步从正 sigma 积分到 0,不在 0 再评估网络;其他配置/自定义表应查看实际 sigmas。网络调用所需的是表内时间值,不能把 enumerate 的整数索引传进 step()。 静态与动态 shift。 静态变换是 $t'=st/[1+(s-1)t]$,其中 $s>0$ 是配置中的 shift。它重新安排模型评估时刻;本文未将位移速度换成 $dz/dt'$ 后再统一网格求解,而是在改变后的原时间点上用其差值积分。动态指数分支使用 $$t'=\frac{\exp(\mu)}{\exp(\mu)+(1/t-1)}.$$ 序列长度到 $\mu$ 的线性插值发生在 pipeline 调用者中:FLUX 调用代码、SD3 调用代码先由实际 token 数 $L$ 计算 $$\mu(L)=\mu_b+\frac{L-L_b}{L_m-L_b}(\mu_m-\mu_b),$$ 再传给调度器;调度器在启用动态 shift 却没收到 $\mu$ 时会报错。以显式配置 $L_b=256$、$L_m=4096$、$\mu_b=0.5$、$\mu_m=1.15$ 为例,中点 $L=2176$ 得 $\mu=0.825$。它不自动截断,$L=8192$ 会外推到约 1.8433;默认值需以具体模型配置为准,不能把所有 SD3/FLUX 模型概括成同一策略。SD3 原论文第 5.3.2 节用常量图像与分辨率相关的信噪比作动机,这不是“每张真实图都按像素数精确缩放信息”的定理。04 节的 toy shift 测试也只报告该分布上的数值结果。 训练时间分布。 SD3 原论文第 3.1 节比较多种时间采样,包含 logit-normal:先采 $a\sim N(m,s^2)$,再取 $t=1/(1+\exp(-a))$;本文关注的 $m=0,s=1$ 在中间时刻权重较大。该形状依赖参数,不能说所有 logit-normal 都只有一个居中众数。固定训练辅助函数按此变换实现,CPU 实跑与同 seed 的 normal→sigmoid 逐位相同。改变时间密度相当于改变有限模型的训练权重;这与推理侧改变离散时间网格是两个设计选择,也不能用噪声目标在高噪声端的系数直接解释 velocity 模型选择这一密度。 06. 代价与边界 直线路径不是免费的午餐。 在这组实验的 Euler、NFE=8 处,线性路径的误差约为 VP 余弦路径的 2.4 倍;这个误差比不等于达到同一质量所需的步数比。需要诚实标注边界:这是一个二维、数据尺度(标准差 1.56)与噪声尺度(1)不匹配的 toy,不能据此断言"VP 路径普遍更省步数";但至少说明直线插值不保证少步积分准确。实际轨迹接近直线有助于理解 reflow 的效果,积分难度仍取决于沿轨迹的速度变化与数值格式。真实模型里路径选择还和训练分布、模型容量、蒸馏方案纠缠在一起,单独归因很难。 reflow 仍受教师分布与学习误差限制。 本次第 2 轮的高 NFE 偏差约为 $0.00403$;第 1 轮模型用于训练的 10 万个生成端点偏差为 $0.00328$。二者评估样本量不同,不能据此定量断言“误差几乎全部继承自教师”。在理论条件满足、回归和积分精确的理想 reflow 中,端点边缘分布保持为教师的分布;有限模型还会增加重训和积分误差。图 4 显示的是少步曲线被压平,不能当作重训自动改善真实数据拟合的证据。 reflow 的账单。 它需要用第 1 轮模型做一次全量生成,生成量要够训第 2 轮。其成本由配对生成量、教师步数和重训步数共同决定,不能固定说成翻倍,所以工程上要么只在最后的精调阶段做,要么直接换成少步蒸馏(已发布的少步蒸馏)。 $\sigma\to0$ 的数值边界。 需要避免在端点进行会除以零的参数化转换;速度场 Euler 更新自身不含该除法。最后从 $\sigma>0$ 到 0 的 Euler 步正是 $x_0=x-\sigma v$,两种说法在直线路径下是同一操作。 07. 经典论文脉络 Lipman et al., 2022,Flow Matching for Generative Modeling:用 simulation-free 条件回归训练速度场,避免训练期间反复数值求解 ODE;不是从 O(1) 复杂度降到 1,提出条件路径 + marginalization trick,是"用回归训速度场"的源头。 Liu et al., 2022,Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow:从线性插值回归出发构造流,并提出 reflow。在论文的理想化条件下,reflow 具有直线度和凸运输成本的相关保证;本文 4.4 节的有限样本、有限模型实验用于观察趋势,不能替代理论条件。 Albergo & Vanden-Eijnden, 2022,Building Normalizing Flows with Stochastic Interpolants:通过随机端点的插值和回归目标构造确定性概率流。 Albergo, Boffi & Vanden-Eijnden, 2023,Stochastic Interpolants: A Unifying Framework for Flows and Diffusions:进一步引入可调噪声项,建立流与扩散过程的统一框架;应与上一项区分引用。 Karras et al., 2022,Elucidating the Design Space of Diffusion-Based Generative Models(EDM):不谈"流",把预条件(参数化)和时间调度当成独立的自由度来调。它把输出预条件、损失权重与采样调度分开设计;本文 3.3 节涉及其中的输出换算与相对权重,不能把换算恒等式当作训练行为完全等价。 Esser et al., 2024,Scaling Rectified Flow Transformers for High-Resolution Image Synthesis(SD3):把 rectified flow 推到大规模文生图,给出 logit-normal 时间采样与分辨率相关 shift——大规模采用该路径的一项代表性工作,不据此断言整个工业界已统一迁移。 08. 常见误解 误解一:"流匹配与扩散完全相同,或完全无关。" Flow Matching 是训练速度场的框架,可以采用扩散的连续高斯边缘路径,也可以采用其他插值路径。DDPM 另有离散马尔可夫链和随机逆过程;同边缘概率流 ODE 不等于相同的随机路径。相同架构和可换算输出不意味着训练损失、模型分布及采样器完全等价。Rectified Flow 在本文取 $\alpha=1-t,\sigma=t$,还需指定端点耦合、时间采样和数值求解器。 误解二:"路径是直的,所以一两步就能出图。" 直的是训练时的插值线;采样走的是边缘场的积分曲线。实测 1-rectified 的弧长/弦长是 $1.65$,NFE=2 误差 $0.04469$。要两步出图,靠的是 reflow 之后的第 2 轮($0.00402$),不是第 1 轮的"直线路径"。 误解三:"reflow 之后质量和速度都变好了。" 只对了一半。步数-精度曲线确实被压平(NFE=2 就到位),但精度仍受教师样本分布与重训误差限制:第 2 轮在本次实验中停在约 $0.00403$,教师生成端点的参考偏差为 $0.00328$。理想 reflow 保持教师端点边缘,有限训练下则需另外评估分布偏差,不能保证质量自动提高。 误解四:"velocity 预测只是把回归目标换了个写法。" 真值层面是,loss 层面不是。$t=0.99$ 处噪声目标对干净图误差的放大倍数是 $0.0101$,速度目标是 $1.0101$,幅度系数差 100 倍、平方权重差 10000 倍;这只描述固定干净图误差的相对权重,不代表高噪声端一半训练样本都无用。 误解五:"流匹配需要知道边缘密度或 score。" 3.2 节的推导全程只用了条件期望和塔性质,训练目标里没有任何一项含 $p_t$。若评估 NLL,需要概率密度或其可计算表示;沿可逆 ODE 跟踪散度是一种做法,并不要求已知数据密度。本文的 RBF 指标之所以有解析参照,是因为选了可计算的 GMM;真实图像任务通常没有这个条件。 09. 动手验证 三个可以自己跑的小实验,按顺序: 恒等式链:python fm_oracle.py。应该看到 $\alpha m+\sigma e=z$ 的残差在 $10^{-15}$ 量级,$v^{\star}$ 的两种算法差约 $10^{-14}$。这些是 float64 和本例尺度下的数值,不是所有 dtype 的固定门槛。较大残差也可能来自精度、端点除法或索引错误;应定位原因,不能仅凭残差认定缺 log-sum-exp。 放大倍数:python param_lab.py。看解析式与数值扰动两列是否完全一致,再看 $t=0.99$ 那一行——噪声目标 $0.0101$ 对速度目标 $1.0101$。 reflow 的残差与采样曲线:python reflow_lab.py(完整两轮 6000 步和十万配对,纯 NumPy;耗时取决于 CPU、BLAS 与线程数)。确认三件事:第 1 轮逐坐标平均 loss 乘以维数 2 后,接近估计的 $S_{pair}\cdot E\|z_1-z_0\|^2$;第 2 轮弧长/弦长 $\approx 1.00$;第 2 轮 NFE 曲线近乎平坦,但仍存在相对真实数据的偏差。 另跑 python fm_checks.py,可复核密度有限差分、连续性、MLP 梯度、真实 NFE 和几何直但非匀速的反例。make_figures.py 复用本次 reflow 实跑结果;快照绑定源码 SHA256、模型权重哈希与训练配置,缺失或过期就完整重算。它不是拿旧图上的数字反填正文。 想改实验设置的话:make_data 里的 radius 控制数据尺度(默认 2.2)。改变它后重新运行 path_lab.py,比较不同路径在相同实际 NFE 下的误差。半径改变会同时影响数据协方差、模式间距和路径难度;不要把某一次误差比当作固定的步数收益。 10. 延伸阅读 前置:DDPM、扩散过程与 score;若想对照另一类生成目标,可读 VAE 的 ELBO。 相邻:采样器与 NFE、CFG。引导形式可对照,场的方向和参数化仍要与具体模型一致。 后继:少步蒸馏、视频生成强化学习。reflow 与蒸馏是相关的加速选择,训练目标和保证不应混称。 附录:完整代码 09 节用到的脚本全文如下(reflow_lab.py、path_lab.py、fm_oracle.py、param_lab.py、make_figures.py、fm_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 reflow_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(四):Reflow —— 用模型自己造的配对再训一轮。 Rectified Flow 最容易被转述错的一句话是「它的路径是直的」。 真的是直的,但直的是**训练时那条插值线** (1-t)x + t*eps; ODE 真正走出来的轨迹是边缘速度场 v*(z,t) = E[eps - x | z_t = z] 的积分曲线, 本例的积分轨迹会弯曲,弧长须把每一小段的欧式长度相加后再与弦长比较。 Reflow 做的事是:用第 1 轮训好的模型把噪声推到数据端,得到一批**配对** (z_1, z_0) = (起点噪声, 模型生成的终点),再拿这批配对重训一轮。 理想化 reflow 的性质有理论条件;本实验另外测量有限模型的轨迹长度比和采样误差。 这一份用 numpy 手搓一个小 MLP 当"模型",分别报告配对插值上的归一化回归残差 S_pair、实际 ODE 轨迹弧长/弦长和 NFE-误差。 """ import hashlib import json import os import platform from pathlib import Path import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, OracleFlow, make_rbf_centers, discrepancy, make_schedule, integrate, ) C, BW = make_rbf_centers() PATH = LinearPath() # ─────────────────── 一个小 MLP(numpy 手写) ─────────────────── class MLP: def __init__(self, sizes, rng): self.W, self.b = [], [] for i in range(len(sizes) - 1): lim = np.sqrt(6.0 / (sizes[i] + sizes[i + 1])) self.W.append(rng.uniform(-lim, lim, (sizes[i], sizes[i + 1]))) self.b.append(np.zeros(sizes[i + 1])) self.m = [np.zeros_like(w) for w in self.W] self.v = [np.zeros_like(w) for w in self.W] self.mb = [np.zeros_like(x) for x in self.b] self.vb = [np.zeros_like(x) for x in self.b] def forward(self, X): A = [X] H = X for i in range(len(self.W) - 1): H = np.tanh(H @ self.W[i] + self.b[i]) A.append(H) A.append(H @ self.W[-1] + self.b[-1]) return A[-1], A def step(self, X, Y, lr, tstep, beta1=0.9, beta2=0.999, eps=1e-8): pred, A = self.forward(X) g = 2.0 * (pred - Y) / pred.size for i in range(len(self.W) - 1, -1, -1): gW = A[i].T @ g gb = g.sum(0) self.m[i] = beta1 * self.m[i] + (1 - beta1) * gW self.v[i] = beta2 * self.v[i] + (1 - beta2) * (gW * gW) self.mb[i] = beta1 * self.mb[i] + (1 - beta1) * gb self.vb[i] = beta2 * self.vb[i] + (1 - beta2) * (gb * gb) mh = self.m[i] / (1 - beta1 ** tstep) vh = self.v[i] / (1 - beta2 ** tstep) # 先用本次前向的旧权重传播梯度,再更新参数。 g_prev = (g @ self.W[i].T) * (1 - A[i] ** 2) if i > 0 else None self.W[i] -= lr * mh / (np.sqrt(vh) + eps) bmh = self.mb[i] / (1 - beta1 ** tstep) bvh = self.vb[i] / (1 - beta2 ** tstep) self.b[i] -= lr * bmh / (np.sqrt(bvh) + eps) if i > 0: g = g_prev return float(((pred - Y) ** 2).mean()) def __call__(self, z, t): tt = np.full((z.shape[0], 1), float(t)) return self.forward(np.concatenate([z, tt], axis=1))[0] def train(pairs_z0, pairs_z1, n_step=4000, batch=512, lr=3e-3, seed=0, fresh=False): """在给定配对上训练速度场:目标 u = z_1 - z_0,z_t = (1-t) z_0 + t z_1。 fresh=True 时重采噪声和时间,数据仍从有限样本池有放回抽取。 这不是每步重新抽取总体数据;独立留出样本用于检查泛化。 """ rng = base_rng(seed) net = MLP([D + 1, 128, 128, D], np.random.default_rng(seed + 1)) n = pairs_z0.shape[0] losses = [] for s in range(1, n_step + 1): if fresh: idx = rng.integers(0, n, batch) z1 = rng.standard_normal((batch, D)) z0 = pairs_z0[idx] # 有限经验数据池,不能当作总体新样本 else: idx = rng.integers(0, n, batch) z0 = pairs_z0[idx] z1 = pairs_z1[idx] t = rng.uniform(0.0, 1.0, (batch, 1)) zt = (1 - t) * z0 + t * z1 u = z1 - z0 X = np.concatenate([zt, t], axis=1) cur_lr = lr * (0.3 ** (s / n_step)) # 余弦退火换成简单指数退火 l = net.step(X, u, cur_lr, s) losses.append(l) return net, float(np.mean(losses[-200:])) # ─────────────────── 两轮的配对 ─────────────────── def round1_pairs(n, seed=0): """第 1 轮:数据与噪声独立配对(这就是 Rectified Flow 原始的训练配对)。""" rng = base_rng(seed) data = make_data() z0 = data.sample(n, rng) # 数据端(t=0) z1 = rng.standard_normal((n, D)) # 噪声端(t=1) return z0, z1 def generate_pairs(model, z1, n_steps=100): """用 RK2 的 n_steps 个积分步生成配对,实际场评估次数为 2*n_steps。""" sched = make_schedule(n_steps) z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2") return z0 # ─────────────────── 评价指标 ─────────────────── def straightness_of(pairs_z0, pairs_z1, vfun, nstep=32): """配对插值上的归一化回归残差;不是论文沿实际 ODE 轨迹定义的 straightness。""" ts = np.linspace(1.0, 0.0, nstep + 1)[:-1] dev = 0.0 for t in ts: zt = (1 - t) * pairs_z0 + t * pairs_z1 dev += float(np.mean(np.sum((vfun(zt, t) - (pairs_z1 - pairs_z0)) ** 2, axis=1))) dev /= len(ts) return dev / float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1))) def arc_over_chord(pairs_z1, vfun, nstep=64): """真走一遍:从 z_1 出发积分到 t=0,量轨迹弧长与端点弦长之比。""" sched = make_schedule(nstep) z0, traj = integrate(vfun, pairs_z1, sched, "rk2") seg = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(0) chord = np.linalg.norm(z0 - pairs_z1, axis=1) return float(np.mean(seg / np.maximum(chord, 1e-12))), z0 def nfe_curve(pairs_z1, vfun, nfe_list, data): flow = OracleFlow(data, PATH) out = [] for nfe in nfe_list: sched = make_schedule(nfe) z0, _ = integrate(vfun, pairs_z1, sched, "euler") out.append(discrepancy(z0, 0.0, flow, C, BW)) return np.array(out) def field_error(model, flow, n=4000, seed=3): """训练出来的场与精确场差多少(相对均方)。 查询点取自真实边缘 p_t(与第 1 轮训练分布一致),并在五个时刻汇总平方误差。 """ rng = base_rng(seed) data = make_data() num = 0.0 den = 0.0 for t in (0.1, 0.3, 0.5, 0.7, 0.9): x = data.sample(n, rng) eps = rng.standard_normal((n, D)) zt = (1 - t) * x + t * eps v = flow.v(zt, t) num += float(np.mean(np.sum((model(zt, t) - v) ** 2, axis=1))) den += float(np.mean(np.sum(v ** 2, axis=1))) return num / den def chord_scale(pairs_z0, pairs_z1): """E||z_1 - z_0||^2,配对残差 S_pair 的分母。""" return float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1))) def state(): data = make_data() flow = OracleFlow(data, PATH) z0_1, z1 = round1_pairs(100000, seed=0) net1, loss1 = train(z0_1, z1, n_step=6000, seed=0, fresh=True) z0_2 = generate_pairs(net1, z1, n_steps=100) net2, loss2 = train(z0_2, z1, n_step=6000, seed=0) nfe_list = [2, 4, 8, 16, 32, 64] eval_z1 = base_rng(999).standard_normal((4000, D)) out = { "nfe": np.array(nfe_list), "loss1": loss1, "loss2": loss2, "ferr1": field_error(net1, flow), "ferr2": field_error(net2, flow), "S1_oracle": straightness_of(z0_1, z1, lambda z, t: flow.v(z, t)), "S1_learned": straightness_of(z0_1, z1, lambda z, t: net1(z, t)), "S2_learned": straightness_of(z0_2, z1, lambda z, t: net2(z, t)), "arc1_oracle": arc_over_chord(z1, lambda z, t: flow.v(z, t))[0], "arc1_learned": arc_over_chord(z1, lambda z, t: net1(z, t))[0], "arc2_learned": arc_over_chord(z1, lambda z, t: net2(z, t))[0], "nfe_oracle": nfe_curve(eval_z1, lambda z, t: flow.v(z, t), nfe_list, data), "nfe_learned1": nfe_curve(eval_z1, lambda z, t: net1(z, t), nfe_list, data), "nfe_learned2": nfe_curve(eval_z1, lambda z, t: net2(z, t), nfe_list, data), "chord1": chord_scale(z0_1, z1), "chord2": chord_scale(z0_2, z1), "teacher_discrepancy": discrepancy(z0_2, 0.0, flow, C, BW), } # 留出噪声经同一教师生成配对;只量回归/数值教师,不假称精确 reflow。 held_z1 = base_rng(1234).standard_normal((4000, D)) held_z0 = generate_pairs(net1, held_z1, n_steps=100) out["S2_heldout"] = straightness_of(held_z0, held_z1, net2) out["evaluation_seeds"] = [] for seed in [999, 1000, 1001, 1002, 1003]: z = base_rng(seed).standard_normal((4000, D)) vals = [float(nfe_curve(z, net, [2], data)[0]) for net in [net1, net2]] out["evaluation_seeds"].append({"seed": seed, "round1_nfe2": vals[0], "round2_nfe2": vals[1]}) arrays = {} for name, net in [("net1", net1), ("net2", net2)]: for i, (w, b) in enumerate(zip(net.W, net.b)): arrays[f"{name}_W{i}"] = w arrays[f"{name}_b{i}"] = b here = Path(__file__).resolve().parent tmp = here / '_reflow_models.tmp.npz' np.savez(tmp, **arrays) os.replace(tmp, here / '_reflow_models.npz') def serial(v): if isinstance(v, np.ndarray): return v.tolist() if isinstance(v, dict): return {k: serial(x) for k, x in v.items()} if isinstance(v, list): return [serial(x) for x in v] return v payload = {"results": serial(out), "inputs": snapshot_inputs(), "numpy": np.__version__, "python": platform.python_version(), "models_sha256": hashlib.sha256((here / '_reflow_models.npz').read_bytes()).hexdigest(), "config": {"pairs": 100000, "steps_per_round": 6000, "batch": 512, "hidden": [128, 128], "teacher_steps": 100, "teacher_method": "rk2", "training_seed": 0, "evaluation_particles": 4000, "S_pair_quadrature": "32 equal intervals, right endpoints in increasing time"}} tmp = here / '_reflow_results.tmp.json' tmp.write_text(json.dumps(payload, ensure_ascii=False, indent=2), encoding='utf8') os.replace(tmp, here / '_reflow_results.json') return out def snapshot_inputs(): here = Path(__file__).resolve().parent return {n: hashlib.sha256((here / n).read_bytes()).hexdigest() for n in ['fm_oracle.py', 'reflow_lab.py']} def reviewed_state(): """配图复用当前代码的真实实跑;缺失/过期时完整重算,不接受旧实验缓存。""" here = Path(__file__).resolve().parent p = here / '_reflow_results.json' if p.exists(): obj = json.loads(p.read_text('utf8')) if obj['inputs'] == snapshot_inputs() and obj['models_sha256'] == hashlib.sha256((here / '_reflow_models.npz').read_bytes()).hexdigest(): return obj['results'] return state() if __name__ == "__main__": result = state() print(json.dumps(result, default=lambda v: v.tolist(), ensure_ascii=False, indent=2)) path_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(三):路径的选择到底值多少 NFE。 直线路径(Rectified Flow)和 VP 余弦路径(DDPM 那一路)通向**同一个**目标分布, 中间分布不同,ODE 的轨迹与时间参数化也会不同。这一份把这件事量成三条曲线: 1. NFE-误差曲线:同一批起点,比较路径和积分器;Euler/RK2/RK4 每步分别评估 1/2/4 次场。 2. 欧式弧长 / 弦长,以及沿实际 ODE 轨迹的归一化速度偏差 S_traj; 后者对 Rectified Flow 的轨迹 straightness 再除以 E||Z_1-Z_0||^2, 不等于 reflow_lab 在原始配对插值上计算的 S_pair。 3. 时间 shift(SD3/FLUX 的做法)在直线路径上到底省不省步数。 误差尺子是 fm_oracle.discrepancy:拿精确边缘 p_t 的 RBF 特征矩当参照, 参照侧没有采样噪声,生成粒子一侧仍有有限样本误差。共享起点可减轻比较方差, 小差异是否稳定仍应更换随机种子验证;单次真实样本偏差不是硬下限。 """ import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, make_rbf_centers, discrepancy, make_schedule, integrate, ) NPART = 4000 C, BW = make_rbf_centers() def start_particles(n, rng): """t=1 端的粒子:精确就是 N(0, I)。""" return rng.standard_normal((n, D)) def sampling_reference(data, n=NPART): """固定一次真实样本与精确 p_data 的偏差,仅作有限采样参考,不是误差下限。""" rng = base_rng(12345) x = data.sample(n, rng) flow = OracleFlow(data, LinearPath()) return discrepancy(x, 0.0, flow, C, BW) def run_sweep(path, method, nfe_list, npart=NPART): rng = base_rng() z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) out = [] calls_per_step = {"euler": 1, "rk2": 2, "rk4": 4}[method] for nfe in nfe_list: if nfe < calls_per_step or nfe % calls_per_step: raise ValueError(f"{method}: NFE must be a positive multiple of {calls_per_step}") sched = make_schedule(nfe // calls_per_step) z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, method) out.append(discrepancy(z0, 0.0, flow, C, BW)) return np.array(out) def straightness(path, npart=1500, nstep=400): """细步长积分出真实轨迹,量它离弦有多远。""" rng = base_rng(777) z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) sched = make_schedule(nstep) z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4") # traj: [nstep+1, npart, 2],index 0 是 t=1 arc = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(axis=0) # [npart],各段欧式长度相加 chord = np.linalg.norm(z0 - z1, axis=1) ratio = float(np.mean(arc / np.maximum(chord, 1e-12))) # S_traj = mean_t ||v(z_t,t) - (z_1 - z_0)||^2 / mean ||z_1 - z_0||^2 chord_dir = (z1 - z0)[None, :, :] # [1,npart,2] ts = sched[:-1] dev = 0.0 for i, t in enumerate(ts): v = flow.v(traj[i], t) dev += float(np.mean(np.sum((v - chord_dir[0]) ** 2, axis=1))) dev /= len(ts) scale = float(np.mean(np.sum((z1 - z0) ** 2, axis=1))) return ratio, dev / scale def shift_sweep(path, nfe_list, shifts, npart=NPART): rng = base_rng() z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) res = {} for sh in shifts: errs = [] for nfe in nfe_list: sched = make_schedule(nfe, shift=sh) z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, "euler") errs.append(discrepancy(z0, 0.0, flow, C, BW)) res[sh] = np.array(errs) return res def state(): """给画图脚本复用:返回与上面打印完全一致的数字。""" data = make_data() nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] out = { "nfe": np.array(nfe_list), "sampling_reference": sampling_reference(data), "sweep": {}, "straight": {}, "shift": {}, } for path in (LinearPath(), CosineVPPath()): for method in ("euler", "rk2"): out["sweep"][(path.name, method)] = run_sweep(path, method, nfe_list) out["straight"][path.name] = straightness(path) out["shift"] = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0]) out["shift_nfe"] = np.array([4, 8, 16, 32, 64]) return out if __name__ == "__main__": data = make_data() print(f"=== 单次采样参考:{NPART} 个真实样本 vs 精确 p_data 的偏差 = " f"{sampling_reference(data):.5f} ===") print("(这不是硬下限或显著性阈值;评估小差异需重复采样)") print() nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] print("=== NFE-误差:直线路径 vs VP 余弦路径 ===") print(" NFE linear/euler linear/rk2 vp/euler vp/rk2") lin_e = run_sweep(LinearPath(), "euler", nfe_list) lin_r = run_sweep(LinearPath(), "rk2", nfe_list) vp_e = run_sweep(CosineVPPath(), "euler", nfe_list) vp_r = run_sweep(CosineVPPath(), "rk2", nfe_list) for i, n in enumerate(nfe_list): print(f"{n:>5}{lin_e[i]:>14.5f}{lin_r[i]:>13.5f}{vp_e[i]:>12.5f}{vp_r[i]:>11.5f}") print() print("=== 轨迹指标(400 步 RK4,即 1600 NFE;数值近似 ODE 轨迹)===") for path in (LinearPath(), CosineVPPath()): ratio, s = straightness(path) print(f" {path.label:<28} 弧长/弦长 = {ratio:.4f} 归一化 S_traj = {s:.4f}") print() print("=== 时间 shift(仅直线路径,Euler)===") res = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0]) print(" NFE shift=1 shift=3 shift=6") for i, n in enumerate([4, 8, 16, 32, 64]): print(f"{n:>5}{res[1.0][i]:>11.5f}{res[3.0][i]:>11.5f}{res[6.0][i]:>11.5f}") fm_oracle.py # -*- coding: utf-8 -*- """flow_matching 实验台(一):任意高斯路径下的精确速度场。 这一份是整个文章所有数字的来源。思想是: 数据分布取二维高斯混合 p_data(K 个各向同性分量),噪声取 N(0, I)。 对任意「高斯路径」 z_t = alpha_t * x + sigma_t * eps(t=1 是纯噪声,t=0 是数据), p_t 仍然是高斯混合(分量均值 alpha*mu_k,方差 alpha^2 s_k^2 + sigma^2), 于是下面四样东西全都有闭式解,不需要训练、不需要采样近似: m(z,t) = E[x | z_t = z] 去噪均值(x0 预测的真值) e(z,t) = E[eps | z_t = z] 噪声均值(epsilon 预测的真值) v(z,t) = alpha' m + sigma' e 边缘速度场(速度预测的真值) score = grad log p_t(z) 有了这些,三种参数化(x0 / eps / v)可以逐点互相换算并验到浮点误差, ODE 的 NFE-误差曲线可以用「精确边缘 p_t」当尺子,不需要跑一条高精参考解。 误差尺子:取一组 RBF 特征 phi_c(z) = exp(-||z-c||^2 / (2h^2)), 它在高斯分布下的期望有闭式,于是 disc(粒子云, t) = mean_c | (1/N) sum_i phi_c(z_i) - E_{p_t}[phi_c] | 经验侧仍有有限样本误差,解析侧不额外引入采样噪声。单次真实样本参考值既不是硬地板, 也不是统计显著性阈值;有限组 RBF 特征矩一致也不能证明两个分布完全一致。 """ import numpy as np D = 2 # 二维,画图方便;公式与代码对任意维都成立 # ─────────────────────────── 随机流 ─────────────────────────── def base_rng(seed=20260928): """所有脚本与画图共用同一条随机流,保证正文数字与图上的数字一致。""" return np.random.default_rng(seed) # ─────────────────────────── 数据分布 ─────────────────────────── class GMM2D: """二维各向同性高斯混合。""" def __init__(self, means, stds, weights=None): self.mu = np.asarray(means, dtype=float) # [K, 2] self.s = np.asarray(stds, dtype=float) # [K] K = self.mu.shape[0] if weights is None: self.w = np.full(K, 1.0 / K) else: self.w = np.asarray(weights, dtype=float) self.w = self.w / self.w.sum() @property def K(self): return self.mu.shape[0] def sample(self, n, rng): k = rng.choice(self.K, size=n, p=self.w) return self.mu[k] + self.s[k][:, None] * rng.standard_normal((n, D)) def mean_cov(self): m = (self.w[:, None] * self.mu).sum(0) c = (self.w[:, None, None] * ( (self.s ** 2)[:, None, None] * np.eye(D)[None] + (self.mu - m)[:, :, None] * (self.mu - m)[:, None, :] )).sum(0) return m, c def make_data(K=8, radius=2.2, std=0.28): """8 个分量摆在半径 2.2 的圆上,每个分量标准差 0.28。""" ang = np.arange(K) * 2 * np.pi / K mu = np.stack([radius * np.cos(ang), radius * np.sin(ang)], axis=1) s = np.full(K, std) # 权重做成确定性的非均匀(1 + 0.35 cos),让混合更不像"一圈一样的点" w = 1.0 + 0.35 * np.cos(ang + 0.7) return GMM2D(mu, s, w / w.sum()) # ─────────────────────────── 路径 ─────────────────────────── class LinearPath: """Rectified Flow 的直线插值路径:z_t = (1-t) x + t eps。""" name = "linear" label = "直线路径(Rectified Flow)" def alpha(self, t): return 1.0 - t def sigma(self, t): return t def dalpha(self, t): return -1.0 def dsigma(self, t): return 1.0 class CosineVPPath: """方差保持(VP)路径:z_t = cos(pi t/2) x + sin(pi t/2) eps。 alpha^2 + sigma^2 = 1,也就是 DDPM 那一路 cosine schedule 的连续化版本。 """ name = "cosine_vp" label = "VP 余弦路径(DDPM 那一路)" def alpha(self, t): return np.cos(0.5 * np.pi * t) def sigma(self, t): return np.sin(0.5 * np.pi * t) def dalpha(self, t): return -0.5 * np.pi * np.sin(0.5 * np.pi * t) def dsigma(self, t): return 0.5 * np.pi * np.cos(0.5 * np.pi * t) # ─────────────────────────── 精确场 ─────────────────────────── class OracleFlow: """给定数据与路径后的精确边缘速度场。""" def __init__(self, data: GMM2D, path): self.data = data self.path = path # 后验responsibility r_k(z,t) 与分量方差 V_k(t) def _post(self, z, t): a = self.path.alpha(t) sg = self.path.sigma(t) V = a * a * self.data.s ** 2 + sg * sg # [K] diff = z[:, None, :] - a * self.data.mu[None, :, :] # [N,K,2] d2 = (diff ** 2).sum(-1) # [N,K] logp = -0.5 * d2 / V[None, :] - np.log(V)[None, :] + np.log(self.data.w)[None, :] logp = logp - logp.max(1, keepdims=True) r = np.exp(logp) r = r / r.sum(1, keepdims=True) return r, V, diff def m(self, z, t): """E[x | z_t = z],也就是 x0 预测的真值。""" a = self.path.alpha(t) r, V, diff = self._post(z, t) ex = self.data.mu[None, :, :] + (a * self.data.s ** 2 / V)[None, :, None] * diff return (r[:, :, None] * ex).sum(1) def e(self, z, t): """E[eps | z_t = z],也就是 epsilon 预测的真值。""" sg = self.path.sigma(t) r, V, diff = self._post(z, t) ee = (sg / V)[None, :, None] * diff return (r[:, :, None] * ee).sum(1) def v(self, z, t): """边缘速度场 v*(z,t) = alpha' m + sigma' e。""" da = self.path.dalpha(t) ds = self.path.dsigma(t) return da * self.m(z, t) + ds * self.e(z, t) def score(self, z, t): """grad log p_t(z)。""" r, V, diff = self._post(z, t) return -(r[:, :, None] * diff / V[None, :, None]).sum(1) def marginal(self, t): """p_t 的分量参数(仍是 GMM):均值 [K,2]、标准差 [K]、权重 [K]。""" a = self.path.alpha(t) sg = self.path.sigma(t) return a * self.data.mu, np.sqrt(a * a * self.data.s ** 2 + sg * sg), self.data.w # ─────────────────────────── 误差尺子 ─────────────────────────── def make_rbf_centers(n=9, extent=3.6, bw=0.9): g = np.linspace(-extent, extent, n) C = np.stack(np.meshgrid(g, g, indexing="ij"), axis=-1).reshape(-1, D) return C, bw def rbf_expectation(means, sds, weights, C, bw): """E_{p_t}[phi_c],phi_c(z)=exp(-||z-c||^2/(2 bw^2)),p_t 为各向同性 GMM。 单个高斯分量 N(m, v I) 下:E[phi_c] = (bw^2/(bw^2+v))^{d/2} * exp(-||m-c||^2/(2(bw^2+v))) """ v = sds ** 2 # [K] coef = (bw ** 2 / (bw ** 2 + v)) ** (D / 2.0) # [K] d2 = ((means[:, None, :] - C[None, :, :]) ** 2).sum(-1) # [K, M] val = coef[:, None] * np.exp(-0.5 * d2 / (bw ** 2 + v)[:, None]) return (weights[:, None] * val).sum(0) # [M] def discrepancy(z, t, flow: OracleFlow, C, bw): """粒子云 z 与精确边缘 p_t 的 RBF 特征矩偏差(越小越好)。""" mu_t, sd_t, w_t = flow.marginal(t) exact = rbf_expectation(mu_t, sd_t, w_t, C, bw) d2 = ((z[:, None, :] - C[None, :, :]) ** 2).sum(-1) emp = np.exp(-0.5 * d2 / bw ** 2).mean(0) return float(np.abs(emp - exact).mean()) # ─────────────────────────── 积分器 ─────────────────────────── def make_schedule(n_steps, shift=1.0): """含 n_steps 个积分区间(不是统一 NFE 预算)的时刻表。shift>1 是 SD3/FLUX 那套把时间往高噪声端推的做法。""" t = np.linspace(1.0, 0.0, n_steps + 1) if shift != 1.0: t = shift * t / (1.0 + (shift - 1.0) * t) return t def integrate(vfun, z, schedule, method="euler"): """从 t=1 走到 t=0。vfun(z, t) 返回对递增时间定义的 dz/dt;负步长负责反向积分。""" z = z.copy() traj = [z.copy()] for i in range(len(schedule) - 1): t = schedule[i] h = schedule[i] - schedule[i + 1] # >0 if method == "euler": dz = vfun(z, t) elif method == "rk2": zm = z - 0.5 * h * vfun(z, t) dz = vfun(zm, t - 0.5 * h) elif method == "rk4": k1 = vfun(z, t) k2 = vfun(z - 0.5 * h * k1, t - 0.5 * h) k3 = vfun(z - 0.5 * h * k2, t - 0.5 * h) k4 = vfun(z - h * k3, t - h) dz = (k1 + 2 * k2 + 2 * k3 + k4) / 6.0 else: raise ValueError(method) z = z - h * dz traj.append(z.copy()) return z, np.stack(traj) # traj: [S+1, N, 2] # ─────────────────────────── 自测 ─────────────────────────── def selfcheck(): rng = base_rng() data = make_data() out = [] for path in (LinearPath(), CosineVPPath()): flow = OracleFlow(data, path) z = rng.standard_normal((4000, D)) * 1.6 for t in (0.05, 0.25, 0.5, 0.75, 0.95): a = path.alpha(t) sg = path.sigma(t) m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) # 恒等式 1:alpha*m + sigma*e == z r1 = float(np.abs(a * m + sg * e - z).max()) # 恒等式 2:v == alpha' m + sigma' e(定义,顺手确认没写反导数) r2 = float(np.abs(v - (path.dalpha(t) * m + path.dsigma(t) * e)).max()) out.append((path.name, t, r1, r2)) return out if __name__ == "__main__": print("=== 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)===") hdr = "path t |a*m+s*e-z| |v-(da*m+ds*e)|" print(hdr) for name, t, r1, r2 in selfcheck(): print(f"{name:<12}{t:>6.2f}{r1:>16.2e}{r2:>18.2e}") rng = base_rng() data = make_data() flow = OracleFlow(data, LinearPath()) print() print("=== 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e ===") for t in (0.1, 0.3, 0.5, 0.7, 0.9): z = rng.standard_normal((2000, D)) * 1.6 lhs = (z - flow.m(z, t)) / t rhs = flow.v(z, t) print(f" t={t:.1f} 最大绝对差 = {np.abs(lhs - rhs).max():.3e}") param_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(二):三种参数化(x0 / eps / v)的换算与 loss 权重。 要回答两个问题: 1. 固定同一条高斯路径和非退化时间,eps / x0 / v 输出能否代数换算? 可以换算同一路径上的输出,但不能据此把 VP 模型直接变成另一条 RF 路径的模型。 三种参数化的真值来自同一个去噪均值 m: z = alpha*m + sigma*e (路径定义,恒等) v = alpha'*m + sigma'*e (速度定义) 两式联立解出 m、e,就得到「速度 -> 噪声/干净图」的换算; 反过来也成立。下面把这些换算逐点验到 1e-14。 2. 输出可换算,为什么不同训练目标仍会产生差异? 因为「等价」指的是**真值**等价,**loss 不等价**:同一个 m 上的误差 delta, 在三种 loss 里被放大的倍数不同: x0 : 1 eps : alpha / sigma v : |alpha' - sigma' * alpha / sigma| 这里列的是误差幅度系数,平方损失权重还需平方。直线路径 t→1 时, eps 系数趋于 0,v 系数趋于 1;这比较固定 m 误差的相对权重, 不等于真实网络的所有梯度或质量。t=1 的 eps->m 换算本身退化。 """ import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, ) # ─────────────────── 换算表的通用形式 ─────────────────── def v_to_me(z, v, path, t): """由 (z, v) 反解 (m, e)。 解 [[alpha', sigma'], [alpha, sigma]] @ [m, e] = [v, z] 行列式 det = alpha'*sigma - sigma'*alpha """ a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) det = da * sg - ds * a m = (sg * v - ds * z) / det e = (da * z - a * v) / det return m, e def eps_to_me(z, eps_hat, path, t): """由 eps 预测反解 (m, e)。""" a, sg = path.alpha(t), path.sigma(t) m = (z - sg * eps_hat) / a return m, np.broadcast_to(eps_hat, m.shape).copy() def me_to_v(m, e, path, t): return path.dalpha(t) * m + path.dsigma(t) * e def check_conversions(): """真值层面三种参数化互转,误差应到浮点量级。""" rng = base_rng() data = make_data() rows = [] for path in (LinearPath(), CosineVPPath()): flow = OracleFlow(data, path) z = rng.standard_normal((3000, D)) * 1.6 for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99): m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) # 真值 v -> (m,e) m2, e2 = v_to_me(z, v, path, t) # 真值 eps -> m -> v m3, _ = eps_to_me(z, e, path, t) v3 = me_to_v(m3, e, path, t) rows.append(( path.name, t, float(np.abs(m2 - m).max()), float(np.abs(e2 - e).max()), float(np.abs(m3 - m).max()), float(np.abs(v3 - v).max()), )) return rows # ─────────────────── 放大倍数 ─────────────────── def weights(path, ts): """返回三种参数化下「m 上的单位误差」被放大的倍数(振幅,非平方)。""" wx = np.ones_like(ts) we, wv = [], [] for t in ts: a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) we.append(a / sg) wv.append(abs(da - ds * a / sg)) return wx, np.array(we), np.array(wv) def numeric_weight_check(): """不靠公式,直接用数值扰动验证放大倍数:给 m 加一个固定扰动,看 loss 变化。""" rng = base_rng() data = make_data() flow = OracleFlow(data, LinearPath()) path = LinearPath() z = rng.standard_normal((4000, D)) * 1.6 out = [] for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99): m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) delta = rng.standard_normal((4000, D)) delta = delta / np.linalg.norm(delta) * 0.01 # 固定长度 0.01 的扰动 mp = m + delta ep = (z - path.alpha(t) * mp) / path.sigma(t) vp = me_to_v(mp, ep, path, t) r_eps = np.linalg.norm(ep - e) / np.linalg.norm(delta) r_v = np.linalg.norm(vp - v) / np.linalg.norm(delta) _, we, wv = weights(path, np.array([t])) out.append((t, r_eps, float(we[0]), r_v, float(wv[0]))) return out if __name__ == "__main__": print("=== 换算残差(真值层面互转,应为 1e-14 量级)===") print("path t v->m v->e eps->m eps->v") for name, t, r1, r2, r3, r4 in check_conversions(): print(f"{name:<11}{t:>5.2f}{r1:>12.2e}{r2:>12.2e}{r3:>12.2e}{r4:>12.2e}") print() print("=== 放大倍数:解析式 vs 数值扰动(直线路径)===") print(" t eps实测 eps解析 v实测 v解析") for t, re_, we_, rv_, wv_ in numeric_weight_check(): print(f"{t:>5.2f}{re_:>10.4f}{we_:>10.4f}{rv_:>10.4f}{wv_:>10.4f}") print() print("=== 放大倍数随 t 的变化(直线路径 vs VP 余弦路径)===") ts = np.array([0.01, 0.05, 0.1, 0.2, 0.4, 0.6, 0.8, 0.9, 0.95, 0.99]) for path in (LinearPath(), CosineVPPath()): wx, we, wv = weights(path, ts) print(f"-- {path.label}") print(" t x0 eps v") for i, t in enumerate(ts): print(f"{t:>7.2f}{wx[i]:>8.3f}{we[i]:>10.3f}{wv[i]:>10.3f}") make_figures.py # -*- coding: utf-8 -*- """画配图。数字全部来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) from fm_oracle import ( # noqa: E402 D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, make_schedule, integrate, ) from param_lab import weights # noqa: E402 import path_lab # noqa: E402 import reflow_lab # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:三种参数化的放大倍数 ─────────────── def fig_weights(): ts = np.linspace(0.01, 0.999, 400) wx, we, wv = weights(LinearPath(), ts) fig, ax = plt.subplots(figsize=(7.4, 4.2)) ax.plot(ts, wv, color=C1, lw=2.4, label="velocity 参数化 v") ax.plot(ts, we, color=C0, lw=2.4, label="噪声参数化 eps") ax.plot(ts, wx, color=CGREY, lw=1.8, ls="--", label="干净图参数化 x0") ax.set_yscale("log") ax.set_xlabel("时间 t(0 = 数据端,1 = 纯噪声端)") ax.set_ylabel("同一份误差被放大的倍数(对数轴)") ax.set_title("图 1:预测误差幅度系数(平方损失权重为其平方)") ax.axvline(0.99, color="#cccccc", lw=1, ls=":") ax.annotate("t=0.99 处 eps 系数为 0.010,\nvelocity 还有 1.010", xy=(0.99, 1.0), xytext=(0.55, 0.35), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#999999", lw=1)) ax.legend(loc="upper right", fontsize=10) ax.grid(alpha=0.25) _save(fig, "fig1_param_weights.png") # ─────────────── 图 2:两条路径的真实 ODE 轨迹 ─────────────── def fig_trajectories(): data = make_data() rng = base_rng(4242) z1 = rng.standard_normal((600, D)) xs = data.sample(1200, base_rng(11)) fig, axes = plt.subplots(1, 2, figsize=(12.0, 5.4), sharex=True, sharey=True) sched = make_schedule(300) for ax, path in zip(axes, (LinearPath(), CosineVPPath())): flow = OracleFlow(data, path) z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4") ax.scatter(xs[:, 0], xs[:, 1], s=8, color="#dddddd", label="数据样本(8 个模式)") for i in range(14): ax.plot(traj[:, i, 0], traj[:, i, 1], color=C1, lw=1.3, alpha=0.9) ax.scatter(z1[:14, 0], z1[:14, 1], s=34, color=C0, zorder=5, label="起点(纯噪声)") ax.scatter(z0[:14, 0], z0[:14, 1], s=34, color=C3, marker="s", zorder=5, label="终点(生成)") ax.set_title(path.label) ax.set_xlabel("dim 1") ax.grid(alpha=0.2) axes[0].set_ylabel("dim 2") axes[0].legend(fontsize=9, loc="upper left") fig.suptitle("图 2:同一批起点,两条路径走出来的 ODE 轨迹(300 步 RK4)", fontsize=13) fig.tight_layout() _save(fig, "fig2_trajectories.png") # ─────────────── 图 3:NFE-误差 ─────────────── def fig_nfe(): nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] floor = path_lab.sampling_reference(make_data()) cur = { "linear/euler": path_lab.run_sweep(LinearPath(), "euler", nfe_list), "linear/rk2": path_lab.run_sweep(LinearPath(), "rk2", nfe_list), "vp/euler": path_lab.run_sweep(CosineVPPath(), "euler", nfe_list), "vp/rk2": path_lab.run_sweep(CosineVPPath(), "rk2", nfe_list), } fig, ax = plt.subplots(figsize=(7.6, 4.6)) for (k, v), col, mk in zip(cur.items(), [C1, C0, C2, C3], ["o", "o", "s", "s"]): ax.loglog(nfe_list, v, marker=mk, color=col, lw=2, label=k) ax.loglog(nfe_list, [floor] * len(nfe_list), color=CGREY, ls="--", lw=1.6, label="单次采样参考(4000 个真实样本)") ax.set_xlabel("NFE(模型评估次数)") ax.set_ylabel("终点分布与精确 p_data 的偏差") ax.set_title("图 3:1-rectified 的直线路径 vs VP 余弦路径") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=10) _save(fig, "fig3_nfe_paths.png") return {"nfe": nfe_list, "curves": {k: v.tolist() for k, v in cur.items()}} # ─────────────── 图 4:Reflow ─────────────── def fig_reflow(): snapshot = reflow_lab.reviewed_state() nfe_list = snapshot['nfe'] o = np.asarray(snapshot['nfe_oracle']) a = np.asarray(snapshot['nfe_learned1']) b = np.asarray(snapshot['nfe_learned2']) floor = path_lab.sampling_reference(make_data()) arc1, arc2 = snapshot['arc1_learned'], snapshot['arc2_learned'] s1, s2 = snapshot['S1_oracle'], snapshot['S2_learned'] fig, axes = plt.subplots(1, 2, figsize=(12.0, 4.8)) ax = axes[0] ax.loglog(nfe_list, o, marker="o", color=CGREY, lw=2, label="精确场(数值积分对照)") ax.loglog(nfe_list, a, marker="o", color=C1, lw=2, label="第 1 轮模型") ax.loglog(nfe_list, b, marker="s", color=C3, lw=2, label="第 2 轮模型(reflow 后)") ax.loglog(nfe_list, [floor] * len(nfe_list), color="#bbbbbb", ls="--", lw=1.5, label="单次采样参考(非下限)") ax.set_xlabel("NFE") ax.set_ylabel("终点偏差") ax.set_title("本实验 reflow 后:NFE≥2 的偏差变化很小") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax = axes[1] names = ["第 1 轮", "第 2 轮"] x = np.arange(2) ax.bar(x - 0.18, [arc1, arc2], width=0.34, color=C0, label="弧长/弦长(1 = 几何直线)") ax.bar(x + 0.18, [s1, s2], width=0.34, color=C2, label="配对残差(第1轮精确场/第2轮模型)") ax.set_xticks(x) ax.set_xticklabels(names) ax.set_yscale("log") ax.set_ylabel("配对残差与轨迹长度比(对数轴)") ax.set_title("第 2 轮:几何轨迹接近直线") ax.grid(alpha=0.25, axis="y") ax.legend(fontsize=9) for i, (av, sv) in enumerate([(arc1, s1), (arc2, s2)]): ax.text(i - 0.18, av * 1.08, f"{av:.4f}", ha="center", fontsize=9) ax.text(i + 0.18, sv * 1.08, f"{sv:.4f}", ha="center", fontsize=9) fig.suptitle("图 4:Reflow 的两轮对比(同一个直线路径、同一批起点)", fontsize=13) fig.tight_layout() _save(fig, "fig4_reflow.png") return {"nfe1": a.tolist(), "nfe2": b.tolist(), "S1": s1, "S2": s2, "arc1": arc1, "arc2": arc2} if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None jobs = { "weights": fig_weights, "trajectories": fig_trajectories, "nfe": fig_nfe, "reflow": fig_reflow, } for k, fn in jobs.items(): if only and k != only: continue print(f"[draw] {k}") fn() print("done") fm_checks.py """Independent numerical checks of the article's mathematics and NumPy MLP.""" import json from pathlib import Path import numpy as np from fm_oracle import (GMM2D, make_data, OracleFlow, LinearPath, CosineVPPath, make_schedule, integrate) from reflow_lab import MLP def density(z, t, data, path): # Direct mixture density, independent of OracleFlow._post/score. var = path.alpha(t)**2 * data.s**2 + path.sigma(t)**2 d = z[:, None, :] - path.alpha(t) * data.mu[None] return (data.w[None] * np.exp(-np.sum(d*d, axis=2)/(2*var[None])) / (2*np.pi*var[None])).sum(1) def main(): rng = np.random.default_rng(7) data = make_data() points = rng.normal(size=(32, 2)) score_error = continuity_error = gaussian_error = 0.0 step = 1e-5 for path in [LinearPath(), CosineVPPath()]: flow = OracleFlow(data, path) for t in [.05, .2, .5, .8, .95]: p = density(points, t, data, path) fd = np.zeros_like(points) div = np.zeros(len(points)) for j in range(2): dz = np.zeros_like(points); dz[:, j] = step pp = density(points+dz, t, data, path) pm = density(points-dz, t, data, path) fd[:, j] = (np.log(pp)-np.log(pm))/(2*step) div += (pp*flow.v(points+dz, t)[:, j] - pm*flow.v(points-dz, t)[:, j])/(2*step) score_error = max(score_error, float(np.max(abs(fd-flow.score(points, t))))) pt = (density(points, t+step, data, path)-density(points, t-step, data, path))/(2*step) continuity_error = max(continuity_error, float(np.max(abs(pt+div)))) gaussian = GMM2D([[.3, -.8]], [.7]) gf = OracleFlow(gaussian, path) a, s, da, ds = path.alpha(t), path.sigma(t), path.dalpha(t), path.dsigma(t) var = a*a*.7**2+s*s exact = da*gaussian.mu[0]+(a*da*.7**2+s*ds)/var*(points-a*gaussian.mu[0]) gaussian_error = max(gaussian_error, float(np.max(abs(gf.v(points, t)-exact)))) assert score_error < 2e-7 and continuity_error < 2e-8 and gaussian_error < 1e-12 # Numerical gradients versus moment buffers from one real Adam update. net = MLP([3, 4, 2], np.random.default_rng(11)) x = rng.normal(size=(5, 3)); y = rng.normal(size=(5, 2)) fdw = []; fdb = [] for params, target in [(net.W, fdw), (net.b, fdb)]: for param in params: g = np.empty_like(param) for idx in np.ndindex(param.shape): old = param[idx]; param[idx] = old+1e-6 lp = ((net.forward(x)[0]-y)**2).mean() param[idx] = old-1e-6 lm = ((net.forward(x)[0]-y)**2).mean() param[idx] = old; g[idx] = (lp-lm)/2e-6 target.append(g) net.step(x, y, .001, 1) grad_error = max(float(np.max(abs(g-m/.1))) for g,m in zip(fdw+fdb,net.m+net.mb)) assert grad_error < 2e-9 orders = []; nfe = [] for method, calls in [('euler',1),('rk2',2),('rk4',4)]: errs = [] for n in [8,16]: counter = [0] def velocity(z,t): counter[0] += 1 return z z,_ = integrate(velocity,np.ones((1,2)),make_schedule(n),method) assert counter[0] == n*calls errs.append(float(abs(z[0,0]-np.exp(-1)))) nfe.append(dict(method=method,steps=n,calls=counter[0])) orders.append(dict(method=method,errors=errs,observed_order=float(np.log2(errs[0]/errs[1])))) assert all(r['observed_order'] > k-.15 for r,k in zip(orders,[1,2,4])) # One geometric line can have nonuniform velocity: z_t=t^2, z'_t=2t. ts = np.linspace(0,1,10001) nonuniform = float(np.trapezoid((2*ts-1)**2,ts)) assert abs(nonuniform-1/3) < 1e-8 report = dict(passed=True,score_fd_max_error=score_error,continuity_max_residual=continuity_error, gaussian_closed_form_error=gaussian_error,mlp_gradient_fd_error=grad_error, integrator_orders=orders,nfe_counts=nfe, straight_line_nonuniform_speed=dict(arc_over_chord=1,velocity_residual=nonuniform,one_step_euler_endpoint=0,exact_endpoint=1), dependent_coupling_counterexample='x=epsilon implies z_t=x and v=0; independent endpoint formulas do not apply', errors=[],warnings=[]) Path(__file__).with_name('validation_results.json').write_text(json.dumps(report,indent=2),encoding='utf8') print(json.dumps(report,indent=2)) if __name__ == '__main__': main()
-
AIGC 基本功|分类器无关引导 CFG 的代价与调法-CFG AIGC 基本功|分类器无关引导 CFG 的代价与调法-CFG 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 训练目标与采样流程($\varepsilon$ 预测器、$\bar\alpha_t$ 与 DDIM 那一步怎么走都在那篇推过,这里直接用结论) 关键词:CFG、guidance scale、噪声预测外推、倾斜分布、guidance interval、guidance rescale、autoguidance 01. 为什么需要它 CFG 经常被说成「不增加参数,所以是免费的」。共享权重的常规实现仍需要条件和参考两支预测:可以串行调用两次,也可以把 batch 合并后调用一次。相对同形状的单条件分支,样本级前向算术量约翻倍;调用次数、延迟和峰值显存各有不同口径,后面分别算。 我搭了一个二维高斯混合的玩具:4 个高斯分量,2 个类别,两类故意重叠(类心只差 1.3,标准差 0.6~1.0),每个类里一个紧分量(方差 0.36)一个松分量(方差 1.00)。选它的理由是:高斯混合的 MMSE 去噪器 $E[x_0|x_t]$ 有闭式解,条件分支和无条件分支都是精确的。也就是说,这个玩具里没有任何训练误差,可把训练误差排除,但仍要控制有限步采样、有限样本与数值积分误差。 然后换上一个可控的弱去噪器:把混合分布近似成各向同性高斯,匹配均值和每维平均方差。它有解析的模型偏差,便于单独观察误差与引导如何相互作用;它不能代表真实 UNet 的误差结构。下面各表采用固定种子20260928、200步DDIM、20000个生成样本和40000个真实条件参照样本,方差比的分母也是样本估计。 $w$ 生成方差 / 真实条件方差 软纯度 1.0 0.9856 0.7035 2.0 0.7754 0.8488 3.0 0.6098 0.9211 5.0 0.3768 0.9621 7.5 0.2061 0.9794 15.0 0.0334 0.9930 修正矩匹配后,$w=1$ 方差比为 0.9856,$w=15$ 为 0.0334,软纯度由 0.7035 变为 0.9930。这个单高斯近似保留总方差,却丢失多模态结构;强引导在本例中进一步改变了分布。它不能证明所有弱模型都会同样塌缩,也没有测量真实图像的颜色或结构。 再换回精确条件/无条件去噪器,观察采样分布: $w$ 软纯度 硬纯度 多样性比 典型度 (nats) 类心偏移 真实条件样本(参照) 0.7388 0.7834 1.0000 +0.0000 0.0000 0.0 0.5001 0.5008 1.2512 +0.0081 0.6651 1.0 0.7409 0.7852 0.9876 +0.0030 0.0075 2.0 0.8770 0.9545 0.8596 −0.1995 0.4546 3.0 0.9245 0.9969 0.8193 −0.4974 0.7721 5.0 0.9503 1.0000 0.8042 −1.2480 1.2615 7.5 0.9636 1.0000 0.7933 −2.3042 1.7809 10.0 0.9744 1.0000 0.7603 −3.3963 2.2545 15.0 0.9905 1.0000 0.6716 −5.5530 3.0681 25.0 0.9985 1.0000 0.6033 −9.7613 4.2532 真实参照与 $w=1$ 的软纯度为0.7388对0.7409,平均对数密度差为0对+0.0030,均值偏移为0对0.0075;它们在这些统计上接近。精确score、正确终端分布和精确反向积分的理想条件下,$w=1$ 对应条件采样;这里仍有有限DDIM步数、纯噪声近似起点与有限样本偏差,不能由表格证明完全同分布。 本例 $w=7.5$ 软纯度为0.9636,但平均对数数据密度差为−2.3042 nats、均值偏移为1.7809。这里沿用「典型度」作该密度差的简称,它不是FID、感知质量或分布距离。高斯混合的支撑是整个空间;较低平均密度不能直接翻译成图像过饱和,较高密度也可能来自模式坍缩,仍须结合方差和覆盖判断。 本文关注两支预测的成本、误差组合与幅度统计,以及强度、区间和rescale分别如何干预它们。二维解析实验帮助核对机制;图像观感与参数选择须回到具体模型验证。 指标先对齐。 软纯度为真实后验的样本平均 $E[p(c|x)]$;硬纯度是马氏最近分量标签属于目标类的比例,并非贝叶斯最优分类准确率。多样性比是每维方差平均值之比,不能衡量全部模式覆盖;类心偏移实际是生成均值与参照样本均值的欧氏距离。代码运行于Windows、Python3.11.9、NumPy2.4.3、matplotlib3.10.7,BLAS/OMP单线程;仅官方参考使用已有局部PyTorch2.10 CPU环境,未做GPU或真实图像质量复现。 02. 最小可用理解 三句话: 机制:常规双分支分别预测条件 $c$ 与空条件,然后把无条件预测沿「条件减无条件」的方向外推 $w$ 倍:$e_{\text{guided}}=e_{\text{un}}+w(e_{\text{c}}-e_{\text{un}})$。 成本:固定网络形状时,两支的样本级算术量约为一支的两倍。保留的示意卷积表给出 $1.898\times10^{11}\to3.796\times10^{11}$ MAC与0.126→0.251 GiB逐层输入输出字节和;它不是实际SD-v1-5 UNet逐层测量,也不是峰值显存。 效果:精确模型在固定噪声时刻的组合score是相应倾斜密度的score,但这些密度通常不是某个共同初始密度的前向边际。本文公式 $w=1$ 是条件分支,$w=0$ 是无条件分支;具体pipeline可能对 $w\le1$ 直接关闭双分支。 图中比较软纯度、方差比、平均对数密度差和均值偏移。纯度在较小强度处增长较快,其后放缓;其他变化不必线性。$w=7.5$ 是本实验参照点,也是固定Diffusers v0.35.1 StableDiffusionPipeline接口默认值,不能推广至整个SD系列或视频模型。 03. 数学推导 3.1 符号与定义 DDPM 的前向过程写成 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\,\varepsilon$,训练以本次噪声 $\varepsilon$ 作回归目标,平方损失的最优预测是 $E[\varepsilon|x_t,c]$。记 $$e_{\text{c}}=\varepsilon_\theta(x_t,t,c),\qquad e_{\text{un}}=\varepsilon_\theta(x_t,t,\varnothing)$$ 其中 $\varnothing$ 是空条件(训练时按一定概率丢弃条件,让同一个权重同时充当两个分支)。CFG 的输出是 $$e_{\text{guided}}=e_{\text{un}}+w\,(e_{\text{c}}-e_{\text{un}})=w\,e_{\text{c}}+(1-w)\,e_{\text{un}}$$ 这个改写值得停一下:它是两支预测的仿射组合,系数和为1;在 $w>1$ 时无条件系数为负。$w=1$ 时退化成纯条件分支,$w=0$ 时退化成纯无条件分支,$w>1$ 时无条件分支的系数 $1-w\lt 0$,也就是把「条件相对无条件的优势」往远处推。 常用实现以随机丢弃条件让同一主干学习两支预测;也可分别训练条件与无条件模型。原CFG论文比较过0.1、0.2、0.5的条件丢弃概率,不能当作文生图全系列配置。共享主干通常避免再存一整套网络,空条件embedding是否有额外参数取决于架构;训练仍需分配容量学习空条件任务。原论文写 $(1+w_{\mathrm{paper}})e_{\mathrm{c}}-w_{\mathrm{paper}}e_{\mathrm{un}}$,本文采用Diffusers的 $w=1+w_{\mathrm{paper}}$,引用强度前先统一约定。 3.2 它和「倾斜分布」是什么关系 先明确精确关系。令 $p_t(x_t|c)$ 为前向加噪后的条件边际,$m_t=E[x_0|x_t,c]$ 为平方损失下最优干净样本预测,$\sigma_t=\sqrt{1-\bar\alpha_t}$。对高斯核求导,再用后验期望提出积分,得到 $$s_t(x_t|c)=\nabla_{x_t}\log p_t(x_t|c)=-\frac{x_t-\sqrt{\bar\alpha_t}m_t}{\sigma_t^2}=-\frac{E[\varepsilon|x_t,c]}{\sigma_t}$$ 最优噪声预测器与真实score只差缩放;一般训练网络只有近似关系,向量场也不必恰好是归一化密度的梯度。下面先在精确模型下讨论: $$\tilde{s}(x_t|c)=\nabla\log p(x_t|\varnothing)+w\big(\nabla\log p(x_t|c)-\nabla\log p(x_t|\varnothing)\big)=(1-w)\nabla\log p(x_t)+w\,\nabla\log p(x_t|c)$$ 每个固定噪声时刻定义 $$q_t(z|c)=Z_t^{-1}p_t(z|c)^w p_t(z)^{1-w}$$ $z$ 为该时刻样本,$Z_t$ 为积分归一化常数,不随 $z$ 变化。对真实离散类别,贝叶斯公式给出 $q_t\propto p_t(z)p_t(c|z)^w$;$w\ge0$ 且类别先验非零时,后验有界保证可归一化。任意两个独立模型或负向prompt的密度比需另行检查。其score为 $$\nabla_z\log q_t(z|c)=w\nabla_z\log p_t(z|c)+(1-w)\nabla_z\log p_t(z)$$ 两式的梯度相同,但这只是固定时刻的恒等式,不保证所有 $q_t$ 能由同一个 $q_0$ 加噪得到。 关键是时间相容性:「先倾斜再加噪」通常不同于「分别加噪再倾斜」。一个可手算反例是 $p(z|c)=N(0,1)$、$p(z)=N(0,2)$、$w=2$。取 $P(c)=1/2$ 时后验最大为 $\sqrt2/2$,另一类密度取 $2p(z)-p(z|c)$ 非负且积分为1,可构成合法条件/边际对。初始倾斜方差为 $(2-1/2)^{-1}=2/3$;再做 $\bar\alpha_t=1/2$ 的前向加噪,方差为 $5/6$。若先分别加噪,两支方差为1与 $3/2$,再倾斜得到 $(2-2/3)^{-1}=3/4$。两种边际不同,说明score恒等式不能直接推出终点分布;特殊模型可能相等,偏差也未必随强度单调增加。 本toy另从归一化倾斜密度作网格近似采样:$w=7.5$ 时CFG样本与倾斜样本的固定目标交叉熵为3.6926与2.2258 nats,结合均值/方差给出数值反证。交叉熵差不是KL,仍需检查网格与抽样误差,见第08节。 几何上看得更直接: 三图为条件密度、归一化倾斜密度和DDIM样本平滑直方图。灰线共用无条件密度标尺,蓝点为真实条件样本均值,右图红点为生成均值,偏移约1.78。窗口仅 $[-4.2,4.2]^2$;直方图丢弃窗外点再在窗口内归一化,不能用颜色比较全部尾部质量,也不能据此量化图像过曝。 3.3 误差放大:为什么最坏上界是 $2w-1$ 设真实的条件/无条件预测为 $e^\star_{\text{c}}$ 与 $e^\star_{\text{un}}$,模型误差为 $\delta_{\text{c}}=e_{\text{c}}-e^\star_{\text{c}}$、$\delta_{\text{un}}=e_{\text{un}}-e^\star_{\text{un}}$。引导后预测相对「同样加权过的真值」$w e^\star_{\text{c}}+(1-w)e^\star_{\text{un}}$ 的误差是 $$\delta_{\text{guided}}=w\,\delta_{\text{c}}+(1-w)\,\delta_{\text{un}}$$ 取范数并放缩: $$\|\delta_{\text{guided}}\|\le w\|\delta_{\text{c}}\|+(w-1)\|\delta_{\text{un}}\|\le(2w-1)\max\big(\|\delta_{\text{c}}\|,\|\delta_{\text{un}}\|\big)$$ 这里限定 $w\ge1$,故 $|1-w|=w-1$;一般强度的系数界为 $|w|+|1-w|$。该界比较引导预测相对同样加权真值的误差,不是相对条件预测的误差,也不是端到端分布或画质界。共同误差 $\delta_{\mathrm{c}}=\delta_{\mathrm{un}}$ 会原样保留;相反误差可达到上界;取 $\delta_{\mathrm{un}}=2\delta_{\mathrm{c}}$、$w=2$ 又能完全抵消。实际误差不必随强度单调放大。 3.4 幅度统计与图像过曝的区别 外推可能增大预测幅度,但并非必然。中心化逐元素方差满足 $$\operatorname{Var}(e_g)=w^2\operatorname{Var}(e_c)+(1-w)^2\operatorname{Var}(e_u)+2w(1-w)\operatorname{Cov}(e_c,e_u)$$ 相关性一个数不足以决定趋势。重建 $\hat x_0=(x_t-\sigma_t e_g)/\sqrt{\bar\alpha_t}$ 还依赖向量方向和噪声档位;标准差大不能直接推出样本远离中心或图像过曝。本文固定探测点上确有幅度增长,作为数值现象报告,Lin等人的图像rescale实验是另一类证据。 04. 代码实现 核心是「精确去噪器 + DDIM」。高斯混合下 $E[x_0|x_t]$ 有闭式解:分量内部是高斯的,所以 $$E[x_0|x_t,k]=\mu_k+\frac{\bar\alpha_t^{1/2}\,\sigma_k^2}{\bar\alpha_t\sigma_k^2+(1-\bar\alpha_t)}\big(x_t-\bar\alpha_t^{1/2}\mu_k\big)$$ 再按分量后验 $r_k=p(k|x_t)$ 加权。代码就是这一行公式: def x0_hat(X, a_bar, logw): s = np.sqrt(a_bar) v = a_bar * VAR + (1.0 - a_bar) gain = VAR * s / v r = posterior(X, a_bar, logw) per = MU[None, :, :] + gain[None, :, None] * (X[:, None, :] - s * MU[None, :, :]) return (r[:, :, None] * per).sum(axis=1) 其中 $k$ 是分量索引,$\mu_k$ 是二维均值,$\sigma_k^2$ 是各向同性方差,$a=\bar\alpha_t$。在分量k内部,高斯条件均值增益是交叉协方差乘观测协方差的逆;各向同性化后其标量系数为 $$g_k=\frac{\sqrt a\sigma_k^2}{a\sigma_k^2+1-a}$$ 因此分量后验为 $$r_k=\frac{\pi_k N(x_t;\sqrt a\mu_k,(a\sigma_k^2+1-a)I)}{\sum_j\pi_j N(x_t;\sqrt a\mu_j,(a\sigma_j^2+1-a)I)}$$ 再用全期望公式加权。条件分支只把 $\pi_k$ 换成类内归一化先验;这是解析计算,不是训练了一个神经网络。弱分支的各向同性矩匹配应为 $$m=\sum_k\pi_k\mu_k,\qquad v=\frac{1}{d}\sum_k\pi_k\left(d\sigma_k^2+\|\mu_k-m\|^2\right)$$ $d=2$,分量内方差必须先乘维数再平均。条件 $v=0.84$、无条件 $v=1.06625$;它只匹配协方差的迹,不能匹配完整协方差和多模态结构。 这里有个实现上的坑值得单独说:类内重新归一化之后,类外分量的先验变成 0,$\log 0$ 会直接炸。所以所有先验都要先过一遍 safe_log,把非正的权重映到 $-\infty$ 而不是让 numpy 抛 RuntimeWarning。这个坑在写倾斜分布那段还会再咬一次——$\log p_{\text{tilde}}$ 的归一化常数要在网格上做数值积分,网格范围取窄了(比如只取 $\pm3.6$)会把分布的尾巴切掉,归一化常数偏小,后面所有交叉熵都跟着错。本文用的是 $\pm9$ 的 420 点网格。 $\varepsilon$ 预测和 DDIM 的一步: def eps_hat(X, t, logw): a = abar(t) return (X - np.sqrt(a) * x0_hat(X, a, logw)) / np.sqrt(1.0 - a) # DDIM (eta=0) 的一步,含 CFG 与引导区间 e_un = fn(X, t, LOGW_UNCOND) e_c = fn(X, t, LOGW_COND) w_eff = w if (lo <= t / T <= hi) else 1.0 e_g = e_un + w_eff * (e_c - e_un) x0 = (X - np.sqrt(1.0 - a) * e_g) / np.sqrt(a) X = np.sqrt(a_prev) * x0 + np.sqrt(max(1.0 - a_prev, 0.0)) * e_g 五行里三个细节值得说: w_eff 那一行的 t / T 是归一化时间索引,区间外直接退回 $w=1$(不是 $w=0$)。这是本教学实现的区间开关;是否跳过参考支另见第06节。 e_g 可以写成 w_eff * e_c + (1 - w_eff) * e_un,两者数值等价但后者在 $w$ 很大时更容易看出负系数——建议保留后者以免误读。 DDIM 的更新里 $x_0$ 和 $e_g$ 用的是同一个 $e_g$,所以缩放 $e_g$ 会同时改变 $x_0$ 和噪声项,不是单向的。这一点在第 06 节 rescale 那一段会咬人。 先验证去噪器本身是对的。做法是数值积分对拍:固定 20 万真实样本,对每个探测点 $x_t$ 按 $q(x_t|x_0)$ 加权求样本平均,跟闭式解比。 [Q1] 精确去噪器 E[x0|xt] 的数值积分对拍 t alpha_bar 闭式解 E[x0] 数值积分 E[x0] 最大绝对差 1 9.999000e-01 [-0.80383,-0.00497] [-0.80352,-0.00542] 3.00e-02 50 9.710157e-01 [+0.33377,-0.32706] [+0.33434,-0.32566] 1.13e-02 200 6.590385e-01 [-1.63345,-1.01052] [-1.62640,-1.00988] 1.32e-02 500 7.858724e-02 [-0.03520,+0.23795] [-0.03229,+0.24075] 1.03e-02 900 2.752059e-04 [+0.01798,-0.00712] [+0.02195,-0.00467] 4.12e-03 1000 4.035830e-05 [+0.00501,-0.00579] [+0.00899,-0.00330] 4.03e-03 这些重要性采样结果与闭式解相容,但误差随噪声变化不能证明公式正确:低噪声时权重可能集中到极少数样本。闭式解的依据是上述高斯条件公式;独立对数密度有限差分验证score/MMSE关系,最大绝对差约 $1.17\times10^{-10}$。附录cfg_checks.py也核对矩匹配、倾斜归一化和实际步数。 再验证采样器步数够不够($w=7.5$): steps 软纯度 多样性比 典型度 类心偏移 50 0.9640 0.7490 -2.2718 1.7794 100 0.9637 0.7782 -2.2930 1.7803 200 0.9636 0.7933 -2.3042 1.7809 400 0.9635 0.8006 -2.3101 1.7814 1000 0.9635 0.8055 -2.3136 1.7815 这些是同一批起点、不同积分网格的敏感性检查;400步现恰好执行400步,原先整除步长会误执行500步。1000步仍不是连续时间真值。后文保留200步口径;不能用单项变化小来声称整个采样器已精确收敛。 05. 工业级实现对照 参考实现: Diffusers固定版本SD pipeline源码 → StableDiffusionPipeline.__call__ 以固定Diffusers v0.35.1源码为准,去噪循环里的核心是这几行: # expand the latents if we are doing classifier free guidance latent_model_input = torch.cat([latents] * 2) if self.do_classifier_free_guidance else latents if hasattr(self.scheduler, "scale_model_input"): latent_model_input = self.scheduler.scale_model_input(latent_model_input, t) noise_pred = self.unet(latent_model_input, t, encoder_hidden_states=prompt_embeds, timestep_cond=timestep_cond, cross_attention_kwargs=self.cross_attention_kwargs, added_cond_kwargs=added_cond_kwargs, return_dict=False)[0] if self.do_classifier_free_guidance: noise_pred_uncond, noise_pred_text = noise_pred.chunk(2) noise_pred = noise_pred_uncond + self.guidance_scale * (noise_pred_text - noise_pred_uncond) if self.do_classifier_free_guidance and self.guidance_rescale > 0.0: noise_pred = rescale_noise_cfg(noise_pred, noise_pred_text, guidance_rescale=self.guidance_rescale) latents = self.scheduler.step(noise_pred, t, latents, **extra_step_kwargs, return_dict=False)[0] 和我的最小实现比,有四处差异,每一处都有理由: 第一,合批不等于只启动一个 kernel。 torch.cat 让一次 UNet 调用同时处理两分支,但网络仍包含很多算子、kernel 和临时张量。理论算术量约翻倍;实际延迟与吞吐取决于 batch、显存、并行和硬件,不能直接断言延迟只涨 30%~60% 或吞吐必然减半。 第二,do_classifier_free_guidance 是一个属性而不是参数: @property def do_classifier_free_guidance(self): return self._guidance_scale > 1 and self.unet.config.time_cond_proj_dim is None 固定实现对 $w\le1$(包括0)都关闭双分支,输出普通条件预测;不能靠把该接口设0复现本文公式的无条件端点。负向embedding也可由调用者预先准备,不能说它在一切情况下从未构造。第二个条件说明带guidance embedding的配置另有路径;LCM、LCM-LoRA和其他少步模型应按实际配置判断。 第三,rescale_noise_cfg 把缩放做成了插值而不是替换: std_text = noise_pred_text.std(dim=list(range(1, noise_pred_text.ndim)), keepdim=True) std_cfg = noise_cfg.std(dim=list(range(1, noise_cfg.ndim)), keepdim=True) noise_pred_rescaled = noise_cfg * (std_text / std_cfg) noise_cfg = guidance_rescale * noise_pred_rescaled + (1 - guidance_rescale) * noise_cfg Lin等人原论文3.4节已包含标准差重缩放与 $\phi$ 插值,并报告其配置下 $w=7.5,\phi=0.7$ 效果较好;插值不是Diffusers额外发明的机制。固定SD和SDXL接口的guidance_rescale默认均为0。统计按每样本跨通道/空间维度求,PyTorch std默认作样本方差校正;缩放整个向量,并未先去均值。原函数无分母下界:常量预测可产生0/0或非有限值,移植时须明确跳过/夹紧策略,并记录该策略改变了退化输入定义。 原rescale函数、属性及原 __call__ 中的CFG算术块已在CPU执行,和独立参考误差为 $4.44\times10^{-16}$ 与 $7.11\times10^{-15}$;没有运行完整pipeline或图像checkpoint。 第四,负向prompt走同一个条件通道。 参考支可由空文本换成负向文本,此时它是另一条件预测,不是真正无条件边际的score。组合公式保留,前述贝叶斯后验的密度解释需改写;「不要什么」是操作意图,公式不保证指定语义必被删除。 06. 代价与边界 6.1 算力账:样本级当量、调用次数与峰值显存 保留受SD通道尺度启发的简化卷积表来说明固定计算图上batch翻倍。它合并了不同残差块的通道、省略真实上下采样细节,不是实际UNet清单,绝对量不能称为真实模型的MAC下限或参数量。 示意表,64×64潜空间、每元素2字节 单分支:MAC 1.898e11;逐层输入输出字节和0.126 GiB 双分支:MAC 3.796e11;逐层输入输出字节和0.251 GiB 示意卷积权重约517.0 M,权重不因batch翻倍 单层公式为 $\mathrm{MAC}=B H_o W_o C_i C_o k^2$,$H_o,W_o$ 为输出高宽,$C_i,C_o$ 为输入输出通道,$k$ 为方形核边长;一次乘加计一个MAC,按乘法和加法分别计FLOPs时主体约为两倍MAC。逐层字节和不是峰值显存或DRAM流量的上下界:权重共享、串行分支复用、残差暂存、工作区和融合都会影响真实占用。1 GiB为 $2^{30}$ 字节。 修正im2col先把窗口转成 $(B,H,W,C,k_h,k_w)$,再展平每位置的卷积核;直接reshape会混淆空间与核维度。逐索引卷积及PyTorch conv2d均对拍通过。下为本机float32、64×64×320→320、3×3卷积计时,预热一次、5次取最小,包括展平和分配: batch=1 : 0.1469 s batch=2 : 0.2883 s 时间比 : 1.9630 串行是两次网络调用,合批是一次batch翻倍的调用;两者均为两个样本级前向当量。50步对应50对100个当量,合批仍是50次UNet调用。CPU/GPU延迟、吞吐和峰值显存须实测,单个卷积时间比不构成完整模型瓶颈证明。 左图倍数只来自示意账本;中图分母为逐点两支误差较大范数的平均,与 $2w-1$ 界一致;右图是在固定探测点上的预测幅度统计。不同图使用各自记录的探测随机流,不应强行对齐最后几位。 6.2 误差组合:同一分母下核对上界 探测点固定为「真实数据前向扩散到 $t$」,与 $w$ 无关,这样排除轨迹漂移的干扰: $t$ $w=1$ $w=2$ $w=3$ $w=5$ $w=7.5$ $w=15$ 1000 1.000 2.411 3.824 6.651 10.186 20.791 700 1.000 2.403 3.808 6.620 10.136 20.685 400 0.986 2.198 3.429 5.899 8.991 18.271 200 0.952 1.915 2.925 4.974 7.551 15.302 50 0.896 1.666 2.518 4.276 6.502 13.217 10 0.890 1.639 2.473 4.198 6.384 12.983 所有列现使用同一分母 $E[\max(\|\delta_c\|,\|\delta_u\|)]$,因此可与对应界1、3、5、9、14、29直接比较。表格只报告此toy探测批结果,不把预测相关系数当作误差相关系数,也不由小t的趋势推导所有模型更易失稳。相反/共同误差与完全抵消反例见第03节和附录。 6.3 幅度膨胀与 rescale 的边界 $t=300$ 处,探测点来自真实条件样本: $w$ 标准差比 0.0 0.9110 1.0 1.0000 2.0 1.1009 3.0 1.2109 5.0 1.4493 7.5 1.7690 10.0 2.1026 15.0 2.7914 25.0 4.2052 本探测批的标准差比由0.9110升至4.2052;它是整批二维坐标的统计,不是图像逐样本统计。不能仅凭无条件分支覆盖更多分量就推导其幅度更小,均值、协方差与探测分布共同决定结果。 下面只做二维 toy 的 batch 标准差线性 rescale,在 $w=15$ 下扫系数 $\phi$。真实图像实现按每个样本的 C/H/W 统计;二维向量只有两个坐标,不能把此处整批统计量当成原论文的逐样本实现: $\phi$ 多样性比 典型度 软纯度 0.0 0.6716 −5.5530 0.9905 0.3 0.8274 −6.1435 0.9910 0.5 0.9513 −6.5778 0.9913 0.7 1.0944 −7.0504 0.9914 1.0 1.3521 −7.8447 0.9916 本toy方差比上升,但平均对数密度差更负;它不能替代真实图像的逐样本rescale实验。若预测乘 $k$,重建改变量为 $$\Delta\hat x_0=(1-k)\frac{\sigma_t}{\sqrt{\bar\alpha_t}}e_g$$ 方向由 $e_g$ 决定,取相反预测就得到相反改变量,不能一般说成「把样本往噪声推」。本实验也无像素或感知指标,不能据此声称已修复过曝。 6.4 引导区间:指标取舍与计算成本 把 $w=7.5$ 只开在归一化噪声档位 $t/T$ 的某个区间内(区间外退回 $w=1$): 区间($t/T$) 软纯度 多样性比 典型度 类心偏移 说明 $[0.0,1.0]$ 0.9636 0.7933 −2.3042 1.7809 全程开 $[0.5,1.0]$ 0.9126 0.9571 −0.8896 0.9365 只在高噪声段(链首) $[0.2,0.8]$ 0.9594 0.8167 −2.0693 1.6609 只在中段 $[0.0,0.5]$ 0.9519 0.7672 −1.1345 1.2251 只在低噪声段(链尾) $[0.0,0.2]$ 0.9042 0.8172 −0.0831 0.4222 只在极低噪声段 $[0.0,0.0]$ 0.7409 0.9876 +0.0030 0.0075 全程不开($w=1$ 基线) 再细扫两族区间,用「纯度增益 / 典型度代价」当性价比: 细扫 A:只开链尾(区间 = [0, hi]) 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比 [0.0,0.1] +0.0829 0.0099 8.345 0.1649 0.8899 [0.0,0.2] +0.1632 0.0861 1.896 0.4222 0.8172 [0.0,0.3] +0.1921 0.3080 0.624 0.6888 0.7890 [0.0,0.4] +0.2040 0.6816 0.299 0.9630 0.7737 [0.0,0.5] +0.2110 1.1375 0.185 1.2251 0.7672 [0.0,0.8] +0.2211 2.1335 0.104 1.7045 0.7862 [0.0,1.0] +0.2226 2.3072 0.097 1.7809 0.7933 细扫 B:只开链首(区间 = [lo, 1.0]) 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比 [0.0,1.0] +0.2226 2.3072 0.097 1.7809 0.7933 [0.3,1.0] +0.2154 2.0350 0.106 1.6224 0.8669 [0.5,1.0] +0.1716 0.8926 0.192 0.9365 0.9571 [0.7,1.0] +0.0674 0.1837 0.367 0.2866 0.9813 [0.9,1.0] +0.0101 0.0209 0.481 0.0438 0.9868 本toy只开链尾10%时纯度增益约0.0829、平均对数密度损失约0.0099,比值约8.345。比值带每nat单位,分母近零时敏感;它不是统一质量指标或计算效率。比值最低的点未必被其他点帕累托支配,因为它可能同时取得最高纯度。区间效果不可简单相加,沿途轨迹会改变。 横轴为相对无引导基线的平均对数密度损失,纵轴为软纯度增益,虚线只是固定比值线。两族仅描述本toy的离散候选,不证明完整帕累托前沿。换模型后若增益或代价非正、接近零,双对数图与比值都需调整。 原论文的图像实验发现高噪声引导可能有害、低噪声多余、中段更有用;本toy的指标偏好链尾,不能直接对齐。这里只说明区间值得检验,不能推出所有模型全程引导必非最优。当前教学代码在区间外仍计算两支再设 $w=1$,只改区间并未省算力;生产实现若跳过参考支,$S$步仅 $G$步引导可由 $2S$ 降至 $S+G$ 个当量。$t/T$ 是时间索引比例,不等于标准差或SNR比例,也不是原论文噪声区间的直接坐标。 6.5 什么时候应先核对实现 guidance embedding或蒸馏模型先核对训练目标与推理接口,避免未经训练支持就叠加双分支。 多样性、覆盖和条件一致性分别测量,不能只凭软纯度上涨继续加大强度。 弱模型效果取决于误差方向,本toy不是一般模型失效定理。 要省算力时检查参考支是否真正跳过,再量目标硬件的延迟与显存。 07. 经典论文脉络 Classifier-Free Diffusion Guidance(原论文):联合学习条件/无条件预测,研究保真度与多样性取舍。其引导强度约定比本文少1,也讨论条件丢弃与推理成本,不应说完全没量化代价。 Common Diffusion Noise Schedules and Sample Steps are Flawed(arXiv:2305.08891)——Lin 等人。其中两项建议是训练端的 zero-terminal-SNR 调度(让最后一步真的能走到纯噪声)与推理端的 guidance rescale(3.4 节)。Rescale 直接对着「$w$ 大了会过曝」这个现象下刀,是 rescale 方法的来源;6.3 节数值由本文二维 batch 统计 toy 实测,并非论文原表。 Applying Guidance in a Limited Interval Improves Sample and Distribution Quality in Diffusion Models(arXiv:2404.07724)——Kynkäänniemi 等人(NeurIPS 2024)。指出引导在链首有害、链尾基本没必要、只有中段有用,把引导限制在噪声水平的某个区间内,ImageNet-512 的 FID 从 1.81 降到 1.40,并建议在所有用引导的扩散模型里把区间作为超参暴露出来。 Guiding a Diffusion Model with a Bad Version of Itself(原论文):用容量较小、训练较少的模型作参考支,保持条件任务一致,研究质量与条件对齐的分离控制;也适用于无条件生成。不能把较差模型简单解释为只保留低频,也不能由负系数推出更语义化方向。 Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference(arXiv:2310.04378)——Luo 等人。把「带引导的反向过程」看成一个增广的概率流 ODE,直接蒸馏它的解。这一步之后 $w$ 变成网络的一个输入,每步只需一次前向——这是「干掉 CFG 那 2×」最彻底的一条路,也是知识树里 step_distillation 那篇要展开的内容。 这些工作分别处理引导组合、噪声日程与rescale、引导区间、参考模型选择及引导蒸馏,并非所有模型必经的单一替代链。专门训练可减少推理步骤/分支,但会增加训练与适用范围上的约束,不能说所有少步模型都把同一个w作为输入。 08. 常见误解 误解一:「CFG 就是在采样 $p(x|c)^w p(x)^{1-w}$。」 精确score在固定时刻恒等,最终分布层面不能由此保证。参考统计量是交叉熵 $-E_{X\sim Q}[\log P(X)]$。不同列目标不同,不能横向比较“越小越像”;即使固定 $P$,较低交叉熵也可能来自模式坍缩,需与均值、方差或分布距离联读: 下表 $H_c,H_t,H_u$ 分别为以条件、倾斜和无条件密度作目标的交叉熵,单位nats;后表保留同一批样本的矩统计。 强度/来源 $H_c$ $H_t$ $H_u$ 真实条件 2.5757 — 2.8562 1.0/CFG 2.5670 2.5670 2.8532 1.0/倾斜 2.5891 2.5891 2.8706 3.0/CFG 2.7405 2.4039 3.3536 3.0/倾斜 2.4824 2.3227 3.0070 7.5/CFG 4.5048 3.6926 5.1605 7.5/倾斜 2.6350 2.2258 3.2287 15.0/CFG 7.7257 6.1882 8.4092 15.0/倾斜 2.9792 2.2782 3.6030 强度/来源 方差比 均值偏移 真实条件 1.0000 0.0000 1.0/CFG 0.9876 0.0075 1.0/倾斜 1.0090 0.0096 3.0/CFG 0.8193 0.7721 3.0/倾斜 0.8944 0.3546 7.5/CFG 0.7933 1.7809 7.5/倾斜 0.9077 0.6028 15.0/CFG 0.6716 3.0681 15.0/倾斜 1.0059 0.8828 $w=1$ 两行有限统计接近,不证明同分布。$w=7.5$ 固定目标交叉熵差约1.47 nats,结合均值偏移1.78对0.60支持本设定中分布不同。log-sum-exp保留归一化偏移;420与840网格的log常数差小于 $1.3\times10^{-14}$,$w=1$ 对数密度恒等误差约 $3.1\times10^{-14}$。这是指定窗口内的数值敏感性检查,不是尾部误差严格界;第03节的解析方差反例不依赖本表抽样。 误解二:「w越大越准。」 必须先定义「准」是条件一致性、覆盖、概率拟合还是观感,不能用一列替代所有目标。 误解三:「没有第二套主干参数,就没有推理成本。」 两支增加样本级当量;示意表MAC由 $1.898\times10^{11}$ 增至 $3.796\times10^{11}$,不等于实际延迟或显存必翻倍。 误解四:「w调小一点就省算力。」 固定双分支配置中由30改成1.01不减少当量;真正关闭参考支或跳过部分步骤才会减少计算,条件计算模型还须检查实际路径。 误解五:「rescale修好了分布,可以无限加w。」 它匹配一种标准差并插值,不保证拟合真实分布;本toy不能替代原论文图像实验。 误解六:「w小于1就是条件采样变弱。」 公式中 $0\lt w\lt 1$ 为预测插值,不是分布混合;固定SD接口对 $w\le1$ 关闭双分支,不能靠把接口设0复现toy的无条件端点。 09. 动手验证 五个小实验,脚本在附录里,全部只依赖 numpy 与 matplotlib。 实验一:独立验证。 先跑cfg_checks.py,以高斯矩、密度有限差分和逐索引卷积核对公式/代码;再看Q1重要性采样,理解小t权重退化,不把误差趋势当正确性证明。 实验二:扫自己的w。 修改SPECS,保持方差为正并归一化权重,比较同一起点的Q2统计。必要时换seed并增加样本,分别观察条件一致性、方差和密度,不要求新模型复现本文曲线。 实验三:扫引导区间。 记录Q5增益与代价的绝对量,检查近零分母;要量计算收益,须真正跳过区间外参考支并核对调用数,指标比值不能替代吞吐。 实验四:算真实模型。 CONVS只演示固定图随batch的变化。实际UNet账本应由真实模块形状导出,区分权重、同时活跃张量、工作区与硬件计时;修改示意表几行不保证得到模型下限。 实验五:构造反例。 cfg_checks.py检查先倾斜/先加噪的5/6与3/4方差、误差保持/达到界/抵消,以及rescale改变量方向可相反。先核对边界,再在真实模型评估画质。 10. 延伸阅读 读这篇之前建议先看: DDPM 训练目标与采样流程——$\varepsilon$ 预测器、$L_{\text{simple}}$、以及采样循环怎么写。本文 04 节的 DDIM 一步直接用了那篇的结论。 扩散过程的前向与反向推导——$\bar\alpha_t$、后验方差、以及 $\varepsilon$ 与 score 的换算关系(3.2 节那一步在那篇推过)。 从 DDIM 到高阶采样器——本文全部实验用 DDIM $\eta=0$,换采样器会改变引导误差累积的方式。 VAE的ELBO——可补读条件期望与训练目标;VAE不是本文CFG的必要前提。 读完之后: 少步蒸馏——继续讨论带引导过程如何进入蒸馏目标。 回到知识树:本文是「生成范式」方向的一级节点,往上接 DDPM,往下接少步蒸馏。 附录:完整代码 09 节用到的脚本全文如下(cfg_checks.py、cfg_gmm.py、cfg_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 cfg_checks.py """Independent CFG algebra, moment, convolution and numerical-boundary checks (NumPy only).""" import json from pathlib import Path import numpy as np import cfg_gmm as G import cfg_lab as L def validate(): rng = np.random.default_rng(20261020) moment_errors = [] for logw in [G.LOGW_COND, G.LOGW_UNCOND]: w = np.exp(logw); w /= w.sum() mean = w @ G.MU cov = sum(w[k]*(G.VAR[k]*np.eye(G.DIM)+np.outer(G.MU[k]-mean,G.MU[k]-mean)) for k in range(G.K)) m,v = G.single_gauss(logw) moment_errors += [float(np.max(np.abs(m-mean))),float(abs(v-np.trace(cov)/G.DIM))] # Direct index convolution checks avoid reproducing im2col's axis order. x = rng.normal(size=(2,2,4,5)); w = rng.normal(size=(3,2,3,3)) padded = np.pad(x,((0,0),(0,0),(1,1),(1,1))) expected = np.zeros((2,3,4,5)) for n in range(2): for co in range(3): for h in range(4): for j in range(5): expected[n,co,h,j] = np.sum(padded[n,:,h:h+3,j:j+3]*w[co]) conv_error = float(np.max(np.abs(L.conv3x3(x,w)-expected))) # Finite-difference log-mixture gradients independently verify MMSE-score identity. X = rng.normal(size=(30,2)); score_errors=[] for t in [1,200,900]: a = G.abar(t); h = 1e-5 for logw in [G.LOGW_COND,G.LOGW_UNCOND]: def lp(q):return G.logsumexp_rows(G.logpdf_comps(q,a)+logw[None,:]) grad = np.column_stack([(lp(X+h*np.eye(2)[i])-lp(X-h*np.eye(2)[i]))/(2*h) for i in range(2)]) pred = -G.eps_hat(X,t,logw)/np.sqrt(1-a) score_errors.append(float(np.max(np.abs(pred-grad)))) # p_u=N(0,2), p_c=N(0,1) can be genuine marginals: prior p(c)=1/2 bounds p(c|x)<=sqrt(2)/2. # w=2 gives tilted variance 2/3 at t=0; alpha_bar=1/2 yields 5/6 after forward noise, # whereas tilting the separately noised branches gives 3/4. tilted0 = 1/(2/1-1/2); forward = 0.5*tilted0+0.5 tilted_t = 1/(2/(0.5*1+0.5)-1/(0.5*2+0.5)) # Error cancellation and tightness do not require Monte Carlo or trained models. dc,du = np.array([1.,-2.]), np.array([-1.,2.]) tight_error = abs(np.linalg.norm(3*dc-2*du)-5*np.linalg.norm(dc)) cancel = 2*np.array([1.,0.])-np.array([2.,0.]) # Rescaling epsilon by k changes x0 by +(1-k)*sqrt((1-a)/a)*epsilon, whose direction is not fixed. a,k = 0.5,0.5 delta = [float((1-k)*np.sqrt((1-a)/a)*eps) for eps in [-2.,2.]] grid = {} for wval in [1.,7.5,15.]: values=[] for n in [420,840]: G.logp_tilt_norm(np.zeros((1,2)),wval,n=n) values.append(G._TILT_CACHE[(wval,-9.,9.,n)]) grid[str(wval)] = dict(logZ=values,absolute_difference=abs(values[0]-values[1])) identity = float(np.max(np.abs(G.logp_tilt_norm(X,1.)-G.logp_cond(X)))) counts={str(s):len(G.ddim_timesteps(s)) for s in [1,50,200,400,1000]} assert max(moment_errors)<1e-12 and conv_error<1e-12 and max(score_errors)<1e-7 assert abs(forward-5/6)<1e-12 and abs(tilted_t-3/4)<1e-12 and tight_error<1e-12 assert np.linalg.norm(cancel)==0 and identity<1e-10 assert all(int(k)==v for k,v in counts.items()) result=dict(passed=True,moment_max_error=max(moment_errors),conditional_isotropic_variance=G.single_gauss(G.LOGW_COND)[1], unconditional_isotropic_variance=G.single_gauss(G.LOGW_UNCOND)[1],convolution_max_error=conv_error, score_finite_difference_max_error=max(score_errors),time_compatibility_counterexample=dict(initial_tilt_variance=tilted0,forward_tilt_variance=forward,tilt_noised_variance=tilted_t), error_bound_tightness_error=tight_error,error_cancellation_norm=float(np.linalg.norm(cancel)),rescale_x0_delta_opposite_signs=delta, tilt_grid_convergence=grid,w1_normalization_error=identity,timestep_counts=counts,errors=[],warnings=[]) return result if __name__ == '__main__': result=validate() Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2),encoding='utf-8') print(json.dumps(result,ensure_ascii=False,indent=2)) cfg_gmm.py # -*- coding: utf-8 -*- """cfg_gmm.py —— 在一个「去噪器可解析求解」的高斯混合模型上把 CFG 做实。 为什么非要用 GMM: CFG 需要一支条件去噪器和一支无条件去噪器。用真网络的话两支都有训练误差, 观察到的形变会混入模型误差。而 GMM 的 MMSE 去噪器 E[x0|xt] 有闭式解,两支都是**精确**的,但采样仍有有限步、起点和有限样本误差。 另外 p_t(x_t|c) 也有解析式,可以直接验证「CFG 是不是在从倾斜分布 p(x|c)^w p(x)^{1-w} 里采样」这个命题。 本脚本回答六个问题(全部是实跑数字,不是推测): Q1 精确去噪器对不对?(数值积分对拍) Q2 w 扫描:条件纯度 / 多样性 / 典型度 怎么变? Q3 CFG 采出来的分布,是不是那个倾斜分布? Q4 w 把去噪器的**误差**放大了多少倍?(最坏上界 2w-1) Q5 只在某个噪声区间开引导,比全程开好吗? Q6 引导后的预测幅度膨胀多少?rescale 能不能压回去? 运行: /usr/local/bin/python3 cfg_gmm.py 依赖: numpy(无 torch,全部闭式解 + 向量化) """ import numpy as np # ═════════════════════════════ 1. 数据:两组、四个高斯分量 ═════════════════════════════ # (均值, 各向同性方差, 无条件权重, 类别标签) # 设计意图:两类故意重叠(类心相距约 1.3,分量标准差 0.6~1.0), # 这样 w=1 时条件采样仍会「漏」到对面,给 CFG 留出可观测的改善空间。 # 两类各有一个「紧」分量和一个「松」分量 —— 方差不齐是后面「模式漂进尾巴」的关键。 SPECS = [ ((-0.90, -0.05), 0.36, 0.25, 0), ((-0.10, -0.85), 1.00, 0.25, 0), ((0.90, 0.05), 0.36, 0.25, 1), ((0.10, 0.85), 1.00, 0.25, 1), ] MU = np.array([s[0] for s in SPECS], dtype=float) # [K, 2] VAR = np.array([s[1] for s in SPECS], dtype=float) # [K] PI = np.array([s[2] for s in SPECS], dtype=float) # [K] CLS = np.array([s[3] for s in SPECS], dtype=int) # [K] K = len(SPECS) DIM = 2 TARGET_CLS = 1 # 本文统一用「条件 = 类别 1」做演示 # ── 调度:DDPM 线性 beta,T=1000(与 ddpm 那篇同一套口径)── T = 1000 BETAS = np.linspace(1e-4, 0.02, T) ALPHAS = 1.0 - BETAS ABAR = np.cumprod(ALPHAS) # alpha_bar,下标 0 对应 t=1 def abar(t): """alpha_bar_t,t 从 1 开始(与论文记号一致)。""" return ABAR[t - 1] def safe_log(w): """对数,0 分量记为 -inf 而不报警告。""" w = np.asarray(w, dtype=float) out = np.full_like(w, -np.inf) m = w > 0 out[m] = np.log(w[m]) return out # ═════════════════════════════ 2. 精确去噪器 ═════════════════════════════ def logpdf_comps(X, a_bar): """每个分量对 x_t 的对数密度:x_t|k ~ N(sqrt(a) mu_k, a var_k + (1-a))。""" s = np.sqrt(a_bar) m = s * MU # [K, 2] v = a_bar * VAR + (1.0 - a_bar) # [K] d2 = ((X[:, None, :] - m[None, :, :]) ** 2).sum(-1) # [N, K] return -0.5 * (d2 / v[None, :] + DIM * np.log(2 * np.pi * v)[None, :]) def posterior(X, a_bar, logw): """分量后验权重 r_k = p(k | x_t)。logw 是分量的对数先验。""" lp = logpdf_comps(X, a_bar) + logw[None, :] lp -= lp.max(axis=1, keepdims=True) r = np.exp(lp) return r / r.sum(axis=1, keepdims=True) def x0_hat(X, a_bar, logw): """MMSE 估计 E[x0 | x_t](精确闭式解)。 分量内部是高斯的,所以 E[x0|x_t,k] 有闭式解: mu_k + S_k sqrt(a) (a S_k + (1-a) I)^{-1} (x_t - sqrt(a) mu_k) 再按后验权重 r_k 加权。S_k = var_k * I,所以增益是个标量。 """ s = np.sqrt(a_bar) v = a_bar * VAR + (1.0 - a_bar) gain = VAR * s / v # [K] r = posterior(X, a_bar, logw) # [N, K] per = MU[None, :, :] + gain[None, :, None] * (X[:, None, :] - s * MU[None, :, :]) return (r[:, :, None] * per).sum(axis=1) # [N, 2] def eps_hat(X, t, logw): """epsilon 预测:eps = (x_t - sqrt(a) x0_hat) / sqrt(1-a)。""" a = abar(t) return (X - np.sqrt(a) * x0_hat(X, a, logw)) / np.sqrt(1.0 - a) def cond_logw(cls): """条件分支的分量对数先验:只保留该类内部分量,类内权重重新归一化。""" w = np.where(CLS == cls, PI, 0.0) w = w / w.sum() return safe_log(w) LOGW_UNCOND = safe_log(PI) # 无条件:全混合 LOGW_COND = cond_logw(TARGET_CLS) # 条件:类别 TARGET_CLS # ── 弱去噪器:把整簇拟合成「一个高斯」之后的线性维纳滤波 ── # 给 Q4 用的「不完美模型」:它是该高斯下的最优线性去噪器,但真实数据是混合体, # 所以误差非零、且随 t 变化 —— 正好用来看 w 的放大倍数。 def single_gauss(logw): """按分量权重算出混合体的均值与平均方差。""" w = np.exp(logw) w = w / w.sum() mu = (w[:, None] * MU).sum(0) var = (w * (DIM * VAR + (MU ** 2).sum(1))).sum() - (mu ** 2).sum() return mu, var / DIM def weak_eps_hat(X, t, logw): """单高斯近似的线性去噪器(有误差)。""" a = abar(t) mu, var = single_gauss(logw) s = np.sqrt(a) v = a * var + (1.0 - a) gain = var * s / v x0 = mu[None, :] + gain * (X - s * mu[None, :]) return (X - s * x0) / np.sqrt(1.0 - a) # ═════════════════════════════ 3. 采样器(DDIM, eta=0) ═════════════════════════════ def ddim_timesteps(steps): """均匀步长的 DDIM 时间步序列,从 T 递减;末次直接到干净端,调用数恰为 steps。""" if not isinstance(steps, int) or not 1 <= steps <= T: raise ValueError("steps must be an integer in [1,T]") if T % steps == 0: return list(range(T, 0, -(T // steps))) return np.linspace(T, 1, steps).round().astype(int).tolist() def ddim_sample(x_T, steps=200, w=1.0, interval=(0.0, 1.0), weak=False, rescale=0.0): """确定性 DDIM 采样(eta=0),带 CFG。 x_T : [N, 2] 纯噪声起点 w : 引导强度(w=1 即纯条件,w=0 即纯无条件) interval : 引导生效的 t/T 区间 (lo, hi)。区间外退化为 w=1。 weak : True 则用单高斯弱去噪器(Q4/Q6 用) rescale : 二维玩具的 batch 标准差线性 rescale 系数 phi;不等于图像逐样本 rescale """ fn = weak_eps_hat if weak else eps_hat ts = ddim_timesteps(steps) X = x_T.copy() lo, hi = interval for i, t in enumerate(ts): a = abar(t) a_prev = abar(ts[i + 1]) if i + 1 < len(ts) else 1.0 e_un = fn(X, t, LOGW_UNCOND) e_c = fn(X, t, LOGW_COND) frac = t / T w_eff = w if (lo <= frac <= hi) else 1.0 e_g = e_un + w_eff * (e_c - e_un) # = w_eff*e_c + (1-w_eff)*e_un if rescale > 0.0: # 二维 toy 用整批统计量;图像实现应按样本跨 C/H/W 统计。 # 沿用线性插值,而不是把标准差比取 phi 次幂。 s_g, s_c = e_g.std(), e_c.std() if s_g > 1e-12: e_g = (1.0 - rescale) * e_g + rescale * e_g * (s_c / s_g) x0 = (X - np.sqrt(1.0 - a) * e_g) / np.sqrt(a) X = np.sqrt(a_prev) * x0 + np.sqrt(max(1.0 - a_prev, 0.0)) * e_g return X # ═════════════════════════════ 4. 度量 ═════════════════════════════ def logsumexp_rows(lp): m = lp.max(axis=1, keepdims=True) return m[:, 0] + np.log(np.exp(lp - m).sum(axis=1)) def logp_data(X): """真实数据分布(无条件 GMM)的对数密度。""" return logsumexp_rows(logpdf_comps(X, 1.0) + safe_log(PI)[None, :]) def logp_cond(X): """真实条件分布 p(x|c=TARGET_CLS) 的对数密度。""" return logsumexp_rows(logpdf_comps(X, 1.0) + LOGW_COND[None, :]) def class_posterior(X): """p(类别=TARGET_CLS | x) —— 用真实 GMM 算,作为「软纯度」。""" lp = logpdf_comps(X, 1.0) + safe_log(PI)[None, :] m = lp.max(axis=1, keepdims=True) r = np.exp(lp - m) r /= r.sum(axis=1, keepdims=True) return (r * (CLS[None, :] == TARGET_CLS)).sum(axis=1) def spread(X): """分布的「宽度」:每维方差的平均。""" return float(np.mean(X.var(axis=0))) def summarize(X, Xref, tag=""): """一组样本的核心指标。Xref 是真实条件分布 p(x|c) 的样本,作为基准。""" d2 = ((X[:, None, :] - MU[None, :, :]) ** 2).sum(-1) / VAR[None, :] return dict( tag=tag, purity=float(class_posterior(X).mean()), hard=float((CLS[np.argmin(d2, axis=1)] == TARGET_CLS).mean()), div=float(spread(X) / spread(Xref)), typicality=float(logp_data(X).mean() - logp_data(Xref).mean()), bias=float(np.linalg.norm(X.mean(0) - Xref.mean(0))), ) def sample_data(rng, n, cls=None): """从真实 GMM 采 n 个样本;cls 非空则只采该类的样本。""" w = PI.copy() if cls is not None: w = np.where(CLS == cls, PI, 0.0) w = w / w.sum() k = rng.choice(K, size=n, p=w) return MU[k] + np.sqrt(VAR[k])[:, None] * rng.standard_normal((n, DIM)) # ═══════════════════════ 5. 倾斜分布 p(x|c)^w p(x)^{1-w} ═══════════════════════ def tilted_logpdf(X, w): """未归一化的倾斜对数密度:w*log p(x|c) + (1-w)*log p(x)。""" return w * logp_cond(X) + (1.0 - w) * logp_data(X) def _tilt_grid(w, lo=-9.0, hi=9.0, n=420): """在方格上算归一化后的倾斜密度,返回 (xs, P[ny, nx]),P 求和为 1。""" xs = np.linspace(lo, hi, n) GX, GY = np.meshgrid(xs, xs) P = np.column_stack([GX.ravel(), GY.ravel()]) lp = tilted_logpdf(P, w) lp -= lp.max() d = np.exp(lp).reshape(n, n) return xs, d / d.sum() _TILT_CACHE = {} def logp_tilt_norm(X, w, lo=-9.0, hi=9.0, n=420): """归一化后的 log p_tilde(x)(归一化常数由方格数值积分得到)。""" key = (float(w), float(lo), float(hi), int(n)) if key not in _TILT_CACHE: xs = np.linspace(lo, hi, n) GX, GY = np.meshgrid(xs, xs) lp = tilted_logpdf(np.column_stack([GX.ravel(), GY.ravel()]), w) offset = lp.max() d = np.exp(lp - offset).reshape(n, n) Z = d.sum() * (xs[1] - xs[0]) ** 2 _TILT_CACHE[key] = offset + np.log(Z) return tilted_logpdf(X, w) - _TILT_CACHE[key] def sample_tilted(rng, w, n): """从倾斜分布 p(x|c)^w p(x)^{1-w} 采样(方格离散近似 + 格内抖动)。""" xs, d = _tilt_grid(w) flat = d.ravel() idx = rng.choice(len(flat), size=n, p=flat / flat.sum()) iy, ix = np.unravel_index(idx, d.shape) step = xs[1] - xs[0] return np.column_stack([xs[ix] + (rng.random(n) - 0.5) * step, xs[iy] + (rng.random(n) - 0.5) * step]) # ═════════════════════════════ 6. 主流程 ═════════════════════════════ def base_rng(): """主实验与画图共用的随机流起点。 两边必须 draw 相同次数、相同顺序,否则图上的数字和正文表格会对不上。 """ rng = np.random.default_rng(20260928) Xref = sample_data(rng, 40000, cls=TARGET_CLS) return rng, Xref def main(): rng, Xref = base_rng() q0_rows = {}; q1_rows = []; weak_rows = {}; rescale_rows = {} N = 20000 STEPS = 200 print("=" * 78) print("CFG 实跑账本 —— 数据:2D 高斯混合,4 分量 / 2 类,条件 = 类别 %d" % TARGET_CLS) print("=" * 78) # ── Q1:精确去噪器对拍(数值积分) ── print("\n[Q1] 精确去噪器 E[x0|xt] 的数值积分对拍") print(" 做法:固定 20 万真实样本,对每个探测点 xt 按 q(xt|x0) 加权求样本平均。") print(" t alpha_bar 闭式解 E[x0] 数值积分 E[x0] 最大绝对差") mc_rng = np.random.default_rng(7) X0 = sample_data(mc_rng, 200000) for t in (1, 50, 200, 500, 900, 1000): a = abar(t) Xt = np.sqrt(a) * X0 + np.sqrt(1 - a) * mc_rng.standard_normal(X0.shape) idx = mc_rng.integers(0, len(X0), size=60) xt_probe = Xt[idx] mc = np.empty_like(xt_probe) s = np.sqrt(a) for j, xp in enumerate(xt_probe): # 逐点算,避免大临时矩阵 # 权重就是 q(xt|x0) ∝ exp(-||xt - sqrt(a) x0||^2 / (2(1-a))) d2 = ((xp[None, :] - s * X0) ** 2).sum(-1) ww = np.exp(-0.5 * (d2 - d2.min()) / (1 - a)) # 减最小值防下溢 ww /= ww.sum() mc[j] = (X0 * ww[:, None]).sum(0) q1_rows.append(dict(t=t, min_ess=float(1.0/(ww@ww)))) cf = x0_hat(xt_probe, a, LOGW_UNCOND) # 探测数据来自全混合,故用无条件先验 print(" %4d %.6e [%+.5f,%+.5f] [%+.5f,%+.5f] %.2e" % (t, a, cf[0, 0], cf[0, 1], mc[0, 0], mc[0, 1], np.abs(mc - cf).max())) print(" → MC差异不能独立证明闭式解正确;小t的重要性权重会退化。独立验证见cfg_checks.py。") # 基准 print("\n基准:真实条件分布 p(x|c=%d)" % TARGET_CLS) print(" 每维方差 %.4f | 均值 [%+.4f,%+.4f] | 平均 log p_data %.4f | 软纯度 %.4f" % (spread(Xref), Xref.mean(0)[0], Xref.mean(0)[1], logp_data(Xref).mean(), class_posterior(Xref).mean())) x_T0 = rng.standard_normal((N, DIM)) # ── 步长收敛检查 ── print("\n[Q0] DDIM 步数收敛检查(w=7.5,看 200 步够不够;1000 步 = 全量 T)") print(" steps 软纯度 多样性比 典型度 类心偏移") for st in (50, 100, 200, 400, 1000): X = ddim_sample(x_T0, steps=st, w=7.5) m = summarize(X, Xref) q0_rows[st] = dict(actual_steps=len(ddim_timesteps(st)), **m) print(" %4d %.4f %.4f %+.4f %.4f" % (st, m["purity"], m["div"], m["typicality"], m["bias"])) # ── Q2:w 扫描 ── print("\n[Q2] 引导强度 w 扫描(精确去噪器,DDIM %d 步,N=%d)" % (STEPS, N)) print(" w 软纯度 硬纯度 多样性比 典型度(nats) 类心偏移") r0 = summarize(Xref, Xref, tag="真实条件") print(" 真实条件样本(参照) %.4f %.4f %.4f %+.4f %.4f" % (r0["purity"], r0["hard"], r0["div"], r0["typicality"], r0["bias"])) sweep = {} for w in (0.0, 1.0, 2.0, 3.0, 5.0, 7.5, 10.0, 15.0, 25.0): X = ddim_sample(x_T0, steps=STEPS, w=w) m = summarize(X, Xref) sweep[w] = m print(" %5.1f %.4f %.4f %.4f %+.4f %.4f" % (w, m["purity"], m["hard"], m["div"], m["typicality"], m["bias"])) print(" 软纯度 = E[p(c|x)](真实后验);硬纯度 = 马氏最近分量属于目标类的比例;") print(" 多样性比 = 生成样本每维方差 / 真实条件方差;") print(" 典型度 = 生成样本与真实样本的平均 log p_data 之差(负 = 平均落在较低密度区,不代表支撑之外)。") # ── Q3:CFG 采的是不是倾斜分布 ── print("\n[Q3] CFG 采出的分布 vs 倾斜目标 p(x|c)^w p(x)^{1-w}") print(" 统计量:固定目标的交叉熵差可否定同分布;更小不保证更像目标") print(" w 样本来源 -E[log p(x|c)] -E[log p_tilde] -E[log p(x)] 方差比 类心偏移") tilt_rows = {} # 参照行:真实条件分布自己的交叉熵(作为「完美拟合」的刻度) print(" ---- 真实条件样本 %10.4f %10s %10.4f %6.4f %6.4f" % (-float(logp_cond(Xref).mean()), "(w=1 时同)", -float(logp_data(Xref).mean()), spread(Xref) / spread(Xref), float(np.linalg.norm(Xref.mean(0) - Xref.mean(0))))) for w in (1.0, 3.0, 7.5, 15.0): Xg = ddim_sample(x_T0, steps=STEPS, w=w) Xt = sample_tilted(rng, w, 20000) for name, X in (("CFG 生成", Xg), ("倾斜目标", Xt)): row = dict( ce_cond=-float(logp_cond(X).mean()), ce_tilt=-float(logp_tilt_norm(X, w).mean()), ce_data=-float(logp_data(X).mean()), div=float(spread(X) / spread(Xref)), bias=float(np.linalg.norm(X.mean(0) - Xref.mean(0))), ) tilt_rows[(w, name)] = row print(" %4.1f %-11s %10.4f %10.4f %10.4f %6.4f %6.4f" % (w, name, row["ce_cond"], row["ce_tilt"], row["ce_data"], row["div"], row["bias"])) print(" ↑ 结合均值和方差判断;仅交叉熵接近不能证明同分布") # ── Q4:误差放大(固定探测分布) ── print("\n[Q4] 弱去噪器(单高斯近似)下,w 把误差放大了多少倍") print(" 探测点固定为「真实数据前向扩散到 t」,与 w 无关,排除轨迹漂移的干扰。") ws4 = (1.0, 2.0, 3.0, 5.0, 7.5, 15.0) print(" t " + " ".join("w=%-4g" % w for w in ws4) + " 最坏上界 2w-1(同序)") probe = sample_data(rng, 20000) amp_by_t = {} for t in (1000, 700, 400, 200, 50, 10): a = abar(t) Xt = np.sqrt(a) * probe + np.sqrt(1 - a) * rng.standard_normal(probe.shape) ec = weak_eps_hat(Xt, t, LOGW_COND) - eps_hat(Xt, t, LOGW_COND) eu = weak_eps_hat(Xt, t, LOGW_UNCOND) - eps_hat(Xt, t, LOGW_UNCOND) base = np.maximum(np.linalg.norm(ec, axis=1), np.linalg.norm(eu, axis=1)).mean() row = [] for w in ws4: amp = np.linalg.norm(w * ec + (1.0 - w) * eu, axis=1).mean() row.append(amp / max(base, 1e-12)) amp_by_t[t] = row print(" %4d " % t + " ".join("%6.3f" % v for v in row) + " " + " ".join("%.0f" % (2 * w - 1) for w in ws4)) print(" → 分母为逐点两支较大误差范数的平均,与2w-1界一致;相关误差可放大也可抵消。") print("\n 各向同性矩匹配弱去噪器下端到端效果(仅本toy):") print(" w 生成方差/真条件 软纯度") for w in ws4: X = ddim_sample(x_T0, steps=STEPS, w=w, weak=True) m = summarize(X, Xref) weak_rows[w] = m print(" %5.1f %.4f %.4f" % (w, m["div"], m["purity"])) # ── Q5:引导区间 ── print("\n[Q5] 只在某个噪声区间开引导(w=7.5,精确去噪器,DDIM %d 步)" % STEPS) print(" 区间(t/T) 软纯度 多样性比 典型度 类心偏移 说明") intervals = [ ((0.0, 1.0), "全程开"), ((0.5, 1.0), "只在高噪声段(链的前半)"), ((0.2, 0.8), "只在中段"), ((0.0, 0.5), "只在低噪声段(链的后半)"), ((0.0, 0.2), "只在极低噪声段"), ((0.0, 0.0), "全程不开(w=1 基线)"), ] interval_rows = {} base = None for (lo, hi), name in intervals: if (lo, hi) == (0.0, 0.0): X = ddim_sample(x_T0, steps=STEPS, w=1.0) else: X = ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(lo, hi)) m = summarize(X, Xref) interval_rows[(lo, hi)] = dict(name=name, **m) if (lo, hi) == (0.0, 0.0): base = m print(" [%.1f,%.1f] %.4f %.4f %+.4f %.4f %s" % (lo, hi, m["purity"], m["div"], m["typicality"], m["bias"], name)) # 细扫:把「区间末端从哪切」和「区间起点从哪切」分别扫一遍,看帕累托前沿 print("\n 细扫 A:只看链的后半段(区间 = [0, hi]),hi 从 0.1 扫到 1.0") print(" 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比") fine_a = {} for hi in (0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0): X = ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(0.0, hi)) m = summarize(X, Xref) g = m["purity"] - base["purity"] c = -(m["typicality"] - base["typicality"]) fine_a[hi] = dict(gain=g, cost=c, ratio=g / c, **m) print(" [0.0,%.1f] %+.4f %.4f %6.3f %.4f %.4f" % (hi, g, c, g / c, m["bias"], m["div"])) print("\n 细扫 B:只看链的前半段(区间 = [lo, 1.0]),lo 从 0.0 扫到 0.9") print(" 区间 纯度增益 典型度代价 性价比 类心偏移 多样性比") fine_b = {} for lo in (0.0, 0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9): X = ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(lo, 1.0)) m = summarize(X, Xref) g = m["purity"] - base["purity"] c = -(m["typicality"] - base["typicality"]) fine_b[lo] = dict(gain=g, cost=c, ratio=g / c, **m) print(" [%.1f,1.0] %+.4f %.4f %6.3f %.4f %.4f" % (lo, g, c, g / c, m["bias"], m["div"])) # ── Q6:幅度膨胀 + rescale ── print("\n[Q6] 引导后预测的幅度膨胀(t=300,探测点来自真实条件样本)") Xp_base = sample_data(rng, 8000, cls=TARGET_CLS) a300 = abar(300) Xp = np.sqrt(a300) * Xp_base + np.sqrt(1 - a300) * rng.standard_normal(Xp_base.shape) e_c = eps_hat(Xp, 300, LOGW_COND) e_u = eps_hat(Xp, 300, LOGW_UNCOND) rho = float(np.corrcoef(e_c.ravel(), e_u.ravel())[0, 1]) print(" 两分支预测的相关系数 rho = %.4f(不等于误差相关性或幅度单调性证明)" % rho) print(" w std(eps_guided)/std(eps_cond)") infl = {} for w in (0.0, 1.0, 2.0, 3.0, 5.0, 7.5, 10.0, 15.0, 25.0): e_g = e_u + w * (e_c - e_u) infl[w] = float(e_g.std() / e_c.std()) print(" %5.1f %.4f" % (w, infl[w])) print("\n guidance rescale 的效果(w=15):") print(" phi 多样性比 典型度 软纯度") for phi in (0.0, 0.3, 0.5, 0.7, 1.0): X = ddim_sample(x_T0, steps=STEPS, w=15.0, rescale=phi) m = summarize(X, Xref) rescale_rows[phi] = m print(" %.1f %.4f %+.4f %.4f" % (phi, m["div"], m["typicality"], m["purity"])) print(" → 本设定(精确去噪器 + DDIM eta=0)下 rescale 把多样性拉回来了,") print(" 但典型度更差:它缩放的是 eps 的幅度,而 x0 是 eps 的仿射函数,") print(" x0的改变量依赖eps向量方向,不可一般解释为往噪声推。") print("\n" + "=" * 78) import json from pathlib import Path result = dict(seed=20260928, N=N, steps=STEPS, q0=q0_rows, q1_last_probe_ess=q1_rows, sweep=sweep, weak=weak_rows, error_amplification=amp_by_t, tilt={str(k):v for k,v in tilt_rows.items()}, intervals={str(k):v for k,v in interval_rows.items()}, fine_a=fine_a, fine_b=fine_b, inflation=infl, rescale=rescale_rows, rho=rho, reference=summarize(Xref,Xref)) Path(__file__).with_name("experiment_results.json").write_text(json.dumps(result,ensure_ascii=False,indent=2),encoding="utf-8") print("全部数字由本脚本实跑产生,结构化结果 experiment_results.json。") print("=" * 78) if __name__ == "__main__": main() cfg_lab.py # -*- coding: utf-8 -*- """cfg_lab.py —— CFG 的代价账本:算术量、逐层输入输出字节和、实测耗时。 这一篇的立论是「CFG 让每步算两遍,是推理成本里最容易被忽视的 2×」。 这句话里「2×」是**在固定示意账本口径下精确**的(batch 维翻倍、权重不变), 但读者真正想知道的是:这个 2× 在真机上兑现成多少墙钟时间。 本脚本做三件事: L1 按 stable-diffusion-v1-5 的 UNet 配置手算一份示意卷积表的算术与张量字节和(fp16), 给出「单步张量字节和」和「单步 MAC」这两个绝对量级。 L2 用 numpy 真跑一个 64x64x320 的 3x3 卷积,实测 batch=1 与 batch=2 的时间比。 (CPU + BLAS,只用于说明算术量翻倍在时间上兑现的程度;GPU 上数字会不同。) L3 把「每步两遍」换算成端到端:50 步采样一共多了多少次前向。 运行: /usr/local/bin/python3 cfg_lab.py 依赖: numpy """ import time import numpy as np # ───────────────────────── L1. UNet 配置与账本 ───────────────────────── # 受SD1.5通道尺度启发的简化示意表,不是实际模型结构清单: # block_out_channels = [320, 640, 1280, 1280],潜空间 64x64(对应 512x512 图) # 下面只列卷积:ResBlock 内部是 GroupNorm-SiLU-Conv3x3-GroupNorm-SiLU-Conv3x3。 # 注意力模块的 QKV / 输出投影、时间嵌入 MLP 都不在表里 —— 它们参数不少, # 原表合并了不同resnet的通道与下采样,不能推作真实UNet的MAC或参数下限。 CONVS = [ # (阶段名, 空间尺寸, in_ch, out_ch, 重复次数) ("conv_in", 64, 4, 320, 1), ("down0.resnet", 64, 320, 320, 4), # 2 个 ResBlock x 2 个 conv ("down0.downsample", 64, 320, 320, 1), ("down1.resnet", 32, 320, 640, 2), ("down1.resnet", 32, 640, 640, 2), ("down1.downsample", 32, 640, 640, 1), ("down2.resnet", 16, 640, 1280, 2), ("down2.resnet", 16, 1280, 1280, 2), ("down2.downsample", 16, 1280, 1280, 1), ("down3.resnet", 8, 1280, 1280, 4), ("mid.resnet", 8, 1280, 1280, 4), ("up0.resnet", 8, 2560, 1280, 3), ("up0.resnet", 8, 1280, 1280, 3), ("up1.resnet", 16, 2560, 1280, 3), ("up1.resnet", 16, 1280, 1280, 3), ("up2.resnet", 32, 1920, 640, 3), ("up2.resnet", 32, 640, 640, 3), ("up3.resnet", 64, 960, 320, 3), ("up3.resnet", 64, 320, 320, 3), ("conv_out", 64, 320, 4, 1), ] def ledger(dtype_bytes=2, batch=1, with_cfg=False): """算一份示意卷积表的算术与张量字节和。 dtype_bytes : fp16 = 2 字节 batch : 一次前向同时处理的样本数 with_cfg : True 则 batch 翻倍(无条件分支拼在 batch 维里) 返回 (总 MAC, 层间张量字节总和, 参数量) """ b = batch * (2 if with_cfg else 1) mac = 0 act = 0 params = 0 for _, hw, cin, cout, rep in CONVS: n = hw * hw mac += b * n * cin * 9 * cout * rep # 一个卷积要留着输入、要写出输出,两块都算层间张量 act += b * n * (cin + cout) * dtype_bytes * rep params += cin * 9 * cout * rep return mac, act, params # ───────────────────────── L2. 实测:一个 3x3 卷积,batch 1 vs 2 ───────────────────────── def conv3x3(X, W): """X: [B, C, H, W],W: [Co, C, 3, 3] —— im2col + 一次大矩阵乘。""" B, C, H, Wd = X.shape Co = W.shape[0] Xp = np.pad(X, ((0, 0), (0, 0), (1, 1), (1, 1))) win = np.lib.stride_tricks.sliding_window_view(Xp, (3, 3), axis=(2, 3)) cols = win.transpose(0, 2, 3, 1, 4, 5).reshape(B * H * Wd, C * 9) out = cols @ W.reshape(Co, C * 9).T return out.reshape(B, H, Wd, Co).transpose(0, 3, 1, 2) def time_conv(hw=64, cin=320, cout=320, batch=1, repeat=5): """对一个具体尺寸的 3x3 卷积计时,取 repeat 次的最小值。""" rng = np.random.default_rng(11) X = rng.standard_normal((batch, cin, hw, hw), dtype=np.float32) W = (rng.standard_normal((cout, cin, 3, 3), dtype=np.float32) / np.sqrt(cin * 9)) conv3x3(X, W) # 预热 best = float("inf") for _ in range(repeat): t0 = time.perf_counter() conv3x3(X, W) best = min(best, time.perf_counter() - t0) return best def main(): print("=" * 78) print("CFG 的代价账本") print("=" * 78) print("\n[L1] SD形状启发的示意卷积表,非真实UNet计数,512x512图(潜空间 64x64),fp16,batch=1") print(" (只算上表列出的卷积;注意力矩阵与 autograd 临时缓冲不计)") print(" ──────────────────────────────────────────────────────────────") print(" %-14s %18s %18s" % ("配置", "示意 MAC", "张量字节和")) for tag, cfg in (("CFG off", False), ("CFG on (w>1)", True)): mac, act, par = ledger(with_cfg=cfg) print(" %-14s %18.3e %18s" % (tag, mac, "%.3f GiB" % (act / 1024 ** 3))) mac0, act0, par0 = ledger(with_cfg=False) mac1, act1, _ = ledger(with_cfg=True) print(" ──────────────────────────────────────────────────────────────") print(" 倍率:MAC %.4f | 激活 %.4f ← 这两个 2 是在固定示意账本口径下精确的" % (mac1 / mac0, act1 / act0)) print(" 示意口径说明:上表只列了卷积,每个卷积只算 1 份输入 + 1 份输出。") print(" 注意力投影、GroupNorm/SiLU 的中间张量、残差分支都没计进去,") print(" 它不是峰值显存的上下界:层间张量可复用,权重、工作区、残差另计。本文只用它给量级,结论只依赖「翻倍」这个比值。") print(" 上表示意卷积权重数 %.1f M(非真实模型参数量," "不作生产UNet差额归因)" % (par0 / 1e6)) print("\n[L2] 实测:一个 64x64x320 -> 320 的 3x3 卷积(SD常见卷积形状,仅测本算子)") print(" CPU + numpy BLAS,取 5 次最小值。用来看算术量翻倍兑现成多少墙钟。") t1 = time_conv(batch=1) t2 = time_conv(batch=2) print(" batch=1 : %.4f s" % t1) print(" batch=2 : %.4f s" % t2) print(" 时间比 : %.4f" % (t2 / t1)) print(" → 此CPU/im2col计时包含展平与分配;比值只描述本次运行;") print(" GPU的延迟、吞吐、峰值显存需要在目标硬件另测,") print(" 理论样本算术量约翻倍;吞吐与峰值显存应在实际硬件测量。") print("\n[L3] 换算成端到端") for steps in (20, 30, 50): print(" %2d 步 DDIM:CFG off 共 %2d 个样本级前向当量 | CFG on 共 %2d 个样本级前向当量" % (steps, steps, 2 * steps)) print(" 部分guidance条件蒸馏模型把w作为输入;其他少步模型配置不同,") print(" 只跑一遍前向 —— 是否使用双分支应核对checkpoint与pipeline。") print("\n" + "=" * 78) if __name__ == "__main__": main() make_figures.py # -*- coding: utf-8 -*- """画本文的四张图。数据源全部来自 cfg_gmm.py / cfg_lab.py 的真实输出,不另造数。 cfg_geometry.png 引导把样本推到了哪:真条件 / 倾斜目标 / CFG 实际生成 w_sweep.png 纯度涨了多少、代价涨了多少(双轴) interval.png 引导只在某个噪声区间开,性价比差多少 cost_ledger.png 那个 2x 的账本,以及 w 对误差的放大 运行: /usr/local/bin/python3 make_figures.py 依赖: numpy, matplotlib(Windows字体Microsoft YaHei;可替换为本机中文字体) 注意:matplotlib 的 mathtext 标签一律用 raw 字符串,且反斜杠后面只能跟字母 ——源码会被 sync-code 原样搬进文章附录,反斜杠后面跟非字母会被体检器判成转义污染。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import cfg_gmm as G import cfg_lab as L plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.facecolor"] = "white" plt.rcParams["axes.facecolor"] = "white" plt.rcParams["savefig.facecolor"] = "white" plt.rcParams["font.size"] = 11 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C_MAIN, C_ALT, C_GREEN, C_GRAY, C_PURPLE = ("#2563eb", "#dc2626", "#059669", "#6b7280", "#7c3aed") STEPS = 200 N = 20000 def smooth(H, sigma=1.6): """可分离高斯平滑(不依赖 scipy)。""" r = int(3 * sigma) xs = np.arange(-r, r + 1) k = np.exp(-0.5 * (xs / sigma) ** 2) k /= k.sum() H = np.apply_along_axis(lambda m: np.convolve(m, k, mode="same"), 0, H) H = np.apply_along_axis(lambda m: np.convolve(m, k, mode="same"), 1, H) return H def kde_on_grid(X, xs, sigma=2.0): """样本 -> 与 grid 同坐标的平滑密度(积分归一)。""" n = len(xs) lo, hi = xs[0], xs[-1] X = X[(X[:,0]>=lo)&(X[:,0]<=hi)&(X[:,1]>=lo)&(X[:,1]<=hi)] idx = np.clip(((X[:, 0] - lo) / (hi - lo) * n).astype(int), 0, n - 1) idy = np.clip(((X[:, 1] - lo) / (hi - lo) * n).astype(int), 0, n - 1) H = np.zeros((n, n)) np.add.at(H, (idy, idx), 1.0) H = smooth(H, sigma) return H / H.sum() def fig_geometry(): """三张等高线:真实条件 / 倾斜目标 / CFG 实际生成。""" rng, Xref = G.base_rng() # 与 cfg_gmm.main 同一条随机流 xs = np.linspace(-4.2, 4.2, 200) GX, GY = np.meshgrid(xs, xs) P = np.column_stack([GX.ravel(), GY.ravel()]) def dens(fn): d = np.exp(fn(P)) d = d.reshape(len(xs), len(xs)) return d / d.sum() D_cond = dens(lambda X: G.logp_cond(X)) D_un = dens(lambda X: G.logp_data(X)) w = 7.5 lp_t = G.tilted_logpdf(P, w) lp_t = lp_t - lp_t.max() D_tilt = np.exp(lp_t).reshape(len(xs), len(xs)) D_tilt /= D_tilt.sum() Xg = G.ddim_sample(rng.standard_normal((N, 2)), steps=STEPS, w=w) D_cfg = kde_on_grid(Xg, xs, sigma=2.2) mean_ref = Xref.mean(0) mean_cfg = Xg.mean(0) lvl_un = np.geomspace(D_un.max() * 1e-4, D_un.max(), 6) fig, axes = plt.subplots(1, 3, figsize=(15.2, 5.0)) panels = [ ("真实条件分布 $p(x|c)$", D_cond, mean_ref, C_MAIN), ("倾斜目标 $p(x|c)^{w}p(x)^{1-w}$", D_tilt, None, C_PURPLE), ("CFG 实际采出的分布", D_cfg, mean_cfg, C_ALT), ] for ax, (title, D, mean, col) in zip(axes, panels): ax.contour(xs, xs, D_un, levels=lvl_un, colors=[C_GRAY], linewidths=0.7, alpha=0.55) lvl = np.geomspace(D.max() * 2e-3, D.max(), 8) ax.contourf(xs, xs, D, levels=lvl, cmap="Blues", alpha=0.85) ax.contour(xs, xs, D, levels=lvl, colors=[col], linewidths=1.1) ax.plot(G.MU[:, 0], G.MU[:, 1], "k+", ms=11, mew=1.8) ax.plot(mean_ref[0], mean_ref[1], "o", color=C_MAIN, ms=9, markeredgecolor="white", mew=1.6) if mean is not None and not np.allclose(mean, mean_ref): ax.plot(mean[0], mean[1], "D", color=C_ALT, ms=8, markeredgecolor="white", mew=1.6) ax.annotate("", xy=mean, xytext=mean_ref, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=2.0)) ax.set_title(title, fontsize=12) ax.set_xlim(xs[0], xs[-1]) ax.set_ylim(xs[0], xs[-1]) ax.set_aspect("equal") ax.grid(alpha=0.15) ax.set_xlabel("$x_1$") ax.set_ylabel("$x_2$") axes[0].text(0.02, 0.03, "灰色细线 = 无条件数据密度\n蓝色圆点 = 真实条件均值", transform=axes[0].transAxes, fontsize=8.5, color=C_GRAY, va="bottom") d_bias = float(np.linalg.norm(mean_cfg - mean_ref)) axes[2].text(0.02, 0.03, "红色菱形 = 生成分布均值\n离真实条件均值 %.2f(本图只显示指定窗口)" % d_bias, transform=axes[2].transAxes, fontsize=8.5, color=C_ALT, va="bottom") fig.suptitle(r"引导强度 $w=7.5$:样本被推到了哪(同一坐标系,网格 $[-4.2,4.2]^2$)", fontsize=13) fig.tight_layout(rect=[0, 0, 1, 0.94]) fig.savefig(os.path.join(FIGDIR, "cfg_geometry.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" cfg_geometry.png 类心偏移 %.4f" % d_bias) def fig_w_sweep(): """纯度涨了多少、代价涨了多少。""" rng, Xref = G.base_rng() # 与 cfg_gmm.main 同一条随机流 ws = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 5.0, 7.5, 10.0, 15.0, 20.0, 25.0]) x_T0 = rng.standard_normal((N, 2)) rows = [G.summarize(G.ddim_sample(x_T0, steps=STEPS, w=float(w)), Xref) for w in ws] pur = np.array([r["purity"] for r in rows]) div = np.array([r["div"] for r in rows]) typ = np.array([r["typicality"] for r in rows]) bias = np.array([r["bias"] for r in rows]) fig, ax = plt.subplots(figsize=(9.6, 5.6)) ax.plot(ws, pur, "o-", color=C_MAIN, lw=2.2, ms=5, label="软纯度 $E[p(c|x)]$") ax.plot(ws, div, "s-", color=C_GREEN, lw=2.2, ms=5, label="多样性比(生成方差/真条件)") ax.axhline(0.7388, color=C_GRAY, ls=":", lw=1.2) ax.text(0.6, 0.752, "真实条件样本 0.7388", color=C_GRAY, fontsize=9) ax.set_xlabel(r"引导强度 $w$") ax.set_ylabel("纯度 / 多样性比", color="black") ax.set_ylim(0.35, 1.35) ax.grid(alpha=0.25) ax.legend(loc="center left", fontsize=9.5) ax2 = ax.twinx() ax2.plot(ws, typ, "^--", color=C_ALT, lw=2.2, ms=5, label=r"典型度 $\Delta\log p_{\mathrm{data}}$(nats)") ax2.plot(ws, bias, "v--", color=C_PURPLE, lw=2.0, ms=5, label="类心偏移") ax2.set_ylabel("典型度 / 类心偏移(越负/越大越糟)") ax2.legend(loc="center right", fontsize=9.5) ax.axvline(1.0, color=C_GRAY, lw=1.0, alpha=0.6) ax.axvline(7.5, color=C_ALT, lw=1.2, ls="-.", alpha=0.8) ax.text(7.9, 1.30, "本实验参照 $w=7.5$", color=C_ALT, fontsize=9.5) ax.text(1.1, 1.28, "$w=1$ 就是纯条件模型", color=C_GRAY, fontsize=9) fig.suptitle("本toy的纯度、方差与平均对数密度变化(DDIM %d 步,N=%d)" % (STEPS, N), fontsize=12.5) fig.tight_layout(rect=[0, 0, 1, 0.95]) fig.savefig(os.path.join(FIGDIR, "w_sweep.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" w_sweep.png w=7.5: 纯度 %.4f / 多样性 %.4f / 典型度 %.4f / 偏移 %.4f" % (rows[8]["purity"], rows[8]["div"], rows[8]["typicality"], rows[8]["bias"])) def fig_interval(): """本toy两个统计指标的离散取舍,不是分布距离或完整帕累托前沿。""" rng, Xref = G.base_rng() # 与 cfg_gmm.main 同一条随机流 x_T0 = rng.standard_normal((N, 2)) base = G.summarize(G.ddim_sample(x_T0, steps=STEPS, w=1.0), Xref) def run(lo, hi): m = G.summarize(G.ddim_sample(x_T0, steps=STEPS, w=7.5, interval=(lo, hi)), Xref) gain = m["purity"] - base["purity"] cost = -(m["typicality"] - base["typicality"]) return gain, cost, m fig, ax = plt.subplots(figsize=(9.8, 6.6)) # 等性价比参考线(双对数坐标下是斜率 1 的直线);标签放在可见范围内 xr = np.logspace(-2.4, 0.6, 60) for k in (0.1, 0.5, 1.0, 5.0): ax.plot(xr, k * xr, "--", color=C_GRAY, lw=0.8, alpha=0.65) x_lab = 0.22 / k if 6e-3 <= x_lab <= 3.0: ax.text(x_lab, k * x_lab * 1.1, "性价比 %.1f" % k, fontsize=8, color=C_GRAY, ha="center", va="bottom", clip_on=True) # A 族:区间 = [0, hi],即只在链的后半(低噪声)开 his = (0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0) pts_a = [run(0.0, hi) for hi in his] ax.plot([p[1] for p in pts_a], [p[0] for p in pts_a], "-o", color=C_GREEN, lw=2.2, ms=8, markeredgecolor="white", mew=1.4, label=r"只在低噪声段开:区间 $[0,h]$") for hi, (g, c, m) in zip(his, pts_a): if hi in (0.1, 0.2, 0.5, 1.0): ax.annotate("$h$=%.1f\n性价比 %.2f" % (hi, g / c), (c, g), textcoords="offset points", xytext=(10, 6) if hi < 0.2 else (-64, 6), fontsize=9, color=C_GREEN) print(" 区间 [0.0,%.1f] 纯度增益 %+.4f 典型度代价 %.4f 性价比 %.3f" % (hi, g, c, g / c)) # B 族:区间 = [lo, 1],即只在链的前半(高噪声)开 los = (0.9, 0.8, 0.7, 0.6, 0.5, 0.4, 0.3, 0.2, 0.1, 0.0) pts_b = [run(lo, 1.0) for lo in los] ax.plot([p[1] for p in pts_b], [p[0] for p in pts_b], "-s", color=C_MAIN, lw=2.2, ms=7, markeredgecolor="white", mew=1.4, label=r"只在高噪声段开:区间 $[l,1]$") for lo, (g, c, m) in zip(los, pts_b): if lo in (0.9, 0.5, 0.0): ax.annotate("$l$=%.1f\n性价比 %.2f" % (lo, g / c), (c, g), textcoords="offset points", xytext=(-68, -22) if lo < 0.1 else (10, -14), fontsize=9, color=C_MAIN) print(" 区间 [%.1f,1.0] 纯度增益 %+.4f 典型度代价 %.4f 性价比 %.3f" % (lo, g, c, g / c)) ax.set_xscale("log") ax.set_yscale("log") ax.set_xlabel(r"代价:典型度损失 $-\Delta\log p_{\mathrm{data}}$(nats)") ax.set_ylabel(r"收益:软纯度增益") ax.set_xlim(6e-3, 4.0) ax.set_ylim(6e-3, 0.4) ax.grid(alpha=0.25, which="both") ax.legend(loc="lower right", fontsize=10) fig.suptitle(r"引导区间的双指标取舍($w=7.5$,DDIM %d 步)" % STEPS, fontsize=12.5) fig.tight_layout(rect=[0, 0, 1, 0.955]) fig.savefig(os.path.join(FIGDIR, "interval.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" interval.png") def fig_cost_ledger(): """2x 账本 + w 对误差的放大。""" rng, _ = G.base_rng() # 与 cfg_gmm.main 同一条随机流 mac0, act0, _ = L.ledger(with_cfg=False) mac1, act1, _ = L.ledger(with_cfg=True) fig, axes = plt.subplots(1, 3, figsize=(15.0, 4.6)) # (a) 账本 ax = axes[0] labels = ["单步 MAC", "层间张量\n(fp16)", "50 步的样本级前向\n次数"] v0 = [mac0 / 1e11, act0 / 1024 ** 3, 50.0] v1 = [mac1 / 1e11, act1 / 1024 ** 3, 100.0] x = np.arange(3) ax.bar(x - 0.19, v0, 0.36, color=C_MAIN, label="CFG off") ax.bar(x + 0.19, v1, 0.36, color=C_ALT, label=r"CFG on($w>1$)") for i, (a, b) in enumerate(zip(v0, v1)): ax.text(i - 0.19, a, "%.2f" % a, ha="center", va="bottom", fontsize=8.5) ax.text(i + 0.19, b, "%.2f" % b, ha="center", va="bottom", fontsize=8.5) ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9.5) ax.set_yscale("log") ax.set_ylabel("(MAC 单位 1e11,张量字节和单位 GiB)") ax.set_title("示意算术表的 2 倍", fontsize=12) ax.legend(fontsize=9) ax.grid(alpha=0.2, axis="y") # (b) 误差放大 ax = axes[1] ws = np.array([1.0, 2.0, 3.0, 5.0, 7.5, 10.0, 15.0, 20.0]) probe = G.sample_data(rng, 20000) for t, col in ((1000, C_MAIN), (200, C_GREEN), (10, C_ALT)): a = G.abar(t) Xt = np.sqrt(a) * probe + np.sqrt(1 - a) * rng.standard_normal(probe.shape) ec = G.weak_eps_hat(Xt, t, G.LOGW_COND) - G.eps_hat(Xt, t, G.LOGW_COND) eu = G.weak_eps_hat(Xt, t, G.LOGW_UNCOND) - G.eps_hat(Xt, t, G.LOGW_UNCOND) base = np.maximum(np.linalg.norm(ec, axis=1), np.linalg.norm(eu, axis=1)).mean() rat = [np.linalg.norm(w * ec + (1 - w) * eu, axis=1).mean() / base for w in ws] ax.plot(ws, rat, "o-", color=col, lw=2.0, ms=5, label="实测 $t=%d$" % t) ax.plot(ws, 2 * ws - 1, "k--", lw=1.6, label=r"最坏上界 $2w-1$") ax.set_xlabel(r"引导强度 $w$") ax.set_ylabel("去噪误差被放大的倍数") ax.set_title("本toy两支误差的组合", fontsize=12) ax.legend(fontsize=9) ax.grid(alpha=0.25) # (c) 幅度膨胀 ax = axes[2] Xb = G.sample_data(rng, 8000, cls=G.TARGET_CLS) a = G.abar(300) Xp = np.sqrt(a) * Xb + np.sqrt(1 - a) * rng.standard_normal(Xb.shape) e_c = G.eps_hat(Xp, 300, G.LOGW_COND) e_u = G.eps_hat(Xp, 300, G.LOGW_UNCOND) wgrid = np.linspace(0, 25, 120) infl = np.array([(e_u + w * (e_c - e_u)).std() / e_c.std() for w in wgrid]) ax.plot(wgrid, infl, "-", color=C_PURPLE, lw=2.4) for w in (1.0, 7.5, 15.0): v = float((e_u + w * (e_c - e_u)).std() / e_c.std()) ax.plot([w], [v], "o", color=C_ALT, ms=7) ax.annotate("$w$=%.1f:%.2f 倍" % (w, v), (w, v), textcoords="offset points", xytext=(8, -12), fontsize=9) ax.axhline(1.0, color=C_GRAY, ls=":", lw=1.2) ax.set_xlabel(r"引导强度 $w$") ax.set_ylabel(r"$\mathrm{std}(\varepsilon_{\mathrm{guided}})/\mathrm{std}(\varepsilon_{\mathrm{cond}})$") ax.set_title("预测幅度膨胀(本toy幅度统计)", fontsize=12) ax.grid(alpha=0.25) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "cost_ledger.png"), dpi=130, bbox_inches="tight") plt.close(fig) print(" cost_ledger.png MAC %.3e -> %.3e" % (mac0, mac1)) def main(): print("画图(数据源:cfg_gmm.py / cfg_lab.py 的真实输出)") fig_geometry() fig_w_sweep() fig_interval() fig_cost_ledger() print("输出目录:%s" % FIGDIR) if __name__ == "__main__": main()
-
AIGC 每日速读|2026-09-28|阿里 397B 只改提示词就涨 50 分,WanPE 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与编辑 5 篇 · 音视频与语音生成 2 篇 · 图像与 3D 生成 2 篇 · 多模态理解与评测 1 篇 重点论文标题列表 WanPE(南大):397B 分镜规划提示词 AV-GRPO(上海人工智能实验室):音视频联合生成的模态解耦 RL ⚡ TRACK(NVIDIA):免训练大小模型按步换班 ViRDM(美国东北大学):砍掉教师与批评家做因果后训练 EditVoice(厦门大学):变长非自回归零样本语音编辑 今日论文速览 1. WanPE:397B 分镜规划提示词 WanPE: Towards Cinematic Prompt Enhancement for Modern Text-to-Video Generation | 南京大学;Wan 团队(阿里巴巴集团);中国科学技术大学;复旦大学;清华大学 | arXiv:2609.30221 关键词:文生视频, 提示词增强, GRPO, 电影分镜, 评测基准 ⚠️ 前序问题:现代视频生成器已能生成 30 秒、并忠实遵循复杂条件,文本提示几乎直接决定多镜头序列里动作、机位轨迹、光效和声音如何展开。但现有的提示增强大多还停留在「可选扩写」层面,面对导演级的镜头级规划(分镜如何组织、跨镜头语义如何不漂)能力明显不足。 本文贡献:提出 WanPE——397B 参数的提示增强模型,在 105 万条真实视频上训练。核心有两块:一是 video-grounded 逆向构建(reverse SFT),从真实视频反推出镜头级电影分镜规划,让模型学到的是「怎么组织分镜」而不是「怎么把句子写长」;二是 Semantic-Consistency GRPO(SC-GRPO),用语义一致性奖励把用户意图在跨镜头、跨时间维度上保住。配套还建了 WanPEval:249 条人工标注请求,覆盖 5–30 秒时长与不同意图粒度,约 1.1 万次盲评 pairwise 比较。 WanPE training pipeline. Video-grounded reverse SFT and semantic-consistency GRPO. 实验效果:驱动 Wan3.0 生成器时,相对原始用户提示,5–15 秒人类偏好提升 10.66–18.84 分,30 秒竞技场提升 50.86 分。5–15 秒子集上专家偏好 S / Bradley–Terry 分数为 50.61 / 61.85,超过 Seedance 2.0(43.42 / 54.70)、MiniMax-H3(36.40 / 49.27)、Kling 3.0(20.80 / 37.40)与 HappyHorse 1.1(24.89 / 40.46)。消融显示逆向构建明显优于正向改写,SC-GRPO 在各模型规模上都能稳住语义保真。 Fine-grained expert evaluation on the 5-15 seconds subset of WanPEval. Left: Preference scores across generation durations and request-granularity levels. Right: Preference scores S across seven content categories. 批判点评:397B 这个体量本身就是最大的成本项,而表里的规模曲线并不支持它:4B 是 43.60 / 56.21,9B 是 46.00 / 58.01,397B 才 50.61 / 61.85——为了最后 5 分,参数量涨了两个数量级。更值得注意的是 30 秒子集:+WanPE-397B 的 Overall 60.24 只是险胜 Seedance 2.5 的 59.76,而且拆开看,动作类 50.00 被 Seedance 2.5 的 68.18 甩开一大截,知识类、演讲类也不占优。换句话说,WanPE 真正补齐的是「镜头语言」,动作生成本身的短板它一个字都没碰。 2. AV-GRPO:音视频联合生成的模态解耦 RL AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation | 上海人工智能实验室;香港理工大学;新加坡国立大学;南洋理工大学;浙江大学 | arXiv:2609.29816 关键词:音视频联合生成, 强化学习后训练, GRPO, 跨模态同步, 扩散模型 ⚠️ 前序问题:音视频联合生成里,异质多模态奖励互相纠缠导致信用分配困难,两个模态塔动力学差异大、联合优化极贵,而同步性评测又依赖成对样本、奖励没法公平比较——直接把 RL 后训练搬过来几乎处处碰壁。 本文贡献:提出 AV-GRPO 这一模态锚定的在线扩散 RL 框架,三个模块:模态锚定 rollout 解耦学习信号并稳定难度;轨迹锁定的冻结塔优化降低成本、重新分配信用;针对模态各自动力学的自适应目标与扰动强度。由此把耦合的多模态偏好学习拆成单模态子问题,实现精确奖励归因。同时构建了 5DAV 数据集,在五个维度上解耦样本、难度可控。基于 LTX-2.3 22B,8 卡 A800 上跑 LoRA 与全参两档。 Overview of the AV-GRPO training pipeline. 实验效果:JavisBench 上 AV-IB 从 0.224 提到 0.247,JavisScore 0.202 → 0.222,DeSync 0.708 → 0.607;VABench 上 Lip Sync 1.439 → 1.646、DeSync 0.726 → 0.542。在生成质量、语义对齐与跨模态同步三项上均超过 LTX-2.3,LoRA 与全参微调两档都成立。 Left: Radar chart comparing performance on the 5DAV and VGGSound datasets. Middle: Metrics are reported as relative percentage changes with respect to the baseline. Right: Comparison of model performance with different alternating step intervals. 批判点评:表里藏着一个不太好看的反差:LTX-2.3+AV-GRPO(lora) 在 Alignment(4.512 对 4.510)、Expressiveness(4.450 对 4.434)、Visual Realism(4.402 对 4.395)三项主观指标上,全都高于全参版。花了全参训练的成本,主观质量却没赢过 LoRA,说明这套「冻结塔 + 分塔信用分配」的收益主要落在同步类客观指标上,主观提升更接近采样噪声。而且这三项差距都在小数点后第三位,论文也没给方差或多次运行,显著性无从判断。 3. TRACK:免训练大小模型按步换班 Accelerating Video Diffusion via Training-Free Trajectory Routing | NVIDIA | arXiv:2609.30096 关键词:视频扩散加速, 免训练, 模型路由, 步级调度, 能耗优化 ⚠️ 前序问题:视频扩散推理昂贵:要把大模型跑很多个去噪步。即便做了步数蒸馏,剩下每一个蒸馏步依然要付一次完整的大模型前向,推理成本还是下不来。 本文贡献:TRACK(TRajectory-Aware Capacity routing via top-K selection)是一种异构去噪策略:离线校准阶段先跑一遍全大模型的参考轨迹,每一步同时收集小模型的预测,与大模型预测比较得到相对分歧分数(两边共享同一 latent、timestep、条件与 guidance),再把该信号跨校准集聚合成分步分歧分数图,据此决定切换策略——质量敏感步留给大模型(如 Wan 2.1 14B),低分歧步路由给小模型(1.3B)。推理时每步只执行被选中的那一个模型,不重训练、不改架构与调度器、也不需要在线双模型评估。 Training-Free Trajectory-Aware Capacity routing. Top: Offline calibration rolls out the all-large-model reference trajectory and, at every step, evaluates the large and small checkpoints using the same latent, timestep, conditioning, and guidance inputs. Bottom: Online inference applies that policy while preserving the shared latent representation and scheduler update. 实验效果:在 Wan 2.1、Cosmos 3、TurboDiffusion、FastVideo 四条管线上分别取得 1.95×、2.04×–2.73×、2.69×、2.17× 加速,聚合质量相当、DreamSim 多样性保留 >95%。在 A100 上用 NVML 实测,去噪能耗降低约 45%–60%:Wan 2.1 每视频省 194.57 kJ,折合每千条视频省 54.05 kWh(降 49.3%);Cosmos 3(Super/Edge)能耗降近 60%。 Speed--quality tradeoffs across video pipelines. Each panel compares the all-large model (baseline) and TRACK (ours) switching policy. All models retain comparable aggregate quality at the selected operating points in most quality dimensions. 批判点评:「质量相当」这个结论要挑一下口径:它取的是 VBench 的时间闪烁、运动平滑、主体一致性、背景一致性四个维度的均值——恰好是「换小模型不太容易崩」的那四个。真正的代价作者写在 Limitations 里:部署时必须同时驻留大小两个模型,显存占用反而高于单模型管线。另外对已经把步数压到 3–4 步的蒸馏管线(FastVideo 只有 2.17×),可换的步数本就只剩个位数,收益上限天然受限。 4. ViRDM:砍掉教师与批评家做因果后训练 ViRDM: Taming Representation Distribution Matching for Few-Step Causal Video Generation | 美国东北大学;Adobe Research | arXiv:2609.28923 关键词:因果视频生成, 分布匹配, 后训练, 显存优化, VBench ⚠️ 前序问题:少步自回归视频扩散能实现低延迟流式生成,但现有后训练方法几乎都依赖 DMD:需要一个庞大的预训练教师和一个在线 critic,靠 diffusion score 估计分布差异。三套网络同时在线,资源开销成了主要门槛。 本文贡献:ViRDM 把教师与 critic 整个去掉,只让生成器对齐一份离线预计算的目标表征分布。三个障碍逐个击破:用一致性式采样 + 随机截断 clean-exit 监督(S 从 U{1..K} 采样,选中的那次评估才吃梯度)把梯度路径变得可行;用轻量 VAE 解码器压显存;用分阶段 vector–Jacobian product 拆解反传。此外还给出了视频 RDM 的生成种群规模与初始化策略(因果 ODE 初始化最优),并加了 flow 动力学正则来补表征分布对时间变化约束不足的问题。 Consistency-style sampling with stochastic exits for few-step video RDM. 实验效果:同样 8 卡 A100 的设置下,峰值显存从 77.1 GB/卡降到 48.3 GB/卡,后训练时间从 22 小时压到 2 小时,VBench Total 从 84.51 提到 84.87。只需 20 次生成器更新、16 A100 GPU-小时,比此前最佳少步因果基线高 0.36 分。用户研究中文本-视频对齐 40.4%、视觉质量 43.0% 均为四步因果方法里最高(Self Forcing 两项均为 32.6%)。 Replacing the resource-intensive teacher-critic stack with direct representation distribution matching for few-step causal video post-training. In the same 8-A100 parallelized training setting, this reduces peak memory from 77.1 to 48.3 GB per GPU and post-training time from 22 to 2 hours, while improving the VBench Total from 84.51 to 84.87. 批判点评:84.87 对 84.51 只涨了 0.36 分,而论文自己的消融表把原因说得很直白:要把 Dynamic Degree 维度单独剔掉再比,ViRDM 才更好看——说明动力学恰恰是 RDM 的软肋(表征分布对时间演化约束不足),得额外加 flow 正则才勉强补回来,等于承认「省掉教师 critic」的代价是引入了新的手工正则。另外 84.87 是在 Wan2.1-1.3B 这个 1.3B 小骨架上拿的,跟动辄 14B 的双向模型不在一个量级,跨量级横向对比要打折扣。 5. EditVoice:变长非自回归零样本语音编辑 EditVoice: Variable-Length Non-Autoregressive Zero-Shot TTS and Speech Editing with Edit Flows | 厦门大学 | arXiv:2609.29889 关键词:零样本 TTS, 语音编辑, 非自回归生成, Edit Flows, 变长序列建模 ⚠️ 前序问题:现有非自回归零样本 TTS 虽然能并行生成,但几乎都要在生成前先指定目标序列长度——长度得靠另一个模块预估,一旦估错就直接影响韵律与内容。 本文贡献:EditVoice 是首个变长 NAR 零样本 TTS:用 Edit Flows 通过插入、删除、替换三类编辑操作同时更新语音内容和序列长度。训练上采用 speech-infilling,把零样本 TTS 与文本驱动语音编辑统一到同一目标下,推理时前缀提示和后缀提示两种摆位都能用;提出 Complementary Prompt Sampling(CPS),按每类操作取两种摆位里速率更大的那个,利用互补的 Edit Flow 预测。还发现模型能编辑训练来源之外的语音(包括它自己生成的),据此做端到端编辑与免训练的后生成精炼。 Overview of the EditVoice zero-shot TTS inference pipeline. Stage one generates semantic speech tokens using CPS, and stage two applies post-generation refinement to the generated sequence before speech detokenization. 实验效果:在 10K 小时 GigaSpeech 上训练 Edit Flow 模型,在 Seed-TTS Eval EN、LibriSpeech-PC 上零样本 TTS 表现具竞争力,在 RealEdit 上语音编辑表现具竞争力。后生成精炼把 WER 从 2.66% 降到 1.55%,且 8 步生成 + 2 步精炼已经超过不做精炼的 16 步生成。 Post-generation refinement on Seed-TTS Eval EN. Starting from the same 8-step CPS output, WER and edits to generated tokens are measured over 8 refinement steps. The dashed line denotes 16-step CPS generation without refinement. 批判点评:全文只有 5 页 3 张图,实验规模偏薄:10K 小时训练的对比对象里有 CosyVoice 2 这类数据量级高一个档的系统,「competitive」具体竞争到什么程度得回表里逐项看。后精炼这个卖点本质是拿推理时算力换质量——8+2 步打败 16 步听起来漂亮,但总步数只少了 6 步,换成真实延迟并不划算。另外「能编辑非训练来源的语音」是意外发现而不是设计,作者没给系统的泛化边界评估,这条能力在多说话人、跨语种上会不会退化是未知数。 6. OREO:用 2D 编辑反馈对齐 3D 保真 OREO: Fidelity Alignment in 3D Generation via On-the-fly Rendering-Editing Optimization | 香港理工大学;腾讯 ARC Lab | arXiv:2609.29788 关键词:3D 生成, 保真对齐, 2D 扩散先验, 强化编辑, ECCV 2026 ⚠️ 前序问题:3D 生成模型进步很快,但产出的资产视觉保真度往往不够——几何、布局对得上,质感与细节就是差一口气,和 2D 扩散模型能达到的写实程度有明显落差。 本文贡献:OREO 是一个对齐框架,核心是不依赖静态数据集,而是建立动态优化闭环:把 3D 输出渲染出的视图交给 2D 模型做 Reinforced Editing,在保持几何、视角和内容不变的前提下提升视觉保真;这些被实时编辑过的渲染图反过来作为高质量 2D 伪目标,监督 3D 生成器从自己的样本里学习、逐步提升画质。 Overview of OREO. 实验效果:以 Trellis 为底座,对参考图 $x^{ref}$ 的 CLIP / DINO 相似度在 Conceptual Design 上从 0.7613 / 0.7916 提到 0.7834 / 0.8065,在 GSO 上从 0.7722 / 0.7022 提到 0.7764 / 0.7069;对比 Photo3D(0.7380 / 0.7837、0.7512 / 0.7034)同样领先。论文已被 ECCV 2026 接收。 Qualitative comparison of 2D feedback sources (Reinforced Editing / NanoBanana Pro / Qwen-Image-Edit). 批判点评:消融表里最刺眼的一行:去掉 Source Branch 后 ΔCLIP / ΔDINO 从 +0.0379 / +0.0298 直接翻成 −0.0523 / −0.0497——比不做对齐还差。整套方法对「保留源分支」这一条设计极其敏感,稳健性存疑。变体对比里把分布匹配换成 DMD,分数掉到 0.5393 / 0.5486,说明这条路和当前主流的 3D 蒸馏范式并不兼容。另外绝对增益全部停在小数点后第二位,而「视觉保真」这件事到头来还是用 CLIP / DINO 相似度做 proxy,离人眼判断有多远没人说得清。 7. ComplexSync:复杂场景 70FPS 实时唇形同步 ComplexSync: High-Fidelity and Real-Time Lip Sync in Complex Scenarios | 广州趣丸网络科技 | arXiv:2609.29225 关键词:唇形同步, 扩散蒸馏, 实时推理, 视觉基础模型, 基准评测 ⚠️ 前序问题:唇形同步要让口型动态与语音精确对齐。扩散模型生成质量高,但在遮挡、侧脸、复杂光照等复杂场景下容易失稳,而且推理延迟高到没法实际部署。 本文贡献:ComplexSync 是一套统一的扩散框架,三块设计:一是双流联合训练策略,抑制参考帧的信息泄漏同时保留自然动态;二是基于蒸馏的单步去噪加速方案,做到 70+ FPS 吞吐;三是关系对齐损失,借助视觉基础模型(VFM)的结构先验提升复杂场景因素下的同步精度与鲁棒性。此外还给出首个专门面向复杂唇形同步的 benchmark,含 200+ 条挑战视频序列与专门指标。 Overview of ComplexSync. (a) Dual-stream joint training strategy designed to suppress spatial information leakage and ensure high-fidelity synthesis. (b) Distillation-based acceleration scheme that facilitates single-step denoising for real-time inference. (c) Relational alignment loss leveraging VFMs to enhance synchronization precision and robustness under unconstrained conditions. 实验效果:在标准场景与复杂场景上均达到 SOTA,同时支持实时推理,吞吐超过 70 FPS。训练分三阶段:第一阶段 8 卡 A100 训 200K 步,第二阶段 4 卡 A100 训 50K 步,第三阶段再训 10K 步,分辨率 512×512。 Qualitative comparison with existing methods. Given that static images cannot fully capture critical temporal attributes such as synchronization, naturalness, and stability, we provide comprehensive video comparisons in the supplementary materials. 批判点评:三阶段累计 260K 步、起步就是 8 张 A100,这个训练预算对一家业务公司来说更像工程投入而非可复现的研究。全文只在 512×512 分辨率验证,而真实配音、数字人场景常见的是 1080p 以上——放大后的口型稳定性没有数据。定性对比仍然用静态帧,同步、自然度、稳定性这些纯时间属性都推给了补充视频,而这恰是唇形同步最容易「单帧好看、连起来崩」的地方。 8. AdaPilot:一套策略零样本迁移各生成器 AdaPilot: Towards Scene-Adaptive Policy Learning for Cross-Generator Text-to-Image Quality Optimization | 南洋理工大学;同花顺研究院 | arXiv:2609.29517 关键词:文生图, 强化学习, 跨生成器迁移, 多轮视觉反馈, 奖励设计 ⚠️ 前序问题:提升文生图质量的路线已经从生成器微调、提示优化走到了带多轮视觉反馈的强化学习,但现有策略都与特定生成器、特定任务深度耦合,学到的能力很难泛化成一套通用的质量优化策略——换个生成器就得重训。 本文贡献:AdaPilot 把多轮图像生成建模成马尔可夫决策过程,用端到端 RL 学一个场景自适应、可跨生成器迁移的质量优化策略。三点关键:策略与生成器内部解耦(只通过 prompt 和编码后的视觉观测交互,不碰梯度与内部状态),因此能跨生成器复用;场景感知奖励(AdaReward)把质量评估维度与任务语义自适应对齐;过程级奖励建模图像质量在多轮里的演化轨迹。实现上用 Qwen2.5-VL-7B-Instruct 作 agent,Qwen-Image-2512 作冻结生成器。 An illustration of the proposed AdaPilot. 实验效果:在 7 个指标(CLIP-T、HPS、GDino、Aesthetic、OCR 用于奖励,Realism、Physics 为留出维度)上超过 Flow-GRPO、T2I-R1、T2I-Copilot 等基线。跨生成器评测中,单一策略零样本迁移到未见过生成器(Qwen-Image、GPT-Image-1、Gemini-3-pro-Image-Preview 等)时,在所有被评生成器上仍保持正平均增益,OOD 数据集上每个维度都领先。 Averages over applicable evaluation metrics for four unseen image generators on four out-of-distribution datasets and overall, comparing results with and without AdaPilot to evaluate zero-shot cross-generator transfer. 批判点评:论文自己给的失败案例很说明问题:一张要求对比八位利物浦前锋的密集信息图,多轮迭代确实把版面理清了,但文字仍基本不可读、球员身份与属性不一致、图表数值不可验证,agent 明知有残缺陷还是终止了。这暴露了「策略只改 prompt」的天花板——当缺陷出在生成器自身的文字渲染与数值编码能力时,再聪明的提示改写也救不回来。另外训练时要同时部署 CLIP ViT-L/14、HPS v2.1、Grounding DINO、GLM-OCR 和 Qwen2.5-VL-72B 五个评估器算奖励,这套推理栈的成本并没有被算进收益里。 9. ZoomDiff:双摄平滑变焦的高保真插值 ZoomDiff: A High-Fidelity Diffusion Model for Dual-Camera Smooth Zooming | 哈尔滨工业大学;淘宝(阿里巴巴集团) | arXiv:2609.28083 关键词:双摄变焦, 帧插值, 扩散模型, 高频重建, 时间一致性 ⚠️ 前序问题:双摄像头之间的数字变焦切换,几何结构和色彩一致性上会出现肉眼可见的跳变。现有双摄平滑变焦(DCSZ)方法多在帧插值模型上微调,扛不住大视差与复杂几何变换;直接套扩散式帧插值模型,又因为条件引导不足、VAE 编码丢高频、时间一致性不够,保真度还是上不去。 本文贡献:ZoomDiff 在潜空间与像素空间同时吃透双摄输入:一是多步去噪过程中强化双图条件引导,提升几何一致性;二是把 VAE 编码器的 flow 对齐多尺度特征注回解码器(ref injector),把 VAE 编码时丢掉的高频细节补回来;三是引入 flow 引导的时间一致性监督($\mathcal{L}_{ftc}$)让转场更顺。并给出把步数从 25 压到 8 / 4 的适配方案。 The dual-camera images ($\mathbf{X}_0$ and $\mathbf{X}_F$) are fed into the VAE encoder and the semantic encoder. 实验效果:合成与真实数据集上全面领先:PSNR 23.80、SSIM 0.761、LPIPS 0.253、PSNR-div 23.01、FVD 131.332,真实集 MUSIQ 73.634、LIQE 4.874、DBCNN 0.692、DOVER 0.665,均为最优。步数压缩上,25 步 45.89s(FLOPs 743T)可压到 8 步 21.28s(2.16×)与 4 步 15.71s(2.92×)。 Visual comparisons on the synthetic dataset and the real-world dataset. Our method still produces more consistent results. 批判点评:两个反差值得记。其一,扩散类基线整体拉胯:Wan2.1 只有 17.71 PSNR、TRF 14.15、Framer 的 DOVER 只有 0.335,全都输给光流法(UPRNet 22.58、RIFE LPIPS 0.261)——说明「生成式先验」在这个任务上并非天然优势,ZoomDiff 的赢面来自双图条件引导与高频注入这两个工程补丁,而非换 backbone。其二,步数压缩后质量反而上升:8 步版 PSNR 24.08 高于 25 步版的 23.80,而去掉步数适配的 8 步版只有 22.32。也就是说 25 步其实是过采样,指标对步数并不单调,任何「步数越少越差」的外推在这里都不成立。 10. ODU-Bench:14 个全模态模型的需求理解评测 Omni Demand Understanding: A Benchmark for Contextual User-Intent Inference in Multimodal Interaction | 上海交通大学;上海创智学院;阿里巴巴;香港中文大学;清华大学;香港理工大学;南开大学;约翰斯·霍普金斯大学 | arXiv:2609.21392 关键词:多模态交互, 需求理解, 评测基准, 误触发, MLLM ⚠️ 前序问题:音视频自然交互正成为 AI 助手的重要入口,但现有交互能力基准主要评「回复质量」,漏掉了更基础的一问:模型能不能从复杂的多模态交互里正确推断用户的真实需求?现实中的需求在口语里往往是欠规格的,得靠视觉线索、声学线索和对话历史补;含糊表达、噪声环境进一步加剧难度。反过来,听起来像请求的 utterance 也可能根本不是给助手的需求,导致误触发。 本文贡献:把 Omni Demand Understanding(ODU)定义成一个独立的多模态上下文推断问题:给定交互流,模型必须判断是否存在需求,并从多模态与对话上下文推断意图,评测覆盖五个维度(M1 需求存在性、M2 关键点命中率、M3 时间跨度 IoU、M4 转录、M5 用户画像),同时覆盖单轮与多轮。ODU-Bench 用挑战驱动的 taxonomy、taxonomy 引导的 agentic 视频生成加真人录制交互来构建,标注从互补媒体证据重建并经人工校验。 Overview of the ODU-Bench construction pipeline. Challenge-driven targets are expanded into coarse-to-fine scripts, screened for plausibility and challenge validity, and realized as synthesized or human-recorded interactions. 实验效果:评测 14 个原生 MLLM:最强者 Gemini 3.1 Pro 也只能恢复 44.7% 必须从视觉、声学或对话上下文推断的关键信息;14 个模型里有 11 个在非需求场景上的误触发率(FTR)超过 50%。 Qualitative error analysis on English generated audio-visual scenes. (a)--(b) Demand-present cases; M2 reports covered/reference key points. (c)--(d) No-demand cases. 批判点评:44.7% 和「11/14 误触发率 >50%」这两个数字,真正打脸的是当前「先响应、后理解」的范式——模型宁可硬猜一个需求,也不愿意说「这不是需求」。可惜基准本身大量依赖 agentic 生成的交互与 LLM judge,虽然论文做了 judge 稳定性检验和真人录制对照(Δ = Rec − Syn),合成数据与真人数据之间的分布差仍是这套结论最大的外推风险:如果 agentic 生成场景的「挑战性」分布和真实用户偏得比较多,44.7% 这个数就未必能平移到线上。 趋势观察 生成的瓶颈正在往「输入端」和「调度端」挪 今天这十篇里有三篇在动生成流程的两端而不是中间:WanPE 用 397B 模型重写提示词,把导演级分镜规划搬到文本空间完成;TRACK 不改模型、不重训练,只决定每一步该派大模型还是小模型上场;AdaPilot 则干脆只通过 prompt 和视觉观测跟生成器打交道。共同点是:底座模型被当成黑箱,可优化的空间被挪到了它前面和外面——这对没算力训底座的团队是好事,对卖底座的团队不是。 「砍掉教师与 critic」成为后训练的新共识 ViRDM 把 DMD 的教师+critic+生成器三件套砍成只训生成器,8 卡 A100 下显存 77.1→48.3 GB、时间 22h→2h,VBench 还涨了 0.36;OREO 同样放弃静态数据与蒸馏范式,改用 2D 编辑实时产出伪目标做自我监督;AV-GRPO 冻结一塔训另一塔来降低 RL 成本。三条独立工作指向同一判断:昂贵的在线监督预算正在被更便宜的离线/自产目标替换,代价往往是引入新的手工正则(ViRDM 的 flow 正则就是这么来的)。 评测基准开始盯「理解」而不是「生成」 ODU-Bench 评测 14 个原生 MLLM 后发现,最强的 Gemini 3.1 Pro 也只能恢复 44.7% 必须靠上下文推断的关键信息,而且 11/14 的模型在非需求场景上误触发率超过 50%。这个数字比任何生成质量榜单都更能说明当前语音/视觉助手的实际状态:问题不在答得好不好,而在该不该答都还没判断对。ComplexSync 也顺手补了首个复杂场景唇形同步 benchmark,200+ 条挑战序列把遮挡、侧脸这些长期被平均掉的case单独拎出来。 人工智能炼丹君 整理 | 2026-09-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注