
搜索到
240
篇与
人工智能炼丹君
的结果
-
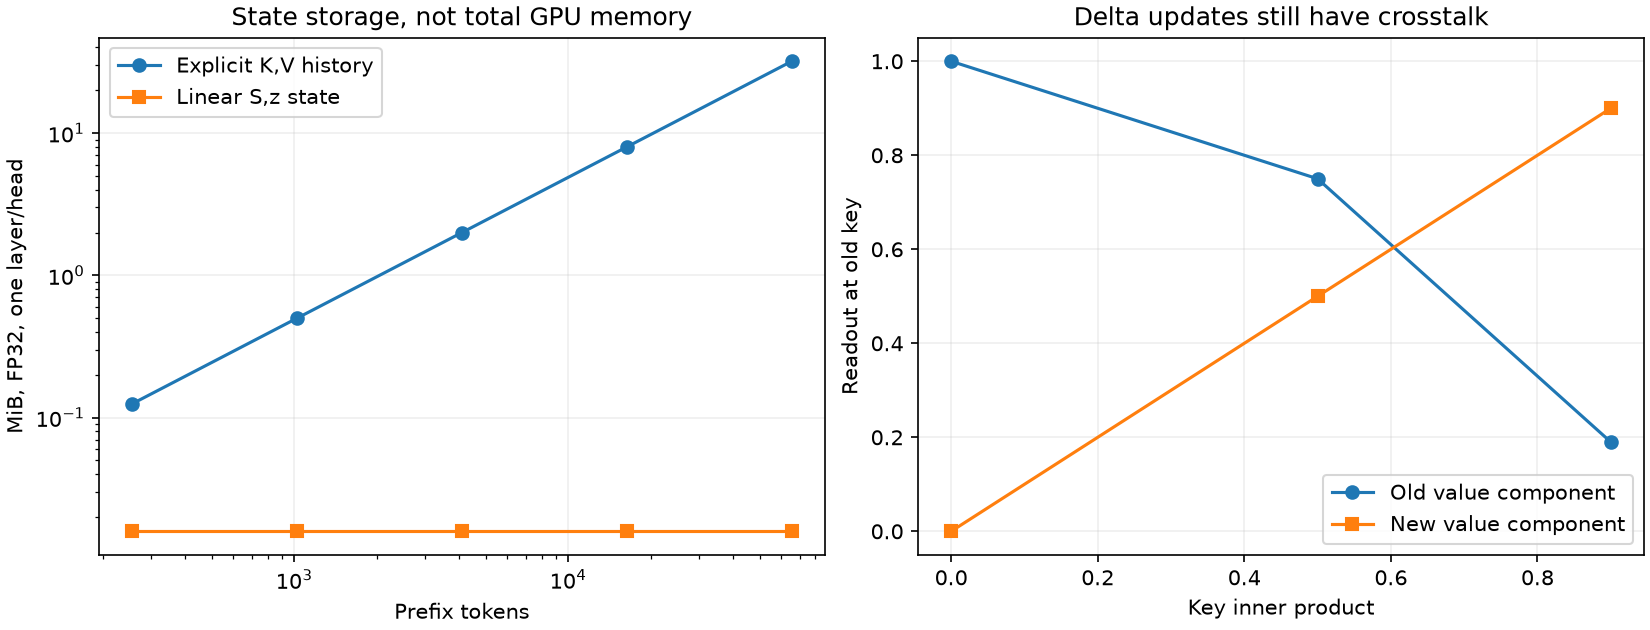
 AIGC 基本功|线性、循环与记忆架构-LinearMem AIGC 基本功|线性、循环与记忆架构-LinearMem 长序列的瓶颈不只在注意力矩阵,还在不断增长的历史状态。本篇从可以手算的线性核出发,推到循环状态与 Delta 更新,再区分序列循环和深度循环。公式中的等价关系、代码中的误差、框架中的工程选择各有适用范围。 先修:自注意力机制的计算与显存账本。本文不训练视频模型,也不以随机张量实验推断视频画质;所有数值实验是 CPU 上的机制验证。本次精修核验日期:2026-11-05;保留原首发日期。读者需要知道矩阵乘法、向量内积、外积与一阶梯度:外积把长度分别为 $r,d_v$ 的两个向量变成 $r\times d_v$ 矩阵,后文会用它写入一条关联。prefill 指一次处理输入前缀,decode 指逐 token 生成;两者可用不同执行路径。 01. 为什么需要它 假设一个流式生成器已经处理了 65536 个 token,单层单头的 key 和 value 维度都是 64。若两者均以 FP32 保存,历史 K、V 就要占 32 MiB。这还没有乘层数、头数和并发数,也没有算模型参数、工作区和训练激活。长视频若把时间与空间都展开成 token,状态增长会直接挤压服务容量。这个账本来自元素计数,不是某张 GPU 的实测峰值。 一种选择是保留历史,并用 FlashAttention 等方法减少中间矩阵和访存;另一种选择是把历史压进固定形状的状态。后者的单层单头状态可以只有 64×64 的矩阵,加一个长度 64 的归一化向量,共 16640 字节,约 0.015869 MiB。两者在这个设定下相差约 2016.49 倍,但这只是注意力历史存储的比例,不能写成模型显存节省或吞吐加速倍数。 压缩状态也会改变信息的组织方式。想象系统先记住“对象 A 的颜色是红”,随后收到“对象 A 的颜色改为蓝”。只做累加的记忆可能把两条记录混在一起,读出平均意见;具备纠错更新的记忆才有机会覆盖旧映射。省空间与能否可靠检索不是同一个问题,本文用这个更新场景把两者连起来。 这也是阅读长序列论文时最值得先问的三件事:保留了多少历史,允许怎样更新历史,训练时又如何并行。只看到“线性复杂度”就认为速度、记忆和生成质量一起改善,会把三个独立问题混成一个结论。 02. 最小可用理解 线性注意力先把 query 和 key 映射到特征空间,再利用矩阵乘法的结合律,把“每个 query 访问所有历史”改写成“每个 query 读取一个累积状态”。循环实现沿 token 方向更新这个状态;Delta 更新则把“直接写入新 value”改成“先读旧 value,再写纠正量”。深度循环共享同一计算块反复修改整段表示,它增加的是每个 token 的计算深度,不能由此推出历史缓存变成固定大小。 这里“线性”主要指固定特征维度时,时间随序列长度线性增长;整层仍包含非线性映射、归一化和前馈网络。这里“记忆”指输入驱动的隐藏状态,并非训练参数永久学到的知识,也不是数据库里逐条可寻址的记录。 把几个概念放在一起看,区别会更清楚: 机制 循环或聚合的轴 持续保留什么 要付的代价 Softmax 因果注意力 query 对历史位置检索 随前缀增长的 K、V 解码读取历史与缓存容量 核线性注意力 token 顺序 累积矩阵及归一化状态 核改变、信息混合 Delta 类记忆 token 顺序 可纠错的矩阵状态 更新依赖、key 干扰 深度循环 Transformer 表示的修订次数 整段表示及所需缓存 重复计算、停止机制 这张表是机制对比,不是性能排行榜。同一系统可以混用不同层;是否适合视频生成还取决于因果性、时间空间组织、条件输入和训练目标。 03. 数学推导 从检索权重开始 设序列长度为 $N$,当前位置为 $t$,历史位置为 $i$。列向量 $q_t,k_i\in\mathbb{R}^{d_k}$ 分别表示 query 和 key,$v_i\in\mathbb{R}^{d_v}$ 表示 value;$d_k$ 是匹配空间维度,$d_v$ 是读出空间维度。因果注意力只允许 $i\le t$,当前 token 可以看见自身。标准缩放点积注意力写成: $$a_{ti}=\frac{\exp(q_t^\top k_i/\sqrt{d_k})}{\sum_{j=1}^{t}\exp(q_t^\top k_j/\sqrt{d_k})},\qquad o_t=\sum_{i=1}^{t}a_{ti}v_i$$ $a_{ti}$ 是当前位置分给第 $i$ 条历史的非负权重,沿历史位置求和为一;$o_t$ 是输出。分母中的 $j$ 只是求和索引。指数作用在 query-key 配对上,因此不能把 Softmax 随意移到乘法外面。下面将换一种相似度,这是改变算子定义的步骤。 选择特征映射 $\phi:\mathbb{R}^{d_k}\to\mathbb{R}^{r}$,$r$ 是映射后的维度,一般映射未必逐元素。本文取 $r=d_k$,对每个分量用 ELU+1:正输入加一,非正输入取指数。在实数运算下,每个分量及映射后内积都严格为正;浮点运算的下溢例外稍后单独检验。定义核相似度: $$s(q,k)=\phi(q)^\top\phi(k),\qquad \phi(u)=\begin{cases}u+1,&u>0\\ \exp(u),&u\le0\end{cases}$$ 这并不等于原来的指数点积核。选择 ELU+1 是一个具体的建模选择;本文接下来验证的是这个新核内部的等价计算,不声称复现 Softmax。核线性化与循环视角的来源是 Linear Transformers。 把历史和移到 query 外面 用新核替换权重后,定义一个带数值保护项的输出。$\epsilon>0$ 是避免极小分母引发数值问题的常量;它会略微改变归一化,因而权重和不再严格等于一。实验的两种实现都会使用相同的 $\epsilon=10^{-6}$;它是每次读出的分母偏置,不是写进历史状态、每来一个 token 就累加一次的量: $$o_t=\frac{\sum_{i=1}^{t}\bigl(\phi(q_t)^\top\phi(k_i)\bigr)v_i}{\sum_{i=1}^{t}\phi(q_t)^\top\phi(k_i)+\epsilon}$$ 分子中,$\phi(q_t)$ 对每个历史位置都相同,因此可以利用分配律先求历史外积的和。外积 $\phi(k_i)v_i^\top$ 的形状是 $r\times d_v$,它不是相似度矩阵。把这些外积累加成 $S_t$,把映射后的 key 累加成 $z_t$: $$S_t=\sum_{i=1}^{t}\phi(k_i)v_i^\top\in\mathbb{R}^{r\times d_v},\qquad z_t=\sum_{i=1}^{t}\phi(k_i)\in\mathbb{R}^{r}$$ 于是输出的转置可写成一行矩阵读取: $$o_t^\top=\frac{\phi(q_t)^\top S_t}{\phi(q_t)^\top z_t+\epsilon}$$ 维度检查很重要:分子是 $1\times d_v$ 的行向量,分母是标量,结果与 $o_t^\top$ 一致。代码里每个 token 都用一维数组表示,因此 fq[t] @ S 直接得到长度 $d_v$ 的数组,不需要显式转置。 历史状态天然有递推式,因为第 $t$ 步的和只比前一步多一项: $$S_t=S_{t-1}+\phi(k_t)v_t^\top,\qquad z_t=z_{t-1}+\phi(k_t),\qquad S_0=0,\ z_0=0$$ 先写入当前 token,再用当前 query 读取,才与 $i\le t$ 的因果定义一致。若先读后写,就变成严格只看过去的另一个算子。全零初态且使用正 epsilon 时,该算子的首步输出为零;这与包含自身的首步输出一般不同。若先把整段所有 key 累进一个状态再逐个读取,则会泄露未来,不能拿来做因果生成。 固定 $r,d_v$ 时,每步更新和读取都需要约 $O(rd_v)$ 运算,整段是 $O(Nrd_v)$。解码期间可持续保留的状态是 $O(rd_v+r)$。这里没有把反向传播所需激活算进去;训练若朴素保存每一步状态,内存仍会随长度增长。前缀和、分块计算和反向重计算解决的是训练工程问题。加法状态的块摘要只需把块内外积与 key 分别求和,块间再加;复杂度还包括特征映射本身,不能只算状态乘加。 还要读懂 epsilon 带来的边界。令 $D_t=\phi(q_t)^\top z_t$,则归一化权重和为: $$\sum_{i=1}^{t}\frac{s(q_t,k_i)}{D_t+\epsilon}=\frac{D_t}{D_t+\epsilon}$$ 因此它相当于把无 epsilon 的加权均值乘以上式的因子。即便所有 value 都为 1,输出也可小于 1;只有 $D_t$ 远大于 epsilon 时偏差才小。把全部特征统一乘常数 $c>0$ 后,相似度乘 $c^2$,固定 epsilon 不变,输出也会改变;不能宣称这个带偏置算子具有任意特征尺度不变性。 浮点还有第二层差异。本文用 exp(min(x,0)) 直接算负分支,避免对正大数执行指数。在本次 CPU FP32 实验中,x=-20 得到约 $2.06115\times10^{-9}$,官方 ELU(x)+1 却因减一再加一的舍入消去而得到 0。数学上相等不保证逐位相同。单 token、单特征且 q=k=-20、v=1 时,本文输出约 $4.24835\times10^{-12}$,主要由 epsilon 决定;q=k=-1000 时,连直接指数也下溢为 0,输出为 0,并没有恢复被丢掉的信息。状态和乘积仍可能溢出,代码会明确报错,不用 epsilon 掩盖非有限值。 从累加改成纠错 归一化线性记忆会混合重复 key 的记录。现在单独讨论一个无分母归一化的关联记忆,不再沿用 ELU+1 权重解释:$k_t\in\mathbb{R}^{r}$ 是单位长度 key,$S\in\mathbb{R}^{r\times d_v}$ 是矩阵状态。它对 key 的预测是行向量 $k_t^\top S$。给定新 value 后,定义单步平方误差: $$\ell_t(S)=\frac12\left\|S^\top k_t-v_t\right\|_2^2$$ 若 $S$ 的第 $a,b$ 个元素变化,只会通过 $k_{t,a}$ 改变预测的第 $b$ 个分量。因此该元素的梯度是 key 的第 $a$ 分量乘以第 $b$ 分量的预测误差;把所有元素拼回去,得到: $$\nabla_S\ell_t=k_t\bigl(k_t^\top S-v_t^\top\bigr)$$ 用更新幅度 $\beta_t$ 做一次梯度步,得到本文方向约定下的 Delta 规则: $$S_t=S_{t-1}+\beta_t k_t\bigl(v_t^\top-k_t^\top S_{t-1}\bigr)$$ $\beta_t$ 是实际更新步长,控制新信息覆盖旧映射的程度;不预设任意非负值都稳定。这是对输入状态的一次在线更新,不等同于对模型全部训练权重进行反向传播。外积写入只纠正当前 key 对应的预测,而不是无条件累加原始 value;这层解释来自 Fast Weight Programmers。 为什么单位 key 能精确覆盖?左乘 $k_t^\top$,利用 $k_t^\top k_t=1$,可得: $$k_t^\top S_t=(1-\beta_t)k_t^\top S_{t-1}+\beta_t v_t^\top$$ 当 $\beta_t=1$,当前单位 key 的读出就恰好等于新 value。更一般地,固定一个非零 key 与目标 value,不遗忘,令行向量误差 $e_t=k^\top S_t-v^\top$,左乘一般 key 可得: $$e_t=\bigl(1-\beta\lVert k\rVert_2^2\bigr)e_{t-1}$$ 这是本文根据上式直接推出的稳定性条件:要让这个固定目标误差严格缩小,需 $0\lt\beta\lVert k\rVert_2^2\lt2$;取等号 2 会等幅振荡,超过 2 可发散。一次精确覆盖则取 $\beta=1/\lVert k\rVert_2^2$,不能把单位 key 的 beta=1 结论搬到任意尺度。例子中 k=2、v=1、零初态,beta=1 一次读出 4;beta=0.25 才读出 1。单位 key、beta=2.5 重复写同一目标时,四次误差为 [1.5,-2.25,3.375,-5.0625]。读另一个 key $h$ 时,它受到的变化是 $\beta_t(h^\top k_t)$ 乘以纠正量:正交 key 不受影响,相似 key 会受到干扰。Delta 规则能纠错,却没有让矩阵成为无碰撞字典。 再引入遗忘系数 $\alpha_t$,先衰减旧状态,再针对衰减后的预测做纠错: $$\widetilde S_{t-1}=\alpha_t S_{t-1},\qquad S_t=\widetilde S_{t-1}+\beta_t k_t\bigl(v_t^\top-k_t^\top\widetilde S_{t-1}\bigr)$$ 展开后是 $\alpha_t(I-\beta_t k_tk_t^\top)S_{t-1}+\beta_t k_tv_t^\top$,$I$ 是 $r\times r$ 单位矩阵。论文常把状态转置成 value-first 方向,式子于是从左乘变成右乘,两者只是布局约定。先遗忘再计算误差这一顺序不能随意改,否则得到另一个更新规则。该组合是 Gated DeltaNet 的核心机制。最小代码接受 $0\le\alpha_t\le1$;alpha=0 会先清空旧矩阵,alpha=1 不全局遗忘。标量例子 S=k=v=1、alpha=0.5、beta=1,正确顺序读出 1;若错误地用未衰减的 S 计算纠正量再叠到衰减状态,只得到 0.5。 矩阵 $I-\beta kk^\top$ 在 key 方向的特征值为 $1-\beta\lVert k\rVert_2^2$,正交方向为 1。配合不超过 1 的非负 alpha 以及上述非扩张范围,两份初态在相同输入驱动下的差异不会被单步放大。但这不是整个训练过程稳定、任意输入下状态有界或任务记忆准确的证明;写入项、不断变化的 key、浮点误差和其他网络层还需分别验收。 循环也不等于训练只能串行。把一步写成仿射变换 $S_t=A_tS_{t-1}+B_t$,其中: $$A_t=\alpha_t(I-\beta_tk_tk_t^\top),\qquad B_t=\beta_tk_tv_t^\top$$ 两步的有序组合是 $(A_2A_1,\ A_2B_1+B_2)$。组合满足结合律,可构造分块摘要或并行扫描,但通常不满足交换律,不能打乱 token 次序。直接物化这些 $r\times r$ 矩阵并做通用矩阵乘也可能很贵,不能凭结合律就声称获得高效 GPU 内核;论文的结构化分块算法与下面的 PyTorch 参考是另一个工程层面。独立脚本以随机非零初态检验了 36 组有序组合。 深度循环沿另一个轴进行 设 $H^{(s)}\in\mathbb{R}^{N\times d}$ 是第 $s$ 次修订后的整段表示,$d$ 是隐藏维度,共享参数为 $\theta$。深度循环可以抽象成: $$H^{(s+1)}=F_\theta\bigl(H^{(s)},P^{(s)}\bigr),\qquad s=0,1,\dots,R-1$$ $P^{(s)}$ 提供位置与修订步信息,$R$ 是执行的修订次数,$F_\theta$ 可包含注意力与前馈网络。不同的 $s$ 重用同一套参数,但每次处理的仍是整段表示。若内部用全注意力,一轮的长度平方成本仍在,多轮修订也仍要付计算。它能改变参数复用和计算深度,却不能直接推出固定历史容量。这是 Universal Transformers 与 token 递推状态的关键区分。 04. 代码实现 完整脚本 linear_memory_demo.py 放在文末附录。只需 Python 3.10+、NumPy 和 matplotlib,保存后执行 python linear_memory_demo.py,会打印结果、写出 JSON,并生成原创图。在项目的 code/ 结构下输出到该文章目录;单独保存时输出到脚本所在目录。依赖安装可以用 python -m pip install numpy matplotlib;没有权重、数据集或 GPU 下载步骤。 先看循环读取的核心。fq 和 fk 是 $\phi(q)$ 与 $\phi(k)$,S 是 $S_t$,z 是 $z_t$。这里没有多头和 batch,目的是让一次状态更新的维度一眼可查。validate_qkv 与 floating_arrays 的完整定义在附录:只接收同 dtype 的有限 FP32/FP64 非空二维数组,维度必须匹配,epsilon 转到输入 dtype 后仍须为有限正数。核心函数与附录逐字一致: def recurrent_linear(q, k, v, eps=1e-6, state=None): eps = validate_qkv(q, k, v, eps) fq, fk = phi(q), phi(k) if state is None: S = np.zeros((k.shape[1], v.shape[1]), dtype=q.dtype) z = np.zeros(k.shape[1], dtype=q.dtype) else: if not isinstance(state, (list, tuple)) or len(state) != 2: raise ValueError('state must contain S and z') S, z = state floating_arrays(q, S, z) if S.shape != (k.shape[1], v.shape[1]) or z.shape != (k.shape[1],) or (z < 0).any(): raise ValueError('Invalid state shape or negative normalizer') S, z = S.copy(), z.copy() out = np.zeros_like(v) with np.errstate(over='raise', invalid='raise', divide='raise'): for t in range(len(q)): S += np.outer(fk[t], v[t]) z += fk[t] out[t] = (fq[t] @ S) / (fq[t] @ z + eps) return out, S, z 脚本还写了一个刻意生成完整 $N\times N$ 权重矩阵的参考实现:先计算 phi(q) @ phi(k).T,再用下三角因果掩码去掉未来位置。这个版本不追求省内存,只作为独立计算路径验证结合律重排。循环版若不小心先读取再更新,或者漏掉 z,这个对照会立即暴露差异。 2026-11-05 在 CPU、NumPy float64、随机种子 7 下重新实际运行,原实验输出保持: q_shape = [8, 4] v_shape = [8, 3] output_shape = [8, 3] state_shape = [4, 3] normalizer_shape = [4] explicit_recurrent_max_error = 1.6653345369377348e-16 linear_softmax_max_difference = 0.9214427905350642 output_min = -1.088998885679583 output_max = 0.8987635397834051 first_two_outputs = [[-0.57930138, -0.19619590, 0.89876354], [0.32426122, -0.78686054, 0.01150493]] future_leak_error = 0.0 第一项误差在 float64 舍入量级,验证新核的两种求值路径。第二项差异是同一组 q、k、v 在新核与标准缩放 Softmax 下的最大绝对差,验证两者是不同算子;它不是精度下降百分比。输出出现负数并不矛盾:权重非负,而 value 本身可以为负。 “未来泄露”实验把最后一个 value 的每个分量加 100,前七个输出保持逐元素相同。因为循环计算先前输出时尚未看到最后一个 value,它对前面的结果没有作用。这个检查只检验该输入上的因果实现;一般的因果性质来自第 03 节的求和范围,而不是一次随机测试证明所有情况。 Delta 实现则用 decayed = alpha * S,随后计算 v - k @ decayed,最后写入 beta * np.outer(k, correction)。代码与前面的转置方向一致。它不使用 z,也不对输出套线性核分母;把两套归一化随意拼接,会失去上述精确覆盖结论。 脚本对同一个单位 key 先写 [1,0],再写 [0,1]。把普通外积累加后除以写入次数,读出是 [0.5,0.5];Delta 取 beta=1 后读出是 [0,1]。这里的平均是一个手工归一化的单 key 例子,不能当成前面随机 ELU+1 注意力实验的整体输出。 接着写入另一个单位 key,控制它与原 key 的内积 $\rho$。旧 key 的读出如下: 新旧 key 内积 $\rho$ 旧 value 的分量 新 value 的分量 0.0 1.0 0.0 0.5 0.75 0.5 0.9 0.19 0.9 这些数字可手算:先写原 key 后,第二次更新把旧分量减去 $\rho^2$,同时写入 $\rho$ 倍新分量。最后一行的 0.19 是按小数显示的舍入值,原始输出为 0.18999999999999995。干扰强度取决于 key 几何关系,不能只看状态矩阵是否足够大。 图左只比较单层单头 FP32 的历史状态元素:K、V 随前缀增长,矩阵状态保持固定。图右来自上述实际更新实验:key 越相似,旧映射受到的干扰越大。请把左右两幅一起看,省掉的历史位置并没有变成免费的精确记忆;两幅图都不是 GPU 吞吐测试。 05. 工业级实现对照 以下以 2026-11-05 核对的固定提交为准,完整源码、原始 URL 和 SHA256 见本地质检。fast-transformers 固定 2ad36b97e64c,FLA 固定 9e82a80fdaef,tensor2tensor 固定 bafdc1b67730。下列链接均锁定这些提交,不把分支布局当永久 API。 idiap/fast-transformers 的 LinearAttention 对 query、key 应用特征映射,用 einsum 聚合 KV,并计算归一化分母。这个文件实现的是无因果掩码版本,只接受全一注意力掩码;不能因为名字里有 Linear 就拿它直接替代因果解码器。它处理 padding 和 batch、多头,而最小代码只有一条序列。 实际 token 递推对应 RecurrentLinearAttention.forward。该实现保存 Si 和 Zi,分别是矩阵及归一化状态,并在推理时原位更新;存在梯度时换成非原位加法。全序列因果计算另在 CausalLinearAttention。训练接口与解码接口分开,是因为前缀扫描、梯度保存和单 token 状态更新需要不同执行方式。 框架中的状态形状还有 batch、head 两个轴。服务时某个请求结束,应只清掉对应请求的状态;若拼接多个样本而不重置,会让第二个样本读到第一个样本的信息。测试新架构时,这类状态边界比单次输出形状更值得核对。本次把最小程序的 state=None 定义为新序列,并允许传入上次返回的 (S,z) 继续同一条序列;函数复制传入状态,不会原位污染调用方保存的快照。切换请求须重新传 None,不能把前一请求的状态当作后一请求的初态。348 组所有合法切分位置的续算与整段逐位一致,且输入状态快照保持;348 组同时扰动未来 q/k/v 的检查保持之前输出不变。这里只实现单序列状态接口,没有实现服务调度器或多请求缓存管理。 本次用 CPU PyTorch 2.10.0 实跑上述固定源码中完整、未改动的 RecurrentLinearAttention 类:12 组 FP32/FP64、不同长度及 batch/head 的前向与密集参考一致,q/k/v 的反向梯度也对齐;另核对无梯度的原位状态分支。运行时仅适配未使用的事件派发接口及 memory=None 的兼容接口,通过 AST 提取避开可选编译扩展。普通输入下与 NumPy 对齐,极负输入的 ELU+1 舍入差异则按第 03 节单独记录,不能声称全输入逐位等价。这不代表整个包或 GPU 性能测试。 FLA 的 GatedDeltaNetBlock 负责模型层组合,实际记忆运算在 GatedDeltaNet.forward。源码调用 chunk_gated_delta_rule 或 fused_recurrent_gated_delta_rule,传入初始状态并按 use_cache 返回末状态。该版本还把 q/k 的 L2 归一化、门与 beta 变换交给内核处理,并使用 value-first 状态布局;读公式时要先核对转置。它对投影后 q/k 使用 SiLU 与 L2 归一化,不是本文 ELU+1 的有分母注意力。默认 query 读出还乘 $1/\sqrt r$,没有 $z_t$;比较数值必须对齐这个缩放。 内核接口 指定原始门输入 u 经 -exp(A_log)*softplus(u+dt_bias) 得到 log(alpha),再取指数得到实际遗忘系数。原始 beta logit 经 sigmoid;allow_neg_eigval=True 才再乘 2,使 beta 可进入 1 到 2 之间的振荡区间,这仍不是任意无界步长。本文直接传入最终 alpha/beta,不能把投影原值直接代入。 还实跑了 FLA 的两个完整 PyTorch 参考函数:12 组非零初态、不同长度/head、含尾块的逐 token 与 chunk 路径。参考函数内部转 FP32;实验预先归一化 q/k、传最终 log(alpha)/beta,并显式设 scale=1 对齐本文公式。与 NumPy 独立递推、末状态及两条官方参考互相对照通过。这些是 CPU 参考运算,不是实际 Triton chunk/fused kernel 的执行证据。 为什么不能用 Python token 循环评判 FLA 的速度?教学循环每步触发许多小运算,训练又有跨步依赖。分块内核把一段更新组织成适合 GPU 的计算,融合递推减少解码调用开销。框架同时管理短卷积状态、padding 和归一化,本文的一个矩阵不是完整层状态。因此“缓存不增长”也要说明指的是哪一种缓存。 UniversalTransformer 的修订逻辑可沿 universal_transformer_basic 阅读:它对整段 state 做 step 预处理,再调用注意力和前馈单元;固定修订次数路径使用 num_rec_steps,另有 ACT 路径。这里的 step 是深度修订,不是缓存下一帧。ACT(Adaptive Computation Time)允许各位置的停止步不同;第 03 节的统一 R 只是固定轮数路径的抽象。是否访问未来取决于实际 attention mask,token 递推与深度循环的区别不能替代因果掩码检查。这个历史 TensorFlow 实现适合解释机制,本文不把它当作今天的视频部署推荐。 06. 代价与边界 首先,有限状态保留的是叠加后的关联,不是每条历史的独立副本。在有限数值精度下,固定大小状态没有随输入长度增长的独立存储位置,因而不能保证对任意长序列中任意位置的任意内容都能精确恢复。这个说法是存储预算约束,不是“模型超过某个长度必然失效”的具体阈值预测。 其次,遗忘与纠错作用不同。$\alpha$ 衰减整个矩阵,包括与当前 key 正交的映射;$\beta$ 控制当前关联的覆盖。脚本先把状态设为单位矩阵,取 alpha=0.8 更新第一个 key,再读第二个正交 key,得到 [0,0.8]。它虽然没有受到 Delta 纠错项的干扰,仍被全局遗忘衰减。把所有变化都归因于“选择性删除”会误读机制。 再者,特征维度也是成本。线性复杂度的前提是 $r$ 不随 $N$ 增长;若为改善检索不断扩大 $r$,矩阵更新和读取也会变贵。短序列时,优化良好的精确注意力可能更合适。必须实测相同硬件、精度、batch、序列长度和质量约束下的端到端延迟,本文的状态元素图无法回答交叉点在哪。 训练与解码还要分别验收。固定解码状态不代表训练显存恒定,不代表单步就没有计算,也不代表批量 prefill 一定更快。工程实现会使用分块、扫描或重计算;其真正收益应由 profiler 以及完整训练步骤验证。把单 token 延迟、首 token 延迟和总生成时间混为一个数字,会掩盖需要付出的成本。 状态账本还应区分“元素数量”和“信息容量”。一个矩阵有固定数量的浮点元素,但这些元素可以用不同方向叠加许多关联,不能简单说它只能记住恰好多少个 token;反过来,也不能把可接受任意长度输入写成能保存任意数量的独立事实。实际检索能力要通过任务衡量:例如改变干扰 key 数量、重复更新次数、查询与写入的距离,以及输入精度,分别观察正确读出率和数值误差。 比较混合模型时,账本应按层拆开。部分层若保留窗口注意力,其显式缓存仍随窗口长度占空间;部分层若保留完整注意力,该部分历史仍会增长。短卷积还可能维护局部状态。只看到某一层用了 Delta 更新,就把整个模型都归为固定状态,会漏掉服务中真正占内存的部分。判断是否合适,应先列清每层状态、精度、并发请求数和最大长度,再用运行时内存测量核对。 落到视觉生成,时间因果性与空间交互必须分开设计。双向 DiT 在同一个去噪步内可以访问整个视频,不能只把注意力换成本文因果递推就声称等价;把空间 token 排成序列后,排列顺序也会影响递推的归纳偏置。自回归视频可以沿时间维护状态,但仍要验证运动、遮挡后对象恢复、长时一致性和跨片段条件变化。 最后,深度循环的参数复用不等于算力复用。执行 $R$ 次修订通常需要重复做 $R$ 次块计算,是否受益要看任务、停止规则与训练是否覆盖该次数。推理时随意把次数从四次加到八次,不保证答案或生成质量改善。本文只用抽象方程定位循环轴,没有提供训练过的深度循环模型或性能结论。 07. 经典论文脉络 这五篇不是同一条单向升级路线,而是围绕“历史怎么保存、计算怎么组织”形成的分支。阅读时先分清 token 轴与深度轴,再理解具体内核优化。 Universal Transformers,2018,1807.03819:在深度方向共享转移,并允许动态修订次数;它保留全局注意力交互,提供的是计算深度视角。 Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention,2020,2006.16236:用特征核与结合律把注意力改写成累积状态,连接全序列计算与因果递推。 Linear Transformers Are Secretly Fast Weight Programmers,2021,2102.11174:将外积状态解释为 fast weights,并引入 Delta 式纠错,针对加法记忆的映射更新问题。 Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,2024,2405.21060:从结构化状态空间对偶组织 Mamba2 的计算,说明递推与并行矩阵形式可以共同设计。 Gated Delta Networks: Improving Mamba2 with Delta Rule,2024,2412.06464:把遗忘门与 Delta 更新结合,并设计高效分块训练,让记忆管理和硬件执行协同。 本文没有直接比较这些论文的榜单分数:训练规模、数据和任务不同,把各自报告的提升并排当成架构优劣,会得出超出证据的结论。真正可迁移的基本功是识别状态、更新规则、归一化及并行形式,再按自己的任务设置对照实验。 08. 常见误解 “线性注意力只是换乘法顺序,数值应该和 Softmax 一样。” 换顺序之前已经换了相似度。显式线性核与递推线性核应一致;与 Softmax 的差异则是正常的算子差异。把两者的误差都叫“实现 bug”,会把建模选择误当工程问题。 “固定状态就是无限上下文精确记忆。” 固定状态能持续接收输入,但它叠加或纠正关联,没有为每条历史开辟新的独立位置。需要逐条引用、精确复制或回溯时,应明确测试检索能力,并考虑显式缓存、外部检索或混合结构。 “Delta 只更新当前 key,所以不会损伤其他信息。” 更新是否影响另一个 key 取决于内积。正交时纠错项不干扰,相似时会串扰;再加遗忘门,连正交映射也会衰减。第 04 节的三个内积点让这个限制可以直接看到。 “代码里的 beta 就是生产模型中的最终更新幅度。” 最小代码直接传最终标量;实际模型通常预测门控参数,再经过内核里的非线性或缩放。本篇固定 FLA 版本的接口明确提供内核归一化、sigmoid 和可选两倍步长;大于 1 的更新会在 key 方向出现负特征值,不能简单解释成旧/新 value 的凸混合。对照时不能只把同名变量代进公式,还要查它处在变换前还是变换后。 “深度循环减少了层数,因此执行成本也按同样比例下降。” 共享参数减少的是独立参数副本,重复执行仍付运算、激活及注意力成本。把参数量、执行深度和上下文状态分开计数,才能解释循环架构到底省了什么。 “对语言长序列有用,所以可以无训练替换视频 DiT。” 时间因果约束、空间邻接和扩散步条件都不同。替换需要训练或有依据的适配,再用视频维度的验收验证;随机 CPU 实验只能说明机制,不能证明视频生成可用。 09. 动手验证 先原样运行附录脚本,确认输出形状及两种线性求值误差低于 1e-12。不同 NumPy 版本可能改变最后几个浮点位,因此逐项复现应使用误差容限,而同 key 的 [0,1] 覆盖例子可以直接手算核对。 第一个改动是把 recurrent_linear 里的读取放到写入之前。第一步读出会变成零,之后只访问严格过去,显式参考实现若仍保留对角线就不再一致。修复不该“放宽误差阈值”,而应把两种实现的因果定义对齐。 第二个改动是把 memory_experiment 的 Delta 更新改成 beta=0.5。重复 key 先后写入两个 value 后,应读出 [0.25,0.5],不是 [0.5,0.5]:零初态到第一条信息本身也只走了半步。这个结果直接来自递推式,不要求训练模型。 第三个改动是去掉门衰减,取 alpha=1,再保留单位初始状态和正交 key 检查。第二个 key 应读出 [0,1];与 alpha=0.8 的 [0,0.8] 对照,就能隔离全局遗忘和关联纠错的作用。 第四个改动是把 q、k、v 的输入改成 float32,状态与掩码也保持输入 dtype,使两条路径都使用 float32。脚本末尾已经执行这组对照并打印 float32_explicit_recurrent_max_error。预期因乘加顺序不同而出现更大的舍入差异,不承诺跨版本固定数值;请同时记录误差、输入长度和状态范围。长度扩展时数值稳定性也应重新测量,而不是沿用短序列的阈值。 附录另有完整的 memory_checks.py,与主脚本放在同一目录运行即可。它用 Python 标量指数与 math.fsum 作独立参考,覆盖 60 组 FP32/FP64、不同序列长度和读写维度;本次最大误差分别为 $2.38419\times10^{-7}$ 与 $4.44089\times10^{-16}$。它还执行全部 348 个切分位置的状态续算与未来扰动、24 组 Delta 状态梯度中央差分(最大误差 $3.57060\times10^{-9}$)、36 组仿射组合,以及 15 个非法输入检查;beta 发散、非单位 key、错误门顺序、epsilon 主导和下溢反例都在真实输出中。这里只报告当前 NumPy/CPU 输出,误差容限不是所有长度的稳定性保证。 最后,可将序列长度加大,只比较状态元素计数,不运行显式平方矩阵版本到内存耗尽。若要做 GPU 性能结论,应该另建真实框架测试,包含同步、预热、完整模型和质量对照;本篇没有把教学脚本执行时间包装成生产加速结果。 10. 延伸阅读 先回到 自注意力,确认权重归一化、因果掩码和矩阵形状;再读 FlashAttention,理解保留精确算子时如何优化中间存储。两条路线可以比较,也可以组合,但证据边界不同。 结合 KV Cache 和 性能建模与 Profiling,分别量出历史容量、解码带宽、首 token 延迟与端到端时间,避免只看理论阶数。进入视频任务时,再对照 自回归视频生成与 Forcing 范式 的训练与推理条件。 知识树下一步可沿稀疏注意力、世界模型和视频评测继续学习。它们分别回答保留哪些显式交互、如何维护可交互环境状态,以及如何发现画质之外的退化;今天的固定状态推导并不能替代这些任务层面的验证。 附录:完整代码 09 节用到的脚本全文如下(linear_memory_demo.py、memory_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 linear_memory_demo.py """CPU teaching experiment: normalized linear attention and delta memory. Install numpy and matplotlib. Run with Python 3.10 or newer. No weights, GPU, dataset downloads, or training are required. """ import json from pathlib import Path import numpy as np import matplotlib matplotlib.use('Agg') import matplotlib.pyplot as plt def floating_arrays(*arrays): if any(not isinstance(a, np.ndarray) or a.dtype not in (np.float32, np.float64) or not np.isfinite(a).all() for a in arrays): raise ValueError('Use finite NumPy float32 or float64 arrays') if len({a.dtype for a in arrays}) != 1: raise ValueError('All arrays must have the same dtype') def phi(a): floating_arrays(a) # exp(min(a,0)) avoids evaluating exp on large positive inputs. return np.where(a > 0, a + 1, np.exp(np.minimum(a, 0))) def validate_qkv(q, k, v, eps): floating_arrays(q, k, v) if (q.ndim != 2 or k.shape != q.shape or v.ndim != 2 or len(v) != len(q) or min(q.shape) == 0 or v.shape[1] == 0): raise ValueError('Expected q,k:[N,r], v:[N,dv], all dimensions positive') if not np.isscalar(eps) or not np.isfinite(eps) or eps <= 0: raise ValueError('eps must be a finite positive scalar') eps = q.dtype.type(eps) if not np.isfinite(eps) or eps <= 0: raise ValueError('eps must remain positive and finite in the input dtype') return eps def explicit_linear(q, k, v, eps=1e-6): eps = validate_qkv(q, k, v, eps) with np.errstate(over='raise', invalid='raise', divide='raise'): weights = phi(q) @ phi(k).T weights *= np.tril(np.ones((len(q), len(q)), dtype=q.dtype)) return weights @ v / (weights.sum(axis=1, keepdims=True) + eps) def recurrent_linear(q, k, v, eps=1e-6, state=None): eps = validate_qkv(q, k, v, eps) fq, fk = phi(q), phi(k) if state is None: S = np.zeros((k.shape[1], v.shape[1]), dtype=q.dtype) z = np.zeros(k.shape[1], dtype=q.dtype) else: if not isinstance(state, (list, tuple)) or len(state) != 2: raise ValueError('state must contain S and z') S, z = state floating_arrays(q, S, z) if S.shape != (k.shape[1], v.shape[1]) or z.shape != (k.shape[1],) or (z < 0).any(): raise ValueError('Invalid state shape or negative normalizer') S, z = S.copy(), z.copy() out = np.zeros_like(v) with np.errstate(over='raise', invalid='raise', divide='raise'): for t in range(len(q)): S += np.outer(fk[t], v[t]) z += fk[t] out[t] = (fq[t] @ S) / (fq[t] @ z + eps) return out, S, z def causal_softmax(q, k, v): validate_qkv(q, k, v, 1e-6) logits = q @ k.T / q.dtype.type(np.sqrt(q.shape[1])) logits[np.triu_indices(len(q), k=1)] = -np.inf logits -= logits.max(axis=1, keepdims=True) weights = np.exp(logits) weights /= weights.sum(axis=1, keepdims=True) return weights @ v def delta_step(S, k, v, beta=1.0, alpha=1.0): floating_arrays(S, k, v) if S.ndim != 2 or k.shape != (S.shape[0],) or v.shape != (S.shape[1],) or min(S.shape) == 0: raise ValueError('Expected S:[r,dv], k:[r], v:[dv]') if not np.isfinite(beta) or beta < 0 or not np.isfinite(alpha) or not 0 <= alpha <= 1: raise ValueError('Require finite beta>=0 and 0<=alpha<=1') # beta above the stability bound remains allowed for the counterexample. with np.errstate(over='raise', invalid='raise', divide='raise'): decayed = S.dtype.type(alpha) * S correction = v - k @ decayed return decayed + S.dtype.type(beta) * np.outer(k, correction) def memory_experiment(): k = np.array([1.0, 0.0]) values = np.array([[1.0, 0.0], [0.0, 1.0]]) additive = sum((np.outer(k, v) for v in values), np.zeros((2, 2))) additive_read = k @ additive / 2.0 S = np.zeros((2, 2)) for v in values: S = delta_step(S, k, v) overwrite_read = k @ S half = np.zeros((2, 2)) for value in values: half = delta_step(half, k, value, beta=0.5) crosstalk = [] for rho in [0.0, 0.5, 0.9]: k2 = np.array([rho, np.sqrt(1.0 - rho ** 2)]) state = delta_step(np.zeros((2, 2)), k, values[0]) state = delta_step(state, k2, values[1]) crosstalk.append({'rho': rho, 'old_key_read': (k @ state).tolist()}) state = np.eye(2) decayed = delta_step(state, k, values[1], beta=1.0, alpha=0.8) return {'additive_same_key': additive_read.tolist(), 'delta_same_key': overwrite_read.tolist(), 'crosstalk': crosstalk, 'gated_unrelated_key': (np.array([0.0, 1.0]) @ decayed).tolist(), 'half_beta_read': (k @ half).tolist(), 'no_forgetting_unrelated_key': (np.array([0.0, 1.0]) @ delta_step(state, k, values[1])).tolist()} def main(): rng = np.random.default_rng(7) q = rng.normal(size=(8, 4)) k = rng.normal(size=(8, 4)) v = rng.normal(size=(8, 3)) direct = explicit_linear(q, k, v) recurrent, S, z = recurrent_linear(q, k, v) softmax = causal_softmax(q, k, v) future_v = v.copy() future_v[-1] += 100 future, _, _ = recurrent_linear(q, k, future_v) agreement = float(np.max(np.abs(direct - recurrent))) future_error = float(np.max(np.abs(future[:-1] - recurrent[:-1]))) q32, k32, v32 = q.astype(np.float32), k.astype(np.float32), v.astype(np.float32) direct32 = explicit_linear(q32, k32, v32) recurrent32, _, _ = recurrent_linear(q32, k32, v32) assert agreement < 1e-12 assert future_error == 0 report = {'seed': 7, 'dtype': str(q.dtype), 'q_shape': list(q.shape), 'v_shape': list(v.shape), 'output_shape': list(recurrent.shape), 'state_shape': list(S.shape), 'normalizer_shape': list(z.shape), 'explicit_recurrent_max_error': agreement, 'linear_softmax_max_difference': float(np.max(np.abs(recurrent - softmax))), 'output_min': float(recurrent.min()), 'output_max': float(recurrent.max()), 'first_two_outputs': recurrent[:2].tolist(), 'future_leak_error': future_error, 'float32_explicit_recurrent_max_error': float(np.max(np.abs(direct32 - recurrent32))), 'float32_output_dtypes': [str(direct32.dtype), str(recurrent32.dtype)], 'memory': memory_experiment()} folder = Path(__file__).resolve().parent if folder.name == 'code': folder = folder.parent figures = folder / 'figures' figures.mkdir(parents=True, exist_ok=True) (folder / 'run_result.json').write_text(json.dumps(report, indent=2), encoding='utf-8') lengths = np.array([256, 1024, 4096, 16384, 65536]) # Single batch/layer/head, FP32, d_k=d_v=r=64. State count only. kv_mib = lengths * 128 * 4 / 2 ** 20 fixed_mib = np.full(len(lengths), (64 * 64 + 64) * 4 / 2 ** 20) fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True) axes[0].loglog(lengths, kv_mib, 'o-', label='Explicit K,V history') axes[0].loglog(lengths, fixed_mib, 's-', label='Linear S,z state') axes[0].set(xlabel='Prefix tokens', ylabel='MiB, FP32, one layer/head', title='State storage, not total GPU memory') axes[0].legend() axes[0].grid(alpha=0.2) rhos = np.array([item['rho'] for item in report['memory']['crosstalk']]) reads = np.array([item['old_key_read'] for item in report['memory']['crosstalk']]) axes[1].plot(rhos, reads[:, 0], 'o-', label='Old value component') axes[1].plot(rhos, reads[:, 1], 's-', label='New value component') axes[1].set(xlabel='Key inner product', ylabel='Readout at old key', title='Delta updates still have crosstalk', ylim=(-0.05, 1.05)) axes[1].legend() axes[1].grid(alpha=0.2) fig.savefig(figures / 'memory_tradeoff.png', dpi=150) plt.close(fig) print(json.dumps(report, indent=2)) print('figure: figures/memory_tradeoff.png') if __name__ == '__main__': main() memory_checks.py """Independent CPU checks; install numpy and matplotlib, run Python 3.10+.""" import json import math from pathlib import Path import numpy as np from linear_memory_demo import explicit_linear, recurrent_linear, delta_step, phi def scalar_reference(q, k, v, eps=1e-6): feature = lambda x: x + 1 if x > 0 else math.exp(x) out = np.zeros(v.shape, dtype=np.float64) for t in range(len(q)): weights = [math.fsum(feature(float(a)) * feature(float(b)) for a, b in zip(q[t], k[i])) for i in range(t + 1)] for j in range(v.shape[1]): out[t, j] = math.fsum(w * float(v[i, j]) for i, w in enumerate(weights)) / (math.fsum(weights) + eps) return out def main(): rng = np.random.default_rng(29) cases = chunks = causal = 0 errors = {name: 0.0 for name in ['float32', 'float64']} chunk_error = 0.0 for dtype in [np.float32, np.float64]: for n in [1, 2, 5, 9, 17]: for r in [1, 3, 6]: for dv in [1, 4]: q, k, v = [a.astype(dtype) for a in [rng.normal(size=(n, r)), rng.normal(size=(n, r)), rng.normal(size=(n, dv))]] expected = scalar_reference(q, k, v) actual, S, z = recurrent_linear(q, k, v) direct = explicit_linear(q, k, v) assert actual.dtype == direct.dtype == S.dtype == z.dtype == dtype error = max(float(np.max(np.abs(expected - actual))), float(np.max(np.abs(direct - actual)))) errors[dtype.__name__] = max(errors[dtype.__name__], error) assert error < (2e-6 if dtype == np.float32 else 1e-12) cases += 1 for cut in range(1, n): prefix, S0, z0 = recurrent_linear(q[:cut], k[:cut], v[:cut]) saved = S0.copy(), z0.copy() suffix, S1, z1 = recurrent_linear(q[cut:], k[cut:], v[cut:], state=(S0, z0)) err = max(float(np.max(np.abs(np.concatenate([prefix, suffix]) - actual))), float(np.max(np.abs(S1 - S))), float(np.max(np.abs(z1 - z)))) chunk_error = max(chunk_error, err) assert err == 0 and np.array_equal(saved[0], S0) and np.array_equal(saved[1], z0) changed = v.copy(); changed[cut:] += dtype(100) changed_q = q.copy(); changed_k = k.copy() changed_q[cut:] += dtype(30); changed_k[cut:] -= dtype(30) out, _, _ = recurrent_linear(changed_q, changed_k, changed) assert np.array_equal(out[:cut], actual[:cut]) chunks += 1; causal += 1 fd_error = 0.0 for _ in range(24): S = rng.normal(size=(3, 2)); k = rng.normal(size=3); v = rng.normal(size=2) analytic = np.outer(k, k @ S - v) numeric = np.zeros_like(S) for index in np.ndindex(S.shape): plus, minus = S.copy(), S.copy(); plus[index] += 1e-6; minus[index] -= 1e-6 numeric[index] = (np.sum((k @ plus - v) ** 2) - np.sum((k @ minus - v) ** 2)) / 4e-6 fd_error = max(fd_error, float(np.max(np.abs(numeric - analytic)))) assert fd_error < 1e-7 affine_error = 0.0 for _ in range(36): initial = rng.normal(size=(3, 2)); state = initial.copy() A = np.eye(3); B = np.zeros((3, 2)) for _ in range(7): k = rng.normal(size=3); k /= np.linalg.norm(k); v = rng.normal(size=2) alpha, beta = rng.uniform(0, 1), rng.uniform(0, 2) state = delta_step(state, k, v, beta=beta, alpha=alpha) At = alpha * (np.eye(3) - beta * np.outer(k, k)); Bt = beta * np.outer(k, v) A, B = At @ A, At @ B + Bt affine_error = max(affine_error, float(np.max(np.abs(state - (A @ initial + B))))) assert affine_error < 1e-12 unstable = []; state = np.zeros((1, 1)); key = np.ones(1); value = np.ones(1) for _ in range(4): state = delta_step(state, key, value, beta=2.5) unstable.append(float((key @ state - value)[0])) assert unstable == [1.5, -2.25, 3.375, -5.0625] nonunit = delta_step(np.zeros((1, 1)), np.array([2.0]), value) normalized_step = delta_step(np.zeros((1, 1)), np.array([2.0]), value, beta=0.25) assert float((np.array([2.0]) @ nonunit)[0]) == 4.0 assert float((np.array([2.0]) @ normalized_step)[0]) == 1.0 order_correct = delta_step(np.ones((1, 1)), key, value, beta=1, alpha=0.5) order_wrong = 0.5 * np.ones((1, 1)) + np.outer(key, value - key @ np.ones((1, 1))) assert order_correct[0, 0] == 1 and order_wrong[0, 0] == 0.5 tiny = np.full((1, 1), -20.0, dtype=np.float32) epsilon_output = float(recurrent_linear(tiny, tiny, np.ones((1, 1), np.float32))[0][0, 0]) underflow = np.full((1, 1), -1000.0) zero_output = float(recurrent_linear(underflow, underflow, np.ones((1, 1)))[0][0, 0]) assert epsilon_output < 5e-12 and zero_output == 0 q = k = v = np.ones((2, 2)) bad = [lambda: recurrent_linear(q[:0], k[:0], v[:0]), lambda: recurrent_linear(q, k[:, :1], v), lambda: explicit_linear(q, k, v[:1]), lambda: recurrent_linear(q.astype(int), k.astype(int), v.astype(int)), lambda: recurrent_linear(q.astype(np.float32), k, v), lambda: recurrent_linear(q * np.nan, k, v), lambda: recurrent_linear(q, k, v, eps=0), lambda: recurrent_linear(q, k, v, eps=-1), lambda: recurrent_linear(q, k, v, eps=np.inf), lambda: recurrent_linear(q.astype(np.float32), k.astype(np.float32), v.astype(np.float32), eps=1e-100), lambda: recurrent_linear(q, k, v, state=(np.zeros((1, 1)), np.ones(2))), lambda: recurrent_linear(q, k, v, state=(np.zeros((2, 2)), -np.ones(2))), lambda: delta_step(np.zeros((2, 2)), np.ones(3), np.ones(2)), lambda: delta_step(np.zeros((2, 2)), np.ones(2), np.ones(2), alpha=1.1), lambda: delta_step(np.zeros((2, 2)), np.ones(2), np.ones(2), beta=-1)] for run in bad: try: run() except ValueError: continue raise AssertionError('Invalid input was accepted') report = dict(passed=True,seed=29,reference_cases=cases,errors=errors,chunk_cases=chunks, chunk_error=chunk_error,causality_cases=causal,delta_gradient_cases=24, delta_gradient_fd_error=fd_error,affine_composition_cases=36,affine_error=affine_error, unstable_beta_errors=unstable,nonunit_read=4.0,nonunit_corrected_read=1.0, correct_gate_order=1.0,wrong_gate_order=0.5,epsilon_dominated_output=epsilon_output, underflow_output=zero_output,invalid_cases=len(bad)) folder = Path(__file__).resolve().parent (folder / 'validation_results.json').write_text(json.dumps(report, indent=2), encoding='utf-8') print(json.dumps(report, indent=2)) if __name__ == '__main__': main()
-
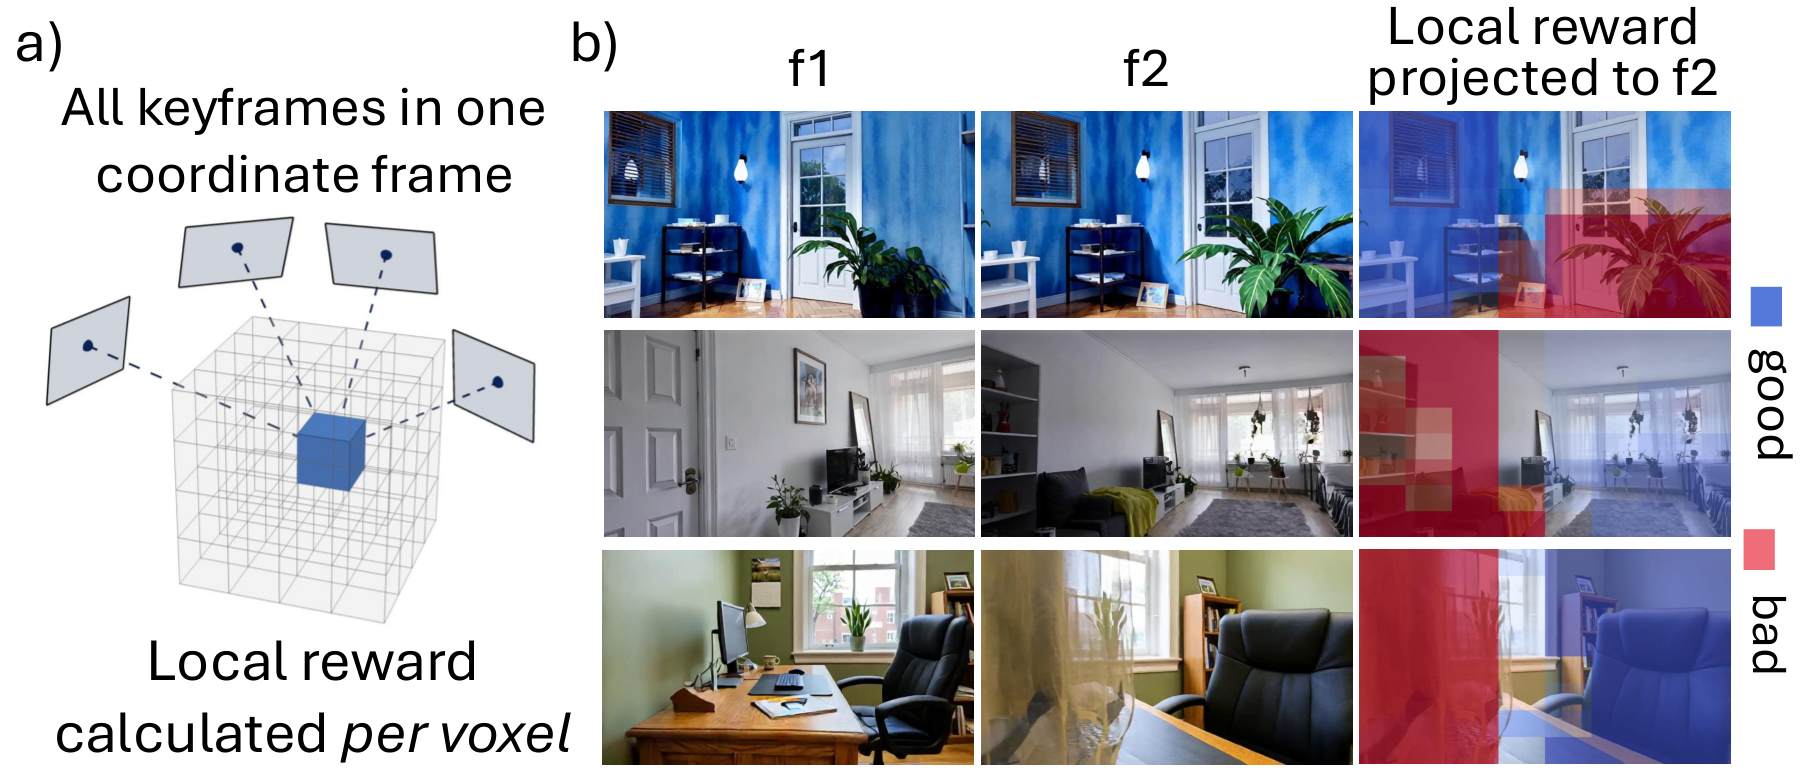
AIGC 每日速读|2026-10-06|加州理工稳住镜头外场景LoGo 今日 AIGC 论文速览 今日共 10 篇 · 长视频一致性与定制 2 篇 · 一步图像生成与后训练 2 篇 · 视频蒸馏与加速 3 篇 · 配对动作生成 1 篇 · 语音与音乐生成 2 篇 重点论文标题列表 LoGo(加州理工):镜头绕一圈场景少变形 Depth as Time(普林斯顿):一步生成把去噪搬进深度 DuoMatching(港中文):图像老师帮视频补回细节 VDOT++(悉尼大学):四步蒸馏别硬配每个token Reward Composition(UCLA):审美加分先过提示词约束 今日论文速览 1. LoGo:镜头绕一圈场景少变形 LoGo: Local-Global Rewards for Consistent Long-Horizon Video Generation | 加州理工学院 | arXiv:2610.03636 关键词:长视频生成, 相机控制, 三维一致性, 局部奖励 前序问题:镜头绕过墙面再回来,门可能移位、墙上数字可能变形。给整段视频一个三维一致性分数,会让局部错误被大面积正确区域稀释;只强化局部几何,又可能鼓励模型把画面变灰、变糊来降低误差。 本文贡献:LoGo 将关键帧经 VGGT 重建到共享三维空间,以 voxel 聚合 RGB 和深度重投影误差,把奖励分配到出错区域。训练混合归一化后的局部与全局奖励,并交替使用美学和相机跟随奖励。它改善的是相机可控视频的后训练信号,而非新增一个持久世界记忆模块。 论文 Figure 4:(a)说明 voxel 奖励如何聚合:把关键帧重建到共享三维空间,按体素汇总局部误差。(b)把局部奖励投影回视频帧进行可视化,突出需要修正的区域。 实验效果:表 1 的 TrajectoryBench 上,Lingbot2 的 PSNR-D 从 16.0 提高到 18.2 dB,极线误差从 1.507 降至 1.111,约下降 26%。表 2 的 DL3DV 上,同一基座极线误差由 2.161 降至 1.365。三个基座均有三维一致性收益,但相机指标并非逐项变好;例如 UniWorld 在表 1 的旋转误差由 13.8 变为 14.0。 论文 Figure 3:LoGo 的动机。(a)只用全局奖励难改善三维一致性;局部奖励改善以 PSNR 衡量的一致性,却降低以 HPSv3 衡量的画质,因此要组合二者。(b)绿色 LoGo 曲线扩展一致性与质量的 Pareto 前沿。(c)训练中的奖励曲线及质量评估显示,局部奖励随训练损害画质,LoGo 在改善一致性的同时维持质量。 批判点评:作者明确限定静态场景,超过 400 帧仍困难;因此不能写成动态世界无限稳定。奖励依赖重建模型估计的几何,改善重投影指标也不等于恢复真实物理。建议优先看局部奖励与画质的消融,再判断自己的相机轨迹是否在测试范围内。代码与 benchmark 已给出官方仓库。 2. Depth as Time:一步生成把去噪搬进深度 Depth as Time in One-Step Generative Models | 普林斯顿大学 | arXiv:2610.03626 关键词:一步生成, 深度探针, 共享权重, 模型压缩 前序问题:一步生成只调用一次网络,但网络内部仍有许多层。多步扩散的逐步去噪到底消失了,还是被重排到网络深度里?仅看最终图像,无法区分一次直达和层内反复细化。 本文贡献:作者用模型自身输出头解码中间层,并用独立训练及随机探针做对照:时间条件 flow-map 模型呈现随深度去噪的规律,部分 MeanFlow 任务甚至先去噪再加噪。进一步用带内部时间区间条件的共享 block 拟合教师隐藏层,把层数与独立参数组数拆开。 论文 Figure 2:大规模一步图像生成器也呈现沿深度逐渐去噪的现象。FLUX-schnell 和 MeanFlow 的逐层终点预测逐渐显露清晰图像结构;不依赖 τ 的 Drifting 模型作为对照。对 FLUX-schnell,模型输出头与独立训练探针得到相似的归一化终点距离下降规律,随机探针不能复现。 实验效果:附录表 1 的 ImageNet 256×256 实验:MeanFlow SiT-L/2 从 459M 参数压到 27.6M,压缩 16.6 倍;经 FD-loss 后训练,FID-50k 为 4.87,教师为 4.01。两组独立 block 的学生用 46.5M 参数达到 4.04。附录表 2 中,另行训练的两组 block 学生将执行次数减半后 FID 为 5.25。 论文 Table 1:ImageNet 256×256 的参数压缩结果。在教师原始深度、固定 K 执行次数下,分别报告 FD-loss 后训练前后的 FID-50k,各行采用最优 CFG 强度 ω。压缩倍数相对教师参数量;高亮行使用单个共享 block,灰色行为教师。增加独立 block 数量可用更多参数换取质量。 批判点评:16.6 倍是参数压缩,单组 block 仍可执行 24 次,不能换算成 16.6 倍延迟加速。相似的深度轨迹也不等于逐点复现教师的采样轨迹;缺少时间索引任务的 Drifting 模型未呈现同样规律。公开代码适合研究内部计算,结论尚不是所有一步模型的普遍定理。 3. DuoMatching:图像老师帮视频补回细节 DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation | 香港中文大学;字节跳动;香港科技大学;香港交互感知研究中心 | arXiv:2610.03543 关键词:视频蒸馏, 联合边缘分布, 图像教师, 潜空间桥接 前序问题:视频教师能教会时间连贯,但少步学生仍可能丢掉 prompt 中的羽毛、毛发等细节。整段视频的联合分布匹配会受到周围帧制约,需要额外的单帧监督补足视觉与语义先验。 本文贡献:DuoMatching 在视频联合 DMD 上增加来自图像教师的边缘 DMD。LatentBridge 将视频 latent、前一片段与局部帧编号映射到图像 latent,避免直接套用不同 VAE 空间;Latent Variation Sampling 用相邻 latent 的差异切分时间区间,每段抽样一片,提高有限监督预算的覆盖。 论文 Figure 3:DuoMatching 总览。(a)用图像教师参考分布 P_i 补充联合分布匹配;每组表示一个视频,节点表示帧级分布。(b)LatentBridge 根据视频 latent z^l、前一片 z^(l−1) 和局部帧编号 i,通过 ℓ₁ 重建损失映射到对应图像 latent。(c)Latent Variation Sampling 用相邻 latent 的差异分段,并在段内随机抽样。 实验效果:表 1 按生成单位和 NFE 分组:两步逐帧设置的 VBench Total 从 Causal Forcing++ 的 80.67 到 83.53;四步 chunk 设置从 82.79 到 83.51。表 2 在同一 Wan2.1 教师下,对四个基线的整体偏好为 80.87%–94.35%;对 Causal Forcing++ 的时间与运动偏好为 49.57%,说明主要收益来自画质与语义。 论文 Figure 1:DuoMatching 的动机与结果。自回归模型的后续帧常退化,图中 Q-Align 曲线展示这一现象。联合 DMD 缓解漂移,但学生与视频教师仍有画质差距,示例中缺少 prompt 要求的羽毛。联合与边缘匹配的组合改善画质、补回羽毛,同时保留时间连贯性;这张示例不代替完整统计评估。 批判点评:Full、Frame、Chunk 的函数评估单位不同,不能跨组把 NFE 当作相同成本排序。图像教师与桥接模块也带来训练成本;更清晰的单帧不是所有运动指标都提高的保证。项目页提供代码,值得在相同生成模式与预算内复现。 4. VDOT++:四步蒸馏别硬配每个token VDOT++: Unified Few-Step Video Generation via Unbalanced Optimal Transport Distillation | 悉尼大学;上海人工智能实验室;香港科技大学;香港中文大学 | arXiv:2610.03221 关键词:少步视频生成, 非平衡最优传输, 跨规模蒸馏, 条件生成 前序问题:同一个文字或图像条件允许多种正确视频。把学生与教师每帧的空间 token 强制全量配对,可能把本来合理但位置不同的内容当作错误,并在分布重叠不足时给出不稳定指导。 本文贡献:VDOT++ 在 DMD 上加入非对称非平衡最优传输:放松学生侧质量约束,下调不可靠 token 的质量,同时保持教师侧覆盖。ℓ₁ 距离使聚合更接近加权中位数,减少远处匹配的影响;DMD 与对抗项分两次反传。相同训练配方分别训练三类任务的生成器,还研究大 score 网络指导小生成器。 论文 Figure 3:VDOT++ 总览。上方:给定条件,少步生成器同时使用 DMD score 差异、逐帧最优传输匹配和对抗损失,经两次顺序反传及一次优化更新。下方图示一对时间帧,为清楚省略扩散时间与帧索引 (t,q)。DMD 在对应时空坐标提供 score 差异;平衡 OTD 显式耦合空间 token,却强制全量匹配;对称 UOT 放松两侧。非对称 UOT 放松学生侧、保持教师侧约束,压低不可靠学生 token 质量并维持教师覆盖。 实验效果:表 III 的文生视频 VBench 中,Wan-14B 四次评估学生的归一化均分为 81.59,50×2 次评估教师为 77.70;表 IV 的图生视频对应为 78.38 和 77.92。表 II 的 flow 条件任务却是 80.29,对应教师 80.35,因此不是每个任务、每项指标都超过教师。 论文 Figure 4:可控视频生成的定性对比。比较 100 次函数评估的 VACE 教师与 4 次评估的 VDOT、VDOT++,任务为(a)flow 条件的视频到视频,(b)视频向外扩展,(c)多参考图像到视频。顶行给出输入条件,每种方法展示 0、2.5、5 秒的帧。 批判点评:“统一”指训练配方跨任务复用,并非一个 checkpoint 同时完成全部任务。NFE 降低也不能直接等同端到端加速倍数。正文提到 CVPR 2026 的是前作 VDOT,这个扩展版本未核实接收证据,不能借前作会议作本篇背书;本文未发现可核验的新代码仓库。 5. Reward Composition:审美加分先过提示词约束 Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards | 加州大学洛杉矶分校;Arena Intelligence | arXiv:2610.02967 关键词:图像后训练, 人类偏好, rubric奖励, 奖励投机 前序问题:优化审美奖励,模型可能擅自添加装饰、乱码或写实风格;只优化提示词完成度,又可能牺牲细节。把不同量纲的分数简单平均,无法处理“这个要求只对某类 prompt 生效”的情况。 本文贡献:这项图像后训练研究组合人类偏好、内容满足度和禁止内容 checklist。各奖励轴独立归一化;只有意图严格的 prompt 激活额外约束;适用的反投机检测发现问题后否决正向偏好加分。不同奖励配置得到的权重再做融合,使审美优化受到意图约束。Reward Composition 是本文的编辑短名。 论文 Figure 2:两类反复出现的奖励投机失败。左侧:prompt 要求不含文字,RL 策略却在餐巾上添加乱码。右侧:prompt 要求 Elsa Beskow 的故事书插画风格,基座保持该风格,而 RL 策略偏向照片写实。这些案例解释为何需要按 prompt 启用约束和否决。 实验效果:表 1 的 2026-09-04 Arena 快照中,FLUX.2-dev 从 1132.8±14 到 1202±13,约增加 69 Elo。表 2 在 1k 验证 prompt、五个候选 checkpoint 中选择最佳值,Stage 3 在 Gemini 评估配 Arena RM 的对比胜率为 0.660,单偏好为 0.507;这些自动评估与线上 Elo 不是同一个指标。 论文 Figure 1:奖励设计可视化。只用偏好训练会偏向通用装饰并忽略要求;只用满足度会洗掉细节并丢失风格和景物;Arena-T2I-Hard 能恢复要求元素但保留多余装饰;不加意图门控的禁止内容奖励,即使 prompt 允许细节也会将其压平。Stage 1 仅在意图严格时施加约束,示例中能满足要求而未明显损伤质量。 批判点评:只测试两个基座、单个随机种子,内容分解问题未经人工逐条审计。排行榜数字属于 9 月 4 日快照,不是今天的排名;多个 checkpoint 择优也需与固定预算评估区分。作者说释放 1k 训练子集,但本次项目页未提供可核验下载入口,因此不声称数据或代码已可下载。 6. PMD:冻结视频模型顺手生出动作 Parasitic Co-Denoising: Unlocking 3D Human Motion Generation in a Frozen Video Diffusion Model | 新加坡南洋理工大学 | arXiv:2610.03047 关键词:三维动作生成, 视频扩散, 共去噪, 多层特征融合 前序问题:视频模型学会了人怎么动,却没有显式输出可用于动画的三维动作。先生成视频再估计动作需要多阶段处理;从零训练动作生成器又受动作数据覆盖限制。 本文贡献:Parasitic Motion Decoder(PMD)附着在冻结的 Wan2.1 上。先对齐动作与视频 latent,再用轻量 flow-matching decoder 读取视频 DiT 多层特征,按噪声水平 σ 自适应融合,并与视频共享去噪日程。视频与动作的噪声独立,耦合来自同一日程和特征条件;一次联合采样流程得到配对输出。 论文 Figure 2:Parasitic Motion Decoder(PMD)的结构。先将动作与视频 latent 对齐,再让动作 decoder 与冻结视频宿主同步去噪;σ 自适应多层融合把宿主的中间特征送入动作流。 实验效果:表 1 的 MBench Protocol B:19M 可训练参数的 PMD,动作条件一致性 0.58、泛化 0.72;2B 可训练参数的 MotionVLA 对应 0.55、0.66。表 2 的 HumanML3D 上,PMD 的 R-Precision Top-1 为 0.537,FID 为 0.098;DisCoRD 的 FID 为 0.032,说明语义对齐优势没有覆盖全部分布质量指标。 论文 Figure 3:MBench prompt 上的定性比较,展示各动作生成方法对文字动作要求的可视化结果。图展示动作语义与轨迹外观;抖动、足部接触等质量仍应结合实验表分别判断。 批判点评:19M 是附加可训练模块,不包含冻结视频宿主,因此不是整个系统只有 19M 参数。冻结宿主没有接受本工作三维动作监督,但附加模块训练仍用配对动作数据。动作抖动、接触和 FID 也并非全面最佳;没有找到作者可核验代码链接,不把模板或会议样式当作接收证据。 7. Custom Forcing:两分钟视频保持同一个主体 Custom Forcing: Training-Free Subject Customization for Autoregressive Video Generation | 韩国庆熙大学;得克萨斯大学奥斯汀分校 | arXiv:2610.02914 关键词:视频个性化, 自回归生成, KV缓存, 免训练定制 前序问题:自回归视频能不断续写,却容易把用户给定的某只宠物或物品变成同类通用实例。固定参考帧只能提供初始锚点;文本的类别先验与后续漂移会逐步削弱主体身份。 本文贡献:Custom Forcing 将五张参考图和一张场景定制 anchor 一次写入持久 KV cache。DVA 根据当前主体相似度相对初始水平的下降增强参考 value;ACG 比较读取与不读取 anchor 的注意力输出,沿远离通用类别先验的方向引导。冻结基座,无需逐主体训练。 论文 Figure 3:Custom Forcing 总览。上方:参考图与 FLUX.2 [klein] 生成的定制 anchor 副本一次写入 KV cache。中间:冻结基座每层 self-attention 在 DVA 以 g(t) 放大参考 value 后,分别读取含及不含 anchor 的缓存,得到 z_+、z_-。左下:DVA 根据当前已完成 chunk 的相似度 s(t) 相对初始 μ_base 的下降设置 g(t)。右下:ACG 以 κ 沿远离 z_- 的方向外推,再与 z_+ 混合。 实验效果:表 1 的两分钟测试:固定 K/V 的首段与末段 DINO-I 为 0.583、0.415,Custom Forcing 为 0.622、0.578。表 2 在单 H100、30 秒、100 个案例上,相对 FramePack-F1、SkyReels-V2 DF、SkyReels-V3 的逐帧生成时间优势为 9.5、11.5、28.5 倍;这些基线架构和规模不同。 论文 Figure 4:两分钟生成示例。只使用定制 K/V 时,主体在第一分钟内发生漂移;Custom Forcing 在展示的两种主体案例中维持到两分钟。两种案例分别生成,并非证明一个视频同时控制两个主体。 批判点评:相对固定 anchor,DVA 与 ACG 增加 11%–13% 生成时间。测试为动物和物品、每段一个主体、最长两分钟,局部细节漂移和多个主体仍未解决。实际能力受冻结基座限制。作者项目页可访问,但没有找到该方法的可核验代码仓库。 8. SpectralCache:复用奇异子空间少算主干 SpectralCache: Accelerating Diffusion-Based World Models via Spectral Feature Caching | 史蒂文斯理工学院;美国东北大学;达姆施塔特工业大学 | arXiv:2610.02660 关键词:扩散加速, 世界视频生成, 频谱缓存, 特征近似 前序问题:世界视频模型每个去噪步都运行昂贵主干。直接复用完整特征没有利用结构:相邻步骤的主导奇异子空间相对稳定,变化更多体现在低维奇异值上。 本文贡献:SpectralCache 在完整步分解最终层特征,缓存最近两次的奇异子空间、奇异值和残差。近似步固定子空间,只线性外推奇异值;误差累积或间隔到阈值后,交替刷新主干和缩放奇异值,以进一步少算完整步骤。它是免训练近似,不是精确复用。 论文 Figure 4:SpectralCache 总览,区分完整主干计算与近似缓存步骤;稳定奇异子空间和残差被复用,奇异值通过外推或缩放更新,触发条件控制刷新。 实验效果:表 1 的 HunyuanVoyager-13B,512×768、49 帧设置下加速 5.22 倍;静态 WorldScore 从基线 66.28 变为 65.90,动态从 46.40 变为 46.13。Aether-5B 的 480×720、41 帧生成加速为 2.20 倍。不同模型与任务的收益应分别读,不能都写成 5.22 倍。 论文 Figure 1:SpectralCache 与基线在 HunyuanWorld-Voyager-13B 上的比较。(a)视觉效果,(b)延迟,(c)质量。在所测条件下加速约 5.22 倍,同时保持较高视频保真;接近原模型仍不代表逐像素无误差。 批判点评:频谱稳定和固定缩放系数来自所测模型的经验,强动态或采样日程改变时需重新验证。质量接近基线仍存在误差,不能写“无损”;PSNR 对齐基线生成也不是对齐真实视频的证明。当前原文没有可核验代码链接,工程复现还需要补足实现和预算测量。 9. DriftTTS:不用生成老师四步合成语音 DriftTTS: Few-Step Text-to-Speech Without Distillation via Distribution-Matching Drift | 马萨诸塞大学阿默斯特分校;伍斯特理工学院 | arXiv:2610.03390 关键词:语音合成, drifting模型, 分布匹配, 少步生成 前序问题:少步 TTS 往往依赖多步生成教师或预设噪声到数据轨迹。能否直接让真实和生成 mel 特征的分布接近,并让生成器学习自己实际会访问的中间状态? 本文贡献:DriftTTS 在原始 mel 与冻结 MelMAE 特征空间构造真实样本吸引、生成样本排斥的 drift 目标,训练文本条件 decoder。on-policy rollout 用模型自身中间状态学习少步更新;MelMAE 只用于训练。推理从高斯噪声逐步替换 mel 状态,再由 HiFi-GAN 转为波形,无生成教师蒸馏。 论文 Figure 1:DriftTTS 总览。文本条件高斯噪声经少步 drift decoder 迭代细化为 mel 频谱,再用 HiFi-GAN 转为波形。训练时在 mel 域特征空间使用真实与生成样本计算 on-policy 分布匹配 drift 目标,优化 decoder。 实验效果:表 1 在 LJSpeech、相同 HiFi-GAN 和 Whisper-medium 评估下,四步 DriftTTS 的 MCD 为 3.87 dB、WER 3.7%,Matcha-TTS 为 3.85 dB、3.4%。表 2 的 MOS 为 4.18±0.16,对方 3.96±0.18;配对检验按受试者聚合 p=0.31,按语句 p=0.044。 论文 Table 1:LJSpeech 评估。所有合成系统使用同一个 HiFi-GAN 声码器,WER 由 Whisper-medium 计算,听测统计另见 Table 2。四步 DriftTTS 的 WER 为 0.037、MCD 为 3.87、UTMOS 为 4.25、MOS 为 4.18;四步 Matcha-TTS 对应 0.034、3.85、4.36、3.96。NFE 是声学生成器的函数评估次数。 批判点评:更高 MOS 均分不能写成所有统计口径显著胜出,两个客观指标还略逊基线。无生成教师不等于没有预训练组件,仍用 MelMAE 与声码器;只报告单说话人数据。推理次数应不超过训练深度 K,训练两步的模型直接跑四步会退化。官方代码可访问。 10. Music Rubric:音乐奖励别只盯一个分数 Rubric-Based Optimization for Text-to-Music Generation | 华盛顿大学;艾伦人工智能研究所 | arXiv:2610.03589 关键词:文本到音乐, rubric奖励, 音频语言模型, 后训练 前序问题:提高某一个音乐自动评分,可能牺牲提示词符合度或其他听觉质量。让音频语言模型按多个维度打分是否更稳,也要区分“音乐听起来好”与“速度、调性、乐器确实正确”。 本文贡献:作者用七维自然语言 rubric 评价 prompt 对齐、风格乐器、旋律、节奏、结构、制作和音乐性。MusicGen-small 与 ACE-Step v1 将候选排名转为 DPO 偏好对;ACE-Step 另用 DiffusionNFT 在线优化标量奖励,并比较一次联合评分和逐维评分。Music Rubric 是本文编辑短名。 论文 Figure 1:MusicCaps 上 DPO 后各评估器分数相对未训练模型的百分比变化,正值为好。上排为 MusicGen-small,下排为 ACE-Step v1。每面板对应一个偏好来源:左三列斜线柱按单一自动指标排序,右三列实心柱按音频语言模型 rubric 排序。面板内三柱对应三个评估器,三柱皆正表示无这三项的取舍。各排尺度不同,上排最大柱使用断轴以保持小柱可读;绝对变化见附录表 1、2,基线分数见表 4。 实验效果:附录表 3:ACE-Step 用 Qwen3-Omni 逐维奖励训练 125 次更新后,相对原模型 CLAP、SongEval、Audiobox 分别增加 0.0180、0.1057、0.3385。第 5.4 节的小听测有 7 人、40 条 caption、52 次判断,36 次偏好训练后模型,即 69%,95% 区间 48%–89%;这些是不同口径的证据。 论文 Figure 2:ACE-Step v1 的 DPO 与 DiffusionNFT 比较,每个评分器一面板。面板内三组为 rubric 偏好 DPO(斜线)、一次请求评价全部维度的联合提示 DiffusionNFT、每维度独立请求的逐维提示 DiffusionNFT。每组三柱为与 Figure 1 同色的三个评估器,以相对未训练模型的分数变化百分比表示。所有面板同尺度,对 Qwen2-Audio 最大柱使用断轴;绝对变化见附录表 2、3,基线分数见表 4。 批判点评:评分器和提问方式决定信号是否有效:Music Flamingo 联合评分可出现奖励上涨而外部指标下降,rubric 也没有改善所测调性准确率。短音乐、少量听测与宽置信区间不足以承诺长曲或专家质量;直接属性测量与 rubric 更适合互补使用。本次未找到可核验的作者代码入口。 趋势观察 奖励要定位错误并尊重条件 LoGo 将几何错误定位到三维区域;图像奖励组合按 prompt 意图启用约束,音乐 rubric 则暴露评分器和提示方式的影响。更细的奖励有机会改善生成,但也需要防止对评分代理的过度优化。 一步调用仍包含内部迭代 Depth as Time 把压缩目标推进到网络深度,SpectralCache 从稳定子空间中减少重复计算。参数、执行次数与端到端延迟是三种预算,本文分别给出对应测试条件。 跨模态先验需要明确桥接 DuoMatching 把图像教师接到视频 latent,PMD 把视频宿主知识接到动作流。对齐接口是关键,但附加参数或少步采样不能抹去宿主与训练的成本。 质量应按维度报告 主观偏好、文字符合度、三维一致性和接触质量不一定同步上升。不同论文的 benchmark、生成单位与采样预算不同,这份日报不把分数拼成统一排行榜。 今日讨论 你会优先改善长视频的一致性,还是压缩少步生成的内部计算? 人工智能炼丹君 整理 | 2026-10-06
-
AIGC 基本功知识树 每日论文速读解决的是广度——今天世界上发生了什么。但读论文有个前提:你得先看得懂。 这里是另一条线:把视觉生成的底层零件一个个拆开讲透。每篇都给数学推导 + 能跑的代码 + 经典论文出处,并标注前置知识,你可以顺着依赖链一路读下来。 当前规划 38 个知识点,已发布 38 篇。 图例:● 已发布 · ◍ 已发布待更新 · ◐ 正在写 · ○ 计划中 数学与优化基础(2/2) 概率、变分推断、随机微分方程——读懂扩散模型公式的最小前置集合。 ● 变分下界与重参数化(ELBO) · 难度:入门前置 不理解 ELBO 就没法理解 VAE 的 KL 项为什么要加权,也没法理解扩散模型的训练目标从哪来。 ● 扩散过程的前向与反向推导(SDE) · 难度:入门前置 · 前置:ELBO 把 DDPM 的离散公式和 SDE 的连续视角对上,后面所有采样器的差异都能一句话解释。 注意力与核心零件(7/7) 注意力、位置编码、稀疏激活与循环记忆——视频生成里最吃显存、最难外推也最影响长程建模的部件。 ● 自注意力机制的计算与显存账本(MHA) · 难度:核心必修 先把 O(N²) 的常数项算清楚,才能判断后面各种稀疏/线性方案到底省在哪一项。 ● 旋转位置编码 RoPE 的原理与实现(RoPE) · 难度:核心必修 · 前置:MHA 许多现代视频 DiT 使用 RoPE;理解旋转和相对位置性质,才能区分坐标可计算与生成质量可外推。 ● FlashAttention 为什么不需要存下注意力矩阵(FlashAttn) · 难度:进阶 · 前置:MHA online softmax 这一个技巧撑起了整个长序列时代,值得把递推式一步步推一遍。 ● 视频 DiT 里的 3D RoPE 与分辨率外推(3D-RoPE) · 难度:进阶 · 前置:RoPE 换分辨率或帧数时,3D RoPE 的坐标、频率与轴分配是需排查的因素之一,还要检查训练分布、VAE 与注意力实现。 ● 混合专家 MoE:稀疏激活怎么省算力(MoE) · 难度:工程实战 · 前置:MHA 统一多模态模型开始普遍用 MoE 扛参数量,但路由不均衡带来的训练不稳定很少被讲清楚。 ● 线性、循环与记忆架构(LinearMem) · 难度:前沿 · 前置:MHA 长序列架构正在从保存完整注意力矩阵转向可更新状态和深度循环;把复杂度、记忆容量与并行性放进同一框架,才能判断它们何时真能替代 Softmax Attention。 ● 视频生成里的稀疏注意力(SparseAttn) · 难度:前沿 · 前置:FlashAttn、3D-RoPE 视频长序列的全注意力成本很高;稀疏化可以减少计算,但免训练部署的质量取舍需和精确 IO 优化、缓存等方案比较。 生成范式(9/9) 从 DDPM 到流匹配,以及把 50 步压到 4 步的蒸馏路线。 ● DDPM 训练目标与采样流程(DDPM) · 难度:核心必修 · 前置:SDE DDPM 是理解扩散模型的重要起点;先读懂其 loss 与采样循环,再比较其他生成路径和训练目标。 ● 分类器无关引导 CFG 的代价与调法(CFG) · 难度:核心必修 · 前置:DDPM CFG 让每步算两遍,是推理成本里最容易被忽视的 2×,也是蒸馏首先要干掉的对象。 ● 从 DDIM 到高阶采样器(DDIM) · 难度:进阶 · 前置:DDPM 采样器换一个、缓存策略就得重调——这是推理加速最常见的踩坑点。 ● 流匹配与 Rectified Flow(FlowMatching) · 难度:进阶 · 前置:SDE、DDPM 流匹配被许多近期生成模型采用;它与 DDPM 的概率路径、监督目标及采样方式值得系统比较。 ● 潜空间扩散与 Stable Diffusion 架构(LDM) · 难度:进阶 · 前置:DDPM、VAE 把扩散搬进潜空间这一步,直接决定了今天视觉生成的算力可行性。 ● DiT:用 Transformer 替掉 UNet(DiT) · 难度:进阶 · 前置:LDM、MHA adaLN-Zero 这个小设计是 DiT 能稳定训起来的关键,值得逐行对照公式看。 ● 自回归视频生成与 Forcing 范式(Forcing) · 难度:工程实战 · 前置:DDPM、DiT 双向扩散没法流式出帧,Forcing 系列是把视频生成变成可交互的关键一步,也是当下最活跃的范式。 ● 少步蒸馏:从 50 步到 4 步(Distill) · 难度:前沿 · 前置:DDIM、CFG 蒸馏是过去两年推理加速收益最大的一条线,也是最容易把质量搞崩的一条。 ● 世界模型:从视频生成到可交互环境(WorldModel) · 难度:前沿 · 前置:Forcing 视频生成正在从「出片」转向「可交互环境」,这是范式转变而不是又一个 SOTA 分数。 表征与压缩(4/4) VAE / Tokenizer——视频生成的「地基」,决定了上限和伪影形态。 ● VAE 结构与训练目标(VAE) · 难度:核心必修 · 前置:ELBO 潜空间扩散依赖编码器输出的统计尺度;像素空间扩散不使用 VAE,不能将 scaling_factor 推广到所有扩散模型。 ● 离散化表征:VQ-VAE 与 VQGAN(VQGAN) · 难度:进阶 · 前置:VAE 离散自回归视觉模型依赖 tokenizer,码本利用率是重要问题;连续潜变量自回归路线不适用这一前提。 ● 视频 VAE 的时空压缩结构(VideoVAE) · 难度:工程实战 · 前置:VAE 时间维压缩比和因果卷积的实现方式,直接决定了长视频能不能逐块解码而不接缝。 ● 视频 VAE 的常见 loss 组合(VAELoss) · 难度:工程实战 · 前置:VideoVAE L1 + KL + LPIPS + GAN 四项的权重配比是玄学重灾区,把每项在管什么讲透很有价值。 对齐与强化学习(4/4) 从 PPO 到 GRPO,以及怎么把 RL 用到扩散和视频生成上。 ● 策略梯度与 PPO 基础(PPO) · 难度:核心必修 PPO 是在线策略优化的重要基础;掌握优势估计和裁剪后,再区分 GRPO 与直接偏好优化等不同路线。 ● 从 DPO 到 GRPO:去掉价值网络(GRPO) · 难度:进阶 · 前置:PPO GRPO 用组内相对奖励省去 critic;净成本还取决于组采样、参考模型、奖励评估和显存,不能统一声称降低一个量级。 ● 把 RL 用到扩散模型上(DiffusionRL) · 难度:前沿 · 前置:GRPO、DDIM 把多步去噪当成一条 MDP 轨迹,是理解视频 RL 各种做法的统一视角。 ● 视频生成中的强化学习与奖励模型(VideoRL) · 难度:前沿 · 前置:DiffusionRL、FlowMatching 视频的奖励要同时管画质、运动和指令遵循,reward hacking 在这里表现得最明显。 分布式训练(4/4) 参数、数据、序列三个维度怎么切,以及切完之后通信量变成多少。 ● 数据并行与 ZeRO 显存切分(ZeRO) · 难度:进阶 先把「参数 + 梯度 + 优化器状态」的显存账算清楚,才知道该切哪一部分。 ● 混合精度与数值稳定性(AMP) · 难度:进阶 BF16、FP16 与 FP8 的范围、精度和缩放机制不同,排查异常时要区分前向溢出、梯度下溢与舍入误差。 ● 张量并行与流水线并行(TP-PP) · 难度:工程实战 · 前置:ZeRO TP 的通信量和 PP 的气泡率都能手算,算完就知道并行度该怎么配。 ● 序列并行与 Ring Attention(SP) · 难度:前沿 · 前置:TP-PP、FlashAttn 超长视频序列可能需要序列或上下文并行;是否值得使用取决于单卡容量、通信和计算重叠。 推理加速与部署(5/5) 先用性能模型定位算力、带宽和显存瓶颈,再用缓存、稀疏、量化与算子融合把生成时间从分钟压到秒。 ● 性能建模与 Profiling:算力、带宽与显存账本(Roofline) · 难度:进阶 · 前置:AMP 不先判断算力、带宽还是显存容量在卡住系统,量化、融合、缓存很容易做成负优化;这篇提供所有推理优化节点共同的测量方法。 ● KV Cache 与自回归视频生成(KVCache) · 难度:进阶 · 前置:MHA、Roofline 自回归视频模型正在把 LLM 的这套缓存工程整体搬过来,值得先打好底。 ● 算子融合与 CUDA Graph(Fusion) · 难度:工程实战 · 前置:MHA、Roofline 小算子多的模型往往卡在访存和 launch 开销上,融合的收益比换算法更确定。 ● 量化:从 INT8 到 FP4(Quant) · 难度:工程实战 · 前置:AMP、Roofline 激活里的离群值是量化掉点的主因,SmoothQuant 的迁移技巧值得逐步推演一遍。 ● 扩散模型的跨步缓存复用(DiffCache) · 难度:前沿 · 前置:DDIM、DiT、Roofline 相邻去噪步的特征高度相似,这是免训练加速里性价比最高的一类手段。 评测与指标(3/3) FID/CLIP/VBench 各自测的是什么,以及它们什么时候会骗人。 ● FID / CLIP Score 到底测了什么(FID) · 难度:核心必修 FID 对样本量和预处理极其敏感,不同论文的数字经常根本不可比。 ● 视频生成评测:VBench 与人工验收(VBench) · 难度:进阶 · 前置:FID 加速类工作最爱报 VBench 总分不变,但分维度看往往能发现明显退化。 ● 音频质量评测:MOS、PESQ 与 FAD 各测什么(AudioEval) · 难度:工程实战 音视频生成里音频质量几乎全靠几个数字说话,但这些数字测的根本不是一回事:SI-SDR 只管波形对齐、PESQ 只为通信语音设计、FAD 看的是分布而不是单条样本的保真度。选错指标会得到自欺欺人的结论——比如用波形指标验收 codec,数字很好听但高频毛刺全在。 最后更新:2026-11-10 09:18
-
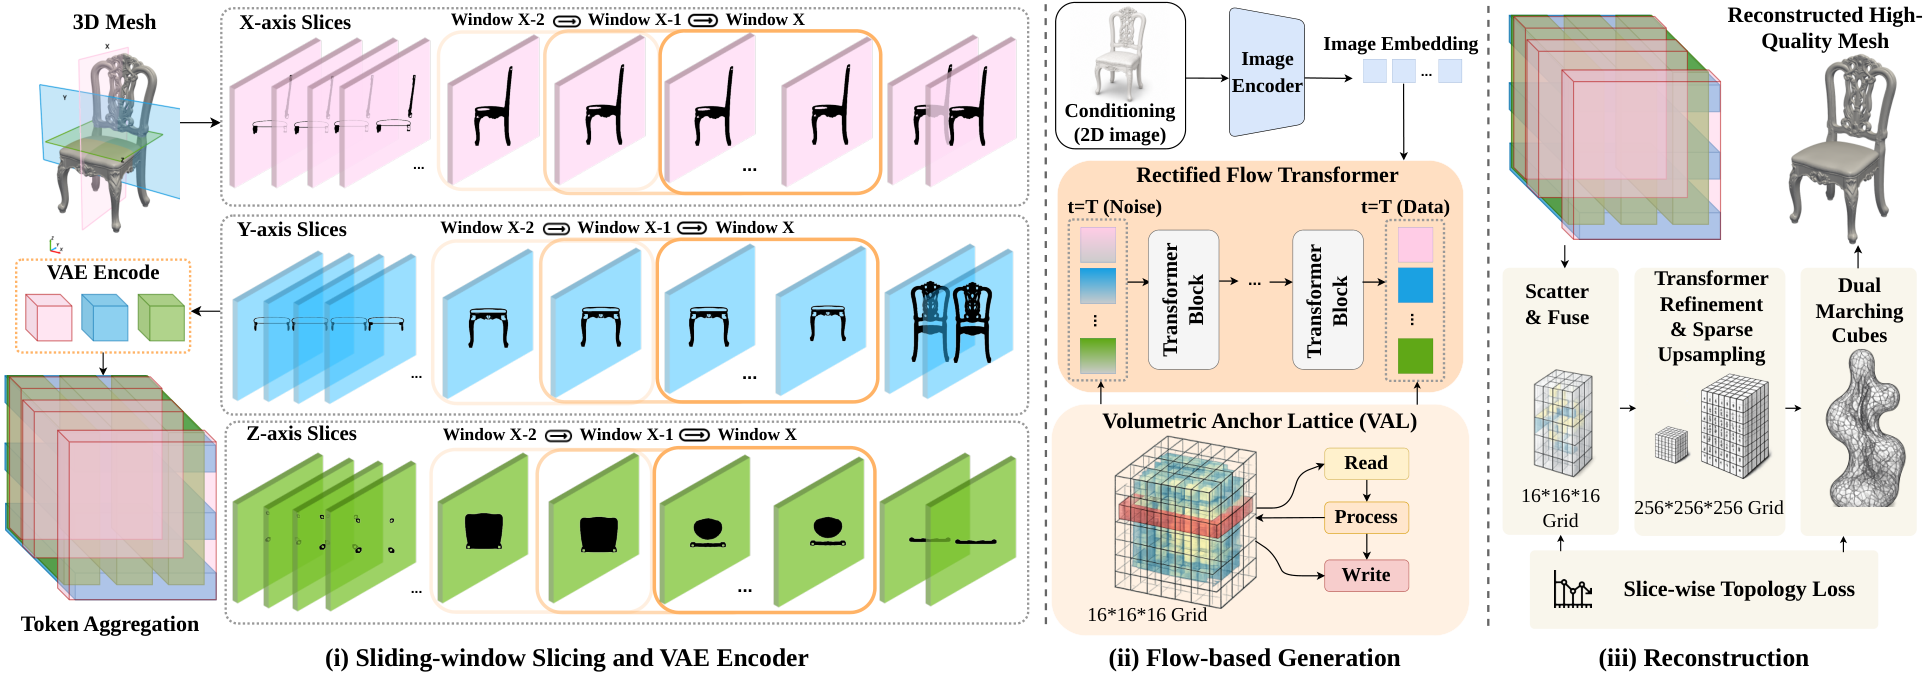
AIGC 每日速读|2026-10-05|NeurIPS省七成token保孔洞SILSA 今日 AIGC 论文速览 今日共 10 篇 · 3D生成 1 篇 · 持久世界建模 2 篇 · 视频表征与3D控制 3 篇 · 个性化图像生成 1 篇 · 音频生成 2 篇 · 视频生成评测 1 篇 重点论文标题列表 SILSA(伊利诺伊大学):省七成token保住孔洞 Oneira(莫纳什大学):新物体能互动且留下后果 World Observer(KAIST):镜头外的物体也继续演化 SemanTok(Stability AI):小模型先学会视频语义 Tacit-TTS(杜比实验室):免转写克隆语音快十倍 今日论文速览 1. SILSA:省七成token保住孔洞 SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation | 伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02201 关键词:图像生成3D, 切片潜空间, Rectified Flow, 拓扑约束 前序问题:高分辨率 3D 生成常先预测活跃体素,再补局部几何;连续曲面被拆成大量局部 token,细杆、孔洞和远距离连接容易断裂。增加体素数能补细节,却同时推高序列长度与训练显存。问题不只是模型画得像不像,还包括生成的网格是否保留原有结构。 本文贡献:SILSA 沿 x、y、z 三轴使用重叠的滑动窗口切片,每个 token 概括一段局部深度窗口。Slice VAE 将带朝向的表面采样编码成切片潜变量,再通过稀疏体积解码器重建网格;Volumetric Anchor Lattice 给三组切片共享的 3D 工作空间。切片级持久同调与相邻切片 Betti 转变损失约束连通分量和孔洞,图像条件 Rectified Flow 则一次生成整组潜变量。 论文 Figure 2:SILSA 总览。沿 x、y、z 轴以重叠切片 latent 表示形状。拓扑感知 SliceVAE 将表面编码为固定的多轴切片 latent,再通过稀疏体积上采样解码为高分辨率网格。图像条件 Rectified Flow Transformer 生成 latent,并以 Volumetric Anchor Lattice 作为共享 3D 记忆协调不同轴。VAE 训练中的切片级持久同调与 Betti 转变损失监督连通分量、孔洞和拓扑一致性。 实验效果:表 3 中固定 384 个 token,对比最紧凑基线 Dora 的 1280 个减少 70.0%;batch size 4、单张 A100 下训练显存 8.7GB,对比 Dora 的 14.6GB 减少 40.4%,端到端推理 0.34 秒/形状,对比 0.82 秒减少约 58.5%。表 1 的 PSNR 为 32.74,SparseFlex 为 30.12;表 2 的 Betti-Err 为 1.582,对比 1.743。arXiv comments 明确标注 Accepted at NeurIPS 2026。 论文 Figure 3:自然场景输入图像的 image-to-3D 生成结果。图中展示 SILSA 从不同输入得到的 3D 形状;这是定性展示,不能仅凭样例推出分布外形状可靠性。 批判点评:这些数字来自不同对照:70% token、显存和延迟以 Dora 为参照,PSNR 与 Betti-Err 的强基线是 SparseFlex,不能拼成对同一模型的全面领先。切片拓扑监督改善结构,并不提供任意形状的拓扑保证;作者也承认分布外结构及信息不足的输入视角会降低保真。值得关注的是表示方式,而不是把单物体结果直接外推到完整场景。 2. Oneira:新物体能互动且留下后果 Oneira: From Open-Ended Generation to Open-World Interaction in Video World Models | 莫纳什大学;大连理工大学;香港中文大学(深圳);牛津大学;布里斯托大学 | arXiv:2610.01614 关键词:交互式视频生成, 显式世界状态, 状态持久性, 条件视频 前序问题:能生成新房间,不代表能持续与新房间里的东西互动。镜头发现一个新苹果,模型要把它变成可操作对象;把苹果拿走之后,再回头也应看到空桌面。纯视频续写往往把交互当作局部视觉效果,缺少记录事件后果并供后续片段查询的状态载体。 本文贡献:Oneira 用显式世界状态表把视频生成与交互闭环连接。coding agent 读取当前观察和目标,定位实体、规划动作并把结果写回表;探索中发现的新物体也会注册。渲染引擎沿相机轨迹把更新后的表转成粗条件视频,视频生成器结合首帧、可选记忆帧和分块 caption 补齐外观与动作;末帧和更新后的状态进入下一段。它的贡献落在生成可互动且状态连续的视频环境。 论文 Figure 2:Oneira 单片段流程。给定输入图像与目标,coding agent A 读取世界状态表并规划动作 P_k。引擎 E 将每个动作写入表,把更新结果 T_k 沿相机路径 C_k 渲染成粗条件视频 V_k(第 3.2 节)。交互表现为物体框的删除或重新着色;被移动物体的框暂时移除,静止后从生成帧重新注册,新露出的物体也如此。视频模型 G 结合首帧、可选记忆帧、V_k 与分块 caption c_k 生成片段(第 3.3 节),末帧与更新后的表启动下一段。球体仅为示意,条件与生成帧来自同一个 Oneira 片段。 实验效果:表 1 的 InteractionBench 包含 100 个交互案例和 50 条记忆链。Oneira 的交互成功率为 0.78、目标正确率 0.82,LingBot-World-V2 分别为 0.49、0.39;记忆部分 State 通过率 0.80,MiniMax-H3 Ref2VA 为 0.68。图 3 展示三个片段组成的 30 秒链,比较执行交互后转回原处的状态。 论文 Figure 3:三个片段组成的 30 秒链的定性比较。各列上方标出当时的动作,橙色单元格表示 caption 携带交互的 chunk,插图显示 Oneira 的条件视频。红色标签标注 baseline 帧中的失败。Oneira 在指定 chunk 控制两次交互,并在相机转回时维持改变后的状态。 批判点评:状态表使“后果被记住”更明确,却没有让底层视频模型成为物理仿真器。作者列出的动作空间仍是离散的,连续控制和精细接触并未解决;长时域视觉一致性仍受生成器能力限制。100 个交互案例与 50 条记忆链是作者的专用评测,不能等同于开放世界任意操作均可靠。 3. World Observer:镜头外的物体也继续演化 World Observer: Joint Actor-Observer Generation for Persistent World Modeling | 韩国科学技术院(KAIST)人工智能学院 | arXiv:2610.02162 关键词:视频世界模型, 全景观察者, 多视角生成, 镜头外动态 前序问题:视频世界模型通常只生成行动者当前看见的画面。汽车驶出视野之后,没有可见证据约束它继续前进;再次入镜时可能丢失、停住或变成别的车。仅保存旧图像能帮助记住外观,却不一定能维护镜头外持续发生的动态。 本文贡献:World Observer 把“行动”和“观察”拆成两个同步生成流:透视 actor 负责当前视角,全景 observer 持续观察选定区域,二者由共享 DiT 联合生成。共同全景源的 warping 建立几何对应;Observer Sink 从高分辨率初始全景取四个透视参考,帮助物体重返视野时恢复细节。观察者还能放在不同位置,或接收单独条件来控制画面外的事件。 论文 Figure 4:模型总览。(a)World Observer 使用共享 DiT 联合生成 actor 与全景 observer 两条流。(b)Observer Sink 将高分辨率初始全景转换为四个透视参考,以保留精细外观信息。 实验效果:表 1 的真实/合成 OOV 测试中,单观察者 2B 模型的 FVD 为 291.7/196.2,LingBot-World 为 420.0/333.3;OOV-D_gt 为 0.426/0.531,对方为 0.337/0.340。多观察者仅在合成集测试,FVD 为 147.0,但 OOV-D_gt 为 0.528,略低于单观察者 0.531。因此视角增加改善部分指标,并非所有动态指标同步上涨。 论文 Figure 7:与其他模型的定性比较。红框标出目标离开视野前与重新进入视野后的物体。已有模型常丢失物体、冻结其状态或不一致地重建它;World Observer 在视野外间隔后更好地保持物体身份与状态演化。 批判点评:方法目前需要全景条件,作者将从普通透视图补全全景列为后续方向;真实世界多观察者条件稀缺,多观察者优势只在合成集有证据。有限的观察者预算也无法覆盖整个世界。它更像把算力分配到感兴趣区域,而不是获得无限范围的世界记忆。 4. SemanTok:小模型先学会视频语义 SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation | Stability AI;卡尔斯鲁厄理工学院 | arXiv:2610.00686 关键词:视频tokenizer, 自回归生成, DINO语义监督, 可变长度token 前序问题:自回归视频生成需要先确定场景是什么,再补纹理细节。可变长度 tokenizer 虽能从粗到细输出,已有 decoder-REPA 对齐却可能利用带噪输入满足损失,未必迫使短 token 前缀本身承载语义;小 AR 模型因此仍可能生成类别不对或随时间漂移的画面。 本文贡献:SemanTok 保留 VideoFlexTok 的可变长度训练和 nested dropout,在编码端加入冻结 DINO 特征,并用轻量 Dense DINO 与 Class DINO 读出头,要求每个保留下来的 token 前缀单独预测教师语义。冻结 tokenizer 后,AR 模型按时间优先、由粗到细的顺序预测 token,再由扩散 decoder 还原视频。语义监督直接落在短前缀,而不只落在 decoder 的中间状态。 论文 Figure 2:方法总览。(1)tokenizer 训练:encoder、FSQ 与扩散 decoder 联合训练,nested dropout 使 decoder 能从任意 token 前缀重建视频。SemanTok 保留 VideoFlexTok 的训练方案(橙色),再加入冻结教师的语义监督:教师特征输入 encoder,每个保留的前缀都学习预测这些特征(紫色;细节见图 3)。(2)AR 训练与生成:冻结 tokenizer,AR 模型按时间优先、粗到细的顺序预测 token,步骤(1)的 decoder 将任意生成前缀渲染为视频。 实验效果:摘要与实验分析报告:201M 的 SemanTok AR 模型可匹配或超过约 3.4 倍规模的 VideoFlexTok AR 模型;附录表 4 中相应规模阶梯为 201M 和 679M。正文还报告在相同 AR 模型下,k=16 时每 token 预测约少用 32% 的 bits。图 7 比较同一 Kinetics-600 弹吉他类别的 rollout,201M 的 SemanTok 随时间退化更慢。 论文 Figure 7:SemanTok 在两种 AR 模型规模下保持优势。图中是同一 Kinetics-600 弹吉他类别的 class-to-video rollout。在 201M 模型下,SemanTok 随时间缓慢退化,而 VideoFlexTok 只在 t=1 时清晰。项目页提供视频。 批判点评:“小模型追上大模型”限定在作者的数据、token 预算与指标配置;参数量减少不等于端到端生成耗时同比减少。正文专门指出每帧仅 1 个 token 时不能兼顾全部目标,附录重建表也显示部分 PSNR/SSIM 逊于基线。语义更准和逐像素重建更准是两种目标,部署时仍需按预算权衡。 5. Tacit-TTS:免转写克隆语音快十倍 Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning | 杜比实验室 | arXiv:2609.38658 关键词:语音克隆, Masked LM, 非自回归生成, ReFlow蒸馏 前序问题:自回归 TTS 逐个预测语义 token,零样本音色克隆效果好但延迟高。非自回归系统更快,却常要求参考音频的转写;参考是陌生语言、婴儿咿呀或无意义发音时,ASR 生成的错误文本反而污染条件。目标是在不要求参考转写的同时降低生成耗时。 本文贡献:Tacit-TTS 从 IndexTTS2 蒸馏,将 text-to-semantic 阶段替换为 masked 非自回归生成,同时保留预训练的说话人和情绪条件。免训练长度估计结合参考音频语速与目标文本音节数,确定输出长度;连续潜表示和 ReFlow 蒸馏则加速下游 semantic-to-mel 的 flow-matching 渲染器,最后由 vocoder 合成波形。 论文 Figure 2:Tacit-TTS 流程总览。输入为参考音频与目标文本,encoder 提取条件表征;text-to-semantic 模型通过 masked-LM 生成语义 token,semantic-to-mel 模型将其转成 mel 频谱,最后由 vocoder 合成波形。 实验效果:单张 NVIDIA A100 上,作者对超过 5 秒的语音报告相对 IndexTTS2 超过 10 倍加速。图 3 的端到端测试包含参考条件计算:4 秒输出约 9.0 倍、31 秒附近最高约 14.9 倍、125 秒为 11.8 倍。表 1 中 LibriSpeech speaker similarity 为 0.875,教师为 0.870;但 WER 为 5.54,教师为 3.115。参考语言另测试了 8 种语言及非词汇声音。 论文 Figure 3:IndexTTS2 与 Tacit-TTS 的端到端生成时间(包含参考条件计算)随输出时长的变化。使用同一参考片段,以固定段落重复延长输出。虚线表示实时速度;Tacit-TTS 曲线上方数字是相对教师的加速比,插图放大 Tacit-TTS 曲线。4 秒、31 秒附近和 125 秒的示例加速比约为 9.0、14.9 和 11.8 倍,不能当作全数据平均。 批判点评:更快没有消除质量损失:普通中文测试上的音色相似度和内容准确度仍落后于教师。图 3 使用固定段落重复拉长输出,最高 14.9 倍不能写成所有语音平均加速;长序列的全注意力成本也开始侵蚀收益。四个常规数据集的其他基线质量数字来自教师论文,而跨语言与非词汇测试由作者重跑,比较范围应分开理解。 6. 4Director:完整网格让物体转身不丢脸 4Director: Controlling Video World Models with Rigid 3D Geometry | Stability AI;伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02160 关键词:可控视频生成, 4D场景, 刚体网格, Motion Adapter 前序问题:2D 框只能指定物体在屏幕上的位置,不能完整表达深度和转向;3D 点或 blob 也缺少完整表面。镜头与物体同时移动时,模型容易每帧重新猜未观测几何,导致物体转了一半、遮挡出错或身份变化。专业创作需要把相机和物体轨迹放进统一的 3D 坐标系。 本文贡献:4Director 从输入图为每个物体一次重建 canonical mesh,每帧只施加一个指定刚体变换。网格、背景点云与相机共享坐标系,用户编排轨迹后渲染成深度视频;可训练 Motion Adapter 将几何条件注入预训练视频模型,后者补充外观、光照与非刚体动态。团队构建含 20,774 个片段的 RealCOD-Rigid,并以身份判断门控 mask IoU,形成 IG-IoU 指标。 论文 Figure 3:4Director 总览。左侧:每个物体只重建一次为完整 canonical mesh,每帧用一次刚体变换移动;网格、背景点云与相机共享坐标系,用户在该坐标系指定物体与相机轨迹,并将场景渲染成深度视频(第 3.1 节)。右侧:可训练的 Motion Adapter 分支将刚体渲染注入预训练视频生成器,由后者补充外观、光照与非刚体动态(第 3.2 节);训练使用 RealCOD-Rigid(第 4 节)。 实验效果:表 1 中 4Director 的 FVD 为 370.4,SymphoMotion 为 405.4、VerseCrafter 为 484.7;IG-IoU 为 60.4,对应 52.9 和 54.8,camera RotErr 为 3.65°。图 5 对比共同相机与物体控制,显示其更完整地跟随指定转向;图 6 另展示物体离开视野后重返的定性案例。 论文 Figure 5:相机与物体共同控制的定性比较。每个片段顶行展示输入图像和规定的轨迹,其下为四个 baseline、4Director 以及源视频按时间对齐的帧。箭头表示物体朝向,源视频中为绿色、生成视频中为红色。该组案例里只有 4Director 完成源视频的转向;baseline 保留原朝向、只转了一部分、模糊或丢失主体。 批判点评:完整网格减少逐帧几何猜测,却会把错误重建固定进控制条件。论文失败案例中,倒立舞者被当作一个刚体平移,生成结果一直保持初始姿态而没有跳舞,说明刚体轮廓可能压制应有的非刚体动作。IG-IoU 还依赖视觉语言裁判判断身份;作者的 VBench 优势多数在 2 个点以内,应避免把图中单例写成稳定保证。 7. GenCine:相机与物体在3D里一起编排 Generative Cinematographer: Composing Camera and Object Motion in 3D | 约翰斯霍普金斯大学 | arXiv:2610.02180 关键词:视频运动控制, 3D运动handle, XYZ引导图, LoRA 前序问题:同一条 2D 拖拽轨迹可能对应完全不同的 3D 运动;相机和物体一起动时,屏幕坐标更难区分“物体真的转身”和“镜头绕过去”。另一方面,整物体刚体控制过硬,人体、动物或机械臂的不同部分需要分别编排,而不必为每类对象建立物理模型。 本文贡献:GenCine 把单张图提升为可编辑的 3D 场景 scaffold,艺术家在共同世界坐标系里设置相机路径,并以局部 3D handle 控制前景不同部分。背景 XYZ、前景 XYZ 和恒定前景身份颜色图分别表达静态位置、动态位置和跨帧对应;有效性 mask 标记缺失条件。轻量 guidance branch 与 Wan 模型的 LoRA 学习这些控制,从真实视频恢复轨迹并结合合成数据训练。 论文 Figure 3:GenCine 的 3D 控制流程。首先从 RGB 图估计深度与动态 mask,再提升为供动作编排的 3D 场景。艺术家通过 Blender 等 3D 界面,在共同世界坐标系指定相机和物体运动。控制转为背景 XYZ、前景 XYZ 和前景身份图,分别指示静态场景位置、移动 handle 的位置及身份。有效性 mask 区分可用条件与缺失值,动态 mask 标出初始前景。冻结的 Wan VAE 将图编码给视频模型;训练配对从视频运动恢复的条件,推理时同样的图表达艺术家编排的控制。 实验效果:表 1 的 Camera Shooting 上,GenCine 的 TransErr 为 1.00,Wan-Move 为 1.02;受控前景 R-LPIPS 为 0.18,对方为 0.19。Object Interactions 上整体 LPIPS 为 0.35,Wan-Move 为 0.37,但整体 PSNR 为 16.54,略低于 Go-w-Track 的 16.59。图 5 给出艺术家编排运动的定性对比,体现 3D 意图与 2D 投影控制的区别。 论文 Figure 5:艺术家编排运动的定性比较。自上而下为 Living room、Bus 和 Robotic arm;每组按行展示 Wan-Move、VerseCrafter、Go-with-the-Track 和 GenCine。第一列为 3D 控制(GenCine)或共享的 2D 投影(baseline),随后四帧采样各控制区间。实线与虚线分别表示已执行和剩余目标路径,圆点表示当前目标,半透明 mask 表示投影目标区域。 批判点评:主要价值是可表达的控制接口,数值优势相当局部,不支持“全指标碾压”的结论。多个 handle 只是分段刚体近似,不能可靠表示复杂形变;单图深度估计出错、遮挡和超出归一化范围的运动都会影响控制。它与 4Director 各有取舍:局部操作更灵活,但没有完整网格带来的全表面约束。 8. PEARL:从用户历史推理个性化画面 Personalized Image Generation with Reasoning and Reflection | 范德堡大学;Adobe;马里兰大学帕克分校;佐治亚大学 | arXiv:2610.00737 关键词:个性化图像生成, 用户历史, 推理反思, DPO 前序问题:个性化图像生成通常依赖挑选好的参考图片,而真实用户偏好分散在评论、帖子、图片和 metadata 中。把某件商品放到什么环境、某个主题应采用什么风格,需要综合历史线索;检索一张最像的图片并不能完整表达生活方式与审美。 本文贡献:PEARL 将多模态 planner、reflector 与冻结图像生成器串成 reason-reflect 循环:先从历史形成场景计划并渲染,再根据实际图像与历史的不匹配修订计划。训练先蒸馏 silver personalization trajectory,再采用交替策略 DPO,用与用户历史相关的检索奖励优化两种策略。配套 benchmark 区分电商商品的 Personalized Scene Generation 和社交媒体的 Personalized Creative Generation。 论文 Figure 2:Pearl 的训练流程。先用 Silver Personalization Trajectory 做 warm start,再通过 Render-in-the-Loop 优化两种策略。图左的教师产生推理与计划供 planner 和 reflector 蒸馏;图右把两种策略与冻结渲染器串接,按奖励给候选排序、构建偏好对并做交替 DPO 更新。 实验效果:表 1 的 Amazon 场景生成中,H@5 为 0.2297,PMG 为 0.2143;MLLM Overall 为 3.92,对方为 3.48。表 2 的 Instagram 创作生成中,跨类别 R@1 为 0.876,Pigeon 为 0.748,MLLM Overall 为 3.541,对方为 3.334。图 4 将两种任务的指标归一化后汇总,比较完整 PEARL 与移除 reflection 的版本。 论文 Figure 4:消融:Pearl 与 Pearl -Reflection 的比较。该可视化对两种任务的指标进行归一化和汇总,展示保留 reflection 前后的差异;坐标是汇总后的相对值,不是原始 benchmark 分数。 批判点评:用户“喜欢”不等于模型能识别出用户:检索与 MLLM 分数只是偏好对齐的代理指标。作者明确指出电商场景没有每个用户—商品组合的自然真实目标图,只能间接评估;策略训练也只做了一轮交替 DPO。Instagram 的 LPIPS 和 MS-SSIM 并非最优,因此不能把摘要中的平均个性化提升写成所有画质指标普遍提升。 9. PLACE:让双耳声像跟随多模态条件 PLACE: Positional Latent Adaptation via Conditioned Embeddings for Binaural Audio Generation | 杜比实验室;佐治亚理工学院 | arXiv:2610.00630 关键词:双耳音频生成, 空间条件, 低秩latent适配, ILD与ITD 前序问题:音频与画面语义一致,还不一定听得出声音来自左边还是右边。现有空间声音生成器的条件接口常较固定,难以同时接收文本、视频和可选音频。想让耳机中的声像随场景变化,需要条件中的空间信息真正改变生成 latent,而不是只描述声源类别。 本文贡献:PLACE 基于 AudioX,增加 Perception Encoder Core 视频特征,将文本与视频表征对齐以提取空间线索,再用依赖条件的低秩变换调整生成 latent。适配器通过解码音频上的耳间声级差 ILD 和时间差 ITD 损失训练;五个预训练 encoder 与 SAO decoder 冻结,AudioX 通过 LoRA 微调。系统支持不同模态条件组合,而非只处理视频输入。 论文 Figure 1:PLACE 框架总览,蓝色突出视频特征路径,橙色突出文本路径。(a)AudioX 生成 latent,空间条件在冻结 SAO decoder 之前驱动其变换;五个预训练 encoder 与 decoder 全部冻结,AudioX 用 LoRA 微调。(b)投影后的 PE Core 特征在 MAF 模块之前补充 CLIP 与 Synchformer 特征。(c)文本—视频 cross-attention 与联合 self-attention 产生空间特征 H_c-sp。 实验效果:表 1 的 FAIR-Play split 1 上,ITD 误差 0.1077ms、ILD 误差 2.0495dB,ViSAGe 分别为 0.1136ms、2.1306dB;split 2 的 ITD 却较差。表 3 的分布外 T2A 听测平均分为 55.5,SpatialSonic 为 44.8;域内 V2A 为 65.3,对方 ViSAGe 为 44.9。原文只写 Submitted to ICASSP 2027,不能称为会议接收。 论文 Table 3:主观听测表。评分范围为 1–100,越高越好;SC 为语义一致性,SI 为空间感,SP 为空间一致性,Sy 为同步性(T2A 不评此项),AR 为音频真实感,Avg 为所评维度的均值。GT 是真实音频参考,不参与最佳模型加粗;粗体表示每种条件各列最优模型。表中区分域内与分布外 T2A、域内与 Gemini 视频条件 V2A;n 统计评分数。PLACE 在域内 T2A 均分 40.5,分布外 T2A 为 55.5,域内 V2A 为 65.3,Gemini V2A 为 58.4。 批判点评:收益取决于模态与分布。域内 T2A 听测均分仅 40.5,低于 SpatialSonic 的 44.4 和 AudioX 的 41.1;BEWO-1M SS-set 上 FSAD、ITD、ILD 也逊于 SpatialSonic,优势集中在原文定义的 SpatialCLAP 差值指标。听测表中的 n 是评分数,不能当作独立听众人数。空间一致性进步不等于全面音质领先。 10. VTR-Bench:视频逼真了字却还常写错 VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation | 香港城市大学;香港科技大学(广州);香港科技大学;西湖大学;电子科技大学 | arXiv:2610.01499 关键词:视频生成评测, 视觉文字渲染, WER, 关键帧引导 前序问题:广告、科学演示和界面视频里的文字常承担核心信息。模型能把灯光与动作做得漂亮,招牌仍可能拼错、缺字或小字不可读;只评审美与物理合理性无法发现这些问题。需要把文本正确性与画面任务完成度分开衡量。 本文贡献:VTR-Bench 用 300 个 prompt 覆盖五类场景,对具体文字载体分别转写并计算 WER,同时用每条 prompt 的 20 问 checklist 检查场景与运动要求。作者另外提出关键帧引导生成流程,由 Director agent 根据视觉反馈反复调整图像、首帧及运动计划,再生成视频。主贡献是生成模型评测与改进,符合 AIGC 范围,而不是通用视频理解。 论文 Figure 2:VTR-Bench 总览。左侧:专家设计五种场景类别,引导场景 seed 生成与人工过滤;保留的 seed 用于构造 prompt,再通过参考图生成和 VLM 审查迭代完善,最后人工复核。右侧:生成视频在两个维度分别评估,Video Score 以 20 问 checklist 衡量场景与视频要求完成度,WER 比较针对具体文字载体的 VLM 转写与参考文字,衡量视觉文字保真。 实验效果:主表 1 比较 11 个视频模型,Wan3.0 的整体 WER 最低,为 0.250,Video Score 为 0.849;MiniMax H3 为 0.447/0.756,Seedance2.5 为 0.641/0.791。表 2 中 Qwen3.8-27B 对文字块 WER 的 Pearson 为 0.9541,视频级为 0.9842,支持其与人工转写的相关性。官方代码:VTR-Bench。 论文 Figure 1:即使视频视觉上可信,现有视频模型仍难正确渲染文字。上方是 Seedance2.5 生成的视频;Video Score 是 20 问 checklist 中满足要求的比例,WER 是相对参考文字的词错误率。左下展示视频中的四种文字渲染问题,右下展示 11 个模型在 VTR-Bench 上的整体 WER。 批判点评:WER 是词级编辑距离,0.250 不等于“25% 的视频失败”,也不能推出每个视频都错四分之一。不同模型的分辨率与生成管线不同,排行榜还受评审模型影响;相关性高不意味着每条转写都正确。关键帧 agent 的迭代成本也应单独核算,不能把更高预算的改进当作单次生成能力。 趋势观察 从像素记忆走向状态载体 Oneira 显式记录交互后果,World Observer 持续生成选定区域的视角;两条路线都让镜头外状态获得约束,但尚未证明无限时域或全面物理可靠性。 控制接口先解决几何歧义 4Director 用完整刚体网格,GenCine 用局部运动 handle;它们共同把相机和物体放进世界坐标系,分别在完整几何与形变灵活性之间取舍。 短序列必须携带可用信息 SILSA 的切片潜变量与 SemanTok 的短语义前缀都减少局部 token 负担;这是不同任务中的表示设计趋势,不能把各论文加速数字横向相乘。 评测拆开能力与代价 视频里的字、音频的空间感、用户历史匹配和端到端耗时都需要独立指标。各论文测试集、评分口径和硬件不同,本期不做跨论文统一排行榜。 今日讨论 SILSA 用切片拓扑监督改善单物体孔洞与连通性;面对输入视角不充分或分布外形状,你会优先增加多视角条件,还是设计可验证的拓扑约束? 人工智能炼丹君 整理 | 2026-10-05
-
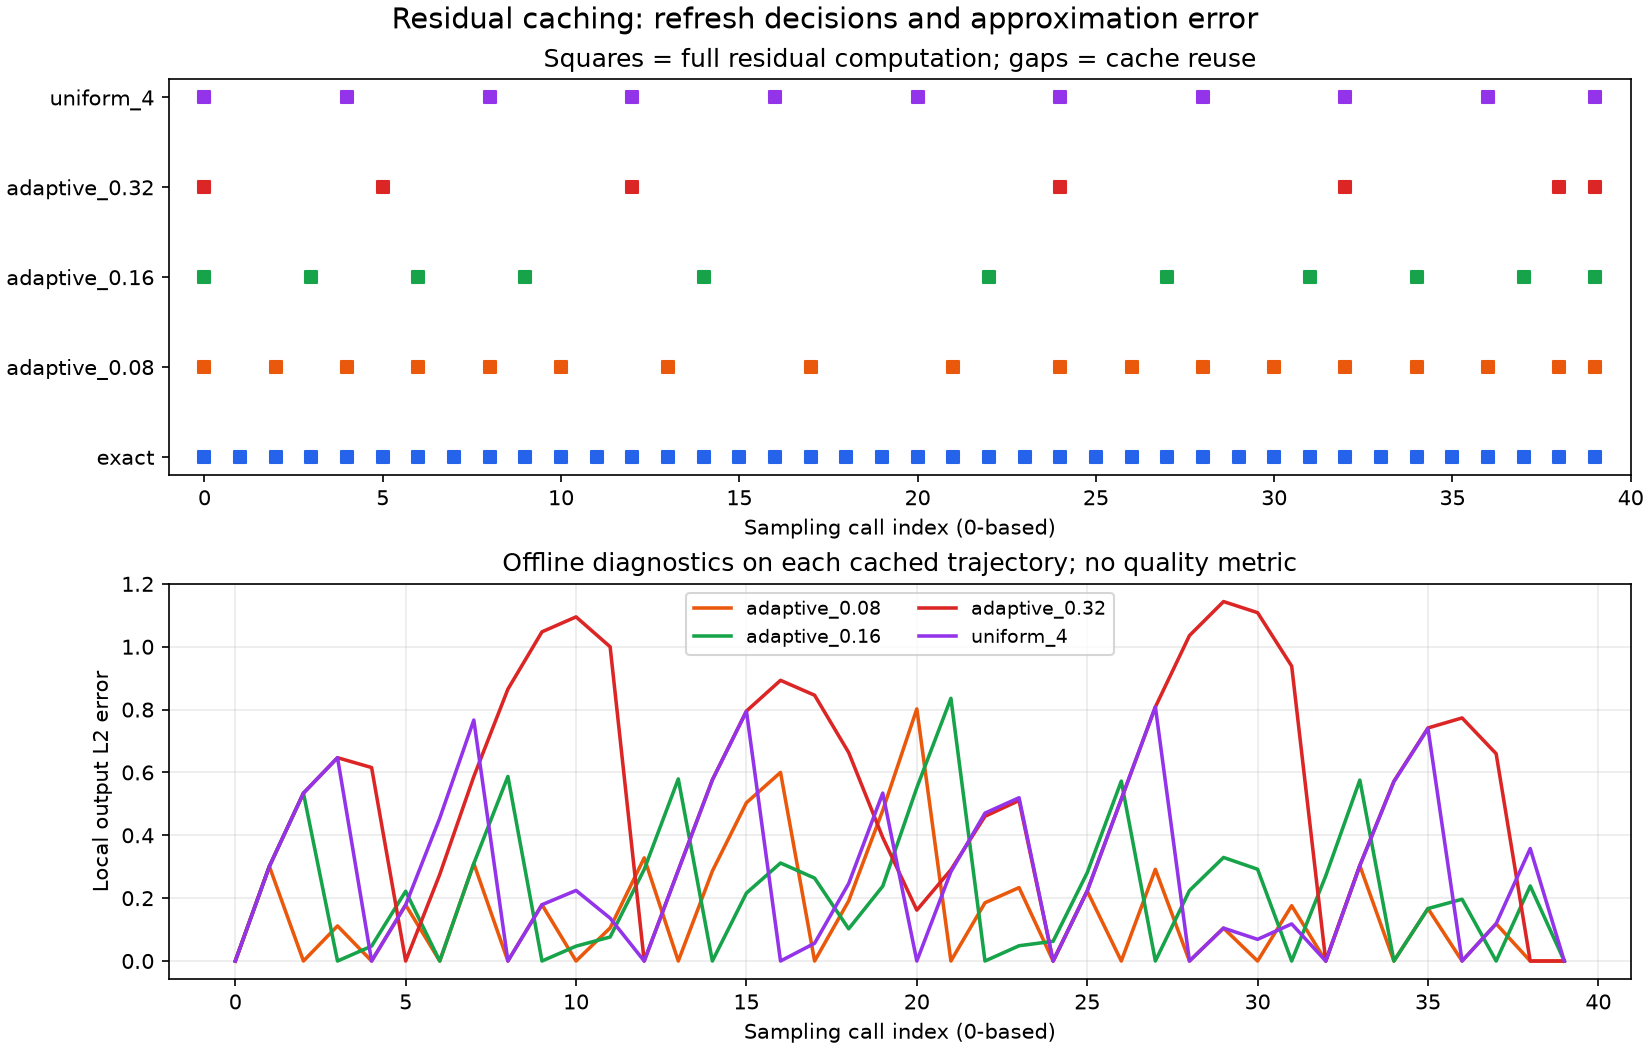
AIGC 基本功|扩散模型的跨步缓存复用-DiffCache AIGC 基本功|扩散模型的跨步缓存复用-DiffCache 同样走完采样器的每一步,能不能少算几次昂贵的去噪网络?跨步缓存把这个问题拆成两件事:复用什么,以及什么时候必须刷新。本文用残差缓存的最小实验解释机制,再对照 DeepCache 和 TeaCache 的真实实现。实验是人工构造的数值系统,不是视频模型的质量或速度复现。 本文承接 DDIM 与高阶采样器、DiT 和 性能建模与 Profiling。默认读者知道采样器会反复调用网络,不要求先读缓存论文。论文版本与固定提交源码核对日期为 2026-11-10。 01. 为什么需要它 一次视频生成中,潜变量在逐步变化,文本条件通常固定,网络却要一遍遍穿过相同的模块。假如两次调用的深层特征几乎一样,重新计算这部分就可能浪费时间。但“几乎一样”只是观测,不能推出“任意一次都可以省”。运动切换、条件变化和采样末期的细节修整,都可能让陈旧特征的误差显现。 这里最具体的失败场景是固定间隔缓存:先完整算一次,之后连续复用,直到计数器要求刷新。如果变化突然出现在间隔中间,策略不会因为内容变了而提前刷新。反过来,如果某段变化很慢,固定间隔也会做多余的完整计算。问题在于日历式排期没有感知当前输入,周期短会损失收益,周期长会增加近似误差。 本文实验保留全部 40 次状态更新。精确版本执行 40 次完整残差计算;自适应阈值为 0.16 时,只执行 11 次,复用 29 次。终点相对误差为 0.008222。它证明了在这个特定数值系统中确实可以减少计算次数,同时也证明输出发生了变化。它不证明视频质量达标,更不证明真实 GPU 上能得到相同的提速。 缓存适合回答“这个步骤里,哪些计算可以暂时沿用”。减少采样步数则改变采样器的离散路径。两种方法可以组合,但组合后的误差要重新评估:单独用缓存通过了一组样例,不意味着换成少步采样器后仍然通过。 02. 最小可用理解 第一,把网络拆成每步仍要计算的部分,以及准备复用的昂贵部分。第二,保存上次完整计算得到的特征或残差,用便宜的变化指标决定是否刷新。第三,即使命中缓存,当前输入仍然要参与输出,采样器仍然继续更新状态。 以残差形式为例,设当前嵌入是 $h_i$,完整模块输出为 $G(h_i,t_i,c)$。缓存保存的是 $R_i=G(h_i,t_i,c)-h_i$。如果上次刷新发生在 $r$,当前近似模块输出是 $h_i+R_r$。符号 $i$ 表示第几次网络调用,$t_i$ 是这次调用的时间条件,$c$ 是固定的文本等条件;$r$ 是缓存的生成时刻,通常小于当前 $i$。 这三句话的重点是“当前输入加旧残差”。如果直接把整个旧输出拿回来,连当前输入的变化也被抹掉了。残差复用仍然有误差,只是保留了输入的直通更新。DeepCache 的 U-Net 高层特征缓存并不等于这个残差写法,不能把所有缓存方法都称为同一个算法。 03. 数学推导 先定义缓存误差发生在哪里 设 $E$ 是便宜的输入嵌入,$G$ 是昂贵模块,$H$ 是输出头。完整调用写为: $$h_i=E(x_i,t_i,c),\quad R_i=G(h_i,t_i,c)-h_i,\quad y_i=H(h_i+R_i,t_i,c)$$ $x_i$ 是采样器当前的潜变量;$h_i$ 是网络内部的嵌入,不必与 $x_i$ 形状相同;$R_i$ 是昂贵模块对嵌入的修正;$y_i$ 是送回采样器的网络预测。这里的预测可以按模型定义代表噪声或速度,缓存逻辑本身不替模型选择参数化。等式只是代数分解,不要求模型专门训练一个名叫“残差缓存”的层。 命中缓存后,输入嵌入和输出头仍按当前条件计算: $$\widehat{y}_i=H(h_i+R_r,t_i,c),\quad r<i$$ 帽子表示近似计算。比较精确与近似时,先固定当前同一个 $h_i$:误差来自 $R_r$ 替代了 $R_i$,而不是来自状态已经分叉。若输出头在所讨论的局部区域满足 Lipschitz 条件,常数记作 $L_H$,那么: $$\|\widehat{y}_i-y_i\|\leq L_H\|R_r-R_i\|$$ Lipschitz 条件的意思是输入变化不能被这个局部映射无限放大;$L_H$ 是放大上限。本文没有测出真实模型的 $L_H$,这个式子是带假设的分析工具,不是线上质量保证。它告诉我们,缓存内部误差小仍然需要考虑输出头的敏感性。 为什么使用便宜的变化代理 直接计算 $\|R_i-R_r\|$ 能判断缓存是否陈旧,但得到 $R_i$ 就已经做了昂贵计算。为了节省计算,需要先观察一个便宜的量 $m_i$。它可以由当前嵌入与时间条件构造。相邻调用的相对 L1 变化写为: $$d_i=\frac{\operatorname{mean}|m_i-m_{i-1}|}{\max(\operatorname{mean}|m_{i-1}|,\varepsilon)}$$ $\operatorname{mean}$ 对张量所有元素取平均,绝对值逐元素计算,$\varepsilon$ 是防止除零的小正数。两次张量形状一致时,均值之比等于 L1 范数之比。这个值没有单位,反映变化相对之前幅度有多大。分母很小时,它也可能变得敏感,不能把这种数值问题误判成内容剧烈变化。 本文教学实现取 $\varepsilon=10^{-12}$。该保护和后面非负累计属于教学实现的防御性处理;不能据此声称官方代码逐字采用相同逻辑。 最直觉的想法是:如果每一步变化都很小,就一直复用。但缓存对应的是刷新时刻 $r$,不是上一时刻。利用三角不等式: $$\|m_i-m_r\|\leq\sum_{j=r+1}^{i}\|m_j-m_{j-1}\|$$ 这里 $j$ 遍历刷新之后的调用。即使单步变化很小,连续多步也会积累成明显差异,因此策略应保留“自上次刷新以来的变化预算”。把范数具体取成平均绝对值,记 $b_j=\max(\operatorname{mean}|m_{j-1}|,\varepsilon)$,则第 $j$ 步的绝对变化正好是 $b_j d_j$。逐项代入三角不等式得到 $$\operatorname{mean}|m_i-m_r|\leq\sum_{j=r+1}^{i}b_j d_j\leq b_{\max}\sum_{j=r+1}^{i}d_j$$ 其中 $b_{\max}=\max_{r\lt j\leq i} b_j$。同一个累计相对值在不同输入幅度下可以对应不同的绝对变化。要进一步控制残差误差,还需要知道代理变化怎样约束残差变化。这里的代理只提供刷新信号。 实际决策可以采用累计代理: $$\widetilde A_i=A_{i-1}+g(d_i),\quad \text{refresh if } \widetilde A_i\geq\delta$$ $\widetilde A_i$ 是做决策前的预算,$A_i$ 是本次调用结束后保存的预算。$g$ 将输入变化映射到预估的输出变化,$\delta$ 是刷新阈值。若刷新,保存新残差并令 $A_i=0$。若命中,令 $A_i=\widetilde A_i$。首次调用还没有相邻代理,直接完整计算并从零开始累计。TeaCache 使用多项式重标定来改善这种代理;拟合关系是经验估计,不会把统计相关性变成对所有样本成立的数学上界。TeaCache 原文第 3.2–3.3 节 给出了指标与累计决策。 本文取 $g(d)=d$,以便只观察状态机。阈值 0.16 因而只属于本实验的代理尺度,不能迁移成真实模型的推荐阈值。换掉嵌入幅度、时间调制或采样路径,同一个阈值对应的刷新频率就会改变。 一次局部近似如何影响后续轨迹 现在让两条轨迹分别使用精确和近似输出。为便于推导,考虑显式 Euler 更新: $$x_{i+1}=x_i+\Delta s_i v(x_i,s_i),\quad \widehat x_{i+1}=\widehat x_i+\Delta s_i\widehat{v}(\widehat x_i,s_i)$$ $s_i$ 是积分坐标,$\Delta s_i>0$ 是步长,$v$ 是精确向量场,$\widehat{v}$ 使用缓存近似。令 $e_i=\|\widehat x_i-x_i\|$ 表示轨迹差异,令 $\eta_i=\|\widehat{v}(\widehat x_i,s_i)-v(\widehat x_i,s_i)\|$ 表示在近似轨迹当前状态上的局部缓存误差。 令 $q_i=\widehat x_i-x_i$。在两条更新的差里加减 $v(\widehat x_i,s_i)$,得到 $$q_{i+1}=q_i+\Delta s_i[\widehat{v}(\widehat x_i,s_i)-v(\widehat x_i,s_i)]+\Delta s_i[v(\widehat x_i,s_i)-v(x_i,s_i)]$$ 第一对方括号用同一个输入状态比较两次预测,范数为 $\eta_i$。第二对方括号来自轨迹分叉。若 $v$ 在覆盖两条轨迹的区域内对状态满足 Lipschitz 条件,其范数至多为 $Le_i$。再用三角不等式得到 $$e_{i+1}\leq(1+\Delta s_iL)e_i+\Delta s_i\eta_i$$ 若初始状态相同,则 $e_0=0$。重复代入可得: $$e_N\leq\sum_{i=0}^{N-1}\Delta s_i\eta_i\prod_{j=i+1}^{N-1}(1+\Delta s_jL)$$ 空乘积取 1。这个展开说明早期误差会通过后续更新传播;最后一次强制刷新只能去掉最后一次局部缓存误差,不能恢复此前已经走偏的轨迹。真实系统可能局部收缩,实际误差小于这个上界;高阶求解器还涉及历史预测,不能把 Euler 的式子直接冒充所有采样器的误差定理。 为什么命中率不能直接当加速比 令 $N$ 是总调用数,$K$ 是完整计算数,$C_0$ 是无缓存基线的一次调用成本,$C_r$ 是带缓存的刷新调用成本,$C_h$ 是命中调用成本。$C_o$ 表示两边相同的固定成本。用各类调用的代表性成本近似整条轨迹,可得 $$S=\frac{NC_0+C_o}{KC_r+(N-K)C_h+C_o}$$ 把分母移到比较式另一侧并按刷新与命中分组,盈亏条件是 $$(N-K)(C_0-C_h)\gt K(C_r-C_0)$$ 左边是命中省下的成本,右边是刷新额外增加的成本。$C_r$ 可以包含代理计算、缓存写入和同步。$C_h$ 仍含嵌入、判定、读缓存、输出头和采样器更新。文本编码、VAE 解码和输出处理等开销由 $C_o$ 计入。各类调用成本波动大时,可以直接对逐次计时求和。 第 04 节取 $C_0=C_r=1$、$C_h=0.08$、$C_o=0$,并代入真实的 $K$ 计算教学成本比。仍以 11 次刷新和 29 次命中为例,如果 $C_r=1.2$、$C_h=0.95$,命中节省 1.45 个单位,刷新却多花 2.20 个单位,总成本为 40.75,超过基线的 40。两种账本的命中率都是 72.5%。这些成本单位都来自假设,实际部署需要逐类测量。 04. 代码实现 完整脚本是文末的 cache_demo.py,依赖 NumPy 与 matplotlib,无需模型权重。它构造一个四层非线性残差函数,用固定随机种子产生输入和矩阵。输入形状是 $(B,L,D)=(1,4,16)$:一个批次、四个位置、十六个通道。张量使用 float64,目的是让读者稳定复核误差,不模拟混合精度推理。 脚本里的 cheap_input 对应 $E$,residual 对应 $R$,proxy 对应 $m$,budget 对应 $A$,threshold 对应 $\delta$。输出头取恒等映射。每次用当前 $h$ 加缓存残差得到预测,然后执行状态更新。积分坐标取 $s_i=i/N$,更新 $N$ 次,每次 $\Delta s_i=1/N$。输入网络的时间标签另取 $t_i=1-i/(N-1)$,只在 $i=0,\ldots,N-1$ 上求值。把代码中的 output 取负作为 $v$,就得到上一节的 Euler 形式。最后一次调用在 $s_{N-1}$,它产生更新后的终点 $s_N=1$。这套时间标签与积分坐标是教学系统的定义。 决策的核心代码如下;变量准备、精确对照、绘图及断言都在完整附录中: budget += max(change, 0.0) boundary = i in (0, STEPS - 1) calculate = boundary or budget >= threshold if calculate: saved_residual = residual(h, t) budget = 0.0 output = h + saved_residual 首次调用没有缓存,所以必须完整算。最后一次强制刷新属于本实现的策略。previous_proxy 每一步都更新,saved_residual 只有刷新时更新:把这两件事混淆,就会把“相邻变化累计”写成另一种算法。simulate 每次创建新的状态,避免后一条请求接着用前一条请求的残差。 为了画误差曲线,离线诊断会在每个命中步骤额外计算一次当前残差。刷新步骤已有当前残差,局部误差直接记为零。图中的误差比较固定在近似轨迹的当前输入上。附录的 cache_checks.py 用 diagnostics=False 关闭诊断,拦截残差函数逐次计数,并验证开关诊断时终点和刷新序列逐元素一致。这里的 full_calls 指实际策略需要的残差求值次数。 真实运行环境为 Python 3.11.9、NumPy 2.4.3。基线终点的元素范围为 [-0.791508, 0.614856]。输出如下: shape=(1, 4, 16), steps=40, seed=7 baseline_range=[-0.791508, 0.614856] name full_calls hits endpoint_relative_error assumed_speed_ratio exact 40 0 0.000000 1.000 adaptive_0.08 18 22 0.004939 2.024 adaptive_0.16 11 29 0.008222 3.003 adaptive_0.32 7 33 0.026326 4.149 uniform_4 11 29 0.008672 3.003 All assertions passed; figure=figures/cache_schedule.png 终点相对误差的定义是近似终点与精确终点之差的 L2 范数,除以精确终点的 L2 范数。因此 0.008222 是这个定义下约 0.8222% 的差异,不是 VBench 下降,也不是图像中有 0.8222% 的像素出错。最后一列来自前节假设的成本模型,没有真实延迟单位。 图上半部分每个方块表示一次完整残差计算,空缺表示复用;下半部分是离线诊断得到的局部输出 L2 误差。请先观察刷新是否集中在同一段,再看复用之间误差如何变化。曲线没有用感知质量指标,纵轴不能解读成画面可接受程度。配图由附录脚本生成,数据与上述输出来自同一次实验。 阈值 0.16 与固定间隔 4 都执行了 11 次完整计算,但终点误差略有差异。这是“同样预算也会因刷新位置不同而得到不同结果”的一个实例。它只有一个种子和一个人工系统,不能证明自适应策略在所有输入上优于固定间隔,更不能作为统计显著性结论。 05. 工业级实现对照 DeepCache 原文第 3.3 节 利用 U-Net 的分支结构:当前浅层特征继续更新,较深分支的高层特征从缓存取回并拼接。它缓存的是特定网络位置的特征,并非本文抽象的整段残差。官方 DeepCache 官方包装器 提供 forward 包装与状态复位;对照时应先找缓存边界,再判断到底省掉了哪些模块。 TeaCache 的 HunyuanVideo 示例 在 teacache_forward 中用首个双流块的时间调制输入计算变化代理。内部调用先把相邻输入的平均绝对差除以上一次输入的平均绝对幅度,再直接累加多项式输出。这个提交没有给分母加 epsilon,也没有把多项式输出截到非负。累计值严格小于阈值时命中,达到阈值时刷新。首尾调用完整计算。命中后把旧的 Transformer 主体残差加到当前图像嵌入上,输出层照常运行。 教学版与上述示例的差异很明确:教学版没有文本分支、真实 patchify、注意力或权重,也没有拟合官方多项式;它只验证预算与残差状态机。真实代码还可能把张量变化转成 CPU 标量,这种同步的代价不能从“指标计算量很小”中自动排除。需要把判定开销也纳入测量。 工程上,缓存状态应属于一次请求,而不是一个可被并发请求共享的随意全局变量。prompt、负向条件、guidance、分辨率、帧数、模型权重或调度器变化时,复用旧状态没有语义依据。只检查张量形状远远不够;两个请求可以形状相同、内容完全不同。失败中断后重新开始生成,也要建立新的缓存生命周期。 若模型采用双分支 CFG,必须考虑条件与无条件分支的缓存分别有效。按 $y=y_u+w(y_c-y_u)$ 写,$y_u$ 与 $y_c$ 分别是无条件和条件预测,$w$ 是 guidance 系数。预测误差满足: $$\|\Delta y\|\leq |w|\|\Delta y_c\|+|1-w|\|\Delta y_u\|$$ 因此较大的 guidance 可能放大分支近似误差。这个式子是代数上的工程分析,不声称所有视频模型都执行双分支 CFG;有些采用蒸馏后的 guidance 条件。接入前要先确认实际预测路径,再决定状态如何隔离。 还要区分采样步和网络调用。调度器可能在一个名义步里求值多次,或重访相同的时间标签。缓存的计数器应跟随真实调用语义。如果只拿界面上显示的步数当数组长度,很容易在错误的位置刷新,或者提前把状态清零。应记录每次实际调用的时间标签、是否刷新和缓存来源,再与调度器对齐。 06. 代价与边界 省的是昂贵模块重复计算,增加的是缓存内存、生命周期管理、判定开销和近似误差。保存一个形状为 $(B,L,D)$ 的残差张量,最低存储量为 $BLDb$ 字节,其中 $b$ 是每个元素的字节数;克隆的输入、多个分支及其他缓存还会额外占空间。长视频中 token 数很大,省算力并不自动省显存。 阈值没有通用刻度。代理的归一化方式、拟合数据、模型层、时间条件与采样器都影响其意义。在某模型上有效的多项式可能在另一个模型或调度器上失配。应在目标分布上先记录输入代理与真实残差变化的对应关系,再评估误判,不能只沿用别人仓库里的常数。 端点刷新是一种保守策略,不是一种证明。即使最后一次完整计算,网络读到的潜变量也已经经过缓存轨迹;它不能把积累误差自动洗掉。判断质量时要看整段生成结果,尤其是动作连续性、物体身份、细节与提示词对应关系,而不是只看最后一个调用的缓存误差归零。 已有很少采样步的蒸馏模型可能没有多少安全的复用空间。短轨迹上每次预测都更重要,进一步减少完整网络调用可能迅速损害质量。动态改变条件的交互式生成、频繁切换控制信号的任务,也不应默认共享同一段缓存。先建立可靠基线,才能判断具体组合是否值得部署。 评测时固定权重、prompt、种子、分辨率、帧数、采样器和 guidance,分别测完整网络计算时间与端到端延迟。预热、设备同步、重复测量和尾延迟都要说明;不要把首次编译的基线与已预热的缓存版放在一起比较。质量样例应包含快速运动、镜头切换、文字、遮挡和多主体交互等容易暴露近似问题的内容。 本文给出的误差曲线只能帮助理解缓存的数值行为。没有真实模型权重,没有样本集,也没有测量硬件延迟。因此本文不提供生产阈值,不给出“无损”的结论,也不声称这些 toy 误差能预测真实视频的主观质量。 还要分别检查代理误判的两种代价。代理高估变化会增加完整计算,主要损失效率;代理低估变化会继续使用陈旧残差,主要增加质量风险。这两种错误不能只用一个平均相关系数概括。即使整体相关性很高,少数快速变化的步骤被漏掉,也可能成为最明显的失败样例。应保留逐步记录,把异常视频定位到具体刷新区间,再判断是代理不敏感、阈值过大还是缓存位置选错。 为避免测试集上的阈值被过度优化,可以先用一组提示词选择阈值,再在另一组提示词上固定参数评估。报告平均质量以外,还要记录最差样例以及变化最大的场景。缓存有时能带来某项评分的小幅上升,但近似轨迹改变本身并不保证改进;应通过更多独立样本判断这是随机波动还是稳定效果。不能挑出一段更好看的视频,就把整条路线称作质量提升技术。 缓存决策在不同请求中可能产生不同的完整计算次数,所以服务端延迟也会随内容变化。只报告平均命中率,会遮蔽慢请求的行为;应同时关注完整计算次数的分布和尾延迟。如果业务要求固定延迟,可以限制最长复用间隔或最低刷新次数,但这些额外约束需要重新纳入成本账本与质量验证。 07. 经典论文脉络 Denoising Diffusion Implicit Models。它提供理解不同采样路径的基础;跨步缓存要先说明是否保留原有离散调用,再比较误差,不能把省模块与改步长混为一谈。 DeepCache: Accelerating Diffusion Models for Free。它把 U-Net 高层特征的跨步复用转成免训练加速方案,主要启发是选择合适的结构边界,而不是对所有中间张量一概缓存。 Real-Time Video Generation with Pyramid Attention Broadcast。它把视频生成中的注意力复用纳入设计,提示我们不同模块可以有不同刷新节奏。本文只把它作为技术脉络,不复现其性能结果。 Timestep Embedding Tells: It's Time to Cache for Video Diffusion Model。它用时间调制输入的变化代理和重标定来选择刷新时刻,把问题从固定周期推进到输入感知的缓存决策。 论文数值也要带条件。DeepCache 的摘要报告 Stable Diffusion v1.5 上 2.3 倍加速、CLIP Score 下降 0.05。原文图 1 标明这组速度结果使用 50 步 PLMS;这是作者特定设置下的结果,不能泛化成所有扩散模型都同样受益。论文摘要与图 1 支持这组数字。 TeaCache v2 的表 1 中,OpenSora-Plan 的 150 步基线使用 65 帧、512×512,延迟为 99.65 秒,slow 配置为 22.62 秒,对应 4.41 倍;VBench 从 80.39% 到 80.32%,差值是 0.07 个百分点。fast 配置在同表报告更高加速,但质量也有不同取舍,所以本文引用 slow 配置,避免把不同配置的最优速度与最优质量拼成一个结果。原文表 1 可直接复核。 这些工作属于相关路线,没有一个统一的阈值或通用缓存张量。先检查缓存边界,再看刷新规则,最后检查采样路径是否改变,是比较它们时更稳定的顺序。方法名称相似、都声称免训练,不代表工程实现可以直接互换。 08. 常见误解 “跨步缓存与 KV cache 是同一种精确复用。” 自回归 KV cache 通常复用固定前缀的计算结果,而扩散过程中潜变量和时间条件在变化。这里复用的是可能陈旧的近似特征,必须单独评估误差。是否等价还取决于模型路径,不能仅凭有个 cache 字段就判断。 “相邻特征相似,所以可以一直复用。” 相邻相似不等于相隔很多步仍相似,更不等于输出质量不变。累计预算关注缓存年龄,刷新机制关注何时恢复完整计算。二者缺一不可。 “阈值 0.16 表示允许 16% 的质量损失。” 阈值只是累计代理的比较值。它不是终点误差、FID、VBench 或主观质量的直接比例。本实验阈值与官方多项式的阈值甚至不在相同刻度上。 “缓存命中后跳过了采样器更新。” 本文所有版本都更新状态 40 次。省掉的是一部分网络计算,当前输入与输出头仍然可以变化。如果代码命中后直接跳过调度器,它执行的是另一种算法。 “最后一次完整计算能补回前面所有误差。” 最后一次局部预测变准确,不等于输入轨迹回到基线。误差传播推导和实验都把这两件事区分开。 “调用次数少三倍,就是端到端快三倍。” 命中步骤、其他固定模块、同步与内存操作仍有成本。本文最后一列只是显式假设的成本比,实际脚本还带额外离线诊断,因此不能拿它的运行时间当加速报告。 09. 动手验证 先把附录完整代码保存为 cache_demo.py,准备 Python 3.10 以上环境,执行: python -m pip install numpy matplotlib python cache_demo.py 单独保存脚本时,结果 JSON 和 figures/cache_schedule.png 都写到脚本所在目录。在仓库的文章 code/ 目录运行时,产物写到文章根目录。数值应与第 04 节一致;换 NumPy 或底层数值库时,浮点尾数可能略有不同。比对完整计算次数、刷新时刻和误差到所列精度,比要求截图或图片压缩字节完全一致更合适。 首先把阈值设成 0。每个步骤都会刷新,完整计算次数应等于 40,终点应与精确基线逐元素一致。附录已经用断言验证这个条件;如果失败,要先修缓存状态机,不要调阈值掩盖问题。 其次比较 0.08、0.16 和 0.32。在本次固定实验里,完整计算次数逐步减少,终点误差逐步增加。这是一个具体样本的趋势,不是所有系统的单调性定理:刷新位置改变、误差相互抵消、轨迹分叉,都可能让某个中间阈值的结果反而更接近基线。 再比较 adaptive_0.16 与 uniform_4。两者的成本模型使用相同的 11 次完整计算,但时刻并不相同。观察图中误差峰值,不只盯终点一个数。如果想研究预算分配,固定计算次数,再调整刷新位置,比仅仅换一个阈值更容易把原因看清。 再把 cache_checks.py 与 cache_demo.py 放在同一目录,运行 python cache_checks.py 反例把便宜嵌入固定为零,把代理固定为全 1,只在索引 1 让真实残差的 64 个分量同时跳到 2。代理预算始终为零。阈值 0.16 的策略仅在索引 0 和 39 刷新,错过这次跳变。局部误差峰值为 $2\sqrt{64}=16$。最后一步的局部误差回到 0,终点仍相差 $16/40=0.4$。这条轨迹隔离了代理漏报与末次刷新之间的关系。 strategy work counts without diagnostics: 40, 40, 18, 11, 7, 11 invalid policies rejected: 10 constant proxy: refreshes=[0, 39], peak local L2=16.0, last local L2=0.0, endpoint L2=0.400000 实际接入模型之前,还应验证两次独立请求是否有相同基线行为、错误中断是否清理状态、同形状不同条件是否互相污染。本文实验用每次 simulate 独立初始化来验证复位;真实服务还需要针对并发与重入的检查。 10. 延伸阅读 先从 DDIM 与高阶采样器 理解调用路径,再用 DiT 找嵌入、主体和输出头的边界,最后通过 性能建模与 Profiling 实测哪些部分值得省。 可以对照 KV cache 理解缓存有效性,也可继续读 量化 比较另一种减少推理成本的方法。少步蒸馏 训练模型在更少的采样调用中逼近教师轨迹。跨步缓存、量化与蒸馏组合时,应重新建立质量和延迟基线。 附录:完整代码 09 节用到的脚本全文如下(cache_demo.py、cache_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 cache_demo.py """Deterministic residual-cache toy; Python 3.10+, pip install numpy matplotlib. Run: python cache_demo.py No trained diffusion weights; cost ratios below are accounting assumptions. """ from pathlib import Path from math import isfinite from numbers import Integral, Real import json import platform import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt STEPS = 40 SHAPE = (1, 4, 16) SEED = 7 rng = np.random.default_rng(SEED) X0 = rng.normal(size=SHAPE).astype(np.float64) W = rng.normal(size=(16, 16)) / 8.0 V = rng.normal(size=(16, 16)) / 8.0 def cheap_input(x, t): return x + 0.05 * np.sin(2 * np.pi * t) def proxy(h, t): return h * (1 + 0.3 * np.sin(2 * np.pi * t)) + 0.1 * np.cos(2 * np.pi * t) def residual(h, t): z = h for _ in range(4): z = np.tanh(z @ W) return 0.15 * h + 0.4 * (z @ V) + 0.08 * np.sin(6 * np.pi * t) def simulate(threshold=None, period=None, *, diagnostics=True): """Use exactly one cache policy, or compute every call with both unset.""" if threshold is not None and period is not None: raise ValueError("choose threshold or period, not both") if threshold is not None and ( isinstance(threshold, bool) or not isinstance(threshold, Real) or not isfinite(threshold) or threshold < 0 ): raise ValueError("threshold must be finite and nonnegative") if period is not None and ( isinstance(period, bool) or not isinstance(period, Integral) or period < 1 ): raise ValueError("period must be a positive integer") x = X0.copy() previous_proxy = None saved_residual = None budget = 0.0 refreshed, local_errors = [], [] for i in range(STEPS): t = 1.0 - i / (STEPS - 1) h = cheap_input(x, t) m = proxy(h, t) change = 0.0 if previous_proxy is None else float( np.mean(np.abs(m - previous_proxy)) / max(np.mean(np.abs(previous_proxy)), 1e-12)) budget += max(change, 0.0) boundary = i in (0, STEPS - 1) if threshold is None and period is None: calculate = True elif period is not None: calculate = boundary or i % period == 0 else: calculate = boundary or budget >= threshold if calculate: saved_residual = residual(h, t) budget = 0.0 output = h + saved_residual if diagnostics: # Offline comparison on this trajectory, never fed into the update. local_error = 0.0 if calculate else float( np.linalg.norm(output - (h + residual(h, t))) ) local_errors.append(local_error) refreshed.append(bool(calculate)) previous_proxy = m.copy() x = x - output / STEPS return {"x": x, "refreshed": refreshed, "local_errors": local_errors} def experiment(): baseline = simulate() rows = [] results = [] settings = [("exact", None, None), ("adaptive_0.08", 0.08, None), ("adaptive_0.16", 0.16, None), ("adaptive_0.32", 0.32, None), ("uniform_4", None, 4)] for name, threshold, period in settings: result = simulate(threshold, period) calls = sum(result["refreshed"]) relative_error = float(np.linalg.norm(result["x"] - baseline["x"]) / np.linalg.norm(baseline["x"])) # Full call = 1 unit; cache hit = 0.08 unit, solely for illustration. assumed_work = calls + (STEPS - calls) * 0.08 rows.append({"name": name, "full_calls": calls, "hits": STEPS - calls, "relative_endpoint_error": relative_error, "assumed_speed_ratio": STEPS / assumed_work, "refresh_indices": [i for i, flag in enumerate(result["refreshed"]) if flag]}) results.append(result) zero = simulate(threshold=0.0) assert np.array_equal(zero["x"], baseline["x"]) assert sum(zero["refreshed"]) == STEPS assert all(r["refreshed"][0] and r["refreshed"][-1] for r in results) assert np.array_equal(simulate(threshold=0.16)["x"], results[2]["x"]) assert all(np.isfinite(r["x"]).all() for r in results) return rows, results, baseline def make_figure(rows, results, destination): fig, axes = plt.subplots(2, 1, figsize=(11, 7), constrained_layout=True) colors = ["#2563eb", "#ea580c", "#16a34a", "#dc2626", "#9333ea"] for y, (row, result) in enumerate(zip(rows, results)): idx = np.flatnonzero(result["refreshed"]) axes[0].scatter(idx, np.full(len(idx), y), marker="s", s=38, color=colors[y]) axes[0].set_yticks(range(len(rows)), [r["name"] for r in rows]) axes[0].set_xlim(-1, STEPS) axes[0].set_xlabel("Sampling call index (0-based)") axes[0].set_title("Squares = full residual computation; gaps = cache reuse") for y, (row, result) in enumerate(zip(rows[1:], results[1:]), start=1): axes[1].plot(result["local_errors"], label=row["name"], linewidth=1.7, color=colors[y]) axes[1].set_xlabel("Sampling call index (0-based)") axes[1].set_ylabel("Local output L2 error") axes[1].set_title("Offline diagnostics on each cached trajectory; no quality metric") axes[1].legend(ncol=2, fontsize=9) axes[1].grid(alpha=0.25) fig.suptitle("Residual caching: refresh decisions and approximation error", fontsize=14) fig.savefig(destination, dpi=150) plt.close(fig) if __name__ == "__main__": rows, results, baseline = experiment() script_dir = Path(__file__).resolve().parent in_article_repo = script_dir.name == "code" and (script_dir.parent / "article.md").is_file() folder = script_dir.parent if in_article_repo else script_dir (folder / "figures").mkdir(parents=True, exist_ok=True) make_figure(rows, results, folder / "figures" / "cache_schedule.png") record = {"seed": SEED, "steps": STEPS, "shape": list(SHAPE), "python": platform.python_version(), "numpy": np.__version__, "baseline_min": float(baseline["x"].min()), "baseline_max": float(baseline["x"].max()), "results": rows, "assertions": "zero-threshold exactness, endpoints, request reset, finite outputs passed"} (folder / "experiment_results.json").write_text( json.dumps(record, ensure_ascii=False, indent=2) + "\n", encoding="utf-8") print(f"shape={SHAPE}, steps={STEPS}, seed={SEED}") print(f"baseline_range=[{record['baseline_min']:.6f}, {record['baseline_max']:.6f}]") print("name full_calls hits endpoint_relative_error assumed_speed_ratio") for row in rows: print(f"{row['name']} {row['full_calls']} {row['hits']} " f"{row['relative_endpoint_error']:.6f} {row['assumed_speed_ratio']:.3f}") print("All assertions passed; figure=figures/cache_schedule.png") cache_checks.py """Numerical checks for the residual-cache demo. Run: python cache_checks.py.""" from unittest.mock import patch import numpy as np import cache_demo as demo def check_work_counts(): for threshold, period, expected in ( (None, None, 40), (0.0, None, 40), (0.08, None, 18), (0.16, None, 11), (0.32, None, 7), (None, 4, 11), ): with patch.object(demo, "residual", wraps=demo.residual) as counted: result = demo.simulate(threshold, period, diagnostics=False) assert counted.call_count == sum(result["refreshed"]) == expected with_diagnostics = demo.simulate(threshold, period) assert np.array_equal(result["x"], with_diagnostics["x"]) assert result["refreshed"] == with_diagnostics["refreshed"] assert not result["local_errors"] and len(with_diagnostics["local_errors"]) == demo.STEPS print("strategy work counts without diagnostics: 40, 40, 18, 11, 7, 11") def check_inputs(): rejected = 0 for kwargs in ( {"threshold": -1}, {"threshold": float("nan")}, {"threshold": float("inf")}, {"threshold": True}, {"threshold": "0.16"}, {"period": 0}, {"period": 1.5}, {"period": True}, {"period": -1}, {"threshold": 0.16, "period": 4}, ): try: demo.simulate(**kwargs) except ValueError: rejected += 1 else: raise AssertionError(f"Accepted invalid policy: {kwargs}") print(f"invalid policies rejected: {rejected}") def check_blind_proxy(): # Inject one hidden, one-call residual spike at zero-based call 1. def residual_spike(h, t): return np.full_like(h, 2.0 if t == 1.0 - 1 / (demo.STEPS - 1) else 0.0) with ( patch.object(demo, "cheap_input", side_effect=lambda x, t: np.zeros_like(x)), patch.object(demo, "proxy", side_effect=lambda h, t: np.ones_like(h)), patch.object(demo, "residual", side_effect=residual_spike), ): exact = demo.simulate() cached = demo.simulate(threshold=0.16) refreshes = np.flatnonzero(cached["refreshed"]).tolist() assert refreshes == [0, demo.STEPS - 1] assert np.count_nonzero(cached["local_errors"]) == 1 local_peak = max(cached["local_errors"]) endpoint = np.linalg.norm(cached["x"] - exact["x"]) assert local_peak == 16.0 and cached["local_errors"][-1] == 0.0 np.testing.assert_allclose(endpoint, 0.4, rtol=1e-14, atol=0) print(f"constant proxy: refreshes={refreshes}, peak local L2={local_peak:.1f}, " f"last local L2={cached['local_errors'][-1]:.1f}, endpoint L2={endpoint:.6f}") if __name__ == "__main__": check_work_counts() check_inputs() check_blind_proxy()
-
AIGC 每日速读|2026-10-04|商汤小模型绕圈反超6.5倍大模型,Looped-DiT 今日 AIGC 论文速览 今日共 10 篇 · 高效文生图架构 3 篇 · 统一多模态 1 篇 · 长视频与音视频生成 2 篇 · 生成推理加速 2 篇 · 视频强化学习与图像评测 2 篇 重点论文标题列表 Looped-DiT(商汤):260M循环4圈赢6.5倍大模型 Multimodal Flow(华科):图文全连续流建模,仅用150B词元 NEPA-DiT(密歇根大学):预测嵌入当条件,FID 1.32 MosaiChunk(康奈尔大学):只训13.6M路由,长视频回访不失忆 Soundwich(西蒙弗雷泽大学):冻结LTX-2.5免训练拆分音轨 今日论文速览 1. Looped-DiT:260M循环4圈赢6.5倍大模型 Looped Diffusion Transformer | 商汤科技;清华大学;南洋理工大学 | arXiv:2609.40305 关键词:文生图, 循环计算, 参数共享, 深度监督, 潜在推理 前序问题:文生图模型提质通常只有两条路:加参数或加去噪步数。语言模型里已验证的「循环复用同一组层」能在不增参数的前提下加深计算,但直接搬进 MMDiT 并不稳定:推理圈数超过训练值后性能先涨后跌,中间表示里可线性解码的空间位置信息逐圈流失。 本文贡献:Looped-DiT 把网络切成前段 6 块、循环段 5 块、后段 6 块,每个去噪步内让循环段共享权重重复 N 次(训练取 4 圈)。两项稳定手段:深度监督,每圈输出都经共享后段解码并计入 flow loss;自调制注意力,用门控或无参的 Exclusive Self-Attention 抑制注意力对局部信息的过度改写。 实验效果:260M 的 B/16 在 GenEval、DPG、PRISM、CoRe、Spatial、TIIF 六项均值 71.5,六项全部高于 1.7B 的 InternVL-U(均值 69.0),也高于 6.6B 的 Uni-CoT(66.8),单图推理算力约为 InternVL-U 的 1/4.9。参数对齐对照里,B/32 均值从 55.2 提到 59.1;同等推理预算下,加圈比加去噪步更划算。 批判点评:「参数不变」不等于「算力不变」:循环版每步推理 267 GFLOPs,是同参数基线的 1.83 倍,训练 1246 GFLOPs 更是 2.83 倍。按推理算力对齐时,加宽版 MiniT2I 已到 58.6,与 Looped-DiT 的 59.1 只差 0.5。分项看,循环擅长约束求解,需要常识推断的 CoRe/Generalization 只 +7.5,远不如文本 CoT 的 +22.2。 2. Multimodal Flow:图文全连续流建模,仅用150B词元 Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces | 华中科技大学;北京交通大学;地平线 | arXiv:2609.40362 关键词:统一多模态, 连续流匹配, 文生图, 视觉理解, 多模态预训练 前序问题:统一理解生成模型多走两条路:文本和图像都离散化,图像要过量化瓶颈;或文本离散、图像连续,两种目标与采样流程各写一套。全连续建模能让两种模态共用一个生成过程,但在多模态预训练规模上很少被系统验证。 本文贡献:MF-1 用冻结的 T5-small 与 SigLIP2 把文本块(每 8 个词元一块)和图像编码成连续表示,按顺序组织成 hyperchunk,交给一个 chunk-causal 的 flow 主干学习单一速度场;注意力投影共享、FFN 按模态分开。训练时并行预测多个目标块,推理时逐块生成,再由预训练图像解码器与单独训练的文本解码器还原。 实验效果:1.6B 版本只用 150B 预训练词元,GenEval 0.82、DPG 83.44,理解侧 POPE 86.1、MMBench 67.2。数据、优化与参数完全对齐时,全连续版 GenEval 0.713、MMBench 46.7,高于 Transfusion 式混合(0.669 / 33.7)与 Chameleon 式全离散(0.374 / 38.4)。 批判点评:生成强、理解弱:MMBench 67.2 落后同量级的 Janus-Pro(75.5)与 JanusFlow(74.9),VQAv2 72.6 也低于 JanusFlow 的 79.8(对方有预训练 LLM 初始化);DPG 83.44 还没追上纯生成的 SD3 Medium(84.08)。scaling 曲线上 1.6B 预训练阶段 GenEval 只到约 0.32,表中 0.82 是再经 5B 词元微调后的结果;「全连续」也依赖冻结编码器与外部解码器,图像输入仅 224 分辨率。 3. NEPA-DiT:预测嵌入当条件,FID 1.32 Embedding Prediction Helps Image Generation | 密歇根大学;卡内基梅隆大学 | arXiv:2610.02203 关键词:类别条件生成, 嵌入预测, 扩散 Transformer, 表征对齐, ImageNet 前序问题:DiT 里类别或文本只嵌入一次,每个去噪步复用同一个条件,「这个条件对眼前这张噪声图意味着什么」全留给生成器自己推断。NEPA(下一嵌入预测自回归)已能在连续嵌入上做自回归预测,作者想知道:能否用预测出的干净图嵌入替代固定条件。 本文贡献:把生成写成「条件 → 噪声图 → 干净图」的嵌入序列,干净图的 patch 嵌入正是条件与噪声图之后的「下一组嵌入」。作者训练 NEPA 模型用多嵌入预测(MEP)一次性预测全部干净嵌入;生成时 DiT 以这些预测为条件,并在每个去噪步按当前噪声状态重新计算,条件随采样进程自适应。 实验效果:ImageNet 256×256 上,NEPA-DiT-XL 结合 REPA,SDE-250 采样 FID 1.32、IS 311.0,ODE-96 采样 FID 1.57;训练为 NEPA 240 + 生成器 80 epoch,约为 REPA(800 epoch)训练算力的三分之一。九组规模交叉实验中,生成器或 NEPA 模型变大,FID 都单调下降。 批判点评:训练省了,推理贵了:多挂一个 711M 的 NEPA 网络,总参数约 1.39B,是 SiT-XL/2+REPA(675M)的两倍;同为 SDE-250,单图 160 TFLOPs,比对方的 91 TFLOPs 多 76%。换成更省的 ODE-96,FID 1.57 反而不如 REPA 原版的 1.42。若放开 tokenizer,表中 SFD、RAEv2 已做到 1.06。 4. MosaiChunk:只训13.6M路由,长视频回访不失忆 MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation | 康奈尔大学;加州大学伯克利分校;哈佛大学;Impossible Inc. | arXiv:2610.02153 关键词:自回归视频生成, 长时记忆, KV 缓存, 记忆路由, 场景回访 前序问题:自回归长视频受限于上下文窗口:物体或场景移出窗口后细节丢失,镜头转回来时往往「重新编」一个。整块检索历史 chunk 能补记忆,但固定显存预算下塞不了几块;滑动窗口则干脆遗忘。 本文贡献:作者先验证冻结的视频生成器能直接消费非连续拼接的历史 KV 并还原对应内容。MosaiChunk 据此把每个历史 chunk 聚成若干 section 并编码描述子,由轻量路由器全局挑出 top-N,在固定活跃显存预算内拼成一块跨时空的 KV 马赛克;生成器全程冻结,只自蒸馏训练路由器。同时发布 RememBench 回访基准,含 T2V 与 I2V 两个子集。 实验效果:在 MiniMax-H3 改造的自回归版 H3-AR(T2V)上,两块远程记忆预算下回访 CLIP 从滑窗基线 0.751 升到 0.936,LPIPS 从 0.652 降到 0.500,优于整块检索 MoC(0.841);LingBot-World-Infinity(I2V)180° 旋转回访 CLIP 0.793→0.863。路由器只有 13.65M 参数。 批判点评:自建基准涨幅大,公开基准涨幅小:WBench 的 Subject 一致性仅 88.10→88.38,两块预算下 Segment 一致性反从 97.47 掉到 94.94;T2V 的 Drift 也略升(0.050→0.055)。论文还写明评测用的是早期 checkpoint:T2V 计划训 4000 步、实取第 416 步,I2V 计划 4768 步、实取第 500 步,未解释为何不用训完的权重。 5. Soundwich:冻结LTX-2.5免训练拆分音轨 Soundwich: Video Generation with Layered and Controllable Audio | 西蒙弗雷泽大学;塞浦路斯大学;CYENS 卓越中心;特拉维夫大学 | arXiv:2610.00691 关键词:音视频联合生成, 音轨分离, 免训练, 时间控制, 可编辑音频 前序问题:联合音视频模型已能生成带同步声音的视频,但音频是一条混好的总轨:谁在何时说话、配乐和环境声都没法单独改。实际制作中,对白、音乐、音效、环境声都是分轨编辑的。 本文贡献:Soundwich 不做训练,直接改造冻结的 LTX-2.5:先把音频轨迹扩成 N 条可编辑分轨加一条内部场景轨,用缓存的「出声 / 静音」特征(timing carrier)在指定时间窗内回放或压制;再用 gather–broadcast 注意力让各分轨共享全局声学语境,并用实体掩码把每条分轨的跨模态注意力路由到画面中对应的发声者。 实验效果:15 个多声源场景上,时间窗成功率 93.1%、窗外误发声 1.7%、声源归属 90.0%,窗内 WER 0.060;同场景原版 LTX-2.5 窗成功率仅 20.4%,MiniMax H3 为 27.0%,Gemini Omni 为 85.0%。去掉 timing carrier,窗成功率从 93.3% 跌到 15.6%。 批判点评:评测规模很小:主表只有 15 个场景、每场景 3 个固定种子,场景广播模块的人评只收回 15 份问卷。真正接近的对手是闭源 Gemini Omni,WER 0.072 对 0.060、窗成功率 85.0% 对 93.1%,且它只有 14 个场景可计 WER。声源归属 90.0% 比朴素批量扩展的 82.2% 只高 7.8 个点。 6. DMAD:判别器替掉辅助分数网络,4步出片 DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation | 得州农工大学;字节跳动智能创作 | arXiv:2610.02188 关键词:少步蒸馏, 分布匹配, 对抗蒸馏, 视频生成, 音视频生成 前序问题:DMD 系列少步蒸馏要从「目标分数 − 学生分数」的差里取梯度,因此必须额外维护一个持续拟合学生分布的辅助扩散模型,显存与算力开销都大,在 14B、33B 级视频模型上尤其吃紧。 本文贡献:DMAD 把分布匹配改写成分类:共享主干上挂两个判别头,分别区分「真实数据 vs 学生」与「教师样本 vs 学生」,用 logit 直接学习对数密度比,学生只用作用在 logit 上的线性损失训练,无需拟合辅助分数。作者证明判别器最优时该损失恰好还原 DMD 的梯度,并用真实头在真实与教师样本间的 logit 差,自适应调节各噪声级上教师监督的权重。 实验效果:ImageNet-64 一步 FID 1.04(加投影判别器),SDXL 四步 COCO-10K FID 14.47,Wan2.1-14B 四步 VBench 85.15,均优于所比少步方法与多步教师。在 MiniMax-H3-33B 联合音视频生成上,四步学生人评总体偏好 79.1% 胜 DMD2、84.6% 胜 rCM;每次生成器更新耗时从 818.1s 降到 233.3s。 批判点评:人评高分主要来自画质与音质(对 DMD2 胜率 84.2% / 87.9%),提示词对齐只有 54.3% 对 45.7%,接近打平。AVGen-Bench 上音画同步 AV 分 49.1,低于 DMD2 的 56.7;唇形同步 30.6,离教师的 39.0 也远。SDXL 一步时 Patch FID 32.42,反而比 DMD2 的 26.98 差,细节保真不如整体 FID 好看。 7. FlashForward:复用在途KV,4卡流水线生成长视频 In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion | Meta;南洋理工大学 | arXiv:2609.32540 关键词:自回归视频扩散, KV 缓存, 流水线并行, 长视频生成, 推理加速 前序问题:少步自回归视频扩散按 chunk 逐段生成。为记住已生成内容,Self-Forcing、HiAR 等方法要额外跑「只更新缓存、不推进输出」的前向来重建干净或低噪 KV。可每次去噪前向本来就算出了当前 chunk 的 KV,这部分被白白浪费。 本文贡献:FlashForward 直接复用每个去噪阶段算出的「在途」KV:当前 chunk 完成一个阶段后,该阶段的缓存即可供下一个 chunk 使用,于是每张 GPU 负责一个去噪阶段,不同 chunk 在卡间流水并行。为弥补噪声历史带来的外观与运动漂移,再由 planner 预先生成稀疏的干净锚点 latent,从前后两侧约束 renderer 的轨迹。 实验效果:4 卡下,16 FPS、20 秒以上视频比 HiAR 快 1.16–1.69 倍、比 Self-Forcing 快 1.42–2.92 倍(1.3B 与 14B,480p / 720p)。1.3B 480p 生成 65 秒视频去噪耗时 21.3s(HiAR 24.7s、Self-Forcing 65.1s);VBench 总分 0.838,65 秒 VBench-Long 0.8395,高于 Self-Forcing 的 0.7806。 批判点评:提速依赖多卡流水:单卡 480p 下它比 Self-Forcing 还慢(20 秒视频 17.77s 对 17.44s,65 秒 59.64s 对 57.89s)。生成 5 秒短片时 4 卡耗时 2.21s,慢于 HiAR 的 2.06s,更慢于双向模型的 1.13s。14B 720p 峰值显存 112.8 GiB/卡,比 Self-Forcing 多约 20 GiB;20 秒视频语义分 0.748 也略低于 HiAR 的 0.757。 8. TVRL:用VLM梯度给视频token分功劳 Token-Level Video Reinforcement Learning | 美国东北大学 | arXiv:2610.01973 关键词:视频生成, 强化学习, GRPO, 信用分配, VLM 奖励 前序问题:视频生成的 RL 后训练通常给整段视频一个标量奖励。可视频的缺陷是局部的:有的 token 已满足提示词,有的才需要修。标量奖励定位不了错误,优化时既会扰动本来正确的区域,又对真正出错的区域用力不足。 本文贡献:TVRL 让奖励自己给出 token 级功劳:冻结 VLM 对提示词拆出的若干是非题给出答案似然,平均后作为视频级奖励;同一 VLM 对视频输入的梯度幅值,则标出哪些生成 token 最影响该得分。在 GRPO 中,组相对优势决定更新方向与强度,经 3×3 平滑、按问题条件化的 credit 图在裁剪策略比内重加权各去噪步的转移对数概率。 实验效果:以 HunyuanVideo-1.5 为底座、Qwen3.5-9B 作奖励,VBench-2.0 Overall 从 54.09 升到 57.69(+3.60),同设置 GRPO 仅 54.54。换 SAGE、Flow、Dance 三种 SDE 采样器,比匹配 GRPO 高 2.68–3.15;换 VideoAlign 等四种奖励模型,高 1.33–3.15。 批判点评:增益并不均匀:常识维度上 TVRL 常不如 GRPO(Qwen3.5-9B 奖励下 64.31 对 64.88,VideoScore2 下 64.60 对 64.89),VideoScore2 下 Human 维度也从 91.52 降到 90.79。评论家规模很关键:换成 Qwen3.5-0.8B 时 Overall 仅 51.85,比未训练的底座 54.09 还低。所有结果都只训 100 步(64 张 A100),单步耗时比 GRPO 多 18%。 9. PixelDense:4个冻结老师分两路对齐像素扩散 PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion | 弗吉尼亚大学;密歇根州立大学;Adobe;Arcade AI | arXiv:2610.00483 关键词:像素扩散, 表征对齐, 稠密预测, 文生图, 几何先验 前序问题:REPA 通过对齐预训练编码器特征来加速 DiT 训练,但对齐目标几乎都是 DINOv2、CLIP 这类语义编码器。已有分析指出起作用的是空间结构而非全局语义,那么专门预测结构的稠密预测模型(分割、深度)为何没人拿来当对齐老师? 本文贡献:在像素空间扩散上,作者先验证 SAM2、Depth Anything v2、Metric3D v2 单独加入都优于只用 DINOv2,但四个老师直接相加反而不如最好的单个几何老师,语义与几何梯度在同一投影上互相争抢。PixelDense 因此让 DINOv2+SAM2 走语义投影流、两个深度模型走几何投影流,再加权重空间正交惩罚让两流处在不相交子空间;老师全部冻结、推理时丢弃。 实验效果:在 PixelGen-XXL(512×512)上,GenEval Overall 0.7927→0.8093,DPG 78.7→78.9,HPS 0.280→0.282;同一配方不调参迁移到 DeCo,GenEval 0.8620→0.8690。部分加噪重建中,τ=0.5 时 COCO 全景 PQ 23.23→31.43;PIE-Bench 上 SDEdit 背景 PSNR 最多高 2.2 dB。论文已接收 NeurIPS 2026。 批判点评:几何探针涨得多,生成指标涨得少:GenEval 只 +0.017、DPG +0.2、HPS +0.002,DeCo 上 +0.007,计数项 58.75 仍低于 PixelGen 原版的 59。消融里单独的几何流(DA2+M3D)只有 0.7960,还不如 DINOv2+DA2 单老师的 0.8069。主实验只是在已发布权重上用 2 张 H200 微调 1 万步,从头训练仅给出「1.23 倍更快达到基线峰值」一项。 10. VIEScore2:16×16网格同时打分并圈出缺陷 VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations | 滑铁卢大学;NVIDIA;台湾大学(中国台湾);南洋理工大学 | arXiv:2610.00994 关键词:图像评测, 缺陷定位, 生成与编辑, GRPO, VLM 评估器 前序问题:现有合成图评估器大多只给一个标量分数,不说明依据在图上哪里;能定位缺陷的模型又通常不打分、也不支持编辑任务的条件图输入。生成与编辑的评测和奖励信号,缺一个「既能打分也能指位置」的统一接口。 本文贡献:VIEScore2 把图像表示为 N×N(默认 16×16)文本网格,单次前向同时输出感知质量、语义一致性分数与缺陷格子位置,支持可选条件图,覆盖文生图、编辑、参考图生成等任务。它基于 Qwen3-VL-8B 在 38K 条混合监督上先 SFT,再以 Dice 重叠、分数准确度与格式奖励做 GRPO,最后用无参数解析器把网格结果转成可读解释。 实验效果:主测试集整体分数 SRCC 0.601,高于同输入下最强的零样本通用 VLM Gemini-3-Flash(0.491)与 GPT-5.6-sol(0.437);联合评测网格 IoU 0.324,Qwen3-VL-8B 原版仅 0.070。缺陷定位在 6 个基准中 3 个第一、5 个进前三。 批判点评:整体领先主要来自训练同源数据:RichHF(0.692)与 EvalMuse(0.803)拉高均值,编辑类子集反被零样本 API 压过,TIE 0.429 对 Gemini-3-Flash 的 0.686,MRIE 0.417 对 GPT-5.6-sol 的 0.684。定位上,轻量的 SegFormer-b0 在主测试集 F1 拿到 0.493,与它的 0.506 相差无几;GRPO 之后 PQ 的 SRCC 还从 0.580 降到 0.558。 趋势观察 「加算力不加参数」成了今天的共同母题 Looped-DiT 让同一组块在每个去噪步里绕 4 圈,NEPA-DiT 每步重算一次预测嵌入当条件,两者都用额外推理算力换质量而不是加参数;但细看算力表,前者每步 1.83 倍 GFLOPs,后者单图多 76% TFLOPs,「小模型赢大模型」的账要连推理成本一起算。另一头,DMAD 与 FlashForward 继续在蒸馏和 KV 复用上压缩视频生成的步数与等待时间,TVRL 与 VIEScore2 则把奖励和评测从一个标量推进到 token 与网格级定位。 人工智能炼丹君 整理 | 2026-10-04 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|量化:从 INT8 到 FP4-Quant AIGC 基本功|量化:从 INT8 到 FP4-Quant 所属方向:推理加速与部署 | 难度:工程实战 | 前置知识:混合精度与数值稳定性、性能建模与 Profiling 关键词:INT8、W8A8、INT4、W4A16、SmoothQuant、AWQ、NVFP4、校准、离群值、分组缩放 01. 为什么需要它 设想一个视频生成服务:DiT 的线性层权重很大,单次生成又要反复经过这些层。团队把 BF16 权重直接换成 4 bit 文件,磁盘占用马上下降;上线后却发现小 batch 时并没有按 4 倍提速,字幕边缘还出现抖动。问题不在于「4 bit 失效」,而是把存储位宽、矩阵乘法位宽、缩放元数据、反量化成本和生成质量混成了同一个数字。若运行时先把 4 bit 权重解回 BF16 再调用普通 GEMM,压缩带来的只是存储或部分读带宽收益;若没有匹配硬件和内核,也不会凭空得到 FP4 算力。 再看一个可复现的小实验:附录的 quant_demo.py 生成 64 维输入,其中第 0 个通道有显著离群值。普通 W8A8 在留出的 64 条输入上的输出均方误差是 0.222085;做一次数学上严格等价的 SmoothQuant 式通道变换后,误差变成 0.001384。这两个数来自本机实际运行,不是论文模型的评测分数。它说明一个关键事实:量化前的实数函数严格相同,浮点实现仍会有舍入差,量化后的误差却能相差很大。要读懂 INT8、AWQ 或 FP4 的论文,先要分清误差落在什么张量、哪个通道,以及内核真正执行了什么。 本文用一条线串起这些问题:先推整数映射与输出误差,再拆 SmoothQuant 如何搬走激活离群值、AWQ 如何保护重要权重,最后解释 NVFP4 为什么需要按块缩放。所有示例都在 CPU 上跑,不依赖模型权重;它们验证机制,不声称复现生产吞吐或画质。 02. 最小可用理解 第一句:量化把连续值映到少数离散码字;位数越少,步长或裁剪误差通常越大,实际误差还取决于缩放粒度和数据分布。第二句:SmoothQuant 面向 W8A8,把难量化的激活通道缩小、相应权重通道放大,使原始浮点线性层保持等价;AWQ 面向权重低比特,用激活统计找重要通道,并搜索权重缩放以减小输出误差。第三句:INT4 与 FP4 只是数字格式,真正的速度由硬件支持、打包布局、反量化位置、batch 和带宽瓶颈共同决定。 这里统一写线性层为 $Y=XW$:$X$ 是形状 $[T,K]$ 的输入激活,$W$ 是 $[K,N]$ 的权重,$Y$ 是 $[T,N]$ 的输出;$T$ 可理解为当前批的 token 数,$K$ 是输入通道,$N$ 是输出通道。真实视频 DiT 的 $T$ 可能包含时间与空间 patch,且随分辨率、帧数、去噪步变化。下文的校准统计只能代表采样过的条件分布,不能自动外推到所有视频场景。 因此,阅读任何“压到 4 bit 后提速”的结论时,先追问四件事:原始精度是什么、量化了权重还是激活、scale 按什么粒度共享、测试时是否调用了对应硬件的低比特内核。若论文只给模型文件大小与单项质量分数,就还不足以判断生产服务的成本收益。 03. 数学推导 3.1 从实数到整数:误差在哪里出现 给一组实数选择步长 $\Delta>0$ 与零点 $z$。一般的仿射量化写成一行: $$q=\operatorname{clip}\bigl(\operatorname{round}(x/\Delta)+z,\ q_{\min},q_{\max}\bigr),\qquad \hat x=\Delta(q-z)$$ $q$ 是存储的整数码字,$\hat x$ 是反量化后参与近似计算的值;$q_{\min},q_{\max}$ 是格式允许的最小、最大整数。对本文 W8A8 实验的对称 INT8,取 $z=0$、范围 $[-127,127]$、$\Delta=\max|x|/127$。没有裁剪且落在舍入区间内时,单个值的绝对误差不超过 $\Delta/2$;超出校准范围被截断后,这个上界不再成立。全张量共用一个步长时,一个大离群值会把 $\Delta$ 拉大,使大多数小值在相邻码字间跳得更粗。按通道或按组各给一个步长能局部化这种损失,但要保存更多缩放因子,并且内核未必支持同样快的计算路径。 线性层两边都有量化误差时,令 $\hat X=X+E_X$、$\hat W=W+E_W$。直接展开,而不是笼统说「精度下降」: $$\hat Y-Y=(X+E_X)(W+E_W)-XW=E_XW+XE_W+E_XE_W$$ 第一项是激活误差被权重放大,第二项是权重误差被输入激活放大,第三项是二者相乘。W8A8 三项都有;W4A16 的激活通常仍用高精度,主要关心第二项。即使某个权重元素误差很小,只要它对应的输入通道经常很大,也可能显著改变输出。这解释了为什么不能只用权重自身的 MSE 判断生成模型是否安全。 为了把“一个离群值拖累整组”算到具体数字,假设 127 级对称量化器要同时覆盖一个大小 20 的值与许多大小约 0.1 的值。若整个张量共用尺度,步长约为 $20/127=0.1575$;一个 0.1 会被舍入到 1 个码字,反量化约 0.1575,误差约 0.0575。假如该张量的最大幅度只有 1,步长便约为 $1/127=0.00787$,0.1 反量化约 0.1024,误差约 0.0024。两种情形都只用 8 bit,差别来自谁和谁共享 scale。实际矩阵乘还要把这些单点误差乘上权重并求和,因此不能只拿这个标量例子推最终 MSE,但它解释了为什么先观察通道直方图比直接改位宽更有用。 校准也有两层口径。静态量化先用代表性输入估计范围,推理时直接复用 scale;如果后来出现更大的输入,就有裁剪风险。动态量化可按当前 token 或当前批重新估计激活范围,减轻分布漂移,却要在运行时付出求最大值、计算 scale 和可能的同步成本。权重通常固定,离线按输出通道或按组量化较容易;激活每次都变,统计粒度过细会增加内核复杂度。本文故意采用校准集估计的静态全张量激活 scale,让离群问题足够清晰;它不是宣称这种设置在所有线上服务中最佳。 3.1.1 舍入、零点和累加并不是免费细节 本文的 np.rint 采用最近偶数舍入:$0.5$ 与 $1.5$ 分别到 0 与 2,负数同样按最近偶数处理。公式里的 round 必须与实现采用同一约定。若静态校准只见到幅度 1,步长是 $1/127$;后来输入 100 会裁剪到 127,反量化为 1,误差是 99,显然不受半步长约束。这是范围失配,不是位数不够时的普通舍入噪声。 对 $z=0$ 的本文 INT8 路径,每个整数乘积绝对值最多是 $127^2=16129$,累加 $K$ 项的保守上界为: $$|A_{t,n}|=\left|\sum_{j=1}^{K}q_{X,t,j}q_{W,j,n}\right|\le K\cdot16129$$ 因此若用有符号 INT32,保证最坏情况不溢出需要 $K\le\lfloor(2^{31}-1)/16129\rfloor=133144$。本例 $K=64$ 很安全,但原来没有限制形状的函数并非任意尺寸都正确。quant_checks.py 实际构造了 $K=133145$、码字全为 127 的情况:数学和是 2147495705,原 INT32 矩阵乘却得到 -2147471591。修订后的教学函数会提前拒绝这个尺寸;真实内核若分段累加、用更宽累加器或采用非零零点,要按其实际契约重算边界。这个上界是保证条件,不代表超过它的每个实际输入都会溢出。Jacob 等人的整数推理公式解释了 scale、zero point 与累加的关系;本段边界由本文码字范围直接推出。 3.2 SmoothQuant:把离群值迁移到更好量化的一侧 取一个所有元素都为正的通道缩放向量 $s\in\mathbb R^K$,令 $D=\operatorname{diag}(s)$。在量化前做: $$X^{\prime}=XD^{-1},\qquad W^{\prime}=DW,\qquad X^{\prime}W^{\prime}=XD^{-1}DW=XW$$ 等号最后一步只用到 $D^{-1}D=I$,所以实数运算中的线性层完全等价;浮点乘除与矩阵乘法仍会留下舍入误差。第 $j$ 个激活通道除以 $s_j$,权重的第 $j$ 个输入通道乘以 $s_j$。如果异常大的激活集中在少数通道,选较大的 $s_j$ 就能把它们压下去;代价是相应权重幅度变大。SmoothQuant 论文的核心判断是:在其研究的 LLM 线性层中,权重一侧通常比激活一侧容易承受这种量化难度。它并非数学定理,具体模型仍要测。 记校准输入第 $j$ 通道的绝对最大值为 $a_j$,权重第 $j$ 个输入通道的绝对最大值为 $b_j$,SmoothQuant 的一种尺度选择是: $$s_j=\frac{a_j^{\alpha}}{b_j^{1-\alpha}},\qquad 0\le\alpha\le1$$ $a_j$ 和 $b_j$ 都要设正下界以免全零通道除零。$\alpha$ 控制把多少难度从激活侧搬往权重侧;本文实验固定 $\alpha=0.5$,不是所有模型的默认最优值。生产实现还要把 $1/s_j$ 融入前一层归一化的参数,避免推理时额外插一个逐元素除法。等价变换保证实数算术中的 $XW$ 不变,不保证浮点结果逐位相同,更不保证量化输出相同,这正是需要校准和误差测量的原因。 图 1:纵轴为绝对最大值的对数刻度,横轴为输入通道。橙色是原始值,蓝色是等价变换后。第 0 通道的激活离群值向权重侧迁移;这是一组程序构造的数据,不是任何论文模型的实测激活分布。 3.3 AWQ:为何要看激活,而不只看权重 若只量化权重,输出误差近似为 $XE_W$。对留出的输入矩阵平方求和,可写成: $$\|XE_W\|_F^2=\operatorname{tr}\bigl(E_W^{\mathsf T}X^{\mathsf T}XE_W\bigr)$$ $\|\cdot\|_F$ 是把所有元素平方后求和再开根号,$X^{\mathsf T}X$ 编码各输入通道的能量与相关性。若暂时忽略通道间相关性,式子近似为各通道「输入能量 × 对应权重误差能量」之和: $$\|XE_W\|_F^2\approx\sum_{j=1}^{K}\|X_{:j}\|_2^2\|E_{W,j:}\|_2^2$$ 所以「权重数值小」不等于「量化它不重要」:如果 $X_{:j}$ 经常大,该通道的权重误差就会被放大。AWQ 论文据此用激活统计找显著权重通道,采用等价缩放和校准误差搜索,而不是把少数通道改成混合精度来增加内核复杂度。其论文报告保护约 1% 显著权重即可明显降低量化误差;这属于论文实验结果,不能直接当成任何 DiT 的固定比例。 上述对角近似只在交叉项可以忽略时才有意义,不能拿它当误差上界。令一条输入 $X=(1,1)$、权重误差 $E_W=(1,-1)^{\mathsf T}$:实际输出误差 $XE_W=0$,对角近似却给平方误差 2;改成 $E_W=(1,1)^{\mathsf T}$,实际平方误差为 4,而对角近似仍是 2。相关通道可以让误差抵消,也可以让它叠加。这也说明为什么搜索要比较模块的实际输出,而不只把各通道分数相加。 我们的教学版对每个输出通道的权重按 32 个输入元素成组做非对称 INT4 伪量化。为避免单侧组把零点推到可表示区间之外,默认把范围扩到包含零:令 $l=\min(0,\min w)$、$h=\max(0,\max w)$,取 $\Delta=\max(h-l,10^{-5})/15$,再计算 $z=\operatorname{clip}(\operatorname{round}(-l/\Delta),0,15)$。范围下界只用于全零或极小动态范围时避免除零,不是新的数据精度。再用激活平均幅度构造 $s_j$,扫 20 个候选指数,在校准输入上找最小输出 MSE。这样抓住了「激活统计 + 缩放搜索 + 分组权重量化」的骨架;它没有 AWQ 的完整模型层搜索、真实 W4A16 内核或端到端精度验证,因此代码称为 awq_toy。 这里保留了一个可切换的反例。官方 AWQ 的该版伪量化先用原始组内 min/max,再裁剪零点;本文的 include_zero=False 明确复现该策略。若一组只有 1 与 1.1,步长约 0.00667、零点会被裁到 0,可表示的最大值只剩 0.1,两个权重都重建成约 0.1。默认包含零后,二者重建为 1.026667 与 1.1;常量 2 的组也能重建为 2。修改默认策略是让教学函数在单侧或常量组上更可解释,不是声称逐项复现 AWQ。原实验的 32 元素组都有正负值,两种策略相同,原 MSE 数字保持。零点取整本身仍会移动网格;即使先包含零,也要检查末端是否发生裁剪,不能对任意仿射网格无条件套用半步长界。 还要验证布局:本文权重是 $[K,N]$,转置为 $[N,K]$ 后,每个输出通道分别沿 $K$ 分组。必须要求 $K$ 能被组大小整除,不能只看 $KN$ 能整除。例如 $K=3,N=2,\text{group}=2$,展平元素总数为 6,原 reshape 能成功,却会把不同输出通道接在同一组里。修订后提前拒绝;需要尾组的生产格式应明确 padding 与对应 scale,而不能悄悄跨通道。 3.4 FP4 不等于把 INT4 改个名字 INT4 通常按整数码字加组缩放与零点解释;FP4 的码字本身有符号、指数和尾数。NVIDIA 的 NVFP4 文档把单个数据码字定义为 E2M1:1 个符号位、2 个指数位、1 个尾数位,再乘以局部 FP8 E4M3 缩放和一个 FP32 全局缩放。以下先讨论连续 16 个元素共享尺度的 1D 布局。因此真实值不是一个孤立的 4 bit 码字,而是: $$x_{\mathrm{recon}}=x_{\mathrm{E2M1}}\,s_{\mathrm{block}}\,s_{\mathrm{global}}$$ 只数存储位数,忽略对齐和打包时,采用上述 1D 布局、长度为 $L$ 且无需尾组填充的张量,平均每元素约用 $4+8/16+32/L$ bit:大张量趋近 4.5 bit/元素,相对 16 bit 的 BF16 理想压缩比约 $16/4.5=3.56$,而不是整齐的 4 倍。这不是所有 NVFP4 配方的统一容量数。此次核对的 Transformer Engine 2.20.2 文档还提供 $16\times16$ 共享尺度的 2D 权重量化,训练配方默认权重用 2D、激活和梯度用 1D;若只数一份 2D 权重及一个全局 scale,其理想平均位数为 $4+8/256+32/L$,大张量约 4.03125 bit/元素。实际存储可能还包含分别量化的行列布局、scale 对齐、padding 或高精度主权重,不能把这个理想数当训练显存账本。文档的 s_global 是重建时的乘数,定义为全张量最大绝对值除以 $448\cdot6$;有些 API 暴露的是它的倒数,必须核对乘除方向。我们的 e2m1_toy 用最近邻 E2M1 可表示值和精确的浮点块缩放说明概念,没有模拟 FP8 缩放舍入、全局缩放、硬件矩阵乘法或 NVFP4 的完整训练配方,不能用它的误差预测真实 NVFP4 模型质量。E2M1 玩具实现的正幅度码字是 0、0.5、1、1.5、2、3、4、6,距离相等时 argmin 选择较小幅度,因此块尺度为 1 时 0.75 会落到 0.5;这不是最近偶数规则,也不是随机舍入。该版官方训练配方对梯度可启用随机舍入,并包含变换与不同缩放布局,不能从这个最近邻玩具推断其训练行为。 分组大小还有一笔容易被省略的元数据账。假设某种 INT4 实现对每 32 个权重同时保存一个 16 bit scale 和一个 16 bit zero point,理想平均是 $4+(16+16)/32=5$ bit/权重,相对 BF16 的理论压缩比是 $16/5=3.2$。若每组 128 个权重,在同一假设下是 $4.25$ bit/权重、约 $3.76$ 倍。这里的数字只是指定元数据布局后的算术示例;AWQ 不同内核可能把零点、scale 以其他精度或打包方式存放,padding 也会改变实际占用。组变小往往改善局部拟合,却可能增加元数据带宽和内核约束。因此选组大小时,至少同时报告量化后的实际显存、输出质量和目标设备延迟,而不能只报告“4 bit”。 还要区分权重量化与激活量化的计算链。W4A16 常见路径保留较高精度激活,只压缩权重;W8A8 则要求两侧都进入 8 bit 路径,整数累加再按 scale 还原。前者通常能让权重读取变轻,却不自动让激活流量变小;后者更可能用 INT8 矩阵乘硬件,但激活离群问题也更直接。训练中的 FP4、推理中的 FP4、权重专用 INT4 同样不能只按“都是四位”合并对比,它们量化统计、可接受误差和内核目标都不同。 3.5 再把性能账接回来 设原权重数为 $KN$。BF16 仅权重约 $2KN$ 字节,裸 INT8 约 $KN$ 字节,裸 4 bit 约 $KN/2$ 字节;后两者还要加各自的缩放、零点及对齐开销。这是容量账。速度账要写成性能建模那篇的下界: $$T\ge\max(F/P,\ D/B)$$ $F$ 是内核运算量,$P$ 是该硬件上该精度路径的有效算力,$D$ 是实际搬运字节,$B$ 是有效带宽。若小 batch 解码反复读大权重,压缩 $D$ 可能有效;若大 token 矩阵乘已受算力限制,就要有真正的 INT8 或 FP4 计算内核才可能受益。若先把低比特权重展开回 BF16,反量化、临时缓冲和 kernel launch 也要入账。低比特文件大小、显存占用、单次延迟和吞吐量是四个不同的观测量,必须分别报告。 04. 代码实现 完整可运行的 quant_demo.py、make_figures.py 和 quant_checks.py 放在文末附录。只需 Python、NumPy、Pillow;没有模型权重、CUDA 或外部数据下载。固定随机种子 7,前 192 条输入作校准,后 64 条作评估,避免直接拿选择缩放的样本当成绩。张量形状是 $X_{\text{cal}}\in\mathbb R^{192\times64}$、$X_{\text{eval}}\in\mathbb R^{64\times64}$、$W\in\mathbb R^{64\times32}$。第 0 激活通道被人为放大,相应权重通道被缩小;这是为了把问题放到显微镜下,不代表真实模型普遍这样分布。 最核心的四行与 3.2 节逐项对应:s 是公式的 $s$,x_s 是 $XD^{-1}$,w_s 是 $DW$。先用未量化的矩阵乘核对代数等价,再分别走 INT8 路径: s = smooth_scales(x_cal, w, alpha=0.5) x_s, w_s = x_eval / s, w * s[:, None] assert np.allclose(x_eval @ w, x_s @ w_s) after = int8_matmul(x_cal / s, x_s, w_s) int8_matmul 把评估输入量化成整数、权重量化成整数,真正用 int32 矩阵乘累加,然后按激活和每输出通道的权重步长反量化。它先以 FP64 计算 scale 和舍入,整数矩阵乘才用 INT32;这与输入文件使用 FP32 或 FP64 是两层口径。量化、缩放与分组函数检查非空二维、有限的 FP32/FP64 数组、通道相容性和合法组大小,并拒绝超出保守累加上界的形状。它没有调用真实 GPU INT8 Tensor Core,所以这里只能谈数值误差,不能谈运行速度。AWQ 教学路径也故意返回反量化浮点权重以便检查输出;若要测 W4A16 吞吐,必须换成真实打包内核。 本次在项目 Python 3.11 + NumPy 上执行 在脚本所在目录执行 python quant_demo.py 的原始输出如下,MSE 均针对同一个留出集的浮点 $XW$;relative 是 MSE 除以该输出的均方值: X_cal (192, 64) X_eval (64, 64) W (64, 32) Smooth alpha=0.50, s[0]=16.2463, median(s)=0.9942 equivalent transform max_abs_error=3.553e-15 int8_before MSE=0.222085 relative=0.015861 int8_after MSE=0.001384 relative=0.000099 int4_plain MSE=0.492117 relative=0.035146 int4_awq MSE=0.089772 relative=0.006411 fp4_toy MSE=0.335760 relative=0.023979 AWQ toy alpha=0.95 calibration_MSE=0.091065 第一个可检验的结论是这组输入的等价变换在浮点下只剩 $3.553\times10^{-15}$ 的舍入差。第二个是这组构造数据里 SmoothQuant 式迁移降低了 W8A8 的输出误差。第三个是 AWQ 教学搜索把 INT4 权重量化的留出集误差从 0.492117 降到 0.089772;选择指数 0.95 只是这批构造样本上的选择。fp4_toy 的 0.335760 不能与前三者直接排模型名次:它的缩放编码与计算路径不同,而且没有真实 FP8 scale 舍入。图 1 由同一组数组生成,因此数值与图是可追溯的一套实验。 05. 工业级实现对照 SmoothQuant 的工业细节在「把除法折进上一层」。 作者公开实现的 smooth_ln_fcs 先从校准激活和多个相邻线性层的权重求通道尺度,再对 LayerNorm 的 weight、bias 除以尺度,并对后续线性层的相应输入权重乘以尺度。多个 Q/K/V 投影可能共享上一层归一化,不能各自随意选一套不一致的缩放。本文代码直接显式写 x/s,便于看清代数关系;真正部署需确认融合位置、归一化类型与残差分支,不能机械把所有线性层都改一遍。以 2026-11-06 核对的固定提交为准。官方函数完整函数体在 CPU 上实跑了 FP32/FP64、3 种宽度的共享三投影,共 6 组;折叠前后最大误差为 2.38e-07。这验证 LayerNorm 仿射参数与后续线性层的等价关系,不代表整个模型或低比特内核已复现。只有该归一化的所有消费者都相应处理时才可这样折叠;若另有未同步缩放的分支,局部恒等式并不能保证整图等价。 AWQ 的工程路径比教学版多了布局与搜索。 作者 pseudo_quantize_tensor 接受位宽、零点与组大小,要求末维能被组大小整除,再计算每组 min/max、scale、zero,最后舍入裁剪;其范围并未默认扩到包含零;auto_scale_block 用校准输入取模块原输出、扫 20 个尺度候选并比较输出 MSE。本文的 int4_groups 与 awq_toy 只提取这两个可解释步骤,默认单侧范围处理与官方不同。官方 pseudo_quantize_tensor 的完整函数体已在 CPU 运行 16 组,包括正负混合、全正、常量与全零,原位与非原位路径一致;教学函数切换到 include_zero=False 后与其 FP64 输出的最大差低于 $10^{-12}$。这验证伪量化算子,未执行完整 auto_scale_block 或 GPU 打包路径。生产还要选择组大小、权重打包顺序、激活精度、融合反量化的 GEMM,以及对 tokenizer、任务和模态有代表性的校准数据。伪量化权重占用浮点内存,不能拿它冒充真实 4 bit 显存占用。 NVFP4 则是格式与硬件共同定义的方案。 NVIDIA Transformer Engine 文档 在此次核对的 2.20.2 版明确区分 E2M1 码字、1D/2D 局部 FP8 缩放和 FP32 全局缩放,也讨论训练时的随机舍入、变换与布局。这与 AWQ 的非对称 INT4 零点方案不同。若在 Blackwell 以外的设备上模拟 E2M1,再调用普通 BF16 GEMM,只是在研究量化误差;没有证据证明获得 NVFP4 Tensor Core 吞吐。对视频 DiT,还应分别统计文本投影、注意力、MLP、VAE 与不同去噪时刻的敏感度,而不是用一个 LLM 基准替代画质验收。 5.1 把这套办法移到视频 DiT 时怎么验 先在模型推理图中列出每个线性层的输入形状、权重字节、调用次数与实测耗时,按去噪步、分辨率和 batch 分桶。一个只调用一次的小投影层即使压到 4 bit,也不如在每一步反复运行的大 MLP 值得优先优化。随后对候选层采样真实生成输入:文本条件、无条件分支、不同帧长和空间分辨率、去噪早中晚步都应覆盖。统计每个输入通道的最大值、分位数及其随条件变化的范围,再决定是对称、非对称、按通道还是按组,而不是从 LLM 的一套 scale 直接复制过来。 然后做逐层替换实验:固定随机种子,只量化一组层,记录该层输出误差、整网中间特征差、生成结果与延迟。若数值误差集中在少数层,可保留这些层为 BF16,其他层继续压缩;但必须把混合精度带来的格式转换也计入耗时。对视频尤其要检查相邻帧的纹理闪烁和文字稳定性,因为单帧指标可能掩盖时间不一致。最后把“模型文件大小、峰值显存、单次生成时延、吞吐、质量”五列并排记录,并列出硬件型号、内核版本和量化格式。这样才能判断收益来自低位宽计算、权重少读、还是单纯把模型装进了原先放不下的卡。 本文的 CPU 脚本只覆盖上述流程的数值诊断第一步,不覆盖真实 DiT 校准、低比特 kernel 或视频验收。这一边界并非小字备注:若读者要据此选择线上格式,必须在实际模型和实际设备上补完后续测量。 06. 代价与边界 精度代价首先来自动态范围:静态校准没见过的 prompt、分辨率或高运动视频,可能把激活推过已选范围,产生裁剪而非普通舍入误差。多步扩散还会把每一步的小偏差沿采样轨迹累积。本文的线性层输出 MSE 只能当局部诊断;最终还需在固定种子和足够多提示词上比较画面结构、文本可读性、时间一致性与人评,不能把 MSE 下降直接翻译成 VBench 上升。 系统代价是尺度与布局。按张量一个 scale 便宜却易被离群值支配;按通道、按组或按 16 元素块能更细地适应分布,但多了元数据、打包、反量化与特定内核限制。对容量,要记 weights + scales + zeros + padding + workspace;对自回归服务的延迟,要分别测 prefill 与单步 decode;对视频扩散,应测不同去噪步、token 数及 batch 下的整步与端到端时间。生产图中若有不支持低比特的算子导致来回格式转换,转换成本可能抵掉 GEMM 收益。 方法边界也不同。SmoothQuant 的迁移假设权重能承受放大,且前后层可安全折叠;AWQ 搜索的是给定校准集、给定位宽和组大小的局部误差,不能保证分布外质量;FP4 的动态范围和非均匀码字不等同于 INT4,不能把一个格式的超参数照搬到另一个。没有兼容内核时,先考虑稳定的 BF16/FP16 路径或更保守的 INT8。对已经被算力、launch 或跨卡通信限制的工作负载,权重文件变小也可能几乎不缩短时间。 一个容易漏掉的验收维度是误差的结构。同样的总体 MSE,误差若集中在少数文本 token、眼睛边缘或连续帧的同一位置,主观影响可能远大于均匀噪声。因此可把误差按层、通道、去噪时刻和内容类型拆开画分布,并检查最大误差与高分位数,而非只看全局平均。对生成视频,建议把原始模型与量化模型用相同 prompt、相同随机种子逐对比较;除整体指标外,抽查运动边界、物体身份、OCR 文本、暗部纹理和高频闪烁。若只是量化器的局部输出误差变小,却没有带来终端质量改善,也应如实报告“局部数值改善,端到端效果未证实”。这种分层验收也能告诉工程师应该先恢复哪一层的精度,而不必把整网退回 BF16。 07. 经典论文脉络 Jacob 等,Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference,CVPR 2018 / arXiv:1712.05877:把 scale、zero point 与整数推理串成可部署的量化路径,是理解本文 3.1 节映射的起点;它的主要实验对象是移动端视觉网络。 Xiao 等,SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models,arXiv:2211.10438:指出 LLM 激活离群值阻碍 W8A8,通过等价通道变换把难度迁到权重侧,目标是同时量化权重与激活。 Frantar 等,GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,arXiv:2210.17323:走权重低比特的另一条路,用近似二阶信息做一次性量化与误差补偿;它说明 INT4 不是只能靠逐元素四舍五入。 Lin 等,AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,arXiv:2306.00978:把激活统计用于识别重要权重,并通过等价缩放保护输出;与 SmoothQuant 都用通道缩放,但目标分别是权重低比特和 W8A8,不能混为一篇算法。 AWQ 条目标题采用 arXiv 元数据的完整标题;其 v5/v6 PDF 封面额外带有 “On-Device”,检索时需留意这个版本内的题名差异,本文没有改写二者。 从这四篇再看 NVFP4 格式文档,会发现研究问题已经从「如何挑量化码字」延伸到「硬件支持哪种码字、块尺度和矩阵布局」。本文关于 NVFP4 的字段与块大小以该官方文档为准;本文没有把它列作四篇论文之一。 08. 常见误解 误解一:INT4 一定比 INT8 快两倍。 4 bit 只说明每个裸权重码字更短。若内核先展开、如果 GEMM 已受算力限制、若尺度加载很重,延迟可能没有相应收益。必须在目标 GPU 上测端到端而非只量文件大小。 误解二:SmoothQuant 把模型函数改好了,所以精度一定升。 它在实数算术下等价,浮点实现有舍入差;被改善或恶化的是后续量化误差。不同层、不同 $\alpha$、不同校准集都可能改变结论。本文的 160 倍左右 MSE 改善来自特意制造的离群通道,不是通用倍率。 误解三:AWQ 只看权重最大值。 3.3 节说明输出误差被输入放大。官方搜索用校准激活和模块输出误差,不是简单挑最大的权重元素。本文虽然也使用权重分组 min/max,但那是码字映射,不是重要性判据。 误解四:FP4 就是 INT4 加一个不同的 scale。 E2M1 的码字间隔非均匀,NVFP4 还有局部 FP8 scale 与全局 scale,且本文已区分 1D 与 2D 布局。即使两个方案都写「4 bit」,误差形态、元数据和硬件路径也不同。 误解五:单层 MSE 合格,视频质量便合格。 视频生成的时间一致性、字符与细节可能对少数层或特定步数敏感;线性层 MSE 只帮助定位,应继续做固定种子的视频样例、人评和任务指标核验。 09. 动手验证 把附录两段代码分别保存为 quant_demo.py 和 make_figures.py,放在同一目录,安装 numpy 与 Pillow 后运行: python quant_demo.py python make_figures.py 图会写到上一级 figures/smooth_migration.png。先确认 equivalent transform max_abs_error 接近零,再把 case() 里的 x[:, 0] *= 20.0 改为 *= 1.0 重跑:离群值消失后,普通 INT8 与 SmoothQuant 的误差差距应明显缩小,但具体数值以你的实跑结果为准。第二个实验把 awq_toy 中的候选指数固定为 0,观察 int4_awq 是否退化到 int4_plain 附近;这对应“不使用激活引导缩放”的基线。第三个实验把分组大小从 32 改成 16 或 64,注意 int4_groups 要同步修改调用处,比较输出 MSE 与理论元数据开销:更细的组通常更能适应局部分布,但真实内核性能仍需另测。 新增的 quant_checks.py 也在附录,可直接 python quant_checks.py。它用 Python 标量整数与独立逐组循环作为参考:24 个 INT8 case、84 个 INT4 case 的输出最大差均为 0;另验证通道缩放、INT32 上界、静态范围漂移、单侧/常量组、非法布局和 E2M1 平分点。脚本会打印并保存 validation_results.json,方便读者逐项核对。 一个值得亲手跑的反例是校准分布变化:脚本用固定 seed 23,让校准数据强调第 0 通道、留出数据强调第 3 通道。第 2 组构造数据中,搜索在校准集上不劣于不缩放基线,却把留出 MSE 从 0.297532 提高到 6.620649;它说明“在校准集选最优候选”不推出“分布外一定更好”。这与 01 节的改善例一起读,才是校准该有的边界。实验完整构造和编号在脚本中,既不是论文指标,也不是现实视频服务的统计结论。 10. 延伸阅读 若不清楚 BF16、FP16 与 FP8 的表示范围,先读混合精度与数值稳定性;若想判断量化后为何没提速,回看性能建模与 Profiling的带宽、算力与容量账;若关心自回归生成的权重带宽之外还有哪些显存项,接着读KV Cache 与自回归视频生成。下一步面对实际视频 DiT,应把本文的输出误差实验移到真实层、真实校准集和多个去噪时刻,再用质量指标与人评决定哪些层保留高精度。 附录:完整代码 09 节用到的脚本全文如下(quant_demo.py、quant_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 quant_demo.py """Minimal CPU quantization experiment. Requires numpy; run: python quant_demo.py.""" import numpy as np def matrix(value, name): value = np.asarray(value) if value.ndim != 2 or 0 in value.shape: raise ValueError(name + " must be a nonempty matrix") if value.dtype not in (np.dtype("float32"), np.dtype("float64")): raise ValueError(name + " must use float32 or float64") if not np.isfinite(value).all(): raise ValueError(name + " must be finite") return value.astype(np.float64, copy=False) def pair(x, w): x, w = matrix(x, "X"), matrix(w, "W") if x.shape[1] != w.shape[0]: raise ValueError("X and W input channels differ") return x, w def groups(w, group): w = matrix(w, "W") if isinstance(group, bool) or not isinstance(group, (int, np.integer)): raise ValueError("group size must be an integer") if group <= 0 or w.shape[0] % group: raise ValueError("group size must divide the input channel count") return w def case(): rng = np.random.default_rng(7) x = rng.normal(0, 0.6, (256, 64)) x[:, 0] *= 20.0 w = rng.normal(0, 0.8, (64, 32)) w[0, :] *= 0.08 return x[:192], x[192:], w def mse(y, y_hat): return float(np.mean((y - y_hat) ** 2)) def smooth_scales(x_cal, w, alpha=0.5): x_cal, w = pair(x_cal, w) if not np.isfinite(alpha) or not 0.0 <= alpha <= 1.0: raise ValueError("alpha must be finite and in [0, 1]") a = np.maximum(np.max(np.abs(x_cal), axis=0), 1e-8) b = np.maximum(np.max(np.abs(w), axis=1), 1e-8) return a**alpha / b**(1.0 - alpha) def int8_matmul(x_cal, x_eval, w): # Worst-case accumulation is K * 127**2; reject possible int32 overflow. x_cal, w = pair(x_cal, w) x_eval, w = pair(x_eval, w) if w.shape[0] > np.iinfo(np.int32).max // (127 * 127): raise ValueError("K exceeds the conservative int32 accumulation bound") # Static per-tensor activation scale, per-output-channel weight scales. sx = max(float(np.max(np.abs(x_cal))) / 127.0, 1e-8) sw = np.maximum(np.max(np.abs(w), axis=0) / 127.0, 1e-8) qx = np.clip(np.rint(x_eval / sx), -127, 127).astype(np.int32) qw = np.clip(np.rint(w / sw), -127, 127).astype(np.int32) return (qx @ qw).astype(np.float64) * sx * sw def int4_groups(w, group=32, include_zero=True): # W is [input, output]; each output row is split across input groups. w = groups(w, group) if not isinstance(include_zero, (bool, np.bool_)): raise ValueError("include_zero must be boolean") out_dim = w.shape[1] rows = w.T.reshape(-1, group) lo = rows.min(axis=1, keepdims=True) hi = rows.max(axis=1, keepdims=True) # Include zero to avoid implicit clipping of one-sided or constant groups. # False reproduces AWQ's min/max range policy, including its boundary. if include_zero: lo, hi = np.minimum(lo, 0.0), np.maximum(hi, 0.0) scale = np.maximum(hi - lo, 1e-5) / 15.0 zero = np.clip(np.rint(-lo / scale), 0, 15) q = np.clip(np.rint(rows / scale) + zero, 0, 15) return ((q - zero) * scale).reshape(out_dim, -1).T def awq_toy(x_cal, w, group=32): x_cal, w = pair(x_cal, w) groups(w, group) # Search a channel scale using calibration output error, as in AWQ's idea. importance = np.maximum(np.mean(np.abs(x_cal), axis=0), 1e-8) target = x_cal @ w trials = [] for alpha in np.linspace(0.0, 0.95, 20): s = importance**alpha s /= np.sqrt(s.max() * s.min()) w_hat = int4_groups(w * s[:, None], group) / s[:, None] trials.append((mse(target, x_cal @ w_hat), float(alpha), w_hat)) return min(trials, key=lambda row: row[0]) def e2m1_toy(w, block=16): w = groups(w, block) # Nearest E2M1 magnitude; exact ties choose the smaller magnitude. # Exact float64 block scales; NOT NVFP4 encoding or nearest-even rounding. levels = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 6.0]) out_dim = w.shape[1] rows = w.T.reshape(-1, block) scale = np.maximum(np.max(np.abs(rows), axis=1, keepdims=True) / 6.0, 1e-8) normalized = np.abs(rows) / scale idx = np.abs(normalized[..., None] - levels).argmin(axis=-1) return (np.sign(rows) * levels[idx] * scale).reshape(out_dim, -1).T def results(): x_cal, x_eval, w = case() y = x_eval @ w s = smooth_scales(x_cal, w) x_s, w_s = x_eval / s, w * s[:, None] before = int8_matmul(x_cal, x_eval, w) after = int8_matmul(x_cal / s, x_s, w_s) awq_cal_error, awq_alpha, w_awq = awq_toy(x_cal, w) w_int4 = int4_groups(w) w_fp4 = e2m1_toy(w) return { "x_cal": x_cal, "x_eval": x_eval, "w": w, "s": s, "x_s": x_s, "w_s": w_s, "exact_error": float(np.max(np.abs(y - x_s @ w_s))), "int8_before": mse(y, before), "int8_after": mse(y, after), "int4_plain": mse(y, x_eval @ w_int4), "int4_awq": mse(y, x_eval @ w_awq), "awq_alpha": awq_alpha, "awq_cal_error": awq_cal_error, "fp4_toy": mse(y, x_eval @ w_fp4), "signal": float(np.mean(y**2)), } def main(): r = results() print("X_cal", r["x_cal"].shape, "X_eval", r["x_eval"].shape, "W", r["w"].shape) print("Smooth alpha=0.50, s[0]=%.4f, median(s)=%.4f" % (r["s"][0], np.median(r["s"]))) print("equivalent transform max_abs_error=%.3e" % r["exact_error"]) for name in ("int8_before", "int8_after", "int4_plain", "int4_awq", "fp4_toy"): print("%s MSE=%.6f relative=%.6f" % (name, r[name], r[name] / r["signal"])) print("AWQ toy alpha=%.2f calibration_MSE=%.6f" % (r["awq_alpha"], r["awq_cal_error"])) if __name__ == "__main__": main() quant_checks.py """Independent scalar references and numerical boundary checks; requires NumPy.""" from pathlib import Path import json, math import numpy as np from quant_demo import case, int8_matmul, int4_groups, smooth_scales, awq_toy, e2m1_toy def scalar_int8(x_cal, x, w): sx = max(max(abs(float(v)) for v in x_cal.flat) / 127, 1e-8) sw = [max(max(abs(float(v)) for v in w[:, n]) / 127, 1e-8) for n in range(w.shape[1])] out = np.zeros((len(x), w.shape[1])) for t in range(len(x)): for n in range(w.shape[1]): acc = 0 for k in range(w.shape[0]): a = min(127, max(-127, round(float(x[t, k]) / sx))) b = min(127, max(-127, round(float(w[k, n]) / sw[n]))) acc += a * b out[t, n] = acc * sx * sw[n] return out def scalar_int4(w, group): out = np.empty_like(w, dtype=np.float64) for n in range(w.shape[1]): for start in range(0, w.shape[0], group): vals = [float(v) for v in w[start:start + group, n]] lo, hi = min(0., min(vals)), max(0., max(vals)) scale = max(hi - lo, 1e-5) / 15 zero = min(15, max(0, round(-lo / scale))) for k, value in enumerate(vals): q = min(15, max(0, round(value / scale) + zero)) out[start + k, n] = (q - zero) * scale return out def main(): rng = np.random.default_rng(19) int8_errors, int4_errors, equivalence = [], [], [] for dtype in [np.float32, np.float64]: for k in [1, 2, 4, 8, 16, 32]: for n in [1, 3]: cal = rng.normal(size=(7, k)).astype(dtype) x = rng.normal(size=(3, k)).astype(dtype) w = rng.normal(size=(k, n)).astype(dtype) int8_errors.append(float(np.max(np.abs(int8_matmul(cal, x, w) - scalar_int8(cal, x, w))))) for group in [g for g in [1, 2, 4, 8, 16, 32] if k % g == 0]: int4_errors.append(float(np.max(np.abs(int4_groups(w, group) - scalar_int4(w, group))))) s = smooth_scales(cal, w, .5) equivalence.append(float(np.max(np.abs(x.astype(float) @ w - (x / s) @ (w * s[:, None]))))) assert max(int8_errors) == 0 and max(int4_errors) == 0 assert max(equivalence) < 1e-12 ksafe = np.iinfo(np.int32).max // (127 * 127) ones = np.ones((1, ksafe), dtype=float) safe = int8_matmul(ones, ones, ones.T)[0, 0] assert safe == ksafe too_big = np.ones((1, ksafe + 1), dtype=float) try: int8_matmul(too_big, too_big, too_big.T) except ValueError: pass else: raise AssertionError("overflow bound not enforced") overflow = int((np.full((1, ksafe + 1), 127, np.int32) @ np.full((ksafe + 1, 1), 127, np.int32))[0, 0]) assert overflow < 0 one_sided = np.array([[1.0], [1.1]]) old = int4_groups(one_sided, 2, include_zero=False) fixed = int4_groups(one_sided, 2) assert np.max(old) < .101 and np.min(fixed) > .9 const = np.full((4, 1), 2.) assert np.array_equal(int4_groups(const, 4), const) x = np.array([[1., 1.]]) ew = np.array([[1.], [-1.]]) exact = float(np.sum((x @ ew) ** 2)) diagonal = float(np.sum(np.sum(x ** 2, axis=0) * np.sum(ew ** 2, axis=1))) assert exact == 0 and diagonal == 2 cal, x, w = case() fp = e2m1_toy(np.array([[.75], [6.]]), 2) assert fp[0, 0] == .5 cal_small = np.ones((2, 1)); unseen = np.array([[100.]]) clip = int8_matmul(cal_small, unseen, np.ones((1, 1)))[0, 0] assert clip == 1 invalid = [lambda: int4_groups(np.ones((3, 2)), 2), lambda: int4_groups(w, 0), lambda: int4_groups(w, True), lambda: e2m1_toy(w, 3), lambda: smooth_scales(cal, w, -1), lambda: smooth_scales(cal, w, np.nan), lambda: int8_matmul(cal, x[:, :-1], w), lambda: int8_matmul(cal[:0], x, w), lambda: int4_groups(np.ones((2, 2), dtype=int), 2), lambda: int4_groups(np.full((2, 2), np.nan), 2), lambda: int4_groups(np.full((2, 2), np.inf), 2), lambda: int4_groups(np.ones(4), 2)] for call in invalid: try: call() except ValueError: pass else: raise AssertionError("invalid input accepted") # Construct a held-out distribution that emphasizes different channels. rng = np.random.default_rng(23) for trial in range(100): a = rng.normal(size=(8, 4)) * [20, 1, 1, 1] b = rng.normal(size=(8, 4)) * [1, 1, 1, 20] z = rng.normal(size=(4, 2)) err, alpha, zhat = awq_toy(a, z, group=4) plain = int4_groups(z, 4) assert err <= np.mean((a @ z - a @ plain) ** 2) + 1e-12 before, after = [float(np.mean((b @ z - b @ q) ** 2)) for q in [plain, zhat]] if after > before * 1.1: break else: raise AssertionError("counterexample not found") record = dict(passed=True, int8_cases=len(int8_errors), int4_cases=len(int4_errors), int8_scalar_max_error=max(int8_errors), int4_scalar_max_error=max(int4_errors), transform_max_error=max(equivalence), ksafe=ksafe, unsafe_int32=overflow, true_unsafe_sum=(ksafe + 1) * 127 ** 2, one_sided_original=old.ravel().tolist(), one_sided_fixed=fixed.ravel().tolist(), correlation_exact=exact, correlation_diagonal=diagonal, clipping_100_reconstruct=clip, e2m1_tie_075=float(fp[0, 0]), distribution_shift=dict(seed=23,trial=trial,alpha=alpha,before=before,after=after), invalid_cases=len(invalid), errors=[], warnings=[]) out = Path(__file__).with_name('validation_results.json') out.write_text(json.dumps(record, indent=2) + '\n', encoding='utf-8') print(json.dumps(record, indent=2)) if __name__ == '__main__': main() make_figures.py """Draw a two-panel SmoothQuant diagram. Requires numpy and Pillow.""" from pathlib import Path import numpy as np from PIL import Image, ImageDraw, ImageFont from quant_demo import case, smooth_scales def font(size): path = Path("C:/Windows/Fonts/arial.ttf") return ImageFont.truetype(str(path), size) if path.exists() else ImageFont.load_default() def panel(draw, left, title, before, after): top, width, height = 95, 570, 280 lo = min(float(before.min()), float(after.min())) hi = max(float(before.max()), float(after.max())) low, high = np.floor(np.log10(lo)), np.ceil(np.log10(hi)) draw.rectangle((left, top, left + width, top + height), outline="#9ca3af", width=2) for power in range(int(low), int(high) + 1): value = 10.0**power y = top + height - (power - low) / (high - low) * height draw.line((left, y, left + width, y), fill="#e5e7eb", width=2) draw.text((left - 62, y - 12), f"{value:g}", fill="#4b5563", font=font(21)) draw.text((left, 42), title, fill="#111827", font=font(28)) for values, color in ((before, "#e76f51"), (after, "#2563eb")): points = [] for i, val in enumerate(values): x = left + i / (len(values) - 1) * width y = top + height - (np.log10(val) - low) / (high - low) * height points.append((float(x), float(y))) draw.line(points, fill=color, width=4) draw.ellipse((points[0][0] - 6, points[0][1] - 6, points[0][0] + 6, points[0][1] + 6), fill=color) draw.text((left, top + height + 14), "channel 0", fill="#4b5563", font=font(19)) draw.text((left + width - 100, top + height + 14), "channel 63", fill="#4b5563", font=font(19)) def main(): x_cal, _, w = case() s = smooth_scales(x_cal, w) before_x = np.max(np.abs(x_cal), axis=0) after_x = np.max(np.abs(x_cal / s), axis=0) before_w = np.max(np.abs(w), axis=1) after_w = np.max(np.abs(w * s[:, None]), axis=1) canvas = Image.new("RGB", (1400, 510), "#ffffff") draw = ImageDraw.Draw(canvas) panel(draw, 110, "Activation channel maximum", before_x, after_x) panel(draw, 800, "Weight input-channel maximum", before_w, after_w) draw.line((860, 455, 910, 455), fill="#e76f51", width=5) draw.text((920, 441), "before", fill="#111827", font=font(22)) draw.line((1040, 455, 1090, 455), fill="#2563eb", width=5) draw.text((1100, 441), "after smoothing", fill="#111827", font=font(22)) out = Path(__file__).resolve().parent.parent / "figures" / "smooth_migration.png" out.parent.mkdir(parents=True, exist_ok=True) canvas.save(out) print("saved", out, "bytes", out.stat().st_size) if __name__ == "__main__": main()
-
AIGC 基本功|混合专家 MoE:稀疏激活怎么省算力-MoE 混合专家 MoE:稀疏激活怎么省算力 所属方向:注意力与位置编码 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本 关键词:MoE、稀疏激活、专家路由、top-k、负载均衡、容量溢出 本文的算例在 CPU 上用 PyTorch 实际运行;它验证路由与容量机制,并不代表 GPU 集群吞吐。参数量账本只计算专家前馈层,明确排除注意力、优化器状态与通信。两篇锚点论文的标题与编号分别核对了 Shazeer 等人,1701.06538 和 Fedus 等人,2101.03961。 01. 为什么需要它 设想你已经把 Transformer 的注意力优化得很好,但还想让模型记住更多视觉对象、动作模式和语言知识。直接把每层前馈网络加宽,参数量和每个 token 的前向计算都会一起涨;训练显存、推理算力也跟着涨。MoE 的出发点是:保留多套前馈参数,让每个 token 只调用其中少数几套。总容量可以长得快,单 token 实际执行的专家计算长得慢。 先看一笔能复算的账。取隐藏宽度 $d=4096$、SwiGLU 中间宽度 $h=14336$。一个专家有 gate、up、down 三块矩阵,忽略偏置后共有 $3dh=176,160,768$ 个参数。放八个专家,总计 $1,409,286,144$ 个专家参数;每个 token 选两个,只触及 $352,321,536$ 个专家参数。在“同样八个专家都计算”的假想稠密基线下,专家矩阵乘的主项是四分之一。这里的“四倍”只属于这一层的专家部分:注意力、路由、分发、合并、跨设备通信一个都没算进去。八套 bf16 专家权重仍占约 2.625 GiB,不会因为每次只用两套就自动缩成四分之一。 真正会让方案失效的是路由。假如 16 个 token 中有 10 个奔向同一专家,其他专家分别只有 3、2、1 个,最忙的卡可能决定整步耗时。若像 Switch Transformer 那样给每个专家固定容量 4,六个 token 会溢出;把容量提到 6,仍有四个溢出。附录的 CPU 实验确实打印了 6/16 与 4/16。容量继续提到 10 才没有溢出,却要为大量空槽留空间。稀疏激活解决了“每个 token 算太多专家”的问题,不能自动解决“专家分工是否均匀”的问题。 图中上半部分故意把总 token 数保持为 16:均衡分配是 [4,4,4,4],坍缩分配是 [16,0,0,0];下半部分用 [10,3,2,1] 计算容量为 4、6、10 时的溢出。它画的是调度代价,不是模型质量曲线。 02. 最小可用理解 第一句:MoE 通常替换 Transformer block 的前馈子层,注意力仍先让 token 互相交换信息,然后每个 token 在前馈阶段自己选专家;Mixtral 原论文明确采用每个 token 选两个 SwiGLU 专家。第二句:路由器先给所有专家打分,再只执行 top-k;参数总数随专家数增加,但单 token 专家计算主要随 $k$ 增加。第三句:专家偏科会造成容量溢出、尾部等待和训练不稳,因此必须把专家负载、溢出率与通信量和任务损失一起看。 它不是“每个专家懂一种人类可命名的技能”的硬分工。专家是网络权重,路由是在每一层、对每个 token 重新做的决定。同一个视频片段里的不同 patch,或同一个句子的不同 token,都可能走不同专家;解释一个专家“负责什么”需要额外分析,不能凭编号想象。 03. 数学推导 3.1 从一层普通前馈网络出发 先把一个 token 的隐藏向量记作 $u$,维度为 $d$。SwiGLU 前馈层可写成: $$F(u)=W_{\mathrm{down}}\bigl(\operatorname{SiLU}(W_{\mathrm{gate}}u)\odot W_{\mathrm{up}}u\bigr)$$ $W_{\mathrm{gate}}$ 和 $W_{\mathrm{up}}$ 各把 $d$ 维映射到 $h$ 维,$W_{\mathrm{down}}$ 再映射回 $d$ 维;$\odot$ 是逐元素乘法。三块矩阵分别有 $dh$、$dh$、$hd$ 个权重,所以主参数量是 $3dh$。一次前向的矩阵乘主项也近似与 $3dh$ 成正比;SiLU、逐元素乘、读写权重及内核发射是额外成本。 现在复制出 $N$ 套这样的前馈层,记作 $F_1,\ldots,F_N$。如果每个 token 都执行全部 $N$ 套,参数量和前馈计算都乘 $N$,这只是昂贵的稠密集成。MoE 的关键是:路由仍观察全部 $N$ 个候选,但只执行其中 $k$ 个专家,通常 $k\ll N$。 3.2 路由概率与 top-k 合并 路由矩阵 $W_{\mathrm{route}}$ 的形状是 $N\times d$。对 token $u_t$,先得分,再做 softmax: $$z_{t,i}=(W_{\mathrm{route}}u_t)_i,\qquad p_{t,i}=\frac{\exp z_{t,i}}{\sum_{j=1}^{N}\exp z_{t,j}}$$ $t$ 是 token 序号,$i$ 是专家序号;$z_{t,i}$ 是尚未归一化的偏好,$p_{t,i}$ 是归一化概率。选出概率最大的 $k$ 个专家,形成集合 $S_t$。以 Mixtral 式 top-2 归一化为例,选中专家的合并权重是: $$a_{t,i}=\frac{p_{t,i}}{\sum_{j\in S_t}p_{t,j}},\quad i\in S_t;\qquad y_t=\sum_{i\in S_t}a_{t,i}F_i(u_t)$$ 分母只对已选中的专家求和,故其权重之和是 1。没有选中的专家既不运行前馈网络,也不贡献输出。路由计算本身的矩阵乘大致是 $Nd$,专家计算主项是 $k(3dh)$,所以在 $h$ 很大而 $k$ 很小时路由通常比专家矩阵乘小;实际耗时仍会受到 token 重排和通信影响。top-k 索引是离散的;反向传播在当前选中集合内可以沿连续权重求导,但不能把“换成另一个专家”的离散跳变当成普通连续导数。 这里有个容易漏掉的细节:若 $k=1$ 还把唯一选中的概率除以自己,合并权重恒为 1,主任务损失就无法经这个权重训练路由器。Switch 的 top-1 路由保留了所选概率作为乘数,并另加负载均衡损失;不能把上面的 top-2 归一化公式机械套到所有 top-1 实现上。实现差别要看原论文与代码,而不是只看“top-1”三个字。 3.3 “省算力”到底在比较什么 专家总参数约为 $P_{\mathrm{all}}=N(3dh)$;单 token 运行的专家参数约为 $P_{\mathrm{active}}=k(3dh)$,因此两者的比值是 $N/k$。这个推导只说明同一 MoE 层内全部专家与激活专家的差异。它没有证明 MoE 相对“参数更少、但充分训练的稠密模型”一定更快或更准;也没有证明端到端延迟会按 $N/k$ 缩短。公平比较要明确横轴是总参数、激活参数、每 token FLOPs、训练吞吐、墙钟时间中的哪一个。 以本文数值为例,$N=8$、$k=2$,所以 $N/k=4$。如果改成 $k=4$,专家计算主项会翻倍而总参数不变;如果把 $N$ 从 8 扩到 16 且保持 $k=2$,激活的专家计算主项近似不变,但权重驻留、路由维度与分布式通信压力会增加。这才是条件计算的交易:用更多存储与更复杂的调度,换更多参数容量与较少的激活计算。 3.4 为什么会需要负载均衡损失 取一批 $T$ 个 token,先讨论 Switch 的 top-1。令 $f_i$ 为实际派给专家 $i$ 的 token 比例,令 $P_i$ 为路由器分给该专家的平均概率。原论文使用下面的辅助项: $$f_i=\frac{1}{T}\sum_{t=1}^{T}\mathbf{1}[\operatorname{argmax}_j p_{t,j}=i],\qquad P_i=\frac{1}{T}\sum_{t=1}^{T}p_{t,i}$$ $$L_{\mathrm{aux}}=\alpha N\sum_{i=1}^{N}f_iP_i$$ $\mathbf{1}$ 是指示函数;$\alpha$ 控制辅助项相对主任务损失的强度。$f_i$ 是由离散 argmax 得到的实际负载,作为本批次统计量不走梯度;$P_i$ 连续可导,给路由器提供调整信号。若四个专家都恰好分到四分之一 token 且平均概率也是四分之一,则不乘 $\alpha$ 的项是 $4\times4\times(1/4)(1/4)=1$。若 16 个 token 全选第 0 个专家,且它的平均概率是 0.7112,同一项约为 $4\times0.7112=2.8449$。附录代码打印的就是这两个值。 不要把辅助项误认为“越小一定越好”的独立目标。它和语言、图像或视频的主任务损失一起优化;给得太重会强迫本来有意义的专家分化变得机械均匀,给得太轻会让路由坍缩。Shazeer 等人的早期方案分别约束 importance 与 load;Switch 把它简化成一个点积项。Switch 论文第 2.2 节报告了 $\alpha=10^{-2}$ 的实验设置,但这个数不是跨任务的通用常数。 3.5 容量与 token 溢出 路由概率决定“想去哪里”,硬件要决定“哪里放得下”。Switch 的 top-1 固定容量在概念上是: $$C=\left\lceil c\frac{T}{N}\right\rceil$$ $C$ 是每个专家本批次最多接收的 token 数,$c$ 是容量因子。若 $T=16$、$N=4$、$c=1$,每个专家只有四个槽;[10,3,2,1] 的第一位会溢出六个。把 $c$ 设成 1.5,容量变六、溢出四个;到 2.5 容量才变十、溢出为零。增加容量会减少丢弃,但静态张量中的空槽也增加。Switch 原论文说明:溢出的 token 跳过该专家层的计算,经残差路径传给下一层;这不是把 token 从整个网络删除。不同生产实现可以使用不同的溢出策略,不能从论文机制推断所有框架都会丢 token。 这一定义专门对应 top-1。top-2 每个 token 会产生两个派发名额,负载与容量的账要按派发次数重新算;直接拿 $T/N$ 给 top-2 算容量会少估。文章后面的代码将 top-2 正确性实验与 top-1 容量实验明确分开。 3.6 再检查三条可验证的守恒关系 把一批输入写成张量形状能看出程序为何必须“先拆再合”。设 batch 有 $B$ 条样本,每条 $S$ 个 token,压平后 $T=BS$;输入是 [T,d],路由 logits 是 [T,N],top-k 索引和权重都是 [T,k]。按专家重新排列后,第 $i$ 位专家只拿到自己的 $L_i$ 行,结果是 [L_i,d];再按原 token 索引累加回 [T,d]。只要每个 token 恰好被派发 $k$ 次,就必有 $\sum_i L_i=kT$。附录的 expert_loads=[8,7,8,9] 总和为 32,恰好等于 $16\times2$。这是发现漏派发或重复派发的第一道检查。 第二条关系来自合并权重。对同一个 token,Mixtral 式归一化后 $\sum_{i\in S_t}a_{t,i}=1$;若实测不等于 1,可能把全部专家的 softmax 概率直接拿来加权,却忘了对选中集合重新归一化。第三条关系是输出维度不变:专家前馈网络虽可扩到中间宽度 $h$,最终都要回到 $d$ 维,才能与 Transformer block 的残差相加。三条关系分别守住派发次数、权重尺度和残差形状,比直接观察最终 loss 更容易定位代码错误。 3.7 辅助项的梯度从哪里来 一次反向传播中,把当前 batch 已统计出的 $f_i$ 当作常量。softmax 的导数是 $\partial p_{t,i}/\partial z_{t,j}=p_{t,i}(\mathbf{1}[i=j]-p_{t,j})$:提高专家 $j$ 的 logit,会抬高它自己的概率,同时压低其他专家的概率。代入上一小节的 $L_{\mathrm{aux}}$,得到: $$\frac{\partial L_{\mathrm{aux}}}{\partial z_{t,j}}=\frac{\alpha N}{T}p_{t,j}\left(f_j-\sum_{i=1}^{N}f_ip_{t,i}\right)$$ 若专家 $j$ 的实际负载 $f_j$ 高于这个 token 所见的加权平均负载,梯度为正,梯度下降倾向于压低它的 logit。低负载专家可能得到相反推力。这只是一次梯度步的局部解释:$f_i$ 由 argmax 决定,会在选择边界突然跳变;主任务梯度、容量限制和数据分布也同时影响下一次路由。因此“有可导辅助项”不等于“必然均衡”,更不等于“均衡后质量一定最好”。 3.8 溢出与空槽是两本账 若第 $i$ 位专家收到 $L_i$ 个 token、每位静态容量都是 $C$,则溢出数为 $\sum_i\max(L_i-C,0)$,空槽数为 $\sum_i\max(C-L_i,0)$。用前面的 [10,3,2,1] 代入:$C=4$ 时溢出 6、空槽 6;$C=6$ 时溢出 4、空槽 12;$C=10$ 时溢出 0、空槽 24。容量越大,溢出变少,却给静态张量留下更多空位。空槽是否真的造成同等比例的计算浪费,还要看内核能否跳过填充;它至少会影响形状、存储或通信安排。 在多模态场景,整体平均负载还可能掩盖局部高峰。文本、图像 patch 与连续视频帧混在一批时,整批的四位专家统计可能接近均匀,但某一类 token 在某一层仍高度集中;按帧解码时的瞬时负载又可能不同于整段视频的平均。一个实用的诊断表应按层、模态和时间片记录最大 $L_i$、平均 $L_i$、溢出数与通信时间。这里是从路由与队列机制推出的监控建议,并非本文已经做过的多模态训练实测。 04. 代码实现 完整代码在文末 moe_lab.py,只依赖 PyTorch,CPU 上直接执行:python moe_lab.py。它先生成形状为 [16,4] 的 token 矩阵,以一个线性路由器选择四个专家中的两个。每个专家是一层很小的 Linear → ReLU → Linear,用于验证路由逻辑;前面的大模型参数账本仍按真实 SwiGLU 的三矩阵结构计算,不能把玩具专家误当成生产模型。 核心的稀疏计算可以缩到下面几行。top_idx 的形状是 [token,k],token_id 和 slot_id 一起定位“这个专家接收了哪个 token、占该 token 的第几个席位”;index_add_ 把两路专家结果加回对应 token。 probs = F.softmax(logits.float(), dim=-1) top_prob, top_idx = probs.topk(k, dim=-1) top_weight = top_prob / top_prob.sum(dim=-1, keepdim=True) result = torch.zeros_like(x) for expert_id, expert in enumerate(experts): token_id, slot_id = torch.where(top_idx == expert_id) if token_id.numel() == 0: continue value = expert(x[token_id]) * top_weight[token_id, slot_id, None] result.index_add_(0, token_id, value) print(result.shape, top_idx.shape) 固定随机种子为 7 后,脚本实际输出 input=(16, 4) output=(16, 4) top_idx=(16, 2),四位专家各接到 [8,7,8,9] 次派发,总和为 32,正好是 $16\times2$。它另用“全部专家都算、最后把没选中的输出乘零”的稠密参考结果做正确性对照,最大绝对误差在打印精度内为 0.000000000。参考实现会浪费计算,但适合检验稀疏实现的索引和加权有没有写错。 接着脚本不训练模型,而是构造两组受控路由 logits:一组让四个专家每人接四个 token,另一组让全部 token 偏向同一个专家。这样能把“负载变了”与“训练也变了”分开。打印结果为:均衡时 $f=P=[0.25,0.25,0.25,0.25]$,未乘 $\alpha$ 的辅助项是 1.0000;坍缩时 $f=[1,0,0,0]$、$P=[0.7112,0.0963,0.0963,0.0963]$,辅助项是 2.8449。容量实验又输出 6/16、4/16、0/16 三档溢出。读者可以独立复跑,不需要下载权重或数据集。 这组数字只证明公式、分发与计数代码互相吻合,不证明训练时加辅助项就一定达到均衡。真实训练还要监控各层的负载直方图、丢弃率、主任务损失、路由熵及设备间 all-to-all 的时间;单看一张 token 直方图不足以判断模型质量。 05. 工业级实现对照 以 2026-10-03 检查的 Hugging Face modeling_mixtral.py 为准,MixtralTopKRouter 先把隐藏状态展平,用 F.linear 得到 [token, expert] logits;它在 float32 中做 softmax,再 top-k,并对选中权重重新归一化。MixtralSparseMoeBlock 负责接路由输出与专家集合,最终还原 batch、sequence、hidden 三维。知识树里的 code_refs 指向这个文件的 MixtralSparseMoeBlock,路径与符号已经实际打开核对。 同一文件中的 MixtralExperts 不为每个 token 单独启动一次专家网络,而是先找出哪些专家被选中,再按专家收集 token,用 index_add_ 汇总。它把多位专家的矩阵存成带专家维的三维权重,并通过 @use_experts_implementation 接入不同执行实现。我们的小脚本保持“每个专家一个模块”,方便看公式;生产代码则必须考虑连续内存布局、分组矩阵乘、编译路径和设备利用率。文件在主分支上会变,正文只核对了本日可见的结构与函数名,没有声称这些细节永久不变。 Mixtral 的 top-2 与 Switch 的 top-1 还不能混成一个实现。前者在路由器里对两个已选概率归一化;后者的论文重点是单专家派发、静态容量、溢出路径与辅助负载损失。Hugging Face 这份 Mixtral 文件的前向代码不是 Switch 论文的 TPU 分布式训练系统,也不能从它有 index_add_ 就断言大集群没有 all-to-all。若专家分布在多卡上,token 必须先到相应设备、计算后再汇总;代价由网络拓扑、批量大小、token 倾斜和实现决定。 还有一个工业层面的数字边界:本文的 3dh 只含 SwiGLU 的三个权重矩阵。真实 Transformer block 还有 Q、K、V、输出投影、归一化、嵌入及可能的共享专家。训练时优化器状态和梯度常比 bf16 权重本身占更多空间;推理时即使每个 token 只用两位专家,服务系统仍需让其他专家随时可访问,或者承担按需调入的时延。因此“激活参数少”不等于“部署内存少”。 06. 代价与边界 收益首先是参数容量对激活计算的比值。 对 $N$ 位同宽专家取 $k$ 位,专家主计算的理想比值是 $N/k$;训练可在近似固定的每 token 专家 FLOPs 下试更多参数。它是否换来更好的任务质量,仍要做同预算、同数据、同训练时长的实验。早期论文报告过优于稠密对照的结果,但不能把某篇任务的收益搬给任意视觉生成模型。 第一笔代价是权重与状态。 参数量按 $N$ 增长,bf16 权重、梯度、优化器状态与检查点大小都要算。只看前向激活的 $k$ 位专家会严重低估训练资源。专家可以并行放在不同设备上,但又引出网络通信。 第二笔代价是路由偏斜。 每个专家的处理时间近似由收到的 token 数决定,整步会等最慢专家。容量限制可以把形状固定,却在溢出时改变有效计算;容量放大又会浪费填充。高平均负载不够,还要检查最忙专家、各层差异、长尾 token 和各设备之间的均衡。附录中的 [10,3,2,1] 正是最小反例。 第三笔代价是通信与小批量。 当专家跨设备切分,派发和合并通常需要集体通信;batch 很小或自回归逐 token 解码时,每位专家分到的 token 少,矩阵乘可能跑不满,固定通信开销更显眼。用单机 CPU 玩具实验不能估算这部分,也不能用“理论 FLOPs 四分之一”宣称端到端四倍加速。 第四笔代价是路由训练本身。 top-k 的硬选择会让专家早期获得的样本不均,冷门专家因训练较少又更难被选中,形成反馈。负载项、噪声、容量因子与专家初始化都会影响稳定性,但也可能伤害有意义的专门化。需要同时报告主任务指标与路由指标,而不是把“每个专家等量接单”当终点。 什么时候不该急着用?模型还小、普通前馈层已足够,或者服务以低 batch、低延迟为主且跨卡通信昂贵时,先用 性能建模与 Profiling 找到实际瓶颈。如果数据与训练预算不足以让多位专家学出差异,多出来的参数只会变成管理负担。这是工程判断,不是 MoE 论文对所有应用的普适否定。 07. 经典论文脉络 Shazeer 等,2017,Outrageously Large Neural Networks:把稀疏门控专家用于大容量模型,明确讨论专家偏科的自强化现象,并分别引入 importance 与 load 的均衡约束。它是理解“为什么光有 top-k 不够”的起点。 GShard,2020:把专家路由与自动分片放进大规模 Transformer 训练,提醒我们专家计算之外还有设备布局与通信问题。 Switch Transformers,2021/2022:用 top-1 简化派发,给出容量因子、溢出处理和可微的 $f\cdot P$ 负载项;本文第 3.4 与 3.5 节主要沿它推导。 ST-MoE,2022:系统研究稀疏专家训练的稳定性和迁移,说明“能扩参数”之后仍要解决训练动态。 Mixtral of Experts,2024:在每个相关层采用 top-2 SwiGLU 专家,是对照当前公开推理实现的具体案例;本文并不把它的结果视为所有视频或多模态 MoE 的结果。 这五篇连起来的主线是:先提出条件计算,再解决大规模分布式派发,接着简化路由与容量控制,最后面对稳定性和实际模型实现。论文里的速度、质量数字都有各自的设备与数据条件;这篇文章只借它们确认机制,不拼接成一个不存在的统一基准。 08. 常见误解 误解一:“八专家选二就是整个模型快四倍。” 四倍只来自专家矩阵乘的理想主项比值。注意力、路由、all-to-all、token 重排及等待最慢专家都在分母里。实验报告应分别列专家 FLOPs 与端到端时延。 误解二:“只激活两位专家,显存里只需放两套权重。” 路由在运行时根据每个 token 的状态变化,未选中的六位专家下一 token 可能被选到。权重需要驻留、分片或按需加载;哪一种都要付存储或调入成本。 误解三:“softmax 概率均匀就说明负载均衡。” 硬 top-1 派发由 argmax 决定,平均概率 $P_i$ 与实际负载 $f_i$ 是两个量。大量 token 的首选专家仍可能相同,所以要同时观察两者。Switch 的辅助项特意把它们相乘。 误解四:“溢出意味着 token 从模型中消失。” 在 Switch 论文描述的残差结构里,溢出 token 跳过这一专家层,后续层仍能接到它。它确实失去本层的专家变换,但不等于整条序列被删除。 误解五:“专家会自动对应数学、代码、图像等人类类别。” 路由学的是降低训练目标的内部划分,可能依赖位置、频率或更难解释的因素。必须用受控输入、路由统计和质量消融来验证专门化;给专家起名字只是叙事。 09. 动手验证 先执行文末两份完整脚本:python moe_lab.py 复现数值,python make_figures.py 生成配图。脚本固定随机种子,CPU 不需要模型权重。练习时一次只改一个条件,并把 主计算、路由负载、溢出率 分开记录。 把 k=2 改为 k=1。top_idx 应从 (16,2) 变成 (16,1),总派发次数从 32 变成 16。注意玩具实现会对唯一概率做归一化,权重恒为 1;这正好验证第 3.2 节提醒的训练梯度陷阱,因此它只能用来做前向路由演示,不能直接拿来训练 Switch。 保持 T=16,N=4,把不均匀分配 [10,3,2,1] 改成 [4,4,4,4]。容量因子 1.0 时,溢出应从 6/16 变 0/16。这是不改网络结构、只改路由就改变有效计算的最小实验。 把容量因子从 1.0、1.5、2.5 依次试过。原分配下脚本应给出容量 4、6、10 和溢出 6、4、0;同时算空槽总数:四位专家的静态槽分别是 16、24、40。容量增大并非免费。 将账本里的 $N=8,k=2$ 改成 $N=16,k=2$。专家总权重翻倍,单 token 激活专家参数不变,理想 $N/k$ 从 4 变 8。再想一想:若专家分散在更多设备上,为什么实际延迟未必更短? 若要进一步实验训练效果,可以在小数据集上加入任务损失与 $L_{\mathrm{aux}}$,逐档扫描 $\alpha$,同时画验证损失和各专家负载。预期是过小的 $\alpha$ 可能坍缩、过大的 $\alpha$ 可能牺牲任务目标;具体拐点依赖数据和实现,本文没有训练实验,因此不提供虚构数值。 10. 延伸阅读 先复习知识树的 自注意力机制:MoE 一般替换前馈子层,不替读者省去注意力的计算与显存账。然后读 性能建模与 Profiling,把“专家 FLOPs 少了”落到实际延迟账本;跨卡部署时再接 数据并行与 ZeRO,理解参数和状态如何分布。知识树中规划中的“量化:从 INT8 到 FP4”会继续回答:专家权重多、驻留贵时,能否用更低精度换内存与带宽,以及质量会付出什么代价。 把这篇用在自己的模型上时,建议先固定总训练 token、硬件与优化器配置,记录稠密前馈基线的质量和耗时;再逐步加入多专家、top-k 路由、容量限制和均衡项。每加一项都单独保存路由直方图、每层最忙专家、溢出比例及端到端吞吐。这样最后即使质量没有提升,也能判断问题出在专家容量不足、调度不均,还是通信把理论上的稀疏收益吃掉了。只报告总参数和激活参数两个数字,很难让读者复现或比较。另外,比较实验要记录随机种子和路由器初始化。路由决策依赖输入分布,同一个模型换一批数据,专家负载也可能改变;只截取一次顺利的运行,无法说明服务长期稳定。 本文最重要的读法是把三根轴分开:总参数量决定可用容量,激活专家数决定每 token 专家计算,实际路由负载决定系统是否跑得顺。 只有把它们放到同一张账本里,MoE 的收益和代价才不会被一个“四倍”掩盖。 附录:完整代码 09 节用到的脚本全文如下(moe_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 moe_lab.py """A small, reproducible MoE routing lab. Requires PyTorch, runs on CPU.""" from __future__ import annotations import math import torch from torch import nn from torch.nn import functional as F def sparse_moe(x: torch.Tensor, logits: torch.Tensor, experts: nn.ModuleList, k: int): """Route each token to k experts and merge the selected outputs.""" probs = F.softmax(logits.float(), dim=-1) top_prob, top_idx = probs.topk(k, dim=-1) top_weight = top_prob / top_prob.sum(dim=-1, keepdim=True) result = torch.zeros_like(x) for expert_id, expert in enumerate(experts): token_id, slot_id = torch.where(top_idx == expert_id) if token_id.numel() == 0: continue value = expert(x[token_id]) * top_weight[token_id, slot_id, None] result.index_add_(0, token_id, value) return result, probs, top_idx, top_weight def switch_aux_loss(probs: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor, torch.Tensor]: """Switch's top-1 balancing term, without the tunable alpha coefficient.""" token_count, expert_count = probs.shape chosen = probs.argmax(dim=-1) fractions = torch.bincount(chosen, minlength=expert_count).float() / token_count mean_prob = probs.mean(dim=0) return expert_count * (fractions * mean_prob).sum(), fractions, mean_prob def capacity_drops(assignments: torch.Tensor, expert_count: int, factor: float): """Count top-1 overflow with a fixed expert capacity.""" capacity = math.ceil(assignments.numel() * factor / expert_count) loads = torch.bincount(assignments, minlength=expert_count) dropped = torch.clamp(loads - capacity, min=0).sum().item() return capacity, loads.tolist(), int(dropped) def main(): torch.manual_seed(7) token_count, dim, hidden, expert_count, k = 16, 4, 8, 4, 2 x = torch.randn(token_count, dim) gate = nn.Linear(dim, expert_count, bias=False) experts = nn.ModuleList( [nn.Sequential(nn.Linear(dim, hidden), nn.ReLU(), nn.Linear(hidden, dim)) for _ in range(expert_count)] ) out, probs, chosen, weights = sparse_moe(x, gate(x), experts, k) # A dense reference evaluates every expert. It is only a correctness oracle. dense_ref = torch.zeros_like(x) for expert_id, expert in enumerate(experts): contribution = torch.zeros(token_count, 1) for slot in range(k): contribution += (chosen[:, slot] == expert_id)[:, None] * weights[:, slot, None] dense_ref += contribution * expert(x) max_error = (out - dense_ref).abs().max().item() print(f"input={tuple(x.shape)} output={tuple(out.shape)} top_idx={tuple(chosen.shape)}") print(f"expert_loads={torch.bincount(chosen.flatten(), minlength=expert_count).tolist()}") print(f"sparse_dense_max_error={max_error:.9f}") # Controlled router logits: the difference is caused by routing, not training. balanced_logits = torch.zeros(token_count, expert_count) balanced_logits[torch.arange(token_count), torch.arange(token_count) % expert_count] = 2.0 collapsed_logits = torch.zeros_like(balanced_logits) collapsed_logits[:, 0] = 2.0 for name, logits in (("balanced", balanced_logits), ("collapsed", collapsed_logits)): loss, fractions, mean_prob = switch_aux_loss(F.softmax(logits, dim=-1)) print(f"{name}: f={fractions.tolist()} P={[round(v, 4) for v in mean_prob.tolist()]} " f"N_sum_fP={loss.item():.4f}") uneven = torch.tensor([0] * 10 + [1] * 3 + [2] * 2 + [3]) even = torch.arange(token_count) % expert_count for name, assignments in (("even", even), ("uneven", uneven)): for factor in (1.0, 1.5, 2.5): capacity, loads, dropped = capacity_drops(assignments, expert_count, factor) print(f"{name} factor={factor:.1f}: capacity={capacity} " f"loads={loads} dropped={dropped}/{token_count}") width, expansion, model_experts, active = 4096, 14336, 8, 2 params_one = 3 * width * expansion # SwiGLU: gate, up, down matrices. params_all = model_experts * params_one params_active = active * params_one print(f"SwiGLU ledger: one={params_one:,} all={params_all:,} " f"active_per_token={params_active:,} all_over_active={params_all / params_active:.1f}x") print(f"expert_weights_bf16={params_all * 2 / 2**30:.3f} GiB; " "this excludes attention, optimizer states, activations and communication") if __name__ == "__main__": main() make_figures.py """Draw the MoE routing/capacity experiment. Requires Pillow only.""" from pathlib import Path from PIL import Image, ImageDraw, ImageFont ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) def font(size): for path in ("C:/Windows/Fonts/arial.ttf", "/usr/share/fonts/truetype/dejavu/DejaVuSans.ttf"): if Path(path).is_file(): return ImageFont.truetype(path, size) return ImageFont.load_default() im = Image.new("RGB", (1200, 540), "#f8fafc") d = ImageDraw.Draw(im) title = font(31) text = font(21) small = font(17) d.text((48, 30), "MoE routing: same token count, different costs", font=title, fill="#0f172a") d.text((50, 100), "Top-1 token load across 4 experts (T = 16)", font=text, fill="#334155") for row, (name, counts, color) in enumerate(( ("Balanced", [4, 4, 4, 4], "#0ea5e9"), ("Collapsed", [16, 0, 0, 0], "#f97316"), )): y = 160 + row * 130 d.text((50, y + 23), name, font=text, fill="#0f172a") for i, value in enumerate(counts): x = 205 + i * 220 d.rectangle((x, y + 20, x + 175, y + 55), fill="#e2e8f0") if value: d.rectangle((x, y + 20, x + 175 * value // 16, y + 55), fill=color) d.text((x + 52, y + 65), f"E{i}: {value}", font=small, fill="#334155") d.line((48, 423, 1150, 423), fill="#cbd5e1", width=2) d.text((50, 443), "Uneven load [10, 3, 2, 1]: drops at capacity 4 / 6 / 10", font=text, fill="#334155") for i, (cap, drops) in enumerate(((4, 6), (6, 4), (10, 0))): x = 650 + i * 170 d.rounded_rectangle((x, 438, x + 145, 490), radius=8, fill="#dbeafe") d.text((x + 12, 453), f"C={cap}: {drops} drop", font=small, fill="#1e3a8a") path = OUT / "routing_capacity.png" im.save(path) print(path)
-
AIGC 基本功|算子融合与 CUDA Graph-Fusion AIGC 基本功|算子融合与 CUDA Graph-Fusion 所属方向:推理加速 | 难度:进阶 | 前置知识:性能建模与 Profiling(performance_profiling)、混合精度(mixed_precision)、自注意力机制(attention_basics) 关键词:算子融合、kernel fusion、CUDA Graph、发射开销、访存瓶颈、torch.compile、Inductor 阅读准备:先读性能建模与 Profiling、混合精度与自注意力。kernel 是一次设备端计算程序;ufunc 是 NumPy 的逐元素数组调用,两者的派发路径不同。本文比较它们共有的“调用成本与中间数组”问题,不把 CPU ufunc 计时换算为 CUDA launch 延迟。 数字与验证范围:2026-11-03 在 Windows CPU、Python 3.11.9、NumPy 2.4.3 上重跑,进程线程设为 1。原版 M1 Pro 数字保留在修订基线。本轮 CUDA 不可用;所有 CUDA 微秒时间线和 kernel 数列表都是显式假设,未运行 GPU kernel、capture/replay 或完整模型。工业对照固定到 PyTorch v2.10.0;官方调度评分函数的 CPU 夹具与图 API 的委托契约另行核对,后者不等于 CUDA 实测。 01. 为什么需要它 先摆三个不同口径的数,避免把模型输入当成实测。 第一个数:手选的一种 decode lowering 列表合计 1093 个 kernel。 launch_model.py 把一层划为 34 个操作节点,32 层加 5 个输出节点,得到 $34\times32+5=1093$。它借用了常见 8B decoder 的层数,只是练习列表:RMSNorm 拆几次、QKV 是否合并、KV 写入与注意力是否融合,都要由后端决定。它不能验证某个真实 Llama 的 kernel 数,也不靠落进一个宽泛区间证明正确。 第二个数:单独假设 700 个 kernel,CPU 每次提交 3 μs、GPU 执行 2 μs。 单流事件模拟得到 eager 2102 μs,其中从计时起点计算的 GPU 未执行时间为 702 μs。若 Graph 首次提交同样取 3 μs,并假设相对 eager 每节点多 0.5 μs,总时长为 1753 μs,模型加速 1.199 倍。这是 700 节点案例,不能和上面的 1093 混用;微秒输入也不是本机测量。NVIDIA 的官方测试区分 CPU 调用时长、设备运行时长、首次上传与重复回放,实际结果还取决于硬件、CUDA 版本和图拓扑。 第三个数:8 段仿射链,CPU 代数合并后实测快 3.80–6.48 倍。 每段是乘加两个 ufunc,所以原链有 16 次数组调用,合并版仍有 2 次;不能称为 8 次对 1 次真实 GPU kernel 融合。小数组调用成本、大数组内存和算术都可能影响这个比值,第 04 节会保留原实验逐项展开。 还有一个更刺眼的数在注意力上。按 $B=8$、$H=16$、$S=2048$、$d=4096$、bf16 算:输入激活 $[B,S,d]$ 是 128.0 MiB,而 score 矩阵 $[B,H,S,S]$ 是 1.000 GiB,正好是输入的 8 倍。放大倍数是 $H \cdot S / d$——$S$ 翻一倍,它翻一倍;$S=8192$ 时是 32 倍。若这五步分别物化,max 读 1 份、减读写 2 份、exp 读写 2 份、sum 读 1 份、除读写 2 份,共 8 份全尺寸 score 流量,即 8 GiB;忽略逐行 max/sum 向量。若整行能留在片上,融合 softmax 读 score 写概率至少 2 GiB。这里仍物化 score 和概率;mask 可以广播或直接按坐标计算,不能凭形状再强加一张 1 GiB mask。 你以为模型卡在算力上,其实它经常卡在「把中间结果写出去再读回来」和「让 CPU 一次又一次地通知 GPU 开工」这两件事上。 02. 最小可用理解 三句话: 融合(fusion):一串相邻算子的中间结果,本来每个算子都要写回显存、下一个再读回来。融合就是把它们放进同一个 kernel,中间结果留在寄存器或共享内存里,只在最开头读一次输入、最末尾写一次输出。只合并调度边界时,可保持数学表达式;进一步代数化简、重算或改变归约顺序,则可能同时改变运算量、临时存储和浮点舍入。 CUDA Graph:那串 kernel 的发射动作(函数名、参数、依赖关系、显存地址)可以录下来,之后一次 cudaGraphLaunch 提交整张图。仅捕获并回放同一组 kernel 时,不改变它们的逻辑数组读写,主要减少逐项的 CPU 提交;设备前端调度也可能变化。这里谈的是同一组 kernel,不排除编译器同时融合或重新安排内存。 先列账本,再用测量判断收益。$K$ 个单输入、等尺寸、各读写一遍的 kernel 合并后,理想全局流量比为 $K$;这不是通用时延上限。Graph 的收益还取决于两侧前端延迟、关键路径、录制与实例化摊销,不能只凭一个执行/发射时间比判定。 一句总结:融合省字节,Graph 省发射。把两者混为一谈,是这一块最常见的错误。 03. 数学推导 3.1 先回到那条判据:roofline 前置文章 performance_profiling 已经建过这条判据,这里只取结论。一个算子的耗时下界由两件事里更慢的那个决定: $$T \ge \max\left(\frac{F}{P_{\text{peak}}},\ \frac{B}{B_{\text{off}}}\right)$$ 其中 $F$ 是浮点运算次数(FLOPs),$P_{\text{peak}}$ 是峰值算力(FLOP/s),$B$ 是需要搬动的字节数(含读和写),$B_{\text{off}}$ 是片外内存带宽(字节/秒)。两者的比值就是算术强度: $$I = \frac{F}{B}$$ $I$ 要与机器的 $P_{\text{peak}}/B_{\text{off}}$ 比较,才能判断理想 roofline 的哪一侧更紧;实际还可能受到派发、并行度、缓存和特殊函数吞吐限制。逐元素算子的 $I$ 是常数:算一个元素做 1 次操作、读 4 字节写 4 字节,$I = 1/8$。在 fp32 下算力峰值除以带宽的量级是每字节几十次操作,所以单次简单加法在足够大的连续数组上常是带宽优化对象。但 exp、三角函数等不能用一次普通 FLOP 的峰值来估计,小数组也可能主要受调用成本限制,不能说逐元素算子永远受带宽限制。 融合可以减少中间全局流量和调用,也可能通过化简减少 $F$,或通过重算增加 $F$ 换取更低存储。后面的账本会注明属于哪一种。 3.2 字节账本:K 段链为什么最多省 K 倍 考虑 $K$ 个串起来的逐元素算子,作用在一个 $N$ 元素的张量上($b$ 为每元素字节数)。 不融合:每个算子单独成一个 kernel,各自读一遍输入、写一遍输出。第 $k$ 个 kernel 的访存是 $2Nb$ 字节(因为输入和输出都是 $N$ 个元素),$K$ 个加起来: $$B_{\text{unfused}} = 2KNb$$ 融合:一个 kernel 从头做到尾。读输入 $Nb$、写输出 $Nb$,中间那 $K-1$ 步全在片上: $$B_{\text{fused}} = 2Nb$$ 两式相除,字节比正好是 $K$: $$\frac{B_{\text{unfused}}}{B_{\text{fused}}} = K$$ 这个推导假设每个算子只有一个等尺寸输入、没有其他消费者、不需溢写,也不重复读输入。它是指定模式的逻辑字节账本,不是 DRAM 性能计数器。若中间结果已命中缓存、融合后寄存器不足而 spill、或 occupancy 降低,时延就不会按字节比缩放。 附录 [A] 同时列三种具体账本,不能混用: 8 段仿射链每段两个 ufunc:V1 共 16 次读写,$4KNb=488.28$ MiB;V3 只有两个 ufunc,$4Nb=61.04$ MiB,二者字节比 8。若真把 16 个逐元素操作放进一个无溢写 kernel,理想为 $2Nb=30.52$ MiB,和 V1 的比是 16。本文 CPU V3 没有达到这最后一种实现。 RMSNorm 需明确权重 $\gamma$。对 $N$ 个元素,忽略较小的逐行统计向量,平方读写 $2N$、mean 读 $N$、乘行尺度读写 $2N$、乘权重读两个输入写一个输出 $3N$,共 $8Nb=122.07$ MiB。若整行保持片上,读输入、读权重、写结果为 $3Nb=45.78$ MiB,流量比 $8/3$。权重广播能否命中缓存、是否重读行数据要看内核;不是四个 pass 对一个 pass。 以同一 bf16 dtype 保存所有完整尺寸中间数组时,attention softmax 的全尺寸流量为 $8Q$ 对 $2Q$,其中 $Q$ 是一份 score 的字节数。本例是 8 GiB 对 2 GiB;FP32 中间数组、溢写与 mask 会另改账本。 还可以做一个条件性两层存储模型:假设融合后仍有 $2(K-1)Nb$ 的中间传输,但全在带宽 $B_{\text{on}}$ 的片上完成,且忽略计算、启动、同步与重叠。令 $\rho=B_{\text{on}}/B_{\text{off}}$,则: $$T_{\text{fused,model}}=\frac{2Nb}{B_{\text{off}}}+\frac{2(K-1)Nb}{B_{\text{on}}},\qquad T_{\text{unfused,model}}=\frac{2KNb}{B_{\text{off}}}$$ $$S_{\text{model}}=\frac{K}{1+(K-1)/\rho}$$ 它在 $\rho=1$ 时为 1,$\rho\to\infty$ 时趋近 $K$,只说明这些假设下的敏感性。寄存器中的中间值不必逐次经历这种“读写”;NumPy 分块则仍逐次执行 ufunc,并新增循环和复制。所以该式既不是融合的硬上限,也不能用任意两组 CPU 吞吐的比值验证 GPU 模型。若融合增加计算、同步或溢写,它完全可能慢于原实现。 3.3 单次调用的固定成本,和它的临界规模 一次算子调用的耗时,在规模足够小时和数据量无关。写成仿射形式: $$t(n) = a + b_{\text{el}} \cdot n$$ $a$ 是固定开销(派发、参数检查、缓冲建立),$b_{\text{el}}$ 是每元素的边际成本。开销和数据各占一半的那个规模是: $$n^{\ast} = \frac{a}{b_{\text{el}}}$$ 本轮 [D] 先预热,再取 7 个批次的中位数,用 $n\le16384$ 的六点拟合:$a=0.476517$ μs,$b_{\text{el}}=61.424$ μs/百万元素,$n^{\ast}=7757.9$ 元素(30.30 KiB)。这些是此 CPU/Python/NumPy 路径的拟合参数,非 CUDA launch 测量,也不要求其他机器出现同一个临界点。 在把每次调用近似成同一个 $a+bn$ 的前提下,16 次调用链里的截距份额是: $$\mathrm{share}_{\mathrm{model}}=\frac{2Ka}{2K(a+b_{\text{el}}n)}=\frac{1}{1+n/n^{\ast}}$$ 这仍是模型分解。拟合误差、ufunc 类型、循环解释器与工作集变化都会影响它,不能把该份额称为实际 GPU 空转率或“实测加速中多少来自访存”。 3.4 发射与执行的时间线:CUDA Graph 到底省什么 令 $N\ge1$ 为 kernel 数,$\ell\ge0$ 为每次 CPU 提交耗时,$e\ge0$ 为每个 kernel 的有效设备耗时。假设单流串行、CPU 连续提交、无其他开销,编号从 $i=1$ 开始。CPU 的第 $i$ 次提交在 $i\ell$ 完成,GPU 必须等该提交及前一个 kernel: $$f_0=0,\qquad s_i=\max(f_{i-1},i\ell),\qquad f_i=s_i+e$$ 由递推可得精确的有限 $N$ 结果:若 $\ell\le e$,首个 kernel 等 $\ell$,之后无间隙,总时长为 $\ell+Ne$;若 $\ell>e$,每次等 CPU,总时长为 $N\ell+e$。合成一个式子: $$T_{\mathrm{eager}}=\ell+e+(N-1)\max(\ell,e)$$ 从 $t=0$ 开始计、只把执行 kernel 算忙碌时,未执行时间为 $T_{\mathrm{eager}}-Ne$;它包括开头等待,不能直接称为设备利用率测量。 Graph 一次提交耗时记为 $g$。若把两侧共有的前端成本已计入 $e$,Graph 每节点相对 eager 的有效增量记为 $\delta$,则一个简化模型为: $$T_{\mathrm{graph}}=g+N(e+\delta),\qquad S=T_{\mathrm{eager}}/T_{\mathrm{graph}}$$ $\delta$ 是待测差值,可以为正、零或负,只要求有效时长非负;它不是 CUDA 必收的一笔额外派发费。原脚本默认 $N=700,\ell=g=3,e=2,\delta=0.5$ μs,故得到 $2102/1753=1.199$。在 CPU 受限分支,解两者相等得到: $$e_{\mathrm{break}}=\frac{N\ell-g-N\delta}{N-1}=2.499285\ldots\ \mathrm{\mu s}$$ 因此原来画在 3 μs 的“盈亏点”并不精确。仍用该组假设,$e=20$ μs 时确实略慢;但换成 $\delta=0$,大 kernel 案例就打平,$\delta=-0.1$ μs 则可稍快。大 kernel 必亏不是普遍规律。 实际图还可能有并行节点、不同的提交成本和设备调度,不能由这张单链模拟包办。 最后把首次录制、实例化、上传等额外成本合计为 $H$,重复回放 $R$ 次。当每轮净节省 $\Delta=T_{\mathrm{eager}}-T_{\mathrm{graph}}>0$ 时,严格回本要求 $R\Delta>H$;本例每轮省 349 μs,若假设 $H=1000$ μs,要至少 3 次。$H$ 也只是演示输入,真实服务还须计入静态输入复制、输出生命周期与必要同步。NVIDIA 官方文档也分别讨论首次运行和重复回放,不能把一次录图成本摊成零。 3.5 因果掩码:白算的那一半 因果注意力里,第 $i$ 个 query 只能看见前 $i$ 个 key。如果老老实实算满 $S \times S$ 的 score 矩阵,被掩掉的部分是纯浪费。精确的保留比例是: $$\text{kept} = \frac{S(S+1)/2}{S^2} = \frac{S+1}{2S}$$ $S=2048$ 时是 50.0%——一半的 score 元素算完就扔。逐元素地跳过在硬件上不现实,实际做法是按块跳:块边长 $B_r$ 时共有 $n_b = S/B_r$ 个 query 块,第 $i$ 个 query 块只算前 $i$ 个 key 块,算下来是 $n_b(n_b+1)/2$ 个块: $$\text{kept}_{\text{block}} = \frac{n_b(n_b+1)/2}{n_b^2} = \frac{n_b+1}{2 n_b} = \frac{1}{2} + \frac{1}{2 n_b}$$ 按上述方形整除块模型计算($S=2048$):块边长 64 时 51.6%,128 时 53.1%,256 时 56.2%。这是把对角块也按整块计算的面积比例,不是整次 attention 的实测耗时;尾块、矩形 tile 和对角块内部掩码另算。相对 $1/2$ 的超额为 $1/(2n_b)$,相对精确保留比例的超额是 $1/(2n_b)-1/(2S)$,所以块越小越接近理论上界——但块越小,片上数据被切得越碎,调度开销越大。这是块大小必须折中的原因,不是调参玄学。 这张图要看什么:左图的 score/输入比例严格按 $HS/d$ 随 $S$ 线性增长,双对数坐标上斜率为 1;灰虚线与它重合。不要把 score 自身的平方增长与这个比例混同。右图展示整除方形块的保留面积比例,64/128/256 块分别为 51.56%/53.13%/56.25%,不是 GPU 时间实测。 04. 代码实现 保留三个原脚本,新增一个独立数值检查脚本,正文末尾都有完整代码。Python 3 与 NumPy 可跑三个原脚本的计算部分;独立 fusion_checks.py 还需 PyTorch(本轮用 2.10 CPU),生成五图需 matplotlib,图中中文字体需系统支持(本轮使用 Microsoft YaHei)。在任意终端用 python 运行: fusion_lab.py:[A] 字节账本、[B] 带宽与工作集、[C] 三种融合形态、[D] 固定开销、[E] attention 尾部 launch_model.py:[F1] 时间线、[F2] 扫描、[F3] kernel 计数、[F4] 收益分解 make_figures.py:把前两脚本落盘的 JSON 画成 5 张图。 fusion_checks.py:独立验证事件闭式、字节计数、分块尾部、稳定 softmax、浮点与非仿射反例。 4.1 三种融合形态 我把「融合」拆成三种可测量的形态,这是本篇的核心实验设计: K = 8 # 8 段链,每段 h <- A*h + B A_S, B_S = 1.01, 0.01 def _v1_unfused(x, buf, K=K): """V1 不融合:K 段,每段 2 次算子调用,每段结果都写回内存。""" np.multiply(x, A_S, out=buf) np.add(buf, B_S, out=buf) for _ in range(K - 1): np.multiply(buf, A_S, out=buf) np.add(buf, B_S, out=buf) return buf def _v3_closed(x, out, K=K): """V3 代数合并:K 段仿射合成一个仿射,只剩 2 次调用。""" Ak = A_S ** K Bk = B_S * sum(A_S ** j for j in range(K)) np.multiply(x, Ak, out=out) np.add(out, Bk, out=out) return out 三种形态要按实际执行的代码区分: V1:8 段,每段乘、加两个 ufunc,共 16 次调用;中间数组会写回 CPU 内存地址,但是否到 DRAM 要看缓存。 V2:每个 tile 做同样 16 次 ufunc,再复制到输出;一个 tile 的临时数组不是寄存器或 CUDA shared memory。CPU 缓存可能复用这些数组,但没有消除这些读写指令;这是分块实验,不是真实 GPU 融合的最佳近似。 V3:用 $h_K=A^Kh_0+B\sum_{j=0}^{K-1}A^j$ 化成一次乘加,再用两个 ufunc 实现。有限和在 $A=1$ 时也合法,比直接除以 $A-1$ 更易处理边界。它同时减少运算量和调用次数,不能把它的加速全归于某一项。 先预热,再交替 V1/V3 顺序,9 轮各自取批次中位数;相对误差定义为最大绝对差除以 V1 最大绝对值。本轮快照如下(时间单位 μs): 元素数 V1 V3 V1/V3 相对误差 512 8.970 2.150 4.172 1.349e-07 4096 9.700 2.550 3.804 1.969e-07 65536 56.430 8.710 6.479 5.115e-07 262144 216.000 34.760 6.214 5.802e-07 1048576 1447.610 233.310 6.205 5.129e-07 4000000 7757.160 1672.110 4.639 6.165e-07 误差是这批输入上的观测,不是任意 dtype/幅值/链长都安全的证明。第 6.2 节给反例。 最大规模上,V2 使用同一新输入、V1 基准 7.763 ms,结果如下;每个 tile 输出均与 V1 逐元素相同: tile 元素数 V2 ms 相对 V1 16384 6.932 1.120 65536 5.423 1.431 262144 5.519 1.407 1048576 7.368 1.054 本机 V2 最快 1.431 倍。把 [B] 的逻辑吞吐比 2.914 机械代入两层模型,会得 2.351 倍;这不是同一物理模型的预测,不能以接近或不同就声称因果成立。tile 分配、复制、Python 循环、ufunc 吞吐和缓存都还存在。 这张图要看什么:左图保留 V1/V3 规模曲线和 V2 最佳点,虚线是单 add 拟合截距的参照,不是所有函数的严格时延下限。右图的 $K=8$ 是 V1/V3 的逻辑字节比,灰线只是 rho 代入算术,两者都不是实测时延上限。 4.2 把带宽层级测出来 [B] 使用 np.add(x, 1.0, out=y),以 $2n_{\mathrm{bytes}}/t$ 计算逻辑吞吐。$n_{\mathrm{bytes}}$ 仅是一张数组大小,$x$ 与 $y$ 的总存活工作集为两倍;下表保留全部规模: 单数组 KiB 两数组工作集 KiB 逻辑 GB/s 32 64 46.479 128 256 106.131 512 1024 97.001 2048 4096 56.988 8192 16384 49.522 32768 65536 19.756 131072 262144 19.362 人为把单数组不超过 8 MiB 的五点叫 small,其余两点叫 large,中位数为 56.988 和 19.559 GB/s,比值 2.914。这两个键在 JSON 中为兼容旧图仍名为 B_cache_GBs / B_dram_GBs,实际只是分组统计;阈值不证明 L1/L2/DRAM 归属,更不是峰值带宽。硬件缓存行、写分配、预取、SIMD 和频率都没有用计数器隔离,所以该比值不能成为 GPU 的片内/片外参数。 4.3 固定开销 [D] 对每个规模预热后连续调用:小规模每批 20000 次、大规模每批 500 次,做 7 批取中位数。循环成本也计入;[C] 则用交替调用的批次计时,这两者是不同微基准,不要求拟合截距恰好预测整条链。 实测单次时间(μs):$n=1$ 为 0.4646、$n=8$ 为 0.4674、$n=64$ 为 0.4669、$n=512$ 为 0.5373、$n=4096$ 为 0.7370、$n=16384$ 为 1.4798、$n=65536$ 为 4.4078、$n=262144$ 为 21.4532、$n=1048576$ 为 129.5942。小端最小二乘给 $a=0.476517$ μs、$b=61.424$ μs/百万元素。拟合得到的 $n^{\ast}=7757.9$ 是模型交叉点,而非机器的缓存容量;若斜率或截距不为正,应判模型失效,脚本会明确报错。 4.4 图:先看两张 这张图要看什么:三组指定模式的逻辑账本,横轴为 MiB 的对数刻度。第一组的“融合后”是真正单 kernel 的理想流量,并非 V3 实跑;RMSNorm 已计入权重读,softmax 忽略行统计并假设中间 dtype 不变。不同规模的字节不能单独决定优化优先级,还要结合调用频率和端到端 trace。 这张图要看什么:左图比较单 add 的实测点和局部拟合,竖线标识模型 $n^{\ast}=7758$;右图是 $1/(1+n/n^{\ast})$ 的模型份额,不是额外测出的 CUDA 发射开销。 4.5 分解:两种收益各占多少 [F4] 把 [D] 的同一 add 模型扩到 V1/V3,保留反事实分解练习。由 $t_1=2K(a+bn)$、$t_3=2(a+bn)$,截距节省为 $2(K-1)a$,每元素项节省为 $2(K-1)bn$;两者除以模型总节省,分别得到 $a/(a+bn)$ 与 $bn/(a+bn)$。 元素数 V1实测 μs V1模型 μs V3实测 μs V3模型 μs 512 8.970 8.127 2.150 1.016 4096 9.700 11.650 2.550 1.456 65536 56.430 72.032 8.710 9.004 262144 216.000 265.254 34.760 33.157 1048576 1447.610 1038.145 233.310 129.768 4000000 7757.160 3938.749 1672.110 492.344 元素数 模型截距份额 512 93.81% 4096 65.45% 65536 10.58% 262144 2.87% 1048576 0.73% 4000000 0.19% 表中差距直接显示模型外推误差。“每元素项”包含算术、缓存和内存成本,不等于访存;“截距项”是 CPU 路径模型,不等于 CUDA 发射。它不能证明加速的 94% 或 100% 来自某种原因。 这张图要看什么:左图只画 8 个 kernel 以便看清间隙,蓝条是提交、绿条是执行,Graph 下排的有效设备段包含假设增量 delta,不代表硬件零派发。右图用 700 个 kernel,红线为本组假设的精确盈亏点约 2.499 μs,阴影不是所有 CUDA Graph 的失败区域。 05. 工业级实现对照 5.1 torch.compile / Inductor:融合是调度器的决策 本节固定到 PyTorch v2.10.0。主入口是 torch/_inductor/compile_fx.py#compile_fx:FX 表达计算图,Inductor 负责 lowering、调度与生成后端代码,GPU 常用 Triton,CPU 也有自己的代码生成路径。 torch/_inductor/scheduler.py#Scheduler中,fuse_nodes 组织融合,can_fuse、can_fuse_vertical 与后端合法性检查判断候选能否合并。score_fusion_memory 的参数顺序是 self、node1、node2、count_bytes,不是把 count_bytes 当第一个参数;默认分支估计两个节点共有读写依赖所代表的内存收益,它的文档也仅称融合评分的第一项。混合顺序归约有单独路径,最终策略还要考虑后端、拓扑、资源与实际基准,不能说评分就是全部节省的字节。 本轮直接从该固定源文件抽取完整评分方法,在 CPU 上用小型依赖图夹具执行共享、非共享、大小集合分支,检查字节估计;没有改写函数体,也没有编译 GPU 内核。这验证了评分语义,未验证端到端 Inductor 性能。 归约、随机数、原地写、别名和动态 shape 都可能限制某一种融合,但不是统一的“禁止融合表”。例如行归约 softmax 正是经典融合目标;随机数需要维持合法 RNG 语义;动态 shape 可通过 guard、符号形状或重编译处理。编译器应先保证依赖与数值语义,再判断成本。 5.2 一个必须在 05 节点名的差异:epilogue fusion 最小实现里的融合是「一串逐元素算子合成一个 kernel」。生产实现里最有价值的融合形态是 epilogue fusion:把接在 GEMM 后面的 bias、激活、缩放并进 GEMM 的 kernel 里,让 GEMM 的输出直接以最终形态写出,不经过显存。 仅对 $[M,N]$ 的 fp32 输出流计数:分离的 GEMM 写一次 $4MN$,bias 加法读写 $8MN$,激活再读写 $8MN$,合计 $20MN$;融合后最终结果写一次 $4MN$。这里输出流量少 80%,不能说整个 GEMM 的总访存降到 $1/5$。 若把两边共有的矩阵输入流量记为 $Q_{AB}$、bias 只读一次的理想流量为 $4N$,则总量比为: $$\frac{Q_{AB}+20MN+4N}{Q_{AB}+4MN+4N}$$ 它通常小于 5,并随输入占比改变;真实 bias 广播、缓存命中与 GEMM 分块还会修改物理字节。融合让累加器中的结果接着做 bias/激活再写出,具体能否采用这种 epilogue,要看 GEMM 后端、dtype 与可用资源。 5.3 CUDA Graph 在 PyTorch 里的落地 固定版本的 torch/cuda/graphs.py#CUDAGraph暴露 capture_begin、capture_end、instantiate、replay。三个细节需要修正: graph_pool_handle() 是可选的跨图共享提示。 capture_begin(pool=None) 合法;PyTorch 的 caching allocator 会为捕获管理私有池。通常要保留静态输入/输出和相关内存的生命周期,并不要求所有张量先由用户显式塞进同一个池。 实例化时机依赖 keep_graph。 默认 keep_graph=False 在 capture_end 已实例化;True 时可显式 instantiate(),否则首次 replay() 自动实例化。提前实例化以避免第一次 replay 延迟增加,是针对后一种路径的建议,不能当作所有调用的强制步骤。 CUDA Graph Trees 管理路径与内存生命周期。 torch/_inductor/cudagraph_trees.py与固定版本说明讨论录制路径、输出存活和内存复用。不同 shape 可能触发新录制;路径分支也不只有前反向形状变化这一种。torch.compile(mode="reduce-overhead") 可以启用相关优化,但不保证任意程序都完整捕获或加速。 本轮 CPU 对原 Python CUDAGraph 包装类做委托契约检查,底层 CUDA 基类用显式测试替身记录参数;同时查验原 C++ 实例化条件。它只能验证包装层的可选参数与委托,并没有执行 CUDA capture/replay。 5.4 差异从哪来:为什么生产实现不能只有最小实现 差异 原因与边界 合法性与成本分开 依赖/别名正确仍不保证融合有收益;寄存器和共享内存可能限制并行度 guard 与形状管理 动态输入可能重编译、分桶或重录;并非所有动态 shape 都无法优化 静态地址与生命周期 捕获的地址须在回放时有效;私有池和跨图共享池有不同用途 RNG、原地更新与输出复用 支持的语义需按后端和 API 核对,不能只看数学表达式 单次成本与重复成本 编译、录制、实例化、上传、输入复制和稳态回放分别计时 06. 代价与边界 6.1 收益受资源与实际执行限制 $K/(1+(K-1)/\rho)$ 是第 3.2 节所列存储假设的结果,不能当成硬件定律。本轮逻辑吞吐比 2.914 与 V2 最佳 1.431 倍只描述这些 CPU 程序;V2 仍有 tile 内的 16 次数组调用与输出复制,不能说“留片上动作已做对”。 V3 只对仿射复合成立,真实融合通常要保留非线性、归约或随机行为。若改成每段 max(A*h+B,0),再直接用无激活的闭式就会算错;新增检查脚本给出该反例。融合也可能增加寄存器压力、溢写和重算,降低 occupancy,所以即便中间逻辑字节更少,也可能更慢。 6.2 融合会改变数值 本轮 V1/V3 最大相对误差约 $6.17\times10^{-7}$,仅对表中随机 fp32 输入成立。舍入重排不是必然有害,也不是自动无害:例如 fp32 中先算 $(10^{20}+(-10^{20}))+3$ 得 3,换成 $10^{20}+((-10^{20})+3)$ 得 0。低精度、溢出、抵消和长链都能扩大差异。 因此验证应比较形状、dtype、绝对/相对误差及任务敏感性;需要逐位复现时不能只说“在许可范围内”。只改变 kernel 边界也未必改变计算顺序,但代数合并、FMA 与归约重排可能改变结果。 6.3 分块 softmax 不能只凭一个耗时比判瓶颈 保留原 [E] 的五步稳定 softmax:减去逐行最大值后指数化,按行求和再除;输入形状 [8,1024,1024]、fp32,一份 score 为 32 MiB,五步完整尺寸逻辑流量为 256 MiB。本轮全数组 16.983 ms,64 行分块 13.183 ms,快 1.288 倍,输出逐位相同;这和旧 M1 观测方向不同。 用 [B] 的 large 逻辑吞吐 19.559 GB/s 做除法,得到 13.724 ms 参照;1.237 倍的差距不能证明主要时间全在 exp。add 的逻辑吞吐不是此 shape 的物理带宽上限,归约、广播、缓存、布局和循环都未隔离。要识别瓶颈需分别计时或硬件 profile,当前结果不提供这种因果证据。 真正融合的 softmax 会改变访存和调用;FlashAttention进一步用分块与在线归一化避免保存完整 score/概率,并可在因果模式跳过无用块。它不是因为“融合对计算受限算子完全无效”才需要存在;某些优化也可能同时改变算法、并行与计算量。 6.4 CUDA Graph 的接口边界与摊销 一次基本 capture 的张量布局、地址和调用拓扑须满足回放契约;不同 shape 可分桶、重录,或在适用时更新图参数。它不是变长服务必然不能用 Graph 的证明。 PyTorch 捕获不能执行依赖 CPU 返回值的同步操作,如 .item();普通 CPU Python 逻辑也不会被录下来在 replay 时重跑。RNG 有受支持的状态管理,需要按 API 使用。 CUDA Graph 本身可以有内存拷贝等节点;因此“不能有 D2H 拷贝”不是 CUDA 图机制的统一限制。是否能在某个 PyTorch 捕获路径中使用,要看主机内存、异步接口与实际版本约束。 显存地址须有效,但用户显式 graph_pool_handle() 不是必需;捕获中原始 cudaMalloc 与框架 allocator 处理的张量分配也不能混为一谈。 大 kernel 常使逐项提交成本更易被隐藏,因此潜在收益可能较小;仍要测实际调度和首次成本,不能宣称必然倒退 2%。 PyTorch 固定版本 CUDA 说明是接口约束的依据。实践上先看 trace 与稳态/端到端延迟,再决定融合、Graph 或二者组合。列表练习中 1093→355 只是给定手选 lowering 的节点数对照,真实框架不会仅凭模型层数自动得到这个结果。 6.5 证据的范围 本机实测:三个原脚本在本轮 Windows CPU 上的 NumPy 输出、配对计时与五图;matplotlib 3.11.2、PyTorch 2.10.0+cpu。线程限制只作用于当前进程,未改系统环境。 数学验证:独立公式、逐项数组计数、稳定 softmax 与形状/尾块反例;验证算术和实现,不是实际 GPU 速度。 工业源码:固定 PyTorch v2.10.0 官方源码;完整评分方法 CPU 执行,以及原包装类契约测试。未执行 CUDA、Inductor GPU 编译、预训练模型或服务性能复现。 假设推演:700 节点事件模型、1093/355 手选列表、Graph 增量与摊销输入。它们可改可复算,不是硬件 trace,也不验证 CPU/GPU 之间的比例。 07. 经典论文脉络 四篇,按「融合是怎么从手工技巧变成系统能力,又怎么被反过来审视」串起来。 TVM: An Automated End-to-End Optimizing Compiler for Deep Learning(arXiv:1802.04799,2018)。把计算图优化与面向硬件的算子调度、自动搜索组织成端到端编译系统;论文讨论 operator fusion,但不据此声称它是自动融合的起点,也不能把本文简化字节式直接等同于其整个搜索目标。 The Deep Learning Compiler: A Comprehensive Survey(arXiv:2002.03794,2020,本文知识树的锚点)。给出一张完整坐标系:图级优化(融合、常量折叠、CSE)、算子级优化、内存分配、后端代码生成。它把融合明确归到「图级优化」——融合通常结合图与算子层的依赖、布局和数值语义;不能从“图级优化”的分类推成编译器对算子数学一无所知。 FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135,2022)。把融合推到极致:不只把 softmax 融进注意力,还根本不实例化 $S \times S$ 的 score 矩阵,用在线 softmax 一边遍历一边归一化。这正是本篇 [A] 节那 1.000 GiB 中间产物的解法,因果模式可跳过无用块;精确节省依 tile、尾块和实现而定,不应对所有模式一概声称减少一半算术。 Operator Fusion in XLA: Analysis and Evaluation(arXiv:2301.13062,2023)。反过来审视这件事:作者去读 XLA 的融合 pass 源码,在 Cartpole 的 2048 并行环境、10000 步、RTX 2080 Ti 测试中,将代码改写、融合边界调整与 10 次循环展开等结合,报告相对论文原始 JAX-XLA baseline 最高 10.56 倍。它不是孤立一次 fusion pass 的通用收益。这篇的价值在于它把「融合是好事」这个默认假设变成了可度量的对象——它提醒我们连同 baseline、shape、后端与改写方式报告结果,不能只保留最大倍数。 至于 CUDA Graph,它不是论文,是 CUDA 10 起提供的一项运行时机制(录制-实例化-回放),说明见 CUDA C++ Programming Guide 的 CUDA Graphs 一节。把它和融合并列讨论,是因为它经常被当成融合的替代品——而它其实解决另一个问题。 08. 常见误解 「融合越大越好」。 依赖合法之后还要看寄存器、共享内存、occupancy、溢写与重复计算;字节更少不保证时延更低。 「CUDA Graph 的盈亏只由执行时间是否小于 launch 决定」。 第 3.4 节展示同一个大 kernel 在不同增量假设下可慢、平、快;还须摊销录制与复制。 「融合不改变数值,或舍入变化一定无害」。 只改变调度不必改变数学,但重排和 FMA 可能改变浮点值;需按任务验证。 「CPU tile 就是 GPU shared memory,rho 一测就能预测融合」。 NumPy 分块仍有多次 ufunc 和复制,工作集分组不识别缓存层级,不能承担这一推断。 「融合永远不改变 FLOPs」。 单纯消除中间存储可不改 FLOPs,代数化简或重算则会改;V3 正是同时改变运算量的例子。 「softmax 比字节除带宽慢,就证明卡在 exp」。 这只显示基准模型不足,当前实验没有隔离 exp、归约、缓存和调度。 09. 动手验证 前三个原脚本计算只需 NumPy(画图另需 matplotlib),独立检查还需 PyTorch CPU,不需要 GPU;按下面顺序运行即可得到本轮同口径的形状与数值,计时随机器和负载变化: python fusion_lab.py ALL python launch_model.py python fusion_checks.py python make_figures.py 实验一:测调用模型。 python fusion_lab.py D 拟合你自己的 $a,b,n^{\ast}$;本轮约 0.477 μs、7758 元素,不能预设其他机器相同。单独运行 D 会覆盖 _fusion_results.json 为当前部分结果,画全套图前应重新运行 ALL。 实验二:把 K 改成 16。 V1 的调用由 16 次变为 32 次,V3 仍为两次。理想逻辑字节比变为 16;实际加速未必贴着 16,也不受此值作为通用时延上限约束。检查较长链的舍入误差和计时变化,而非预设一定更快。 实验三:改变访问步长。 对相同逻辑元素数分配更大底层数组,再用步长视图测 add。分别报告逻辑字节、底层地址跨度和计时;步长可能增加缓存行流量,但不能据此预设 small/large 比必然趋向 1。两层模型只是要被检验的假设。 实验四:查模型反例。 fusion_checks.py 比较事件闭式与递推,验证 $N=1$、相等提交/执行时间、尾 tile、极端 softmax、非仿射与浮点抵消。把 Graph 的增量改成 0 或负值,看“大 kernel 必亏”如何失效。 实验五:自己列 kernel。 在 launch_model.py 的 per_layer 中改 lowering 情景,再对真实 GPU profiler 的 kernel trace(若有)核对;列表和不能当作实测。要测 CUDA Graph,应另外按官方示例准备 GPU、静态输入、预热和同步,并分别报告录制成本与多次稳态回放;本篇没有把这部分标为已跑。 10. 延伸阅读 performance_profiling|性能建模与 Profiling:本篇 3.1 节的 roofline 判据来自那里,需要区分理想物理带宽与程序的逻辑吞吐。 attention_basics|自注意力机制:理解 3.5 节因果掩码和 [A] 节 score 矩阵形状的前提。 flash_attention|FlashAttention:本篇 [A] 节那 1.000 GiB 中间产物的正式解法,融合走到极致的样子。 mixed_precision|混合精度:数据类型决定 $b$(每元素字节数),直接进 3.2 节的账本。 kv_cache|KV Cache 与自回归视频生成:decode 场景为什么 kernel 又多又小,那篇给的 cache 账本是本篇 6.4 节「分段 capture」动机的来源。 附录:完整代码 09 节用到的脚本全文如下(launch_model.py、fusion_checks.py、fusion_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 launch_model.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ launch_model.py —— 发射开销、CUDA Graph,以及它们和融合的分工 只捕获回放同一组kernel时逻辑字节不变;融合与代数化简可能改变字节和算术。 这个脚本把两件事分开算: [F1] 离散事件时间线:eager 逐个发射 vs CUDA Graph 一次发射 [F2] 扫描:单个 kernel 执行多久时,CUDA Graph 才赚? [F3] 按 Llama-3-8B 架构手数一步 decode 有多少个 kernel [F4] 分解:本机实测的 K 段链加速里,截距项和每元素项的条件性分解 所有微秒输入与kernel列表都是教学假设,不是当前机器CUDA实测。 官方背景:https://developer.nvidia.com/blog/cuda-graphs/ 固定开销模型不能证明大kernel必亏;td为相对eager的假设增量。 运行: python launch_model.py """ from __future__ import annotations import json import os import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # ══════════════════════════════════════════════════════════════ # [F1] 离散事件时间线 # ══════════════════════════════════════════════════════════════ def simulate_eager(n_kernel, t_launch, t_exec): """eager:CPU 逐个 cudaLaunchKernel,GPU 逐个执行,单流异步。 CPU 发第 i 个要花 t_launch,发完就不用管了,可以继续发下一个; GPU 要等「前一个跑完」且「这个已经被发出去」才能开始。 两个条件里慢的那个决定 GPU 什么时候开工,差出来的就是 GPU 空转。 """ if not isinstance(n_kernel,int) or n_kernel < 1 or t_launch < 0 or t_exec < 0: raise ValueError("positive kernel count and nonnegative times required") gpu_free = 0.0 idle = 0.0 for i in range(n_kernel): cpu_done = (i + 1) * t_launch # CPU 发完第 i 个的时刻 start = max(gpu_free, cpu_done) # GPU 能开工的时刻 idle += start - gpu_free gpu_free = start + t_exec return {"total": gpu_free, "idle": idle, "idle_frac": idle / gpu_free if gpu_free > 0 else 0.0} def simulate_graph(n_kernel, t_launch, t_exec, t_dispatch): """CUDA Graph:一次 cudaGraphLaunch 提交整张图。 t_launch在此代表整图CPU提交时间;t_dispatch为每节点相对eager 的设备耗时增量。它可以为零或负,不是CUDA固定派发罚金。 """ if not isinstance(n_kernel,int) or n_kernel < 1 or t_launch < 0 or t_exec < 0 or t_exec+t_dispatch < 0: raise ValueError("invalid graph model inputs") total = t_launch + n_kernel * (t_exec + t_dispatch) return {"total": total, "idle": t_launch, "idle_frac": t_launch / total if total > 0 else 0.0} def section_F1(): print("\n" + "=" * 72) print("[F1] 时间线:eager 逐个发射 vs CUDA Graph 一次发射") print("=" * 72) N, tl, te, td = 700, 3.0, 2.0, 0.5 e = simulate_eager(N, tl, te) g = simulate_graph(N, tl, te, td) print(f"\n 设定:N={N} 个 kernel,发射 {tl} us,执行 {te} us," f"graph 内派发 {td} us") print(f" eager 总时长 {e['total']:8.1f} us,GPU 空转 {e['idle']:7.1f} us" f"({e['idle_frac']*100:.0f}%)") print(f" CUDA Graph 总时长 {g['total']:8.1f} us,GPU 空转 {g['idle']:7.1f} us" f"({g['idle_frac']*100:.0f}%)") print(f" 加速比 = {e['total']/g['total']:.2f}x") # 换一个大 kernel 场景:执行时间远大于发射 e2 = simulate_eager(N, tl, 20.0) g2 = simulate_graph(N, tl, 20.0, td) print(f"\n 换成大 kernel(执行 20 us):") print(f" eager {e2['total']:8.1f} us,空转 {e2['idle_frac']*100:.0f}%") print(f" CUDA Graph {g2['total']:8.1f} us,空转 {g2['idle_frac']*100:.0f}%") print(f" 加速比 = {e2['total']/g2['total']:.2f}x -> 几乎没用") print("这是delta=0.5us的假设案例,大kernel是否收益须测两侧前端及摊销。") return {"N": N, "t_launch": tl, "t_exec": te, "t_dispatch": td, "eager": e, "graph": g, "speedup": e["total"] / g["total"], "big": {"eager": e2, "graph": g2, "speedup": e2["total"] / g2["total"]}} # ══════════════════════════════════════════════════════════════ # [F2] 扫描:什么时候值得上 CUDA Graph # ══════════════════════════════════════════════════════════════ def section_F2(): print("\n" + "=" * 72) print("[F2] 扫描:单 kernel 执行时间 t_exec 对加速比的影响") print("=" * 72) N, tl, td = 700, 3.0, 0.5 print(f"\n N={N}, 发射 {tl} us, graph 内派发 {td} us") print(f"\n {'t_exec(us)':>11} {'eager(us)':>11} {'graph(us)':>11} " f"{'加速':>7} {'eager空转':>9}") rows = [] for te in [0.5, 1.0, 2.0, 3.0, 5.0, 8.0, 12.0, 20.0, 40.0]: e = simulate_eager(N, tl, te) g = simulate_graph(N, tl, te, td) rows.append({"t_exec": te, "eager_us": e["total"], "graph_us": g["total"], "speedup": e["total"] / g["total"], "idle_frac": e["idle_frac"]}) print(f" {te:>11.1f} {e['total']:>11.1f} {g['total']:>11.1f} " f"{e['total']/g['total']:6.2f}x {e['idle_frac']*100:8.0f}%") crossover=(N*tl- tl-td*N)/(N-1) print(f"本假设CPU受限分支精确盈亏点 {crossover:.9f}us;不是通用CUDA边界") return {"N": N, "t_launch": tl, "t_dispatch": td, "rows": rows} # ══════════════════════════════════════════════════════════════ # [F3] 一步 decode 有多少个 kernel(按架构手数) # ══════════════════════════════════════════════════════════════ # Llama-3-8B 的公开配置 LLAMA3_8B = dict(n_layer=32, d_model=4096, n_head=32, n_kv_head=8, head_dim=128, d_ffn=14336, vocab=128256) def section_F3(): print("\n" + "=" * 72) print("[F3] 一步 decode 有多少个 kernel(按 Llama-3-8B 架构手数)") print("=" * 72) print("\n ⚠ 这是**按架构推导**,不是实测。真实数字取决于编译器怎么 lowering,") print(" 列表是手选lowering情景,架构不能决定真实kernel数。") cfg = LLAMA3_8B # 每层:括号里是不融合时这个模块会拆成几个 kernel per_layer = [ ("输入 RMSNorm", 4), # 平方 / 归约 / 乘 / 缩放 ("q_proj", 1), ("k_proj", 1), ("v_proj", 1), ("RoPE on q", 3), # cos/sin 表取 + 旋转 + 拼接 ("RoPE on k", 3), ("KV cache 写入", 2), # k、v 各一次 scatter ("QK^T", 1), ("scale + mask", 2), ("softmax", 3), # max / sub+exp / sum+div ("@V", 1), ("o_proj", 1), ("残差加", 1), ("后注意力 RMSNorm", 4), ("gate_proj", 1), ("up_proj", 1), ("SiLU", 1), ("逐元素乘", 1), ("down_proj", 1), ("残差加", 1), ] total_per_layer = sum(k for _, k in per_layer) n_layer = cfg["n_layer"] total = total_per_layer * n_layer + 5 # + 输出层 norm / lm_head / 采样等 print(f"\n 每层 {total_per_layer} 个 kernel:") for name, k in per_layer: print(f" {name:<22} {k}") print(f"\n x {n_layer} 层 = {total_per_layer*n_layer},加输出头约 5 个") print(f" 合计 ≈ {total} 个 kernel / token") print("这是列表求和,不是GPU trace,也不构成对真实kernel数的验证。") # 融合后:把每层里能合的合掉 fused_per_layer = [ ("RMSNorm 融合", 1), ("QKV 一次 GEMM", 1), ("RoPE 融合", 1), ("KV cache 写入", 1), ("注意力融合(Flash)", 1), ("o_proj", 1), ("残差 + RMSNorm 融合", 1), ("gate/up 一次 GEMM", 1), ("SiLU + 乘 融合", 1), ("down_proj", 1), ("残差加", 1), ] fused_pl = sum(k for _, k in fused_per_layer) fused_total = fused_pl * n_layer + 3 print(f"\n 融合后每层 {fused_pl} 个 -> 合计 ≈ {fused_total} 个/token") print(f" kernel 数减少 {total/fused_total:.1f}x") print(f"\n 注意:融合减少的是 kernel 数,CUDA Graph 不减少 kernel 数,") print(f" 它只是把 {total} 次 CPU 发射合并成 1 次。两者正交,可以同时用。") return {"cfg": cfg, "per_layer": per_layer, "total_per_layer": total_per_layer, "total": total, "fused_per_layer": fused_per_layer, "fused_total": fused_total, "reduce": total / fused_total} # ══════════════════════════════════════════════════════════════ # [F4] 分解:本机实测的加速里,发射和字节各占多少 # ══════════════════════════════════════════════════════════════ def section_F4(fus): print("\n" + "=" * 72) print("[F4] 分解:本机 K 段链的加速里,多少归于调用截距项、多少归于每元素项") print("=" * 72) D = fus["D"] C = fus["C"] a = D["a_us"] # 每次调用的固定开销(拟合) b = D["b_us_per_elem"] # 每元素的边际成本(拟合) K = C["K"] print(f"\n 局部拟合截距 a = {a:.3f} us/次,边际 b = {b*1e6:.2f} us/百万元素") print(f"\n {'n':>9} {'V1 实测':>10} {'V1 模型':>10} {'V3 实测':>10} " f"{'V3 模型':>10} {'发射贡献':>9}") rows = [] for c in C["curves"]: n = c["n"] # V1: 2K 次调用,每次搬 n 个元素;V3: 2 次调用 t1_model = 2 * K * (a + b * n) t3_model = 2 * (a + b * n) # 反事实:只把调用次数从 2K 降到 2,数据量不变(纯发射收益) t_launch_only = 2 * K * a + 2 * K * b * n - (2 * a + 2 * K * b * n) total_gain = t1_model - t3_model frac = t_launch_only / total_gain if total_gain > 0 else 1.0 rows.append({"n": n, "t1_model": t1_model, "t3_model": t3_model, "launch_frac": frac}) print(f" {n:>9} {c['t1_us']:9.2f} us {t1_model:9.2f} us " f"{c['t3_us']:9.2f} us {t3_model:9.2f} us {frac*100:8.0f}%") small = rows[0] big = rows[-1] print(f"\n n={small['n']}({small['n']*4/1024:.1f} KiB):" f"仿射模型分解的 {small['launch_frac']*100:.0f}% 归于调用截距项," f"只有 {(1-small['launch_frac'])*100:.0f}% 归于每元素项。") print(f" n={big['n']}({big['n']*4/1024/1024:.1f} MiB):" f"反过来,{big['launch_frac']*100:.0f}% 归于调用截距项," f"{(1-big['launch_frac'])*100:.0f}% 归于每元素项。") print(f"\n 这就是本文最想说的一句话:") print(f" **模型分解不等于实测因果;每元素项含算术、缓存与内存等成本。**") print(f" CUDA Graph 只做前一件,而且做得更彻底(一次发射整张图)。") return {"a_us": a, "b_us_per_elem": b, "rows": rows} # ══════════════════════════════════════════════════════════════ def main(): res = {} res["F1"] = section_F1() res["F2"] = section_F2() res["F3"] = section_F3() p = os.path.join(HERE, "_fusion_results.json") if os.path.exists(p): with open(p, encoding="utf-8") as f: fus = json.load(f) if "C" in fus and "D" in fus: res["F4"] = section_F4(fus) else: print("\n[F4] 跳过:先跑 fusion_lab.py ALL 生成 _fusion_results.json") p = os.path.join(HERE, "_launch_results.json") with open(p, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=2) print(f"\n结果已写入 {p}") if __name__ == "__main__": main() fusion_checks.py """Independent CPU checks for the article; no CUDA execution is claimed.""" from pathlib import Path import json,math import numpy as np import fusion_lab as f import launch_model as l def main(): rng=np.random.default_rng(113) cases=0;relmax=0.0 for n in [1,7,16,31,257,4097]: for k in [1,2,8,16]: x=rng.normal(size=n).astype(np.float32) a=f._v1_unfused(x,np.empty_like(x),k).copy() for tile in [1,7,32,10000]: b=f._v2_tiled(x,np.empty_like(x),tile,k) assert np.array_equal(a,b);cases+=1 b=f._v3_closed(x,np.empty_like(x),k) expected=(float(f.A_S)**k)*x.astype(np.float64)+f.B_S*sum(f.A_S**j for j in range(k)) err=float(np.max(np.abs(b-expected))/max(1,np.max(np.abs(expected)))) relmax=max(relmax,err);assert err<1e-6 event=0 for n in [1,2,7,700,1093]: for launch in [0.0,0.5,3.0]: for execute in [0.0,0.5,2,3,20]: r=l.simulate_eager(n,launch,execute) exact=launch+execute+(n-1)*max(launch,execute) assert math.isclose(r['total'],exact,abs_tol=1e-9) assert math.isclose(r['idle'],exact-n*execute,abs_tol=1e-9);event+=1 big={str(d):l.simulate_eager(700,3,20)['total']/l.simulate_graph(700,3,20,d)['total']for d in [.5,0,-.1]} assert big['0']==1 and big['-0.1']>1 and big['0.5']<1 crossover=(700*3-3-700*.5)/699 assert abs(l.simulate_eager(700,3,crossover)['total']-l.simulate_graph(700,3,crossover,.5)['total'])<1e-9 h=1000;delta=2102-1753 assert 2*delta<=h and 3*delta>h soft=0;softmaxerr=0.0 import torch torch.set_num_threads(1) for shape in [(1,1,3),(2,7,17),(3,9,64)]: for scale in [1,1000]: x=(rng.normal(size=shape)*scale).astype(np.float32) y=f._softmax_unfused(x,np.empty_like(x)).copy() for rows in [1,4,100]: z=f._softmax_tiled(x,np.empty_like(x),rows);assert np.array_equal(y,z);soft+=1 ref=torch.softmax(torch.from_numpy(x).double(),dim=-1).numpy() err=float(np.max(np.abs(y-ref)));softmaxerr=max(err,softmaxerr);assert err<2e-7 assert np.all(np.isfinite(y))and np.all(y>=0)and np.allclose(y.sum(-1),1,atol=2e-7) blocks=0 for seq in [1,2,7,16,64]: mask=np.tril(np.ones((seq,seq),dtype=bool));assert mask.sum()==seq*(seq+1)//2 for tile in [1,2,4,8]: cells=[mask[i:i+tile,j:j+tile].any()for i in range(0,seq,tile)for j in range(0,seq,tile)] nb=math.ceil(seq/tile);assert sum(cells)==nb*(nb+1)//2;blocks+=1 left=np.float32(np.float32(1e20)+np.float32(-1e20))+np.float32(3) right=np.float32(1e20)+(np.float32(-1e20)+np.float32(3));assert left==3 and right==0 x=np.array([-10,-1,1],dtype=np.float64);relu=x.copy() for _ in range(8):relu=np.maximum(f.A_S*relu+f.B_S,0) affine=f.A_S**8*x+f.B_S*sum(f.A_S**j for j in range(8));assert relu[0]>affine[0] rejected=0 for fn in [lambda:f._v1_unfused(np.ones(1),np.empty(1),0),lambda:f._v2_tiled(np.ones(1),np.empty(1),0),lambda:f._v3_closed(np.ones(1),np.empty(1),-1),lambda:l.simulate_eager(0,1,1),lambda:l.simulate_graph(1,1,1,-2)]: try:fn() except ValueError:rejected+=1 else:raise AssertionError('Invalid input accepted') # Scalar, full-size stream count under the assumptions in section3.2. n=4000000;b=4;chain=16*2*n*b;v3=2*2*n*b;ideal=2*n*b assert chain/v3==8 and chain/ideal==16 assert (2+1+2+3)*n*b/(3*n*b)==8/3 result=dict(passed=True,block_tail_exact_cases=cases,affine_float64_reference_max_relative_error=relmax,event_cases=event,graph_big_kernel_speedups=big,graph_crossover_us=crossover,amortization_min_replays=3,softmax_tiled_cases=soft,softmax_torch_float64_max_error=softmaxerr,causal_block_cases=blocks,float32_reassociation=[float(left),float(right)],nonlinear_counterexample=[relu.tolist(),affine.tolist()],invalid_inputs_rejected=rejected,logical_bytes=dict(v1=chain,v3=v3,ideal_fused=ideal),scope='CPU NumPy, original event simulator and Torch softmax reference; no CUDA or physical memory profiling',errors=[],warnings=[]) p=Path(__file__).with_name('validation_results.json');p.write_text(json.dumps(result,indent=2),encoding='utf8');print(json.dumps(result,indent=2)) if __name__=='__main__':main() fusion_lab.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ fusion_lab.py —— 算子融合的「字节账本 + 实测校验」 本脚本用 NumPy 在 CPU 上测量调用和逻辑数组流量,不需要 NVIDIA GPU。 历史版本的 M1 结果保留于基线;当前环境与输出由实跑证据另行记录。 本脚本不能识别实际缓存驻留、DRAM 字节或 CUDA launch 成本。 可测的是CPU数组程序在不同规模下的耗时和逻辑吞吐,不能凭此 识别缓存层级或把每次调用的截距当成CUDA launch成本。 五组实验: [A] 字节账本 —— 几类常见 pattern 融合前后各搬多少字节(所列流量假设下的算术) [B] 带宽–工作集 —— 不同数组规模下的逻辑吞吐比 rho [C] 融合三形态 —— 不融合 / CPU分块 / 代数合并,扫规模看各自值多少 [D] 固定开销 —— 拟合出每次调用的固定成本,算它占总耗时的比例 [E] attention尾 —— score 矩阵账本、本机 softmax 对照 运行: python fusion_lab.py ALL """ from __future__ import annotations import json import os import time import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) RNG_SEED = 20261002 MIB = float(1024 ** 2) GIB = float(1024 ** 3) # 逐元素链的形态:每段 h <- A*h + B,共 K 段 K_CHAIN = 8 A_S, B_S = 1.01, 0.01 def bench(fn, reps=7): """预热后取批次中位数;包括Python调用成本,不是硬件计数器。""" fn() ts = [] for _ in range(max(7, min(reps, 21))): t0 = time.perf_counter() for _ in range(10): fn() ts.append((time.perf_counter() - t0) / 10) return float(np.median(ts)) def paired_bench(fn1, fn2): fn1(); fn2() samples = [[], []] for r in range(9): for i in ([0, 1] if r % 2 == 0 else [1, 0]): samples[i].append(bench((fn1, fn2)[i], reps=7)) return tuple(float(np.median(t)) for t in samples), samples def passes_to_bytes(n_elem, dtype_bytes, n_passes): """1 个 pass = 把整个张量读一遍再写一遍 = 2 * 字节数。""" return 2.0 * n_elem * dtype_bytes * n_passes # ══════════════════════════════════════════════════════════════ # [A] 字节账本:融合前后各搬多少字节 # ══════════════════════════════════════════════════════════════ def section_A(): print("\n" + "=" * 72) print("[A] 字节账本:融合前后各搬多少字节(所列流量假设下的算术)") print("=" * 72) out = {} n = 4_000_000 # 一个中等激活张量,fp32 b = 4 # ── A1. K 段逐元素链 ────────────────────────────────── K = K_CHAIN unf = passes_to_bytes(n, b, 2 * K) fus = passes_to_bytes(n, b, 1) print(f"\n A1 {K} 段逐元素链({n/1e6:.0f}M 元素,fp32)") print(f" V1 的 {2*K} 个 ufunc : {unf/MIB:8.1f} MiB") print(f" 融合成 1 个 kernel : {fus/MIB:8.1f} MiB -> 流量比 {unf/fus:.2f}x") out["chain"] = {"K": K, "calls": 2*K, "v3_MiB": passes_to_bytes(n,b,2)/MIB, "unfused_MiB": unf / MIB, "fused_MiB": fus / MIB, "ratio": unf / fus} # ── A2. RMSNorm ─────────────────────────────────────── # 不融合:x*x(读写) / reduce mean(读) / x*r(读写) / *g(读写) unf = 8 * n * b fus = 3 * n * b # 只计完整尺寸流:平方2N、归约N、乘行尺度2N、乘gamma3N; # 融合读x/gamma写y共3N,忽略行尺度向量、缓存和溢写。 print(f"\n A2 RMSNorm({n/1e6:.0f}M 元素)") print(f" 分离完整尺寸流 : {unf/MIB:8.1f} MiB") print(f" 融合完整尺寸流 : {fus/MIB:8.1f} MiB -> 流量比 {unf/fus:.2f}x") out["rmsnorm"] = {"unfused_MiB": unf / MIB, "fused_MiB": fus / MIB, "ratio": unf / fus} # ── A3. attention 的 score 矩阵 ─────────────────────── Bs, H, S, D = 8, 16, 2048, 4096 dt = 2 # bf16 act_bytes = Bs * S * D * dt score_bytes = Bs * H * S * S * dt half = 1 + 2 + 2 + 1 + 2 # softmax 五步各读写几份 score unf = half * score_bytes fus = 2 * score_bytes print(f"\n A3 attention score(B={Bs}, H={H}, S={S}, d={D}, bf16)") print(f" 输入激活 [B,S,d] : {act_bytes/MIB:8.1f} MiB") print(f" score 矩阵 [B,H,S,S] : {score_bytes/GIB:8.3f} GiB" f" = 输入的 {score_bytes/act_bytes:.0f}x") print(f" softmax 不融合 {half} 份读写 : {unf/GIB:8.3f} GiB") print(f" softmax 融合 : {fus/GIB:8.3f} GiB -> 省 {unf/fus:.1f}x") print(" mask可广播或由坐标生成,不假定物化[B,H,S,S];未计mask额外流量") print(f"\n 放大倍数 = H*S/d = {H}*{S}/{D} = {H*S/D:.0f}x") print(f" S 翻一倍 -> 放大倍数翻一倍(score 按 S 的平方长,激活按 S 长)") for s in (1024, 2048, 4096, 8192): print(f" S={s:>5}: score/激活 = {H*s/D:5.1f}x") out["softmax"] = {"B": Bs, "H": H, "S": S, "d": D, "act_MiB": act_bytes / MIB, "score_GiB": score_bytes / GIB, "blowup": score_bytes / act_bytes, "unfused_GiB": unf / GIB, "fused_GiB": fus / GIB, "ratio": unf / fus, "mask_GiB": score_bytes / GIB, "blowup_curve": [{"S": s, "x": H * s / D} for s in (1024, 2048, 4096, 8192)]} # ── A4. 因果掩码:块级跳过能省多少 ──────────────────── total = S * S kept_exact = S * (S + 1) // 2 rows = [] print(f"\n A4 因果掩码 S={S}:块级跳过 vs 精确跳过") for br in (64, 128, 256): nb = S // br blocks_done = nb * (nb + 1) // 2 # query 块 i 只算 j<=i 的 key 块 rows.append({"br": br, "nb": nb, "frac": blocks_done / (nb * nb)}) print(f" 块边长 {br:>4}: 算 {blocks_done:>4}/{nb*nb:<4} 块" f" = {blocks_done/(nb*nb)*100:5.1f}% 工作量") print(f" 理论上界(逐元素精确): {kept_exact/total*100:5.1f}%") print(f" 完全不跳 : {100.0:5.1f}% -> 白算 " f"{100-kept_exact/total*100:.1f}%") out["causal"] = {"S": S, "exact_frac": kept_exact / total, "blocks": rows} return out # ══════════════════════════════════════════════════════════════ # [B] 工作集与逻辑吞吐 # ══════════════════════════════════════════════════════════════ def section_B(): print("\n" + "=" * 72) print("[B] 带宽 vs 工作集(np.add(x, 1, out=y):1 读 1 写)") print("=" * 72) rng = np.random.default_rng(RNG_SEED) print(f"\n {'工作集':>12} {'耗时':>10} {'带宽':>10} 归属") rows = [] for nbytes in [32 << 10, 128 << 10, 512 << 10, 2 << 20, 8 << 20, 32 << 20, 128 << 20]: n = nbytes // 4 x = rng.standard_normal(n).astype(np.float32) y = np.empty_like(x) bench(lambda: np.add(x, 1.0, out=y), reps=3) t = bench(lambda: np.add(x, 1.0, out=y), reps=11) bw = 2 * nbytes / t / 1e9 tag = "small" if nbytes <= (8 << 20) else "large" rows.append({"KiB": nbytes >> 10, "total_live_KiB": 2*nbytes/1024, "ms": t * 1e3, "GBs": bw, "tag": tag}) print(f" {nbytes>>10:>10} KiB {t*1e3:9.3f} ms {bw:9.1f} GB/s {tag}") del x, y b_cache = float(np.median([r["GBs"] for r in rows if r["tag"] == "small"])) b_dram = float(np.median([r["GBs"] for r in rows if r["tag"] == "large"])) rho = b_cache / b_dram print(f"逻辑吞吐small={b_cache:.3f}GB/s large={b_dram:.3f}GB/s rho={rho:.3f}") print("每行标称是单个数组大小;x与y的存活工作集为两倍。") print("阈值分组不证明缓存归属;此rho不能用作GPU片内/片外带宽比。") return {"rows": rows, "B_cache_GBs": b_cache, "B_dram_GBs": b_dram, "rho": rho} # ══════════════════════════════════════════════════════════════ # [C] 融合三形态 × 规模扫描 # ══════════════════════════════════════════════════════════════ def _v1_unfused(x, buf, K=K_CHAIN): """V1 不融合:K 段,每段 2 次算子调用,每段结果都写回内存。""" if not isinstance(K, int) or K < 1: raise ValueError("K must be a positive integer") np.multiply(x, A_S, out=buf) np.add(buf, B_S, out=buf) for _ in range(K - 1): np.multiply(buf, A_S, out=buf) np.add(buf, B_S, out=buf) return buf def _v2_tiled(x, out, tile, K=K_CHAIN): """CPU分块ufunc:仍执行2K次完整tile读写,不是真实寄存器融合。""" if not isinstance(tile, int) or tile < 1 or not isinstance(K, int) or K < 1: raise ValueError("tile and K must be positive integers") t = np.empty(tile, dtype=np.float32) for s in range(0, x.size, tile): m = min(tile, x.size - s) v = t[:m] np.multiply(x[s:s + m], A_S, out=v) np.add(v, B_S, out=v) for _ in range(K - 1): np.multiply(v, A_S, out=v) np.add(v, B_S, out=v) out[s:s + m] = v return out def _v3_closed(x, out, K=K_CHAIN): """V3 代数合并:K 段仿射合成一个仿射,只剩 2 次调用。 h_K = A^K * h_0 + B*(A^K - 1)/(A - 1) 中间结果根本不存在,连「留在片上」都不需要。 """ if not isinstance(K, int) or K < 1: raise ValueError("K must be a positive integer") Ak = A_S ** K Bk = B_S * sum(A_S ** j for j in range(K)) np.multiply(x, Ak, out=out) np.add(out, Bk, out=out) return out def section_C(rho): print("\n" + "=" * 72) print(f"[C] 融合三形态 × 规模扫描(K={K_CHAIN} 段 h <- {A_S}*h + {B_S})") print("=" * 72) rng = np.random.default_rng(RNG_SEED) sizes = [512, 4096, 65536, 262144, 1 << 20, 4_000_000] curves = [] print(f"\n {'n':>9} {'V1 不融合':>11} {'V3 代数合并':>11} " f"{'V1/V3':>7} {'相对误差':>10}") for n in sizes: x = rng.standard_normal(n).astype(np.float32) buf, out = np.empty_like(x), np.empty_like(x) (t1, t3), samples = paired_bench(lambda: _v1_unfused(x, buf), lambda: _v3_closed(x, out)) rel = float(np.max(np.abs(buf - out)) / np.max(np.abs(buf))) curves.append({"n": n, "t1_us": t1 * 1e6, "t3_us": t3 * 1e6, "speedup": t1 / t3, "rel_err": rel, "paired_samples_seconds": samples}) print(f" {n:>9} {t1*1e6:9.2f} us {t3*1e6:9.2f} us " f"{t1/t3:6.2f}x {rel:10.2e}") # V2在最大规模上比较不同tile;不据数组大小推断缓存归属。 print(f"\n V2 分块融合(n=4,000,000,扫 tile):") x = rng.standard_normal(4_000_000).astype(np.float32) buf, out = np.empty_like(x), np.empty_like(x) bench(lambda: _v1_unfused(x, buf), reps=3) t1_big = bench(lambda: _v1_unfused(x, buf), reps=11) print(f" V1 不融合基准: {t1_big*1e3:.3f} ms") v2 = [] for tile in [16384, 65536, 262144, 1 << 20]: bench(lambda: _v2_tiled(x, out, tile), reps=3) t = bench(lambda: _v2_tiled(x, out, tile), reps=11) assert np.array_equal(_v1_unfused(x,buf),out) v2.append({"tile": tile, "ms": t * 1e3, "speedup": t1_big / t, "exact_match": True}) print(f" tile={tile:>8}: {t*1e3:8.3f} ms {t1_big/t:5.2f}x") best2 = max(v2, key=lambda r: r["speedup"]) K = K_CHAIN pred = K / (1 + (K - 1) / rho) print(f"\n V2 最佳 {best2['speedup']:.2f}x(tile={best2['tile']})") print(f" 模型预测 K/(1+(K-1)/rho) = {K}/(1+{K-1}/{rho:.3f}) = {pred:.2f}x") print("该rho代入式子仅作敏感性算术,不是V2预测;分块仍有ufunc和拷贝成本。") print("V3减少算术与调用;K字节比不是普遍延迟上限,不能据此作因果归因。") return {"K": K, "rho": rho, "curves": curves, "v2": v2, "v2_best": best2, "v2_pred": pred, "t1_big_ms": t1_big * 1e3} # ══════════════════════════════════════════════════════════════ # [D] 固定开销:每次调用的地板成本 # ══════════════════════════════════════════════════════════════ def section_D(): print("\n" + "=" * 72) print("[D] 单次调用的固定开销(np.add(x, 1, out=y))") print("=" * 72) rng = np.random.default_rng(RNG_SEED) sizes = [1, 8, 64, 512, 4096, 16384, 65536, 262144, 1 << 20] print(f"\n {'n':>9} {'单次耗时':>11}") rows = [] for n in sizes: a = rng.standard_normal(n).astype(np.float32) b = np.empty_like(a) reps = 20000 if n <= 4096 else 500 samples = [] for _ in range(7): np.add(a, 1.0, out=b) t0 = time.perf_counter() for _ in range(reps): np.add(a, 1.0, out=b) samples.append((time.perf_counter() - t0) / reps) t = float(np.median(samples)) rows.append({"n": n, "us": t * 1e6, "samples_seconds": samples}) print(f" {n:>9} {t*1e6:9.3f} us") # 拟合范围限于小数组;不同规模的缓存/算术吞吐可能使仿射模型失效。 ns = np.array([r["n"] for r in rows if r["n"] <= 16384], dtype=float) ts = np.array([r["us"] for r in rows if r["n"] <= 16384], dtype=float) A = np.stack([np.ones_like(ns), ns], axis=1) coef, *_ = np.linalg.lstsq(A, ts, rcond=None) a_us, slope = float(coef[0]), float(coef[1]) print(f"\n 拟合 t = a + b*n(n <= 16384):") print(f" 固定开销 a = {a_us:.3f} us / 次") print(f" 边际成本 b = {slope*1e6:.3f} us / 百万元素") if a_us <= 0 or slope <= 0: raise RuntimeError("Affine fit invalid; do not claim a positive crossover") n_half = a_us / slope print(f" 开销与数据各占一半的临界规模 n* = a/b = {n_half:.0f} 元素" f"({n_half*4/1024:.1f} KiB)") print(f"\n {K_CHAIN} 段链({2*K_CHAIN} 次调用)里固定开销的占比:") share = [] for r in rows: n = r["n"] fixed = 2 * K_CHAIN * a_us tc = 2 * K_CHAIN * (a_us + slope * n) frac = fixed / tc if tc > 0 else 1.0 share.append({"n": n, "fixed_frac": frac}) print(f" n={n:>9}: 固定部分占 {frac*100:5.1f}%") return {"rows": rows, "a_us": a_us, "b_us_per_elem": slope, "n_half": n_half, "share": share, "K": K_CHAIN} # ══════════════════════════════════════════════════════════════ # [E] attention 尾部:本机 softmax 对照 # ══════════════════════════════════════════════════════════════ def _softmax_unfused(x, out): m = np.max(x, axis=-1, keepdims=True) # 读 np.subtract(x, m, out=out) # 读 x + 写 out np.exp(out, out=out) # 读 + 写 s = np.sum(out, axis=-1, keepdims=True) # 读 np.divide(out, s, out=out) # 读 + 写 return out def _softmax_tiled(x, out, rows): for i in range(0, x.shape[1], rows): sl = slice(i, i + rows) blk, dst = x[:, sl, :], out[:, sl, :] m = np.max(blk, axis=-1, keepdims=True) np.subtract(blk, m, out=dst) np.exp(dst, out=dst) s = np.sum(dst, axis=-1, keepdims=True) np.divide(dst, s, out=dst) return out def section_E(b_dram): print("\n" + "=" * 72) print("[E] attention 尾部:本机 softmax 分块对照") print("=" * 72) rng = np.random.default_rng(RNG_SEED) H, S = 8, 1024 x = rng.standard_normal((H, S, S)).astype(np.float32) nbytes = x.nbytes print(f"\n score 矩阵 [H={H}, S={S}, S={S}] = {nbytes/MIB:.1f} MiB") out = np.empty_like(x) bench(lambda: _softmax_unfused(x, out), reps=3) t_unf = bench(lambda: _softmax_unfused(x, out), reps=11) ref = out.copy() o2 = np.empty_like(x) bench(lambda: _softmax_tiled(x, o2, 64), reps=3) t_til = bench(lambda: _softmax_tiled(x, o2, 64), reps=11) diff = float(np.max(np.abs(ref - o2))) traffic = 8 * nbytes # [A3] 里的 8 份读写 roof = traffic / (b_dram * 1e9) * 1e3 print(f"\n 不融合(5 次 NumPy 调用,共 {traffic/MIB:.0f} MiB 读写): {t_unf*1e3:8.3f} ms") print(f" 分块融合(rows=64) : {t_til*1e3:8.3f} ms" f" speedup={t_unf/t_til:.2f}x diff={diff:.1e}") print(f"\n add逻辑吞吐参照 = {traffic/MIB:.0f} MiB / {b_dram:.0f} GB/s = {roof:.3f} ms") print(f" 实测 / 参照 = {t_unf*1e3/roof:.2f}x") print("逻辑字节/实测add吞吐只是参照估计,不是物理访存下界。") print("耗时比不能隔离exp、归约、缓存、布局、循环或调度;需要分别profile。") assert np.allclose(ref.sum(axis=-1), 1, atol=2e-7) assert np.array_equal(ref,o2) return {"H": H, "S": S, "score_MB": nbytes / MIB, "t_unfused_ms": t_unf * 1e3, "t_tiled_ms": t_til * 1e3, "speedup": t_unf / t_til, "diff": diff, "traffic_MB": traffic / MIB, "roof_ms": roof, "over_roof": t_unf * 1e3 / roof} # ══════════════════════════════════════════════════════════════ def main(): import sys which = sys.argv[1] if len(sys.argv) > 1 else "ALL" if which not in ("ALL", "A", "B", "C", "D", "E"): raise ValueError("Expected ALL or A/B/C/D/E") res = {} if which in ("ALL", "A"): res["A"] = section_A() if which in ("ALL", "B"): res["B"] = section_B() if which in ("ALL", "C"): rho = res.get("B", {}).get("rho") if rho is None: res["B"] = section_B() rho = res["B"]["rho"] res["C"] = section_C(rho) if which in ("ALL", "D"): res["D"] = section_D() if which in ("ALL", "E"): bd = res.get("B", {}).get("B_dram_GBs") if bd is None: res["B"] = section_B() bd = res["B"]["B_dram_GBs"] res["E"] = section_E(bd) p = os.path.join(HERE, "_fusion_results.json") with open(p, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=2) print(f"\n结果已写入 {p}") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ make_figures.py —— 画本文的 5 张配图。 数据全部读已经跑完的实验(_fusion_results.json / _launch_results.json), 不在这里重新算,避免图上的数字和正文漂移。 运行: python make_figures.py """ from __future__ import annotations import json import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") try: os.makedirs(FIGDIR, exist_ok=True) except FileExistsError: pass # 配色(正文写「这张图要看什么」时按这几个名字描述) C_MAIN = "#1f4e79" # 深蓝:主曲线 C_ALT = "#c1440e" # 橙红:对照曲线 C_GREEN = "#2e7d32" # 绿:第三组 / 融合后 C_PURPLE = "#7b1fa2" # 紫:标注线 C_GRAY = "#8a8a8a" # 灰:参考线 C_LIGHT = "#bcd7ee" # 浅蓝:填充 C_RED = "#b71c1c" # 红:越界 / 地板 plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 plt.rcParams["savefig.dpi"] = 130 MIB = float(1024 ** 2) def _load(name): p = os.path.join(HERE, name) if not os.path.exists(p): raise SystemExit(f"缺少 {name},先跑 fusion_lab.py ALL / launch_model.py") with open(p, encoding="utf-8") as f: return json.load(f) # ══════════════════════════════════════════════════════════════ # 图 1:字节账本 # ══════════════════════════════════════════════════════════════ def fig_traffic(fus): A = fus["A"] items = [ ("8段仿射/16ufunc\n(4M 元素 fp32)", A["chain"]["unfused_MiB"], A["chain"]["fused_MiB"]), ("RMSNorm\n(4M 元素 fp32)", A["rmsnorm"]["unfused_MiB"], A["rmsnorm"]["fused_MiB"]), ("attention softmax\n(B=8,H=16,S=2048,bf16)", A["softmax"]["unfused_GiB"] * 1024, A["softmax"]["fused_GiB"] * 1024), ] labels = [t[0] for t in items] unf = [t[1] for t in items] fs = [t[2] for t in items] fig, ax = plt.subplots(figsize=(9.2, 4.4)) y = np.arange(len(items)) h = 0.34 ax.barh(y + h / 2, unf, height=h, color=C_ALT, label="不融合") ax.barh(y - h / 2, fs, height=h, color=C_GREEN, label="融合后") for i, (u, f) in enumerate(zip(unf, fs)): ax.text(u * 1.15, i + h / 2, f"{u:.1f} MiB", va="center", fontsize=9, color=C_ALT) ax.text(f * 1.15, i - h / 2, f"{f:.1f} MiB", va="center", fontsize=9, color=C_GREEN) ax.annotate(f"{u/f:.2f}x", xy=(u, i), xytext=(u * 1.15, i - 0.05), fontsize=9, color=C_MAIN, fontweight="bold") ax.set_yticks(y) ax.set_yticklabels(labels, fontsize=9) ax.set_xscale("log") ax.set_xlim(8, 40000) ax.set_xlabel("逻辑流量(MiB,对数刻度)", fontsize=10) ax.set_title("图 1:融合前后各搬多少字节", fontsize=12, color=C_MAIN) ax.legend(loc="lower right", fontsize=9) ax.grid(axis="x", alpha=0.3, linestyle=":") ax.set_axisbelow(True) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_traffic.png"), bbox_inches="tight") plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 2:score 矩阵的放大倍数 + 因果块级跳过 # ══════════════════════════════════════════════════════════════ def fig_blowup(fus): A = fus["A"] sm = A["softmax"] ca = A["causal"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.4, 4.2)) # 左:放大倍数随 S 增长 ss = [d["S"] for d in sm["blowup_curve"]] xx = [d["x"] for d in sm["blowup_curve"]] ax1.plot(ss, xx, "o-", color=C_MAIN, linewidth=2, markersize=7) ax1.plot(ss, np.array(ss) * (sm["H"]/sm["d"]), "--", color=C_GRAY, linewidth=1.2, label="线性参照,与H*S/d重合") ax1.set_xscale("log", base=2) ax1.set_yscale("log", base=2) ax1.set_xticks(ss) ax1.set_xticklabels([str(s) for s in ss], fontsize=9) ax1.set_yticks(xx) ax1.set_yticklabels([f"{v:.0f}x" for v in xx], fontsize=9) ax1.minorticks_off() ax1.set_xlabel("序列长度 S", fontsize=10) ax1.set_ylabel("score 矩阵 / 输入激活", fontsize=10) ax1.set_title(f"中间产物被放大 H*S/d = {sm['H']}*S/{sm['d']} 倍", fontsize=11, color=C_MAIN) ax1.grid(alpha=0.3, linestyle=":") ax1.legend(fontsize=8, loc="upper left") ax1.set_axisbelow(True) for s, v in zip(ss, xx): ax1.annotate(f"{v:.0f}x", (s, v), textcoords="offset points", xytext=(6, -12), fontsize=8, color=C_MAIN) # 右:因果块级跳过 brs = [str(b["br"]) for b in ca["blocks"]] fr = [b["frac"] * 100 for b in ca["blocks"]] bars = ax2.bar(brs, fr, color=C_LIGHT, edgecolor=C_MAIN, width=0.55) ax2.axhline(ca["exact_frac"] * 100, color=C_GREEN, linestyle="--", linewidth=1.6, label=f"理论上界 {ca['exact_frac']*100:.1f}%") ax2.axhline(100, color=C_GRAY, linestyle=":", linewidth=1.2, label="不跳过 100%") for b, v in zip(bars, fr): ax2.text(b.get_x() + b.get_width() / 2, v + 1.2, f"{v:.1f}%", ha="center", fontsize=9, color=C_MAIN) ax2.set_ylim(0, 118) ax2.set_xlabel("块边长", fontsize=10) ax2.set_ylabel("保留score块比例 (%)", fontsize=10) ax2.set_title(f"因果掩码块级跳过(S={ca['S']})", fontsize=11, color=C_MAIN) ax2.legend(fontsize=8, loc="upper left") ax2.grid(axis="y", alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 2:attention 的两本账——中间产物多大、白算多少", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_blowup.png"), bbox_inches="tight") plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 3:融合三形态 × 规模扫描 # ══════════════════════════════════════════════════════════════ def fig_three_forms(fus): C = fus["C"] D = fus["D"] K = C["K"] a = D["a_us"] cur = C["curves"] ns = [c["n"] for c in cur] t1 = [c["t1_us"] for c in cur] t3 = [c["t3_us"] for c in cur] sp = [c["speedup"] for c in cur] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.3)) # 左:耗时 vs 规模 ax1.loglog(ns, t1, "o-", color=C_ALT, linewidth=2, markersize=6, label="V1 不融合(2K 次调用)") ax1.loglog(ns, t3, "s-", color=C_GREEN, linewidth=2, markersize=6, label="V3 代数合并(2 次调用)") floor = 2 * K * a ax1.axhline(floor, color=C_RED, linestyle="--", linewidth=1.4, label=f"V1 的截距参照 2K*a = {floor:.1f} μs") ax1.axhline(2 * a, color=C_PURPLE, linestyle=":", linewidth=1.4, label=f"V3 的截距参照 2*a = {2*a:.1f} μs") # V2 在最大规模上的结果 v2b = C["v2_best"] ax1.plot([ns[-1]], [v2b["ms"] * 1e3], "D", color=C_GRAY, markersize=9, label=f"V2 CPU分块 {v2b['ms']*1e3:.0f} μs") ax1.set_xlabel("张量元素数", fontsize=10) ax1.set_ylabel("单次耗时 (μs)", fontsize=10) ax1.set_title(f"三种形态的耗时(K={K})", fontsize=11, color=C_MAIN) ax1.legend(fontsize=8, loc="upper left") ax1.grid(alpha=0.3, linestyle=":") ax1.set_axisbelow(True) # 右:加速比 ax2.semilogx(ns, sp, "o-", color=C_MAIN, linewidth=2, markersize=6, label="V1 / V3(代数合并)") ax2.axhline(K, color=C_GREEN, linestyle="--", linewidth=1.6, label=f"V1/V3逻辑字节比 K = {K}x") ax2.axhline(C["v2_pred"], color=C_GRAY, linestyle=":", linewidth=1.6, label=f"rho代入参照 {C['v2_pred']:.2f}x") ax2.plot([ns[-1]], [v2b["speedup"]], "D", color=C_ALT, markersize=9, label=f"V2 实测 {v2b['speedup']:.2f}x") ax2.set_ylim(0, max(K * 1.25,max(sp)*1.2)) ax2.set_xlabel("张量元素数", fontsize=10) ax2.set_ylabel("加速比", fontsize=10) ax2.set_title("各自兑现了多少", fontsize=11, color=C_MAIN) ax2.legend(fontsize=8, loc="lower left") ax2.grid(alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 3:融合三形态 × 规模扫描(本机实测,Windows CPU / NumPy)", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_three_forms.png"), bbox_inches="tight") plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 4:单次调用的固定开销 # ══════════════════════════════════════════════════════════════ def fig_launch(fus): D = fus["D"] rows = D["rows"] ns = np.array([r["n"] for r in rows], dtype=float) us = np.array([r["us"] for r in rows], dtype=float) a, b = D["a_us"], D["b_us_per_elem"] n_half = D["n_half"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.2)) # 左:延迟 vs 规模,含地板 ax1.loglog(ns, us, "o", color=C_MAIN, markersize=7, label="实测") grid = np.logspace(0, np.log10(ns.max()), 60) ax1.loglog(grid, a + b * grid, "-", color=C_ALT, linewidth=1.8, label=f"拟合 a + b*n(a={a:.2f} μs)") ax1.axhline(a, color=C_RED, linestyle="--", linewidth=1.6, label=f"固定开销地板 a = {a:.2f} μs") ax1.axvline(n_half, color=C_PURPLE, linestyle=":", linewidth=1.6, label=f"各占一半 n* = {n_half:.0f} 元素") ax1.set_xlabel("张量元素数", fontsize=10) ax1.set_ylabel("单次调用耗时 (μs)", fontsize=10) ax1.set_title("小到一定程度,耗时就和数据无关了", fontsize=11, color=C_MAIN) ax1.legend(fontsize=8, loc="upper left") ax1.grid(alpha=0.3, linestyle=":") ax1.set_axisbelow(True) # 右:一条 K 段链里固定开销的占比 share = D["share"] sn = np.array([s["n"] for s in share], dtype=float) sf = np.array([s["fixed_frac"] for s in share]) * 100 ax2.semilogx(sn, sf, "o-", color=C_MAIN, linewidth=2, markersize=6) ax2.axhline(50, color=C_GRAY, linestyle=":", linewidth=1.3) ax2.fill_between(sn, 0, sf, color=C_LIGHT, alpha=0.55) for x, v in zip(sn, sf): if v > 55 or v < 12: ax2.annotate(f"{v:.0f}%", (x, v), textcoords="offset points", xytext=(0, 8), fontsize=8, color=C_MAIN, ha="center") ax2.set_ylim(0, 108) ax2.set_xlabel("张量元素数", fontsize=10) ax2.set_ylabel("固定开销占总耗时 (%)", fontsize=10) ax2.set_title(f"{D['K']} 段链({2*D['K']} 次调用)里,截距模型占比", fontsize=11, color=C_MAIN) ax2.grid(alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 4:每次调用都有一个和数据规模无关的地板(本机实测)", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_launch.png"), bbox_inches="tight") plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 5:CUDA Graph 的时间线 # ══════════════════════════════════════════════════════════════ def fig_graph(lnc): F1 = lnc["F1"] F2 = lnc["F2"] tl, te, td = F1["t_launch"], F1["t_exec"], F1["t_dispatch"] fig, (ax1, ax2) = plt.subplots( 1, 2, figsize=(11.2, 4.3), gridspec_kw={"width_ratios": [1.25, 1]}) # ── 左:甘特图,只画前 8 个 kernel ── n_show = 8 # eager:CPU 逐个发射,GPU 要等「前一个跑完」且「这个已发出」才能开工。 # 时刻逐事件推算,和图里的条形严格同源。 gpu_free, segs_cpu, segs_gpu, segs_idle = 0.0, [], [], [] for i in range(n_show): cpu_done = (i + 1) * tl start = max(gpu_free, cpu_done) if start > gpu_free: segs_idle.append((gpu_free, start - gpu_free)) segs_gpu.append((start, te)) segs_cpu.append((i * tl, tl)) gpu_free = start + te ax1.broken_barh(segs_cpu, (3.4, 0.8), facecolors=C_LIGHT, edgecolor=C_MAIN, linewidth=0.6) ax1.broken_barh(segs_gpu, (2.2, 0.8), facecolors=C_GREEN, edgecolor=C_GREEN, linewidth=0.6) ax1.broken_barh(segs_idle, (2.2, 0.8), facecolors="#f0c9c9", edgecolor=C_RED, linewidth=0.6, hatch="//") # graph:一次发射,之后背靠背 g_cpu = [(0, tl)] g_gpu = [(tl, n_show * (te + td))] ax1.broken_barh(g_cpu, (1.0, 0.8), facecolors=C_LIGHT, edgecolor=C_MAIN, linewidth=0.6) ax1.broken_barh(g_gpu, (-0.2, 0.8), facecolors=C_GREEN, edgecolor=C_GREEN, linewidth=0.6) ax1.set_yticks([3.8, 2.6, 1.4, 0.2]) ax1.set_yticklabels(["CPU 发射", "GPU 执行", "CPU 发射", "GPU 执行"], fontsize=9) ax1.set_xlabel("时间 (μs)", fontsize=10) ax1.set_xlim(-0.5, n_show * tl + te + 3) ax1.set_ylim(-0.6, 5.4) ax1.set_title(f"eager(上)vs CUDA Graph(下) " f"发射 {tl} μs / 执行 {te} μs", fontsize=10.5, color=C_MAIN) ax1.grid(axis="x", alpha=0.3, linestyle=":") ax1.set_axisbelow(True) ax1.text(0.4, 4.95, "eager:每次发射 GPU 都要等(斜纹 = 空转)", fontsize=8.5, color=C_ALT, va="center") ax1.text(0.4, 0.78, "graph:只发射一次,之后 GPU 背靠背(无空转)", fontsize=8.5, color=C_GREEN, va="center") # ── 右:加速比 vs 单 kernel 执行时间 ── rws = F2["rows"] tes = [r["t_exec"] for r in rws] sps = [r["speedup"] for r in rws] ax2.plot(tes, sps, "o-", color=C_MAIN, linewidth=2, markersize=6) ax2.axhline(1.0, color=C_GRAY, linestyle=":", linewidth=1.3, label="盈亏线 1.0x") ax2.axvline((F2["N"]*F2["t_launch"]-F2["t_launch"]-F2["N"]*F2["t_dispatch"])/(F2["N"]-1), color=C_RED, linestyle="--", linewidth=1.5, label="本假设盈亏点约2.499μs") ax2.fill_between(tes, 0, 1.0, where=np.array(sps) < 1.0, color="#f0c9c9", alpha=0.6, label="graph 反而更慢") ax2.set_xscale("log") ax2.set_xlabel("单个 kernel 的执行时间 (μs)", fontsize=10) ax2.set_ylabel("CUDA Graph 加速比", fontsize=10) ax2.set_title(f"N={F2['N']} 个 kernel", fontsize=11, color=C_MAIN) ax2.legend(fontsize=8, loc="lower right") ax2.grid(alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 5:CUDA Graph 提交模型(delta=0.5us假设)(模型推演)", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_graph.png"), bbox_inches="tight") plt.close(fig) # ══════════════════════════════════════════════════════════════ def main(): fus = _load("_fusion_results.json") lnc = _load("_launch_results.json") fig_traffic(fus) fig_blowup(fus) fig_three_forms(fus) fig_launch(fus) fig_graph(lnc) print("已生成 5 张图:") for f in sorted(os.listdir(FIGDIR)): if f.endswith(".png"): p = os.path.join(FIGDIR, f) print(f" {f} {os.path.getsize(p)/1024:.0f} KiB") if __name__ == "__main__": main()
-
AIGC 基本功|离散化表征:VQ-VAE 与 VQGAN-VQGAN AIGC 基本功|离散化表征:VQ-VAE 与 VQGAN-VQGAN 所属方向:表征 | 难度:进阶 | 前置知识:变分下界与重参数化(ELBO)、VAE 结构与训练目标(知道「重参数化」和「KL 项怎么来的」就够了) 关键词:VQ-VAE、VQGAN、码本、straight-through、码本坍缩、感知损失 01. 为什么需要它 先算一笔账,这是 VQGAN 原文 的一个重要动机,另一个是让压缩后的局部表征保留可感知的结构。把一张 256×256 的 RGB 图像当成序列直接做自回归:每个像素三个通道各算一个 token,序列长度是 256 × 256 × 3 = 196,608。自回归 Transformer 的注意力矩阵是序列长度的平方,也就是 3.87 × 10¹⁰ 个元素——单张显式 BF16 分数矩阵约 72 GiB,尚未乘 batch、头数和训练保存量。这里比较的是朴素稠密注意力的逻辑矩阵大小,不能等同于 FlashAttention 的实际显存或整网耗时。 我按这个口径把不同下采样率的账都算了一遍(token_budget.py,本机实跑): 下采样率 f 256² 图像的 token 数 注意力矩阵规模 相对像素级 像素级 RGB 196,608 3.87 × 10¹⁰ 1 f=4 4,096 1.68 × 10⁷ 4.3 × 10⁻⁴ f=8 1,024 1.05 × 10⁶ 2.7 × 10⁻⁵ f=16 256 6.55 × 10⁴ 1.7 × 10⁻⁶ 这张图要看的是两件事:左图里三条 tokenizer 曲线与像素级虚线之间的纵向鸿沟——f=16 时 256² 图像只有 256 个 token,是像素级序列的 1/768;右图是同一个事实在注意力开销上的投影,柱子从 3.87 × 10¹⁰ 掉到 6.55 × 10⁴,省了约 59 万倍。分辨率越高鸿沟越陡(1024² 图像在 f=16 下是 4,096 个 token),视频账本还要约定时间边界:这里取 121 个采样时刻,24fps 下首末相距 5 秒;采用「首帧单独保留,其余 120 帧每 4 帧一组」的示意规则,时间长度为 31,空间 f=16 时共有 31×256=7,936 个 token。这是明示的计数约定,并非所有视频 tokenizer 的通用长度公式;实际应读它的卷积、填充和截断规则。 压缩让序列变短,离散化则让下游能够用 K 分类交叉熵预测码字编号,复用离散序列建模设施。这是 VQ 路线的便利,自回归本身并不要求离散变量:MAR 就在连续潜变量上构造条件生成器。不能笼统说连续目标一定病态。原 DALL-E 用 8192 类的 dVAE 和 32×32=1024 个图像 token;VQGAN 的 f=16 配置给出 16×16=256 个 token,MaskGIT 和 VAR 再改变这些离散表征的预测顺序。 不过离散化是有代价的,而且真正容易被忽视的代价不在「码本有多大」,在「码本用得怎么样」。我在 8×8 小块的玩具上训了一个 K=512 的 VQ 自编码器(collapse_lab.py,实跑):512 个码字里只有 17 个被用到,96.7% 的码在最终 4096 样本评估窗口未命中;码本标称 9 bit,边缘使用熵为 log2(14.50)=3.86 bit/token;这不是固定长度索引实际只存了 3.86 bit。这篇就讲三件事:量化怎么写进损失函数、码本怎么训练才不会死、以及为什么追求感知质量时会加入感知损失和对抗损失,而像素保真任务可能继续重视 MSE。 02. 最小可用理解 三句话: 机制:编码器把图像压成连续向量序列 $z_e$;每个 $z_e$ 在码本(K 个可学习的向量)里找最近邻,换成那个码字得到 $z_q$;解码器只从 $z_q$ 重建图像。在没有旁路或额外条件的这条路径里,解码器只收到码字,收不到量化前向量的精确位置;空间下采样、网络容量和训练也会限制重建。 训练:三个损失各管一段。重建损失管「编码器+解码器」 jointly,但 argmin 不可导,梯度靠 straight-through(把 $z_q$ 的梯度原样抄给 $z_e$);码本本身要么用字典损失往编码器输出上拉,要么用 EMA 直接滑向被选中样本的均值;commitment 项(权重 $\beta$)把编码器往码字上拉,防止两头越走越远。 代价:有限码本会产生量化失真,也可能出现低利用率;高码率理论中的 $K^{-2/d}$ 只是带条件的渐近参照。平方误差的最优确定性输出是条件均值,只有潜变量丢掉了多模态细节时,平均才会造成模糊;VQGAN 用 LPIPS 加 PatchGAN 改变这一取舍。 03. 数学推导 3.1 从 VAE 到 VQ-VAE:KL 项去哪了 VQ-VAE(Neural Discrete Representation Learning)的名字里有 VAE,推导起点也确实是 ELBO: $$\log p(x) \ge \mathbb{E}_{q(z \mid x)} \big[ \log p(x \mid z) \big] - \mathrm{KL}\big( q(z \mid x) \,\Vert\, p(z) \big)$$ 每一项的含义:$q(z \mid x)$ 是编码器给出的「后验」,$p(z)$ 是我们先验地相信 latent 该有的分布,$p(x \mid z)$ 是解码器。VAE 里这三样都是连续分布,KL 项把后验往先验上压,重参数化让采样可导。下面先看原论文第一阶段的简化模型。用 $k$ 表示码字的离散索引,$e_k$ 是其向量值: $q(z \mid x)$ 是退化的离散分布:$z$ 就是被选中的那个码字 $e_k$,配合 one-hot 指示变量,相当于 $q(z = e_k \mid x) = 1$,对其他码字取 0; $p(z)$ 取 K 个码字上的均匀分布; $p(x \mid z)$ 是解码器(高斯均值或离散化的像素分布),第一项就是重建损失。 把这个确定性后验和均匀先验代进 KL:$q$ 在 $e_k$ 处为 1、其余为 0,求和只剩被选中那一项: $$\mathrm{KL}\big( q \,\Vert\, p \big) = \sum_{j=1}^{K} q_j \log \frac{q_j}{p_j} = 1 \cdot \log \frac{1}{1/K} = \log K$$ $\log K$ 在 K 固定时为常数;若一张图有 N 个索引、先验对各位置独立均匀,整张图的 KL 为 $N\log K$。因此这个阶段的 KL 不给编码器可用的优化信号,但数学上的离散后验和变分下界仍存在。字典与 commitment 项是处理量化训练的附加代理项,不能说是从常数 KL 严格推出来的。原论文随后另训自回归先验 $p_\psi(k_1,\ldots,k_N)$;学习到的先验通常不均匀,相应 KL 就不再是常数。 3.2 argmin 不可导,梯度要靠「装傻」 量化操作本身是: $$z_q = e_k, \quad k = \arg\min_{j} \, \Vert z_e - e_j \Vert_2^2$$ 符号含义:$z_e \in \mathbb{R}^d$ 是编码器输出(e 指 encoder),$e_j \in \mathbb{R}^d$ 是第 j 个码字,$z_q$ 是替换后的向量(q 指 quantized)。问题出在 $\arg\min$:它是分段常数函数。训练中把 $z_e$ 微动一点点,只要不跨过两个码字的垂直平分面,选中的 $k$ 根本不变,$z_q$ 不变,重建损失也不变。 在不跨越最近邻分区的区域内部,硬量化对输入的导数为零;分区边界可能跳变、不可导。我在训好的 VQ-AE 上用有限差分实测过(vq_core.py 的 [D] 段,512 个样本,沿随机单位方向扰动 $z_e$): 扰动步长 eps 有限差分 $\partial L/\partial z_e$ argmin 保持不变的样本比例 10⁻¹ −7.6 × 10⁻⁶ 0.9941 10⁻² 0.0(精确为零) 1.0000 10⁻³ 0.0(精确为零) 1.0000 10⁻⁴ 0.0(精确为零) 1.0000 eps=10⁻¹ 那一行有 0.59% 的样本跨过了平分面,所以差分不为零——这也正是 argmin「分段常数、边界处跳变」的直接展示。而在平分面之间的整片区域里,重建损失对编码器没有任何梯度。VQ-VAE 的解法是 straight-through:假装量化是恒等映射,把解码器对 $z_q$ 的梯度原封不动地抄给 $z_e$: $$\frac{\partial L}{\partial z_e} \mathrel{:=} \frac{\partial L}{\partial z_q}$$ 要强调的是:这不是真实梯度的估计,是替代品。真实梯度是 0,直通梯度实测平均范数 1.49 × 10⁻⁴(同一组权重),它携带的信息是「如果量化不存在,往哪边调编码器能让重建更好」。这是让局部连续优化能推进训练的启发式,并不保证每次更新都选到更好的码字,也不保证沿硬目标下降。commitment 与码本更新帮助两侧协调,具体稳定性仍须验证。 实现上只有一行(taming-transformers 的写法,见 05 节):z_q = z + (z_q - z).detach()。前向时 $z_q$ 是真的码字,反向时梯度绕过 $(z_q - z)$ 这个常量直接流向 $z$。 3.3 码本的两条更新路线 直通梯度有个致命遗漏:码本自己拿不到任何来自重建损失的梯度。查表本身能对被选中的码字求导,不能对离散索引求导。这里重建梯度不进入码本,是因为 z + (z_q-z).detach() 显式切断了量化分支的反向路径;直通让它转而进入编码器。如果什么都不加,码本会永远停在初始化的位置。我在玩具上实测过这条「什么都不加」的路线(vq_core.py [E] 段,K=64,800 步):码本位移精确为 0.000000,重建 MSE 0.185734,是正常训练的 3 倍多。 所以码本必须有独立的更新机制,VQ-VAE 给了第一条路——字典损失。把编码器输出当成常数(stop-gradient,记作 sg),把码字往它身上拉: $$L_{\text{codebook}} = \big\Vert \mathrm{sg}[z_e] - e_k \big\Vert_2^2, \qquad \frac{\partial L_{\text{codebook}}}{\partial e_k} = 2\,(e_k - z_e)$$ 第二条路是 EMA(原 VQ-VAE 的附录 A.1 已经给出,不是 VQ-VAE-2 才引入):不用梯度,直接对「每个码字被选中样本的均值」做指数滑动。记第 t 步里码字 j 被选中了 $n_j$ 次、被选中样本之和为 $s_j$,则 $$c_j \leftarrow \gamma c_j + (1-\gamma)\, n_j, \quad m_j \leftarrow \gamma m_j + (1-\gamma)\, s_j, \quad e_j \leftarrow \frac{m_j}{c_j + \epsilon_{\text{smooth}}}$$ $\gamma$ 是滑动系数(taming 里 decay=0.99),$c_j$ 是每个码字的滑动计数,$m_j$ 是滑动累加的样本和,$\epsilon_{\text{smooth}}$ 用来防止某个几乎没人用的码字除以接近零的数(taming 的平滑是 $(c_j + \epsilon) \cdot n / (n + K\epsilon)$,其中 $n$ 是全部计数之和)。EMA 的本质是把码字变成「最近被它编码过的那些向量的滑动平均」,不走码本的梯度优化器,但仍有 decay、平滑、初始化和重启阈值等选择;梯度更新与 EMA 两种路线都在使用。本文玩具的计数初始为 1,官方 EmbeddingEMA 初始为 0、累积向量初始非零,二者不能冒充逐步数值等价。未命中码字的计数和向量会一起衰减,平滑也会改变比值;它并非必然立即变成 0/0。 3.4 commitment 项:另一头的绳子 现在把绳子接上另一头。EMA 把码字往编码器输出上拉,但没有任何东西把编码器输出往码字上拉——编码器完全可以漂走,让量化误差 $\Vert z_e - e_k \Vert^2$ 失控。commitment 项就是拴住编码器的那根绳: $$L_{\text{commit}} = \beta \,\big\Vert z_e - \mathrm{sg}[e_k] \big\Vert_2^2$$ 注意方向和字典损失正好相反:字典损失动了 $e_k$($z_e$ 被 stop-gradient 冻住),commitment 动了 $z_e$($e_k$ 被冻住)。字典梯度路线最小化下面的目标;若用 EMA,则以码本更新规则替代字典损失的梯度步骤,不把 EMA 当作额外损失相加: $$L = \underbrace{-\log p(x \mid z_q)}_{\text{重建,经直通传给编码器}} + \underbrace{\big\Vert \mathrm{sg}[z_e] - e_k \big\Vert_2^2}_{\text{字典损失}} + \underbrace{\beta \big\Vert z_e - \mathrm{sg}[e_k] \big\Vert_2^2}_{\text{commitment}}$$ $\beta$ 不能脱离损失归约方式来比较。本文训练对重建项取 batch×64 的均值,对 commitment 取 batch×d 的均值;两者都要除 batch。原核验漏给 commitment 除 512,错误地产生了「429 倍」。修正后同一工作点的直通梯度平均范数为 1.490013×10⁻⁴,commitment 为 1.249852×10⁻⁴,比值约 0.839。这撤回了原文的梯度量级归因,不改变训练循环本来就正确的归约。$\beta$ 扫描的实测结果(collapse_lab.py [A] 段,K=64,1200 步): $\beta$ 0 0.05 0.25 1.0 4.0 重建 MSE 0.0673 0.0484 0.0600 0.0387 0.0385 活跃码数 14 14 16 17 18 这次单 seed、同训练预算的扫描中,1.0 比 0.25 的 MSE 低约 35%,4.0 的 MSE 还略低;不能把 1.0 宣称为普遍最优。更不能把改善归因于已撤回的 429 倍。改变重建项量纲、均值/求和归约、初始化或训练时长,都可能改变合适的 $\beta$。 3.5 VQGAN 补上的两块 若多个真实纹理被映到同一个 latent,逐像素 MSE 的最优确定性解码就会平均它们;当 latent 已保留足够细节时,这个前提未必成立。06 节用刻意丢掉纹理极性的玩具展开。VQGAN 把重建侧换成三件套: $$L_{\text{VQGAN}} = \underbrace{\big\Vert x - \hat x \big\Vert_1 + \lambda_{\text{lpips}} L_{\text{LPIPS}}(x, \hat x)}_{\text{感知重建}} + \underbrace{\lambda_{\text{GAN}} \big( -\mathbb{E}[D(\hat x)] \big)}_{\text{对抗}} + \underbrace{\lambda_{\text{cb}} L_{\text{codebook}} + \beta L_{\text{commit}}}_{\text{量化}}$$ $\hat x$ 是解码器输出,$D$ 是 PatchGAN 判别器,LPIPS 是在 VGG16 五层特征上算距离再加一层学出来的 1×1 卷积(lpips.py 里五个 NetLinLayer,实读源码确认)。这里按官方代码采用判别器的未归一化 logit,生成器损失为负平均 logit;默认判别器用 hinge:真实项 $\max(0,1-D(x))$ 与生成项 $\max(0,1+D(\hat x))$ 各取均值,再平均两项。它与 sigmoid 概率上的负 log 损失不同。对抗项权重有自适应部分,也仍有手设乘数:对解码器最后一层分别求重建损失和对抗损失的梯度,取范数比 $\lambda_{\text{GAN}} \leftarrow \Vert \nabla L_{\text{rec}} \Vert / \Vert \nabla L_{\text{GAN}} \Vert$,实际分母加 $10^{-4}$,比值截断至 $[0,10^4]$、停止梯度,再乘 disc_weight 和按 disc_start 开启的 disc_factor。这是按最后一层局部范数平衡两种信号,并不保证全网梯度或质量稳定。固定 官方损失源码 与 CPU 原方法核验可对照。 3.6 怎么量「码本用得怎么样」 三个从粗到细的指标,别混用: 活跃码数:指定评估窗口中至少被选中过一次的码字个数;再除以 K 才是活跃比例。本文训练曲线在固定 2048 个训练样本上评估,最终表在全部 4096 个训练样本上评估,都不是训练全过程的累积命中数。最直观,但它是二值的——一个只被用过 3 次的码字和用过 3 万次的算得一样。 perplexity:把码字的使用频率 $p_j$ 看成一个分布,取 $\mathrm{ppl} = \exp\big( -\sum_{j} p_j \log p_j \big)$。完全均匀使用时等于 K,退化到只用一个码时等于 1。它把长尾压成一个数,是训练日志里最常盯的那个量。 有效 bit:$\log_2 \mathrm{ppl}$,可以直接和标称 bit $\log_2 K$ 比。本文 K=512 的边缘熵为 3.86 bit/token,比均匀分布的最大熵 9 bit 低约 57%。固定长度存储仍需 $\lceil\log_2K\rceil$ bit/index;接近熵的码率还需足够长序列和合适的编码器。相邻索引相关时,条件熵还可低于边缘熵;熵也不衡量语义信息或重建质量。 两个容易踩的坑。第一,perplexity 是分布层面的量:它下降只说明使用分布变尖了,既不告诉你死码落在哪,也不等价于重建质量——要看死码分布得直接画使用次数的直方图(图 4 干的就是这件事)。第二,taming 是在当前 batch 上算 avg_probs 的,batch 越小噪声越大;小 batch 上看到 ppl 上下抖动不等于坍缩,别急着改 decay 或加重启。 04. 代码实现 最小实现不需要网络,一个「线性编码器 + VQ + 线性解码器」就能把所有机制跑出来。数据是我合成的 8×8 小块:16 个低频类心,类内加连续变化和白噪声(make_patch_data,4096 个样本,种子 0;Python 3.11.9、NumPy 2.4.3、单 BLAS 线程实跑。表格除特别注明留出集外都来自训练分布内评估,不是泛化质量结论)。核心的量化与直通就这几行(完整脚本在附录): def quantize(z_e, codebook): d2 = ((z_e[:, None, :] - codebook[None, :, :]) ** 2).sum(-1) # [N, K] idx = d2.argmin(axis=1) # 最近邻 return codebook[idx], idx, d2[np.arange(len(idx)), idx] # 训练循环里(z_q 是查表结果,e_k = z_q): x_hat = z_q @ params["Wd"] + params["bd"] dxh = 2.0 * (x_hat - x) / (len(x) * d_in) # 对 x_hat 的梯度 dz_q = dxh @ params["Wd"].T # 解码器传给 z_q 的梯度 dz_e = dz_q + beta * 2.0 * (z_e - z_q) / (len(x) * d_lat) # 直通 + commitment # 码本走 EMA(onehot 统计被选中的次数与样本和,见附录 vq_core.py) 第一件事:误差到底由哪几块组成。 用同一组训练后权重,把「走不走量化」作为开关(vq_core.py [C] 段,K=64,d=8): 通路 重建 MSE/像素 连续自编码器参考(无 VQ,独立训练 800 步) 0.011082 同一组 VQ-AE 权重,绕开量化(直接用 $z_e$ 过解码器) 0.023360 同一组 VQ-AE 权重,正常走量化 0.060345 同一组 VQ-AE 权重下,量化通路比连续通路多 0.036985(+158.3%)MSE。这是开关量化的像素误差差值,不等于潜空间的 $\mathbb{E}\Vert z_e-z_q\Vert^2/d$,后者为 0.158759。定义连续重建残差 $r=z_eW_d+b-x$、量化带来的输出改变量 $\delta=(z_q-z_e)W_d$,逐项展开有: $$\mathbb{E}\Vert r+\delta\Vert^2=\mathbb{E}\Vert r\Vert^2+\mathbb{E}\Vert\delta\Vert^2+2\mathbb{E}\langle r,\delta\rangle$$ 只有证明交叉项为零,才可称正交误差分解;一般不能保证量化后误差一定增加。同样,独立连续模型的 0.011082 与 VQ 模型的 0.023360 来自不同训练目标和参数,体现组合训练的差异,不能单独定位为 commitment 的因果代价。vq_checks.py 对 40 组随机夹具验证了这条带交叉项的恒等式。 第二件事:固定潜分布后看码本容量收益。 固定一个训好的连续编码器,对它的潜变量做 k-means(k-means 就是「给定 K 个码字的最优最近邻量化器」的近似),在留出集上测失真随 K 的变化: 码本维度 d 理论斜率 −2/d 实测斜率(K≥16 段) K 从 8 加到 512,失真降多少 2 −1.00 −0.87 66.5 倍 4 −0.50 −0.40 33.8 倍 8 −0.25 −0.28 13.9 倍 16 −0.125 −0.36 12.7 倍 这张图比较实测线与渐近参照,不能当作普适定律的验证。直观上,若 K 个小单元覆盖固定的 d 维体积,每个单元的线性尺度约为 $K^{-1/d}$,平方误差才有 $K^{-2/d}$ 的尺度。这个解释要求足维连续密度、足够大的 K 和接近最优的码本;有限样本的局部 k-means 不满足全部条件。这里 d=16 的数据主要由 9 个低频基方向加噪声产生,潜分布的有效维度也未必是 16。不能把偏离唯一归因于「每码只有 8 个训练样本」。这些数值只描述本次固定编码器和留出集;它们不预测 rFID。 第三件事:码本坍缩与两副解药。 K=512、随机初始化、EMA 更新,训练 1200 步: 配置 重建 MSE 活跃码数 perplexity 有效 bit(log2 ppl) 随机初始化 0.049067 17 / 512 14.50 3.86 连续 AE 预训练 + k-means 0.017501 512 / 512 450.51 8.82 死码重采样重启 0.018368 500 / 512 426.71 8.74 这张图要读两种评估窗口:曲线是固定 2048 样本,表格是最终全部 4096 样本,因此绿线末端 466 与表中 500、蓝线末端 491 与表中 512 并不矛盾。随机初始化早期就只使用少量码字,但「当前未命中」不证明此后永不命中。重启分支将 EMA 计数小于 1 的码替换成当批真实编码向量,改变了训练动力学。预训练分支额外付出 800 步连续 AE 和 20 轮 k-means,随后携带同一编码器/解码器权重进入 1200 步 VQ;原代码把码本初始化在预训练坐标里、却重置了编码器,本轮修正了这一坐标错配。该分支不能当作零额外成本的纯初始化消融。 这张图的索引按使用次数排序,零计数无法在对数轴显示,缺席不表示日志丢失。随机分支最终只有 17 个活码;重启分支把很多码带回了当前评估窗口,但利用率不是重建质量的充分条件。两分支训练样本 MSE 为 0.049067 和 0.018368,单次比约 2.67,不推广到真实图像。 字典梯度更新也未被这个实验淘汰:同一玩具、800 步时,码本 SGD 学习率从 0.02 增到 10,MSE 从 0.241819 到 0.053808;后者还低于不重启 EMA 的 0.059999。优化器、初始化和训练预算都影响比较,不能说「主流全部转向 EMA」或「梯度始终追不上 EMA」。 05. 工业级实现对照 上面是最小实现,以下按 2026-11-01 核对的官方提交 3ba01b2 对照 量化器、损失 和 模型配置。完整原类 AST 在 CPU 实际执行,范围是量化、梯度分流、EMA 更新和局部权重,不是预训练 VQGAN 的图像质量复现。 距离计算用展开式。 教学版广播会物化 N×K×d 的中间数组;官方用平方范数和点积,只构造 N×K 距离表。等价的核心函数如下,完整教学脚本仍在附录: def squared_distances(z_flattened, weight): return (z_flattened.square().sum(1, keepdim=True) + weight.square().sum(1)[None, :] - 2 * (z_flattened @ weight.T)) 这里 N=batch×latent高×latent宽。展开式减轻中间存储,但仍有 N×K 成本,低精度相消也可能改变边界附近最近邻;大码本还可分块检索。 直通就一行,和推导完全一致:z_q = z + (z_q - z).detach()。 taming 保留了一个带 bug 的版本。 VectorQuantizer2 有个 legacy 开关,legacy=True(默认)时损失是 loss = mean((z_q.detach()-z)**2) + beta * mean((z_q - z.detach())**2)——$\beta$ 被加在了码本项上,而不是 commitment 项,与论文公式相反。源码注释直说这是历史 bug,为了兼容旧 checkpoint 保留默认。读老代码、对老权重时要注意这个坑。 官方这份 EMA 基元的权重是 requires_grad=False 的。EmbeddingEMA 里 weight、cluster_size、embed_avg 全是关闭梯度的参数,更新完全靠滑动平均——其平滑公式见 3.3,但初始计数不同。还须指出该提交 EMAVectorQuantizer.__init__ 使用未定义的 codebook_dim、num_tokens,不能直接把这个包装类称作已运行生产实现;本轮执行的是完整、可工作的 EmbeddingEMA 类。原 VectorQuantizer 还计算 perplexity:exp(-sum(avg_probs * log(avg_probs))),这正是我用来诊断坍缩的量。 decay 不是「越接近 1 越稳」,它是一个时间常数。 衰减系数 $\gamma$ 决定码字「记得多久以前的样本」:$\gamma=0.99$ 时一个历史样本的贡献半衰期是 $\log 0.5 / \log 0.99 \approx 69$ 步,458 步后只剩 1%;$\gamma=0.999$ 半衰期拉到 693 步,$\gamma=0.95$ 只有 13.5 步。这个数要和 batch 里的 token 数对着调:VQGAN f=16 时一张 256² 图给 256 个 token,batch=8 一共 2048 个 token,摊到 K=16384 的码本上平均每步每个码字只被选中 0.125 次。也就是说大码本下 EMA 的计数极其稀疏,decay 太小时计数的历史权重快速衰减,平滑或重启更容易影响罕用码;这只是可能的动力学,不能从平均命中数断言必然坍缩。 损失在 losses/vqperceptual.py:L1 + LPIPS + hinge GAN。 三个值得抄的细节:一是 adopt_weight,判别器从第 disc_start 步才介入(先让重建学好,再上对抗);二是 calculate_adaptive_weight,取 $\Vert \nabla_{\text{last}} L_{\text{rec}} \Vert / \Vert \nabla_{\text{last}} L_{\text{GAN}} \Vert$ 并 clamp 到 10⁴;三是判别器是 NLayerPatchGAN,按 patch 判真假,这样高分辨率下判别器参数量不随分辨率爆炸。 官方数字(固定 README 的重建 FID 表): 模型 f K rFID 对训练集 rFID 对验证集 DALL-E dVAE(Gumbel) 8 8192 33.88 32.01 VQGAN ImageNet 16 1024 10.54 7.94 VQGAN ImageNet 16 16384 7.41 4.98 VQGAN OpenImages 8 256 未报告 1.49 VQGAN OpenImages 8 16384 未报告 1.14 数值逐列来自固定 README 重建表。rFID 比较原图分布与重建分布的特征统计,越低越好,但数值比不是「质量好多少倍」。原文将训练参照的 33.88 与验证参照的 1.49 混除成 22 倍,还把跨模型/训练数据差异归因于某一种损失,本轮撤回这种读法。ImageNet 两行显示该组配置增大 K 后统计指标改善,但并非只改 K 的受控消融;已核实的 1024 配置 embed_dim=256,不能仅因 quant_conv 存在就推断所有 checkpoint 的维度。潜空间欧氏失真幂律也不预测 rFID。 06. 代价与边界 代价一:有损量化与有限容量。 固定连续 AE 的另一个留出实验(codebook_size_law.py,1500 步,d=8)在 K=512 时,连续通路 MSE 为 0.011378,量化通路为 0.020533,增幅 80.5%。这与 04 节的联合 VQ 训练不是同一组权重。可以研究更多码字、较低的有效维度、残差/多级量化等选择,但没有「加 K 必然最差」的通用排序;解码器也会放大量化扰动。 代价二:低利用率的处理有代价。 本玩具随机初始化有 96.7% 的码在最终窗口未命中,但这不是所有 VQ 必然经历的比例。预训练加 k-means 有额外成本;重启改变码字语义,还需考虑下游先验是否已在使用原索引。FSQ 用少量坐标上的固定标量格点,LFQ 用符号二值化产生隐式码,减少学习每个独立向量的负担;它们都不保证任意数据和训练下 100% 命中。把编码器恒定输出一个格点,就是只使用一个码的反例。 代价三:感知重建会「编」细节。 这是 3.5 节埋的伏笔,用一个能算清楚的玩具展开(perceptual_lab.py)。构造:一个 latent 对应两种等概率的纹理 $x = m \pm p$(m 是低频内容,p 是棋盘纹理,纹理相对于正极性样本的梯度能量比约 83.5%,该样本仍有内容/纹理交叉项)。在候选输出 $m + c \cdot p$ 上比较两种损失: 候选输出 MSE SNR 梯度能量保留 到最近模态的距离 $c=0$(MSE 最优,条件均值) 0.250000 5.30 dB 18.6% 0.250 $c=-0.785$(网格上的特征最优) 0.404056 3.22 dB 70.7% 0.012 $c=1$(选一个清晰模态) 0.500000 2.29 dB 97.5% 0.000 这张图要看条件均值与单个模态的不同偏好。本玩具使用 $\phi(x)=[x,\alpha|\nabla x|]$,不是 LPIPS,也没有训练 GAN;候选为 $m+cp$,在步长 0.005 的有限网格上选最优。按两种真值取期望,MSE 可直接化成 $\Vert p\Vert^2(1+c^2)/64$,所以 $c=0$ 最优;非线性特征距离可偏好非零 c。表中 dB 是 $10\log_{10}(P_{\mathrm{signal}}/\mathrm{MSE})$、信号能量 0.8474 作基准的 SNR,不是峰值固定的 PSNR;这个合成数据也未限定在 [0,1]。 perceptual_lab.py 的 0.7356 阈值只比较两个候选 c=1 与 c=0:记它们的未归一化梯度幅值误差为 G(1)、G(0),则 $\alpha^2>[\Vert p\Vert^2/(G(0)-G(1))]$ 时前者更好,要求分母为正。它不是全体 c 的最优解首次偏离零的阈值,更不是普遍 LPIPS 参数。该实验说明信息丢失时不同目标可作不同取舍,不能说明真实 LPIPS/rFID 一定支持某个输出,也不能宣称此后无人报告 PSNR。 但这笔账的另一面是:对抗训练出来的「细节」不保证是真的。判别器只关心「像不像真图」,不关心「是不是这张图」,所以感知+GAN 的重建会补出数据集里常见的纹理——做压缩、做医学影像这类需要像素保真的任务时,这条路要慎走(GAN 训练不稳的代价也真实存在,05 节的 disc_start 和自适应权重都是为此付的工程税)。 边界:下游是否真正需要离散接口。 若目标是离散先验、掩码预测或可编码索引,VQ 是有意义的候选;连续潜空间扩散通常直接使用连续 VAE,但也有其他表示组合。离散化还服务压缩和表征学习,不能说非自回归就毫无收益。选型需同时看下游接口、率失真、重建质量与训练成本。 最后坦诚标注边界:本文教学训练与感知实验数字来自 8×8 合成小块上的玩具(numpy 实跑,可复现),规模和真实 VQGAN(f=16、d=256、K=16384、百万级图像)差几个数量级;直通的梯度分流与 EMA 更新式可对照源码,但训练稳定性、利用率及感知偏好都不能直接外推;具体数字(比如 $\beta=1.0$ 更好)不能外推,它依赖我的损失量纲。 07. 经典论文脉络 Neural Discrete Representation Learning(VQ-VAE):硬最近邻、直通与独立码本更新;附录已含 EMA。 Generating Diverse High-Fidelity Images with VQ-VAE-2:分层离散表征与自回归先验。 Taming Transformers for High-Resolution Image Synthesis(VQGAN):感知/对抗重建与离散序列 Transformer 的组合。 Zero-Shot Text-to-Image Generation(DALL-E):dVAE 与文本、图像联合自回归。 Vector-quantized Image Modeling with Improved VQGAN(ViT-VQGAN):研究 ViT tokenizer 及量化表征的设计。 MaskGIT: Masked Generative Image Transformer:对离散视觉 token 做掩码并行解码。 Language Model Beats Diffusion — Tokenizer is Key to Visual Generation(MAGVIT-v2/LFQ) 与 Finite Scalar Quantization: VQ-VAE Made Simple:分别以二值符号与固定标量格点构造隐式码本;利用率依赖训练和评估条件。 Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction(VAR):多尺度残差量化与下一尺度预测。原文 2404.08560 实际是角概念的数学论文,本轮按完整题名更正。 08. 常见误解 误解一:「KL 是常数,所以没有变分解释」。 one-hot 仍是离散分布;第一阶段固定均匀先验使 KL 为常数,不等于模型不再有变分下界。另训的自回归先验不是这个均匀先验。 误解二:「查表挡住了所有码本梯度」。 对固定索引,查表可以向码字反传;本实现由 detach 将重建梯度引入编码器,码本再由字典损失或 EMA 更新。 误解三:「straight-through 是硬目标梯度的无偏估计」。 区域内部硬梯度为零、边界处可能不可导;STE 是局部替代方向,不能当作硬目标的无偏梯度。 误解四:「高 perplexity 就代表高质量、低实际码率」。 它衡量指定窗口的边缘分布;固定长度码率、联合熵、率失真和语义质量各有定义。 误解五:「beta=0.25 或 1.0 可以照抄」。 本玩具的最优扫描点不等于其他数据、损失和归约下的最优点。原先 429 倍论据已撤回,修正后的 commitment/直通范数比为 0.839。 09. 动手验证 下面四个原实验都可以在附录代码里一键复现(numpy only,不需要 GPU): 亲手确认 argmin 的梯度是零:跑 python vq_core.py,看 [D] 段——把 $z_e$ 沿随机方向扰动 10⁻² 到 10⁻⁴,有限差分精确为 0,argmin 保持不变的样本比例是 1.0000;对比直通梯度平均范数 1.49 × 10⁻⁴。 亲手制造并修好码本坍缩:跑 python collapse_lab.py,看 [B][C] 段——K=512 随机初始化最终只有 17 个活码(96.7% 死码)、重建 MSE 0.0491;换死码重采样后 500 个活码、MSE 0.0184。你也可以把 restart_dead=True 关掉再跑一遍,确认结果回到 17。 验证信息丢失时的条件均值:跑 python perceptual_lab.py,把文件顶部的 AMP(纹理幅度)从 0.5 改成 0.1 再跑——你会发现梯度能量保留率对纹理幅度极其敏感,而 MSE 最优解的纹理保留永远是 0(条件均值把 ±纹理精确抵消)。 亲手确认「加码本不如降维度」:跑 python codebook_size_law.py,读 [A] 段输出——d=16 时 K 从 8 加到 512 只把失真降到 1/12.7,d=2 时同样 64 倍的预算能降到 1/66.5。改变 n_cluster 或噪声后应重新报告整条曲线,不能预先保证斜率变陡。要独立核对梯度归约、熵、121 帧计数与误差交叉项,再跑附录 vq_checks.py,预期 27 组最近邻、40 组误差恒等式和 7 个非法输入通过。 10. 延伸阅读 前置:变分下界与重参数化(ELBO)、VAE 结构与训练目标——本文 3.1 节是 ELBO 在离散情形下的特例。 同方向:视频 VAE 的时空压缩结构(f_t 的时间维压缩,01 节视频账本用到了)、视频 VAE 的常见 loss 组合(GAN/LPIPS 组合的连续版)。 相关:潜空间扩散与 Stable Diffusion 架构(06 节「什么时候不用 VQ」的那条连续路线)、自回归视频生成(离散 token 的下游)、FID / CLIP Score 到底测了什么(05 节 rFID 的定义与陷阱)。 附录:完整代码 09 节用到的脚本全文如下(token_budget.py、collapse_lab.py、vq_core.py、vq_checks.py、codebook_size_law.py、perceptual_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 token_budget.py """token_budget.py —— 离散化到底换来多少「序列长度」上的便宜。 显式稠密注意力矩阵随序列长度平方增长;压缩 tokenizer 是降低逻辑成本的一条路线。 本脚本把这笔账算成具体的数: [A] 不同分辨率 / 下采样率下的 token 数与注意力规模 [B] 码本大小 K 决定每个 token 多少 bit,折算成每张图多少 bpp [C] 视频的 token 数(时空压缩一起算) [D] 码本坍缩要付的比特代价:perplexity 描述边缘使用熵 运行:python token_budget.py """ from __future__ import annotations import numpy as np def n_tokens(h, w, f, t=1, f_t=1): """空间整除;首帧独立、后续按 f_t 分组,无填充的显式约定。""" if any(not isinstance(v, (int, np.integer)) or isinstance(v, bool) or v <= 0 for v in (h, w, f, t, f_t)): raise ValueError("positive integer dimensions required") if h % f or w % f or (t - 1) % f_t: raise ValueError("spatial dimensions and remaining frames must divide exactly") return (1 + (t - 1) // f_t) * (h // f) * (w // f) def main(): print("[A] 图像:边长 H 与下采样率 f 决定 token 数(注意力按 n^2 涨)") print(" H f token 数 注意力矩阵 n^2 相对像素级") for H in (256, 512, 1024): base = H * H * 3 # 像素级(RGB 逐通道) for f in (4, 8, 16): n = n_tokens(H, H, f) print(" %-5d %-4d %-12d %-18.3e %.4g" % ( H, f, n, float(n) ** 2, float(n * n) / float(base * base))) print(" (像素级 RGB 序列 %d,n^2 = %.3e)" % (base, float(base) ** 2)) print() print("[B] 码本容量 K 决定每个 token 的 bit 数(256x256 图像)") print(" K bit/token f=8: bit/图 bpp f=16: bit/图 bpp") for K in (256, 512, 1024, 4096, 16384, 262144): bit = np.log2(K) row = [K, bit] for f in (8, 16): n = n_tokens(256, 256, f) total = n * bit row += [total, total / (256 * 256)] print(" %-8d %-10.2f %-12.0f %-7.3f %-12.0f %.3f" % tuple(row)) print(" bpp 是固定长度码索引的逻辑 bit/pixel,未含码本、解码器、容器或熵编码。") print() print("[C] 视频:时间维也要压(121 个采样时刻(24fps 的首末时刻相距 5 秒),256x256)") print(" f_t f token 数 上下文长度对比(相对 121x256x256x3 像素)") pixel = 121 * 256 * 256 * 3 for f_t in (1, 4, 8): for f in (8, 16): n = n_tokens(256, 256, f, t=121, f_t=f_t) print(" %-5d %-4d %-14d %.5g" % ( f_t, f, n, float(n) / pixel)) print() print("[D] 码本坍缩的比特代价:边缘使用熵看 perplexity,不是看 K") print(" K perplexity 标称 bit 边缘熵 bit 相对最大熵差") for K, ppl in [(512, 14.50), (512, 450.51), (512, 426.71), (16384, 14.50), (16384, 1000.0), (16384, 16384.0)]: nominal = np.log2(K) eff = np.log2(ppl) print(" %-6d %-11.2f %-10.2f %-10.2f %.1f%%" % ( K, ppl, nominal, eff, 100 * (nominal - eff) / nominal)) print(" 前3行来自 collapse_lab.py 的实测:K=512 随机初始化只有 17 个码活着,") print(" 9 bit 的码本边缘熵为 3.86 bit;死码重启后回到 8.74 bit。") print() print("[E] 一句话总结") f16 = n_tokens(256, 256, 16) print(" 256x256 图像在 f=16 下是 %d 个 token,是像素级 RGB 序列的 1/%.0f;" % (f16, (256 * 256 * 3) / f16)) print(" 注意力规模从 %.2e 降到 %.2e,省了 %.0f 倍——这才是采用压缩 tokenizer 的一个动机。" % (float(256 * 256 * 3) ** 2, float(f16) ** 2, float(256 * 256 * 3) ** 2 / float(f16) ** 2)) if __name__ == "__main__": main() collapse_lab.py """collapse_lab.py —— 码本坍缩(codebook collapse)是怎么发生的,能救回来多少。 码本坍缩指的是:K 个码字里只有一小撮被用到,剩下的在当前评估窗口里没有被选中 (死码)。花了一整个 K×d 的码本,当前边缘码分布的熵为 log2(perplexity) bit。 [A] commitment 权重 beta 怎么影响坍缩程度 [B] 大码本在训练过程中怎么一步步坍缩(活跃码数曲线) [C] 两种常用解药有多大用:连续AE预训练 + k-means码本 / 死码重采样重启 运行:python collapse_lab.py """ from __future__ import annotations import argparse import numpy as np from vq_core import kmeans, make_patch_data, perplexity, quantize, train_ae BIG_K = 512 def stats(X, params, codebook): """给定训练好的权重与码本,算重建误差与使用分布统计量。""" z_e = X @ params["We"] z_q, idx, _ = quantize(z_e, codebook) cnt = np.bincount(idx, minlength=len(codebook)).astype(np.float64) rec = float((((z_q @ params["Wd"] + params["bd"]) - X) ** 2).mean()) frac = np.sort(cnt / cnt.sum())[::-1] return { "rec": rec, "alive": int((cnt > 0).sum()), "ppl": perplexity(cnt), "top1": float(frac[0]), "bottom_half": float(frac[len(frac) // 2:].sum()), "counts": cnt, } def run_vq(X, K=BIG_K, beta=0.25, steps=1200, seed=0, mode="ema", init_cb=None, restart=False, log_every=100, init_params=None): """跑一次 VQ-AE 训练,返回 (stats, hist)。""" p, c, h, _ = train_ae(X, 8, mode, K=K, beta=beta, steps=steps, seed=seed, restart_dead=restart, init_cb=init_cb, log_every=log_every, init_params=init_params) return stats(X, p, c), h def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=1200) ap.add_argument("--K", type=int, default=BIG_K) ap.add_argument("--seed", type=int, default=0) args = ap.parse_args() X, _, _, _ = make_patch_data(n=4096, seed=args.seed) print("数据 X%s,训练 %d 步" % (X.shape, args.steps)) print() # ---------------- [A] beta 扫描 ---------------- print("[A] commitment 权重 beta 的影响(K=64,码本 EMA,%d 步)" % args.steps) print(" beta 重建MSE 活跃码 perplexity") for beta in (0.0, 0.05, 0.25, 1.0, 4.0): s, _ = run_vq(X, K=64, beta=beta, steps=args.steps, seed=args.seed) print(" %-9.2f %.6f %4d %.2f" % ( beta, s["rec"], s["alive"], s["ppl"])) print(" -> beta=0 时没有commitment约束;改变beta会影响训练,结果还依赖") print(" 初始化、损失归约和训练预算(不能从单 seed 归纳最优 beta)。") print() # ---------------- [B] 大码本的坍缩过程 ---------------- print("[B] 大码本 K=%d 的坍缩过程(beta=0.25,EMA,随机初始化)" % args.K) s0, h0 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed, log_every=200) print(" 步数 重建MSE 活跃码 perplexity") for i in range(len(h0["step"])): print(" %5d %.6f %4d %.2f" % ( h0["step"][i], h0["recon"][i], h0["alive"][i], h0["ppl"][i])) print(" 最终:%d 个码字里只有 %d 个活着;perplexity %.2f 对应 %.2f bit," "而固定长度索引是 %.2f bit" % ( args.K, s0["alive"], s0["ppl"], np.log2(max(s0["ppl"], 1e-12)), np.log2(args.K))) print(" 最热的 1 个码占 %.3f 的使用量,最冷的一半码一共只占 %.4f" % (s0["top1"], s0["bottom_half"])) print() # ---------------- [C] 解药 ---------------- print("[C] 两种解药(同为 K=%d,%d 步)" % (args.K, args.steps)) p_init, _, _, _ = train_ae(X, 8, "continuous", steps=800, seed=args.seed) init_cb = kmeans(X @ p_init["We"], args.K, seed=args.seed, iters=20) s1, h1 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed, init_cb=init_cb, log_every=200, init_params=p_init) s2, h2 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed, restart=True, log_every=200) print(" 配置 重建MSE 活跃码 perplexity 边缘熵bit") for tag, s in [("随机初始化", s0), ("连续AE预训练 + k-means", s1), ("死码重采样重启", s2)]: print(" %-16s %.6f %4d/%4d %6.2f %.2f" % ( tag, s["rec"], s["alive"], args.K, s["ppl"], np.log2(max(s["ppl"], 1e-12)))) print() print(" 注:本玩具有 16 个类心,但类内连续变化允许超过 16 个活码;") print(" 活跃数不等于信息质量。预训练分支另付 800 步连续AE及 k-means 成本。") print() print("[D] 活跃码数随训练步数的变化(供配图)") print(" 随机初始化 :", list(zip(h0["step"], h0["alive"]))) print(" 连续AE预训练 + k-means:", list(zip(h1["step"], h1["alive"]))) print(" 死码重采样 :", list(zip(h2["step"], h2["alive"]))) if __name__ == "__main__": main() vq_core.py """vq_core.py —— 向量量化器(VQ)的最小实现,外加一个真跑得起来的训练实验。 无 torch 依赖,纯 numpy。使用 Python 3.10+;本轮环境见 quality_report.md。 运行: /usr/local/bin/python3 vq_core.py /usr/local/bin/python3 vq_core.py --steps 1200 --K 64 --beta 0.25 输出分五段: [A] 连续自编码器基线(无量化)——独立优化的参考 [B] VQ-AE 训练结果:重建误差 / 量化误差 / 码本使用率 / perplexity [C] 固定权重对照:连续通路与量化通路(含交叉项) [D] straight-through 的梯度核验:真实有限差分 vs 直通梯度 [E] 码本更新方式对照(不更新 / 梯度 / EMA / EMA+死码重启) """ from __future__ import annotations import argparse import os import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # ------------------------------------------------------------------ 数据 def cos_basis(patch: int = 8, n_freq: int = 3): """8x8 小块的低频余弦基,共 n_freq^2 = 9 个,已按行归一化。""" t = np.arange(patch) + 0.5 one_d = [np.ones(patch)] for k in range(1, n_freq): one_d.append(np.cos(np.pi * k * t / patch)) B = np.stack([np.outer(a, b).ravel() for a in one_d for b in one_d]) return B / np.linalg.norm(B, axis=1, keepdims=True) def make_patch_data(n=4096, patch=8, n_cluster=16, seed=0, center_scale=2.0, intra=0.35, noise=0.05): """合成一批 8x8 小块:16 个类心 + 类内低频连续变化 + 白噪声。 返回 X[N, 64]、类标、类心、基。类间方差远大于类内,所以码本有机会学到 「块类别」这种离散结构;白噪声部分不可压缩,构成误差地板。 """ rng = np.random.default_rng(seed) B = cos_basis(patch) # [9, 64] dim_b = B.shape[0] centers = center_scale * (rng.normal(size=(n_cluster, dim_b)) @ B) labels = rng.integers(0, n_cluster, size=n) X = centers[labels].copy() X += intra * (rng.normal(size=(n, dim_b)) @ B) # 类内连续变化 X += noise * rng.normal(size=(n, patch * patch)) # 不可压缩噪声 return X, labels, centers, B # ------------------------------------------------------------------ 量化 def quantize(z_e, codebook): """最近邻量化。z_e [N, d],codebook [K, d]。 返回 z_q[N, d]、索引 idx[N]、量化误差(每样本 d 维平方和)。 """ z_e, codebook = np.asarray(z_e), np.asarray(codebook) if (z_e.ndim != 2 or codebook.ndim != 2 or not len(z_e) or not len(codebook) or z_e.shape[1] != codebook.shape[1] or not z_e.shape[1] or not np.isfinite(z_e).all() or not np.isfinite(codebook).all()): raise ValueError("finite nonempty [N,d] and [K,d] arrays required") d2 = ((z_e[:, None, :] - codebook[None, :, :]) ** 2).sum(-1) # [N, K] idx = d2.argmin(axis=1) return codebook[idx], idx, d2[np.arange(len(idx)), idx] def kmeans(data, k, seed=0, iters=25): """Lloyd 迭代 + kmeans++ 初始化。空簇用「当前最差点」补齐。""" rng = np.random.default_rng(seed) n, d = data.shape k = min(k, n) centers = np.empty((k, d), dtype=data.dtype) centers[0] = data[rng.integers(n)] closest = ((data - centers[0]) ** 2).sum(1) for j in range(1, k): tot = closest.sum() if tot <= 0: centers[j] = data[rng.integers(n)] else: centers[j] = data[rng.choice(n, p=closest / tot)] closest = np.minimum(closest, ((data - centers[j]) ** 2).sum(1)) for _ in range(iters): _, assign, dist = quantize(data, centers) dist = dist.copy() for j in range(k): mask = assign == j if mask.any(): centers[j] = data[mask].mean(0) else: # 空簇:拿当前最差的点填 j_worst = int(np.argmax(dist)) centers[j] = data[j_worst] dist[j_worst] = -1.0 return centers def perplexity(counts): """码本 perplexity = exp(使用分布的熵),上界是码本大小 K。""" p = np.asarray(counts, dtype=np.float64) if p.ndim != 1 or not len(p) or not np.isfinite(p).all() or (p < 0).any() or p.sum() <= 0: raise ValueError("nonnegative finite counts with positive total required") p = p / p.sum() nz = p[p > 0] return float(np.exp(-(nz * np.log(nz)).sum())) # ------------------------------------------------------------------ 训练 class Adam: """够用的 Adam,只处理一组 numpy 参数。""" def __init__(self, params, lr=0.02, b1=0.9, b2=0.999, eps=1e-8): self.p = params self.m = {k: np.zeros_like(v) for k, v in params.items()} self.v = {k: np.zeros_like(v) for k, v in params.items()} self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps self.t = 0 def step(self, grads): self.t += 1 for k, g in grads.items(): self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * g self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * (g * g) mhat = self.m[k] / (1 - self.b1 ** self.t) vhat = self.v[k] / (1 - self.b2 ** self.t) self.p[k] -= self.lr * mhat / (np.sqrt(vhat) + self.eps) def make_params(d_in, d_lat, seed=0): rng = np.random.default_rng(seed) return { "We": rng.normal(scale=0.1, size=(d_in, d_lat)), "Wd": rng.normal(scale=0.1, size=(d_lat, d_in)), "bd": np.zeros(d_in), } def evaluate(X, params, codebook, eval_idx): """在固定评估集上算重建 MSE、量化误差、活跃码数、perplexity。""" x = X[eval_idx] z_e = x @ params["We"] d_lat = params["We"].shape[1] if codebook is None: z_q, qerr, alive, ppl, counts = z_e, 0.0, 0, 0.0, None else: z_q, idx, qerr = quantize(z_e, codebook) counts = np.bincount(idx, minlength=len(codebook)).astype(np.float64) alive = int((counts > 0).sum()) ppl = perplexity(counts) x_hat = z_q @ params["Wd"] + params["bd"] return { "recon": float(((x_hat - x) ** 2).mean()), "quant": float(np.mean(qerr)) / d_lat if codebook is not None else 0.0, "alive": alive, "ppl": ppl, "counts": counts, } def train_ae(X, d_lat, codebook_mode, K=64, beta=0.25, steps=800, batch=512, lr=0.02, seed=0, decay=0.99, restart_dead=False, log_every=100, cb_lr=10.0, init_cb=None, init_params=None): """训练「线性编码器 + VQ + 线性解码器」。 codebook_mode: "continuous" —— 无量化,连续自编码器基线 "none" —— 码本完全不更新(只有 straight-through) "grad" —— 码本用 ||sg[z_e] - e||^2 的梯度更新 "ema" —— 码本用指数滑动平均更新(cluster_size + embed_avg) """ if codebook_mode not in {"continuous", "none", "grad", "ema"} or not 0 <= decay < 1: raise ValueError("invalid quantizer mode or EMA decay") if min(steps, batch, K, d_lat, log_every) <= 0 or beta < 0: raise ValueError("positive sizes/steps and nonnegative beta required") rng = np.random.default_rng(seed) eval_rng = np.random.default_rng(1000 + seed) eval_idx = eval_rng.choice(len(X), size=min(2048, len(X)), replace=False) n, d_in = X.shape params = make_params(d_in, d_lat, seed=seed) if init_params is not None: if set(init_params) != set(params) or any(init_params[k].shape != v.shape for k, v in params.items()): raise ValueError("initial parameter shapes differ") params = {k: np.asarray(v).copy() for k, v in init_params.items()} opt = Adam(params, lr=lr) has_vq = codebook_mode != "continuous" if has_vq: # 码本初始化:小方差(呼应 taming 里 uniform(-1/n_e, 1/n_e) 的量级) codebook = (rng.normal(scale=1.0 / K, size=(K, d_lat)) if init_cb is None else np.asarray(init_cb).copy()) if codebook.shape != (K, d_lat) or not np.isfinite(codebook).all(): raise ValueError("initial codebook shape or values invalid") init_codebook = codebook.copy() cluster_size = np.ones(K, dtype=np.float64) # EMA 用 embed_avg = codebook.copy() # EMA 用 else: codebook = init_codebook = None cluster_size = embed_avg = None hist = {"step": [], "recon": [], "quant": [], "alive": [], "ppl": []} for step in range(1, steps + 1): b = rng.choice(n, size=min(batch, n), replace=False) x = X[b] z_e = x @ params["We"] # [B, d] if has_vq: z_q, idx, _ = quantize(z_e, codebook) e_k = z_q x_hat = z_q @ params["Wd"] + params["bd"] # 反传:解码器对 z_q 的梯度,原封不动地当作对 z_e 的梯度 dxh = 2.0 * (x_hat - x) / (len(x) * d_in) # [B, d_in] dz_q = dxh @ params["Wd"].T # [B, d] dz_e = dz_q + beta * 2.0 * (z_e - e_k) / (len(x) * d_lat) opt.step({"We": x.T @ dz_e, "Wd": z_q.T @ dxh, "bd": dxh.sum(0)}) if codebook_mode == "grad": # d/de ||sg[z_e] - e||^2 = 2 (e - z_e)。注意码本是普通 SGD, # 不走 Adam,所以它的有效步长要单独调(见 [E] 的 cb_lr 扫描)。 g = 2.0 * (e_k - z_e) / (len(x) * d_lat) np.add.at(codebook, idx, -cb_lr * g) elif codebook_mode == "ema": onehot = np.zeros((len(x), K)) onehot[np.arange(len(x)), idx] = 1.0 cnt = onehot.sum(0) cluster_size = decay * cluster_size + (1 - decay) * cnt embed_avg = decay * embed_avg + (1 - decay) * (onehot.T @ z_e) tot = cluster_size.sum() smoothed = (cluster_size + 1e-5) / (tot + K * 1e-5) * tot codebook = embed_avg / smoothed[:, None] if restart_dead: dead = np.where(cluster_size < 1.0)[0] for j in dead: # 死码重采样为真实的编码器输出 codebook[j] = z_e[rng.integers(len(z_e))] cluster_size[j] = 1.0 embed_avg[j] = codebook[j] else: x_hat = z_e @ params["Wd"] + params["bd"] dxh = 2.0 * (x_hat - x) / (len(x) * d_in) opt.step({"We": x.T @ (dxh @ params["Wd"].T), "Wd": z_e.T @ dxh, "bd": dxh.sum(0)}) if step % log_every == 0 or step == steps: m = evaluate(X, params, codebook, eval_idx) hist["step"].append(step) for k in ("recon", "quant", "alive", "ppl"): hist[k].append(m[k]) shift = None if has_vq: shift = float(np.abs(codebook - init_codebook).mean()) return params, codebook, hist, shift # ------------------------------------------------------------------ 主流程 def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=800) ap.add_argument("--K", type=int, default=64) ap.add_argument("--d", type=int, default=8) ap.add_argument("--beta", type=float, default=0.25) ap.add_argument("--seed", type=int, default=0) args = ap.parse_args() X, labels, centers, B = make_patch_data(n=4096, seed=args.seed) n, d_in = X.shape print("数据: X%s 样本范数均值 %.4f" % (X.shape, np.linalg.norm(X, axis=1).mean())) print("码本 K=%d, 潜维度 d=%d, beta=%.2f" % (args.K, args.d, args.beta)) print() # ---------------- [A] 连续自编码器基线 ---------------- pc, _, hc, _ = train_ae(X, args.d, "continuous", steps=args.steps, seed=args.seed) recon_c = hc["recon"][-1] print("[A] 连续自编码器(无量化,独立训练的线性参考)") print(" 重建 MSE/像素 = %.6f" % recon_c) print() # ---------------- [B] VQ-AE ---------------- pv, cb, hv, _ = train_ae(X, args.d, "ema", K=args.K, beta=args.beta, steps=args.steps, seed=args.seed) print("[B] VQ-AE(码本 EMA 更新, decay=0.99)训练曲线") print(" 步数 重建MSE 量化误差/d 活跃码 perplexity") for i in range(len(hv["step"])): print(" %5d %.6f %.6f %5d %.2f" % ( hv["step"][i], hv["recon"][i], hv["quant"][i], hv["alive"][i], hv["ppl"][i])) counts = np.bincount(quantize(X @ pv["We"], cb)[1], minlength=args.K).astype(np.float64) print(" 最终活跃码 %d / %d,perplexity %.2f(上界 %d)" % ( (counts > 0).sum(), args.K, perplexity(counts), args.K)) print() # ---------------- [C] 误差分解 ---------------- z_e = X @ pv["We"] z_q, _, qerr = quantize(z_e, cb) rec_vq = (((z_q @ pv["Wd"] + pv["bd"]) - X) ** 2).mean() rec_cont = (((z_e @ pv["Wd"] + pv["bd"]) - X) ** 2).mean() print("[C] 误差分解(同一组 VQ-AE 权重,只换「走不走量化」)") print(" 连续通路重建 MSE = %.6f (固定权重的连续通路)" % rec_cont) print(" 量化后重建 MSE = %.6f" % rec_vq) print(" 差值(量化引入) = %.6f (%.1f%%)" % ( rec_vq - rec_cont, 100 * (rec_vq - rec_cont) / rec_cont)) print(" [A] 连续基线 = %.6f" % recon_c) print(" 量化误差 E||z_e-e||^2/d = %.6f" % (qerr.mean() / args.d)) print() # ---------------- [D] straight-through 梯度核验 ---------------- # 用 [B] 训好的 VQ-AE,在真实工作点上做有限差分。 rng = np.random.default_rng(7) x0 = X[:512] z_e0 = x0 @ pv["We"] z_q0, idx0, _ = quantize(z_e0, cb) xh0 = z_q0 @ pv["Wd"] + pv["bd"] L0 = ((xh0 - x0) ** 2).mean() direction = rng.normal(size=args.d) direction /= np.linalg.norm(direction) print("[D] straight-through 梯度核验(512 样本,取 [B] 训好的权重)") print(" 有限差分:把 z_e 沿随机单位方向微扰 eps,看 L 怎么变") for eps in (1e-1, 1e-2, 1e-3, 1e-4): z_p = z_e0 + eps * direction z_qp, idxp, _ = quantize(z_p, cb) Lp = ((z_qp @ pv["Wd"] + pv["bd"] - x0) ** 2).mean() same = float((idxp == idx0).mean()) print(" eps=%.0e : dL/dz_e = %+.10f (argmin 保持不变的样本 %.4f)" % ( eps, (Lp - L0) / eps, same)) dxh = 2.0 * (xh0 - x0) / (len(x0) * d_in) dz_q = dxh @ pv["Wd"].T st_grad = float((dz_q * direction).sum()) st_norm = float(np.linalg.norm(dz_q, axis=1).mean()) commit = 2.0 * args.beta * (z_e0 - z_q0) / (len(x0) * args.d) commit_norm = float(np.linalg.norm(commit, axis=1).mean()) print(" 直通梯度 dL/dz_q 投影到同一方向 = %+.10f" % st_grad) print(" 直通梯度平均范数 ||dL/dz_q|| = %.6e" % st_norm) print(" commitment 项平均范数 = %.6e" % commit_norm) print(" -> Voronoi 区域内部真实梯度为 0(边界处不可导),直通梯度非零;") print(" 它是「假装量化是恒等映射」的替代品,不是真实梯度的估计。") print() # ---------------- [E] 码本更新方式对照 ---------------- print("[E] 码本更新方式对照(同为 %d 步,K=%d,beta=%.2f)" % ( args.steps, args.K, args.beta)) print(" 模式 重建MSE 活跃码 perplexity 码本位移") for mode, rst, cbl in [("none", False, 10.0), ("grad", False, 10.0), ("ema", False, 10.0), ("ema", True, 10.0)]: p, c, h, shift = train_ae(X, args.d, mode, K=args.K, beta=args.beta, steps=args.steps, seed=args.seed, restart_dead=rst, cb_lr=cbl) cnt = np.bincount(quantize(X @ p["We"], c)[1], minlength=args.K).astype(np.float64) tag = mode + ("+restart" if rst else "") print(" %-18s %.6f %5d %.2f %.6f" % ( tag, h["recon"][-1], int((cnt > 0).sum()), perplexity(cnt), shift)) print() print(" 附:grad 模式对码本步长极敏感(码本是普通 SGD,不走 Adam)") for cbl in (0.02, 0.1, 1.0, 10.0): p, c, h, _ = train_ae(X, args.d, "grad", K=args.K, beta=args.beta, steps=args.steps, seed=args.seed, cb_lr=cbl) cnt = np.bincount(quantize(X @ p["We"], c)[1], minlength=args.K).astype(np.float64) print(" cb_lr=%-6.2f 重建MSE %.6f 活跃码 %3d perplexity %.2f" % ( cbl, h["recon"][-1], int((cnt > 0).sum()), perplexity(cnt))) print() if __name__ == "__main__": main() vq_checks.py """独立核验 VQ 的局部梯度、信息熵、量化边界和固定解码器误差恒等式。 运行 python vq_checks.py;只依赖 NumPy,不训练模型、不需要权重。 """ from pathlib import Path import json import numpy as np from vq_core import quantize, perplexity, train_ae, make_patch_data, make_params from token_budget import n_tokens from perceptual_lab import make_toy, evaluate_candidate, phi def main(): rng = np.random.default_rng(17) nearest = 0 for n in (1, 3, 11): for d in (1, 2, 8): for k in (1, 4, 9): z, e = rng.normal(size=(n, d)), rng.normal(size=(k, d)) q, idx, err = quantize(z, e) expected = np.array([min(range(k), key=lambda j: sum((z[i, l]-e[j, l])**2 for l in range(d))) for i in range(n)]) assert np.array_equal(idx, expected) assert np.allclose(err, ((z-q)**2).sum(1)) nearest += 1 assert quantize(np.array([[0.]]), np.array([[-1.], [1.]]))[1][0] == 0 z = np.array([[.2], [.3]]) e = np.array([[-1.], [1.]]) q, idx, _ = quantize(z, e) f = lambda v: float(((quantize(v, e)[0]-.4)**2).mean()) hard_fd = (f(z+1e-6)-f(z-1e-6))/2e-6 assert hard_fd == 0 # 对当前量化点构造局部恒等替代目标,验证STE的局部梯度;并不声称它是硬目标真梯度。 assert f(np.full_like(z, -.2)) != f(z) grad = 2*(q-.4)/q.size surrogate = lambda v: float(((q+v-z-.4)**2).mean()) surrogate_fd = (surrogate(z+1e-6)-surrogate(z-1e-6))/2e-6 assert abs(surrogate_fd-grad.sum()) < 1e-9 entropy = [] for counts in [np.ones(8), np.array([9, 0, 0]), np.array([1, 2, 3, 0])]: p=counts/counts.sum();h=-sum(float(v*np.log2(v)) for v in p if v>0) assert abs(np.log2(perplexity(counts))-h) < 1e-14 entropy.append(h) # 边缘熵不是序列联合熵:三位完全相同、各位边缘均匀;联合熵1bit而边缘和3bit。 assert np.log2(perplexity([1,1])) == 1 time_counts = [n_tokens(256,256,16,t=t,f_t=4) for t in (1,5,121)] assert time_counts == [256,512,7936] invalid = 0 cases=[lambda: perplexity([0,0]),lambda:perplexity([-1,2]),lambda:perplexity([np.nan]),lambda:quantize(np.zeros((2,2)),np.zeros((3,1))),lambda:quantize(np.zeros((0,2)),np.zeros((3,2))),lambda:n_tokens(256,256,16,t=120,f_t=4),lambda:n_tokens(255,256,16)] for fn in cases: try: fn() except ValueError: invalid += 1 else: raise AssertionError('invalid input accepted') # 解码器放大和交叉项;潜空间距离不是像素误差增量。 errors=[] for _ in range(40): x,z,e,w,b=(rng.normal(size=shape) for shape in [(5,7),(5,3),(4,3),(3,7),(7,)]) q,_,_=quantize(z,e);r=z@w+b-x;delta=(q-z)@w difference=((r+delta)**2).mean()-(r*r).mean() rhs=(delta*delta).mean()+2*(r*delta).mean();errors.append(abs(difference-rhs)) assert max(errors)<1e-12 # commitment、码本项分别使用均值归约,有限差分验证同一批次量纲。 z=rng.normal(size=(4,3));e=rng.normal(size=(4,3));beta=.25;step=1e-6 commit=lambda a: beta*((a-e)**2).mean();g=2*beta*(z-e)/z.size fd=[] for index in np.ndindex(z.shape): p=z.copy();q=z.copy();p[index]+=step;q[index]-=step fd.append(abs((commit(p)-commit(q))/(2*step)-g[index])) assert max(fd)<1e-9 # 暖启动保留同一编码器/解码器坐标;零学习率一步不会偷偷重置参数。 X,*_=make_patch_data(n=64);params=make_params(64,2);cb=(X@params['We'])[:8] trained,_,_,_=train_ae(X,2,'ema',K=8,steps=1,batch=16,lr=0,init_cb=cb,init_params=params) assert all(np.array_equal(v,trained[k]) for k,v in params.items()) m,p=make_toy();a=float((p*p).mean());mse_error=0 for c in (-1.,-.79,0.,.5,1.): result=evaluate_candidate(m,p,c,1.);mse_error=max(mse_error,abs(result['mse']-a*(1+c*c))) direct=.5*((phi(m+c*p,1)-phi(m+p,1))**2).mean()+.5*((phi(m+c*p,1)-phi(m-p,1))**2).mean() assert abs(direct-result['feat'])<1e-14 assert mse_error<1e-14 out=dict(passed=True,nearest_cases=nearest,invalid_cases=invalid,hard_fd=hard_fd,ste_surrogate_fd=surrogate_fd,entropy_bits=entropy,video_tokens=time_counts,error_identity_max=max(errors),commitment_fd_max=max(fd),mse_identity_max=mse_error,errors=[],warnings=[]) Path(__file__).with_name('validation_results.json').write_text(json.dumps(out,ensure_ascii=False,indent=2)+'\n',encoding='utf8') print(json.dumps(out,ensure_ascii=False,indent=2)) if __name__ == '__main__': main() codebook_size_law.py """codebook_size_law.py —— 码本容量 K 的收益到底有多大? 核心问题:把码本从 512 加到 16384,重建能好多少?直觉是「容量越大越好」, 但高维量化的经典结论(Zador 定理的渐近形式)说:最优量化失真随码本大小 在足维连续密度、高码率和最优码本等条件下渐近按 K^(-2/d) 衰减。d=256 时指数只有 -1/128,也就是 K 翻一倍、失真只降 0.5%。 本脚本的实测方式:先训一个连续自编码器把潜分布固定住,再对潜变量做 k-means (k-means 就是「给定 K 个码字的局部优化最近邻量化器」的近似),在**留出集**上 测失真(避免用训练集测失真造成的过拟合假象)。 [A] 不同 d 下,量化失真 vs K 的双对数斜率,与 -2/d 对拍 [B] 像素重建误差怎样随潜量化改变(继续加 K 的收益拐点) 运行:python codebook_size_law.py """ from __future__ import annotations import argparse import numpy as np from vq_core import kmeans, make_patch_data, quantize, train_ae def distortion_curve(z_fit, z_test, k_list, seed=0, iters=20): """在 z_fit 上拟合 k-means,在 z_test 上测失真(留出集估计)。""" out = [] for k in k_list: c = kmeans(z_fit, k, seed=seed, iters=iters) _, _, d2 = quantize(z_test, c) out.append(float(d2.mean()) / z_fit.shape[1]) return np.array(out) def fit_slope(k_list, dist): """双对数线性拟合:log D = a * log K + b,返回斜率 a。""" lk = np.log(np.asarray(k_list, dtype=np.float64)) ld = np.log(np.asarray(dist, dtype=np.float64)) a, b = np.polyfit(lk, ld, 1) return float(a), float(b) def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=1500, help="连续自编码器训练步数") ap.add_argument("--seed", type=int, default=0) args = ap.parse_args() X, _, _, _ = make_patch_data(n=8192, seed=args.seed) d_in = X.shape[1] # 前一半拟合码本,后一半当留出集测失真 X_fit, X_test = X[:4096], X[4096:] k_list = [2, 4, 8, 16, 32, 64, 128, 256, 512] print("数据 X%s(前 4096 拟合码本,后 4096 留出评估)" % (X.shape,)) print() print("[A] 量化失真 D(K) = E||z - q(z)||^2 / d 的双对数斜率") print(" d 理论 -2/d 实测斜率(K>=16) D(8) D(512) 衰减倍数") results = {} for d in (2, 4, 8, 16): params, _, hist, _ = train_ae(X_fit, d, "continuous", steps=args.steps, seed=args.seed) z_fit = X_fit @ params["We"] z_test = X_test @ params["We"] dist = distortion_curve(z_fit, z_test, k_list, seed=args.seed) slope, _ = fit_slope(k_list[3:], dist[3:]) # 只拟合 K>=16 段,不预设已到渐近区间 results[d] = {"dist": dist, "slope": slope, "params": params, "z_fit": z_fit, "z_test": z_test} print(" %-4d %-11.4f %-17.4f %.4e %.4e %.1fx" % ( d, -2.0 / d, slope, dist[2], dist[-1], dist[2] / dist[-1])) print() print(" K 从 8 加到 512(64 倍):d=2 失真降 %.1f 倍,d=16 只降 %.1f 倍。" % (results[2]["dist"][2] / results[2]["dist"][-1], results[16]["dist"][2] / results[16]["dist"][-1])) print(" -2/d 仅为高码率、足维连续分布和最优码本的渐近参照;") print(" 有限样本、非均匀密度、局部 k-means 和有效维度都能改变实测斜率。") print() # ---------------- [B] 拐点:量化误差 vs 子空间残差 ---------------- params = results[8]["params"] z_fit, z_test = results[8]["z_fit"], results[8]["z_test"] rec_cont = (((z_test @ params["Wd"] + params["bd"]) - X_test) ** 2).mean() print("[B] 码本大到什么程度,像素误差相对连续通路如何改变(d=8,留出集)") print(" 连续通路重建 MSE(子空间残差) = %.6f" % rec_cont) print(" K 量化失真/d 量化后重建MSE 相对残差涨幅") for k in k_list: c = kmeans(z_fit, k, seed=args.seed, iters=20) z_q, _, d2 = quantize(z_test, c) rec = (((z_q @ params["Wd"] + params["bd"]) - X_test) ** 2).mean() print(" %-7d %.4e %.6f %+.1f%%" % ( k, d2.mean() / 8, rec, 100 * (rec - rec_cont) / rec_cont)) print() if __name__ == "__main__": main() perceptual_lab.py """perceptual_lab.py —— 为什么 信息丢失时不同重建目标的取舍:一个能算清的玩具。 VQ-VAE 用 MSE(或像素空间的似然)训练解码器。MSE 的最优解是条件均值, 而条件均值会把「同一 latent 对应多种合理细节」平均掉 —— 这就是重建发糊的 数学根源,不是玄学。VQGAN 的解法是换掉重建损失:改成特征空间距离(LPIPS) 外加一个对抗项。 本脚本用一个双模态玩具把这个机制算清楚: [A] 构造:同一个 latent 对应两种等概率的纹理(+p 和 -p) [B] MSE 最优 = 条件均值,纹理被平均掉;高频(梯度)能量只剩多少 [C] 换成非线性特征空间后,最优解沿候选网格偏离均值;求阈值 alpha 并与解析式对拍 [D] 三种候选输出的三项指标对比:SNR / 梯度能量保留 / 到最近模态的距离 注意:这里的特征映射 phi(x) = [x, alpha * |grad x|] 是我手工造的非线性特征, 仅演示一个特定非线性特征的偏好;本文对照的LPIPS实现使用VGG16 五层特征加 一层学习的 1x1 卷积,仅是定性类比,不能据此验证真实 LPIPS/GAN 的质量。 运行:python perceptual_lab.py """ from __future__ import annotations import numpy as np PATCH = 8 AMP = 0.5 # 纹理幅度 SEED = 0 def gradient_magnitude(img): """前向差分后取绝对值:|grad x| 的展平向量(水平 56 个 + 垂直 56 个)。""" gx = np.diff(img, axis=1) gy = np.diff(img, axis=0) return np.concatenate([np.abs(gx).ravel(), np.abs(gy).ravel()]) def phi(img, alpha): """非线性特征映射:图像本身 + alpha 乘梯度幅值。""" return np.concatenate([img.ravel(), alpha * gradient_magnitude(img)]) def make_toy(): """低频内容 m + 等概率的 ±棋盘纹理 p。""" rng = np.random.default_rng(SEED) u = np.arange(PATCH) + 0.5 m = np.outer(np.cos(np.pi * u / PATCH), np.cos(np.pi * u / PATCH)) * 1.5 m += 0.3 * rng.normal(size=(PATCH, PATCH)) # 让内容不那么对称 ii, jj = np.meshgrid(np.arange(PATCH), np.arange(PATCH), indexing="ij") p = AMP * ((-1.0) ** (ii + jj)) return m, p def evaluate_candidate(m, p, c, alpha): """候选输出 x_hat = m + c * p,返回三项指标。""" x_hat = m + c * p x_plus, x_minus = m + p, m - p # MSE(对两种真值取期望) mse = 0.5 * (((x_hat - x_plus) ** 2).mean() + ((x_hat - x_minus) ** 2).mean()) # 特征空间距离(对两种真值取期望) f_hat = phi(x_hat, alpha) feat = 0.5 * (((f_hat - phi(x_plus, alpha)) ** 2).mean() + ((f_hat - phi(x_minus, alpha)) ** 2).mean()) # 梯度能量保留(相对真值的期望梯度能量) g_hat = np.concatenate([np.diff(x_hat, axis=1).ravel(), np.diff(x_hat, axis=0).ravel()]) g_true = 0.5 * (np.concatenate([np.diff(x_plus, axis=1).ravel(), np.diff(x_plus, axis=0).ravel()]) ** 2).sum() g_true += 0.5 * (np.concatenate([np.diff(x_minus, axis=1).ravel(), np.diff(x_minus, axis=0).ravel()]) ** 2).sum() grad_keep = float((g_hat ** 2).sum() / g_true) # 到最近模态的距离(越小说明落在数据流形上) to_mode = float(min(((x_hat - x_plus) ** 2).mean(), ((x_hat - x_minus) ** 2).mean())) return {"c": c, "mse": float(mse), "feat": float(feat), "grad_keep": grad_keep, "to_mode": to_mode} def best_c(m, p, alpha, grid=None): if grid is None: grid = np.linspace(-1.5, 1.5, 601) losses = np.array([evaluate_candidate(m, p, c, alpha)["feat"] for c in grid]) return float(grid[int(np.argmin(losses))]), grid, losses def main(): m, p = make_toy() signal_power = float(((0.5 * ((m + p) ** 2).mean() + 0.5 * ((m - p) ** 2).mean()))) print("[A] 玩具构造:8x8 patch,x = m + s * p,s = +1 / -1 各 0.5") print(" 低频内容 m: 范数 %.4f,梯度能量 %.4f" % ( np.linalg.norm(m), (np.concatenate([np.diff(m, axis=1).ravel(), np.diff(m, axis=0).ravel()]) ** 2).sum())) print(" 棋盘纹理 p: 范数 %.4f,梯度能量 %.4f(纹理占了 %.1f%% 的梯度能量)" % ( np.linalg.norm(p), (np.concatenate([np.diff(p, axis=1).ravel(), np.diff(p, axis=0).ravel()]) ** 2).sum(), 100 * (np.concatenate([np.diff(p, axis=1).ravel(), np.diff(p, axis=0).ravel()]) ** 2).sum() / (np.concatenate([np.diff(m + p, axis=1).ravel(), np.diff(m + p, axis=0).ravel()]) ** 2).sum())) print() print("[B] MSE 最优 = 条件均值(c=0,纹理被平均掉)") c_star, grid, losses = best_c(m, p, 0.0) r0 = evaluate_candidate(m, p, 0.0, 0.0) psnr0 = 10 * np.log10(signal_power / r0["mse"]) print(" MSE 最优的 c* = %.3f(理论值 0)" % c_star) print(" 重建 MSE = %.6f,SNR = %.2f dB" % (r0["mse"], psnr0)) print(" 梯度能量保留 = %.4f(条件均值必然丢高频:E||grad x||^2 = " "||grad E[x]||^2 + E||grad(x - E[x])||^2)" % r0["grad_keep"]) print() print("[C] 换成特征空间后,最优解沿候选网格偏离均值") print(" alpha 最优 c* 该点的 MSE SNR(dB) 梯度能量保留") for alpha in (0.0, 0.2, 0.3, 0.378, 0.4, 0.5, 1.0, 2.0): c_a, _, _ = best_c(m, p, alpha) r = evaluate_candidate(m, p, c_a, alpha) psnr = 10 * np.log10(signal_power / r["mse"]) print(" %-8.3f %-10.3f %-13.6f %-10.2f %.4f" % ( alpha, c_a, r["mse"], psnr, r["grad_keep"])) # 解析阈值:alpha^2 > ||p||^2 / ||grad p||^2 gp = np.concatenate([np.diff(p, axis=1).ravel(), np.diff(p, axis=0).ravel()]) thresh = float(np.sqrt((p ** 2).sum() / (gp ** 2).sum())) print(" 粗略解析估计 alpha* = sqrt(||p||^2 / ||grad p||^2) = %.4f" "(假设纹理梯度远大于内容梯度)" % thresh) # 精确的「两个候选」比较:L(c) = (c^2+1)||p||^2 + alpha^2 * G(c), # 于是「清晰模态 L(1)」优于「模糊均值 L(0)」的条件是 alpha^2 > ||p||^2/(G(0)-G(1)) g0 = 0.5 * ((gradient_magnitude(m) - gradient_magnitude(m + p)) ** 2).sum() g0 += 0.5 * ((gradient_magnitude(m) - gradient_magnitude(m - p)) ** 2).sum() g1 = 0.5 * ((gradient_magnitude(m + p) - gradient_magnitude(m - p)) ** 2).sum() exact = float(np.sqrt((p ** 2).sum() / (g0 - g1))) print(" 精确阈值:G(0)=%.4f, G(1)=%.4f,L(1)<L(0) 要求 alpha > %.4f" % (g0, g1, exact)) print(" -> alpha 超过 %.3f 之后,「输出一个清晰模态」在特征损失上严格优于" "「输出模糊均值」;" % exact) print(" alpha 继续加大,最优 c 沿坐标轴继续往 ±1 移(不是跳变," "因为 |grad(m+c*p)| 关于 c 连续)。") print() print("[D] 四种候选输出的指标对比(SNR 用信号能量 %.4f 作基准)" % signal_power) print(" 候选 MSE SNR(dB) 梯度保留 到最近模态距离") c_feat, _, _ = best_c(m, p, 1.0) for tag, c in [("MSE 最优 (c=0)", 0.0), ("折中 (c=0.5)", 0.5), ("特征最优 (c=%.3f)" % c_feat, c_feat), ("清晰模态 (c=1)", 1.0)]: r = evaluate_candidate(m, p, c, 1.0) psnr = 10 * np.log10(signal_power / r["mse"]) print(" %-20s %.6f %-10.2f %-9.4f %.6f" % ( tag, r["mse"], psnr, r["grad_keep"], r["to_mode"])) print() r_mean = evaluate_candidate(m, p, 0.0, 1.0) r_sharp = evaluate_candidate(m, p, 1.0, 1.0) r_feat = evaluate_candidate(m, p, c_feat, 1.0) print(" SNR 的绝对值很小,是因为这个玩具里纹理完全无法从 latent 预测,") print(" 要看的是相对差:") print(" · 特征最优解 (c=%.3f) 的 MSE 是模糊均值的 %.2f 倍(SNR 低 %.2f dB);" % (c_feat, r_feat["mse"] / r_mean["mse"], -10 * np.log10(r_mean["mse"] / r_feat["mse"]))) print(" · 但它保留了 %.0f%% 的梯度能量,模糊均值只保留 %.0f%%;" % (100 * r_feat["grad_keep"], 100 * r_mean["grad_keep"])) print(" · 完全选一个模态 (c=1) 时 MSE 是均值的 %.1f 倍(SNR 低 %.2f dB)," "梯度能量保留 %.0f%%,且到最近模态距离为 0 —— 它落在数据流形上。" % (r_sharp["mse"] / r_mean["mse"], -10 * np.log10(r_mean["mse"] / r_sharp["mse"]), 100 * r_sharp["grad_keep"])) print(" 这里是自造特征距离与信号能量 SNR,不是 LPIPS/FID 或峰值 PSNR;") print(" 不能从本玩具推断真实 tokenizer 的指标排序。") if __name__ == "__main__": main() make_figures.py """make_figures.py —— 画正文用到的五张示意图。 所有数字都现场重算(不读缓存),来源是同目录下的实验脚本: token_budget.py -> 图 1(序列长度与注意力规模) codebook_size_law.py-> 图 2(码本容量 K 的收益曲线) collapse_lab.py -> 图 3、图 4(坍缩过程与使用分布) perceptual_lab.py -> 图 5(MSE 最优 vs 特征空间最优) 运行:/usr/local/bin/python3 make_figures.py 输出:../figures/*.png """ from __future__ import annotations import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np import codebook_size_law as CSL import collapse_lab as CL import perceptual_lab as PL import token_budget as TB from vq_core import kmeans, make_patch_data, quantize, train_ae HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, os.pardir, "figures") os.makedirs(FIGDIR, exist_ok=True) plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False C_A = "#2E6DB4" # 蓝:主曲线 / 基线 C_B = "#C0504D" # 红:第二种配置 C_C = "#4FA96B" # 绿:第三种配置 / 好的一方 C_D = "#E08A2E" # 橙:强调 C_GREY = "#8C8C8C" def _save(fig, name): path = os.path.join(FIGDIR, name) fig.savefig(path, dpi=140, bbox_inches="tight", facecolor="white") plt.close(fig) print(" -> %s" % path) # ---------------------------------------------------------------- 图 1 def fig_token_budget(): sizes = np.array([128, 256, 512, 1024, 2048], dtype=float) fig, axes = plt.subplots(1, 2, figsize=(11.5, 4.3)) ax = axes[0] for f, col, mk in [(4, C_D, "o"), (8, C_A, "s"), (16, C_C, "^")]: n = (sizes / f) ** 2 ax.plot(sizes, n, color=col, marker=mk, lw=1.8, label=r"tokenizer $f$=%d" % f) ax.plot(sizes, sizes ** 2 * 3, color=C_GREY, marker="d", lw=1.8, ls="--", label="像素级 RGB") ax.set_xscale("log", base=2) ax.set_yscale("log") ax.set_xlabel("边长 H (像素)") ax.set_ylabel("序列长度(token 数)") ax.set_title("(a) 压缩率决定序列长度") ax.grid(alpha=0.3, which="both") ax.legend(fontsize=9) ax.annotate("H=256, f=16\n只有 256 个 token", xy=(256, 256), xytext=(300, 60), fontsize=9, color=C_C, arrowprops=dict(arrowstyle="->", color=C_C, lw=1.2)) ax = axes[1] labels = ["像素级\nRGB", "f=4", "f=8", "f=16"] vals = [(256 * 256 * 3) ** 2, ((256 / 4) ** 2) ** 2, ((256 / 8) ** 2) ** 2, ((256 / 16) ** 2) ** 2] colors = [C_GREY, C_D, C_A, C_C] bars = ax.bar(labels, vals, color=colors) ax.set_yscale("log") ax.set_ylabel(r"注意力矩阵规模 $n^2$") ax.set_title("(b) 256x256 图像的自注意力开销") ax.grid(alpha=0.3, axis="y") for b, v in zip(bars, vals): ax.text(b.get_x() + b.get_width() / 2, v * 1.6, "%.1e" % v, ha="center", fontsize=9) ax.annotate("省 5.9e5 倍", xy=(3, vals[3]), xytext=(2.55, 1e8), fontsize=9, color=C_C, arrowprops=dict(arrowstyle="->", color=C_C, lw=1.2)) fig.suptitle("图 1:压缩 tokenizer 的逻辑序列账本(数字来自 token_budget.py)", fontsize=11) fig.tight_layout() _save(fig, "token_budget.png") # ---------------------------------------------------------------- 图 2 def fig_codebook_law(): X, _, _, _ = make_patch_data(n=8192, seed=0) X_fit, X_test = X[:4096], X[4096:] k_list = [2, 4, 8, 16, 32, 64, 128, 256, 512] fig, ax = plt.subplots(figsize=(7.6, 5.2)) color_map = {2: C_C, 4: C_A, 8: C_D, 16: C_B} slopes = {} for d in (2, 4, 8, 16): params, _, _, _ = train_ae(X_fit, d, "continuous", steps=1500, seed=0) z_fit = X_fit @ params["We"] z_test = X_test @ params["We"] dist = CSL.distortion_curve(z_fit, z_test, k_list, seed=0) slope, _ = CSL.fit_slope(k_list[3:], dist[3:]) slopes[d] = slope ax.plot(k_list, dist, color=color_map[d], marker="o", lw=1.8, label=r"$d$=%d 实测斜率 %.2f" % (d, slope)) # 理论斜率 -2/d,锚定在 K=16 处 anchor = dist[3] theo = anchor * (np.array(k_list[3:], dtype=float) / 16.0) ** (-2.0 / d) ax.plot(k_list[3:], theo, color=color_map[d], lw=1.0, ls=":", alpha=0.75) ax.set_xscale("log", base=2) ax.set_yscale("log") ax.set_xlabel(r"码本大小 $K$") ax.set_ylabel(r"量化失真 $E\Vert z-q(z)\Vert^2/d$(留出集)") ax.set_title("图 2:固定编码器的有限样本量化实验\n" "实线=实测,点线=渐近参照斜率 -2/d(数字来自 codebook_size_law.py)", fontsize=11) ax.grid(alpha=0.3, which="both") ax.legend(fontsize=9) _save(fig, "codebook_size_law.png") return slopes # ---------------------------------------------------------------- 图 3、4 def fig_collapse(): X, _, _, _ = make_patch_data(n=4096, seed=0) K = CL.BIG_K s_rand, h_rand = CL.run_vq(X, K=K, steps=1200, seed=0, log_every=100) p_init, _, _, _ = train_ae(X, 8, "continuous", steps=800, seed=0) init_cb = kmeans(X @ p_init["We"], K, seed=0, iters=20) s_km, h_km = CL.run_vq(X, K=K, steps=1200, seed=0, init_cb=init_cb, log_every=100, init_params=p_init) s_rs, h_rs = CL.run_vq(X, K=K, steps=1200, seed=0, restart=True, log_every=100) fig, ax = plt.subplots(figsize=(7.6, 5.0)) for h, col, mk, tag in [(h_rand, C_B, "o", "随机初始化"), (h_km, C_A, "s", "预训练 + k-means"), (h_rs, C_C, "^", "死码重采样重启")]: ax.plot(h["step"], h["alive"], color=col, marker=mk, lw=1.8, label=tag) ax.axhline(K, color=C_GREY, ls="--", lw=1.2) ax.text(max(h_rand["step"]) * 0.55, K * 1.08, "码本容量 K=%d(全活)" % K, color=C_GREY, fontsize=9) ax.set_xlabel("训练步数") ax.set_ylabel("活跃码数(当前固定评估窗口内被选中)") ax.set_title("图 3:码本坍缩过程\n" "K=%d,最终4096样本评估命中 %d 个码(%.1f%%)" % (K, s_rand["alive"], 100.0 * s_rand["alive"] / K), fontsize=11) ax.grid(alpha=0.3) ax.legend(fontsize=9) ax.set_ylim(0, K * 1.25) _save(fig, "collapse_curve.png") fig, ax = plt.subplots(figsize=(7.6, 4.8)) for s, col, tag in [(s_rand, C_B, "随机初始化"), (s_rs, C_C, "死码重采样重启")]: frac = np.sort(s["counts"] / s["counts"].sum())[::-1] ax.plot(np.arange(1, len(frac) + 1), frac, color=col, lw=1.8, label="%s:%d 个活码,perplexity %.1f" % (tag, s["alive"], s["ppl"])) ax.set_yscale("log") ax.set_xlabel("码字按使用频次从高到低排序") ax.set_ylabel("使用占比") ax.set_title("图 4:使用分布的长尾与死码\n" "随机初始化有 %.1f%% 的码在最终4096样本中未命中" % (100.0 * (1 - s_rand["alive"] / K)), fontsize=11) ax.grid(alpha=0.3, which="both") ax.legend(fontsize=9) _save(fig, "usage_hist.png") return s_rand, s_km, s_rs # ---------------------------------------------------------------- 图 5 def fig_perceptual(): m, p = PL.make_toy() signal_power = float(0.5 * ((m + p) ** 2).mean() + 0.5 * ((m - p) ** 2).mean()) c_feat, _, _ = PL.best_c(m, p, 1.0) cands = [("真值样本 s=+1", m + p), ("真值样本 s=-1", m - p), ("MSE 最优 c=0", m), ("特征最优 c=%.2f" % c_feat, m + c_feat * p)] fig, axes = plt.subplots(2, 4, figsize=(12.0, 5.6), gridspec_kw={"height_ratios": [1.0, 0.92]}) vmin = min(a.min() for _, a in cands) vmax = max(a.max() for _, a in cands) for ax, (tag, img) in zip(axes[0], cands): im = ax.imshow(img, cmap="gray", vmin=vmin, vmax=vmax, interpolation="nearest") ax.set_title(tag, fontsize=10) ax.set_xticks([]) ax.set_yticks([]) axes[0][0].set_ylabel("8x8 patch", fontsize=9) rows = [("MSE 最优 c=0", 0.0), ("折中 c=0.5", 0.5), ("特征最优 c=%.2f" % c_feat, c_feat), ("清晰模态 c=1", 1.0)] psnrs, keeps = [], [] for tag, c in rows: r = PL.evaluate_candidate(m, p, c, 1.0) psnrs.append(10 * np.log10(signal_power / r["mse"])) keeps.append(100 * r["grad_keep"]) xpos = np.arange(len(rows)) ax = axes[1][0] bs = ax.bar(xpos, psnrs, color=[C_A, C_GREY, C_D, C_C]) ax.set_xticks(xpos) ax.set_xticklabels(["MSE\n最优", "折中", "特征\n最优", "清晰\n模态"], fontsize=8) ax.set_ylabel("SNR (dB)") ax.set_title("(e) 像素误差:模糊均值最好", fontsize=10) ax.grid(alpha=0.3, axis="y") ax.set_ylim(0, max(psnrs) * 1.3) for b, v in zip(bs, psnrs): ax.text(b.get_x() + b.get_width() / 2, v + 0.08, "%.2f" % v, ha="center", fontsize=8) ax = axes[1][1] bs = ax.bar(xpos, keeps, color=[C_A, C_GREY, C_D, C_C]) ax.set_xticks(xpos) ax.set_xticklabels(["MSE\n最优", "折中", "特征\n最优", "清晰\n模态"], fontsize=8) ax.set_ylabel("梯度能量保留 (%)") ax.set_title("(f) 细节保留:不同指标偏好不同", fontsize=10) ax.grid(alpha=0.3, axis="y") ax.set_ylim(0, 118) for b, v in zip(bs, keeps): ax.text(b.get_x() + b.get_width() / 2, v + 1.5, "%.0f%%" % v, ha="center", fontsize=8) # 右侧两格合并成一条 alpha 扫描曲线(先把占位的两个空轴关掉) axes[1][2].axis("off") axes[1][3].axis("off") ax = plt.subplot2grid((2, 4), (1, 2), colspan=2) alphas = np.linspace(0.0, 2.0, 41) cs = [PL.best_c(m, p, a)[0] for a in alphas] ax.plot(alphas, np.abs(cs), color=C_A, lw=1.8) ax.axhline(1.0, color=C_GREY, ls="--", lw=1.0) ax.axhline(0.0, color=C_GREY, ls="--", lw=1.0) ax.set_xlabel(r"特征里高频项的权重 $\alpha$") ax.set_ylabel("最优输出的纹理系数 |c|") ax.set_title(r"(g) $\alpha$ 越大,候选网格最优值的变化", fontsize=10) ax.grid(alpha=0.3) ax.set_ylim(-0.05, 1.15) ax.set_xticks([0.0, 0.5, 1.0, 1.5, 2.0]) fig.suptitle("图 5:丢失纹理极性时,不同重建目标的取舍" "(数字来自 perceptual_lab.py)", fontsize=11) fig.tight_layout() _save(fig, "perceptual_tradeoff.png") def main(): print("画图:所有数字现场重算,不读缓存") print("[1/5] token_budget.png") fig_token_budget() print("[2/5] codebook_size_law.png") slopes = fig_codebook_law() print(" 实测斜率:", {k: round(v, 3) for k, v in slopes.items()}) print("[3/5] collapse_curve.png + usage_hist.png") s_rand, s_km, s_rs = fig_collapse() print(" 随机初始化: alive=%d ppl=%.2f rec=%.6f" % ( s_rand["alive"], s_rand["ppl"], s_rand["rec"])) print(" 预训练 + k-means: alive=%d ppl=%.2f rec=%.6f" % ( s_km["alive"], s_km["ppl"], s_km["rec"])) print(" 死码重采样: alive=%d ppl=%.2f rec=%.6f" % ( s_rs["alive"], s_rs["ppl"], s_rs["rec"])) print("[5/5] perceptual_tradeoff.png") fig_perceptual() print("完成,图在 %s" % os.path.abspath(FIGDIR)) if __name__ == "__main__": main()
-
AIGC 每日速读|2026-10-02|NVIDIA砍掉视觉编码器,PixelUMM图像视频同模 今日 AIGC 论文速览 今日共 10 篇 · 统一理解生成与三维细节 2 篇 · 推理式与可控视频生成 2 篇 · 音视频联合生成 1 篇 · 视频推理加速 4 篇 · 视频文字编辑评测 1 篇 重点论文标题列表 PixelUMM(NVIDIA):像素直进图像视频同模型 BTC3D(香港城市大学(东莞)):分块条件补3D细节 ThinkV2V(港中大):先推理再改视频 LIFT(加州大学圣迭戈分校):只画终帧也能控未来 StereoBind(西电):声源移动立体声跟着走 今日论文速览 1. PixelUMM:像素直进图像视频同模型 PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation | NVIDIA;滑铁卢大学 | arXiv:2609.38597 关键词:统一多模态, 像素空间, 图像生成, 视频生成, 视觉理解 前序问题:统一理解与生成模型通常给同一张图准备两套表示:ViT 特征服务理解,VAE latent 服务生成。这不只让视觉上下文变长,也把成熟的视觉语言预训练与生成接口绑在两条管线上。图像还能直接切 patch,视频却要同时兼容理解侧的采样帧与生成侧的连续时空块,统一接口更难。 本文贡献:PixelUMM 取消预训练视觉编码器和 VAE,把图像变成空间 patch、视频变成时空 tubelet,都只用一层线性投影接入 8B Mixture-of-Transformers。理解走自回归文本预测,生成在原始像素上做 flow matching;共享 attention 让干净条件与带噪目标直接交互。论文还系统比较 patch/tubelet 大小、线性头与卷积解码头,发现卷积头能压掉格子伪影。 实验效果:不使用视觉 encoder/tokenizer 时,PixelUMM 在图像理解 MMMU 得 41.67、视频理解 MVBench 得 70.53;图像生成 GenEval 原始 prompt 为 0.77,用 BAGEL-long 重写后为 0.83,DPG-Bench 为 85.74。视频生成 VBench 总分 83.24,处于统一模型可比区间,但不是各榜第一。 批判点评:“统一”仍有边界:理解与生成使用两套 Transformer expert,只共享 attention,并非一组参数同时做两件事。原始像素 token 让更小 patch 和 tubelet 虽然降低 loss,却直接抬高序列长度与训练成本。作者也提醒各模型训练数据不同,当前表格不能证明 encoder-free 架构本身更优;MMMU 41.67 与主流 8B VLM 仍有明显差距。 2. BTC3D:分块条件补3D细节 BTC3D: Blended Tile Conditioning for Detail-Enhancing Image-to-3D Generation | 香港城市大学(东莞);SB Intuitions;巴塞罗那自治大学 | arXiv:2609.39709 关键词:图像生成3D, 免训练, 分块条件, 细节保真, 流匹配 前序问题:扩散式 image-to-3D 已经能出像样模型,可一旦输入图细节丰富,纹理就糊成一团。主流做法把整张图压成一个全局条件特征,空间信息在这一步被压掉,作者称之为 detail attenuation;而想补细节通常要重训或微调大模型,对 3D 管线代价过高。 本文贡献:BTC3D 是推理时即插即用的免训练框架。它先验证 image-to-3D 模型存在「图像特征可加性」:把局部图块的特征相加,仍能得到语义一致且保留局部细节的 3D 输出。据此把输入图切成若干 tile,各自提取局部条件并按前景权重聚合成 blended tile embedding;再配一个 dynamic conditioning 调度,在扩散后期低噪声阶段逐步加大 tile 条件的权重,早期仍交给全局条件主导结构。 实验效果:在 3D-Arena 与 Toys4K 上,把 BTC3D 接到 TRELLIS、TRELLIS.2、Hunyuan3D-v2.1 上都提升了纹理与视觉保真,且保持全局结构一致。20 名参与者、400 次两两偏好测试中,接入 BTC3D 的 TRELLIS.2 拿到 67.25% 选票(269 票),基线只有 32.75%(131 票),纹理密集的样本优势最明显。 批判点评:收益主要靠人眼偏好而非几何或纹理指标说话,67.25% 也是相对自家基线的增幅,缺少跨方法横评;论文同时承认纹理稀疏的样本上两者偏好接近持平,说明方法吃的是「有没有细节可补」。另外 tile 切分与融合系数 α、β 都是人工超参,动态调度只按扩散时间步推进,不看当前生成内容。 3. ThinkV2V:先推理再改视频 ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing | 香港中文大学;字节跳动;浙江大学;俄亥俄州立大学 | arXiv:2609.38541 关键词:视频编辑, 多模态大模型, 显式推理, DiT, 指令跟随 前序问题:现有指令视频编辑器多把 MLLM 当语义编码器,直接把 prompt 压成条件。碰到“把会被雨淋湿的东西收起来”这类不直接点名目标的指令,模型必须先理解因果与对象关系,再决定改哪里;只抓关键词往往画面能改,却改错对象或违背真实意图。 本文贡献:ThinkV2V 让 MLLM 先显式分析源视频和指令,再通过 learnable-query connector 把推理结果送给多条件 DiT。训练采用从直接编辑到推理密集样本的 progressive curriculum;推理时生成多份候选编辑 prompt,迭代反思并选择最可靠的一份。团队同时整理 ThinkV2V-150K 与专门考隐式意图、因果编辑的 ThinkV2V-Bench。 实验效果:5B 编辑器在 ThinkV2V-Bench 上由 Seed-1.6-VL 评测的 Overall 为 2.72,高于 OpenVE-Edit 的 2.09 和 14B DITTO 的 2.02;Gemini-2.5-Pro 评测下为 2.61,也高于 ICVE 的 2.52。模型在 32 卡上分三阶段训练,最终 720p 推理,以小于多条 10B–14B 基线的规模拿到最佳综合分。 批判点评:核心结论依赖 Seed-1.6-VL 与 Gemini-2.5-Pro 充当裁判,复杂编辑的自动分数仍可能偏向更会“讲意图”的输出。Inference-Time Thinking Scaling 需要多候选生成、反思和筛选,论文没有把新增延迟与算力单独量化。150K 数据由既有模型与筛选流程构建,推理能力有多少来自 MLLM、多少来自数据课程,还缺更严格的因果拆分。 4. LIFT:只画终帧也能控未来 LIFT: Layout-In-Future Video Generation under Large Viewpoint Change via On-Policy Self-Distillation | 加州大学圣迭戈分校;弗吉尼亚大学;Meta;Amazon;Lambda | arXiv:2609.38146 关键词:视频生成, 相机控制, 未来布局, on-policy self-distillation, 图生视频 前序问题:相机大幅移动时,首帧之外会露出全新区域。只给相机轨迹能控制“镜头往哪走”,却不能指定新区域里出现什么;逐帧框轨迹虽然能控布局,标注和交互成本又太高。真正实用的接口应允许用户只在未来关键帧画几个框,同时让中间过程自然长出来。 本文贡献:LIFT 把最后一帧的 bounding box 与局部 prompt 编成稀疏 layout latent,与首帧和噪声视频一起送入 DiT,相机 token 另行注入。训练时用拥有逐帧 dense layout 的冻结教师,在学生自己访问的 ODE 状态上做 on-policy self-distillation,把 dense 轨迹知识蒸馏给只看终帧布局的学生;同一个学生交替学习有布局与仅相机两种模式。 实验效果:LIFT 1.3B 在终帧布局控制上 mIoU 0.51,高于需要逐帧框的 MagicMotion 0.41;同时相机 RotErr 2.97、TransErr 0.59,视频 FVD 99.35。OPSD 只用 500×16=8000 次样本更新,直接或 dense-to-sparse SFT 都要 4000×32=12.8 万次,训练样本量缩到 1/16。 批判点评:布局接口仍只是 2D 框加局部文字,没有深度、朝向、遮挡和实例关系;相机一转,两个框在 3D 中究竟谁挡谁并未显式建模。所谓 1/16 训练量比较的是作者设定的更新预算,并不等于端到端数据与教师成本也缩到 1/16;OPSD 还依赖一个先用 dense layout 训练好的教师。 5. StereoBind:声源移动立体声跟着走 Here the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation | 西安电子科技大学;vivo 蓝图影像实验室 | arXiv:2609.38748 关键词:音视频联合生成, 立体声, 空间音频, 运动轨迹, 跨模态对应 前序问题:联合音视频模型已经能做到“画面里有什么就听到什么”和大致同步,却很少管声音来自哪里。AR/VR 中声源从左往右移动时,左右声道也应连续变化;只用文本或整段视频条件生成声音,往往知道是汽车声,却无法让声像跟随汽车轨迹。 本文贡献:StereoBind 把可见声源的 motion track 作为共同坐标系:Visual Motion Binding 绑定视觉运动与音频 token,Spatial Track Encoder 提供绝对位置,Residual Track RoPE 编码相对位移。团队用真实视频定位跟踪加合成立体声、再配合可控合成场景,构建 StereoWorld-29K,并用 StereoWorldBench 单独评测动态空间对应。 实验效果:在 StereoWorldBench 上,StereoBind 的 ILD-W 为 2.754、SELD-Acc 0.757、SMR-Err 14.86、AST-Ang 0.465、AST-Cal 0.314,五项空间指标都优于表中 Ovi、MiniMax-H3、LTX-2.5/2.3 及两条 video-to-spatial-audio 基线;视觉 Subject Consistency 0.955、Motion Smoothness 0.996,整体画面质量没有明显牺牲。 批判点评:当前条件是一条主要声源轨迹,训练和评测强调水平声像移动;多声源竞争、声源与听者同时运动、遮挡和完整 3D 声场仍被列为未来工作。空间指标全面领先不代表总体音质全面领先,Subject Consistency 0.955 低于 MiniMax-H3 的 0.968,Audio PQ 6.86 也只是略高于 6.81。 6. ReCaVSR:1080p单卡跑21.2FPS ReCaVSR: One-Step Streaming Diffusion Video Super-Resolution with Recycled Latents and Learned Cache Routing | 中国科学技术大学 | arXiv:2609.37831 关键词:视频超分辨率, 流式扩散, KV Cache, 一步生成, 实时推理 前序问题:扩散式视频超分画质好,却很难满足直播级延迟。现有流式方案要么多步去噪,要么每层都保留完整历史 KV;但视频超分当前帧已有低清观测,上一块超分 latent 也带着局部时序信息,继续为所有层保存同样长的历史既占显存又拖慢注意力。 本文贡献:ReCaVSR 基于 Wan2.2 做一步流式超分,把上一块生成的 SR latent 直接回收为下一块条件,再为每个 DiT 层学习不同的历史缓存范围,训练完导出固定路由。生成器用 sequential self-rollout 对齐真实因果推理;Multi-Scope Query 判别器同时看全局、空间窗口和时间 tube;LR-conditioned FlashDecoder 在解码时再次利用低清观测。 实验效果:单张 A100-80GB 输出 1080×1920 时达到 21.20 FPS、峰值显存 15.16GB,相对 FlashVSR Tiny 快 2.72 倍、少用 38.0% 显存,首个完整 RGB 输出的模型时间为 0.982 秒。LongVSR60 上 MUSIQ 57.89、CLIP-IQA 0.4932、DOVER 0.6075,后三项都高于列出的流式基线。 批判点评:它并非所有重建指标都第一:REDS30 的 PSNR 21.67 明显低于 RealViformer 23.32,说明生成式纹理仍会牺牲逐像素保真。缓存路由在训练后固定,遇到运动强度突变或硬切镜不能自适应;论文的长视频测试还是单段连续镜头,跨场景时旧 latent 和 KV 会不会污染新镜头尚未验证。 7. PARK:稀疏注意力快1.76倍 PARK: Accurate Block Retrieval for Sparse Attention in Video Diffusion Transformers | 华南理工大学 | arXiv:2609.38978 关键词:视频生成, 稀疏注意力, DiT, block retrieval, 免训练加速 前序问题:视频 DiT 的稀疏注意力通常先把 query 与 key 分块求均值,再按块检索。这个近似有两重错位:Softmax 前把多个 query 平均会抹掉各自偏好的 key;在原始 key 空间做欧氏聚类,也不保证同一簇的 key 在当前 query 下拥有相似 QK 分数。检索一旦选错块,要么掉画质,要么为了兜底算太多。 本文贡献:PARK 保留块内每一个原始 query,分别对 key block 做归一化后再平均分布,避免 query-centroid 代替整块偏好;key 侧则从当前 query 推导度量,先变换 key 再做 K-means,让欧氏距离对应 QK-score 误差。方法完全免训练,并把 PAMA 检索写成融合 GPU kernel,把准确率收益留住而不让检索开销反噬。 实验效果:在 Wan2.1-1.3B 上,PARK 将单次测试从 745 秒降到 423 秒,端到端 1.76 倍加速,同时 PSNR 27.52、SSIM 0.908、LPIPS 0.177,优于同表其他稀疏基线。跨 Wan2.2-14B、Wan2.1-14B、Wan2.1-1.3B 和 HunyuanVideo 四个模型,相对 dense 的加速范围为 1.53–1.76 倍。 批判点评:收益建立在四个视频扩散模型和固定检索配置上,作者明确没有验证 LLM 或其他多模态任务。主表中 Wan2.2 的 Aesthetic Quality 65.29% 仍低于 dense 的 65.56%,Wan2.1-1.3B 的 Background Consistency 96.87% 也低于 dense 的 96.99%;它更像高质量近似,而不是无损替换。 8. UnStep:免训练把视频推到50FPS UnStep: Training-Free Acceleration of Causal Video Diffusion with Fewer Steps Than Distillation | Meta 超级智能实验室 | arXiv:2609.32518 关键词:视频生成, 因果扩散, 免训练加速, KV Cache, 推理优化 前序问题:四步因果蒸馏已经比 50 步双向教师快,但 Self Forcing 在 H100 上仍只有 17 FPS。步数继续砍到一两步会掉质量,历史 KV 随视频变长继续膨胀;同时当 DiT 已经很少步,RoPE、cache 索引、attention 调度和 VAE 解码这些过去被遮住的系统开销反而成了瓶颈。 本文贡献:UnStep 是不改权重的推理 wrapper:后续块从四步减到两步,只保留 sink 加最近窗口;把已生成 latent 重新加到近干净噪声,再复用原有 clean-cache pass 做一次修正,并对 attention 的 V/O 投影做截断 SVD 抵消少步误差。系统侧再融合 RoPE、缓存系数、固定长度 attention,并把 VAE 改成 FP16 与 channels-last 卷积。 实验效果:同一 Self Forcing checkpoint 在 H100 上从 17.0 FPS 提到 49.8 FPS,VBench Total 反而从 84.31 到 84.56;相同 wrapper 套在 Causal Forcing 和 LongLive 1.0 上也都约 49.8 FPS。若推理时改成一步,H100 达 59.6 FPS;GB200 最快报告 77 FPS,全程没有重训。 批判点评:所有超参数只在 Self Forcing、5 秒 T2V、单张 H100 这一套设置上调过,迁移结果证明“能用”,不代表每个 checkpoint、GPU、任务和长度都最优。50 FPS 的成绩同时叠加算法减步与大量 H100 专用 kernel 优化,不能全部归功于新的生成算法;而训练自由的约束也限制了更激进稀疏或量化后的质量恢复。 9. DeCoPrune:剪85%缓存仍保上下文 DeCoPrune: Efficient KV-Cache Pruning for Autoregressive Video Diffusion via Denoising Consistency | 南洋理工大学;清华大学;普林斯顿大学 | arXiv:2609.39096 关键词:自回归视频, KV Cache, 训练自由剪枝, 长上下文, 一致性 前序问题:自回归视频扩散把每段历史都塞进 KV Cache,时间越长,显存和 attention 成本越大。固定滑窗只看远近,attention 权重或相似度剪枝又不直接回答“这个历史块是否提供了不可替代的信息”,所以容易把稍后 prompt 才会重新提到的物体细节一起删掉。 本文贡献:DeCoPrune 用同一条去噪轨迹里的中间 probe 与最终预测做差:没有历史支持时难以稳定去噪、step-to-final discrepancy 较大的 token 被判为更需要上下文,因此保留高差异 token,再物理压紧历史 KV。论文同时构建 CMBench,用一分钟上下文中的物体取放、场景恢复等续写任务专测“前文记没记住”,并提供按 attention head 类型分组的 HS 版本。 实验效果:主设置剪掉 85.43% 历史 KV,续写 FPS 从 FullKV 的 1.568 提到 6.489,快 4.14 倍;CMBench DINO 从 0.6803 只降到 0.6701。head-specialized 版本在 86.19% 剪枝率下 DINO 为 0.6783,几乎追平 FullKV,且 VBench 的图像质量项没有出现系统性崩塌。 批判点评:“剪掉 85%”并不等于显存有硬上限,作者明确承认剩余缓存仍随视频长度线性增长。Denoising consistency 是 future-agnostic 的:某个细节此刻很好去噪、因此被删掉,但未来指令恰好再次询问它时仍可能失忆。主干又集中在 LingBot World v2,其他开源模型的分钟级 FullKV 本身就不稳定,方法与 backbone 上限难完全拆开。 10. ViTeX-Bench:387段视频检验动态改字 ViTeX-Bench: Benchmarking High-Fidelity Video Scene Text Editing | 得州农工大学 | arXiv:2609.40356 关键词:视频编辑, 场景文字, 评测基准, 时序一致性, 编辑局部性 前序问题:视频里的招牌、球衣或屏幕改字,要同时满足字符串正确、跨帧不漂、背景不被改。通用视频编辑指标可能把“画面很稳但根本没改字”的结果评得很高,静态 OCR 又看不见闪烁与字符漂移,现有公开数据也缺少真实视频的成对编辑参考。 本文贡献:ViTeX-Bench 收集 387 段 720p、120 帧、24 FPS 真实视频,其中 230 段提供人工复核的成对训练编辑,157 段冻结测试。评测拆成文字正确性、视觉/时序质量、编辑局部性三轴共 13 个指标,并用 OCR 校准、人评相关性与 Pareto 前沿解释取舍;配套的 ViTeX-Edit-14B 用随运动对齐的 glyph-video 条件微调 VACE。 实验效果:八条基线中,ViTeX-Edit-14B 在 video-native 编辑器里 CharAcc 最高,为 0.688,text-crop Warp 1.53 也最低;相较 VideoPainter 的 CharAcc 0.619 提升 0.069。但逐帧 FLUX-Text 的 CharAcc 仍达 0.737,代价是 Warpc 13.01、字符跨帧严重漂。人评与 OCR 方法排名的 Spearman 相关系数为 0.95。 批判点评:这个基准把“漂亮、正确、稳定、局部”拆开是优点,也暴露了参考模型并非全面第一:ViTeX-Edit 的 SeqAcc 0.341 低于 FLUX-Text 0.528。数据以清晰、局部、拉丁文字为主;非拉丁切片里除 AnyText2 外其余编辑器 CharAcc 都低于 0.19,严重运动、曲面文字、密集排版的覆盖仍不足。 趋势观察 加速的战场从「少走几步」挪到了「每层只记该记的」 ReCaVSR 给每个 DiT 层学一个缓存跨度,PARK 修正稀疏注意力的块检索误差,UnStep 把两步采样、限窗 KV 与 kernel 优化叠进同一个免训练 wrapper,DeCoPrune 则用去噪一致性挑出真正依赖历史的 token,四篇都指向同一件事:视频模型已进入少步时代,下一轮效率竞争发生在缓存、检索与运行时细节。另一头,PixelUMM 去掉视觉编码器让像素直进统一模型,说明「统一」正在从拼模块转向砍模块。 人工智能炼丹君 整理 | 2026-10-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|KV Cache 与自回归视频生成-KVCache AIGC 基本功|KV Cache 与自回归视频生成-KVCache 所属方向:推理加速 | 难度:进阶 | 前置知识:自注意力机制、性能建模与 Profiling 关键词:KV Cache、显存带宽、自回归生成、因果注意力、缓存驱逐、PagedAttention 01. 为什么需要它 先给三个数,都是本篇附录按明确假设计算的账本;它们不是实际部署峰值显存。 第一个数:一个 token 的 KV cache 是 128 KiB。 按 Meta Llama 模型配置 中 Llama-3-8B 的结构算(32 层、8 个 KV 头、每头 128 维、BF16 两个字节):每个 token 要缓存 $2 \times 32 \times 8 \times 128 \times 2 = 131072$ 字节,正好 128 KiB。所以一条 8192 token 的序列,KV cache 恰好是 1.00 GiB。这个整数不是巧合,是配置凑出来的——记住它,后面所有账都从它出发。 第二个数:batch=32 时,KV cache 是权重的 2.14 倍。 权重按约 $8.03\times10^9$ 个参数、每参数 2 字节估算为 14.96 GiB,KV cache $32 \times 1.00 = 32.00$ GiB,合计 46.96 GiB。batch 加到 64,合计 78.96 GiB——已经接近本文假设的 80 GiB 总预算,其中约 81% 是 KV cache;还未计入激活、临时空间与框架开销。实际 A100 型号标称 80 GB,可用字节应以设备查询为准,不能把理想 80 GiB 预算当作部署保证。你以为你在被权重压垮,其实在被缓存压垮。 第三个数:一组视频假设会产生 52.7 GiB 的 KV。 假设沿用上面的 Llama 结构、缓存全部历史、不做额外 latent patch 化:5 秒 24fps、时间维 4 倍压缩、空间 8×8 压缩,是 30 帧 × 14400 token = 432000 token,按同样的 128 KiB/token 算就是 52.73 GiB——还没算权重,一条视频就吃掉大半张卡。10 秒 105.47 GiB,30 秒 316.41 GiB。这是展示量级的假想配置,不是真实视频模型的统一用量;VAE、patch、窗口与模型层数都能改变它。 玩具 decoder 的全量重算与缓存增量解码还展示了一点:计算量减少不等于同倍数加速。修正了密集注意力 FLOPs 计数、输出头计数和最后一次无用 decode 后,当前代码解析比为 105.61 倍;在本轮 Windows/Python 3.11.9、NumPy 2.4.3、单 BLAS 线程、FP32 条件下,预热后交替顺序各计时三次,中位数之比为 48.17 倍。Python 调度、临时数组、重复 KV 头和小矩阵效率都会影响耗时,单靠这个比值不能认定差额全来自内存带宽。 02. 最小可用理解 三句话: 机制:因果注意力里,每层位置 $j$ 的 key 和 value 由固定前缀 $1\ldots j$ 的隐藏状态决定,跟它后面来了什么 token 无关。所以生成第 $t$ 个 token 时,前 $t-1$ 个位置的 K、V 和上一步完全一样——把它们留在显存里,每步只算新 token 自己的那一个 query、一对 K/V。用空间换时间,空间就是 KV cache。 成本:省的算力是真实的(每步从 $O(S^2)$ 降到 $O(S)$,整段生成从 $O(S^3)$ 降到 $O(S^2)$),长上下文下注意力常受访存约束。理想融合的单 query 注意力有 $I=2g/p$,但实际瓶颈还取决于 batch、kernel、缓存命中、并行与硬件,decode 仍有投影和 FFN 运算。同时缓存自己按 $2 L n_{\text{kv}} d p$ 字节每 token 线性膨胀,长上下文和视频场景下反过来成了显存的主宰。 效果与代价:文本因果 decoder 常用它减少重复计算;按本文的视频假设,token 数远大于短文本,因此还需要考虑缓存能否装下——分页管理、GQA、缓存量化、块级因果,全是被这个量级逼出来的。 03. 数学推导 3.1 因果注意力里,什么是死的 自注意力一步的计算是 $$\mathrm{Attn}(Q, K, V) = \mathrm{softmax}\left( \frac{Q K^{\top}}{\sqrt{d}} + M \right) V$$ 这里按单个注意力头说明:$Q,K,V$ 的形状均为 $[S,d]$,$S$ 是输入长度、$d$ 是头维度;softmax 沿 key 位置逐行归一化。$i$ 是 query 位置、$j$ 是 key 位置,$o_t$ 是当前位置的注意力输出。GQA 的头数差异稍后单独计入。 其中 $M$ 是因果掩码,$M_{ij} = 0$($j \le i$)或 $-\infty$($j \gt i$)。关键在 $Q$、$K$、$V$ 是怎么来的:第 $i$ 个位置的 query、key、value 是 $$q_i = W_q x_i, \quad k_i = W_k x_i, \quad v_i = W_v x_i$$ 式子把 $x_i$ 记为列向量,$W_q/W_k/W_v$ 是相应线性映射;代码以行向量存储,写成 h @ w,权重矩阵随之转置。这里的 $x_i$ 是该层输入隐藏状态,不是只含第 $i$ 个 token 的原始 embedding。在多层 decoder 中,它已经聚合了前面位置的信息。正确的论证是逐层归纳:固定权重、位置、条件与推理随机性后,因果掩码保证历史位置不能看未来;追加 token 不会改变旧位置的隐藏状态,所以其 K/V 可复用。此处 $t$ 表示正在处理的输入位置,$j\lt t$ 的缓存已存在,$q_t,k_t,v_t$ 是本步新计算的量。改变前缀、RoPE 位置、条件、模型权重或噪声等级,都可能使旧缓存失效。 所以增量解码的正确姿势是: $$o_t = \sum_{j=1}^{t} \mathrm{softmax}_j \left( \frac{q_t k_j^{\top}}{\sqrt{d}} \right) v_j$$ 注意这个式子里只有 $q_t$、$k_t$、$v_t$ 是新的,$k_j$、$v_j$($j \lt t$)全部从缓存里读。softmax 的分母也只在这一行上归一化——不需要重算别的行,因为别的行的输出早就有了,而且以后也不会变。 这里有一个值得停一下的对比:训练时我们并行算所有位置,$Q K^{\top}$ 是一个 $S \times S$ 的矩阵;decode 时一次只有一个 query,$Q K^{\top}$ 退化成一个 $1 \times t$ 的向量。同一个算子,在两个阶段里形状完全不同,这让长 prefill 通常更容易利用矩阵计算资源,而单 token decode 的注意力通常更容易受带宽或并行度限制,仍需实测确认。 顺带回答一个常见疑问:为什么缓存的是 K 和 V,而不是 Q?因为它们的生命周期不同。$q_t$ 在这一步算完、和缓存做完内积之后就没用了——下一个 token 不会再来问它;而 $k_j$、$v_j$ 是「将来所有 query 都要来查一遍」的公共数据,未来第 $t+1$、$t+2$ 步的注意力都要用。缓存的对象必须是「写入后不再变、且会被反复读」的东西,这正好是 3.4 节那个算术强度问题的另一半来源:省下的是重算 K/V 的算力,付出的是每步把这块只读数据整个搬一遍的带宽。 3.2 省了多少算力 先把常数固定,避免把「有效因果三角」和「先算密集矩阵再掩码」混在一起。以下只计一层注意力的矩阵乘,约定一次乘加为 2 FLOP,忽略 softmax、归一化和投影。令 $C=4n_qd$,其中 $n_q$ 是 query 头数;一个 query 读 $t$ 个 key 的 QK 与 AV 合计为 $Ct$ FLOP。 如果全量 kernel 真能跳过上三角,长度 $t$ 的有效 query-key 对数是 $t(t+1)/2$,计算量是 $Ct(t+1)/2$;本文 NumPy 先做完整矩阵乘,它实际计算 $Ct^2$。先不引入额外的长 prompt,考虑从一个起始 token 开始、逐次处理长度 1 到 $S$ 的简化计数: $$F_{\text{triangle}}=C\sum_{t=1}^{S}\frac{t(t+1)}{2}=\frac{CS(S+1)(S+2)}{6}$$ $$F_{\text{dense}}=C\sum_{t=1}^{S}t^2=\frac{CS(S+1)(2S+1)}{6},\qquad F_{\text{cache}}=C\sum_{t=1}^{S}t=\frac{CS(S+1)}{2}$$ 相除得到精确比值 $(S+2)/3$ 和 $(2S+1)/3$,大 $S$ 时分别趋于 $S/3$ 和 $2S/3$。这只是注意力矩阵乘的比较,不是完整模型加速比;同一个 $C$ 在三条路径里的含义始终相同。附录逐一枚举 $S=1\ldots32$ 核对有限和。 投影与 FFN 的账不同:全量路线每步重算前缀各 token,累计为 $O(S^2D^2)$;缓存路线累计为 $O(SD^2)$,$D$ 为隐藏宽度。注意力累计阶数则分别是 $O(S^3D)$ 和 $O(S^2D)$。有长度 $P$ 的 prompt 时应从 $P$ 开始求和,生成 $G$ 个输出只需一次 prefill 加 $G-1$ 次 decode,因为 prefill 已给出首个预测。附录的解析计数按实际密集 NumPy 矩阵乘与每步单个输出头计数,省略 norm、softmax 等逐元素操作。 3.3 缓存自己要多大:显存公式 每生成一个 token,要在缓存里留下这一层的 $k_t$ 和 $v_t$。数一数字节数: $$B_{\text{tok}} = \underbrace{2}_{K,V} \times \; L \times n_{\text{kv}} \times d \times p$$ $L$ 是层数,$n_{\text{kv}}$ 是 KV 头数(GQA 下小于 query 头数 $n_q$),$d$ 是每头维度,$p$ 是 dtype 字节数(BF16 是 2)。这个公式里没有 S——每个 token 的缓存占用与上下文长度无关,缓存总量才随 $S$ 线性增长。下面是各层头数相同、未跨设备切分、未量化且不含分配余量的有效载荷: $$B_{\text{kv}} = B_{\text{tok}} \times S \times B_{\text{batch}}$$ 不同请求长度为 $S_r$ 时,总载荷是 $B_{\text{tok}}\sum_rS_r$;$r$ 是请求编号。若每页容纳 $b$ 个 token,未共享前缀的分页容量则为 $B_{\text{tok}}b\sum_r\lceil S_r/b\rceil$,还要加块表、量化 scale 和工作区。静态缓存按容量而非实际长度分配;张量并行时要逐设备数本地 KV 头,存在复制时不能直接除以设备数。 代 Llama-3-8B($L=32$,$n_{\text{kv}}=8$,$d=128$,$p=2$):$B_{\text{tok}} = 131072$ 字节。8192 token 一条序列 = 1.00 GiB;batch=32 就是 32.00 GiB,是 14.96 GiB 权重的 2.14 倍。如果换成 MHA($n_{\text{kv}} = 32$),每个 token 变成 512 KiB,batch=32 时 128 GiB——GQA 在这里把 KV 显存降低 4 倍,也会减少 K/V 投影计算;query 头上的注意力乘加不同比例下降。 这张图要看什么:左图是 batch 从 1 扫到 128 时显存账本的构成(seq=8192),深蓝是权重、橙红是 KV cache、浅蓝是激活和余量,红色虚线是 80 GiB——注意从 batch=16 开始橙红就盖过深蓝,计入示意的 4 GiB 余量后 batch=64 已超过 80 GiB 预算、batch=128 直接越界,增长主要来自 KV cache。右图固定 batch 看 KV cache 随序列长度的增长(对数-对数坐标),三条线都是斜率 1 的直线(线性增长),紫色虚线(MHA)比橙色(GQA batch=8)高一截;61 GiB 灰线表示扣除假设权重和余量后的缓存预算,曲线与它的交点给出该简化预算下的长度上限。 3.4 算术强度:为什么上下文再长,decode 也快不起来 这是全篇最要紧的一节。上一篇(性能建模)说过,一个操作的算术强度 $I$ = 算力 / 访存字节数,它和硬件的山脊点(ridge point)比一比,就知道这个操作是算力受限还是带宽受限。 先只看理想融合的单 query 注意力,假设每份 KV 从所分析的存储层读一次,并在一组 query 头之间共享,忽略 Q/O 和中间量:对每个 query 头,$QK^{\top}$ 是 $1 \times d$ 乘 $d \times S$,$2 S d$ FLOP;再加权和 $AV$ 同样 $2 S d$ FLOP。$n_q$ 个头合计 $4 n_q d S$ FLOP。访存呢?要把 K 和 V 的缓存全部读一遍:$2 n_{\text{kv}} d S p$ 字节。两者一除: $$I_{\text{dec}} = \frac{4 \, n_q \, d \, S}{2 \, n_{\text{kv}} \, d \, S \, p} = \frac{2 g}{p}, \quad g = \frac{n_q}{n_{\text{kv}}}$$ $S$ 在这个理想模型中约掉了。 算术强度不随 $S$ 变化,但实际效率可能随上下文而变:短序列并行不足,长序列跨越缓存容量,kernel 的分块和归约成本也会变化。而且注意力之外仍有读权重、投影与 FFN,不能用一个注意力公式概括完整 decode。 代数字(BF16,$p=2$,$I = g$):MHA($g=1$)的 $I = 1$ FLOP/byte;Llama-3 的 GQA($g=4$)是 4;MQA($g=32$)是 32。而 A100 的山脊点是 $312\ \text{TFLOP/s} \div 2.04\ \text{TB/s} = 153$ FLOP/byte。这些理想强度低于该 BF16 山脊点,提示带宽约束;实际 kernel 还可能受并行度与延迟约束。 下图把本机 FP32 微基准的最好观测值(152.27 GFLOP/s、32.18 GB/s)与 A100 80GB SXM 官方规格 的 BF16 理论峰值分别作为屋顶。CPU 与 GPU 使用不同 dtype,因此同一 $g$ 的 CPU 理想强度为 GPU 的一半。 图中各点是把解析强度放到屋顶上计算出的上界,不是测得的 attention 性能。本机屋顶来自预热后大矩阵和流式数组微基准的最短耗时,不保证小算子能达到,也不是硬件规格峰值。数组带宽按读一份、写一份的逻辑字节计算;实际 DRAM 流量、写分配与缓存命中未测。图中的 decode 点只计注意力;prefill 点包含粗估投影和激活流量,统计范围不同,不能用两点之差分解优化收益。改变 GQA、精度、融合、序列并行或多 query 批处理都可能改善性能;MLA 有自己的压缩结构,不能简单当成增大 $g$。 长 prefill 一次处理多个 query,更容易复用权重和 KV,因此通常有更高强度。附录使用 $2NS$ 近似投影计算量($N$ 为参数量),并假定每层激活搬运为 10*S*D*p,得到示意强度 3973.9 FLOP/byte(BF16)。这是粗略模型,不是逐算子的显存流量测量;输入很短、注意力未融合、张量并行通信或低效 kernel 都可能改变实际瓶颈。不能仅凭这个数断言 prefill 必定吃满 GPU。 这个视角还能直接写出 decode 一步的耗时下限。若权重与全部 KV 每步都需从 HBM 读取,字节数除带宽给出一个下界;还须同时满足 FLOPs/算力下界: $$T_{\text{step}} \ge \frac{W + B_{\text{batch}} \, B_{\text{tok}} \, S}{\mathrm{BW}}$$ $W$ 是本模型假定每步需读取的权重字节数(batch 可摊薄它),$B_{\text{batch}} B_{\text{tok}} S$ 是全部序列的缓存(batch 摊不了)。代 Llama-3-8B、seq=8192、A100 的 2.04 TB/s:batch=1 时 $(14.96 + 1.00)$ GiB 除以带宽得 8.4 ms,也就是单流吞吐的上限约 119 token/s——仅是单设备、该精度、该访存假设下的上界;权重量化、共享前缀、投机解码、多设备等会改变假设。第 6.1 节进一步说明 batch 对这个模型的影响。 04. 代码实现 核心是三段:完整前向(prefill)、单步(decode)、以及承载它们的缓存。下面是 kv_cache_lab.py 的主干,完整版在文末附录,纯 numpy 可跑。 def attn_full(Q, K, V): """完整因果注意力。Q:[S,Hq,Dh] K/V:[S,Hkv,Dh] -> [S,Hq,Dh]""" S, Hq, Dh = Q.shape g = Hq // K.shape[1] Kk = np.repeat(K, g, axis=1) Vv = np.repeat(V, g, axis=1) scale = Q.dtype.type(1.0 / math.sqrt(Dh)) logits = np.einsum("qhd,khd->hqk", Q, Kk) * scale # [Hq,S,S] mask = np.triu(np.ones((S, S), dtype=bool), 1) logits = np.where(mask[None, :, :], -np.inf, logits) logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hqk,khd->qhd", p, Vv) def attn_step(q, K, V): """单步注意力:一个 query 对长度 S 的缓存。q:[Hq,Dh] K/V:[S,Hkv,Dh] -> [Hq,Dh]""" Hq, Dh = q.shape g = Hq // K.shape[1] Kk = np.repeat(K, g, axis=1) Vv = np.repeat(V, g, axis=1) scale = q.dtype.type(1.0 / math.sqrt(Dh)) logits = np.einsum("hd,khd->hk", q, Kk) * scale # [Hq,S] logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hk,khd->hd", p, Vv) def block_step(x_new, w, cache, pos, cfg=CFG): """decode 一步:只算新 token。x_new:[1,D] -> [1,D],并把它的 K/V 写进 pos。""" if pos != cache["used"] or not 0 <= pos < len(cache["k"]): raise ValueError("append position must equal used length and fit capacity") D = x_new.shape[1] hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"] h = rmsnorm(x_new) q = (h @ w["wq"]).reshape(hq, dh) k = (h @ w["wk"]).reshape(hkv, dh) v = (h @ w["wv"]).reshape(hkv, dh) cache["k"][pos] = k cache["v"][pos] = v cache["used"] = pos + 1 o = attn_step(q, cache["k"][:pos + 1], cache["v"][:pos + 1]).reshape(1, hq * dh) y = x_new + o @ w["wo"] y = y + np.maximum(y @ w["w1"], 0.0) @ w["w2"] return y 变量名和 03 节的符号一一对应:Q/K/V 是 $Q$、$K$、$V$,Hq/Hkv 是 $n_q$、$n_{\text{kv}}$,g 就是 GQA 的分组数 $g$,pos 是从 0 开始的写入下标;数学位置 $t$ 从 1 开始,因此 pos=t-1。长度为 $P$ 的实际 prompt 要生成 $G$ 个输出时,最后一个输出无需再作为输入处理,缓存容量和最终有效长度都是 $P+G-1$。默认例子是每层 [207,2,32],四层 K/V 的真实数组载荷为 423936 字节,不含 Python 对象和临时数组。KV 更新按下标原地写入;注意力仍创建临时数组,并用 np.repeat 实际复制 KV 头,因此它没有实现理论分析所假定的完美 GQA 访存复用。 修订后的代码在本机运行得到(时间随机器、BLAS 和负载变化): 生成 token 一致数:192 / 192 最后 logits 最大绝对误差:2.110e-05 相对误差:1.157e-06 logits dtype:float32 无缓存矩阵乘 FLOPs:1.3005e+11 缓存矩阵乘 FLOPs:1.2314e+09 解析比值:105.61x 无缓存 / 缓存墙钟中位数:3.734s / 0.078s 本次加速比:48.17x 全量与增量在精确算术下等价,FP32 累加顺序会带来小误差。真实模型若候选 logits 很接近,舍入也可能改变 argmax,所以不要求所有模型都逐 token 位级一致。附录固定种子玩具例子对序列与误差都加了断言。本例是随机未训练的 ReLU decoder,省略位置编码和真实模型的 gated FFN,用于验证缓存数据流。旧版在 NumPy 2.4.3 下用 np.sqrt(Dh) 得到 NumPy FP64 标量,使 FP32 attention 输出提升为 FP64;现在缩放因子显式使用输入 dtype,缓存与隐藏状态保持 FP32。不能把旧数字与新计时直接比较来判断算法改进收益。 block_forward 只支持从零开始的完整 prefill;base 非零会明确报错,它没有实现 chunked prefill。block_step 只允许在有效长度末尾追加,拒绝跳号或超容量;gen_cached 按实际 prompt 长度分配,不依赖配置中的示例长度。新增 kv_cache_checks.py 用 MQA/GQA/MHA、两种种子、三种 prompt 和三种生成长度共 54 组验证,最大生成 logits 差 1.431e-06;另有 216 次固定输入逐位置对照,确认旧缓存前缀未改写。对 RoPE 的验证限于位置重置的反例,尚未复现完整含 RoPE 的 decoder 或视频模型。 解析 FLOPs 与墙钟的差额只说明实现效率不同。若要确认带宽瓶颈,还需测实际带宽、kernel 时间、线程设置和缓存命中,不能由加速比倒推出原因。 05. 工业级实现对照 HF transformers:动态缓存与静态缓存是不同路径。 cache_utils.py 的 DynamicLayer.update(固定 v4.57.1,在 2026-10-31 核对)是这么追加一个 token 的: self.keys = torch.cat([self.keys, key_states], dim=-2) self.values = torch.cat([self.values, value_states], dim=-2) torch.cat 每一步都分配一块新内存、把旧缓存整个抄过去。缓存越大这一步越贵,到长上下文时拷贝会增加流量,实际占比需用 profiler 测量——而带宽恰恰是 decode 最缺的东西。它换来的是简单:形状任意增长、随便 crop、随便回滚,对 batch=1 的研究代码完全够用。我第一版玩具实现也是这么写的,后来才意识到「预分配 + 下标写入」差在哪:预分配省去增长时反复复制旧 KV 的开销,同时提前占用未使用容量;两者都仍需读取有效缓存。 同一份 cache_utils.py 还提供 StaticLayer,预分配后原地更新;不能把动态 torch.cat 描述为 transformers 唯一方式。动态拼接与按最大长度预留是两种不同策略,前者可能复制和碎片化,后者有未用容量。固定官方完整 CacheLayerMixin/DynamicLayer/StaticLayer 类已在 CPU Torch 2.10.0 上执行:16 组 dtype、batch、头数和分块夹具中,动态缓存拼接后地址变化、静态缓存地址保持,写入的有效 K/V 逐元素一致。 静态接口有两处容易踩坑:每次应显式给出当前写入的 cache_position,缺省时本版本从零开始写,并不自动 append;返回值包含全部容量,未用槽位必须被 attention mask 排除。一个 query 对 1 个有效 value=2、另 3 个全零槽的反例中,不掩码得到 0.5,掩码后才是 2。CPU 验证没有运行编译图或完整 Transformers 生成流程。 vLLM:把缓存当成页来管。 当服务请求长度不确定时,按最大长度预留可能浪费容量。vLLM(PagedAttention,arXiv:2309.06180)的解法是把操作系统管内存的那一套搬过来:缓存切成固定大小的块(block),每条请求维护一张块表(block table),逻辑上连续、物理上散落。vLLM v0.16.0 的 FlashAttention 后端源码 中可检查 FlashAttentionImpl.forward、key_cache, value_cache = kv_cache.unbind(0) 与 block_table 的使用。缓存张量布局会随版本和后端变化,不能把某个 2 * head_size 排列写成 vLLM 的统一规定。稳定的设计要点是逻辑块映射到物理块,kernel 按块表寻址,新增 K/V 按 slot 映射写入;prefill/decode 通过长度等元数据区分。此版本 FlashAttentionBackend.get_kv_cache_shape 返回 [2,页数,b,KV头数,d],要求 $b$ 为 16 的倍数;stride order 还可取 NHD/HND,形状顺序不能代替实际步长。三个合法页尺寸、四种 stride 分支及非法页尺寸已实际执行原始方法;FlashAttentionImpl.forward 的 block_table 与写入路径的 slot_mapping 另做原源码核对,未执行其 GPU kernel。 对逻辑位置 $s$(从零开始),令 $\ell=\lfloor s/b\rfloor$、$r=s\bmod b$,物理地址由 block_table[ell] 与页内偏移 $r$ 决定。教学检查用 4-token 小页演示寻址,它不满足上述后端的页对齐限制,不能直接拿去配置 vLLM。长度 1/4/5/13 的随机物理页重排后,恢复的 K/V 与连续数组逐元素一致。 分页到底值多少?附录 paged_alloc.py 在同一个 61 GiB 预算下做了模拟(Llama-3-8B,块 16): --- 负载:长度均匀 512~4096 --- 策略 并发请求 占用 真实用到 利用率 连续预留 122 61.00 GiB 34.52 GiB 56.59% 分页(块16) 214 60.85 GiB 60.67 GiB 99.70% 并发提升 : 1.75x --- 负载:长短混合:八成 256~1024 --- 连续预留 122 61.00 GiB 18.37 GiB 30.11% 分页(块16) 405 60.79 GiB 60.42 GiB 99.40% 并发提升 : 3.32x 浪费的两半也拆开了:连续预留平均每条请求浪费 223.26 MiB(预留 4096、平均只用 2310),分页只有 0.93 MiB(最后一个块没填满),239 倍。分页确实减少预留浪费和碎片,未改变有效 KV 每 token 的字节数。这里是静态容量模拟:1.75~3.32 倍是可容纳请求数之比,不是测得的吞吐倍数;尚未模拟到达、释放、动态增长和调度。 这张图要看什么:左图是分页的时空图,上面各行是每条请求的逻辑视图(块连续),下面一行是物理块池(按申请顺序排列,颜色表示属于谁)——灰色细线从逻辑块指向它真正的物理块,能看到同一条请求的块在物理上是散的;块里的白字是「已用/容量」,只有每条请求的最后一块没填满。右图是两种策略在同一预算下的并发数,灰色(连续预留)在长短混合负载下利用率只剩 30%,蓝色(分页)两种负载都在 99% 以上。这里的「长短混合」是有界双峰教学分布,不是严格意义的重尾;接纳策略按给定请求顺序取最长可容纳前缀,遇到下一条装不下即停止,不是全局最优装箱。 还有一个 decode 特有的并行技巧。 prefill 可以把 $S^2$ 的注意力摊到很多 SM 上,decode 只有一个 query、$S$ 个 key——并行度天然不足(FlashDecoding 的出发点)。做法是把序列维切成几段,各段独立算局部 softmax 再合并(online softmax 的分治),用更多并行度换带宽利用率。这与 3.4 节的结论一致:decode 的问题是算术强度低,切序列不改变 $I$,但能把空闲的算力单元动员起来去搬字节。 分段结果不能直接平均。设第 $a$ 段 logits 为 $z_j=q^\top k_j/\sqrt d$,保留最大值 $m_a$、指数和 $l_a=\sum_j e^{z_j-m_a}$ 和未归一化加权和 $u_a=\sum_j e^{z_j-m_a}v_j$。合并两段时先取 $m=\max(m_1,m_2)$,再把旧尺度换到同一尺度: $$l=e^{m_1-m}l_1+e^{m_2-m}l_2,\qquad u=e^{m_1-m}u_1+e^{m_2-m}u_2,\qquad o=u/l$$ 这和一次 softmax 完全相同,因为每段的指数都补回同一个全局最大值;直接平均各段已归一化输出会忽略段长和归一化常数。新增检查覆盖不等长尾段、四种切分和量级放大 1000 的 logits,32 组与密集 float64 参照最大差 $3.33\times10^{-16}$。这验证数学与页寻址,没有验证 Flash-Decoding GPU 吞吐。 生产部署还要考虑块表处理、CPU 调度、编译与内核启动开销。分页增加了寻址和管理成本,是否获益取决于请求负载,不能只看有效容量。 06. 代价与边界 6.1 batch 摊权重,但独立请求的 KV 随 batch 增长 在第 3.4 节的带宽模型里,一批请求共享一次权重读取,而各自拥有不同 KV。若上下文相同,batch 增大时总 KV 字节数线性增长;单步吞吐上界是 $B_{\text{batch}}/T_{\text{step}}$,不会无限线性增加。共享前缀、不同长度调度、投机解码和张量并行会改变这张账,需重新列出复用假设。若所有请求长度均为 $S$、每步各产出一个 token,带宽模型给出 $$\mathrm{TPS}\le\frac{B_{\text{batch}}\mathrm{BW}}{W+B_{\text{batch}}B_{\text{tok}}S}$$ batch 很大时右侧趋于 $\mathrm{BW}/(B_{\text{tok}}S)$,本例 $S=8192$、2.039 TB/s 时约 1899 token/s。这是总吞吐的条件上限,单请求延迟仍随 batch 的 KV 读取增加;计算能力、容量和调度会更早限制实际吞吐。 6.2 分页不改变有效 KV 大小,但减少浪费 块大小越小,最后一块的空槽通常越少,块表却越长。若长度模块大小的余数均匀,块大小 $b$ 的平均空槽是 $(b-1)/2$,不是无条件精确的 $b/2$。本例平均长度约 2310,16/32 token 块的空槽比例约 0.32%/0.67%;真实工作负载与 kernel 对齐要求应共同决定块大小。分页能让原本浪费的显存参与服务,也支持一些共享场景;batch=1 同样可能减少预留容量,但未必带来明显延迟收益。 6.3 视频缓存:因果掩码只是必要条件之一 一些自回归视频系统按帧或块推进,块内双向、块间因果;另一些按离散 token 生成或采用不同的窗口。下图仅展示一种块因果结构: 图中右上角为空表示不能读未来块,对角块为满表示当前块内双向。允许读取历史,不等于历史 K/V 在所有去噪步都不变。 当前块的噪声状态随去噪变化,其 K/V 通常必须重算;历史块只有在输入、位置、时间/噪声条件、模型权重均固定且架构允许时才能精确缓存。若历史也被重新加噪或全局时间条件改变,需按模型缓存策略重建,不能直接套文本 decoder 的永久缓存假设。 本例假设 720p、空间压缩 8×8、时间压缩 4×、每 latent 位置一个 token、全历史保留,并套用 Llama-3-8B 的缓存结构;5/10/30 秒分别为 52.73/105.47/316.41 GiB。额外 2×2 patch 化会让空间 token 数约为四分之一;因果 VAE 的首帧约定、边界取整、滑动窗口、层数与头数还会继续改变数字。一帧的 1.76 GiB 是这组假设的计算结果,不是视频模型的普遍常数。 语义块和分配块不必相同。 一帧可包含很多物理缓存页,原有 token 分页机制仍可复用;需要调整的是掩码、批处理和缓存生命周期。不能仅凭帧内双向就断言块表必须整帧分配,或元数据一定压垮 CPU。 位置必须保留逻辑含义。 3D RoPE 需要时间/高/宽坐标,不能只用缓存里的 token 条数推断它们。滑窗驱逐后,存储长度尤其不等于全局逻辑位置,需单独维护 position_ids 或绝对偏移。丢缓存并不删除已输出的视频帧,只会改变未来生成能读到的上下文,可能影响长时一致性。 量化、驱逐、压缩各有条件。 理想地把 KV 每元素字节从 2 降到 1,载荷减半,但总存储还包括量化 scale、元数据和工作区。FP8 不同格式有不同动态范围,离群值与精度误差要验证,不能只按「减半」判断能部署。MLA 是训练时设计的潜在注意力结构,不是给任意既有模型套一个无损压缩器;滑窗或驱逐会改变可见历史。 6.4 证据的范围 本篇证实了玩具文本 decoder 的缓存等价性,计算了指定配置的显存账,并做了静态分页容量模拟。Roofline 给出假设下的上界,未测 A100 kernel,未实现完整视频去噪缓存,也没有证明任何真实视频模型必须采用某个驱逐策略。CPU FP32 微基准、GPU BF16 理论峰值与 NumPy 教学实现的访存行为要分开理解。 07. 经典论文脉络 Attention Is All You Need——decoder 的因果结构允许缓存固定历史,缓存是利用因果结构减少重复计算的常见优化,并非数学正确性所必需。 Fast Transformer Decoding: One Write-Head is All You Need(MQA)——系统讨论了 decode 的瓶颈是带宽而非算力,并把所有 query 头共享一对 KV 头,把缓存压到 $1/g$。该工作以增量解码的数据搬运成本为动机,报告其设置下的速度与质量取舍;不能概括为所有 decode 都由带宽主导。 GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints——在论文的模型和任务设置中,用中间数量的 KV 头折中 MQA 的质量损失,并给出从 MHA 检查点继续训练的路线。本文 8 个 KV 头、容量降至 1/4 来自 Llama-3-8B 的 32-query/8-KV 配置,不是任意 GQA 都具有的比例或质量保证。 FlashAttention 与官方介绍的 Flash-Decoding——前者说明注意力可以不把 $S \times S$ 矩阵写回显存(本系列已写过);后者把 decode 的序列维切开并行,专治「一个 query、一长串 key」的并行度不足。它们改善不同形状的 IO 与并行效率,但不保证始终达到理论带宽。 Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM)——把虚拟内存的分页思想搬进 KV cache,解决「输出长度未知导致的预留浪费与外部碎片」,本篇 05 节用自设负载模拟预留浪费,不是论文 benchmark 的直接复现。它把缓存分配、共享与批处理容量一起纳入推理服务设计。 两条缓存压缩路线的起点:StreamingLLM 在其流式语言模型实验中保留 attention sink 和最近窗口,改善有限缓存下的流式表现;这不等于保留完整上下文检索能力,也不能直接推出视频中的长期一致性。DeepSeek-V2 的 MLA 缓存压缩后的联合潜在表示,并处理解耦 RoPE 所需状态;实际容量要按模型结构计算,不能由 GQA 公式直接替代。前者改变可见上下文,后者是在训练中学习的注意力参数化,都直接对应 6.3 节视频场景里那道「丢什么、怎么丢」的选择题。 08. 常见误解 误解 1:「算力少 100 倍就一定快 100 倍。」 墙钟还受 kernel、调度、带宽和分配影响,加速比需实测。上下文变长使缓存路线自身更慢,但相对全量重算的加速比可能反而增大,不能说必然恶化。 误解 2:「所有 decode 都是纯访存。」 低 batch、长上下文的注意力常受带宽限制,但整体 decode 还有投影、FFN、通信与 CPU 开销。先用 profiler 定位。 误解 3:「GQA 只影响质量。」 它减少 KV 容量、KV 投影与理想读取字节,但 query 头数不变;代价要结合训练质量和实际 kernel 评估。 误解 4:「分页不省显存,容量增益直接等于吞吐增益。」 分页减少的是预留与碎片浪费,有效 KV 本身不变。能放更多请求并不保证同倍数 tokens/s。 误解 5:「缓存长度就是新 token 的位置。」 仅在简单连续全缓存情形下成立。驱逐、packing、padding 或 3D 坐标都需要额外位置元数据,不能从当前存储长度猜。 误解 6:「因果视频掩码就保证跨去噪步复用 KV。」 掩码约束依赖方向,缓存还要求被缓存的隐藏状态不变;当前噪声块及发生条件变化的历史必须重新计算。 09. 动手验证 数值脚本依赖 numpy,配图另需 matplotlib,均不需要 torch: python kv_cache_lab.py ALL # 三次计时,时长随机器变化:等价性、算力/显存账、Roofline python paged_alloc.py ALL # 分页 vs 连续预分配的静态容量与浪费 python kv_cache_checks.py # 54组缓存对照、分页/合并、有限和和位置反例 预期结果(实跑输出,可以直接对): kv_cache_lab.py 的 [A1] 必须是 192 / 192 完全一致,[A2] 的本轮相对误差约 $1.16\times10^{-6}$,不同 NumPy/BLAS 的末位会变化。如果 [A2] 达到 $10^{-2}$ 量级,应先检查参照解是否多喂了 token([A] 段注释里那个 off-by-one,我第一版就踩了)。 [A3] 修订后的矩阵乘计算量比约 105.61;[A4] 时间不设固定范围,它取决于机器和运行条件。 [B1] 每个 token 131072 字节、8192 token 正好 1.0000 GiB;[B4] 三条视频账 52.73 / 105.47 / 316.41 GiB。 paged_alloc.py 的 [A]:均匀负载 122 → 214(1.75x),长短混合负载 122 → 405(3.32x);[B] 两类浪费之比约 239 倍。 想自己碰一下边界?改 kv_cache_lab.py 顶部的 CFG["n_kv_head"](从 2 改到 8,变成 MHA),再跑一遍:缓存载荷变 4 倍,但投影结构、临时复制与两条路线的耗时也会变化,实测加速比不保证单调。NumPy 的 repeat 会削弱理想 GQA 访存收益,因此这个实验不能直接验证 GPU 带宽模型。 10. 延伸阅读 性能建模与 Profiling:算力、带宽与显存账本——算术强度、山脊点与实跑标定的前置知识。 自注意力机制的计算与显存账本——先理解 Q/K/V、因果 mask 和训练态矩阵账本。 FlashAttention 为什么不需要存下注意力矩阵——online softmax 的分块与合并。 自回归视频生成与 Forcing 范式——视频帧/块因果结构与 Forcing 训练设置。 扩散模型的跨步缓存复用——已发布;跨去噪步近似复用,与本文固定历史的精确缓存对照。 附录:完整代码 09 节用到的脚本全文如下(kv_cache_lab.py、kv_cache_checks.py、paged_alloc.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 kv_cache_lab.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """KV Cache 实验室。 三个问题,全部用可复现的实跑回答,不靠记忆里的结论: [A] 增量解码(用缓存)和「每步把整个前缀重算一遍」,得到的到底是不是同一个东西? 以及真实加速比是多少、算力量省了多少倍。 [B] 缓存自己要吃掉多少显存?按 Llama-3-8B 的真实配置算一遍, 再算一遍自回归视频的 token 数,看哪个先爆。 [C] decode 一步的算术强度为什么和上下文长度无关?把它放到 Roofline 上看。 纯 numpy,不需要 torch / scipy。 python kv_cache_lab.py ALL # 全部,约 30 秒 python kv_cache_lab.py A # 只跑等价性与加速比 python kv_cache_lab.py B # 只跑显存账本 python kv_cache_lab.py C # 只跑算术强度与 Roofline """ from __future__ import annotations import argparse import json import math import os import time import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # 玩具模型的配置:刻意做成 GQA(8 个 q 头共享 2 个 kv 头,g = 4), # 它是常见的一种结构;MHA 是 g = 1 的特例,其他模型也可能采用 MQA/MLA。 CFG = dict( n_layer=4, n_q_head=8, n_kv_head=2, d_head=32, ffn_mult=4, prompt=16, gen=192, vocab=32, dtype_bytes=4, # 玩具模型用 fp32 跑,记账就按 4 字节 ) def d_model(cfg=CFG): return cfg["n_q_head"] * cfg["d_head"] # ══════════════════════════════════════════════════════════════ # 0. 一个能跑的小 Transformer decoder # ══════════════════════════════════════════════════════════════ def validate_cfg(cfg): for name in ["n_layer", "n_q_head", "n_kv_head", "d_head", "ffn_mult", "vocab"]: if not isinstance(cfg[name], (int, np.integer)) or cfg[name] <= 0: raise ValueError(f"{name} must be a positive integer") if cfg["n_q_head"] % cfg["n_kv_head"]: raise ValueError("query heads must be divisible by KV heads") def validate_generation(cfg, prompt_tokens): validate_cfg(cfg) if not isinstance(cfg["gen"], (int, np.integer)) or cfg["gen"] < 1: raise ValueError("gen must be a positive integer") if len(prompt_tokens) == 0 or any( not isinstance(t, (int, np.integer)) or not 0 <= t < cfg["vocab"] for t in prompt_tokens ): raise ValueError("prompt must contain valid integer token IDs") def make_weights(cfg=CFG, seed=0): validate_cfg(cfg) rng = np.random.default_rng(seed) D = d_model(cfg) Dk = cfg["n_kv_head"] * cfg["d_head"] F = cfg["ffn_mult"] * D s = 1.0 / math.sqrt(D) blocks = [] for _ in range(cfg["n_layer"]): blocks.append(dict( wq=rng.normal(0, s, (D, D)).astype(np.float32), wk=rng.normal(0, s, (D, Dk)).astype(np.float32), wv=rng.normal(0, s, (D, Dk)).astype(np.float32), wo=rng.normal(0, s, (D, D)).astype(np.float32), w1=rng.normal(0, s, (D, F)).astype(np.float32), w2=rng.normal(0, s, (F, D)).astype(np.float32), )) E = rng.normal(0, s, (cfg["vocab"], D)).astype(np.float32) # token embedding head = rng.normal(0, s, (D, cfg["vocab"])).astype(np.float32) return blocks, E, head def rmsnorm(x, eps=1e-8): return x / np.sqrt(np.mean(x * x, axis=-1, keepdims=True) + eps) def attn_full(Q, K, V): """完整因果注意力。Q:[S,Hq,Dh] K/V:[S,Hkv,Dh] -> [S,Hq,Dh]""" S, Hq, Dh = Q.shape g = Hq // K.shape[1] Kk = np.repeat(K, g, axis=1) Vv = np.repeat(V, g, axis=1) scale = Q.dtype.type(1.0 / math.sqrt(Dh)) logits = np.einsum("qhd,khd->hqk", Q, Kk) * scale # [Hq,S,S] mask = np.triu(np.ones((S, S), dtype=bool), 1) logits = np.where(mask[None, :, :], -np.inf, logits) logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hqk,khd->qhd", p, Vv) def attn_step(q, K, V): """单步注意力:一个 query 对长度 S 的缓存。q:[Hq,Dh] K/V:[S,Hkv,Dh] -> [Hq,Dh]""" Hq, Dh = q.shape g = Hq // K.shape[1] Kk = np.repeat(K, g, axis=1) Vv = np.repeat(V, g, axis=1) scale = q.dtype.type(1.0 / math.sqrt(Dh)) logits = np.einsum("hd,khd->hk", q, Kk) * scale # [Hq,S] logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hk,khd->hd", p, Vv) def block_forward(x, w, cfg=CFG, cache=None, base=0): """对一个前缀做完整因果前向。x:[S,D] -> [S,D]。 cache 不为 None 时,顺手把这一层的 K/V 写进 cache[base:base+S]。""" if base != 0: raise ValueError("block_forward is full prefill only; use block_step to append") S, D = x.shape hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"] h = rmsnorm(x) Q = (h @ w["wq"]).reshape(S, hq, dh) K = (h @ w["wk"]).reshape(S, hkv, dh) V = (h @ w["wv"]).reshape(S, hkv, dh) if cache is not None: cache["k"][base:base + S] = K cache["v"][base:base + S] = V cache["used"] = S o = attn_full(Q, K, V).reshape(S, D) x = x + o @ w["wo"] x = x + np.maximum(x @ w["w1"], 0.0) @ w["w2"] return x def block_step(x_new, w, cache, pos, cfg=CFG): """decode 一步:只算新 token。x_new:[1,D] -> [1,D],并把它的 K/V 写进 pos。""" if pos != cache["used"] or not 0 <= pos < len(cache["k"]): raise ValueError("append position must equal used length and fit capacity") D = x_new.shape[1] hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"] h = rmsnorm(x_new) q = (h @ w["wq"]).reshape(hq, dh) k = (h @ w["wk"]).reshape(hkv, dh) v = (h @ w["wv"]).reshape(hkv, dh) cache["k"][pos] = k cache["v"][pos] = v cache["used"] = pos + 1 o = attn_step(q, cache["k"][:pos + 1], cache["v"][:pos + 1]).reshape(1, hq * dh) y = x_new + o @ w["wo"] y = y + np.maximum(y @ w["w1"], 0.0) @ w["w2"] return y def new_cache(cfg=CFG, total=None): validate_cfg(cfg) total = cfg["prompt"] + cfg["gen"] - 1 if total is None else total if not isinstance(total, (int, np.integer)) or total < 1: raise ValueError("cache capacity must be a positive integer") return [dict(k=np.zeros((total, cfg["n_kv_head"], cfg["d_head"]), np.float32), v=np.zeros((total, cfg["n_kv_head"], cfg["d_head"]), np.float32), used=0) for _ in range(cfg["n_layer"])] # ══════════════════════════════════════════════════════════════ # [A] 等价性与加速比 # ══════════════════════════════════════════════════════════════ def gen_naive(blocks, E, head, prompt_tokens, cfg=CFG): """不用缓存:每一步把整个前缀重算一遍,只取最后一个位置的输出。""" validate_generation(cfg, prompt_tokens) X = E[prompt_tokens].copy() toks, last_logits = [], None for _ in range(cfg["gen"]): h = X for w in blocks: h = block_forward(h, w, cfg) logits = h[-1] @ head tok = int(np.argmax(logits)) toks.append(tok) last_logits = logits X = np.vstack([X, E[tok][None, :]]) return toks, last_logits def gen_cached(blocks, E, head, prompt_tokens, cfg=CFG): """用 KV cache:prefill 一次,之后每步只算一个新 token。""" validate_generation(cfg, prompt_tokens) total = len(prompt_tokens) + cfg["gen"] - 1 caches = new_cache(cfg, total) X = E[prompt_tokens].copy() h = X for i, w in enumerate(blocks): h = block_forward(h, w, cfg, cache=caches[i], base=0) pos = len(prompt_tokens) - 1 h_last = h[-1:] toks, last_logits = [], None for t in range(cfg["gen"]): logits = h_last[0] @ head tok = int(np.argmax(logits)) toks.append(tok) last_logits = logits if t == cfg["gen"] - 1: break # 已得到最后一个预测,不再做一次未使用的 decode x_new = E[tok][None, :] pos += 1 h_new = x_new for i, w in enumerate(blocks): h_new = block_step(h_new, w, caches[i], pos, cfg) h_last = h_new return toks, last_logits, caches def forward_full(blocks, E, head, tokens, cfg=CFG): """一次性对整段 token 做完整前向(参照解)。""" h = E[tokens] for w in blocks: h = block_forward(h, w, cfg) return h[-1] @ head def flops_full(S, cfg=CFG): """一次长度 S 的完整因果前向的 FLOPs(只算矩阵乘,2*macs)。""" D = d_model(cfg) Dk = cfg["n_kv_head"] * cfg["d_head"] F = cfg["ffn_mult"] * D per_layer = (2 * (D * D) # wq + 2 * (D * Dk) # wk + 2 * (D * Dk) # wv + 2 * (D * D) # wo + 2 * (D * F) # w1 + 2 * (F * D)) # w2 # 实际代码只对最后一个位置计算输出头,计 2*D*vocab FLOP。 proj = cfg["n_layer"] * S * per_layer + 2 * D * cfg["vocab"] # NumPy 实现先做完整密集矩阵乘再掩码,不能按跳过上三角计数。 attn = cfg["n_layer"] * 4 * cfg["n_q_head"] * cfg["d_head"] * S * S return proj + attn def flops_step(S, cfg=CFG): """decode 一步(上下文长度 S)的 FLOPs。""" D = d_model(cfg) Dk = cfg["n_kv_head"] * cfg["d_head"] F = cfg["ffn_mult"] * D per_layer = (2 * (D * D) + 2 * (D * Dk) + 2 * (D * Dk) + 2 * (D * D) + 2 * (D * F) + 2 * (F * D)) proj = cfg["n_layer"] * per_layer + 2 * D * cfg["vocab"] attn = cfg["n_layer"] * 2 * (2 * cfg["n_q_head"] * cfg["d_head"] * S) return proj + attn def section_A(cfg=CFG): print("=" * 72) print("[A] 增量解码 vs 每步全量重算") print("=" * 72) blocks, E, head = make_weights(cfg) rng = np.random.default_rng(7) prompt_tokens = list(rng.integers(0, cfg["vocab"], cfg["prompt"])) S_end = cfg["prompt"] + cfg["gen"] # 预热只用于排除首次调用;交替顺序减少固定先后偏差。 warm = dict(cfg, gen=2) gen_cached(blocks, E, head, prompt_tokens, warm) gen_naive(blocks, E, head, prompt_tokens, warm) times = {"naive": [], "cached": []} for trial in range(3): for name in (["cached", "naive"] if trial % 2 == 0 else ["naive", "cached"]): t0 = time.perf_counter() if name == "cached": toks_c, logits_c, caches = gen_cached(blocks, E, head, prompt_tokens, cfg) else: toks_n, logits_n = gen_naive(blocks, E, head, prompt_tokens, cfg) times[name].append(time.perf_counter() - t0) t_cached = float(np.median(times["cached"])) t_naive = float(np.median(times["naive"])) # ── A3 参照解:一次性完整前向 ── # 对齐位置很容易错:最后一步的 logits 是在「倒数第二个 token」上算出来的 # (它用来预测最后一个 token),所以参照解只能喂到 toks_c[:-1]。 # 多喂一个 token,比的就是下一步的 logits 了。 all_tokens = list(prompt_tokens) + toks_c[:-1] logits_ref = forward_full(blocks, E, head, all_tokens, cfg) same = sum(1 for a, b in zip(toks_c, toks_n) if a == b) dif = float(np.max(np.abs(logits_c - logits_ref))) scale = float(np.max(np.abs(logits_ref))) assert same == cfg["gen"], "token sequences differ" assert dif <= 1e-5 * max(scale, 1.0), "cached/full logits mismatch" print("\n[A1] 两条路线生成的 token 序列") print(f" 序列长度 : {cfg['gen']}") print(f" 完全一致的 token : {same} / {cfg['gen']}") print("\n[A2] 缓存路线最后一步的 logits vs 一次性完整前向(参照解)") print(f" max |Δ| : {dif:.3e}") print(f" 参照解的量级 : {scale:.6f}") print(f" 相对误差 : {dif / scale:.3e}") # ── A4 算力账 ── f_naive = sum(flops_full(cfg["prompt"] + t, cfg) for t in range(cfg["gen"])) f_cached = (flops_full(cfg["prompt"], cfg) + sum(flops_step(cfg["prompt"] + t, cfg) for t in range(1, cfg["gen"]))) print("\n[A3] 算力账(解析计数,单位 FLOP)") print(f" 无缓存总算力 : {f_naive:.4e}") print(f" 有缓存总算力 : {f_cached:.4e}") print(f" 算力节省倍数 : {f_naive / f_cached:.2f}x") print("\n[A4] 真实墙钟(预热后交替顺序,各跑三次取中位数)") print(f" 无缓存 : {t_naive:.3f} s") print(f" 有缓存 : {t_cached:.3f} s") print(f" 实测加速比 : {t_naive / t_cached:.2f}x") print(f" (算力省了 {f_naive / f_cached:.1f}x,墙钟只快 {t_naive / t_cached:.1f}x —— " f"差额还含 Python、分配、KV 复制和小矩阵效率,不能仅归因于带宽)") return dict( gen=cfg["gen"], same_tokens=same, max_diff=dif, ref_scale=scale, flops_naive=f_naive, flops_cached=f_cached, flops_ratio=f_naive / f_cached, t_naive=t_naive, t_cached=t_cached, speedup=t_naive / t_cached, seq_end=S_end, timing_samples=times, timing_statistic="median_of_3", logits_dtype=str(logits_c.dtype), cache_shape=list(caches[0]["k"].shape), cached_input_tokens=int(caches[0]["used"]), ) # ══════════════════════════════════════════════════════════════ # [B] 显存账本 # ══════════════════════════════════════════════════════════════ # Llama-3-8B 的公开配置 LLAMA3_8B = dict(name="Llama-3-8B", n_layer=32, n_q_head=32, n_kv_head=8, d_head=128, params=8.03e9, dtype_bytes=2) def kv_bytes_per_token(cfg, n_kv_head=None): """每个 token 的 KV cache 字节数(所有层)。""" nkv = cfg["n_kv_head"] if n_kv_head is None else n_kv_head return 2 * cfg["n_layer"] * nkv * cfg["d_head"] * cfg["dtype_bytes"] def kv_bytes_total(cfg, S, batch, n_kv_head=None): return kv_bytes_per_token(cfg, n_kv_head) * S * batch def section_B(): print("\n" + "=" * 72) print("[B] KV cache 自己吃掉多少显存") print("=" * 72) c = LLAMA3_8B bpt = kv_bytes_per_token(c) print("\n[B1] 每个 token 的 KV cache(Llama-3-8B,BF16)") print(f" 2 (K,V) x {c['n_layer']} 层 x {c['n_kv_head']} kv头 x {c['d_head']} 维 x 2 字节") print(f" = {bpt} 字节/token = {bpt / 1024:.0f} KiB/token") print(f" 8192 token 一条序列 = {bpt * 8192 / (1024**3):.4f} GiB") w_bytes = c["params"] * c["dtype_bytes"] print(f"\n[B2] 和权重比一比(权重 {w_bytes / (1024**3):.2f} GiB)") print(f" {'batch':>6} {'seq':>6} {'KV cache':>12} {'KV/权重':>9} {'合计':>10}") rows = [] for batch, S in [(1, 8192), (8, 8192), (16, 8192), (32, 8192), (64, 8192), (32, 32768)]: kb = kv_bytes_total(c, S, batch) rows.append(dict(batch=batch, seq=S, kv=kb, total=kb + w_bytes, ratio=kb / w_bytes)) print(f" {batch:>6} {S:>6} {kb / (1024**3):>9.2f} GiB " f"{kb / w_bytes:>8.2f}x {(kb + w_bytes) / (1024**3):>7.2f} GiB") # MHA 对照 bpt_mha = kv_bytes_per_token(c, n_kv_head=c["n_q_head"]) print(f"\n[B3] 如果换成 MHA(32 个 kv 头而不是 8 个)") print(f" {bpt_mha} 字节/token = {bpt_mha / 1024:.0f} KiB/token" f" (GQA 的 {bpt_mha / bpt:.0f} 倍)") print(f" batch=32 / seq=8192 时:" f"{kv_bytes_total(c, 8192, 32, c['n_q_head']) / (1024**3):.2f} GiB" f" vs GQA {kv_bytes_total(c, 8192, 32) / (1024**3):.2f} GiB") # ── 视频 ── print("\n[B4] 自回归视频:token 数先把你压垮") vcfg = dict(c, dtype_bytes=2) cases = [] for name, frames, tf, h, w, fps, sec in [ ("5s 720p", 120, 4, 1280, 720, 24, 5), ("10s 720p", 240, 4, 1280, 720, 24, 10), ("30s 720p", 720, 4, 1280, 720, 24, 30), ]: lat_frames = frames // tf tok_per_frame = (h // 8) * (w // 8) # 空间 8x8 压缩 ntok = lat_frames * tok_per_frame kb = ntok * bpt cases.append(dict(name=name, lat_frames=lat_frames, tok_per_frame=tok_per_frame, ntok=ntok, kv=kb)) print(f" {name:>8}: 潜在帧 {lat_frames:>3} x 每帧 {tok_per_frame:>5} token" f" = {ntok:>8} token -> KV cache {kb / (1024**3):>8.2f} GiB(单条视频)") return dict(bytes_per_token=bpt, bytes_per_token_mha=bpt_mha, weight_bytes=w_bytes, rows=rows, video=cases) # ══════════════════════════════════════════════════════════════ # [C] 算术强度与 Roofline # ══════════════════════════════════════════════════════════════ def probe_peak(n=3072, n_bytes=20_000_000, repeat=5): """大矩阵/数组微基准的最好观测值,作为示意屋顶。 n_bytes 是沿用的参数名,实际表示 float32 元素数;默认每数组80MB。 流量按读一份、写一份的逻辑字节计算,不测物理DRAM流量或写分配。 缓存、线程、BLAS、调度与数组分配都能改变数值,非硬件规格峰值。 """ rng = np.random.default_rng(0) a = rng.normal(size=(n, n)).astype(np.float32) b = rng.normal(size=(n, n)).astype(np.float32) a @ b # 预热BLAS best = float("inf") for _ in range(repeat): t0 = time.perf_counter() a @ b best = min(best, time.perf_counter() - t0) peak_flops = 2.0 * n ** 3 / best x = rng.normal(size=n_bytes).astype(np.float32) y = np.empty_like(x) best = float("inf") for fn in (lambda: np.copyto(y, x), lambda: np.add(x, 1.0, out=y)): fn() for _ in range(4): t0 = time.perf_counter() fn() best = min(best, time.perf_counter() - t0) peak_bw = (2 * x.nbytes) / best # 读一份 + 写一份 return peak_flops, peak_bw def intensity_decode(g, dtype_bytes=2): """decode 一步「注意力部分」的算术强度 I = 2g/p,与上下文长度无关。""" return 2.0 * g / dtype_bytes def section_C(): print("\n" + "=" * 72) print("[C] 算术强度:为什么上下文再长,decode 也改善不了") print("=" * 72) print("\n[C1] decode 一步的注意力部分(上下文长度 S,GQA 分组数 g,dtype 字节 p)") print(" 算力 = 4 * n_q * d * S (QK^T 与 AV 各 2*n_q*d*S)") print(" 访存 = 2 * n_kv * d * S * p (K、V 各一份)") print(" I = 4 n_q d S / (2 n_kv d S p) = 2 (n_q/n_kv) / p = 2g/p") print(" —— 理想融合注意力中 S 被约去;不代表实际 kernel 效率随 S 不变。") print() print(f" {'g (n_q/n_kv)':>12} {'I = 2g/p (BF16)':>16}") rows_g = [] for g in [1, 2, 4, 8, 16, 32]: I = intensity_decode(g, 2) rows_g.append(dict(g=g, I=I)) print(f" {g:>12} {I:>16.1f}") # ── prefill 对照 ── c = LLAMA3_8B D = c["n_q_head"] * c["d_head"] print("\n[C2] prefill 的算术强度(Llama-3-8B,S=8192)") S = 8192 attn_flops = c["n_layer"] * 2 * (2 * c["n_q_head"] * c["d_head"] * S * (S + 1) / 2) proj_flops = 2 * c["params"] * S # 粗略 2NS 估计,不是逐层实测 FLOPs w_bytes = c["params"] * c["dtype_bytes"] act_bytes = c["n_layer"] * 10 * S * D * c["dtype_bytes"] I_pre = (attn_flops + proj_flops) / (w_bytes + act_bytes) print(f" 注意力算力 : {attn_flops / 1e12:.2f} TFLOP") print(f" 投影层算力 : {proj_flops / 1e12:.2f} TFLOP <-- dominates") print(f" 访存(权重+激活): {(w_bytes + act_bytes) / (1024**3):.2f} GiB") print(f" I_prefill : {I_pre:.1f} FLOP/byte") # ── Roofline ── peak_flops, peak_bw = probe_peak() ridge = peak_flops / peak_bw print("\n[C3] 本机标定(numpy / CPU,实跑)") print(f" 最好矩阵乘: {peak_flops / 1e9:.2f} GFLOP/s") print(f" 最好逻辑带宽: {peak_bw / 1e9:.2f} GB/s") print(f" 山脊点 : {ridge:.2f} FLOP/byte") # A100-80GB 公开规格 a100 = dict(flops=312e12, bw=2.039e12) print(f"\n A100-80GB(公开规格,非实测):{a100['flops'] / 1e12:.0f} TFLOP/s BF16 / " f"{a100['bw'] / 1e12:.2f} TB/s -> 山脊点 {a100['flops'] / a100['bw']:.1f} FLOP/byte") print("\n[C4] 理想注意力 Roofline:CPU 按 FP32 (I 为 BF16 的一半),A100 按 BF16") print(f" {'工作负载':>18} {'I':>10} {'本机判定':>10} {'A100 判定':>10}") pts = [] for g in [1, 4, 8]: I = intensity_decode(g, 2) pts.append(dict(name=f"decode g={g}", I=I, I_local=I / 2, local="带宽" if I / 2 < ridge else "算力", a100="带宽" if I < a100["flops"] / a100["bw"] else "算力")) print(f" {f'decode g={g}':>18} {I:>10.1f} {pts[-1]['local']:>10} {pts[-1]['a100']:>10}") pts.append(dict(name="prefill S=8192", I=I_pre, I_local=I_pre / 2, local="带宽" if I_pre / 2 < ridge else "算力", a100="带宽" if I_pre < a100["flops"] / a100["bw"] else "算力")) print(f" {'prefill S=8192':>18} {I_pre:>10.1f} {pts[-1]['local']:>10} {pts[-1]['a100']:>10}") return dict(rows_g=rows_g, I_prefill=I_pre, I_prefill_local=I_pre / 2, peak_flops=peak_flops, peak_bw=peak_bw, ridge=ridge, a100_flops=a100["flops"], a100_bw=a100["bw"], a100_ridge=a100["flops"] / a100["bw"], points=pts) def main(): ap = argparse.ArgumentParser() ap.add_argument("which", nargs="?", default="ALL") args = ap.parse_args() w = args.which.upper() out = {} if w in ("ALL", "A"): out["A"] = section_A() if w in ("ALL", "B"): out["B"] = section_B() if w in ("ALL", "C"): out["C"] = section_C() if w == "ALL": with open(os.path.join(HERE, "_kv_results.json"), "w", encoding="utf-8") as f: json.dump(out, f, ensure_ascii=False, indent=1) print("\n结果已写入 _kv_results.json(画图脚本读它,避免图上的数字和正文漂移)") if __name__ == "__main__": main() kv_cache_checks.py """独立验证缓存等价性、分页寻址、分段softmax及公式边界。仅需NumPy。""" from __future__ import annotations import json from pathlib import Path import numpy as np import kv_cache_lab as lab import paged_alloc as paged def softmax(a): e = np.exp(a - np.max(a, axis=-1, keepdims=True)) return e / e.sum(axis=-1, keepdims=True) def split_attention(q, keys, values, chunk): """每段保留最大值m、指数和l和未归一化加权和u,再稳定合并。""" if len(keys) == 0 or chunk < 1: raise ValueError("nonempty keys and positive chunk required") hq, d = q.shape group = hq // keys.shape[1] m = np.full(hq, -np.inf) den = np.zeros(hq) num = np.zeros_like(q) for start in range(0, len(keys), chunk): k = np.repeat(keys[start:start + chunk], group, axis=1) v = np.repeat(values[start:start + chunk], group, axis=1) score = np.einsum("hd,shd->hs", q, k) / np.sqrt(d) block_m = score.max(axis=-1) weight = np.exp(score - block_m[:, None]) block_den = weight.sum(axis=-1) block_num = np.einsum("hs,shd->hd", weight, v) new_m = np.maximum(m, block_m) left, right = np.exp(m - new_m), np.exp(block_m - new_m) den = left * den + right * block_den num = left[:, None] * num + right[:, None] * block_num m = new_m return num / den[:, None] def main(): rng = np.random.default_rng(31) errors, cases, cache_checks = [], [], 0 for seed in [0, 1]: for nkv in [1, 2, 4]: for prompt in [1, 3, 9]: for gen in [1, 2, 5]: cfg = dict(lab.CFG, n_layer=2, n_q_head=4, n_kv_head=nkv, d_head=4, ffn_mult=2, prompt=2, gen=gen, vocab=13) weights, embedding, head = lab.make_weights(cfg, seed) tokens = list(rng.integers(0, cfg['vocab'], prompt)) tc, lc, caches = lab.gen_cached(weights, embedding, head, tokens, cfg) tn, ln = lab.gen_naive(weights, embedding, head, tokens, cfg) err = float(np.max(np.abs(lc - ln))) assert tc == tn and err < 2e-5 assert lc.dtype == np.float32 assert all(c['used'] == prompt + gen - 1 for c in caches) nbytes = sum(c['k'].nbytes + c['v'].nbytes for c in caches) assert nbytes == lab.kv_bytes_per_token(cfg) * (prompt + gen - 1) cases.append(dict(seed=seed, kv_heads=nkv, prompt=prompt, gen=gen, max_error=err, payload_bytes=nbytes)) errors.append(err) # 固定输入逐位置比对,避免只看最终argmax掩盖中间错误。 fixed = tokens + list(rng.integers(0, cfg['vocab'], 4)) caches = lab.new_cache(cfg, len(fixed)) h = embedding[tokens] for i, w in enumerate(weights): h = lab.block_forward(h, w, cfg, cache=caches[i]) for pos in range(prompt, len(fixed)): old = [c['k'][:pos].copy() for c in caches] h = embedding[fixed[pos]][None, :] for i, w in enumerate(weights): h = lab.block_step(h, w, caches[i], pos, cfg) ref = lab.forward_full(weights, embedding, head, fixed[:pos + 1], cfg) assert np.max(np.abs(h[0] @ head - ref)) < 2e-5 assert all(np.array_equal(c['k'][:pos], before) for c, before in zip(caches, old)) cache_checks += 1 # 模拟不连续物理页:logical s -> block_table[s//b]*b+s%b。 page_errors = [] for n in [1, 4, 5, 13]: block = 4 pages = (n + block - 1) // block table = rng.permutation(pages) keys = rng.normal(size=(n, 2, 4)) values = rng.normal(size=(n, 2, 4)) kp = np.zeros((pages, block, 2, 4)) vp = np.zeros_like(kp) for s in range(n): kp[table[s // block], s % block] = keys[s] vp[table[s // block], s % block] = values[s] recovered_k = np.array([kp[table[s // block], s % block] for s in range(n)]) recovered_v = np.array([vp[table[s // block], s % block] for s in range(n)]) assert np.array_equal(recovered_k, keys) and np.array_equal(recovered_v, values) for magnitude in [1, 1000]: q = rng.normal(size=(4, 4)) * magnitude scores = np.einsum('hd,shd->hs', q, np.repeat(keys, 2, axis=1)) / 2 ref = np.einsum('hs,shd->hd', softmax(scores), np.repeat(values, 2, axis=1)) for chunk in [1, 2, 7, 32]: err = float(np.max(np.abs(split_attention(q, recovered_k, recovered_v, chunk) - ref))) assert err < 1e-12 page_errors.append(err) # c0=4*nq*d;三角与密集的精确有限和,不能混用常数。 for s in range(1, 33): tri = sum(t * (t + 1) // 2 for t in range(1, s + 1)) dense = sum(t * t for t in range(1, s + 1)) cached = sum(range(1, s + 1)) assert tri == s * (s + 1) * (s + 2) // 6 assert dense == s * (s + 1) * (2 * s + 1) // 6 assert tri / cached == (s + 2) / 3 assert dense / cached == (2 * s + 1) / 3 fragments = [] for block in [1, 4, 16, 32]: waste = [(-length) % block for length in range(1, block + 1)] assert sum(waste) / block == (block - 1) / 2 fragments.append(dict(block=block, mean_waste=sum(waste) / block)) bpt = lab.kv_bytes_per_token(lab.LLAMA3_8B) assert bpt == 131072 and lab.kv_bytes_total(lab.LLAMA3_8B, 8192, 32) == 32 * 1024**3 # 页容量是先后请求顺序的前缀接纳,下一条失败后没有跳过它找短请求。 assert paged.admit([1, 9, 1], [1, 9, 1], 3) == (1, 1) # 滑窗后只重置query位置、旧key仍保留全局RoPE,会改变相对位置。 def rotate(x, position): y = x.reshape(-1, 2).copy() theta = position * np.array([1.0, 0.01]) a, b = y[:, 0].copy(), y[:, 1].copy() y[:, 0] = a * np.cos(theta) - b * np.sin(theta) y[:, 1] = a * np.sin(theta) + b * np.cos(theta) return y.ravel() q, k = rng.normal(size=(2, 4)) correct = float(rotate(q, 13) @ rotate(k, 10)) wrong = float(rotate(q, 3) @ rotate(k, 10)) shifted = float(rotate(q, 3) @ rotate(k, 0)) assert abs(correct - shifted) < 1e-12 and abs(correct - wrong) > 0.01 invalid = [] def reject(label, fn): try: fn() except (ValueError, IndexError): invalid.append(label) else: raise AssertionError(label) cfg = dict(lab.CFG, n_layer=1, n_q_head=4, n_kv_head=2, d_head=4, gen=2) weights, embedding, head = lab.make_weights(cfg) reject('head divisibility', lambda: lab.make_weights(dict(cfg, n_kv_head=3))) reject('zero capacity', lambda: lab.new_cache(cfg, 0)) reject('empty prompt', lambda: lab.gen_cached(weights, embedding, head, [], cfg)) reject('invalid token', lambda: lab.gen_cached(weights, embedding, head, [-1], cfg)) reject('zero generation', lambda: lab.gen_cached(weights, embedding, head, [1], dict(cfg, gen=0))) reject('chunked prefill unsupported', lambda: lab.block_forward(embedding[[1]], weights[0], cfg, base=1)) cache = lab.new_cache(cfg, 1)[0] reject('gap append', lambda: lab.block_step(embedding[[1]], weights[0], cache, 1, cfg)) lab.block_forward(embedding[[1]], weights[0], cfg, cache=cache) reject('capacity exceeded', lambda: lab.block_step(embedding[[1]], weights[0], cache, 1, cfg)) reject('unknown workload', lambda: paged.workload('typo')) out = dict(passed=True, equivalence_cases=cases, max_generation_error=max(errors), fixed_prefix_checks=cache_checks, page_split_cases=len(page_errors), max_page_split_error=max(page_errors), finite_sum_cases=32, fragments=fragments, rope_correct=correct, rope_wrong=wrong, invalid_inputs=invalid, errors=[], warnings=[]) Path(__file__).with_name('validation_results.json').write_text( json.dumps(out, ensure_ascii=False, indent=2) + '\n', encoding='utf8') print(json.dumps({k:v for k,v in out.items() if k != 'equivalence_cases'}, ensure_ascii=False, indent=2)) if __name__ == '__main__': main() paged_alloc.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """PagedAttention 的分页分配,到底省在哪。 KV cache 有一个和别的张量都不一样的地方:**它是在请求进行中一点点长出来的**。 你事先不知道这条请求最终会有多长,所以要么按最大长度预留(浪费), 要么让它能非连续地增长(分页)。这个脚本把两种做法放在同一个显存预算下对比。 [A] 同一个显存预算,两种分配策略各能同时服务多少条请求 [B] 浪费来自哪里:预留浪费 vs 块内碎片 [C] 块大小怎么选:越小越省,但不是越小越好 python paged_alloc.py ALL """ from __future__ import annotations import argparse import json import math import os import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # Llama-3-8B / BF16 在假设 80 GiB 总预算下的账(不是设备可用显存实测)(与 kv_cache_lab.py [B] 同源) N_LAYER, N_KV, D_HEAD, DTYPE = 32, 8, 128, 2 BYTES_PER_TOKEN = 2 * N_LAYER * N_KV * D_HEAD * DTYPE # 131072 = 128 KiB GPU_BYTES = 80 * (1024 ** 3) WEIGHT_BYTES = 8.03e9 * DTYPE OTHER_BYTES = 4 * (1024 ** 3) # 激活 / 框架 / 碎片余量 MAX_LEN = 4096 def budget_tokens(): return int((GPU_BYTES - WEIGHT_BYTES - OTHER_BYTES) // BYTES_PER_TOKEN) def workload(kind, n=4000, seed=11): """两种典型负载:长度均匀的(批处理)和有界长短混合(教学负载)。""" rng = np.random.default_rng(seed) if kind == "uniform": lens = rng.integers(512, MAX_LEN + 1, n) elif kind == "heavy": # 双峰有界混合,非数学重尾分布 short = rng.integers(256, 1025, int(n * 0.8)) long_ = rng.integers(3072, MAX_LEN + 1, n - int(n * 0.8)) lens = np.concatenate([short, long_]) rng.shuffle(lens) else: raise ValueError("unknown workload kind") return lens def admit(lens, bytes_each, budget): """贪心接纳:按请求顺序一直加,直到预算装不下。返回接纳条数。""" used, k = 0, 0 for b in bytes_each: if used + b > budget: break used += b k += 1 return k, used def section_A(): print("=" * 72) print("[A] 同一块显存,两种分配策略能同时服务多少条请求") print("=" * 72) cap = budget_tokens() budget = cap * BYTES_PER_TOKEN print(f"\n显存预算:80 GiB - 权重 {WEIGHT_BYTES / (1024**3):.2f} GiB" f" - 其他 {OTHER_BYTES / (1024**3):.0f} GiB = {budget / (1024**3):.2f} GiB") print(f"折合 token 容量 : {cap} tokens({BYTES_PER_TOKEN} B/token)") out = {} for kind, label in [("uniform", "长度均匀 512~4096"), ("heavy", "长短混合:八成 256~1024")]: print(f"\n--- 负载:{label} ---") lens = workload(kind) b_cont = np.full(len(lens), MAX_LEN * BYTES_PER_TOKEN) # 按最大长度预留 b_paged = (np.ceil(lens / 16) * 16) * BYTES_PER_TOKEN # 分页,块 16 k_c, u_c = admit(lens, b_cont, budget) k_p, u_p = admit(lens, b_paged, budget) used_tok_c = lens[:k_c].sum() used_tok_p = lens[:k_p].sum() util_c = used_tok_c * BYTES_PER_TOKEN / u_c util_p = used_tok_p * BYTES_PER_TOKEN / u_p print(f" {'策略':>12} {'并发请求':>9} {'占用':>10} {'真实用到':>10} {'利用率':>8}") print(f" {'连续预留':>12} {k_c:>9} {u_c / (1024**3):>7.2f} GiB " f"{used_tok_c * BYTES_PER_TOKEN / (1024**3):>7.2f} GiB {util_c:>7.2%}") print(f" {'分页(块16)':>12} {k_p:>9} {u_p / (1024**3):>7.2f} GiB " f"{used_tok_p * BYTES_PER_TOKEN / (1024**3):>7.2f} GiB {util_p:>7.2%}") print(f" 并发提升 : {k_p / k_c:.2f}x") out[kind] = dict(k_cont=int(k_c), k_paged=int(k_p), util_cont=float(util_c), util_paged=float(util_p), gain=float(k_p / k_c), bytes_cont=float(u_c), bytes_paged=float(u_p), real_cont=float(used_tok_c * BYTES_PER_TOKEN), real_paged=float(used_tok_p * BYTES_PER_TOKEN)) out["cap_tokens"] = cap out["budget_bytes"] = float(budget) return out def section_B(): print("\n" + "=" * 72) print("[B] 浪费的两半:预留浪费 和 块内碎片") print("=" * 72) lens = workload("uniform") bs = 16 reserve_waste = (MAX_LEN - lens).mean() * BYTES_PER_TOKEN frag = ((np.ceil(lens / bs) * bs) - lens).mean() * BYTES_PER_TOKEN print(f"\n每条请求的平均长度 : {lens.mean():.1f} tokens") print(f"连续预留的浪费/条 : {reserve_waste / (1024**2):.2f} MiB" f"(预留 {MAX_LEN},平均只用 {lens.mean():.0f})") print(f"分页的块内碎片/条 : {frag / (1024**2):.2f} MiB" f"(只有最后一个块没填满,余数均匀时约 {(bs - 1) / 2} 个空槽)") print(f"两者之比 : {reserve_waste / frag:.1f}x") print("\n分页把「不知道会多长」这个不确定性,从「按最坏情况预留」" "换成了「最多浪费一个块」——这是整个设计的关键一跳。") return dict(reserve_waste=float(reserve_waste), frag=float(frag), ratio=float(reserve_waste / frag), mean_len=float(lens.mean())) def section_C(): print("\n" + "=" * 72) print("[C] 块大小怎么选") print("=" * 72) lens = workload("uniform") mean_len = lens.mean() print(f"\n平均请求长度 {mean_len:.1f} tokens。块越大,最后一块的空槽越多;" f"块越小,块表越长、kernel 里要 Gather 的次数越多。") print(f"\n {'块大小':>6} {'碎片/条':>10} {'理论利用率':>10} {'块表条目/请求':>14}") rows = [] for bs in [1, 4, 8, 16, 32, 64, 128, 256]: frag = ((np.ceil(lens / bs) * bs) - lens).mean() util = mean_len / (mean_len + frag) nblk = float(np.ceil(lens / bs).mean()) rows.append(dict(bs=bs, frag=float(frag), util=float(util), nblk=nblk)) print(f" {bs:>6} {frag:>8.1f} tk {util:>9.3%} {nblk:>14.1f}") print("\n长度模 bs 的余数均匀时,块内空槽期望为 (bs-1)/2;" "真实碎片取决于长度分布。16 或 32 是常见候选,需实测:" "本例平均长度约 2310,16/32 块约有 0.32%/0.67% 空槽;元数据和 kernel 开销另计。") return dict(rows=rows, mean_len=float(mean_len)) def main(): ap = argparse.ArgumentParser() ap.add_argument("which", nargs="?", default="ALL") w = ap.parse_args().which.upper() out = {} if w in ("ALL", "A"): out["A"] = section_A() if w in ("ALL", "B"): out["B"] = section_B() if w in ("ALL", "C"): out["C"] = section_C() if w == "ALL": # 画图用的示意数据:3 条请求怎么被切成块 lens = [37, 21, 45] bs = 16 seqs = [] for i, L in enumerate(lens): seqs.append(dict(idx=i, length=L, n_blocks=int(math.ceil(L / bs)), last_used=L % bs or bs)) out["demo"] = dict(block_size=bs, seqs=seqs) with open(os.path.join(HERE, "_paged_results.json"), "w", encoding="utf-8") as f: json.dump(out, f, ensure_ascii=False, indent=1) print("\n结果已写入 _paged_results.json") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ make_figures.py —— 画本文的 4 张配图。 数据全部来自已经跑完的实验(_kv_results.json / _paged_results.json), 不在这里重新算,避免图上的数字和正文漂移。 运行: python make_figures.py """ from __future__ import annotations import json import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import matplotlib.patches as mpatches import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") try: os.makedirs(FIGDIR, exist_ok=True) except FileExistsError: pass # 配色(正文里写「这张图要看什么」时按这六个名字来描述) C_MAIN = "#1f4e79" # 深蓝:主曲线 C_ALT = "#c1440e" # 橙红:对照曲线 C_GREEN = "#2e7d32" # 绿:第三组 C_PURPLE = "#7b1fa2" # 紫:标注线 C_GRAY = "#8a8a8a" # 灰:参考线 C_LIGHT = "#bcd7ee" # 浅蓝:填充 C_RED = "#b71c1c" # 红:越界线 plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 plt.rcParams["savefig.dpi"] = 130 def _load(name): p = os.path.join(HERE, name) if not os.path.exists(p): raise SystemExit(f"缺少 {name},先跑 kv_cache_lab.py ALL / paged_alloc.py ALL") with open(p, encoding="utf-8") as f: return json.load(f) GIB = float(1024 ** 3) # ══════════════════════════════════════════════════════════════ # 图 1:显存账本 # ══════════════════════════════════════════════════════════════ def fig_mem_ledger(res): B = res["B"] w = B["weight_bytes"] bpt, bpt_mha = B["bytes_per_token"], B["bytes_per_token_mha"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 4.9)) # ── 左:batch 扫描下的显存构成 ── batches = [1, 8, 16, 32, 64, 128] seq = 8192 kv = [bpt * seq * b for b in batches] others = 4 * GIB xs = np.arange(len(batches)) ax1.bar(xs, [w / GIB] * len(batches), color=C_MAIN, label="模型权重(14.96 GiB)") ax1.bar(xs, [k / GIB for k in kv], bottom=[w / GIB] * len(batches), color=C_ALT, label="KV cache") ax1.bar(xs, [others / GIB] * len(batches), bottom=[(w + k) / GIB for k in kv], color=C_LIGHT, label="激活 / 框架 / 余量") ax1.axhline(80, color=C_RED, ls="--", lw=1.6) ax1.text(0.05, 81.4, "假设总预算 80 GiB", color=C_RED, fontsize=9) ax1.set_xticks(xs) ax1.set_xticklabels([str(b) for b in batches]) ax1.set_xlabel("batch size") ax1.set_ylabel("显存(GiB)") ax1.set_title("显存账本:batch 一大,权重就不再是主角", fontsize=11) ax1.legend(fontsize=8, loc="upper left") ax1.set_ylim(0, 200) # ── 右:序列长度扫描,GQA vs MHA ── seqs = np.array([512, 1024, 2048, 4096, 8192, 16384, 32768, 65536, 131072]) for b in (1, 8): ax2.plot(seqs, bpt * seqs * b / GIB, "-o", ms=3.5, color=C_MAIN if b == 1 else C_ALT, label=f"GQA batch={b}") ax2.plot(seqs, bpt_mha * seqs * 8 / GIB, "--s", ms=3.5, color=C_PURPLE, label="MHA batch=8(kv 头 32 个)") ax2.axhline(61, color=C_GRAY, ls=":", lw=1.4) ax2.text(seqs[0], 66, "KV 预算约 61 GiB", color=C_GRAY, fontsize=8.5) ax2.axhline(80, color=C_RED, ls="--", lw=1.4) ax2.text(seqs[0] * 1.6, 88, "80 GiB 显存上限", color=C_RED, fontsize=8.5) ax2.set_xscale("log", base=2) ax2.set_yscale("log") ax2.set_xlabel("每条序列的长度(token)") ax2.set_ylabel("KV cache(GiB,对数刻度)") ax2.set_title("KV cache 随长度线性增长,随 batch 线性增长", fontsize=11) ax2.legend(fontsize=8) ax2.grid(alpha=0.25, which="both") fig.tight_layout() p = os.path.join(FIGDIR, "fig_mem_ledger.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) # ══════════════════════════════════════════════════════════════ # 图 2:Roofline # ══════════════════════════════════════════════════════════════ def fig_roofline(res): C = res["C"] pf, pb = C["peak_flops"], C["peak_bw"] ridge = pf / pb af, ab = C["a100_flops"], C["a100_bw"] aridge = af / ab pts = [(1, "decode g=1(MHA)", C_RED), (4, "decode g=4(GQA)", C_GREEN), (8, "decode g=8", C_PURPLE), (C["I_prefill"], "整层 prefill 粗估", C_MAIN)] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 5.2)) I = np.logspace(-1, 5, 400) # ── 左:本机(实跑观测,GFLOP/s)── ax1.plot(I, np.minimum(pf, I * pb) / 1e9, color=C_MAIN, lw=2.0) ax1.fill_betweenx([1e-2, pf / 1e9 * 2], 1e-1, ridge, color=C_LIGHT, alpha=0.3) ax1.axvline(ridge, color=C_MAIN, ls=":", lw=1.2) ax1.text(ridge * 1.12, 3.0, f"山脊点 {ridge:.0f}", color=C_MAIN, fontsize=8.5, rotation=90, va="bottom") for i, name, col in pts: i = i / 2 # 本机峰值来自 FP32,字节数是 BF16 的两倍 y = min(pf, i * pb) / 1e9 ax1.plot([i], [y], "o", ms=8, color=col, zorder=5) off = (-108, -20) if i >= 100 else (7, -13 if i < 100 else -3) ax1.annotate(name, (i, y), textcoords="offset points", xytext=off, fontsize=8.5, color=col) ax1.text(0.13, pf / 1e9 * 1.35, "带宽受限区", color=C_MAIN, fontsize=9) ax1.set_xscale("log") ax1.set_yscale("log") ax1.set_xlim(0.1, 1e4) ax1.set_ylim(1.0, pf / 1e9 * 2.2) ax1.set_xlabel("算术强度 I(FLOP / byte)") ax1.set_ylabel("理论上界(GFLOP/s)") ax1.set_title(f"本机 FP32 最好观测值:{pf / 1e9:.0f} GFLOP/s / {pb / 1e9:.0f} GB/s", fontsize=10.5) ax1.grid(alpha=0.25, which="both") # ── 右:A100(公开规格,TFLOP/s)── ax2.plot(I, np.minimum(af, I * ab) / 1e12, color=C_ALT, lw=2.0) ax2.fill_betweenx([1e-2, af / 1e12 * 2], 1e-1, aridge, color="#f6d9c9", alpha=0.45) ax2.axvline(aridge, color=C_ALT, ls=":", lw=1.2) ax2.text(aridge * 1.12, 0.9, f"山脊点 {aridge:.0f}", color=C_ALT, fontsize=8.5, rotation=90, va="bottom") for i, name, col in pts: y = min(af, i * ab) / 1e12 ax2.plot([i], [y], "o", ms=8, color=col, zorder=5) off = (-108, -20) if i >= 100 else (7, -13 if i < 100 else -3) ax2.annotate(name, (i, y), textcoords="offset points", xytext=off, fontsize=8.5, color=col) ax2.text(0.13, af / 1e12 * 1.35, "带宽受限区", color=C_ALT, fontsize=9) ax2.set_xscale("log") ax2.set_yscale("log") ax2.set_xlim(0.1, 1e5) ax2.set_ylim(0.3, af / 1e12 * 2.2) ax2.set_xlabel("算术强度 I(FLOP / byte)") ax2.set_ylabel("理论上界(TFLOP/s)") ax2.set_title(f"A100-80GB(公开规格):{af / 1e12:.0f} TFLOP/s / {ab / 1e12:.2f} TB/s", fontsize=10.5) ax2.grid(alpha=0.25, which="both") fig.suptitle("Roofline 示意:decode 注意力与整层 prefill 粗估(非 kernel 实测)", fontsize=12, y=1.02) fig.tight_layout() p = os.path.join(FIGDIR, "fig_roofline.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) # ══════════════════════════════════════════════════════════════ # 图 3:PagedAttention 的分页布局 + 并发对比 # ══════════════════════════════════════════════════════════════ def fig_paged(res): demo = res.get("demo", {}) bs = demo.get("block_size", 16) lens = [s["length"] for s in demo.get("seqs", [])] or [37, 21, 45, 29] colors = [C_MAIN, C_ALT, C_GREEN, C_PURPLE, C_GRAY] n_seq = len(lens) # 模拟「边生成边分配」:每条请求轮流出 1 个 token,块不够了才申请新的 pos = [0] * n_seq blocks = [[] for _ in range(n_seq)] # 逻辑块 -> 物理块号 phys_owner, phys_fill, phys_cap = [], [], [] while any(pos[i] < lens[i] for i in range(n_seq)): for i in range(n_seq): if pos[i] >= lens[i]: continue if pos[i] % bs == 0: # 需要一个新的物理块 phys_owner.append(i) phys_fill.append(0) phys_cap.append(bs) blocks[i].append(len(phys_owner) - 1) phys_fill[blocks[i][-1]] += 1 pos[i] += 1 n_phys = len(phys_owner) + 3 # 末尾留 3 个空块 fig = plt.figure(figsize=(12.6, 5.0)) gs = fig.add_gridspec(1, 2, width_ratios=[1.25, 1.0]) # ── 左:逻辑视图 -> 物理块池 ── axL = fig.add_subplot(gs[0, 0]) axL.set_xlim(-0.6, n_phys + 0.6) axL.set_ylim(-0.5, n_seq + 2.6) axL.axis("off") axL.set_title("逻辑块 → 物理块:请求可以非连续地长", fontsize=11, loc="left") bw_l, bh = 0.82, 0.62 # 逻辑视图:每条请求一行,块连续排列 for i in range(n_seq): y = n_seq - i + 1.35 axL.text(-0.5, y + bh / 2, f"请求 {i + 1}", fontsize=8.5, ha="right", va="center") for j, p in enumerate(blocks[i]): x = j * (bw_l + 0.06) axL.add_patch(mpatches.Rectangle( (x, y), bw_l, bh, facecolor=colors[i], alpha=0.30, edgecolor=colors[i], lw=1.2)) used = phys_fill[p] axL.add_patch(mpatches.Rectangle( (x, y), bw_l * used / bs, bh, facecolor=colors[i], alpha=0.85)) if used < bs: axL.text(x + bw_l * used / bs / 2, y + bh / 2, f"{used}/{bs}", fontsize=6.4, ha="center", va="center", color="white") # 物理块池:一行,按申请顺序排列 y_p = 0.15 axL.text(-0.5, y_p + bh / 2, "物理块池", fontsize=8.5, ha="right", va="center") for p in range(n_phys): x = p * (bw_l + 0.06) if p < len(phys_owner): c = colors[phys_owner[p]] axL.add_patch(mpatches.Rectangle( (x, y_p), bw_l, bh, facecolor=c, alpha=0.30, edgecolor=c, lw=1.2)) axL.add_patch(mpatches.Rectangle( (x, y_p), bw_l * phys_fill[p] / bs, bh, facecolor=c, alpha=0.85)) axL.text(x + bw_l / 2, y_p - 0.28, str(p), fontsize=6.4, ha="center", color=C_GRAY) else: axL.add_patch(mpatches.Rectangle( (x, y_p), bw_l, bh, facecolor="white", edgecolor=C_GRAY, lw=1.0, hatch="//")) axL.text(x + bw_l / 2, y_p - 0.28, str(p), fontsize=6.4, ha="center", color=C_GRAY) axL.text(n_phys * (bw_l + 0.06) + 0.1, y_p + bh / 2, "空闲", fontsize=8, va="center", color=C_GRAY) # 几条连线:从逻辑块指到它真正的物理块 for i in range(n_seq): for j, p in enumerate(blocks[i]): x0 = j * (bw_l + 0.06) + bw_l / 2 y0 = n_seq - i + 1.35 x1 = p * (bw_l + 0.06) + bw_l / 2 axL.annotate("", xy=(x1, y_p + bh), xytext=(x0, y0), arrowprops=dict(arrowstyle="-", color=C_GRAY, lw=0.7, alpha=0.55)) axL.text(0, n_seq + 2.2, f"块大小 {bs}:只有每条请求的最后一块没填满(白字是「已用/容量」)", fontsize=8.5, color=C_GRAY) # ── 右:并发对比 ── axR = fig.add_subplot(gs[0, 1]) A = res["A"] labels = ["长度均匀\n512~4096", "长短混合\n八成短请求"] kc = [A["uniform"]["k_cont"], A["heavy"]["k_cont"]] kp = [A["uniform"]["k_paged"], A["heavy"]["k_paged"]] uc = [A["uniform"]["util_cont"], A["heavy"]["util_cont"]] up = [A["uniform"]["util_paged"], A["heavy"]["util_paged"]] xs = np.arange(2) wbar = 0.36 b1 = axR.bar(xs - wbar / 2, kc, wbar, color=C_GRAY, label="连续预分配(按 4096 预留)") b2 = axR.bar(xs + wbar / 2, kp, wbar, color=C_MAIN, label="分页(块 16)") for i, (a, b) in enumerate(zip(kc, kp)): axR.text(i - wbar / 2, a + 6, f"{a}\n利用率 {uc[i]:.1%}", ha="center", fontsize=8) axR.text(i + wbar / 2, b + 6, f"{b}\n利用率 {up[i]:.1%}", ha="center", fontsize=8, color=C_MAIN) axR.text(i, max(a, b) + 58, f"{b / a:.2f}x", ha="center", fontsize=10, color=C_RED, fontweight="bold") axR.set_xticks(xs) axR.set_xticklabels(labels, fontsize=9) axR.set_ylabel("同一 61 GiB 预算下的并发请求数") axR.set_title("分页减少预留浪费,提高静态可容纳请求数", fontsize=11) axR.legend(fontsize=8) axR.set_ylim(0, max(kp) * 1.42) axR.grid(alpha=0.2, axis="y") fig.tight_layout() p = os.path.join(FIGDIR, "fig_paged.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) # ══════════════════════════════════════════════════════════════ # 图 4:自回归视频的掩码结构 + 缓存规模 # ══════════════════════════════════════════════════════════════ def fig_video(res): B = res["B"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 4.9)) # ── 左:块内双向 + 块间因果的掩码 ── n_frame, tok_per_frame = 5, 12 n = n_frame * tok_per_frame M = np.zeros((n, n)) for a in range(n_frame): for b in range(n_frame): if b <= a: # 只能看当前帧和之前的帧 M[a * tok_per_frame:(a + 1) * tok_per_frame, b * tok_per_frame:(b + 1) * tok_per_frame] = 1.0 ax1.imshow(M, cmap="Blues", vmin=0, vmax=1.4, interpolation="nearest") for f in range(n_frame + 1): ax1.axhline(f * tok_per_frame - 0.5, color=C_ALT, lw=1.0) ax1.axvline(f * tok_per_frame - 0.5, color=C_ALT, lw=1.0) ax1.set_xlabel("key / value 位置(时间从前到后)") ax1.set_ylabel("query 位置") ax1.set_title("块内双向、块间因果", fontsize=11) ax1.set_xticks([f * tok_per_frame + (tok_per_frame - 1) / 2 for f in range(n_frame)]) ax1.set_xticklabels([f"帧{f + 1}" for f in range(n_frame)], fontsize=8) ax1.set_yticks([f * tok_per_frame + (tok_per_frame - 1) / 2 for f in range(n_frame)]) ax1.set_yticklabels([f"帧{f + 1}" for f in range(n_frame)], fontsize=8) ax1.text(1, n - 3, "对角块 = 块内双向示例\n(扩散当前块仍须重算)", fontsize=8.5, color=C_ALT, bbox=dict(fc="white", ec=C_ALT, alpha=0.85)) ax1.text(n * 0.34, n * 0.12, "下三角块 = 能看到过去帧\n(仅固定且兼容的历史可缓存)", fontsize=8.5, color=C_MAIN, bbox=dict(fc="white", ec=C_MAIN, alpha=0.85)) # ── 右:单条视频的 KV cache 规模 ── cases = B["video"] names = [c["name"] for c in cases] vals = [c["kv"] / GIB for c in cases] toks = [c["ntok"] for c in cases] bars = ax2.bar(names, vals, color=[C_GREEN, C_ALT, C_RED], width=0.55) ax2.axhline(80, color=C_RED, ls="--", lw=1.6) ax2.axhline(61, color=C_GRAY, ls=":", lw=1.4) ax2.text(2.52, 83, "假设总预算 80 GiB", color=C_RED, fontsize=8.5, ha="right", bbox=dict(fc="white", ec="none", alpha=0.9)) ax2.text(2.52, 64, "扣除权重与余量后 KV 约 61 GiB", color=C_GRAY, fontsize=8.5, ha="right", bbox=dict(fc="white", ec="none", alpha=0.9)) for b, v, t in zip(bars, vals, toks): ax2.text(b.get_x() + b.get_width() / 2, v + 10, f"{v:.1f} GiB\n{t // 1000}k tokens", ha="center", fontsize=8.5) ax2.set_ylabel("单条视频的 KV cache(GiB)") ax2.set_title("720p 假设账本:无额外 patch 化,缓存全部历史", fontsize=11) ax2.set_ylim(0, max(vals) * 1.30) ax2.grid(alpha=0.2, axis="y") fig.tight_layout() p = os.path.join(FIGDIR, "fig_video_mask.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) def main(): kv = _load("_kv_results.json") pg = _load("_paged_results.json") print("画图:") fig_mem_ledger(kv) fig_roofline(kv) fig_paged(pg) fig_video(kv) if __name__ == "__main__": main()