今日 AIGC 论文速览
今日共 10 篇 · 视频表示与自回归生成 3 篇 · 图像token与跨模态编辑 2 篇 · 几何与物理场景生成 2 篇 · 连续语音与情绪控制 2 篇 · 生成图像文字评测 1 篇
重点论文标题列表
GRACE (KAIST):压缩潜空间让视频快11.1倍QuadTok (UCSD):用四叉树把token留给细节SGF+ (清华):让记忆写入与去噪各练各的CrossEdit (Adobe):从复杂音频编辑迁移到音视频Tetris3D (KAIST):生成能互相支撑的3D物体
今日论文速览
1. GRACE:压缩潜空间让视频快11.1倍
GRACE: Generation-aware latent compression for efficient video generation | 韩国科学技术院;Kakao | arXiv:2610.10524
关键词 :视频潜空间, 双潜变量, 生成对齐, 非对称去噪
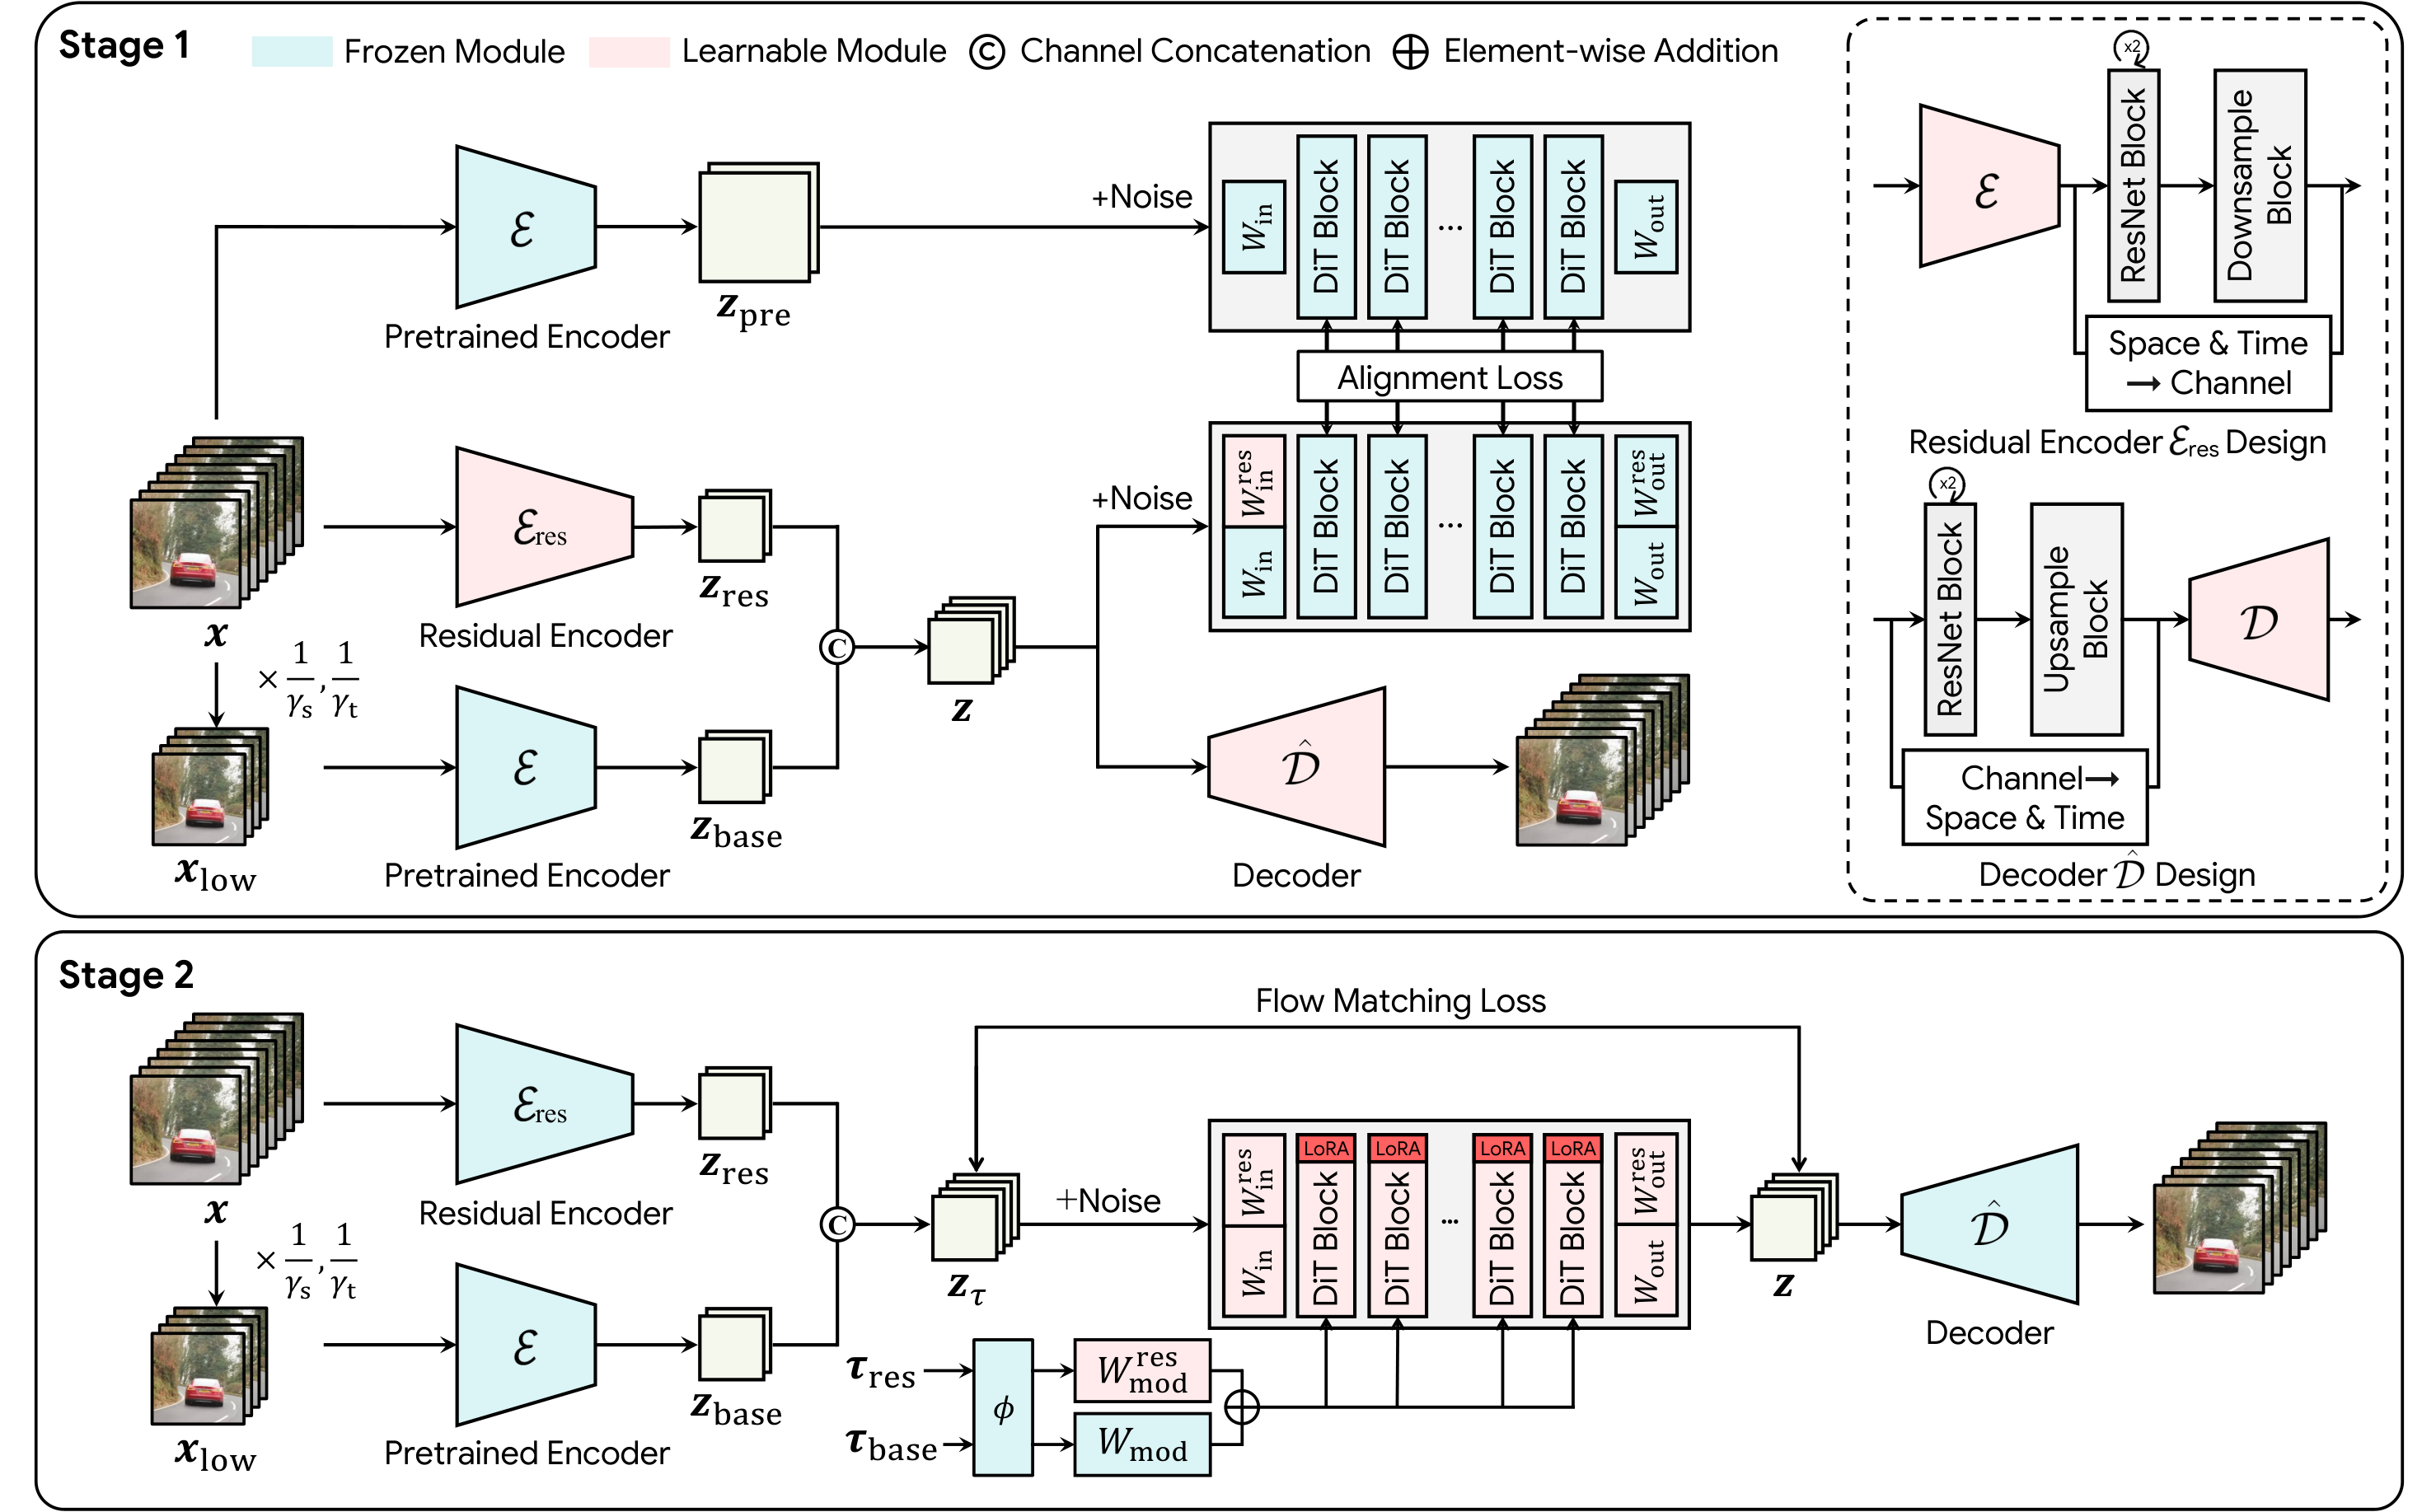
前序问题 :更强的 VAE 压缩能减少视频 token,却会改变预训练生成模型熟悉的分布。重建更清楚的潜空间,也未必更容易生成。本文贡献 :GRACE 保留冻结编码器从降采样视频得到的基础潜变量,另学残差潜变量补回丢失信息;在冻结 DiT(用 Transformer 做扩散生成)的特征空间对齐压缩前后表示。第二阶段用 LoRA 适配 DiT,让基础部分比残差更早去噪,后者依托已稳定的结构补细节。
论文 Figure 2:GRACE 总览。第一阶段冻结编码器从降采样视频提取基础潜变量,残差编码器从完整视频补信息,联合解码;对齐损失在冻结 DiT 内匹配压缩前后表示,右侧虚线框示意新增模块。第二阶段用 LoRA 适配 DiT,每步让基础部分处于更低噪声,先于残差稳定。
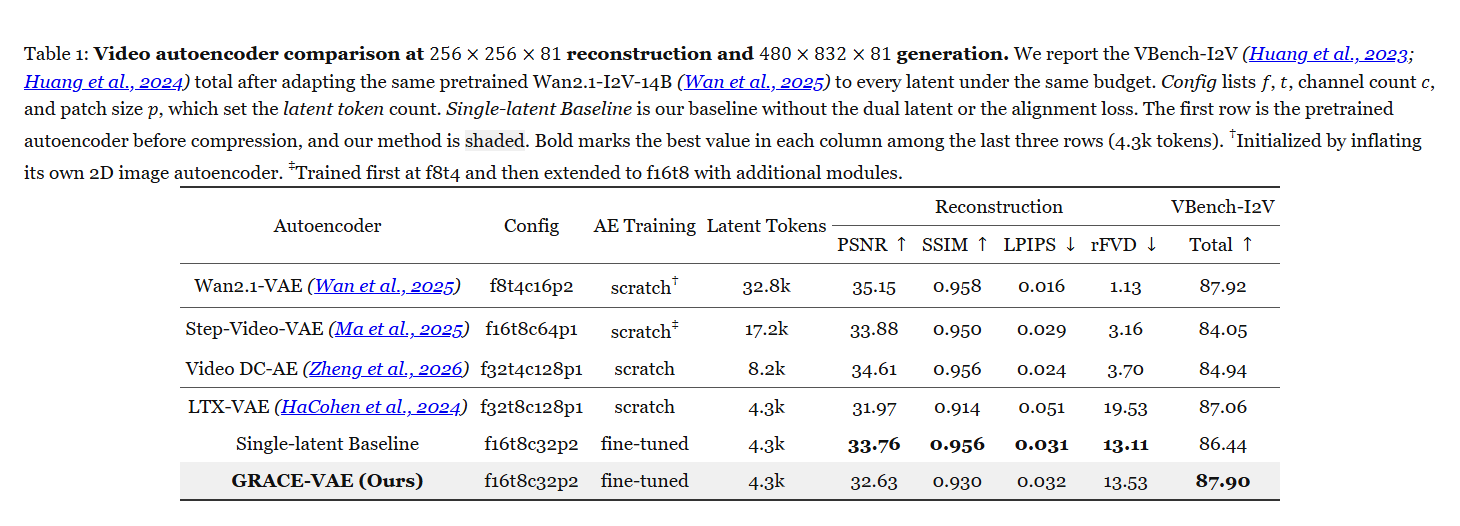
实验效果 :表 1、2:Wan2.1-I2V-14B 的 token 约 32.8k→4.3k,VBench-I2V 总分 87.92→87.90;480×832、81 帧、50 步、单 A100 下加速 11.1 倍。表 3 的 736×1280、81 帧配置为 15.5 倍。计时含条件图编码、去噪和视频解码,不含加载、文本编码及 MP4 写盘。
论文 Table 1:视频自编码器在 256×256×81 重建与 480×832×81 生成条件下的对比。GRACE 将潜变量 token 从 32.8k 减至 4.3k,适配同一 Wan2.1-I2V-14B 后总分 87.92→87.90;但重建 PSNR 35.15→32.63 dB。灰色行是本文方法,粗体仅比较后三种同为 4.3k token 的压缩表示。
批判点评 :接近的总分不保证逐项或逐帧无损;表 1 重建 PSNR 35.15→32.63 dB,说明优化生成不等于改善重建。仍需训练 VAE 与适配主干,不能即插即用,更不能把特定 GPU 与视频长度的倍数外推所有配置。作者项目页 提供演示与方法入口。
2. QuadTok:用四叉树把token留给细节
QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation | 加州大学圣迭戈分校 | arXiv:2610.10497
关键词 :自回归图像, 四叉树token, 空间对应, 复杂度引导
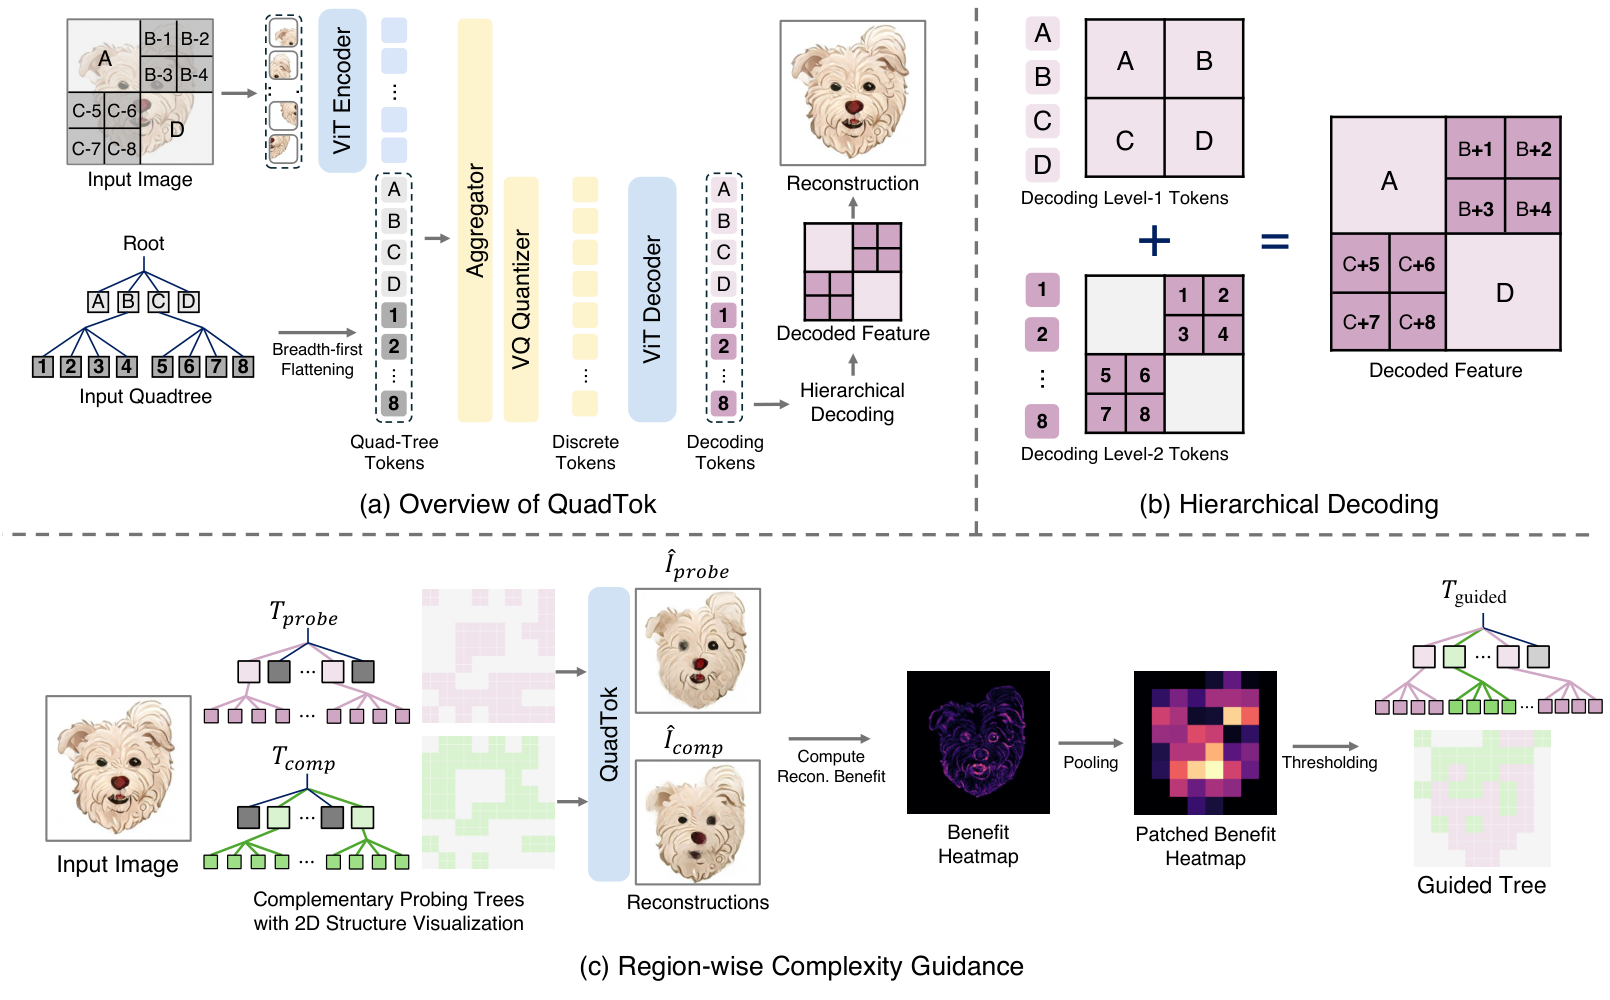
前序问题 :固定二维网格把平滑背景和复杂纹理分到相同预算;一维压缩序列虽灵活,却容易丢掉 token 与空间区域的明确对应。本文贡献 :QuadTok 用四叉树逐级细分区域,并按广度优先顺序串成序列。tokenizer 的亲缘注意力限制粗细层与兄弟节点交互;互补探测树的重建收益决定哪些区域多分 token。生成器在预先给定的树拓扑上,用普通因果注意力逐项预测视觉码,保留零样本布局控制。
论文 Figure 2:(a)四叉树按广度优先遍历串成一维序列,ViT 特征聚合成树节点,再量化与解码;(b)层级解码,粗节点恢复整体结构,细节点补局部;(c)互补探测树估计各区域的重建收益,用于形成内容自适应树。
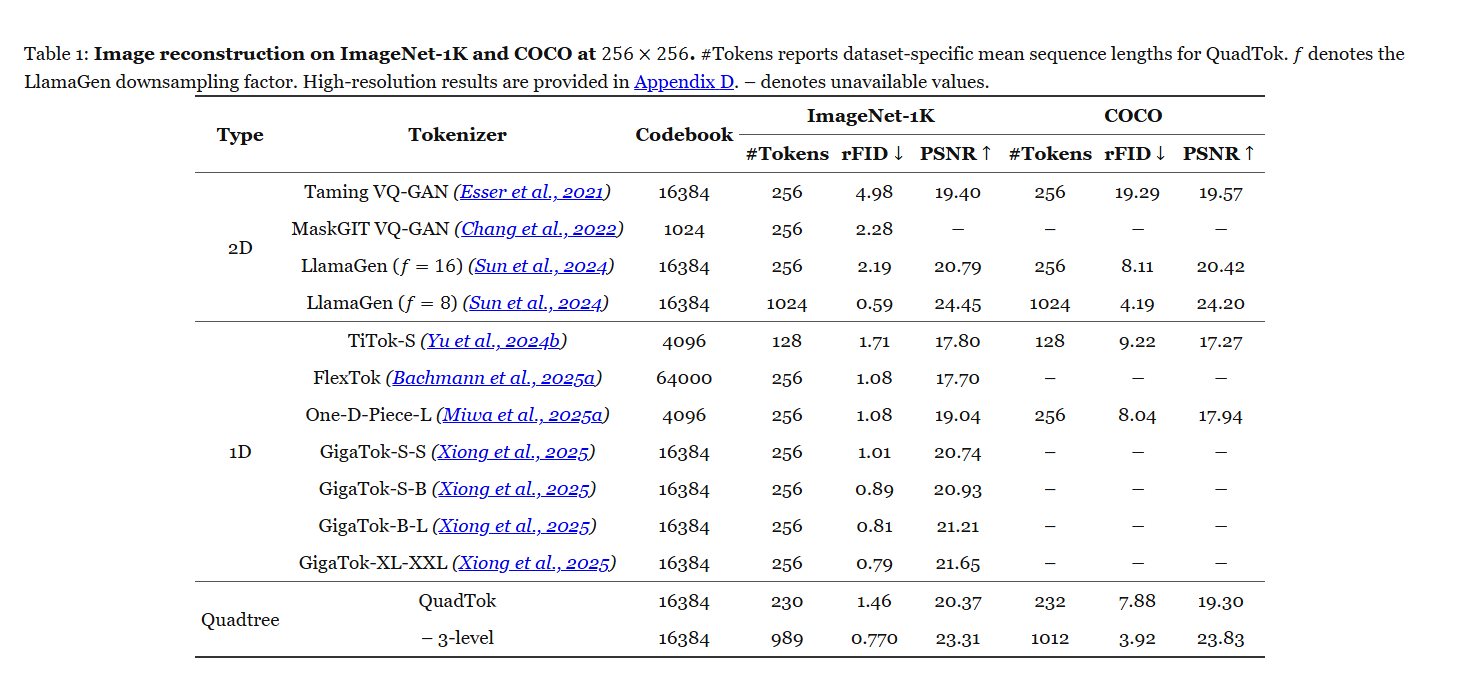
实验效果 :表 1:256×256 ImageNet 上平均 230 个 token,相比 LlamaGen 的 256 个少约 10%,rFID 2.19→1.46,但 PSNR 20.79→20.37;零样本 COCO 为 232 个 token、rFID 7.88。表 2 的 947M 类别条件生成模型 gFID 为 2.08。
论文 Table 1:256×256 ImageNet 与 COCO 重建比较。QuadTok 的 token 数是各数据集平均序列长度,ImageNet 训练的 tokenizer 直接迁移 COCO;f 为 LlamaGen 降采样倍率。表中更低 rFID 与更低 PSNR 可同时出现;三层树预算更多,不能只按树深度归因。
批判点评 :重建时的内容自适应树不等于生成器自行预测树:采样前须指定拓扑。文生图仍是未来工作,类别条件与布局控制不能直接叫通用文生图。表 2 各系统训练与采样设置不同,不能只凭 gFID 归因于树结构。官方仓库 已提供 tokenizer 训练、重建与预编码,生成模型不在该发布范围。
3. SGF+:让记忆写入与去噪各练各的
SGF+: Decoupling Gradient Flows for Autoregressive Video Generation | 清华大学;京东探索研究院;香港中文大学 | arXiv:2610.10429
关键词 :自回归视频, 上下文梯度, 参数分离, 长时生成
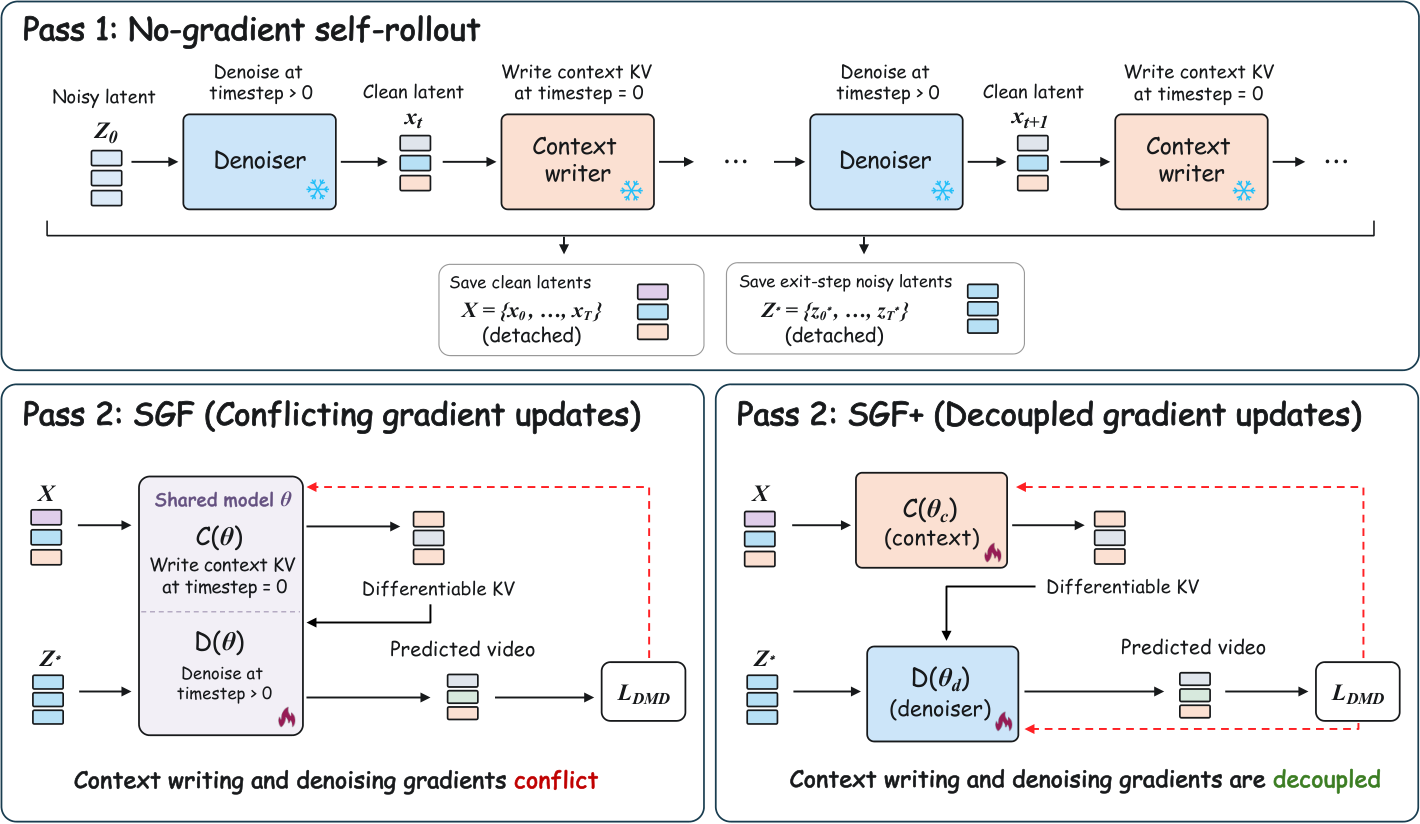
前序问题 :当前帧去噪和给未来写入 KV 记忆若共享参数,两种梯度可能冲突;只截断记忆梯度,又让后续生成无法监督记忆怎么写。本文贡献 :SGF+ 先无梯度自生成并记录干净上下文与采样出口,再并行重算可微 KV,让未来预测的原生成损失监督记忆写入。把写入与去噪参数分开,以因果注意力连接两者,不增加辅助损失。论文实测采用两套完整参数,而非只训练两个小 adapter。
论文 Figure 4:SGF 与 SGF+ 的两遍训练。第一遍无梯度自回归生成,记录停止梯度的干净上下文 X 和采样出口的带噪目标 Z*;第二遍从记录重构计算,让未来生成损失通过可微 KV 监督上下文。SGF 共享 θ,SGF+ 分别使用写入 θ_c 与去噪 θ_d。
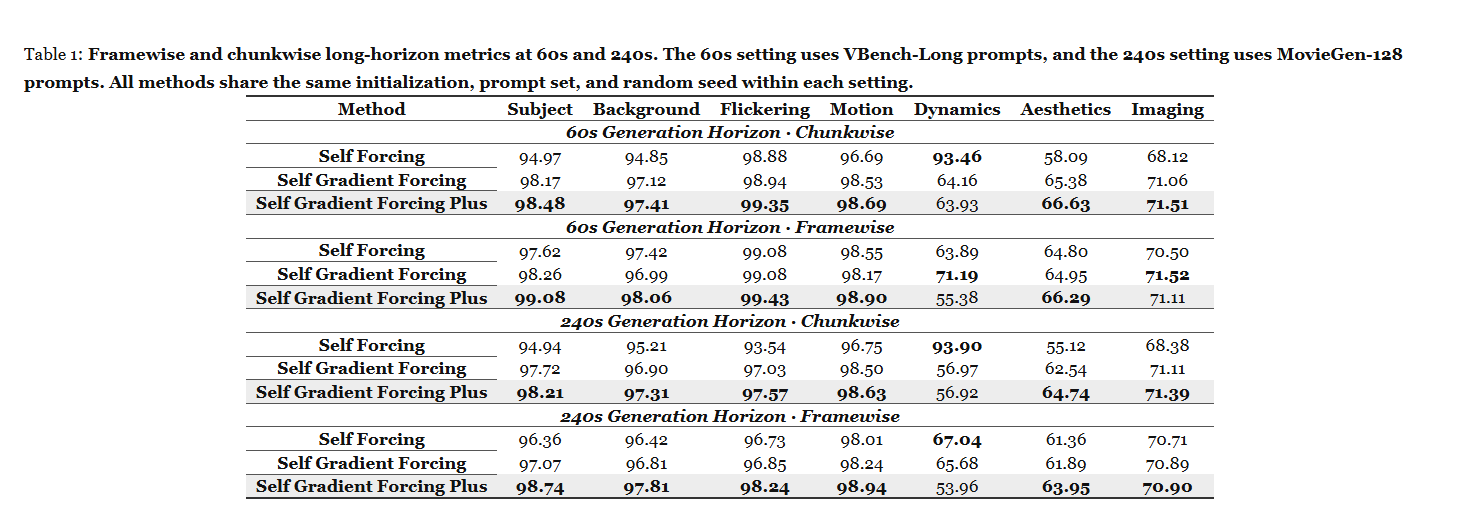
实验效果 :表 1 的 240 秒、分块生成,主体一致性由 SGF 的 97.72→98.21,审美 62.54→64.74,动态程度 56.97→56.92。训练窗口为 5 秒;作者另展示最长 24 小时连续生成,定量主表评测的是 60 秒与 240 秒。
论文 Table 1:60 秒和 240 秒的逐帧、分块生成比较,分别使用 VBench-Long 和 MovieGen-128 prompt。每组各方法的初始化、prompt 与随机种子一致;质量与一致性指标越高越好。动态程度可能因跳景或形变变高,不能单项决定质量;此表不是 24 小时量化评测。
批判点评 :24 小时是演示能力,不是完整时长的定量质量或剧情评测。动态程度及部分图像质量并非全面更好;复制参数还增加存储成本。长期画面稳定不保证事件逻辑成立。作者项目页 包含长视频材料。
4. CrossEdit:从复杂音频编辑迁移到音视频
CrossEdit: Cross-Modal Training Enables Rich Audio-Visual Editing | Adobe Research;卡内基梅隆大学 | arXiv:2610.10264
关键词 :音视频编辑, 跨模态迁移, 合成编辑对, 指令遵循
前序问题 :修改电影场景时既要理解组合指令,又要只动指定内容并保持声音与画面一致;这样的真实音视频编辑配对很难大规模收集。本文贡献 :CrossEdit 利用声音可相加的特点合成复杂音频编辑对,结合音视频掩码重建、唇同步编辑及精选跨模态任务做微调。统一 MoE DiT 通过 flow matching 编辑图像、音频与视频,将已学的复杂指令能力迁移到未见过的音视频场景编辑组合,并提出 CrossEditBench 与 AV-FES。
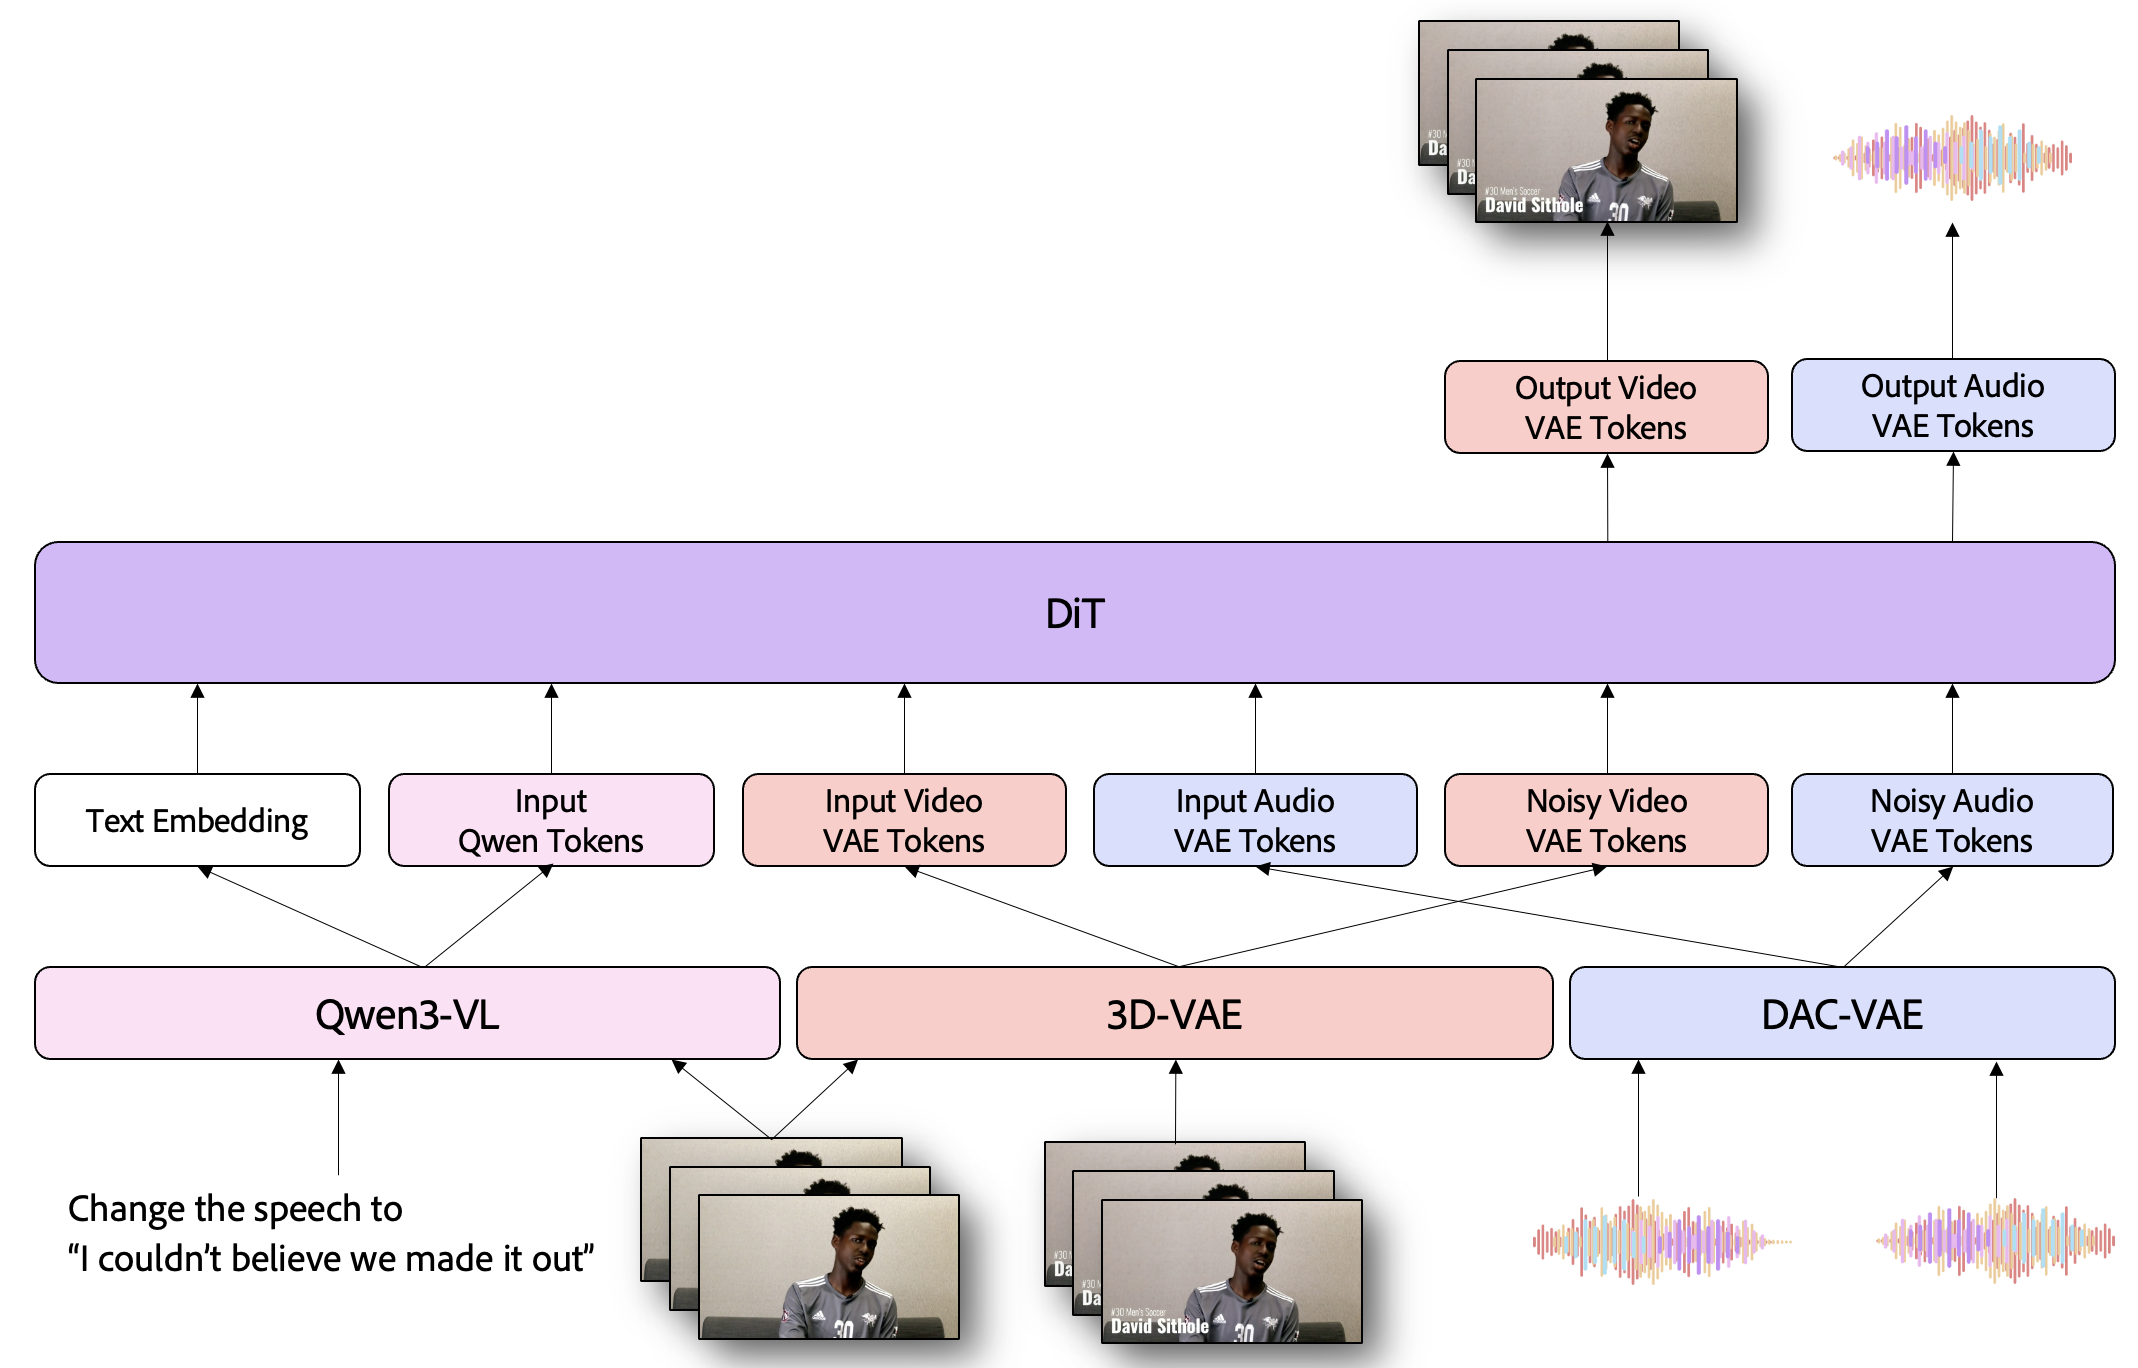
论文 Figure 2:CrossEdit 编码音视频输入的架构。图中省略图像,因为图像按单帧视频处理;音频与视觉经各自 VAE 进入统一生成模型,条件侧还使用干净语义表示。跨模态迁移仍依赖音视频重建等训练任务。
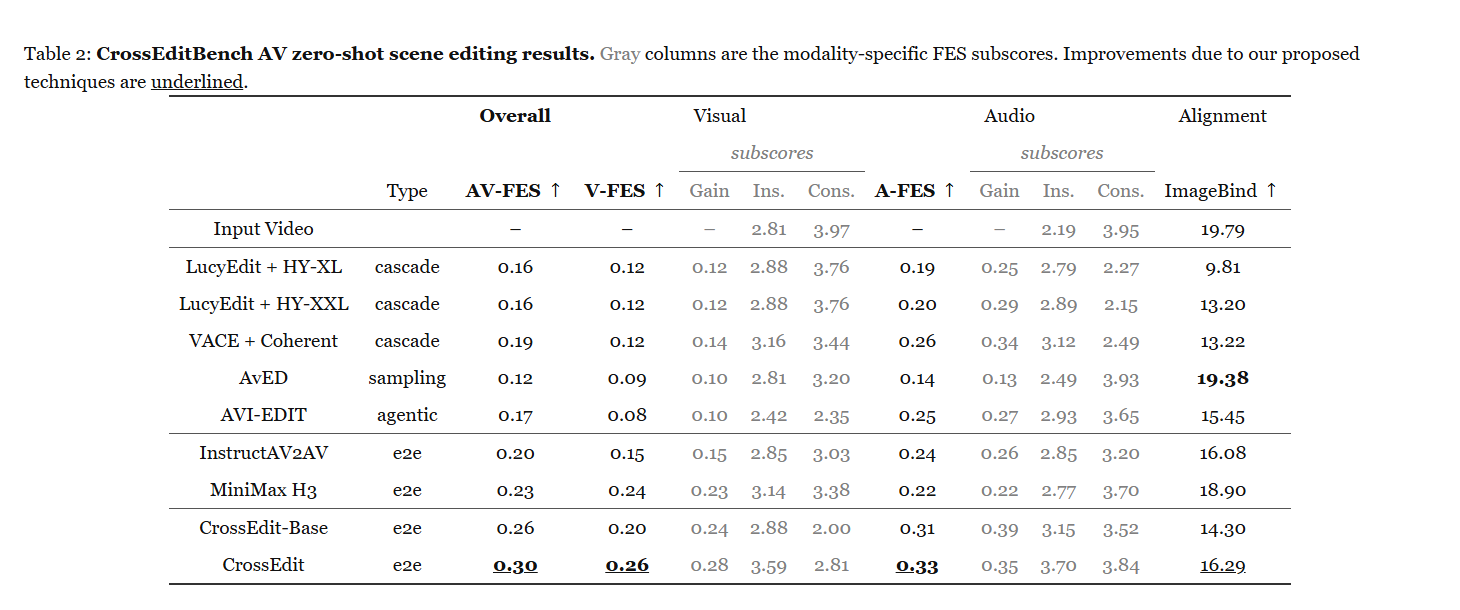
实验效果 :表 2 的 CrossEditBench:相对 CrossEdit-Base,AV-FES 0.26→0.30,视觉子分 0.20→0.26,音频子分 0.31→0.33。模型总参数 12B、每次激活 3B;这些编辑分是论文协议下的综合评分,不是 30% 任务成功率。
论文 Table 2:CrossEditBench 的零样本音视频场景编辑。灰色列为单模态 FES 子分,带下划线为所提技术带来的改善;表中另列指令、内容一致性与 ImageBind 音画对齐。综合 AV-FES 0.30 是协议评分,不是任务成功率。
批判点评 :零样本指特定未训练任务与指令组合,不是没用过音视频数据;唇同步编辑和掩码重建都参与训练。表中 ImageBind 对齐分 16.29 仍低于输入的 19.79,某些未编辑内容可能漂移。演示不等于模型权重已公开。作者演示页 。
5. Tetris3D:生成能互相支撑的3D物体
Tetris3D: 3D Scene Generation With Objects That Fit Together | 韩国科学技术院 | arXiv:2610.10539
关键词 :3D场景生成, 物理关系, 遮挡补全, 自回归物体
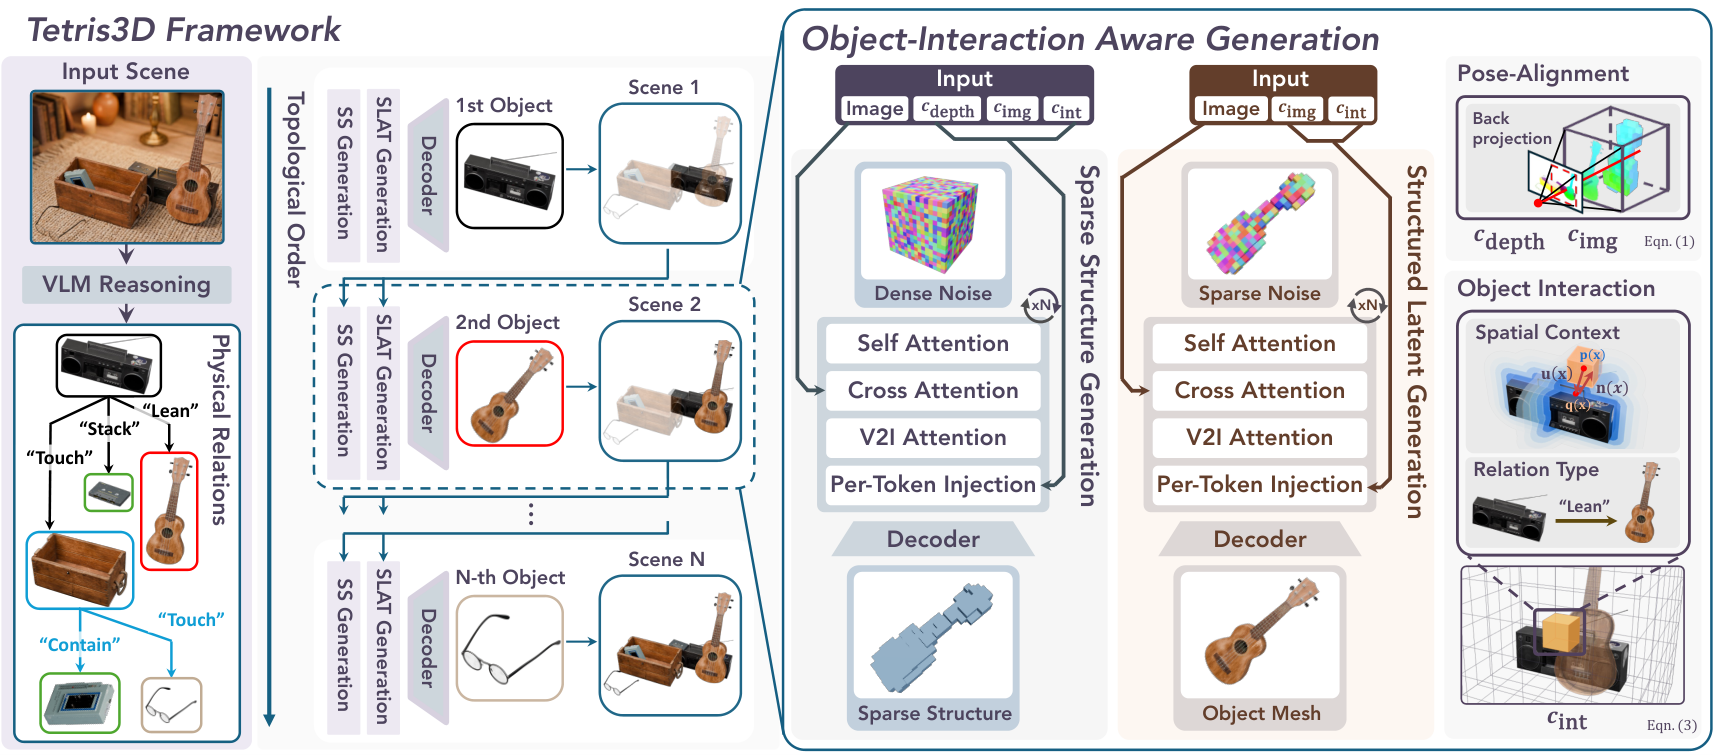
前序问题 :单张图恢复多个物体时,各自漂亮的形状摆到一起仍可能相交、悬空或不稳;遮挡又让真正接触的区域不可见。本文贡献 :Tetris3D 按视觉语言模型推断的物理依赖顺序生成物体,显式读取邻居几何和支撑、容纳等关系。深度与反投影图像特征把形状直接放到场景坐标中,可见到不可见的交叉注意力帮助补全遮挡部分;ComOb 提供 120 万个带物体网格与关系标注的模拟场景。
论文 Figure 2:Tetris3D 按视觉语言模型推断的物理依赖拓扑顺序自回归生成场景。每个物体经过稀疏结构及结构化潜变量两阶段;各 DiT 将深度、反投影图像与交互条件注入对应网格 token,可见到不可见交叉注意力补全遮挡区域。
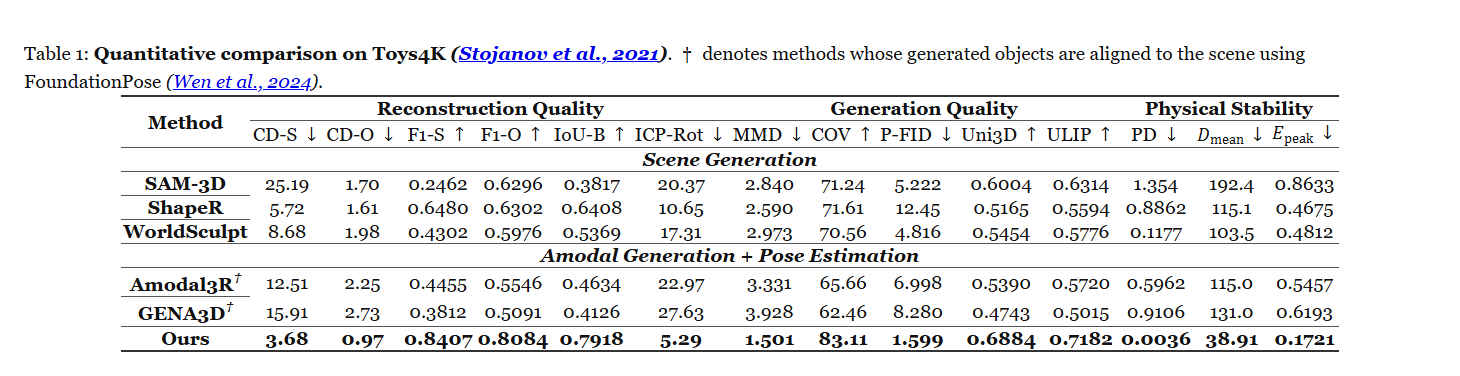
实验效果 :表 1 的 Toys4K 组合场景中,相对 ShapeR,场景 F1 0.6480→0.8407,平均位移 D_mean 115.1→38.91,穿透深度 PD 0.8862→0.0036,均按原表量纲。真实 MessyKitchens 表 2 的场景 F1 为 0.9620,PD 为 0.0011。
论文 Table 1:Toys4K 组合场景的重建、分布生成和物理稳定比较。带 † 方法用 FoundationPose 将生成物体对齐场景;所有方法使用真值深度。CD、MMD 与覆盖率的缩放及位移单位遵循原文,物理稳定是指定模拟协议下的结果。
批判点评 :Toys4K 主表给所有方法真值深度;真实数据才用估计深度与推断关系,两种条件不能混成统一收益。物理稳定是引擎与对象假设内的评估,不是任意现实接触的保证。没有从论文项目入口确认方法代码已发布。
6. PositionForcing:用预测位置引导单阶段3D
Position Forcing: Self-Conditioning 3D Generation | 南开大学;腾讯混元;香港中文大学;复旦大学;上海创智学院;香港大学 | arXiv:2610.10342
关键词 :单阶段3D生成, 位置自条件, 逐级量化, 位置VAE
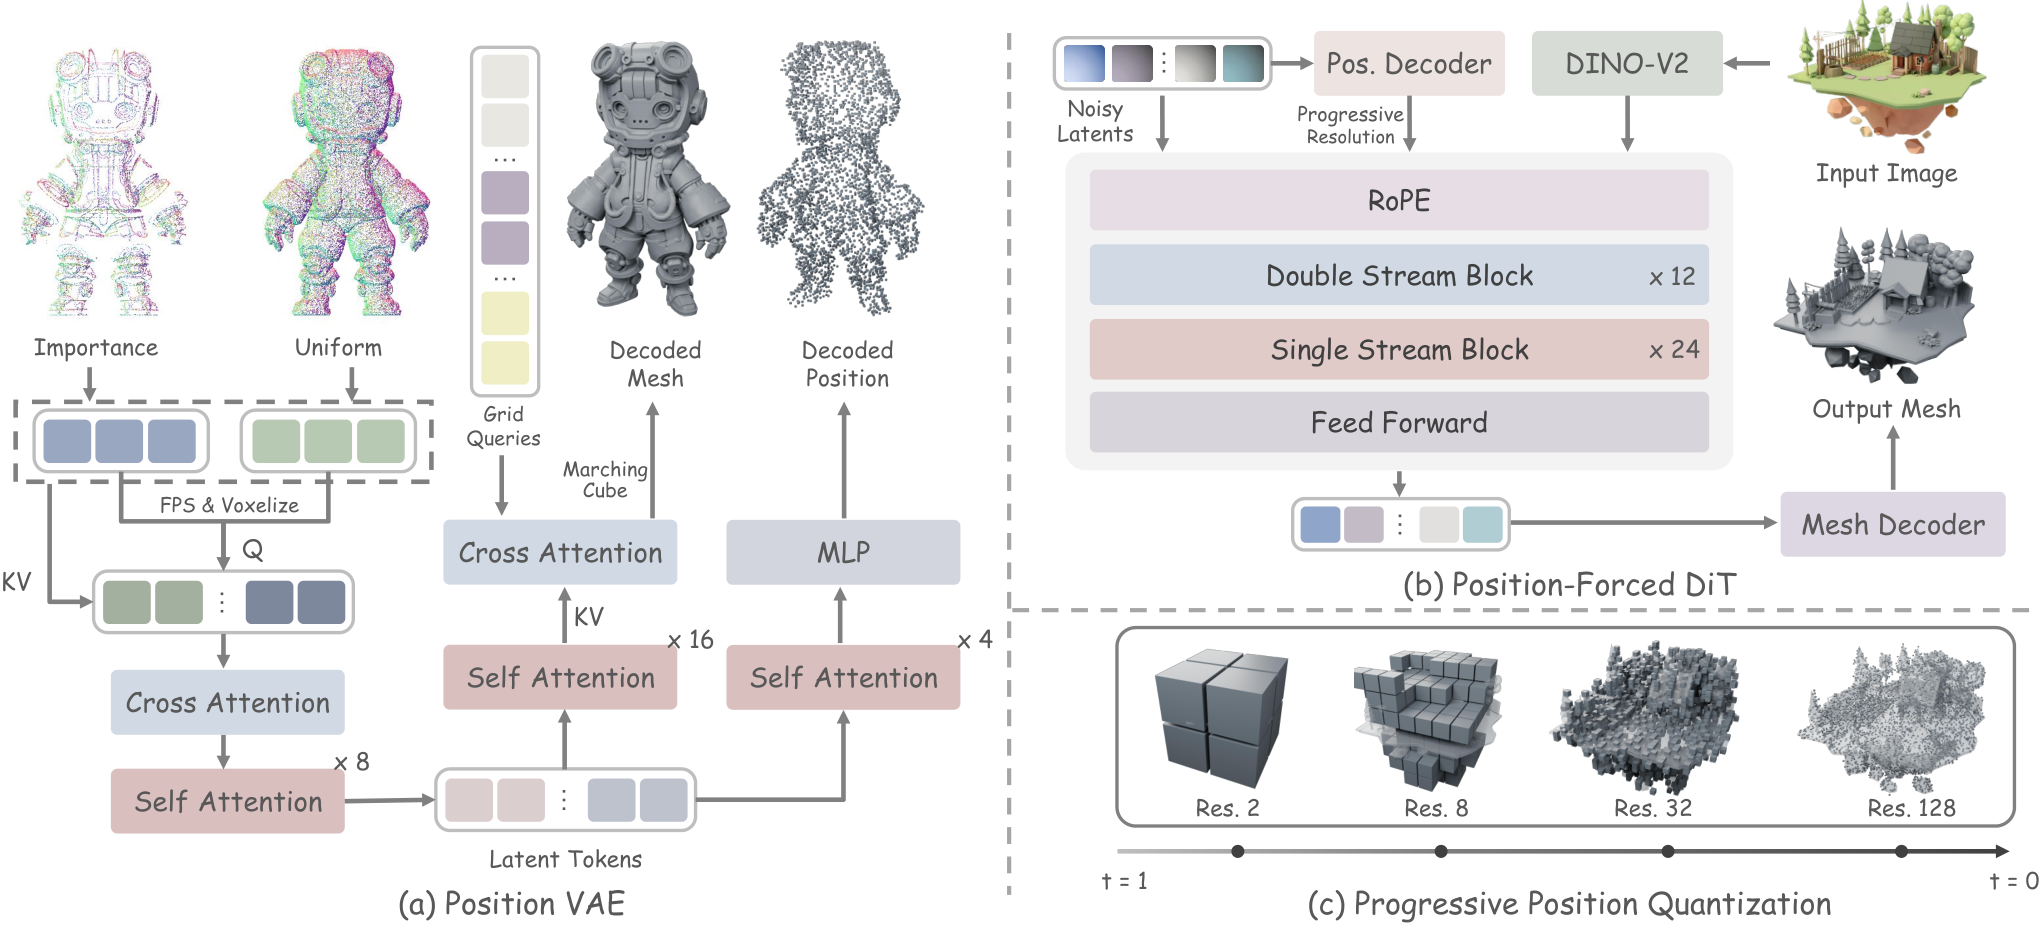
前序问题 :无序形状 token 在单阶段生成中仍需隐式找位置;先单独生成位置虽然能提供结构,却又多出一条生成阶段。本文贡献 :Position VAE 联合学习形状解码与 token 位置恢复。每个去噪步从预测的干净潜变量恢复位置,按当前噪声程度由粗到细量化,再通过 RoPE 反馈给 DiT;训练阶段用真值 query 位置。这种自条件提供空间引导,无需独立位置生成阶段。
论文 Figure 2:(a)Position VAE 学习形状与 token 位置的对应,可同时解码几何与位置;(b)去噪中从预测干净潜变量恢复位置,通过 RoPE 注入后续步骤;(c)位置随去噪逐级量化,由粗到细提供引导。
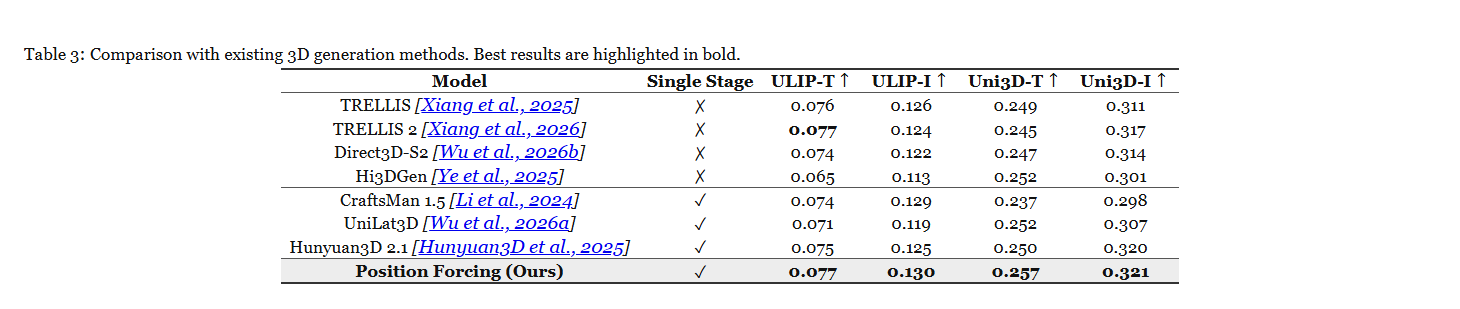
实验效果 :表 3 的图像条件 3D 生成,相比 Hunyuan3D 2.1,ULIP-I 0.125→0.130,Uni3D-I 0.320→0.321,ULIP-T 为 0.077、与 TRELLIS 2 持平。表 1 的 20% 噪声位置恢复准确率,联合微调 92.5%,冻结 VAE 为 23.0%。
论文 Table 3:图像条件 3D 生成比较。列出是否单阶段,以及 ULIP-T/I、Uni3D-T/I 的文本与图像语义相似度;粗体为该列最佳。Position Forcing 的 ULIP-T 与 TRELLIS 2 持平,其他小幅增益也不构成所有网格质量的保证。
批判点评 :小幅语义相似度改善不等于每个网格拓扑都正确;位置恢复准确率是在指定 128³ 网格与噪声下测得,不能当生成成功率。需要位置解码器和联合训练,新增位置恢复的时延不能视为免费。作者项目页 提供结果入口。
7. MORCA:按最终视频误差决定缓存复用
MORCA: Offline-to-Online Reinforcement Learning for Adaptive Cache Reuse in Video Diffusion Acceleration | 上海交通大学;阿里云;阿里巴巴 | arXiv:2610.10457
关键词 :视频扩散缓存, 终点误差, 潜变量状态, 离线在线强化学习
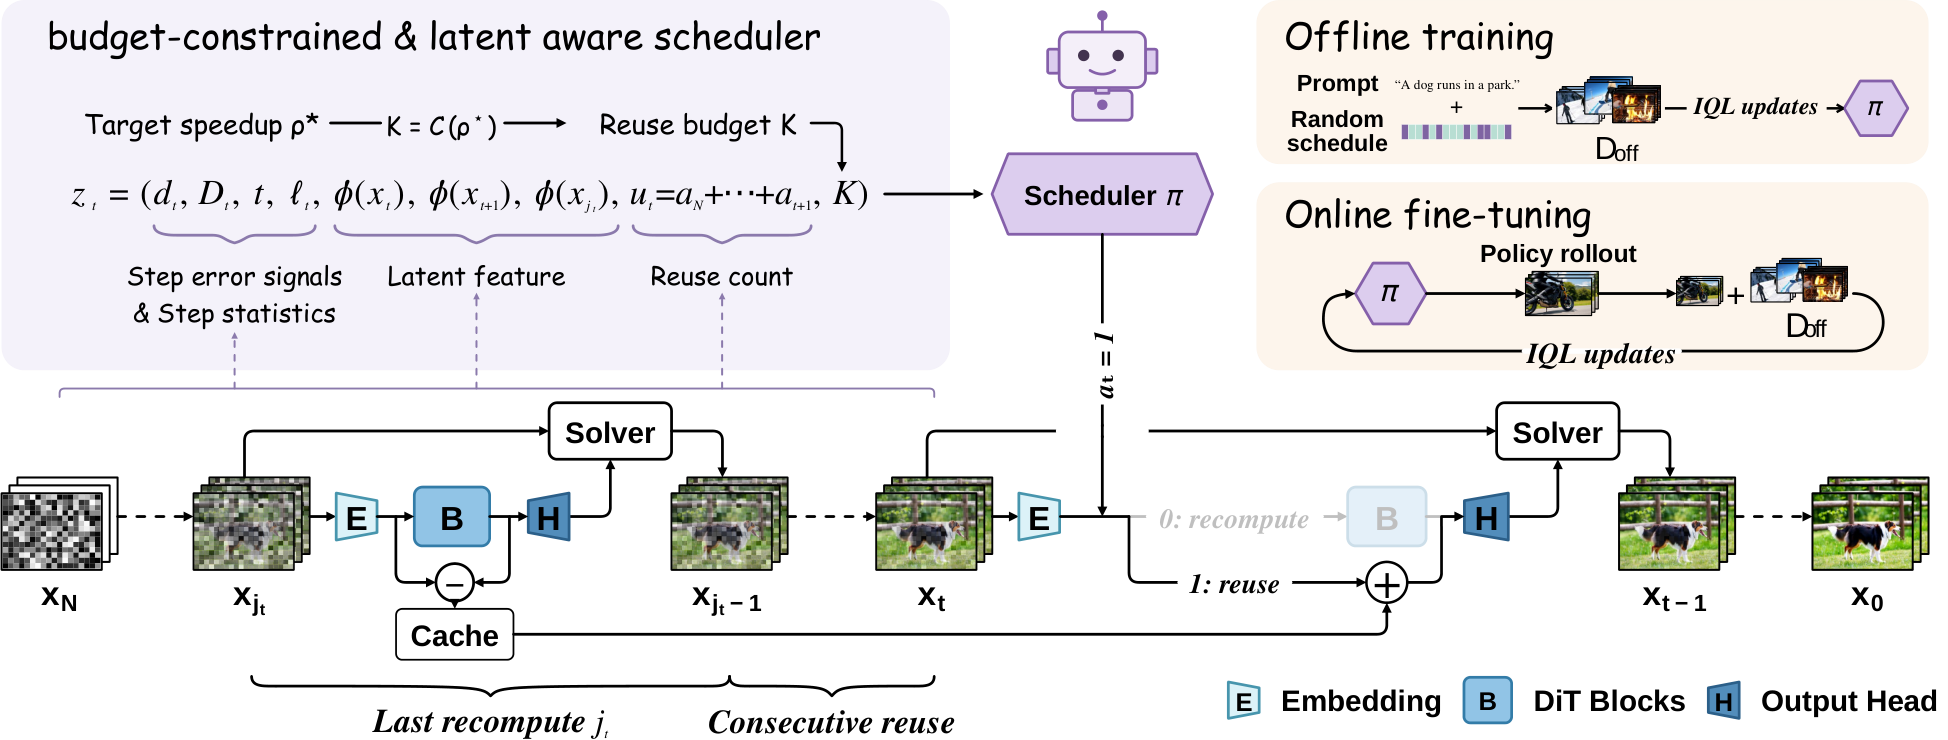
前序问题 :当前步的缓存误差不必对应最终视频损伤;固定阈值也难准确满足用户指定的加速预算。本文贡献 :MORCA 保留 SeaCache 的残差缓存粒度,用学习到的调度器替代阈值。状态同时包含潜变量特征、误差代理与剩余复用预算;以相对无缓存视频的终点保真度训练策略,先做离线 IQL,再在线补充轨迹,决定本步重算还是复用。
论文 Figure 2:MORCA 总览。下部调度器逐步选择缓存复用或重算;左上将目标加速映射为复用总预算,与误差代理、步统计、潜变量特征及当前复用数共同组成状态;右上以 IQL 做离线到在线强化学习。
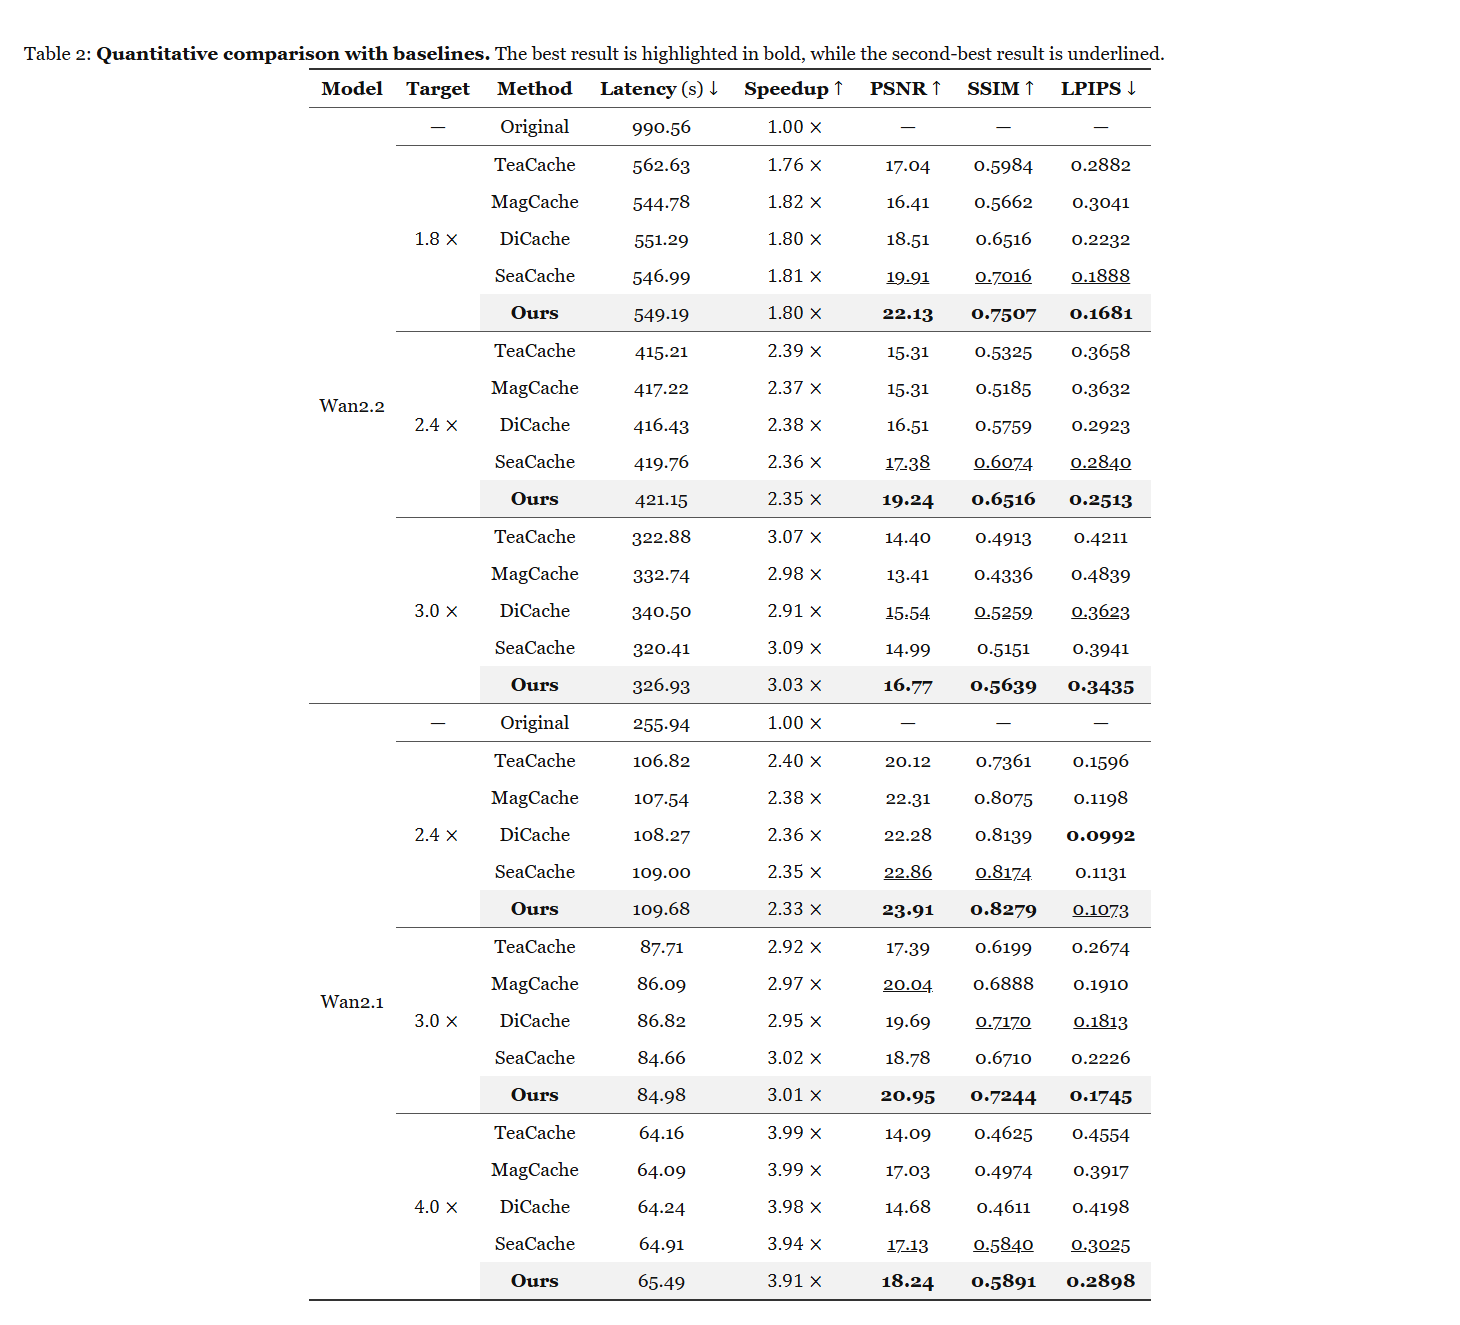
实验效果 :表 2:50 步 Wan2.2-A14B、RTX A6000,在约 3 倍加速时,SeaCache 为 320.41 秒、PSNR 14.99,MORCA 为 326.93 秒、PSNR 16.77、LPIPS 0.3435。Wan2.1-1.3B、RTX 4090 的 MORCA 为 84.98 秒、实际 3.01 倍,PSNR 20.95。
论文 Table 2:Wan2.2 与 Wan2.1 在不同目标加速下的时延及相对无缓存输出保真度,粗体为最佳、下划线为次佳。PSNR、SSIM、LPIPS 用相同 prompt 与种子的无缓存视频作参考,不是现实视频真值;目标与实际加速略有差异。
批判点评 :PSNR、SSIM、LPIPS 比的是同 prompt 与种子的无缓存输出,不是现实视频真值或人工偏好。不是免训练缓存法,离线数据与在线 rollout 都有成本;预算离散会留下加速误差。在约 2.4 倍的 Wan2.1 配置,LPIPS 未胜过全部基线。作者仓库 当前只标 Coming soon,方法实现尚未公开。
8. JoyAI-Voice2.0:连续潜空间同时规划语义声学
JoyAI-Voice 2.0: A Full-Continuous Autoregressive Speech Generation Model with Semantic-Acoustic Joint Representation | 京东探索研究院 | arXiv:2610.08834
关键词 :连续语音生成, 语义声学双编码, 局部扩散, 语音克隆
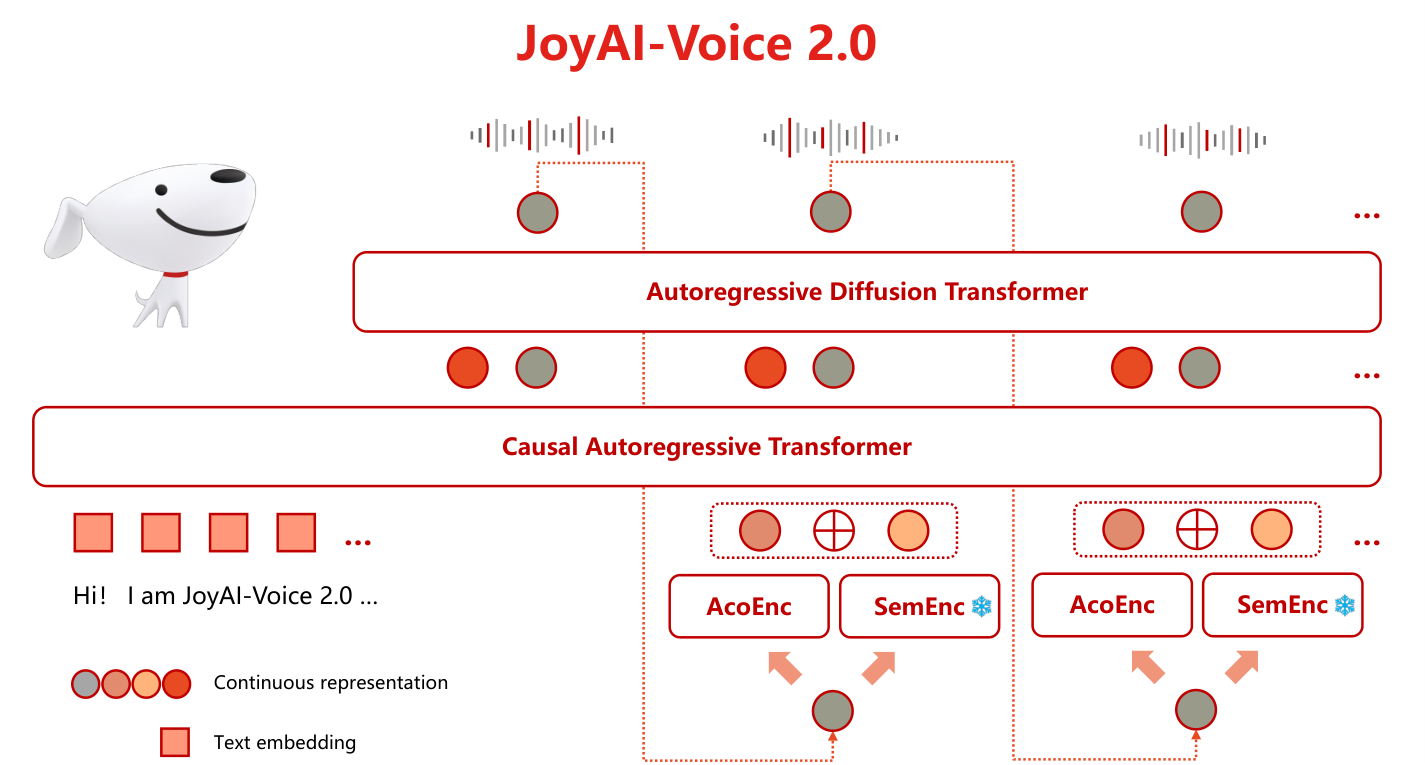
前序问题 :连续语音生成避免量化损失,却可能把声学噪声传回自回归规划,长期输出不稳定;只保语义又会丢掉音色与微小韵律。本文贡献 :JoyAI-Voice 2.0 将 AudioVAE 连续潜变量分成 patch,双编码器分别抽取纯化语义与完整声学信息,融合后交给 1.5B 因果 Transformer 规划下一块。局部 DiT 以历史块为条件生成下一块,再解码为 48 kHz 波形;训练结合 flow matching、停止预测、SFT 与 DiffusionNFT。
论文 Figure 3:JoyAI-Voice 2.0 架构。原始波形由 AudioVAE 压缩为连续潜变量并分块,双编码器抽取纯化语义和声学表示,融合后由因果自回归 Transformer 规划;局部 DiT 生成下一块完整潜变量,最终解码为 48 kHz 波形。
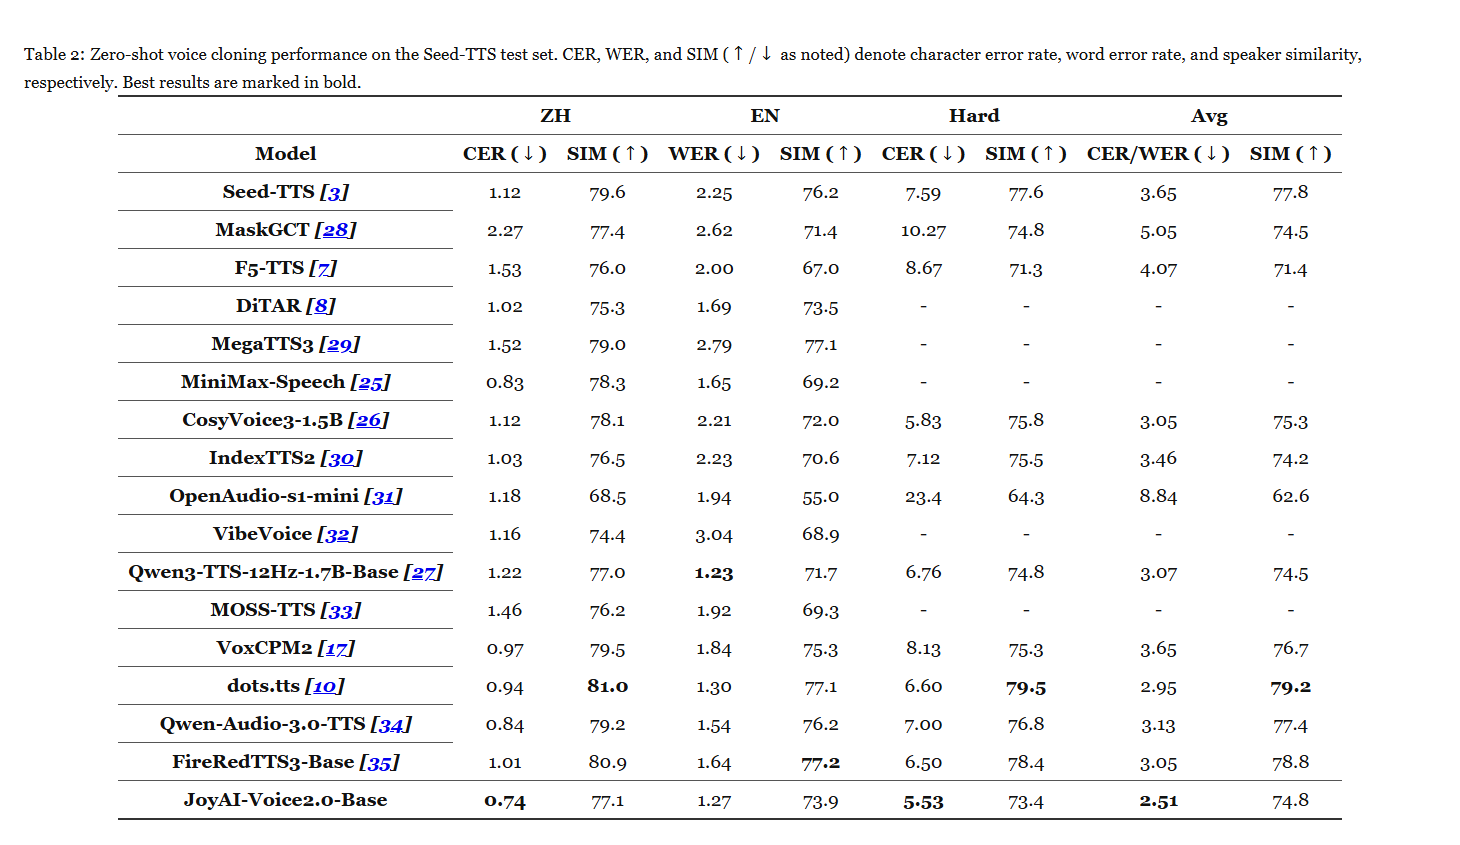
实验效果 :表 2 的 Seed-TTS,中文 CER 0.74%、英文 WER 1.27%、困难集 CER 5.53%;三个子集的平均识别错误率为 2.51%,相对 dots.tts 的 2.95% 降低 14.9%。说话人相似度平均 74.8,低于 dots.tts 的 79.2,内容正确不等于声线最像。
论文 Table 2:Seed-TTS 零样本语音克隆。中文及困难集用 CER,英文用 WER,SIM 为说话人相似度;错误率越低越好、SIM 越高越好。平均识别错误率混合不同子集口径,2.51% 不能当所有语言的统一 WER;粗体标注各列最佳。
批判点评 :平均 2.51% 混合中文 CER 与英文 WER,不能统称所有语种 WER。MDVD-Eval 是作者的中文多属性集,并用模型裁判评分;不能外推任意语言与真实交互延迟。原文首发 9 月 29 日,本期从候选池补充这篇未读报告,未确认官方代码或权重公开。
9. SteerSpeech:用小向量调节说话情绪强度
Steerspeech: Activation Steering For Emotion Control In Generated Speech | 弗吉尼亚大学;Netflix | arXiv:2610.10415
关键词 :语音情绪控制, 激活steering, 低秩变换, 多专家监督
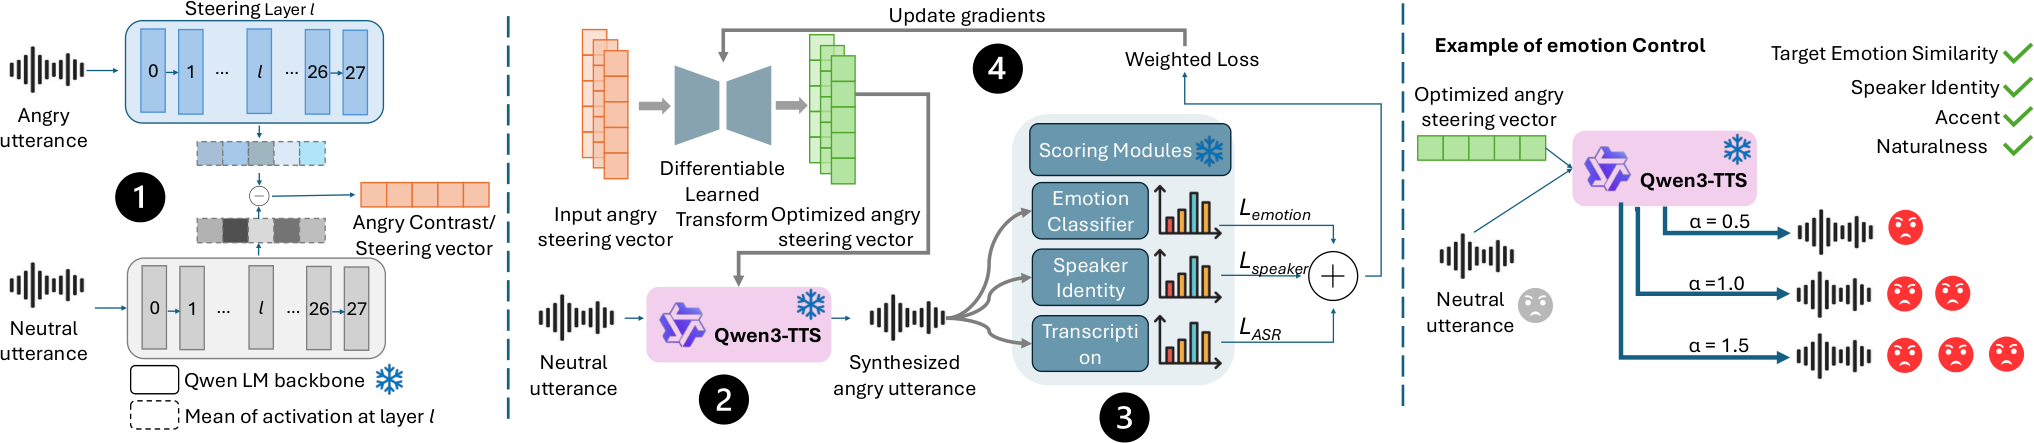
前序问题 :情绪 prompt 或参考语音难细调强度;直接加激活差向量又可能改掉说话人身份与文本内容。本文贡献 :SteerSpeech 冻结 Qwen3-TTS 主干,为每种情绪训练 33,793 参数的低秩变换。将情绪与中性激活差修正为 steering 向量,用情绪、身份和转录专家共同监督;生成后再 replay,并用直通估计器跨过离散语音 token 训练,推理时以强度 α 注入隐藏层。
论文 Figure 1:SteerSpeech 总览。冻结语音主干,只学习情绪 steering 的低秩变换;训练经生成与 replay,用情绪、身份和转录专家监督修正向量,推理以 α 调节注入强度。免主干微调不等于完全免训练。
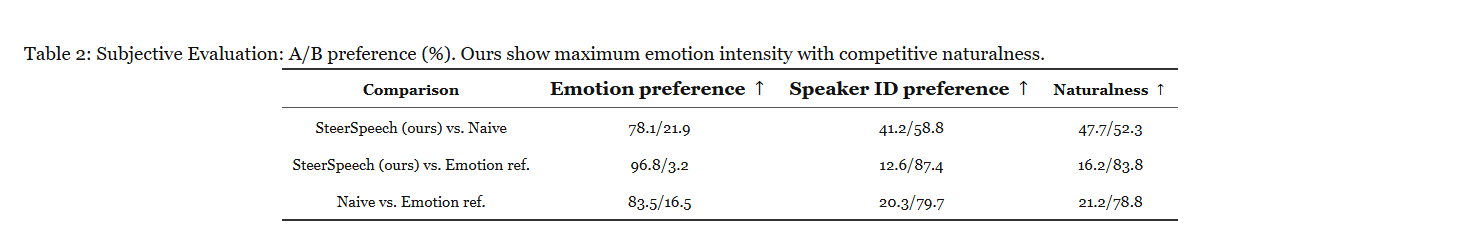
实验效果 :表 1 汇总:愤怒目标情绪分从朴素 steering 的 0.651→0.835,WER 6.0%→5.1%;快乐情绪分 0.487→0.524,但 WER 7.1%→9.7%。表 2 的代表性情绪 A/B 主观比较中,相对朴素 steering,情绪强度偏好为 78.1%。
论文 Table 2:代表性情绪的主观 A/B 偏好,三组比较分别列情绪强度、身份保留与自然度。SteerSpeech 相对朴素 steering 的情绪偏好 78.1%,但身份与自然度偏好为 41.2%、47.7%;相对情绪参考语音也并非全项占优。
批判点评 :更强情绪并非所有属性都更好;表 2 相对参考语音,身份偏好仅 12.6%、自然度偏好 16.2%。因此不能把强度偏好称为整体音质胜率。需训练低秩变换,且仅在指定主干与情绪上验证;arXiv 注释明确 ICASSP 2027 在审,未接收,也未确认官方代码。
10. UltraText:检查整幅图里的长文本是否对
UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation | 西湖大学;蚂蚁集团;浙江大学;上海创智学院;香港科技大学;中科院自动化所;微信AI;MBZUAI;香港城市大学;北京大学 | arXiv:2610.09823
关键词 :生成文字评测, 双语密集文本, 整图裁判, 保真度与清晰度
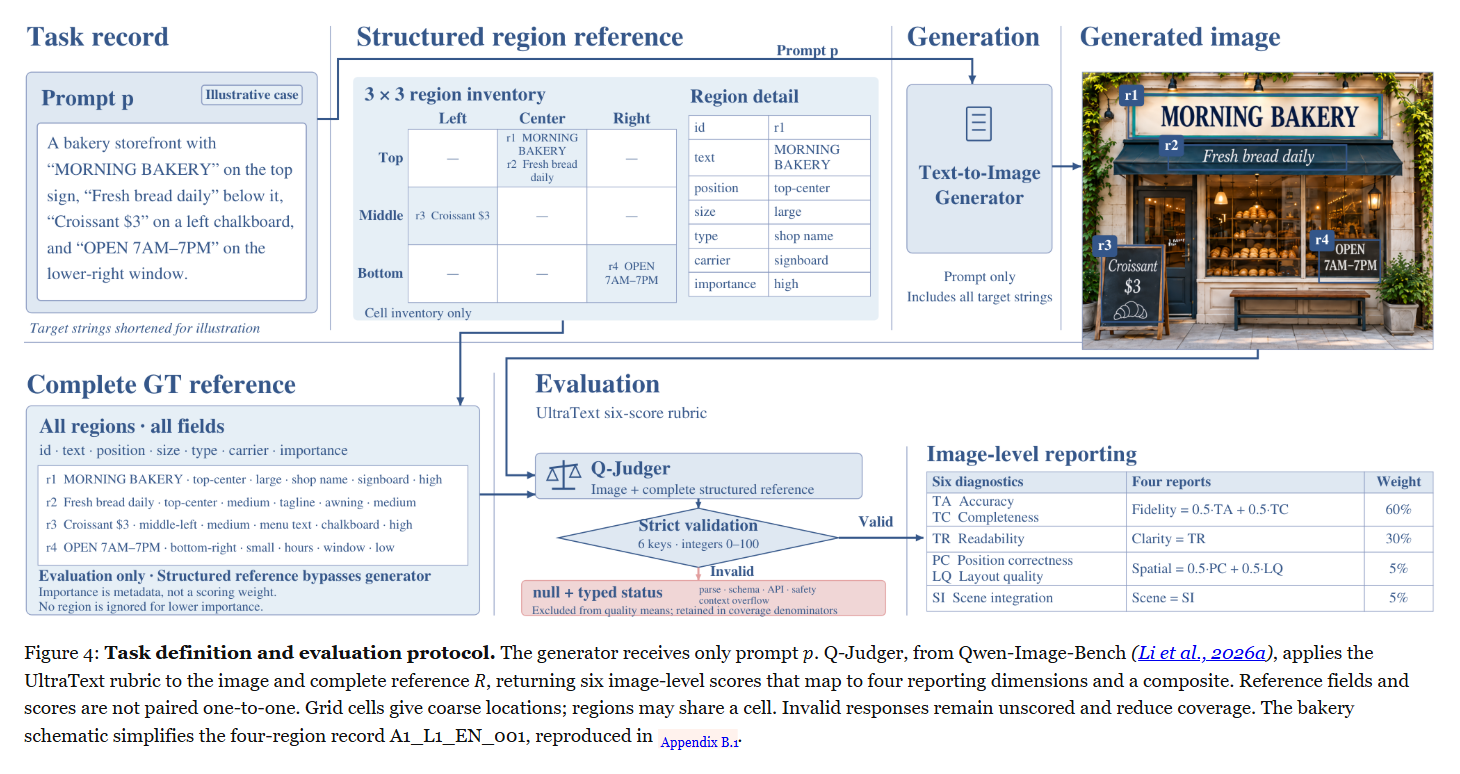
前序问题 :一个招牌写对,不代表海报、菜单或网页里的所有区域都对。文字看起来清楚,也可能遗漏或改写指定内容。本文贡献 :UltraText Bench 提供 432 个英中文 prompt,覆盖 24 类场景、三个难度和每图 4–12 个文本区域;生成器只接收 prompt。完整结构化参考交给 Q-Judger,对整图六项评分映射为文字保真、清晰、空间与场景四维,并把失败覆盖率与有效图质量均值分开报告。
论文 Figure 4:任务与评分协议。生成器只接收 prompt,Q-Judger 读取完整参考与生成图,输出六项整图评分,再合成为四维与综合分;参考字段并非与分数逐项对应,网格只给粗位置,可共享格子。无效响应不评分并降低覆盖率;面包店示意简化自指定四区域记录。
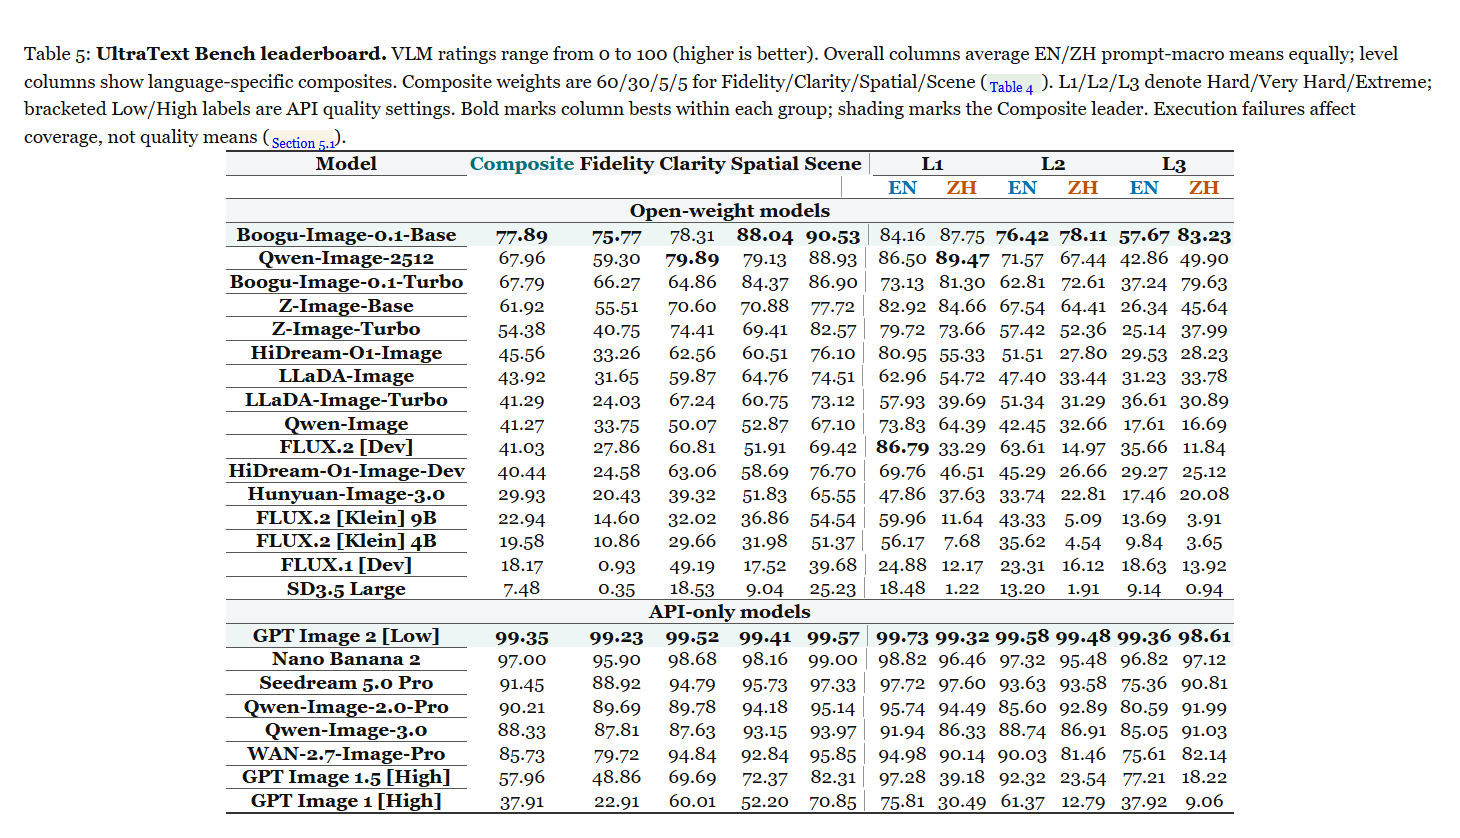
实验效果 :表 5 的 24 个模型配置:Z-Image-Turbo 相比 Base,清晰度 70.60→74.41,保真度 55.51→40.75;Qwen-Image-2512 的英文综合分由 L1 的 86.50 降到 L3 的 42.86。综合分权重为 60/30/5/5,分数在 0–100 范围。
论文 Table 5:24 个模型配置排行榜。VLM 评分 0–100,英中文 prompt 宏平均等权汇总;综合权重为保真、清晰、空间、场景 60/30/5/5。L1/L2/L3 为不同负载,Low/High 为 API 品质;失败影响覆盖率而不直接记零分,排名不等于字符正确率。
批判点评 :这些是视觉语言模型评分,不是正确字符百分比;默认采样、分辨率和 API 设置不同,不能把 Base/Turbo 差异单独归因于加速。语言集独立编写且字符负载不同;报告没有置信区间,近分排名须谨慎。官方数据与评测仓库 。
趋势观察
表示要为生成目标服务
GRACE 用 DiT 特征指导潜空间压缩,QuadTok 给复杂区域更多 token,JoyAI 把语义与声学分开再融合。重建指标、token 数和生成质量需要分别核对。
不同计算职责可以明确拆分
SGF+ 分开上下文写入与去噪,Position Forcing 从预测干净形状恢复位置,MORCA 按终点误差调度缓存。相似模块的职责不同,训练与部署成本也不同。
控制需要保留未编辑属性
CrossEdit 在组合指令中兼顾音画与内容,Tetris3D 条件化邻居关系,SteerSpeech 约束声线与转录漂移。控制强度或几何稳定单项更好,都不能代替整体质量。
把指标拆开才看得见代价
JoyAI 的低识别错误不代表最高说话人相似度;UltraText 的文字清晰不代表内容正确。总分与偏好都有边界,评估时要同时看分项、失败覆盖率和实验设置。
今日讨论
GRACE 用双潜变量在指定 A100 设置实现 11.1 倍提速,但重建 PSNR 下降;你会用哪些指标与逐帧证据,验证残差潜变量补回的信息足以满足上线画质要求?
人工智能炼丹君 整理 | 2026-10-09





评论 (0)