今日 AIGC 论文速览
今日共 10 篇 · 音画与流式声音生成 2 篇 · 规则一致性与四维世界 2 篇 · 图像生成与连续编辑 2 篇 · 视频编辑与推理加速 3 篇 · 结构可控声音变形 1 篇
重点论文标题列表
Prism (腾讯):原生二千像素音画训练提速S2PD (剑桥):先串行推演再并行修画面PVD (港理工):两个半身专家接力生成图像WorldSonus (港科大):世界画面逐段配上立体声音ALIVE (罗切斯特):插入的物体跟着人物互动
今日论文速览
1. Prism:原生二千像素音画训练提速
Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training | 腾讯混元;复旦大学;浙江大学 | arXiv:2610.05416
关键词 :联合音画生成, 原生2K训练, 动态稀疏注意力, 跨模态引导
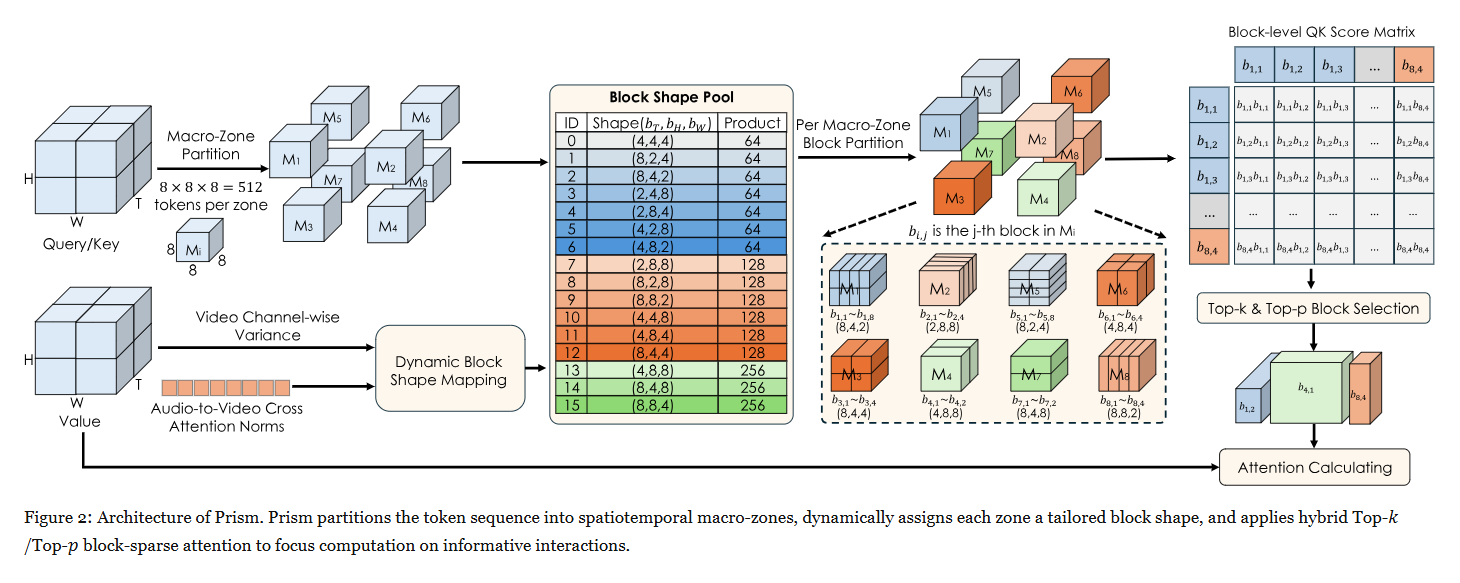
前序问题 :2K 视频的 token 数量让全注意力训练昂贵,先生成低分辨率再超分又难补回原生细节。固定稀疏块还可能把不同运动方向或关键发声区域混在一起,省了计算却损伤动作与声音对应。本文贡献 :Prism 在 MOVA 双分支 DiT 中替换视频自注意力,保留音频与跨模态注意力。先划分 8×8×8 时空宏区,结合视频特征通道方差和音频到视频交叉注意力范数,为各区选择 64、128 或 256 token 的块形状;再用 Top-k/Top-p 混合策略分配注意力预算。稀疏布局适应空间结构和音画耦合,而非统一删去固定区域。
论文 Figure 2:Prism 架构。把 token 序列划分为时空宏区,动态给各宏区指定适配的块形状,再以 Top-k/Top-p 混合块稀疏注意力把计算集中到信息量高的交互。
实验效果 :作者在十万条 2K 视频上训练,报告原生 2K 联合音画训练加速 2.5 倍。表 2 的 95% 稀疏配置相对全注意力训练:cpCER 从 0.374 降到 0.187,DeSync 从 1.05 降到 0.63,MotionQ 从 0.53 升到 0.89。2K-Bench 为 300 条未见的十秒视频;训练吞吐与这些质量指标是两类证据。
论文 Figure 3:与此前开源方法的定性比较。音频必须参看项目演示视频,更多结果见附录 A.7;此静态图展示视频画面,不单独证明音频质量。
批判点评 :2.5 倍不能移写成端到端生成速度,95% 稀疏也不等于整个模型少算 95%。静态截图无法核对音频,须结合项目音画演示。自建测试集和自动评价不代表所有镜头、说话人与低分辨率任务都同样获益。项目页 与官方代码 给出复现入口。
2. S2PD:先串行推演再并行修画面
S2PD: Serial-to-Parallel Diffusion for Physically and Logically Consistent Video Generation | 剑桥大学;丰田欧洲 | arXiv:2610.06847
关键词 :视频扩散, 串并行采样, 物理一致性, 游戏规则
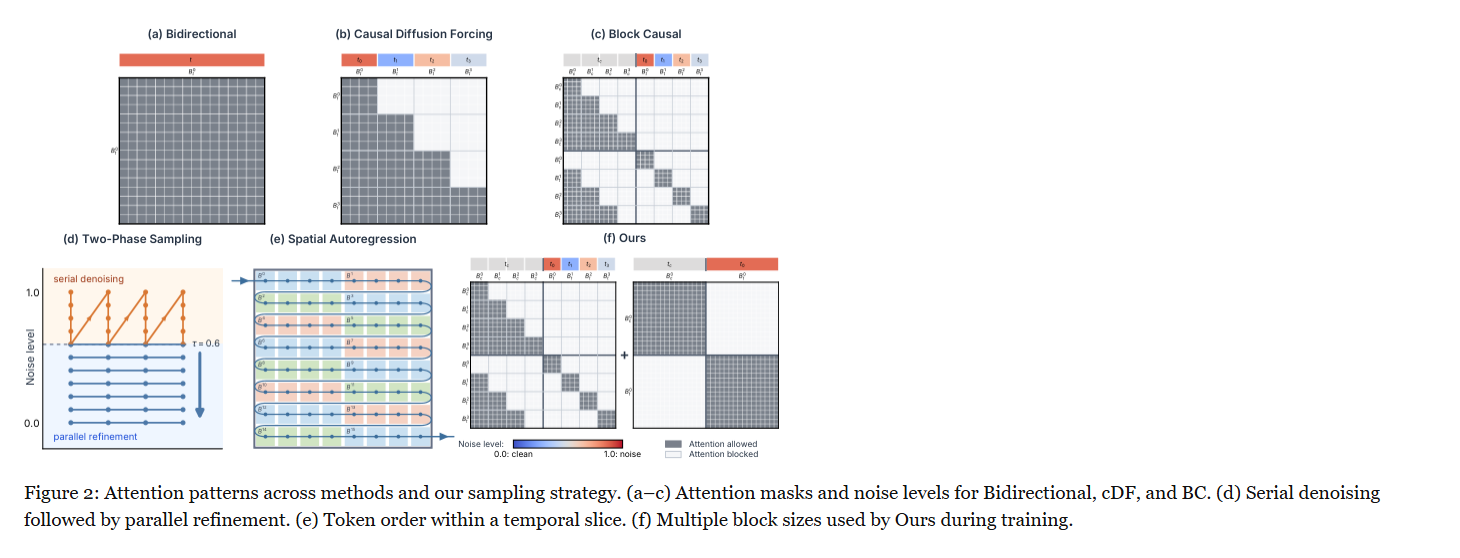
前序问题 :即使不断采样程序生成的训练数据,并行视频扩散仍会生成违规棋步、错误碰撞或不连贯物体。问题可能在于模型缺少逐段协调事件的串行计算,而不只是数据不够。本文贡献 :Serial-to-Parallel Diffusion 在高噪声阶段按时间块自回归去噪,先协调相互依赖的事件;到较低噪声再切换为整段并行细化,减少纯串行采样的闪烁。训练使用多种块大小;实验在从零训练的 DiT-B 与 Wan-5B-LoRA 上,按匹配训练预算比较双向并行、因果 Diffusion Forcing 和 Block Causal。
论文 Figure 2:各方法的注意力模式与本文采样策略。(a–c)分别为双向、因果 Diffusion Forcing(cDF)与 Block Causal(BC)的注意力掩码及噪声水平;(d)先串行去噪再并行细化;(e)时间切片内部的 token 顺序;(f)训练使用多种块大小。
实验效果 :表 2:DiT-B 的 2048 每次 rollout 非法转移从并行基线 47.9 降到 0.9,双摆动力学误差从 73.4 降到 1.1;Wan 的 Kubric MOVi-A CD-FVD 从 252.8 降到 137.0。国际象棋则为 51.0→12.3,仍逊于另两种串行方法的 4.6 和 6.8,不能写成全任务最优。
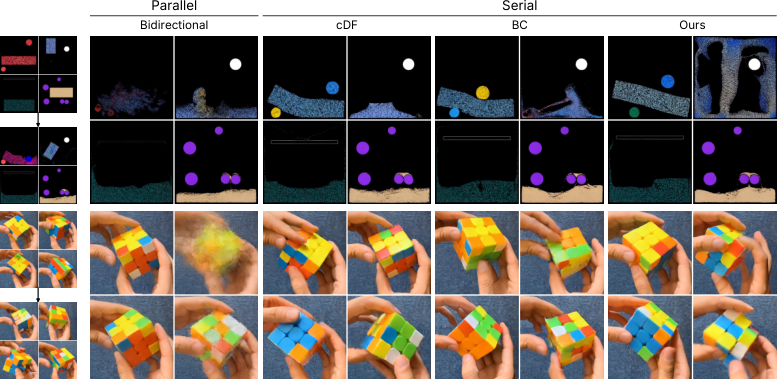
论文 Figure 6:Wan-5B-LoRA 架构的定性比较。在 MPMWorlds 与真实魔方数据集上,串行方法表现相近,相比双向基线生成更连贯的视频。
批判点评 :程序世界中的规则错误减少,不是开放世界物理定律的保证。串行块越小通常越慢,表 4 显示质量和采样成本需一起调;混合方法相对纯并行也有额外串行开销。建议先检查自己的事件依赖是否需要串行推演。项目页 可核验,本文不使用未经确认的会议接收背书。
3. PVD:两个半身专家接力生成图像
Two Halves are More than One: Phase-wise Velocity Distillation for Fast and High-Quality Image Generation | 香港理工大学;OPPO研究院 | arXiv:2610.08070
关键词 :图像生成, 分阶段蒸馏, 平均速度, 显存压缩
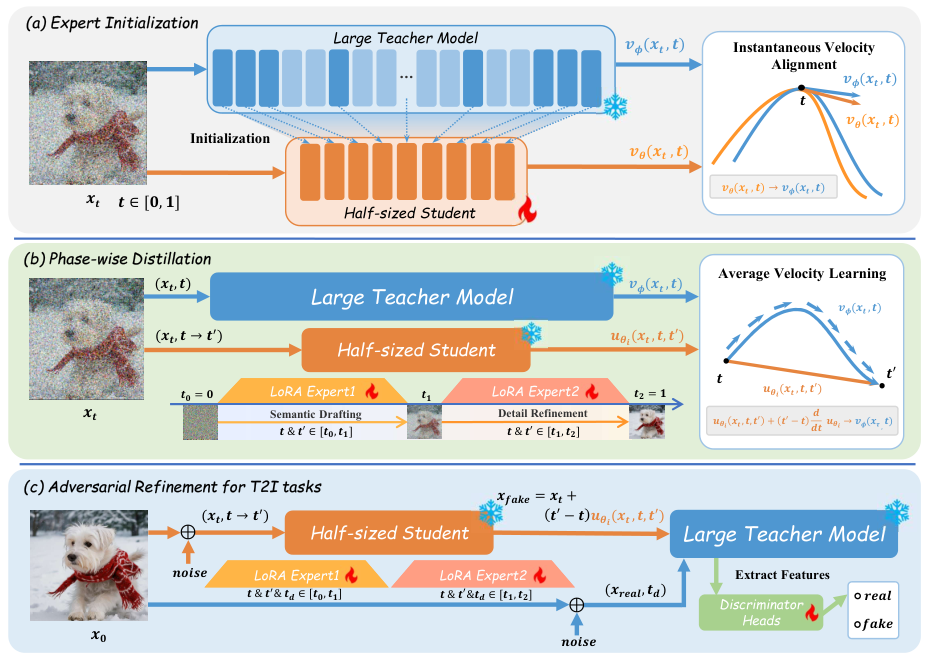
前序问题 :粗结构与细节生成发生在不同噪声区间,却常由同一个完整学生网络承担。压到一次完整主干计算预算时,统一学生容易兼顾不好两个阶段;少步模型也未必减少活跃参数或显存。本文贡献 :Phase-wise Velocity Distillation 从教师抽取约半深度主干,先用 flow matching 对齐初始化,再学习粗到细两个区间的平均速度;文生图采用共享冻结主干与阶段 LoRA,并加阶段判别器做对抗细化。两个半身专家依次执行,累计 FLOPs 约等于一次完整教师主干前向,但实际仍是两次专家调用。
论文 Figure 3:PVD 总览。(a)从教师抽取半身主干,经 flow matching 微调初始化局部学生;(b)分阶段 LoRA 专家在划分的时间区间上学习平均速度;(c)文生图任务使用分阶段判别器进行对抗细化。
实验效果 :表 1 的 ImageNet 256×256、归一化计算预算 1.00 下,PVD FID-50K 为 1.48,iMF 为 1.72,多步 LightningDiT 为 1.35。表 3 的 Qwen-Image 蒸馏:活跃参数 20.43B→10.40B,峰值显存 38.42→19.84 GiB,减少 48.36%;GenEval 为 0.8720→0.8846。
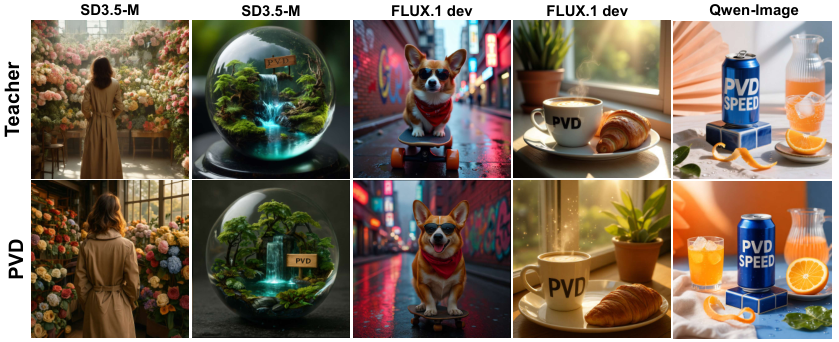
论文 Figure 1:文生图结果。上排为教师:Stable Diffusion 3.5-Medium、FLUX.1-dev、Qwen-Image,分别使用 50×2、50、50×2 步;下排以两个半身分阶段专家顺序生成,累计计算约等于一次完整教师主干前向。这是计算预算比较,不能读成只调用一个专家。
批判点评 :活跃参数不是所有权重总量,等 FLOPs 也不是已实测的一倍调用延迟。Qwen 的 DPG 从 89.10 降到 86.54,WISE 从 0.64 降到 0.59,质量没有全面超过教师;密集计数和罕见布局仍困难。可从官方仓库 核对权重与实现,再按具体 GPU 测显存及延迟。
4. WorldSonus:世界画面逐段配上立体声音
WorldSonus: Bringing Sound to Worlds | 香港科技大学;Noiz AI;沐曦;上海交通大学 | arXiv:2610.08760
关键词 :视频到音频, 因果流式生成, 立体声, 交互提示
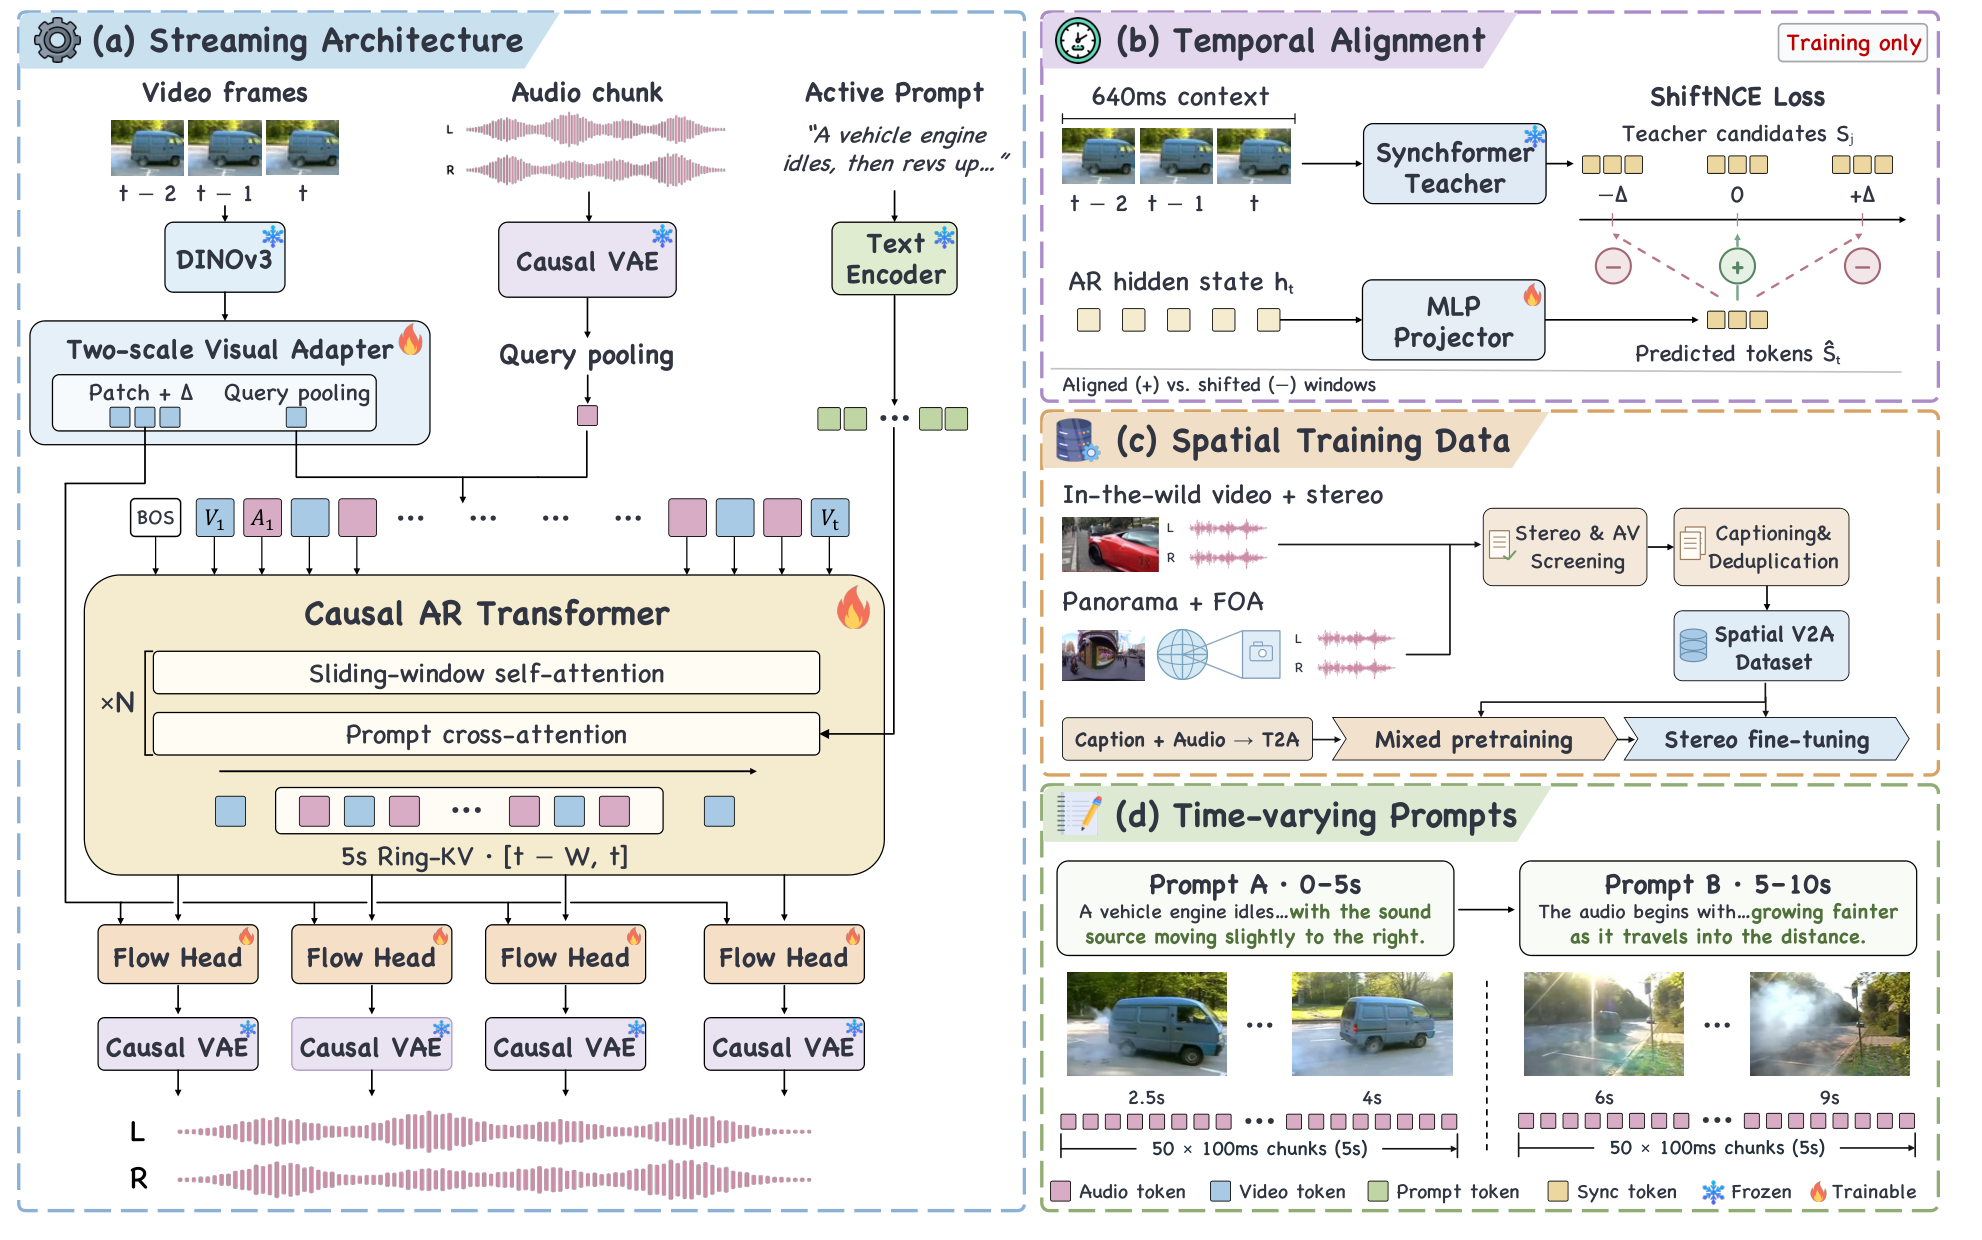
前序问题 :交互视频的未来画面尚未产生,双向配音不能等待整段视频再工作。声音还要随左右位置与用户文字控制变化,同时维持跨块连续性。本文贡献 :WorldSonus 用因果自回归 Transformer 与 rectified-flow 头,逐块输出 48 kHz 立体声。两种时间尺度的视觉 token 同时提供场景计划与帧级线索,环形 KV 缓存限制历史长度;提示词在块边界更新。训练用冻结 Synchformer 的 ShiftNCE 做时间对齐,结合真实立体声筛选和全景一阶 Ambisonics 的视角解码学习方向,教师只在训练使用。
论文 Figure 1:WorldSonus 总览。(a)因果流式流程:视频映射为两种时间尺度的视觉 token,条件化自回归 Transformer 和 rectified-flow 头;(b)训练专用 ShiftNCE:冻结 Synchformer 教师以对比窗口匹配指导时间对齐;(c)立体声空间监督:真实立体声筛选与全景一阶 Ambisonics 视角解码提供方向依据;(d)交互文字控制:在块边界动态更新提示,保留会话状态和声学连续性。
实验效果 :表 1 的单 H100 设置中,100 ms 音频块计算为 41.2 ms,实时因子约 0.41。VGG 五秒测试 FAD 为 1.73,PrismAudio 为 2.09;交互五秒为 2.68 对 6.22。五秒与十秒拆分各 4096 条,三十秒拆分为 1024 条,跨时长结果分别统计。
论文 Figure 2:两个交互片段中,与双向基线比较立体声布局。红框标出声源;能量平衡曲线中负值表示左声道占优,正值表示右声道占优。
批判点评 :41.2 ms 是模型块计算,不是含采集、传输、播放缓冲的完整交互延迟。时间同步并非全优:VGG 五秒 DeSync 为 0.686,PrismAudio 为 0.539,后者更低。因果音频表示和有限立体声数据仍构成限制,三十秒评测不足以保证无限长会话稳定。项目页 可听原始演示。
5. ALIVE:插入的物体跟着人物互动
ALIVE: Interaction-Aligned Object Insertion for First-Frame-Guided Video Editing | 罗切斯特大学;Adobe Research | arXiv:2610.08779
关键词 :视频编辑, 首帧引导, 物体插入, 时间局部条件
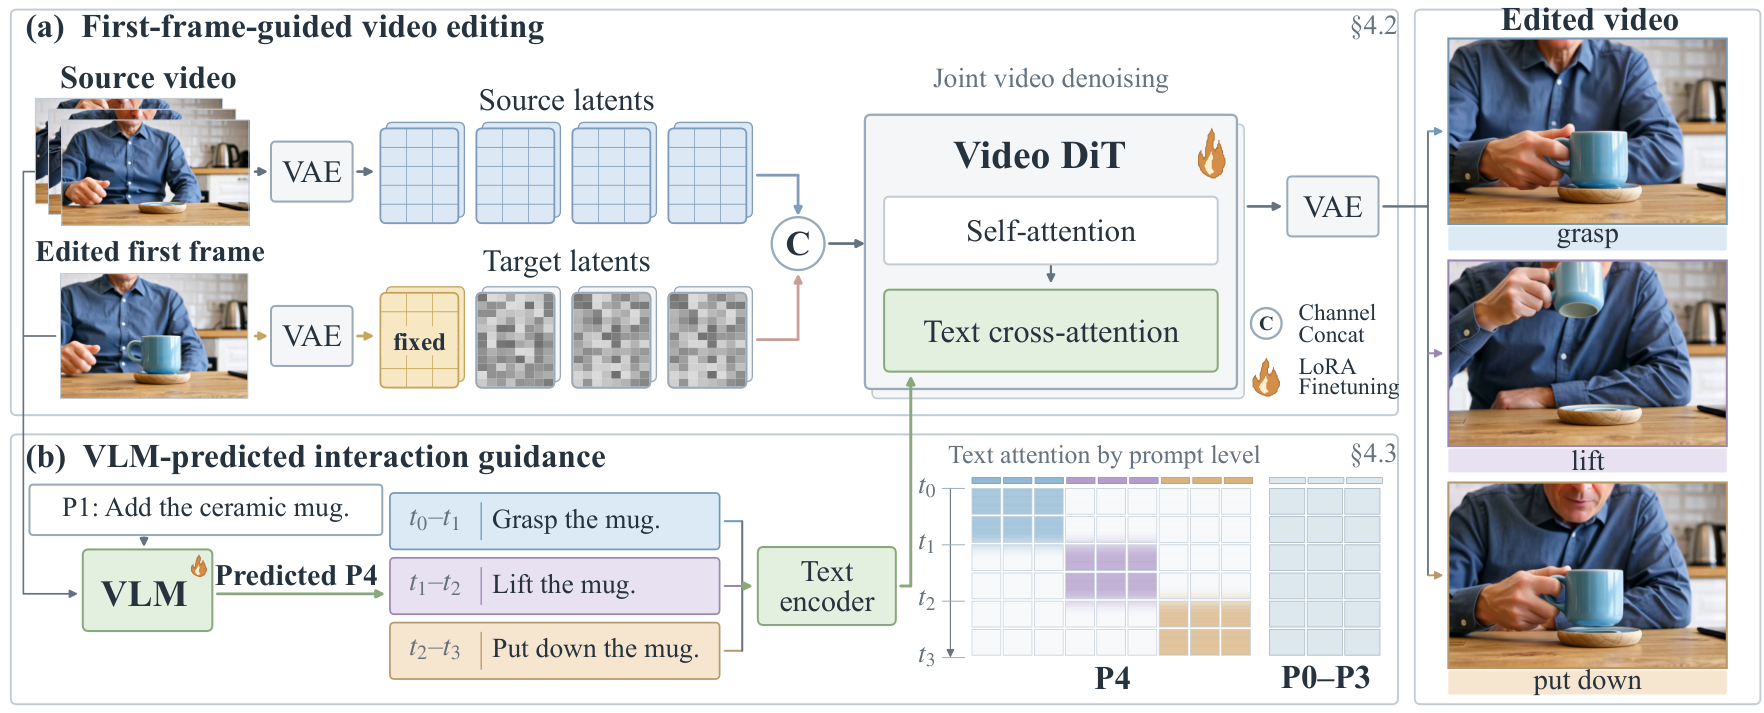
前序问题 :给视频首帧加一本书很容易,随后让人拿起、翻开它却难:插入物体常留在原地或穿过手。只写物体名称,也缺少每个阶段该发生什么交互的描述。本文贡献 :ALIVE 把干净源视频 latent 与带噪目标 latent 沿通道拼接,编辑后的首帧保持干净,以 LoRA 训练 LTX-2.5 22B 编辑器。35,800 对数据混合渲染、真实、模型生成与通用编辑来源,并标注多级提示。可选 VLM 从原视频、编辑首帧和物体名称预测分段交互描述与帧区间,再通过时间局部交叉注意力路由到对应片段。
论文 Figure 3:ALIVE 总览。(a)源视频与带噪目标 latent 沿通道拼接(C),编辑首帧 latent 保持干净(金色);火焰表示编辑器及 VLM 的 LoRA 微调。(b)监督 VLM 从同样的视觉输入与物体名提示 P1 预测 P4 描述及帧区间,P4 文本独立编码;注意力图比较共享的 P0–P3 条件与时间局部 P4 条件。
实验效果 :表 1 的 128 例交互插入测试中,0–100 的 VLM Overall:只给物体名的 ALIVE 为 86.71,Señorita 为 60.24;预测分段提示后为 87.66。103 例通用插入中,ALIVE 为 92.28,加入 VLM 后为 91.71,增强并非对所有任务有益。
论文 Figure 4:交互物体插入定性结果。(a)拿书,(b)提篮,分别展示首帧、视频 40% 和 90% 位置。AnyV2V 的方形帧以较窄宽度展示;† 表示按照各方法官方提示格式额外提供交互指导。
批判点评 :这些是自动 VLM 判断与抽帧协议下的分数,不能当作接触力或真实物理正确率。区间预测错误、布料和物体旋转仍会造成伪影;编辑器也不是在线流式生成器。论文明确实现和实验在罗切斯特完成,署名 Adobe 合作不应改写为单一机构成果。项目页 可查演示,未确认可下载的方法代码。
6. MC-Sparse:缓存稀疏布局再补注意力尾项
MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers | 腾讯混元;复旦大学;上海创智学院;香港中文大学;南开大学;北京大学;上海交通大学 | arXiv:2610.06801
关键词 :视频生成加速, 稀疏注意力, 元数据缓存, 残差补偿
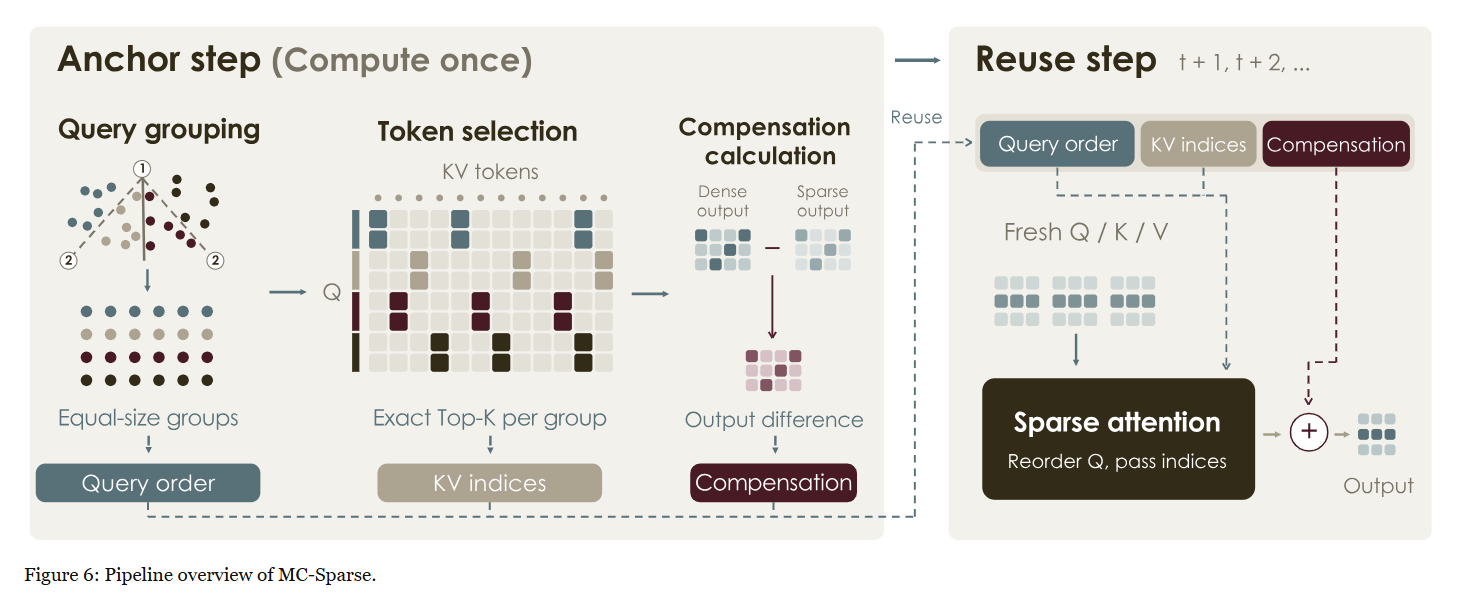
前序问题 :稀疏注意力与完整注意力之间的差距不只来自删掉低权重连接,还来自块结构绑定和近似选择错误。每步重新精确筛选又可能吞掉节省的计算。本文贡献 :MC-Sparse 在锚点步骤精确选择 KV 索引,并用相似查询重排与 token 级选择减少结构误差;跨去噪步缓存查询分组、选择索引及完整减稀疏的残差,近似补回被丢弃尾项。Q、K、V 特征仍在当前步重新计算,因此不是复用旧视频 token。预热、锚点刷新和 CUDA 实现成本都需计入。
论文 Figure 6:MC-Sparse 流程总览,展示查询分组、精确选择及元数据复用、token 稀疏注意力和尾项补偿之间的连接;具体预算与刷新策略以正文为准。
实验效果 :表 1 的 Minimax-H3-Base 768p 视频分支:15% 注意力密度下,DiT 去噪加速 1.80 倍,相对完整注意力输出 PSNR 为 27.30 dB;25% 密度为 1.61 倍、28.44 dB。15% 时 VBench ImgQual 从 69.20 变为 68.94,接近基线仍有质量差异。
论文 Figure 1:Minimax-H3-Base 768p 的质量和效率。左侧为质量指标及 DiT 去噪延迟:15%、25% 注意力密度分别相对 FA3 全注意力加速 1.80、1.61 倍;右侧为 15% 密度生成帧与完整注意力参考的逐段比较。接近参考不代表无损。
批判点评 :这里的 PSNR 对齐完整模型输出,不是真实视频;1.80 倍也不包含 VAE 与条件编码。各任务约五十个评测样本、硬件并行设置和内部三维数据限制泛化与复现判断,不能宣传无损或全系统同幅提速。项目页 已给出,未把未知代码状态写成开源完成。
7. CtrlCache:转向与动作变化决定是否复算
CtrlCache: Accelerating Interactive Video World Models with Control-Aware Caching | 奥克兰大学;新南威尔士大学 | arXiv:2610.08777
关键词 :交互世界视频, 免训练加速, 控制感知, 残差缓存
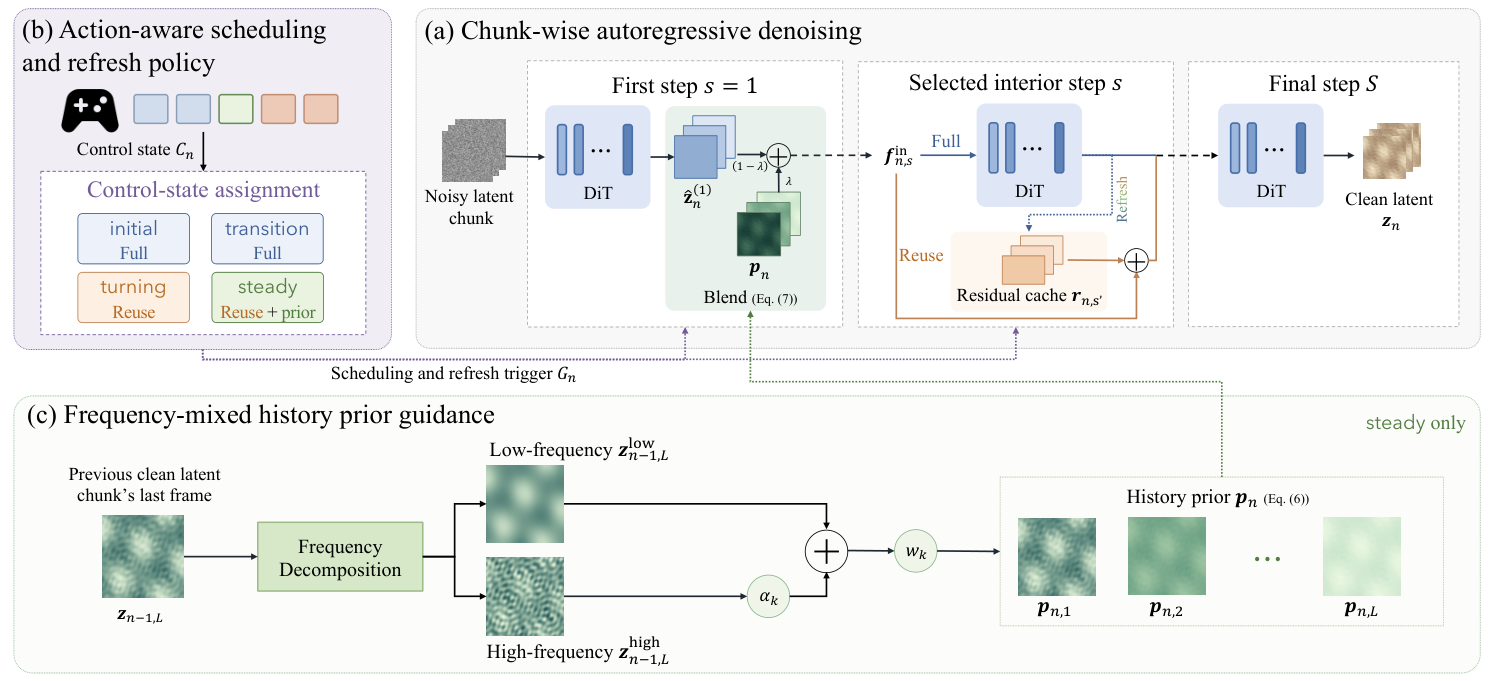
前序问题 :少步交互世界模型还要多次运行昂贵 DiT。只按内部特征相似度决定缓存,容易忽视用户突然转向或改变动作时需要及时刷新。本文贡献 :CtrlCache 先把输入控制分成初始、变化、持续转向与稳定状态:初始及动作变化块完整计算,转向和稳定块才在选定内部去噪步复用本块最近完整步的残差,首尾步骤始终完整。稳定交互时,再把上一块最后一帧的低频历史先验混入首步干净 latent 估计;无需重新训练,也不把所有历史特征无条件沿用。
论文 Figure 3:CtrlCache 总览。(a)按块自回归去噪,首尾步骤保持完整计算;(b)动作感知策略在转向与稳定块的选定内部步复用残差,在初始及动作变化块保留完整计算;(c)稳定交互中,频率混合历史先验把前一块最后干净帧的结构用于指导首步干净 latent 估计。
实验效果 :表 1 的 WBench 导航、单 A100 设置:Matrix-Game 2.0 去噪时间 14.99→10.67 秒,加速 1.41 倍,Overall 0.6543→0.6786;LingBot-World v1 为 1.26 倍、0.7816→0.8127,v2 为 1.21 倍、0.8042→0.8201。使用相同提示、控制和初始帧比较。
论文 Figure 4:CtrlCache 与基线的定性比较。各方法使用相同初始条件和控制序列;蓝色虚线框用于比较布局、物体位置及运动细节,红框标出外观或结构失真,绿框标出本文保留较好的细节。控制字符串沿用 WBench:W/S/A/D 为平移,left/right/up/down 为视角变化。
批判点评 :计时排除 KV 提交与更新,不能直接当完整交互延迟;TeaCache 与 EasyCache 在此表还更快,CtrlCache 选择了不同质量取舍。v2 的画质与交互分项略降,不能写成每项提升。复用步位置和控制规则依赖具体模型,移植时需要重新验证。项目页 提供方法说明。
8. UniSlider:滑杆刻度对应感知变化
UniSlider: Perceptually Uniform Sliders for Continuous Image Editing | 巴塞罗那自治大学计算机视觉中心;Adobe Research | arXiv:2610.06831
关键词 :连续图像编辑, 感知均匀性, LoRA, 自适应采样
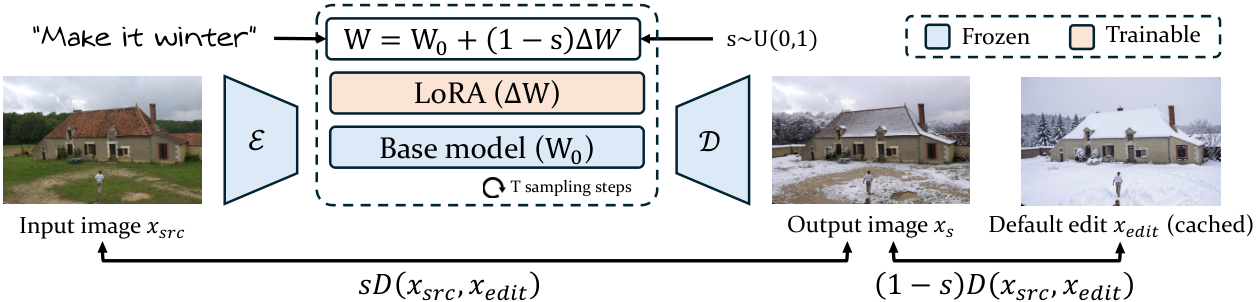
前序问题 :把编辑强度从 0.2 拉到 0.3,有时完全没变化,有时突然跳到另一种样子。现有强度参数并不对应均匀的可感知变化,界面有刻度却缺少稳定控制。本文贡献 :UniSlider 在冻结的 FLUX.2-klein-4B 上训练按强度缩放的 LoRA,完整运行少步采样,用 DreamSim 距离把中间图推向输入与满强度输出之间的相应感知位置。满强度目标只需缓存基座的默认编辑,不需人工中间图。推理再测量样本的感知曲线,自适应重映射滑杆参数,补偿残余不均匀。
论文 Figure 3:UniSlider 训练。采样强度 s,按公式 3 缩放可训练 LoRA 与冻结主干组合,完整运行 T 步得到 x_s;满强度 x_edit 在 s=1 时仅缓存一次。公式 4 的损失把 x_s 推向输入 x_src 与 x_edit 之间由 s 指定的感知位置。
实验效果 :表 1 的 300 例基准:感知距离变异系数 CV-DSim 为 0.652,SliderEdit 为 1.199;LPIPS 单调性违例率为 0.016 对 0.251。表 3 中,只用均匀采样的 UniSlider 为 0.871,自适应采样后为 0.652,表明训练和参数重映射均有作用。
论文 Figure 2:训练缩小滑杆不均匀差距,自适应采样继续补偿。三行对同一图像执行同一指令:左侧为等滑杆刻度的 SliderEdit、仅用训练损失的 Vanilla、带强度重参数化的完整 UniSlider;右侧为每张图相对输入的 DreamSim 感知距离,以输入到完整编辑的总距离归一化。对角线表示理想均匀变化。
批判点评 :DreamSim 上的匀速不等于每种语义属性都线性变化,原文失败例中颜色变化会掩盖球尚未膨胀的问题。编辑身份保持与 VQA 单调性也并非逐项最佳,基座本身的错误会沿滑杆传播。不同基座的比较需看附录同基座对照。作者项目站本次 TLS 验证失败,未降级访问,也不声称演示或代码已核验;本卡依据可访问的原论文全文。
9. ChronoWorld:用四维记忆回看修正世界
ChronoWorld: Camera-Controlled Consistent 4D World Generation via Spatiotemporal Cues and Geometric Reflections | 北京大学王选计算机研究所;加州大学默塞德分校 | arXiv:2610.06687
关键词 :相机可控生成, 四维世界, 几何记忆, 反思修正
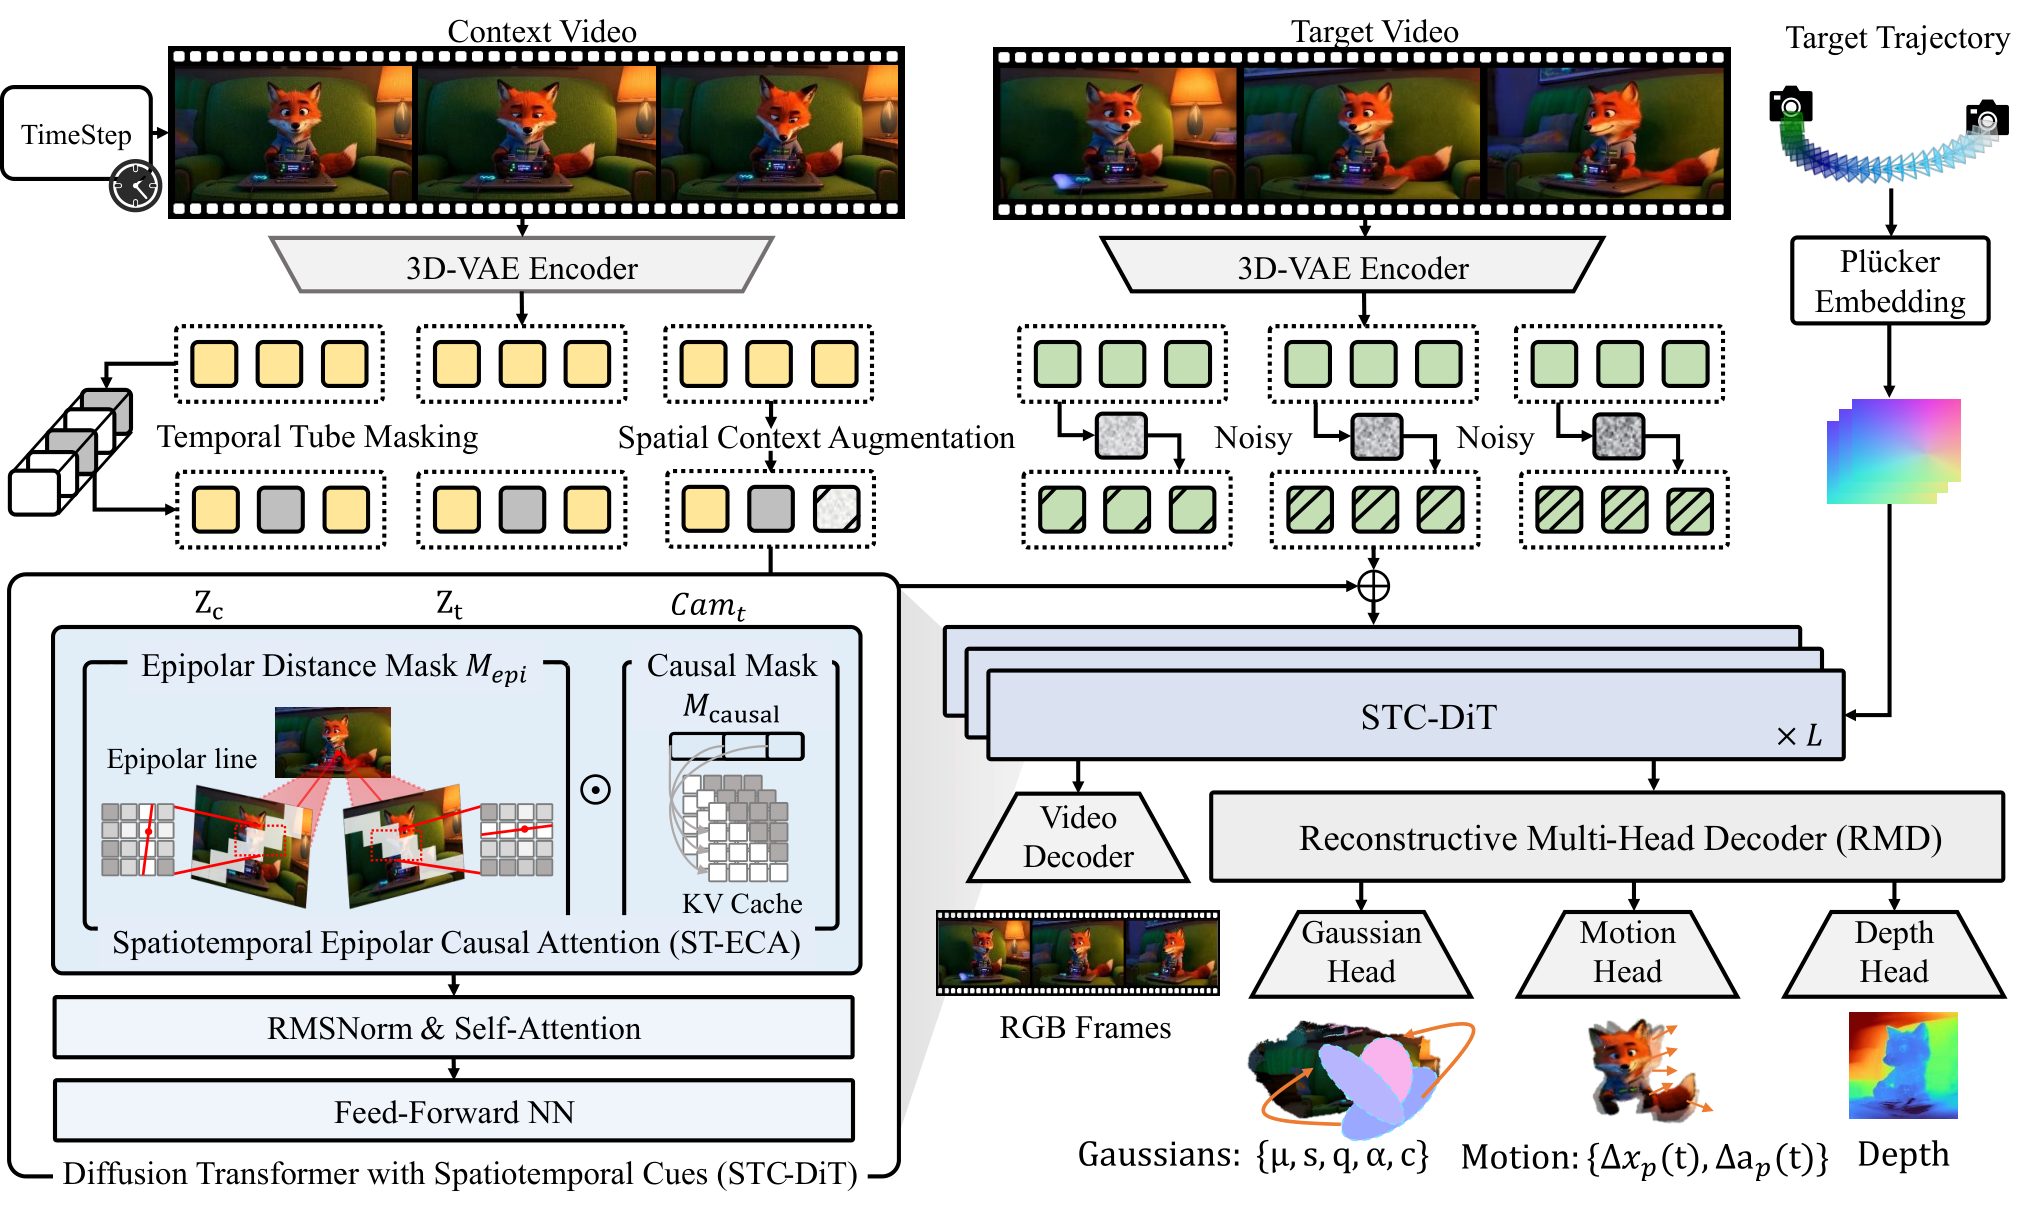
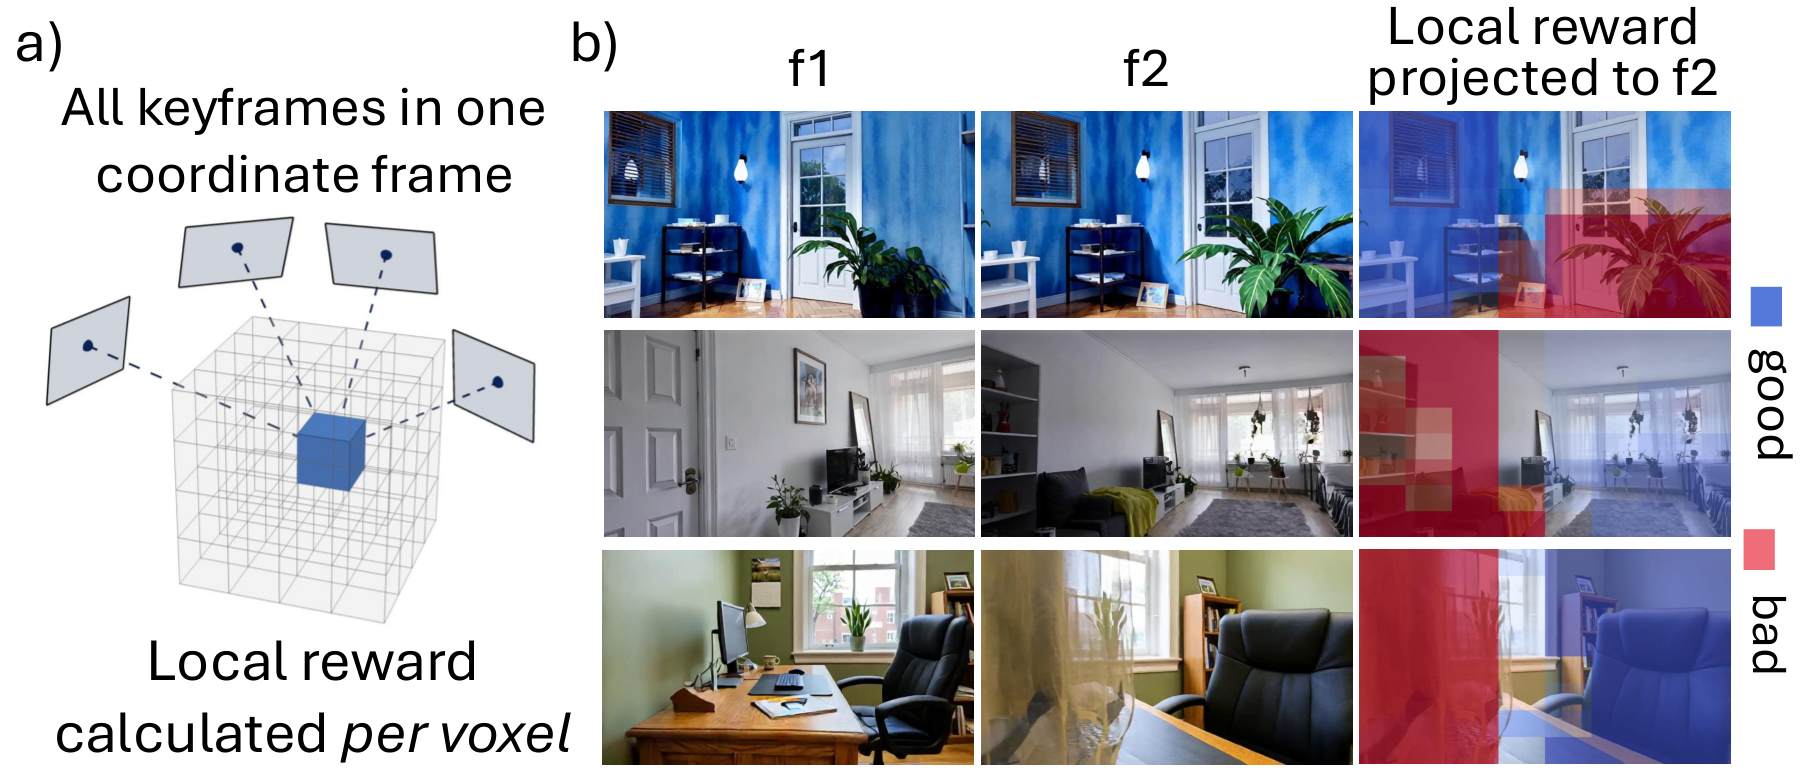
前序问题 :按新相机轨迹生成视频时,动态物体在不同视角可能对不上,局部漂亮也不能保证整个时空场景一致。需要把生成结果放回可重建的几何状态,再检查历史视角。本文贡献 :ChronoWorld 的 Observation–State–Reflection 框架以相机条件 STC-DiT 生成视频,通过时空极线因果注意力联结视角约束和时间顺序;多头重建 decoder 预测颜色、几何与运动等四维属性。统一 4D 记忆用于检索和重渲染,几何反思再据不一致结果做校正,把视频观察转成可检查的世界状态。
论文 Figure 2:ChronoWorld 框架。相机轨迹条件化的时空线索 Diffusion Transformer(STC-DiT)去噪目标视频,多头重建 decoder 预测四维属性。
实验效果 :表 1 的相同输入视频与目标相机轨迹设置:ChronoWorld 的 FVD-4D 为 177.41,Free4D 为 216.67;相对位姿旋转、平移误差为 0.95、2.34,对方为 1.73、3.28。表 2 的重建一致性 PSNR 为 18.87、SSIM 为 0.73。本次也核对 v2,相应主表数字一致。
论文 Figure 4:不同相机轨迹下 ChronoWorld 与基线的定性结果。作者提示放大查看局部细节;量化效果须结合 FVD-4D、相机误差和重建一致性表格。
批判点评 :4D 同步、相机误差与重建一致性是不同指标,不宜合并为现实世界正确率。几何由生成和估计共同建立,回看改进仍可能继承错误;原文未给出足以验证无限场景或完整实时延迟的证据。训练使用八张 A100 80GB,推理单 A100;未确认官方项目或代码入口,不宣称已开源。
10. Smorph:换音色时保留节奏与音高
Smorph: Playable Sound Morphing with Diffusion Models | 美国西北大学;Adobe Research;Wizdom Music | arXiv:2610.06478
关键词 :声音生成, 音色变形, 结构引导, 音乐交互
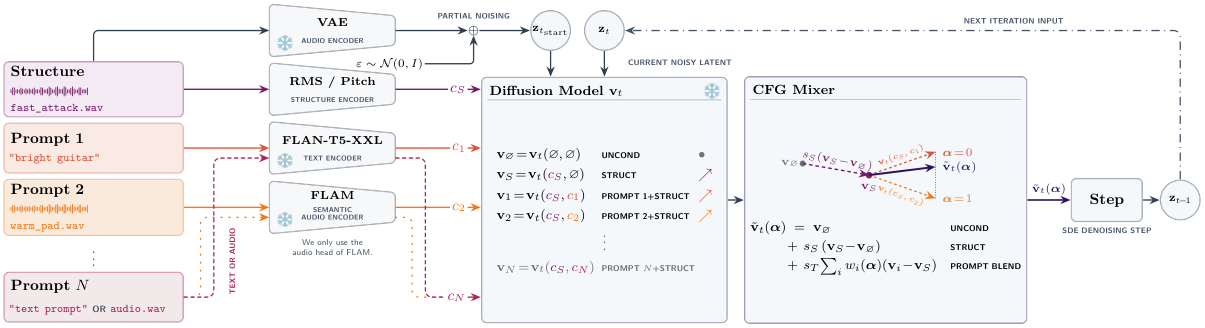
前序问题 :从铜管变成弦乐、从鼓声变成气泡声时,音色与节奏结构常一起变化。音乐设计希望保持音高轮廓或响度包络,让声音身份沿连续路径变化。本文贡献 :Smorph 在扩散采样中组合文本或音频端点引导,并让所有中间状态共享固定的 RMS 或音高结构条件;支持提示到提示、音频到提示和音频到音频变形。SoundCanvas 预生成 5×5、共 25 个声音组成二维网格,鼠标在邻近样本间双线性交叉混音,MIDI 键盘触发当前音色。当前引导无需额外训练,但所用基座与音频条件模块已有预训练或适配。
论文 Figure 2:结构引导的组合指导,详见第 3.1 节。变形参数 α∈[0,1] 插值音频或文本端点条件 c_1…c_N;共享结构参考 c_S 为所有中间状态锚定时间包络或音高轮廓,并在全部 T 个去噪步保持固定。
实验效果 :表 2 的 Clotho→Clotho、RMS 音频到提示设置:相对 SDEdit,结构控制分数 S_ctrl 从 0.356 升到 0.646,mel-L1 从 1.518 降到 1.027;目标音色相似度从 0.695 降到 0.646,KAD 从 4.420 升到 4.902。结构保留增强伴随目标变形及分布质量取舍。
论文 Figure 3:有显式结构控制(上排)与无显式控制(下排)的变形路径。每格为 mel 频谱,灰线为输入 RMS、橙线为生成 RMS;显式控制在展示的路径中更好保留预期时间包络。
批判点评 :实时的是预生成样本间的演奏与混音,不是鼠标每次移动都实时运行扩散。感知路径也不保证处处线性;音乐人案例属于探索性反馈。机构由作者项目页 核实,arXiv 注释和项目页标示 ISMIR 2026,但本期不把这一标示扩大为独立查证的接收结论;没有确认方法代码下载。
趋势观察
计算应随阶段与控制变化
S2PD 把高噪声串行推演和低噪声并行细化分开,PVD 把粗细生成交给不同专家,CtrlCache 在动作变化时刷新。减少计算之前,需要先识别哪些阶段或控制状态承载关键依赖。
缓存内容比缓存数量更关键
MC-Sparse 缓存布局与误差补偿,WorldSonus 限制流式历史,ChronoWorld 保存可重建的四维状态。缓存有不同语义,不能把索引、旧特征与几何记忆混为同一种技巧。
连续控制需要可测的约束
UniSlider 用感知距离修正滑杆,Smorph 用音高或响度结构锚定音色变化,ALIVE 用时间区间对齐交互。控制的意义要落到具体条件与失败例,而非只展示连续参数。
速度与质量必须分别核对
训练吞吐、DiT 去噪、单音频块计算和端到端响应是不同预算。自动质量分数的改善也常伴随其他维度退步,本期逐项写清测试条件,不拼成统一性能榜。
今日讨论
你的生成工作流更需要降低训练成本,还是让交互控制更稳定?
人工智能炼丹君 整理 | 2026-10-07















评论 (0)