


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:注意力与核心零件 | 难度:前沿 | 前置知识:FlashAttention、3D RoPE
关键词:视频生成、稀疏注意力、概率质量、块稀疏、时空布局、在线 profiling
本文以 2026-10-07 核验的论文与官方源码为准。全部实验来自 CPU 合成输入,不涉及模型权重、GPU 内核测速或生成视频质量评测。
视频的 token 数往往同时受帧数与每帧空间分辨率影响。把帧数翻倍,不只意味着多看一倍内容:若所有 token 两两计算注意力,配对数会变成四倍。这里的 token 指模型输入注意力层的潜空间 patch,不能直接用原视频像素数替代。VAE 的压缩率、patch 化方式和文本序列拼接,都会改变实际长度。
本篇先用一个能完全检查的小视频账本:4 帧,每帧 4×4 个位置,共 64 个 token。全注意力有 4096 对 query/key。只保留同帧配对,就剩 1024 对;只保留同一空间位置跨帧配对,就剩 256 对。上述数值由附录脚本实际构造布尔掩码并计数。小规模是为了看清算子,不能据此估算真实视频的显存占用。
真实论文也提醒我们,注意力可能占据很大一部分生成耗时。Sliding Tile Attention 论文在其 HunyuanVideo 实验设置中报告:基于 FlashAttention-3 的总耗时为 945 秒,其中注意力占 800 秒。这个数字带有论文的模型、分辨率和硬件条件,不是所有视频模型的固定比例。本文不将它移植到本地 CPU 实验,也不把论文的 GPU 加速当作已经复现的结果。
难点在于,少算配对同时改变信息来源。假设一个运动物体从左边移到右边,同一空间坐标跨帧未必一直指向同一物体。若硬性只保留原坐标,关键运动关联就可能被删掉。另一方面,即使保留的关联都正确,GPU 也可能仍然在混合计算块里做无效工作。理解稀疏注意力,必须同时回答两个问题:输出改变多少,保留下来的模式是否能让硬件真正少算。
用三句话建立框架:为每个 query 选一组允许读取的 key;在这组 key 上重新做 Softmax;把允许的配对组织成可以整块跳过或整块计算的布局。第一步决定信息损失,第二步保证权重重新归一化,第三步决定计算节约能否兑现。
稀疏注意力有两种常见来源。训练时就限定稀疏结构,模型能适应这种通信图;对已经训练好的全注意力模型做免训练稀疏替换,则需要评估替换误差。二者都可能用相同的掩码代码,但质量证据不能相互代用。本文重点讨论后者,同时保留训练适应这条路线的边界。
还要把它与已讲过的零件连起来。FlashAttention 在相同算子定义下优化读写与分块,目标是精确注意力,仍有浮点舍入差异。稀疏注意力一般删掉部分配对,因而改变算子。跨步缓存则复用不同去噪步骤之间的结果。三种方式的误差来源与可省成本不同,组合时要重新评测,不能把各自加速倍数直接相乘。
先只看一个头、一个样本,不含 dropout。设总长度为 $N$,query 和 key 维数为 $d$,value 维数为 $d_v$。矩阵 $Q,K$ 的形状都是 $N\times d$,$V$ 的形状是 $N\times d_v$。小写 $q_i,k_j,v_j$ 分别是第 $i$ 个 query、第 $j$ 个 key 与 value。它们是经过投影及位置处理后的向量;本文的掩码推导不要求投影矩阵采用某个具体模型。
缩放分数 $s_{ij}$ 和全注意力权重 $p_{ij}$ 为:
$$s_{ij}=\frac{q_i^\top k_j}{\sqrt{d}},\qquad p_{ij}=\frac{\exp(s_{ij})}{\sum_{\ell=1}^{N}\exp(s_{i\ell})}.$$
除以维数的平方根,是标准缩放点积注意力的定义。每一行权重为正且求和为一,因此输出 $y_i$ 是所有 value 的加权平均:
$$y_i=\sum_{j=1}^{N}p_{ij}v_j.$$
为第 $i$ 行定义保留集合 $S_i$。被删除的 key 分数设为负无穷,因为其指数为零。只要集合非空,受限权重 $\widetilde p_{ij}$ 可以直接写成原概率除以保留质量 $z_i$:
$$z_i=\sum_{j\in S_i}p_{ij},\qquad \widetilde p_{ij}=\begin{cases}p_{ij}/z_i,&j\in S_i,\\0,&j\notin S_i.\end{cases}$$
为什么可以这样写?原概率的分子是指数分数,分母是整行指数之和。把保留概率再求和,得到保留指数之和除以整行指数之和。二者相除时,原先的整行分母抵消,剩下的正是在保留 key 上做 Softmax。于是稀疏输出是:
$$\widetilde y_i=\sum_{j\in S_i}\frac{p_{ij}}{z_i}v_j.$$
这里的 $z_i$ 是概率质量,不是保留 token 的比例。保留四分之一 key,可能保住几乎全部质量,也可能丢掉大部分质量。空集合没有定义:所有分数为负无穷时,稳定 Softmax 的减最大值操作会产生无效值。代码必须拒绝空行或预先设计合法的保留策略,不能靠一个很小的 epsilon 假装集合有内容。
定义删除质量 $\alpha_i=1-z_i$。当删除集合非空时,令 $u_i$ 表示被删除 value 按原概率重新归一化后的平均;令 $r_i$ 表示保留集合的平均,即稀疏输出。原输出分成两部分:
$$y_i=(1-\alpha_i)r_i+\alpha_i u_i,\qquad \widetilde y_i=r_i.$$
相减时保留部分合并,得到一个精确恒等式:
$$\widetilde y_i-y_i=\alpha_i(r_i-u_i).$$
它解释了误差的两个因素:删除了多少概率,以及删除部分与保留部分的 value 有多不同。若所有 value 的欧氏范数都不超过 $M$,加权平均的范数也不超过 $M$。再用三角不等式,得到逐行上界:
$$\lVert\widetilde y_i-y_i\rVert_2\leq\alpha_i(\lVert r_i\rVert_2+\lVert u_i\rVert_2)\leq2\alpha_i M.$$
当全部 key 都保留时,删除质量为零、误差为零,不需要定义删除均值。这是条件明确的单层局部上界,不是最终视频画质保证。后续输出投影、残差连接和多次去噪可能传播这些差异;推导也没有给出整个模型的 Lipschitz 常数。更紧的估计需要观测两类 value 均值的距离,而不仅仅数被删掉的 token。
一个反例能直接检查条件:两项概率分别为 0.99 和 0.01,value 分别为 0 和 100。删掉第二项,保留质量仍有 0.99,但输出从 1 变成 0。脚本以 query 为 1、两个 key 为 log(99) 与 0 构造这个分布,并实际得到上述结果。概率质量高的确有帮助,然而不说明 value 尺度就不能宣称绝对误差很小。
设帧数为 $T$,每帧位置数为 $P=H W$,其中 $H,W$ 是 token 网格的高和宽。序列长度为 $N=TP$,先忽略文本等额外 token。按帧展平时,位置索引 $i=tP+p$,$t$ 表示帧,$p$ 表示帧内位置。教学空间掩码只保留同帧,时间掩码只保留同位置跨帧。
$$D_{\mathrm{full}}=T^2P^2,\qquad D_{\mathrm{spatial}}=TP^2,\qquad D_{\mathrm{temporal}}=PT^2.$$
这里的 $D$ 表示允许的 query/key 配对数。空间模式中每个 query 可以读整帧的 $P$ 个 key,乘以 $TP$ 个 query;时间模式中每个 query 读 $T$ 个同位置 key。分别除以全配对数,密度为 $1/T$ 和 $1/P$。空间和时间取并集时,每行保留 $P+T-1$ 个 key,因为自己的 token 被两种集合各数了一次。
$$\rho_{\mathrm{union}}=\frac{P+T-1}{TP}.$$
这组公式描述本文的简化掩码。SVG 论文的实际空间候选还可覆盖邻帧,时间候选也包含实现选择的带宽;模型还可能带文本上下文。不能把本文的同帧掩码称为完整 SVG 算法,更不能声称每个真实视频头都有密度 $1/T$。
令 $\Pi$ 是排列矩阵,对应重新编号 token;令 $A$ 是允许配对的布尔掩码。对 $Q,K,V$ 同步左乘排列矩阵,掩码的两个轴也同步重排,得到 $A'=\Pi A\Pi^\top$。分数的行列相应重排,逐行 Softmax 不受 key 顺序影响,因此:
$$\operatorname{Attn}(\Pi Q,\Pi K,\Pi V,A')=\Pi\operatorname{Attn}(Q,K,V,A).$$
最后乘逆排列,把输出放回原位置,就恢复同一稀疏算子的结果。成立的前提是位置编码已经正确关联原 token,Q/K/V 和掩码保持一致。若重排后用新序号重新生成 RoPE,却没有维护原来的时空坐标,就改变了分数,以上等价性不再适用。布局是存放方式,不能顺手改掉位置语义。
附录的 sparse_attention_demo.py 只需要 NumPy 与 matplotlib,读者可以先安装依赖,再运行脚本。它不下载权重、不调用 GPU。核心函数完整地实现同一公式,稳定 Softmax 先减每行最大值,掩码关闭的分数设为负无穷:
def attention(q, k, v, mask):
    if not mask.any(axis=-1).all():
        raise ValueError('Every query must retain at least one key')
    scores = q @ k.T / np.sqrt(q.shape[-1])
    weights = softmax(np.where(mask, scores, -np.inf))
    return weights @ v, weights
正文片段依赖附录里的 softmax 和 NumPy 导入;文末附录提供全部可运行代码。为了构造两个可解释的头,实验把第一个头的 Q/K 主信号放在帧的 one-hot 维度,第二个头放在帧内位置的 one-hot 维度,再加入标准差 0.15 的高斯扰动。主信号幅度为 6,随机种子为 7。这样主动造出一个偏空间、一个偏时间的分布,而不是从预训练视频模型测出来的头分工。
真实形状为 Q=(2,64,20)、V=(64,3),其中最前面的 2 是两个头,最后的 20 来自 4 个帧维度与 16 个位置维度。每头输出为 (64,3)。两个头共享同一 V,是为了让掩码误差可比较,未实现多头拼接及输出投影。相同输入与全掩码比较时,最大误差为零。
| 合成头 | 保留模式 | 配对密度 | 平均保留质量 | 对全注意力输出的 MSE |
|---|---|---|---|---|
| 空间头 | 同帧 | 0.25 | 0.9989513131 | 6.1315309714e-08 |
| 空间头 | 同位置跨帧 | 0.0625 | 0.0680910956 | 0.9388219956 |
| 时间头 | 同帧 | 0.25 | 0.2703426737 | 0.6489679917 |
| 时间头 | 同位置跨帧 | 0.0625 | 0.9950700202 | 8.8294241814e-06 |
MSE 是对全部 64×3 个输出元素的平方误差求平均。它不是每行向量范数,也不是视频质量下降百分比。空间头用更激进的时间掩码时,虽然密度更低,却丢失了大部分概率质量;同一个稀疏比例换到另一个头,结果会完全不同。表格中的数值经过四舍五入,完整浮点输出由脚本打印并保存在运行结果中。
脚本还逐行检查数学上界。在空间头配合同帧掩码时,最大行误差为 0.0008639397,而这组行中的最大上界为 0.0117092274。断言比较的是每行误差与该行上界,不能把两个最大值的大小关系当成逐行证明。时间头配时间掩码同样通过断言;上界较松,是因为它使用整个 V 的最大范数,丢失了两类均值之间的具体方向。
并集掩码密度为 0.296875,两个头的 MSE 分别为 5.5294485880e-08 和 5.0711107889e-06。它在这组输入里比各自专用模式更接近全输出,但配对更多。这只是本次观测;增加保留集合同时改变归一化,误差并没有对任意输入都单调下降的定理。只看这张表,不能推出并集是通用最优选择。
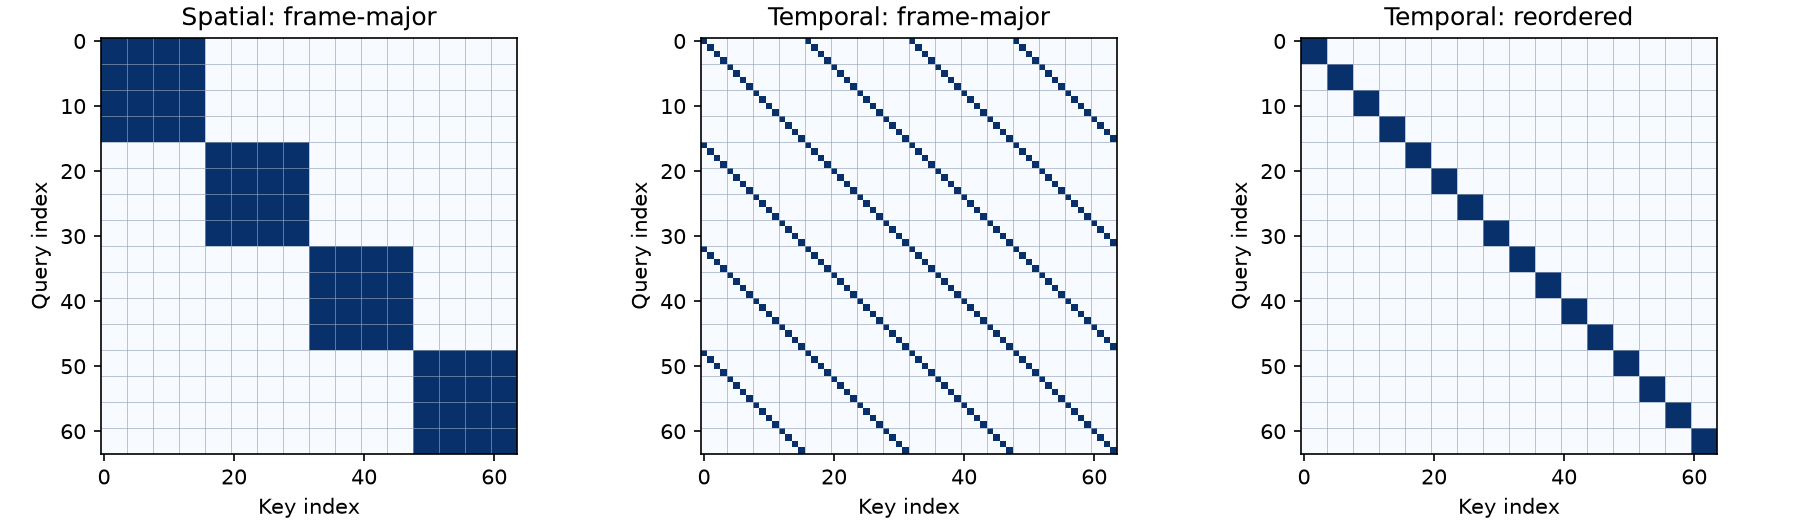
图由同一实跑脚本生成。深色格子表示允许配对,细线每隔 4 个 token 划出计算块。中间与右侧保留完全相同的时间关联,但右侧把同位置的四帧放到一起,混合块变成完整小方块。它展示的是索引布局变化,不是视频内容或真实注意力热力图。
代码的 block_cost 假设每个 4×4 块只要有一个允许配对,就要计算整块。原时间掩码有 256 个有效配对,却分布在 64 个活跃块里,需要计算 1024 个位置,利用率为 0.25;重排后活跃块为 16 个、计算位置为 256 个、利用率为 1。重排再还原的最大绝对输出差为 2.2204460493e-16。这里的四倍是这个块账本中的工作量比例,未测延迟,真实内核可能采用不同块形状与融合策略。
核验的官方代码为 svg-project/Sparse-VideoGen 的 Wan attention.py,关键位置是 WanAttn_SVGAttn_Processor2_0.sample_mse 与 sparse_head_placement;布局参考实现位于 placement.py。以上以 2026-10-07 下载的源码为准,快照与 SHA256 留在本地证据目录,分支 URL 将来可能重构。
sample_mse 抽取 query 行,分别计算全注意力和两个候选掩码的输出,随后以输出 MSE 评估候选。这比只比较注意力概率更贴近实际 value 聚合结果,但只看抽样行,仍有漏掉稀有困难 query 的风险。论文介绍随机采样约 1% 行的设置;当前 Wan 类里可以看到 num_sampled_rows=32 的类属性,实际采样数还会受序列长度限制。论文比例与某个源码默认值不是同一配置,部署时应查看运行参数的最终取值。
本次额外执行了官方函数体:保留数学运算,移除计时装饰器,以 CPU PyTorch 运行同一合成 Q/K/V,并配置 32 个采样行。官方 MSE 的输出形状为 (2,1,2),依次对应候选掩码、样本与头;argmin 选出的头类型为 [[0,1]],即空间头选空间候选、时间头选时间候选。这里只运行 profiling 和布局的参考函数,没有安装整套 SVG CUDA/Triton 扩展,也没有宣称完成视频推理复现。
实跑的两组采样 MSE 分别为 [6.8160804146e-08, 0.7533096337] 与 [1.0477995207, 7.9057440928e-06],列表中按空间头、时间头排列。它们与第 04 节对全部行计算的 MSE 不完全相同,因为这里随机抽取 32 行,而且官方函数使用带放回的 torch.randint,可能多次抽中同一个 query。不要把“抽了 32 行”直接理解成“覆盖 32 个不同位置”。这个细节不会改变本次选出的类型,却会影响评估样本覆盖程度。
sparse_head_placement 调用 ref_wan_sparse_head_placement,将时间头的视频部分从 frame-major 转为 token-major,保留末尾上下文 token 的位置。测试在视频的 64 个 token 后增加 2 个上下文 token,将官方参考结果与独立的 reshape/permutation 预期比较,Q/K/V 的最大差为零,上下文逐元素保持不变。这个上下文长度是测试参数,不能照搬为真实模型默认长度。
工业版本还提供 Triton 头布局与输出还原函数,处理批次、多头、步数及前若干层保留全精度等逻辑;当前仓库还包括后续 SVG2、SVG-EAR 路径。本文只分析已核验的 SVG1 候选模式与相关 Wan 参考函数,不把同一仓库中的所有更新归到原始论文。源码里的窗口、文本及图像条件处理,比同帧/同位置两个布尔条件复杂得多。
Sliding Tile Attention 则从计算块出发,让同一 query tile 共享一组 key tiles,尽量避免只保留少数元素的混合块。这与普通逐 token 滑窗有区别:二者的窗口边界不必完全相同。论文同时讨论无需训练与微调后的设置;更激进稀疏配置的结果若依赖微调,不能贴上免训练标签。选实现时要同时对照保留图的语义和实际 kernel 的结构,API 名称里带 sparse 并不足以保证收益。
第一个代价是选择掩码的成本。若先算完整的全注意力,再从全部权重中寻找最重要连接,已经支付了最昂贵的部分。在线 profiling 通过抽样降低选择开销,但抽样误差也需要被监控。尤其是少数快速运动、镜头切换或长程交互 query,平均误差可能掩盖局部失败;候选集合里若根本没有合适模式,选出较小 MSE 也不代表它足够好。
可以把选择与验收分成两件事:先比较两个候选谁更好,再判断胜出的候选是否跨过允许误差的门槛。候选 MSE 都很高时,单纯的 argmin 仍然会返回一个类型,但它只表示相对更好。若要加入全注意力回退,应明确阈值用的是绝对误差、归一化误差还是其它指标,并记录每层、每步、每头的回退比例。本文没有为真实视频模型拟定通用阈值,也没有把教学输出范围当作部署标准。
同样,平均保留质量与最差行质量应分开记录。平均值接近一,仍可能存在少数严重失真的行;而即便删除质量相同,value 的方向分布也会让输出误差不同。检查局部误差时,可以同时看均值、最大值以及具体失败 query 的时空位置。这样的诊断有助于辨别错误来自窗口太小、头类型选错,还是位置编码与重排错配,避免把所有问题都归因于“稀疏率太高”。
第二个代价是布局、索引与数据搬运。布尔掩码的零不会自动让 NumPy 的 q @ k.T 少做乘法:本文最小实现先算完整分数,再应用掩码,所以它验证语义与误差,计算复杂度仍然是平方级。真正的稀疏内核必须提前知道活跃块,并跳过空块。若运行过程中每步重新排列 Q/K/V,排列本身的读写也要算入端到端时间。
第三个代价是全局交流能力。完全同帧的头不能直接读取其他帧;完全同位置的头不能直接读取别的位置。多头、残差与后续层可间接传播信息,但不能凭这种可能性认定某个被删除连接不重要。文本 token、首帧图像条件和特殊全局 token 常需要单独保留策略,训练时学习出的依赖不能任意删掉。
端到端收益可用成本模型先做量级检查。设全流程中注意力耗时比例为 $f$,稀疏后注意力加速倍数为 $r$,新增 profiling 与布局成本占原总耗时的比例为 $g$。在其它环节耗时不变的假设下:
$$R_{\mathrm{total}}=\frac{1}{(1-f)+f/r+g}.$$
若教学假设 $f=0.8$、$r=4$,不算新增开销时总加速为 2.5;再假设 $g=0.05$,就降为 2.2222222222。脚本实际计算这两个数值,然而参数是人为假设,既非本地测得的耗时,也非 SVG 的论文配置。这个模型的用途是防止把注意力内核四倍加速写成整段视频四倍加速。
还要看基线。对比普通全注意力,与对比优化后的 FlashAttention,收益可能差得很大。dtype、设备、分辨率、帧数、批量、是否计入编译与 warmup,都影响结论。本文只验证 float64 CPU 算子,没有 BF16/FP16 下的稳定性结论。某一精度的有限误差,不能推断另一精度的内核也会产生同样结果。
最后,稀疏模式的效果依赖去噪步和层。早期噪声状态、后期细节状态可能需要不同通信图;某些关键层适合全注意力回退。最终验收应固定同一模型、输入、随机种子与采样配置,同时看视频的运动连贯性、人物身份和提示词遵循。单层输出 MSE 是诊断信号,论文里的质量指标是其具体实验的证据,两者都不能替代待部署配置的实际验收。
以下四篇提供不同层面的认识,英文标题与 arXiv 条目逐一核对。
这条脉络不是后一篇全面取代前一篇。精确 IO 优化回答怎样更高效地算相同注意力,稀疏连接回答哪些配对可以删,tile 与排列回答剩余配对怎样落到硬件。把三个问题分开,才看得懂方法之间有哪些可以组合、哪些只是比较口径不同。
误解一:掩码里有零,就已经省掉了对应乘法。 本文的 NumPy 路径是反例,它先产生完整分数。代码里存在掩码只说明语义受限;确认算力节约,需要看 kernel 是否跳过了整块,以及它为了识别和排列块支付了多少成本。
误解二:保留 99% 概率,输出误差必然不超过 1%。 百分比的分母没有定义,value 尺度也被忽略。本文反例的绝对误差为 1;若全输出接近零,相对误差还可能非常大。报告误差时应明确范数、聚合方式和参照量。
误解三:时间头等于把未来帧屏蔽掉。 本文时间模式连接同位置的全部帧,没有使用因果掩码。视频扩散常对一段视频同时去噪,不能直接套用自回归解码的因果约束;具体模型若确有因果设计,需要另行叠加并重新检查每行是否合法。
误解四:先重排 token,再随意换一下 position_ids 也等价。 等价的是一致的索引排列,原坐标语义必须保留。RoPE、条件 token 的边界及输出逆排列都参与正确性;只比较张量形状完全看不出这些错误。
误解五:低 MSE 的单层结果就能保证最终视频不变。 合成实验只证实给定输入上的局部性质。真实模型会反复调用注意力,误差可能叠加或放大,也可能被后续操作抑制。是否可以接受,要靠配置一致的端到端证据,不应将一个教学表格写成部署承诺。
把附录完整代码保存为 sparse_attention_demo.py,运行 python -m pip install numpy matplotlib 后执行 python sparse_attention_demo.py。脚本会输出 JSON 并在相邻目录生成运行结果和配图;随机种子固定为 7,使用 float64。不同 NumPy/BLAS 版本末位可能有微小差异,检查数量级和断言,不要求所有打印尾数逐字节相同。
第一步,确认三组形状、4096/1024/256 的配对计数及表格数值。把第一个头误用时间掩码,应该看到保留质量远低于同帧掩码,输出 MSE 明显变大。这验证“模式必须适配头”的逻辑,而不是观察任意真实模型头是否属于这两类。
第二步,检查时间掩码重排前后的块账本。有效配对始终为 256,活跃块分别为 64 与 16,逆排列输出最大差约为 2.22e-16。保持 Q/K/V 与掩码同步时,它们计算的是同一个算子;如果只重排 Q 而不重排 K/V,那是在故意制造错配,不能用它评估正常布局变化的误差。
第三步,查看 counterexample:保留质量 0.99、原输出 1、稀疏输出 0。再把 value 的 100 改成更大或更小的数,并重新运行;这是读者的扩展实验,本文没有预先声称改动后的实测输出。公式预言绝对误差随 value 尺度线性变化,可以用自己的运行验证。
第四步,脚本对空掩码执行捕获异常,empty_row_rejected 必须为 true。不要删掉这个检查后把 NaN 当成误差为零。若要研究更复杂窗口,先确认每个 query 至少有一个合法 key,再验证归一化、输出与块占用。最终准备换进模型时,还需要独立的 GPU 内核一致性测试及视频质量测试,本文的 CPU 演示只提供原理层的验算起点。
从 FlashAttention回看平方计算与 IO 成本的区别,再用 3D RoPE检查 token 重排是否保持原时空坐标。前者帮助建立正确的速度基线,后者帮助排查形状正确但位置语义错误的实现。
与 跨步缓存 DiffCache比较时,重点看复用轴:稀疏是在一次注意力调用内选择连接,缓存是在去噪步骤之间复用计算。若继续阅读 线性与循环记忆 LinearMem,则关注另一条路线如何改变聚合结构及历史状态的存储。这些零件能帮助组织性能问题,仍需在具体模型中各自验证,再评估组合误差与收益。
09 节用到的脚本全文如下(sparse_attention_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""CPU teaching experiment; pair counts are not hardware speed measurements."""
import json
from pathlib import Path
import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt


def softmax(scores):
    exp = np.exp(scores - scores.max(axis=-1, keepdims=True))
    return exp / exp.sum(axis=-1, keepdims=True)


def attention(q, k, v, mask):
    if not mask.any(axis=-1).all():
        raise ValueError('Every query must retain at least one key')
    scores = q @ k.T / np.sqrt(q.shape[-1])
    weights = softmax(np.where(mask, scores, -np.inf))
    return weights @ v, weights


def block_cost(mask, block=4):
    n = mask.shape[0]
    assert n % block == 0
    tiles = mask.reshape(n // block, block, n // block, block)
    active = tiles.any(axis=(1, 3))
    pairs = int(mask.sum())
    computed = int(active.sum()) * block * block
    return {'useful_pairs': pairs, 'active_tiles': int(active.sum()),
            'computed_pairs': computed, 'utilization': pairs / computed}


def main():
    rng = np.random.default_rng(7)
    t, height, width = 4, 4, 4
    positions = height * width
    n, d = t * positions, t + positions
    frame = np.repeat(np.arange(t), positions)
    pixel = np.tile(np.arange(positions), t)
    full = np.ones((n, n), dtype=bool)
    spatial = frame[:, None] == frame[None, :]
    temporal = pixel[:, None] == pixel[None, :]
    masks = {'full': full, 'spatial': spatial, 'temporal': temporal,
             'union': spatial | temporal}
    q = np.zeros((2, n, d), dtype=np.float64)
    q[0, np.arange(n), frame] = 6.0
    q[1, np.arange(n), t + pixel] = 6.0
    q += rng.normal(0, 0.15, size=q.shape)
    k = q.copy()
    v = rng.normal(size=(n, 3))
    results = []
    outputs = []
    max_value_norm = np.linalg.norm(v, axis=-1).max()
    for head in range(2):
        golden, p = attention(q[head], k[head], v, full)
        head_outputs = {}
        for name, mask in masks.items():
            y, p_sparse = attention(q[head], k[head], v, mask)
            retained = (p * mask).sum(axis=-1)
            removed = np.maximum(0, 1 - retained)
            error = np.linalg.norm(y - golden, axis=-1)
            bound = 2 * removed * max_value_norm
            assert np.all(error <= bound + 1e-12)
            assert np.allclose(p_sparse.sum(axis=-1), 1)
            results.append({'head': head, 'mask': name,
                            'density': float(mask.mean()),
                            'retained_mass_mean': float(retained.mean()),
                            'mse': float(np.mean((y - golden) ** 2)),
                            'max_row_error': float(error.max()),
                            'max_bound': float(bound.max())})
            head_outputs[name] = y
        outputs.append(head_outputs)
    # Group tokens by spatial coordinate, then frame: an exact permutation.
    perm = np.argsort(pixel, kind='stable')
    permuted = temporal[np.ix_(perm, perm)]
    old_y, _ = attention(q[1], k[1], v, temporal)
    new_y, _ = attention(q[1, perm], k[1, perm], v[perm], permuted)
    restored = np.empty_like(new_y)
    restored[perm] = new_y
    permutation_error = float(np.max(np.abs(restored - old_y)))
    # A small deleted probability can matter when values have large magnitude.
    small_q = np.array([[1.0]])
    small_k = np.array([[np.log(99.0)], [0.0]])
    small_v = np.array([[0.0], [100.0]])
    dense_y, dense_p = attention(small_q, small_k, small_v, np.array([[True, True]]))
    pruned_y, _ = attention(small_q, small_k, small_v, np.array([[True, False]]))
    try:
        attention(q[0], k[0], v, np.zeros_like(full))
    except ValueError:
        empty_row_rejected = True
    else:
        raise AssertionError('An empty row was accepted')
    # Idealized cost model, not timings: 80% attention, 4x attention acceleration.
    f, r, profiling = 0.8, 4.0, 0.05
    result = {'seed': 7, 'q_shape': list(q.shape), 'v_shape': list(v.shape),
              'output_shape': list(old_y.shape), 'results': results,
              'temporal_blocks_before': block_cost(temporal),
              'temporal_blocks_after': block_cost(permuted),
              'permutation_max_error': permutation_error,
              'counterexample': {'retained_mass': float(dense_p[0, 0]),
                                 'dense_output': float(dense_y[0, 0]),
                                 'pruned_output': float(pruned_y[0, 0])},
              'empty_row_rejected': empty_row_rejected,
              'assumed_amdahl_speedup_without_profile': 1 / ((1 - f) + f / r),
              'assumed_amdahl_speedup_with_profile': 1 / ((1 - f) + f / r + profiling)}
    folder = Path(__file__).resolve().parents[1]
    (folder / 'figures').mkdir(parents=True, exist_ok=True)
    fig, axes = plt.subplots(1, 3, figsize=(12, 3.5), constrained_layout=True)
    for ax, mask, title in zip(axes, [spatial, temporal, permuted],
                                ['Spatial: frame-major', 'Temporal: frame-major', 'Temporal: reordered']):
        ax.imshow(mask, cmap='Blues', vmin=0, vmax=1, interpolation='nearest')
        ax.set_title(title)
        ax.set_xlabel('Key index')
        ax.set_ylabel('Query index')
        for edge in range(3, n, 4):
            ax.axhline(edge + .5, color='#94a3b8', lw=.3)
            ax.axvline(edge + .5, color='#94a3b8', lw=.3)
    fig.savefig(folder / 'figures/sparse_layout.png', dpi=150,
                metadata={'Software': 'SparseAttentionTeachingDemo'})
    plt.close(fig)
    (folder / 'run_result.json').write_text(json.dumps(result, indent=2), encoding='utf8')
    print(json.dumps(result, indent=2))


if __name__ == '__main__':
    main()

评论 (0)