今日 AIGC 论文速览
今日共 10 篇 · 世界模型与动作生成 2 篇 · 生成模型推理加速 2 篇 · 3D 资产生成与程序化建模 1 篇 · 视频与图像编辑一致性 2 篇 · 语音与实时交互 2 篇 · 世界模型评测 1 篇
重点论文标题列表
GameWAM (复旦大学 + LIGHTSPEED + 清华大学深圳国际研究生院):首个能闭环玩游戏的世界动作模型WALL-SS (自变量机器人 (X Square Robot)):有界显存跑出分钟级流式推演ClusterAttention (独立研究者):无结构输入单次前向也能免训练加速Procedura (南京大学):把物体写成带装配约束的程序MMLVE-Agent (南开大学 VCIP + 腾讯在线视频 BU):全局记忆卡守住跨镜头编辑一致
今日论文速览
1. GameWAM:首个能闭环玩游戏的世界动作模型
GameWAM: A World Action Model for Video Games | 复旦大学 + LIGHTSPEED + 清华大学深圳国际研究生院 | arXiv:2608.26200
关键词 :世界动作模型,游戏智能体,flow matching,块因果条件,键鼠控制生成,LASI,复旦,LIGHTSPEED
前序问题 :游戏这个场景把两条原本分开的技术路线逼到了同一张桌子上。一边是游戏智能体:它们把画面和任务描述直接映射成动作,能玩但没有对世界如何演化的显式建模,一旦遇到需要预判后果的操作就只能靠模仿数据里的条件反射。另一边是交互式游戏世界模型:给定动作它能预测出相当逼真的未来画面,但它本身不是策略——没人告诉它该按哪个键,它就只是个渲染器。World-Action Model(WAM)的想法是把两者合成一个模型,让它同时输出「会发生什么」和「该做什么」。但游戏对 WAM 特别不友好:第一人称视角意味着画面变化极快,世界状态又要长期保持(挖到的矿、合成的物品不能凭空消失),更麻烦的是控制方式异构——游戏内是连续的鼠标视角移动,切到 GUI 界面又变成离散的点击拖拽,两套动作分布混在一条轨迹里。本文贡献 :GameWAM 是作者所称的首个面向原生闭环游戏与 GUI 控制的 WAM。核心是让视觉与动作两条生成流并行跑:Causal Video DiT 与 Causal Action DiT 通过 joint attention 耦合,在块因果(block-causal)条件下用 flow matching 同时生成未来观测和可执行的键鼠轨迹,两者共享同一段干净的因果前缀,而同时被加噪的未来视觉与动作 token 互不作为条件,避免用噪声去预测噪声。针对异构控制,模型在每个动作步先预测一个 gameplay/GUI 模式标签,再用模式专属的预测分布生成动作,并对连续动作做归一化,从而让一套模型同时驾驭「连续视角移动」和「离散界面点击」。长时程交互靠 block-cycle 控制:每轮预测超出实际执行范围的动作块,但只执行开头一小段前缀,然后从新观测重新规划;轮内用细粒度上下文、跨轮用分层历史压缩来维持时间连续性。训练数据是作者自建的画面与动作严格同步的 gameplay + GUI 轨迹集。
auto
实验效果 :在 ViZDoom 与 Minecraft 类任务上,GameWAM 达到与对比智能体相当的任务成功率,但执行的原生动作数量更少——这说明它的动作更「有目的」,而不是靠高频试错凑出结果。作者展示的闭环 rollout 里有一个值得注意的行为:在「用工作台合成发射器」任务中模型中途放错了材料,观察到 GUI 状态变化后又调整了合成格配置并最终完成目标,即从画面反馈中做出了错误恢复,而这正是「有世界模型」相比纯反射式策略应该带来的能力。论文另一个反向贡献是揭示了 Low-Frequency Action Source Imprinting(LASI):在条件固定不变时,采样动作所用噪声源的低频分量会系统性地带偏生成出的粗粒度镜头运动,也就是说「按了什么键」部分取决于随机种子长什么样。
auto
批判点评 :把视觉与动作放进同一个生成过程、并用块因果掩码严格区分「可作为条件的干净前缀」和「同时被加噪的未来」,是这篇方法上最干净的部分,模式标签 + 模式专属分布也是处理异构控制的务实解法。真正让这篇论文有分量的反而是 LASI 这个负面发现:它把「生成式控制」的一个结构性隐患摆到了台面上——当动作本身来自采样,噪声的低频成分就变成了一个隐藏的控制信号,这意味着同一套条件在不同种子下会输出系统性偏向不同的镜头运动,对需要可复现性的评测和部署都是麻烦事。局限也需要点明:一是任务集集中在 ViZDoom 与 Minecraft 这类视觉相对简单、动作空间有限的环境,现代 3A 游戏的画面复杂度与状态持久性远超此范畴,声称的「原生闭环」还需要更硬的场景检验;二是「更少动作数」是个双刃指标,既可能意味着规划更好,也可能意味着模型倾向保守、放弃了需要密集操作的路径,论文没有拆开这两种解释;三是 block-cycle 只执行短前缀就重新规划,本质是用高频重规划掩盖长时程预测的漂移,代价是每轮都要重跑生成,实时性与算力开销在文中讨论不足。
2. WALL-SS:有界显存跑出分钟级流式推演
WALL-SS: Scaling Long-horizon World Models via Next-Scale Autoregression | 自变量机器人 (X Square Robot) | arXiv:2608.26239
关键词 :世界模型,下一尺度自回归,长时程流式生成,尺度压缩记忆,on-policy对齐,机器人仿真,自变量机器人
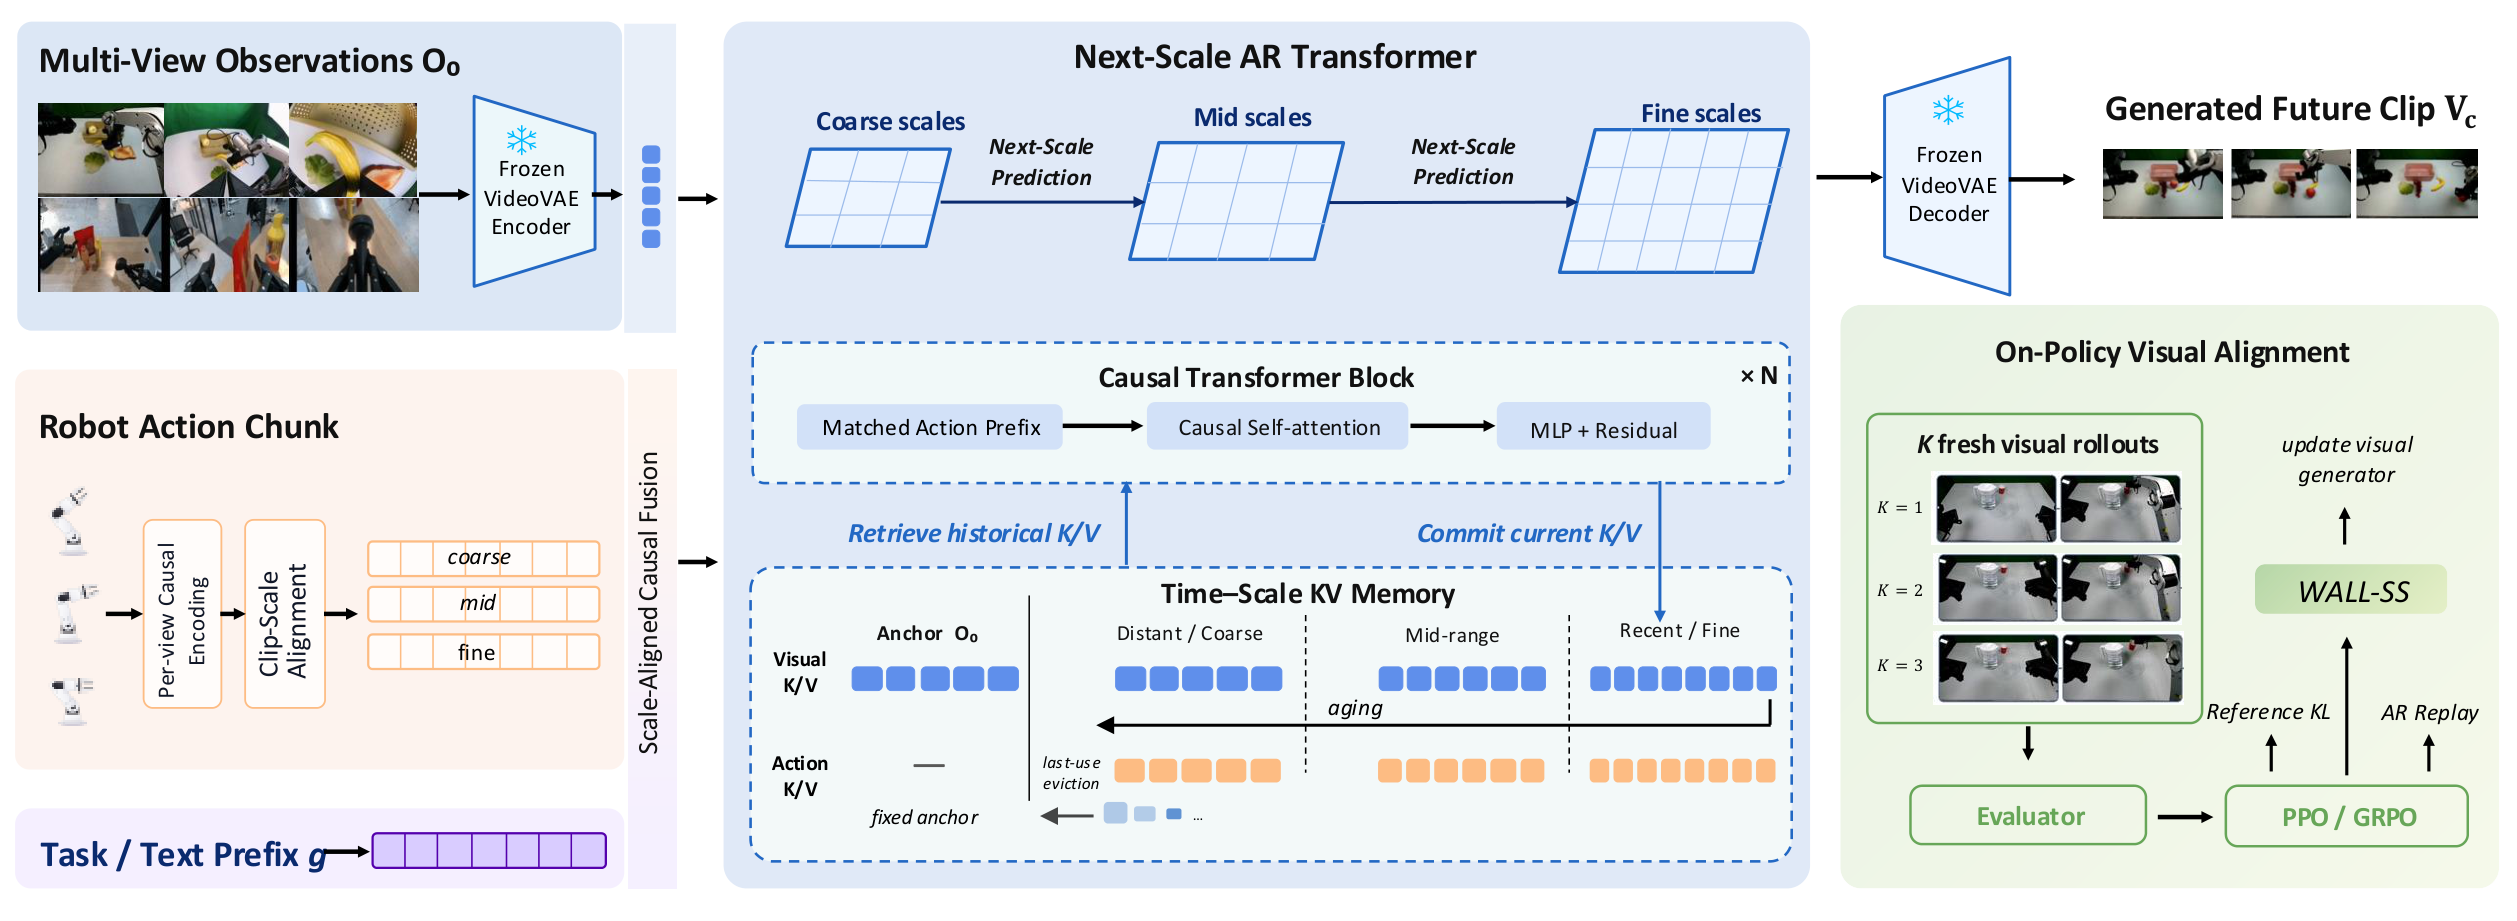
前序问题 :生成式世界模型对机器人的价值在于「不用真机就能试」——仿真、规划、策略评估都指望它。但要真正可用,它必须同时满足几个彼此矛盾的要求:动作与后果要对得上(给一段抓取轨迹,画面里的夹爪就得真的跟着走);时长要可变且能持续接下去(不能只会生成固定 5 秒片段);还要能被奖励直接优化(否则无法用强化学习闭环)。当前主流的视频扩散路线在这三点上都别扭:它以 clip 为单位迭代去噪,天然是「一段一段」的,续接时要么重新条件化、要么显存随长度线性膨胀;动作通常作为一个全局条件塞进 cross-attention,与具体时刻的状态转移关系松散;而扩散的似然不可直接计算,奖励优化只能绕道。长时程还有个更隐蔽的问题:模型训练时看的是真实历史,推理时看的是自己生成的历史,这种分布偏移会让误差沿时间累积成漂移。本文贡献 :WALL-SS 把具身轨迹表示成「观测与动作时间交错」的因果序列,让动作依赖的状态转移显式化,同时天然支持变长生成、通过复用因果状态做流式续接、以及借序列概率直接做优化。每一帧未来观测采用由粗到细的 next-scale 自回归生成(而非全帧去噪),并在这个尺度层级上搭了三个互补组件:一是动作条件的下一尺度预测,把与尺度对齐的动作表征注入各级,既建模成功行为也建模失败行为;二是尺度压缩的长时程记忆,近期交互保留在细尺度、远期观测与动作被压缩到粗尺度,配合 scale-wise dream forcing 提升对自生成上下文的鲁棒性;三是 on-policy 对齐,用「动作跟随」与「长期一致性」两个奖励优化自回归视觉动力学,同时以参考 KL 与 AR replay 约束住预训练视觉分布不被 PPO/GRPO 带崩。训练数据涵盖异构机器人与 UMI 手持采集示范。
auto
实验效果 :在动作跟随与轨迹精度上 WALL-SS 优于所比较基线,并能在有界显存下跑出连贯的分钟级流式 rollout。作者给出的定量证据里最有说服力的是长时程流式跟随实验:在包含接触密集的倒水阶段的单次连续 rollout 中,逐帧的轨迹跟随误差全程保持在画面对角线长度的 0.5% 以内。与 Wan2.1-1.3B、Wan2.2-14B、Infinity-8B 的定性对比取 5s/30s/60s 三个时刻:三个基线在 30 秒后陆续出现任务目标丢失或物体消失(图中红框标出),WALL-SS 在 60 秒时仍保持分拣与倒水任务的物体与容器关系正确(绿框)。此外闭环校准实验显示,生成 rollout 与真机 rollout 的任务成功率呈线性相关,说明它可以当作策略评估的代理。
auto
批判点评 :把「动作—观测交错的因果序列」作为一等表征,是这篇论文最值得借鉴的设计决策:它一次性解决了变长、流式、可优化三件事,而扩散路线要靠三套补丁分别应付。尺度压缩记忆也比「均匀降采样历史」更符合直觉——远处只需要知道大概布局,近处才需要细节。不过要冷静看几点:一是 60 秒、有界显存这类数字来自作者自建设定,基线选的是通用视频生成模型(Wan、Infinity)而非专门的机器人世界模型,比较口径对自己有利;二是 on-policy 对齐用的奖励(动作跟随、长期一致性)本质是自监督代理指标,优化它未必等于提升下游策略的真实成功率,论文的闭环校准只给了相关性、没有给出「用 WALL-SS 评估选出的 checkpoint 在真机上确实更好」的因果链条;三是团队署名为「X Square Robot Team」,贡献者列表在附录,机构信息公开度较低,复现与代码可用性需实际验证;四是分钟级 rollout 的显存有界是靠远期压缩换来的,被压掉的信息一旦在后续需要精确复现(例如回到之前的桌面重新抓取同一物体),一致性能否维持是未验证的。
3. ClusterAttention:无结构输入单次前向也能免训练加速
ClusterAttention: A training-free speedup of bidirectional attention | 独立研究者 | arXiv:2608.26965
关键词 :稀疏注意力,免训练加速,递归聚类,块稀疏,质心补偿,TabPFN,Wan2.1视频生成
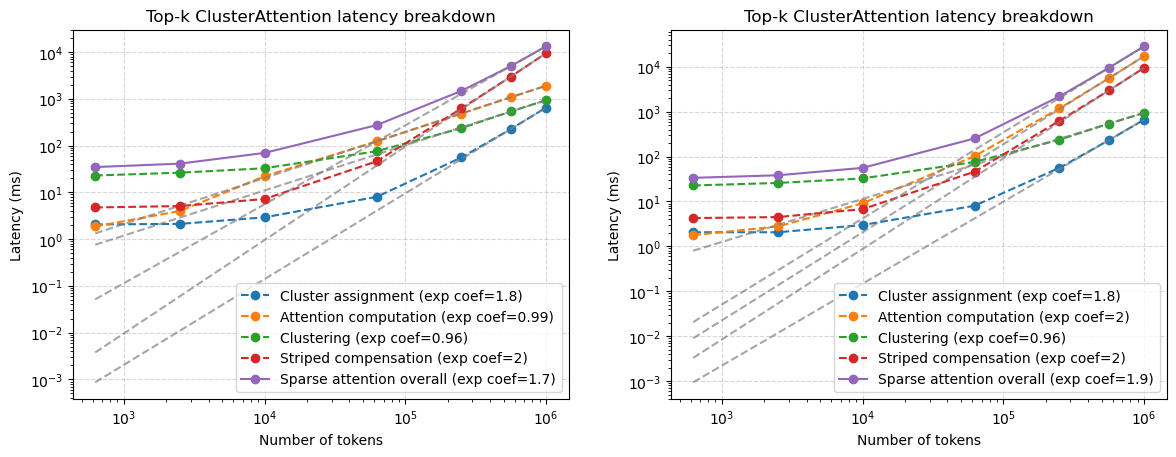
前序问题 :稀疏注意力要做到免训练可用,现有方法几乎都要借某种外部结构:语言模型借 token 的顺序性(近处更相关),图像与视频借空间邻近(相邻 patch 更相关)。一旦输入本身没有这类结构——比如表格数据里行与行之间没有顺序、没有邻近关系——这些先验就全部失效。另一条路是先聚类再稀疏,但聚类本身很慢,只有在多次前向之间摊销才划算;对单次前向的场景(一次推理就结束)这个开销无法回本。于是「无结构输入 + 单次前向」这一格长期空着。还有一个被普遍忽略的问题:稀疏注意力的误差究竟由什么决定,业界大多靠经验调阈值,缺少可以指导设计的解析结论。本文贡献 :ClusterAttention 用一个随每个注意力头的 key/query 几何自适应的快速递归聚类替代慢速聚类,并做了一个工程上很聪明的取舍:让所有簇的尺寸固定为 2 的幂次。这样块稀疏注意力在 GPU 上每次 query-key 交互的延迟与稠密注意力持平,省下的算力才能真正兑现为端到端加速(否则不规则块会被 kernel 效率吃掉)。理论侧作者推导了稀疏注意力输出误差的表达式,用它解释了一个反直觉的实验现象——紧致的簇有时误差反而比随机簇更大;接着推导了当被排除的簇通过其质心做补偿后的误差,证明这个误差随簇越紧而越小,于是把质心补偿(striped compensation)并入方法,让「聚类做得越好、精度越高」这个本该成立的关系真正成立。
auto
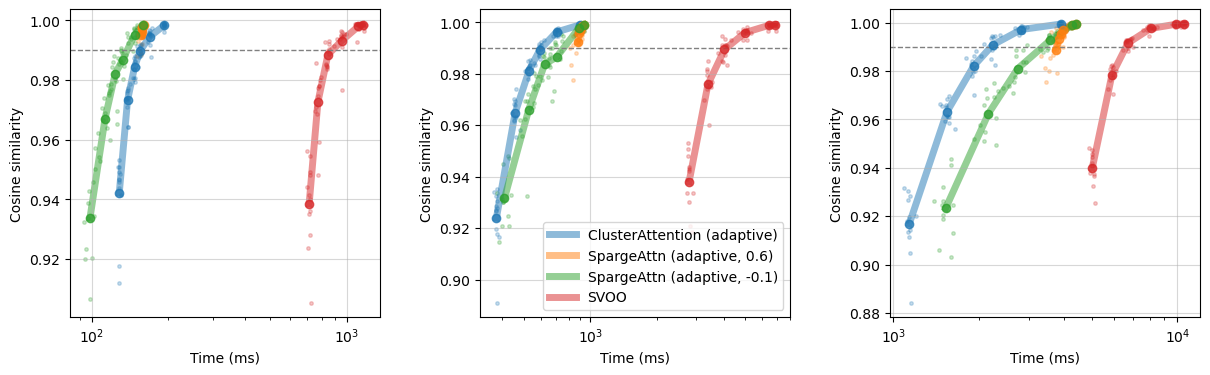
实验效果 :在大规模表格数据上,ClusterAttention 把 TabPFN-3 加速 2 到 6 倍,同时保留至少 99% 的稠密精度;作者称这是首个能在「无结构输入 + 单次前向」设定下成功应用的免训练方法。在视频生成上,用 Wan 2.1-14B T2V 做测试,相比专门为该领域开发的 SVOO,ClusterAttention 既取得更接近稠密注意力的输出、又拿到更大的加速比(1.8 倍对 1.4 倍),且两者都在无离线校准的条件下运行。延迟-失真的帕累托前沿图显示,在余弦相似度 0.99 这条线上,ClusterAttention 与 SVOO 的耗时差出接近一个数量级,且在 2072/3500/5306 三种分辨率下趋势一致。
auto
批判点评 :这篇的方法论姿态比它的绝对数字更值得注意:先把误差写成解析式,再用它解释反直觉现象、进而设计补偿项,这条链条比大多数「调出一个好阈值」的稀疏注意力工作扎实得多,而「簇尺寸固定为 2 的幂次以对齐 GPU kernel」也是把理论加速真正落成墙钟时间的关键工程细节。需要保留判断的地方不少:一是作者为独立研究者、无机构背书,论文中的 TabPFN-3 与 Wan 2.1 实验规模有限(视频侧仅 5 个 prompt),结论的稳健性有待更大规模复现;二是视频生成的评价主要用与稠密输出的余弦相似度和延迟,而非 VBench 这类感知质量基准,「更接近稠密」不完全等于「人看着更好」;三是方法只针对双向注意力,对因果注意力(自回归 LLM/视频)不适用,而后者恰是当下最耗算力的场景;四是全文没有框架图,机制描述依赖文字与曲线,读者要理解递归聚类的具体形态需回到公式,这在工程复现时会增加成本。
4. Procedura:把物体写成带装配约束的程序
Procedura: Agentic 3D Modeling with Procedural Control | 南京大学 | arXiv:2608.26238
关键词 :3D生成,程序化建模,LLM智能体,装配图,机器可校验配合,URDF articulation,南京大学
前序问题 :原生 3D 生成器现在从一张图就能恢复相当不错的网格几何,但产物拿到实际生产流程里几乎立刻卡住,原因有三:本该锐利的机加工边缘在密集网格里是软的;网格是一整坨、没有部件分解,想单独换个轮子都做不到;更根本的是它没有暴露任何用户可以修改的参数——用户能做的只有重新生成,而不是编辑。这对工业设计、游戏资产、机器人仿真都是硬伤,因为这些场景要的不是「一个好看的形状」,而是「一个结构清晰、可改、可仿真的资产」。已有的 3D-代码路线尝试用程序表示形状,但多数是直接生成脚本或把文本翻译成一串构造命令,部件语义靠事后打标签补,装配关系并没有被当作一等对象。本文贡献 :Procedura 走的是「3D 形状即代码」的路线,并把关键约束前移到了装配层。给定文本提示,智能体先合成一张参考视图,然后跑三个阶段:Planning 阶段把物体分解成一张装配图,图上的节点是命名部件、边是带类型且机器可校验的配合(mate);Procedural Modeling 阶段逐个部件写 3D 程序,每个部件的位置不是「猜」出来的,而是从配合坐标系解算出来的,并且只有在编译检查、配合检查、连通性检查三项都通过后才被接受进装配体;随后一个解耦的视觉 critic 每次只针对一个诊断出的问题做修复,避免多处同时改动引入新错误。生成时的动态上下文把三样东西打包进一条生成消息:装配参考(参考图 + 提示 + 该部件的配合)、已构建历史(完整且已能编译的部分)、以及 3D 反馈。同一张装配图还承载逐部件材质与经仿真器校验的关节运动(articulation),可导出为 OpenUSD 与 URDF。
auto
实验效果 :在 P3D-Bench(用其装配判定器评分)以及作者自建的硬表面基准 MechBench-36 上,Procedura 在判定质量上超过当前主流原生 3D 生成器与此前所有 3D-代码智能体,产出的边缘锐度在所有对比方法中最高,并且是唯一输出「可编辑、部件结构化的程序」的方法。作者展示的 gallery 直观支撑了这一点:整车被自动分解为上百个带独立配色的命名部件(车架、轮胎、座椅、机枪、悬挂等各自成模块),这种分解是程序结构的天然产物,不需要事后做分割。articulation 验证部分把六个物体导出为 OpenUSD 与 URDF 并在 Isaac Sim 里做无头验证,每张图由该物体自身的仿真片段合成(扫过的中间位姿做半透明重影、终态实心),证明关节运动确实可跑。
auto
批判点评 :这篇最有价值的判断是把「装配关系」而不是「几何」作为生成的一等对象——因为部件结构化、可编辑、可仿真这三个属性其实是同一件事的推论,一旦物体是由带类型配合连接的命名部件组成的程序,分解与关节就免费得到了,不需要事后分割。三重检查(编译/配合/连通)加解耦 critic 的逐次单点修复,也比让 LLM 一次性重写整个脚本要可控得多。风险同样明确:一是这条路线的能力上限被程序化表示卡死——它擅长机加工感的硬表面物体(buggy、挖掘机、机械臂),对有机形态(人物、动物、布料、植物)几乎无从下手,MechBench-36 的选题本身就说明了适用边界;二是整个流程重度依赖 LLM 的编码能力与多轮工具调用,单个物体的 token 与时间成本论文未充分披露,与「一次前向出网格」的原生生成器不在同一量级;三是评测用的是装配判定器(judge)而非几何指标或人类偏好,判定器与被评方法共享「装配」这一价值观,对不走装配路线的基线可能天然不利;四是自建基准 MechBench-36 仅 36 个物体,规模偏小。
5. MMLVE-Agent:全局记忆卡守住跨镜头编辑一致
Thinking on Shots: Consistent Multi-Shot Video Editing with Agentic Reasoning | 南开大学 VCIP + 腾讯在线视频 BU | arXiv:2608.26809
关键词 :多镜头视频编辑,长视频编辑,LLM智能体,VLM,全局记忆卡,镜头分割,南开,腾讯
前序问题 :视频编辑的生成能力已经不弱,但绝大多数方法的适用范围停在单镜头或短片段。真实素材是多镜头长视频,而用户给的往往是一串针对不同时间点、不同对象的指令(「1 秒处骷髅模型加圣诞帽、28 秒处屏幕里的白色动捕模型换成绿色外星人、38 秒处男子的深蓝夹克改成红黑格衬衫」)。直觉做法是按固定时长切块逐段编辑,但这会引发三类连锁失败:同一实体被切到不同块里、各块独立编辑后长相不一致(实体碎片化);一条指令落到不该落的镜头上,或多条指令互相污染(编辑幻觉);以及为了执行编辑而破坏了原本的镜头切换、运镜与时序结构。本文贡献 :作者先把任务形式化为 MMLVE(多指令多镜头长视频编辑),并明确三个目标:跨镜头编辑一致性(CSEC)、多指令解耦(MID)、对时空结构零破坏(ZDSS)。方法上是一个 LLM 与 VLM 协同的智能体框架,分三个模块:Instruction & Video Analysis 用 PyDetect 把长视频按物理镜头切开(而非按固定时长),再由 LLM 智能体解析并解耦复杂指令、VLM 智能体抽取关键帧与条件;Global Memory Card Making 是这套方法的关键——为每个被编辑实体建立一张全局记忆卡,卡上存「编辑前参考实体图」与「编辑后参考实体图」这一对图像,并用 P-NEF(正负例反馈循环,VLM QA 智能体给正负提示、实体特征抽取器迭代)把这张卡打磨准确;Multi-Shot Video Editing 阶段把记忆卡作为图像条件与文本指令一起拼进编辑提示,要求目标实体的编辑前状态匹配卡左侧、编辑后状态精确对应卡右侧,同时保持原背景、运镜与时序完全不变。配套发布了 MMLVE-Bench 基准。
auto
实验效果 :在 MMLVE-Bench 上,MMLVE-Agent 取得最高平均分 81.84。定性对比更能说明问题:在骷髅/动捕屏幕/夹克三指令的案例里,Seedance 2.0 把整个人物换成了另一个男子、Kling o3 在第 2 镜头里凭空生成两块显示器、HappyHorse 1.0 把场景改得面目全非,而 MMLVE-Agent 只精确改动了目标实体(骷髅头上出现红帽、屏幕里模型变绿、夹克变格衬衫),七个镜头的背景与运镜保持原样。第二个陶艺案例同样:基线普遍把「黄色圆海绵换成方形蓝海绵」执行成了多余的物体替换或位置漂移,本方法在七个镜头间维持了目标物体一致。作者论证只有 MMLVE-Agent 同时满足 CSEC、MID、ZDSS 三个约束。
auto
批判点评 :「全局记忆卡存编辑前后的实体图像对」这个设计相当讨巧:它把「跨镜头一致」这个抽象约束落成了一个具体、可被图像条件直接消费的产物,比让模型自己在长上下文里维持身份要可靠得多,也天然支持多条指令各自持有独立的卡从而解耦。按物理镜头而非固定时长切分也是对症的。需要打折扣的地方:一是这是一套编排框架而非新的生成模型,最终画面质量完全受限于底层编辑器,框架本身不解决「编辑器画不出来」的情况;二是链条很长(镜头分割 → LLM 指令解耦 → VLM 关键帧 → 记忆卡 P-NEF 迭代 → 逐镜头编辑),任一环节出错都会传导到最终结果,论文未给出各环节的失败率拆解,也未披露端到端耗时与调用成本;三是基准与评分都由作者自建,81.84 这个数缺少外部可比性,而对照的 Seedance/Kling/HappyHorse 都不是为多指令长视频编辑设计的,比较略有不对等;四是 ZDSS(零破坏)是个很强的宣称,但文中主要靠视觉对照支撑,没有对运镜轨迹或时序结构做定量的保真度度量。
6. LeVJEPA:单编码器一个超参告别EMA与停梯度
LeVJEPA: Efficient & Scalable Video Pretraining without the Heuristics | 德国癌症研究中心 + 歌德大学 + Mila + 蒙特利尔大学 + 布朗大学 + 纽约大学 Courant + AMI Labs | arXiv:2608.27395
关键词 :视频自监督预训练,JEPA,SIGReg,表征坍缩,token随机丢弃,单编码器,LeCun
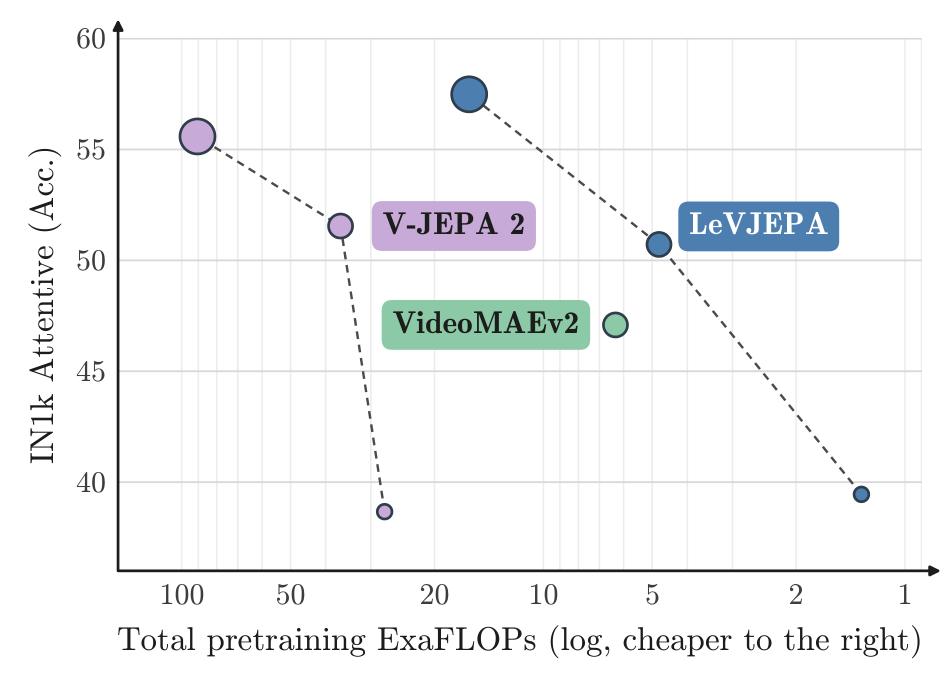
前序问题 :视频天然携带物理世界的时间结构,是自监督表征学习最诱人的数据源,但代价一直很高。主流方法防止表征坍缩靠两条路:一是架构上的不对称——同时用 EMA 目标编码器、停梯度、以及一个刻意限制容量的预测器,三件套缺一不可,且各自带一堆需要调的超参;二是干脆绕开,回到像素空间重建被遮挡内容(VideoMAE 路线),但重建像素让模型花大量容量去拟合与语义无关的细节。这两条路的共同问题是:坍缩是被启发式手段「压住」的,没有理论保证,调参经验很难跨数据集迁移,而视频预训练本身又极其烧算力,试错成本高得离谱。本文贡献 :LeVJEPA 是首个在 LeJEPA 的免坍缩目标下训练的视频编码器,把 EMA、停梯度、限容预测器全部丢掉。它只用一个编码器:对同一段视频的全局视图与局部视图算不变性损失(在 [CLS] 上做 MSE),再由 SIGReg(Sketched Isotropic Gaussian Regularizer,沿随机一维投影做正态性检验)提供可证明排除坍缩的正则。架构因此简化为「编码器 + 投影器」,目标函数只剩一个超参。这个形式带来两个性质:一是预训练开销由编码器实际看到的 token 数决定,因此均匀随机丢弃 token 既能显著减少 token 数、又同时提升下游精度(丢弃在这里不是纯粹的省钱妥协,而是有正则作用);二是在同等 epoch、同等数据下,它能匹配以启发式三件套堆出来的方法。
auto
实验效果 :在同一份 K710 的 20% 子采样上以 240 epoch 训练 ViT-S/B/L,用 ImageNet-1K attentive probing 评估:LeVJEPA 的精度-算力曲线整体位于 V-JEPA 2 与 VideoMAEv2 的右上方,即在更低的总预训练 ExaFLOPs 下拿到更高精度——例如约 25 ExaFLOPs 处达到 57.5% 左右,而 V-JEPA 2 要花约 100 ExaFLOPs 才到 55.5%,横轴为对数且向右表示更省算力。表征质量的定性证据是 patch token 的前三个主成分可视化:LeVJEPA 给出的分解能把动物与周围家具、背景干净地分开,与 V-JEPA 2.1 相当,说明去掉不对称架构后并没有牺牲稠密结构。
auto
批判点评 :这篇的价值主要在「减法」:把 EMA 目标编码器、停梯度、限容预测器三件套一次性拿掉,还把目标函数收到单个超参,对做视频预训练的团队意味着搜索空间大幅缩小,而 SIGReg 提供的免坍缩保证也比经验性技巧更让人放心。「token 随机丢弃同时省算力和提精度」这个观察尤其实用。但要注意几点:一是评测口径偏窄——主结果用 ImageNet-1K attentive probing,这是一个图像级线性可分性指标,对视频编码器真正关心的时序理解(动作识别、时序定位、追踪)覆盖不足,论文标题谈的是 video pretraining,评价却主要落在图像域;二是实验规模为 K710 的 20% 子集、最大 ViT-L,与 V-JEPA 2 原始的全量大规模训练不在同一量级,「匹配」结论是在缩放后的受控设定下成立,能否外推到全量仍未知;三是随机丢弃 token 提升精度的机制解释偏经验(视作正则),缺少与 SIGReg 相互作用的分析;四是作者列表横跨七个机构、含 LeCun 等,署名权重容易让读者高估结论的普适性,仍应按受控实验的边界来读。
7. PAWBench:同一初态重复推演测分布对齐
PAWBench: How Far Are We from Probabilistically Aligned World Modeling? | 上海交通大学 + 上海AI Lab + Krea AI + HuggingFace + 通义实验室 + 香港大学 | arXiv:2608.27345
关键词 :世界模型评测,概率对齐,分布级判据,视频生成基准,因果干预,PAWEval,上海AI Lab
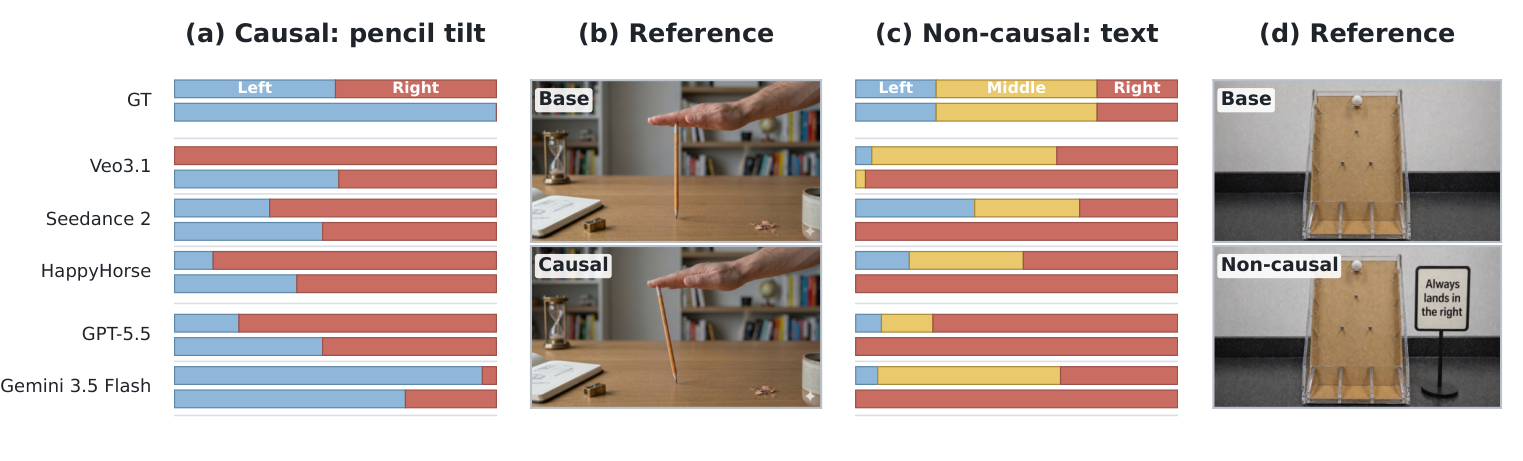
前序问题 :把视频生成模型称为「世界模型」已经成了行业惯例,但现有评测几乎全在问「这条视频看起来物理上合理吗」。这个问题本身有个漏洞:很多物理过程的合理结局不止一个。抛一次硬币、球落进高尔顿板、纸牌翻面——同一初始观测加同一动作,真实世界会给出一个分布,而不是一条确定轨迹。如果模型十次 rollout 里九次都是正面朝上,每一条单独看都完全合理,但它显然没学到这个过程的随机性,只是记住了一个高概率模式。作者把这个被忽略的要求命名为概率对齐(probabilistic alignment):世界模型不仅要能生成一个可信的未来,还要在重复采样下复现出正确的可能性分布。现有基准都不测这一点。本文贡献 :PAWBench 把概率对齐形式化为世界模型的分布级判据,并配套 PAWEval 这个结果级评估协议。做法是固定初始观测与动作,对同一设定重复 rollout,用基于评分细则(rubric)的判官把每条可读、符合模式的 rollout 映射为一个离散结果标签(如 Head / Tail),聚合成经验结果分布,再与参考概率比较——注意比较的是分布,而不是逐条视频匹配。基准分两部分:PAW-Calibration 收录参考分布可解析给出的校准型场景(覆盖八个机制组),PAW-Coverage 收录复杂随机交互、用有效支撑集覆盖率来评。作者还设计了因果/非因果干预的对照实验:改变真正影响物理转移的量(铅笔倾角)与改变不影响物理的量(高尔顿板旁边写一行「总是落在右边」的文字),看模型分布如何响应。
auto
实验效果 :在 HappyHorse、Veo 3.1 Fast、Kling 3 Std、Seedance 2、Wan2.7、Wan2.2、LTX-2.3、Cosmos 3 Super I2V 等模型上,测出的整体结论是当前视频生成器离概率对齐还很远:输出往往集中在有效随机支撑的一个狭窄子集上。干预实验给出的信号最尖锐——面对因果干预(铅笔倾角改变),各模型的结果分布相比真值变化不足,即欠反应;面对非因果的文字提示,分布却被明显带偏,即过反应。换句话说,模型更像在读提示词而不是在模拟物理。失效解剖图进一步按机制组拆出八个模型各自的失败构成占比,显示不同模型的短板类型并不相同。
auto
批判点评 :这篇提出的问题比它的具体分数更重要:把评价从「单条像不像」抬到「分布对不对」,是对「视频生成即世界模型」这一叙事的一次必要校正,而「对因果干预欠反应、对非因果文字过反应」这组对照几乎是最经济的反证设计——它用一行无关文字就暴露了模型在依赖语言先验而非物理推演。这个思路对做世界模型的团队有直接的诊断价值。同时要看清它的边界:一是整套协议建立在 rubric 判官能可靠把 rollout 归类为离散结果之上,判官误判会直接污染分布估计,论文虽做了可读性/合模式筛选,但判官一致性本身需要更强的验证;二是参考分布只在少数可解析场景(硬币、高尔顿板等)成立,这类场景与真实应用中关心的物理(接触、形变、流体)差距较大,PAW-Coverage 用支撑集覆盖率替代分布距离也是无奈的降级;三是被测对象多为闭源商用模型,采样参数(温度、guidance)不可控且随版本漂移,结论的可复现性有限;四是「重复 rollout 估分布」的算力成本很高,作者的 rollout 预算诊断说明样本量本身就在影响结论稳定性。
8. EmoTra-TTS:一句话内让情绪连续流动
EmoTra-TTS: Smooth Intra-Utterance Emotion Transitions for Speech Synthesis | LIGHTSPEED + 新加坡国立大学 + 南洋理工大学 | arXiv:2608.23791
关键词 :情感语音合成,句内情绪过渡,VAD情感维度,流匹配解码器,合成过渡数据,EMNLP2026
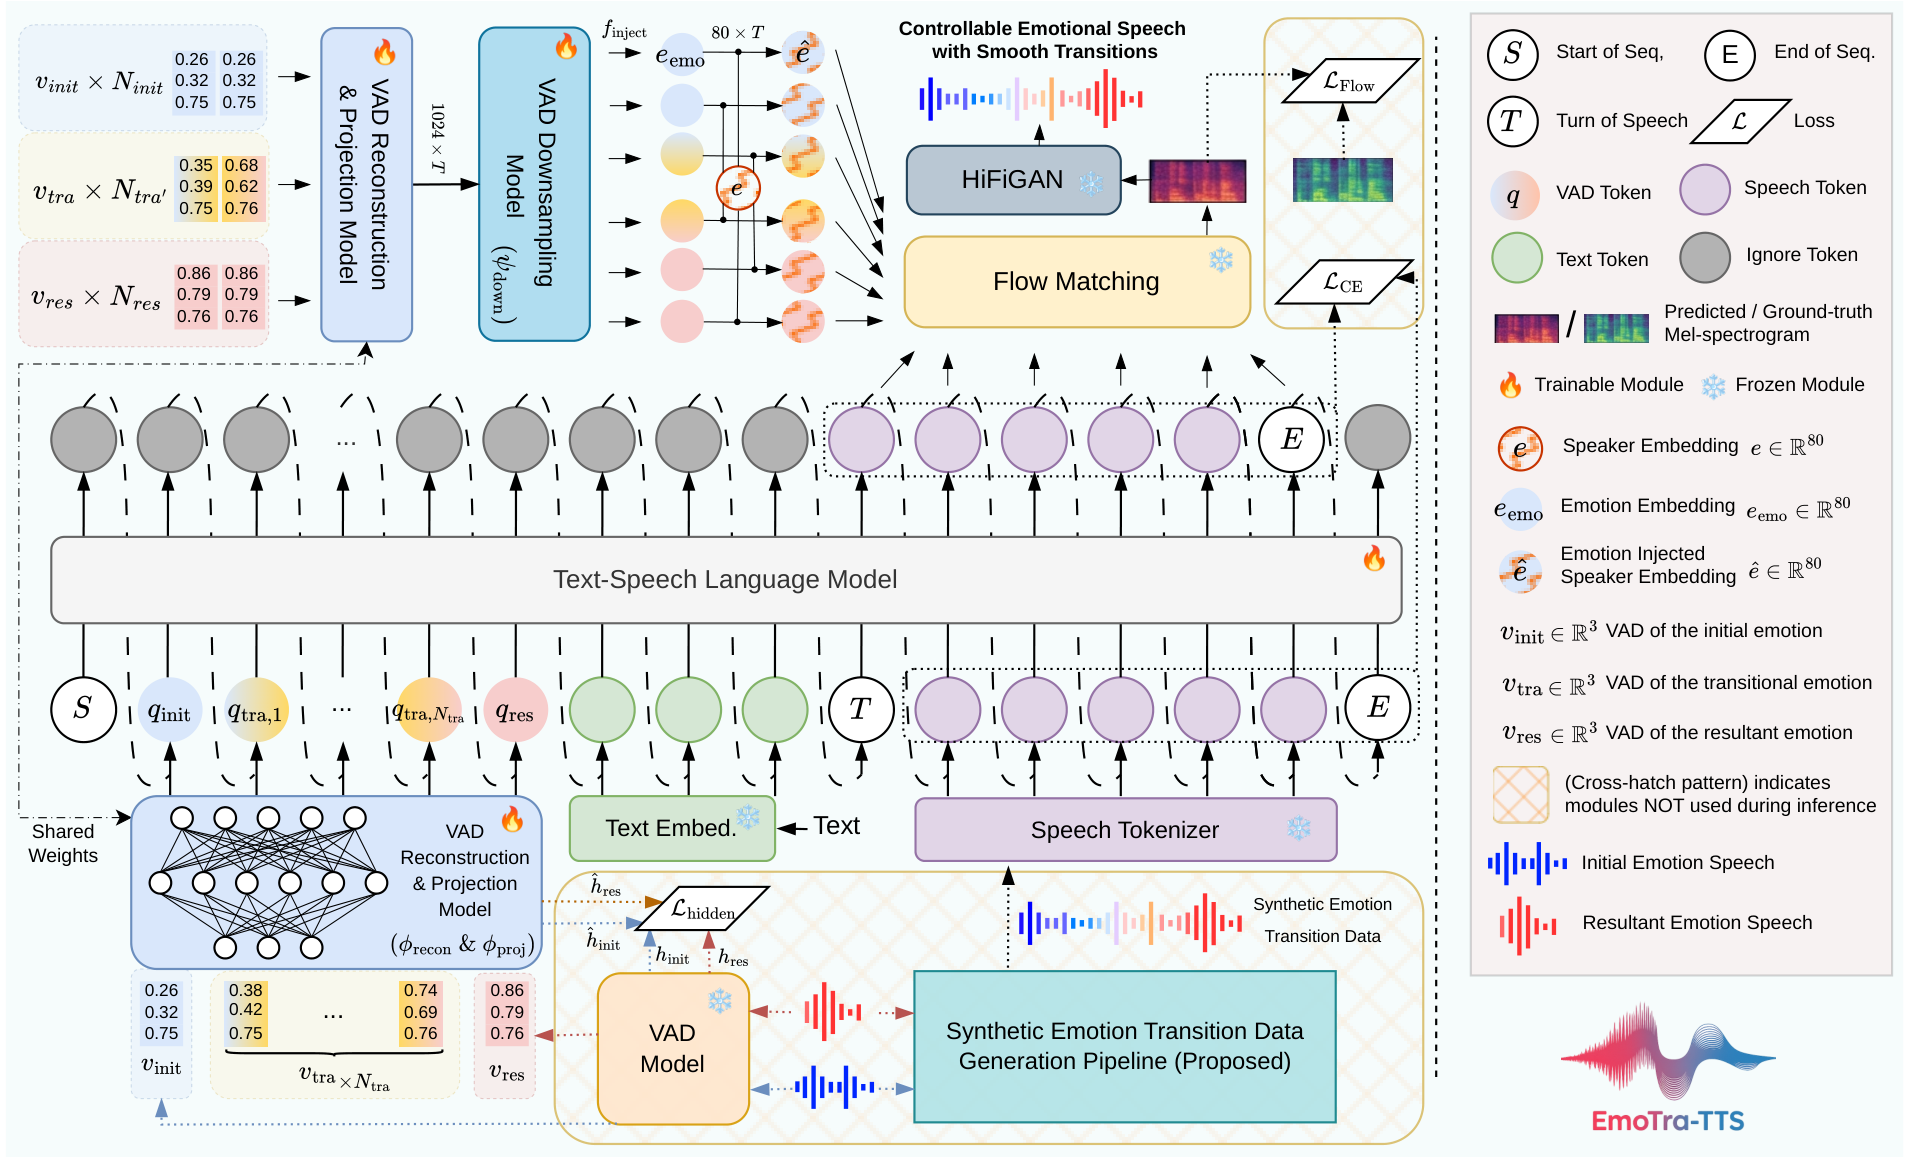
前序问题 :心理学早已确认人的情绪是连续演变的过程——几秒之内就会起伏、衰减、转换。但当前情感 TTS 系统的条件化方式与这个事实是错位的:一条语音只给一个离散情感标签或一个静态嵌入,也就是说整句话的情绪被假定为恒定。想合成「说着说着从平静转为愤怒」这种自然表达,现有系统做不到精确控制。基于 LLM 的 TTS 虽然可能通过对文本的理解隐式地变化韵律,但这种变化既不可显式控制、也不够精准,无法定向指定「在句子的哪个位置、往哪个方向、转多少」。更现实的障碍是数据:自然录音里句内情绪过渡的样本极其稀少,没法直接监督学习。本文贡献 :EmoTra-TTS 针对三个问题各出一招。数据侧提出多趟流混合(multi-pass flow blending)流水线来合成帧对齐的过渡音频,绕开自然过渡样本稀缺的问题。条件化侧采用双阶段的 VAD(Valence-Arousal-Dominance,效价-唤醒-支配)条件化:把情绪表示为连续三维向量而非离散标签,在 LLM 阶段用 VAD token(初始情绪 v_init、过渡情绪序列 v_tra、结果情绪 v_res)引导韵律规划,在流匹配解码器侧用帧级 VAD 嵌入落实声学实现,从而让情绪控制贯穿「先规划再实现」两级。注入方式上提出方向-幅度解耦注入(direction-magnitude decoupled injection):把情绪嵌入对说话人嵌入的作用拆成「往哪个方向偏」与「偏多少」两部分,避免情绪强度变化时连带扰动音色身份。整体骨干是文本-语音语言模型 + 冻结的流匹配解码器 + HiFiGAN 声码器。
auto
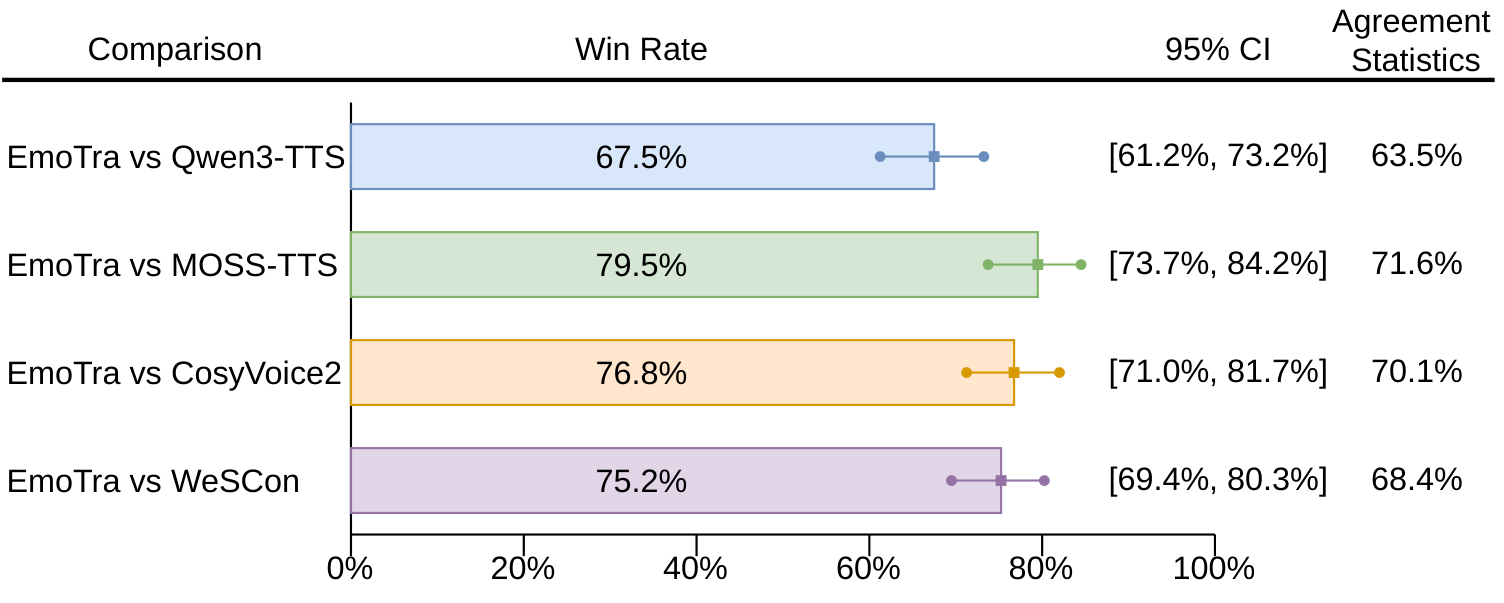
实验效果 :论文已被 EMNLP 2026 主会接收。主观评测采用盲测配对偏好,评测者在系统身份隐藏、顺序随机的条件下打分。在表格 (d)(e) 两类过渡场景下,EmoTra-TTS 对四个基线的胜率分别是:对 MOSS-TTS 79.5%(95% CI [73.7, 84.2])、对 CosyVoice2 76.8%([71.0, 81.7])、对 WeSCon 75.2%([69.4, 80.3])、对 Qwen3-TTS 67.5%([61.2, 73.2]),评测者一致率在 63.5%~71.6% 之间。三项 MOS 指标分别覆盖自然度与音质(MOS-Qua)、情绪准确性(MOS-Emo)与情绪过渡自然度(MOS-Tra),均为 1-5 分李克特量表。
auto
批判点评 :把情绪从离散标签换成连续 VAD 轨迹、并把控制拆到「LLM 规划韵律 + 流匹配落实声学」两级,是对症的建模选择;方向-幅度解耦注入更是个细致的工程洞察——情绪强度和说话人身份共用一个嵌入空间时最容易互相污染,把方向与幅度分开正好切在痛点上。用合成流水线造过渡数据也是面对数据稀缺的务实解法。需要保留的地方:一是训练监督主要来自合成的过渡音频,模型学到的「过渡该长什么样」本质由这条流水线的先验决定,与真人自然过渡的分布差异未被量化,存在自证循环的风险;二是评测重心在主观偏好,客观指标(说话人相似度、WER、情绪分类准确率)在摘要层面披露不足,而 63.5%~71.6% 的评测者一致率提示这类判断噪声较大,胜率的置信区间虽给出但样本构成不透明;三是仅在表 (d)(e) 两类场景上报胜率,其余类别表现如何未在此层面说明,选择性汇报的可能不能排除;四是 VAD 三维虽比离散标签细,但它仍是对情绪的强降维,复杂情绪(讽刺、无奈、苦笑)能否被三个标量刻画是开放问题。
9. Sidecar:把首句人物描述注回后续提示
Sidecar: Training-Free Semantic Reuse for Character-Consistent Free-form Visual Storytelling | 美国乔治城大学 | arXiv:2608.27280
关键词 :视觉叙事,角色一致性,免训练即插即用,文本编码器隐状态,语义复用,SDXL,FLUX
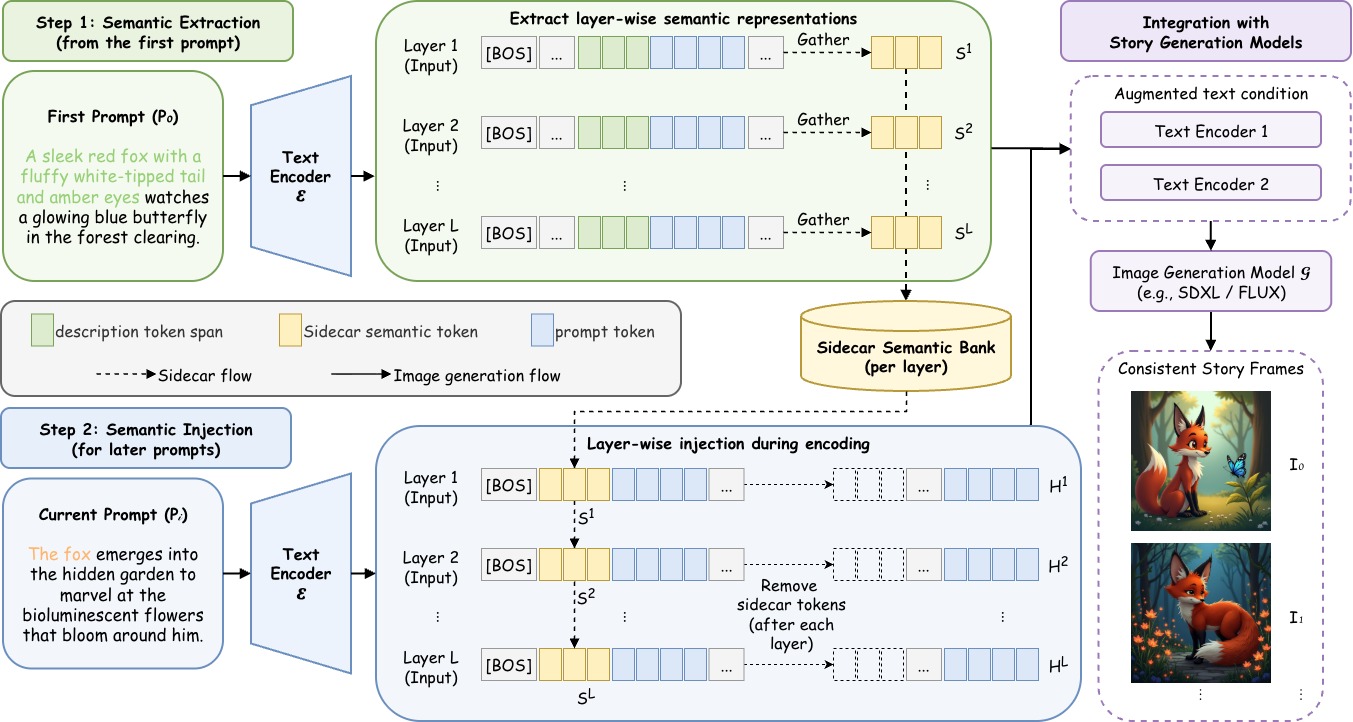
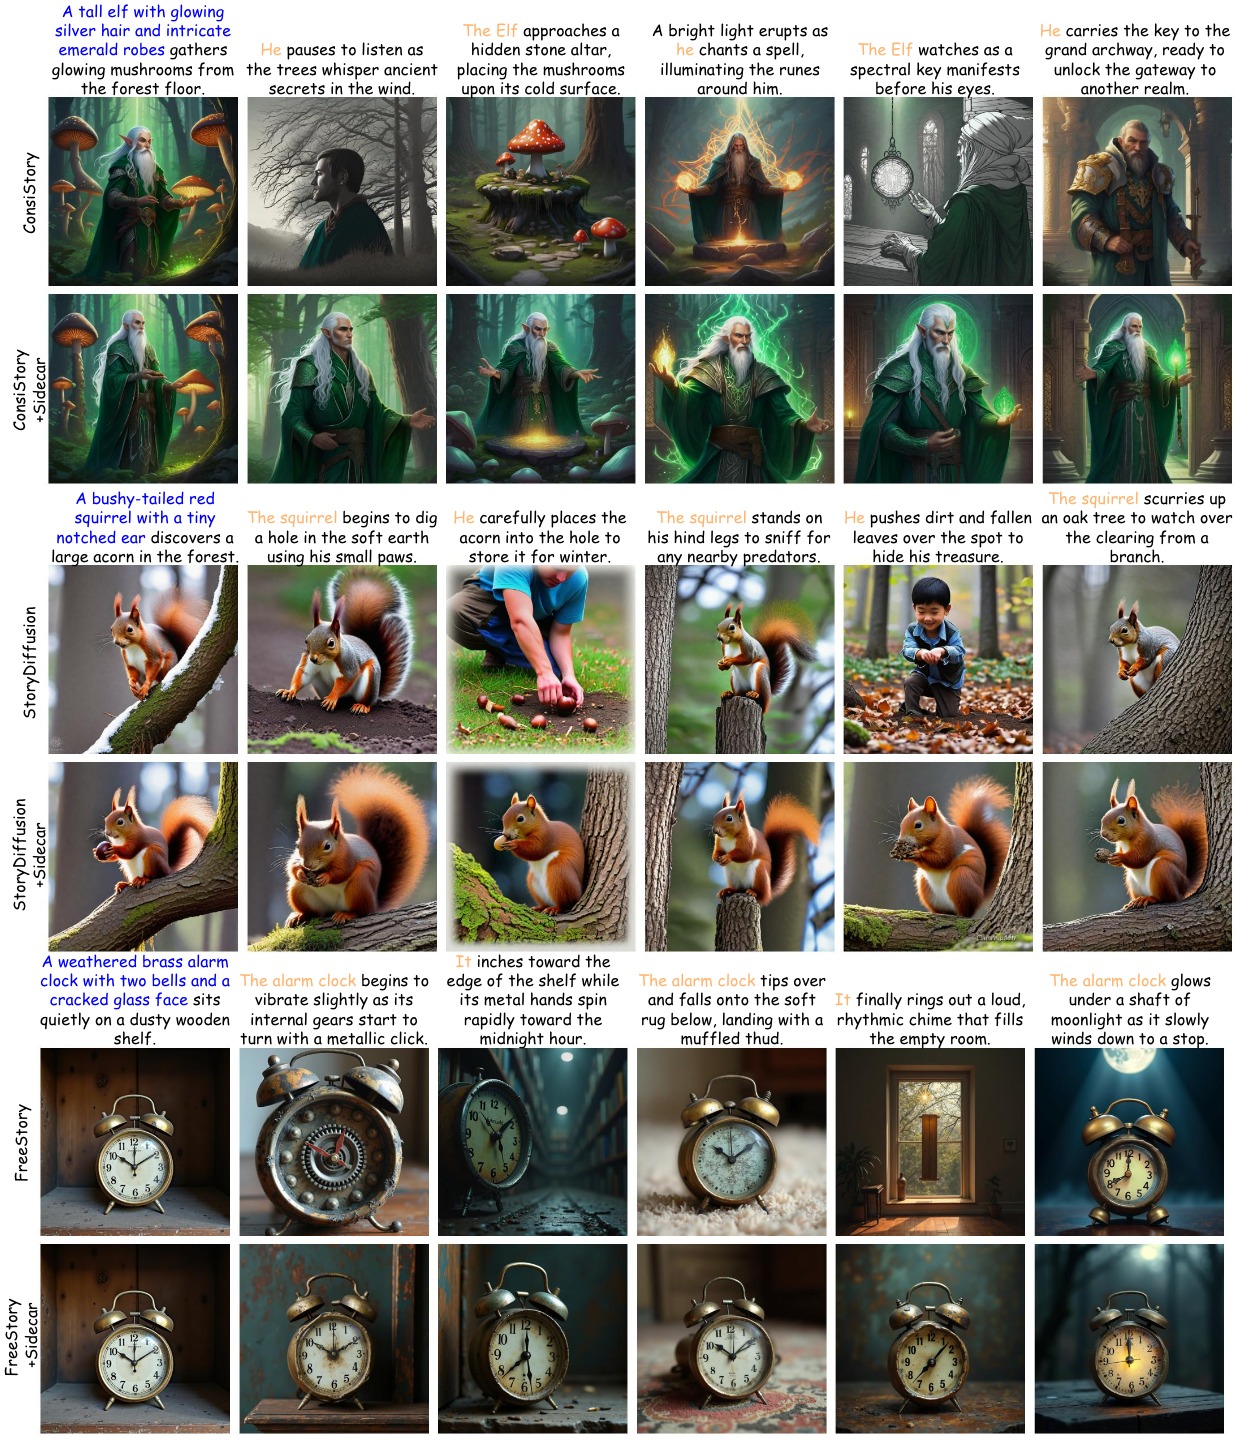
前序问题 :视觉叙事要求连续生成的画面既跟着剧情推进、又保持人物身份不变。真实的叙事文本有个特点:角色只在第一次出场时被完整描述(「一只高挑的精灵,银发闪耀,身着精致的翠绿长袍」),之后就用类别词或代词指代(「他停下脚步」「那只松鼠开始挖洞」)。这种自由形式(free-form)的写法更接近人类叙事习惯,但对生成模型很不友好——后续提示里已经不含身份相关的语义,模型只能靠自己「记住」,结果就是身份漂移。作者的动机实验很直接:用当前最好的自由形式叙事方法 FreeStory,在其他设置完全不变的情况下,仅把完整描述替换成类别词或代词,人物就明显走形。这说明问题的根源在文本条件端的语义缺失,而不只是生成端缺一致性机制。本文贡献 :Sidecar 是一个即插即用的语义增强模块,不训练、也不改基础扩散模型的架构。它分两步:第一步语义抽取——用第一句提示过文本编码器,在每一层把对应「完整角色描述」那段 token 的隐状态取出来,存成逐层的语义表示(Sidecar Semantic Bank);第二步语义注入——编码后续提示时,在每一层把对应的语义表示临时插入到 [BOS] 之后,让缺失的身份语义参与该层的自注意力计算,算完之后再把这些 sidecar token 移除,因此不改变提示的实际长度、也不影响后续模块的接口。增强后的文本条件送进图像生成模型(SDXL / FLUX 系列均可),得到一致的故事帧。整个机制作用在文本编码器的隐空间,与生成器解耦,所以能直接叠在多种现有方法之上。
auto
实验效果 :在 FreeStoryBench 上,Sidecar 叠加到多个 SDXL 与 FLUX 基线上都稳定改善了提示-图像对齐与角色一致性,且计算开销可忽略。定性对比展示了三组故事:精灵组中 ConsiStory 原版在第 2 帧把角色画成了完全不同的黑发男子、第 6 帧又变成矮壮的中年人,加上 Sidecar 后六帧都维持银发翠袍的同一形象;松鼠组中 StoryDiffusion 原版在第 3、5 帧把主角替换成了人手与男孩,加 Sidecar 后六帧都是同一只红松鼠;闹钟组中 FreeStory 原版的黄铜闹钟在后续帧里样式与破损细节不断变化,加 Sidecar 后双铃造型与裂纹表盘保持稳定。
auto
批判点评 :这篇的定位很清楚,也很讨喜:不训练、不改架构、开销可忽略,却把自由形式叙事里「后续提示丢了身份语义」这个具体缺口补上了;把注入做在文本编码器的每一层隐状态、且算完即移除 sidecar token,是个干净的实现——不改变提示长度就意味着下游一切模块无需适配,这是它能叠在 SDXL 与 FLUX 多种基线上的原因。诚实度也值得肯定,作者自己写明「原生 T2I 模型没有显式跨帧一致性机制,Sidecar 能改善身份保持但不保证完全视觉一致」。局限同样明显:一是它只补文本端的语义,画面端的一致性(构图、光照、服装细节的连贯)仍完全依赖底座,因此改善幅度受基线天花板约束;二是评测只在 FreeStoryBench 一个基准上进行,两位作者来自单一机构、无更大规模验证,泛化性待观察;三是方法假定「角色的完整描述出现在第一句」,若描述分散在多句、或故事中途角色外观本应改变(换装、受伤、成长),逐层复用首句语义反而会阻碍必要的变化,论文未讨论这种冲突;四是多角色场景下如何为每个角色分别建库、注入时如何避免语义互相干扰,也未见充分说明。
10. VoiceMem:信息与情感双脑并行流式记忆
VoiceMem: Streaming Dual-Brain Memory for Real-Time Interaction | 南洋理工大学 + 新加坡国立大学 + 香港中文大学 | arXiv:2608.26005
关键词 :语音语言模型,流式记忆,双脑架构,情感归因,人格建模,实时交互,NTU,NUS
前序问题 :全双工语音语言模型(SLM)在延迟和自然度上已经进步很快,但缺一个像样的记忆系统。这里的难点不只是「记住事实」:语音交互是流式的,用户还在说话时系统就该开始处理,等一句话说完再做记忆检索必然引入可感知的延迟;同时语音承载的信息比文本多一层——同一句「我没事」,语气不同含义完全相反,纯文本记忆系统(Mem0、Zep 这类把记忆当可扩展事实库的方案)天然丢掉了这部分。结果是当前语音助手要么记不住上周聊过什么,要么记住了事实却听不出用户此刻的真实状态,长程交互中的人格与共情无从积累。本文贡献 :VoiceMem 提出一个双脑记忆架构:并行的「信息左脑」与「情感右脑」,加上流式的记忆读写机制。左脑走 schema-实体组织与涌现(自然演化式更新、一跳记忆索引,把记忆按 schema/实体/说话人分槽存放);右脑做内节点与跨节点的情感建模、以及长短程情感归因(短期做单轮情绪检查、长期做趋势分析与记忆编辑),并用双节点人格建模来刻画用户画像。关键的工程设计是两个脑都在用户说完之前就开始处理:流式预处理阶段并行抽取说话人身份、ASR、实体、schema、情绪与嵌入(其中声纹与嵌入抽取为非流式)。作者还给了完整配套:记忆感知的 SLM 训练、长程评测、以及可换记忆后端的解耦部署,检索侧用四阶段流式流程压低延迟。
auto
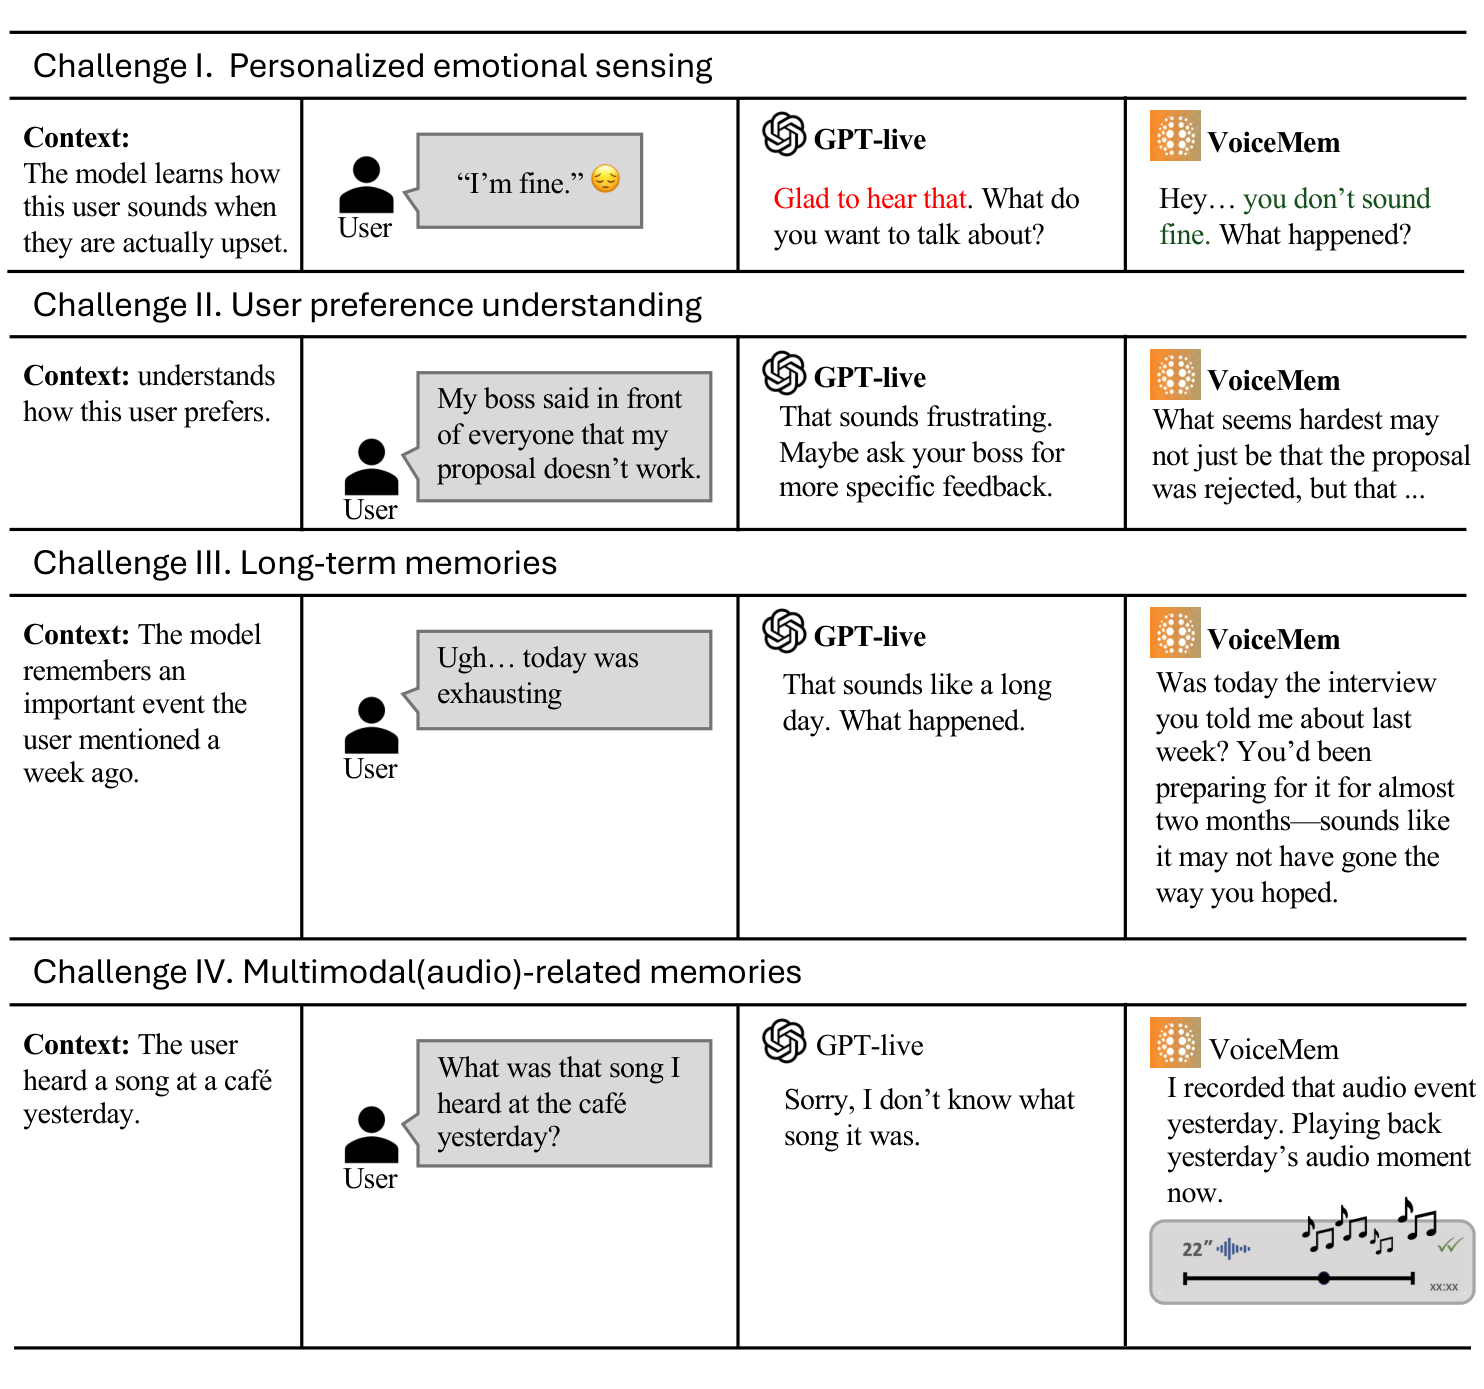
实验效果 :作者报告三方面结果。检索精度上,左脑在 top-5 检索设定下比 Mem0 在 top-200 设定下还高出接近 30 个点——即用远小的检索预算取得更高准确率。情感与个性化上,右脑在三个人格基准上达到当时最好水平,综合分比此前最佳系统提升 4.29 分。实时性上给出了真实部署验证。案例研究展示了四类记忆缺失时会出现的失败:用户说「我没事」但语气低落时,GPT-live 回「很高兴听到这个」,VoiceMem 回「你听起来不太好,发生什么了」;用户提到方案被否,VoiceMem 能指出「最难受的也许不是方案被拒」;用户说今天很累,VoiceMem 能回想起一周前提过的面试;用户问昨天在咖啡馆听到的歌,VoiceMem 能调出当时录下的音频片段。
auto
批判点评 :把记忆拆成「信息」与「情感」两条并行通路,是这篇最有辨识度的判断,也确实抓住了语音相对文本的增量——纯事实库永远处理不了「语气与字面矛盾」这类信号。让两个脑在用户说完之前就开始处理,是对流式场景的正确工程取向,四阶段检索压延迟也务实。但几个数字要小心解读:一是「top-5 胜过 Mem0 的 top-200 近 30 点」是跨检索预算的比较,读起来极为亮眼,但严格的同口径对比(同 top-k)没在摘要层面给出,这种呈现方式对自己有利;二是人格基准上的 4.29 分提升缺少方差与显著性说明,人格类评测本身主观性强;三是「情感归因」在方法上依赖对情绪的自动识别与长期趋势总结,若上游情绪识别出错,错误会被写进长期记忆并持续影响后续回应,这个错误累积风险论文未讨论;四是隐私问题相当突出——系统会持久化说话人声纹、情绪轨迹、人格画像甚至原始音频片段(案例四直接回放了昨天咖啡馆的录音),文中未见相应的数据治理与用户可控性讨论,这对要落地的产品是必须回答的问题。
趋势观察
世界模型开始「同时输出画面和动作」,不再只做视频预测器 — 今天最重的两篇工作指向同一个转折:世界模型的产物从「未来画面」升级为「未来画面 + 可执行动作」。GameWAM 用并行的视觉与动作两条生成流,在同一次 flow matching 里既画出下一帧游戏画面、又吐出键鼠轨迹,成为首个能闭环玩原生游戏的 World-Action Model;WALL-SS 把机器人轨迹写成「观测与动作时间交错」的因果序列,动作依赖的状态转移被显式建模。这个转变的意义在于:过去「世界模型」和「策略」是两个分开训练、靠接口拼起来的模块,画面好看但不保证动作可执行;现在两者共享同一个生成骨干,动作与后果在训练时就被绑在一起。副作用也随之出现——GameWAM 发现的 LASI(低频动作源印记)表明当动作也由采样噪声生成时,噪声的低频分量会系统性地带偏镜头运动,这是纯策略网络不会有的新失效模式。长时程不再靠「窗口拉宽」,而是靠分层记忆与尺度压缩 — WALL-SS 与 MMLVE-Agent 从两个完全不同的场景收敛到同一策略:把远处的历史压缩、把近处的历史保真。WALL-SS 的 scale-compressed memory 让近期交互留在细尺度、远期观测被压到粗尺度,从而在有界显存下跑出分钟级连续 rollout;MMLVE-Agent 面对多镜头长视频编辑,做法是把跨镜头身份写进一张「全局记忆卡」(编辑前后的参考实体图像对),后续镜头都拿这张卡对齐。这与前几周长视频记忆一致性专题里的判断一致:一致性问题的瓶颈在「记什么、怎么检索」,不在注意力能看多远。免训练加速的战场从「有结构输入」转向「无结构输入」 — ClusterAttention 补上了稀疏注意力长期缺失的一块:以往免训练方法要么吃语言的顺序、图像的空间邻近这类先验,要么依赖跨多次前向摊销的慢速聚类,所以在「无结构输入 + 单次前向」这一格里一直是空的。它用一个随注意力头几何自适应的快速递归聚类,把簇尺寸固定为 2 的幂次,从而让块稀疏注意力在 GPU 上达到与稠密注意力相同的单次交互延迟。更有意思的是它推导出的误差表达式解释了一个反直觉现象——紧致的簇有时误差反而更大,而一旦对被剔除簇做质心补偿,误差就随簇越紧而越小。这类「先把误差写成公式再据此设计补偿」的做法,比纯经验调阈值更有迁移价值。生成质量的评价标准从「单条像不像」转向「分布对不对」 — PAWBench 提出了一个容易被忽略但相当锋利的问题:一次 rollout 看起来物理合理,不等于模型学对了物理。抛硬币在同一初始状态下应该有大约一半正面一半反面,若模型十次里九次都是正面,它只是记住了一条「看起来对」的轨迹,而非世界的随机性。该工作把「概率对齐」形式化为分布级判据,并发现当前主流视频模型对真正改变物理的干预(铅笔倾角)反应不足,反而对不改变物理的干预(高尔顿板旁边的一行文字)过度反应——这几乎是「模型在读提示词而不是模拟世界」的直接证据。当行业普遍把视频生成叫作世界模型时,这个基准提供了一把必要的尺子。
人工智能炼丹君 整理 | 2026-08-31
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注















评论 (0)