今日 AIGC 论文速览
今日共 10 篇 · 世界模型与可执行状态 2 篇 · 长视频生成的记忆与一致性 2 篇 · 注意力与推理加速 1 篇 · 视频生成模型作为几何/物理先验 2 篇 · 生成式模型的规模律 1 篇 · 可控生成与工业落地 2 篇
重点论文标题列表
Code World Model (西湖大学 AGI Lab + 南洋理工大学):让写代码的智能体当世界大脑LayerRecall (浙江大学 + 香港大学):只往记忆敏感层注入历史K/VSWA vs Linear Attention (Microsoft Applied Sciences Group):免训练滑窗高线性注意力2-10倍DensityKV (Manifold AI + 清华大学):免训练把120秒历史压到3.28GiBCLAP (普林斯顿大学):人类视频也能训机器人世界模型
今日论文速览
1. Code World Model:让写代码的智能体当世界大脑
Code World Model: Coding Agent as World Brain | 西湖大学 AGI Lab + 南洋理工大学 | arXiv:2608.25927
关键词 :世界模型,coding agent,可执行世界状态,proxy 视频,MiniMax-H3,时空约束,西湖大学,南洋理工
前序问题 :现在的视频世界模型基本都是从视觉观测里学动力学,这条路有个结构性的短板:视频只呈现「发生了什么结果」,并不承载「为什么会这样、规则是什么」。于是模型学到的是像素层面的统计关联,而不是支配世界演化的知识与机制。后果很具体——持久性守不住。玩家砸碎的花瓶在几十帧之后可能自己复原,捡走的道具会重新出现在原地,因为「这个物体已经不存在了」这件事从来没有被显式记录,只是被寄望于模型的隐式记忆能扛住。开放式演化更是无从谈起:一个只会预测下一帧的模型没有可查询、可修改的世界状态,你无法问它「现在背包里有几把剑」,也无法让它在规则层面上一致地长期跑下去。真正缺的东西是一个显式、持久、可按规则更新的状态表示,而这恰好是视频模型这种表示形式最不擅长承载的。本文贡献 :Code World Model 的做法是把「世界如何演化」和「世界长什么样」彻底分开。前者交给语言模型的推理与编码能力:一个 coding agent 充当 world brain,接收交互意图,推理事件及其后果,然后写出可执行代码去更新一份持久的世界状态,从而保证演化是符合规则的、后果是留得住的。后者交给视频模型的生成先验。两者之间的桥梁是作者提出的 proxy representation——把世界状态编译成一段编码了逐帧时空约束的 proxy 视频(画面里是分割色块与骨架这类粗糙几何),再用它去条件化视频模型渲染出高保真观测。为此作者还建了数据管线,从游戏录像和真实视频里构造对齐的 proxy–observation 配对数据。实验用 MiniMax-H3 作为视频骨干在配对的 gameplay 数据上微调,结果它能跟随 coding agent 搭出的简单交互世界所给定的 proxy 时空规格,同时保留丰富的视觉细节与动态。
auto
实验效果 :作者展示的核心结果是这套「代码管状态、视频管画面」的组合确实能跑通:微调后的 MiniMax-H3 遵循 proxy 指定的时空结构,把粗糙的色块骨架渲染成细节丰富的画面。视觉质量部分最值得注意的是数据效率——仅用五小时 GTA V 游戏录像做微调,模型就在角色、环境、运动方式和相机轨迹都不同的场景上表现出泛化能力,论文的 case 图里既有真人角色也有二次元角色(美少女战士造型),说明外观由文本与视频先验控制、运动由 proxy 控制这个分工是成立的。此外作者也在真实视频上构造了 proxy–observation 配对,说明这套表示不只适用于游戏。整体上论文的定位是可行性验证与范式提出,而不是刷榜。
auto
批判点评 :这篇最有价值的地方是把「持久性」这个问题从模型能力问题重新定义成了系统架构问题。既然规则和状态本来就适合用代码表达,那硬要视频模型在隐空间里隐式维护它,本身就是拿错了工具;让 coding agent 写代码维护状态、视频模型只做渲染,是一个分工干净且可验证的设计——世界状态可以被打印、被断言、被单元测试,这在纯生成式世界模型里是做不到的。proxy 视频作为界面也选得务实:它同时携带几何与时序约束,又足够粗糙以至于生成模型有充分自由度补细节。但局限相当明显。第一,整套系统的天花板被 coding agent 顶住了——世界的规则得先被语言模型正确地推理并写成代码,稍微复杂的物理(流体、形变、多体接触)根本不是几行代码能覆盖的,论文验证的也确实是「simple interactive worlds」。第二,proxy 到观测这一步是有信息瓶颈的:proxy 只编码了粗粒度时空约束,那些不在 proxy 里的物理细节(材质变化、光影随事件的响应)就只能由视频模型自由发挥,未必与代码里的状态一致,这等于在系统中留了一道「状态与画面可能对不上」的缝。第三,实验缺少对照——没有和强视频世界模型在同一任务上比长程一致性,也没有量化「持久性」这个自己主打的卖点,比如「事件发生 N 秒后后果是否仍被正确渲染」这样的指标,读者只能从 case 里目测。
2. LayerRecall:只往记忆敏感层注入历史K/V
LayerRecall: A State-Conditioned Memory Router for Long-Horizon Consistency in Video Generation | 浙江大学 + 香港大学 | arXiv:2608.28460
关键词 :长视频生成,记忆路由,分层注意力,K/V 检索,多镜头一致性,MemoBench,浙江大学,香港大学
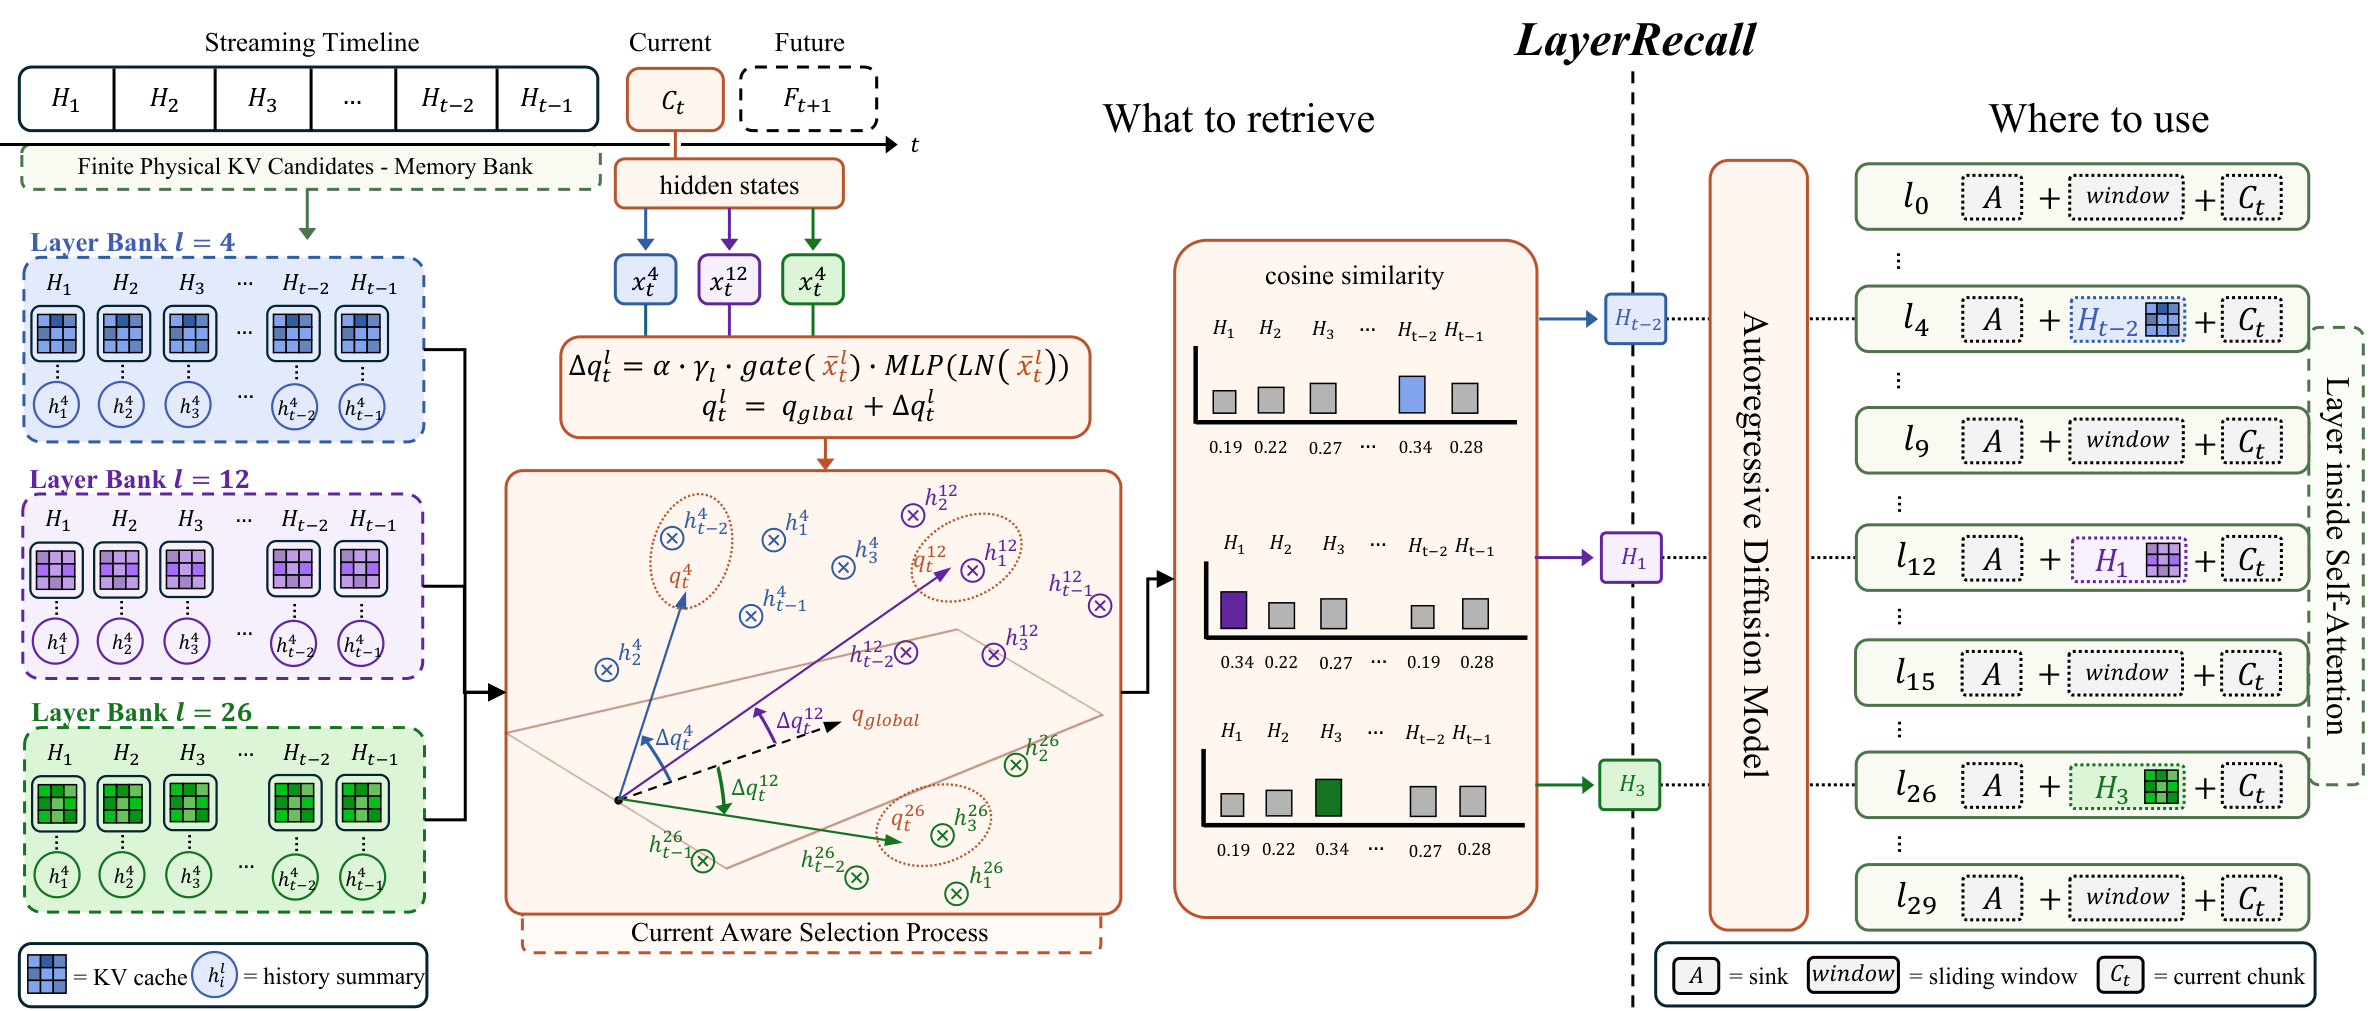
前序问题 :自回归视频扩散靠一个有界的近期上下文逐块生成,这让长视频在算力上变得可行,但也埋了一个必然的漏洞:基于时间邻近的缓存策略会把「暂时用不到」的历史逐出,而一旦某个主体、物体、场景或属性在几十秒后重新出现,需要的线索恰恰是刚被逐出的那部分。已有的记忆机制思路是给模型开一个通往非局部历史的通道,但作者指出一个关键区别——「能访问」不等于「会用」。他们的分析发现 video DiT 的各层对当前块、近期上下文与远期历史的偏好差异明显,也就是说层与层之间在记忆这件事上分工不同。这意味着长程记忆其实是两个耦合的决策:检索什么,以及在哪里用它。把历史无差别地灌进所有层,既浪费又可能干扰那些本该专注局部连续性的层。另一个现实约束是数据:高质量的长时程视频稀缺,显式的「记忆分配」标注更是根本不存在。本文贡献 :LayerRecall 是一个以当前状态为条件、按层选择的记忆路由器。它维护按层索引的记忆库存放有限的历史 K/V 候选,用当前块的隐状态算出一个查询(图中给出的形式是全局查询加上一个由 gate 与 MLP 调制的层相关增量 Δq),再用余弦相似度对各历史片段打分,决定检索哪些。关键的第二步是注入位置:检索到的状态只被送进事先剖析出的「记忆敏感层」,其余层完整保留原有的 sink、滑动窗口与当前块注意力上下文,因此局部连续性不受影响,额外开销也很小。为了摆脱对稀缺长视频和记忆分配标注的依赖,作者提出 Cross-Horizon Prediction Matching(CHPM),用短时程可得的监督信号来训练这个在预测空间工作的有界记忆路由器,绕开了显式标注。
auto
实验效果 :在 100 条多镜头评测提示上,LayerRecall 在 MemoBench 与 MovieBench 上取得最好的整体结果,同时在 VBench-Long 上与其骨干持平——这个组合是它主张的核心证据:增强了长程恢复能力,但没有牺牲局部连续性。定性分析里作者展示了一个叫「记忆引导的自我纠正」的现象:三镜头序列中主体在第一镜头穿纯蓝内搭,第二镜头离场,第三镜头重新出现时最初带了错误的花纹,随后 LayerRecall 把早先的纯蓝外观召回,同时保住了人物身份、灰色开衫、正在进行的动作与场景结构,也就是说属性恢复是局部发生的,没有触发整体画面的重置。作者另外给了跨骨干可移植性与推理开销可忽略的分析,但明确把这一点表述为「在所测模型上的可移植性」而非普适的零样本适用性。
auto
批判点评 :「层各有偏好,所以记忆要选层注入」是个漂亮且可验证的观察,也是这篇比一般「加个记忆库」工作高明的地方——它把注入位置当成与检索内容同等重要的决策变量,而选择性注入自然带来了低开销和不破坏局部注意力这两个副产品,工程上很讨喜。CHPM 用跨时程预测匹配替代不存在的记忆分配标注,也是务实的解法。需要保留的疑问有几点。首先,记忆敏感层是「剖析」出来的,这就引入了一个骨干相关的先验步骤,论文也诚实地把跨骨干结论限定在所测模型内;那么换一个架构差异较大的骨干时,这套剖析要重做多少、成本多高,是决定它能否成为通用组件的关键,文中讨论不足。其次,VBench-Long 只是持平,说明当前收益集中在「重现一致性」这个特定维度,对整体视频质量并无提升,这个边界读者应当清楚。第三,自我纠正那个案例虽然很有说服力,但它同时暴露一个隐忧:模型是在出错之后才召回正确属性的,也就是说错误已经被生成出来并停留了若干帧,路由器扮演的是事后修正而非事前预防;对需要严格连续性的应用,这种「先错后改」的行为模式本身就是一种瑕疵,论文没有量化它出现的频率与持续时长。
3. SWA vs Linear Attention:免训练滑窗高线性注意力2-10倍
Sliding-window beats linear attention | Microsoft Applied Sciences Group | arXiv:2608.28444
关键词 :线性注意力,滑动窗口注意力,attention sink,KV cache,长上下文,推理加速,基线对比,微软
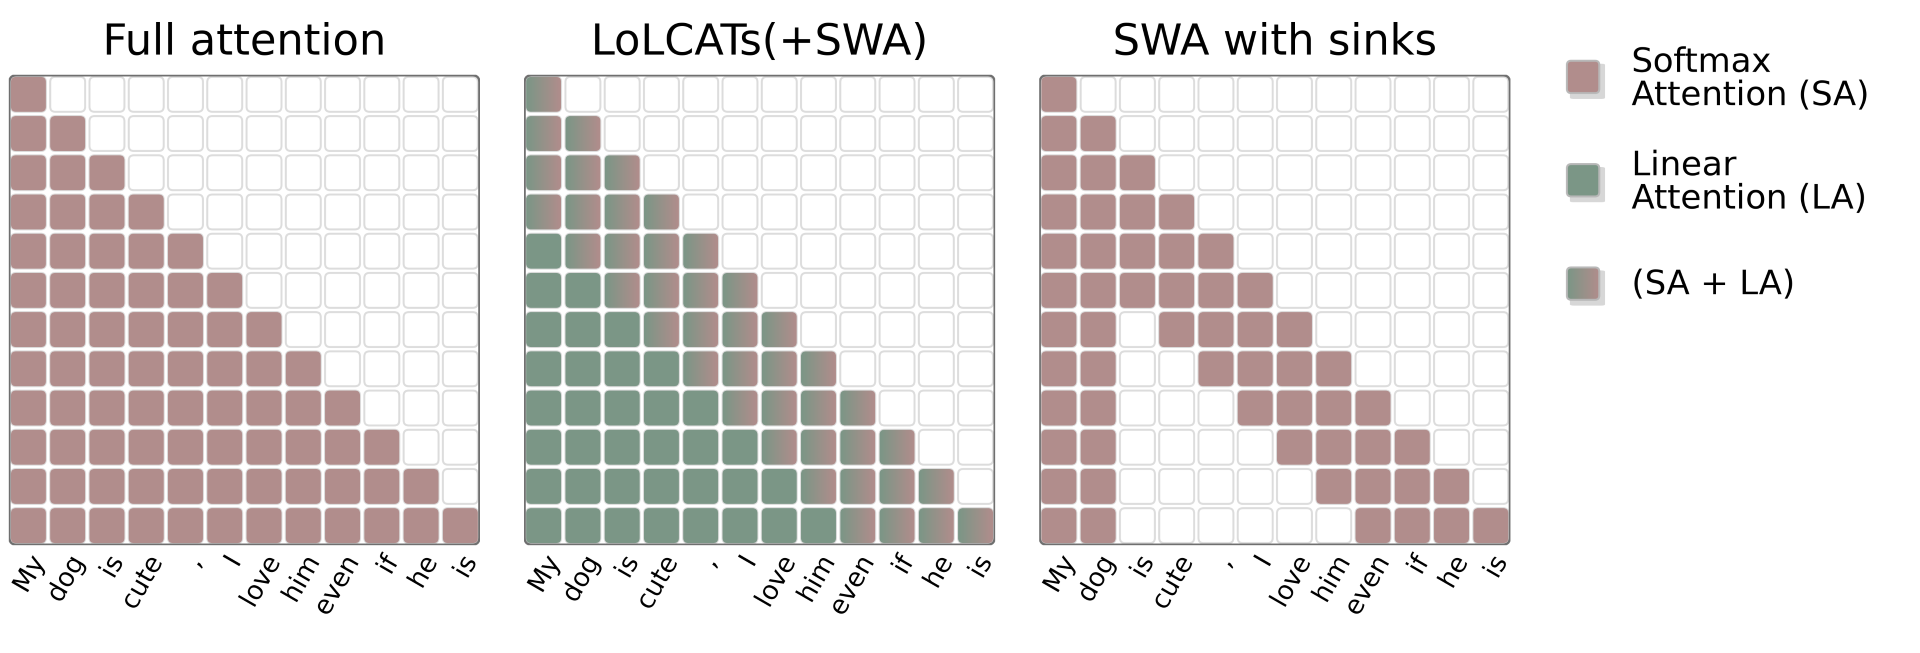
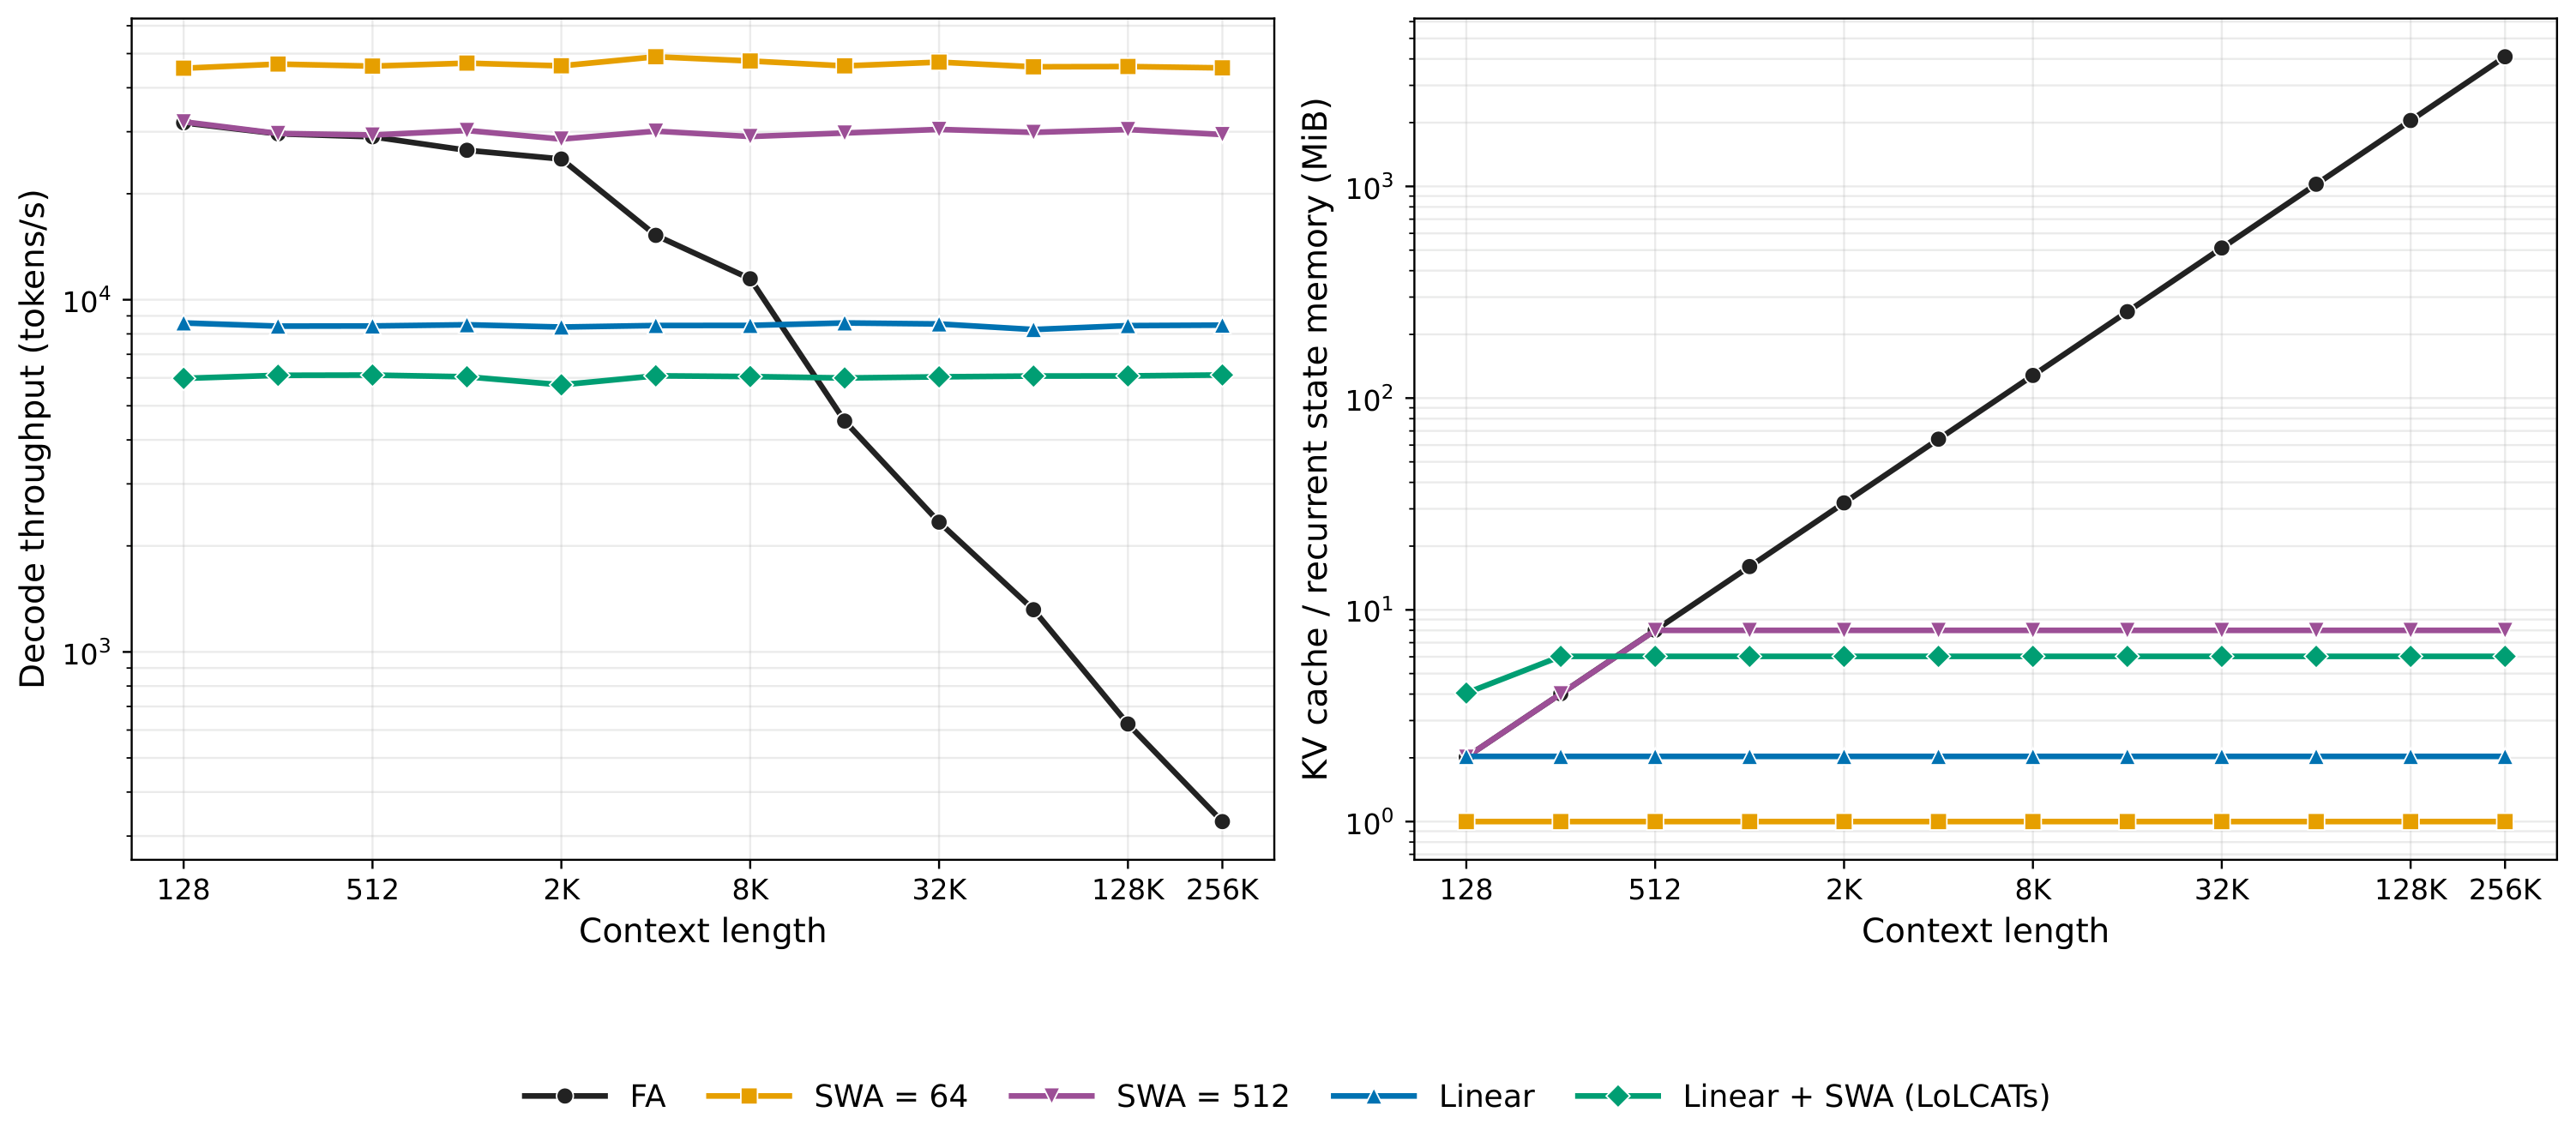
前序问题 :二次复杂度注意力让大模型在内存和能耗上都不可持续:每个新 token 的代价都比前一个大,因为它的 key 和 value 必须被无限期地存在显存里。为了解决这个问题,一条备受关注的路线是把已经训好的模型改造成线性注意力(retrofitting),承诺以很低的成本换来常数级的状态开销和接近原始水平的性能,相关工作这几年数量可观。作者的批评切中要害:这条线一直没有和足够简单的基线做过认真对比。滑动窗口注意力(SWA)就是那个被跳过的对照组——它同样把每步的注意力开销限死在窗口大小内,同样让 KV 占用与序列长度解耦,但它不需要任何改造训练,是一行配置就能开启的方案。当一个研究方向连年在自己的评测里进步,却从未被最朴素的替代方案挑战过,那么这些进步究竟来自方法本身还是来自评测协议的选择,就成了一个必须回答的问题。本文贡献 :这篇不提新方法,而是补上那场缺失的对照实验:把带 attention sink 的 SWA 与经过 post-training 的线性注意力模型,在多个不同的 LLM 与多类下游任务上做系统比较。论文用一张注意力掩码对照图把三种方案的机制差异讲清楚:完整注意力是满的下三角;LoLCATs / Liger-GLA 这类混合方案在近处用 softmax、远处叠加线性注意力,覆盖整个下三角;带 sink 的 SWA 则只保留最左侧的 sink 列与主对角线附近的窗口带,其余位置直接留空。除了任务效果,作者还量化了解码吞吐与状态内存随上下文长度(128 到 256K)的变化曲线,把「快多少、省多少」和「准多少」放在同一张桌子上比较。最后给出的是一条明确的部署建议,而不是一个新架构。
auto
实验效果 :结论是带 sink 的 SWA 在多个 LLM、多类下游任务上表现与 post-trained 线性注意力持平或更好;而在长上下文推理任务上差距被拉开——Needle-in-a-Haystack 与 BABILong 上 SWA 的表现是线性注意力的 2 到 10 倍。效率侧的曲线同样一边倒:完整注意力的解码吞吐从 128 上下文起就随长度持续下滑,到 256K 时降了一个多数量级,KV 占用则近乎线性地涨到 10³ MiB 量级;SWA(窗口 64 与 512)与线性方案的吞吐则在全区间基本是平的,内存占用保持在个位数 MiB 的常数水平,其中 SWA=64 的吞吐是所有方案中最高的。作者据此给出的建议相当直白:要降低推理内存成本,应该直接切到 SWA,而不是去 post-train 线性模型;线性注意力若要追上 SWA,恐怕得从头训练或投入远更大规模的 post-training。
auto
批判点评 :这篇的价值不在技术新意而在方法论卫生:它用一个被长期忽略的朴素基线,检验了一个热门方向的实际收益,并且检验方式是公平的——同时报吞吐、内存与任务效果,而不是只挑有利维度。长上下文推理上 2 到 10 倍的差距尤其值得警惕,因为它指向一个具体的机制解释:线性注意力把历史压成固定大小的状态,本质上是有损压缩,需要精确回忆某个远处细节的任务(大海捞针正是如此)最容易暴露这种损失;而 SWA 虽然看不到远处,但它对窗口内的信息是无损的,配上 sink 又能保住那个对稳定性至关重要的锚点。不过这个结论的适用边界必须说清楚。首先它比较的对象是「post-trained」线性模型,作者自己也承认从头训练的线性注意力可能是另一回事,因此不能被读成「线性注意力这条路错了」。其次,SWA 的强项恰好是它的弱点的另一面:它在窗口外真的什么都看不到,那些需要跨越超长距离做全局聚合(而非精确检索)的任务,理论上应该更利于线性注意力,论文若能补上这类任务的反例会更完整。第三,attention sink 这个关键组件的贡献没有被单独拆开——SWA 好在哪里,有多少来自窗口本身、多少来自 sink,读者无法从现有结果中分离。
4. DensityKV:免训练把120秒历史压到3.28GiB
DensityKV: Density-Guided KV Cache Compression for Long Video Generation | Manifold AI + 清华大学 | arXiv:2608.27922
关键词 :长视频生成,KV cache 压缩,免训练,Soft-Riesz 密度,post-RoPE key,滑动窗口注意力,Manifold AI,清华大学
前序问题 :自回归视频扩散用滑动窗口注意力实现流式生成,但每个新块都以之前生成的内容为条件,于是外观和运动上的误差会沿着 rollout 递归地传播放大。保留历史 K/V 记忆可以留住早先的主体与场景状态,对长时程一致性有实质帮助,但直接全存下来会带来两个问题。一是存储随 rollout 无限增长——生成得越久,这份历史档案就越大,没有上界;二是这些状态之间存在大量冗余:视频里的循环性内容(同一个人反复出现、同一片背景反复入画)会让相似的 key 一遍又一遍地被写进记忆,重复覆盖同一片区域,占了空间却没有带来新信息。已有的检索式方案(如 LongLive-RAG)保留全部被逐出的历史再按需检索,一致性是换来了,但存储代价随时长线性上升,这在实际部署里很快就不可接受。本文贡献 :DensityKV 是一个免训练的历史 K/V 库管理策略,核心思想是用「局部冗余度」来决定一个新状态该不该被收进记忆。它为每个注意力头维护独立的 token 级 K/V 库,并且只在 post-RoPE 的 key 上度量冗余——理由很具体:直接参与注意力路由计算的正是这些 post-RoPE key,冗余应当在真正影响路由的那个空间里衡量。度量方式是 Soft-Riesz 密度:候选 key 落在已有 key 的高密度邻域里就说明信息重复,予以拒收;落在稀疏区域则接纳。通过约束状态进入库之后的邻域密度增长,DensityKV 限制了历史的重复累积,同时保留那些真正携带不同状态的片段,且每个 value 与其 key 严格配对。在生成时,这个有界的压缩历史与本地滑动窗口一起被当前帧注意,不需要任何训练或改结构。
auto
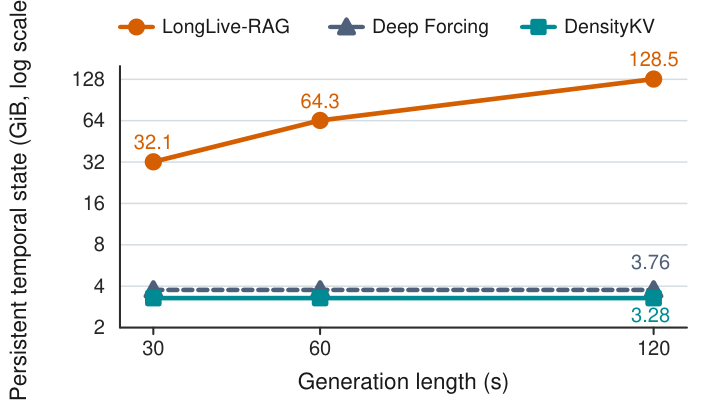
实验效果 :存储侧的对比最直观:随生成长度增加,检索式的 LongLive-RAG 的持久时序状态是线性增长的,30 秒 32.1 GiB、60 秒 64.3 GiB、120 秒 128.5 GiB;而 DensityKV 与 Deep Forcing 保持有界,120 秒时分别只有 3.28 GiB 和 3.76 GiB——DensityKV 是三者中最低的,且与 rollout 长度无关。质量侧,作者在三个自回归视频生成骨干与多个生成长度上做了评估,结论是在相同的历史 KV 容量上限下,DensityKV 提升了长时程一致性与生成稳定性,同时持久历史存储不随 rollout 增长。作者还在与 LongLive-RAG 对齐的评测协议下报告了 30/60/120 秒的单指标胜率统计,以及 120 秒长度上两组骨干–提示配对的定性对比。
auto
批判点评 :把冗余度量放在 post-RoPE key 上是这篇最见功力的一个细节——很多 KV 压缩工作在 pre-RoPE 表示或 value 空间上做相似度判断,但真正决定「这个历史 token 会不会被注意到」的是加了位置编码之后的 key,度量空间和作用空间对齐了,判据才有意义。免训练、每头独立建库这两点也让它作为即插即用组件的门槛很低。可质疑之处主要在评估口径。第一,主要卖点是「有界存储 + 一致性更好」,但 Deep Forcing 同样有界(3.76 vs 3.28 GiB),两者差距其实很小,所以真正的胜负要看质量维度,而质量对比是在「相同容量上限」这个受控前提下给出的相对改善,加上以单指标胜率的形式汇报,读者很难判断绝对差距有多大——胜率高不代表差距显著。第二,密度判据本身是个启发式:Soft-Riesz 密度衡量的是表示空间里的几何拥挤程度,而「表示相近」并不严格等价于「语义冗余」,一个在视觉上关键但恰好落在密集区的状态会被误拒,论文没有分析这种误拒的代价。第三,方法针对的是「循环性内容造成的重复覆盖」,那么在场景持续大幅变化、几乎没有重复的视频上,密度筛选可用的压缩空间理应很小,此时它退化成什么行为、还有多少收益,文中缺少这类不利场景的讨论。
5. CLAP:人类视频也能训机器人世界模型
CLAP: Cross-Embodiment Video World Models are Zero-Shot Physical Simulators | 普林斯顿大学 | arXiv:2608.27406
关键词 :跨本体,动作条件视频生成,世界模型,latent action,末端执行器位姿,零样本部署,DROID,普林斯顿
前序问题 :当前最好的动作条件视频模型基本都被绑在单一机器人本体上,这让它们无法利用互联网上海量的异构视频——那些视频里其实包含了学习可泛化物理规律所需的丰富信号,只是拍摄主体从某型机械臂换成了人手或别的机器人。跨本体学习之所以难,症结在动作表示:不同机器人平台的动作空间差异极大(自由度不同、坐标系不同、抓取方式不同),而人类视频里根本就没有动作标注这回事。于是研究者面临一个两难,要么放弃海量人类视频只用带标注的机器人数据,要么用一个高度抽象的统一表示但丢掉精度。作者的出发点是一个物理上的判断:支配时空动力学的普适物理规律并不关心执行者是谁,所以跨本体的数据本应是可以共用的,缺的只是把异构动作对齐起来的机制。本文贡献 :CLAP 是一个跨本体动作条件视频生成框架,能在人类与机器人混合的互联网规模视频上训练。它先用三种表示来调和不同的动作空间:末端执行器位姿(精度高但需要标注与统一坐标系)、语言指令(对基础模型而言域间差异最小但精度差)、以及 latent action(可从无标注视频里自监督学到)。为了绕开每种表示各自的短板,作者设计了基于课程的跨本体学习配方:第一阶段用 latent action 在大量无标注视频上学基础物理先验,第二阶段再把这些先验落地到末端执行器动作空间,从而支持零样本部署到真实任务。作者把 latent action、课程版、末端执行器版分别做成了模型变体,并开源了全部代码与模型。
auto
实验效果 :在 DROID 这类有挑战性的环境里,CLAP 接近或超过了当前最好的单本体视频模型;在 Bridge 这类较简单的域上只有轻微的保真度下降。在混合了多种本体的 OXE-Mix 数据上,latent action 版与课程版取得最高的预测精度,末端执行器版紧随其后。作者强调这些优势会通过少样本适配进一步复合放大——用 CLAP 作骨干微调后,在 G1 人形机器人上实现了高精度的动力学预测;论文也展示了对双臂 YAM 机器人的少样本适配。最终交付的是作者称为迄今最全面的一套动作条件视频世界模型,覆盖三种动作条件空间(末端执行器、语言、latent)与多种机器人形态,包括跨本体、DROID、Bridge、双臂 YAM 与 G1 人形。作者在附录中还主动澄清了几点:CLAP 并非普遍优于单本体模型,偶尔会不如为单一本体定制的模型;也没有哪一种动作表示能普遍胜出。
auto
批判点评 :把跨本体的核心难点定位为「动作表示对齐」而不是「模型容量不够」,并且用三种表示各取所长、再用课程把它们串起来,这个设计是有物理直觉支撑的:先在无标注数据上用 latent action 学通用动力学,再用末端执行器位姿把抽象先验锚定到可执行的动作空间,顺序符合「先学规律后学接口」的逻辑。附录里主动写明「不普遍优于单本体模型」「没有单一最优表示」这类结论,在当下的论文风气里是值得肯定的诚实。但仍有值得追问的地方。第一,末端执行器位姿虽然比关节角通用,仍然是个偏「机械臂中心」的表示,用它去描述人手的复杂操作(多指协同、手内调整)必然是降维的,那么第二阶段的落地过程中,第一阶段从人类视频学到的精细动力学有多少能真正被继承下来,论文没有拆解。第二,主要指标是视频预测精度,而世界模型的最终价值在于能否支撑决策——预测得像不代表推演得对,如果没有下游策略学习或规划任务上的对照,「zero-shot physical simulator」这个说法是超出证据范围的。第三,Bridge 上的保真度下降虽然被描述为轻微,但它暴露的是跨本体学习的固有代价:容量被分摊到多个域,简单域上不如专用模型,这个 trade-off 在什么规模下会翻转,值得给出定量的规模分析。
6. Manifold4D:几何信息注入初始噪声而非条件
Manifold4D: Denoising on Point Cloud Rendered Manifolds for Video Re-shooting | 浙江大学 + Manifold Tech + 上海科技大学 + 剑桥大学 | arXiv:2608.28174
关键词 :视频重拍,相机轨迹控制,flow matching,噪声流形,点云渲染,4D 重建,浙江大学,剑桥大学
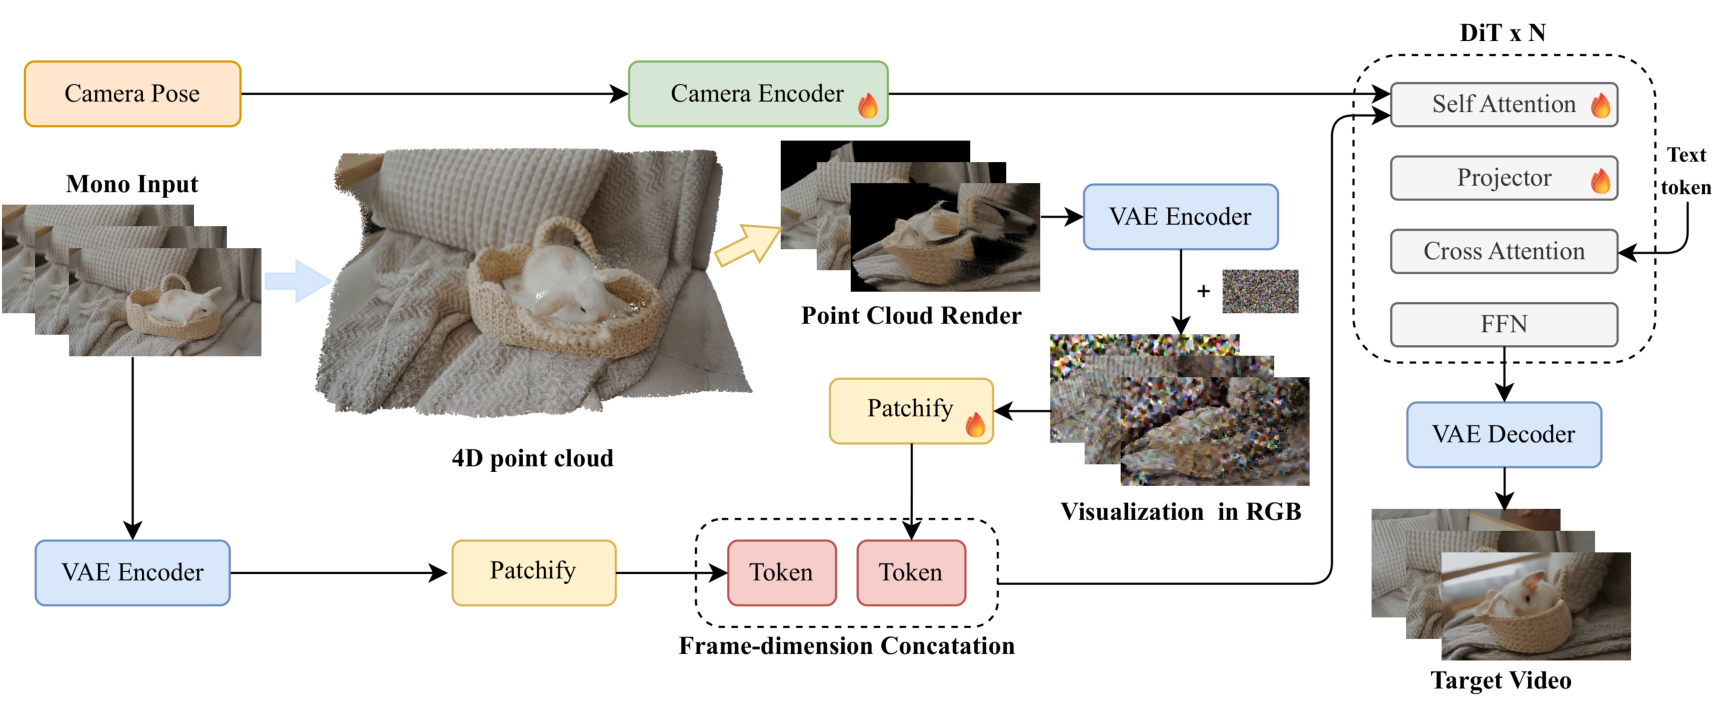
前序问题 :视频重拍要做的事是:给一段单目视频和一条用户指定的相机轨迹,把这段动态场景沿新轨迹重新渲染出来。主流做法是把目标几何显式地喂给网络——用逐帧深度把源视频抬升成 4D 点云,再沿目标轨迹光栅化成一张点云渲染图。问题出在这张渲染图和源视频被同时当作视觉条件送进网络:它们在每一个去噪步骤上互相竞争,模型被迫面对一个「信任困境」——该信渲染图几分?渲染图携带正确的目标视角几何但通常稀疏、有空洞、动态主体容易糊;源视频有完整的外观与运动但视角是错的。训练分布内还能靠数据学出一个折中,一旦遇到分布外的数据,这个折中就会失衡,表现为要么轨迹控制不准(太信源视频),要么画质崩坏(太信渲染图)。本文贡献 :作者的主张很干脆:一张已经与目标视角像素对齐的渲染图,压根不需要作为显式的条件流被送进网络。Manifold4D 把渲染图直接注入 flow matching 的初始噪声——生成不再从标准高斯噪声出发,而是从一个携带几何信息的新噪声流形出发,源视频因此成为唯一的视觉条件。这样一来渲染图恰好被使用一次,网络也从来不需要学习「怎么读懂这张渲染图」;在后续的每个去噪步骤里,模型可以专心处理源视频。具体流程是:由单目视频重建 4D 点云并沿目标轨迹渲染,渲染结果的 VAE latent 被注入噪声并 patchify 成 token,源视频同样编码成 token,两者在帧维度拼接后连同编码后的相机轨迹一起送入 DiT 去噪。作者还构建了 DAVIS-Traj 基准用于评测。
auto
实验效果 :在自建的 DAVIS-Traj 基准和 Vista4D 评测集上,Manifold4D 在所有相机控制指标上都取得最好成绩:旋转误差分别降低 25% 和 27%,平移误差最多降低 32%,同时在视频保真度上与最强基线持平,并在真实场景的新视角光度质量上领先。用户研究显示它在轨迹跟随与动态一致性上有明显优势。两个补充实验支撑了它的核心主张:一是当偏航幅度超出训练范围时,它与基线的差距进一步拉大,说明这种几何注入方式的外推性更好;二是当刻意破坏渲染图(去掉运动掩码,让所有帧的动态点堆叠在一起把主体糊掉)时,模型仍能从源视频里恢复出正确的运动——这证明几何先验起的是引导作用,而不是压制生成。
auto
批判点评 :这篇的核心洞察相当漂亮,而且是那种一旦说出来就显得理所当然的洞察:条件流的作用是给网络提供「需要被理解和转换」的信息,而一张已经和目标视角像素对齐的渲染图不需要被理解,它需要的只是被作为起点。把它挪到初始噪声里,等于把一个「网络得学着去信任多少」的软决策,换成了一个「先天就在那里」的硬约束,信任困境就此消失。两个验证实验也设计得很到位——外推区间差距拉大证明了几何先验的泛化性,故意破坏渲染图仍能恢复运动则证明了它没有过度依赖先验,一正一反把「引导而非覆盖」这个说法钉住了。需要注意的边界是:整套方法建立在「渲染图与目标视角像素对齐」这个前提上,而这个对齐完全依赖前置的深度估计与 4D 重建质量;深度出系统性错误时,错误会被直接编码进初始噪声,而此时网络甚至没有一个条件通道可以用来纠偏——鲁棒性实验破坏的是动态主体的清晰度(糊),并没有测试深度尺度或结构性错误这类更致命的失效。其次,视频保真度只是与最强基线持平,收益集中在相机控制精度上,读者不应把它理解为画质也更好。第三,DAVIS-Traj 是作者自建的基准,虽然同时在 Vista4D 上做了验证,但主基准自建这件事在轨迹幅度分布的选择上天然存在有利于自己方法的空间。
7. GeoNeXt:深度法向重写成下一帧预测
Video Generative Models as Geometry Learner | 萨里大学 + 帝国理工学院 | arXiv:2608.28549
关键词 :单目深度估计,表面法向,视频扩散,几何先验,数据高效,零样本,ECCV,萨里大学
前序问题 :用生成模型做几何估计现在有两条常见路径,各有各的浪费。第一条是拿现成的图像扩散模型分别为深度和法向训练任务专属模型,每个几何目标一个模型,这样做丢掉了一件本该利用的事——深度和法向在几何上是强相关的(法向可以由深度的梯度导出),分开训练等于放弃了联合建模的机会。第二条是改造图像扩散骨干(比如动自注意力结构)做联合微调,这条路能共享表示,但代价是通常需要大量标注数据,而带真值几何标注的数据本身就贵。作者认为这两条路的共同局限来自骨干选错了:图像扩散模型的先验是单帧的,而几何估计本质上需要跨视角、跨帧的结构化理解,这恰好是视频生成模型在预训练中天然获得的东西。本文贡献 :GeoNeXt 把预训练视频生成模型重新用作几何估计的统一且数据高效的框架,关键在于把任务创新性地表述成「下一帧预测」:图像和几何目标被放在同一个时间序列的不同槽位上,于是「从图像推几何」和「从几何推图像」都变成视频模型最擅长的那件事——预测序列的下一段。具体实现上,从预训练的 Stable Video Diffusion 出发,用冻结的 Stable Diffusion VAE 把 RGB 图像、深度、表面法向分别编码进隐空间;加噪时把图像 latent 复制到深度与法向这两个几何槽位,并通过拼接几何 latent 做进一步条件化;只微调 GeoNeXt U-Net(跳过 cross-attention),训练目标是图像、深度、法向三项重建损失之和。这样模型既继承了视频模型天然结构化的知识与更丰富的先验,又能联合建模图像与几何两个方向。
auto
实验效果 :在多个数据集上的零样本单目深度与表面法向估计实验中,GeoNeXt 同时超过了此前的任务专属生成方法和统一生成方法,而且用的训练数据显著更少。更值得注意的是它与判别式方法的对比:论文称其性能可与那些多用了 100 倍以上数据训练的判别式 SOTA 方法相媲美,在若干基准上甚至更为突出。定性结果方面,作者展示的跨数据集深度对比显示 GeoNeXt 对精细结构的重建更好,法向对比则显示它产生的法向更准确、细节更多,能有效捕捉细小几何结构与表面朝向。整体上论文的卖点是数据效率——同等或更好的效果,训练数据少一到两个数量级。
auto
批判点评 :「几何估计其实是个序列预测问题」这个重构是这篇的核心贡献,也是它数据效率高的原因所在——它没有让模型从头学几何,而是把几何塞进了模型已经很擅长的那个任务形式里,于是预训练里积累的时空结构先验可以直接复用。把图像 latent 复制到几何槽位这个细节也很聪明:它给了模型一个「几何应当与图像空间对齐」的强初始化,而不是让它从噪声里猜。真正的局限在于代价与定位。第一,视频扩散骨干比图像扩散骨干重得多,推理成本必然更高,而深度估计在实际应用里往往是实时或近实时的需求,论文若不给出与判别式方法的推理开销对比,「相媲美」这个结论在部署视角下是不完整的——用 100 倍少的数据换 N 倍的推理时间,是否划算取决于场景。第二,与判别式 SOTA 的关系被表述为「rivals」并在部分基准领先,这意味着并未全面超越,读者应把这篇的价值定位在数据效率而非绝对精度。第三,深度与法向的联合建模被当作卖点,但论文(从摘要层面)没有量化这种联合到底贡献了多少——如果单独训练两个 GeoNeXt 也能达到接近的效果,那「利用几何目标内在相关性」这个动机就削弱了,一个联合 vs 分离的消融是必要的。
8. ATA:单张参考图学出可加减属性向量
Attribute Token Arithmetic: Disentangled and Continuous Semantic Control for Visual Autoregressive Models | 莫纳什大学 | arXiv:2608.28082
关键词 :视觉自回归,属性解耦,连续语义控制,向量算术,VAR,单图学习,免重训,莫纳什大学
前序问题 :自回归文生图最近进展很快,用一个统一的生成框架就能做出高保真图像,但细粒度语义控制一直不好做,原因有两个:属性之间是纠缠的,以及文本表示和细粒度视觉表示之间存在错位。具体表现是你想让猫「胖一点」,改了提示词之后猫可能连品种和身份都变了;你想控制「胖」的程度,语言又给不出连续的刻度——「a fat cat」和「a very fat cat」之间没有可靠的插值。已有的自回归编辑方法要么需要重训模型或大规模监督,要么只能做离散的、整体性的替换,不能做「把这一个属性沿一条轴连续推一点」这种操作,更做不到把多个属性各自独立地叠加上去。本文贡献 :ATA 的灵感来自词嵌入里那个经典的向量算术性质:既然语义在嵌入空间里可以加减,那视觉属性也许可以。方法在预训练自回归模型的隐空间里直接找出对应视觉属性(论文举的例子是变老、变胖、情绪)的语义方向,而且这些方向只需从单张参考图学得,不需要重训模型也不需要大规模监督。做法上,给定一张参考图和一对语义只差一个属性的提示词(比如「A fat cat on the ground」与「A cat on the ground」),ATA 学出两个语义方向,并通过一个 Delta-Mod 模块把学到的方向加到 cross-attention 里对应的 VAR 对齐文本 token 上——关键是加到属性 token(「fat」)而不是身份 token(「cat」)上。生成时属性就可以通过与其他属性 token 的简单算术运算被连续调节与组合式叠加。
auto
实验效果 :实验显示 ATA 实现了保持身份的、细粒度的、多属性同时调节的编辑效果,在可控性、通用性和计算效率三方面都优于已有的自回归编辑基线。作者展示的能力包括:连续调节单个属性强度并可将两个属性依次增强;跨类别的属性迁移——把「苹果形状」这个属性施加到「蛋糕」上时,ATA 是让蛋糕逐渐变成苹果形状的蛋糕,而基线方法直接把蛋糕变成了苹果,把原本定义在斯芬克斯猫上的「Sphynx」属性迁移到羊身上也能得到渐变的无毛效果;身份与属性的组合性——从三张参考图提取身份方向后与眼镜、帽子、项链、雾等属性方向自由重组,身份保持不变。消融实验支撑了「加到属性 token」这个设计:把方向优化到身份 token「cat」上会改变主体身份,加到与属性无关的 token「ground」上则完全不产生变胖效果。
auto
批判点评 :这篇最有说服力的部分是那个消融:把方向加到「cat」会改身份、加到「ground」什么也不发生、只有加到「fat」才既变胖又保身份——这三条对照直接证明了语义方向的作用位置是可定位、可解释的,而不是碰巧调出来的效果。跨类别迁移那组结果也很能说明解耦的质量:基线把蛋糕变成苹果,ATA 变成苹果形状的蛋糕,前者是把属性当成了类别替换,后者才是真正把「形状」这一维从「是什么东西」里剥离出来。单张参考图、免重训这两点也让实用门槛很低。局限主要在适用范围。第一,方法绑定在视觉自回归(VAR)这一类模型的「VAR 对齐文本 token + cross-attention」结构上,是否能迁移到扩散类主流模型并不显然,而当前工业界的图像编辑主力仍是扩散模型,这限制了影响面。第二,整套机制依赖「提示词对里的差异恰好对应一个可分离的视觉属性」,那些语言上难以用单个 token 差异表达的属性(复杂光照、特定构图、多物体空间关系)恐怕找不到干净的方向,论文自己也保留了一张 limitations 图。第三,对比对象限定在自回归编辑基线,没有与更强的扩散类编辑方法同台,「优于已有方法」的适用范围应当按这个口径理解。
9. VATIX:9B驾驶视频模型的规模律实测
How Far Can 5,500 Hours of Driving Take You? A Scaling Law Analysis of Video Diffusion Models | valeo.ai + 索邦大学 | arXiv:2608.28404
关键词 :规模律,视频扩散,自动驾驶,固定数据集,训练预算分配,nuScenes,开源SOTA,valeo.ai
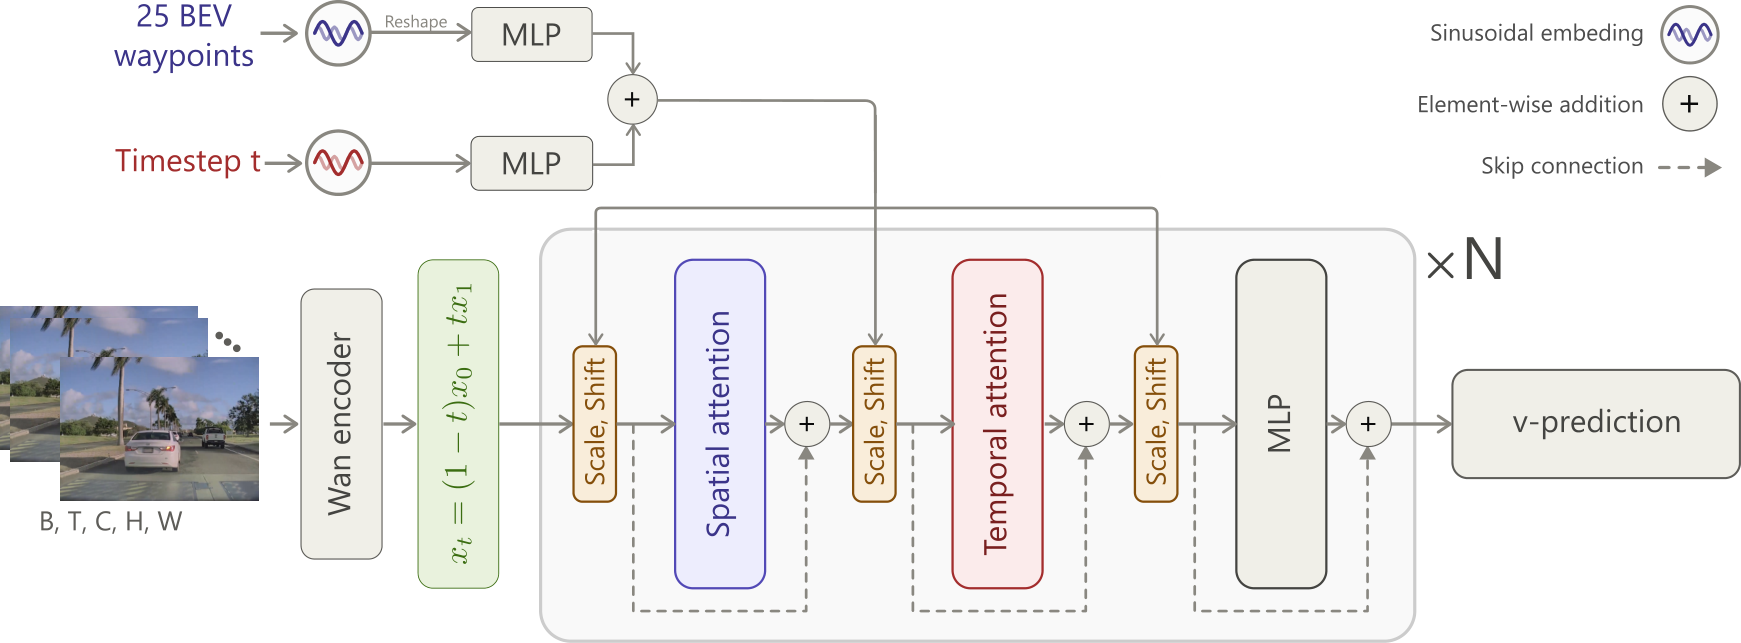
前序问题 :自动驾驶的视频生成走不通网络规模那条路:驾驶数据采集昂贵、受隐私法规约束、也不能随便抓取,所以模型必须在一个固定语料上把价值榨干。这就使得「算力该怎么花」变成一个真问题而不是学术趣味——同样的预算,是拿去把模型做大,还是拿去训得更久?还需不需要再采数据?在网络规模数据的语境下这些问题往往被「加数据就好」掩盖过去,但在固定语料的约束下必须正面回答。此前领域内缺少针对驾驶视频扩散模型、从零训练、覆盖足够宽参数区间的系统规模律研究,从业者只能凭直觉分配预算。本文贡献 :作者做了一次系统的规模律研究:从零训练一族参数量从 1M 到 9B 的视频扩散模型,在最多 5,500 小时的驾驶数据上按不同曝光量训练,观察验证损失如何随模型规模与训练曝光变化。模型架构是标准的 flow matching 视频 DiT:视频 latent 由 Wan encoder 编码后加噪,经 N 个 transformer 块处理,每块含空间注意力、时间注意力与 MLP,全部由 AdaLN 调制;时间步 t 与自车轨迹的 25 个 BEV waypoint 分别用正弦特征嵌入并各过一个 MLP,相加后切成 scale 与 shift 两份用于调制,输出是速度(v-prediction)。也就是说轨迹条件是通过调制通路而非 cross-attention 注入的。作者开源了代码与预训练模型,底层驾驶数据由 NATIX 分阶段单独发布。
auto
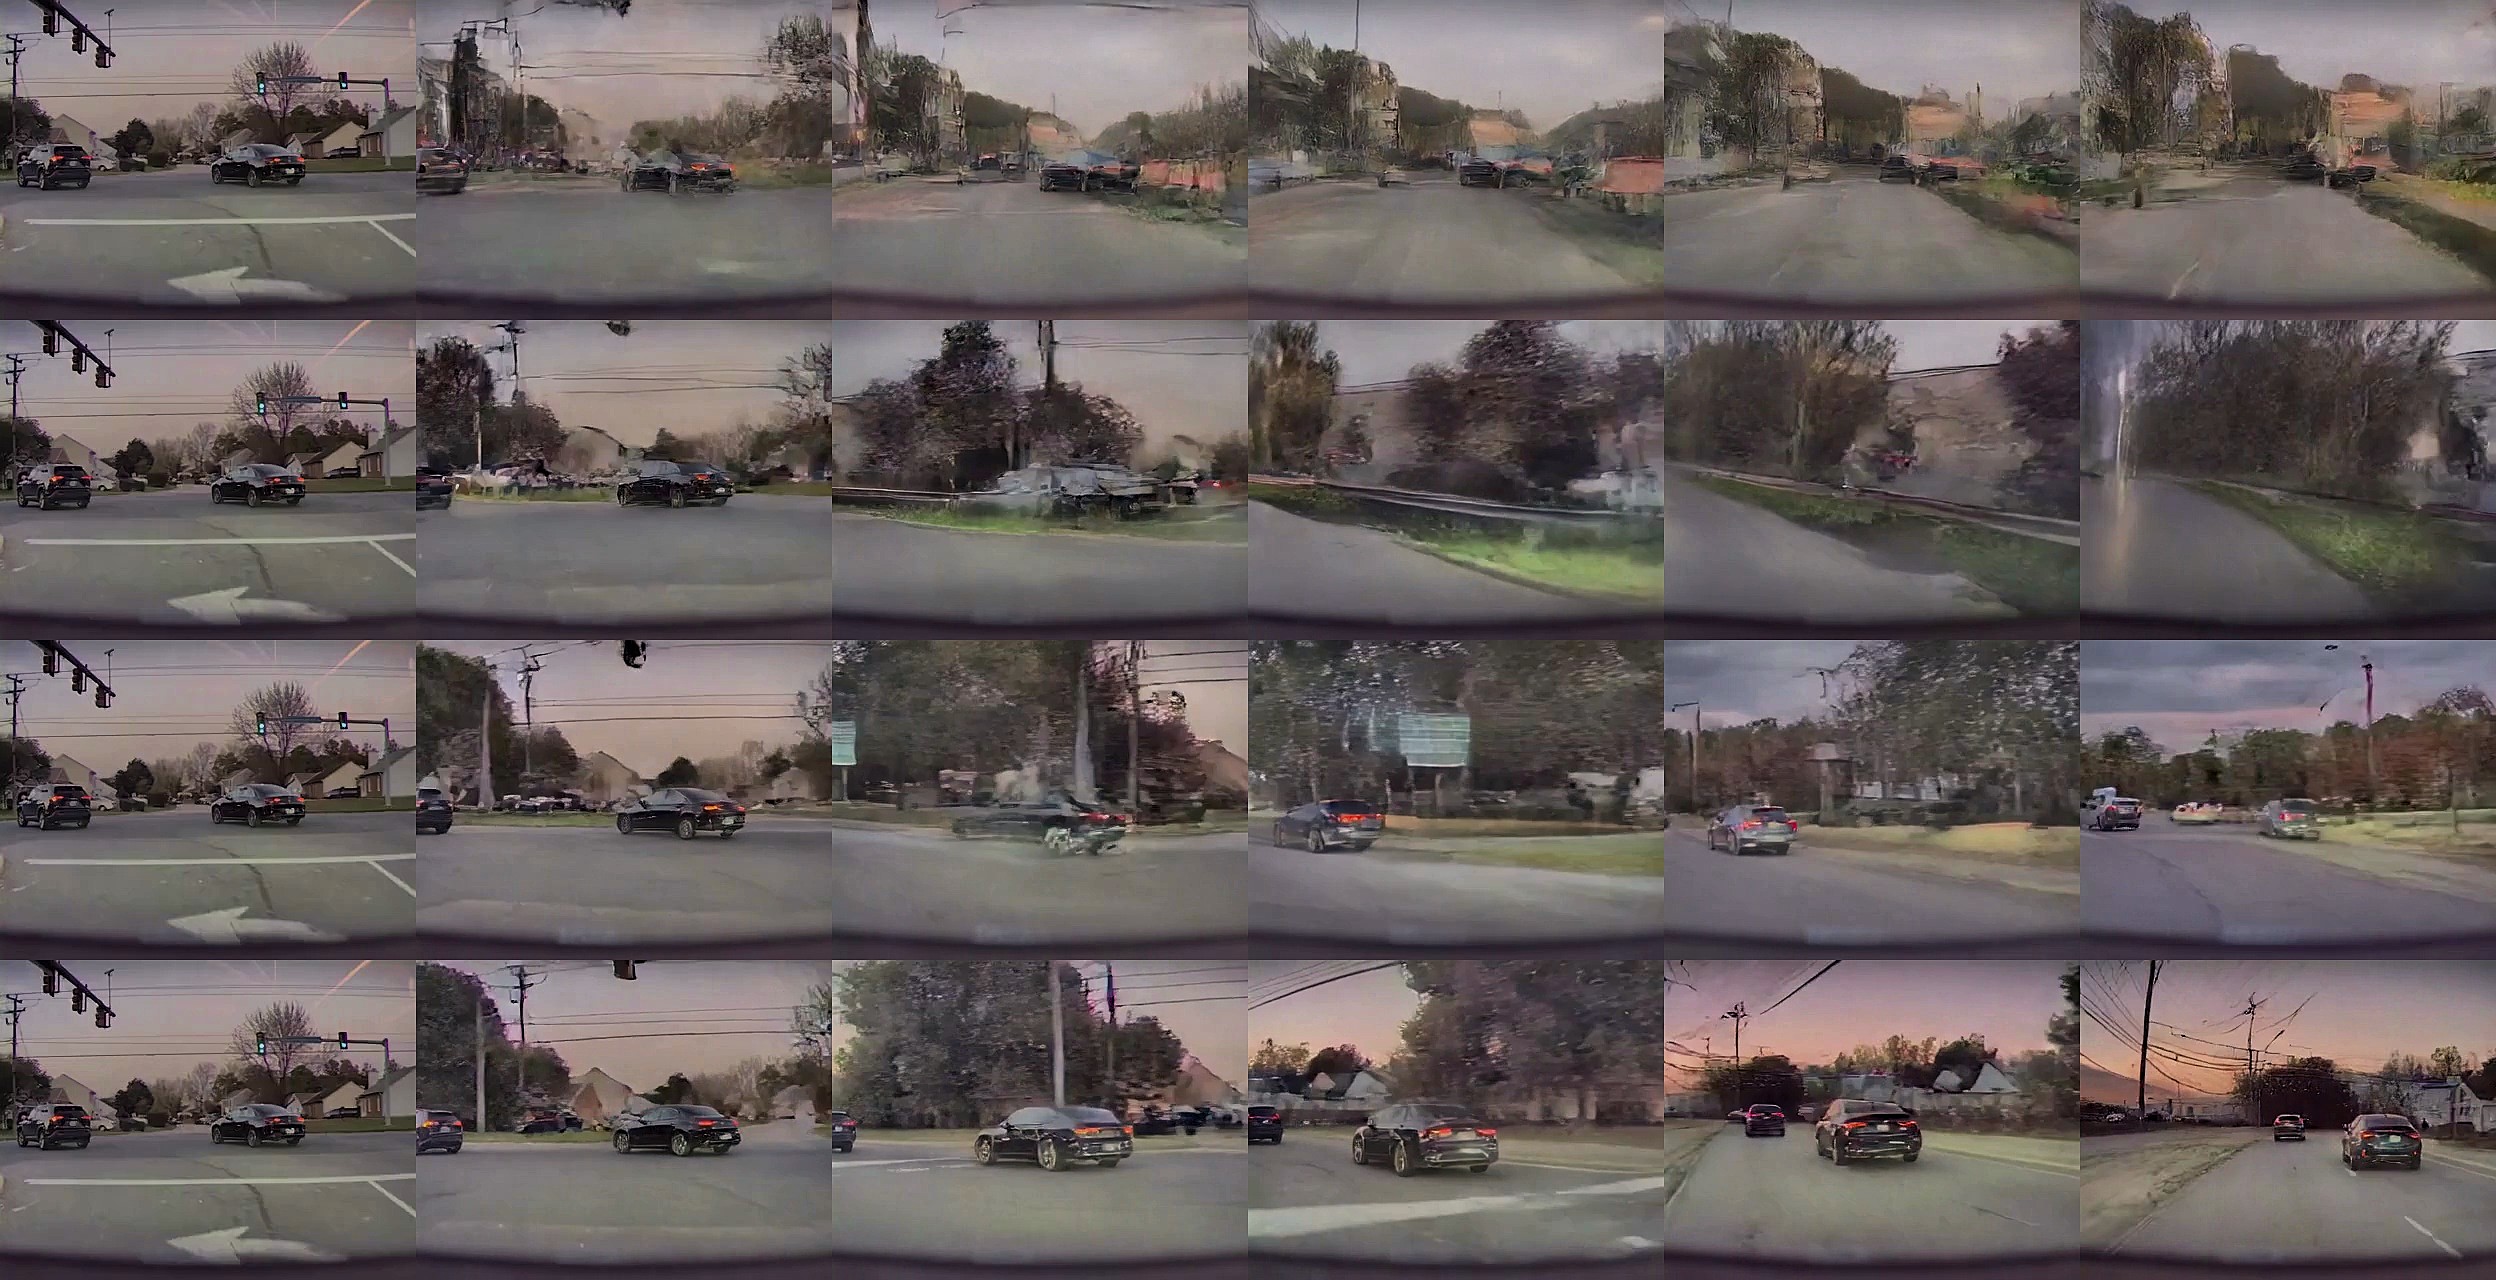
实验效果 :验证损失在模型规模与训练曝光两个维度上都呈现一致的幂律。最实用的一条结论是两者的敏感度不对称:损失随训练曝光下降得远比随模型规模下降得快,因此在算力受限时,把预算投给更长的训练是提升一个固定模型最有效的方式;但更大的模型仍然能达到更低的渐近损失,所以当算力足够时,计算最优的扩展方向依然是把模型做大。基于这套分析作者训了一个 9B 参数模型,据其所知是在驾驶数据上从零训练的最大视频扩散模型,并在 nuScenes 上刷出了驾驶视频生成的开源新 SOTA。定性方面,5 秒生成的对比显示:20M 以下的小模型能抓住整体场景布局但很快跨帧丢失物体一致性;135M 的基础模型对场景理解更好(比如能正确预测车辆正在左转),但在更长时程上难以维持连贯动态;1.1B 模型进一步改善画质与场景结构,却仍有时间不一致并在约 2.5 秒后开始崩坏。
auto
批判点评 :这类工作的价值不在方法新意而在把从业者的直觉换成可查的曲线,而且它选的约束条件——固定语料、不能靠抓数据解围——正是自动驾驶、医疗影像这些受限领域的真实处境,因此结论的可迁移性比在网络规模数据上做的规模律更强。「曝光的边际收益大于参数量、但大模型渐近更低」这个不对称结论也很有操作价值:它把「小算力延长训练、大算力放大模型」这条分界线画了出来。诚实之处在于定性结果没有粉饰,直接写明 1.1B 模型在约 2.5 秒后就开始崩坏。需要保留的疑问有三点。第一,所有规模律结论都建立在验证损失上,而扩散模型的验证损失与人类感知质量、下游可用性之间的相关性并不牢固——损失继续下降不一定换来更长的时间一致性,这恰好是驾驶视频最关键的属性,论文若能给出「损失 vs 崩坏时长」的对应关系会有力得多。第二,5,500 小时这个上界本身就是结论的边界:所有关于「还需不需要更多数据」的判断都是在这个尺度内的外推,超出后曲线是否仍成立无从检验。第三,架构是固定的单一族系(Wan encoder + AdaLN 调制的时空注意力块),而规模律对架构选择是敏感的,把轨迹通过 AdaLN 调制注入而非 cross-attention 也是一个具体选择,换一种条件注入方式时这些幂律的系数能否保持,文中未作讨论。
10. CommerceVibe:电商创意生成HTML而非像素
CommerceVibe: Learning to Design E-Commerce Creatives as Executable Visual Code via Dual-Feedback Reinforcement Learning | 同济大学 + 阿里巴巴 | arXiv:2608.27893
关键词 :电商创意生成,可执行视觉代码,HTML/CSS 合成,双反馈强化学习,GRPO,VLM 评判,阿里巴巴,同济大学
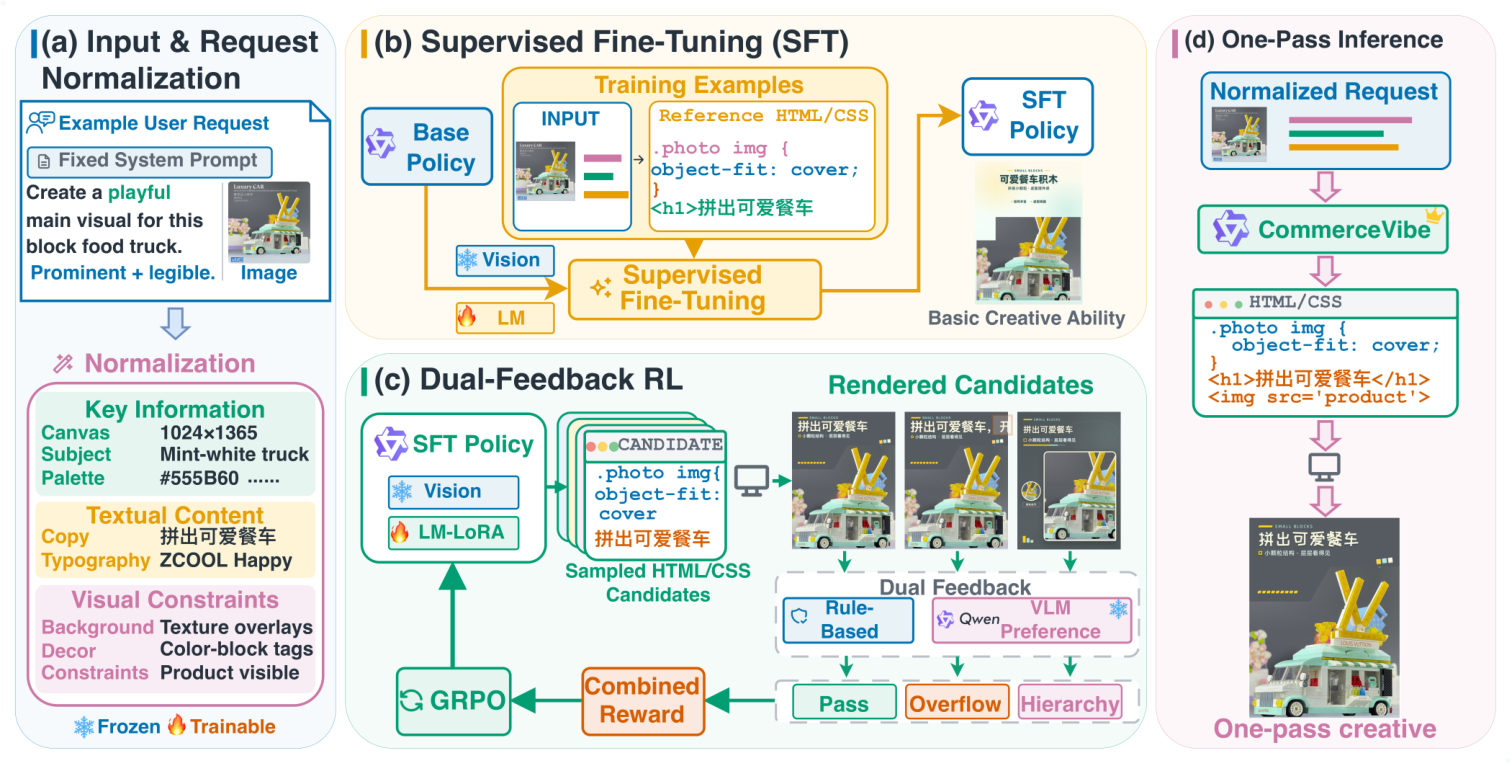
前序问题 :高质量电商创意图是展示商品和传达营销信息的关键。扩散模型让创意生成变得可规模化,也能产出视觉上很好看的图,但落到实际投放前总要返工,原因很实在:文字会畸变、商品细节不一致。更麻烦的是产物形态——扩散模型输出的是一张压平的位图,没有显式结构,因此难以编辑与复用,改一个价格数字都得重新生成整张图。还有第三个障碍在训练侧:电商创意的设计要求往往是复合的、带硬约束的(文字必须清晰可读、商品必须可见不被遮挡、版式必须合法),这类要求很难被编码成可验证的训练信号,而没有可验证信号就没法做有效的强化学习。本文贡献 :CommerceVibe 换掉了产物形态:把创意表示为可执行的视觉代码,生成任务因此被表述成条件化的 HTML/CSS 程序合成。给定商品图、设计要求和商品信息,它产出可渲染、可编辑、可复用的创意。为了让复合设计要求变成训练信号,作者提出双反馈强化学习:一路是基于规则的反馈,对渲染后的程序检查文字可读性、商品可见性和版式合法性——这些都是渲染完就能机械判定的硬指标;另一路是来自视觉语言模型的视觉反馈,从六个感知与商业维度评判渲染出的创意是否符合输入规格。两路信号互补,前者管约束满足,后者管依赖感知的质量。训练流程是先用超过 28,000 条电商样本对 Qwen3.5-9B 做监督微调建立基础创意能力,再用双反馈奖励通过 GRPO 做强化学习优化策略,最终一次推理直出创意。
auto
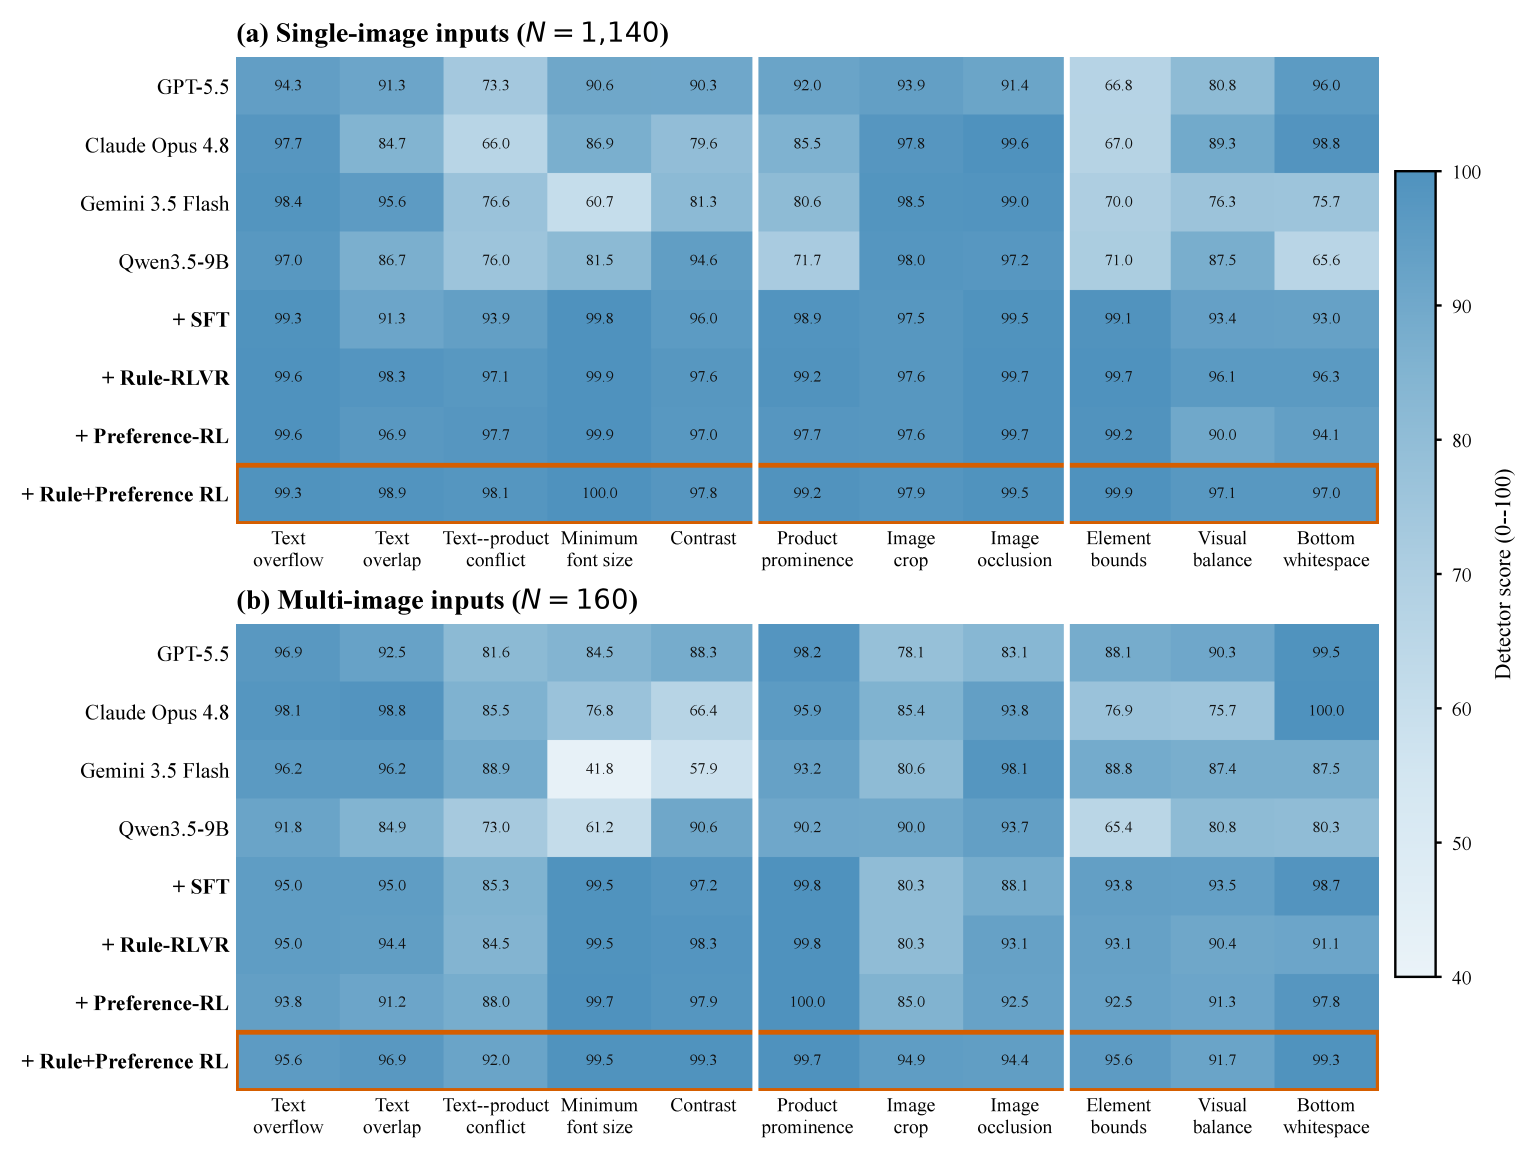
实验效果 :在 1,300 例的基准上,优化后的 CommerceVibe 拿到 94.0/100 的加权分,而只做监督微调的版本是 87.3,也就是说双反馈强化学习贡献了约 6.7 分的提升,同时优于若干强外部模型。作者还请了五位电商设计专家做盲评,结果进一步验证了这些改进——这一点比自动指标更关键,因为规则分和 VLM 打分都可能被针对性优化,而人类专家的盲评是相对独立的检验。细粒度结果按 1,140 例单图与 160 例多图两类分别报告了检测器级别的规则子分和 VLM 评判各维度的评分。定性对比里作者用不同颜色的轮廓标出了文字、商品、版式、VLM 四类代表性问题的位置,未被识别出问题的类别则打绿勾。
auto
批判点评 :把创意从位图改成 HTML/CSS 是一次典型的「换表示解决一类问题」:文字畸变消失了,因为文字是真的文字而不是画出来的像素;可编辑性有了,因为产物本来就是结构化代码;更妙的是它顺手解决了强化学习最缺的那件东西——可验证的奖励。渲染完的程序可以用检测器机械地判定文字是否可读、商品是否被遮挡、版式是否越界,这些硬约束在像素空间里很难可靠判定,在代码+渲染的组合里却是现成的。双反馈的分工也合理:规则管能判定的,VLM 管只能感知的。可质疑的地方集中在评估与边界。第一,奖励里有 VLM 打分,而基准的加权分很可能也包含 VLM 判定维度,这就存在训练信号与评测指标同源的隐患——94.0 这个分数有多少来自真实质量提升、多少来自对评判器偏好的拟合,需要更强的隔离设计,专家盲评是好的补充但只有五人。第二,HTML/CSS 表示的表达力有天花板:它擅长版式、文字与图层合成,但那些需要像素级生成的创意元素(商品与背景的自然融合、光影一致、艺术化质感)不是 CSS 能表达的,因此这套方案更准确的定位是「可编程版式合成」而非通用创意生成,与扩散模型是互补关系而非替代。第三,1,300 例基准与 28,000 条训练样本都来自同一电商生态,品类分布、审美规范高度同质,跨平台或跨文化的泛化能力没有证据支撑。
趋势观察
世界模型开始把「状态」从像素里拆出来,交给代码托管 — 今天最值得读的一篇工作提出了一个有点反直觉的分工:世界的演化规则不要让视频模型去学,交给会写代码的语言模型;视频模型只负责把状态渲染成好看的画面。Code World Model 让 coding agent 充当「世界大脑」,把事件与后果推理成可执行代码,代码维护一份持久化的世界状态,状态再被编译成一段粗糙的 proxy 视频去条件化视频模型。这个拆法直指纯视频世界模型的老毛病——视频只呈现「结果」,不承载「规则」,所以模型很难保证「我刚才砸碎的花瓶下一帧还是碎的」。把状态搬进代码后,持久性由程序保证而不是靠模型记性。同一天的 CLAP 从另一侧呼应:它用末端执行器位姿、语言指令、latent action 三种表示把人类视频和多种机器人本体统一到一个动作空间,让世界模型能吃下互联网规模的异构视频。两条路线的共同判断是:世界模型要往前走,得先把「动作/状态的表示」这件脏活干干净。长视频一致性的战场已经从「窗口多大」转向「记什么、记在哪一层」 — LayerRecall 和 DensityKV 是今天最像一对的两篇,都在攻自回归视频扩散的历史记忆,但切入点完全不同。LayerRecall 的观察是:video DiT 的不同层对「当前/近期/远期」上下文的偏好并不一样,所以长程记忆是个双重决策——检索哪些历史 K/V,以及注入到哪几层。它只往少数「记忆敏感层」注入,其余层保留原来的 sink + 滑窗注意力,因此几乎零推理开销还能跨骨干迁移。DensityKV 则完全免训练,用 post-RoPE key 的 Soft-Riesz 局部密度判断新状态是否冗余:密度高就拒收,从而把持久历史存储限死在与 rollout 长度无关的常数上——120 秒生成时 LongLive-RAG 要 128.5 GiB,DensityKV 只用 3.28 GiB。两篇加在一起说明一件事:「无限长视频」这个目标的瓶颈已经不是注意力算得多快,而是历史怎么以有界代价被有选择地保留。效率研究出现一波「回头验旧基线」的反思,结论不太体面 — 微软那篇《Sliding-window beats linear attention》标题就把结论说完了:带 sink 的滑动窗口注意力在多个 LLM、多个下游任务上打平或打赢经过 post-training 的线性注意力模型;在 Needle-in-a-Haystack 和 BABILong 这类长上下文推理上,SWA 高出 2 到 10 倍,而且它压根不需要 post-training。作者的批评相当直接——线性注意力这条线一直没有和足够简单的基线做过公平对比。这类工作在今天的效率研究里越来越重要:当一个方向在自己的评测里连年进步,却从未被最朴素的对照组挑战过,进步就可能是评测协议的产物。同一天 DensityKV 也是免训练路线,两篇一起构成一个信号:先把最便宜的方案做到位,再谈复杂改造。视频生成模型正被反过来当作几何与物理的通用先验 — GeoNeXt 把单目深度与法向估计重写成「next-frames prediction」,直接复用预训练视频生成模型,理由是视频模型天然携带结构化的时空先验,比图像扩散模型更适合联合建模「图像↔几何」,实测能用远少的数据打赢那些多训 100 倍数据的判别式方法。Manifold4D 的思路更巧:视频重拍任务里点云渲染图和原视频作为两路条件会互相打架,模型不知道该信谁多少,于是它干脆不把渲染图当条件,而是注入到 flow matching 的初始噪声里——生成从一个「带几何信息的噪声流形」出发,渲染图只被用一次,网络也不必学会怎么读它,旋转误差因此降了 25% 与 27%。这两篇的共性是把视频生成模型当成基础设施而不是终点产品:它提供先验,任务只是换个输出头或换个注入位置。
人工智能炼丹君 整理 | 2026-09-01
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注
















评论 (0)