今日 AIGC 论文速览
今日共 10 篇 · 原生音视频联合生成与 2K 高清化 1 篇 · 交互式世界模型的记忆与几何一致性 2 篇 · 推理期物理与质量增强,不改权重 3 篇 · 扩散推理加速:token 压缩与区域复用 2 篇 · 像素空间生成范式与端到端隐空间 2 篇 · 工业级细节保真与 RL 后训练 1 篇
重点论文标题列表
DreamX-Creator (阿里巴巴 DreamX Team):7B原生音视频联合生成打到2KMatrix-Game 3.5 (昆仑万维 Skywork):把世界记忆细到patch级3D云OMR (越南 Fulbright 大学 + 加州大学洛杉矶分校(BMVC 2026)):用冻结V-JEPA梯度纠物理违背ShellGame (首尔国立大学 + Roblox):视频世界模型追不住隐藏状态GEARS (北京大学 + 阿里巴巴(ACM TOG / SIGGRAPH Asia 2026)):把丢掉的候选诊断修复再利用
今日论文速览
1. DreamX-Creator:7B原生音视频联合生成打到2K
DreamX-Creator: Democratizing Native Audio-Video Generation at 2K Resolution | 阿里巴巴 DreamX Team | arXiv:2608.31106
关键词 :原生音视频联合生成,门控跨模态注意力(Gated Cross-Modal Attention),2K自回归精修,音视频强化学习,阿里巴巴,DreamX-Creator
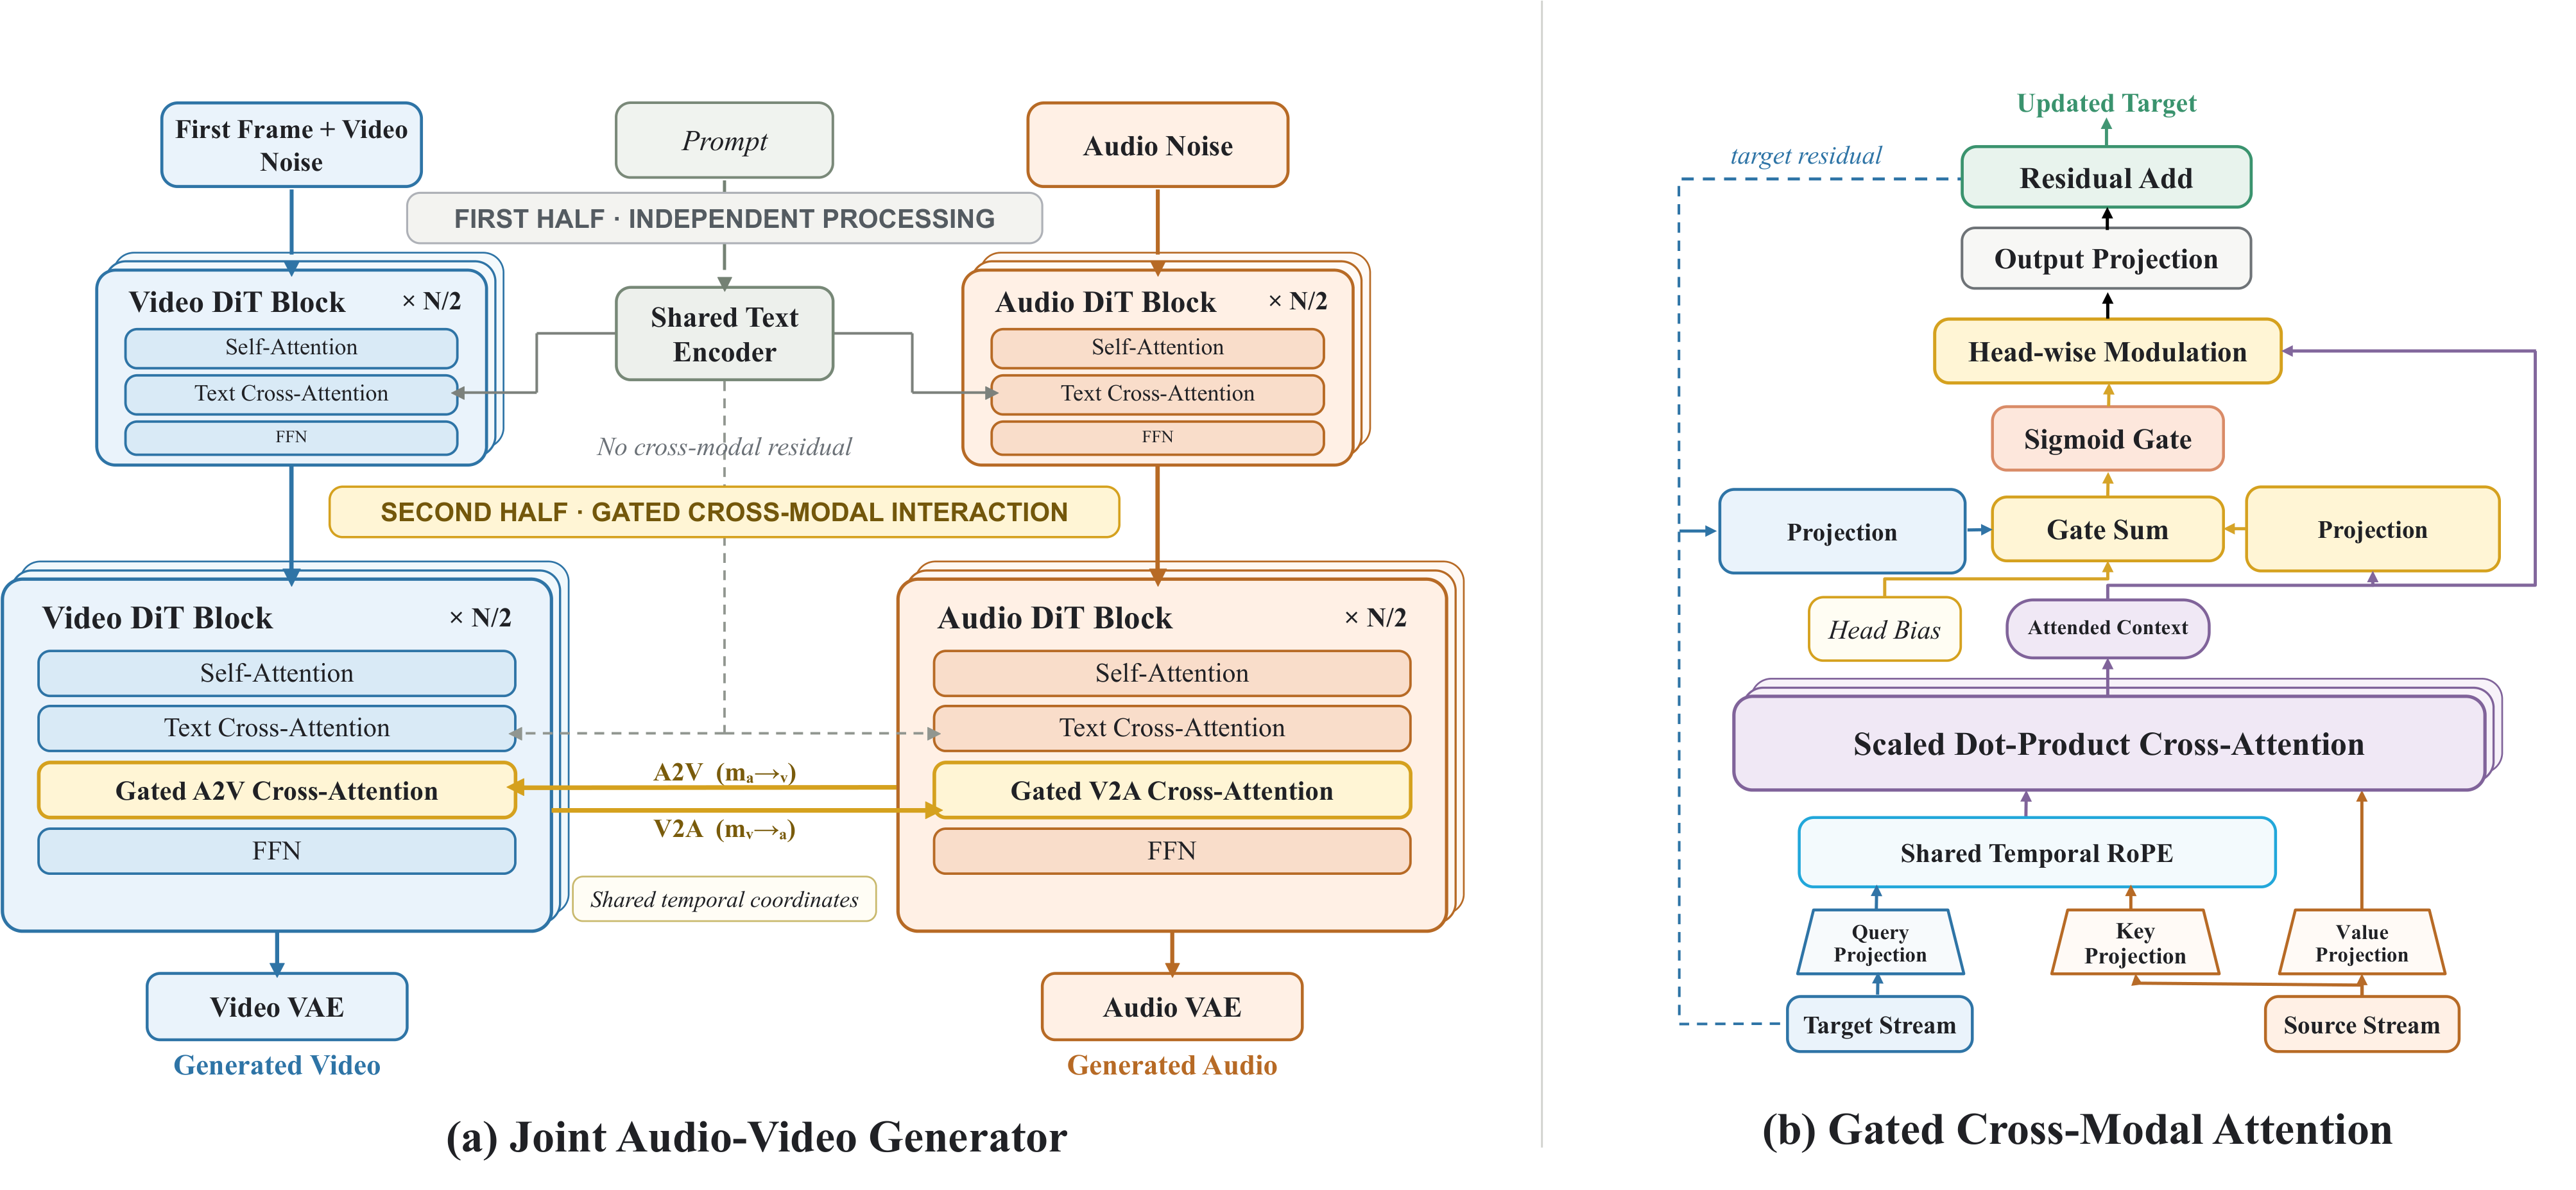
前序问题 :现在的视频生成器对声音的处理基本是两种姿势:要么干脆不生成音频,要么先把视频做完、再拿另一个模型去配音。这两条路都切断了视觉动态与声学事件之间的互相建模——画面里杯子落地的那一帧和「啪」这一声本该是同一个物理事件的两个投影,级联管线却只能让后者去追前者,声音沦为画面的附属品,而不能反过来约束画面。真正的原生联合生成又有另一重现实障碍:可用的开源方案要么规模很大(33B 量级),要么不开放权重,导致这个方向的研究门槛被模型尺寸和可得性顶住了。于是问题变成一个很具体的工程判断:能不能在 7B 这种「一张卡装得下」的尺度上,把音频与视频真正放在同一个去噪过程里联合建模,同时还要覆盖 2K 这种实用分辨率?难点在于两个模态的表示、时间尺度和信息密度差异都很大,一上来就全程共享参数容易互相拖累,而完全独立又回到了级联的老问题。本文贡献 :DreamX-Creator 1.0 的核心判断是:耦合不必从第一层开始,但必须细到 token 与 head。它以一个 7B 生成器为中心,条件是首帧加文本提示,然后让模态专用的音频流与视频流联合去噪——网络前一半两条流完全独立处理(此处没有跨模态残差),后一半才通过 Gated Cross-Modal Attention 双向耦合:A2V 与 V2A 两个方向各有一路门控交叉注意力,门作用在每个激活的跨模态注意力头的输出上,且是 token 级与 head 级的,等于让模型自己学「这一帧、这个头到底要不要听对面模态」,两条流之间还共享文本编码器与时间坐标系。数据侧配了统一的 Audio-Video Data System,负责构造并过滤时间上连贯的片段、产出结构化多模态标注,并把片段按能力维度组织成数据池。训练走渐进式联合训练:两个音视频预训练阶段之后接高质量微调。再往后是 Audio-Video Reinforcement Learning,用 Modality-Aware Multimodal Feedback 把视频侧、音频侧和跨模态的反馈分别路由回对应的流。高分辨率不靠原生 2K 训练,而是一条自回归 1 步 2K 精修管线。
auto
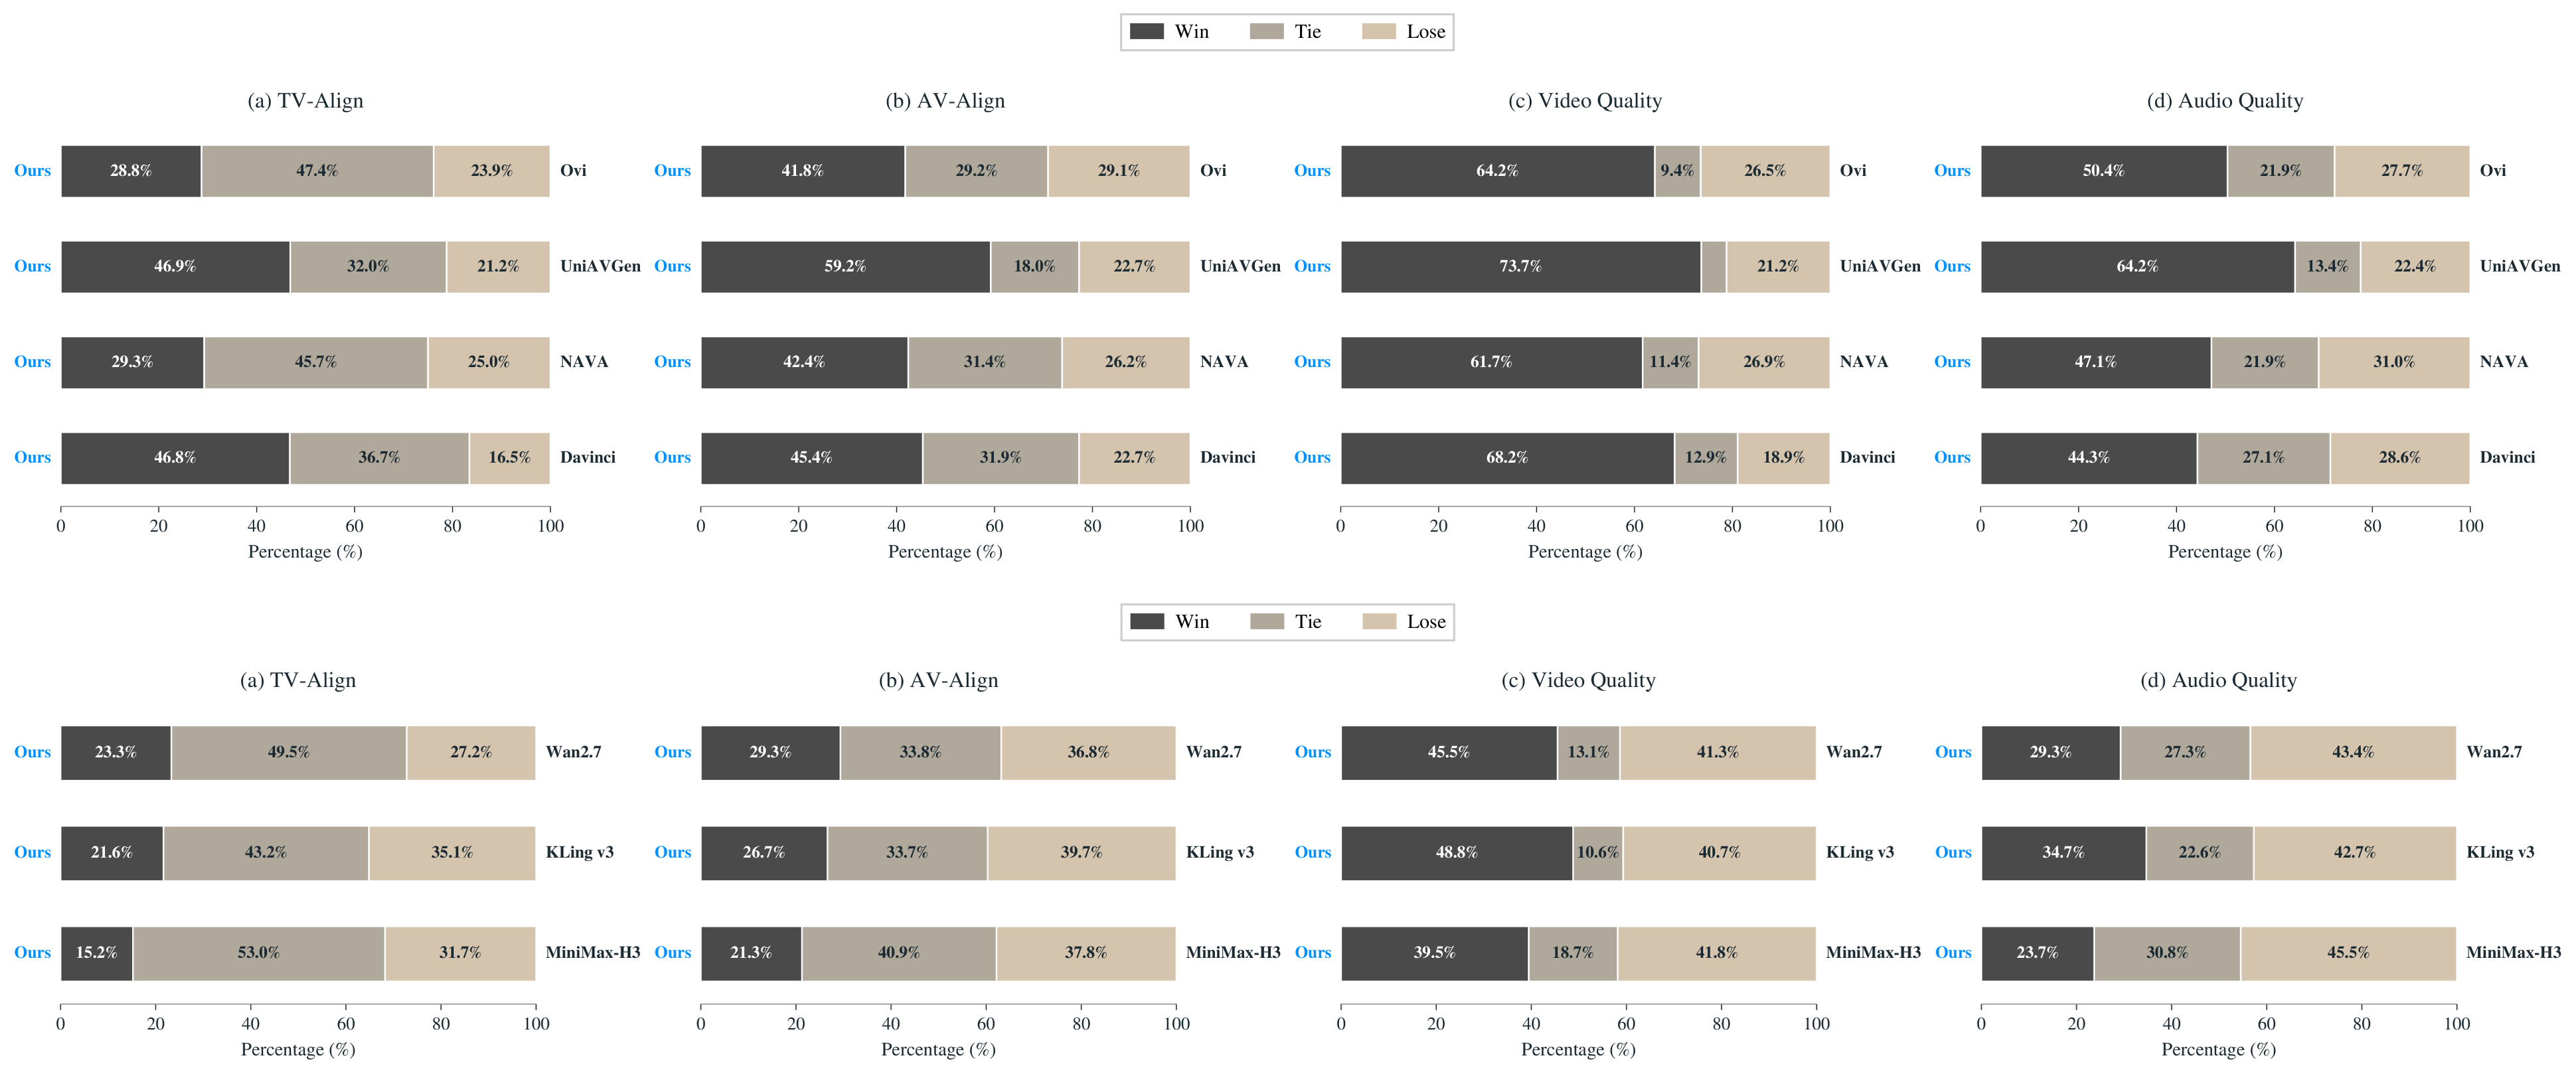
实验效果 :论文用盲测的双人对比给出了最有说服力的结果:面对参数量远大于自己的开源与闭源系统,7B 的 DreamX-Creator 在视频质量上对 Wan2.7 拿到 45.5% 胜 / 13.1% 平 / 41.3% 负,对 KLing v3 是 48.8% 胜 / 10.6% 平 / 40.7% 负,对 33B 的 MiniMax-H3 是 39.5% 胜 / 18.7% 平 / 41.8% 负——也就是说在纯视觉观感上它已经和这些系统在同一量级上互有胜负。但短板同样被论文自己摆了出来:音频质量对 MiniMax-H3 只有 23.7% 胜而 45.5% 负,对 Wan2.7 是 29.3% 胜 / 43.4% 负;文本-视频对齐(TV-Align)对 MiniMax-H3 仅 15.2% 胜、53.0% 平、31.7% 负。相对 LTX-2.3 与 MiniMax-H3 的自动指标里,它在部分维度落后但在 PQ(6.7169 vs 6.4094)与 IB(0.3081 vs 0.2677)上占优。
auto
批判点评 :这篇最扎实的贡献是把「原生联合」从一个规模问题重新框成了架构问题:前一半独立、后一半门控耦合,本质上承认了音频和视频在低层特征上没什么可共享的,真正需要交互的是语义与事件层面,而 token 级 + head 级门控又把「什么时候交互」交给数据决定而不是人手设计。这个设计让 7B 有机会在视觉质量上和 33B 掰手腕,是有说服力的。1 步 2K 精修的分工也务实——把分辨率从训练成本里剥离出去。但要注意几个真实的边界。第一,音频侧的差距不是小瑕疵而是结构性的:对 MiniMax-H3 的音频质量只有 23.7% 胜率,几乎是一半场次输掉,这说明「让音频流分走一半参数」在 7B 尺度上给音频留的容量确实不够,门控耦合能改善同步但补不了音质本身。第二,TV-Align 上 53% 的高平局率值得警惕,这往往意味着评测者难以分辨差异,此时胜率的含义会被稀释,用它论证提示遵循能力偏弱说服力有限。第三,2K 是精修出来的而不是生成出来的,那么 2K 尺度上的细节是模型「知道」的还是精修器「补」的,论文没有拆开——如果是后者,2K 的语义正确性并没有得到额外保证。第四,机构与贡献者名单在源码里写着「将随公开版本最终确定」,也就是说这仍是一份技术报告状态的工作,权重是否真开放、开放到什么程度,决定了标题里 Democratizing 这个词能兑现多少。
2. Matrix-Game 3.5:把世界记忆细到patch级3D云
Matrix-Game 3.5: Enhancing Real-Time Streaming Interactive World Models with Patch Memory | 昆仑万维 Skywork | arXiv:2608.29910
关键词 :交互式世界模型,patch memory,tiled PRoPE,静态动态解耦,渐进式长程蒸馏,单卡720p实时20FPS,昆仑万维
前序问题 :交互式世界模型要做的事情比视频生成难一个量级:它必须以闭环自回归的方式生成未来观测,同时响应相机运动、用户动作和高层提示。麻烦在于自回归会把自己的预测当成后续的上下文,视觉与几何误差因此持续累积,场景逐渐漂移、身份不再一致、可控性退化。有限的上下文窗口又意味着模型无法直接访问远处的观测,所以「回到之前去过的地方」这件事越往后越难;大幅视角变化时,模型不仅要检索到相关的历史信息,还得判断这些信息在当前相机下的正确几何对应位置。更棘手的是持久性与演化的张力:静态环境应当长期保持不变,动态实体却要随用户交互和提示而变化——一刀切地「全部记住」或「全部重新生成」都不对。既有方案的分歧其实在于历史观测以什么单位存储:压缩成 latent token 或 transformer memory 的路线高效但只是隐式表示;按整帧存储再用相机几何检索(Context as Memory、WorldMem、Matrix-Game 3.0)能靠显式空间线索改善场景重访,但一帧是不可分割的记忆单元,只能整体取出、且只能从它原本的视角取出;显式重建成点云或 splat 则几何约束强但难以合成未观测或新出现的内容。本文贡献 :Matrix-Game 3.5 的核心想法是把历史观测组织成显式的、几何感知的持久记忆,粒度落在图像 patch 而不是整帧或压缩 latent。统一的几何感知记忆框架由两部分组成,且 patch-memory 与 tiled-PRoPE 都不引入任何额外可学习参数:patch memory 把历史图像 patch 用度量深度加相机内外参反投影到一个共同的 3D 空间形成 patch 云,目标相机视锥去查询这个云,并在目标视角下用 z-buffer 为每个 latent 位置只保留离相机最近的表面、丢弃被遮挡的候选,最后把选中的 patch 散射进一张对齐目标视角的记忆画布;tiled PRoPE 是作者对 PRoPE 的视频化改造,在检索到的记忆与目标视角注意力之间建立显式几何对应,与原生 RoPE 在同一个注意力核里协同——温和到直线行走时注意力图相对纯时序核的最大变化仅约 1.3%。动态建模上,用运动感知的物体过滤把静态场景观测与动态主体分开,静态区域融进 patch memory,动态主体用轻量的多视角参考 token 表示,配合上下文遮罩与辅助训练损失抑制鬼影和身份漂移。最后是渐进式长程蒸馏:先用教师强制的 Perceptual Flow Matching 得到高质量少步因果初始化模型,再用 self-rollout DMD 直接优化推理时的自回归过程,按课程逐步蒸馏无分类器引导、相机控制与记忆条件化生成。
auto
实验效果 :训练数据来自 Unreal 仿真环境、开放世界游戏与互联网视频三类来源,论文报告模型在长程场景回忆、几何一致的相机控制、主体一致性生成、提示驱动的世界演化,以及稳定的开放世界实时交互上都取得了不错的表现,实测能力是单张 GPU 上 720p 分辨率最高 20 FPS 的实时生成。定性结果里最能说明问题的是参考 token 的消融:在其他条件完全固定、只切换有无参考 token 前缀的匹配 rollout 中,取第 300–400 帧来看,加入参考条件后相机运动下的身份与外观漂移明显减少——而且论文特别说明参考帧只取自因果可得的初始化与历史,真值帧仅作视觉比对用、从不喂给模型。tiled PRoPE 的分析图则显示它在保留时序带状结构的同时奖励位姿相似性,两种机制在一个注意力核里并存而非互相干扰。
auto
批判点评 :这篇的判断力体现在选对了「记忆单元」这个变量。整帧检索的问题不在于存得少,而在于一帧是原子的——你只能把它整体搬过来,且只能沿它原来的视角看,视角一变这份记忆就半废。降到 patch 粒度之后,记忆天然变成可按可见性筛选、可按几何重排的东西,z-buffer 那一步等于把遮挡推理直接做进了检索里,这比让注意力自己去学遮挡关系要可靠得多。更值得称道的是 patch-memory 与 tiled-PRoPE 都不加可学习参数,这让它有机会作为一个通用组件接到别的骨干上,而不是又一个只能整体接受的架构。静态动态解耦也切中了实际痛点:长程 rollout 里最难看的失败恰恰是本该不动的墙在漂、本该保持身份的角色在变脸。但局限也很清楚。第一,整套机制吃深度和位姿:patch 要靠度量深度反投影、要靠相机内外参对齐,那么深度估计误差和位姿噪声会直接变成记忆里的几何错位,论文没有给出这条链路的敏感性分析——在真实互联网视频这类位姿本就不准的数据上,这个风险不小。第二,persistent 3D patch 云是会一直长的,论文强调了组件不加参数,但没说清内存与检索代价如何随交互时长增长、有没有淘汰策略,而这恰恰是「长程」的成本核心。第三,静态与动态的二分依赖运动感知过滤器,那些介于两者之间的东西(缓慢变化的光照、被推动后停下的物体)落在哪一侧并不明确,分错的代价是鬼影或不该有的持久化。第四,作为技术报告,缺少与同类记忆方案的统一定量对比,20 FPS 也只是单一配置下的数字,读者难以判断这套机制相对整帧检索的净收益到底有多大。
3. OMR:用冻结V-JEPA梯度纠物理违背
Off-Manifold Refinement: Guiding Video Generators with a Frozen World Model | 越南 Fulbright 大学 + 加州大学洛杉矶分校(BMVC 2026) | arXiv:2608.29904
关键词 :推理期物理修正,V-JEPA 2.1意外度能量,单轨迹梯度注入,训练无关,Wan2.2,Physics-IQ,BMVC 2026
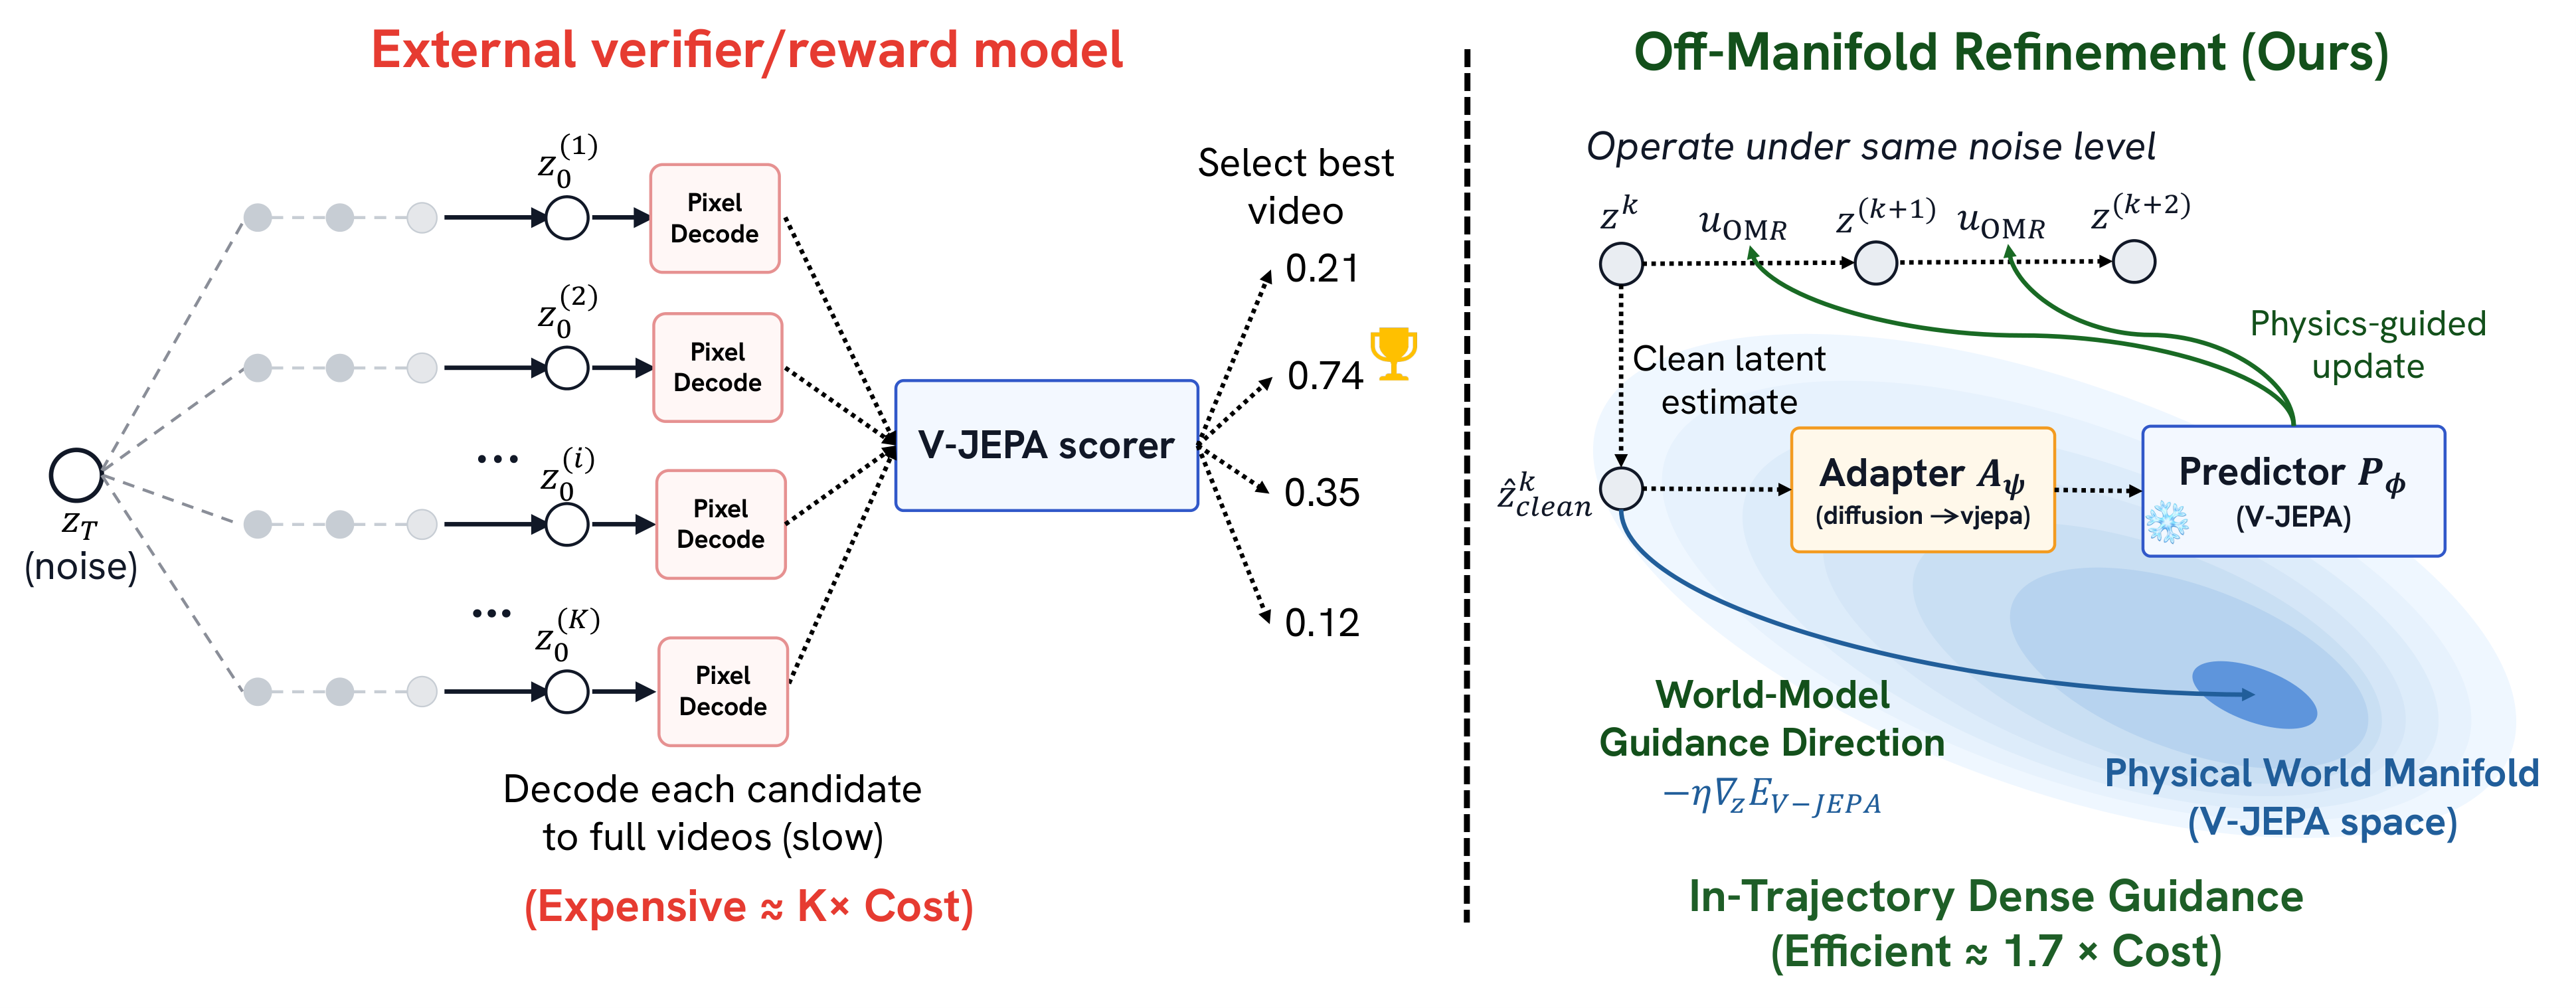
前序问题 :现在的视频生成器在物理动力学上会犯很低级的错:物体悬在空中、轨迹违反重力、接触关系凭空消失。根子在于目标函数——标准的去噪与流匹配目标拟合的是视觉数据分布,它并不显式惩罚这类物理违背,画面只要看着像训练数据里的样子就够了。既有的补救办法都能改善物理一致性,但代价通常不小。候选选择类方法要生成多个视频再逐个打分,算力开销随候选数线性上涨;基于梯度的世界模型引导需要反复解码再重新编码中间估计,每一步都过一遍 VAE;生成器内部的精修方案要加扰动再重新去噪的循环;而后训练路线则要准备精选数据并额外做一轮优化,成本最高也最不灵活。于是留下一个很实际的缺口:能不能在完全不动模型权重、不生成多个候选、也不反复解码的前提下,把「这个片段物理上不合理」这个信号送进采样过程?本文贡献 :作者提出 Off-Manifold Refinement(OMR),一种推理期方法,把世界模型的反馈直接注入单条采样轨迹,而不是在多条轨迹之间做选择。具体做法是在计划好的中段 ODE 步上,给生成器的速度场加上一项梯度——来自 adapter 空间里 V-JEPA 2.1 的「意外度能量」(surprise energy)。V-JEPA 有一个编码器和一个从可见上下文预测被遮挡未来嵌入的预测器,它在真实视频上训练出的这套目标提供了一个关于「合理时间延续」的学习先验:物体应当持续存在、运动应当平滑、接触关系应当成立。作者从每段 81 帧视频里取 48 帧窗口来算这个能量。这项外部修正会把 latent 推离未修正的采样轨迹,推向被冻结预测器判定为物理上更合理的区域,然后生成器从修正后的状态继续渲染。中间有一个跨表示的桥梁问题:Wan 的 latent 与 V-JEPA 的目标在同一段视频上编码的是不同目标下的表示,一个为合成保留内容与运动、一个为预测保留结构,所以作者训练了一个 adapter 做任务特定的变换,且这个 adapter 是在真实 OpenVid-1M 片段编码出的 latent 上训练、却用在生成过程中从带噪采样状态推出的临时干净预测上。
auto
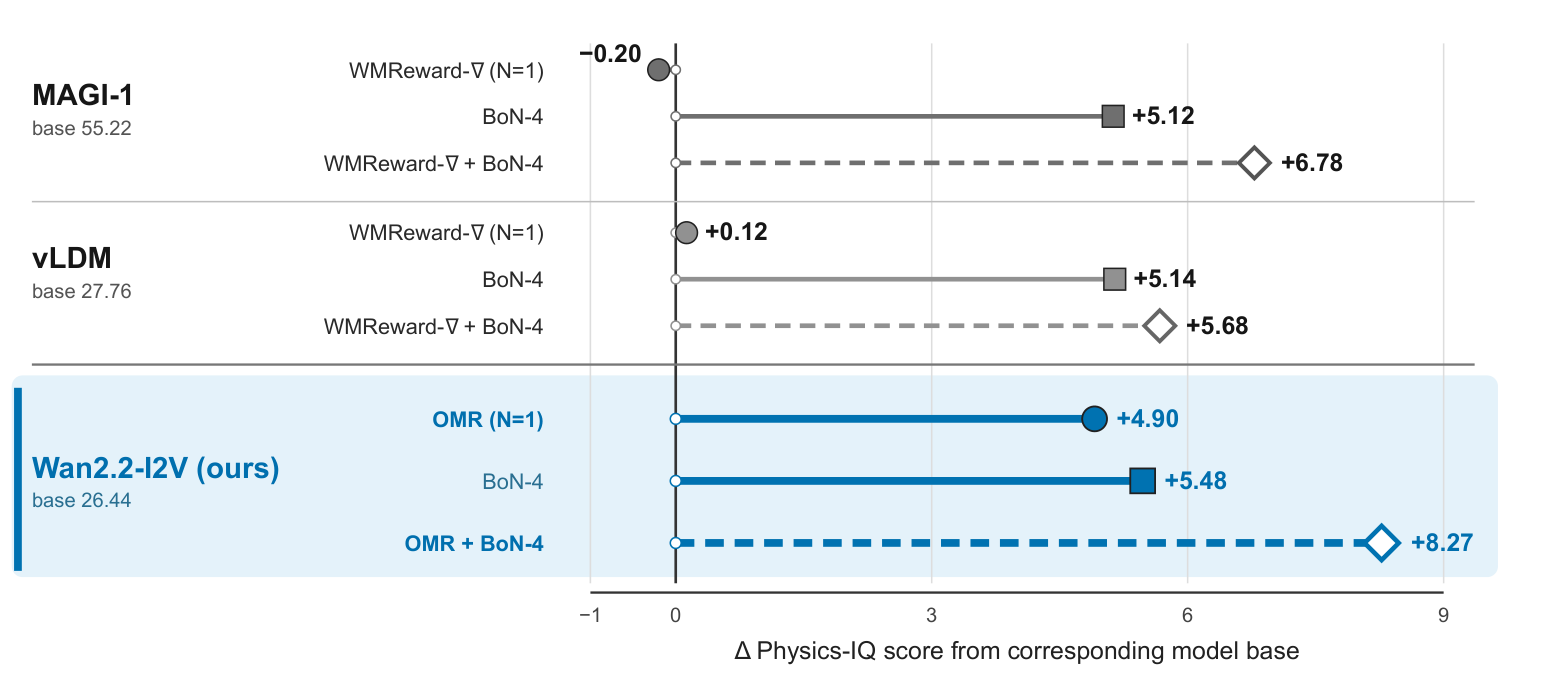
实验效果 :论文的定性结果最直观:同一个 Wan2.2 生成器下,基线在后空翻落地时出现腿部运动时序不一致和身体姿态的突变,而 OMR 给出了连贯的腿-身协同、垫子形变、符合重力的衣物运动和惯性驱动的下落。四组帧条对比把 Wan2.2、P&P 与 OMR 并排放在一起,强调的是时间上的因果:撞击应当与材料响应同时发生、工具应当与被它形变的物体保持耦合、身体运动应当在帧间保持支撑与动量——在第一组里 Wan2.2 在明确撞击之前就出现了破洞、P&P 有损伤但缺少同步的接触,OMR 的撞击与响应对齐得最好。定量侧作者在 Physics-IQ 上以固定 50 条提示做了 Wan2.2-I2V 的试点,比较引导、BoN-4 及两者组合三种设定;混合现象的「其他物理原理」一行从 46.6% 提升到 47.6% 的联合分数,其中 PC≥4 的比例从 56.6% 升到 58.7%。稳定性诊断显示中段轨迹的预测干净 latent 与对应的完成 latent 在 cosine/ρ/τ 上分别为 0.762/0.617/0.446 与 0.769/0.624/0.451,两行相当接近,支持了 adapter 用在 OMR 实际工作分布上的合理性。
auto
批判点评 :这篇的巧劲在于找到了一个便宜的干预点。既有方案要么在多条轨迹之间选(贵在候选数),要么反复解码回像素域再编码(贵在 VAE),OMR 直接在 latent 空间借 V-JEPA 的预测误差当能量、只在中段几步加一次梯度,本质上是把「物理合理性」当成一个可微的正则项挂在采样轨迹上。选 V-JEPA 也选得对——它的训练目标天然就是「从可见推未见」,这正是物理直觉的操作化定义,比拿一个判别式打分器要更贴近因果。那个 adapter 的诊断实验也做得诚实,用中段预测 latent 与完成 latent 的相关性接近来论证分布匹配,是个恰当的稳定性检查。但要清楚它证明了什么、没证明什么。第一,定量证据很薄:Physics-IQ 上 46.6%→47.6% 是约 1 个百分点的提升,而且是 50 条提示的试点规模,作者自己也只把它当作「聚合分数没崩」的对照——把这篇当成「解决了视频物理问题」来读会过度解释,它更像一个可行性演示。第二,adapter 存在明确的分布错配:训练在真实视频 latent 上,使用在从带噪状态推出的临时干净预测上,论文用相关性接近来辩护,但相关系数 0.76 的 cosine 并不算高,在物理更极端的片段上这个 gap 可能被放大。第三,方法的上限被 V-JEPA 顶住——它能判「这看起来不像真实视频的延续」,但不能判「这违反了动量守恒」,所以对训练分布内常见的物理它有效,对罕见但严格的物理约束未必。第四,只在中段 ODE 步注入是个超参选择,注入的时机与强度如何影响画面质量与物理性的权衡,论文没有给出充分的敏感性分析。
4. ShellGame:视频世界模型追不住隐藏状态
Can Video World Models Track Unobserved World States? | 首尔国立大学 + Roblox | arXiv:2608.30692
关键词 :隐藏状态追踪,视频版猜球游戏(Shell Game),S5状态追踪,线性注意力负特征值,LaCT快速权重,Transformer KV缓存局限,Roblox
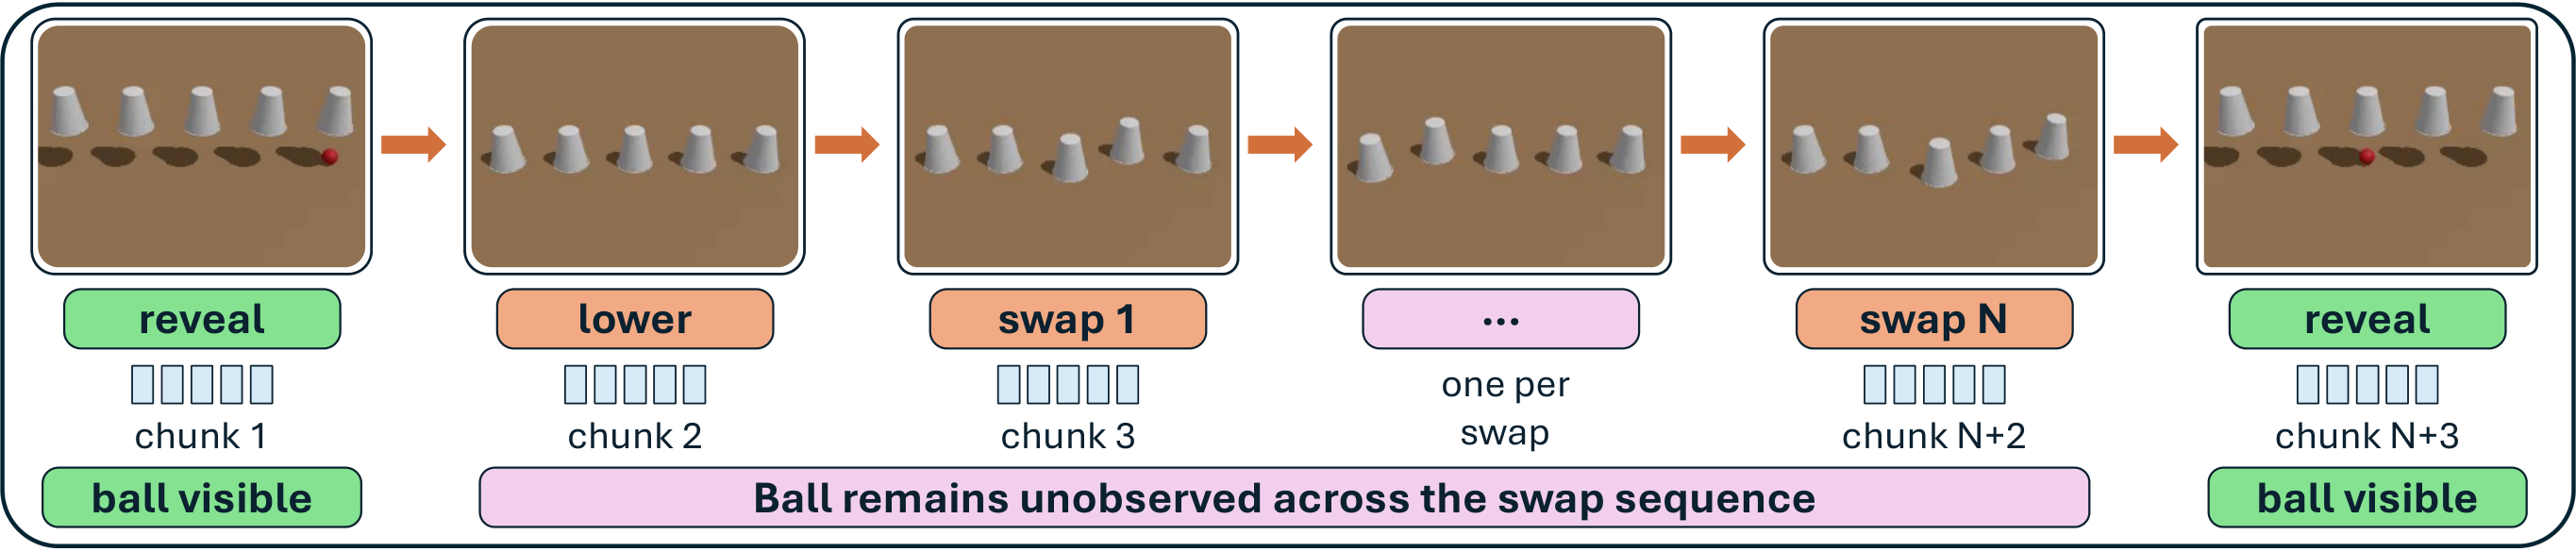
前序问题 :视频世界模型越来越多地被当作模拟器来用,但一个尖锐的问题被视觉保真度掩盖了:画面生成得像,并不能证明模型维护了世界的隐藏状态。世界里大量重要的东西是当前不可见的——被盖住的球、关上门后房间里的陈设、背包里的物品。如果模型只是把「看起来合理的下一帧」渲染出来,它可以在完全不知道球在哪个杯子下的情况下,依然画出一个像样的揭晓画面。这就使得现有的评测方式存在系统性盲区:几乎所有指标都在衡量渲染质量、时间一致性或提示遵循,没有一个在直接考察「不可见的状态有没有被正确携带」。作者要回答的正是这个被绕开的问题——把视觉渲染与隐藏状态的合成解耦开,单独测后者。本文贡献 :作者设计了一个动作条件化的视频版 Shell Game 作为探针,它是 $S_5$ 状态追踪问题的视觉类比:先揭晓球在哪个杯子下,然后把杯子盖上,经过一串交换动作,最后再揭晓——整个交换序列里球始终不可见,模型必须在架构内部携带并更新这个状态。他们在这个任务上系统比较了双向与自回归 Transformer、Mamba,以及转移特征值被限制在非负区间的线性注意力。诊断的关键洞察是:像素扩散目标从来没有监督过那个看不见的隐藏状态,所以生成的帧本身不可能承载它,状态只能活在架构里而不是 token 里。对 Transformer 来说,那个架构状态只是一个只增不减(append-only)的 KV 缓存,因此模型必须在每个 chunk 都从整段历史里重新推导出隐藏的排列,而不是维护它。作者进一步找到两个确实能外推的机制,共同点是都跨 chunk 携带一个状态并原地修改它:一是线性注意力——一旦允许转移特征值取负就能成功;二是 LaCT,其外推能力随快速权重头数 H 增加而提升。他们还在纯文本的 $S_3$/$S_5$ 词问题上做了对照,测量各架构解决长度 N 问题所需的最少层数与长度外推行为。
auto
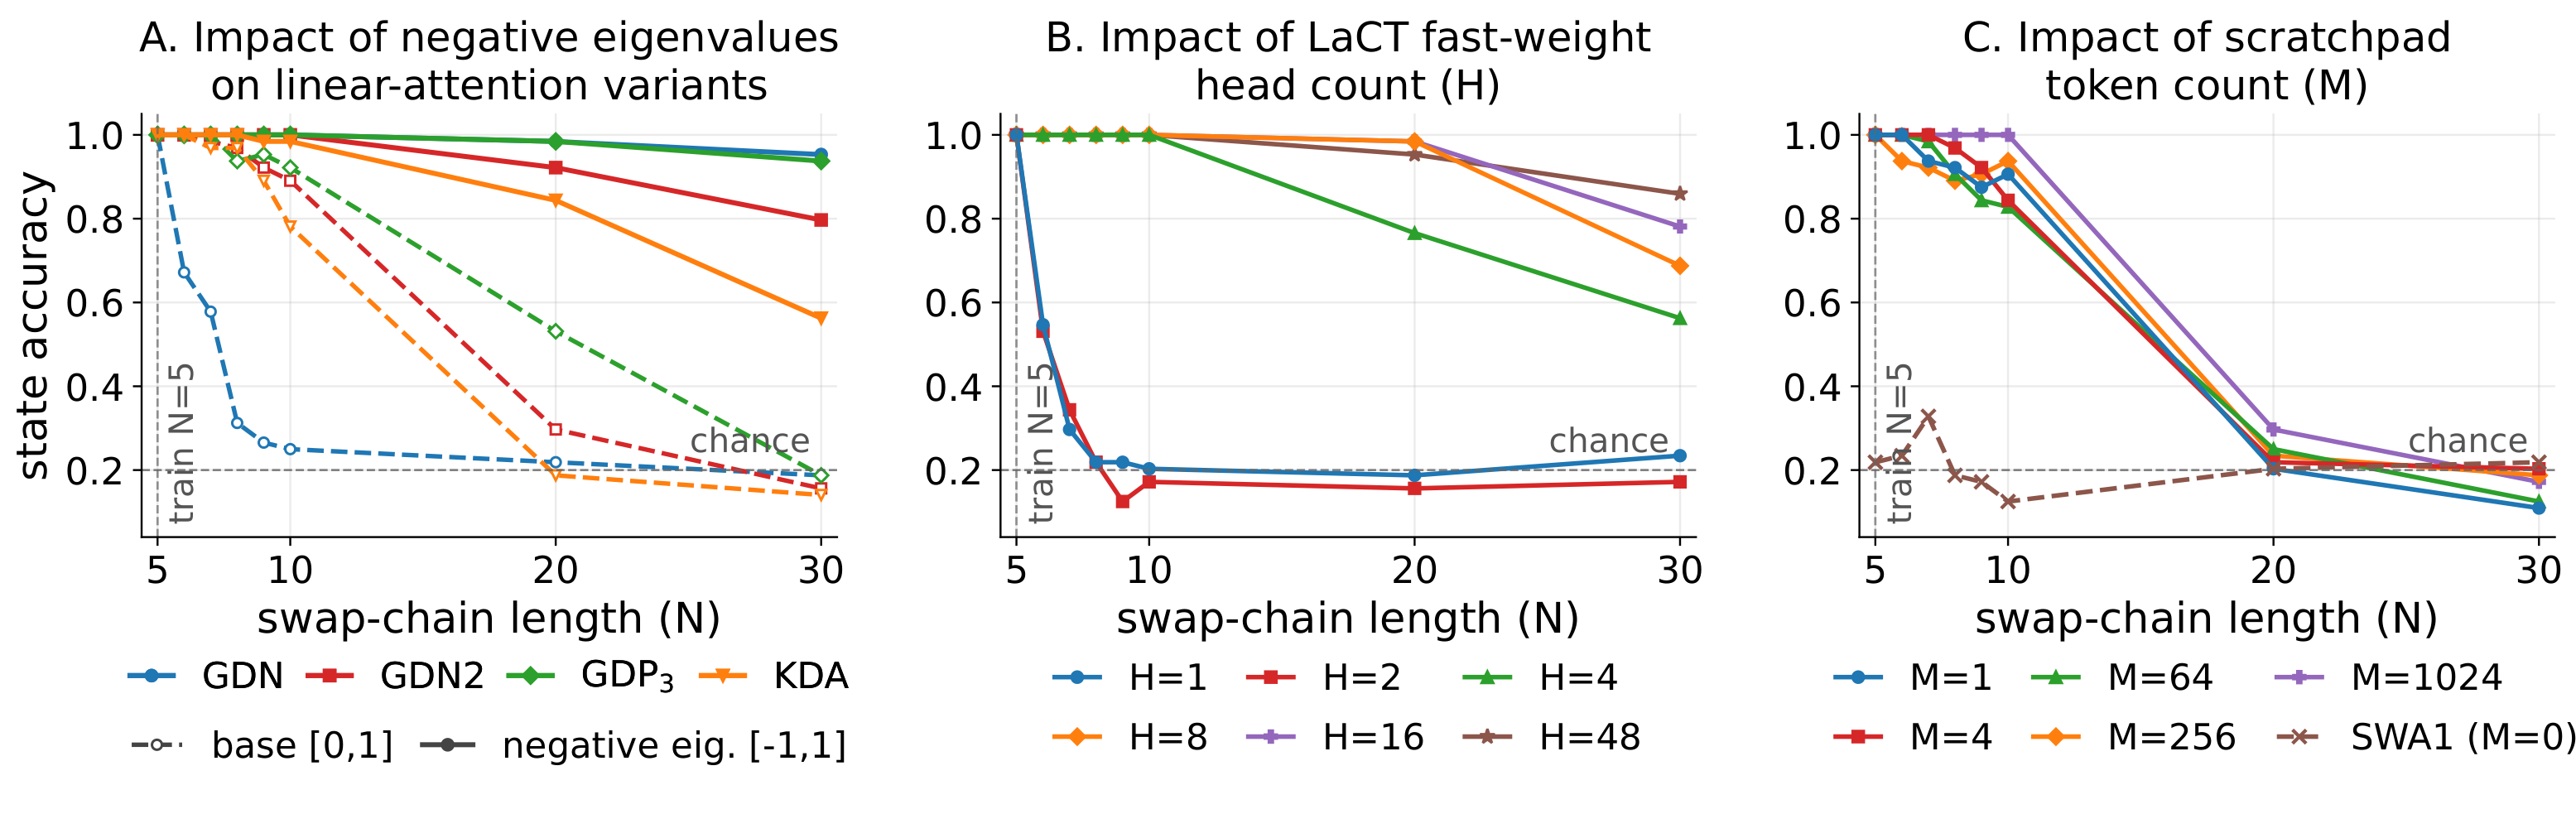
实验效果 :结论相当刺眼:双向和自回归 Transformer、Mamba、以及转移特征值限制在 $[0,1]$ 的线性注意力,全都只能拟合训练时的 5 次交换,交换链一长就朝随机水平掉下去,但同时仍在生成看起来合理的视频,而且增加去噪步数完全没有帮助。机制侧的量化很清楚:把转移特征值范围从 $[0,1]$ 放宽到 $[-1,1]$ 后,多个线性注意力变体(GDN、GDN2、GDP₃、KDA)的状态准确率在整条曲线上都提升,GDN2 在 N=30 时仍有约 0.8;LaCT 的外推随快速权重头数变好,H=16 在 N=30 时约 0.87、H=1/H=2 则贴在随机线上;scratchpad token 数量 M 的影响则弱得多,M 从 1 加到 1024 在 N=20 之后都掉向随机,而作为自然随机水平对照的裸 SWA1 骨干(M=0)连训练内长度 N=5 都做不到。定性 rollout 里,在训练长度两倍(N=10)的 Shell Game 上,GDN-neg 与 LaCT8 最终落在与真值相同的杯子上,而因果 DiT 与普通 GDN 没有;在纹理化 3D Block World 的局部动作条件化任务上(80 帧干净前缀 + 240 帧延续),LaCT8 能把方块和球保持在接近真值的位置,其他骨干渲染出的房间看着连贯但里面的东西已经漂走了。
auto
批判点评 :这是今天最有方法论价值的一篇,因为它把一个大家隐约感觉到但说不清的问题变成了可测量的:视觉保真度和状态追踪是两件事,而现有评测只测前者。Shell Game 这个探针设计得很干净——球被盖住之后画面里再没有任何关于它的信息,模型要么在架构里带着这个状态,要么只能猜,没有中间地带;而「增加去噪步数毫无帮助」这个观察尤其致命,它排除了「算力不够」这种廉价解释,把矛头精确指向表示能力。对 Transformer 的诊断也说到了本质:append-only 的 KV 缓存不是一个可以原地更新的状态寄存器,模型每个 chunk 都得从整段历史里重新推导排列,这在长序列上必然崩。找到的两个正面机制(负特征值、快速权重)共享「跨 chunk 带状态且原地改」这一性质,这个统一解释很有力。但要注意它的适用边界。第一,这是合成探针,$S_5$ 状态追踪是一个刻意构造的、纯组合性的困难任务,真实世界的隐藏状态往往有大量视觉与常识线索可借(东西通常不会凭空移动、遮挡物有形状约束),所以「在 Shell Game 上失败」不等于「在真实场景里同样糟」,这个外推需要谨慎。第二,反过来说负面结果也可能被低估——真实场景的状态空间比 5 个杯子大得多,若连这个都做不到,实际情况恐怕更差;论文没有在两个方向上都给出校准。第三,正面机制目前只在这些探针上被验证,负特征值线性注意力和 LaCT 在真实视频生成质量上要付什么代价(画质、训练稳定性、吞吐)文中没有交代,而这恰恰决定它们能不能真的替换现有骨干。第四,作者把「状态必须活在架构里」这一点讲得很好,但没有讨论第三条路——把状态显式外置成可读写的结构(今天另一条线的做法),这在方法空间上留了一块空白。
5. GEARS:把丢掉的候选诊断修复再利用
Test-Time Scaling for Video Diffusion Models via Diagnosis-Guided Candidate Recycling | 北京大学 + 阿里巴巴(ACM TOG / SIGGRAPH Asia 2026) | arXiv:2608.29322
关键词 :test-time scaling,候选回收,诊断式latent编辑,分阶段调度,Wan2.1-T2V-1.3B,SIGGRAPH Asia 2026,北京大学
前序问题 :视频扩散模型的生成质量已经很高,但高保真结果在很大程度上仍依赖闭源系统或昂贵的大规模基础设施。Test-time scaling(TTS)提供了一条免训练的路子:靠推理阶段多花算力来提升轻量生成器。问题是现有方法基本都困在「噪声搜索」这一个范式里——采样、选择、扰动去噪轨迹,然后把低分候选在昂贵的生成完成之后直接丢掉。这个「生成再丢弃」的流程浪费的不只是算力,更是那些可回收样本里已经编码好的部分运动、布局或外观结构:一个候选可能整体评分低,但它的镜头构图是对的、主体运动方向是对的,只是某个局部崩了。把它整条丢掉,等于把对的部分和错的部分一起扔。于是问题变成:能不能把低分候选当成可编辑的先验,而不是垃圾?这需要回答三个子问题——此刻该修什么、什么时候修、哪些候选值得修。本文贡献 :作者提出 GEARS(Guided Editing for Adaptive Recycling Search),一个免训练框架,把诊断引导的候选回收引入视频 TTS,通过「生成-评估-编辑」的循环把候选变成可编辑先验。它沿着从纯噪声到干净 latent 的去噪轨迹插入多个「生成转编辑」检查点 $s_0, s_1, \ldots, s_k$,并明确区分高噪区间(偏重运动)与低噪区间(偏重视觉)。框架由两个协作组件构成。Stage-Aware Scheduler 决定修什么、何时修、以及哪些候选该被保留、回收或丢弃:它先确定当前阶段的关注点(高噪阶段用运动质量 MQ、低噪阶段用视觉质量 VQ 作为排序依据),再做排序与路由——语义门控在低文本对齐时直接丢弃、把「弱但有希望」的一批送去回收器、其余有效候选作为精英保留。Candidate Recycler 则负责诊断与修复:由一个 MLLM 根据当前阶段的运动/视觉关注点与关键帧,把候选的提示改写成更好的版本,再配合流形感知的 SDE 去噪把修复落地。关键的一个设计细节是:在每个检查点,候选是先被完整去噪、解码、当作干净视频来评估的,带噪 latent 从不被直接打分——这避免了在噪声态上做不可靠的质量判断。奖励模型是运动质量、视觉质量与文本对齐三项之和。
auto
实验效果 :论文的机制展示很直观:一个排名靠后但语义上有效的候选,在传统「生成即选择」的 TTS 里会被丢掉,而 GEARS 先在高噪检查点修掉它的运动缺陷、再在低噪检查点增强视觉细节,修复后的候选回到最终候选池并被选为最佳视频。分阶段修复的案例里,第一阶段(高噪)候选没有充分实现要求的行走动作,回收器在保留兔子主体与奇幻场景的同时恢复了连贯的主体运动,右侧插图用共享尺度的背景补偿光流显示残余运动的大小与方向;第二阶段(低噪)则在保持结构的前提下精修外观与纹理。分布层面的证据是 VQ–MQ 空间里的联合与边缘分布对比:GEARS 把可回收候选整体推向更高的联合质量区域,而不只是把最好的那个挑出来。scaling 行为在 Wan2.1-T2V-1.3B 与 Wan2.1-VACE-1.3B 两个骨干上都做了验证。
auto
批判点评 :这篇的洞察其实很朴素但少有人认真对待:TTS 的浪费不在采样,而在丢弃。既有方法从 Video-T1 的独立轨迹选优、到 DLBS 的逐步保留 K 个精英做束搜索、再到 EvoSearch 在精英附近做中段变异,路线越来越精细,但共同前提都是「低分即无用」。GEARS 把这个前提拆了——低分候选是一个有部分正确结构的初值,值得诊断而不是抛弃。两个设计决策尤其站得住:一是候选必须先完整去噪解码成干净视频再评估,绝不给带噪 latent 打分,这一条避免了整个领域常见的「用噪声态代理指标做决策」的可靠性问题;二是把高噪修运动、低噪修细节这个分工写进调度器,与扩散过程本身的信息层级对齐,而不是在所有阶段用同一个标准。用 MLLM 做诊断并改写提示,也比用一个不可解释的打分器更容易调试。但有几处需要保留判断。第一,成本核算不透明:每个检查点都要把候选完整去噪、解码、评估,再对被回收者做编辑与重新去噪,这些开销相对「直接多采几条轨迹」是否真的更划算,需要在同等算力预算下比较,而这类等价预算对照是 TTS 类工作最容易含糊的地方。第二,整条链路依赖奖励模型(MQ+VQ+TA 之和)的可靠性,而运动质量的自动评估本身是公认的难题,如果 MQ 有系统偏差,调度器的「该修什么」判断会跟着偏,且这种偏差会被回收循环放大而非抵消。第三,MLLM 改写提示引入了一个不易复现的环节——同一个候选在不同 MLLM 或不同温度下会得到不同的修复方向,论文对这部分的方差没有交代。第四,验证骨干集中在 1.3B 规模,在更大的生成器上,「候选本身已经不错、可回收空间变小」这一效应会不会吃掉大部分收益,仍是开放问题。
6. RTI:希尔伯特曲线切出内容形状token
Elastic Token Compression for Pixel-Space Diffusion Transformers | 德国维尔茨堡大学 + Google | arXiv:2608.29281
关键词 :像素空间扩散,弹性token压缩,希尔伯特曲线排序,区域token接口(RTI),单checkpoint多预算,GenEval,维尔茨堡大学
前序问题 :自然图像把细节集中在画面很小的一部分,但扩散模型对每个 patch、在每一层、每个时间步都花一个完整的 token。这种浪费在像素空间模型里最严重,因为它没有 autoencoder 先把低层冗余吸收掉。作者探测一个预训练的像素文生图 transformer,发现它中间块的 token 在图像平坦处是冗余的,而且这种冗余占据的是连通的、随内容成形的区域——这就带来一个表示上的要求:要利用这种冗余,就需要几何形状与之匹配的 token,而不是规则网格块。既有的降维方案各自丢掉了这个性质的一部分:相似度合并会把同一组的成员散落在画面各处,不再是连通区域;隐空间瓶颈把位置信息丢了;直接跳过则是把本该被总结的内容删掉。于是核心难题是:怎样得到「形状随内容变化、又能高效实现」的 token 分组——二维空间上的任意连通区域划分在实现上是很昂贵的。本文贡献 :解法的巧劲在于降维:沿希尔伯特曲线给 patch 排序。这条空间填充曲线的性质是相邻位置在图像上永远是邻居,因此任意一段连续区间都对应一个连通区域,且这个区域的大小与形状会随内容自然变化——于是「在二维上做分组」这个难题变成了「在一维上做切割」。作者在模型特征变化最大的位置切开,把每一段池化成一个 region token。为了让模型适应这种新 token,他们提出 Region Token Interface(RTI)做适配;训练时 region 数量是随机抽取的,所以同一个 checkpoint 能服务所有压缩预算,这就是标题里 elastic 的含义——不必为每个算力预算各训一版。作者在 MiniT2I 系列的两个模型规模上验证,并与相似度合并(Feat Sim)、隐空间数组(Latent Array)、token 跳过(Token Skip)等做了机制层面的对照,还做了排序方式的消融(希尔伯特 vs 光栅)以检验「连通性是否真的重要」。
auto
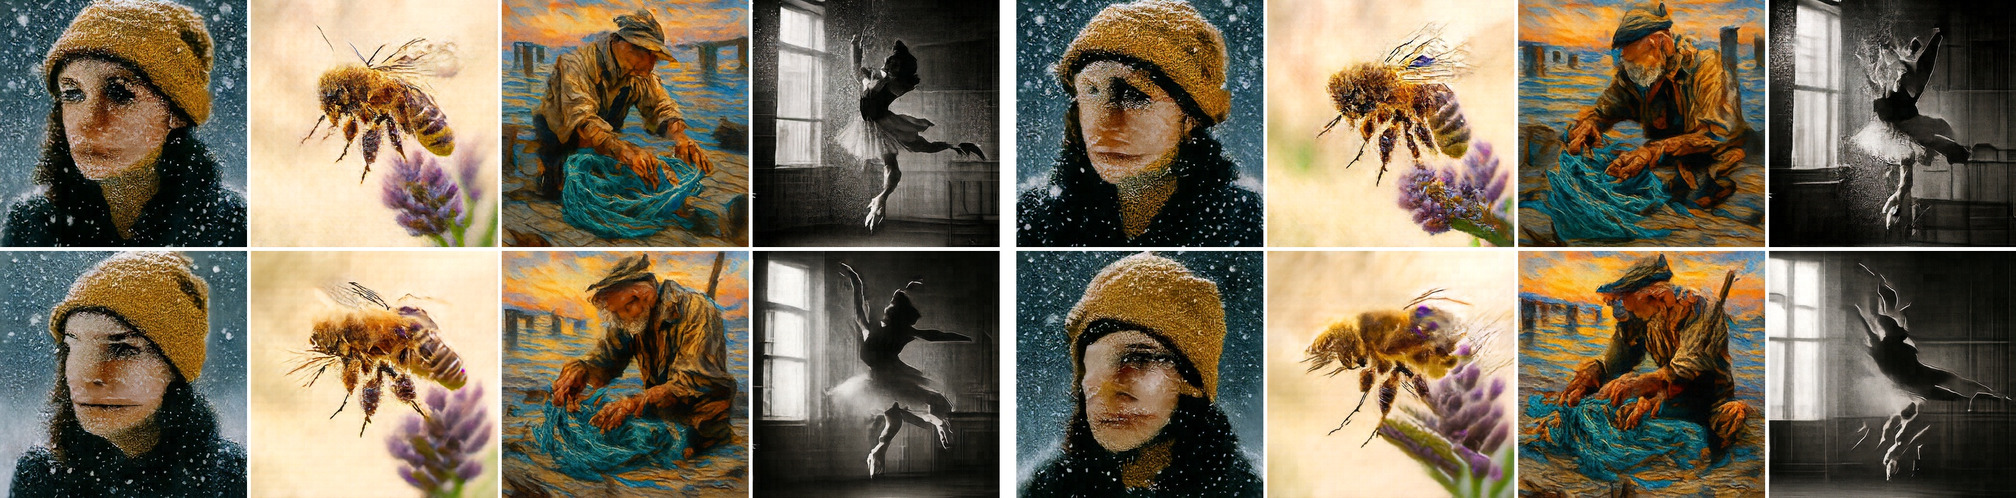
实验效果 :机制对照图把四种方案的分组结构与生成结果并排放在一起:RTI 的分组呈现出与图像内容贴合的连通色块、生成结果保住了主体(背着风笛的犰狳)的完整结构与纹理;Feat Sim 的分组碎裂成散点、生成结果虽然还成形但细节退化;Latent Array 完全丢掉了空间结构、生成结果崩成一团抽象形体;Token Skip 大面积留白、结果只剩轮廓。排序消融给出了「连通性必要性」的直接证据:在 MiniT2I-B/16 上比较希尔伯特与光栅两种排序,在较宽松的预算($R_{cells}=128$)下两者接近,但预算压到 $R_{cells}=64$ 时希尔伯特保住了人脸、翅膀与网格结构,光栅则把它们抹开、人物形体也散掉。效率-质量曲线上,RTI 在 $R_{cells}=256$ 时以 1.79 秒/图达到 GenEval 82.7%、ImageReward 0.953,而基线 MiniT2I-L/16 要花到 4.62 秒才达到 86.4% / 0.950——也就是说在 ImageReward 这个指标上 RTI 用约 2.6 倍更短的时间达到了同等水平;把预算放到 5.58 秒时 RTI 达到 86.2% / 1.155,ImageReward 超过基线 5.77 秒的 1.039。
auto
批判点评 :这篇最漂亮的地方是把一个几何难题化成了排序问题。「需要形状随内容变化的 token」这个需求听起来必须做复杂的二维分割,但希尔伯特曲线的局部性保证让一维上的任意连续段自动成为二维上的连通区域,于是分组变成切割,实现代价陡降。更值得肯定的是它对既有方案的批评是结构性而非性能性的——指出相似度合并散落分组、隐空间瓶颈丢位置、跳过删内容,各自丢掉了「连通、有位置、被总结」这三个性质中的一个,这种分析比单纯比分数有说服力得多,而排序消融(希尔伯特 vs 光栅)恰好把「连通性」单独隔离出来做了验证,是很干净的对照设计。训练时随机抽 region 数从而一个 checkpoint 覆盖所有预算,也是很实用的工程决策。但要注意几个边界。第一,作者自己承认速度有天花板:prelude、coda 与文本流不参与压缩,所以再怎么压 region 数,端到端加速也会饱和——这意味着该方法适合中等压缩率区间,指望它带来数量级提速是不现实的。第二,GenEval 上并没有全面胜出:长预算下 86.2% 对基线 87.0%,是略低的;真正的优势集中在短预算区间和 ImageReward 上,而 ImageReward 是偏好类指标,与 GenEval 这种组合性正确率指标的结论不一致时,应当分开陈述而不是合并成「更好」。第三,方法针对的是像素空间扩散这个相对小众的设定——论文自己说浪费在像素空间最大,那么在主流的 latent 扩散上,autoencoder 已经吸收了大部分低层冗余,这套机制还剩多少收益空间是未验证的。第四,切割位置由「特征变化最大处」决定,这个判据依赖被探测模型的中间层表示,换骨干后是否仍然稳定、需不需要重新校准,文中没有交代。
7. RegionCache:多轮编辑只重算改动区域
RegionCache: Semantic-Aware Region Reuse for Efficient Multi-Turn Image Generation | 东北大学计算机科学与工程学院(IJCAI 2026) | arXiv:2608.29809
关键词 :多轮图像编辑,语义感知区域复用,cross-attention定位,自适应复用调度,PixArt-alpha,1.43-2.55倍加速,IJCAI 2026
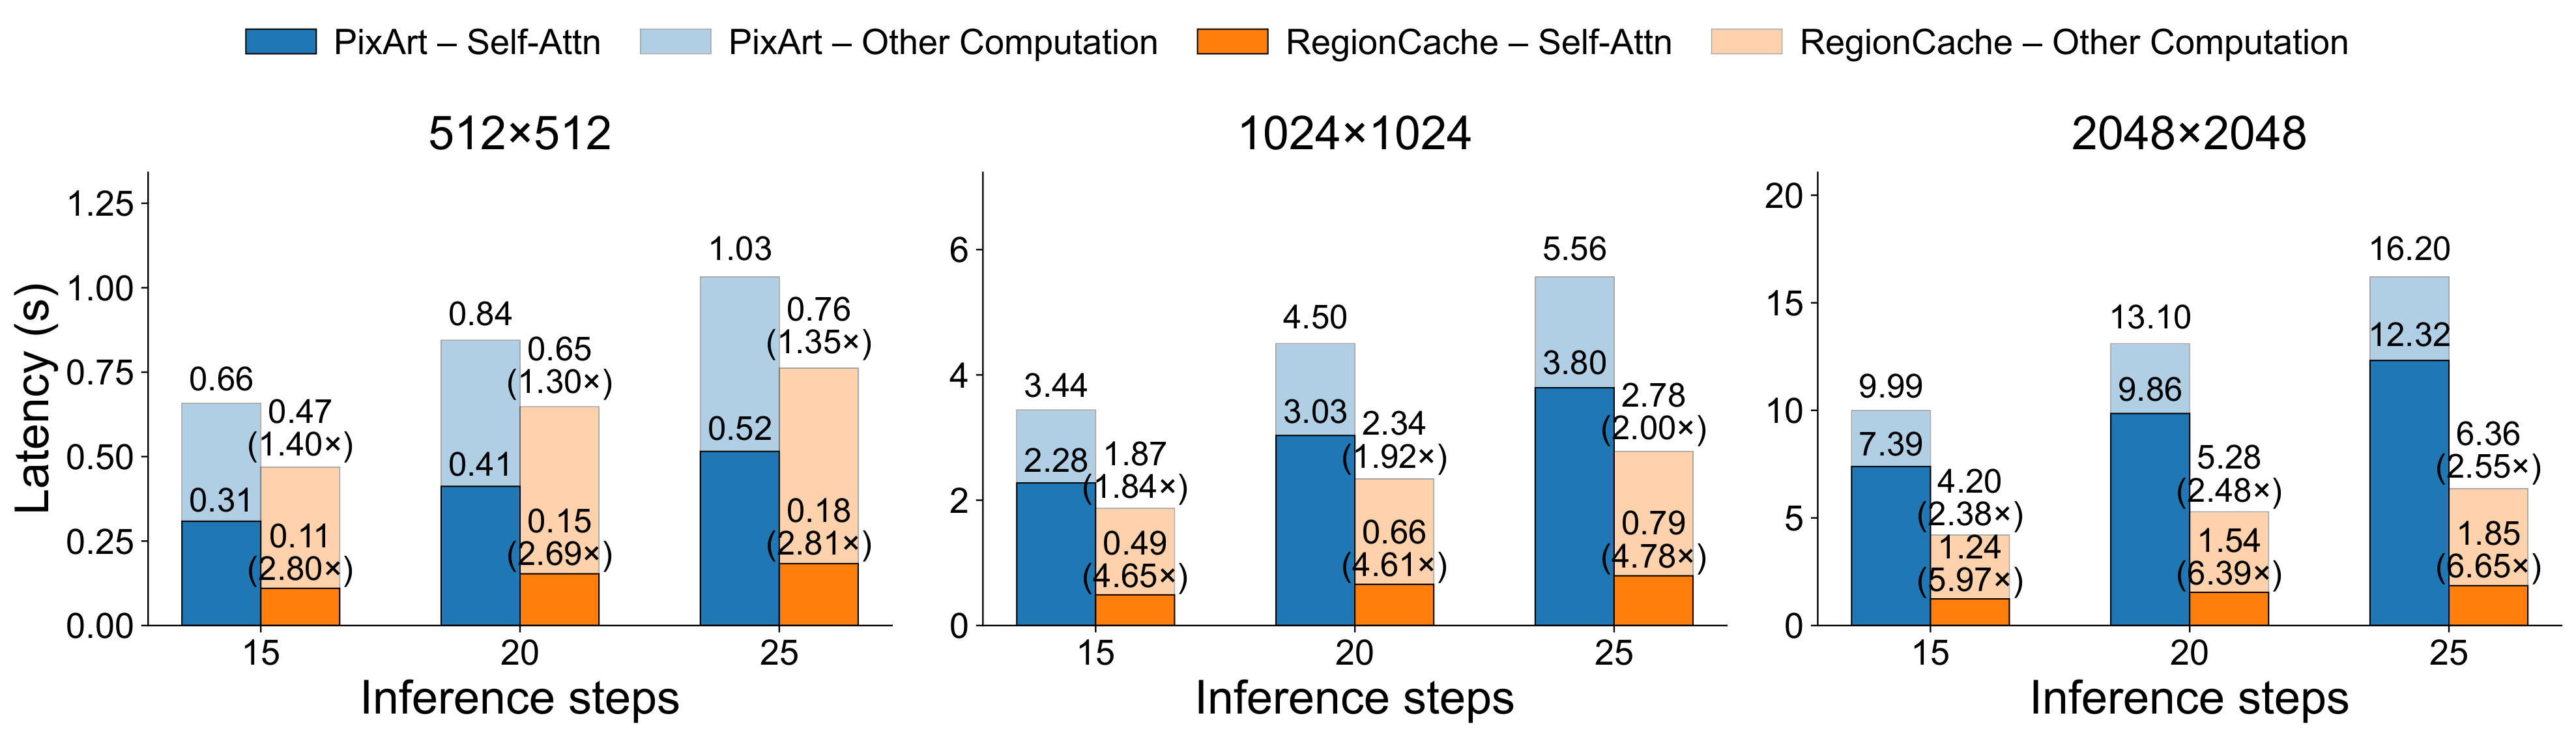
前序问题 :真实世界的图像生成往往是多轮编辑:用户一轮一轮地改小块区域,而大部分画面内容保持不变。但现有基于 DiT 的编辑管线在每一轮都把整张图重算一遍,产生大量冗余计算——用户只是把「一只猫在星空下」改成「一只狗在星空下」,星空那部分的去噪过程却要从头再跑一次。现有的 DiT 加速方法又都忽略了跨提示的语义对应关系,于是落入两种错误:要么保守地不复用、造成不必要的重算,要么激进地复用了实际已经改变的区域、损害编辑质量。问题的难点在于要同时回答两件事——哪些区域在这一轮语义上确实没变(这需要跨提示的语义比对,而不只是像素比对),以及对这些区域可以复用到什么程度(完全跳过整个去噪过程,还是只在部分时间步复用)。本文贡献 :作者提出 RegionCache,一个面向多轮图像编辑的语义感知复用框架,选择性地复用未改变区域的扩散状态。它由两部分构成。Prompt-aligned Region Caching 负责识别与缓存:通过连续提示之间的语义重叠(Semantic Overlap Identification)确定哪些语义单元延续了下来,再用 cross-attention 定位把每个语义单元对应到图像上的具体区域,把该区域的 mask 与隐状态存进 cache pool——比如「cat」与「starlite」各自被独立缓存。Semantic-aware Region Reusing 负责决定复用策略:它把区域分成改变区域与未改变区域,在区域级稀疏注意力下,语义未变的部分(如 starlite)可以在全部时间步复用,而语义已变的部分(cat→dog)只在早期步复用;复用的时间表是自适应的,依据提示相似度与上下文一致性来定,而不是固定阈值。作者还测量了自注意力与其他计算在不同推理步数和分辨率下的延迟占比,用以定位加速空间到底在哪里。
auto
实验效果 :在 PixArt-alpha 上,RegionCache 实现了 1.43 倍到 2.55 倍的端到端加速,同时保持可比的图像质量。框架图给出的机制示例很直白:从「A cat under the starlite」到「A dog under the starlite」,starlite 被判为语义未变从而全步复用,cat→dog 这一改变区域只在早期步复用、后续正常重算,因此改动准确落在主体上而背景星空的观感保持一致。案例研究把 RegionCache 与既有多轮编辑框架并排比较了多轮编辑的结果质量。延迟拆解则显示自注意力在不同推理步与分辨率下的占比,是复用设计的依据。
auto
批判点评 :这篇选的问题很贴近真实使用:多轮编辑是图像生成产品里最常见的交互形态,而每轮全量重算确实是明显的浪费。它的关键判断是把复用的依据从像素相似度提升到语义重叠——用提示之间的语义比对加 cross-attention 定位来决定复用区域,这比在 latent 上做相似度阈值要可靠,因为「猫变成狗」在像素上可能相似度不低,但语义上必须重算。区分「全步复用」与「仅早期步复用」也是有见地的:扩散的早期步决定布局与低频结构,改变区域在这个阶段与原图共享的信息其实不少,一刀切地全部重算同样是浪费。用延迟拆解来定位加速空间,说明作者是先量了再设计,而不是凭直觉。但这篇的分量比较轻,几处需要注意。第一,1.43–2.55 倍这个区间很宽,说明收益强烈依赖每轮改动占画面的比例——改一个小配饰接近上界、重构主体接近下界,论文用一个区间概括,读者难以判断在自己的使用分布下能拿到多少。第二,只在 PixArt-alpha 上验证,而 PixArt-alpha 相对当前主流的编辑骨干已经偏旧,这套机制在更强的编辑模型(其注意力模式与语义定位质量都不同)上是否同样有效并未回答。第三,质量结论停留在「comparable」这个定性表述与案例图,而复用本质上是一种近似,最该被量化的恰恰是「复用带来的质量损失」在多轮累积后会不会漂移——第 5 轮、第 10 轮之后误差是否累积,论文没有给出多轮深度上的退化曲线。第四,整条链路依赖语义重叠判断的准确性,一旦把实际改变的区域误判为未变,错误会被缓存下来并影响后续所有轮次,这个失效模式的代价比一般加速方法要重,但文中没有讨论回退机制。
8. PixelIR:保真与感知拆成两条流
PixelIR: Fidelity-Perception Decoupling via Pixel-Space Image-Residual Flow Matching for Efficient One-Step Real-World Super-Resolution | 上海交通大学(实习期间完成) | arXiv:2608.30782
关键词 :真实图像超分,保真-感知解耦,像素空间残差流匹配,一步蒸馏,双粒度像素transformer,上海交通大学
auto
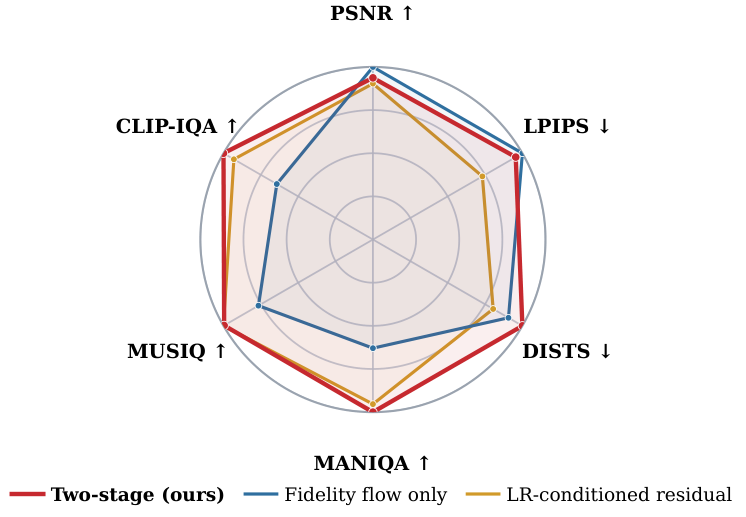
实验效果 :论文在 DIV2K 上给出六指标的组件剖面雷达图(每个指标方向对齐并按最优值归一化,越远越好)来展示解耦消融的效果,并在 LSDIR 与 RealSR 的困难样例上做了定性对比。方法层面最实质的效率结论是:教师用 4+4 步、学生蒸馏为一步,且骨干通过五阶段金字塔逐步收窄——这直接针对「一步方法仍继承昂贵高分辨率骨干」这一痛点,即把计算按 patch 粒度分层,语义处理放在粗粒度、像素处理放在细粒度,而不是全程在高分辨率上跑完整 transformer。
auto
批判点评 :这篇的架构判断是对的:保真与感知的冲突不是调参问题而是表示问题,让一个网络用一组权重同时承载「不要偏离观测」和「大胆编细节」两个相反的诉求,本身就在制造干扰。拆成基础重建 + 残差合成之后,残差流只需要建模「差什么」,不必反复重学已经解好的整体结构,这个分解在信息论上也更经济。双粒度设计(DiT 管语义、PiT 管像素)与五阶段金字塔蒸馏配合得很自然——把昂贵的注意力放在粗粒度、把逐像素处理放在细粒度,正面回应了「一步方法仍背着高分辨率骨干」这个真实成本问题。双锚点蒸馏同时对齐教师与真值,也比只蒸馏教师更稳。但有几处需要留意。第一,训练与部署链路相当长:4 步图像流 + 4 步残差流的教师,再蒸馏成五阶段一步学生,中间每一环都有超参与对齐损失,复现成本和调试难度都不低,而论文对这条链路的稳定性(比如残差流在基础重建质量波动时是否鲁棒)交代不多。第二,残差流以冻结的基础重建为条件,这意味着基础重建的错误会被完整继承——如果第一阶段把结构判断错了,第二阶段只会把错误结构渲染得更「真实」,这类失效在超分里恰恰是最有害的(把噪点补成清晰的伪细节),论文没有专门分析。第三,评测证据以雷达图与定性对比为主,六个指标归一化后画在一张雷达图上很好看,但归一化会掩盖绝对差距的大小,读者无法判断某个维度上的领先是显著还是微弱。第四,署名信息显示工作在实习期间完成、机构标注较为简略,作为一篇方法论文其可复现材料(代码、权重)是否释出会明显影响这套多阶段管线的实际影响力。
9. GenFirst:先练生成再练重建防塌缩
GenFirst: Generation Before Reconstruction for Stable End-to-End Latent Generative Modeling | 中国科学技术大学 + 字节跳动 Seed | arXiv:2608.29335
关键词 :端到端隐空间训练,隐空间塌缩,KL熵项,生成-重建冲突,非对称学习动态,REPA-E,字节跳动Seed
前序问题 :隐空间生成模型的标准做法是两阶段:先训一个 VAE 做重建,再在冻结的隐空间上训生成模型。但为重建优化出来的隐空间不一定适合生成——重建只要求信息可恢复,生成还要求分布可采样,两者的最优解未必重合。于是联合训练看起来很有吸引力,可直接端到端训练一直很难做:一是容易发生隐空间塌缩,二是面临生成-重建冲突。已有的折中方案 REPA-E 通过截断生成梯度、并用一个外部的表示对齐损失(DINOv2)来重塑隐空间以避免塌缩,但这么做的代价是生成目标不再直接塑造隐空间——绕开了塌缩,也绕开了「让隐空间为生成服务」这个初衷。作者要回答的是:能不能让生成损失真的作用在编码器上,同时不塌缩?本文贡献 :作者重新分析了不同目标如何塑造隐空间,得到两个关键洞察。第一,KL 散度目标里的熵项是防止塌缩的关键:重建与先验拟合都倾向于收缩后验,而熵项保留了非退化的隐空间不确定性——换句话说,塌缩不是生成梯度本身的错,而是缺了一个撑开后验的力。第二,重建与生成呈现非对称的学习动态:重建快且监督强,在很少的训练步内就能达到不错的图像保真度;生成慢且更难优化,需要长得多的过程才能学出一个可采样的隐分布。基于这两点,他们实现了首次不发生隐空间塌缩的直接端到端训练,并提出 GenFirst——一个简单的「生成先于重建」策略:让生成目标先塑造隐空间,之后再refine重建。论文的对比图把四种范式并置:(a) 传统两阶段用固定的重建优化隐空间,对生成次优;(b) 朴素端到端让生成损失更新编码器但导致塌缩;(c) REPA-E 靠 stop-grad 加外部 REPA 损失避免塌缩,但生成损失不直接塑造隐空间;(d) 本文方法用先验损失塑造隐空间、熵项防止塌缩。作者还做了扩展实验:隐空间级 SigLIP 监督以学习生成与表示共享的隐空间、基于 caption 的 VLM-NLL 监督施加在中间视觉特征上、以及用块因果扩散 transformer 做统一文本-图像建模(连续文本与图像 latent 联合优化,支持双向的文生图与图生文)。
auto
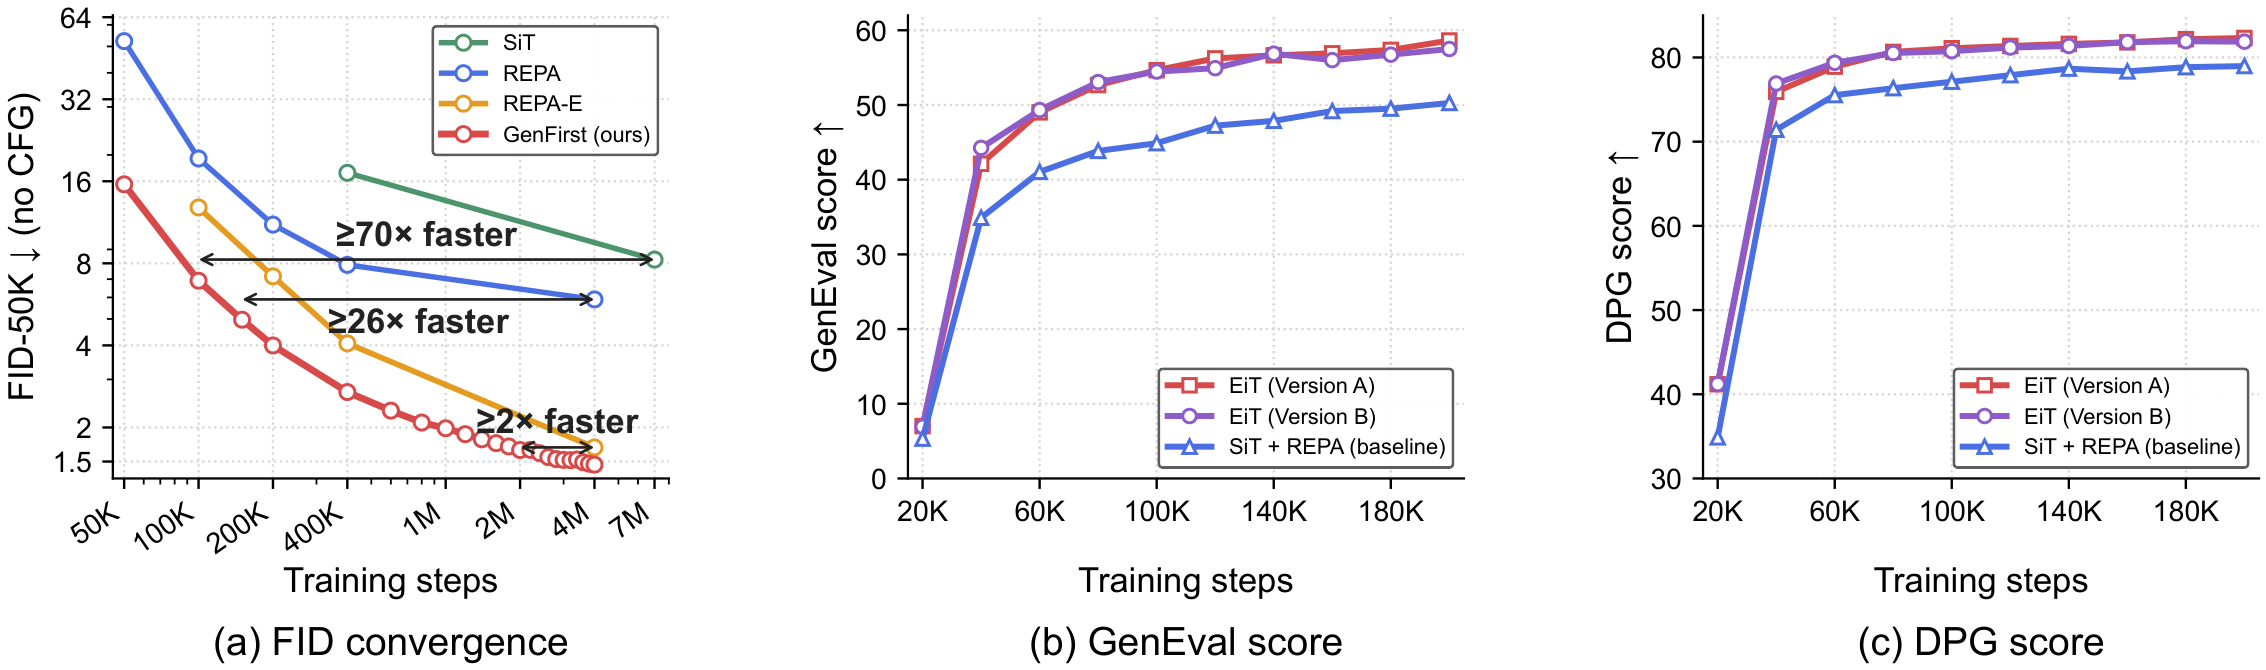
实验效果 :收敛加速是最直接的证据:在类条件 ImageNet 生成上报告不带 CFG 的 FID-50K 曲线,在文生图上报告 EiT Version A/B 与 SiT+REPA 基线的 GenEval 与 DPG 分数——两个 EiT 变体都在 80K 步就超过了基线 200K 步的表现,也就是约 2.5 倍的步数效率。非对称动态的可视化清楚显示重建在远少的步数内达到良好图像保真度,而生成需要更长的优化过程才学到可采样的隐分布,这正是「先生成后重建」这个次序的依据。定性上,三种隐空间设定用同一个 MMDiT 与采样配置对比:DPG-Bench 上的文生图与 COCO Karpathy 测试集上的图生文都显示端到端训练的隐空间提升了提示保真度与描述连贯性,其中文本-图像联合隐空间训练的定性结果最强。消融给出了 gFID 与 rFID 的权衡曲线:没有任何固定的先验损失权重能同时兼顾生成与重建,而在重建精修阶段用一个中等先验权重能得到最好的权衡。
auto
批判点评 :这篇的分析质量高于它的方法复杂度,而这恰恰是优点。「塌缩的原因是缺了熵项撑开后验」这个诊断把问题从「生成梯度有毒、必须截断」纠正成「少了一个平衡力」,直接否定了 REPA-E 那条绕行路线的必要性——后者为避免塌缩付出的代价是生成损失不再塑造隐空间,等于放弃了端到端的意义。第二个洞察「重建快、生成慢」看起来朴素,但它把训练次序变成一个有依据的设计变量而非试错结果:既然慢的那个更需要主导隐空间的形状,就让它先来。方法本身简单到几乎不增加实现负担,却拿到约 2.5 倍的步数效率,这种「分析驱动的简单解」比堆结构更有价值。消融里「没有任何固定先验权重能兼顾生成与重建」这个结论也很诚实,它说明这不是调参能解决的问题,从而反过来支持了分阶段的必要性。但要注意几点。第一,主要收益是收敛速度而非质量上限:80K 步超过基线 200K 步说的是效率,论文没有强调最终收敛质量拉开了多大差距,把这篇读成「生成质量大幅提升」会误读。第二,FID 曲线是不带 CFG 的,而实际部署几乎都开 CFG,无 CFG 下的 FID 优势能否在开 CFG 后保持,是这类工作常见的落差点。第三,扩展实验(SigLIP 监督、VLM-NLL、块因果统一建模)铺得很开,每一项都只给了「稳定训练」的定性结论,广度换走了深度——尤其统一文本-图像建模是个大命题,用一张扩展图交代略显单薄。第四,实验规模集中在 ImageNet 类条件与中等规模文生图,端到端联合训练在更大数据与更大模型上是否仍然稳定(熵项的权重是否需要随规模重新校准)没有回答,而这决定它能否进入真实的大规模训练流程。
10. RAGDiffusion++:RL救回SFT抹平的高频纹理
RAGDiffusion++: From Macro-Retrieval to Micro-Fidelity Alignment for Garment Generation | 上海交通大学 + 阿里巴巴 | arXiv:2608.29280
关键词 :服装资产生成,高频轨迹塌缩,AR-GRPO,Garment-RM奖励模型,artifact hacking,双图像流DiT,上海交通大学
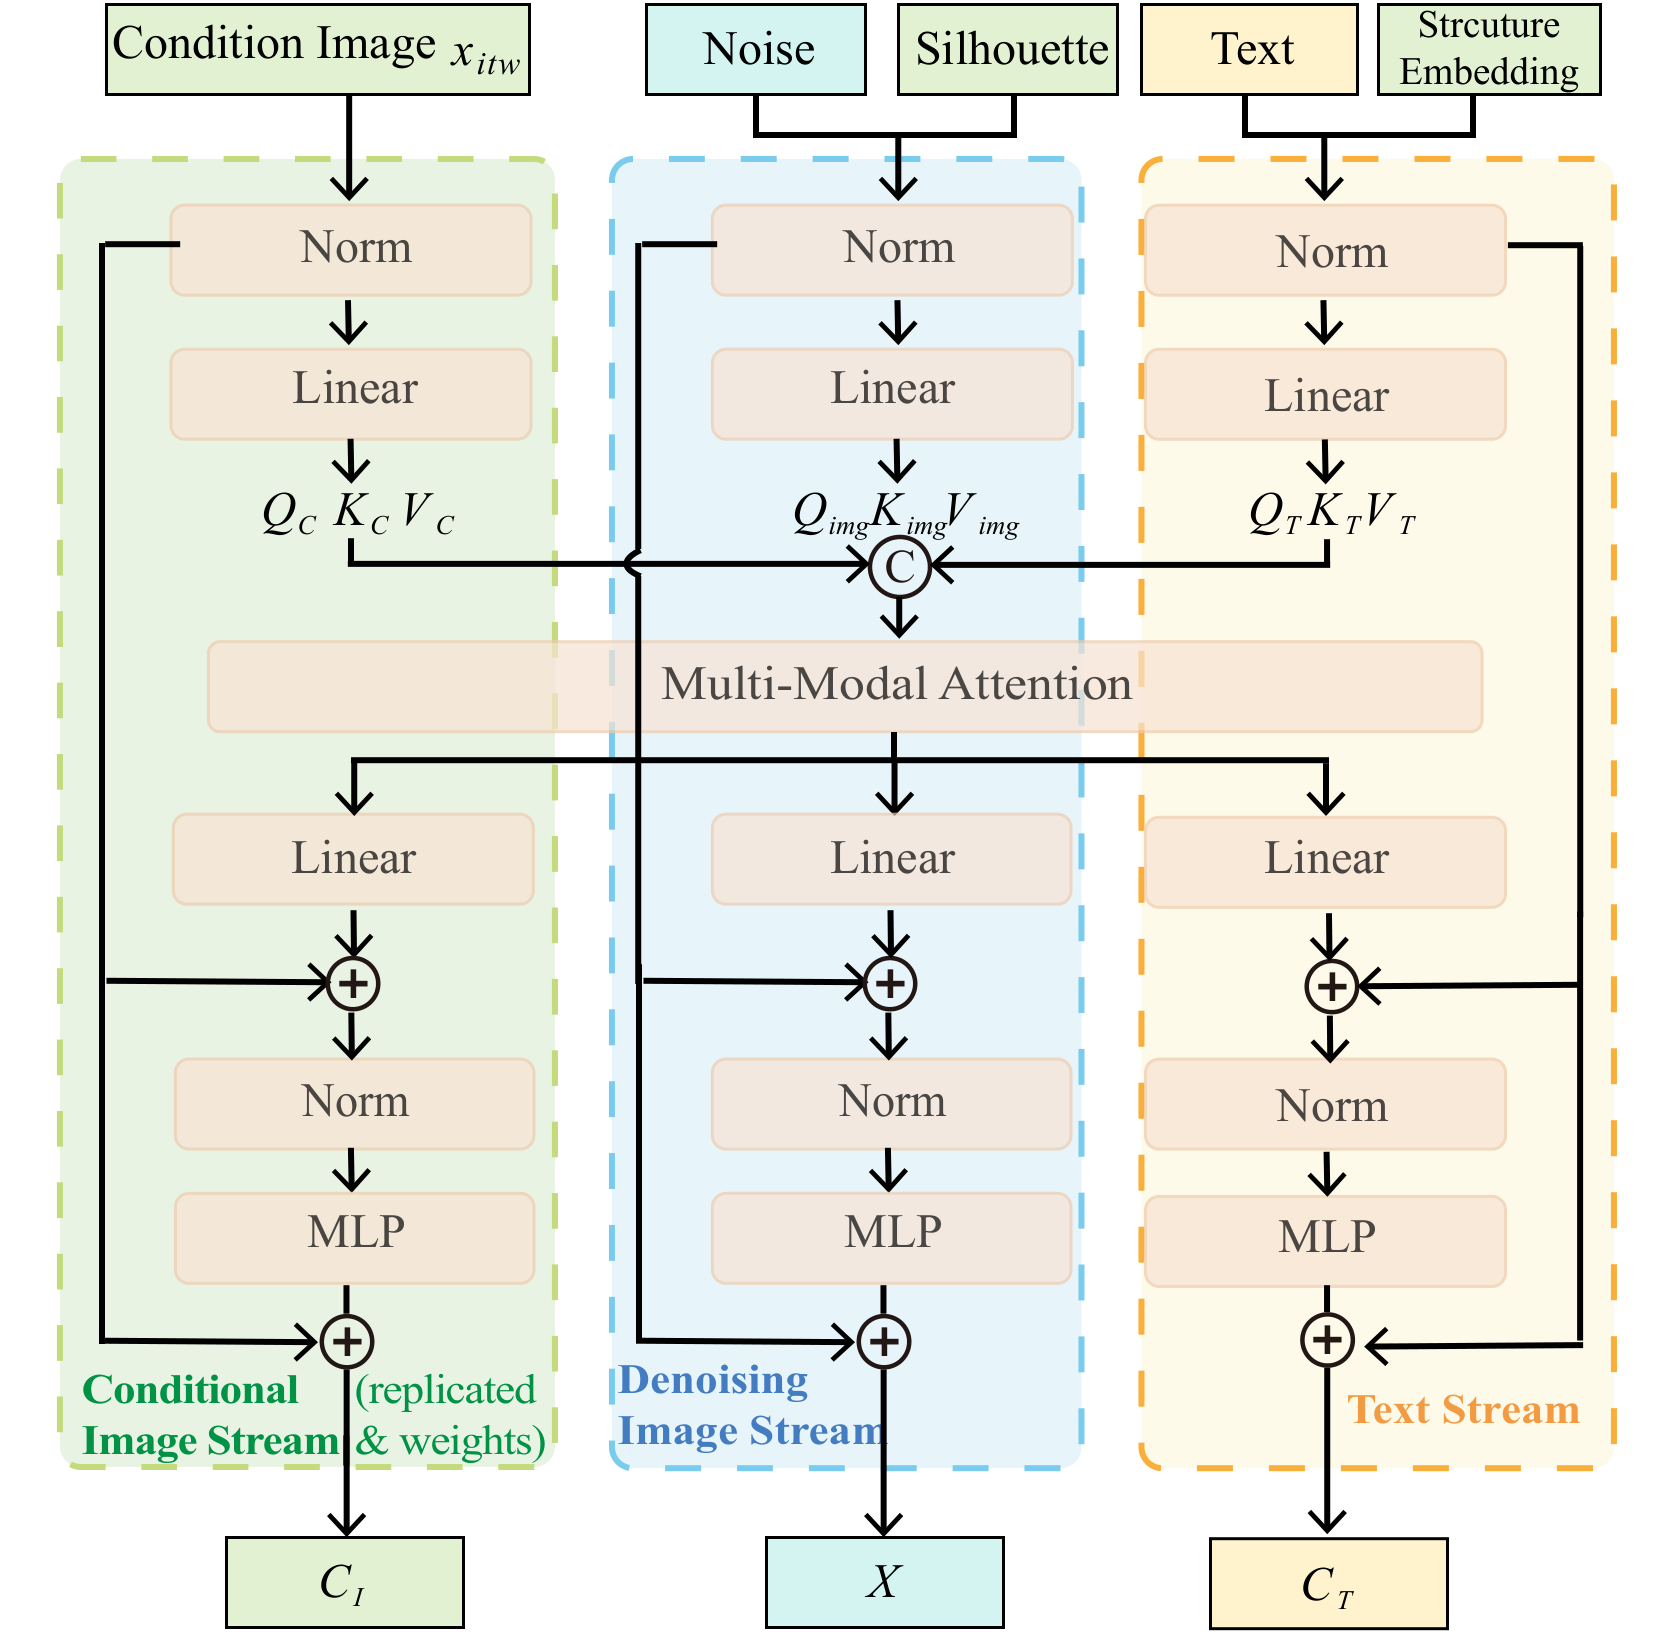
前序问题 :标准服装资产生成——把各种真实场景里的衣服还原成正面平铺图——商业价值很大,但同时要求宏观拓扑准确与微观物理保真。作者前作 RAGDiffusion 已经用检索增强的宏观约束消除了大尺度结构幻觉,可工业级的微观纹理真实感仍是未解的瓶颈。他们把这个限制正式命名为 High-Frequency Trajectory Collapse(高频轨迹塌缩):监督微调(SFT)收敛到训练分布的条件均值,而这个分布由平滑的低频纹理主导,于是高频图案(织物纹理、复杂 logo)变得几乎不可采样——不是模型学不会,是它被拉向了均值。而天真地加上强化学习后训练又会引发另一个问题 Artifact Hacking:模型利用通用奖励模型里的语义偏差,生成具有欺骗性的棋盘格噪声来骗高分,看着「细节丰富」实际是伪影。所以真正的难题是双重的:既要让 RL 把采样分布往高频模式上重塑,又要防止它塌向奖励可被利用的伪影解。本文贡献 :作者的核心洞察是 RL 能从根本上重塑流模型的采样分布——在准确的奖励引导下提升高保真轨迹的概率——同时用对抗正则化来约束这个过程不跑偏。方法上提出 AR-GRPO,并配套一个领域专用奖励模型 Garment-RM 来提供细粒度、属性感知的信号,替代通用大模型作为奖励来源。架构侧是 Dual-Image-Stream DiT:通过复制部分去噪图像流及其预训练权重,引入一条专门的条件图像流,让条件信息在与去噪信息同构的通道里流动而不是被挤进 cross-attention。针对 reward hacking,他们对比了 Adv-GRPO 的做法(用对抗损失激进地更新所有奖励模型,导致奖励模型丧失分类能力),改为让判别器先加速早期奖励上升、再把 $R_{GRM}$ 与 $R_{LPIPS}$ 稳定在一个无伪影的均衡点上。
auto
实验效果 :最有说服力的是打破 SFT 瓶颈这条曲线:SFT 阶段模型达到性能平台期,延长训练时长或扩大数据都只有递减回报,而引入 AR-GRPO 后 FID 出现急剧下降,瓶颈被突破;配套的视觉对比展示了 SFT 在捕捉高频物理细节(复杂织物纹理、精细图案)上的局限以及 RL 优化带来的显著改善。频域分析给出了机制层面的证据:相比基础 SFT 模型,RL 结果与真实图像之间的频谱差异更小、方向性偏差更弱,径向平均的频谱误差曲线显示 RL 模型在中高频的宽区间上误差更低。奖励模型侧,Garment-RM 在细粒度属性感知上全面超过 GPT-4o 与 Qwen3-VL 这些通用大模型,从而为 RL 阶段提供可靠的属性感知信号;作者还用 Garment-RM 嵌入的 t-SNE 图与人类偏好选择实验验证其有效性。防 hacking 的对照很直接:标准 GRPO 与 Adv-GRPO 都塌缩成棋盘格伪影,而 AR-GRPO 保持输出干净。
auto
批判点评 :这篇的诊断做得比方法更好。「High-Frequency Trajectory Collapse」是个准确的命名:SFT 回归条件均值这件事在理论上早就清楚,但把它与「高频纹理变得不可采样」直接挂钩、再用频域误差曲线量化出来,把一个模糊的「SFT 生成发糊」变成了可测量的现象,这比笼统地说「RL 效果更好」有价值得多。更值得肯定的是它没有停在「用 RL 就好了」——而是同时指认了 RL 的失效模式 Artifact Hacking,并且给出了机制解释:通用奖励模型有语义偏差,模型会生成棋盘格噪声去利用它。这种「问题-解法-解法的新问题」的递进是扎实工作的标志。用领域专用的 Garment-RM 替代通用 VLM 做奖励,也是个正确判断:细粒度属性感知上 GPT-4o 这类通用模型确实不可靠,而奖励模型的偏差在 RL 里会被放大而非平均掉。但边界也清楚。第一,这是一个高度垂直的任务——正面平铺服装图有强先验(构图固定、拓扑已知),所以「用检索约束宏观、用 RL 攻微观」这套组合能奏效,它对通用文生图的可迁移性存疑,因为通用场景既没有可检索的模板也没有 Garment-RM 这样能训出来的窄域奖励。第二,Garment-RM 本身成为新的单点依赖:整个 RL 的方向由它决定,而论文验证它的方式是与通用模型比较加 t-SNE 加人类偏好,这证明了它比通用模型好,但没有刻画它自己的盲区在哪——一个有系统偏差的窄域奖励模型,其偏差会被 RL 忠实地放大。第三,对抗正则化引入了判别器与两个奖励项($R_{GRM}$、$R_{LPIPS}$)的三方平衡,论文说它稳定在无伪影均衡点,但这类平衡对超参往往敏感,训练稳定性的证据主要是奖励轨迹图,缺少多次运行的方差。第四,作为前作的延续版本,宏观检索部分的贡献不属于本文,读者需要注意本文的净增量集中在 RL 后训练与奖励设计上。
趋势观察
原生音视频联合生成开始用「先分开、后门控耦合」压小模型尺寸 — 今天最值得读的一篇是阿里 DreamX 团队的 DreamX-Creator 1.0,它给出了一个很务实的判断:音视频联合生成不需要一上来就把两个模态揉在一起。它的 7B 生成器让音频流和视频流在网络前一半完全独立去噪,只在后一半通过 Gated Cross-Modal Attention 耦合,而且门控是 token 级与 head 级的,等于让模型自己决定「哪一帧、哪个注意力头需要听对面模态」。这个设计的意义在于用结构换参数量——在与 33B 的 MiniMax-H3、以及 Wan2.7 / KLing v3 的盲测对比里,7B 的它在视频质量上对 Wan2.7 拿到 45.5% 胜率、对 KLing v3 拿到 48.8%,虽然音频质量仍明显落后(对 MiniMax-H3 只有 23.7% 胜、45.5% 负),但这已经说明「原生联合」不必等大模型。它还配了一条自回归 1 步 2K 精修管线,把高分辨率从训练问题变成后处理问题。同一天的 VIBE 从另一侧呼应:视频配乐不能只靠重建损失,得把 tempo、调性这类可验证约束和「好听」这类主观质量分开做奖励。两条路线的共同判断是,多模态生成的下一步是把模态间的耦合点和奖励信号都设计得更细。交互世界模型的持久性之争,从「存多少帧」转向「以什么粒度存」 — Matrix-Game 3.5 和 ShellGame 这两篇是今天最像一对的论文,都在追问世界模型能否真的记住世界,但一个给方案、一个下判决。昆仑万维 Skywork 的 Matrix-Game 3.5 把历史记忆的粒度从「整帧」降到「patch」:它把历史 latent patch 按深度和相机位姿反投影进一个持久 3D 空间,目标相机的视锥去查询这个 patch 云,再用 z-buffer 只保留每个位置最靠前的表面,最后散射成一张对齐当前视角的 memory canvas。关键是 patch-memory 与 tiled-PRoPE 两个组件都不引入任何新的可学习参数,所以能直接接在骨干上,单卡 720p 做到 20 FPS 实时。它还把静态场景和动态主体拆开,前者进 patch memory、后者用轻量参考 token,专门治长程 rollout 里的鬼影和身份漂移。而 ShellGame(首尔国立大学 + Roblox)则用一个精心设计的反例给整个方向降温:他们把 $S_5$ 状态追踪问题包装成视频版「猜球在哪个杯子下」,球被盖住后经过 N 次交换再揭晓。结论相当刺眼——双向和自回归 Transformer、Mamba、以及特征值被限制在非负区间的线性注意力,全都只能拟合训练时的 5 次交换,交换链一长就掉到随机水平,但画面依然生成得很像样,加更多去噪步数毫无帮助。根因在于像素扩散目标从来没有监督过那个看不见的隐藏状态,所以状态只能活在架构里而非 token 里。他们找到两个真能外推的机制,共同点是都跨 chunk 携带状态并原地修改:线性注意力一旦允许转移特征值取负就成功,LaCT 则随快速权重头数增加而变好。两篇合起来的信号是:视觉保真度完全不能作为世界模型「懂世界」的证据,得单独设计状态追踪的诊断任务。推理期干预成为提升生成质量的主战场:不改权重、不重训 — 今天有三篇不约而同地把算力花在推理阶段而非训练阶段,而且都刻意避开了「重训一版」这条路。Off-Manifold Refinement(越南 Fulbright 大学 + UCLA,BMVC 2026)针对视频生成的物理违背问题:物体悬空、轨迹违反重力、接触消失。它的做法是在采样轨迹中段的若干 ODE 步,把冻结的 V-JEPA 2.1 「意外度能量」的梯度加到生成器速度场上,把 latent 推离原轨迹、推向被预测器判为更物理合理的区域,然后让生成器继续渲染。相比要生成并打分多个候选、或反复解码再编码的既有方案,它只在单条轨迹上做一次外部纠正。GEARS(北大 + 阿里,ACM TOG / SIGGRAPH Asia 2026)攻的是 test-time scaling 的浪费:现有方法采样一堆轨迹然后把低分候选直接丢掉,而那些候选里已经编码了可用的运动、布局或外观结构。它在去噪轨迹上插入多个检查点,由 Stage-Aware Scheduler 决定此刻该修什么、哪些候选该留该回收该丢,再由 Candidate Recycler 通过诊断式 latent 编辑把「弱但有希望」的候选修回来,高噪阶段修运动、低噪阶段修细节。NoisEasier(ECCV 2026)则用可微奖励引导优化整条随机轨迹而非只优化初始 latent,在 VBench 与 T2V-CompBench 的属性绑定、物体交互、计数这些难维度上平均提升超过 10%。三篇的共同判断是:与其冒 reward hacking 的风险去微调权重,不如把冻结模型当成可被引导的对象。扩散加速的新抓手是「内容形状」和「语义复用」,不再是均匀砍 token — RTI(维尔茨堡大学 + Google)和 RegionCache(东北大学,IJCAI 2026)代表了扩散加速的两个新角度,都放弃了「均匀降采样」这个默认动作。RTI 处理的是像素空间扩散的结构性浪费:自然图像的细节只集中在画面一小部分,但模型在每一层、每个时间步都给每个 patch 分配一个完整 token,而像素空间模型没有 autoencoder 先吸收低层冗余,浪费最大。它探测到中间块的 token 在图像平坦处冗余,且冗余占据的是连通的、随内容成形的区域——于是需要形状同样随内容变化的 token。解法很巧:沿 Hilbert 曲线给 patch 排序,因为相邻位置在图像上永远是邻居,任意连续段就是一个连通区域,二维分组变成一维切割。切在特征变化最大处,每段池化成一个 region token,微调时随机抽取 region 数量,所以一个 checkpoint 服务所有预算。相比之下相似度合并会打散分组、隐空间瓶颈丢掉位置、直接跳过则是把该总结的东西删掉。RegionCache 针对的是多轮编辑场景:用户往往只改一小块,但 DiT 管线每轮都重算整张图。它用连续 prompt 之间的语义重叠加 cross-attention 定位找出可复用区域,按 prompt 相似度自适应决定复用力度,在 PixArt-alpha 上端到端加速 1.43–2.55 倍。两篇都在说同一件事:加速的抓手应该来自内容和语义的结构,而不是对 token 一刀切。
人工智能炼丹君 整理 | 2026-09-02
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注

















评论 (0)