


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

长序列的瓶颈不只在注意力矩阵,还在不断增长的历史状态。本篇从可以手算的线性核出发,推到循环状态与 Delta 更新,再区分序列循环和深度循环。公式中的等价关系、代码中的误差、框架中的工程选择各有适用范围。
先修:自注意力机制的计算与显存账本。本文不训练视频模型,也不以随机张量实验推断视频画质;所有数值实验是 CPU 上的机制验证。论文与源码核验日期:2026-10-06。
假设一个流式生成器已经处理了 65536 个 token,单层单头的 key 和 value 维度都是 64。若两者均以 FP32 保存,历史 K、V 就要占 32 MiB。这还没有乘层数、头数和并发数,也没有算模型参数、工作区和训练激活。长视频若把时间与空间都展开成 token,状态增长会直接挤压服务容量。这个账本来自元素计数,不是某张 GPU 的实测峰值。
一种选择是保留历史,并用 FlashAttention 等方法减少中间矩阵和访存;另一种选择是把历史压进固定形状的状态。后者的单层单头状态可以只有 64×64 的矩阵,加一个长度 64 的归一化向量,共 16640 字节,约 0.015869 MiB。两者在这个设定下相差约 2016.49 倍,但这只是注意力历史存储的比例,不能写成模型显存节省或吞吐加速倍数。
压缩状态也会改变信息的组织方式。想象系统先记住“对象 A 的颜色是红”,随后收到“对象 A 的颜色改为蓝”。只做累加的记忆可能把两条记录混在一起,读出平均意见;具备纠错更新的记忆才有机会覆盖旧映射。省空间与能否可靠检索不是同一个问题,本文用这个更新场景把两者连起来。
这也是阅读长序列论文时最值得先问的三件事:保留了多少历史,允许怎样更新历史,训练时又如何并行。只看到“线性复杂度”就认为速度、记忆和生成质量一起改善,会把三个独立问题混成一个结论。
线性注意力先把 query 和 key 映射到特征空间,再利用矩阵乘法的结合律,把“每个 query 访问所有历史”改写成“每个 query 读取一个累积状态”。循环实现沿 token 方向更新这个状态;Delta 更新则把“直接写入新 value”改成“先读旧 value,再写纠正量”。深度循环共享同一计算块反复修改整段表示,它增加的是每个 token 的计算深度,不能由此推出历史缓存变成固定大小。
这里“线性”主要指固定特征维度时,时间随序列长度线性增长;整层仍包含非线性映射、归一化和前馈网络。这里“记忆”指输入驱动的隐藏状态,并非训练参数永久学到的知识,也不是数据库里逐条可寻址的记录。
把几个概念放在一起看,区别会更清楚:
| 机制 | 循环或聚合的轴 | 持续保留什么 | 要付的代价 |
|---|---|---|---|
| Softmax 因果注意力 | query 对历史位置检索 | 随前缀增长的 K、V | 解码读取历史与缓存容量 |
| 核线性注意力 | token 顺序 | 累积矩阵及归一化状态 | 核改变、信息混合 |
| Delta 类记忆 | token 顺序 | 可纠错的矩阵状态 | 更新依赖、key 干扰 |
| 深度循环 Transformer | 表示的修订次数 | 整段表示及所需缓存 | 重复计算、停止机制 |
这张表是机制对比,不是性能排行榜。同一系统可以混用不同层;是否适合视频生成还取决于因果性、时间空间组织、条件输入和训练目标。
设序列长度为 $N$,当前位置为 $t$,历史位置为 $i$。列向量 $q_t,k_i\in\mathbb{R}^{d_k}$ 分别表示 query 和 key,$v_i\in\mathbb{R}^{d_v}$ 表示 value;$d_k$ 是匹配空间维度,$d_v$ 是读出空间维度。因果注意力只允许 $i\le t$,当前 token 可以看见自身。标准缩放点积注意力写成:
$$a_{ti}=\frac{\exp(q_t^\top k_i/\sqrt{d_k})}{\sum_{j=1}^{t}\exp(q_t^\top k_j/\sqrt{d_k})},\qquad o_t=\sum_{i=1}^{t}a_{ti}v_i$$
$a_{ti}$ 是当前位置分给第 $i$ 条历史的非负权重,沿历史位置求和为一;$o_t$ 是输出。分母中的 $j$ 只是求和索引。指数作用在 query-key 配对上,因此不能把 Softmax 随意移到乘法外面。下面将换一种相似度,这是改变算子定义的步骤。
选择逐元素特征映射 $\phi:\mathbb{R}^{d_k}\to\mathbb{R}^{r}$,$r$ 是映射后的维度。本文用 $r=d_k$ 的 ELU+1:正输入加一,非正输入取指数。这样每个分量为正,两个映射向量的点积为正,归一化分母就有明确意义。定义核相似度:
$$s(q,k)=\phi(q)^\top\phi(k),\qquad \phi(u)=\begin{cases}u+1,&u>0\\ \exp(u),&u\le0\end{cases}$$
这并不等于原来的指数点积核。选择 ELU+1 是一个具体的建模选择;本文接下来验证的是这个新核内部的等价计算,不声称复现 Softmax。核线性化与循环视角的来源是 Linear Transformers。
用新核替换权重后,定义一个带数值保护项的输出。$\epsilon>0$ 是避免极小分母引发数值问题的常量;它会略微改变归一化,因而权重和不再严格等于一。实验的两种实现都会使用相同的 $\epsilon=10^{-6}$:
$$o_t=\frac{\sum_{i=1}^{t}\bigl(\phi(q_t)^\top\phi(k_i)\bigr)v_i}{\sum_{i=1}^{t}\phi(q_t)^\top\phi(k_i)+\epsilon}$$
分子中,$\phi(q_t)$ 对每个历史位置都相同,因此可以利用分配律先求历史外积的和。外积 $\phi(k_i)v_i^\top$ 的形状是 $r\times d_v$,它不是相似度矩阵。把这些外积累加成 $S_t$,把映射后的 key 累加成 $z_t$:
$$S_t=\sum_{i=1}^{t}\phi(k_i)v_i^\top\in\mathbb{R}^{r\times d_v},\qquad z_t=\sum_{i=1}^{t}\phi(k_i)\in\mathbb{R}^{r}$$
于是输出的转置可写成一行矩阵读取:
$$o_t^\top=\frac{\phi(q_t)^\top S_t}{\phi(q_t)^\top z_t+\epsilon}$$
维度检查很重要:分子是 $1\times d_v$ 的行向量,分母是标量,结果与 $o_t^\top$ 一致。代码里每个 token 都用一维数组表示,因此 fq[t] @ S 直接得到长度 $d_v$ 的数组,不需要显式转置。
历史状态天然有递推式,因为第 $t$ 步的和只比前一步多一项:
$$S_t=S_{t-1}+\phi(k_t)v_t^\top,\qquad z_t=z_{t-1}+\phi(k_t),\qquad S_0=0,\ z_0=0$$
先写入当前 token,再用当前 query 读取,才与 $i\le t$ 的因果定义一致。若先读后写,就变成严格只看过去的另一个算子。若先把整段所有 key 累进一个状态再逐个读取,则会泄露未来,不能拿来做因果生成。
固定 $r,d_v$ 时,每步更新和读取都需要约 $O(rd_v)$ 运算,整段是 $O(Nrd_v)$。解码期间可持续保留的状态是 $O(rd_v+r)$。这里没有把反向传播所需激活算进去;训练若朴素保存每一步状态,内存仍会随长度增长。前缀和、分块计算和反向重计算解决的是训练工程问题。
归一化线性记忆会混合重复 key 的记录。现在单独讨论一个无分母归一化的关联记忆,不再沿用 ELU+1 权重解释:$k_t\in\mathbb{R}^{r}$ 是单位长度 key,$S\in\mathbb{R}^{r\times d_v}$ 是矩阵状态。它对 key 的预测是行向量 $k_t^\top S$。给定新 value 后,定义单步平方误差:
$$\ell_t(S)=\frac12\left\|S^\top k_t-v_t\right\|_2^2$$
若 $S$ 的第 $a,b$ 个元素变化,只会通过 $k_{t,a}$ 改变预测的第 $b$ 个分量。因此该元素的梯度是 key 的第 $a$ 分量乘以第 $b$ 分量的预测误差;把所有元素拼回去,得到:
$$\nabla_S\ell_t=k_t\bigl(k_t^\top S-v_t^\top\bigr)$$
用更新幅度 $\beta_t$ 做一次梯度步,得到本文方向约定下的 Delta 规则:
$$S_t=S_{t-1}+\beta_t k_t\bigl(v_t^\top-k_t^\top S_{t-1}\bigr)$$
$\beta_t$ 控制新信息覆盖旧映射的程度。这是对输入状态的一次在线更新,不等同于对模型全部训练权重进行反向传播。外积写入只纠正当前 key 对应的预测,而不是无条件累加原始 value;这层解释来自 Fast Weight Programmers。
为什么单位 key 能精确覆盖?左乘 $k_t^\top$,利用 $k_t^\top k_t=1$,可得:
$$k_t^\top S_t=(1-\beta_t)k_t^\top S_{t-1}+\beta_t v_t^\top$$
当 $\beta_t=1$,当前 key 的读出就恰好等于新 value;若 key 未归一化,更新会额外乘上它的平方范数,这个覆盖结论就不成立。读另一个 key $h$ 时,它受到的变化是 $\beta_t(h^\top k_t)$ 乘以纠正量:正交 key 不受影响,相似 key 会受到干扰。Delta 规则能纠错,却没有让矩阵成为无碰撞字典。
再引入遗忘系数 $\alpha_t$,先衰减旧状态,再针对衰减后的预测做纠错:
$$\widetilde S_{t-1}=\alpha_t S_{t-1},\qquad S_t=\widetilde S_{t-1}+\beta_t k_t\bigl(v_t^\top-k_t^\top\widetilde S_{t-1}\bigr)$$
展开后是 $\alpha_t(I-\beta_t k_tk_t^\top)S_{t-1}+\beta_t k_tv_t^\top$,$I$ 是 $r\times r$ 单位矩阵。论文常把状态转置成 value-first 方向,式子于是从左乘变成右乘,两者只是布局约定。先遗忘再计算误差这一顺序不能随意改,否则得到另一个更新规则。该组合是 Gated DeltaNet 的核心机制。
设 $H^{(s)}\in\mathbb{R}^{N\times d}$ 是第 $s$ 次修订后的整段表示,$d$ 是隐藏维度,共享参数为 $\theta$。深度循环可以抽象成:
$$H^{(s+1)}=F_\theta\bigl(H^{(s)},P^{(s)}\bigr),\qquad s=0,1,\dots,R-1$$
$P^{(s)}$ 提供位置与修订步信息,$R$ 是执行的修订次数,$F_\theta$ 可包含注意力与前馈网络。不同的 $s$ 重用同一套参数,但每次处理的仍是整段表示。若内部用全注意力,一轮的长度平方成本仍在,多轮修订也仍要付计算。它能改变参数复用和计算深度,却不能直接推出固定历史容量。这是 Universal Transformers 与 token 递推状态的关键区分。
完整脚本 linear_memory_demo.py 放在文末附录。只需 Python 3.10+、NumPy 和 matplotlib,保存后执行 python linear_memory_demo.py,会打印结果、写出 JSON,并生成原创图。在项目的 code/ 结构下输出到该文章目录;单独保存时输出到脚本所在目录。依赖安装可以用 python -m pip install numpy matplotlib;没有权重、数据集或 GPU 下载步骤。
先看循环读取的核心。fq 和 fk 是 $\phi(q)$ 与 $\phi(k)$,S 是 $S_t$,z 是 $z_t$。这里没有多头和 batch,目的是让一次状态更新的维度一眼可查:
def recurrent_linear(q, k, v, eps=1e-6):
    fq, fk = phi(q), phi(k)
    S = np.zeros((fk.shape[1], v.shape[1]), dtype=np.float64)
    z = np.zeros(fk.shape[1], dtype=np.float64)
    out = np.zeros_like(v)
    for t in range(len(q)):
        S += np.outer(fk[t], v[t])
        z += fk[t]
        out[t] = (fq[t] @ S) / (fq[t] @ z + eps)
    return out, S, z
脚本还写了一个刻意生成完整 $N\times N$ 权重矩阵的参考实现:先计算 phi(q) @ phi(k).T,再用下三角因果掩码去掉未来位置。这个版本不追求省内存,只作为独立计算路径验证结合律重排。循环版若不小心先读取再更新,或者漏掉 z,这个对照会立即暴露差异。
2026-10-06 在 CPU、NumPy float64、随机种子 7 下实际运行得到:
q_shape = [8, 4]       v_shape = [8, 3]
output_shape = [8, 3]  state_shape = [4, 3]
normalizer_shape = [4]
explicit_recurrent_max_error = 1.6653345369377348e-16
linear_softmax_max_difference = 0.9214427905350642
output_min = -1.088998885679583
output_max = 0.8987635397834051
first_two_outputs = [[-0.57930138, -0.19619590, 0.89876354],
                     [0.32426122, -0.78686054, 0.01150493]]
future_leak_error = 0.0
第一项误差在 float64 舍入量级,验证新核的两种求值路径。第二项差异是同一组 q、k、v 在新核与标准缩放 Softmax 下的最大绝对差,验证两者是不同算子;它不是精度下降百分比。输出出现负数并不矛盾:权重非负,而 value 本身可以为负。
“未来泄露”实验把最后一个 value 的每个分量加 100,前七个输出保持逐元素相同。因为循环计算先前输出时尚未看到最后一个 value,它对前面的结果没有作用。这个检查只检验该输入上的因果实现;一般的因果性质来自第 03 节的求和范围,而不是一次随机测试证明所有情况。
Delta 实现则用 decayed = alpha * S,随后计算 v - k @ decayed,最后写入 beta * np.outer(k, correction)。代码与前面的转置方向一致。它不使用 z,也不对输出套线性核分母;把两套归一化随意拼接,会失去上述精确覆盖结论。
脚本对同一个单位 key 先写 [1,0],再写 [0,1]。把普通外积累加后除以写入次数,读出是 [0.5,0.5];Delta 取 beta=1 后读出是 [0,1]。这里的平均是一个手工归一化的单 key 例子,不能当成前面随机 ELU+1 注意力实验的整体输出。
接着写入另一个单位 key,控制它与原 key 的内积 $\rho$。旧 key 的读出如下:
| 新旧 key 内积 $\rho$ | 旧 value 的分量 | 新 value 的分量 |
|---|---|---|
| 0.0 | 1.0 | 0.0 |
| 0.5 | 0.75 | 0.5 |
| 0.9 | 0.19 | 0.9 |
这些数字可手算:先写原 key 后,第二次更新把旧分量减去 $\rho^2$,同时写入 $\rho$ 倍新分量。最后一行的 0.19 是按小数显示的舍入值,原始输出为 0.18999999999999995。干扰强度取决于 key 几何关系,不能只看状态矩阵是否足够大。
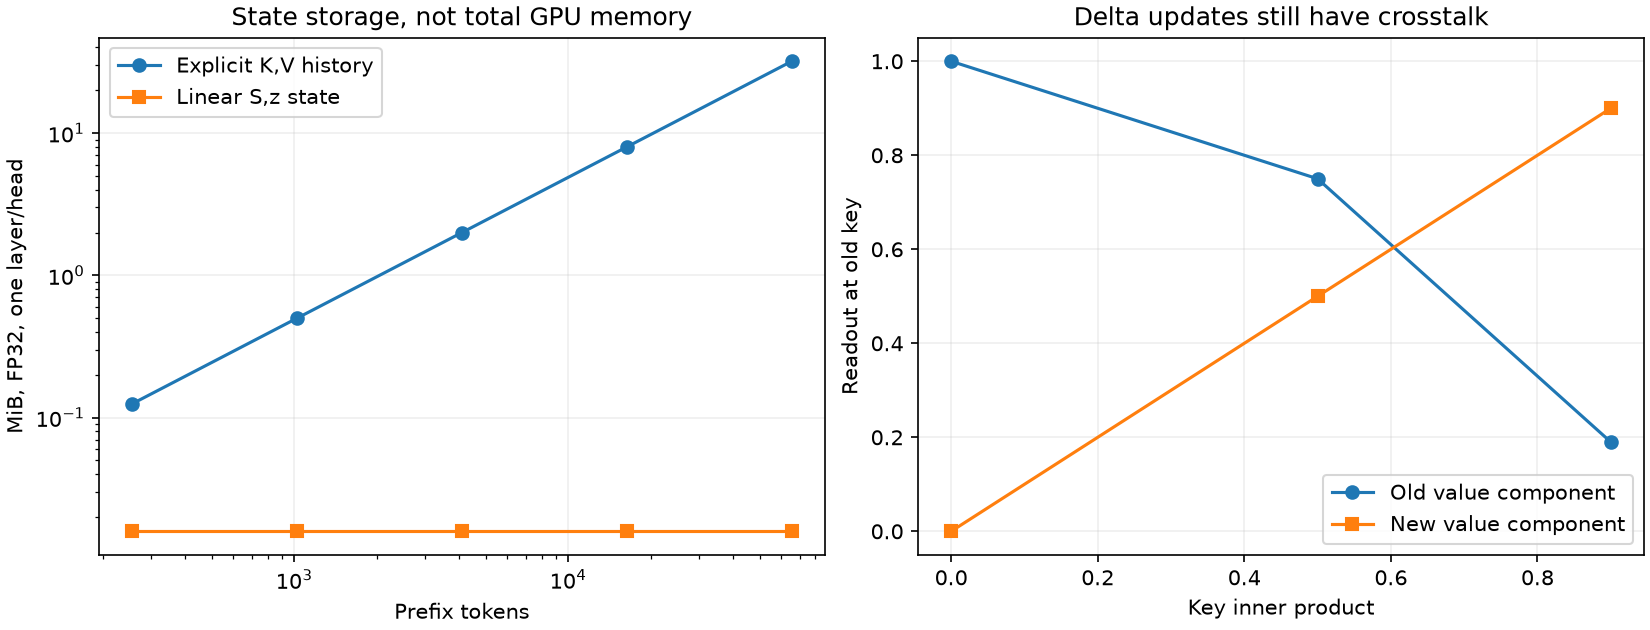
图左只比较单层单头 FP32 的历史状态元素:K、V 随前缀增长,矩阵状态保持固定。图右来自上述实际更新实验:key 越相似,旧映射受到的干扰越大。请把左右两幅一起看,省掉的历史位置并没有变成免费的精确记忆;两幅图都不是 GPU 吞吐测试。
以下均以 2026-10-06 实际读取的官方源码为准,原文件及 SHA256 快照已随本地质检保存。上游分支链接可能变化,所以这里同时注明文件和符号,不把今天的布局当永久 API。
idiap/fast-transformers 的 LinearAttention 对 query、key 应用特征映射,用 einsum 聚合 KV,并计算归一化分母。这个文件实现的是无因果掩码版本,只接受全一注意力掩码;不能因为名字里有 Linear 就拿它直接替代因果解码器。它处理 padding 和 batch、多头,而最小代码只有一条序列。
实际 token 递推对应 RecurrentLinearAttention.forward。该实现保存 Si 和 Zi,分别是矩阵及归一化状态,并在推理时原位更新;存在梯度时换成非原位加法。全序列因果计算另在 CausalLinearAttention。训练接口与解码接口分开,是因为前缀扫描、梯度保存和单 token 状态更新需要不同执行方式。
框架中的状态形状还有 batch、head 两个轴。服务时某个请求结束,应只清掉对应请求的状态;若拼接多个样本而不重置,会让第二个样本读到第一个样本的信息。测试新架构时,这类状态边界比单次输出形状更值得核对。最小程序每次调用都新建零状态,因此不提供跨请求复用接口。
本次还用 CPU PyTorch 2.10.0 实跑下载源码中未改动的 RecurrentLinearAttention 类:同一输入与 NumPy 结果的最大误差为 2.220446049250313e-16,末状态也一致。运行时仅适配未使用的事件派发接口及 memory=None 的兼容接口,未测试整个包的可选编译扩展;这个证据验证递推方法的源码对照,不代表完整框架性能测试。
FLA 的 GatedDeltaNetBlock 负责模型层组合,实际记忆运算在 fla/layers/gated_deltanet.py#GatedDeltaNet.forward。源码调用 chunk_gated_delta_rule 或 fused_recurrent_gated_delta_rule,传入初始状态并按 use_cache 返回末状态。当前实现还把 q/k 的 L2 归一化、门与 beta 变换交给内核处理,并使用 value-first 状态布局;读公式时要先核对转置。
为什么不能用 Python token 循环评判 FLA 的速度?教学循环每步触发许多小运算,训练又有跨步依赖。分块内核把一段更新组织成适合 GPU 的计算,融合递推减少解码调用开销。框架同时管理短卷积状态、padding 和归一化,本文的一个矩阵不是完整层状态。因此“缓存不增长”也要说明指的是哪一种缓存。
UniversalTransformer 的修订逻辑可沿 universal_transformer_util.py#universal_transformer_basic 阅读:它对整段 state 做 step 预处理,再调用注意力和前馈单元;固定修订次数路径使用 num_rec_steps,另有 ACT 路径。这里的 step 是深度修订,不是缓存下一帧。这个历史 TensorFlow 实现适合解释机制,本文不把它当作今天的视频部署推荐。
首先,有限状态保留的是叠加后的关联,不是每条历史的独立副本。在有限数值精度下,固定大小状态没有随输入长度增长的独立存储位置,因而不能保证对任意长序列中任意位置的任意内容都能精确恢复。这个说法是存储预算约束,不是“模型超过某个长度必然失效”的具体阈值预测。
其次,遗忘与纠错作用不同。$\alpha$ 衰减整个矩阵,包括与当前 key 正交的映射;$\beta$ 控制当前关联的覆盖。脚本先把状态设为单位矩阵,取 alpha=0.8 更新第一个 key,再读第二个正交 key,得到 [0,0.8]。它虽然没有受到 Delta 纠错项的干扰,仍被全局遗忘衰减。把所有变化都归因于“选择性删除”会误读机制。
再者,特征维度也是成本。线性复杂度的前提是 $r$ 不随 $N$ 增长;若为改善检索不断扩大 $r$,矩阵更新和读取也会变贵。短序列时,优化良好的精确注意力可能更合适。必须实测相同硬件、精度、batch、序列长度和质量约束下的端到端延迟,本文的状态元素图无法回答交叉点在哪。
训练与解码还要分别验收。固定解码状态不代表训练显存恒定,不代表单步就没有计算,也不代表批量 prefill 一定更快。工程实现会使用分块、扫描或重计算;其真正收益应由 profiler 以及完整训练步骤验证。把单 token 延迟、首 token 延迟和总生成时间混为一个数字,会掩盖需要付出的成本。
状态账本还应区分“元素数量”和“信息容量”。一个矩阵有固定数量的浮点元素,但这些元素可以用不同方向叠加许多关联,不能简单说它只能记住恰好多少个 token;反过来,也不能把可接受任意长度输入写成能保存任意数量的独立事实。实际检索能力要通过任务衡量:例如改变干扰 key 数量、重复更新次数、查询与写入的距离,以及输入精度,分别观察正确读出率和数值误差。
比较混合模型时,账本应按层拆开。部分层若保留窗口注意力,其显式缓存仍随窗口长度占空间;部分层若保留完整注意力,该部分历史仍会增长。短卷积还可能维护局部状态。只看到某一层用了 Delta 更新,就把整个模型都归为固定状态,会漏掉服务中真正占内存的部分。判断是否合适,应先列清每层状态、精度、并发请求数和最大长度,再用运行时内存测量核对。
落到视觉生成,时间因果性与空间交互必须分开设计。双向 DiT 在同一个去噪步内可以访问整个视频,不能只把注意力换成本文因果递推就声称等价;把空间 token 排成序列后,排列顺序也会影响递推的归纳偏置。自回归视频可以沿时间维护状态,但仍要验证运动、遮挡后对象恢复、长时一致性和跨片段条件变化。
最后,深度循环的参数复用不等于算力复用。执行 $R$ 次修订通常需要重复做 $R$ 次块计算,是否受益要看任务、停止规则与训练是否覆盖该次数。推理时随意把次数从四次加到八次,不保证答案或生成质量改善。本文只用抽象方程定位循环轴,没有提供训练过的深度循环模型或性能结论。
这五篇不是同一条单向升级路线,而是围绕“历史怎么保存、计算怎么组织”形成的分支。阅读时先分清 token 轴与深度轴,再理解具体内核优化。
本文没有直接比较这些论文的榜单分数:训练规模、数据和任务不同,把各自报告的提升并排当成架构优劣,会得出超出证据的结论。真正可迁移的基本功是识别状态、更新规则、归一化及并行形式,再按自己的任务设置对照实验。
“线性注意力只是换乘法顺序,数值应该和 Softmax 一样。” 换顺序之前已经换了相似度。显式线性核与递推线性核应一致;与 Softmax 的差异则是正常的算子差异。把两者的误差都叫“实现 bug”,会把建模选择误当工程问题。
“固定状态就是无限上下文精确记忆。” 固定状态能持续接收输入,但它叠加或纠正关联,没有为每条历史开辟新的独立位置。需要逐条引用、精确复制或回溯时,应明确测试检索能力,并考虑显式缓存、外部检索或混合结构。
“Delta 只更新当前 key,所以不会损伤其他信息。” 更新是否影响另一个 key 取决于内积。正交时纠错项不干扰,相似时会串扰;再加遗忘门,连正交映射也会衰减。第 04 节的三个内积点让这个限制可以直接看到。
“代码里的 beta 就是生产模型中的最终更新幅度。” 最小代码直接传最终标量;实际模型通常预测门控参数,再经过内核里的非线性或缩放。FLA 当前接口明确提供内核归一化和 sigmoid 选项。对照时不能只把同名变量代进公式,还要查它处在变换前还是变换后。
“深度循环减少了层数,因此执行成本也按同样比例下降。” 共享参数减少的是独立参数副本,重复执行仍付运算、激活及注意力成本。把参数量、执行深度和上下文状态分开计数,才能解释循环架构到底省了什么。
“对语言长序列有用,所以可以无训练替换视频 DiT。” 时间因果约束、空间邻接和扩散步条件都不同。替换需要训练或有依据的适配,再用视频维度的验收验证;随机 CPU 实验只能说明机制,不能证明视频生成可用。
先原样运行附录脚本,确认输出形状及两种线性求值误差低于 1e-12。不同 NumPy 版本可能改变最后几个浮点位,因此逐项复现应使用误差容限,而同 key 的 [0,1] 覆盖例子可以直接手算核对。
第一个改动是把 recurrent_linear 里的读取放到写入之前。第一步读出会变成零,之后只访问严格过去,显式参考实现若仍保留对角线就不再一致。修复不该“放宽误差阈值”,而应把两种实现的因果定义对齐。
第二个改动是把 memory_experiment 的 Delta 更新改成 beta=0.5。重复 key 先后写入两个 value 后,应读出 [0.25,0.5],不是 [0.5,0.5]:零初态到第一条信息本身也只走了半步。这个结果直接来自递推式,不要求训练模型。
第三个改动是去掉门衰减,取 alpha=1,再保留单位初始状态和正交 key 检查。第二个 key 应读出 [0,1];与 alpha=0.8 的 [0,0.8] 对照,就能隔离全局遗忘和关联纠错的作用。
第四个改动是把 q、k、v 的输入改成 float32,状态与掩码也保持输入 dtype,使两条路径都使用 float32。脚本末尾已经执行这组对照并打印 float32_explicit_recurrent_max_error。预期因乘加顺序不同而出现更大的舍入差异,不承诺跨版本固定数值;请同时记录误差、输入长度和状态范围。长度扩展时数值稳定性也应重新测量,而不是沿用短序列的阈值。
最后,可将序列长度加大,只比较状态元素计数,不运行显式平方矩阵版本到内存耗尽。若要做 GPU 性能结论,应该另建真实框架测试,包含同步、预热、完整模型和质量对照;本篇没有把教学脚本执行时间包装成生产加速结果。
先回到 自注意力,确认权重归一化、因果掩码和矩阵形状;再读 FlashAttention,理解保留精确算子时如何优化中间存储。两条路线可以比较,也可以组合,但证据边界不同。
结合 KV Cache 和 性能建模与 Profiling,分别量出历史容量、解码带宽、首 token 延迟与端到端时间,避免只看理论阶数。进入视频任务时,再对照 自回归视频生成与 Forcing 范式 的训练与推理条件。
知识树下一步可沿稀疏注意力、世界模型和视频评测继续学习。它们分别回答保留哪些显式交互、如何维护可交互环境状态,以及如何发现画质之外的退化;今天的固定状态推导并不能替代这些任务层面的验证。
09 节用到的脚本全文如下(linear_memory_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""CPU teaching experiment: normalized linear attention and delta memory.

Install numpy and matplotlib. Run with Python 3.10 or newer.
No weights, GPU, dataset downloads, or training are required.
"""
import json
from pathlib import Path
import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt


def phi(a):
    return np.where(a > 0, a + 1, np.exp(np.minimum(a, 0)))


def explicit_linear(q, k, v, eps=1e-6):
    n = len(q)
    weights = phi(q) @ phi(k).T
    weights *= np.tril(np.ones((n, n), dtype=weights.dtype))
    return weights @ v / (weights.sum(axis=1, keepdims=True) + eps)


def recurrent_linear(q, k, v, eps=1e-6):
    fq, fk = phi(q), phi(k)
    S = np.zeros((fk.shape[1], v.shape[1]), dtype=q.dtype)
    z = np.zeros(fk.shape[1], dtype=q.dtype)
    out = np.zeros_like(v)
    for t in range(len(q)):
        S += np.outer(fk[t], v[t])
        z += fk[t]
        out[t] = (fq[t] @ S) / (fq[t] @ z + eps)
    return out, S, z


def causal_softmax(q, k, v):
    logits = q @ k.T / np.sqrt(q.shape[1])
    logits[np.triu_indices(len(q), k=1)] = -np.inf
    logits -= logits.max(axis=1, keepdims=True)
    weights = np.exp(logits)
    weights /= weights.sum(axis=1, keepdims=True)
    return weights @ v


def delta_step(S, k, v, beta=1.0, alpha=1.0):
    decayed = alpha * S
    correction = v - k @ decayed
    return decayed + beta * np.outer(k, correction)


def memory_experiment():
    k = np.array([1.0, 0.0])
    values = np.array([[1.0, 0.0], [0.0, 1.0]])
    additive = sum((np.outer(k, v) for v in values), np.zeros((2, 2)))
    additive_read = k @ additive / 2.0
    S = np.zeros((2, 2))
    for v in values:
        S = delta_step(S, k, v)
    overwrite_read = k @ S
    half = np.zeros((2, 2))
    for value in values:
        half = delta_step(half, k, value, beta=0.5)
    crosstalk = []
    for rho in [0.0, 0.5, 0.9]:
        k2 = np.array([rho, np.sqrt(1.0 - rho ** 2)])
        state = delta_step(np.zeros((2, 2)), k, values[0])
        state = delta_step(state, k2, values[1])
        crosstalk.append({'rho': rho, 'old_key_read': (k @ state).tolist()})
    state = np.eye(2)
    decayed = delta_step(state, k, values[1], beta=1.0, alpha=0.8)
    return {'additive_same_key': additive_read.tolist(),
            'delta_same_key': overwrite_read.tolist(), 'crosstalk': crosstalk,
            'gated_unrelated_key': (np.array([0.0, 1.0]) @ decayed).tolist(),
            'half_beta_read': (k @ half).tolist(),
            'no_forgetting_unrelated_key': (np.array([0.0, 1.0]) @ delta_step(state, k, values[1])).tolist()}


def main():
    rng = np.random.default_rng(7)
    q = rng.normal(size=(8, 4))
    k = rng.normal(size=(8, 4))
    v = rng.normal(size=(8, 3))
    direct = explicit_linear(q, k, v)
    recurrent, S, z = recurrent_linear(q, k, v)
    softmax = causal_softmax(q, k, v)
    future_v = v.copy()
    future_v[-1] += 100
    future, _, _ = recurrent_linear(q, k, future_v)
    agreement = float(np.max(np.abs(direct - recurrent)))
    future_error = float(np.max(np.abs(future[:-1] - recurrent[:-1])))
    q32, k32, v32 = q.astype(np.float32), k.astype(np.float32), v.astype(np.float32)
    direct32 = explicit_linear(q32, k32, v32)
    recurrent32, _, _ = recurrent_linear(q32, k32, v32)
    assert agreement < 1e-12
    assert future_error == 0
    report = {'seed': 7, 'dtype': str(q.dtype), 'q_shape': list(q.shape),
        'v_shape': list(v.shape), 'output_shape': list(recurrent.shape),
        'state_shape': list(S.shape), 'normalizer_shape': list(z.shape),
        'explicit_recurrent_max_error': agreement,
        'linear_softmax_max_difference': float(np.max(np.abs(recurrent - softmax))),
        'output_min': float(recurrent.min()), 'output_max': float(recurrent.max()),
        'first_two_outputs': recurrent[:2].tolist(), 'future_leak_error': future_error,
        'float32_explicit_recurrent_max_error': float(np.max(np.abs(direct32 - recurrent32))),
        'float32_output_dtypes': [str(direct32.dtype), str(recurrent32.dtype)],
        'memory': memory_experiment()}
    folder = Path(__file__).resolve().parent
    if folder.name == 'code':
        folder = folder.parent
    figures = folder / 'figures'
    figures.mkdir(parents=True, exist_ok=True)
    (folder / 'run_result.json').write_text(json.dumps(report, indent=2), encoding='utf-8')
    lengths = np.array([256, 1024, 4096, 16384, 65536])
    # Single batch/layer/head, FP32, d_k=d_v=r=64. State count only.
    kv_mib = lengths * 128 * 4 / 2 ** 20
    fixed_mib = np.full(len(lengths), (64 * 64 + 64) * 4 / 2 ** 20)
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True)
    axes[0].loglog(lengths, kv_mib, 'o-', label='Explicit K,V history')
    axes[0].loglog(lengths, fixed_mib, 's-', label='Linear S,z state')
    axes[0].set(xlabel='Prefix tokens', ylabel='MiB, FP32, one layer/head',
                title='State storage, not total GPU memory')
    axes[0].legend()
    axes[0].grid(alpha=0.2)
    rhos = np.array([item['rho'] for item in report['memory']['crosstalk']])
    reads = np.array([item['old_key_read'] for item in report['memory']['crosstalk']])
    axes[1].plot(rhos, reads[:, 0], 'o-', label='Old value component')
    axes[1].plot(rhos, reads[:, 1], 's-', label='New value component')
    axes[1].set(xlabel='Key inner product', ylabel='Readout at old key',
                title='Delta updates still have crosstalk', ylim=(-0.05, 1.05))
    axes[1].legend()
    axes[1].grid(alpha=0.2)
    fig.savefig(figures / 'memory_tradeoff.png', dpi=150)
    plt.close(fig)
    print(json.dumps(report, indent=2))
    print('figure: figures/memory_tradeoff.png')


if __name__ == '__main__':
    main()
评论 (0)