今日 AIGC 论文速览
今日共 10 篇 · 长视频一致性与定制 2 篇 · 一步图像生成与后训练 2 篇 · 视频蒸馏与加速 3 篇 · 配对动作生成 1 篇 · 语音与音乐生成 2 篇
重点论文标题列表
- LoGo(加州理工):镜头绕一圈场景少变形
- Depth as Time(普林斯顿):一步生成把去噪搬进深度
- DuoMatching(港中文):图像老师帮视频补回细节
- VDOT++(悉尼大学):四步蒸馏别硬配每个token
- Reward Composition(UCLA):审美加分先过提示词约束
今日论文速览
1. LoGo:镜头绕一圈场景少变形
LoGo: Local-Global Rewards for Consistent Long-Horizon Video Generation | 加州理工学院 | arXiv:2610.03636
关键词:长视频生成, 相机控制, 三维一致性, 局部奖励
- 前序问题:镜头绕过墙面再回来,门可能移位、墙上数字可能变形。给整段视频一个三维一致性分数,会让局部错误被大面积正确区域稀释;只强化局部几何,又可能鼓励模型把画面变灰、变糊来降低误差。
- 本文贡献:LoGo 将关键帧经 VGGT 重建到共享三维空间,以 voxel 聚合 RGB 和深度重投影误差,把奖励分配到出错区域。训练混合归一化后的局部与全局奖励,并交替使用美学和相机跟随奖励。它改善的是相机可控视频的后训练信号,而非新增一个持久世界记忆模块。
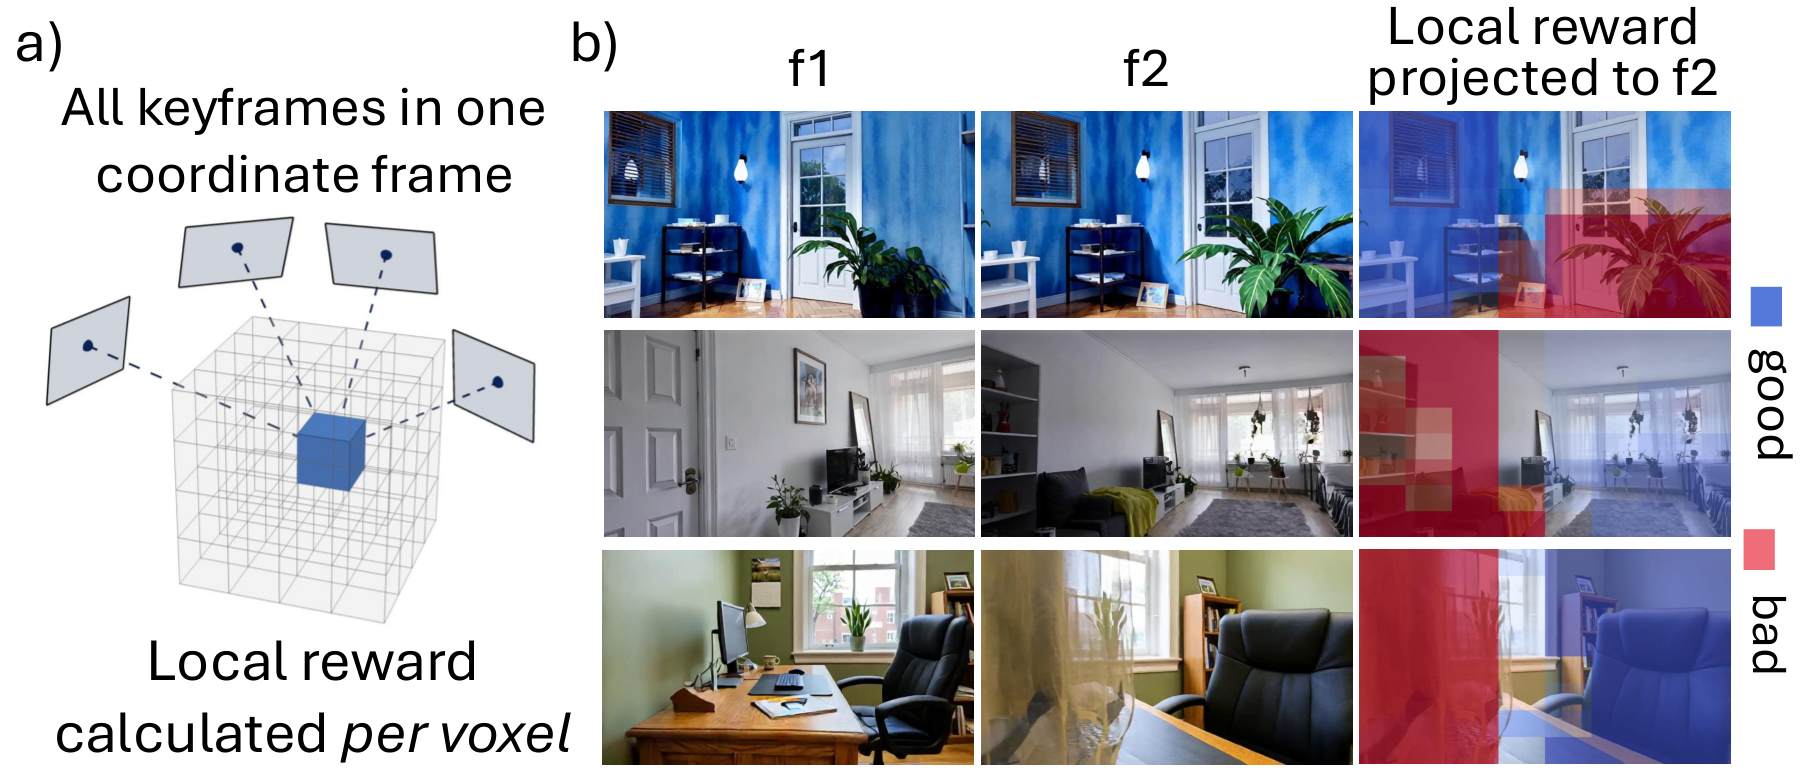 论文 Figure 4:(a)说明 voxel 奖励如何聚合:把关键帧重建到共享三维空间,按体素汇总局部误差。(b)把局部奖励投影回视频帧进行可视化,突出需要修正的区域。
- 实验效果:表 1 的 TrajectoryBench 上,Lingbot2 的 PSNR-D 从 16.0 提高到 18.2 dB,极线误差从 1.507 降至 1.111,约下降 26%。表 2 的 DL3DV 上,同一基座极线误差由 2.161 降至 1.365。三个基座均有三维一致性收益,但相机指标并非逐项变好;例如 UniWorld 在表 1 的旋转误差由 13.8 变为 14.0。
 论文 Figure 3:LoGo 的动机。(a)只用全局奖励难改善三维一致性;局部奖励改善以 PSNR 衡量的一致性,却降低以 HPSv3 衡量的画质,因此要组合二者。(b)绿色 LoGo 曲线扩展一致性与质量的 Pareto 前沿。(c)训练中的奖励曲线及质量评估显示,局部奖励随训练损害画质,LoGo 在改善一致性的同时维持质量。
- 批判点评:作者明确限定静态场景,超过 400 帧仍困难;因此不能写成动态世界无限稳定。奖励依赖重建模型估计的几何,改善重投影指标也不等于恢复真实物理。建议优先看局部奖励与画质的消融,再判断自己的相机轨迹是否在测试范围内。代码与 benchmark 已给出官方仓库。
2. Depth as Time:一步生成把去噪搬进深度
Depth as Time in One-Step Generative Models | 普林斯顿大学 | arXiv:2610.03626
关键词:一步生成, 深度探针, 共享权重, 模型压缩
- 前序问题:一步生成只调用一次网络,但网络内部仍有许多层。多步扩散的逐步去噪到底消失了,还是被重排到网络深度里?仅看最终图像,无法区分一次直达和层内反复细化。
- 本文贡献:作者用模型自身输出头解码中间层,并用独立训练及随机探针做对照:时间条件 flow-map 模型呈现随深度去噪的规律,部分 MeanFlow 任务甚至先去噪再加噪。进一步用带内部时间区间条件的共享 block 拟合教师隐藏层,把层数与独立参数组数拆开。
 论文 Figure 2:大规模一步图像生成器也呈现沿深度逐渐去噪的现象。FLUX-schnell 和 MeanFlow 的逐层终点预测逐渐显露清晰图像结构;不依赖 τ 的 Drifting 模型作为对照。对 FLUX-schnell,模型输出头与独立训练探针得到相似的归一化终点距离下降规律,随机探针不能复现。
- 实验效果:附录表 1 的 ImageNet 256×256 实验:MeanFlow SiT-L/2 从 459M 参数压到 27.6M,压缩 16.6 倍;经 FD-loss 后训练,FID-50k 为 4.87,教师为 4.01。两组独立 block 的学生用 46.5M 参数达到 4.04。附录表 2 中,另行训练的两组 block 学生将执行次数减半后 FID 为 5.25。
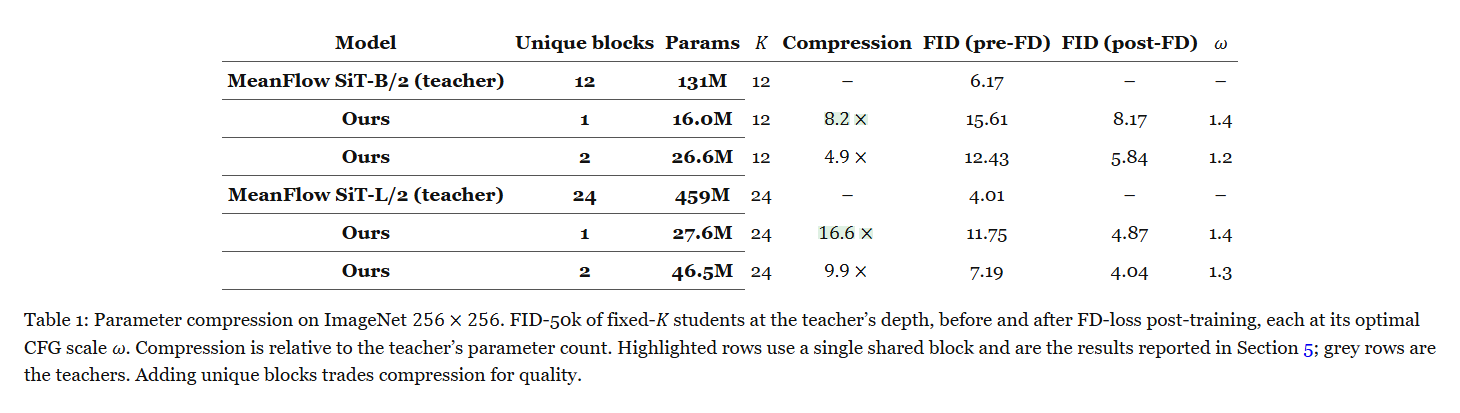 论文 Table 1:ImageNet 256×256 的参数压缩结果。在教师原始深度、固定 K 执行次数下,分别报告 FD-loss 后训练前后的 FID-50k,各行采用最优 CFG 强度 ω。压缩倍数相对教师参数量;高亮行使用单个共享 block,灰色行为教师。增加独立 block 数量可用更多参数换取质量。
- 批判点评:16.6 倍是参数压缩,单组 block 仍可执行 24 次,不能换算成 16.6 倍延迟加速。相似的深度轨迹也不等于逐点复现教师的采样轨迹;缺少时间索引任务的 Drifting 模型未呈现同样规律。公开代码适合研究内部计算,结论尚不是所有一步模型的普遍定理。
3. DuoMatching:图像老师帮视频补回细节
DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation | 香港中文大学;字节跳动;香港科技大学;香港交互感知研究中心 | arXiv:2610.03543
关键词:视频蒸馏, 联合边缘分布, 图像教师, 潜空间桥接
- 前序问题:视频教师能教会时间连贯,但少步学生仍可能丢掉 prompt 中的羽毛、毛发等细节。整段视频的联合分布匹配会受到周围帧制约,需要额外的单帧监督补足视觉与语义先验。
- 本文贡献:DuoMatching 在视频联合 DMD 上增加来自图像教师的边缘 DMD。LatentBridge 将视频 latent、前一片段与局部帧编号映射到图像 latent,避免直接套用不同 VAE 空间;Latent Variation Sampling 用相邻 latent 的差异切分时间区间,每段抽样一片,提高有限监督预算的覆盖。
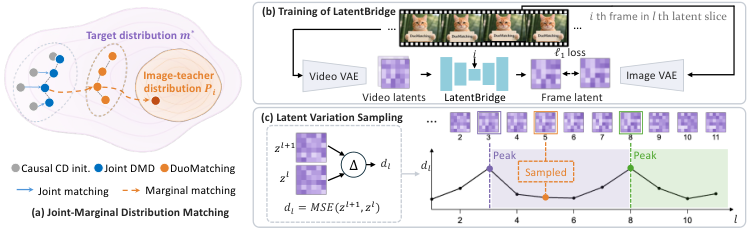 论文 Figure 3:DuoMatching 总览。(a)用图像教师参考分布 P_i 补充联合分布匹配;每组表示一个视频,节点表示帧级分布。(b)LatentBridge 根据视频 latent z^l、前一片 z^(l−1) 和局部帧编号 i,通过 ℓ₁ 重建损失映射到对应图像 latent。(c)Latent Variation Sampling 用相邻 latent 的差异分段,并在段内随机抽样。
- 实验效果:表 1 按生成单位和 NFE 分组:两步逐帧设置的 VBench Total 从 Causal Forcing++ 的 80.67 到 83.53;四步 chunk 设置从 82.79 到 83.51。表 2 在同一 Wan2.1 教师下,对四个基线的整体偏好为 80.87%–94.35%;对 Causal Forcing++ 的时间与运动偏好为 49.57%,说明主要收益来自画质与语义。
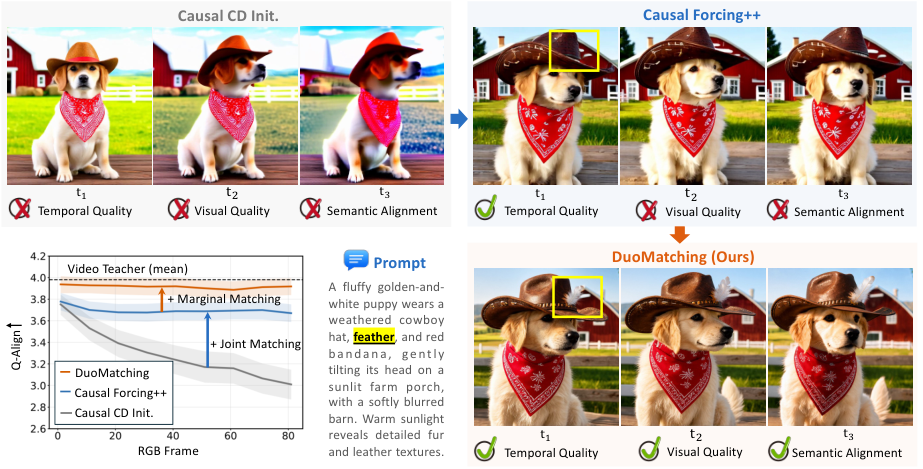 论文 Figure 1:DuoMatching 的动机与结果。自回归模型的后续帧常退化,图中 Q-Align 曲线展示这一现象。联合 DMD 缓解漂移,但学生与视频教师仍有画质差距,示例中缺少 prompt 要求的羽毛。联合与边缘匹配的组合改善画质、补回羽毛,同时保留时间连贯性;这张示例不代替完整统计评估。
- 批判点评:Full、Frame、Chunk 的函数评估单位不同,不能跨组把 NFE 当作相同成本排序。图像教师与桥接模块也带来训练成本;更清晰的单帧不是所有运动指标都提高的保证。项目页提供代码,值得在相同生成模式与预算内复现。
4. VDOT++:四步蒸馏别硬配每个token
VDOT++: Unified Few-Step Video Generation via Unbalanced Optimal Transport Distillation | 悉尼大学;上海人工智能实验室;香港科技大学;香港中文大学 | arXiv:2610.03221
关键词:少步视频生成, 非平衡最优传输, 跨规模蒸馏, 条件生成
- 前序问题:同一个文字或图像条件允许多种正确视频。把学生与教师每帧的空间 token 强制全量配对,可能把本来合理但位置不同的内容当作错误,并在分布重叠不足时给出不稳定指导。
- 本文贡献:VDOT++ 在 DMD 上加入非对称非平衡最优传输:放松学生侧质量约束,下调不可靠 token 的质量,同时保持教师侧覆盖。ℓ₁ 距离使聚合更接近加权中位数,减少远处匹配的影响;DMD 与对抗项分两次反传。相同训练配方分别训练三类任务的生成器,还研究大 score 网络指导小生成器。
 论文 Figure 3:VDOT++ 总览。上方:给定条件,少步生成器同时使用 DMD score 差异、逐帧最优传输匹配和对抗损失,经两次顺序反传及一次优化更新。下方图示一对时间帧,为清楚省略扩散时间与帧索引 (t,q)。DMD 在对应时空坐标提供 score 差异;平衡 OTD 显式耦合空间 token,却强制全量匹配;对称 UOT 放松两侧。非对称 UOT 放松学生侧、保持教师侧约束,压低不可靠学生 token 质量并维持教师覆盖。
- 实验效果:表 III 的文生视频 VBench 中,Wan-14B 四次评估学生的归一化均分为 81.59,50×2 次评估教师为 77.70;表 IV 的图生视频对应为 78.38 和 77.92。表 II 的 flow 条件任务却是 80.29,对应教师 80.35,因此不是每个任务、每项指标都超过教师。
 论文 Figure 4:可控视频生成的定性对比。比较 100 次函数评估的 VACE 教师与 4 次评估的 VDOT、VDOT++,任务为(a)flow 条件的视频到视频,(b)视频向外扩展,(c)多参考图像到视频。顶行给出输入条件,每种方法展示 0、2.5、5 秒的帧。
- 批判点评:“统一”指训练配方跨任务复用,并非一个 checkpoint 同时完成全部任务。NFE 降低也不能直接等同端到端加速倍数。正文提到 CVPR 2026 的是前作 VDOT,这个扩展版本未核实接收证据,不能借前作会议作本篇背书;本文未发现可核验的新代码仓库。
5. Reward Composition:审美加分先过提示词约束
Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards | 加州大学洛杉矶分校;Arena Intelligence | arXiv:2610.02967
关键词:图像后训练, 人类偏好, rubric奖励, 奖励投机
- 前序问题:优化审美奖励,模型可能擅自添加装饰、乱码或写实风格;只优化提示词完成度,又可能牺牲细节。把不同量纲的分数简单平均,无法处理“这个要求只对某类 prompt 生效”的情况。
- 本文贡献:这项图像后训练研究组合人类偏好、内容满足度和禁止内容 checklist。各奖励轴独立归一化;只有意图严格的 prompt 激活额外约束;适用的反投机检测发现问题后否决正向偏好加分。不同奖励配置得到的权重再做融合,使审美优化受到意图约束。Reward Composition 是本文的编辑短名。
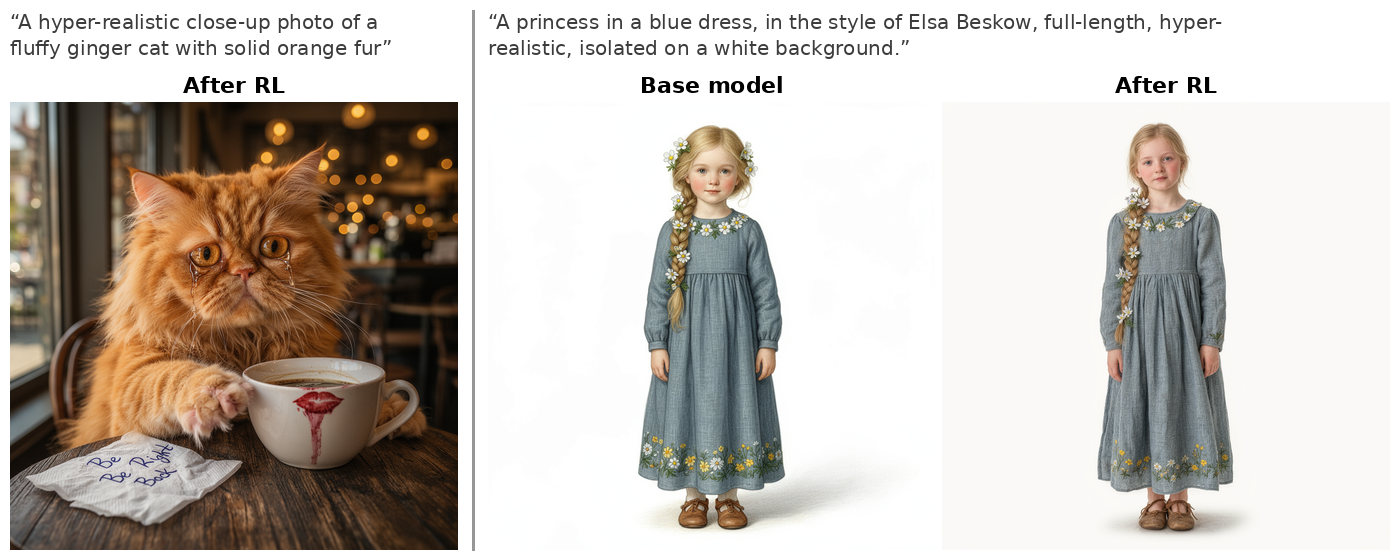 论文 Figure 2:两类反复出现的奖励投机失败。左侧:prompt 要求不含文字,RL 策略却在餐巾上添加乱码。右侧:prompt 要求 Elsa Beskow 的故事书插画风格,基座保持该风格,而 RL 策略偏向照片写实。这些案例解释为何需要按 prompt 启用约束和否决。
- 实验效果:表 1 的 2026-09-04 Arena 快照中,FLUX.2-dev 从 1132.8±14 到 1202±13,约增加 69 Elo。表 2 在 1k 验证 prompt、五个候选 checkpoint 中选择最佳值,Stage 3 在 Gemini 评估配 Arena RM 的对比胜率为 0.660,单偏好为 0.507;这些自动评估与线上 Elo 不是同一个指标。
 论文 Figure 1:奖励设计可视化。只用偏好训练会偏向通用装饰并忽略要求;只用满足度会洗掉细节并丢失风格和景物;Arena-T2I-Hard 能恢复要求元素但保留多余装饰;不加意图门控的禁止内容奖励,即使 prompt 允许细节也会将其压平。Stage 1 仅在意图严格时施加约束,示例中能满足要求而未明显损伤质量。
- 批判点评:只测试两个基座、单个随机种子,内容分解问题未经人工逐条审计。排行榜数字属于 9 月 4 日快照,不是今天的排名;多个 checkpoint 择优也需与固定预算评估区分。作者说释放 1k 训练子集,但本次项目页未提供可核验下载入口,因此不声称数据或代码已可下载。
6. PMD:冻结视频模型顺手生出动作
Parasitic Co-Denoising: Unlocking 3D Human Motion Generation in a Frozen Video Diffusion Model | 新加坡南洋理工大学 | arXiv:2610.03047
关键词:三维动作生成, 视频扩散, 共去噪, 多层特征融合
- 前序问题:视频模型学会了人怎么动,却没有显式输出可用于动画的三维动作。先生成视频再估计动作需要多阶段处理;从零训练动作生成器又受动作数据覆盖限制。
- 本文贡献:Parasitic Motion Decoder(PMD)附着在冻结的 Wan2.1 上。先对齐动作与视频 latent,再用轻量 flow-matching decoder 读取视频 DiT 多层特征,按噪声水平 σ 自适应融合,并与视频共享去噪日程。视频与动作的噪声独立,耦合来自同一日程和特征条件;一次联合采样流程得到配对输出。
 论文 Figure 2:Parasitic Motion Decoder(PMD)的结构。先将动作与视频 latent 对齐,再让动作 decoder 与冻结视频宿主同步去噪;σ 自适应多层融合把宿主的中间特征送入动作流。
- 实验效果:表 1 的 MBench Protocol B:19M 可训练参数的 PMD,动作条件一致性 0.58、泛化 0.72;2B 可训练参数的 MotionVLA 对应 0.55、0.66。表 2 的 HumanML3D 上,PMD 的 R-Precision Top-1 为 0.537,FID 为 0.098;DisCoRD 的 FID 为 0.032,说明语义对齐优势没有覆盖全部分布质量指标。
 论文 Figure 3:MBench prompt 上的定性比较,展示各动作生成方法对文字动作要求的可视化结果。图展示动作语义与轨迹外观;抖动、足部接触等质量仍应结合实验表分别判断。
- 批判点评:19M 是附加可训练模块,不包含冻结视频宿主,因此不是整个系统只有 19M 参数。冻结宿主没有接受本工作三维动作监督,但附加模块训练仍用配对动作数据。动作抖动、接触和 FID 也并非全面最佳;没有找到作者可核验代码链接,不把模板或会议样式当作接收证据。
7. Custom Forcing:两分钟视频保持同一个主体
Custom Forcing: Training-Free Subject Customization for Autoregressive Video Generation | 韩国庆熙大学;得克萨斯大学奥斯汀分校 | arXiv:2610.02914
关键词:视频个性化, 自回归生成, KV缓存, 免训练定制
- 前序问题:自回归视频能不断续写,却容易把用户给定的某只宠物或物品变成同类通用实例。固定参考帧只能提供初始锚点;文本的类别先验与后续漂移会逐步削弱主体身份。
- 本文贡献:Custom Forcing 将五张参考图和一张场景定制 anchor 一次写入持久 KV cache。DVA 根据当前主体相似度相对初始水平的下降增强参考 value;ACG 比较读取与不读取 anchor 的注意力输出,沿远离通用类别先验的方向引导。冻结基座,无需逐主体训练。
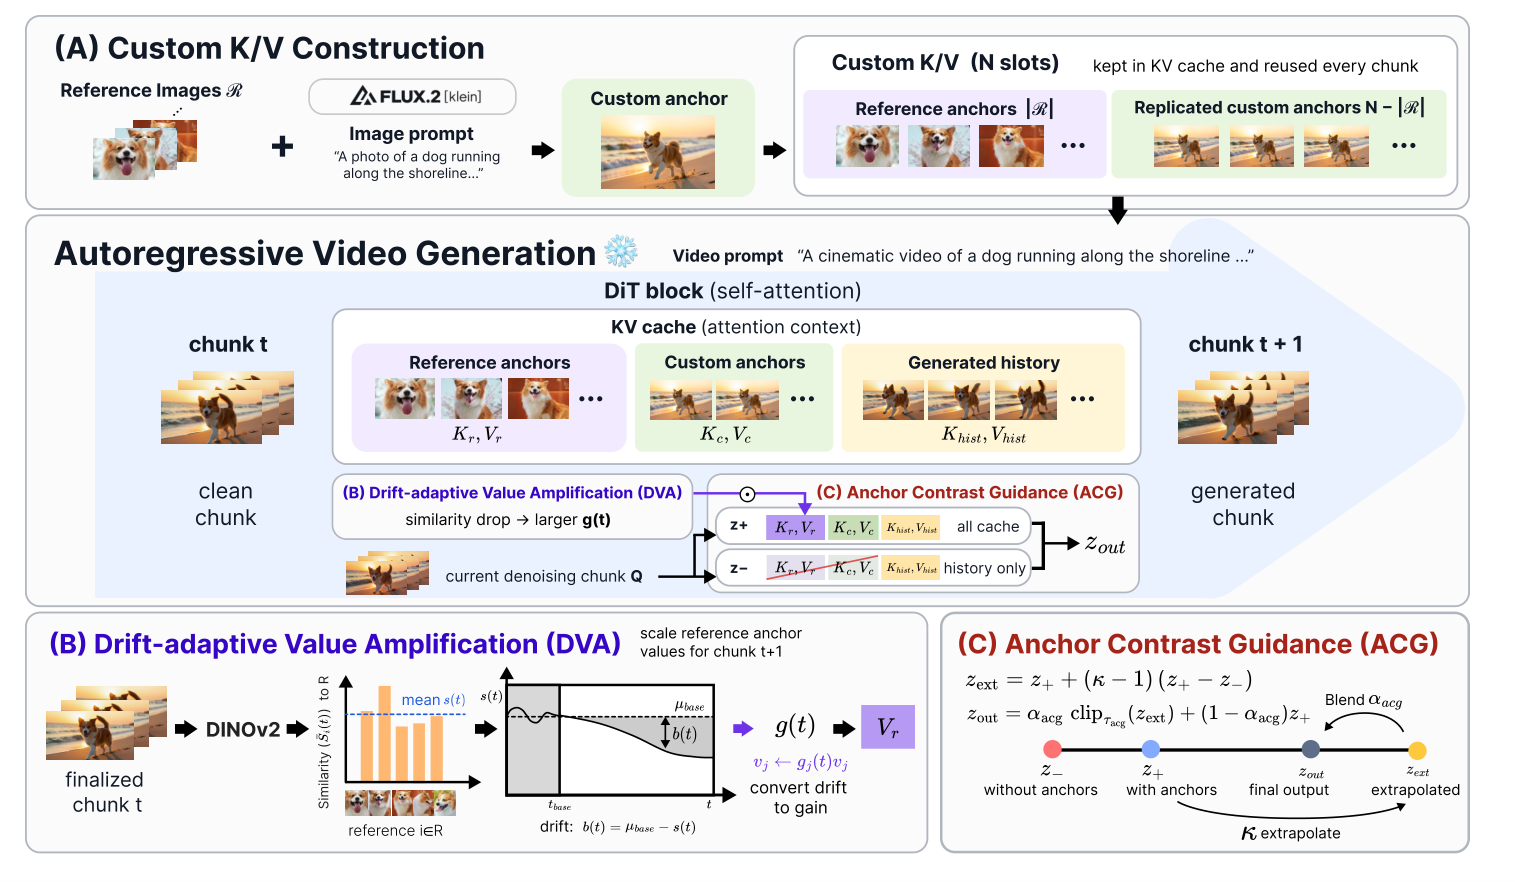 论文 Figure 3:Custom Forcing 总览。上方:参考图与 FLUX.2 [klein] 生成的定制 anchor 副本一次写入 KV cache。中间:冻结基座每层 self-attention 在 DVA 以 g(t) 放大参考 value 后,分别读取含及不含 anchor 的缓存,得到 z_+、z_-。左下:DVA 根据当前已完成 chunk 的相似度 s(t) 相对初始 μ_base 的下降设置 g(t)。右下:ACG 以 κ 沿远离 z_- 的方向外推,再与 z_+ 混合。
- 实验效果:表 1 的两分钟测试:固定 K/V 的首段与末段 DINO-I 为 0.583、0.415,Custom Forcing 为 0.622、0.578。表 2 在单 H100、30 秒、100 个案例上,相对 FramePack-F1、SkyReels-V2 DF、SkyReels-V3 的逐帧生成时间优势为 9.5、11.5、28.5 倍;这些基线架构和规模不同。
 论文 Figure 4:两分钟生成示例。只使用定制 K/V 时,主体在第一分钟内发生漂移;Custom Forcing 在展示的两种主体案例中维持到两分钟。两种案例分别生成,并非证明一个视频同时控制两个主体。
- 批判点评:相对固定 anchor,DVA 与 ACG 增加 11%–13% 生成时间。测试为动物和物品、每段一个主体、最长两分钟,局部细节漂移和多个主体仍未解决。实际能力受冻结基座限制。作者项目页可访问,但没有找到该方法的可核验代码仓库。
8. SpectralCache:复用奇异子空间少算主干
SpectralCache: Accelerating Diffusion-Based World Models via Spectral Feature Caching | 史蒂文斯理工学院;美国东北大学;达姆施塔特工业大学 | arXiv:2610.02660
关键词:扩散加速, 世界视频生成, 频谱缓存, 特征近似
- 前序问题:世界视频模型每个去噪步都运行昂贵主干。直接复用完整特征没有利用结构:相邻步骤的主导奇异子空间相对稳定,变化更多体现在低维奇异值上。
- 本文贡献:SpectralCache 在完整步分解最终层特征,缓存最近两次的奇异子空间、奇异值和残差。近似步固定子空间,只线性外推奇异值;误差累积或间隔到阈值后,交替刷新主干和缩放奇异值,以进一步少算完整步骤。它是免训练近似,不是精确复用。
 论文 Figure 4:SpectralCache 总览,区分完整主干计算与近似缓存步骤;稳定奇异子空间和残差被复用,奇异值通过外推或缩放更新,触发条件控制刷新。
- 实验效果:表 1 的 HunyuanVoyager-13B,512×768、49 帧设置下加速 5.22 倍;静态 WorldScore 从基线 66.28 变为 65.90,动态从 46.40 变为 46.13。Aether-5B 的 480×720、41 帧生成加速为 2.20 倍。不同模型与任务的收益应分别读,不能都写成 5.22 倍。
 论文 Figure 1:SpectralCache 与基线在 HunyuanWorld-Voyager-13B 上的比较。(a)视觉效果,(b)延迟,(c)质量。在所测条件下加速约 5.22 倍,同时保持较高视频保真;接近原模型仍不代表逐像素无误差。
- 批判点评:频谱稳定和固定缩放系数来自所测模型的经验,强动态或采样日程改变时需重新验证。质量接近基线仍存在误差,不能写“无损”;PSNR 对齐基线生成也不是对齐真实视频的证明。当前原文没有可核验代码链接,工程复现还需要补足实现和预算测量。
9. DriftTTS:不用生成老师四步合成语音
DriftTTS: Few-Step Text-to-Speech Without Distillation via Distribution-Matching Drift | 马萨诸塞大学阿默斯特分校;伍斯特理工学院 | arXiv:2610.03390
关键词:语音合成, drifting模型, 分布匹配, 少步生成
- 前序问题:少步 TTS 往往依赖多步生成教师或预设噪声到数据轨迹。能否直接让真实和生成 mel 特征的分布接近,并让生成器学习自己实际会访问的中间状态?
- 本文贡献:DriftTTS 在原始 mel 与冻结 MelMAE 特征空间构造真实样本吸引、生成样本排斥的 drift 目标,训练文本条件 decoder。on-policy rollout 用模型自身中间状态学习少步更新;MelMAE 只用于训练。推理从高斯噪声逐步替换 mel 状态,再由 HiFi-GAN 转为波形,无生成教师蒸馏。
 论文 Figure 1:DriftTTS 总览。文本条件高斯噪声经少步 drift decoder 迭代细化为 mel 频谱,再用 HiFi-GAN 转为波形。训练时在 mel 域特征空间使用真实与生成样本计算 on-policy 分布匹配 drift 目标,优化 decoder。
- 实验效果:表 1 在 LJSpeech、相同 HiFi-GAN 和 Whisper-medium 评估下,四步 DriftTTS 的 MCD 为 3.87 dB、WER 3.7%,Matcha-TTS 为 3.85 dB、3.4%。表 2 的 MOS 为 4.18±0.16,对方 3.96±0.18;配对检验按受试者聚合 p=0.31,按语句 p=0.044。
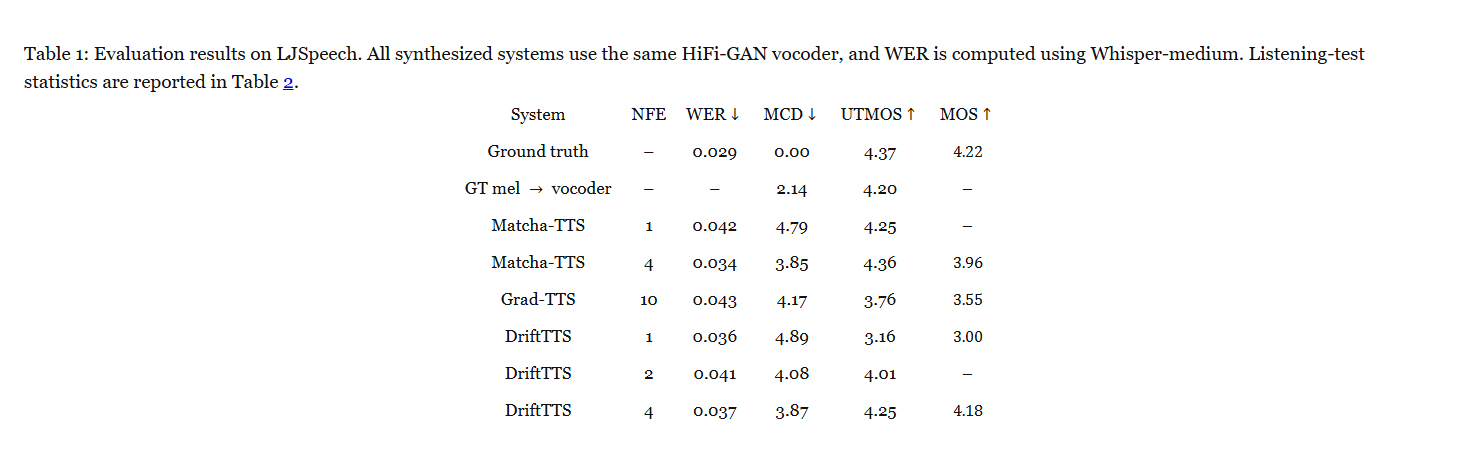 论文 Table 1:LJSpeech 评估。所有合成系统使用同一个 HiFi-GAN 声码器,WER 由 Whisper-medium 计算,听测统计另见 Table 2。四步 DriftTTS 的 WER 为 0.037、MCD 为 3.87、UTMOS 为 4.25、MOS 为 4.18;四步 Matcha-TTS 对应 0.034、3.85、4.36、3.96。NFE 是声学生成器的函数评估次数。
- 批判点评:更高 MOS 均分不能写成所有统计口径显著胜出,两个客观指标还略逊基线。无生成教师不等于没有预训练组件,仍用 MelMAE 与声码器;只报告单说话人数据。推理次数应不超过训练深度 K,训练两步的模型直接跑四步会退化。官方代码可访问。
10. Music Rubric:音乐奖励别只盯一个分数
Rubric-Based Optimization for Text-to-Music Generation | 华盛顿大学;艾伦人工智能研究所 | arXiv:2610.03589
关键词:文本到音乐, rubric奖励, 音频语言模型, 后训练
- 前序问题:提高某一个音乐自动评分,可能牺牲提示词符合度或其他听觉质量。让音频语言模型按多个维度打分是否更稳,也要区分“音乐听起来好”与“速度、调性、乐器确实正确”。
- 本文贡献:作者用七维自然语言 rubric 评价 prompt 对齐、风格乐器、旋律、节奏、结构、制作和音乐性。MusicGen-small 与 ACE-Step v1 将候选排名转为 DPO 偏好对;ACE-Step 另用 DiffusionNFT 在线优化标量奖励,并比较一次联合评分和逐维评分。Music Rubric 是本文编辑短名。
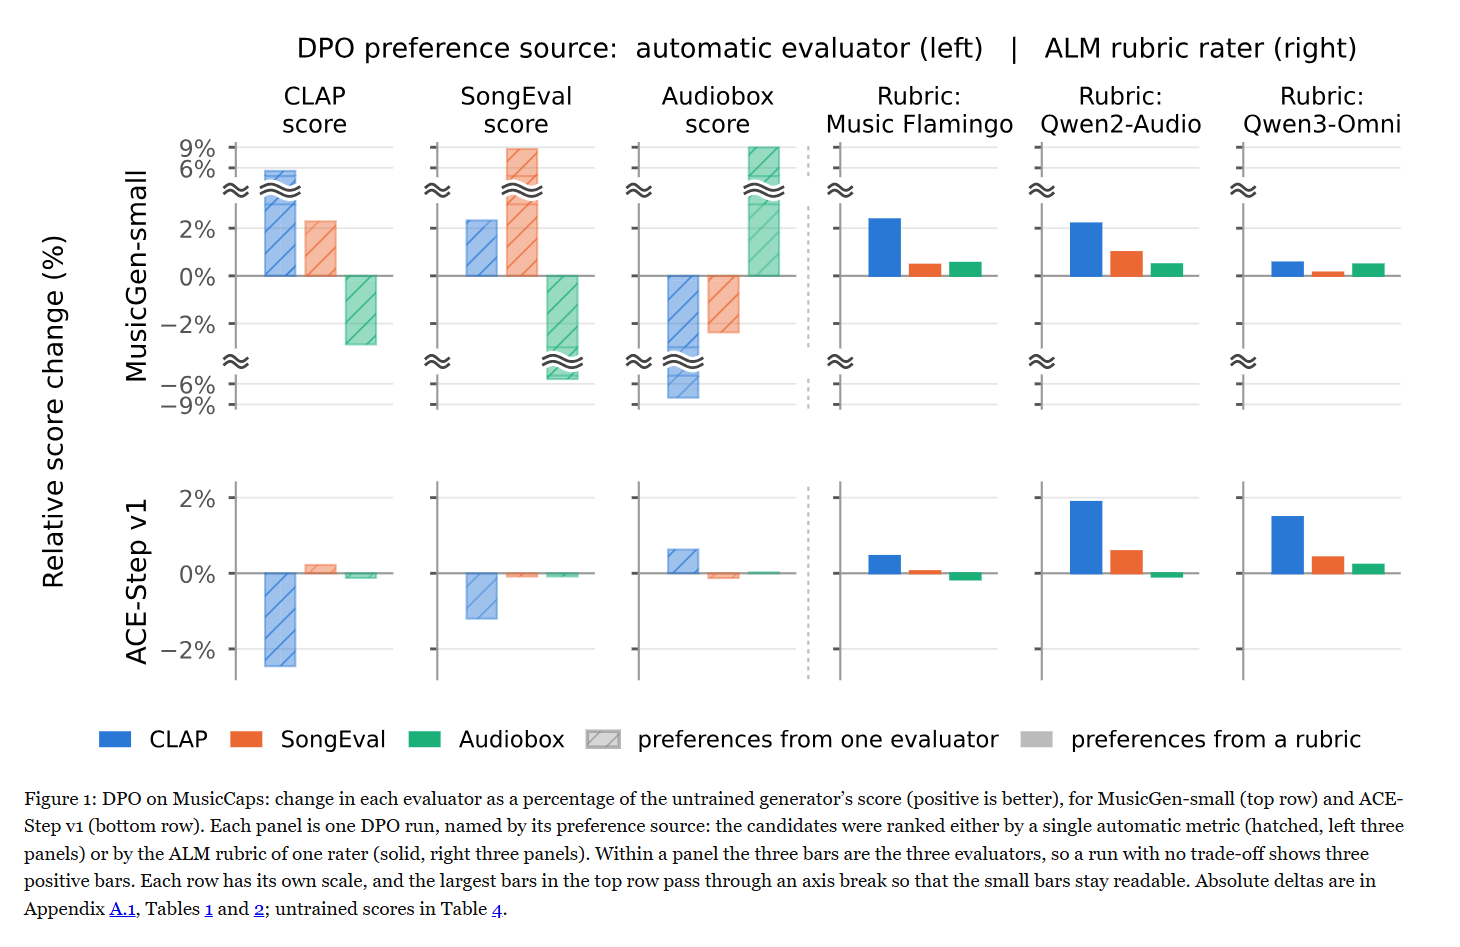 论文 Figure 1:MusicCaps 上 DPO 后各评估器分数相对未训练模型的百分比变化,正值为好。上排为 MusicGen-small,下排为 ACE-Step v1。每面板对应一个偏好来源:左三列斜线柱按单一自动指标排序,右三列实心柱按音频语言模型 rubric 排序。面板内三柱对应三个评估器,三柱皆正表示无这三项的取舍。各排尺度不同,上排最大柱使用断轴以保持小柱可读;绝对变化见附录表 1、2,基线分数见表 4。
- 实验效果:附录表 3:ACE-Step 用 Qwen3-Omni 逐维奖励训练 125 次更新后,相对原模型 CLAP、SongEval、Audiobox 分别增加 0.0180、0.1057、0.3385。第 5.4 节的小听测有 7 人、40 条 caption、52 次判断,36 次偏好训练后模型,即 69%,95% 区间 48%–89%;这些是不同口径的证据。
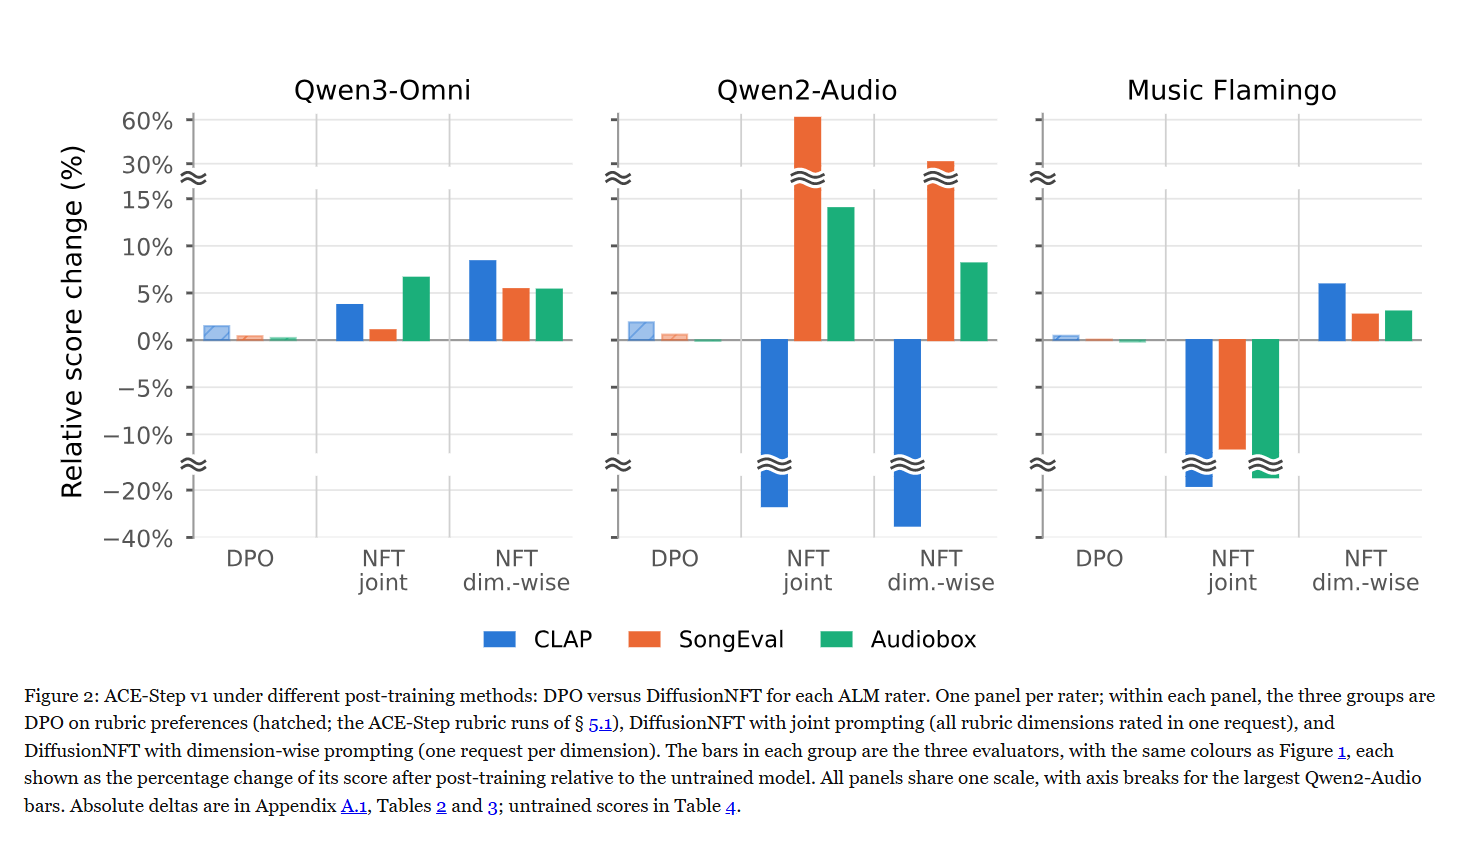 论文 Figure 2:ACE-Step v1 的 DPO 与 DiffusionNFT 比较,每个评分器一面板。面板内三组为 rubric 偏好 DPO(斜线)、一次请求评价全部维度的联合提示 DiffusionNFT、每维度独立请求的逐维提示 DiffusionNFT。每组三柱为与 Figure 1 同色的三个评估器,以相对未训练模型的分数变化百分比表示。所有面板同尺度,对 Qwen2-Audio 最大柱使用断轴;绝对变化见附录表 2、3,基线分数见表 4。
- 批判点评:评分器和提问方式决定信号是否有效:Music Flamingo 联合评分可出现奖励上涨而外部指标下降,rubric 也没有改善所测调性准确率。短音乐、少量听测与宽置信区间不足以承诺长曲或专家质量;直接属性测量与 rubric 更适合互补使用。本次未找到可核验的作者代码入口。
趋势观察
奖励要定位错误并尊重条件
LoGo 将几何错误定位到三维区域;图像奖励组合按 prompt 意图启用约束,音乐 rubric 则暴露评分器和提示方式的影响。更细的奖励有机会改善生成,但也需要防止对评分代理的过度优化。
一步调用仍包含内部迭代
Depth as Time 把压缩目标推进到网络深度,SpectralCache 从稳定子空间中减少重复计算。参数、执行次数与端到端延迟是三种预算,本文分别给出对应测试条件。
跨模态先验需要明确桥接
DuoMatching 把图像教师接到视频 latent,PMD 把视频宿主知识接到动作流。对齐接口是关键,但附加参数或少步采样不能抹去宿主与训练的成本。
质量应按维度报告
主观偏好、文字符合度、三维一致性和接触质量不一定同步上升。不同论文的 benchmark、生成单位与采样预算不同,这份日报不把分数拼成统一排行榜。
今日讨论
你会优先改善长视频的一致性,还是压缩少步生成的内部计算?
人工智能炼丹君 整理 | 2026-10-06








评论 (0)