今日 AIGC 论文速览
今日共 10 篇 · 生成架构与后训练 3 篇 · 图像视频算力与量化 3 篇 · 多参考图与长视频记忆 2 篇 · 数字人与生成语音增强 2 篇
重点论文标题列表
- LoT(Stanford):按细节分配视频生成算力
- LiFT(阿姆斯特丹):共享主干多循环细化图像
- MEND(得州奥斯汀):奖励收益够大才移动样本
- RefRoute(达特茅斯):十六张参考图也能轻量合成
- Keepsake(中佛罗里达):长视频只留难替代的历史帧
今日论文速览
1. LoT:按细节分配视频生成算力
Level-of-Token Diffusion | 斯坦福大学;Google | arXiv:2610.05816
关键词:多分辨率token, 图像视频生成, 算力分配, 不对称flow
- 前序问题:天空、虚化背景和人脸被分配同样密度的 token,生成时算力花在很多低细节区域。直接压缩 token 又会让预训练 DiT 只能输出低分辨率流场,难兼顾省计算与完整画面。
- 本文贡献:Level-of-Token 把框、语义掩码、纹理方差或景深转成大小和形状不同的矩形 token 布局。重要区域用细 token,其余区域合并;经分块不对称 flow、形状嵌入、与原网格对齐的 RoPE 及按形状区分的输出头,DiT 处理较短序列,但每步仍恢复完整分辨率速度场。需要微调预训练模型。
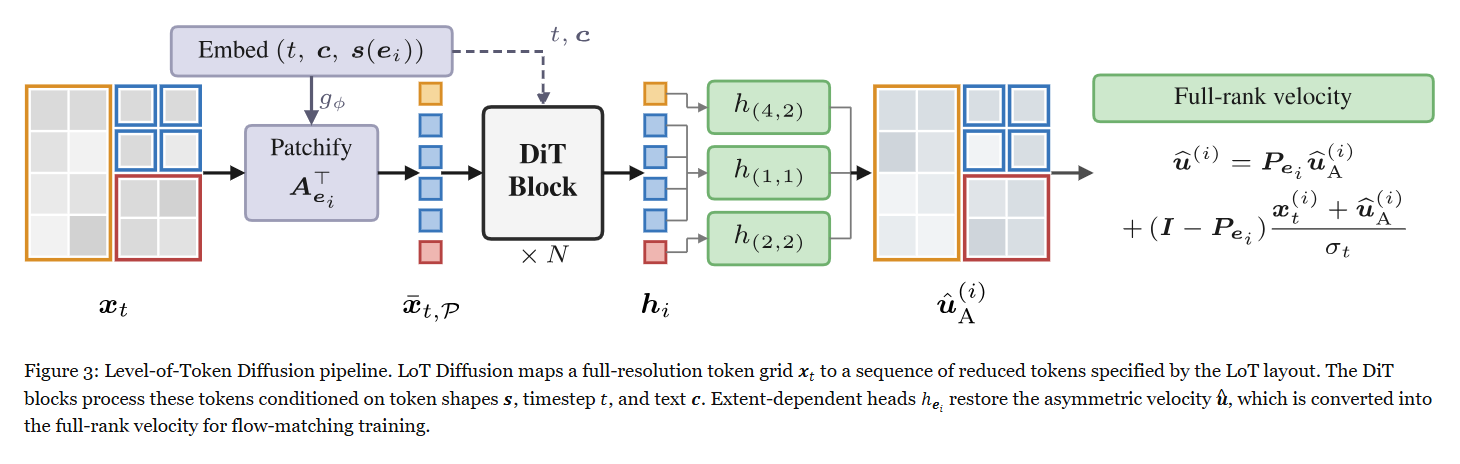 论文 Figure 3:LoT 流程。完整分辨率 token 网格 x_t 按 LoT 布局映射成较短序列,DiT 以 token 形状 s、时间步 t 与文本 c 为条件处理;按形状区分的输出头 h_e_i 恢复不对称速度 u,再转为完整秩速度用于 flow-matching 训练。
- 实验效果:表 2 的 Wan2.1 14B、三倍 token 压缩预算下,论文报告平均视频生成加速 3.530 倍;Aesthetic 为 0.5104、Imaging 为 0.5650,完整基座为 0.5518、0.6465。表 1 的 FLUX2 4B 对应预算最高加速 2.040 倍。数字代表不同预算下的速度与质量取舍。
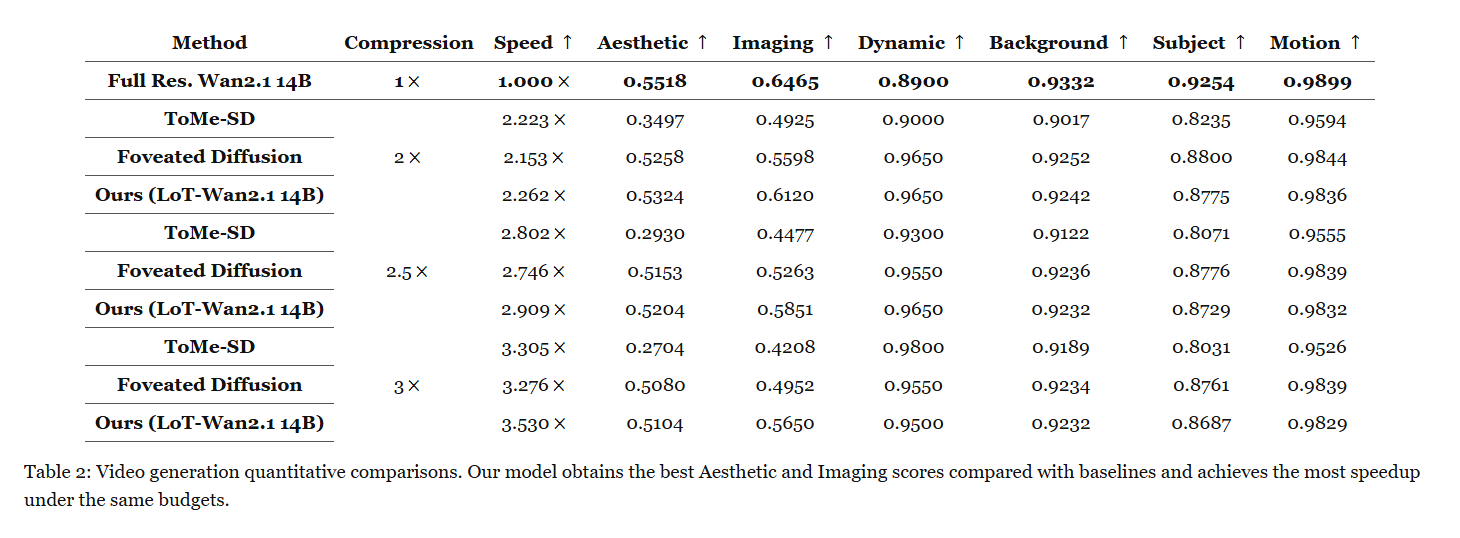 论文 Table 2:视频生成量化比较。相同 token 预算下,与压缩基线相比,LoT 的 Aesthetic、Imaging 分数及加速更好;表内同时列出完整分辨率 Wan2.1 14B,压缩后这些质量分仍低于完整模型,不能把基线间优势读成全面无损。
- 批判点评:标题的 3.53 倍限于上述视频配置,不代表任意布局或所有模型。全画面都需要细纹理时,可减少的 token 很少;压缩过强仍损害细节。它不是只靠换采样器的免训练技巧。可从作者项目页核对布局及演示,本期未确认可下载的方法代码。
2. LiFT:共享主干多循环细化图像
LiFT: Loop Flow Transformers | 阿姆斯特丹大学;TNO | arXiv:2610.05538
关键词:循环DiT, flow matching, 推理深度, 参数共享
- 前序问题:生成质量通常随参数增长,模型存储预算有限时很难扩容。让同一主干循环多次,又常要求每次直接猜最终目标,训练深度之外未必继续改善。
- 本文贡献:LiFT 反复调用共享 DiT 核心,给每次循环连续深度坐标,并把各步预测监督到初始速度估计与 flow-matching 目标之间直线路径的对应位置。训练随机采样内部坐标,推理使用均匀网格;一个固定 checkpoint 可在不增加参数、不重新训练的情况下改变循环次数,并和外层积分步数共同分配计算。
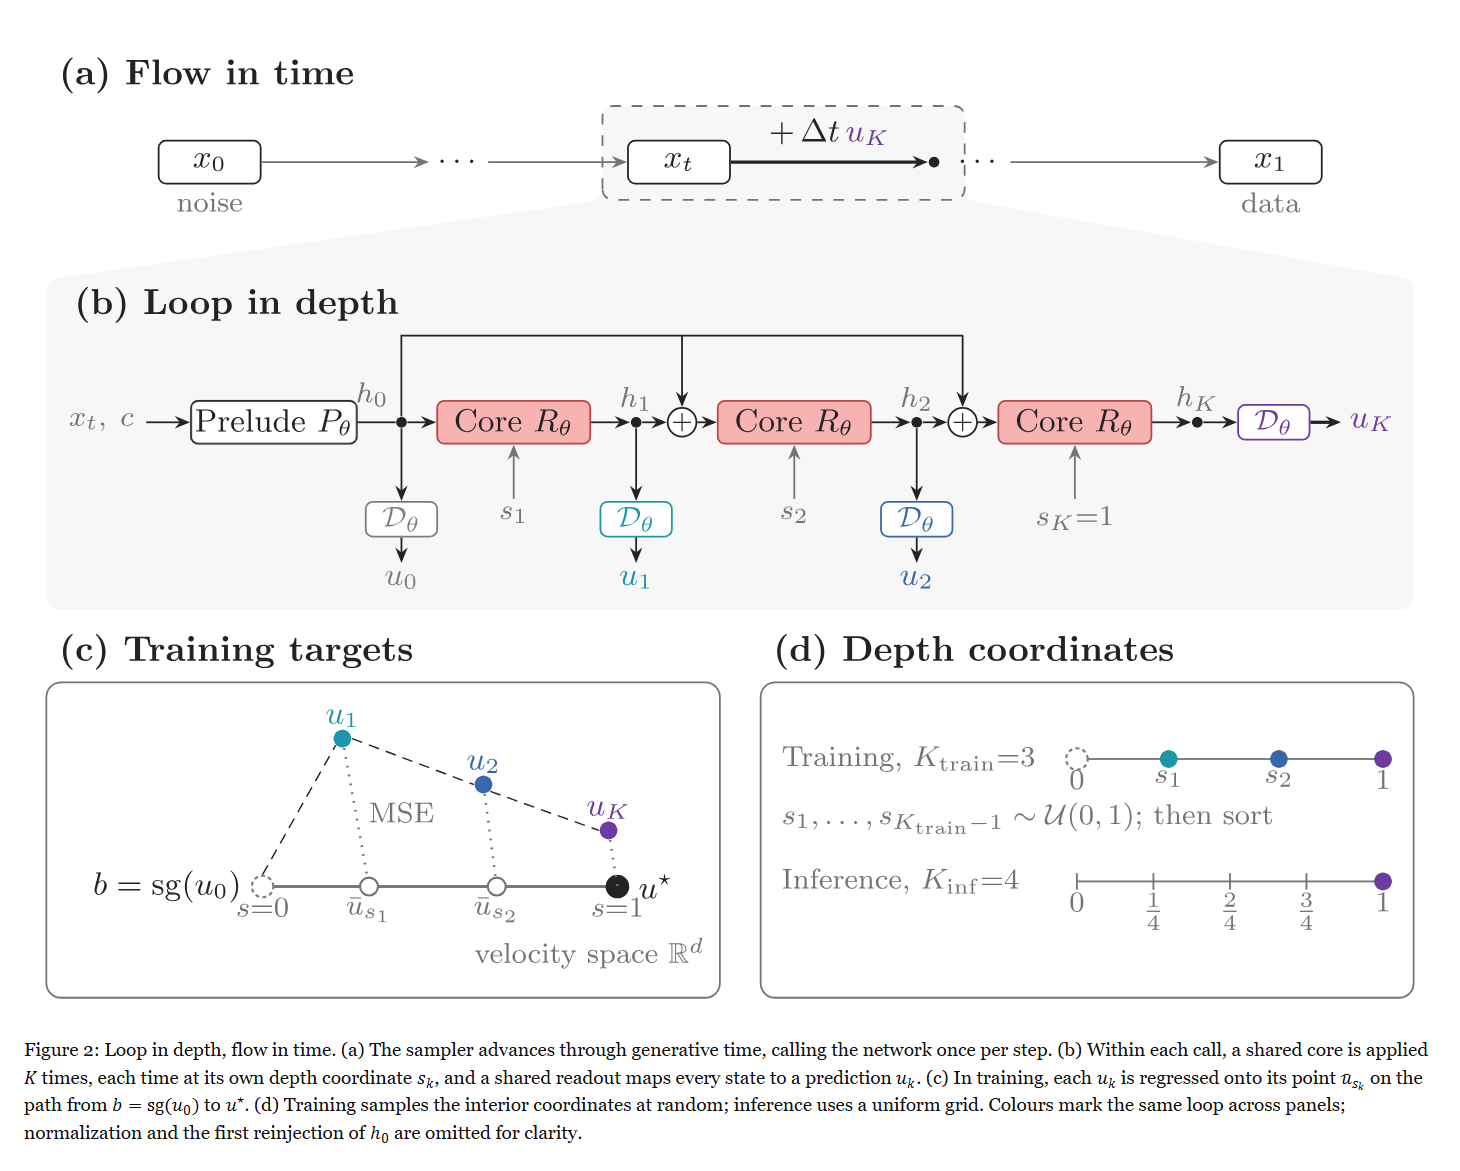 论文 Figure 2:深度循环与时间 flow。(a)采样器沿生成时间推进,每步调用一次网络;(b)每次调用把共享核心运行 K 次,每次有自己的深度坐标 s_k,共享读出头给出预测 u_k;(c)训练把每个预测回归到从停止梯度的初始估计 b=sg(u_0) 到 u* 的路径对应点;(d)训练随机采样内部坐标,推理用均匀网格。各面板颜色标出同一循环,为清晰省略归一化及首次 h_0 重注入。
- 实验效果:表 2 的 ImageNet 256×256、50 个积分步设置:L/2 R10 在训练的两次循环时 FID 为 20.30,推理八次循环为 10.95。图 7 对应 dense L/2 的 250 步为 15.74,八次循环 LiFT 计算约少 30%。所有点均按五万张生成图评价。
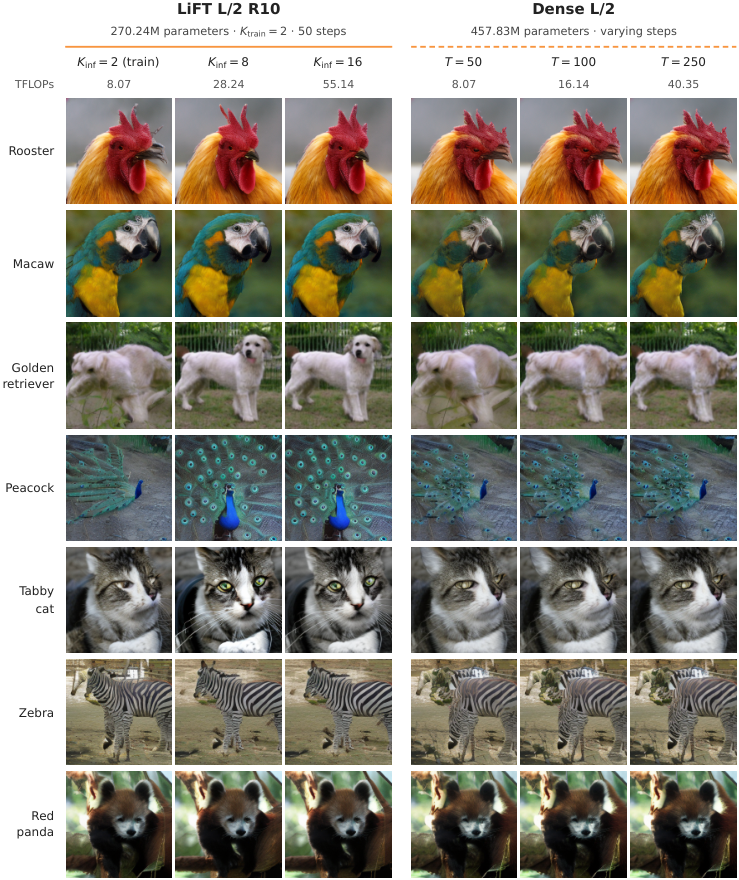 论文 Figure 7:增加循环细化相同噪声的图像。展示 LiFT L/2 R10 在 50 个积分步与 dense L/2 在不同步数的选定配对样本,各行共享类别及初始噪声,列标题给每图 TFLOPs。第二列八次循环与末列 dense 的 250 步相比,计算少约 30%、FID 10.95 对 15.74;这些选定图不替代五万张量化评测。
- 批判点评:更深并非始终更好,八次后也有回退;B/2 小模型在所测预算下仍落后 dense 基线。实验为无 CFG 的类别条件图像生成,不能直接推广视频或文生图。FLOPs 是解析估计,未验证设备延迟、能耗或峰值显存;作者页中的代码入口仍标为 Coming Soon。
3. MEND:奖励收益够大才移动样本
MEND: RL For Flow Models via Proximal Velocity Matching | 得州大学奥斯汀分校;Google;科罗拉多大学博尔德分校 | arXiv:2610.05954
关键词:生成后训练, 可微奖励, 近端速度匹配, 多样性
- 前序问题:奖励重加权需要大量更新,直接沿奖励梯度推动所有样本又可能牺牲多样性。一个高分样本是否还该移动、移动多远,常由统一更新幅度决定。
- 本文贡献:MEND 在同一 prompt 组内给奖励设上限,已达上限的样本保持不动;其余样本沿奖励梯度提出三个不同长度的候选,只有截断后的奖励收益超过二次位移代价才接受。再把接受的位移转成存储状态处的速度回归目标。行为 adapter 随训练做 EMA,方法不使用冻结参考、KL 项或 advantage 权重。
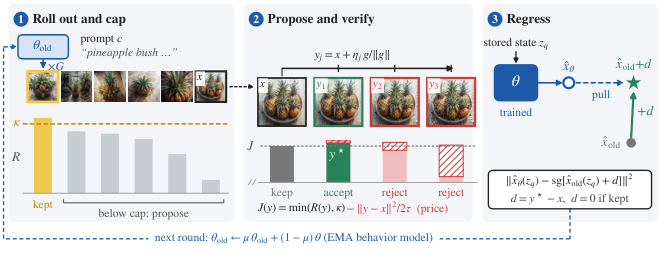 论文 Figure 4:MEND 总览。(1)同一 prompt c 的组中,达到奖励上限 κ 的样本保持;(2)低于上限的样本沿奖励梯度得到三个提议,判据从截断奖励扣除位移代价并选最佳候选,示例选最短 y_1;(3)训练 adapter 在存储状态回归到行为预测加接受位移 d 的目标,即公式 5 的速度目标,行为模型随后用 EMA 跟随。
- 实验效果:表 2 的 DrawBench 200 个提示、每个五个种子:训练 PickScore 的 MEND 100 次更新得到 23.70,Flow-GRPO 约四千次为 23.52,两者到基座的距离同为 0.313;MEND 六个评价指标中五个更高。另一个等预算协议的表 7:PickScore 为 24.03,ReFL 23.92、DiffusionNFT 23.43,不能混成同一实验。
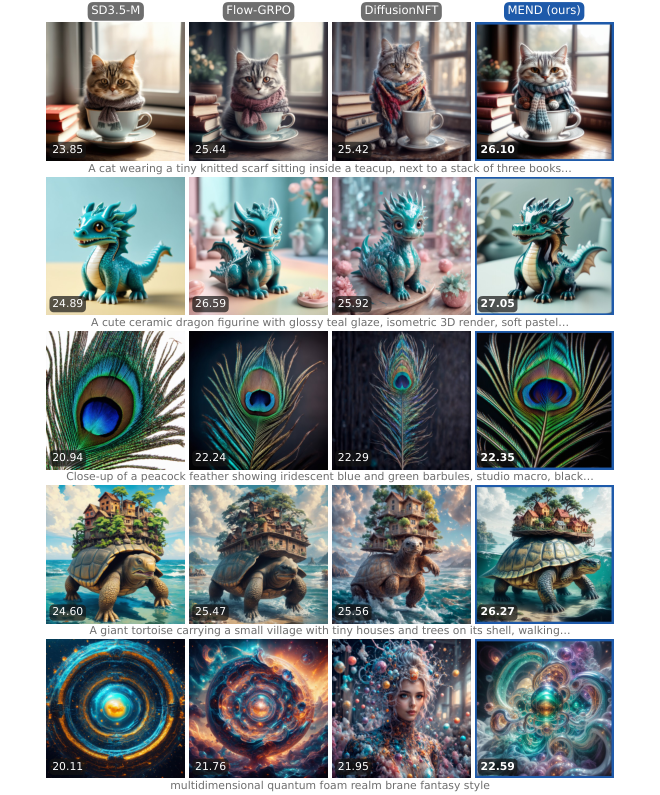 论文 Figure 3:SD3.5-M、Flow-GRPO、DiffusionNFT 与 MEND 的图像比较。每行共享同一提示与种子,各图标注 PickScore;这是配对示例而非整体成功率。
- 批判点评:更新次数差距不等于训练时间快四十倍,候选需解码和奖励评价。必须有可微奖励;目标选择的收益保证不等于模型每次更新保证,更无法识别错误奖励。长训练仍可能奖励投机;表 2 美学分数还低于 Flow-GRPO。作者项目页提供复现入口,实际代码状态按页面核验。
4. RefRoute:十六张参考图也能轻量合成
RefRoute: Decoupling Conditioning Cost from References via Compact Residual Conditioning and Spatial Routing | 达特茅斯学院 | arXiv:2610.07720
关键词:多参考图生成, 紧凑残差条件, 空间路由, 注意力加速
- 前序问题:多张参考图都编码成密集网格再全局注意力,计算随数量和分辨率上涨;不同参考的外观还会串到错误人物或物体上。
- 本文贡献:RefRoute 把每张参考图先降采样再 VAE 编码,用全分辨率像素残差编码器补回细节。条件路由与注意力路由把参考分配到目标区域,限制跨参考交互,同时允许区域外的选择性访问以处理反射、接触等场景关系。单张 1024×1024 参考的 token 从 4096 减为 256,仍需训练及多参考微调。
 论文 Figure 2:RefRoute 总览。每张参考图先降采样并由 VAE 编码成紧凑 token,残差编码器从完整分辨率提取互补特征,在 DiT 输入投影后加到对应参考嵌入;增强嵌入与文本、带噪目标通过条件专用 adapter 和注意力路由联合处理。
- 实验效果:图 4 独立计算成本实验中,16 张参考图、50 步和四步配置分别比对应 FLUX 基线快 18.3、14.2 倍。表 2 的 ManyRef100 包含 10–17 张参考,多参考微调后的 Weighted-Ref-VIEScore 为 36.06,FLUX.2-Klein-9B 为 8.88;该分数不是成功率。
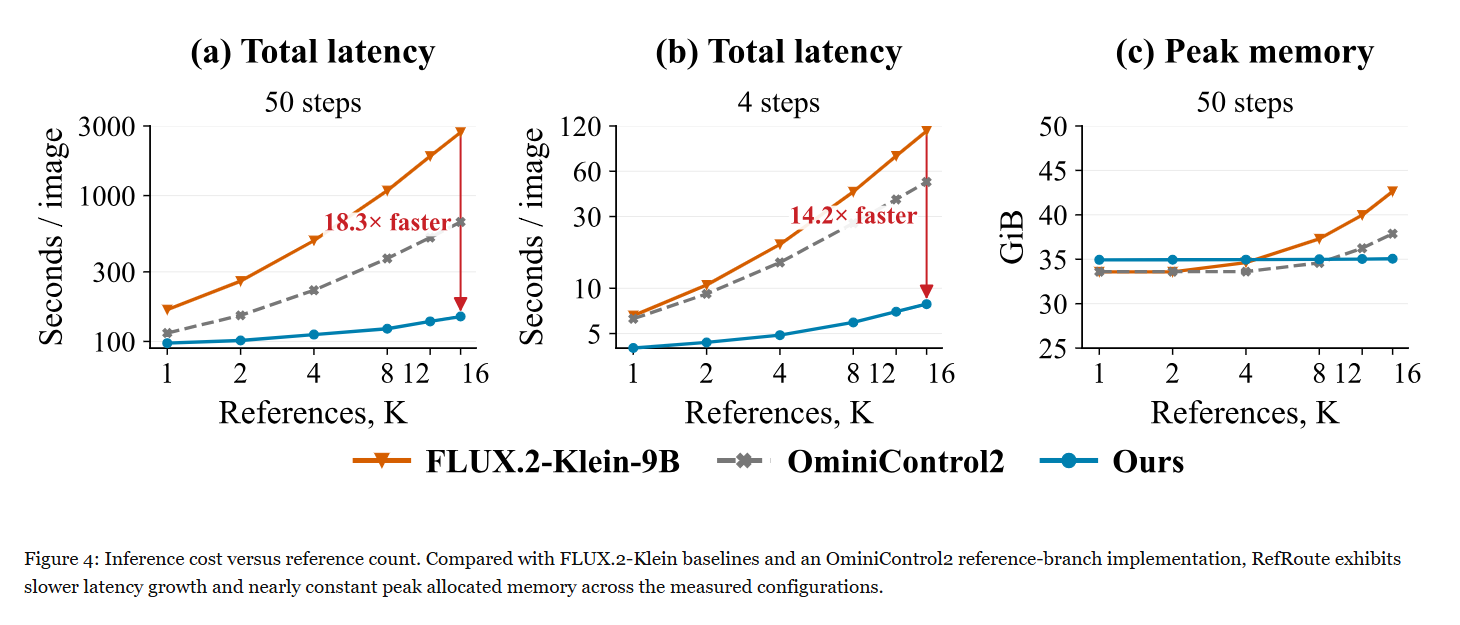 论文 Figure 4:参考数量与推理成本。与 FLUX.2-Klein 基线及相同主干上的 OminiControl2 参考分支实现相比,RefRoute 在所测配置中时延增长更慢、峰值分配显存接近恒定;分支实现比较不代表完整 OminiControl2 训练系统。
- 批判点评:加速实验和微调质量实验需分别理解。少参考 MICo-Bench 的 52.81 仍低于对应基座 55.67,不能宣传所有参考数量都更好。评分依赖多模态模型,自建数据有合成及筛选偏差。原文仅承诺发表后释放代码、配置和相关数据,不能写成当前已开源。
5. Keepsake:长视频只留难替代的历史帧
Keepsake: Selective Spatial Memory for Long-Horizon Video Generation | 中佛罗里达大学 | arXiv:2610.06588
关键词:长视频生成, 空间记忆, 固定容量, 免训练控制
- 前序问题:生成越久就保存越多历史帧,检索和存储持续增长;只保留最新帧又会忘掉刚离开的场景。历史帧价值随新视角出现而改变,一次性决定保留不够。
- 本文贡献:Keepsake 在每个视频块生成后,把已有和新增观察建成位姿—外观图,以相机距离及视觉相似度衡量替代关系。保留优先级同时看强替代帧数量与最近替代者相似度,优先留下难替代观察,逐步删除冗余直到满足固定容量。只修改持久记忆更新规则,宿主生成器、采样及检索规则保持原样,无需再训练。
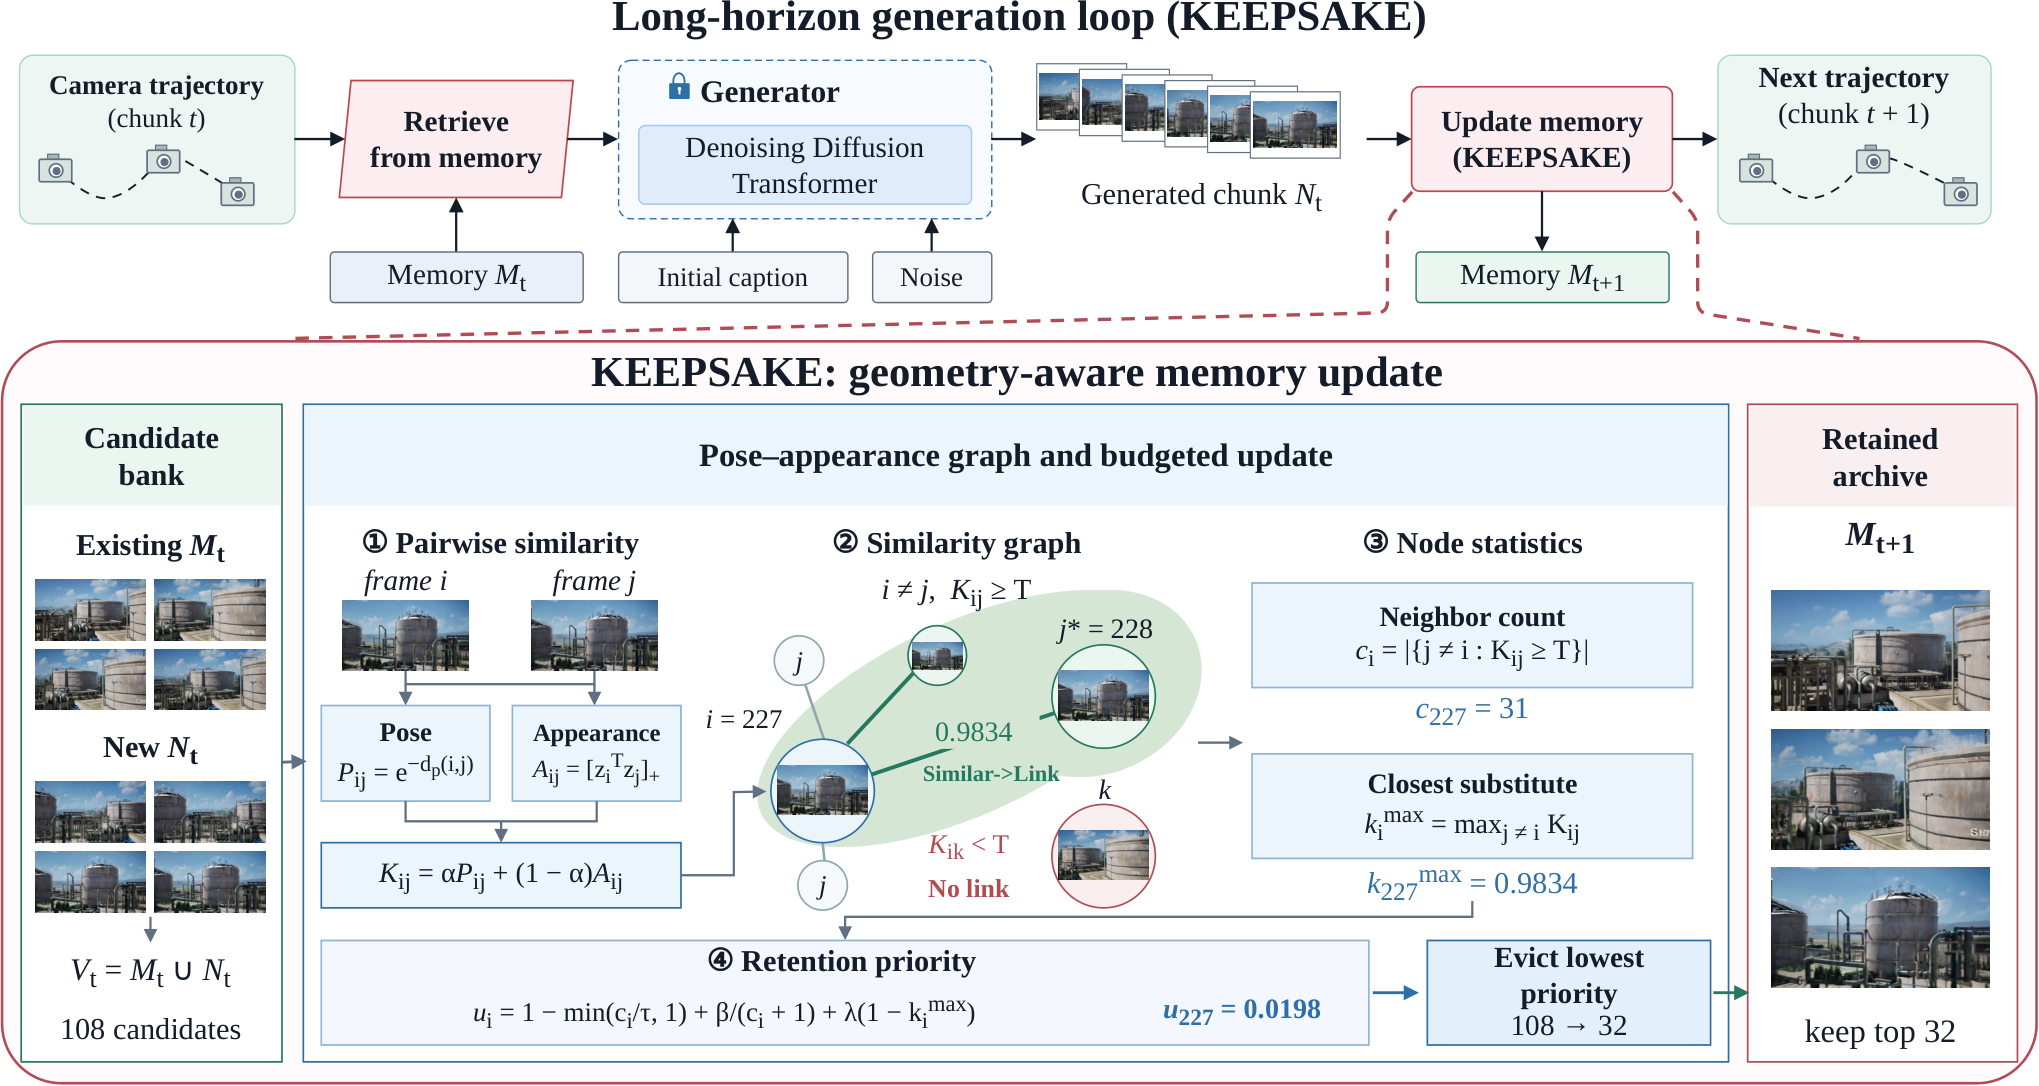 论文 Figure 2:Keepsake 总览。上部将它插入长视频循环作为记忆更新模块,每个生成块后更新持久记忆,保持生成器及检索规则;下部把旧记忆和新观察汇集成位姿—外观图,边权结合相机邻近与视觉相似度。节点统计强替代者数量和最近替代者相似度,共同决定保留优先级;删除低优先级观察直到满足容量 B。缩略图与展示分数为说明示意。
- 实验效果:附录表 5 的十五条匹配 180 秒 MemCam 轨迹:完整记忆 5397 帧、FVD 734.2;Keepsake 留 32 帧、FVD 476.6,降低 35.1%,LPIPS 0.5980→0.5876。表 1 的另一组 60 秒 WorldMem:FVD 3077.6→1116.9,每次检索 77.92→4.54 ms。
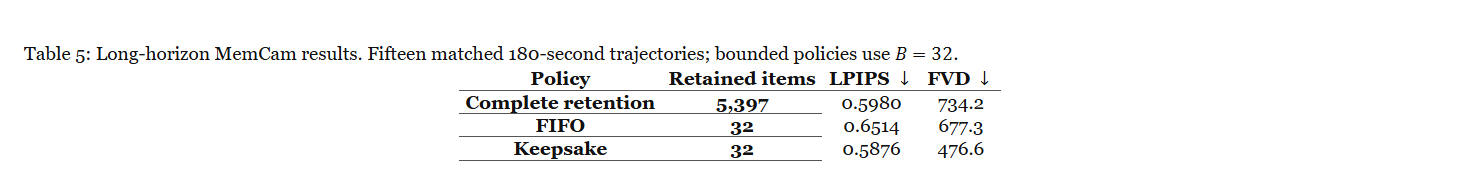 论文 Table 5:长时 MemCam 结果。十五条匹配的 180 秒轨迹,有限记忆策略容量 B=32;比较完整保留、FIFO 与 Keepsake 的存储条目、LPIPS 和 FVD。Keepsake 的 32 帧相对完整 5397 帧仍改善质量,不能由检索收益推出完整生成时延。
- 批判点评:检索毫秒不是整段生成耗时,32 帧是记忆库容量而非视频长度。样本仅十五条匹配轨迹,几何与视觉相似度也未必代表未来所有重要事件;最优预算随任务变化。原文称策略代码在补充材料,本期未确认独立公开仓库,不能泛称无限长记忆已解决。
6. CentriQ:先去均值再做低比特量化
CentriQ: Calibration-Free Quantization of Diffusion Transformers via Exact Mean Centering | Tenstorrent;洛桑联邦理工学院 | arXiv:2610.06260
关键词:DiT量化, 无校准, 均值补偿, 四比特激活
- 前序问题:DiT 的条件归一化会重新引入逐 token 均值。Hadamard 旋转不一定能把这部分能量均匀摊开,单个大坐标会撑大量化范围;照搬语言模型的免校准量化会损伤图像。
- 本文贡献:CentriQ 先减去每个 token 的通道均值,再旋转与量化;减去的成分通过完整精度的 rank-1 分支精确补回线性层输出,因此不是丢掉均值。激活尺度由无数据规则得到,权重拟合使用抑制重尾影响的稳健目标。同一路径覆盖 PixArt-Σ、FLUX.1-schnell 和 SANA 的 adaLN 条件设计。
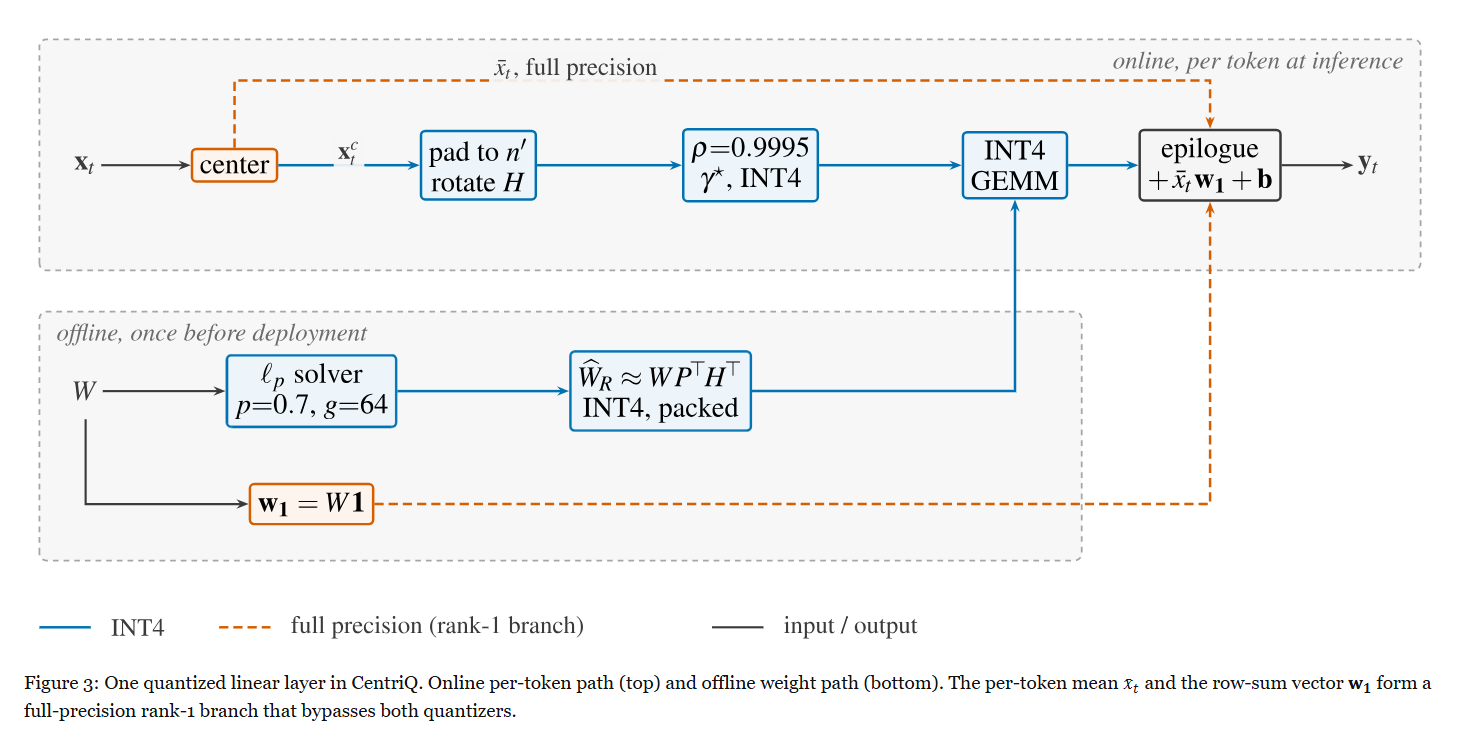 论文 Figure 3:CentriQ 的一个量化线性层。上部为在线逐 token 路径,下部为离线权重路径;每个 token 的均值 x̄_t 与权重行和向量 w_1 构成全精度 rank-1 分支,绕过权重与激活量化并补回均值分量。
- 实验效果:表 1 的 MJHQ、W4A4:FLUX.1-schnell 的 FID 为 18.8,带校准 SVDQuant 为 18.3,BF16 为 19.5;SANA-1.6B 为 16.2、19.3、16.0。表 2 的 FLUX W4A2 消融中,完整方法 FID 35.59,只有旋转为 455.30,二比特结果仍有明显质量差距。
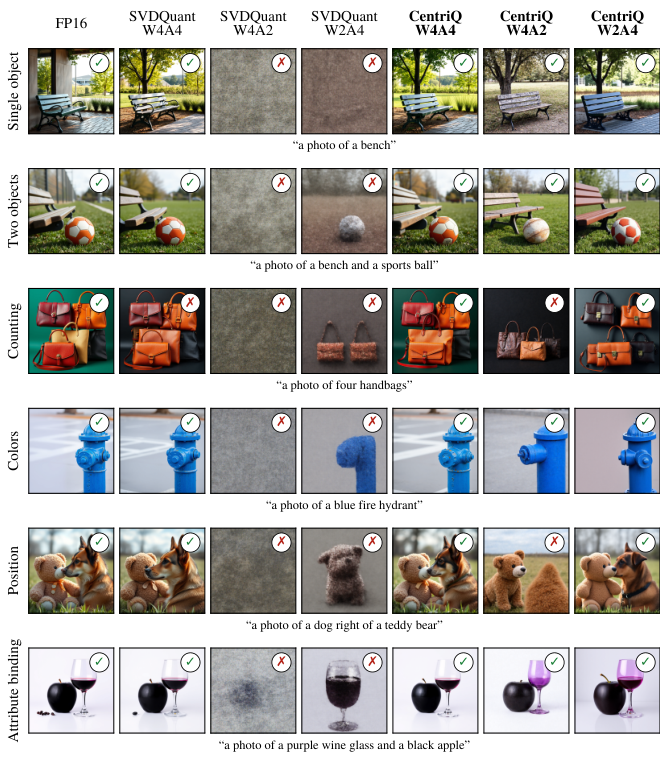 论文 Figure 4:FLUX.1-schnell 在 W4A4、W4A2 与 W2A4 下的 GenEval 提示结果,同一行共享提示和种子;标记是 GenEval 检测器的判断,而非人工成功率。
- 批判点评:rank-1 补偿精确不代表整个量化模型无损。二比特激活采用模拟量化,没有支持它的融合 kernel;A100 整数张量核结果不能等同新 GPU 的 NVFP4。FID 单项改善也不是逐张更好。arXiv 注释明确代码及项目页将稍后发布,本期不放尚未确认的方法仓库。
7. BASA:标准注意力后端也能高效稀疏
Backend-Agnostic Sparse Attention for Fast High-Resolution Visual Generation | 上海交通大学;复旦大学;香港大学 | arXiv:2610.08772
关键词:稀疏注意力, 平移窗口, 全局KV池化, 高分辨率生成
- 前序问题:固定窗口算得快但边界易出方格伪影,细粒度滑窗质量较好却依赖复杂专用 kernel。理论注意力稀疏度并不保证实际加速。
- 本文贡献:BASA 在不同 DiT 层与去噪步交错平移空间窗口,让邻域跨边界交换信息;池化的全局 K/V 补长程上下文,标准 SDPA 完成本地与全局计算。视频窗口保留完整时间跨度,仅做空间稀疏。实验还用密集教师蒸馏注意力层,不应把全部结果写成免训练替换。
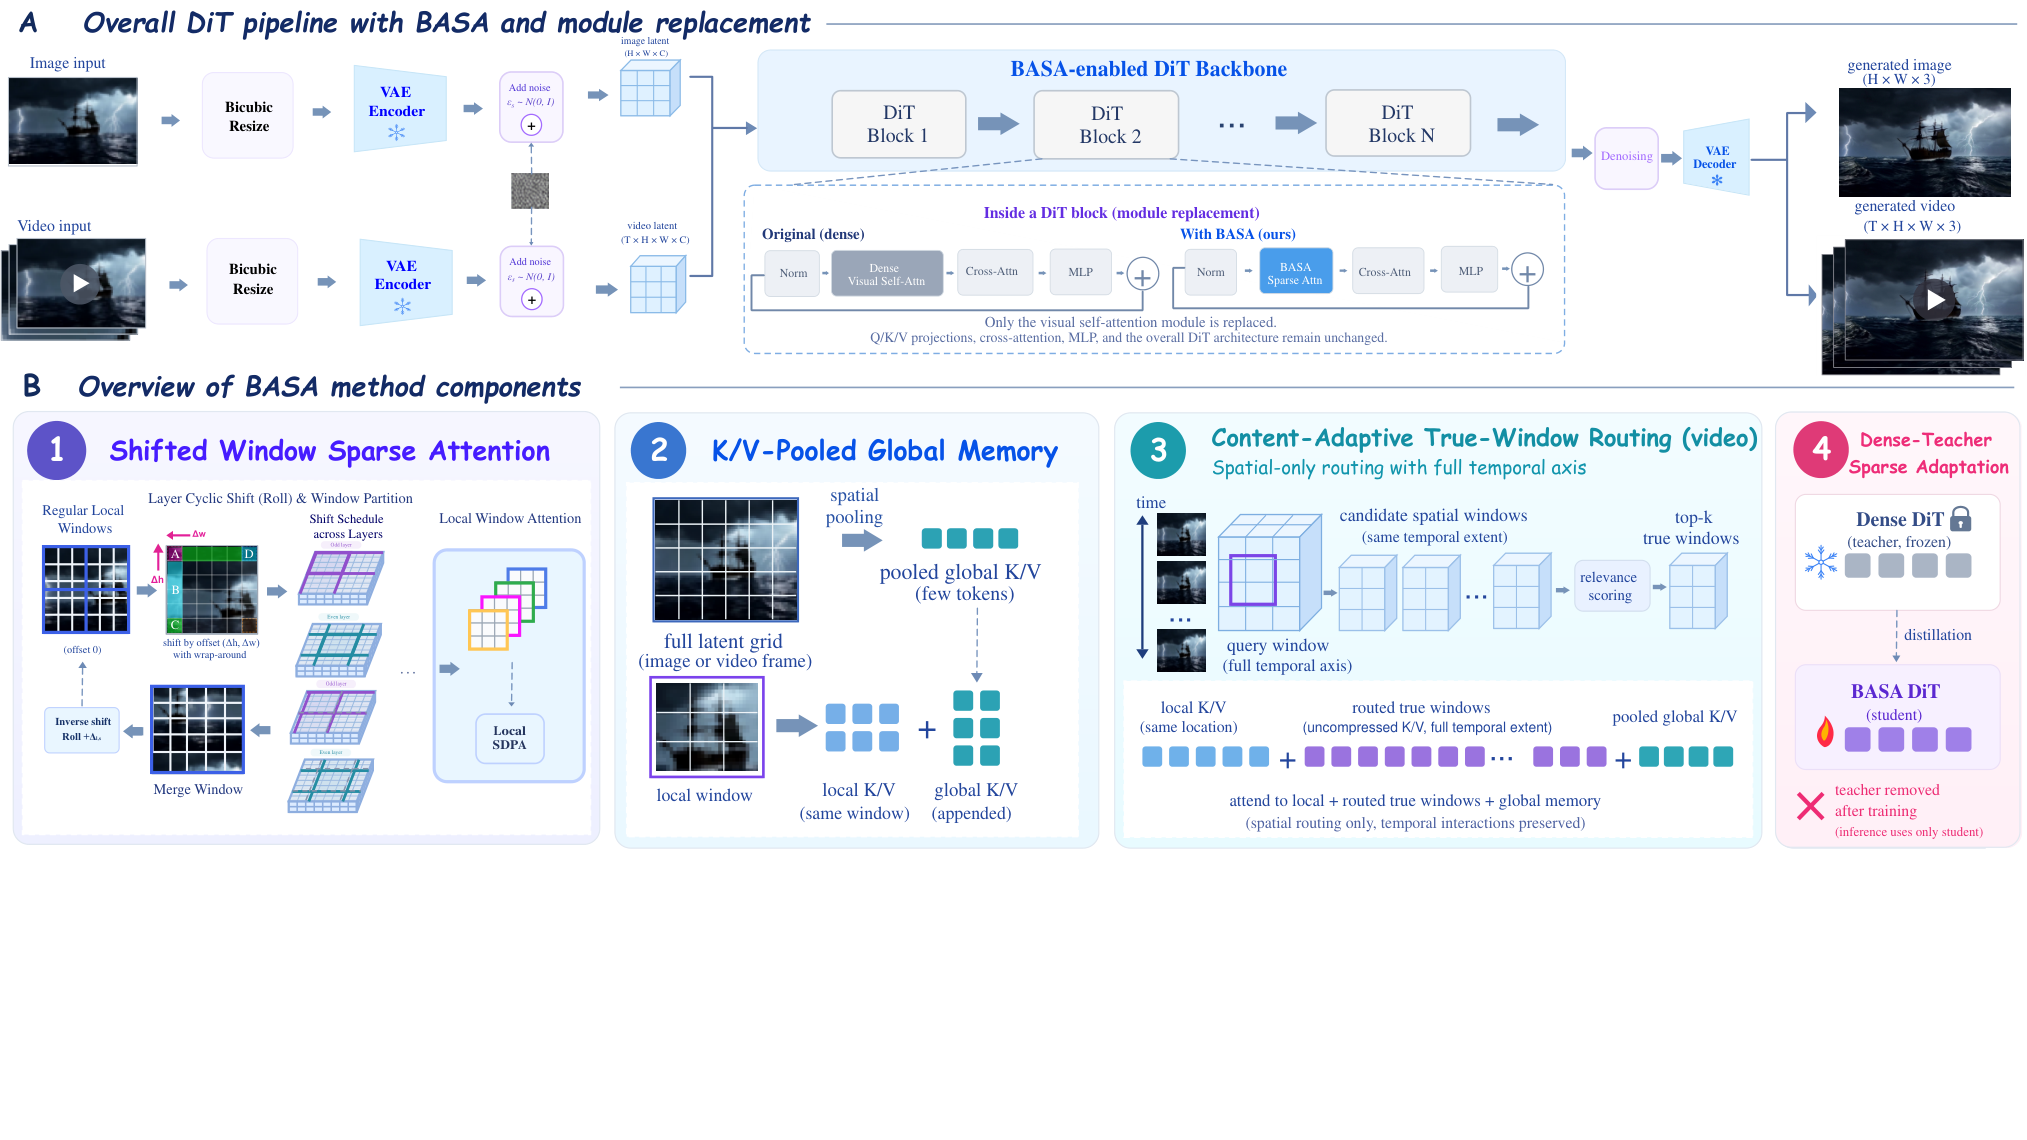 论文 Figure 3:BASA 总览。(a)稀疏注意力结合多个组件,在减少注意力成本时恢复局部及全局视觉交互;(b)作为 DiT 块视觉自注意力模块的替换,其余生成流水线保留。实验中的注意力蒸馏仍需训练。
- 实验效果:表 3 的单 A100、Wan2.1-T2V-1.3B,从 832×480 外推到 1664×960:窗口 10×10、池化 4×4 时,预热后注意力前向延迟 509.66→112.84 ms,加速 4.52 倍、稀疏度 90%。表 4 的一百段视频中,Imaging Quality 65.22%→67.02%,Aesthetic 57.53%→56.87%。
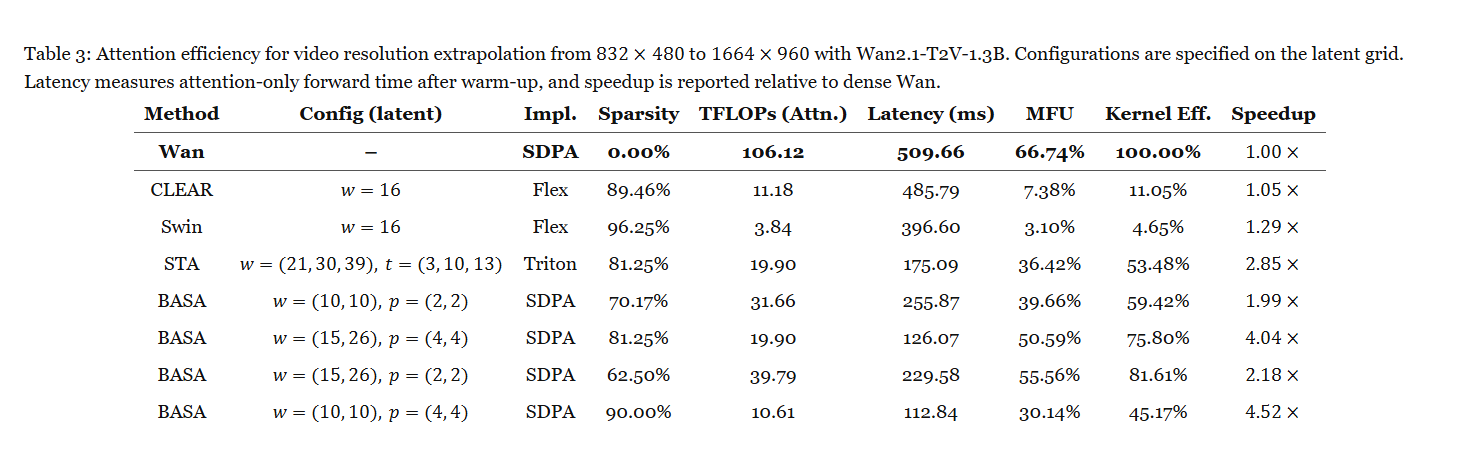 论文 Table 3:Wan2.1-T2V-1.3B 从 832×480 到 1664×960 的视频分辨率外推注意力效率。配置在 latent 网格上定义;时延为预热后的注意力前向耗时,加速相对 dense Wan,列出实现、稀疏度、TFLOPs、MFU 与 kernel 效率,不是端到端采样速度。
- 批判点评:4.52 倍限注意力前向,不能当端到端视频生成加速。各质量维度有升有降,表 1 的相似度还是与密集模型输出比较。窗口过小可能损伤保真度,标准后端兼容也不等于所有硬件都实测;未确认该方法独立代码链接。
8. TalkLikeYou:一步生成个人说话习惯
Talk Like You: Imitating How You Speak in Real-Time Talking Head Generation | 中国科学院自动化研究所;中国科学院大学;中科院香港创新研究院;澳门科技大学 | arXiv:2610.06658
关键词:数字人生成, 说话习惯, 一步flow, 运动空间
- 前序问题:同一发音,不同人露齿、张嘴和嘴角运动习惯不同。只保证音画同步与清晰度容易生成千人一面的表情,单人微调又增加部署成本。
- 本文贡献:TalkLikeYou 在隐式关键点运动空间建模说话习惯,用音频、源运动与可选习惯条件生成旋转和表情变化,再以冻结渲染模块合成视频。flow 模型预测干净运动,一步采样;两阶段学习先用预设 one-hot 习惯,再学习参考视频到统一习惯空间,并用 PLAD 评价相似性和多样性。
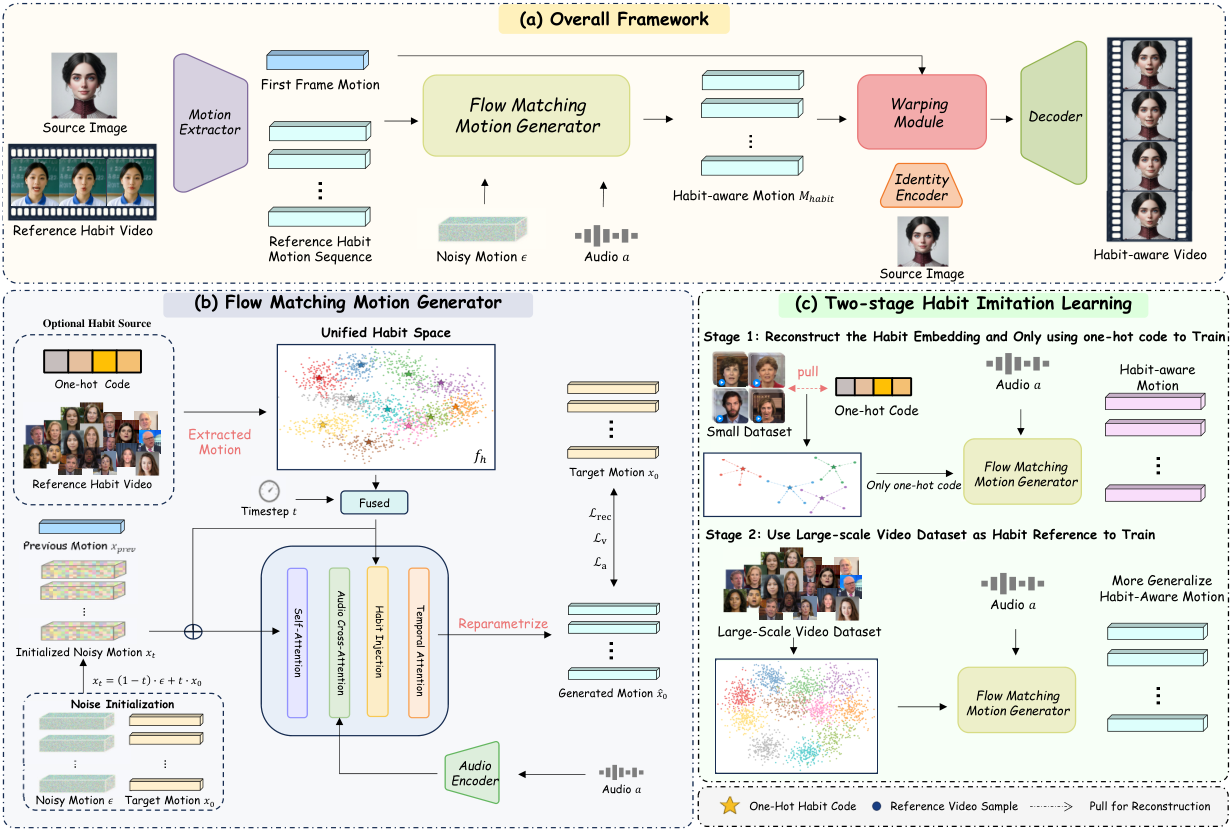 论文 Figure 2:TalkLikeYou 框架。flow 运动生成器从可选习惯来源一步采样习惯感知运动,再渲染视频;两阶段习惯学习增强泛化与稳定性。统一习惯空间中星号表示 one-hot 习惯编码、圆点为参考视频样本;第一阶段用对齐损失关联视频特征及对应习惯编码。
- 实验效果:表 1 的 HDTF:FID 7.71、FVD 112.94、身份相似度 CSIM 0.94,对应 Ditto 为 21.61、319.03、0.87。Sync-C 为 8.73,但 Sync-D 6.82 仍高于 Sonic 的 6.70,唇同步并非所有指标最优。推理运动采样为一步,训练两阶段在 RTX 3090 上分别 48、72 小时。
 论文 Figure 3:三种选定说话习惯下与先进基线的视觉与唇同步比较。需放大观察细节,动态视频见作者补充材料;静态帧不单独证明完整时序质量。
- 批判点评:一步运动采样不代表整条视频流水线只做一次前向,静态图也无法证明时序同步或个人习惯完整复现。定制需参考视频或预设习惯,跨人物、姿态与口型应另测。作者项目页和官方仓库提供方法入口。
9. AuraSE:降噪时尽量不改词与声线
AuraSE: Low-Hallucination Generative Speech Enhancement via Multimodal Flow Matching and Inference Policy Optimization | 香港中文大学深圳;Microsoft Research | arXiv:2610.06632
关键词:生成语音增强, 多模态flow, 推理策略优化, 内容保真
- 前序问题:生成式降噪能让音频更干净,却可能改词或改说话人。即便输入转录文本,不同句子的最佳 guidance、温度和步数也不同。
- 本文贡献:AuraSE 用文本与声学双流再转单流的 MMDiT,保留退化音频的专门通路。IPO 从当前模型在多组解码配置下生成候选,按感知质量、词错误率、说话人相似度和语义保真组合奖励形成偏好对,周期刷新数据并优化。部署最终固定十步 ODE,不做逐句搜索,不使用 CFG。
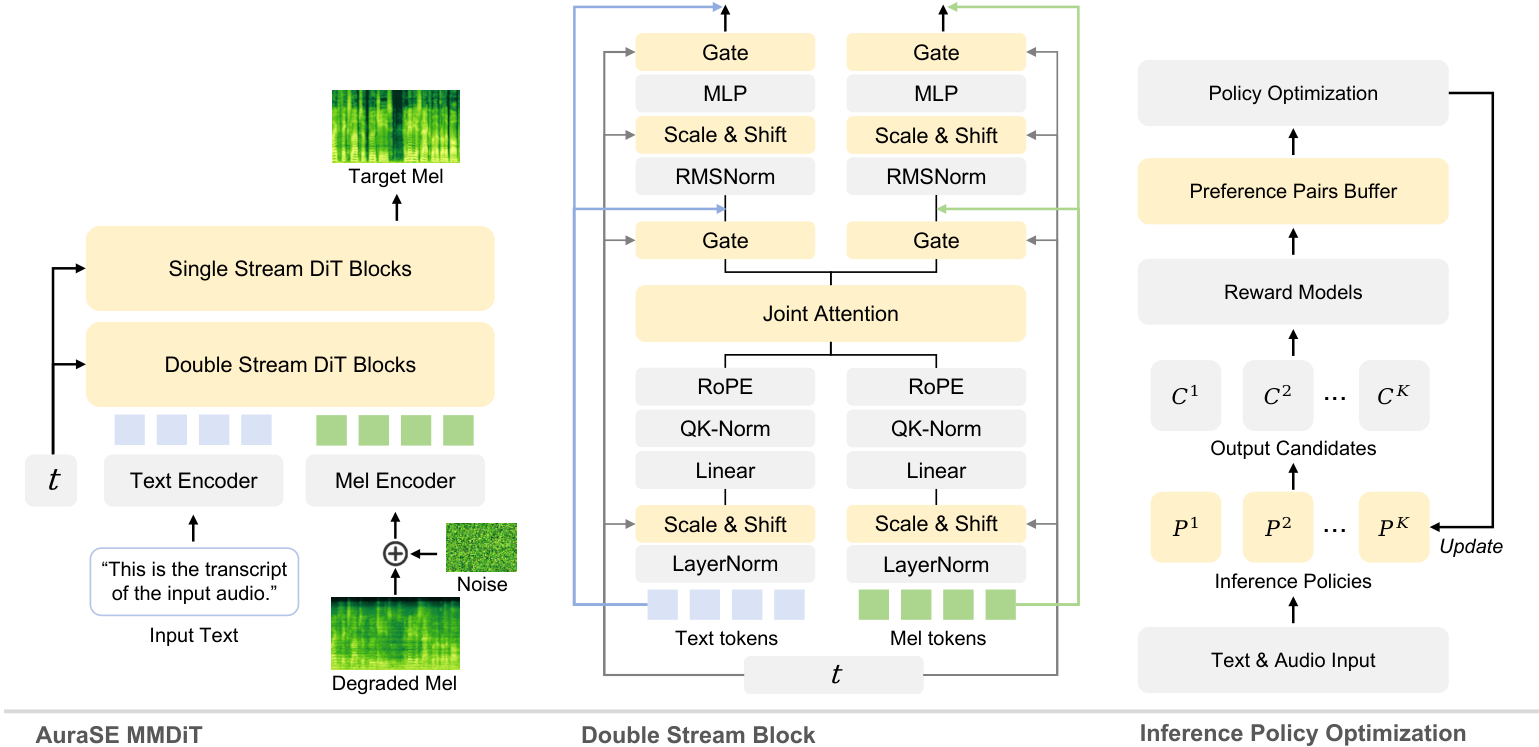 论文 Figure 1:AuraSE 总览。左侧双流再转单流 MMDiT 以转录为条件增强退化 mel 并预测 flow 速度;中央双流块让 mel 与文本共同注意力但保持独立投影;右侧 IPO 用多样推理策略解码、评分、在缓冲中组成自生成偏好对,再闭环更新模型。
- 实验效果:表 3 每个合成测试集 824 句:有混响 WER 从 AuraSE 基础版 9.65% 降至 IPO 8.22%,无混响从 8.43% 降至 6.98%。表 4 的真实 DNS 盲测 OVRL 3.144→3.365,人类盲听综合分 3.60±0.13→3.74±0.13,区间为 95% 置信区间半宽。
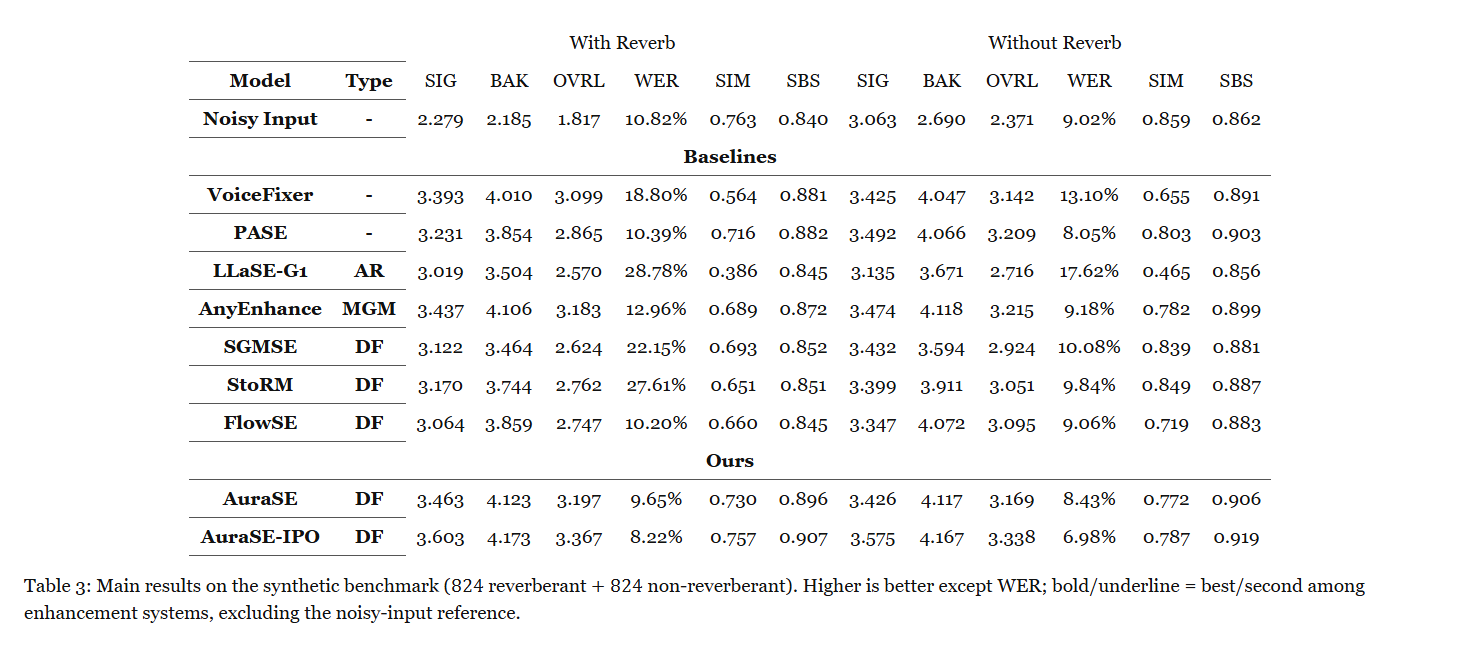 论文 Table 3:合成主测试,有混响与无混响各 824 句;除 WER 外越高越好,粗体及下划线为增强系统中最佳与次佳,排除原始噪声音频参考。SIG、BAK、OVRL 是感知质量,SIM 是说话人相似度,SBS 是语义保真,不能只选一个维度宣称零幻觉。
- 批判点评:低 WER 不等于零幻觉,说话人相似度也并非所有系统最高。输入转录及评测依赖外部识别器,后训练还要多次声码器及奖励计算。结果限于论文的英语增强条件,不可直接外推所有语言、麦克风和音乐修复;本期未确认官方代码入口。
10. CoAl:对齐上下文token提升生成
Learning to Read the Contextual Tokens in Diffusion Transformers | 特拉维夫大学;康奈尔大学 | arXiv:2610.06844
关键词:多模态DiT, 上下文对齐, 全局语义, 生成表征
- 前序问题:多模态 DiT 会不断更新文本 token,但其内容与生成质量的关系不清楚。只对齐图像 token 的局部特征,可能忽略上下文中逐步形成的全局场景信息。
- 本文贡献:作者先用轻量瓶颈把多层上下文 token 映射给冻结语言模型,从隐表示询问生成图语义;再提出 Contextual Alignment(CoAl),把单个早期层的上下文表示通过小型 Q-Former 对齐到干净图的冻结 SigLIP 全局语义嵌入。空提示条件加权减少照抄 prompt 的捷径,额外对齐网络只在训练使用。
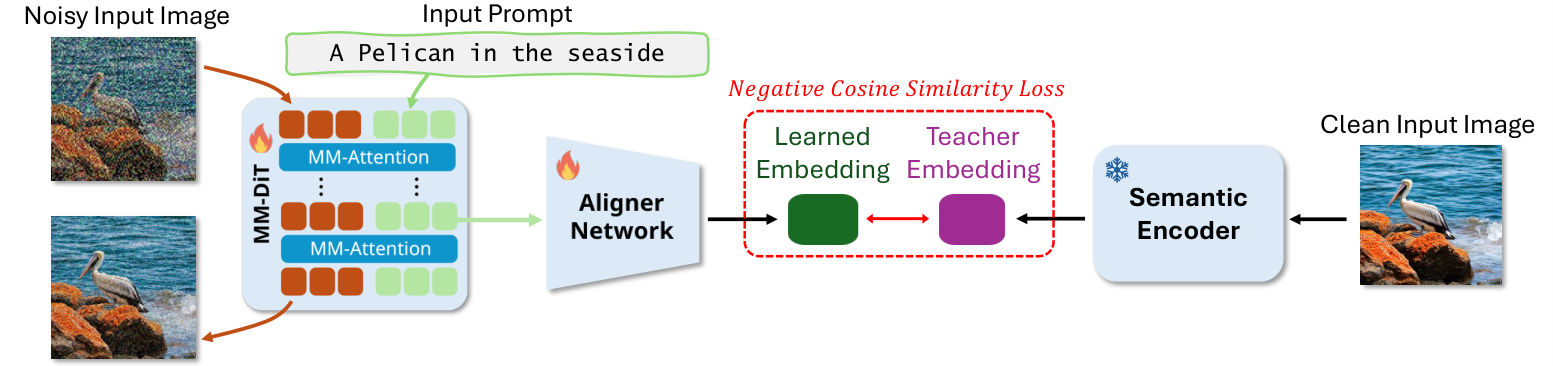 论文 Figure 6:Contextual Alignment。轻量 Aligner 把多模态 DiT 的上下文 token 映射成嵌入,以负余弦相似度损失对齐到冻结语义编码器从干净输入图得到的教师嵌入。
- 实验效果:表 1 的从零训练实验:REPA 加 CoAl 后 FID 4.95→4.29,Recall 0.338→0.407;另一个 SD3 在 Fine-T2I 上微调实验,基础 FID 19.30、常规 flow 微调 17.18、CoAl 16.75。两种协议数据与指标范围不同,不能直接排名。
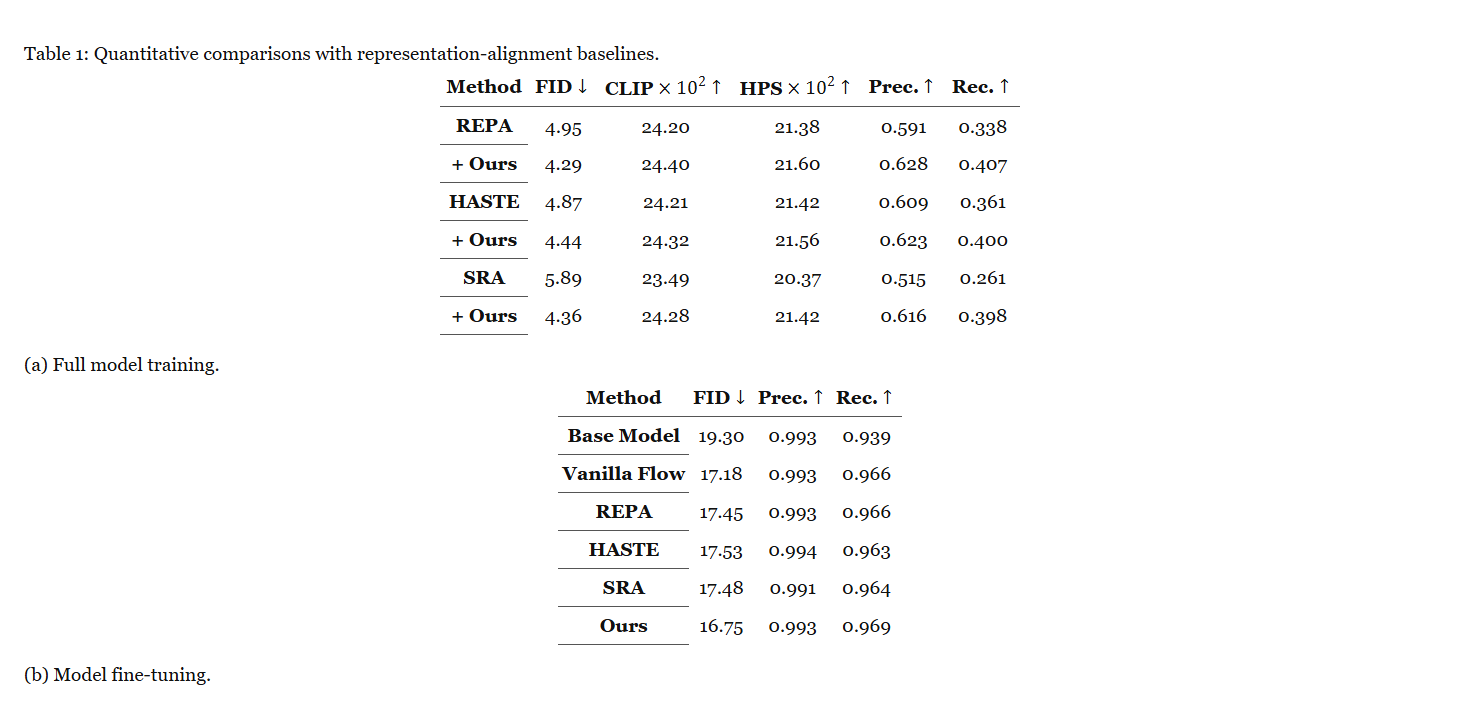 论文 Table 1:与表征对齐基线的量化比较。(a)完整模型从零训练:给 REPA、HASTE、SRA 加 CoAl,分别列 FID、CLIP、HPS、Precision 与 Recall;(b)预训练模型微调:比较基础、常规 flow、视觉对齐及 CoAl 的 FID 和分布覆盖。两种实验使用不同协议,数字不能横向混排。
- 批判点评:读到语义及与偏好分相关,不等于模型能逐步逻辑推理或保证最终画面。Reader 训练集中于单个人物和十五类问题,标签来自 VLM;全局语义对齐也不能保证局部细节正确。这篇入选依据是实际改进生成的 CoAl,而非一般视觉问答;未确认方法代码已公开。
趋势观察
预算应跟随内容与条件
LoT 根据画面细节改变 token 布局,RefRoute 压缩参考条件并路由到指定区域,Keepsake 留下难替代视角。减少重复信息比统一压缩所有输入更值得先测。
计算位置和更新目标都能调整
LiFT 把计算放在共享主干循环,MEND 先检查样本移动是否值得,AuraSE 把多配置偏好训练进固定解码器。它们减少的是不同成本,不能用同一加速口径相互比较。
低比特与稀疏仍需保留关键通路
CentriQ 用精度较高的分支补回均值,BASA 用全局池化恢复长程信息。压缩不是简单删去内容,关键是被省略的部分如何表达及补偿。
可解释表征要落到生成验证
TalkLikeYou 用运动空间表示习惯,CoAl 对齐上下文全局语义。表征可读不等于可靠控制,仍须核对质量变化、数据范围与失败例。
今日讨论
你的生成内容中,哪些区域可以降低细节预算,哪些区域必须保持完整?
人工智能炼丹君 整理 | 2026-10-08






评论 (0)