


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:评测 | 难度:进阶 | 前置知识:FID / CLIP Score 到底测了什么
关键词:视频评测、VBench、时序一致性、运动幅度、成对比较、人工盲评、置信区间
假设你正在验收一个视频推理加速方案:运行时间降了,但角色走到一半换了脸,镜头运动变成小幅抖动。报告却写着“综合质量保持”。问题可能出在评测:更锐利的单帧补偿了变差的时序,多个维度压成一个数以后,故障被平均掉了。速度收益可以真实存在,质量结论也仍然可能不充分。
本文先给一组真正跑出的反例。把一张红色圆盘的图片复制成 25 帧,得到冻结视频;另一个视频让圆盘每帧向右移动 1 像素。我们自定义的轨迹平滑度在两者上都是 1.000000,但运动量分别是 0 与 1 像素/帧。冻结视频的相邻帧像素差还是 0,若验收只要求“变化小、足够平滑”,它会轻松过关,而“主体向右行走”的需求并没有完成。这些数字来自本文 CPU 合成实验,不是 VBench 分数,也不是任何真实生成模型的测量。
第二个反例更隐蔽:给平滑轨迹加上左右交替的位移,主体颜色始终一样,玩具身份一致性仍接近 1,运动量却升到 6 像素/帧,玩具平滑度降到约 0.000006。运动更多不代表运动更好,身份稳定也不代表时间连续。评测首先要把这些命题拆开,才有资格讨论“质量不变”。
视频比图像多了时间轴,而时间轴不能靠多算几张 FID 补齐。逐帧看起来漂亮的图像串,可能含有冻结、闪烁、速度突变、身份漂移和动作错误;看起来稳定的视频,也可能没有执行提示词要求的动作。接下来我们从可控反例推导几个量,再对照 VBench 的真实实现,最后把人工验收做成可以重复执行的协议。
第一句:视频质量至少包含“每一帧是否好看”“时间上是否连贯”“是否完成条件要求”三个问题,任何一个问题的代理指标都不能承担另外两个问题。
第二句:VBench 把问题细分为多个维度,维度对应特定提示词和评测器;它应当先被当作一组诊断结果,再被汇总成排名分数。原始 VBench 的 16 维可以分成 7 个视频质量维度和 9 个条件一致性维度,具体分组和权重以第 05 节固定版本的官方代码为准。
第三句:人工验收把自动指标漏掉的失败拿出来检查,但人的判断也需要控制提示词、抽样、展示顺序和统计单位;“我看了几条觉得不错”不能支持整个任务分布上的质量结论。
后面的 NumPy 实验只演示指标会如何混淆不同故障,不实现 DINO、RAFT 或 AMT,也不冒充官方榜单。把机制讲清楚与复现基准是两件不同的工作,读者可以在普通 CPU 上完成前者,再按正式协议组织后者。
记视频为 $V=(X_0,\ldots,X_{T-1})$,每一帧 $X_t$ 是 $H\times W\times C$ 的像素数组。$T$ 是帧数,$H,W$ 是画面高度和宽度,$C=3$ 表示 RGB 通道;本文把像素映射到 $[0,1]$。最直接的时间变化量是相邻帧平均绝对误差:
$$D_{\mathrm{pixel}}=\frac{1}{(T-1)HWC}\sum_{t=1}^{T-1}\sum_{h,w,c}|X_t(h,w,c)-X_{t-1}(h,w,c)|$$
分母是参与比较的像素通道总数,所以不同尺寸可以在同一尺度上读数;绝对值避免亮暗变化抵消。可是圆盘平移时,进入圆盘的像素由背景变为红色,离开的像素由红色变为背景。即使纹理完全不闪烁,边缘也产生非零误差。因此 $D_{\mathrm{pixel}}$ 同时包含运动、外观变化、光照变化、噪声和遮挡,不是纯粹的闪烁量。
如果已知帧间位移 $u_t$,先把上一帧对齐到当前帧再比较,就得到运动补偿残差:
$$R=\frac{1}{(T-1)HWC}\sum_{t=1}^{T-1}\|X_t-\mathcal{W}(X_{t-1},u_t)\|_1$$
$\mathcal{W}$ 是按位移重采样的算子,$\|\cdot\|_1$ 表示所有像素通道绝对值之和。在本文整数平移的场景中,它是数组平移;一般视频中需要光流、插值和可见性处理。正确平移而纹理不变时,残差可以为零;固定位置亮度跳变时,位移为零,残差保留亮度变化。这个对照说明为什么必须先辨别运动,才能谈闪烁。
残差仍不能直接等于闪烁。新露出的区域在上一帧没有对应点,光流可能算错,物体变色也会产生残差。实际使用时要考虑遮挡掩码、镜头切换和评测器误差。本文背景统一、圆盘远离边界,才允许用整幅图像的循环平移演示机制;真实画面不能直接照搬这个边界处理。
为了把运动单独拿出来,先用已知场景的阈值分割获得主体中心 $c_t\in\mathbb{R}^2$。位置的一阶差分是每帧位移,二阶差分是位移的变化:
$$v_t=c_t-c_{t-1},\qquad a_t=c_{t+1}-2c_t+c_{t-1}$$
$v_t$ 的单位是像素/帧,$a_t$ 的单位是像素/帧平方;若希望比较物理时间中的速度和加速度,需要分别乘以帧率及其平方。本文所有样本用同一时间采样,因而直接使用帧单位。用欧氏范数去掉方向,再求平均:
$$M=\frac{1}{T-1}\sum_{t=1}^{T-1}\|v_t\|_2,\qquad A=\frac{1}{T-2}\sum_{t=1}^{T-2}\|a_t\|_2$$
$M$ 测运动量,$A$ 测速度变化程度。为方便演示,把第二个量映射成“越高越平滑”的玩具分数 $S$:
$$S=\exp(-A/\tau),\qquad \tau=1\ \text{像素/帧平方}$$
指数的输入必须无量纲,所以 $\tau$ 与 $A$ 同单位。$A=0$ 时 $S=1$,$A$ 越大,$S$ 越低。这只是我们为反例选择的尺度,VBench motion smoothness 不使用这个公式。冻结与匀速移动的二阶差分都为零,因此两者的 $S$ 一样;左右抖动的一阶差分较大,二阶差分也很大,故 $M$ 大而 $S$ 小。
这里还有一个重要边界:正常动作会加减速,抛物运动有加速度,舞蹈动作可能刻意急停。低二阶差分不是通用的好视频标准。这个量适合解释“运动大小”和“运动变化”不能合并,是否自然还需要更强的视觉模型和具体任务判断。
让 $f_t$ 表示第 $t$ 帧提取出的特征,先归一化成单位向量 $z_t=f_t/\|f_t\|_2$,于是余弦相似度就是内积 $z_t^\top z_s$。只比较邻帧时,一个主体可以每帧只改变一点,最后完全换成另一种外观,而每一步仍很相似。再增加与首帧的比较,可以让慢漂移受到惩罚。
$$I=\frac{1}{T-1}\sum_{t=1}^{T-1}\frac{\max(0,z_t^\top z_{t-1})+\max(0,z_t^\top z_0)}{2}$$
两个相似度分别检验局部连续性和相对于最初外观的保持,等权平均。这个结构对应固定版本官方 subject_consistency 的逐视频计算;本文的特征却只是圆盘内平均 RGB,官方用的是 DINO 图像特征。相同的聚合式不代表相同的评测能力:颜色描述符无法识别人脸身份、衣服细节和类别语义,DINO 特征也不是专用的身份识别证明。官方 subject_consistency.py
亮度变化可能影响特征方向,镜头变化也可能让同一主体的图像特征改变。这个指标测的是所选特征空间里的外观稳定性,不能从高分推出“剧情中始终是同一个人”。更不能从高分推出“人物做了正确动作”:红色圆盘左右抖动时,颜色方向仍然不变。
前置文章中的 FID 先提取图像特征;FVD 使用视频特征,原始工作采用 I3D 相关视频表征。设真实与生成视频特征的均值为 $\mu_r,\mu_g$,协方差为 $\Sigma_r,\Sigma_g$,高斯近似下的距离仍然是:
$$\mathrm{FVD}=\|\mu_r-\mu_g\|_2^2+\mathrm{Tr}(\Sigma_r+\Sigma_g-2(\Sigma_r^{1/2}\Sigma_g\Sigma_r^{1/2})^{1/2})$$
这里 $r,g$ 标记真实与生成集合,$\mathrm{Tr}$ 是迹。时间信息是否保留、保留什么,取决于视频特征器和片段采样;公式本身只比较一阶与二阶统计。它可以衡量两组视频表征的分布差异,却不会逐条指出“第 12 帧换脸”,也不直接校验某个提示词是否完成。样本量、特征器、裁剪、长度和帧率不一致时,跨实验数值不宜直接比较。FVD 原始论文
比较方案 A 与 B 时,用相同 prompt 集合、匹配的 seed 编号和相同输出规范,得到分数 $q_{p,s}^{A},q_{p,s}^{B}$。$p$ 标记 prompt,$s$ 标记重复生成。先在同一任务内取差,再平均 seed:
$$\delta_p=\frac{1}{K}\sum_{s=1}^{K}(q_{p,s}^{B}-q_{p,s}^{A}),\qquad \widehat{\Delta}=\frac{1}{P}\sum_{p=1}^{P}\delta_p$$
$K$ 是每个 prompt 的 seed 数,$P$ 是 prompt 数。这样困难任务在两组中共享,任务难度不会轻易掩盖方案差异。相同 seed 编号只是控制抽样的一部分,不保证不同架构生成完全相同的随机轨迹;报告仍应保留多次生成和失败样本。
视频中的帧高度相关,同一 prompt 的多个 seed 也共享任务难度。本文因此按 prompt 有放回抽样,每次保留该 prompt 的全部成对 seed,重新计算均值差,重复 10000 次,以 2.5% 和 97.5% 分位数得到 bootstrap 百分位区间。这是在已观测 seed 集合条件下,对任务抽样不确定性的近似,不完整刻画换一批 seed 的不确定性,也不包含协议偏差和未覆盖任务。这个过程本身不证明 prompt 具有代表性;若任务分层且样本比例预先固定,应在各层内部重采样,再按目标任务比例汇总。
文末完整脚本 video_metrics_lab.py 只依赖 NumPy。它生成 5 组形状为 (25, 48, 64, 3) 的浮点视频,正常样本像素范围 [0.08, 0.85]。背景为均匀灰色,圆盘半径为 5 像素,正常轨迹从横坐标 16 移到 40,保持在画面内部。固定半径和背景的目的,是把遮挡、变焦和复杂纹理先拿掉,留下容易检查的变化因素。
五组样本分别是:正常匀速移动、位置冻结、位置左右交替偏移 3 像素、全画面交替增加 0.08 亮度、圆盘在第 12 帧从红色变成绿色。颜色变化只是“外观改变”的合成代理,不宣称等价于真实人物换脸。所有位置都是整数,正文里运动补偿残差为零的结果才可以精确验证,而不是受双线性插值误差影响。
核心计算对应第 03 节的一阶与二阶差分:
speed = np.linalg.norm(np.diff(centers, axis=0), axis=1)
acceleration = np.linalg.norm(np.diff(centers, n=2, axis=0), axis=1)
motion = speed.mean()
smoothness = np.exp(-acceleration.mean())
这里 centers 就是公式里的 $c_t$,acceleration 对应 $\|a_t\|_2$;指数默认采用 $\tau=1$ 的像素/帧平方尺度。主体阈值分割要求至少一个通道大于 0.35,这是为已知合成场景设计的,拿到真实视频不会自动获得可靠主体掩码。
2026-10-08 在 CPU 上执行后,正常移动的 pixel_mae 为 0.002029080,aligned_mae 为 0,运动量为 1,玩具平滑度为 1。冻结样本的两个误差和运动量都为 0,玩具平滑度仍为 1。这组结果直接证明相邻像素差会处罚正确运动,而单独的平滑度又会放过冻结。
抖动样本的 pixel_mae 为 0.010329861,运动量为 6,二阶差分均值为 12,玩具平滑度为 0.000006144,玩具身份一致性约 1。原地或来回乱动同样能增加运动量,所以“更动态”不能独立成为加分目标。
亮度闪烁样本的 pixel_mae 为 0.081647135,对齐后残差为 0.08,运动量和玩具平滑度仍为 1。主体变色样本的玩具身份一致性降为 0.793119704,运动量和平滑度仍为 1。浮点余弦可能出现 $1+\epsilon$ 的末位误差,脚本保留原始计算,不把它解释成实际相似度超过 1。
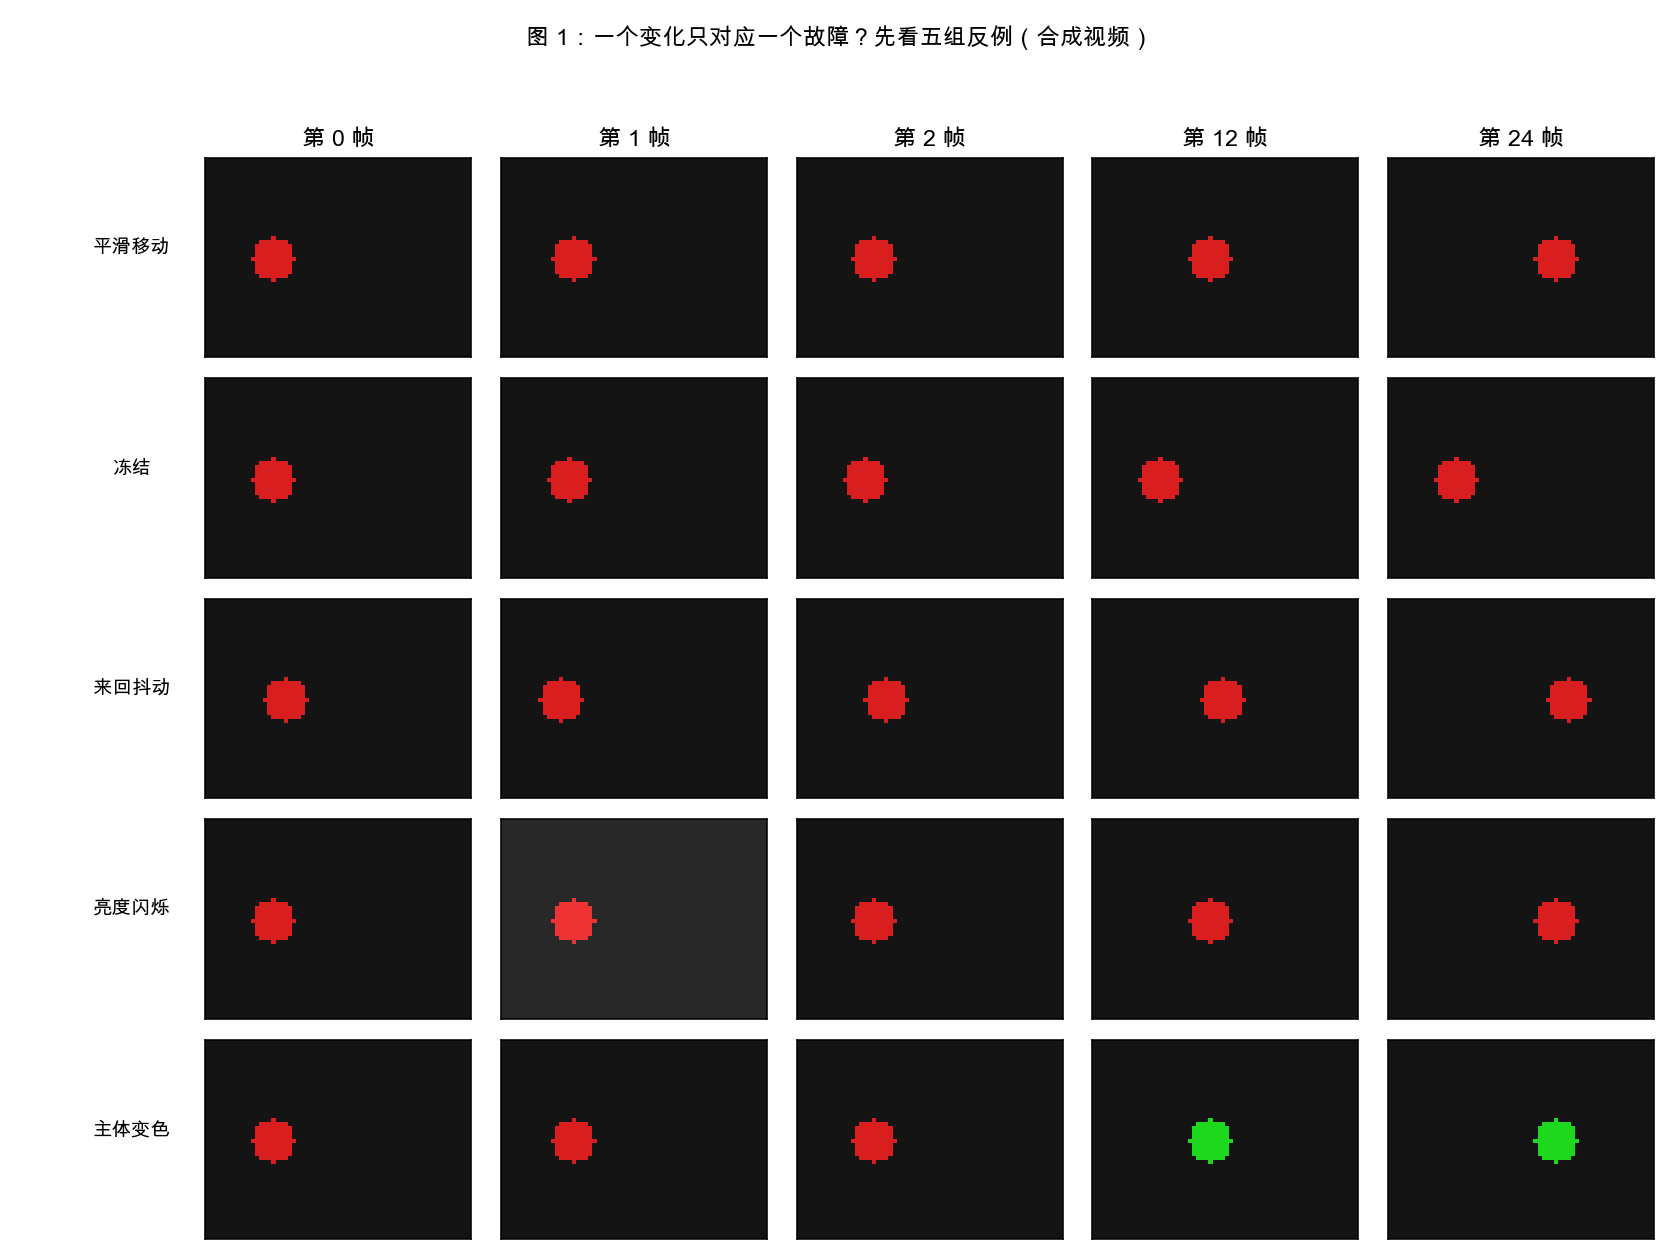
看图时先沿行观察:前 3 列选用连续帧,冻结行的位置不变,抖动行在平移上叠加往返,闪烁行的背景与主体一起变亮,变色行从中段开始外观改变。若只等间隔抽到偶数帧,交替闪烁会被采样漏掉;同一故障可能影响多个量,而某些量对明显故障完全不敏感。
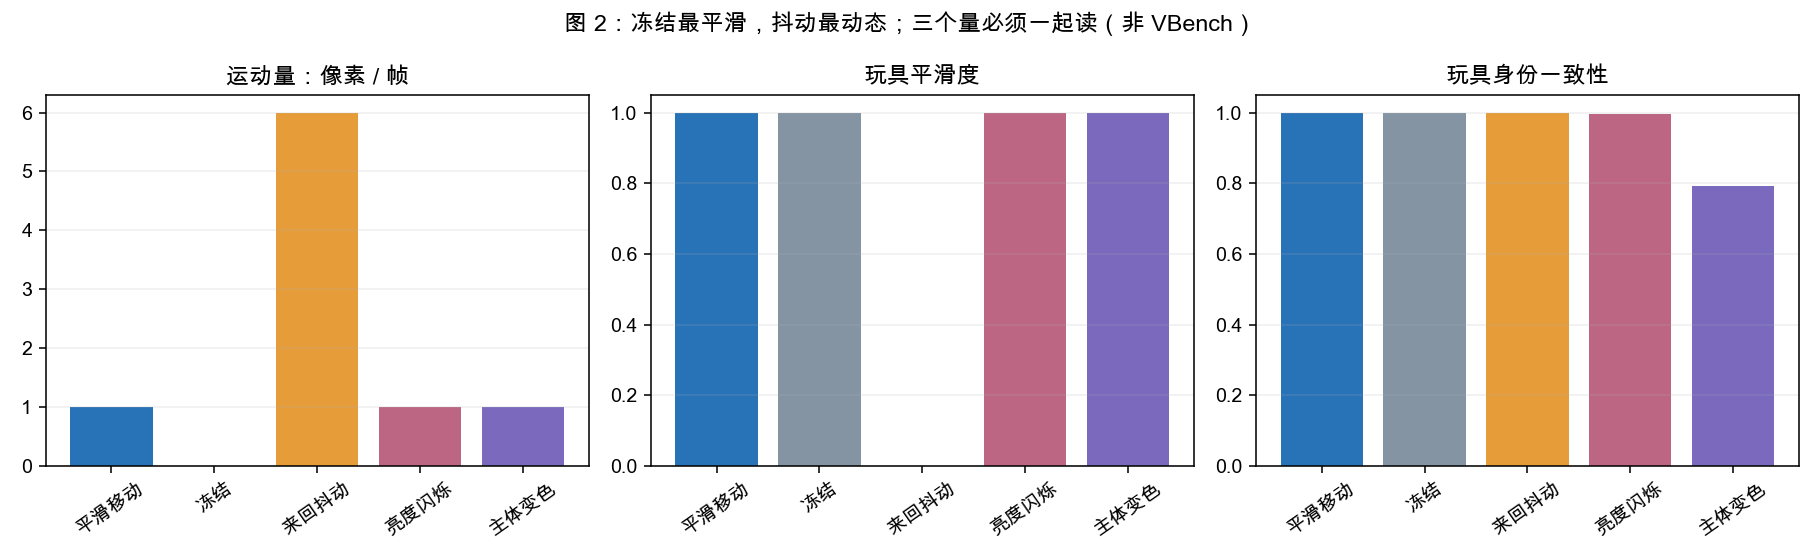
这张图的重点是冻结与正常移动同样平滑、抖动保持颜色身份却最动态。图中的三个量均为本文玩具指标,不是 VBench radar chart,也不能填进 VBench 报告。
为了只检验统计流程,脚本再创建 24 个合成任务、每任务 3 个成对 seed。每个任务共享一个轨迹难度,A 叠加正弦扰动,B 把同一扰动振幅乘以 0.65,然后计算第 03 节的玩具平滑度。这些任务没有自然语言语义,只是带 task ID 的受控轨迹实验;“prompt”在数组维度中代表统计上的任务组。
结果为 B − A = 0.089640896,以 prompt 为单位的 10000 次 bootstrap 得到 95% 百分位区间 [0.081229656, 0.098102901]。代码保存逐任务差值和 bootstrap 样本,读者可以检查区间是怎样产生的。区间排除了 0,只支持“这组受控扰动减弱后,玩具平滑度均值提高”这个命题,不支持真实视频质量或用户偏好提高。
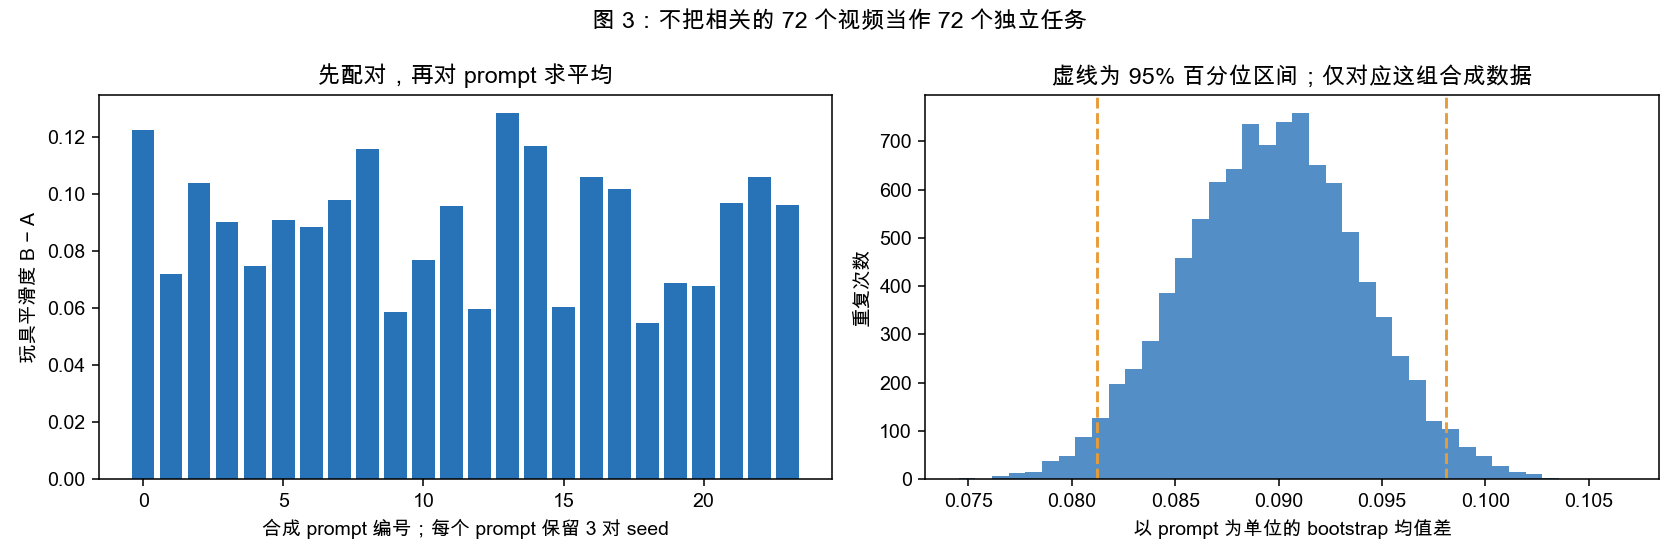
左图每根柱子是一个任务内对 3 对 seed 求平均的差;右图按任务重采样,虚线是百分位区间。把 72 个视频当作 72 个独立 prompt,会改变估计的抽样层级;把所有帧当作独立样本会更严重地高估证据量。
本节源码固定为 Vchitect/VBench,提交 fd18b3d055cb0fc6f066ca90fe2c3c8cbb698490,于 2026-10-08 核验。首先确定评测范围:这里讲原始 VBench 的 text-to-video 16 维路径;VBench++ 的 image-to-video、长视频和可信性扩展,以及 VBench-2.0 的内在真实性评测,具有各自入口,不能只因目录名字接近就混用分数。
质量组包括主体一致性、背景一致性、时间闪烁、运动平滑度、动态程度、美学质量和成像质量。条件一致性组包括物体类别、多物体、人类动作、颜色、空间关系、场景、外观风格、时间风格和整体一致性。每个名字背后都有适合它的测试提示词,而不是把任意业务视频塞给 16 个评测器后就获得同等有效的解释。官方维度与分组常量
VBench 的方法论文同时组织维度、提示词和人类偏好验证;自动分数与人的判断存在经验上的相关性,不等于对所有新模型和新业务场景都有校准保证。工程应用还要保留完整输入清单、逐视频结果与失败原因,才能知道一个平均分究竟来自哪些样本。原始 VBench 方法论文
vbench/subject_consistency.py#subject_consistency 对每帧提取并归一化 DINO 特征,计算与邻帧及首帧的非负余弦相似度,正是第 3.3 节的结构。它处理的是图像特征,不是本文的掩码 RGB,也不是人脸跟踪系统。在单进程代码中总体分数按实际帧对数累加;多进程汇总分支对逐视频分数取平均。各视频帧数相同时二者一致,变长样本时要额外核对聚合口径。
vbench/dynamic_degree.py#DynamicDegree 使用 RAFT 光流。对相邻抽样帧,取光流模长最大的 5% 像素的平均值,与按短边尺寸缩放的阈值比较;超过阈值的帧对数量达到与抽样帧数相关的要求,视频被判为动态。固定实现从 MP4 约按 8 fps 抽样,阈值为 $6\min(H,W)/256$,计数门槛为 $\mathrm{round}(4N/16)$,$N$ 是抽样后的帧数。最终对逐视频布尔值取平均,因此它更接近“被判为动态的视频比例”,不能当成平均光流速度或动作正确率。官方 dynamic_degree.py
vbench/motion_smoothness.py#MotionSmoothness.motion_score 用 AMT 插帧:保留偶数索引帧,预测夹在中间的帧,再与原视频相应奇数索引帧比较像素绝对误差,并用 $1-\mathrm{MAE}/255$ 转成分数。它衡量插帧模型对时间连续性的解释程度,不是质心二阶差分。遮挡、大动作、风格变化及插帧模型能力都会影响分数。官方 motion_smoothness.py
vbench/temporal_flickering.py#cal_score 直接对相邻帧像素差做归一化,并在代码中明确要求静态视频。这个前提解决了第 3.1 节的混淆:如果测试提示词本来允许大幅运动,移动的边缘会进入像素差,就不能把低分全部归因于闪烁。本文运动补偿实验是教学扩展,不是官方 temporal flickering 的计算方法。官方 temporal_flickering.py
设第 $j$ 维原始分数为 $r_j$,官方常量给出的锚点为 $l_j,u_j$,该维权重为 $w_j$。固定版本的 get_nomalized_score 按下面的线性映射计算加权分数:
$$n_j=\frac{r_j-l_j}{u_j-l_j},\qquad Q=\frac{\sum_{j\in\mathcal{Q}}w_j n_j}{\sum_{j\in\mathcal{Q}}w_j},\qquad C=\frac{\sum_{j\in\mathcal{C}}w_j n_j}{\sum_{j\in\mathcal{C}}w_j},\qquad F=\frac{4Q+C}{5}$$
$\mathcal{Q}$ 是上述 7 个质量维度,$\mathcal{C}$ 是上述 9 个条件维度;这里 $C$ 表示条件组分数,不是前文图像通道数。动态程度的 $w_j=0.5$,其余维度为 1;质量组总权重为 6.5,条件组为 9。锚点来自版本内固定常量,不是每次提交动态取最小最大值,也不是把 16 个原始百分数直接平均。官方总分函数
例如运动平滑度的锚点是 0.706 与 0.9975,外观风格的锚点是 0.0009 与 0.2855。相同的原始分数变化,经不同区间映射后幅度不同。这个版本没有把归一化结果截断到 [0,1];用合成原始输入 0.5 调用官方运动平滑度归一化路径,实际返回 −0.706689537。负值表示低于所用锚点,不表示执行错误,也不能擅自裁成零后仍称为同一协议。
我们把固定源码的四个纯聚合函数取出实际执行,同时构造两组“假想归一化维度向量”做反例:A 所有维度为 0.8;B 只把运动平滑度降低 0.08、成像质量提高 0.12,其余保持不变。官方聚合函数给出总分 0.800000 → 0.804923,虽然平滑度下降,总分仍上升。这些是合成输入上的权重算术验证,不是真实模型的 VBench 成绩。
这也给“总分不变”划出准确边界:它约束一个加权线性组合,不约束每个维度。若推理加速特别容易损伤时间连续性,就应预先把主体一致性、平滑度等相关维度设为单独验收项,不能等待总分出来后再挑对方案有利的指标解释。
自动化可以重复处理较多样本,给回归检查提供稳定入口,并把某些故障定位到相应维度;代价是依赖特征器、检测器或插帧模型。换权重、帧率、尺寸或解码方式,可能改变结果。镜头切换会影响一致性,运镜可能触发动态判定,插帧困难可能拉低平滑度,复杂画风可能影响检测,这些都需要回到视频和任务本身解释。
真实生成任务也不是所有维度都越高越好。静态产品展示不必追求动态比例,镜头切换不应被无条件当作背景故障,剧情里允许角色换装,恐怖题材可能需要闪光。这些需求应在测试集设计时分层,明确哪些维度适用。按官方任务跑公开基准时尊重官方协议;按业务任务做验收时明确命名为业务评测,不把自选提示词和改过阈值的数值混成官方榜单。
下面是一套建议协议,本文没有执行真人盲评,也没有声称获得人类偏好结果。先锁定目标任务,例如人物近景、复杂手部动作、运镜、长时身份保持;固定任务比例、提示词、生成次数、分辨率、帧率和时长。A、B 对同一 prompt 生成成对样本,全部纳入样本清单,失败和空视频也按预先规定计入,避免只挑好看的样本。
展示时隐藏模型名和方案信息,随机交换左右位置,并保存交换映射,确保统计时能恢复 A、B 身份。让标注者分别判断“身份保持”“运动自然”“动作符合提示词”和“整体可用”,提供 A 好、B 好、平局以及无法判断的选项。先用一小组示例统一判定标准,给正常播放速度与重复观看机会;不要用截帧替代视频,也不要把每个维度的问题写成“哪个更好看”。
定义一次成对判断 $y$:B 胜为 1,平局为 0.5,A 胜为 0。无法判断需要单独报告比例,不能事后当平局。对每个 prompt 的 seed 和标注者先按预先规则汇总,再按 prompt 计算偏好均值并进行分组 bootstrap。如果同一批标注者参与很多任务,还要承认跨任务的标注者相关性;可以采用按任务和标注者的双重重采样,或另作标注者层面的敏感性分析。
包含平局时,$y$ 不再是普通伯努利变量,所以不能把半胜计数直接塞进标准二项区间而不解释假设。应报告胜、负、平局、无法判断、任务数、标注者数与置信区间,结合具体失败类型读结果。多人标注可以减少单人的偶然判断,但“多数人同意”仍取决于任务代表性和问法;它不能替代目标用户的实际可用性要求。
若目标是证明加速后质量没有明显损失,应在实验前为重要维度定义最小可接受差值 $-\epsilon$。对越高越好的指标,只有差值区间下界高于 $-\epsilon$ 时,才有相应证据支持这个任务分布上的非劣结论。区间跨过零只说明优劣尚不清楚,不自动证明两者相等。本文合成实验只示范区间计算,不替任何真实产品选择 $\epsilon$。
同样,显著的小幅提升不一定有实际价值。验收应同时考虑效果大小、故障严重程度和速度收益。例如少量严重换脸不能被许多轻微清晰度改善完全抵消,应该设置单独的失败率或人工否决条件。自动维度、人工偏好和关键故障率共同提供证据,任何一个都不是最终业务决策的全权替代。
这条脉络不是“新论文让旧指标作废”,而是不断增加可以提出的问题。FVD 适合分布层面的比较,原始 VBench 适合分维度诊断,新一代基准增加更深的能力检查;人工验收仍负责特定业务能否交付。
误解一:相邻帧差越小,视频越好。 冻结视频为零,正常平移却非零。只有在静态测试前提下,像素差才更接近闪烁诊断;不能用它无条件惩罚动态场景。
误解二:动态程度高就说明动作自然。 抖动、运镜和正确动作都可能产生运动;运动存在与运动是否符合要求是不同问题。本文最动态的样本,恰好是明显抖动的样本。
误解三:主体一致性高就说明人物身份可靠。 高分是所选特征器下的相似性证据,不能替代局部身份核验。本文颜色不变时,抖动样本照样接近满分;真实场景还会混入背景和视角因素。
误解四:VBench 总分是 16 维的简单平均。 固定版本先做锚点归一化,动态程度权重是 0.5,质量与条件组再以 4:1 合成。改变归一化范围或补上 clipping,都改变了协议。
误解五:置信区间跨过零,就证明加速没有损失。 没有检测出差异可能是数据不足;非劣结论还需要事前容忍幅度。扩大帧数不能代替扩大独立任务数。
误解六:玩具实验跑通,就复现了 VBench。 本文只验证数学机制与统计流程,没有运行官方深度模型评测器,也没有真实生成模型的分数;完整基准复现还需要指定权重、官方提示词和严格预处理。
从文末复制 video_metrics_lab.py 与 make_figures.py 到同一个 code/ 目录,安装 numpy matplotlib,依次运行:
python code/video_metrics_lab.py
python code/make_figures.py
脚本以所在文件推断文章目录,不依赖当前工作路径;放在 code/ 时输出保存在文章目录的 _evidence/,图片在 figures/;直接把两份脚本放在普通目录时,则统一写入该目录下的 video_metrics_results/。预期看到 assertions: passed、五组合成数据结果和上面的 bootstrap 区间。修改内容后数值自然会变化,应重新运行并保存新的输出,不能继续抄用旧数字。
做三个小实验:把冻结样本与正常移动交换查看,确认单独平滑度无法排序;加上 --jitter-amplitude 1,把抖动幅度从 3 改为 1,观察运动量与二阶差分的变化;加上 --repair-scale 1,让 A、B 完全同轨迹,确认成对差值与区间都变为零。最后这个构造验证的是代码自洽,不意味着真实实验的同等质量可以这样证明。脚本会保存本次参数;这些参数实验会更新输出文件,运行默认命令可以恢复正文的基线结果。
再把每任务 seed 数增加但保持任务数不变,思考它减少的是生成随机性还是任务覆盖误差。两种不确定性来自不同层级,应该分别设计样本量。要进一步复现官方分数,先安装固定版本官方仓库,核对 checkpoint、提示词集、视频清单与各维度预处理;本文 CPU 脚本不承担这一功能。
先读 FID / CLIP Score 到底测了什么,理解特征空间、分布距离和有限样本偏差;再回到 AIGC 基本功知识树,寻找视频自回归、世界模型和推理加速的相邻主题。
读视频加速论文时,把“质量保持”拆成可核对的问题:用了哪版基准、哪些任务、哪些维度、多少独立样本、什么聚合与区间;读世界模型时,增加动作可控性、长时记忆和因果响应,不能只沿用短视频的技术质量分数。评测的价值在于让失败可见,并让下一次改进有明确目标。
09 节用到的脚本全文如下(video_metrics_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""CPU synthetic video diagnostics. These are NOT official VBench scores."""
import argparse
import json
from pathlib import Path

import numpy as np


SCRIPT_DIR = Path(__file__).resolve().parent
ROOT = SCRIPT_DIR.parent if SCRIPT_DIR.name == "code" else SCRIPT_DIR / "video_metrics_results"


def render_video(positions, colors, brightness=None):
    """Render integer-position disks into float RGB frames [T, H, W, C]."""
    positions = np.asarray(positions)
    colors = np.asarray(colors)
    t = len(positions)
    frames = np.full((t, 48, 64, 3), 0.08, dtype=np.float64)
    yy, xx = np.mgrid[:48, :64]
    for i in range(t):
        mask = (xx - positions[i, 0]) ** 2 + (yy - positions[i, 1]) ** 2 <= 25
        frames[i, mask] = colors[i]
    if brightness is not None:
        frames = np.clip(frames + np.asarray(brightness)[:, None, None, None], 0, 1)
    return frames


def measure_video(frames):
    """Known-scene segmentation and color features, with no learned model."""
    yy, xx = np.mgrid[:frames.shape[1], :frames.shape[2]]
    centers, features = [], []
    for frame in frames:
        mask = frame.max(axis=-1) > 0.35
        if not mask.any():
            raise ValueError("Synthetic object disappeared from the frame")
        centers.append([xx[mask].mean(), yy[mask].mean()])
        color = frame[mask].mean(axis=0)
        features.append(color / np.linalg.norm(color))
    centers = np.asarray(centers)
    features = np.asarray(features)
    adjacent = np.maximum(0, np.sum(features[1:] * features[:-1], axis=1))
    anchored = np.maximum(0, features[1:] @ features[0])
    speed = np.linalg.norm(np.diff(centers, axis=0), axis=1)
    acceleration = np.linalg.norm(np.diff(centers, n=2, axis=0), axis=1)
    residuals = []
    for i in range(1, len(frames)):
        shift = np.rint(centers[i] - centers[i - 1]).astype(int)
        aligned = np.roll(frames[i - 1], (shift[1], shift[0]), axis=(0, 1))
        residuals.append(np.abs(frames[i] - aligned).mean())
    return {
        "pixel_mae": float(np.abs(np.diff(frames, axis=0)).mean()),
        "aligned_mae": float(np.mean(residuals)),
        "motion_px_per_frame": float(speed.mean()),
        "acceleration_px_per_frame2": float(acceleration.mean()),
        "toy_smoothness": float(np.exp(-acceleration.mean())),
        "toy_identity": float(((adjacent + anchored) / 2).mean()),
    }, centers


def make_examples(jitter_amplitude=3):
    t = 25
    positions = np.stack([np.arange(t) + 16, np.full(t, 24)], axis=1)
    red = np.tile([0.85, 0.12, 0.12], (t, 1))
    jitter = positions.copy()
    jitter[:, 0] += jitter_amplitude * np.where(np.arange(t) % 2 == 0, 1, -1)
    changed = red.copy()
    changed[t // 2:] = [0.12, 0.85, 0.12]
    return {
        "smooth": render_video(positions, red),
        "freeze": render_video(np.tile(positions[0], (t, 1)), red),
        "jitter": render_video(jitter, red),
        "flicker": render_video(positions, red, 0.08 * (np.arange(t) % 2)),
        "identity_change": render_video(positions, changed),
    }


def paired_bootstrap(a, b, seed=20261008, replicates=10000):
    """Resample prompts, retaining all paired seeds within each prompt."""
    if a.shape != b.shape or a.ndim != 2:
        raise ValueError("Expected equally shaped arrays [prompts, paired_seeds]")
    delta = (b - a).mean(axis=1)
    rng = np.random.default_rng(seed)
    indices = rng.integers(0, len(delta), size=(replicates, len(delta)))
    boot = delta[indices].mean(axis=1)
    ci = np.quantile(boot, [0.025, 0.975])
    return delta, boot, {
        "prompts": len(delta), "seeds_per_prompt": a.shape[1],
        "replicates": replicates, "mean_b_minus_a": float(delta.mean()),
        "percentile_95_ci": ci.tolist(),
    }


def make_paired_metrics(repair_scale=0.65):
    """A controlled trajectory repair, with prompt-level difficulty shared."""
    rng = np.random.default_rng(17)
    difficulty = rng.uniform(0.4, 1.2, (24, 1))
    seeds = rng.uniform(0.8, 1.2, (24, 3))
    t = np.arange(25)
    a = np.empty((24, 3))
    b = np.empty_like(a)
    for p in range(24):
        for s in range(3):
            phase = rng.uniform(0, np.pi)
            wiggle = np.sin(0.9 * t + phase) * difficulty[p, 0] * seeds[p, s]
            for out, scale in [(a, 1.0), (b, repair_scale)]:
                trajectory = t + scale * wiggle
                acceleration = np.abs(np.diff(trajectory, n=2)).mean()
                out[p, s] = np.exp(-acceleration)
    return a, b


def illustrative_weight_tradeoff():
    """Use official aggregation weights on invented normalized vectors."""
    quality_weights = np.array([1, 1, 1, 1, 1, 1, 0.5])
    qa = np.full(7, 0.8)
    qb = qa.copy()
    qb[3] -= 0.08
    qb[5] += 0.12
    sa = sb = np.full(9, 0.8)
    score_a = (4 * np.average(qa, weights=quality_weights) + sa.mean()) / 5
    score_b = (4 * np.average(qb, weights=quality_weights) + sb.mean()) / 5
    return {"synthetic_normalized_only": True, "total_a": score_a,
            "total_b": score_b, "smoothness_delta": qb[3] - qa[3]}


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--jitter-amplitude", type=int, default=3)
    parser.add_argument("--repair-scale", type=float, default=0.65)
    args = parser.parse_args()
    if not 0 <= args.jitter_amplitude <= 8 or not 0 <= args.repair_scale <= 1:
        parser.error("Require jitter amplitude in [0,8] and repair scale in [0,1]")
    evidence = ROOT / "_evidence"
    evidence.mkdir(parents=True, exist_ok=True)
    videos = make_examples(args.jitter_amplitude)
    metrics = {name: measure_video(video)[0] for name, video in videos.items()}
    assert metrics["freeze"]["toy_smoothness"] == 1.0
    assert metrics["freeze"]["motion_px_per_frame"] == 0.0
    assert metrics["smooth"]["pixel_mae"] > 0
    assert metrics["smooth"]["aligned_mae"] == 0
    assert metrics["jitter"]["toy_identity"] > 0.999
    if args.jitter_amplitude == 3:
        assert metrics["jitter"]["toy_smoothness"] < 0.01
    assert metrics["identity_change"]["toy_identity"] < 0.9
    a, b = make_paired_metrics(args.repair_scale)
    delta, boot, comparison = paired_bootstrap(a, b)
    if args.repair_scale < 1:
        assert comparison["percentile_95_ci"][0] > 0
    else:
        assert np.all(delta == 0) and np.all(boot == 0)
    result = {"not_official_vbench": True,
              "experiment": {"jitter_amplitude": args.jitter_amplitude,
                             "repair_scale": args.repair_scale},
              "shape": list(videos["smooth"].shape),
              "range": [float(videos["smooth"].min()), float(videos["smooth"].max())],
              "examples": metrics, "paired_comparison": comparison,
              "weight_tradeoff": illustrative_weight_tradeoff()}
    payload = json.dumps(result, ensure_ascii=False, indent=2)
    (evidence / "lab_outputs.json").write_text(payload + chr(10), encoding="utf-8")
    np.savez(evidence / "bootstrap_samples.npz", a=a, b=b, delta=delta, boot=boot)
    print(payload)
    print("assertions: passed (mechanism checks on synthetic data)")


if __name__ == "__main__":
main()"""Create diagrams from the CPU synthetic experiment, without model weights."""
import os
import tempfile
from pathlib import Path
os.environ.setdefault("MPLCONFIGDIR", str(Path(tempfile.gettempdir()) / "vbench_mpl"))
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from video_metrics_lab import make_examples, measure_video, make_paired_metrics, paired_bootstrap
SCRIPT_DIR = Path(__file__).resolve().parent
ROOT = SCRIPT_DIR.parent if SCRIPT_DIR.name == "code" else SCRIPT_DIR / "video_metrics_results"
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
plt.rcParams["figure.dpi"] = 140
plt.rcParams["savefig.dpi"] = 140
def main():
folder = ROOT / "figures"
folder.mkdir(parents=True, exist_ok=True)
videos = make_examples()
names = list(videos)
labels = ["平滑移动", "冻结", "来回抖动", "亮度闪烁", "主体变色"]
fig, axes = plt.subplots(5, 5, figsize=(12, 9))
for row, name in enumerate(names):
for col, frame in enumerate([0, 1, 2, 12, 24]):
axes[row, col].imshow(videos[name][frame])
axes[row, col].set_xticks([])
axes[row, col].set_yticks([])
if row == 0:
axes[row, col].set_title(f"第 {frame} 帧")
if col == 0:
axes[row, col].set_ylabel(labels[row], rotation=0, labelpad=38)
fig.suptitle("图 1:一个变化只对应一个故障?先看五组反例(合成视频)")
fig.tight_layout(rect=(0.04, 0, 1, 0.95))
fig.savefig(folder / "counterexample_frames.png")
plt.close(fig)
fig, axes = plt.subplots(1, 3, figsize=(13, 4))
values = [measure_video(videos[name])[0] for name in names]
for ax, key, label in zip(axes, ["motion_px_per_frame", "toy_smoothness", "toy_identity"],
["运动量:像素 / 帧", "玩具平滑度", "玩具身份一致性"]):
ax.bar(labels, [v[key] for v in values], color=["#2872b8", "#8594a3", "#e79c3a", "#bd6684", "#7a69bc"])
ax.tick_params(axis="x", rotation=35)
ax.set_title(label)
ax.grid(axis="y", alpha=0.2)
fig.suptitle("图 2:冻结最平滑,抖动最动态;三个量必须一起读(非 VBench)")
fig.tight_layout()
fig.savefig(folder / "metric_tradeoffs.png")
plt.close(fig)
a, b = make_paired_metrics()
delta, boot, comparison = paired_bootstrap(a, b)
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
axes[0].bar(np.arange(len(delta)), delta, color="#2872b8")
axes[0].set_xlabel("合成 prompt 编号;每个 prompt 保留 3 对 seed")
axes[0].set_ylabel("玩具平滑度 B − A")
axes[0].set_title("先配对,再对 prompt 求平均")
axes[1].hist(boot, bins=40, color="#2872b8", alpha=0.8)
for bound in comparison["percentile_95_ci"]:
axes[1].axvline(bound, color="#e79c3a", linestyle="--")
axes[1].set_xlabel("以 prompt 为单位的 bootstrap 均值差")
axes[1].set_ylabel("重复次数")
axes[1].set_title("虚线为 95% 百分位区间;仅对应这组合成数据")
fig.suptitle("图 3:不把相关的 72 个视频当作 72 个独立任务")
fig.tight_layout()
fig.savefig(folder / "paired_bootstrap.png")
plt.close(fig)
print("figures: counterexample_frames.png, metric_tradeoffs.png, paired_bootstrap.png")
if __name__ == "__main__":
main()
评论 (0)