


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

从同一张画面出发,按左键和按右键,未来应该不同。本篇沿着动作条件、状态记忆、长程误差和模型内规划这条线,把「能生成视频」到「能当环境使用」之间的距离拆开。附录提供无需权重、只用 NumPy 与 matplotlib 的完整 CPU 实验;实验学习的是合成环境的二维状态动力学,不是训练好的视觉世界模型。
想象一个球正向墙壁运动。视频生成器看过很多相似片段,接下来画出球碰墙反弹,画面连贯,观看体验很好。现在给球一个向左的控制指令,生成器却继续播原来的反弹轨迹。它预测了「录像通常怎样继续」,但没有回答「我采取这个动作以后会怎样」。用于动画制作时,这可能只需要换提示词;用于训练控制器时,这是环境接口失效,因为动作与结果之间的联系已经被切断。
更隐蔽的失败是每一步都很准,连续走几十步却越来越离谱。本篇实际运行的小实验中,动作条件模型在独立测试集上的单步状态均方误差为 5.605065e-08,但连续预测到第 60 步时升到 0.492476。这些是二维合成动力系统、固定随机种子下的实测数值,不是任何论文的游戏成绩。误差增长还伴随着状态离开训练范围,后面会把两种原因分开解释。一个漂亮的单步损失,不能直接当作长程交互能力的证书。
世界模型要服务的用途很具体:让智能体在真正执行动作前,低成本地比较几种可能未来;让昂贵的机器人交互、稀缺的游戏样本被重复利用;或者让用户在生成的环境里逐帧改变行动。如果目标只是导出一段不可修改的短视频,动作接口、奖励预测、终止处理可能都不是必需组件。只有当未来要随行动改变,或者模型将被控制器反复调用,这些要求才变成核心问题。
第一,世界模型学习的是「给定过去和动作,未来的状态或观测如何变化」,一个常见形式是条件分布 $p_{\theta}(o_{t+1}\mid o_{\leq t},a_{\leq t})$。其中 $o$ 是观测,$a$ 是动作,$\theta$ 是模型参数,下标 $t$ 表示环境中的时间步。
第二,画面不一定等于状态:同一张球的位置图,可能对应向左或向右的速度。因此模型要从历史构造记忆,必要时还要表达不确定性;把过去压缩成潜变量只是实现方式之一。
第三,模型的使用方式会改变它需要满足的质量要求。拿它做视频续写,需要合理的观测序列;拿它做规划或训练策略,还需要动作响应、奖励与终止语义、长程误差和真实环境中的任务效果。本文用显式位置与速度替代视觉编码,先把这个闭环跑通,再对照真实扩散世界模型的接口。
可以把系统想成三个角色:表示模型保存当前可用信息,动力学模型回答动作后的变化,控制器根据目标选择动作。三个角色可以由不同网络实现,也可以在一个大型生成模型里合并。名字并不决定能力;是否能从相同历史分叉出可信、可控的未来,才是更有用的判断问题。
设真实状态为 $s_t$,动作是 $a_t$,环境转移规律为 $P(s_{t+1}\mid s_t,a_t)$,观测规律为 $P(o_t\mid s_t)$。状态包括影响未来的一切信息,例如物体位置、速度和遮挡后的位置;相机给出的图像只是其中一部分。所谓马尔可夫性,是在知道完整状态与当前动作后,更早的历史不再为下一步增加信息。实际智能体往往拿不到完整状态,所以需要保存历史 $H_t=(o_0,a_0,o_1,\ldots,a_{t-1},o_t)$。
理论上可以保留一个信念分布 $b_t(s)=P(s_t=s\mid H_t)$。新动作执行后,先用转移规律把每个可能状态推进一步,再用新观测筛掉不吻合的状态:
$$b_{t+1}(s')\propto P(o_{t+1}\mid s')\int P(s'\mid s,a_t)b_t(s)ds.$$
这里 $s'$ 是下一步候选状态,积分把当前所有可能状态的贡献相加,比例符号表示最后还要归一化。这个式子解释了为什么只记一张图片可能不够,也解释了「模型自己想象」与「看见真实新观测」的区别:前者只做预测,后者还能修正记忆。神经世界模型一般不会显式积分,而是用递归状态、历史 token 或有限帧堆叠近似这个信息更新过程。近似是否足够,要由具体任务判断。
假设用编码器或历史聚合器构造 $z_t=E_{\phi}(H_t)$,$z_t$ 就是模型可访问的表示,$\phi$ 是表示模块参数。动作条件动力学、观测生成、奖励与终止预测可以写成:
$$z_{t+1}\sim p_{\theta}(z_{t+1}\mid z_t,a_t),\quad o_{t+1}\sim p_{\psi}(o_{t+1}\mid z_{t+1}),\quad (r_t,d_{t+1})\sim p_{\omega}(r_t,d_{t+1}\mid z_t,a_t,z_{t+1}).$$
$r_t$ 表示这次转移的奖励,$d_{t+1}$ 表示下一步是否结束,$\psi$ 与 $\omega$ 分别是解码和任务预测参数。这是一个便于分析的分解,不要求所有模型都采用这种条件独立结构;图像空间扩散模型也可以直接生成下一张图。奖励头不是定义世界模型的唯一条件,却是把模型作为强化学习环境使用时常见的必要接口。
当训练数据由行为策略 $\mu(a\mid H_t)$ 收集,但预测器忽略动作时,它学到的是混合后的未来:
$$P(o_{t+1}\mid H_t)=\sum_a P(o_{t+1}\mid H_t,a)\mu(a\mid H_t).$$
求和把向左、向右和不动的后果混在一起。这个模型可能很好地复现旧策略拍出的录像,却无法直接回答指定动作的后果。如果下一帧预测采用平方误差,最优输出还是条件均值:两种互斥未来可能被平均成一个并不存在的中间结果。换成更强的生成器可以表达多个未来,但若缺少动作条件,它仍然不知道用户选中了哪个分支。
动作标签也不自动保证因果正确。若训练里「向左」只在道路左侧出现,模型可能同时利用背景位置推测动作效果;到了另一侧,控制就会错。要接近可干预的接口,需要覆盖相关的状态与动作组合、准确的时间对齐,并排查相机变化等混杂因素。这是数据与评估的要求,不能靠把动作 embedding 拼进网络就宣告解决。
本篇环境取 $s_t=(p_t,v_t)$,其中 $p_t$ 为位置,$v_t$ 为速度,动作 $a_t\in\{-1,0,1\}$ 是加速度指令。一步更新定义为:
$$v_{t+1}=0.92v_t+0.25a_t,\quad p_{t+1}=p_t+v_{t+1}=p_t+0.92v_t+0.25a_t.$$
系数 0.92 让旧速度逐渐衰减,0.25 决定控制力度,时间步长被定义为一个单位。先更新速度再更新位置,避免在公式与代码之间偷偷换成另一种积分顺序。虽然系统很小,它已经包含了惯性、动作后果以及位置累积。
把每条训练记录写成行向量 $\varphi_i=(p_i,v_i,a_i,1)$,最后的常数项让模型能够学习偏置。把所有 $N$ 条特征叠成 $\Phi\in\mathbb{R}^{N\times4}$,下一步状态叠成 $Y\in\mathbb{R}^{N\times2}$,待学习权重为 $W\in\mathbb{R}^{4\times2}$。于是预测是 $\widehat{Y}=\Phi W$。这只是线性动力学回归,不包含视觉编码器、神经网络或潜动作发现。
假设每个目标维度存在同方差高斯测量噪声,最大化条件似然等价于最小化平方误差。加入权重惩罚后,用以下目标拟合:
$$L(W)=\|\Phi W-Y\|_F^2+\lambda\|W\|_F^2.$$
$\|\cdot\|_F^2$ 是矩阵中所有元素平方之和,$\lambda=10^{-4}$ 是本实验的岭惩罚强度。这个定义使用误差总和而不是平均值,所以换训练样本数时,保持相同的 $\lambda$ 不等于保持相同的相对正则强度。对 $W$ 求导,误差项给出 $2\Phi^{\top}(\Phi W-Y)$,惩罚项给出 $2\lambda W$;令梯度为零得到:
$$\left(\Phi^{\top}\Phi+\lambda I\right)W=\Phi^{\top}Y.$$
$I$ 是四阶单位矩阵。左侧矩阵在正的岭惩罚下可逆,但代码用 np.linalg.solve 解方程,不显式求逆,以减少不必要的数值误差。W 的第一行对应位置、第二行对应速度、第三行对应动作、第四行对应常数;理想的无噪声权重分别是 (1,0)、(0.92,0.92)、(0.25,0.25)、(0,0)。
真实动力学记为 $f$,学到的动力学记为 $\widehat f$。给它们相同动作序列,从同一初始状态出发。自由滚动误差定义为 $e_t=\|\widehat s_t-s_t\|$。在一步中加减 $f(\widehat s_t,a_t)$,再使用三角不等式:
$$e_{t+1}\leq\|\widehat f(\widehat s_t,a_t)-f(\widehat s_t,a_t)\|+\|f(\widehat s_t,a_t)-f(s_t,a_t)\|.$$
如果在滚动真正到达的区域内,模型误差上界为 $\varepsilon$,真实动力学对状态的 Lipschitz 常数为 $K$,第二项至多为 $Ke_t$,于是得到 $e_{t+1}\leq\varepsilon+Ke_t$。从 $e_0=0$ 递推:
$$e_H\leq\varepsilon\sum_{j=0}^{H-1}K^j.$$
$H$ 是滚动长度。如果 $K<1$,上界趋向有限值;如果 $K=1$,上界线性增长为 $H\varepsilon$;如果 $K>1$,这个粗上界可能快速增长。这是带条件的范数上界,不是所有世界模型误差曲线的精确规律,也不能把实验中的均方误差直接代进去。训练集上的平均误差很小,并不说明离开训练分布后仍有同一个 $\varepsilon$。
Teacher forcing 每一步用真实状态作为输入,相当于不断把前面输入偏差清零;自由滚动把上一步预测当作下一步输入,偏差会反馈。两者可以用于同一个训练好的模型,但测量的风险不同。后面的误差图将把它们放在一起,让「独立单步测试」「沿真实轨迹逐步预测」「连续自己预测」三种条件不再混淆。
模型能够回答后果后,还缺「哪个后果值得追求」。给定目标位置 $p^*=2$,定义一个有限长度动作序列的代价:
$$J(a_{t:t+H-1})=\sum_{k=1}^{H}\left[(\widehat p_{t+k}-p^*)^2+0.5\widehat v_{t+k}^2+0.02a_{t+k-1}^2\right].$$
第一项希望接近目标,第二项希望到达时不要带着很大的速度冲过去,第三项轻微惩罚控制力度。权重是教学实验的设计,不是论文超参数。动作离散且序列很多,我们用随机射击法:采样多条动作序列,在模型里逐条模拟,取代价最低的一条。
Model Predictive Control,也就是 MPC,不把这条计划全部执行完。它只执行最优候选的第一个动作,再读真实状态,用新的状态重新规划。每次与真实环境交互都给模型一次纠偏机会。这样的闭环通常能缓解长时间开环预测的问题,但无法消除模型对关键事件的系统性误判;如果短期内就把碰撞预测错,反复规划也可能反复犯错。
完整实现是附录中的 world_model_demo.py。只需 Python、NumPy 与 matplotlib,不需要下载数据、权重或游戏。脚本在运行时生成训练样本,拟合两个模型,执行长程滚动和 MPC,再生成三张图。随机种子为 20261008;本次环境为 NumPy 2.1.3 与 matplotlib 3.10.5,不同版本可能产生末位数值差异。
训练状态均匀采样在 [-1,1],动作在 -1、0、1 中随机选取。目标状态由真实动力学生成,再叠加标准差 0.01 的独立高斯噪声,模拟带噪监督记录。独立单步测试用另一批状态和动作,并以无噪声真实下一状态为目标,因此本文报告的测试误差不包含测量噪声的不可约下限。若直接拿有噪目标测试,这一误差的尺度会改变。
与前面的正规方程对应,核心拟合代码如下:
import numpy as np

def fit_model(s, a, next_s, use_action=True):
    action = np.asarray(a).reshape(s.shape[:-1] + (1,))
    bias = np.ones(s.shape[:-1] + (1,))
    columns = (s, action, bias) if use_action else (s, bias)
    phi = np.concatenate(columns, axis=-1)
    ridge = 1e-4
    W = np.linalg.solve(phi.T @ phi + ridge * np.eye(phi.shape[-1]),
                        phi.T @ next_s)
    return W

s = np.array([[0.0, 0.0], [1.0, 0.2], [-1.0, -0.2], [0.5, -0.1]])
a = np.array([1, -1, 0, 1])
v_next = 0.92 * s[:, 1] + 0.25 * a
next_s = np.stack((s[:, 0] + v_next, v_next), axis=-1)
print("feature shape:", (len(s), 4))
print("W shape:", fit_model(s, a, next_s).shape)
这一小段可独立运行,输出特征 (4,4) 与权重 (4,2);它只示范拟合接口。下面的大样本数值来自完整脚本,不能用这四条示范记录替代。完整实验里,训练状态为 (4096,2),特征为 (4096,4),权重为 (4,2);128 条轨迹滚动 60 步,加上初始状态,得到 (61,128,2)。数组第一轴始终是环境时间,第二轴是轨迹,第三轴是位置与速度。
真实学习到的四行权重,保留六位小数为 (1.000380,0.000147)、(0.919667,0.920085)、(0.249902,0.249973)、(-0.000010,0.000090)。动作行接近理想值 0.25,说明模型学到了控制力度。位置行的速度输出却出现了一个很小的非零系数 0.000147,这会让位置反过来影响速度,而真实环境没有这种机制。看似无关紧要的参数泄漏,在长程位置越来越大时会被放大。
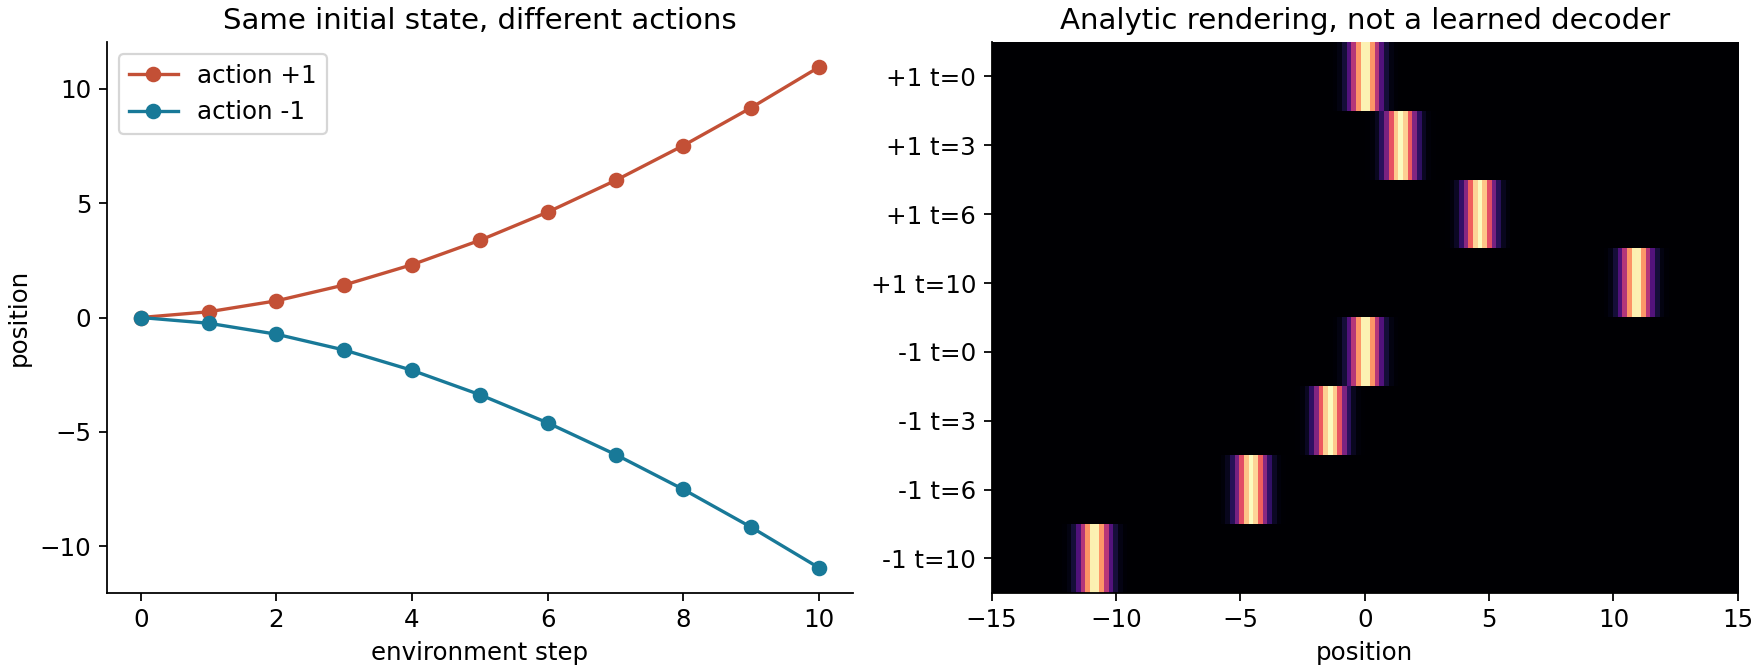
左图让两个模型副本从完全相同的初始位置与速度出发,分别连续接收 +1 与 -1;两条位置轨迹分开,动作改变了未来。右图把状态通过手写高斯亮点映射到图像,只用于显示分支。亮点图片既不是训练输入,也不是学习出来的解码结果,不能把它当作视觉生成质量证据。
无动作模型也用同一批训练记录拟合,但特征只保留位置、速度和常数。这次独立测试的动作条件单步 MSE 为 5.605065e-08,无动作单步 MSE 为 0.04053985。由于训练动作近似对称,忽略动作的最佳平方误差预测会接近「平均动作等于零」的未来。它不是完全不会动,而是无法可靠区分当前指令造成的偏移。
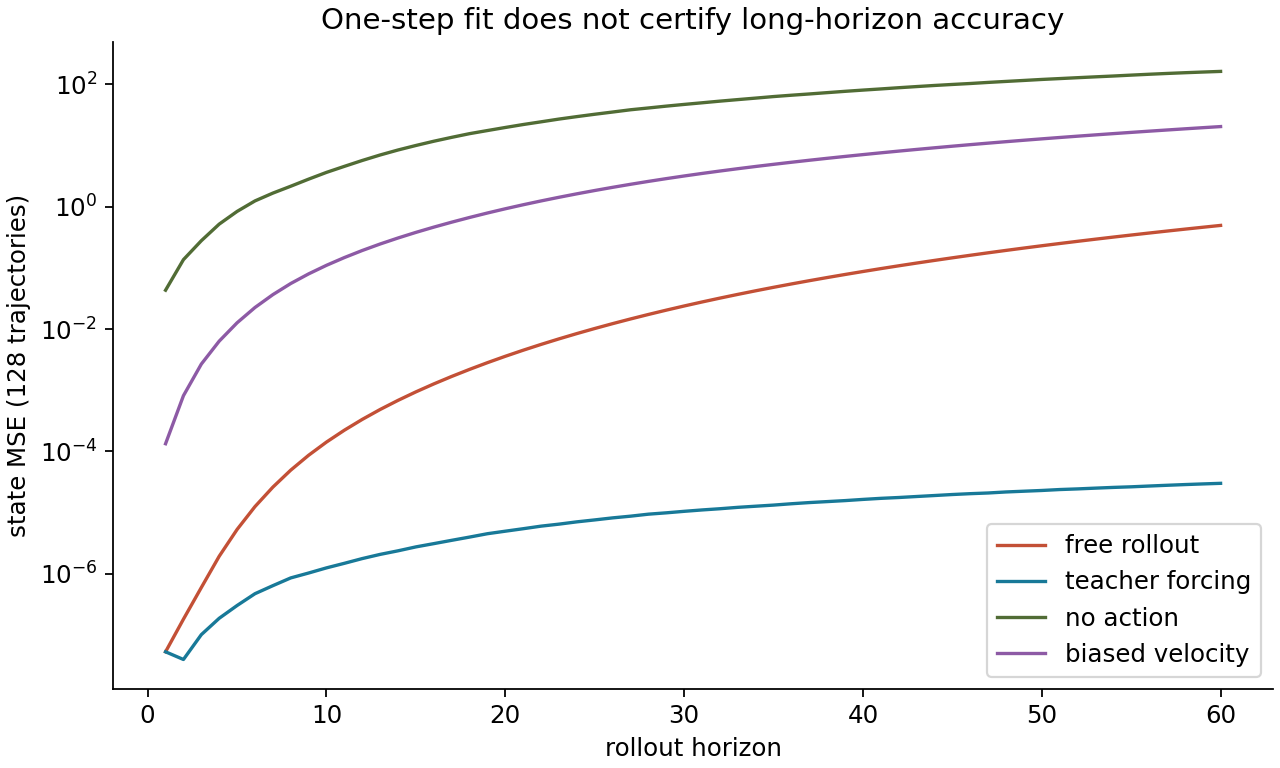
图的纵轴为状态 MSE,采用对数坐标,所以不同曲线的量级更容易比较。第 60 步,沿真实轨迹执行 teacher forcing 的误差为 3.021024e-05,自由滚动为 0.492476,无动作模型为 161.336796。图中还有一个专门的扰动对照:在学习后的速度特征行两个系数上都加 0.02,其第 60 步误差为 20.262952。这是人为破坏动力学参数的诊断实验,没有重新训练,也不是新的学习方法。
为什么 teacher forcing 的后期误差也高于独立单步测试?因为单步测试的位置仍在 [-1,1],长程真实轨迹的位置绝对值最大到了 52.139858。对真实输入预测消除了输入偏差反馈,却没有消除分布外外推。自由滚动还额外引入了预测状态反馈,因此更差。用同一个 MSE 名字展示指标时,必须同时交代输入分布和是否注入真实观测,否则读者会误以为是在测同一件事。
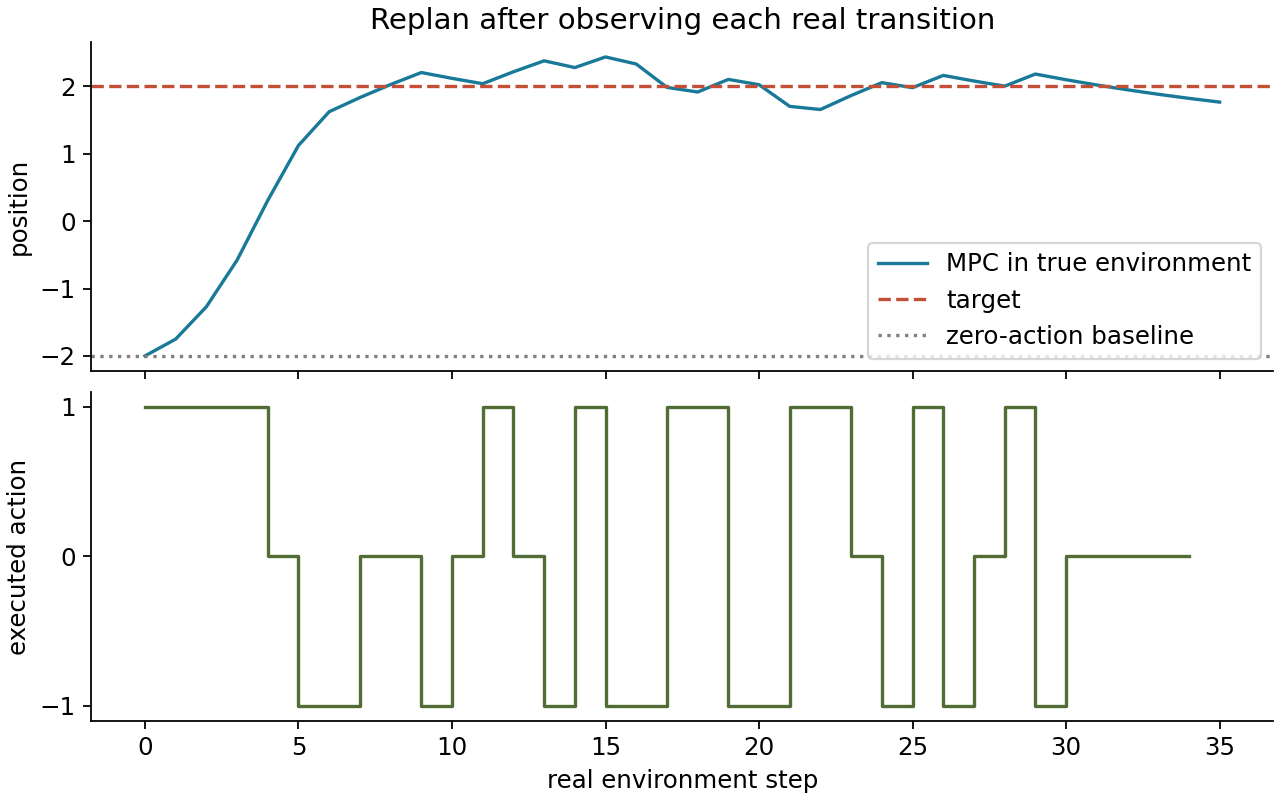
MPC 每步比较 512 条长度为 12 的动作序列,只执行最佳候选的第一个动作。35 次真实交互后,位置为 1.766138,速度为 -0.055751;执行过程中累计位置误差平方为 36.255730,一直不执行动作的同一指标为 560.0。这里后两个数只累计位置项,没有把规划目标中的速度与动作惩罚混进去。控制器明显接近了目标,但没有精确收敛;有限候选搜索与离散动作会留下残差,也可能出现左右切换。图上的偏差比把它描述为「成功到达」更诚实。
实验的价值是可定位:动作消融对应条件变量,参数扰动对应动力学误差,teacher forcing 对照对应输入分布,MPC 对应观测纠偏。完整输出还保存为 JSON 与 NumPy 数组,三张图直接由同一次运行生成,正文数字不依赖手工抄造的曲线。
现实视觉世界模型不能直接读取位置与速度。本篇选择 DIAMOND 官方代码 做参照,并在 2026-10-08 实际下载、检查了提交 5bcd1599755b4f2fae8e5e079e02f0728e174965 的 Atari 主分支。以下链接固定到该提交,未来上游重构也不会改变它们指向的代码。这里只检查实现并验证了采样日程的算术;没有安装全套训练环境,也没有运行预训练 DIAMOND 游戏,因此不报告其推理速度、画面或任务分数。
最外层是 src/envs/world_model_env.py#WorldModelEnv。step 将当前动作写入动作缓存,再生成下一帧,预测奖励与结束标记,滚动观测缓存。如果回合结束或超过想象长度,还会重置对应环境。这里可以直接看到一个可交互生成器变成训练环境需要补上的工作:批量回合管理、终止与截断区别、重置条件、奖励和缓存对齐。仅把图像生成函数命名成环境,不会自动得到这些语义。
生成下一帧的是 src/models/diffusion/diffusion_sampler.py#DiffusionSampler.sample。它接收历史观测 prev_obs 与动作 prev_act,把历史帧的时间与通道合并,然后从噪声开始多次调用去噪器。这里有两个时间轴:一个是环境往前走一帧的 $t$,另一个是为这一帧逐步去噪的噪声尺度 $\sigma$。减少去噪步数可以减少每帧调用次数,但不等于环境历史变短。
为了验证源码中的数值约定,本次从固定版本提取了 build_sigmas 函数原样执行,只用 NumPy 适配其张量算术,没有加载网络。指定三步、最小噪声 0.002、最大噪声 5、幂指数 7 时,得到约 [5.0,0.283082,0.002,0.0];末尾的零是额外追加的终点。这只验证噪声日程计算,不能替代神经模型采样或证明三步足够完成任何任务。
真实默认配置 config/agent/default.yaml 中 num_steps_conditioning 为 4;这表示该配置用有限帧堆叠作为图像动力学的历史条件,不能据此宣称它具有任意长度的持久记忆。默认去噪组件也有自己的噪声缩放参数,它们与本文二维线性回归的岭惩罚不是同一个概念,不能把 toy 的超参数搬过去。
去噪器位于 src/models/diffusion/denoiser.py#Denoiser。compute_conditioners 随噪声尺度计算输入、输出和跳连缩放;compute_model_output 把噪声图、历史观测和动作传给内部网络。尤其值得读的是 forward:它复制观测序列,在每个训练位置生成去噪结果,并把结果写回 all_obs,让后续片段用到模型生成的上下文。这比只在真实前缀上优化独立下一帧,更直接面对自回归使用时的上下文偏差;具体训练流程仍要以该版本源码为准。
还有一个容易漏掉的细节:wrap_model_output 会裁剪并量化到 8 位图像尺度,再映射回归一化区间。因此模型输出、观测记录和下一轮输入的数值约定必须一致,不能把任意连续张量直接塞入缓存。本文状态模型没有像素量化,也没有卷积网络,它省略了视觉表示的损失、采样计算和多模态未来,只保留「动作进入预测」「预测反馈」「任务闭环」这三个结构。
为什么不用 Genie 的社区实现当工业锚点?本篇讨论的是 Genie 原论文 中的潜动作模型、视频 tokenizer 与动力学组合,没有将社区重写认定为官方复现。论文里的潜动作是从无动作标签视频中学习的离散接口;潜动作索引需要解释或映射,不能天然等同真实键盘动作。DIAMOND 的官方实现则给出了可检查的环境接口,适合把动作条件、去噪和回合管理连接起来阅读。
世界模型把真实交互的一部分成本换成模型训练和想象计算。环境样本很昂贵时,这种交换可能有价值;如果已有便宜、精确的模拟器,增加一个有偏差的学习模型反而可能添负担。像素空间扩散能保留许多视觉细节,但每个环境步还要多次去噪;离散或连续潜空间更紧凑,但压缩可能漏掉任务关键细节。选择时要看任务需要的后果,而不能只根据生成画面是否细腻判断。
记忆也有账本。有限帧堆叠便宜,却可能忘记遮挡前出现的物体;递归状态节省历史存储,却可能因瓶颈丢信息;长上下文 token 保留更多过去,但推理延迟与缓存成本上升。检验记忆最直接的方法之一,是让两个状态具有相同当前画面、不同过去,并查看预测能否区分它们。例如球在遮挡物后从左侧进入还是从右侧进入,会改变重新出现的位置。只播放无长期遮挡的短片,不能证明这种记忆能力。
本实验还提示一个结构约束问题。真实系统的状态转移特征值为 1 与 0.92,学习后的值为 1.002029 与 0.918436。第一个值略微超过 1,和位置向速度泄漏一起,引入了真实系统没有的反馈。由这个现象可提出一个可检验的改进:强制速度更新不依赖绝对位置,把已知平移对称性写进模型。但「增加结构约束一定更好」不是通用结论;如果真实环境中有位置相关的力场,这个约束就会把需要学习的规律删掉。
随机性也要区分。观测里本来存在不可预测因素,是数据不确定性;模型没见过某类状态,是知识不足。前者需要合理的未来分布,后者更需要覆盖、估计和谨慎使用。每次采样出不同视频,不代表模型对分布外事件知道自己不确定。本文模型预测均值,没有学习方差,不能用它做风险敏感控制,也不能从它的多条随机动作轨迹估计模型置信度。
规划还有一个特别的风险:优化器会主动寻找模型中的漏洞。模型错误地相信「持续向右能穿过墙而不受罚」,控制器就可能偏爱这个在想象里得分很高的方案。预测误差要沿智能体真正访问的状态评估,任务成绩则必须回到真实环境检验。MPC 用新观测不断纠偏,策略在想象中训练后再真实测试,模型集成估计分歧,都是处理风险的工具;它们分别作用于不同环节,没有一个单独保证仿真到真实转移成功。
本文最小实现的边界应明确保留:状态完全可见、动力学线性、动作标注准确、无碰撞、无遮挡、无终止事件、奖励由作者手写。它证明这些接口能在一个小系统中相互配合,并展示失败如何出现;它没有证明在自然视频上自动学到物理规律,更没有证明模型拥有通用空间理解、完整因果模型或现实安全保证。
World Models,1803.10122,2018。它用视觉压缩、时序概率模型与控制器连接感知和行动,并探索在模型生成的梦境里训练策略。值得带走的是表示、动力学、控制器的分工,以及模型漏洞会影响控制器这一问题;不要把特定环境里的转移结果泛化成任何生成器都能替代真实环境。
PlaNet:Learning Latent Dynamics for Planning from Pixels,1811.04551,2018 年首版。它把从图像学习潜动力学与在线潜空间规划连接起来,并关注多步预测。阅读时重点看「当前观测修正状态,然后再规划」的循环,它与本篇 MPC 的教学接口相邻;本文线性拟合不复现其神经潜状态模型。
Dreamer:Dream to Control,1912.01603,2019 年首版。它从潜空间想象轨迹学习行为,将价值与行为学习连接到世界模型。与每步重新搜索候选计划相比,这条路线关注如何把想象轨迹用于学习一个可快速执行的策略。两种用法都需要模型,不能因为有策略网络就把模型训练与策略训练混成一个目标。
Genie:Generative Interactive Environments,2402.15391,2024。它展示了从无真实动作标签的视频中学习潜动作接口,再通过视频 tokenizer 与动力学模型产生可交互观测的路线。这里新的问题是「如何从录像中发现可用控制变量」,并不意味着潜动作索引天然有真实操纵杆的语义。
DIAMOND:Diffusion for World Modeling: Visual Details Matter in Atari,2405.12399,2024。它把扩散预测用于世界模型,并提供官方可交互实现。这里的阅读重点是像素细节、条件遵循和逐帧采样怎样影响模型作为环境的使用;本篇不把论文发表时的排名描述为今天的最新水平,也不把不同任务与协议的分数横向混比。
这五篇可以按问题阅读,而不只是按年代记名词:先问是否有紧凑状态,再问如何从预测选动作,再问能否通过想象学习策略,接着问缺动作标签怎么办,最后问观测生成范式如何影响控制。大模型参数量、视频分辨率和推理帧率都是重要工程指标,但它们回答不了这条链上所有问题。
误解一:视频连续就是世界模型合格。 连续说明模型擅长某种观测分布;交互还需要在相同历史下响应不同动作。最小诊断是复制同一初始条件,控制随机性,分别施加两个动作,比较响应是否符合任务语义。变化太弱可能是条件被忽略,变化过强也可能是乱改场景,不能只看有没有差异。
误解二:单步 loss 很低,几十步一定准。 本文单步与长程实测已经给出反例。要同时检查是否持续注入真实观测、测试状态是否在训练范围内、预测误差是否影响下一个输入。否则「预测下一帧」和「自主滚动一整段」只是共用一个模型名,实际测试条件完全不同。
误解三:动作条件自动等于因果模型。 拼接动作提供了表达能力,没有替代数据覆盖、干预检验和时间同步。一个动作在数据里总伴随镜头移动时,模型可能只学会镜头响应,仍然忽略角色本身。潜动作学习还要额外确认潜变量表达的是可操控变化,而不是背景抖动。
误解四:潜变量越小,模型越高效越好。 压缩减少计算,但一个很小的目标、计分板变化或遮挡后的记忆都可能影响奖励。要检查任务相关信息能否从表示中恢复或影响预测;不能用重建图像整体看起来还行,代替对关键细节的测试。
误解五:梦境里得分高,真实环境自然也高。 控制器可能利用模型漏洞,数据分布也会随策略变化。应保持真实环境评估,并检查同一策略在真实与模型环境中的差距。本篇 MPC 的每个执行动作都通过手写真实动力学推进,报告的是这个合成真实环境里的轨迹,没有把模型内代价当实际成绩。
误解六:随机生成未来就等于估计了不确定性。 生成多样性、环境随机性和模型知识不足是不同问题。若模型对未见事件高度自信地生成错误画面,多次采样也未必暴露问题;需要专门的校准、覆盖和风险评估,不能只调采样温度。
把附录代码保存为 world_model_demo.py,安装 NumPy 与 matplotlib,然后运行以下命令。脚本会在指定目录创建 figures/ 与 _evidence/,输出 JSON 数值;无需联网即可重新生成三张图。
python -m pip install numpy matplotlib
python world_model_demo.py --output-dir ./world_model_results
先原样运行一次,核对训练特征 (4096,4)、滚动状态 (61,128,2)、单步有动作误差约 5.61e-08、无动作误差约 0.04054。这些预期来自本文保存的实际运行;版本变化时允许末位差异。如果量级完全不同,先检查动作与目标是否按同一个时间步对齐,以及 true_step 的速度、位置更新顺序是否改了。
随后做三个独立改动,每次只改一个,并保留基准输出。第一,把训练目标噪声 0.01 改为零,观察学到的泄漏系数与长程误差是否下降;岭惩罚仍在,所以不应强求所有参数逐字等于理想值。第二,把训练状态的采样范围扩大,但保持测试协议与随机种子明确记录,观察 teacher forcing 后期误差与自由滚动误差怎样变化;不要预先假定二者会按相同比例改善。第三,把 MPC 里的候选条数从 512 改成 64,再改成 2048,比较实际执行轨迹与累计位置误差,同时记录运行耗时。候选数增加会增加计算,单个随机种子的成绩也不保证严格单调。
还可以做一个表示实验:让模型输入只有位置,不再提供速度,再用连续两帧的位置差构造速度估计。因为相同位置可能有不同速度,只有当前位置的预测会面对互斥未来;加入历史应改善可辨识性。这个扩展本篇没有运行,因此没有给出伪造数值;验证时要重新定义特征、拟合与测试,不能只删数组一列然后继续引用原文的结论。
读完图以后,写下四个答案:控制变量是否真的改变未来;误差增长来自输入反馈还是外推;真实新观测能纠正哪一部分;规划器怎样把模型误差变成错误选择。这四问比只核对脚本「能运行」更接近世界模型实验需要回答的问题。
回到 AIGC 基本功知识树,先读 自回归视频生成,理解时间因果掩码、逐帧生成和预测反馈,再把其中的条件变量从历史扩展到动作。
沿着树中的 VAE 与视觉 tokenizer 继续读,重点追问压缩是否保留控制相关信息;沿着 DDPM 与扩散数学继续读,区分噪声时间和环境时间,理解下一帧内部为何还要多步采样;沿着强化学习基础继续读,补齐奖励、折扣、终止与策略评估,再理解世界模型怎样参与行为学习。理解这三个接口后,阅读新的可交互生成论文,就能分辨它改进了观测生成、控制接口、记忆还是决策,而不会把所有能力都归到一个「世界模型」标签里。
09 节用到的脚本全文如下(world_model_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""CPU toy: learn action-conditioned state dynamics, then roll out and plan.

This is a synthetic state-space teaching experiment, not a visual world model.
Run: python world_model_demo.py --output-dir ./world_model_results
Dependencies: NumPy and matplotlib. No pretrained weights or network required.
"""
import argparse
import json
import os
from pathlib import Path

os.environ.setdefault("MPLCONFIGDIR", "/tmp/world_model_matplotlib")
import numpy as np
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt


def true_step(s, a):
    """s[..., 0] = position, s[..., 1] = velocity; a is acceleration command."""
    velocity = 0.92 * s[..., 1] + 0.25 * np.asarray(a)
    position = s[..., 0] + velocity
    return np.stack((position, velocity), axis=-1)


def features(s, a, use_action=True):
    action = np.asarray(a).reshape(s.shape[:-1] + (1,))
    bias = np.ones(s.shape[:-1] + (1,))
    columns = (s, action, bias) if use_action else (s, bias)
    return np.concatenate(columns, axis=-1)


def fit_model(s, a, next_s, use_action=True):
    phi = features(s, a, use_action)
    ridge = 1e-4
    regularizer = ridge * np.eye(phi.shape[-1])
    W = np.linalg.solve(phi.T @ phi + regularizer, phi.T @ next_s)
    return W


def model_step(s, a, W, use_action=True):
    return features(s, a, use_action) @ W


def rollout(step, initial_s, actions):
    states = [np.asarray(initial_s).copy()]
    for action in actions:
        states.append(step(states[-1], action))
    return np.stack(states)


def evaluate_rollouts(W, W_no_action, rng):
    count, horizon = 128, 60
    initial_s = rng.uniform(-1, 1, size=(count, 2))
    actions = rng.integers(-1, 2, size=(horizon, count))
    truth = rollout(true_step, initial_s, actions)
    learned = rollout(lambda s, a: model_step(s, a, W), initial_s, actions)
    no_action = rollout(lambda s, a: model_step(s, a, W_no_action, False), initial_s, actions)
    W_biased = W.copy()
    W_biased[1] += 0.02
    biased = rollout(lambda s, a: model_step(s, a, W_biased), initial_s, actions)
    teacher = np.stack([model_step(truth[t], actions[t], W) for t in range(horizon)])
    teacher_error = np.mean((teacher - truth[1:]) ** 2, axis=(1, 2))
    curves = {
        "free_rollout": np.mean((learned[1:] - truth[1:]) ** 2, axis=(1, 2)),
        "teacher_forcing": teacher_error,
        "no_action": np.mean((no_action[1:] - truth[1:]) ** 2, axis=(1, 2)),
        "biased_velocity": np.mean((biased[1:] - truth[1:]) ** 2, axis=(1, 2)),
    }
    return truth, learned, curves


def plan_action(s, W, candidates, target=2.0):
    imagined_s = np.repeat(s[None], len(candidates), axis=0)
    costs = np.zeros(len(candidates))
    for t in range(candidates.shape[1]):
        a = candidates[:, t]
        imagined_s = model_step(imagined_s, a, W)
        costs += (imagined_s[:, 0] - target) ** 2 + 0.5 * imagined_s[:, 1] ** 2 + 0.02 * a ** 2
    return int(candidates[np.argmin(costs), 0])


def run_mpc(W, rng):
    s = np.array([-2.0, 0.0])
    states, actions = [s.copy()], []
    for _ in range(35):
        candidates = rng.integers(-1, 2, size=(512, 12))
        candidates[0] = 0
        a = plan_action(s, W, candidates)
        s = true_step(s, a)
        states.append(s.copy())
        actions.append(a)
    return np.array(states), np.array(actions)


def make_figures(output_dir, W, curves, mpc_states, mpc_actions):
    fig_dir = output_dir / "figures"
    fig_dir.mkdir(parents=True, exist_ok=True)
    plt.rcParams.update({"font.size": 11, "axes.spines.top": False, "axes.spines.right": False})
    colors = ["#c35036", "#187998", "#516c35", "#8d5aa5"]
    s0 = np.array([0.0, 0.0])
    positive = rollout(lambda s, a: model_step(s, a, W), s0, np.ones(10))
    negative = rollout(lambda s, a: model_step(s, a, W), s0, -np.ones(10))
    fig, ax = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True)
    ax[0].plot(positive[:, 0], label="action +1", marker="o", color=colors[0])
    ax[0].plot(negative[:, 0], label="action -1", marker="o", color=colors[1])
    ax[0].set(xlabel="environment step", ylabel="position", title="Same initial state, different actions")
    ax[0].legend()
    grid = np.linspace(-15, 15, 160)
    strips = []
    for branch in (positive, negative):
        for t in (0, 3, 6, 10):
            strips.append(np.exp(-0.5 * ((grid - branch[t, 0]) / 0.4) ** 2))
    ax[1].imshow(np.stack(strips), aspect="auto", cmap="magma", extent=(-15, 15, 8, 0))
    ax[1].set(xlabel="position", title="Analytic rendering, not a learned decoder")
    ax[1].set_yticks(np.arange(8) + 0.5, ["+1 t=0", "+1 t=3", "+1 t=6", "+1 t=10", "-1 t=0", "-1 t=3", "-1 t=6", "-1 t=10"])
    fig.savefig(fig_dir / "action_branches.png", dpi=160)
    plt.close(fig)

    fig, ax = plt.subplots(figsize=(8, 4.8), constrained_layout=True)
    for color, (name, error) in zip(colors, curves.items()):
        ax.semilogy(np.arange(1, len(error) + 1), error, label=name.replace("_", " "), color=color)
    ax.set(xlabel="rollout horizon", ylabel="state MSE (128 trajectories)", title="One-step fit does not certify long-horizon accuracy")
    ax.legend()
    fig.savefig(fig_dir / "rollout_error.png", dpi=160)
    plt.close(fig)

    fig, ax = plt.subplots(2, 1, figsize=(8, 5), constrained_layout=True, sharex=True)
    ax[0].plot(mpc_states[:, 0], color=colors[1], label="MPC in true environment")
    ax[0].axhline(2, linestyle="--", color=colors[0], label="target")
    ax[0].axhline(-2, linestyle=":", color="gray", label="zero-action baseline")
    ax[0].set(ylabel="position", title="Replan after observing each real transition")
    ax[0].legend(loc="lower right")
    ax[1].step(np.arange(len(mpc_actions)), mpc_actions, where="post", color=colors[2])
    ax[1].set(xlabel="real environment step", ylabel="executed action", yticks=[-1, 0, 1])
    fig.savefig(fig_dir / "mpc_control.png", dpi=160)
    plt.close(fig)


def main():
    script_dir = Path(__file__).resolve().parent
    default_dir = script_dir.parent if script_dir.name == "code" else script_dir / "world_model_results"
    parser = argparse.ArgumentParser()
    parser.add_argument("--output-dir", type=Path, default=default_dir)
    args = parser.parse_args()
    args.output_dir.mkdir(parents=True, exist_ok=True)
    rng = np.random.default_rng(20261008)
    s = rng.uniform(-1, 1, size=(4096, 2))
    a = rng.integers(-1, 2, size=4096)
    next_s = true_step(s, a) + rng.normal(0, 0.01, size=s.shape)
    W = fit_model(s, a, next_s)
    W_no_action = fit_model(s, a, next_s, False)
    test_s = rng.uniform(-1, 1, size=(2048, 2))
    test_a = rng.integers(-1, 2, size=2048)
    test_target = true_step(test_s, test_a)
    action_mse = np.mean((model_step(test_s, test_a, W) - test_target) ** 2)
    no_action_mse = np.mean((model_step(test_s, test_a, W_no_action, False) - test_target) ** 2)
    truth, learned, curves = evaluate_rollouts(W, W_no_action, rng)
    mpc_states, mpc_actions = run_mpc(W, rng)
    results = {
        "seed": 20261008,
        "numpy_version": np.__version__,
        "matplotlib_version": matplotlib.__version__,
        "training_state_shape": list(s.shape),
        "training_feature_shape": list(features(s, a).shape),
        "W_shape": list(W.shape),
        "W": W.tolist(),
        "learned_transition_eigenvalues": np.linalg.eigvals(W[:2].T).tolist(),
        "rollout_max_absolute_position": float(np.max(np.abs(truth[:, :, 0]))),
        "rollout_shape": list(truth.shape),
        "one_step_action_mse": float(action_mse),
        "one_step_no_action_mse": float(no_action_mse),
        "error_horizon_1": {name: float(error[0]) for name, error in curves.items()},
        "error_horizon_60": {name: float(error[-1]) for name, error in curves.items()},
        "mpc_final_position": float(mpc_states[-1, 0]),
        "mpc_final_velocity": float(mpc_states[-1, 1]),
        "mpc_position_cost": float(np.sum((mpc_states[1:, 0] - 2.0) ** 2)),
        "zero_action_position_cost": float(35 * (-2.0 - 2.0) ** 2),
        "mpc_actions": mpc_actions.tolist(),
    }
    make_figures(args.output_dir, W, curves, mpc_states, mpc_actions)
    evidence_dir = args.output_dir / "_evidence"
    evidence_dir.mkdir(parents=True, exist_ok=True)
    (evidence_dir / "experiment_results.json").write_text(json.dumps(results, indent=2), encoding="utf-8")
    np.savez(evidence_dir / "experiment_arrays.npz", truth=truth, learned=learned, mpc_states=mpc_states, mpc_actions=mpc_actions, **curves)
    print(json.dumps(results, indent=2))
    print("Figures: action_branches.png, rollout_error.png, mpc_control.png")


if __name__ == "__main__":
    main()
评论 (0)