

版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:生成范式 | 难度:前沿 | 前置知识:DDIM 与采样器、CFG
关键词:少步生成、渐进蒸馏、一致性模型、LCM、DMD、教师目标
论文与源码核验日期:2026-11-09。本文的数值来自一维高斯教学问题的 CPU 实跑;没有训练图像模型,也没有复现论文的 FID 或 GPU 加速。
把一个原来需要反复去噪的模型改成少步,最容易想到的操作是删掉时间点。问题在于,原模型每次只学会在当前噪声水平上估计一个局部方向;跨得更远以后,这个方向未必仍然合适。采样器可以改善数值积分,却不能自动让已有网络学会一次完成一整段轨迹。蒸馏要解决的正是这部分能力缺口。
先看一个可以亲自检查的失败场景。本篇用同一批 512 个初始噪声,将一个确定性教师的 16 步结果当作参照。直接把时间表缩成 4 步,终点均方根误差为 0.105562;缩成 1 步,误差为 0.410312。逐级训练学生去模仿教师合成的转移后,4 步误差降到约 2.94e-16。这不是图像质量提升,而是一个极其简单的仿射系统中,目标改变确实改变了少步行为的证据。
现实里,用户需要的不只是较少的循环次数,而是尽快得到符合提示词的图像或视频。若少步结果丢了主体关系、文字或运动一致性,再小的耗时也未必可用。因此讨论蒸馏时,必须同时问:学生学的究竟是什么;少掉的是几次网络评估;新的分布与任务能力损失在哪里。
标题中的少步没有保证任意模型都能从某个固定步数降到另一个固定步数。Progressive Distillation 论文给出逐次减半的路线;LCM 论文讨论潜空间中的少步生成。它们使用不同模型与训练目标,不能用一张演示图推导出通用的质量结论。
三句话建立框架:教师负责提供可信的生成行为或分布信号;学生通过训练把这些信号压进更少次调用;推理时必须使用与学生训练匹配的时间表、参数化和条件方式。仅仅替换 scheduler,不会凭空产生蒸馏后的权重。
少步蒸馏可以按监督对象分成几条路线。渐进蒸馏让一步学生贴近两步教师的终点。一致性蒸馏要求同一条去噪轨迹上的不同状态映射到相同终点。分布匹配则关注学生生成样本整体是否接近教师分布,而非要求每一个噪声种子生成完全相同的样本。这些目标可以结合,但不是换个名字的同一个损失。
本文先把渐进蒸馏推到能跑,再解释一致性与分布匹配改变了什么。先修 DDIM 提供确定性转移公式,CFG 提醒我们条件引导本身也是教师行为的一部分。若教师使用某种引导强度,学生的目标就依赖它;训练时没有覆盖的强度,在推理时任意调整不一定可靠。
设干净数据为 $x_0$,时刻 $t$ 的带噪状态为 $x_t$。信号系数是 $\alpha_t$,噪声系数是 $\sigma_t$,教学问题使用保持方差的条件 $\alpha_t^2+\sigma_t^2=1$。标准高斯噪声为 $\epsilon$,前向状态写成:
$$x_t=\alpha_t x_0+\sigma_t\epsilon.$$
教师网络或解析预测器给出的干净样本估计记为 $\widehat x_0(x_t,t)$。它不是已知真值。用当前状态减去估计的信号,再除以噪声尺度,得到与该估计相容的噪声:
$$\widehat\epsilon(x_t,t)=\frac{x_t-\alpha_t\widehat x_0(x_t,t)}{\sigma_t}.$$
本文只讨论不额外注入随机噪声的 DDIM 转移,目标时刻 $s\lt t$。保留估计的干净样本与噪声方向,用目标时刻的系数组合:
$$x_s=\alpha_s\widehat x_0+\sigma_s\widehat\epsilon.$$
将上一式的噪声估计代入,把所有乘在 $x_t$ 前的系数归到一起,得到:
$$x_s=A_{ts}x_t+B_{ts}\widehat x_0(x_t,t),\qquad A_{ts}=\frac{\sigma_s}{\sigma_t},\quad B_{ts}=\alpha_s-\frac{\sigma_s}{\sigma_t}\alpha_t.$$
这一步只有代数整理,没有假设教师完美。$A_{ts}$ 表示直接保留当前状态的比例,$B_{ts}$ 表示干净样本估计对目标状态的贡献。分母要求当前噪声尺度非零,因此不能从零噪声端再向前执行这类转移。最后一步可以到达零噪声端,因为此时分子为零而当前分母仍非零。
选择三个降序时刻 $t>u>s$。教学时间表用三角恒等式把分母改写为 $B_{ts}=\sin(t-s)/\sin t$,避免两个接近的乘积相减。在 $0\leq s\lt t\leq\pi/2$ 内它为正,起点固定时随两点重合趋近零。这个简写适用于本文的正弦、余弦调度。教师先从 $x_t$ 到 $x_u$,再在新的输入 $x_u$ 上重新预测并到达 $x_s^{\mathrm{teach}}$:
$$x_u=A_{tu}x_t+B_{tu}\widehat x_0^{\mathrm{teach}}(x_t,t),\qquad x_s^{\mathrm{teach}}=A_{us}x_u+B_{us}\widehat x_0^{\mathrm{teach}}(x_u,u).$$
第二次预测必须接收第一步输出,而不能继续拿原输入代替。否则监督的不是教师真实走过的两步。现在要求学生从同一个 $x_t$ 一次到达相同目标,其一步公式为:
$$x_s^{\mathrm{student}}=A_{ts}x_t+B_{ts}\widehat x_0^{\mathrm{student}}(x_t,t).$$
把学生终点设为教师终点,移项并除以非零的 $B_{ts}$,得到学生应该预测的干净样本目标:
$$\widetilde x_0=\frac{x_s^{\mathrm{teach}}-A_{ts}x_t}{B_{ts}},\qquad L_{\mathrm{pair}}=\mathbb E\left[\left\|\widehat x_0^{\mathrm{student}}(x_t,t)-\widetilde x_0\right\|_2^2\right].$$
这里的 $L_{\mathrm{pair}}$ 是教学用的未加权回归,期望取自训练输入。同一区间、同一输入的学生终点误差等于 $B_{ts}$ 乘预测误差,故终点平方误差比预测平方误差多一个 $B_{ts}^2$。独立拟合每段时,这个正常数不会改变该段的最小二乘解。共享一个时间条件网络时,权重会改变不同时间对梯度的贡献。渐进蒸馏原论文 §3–4 从训练数据构造带噪输入,并讨论截断 SNR 和 SNR+1 权重。下文为隔离代数关系,统一用标准正态标量拟合各区间。
波浪号表示“由教师转移反解出来的目标”,它一般不同于原训练数据的真实 $x_0$,也不必等于教师在时刻 $t$ 的第一次估计。蒸馏改变了监督:学生需要补偿较大跨度,让一步尽量承担教师两步的作用。若继续用旧的局部估计、只删时间点,就没有完成这个目标替换。
训练完一次,将学生固定为下一轮教师,再把时间点成对合并。本文走 16、8、4、2、1 步的减半链。真实模型可以在某一轮停止;继续压缩意味着更困难的函数逼近,不能由代数公式保证学习成功。
若输入和系数固定,教师终点的绝对扰动 $\Delta x_s$ 会变成目标扰动 $\Delta x_s/B_{ts}$,所以 $1/|B_{ts}|$ 是这项误差的绝对放大倍数。分子相减仍可能损失有效数字。代码在采样和拟合中共享系数计算,并拒绝 $B_{ts}$ 小于 1e-10 的区间。实际训练还要考虑噪声参数化、损失权重与时间采样,不能把一个没有报除零错误的实现当作稳定训练方案。
渐进蒸馏贴近有限跨度的转移;一致性模型的函数 $f_\theta(x_t,t)$ 则尝试直接预测轨迹接近数据端的终点。若 $x_t$ 与 $x_u$ 位于同一条概率流 ODE 轨迹,理想情况是两者给出相同结果。一个示意的一致性蒸馏目标为:
$$L_{\mathrm{cons}}=\mathbb E\left[d\left(f_\theta(x_t,t),\operatorname{stopgrad}\left(f_{\bar\theta}(x_u,u)\right)\right)\right].$$
$\theta$ 是当前学生参数,$\bar\theta$ 是目标网络参数,常通过指数滑动平均更新;$d$ 是比较两个输出的距离;$\operatorname{stopgrad}$ 表示右侧不参与此次反向传播。这里的低噪声状态由教师轨迹转移得到,不能任意选择一张无关带噪图。本文省略了论文具体的采样权重与离散化细节,所以这条式子用于解释监督关系,不是完整训练配方。
只要求两个输出相同还不够:无论输入是什么都输出常数,也会满足这种相等。为排除这一类没有生成意义的解,需要数据端边界条件。原一致性模型使用小的正端点 $\varepsilon$,要求:
$$f_\theta(x,\varepsilon)=x,\qquad f_\theta(x,t)=c_{\mathrm{skip}}(t)x+c_{\mathrm{out}}(t)F_\theta(x,t).$$
$F_\theta$ 是可训练网络。若 $c_{\mathrm{skip}}(\varepsilon)=1$ 且 $c_{\mathrm{out}}(\varepsilon)=0$,边界就由结构保证,不依赖训练恰好学会恒等映射。若同一条真实轨迹上的相等关系一直成立到端点,就有 $f_\theta(x_t,t)=f_\theta(x_\varepsilon,\varepsilon)=x_\varepsilon$。训练通常只覆盖有限时间点和数据,且相邻状态由数值求解近似。只检查端点和若干内部配对,会漏过一个反例:函数在端点返回输入,在所有内部时刻返回零。内部配对相等,跨到端点就失败。这个函数在端点不连续,说明离散检查不能替代轨迹覆盖和函数正则性。
本文演示 Consistency Models 附录 C 的连续系数,用 512 个输入检查恒等边界。Diffusers 的离散 LCM 使用另一组时间缩放系数。端点测试只核对参数化,轨迹配对和最终样本仍需另行验证。
设学生生成器为 $G_\theta(z)$,$z$ 是初始噪声。原始 DMD 同时用两种监督:不配对的分布匹配和配对的感知回归。先把学生样本加噪成 $x_t=\alpha_tG_\theta(z)+\sigma_t\xi$,$\xi$ 是独立高斯噪声。将学生与目标用相同的前向核加噪,分别得到时刻 $t$ 的边缘密度 $p_{\mathrm{fake},t}$ 和 $p_{\mathrm{ref},t}$。原论文从反向 KL 出发,实际在带噪边缘上优化,因为平滑后两组样本的支撑更容易重叠。可把理想化目标写成:
$$L_{\mathrm{dist}}=\mathbb E_t D_{\mathrm{KL}}\left(p_{\mathrm{fake},t}\mathrel{\|}p_{\mathrm{ref},t}\right).$$
实际训练通过预训练去噪器估计参考 score,不能直接把参考等同于某个固定步数采样器的输出密度。对密度 $p$,score 指 $\nabla_{x_t}\log p(x_t)$。固定 $t$ 后,KL 是从学生样本出发的对数密度比期望。对参数求导时,固定坐标处 $\log p_{\mathrm{fake},t}$ 的显式参数导数在自身密度下积分为零,因为密度的积分恒等于 1。剩下的项经样本坐标传回生成器。设 $J_\theta G_\theta(z)$ 是学生输出对参数的雅可比矩阵,得到:
$$\nabla_\theta L_{\mathrm{dist}}=\mathbb E_{t,z,\xi}\left[\alpha_t(J_\theta G_\theta(z))^\top\bigl(s_{\mathrm{fake}}(x_t,t)-s_{\mathrm{ref}}(x_t,t)\bigr)\right].$$
上式假设密度光滑且可交换积分与求导。减号顺序对应梯度,更新参数时沿负梯度走。实际 DMD 用一个随学生变化而更新的去噪器估计 $s_{\mathrm{fake}}$,用冻结的预训练模型估计 $s_{\mathrm{ref}}$,并额外重加权时间与样本。配对回归另用同一个 $z$ 产生的教师样本提供 LPIPS 感知约束。前者约束总体分布,后者补充噪声到图像的对应关系。第 09 节用同方差的一维高斯检查 score 差的符号。DMD 原论文 §3.1–3.4
例如 $z$ 服从标准高斯时,映射 $G(z)=z$ 和 $G(z)=-z$ 的输出分布相同,但同种子的均方差为 $4$。反过来,少量配对样本的误差小也不足以证明覆盖了所有模式。
完整脚本是文末的 distill_demo.py。依赖 NumPy 与 matplotlib,不需要下载模型权重。教学数据分布选择均值为 1、方差为 0.25 的一维高斯;时间表使用 $\alpha_t=\cos t$、$\sigma_t=\sin t$,从 1.4 弧度走到零。这里的 $t$ 是调度参数,不是秒,也不是 Diffusers 的整数时间索引。
设 $x_0$ 和噪声独立,$x_0$ 的均值、方差分别是 $\mu,v$。于是 $x_t$ 的均值是 $\alpha_t\mu$,方差是 $\alpha_t^2v+\sigma_t^2$,与 $x_0$ 的协方差是 $\alpha_tv$。协方差除以带噪方差,再乘上观测偏差 $x-\alpha_t\mu$,得到从先验均值到后验均值的修正:
$$\widehat x_0^{\mathrm{teach}}(x,t)=\mu+\frac{\alpha_t v}{\alpha_t^2v+\sigma_t^2}(x-\alpha_t\mu),\qquad \mu=1,\quad v=0.25.$$
符号 $v$ 在这里是数据方差,不是扩散网络的 velocity 参数化。这个预测器是条件均值,并非声称每一个噪声对应已知干净样本。高斯条件均值对输入是仿射函数,DDIM 转移也是仿射函数;两步复合后仍然仿射。因此学生只要学习斜率与截距,就可以精确表示教师合成目标。这是实验误差接近机器精度的关键原因。
核心代码直接对应第 03 节的移项公式:
a, b = coefficients_for_step(t, s)
x0_target = (target - a * train) / b
design = np.column_stack([train, np.ones_like(train)])
slope, intercept = np.linalg.lstsq(design, x0_target, rcond=None)[0]
print(slope, intercept)
a 对应 $A_{ts}$,b 对应 $B_{ts}$,target 是教师两步终点。线性最小二乘只用于这个能够精确表示的教学系统;真实网络会用小批量优化,不能用两个系数取代图像生成器。各轮学生系数独立依赖对应的转移区间。真实模型通常以时间条件共享网络参数,本篇采用每个区间一个仿射预测器,是为了让目标与拟合误差完全可查。
运行固定随机种子 7,训练输入形状为 (256,),测试输入和输出形状均为 (512,),全部为 float64。测试输入与拟合输入分开采样。下面的数值直接取自本地 run_result.json:
| 网络评估次数 | 逐级蒸馏相对教师 RMSE | 不训练只删时间点 RMSE |
|---|---|---|
| 16 | 0 | 参照教师 |
| 8 | 2.65819e-16 | 0.0370682 |
| 4 | 2.93630e-16 | 0.105562 |
| 2 | 3.20441e-16 | 0.226265 |
| 1 | 2.89642e-16 | 0.410312 |
一阶段学生最终学到的斜率为 0.4646808695,截距为 0.9210195202。注意这是学生的干净样本预测器参数;由于最后转移到零噪声,终点恰好等于该预测。16 步教师终点的样本均值为 0.892840、标准差为 0.439749。这些数值也提醒我们:贴近教师终点不等于已经复原理论数据分布。这里有两个能分开量化的差异。设 $V_t=\alpha_t^2v+\sigma_t^2$。一维高斯的概率流 ODE 保持标准化坐标 $(x_t-\alpha_t\mu)/\sqrt{V_t}$:在一维,保持样本顺序且把当前高斯边缘映到下一高斯边缘的流保持分位数。到数据端,把标准化坐标乘 $\sqrt v$ 再加 $\mu$。在 $t=1.4$,真实起始边缘的均值约为 0.169967,标准差约为 0.989107。若仍从标准正态启动,即使精确流到零,输出总体均值也只有约 0.914081,标准差约为 0.505506。反过来,即使改用正确起始边缘,16 步教师与精确流的实测 RMSE 仍约为 0.041455。前者来自初始分布,后者来自有限步转移。
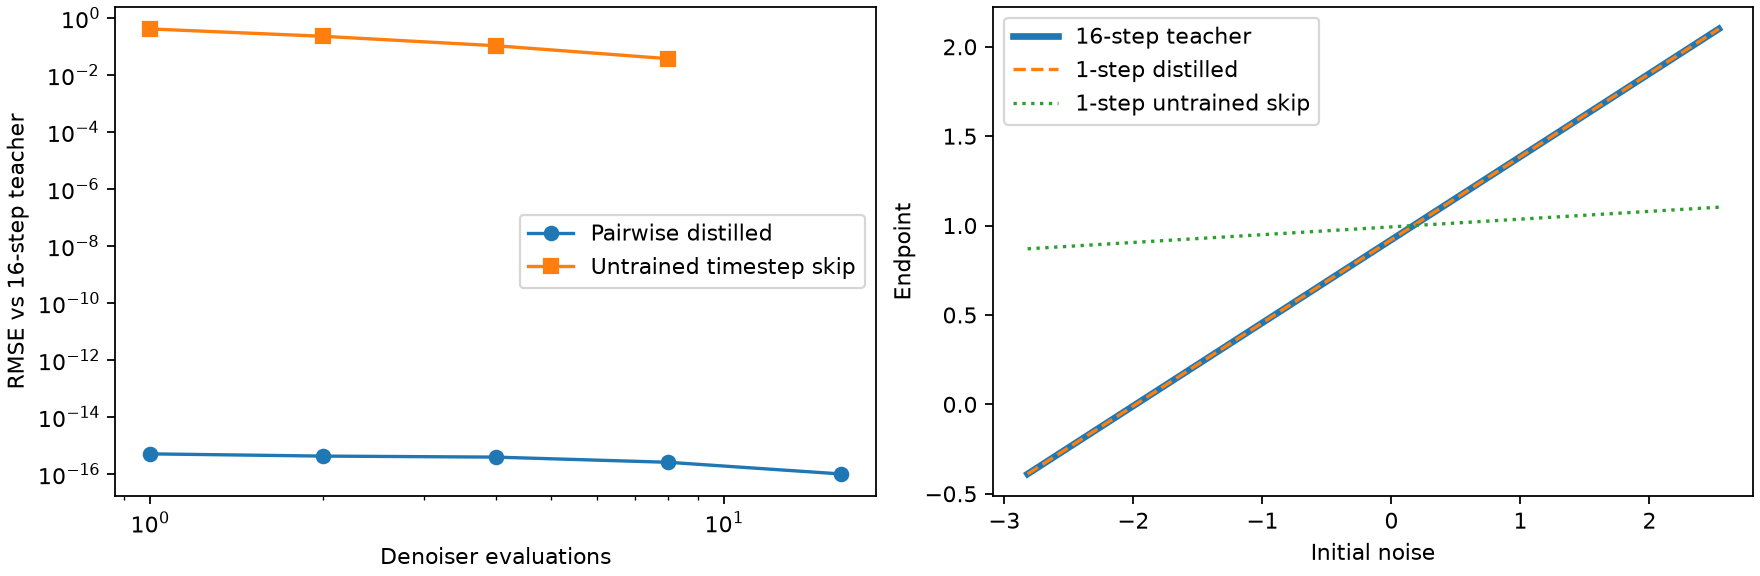
图左保留首发实跑的对数坐标,参照教师的零误差仅为作图截到 1e-16。上表来自本次重新实跑,浮点末位随实现变动,结论取决于跳步误差和舍入误差之间的数量级差距。图右看同一初始噪声对应的终点:一步学生与 16 步教师重合,未训练的一步跳转则明显偏离。配图由完整脚本生成,不包含真实图像模型实验。
实验保存每轮的最小分母绝对值与全部拟合系数。第一次减半的最小分母绝对值约为 0.176679,最后一步为 1。若更改时间表导致分母逼近零,应先解决调度与参数化问题,不要靠把无穷值裁剪成有限数掩盖目标失效。
本节以实际读取的 Diffusers v0.35.1 源码为准。固定版本与本地源码 SHA256 一起保存,可以避免将未来上游改动混进本次解释。知识树锚点是 scheduling_lcm.py 中的 LCMScheduler.step,训练对照是 train_lcm_distill_sd_wds.py。
首先,采样器要知道网络输出的语义。prediction_type 可以是噪声、干净样本或 velocity;代码先把它们转换成原始样本估计,再通过 c_out 与 c_skip 得到 denoised。若模型输出是 velocity 却按噪声解释,时间表看似正常,结果仍会错。最小代码从头到尾直接预测干净样本,省去了接口兼容层。
其次,LCM 多步采样不是照抄本文确定性 DDIM。该版本 step 在非末步将 denoised 按下一时刻的信号系数缩放,并加入新噪声;末步直接返回 denoised。随机数生成器、设备、dtype 和当前步索引都会影响实际行为。把一次生成的全部中间状态当成完全确定的同一轨迹,在这种采样模式下就需要重新说明随机性条件。
再看训练脚本,DDIMSolver.ddim_step 使用索引从累计信号系数中取对应时间点;教师进行条件与无条件预测后构造引导结果;目标学生在较低噪声状态上预测终点;当前学生与停止梯度的目标输出进行比较。滑动平均目标网络提供较平稳的监督。教师、当前学生、目标学生是不同角色,不能因为它们最初权重相同,就把三份输出混为一谈。
设 $q_c,q_\varnothing$ 分别是条件与无条件预测。该脚本把 LCM 约定的 $w$ 用在 $q_c+w(q_c-q_\varnothing)$,并将 $w$ 编码后传给学生。Imagen 风格常写成 $q_\varnothing+g(q_c-q_\varnothing)$。展开第一式便得 $g=w+1$,例如 $w=3$ 对应 $g=4$。固定版本在干净样本估计和噪声估计上都应用同一个 $w$,再调用 DDIM 求解器推进一次教师转移。Diffusers v0.35.1 训练实现
本文还在本地实际执行了官方 LCMScheduler.step 与离散边界系数方法的源码片段,使用 CPU 张量核对末步和非末步的数值、形状与随机数分支。该验证覆盖采样方法的运算,未加载完整 pipeline、没有模型权重,也没有测 GPU 性能。它能支持本节对分支逻辑的说明,不能支持某个图像模型已达到论文质量的说法。
实际输入张量形状为 (1, 1, 2, 2),类型为 float64,随机种子为 19。非末步输出与单独按公式计算的最大差为 1.11022e-16,末步输出与 denoised 的最大差为 0;两步中仅非末步调用一次噪声生成。这些检查使用原方法与显式配置夹具,不等同于完整库的端到端测试。
工业训练还包含 VAE 编码、文本条件、混合精度、梯度裁剪、分布式数据流、训练状态恢复和验证集。最小实验刻意隔离这些因素,让读者先查明“损失是不是在教学生完成更大的跨度”。进入生产时,这些系统环节会重新成为质量与稳定性的约束,不能把教学脚本直接称为部署实现。
少步节约的是推理阶段反复评估去噪器的成本,代价包括教师构造目标、学生训练与新增权重的管理。训练是否划算,取决于实际生成请求量、教师成本、学生维护周期和质量验收要求。不是所有偶尔使用的模型都值得蒸馏。
网络评估次数不等于端到端加速倍数。设固定开销为 $T_{\mathrm{fixed}}$,单次网络评估耗时为 $T_{\mathrm{eval}}$,评估次数为 $N$,一个仅用于预算的模型是:
$$T(N)=T_{\mathrm{fixed}}+N T_{\mathrm{eval}}.$$
这里固定开销包括可能的文本编码、VAE 解码、传输与后处理。该式假设每次评估成本相同,真实 CFG 批处理和内核行为可能打破假设。本文没有实测这些项,所以不报告墙钟加速。即使循环次数大幅下降,VAE 解码占比也会升高,随后要优化的瓶颈可能已经换了位置。
质量边界至少有三个层面。第一,学生近似教师时可能继承教师已有的偏差;第二,有限容量与优化误差会产生额外偏差;第三,训练条件以外的提示词、分辨率、长视频长度和引导强度可能引发分布外问题。高质量的平均评分不能自动证明每个困难场景都被保留。
本文的仿射教师让函数复合仍留在同一个表示族里,学生可以达到数值精度。真实神经网络的两步复合通常更复杂,一次调用不一定有足够容量表达。若将本实验的近零误差当成“一步生成原则上没有任何质量损失”的证明,就越过了实验边界。
还可以给误差积累一个有条件的上界。记第 $i$ 段教师转移为 $T_i$,学生转移为 $S_i$,两条轨迹进入该段时的状态差为 $e_i$。假设在实际经过的状态范围内,学生转移对输入变化的放大系数不超过 $K_i$,并且同一教师输入上的学生转移误差不超过 $\delta_i$。加减同一个学生转移项,再使用三角不等式,可得:
$$e_{i+1}\leq K_i e_i+\delta_i.$$
这是把两种误差拆开:旧状态差经过学生映射被放大,新转移近似又添加一项。由同样初始状态出发,初始误差为零,递推展开得到:
$$e_m\leq\sum_{i=0}^{m-1}\delta_i\prod_{j=i+1}^{m-1}K_j.$$
空乘积取一。该上界要求真的具有上述局部放大与误差界,本文没有测量真实网络的这些常数,因此不将它当作质量保证。它说明为什么只看训练样本上的单段误差不够:后续映射可能放大差异,而学生在前段产生的新状态也可能超出监督覆盖范围。推理验收需要完整走完轨迹,不能只展示教师输入上的一张损失曲线。
采样器的高阶积分、跨步缓存、量化和蒸馏可以一起考虑,但需要组合验收。缓存引入的时序近似、量化的数值误差、蒸馏的学习误差未必相互独立。不能把单独测试的加速倍数相乘,再宣称组合后同时保留各自的质量结果。
对于交互式编辑与可控生成,还要检查原模型所支持的控制插件、低秩适配和条件接口是否与学生兼容。某个模型在简单文生图上通过验收,不等于已有的编辑工作流可以直接迁移。这里是工程验收建议,而非对所有蒸馏模型作相同能力限制。
下面五篇按它们改变的对象排列,并非所有方法都沿着单一继承链发展。没有标注会议、评分或硬件数字的地方,不应自行补上这些背书。
读这一脉络时,先标记“没有改权重而改采样”、“学有限跨度转移”、“学轨迹终点”和“学分布”这几类对象,再比较成本与质量。否则容易把一篇论文的训练方式和另一篇论文的采样器拼成不存在的方法。
论文之间的评测设置也不同。某个数据集上的无条件 FID、某个文生图模型的人工偏好与视频的时序稳定性不是同一问题。本文保留论文身份与机制关联,避免把不同基准的数字排成一个貌似统一的排行榜。
误解一:把 50 个时间点改成 4 个就是蒸馏。 这只是删时间点或换采样设置。学生权重是否经过专门训练、目标是否考虑大跨度,才决定是否完成了蒸馏。本文的不训练跳步对照给出了明确反例。
误解二:学生预测的干净图必须等于训练数据真值。 在本文渐进目标里,学生预测的是为了重现教师两步终点而反解的量。它承担了有限步转移的补偿,不能机械套用原始去噪标签解释。
误解三:一致性只是任意两张带噪图输出一样。 输入之间需要相应的轨迹关系,数据端还需要边界约束。任意配对可能破坏监督;缺少边界约束则连常数输出都可能满足相等。
误解四:同种子图像不同说明分布蒸馏失败。 配对一致与分布一致是不同目标。判断 DMD 等路线需要分布与任务评测,同种子逐像素差异不能单独决定成功或失败。
误解五:scheduler 中的边界系数已经完成了一致性训练。 系数提供结构与采样规则,真正承载学到的生成映射的是权重。未蒸馏的网络接入一个 LCM scheduler,不会因为公式合法就拥有 LCM 能力。
误解六:本实验一步误差近零证明图像也能无损一步。 本实验的仿射表示族对复合封闭,且监督完全可计算。图像网络没有获得这项保证;还存在有限训练、数据覆盖和条件组合等问题。
从文末把 distill_demo.py 和 distill_checks.py 复制到同一目录,安装依赖后运行。主脚本会打印 JSON,并在脚本目录生成 run_result.json 与配图。若脚本位于项目的 code/ 下,默认输出到文章目录。也可以用 --output-dir 单独保存本次结果。
python -m pip install numpy matplotlib
python distill_demo.py
python distill_checks.py
先不改任何参数,对照表格中的四种压缩结果。不同 NumPy 与线性代数库可能使最后几位舍入误差不同;应检查数量级与断言通过,不要求每一个浮点字符串逐字相同。直接跳步的误差应明显大于机器精度,逐级拟合则在这个仿射问题中接近机器精度。
distill_checks.py 给教师预测加上 0.05 * np.tanh(x),固定 seed 23,用 256 个输入拟合,另用 512 个输入测试。在第一个两步区间,仿射学生的终点 RMSE 约为 0.001599,明显高于仿射教师的舍入误差。脚本还检查一个同方差高斯例子:学生均值偏大时,反向 KL 的解析梯度约为 0.63,与中心有限差分相差约 7.01e-12。沿负梯度移动会降低 KL,这让第 03 节 score 差的符号可以直接检查。
验证脚本还检查了九个非法输入。重复时间点由时间表校验拦下,几乎重合的时间点由最小分母拦下。奇数步、网格与预测器数目不匹配及秩亏拟合也会明确报错。这帮助区分“训练效果差”和“监督本身没有定义”。如果只是把 NaN 替换成零,后面的均方误差会产生没有意义的数值。
最后单独检查一致性端点。本脚本已经实际调用边界函数,输出 boundary_max_error 为 0。若删除跳连系数或让输出系数在端点仍非零,恒等边界便不再由结构保证。这个实验不等于训练了一致性生成器,但能验证参数化究竟保证了哪一个性质。
先回到 DDIM 与高阶采样器,区分数值积分误差和网络误差;再读 CFG 的代价与调法,把教师的条件组合与学生条件输入接起来。若连教师在何种引导方式下产生目标都没确定,少步比较就缺少共同基准。
同在推理加速方向,扩散跨步缓存关注复用已有计算,量化关注数值表示的成本。它们与训练学生解决不同的成本来源,适合通过统一质量预算比较,而不是只排列循环次数。
视频生成评测 进一步说明怎么把少步生成的时序稳定性、主体保持和提示词遵循拆开验收。本文到这里建立的是监督目标与可复现代数实验,真正选择一个少步模型,还要回到自己的任务、条件范围和实际质量门槛。
09 节用到的脚本全文如下(distill_demo.py、distill_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""CPU teaching experiment: exact pairwise DDIM distillation for an affine teacher.

Dependencies: numpy, matplotlib. No model weights or image-quality benchmark.
"""
import argparse
import json
from pathlib import Path
import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt


def schedule(t):
    return np.cos(t), np.sin(t)


def teacher_x0(x, t):
    # Posterior mean for one-dimensional N(mu, variance) data under VP noise.
    mu, variance = 1.0, 0.25
    alpha, sigma = schedule(t)
    weight = alpha * variance / (alpha * alpha * variance + sigma * sigma)
    return mu + weight * (x - alpha * mu)


def coefficients_for_step(t, s):
    if not 0.0 <= s < t <= np.pi / 2:
        raise ValueError('Expected 0 <= s < t <= pi/2')
    sigma_t = np.sin(t)
    a = np.sin(s) / sigma_t
    b = np.sin(t - s) / sigma_t
    if b < 1e-10:
        raise ValueError('Degenerate distillation interval')
    return a, b


def ddim(x, x0, t, s):
    a, b = coefficients_for_step(t, s)
    return a * x + b * x0


def validate_grid(predictors, grid):
    grid = np.asarray(grid, dtype=np.float64)
    if grid.shape != (len(predictors) + 1,) or not predictors:
        raise ValueError('Expected one more time point than predictors')
    if not np.all((0 <= grid) & (grid <= np.pi / 2)) or not np.all(np.diff(grid) < 0):
        raise ValueError('Expected a strictly decreasing grid within [0, pi/2]')
    return grid


def sample(predictors, grid, x):
    grid = validate_grid(predictors, grid)
    x = np.asarray(x, dtype=np.float64).copy()
    for i, predictor in enumerate(predictors):
        x = ddim(x, predictor(x, grid[i]), grid[i], grid[i + 1])
    return x


def distill(predictors, grid, train):
    grid = validate_grid(predictors, grid)
    if len(predictors) % 2:
        raise ValueError('Pairwise distillation requires an even number of steps')
    train = np.asarray(train, dtype=np.float64)
    if train.ndim != 1 or train.size < 2 or not np.isfinite(train).all():
        raise ValueError('Expected at least two finite scalar training inputs')
    design = np.column_stack([train, np.ones_like(train)])
    if np.linalg.matrix_rank(design) != 2:
        raise ValueError('The affine training design must have rank 2')
    new_grid = grid[::2]
    students, coefficients, denominators = [], [], []
    for j in range(0, len(predictors), 2):
        t, u, s = grid[j:j + 3]
        middle = ddim(train, predictors[j](train, t), t, u)
        target = ddim(middle, predictors[j + 1](middle, u), u, s)
        a, b = coefficients_for_step(t, s)
        x0_target = (target - a * train) / b
        slope, intercept = np.linalg.lstsq(design, x0_target, rcond=None)[0]

        def predictor(x, unused_t, slope=slope, intercept=intercept):
            return slope * x + intercept

        students.append(predictor)
        coefficients.append([float(slope), float(intercept)])
        denominators.append(float(b))
    return students, new_grid, coefficients, denominators


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('--output-dir', type=Path, help='Directory for JSON and figures')
    args = parser.parse_args()
    here = Path(__file__).resolve().parent
    folder = args.output_dir or (here.parent if here.name == 'code' else here)
    rng = np.random.default_rng(7)
    train = rng.normal(size=256)
    test = rng.normal(size=512)
    grid = np.linspace(1.4, 0.0, 17)
    predictors = [teacher_x0] * 16
    golden = sample(predictors, grid, test)
    rows = [{'steps': 16, 'max_error': 0.0, 'rmse': 0.0}]
    stages = []
    while len(predictors) > 1:
        predictors, grid, coefficients, denominators = distill(predictors, grid, train)
        result = sample(predictors, grid, test)
        rows.append({'steps': len(predictors), 'max_error': float(np.max(np.abs(result - golden))),
                     'rmse': float(np.sqrt(np.mean((result - golden) ** 2)))})
        stages.append({'steps': len(predictors), 'coefficients': coefficients,
                       'min_abs_denominator': float(np.min(np.abs(denominators)))})
        assert np.allclose(result, golden, rtol=1e-11, atol=1e-11)
    skipping = []
    for steps in [8, 4, 2, 1]:
        skip_grid = np.linspace(1.4, 0.0, steps + 1)
        result = sample([teacher_x0] * steps, skip_grid, test)
        skipping.append({'steps': steps, 'rmse': float(np.sqrt(np.mean((result - golden) ** 2)))})
    # Boundary identity: f(x,t)=c_skip*x+c_out*F(x,t), sigma_data=0.5.
    eps, sigma_data = 0.002, 0.5
    def consistency_boundary(x, t):
        delta = t - eps
        c_skip = sigma_data ** 2 / (delta ** 2 + sigma_data ** 2)
        c_out = sigma_data * delta / np.sqrt(t ** 2 + sigma_data ** 2)
        return c_skip * x + c_out * np.tanh(x)
    boundary_error = float(np.max(np.abs(consistency_boundary(test, eps) - test)))
    assert boundary_error == 0.0
    result = {'seed': 7, 'dtype': str(test.dtype), 'train_shape': list(train.shape),
              'test_shape': list(test.shape), 'output_shape': list(golden.shape),
              'teacher_endpoint_mean': float(golden.mean()), 'teacher_endpoint_std': float(golden.std()),
              'distilled': rows, 'untrained_skip': skipping, 'stages': stages,
              'boundary_max_error': boundary_error,
              'scope': 'affine Gaussian teaching teacher; no neural network or image-quality claim'}
    (folder / 'figures').mkdir(parents=True, exist_ok=True)
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6), constrained_layout=True)
    axes[0].plot([r['steps'] for r in rows], [max(r['rmse'], 1e-16) for r in rows], 'o-', label='Pairwise distilled')
    axes[0].plot([r['steps'] for r in skipping], [r['rmse'] for r in skipping], 's-', label='Untrained timestep skip')
    axes[0].set(xscale='log', yscale='log', xlabel='Denoiser evaluations', ylabel='RMSE vs 16-step teacher')
    axes[0].legend()
    order = np.argsort(test)
    skip_one = sample([teacher_x0], np.array([1.4, 0.0]), test)
    one = sample(predictors, grid, test)
    axes[1].plot(test[order], golden[order], label='16-step teacher', lw=3)
    axes[1].plot(test[order], one[order], '--', label='1-step distilled')
    axes[1].plot(test[order], skip_one[order], ':', label='1-step untrained skip')
    axes[1].set(xlabel='Initial noise', ylabel='Endpoint')
    axes[1].legend()
    fig.savefig(folder / 'figures/distillation_error.png', dpi=160,
                metadata={'Software': 'PairwiseDistillationTeachingDemo'})
    plt.close(fig)
    (folder / 'run_result.json').write_text(json.dumps(result, indent=2), encoding='utf8')
    print(json.dumps(result, indent=2))


if __name__ == '__main__':
main()"""Independent scalar checks for the distillation article. Run with NumPy."""
import json
import numpy as np
from distill_demo import coefficients_for_step, ddim, distill, sample, teacher_x0
def main():
rng = np.random.default_rng(23)
x = rng.normal(size=512)
grid = np.linspace(1.4, 0.0, 17)
train = rng.normal(size=256)
affine_errors = []
for t, u, s in zip(grid[::2], grid[1::2], grid[2::2]):
# Derive each Gaussian conditional mean slope and intercept independently.
at, au = np.cos([t, u])
vt, vu = 0.25 * np.cos([t, u]) ** 2 + np.sin([t, u]) ** 2
mt, mu = 0.25 * at / vt, 0.25 * au / vu
ct, cu = 1 - mt * at, 1 - mu * au
a1, a2 = np.sin([u, s]) / np.sin([t, u])
b1, b2 = np.cos([u, s]) - np.cos([t, u]) * [a1, a2]
m1, m2 = a1 + b1 * mt, a2 + b2 * mu
expected = m2 * m1 * x + m2 * b1 * ct + b2 * cu
student, short_grid, _, _ = distill([teacher_x0] * 2, [t, u, s], train)
affine_errors.append(float(np.max(np.abs(sample(student, short_grid, x) - expected))))
assert max(affine_errors) < 1e-12
def nonlinear(inputs, t):
return teacher_x0(inputs, t) + 0.05 * np.tanh(inputs)
t, u, s = grid[:3]
student, short_grid, _, _ = distill([nonlinear] * 2, [t, u, s], train)
reference = sample([nonlinear] * 2, [t, u, s], x)
nonlinear_rmse = float(np.sqrt(np.mean((sample(student, short_grid, x) - reference) ** 2)))
assert nonlinear_rmse > 1e-4
invalid_cases = [
lambda: sample([teacher_x0], [1, 0.5, 0], x),
lambda: sample([teacher_x0], [0, 0.5], x),
lambda: sample([teacher_x0] * 2, [1, 1, 0], x),
lambda: sample([teacher_x0], [np.nan, 0], x),
lambda: distill([teacher_x0], [1, 0], train),
lambda: distill([teacher_x0] * 2, [1, 0.5, 0], np.ones(4)),
lambda: distill([teacher_x0] * 2, [1, 0.5, 0], [0, np.inf]),
lambda: ddim(x, x, 0, 0),
lambda: coefficients_for_step(1, 1 - 1e-12),
]
rejected = []
for case in invalid_cases:
try:
case()
except ValueError as error:
rejected.append(str(error))
else:
raise AssertionError('Invalid input accepted')
# One scalar reverse KL. The smoothed fake and target share variance.
alpha, sigma, theta, target_mean = 0.6, 0.8, 1.25, -0.5
variance = alpha ** 2 + sigma ** 2
def kl(mean):
return (alpha * (mean - target_mean)) ** 2 / (2 * variance)
delta = 1e-5
numerical = (kl(theta + delta) - kl(theta - delta)) / (2 * delta)
noisy = alpha * (x + theta) + sigma * rng.normal(size=x.shape)
fake_score = -(noisy - alpha * theta) / variance
target_score = -(noisy - alpha * target_mean) / variance
by_score = float(np.mean(alpha * (fake_score - target_score)))
assert abs(numerical - by_score) < 1e-10 and by_score > 0
assert kl(theta - 0.1 * by_score) < kl(theta)
# Endpoint boundary alone can hold while all sampled interior values collapse.
eps = 0.002
def boundary_only(z, time):
return z if time == eps else np.zeros_like(z)
assert np.array_equal(boundary_only(x, eps), x)
assert np.array_equal(boundary_only(x, 0.5), boundary_only(x + 2, 1.0))
assert not np.array_equal(boundary_only(x, 0.5), boundary_only(x, eps))
# Exact transport for a one-dimensional Gaussian marginal under the VP schedule.
terminal = 1.4
start_mean = float(np.cos(terminal))
start_std = float(np.sqrt(0.25 * np.cos(terminal) ** 2 + np.sin(terminal) ** 2))
exact_from_gaussian = 1 + 0.5 * ((start_mean + start_std * x) - start_mean) / start_std
assert np.allclose(exact_from_gaussian, 1 + 0.5 * x, atol=1e-14, rtol=0)
finite_grid = sample([teacher_x0] * 16, grid, start_mean + start_std * x)
print(json.dumps({
'seed': 23, 'cases': len(affine_errors), 'affine_max_abs': max(affine_errors),
'nonlinear_pair_rmse': nonlinear_rmse, 'rejected_invalid_cases': rejected,
'dmd_score_gradient': by_score, 'dmd_finite_difference': numerical,
'boundary_only_collapse_confirmed': True,
'start_true_mean': start_mean, 'start_true_std': start_std,
'ideal_data_mean_from_standard_prior': 1 - 0.5 * start_mean / start_std,
'ideal_data_std_from_standard_prior': 0.5 / start_std,
'finite_teacher_with_exact_start_rmse': float(np.sqrt(np.mean((finite_grid - exact_from_gaussian) ** 2))),
'assertions': 'passed'
}, indent=2))
if __name__ == '__main__':
main()

评论 (0)