
搜索到
240
篇与
人工智能炼丹君
的结果
-
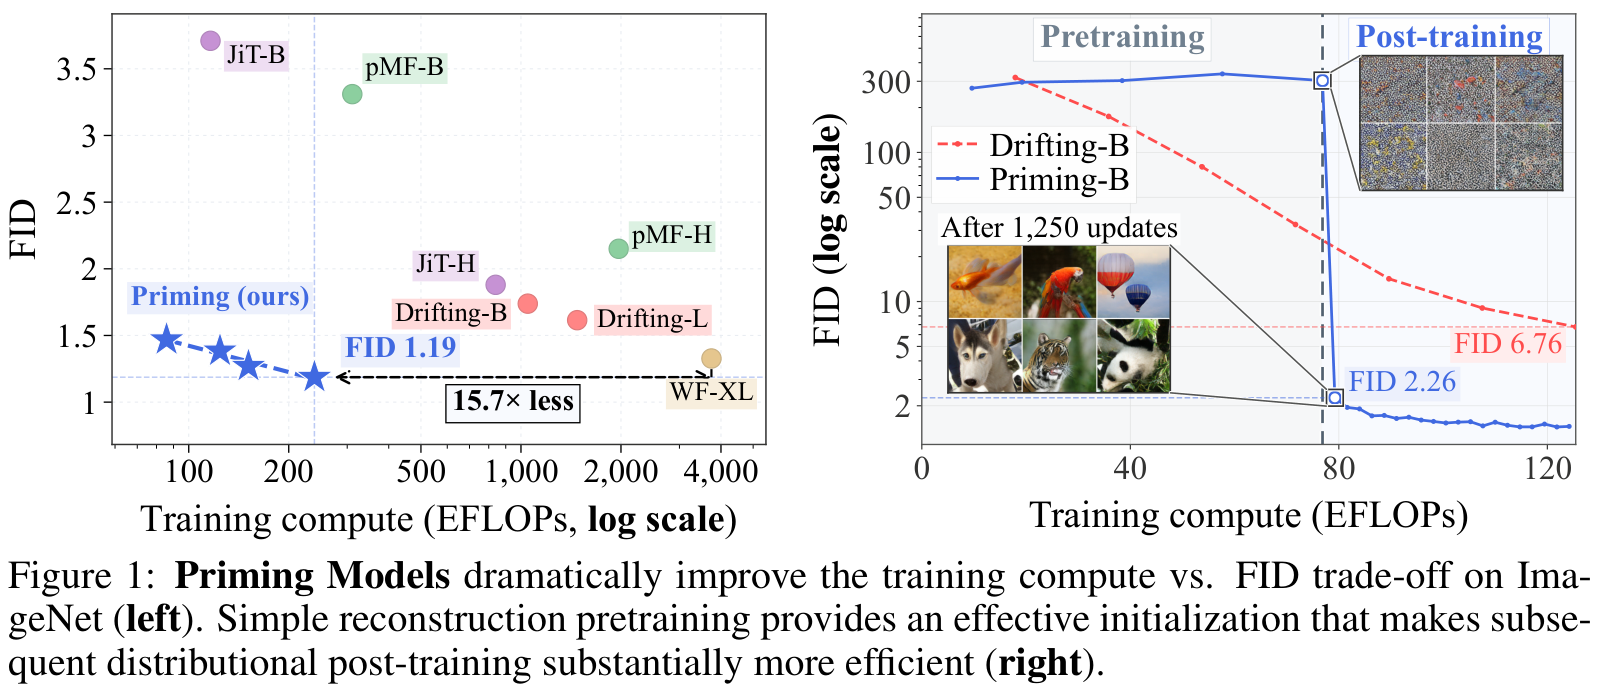
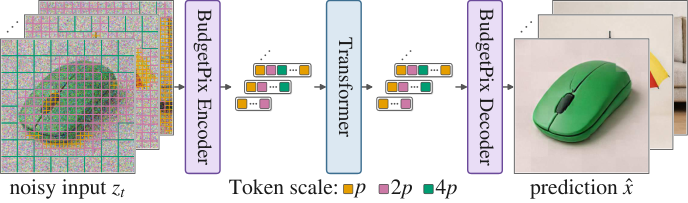
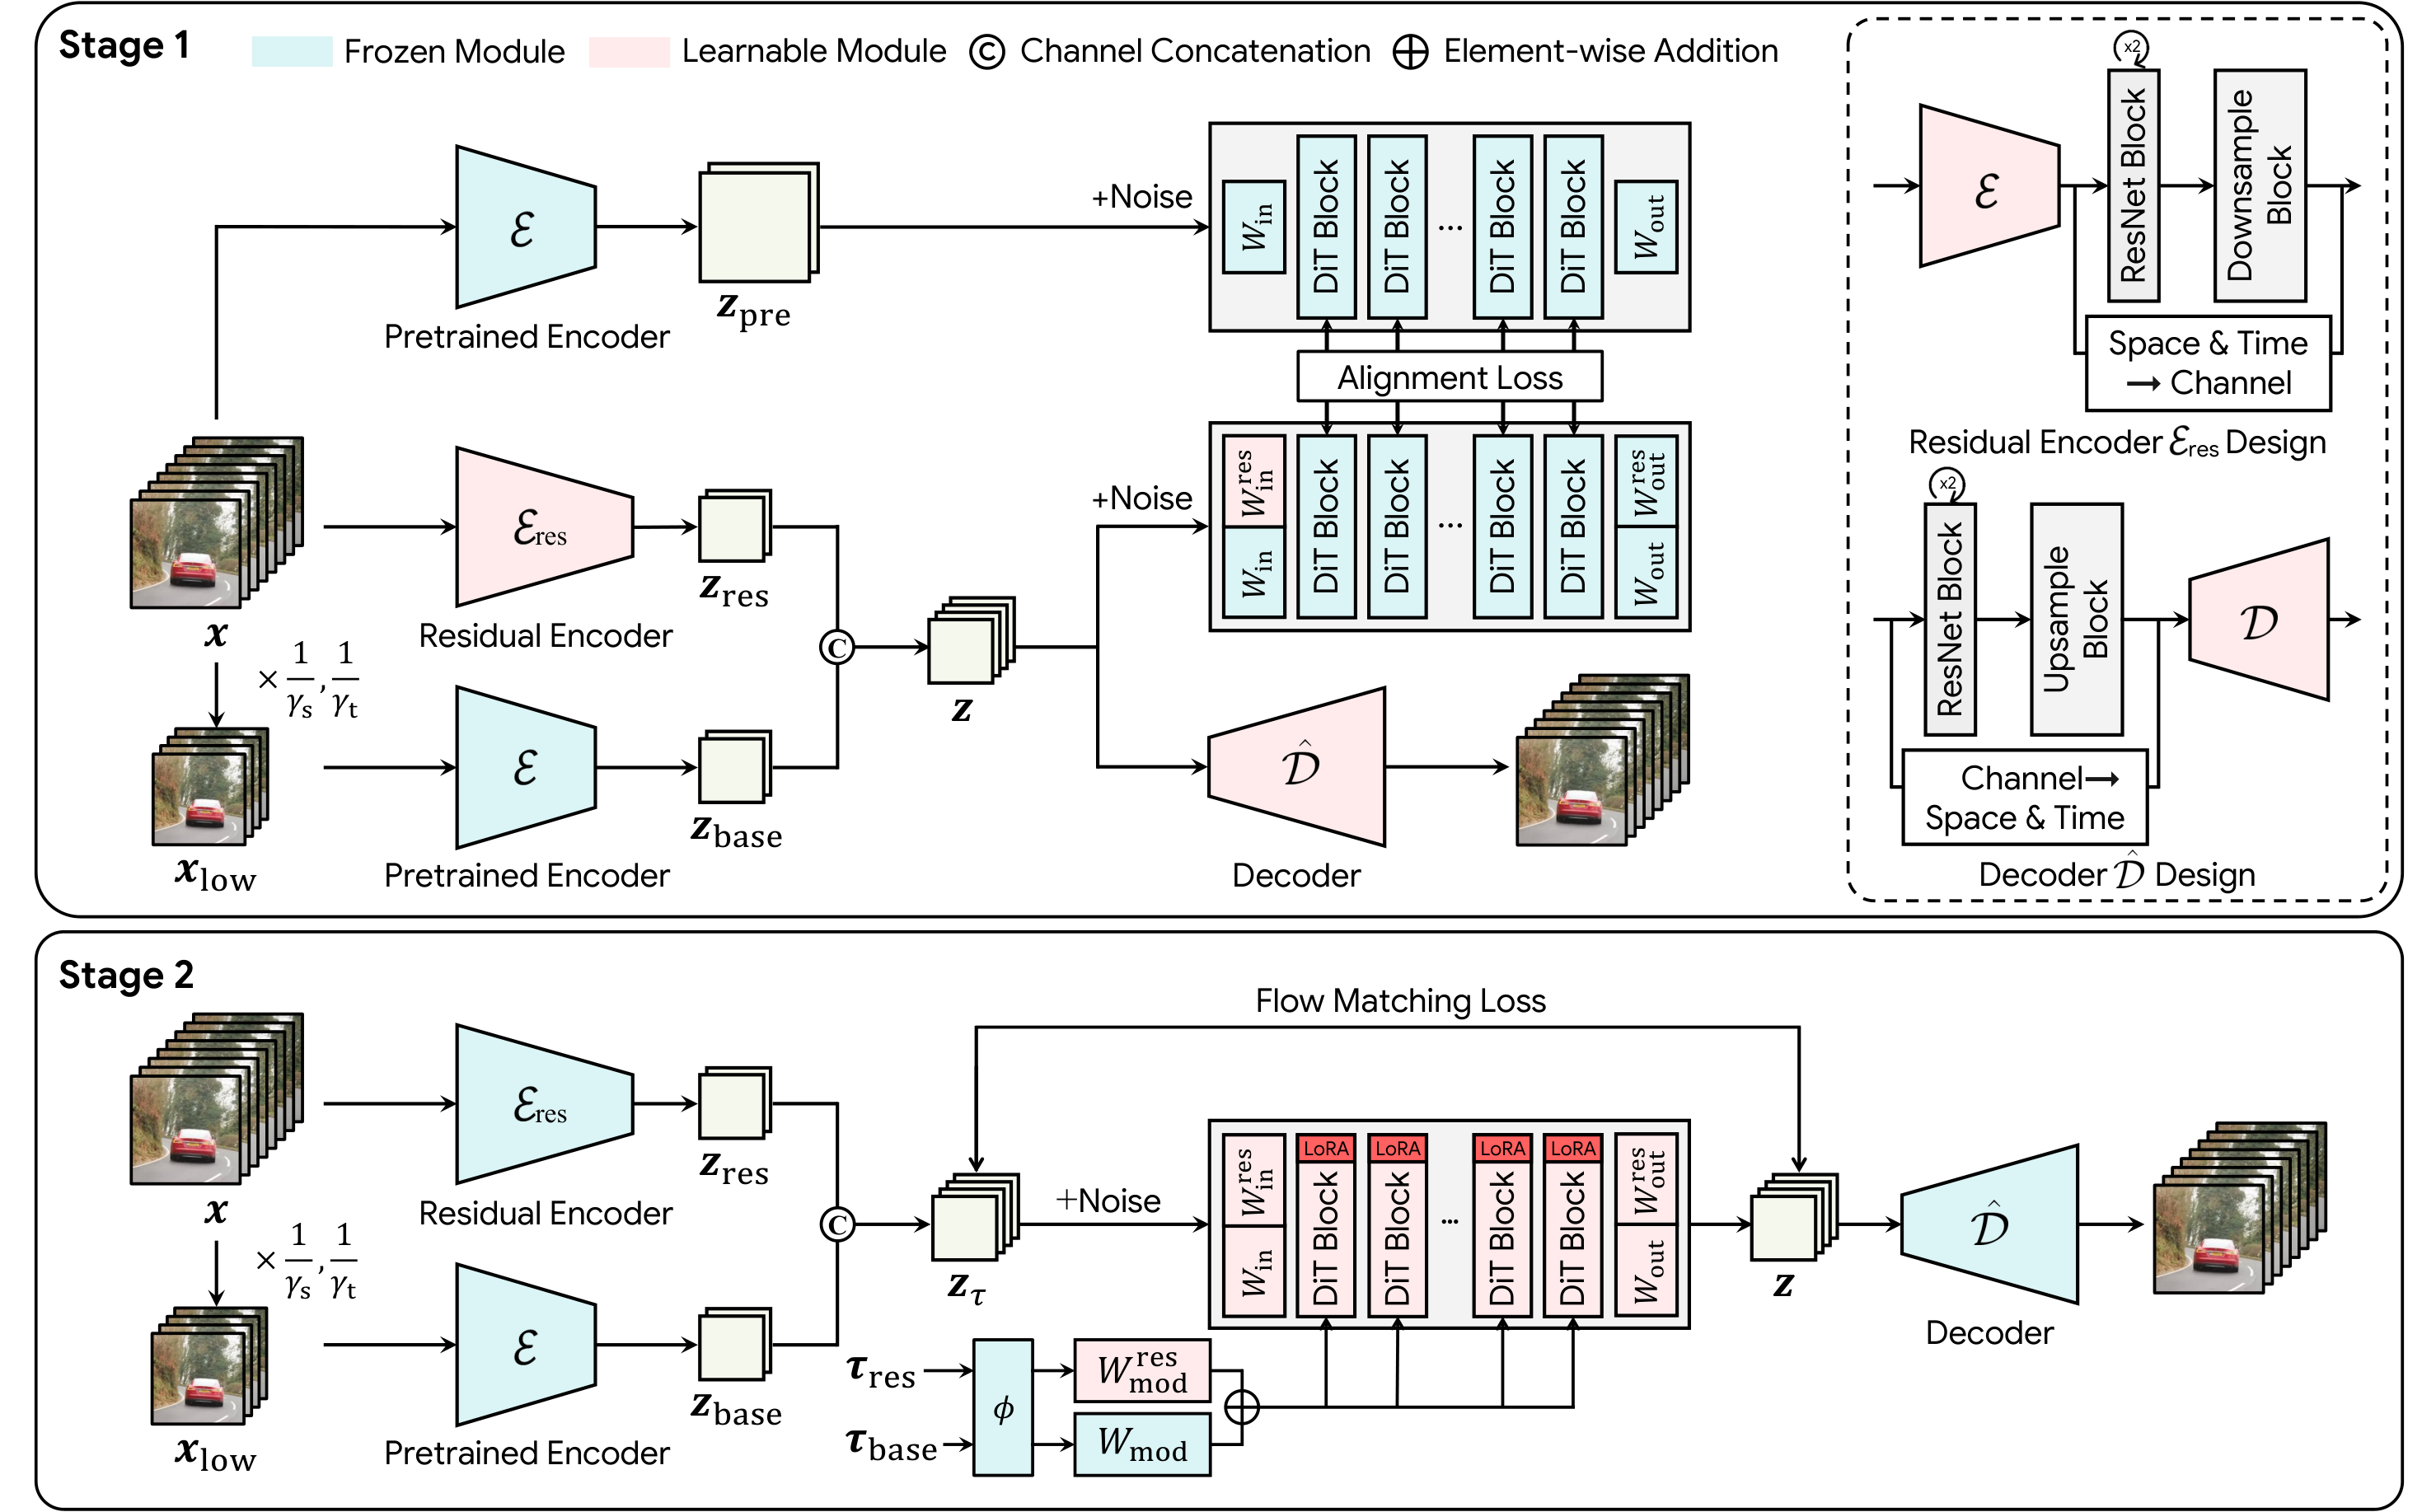
 AIGC 每日速读|2026-10-16|首尔大学先修图再一步生成Priming 今日 AIGC 论文速览 今日共 10 篇 · 一步生成与表征训练 2 篇 · 视频蒸馏与交互服务 2 篇 · 视频缓存压缩 1 篇 · 原生高分辨率编辑 1 篇 · 三维场景生成 1 篇 · 语音驱动与语音合成 2 篇 · 生成视频物理评测 1 篇 重点论文标题列表 Priming(首尔大学):先学修复再学一步作画 RECON(澳国立):把语义送进生成器后半段 Glance Forcing(武汉大学):一条轨迹只负责初始化 Speculative Sampling(中科大):先画未来但别急着提交 TempoKV(上交):缓存只存难预测的残差 选读入口:训练一步图像模型先读 Priming,再读 RECON 理解语义如何传到后层;做少步视频看 Glance Forcing,搭交互产品再看 Speculative Sampling 的到显示时延,长视频显存紧张看 TempoKV。需要4K改图看 BluePixel 的背景保留,换相机重访同一场景看 SceneAE。语音驱动人像看 Kandinsky S2V,要研究解码能否改错看 Revise-TTS;最后用 PhyMetric 检查视频到底违反了什么物理现象。 今日论文速览 1. Priming:先学修复再学一步作画 Are We Overthinking One-Step Generation? | 首尔大学;哈佛大学 | arXiv:2610.20331 关键词:一步生成, 重建预训练, 分布后训练, 最优传输 前序问题:想把噪声一次变成图像,直接从零匹配整批生成图与真实图的分布,训练常很昂贵。模型还没学会物体结构,就要同时解决像什么、覆盖哪些样本的问题。 方法直觉:先练修复被噪声破坏的图像,再练从纯噪声作画。修复阶段有一一对应的正确答案,先教会网络图像长什么样;后训练再要求一批作品的整体分布接近真实数据。 本文贡献:Priming Models 两阶段使用同一生成网络。第一阶段在固定噪声水平 s=0.8 做像素重建,并加感知特征损失;s 表示混入噪声的水平,不是采样步数。第二阶段从高斯噪声一步生成,利用冻结图像编码器的特征做熵正则最优传输:在两批特征间分配匹配关系,并加入停止梯度的生成样本项,即该分支只作数值参照、不反向更新,以优化分布而非逐图照抄。默认不用额外可学习风格向量,也不需要多步扩散教师蒸馏。 图1|Priming 的训练投入与生成质量:左侧在ImageNet比较训练浮点运算量与FID,展示质量和训练成本的权衡;右侧说明简单重建预训练提供有效初始化,使后续分布后训练更高效。FID是生成与真实特征分布的距离,越低越好。 实验效果:ImageNet 的256×256类别条件生成中,约4.051亿参数的 Priming-L 先训练160遍数据,再后训练25000次更新,FID为1.19,总训练量238.95 EFLOPs;1 EFLOP代表10的18次方浮点运算。FID衡量生成与真实图像特征分布差异,越低越好。原表 W-Flow 为1.33、3744.43 EFLOPs,属于不同方法的训练账本比较。文生图的一步版本 GenEval 从一步 MeanFlow 的0.548提高到0.818;GenEval测物体、属性与空间组合正确率,但仍低于100步流模型的0.873。 表2|文生图对比:Priming优于一步MeanFlow,使用logit-normal噪声分布预训练的变体以较少训练运算接近四步MeanFlow;扩展到两步也具有竞争力。†标记的对照数值来自Wang等人2026a论文。GenEval衡量物体属性组合正确率,DPG-Bench衡量密集文本指令遵循,均越高越好;EFLOPs是训练浮点运算总量,不是秒数。 批判点评:摘要“约十分之一训练量”不能解释为同硬件快十倍;预训练、特征编码与批间传输计算仍要支付。训练特征选择也会改变排名:更换编码器可改善另一分布指标却恶化FID,说明单分数不足以验收。RT-1视频预测中,其FVD(视频特征分布距离,越低越好)为30.96,仍差于32步流模型的27.24,不能照搬表注称所有质量指标均胜。本文代码提供训练入口,本次未实跑模型。作者代码。 2. RECON:把语义送进生成器后半段 Representation Conditioning for Generation | 澳大利亚国立大学 | arXiv:2610.20608 关键词:表征条件, 语义注入, 训练加速, 扩散Transformer 前序问题:用视觉编码器监督生成器的前几层,前半段学到了物体语义,后半段却未必能用好。以往 REPA 表征对齐训练结束后,还会丢掉连接两种特征的投影头。 方法直觉:把已经学会的语义做成一张便签,直接交给后面的绘图层。训练时用真实图像提取的可靠便签;生成时没有真实图,就让保留下来的投影头估计这张便签。 本文贡献:Representation Conditioning(RECON,表征条件)将视觉编码器特征池化成默认1个语义 token,即供网络注意力读取的特征单元,与图像块特征拼接送入后续层。推理复用 REPA 的多层感知机投影头,因此不再调用真实图像编码器。为缓解训练用真特征、推理用预测特征的落差,只在归一化噪声时间 t<0.5 时注入;高噪声阶段不提供便签。默认大模型用零填充对齐维度,无新增参数;小模型若特征维度不足,仍可能增加线性映射。 图1|RECON把原先丢弃的表征用于后层条件:(a)REPA以冻结视觉编码器监督投影头gϕ,推理时丢弃该头;(b)RECON训练时将视觉编码器的token送往后层;(c)推理保留gϕ作为编码器代理,执行同样条件注入;(d)ImageNet 256×256、无引导的五万样本生成FID随训练步数变化,RECON更早达到SiT-XL/2与REPA最终质量。 实验效果:ImageNet 256×256、SiT-XL/2、批量256、无引导设置下,训练40万次更新后,RECON的生成FID为3.25,REPA为7.90;延长到240万次为2.21。该指标用5万生成样本估计,越低越好。摘要63倍对SiT、25倍对REPA指达到相近质量所需的训练收敛进度,不是推理速度。MS-COCO文生图在MMDiT、15万次训练、50次网络评估、引导强度1下,FID从9.85降到8.26,图文特征相似度CLIP从0.2273升到0.2313。 表3|MS-COCO文生图:MMDiT主干,常微分方程采样,50 NFE(网络函数评估次数),训练150000次;w是引导强度。FID越低越好,CLIP图文相似度越高越好;在展示的两种引导强度下RECON优于REPA。 批判点评:保留投影头、拼接语义token都需要运行,参数不增不代表零推理开销。ImageNet主协议仍用250步随机微分方程采样,文生图用50步常微分方程采样,不能称一步生成。不同引导方式会改变最终排名;有引导的系统对比还包含Autoguidance(以较弱生成模型作参照的引导),必须与无引导收敛图分开读。作者代码。 3. Glance Forcing:一条轨迹只负责初始化 Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance | 武汉大学;电子科技大学;中山大学;华盛顿大学;新加坡国立大学;中南大学 | arXiv:2610.20220 关键词:视频蒸馏, 慢快专家, 轨迹初始化, 分布匹配 前序问题:把能同时看前后帧的视频模型变成实时逐块生成器,通常先收集大量教师去噪轨迹。若只留一条轨迹,单个学生同时拟合布局和纹理,质量会明显崩塌。 方法直觉:先搭骨架和最后描细节,本来就不该由同一种步伐完成。把高噪声阶段的语义布局与低噪声阶段的细节交给不同适配器,减少它们争用同一表示的冲突。 本文贡献:Glance Forcing 使用慢、快两组 LoRA,即少量低秩可训练权重;预训练教师保持冻结。慢专家处理早期结构,快专家处理后期纹理,各自接受阶段目标。概率流常微分方程轨迹用于把少步路径拉直,之后的分布匹配蒸馏仍负责生成质量。单样本设置压缩的是轨迹监督,不是从零只看一个视频就学会所有内容;后续分布匹配仍使用25000规模的数据。 图3|慢快专家流程:逐块自回归扩散模型使用分阶段LoRA适配器完成去噪,Slow-LoRA在早期产生粗结构,Fast-LoRA在后期细化细节;专家各自的目标进一步改善时间连贯性与空间保真度。LoRA是以少量低秩权重适配原网络。 实验效果:Wan2.1-1.3B(13亿参数)、480×832、81帧,使用8张A100训练。逐块四步设置的完整模型 VBench 综合分84.33,Causal Forcing为84.04;VBench汇总视频质量与语义等维度,越高越好。单轨迹版本后训练后为84.22,但语义分79.11低于对照81.84。轨迹采集约1个A100 GPU小时,是初始化数据准备成本;不能把图示11600倍扩展成完整训练或推理收益。完整模型相对Causal Forcing人评胜率63.3%,来自50条提示、3名标注者、150票,不能套给所有单样本变体。 表1|与既有模型对比,生成质量与此前方法相当或更好。Data为训练数据规模,Dyn.为动态程度,Vision.为VisionReward视觉奖励分,Instruct.为指令遵循;*表示跨阶段沿用同组模型。吞吐与首段时延在H100上分别用每秒帧数与秒报告,不含VAE解码时间;轨迹初始化行与分布匹配后训练行应分开比较,单轨迹版语义分并非最优。 批判点评:单条轨迹的内容很敏感:低运动样本后训练总分79.81,而默认男孩样本84.22,差异远大于对照间的零点几分。两个专家也要按阶段切换,单轨迹并未消除冻结大教师、后训练和适配器成本。应先检查自己的运动分布和语义需求。作者项目页。 4. Speculative Sampling:先画未来但别急着提交 Speculative Sampling in Interactive Video Generation | 中国科学技术大学;香港中文大学;独立研究者 | arXiv:2610.20556 关键词:交互视频, 预测缓存, 可撤换未来, 端到端时延 前序问题:用户改变动作指令后,即使模型采样很快,也可能要等到整段视频播完才生效。缩小生成块能减少等待,却损失联合建模质量和GPU并行效率。 方法直觉:可以一次画出较长的未来,但每次只交付一小段;没交付的部分先放缓存。指令不变就继续用,指令变了就替换尚未承诺的未来,已经交付的前缀保持不动。 本文贡献:每次将接下来要交付的1个潜帧与额外噪声潜帧拼成较大的双向窗口,共同采样并缓存预测。潜帧是视频压缩空间中的时间单元,通常对应多个像素帧。有限状态机协调生成和缓存消费;新条件触发可行位置重规划,不强行打断正在执行的生成。作者把到显示的时延拆成生成前等待、首个可交付输出计算(含视频解码)、播放排队,避免只报Transformer单次前向时间。 图3|投机采样服务控制:(a)联合生成填充预测缓存,供细粒度交付及播放,按播放进度补充;(b)有限状态机在Produce生成与Consume复用之间协调,此例每次交付q=1个潜帧。新条件在可行位置重规划,不中断正在执行的生成,两种状态下播放均继续。 实验效果:每组服务臂使用30条配对的60秒交互轨迹。Wan1.3B的480p长块在低频更新下,响应时延中位数从3.23秒降到1.32秒,95百分位从4.64秒降到1.91秒;高频更新中位数从3.11秒降到1.35秒。长块设置用8张B300运行扩散主干,另有视频解码GPU;短块用4张,两种资源配置不能直接当同成本比较。LTX长块低频中位数4.82→2.39秒,但播放欠载比例0.069%→0.204%。 表3|Wan1.3B、LTX-2.3及Sol-H3的480p级在线服务实验。Baseline为整块承诺,投机采样为本方法;LTX括号内配置对扩散Transformer应用CUDA Graph录制与重放。普通执行下长短块隔离块大小,括号内外的短块隔离执行方式。L50、L95分别是响应时延中位数与95百分位,单位秒;GPU内核活跃度与播放欠载为百分比,GPU活跃度是所监测设备按时间加权的平均值,设备覆盖范围按各模型正文定义。 批判点评:缓存的未来可能被新指令废弃,因此要额外支付生成、存储及重规划成本。它移除了固定块边界的部分等待,却不保证所有模型和执行模式更好:LTX短块采用CUDA Graph时,低频中位时延反而从1.81升到2.01秒,欠载也增加。CUDA Graph是预录制并重放GPU工作以减少调度开销,不能与普通执行混成一个对照。作者项目页。 5. TempoKV:缓存只存难预测的残差 TempoKV: Predictive KV Cache Quantization for Autoregressive Video Generation | 上海交通大学;华南理工大学;阿里巴巴 | arXiv:2610.15324 关键词:视频缓存量化, 时序预测, 非对称KV, 低比特残差 前序问题:长视频逐段生成时,注意力要保存以往帧的key/value缓存,显存不断增长。直接套语言模型的量化方案,会忽略视频相邻帧的冗余,也可能使误差随时间放大。 方法直觉:能从历史猜到的部分不用完整抄一遍,只存猜错多少。key负责注意力匹配,value是按匹配结果取回的内容;先猜key,再用重建key帮助猜value,比两者各猜各的更准确。 本文贡献:TempoKV 用8条BF16校准提示离线收集缓存,线性回归拟合固定预测器。BF16是16位脑浮点格式。推理先从同位置历史key预测当前key,再从已重建当前key和短value历史预测value,只对预测残差做低位量化。默认key看前2帧、value看前1帧,并可让key获得更多比特;不更新生成模型权重,但并非无需校准或额外算子。 图2|TempoKV:(a)离线从8条校准提示采集干净BF16缓存轨迹,以线性回归拟合预测器;(b)在线由重建key历史预测当前key,再由对齐的重建key与value历史预测value,只存低位残差R。key用于注意力匹配,value用于内容聚合,BF16是16位脑浮点格式。 实验效果:MovieGen前128条提示、832×480、717帧的Causal Forcing实验中,key/value各2比特的k2v2达到6.71倍缓存压缩,六项VBench视觉分均值77.04,BF16为76.95;改用k4v2,压缩4.73倍、均值77.11。k4v2表示key4比特、value2比特。Self-Forcing同协议k2v2为73.32,仍低于BF16的74.23,说明高压缩在不同主干上代价不同。 表1|MovieGen上的Causal Forcing,832×480、717帧。每个精度组内最优与次优分别用粗体与下划线标记。压缩比仅针对缓存;k4v2表示key4比特、value2比特。PSNR/SSIM越高越接近BF16,LPIPS/FID越低越接近;Visual Quality是六种视频视觉维度均值,不能当作整机加速。 批判点评:6.71倍是缓存体积的压缩比,包含量化元数据等开销,不能换算整机显存减少6.71倍或推理快6.71倍。预测器、反量化和保留历史都有成本;必须与自己的注意力实现一起计时。论文称代码将发布,未给可核实的作者仓库,本期不补造代码链接。 6. BluePixel:原生4K编辑还要守住背景 BluePixel: Toward Native 4K Agentic Image Editing | vivo;南京大学;上海交通大学 | arXiv:2610.19882 关键词:原生4K编辑, 渐进VAE适配, 背景保持, 专家协作 前序问题:把图片中的字或衣服改对,背景也可能悄悄变化;到4K分辨率,微小漂移尤其明显。只提高分辨率,也不能让通用编辑器自动具备调色、虚拟试穿等专长。 方法直觉:先让模型承载大画布,再按任务学专长,最后提速。编辑处跟教师走,不编辑处锚定原图;精确调色等操作交给专用工具,系统再逐次检查。 本文贡献:BluePixel 把1K预训练编辑器通过渐进式VAE适配升到原生4K;VAE是将像素压缩到潜空间并重建的自编码器。后续以监督微调、持续学习和奖励优化兼顾能力与细节。少步蒸馏的SATP(源图锚定目标投影)按教师预测相对源图的编辑强度区分保留区域与变化区域,构造教师结果和原图潜变量的混合目标,补偿非编辑区漂移。配套系统分解指令、路由专家,以同一奖励模型验收并有限重试。 图2|第一阶段与最终模型对比:第一阶段检查点能够编辑但能力有限;经历第二阶段的渐进监督微调、按基准定向微调、持续学习与强化学习后,最终模型的编辑质量及细节保真度明显提高。此图是阶段结果对照,不是SATP模块架构。 实验效果:50步教师压到4步后,单张昆仑芯P800 XPU、BF16精度、无其他优化下完成一次4K编辑为8.7秒,正文称约4倍加速;这是编辑器,未包含任意多轮工具调用。VINS-4KEval++共3305例,七模型共同覆盖2513例的表8中,BluePixel综合8.62/10、成功率63.2%,GPT Image 2为9.15、74.8%;非编辑区一致性9.06,对照9.34。 表8|VINS-4KEval++七模型共同覆盖2513例,BluePixel综合排名第二,仅次GPT Image 2,非编辑区一致性也第二。采用BluePixReward裁判,BluePixel做提示改写并报告8个种子的均值,外部模型每例一个输出;每种子明细在原论文表4。分数0至10、越高越好,Success为同一裁判认定成功的比例;IF为指令遵循,NC为非编辑区一致性,VQ为视觉质量。 批判点评:本模型报8个随机种子的平均值并做提示改写,外部模型每例1个输出;同一自家奖励模型又用于训练与评测,排名应配合独立人评。完整系统会增加规划、验收和重试时延;8.7秒不能代表整套系统。SATP完整推导与训练配方另待配套论文,当前论文并非所有环节都可独立复现。作者代码。 7. SceneAE:存一个场景再换相机看 SceneAE: Scene Generation and Reconstruction in Queryable 3D-Anchored Latent Space | 北京邮电大学;加州大学伯克利分校;鉴智机器人;SynapX | arXiv:2610.19708 关键词:三维锚点潜空间, 场景生成, 几何内容解耦, 相机控制 前序问题:按视频帧存场景,同一个房间换一条相机路线就可能又生成一遍,还会把物体外观与观察角度绑在一起。记住了之前的画面,不等于有可重复查询的场景。 方法直觉:把场景记成稀疏的空间笔记:每条笔记有三维坐标和局部内容。相机移动时只查询这些笔记并渲染;生成时先安排几何,再给几何填外观。 本文贡献:SceneAE 以3000个显式三维锚点及其隐式内容特征表示场景。编码器借冻结的Depth Anything 3估深度并提特征,反投影成点云后选择锚点,聚合可见视角信息;解码器按目标相机输出RGB和深度。生成Transformer先按相机控制未来几何布局,再以几何为条件生成内容,避免每换轨迹都重新合成整段视频。 图3|几何与内容解耦的扩散Transformer:先以相机条件控制未来几何布局,再用几何布局控制纹理内容,因而更准确跟随相机。场景潜空间直接锚定三维位置,解码时可重复查询。 实验效果:DL3DV、RealEstate10K和ScanNet训练样本用9视角,分辨率518×376,8张A800训练10万次。RealEstate10K双视角条件下,像素重建信噪比PSNR为19.8、结构相似度SSIM为0.68,对照GLD为19.4、0.67,均越高越好;DL3DV同设置PSNR17.9却低于GLD的18.1。表1每步145毫秒,对照285毫秒,不能称完整视频仅145毫秒。往返轨迹记忆实验PSNR30.7,对照GEN3C29.8。 表1|外观生成定量对照:报告像素重建信噪比PSNR、结构相似度SSIM,以及VBench的主体、背景和多视角一致性,均越高越好;另报GFLOPs(十亿次浮点运算)与每步毫秒数衡量效率。单视角、双视角及两个数据集应分别看,不能把每步时间当整段端到端时间。 批判点评:重复查看同一表示很有吸引力,但几何质量依赖深度基础模型、相机位姿和可见性估计。几何对比中Gen3R采用VGGT生成评估参考,本方法与GLD采用DA3,参考源不同,不能简单当同一真实三维标尺。它主要展示相机驱动场景生成与重建,尚不能据此声称任意动态世界均稳定;未确认作者代码入口。 8. Kandinsky S2V:语音驱动人物且记住前情 Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation | Kandinsky 实验室(Kandinsky Lab) | arXiv:2610.19290 关键词:语音驱动视频, 多尺度记忆, 口型同步, 策略蒸馏 前序问题:单张照片配音生成长人物视频,既要嘴型跟得上声音,又要跨段保持身份、姿态和动作;只盯嘴部,容易丢掉整个人物的连贯表演。 方法直觉:声音与文字负责当下怎么说,参考图负责是谁,压缩记忆负责刚才怎么动。旧帧记粗略轮廓,最近帧保留细节,把记忆预算花在时间上更近的地方。 本文贡献:Kandinsky S2V 1.0 用冻结Qwen2.5-Omni的文本和音频特征,参考图经视频VAE编码,三尺度FramePack将过去30个潜帧按远到近分为24、4、2帧并逐级减小压缩;当前视频帧只注意对应时间段的音频。训练117万单说话人片段,结合参考记忆混合和按脸面积调整的损失。π-Flow蒸馏把每段策略的5个干净潜变量估计一次预测出来,再通过无需额外网络调用的子步积分,最终16个策略段、不用有无条件双分支引导。 图2|Kandinsky S2V架构:冻结Qwen2.5-Omni的Thinker文本特征及音频塔特征,分别进入扩散Transformer内Nt个文本块与Na个音频块。参考图经冻结Hunyuan三维VAE编码,其潜变量与带噪目标zt及多尺度FramePack历史记忆拼接,C表示拼接。每个块执行视觉自注意力V2V、文本交叉注意力V2T、按周期插入的音频交叉注意力V2A及前馈层;最后由冻结VAE解码回像素。交叉注意力使当前视觉特征读取相应条件。 实验效果:Lite与Pro是系列简称,实际参数约23亿和214亿。每段生成125帧、25 FPS,对应5秒播放时长。H100、512×768、单GPU上,Pro基础版每段914秒,蒸馏版173秒;8GPU时162秒与57秒。1280×768单GPU为3854秒与675秒,体现设备、分辨率不同不能只报一个速度。作者摘要给5.4倍端到端收益;80条俄语HD人评中,多数项目74%至100%打平,牙齿嘴部蒸馏版获38%偏好、基础版3%。 表5|发布推理代码在H100上对Lite与Pro逐块计时。每行GPU数量与耗时按位置一一对应;SD为512×768,HD为1280×768,时间单位秒。每块125帧、25 FPS,故播放时长5秒;单卡Pro蒸馏版SD为173秒、基础914秒,不能将输出帧率当生成速度。 批判点评:25 FPS是输出帧率,不是实时生成吞吐。Pro蒸馏后EMTD口型相关分8.03略低于基础8.05,Lite也出现同步下降,不能写蒸馏后所有指标都升。自回归长链还会累积误差,数据以单说话人为主,多人互动并非已验证能力。作者项目页。论文所列代码仓库及权重集合本次回读均为404,暂未确认可下载状态。 9. Revise-TTS:说错的声音token还能再改 Revise-TTS: A Non-Masking Refinement Framework for Masked Diffusion Models in Text-to-Speech | 谢菲尔德大学;HojoAI | arXiv:2610.19499 关键词:语音合成, 非掩码修正, 层级二值量化, 迭代自纠错 前序问题:掩码扩散语音模型像填空,一旦高置信度预测被提交,后续步骤通常不再改它。早期发错的声音单元会留在上下文里,继续影响后面。 方法直觉:允许已经写上的答案被擦掉重做。声音先编码成可从粗到细细化的二进制单元,模型既练补全缺失内容,也练从掺杂错误的整段内容里恢复正确声音。 本文贡献:HBQ是层级二值量化,每次把当前量化区间对半分,形成有粗细次序的位串,可打包成整数或逐位预测。GRN是生成式修正网络,训练输入混合真实和随机token;token是离散声音单元。模型预测完整序列,推理按余弦进度保留部分预测、把剩余位置换成随机token再修正,而非用专门掩码符号永久填空。一次重建训练目标不等于一次推理,主实验仍迭代32步。 图1|层级二值量化HBQ:每轮将选定量化区间对半分。连续值z=-0.113经过三轮产生位序列011,对应离散索引3;按正文重建值为-0.125。二值位可按整数或逐位提供给语音模型。 实验效果:主模型使用Emilia英语46800小时、中文49900小时,16张A100训练25万次;小规模消融另用4卡,不能混成主训练成本。LS-PC英语测试中,Revise-TTS单词错误率2.00%,OmniVoice为1.57%,说话人相似度0.519对0.697;Seed中文测试错误率1.19%对0.89%,中文这里按字符计错。32步修正保留了可用自然度,但没有全面超越基线。Higgs编码器的受控实验中,修正模式同样弱于掩码模式的说话人相似度。 表4|固定Higgs声音编码器,用8张GPU在Emilia英语/中文微调后,比较掩码与生成修正解码。Steps列100k指100000次训练更新,不是100000次推理;主推理协议是32次修正。SIM是说话人相似度、越高越好,英语WER为单词错误率、中文同列按字符计错,越低越好。修正并未在所有数据集和指标占优。 批判点评:这篇的价值是展示可撤回的解码机制及量化接口的限制。词错率越低越好,说话人相似度越高越好;二者要一起验收。换到HBQ的编码器重建本身就较差,不能把主系统的差距全归因于修正策略。作者明确Under review,不写会议接收;没有核实到作者代码和真实端到端计时,32步也不等于实时。 10. PhyMetric:别只问视频看起来合理吗 PhyMetric: Diagnosing Physical Plausibility in Text-to-Video Generation via Scene-Level QA | 内华达大学里诺分校 | arXiv:2610.19823 关键词:视频生成评测, 物理合理性, 场景诊断, 问答裁判 前序问题:生成的玻璃杯碰撞后没有正确反应,画面却很逼真;泛泛问“符合物理吗”,视觉语言模型可能高置信度说是。整体分数无法告诉开发者究竟哪一步坏了。 方法直觉:把验收改成观察清单:针对这个场景本应出现的现象逐项问是非题,再挑能回答问题的时间帧。问的是可见后果,而非让裁判凭印象打一个总分。 本文贡献:PhyMetric覆盖6类物理领域、50个细分类别、1115个场景,每场景8个平衡是非问题,共8920题,带12种诊断维度。为每个场景提供物理规律、预期时序、可见征象与常见失败的结构化先验,再按问题选择视频帧交给视觉语言模型作答,逐场景、维度与类别聚合;它评估生成结果,不是给生成器装物理仿真引擎。 图3|PhyMetric评估:给定物理场景s,文生视频模型按描述cs生成视频Vs。对每个场景是非问题,按问题抽取帧,并提供描述规律、预期后果和常见失败的结构化物理先验Ks;视觉语言模型结合帧与先验回答。问题正确率先聚成场景分S(s,Vs),再对全部场景平均成模型分,使整体印象转成可诊断的物理检查。 实验效果:完整1115场景、两种开源裁判的平均总体分,Wan2.2-14B为72.78,Cosmos-7B为72.59;数值接近,且会随裁判变化。受控消融中,Qwen3.5-9B裁判使用场景问题及先验为74.91,无先验72.75;换成泛化的整体问题时48.88,接近均衡是非题的50%机会水平。该受控结果不是完整榜单分数,也不是人类标注准确率。 表2|完整1115场景的开源视觉语言裁判结果。Average是两种裁判的平均分;Overall为总体聚合,Weighted按题目难度和诊断维度权重聚合,分数越高越好,不能与100场景受控实验混用。Wan2.2-14B平均Overall为72.78,Cosmos-7B为72.59,两个裁判下细微顺序会变化。 批判点评:先验并非越多越好:GPT-5.4裁判加入默认先验后受控分数从73.94降到72.25,尽管与人的相关性可能改善。问题构造、抽帧和裁判偏差仍影响结论;每场景8次问题判断还增加评估调用成本。接近0.2分的模型差距不应写成已证明的绝对物理优势。作者项目页。 趋势观察 先学什么影响后训练成本 Priming先做重建,RECON把语义送给后层,Glance按噪声区间分工;同样少步,不同初始化承担的责任不同。 交付与计算要分开计账 投机采样延后未来帧的承诺,TempoKV只压缓存,Kandinsky输出25 FPS但仍慢生成;吞吐、响应、存储和播放时长是四件事。 保留接口比追求单分数更难 BluePixel锚定未编辑背景,SceneAE解耦几何与内容,Revise-TTS暴露声音编码器质量瓶颈;模块相接处决定最终效果。 诊断问题需要足够具体 PhyMetric把整体合理性拆成场景问题;其不同裁判并非一致受益,BluePixel也用自家奖励判定成功,验收来源应明确。 今日讨论 Priming-L在ImageNet 256×256达到FID 1.19,但RT-1视频的FVD为30.96,仍高于32步流模型的27.24。若要判断“先重建再一步生成”能否替代你的少步模型,哪种实验能固定总训练算量,并同时检查图像分布、长时序一致性和特征编码器带来的评价偏差? 人工智能炼丹君 整理 | 2026-10-16
-
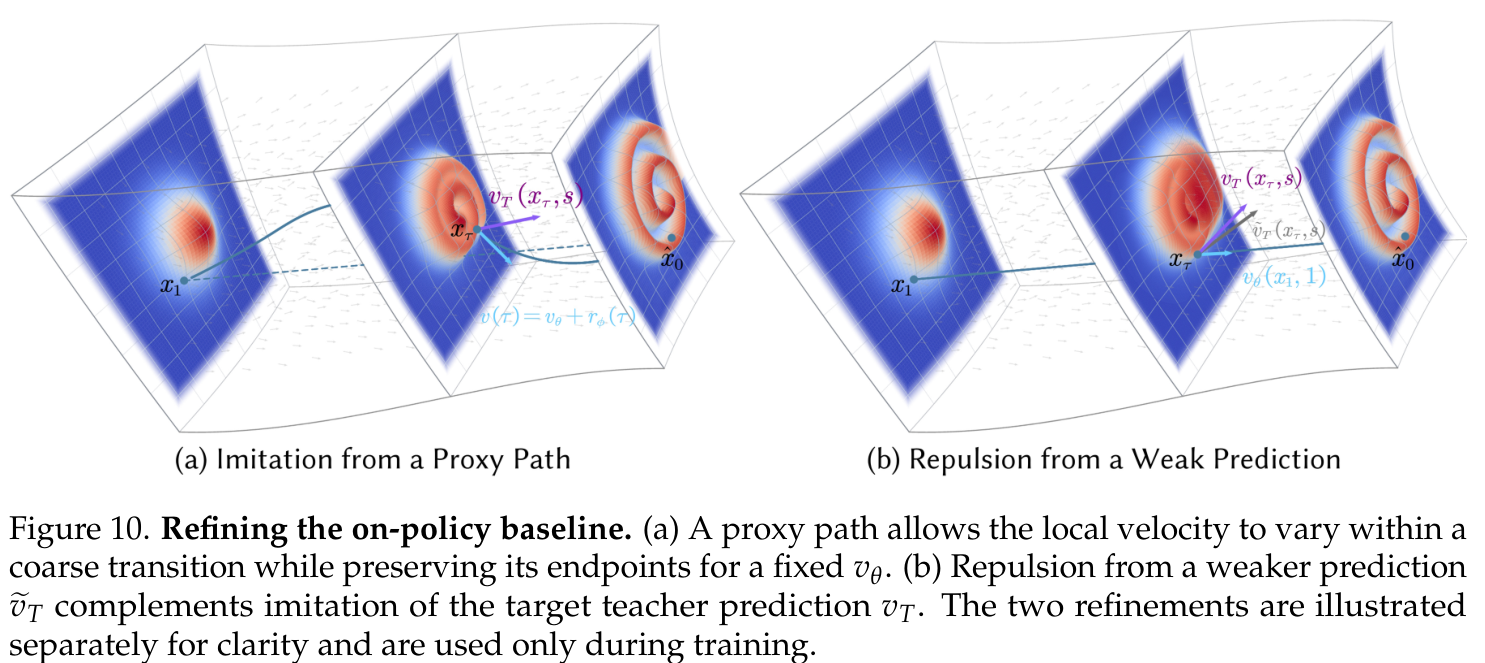
AIGC 每日速读|2026-10-15|微软把生成压到4次评估SMD 今日 AIGC 论文速览 今日共 10 篇 · 少步生成与高分辨率 2 篇 · 理解与编辑控制 2 篇 · 视频超分与运镜 2 篇 · 原生三维生成 1 篇 · 语音与歌声编辑 2 篇 · 音画同步评测与奖励 1 篇 重点论文标题列表 SMD(微软):把局部弯路留给训练 AReA(多伦多大学):大画布先看全局再看细节 DuplexBridge(中科大):先分清没听懂还是没画对 QK-Edit(字节):只换查询与键保住原结构 FlashVSR+(上海AI Lab):单张4090做完整4K超分 选读入口:如果你要缩短生成等待,先读 SMD,接着用 AReA 看大分辨率下如何省注意力;做视频修复再读 FlashVSR+ 的4090卸载条件。复杂编辑失败先读 DuplexBridge 的责任划分,需要保留原视频结构再读 QK-Edit,运镜控制看 GTL。三维贴图异常看 Channel Match;有现场噪声的改词看 AnyEdit,改变语气看 Prime-EVC,音画验收最后读 SyncReward。 今日论文速览 1. SMD:把局部弯路留给训练 Simplifying and Improving On-Policy Distillation for Few-Step Diffusion | 微软研究院;纽约大学;香港科技大学 | arXiv:2610.18472 关键词:少步蒸馏, 同策略回归, 代理路径, 教师排斥 前序问题:把几十次去噪直接缩成几次,常会遇到同一大步内教师方向不断变化:学生只预测一个方向,局部监督互相打架,视频训练还可能先变好再退化。 方法直觉:像用一条直线代替弯路:学生学习这一大段的平均方向,训练时另找一个能弯曲、但不改变起终点的辅助路径,接住局部变化。部署时只走学生的大步。 本文贡献:Simplified Matching Distillation(SMD,简化匹配蒸馏)沿学生当前生成路径查询冻结教师,回归速度。Pivot 辅助网络输出积分为零的残差,使区间内方向可变而终点不变;再用同一教师的弱引导或跳层预测作负参照,拉开与较差方向的距离。只在训练使用 Pivot 和教师,不依赖在线分数估计或对抗训练,也不改部署模型结构。 图10|对同策略回归的两项改进:(a)代理路径允许一个粗步长内的局部速度变化,但固定学生速度时保持起终点不变;(b)排斥同一教师较弱的预测,与模仿目标教师预测互补。两项改进为便于解释分别展示,均只用于训练。 实验效果:原论文 Qwen-Image 实验统一为 4 NFE;NFE 是生成网络前向调用次数,教师 50 步含有条件与无条件两分支,共 100 次。SMD 的 GenEval(物体及属性组合正确率)0.873,高于 Lightning 的 0.852,略低于教师 0.874;密集指令遵循分 DPG 为 88.7,教师 88.3。OneIG 综合分同为 0.540,但多样性 0.144 低于教师 0.195。 表2|Qwen-Image 文生图:NFE 计算网络前向评估次数,教师的 50×2 包括有条件与无条件两个 CFG 引导分支;粗体和下划线为少步方法中的第一、第二,不含教师。†是 PDD 原文表3及6–8的欧拉版本,未有公开 checkpoint。各项越高越好;综合分不等于每项都领先。 批判点评:少调用网络不能直接换算墙钟加速;训练仍要教师查询和 Pivot。Wan2.1-14B 视频的语义分 80.52 低于 AnyFlow 的 82.10,330亿参数(33B)的音画联合模型分别测 4/8 次调用,不能统称全任务四次且全面领先。作者代码含推理与训练入口,本次未执行模型复现。 2. AReA:大画布先看全局再看细节 AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers | 多伦多大学;Vector研究所 | arXiv:2610.17227 关键词:高分辨率生成, 自适应感受野, 跨尺度注意力, 局部窗口 前序问题:把原生约千像素的图像模型直接拉到四千像素,注意力计算猛增,还容易复制主体、扭曲布局。只改位置编码,不能同时处理关注对象数量暴涨的问题。 方法直觉:构图时看整幅画的缩略版,修细节时只看邻近区域。缩的是被查询的上下文,输出画布始终保持目标分辨率,因此不需要先生成小图再放大。 本文贡献:AReA 即自适应感受野注意力,无需训练。早期保留全分辨率 query(查询),对 key/value(供匹配与聚合的信息)按块取中心代表,统一到较粗坐标;后期改用逐渐收缩的窗口。稀疏全局信息桥维持远处联系,重叠边界缓解接缝,离散小波变换识别平滑区并进一步拆窗。切换按噪声水平设定,FLUX.1 前 8 步、Qwen-Image 前 20 步采用全局粗阶段。 图4|AReA 流程:在噪声水平阈值 σ⋆处从阶段一切换到阶段二。阶段一全分辨率查询访问每个 f×f 块选出的一个 key/value,f 随步数调整,坐标映射到接近训练分辨率的网格;阶段二逐渐缩小局部窗口,并进一步拆分离散小波变换图中平滑区域的窗口以降低计算。 实验效果:H100 上的 Aesthetic-4K 含 195 条提示。在 4096×4096 的 FLUX.1 设置,单图时间从全注意力 314 秒降至 151 秒;另用 1000 条复杂提示组成 HRGen-1K,图文对齐 CLIP 分从 23.36 到 29.89,偏好预测 PickScore 从 19.04 到 21.44,均越高越好。6144×6144 的最高加速 3.2 倍属于另一分辨率设置。 表1|Aesthetic-4K 上 FLUX.1 与 Qwen-Image 在不同分辨率和宽高比的对照,粗体为最佳、下划线为第二;时延单位秒、越低越好,奖励、美学、图文匹配和偏好分越高越好,整体与局部裁剪的 Fréchet 距离越低越好。收益随主干与分辨率变化。 批判点评:不增参数仍需实现窗口、信息桥与拆窗调度;切换阈值按主干经验选择。固定窗口消融虽有不错的美学或 CLIP 分,却出现布局破碎,因此这些分数不能替代主体数量和接缝检查。作者项目页提供演示及代码入口,未实跑其模型。 3. DuplexBridge:先分清没听懂还是没画对 DuplexBridge: Coordinating Understanding and Generation for Unified Image Editing | 中国科学技术大学;阿里巴巴Wan团队 | arXiv:2610.18819 关键词:统一图像编辑, 角色分工, 双向信任门控, 完整遵循评测 前序问题:让统一模型先理解指令再编辑,最终改错时却不知道该罚谁:可能理解阶段认错对象,也可能条件没错、生成阶段执行失误。共享一个奖励会把责任混在一起。 方法直觉:先把任务写成可验收的交接单:改哪个对象、最终变成什么、哪些内容必须保留。理解者对交接单是否忠实负责,绘图者对是否照交接单完成负责。 本文贡献:同一模型分别承担理解与生成角色,不另接外部理解模块。源图约束的结构化 bridge 传递目标、变化和不变量;理解的局部监督不看生成图,生成的局部监督检查实际收到的条件。只有伙伴可信时才接收相应全局任务反馈,同时保留有效局部反馈,交替训练两角色。 图3|伙伴互信门控:执行可信度控制理解者能否接收全局反馈,提示可信度控制生成者能否接收全局反馈;局部反馈仍各有独立有效性掩码。图将两角色的全局资格及局部奖励符号简写;路由矩阵假定判断可用,Yr 是基准编辑结果,与任务提供的参考图不同。 实验效果:CE-Bench 有 1200 个任务;CCR 指所有变化与保留要求同时通过的任务比例,区别于平均要求通过率。Wan-Image-7B 直接编辑的 CCR 为 53.83%,完整系统 77.08%,包括提示增强、监督微调及强化学习。共同监督初始化后,仅比较门控:无门控 70.92%,双门控 77.08%,不能把全系统增益都归给门控。 表10|Wan-Image 全局奖励门控消融:前四行只变化两项语义信任决策,保留局部监督与奖励有效性条件。oracle 使用额外标注;等数量随机门控与保留分组结构的随机门控是不同对照。CCR 为全部变化与保留要求同时通过的任务百分比,双门控为77.08,无门控为70.92。 批判点评:推理增加了原生理解及条件生成环节,训练还需奖励判断;文中奖励模型的相对时延不等于整套编辑端到端时延。自动裁判与人评仍有误差,公开任务类别构成也随要求数量变化,不能把要求越多分越低解读为单变量因果。未确认作者完整训练实现的公开入口。 4. QK-Edit:只换查询与键保住原结构 QK-Edit: Revisiting Attention-based Injection in MM-DiT for Image and Video Editing | 加州大学默塞德分校;字节跳动Seed;字节跳动智能创作;香港中文大学 | arXiv:2610.17829 关键词:图像视频编辑, 查询键替换, 多模态注意力, 无需训练 前序问题:给真实视频换主体时,直接套用旧图像编辑的注意力注入,可能保住原结构却不听新指令,或跟上指令却把动作与背景弄坏。 方法直觉:注意力里,query 像每个位置提出的问题,key 用于匹配位置,value 才是取回的内容。借用原视频的查询与键来固定布局,同时让新文本和当前内容负责改变外观。 本文贡献:在把文本与视觉合并处理的多模态扩散 Transformer 中,只替换视觉 query/key,保留目标文本特征与目标 value。生成素材可在原采样时缓存,真实素材先反演回噪声并记录特征;图像仅在前 30% 去噪步注入,视频为前 20%。不训练参数,但需要源特征缓存及真实素材的反演计算。 图6|查询与键操纵策略:替换注意力 Q 与 K 的视觉部分,在目标提示遵循和源结构保持之间取得平衡;Q 是查询特征,K 是用于匹配的键,文本部分及用于聚合内容的 value 保留目标分支。 实验效果:A100 上以 FLUX.1-dev 编辑图像、HunyuanVideo 编辑视频。真实 TGVE+ 视频中,帧间 CLIP 余弦一致性 0.921、偏好预测 PickScore 20.52,Flatten 为 0.887、19.91;但描述修改方向的 ViCLIP 分为 0.196,低于 Flatten 0.204。论文覆盖 65 至 129 帧、320×320 至 1280×720 的视频设置。 表3|TGVE+ 真实视频编辑:比较修改方向及输出整体的 ViCLIP 语义对齐、帧间 CLIP 一致性和 PickScore 偏好预测,箭头均向上。QK-Edit 的方向分0.196低于 Flatten 的0.204,其他展示列较高,不能解读为所有指标第一。 批判点评:结构保持不等于所有语义指标最佳,且不是每条基准样本都使用最大分辨率和帧数。缓存与反演使“免训练”仍有时间和显存成本,原文未给统一端到端开销数字。真实反演在复杂运动中易有误差,未改区域仍可能被轻微改动;文字渲染与体操等复杂运动也受主干限制。未确认作者方法仓库可用。 5. FlashVSR+:单张4090做完整4K超分 FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching | 上海人工智能实验室;香港中文大学;清华大学;CPII(InnoHK) | arXiv:2610.17552 关键词:生成式视频超分, 混合注意力, 奖励蒸馏, 缓存卸载 前序问题:视频超分即从低分辨率恢复高分辨率;即使把扩散压成一步,4K 时空注意力仍可能撑爆显存,切成小块又容易产生边缘瑕疵,普通蒸馏也未必保住文字。 方法直觉:大部分层只管附近像素和前面的帧,少数层负责远处联系;训练时多学习奖励高的教师轨迹,奖励模型只负责打分,无需把梯度穿过它。 本文贡献:每五个扩散 Transformer 块保留一个全局块,其余采用局部时空注意力,适配训练后再蒸馏。Ry-DMD(奖励收益分布匹配蒸馏)用奖励加权的教师轨迹修改目标分布估计,支持不可微的黑盒奖励。4090 上另用适配注意力算子,并把保留全局层的 key/value 缓存卸到 CPU 固定内存,异步预取回显卡。 图2|FlashVSR+ 三阶段训练:第一阶段用图像视频数据训练140亿参数的全注意力多步教师;第二阶段适配混合注意力学生获得强初始化;第三阶段用 Ry-DMD 蒸馏成一步生成器,奖励反馈修改教师项估计,无需奖励梯度。 实验效果:效率测 89 帧视频,含 1080p、2K、4K。最高约 2 倍是去噪主干加速,峰值显存约降 45%;单张 24GB RTX 4090 的 4K 运行还包含上述卸载优化。文字识别奖励实验中,识别准确指标从基线 0.624 到 0.776;像素保真 PSNR 从 23.94 到 24.86,感知差异 LPIPS 从 0.246 到 0.240,后者越低越好。 图6|89帧视频的效率对照:(a)H200同级 GPU 上的 GPU 计算时间与峰值显存;(b)RTX4090 的端到端墙钟推理时间,包含 CPU key/value 缓存卸载与异步预取开销。SeedVR2整帧运行显存不足,改用切块;H200同级设备上的Ours-Base与旧FlashVSR结构及流程相同,旧算子不支持4090。两个面板口径不同,主干加速不能直接当完整路径加速。 批判点评:一步不等于实时;CPU 传输、预取、编码解码仍占时间。真实 VideoLQ 上无参考质量 MUSIQ 为 47.64,低于旧 FlashVSR 的 49.70,不能宣称所有质量分都更好。项目与代码入口已核验,训练适配和高分辨率设备条件需要一起复现。 6. GTL:把运镜主体和焦点分开控 Gen Through the Lens: Camera-Controllable Video Generation via Cross-Coordinate Conditioning Fusion | 腾讯视频太阳系 | arXiv:2610.15900 关键词:可控视频生成, 三坐标条件, 三维框控制, 景深与变焦 前序问题:输入一张照片再让相机环绕人物,常分不清是相机动、人物动还是焦距变;只给相机轨迹,人物位置与景深也未必按要求走。 方法直觉:分别给摄影机设置、世界里的运动轨迹、主体的三维占位框,再让它们在同一几何空间中对齐,避免把所有摄影要求挤进一句模糊提示。 本文贡献:Gen Through the Lens(GTL)融合相机、世界、物体三个坐标空间:恢复有统一实际尺度的相机参数,以彩色世界网格编码运镜,以带深度的三维框编码主体位姿,并加入分层景深与变焦条件。Wan2.1-14B(140亿参数)的编码器、解码器与生成主干冻结,只训练上下文适配器,分运镜、主体及变焦、景深三阶段加入控制。 图3|GTL 总体架构:在相机、世界与物体坐标空间联合输入相机运动、物体运动及景深控制信号,引导视频生成,源图像和几何条件共同约束生成主干。 实验效果:训练基础集约 11 万段,另构建 8000 段变焦与 15000 段景深数据,统一 81 帧、480p;原文报告约 288 GPU 小时。1000 段独立测试中,GTL 的视频分布距离 FVD 为 86.54,RealCam-I2V 为 98.76,越低越好;相机平移误差 8.59 对 9.86,但旋转误差 4.89°高于对照 4.63°。 表2|与现有方法的定量比较:误差及分布距离越低越好,重叠及语义指标越高越好;屏幕空间误差按图像对角线的百分比报告。*列需谨慎,RealCam-I2V 与 GEN3C 不支持显式物体运动或目标定位,可能使它们的物体指标较差。GTL旋转误差并非最优。 批判点评:主体框训练以人为主,非人物泛化主要来自定性展示;部分对照不支持显式物体控制,物体指标并非同等功能比较。几何来自自动估计,误差会传到条件和评测,训练成本也不是单次生成时延;未提供可直接对照的推理显存或时间,未确认完整开源实现。 7. Channel Match:形状没坏也要校准纹理接口 Channel Match: Calibrating Shape Latents for Few-Step 3D Generation | 威廉玛丽学院;SparcAI公司 | arXiv:2610.15321 关键词:原生三维生成, 少步蒸馏, 通道统计校准, 几何纹理接口 前序问题:三维模型两步就生成了正确形状,贴上材质却出现黑斑,问题可能不是网格坏了,而是几何隐变量的统计分布偏离纹理模型训练时的输入。 方法直觉:几何与纹理像两道串联工序:前一道加速后输出格式没变,数值分布却变了。先把接口上每个通道的均值与波动尺度校准,再交给原来的纹理生成器。 本文贡献:在 TRELLIS.2 的 1024³ 分辨率设置,用连续自一致性与解析速度回归联合蒸馏几何模型,自适应平衡两种损失。自定义 JVP 注意力核计算沿教师方向的速度变化;JVP 是雅可比矩阵与向量之积,无需显式存整张雅可比矩阵。Channel Match 无需再训练,按通道标准差亏损检测分布塌缩,触发尺度或均值加尺度校准,保持生成器不变。 图1|少步分布偏移及 Channel Match 校准:从左到右是输入、未校准两步学生的无纹理网格与物理材质渲染,以及校准后网格与渲染。偏移的形状潜变量会让冻结纹理模型产生黑斑;校准后几何保持不变。示例选择几何简单、两步教师和学生都接近多步参考的样本,以隔离潜变量统计偏移而非几何重建错误,并非全部复杂物体的保证。 实验效果:单张 A800-80GB 上,几何采样从 5.29 秒到 1.18 秒,约 4.5 倍;图像到形状完整路径 11.51 秒到 7.55 秒,约 1.5 倍。72 个容易出材质伪影的演示资产,统一四视角、对照十二步教师渲染,完整校准将感知差异 LPIPS 从 0.0802 降到 0.0747;这是更接近教师,不是接近真实照片的直接测量。 表3|TRELLIS.2 的72个演示资产与十二步教师渲染作四视角比较。仅标准差和均值加标准差两种校准都使学生更接近教师,完整校准在这批材质伪影较多的资产上收益更大。下半部分为各指标改善的资产比例;它不代表完整 Toys4K 或真实纹理误差。 批判点评:3216 个较简单 Toys4K 资产中,单独校准标准差更稳,完整均值校准反而可能稍差。JVP 增加的是训练开销,纹理阶段保持不变限制总加速。原文的结构相似度 SSIM、像素保真 PSNR 在正文与表格有个别数值不一致,因此本文只采用一致的 LPIPS 与计时数据;尚未确认作者完整公开实现。 8. AnyEdit:改人声时留下现场的声音 AnyEdit: A Unified Framework for Speech and Singing Voice Editing with Real-World Environmental Consistency | 香港中文大学(深圳);华为媒体技术与体验设计研究所;澳门城市大学;Amphion公司 | arXiv:2610.15665 关键词:语音歌声编辑, 环境一致性, 抗噪韵律, 分阶段声学渲染 前序问题:在有伴奏、回声或街噪的录音里换一句话,常把环境声一并擦掉,或让没修改的词也变了音调。先做人声分离还会引入分离伪影。 方法直觉:先在干净的语义空间里决定说什么、怎么唱,再借周围原始声音还原现场感。这样编辑能力和噪声混响的处理不必在同一个步骤里互相干扰。 本文贡献:不显式分离人声:自回归模型生成韵律与内容风格 token(离散片段编码);教师学生训练从受损录音恢复干净韵律,50Hz 特征压成 6.25Hz token。流匹配声学模型再依据原音色及上下文渲染频谱。未修改区域加权监督稳定原有语气,并用歌曲重复段对齐挖出的真实配对做直接偏好优化;这仍依赖合适的重复结构。 图1|AnyEdit 总体架构:先在干净语义空间预测韵律与内容风格,再结合原声学上下文生成频谱并还原波形;NFE 为流匹配推理时的函数评估次数,图中按常微分方程积分步骤计,不包含全部前后处理。 实验效果:AnyEditBench 同时覆盖中英语音和歌声、干净/模拟/真实环境。真实英语语音中,单词错误率 WER 为 0.0616,Vevo2 为 0.0778;真实英语歌声 WER 为 0.1749,对照 0.2809,背景嵌入相似度为 0.7384,对照 0.5671,后者越高越好。但英语语音背景相似度 0.7705 低于 SSR-Speech 的 0.8729。 表2|AnyEditBench 真实环境子集,分语音与歌声两域。英语用单词错误率 WER、中文用字符错误率 CER,基频相关仅测歌声;粗体为各域最优,下划线指优于统一基线 Vevo2。另列说话人及背景相似度、混响时间误差与信噪比误差,不能仅以识别率概括环境保持。 批判点评:极端语音信噪比 0dB,即信号与噪声功率相当时,WER 为 0.386,差于 Vevo2 的 0.196,不能把平均收益当全条件保证。两阶段处理与多步声学解码仍有成本,未给统一时延。arXiv 备注明确称 NeurIPS 2026 接收;作者演示与公开评测集可访问,未确认完整训练代码。 9. Prime-EVC:情绪先配好再一步变声 Prime-EVC: One-Step Expressive Emotional Voice Conversion via Emotion-Primed Flow Matching | 九州大学;东华大学;腾讯混元;日本国立情报学研究所;东京大学;独立研究者 | arXiv:2610.16036 关键词:情绪语音转换, 一步流匹配, 韵律条件, 说话人保持 前序问题:想把同一句话由平静改成兴奋,直接把多步情绪转换模型砍成一步,往往只剩平滑的平均音色,目标情绪没真正进入音高和能量。 方法直觉:与其让一步采样临时猜出情绪,不如先预测“这个人表达这种情绪时”的逐帧音高与强弱,把难题移到条件端,再让解码器完成剩下的声学细节。 本文贡献:Prime-EVC 是情绪语音转换而非从文本直接生成。冻结 HuBERT 提取内容,通过 FiLM(按特征缩放和偏移)融合说话人与五类情绪;情绪方差适配器预测逐帧音高与能量,再施加情绪分类及频谱时间变化监督。扩散 Transformer 的条件流匹配解码器一步欧拉更新生成梅尔频谱,BigVGAN 将其转成波形。 图1|Prime-EVC 的编码、条件、渲染流程:从原语音取得内容,以说话人与情绪融合风格及逐帧韵律构造条件,再由一步条件流匹配解码器和声码器生成转换语音。一步指流解码更新,不是整条路径只有一次计算。 实验效果:ESD 英语十位说话人、五类情绪、16kHz,6000 次转换;16 位听者评每系统 100 条样本。自然度主观均分 3.77±0.03、情绪均分 3.90±0.04(±表示95%置信区间半宽),高于四步 DurFlex 的 3.63、3.79。A6000、批量 1,含声学模型及声码器的 RTF 为 0.038(耗时/音频时长),对照四步 0.132、百步 1.917。 表1|ESD 上整体比较,粗体仅在转换系统中排名;GT 为真实语音,vocoded 为声码器重建。自然度与情绪主观评分给均值及95%置信区间,自动质量、情绪与说话人相似度越高越好,字符及单词错误率、RTF越低越好;RTF包含声学模型及共享声码器,主干参数量并不相同。 批判点评:一步只计流解码器的网络评估,内容编码与声码器仍执行;模型约 9800 万参数,对照约 1.59 亿,也影响速度。说话人是训练过的十个嵌入,不是任意新音色克隆;去掉部分监督时 WER 还略好,情绪与可懂度需一起看。arXiv 标注在研预印本;作者样例可听,未确认训练代码。 10. SyncReward:声音对得上也得让人认同 SyncReward: Human-Aligned Synchronization Reward for Audio-Visual Generation | 中国人民大学;腾讯微信 | arXiv:2610.16338 关键词:音画同步奖励, 人类评分对齐, 时间对比学习, 生成后训练 前序问题:视频里的声音语义相关,却未在可见动作发生时响起;只奖励某个同步指标,模型可能把指标刷高,观众仍觉得嘴型或撞击声对不上。 方法直觉:先学习同一片段中哪个声音对应哪个时刻,再学人类如何判定“完全不同步、部分同步、同步”。内容匹配与时间对齐分别训练,避免只靠主题相似过关。 本文贡献:基于音画感知编码器,先用同片段错时负样本及跨片段语义负样本做对比学习,再冻结编码器,以人类 0/1/2 级评分训练交互 Transformer 与打分头,结合回归和成对排序。输出 0–2 的同步分。SyncReward-Data-80K 是约 8 万条评分;作者仓库说明为 80001 条评分覆盖 57099 个片段,不能把评分数直接写成独立片段数。 图3|SyncReward 两阶段训练:第一阶段以匹配音画片段、同视频错时负样本和同批跨视频语义负样本做对比学习;第二阶段冻结两种编码器,只训练跨模态 Transformer 与评分头,结合人类同步评分的回归和成对排序损失,输出0–2分。火焰与雪花分别表示训练和冻结。 实验效果:整体人评排序相关 Spearman ρ×100 为 78.2、成对排序准确率 83.6%,只做第一阶段为 60.5、74.6%。LTX-2.3 每提示生成 16 条再择优,人类偏好分为 63.67%,基模为 32.31%;用 DiffusionNFT 后训练为 65.78%。这些偏好分是基于基模比较的暂定估计,原文说明尚待完整两两评估,不能当全对全胜率。 表2|以同步分作奖励,分别比较十六选一与 DiffusionNFT 后训练;人类和 Gemini 偏好使用相同留出提示,自动指标也在同一批生成视频计算。当前偏好分为相对基模比较的暂定估计,作者说明将以完整两两评估替换;不同自动指标不构成统一胜率。 批判点评:十六选一要支付 16 次生成与打分成本;后训练有额外训练预算,未提供完整部署时延。模型可能提高嘴型同步却遗漏提示要求的乐器,同步奖励不能单独保证内容遵循。作者仓库提供打分、训练及基准入口,本次未复现;四类声音覆盖也不等于所有长视频场景。 趋势观察 把额外工作放到合适阶段 SMD的Pivot只留训练,AReA随去噪进度改感受野,Prime-EVC先把情绪放进条件。一步或少步的含义,要结合其余模块和前后处理判断。 编辑失败需要明确责任 DuplexBridge区分理解与执行,QK-Edit区分结构与内容。局部机制有效不保证所有语义指标都赢,验收要同时覆盖改变与保留。 接口分布同样影响最终质量 Channel Match的形状没坏但材质变差,AnyEdit把干净编辑与现场渲染分开。模块单独达标仍可能在连接处出错。 奖励与设备条件决定兑现方式 FlashVSR+依赖混合训练及4090缓存卸载,SyncReward十六选一需要额外生成。偏好分、去噪速度和完整产品耗时是不同账本。 今日讨论 SMD把Qwen-Image从教师100次网络评估压到4次,GenEval为0.873对0.874,但多样性从0.195降到0.144。训练仍要教师查询与Pivot,部署也有前后处理;你会用哪些指标和固定预算实验,验证减少网络调用后是否仍保住服务需要的变体覆盖? 人工智能炼丹君 整理 | 2026-10-15
-
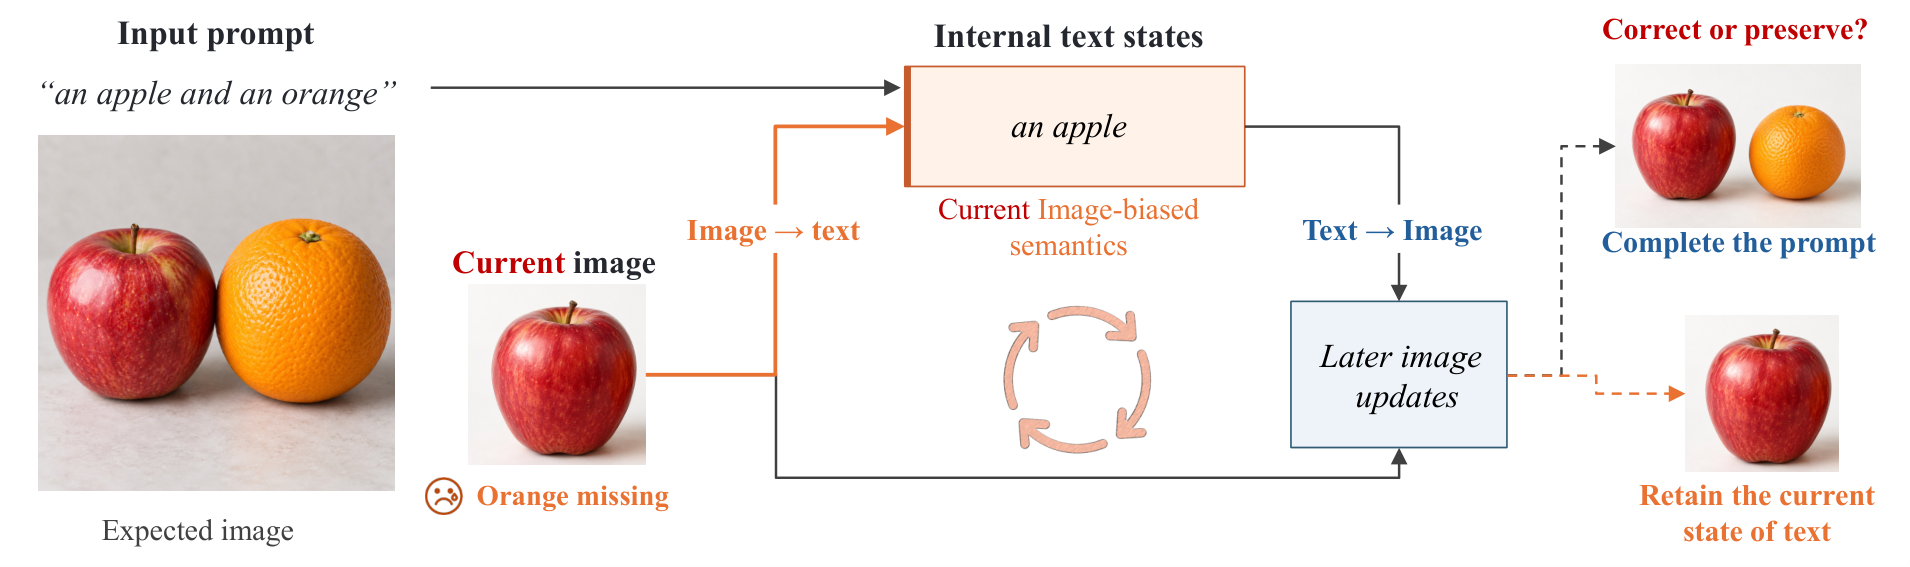
AIGC 每日速读|2026-10-14|斯坦福让图像少误导文本SFG 今日 AIGC 论文速览 今日共 10 篇 · 图像生成机制 2 篇 · 视频缓存、压缩与纠错 3 篇 · 原生三维编辑 1 篇 · 流式动作与长动作评测 2 篇 · 情绪语音生成 1 篇 · 视频文字评测 1 篇 重点论文标题列表 SFG(斯坦福):减少图像对文本的错误反馈 T2I Sinks(复旦):高注意力位置不能随手删 CORAL-KV(AMD):跨层预测压小视频缓存 UniGVC(中科大):同一码流选直播或高清回看 PreCoG(港大):先看预览再修缓存轨迹 今日论文速览 1. SFG:减少图像对文本的错误反馈 Images Talk Back: Guiding MMDiTs by Suppressing Image-to-Text Feedback | 斯坦福大学;清华大学;纽约大学 | arXiv:2610.13941 关键词:多模态扩散, 语义反馈引导, 双向注意力, 推理期控制 前序问题:MMDiT 用联合注意力让当前图像更新内部文本表征;图像少画一个物体时,这条反馈可能把错误写回文本,并继续影响后续图像。 本文贡献:Semantic Feedback Guidance(SFG,语义反馈引导)在冻结模型中增加辅助分支:加强图像到文本反馈、减弱文本到图像条件,再让采样方向远离该分支。iSFG 则在正常条件前向内直接抑制前者、加强后者。修改位置在 softmax 与 value 聚合后,保留注意力归一化和模态内项;图像 SFG 只在前 20% 采样步启用额外分支。 图2|图像对文本反馈路径:输入prompt保持不变,当前图像通过图像到文本消息写入内部文本状态,随后文本再指导图像更新。缺失橙子的中间图像可能被纠正,也可能把缺失状态延续;文本标签和AI生成水果仅示意可能状态。 实验效果:表 2:1024×1024 图像、相同 prompt 与 seed,FLUX 的 CFG→CFG+SFG,GenEval 0.6661→0.7479,HPSv2.1 30.96→31.66;SD3.5M 的 GenEval 0.6890→0.7110。表 3:SD3.5M 的 iSFG 为 0.7047、HPS 32.98,比 CFG 高 1.33,增益与 SFG 不相同。 表2|有CFG的文生图比较:SD3.5M与FLUX上,各额外引导均叠加CFG。Count、Pos、C.-Attr分别为计数、位置、颜色属性,Overall为六类平均;HPSv2.1为四风格平均,ImageReward用同图像。各方法prompt与seed相同,FLUX的GenEval从0.6661至0.7479。 批判点评:SFG 无 CFG 时约用 1.2K 次模型评估,有 CFG 时约 2.2K;iSFG 零额外评估不等于零时延,也不能套用 SFG 的较大 GenEval 收益。干预支持反馈方向解释,尚不证明所有模型、场景都有效。官方仓库可见图像与视频推理源代码及配置,未运行复现。 2. T2I Sinks:高注意力位置不能随手删 Exploring Attention Sinks in Text-to-Image Transformers from Diffusion and Autoregressive Models | 复旦大学;上海创智学院;上海科学智能研究院 | arXiv:2610.13337 关键词:生成注意力分析, attention sink, 结构性位置, register探针 前序问题:某些 token 获得异常多的注意力,并不说明它们可有可无;把语言模型中对 attention sink 的直觉直接套给图像生成,可能损坏结构。 本文贡献:本文以 T2I Sinks 作阅读简称。对 FLUX.1、Z-Image 和 Infinity-2B 逐层逐头分析注意力,再以 logit 惩罚、value 清零、头剪枝及阶段性 token 移除作干预。扩散模型的 sink 常在模态边界、文本区和空间角落;自回归模型集中于首个全局 token。额外 register token 只作小范围探针。 图1|图像生成attention sink研究总览:(a)双向扩散与因果自回归架构;(b)FLUX.1与Infinity-2B的代表性sink;(c)logit惩罚、value替换和头剪枝;(d)干预及分阶段全局token移除结果。扩散sink聚集在模态边界和空间角落,Infinity首个全局token明显集中。 实验效果:表 5:Infinity-2B 从首尺度起移除全局 token,GenEval 64.56→11.37;从第 4 尺度开始为 62.90。FLUX 全程移除结构位置则为 67.14→64.81。表 7:FLUX 加 register,GenEval 67.14→68.85、DPG 83.67→84.01,register 的 top-1 sink 比例仅 0.53%。 表7|FLUX的register token探针:加入register后GenEval和DPG改善,原生sink位置的top-1比例略降;register自身比例0.53%,说明部分重新分配,不能称完全取代结构性sink。 批判点评:结构角色依赖生成范式和阶段,不能把 sink 都称为坏注意力。register 的结果是单主干探针;部分位置干预影响小,但剪掉高 sink 头更伤,关注位置不能替代关注头。本文未提供可确认的作者方法代码入口,也未证明通用推理加速。 3. CORAL-KV:跨层预测压小视频缓存 CORAL-KV: Compact Cross-Layer Prediction and Residual Coding for Autoregressive Video KV Caches | AMD;威斯康星大学麦迪逊分校 | arXiv:2610.12514 关键词:视频KV压缩, 跨层预测, 低秩加分块, 残差量化 前序问题:长视频的历史 key/value 缓存不断增长;只在单层内聚类量化,残差误差会随生成累积,边界处还可能突然失真。 本文贡献:CORAL-KV 先用上一层重建缓存预测当前 key,再用当前重建 key 和上一层 value 预测当前 value,只量化预测残差。block-DPLR 用块对角项建模头内通道、低秩项建模跨头联系;可跨视频复用离线预测器,也可固定低秩项、为当前视频重拟合块对角项,以更大缓存换保真。 图3|CORAL-KV重建:第ℓ层由前一层重建缓存预测key,加量化key残差;再用当前重建key与上一层value预测value,加量化value残差。两预测器都由块对角与rank-r低秩部分组成,解码不取原始key/value。 实验效果:表 1:单视频 HY-WorldPlay 285 帧,QVG-4→复用 CORAL-KV,缓存 13.36→6.90 GB、相对 BF16 输出的 PSNR 16.66→16.98 dB;MAGI-1 192 帧为 1.58→0.99 GB、26.14→31.09 dB。视频适配版本 MAGI-1 为 1.15 GB、32.47 dB,相对 BF16 的生成时延增加 10.0%。 表1|匹配比较中的保真与总缓存:HY-WorldPlay含285帧的已完成缓存块,保真评估保留最近48个latent帧;16视频列把共享预测器只计一次。PSNR/SSIM/LPIPS相对BF16生成,时延列为相对BF16开销,协议见附录F.3,不是全进程峰值显存或并发吞吐。 批判点评:内存数字只涵盖存储缓存,不是整个进程峰值显存;16 视频数是共享参数核算,不是16路并发实测。时延在 MI355X 测量,HY-WorldPlay 适配版本开销达29.1%。保真对照是同 seed 的 BF16 输出,不能当真实视频准确率。只验证两个主干,本文未确认作者代码入口。 4. UniGVC:同一码流选直播或高清回看 Unified Generative Video Compression with Autoregressive and Bidirectional Video Diffusion | 中国科学技术大学;快手 | arXiv:2610.13023 关键词:生成式视频压缩, 共享码流, 双模式解码, 单步蒸馏 前序问题:双向扩散解码画质更好却需要整段视频;自回归解码适合流式播放,但上下文受限。同一视频直播和回看不应被迫存两份码流。 本文贡献:层次潜变量 codec 生成同一压缩码流和递归条件,分别驱动双向 BI-DiT 与窗口自回归 AR-DiT。先联合适配 codec 和两套 LoRA,再用双向模型作教师把 AR 蒸馏到一步,最后在像素空间微调并训练条件 tiny decoder。共享的是传输表示,解码端仍保留两套参数。 图1|UniGVC训练与推理:(a)共同适配共享latent codec和双向/窗口因果DiT的LoRA;(b)合并LoRA,在相同codec条件下用双向DiT的真实score、伪score及对抗监督将AR蒸馏为一步;(c)像素空间改进AR及条件tiny decoder;(d)同一codec条件选择回看或流式解码。 实验效果:表 2:HEVC-B 1080p、0.0005–0.004 bpp,50步双向+原VAE为0.14 FPS,一步AR+tiny decoder为36.85 FPS。每帧 codec、DiT、解码器分别7.42、16.10、3.62 ms;最终训练组合相对双向基线的 BD-LPIPS +0.001、BD-DISTS +0.017,仍有感知差距。 表2|解码加速和增强消融:BI-50为50步双向,AR-1为一步自回归,Orig为原Wan VAE,Tiny为轻量解码器;Adv.DMD、Pixel FT、Cond.VAE-D为不同训练组件。在HEVC-B 1080p与0.0005–0.004 bpp四码率测试,最终AR为36.85 FPS,BD-LPIPS和BD-DISTS仍高于双向基线。 批判点评:250倍左右是对该50步双向方案的解码速度比较,不能称比通用视频编码器快250倍。极低码率可能补出合理但非原视频的细节;高FPS依赖一步AR与tiny decoder,不能套给双向质量档。原文声明代码和模型以后发布,未确认已开放。 5. PreCoG:先看预览再修缓存轨迹 PreCoG: Preview-Edit for Efficient Video Correction in Generation-Time | 香港大学NICE Lab;北京邮电大学 | arXiv:2610.13174 关键词:视频生成纠错, 低成本预览, 缓存轨迹编辑, 反事实软投影 前序问题:每次查出漏物体、动作绑定或时序错误就重新完整生成,既重复计算,又可能把已正确的内容改坏。 本文贡献:PreQA 用规划、评估、修正三个步骤,将原 prompt 拆成固定要求并从低步数预览诊断失败;PreEdit 以目标与反事实条件的预测差编辑缓存轨迹,用分块软投影减弱无关方向变化。每次选要求覆盖率最高的预览继续改,只对最终选中候选完整渲染;无需额外训练视频主干。 图1|共用轨迹的预览与完整渲染:成对视频具有相同prompt与seed,预览用少步完成。图中百分比是采样步数比例,不是实测耗时比例;主体与阶段大体对应,细节和姿态仍可能不同。 实验效果:表 1:Wan2.2-T2V-A14B、81帧、832×480、原40步,预览14+2+2步、最多4轮。直接生成→PreCoG,VBench 82.06→83.49、T2V-Comp 55.27→62.28、VS2 3.708→3.854;耗时895.0→2022.9秒,为2.26倍。相对VSR的3620.3秒更快,但VSR的VS2为3.973。 表1|视频纠错比较:列出VBench、T2V-CompBench、VS2及推理耗时,Δ为相对直接生成。PreCoG提高质量和对齐,耗时2022.9秒仍是直接生成的2.26倍;VS2 3.854低于VSR的3.973,不代表各项最高。 批判点评:这里的VBench是六维均值,不与其他论文全维总分直接比。98.24%预览一致性来自固定seed的初始候选诊断,不能保证任意纠错后续。规划和反馈依赖Qwen3.8-27B,多轮纠错仍有额外成本;人工评估仅4人。未确认作者完整框架代码入口。 6. 3DRAG:在原生三维潜空间拖动物体 3DRAG: 3D-Native Object Drag Editing with Generative Models | 上海科技大学 | arXiv:2610.13216 关键词:原生3D拖拽, 稀疏体素, 占用感知位移, logits级融合 前序问题:用2D扩散监督拖3D常有视角不一致,纯几何变形又容易破坏拓扑、纹理或未编辑区域。 本文贡献:在TRELLIS的稀疏3D潜空间构建弹性位移场,用占用感知winner-takes-all避免映射冲突;对结构和SLAT两阶段反演,缓存潜变量及Q/K/V。生成时搬移潜状态,在logits层融合目标与缓存源token,未编辑区域用缓存保留。无需训练或每次编辑优化,仍需反演与去噪。 图2|3DRAG流程:输入物体编码到稀疏体素潜空间,同时由拖拽指令建立位移场。TRELLIS结构ST与SLAT阶段反演获取缓存潜变量和Q/K/V;采样时用缓存与位移场保持细节、产生自然变形并保留未编辑区域。 实验效果:表 1:100个3D物体、单H20、64³体素,反演及去噪各25步。3DRAG未编辑区域PSNR 31.50、拖拽MD 15.89、FID 21.99、耗时227.74秒;APAP为22.52、18.01、63.31、275.13秒。纯几何ARAP仅3.32秒,不能称全表最快或交互实时。 表1|3D拖拽比较:评估未编辑区域保留、拖拽准确、整体3D质量和运行时间,向上/下箭头标明优劣。3DRAG的PSNR为31.50、MD为15.89、耗时227.74秒;ARAP仅3.32秒,生成方法的质量收益不能当全表最快。 批判点评:64³限制细薄结构精度,TRELLIS的VAE仍带色偏;GPTEval3D由模型裁判给分,不能当独立人工真值。原文列MM ’26会议信息与DOI,未把其他稿件模板当接收。官方仓库可见编辑UI、推理及依赖配置,需另备TRELLIS权重,未运行复现。 7. Sonic-AMG:声音边来角色边做反应 Sonic-AMG: Streaming Human Motion Generation from Spatial Audio | 布朗大学;麻省理工学院;耶鲁大学;香港大学 | arXiv:2610.13300 关键词:空间音频动作生成, 因果flow, 自身rollout训练, 空间反馈 前序问题:离线模型先知道整段声音及真实身体位置,在线角色却要边听边动;生成姿态的误差又会改变声源相对位置,形成训练推理差异。 本文贡献:将声学内容与身体相对声源位置分成token,用因果Transformer和flow head生成动作潜变量,再以因果解码器还原四帧片段。rehearsal训练结合整段teacher forcing与短自身rollout;空间反馈根据生成root姿态重新计算声源相对位置,使训练和在线条件一致。 图2|Sonic-AMG架构:交错声学what、空间where与动作token,经因果Transformer与flow head生成动作latent;空间反馈从解码root姿态更新身体相对声源位置SSL。Xk、zk、mk分别为四帧动作块、latent及投影token。 实验效果:表 2:SAM,在真实身体位置GT条件下,MOSPA→Sonic-AMG,FID 8.242→6.505、R@1 0.942→0.957;实际Online条件下Sonic为FID 8.066、R@1 0.943。作者项目报告RTX A6000首帧184 ms,对照MOSPA为10846 ms;首帧时延不是长期稳定吞吐。 表2|SAM定量比较:Causal表示支持因果生成,†表示引用Xu等2025报告;GT使用真实身体的声源相对位置,Online由生成root姿态更新。Sonic-AMG GT的FID为6.505,Online为8.066;R-precision与Diversity含95%置信区间,不应混用协议。 批判点评:主实验仍假设已知世界声源位置,且给4帧真实初始动作;不能把GT最优数字当完全自主在线表现。长时连贯与多事件切换主要是定性证据,机器人演示是离线物理仿真。作者项目页已核验;原文称代码与模型将在接收后发布,未确认接收。 8. Emo-BPO:同时学目标情绪和反向情绪 Emo-BPO: Emotion Bidirectional Preference Optimization for Diffusion-based Emotional TTS | 威廉玛丽学院;埃默里大学;乔治梅森大学 | arXiv:2610.12958 关键词:情绪语音生成, 双向偏好优化, 对比扩散引导, 后期引导调度 前序问题:只奖励目标情绪,没有学习如何远离竞争情绪,CFG的正反预测容易缺少区分,细粒度语气控制不稳。 本文贡献:把同文本、不同情绪的音频对调换次序,训练情绪对齐与情绪对比两条score分支;推理用对比CFG强化目标、压低其他情绪,并把引导强度留给后期去噪。基于Grad-TTS,只微调扩散解码器,冻结文本编码器及时长预测器,波形用HiFi-GAN生成;仍依赖已有情绪标注。 图1|Emo-BPO总览:训练调换同文本情绪对,部分微调预训练主干,同时学习情绪对齐EA与情绪对比EC扩散分支。推理在CFG内组合两路预测,强化目标情绪并抑制竞争情绪;训练仍利用已有情绪标注。 实验效果:表 1:英语ESD与EmoVoiceDB、三次运行均值,Emo-BPO的Emo SIM 99.23、UTMOS 4.52、平均情绪识别0.87;CosyVoice2为98.47、4.43、0.82。WER为3.84,略高于CosyVoice2的3.77,不能说可懂度也最佳。表 2的30人主观MOS为3.93、情绪MOS 4.25。 表1|客观情绪TTS评估:比较Emo SIM、韵律相似、可懂度、UTMOS及五类情绪识别,三次独立运行取平均。Emo-BPO的UTMOS为4.52、情绪识别均值0.87;可懂度列实为WER、越低越好,3.84不优于CosyVoice2的3.77。 批判点评:只有英语五类情绪,同文本配对与情绪标签是数据条件,免新增标注不等于无监督。自动MOS和情绪分类器可能有域偏差,没有给出完整部署时延。arXiv备注明确称Interspeech 2026接收;作者项目页可听样例,未确认完整训练代码开放。 9. ELMA:长动作要记住上一段约束 ELMA: Benchmarking Anaphoric Compositions for Long-Term Text-to-Motion Generation | 庆应义塾大学;庆应AI中心;索尼集团 | arXiv:2610.13549 关键词:长动作生成, 跨段指代, 连续数据集, 状态保持评测 前序问题:“继续敬礼并走路”要求保留上一段手势,只给各段独立字幕会让生成角色换动作时忘记约束。 本文贡献:从真实连续视频筛出30秒全身动作,以自动跟踪、姿态恢复和两阶段质量过滤构建ELMA,再生成带前文的六段字幕并标注指代依赖。数据含13.2k片段、110小时;ELMABench取测试集1k片段,每段5秒,只在指代目标段计分。A2M训练把当前与此前CLIP文本嵌入加权融合。 图3|ELMA数据构建:上部为动作收集,下部为字幕标注。SAM2人物跟踪与两阶段后处理筛出高质量动作,先生成连贯episode的分段字幕,再识别指代目标和跨段依赖;全部自动生成,仍有恢复和标注误差。 实验效果:表 2:FlowMDM在T2M训练→A2M推理时FID 1.9363、R-P@3 0.4211;A2M训练→A2M推理为1.5287、0.4662。但Matching Score 7.6015→8.1161变差;UniMotion的FID 18.3490→19.0050也未改善。不能把数据微调收益称跨模型普遍有效。 表2|不同训练推理设置:T2M为独立指令,A2M为带前文依赖指令;FID、Matching Score越低越好,R-P@3越高越好,Diversity应接近GT。FlowMDM的A2M训练改善FID与检索,但Matching Score变差,UniMotion也非统一改善。 批判点评:由视频恢复的动作和自动字幕有噪声,30秒及六段不能代表任意长流。依赖保持仍用分布与文本动作嵌入度量,需检查具体状态。arXiv备注与项目页称NeurIPS 2026 Evaluations & Datasets接收;作者项目页仍为Coming Soon,数据和代码未确认可下载。 10. TextVBench:分开测视频文字正确和稳定 TextVBench: Evaluating Text Rendering and Preservation in Video Generation | 中国科学技术大学 | arXiv:2610.13412 关键词:视频文字生成评测, OCR目标匹配, 时间一致性, 多参考文字保留 前序问题:视频里的字可能一直错但十分稳定,也可能每帧变;只看清晰度或OCR识别率,会混淆字符正确、跨帧保持与额外乱码。 本文贡献:分别构建300个中英T2V prompt和200个Ref2V参考,先把OCR候选关联到指定文字目标,再算空间字符保真S、同目标相邻观测的时间保真T,以长度加权聚合成TextVScore。多参考只在活跃视角匹配并处理重现;额外可读文字单列Extra,不混进主分。 图2|TextVBench统一评估:目标来自T2V指定文本或Ref2V参考区,编号框为OCR观测;同目标可跨框拼接而不改写。空间保真对目标,时间保真对同目标前后观测;漏掉EVERY DAY是24个归一字符中的8个。多参考跳过不活跃视角并在重现时比较;长度加权得到S/T,额外文字独立报告。场景和数值是示意。 实验效果:表 1:八个T2V模型、六个Ref2V模型,共2400+1200视频,3FPS抽样、最多30帧、OCR置信阈值0.80。T2V中MiniMax-H3的TextVScore 68.320,Wan2.2-A14B为43.853;Ref2V头三名仅56.506、56.465、56.388,相差0.119分,不足以宣称可靠总排名。 表1|总体结果:T2V测指定文字生成,Ref2V测参考文字保留;Spatial和Temporal范围0–1,TextVScore为0–100,Extra越低越好,粗体仅为各轨道列内最优。Ref2V前三名只差0.119分,不能将小差距看作可靠总排序。 批判点评:模型按各自推荐设置测试,不是算力对齐。未决OCR候选路由依赖Qwen3.8-27B;难度同时改变文字量、布局等属性,切片下降不证明单一原因。3FPS也会漏短暂闪烁,中文字形等OCR误差仍影响得分。本文未确认作者评测实现或数据下载入口。 趋势观察 信息流要看因果作用 SFG抑制错误回写,T2I Sinks显示高注意力token可能有结构作用。注意力数值、语义直觉和干预结果应分开看。 共享表示不消除部署成本 CORAL-KV共享预测器,UniGVC共享码流,PreCoG共享缓存轨迹;分别节省缓存、传输或重复渲染,仍有拟合、解码模型和反馈计算。 在线与长时条件各有门槛 Sonic-AMG在线重算空间位置,但主实验仍需声源坐标;ELMA测跨段依赖,部分指标和模型未改善。真实状态保持还要逐段验收。 可控性需要具体失败指标 3DRAG分别测未编辑区域与拖拽,Emo-BPO同时看情绪和WER,TextVBench分开正确文字与稳定文字。单一总分不能代替产品目标。 今日讨论 SFG把FLUX的GenEval从0.6661提高到0.7479,iSFG零额外模型评估但增益较小;如果你的图像任务更在意物体计数、偏好分或时延,会用哪些实测证据选择这两种控制? 人工智能炼丹君 整理 | 2026-10-14
-
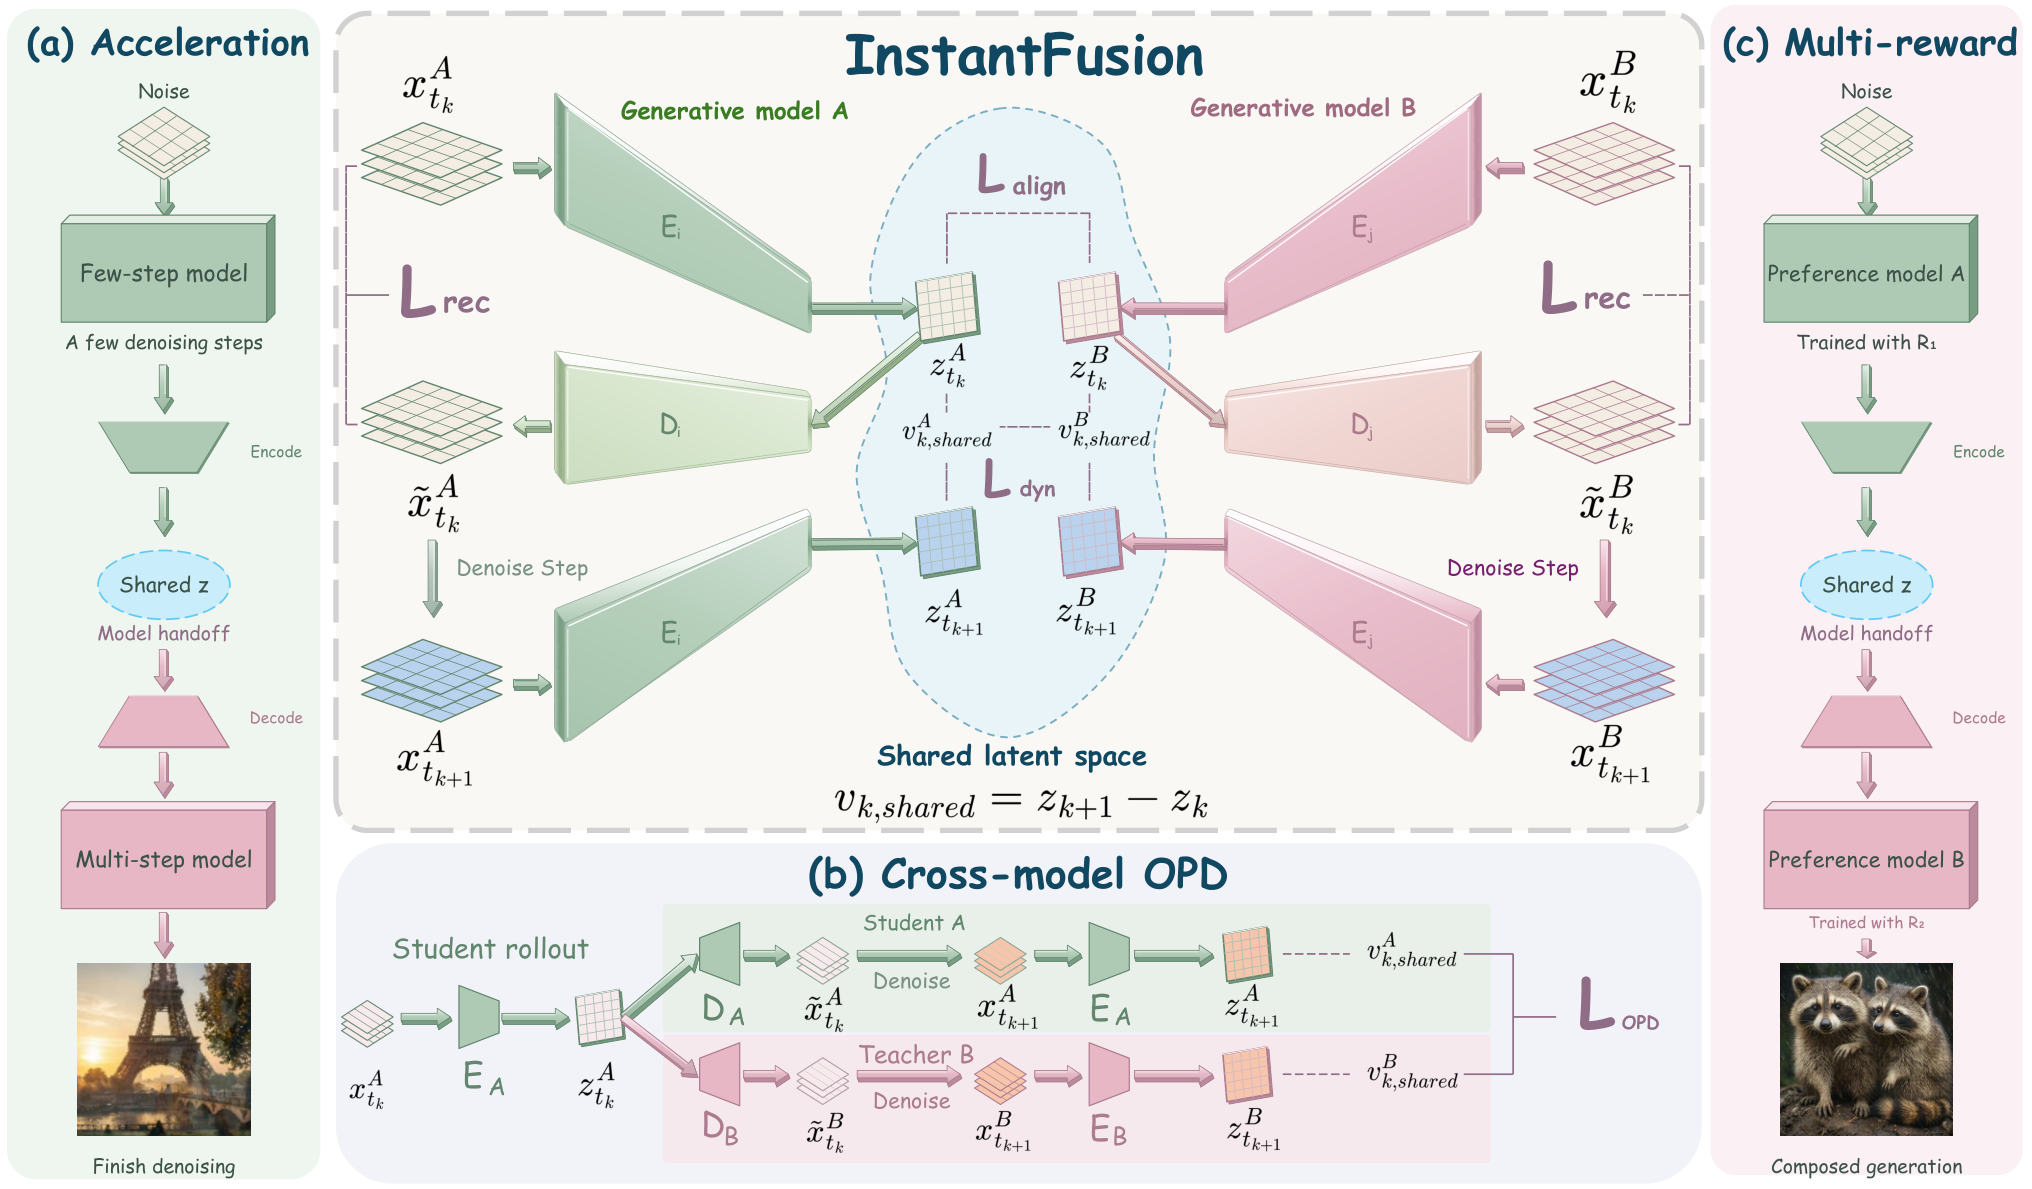
AIGC 每日速读|2026-10-13|上海AI Lab接力画图InstantFusion 今日 AIGC 论文速览 今日共 10 篇 · 图像生成接口与表征 3 篇 · 流式视频与效率 4 篇 · 语义图像编辑 1 篇 · 语音量化 1 篇 · 音乐生成评测 1 篇 重点论文标题列表 InstantFusion(上海AI Lab):让不同图像模型接力去噪 RG(阿里):让内部表征真正带动画图 CoVA(南开):把VAE特征分阶段用好 Memory Forcing(快手):固定缓存也保留中程历史 ForcingBooster(港科大):简单区域提前停复杂区域多算 今日论文速览 1. InstantFusion:让不同图像模型接力去噪 InstantFusion: A Shared Latent Interface for Heterogeneous Image Generators | 上海人工智能实验室;复旦大学;上海交通大学;香港中文大学 | arXiv:2610.13944 关键词:跨模型图像生成, 共享潜空间, 动态对齐, 接力去噪 前序问题:不同生成器各有所长,但中间状态直接交给另一模型会出现伪影;为每对模型训练桥接器,又难随着模型数量扩展。 本文贡献:为每个冻结生成器训练轻量 Latent AutoEncoder,把中间状态编码到共享空间,再由目标模型解码。训练同时约束重建、同噪声状态对齐与局部去噪速度对齐;推理根据预测干净潜变量的变化选择交接点。同一接口支持模型组合、接力加速及跨架构蒸馏,不必为每对模型单独建映射。 论文 Figure 1:InstantFusion 概览。训练时,每个冻结生成器的专用 LAE 把中间状态映射到共享表示空间,同时对齐潜状态与去噪动态。推理时,发送模型的状态经共享空间翻译到接收模型的潜空间,自适应准则决定接收模型何时接管去噪。图中接口、接力加速、偏好组合与蒸馏是不同用途。 实验效果:表 2:接入 Qwen-Image 后,SD3 的 GenEval-v2 从 22.14→35.06,FLUX.1 从 22.86→36.54,分别增加 12.92、13.68 分;OneIG-Bench 平均分为 0.4776、0.5007。SD3 组合的 CLIP 分 28.65→26.98、推理分 0.2770→0.2730,不能说所有指标同时提升。 论文 Table 2:基础生成器与跨模型组合比较,展示少量高质量生成器如何帮助较弱模型。列含 GenEval-v2、CVTG-2K、CLIP 及 OneIG-Bench 的对齐、文字、多样性、风格、推理与平均分。Qwen-Image+SD3 的 GenEval-v2 为 35.06,+FLUX.1 为 36.54;各自增量为 12.92、13.68 分。部分 CLIP 与推理数值下降,原表增量箭头不能替代实际数值判断。 批判点评:当前方法要求共享 VAE 和兼容时间参数,不能任意拼接不同编解码器;同时装载多个主干增加显存与存储。冻结主干仍需训练接口,重复往返也会损伤保真度。表 3 不同接力对象有速度与质量取舍,不能把摘要加速范围外推所有组合。官方仓库可见 LAE/OPD 训练及 SD3/Qwen 推理实现,HuggingFace 可见接口权重;其他演示组合未逐一确认实现,未运行复现。 2. RG:让内部表征真正带动画图 Learning Representations to Guide Pixel Diffusion Transformers | 中山大学;阿里巴巴;香港大学;上海交通大学 | arXiv:2610.12978 关键词:像素空间生成, 表征引导, 低维瓶颈, 训练目标修正 前序问题:中间层对齐视觉教师后,语义可能被后续像素合成覆盖;更强表征或更复杂像素解码器,不一定换来更好的生成。 本文贡献:Representation Guidance 用低维瓶颈连接普通 Transformer 编码器与解码器;比较解码器有无内部表征时的预测速度差,把停止梯度后的差值加进 flow matching 训练目标,迫使生成使用表征。默认由 EMA 网络形成引导,训练仍叠加 DINOv2 的 REPA 对齐;内部引导不能说成完全不用外部表征监督。 论文 Figure 6:Representation Guidance 训练。编码器把带噪输入 z_t 经瓶颈映射为 r;共享解码器在有 r 和无 r 两种条件下预测干净图像,再转成 v_with_rep 和 v_without_rep,其差为 Δv_rep。无表征分支由原 flow matching 目标 v=x−ε 监督,有表征分支由沿停止梯度偏移外推的 v_RG 监督。 实验效果:表 2:ImageNet 256×256,RG-XL/16 为 725M 参数、600 epochs,FID 1.55;RG-L/16 为 459M、同训练轮数,FID 1.79。表中的 PixelDiT-XL 为 797M、320 epochs、FID 1.61,JiT-G/16 为 2B、600 epochs、FID 1.82;训练预算与外部模型并不完全相同。 论文 Table 2:ImageNet 256×256 类别条件结果,比较潜空间与像素空间模型。预训练列列出额外使用的外部模型,粗体标示列内最佳。RG-XL/16 在 600 epochs 达 FID 1.55,725M 参数,外部表征列为 DINOv2;同时列出 IS、Precision、Recall。不同模型训练轮数及预训练组件不同,FID 排名不等于同成本比较。 批判点评:RG 增加两次无梯度 EMA 前向,推理无需这两次教师调用,但训练成本仍存在;低噪声区间、warm-up 和引导强度均属方法条件。现有实验聚焦图像,视频、3D、音频迁移尚未证实。官方仓库目前仅有 README 与展示素材,作者把代码和权重列为待发布,不能称已开源实现。 3. CoVA:把VAE特征分阶段用好 CoVA: Composing VAE Representations for Generative Learning | 极豪科技;南开大学 | arXiv:2610.13322 关键词:生成表征学习, VAE特征组合, 分阶段监督, 软标签幅值 前序问题:VAE 特征擅长重建,却不一定带来生成需要的语义结构;直接平均类别嵌入又会改变幅值,让 FID 改善与语义作用混在一起。 本文贡献:在线训练小型 latent composer,通过类别监督、掩码重建和水平翻转一致性整理 VAE 特征。前期用其密集特征对齐 SiT,中后期停止对齐,最后阶段使用停止梯度的类别后验软条件,并恢复硬标签嵌入的幅值,隔离方向语义与条件强度效应。辅助模块只在训练使用。 论文 Figure 3:SRA2 与 CoVA 比较。(a)SRA2 通过轻量投影与辅助对齐损失,把 SiT 中间特征对齐到 VAE 特征。(b)CoVA 在线组合干净 VAE 潜变量,语义及空间目标训练 composer,早期用密集特征作对齐,后期用停止梯度的类别后验作软条件。(c)分阶段从对齐转为软条件,使训练收敛更快、生成质量更好。 实验效果:表 1:ImageNet 256×256、batch 256、不开 CFG,同为 400K 次训练,SiT-XL/2 的 FID 从 17.2→7.4,REPA 为 7.9。表 3:增加 8.5M 辅助参数,训练吞吐从 8.1→7.0 iter/s,计算量 114.46→122.69 GFLOPs;改善收敛不等于单次训练更快。 论文 Table 1:不同训练迭代数的 FID。全部在 ImageNet 256×256、batch 256、不开 CFG;列出 SiT-B/2、L/2、XL/2 的参数数目及 REPA、SRA2、CoVA。XL/2 同为 400K 时原 SiT 17.2、REPA 7.9、CoVA 7.4;CoVA 1M 为 4.4、2M 为 3.6,不能把不同迭代数当同预算结果。 批判点评:主实验是类别条件 ImageNet,不能外推开放域文生图。表 5 显示只缩小条件幅值就能降 FID,却损失 Recall,评估应一起看覆盖度。原文未给出可确认的 CoVA 官方方法代码入口。 4. Memory Forcing:固定缓存也保留中程历史 Memory Forcing: Attendable Mid-Horizon History for Streaming Video Generation | 南京大学;清华大学;快手可灵团队;上海人工智能实验室 | arXiv:2610.11756 关键词:流式视频生成, 固定KV缓存, 中程记忆, 分库RoPE 前序问题:只保留开头与最近帧的 KV 缓存,会忘掉已离开窗口的事件;人物离场再回来,身份和场景容易漂移。 本文贡献:把原有固定大小缓存分成 sink、archive、working 三区。近期区满时,将与新片段最不相似的旧片段移入档案区,档案满后按 FIFO 淘汰;所有 key 保持原始形式,在注意力时用 Bank-aware RoPE 重赋时间位置,使旧事件可被检索。继续沿用 Rolling Forcing 的滚动去噪和 DMD 训练。 论文 Figure 2:Archive & Working Banks,每行缓存大小相同。(a)只有当前窗口被填满。(b)首个 chunk 进入 sink 并固定保留。(c)有空位时后续 chunk 写入 working。(d)working 满后,根据与新片段的相似度选历史写入 archive。(e)archive 满时由 FIFO 丢弃最旧 chunk。原 caption 分五步叙述,原图(d)合并相似写入与 FIFO 淘汰;颜色区分三类记忆,未增加独立历史存储。 实验效果:表 1:1.3B 模型,官方 VBench 总分 5 秒 83.88、60 秒 83.20,下降 0.68 分;LongLive 为 83.23→82.21,下降 1.02 分。表 2 的 30 秒消融中,working-only 总分 82.41,archive+working 为 83.58;60 秒 similarity 写入为 83.20,FIFO 为 82.96。 论文 Table 2:Wan2.1-T2V-1.3B 在官方 VBench 的 30秒及60秒消融,全部为16 FPS、832×480,报告总分、质量、语义。(a)记忆库;(b)Bank-aware RoPE 的连续、阶梯、折叠、插值分配;(c)相似度写入与 FIFO。30秒 archive+working 为83.58,working-only为82.41;60秒相似度写入为83.20、FIFO为82.96。 批判点评:缓存不增大不等于保存全部过去,档案仍会淘汰,最不相似也不必然等于最重要;分库和 RoPE 需要适配训练。论文对 Gen-Complex、MovieGen 等集合的结果不同,不能只用一个总分替代记忆验收。原文明确代码与权重拟在接收后发布,未确认会议接收或现已开源。 5. ForcingBooster:简单区域提前停复杂区域多算 ForcingBooster: Adaptive Patch-wise Denoising for Fast Autoregressive Video Diffusion | 香港科技大学;VAST;澳门科技大学 | arXiv:2610.12625 关键词:自回归视频加速, patch动态路由, 提前退出, on-policy训练 前序问题:每个 patch 都执行相同去噪步数,静态背景浪费计算;统一减步又让新区域与复杂细节得不到足够修正。 本文贡献:轻量 router 在每步预测各 patch 的停止概率,提前停止的干净预测及其 KV 作为仍在去噪区域的上下文。通过无梯度自身 rollout 记录退出并回放,以重建损失和计算成本训练路由概率;主干和时间表固定,首个 chunk 仍用四步。这里需要路由器训练,并非免训练加速。 论文 Figure 2:自适应 patch 推理与 on-policy router 训练。(a)router 选择继续去噪的 patch,已停止 patch 的预测提供可复用 KV 上下文。(b)无梯度 rollout 记录退出位置用于回放,重建和计算成本通过停止概率训练 router。主干固定,路由模块仍需训练。 实验效果:表 1:Causal Forcing 1.3B、81 帧、480×832、16 FPS,单 A800、BF16、batch 1。含文本编码、router、KV 与 VAE 的平均端到端时间 11.15→8.56 秒,1.30 倍;patch-NFE 减少 50.19%,VBench 总分 82.08→81.55。减少一半 patch 更新不能叫两倍端到端加速。 论文 Table 1:Causal Forcing checkpoint 上的比较,时间包括生成直至 VAE 解码。加速和 denoising patch-NFE 减少均相对该模型四步基线;列含质量、语义、总分、时间、加速及 NFE 减少。ForcingBooster 时间8.56秒、1.30倍、减少50.19%,总分81.55;四步11.15秒、总分82.08。首段统一四步,不能将 NFE 减少等同整体加速。 批判点评:保留质量是接近基线而非完全相同;路由误判会让尚未完成的细节早退,不同主干加速幅度也不同。文中路由器训练 500 steps,动态稀疏执行有开销。作者项目页及官方仓库可见 Wan 方法实现和权重入口,未运行复现。 6. CacheScope:把完整计算留给高风险步骤 CacheScope: Exact-Compute Allocation for Training-Free Diffusion Acceleration | 中山大学 | arXiv:2610.12530 关键词:扩散缓存加速, 轨迹归一化, 浅层探针, 完整计算调度 前序问题:浅层特征变化同时受到输入轨迹位移和网络响应影响;直接用变化量决定缓存更新,可能把计算花在错误步骤。 本文贡献:每步运行第一个 Transformer block,分别量出输入位移 Δx 与输出变化 Δy,用 s=Δy/(Δx+ε) 衡量沿当前轨迹的灵敏度。累计达到阈值才运行余下 blocks 并更新缓存,否则沿用同一有界一阶重建器;CFG 两分支分别累计。无需训练、梯度或辅助网络,改变的是完整计算落点。 论文 Figure 2:CacheScope 概览。每步先运行第一个 Transformer block 为浅层探针,量出输入轨迹相对位移 Δx_t 和探针响应 Δy_t,累计 s_t=Δy_t/(Δx_t+ε)。超过阈值 τ 才精确计算其余 blocks 并刷新缓存,否则沿用不变的有界一阶重建器。这是相对原探针调度的唯一改动;CFG 的两分支维护独立累计量与缓存。 实验效果:表 2:32 个留出 prompt、各指标取中位数。Wan2.1 Moderate 的原始探针调度 D 与 CacheScope S 约为 2.492、2.493 倍加速,LPIPS 0.0772→0.0414;但 SSIM 0.8961→0.9220。FLUX Fast 下 S 为 3.566 倍、LPIPS 0.1246;数值需按同主干、速度区间和同一重建器解释。 论文 Table 2:32个留出 prompt 的受控调度比较,指标为 prompt 中位数。D、M、S 信号共享同一个 DiCache 有界一阶 Γ 重建器、探针深度和 warm-up,只改变累积信号;统计检验使用附录F.2严格匹配跳步的子集。列含加速、LPIPS、PSNR、SSIM,粗体/下划线为主干和速度档内最佳/次佳。Wan Moderate 的D/S LPIPS为0.0772/0.0414,FLUX Fast 的S为3.566倍、0.1246。 批判点评:LPIPS、PSNR、SSIM 是相对密集生成输出的保真,不是真实图像真值。浅层探针不是完整误差证明,阈值与 warm-up 仍需选;快档可能出现细节偏差,不能称无损。原文未给出可确认的作者方法代码入口,部署价值需在自己的 prompt 与采样器上验证。 7. HD-VSR:消费卡靠关键帧与插帧做超分 High-Throughput Generative Video Super-Resolution on a Single Consumer GPU | Ethical AI Novelties;塞浦路斯理工大学 | arXiv:2610.13179 关键词:生成式视频超分, 稀疏关键帧, RIFE插帧, 邻域注意力 前序问题:逐帧运行扩散超分成本高;全局时空耦合虽能稳视频,却难在单张消费卡上兼顾吞吐和显存。 本文贡献:本文以 HD-VSR 作阅读简称。用预训练一步 AdcSR 增强稀疏关键帧,用 RIFE 从相邻高分辨率关键帧插出中间帧,再以运动门控决定是否回退生成;把部分高分辨率全局注意力替换为邻域注意力,语义关键低分辨率层保留全局。zero-shot 指推理时组合,不是组件从未训练。 论文 Figure 2:所提流程。复用两个预训练组件:AdcSR 对稀疏关键帧做超分,RIFE 作时间插帧。新贡献在组合方式:运动感知交错关键帧策略决定何时调用生成主干,免微调的混合注意力加速空间生成器高分辨率层,时间装配把超分关键帧和插帧合并为完整序列。 实验效果:表 1:RTX 4090、1280×720、关键帧间隔 K=3、batch B=8,吞吐 32.66 FPS、峰值显存 8.99 GB;同 K、B=1 为 8.28 FPS、2.33 GB。表 4 的 4K、B=1,邻域注意力相对原实现 0.76→1.10 FPS,44.7% 提升,基线和口径不同。 论文 Table 1:1280×720下不同关键帧间隔K和batch B的吞吐与显存。K=1、B=1为3.04 FPS、2.03 GB,K=3、B=1为8.28 FPS、2.33 GB;K=3、B=8为32.66 FPS、8.99 GB。K增大时更多帧来自插帧,B增大是吞吐批量,表格不能证明单流32.66 FPS的低延迟。 批判点评:32.66 FPS 是批量交错吞吐,不能当单段低延迟实时生成;插帧需要后一关键帧,高运动和遮挡会受影响。表 3 有感知分下降,作者明确以重建保真换效率,不能称超分质量全面领先。本文未提供可确认的整套框架官方代码入口,AdcSR 与 RIFE 本身也不是本文新模型。 8. ThinkDrag:先理解拖拽意图再改变图像 ThinkDrag: Semantic Drag-Based Image Editing with Visual Reasoning | 南洋理工大学S-Lab | arXiv:2610.13316 关键词:拖拽图像编辑, 视觉推理, 端点标记, 语义编辑评测 前序问题:把拖拽当几何位移,容易移动了像素却没有形成合理的姿态或物体变化;大结构改动也让特征点跟踪失准。 本文贡献:基于 BAGEL 训练统一理解与生成模型,用合成语义编辑对、拖拽点和推理轨迹监督 LoRA。Drag Endpoint Markers 为起终点建立图像空间对应,可直接生成,也可先输出显式推理。构建 145 例 DragBench++,以参考编辑与语义点跟踪补充原有几何距离评测。 论文 Figure 4:ThinkDrag 统一多模态模型流程。源图像、文本化拖拽约束及 Drag Endpoint Markers 为图像生成提供空间对应;模型可直接编辑,或先产生解释拖拽意图的推理轨迹再编辑。图中两种模式共享理解与生成模型,端点标记区别于仅用于展示的箭头。 实验效果:表 1:DragBench++,ThinkDrag 参考图保真 IF* 为 0.905、MD_MLLM 为 34.24;LightningDrag 为 0.836、57.28。原 DragBench 上 ThinkDrag FID 30.05、MD 28.84,GeoDrag MD 22.77 更低。附录推理模式相对直接模式只赢 75/145,即 51.7%,不是稳定全面胜出。 论文 Table 1:DragBench++与DragBench结果,TTO/OS/FT分别为测试时优化、一步方法、微调。IF对输入图像,IF*对参考编辑,MD为DIFT跟踪距离,MD_MLLM为语义跟踪距离,FID衡量分布差异;↑/↓标指标方向,缺测为横线。ThinkDrag主表为直接模式:++上IF*0.905、MD_MLLM34.24;原DragBench的MD28.84,GeoDrag22.77更低。 批判点评:数据和新评测含合成图像及模型裁判,参考编辑也不是唯一正确解。主表采用直接模式,不能把全部提升归给显式推理;推理增加串行生成时间,点跟随精度未处处最好。作者项目页与仓库已核验;当前仅 README/LICENSE/assets,数据、权重和推理代码均列 TODO,尚不能据此复现。 9. TTS-Q:把量化精度留给后期音色 TTS-Q: Perception-Guided Post-Training Quantization of Text-to-Speech Diffusion Transformers | Wyze;纽约市立大学城市学院;中科院计算所;台湾大学;清华大学 | arXiv:2610.12474 关键词:语音扩散量化, 音色保真, 任务匹配校准, 后期FFN精度 前序问题:低字词错误率不代表声音仍像目标说话人;四位语音扩散量化的音色损失集中在特定层与去噪阶段。 本文贡献:在任务匹配候选中选初始重建误差高的语音,取特定采样状态校准 FlatQuant;权重保持 W4,把末期 FFN 激活升为 A9,其余用 A3,匹配约四位的名义激活预算。该预算按参数加权,并不保证同样的实测时延;没有重新训练 TTS 主干,仍有离线校准优化。 论文 Figure 1:TTS-Q。上方文本和说话人参考条件化TTS DiT,采样状态用于离线校准,阴影FFN为推理精度分配;CER/SIM为字符错误率/说话人相似度。左下按初始损失排序任务匹配候选,取语音-步数快照拟合均匀W4A4。右下权重W4,晚期FFN激活升精度、其他位置降精度;早晚示意在相同名义预算比较,名义预算不等于实测时延。 实验效果:表 1:Seed-TTS-eval 留出集,3.5B 英文,均匀 W4A4 参考 SIM 0.7796→TTS-Q 0.7829,全精度为 0.7834;WER 1.813%→1.918%,全精度 1.919%。各方案 32 条校准、steps {13,14}。附录 S11 的 15.83→4.44 GB 来自均匀 W4A4 部署,未测试混合 TTS-Q 路径。 论文 Table 1:Seed-TTS-eval留出集,zh/hard/en为1720/300/888项;中文CER和英文WER均为百分数,另报SIM。校准均为32项、steps{13,14}、64快照;三个均匀W4A4行仅选择数据不同,lossmax为均匀参考。TTS-Q权重W4,A9/A3均衡预算在1B/3.5B为4.000/3.947位;粗体只在量化结果中按列比较,全精度不参与。3.5B英文SIM为0.7829、WER为1.918%。 批判点评:名义四位不等于全程 W4A4,更不能把均匀量化的显存和速度归给混合方案;1B 部署量化路径还可能更慢。原摘要与 PDF 均记首发 8月11日,本期是首次纳入,不能称10月新发。原文未给出可确认的方法官方仓库或权重入口。 10. MusicEval Probes:音乐裁判是否真的听了音频 What Do Audio-Language Judges of Generated Music Listen For? Four Probes with Controls from Expert Ratings | 华沙理工大学计算机科学研究所 | arXiv:2610.13247 关键词:音乐生成评测, 音频语言裁判, 位置偏差, 专家对照 前序问题:裁判评分与专家相关,不等于它真正听懂音乐质量;文本提示、候选位置和问法都可能改变生成模型排名。 本文贡献:以 MusicEval Probes 作阅读简称,审计五个开放音频语言裁判:去掉音频、同 prompt 换另一模型音乐、交换成对顺序、重写指令,并用专家评分计算相应对照。MusicEval 覆盖 2748 段音乐,后两项也测 SongEval,直接检验生成音乐评价是否可靠,而非提出音乐生成器。 论文 Figure 1:五个裁判的四种探针中两种,附95% bootstrap区间。左侧同prompt换音乐,实心/空心为裁判分对实际播放片段/被替换片段专家分的标准化系数,分别看质量与对齐;真正听音频应追随播放片段。右侧在相同300段音乐上换三种指令问法,比较与专家质量分的相关。 实验效果:表 1:Qwen3-Omni 音乐质量 Spearman 相关为 0.31;去掉音频后为 0.04,专家构造的 prompt-only 对照为 0.08。表 2:600 对样本交换顺序,Music Flamingo 99% 仍选同一位置,Qwen3-Omni 为 25%;随机参照是 50%,同位置意味着优选音乐随交换改变。 论文 Table 2:同prompt交换的列报告裁判分对实际播放与被替换片段专家分的标准化回归系数,共2327次交换。顺序交换列报告600对样本两种顺序下选同位置的比例、其中选第二位置的比例、顺序平均偏好与专家一致的比例;随机参照为0.50/0.25/0.50,区间见表13和12。Music Flamingo同位置0.99,Qwen3-Omni为0.25,不能把同位置率当音质准确率。 批判点评:相关系数不是准确率,位置偏差也不是总体音质差。问法实验使用固定 300 段片段,结论受裁判版本、prompt 和数据集约束。模型级相关与片段级相关不能混用,选音乐生成器时应同时做专家验证。原论文未提供可确认的本研究官方实现入口。 趋势观察 表征既要对齐也要服务生成 InstantFusion对齐中间状态与速度,RG直接改变内部表征对预测的影响,CoVA分阶段使用VAE特征。表征图看着更有语义,不等于最终生成收益。 预算应该落在最需要的位置 Memory Forcing决定缓存留下谁,ForcingBooster决定哪些patch继续去噪,CacheScope决定哪些步骤完整计算,TTS-Q把名义精度留给晚期FFN。预算口径不同,收益须配条件。 吞吐与训练收敛各有代价 HD-VSR高FPS依靠批量和插帧;CoVA单步训练更慢但同迭代FID更低。不能把batch吞吐叫单流低延迟,也不能把少训练轮数直接等同省时比例。 评测要拆开目标和对照 ThinkDrag的几何点距与语义合理性未必一致,MusicEval Probes检验音频、位置和问法的干扰。生成部署需要原始任务与人工验收共同决定。 今日讨论 InstantFusion把SD3的GenEval-v2从22.14提高到35.06,但仍要求共享VAE、兼容时间参数并装载多个主干;你需要哪些指标和显存证据,如何判断接力生成是否值得用在自己的图像工作流中? 人工智能炼丹君 整理 | 2026-10-13
-
AIGC 每日速读|2026-10-12|Google把token留给细节BudgetPix 今日 AIGC 论文速览 今日共 10 篇 · 图像计算与自训练 3 篇 · 视频编辑与加速 3 篇 · 局部三维生成 1 篇 · 音视频与语音控制 2 篇 · 生成编辑评测 1 篇 重点论文标题列表 BudgetPix(Google):按细节分配可变token预算 Data-space DMD(字节):不用时间表直接反复修图 Rubric-CEPR(MBZUAI):只把核验通过的编辑教回模型 VINCIE-NExT(字节):先编辑关键帧再把变化传给视频 PTD(NVIDIA):让四步学生沿自己的曲线学 今日论文速览 1. BudgetPix:按细节分配可变token预算 BudgetPix: Compute-Adaptive Tokenization for Pixel-Space Image Diffusion | 伊利诺伊大学厄巴纳-香槟分校;Google | arXiv:2610.12307 关键词:像素空间扩散, 四叉树, 可变token预算, 多尺度解码 前序问题:固定网格给平滑背景和复杂纹理相同的计算预算;直接减少 token 又容易破坏细节,难用一个模型适配不同推理预算。 本文贡献:BudgetPix 按图像强度直方图熵构造四叉树,复杂区域保留细 patch,平滑区域合并为粗 token;多尺度 Patch Aggregator 编码粗格,Refiner 恢复固定分辨率。训练时扰动布局与预算,推理按当前去噪预测重估布局。新增编解码路径需要训练,Transformer 从已有像素空间扩散模型初始化。 论文 Figure 3:BudgetPix 总览。编码器把固定大小图像变成不同尺度、可变数量的 token,解码器恢复固定分辨率,训练和推理都支持不同 token 数。紫色编码器与解码器从头训练,蓝色 Transformer 从已有主干初始化;图中三部分共同构成预算自适应像素空间扩散。 实验效果:表 1:1024² PixelDiT-T2I,BudgetPix 在 25% token 预算下 GenEval 为 0.725、DPG-Bench 为 83.7;原模型全预算分别为 0.721、84.8。原模型同为 25% 预算时降至 0.323、55.1。不同指标说明保留指令遵循的程度,不能把 25% token 预算直接当四倍端到端加速。 论文 Table 1:1024² PixelDiT 文生图在 100%、90%、80%、70%、60%、50%、25% token 预算下的 GenEval 与 DPG-Bench。BudgetPix 各预算指标高于对应原模型;25% 时 GenEval 0.725、DPG 83.7,原模型全预算为 0.721、84.8。这里是预算与指标比较,未给出四倍端到端时延。 批判点评:布局依据中间预测,尚未出现的小细节可能分不到 token;PixelDiT 的全分辨率像素阶段还形成计算下限。需先微调,不能视为免训练插件,也不能把一个指标接近说成画质无损。作者项目页目前未提供可确认的方法代码或权重入口。 2. Data-space DMD:不用时间表直接反复修图 Few-Step Generation via Data-Space Iteration | 字节 Seed | arXiv:2610.12102 关键词:少步图像生成, 数据空间迭代, DMD蒸馏, 自rollout 前序问题:少步采样通常仍沿概率流选定几个时间点;难例和不同空间区域需要的修正次数不同,手工时间表未必适合。 本文贡献:共享生成器从噪声开始,直接把上一轮数据预测、原始噪声和迭代编号作为条件,反复修正干净样本,不再在每轮输出后按指定时间点重新加噪。通过分布匹配蒸馏 DMD 训练每一轮输出,并用自身 rollout 形成训练输入。它取消流时间离散化,仍需选择迭代次数与训练噪声采样。 论文 Figure 1:(a)现有少步生成沿概率流空间迭代,需要预定时间离散化,可能并不最优;图中从初始噪声经多个带噪状态到数据端点。(b)数据空间迭代直接修正每轮数据预测,以原始噪声和轮次作条件,取消流时间离散化瓶颈。两排小图用于示意各自迭代过程。 实验效果:表 3:类别条件 ImageNet 256×256,四次网络评估、启用 CFG 时,Data-space DMD 的 FID 为 2.29,均匀时间表 DMD 为 2.61,搜索三种时间表后的 Phased DMD 为 2.37。250 次评估的流模型 FID 为 2.06,少步方案尚未达到该教师水平。 论文 Table 3:ImageNet 256×256 的主结果,FID 越低越好。上半不开 CFG,下半启用 CFG;比较 250 NFE 流模型、1–4 NFE DMD、4 NFE Phased DMD 与数据空间 DMD。oracle 仅取三种搜索时间表中的最佳结果;数据空间方法无需时间表,启用 CFG 的四步 FID 为 2.29,教师 250 NFE 为 2.06。 批判点评:主结果是类别条件小图,文生图与其他模态仍属未来工作;自 rollout 有训练成本,不是把任何现有采样器换个循环就有效。不同训练权重与 CFG 需同时核对。作者在附录给出实现细节,未从论文入口确认独立代码仓库或权重。 3. Rubric-CEPR:只把核验通过的编辑教回模型 Rubric-CEPR: Self-Evolving Image Editing via Reward-Verified Self-Distillation | 穆罕默德·本·扎耶德人工智能大学;阿尔托大学 | arXiv:2610.12469 关键词:图像编辑, 内部奖励, 可行性门控, 自蒸馏 前序问题:模型自己生成的编辑样本可能真实却没按指令改;单一奖励还可能让“保留得好”补偿“根本没编辑”,把失败教回模型。 本文贡献:Planner 从未标注图像提出结构化编辑要求,Editor 采样多个候选,冻结 Critic 利用原编辑器的视觉语言特征和 VAE 潜变量检查新状态、旧状态消除及局部保留。任何适用检查不通过就拒绝,再把最佳可行样本用于 LoRA 加权去噪训练;主要循环不查询外部奖励模型。 论文 Figure 2:Rubric-CEPR 的提出、编辑、核验与蒸馏循环。冻结 Qwen-Image-Edit 提供 Qwen2.5-VL 理解分支、MMDiT 与 VAE;Planner 的 LoRA 给出指令 c 和结构化要求 s,Editor 的 LoRA 采样 K 个编辑。冻结 Critic 以语义支持与增益、VAE 保留检查构成 R=Gate·√(Edit×Preserve),新状态、旧状态消除、正确操作、无关内容保留与局部性任一适用项失败即拒绝;最佳通过样本训练 Editor,难度带内提案轨迹训练 Planner,进入下一轮。主要循环不查询外部奖励模型。 实验效果:表 1:Qwen-Image-Edit-2509 在 ImgEdit 的 0–5 分制总分 4.36→4.60,相对提升 5.5%;物体分离 3.41→4.26,相对提升 24.9%。总分差为 0.24±0.02,报告的是三次训练种子的标准差。表 2 的 GEdit-Bench 总分 7.39→8.31。 论文 Table 1:ImgEdit 各编辑类别及总分,0–5 分制。内部奖励自蒸馏使 Qwen-Image-Edit-2509 总分 4.36→4.60,相对提升 5.5%,差值 0.24±0.02 为三种子标准差;物体分离 3.41→4.26,相对提升 24.9%。Δ 按 100×(适配分−原分)/原分计算;† UniWorld 使用外部奖励,其原模型与裁判协议不同,不能直接横向归因。 批判点评:内部可检查的编辑更受益:若原模型完全采不到正确样本,多采样也找不到训练目标;调整类内部信号最多追回 30% 的 oracle 空间。主要结果是一次适配,不能称为持续多轮自进化。跨论文裁判协议不同。作者仓库可访问,未运行复现。 4. VINCIE-NExT:先编辑关键帧再把变化传给视频 VINCIE-NExT: Unlocking Video Editing from Images via In-Context Modeling | 新加坡国立大学;字节 Seed;中国科学技术大学 | arXiv:2610.12104 关键词:视频编辑, 图像示范, 共享空间位置, 编辑链 前序问题:视频编辑三元组昂贵;成熟图像编辑数据很多,但改对一帧不代表变化能稳定传到所有视频帧。 本文贡献:把任务拆成视频→图像→编辑图像→视频,以源与目标图像对作为上下文示范;TDF3D-RoPE 将示范和视频帧放在共享空间坐标中,统一扩散主干联合学习各子链。Chain-of-Editing 在推理时先得到编辑图像,再生成编辑视频,也允许更强图像编辑器提供示范。 论文 Figure 2:VINCIE-NExT 总体架构。把视频编辑分成视频→图像→图像→视频子任务链,源图 Iˢ 与编辑图 Iᵗ 作为上下文视觉示范。统一扩散主干据此把成熟图像编辑先验迁移到视频帧;图中各段代表可组合子链,而非完全无需视频编辑训练数据。 实验效果:表 1:431 段 OpenVE-Bench,Gemini 2.5 Pro 按 1–5 分评分,VINCIE-NExT 总分 3.08,高于 OpenVE-Edit 的 2.49,但低于 Runway Aleph 的 3.65;输出分辨率分别为 640×480、1280×704、1280×720。表 2 的第一阶段 256×256 模型,全数据加 CoE 为 2.65,不是同条件的 3.08。 论文 Table 1:OpenVE-Bench 八类编辑比较,Gemini 2.5 Pro 按 1–5 分自动评分。#Reso. 为输出分辨率,灰行是闭源商业模型。VINCIE-NExT 在 640×480 总分 3.08,OpenVE-Edit 在 1280×704 为 2.49,Runway Aleph 在 1280×720 为 3.65;各类包括全局风格、背景、局部改删增、字幕、创意与相机编辑。 批判点评:训练仍用了 OpenVE 视频编辑配对,不能叫完全不用配对视频;关键帧编辑错误会被传播,长视频与大相机运动仍待验证。CoE 增加串行扩散阶段。arXiv 注释明确已接收 NeurIPS 2026。作者项目页有仓库入口,但当前仓库只有 LICENSE 和 README,方法实现与权重尚未公开。 5. PTD:让四步学生沿自己的曲线学 Parametric Trajectory Distillation for Few-Step Video Generation | 洛桑联邦理工学院;NVIDIA;斯坦福大学 | arXiv:2610.11498 关键词:视频少步蒸馏, 参数化轨迹, 教师速度监督, 多样性 前序问题:把高度弯曲的教师轨迹压成几次学生评估,学生容量可能学不动,导致细节变软或不同种子生成近似视频。 本文贡献:Parametric Trajectory Distillation 让学生预测片段的平均速度与多项式曲率,在学生当前曲线上查询教师速度,以最小二乘损失同时学位移和形状;部署时去掉曲率头,只用平均速度更新端点。MiniMax-H3 的最后一个较平滑片段采用教师积分目标,并非所有片段都同一种监督。 论文 Figure 2:参数化轨迹蒸馏。一次学生评估输出平均速度 h 与曲率系数 c,参数化潜变量去噪片段;在学生曲线上查询教师速度,以同一个最小二乘损失监督两者。推理只使用 h 更新片段端点,移除曲率头。小视频图示意片段终止于数据端点,同样构造适用于中间噪声层;箭头为步长缩放速度,默认每片段查询两次教师。 实验效果:表 1:Wan2.1-14B 四次网络评估,匹配训练设置的 PDD 复现 VBench 总分 83.67→PTD 84.57,语义分 77.40→81.10。盲测人类偏好份额相对 PDD 为 55.1%,相对 MiniMax-H3 上的 LightX2V Turbo 为 63.4%。这是两项独立比较,不是所有基线的平均胜率。 论文 Table 1:Wan2.1-14B 的 VBench 与多样性。粗体只对比相同训练设置下 PDD 第96次更新与 PTD 第64次更新;灰色行是已发表参考,训练预算及协议不同。NFE 含引导评估,教师为 50×2;多样性是 V-JEPA 2 与 VideoMAE V2 特征余弦距离。PTD 总分和语义分提升,但这两项多样性不高于该 PDD 复现;rCM 用专有 prompt 且未报告多样性。 批判点评:表 1 的 VideoMAE 多样性 0.0254→0.0180,改善并非所有指标同时成立;发表的参考行训练预算和协议不同。去掉训练曲率头不等于不用蒸馏,四次评估也不等于视频生成时延。作者项目页有演示,未确认 PTD 方法权重公开。 6. iCATS:按交互与噪声动态稀疏注意力 iCATS: Fast Video Generation via Interaction-Aware Sparse Attention and Timestep-Adaptive Sparsity | 杭州师范大学;平头哥半导体;阿里巴巴 | arXiv:2610.11302 关键词:视频DiT加速, 交互聚类, SNR稀疏调度, 尾部合并 前序问题:独立按特征距离聚类 query 与 key,未必保留实际注意力交互;固定稀疏度和不规则簇填充又会损伤画质与 GPU 利用率。 本文贡献:iCATS 用 query-key 点积交互定义聚类目标,并改写成低成本二次型;以信噪比 SNR 调整各去噪时间步的 top-p 稀疏掩码。执行时将不满计算块的尾部 token 重新分配,减少 padding。无需微调生成主干,但聚类、调度与稀疏 kernel 都有实际开销。 论文 Figure 3:iCATS 的稀疏注意力流程。①按 query-key 交互聚类,用簇中心估计簇级 softmax;②以 SNR 引导每个去噪步的 top-p 值并选注意力计算区域;③在稀疏 kernel 前重分配未对齐计算块的 query 簇尾部 token,减少不规则簇的 padding。图中 interaction clustering 为交互聚类,Euclidean clustering 仅用于首个稀疏步初始化 query 簇。 实验效果:表 1:5 秒 720p、八张 H100,HunyuanVideo-T2V-13B 的 iCATS-Base 从 1730 秒降至 854 秒,2.03 倍,PSNR 31.017 dB;Wan2.1-T2V-14B 从 1889→1222 秒,1.55 倍,PSNR 29.301 dB。相应 VBench 为 0.844 与 0.838。 论文 Table 1:三种视频主干的密集、SVG、SVG2、iCATS-Base 与 Turbo 比较。PSNR、SSIM、LPIPS 衡量相对原模型输出的保真度,VBench 衡量视频质量,Time 是实测秒数,Sparsity 是理论注意力计算削减比例。5秒720p、八H100下,Hunyuan Base 为854秒、2.03倍、31.017dB,Wan文生视频 Base 为1222秒、1.55倍、29.301dB;不可把稀疏率当整体加速率。 批判点评:PSNR 比的是相同配置的原密集模型输出,不是真实视频真值;理论稀疏率不能当实际整体加速率。八卡结果不能外推单卡,且聚类多卡并行和 token 级 kernel 仍待优化。未从论文作者入口确认代码或权重公开。 7. SpaceFlow:不同3D部位分配不同控制强度 SpaceFlow: Locally Controllable 3D Generation | 苏黎世联邦理工学院;斯坦福大学;Microsoft | arXiv:2610.12399 关键词:3D生成, 局部几何控制, 部件条件路由, 自相似引导 前序问题:对整个物体统一控制强度,难同时保住指定结构并让其他部位自由生成;局部材质 prompt 还可能串到别的部件。 本文贡献:SpaceFlow 在 TRELLIS 推理中给每个几何 primitive 指定强弱控制,在受控时间段注入高控制区域;生成结构后用 PartField 划分部件,将局部文本或图像外观条件路由到对应区域,再用自相似引导细化外观。几何约束与外观条件分别作用,支持同一物体各部位不同自由度。 论文 Figure 2:SpaceFlow 流程。输入可编辑几何及局部控制强度 τᵢ,在受控时间段把高控制区域注入稀疏结构 flow;PartField 分割生成结构后,将每个部件的文字或图像条件只路由到该部件,再经外观 flow 与自相似引导得到局部几何和外观可控的3D资产。 实验效果:表 1:83 个资产,局部 τ=3/10 对比统一 τ=3,prompt 与几何保真胜率 78.3%、总体胜率 75.9%,但真实感胜率仅 43.4%;对比统一 τ=10,总体胜率为 68.7%。表 4 的外观总体评分 6.78,但纹理细节 6.49 低于 TRELLIS 的 6.87。 论文 Table 1:83个资产上局部几何控制胜率。SpaceFlow 低/高 τ 为3/10,与统一全局 τ=3及τ=10的 SpaceControl 比较 prompt与几何保真、真实感和总体偏好;括号为95% Wilson区间。对τ=3,总体75.9%但真实感43.4%;对τ=10,总体68.7%,说明保真与真实感存在条件相关取舍。 批判点评:胜率来自指定视觉语言裁判与资产集,表中附 95% Wilson 区间,不能当任意3D对象的成功率。语义与强几何约束冲突时会变形;更多局部控制也未必提升纹理细节。原文给出推理设置,未确认作者已发布 SpaceFlow 实现。 8. SepGen:同次生成视频混音和两路分轨 SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model | 特拉维夫大学;Google | arXiv:2610.11361 关键词:音视频生成, 分轨生成, 文本寻址, 混音噪声调度 前序问题:音视频模型通常只给一条混音;想换视角做空间音频,或单独编辑某个声源,就缺少可寻址的独立波形。 本文贡献:SepGen 在预训练音视频双流模型中增加分轨 adapter,每路由独立描述指定声源,在同次采样中生成视频、混音与分轨。分离模式保持输入混音干净;生成模式在高噪声读取带噪混音,低于阈值 σ_g 后读取其干净预测,减少分轨与混音错位。原混音主干保持不变。 论文 Figure 2:σ空间中的三种推理调度,从左到右:(a)分离模式保持混音 m 干净;(b)朴素共享噪声生成让分轨和混音处于同一噪声层;(c)SepGen 的分轨在 σ_g 以上读带噪混音,以下读其干净估计 ẑ₀,m,以改善生成时各声源与混音的对应。 实验效果:表 1:134 个声音案例和 60 个语音案例,联合生成的声音裁判分为 3.82,FlowSep 串行分离为 3.35;语音 WER 为 0.07,即 7%,FlowSep 为 1.03,即 103%。额外自分离声音分为 4.21,却使 WER 变为 0.10;这需要再运行一次,不能算同次采样。 论文 Table 1:生成评测,134个声音与60个语音案例;所有串行基线对同一生成混音和相同描述做分离,两行 SepGen 都使用生成 checkpoint。Judge/J-swap 为声音裁判及描述交换分,CLAP/C-swap为声音文本对齐及交换分,越高越好;语音WER与跨轨Cosine越低越好。联合采样WER0.07是7%,额外自分离WER0.10是10%;粗体与下划线是最好与次好,不代表额外自分离也是一次采样。 批判点评:当前训练和评估固定两个声源,不能声称任意数量分轨;声源仍带原场景混响与距离线索,完整新视角空间渲染属于后续工作。codec 重合成相位还影响 SI-SDR 的解释。作者项目页列出代码、模型和数据入口,未运行复现。 9. EDICT:全局改音色局部切换说话方式 Edit Who Speaks, Control How They Speak: Global Timbre Editing and Local Instruction Control for TTS | 新加坡国立大学;LIGHTSPEED;南洋理工大学;独立研究者 | arXiv:2610.11437 关键词:语音生成, 音色编辑, 局部指令, KV缓存重建 前序问题:参考语音克隆保留旧音色,文字设计又难在同一参考上微改;整句表达指令无法准确控制每个文本片段的语气。 本文贡献:EDICT 先把参考语音和结构化属性编辑送入可训练音色编辑器,生成 codec token 参考,作为各段共享的身份锚。冻结 TTS 主干按分段指令连续生成,在每个边界重建 KV 缓存:换入新指令和文本,同时保留首段与最近一段选定声学上下文,让表达变化但声音身份连续。 论文 Figure 1:EDICT 联合全局音色编辑与局部表达控制。可训练编辑器读取源参考和全局编辑指令,输出共享codec参考;每段冻结TTS均使用它。在指令边界重建KV缓存,以选定历史声学上下文保持衔接,多个片段组成一条连续话语。 实验效果:表 4:Qwen3-TTS-VD 联合控制,EDICT 的片段指令准确率 81.62%、过渡质量 83.45%;原 Joint 为 60.19%、70.07%。段间说话人相似度为 0.917、与原 0.918 接近;英文 WER 3.6%→5.1%,中文 CER 1.2%→1.9%,内容正确性付出代价。 论文 Table 4:Qwen3-TTS-VD上的联合音色及表达控制,请求结合TimbreEdit-Bench的音色编辑与IntraTTS-Bench的分段指令。SIM-T是整条语音与目标声线相似度,SIM-I是段间相似度;WER/CER分别为英文/中文百分数,粗体/下划线为最好/次好且分语种排名。EDICT的SegAcc81.62%、Trans83.45%、SIM-I0.917;错误率5.1%/1.9%,须与控制分共同看。 批判点评:音色编辑器仍要训练,冻结 TTS 主干不等于全系统免训练;训练、指令构造和评测含合成数据与模型裁判。指令遵循更高不能代替低错误率,推广到更多声线还待验证。作者演示页,未确认官方方法代码与权重入口。 10. RISEBench++:检查图像编辑是否真的推理对 Reasoning-Informed Visual Editing | 上海交通大学;东南大学;华南理工大学;微软亚洲研究院;复旦大学;华东师范大学 | arXiv:2610.12343 关键词:生成编辑评测, 隐式规则, 多轮一致性, 多图条件 前序问题:画得自然或保住外观,不代表模型从图中推断了正确状态;因果、空间规则和多轮条件经常在编辑图像中失效。 本文贡献:RISEBench++ 用六类推理、12 个子类和 65 种任务组织 1000 个英中文人工标注案例,覆盖单图、多图与多轮编辑。裁判分别评指令推理、外观一致性和视觉合理性,以任务条件检查生成图像;论文另研究带规划与核验的编辑执行流程,本期关注生成能力评测。 论文 Figure 3:RISEBench++的三维评测与流程。指令推理与外观一致性由Gemini-3-Flash按类别专用prompt评判,视觉合理性由Gemini-3.1-Flash-Lite评判;分别检查是否推理并执行正确、保留应保内容及画面是否合理,不能以自然外观替代推理正确性。 实验效果:表 1、2:共评估 58 个视觉编辑方案。英文集 GPT-Image-2.5 Sunburst 总任务准确率 56.6%,逻辑类 27.0%、混合类 39.0%;Nano Banana Pro 总分 54.6%,逻辑类 36.0%。领先总分也可能有明显类别短板,不能从一个榜单分推断所有编辑能力。 论文 Figure 6:英文RISEBench++细粒度任务准确率雷达图,展示七个模型在12个子类的65种任务上的表现。各轴对应不同任务,局部短板与总分排名并不一致;数值是此评测协议的任务判定,不是所有真实编辑的通用成功率。 批判点评:准确率是本数据集、指定模型版本和裁判协议下的任务判定;混合多轮错误会累积,英中文结果须分别看。不是纯视觉理解测验,产出要求确实编辑图像。官方仓库提供评测说明与样例,完整千例数据链接已单独核查。 趋势观察 先定义计算预算再谈加速 BudgetPix分配token,Data-space DMD调整迭代位置,PTD匹配学生能学的曲线,iCATS兼顾注意力保真和kernel开销。token比例、网络评估次数和端到端时延是不同口径。 内部监督也要验证失败条件 Rubric-CEPR用不可互相补偿的门控筛目标;RISEBench++把推理执行与外观合理性分开。画面真实或自评高分都不够,仍要检查未编辑内容和真实任务约束。 把控制绑定到正确对象与时间 VINCIE-NExT绑定关键帧示范,SpaceFlow路由到局部部件,SepGen分配声源描述,EDICT在分段边界重建上下文。局部控制有效,还要验证全局一致性与连续性。 更高总分仍可能付出代价 EDICT内容错误率、SpaceFlow纹理细节、PTD部分多样性都揭示不同目标间的取舍。部署时应使用自己的分辨率、声源数、视频长度与硬件复核。 今日讨论 BudgetPix用四叉树按熵分配token,在25%预算下GenEval为0.725,但全分辨率像素阶段形成计算下限;你会用哪些细节证据与端到端时延测量,判断这种预算在自己的图像生成场景中是否值得采用? 人工智能炼丹君 整理 | 2026-10-12
-
AIGC 每日速读|2026-10-09|KAIST视频生成快11.1倍GRACE 今日 AIGC 论文速览 今日共 10 篇 · 视频表示与自回归生成 3 篇 · 图像token与跨模态编辑 2 篇 · 几何与物理场景生成 2 篇 · 连续语音与情绪控制 2 篇 · 生成图像文字评测 1 篇 重点论文标题列表 GRACE(KAIST):压缩潜空间让视频快11.1倍 QuadTok(UCSD):用四叉树把token留给细节 SGF+(清华):让记忆写入与去噪各练各的 CrossEdit(Adobe):从复杂音频编辑迁移到音视频 Tetris3D(KAIST):生成能互相支撑的3D物体 今日论文速览 1. GRACE:压缩潜空间让视频快11.1倍 GRACE: Generation-aware latent compression for efficient video generation | 韩国科学技术院;Kakao | arXiv:2610.10524 关键词:视频潜空间, 双潜变量, 生成对齐, 非对称去噪 前序问题:更强的 VAE 压缩能减少视频 token,却会改变预训练生成模型熟悉的分布。重建更清楚的潜空间,也未必更容易生成。 本文贡献:GRACE 保留冻结编码器从降采样视频得到的基础潜变量,另学残差潜变量补回丢失信息;在冻结 DiT(用 Transformer 做扩散生成)的特征空间对齐压缩前后表示。第二阶段用 LoRA 适配 DiT,让基础部分比残差更早去噪,后者依托已稳定的结构补细节。 论文 Figure 2:GRACE 总览。第一阶段冻结编码器从降采样视频提取基础潜变量,残差编码器从完整视频补信息,联合解码;对齐损失在冻结 DiT 内匹配压缩前后表示,右侧虚线框示意新增模块。第二阶段用 LoRA 适配 DiT,每步让基础部分处于更低噪声,先于残差稳定。 实验效果:表 1、2:Wan2.1-I2V-14B 的 token 约 32.8k→4.3k,VBench-I2V 总分 87.92→87.90;480×832、81 帧、50 步、单 A100 下加速 11.1 倍。表 3 的 736×1280、81 帧配置为 15.5 倍。计时含条件图编码、去噪和视频解码,不含加载、文本编码及 MP4 写盘。 论文 Table 1:视频自编码器在 256×256×81 重建与 480×832×81 生成条件下的对比。GRACE 将潜变量 token 从 32.8k 减至 4.3k,适配同一 Wan2.1-I2V-14B 后总分 87.92→87.90;但重建 PSNR 35.15→32.63 dB。灰色行是本文方法,粗体仅比较后三种同为 4.3k token 的压缩表示。 批判点评:接近的总分不保证逐项或逐帧无损;表 1 重建 PSNR 35.15→32.63 dB,说明优化生成不等于改善重建。仍需训练 VAE 与适配主干,不能即插即用,更不能把特定 GPU 与视频长度的倍数外推所有配置。作者项目页提供演示与方法入口。 2. QuadTok:用四叉树把token留给细节 QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation | 加州大学圣迭戈分校 | arXiv:2610.10497 关键词:自回归图像, 四叉树token, 空间对应, 复杂度引导 前序问题:固定二维网格把平滑背景和复杂纹理分到相同预算;一维压缩序列虽灵活,却容易丢掉 token 与空间区域的明确对应。 本文贡献:QuadTok 用四叉树逐级细分区域,并按广度优先顺序串成序列。tokenizer 的亲缘注意力限制粗细层与兄弟节点交互;互补探测树的重建收益决定哪些区域多分 token。生成器在预先给定的树拓扑上,用普通因果注意力逐项预测视觉码,保留零样本布局控制。 论文 Figure 2:(a)四叉树按广度优先遍历串成一维序列,ViT 特征聚合成树节点,再量化与解码;(b)层级解码,粗节点恢复整体结构,细节点补局部;(c)互补探测树估计各区域的重建收益,用于形成内容自适应树。 实验效果:表 1:256×256 ImageNet 上平均 230 个 token,相比 LlamaGen 的 256 个少约 10%,rFID 2.19→1.46,但 PSNR 20.79→20.37;零样本 COCO 为 232 个 token、rFID 7.88。表 2 的 947M 类别条件生成模型 gFID 为 2.08。 论文 Table 1:256×256 ImageNet 与 COCO 重建比较。QuadTok 的 token 数是各数据集平均序列长度,ImageNet 训练的 tokenizer 直接迁移 COCO;f 为 LlamaGen 降采样倍率。表中更低 rFID 与更低 PSNR 可同时出现;三层树预算更多,不能只按树深度归因。 批判点评:重建时的内容自适应树不等于生成器自行预测树:采样前须指定拓扑。文生图仍是未来工作,类别条件与布局控制不能直接叫通用文生图。表 2 各系统训练与采样设置不同,不能只凭 gFID 归因于树结构。官方仓库已提供 tokenizer 训练、重建与预编码,生成模型不在该发布范围。 3. SGF+:让记忆写入与去噪各练各的 SGF+: Decoupling Gradient Flows for Autoregressive Video Generation | 清华大学;京东探索研究院;香港中文大学 | arXiv:2610.10429 关键词:自回归视频, 上下文梯度, 参数分离, 长时生成 前序问题:当前帧去噪和给未来写入 KV 记忆若共享参数,两种梯度可能冲突;只截断记忆梯度,又让后续生成无法监督记忆怎么写。 本文贡献:SGF+ 先无梯度自生成并记录干净上下文与采样出口,再并行重算可微 KV,让未来预测的原生成损失监督记忆写入。把写入与去噪参数分开,以因果注意力连接两者,不增加辅助损失。论文实测采用两套完整参数,而非只训练两个小 adapter。 论文 Figure 4:SGF 与 SGF+ 的两遍训练。第一遍无梯度自回归生成,记录停止梯度的干净上下文 X 和采样出口的带噪目标 Z*;第二遍从记录重构计算,让未来生成损失通过可微 KV 监督上下文。SGF 共享 θ,SGF+ 分别使用写入 θ_c 与去噪 θ_d。 实验效果:表 1 的 240 秒、分块生成,主体一致性由 SGF 的 97.72→98.21,审美 62.54→64.74,动态程度 56.97→56.92。训练窗口为 5 秒;作者另展示最长 24 小时连续生成,定量主表评测的是 60 秒与 240 秒。 论文 Table 1:60 秒和 240 秒的逐帧、分块生成比较,分别使用 VBench-Long 和 MovieGen-128 prompt。每组各方法的初始化、prompt 与随机种子一致;质量与一致性指标越高越好。动态程度可能因跳景或形变变高,不能单项决定质量;此表不是 24 小时量化评测。 批判点评:24 小时是演示能力,不是完整时长的定量质量或剧情评测。动态程度及部分图像质量并非全面更好;复制参数还增加存储成本。长期画面稳定不保证事件逻辑成立。作者项目页包含长视频材料。 4. CrossEdit:从复杂音频编辑迁移到音视频 CrossEdit: Cross-Modal Training Enables Rich Audio-Visual Editing | Adobe Research;卡内基梅隆大学 | arXiv:2610.10264 关键词:音视频编辑, 跨模态迁移, 合成编辑对, 指令遵循 前序问题:修改电影场景时既要理解组合指令,又要只动指定内容并保持声音与画面一致;这样的真实音视频编辑配对很难大规模收集。 本文贡献:CrossEdit 利用声音可相加的特点合成复杂音频编辑对,结合音视频掩码重建、唇同步编辑及精选跨模态任务做微调。统一 MoE DiT 通过 flow matching 编辑图像、音频与视频,将已学的复杂指令能力迁移到未见过的音视频场景编辑组合,并提出 CrossEditBench 与 AV-FES。 论文 Figure 2:CrossEdit 编码音视频输入的架构。图中省略图像,因为图像按单帧视频处理;音频与视觉经各自 VAE 进入统一生成模型,条件侧还使用干净语义表示。跨模态迁移仍依赖音视频重建等训练任务。 实验效果:表 2 的 CrossEditBench:相对 CrossEdit-Base,AV-FES 0.26→0.30,视觉子分 0.20→0.26,音频子分 0.31→0.33。模型总参数 12B、每次激活 3B;这些编辑分是论文协议下的综合评分,不是 30% 任务成功率。 论文 Table 2:CrossEditBench 的零样本音视频场景编辑。灰色列为单模态 FES 子分,带下划线为所提技术带来的改善;表中另列指令、内容一致性与 ImageBind 音画对齐。综合 AV-FES 0.30 是协议评分,不是任务成功率。 批判点评:零样本指特定未训练任务与指令组合,不是没用过音视频数据;唇同步编辑和掩码重建都参与训练。表中 ImageBind 对齐分 16.29 仍低于输入的 19.79,某些未编辑内容可能漂移。演示不等于模型权重已公开。作者演示页。 5. Tetris3D:生成能互相支撑的3D物体 Tetris3D: 3D Scene Generation With Objects That Fit Together | 韩国科学技术院 | arXiv:2610.10539 关键词:3D场景生成, 物理关系, 遮挡补全, 自回归物体 前序问题:单张图恢复多个物体时,各自漂亮的形状摆到一起仍可能相交、悬空或不稳;遮挡又让真正接触的区域不可见。 本文贡献:Tetris3D 按视觉语言模型推断的物理依赖顺序生成物体,显式读取邻居几何和支撑、容纳等关系。深度与反投影图像特征把形状直接放到场景坐标中,可见到不可见的交叉注意力帮助补全遮挡部分;ComOb 提供 120 万个带物体网格与关系标注的模拟场景。 论文 Figure 2:Tetris3D 按视觉语言模型推断的物理依赖拓扑顺序自回归生成场景。每个物体经过稀疏结构及结构化潜变量两阶段;各 DiT 将深度、反投影图像与交互条件注入对应网格 token,可见到不可见交叉注意力补全遮挡区域。 实验效果:表 1 的 Toys4K 组合场景中,相对 ShapeR,场景 F1 0.6480→0.8407,平均位移 D_mean 115.1→38.91,穿透深度 PD 0.8862→0.0036,均按原表量纲。真实 MessyKitchens 表 2 的场景 F1 为 0.9620,PD 为 0.0011。 论文 Table 1:Toys4K 组合场景的重建、分布生成和物理稳定比较。带 † 方法用 FoundationPose 将生成物体对齐场景;所有方法使用真值深度。CD、MMD 与覆盖率的缩放及位移单位遵循原文,物理稳定是指定模拟协议下的结果。 批判点评:Toys4K 主表给所有方法真值深度;真实数据才用估计深度与推断关系,两种条件不能混成统一收益。物理稳定是引擎与对象假设内的评估,不是任意现实接触的保证。没有从论文项目入口确认方法代码已发布。 6. PositionForcing:用预测位置引导单阶段3D Position Forcing: Self-Conditioning 3D Generation | 南开大学;腾讯混元;香港中文大学;复旦大学;上海创智学院;香港大学 | arXiv:2610.10342 关键词:单阶段3D生成, 位置自条件, 逐级量化, 位置VAE 前序问题:无序形状 token 在单阶段生成中仍需隐式找位置;先单独生成位置虽然能提供结构,却又多出一条生成阶段。 本文贡献:Position VAE 联合学习形状解码与 token 位置恢复。每个去噪步从预测的干净潜变量恢复位置,按当前噪声程度由粗到细量化,再通过 RoPE 反馈给 DiT;训练阶段用真值 query 位置。这种自条件提供空间引导,无需独立位置生成阶段。 论文 Figure 2:(a)Position VAE 学习形状与 token 位置的对应,可同时解码几何与位置;(b)去噪中从预测干净潜变量恢复位置,通过 RoPE 注入后续步骤;(c)位置随去噪逐级量化,由粗到细提供引导。 实验效果:表 3 的图像条件 3D 生成,相比 Hunyuan3D 2.1,ULIP-I 0.125→0.130,Uni3D-I 0.320→0.321,ULIP-T 为 0.077、与 TRELLIS 2 持平。表 1 的 20% 噪声位置恢复准确率,联合微调 92.5%,冻结 VAE 为 23.0%。 论文 Table 3:图像条件 3D 生成比较。列出是否单阶段,以及 ULIP-T/I、Uni3D-T/I 的文本与图像语义相似度;粗体为该列最佳。Position Forcing 的 ULIP-T 与 TRELLIS 2 持平,其他小幅增益也不构成所有网格质量的保证。 批判点评:小幅语义相似度改善不等于每个网格拓扑都正确;位置恢复准确率是在指定 128³ 网格与噪声下测得,不能当生成成功率。需要位置解码器和联合训练,新增位置恢复的时延不能视为免费。作者项目页提供结果入口。 7. MORCA:按最终视频误差决定缓存复用 MORCA: Offline-to-Online Reinforcement Learning for Adaptive Cache Reuse in Video Diffusion Acceleration | 上海交通大学;阿里云;阿里巴巴 | arXiv:2610.10457 关键词:视频扩散缓存, 终点误差, 潜变量状态, 离线在线强化学习 前序问题:当前步的缓存误差不必对应最终视频损伤;固定阈值也难准确满足用户指定的加速预算。 本文贡献:MORCA 保留 SeaCache 的残差缓存粒度,用学习到的调度器替代阈值。状态同时包含潜变量特征、误差代理与剩余复用预算;以相对无缓存视频的终点保真度训练策略,先做离线 IQL,再在线补充轨迹,决定本步重算还是复用。 论文 Figure 2:MORCA 总览。下部调度器逐步选择缓存复用或重算;左上将目标加速映射为复用总预算,与误差代理、步统计、潜变量特征及当前复用数共同组成状态;右上以 IQL 做离线到在线强化学习。 实验效果:表 2:50 步 Wan2.2-A14B、RTX A6000,在约 3 倍加速时,SeaCache 为 320.41 秒、PSNR 14.99,MORCA 为 326.93 秒、PSNR 16.77、LPIPS 0.3435。Wan2.1-1.3B、RTX 4090 的 MORCA 为 84.98 秒、实际 3.01 倍,PSNR 20.95。 论文 Table 2:Wan2.2 与 Wan2.1 在不同目标加速下的时延及相对无缓存输出保真度,粗体为最佳、下划线为次佳。PSNR、SSIM、LPIPS 用相同 prompt 与种子的无缓存视频作参考,不是现实视频真值;目标与实际加速略有差异。 批判点评:PSNR、SSIM、LPIPS 比的是同 prompt 与种子的无缓存输出,不是现实视频真值或人工偏好。不是免训练缓存法,离线数据与在线 rollout 都有成本;预算离散会留下加速误差。在约 2.4 倍的 Wan2.1 配置,LPIPS 未胜过全部基线。作者仓库当前只标 Coming soon,方法实现尚未公开。 8. JoyAI-Voice2.0:连续潜空间同时规划语义声学 JoyAI-Voice 2.0: A Full-Continuous Autoregressive Speech Generation Model with Semantic-Acoustic Joint Representation | 京东探索研究院 | arXiv:2610.08834 关键词:连续语音生成, 语义声学双编码, 局部扩散, 语音克隆 前序问题:连续语音生成避免量化损失,却可能把声学噪声传回自回归规划,长期输出不稳定;只保语义又会丢掉音色与微小韵律。 本文贡献:JoyAI-Voice 2.0 将 AudioVAE 连续潜变量分成 patch,双编码器分别抽取纯化语义与完整声学信息,融合后交给 1.5B 因果 Transformer 规划下一块。局部 DiT 以历史块为条件生成下一块,再解码为 48 kHz 波形;训练结合 flow matching、停止预测、SFT 与 DiffusionNFT。 论文 Figure 3:JoyAI-Voice 2.0 架构。原始波形由 AudioVAE 压缩为连续潜变量并分块,双编码器抽取纯化语义和声学表示,融合后由因果自回归 Transformer 规划;局部 DiT 生成下一块完整潜变量,最终解码为 48 kHz 波形。 实验效果:表 2 的 Seed-TTS,中文 CER 0.74%、英文 WER 1.27%、困难集 CER 5.53%;三个子集的平均识别错误率为 2.51%,相对 dots.tts 的 2.95% 降低 14.9%。说话人相似度平均 74.8,低于 dots.tts 的 79.2,内容正确不等于声线最像。 论文 Table 2:Seed-TTS 零样本语音克隆。中文及困难集用 CER,英文用 WER,SIM 为说话人相似度;错误率越低越好、SIM 越高越好。平均识别错误率混合不同子集口径,2.51% 不能当所有语言的统一 WER;粗体标注各列最佳。 批判点评:平均 2.51% 混合中文 CER 与英文 WER,不能统称所有语种 WER。MDVD-Eval 是作者的中文多属性集,并用模型裁判评分;不能外推任意语言与真实交互延迟。原文首发 9 月 29 日,本期从候选池补充这篇未读报告,未确认官方代码或权重公开。 9. SteerSpeech:用小向量调节说话情绪强度 Steerspeech: Activation Steering For Emotion Control In Generated Speech | 弗吉尼亚大学;Netflix | arXiv:2610.10415 关键词:语音情绪控制, 激活steering, 低秩变换, 多专家监督 前序问题:情绪 prompt 或参考语音难细调强度;直接加激活差向量又可能改掉说话人身份与文本内容。 本文贡献:SteerSpeech 冻结 Qwen3-TTS 主干,为每种情绪训练 33,793 参数的低秩变换。将情绪与中性激活差修正为 steering 向量,用情绪、身份和转录专家共同监督;生成后再 replay,并用直通估计器跨过离散语音 token 训练,推理时以强度 α 注入隐藏层。 论文 Figure 1:SteerSpeech 总览。冻结语音主干,只学习情绪 steering 的低秩变换;训练经生成与 replay,用情绪、身份和转录专家监督修正向量,推理以 α 调节注入强度。免主干微调不等于完全免训练。 实验效果:表 1 汇总:愤怒目标情绪分从朴素 steering 的 0.651→0.835,WER 6.0%→5.1%;快乐情绪分 0.487→0.524,但 WER 7.1%→9.7%。表 2 的代表性情绪 A/B 主观比较中,相对朴素 steering,情绪强度偏好为 78.1%。 论文 Table 2:代表性情绪的主观 A/B 偏好,三组比较分别列情绪强度、身份保留与自然度。SteerSpeech 相对朴素 steering 的情绪偏好 78.1%,但身份与自然度偏好为 41.2%、47.7%;相对情绪参考语音也并非全项占优。 批判点评:更强情绪并非所有属性都更好;表 2 相对参考语音,身份偏好仅 12.6%、自然度偏好 16.2%。因此不能把强度偏好称为整体音质胜率。需训练低秩变换,且仅在指定主干与情绪上验证;arXiv 注释明确 ICASSP 2027 在审,未接收,也未确认官方代码。 10. UltraText:检查整幅图里的长文本是否对 UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation | 西湖大学;蚂蚁集团;浙江大学;上海创智学院;香港科技大学;中科院自动化所;微信AI;MBZUAI;香港城市大学;北京大学 | arXiv:2610.09823 关键词:生成文字评测, 双语密集文本, 整图裁判, 保真度与清晰度 前序问题:一个招牌写对,不代表海报、菜单或网页里的所有区域都对。文字看起来清楚,也可能遗漏或改写指定内容。 本文贡献:UltraText Bench 提供 432 个英中文 prompt,覆盖 24 类场景、三个难度和每图 4–12 个文本区域;生成器只接收 prompt。完整结构化参考交给 Q-Judger,对整图六项评分映射为文字保真、清晰、空间与场景四维,并把失败覆盖率与有效图质量均值分开报告。 论文 Figure 4:任务与评分协议。生成器只接收 prompt,Q-Judger 读取完整参考与生成图,输出六项整图评分,再合成为四维与综合分;参考字段并非与分数逐项对应,网格只给粗位置,可共享格子。无效响应不评分并降低覆盖率;面包店示意简化自指定四区域记录。 实验效果:表 5 的 24 个模型配置:Z-Image-Turbo 相比 Base,清晰度 70.60→74.41,保真度 55.51→40.75;Qwen-Image-2512 的英文综合分由 L1 的 86.50 降到 L3 的 42.86。综合分权重为 60/30/5/5,分数在 0–100 范围。 论文 Table 5:24 个模型配置排行榜。VLM 评分 0–100,英中文 prompt 宏平均等权汇总;综合权重为保真、清晰、空间、场景 60/30/5/5。L1/L2/L3 为不同负载,Low/High 为 API 品质;失败影响覆盖率而不直接记零分,排名不等于字符正确率。 批判点评:这些是视觉语言模型评分,不是正确字符百分比;默认采样、分辨率和 API 设置不同,不能把 Base/Turbo 差异单独归因于加速。语言集独立编写且字符负载不同;报告没有置信区间,近分排名须谨慎。官方数据与评测仓库。 趋势观察 表示要为生成目标服务 GRACE 用 DiT 特征指导潜空间压缩,QuadTok 给复杂区域更多 token,JoyAI 把语义与声学分开再融合。重建指标、token 数和生成质量需要分别核对。 不同计算职责可以明确拆分 SGF+ 分开上下文写入与去噪,Position Forcing 从预测干净形状恢复位置,MORCA 按终点误差调度缓存。相似模块的职责不同,训练与部署成本也不同。 控制需要保留未编辑属性 CrossEdit 在组合指令中兼顾音画与内容,Tetris3D 条件化邻居关系,SteerSpeech 约束声线与转录漂移。控制强度或几何稳定单项更好,都不能代替整体质量。 把指标拆开才看得见代价 JoyAI 的低识别错误不代表最高说话人相似度;UltraText 的文字清晰不代表内容正确。总分与偏好都有边界,评估时要同时看分项、失败覆盖率和实验设置。 今日讨论 GRACE 用双潜变量在指定 A100 设置实现 11.1 倍提速,但重建 PSNR 下降;你会用哪些指标与逐帧证据,验证残差潜变量补回的信息足以满足上线画质要求? 人工智能炼丹君 整理 | 2026-10-09
-
AIGC 基本功|视频生成评测:VBench 与人工验收-VBench AIGC 基本功|视频生成评测:VBench 与人工验收-VBench 所属方向:评测 | 难度:进阶 | 前置知识:FID / CLIP Score 到底测了什么 关键词:视频评测、VBench、时序一致性、运动幅度、成对比较、人工盲评、置信区间 01. 为什么需要它 假设你正在验收一个视频推理加速方案:运行时间降了,但角色走到一半换了脸,镜头运动变成小幅抖动。报告却写着“综合质量保持”。问题可能出在评测:更锐利的单帧补偿了变差的时序,多个维度压成一个数以后,故障被平均掉了。速度收益可以真实存在,质量结论也仍然可能不充分。 本文先给一组真正跑出的反例。把一张红色圆盘的图片复制成 25 帧,得到冻结视频;另一个视频让圆盘每帧向右移动 1 像素。我们自定义的轨迹平滑度在两者上都是 1.000000,但运动量分别是 0 与 1 像素/帧。冻结视频的相邻帧像素差还是 0,若验收只要求“变化小、足够平滑”,它会轻松过关,而“主体向右行走”的需求并没有完成。这些数字来自本文 CPU 合成实验,不是 VBench 分数,也不是任何真实生成模型的测量。 第二个反例更隐蔽:给平滑轨迹加上左右交替的位移,主体颜色始终一样,玩具身份一致性仍接近 1,运动量却升到 6 像素/帧,玩具平滑度降到约 0.000006。运动更多不代表运动更好,身份稳定也不代表时间连续。评测首先要把这些命题拆开,才有资格讨论“质量不变”。 视频比图像多了时间轴,而时间轴不能靠多算几张 FID 补齐。逐帧看起来漂亮的图像串,可能含有冻结、闪烁、速度突变、身份漂移和动作错误;看起来稳定的视频,也可能没有执行提示词要求的动作。接下来我们从可控反例推导几个量,再对照 VBench 的真实实现,最后把人工验收做成可以重复执行的协议。 02. 最小可用理解 第一句:视频质量至少包含“每一帧是否好看”“时间上是否连贯”“是否完成条件要求”三个问题,任何一个问题的代理指标都不能承担另外两个问题。 第二句:VBench 把问题细分为多个维度,维度对应特定提示词和评测器;它应当先被当作一组诊断结果,再被汇总成排名分数。原始 VBench 的 16 维可以分成 7 个视频质量维度和 9 个条件一致性维度,具体分组和权重以第 05 节固定版本的官方代码为准。 第三句:人工验收把自动指标漏掉的失败拿出来检查,但人的判断也需要控制提示词、抽样、展示顺序和统计单位;“我看了几条觉得不错”不能支持整个任务分布上的质量结论。 后面的 NumPy 实验只演示指标会如何混淆不同故障,不实现 DINO、RAFT 或 AMT,也不冒充官方榜单。把机制讲清楚与复现基准是两件不同的工作,读者可以在普通 CPU 上完成前者,再按正式协议组织后者。 03. 数学推导 3.1 相邻帧差为什么会惩罚正确运动 记视频为 $V=(X_0,\ldots,X_{T-1})$,每一帧 $X_t$ 是 $H\times W\times C$ 的像素数组。$T$ 是帧数,$H,W$ 是画面高度和宽度,$C=3$ 表示 RGB 通道;本文把像素映射到 $[0,1]$。最直接的时间变化量是相邻帧平均绝对误差: $$D_{\mathrm{pixel}}=\frac{1}{(T-1)HWC}\sum_{t=1}^{T-1}\sum_{h,w,c}|X_t(h,w,c)-X_{t-1}(h,w,c)|$$ 分母是参与比较的像素通道总数,所以不同尺寸可以在同一尺度上读数;绝对值避免亮暗变化抵消。可是圆盘平移时,进入圆盘的像素由背景变为红色,离开的像素由红色变为背景。即使纹理完全不闪烁,边缘也产生非零误差。因此 $D_{\mathrm{pixel}}$ 同时包含运动、外观变化、光照变化、噪声和遮挡,不是纯粹的闪烁量。 如果已知帧间位移 $u_t$,先把上一帧对齐到当前帧再比较,就得到运动补偿残差: $$R=\frac{1}{(T-1)HWC}\sum_{t=1}^{T-1}\|X_t-\mathcal{W}(X_{t-1},u_t)\|_1$$ $\mathcal{W}$ 是按位移重采样的算子,$\|\cdot\|_1$ 表示所有像素通道绝对值之和。在本文整数平移的场景中,它是数组平移;一般视频中需要光流、插值和可见性处理。正确平移而纹理不变时,残差可以为零;固定位置亮度跳变时,位移为零,残差保留亮度变化。这个对照说明为什么必须先辨别运动,才能谈闪烁。 残差仍不能直接等于闪烁。新露出的区域在上一帧没有对应点,光流可能算错,物体变色也会产生残差。实际使用时要考虑遮挡掩码、镜头切换和评测器误差。本文背景统一、圆盘远离边界,才允许用整幅图像的循环平移演示机制;真实画面不能直接照搬这个边界处理。 3.2 运动量与运动平滑度测的是不同阶差分 为了把运动单独拿出来,先用已知场景的阈值分割获得主体中心 $c_t\in\mathbb{R}^2$。位置的一阶差分是每帧位移,二阶差分是位移的变化: $$v_t=c_t-c_{t-1},\qquad a_t=c_{t+1}-2c_t+c_{t-1}$$ $v_t$ 的单位是像素/帧,$a_t$ 的单位是像素/帧平方;若希望比较物理时间中的速度和加速度,需要分别乘以帧率及其平方。本文所有样本用同一时间采样,因而直接使用帧单位。用欧氏范数去掉方向,再求平均: $$M=\frac{1}{T-1}\sum_{t=1}^{T-1}\|v_t\|_2,\qquad A=\frac{1}{T-2}\sum_{t=1}^{T-2}\|a_t\|_2$$ $M$ 测运动量,$A$ 测速度变化程度。为方便演示,把第二个量映射成“越高越平滑”的玩具分数 $S$: $$S=\exp(-A/\tau),\qquad \tau=1\ \text{像素/帧平方}$$ 指数的输入必须无量纲,所以 $\tau$ 与 $A$ 同单位。$A=0$ 时 $S=1$,$A$ 越大,$S$ 越低。这只是我们为反例选择的尺度,VBench motion smoothness 不使用这个公式。冻结与匀速移动的二阶差分都为零,因此两者的 $S$ 一样;左右抖动的一阶差分较大,二阶差分也很大,故 $M$ 大而 $S$ 小。 这里还有一个重要边界:正常动作会加减速,抛物运动有加速度,舞蹈动作可能刻意急停。低二阶差分不是通用的好视频标准。这个量适合解释“运动大小”和“运动变化”不能合并,是否自然还需要更强的视觉模型和具体任务判断。 3.3 身份一致性为什么要同时看首帧和邻帧 让 $f_t$ 表示第 $t$ 帧提取出的特征,先归一化成单位向量 $z_t=f_t/\|f_t\|_2$,于是余弦相似度就是内积 $z_t^\top z_s$。只比较邻帧时,一个主体可以每帧只改变一点,最后完全换成另一种外观,而每一步仍很相似。再增加与首帧的比较,可以让慢漂移受到惩罚。 $$I=\frac{1}{T-1}\sum_{t=1}^{T-1}\frac{\max(0,z_t^\top z_{t-1})+\max(0,z_t^\top z_0)}{2}$$ 两个相似度分别检验局部连续性和相对于最初外观的保持,等权平均。这个结构对应固定版本官方 subject_consistency 的逐视频计算;本文的特征却只是圆盘内平均 RGB,官方用的是 DINO 图像特征。相同的聚合式不代表相同的评测能力:颜色描述符无法识别人脸身份、衣服细节和类别语义,DINO 特征也不是专用的身份识别证明。官方 subject_consistency.py 亮度变化可能影响特征方向,镜头变化也可能让同一主体的图像特征改变。这个指标测的是所选特征空间里的外观稳定性,不能从高分推出“剧情中始终是同一个人”。更不能从高分推出“人物做了正确动作”:红色圆盘左右抖动时,颜色方向仍然不变。 3.4 FVD 把时间放进特征,但仍然是分布比较 前置文章中的 FID 先提取图像特征;FVD 使用视频特征,原始工作采用 I3D 相关视频表征。设真实与生成视频特征的均值为 $\mu_r,\mu_g$,协方差为 $\Sigma_r,\Sigma_g$,高斯近似下的距离仍然是: $$\mathrm{FVD}=\|\mu_r-\mu_g\|_2^2+\mathrm{Tr}(\Sigma_r+\Sigma_g-2(\Sigma_r^{1/2}\Sigma_g\Sigma_r^{1/2})^{1/2})$$ 这里 $r,g$ 标记真实与生成集合,$\mathrm{Tr}$ 是迹。时间信息是否保留、保留什么,取决于视频特征器和片段采样;公式本身只比较一阶与二阶统计。它可以衡量两组视频表征的分布差异,却不会逐条指出“第 12 帧换脸”,也不直接校验某个提示词是否完成。样本量、特征器、裁剪、长度和帧率不一致时,跨实验数值不宜直接比较。FVD 原始论文 3.5 成对比较的统计单位是任务,不是帧 比较方案 A 与 B 时,用相同 prompt 集合、匹配的 seed 编号和相同输出规范,得到分数 $q_{p,s}^{A},q_{p,s}^{B}$。$p$ 标记 prompt,$s$ 标记重复生成。先在同一任务内取差,再平均 seed: $$\delta_p=\frac{1}{K}\sum_{s=1}^{K}(q_{p,s}^{B}-q_{p,s}^{A}),\qquad \widehat{\Delta}=\frac{1}{P}\sum_{p=1}^{P}\delta_p$$ $K$ 是每个 prompt 的 seed 数,$P$ 是 prompt 数。这样困难任务在两组中共享,任务难度不会轻易掩盖方案差异。相同 seed 编号只是控制抽样的一部分,不保证不同架构生成完全相同的随机轨迹;报告仍应保留多次生成和失败样本。 视频中的帧高度相关,同一 prompt 的多个 seed 也共享任务难度。本文因此按 prompt 有放回抽样,每次保留该 prompt 的全部成对 seed,重新计算均值差,重复 10000 次,以 2.5% 和 97.5% 分位数得到 bootstrap 百分位区间。这是在已观测 seed 集合条件下,对任务抽样不确定性的近似,不完整刻画换一批 seed 的不确定性,也不包含协议偏差和未覆盖任务。这个过程本身不证明 prompt 具有代表性;若任务分层且样本比例预先固定,应在各层内部重采样,再按目标任务比例汇总。 04. 代码实现 4.1 一个可以逐项解释的 CPU 实验 文末完整脚本 video_metrics_lab.py 只依赖 NumPy。它生成 5 组形状为 (25, 48, 64, 3) 的浮点视频,正常样本像素范围 [0.08, 0.85]。背景为均匀灰色,圆盘半径为 5 像素,正常轨迹从横坐标 16 移到 40,保持在画面内部。固定半径和背景的目的,是把遮挡、变焦和复杂纹理先拿掉,留下容易检查的变化因素。 五组样本分别是:正常匀速移动、位置冻结、位置左右交替偏移 3 像素、全画面交替增加 0.08 亮度、圆盘在第 12 帧从红色变成绿色。颜色变化只是“外观改变”的合成代理,不宣称等价于真实人物换脸。所有位置都是整数,正文里运动补偿残差为零的结果才可以精确验证,而不是受双线性插值误差影响。 核心计算对应第 03 节的一阶与二阶差分: speed = np.linalg.norm(np.diff(centers, axis=0), axis=1) acceleration = np.linalg.norm(np.diff(centers, n=2, axis=0), axis=1) motion = speed.mean() smoothness = np.exp(-acceleration.mean()) 这里 centers 就是公式里的 $c_t$,acceleration 对应 $\|a_t\|_2$;指数默认采用 $\tau=1$ 的像素/帧平方尺度。主体阈值分割要求至少一个通道大于 0.35,这是为已知合成场景设计的,拿到真实视频不会自动获得可靠主体掩码。 4.2 实际输出应该怎样读 2026-10-08 在 CPU 上执行后,正常移动的 pixel_mae 为 0.002029080,aligned_mae 为 0,运动量为 1,玩具平滑度为 1。冻结样本的两个误差和运动量都为 0,玩具平滑度仍为 1。这组结果直接证明相邻像素差会处罚正确运动,而单独的平滑度又会放过冻结。 抖动样本的 pixel_mae 为 0.010329861,运动量为 6,二阶差分均值为 12,玩具平滑度为 0.000006144,玩具身份一致性约 1。原地或来回乱动同样能增加运动量,所以“更动态”不能独立成为加分目标。 亮度闪烁样本的 pixel_mae 为 0.081647135,对齐后残差为 0.08,运动量和玩具平滑度仍为 1。主体变色样本的玩具身份一致性降为 0.793119704,运动量和平滑度仍为 1。浮点余弦可能出现 $1+\epsilon$ 的末位误差,脚本保留原始计算,不把它解释成实际相似度超过 1。 看图时先沿行观察:前 3 列选用连续帧,冻结行的位置不变,抖动行在平移上叠加往返,闪烁行的背景与主体一起变亮,变色行从中段开始外观改变。若只等间隔抽到偶数帧,交替闪烁会被采样漏掉;同一故障可能影响多个量,而某些量对明显故障完全不敏感。 这张图的重点是冻结与正常移动同样平滑、抖动保持颜色身份却最动态。图中的三个量均为本文玩具指标,不是 VBench radar chart,也不能填进 VBench 报告。 4.3 真实运行的成对 bootstrap 为了只检验统计流程,脚本再创建 24 个合成任务、每任务 3 个成对 seed。每个任务共享一个轨迹难度,A 叠加正弦扰动,B 把同一扰动振幅乘以 0.65,然后计算第 03 节的玩具平滑度。这些任务没有自然语言语义,只是带 task ID 的受控轨迹实验;“prompt”在数组维度中代表统计上的任务组。 结果为 B − A = 0.089640896,以 prompt 为单位的 10000 次 bootstrap 得到 95% 百分位区间 [0.081229656, 0.098102901]。代码保存逐任务差值和 bootstrap 样本,读者可以检查区间是怎样产生的。区间排除了 0,只支持“这组受控扰动减弱后,玩具平滑度均值提高”这个命题,不支持真实视频质量或用户偏好提高。 左图每根柱子是一个任务内对 3 对 seed 求平均的差;右图按任务重采样,虚线是百分位区间。把 72 个视频当作 72 个独立 prompt,会改变估计的抽样层级;把所有帧当作独立样本会更严重地高估证据量。 05. 工业级实现对照 5.1 VBench 不是一个通用“视频好坏函数” 本节源码固定为 Vchitect/VBench,提交 fd18b3d055cb0fc6f066ca90fe2c3c8cbb698490,于 2026-10-08 核验。首先确定评测范围:这里讲原始 VBench 的 text-to-video 16 维路径;VBench++ 的 image-to-video、长视频和可信性扩展,以及 VBench-2.0 的内在真实性评测,具有各自入口,不能只因目录名字接近就混用分数。 质量组包括主体一致性、背景一致性、时间闪烁、运动平滑度、动态程度、美学质量和成像质量。条件一致性组包括物体类别、多物体、人类动作、颜色、空间关系、场景、外观风格、时间风格和整体一致性。每个名字背后都有适合它的测试提示词,而不是把任意业务视频塞给 16 个评测器后就获得同等有效的解释。官方维度与分组常量 VBench 的方法论文同时组织维度、提示词和人类偏好验证;自动分数与人的判断存在经验上的相关性,不等于对所有新模型和新业务场景都有校准保证。工程应用还要保留完整输入清单、逐视频结果与失败原因,才能知道一个平均分究竟来自哪些样本。原始 VBench 方法论文 5.2 三个时序维度各用了什么 vbench/subject_consistency.py#subject_consistency 对每帧提取并归一化 DINO 特征,计算与邻帧及首帧的非负余弦相似度,正是第 3.3 节的结构。它处理的是图像特征,不是本文的掩码 RGB,也不是人脸跟踪系统。在单进程代码中总体分数按实际帧对数累加;多进程汇总分支对逐视频分数取平均。各视频帧数相同时二者一致,变长样本时要额外核对聚合口径。 vbench/dynamic_degree.py#DynamicDegree 使用 RAFT 光流。对相邻抽样帧,取光流模长最大的 5% 像素的平均值,与按短边尺寸缩放的阈值比较;超过阈值的帧对数量达到与抽样帧数相关的要求,视频被判为动态。固定实现从 MP4 约按 8 fps 抽样,阈值为 $6\min(H,W)/256$,计数门槛为 $\mathrm{round}(4N/16)$,$N$ 是抽样后的帧数。最终对逐视频布尔值取平均,因此它更接近“被判为动态的视频比例”,不能当成平均光流速度或动作正确率。官方 dynamic_degree.py vbench/motion_smoothness.py#MotionSmoothness.motion_score 用 AMT 插帧:保留偶数索引帧,预测夹在中间的帧,再与原视频相应奇数索引帧比较像素绝对误差,并用 $1-\mathrm{MAE}/255$ 转成分数。它衡量插帧模型对时间连续性的解释程度,不是质心二阶差分。遮挡、大动作、风格变化及插帧模型能力都会影响分数。官方 motion_smoothness.py vbench/temporal_flickering.py#cal_score 直接对相邻帧像素差做归一化,并在代码中明确要求静态视频。这个前提解决了第 3.1 节的混淆:如果测试提示词本来允许大幅运动,移动的边缘会进入像素差,就不能把低分全部归因于闪烁。本文运动补偿实验是教学扩展,不是官方 temporal flickering 的计算方法。官方 temporal_flickering.py 5.3 总分先归一化,再分组加权 设第 $j$ 维原始分数为 $r_j$,官方常量给出的锚点为 $l_j,u_j$,该维权重为 $w_j$。固定版本的 get_nomalized_score 按下面的线性映射计算加权分数: $$n_j=\frac{r_j-l_j}{u_j-l_j},\qquad Q=\frac{\sum_{j\in\mathcal{Q}}w_j n_j}{\sum_{j\in\mathcal{Q}}w_j},\qquad C=\frac{\sum_{j\in\mathcal{C}}w_j n_j}{\sum_{j\in\mathcal{C}}w_j},\qquad F=\frac{4Q+C}{5}$$ $\mathcal{Q}$ 是上述 7 个质量维度,$\mathcal{C}$ 是上述 9 个条件维度;这里 $C$ 表示条件组分数,不是前文图像通道数。动态程度的 $w_j=0.5$,其余维度为 1;质量组总权重为 6.5,条件组为 9。锚点来自版本内固定常量,不是每次提交动态取最小最大值,也不是把 16 个原始百分数直接平均。官方总分函数 例如运动平滑度的锚点是 0.706 与 0.9975,外观风格的锚点是 0.0009 与 0.2855。相同的原始分数变化,经不同区间映射后幅度不同。这个版本没有把归一化结果截断到 [0,1];用合成原始输入 0.5 调用官方运动平滑度归一化路径,实际返回 −0.706689537。负值表示低于所用锚点,不表示执行错误,也不能擅自裁成零后仍称为同一协议。 我们把固定源码的四个纯聚合函数取出实际执行,同时构造两组“假想归一化维度向量”做反例:A 所有维度为 0.8;B 只把运动平滑度降低 0.08、成像质量提高 0.12,其余保持不变。官方聚合函数给出总分 0.800000 → 0.804923,虽然平滑度下降,总分仍上升。这些是合成输入上的权重算术验证,不是真实模型的 VBench 成绩。 这也给“总分不变”划出准确边界:它约束一个加权线性组合,不约束每个维度。若推理加速特别容易损伤时间连续性,就应预先把主体一致性、平滑度等相关维度设为单独验收项,不能等待总分出来后再挑对方案有利的指标解释。 06. 代价与边界 6.1 自动评测省了什么,又遗漏什么 自动化可以重复处理较多样本,给回归检查提供稳定入口,并把某些故障定位到相应维度;代价是依赖特征器、检测器或插帧模型。换权重、帧率、尺寸或解码方式,可能改变结果。镜头切换会影响一致性,运镜可能触发动态判定,插帧困难可能拉低平滑度,复杂画风可能影响检测,这些都需要回到视频和任务本身解释。 真实生成任务也不是所有维度都越高越好。静态产品展示不必追求动态比例,镜头切换不应被无条件当作背景故障,剧情里允许角色换装,恐怖题材可能需要闪光。这些需求应在测试集设计时分层,明确哪些维度适用。按官方任务跑公开基准时尊重官方协议;按业务任务做验收时明确命名为业务评测,不把自选提示词和改过阈值的数值混成官方榜单。 6.2 把人工验收写成可执行的协议 下面是一套建议协议,本文没有执行真人盲评,也没有声称获得人类偏好结果。先锁定目标任务,例如人物近景、复杂手部动作、运镜、长时身份保持;固定任务比例、提示词、生成次数、分辨率、帧率和时长。A、B 对同一 prompt 生成成对样本,全部纳入样本清单,失败和空视频也按预先规定计入,避免只挑好看的样本。 展示时隐藏模型名和方案信息,随机交换左右位置,并保存交换映射,确保统计时能恢复 A、B 身份。让标注者分别判断“身份保持”“运动自然”“动作符合提示词”和“整体可用”,提供 A 好、B 好、平局以及无法判断的选项。先用一小组示例统一判定标准,给正常播放速度与重复观看机会;不要用截帧替代视频,也不要把每个维度的问题写成“哪个更好看”。 定义一次成对判断 $y$:B 胜为 1,平局为 0.5,A 胜为 0。无法判断需要单独报告比例,不能事后当平局。对每个 prompt 的 seed 和标注者先按预先规则汇总,再按 prompt 计算偏好均值并进行分组 bootstrap。如果同一批标注者参与很多任务,还要承认跨任务的标注者相关性;可以采用按任务和标注者的双重重采样,或另作标注者层面的敏感性分析。 包含平局时,$y$ 不再是普通伯努利变量,所以不能把半胜计数直接塞进标准二项区间而不解释假设。应报告胜、负、平局、无法判断、任务数、标注者数与置信区间,结合具体失败类型读结果。多人标注可以减少单人的偶然判断,但“多数人同意”仍取决于任务代表性和问法;它不能替代目标用户的实际可用性要求。 6.3 “不退化”需要事先定义容忍幅度 若目标是证明加速后质量没有明显损失,应在实验前为重要维度定义最小可接受差值 $-\epsilon$。对越高越好的指标,只有差值区间下界高于 $-\epsilon$ 时,才有相应证据支持这个任务分布上的非劣结论。区间跨过零只说明优劣尚不清楚,不自动证明两者相等。本文合成实验只示范区间计算,不替任何真实产品选择 $\epsilon$。 同样,显著的小幅提升不一定有实际价值。验收应同时考虑效果大小、故障严重程度和速度收益。例如少量严重换脸不能被许多轻微清晰度改善完全抵消,应该设置单独的失败率或人工否决条件。自动维度、人工偏好和关键故障率共同提供证据,任何一个都不是最终业务决策的全权替代。 07. 经典论文脉络 Towards Accurate Generative Models of Video: A New Metric & Challenges,1812.01717:提出 FVD,用视频表征把时间信息引入分布比较;它延续了图像分布距离思路,但不能逐故障诊断。 Emerging Properties in Self-Supervised Vision Transformers,2104.14294:DINO 提供可用于相似度计算的自监督视觉表征,是理解主体一致性评测器的背景材料;它本身不是视频评测基准。 VBench: Comprehensive Benchmark Suite for Video Generative Models,2311.17982:把评测组织为细分维度、对应提示词及自动方法,并以人类偏好检验对齐,适合诊断早期视频生成的不同短板。 VBench++: Comprehensive and Versatile Benchmark Suite for Video Generative Models,2411.13503:扩展图生视频及更丰富的评测设置与可信性范围;使用时应核对适用任务和专门入口。 VBench-2.0: Advancing Video Generation Benchmark Suite for Intrinsic Faithfulness,2503.21755:关注更复杂的内在真实性问题,说明高基础技术质量仍不足以概括物理、常识和复杂动作能力。 这条脉络不是“新论文让旧指标作废”,而是不断增加可以提出的问题。FVD 适合分布层面的比较,原始 VBench 适合分维度诊断,新一代基准增加更深的能力检查;人工验收仍负责特定业务能否交付。 08. 常见误解 误解一:相邻帧差越小,视频越好。 冻结视频为零,正常平移却非零。只有在静态测试前提下,像素差才更接近闪烁诊断;不能用它无条件惩罚动态场景。 误解二:动态程度高就说明动作自然。 抖动、运镜和正确动作都可能产生运动;运动存在与运动是否符合要求是不同问题。本文最动态的样本,恰好是明显抖动的样本。 误解三:主体一致性高就说明人物身份可靠。 高分是所选特征器下的相似性证据,不能替代局部身份核验。本文颜色不变时,抖动样本照样接近满分;真实场景还会混入背景和视角因素。 误解四:VBench 总分是 16 维的简单平均。 固定版本先做锚点归一化,动态程度权重是 0.5,质量与条件组再以 4:1 合成。改变归一化范围或补上 clipping,都改变了协议。 误解五:置信区间跨过零,就证明加速没有损失。 没有检测出差异可能是数据不足;非劣结论还需要事前容忍幅度。扩大帧数不能代替扩大独立任务数。 误解六:玩具实验跑通,就复现了 VBench。 本文只验证数学机制与统计流程,没有运行官方深度模型评测器,也没有真实生成模型的分数;完整基准复现还需要指定权重、官方提示词和严格预处理。 09. 动手验证 从文末复制 video_metrics_lab.py 与 make_figures.py 到同一个 code/ 目录,安装 numpy matplotlib,依次运行: python code/video_metrics_lab.py python code/make_figures.py 脚本以所在文件推断文章目录,不依赖当前工作路径;放在 code/ 时输出保存在文章目录的 _evidence/,图片在 figures/;直接把两份脚本放在普通目录时,则统一写入该目录下的 video_metrics_results/。预期看到 assertions: passed、五组合成数据结果和上面的 bootstrap 区间。修改内容后数值自然会变化,应重新运行并保存新的输出,不能继续抄用旧数字。 做三个小实验:把冻结样本与正常移动交换查看,确认单独平滑度无法排序;加上 --jitter-amplitude 1,把抖动幅度从 3 改为 1,观察运动量与二阶差分的变化;加上 --repair-scale 1,让 A、B 完全同轨迹,确认成对差值与区间都变为零。最后这个构造验证的是代码自洽,不意味着真实实验的同等质量可以这样证明。脚本会保存本次参数;这些参数实验会更新输出文件,运行默认命令可以恢复正文的基线结果。 再把每任务 seed 数增加但保持任务数不变,思考它减少的是生成随机性还是任务覆盖误差。两种不确定性来自不同层级,应该分别设计样本量。要进一步复现官方分数,先安装固定版本官方仓库,核对 checkpoint、提示词集、视频清单与各维度预处理;本文 CPU 脚本不承担这一功能。 10. 延伸阅读 先读 FID / CLIP Score 到底测了什么,理解特征空间、分布距离和有限样本偏差;再回到 AIGC 基本功知识树,寻找视频自回归、世界模型和推理加速的相邻主题。 读视频加速论文时,把“质量保持”拆成可核对的问题:用了哪版基准、哪些任务、哪些维度、多少独立样本、什么聚合与区间;读世界模型时,增加动作可控性、长时记忆和因果响应,不能只沿用短视频的技术质量分数。评测的价值在于让失败可见,并让下一次改进有明确目标。 附录:完整代码 09 节用到的脚本全文如下(video_metrics_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 video_metrics_lab.py """CPU synthetic video diagnostics. These are NOT official VBench scores.""" import argparse import json from pathlib import Path import numpy as np SCRIPT_DIR = Path(__file__).resolve().parent ROOT = SCRIPT_DIR.parent if SCRIPT_DIR.name == "code" else SCRIPT_DIR / "video_metrics_results" def render_video(positions, colors, brightness=None): """Render integer-position disks into float RGB frames [T, H, W, C].""" positions = np.asarray(positions) colors = np.asarray(colors) t = len(positions) frames = np.full((t, 48, 64, 3), 0.08, dtype=np.float64) yy, xx = np.mgrid[:48, :64] for i in range(t): mask = (xx - positions[i, 0]) ** 2 + (yy - positions[i, 1]) ** 2 <= 25 frames[i, mask] = colors[i] if brightness is not None: frames = np.clip(frames + np.asarray(brightness)[:, None, None, None], 0, 1) return frames def measure_video(frames): """Known-scene segmentation and color features, with no learned model.""" yy, xx = np.mgrid[:frames.shape[1], :frames.shape[2]] centers, features = [], [] for frame in frames: mask = frame.max(axis=-1) > 0.35 if not mask.any(): raise ValueError("Synthetic object disappeared from the frame") centers.append([xx[mask].mean(), yy[mask].mean()]) color = frame[mask].mean(axis=0) features.append(color / np.linalg.norm(color)) centers = np.asarray(centers) features = np.asarray(features) adjacent = np.maximum(0, np.sum(features[1:] * features[:-1], axis=1)) anchored = np.maximum(0, features[1:] @ features[0]) speed = np.linalg.norm(np.diff(centers, axis=0), axis=1) acceleration = np.linalg.norm(np.diff(centers, n=2, axis=0), axis=1) residuals = [] for i in range(1, len(frames)): shift = np.rint(centers[i] - centers[i - 1]).astype(int) aligned = np.roll(frames[i - 1], (shift[1], shift[0]), axis=(0, 1)) residuals.append(np.abs(frames[i] - aligned).mean()) return { "pixel_mae": float(np.abs(np.diff(frames, axis=0)).mean()), "aligned_mae": float(np.mean(residuals)), "motion_px_per_frame": float(speed.mean()), "acceleration_px_per_frame2": float(acceleration.mean()), "toy_smoothness": float(np.exp(-acceleration.mean())), "toy_identity": float(((adjacent + anchored) / 2).mean()), }, centers def make_examples(jitter_amplitude=3): t = 25 positions = np.stack([np.arange(t) + 16, np.full(t, 24)], axis=1) red = np.tile([0.85, 0.12, 0.12], (t, 1)) jitter = positions.copy() jitter[:, 0] += jitter_amplitude * np.where(np.arange(t) % 2 == 0, 1, -1) changed = red.copy() changed[t // 2:] = [0.12, 0.85, 0.12] return { "smooth": render_video(positions, red), "freeze": render_video(np.tile(positions[0], (t, 1)), red), "jitter": render_video(jitter, red), "flicker": render_video(positions, red, 0.08 * (np.arange(t) % 2)), "identity_change": render_video(positions, changed), } def paired_bootstrap(a, b, seed=20261008, replicates=10000): """Resample prompts, retaining all paired seeds within each prompt.""" if a.shape != b.shape or a.ndim != 2: raise ValueError("Expected equally shaped arrays [prompts, paired_seeds]") delta = (b - a).mean(axis=1) rng = np.random.default_rng(seed) indices = rng.integers(0, len(delta), size=(replicates, len(delta))) boot = delta[indices].mean(axis=1) ci = np.quantile(boot, [0.025, 0.975]) return delta, boot, { "prompts": len(delta), "seeds_per_prompt": a.shape[1], "replicates": replicates, "mean_b_minus_a": float(delta.mean()), "percentile_95_ci": ci.tolist(), } def make_paired_metrics(repair_scale=0.65): """A controlled trajectory repair, with prompt-level difficulty shared.""" rng = np.random.default_rng(17) difficulty = rng.uniform(0.4, 1.2, (24, 1)) seeds = rng.uniform(0.8, 1.2, (24, 3)) t = np.arange(25) a = np.empty((24, 3)) b = np.empty_like(a) for p in range(24): for s in range(3): phase = rng.uniform(0, np.pi) wiggle = np.sin(0.9 * t + phase) * difficulty[p, 0] * seeds[p, s] for out, scale in [(a, 1.0), (b, repair_scale)]: trajectory = t + scale * wiggle acceleration = np.abs(np.diff(trajectory, n=2)).mean() out[p, s] = np.exp(-acceleration) return a, b def illustrative_weight_tradeoff(): """Use official aggregation weights on invented normalized vectors.""" quality_weights = np.array([1, 1, 1, 1, 1, 1, 0.5]) qa = np.full(7, 0.8) qb = qa.copy() qb[3] -= 0.08 qb[5] += 0.12 sa = sb = np.full(9, 0.8) score_a = (4 * np.average(qa, weights=quality_weights) + sa.mean()) / 5 score_b = (4 * np.average(qb, weights=quality_weights) + sb.mean()) / 5 return {"synthetic_normalized_only": True, "total_a": score_a, "total_b": score_b, "smoothness_delta": qb[3] - qa[3]} def main(): parser = argparse.ArgumentParser(description=__doc__) parser.add_argument("--jitter-amplitude", type=int, default=3) parser.add_argument("--repair-scale", type=float, default=0.65) args = parser.parse_args() if not 0 <= args.jitter_amplitude <= 8 or not 0 <= args.repair_scale <= 1: parser.error("Require jitter amplitude in [0,8] and repair scale in [0,1]") evidence = ROOT / "_evidence" evidence.mkdir(parents=True, exist_ok=True) videos = make_examples(args.jitter_amplitude) metrics = {name: measure_video(video)[0] for name, video in videos.items()} assert metrics["freeze"]["toy_smoothness"] == 1.0 assert metrics["freeze"]["motion_px_per_frame"] == 0.0 assert metrics["smooth"]["pixel_mae"] > 0 assert metrics["smooth"]["aligned_mae"] == 0 assert metrics["jitter"]["toy_identity"] > 0.999 if args.jitter_amplitude == 3: assert metrics["jitter"]["toy_smoothness"] < 0.01 assert metrics["identity_change"]["toy_identity"] < 0.9 a, b = make_paired_metrics(args.repair_scale) delta, boot, comparison = paired_bootstrap(a, b) if args.repair_scale < 1: assert comparison["percentile_95_ci"][0] > 0 else: assert np.all(delta == 0) and np.all(boot == 0) result = {"not_official_vbench": True, "experiment": {"jitter_amplitude": args.jitter_amplitude, "repair_scale": args.repair_scale}, "shape": list(videos["smooth"].shape), "range": [float(videos["smooth"].min()), float(videos["smooth"].max())], "examples": metrics, "paired_comparison": comparison, "weight_tradeoff": illustrative_weight_tradeoff()} payload = json.dumps(result, ensure_ascii=False, indent=2) (evidence / "lab_outputs.json").write_text(payload + chr(10), encoding="utf-8") np.savez(evidence / "bootstrap_samples.npz", a=a, b=b, delta=delta, boot=boot) print(payload) print("assertions: passed (mechanism checks on synthetic data)") if __name__ == "__main__": main() make_figures.py """Create diagrams from the CPU synthetic experiment, without model weights.""" import os import tempfile from pathlib import Path os.environ.setdefault("MPLCONFIGDIR", str(Path(tempfile.gettempdir()) / "vbench_mpl")) import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from video_metrics_lab import make_examples, measure_video, make_paired_metrics, paired_bootstrap SCRIPT_DIR = Path(__file__).resolve().parent ROOT = SCRIPT_DIR.parent if SCRIPT_DIR.name == "code" else SCRIPT_DIR / "video_metrics_results" plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 140 plt.rcParams["savefig.dpi"] = 140 def main(): folder = ROOT / "figures" folder.mkdir(parents=True, exist_ok=True) videos = make_examples() names = list(videos) labels = ["平滑移动", "冻结", "来回抖动", "亮度闪烁", "主体变色"] fig, axes = plt.subplots(5, 5, figsize=(12, 9)) for row, name in enumerate(names): for col, frame in enumerate([0, 1, 2, 12, 24]): axes[row, col].imshow(videos[name][frame]) axes[row, col].set_xticks([]) axes[row, col].set_yticks([]) if row == 0: axes[row, col].set_title(f"第 {frame} 帧") if col == 0: axes[row, col].set_ylabel(labels[row], rotation=0, labelpad=38) fig.suptitle("图 1:一个变化只对应一个故障?先看五组反例(合成视频)") fig.tight_layout(rect=(0.04, 0, 1, 0.95)) fig.savefig(folder / "counterexample_frames.png") plt.close(fig) fig, axes = plt.subplots(1, 3, figsize=(13, 4)) values = [measure_video(videos[name])[0] for name in names] for ax, key, label in zip(axes, ["motion_px_per_frame", "toy_smoothness", "toy_identity"], ["运动量:像素 / 帧", "玩具平滑度", "玩具身份一致性"]): ax.bar(labels, [v[key] for v in values], color=["#2872b8", "#8594a3", "#e79c3a", "#bd6684", "#7a69bc"]) ax.tick_params(axis="x", rotation=35) ax.set_title(label) ax.grid(axis="y", alpha=0.2) fig.suptitle("图 2:冻结最平滑,抖动最动态;三个量必须一起读(非 VBench)") fig.tight_layout() fig.savefig(folder / "metric_tradeoffs.png") plt.close(fig) a, b = make_paired_metrics() delta, boot, comparison = paired_bootstrap(a, b) fig, axes = plt.subplots(1, 2, figsize=(12, 4)) axes[0].bar(np.arange(len(delta)), delta, color="#2872b8") axes[0].set_xlabel("合成 prompt 编号;每个 prompt 保留 3 对 seed") axes[0].set_ylabel("玩具平滑度 B − A") axes[0].set_title("先配对,再对 prompt 求平均") axes[1].hist(boot, bins=40, color="#2872b8", alpha=0.8) for bound in comparison["percentile_95_ci"]: axes[1].axvline(bound, color="#e79c3a", linestyle="--") axes[1].set_xlabel("以 prompt 为单位的 bootstrap 均值差") axes[1].set_ylabel("重复次数") axes[1].set_title("虚线为 95% 百分位区间;仅对应这组合成数据") fig.suptitle("图 3:不把相关的 72 个视频当作 72 个独立任务") fig.tight_layout() fig.savefig(folder / "paired_bootstrap.png") plt.close(fig) print("figures: counterexample_frames.png, metric_tradeoffs.png, paired_bootstrap.png") if __name__ == "__main__": main()
-
AIGC 基本功|世界模型:从视频生成到可交互环境-WorldModel AIGC 基本功|世界模型:从视频生成到可交互环境-WorldModel 从同一张画面出发,按左键和按右键,未来应该不同。本篇沿着动作条件、状态记忆、长程误差和模型内规划这条线,把「能生成视频」到「能当环境使用」之间的距离拆开。附录提供无需权重、只用 NumPy 与 matplotlib 的完整 CPU 实验;实验学习的是合成环境的二维状态动力学,不是训练好的视觉世界模型。 01. 为什么需要它 想象一个球正向墙壁运动。视频生成器看过很多相似片段,接下来画出球碰墙反弹,画面连贯,观看体验很好。现在给球一个向左的控制指令,生成器却继续播原来的反弹轨迹。它预测了「录像通常怎样继续」,但没有回答「我采取这个动作以后会怎样」。用于动画制作时,这可能只需要换提示词;用于训练控制器时,这是环境接口失效,因为动作与结果之间的联系已经被切断。 更隐蔽的失败是每一步都很准,连续走几十步却越来越离谱。本篇实际运行的小实验中,动作条件模型在独立测试集上的单步状态均方误差为 5.605065e-08,但连续预测到第 60 步时升到 0.492476。这些是二维合成动力系统、固定随机种子下的实测数值,不是任何论文的游戏成绩。误差增长还伴随着状态离开训练范围,后面会把两种原因分开解释。一个漂亮的单步损失,不能直接当作长程交互能力的证书。 世界模型要服务的用途很具体:让智能体在真正执行动作前,低成本地比较几种可能未来;让昂贵的机器人交互、稀缺的游戏样本被重复利用;或者让用户在生成的环境里逐帧改变行动。如果目标只是导出一段不可修改的短视频,动作接口、奖励预测、终止处理可能都不是必需组件。只有当未来要随行动改变,或者模型将被控制器反复调用,这些要求才变成核心问题。 02. 最小可用理解 第一,世界模型学习的是「给定过去和动作,未来的状态或观测如何变化」,一个常见形式是条件分布 $p_{\theta}(o_{t+1}\mid o_{\leq t},a_{\leq t})$。其中 $o$ 是观测,$a$ 是动作,$\theta$ 是模型参数,下标 $t$ 表示环境中的时间步。 第二,画面不一定等于状态:同一张球的位置图,可能对应向左或向右的速度。因此模型要从历史构造记忆,必要时还要表达不确定性;把过去压缩成潜变量只是实现方式之一。 第三,模型的使用方式会改变它需要满足的质量要求。拿它做视频续写,需要合理的观测序列;拿它做规划或训练策略,还需要动作响应、奖励与终止语义、长程误差和真实环境中的任务效果。本文用显式位置与速度替代视觉编码,先把这个闭环跑通,再对照真实扩散世界模型的接口。 可以把系统想成三个角色:表示模型保存当前可用信息,动力学模型回答动作后的变化,控制器根据目标选择动作。三个角色可以由不同网络实现,也可以在一个大型生成模型里合并。名字并不决定能力;是否能从相同历史分叉出可信、可控的未来,才是更有用的判断问题。 03. 数学推导 从环境状态到可用记忆 设真实状态为 $s_t$,动作是 $a_t$,环境转移规律为 $P(s_{t+1}\mid s_t,a_t)$,观测规律为 $P(o_t\mid s_t)$。状态包括影响未来的一切信息,例如物体位置、速度和遮挡后的位置;相机给出的图像只是其中一部分。所谓马尔可夫性,是在知道完整状态与当前动作后,更早的历史不再为下一步增加信息。实际智能体往往拿不到完整状态,所以需要保存历史 $H_t=(o_0,a_0,o_1,\ldots,a_{t-1},o_t)$。 理论上可以保留一个信念分布 $b_t(s)=P(s_t=s\mid H_t)$。新动作执行后,先用转移规律把每个可能状态推进一步,再用新观测筛掉不吻合的状态: $$b_{t+1}(s')\propto P(o_{t+1}\mid s')\int P(s'\mid s,a_t)b_t(s)ds.$$ 这里 $s'$ 是下一步候选状态,积分把当前所有可能状态的贡献相加,比例符号表示最后还要归一化。这个式子解释了为什么只记一张图片可能不够,也解释了「模型自己想象」与「看见真实新观测」的区别:前者只做预测,后者还能修正记忆。神经世界模型一般不会显式积分,而是用递归状态、历史 token 或有限帧堆叠近似这个信息更新过程。近似是否足够,要由具体任务判断。 假设用编码器或历史聚合器构造 $z_t=E_{\phi}(H_t)$,$z_t$ 就是模型可访问的表示,$\phi$ 是表示模块参数。动作条件动力学、观测生成、奖励与终止预测可以写成: $$z_{t+1}\sim p_{\theta}(z_{t+1}\mid z_t,a_t),\quad o_{t+1}\sim p_{\psi}(o_{t+1}\mid z_{t+1}),\quad (r_t,d_{t+1})\sim p_{\omega}(r_t,d_{t+1}\mid z_t,a_t,z_{t+1}).$$ $r_t$ 表示这次转移的奖励,$d_{t+1}$ 表示下一步是否结束,$\psi$ 与 $\omega$ 分别是解码和任务预测参数。这是一个便于分析的分解,不要求所有模型都采用这种条件独立结构;图像空间扩散模型也可以直接生成下一张图。奖励头不是定义世界模型的唯一条件,却是把模型作为强化学习环境使用时常见的必要接口。 为什么动作一定要进入条件 当训练数据由行为策略 $\mu(a\mid H_t)$ 收集,但预测器忽略动作时,它学到的是混合后的未来: $$P(o_{t+1}\mid H_t)=\sum_a P(o_{t+1}\mid H_t,a)\mu(a\mid H_t).$$ 求和把向左、向右和不动的后果混在一起。这个模型可能很好地复现旧策略拍出的录像,却无法直接回答指定动作的后果。如果下一帧预测采用平方误差,最优输出还是条件均值:两种互斥未来可能被平均成一个并不存在的中间结果。换成更强的生成器可以表达多个未来,但若缺少动作条件,它仍然不知道用户选中了哪个分支。 动作标签也不自动保证因果正确。若训练里「向左」只在道路左侧出现,模型可能同时利用背景位置推测动作效果;到了另一侧,控制就会错。要接近可干预的接口,需要覆盖相关的状态与动作组合、准确的时间对齐,并排查相机变化等混杂因素。这是数据与评估的要求,不能靠把动作 embedding 拼进网络就宣告解决。 用最简单的系统看清参数 本篇环境取 $s_t=(p_t,v_t)$,其中 $p_t$ 为位置,$v_t$ 为速度,动作 $a_t\in\{-1,0,1\}$ 是加速度指令。一步更新定义为: $$v_{t+1}=0.92v_t+0.25a_t,\quad p_{t+1}=p_t+v_{t+1}=p_t+0.92v_t+0.25a_t.$$ 系数 0.92 让旧速度逐渐衰减,0.25 决定控制力度,时间步长被定义为一个单位。先更新速度再更新位置,避免在公式与代码之间偷偷换成另一种积分顺序。虽然系统很小,它已经包含了惯性、动作后果以及位置累积。 把每条训练记录写成行向量 $\varphi_i=(p_i,v_i,a_i,1)$,最后的常数项让模型能够学习偏置。把所有 $N$ 条特征叠成 $\Phi\in\mathbb{R}^{N\times4}$,下一步状态叠成 $Y\in\mathbb{R}^{N\times2}$,待学习权重为 $W\in\mathbb{R}^{4\times2}$。于是预测是 $\widehat{Y}=\Phi W$。这只是线性动力学回归,不包含视觉编码器、神经网络或潜动作发现。 假设每个目标维度存在同方差高斯测量噪声,最大化条件似然等价于最小化平方误差。加入权重惩罚后,用以下目标拟合: $$L(W)=\|\Phi W-Y\|_F^2+\lambda\|W\|_F^2.$$ $\|\cdot\|_F^2$ 是矩阵中所有元素平方之和,$\lambda=10^{-4}$ 是本实验的岭惩罚强度。这个定义使用误差总和而不是平均值,所以换训练样本数时,保持相同的 $\lambda$ 不等于保持相同的相对正则强度。对 $W$ 求导,误差项给出 $2\Phi^{\top}(\Phi W-Y)$,惩罚项给出 $2\lambda W$;令梯度为零得到: $$\left(\Phi^{\top}\Phi+\lambda I\right)W=\Phi^{\top}Y.$$ $I$ 是四阶单位矩阵。左侧矩阵在正的岭惩罚下可逆,但代码用 np.linalg.solve 解方程,不显式求逆,以减少不必要的数值误差。W 的第一行对应位置、第二行对应速度、第三行对应动作、第四行对应常数;理想的无噪声权重分别是 (1,0)、(0.92,0.92)、(0.25,0.25)、(0,0)。 为什么一步误差会累积 真实动力学记为 $f$,学到的动力学记为 $\widehat f$。给它们相同动作序列,从同一初始状态出发。自由滚动误差定义为 $e_t=\|\widehat s_t-s_t\|$。在一步中加减 $f(\widehat s_t,a_t)$,再使用三角不等式: $$e_{t+1}\leq\|\widehat f(\widehat s_t,a_t)-f(\widehat s_t,a_t)\|+\|f(\widehat s_t,a_t)-f(s_t,a_t)\|.$$ 如果在滚动真正到达的区域内,模型误差上界为 $\varepsilon$,真实动力学对状态的 Lipschitz 常数为 $K$,第二项至多为 $Ke_t$,于是得到 $e_{t+1}\leq\varepsilon+Ke_t$。从 $e_0=0$ 递推: $$e_H\leq\varepsilon\sum_{j=0}^{H-1}K^j.$$ $H$ 是滚动长度。如果 $K<1$,上界趋向有限值;如果 $K=1$,上界线性增长为 $H\varepsilon$;如果 $K>1$,这个粗上界可能快速增长。这是带条件的范数上界,不是所有世界模型误差曲线的精确规律,也不能把实验中的均方误差直接代进去。训练集上的平均误差很小,并不说明离开训练分布后仍有同一个 $\varepsilon$。 Teacher forcing 每一步用真实状态作为输入,相当于不断把前面输入偏差清零;自由滚动把上一步预测当作下一步输入,偏差会反馈。两者可以用于同一个训练好的模型,但测量的风险不同。后面的误差图将把它们放在一起,让「独立单步测试」「沿真实轨迹逐步预测」「连续自己预测」三种条件不再混淆。 从预测到规划 模型能够回答后果后,还缺「哪个后果值得追求」。给定目标位置 $p^*=2$,定义一个有限长度动作序列的代价: $$J(a_{t:t+H-1})=\sum_{k=1}^{H}\left[(\widehat p_{t+k}-p^*)^2+0.5\widehat v_{t+k}^2+0.02a_{t+k-1}^2\right].$$ 第一项希望接近目标,第二项希望到达时不要带着很大的速度冲过去,第三项轻微惩罚控制力度。权重是教学实验的设计,不是论文超参数。动作离散且序列很多,我们用随机射击法:采样多条动作序列,在模型里逐条模拟,取代价最低的一条。 Model Predictive Control,也就是 MPC,不把这条计划全部执行完。它只执行最优候选的第一个动作,再读真实状态,用新的状态重新规划。每次与真实环境交互都给模型一次纠偏机会。这样的闭环通常能缓解长时间开环预测的问题,但无法消除模型对关键事件的系统性误判;如果短期内就把碰撞预测错,反复规划也可能反复犯错。 04. 代码实现 完整实现是附录中的 world_model_demo.py。只需 Python、NumPy 与 matplotlib,不需要下载数据、权重或游戏。脚本在运行时生成训练样本,拟合两个模型,执行长程滚动和 MPC,再生成三张图。随机种子为 20261008;本次环境为 NumPy 2.1.3 与 matplotlib 3.10.5,不同版本可能产生末位数值差异。 训练状态均匀采样在 [-1,1],动作在 -1、0、1 中随机选取。目标状态由真实动力学生成,再叠加标准差 0.01 的独立高斯噪声,模拟带噪监督记录。独立单步测试用另一批状态和动作,并以无噪声真实下一状态为目标,因此本文报告的测试误差不包含测量噪声的不可约下限。若直接拿有噪目标测试,这一误差的尺度会改变。 与前面的正规方程对应,核心拟合代码如下: import numpy as np def fit_model(s, a, next_s, use_action=True): action = np.asarray(a).reshape(s.shape[:-1] + (1,)) bias = np.ones(s.shape[:-1] + (1,)) columns = (s, action, bias) if use_action else (s, bias) phi = np.concatenate(columns, axis=-1) ridge = 1e-4 W = np.linalg.solve(phi.T @ phi + ridge * np.eye(phi.shape[-1]), phi.T @ next_s) return W s = np.array([[0.0, 0.0], [1.0, 0.2], [-1.0, -0.2], [0.5, -0.1]]) a = np.array([1, -1, 0, 1]) v_next = 0.92 * s[:, 1] + 0.25 * a next_s = np.stack((s[:, 0] + v_next, v_next), axis=-1) print("feature shape:", (len(s), 4)) print("W shape:", fit_model(s, a, next_s).shape) 这一小段可独立运行,输出特征 (4,4) 与权重 (4,2);它只示范拟合接口。下面的大样本数值来自完整脚本,不能用这四条示范记录替代。完整实验里,训练状态为 (4096,2),特征为 (4096,4),权重为 (4,2);128 条轨迹滚动 60 步,加上初始状态,得到 (61,128,2)。数组第一轴始终是环境时间,第二轴是轨迹,第三轴是位置与速度。 真实学习到的四行权重,保留六位小数为 (1.000380,0.000147)、(0.919667,0.920085)、(0.249902,0.249973)、(-0.000010,0.000090)。动作行接近理想值 0.25,说明模型学到了控制力度。位置行的速度输出却出现了一个很小的非零系数 0.000147,这会让位置反过来影响速度,而真实环境没有这种机制。看似无关紧要的参数泄漏,在长程位置越来越大时会被放大。 左图让两个模型副本从完全相同的初始位置与速度出发,分别连续接收 +1 与 -1;两条位置轨迹分开,动作改变了未来。右图把状态通过手写高斯亮点映射到图像,只用于显示分支。亮点图片既不是训练输入,也不是学习出来的解码结果,不能把它当作视觉生成质量证据。 无动作模型也用同一批训练记录拟合,但特征只保留位置、速度和常数。这次独立测试的动作条件单步 MSE 为 5.605065e-08,无动作单步 MSE 为 0.04053985。由于训练动作近似对称,忽略动作的最佳平方误差预测会接近「平均动作等于零」的未来。它不是完全不会动,而是无法可靠区分当前指令造成的偏移。 图的纵轴为状态 MSE,采用对数坐标,所以不同曲线的量级更容易比较。第 60 步,沿真实轨迹执行 teacher forcing 的误差为 3.021024e-05,自由滚动为 0.492476,无动作模型为 161.336796。图中还有一个专门的扰动对照:在学习后的速度特征行两个系数上都加 0.02,其第 60 步误差为 20.262952。这是人为破坏动力学参数的诊断实验,没有重新训练,也不是新的学习方法。 为什么 teacher forcing 的后期误差也高于独立单步测试?因为单步测试的位置仍在 [-1,1],长程真实轨迹的位置绝对值最大到了 52.139858。对真实输入预测消除了输入偏差反馈,却没有消除分布外外推。自由滚动还额外引入了预测状态反馈,因此更差。用同一个 MSE 名字展示指标时,必须同时交代输入分布和是否注入真实观测,否则读者会误以为是在测同一件事。 MPC 每步比较 512 条长度为 12 的动作序列,只执行最佳候选的第一个动作。35 次真实交互后,位置为 1.766138,速度为 -0.055751;执行过程中累计位置误差平方为 36.255730,一直不执行动作的同一指标为 560.0。这里后两个数只累计位置项,没有把规划目标中的速度与动作惩罚混进去。控制器明显接近了目标,但没有精确收敛;有限候选搜索与离散动作会留下残差,也可能出现左右切换。图上的偏差比把它描述为「成功到达」更诚实。 实验的价值是可定位:动作消融对应条件变量,参数扰动对应动力学误差,teacher forcing 对照对应输入分布,MPC 对应观测纠偏。完整输出还保存为 JSON 与 NumPy 数组,三张图直接由同一次运行生成,正文数字不依赖手工抄造的曲线。 05. 工业级实现对照 现实视觉世界模型不能直接读取位置与速度。本篇选择 DIAMOND 官方代码 做参照,并在 2026-10-08 实际下载、检查了提交 5bcd1599755b4f2fae8e5e079e02f0728e174965 的 Atari 主分支。以下链接固定到该提交,未来上游重构也不会改变它们指向的代码。这里只检查实现并验证了采样日程的算术;没有安装全套训练环境,也没有运行预训练 DIAMOND 游戏,因此不报告其推理速度、画面或任务分数。 最外层是 src/envs/world_model_env.py#WorldModelEnv。step 将当前动作写入动作缓存,再生成下一帧,预测奖励与结束标记,滚动观测缓存。如果回合结束或超过想象长度,还会重置对应环境。这里可以直接看到一个可交互生成器变成训练环境需要补上的工作:批量回合管理、终止与截断区别、重置条件、奖励和缓存对齐。仅把图像生成函数命名成环境,不会自动得到这些语义。 生成下一帧的是 src/models/diffusion/diffusion_sampler.py#DiffusionSampler.sample。它接收历史观测 prev_obs 与动作 prev_act,把历史帧的时间与通道合并,然后从噪声开始多次调用去噪器。这里有两个时间轴:一个是环境往前走一帧的 $t$,另一个是为这一帧逐步去噪的噪声尺度 $\sigma$。减少去噪步数可以减少每帧调用次数,但不等于环境历史变短。 为了验证源码中的数值约定,本次从固定版本提取了 build_sigmas 函数原样执行,只用 NumPy 适配其张量算术,没有加载网络。指定三步、最小噪声 0.002、最大噪声 5、幂指数 7 时,得到约 [5.0,0.283082,0.002,0.0];末尾的零是额外追加的终点。这只验证噪声日程计算,不能替代神经模型采样或证明三步足够完成任何任务。 真实默认配置 config/agent/default.yaml 中 num_steps_conditioning 为 4;这表示该配置用有限帧堆叠作为图像动力学的历史条件,不能据此宣称它具有任意长度的持久记忆。默认去噪组件也有自己的噪声缩放参数,它们与本文二维线性回归的岭惩罚不是同一个概念,不能把 toy 的超参数搬过去。 去噪器位于 src/models/diffusion/denoiser.py#Denoiser。compute_conditioners 随噪声尺度计算输入、输出和跳连缩放;compute_model_output 把噪声图、历史观测和动作传给内部网络。尤其值得读的是 forward:它复制观测序列,在每个训练位置生成去噪结果,并把结果写回 all_obs,让后续片段用到模型生成的上下文。这比只在真实前缀上优化独立下一帧,更直接面对自回归使用时的上下文偏差;具体训练流程仍要以该版本源码为准。 还有一个容易漏掉的细节:wrap_model_output 会裁剪并量化到 8 位图像尺度,再映射回归一化区间。因此模型输出、观测记录和下一轮输入的数值约定必须一致,不能把任意连续张量直接塞入缓存。本文状态模型没有像素量化,也没有卷积网络,它省略了视觉表示的损失、采样计算和多模态未来,只保留「动作进入预测」「预测反馈」「任务闭环」这三个结构。 为什么不用 Genie 的社区实现当工业锚点?本篇讨论的是 Genie 原论文 中的潜动作模型、视频 tokenizer 与动力学组合,没有将社区重写认定为官方复现。论文里的潜动作是从无动作标签视频中学习的离散接口;潜动作索引需要解释或映射,不能天然等同真实键盘动作。DIAMOND 的官方实现则给出了可检查的环境接口,适合把动作条件、去噪和回合管理连接起来阅读。 06. 代价与边界 世界模型把真实交互的一部分成本换成模型训练和想象计算。环境样本很昂贵时,这种交换可能有价值;如果已有便宜、精确的模拟器,增加一个有偏差的学习模型反而可能添负担。像素空间扩散能保留许多视觉细节,但每个环境步还要多次去噪;离散或连续潜空间更紧凑,但压缩可能漏掉任务关键细节。选择时要看任务需要的后果,而不能只根据生成画面是否细腻判断。 记忆也有账本。有限帧堆叠便宜,却可能忘记遮挡前出现的物体;递归状态节省历史存储,却可能因瓶颈丢信息;长上下文 token 保留更多过去,但推理延迟与缓存成本上升。检验记忆最直接的方法之一,是让两个状态具有相同当前画面、不同过去,并查看预测能否区分它们。例如球在遮挡物后从左侧进入还是从右侧进入,会改变重新出现的位置。只播放无长期遮挡的短片,不能证明这种记忆能力。 本实验还提示一个结构约束问题。真实系统的状态转移特征值为 1 与 0.92,学习后的值为 1.002029 与 0.918436。第一个值略微超过 1,和位置向速度泄漏一起,引入了真实系统没有的反馈。由这个现象可提出一个可检验的改进:强制速度更新不依赖绝对位置,把已知平移对称性写进模型。但「增加结构约束一定更好」不是通用结论;如果真实环境中有位置相关的力场,这个约束就会把需要学习的规律删掉。 随机性也要区分。观测里本来存在不可预测因素,是数据不确定性;模型没见过某类状态,是知识不足。前者需要合理的未来分布,后者更需要覆盖、估计和谨慎使用。每次采样出不同视频,不代表模型对分布外事件知道自己不确定。本文模型预测均值,没有学习方差,不能用它做风险敏感控制,也不能从它的多条随机动作轨迹估计模型置信度。 规划还有一个特别的风险:优化器会主动寻找模型中的漏洞。模型错误地相信「持续向右能穿过墙而不受罚」,控制器就可能偏爱这个在想象里得分很高的方案。预测误差要沿智能体真正访问的状态评估,任务成绩则必须回到真实环境检验。MPC 用新观测不断纠偏,策略在想象中训练后再真实测试,模型集成估计分歧,都是处理风险的工具;它们分别作用于不同环节,没有一个单独保证仿真到真实转移成功。 本文最小实现的边界应明确保留:状态完全可见、动力学线性、动作标注准确、无碰撞、无遮挡、无终止事件、奖励由作者手写。它证明这些接口能在一个小系统中相互配合,并展示失败如何出现;它没有证明在自然视频上自动学到物理规律,更没有证明模型拥有通用空间理解、完整因果模型或现实安全保证。 07. 经典论文脉络 World Models,1803.10122,2018。它用视觉压缩、时序概率模型与控制器连接感知和行动,并探索在模型生成的梦境里训练策略。值得带走的是表示、动力学、控制器的分工,以及模型漏洞会影响控制器这一问题;不要把特定环境里的转移结果泛化成任何生成器都能替代真实环境。 PlaNet:Learning Latent Dynamics for Planning from Pixels,1811.04551,2018 年首版。它把从图像学习潜动力学与在线潜空间规划连接起来,并关注多步预测。阅读时重点看「当前观测修正状态,然后再规划」的循环,它与本篇 MPC 的教学接口相邻;本文线性拟合不复现其神经潜状态模型。 Dreamer:Dream to Control,1912.01603,2019 年首版。它从潜空间想象轨迹学习行为,将价值与行为学习连接到世界模型。与每步重新搜索候选计划相比,这条路线关注如何把想象轨迹用于学习一个可快速执行的策略。两种用法都需要模型,不能因为有策略网络就把模型训练与策略训练混成一个目标。 Genie:Generative Interactive Environments,2402.15391,2024。它展示了从无真实动作标签的视频中学习潜动作接口,再通过视频 tokenizer 与动力学模型产生可交互观测的路线。这里新的问题是「如何从录像中发现可用控制变量」,并不意味着潜动作索引天然有真实操纵杆的语义。 DIAMOND:Diffusion for World Modeling: Visual Details Matter in Atari,2405.12399,2024。它把扩散预测用于世界模型,并提供官方可交互实现。这里的阅读重点是像素细节、条件遵循和逐帧采样怎样影响模型作为环境的使用;本篇不把论文发表时的排名描述为今天的最新水平,也不把不同任务与协议的分数横向混比。 这五篇可以按问题阅读,而不只是按年代记名词:先问是否有紧凑状态,再问如何从预测选动作,再问能否通过想象学习策略,接着问缺动作标签怎么办,最后问观测生成范式如何影响控制。大模型参数量、视频分辨率和推理帧率都是重要工程指标,但它们回答不了这条链上所有问题。 08. 常见误解 误解一:视频连续就是世界模型合格。 连续说明模型擅长某种观测分布;交互还需要在相同历史下响应不同动作。最小诊断是复制同一初始条件,控制随机性,分别施加两个动作,比较响应是否符合任务语义。变化太弱可能是条件被忽略,变化过强也可能是乱改场景,不能只看有没有差异。 误解二:单步 loss 很低,几十步一定准。 本文单步与长程实测已经给出反例。要同时检查是否持续注入真实观测、测试状态是否在训练范围内、预测误差是否影响下一个输入。否则「预测下一帧」和「自主滚动一整段」只是共用一个模型名,实际测试条件完全不同。 误解三:动作条件自动等于因果模型。 拼接动作提供了表达能力,没有替代数据覆盖、干预检验和时间同步。一个动作在数据里总伴随镜头移动时,模型可能只学会镜头响应,仍然忽略角色本身。潜动作学习还要额外确认潜变量表达的是可操控变化,而不是背景抖动。 误解四:潜变量越小,模型越高效越好。 压缩减少计算,但一个很小的目标、计分板变化或遮挡后的记忆都可能影响奖励。要检查任务相关信息能否从表示中恢复或影响预测;不能用重建图像整体看起来还行,代替对关键细节的测试。 误解五:梦境里得分高,真实环境自然也高。 控制器可能利用模型漏洞,数据分布也会随策略变化。应保持真实环境评估,并检查同一策略在真实与模型环境中的差距。本篇 MPC 的每个执行动作都通过手写真实动力学推进,报告的是这个合成真实环境里的轨迹,没有把模型内代价当实际成绩。 误解六:随机生成未来就等于估计了不确定性。 生成多样性、环境随机性和模型知识不足是不同问题。若模型对未见事件高度自信地生成错误画面,多次采样也未必暴露问题;需要专门的校准、覆盖和风险评估,不能只调采样温度。 09. 动手验证 把附录代码保存为 world_model_demo.py,安装 NumPy 与 matplotlib,然后运行以下命令。脚本会在指定目录创建 figures/ 与 _evidence/,输出 JSON 数值;无需联网即可重新生成三张图。 python -m pip install numpy matplotlib python world_model_demo.py --output-dir ./world_model_results 先原样运行一次,核对训练特征 (4096,4)、滚动状态 (61,128,2)、单步有动作误差约 5.61e-08、无动作误差约 0.04054。这些预期来自本文保存的实际运行;版本变化时允许末位差异。如果量级完全不同,先检查动作与目标是否按同一个时间步对齐,以及 true_step 的速度、位置更新顺序是否改了。 随后做三个独立改动,每次只改一个,并保留基准输出。第一,把训练目标噪声 0.01 改为零,观察学到的泄漏系数与长程误差是否下降;岭惩罚仍在,所以不应强求所有参数逐字等于理想值。第二,把训练状态的采样范围扩大,但保持测试协议与随机种子明确记录,观察 teacher forcing 后期误差与自由滚动误差怎样变化;不要预先假定二者会按相同比例改善。第三,把 MPC 里的候选条数从 512 改成 64,再改成 2048,比较实际执行轨迹与累计位置误差,同时记录运行耗时。候选数增加会增加计算,单个随机种子的成绩也不保证严格单调。 还可以做一个表示实验:让模型输入只有位置,不再提供速度,再用连续两帧的位置差构造速度估计。因为相同位置可能有不同速度,只有当前位置的预测会面对互斥未来;加入历史应改善可辨识性。这个扩展本篇没有运行,因此没有给出伪造数值;验证时要重新定义特征、拟合与测试,不能只删数组一列然后继续引用原文的结论。 读完图以后,写下四个答案:控制变量是否真的改变未来;误差增长来自输入反馈还是外推;真实新观测能纠正哪一部分;规划器怎样把模型误差变成错误选择。这四问比只核对脚本「能运行」更接近世界模型实验需要回答的问题。 10. 延伸阅读 回到 AIGC 基本功知识树,先读 自回归视频生成,理解时间因果掩码、逐帧生成和预测反馈,再把其中的条件变量从历史扩展到动作。 沿着树中的 VAE 与视觉 tokenizer 继续读,重点追问压缩是否保留控制相关信息;沿着 DDPM 与扩散数学继续读,区分噪声时间和环境时间,理解下一帧内部为何还要多步采样;沿着强化学习基础继续读,补齐奖励、折扣、终止与策略评估,再理解世界模型怎样参与行为学习。理解这三个接口后,阅读新的可交互生成论文,就能分辨它改进了观测生成、控制接口、记忆还是决策,而不会把所有能力都归到一个「世界模型」标签里。 附录:完整代码 09 节用到的脚本全文如下(world_model_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 world_model_demo.py """CPU toy: learn action-conditioned state dynamics, then roll out and plan. This is a synthetic state-space teaching experiment, not a visual world model. Run: python world_model_demo.py --output-dir ./world_model_results Dependencies: NumPy and matplotlib. No pretrained weights or network required. """ import argparse import json import os from pathlib import Path os.environ.setdefault("MPLCONFIGDIR", "/tmp/world_model_matplotlib") import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt def true_step(s, a): """s[..., 0] = position, s[..., 1] = velocity; a is acceleration command.""" velocity = 0.92 * s[..., 1] + 0.25 * np.asarray(a) position = s[..., 0] + velocity return np.stack((position, velocity), axis=-1) def features(s, a, use_action=True): action = np.asarray(a).reshape(s.shape[:-1] + (1,)) bias = np.ones(s.shape[:-1] + (1,)) columns = (s, action, bias) if use_action else (s, bias) return np.concatenate(columns, axis=-1) def fit_model(s, a, next_s, use_action=True): phi = features(s, a, use_action) ridge = 1e-4 regularizer = ridge * np.eye(phi.shape[-1]) W = np.linalg.solve(phi.T @ phi + regularizer, phi.T @ next_s) return W def model_step(s, a, W, use_action=True): return features(s, a, use_action) @ W def rollout(step, initial_s, actions): states = [np.asarray(initial_s).copy()] for action in actions: states.append(step(states[-1], action)) return np.stack(states) def evaluate_rollouts(W, W_no_action, rng): count, horizon = 128, 60 initial_s = rng.uniform(-1, 1, size=(count, 2)) actions = rng.integers(-1, 2, size=(horizon, count)) truth = rollout(true_step, initial_s, actions) learned = rollout(lambda s, a: model_step(s, a, W), initial_s, actions) no_action = rollout(lambda s, a: model_step(s, a, W_no_action, False), initial_s, actions) W_biased = W.copy() W_biased[1] += 0.02 biased = rollout(lambda s, a: model_step(s, a, W_biased), initial_s, actions) teacher = np.stack([model_step(truth[t], actions[t], W) for t in range(horizon)]) teacher_error = np.mean((teacher - truth[1:]) ** 2, axis=(1, 2)) curves = { "free_rollout": np.mean((learned[1:] - truth[1:]) ** 2, axis=(1, 2)), "teacher_forcing": teacher_error, "no_action": np.mean((no_action[1:] - truth[1:]) ** 2, axis=(1, 2)), "biased_velocity": np.mean((biased[1:] - truth[1:]) ** 2, axis=(1, 2)), } return truth, learned, curves def plan_action(s, W, candidates, target=2.0): imagined_s = np.repeat(s[None], len(candidates), axis=0) costs = np.zeros(len(candidates)) for t in range(candidates.shape[1]): a = candidates[:, t] imagined_s = model_step(imagined_s, a, W) costs += (imagined_s[:, 0] - target) ** 2 + 0.5 * imagined_s[:, 1] ** 2 + 0.02 * a ** 2 return int(candidates[np.argmin(costs), 0]) def run_mpc(W, rng): s = np.array([-2.0, 0.0]) states, actions = [s.copy()], [] for _ in range(35): candidates = rng.integers(-1, 2, size=(512, 12)) candidates[0] = 0 a = plan_action(s, W, candidates) s = true_step(s, a) states.append(s.copy()) actions.append(a) return np.array(states), np.array(actions) def make_figures(output_dir, W, curves, mpc_states, mpc_actions): fig_dir = output_dir / "figures" fig_dir.mkdir(parents=True, exist_ok=True) plt.rcParams.update({"font.size": 11, "axes.spines.top": False, "axes.spines.right": False}) colors = ["#c35036", "#187998", "#516c35", "#8d5aa5"] s0 = np.array([0.0, 0.0]) positive = rollout(lambda s, a: model_step(s, a, W), s0, np.ones(10)) negative = rollout(lambda s, a: model_step(s, a, W), s0, -np.ones(10)) fig, ax = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True) ax[0].plot(positive[:, 0], label="action +1", marker="o", color=colors[0]) ax[0].plot(negative[:, 0], label="action -1", marker="o", color=colors[1]) ax[0].set(xlabel="environment step", ylabel="position", title="Same initial state, different actions") ax[0].legend() grid = np.linspace(-15, 15, 160) strips = [] for branch in (positive, negative): for t in (0, 3, 6, 10): strips.append(np.exp(-0.5 * ((grid - branch[t, 0]) / 0.4) ** 2)) ax[1].imshow(np.stack(strips), aspect="auto", cmap="magma", extent=(-15, 15, 8, 0)) ax[1].set(xlabel="position", title="Analytic rendering, not a learned decoder") ax[1].set_yticks(np.arange(8) + 0.5, ["+1 t=0", "+1 t=3", "+1 t=6", "+1 t=10", "-1 t=0", "-1 t=3", "-1 t=6", "-1 t=10"]) fig.savefig(fig_dir / "action_branches.png", dpi=160) plt.close(fig) fig, ax = plt.subplots(figsize=(8, 4.8), constrained_layout=True) for color, (name, error) in zip(colors, curves.items()): ax.semilogy(np.arange(1, len(error) + 1), error, label=name.replace("_", " "), color=color) ax.set(xlabel="rollout horizon", ylabel="state MSE (128 trajectories)", title="One-step fit does not certify long-horizon accuracy") ax.legend() fig.savefig(fig_dir / "rollout_error.png", dpi=160) plt.close(fig) fig, ax = plt.subplots(2, 1, figsize=(8, 5), constrained_layout=True, sharex=True) ax[0].plot(mpc_states[:, 0], color=colors[1], label="MPC in true environment") ax[0].axhline(2, linestyle="--", color=colors[0], label="target") ax[0].axhline(-2, linestyle=":", color="gray", label="zero-action baseline") ax[0].set(ylabel="position", title="Replan after observing each real transition") ax[0].legend(loc="lower right") ax[1].step(np.arange(len(mpc_actions)), mpc_actions, where="post", color=colors[2]) ax[1].set(xlabel="real environment step", ylabel="executed action", yticks=[-1, 0, 1]) fig.savefig(fig_dir / "mpc_control.png", dpi=160) plt.close(fig) def main(): script_dir = Path(__file__).resolve().parent default_dir = script_dir.parent if script_dir.name == "code" else script_dir / "world_model_results" parser = argparse.ArgumentParser() parser.add_argument("--output-dir", type=Path, default=default_dir) args = parser.parse_args() args.output_dir.mkdir(parents=True, exist_ok=True) rng = np.random.default_rng(20261008) s = rng.uniform(-1, 1, size=(4096, 2)) a = rng.integers(-1, 2, size=4096) next_s = true_step(s, a) + rng.normal(0, 0.01, size=s.shape) W = fit_model(s, a, next_s) W_no_action = fit_model(s, a, next_s, False) test_s = rng.uniform(-1, 1, size=(2048, 2)) test_a = rng.integers(-1, 2, size=2048) test_target = true_step(test_s, test_a) action_mse = np.mean((model_step(test_s, test_a, W) - test_target) ** 2) no_action_mse = np.mean((model_step(test_s, test_a, W_no_action, False) - test_target) ** 2) truth, learned, curves = evaluate_rollouts(W, W_no_action, rng) mpc_states, mpc_actions = run_mpc(W, rng) results = { "seed": 20261008, "numpy_version": np.__version__, "matplotlib_version": matplotlib.__version__, "training_state_shape": list(s.shape), "training_feature_shape": list(features(s, a).shape), "W_shape": list(W.shape), "W": W.tolist(), "learned_transition_eigenvalues": np.linalg.eigvals(W[:2].T).tolist(), "rollout_max_absolute_position": float(np.max(np.abs(truth[:, :, 0]))), "rollout_shape": list(truth.shape), "one_step_action_mse": float(action_mse), "one_step_no_action_mse": float(no_action_mse), "error_horizon_1": {name: float(error[0]) for name, error in curves.items()}, "error_horizon_60": {name: float(error[-1]) for name, error in curves.items()}, "mpc_final_position": float(mpc_states[-1, 0]), "mpc_final_velocity": float(mpc_states[-1, 1]), "mpc_position_cost": float(np.sum((mpc_states[1:, 0] - 2.0) ** 2)), "zero_action_position_cost": float(35 * (-2.0 - 2.0) ** 2), "mpc_actions": mpc_actions.tolist(), } make_figures(args.output_dir, W, curves, mpc_states, mpc_actions) evidence_dir = args.output_dir / "_evidence" evidence_dir.mkdir(parents=True, exist_ok=True) (evidence_dir / "experiment_results.json").write_text(json.dumps(results, indent=2), encoding="utf-8") np.savez(evidence_dir / "experiment_arrays.npz", truth=truth, learned=learned, mpc_states=mpc_states, mpc_actions=mpc_actions, **curves) print(json.dumps(results, indent=2)) print("Figures: action_branches.png, rollout_error.png, mpc_control.png") if __name__ == "__main__": main()
-
AIGC 基本功|少步蒸馏的目标、误差与采样-Distill AIGC 基本功|少步蒸馏的目标、误差与采样-Distill 所属方向:生成范式 | 难度:前沿 | 前置知识:DDIM 与采样器、CFG 关键词:少步生成、渐进蒸馏、一致性模型、LCM、DMD、教师目标 论文与源码核验日期:2026-11-09。本文的数值来自一维高斯教学问题的 CPU 实跑;没有训练图像模型,也没有复现论文的 FID 或 GPU 加速。 01. 为什么需要它 把一个原来需要反复去噪的模型改成少步,最容易想到的操作是删掉时间点。问题在于,原模型每次只学会在当前噪声水平上估计一个局部方向;跨得更远以后,这个方向未必仍然合适。采样器可以改善数值积分,却不能自动让已有网络学会一次完成一整段轨迹。蒸馏要解决的正是这部分能力缺口。 先看一个可以亲自检查的失败场景。本篇用同一批 512 个初始噪声,将一个确定性教师的 16 步结果当作参照。直接把时间表缩成 4 步,终点均方根误差为 0.105562;缩成 1 步,误差为 0.410312。逐级训练学生去模仿教师合成的转移后,4 步误差降到约 2.94e-16。这不是图像质量提升,而是一个极其简单的仿射系统中,目标改变确实改变了少步行为的证据。 现实里,用户需要的不只是较少的循环次数,而是尽快得到符合提示词的图像或视频。若少步结果丢了主体关系、文字或运动一致性,再小的耗时也未必可用。因此讨论蒸馏时,必须同时问:学生学的究竟是什么;少掉的是几次网络评估;新的分布与任务能力损失在哪里。 标题中的少步没有保证任意模型都能从某个固定步数降到另一个固定步数。Progressive Distillation 论文给出逐次减半的路线;LCM 论文讨论潜空间中的少步生成。它们使用不同模型与训练目标,不能用一张演示图推导出通用的质量结论。 02. 最小可用理解 三句话建立框架:教师负责提供可信的生成行为或分布信号;学生通过训练把这些信号压进更少次调用;推理时必须使用与学生训练匹配的时间表、参数化和条件方式。仅仅替换 scheduler,不会凭空产生蒸馏后的权重。 少步蒸馏可以按监督对象分成几条路线。渐进蒸馏让一步学生贴近两步教师的终点。一致性蒸馏要求同一条去噪轨迹上的不同状态映射到相同终点。分布匹配则关注学生生成样本整体是否接近教师分布,而非要求每一个噪声种子生成完全相同的样本。这些目标可以结合,但不是换个名字的同一个损失。 本文先把渐进蒸馏推到能跑,再解释一致性与分布匹配改变了什么。先修 DDIM 提供确定性转移公式,CFG 提醒我们条件引导本身也是教师行为的一部分。若教师使用某种引导强度,学生的目标就依赖它;训练时没有覆盖的强度,在推理时任意调整不一定可靠。 03. 数学推导 3.1 先把确定性 DDIM 写成两个系数 设干净数据为 $x_0$,时刻 $t$ 的带噪状态为 $x_t$。信号系数是 $\alpha_t$,噪声系数是 $\sigma_t$,教学问题使用保持方差的条件 $\alpha_t^2+\sigma_t^2=1$。标准高斯噪声为 $\epsilon$,前向状态写成: $$x_t=\alpha_t x_0+\sigma_t\epsilon.$$ 教师网络或解析预测器给出的干净样本估计记为 $\widehat x_0(x_t,t)$。它不是已知真值。用当前状态减去估计的信号,再除以噪声尺度,得到与该估计相容的噪声: $$\widehat\epsilon(x_t,t)=\frac{x_t-\alpha_t\widehat x_0(x_t,t)}{\sigma_t}.$$ 本文只讨论不额外注入随机噪声的 DDIM 转移,目标时刻 $s\lt t$。保留估计的干净样本与噪声方向,用目标时刻的系数组合: $$x_s=\alpha_s\widehat x_0+\sigma_s\widehat\epsilon.$$ 将上一式的噪声估计代入,把所有乘在 $x_t$ 前的系数归到一起,得到: $$x_s=A_{ts}x_t+B_{ts}\widehat x_0(x_t,t),\qquad A_{ts}=\frac{\sigma_s}{\sigma_t},\quad B_{ts}=\alpha_s-\frac{\sigma_s}{\sigma_t}\alpha_t.$$ 这一步只有代数整理,没有假设教师完美。$A_{ts}$ 表示直接保留当前状态的比例,$B_{ts}$ 表示干净样本估计对目标状态的贡献。分母要求当前噪声尺度非零,因此不能从零噪声端再向前执行这类转移。最后一步可以到达零噪声端,因为此时分子为零而当前分母仍非零。 3.2 两步教师怎样变成一步学生的监督 选择三个降序时刻 $t>u>s$。教学时间表用三角恒等式把分母改写为 $B_{ts}=\sin(t-s)/\sin t$,避免两个接近的乘积相减。在 $0\leq s\lt t\leq\pi/2$ 内它为正,起点固定时随两点重合趋近零。这个简写适用于本文的正弦、余弦调度。教师先从 $x_t$ 到 $x_u$,再在新的输入 $x_u$ 上重新预测并到达 $x_s^{\mathrm{teach}}$: $$x_u=A_{tu}x_t+B_{tu}\widehat x_0^{\mathrm{teach}}(x_t,t),\qquad x_s^{\mathrm{teach}}=A_{us}x_u+B_{us}\widehat x_0^{\mathrm{teach}}(x_u,u).$$ 第二次预测必须接收第一步输出,而不能继续拿原输入代替。否则监督的不是教师真实走过的两步。现在要求学生从同一个 $x_t$ 一次到达相同目标,其一步公式为: $$x_s^{\mathrm{student}}=A_{ts}x_t+B_{ts}\widehat x_0^{\mathrm{student}}(x_t,t).$$ 把学生终点设为教师终点,移项并除以非零的 $B_{ts}$,得到学生应该预测的干净样本目标: $$\widetilde x_0=\frac{x_s^{\mathrm{teach}}-A_{ts}x_t}{B_{ts}},\qquad L_{\mathrm{pair}}=\mathbb E\left[\left\|\widehat x_0^{\mathrm{student}}(x_t,t)-\widetilde x_0\right\|_2^2\right].$$ 这里的 $L_{\mathrm{pair}}$ 是教学用的未加权回归,期望取自训练输入。同一区间、同一输入的学生终点误差等于 $B_{ts}$ 乘预测误差,故终点平方误差比预测平方误差多一个 $B_{ts}^2$。独立拟合每段时,这个正常数不会改变该段的最小二乘解。共享一个时间条件网络时,权重会改变不同时间对梯度的贡献。渐进蒸馏原论文 §3–4 从训练数据构造带噪输入,并讨论截断 SNR 和 SNR+1 权重。下文为隔离代数关系,统一用标准正态标量拟合各区间。 波浪号表示“由教师转移反解出来的目标”,它一般不同于原训练数据的真实 $x_0$,也不必等于教师在时刻 $t$ 的第一次估计。蒸馏改变了监督:学生需要补偿较大跨度,让一步尽量承担教师两步的作用。若继续用旧的局部估计、只删时间点,就没有完成这个目标替换。 训练完一次,将学生固定为下一轮教师,再把时间点成对合并。本文走 16、8、4、2、1 步的减半链。真实模型可以在某一轮停止;继续压缩意味着更困难的函数逼近,不能由代数公式保证学习成功。 若输入和系数固定,教师终点的绝对扰动 $\Delta x_s$ 会变成目标扰动 $\Delta x_s/B_{ts}$,所以 $1/|B_{ts}|$ 是这项误差的绝对放大倍数。分子相减仍可能损失有效数字。代码在采样和拟合中共享系数计算,并拒绝 $B_{ts}$ 小于 1e-10 的区间。实际训练还要考虑噪声参数化、损失权重与时间采样,不能把一个没有报除零错误的实现当作稳定训练方案。 3.3 一致性目标怎样改变问题 渐进蒸馏贴近有限跨度的转移;一致性模型的函数 $f_\theta(x_t,t)$ 则尝试直接预测轨迹接近数据端的终点。若 $x_t$ 与 $x_u$ 位于同一条概率流 ODE 轨迹,理想情况是两者给出相同结果。一个示意的一致性蒸馏目标为: $$L_{\mathrm{cons}}=\mathbb E\left[d\left(f_\theta(x_t,t),\operatorname{stopgrad}\left(f_{\bar\theta}(x_u,u)\right)\right)\right].$$ $\theta$ 是当前学生参数,$\bar\theta$ 是目标网络参数,常通过指数滑动平均更新;$d$ 是比较两个输出的距离;$\operatorname{stopgrad}$ 表示右侧不参与此次反向传播。这里的低噪声状态由教师轨迹转移得到,不能任意选择一张无关带噪图。本文省略了论文具体的采样权重与离散化细节,所以这条式子用于解释监督关系,不是完整训练配方。 只要求两个输出相同还不够:无论输入是什么都输出常数,也会满足这种相等。为排除这一类没有生成意义的解,需要数据端边界条件。原一致性模型使用小的正端点 $\varepsilon$,要求: $$f_\theta(x,\varepsilon)=x,\qquad f_\theta(x,t)=c_{\mathrm{skip}}(t)x+c_{\mathrm{out}}(t)F_\theta(x,t).$$ $F_\theta$ 是可训练网络。若 $c_{\mathrm{skip}}(\varepsilon)=1$ 且 $c_{\mathrm{out}}(\varepsilon)=0$,边界就由结构保证,不依赖训练恰好学会恒等映射。若同一条真实轨迹上的相等关系一直成立到端点,就有 $f_\theta(x_t,t)=f_\theta(x_\varepsilon,\varepsilon)=x_\varepsilon$。训练通常只覆盖有限时间点和数据,且相邻状态由数值求解近似。只检查端点和若干内部配对,会漏过一个反例:函数在端点返回输入,在所有内部时刻返回零。内部配对相等,跨到端点就失败。这个函数在端点不连续,说明离散检查不能替代轨迹覆盖和函数正则性。 本文演示 Consistency Models 附录 C 的连续系数,用 512 个输入检查恒等边界。Diffusers 的离散 LCM 使用另一组时间缩放系数。端点测试只核对参数化,轨迹配对和最终样本仍需另行验证。 3.4 分布匹配为什么不等于逐样本复制 设学生生成器为 $G_\theta(z)$,$z$ 是初始噪声。原始 DMD 同时用两种监督:不配对的分布匹配和配对的感知回归。先把学生样本加噪成 $x_t=\alpha_tG_\theta(z)+\sigma_t\xi$,$\xi$ 是独立高斯噪声。将学生与目标用相同的前向核加噪,分别得到时刻 $t$ 的边缘密度 $p_{\mathrm{fake},t}$ 和 $p_{\mathrm{ref},t}$。原论文从反向 KL 出发,实际在带噪边缘上优化,因为平滑后两组样本的支撑更容易重叠。可把理想化目标写成: $$L_{\mathrm{dist}}=\mathbb E_t D_{\mathrm{KL}}\left(p_{\mathrm{fake},t}\mathrel{\|}p_{\mathrm{ref},t}\right).$$ 实际训练通过预训练去噪器估计参考 score,不能直接把参考等同于某个固定步数采样器的输出密度。对密度 $p$,score 指 $\nabla_{x_t}\log p(x_t)$。固定 $t$ 后,KL 是从学生样本出发的对数密度比期望。对参数求导时,固定坐标处 $\log p_{\mathrm{fake},t}$ 的显式参数导数在自身密度下积分为零,因为密度的积分恒等于 1。剩下的项经样本坐标传回生成器。设 $J_\theta G_\theta(z)$ 是学生输出对参数的雅可比矩阵,得到: $$\nabla_\theta L_{\mathrm{dist}}=\mathbb E_{t,z,\xi}\left[\alpha_t(J_\theta G_\theta(z))^\top\bigl(s_{\mathrm{fake}}(x_t,t)-s_{\mathrm{ref}}(x_t,t)\bigr)\right].$$ 上式假设密度光滑且可交换积分与求导。减号顺序对应梯度,更新参数时沿负梯度走。实际 DMD 用一个随学生变化而更新的去噪器估计 $s_{\mathrm{fake}}$,用冻结的预训练模型估计 $s_{\mathrm{ref}}$,并额外重加权时间与样本。配对回归另用同一个 $z$ 产生的教师样本提供 LPIPS 感知约束。前者约束总体分布,后者补充噪声到图像的对应关系。第 09 节用同方差的一维高斯检查 score 差的符号。DMD 原论文 §3.1–3.4 例如 $z$ 服从标准高斯时,映射 $G(z)=z$ 和 $G(z)=-z$ 的输出分布相同,但同种子的均方差为 $4$。反过来,少量配对样本的误差小也不足以证明覆盖了所有模式。 04. 代码实现 完整脚本是文末的 distill_demo.py。依赖 NumPy 与 matplotlib,不需要下载模型权重。教学数据分布选择均值为 1、方差为 0.25 的一维高斯;时间表使用 $\alpha_t=\cos t$、$\sigma_t=\sin t$,从 1.4 弧度走到零。这里的 $t$ 是调度参数,不是秒,也不是 Diffusers 的整数时间索引。 设 $x_0$ 和噪声独立,$x_0$ 的均值、方差分别是 $\mu,v$。于是 $x_t$ 的均值是 $\alpha_t\mu$,方差是 $\alpha_t^2v+\sigma_t^2$,与 $x_0$ 的协方差是 $\alpha_tv$。协方差除以带噪方差,再乘上观测偏差 $x-\alpha_t\mu$,得到从先验均值到后验均值的修正: $$\widehat x_0^{\mathrm{teach}}(x,t)=\mu+\frac{\alpha_t v}{\alpha_t^2v+\sigma_t^2}(x-\alpha_t\mu),\qquad \mu=1,\quad v=0.25.$$ 符号 $v$ 在这里是数据方差,不是扩散网络的 velocity 参数化。这个预测器是条件均值,并非声称每一个噪声对应已知干净样本。高斯条件均值对输入是仿射函数,DDIM 转移也是仿射函数;两步复合后仍然仿射。因此学生只要学习斜率与截距,就可以精确表示教师合成目标。这是实验误差接近机器精度的关键原因。 核心代码直接对应第 03 节的移项公式: a, b = coefficients_for_step(t, s) x0_target = (target - a * train) / b design = np.column_stack([train, np.ones_like(train)]) slope, intercept = np.linalg.lstsq(design, x0_target, rcond=None)[0] print(slope, intercept) a 对应 $A_{ts}$,b 对应 $B_{ts}$,target 是教师两步终点。线性最小二乘只用于这个能够精确表示的教学系统;真实网络会用小批量优化,不能用两个系数取代图像生成器。各轮学生系数独立依赖对应的转移区间。真实模型通常以时间条件共享网络参数,本篇采用每个区间一个仿射预测器,是为了让目标与拟合误差完全可查。 运行固定随机种子 7,训练输入形状为 (256,),测试输入和输出形状均为 (512,),全部为 float64。测试输入与拟合输入分开采样。下面的数值直接取自本地 run_result.json: 网络评估次数 逐级蒸馏相对教师 RMSE 不训练只删时间点 RMSE 16 0 参照教师 8 2.65819e-16 0.0370682 4 2.93630e-16 0.105562 2 3.20441e-16 0.226265 1 2.89642e-16 0.410312 一阶段学生最终学到的斜率为 0.4646808695,截距为 0.9210195202。注意这是学生的干净样本预测器参数;由于最后转移到零噪声,终点恰好等于该预测。16 步教师终点的样本均值为 0.892840、标准差为 0.439749。这些数值也提醒我们:贴近教师终点不等于已经复原理论数据分布。这里有两个能分开量化的差异。设 $V_t=\alpha_t^2v+\sigma_t^2$。一维高斯的概率流 ODE 保持标准化坐标 $(x_t-\alpha_t\mu)/\sqrt{V_t}$:在一维,保持样本顺序且把当前高斯边缘映到下一高斯边缘的流保持分位数。到数据端,把标准化坐标乘 $\sqrt v$ 再加 $\mu$。在 $t=1.4$,真实起始边缘的均值约为 0.169967,标准差约为 0.989107。若仍从标准正态启动,即使精确流到零,输出总体均值也只有约 0.914081,标准差约为 0.505506。反过来,即使改用正确起始边缘,16 步教师与精确流的实测 RMSE 仍约为 0.041455。前者来自初始分布,后者来自有限步转移。 图左保留首发实跑的对数坐标,参照教师的零误差仅为作图截到 1e-16。上表来自本次重新实跑,浮点末位随实现变动,结论取决于跳步误差和舍入误差之间的数量级差距。图右看同一初始噪声对应的终点:一步学生与 16 步教师重合,未训练的一步跳转则明显偏离。配图由完整脚本生成,不包含真实图像模型实验。 实验保存每轮的最小分母绝对值与全部拟合系数。第一次减半的最小分母绝对值约为 0.176679,最后一步为 1。若更改时间表导致分母逼近零,应先解决调度与参数化问题,不要靠把无穷值裁剪成有限数掩盖目标失效。 05. 工业级实现对照 本节以实际读取的 Diffusers v0.35.1 源码为准。固定版本与本地源码 SHA256 一起保存,可以避免将未来上游改动混进本次解释。知识树锚点是 scheduling_lcm.py 中的 LCMScheduler.step,训练对照是 train_lcm_distill_sd_wds.py。 首先,采样器要知道网络输出的语义。prediction_type 可以是噪声、干净样本或 velocity;代码先把它们转换成原始样本估计,再通过 c_out 与 c_skip 得到 denoised。若模型输出是 velocity 却按噪声解释,时间表看似正常,结果仍会错。最小代码从头到尾直接预测干净样本,省去了接口兼容层。 其次,LCM 多步采样不是照抄本文确定性 DDIM。该版本 step 在非末步将 denoised 按下一时刻的信号系数缩放,并加入新噪声;末步直接返回 denoised。随机数生成器、设备、dtype 和当前步索引都会影响实际行为。把一次生成的全部中间状态当成完全确定的同一轨迹,在这种采样模式下就需要重新说明随机性条件。 再看训练脚本,DDIMSolver.ddim_step 使用索引从累计信号系数中取对应时间点;教师进行条件与无条件预测后构造引导结果;目标学生在较低噪声状态上预测终点;当前学生与停止梯度的目标输出进行比较。滑动平均目标网络提供较平稳的监督。教师、当前学生、目标学生是不同角色,不能因为它们最初权重相同,就把三份输出混为一谈。 设 $q_c,q_\varnothing$ 分别是条件与无条件预测。该脚本把 LCM 约定的 $w$ 用在 $q_c+w(q_c-q_\varnothing)$,并将 $w$ 编码后传给学生。Imagen 风格常写成 $q_\varnothing+g(q_c-q_\varnothing)$。展开第一式便得 $g=w+1$,例如 $w=3$ 对应 $g=4$。固定版本在干净样本估计和噪声估计上都应用同一个 $w$,再调用 DDIM 求解器推进一次教师转移。Diffusers v0.35.1 训练实现 本文还在本地实际执行了官方 LCMScheduler.step 与离散边界系数方法的源码片段,使用 CPU 张量核对末步和非末步的数值、形状与随机数分支。该验证覆盖采样方法的运算,未加载完整 pipeline、没有模型权重,也没有测 GPU 性能。它能支持本节对分支逻辑的说明,不能支持某个图像模型已达到论文质量的说法。 实际输入张量形状为 (1, 1, 2, 2),类型为 float64,随机种子为 19。非末步输出与单独按公式计算的最大差为 1.11022e-16,末步输出与 denoised 的最大差为 0;两步中仅非末步调用一次噪声生成。这些检查使用原方法与显式配置夹具,不等同于完整库的端到端测试。 工业训练还包含 VAE 编码、文本条件、混合精度、梯度裁剪、分布式数据流、训练状态恢复和验证集。最小实验刻意隔离这些因素,让读者先查明“损失是不是在教学生完成更大的跨度”。进入生产时,这些系统环节会重新成为质量与稳定性的约束,不能把教学脚本直接称为部署实现。 06. 代价与边界 少步节约的是推理阶段反复评估去噪器的成本,代价包括教师构造目标、学生训练与新增权重的管理。训练是否划算,取决于实际生成请求量、教师成本、学生维护周期和质量验收要求。不是所有偶尔使用的模型都值得蒸馏。 网络评估次数不等于端到端加速倍数。设固定开销为 $T_{\mathrm{fixed}}$,单次网络评估耗时为 $T_{\mathrm{eval}}$,评估次数为 $N$,一个仅用于预算的模型是: $$T(N)=T_{\mathrm{fixed}}+N T_{\mathrm{eval}}.$$ 这里固定开销包括可能的文本编码、VAE 解码、传输与后处理。该式假设每次评估成本相同,真实 CFG 批处理和内核行为可能打破假设。本文没有实测这些项,所以不报告墙钟加速。即使循环次数大幅下降,VAE 解码占比也会升高,随后要优化的瓶颈可能已经换了位置。 质量边界至少有三个层面。第一,学生近似教师时可能继承教师已有的偏差;第二,有限容量与优化误差会产生额外偏差;第三,训练条件以外的提示词、分辨率、长视频长度和引导强度可能引发分布外问题。高质量的平均评分不能自动证明每个困难场景都被保留。 本文的仿射教师让函数复合仍留在同一个表示族里,学生可以达到数值精度。真实神经网络的两步复合通常更复杂,一次调用不一定有足够容量表达。若将本实验的近零误差当成“一步生成原则上没有任何质量损失”的证明,就越过了实验边界。 还可以给误差积累一个有条件的上界。记第 $i$ 段教师转移为 $T_i$,学生转移为 $S_i$,两条轨迹进入该段时的状态差为 $e_i$。假设在实际经过的状态范围内,学生转移对输入变化的放大系数不超过 $K_i$,并且同一教师输入上的学生转移误差不超过 $\delta_i$。加减同一个学生转移项,再使用三角不等式,可得: $$e_{i+1}\leq K_i e_i+\delta_i.$$ 这是把两种误差拆开:旧状态差经过学生映射被放大,新转移近似又添加一项。由同样初始状态出发,初始误差为零,递推展开得到: $$e_m\leq\sum_{i=0}^{m-1}\delta_i\prod_{j=i+1}^{m-1}K_j.$$ 空乘积取一。该上界要求真的具有上述局部放大与误差界,本文没有测量真实网络的这些常数,因此不将它当作质量保证。它说明为什么只看训练样本上的单段误差不够:后续映射可能放大差异,而学生在前段产生的新状态也可能超出监督覆盖范围。推理验收需要完整走完轨迹,不能只展示教师输入上的一张损失曲线。 采样器的高阶积分、跨步缓存、量化和蒸馏可以一起考虑,但需要组合验收。缓存引入的时序近似、量化的数值误差、蒸馏的学习误差未必相互独立。不能把单独测试的加速倍数相乘,再宣称组合后同时保留各自的质量结果。 对于交互式编辑与可控生成,还要检查原模型所支持的控制插件、低秩适配和条件接口是否与学生兼容。某个模型在简单文生图上通过验收,不等于已有的编辑工作流可以直接迁移。这里是工程验收建议,而非对所有蒸馏模型作相同能力限制。 07. 经典论文脉络 下面五篇按它们改变的对象排列,并非所有方法都沿着单一继承链发展。没有标注会议、评分或硬件数字的地方,不应自行补上这些背书。 Denoising Diffusion Implicit Models,2010.02502:提供确定性采样等选择,让既有扩散训练目标能够配合更快的生成过程,是本文转移推导的起点。 Progressive Distillation for Fast Sampling of Diffusion Models,2202.00512:把确定性教师两步压成学生一步,再重复减半,是本文最小实验的直接概念来源;我们的解析高斯例子不是论文图像实验的复现。 Consistency Models,2303.01469:让轨迹上不同状态预测同一终点,并讨论蒸馏与独立训练;所以“一致性模型必须依赖预训练教师”并不是其完整定义。 Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference,2310.04378:将一致性路线用于潜空间与带引导的生成,是工业采样和训练源码对照的背景。 One-step Diffusion with Distribution Matching Distillation,2311.18828:引入分布匹配监督来训练一步生成器,原方法结合回归;它不是对本文逐级二步目标进行简单重命名。 读这一脉络时,先标记“没有改权重而改采样”、“学有限跨度转移”、“学轨迹终点”和“学分布”这几类对象,再比较成本与质量。否则容易把一篇论文的训练方式和另一篇论文的采样器拼成不存在的方法。 论文之间的评测设置也不同。某个数据集上的无条件 FID、某个文生图模型的人工偏好与视频的时序稳定性不是同一问题。本文保留论文身份与机制关联,避免把不同基准的数字排成一个貌似统一的排行榜。 08. 常见误解 误解一:把 50 个时间点改成 4 个就是蒸馏。 这只是删时间点或换采样设置。学生权重是否经过专门训练、目标是否考虑大跨度,才决定是否完成了蒸馏。本文的不训练跳步对照给出了明确反例。 误解二:学生预测的干净图必须等于训练数据真值。 在本文渐进目标里,学生预测的是为了重现教师两步终点而反解的量。它承担了有限步转移的补偿,不能机械套用原始去噪标签解释。 误解三:一致性只是任意两张带噪图输出一样。 输入之间需要相应的轨迹关系,数据端还需要边界约束。任意配对可能破坏监督;缺少边界约束则连常数输出都可能满足相等。 误解四:同种子图像不同说明分布蒸馏失败。 配对一致与分布一致是不同目标。判断 DMD 等路线需要分布与任务评测,同种子逐像素差异不能单独决定成功或失败。 误解五:scheduler 中的边界系数已经完成了一致性训练。 系数提供结构与采样规则,真正承载学到的生成映射的是权重。未蒸馏的网络接入一个 LCM scheduler,不会因为公式合法就拥有 LCM 能力。 误解六:本实验一步误差近零证明图像也能无损一步。 本实验的仿射表示族对复合封闭,且监督完全可计算。图像网络没有获得这项保证;还存在有限训练、数据覆盖和条件组合等问题。 09. 动手验证 从文末把 distill_demo.py 和 distill_checks.py 复制到同一目录,安装依赖后运行。主脚本会打印 JSON,并在脚本目录生成 run_result.json 与配图。若脚本位于项目的 code/ 下,默认输出到文章目录。也可以用 --output-dir 单独保存本次结果。 python -m pip install numpy matplotlib python distill_demo.py python distill_checks.py 先不改任何参数,对照表格中的四种压缩结果。不同 NumPy 与线性代数库可能使最后几位舍入误差不同;应检查数量级与断言通过,不要求每一个浮点字符串逐字相同。直接跳步的误差应明显大于机器精度,逐级拟合则在这个仿射问题中接近机器精度。 distill_checks.py 给教师预测加上 0.05 * np.tanh(x),固定 seed 23,用 256 个输入拟合,另用 512 个输入测试。在第一个两步区间,仿射学生的终点 RMSE 约为 0.001599,明显高于仿射教师的舍入误差。脚本还检查一个同方差高斯例子:学生均值偏大时,反向 KL 的解析梯度约为 0.63,与中心有限差分相差约 7.01e-12。沿负梯度移动会降低 KL,这让第 03 节 score 差的符号可以直接检查。 验证脚本还检查了九个非法输入。重复时间点由时间表校验拦下,几乎重合的时间点由最小分母拦下。奇数步、网格与预测器数目不匹配及秩亏拟合也会明确报错。这帮助区分“训练效果差”和“监督本身没有定义”。如果只是把 NaN 替换成零,后面的均方误差会产生没有意义的数值。 最后单独检查一致性端点。本脚本已经实际调用边界函数,输出 boundary_max_error 为 0。若删除跳连系数或让输出系数在端点仍非零,恒等边界便不再由结构保证。这个实验不等于训练了一致性生成器,但能验证参数化究竟保证了哪一个性质。 10. 延伸阅读 先回到 DDIM 与高阶采样器,区分数值积分误差和网络误差;再读 CFG 的代价与调法,把教师的条件组合与学生条件输入接起来。若连教师在何种引导方式下产生目标都没确定,少步比较就缺少共同基准。 同在推理加速方向,扩散跨步缓存关注复用已有计算,量化关注数值表示的成本。它们与训练学生解决不同的成本来源,适合通过统一质量预算比较,而不是只排列循环次数。 视频生成评测 进一步说明怎么把少步生成的时序稳定性、主体保持和提示词遵循拆开验收。本文到这里建立的是监督目标与可复现代数实验,真正选择一个少步模型,还要回到自己的任务、条件范围和实际质量门槛。 附录:完整代码 09 节用到的脚本全文如下(distill_demo.py、distill_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 distill_demo.py """CPU teaching experiment: exact pairwise DDIM distillation for an affine teacher. Dependencies: numpy, matplotlib. No model weights or image-quality benchmark. """ import argparse import json from pathlib import Path import numpy as np import matplotlib matplotlib.use('Agg') import matplotlib.pyplot as plt def schedule(t): return np.cos(t), np.sin(t) def teacher_x0(x, t): # Posterior mean for one-dimensional N(mu, variance) data under VP noise. mu, variance = 1.0, 0.25 alpha, sigma = schedule(t) weight = alpha * variance / (alpha * alpha * variance + sigma * sigma) return mu + weight * (x - alpha * mu) def coefficients_for_step(t, s): if not 0.0 <= s < t <= np.pi / 2: raise ValueError('Expected 0 <= s < t <= pi/2') sigma_t = np.sin(t) a = np.sin(s) / sigma_t b = np.sin(t - s) / sigma_t if b < 1e-10: raise ValueError('Degenerate distillation interval') return a, b def ddim(x, x0, t, s): a, b = coefficients_for_step(t, s) return a * x + b * x0 def validate_grid(predictors, grid): grid = np.asarray(grid, dtype=np.float64) if grid.shape != (len(predictors) + 1,) or not predictors: raise ValueError('Expected one more time point than predictors') if not np.all((0 <= grid) & (grid <= np.pi / 2)) or not np.all(np.diff(grid) < 0): raise ValueError('Expected a strictly decreasing grid within [0, pi/2]') return grid def sample(predictors, grid, x): grid = validate_grid(predictors, grid) x = np.asarray(x, dtype=np.float64).copy() for i, predictor in enumerate(predictors): x = ddim(x, predictor(x, grid[i]), grid[i], grid[i + 1]) return x def distill(predictors, grid, train): grid = validate_grid(predictors, grid) if len(predictors) % 2: raise ValueError('Pairwise distillation requires an even number of steps') train = np.asarray(train, dtype=np.float64) if train.ndim != 1 or train.size < 2 or not np.isfinite(train).all(): raise ValueError('Expected at least two finite scalar training inputs') design = np.column_stack([train, np.ones_like(train)]) if np.linalg.matrix_rank(design) != 2: raise ValueError('The affine training design must have rank 2') new_grid = grid[::2] students, coefficients, denominators = [], [], [] for j in range(0, len(predictors), 2): t, u, s = grid[j:j + 3] middle = ddim(train, predictors[j](train, t), t, u) target = ddim(middle, predictors[j + 1](middle, u), u, s) a, b = coefficients_for_step(t, s) x0_target = (target - a * train) / b slope, intercept = np.linalg.lstsq(design, x0_target, rcond=None)[0] def predictor(x, unused_t, slope=slope, intercept=intercept): return slope * x + intercept students.append(predictor) coefficients.append([float(slope), float(intercept)]) denominators.append(float(b)) return students, new_grid, coefficients, denominators def main(): parser = argparse.ArgumentParser(description=__doc__) parser.add_argument('--output-dir', type=Path, help='Directory for JSON and figures') args = parser.parse_args() here = Path(__file__).resolve().parent folder = args.output_dir or (here.parent if here.name == 'code' else here) rng = np.random.default_rng(7) train = rng.normal(size=256) test = rng.normal(size=512) grid = np.linspace(1.4, 0.0, 17) predictors = [teacher_x0] * 16 golden = sample(predictors, grid, test) rows = [{'steps': 16, 'max_error': 0.0, 'rmse': 0.0}] stages = [] while len(predictors) > 1: predictors, grid, coefficients, denominators = distill(predictors, grid, train) result = sample(predictors, grid, test) rows.append({'steps': len(predictors), 'max_error': float(np.max(np.abs(result - golden))), 'rmse': float(np.sqrt(np.mean((result - golden) ** 2)))}) stages.append({'steps': len(predictors), 'coefficients': coefficients, 'min_abs_denominator': float(np.min(np.abs(denominators)))}) assert np.allclose(result, golden, rtol=1e-11, atol=1e-11) skipping = [] for steps in [8, 4, 2, 1]: skip_grid = np.linspace(1.4, 0.0, steps + 1) result = sample([teacher_x0] * steps, skip_grid, test) skipping.append({'steps': steps, 'rmse': float(np.sqrt(np.mean((result - golden) ** 2)))}) # Boundary identity: f(x,t)=c_skip*x+c_out*F(x,t), sigma_data=0.5. eps, sigma_data = 0.002, 0.5 def consistency_boundary(x, t): delta = t - eps c_skip = sigma_data ** 2 / (delta ** 2 + sigma_data ** 2) c_out = sigma_data * delta / np.sqrt(t ** 2 + sigma_data ** 2) return c_skip * x + c_out * np.tanh(x) boundary_error = float(np.max(np.abs(consistency_boundary(test, eps) - test))) assert boundary_error == 0.0 result = {'seed': 7, 'dtype': str(test.dtype), 'train_shape': list(train.shape), 'test_shape': list(test.shape), 'output_shape': list(golden.shape), 'teacher_endpoint_mean': float(golden.mean()), 'teacher_endpoint_std': float(golden.std()), 'distilled': rows, 'untrained_skip': skipping, 'stages': stages, 'boundary_max_error': boundary_error, 'scope': 'affine Gaussian teaching teacher; no neural network or image-quality claim'} (folder / 'figures').mkdir(parents=True, exist_ok=True) fig, axes = plt.subplots(1, 2, figsize=(11, 3.6), constrained_layout=True) axes[0].plot([r['steps'] for r in rows], [max(r['rmse'], 1e-16) for r in rows], 'o-', label='Pairwise distilled') axes[0].plot([r['steps'] for r in skipping], [r['rmse'] for r in skipping], 's-', label='Untrained timestep skip') axes[0].set(xscale='log', yscale='log', xlabel='Denoiser evaluations', ylabel='RMSE vs 16-step teacher') axes[0].legend() order = np.argsort(test) skip_one = sample([teacher_x0], np.array([1.4, 0.0]), test) one = sample(predictors, grid, test) axes[1].plot(test[order], golden[order], label='16-step teacher', lw=3) axes[1].plot(test[order], one[order], '--', label='1-step distilled') axes[1].plot(test[order], skip_one[order], ':', label='1-step untrained skip') axes[1].set(xlabel='Initial noise', ylabel='Endpoint') axes[1].legend() fig.savefig(folder / 'figures/distillation_error.png', dpi=160, metadata={'Software': 'PairwiseDistillationTeachingDemo'}) plt.close(fig) (folder / 'run_result.json').write_text(json.dumps(result, indent=2), encoding='utf8') print(json.dumps(result, indent=2)) if __name__ == '__main__': main() distill_checks.py """Independent scalar checks for the distillation article. Run with NumPy.""" import json import numpy as np from distill_demo import coefficients_for_step, ddim, distill, sample, teacher_x0 def main(): rng = np.random.default_rng(23) x = rng.normal(size=512) grid = np.linspace(1.4, 0.0, 17) train = rng.normal(size=256) affine_errors = [] for t, u, s in zip(grid[::2], grid[1::2], grid[2::2]): # Derive each Gaussian conditional mean slope and intercept independently. at, au = np.cos([t, u]) vt, vu = 0.25 * np.cos([t, u]) ** 2 + np.sin([t, u]) ** 2 mt, mu = 0.25 * at / vt, 0.25 * au / vu ct, cu = 1 - mt * at, 1 - mu * au a1, a2 = np.sin([u, s]) / np.sin([t, u]) b1, b2 = np.cos([u, s]) - np.cos([t, u]) * [a1, a2] m1, m2 = a1 + b1 * mt, a2 + b2 * mu expected = m2 * m1 * x + m2 * b1 * ct + b2 * cu student, short_grid, _, _ = distill([teacher_x0] * 2, [t, u, s], train) affine_errors.append(float(np.max(np.abs(sample(student, short_grid, x) - expected)))) assert max(affine_errors) < 1e-12 def nonlinear(inputs, t): return teacher_x0(inputs, t) + 0.05 * np.tanh(inputs) t, u, s = grid[:3] student, short_grid, _, _ = distill([nonlinear] * 2, [t, u, s], train) reference = sample([nonlinear] * 2, [t, u, s], x) nonlinear_rmse = float(np.sqrt(np.mean((sample(student, short_grid, x) - reference) ** 2))) assert nonlinear_rmse > 1e-4 invalid_cases = [ lambda: sample([teacher_x0], [1, 0.5, 0], x), lambda: sample([teacher_x0], [0, 0.5], x), lambda: sample([teacher_x0] * 2, [1, 1, 0], x), lambda: sample([teacher_x0], [np.nan, 0], x), lambda: distill([teacher_x0], [1, 0], train), lambda: distill([teacher_x0] * 2, [1, 0.5, 0], np.ones(4)), lambda: distill([teacher_x0] * 2, [1, 0.5, 0], [0, np.inf]), lambda: ddim(x, x, 0, 0), lambda: coefficients_for_step(1, 1 - 1e-12), ] rejected = [] for case in invalid_cases: try: case() except ValueError as error: rejected.append(str(error)) else: raise AssertionError('Invalid input accepted') # One scalar reverse KL. The smoothed fake and target share variance. alpha, sigma, theta, target_mean = 0.6, 0.8, 1.25, -0.5 variance = alpha ** 2 + sigma ** 2 def kl(mean): return (alpha * (mean - target_mean)) ** 2 / (2 * variance) delta = 1e-5 numerical = (kl(theta + delta) - kl(theta - delta)) / (2 * delta) noisy = alpha * (x + theta) + sigma * rng.normal(size=x.shape) fake_score = -(noisy - alpha * theta) / variance target_score = -(noisy - alpha * target_mean) / variance by_score = float(np.mean(alpha * (fake_score - target_score))) assert abs(numerical - by_score) < 1e-10 and by_score > 0 assert kl(theta - 0.1 * by_score) < kl(theta) # Endpoint boundary alone can hold while all sampled interior values collapse. eps = 0.002 def boundary_only(z, time): return z if time == eps else np.zeros_like(z) assert np.array_equal(boundary_only(x, eps), x) assert np.array_equal(boundary_only(x, 0.5), boundary_only(x + 2, 1.0)) assert not np.array_equal(boundary_only(x, 0.5), boundary_only(x, eps)) # Exact transport for a one-dimensional Gaussian marginal under the VP schedule. terminal = 1.4 start_mean = float(np.cos(terminal)) start_std = float(np.sqrt(0.25 * np.cos(terminal) ** 2 + np.sin(terminal) ** 2)) exact_from_gaussian = 1 + 0.5 * ((start_mean + start_std * x) - start_mean) / start_std assert np.allclose(exact_from_gaussian, 1 + 0.5 * x, atol=1e-14, rtol=0) finite_grid = sample([teacher_x0] * 16, grid, start_mean + start_std * x) print(json.dumps({ 'seed': 23, 'cases': len(affine_errors), 'affine_max_abs': max(affine_errors), 'nonlinear_pair_rmse': nonlinear_rmse, 'rejected_invalid_cases': rejected, 'dmd_score_gradient': by_score, 'dmd_finite_difference': numerical, 'boundary_only_collapse_confirmed': True, 'start_true_mean': start_mean, 'start_true_std': start_std, 'ideal_data_mean_from_standard_prior': 1 - 0.5 * start_mean / start_std, 'ideal_data_std_from_standard_prior': 0.5 / start_std, 'finite_teacher_with_exact_start_rmse': float(np.sqrt(np.mean((finite_grid - exact_from_gaussian) ** 2))), 'assertions': 'passed' }, indent=2)) if __name__ == '__main__': main()
-
AIGC 每日速读|2026-10-08|Stanford视频生成快3.53倍LoT 今日 AIGC 论文速览 今日共 10 篇 · 生成架构与后训练 3 篇 · 图像视频算力与量化 3 篇 · 多参考图与长视频记忆 2 篇 · 数字人与生成语音增强 2 篇 重点论文标题列表 LoT(Stanford):按细节分配视频生成算力 LiFT(阿姆斯特丹):共享主干多循环细化图像 MEND(得州奥斯汀):奖励收益够大才移动样本 RefRoute(达特茅斯):十六张参考图也能轻量合成 Keepsake(中佛罗里达):长视频只留难替代的历史帧 今日论文速览 1. LoT:按细节分配视频生成算力 Level-of-Token Diffusion | 斯坦福大学;Google | arXiv:2610.05816 关键词:多分辨率token, 图像视频生成, 算力分配, 不对称flow 前序问题:天空、虚化背景和人脸被分配同样密度的 token,生成时算力花在很多低细节区域。直接压缩 token 又会让预训练 DiT 只能输出低分辨率流场,难兼顾省计算与完整画面。 本文贡献:Level-of-Token 把框、语义掩码、纹理方差或景深转成大小和形状不同的矩形 token 布局。重要区域用细 token,其余区域合并;经分块不对称 flow、形状嵌入、与原网格对齐的 RoPE 及按形状区分的输出头,DiT 处理较短序列,但每步仍恢复完整分辨率速度场。需要微调预训练模型。 论文 Figure 3:LoT 流程。完整分辨率 token 网格 x_t 按 LoT 布局映射成较短序列,DiT 以 token 形状 s、时间步 t 与文本 c 为条件处理;按形状区分的输出头 h_e_i 恢复不对称速度 u,再转为完整秩速度用于 flow-matching 训练。 实验效果:表 2 的 Wan2.1 14B、三倍 token 压缩预算下,论文报告平均视频生成加速 3.530 倍;Aesthetic 为 0.5104、Imaging 为 0.5650,完整基座为 0.5518、0.6465。表 1 的 FLUX2 4B 对应预算最高加速 2.040 倍。数字代表不同预算下的速度与质量取舍。 论文 Table 2:视频生成量化比较。相同 token 预算下,与压缩基线相比,LoT 的 Aesthetic、Imaging 分数及加速更好;表内同时列出完整分辨率 Wan2.1 14B,压缩后这些质量分仍低于完整模型,不能把基线间优势读成全面无损。 批判点评:标题的 3.53 倍限于上述视频配置,不代表任意布局或所有模型。全画面都需要细纹理时,可减少的 token 很少;压缩过强仍损害细节。它不是只靠换采样器的免训练技巧。可从作者项目页核对布局及演示,本期未确认可下载的方法代码。 2. LiFT:共享主干多循环细化图像 LiFT: Loop Flow Transformers | 阿姆斯特丹大学;TNO | arXiv:2610.05538 关键词:循环DiT, flow matching, 推理深度, 参数共享 前序问题:生成质量通常随参数增长,模型存储预算有限时很难扩容。让同一主干循环多次,又常要求每次直接猜最终目标,训练深度之外未必继续改善。 本文贡献:LiFT 反复调用共享 DiT 核心,给每次循环连续深度坐标,并把各步预测监督到初始速度估计与 flow-matching 目标之间直线路径的对应位置。训练随机采样内部坐标,推理使用均匀网格;一个固定 checkpoint 可在不增加参数、不重新训练的情况下改变循环次数,并和外层积分步数共同分配计算。 论文 Figure 2:深度循环与时间 flow。(a)采样器沿生成时间推进,每步调用一次网络;(b)每次调用把共享核心运行 K 次,每次有自己的深度坐标 s_k,共享读出头给出预测 u_k;(c)训练把每个预测回归到从停止梯度的初始估计 b=sg(u_0) 到 u* 的路径对应点;(d)训练随机采样内部坐标,推理用均匀网格。各面板颜色标出同一循环,为清晰省略归一化及首次 h_0 重注入。 实验效果:表 2 的 ImageNet 256×256、50 个积分步设置:L/2 R10 在训练的两次循环时 FID 为 20.30,推理八次循环为 10.95。图 7 对应 dense L/2 的 250 步为 15.74,八次循环 LiFT 计算约少 30%。所有点均按五万张生成图评价。 论文 Figure 7:增加循环细化相同噪声的图像。展示 LiFT L/2 R10 在 50 个积分步与 dense L/2 在不同步数的选定配对样本,各行共享类别及初始噪声,列标题给每图 TFLOPs。第二列八次循环与末列 dense 的 250 步相比,计算少约 30%、FID 10.95 对 15.74;这些选定图不替代五万张量化评测。 批判点评:更深并非始终更好,八次后也有回退;B/2 小模型在所测预算下仍落后 dense 基线。实验为无 CFG 的类别条件图像生成,不能直接推广视频或文生图。FLOPs 是解析估计,未验证设备延迟、能耗或峰值显存;作者页中的代码入口仍标为 Coming Soon。 3. MEND:奖励收益够大才移动样本 MEND: RL For Flow Models via Proximal Velocity Matching | 得州大学奥斯汀分校;Google;科罗拉多大学博尔德分校 | arXiv:2610.05954 关键词:生成后训练, 可微奖励, 近端速度匹配, 多样性 前序问题:奖励重加权需要大量更新,直接沿奖励梯度推动所有样本又可能牺牲多样性。一个高分样本是否还该移动、移动多远,常由统一更新幅度决定。 本文贡献:MEND 在同一 prompt 组内给奖励设上限,已达上限的样本保持不动;其余样本沿奖励梯度提出三个不同长度的候选,只有截断后的奖励收益超过二次位移代价才接受。再把接受的位移转成存储状态处的速度回归目标。行为 adapter 随训练做 EMA,方法不使用冻结参考、KL 项或 advantage 权重。 论文 Figure 4:MEND 总览。(1)同一 prompt c 的组中,达到奖励上限 κ 的样本保持;(2)低于上限的样本沿奖励梯度得到三个提议,判据从截断奖励扣除位移代价并选最佳候选,示例选最短 y_1;(3)训练 adapter 在存储状态回归到行为预测加接受位移 d 的目标,即公式 5 的速度目标,行为模型随后用 EMA 跟随。 实验效果:表 2 的 DrawBench 200 个提示、每个五个种子:训练 PickScore 的 MEND 100 次更新得到 23.70,Flow-GRPO 约四千次为 23.52,两者到基座的距离同为 0.313;MEND 六个评价指标中五个更高。另一个等预算协议的表 7:PickScore 为 24.03,ReFL 23.92、DiffusionNFT 23.43,不能混成同一实验。 论文 Figure 3:SD3.5-M、Flow-GRPO、DiffusionNFT 与 MEND 的图像比较。每行共享同一提示与种子,各图标注 PickScore;这是配对示例而非整体成功率。 批判点评:更新次数差距不等于训练时间快四十倍,候选需解码和奖励评价。必须有可微奖励;目标选择的收益保证不等于模型每次更新保证,更无法识别错误奖励。长训练仍可能奖励投机;表 2 美学分数还低于 Flow-GRPO。作者项目页提供复现入口,实际代码状态按页面核验。 4. RefRoute:十六张参考图也能轻量合成 RefRoute: Decoupling Conditioning Cost from References via Compact Residual Conditioning and Spatial Routing | 达特茅斯学院 | arXiv:2610.07720 关键词:多参考图生成, 紧凑残差条件, 空间路由, 注意力加速 前序问题:多张参考图都编码成密集网格再全局注意力,计算随数量和分辨率上涨;不同参考的外观还会串到错误人物或物体上。 本文贡献:RefRoute 把每张参考图先降采样再 VAE 编码,用全分辨率像素残差编码器补回细节。条件路由与注意力路由把参考分配到目标区域,限制跨参考交互,同时允许区域外的选择性访问以处理反射、接触等场景关系。单张 1024×1024 参考的 token 从 4096 减为 256,仍需训练及多参考微调。 论文 Figure 2:RefRoute 总览。每张参考图先降采样并由 VAE 编码成紧凑 token,残差编码器从完整分辨率提取互补特征,在 DiT 输入投影后加到对应参考嵌入;增强嵌入与文本、带噪目标通过条件专用 adapter 和注意力路由联合处理。 实验效果:图 4 独立计算成本实验中,16 张参考图、50 步和四步配置分别比对应 FLUX 基线快 18.3、14.2 倍。表 2 的 ManyRef100 包含 10–17 张参考,多参考微调后的 Weighted-Ref-VIEScore 为 36.06,FLUX.2-Klein-9B 为 8.88;该分数不是成功率。 论文 Figure 4:参考数量与推理成本。与 FLUX.2-Klein 基线及相同主干上的 OminiControl2 参考分支实现相比,RefRoute 在所测配置中时延增长更慢、峰值分配显存接近恒定;分支实现比较不代表完整 OminiControl2 训练系统。 批判点评:加速实验和微调质量实验需分别理解。少参考 MICo-Bench 的 52.81 仍低于对应基座 55.67,不能宣传所有参考数量都更好。评分依赖多模态模型,自建数据有合成及筛选偏差。原文仅承诺发表后释放代码、配置和相关数据,不能写成当前已开源。 5. Keepsake:长视频只留难替代的历史帧 Keepsake: Selective Spatial Memory for Long-Horizon Video Generation | 中佛罗里达大学 | arXiv:2610.06588 关键词:长视频生成, 空间记忆, 固定容量, 免训练控制 前序问题:生成越久就保存越多历史帧,检索和存储持续增长;只保留最新帧又会忘掉刚离开的场景。历史帧价值随新视角出现而改变,一次性决定保留不够。 本文贡献:Keepsake 在每个视频块生成后,把已有和新增观察建成位姿—外观图,以相机距离及视觉相似度衡量替代关系。保留优先级同时看强替代帧数量与最近替代者相似度,优先留下难替代观察,逐步删除冗余直到满足固定容量。只修改持久记忆更新规则,宿主生成器、采样及检索规则保持原样,无需再训练。 论文 Figure 2:Keepsake 总览。上部将它插入长视频循环作为记忆更新模块,每个生成块后更新持久记忆,保持生成器及检索规则;下部把旧记忆和新观察汇集成位姿—外观图,边权结合相机邻近与视觉相似度。节点统计强替代者数量和最近替代者相似度,共同决定保留优先级;删除低优先级观察直到满足容量 B。缩略图与展示分数为说明示意。 实验效果:附录表 5 的十五条匹配 180 秒 MemCam 轨迹:完整记忆 5397 帧、FVD 734.2;Keepsake 留 32 帧、FVD 476.6,降低 35.1%,LPIPS 0.5980→0.5876。表 1 的另一组 60 秒 WorldMem:FVD 3077.6→1116.9,每次检索 77.92→4.54 ms。 论文 Table 5:长时 MemCam 结果。十五条匹配的 180 秒轨迹,有限记忆策略容量 B=32;比较完整保留、FIFO 与 Keepsake 的存储条目、LPIPS 和 FVD。Keepsake 的 32 帧相对完整 5397 帧仍改善质量,不能由检索收益推出完整生成时延。 批判点评:检索毫秒不是整段生成耗时,32 帧是记忆库容量而非视频长度。样本仅十五条匹配轨迹,几何与视觉相似度也未必代表未来所有重要事件;最优预算随任务变化。原文称策略代码在补充材料,本期未确认独立公开仓库,不能泛称无限长记忆已解决。 6. CentriQ:先去均值再做低比特量化 CentriQ: Calibration-Free Quantization of Diffusion Transformers via Exact Mean Centering | Tenstorrent;洛桑联邦理工学院 | arXiv:2610.06260 关键词:DiT量化, 无校准, 均值补偿, 四比特激活 前序问题:DiT 的条件归一化会重新引入逐 token 均值。Hadamard 旋转不一定能把这部分能量均匀摊开,单个大坐标会撑大量化范围;照搬语言模型的免校准量化会损伤图像。 本文贡献:CentriQ 先减去每个 token 的通道均值,再旋转与量化;减去的成分通过完整精度的 rank-1 分支精确补回线性层输出,因此不是丢掉均值。激活尺度由无数据规则得到,权重拟合使用抑制重尾影响的稳健目标。同一路径覆盖 PixArt-Σ、FLUX.1-schnell 和 SANA 的 adaLN 条件设计。 论文 Figure 3:CentriQ 的一个量化线性层。上部为在线逐 token 路径,下部为离线权重路径;每个 token 的均值 x̄_t 与权重行和向量 w_1 构成全精度 rank-1 分支,绕过权重与激活量化并补回均值分量。 实验效果:表 1 的 MJHQ、W4A4:FLUX.1-schnell 的 FID 为 18.8,带校准 SVDQuant 为 18.3,BF16 为 19.5;SANA-1.6B 为 16.2、19.3、16.0。表 2 的 FLUX W4A2 消融中,完整方法 FID 35.59,只有旋转为 455.30,二比特结果仍有明显质量差距。 论文 Figure 4:FLUX.1-schnell 在 W4A4、W4A2 与 W2A4 下的 GenEval 提示结果,同一行共享提示和种子;标记是 GenEval 检测器的判断,而非人工成功率。 批判点评:rank-1 补偿精确不代表整个量化模型无损。二比特激活采用模拟量化,没有支持它的融合 kernel;A100 整数张量核结果不能等同新 GPU 的 NVFP4。FID 单项改善也不是逐张更好。arXiv 注释明确代码及项目页将稍后发布,本期不放尚未确认的方法仓库。 7. BASA:标准注意力后端也能高效稀疏 Backend-Agnostic Sparse Attention for Fast High-Resolution Visual Generation | 上海交通大学;复旦大学;香港大学 | arXiv:2610.08772 关键词:稀疏注意力, 平移窗口, 全局KV池化, 高分辨率生成 前序问题:固定窗口算得快但边界易出方格伪影,细粒度滑窗质量较好却依赖复杂专用 kernel。理论注意力稀疏度并不保证实际加速。 本文贡献:BASA 在不同 DiT 层与去噪步交错平移空间窗口,让邻域跨边界交换信息;池化的全局 K/V 补长程上下文,标准 SDPA 完成本地与全局计算。视频窗口保留完整时间跨度,仅做空间稀疏。实验还用密集教师蒸馏注意力层,不应把全部结果写成免训练替换。 论文 Figure 3:BASA 总览。(a)稀疏注意力结合多个组件,在减少注意力成本时恢复局部及全局视觉交互;(b)作为 DiT 块视觉自注意力模块的替换,其余生成流水线保留。实验中的注意力蒸馏仍需训练。 实验效果:表 3 的单 A100、Wan2.1-T2V-1.3B,从 832×480 外推到 1664×960:窗口 10×10、池化 4×4 时,预热后注意力前向延迟 509.66→112.84 ms,加速 4.52 倍、稀疏度 90%。表 4 的一百段视频中,Imaging Quality 65.22%→67.02%,Aesthetic 57.53%→56.87%。 论文 Table 3:Wan2.1-T2V-1.3B 从 832×480 到 1664×960 的视频分辨率外推注意力效率。配置在 latent 网格上定义;时延为预热后的注意力前向耗时,加速相对 dense Wan,列出实现、稀疏度、TFLOPs、MFU 与 kernel 效率,不是端到端采样速度。 批判点评:4.52 倍限注意力前向,不能当端到端视频生成加速。各质量维度有升有降,表 1 的相似度还是与密集模型输出比较。窗口过小可能损伤保真度,标准后端兼容也不等于所有硬件都实测;未确认该方法独立代码链接。 8. TalkLikeYou:一步生成个人说话习惯 Talk Like You: Imitating How You Speak in Real-Time Talking Head Generation | 中国科学院自动化研究所;中国科学院大学;中科院香港创新研究院;澳门科技大学 | arXiv:2610.06658 关键词:数字人生成, 说话习惯, 一步flow, 运动空间 前序问题:同一发音,不同人露齿、张嘴和嘴角运动习惯不同。只保证音画同步与清晰度容易生成千人一面的表情,单人微调又增加部署成本。 本文贡献:TalkLikeYou 在隐式关键点运动空间建模说话习惯,用音频、源运动与可选习惯条件生成旋转和表情变化,再以冻结渲染模块合成视频。flow 模型预测干净运动,一步采样;两阶段学习先用预设 one-hot 习惯,再学习参考视频到统一习惯空间,并用 PLAD 评价相似性和多样性。 论文 Figure 2:TalkLikeYou 框架。flow 运动生成器从可选习惯来源一步采样习惯感知运动,再渲染视频;两阶段习惯学习增强泛化与稳定性。统一习惯空间中星号表示 one-hot 习惯编码、圆点为参考视频样本;第一阶段用对齐损失关联视频特征及对应习惯编码。 实验效果:表 1 的 HDTF:FID 7.71、FVD 112.94、身份相似度 CSIM 0.94,对应 Ditto 为 21.61、319.03、0.87。Sync-C 为 8.73,但 Sync-D 6.82 仍高于 Sonic 的 6.70,唇同步并非所有指标最优。推理运动采样为一步,训练两阶段在 RTX 3090 上分别 48、72 小时。 论文 Figure 3:三种选定说话习惯下与先进基线的视觉与唇同步比较。需放大观察细节,动态视频见作者补充材料;静态帧不单独证明完整时序质量。 批判点评:一步运动采样不代表整条视频流水线只做一次前向,静态图也无法证明时序同步或个人习惯完整复现。定制需参考视频或预设习惯,跨人物、姿态与口型应另测。作者项目页和官方仓库提供方法入口。 9. AuraSE:降噪时尽量不改词与声线 AuraSE: Low-Hallucination Generative Speech Enhancement via Multimodal Flow Matching and Inference Policy Optimization | 香港中文大学深圳;Microsoft Research | arXiv:2610.06632 关键词:生成语音增强, 多模态flow, 推理策略优化, 内容保真 前序问题:生成式降噪能让音频更干净,却可能改词或改说话人。即便输入转录文本,不同句子的最佳 guidance、温度和步数也不同。 本文贡献:AuraSE 用文本与声学双流再转单流的 MMDiT,保留退化音频的专门通路。IPO 从当前模型在多组解码配置下生成候选,按感知质量、词错误率、说话人相似度和语义保真组合奖励形成偏好对,周期刷新数据并优化。部署最终固定十步 ODE,不做逐句搜索,不使用 CFG。 论文 Figure 1:AuraSE 总览。左侧双流再转单流 MMDiT 以转录为条件增强退化 mel 并预测 flow 速度;中央双流块让 mel 与文本共同注意力但保持独立投影;右侧 IPO 用多样推理策略解码、评分、在缓冲中组成自生成偏好对,再闭环更新模型。 实验效果:表 3 每个合成测试集 824 句:有混响 WER 从 AuraSE 基础版 9.65% 降至 IPO 8.22%,无混响从 8.43% 降至 6.98%。表 4 的真实 DNS 盲测 OVRL 3.144→3.365,人类盲听综合分 3.60±0.13→3.74±0.13,区间为 95% 置信区间半宽。 论文 Table 3:合成主测试,有混响与无混响各 824 句;除 WER 外越高越好,粗体及下划线为增强系统中最佳与次佳,排除原始噪声音频参考。SIG、BAK、OVRL 是感知质量,SIM 是说话人相似度,SBS 是语义保真,不能只选一个维度宣称零幻觉。 批判点评:低 WER 不等于零幻觉,说话人相似度也并非所有系统最高。输入转录及评测依赖外部识别器,后训练还要多次声码器及奖励计算。结果限于论文的英语增强条件,不可直接外推所有语言、麦克风和音乐修复;本期未确认官方代码入口。 10. CoAl:对齐上下文token提升生成 Learning to Read the Contextual Tokens in Diffusion Transformers | 特拉维夫大学;康奈尔大学 | arXiv:2610.06844 关键词:多模态DiT, 上下文对齐, 全局语义, 生成表征 前序问题:多模态 DiT 会不断更新文本 token,但其内容与生成质量的关系不清楚。只对齐图像 token 的局部特征,可能忽略上下文中逐步形成的全局场景信息。 本文贡献:作者先用轻量瓶颈把多层上下文 token 映射给冻结语言模型,从隐表示询问生成图语义;再提出 Contextual Alignment(CoAl),把单个早期层的上下文表示通过小型 Q-Former 对齐到干净图的冻结 SigLIP 全局语义嵌入。空提示条件加权减少照抄 prompt 的捷径,额外对齐网络只在训练使用。 论文 Figure 6:Contextual Alignment。轻量 Aligner 把多模态 DiT 的上下文 token 映射成嵌入,以负余弦相似度损失对齐到冻结语义编码器从干净输入图得到的教师嵌入。 实验效果:表 1 的从零训练实验:REPA 加 CoAl 后 FID 4.95→4.29,Recall 0.338→0.407;另一个 SD3 在 Fine-T2I 上微调实验,基础 FID 19.30、常规 flow 微调 17.18、CoAl 16.75。两种协议数据与指标范围不同,不能直接排名。 论文 Table 1:与表征对齐基线的量化比较。(a)完整模型从零训练:给 REPA、HASTE、SRA 加 CoAl,分别列 FID、CLIP、HPS、Precision 与 Recall;(b)预训练模型微调:比较基础、常规 flow、视觉对齐及 CoAl 的 FID 和分布覆盖。两种实验使用不同协议,数字不能横向混排。 批判点评:读到语义及与偏好分相关,不等于模型能逐步逻辑推理或保证最终画面。Reader 训练集中于单个人物和十五类问题,标签来自 VLM;全局语义对齐也不能保证局部细节正确。这篇入选依据是实际改进生成的 CoAl,而非一般视觉问答;未确认方法代码已公开。 趋势观察 预算应跟随内容与条件 LoT 根据画面细节改变 token 布局,RefRoute 压缩参考条件并路由到指定区域,Keepsake 留下难替代视角。减少重复信息比统一压缩所有输入更值得先测。 计算位置和更新目标都能调整 LiFT 把计算放在共享主干循环,MEND 先检查样本移动是否值得,AuraSE 把多配置偏好训练进固定解码器。它们减少的是不同成本,不能用同一加速口径相互比较。 低比特与稀疏仍需保留关键通路 CentriQ 用精度较高的分支补回均值,BASA 用全局池化恢复长程信息。压缩不是简单删去内容,关键是被省略的部分如何表达及补偿。 可解释表征要落到生成验证 TalkLikeYou 用运动空间表示习惯,CoAl 对齐上下文全局语义。表征可读不等于可靠控制,仍须核对质量变化、数据范围与失败例。 今日讨论 你的生成内容中,哪些区域可以降低细节预算,哪些区域必须保持完整? 人工智能炼丹君 整理 | 2026-10-08
-
AIGC 每日速读|2026-10-07|腾讯原生2K音画训练快2.5倍Prism 今日 AIGC 论文速览 今日共 10 篇 · 音画与流式声音生成 2 篇 · 规则一致性与四维世界 2 篇 · 图像生成与连续编辑 2 篇 · 视频编辑与推理加速 3 篇 · 结构可控声音变形 1 篇 重点论文标题列表 Prism(腾讯):原生二千像素音画训练提速 S2PD(剑桥):先串行推演再并行修画面 PVD(港理工):两个半身专家接力生成图像 WorldSonus(港科大):世界画面逐段配上立体声音 ALIVE(罗切斯特):插入的物体跟着人物互动 今日论文速览 1. Prism:原生二千像素音画训练提速 Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training | 腾讯混元;复旦大学;浙江大学 | arXiv:2610.05416 关键词:联合音画生成, 原生2K训练, 动态稀疏注意力, 跨模态引导 前序问题:2K 视频的 token 数量让全注意力训练昂贵,先生成低分辨率再超分又难补回原生细节。固定稀疏块还可能把不同运动方向或关键发声区域混在一起,省了计算却损伤动作与声音对应。 本文贡献:Prism 在 MOVA 双分支 DiT 中替换视频自注意力,保留音频与跨模态注意力。先划分 8×8×8 时空宏区,结合视频特征通道方差和音频到视频交叉注意力范数,为各区选择 64、128 或 256 token 的块形状;再用 Top-k/Top-p 混合策略分配注意力预算。稀疏布局适应空间结构和音画耦合,而非统一删去固定区域。 论文 Figure 2:Prism 架构。把 token 序列划分为时空宏区,动态给各宏区指定适配的块形状,再以 Top-k/Top-p 混合块稀疏注意力把计算集中到信息量高的交互。 实验效果:作者在十万条 2K 视频上训练,报告原生 2K 联合音画训练加速 2.5 倍。表 2 的 95% 稀疏配置相对全注意力训练:cpCER 从 0.374 降到 0.187,DeSync 从 1.05 降到 0.63,MotionQ 从 0.53 升到 0.89。2K-Bench 为 300 条未见的十秒视频;训练吞吐与这些质量指标是两类证据。 论文 Figure 3:与此前开源方法的定性比较。音频必须参看项目演示视频,更多结果见附录 A.7;此静态图展示视频画面,不单独证明音频质量。 批判点评:2.5 倍不能移写成端到端生成速度,95% 稀疏也不等于整个模型少算 95%。静态截图无法核对音频,须结合项目音画演示。自建测试集和自动评价不代表所有镜头、说话人与低分辨率任务都同样获益。项目页与官方代码给出复现入口。 2. S2PD:先串行推演再并行修画面 S2PD: Serial-to-Parallel Diffusion for Physically and Logically Consistent Video Generation | 剑桥大学;丰田欧洲 | arXiv:2610.06847 关键词:视频扩散, 串并行采样, 物理一致性, 游戏规则 前序问题:即使不断采样程序生成的训练数据,并行视频扩散仍会生成违规棋步、错误碰撞或不连贯物体。问题可能在于模型缺少逐段协调事件的串行计算,而不只是数据不够。 本文贡献:Serial-to-Parallel Diffusion 在高噪声阶段按时间块自回归去噪,先协调相互依赖的事件;到较低噪声再切换为整段并行细化,减少纯串行采样的闪烁。训练使用多种块大小;实验在从零训练的 DiT-B 与 Wan-5B-LoRA 上,按匹配训练预算比较双向并行、因果 Diffusion Forcing 和 Block Causal。 论文 Figure 2:各方法的注意力模式与本文采样策略。(a–c)分别为双向、因果 Diffusion Forcing(cDF)与 Block Causal(BC)的注意力掩码及噪声水平;(d)先串行去噪再并行细化;(e)时间切片内部的 token 顺序;(f)训练使用多种块大小。 实验效果:表 2:DiT-B 的 2048 每次 rollout 非法转移从并行基线 47.9 降到 0.9,双摆动力学误差从 73.4 降到 1.1;Wan 的 Kubric MOVi-A CD-FVD 从 252.8 降到 137.0。国际象棋则为 51.0→12.3,仍逊于另两种串行方法的 4.6 和 6.8,不能写成全任务最优。 论文 Figure 6:Wan-5B-LoRA 架构的定性比较。在 MPMWorlds 与真实魔方数据集上,串行方法表现相近,相比双向基线生成更连贯的视频。 批判点评:程序世界中的规则错误减少,不是开放世界物理定律的保证。串行块越小通常越慢,表 4 显示质量和采样成本需一起调;混合方法相对纯并行也有额外串行开销。建议先检查自己的事件依赖是否需要串行推演。项目页可核验,本文不使用未经确认的会议接收背书。 3. PVD:两个半身专家接力生成图像 Two Halves are More than One: Phase-wise Velocity Distillation for Fast and High-Quality Image Generation | 香港理工大学;OPPO研究院 | arXiv:2610.08070 关键词:图像生成, 分阶段蒸馏, 平均速度, 显存压缩 前序问题:粗结构与细节生成发生在不同噪声区间,却常由同一个完整学生网络承担。压到一次完整主干计算预算时,统一学生容易兼顾不好两个阶段;少步模型也未必减少活跃参数或显存。 本文贡献:Phase-wise Velocity Distillation 从教师抽取约半深度主干,先用 flow matching 对齐初始化,再学习粗到细两个区间的平均速度;文生图采用共享冻结主干与阶段 LoRA,并加阶段判别器做对抗细化。两个半身专家依次执行,累计 FLOPs 约等于一次完整教师主干前向,但实际仍是两次专家调用。 论文 Figure 3:PVD 总览。(a)从教师抽取半身主干,经 flow matching 微调初始化局部学生;(b)分阶段 LoRA 专家在划分的时间区间上学习平均速度;(c)文生图任务使用分阶段判别器进行对抗细化。 实验效果:表 1 的 ImageNet 256×256、归一化计算预算 1.00 下,PVD FID-50K 为 1.48,iMF 为 1.72,多步 LightningDiT 为 1.35。表 3 的 Qwen-Image 蒸馏:活跃参数 20.43B→10.40B,峰值显存 38.42→19.84 GiB,减少 48.36%;GenEval 为 0.8720→0.8846。 论文 Figure 1:文生图结果。上排为教师:Stable Diffusion 3.5-Medium、FLUX.1-dev、Qwen-Image,分别使用 50×2、50、50×2 步;下排以两个半身分阶段专家顺序生成,累计计算约等于一次完整教师主干前向。这是计算预算比较,不能读成只调用一个专家。 批判点评:活跃参数不是所有权重总量,等 FLOPs 也不是已实测的一倍调用延迟。Qwen 的 DPG 从 89.10 降到 86.54,WISE 从 0.64 降到 0.59,质量没有全面超过教师;密集计数和罕见布局仍困难。可从官方仓库核对权重与实现,再按具体 GPU 测显存及延迟。 4. WorldSonus:世界画面逐段配上立体声音 WorldSonus: Bringing Sound to Worlds | 香港科技大学;Noiz AI;沐曦;上海交通大学 | arXiv:2610.08760 关键词:视频到音频, 因果流式生成, 立体声, 交互提示 前序问题:交互视频的未来画面尚未产生,双向配音不能等待整段视频再工作。声音还要随左右位置与用户文字控制变化,同时维持跨块连续性。 本文贡献:WorldSonus 用因果自回归 Transformer 与 rectified-flow 头,逐块输出 48 kHz 立体声。两种时间尺度的视觉 token 同时提供场景计划与帧级线索,环形 KV 缓存限制历史长度;提示词在块边界更新。训练用冻结 Synchformer 的 ShiftNCE 做时间对齐,结合真实立体声筛选和全景一阶 Ambisonics 的视角解码学习方向,教师只在训练使用。 论文 Figure 1:WorldSonus 总览。(a)因果流式流程:视频映射为两种时间尺度的视觉 token,条件化自回归 Transformer 和 rectified-flow 头;(b)训练专用 ShiftNCE:冻结 Synchformer 教师以对比窗口匹配指导时间对齐;(c)立体声空间监督:真实立体声筛选与全景一阶 Ambisonics 视角解码提供方向依据;(d)交互文字控制:在块边界动态更新提示,保留会话状态和声学连续性。 实验效果:表 1 的单 H100 设置中,100 ms 音频块计算为 41.2 ms,实时因子约 0.41。VGG 五秒测试 FAD 为 1.73,PrismAudio 为 2.09;交互五秒为 2.68 对 6.22。五秒与十秒拆分各 4096 条,三十秒拆分为 1024 条,跨时长结果分别统计。 论文 Figure 2:两个交互片段中,与双向基线比较立体声布局。红框标出声源;能量平衡曲线中负值表示左声道占优,正值表示右声道占优。 批判点评:41.2 ms 是模型块计算,不是含采集、传输、播放缓冲的完整交互延迟。时间同步并非全优:VGG 五秒 DeSync 为 0.686,PrismAudio 为 0.539,后者更低。因果音频表示和有限立体声数据仍构成限制,三十秒评测不足以保证无限长会话稳定。项目页可听原始演示。 5. ALIVE:插入的物体跟着人物互动 ALIVE: Interaction-Aligned Object Insertion for First-Frame-Guided Video Editing | 罗切斯特大学;Adobe Research | arXiv:2610.08779 关键词:视频编辑, 首帧引导, 物体插入, 时间局部条件 前序问题:给视频首帧加一本书很容易,随后让人拿起、翻开它却难:插入物体常留在原地或穿过手。只写物体名称,也缺少每个阶段该发生什么交互的描述。 本文贡献:ALIVE 把干净源视频 latent 与带噪目标 latent 沿通道拼接,编辑后的首帧保持干净,以 LoRA 训练 LTX-2.5 22B 编辑器。35,800 对数据混合渲染、真实、模型生成与通用编辑来源,并标注多级提示。可选 VLM 从原视频、编辑首帧和物体名称预测分段交互描述与帧区间,再通过时间局部交叉注意力路由到对应片段。 论文 Figure 3:ALIVE 总览。(a)源视频与带噪目标 latent 沿通道拼接(C),编辑首帧 latent 保持干净(金色);火焰表示编辑器及 VLM 的 LoRA 微调。(b)监督 VLM 从同样的视觉输入与物体名提示 P1 预测 P4 描述及帧区间,P4 文本独立编码;注意力图比较共享的 P0–P3 条件与时间局部 P4 条件。 实验效果:表 1 的 128 例交互插入测试中,0–100 的 VLM Overall:只给物体名的 ALIVE 为 86.71,Señorita 为 60.24;预测分段提示后为 87.66。103 例通用插入中,ALIVE 为 92.28,加入 VLM 后为 91.71,增强并非对所有任务有益。 论文 Figure 4:交互物体插入定性结果。(a)拿书,(b)提篮,分别展示首帧、视频 40% 和 90% 位置。AnyV2V 的方形帧以较窄宽度展示;† 表示按照各方法官方提示格式额外提供交互指导。 批判点评:这些是自动 VLM 判断与抽帧协议下的分数,不能当作接触力或真实物理正确率。区间预测错误、布料和物体旋转仍会造成伪影;编辑器也不是在线流式生成器。论文明确实现和实验在罗切斯特完成,署名 Adobe 合作不应改写为单一机构成果。项目页可查演示,未确认可下载的方法代码。 6. MC-Sparse:缓存稀疏布局再补注意力尾项 MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers | 腾讯混元;复旦大学;上海创智学院;香港中文大学;南开大学;北京大学;上海交通大学 | arXiv:2610.06801 关键词:视频生成加速, 稀疏注意力, 元数据缓存, 残差补偿 前序问题:稀疏注意力与完整注意力之间的差距不只来自删掉低权重连接,还来自块结构绑定和近似选择错误。每步重新精确筛选又可能吞掉节省的计算。 本文贡献:MC-Sparse 在锚点步骤精确选择 KV 索引,并用相似查询重排与 token 级选择减少结构误差;跨去噪步缓存查询分组、选择索引及完整减稀疏的残差,近似补回被丢弃尾项。Q、K、V 特征仍在当前步重新计算,因此不是复用旧视频 token。预热、锚点刷新和 CUDA 实现成本都需计入。 论文 Figure 6:MC-Sparse 流程总览,展示查询分组、精确选择及元数据复用、token 稀疏注意力和尾项补偿之间的连接;具体预算与刷新策略以正文为准。 实验效果:表 1 的 Minimax-H3-Base 768p 视频分支:15% 注意力密度下,DiT 去噪加速 1.80 倍,相对完整注意力输出 PSNR 为 27.30 dB;25% 密度为 1.61 倍、28.44 dB。15% 时 VBench ImgQual 从 69.20 变为 68.94,接近基线仍有质量差异。 论文 Figure 1:Minimax-H3-Base 768p 的质量和效率。左侧为质量指标及 DiT 去噪延迟:15%、25% 注意力密度分别相对 FA3 全注意力加速 1.80、1.61 倍;右侧为 15% 密度生成帧与完整注意力参考的逐段比较。接近参考不代表无损。 批判点评:这里的 PSNR 对齐完整模型输出,不是真实视频;1.80 倍也不包含 VAE 与条件编码。各任务约五十个评测样本、硬件并行设置和内部三维数据限制泛化与复现判断,不能宣传无损或全系统同幅提速。项目页已给出,未把未知代码状态写成开源完成。 7. CtrlCache:转向与动作变化决定是否复算 CtrlCache: Accelerating Interactive Video World Models with Control-Aware Caching | 奥克兰大学;新南威尔士大学 | arXiv:2610.08777 关键词:交互世界视频, 免训练加速, 控制感知, 残差缓存 前序问题:少步交互世界模型还要多次运行昂贵 DiT。只按内部特征相似度决定缓存,容易忽视用户突然转向或改变动作时需要及时刷新。 本文贡献:CtrlCache 先把输入控制分成初始、变化、持续转向与稳定状态:初始及动作变化块完整计算,转向和稳定块才在选定内部去噪步复用本块最近完整步的残差,首尾步骤始终完整。稳定交互时,再把上一块最后一帧的低频历史先验混入首步干净 latent 估计;无需重新训练,也不把所有历史特征无条件沿用。 论文 Figure 3:CtrlCache 总览。(a)按块自回归去噪,首尾步骤保持完整计算;(b)动作感知策略在转向与稳定块的选定内部步复用残差,在初始及动作变化块保留完整计算;(c)稳定交互中,频率混合历史先验把前一块最后干净帧的结构用于指导首步干净 latent 估计。 实验效果:表 1 的 WBench 导航、单 A100 设置:Matrix-Game 2.0 去噪时间 14.99→10.67 秒,加速 1.41 倍,Overall 0.6543→0.6786;LingBot-World v1 为 1.26 倍、0.7816→0.8127,v2 为 1.21 倍、0.8042→0.8201。使用相同提示、控制和初始帧比较。 论文 Figure 4:CtrlCache 与基线的定性比较。各方法使用相同初始条件和控制序列;蓝色虚线框用于比较布局、物体位置及运动细节,红框标出外观或结构失真,绿框标出本文保留较好的细节。控制字符串沿用 WBench:W/S/A/D 为平移,left/right/up/down 为视角变化。 批判点评:计时排除 KV 提交与更新,不能直接当完整交互延迟;TeaCache 与 EasyCache 在此表还更快,CtrlCache 选择了不同质量取舍。v2 的画质与交互分项略降,不能写成每项提升。复用步位置和控制规则依赖具体模型,移植时需要重新验证。项目页提供方法说明。 8. UniSlider:滑杆刻度对应感知变化 UniSlider: Perceptually Uniform Sliders for Continuous Image Editing | 巴塞罗那自治大学计算机视觉中心;Adobe Research | arXiv:2610.06831 关键词:连续图像编辑, 感知均匀性, LoRA, 自适应采样 前序问题:把编辑强度从 0.2 拉到 0.3,有时完全没变化,有时突然跳到另一种样子。现有强度参数并不对应均匀的可感知变化,界面有刻度却缺少稳定控制。 本文贡献:UniSlider 在冻结的 FLUX.2-klein-4B 上训练按强度缩放的 LoRA,完整运行少步采样,用 DreamSim 距离把中间图推向输入与满强度输出之间的相应感知位置。满强度目标只需缓存基座的默认编辑,不需人工中间图。推理再测量样本的感知曲线,自适应重映射滑杆参数,补偿残余不均匀。 论文 Figure 3:UniSlider 训练。采样强度 s,按公式 3 缩放可训练 LoRA 与冻结主干组合,完整运行 T 步得到 x_s;满强度 x_edit 在 s=1 时仅缓存一次。公式 4 的损失把 x_s 推向输入 x_src 与 x_edit 之间由 s 指定的感知位置。 实验效果:表 1 的 300 例基准:感知距离变异系数 CV-DSim 为 0.652,SliderEdit 为 1.199;LPIPS 单调性违例率为 0.016 对 0.251。表 3 中,只用均匀采样的 UniSlider 为 0.871,自适应采样后为 0.652,表明训练和参数重映射均有作用。 论文 Figure 2:训练缩小滑杆不均匀差距,自适应采样继续补偿。三行对同一图像执行同一指令:左侧为等滑杆刻度的 SliderEdit、仅用训练损失的 Vanilla、带强度重参数化的完整 UniSlider;右侧为每张图相对输入的 DreamSim 感知距离,以输入到完整编辑的总距离归一化。对角线表示理想均匀变化。 批判点评:DreamSim 上的匀速不等于每种语义属性都线性变化,原文失败例中颜色变化会掩盖球尚未膨胀的问题。编辑身份保持与 VQA 单调性也并非逐项最佳,基座本身的错误会沿滑杆传播。不同基座的比较需看附录同基座对照。作者项目站本次 TLS 验证失败,未降级访问,也不声称演示或代码已核验;本卡依据可访问的原论文全文。 9. ChronoWorld:用四维记忆回看修正世界 ChronoWorld: Camera-Controlled Consistent 4D World Generation via Spatiotemporal Cues and Geometric Reflections | 北京大学王选计算机研究所;加州大学默塞德分校 | arXiv:2610.06687 关键词:相机可控生成, 四维世界, 几何记忆, 反思修正 前序问题:按新相机轨迹生成视频时,动态物体在不同视角可能对不上,局部漂亮也不能保证整个时空场景一致。需要把生成结果放回可重建的几何状态,再检查历史视角。 本文贡献:ChronoWorld 的 Observation–State–Reflection 框架以相机条件 STC-DiT 生成视频,通过时空极线因果注意力联结视角约束和时间顺序;多头重建 decoder 预测颜色、几何与运动等四维属性。统一 4D 记忆用于检索和重渲染,几何反思再据不一致结果做校正,把视频观察转成可检查的世界状态。 论文 Figure 2:ChronoWorld 框架。相机轨迹条件化的时空线索 Diffusion Transformer(STC-DiT)去噪目标视频,多头重建 decoder 预测四维属性。 实验效果:表 1 的相同输入视频与目标相机轨迹设置:ChronoWorld 的 FVD-4D 为 177.41,Free4D 为 216.67;相对位姿旋转、平移误差为 0.95、2.34,对方为 1.73、3.28。表 2 的重建一致性 PSNR 为 18.87、SSIM 为 0.73。本次也核对 v2,相应主表数字一致。 论文 Figure 4:不同相机轨迹下 ChronoWorld 与基线的定性结果。作者提示放大查看局部细节;量化效果须结合 FVD-4D、相机误差和重建一致性表格。 批判点评:4D 同步、相机误差与重建一致性是不同指标,不宜合并为现实世界正确率。几何由生成和估计共同建立,回看改进仍可能继承错误;原文未给出足以验证无限场景或完整实时延迟的证据。训练使用八张 A100 80GB,推理单 A100;未确认官方项目或代码入口,不宣称已开源。 10. Smorph:换音色时保留节奏与音高 Smorph: Playable Sound Morphing with Diffusion Models | 美国西北大学;Adobe Research;Wizdom Music | arXiv:2610.06478 关键词:声音生成, 音色变形, 结构引导, 音乐交互 前序问题:从铜管变成弦乐、从鼓声变成气泡声时,音色与节奏结构常一起变化。音乐设计希望保持音高轮廓或响度包络,让声音身份沿连续路径变化。 本文贡献:Smorph 在扩散采样中组合文本或音频端点引导,并让所有中间状态共享固定的 RMS 或音高结构条件;支持提示到提示、音频到提示和音频到音频变形。SoundCanvas 预生成 5×5、共 25 个声音组成二维网格,鼠标在邻近样本间双线性交叉混音,MIDI 键盘触发当前音色。当前引导无需额外训练,但所用基座与音频条件模块已有预训练或适配。 论文 Figure 2:结构引导的组合指导,详见第 3.1 节。变形参数 α∈[0,1] 插值音频或文本端点条件 c_1…c_N;共享结构参考 c_S 为所有中间状态锚定时间包络或音高轮廓,并在全部 T 个去噪步保持固定。 实验效果:表 2 的 Clotho→Clotho、RMS 音频到提示设置:相对 SDEdit,结构控制分数 S_ctrl 从 0.356 升到 0.646,mel-L1 从 1.518 降到 1.027;目标音色相似度从 0.695 降到 0.646,KAD 从 4.420 升到 4.902。结构保留增强伴随目标变形及分布质量取舍。 论文 Figure 3:有显式结构控制(上排)与无显式控制(下排)的变形路径。每格为 mel 频谱,灰线为输入 RMS、橙线为生成 RMS;显式控制在展示的路径中更好保留预期时间包络。 批判点评:实时的是预生成样本间的演奏与混音,不是鼠标每次移动都实时运行扩散。感知路径也不保证处处线性;音乐人案例属于探索性反馈。机构由作者项目页核实,arXiv 注释和项目页标示 ISMIR 2026,但本期不把这一标示扩大为独立查证的接收结论;没有确认方法代码下载。 趋势观察 计算应随阶段与控制变化 S2PD 把高噪声串行推演和低噪声并行细化分开,PVD 把粗细生成交给不同专家,CtrlCache 在动作变化时刷新。减少计算之前,需要先识别哪些阶段或控制状态承载关键依赖。 缓存内容比缓存数量更关键 MC-Sparse 缓存布局与误差补偿,WorldSonus 限制流式历史,ChronoWorld 保存可重建的四维状态。缓存有不同语义,不能把索引、旧特征与几何记忆混为同一种技巧。 连续控制需要可测的约束 UniSlider 用感知距离修正滑杆,Smorph 用音高或响度结构锚定音色变化,ALIVE 用时间区间对齐交互。控制的意义要落到具体条件与失败例,而非只展示连续参数。 速度与质量必须分别核对 训练吞吐、DiT 去噪、单音频块计算和端到端响应是不同预算。自动质量分数的改善也常伴随其他维度退步,本期逐项写清测试条件,不拼成统一性能榜。 今日讨论 你的生成工作流更需要降低训练成本,还是让交互控制更稳定? 人工智能炼丹君 整理 | 2026-10-07
-
AIGC 基本功|视频稀疏注意力的误差与布局-SparseAttn AIGC 基本功|视频稀疏注意力的误差与布局-SparseAttn 所属方向:注意力与核心零件 | 难度:前沿 | 前置知识:FlashAttention、3D RoPE 关键词:视频生成、稀疏注意力、概率质量、块稀疏、时空布局、在线 profiling 本文以 2026-10-07 核验的论文与官方源码为准。全部实验来自 CPU 合成输入,不涉及模型权重、GPU 内核测速或生成视频质量评测。 01. 为什么需要它 视频的 token 数往往同时受帧数与每帧空间分辨率影响。把帧数翻倍,不只意味着多看一倍内容:若所有 token 两两计算注意力,配对数会变成四倍。这里的 token 指模型输入注意力层的潜空间 patch,不能直接用原视频像素数替代。VAE 的压缩率、patch 化方式和文本序列拼接,都会改变实际长度。 本篇先用一个能完全检查的小视频账本:4 帧,每帧 4×4 个位置,共 64 个 token。全注意力有 4096 对 query/key。只保留同帧配对,就剩 1024 对;只保留同一空间位置跨帧配对,就剩 256 对。上述数值由附录脚本实际构造布尔掩码并计数。小规模是为了看清算子,不能据此估算真实视频的显存占用。 真实论文也提醒我们,注意力可能占据很大一部分生成耗时。Sliding Tile Attention 论文在其 HunyuanVideo 实验设置中报告:基于 FlashAttention-3 的总耗时为 945 秒,其中注意力占 800 秒。这个数字带有论文的模型、分辨率和硬件条件,不是所有视频模型的固定比例。本文不将它移植到本地 CPU 实验,也不把论文的 GPU 加速当作已经复现的结果。 难点在于,少算配对同时改变信息来源。假设一个运动物体从左边移到右边,同一空间坐标跨帧未必一直指向同一物体。若硬性只保留原坐标,关键运动关联就可能被删掉。另一方面,即使保留的关联都正确,GPU 也可能仍然在混合计算块里做无效工作。理解稀疏注意力,必须同时回答两个问题:输出改变多少,保留下来的模式是否能让硬件真正少算。 02. 最小可用理解 用三句话建立框架:为每个 query 选一组允许读取的 key;在这组 key 上重新做 Softmax;把允许的配对组织成可以整块跳过或整块计算的布局。第一步决定信息损失,第二步保证权重重新归一化,第三步决定计算节约能否兑现。 稀疏注意力有两种常见来源。训练时就限定稀疏结构,模型能适应这种通信图;对已经训练好的全注意力模型做免训练稀疏替换,则需要评估替换误差。二者都可能用相同的掩码代码,但质量证据不能相互代用。本文重点讨论后者,同时保留训练适应这条路线的边界。 还要把它与已讲过的零件连起来。FlashAttention 在相同算子定义下优化读写与分块,目标是精确注意力,仍有浮点舍入差异。稀疏注意力一般删掉部分配对,因而改变算子。跨步缓存则复用不同去噪步骤之间的结果。三种方式的误差来源与可省成本不同,组合时要重新评测,不能把各自加速倍数直接相乘。 03. 数学推导 3.1 从全注意力到受限 Softmax 先只看一个头、一个样本,不含 dropout。设总长度为 $N$,query 和 key 维数为 $d$,value 维数为 $d_v$。矩阵 $Q,K$ 的形状都是 $N\times d$,$V$ 的形状是 $N\times d_v$。小写 $q_i,k_j,v_j$ 分别是第 $i$ 个 query、第 $j$ 个 key 与 value。它们是经过投影及位置处理后的向量;本文的掩码推导不要求投影矩阵采用某个具体模型。 缩放分数 $s_{ij}$ 和全注意力权重 $p_{ij}$ 为: $$s_{ij}=\frac{q_i^\top k_j}{\sqrt{d}},\qquad p_{ij}=\frac{\exp(s_{ij})}{\sum_{\ell=1}^{N}\exp(s_{i\ell})}.$$ 除以维数的平方根,是标准缩放点积注意力的定义。每一行权重为正且求和为一,因此输出 $y_i$ 是所有 value 的加权平均: $$y_i=\sum_{j=1}^{N}p_{ij}v_j.$$ 为第 $i$ 行定义保留集合 $S_i$。被删除的 key 分数设为负无穷,因为其指数为零。只要集合非空,受限权重 $\widetilde p_{ij}$ 可以直接写成原概率除以保留质量 $z_i$: $$z_i=\sum_{j\in S_i}p_{ij},\qquad \widetilde p_{ij}=\begin{cases}p_{ij}/z_i,&j\in S_i,\\0,&j\notin S_i.\end{cases}$$ 为什么可以这样写?原概率的分子是指数分数,分母是整行指数之和。把保留概率再求和,得到保留指数之和除以整行指数之和。二者相除时,原先的整行分母抵消,剩下的正是在保留 key 上做 Softmax。于是稀疏输出是: $$\widetilde y_i=\sum_{j\in S_i}\frac{p_{ij}}{z_i}v_j.$$ 这里的 $z_i$ 是概率质量,不是保留 token 的比例。保留四分之一 key,可能保住几乎全部质量,也可能丢掉大部分质量。空集合没有定义:所有分数为负无穷时,稳定 Softmax 的减最大值操作会产生无效值。代码必须拒绝空行或预先设计合法的保留策略,不能靠一个很小的 epsilon 假装集合有内容。 3.2 删除质量怎样进入误差 定义删除质量 $\alpha_i=1-z_i$。当删除集合非空时,令 $u_i$ 表示被删除 value 按原概率重新归一化后的平均;令 $r_i$ 表示保留集合的平均,即稀疏输出。原输出分成两部分: $$y_i=(1-\alpha_i)r_i+\alpha_i u_i,\qquad \widetilde y_i=r_i.$$ 相减时保留部分合并,得到一个精确恒等式: $$\widetilde y_i-y_i=\alpha_i(r_i-u_i).$$ 它解释了误差的两个因素:删除了多少概率,以及删除部分与保留部分的 value 有多不同。若所有 value 的欧氏范数都不超过 $M$,加权平均的范数也不超过 $M$。再用三角不等式,得到逐行上界: $$\lVert\widetilde y_i-y_i\rVert_2\leq\alpha_i(\lVert r_i\rVert_2+\lVert u_i\rVert_2)\leq2\alpha_i M.$$ 当全部 key 都保留时,删除质量为零、误差为零,不需要定义删除均值。这是条件明确的单层局部上界,不是最终视频画质保证。后续输出投影、残差连接和多次去噪可能传播这些差异;推导也没有给出整个模型的 Lipschitz 常数。更紧的估计需要观测两类 value 均值的距离,而不仅仅数被删掉的 token。 一个反例能直接检查条件:两项概率分别为 0.99 和 0.01,value 分别为 0 和 100。删掉第二项,保留质量仍有 0.99,但输出从 1 变成 0。脚本以 query 为 1、两个 key 为 log(99) 与 0 构造这个分布,并实际得到上述结果。概率质量高的确有帮助,然而不说明 value 尺度就不能宣称绝对误差很小。 3.3 时空模式与密度 设帧数为 $T$,每帧位置数为 $P=H W$,其中 $H,W$ 是 token 网格的高和宽。序列长度为 $N=TP$,先忽略文本等额外 token。按帧展平时,位置索引 $i=tP+p$,$t$ 表示帧,$p$ 表示帧内位置。教学空间掩码只保留同帧,时间掩码只保留同位置跨帧。 $$D_{\mathrm{full}}=T^2P^2,\qquad D_{\mathrm{spatial}}=TP^2,\qquad D_{\mathrm{temporal}}=PT^2.$$ 这里的 $D$ 表示允许的 query/key 配对数。空间模式中每个 query 可以读整帧的 $P$ 个 key,乘以 $TP$ 个 query;时间模式中每个 query 读 $T$ 个同位置 key。分别除以全配对数,密度为 $1/T$ 和 $1/P$。空间和时间取并集时,每行保留 $P+T-1$ 个 key,因为自己的 token 被两种集合各数了一次。 $$\rho_{\mathrm{union}}=\frac{P+T-1}{TP}.$$ 这组公式描述本文的简化掩码。SVG 论文的实际空间候选还可覆盖邻帧,时间候选也包含实现选择的带宽;模型还可能带文本上下文。不能把本文的同帧掩码称为完整 SVG 算法,更不能声称每个真实视频头都有密度 $1/T$。 3.4 布局重排为何不改变同一掩码的结果 令 $\Pi$ 是排列矩阵,对应重新编号 token;令 $A$ 是允许配对的布尔掩码。对 $Q,K,V$ 同步左乘排列矩阵,掩码的两个轴也同步重排,得到 $A'=\Pi A\Pi^\top$。分数的行列相应重排,逐行 Softmax 不受 key 顺序影响,因此: $$\operatorname{Attn}(\Pi Q,\Pi K,\Pi V,A')=\Pi\operatorname{Attn}(Q,K,V,A).$$ 最后乘逆排列,把输出放回原位置,就恢复同一稀疏算子的结果。成立的前提是位置编码已经正确关联原 token,Q/K/V 和掩码保持一致。若重排后用新序号重新生成 RoPE,却没有维护原来的时空坐标,就改变了分数,以上等价性不再适用。布局是存放方式,不能顺手改掉位置语义。 04. 代码实现 附录的 sparse_attention_demo.py 只需要 NumPy 与 matplotlib,读者可以先安装依赖,再运行脚本。它不下载权重、不调用 GPU。核心函数完整地实现同一公式,稳定 Softmax 先减每行最大值,掩码关闭的分数设为负无穷: def attention(q, k, v, mask): if not mask.any(axis=-1).all(): raise ValueError('Every query must retain at least one key') scores = q @ k.T / np.sqrt(q.shape[-1]) weights = softmax(np.where(mask, scores, -np.inf)) return weights @ v, weights 正文片段依赖附录里的 softmax 和 NumPy 导入;文末附录提供全部可运行代码。为了构造两个可解释的头,实验把第一个头的 Q/K 主信号放在帧的 one-hot 维度,第二个头放在帧内位置的 one-hot 维度,再加入标准差 0.15 的高斯扰动。主信号幅度为 6,随机种子为 7。这样主动造出一个偏空间、一个偏时间的分布,而不是从预训练视频模型测出来的头分工。 真实形状为 Q=(2,64,20)、V=(64,3),其中最前面的 2 是两个头,最后的 20 来自 4 个帧维度与 16 个位置维度。每头输出为 (64,3)。两个头共享同一 V,是为了让掩码误差可比较,未实现多头拼接及输出投影。相同输入与全掩码比较时,最大误差为零。 合成头 保留模式 配对密度 平均保留质量 对全注意力输出的 MSE 空间头 同帧 0.25 0.9989513131 6.1315309714e-08 空间头 同位置跨帧 0.0625 0.0680910956 0.9388219956 时间头 同帧 0.25 0.2703426737 0.6489679917 时间头 同位置跨帧 0.0625 0.9950700202 8.8294241814e-06 MSE 是对全部 64×3 个输出元素的平方误差求平均。它不是每行向量范数,也不是视频质量下降百分比。空间头用更激进的时间掩码时,虽然密度更低,却丢失了大部分概率质量;同一个稀疏比例换到另一个头,结果会完全不同。表格中的数值经过四舍五入,完整浮点输出由脚本打印并保存在运行结果中。 脚本还逐行检查数学上界。在空间头配合同帧掩码时,最大行误差为 0.0008639397,而这组行中的最大上界为 0.0117092274。断言比较的是每行误差与该行上界,不能把两个最大值的大小关系当成逐行证明。时间头配时间掩码同样通过断言;上界较松,是因为它使用整个 V 的最大范数,丢失了两类均值之间的具体方向。 并集掩码密度为 0.296875,两个头的 MSE 分别为 5.5294485880e-08 和 5.0711107889e-06。它在这组输入里比各自专用模式更接近全输出,但配对更多。这只是本次观测;增加保留集合同时改变归一化,误差并没有对任意输入都单调下降的定理。只看这张表,不能推出并集是通用最优选择。 图由同一实跑脚本生成。深色格子表示允许配对,细线每隔 4 个 token 划出计算块。中间与右侧保留完全相同的时间关联,但右侧把同位置的四帧放到一起,混合块变成完整小方块。它展示的是索引布局变化,不是视频内容或真实注意力热力图。 代码的 block_cost 假设每个 4×4 块只要有一个允许配对,就要计算整块。原时间掩码有 256 个有效配对,却分布在 64 个活跃块里,需要计算 1024 个位置,利用率为 0.25;重排后活跃块为 16 个、计算位置为 256 个、利用率为 1。重排再还原的最大绝对输出差为 2.2204460493e-16。这里的四倍是这个块账本中的工作量比例,未测延迟,真实内核可能采用不同块形状与融合策略。 05. 工业级实现对照 核验的官方代码为 svg-project/Sparse-VideoGen 的 Wan attention.py,关键位置是 WanAttn_SVGAttn_Processor2_0.sample_mse 与 sparse_head_placement;布局参考实现位于 placement.py。以上以 2026-10-07 下载的源码为准,快照与 SHA256 留在本地证据目录,分支 URL 将来可能重构。 sample_mse 抽取 query 行,分别计算全注意力和两个候选掩码的输出,随后以输出 MSE 评估候选。这比只比较注意力概率更贴近实际 value 聚合结果,但只看抽样行,仍有漏掉稀有困难 query 的风险。论文介绍随机采样约 1% 行的设置;当前 Wan 类里可以看到 num_sampled_rows=32 的类属性,实际采样数还会受序列长度限制。论文比例与某个源码默认值不是同一配置,部署时应查看运行参数的最终取值。 本次额外执行了官方函数体:保留数学运算,移除计时装饰器,以 CPU PyTorch 运行同一合成 Q/K/V,并配置 32 个采样行。官方 MSE 的输出形状为 (2,1,2),依次对应候选掩码、样本与头;argmin 选出的头类型为 [[0,1]],即空间头选空间候选、时间头选时间候选。这里只运行 profiling 和布局的参考函数,没有安装整套 SVG CUDA/Triton 扩展,也没有宣称完成视频推理复现。 实跑的两组采样 MSE 分别为 [6.8160804146e-08, 0.7533096337] 与 [1.0477995207, 7.9057440928e-06],列表中按空间头、时间头排列。它们与第 04 节对全部行计算的 MSE 不完全相同,因为这里随机抽取 32 行,而且官方函数使用带放回的 torch.randint,可能多次抽中同一个 query。不要把“抽了 32 行”直接理解成“覆盖 32 个不同位置”。这个细节不会改变本次选出的类型,却会影响评估样本覆盖程度。 sparse_head_placement 调用 ref_wan_sparse_head_placement,将时间头的视频部分从 frame-major 转为 token-major,保留末尾上下文 token 的位置。测试在视频的 64 个 token 后增加 2 个上下文 token,将官方参考结果与独立的 reshape/permutation 预期比较,Q/K/V 的最大差为零,上下文逐元素保持不变。这个上下文长度是测试参数,不能照搬为真实模型默认长度。 工业版本还提供 Triton 头布局与输出还原函数,处理批次、多头、步数及前若干层保留全精度等逻辑;当前仓库还包括后续 SVG2、SVG-EAR 路径。本文只分析已核验的 SVG1 候选模式与相关 Wan 参考函数,不把同一仓库中的所有更新归到原始论文。源码里的窗口、文本及图像条件处理,比同帧/同位置两个布尔条件复杂得多。 Sliding Tile Attention 则从计算块出发,让同一 query tile 共享一组 key tiles,尽量避免只保留少数元素的混合块。这与普通逐 token 滑窗有区别:二者的窗口边界不必完全相同。论文同时讨论无需训练与微调后的设置;更激进稀疏配置的结果若依赖微调,不能贴上免训练标签。选实现时要同时对照保留图的语义和实际 kernel 的结构,API 名称里带 sparse 并不足以保证收益。 06. 代价与边界 第一个代价是选择掩码的成本。若先算完整的全注意力,再从全部权重中寻找最重要连接,已经支付了最昂贵的部分。在线 profiling 通过抽样降低选择开销,但抽样误差也需要被监控。尤其是少数快速运动、镜头切换或长程交互 query,平均误差可能掩盖局部失败;候选集合里若根本没有合适模式,选出较小 MSE 也不代表它足够好。 可以把选择与验收分成两件事:先比较两个候选谁更好,再判断胜出的候选是否跨过允许误差的门槛。候选 MSE 都很高时,单纯的 argmin 仍然会返回一个类型,但它只表示相对更好。若要加入全注意力回退,应明确阈值用的是绝对误差、归一化误差还是其它指标,并记录每层、每步、每头的回退比例。本文没有为真实视频模型拟定通用阈值,也没有把教学输出范围当作部署标准。 同样,平均保留质量与最差行质量应分开记录。平均值接近一,仍可能存在少数严重失真的行;而即便删除质量相同,value 的方向分布也会让输出误差不同。检查局部误差时,可以同时看均值、最大值以及具体失败 query 的时空位置。这样的诊断有助于辨别错误来自窗口太小、头类型选错,还是位置编码与重排错配,避免把所有问题都归因于“稀疏率太高”。 第二个代价是布局、索引与数据搬运。布尔掩码的零不会自动让 NumPy 的 q @ k.T 少做乘法:本文最小实现先算完整分数,再应用掩码,所以它验证语义与误差,计算复杂度仍然是平方级。真正的稀疏内核必须提前知道活跃块,并跳过空块。若运行过程中每步重新排列 Q/K/V,排列本身的读写也要算入端到端时间。 第三个代价是全局交流能力。完全同帧的头不能直接读取其他帧;完全同位置的头不能直接读取别的位置。多头、残差与后续层可间接传播信息,但不能凭这种可能性认定某个被删除连接不重要。文本 token、首帧图像条件和特殊全局 token 常需要单独保留策略,训练时学习出的依赖不能任意删掉。 端到端收益可用成本模型先做量级检查。设全流程中注意力耗时比例为 $f$,稀疏后注意力加速倍数为 $r$,新增 profiling 与布局成本占原总耗时的比例为 $g$。在其它环节耗时不变的假设下: $$R_{\mathrm{total}}=\frac{1}{(1-f)+f/r+g}.$$ 若教学假设 $f=0.8$、$r=4$,不算新增开销时总加速为 2.5;再假设 $g=0.05$,就降为 2.2222222222。脚本实际计算这两个数值,然而参数是人为假设,既非本地测得的耗时,也非 SVG 的论文配置。这个模型的用途是防止把注意力内核四倍加速写成整段视频四倍加速。 还要看基线。对比普通全注意力,与对比优化后的 FlashAttention,收益可能差得很大。dtype、设备、分辨率、帧数、批量、是否计入编译与 warmup,都影响结论。本文只验证 float64 CPU 算子,没有 BF16/FP16 下的稳定性结论。某一精度的有限误差,不能推断另一精度的内核也会产生同样结果。 最后,稀疏模式的效果依赖去噪步和层。早期噪声状态、后期细节状态可能需要不同通信图;某些关键层适合全注意力回退。最终验收应固定同一模型、输入、随机种子与采样配置,同时看视频的运动连贯性、人物身份和提示词遵循。单层输出 MSE 是诊断信号,论文里的质量指标是其具体实验的证据,两者都不能替代待部署配置的实际验收。 07. 经典论文脉络 以下四篇提供不同层面的认识,英文标题与 arXiv 条目逐一核对。 Generating Long Sequences with Sparse Transformers(1904.10509):较早系统探索结构化稀疏连接,帮助理解通信图如何限制上下文路径;不能把训练得到的结果直接当作视频模型免训练剪枝证据。 FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(2205.14135):在算子不变时优化 IO 与分块,提供比较稀疏方法时需要的精确基线。 Sparse VideoGen: Accelerating Video Diffusion Transformers with Spatial-Temporal Sparsity(2502.01776):结合头的时空模式、在线选择和布局变换;摘要报告 CogVideoX-v1.5 与 HunyuanVideo 的最高端到端加速分别为 2.28×、2.33×,属于作者实验,本文未复现这些速度。 Fast Video Generation with Sliding Tile Attention(2502.04507):用 tile 组织局部注意力,减少混合块;其无需训练与微调设置应分开比较,说明稀疏结构和硬件块设计需要一起考虑。 这条脉络不是后一篇全面取代前一篇。精确 IO 优化回答怎样更高效地算相同注意力,稀疏连接回答哪些配对可以删,tile 与排列回答剩余配对怎样落到硬件。把三个问题分开,才看得懂方法之间有哪些可以组合、哪些只是比较口径不同。 08. 常见误解 误解一:掩码里有零,就已经省掉了对应乘法。 本文的 NumPy 路径是反例,它先产生完整分数。代码里存在掩码只说明语义受限;确认算力节约,需要看 kernel 是否跳过了整块,以及它为了识别和排列块支付了多少成本。 误解二:保留 99% 概率,输出误差必然不超过 1%。 百分比的分母没有定义,value 尺度也被忽略。本文反例的绝对误差为 1;若全输出接近零,相对误差还可能非常大。报告误差时应明确范数、聚合方式和参照量。 误解三:时间头等于把未来帧屏蔽掉。 本文时间模式连接同位置的全部帧,没有使用因果掩码。视频扩散常对一段视频同时去噪,不能直接套用自回归解码的因果约束;具体模型若确有因果设计,需要另行叠加并重新检查每行是否合法。 误解四:先重排 token,再随意换一下 position_ids 也等价。 等价的是一致的索引排列,原坐标语义必须保留。RoPE、条件 token 的边界及输出逆排列都参与正确性;只比较张量形状完全看不出这些错误。 误解五:低 MSE 的单层结果就能保证最终视频不变。 合成实验只证实给定输入上的局部性质。真实模型会反复调用注意力,误差可能叠加或放大,也可能被后续操作抑制。是否可以接受,要靠配置一致的端到端证据,不应将一个教学表格写成部署承诺。 09. 动手验证 把附录完整代码保存为 sparse_attention_demo.py,运行 python -m pip install numpy matplotlib 后执行 python sparse_attention_demo.py。脚本会输出 JSON 并在相邻目录生成运行结果和配图;随机种子固定为 7,使用 float64。不同 NumPy/BLAS 版本末位可能有微小差异,检查数量级和断言,不要求所有打印尾数逐字节相同。 第一步,确认三组形状、4096/1024/256 的配对计数及表格数值。把第一个头误用时间掩码,应该看到保留质量远低于同帧掩码,输出 MSE 明显变大。这验证“模式必须适配头”的逻辑,而不是观察任意真实模型头是否属于这两类。 第二步,检查时间掩码重排前后的块账本。有效配对始终为 256,活跃块分别为 64 与 16,逆排列输出最大差约为 2.22e-16。保持 Q/K/V 与掩码同步时,它们计算的是同一个算子;如果只重排 Q 而不重排 K/V,那是在故意制造错配,不能用它评估正常布局变化的误差。 第三步,查看 counterexample:保留质量 0.99、原输出 1、稀疏输出 0。再把 value 的 100 改成更大或更小的数,并重新运行;这是读者的扩展实验,本文没有预先声称改动后的实测输出。公式预言绝对误差随 value 尺度线性变化,可以用自己的运行验证。 第四步,脚本对空掩码执行捕获异常,empty_row_rejected 必须为 true。不要删掉这个检查后把 NaN 当成误差为零。若要研究更复杂窗口,先确认每个 query 至少有一个合法 key,再验证归一化、输出与块占用。最终准备换进模型时,还需要独立的 GPU 内核一致性测试及视频质量测试,本文的 CPU 演示只提供原理层的验算起点。 10. 延伸阅读 从 FlashAttention回看平方计算与 IO 成本的区别,再用 3D RoPE检查 token 重排是否保持原时空坐标。前者帮助建立正确的速度基线,后者帮助排查形状正确但位置语义错误的实现。 与 跨步缓存 DiffCache比较时,重点看复用轴:稀疏是在一次注意力调用内选择连接,缓存是在去噪步骤之间复用计算。若继续阅读 线性与循环记忆 LinearMem,则关注另一条路线如何改变聚合结构及历史状态的存储。这些零件能帮助组织性能问题,仍需在具体模型中各自验证,再评估组合误差与收益。 附录:完整代码 09 节用到的脚本全文如下(sparse_attention_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 sparse_attention_demo.py """CPU teaching experiment; pair counts are not hardware speed measurements.""" import json from pathlib import Path import numpy as np import matplotlib matplotlib.use('Agg') import matplotlib.pyplot as plt def softmax(scores): exp = np.exp(scores - scores.max(axis=-1, keepdims=True)) return exp / exp.sum(axis=-1, keepdims=True) def attention(q, k, v, mask): if not mask.any(axis=-1).all(): raise ValueError('Every query must retain at least one key') scores = q @ k.T / np.sqrt(q.shape[-1]) weights = softmax(np.where(mask, scores, -np.inf)) return weights @ v, weights def block_cost(mask, block=4): n = mask.shape[0] assert n % block == 0 tiles = mask.reshape(n // block, block, n // block, block) active = tiles.any(axis=(1, 3)) pairs = int(mask.sum()) computed = int(active.sum()) * block * block return {'useful_pairs': pairs, 'active_tiles': int(active.sum()), 'computed_pairs': computed, 'utilization': pairs / computed} def main(): rng = np.random.default_rng(7) t, height, width = 4, 4, 4 positions = height * width n, d = t * positions, t + positions frame = np.repeat(np.arange(t), positions) pixel = np.tile(np.arange(positions), t) full = np.ones((n, n), dtype=bool) spatial = frame[:, None] == frame[None, :] temporal = pixel[:, None] == pixel[None, :] masks = {'full': full, 'spatial': spatial, 'temporal': temporal, 'union': spatial | temporal} q = np.zeros((2, n, d), dtype=np.float64) q[0, np.arange(n), frame] = 6.0 q[1, np.arange(n), t + pixel] = 6.0 q += rng.normal(0, 0.15, size=q.shape) k = q.copy() v = rng.normal(size=(n, 3)) results = [] outputs = [] max_value_norm = np.linalg.norm(v, axis=-1).max() for head in range(2): golden, p = attention(q[head], k[head], v, full) head_outputs = {} for name, mask in masks.items(): y, p_sparse = attention(q[head], k[head], v, mask) retained = (p * mask).sum(axis=-1) removed = np.maximum(0, 1 - retained) error = np.linalg.norm(y - golden, axis=-1) bound = 2 * removed * max_value_norm assert np.all(error <= bound + 1e-12) assert np.allclose(p_sparse.sum(axis=-1), 1) results.append({'head': head, 'mask': name, 'density': float(mask.mean()), 'retained_mass_mean': float(retained.mean()), 'mse': float(np.mean((y - golden) ** 2)), 'max_row_error': float(error.max()), 'max_bound': float(bound.max())}) head_outputs[name] = y outputs.append(head_outputs) # Group tokens by spatial coordinate, then frame: an exact permutation. perm = np.argsort(pixel, kind='stable') permuted = temporal[np.ix_(perm, perm)] old_y, _ = attention(q[1], k[1], v, temporal) new_y, _ = attention(q[1, perm], k[1, perm], v[perm], permuted) restored = np.empty_like(new_y) restored[perm] = new_y permutation_error = float(np.max(np.abs(restored - old_y))) # A small deleted probability can matter when values have large magnitude. small_q = np.array([[1.0]]) small_k = np.array([[np.log(99.0)], [0.0]]) small_v = np.array([[0.0], [100.0]]) dense_y, dense_p = attention(small_q, small_k, small_v, np.array([[True, True]])) pruned_y, _ = attention(small_q, small_k, small_v, np.array([[True, False]])) try: attention(q[0], k[0], v, np.zeros_like(full)) except ValueError: empty_row_rejected = True else: raise AssertionError('An empty row was accepted') # Idealized cost model, not timings: 80% attention, 4x attention acceleration. f, r, profiling = 0.8, 4.0, 0.05 result = {'seed': 7, 'q_shape': list(q.shape), 'v_shape': list(v.shape), 'output_shape': list(old_y.shape), 'results': results, 'temporal_blocks_before': block_cost(temporal), 'temporal_blocks_after': block_cost(permuted), 'permutation_max_error': permutation_error, 'counterexample': {'retained_mass': float(dense_p[0, 0]), 'dense_output': float(dense_y[0, 0]), 'pruned_output': float(pruned_y[0, 0])}, 'empty_row_rejected': empty_row_rejected, 'assumed_amdahl_speedup_without_profile': 1 / ((1 - f) + f / r), 'assumed_amdahl_speedup_with_profile': 1 / ((1 - f) + f / r + profiling)} folder = Path(__file__).resolve().parents[1] (folder / 'figures').mkdir(parents=True, exist_ok=True) fig, axes = plt.subplots(1, 3, figsize=(12, 3.5), constrained_layout=True) for ax, mask, title in zip(axes, [spatial, temporal, permuted], ['Spatial: frame-major', 'Temporal: frame-major', 'Temporal: reordered']): ax.imshow(mask, cmap='Blues', vmin=0, vmax=1, interpolation='nearest') ax.set_title(title) ax.set_xlabel('Key index') ax.set_ylabel('Query index') for edge in range(3, n, 4): ax.axhline(edge + .5, color='#94a3b8', lw=.3) ax.axvline(edge + .5, color='#94a3b8', lw=.3) fig.savefig(folder / 'figures/sparse_layout.png', dpi=150, metadata={'Software': 'SparseAttentionTeachingDemo'}) plt.close(fig) (folder / 'run_result.json').write_text(json.dumps(result, indent=2), encoding='utf8') print(json.dumps(result, indent=2)) if __name__ == '__main__': main()