搜索到
224
篇与
人工智能炼丹君
的结果
-
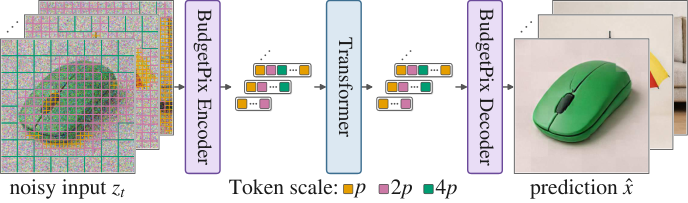
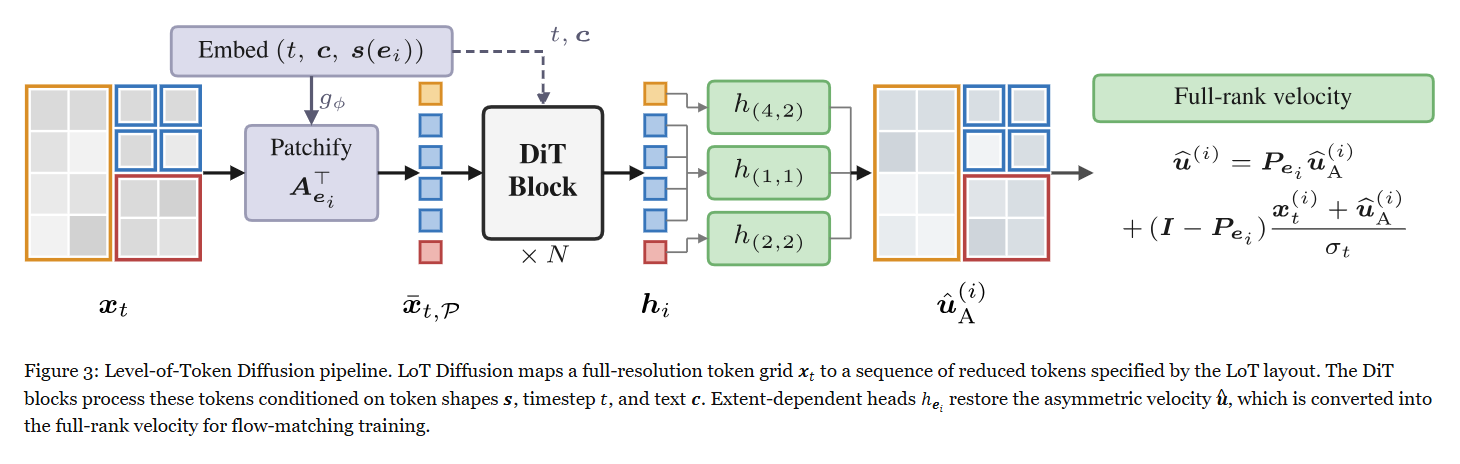
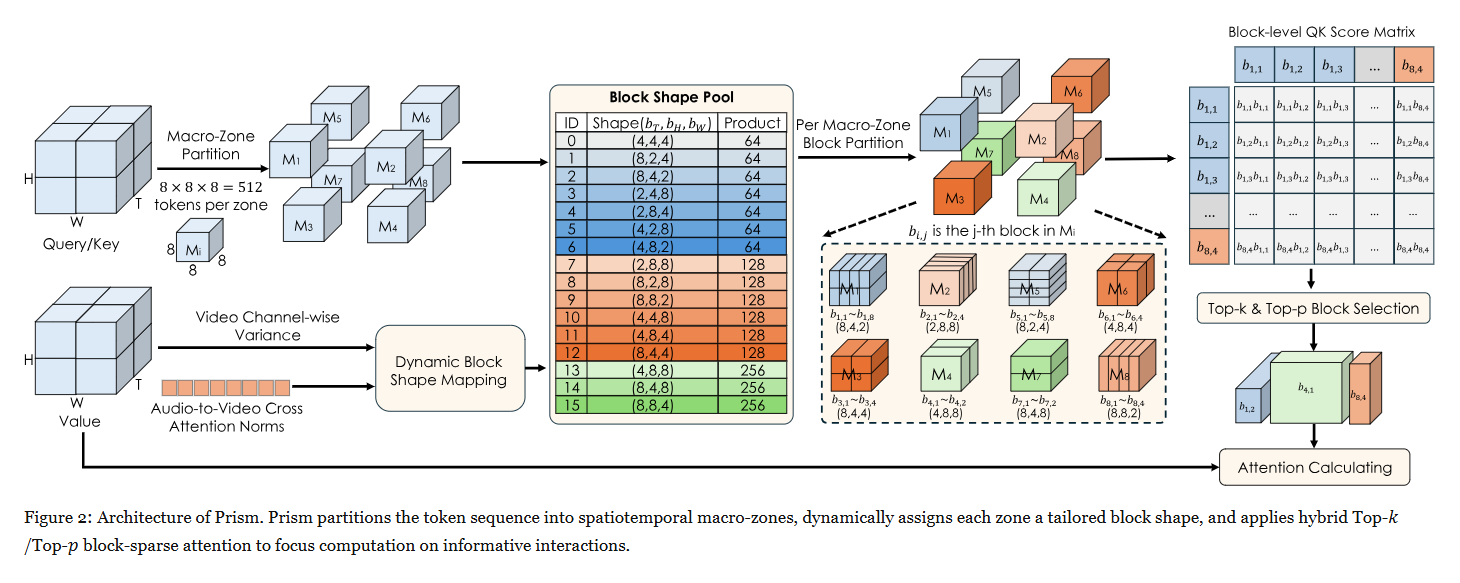
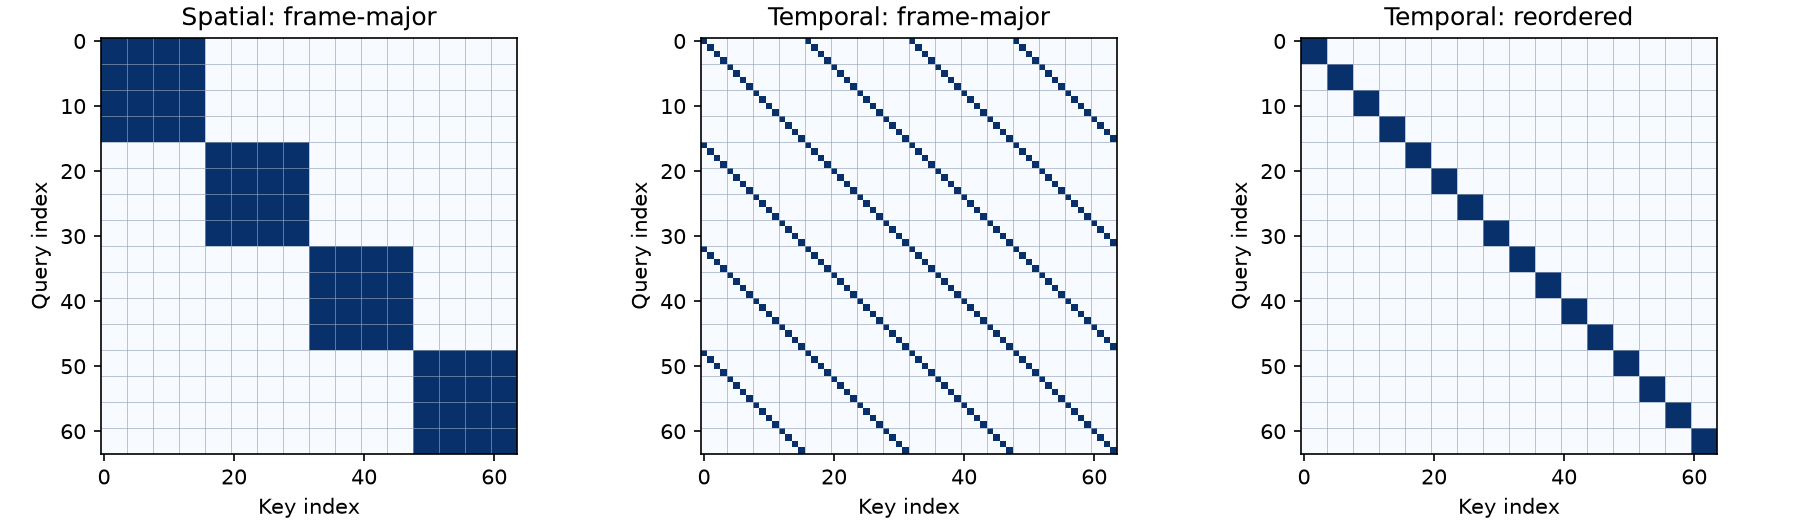
 AIGC 每日速读|2026-10-12|Google把token留给细节BudgetPix 今日 AIGC 论文速览 今日共 10 篇 · 图像计算与自训练 3 篇 · 视频编辑与加速 3 篇 · 局部三维生成 1 篇 · 音视频与语音控制 2 篇 · 生成编辑评测 1 篇 重点论文标题列表 BudgetPix(Google):按细节分配可变token预算 Data-space DMD(字节):不用时间表直接反复修图 Rubric-CEPR(MBZUAI):只把核验通过的编辑教回模型 VINCIE-NExT(字节):先编辑关键帧再把变化传给视频 PTD(NVIDIA):让四步学生沿自己的曲线学 今日论文速览 1. BudgetPix:按细节分配可变token预算 BudgetPix: Compute-Adaptive Tokenization for Pixel-Space Image Diffusion | 伊利诺伊大学厄巴纳-香槟分校;Google | arXiv:2610.12307 关键词:像素空间扩散, 四叉树, 可变token预算, 多尺度解码 前序问题:固定网格给平滑背景和复杂纹理相同的计算预算;直接减少 token 又容易破坏细节,难用一个模型适配不同推理预算。 本文贡献:BudgetPix 按图像强度直方图熵构造四叉树,复杂区域保留细 patch,平滑区域合并为粗 token;多尺度 Patch Aggregator 编码粗格,Refiner 恢复固定分辨率。训练时扰动布局与预算,推理按当前去噪预测重估布局。新增编解码路径需要训练,Transformer 从已有像素空间扩散模型初始化。 论文 Figure 3:BudgetPix 总览。编码器把固定大小图像变成不同尺度、可变数量的 token,解码器恢复固定分辨率,训练和推理都支持不同 token 数。紫色编码器与解码器从头训练,蓝色 Transformer 从已有主干初始化;图中三部分共同构成预算自适应像素空间扩散。 实验效果:表 1:1024² PixelDiT-T2I,BudgetPix 在 25% token 预算下 GenEval 为 0.725、DPG-Bench 为 83.7;原模型全预算分别为 0.721、84.8。原模型同为 25% 预算时降至 0.323、55.1。不同指标说明保留指令遵循的程度,不能把 25% token 预算直接当四倍端到端加速。 论文 Table 1:1024² PixelDiT 文生图在 100%、90%、80%、70%、60%、50%、25% token 预算下的 GenEval 与 DPG-Bench。BudgetPix 各预算指标高于对应原模型;25% 时 GenEval 0.725、DPG 83.7,原模型全预算为 0.721、84.8。这里是预算与指标比较,未给出四倍端到端时延。 批判点评:布局依据中间预测,尚未出现的小细节可能分不到 token;PixelDiT 的全分辨率像素阶段还形成计算下限。需先微调,不能视为免训练插件,也不能把一个指标接近说成画质无损。作者项目页目前未提供可确认的方法代码或权重入口。 2. Data-space DMD:不用时间表直接反复修图 Few-Step Generation via Data-Space Iteration | 字节 Seed | arXiv:2610.12102 关键词:少步图像生成, 数据空间迭代, DMD蒸馏, 自rollout 前序问题:少步采样通常仍沿概率流选定几个时间点;难例和不同空间区域需要的修正次数不同,手工时间表未必适合。 本文贡献:共享生成器从噪声开始,直接把上一轮数据预测、原始噪声和迭代编号作为条件,反复修正干净样本,不再在每轮输出后按指定时间点重新加噪。通过分布匹配蒸馏 DMD 训练每一轮输出,并用自身 rollout 形成训练输入。它取消流时间离散化,仍需选择迭代次数与训练噪声采样。 论文 Figure 1:(a)现有少步生成沿概率流空间迭代,需要预定时间离散化,可能并不最优;图中从初始噪声经多个带噪状态到数据端点。(b)数据空间迭代直接修正每轮数据预测,以原始噪声和轮次作条件,取消流时间离散化瓶颈。两排小图用于示意各自迭代过程。 实验效果:表 3:类别条件 ImageNet 256×256,四次网络评估、启用 CFG 时,Data-space DMD 的 FID 为 2.29,均匀时间表 DMD 为 2.61,搜索三种时间表后的 Phased DMD 为 2.37。250 次评估的流模型 FID 为 2.06,少步方案尚未达到该教师水平。 论文 Table 3:ImageNet 256×256 的主结果,FID 越低越好。上半不开 CFG,下半启用 CFG;比较 250 NFE 流模型、1–4 NFE DMD、4 NFE Phased DMD 与数据空间 DMD。oracle 仅取三种搜索时间表中的最佳结果;数据空间方法无需时间表,启用 CFG 的四步 FID 为 2.29,教师 250 NFE 为 2.06。 批判点评:主结果是类别条件小图,文生图与其他模态仍属未来工作;自 rollout 有训练成本,不是把任何现有采样器换个循环就有效。不同训练权重与 CFG 需同时核对。作者在附录给出实现细节,未从论文入口确认独立代码仓库或权重。 3. Rubric-CEPR:只把核验通过的编辑教回模型 Rubric-CEPR: Self-Evolving Image Editing via Reward-Verified Self-Distillation | 穆罕默德·本·扎耶德人工智能大学;阿尔托大学 | arXiv:2610.12469 关键词:图像编辑, 内部奖励, 可行性门控, 自蒸馏 前序问题:模型自己生成的编辑样本可能真实却没按指令改;单一奖励还可能让“保留得好”补偿“根本没编辑”,把失败教回模型。 本文贡献:Planner 从未标注图像提出结构化编辑要求,Editor 采样多个候选,冻结 Critic 利用原编辑器的视觉语言特征和 VAE 潜变量检查新状态、旧状态消除及局部保留。任何适用检查不通过就拒绝,再把最佳可行样本用于 LoRA 加权去噪训练;主要循环不查询外部奖励模型。 论文 Figure 2:Rubric-CEPR 的提出、编辑、核验与蒸馏循环。冻结 Qwen-Image-Edit 提供 Qwen2.5-VL 理解分支、MMDiT 与 VAE;Planner 的 LoRA 给出指令 c 和结构化要求 s,Editor 的 LoRA 采样 K 个编辑。冻结 Critic 以语义支持与增益、VAE 保留检查构成 R=Gate·√(Edit×Preserve),新状态、旧状态消除、正确操作、无关内容保留与局部性任一适用项失败即拒绝;最佳通过样本训练 Editor,难度带内提案轨迹训练 Planner,进入下一轮。主要循环不查询外部奖励模型。 实验效果:表 1:Qwen-Image-Edit-2509 在 ImgEdit 的 0–5 分制总分 4.36→4.60,相对提升 5.5%;物体分离 3.41→4.26,相对提升 24.9%。总分差为 0.24±0.02,报告的是三次训练种子的标准差。表 2 的 GEdit-Bench 总分 7.39→8.31。 论文 Table 1:ImgEdit 各编辑类别及总分,0–5 分制。内部奖励自蒸馏使 Qwen-Image-Edit-2509 总分 4.36→4.60,相对提升 5.5%,差值 0.24±0.02 为三种子标准差;物体分离 3.41→4.26,相对提升 24.9%。Δ 按 100×(适配分−原分)/原分计算;† UniWorld 使用外部奖励,其原模型与裁判协议不同,不能直接横向归因。 批判点评:内部可检查的编辑更受益:若原模型完全采不到正确样本,多采样也找不到训练目标;调整类内部信号最多追回 30% 的 oracle 空间。主要结果是一次适配,不能称为持续多轮自进化。跨论文裁判协议不同。作者仓库可访问,未运行复现。 4. VINCIE-NExT:先编辑关键帧再把变化传给视频 VINCIE-NExT: Unlocking Video Editing from Images via In-Context Modeling | 新加坡国立大学;字节 Seed;中国科学技术大学 | arXiv:2610.12104 关键词:视频编辑, 图像示范, 共享空间位置, 编辑链 前序问题:视频编辑三元组昂贵;成熟图像编辑数据很多,但改对一帧不代表变化能稳定传到所有视频帧。 本文贡献:把任务拆成视频→图像→编辑图像→视频,以源与目标图像对作为上下文示范;TDF3D-RoPE 将示范和视频帧放在共享空间坐标中,统一扩散主干联合学习各子链。Chain-of-Editing 在推理时先得到编辑图像,再生成编辑视频,也允许更强图像编辑器提供示范。 论文 Figure 2:VINCIE-NExT 总体架构。把视频编辑分成视频→图像→图像→视频子任务链,源图 Iˢ 与编辑图 Iᵗ 作为上下文视觉示范。统一扩散主干据此把成熟图像编辑先验迁移到视频帧;图中各段代表可组合子链,而非完全无需视频编辑训练数据。 实验效果:表 1:431 段 OpenVE-Bench,Gemini 2.5 Pro 按 1–5 分评分,VINCIE-NExT 总分 3.08,高于 OpenVE-Edit 的 2.49,但低于 Runway Aleph 的 3.65;输出分辨率分别为 640×480、1280×704、1280×720。表 2 的第一阶段 256×256 模型,全数据加 CoE 为 2.65,不是同条件的 3.08。 论文 Table 1:OpenVE-Bench 八类编辑比较,Gemini 2.5 Pro 按 1–5 分自动评分。#Reso. 为输出分辨率,灰行是闭源商业模型。VINCIE-NExT 在 640×480 总分 3.08,OpenVE-Edit 在 1280×704 为 2.49,Runway Aleph 在 1280×720 为 3.65;各类包括全局风格、背景、局部改删增、字幕、创意与相机编辑。 批判点评:训练仍用了 OpenVE 视频编辑配对,不能叫完全不用配对视频;关键帧编辑错误会被传播,长视频与大相机运动仍待验证。CoE 增加串行扩散阶段。arXiv 注释明确已接收 NeurIPS 2026。作者项目页有仓库入口,但当前仓库只有 LICENSE 和 README,方法实现与权重尚未公开。 5. PTD:让四步学生沿自己的曲线学 Parametric Trajectory Distillation for Few-Step Video Generation | 洛桑联邦理工学院;NVIDIA;斯坦福大学 | arXiv:2610.11498 关键词:视频少步蒸馏, 参数化轨迹, 教师速度监督, 多样性 前序问题:把高度弯曲的教师轨迹压成几次学生评估,学生容量可能学不动,导致细节变软或不同种子生成近似视频。 本文贡献:Parametric Trajectory Distillation 让学生预测片段的平均速度与多项式曲率,在学生当前曲线上查询教师速度,以最小二乘损失同时学位移和形状;部署时去掉曲率头,只用平均速度更新端点。MiniMax-H3 的最后一个较平滑片段采用教师积分目标,并非所有片段都同一种监督。 论文 Figure 2:参数化轨迹蒸馏。一次学生评估输出平均速度 h 与曲率系数 c,参数化潜变量去噪片段;在学生曲线上查询教师速度,以同一个最小二乘损失监督两者。推理只使用 h 更新片段端点,移除曲率头。小视频图示意片段终止于数据端点,同样构造适用于中间噪声层;箭头为步长缩放速度,默认每片段查询两次教师。 实验效果:表 1:Wan2.1-14B 四次网络评估,匹配训练设置的 PDD 复现 VBench 总分 83.67→PTD 84.57,语义分 77.40→81.10。盲测人类偏好份额相对 PDD 为 55.1%,相对 MiniMax-H3 上的 LightX2V Turbo 为 63.4%。这是两项独立比较,不是所有基线的平均胜率。 论文 Table 1:Wan2.1-14B 的 VBench 与多样性。粗体只对比相同训练设置下 PDD 第96次更新与 PTD 第64次更新;灰色行是已发表参考,训练预算及协议不同。NFE 含引导评估,教师为 50×2;多样性是 V-JEPA 2 与 VideoMAE V2 特征余弦距离。PTD 总分和语义分提升,但这两项多样性不高于该 PDD 复现;rCM 用专有 prompt 且未报告多样性。 批判点评:表 1 的 VideoMAE 多样性 0.0254→0.0180,改善并非所有指标同时成立;发表的参考行训练预算和协议不同。去掉训练曲率头不等于不用蒸馏,四次评估也不等于视频生成时延。作者项目页有演示,未确认 PTD 方法权重公开。 6. iCATS:按交互与噪声动态稀疏注意力 iCATS: Fast Video Generation via Interaction-Aware Sparse Attention and Timestep-Adaptive Sparsity | 杭州师范大学;平头哥半导体;阿里巴巴 | arXiv:2610.11302 关键词:视频DiT加速, 交互聚类, SNR稀疏调度, 尾部合并 前序问题:独立按特征距离聚类 query 与 key,未必保留实际注意力交互;固定稀疏度和不规则簇填充又会损伤画质与 GPU 利用率。 本文贡献:iCATS 用 query-key 点积交互定义聚类目标,并改写成低成本二次型;以信噪比 SNR 调整各去噪时间步的 top-p 稀疏掩码。执行时将不满计算块的尾部 token 重新分配,减少 padding。无需微调生成主干,但聚类、调度与稀疏 kernel 都有实际开销。 论文 Figure 3:iCATS 的稀疏注意力流程。①按 query-key 交互聚类,用簇中心估计簇级 softmax;②以 SNR 引导每个去噪步的 top-p 值并选注意力计算区域;③在稀疏 kernel 前重分配未对齐计算块的 query 簇尾部 token,减少不规则簇的 padding。图中 interaction clustering 为交互聚类,Euclidean clustering 仅用于首个稀疏步初始化 query 簇。 实验效果:表 1:5 秒 720p、八张 H100,HunyuanVideo-T2V-13B 的 iCATS-Base 从 1730 秒降至 854 秒,2.03 倍,PSNR 31.017 dB;Wan2.1-T2V-14B 从 1889→1222 秒,1.55 倍,PSNR 29.301 dB。相应 VBench 为 0.844 与 0.838。 论文 Table 1:三种视频主干的密集、SVG、SVG2、iCATS-Base 与 Turbo 比较。PSNR、SSIM、LPIPS 衡量相对原模型输出的保真度,VBench 衡量视频质量,Time 是实测秒数,Sparsity 是理论注意力计算削减比例。5秒720p、八H100下,Hunyuan Base 为854秒、2.03倍、31.017dB,Wan文生视频 Base 为1222秒、1.55倍、29.301dB;不可把稀疏率当整体加速率。 批判点评:PSNR 比的是相同配置的原密集模型输出,不是真实视频真值;理论稀疏率不能当实际整体加速率。八卡结果不能外推单卡,且聚类多卡并行和 token 级 kernel 仍待优化。未从论文作者入口确认代码或权重公开。 7. SpaceFlow:不同3D部位分配不同控制强度 SpaceFlow: Locally Controllable 3D Generation | 苏黎世联邦理工学院;斯坦福大学;Microsoft | arXiv:2610.12399 关键词:3D生成, 局部几何控制, 部件条件路由, 自相似引导 前序问题:对整个物体统一控制强度,难同时保住指定结构并让其他部位自由生成;局部材质 prompt 还可能串到别的部件。 本文贡献:SpaceFlow 在 TRELLIS 推理中给每个几何 primitive 指定强弱控制,在受控时间段注入高控制区域;生成结构后用 PartField 划分部件,将局部文本或图像外观条件路由到对应区域,再用自相似引导细化外观。几何约束与外观条件分别作用,支持同一物体各部位不同自由度。 论文 Figure 2:SpaceFlow 流程。输入可编辑几何及局部控制强度 τᵢ,在受控时间段把高控制区域注入稀疏结构 flow;PartField 分割生成结构后,将每个部件的文字或图像条件只路由到该部件,再经外观 flow 与自相似引导得到局部几何和外观可控的3D资产。 实验效果:表 1:83 个资产,局部 τ=3/10 对比统一 τ=3,prompt 与几何保真胜率 78.3%、总体胜率 75.9%,但真实感胜率仅 43.4%;对比统一 τ=10,总体胜率为 68.7%。表 4 的外观总体评分 6.78,但纹理细节 6.49 低于 TRELLIS 的 6.87。 论文 Table 1:83个资产上局部几何控制胜率。SpaceFlow 低/高 τ 为3/10,与统一全局 τ=3及τ=10的 SpaceControl 比较 prompt与几何保真、真实感和总体偏好;括号为95% Wilson区间。对τ=3,总体75.9%但真实感43.4%;对τ=10,总体68.7%,说明保真与真实感存在条件相关取舍。 批判点评:胜率来自指定视觉语言裁判与资产集,表中附 95% Wilson 区间,不能当任意3D对象的成功率。语义与强几何约束冲突时会变形;更多局部控制也未必提升纹理细节。原文给出推理设置,未确认作者已发布 SpaceFlow 实现。 8. SepGen:同次生成视频混音和两路分轨 SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model | 特拉维夫大学;Google | arXiv:2610.11361 关键词:音视频生成, 分轨生成, 文本寻址, 混音噪声调度 前序问题:音视频模型通常只给一条混音;想换视角做空间音频,或单独编辑某个声源,就缺少可寻址的独立波形。 本文贡献:SepGen 在预训练音视频双流模型中增加分轨 adapter,每路由独立描述指定声源,在同次采样中生成视频、混音与分轨。分离模式保持输入混音干净;生成模式在高噪声读取带噪混音,低于阈值 σ_g 后读取其干净预测,减少分轨与混音错位。原混音主干保持不变。 论文 Figure 2:σ空间中的三种推理调度,从左到右:(a)分离模式保持混音 m 干净;(b)朴素共享噪声生成让分轨和混音处于同一噪声层;(c)SepGen 的分轨在 σ_g 以上读带噪混音,以下读其干净估计 ẑ₀,m,以改善生成时各声源与混音的对应。 实验效果:表 1:134 个声音案例和 60 个语音案例,联合生成的声音裁判分为 3.82,FlowSep 串行分离为 3.35;语音 WER 为 0.07,即 7%,FlowSep 为 1.03,即 103%。额外自分离声音分为 4.21,却使 WER 变为 0.10;这需要再运行一次,不能算同次采样。 论文 Table 1:生成评测,134个声音与60个语音案例;所有串行基线对同一生成混音和相同描述做分离,两行 SepGen 都使用生成 checkpoint。Judge/J-swap 为声音裁判及描述交换分,CLAP/C-swap为声音文本对齐及交换分,越高越好;语音WER与跨轨Cosine越低越好。联合采样WER0.07是7%,额外自分离WER0.10是10%;粗体与下划线是最好与次好,不代表额外自分离也是一次采样。 批判点评:当前训练和评估固定两个声源,不能声称任意数量分轨;声源仍带原场景混响与距离线索,完整新视角空间渲染属于后续工作。codec 重合成相位还影响 SI-SDR 的解释。作者项目页列出代码、模型和数据入口,未运行复现。 9. EDICT:全局改音色局部切换说话方式 Edit Who Speaks, Control How They Speak: Global Timbre Editing and Local Instruction Control for TTS | 新加坡国立大学;LIGHTSPEED;南洋理工大学;独立研究者 | arXiv:2610.11437 关键词:语音生成, 音色编辑, 局部指令, KV缓存重建 前序问题:参考语音克隆保留旧音色,文字设计又难在同一参考上微改;整句表达指令无法准确控制每个文本片段的语气。 本文贡献:EDICT 先把参考语音和结构化属性编辑送入可训练音色编辑器,生成 codec token 参考,作为各段共享的身份锚。冻结 TTS 主干按分段指令连续生成,在每个边界重建 KV 缓存:换入新指令和文本,同时保留首段与最近一段选定声学上下文,让表达变化但声音身份连续。 论文 Figure 1:EDICT 联合全局音色编辑与局部表达控制。可训练编辑器读取源参考和全局编辑指令,输出共享codec参考;每段冻结TTS均使用它。在指令边界重建KV缓存,以选定历史声学上下文保持衔接,多个片段组成一条连续话语。 实验效果:表 4:Qwen3-TTS-VD 联合控制,EDICT 的片段指令准确率 81.62%、过渡质量 83.45%;原 Joint 为 60.19%、70.07%。段间说话人相似度为 0.917、与原 0.918 接近;英文 WER 3.6%→5.1%,中文 CER 1.2%→1.9%,内容正确性付出代价。 论文 Table 4:Qwen3-TTS-VD上的联合音色及表达控制,请求结合TimbreEdit-Bench的音色编辑与IntraTTS-Bench的分段指令。SIM-T是整条语音与目标声线相似度,SIM-I是段间相似度;WER/CER分别为英文/中文百分数,粗体/下划线为最好/次好且分语种排名。EDICT的SegAcc81.62%、Trans83.45%、SIM-I0.917;错误率5.1%/1.9%,须与控制分共同看。 批判点评:音色编辑器仍要训练,冻结 TTS 主干不等于全系统免训练;训练、指令构造和评测含合成数据与模型裁判。指令遵循更高不能代替低错误率,推广到更多声线还待验证。作者演示页,未确认官方方法代码与权重入口。 10. RISEBench++:检查图像编辑是否真的推理对 Reasoning-Informed Visual Editing | 上海交通大学;东南大学;华南理工大学;微软亚洲研究院;复旦大学;华东师范大学 | arXiv:2610.12343 关键词:生成编辑评测, 隐式规则, 多轮一致性, 多图条件 前序问题:画得自然或保住外观,不代表模型从图中推断了正确状态;因果、空间规则和多轮条件经常在编辑图像中失效。 本文贡献:RISEBench++ 用六类推理、12 个子类和 65 种任务组织 1000 个英中文人工标注案例,覆盖单图、多图与多轮编辑。裁判分别评指令推理、外观一致性和视觉合理性,以任务条件检查生成图像;论文另研究带规划与核验的编辑执行流程,本期关注生成能力评测。 论文 Figure 3:RISEBench++的三维评测与流程。指令推理与外观一致性由Gemini-3-Flash按类别专用prompt评判,视觉合理性由Gemini-3.1-Flash-Lite评判;分别检查是否推理并执行正确、保留应保内容及画面是否合理,不能以自然外观替代推理正确性。 实验效果:表 1、2:共评估 58 个视觉编辑方案。英文集 GPT-Image-2.5 Sunburst 总任务准确率 56.6%,逻辑类 27.0%、混合类 39.0%;Nano Banana Pro 总分 54.6%,逻辑类 36.0%。领先总分也可能有明显类别短板,不能从一个榜单分推断所有编辑能力。 论文 Figure 6:英文RISEBench++细粒度任务准确率雷达图,展示七个模型在12个子类的65种任务上的表现。各轴对应不同任务,局部短板与总分排名并不一致;数值是此评测协议的任务判定,不是所有真实编辑的通用成功率。 批判点评:准确率是本数据集、指定模型版本和裁判协议下的任务判定;混合多轮错误会累积,英中文结果须分别看。不是纯视觉理解测验,产出要求确实编辑图像。官方仓库提供评测说明与样例,完整千例数据链接已单独核查。 趋势观察 先定义计算预算再谈加速 BudgetPix分配token,Data-space DMD调整迭代位置,PTD匹配学生能学的曲线,iCATS兼顾注意力保真和kernel开销。token比例、网络评估次数和端到端时延是不同口径。 内部监督也要验证失败条件 Rubric-CEPR用不可互相补偿的门控筛目标;RISEBench++把推理执行与外观合理性分开。画面真实或自评高分都不够,仍要检查未编辑内容和真实任务约束。 把控制绑定到正确对象与时间 VINCIE-NExT绑定关键帧示范,SpaceFlow路由到局部部件,SepGen分配声源描述,EDICT在分段边界重建上下文。局部控制有效,还要验证全局一致性与连续性。 更高总分仍可能付出代价 EDICT内容错误率、SpaceFlow纹理细节、PTD部分多样性都揭示不同目标间的取舍。部署时应使用自己的分辨率、声源数、视频长度与硬件复核。 今日讨论 BudgetPix用四叉树按熵分配token,在25%预算下GenEval为0.725,但全分辨率像素阶段形成计算下限;你会用哪些细节证据与端到端时延测量,判断这种预算在自己的图像生成场景中是否值得采用? 人工智能炼丹君 整理 | 2026-10-12
-
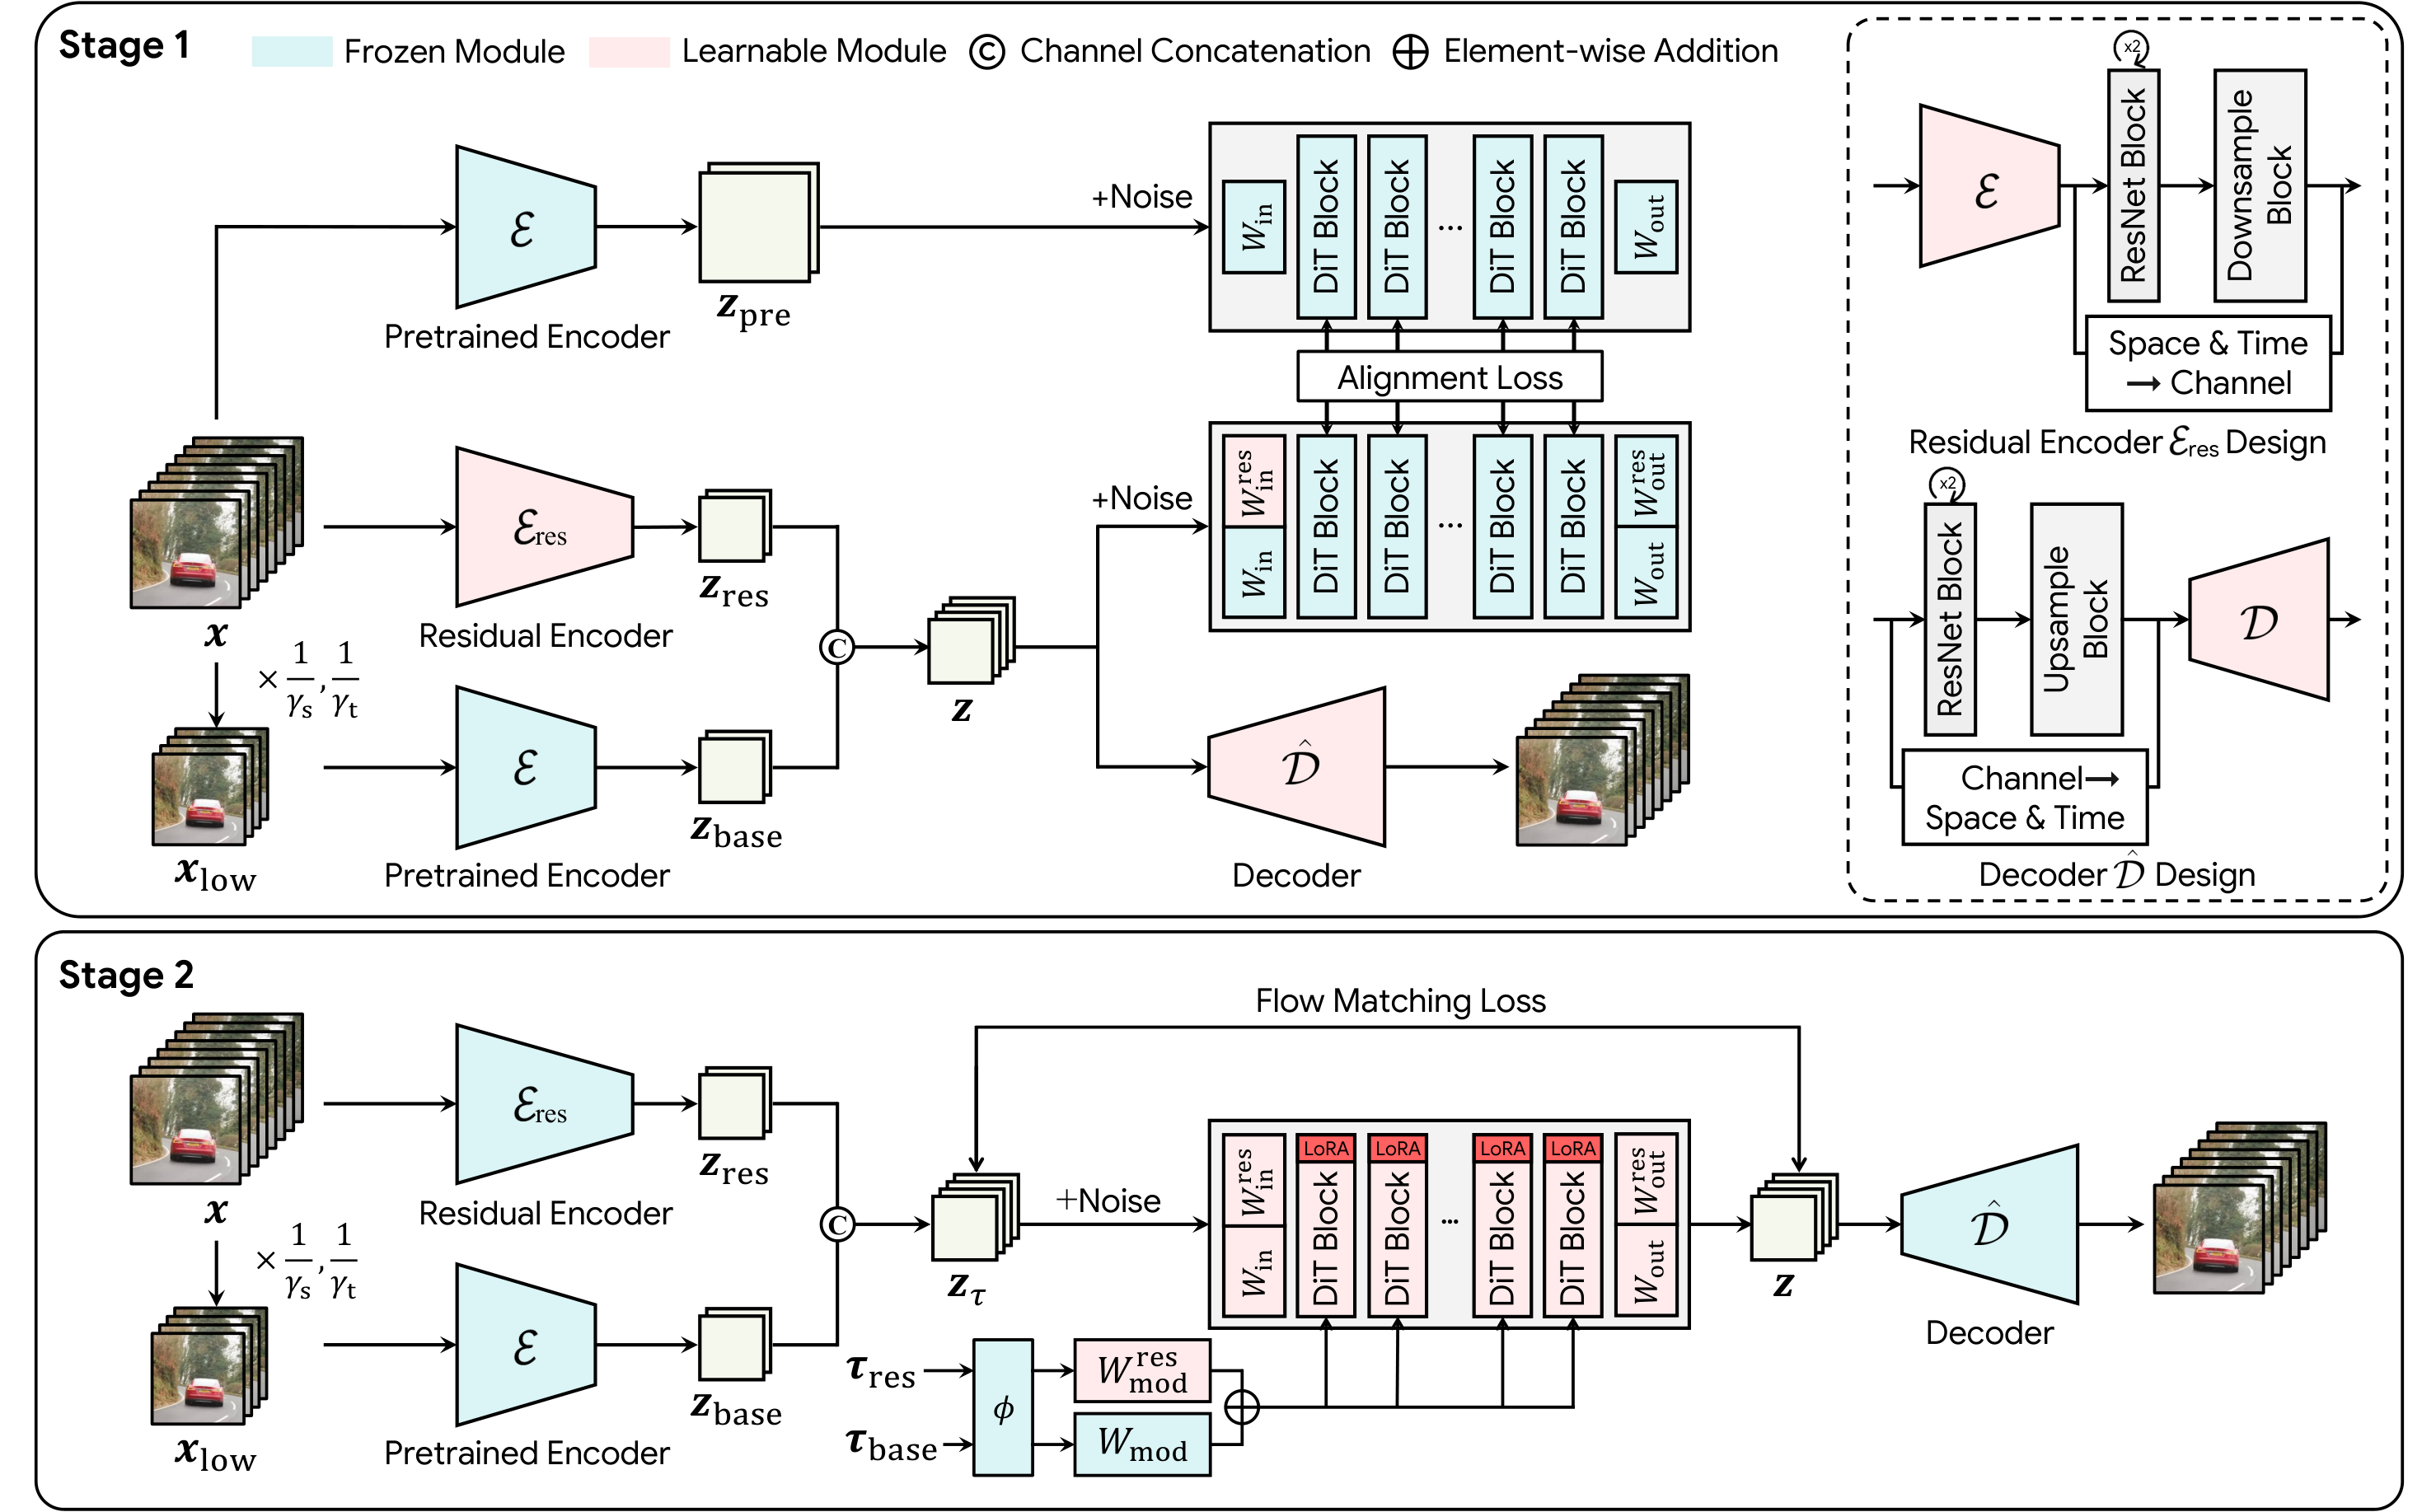
AIGC 每日速读|2026-10-09|KAIST视频生成快11.1倍GRACE 今日 AIGC 论文速览 今日共 10 篇 · 视频表示与自回归生成 3 篇 · 图像token与跨模态编辑 2 篇 · 几何与物理场景生成 2 篇 · 连续语音与情绪控制 2 篇 · 生成图像文字评测 1 篇 重点论文标题列表 GRACE(KAIST):压缩潜空间让视频快11.1倍 QuadTok(UCSD):用四叉树把token留给细节 SGF+(清华):让记忆写入与去噪各练各的 CrossEdit(Adobe):从复杂音频编辑迁移到音视频 Tetris3D(KAIST):生成能互相支撑的3D物体 今日论文速览 1. GRACE:压缩潜空间让视频快11.1倍 GRACE: Generation-aware latent compression for efficient video generation | 韩国科学技术院;Kakao | arXiv:2610.10524 关键词:视频潜空间, 双潜变量, 生成对齐, 非对称去噪 前序问题:更强的 VAE 压缩能减少视频 token,却会改变预训练生成模型熟悉的分布。重建更清楚的潜空间,也未必更容易生成。 本文贡献:GRACE 保留冻结编码器从降采样视频得到的基础潜变量,另学残差潜变量补回丢失信息;在冻结 DiT(用 Transformer 做扩散生成)的特征空间对齐压缩前后表示。第二阶段用 LoRA 适配 DiT,让基础部分比残差更早去噪,后者依托已稳定的结构补细节。 论文 Figure 2:GRACE 总览。第一阶段冻结编码器从降采样视频提取基础潜变量,残差编码器从完整视频补信息,联合解码;对齐损失在冻结 DiT 内匹配压缩前后表示,右侧虚线框示意新增模块。第二阶段用 LoRA 适配 DiT,每步让基础部分处于更低噪声,先于残差稳定。 实验效果:表 1、2:Wan2.1-I2V-14B 的 token 约 32.8k→4.3k,VBench-I2V 总分 87.92→87.90;480×832、81 帧、50 步、单 A100 下加速 11.1 倍。表 3 的 736×1280、81 帧配置为 15.5 倍。计时含条件图编码、去噪和视频解码,不含加载、文本编码及 MP4 写盘。 论文 Table 1:视频自编码器在 256×256×81 重建与 480×832×81 生成条件下的对比。GRACE 将潜变量 token 从 32.8k 减至 4.3k,适配同一 Wan2.1-I2V-14B 后总分 87.92→87.90;但重建 PSNR 35.15→32.63 dB。灰色行是本文方法,粗体仅比较后三种同为 4.3k token 的压缩表示。 批判点评:接近的总分不保证逐项或逐帧无损;表 1 重建 PSNR 35.15→32.63 dB,说明优化生成不等于改善重建。仍需训练 VAE 与适配主干,不能即插即用,更不能把特定 GPU 与视频长度的倍数外推所有配置。作者项目页提供演示与方法入口。 2. QuadTok:用四叉树把token留给细节 QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation | 加州大学圣迭戈分校 | arXiv:2610.10497 关键词:自回归图像, 四叉树token, 空间对应, 复杂度引导 前序问题:固定二维网格把平滑背景和复杂纹理分到相同预算;一维压缩序列虽灵活,却容易丢掉 token 与空间区域的明确对应。 本文贡献:QuadTok 用四叉树逐级细分区域,并按广度优先顺序串成序列。tokenizer 的亲缘注意力限制粗细层与兄弟节点交互;互补探测树的重建收益决定哪些区域多分 token。生成器在预先给定的树拓扑上,用普通因果注意力逐项预测视觉码,保留零样本布局控制。 论文 Figure 2:(a)四叉树按广度优先遍历串成一维序列,ViT 特征聚合成树节点,再量化与解码;(b)层级解码,粗节点恢复整体结构,细节点补局部;(c)互补探测树估计各区域的重建收益,用于形成内容自适应树。 实验效果:表 1:256×256 ImageNet 上平均 230 个 token,相比 LlamaGen 的 256 个少约 10%,rFID 2.19→1.46,但 PSNR 20.79→20.37;零样本 COCO 为 232 个 token、rFID 7.88。表 2 的 947M 类别条件生成模型 gFID 为 2.08。 论文 Table 1:256×256 ImageNet 与 COCO 重建比较。QuadTok 的 token 数是各数据集平均序列长度,ImageNet 训练的 tokenizer 直接迁移 COCO;f 为 LlamaGen 降采样倍率。表中更低 rFID 与更低 PSNR 可同时出现;三层树预算更多,不能只按树深度归因。 批判点评:重建时的内容自适应树不等于生成器自行预测树:采样前须指定拓扑。文生图仍是未来工作,类别条件与布局控制不能直接叫通用文生图。表 2 各系统训练与采样设置不同,不能只凭 gFID 归因于树结构。官方仓库已提供 tokenizer 训练、重建与预编码,生成模型不在该发布范围。 3. SGF+:让记忆写入与去噪各练各的 SGF+: Decoupling Gradient Flows for Autoregressive Video Generation | 清华大学;京东探索研究院;香港中文大学 | arXiv:2610.10429 关键词:自回归视频, 上下文梯度, 参数分离, 长时生成 前序问题:当前帧去噪和给未来写入 KV 记忆若共享参数,两种梯度可能冲突;只截断记忆梯度,又让后续生成无法监督记忆怎么写。 本文贡献:SGF+ 先无梯度自生成并记录干净上下文与采样出口,再并行重算可微 KV,让未来预测的原生成损失监督记忆写入。把写入与去噪参数分开,以因果注意力连接两者,不增加辅助损失。论文实测采用两套完整参数,而非只训练两个小 adapter。 论文 Figure 4:SGF 与 SGF+ 的两遍训练。第一遍无梯度自回归生成,记录停止梯度的干净上下文 X 和采样出口的带噪目标 Z*;第二遍从记录重构计算,让未来生成损失通过可微 KV 监督上下文。SGF 共享 θ,SGF+ 分别使用写入 θ_c 与去噪 θ_d。 实验效果:表 1 的 240 秒、分块生成,主体一致性由 SGF 的 97.72→98.21,审美 62.54→64.74,动态程度 56.97→56.92。训练窗口为 5 秒;作者另展示最长 24 小时连续生成,定量主表评测的是 60 秒与 240 秒。 论文 Table 1:60 秒和 240 秒的逐帧、分块生成比较,分别使用 VBench-Long 和 MovieGen-128 prompt。每组各方法的初始化、prompt 与随机种子一致;质量与一致性指标越高越好。动态程度可能因跳景或形变变高,不能单项决定质量;此表不是 24 小时量化评测。 批判点评:24 小时是演示能力,不是完整时长的定量质量或剧情评测。动态程度及部分图像质量并非全面更好;复制参数还增加存储成本。长期画面稳定不保证事件逻辑成立。作者项目页包含长视频材料。 4. CrossEdit:从复杂音频编辑迁移到音视频 CrossEdit: Cross-Modal Training Enables Rich Audio-Visual Editing | Adobe Research;卡内基梅隆大学 | arXiv:2610.10264 关键词:音视频编辑, 跨模态迁移, 合成编辑对, 指令遵循 前序问题:修改电影场景时既要理解组合指令,又要只动指定内容并保持声音与画面一致;这样的真实音视频编辑配对很难大规模收集。 本文贡献:CrossEdit 利用声音可相加的特点合成复杂音频编辑对,结合音视频掩码重建、唇同步编辑及精选跨模态任务做微调。统一 MoE DiT 通过 flow matching 编辑图像、音频与视频,将已学的复杂指令能力迁移到未见过的音视频场景编辑组合,并提出 CrossEditBench 与 AV-FES。 论文 Figure 2:CrossEdit 编码音视频输入的架构。图中省略图像,因为图像按单帧视频处理;音频与视觉经各自 VAE 进入统一生成模型,条件侧还使用干净语义表示。跨模态迁移仍依赖音视频重建等训练任务。 实验效果:表 2 的 CrossEditBench:相对 CrossEdit-Base,AV-FES 0.26→0.30,视觉子分 0.20→0.26,音频子分 0.31→0.33。模型总参数 12B、每次激活 3B;这些编辑分是论文协议下的综合评分,不是 30% 任务成功率。 论文 Table 2:CrossEditBench 的零样本音视频场景编辑。灰色列为单模态 FES 子分,带下划线为所提技术带来的改善;表中另列指令、内容一致性与 ImageBind 音画对齐。综合 AV-FES 0.30 是协议评分,不是任务成功率。 批判点评:零样本指特定未训练任务与指令组合,不是没用过音视频数据;唇同步编辑和掩码重建都参与训练。表中 ImageBind 对齐分 16.29 仍低于输入的 19.79,某些未编辑内容可能漂移。演示不等于模型权重已公开。作者演示页。 5. Tetris3D:生成能互相支撑的3D物体 Tetris3D: 3D Scene Generation With Objects That Fit Together | 韩国科学技术院 | arXiv:2610.10539 关键词:3D场景生成, 物理关系, 遮挡补全, 自回归物体 前序问题:单张图恢复多个物体时,各自漂亮的形状摆到一起仍可能相交、悬空或不稳;遮挡又让真正接触的区域不可见。 本文贡献:Tetris3D 按视觉语言模型推断的物理依赖顺序生成物体,显式读取邻居几何和支撑、容纳等关系。深度与反投影图像特征把形状直接放到场景坐标中,可见到不可见的交叉注意力帮助补全遮挡部分;ComOb 提供 120 万个带物体网格与关系标注的模拟场景。 论文 Figure 2:Tetris3D 按视觉语言模型推断的物理依赖拓扑顺序自回归生成场景。每个物体经过稀疏结构及结构化潜变量两阶段;各 DiT 将深度、反投影图像与交互条件注入对应网格 token,可见到不可见交叉注意力补全遮挡区域。 实验效果:表 1 的 Toys4K 组合场景中,相对 ShapeR,场景 F1 0.6480→0.8407,平均位移 D_mean 115.1→38.91,穿透深度 PD 0.8862→0.0036,均按原表量纲。真实 MessyKitchens 表 2 的场景 F1 为 0.9620,PD 为 0.0011。 论文 Table 1:Toys4K 组合场景的重建、分布生成和物理稳定比较。带 † 方法用 FoundationPose 将生成物体对齐场景;所有方法使用真值深度。CD、MMD 与覆盖率的缩放及位移单位遵循原文,物理稳定是指定模拟协议下的结果。 批判点评:Toys4K 主表给所有方法真值深度;真实数据才用估计深度与推断关系,两种条件不能混成统一收益。物理稳定是引擎与对象假设内的评估,不是任意现实接触的保证。没有从论文项目入口确认方法代码已发布。 6. PositionForcing:用预测位置引导单阶段3D Position Forcing: Self-Conditioning 3D Generation | 南开大学;腾讯混元;香港中文大学;复旦大学;上海创智学院;香港大学 | arXiv:2610.10342 关键词:单阶段3D生成, 位置自条件, 逐级量化, 位置VAE 前序问题:无序形状 token 在单阶段生成中仍需隐式找位置;先单独生成位置虽然能提供结构,却又多出一条生成阶段。 本文贡献:Position VAE 联合学习形状解码与 token 位置恢复。每个去噪步从预测的干净潜变量恢复位置,按当前噪声程度由粗到细量化,再通过 RoPE 反馈给 DiT;训练阶段用真值 query 位置。这种自条件提供空间引导,无需独立位置生成阶段。 论文 Figure 2:(a)Position VAE 学习形状与 token 位置的对应,可同时解码几何与位置;(b)去噪中从预测干净潜变量恢复位置,通过 RoPE 注入后续步骤;(c)位置随去噪逐级量化,由粗到细提供引导。 实验效果:表 3 的图像条件 3D 生成,相比 Hunyuan3D 2.1,ULIP-I 0.125→0.130,Uni3D-I 0.320→0.321,ULIP-T 为 0.077、与 TRELLIS 2 持平。表 1 的 20% 噪声位置恢复准确率,联合微调 92.5%,冻结 VAE 为 23.0%。 论文 Table 3:图像条件 3D 生成比较。列出是否单阶段,以及 ULIP-T/I、Uni3D-T/I 的文本与图像语义相似度;粗体为该列最佳。Position Forcing 的 ULIP-T 与 TRELLIS 2 持平,其他小幅增益也不构成所有网格质量的保证。 批判点评:小幅语义相似度改善不等于每个网格拓扑都正确;位置恢复准确率是在指定 128³ 网格与噪声下测得,不能当生成成功率。需要位置解码器和联合训练,新增位置恢复的时延不能视为免费。作者项目页提供结果入口。 7. MORCA:按最终视频误差决定缓存复用 MORCA: Offline-to-Online Reinforcement Learning for Adaptive Cache Reuse in Video Diffusion Acceleration | 上海交通大学;阿里云;阿里巴巴 | arXiv:2610.10457 关键词:视频扩散缓存, 终点误差, 潜变量状态, 离线在线强化学习 前序问题:当前步的缓存误差不必对应最终视频损伤;固定阈值也难准确满足用户指定的加速预算。 本文贡献:MORCA 保留 SeaCache 的残差缓存粒度,用学习到的调度器替代阈值。状态同时包含潜变量特征、误差代理与剩余复用预算;以相对无缓存视频的终点保真度训练策略,先做离线 IQL,再在线补充轨迹,决定本步重算还是复用。 论文 Figure 2:MORCA 总览。下部调度器逐步选择缓存复用或重算;左上将目标加速映射为复用总预算,与误差代理、步统计、潜变量特征及当前复用数共同组成状态;右上以 IQL 做离线到在线强化学习。 实验效果:表 2:50 步 Wan2.2-A14B、RTX A6000,在约 3 倍加速时,SeaCache 为 320.41 秒、PSNR 14.99,MORCA 为 326.93 秒、PSNR 16.77、LPIPS 0.3435。Wan2.1-1.3B、RTX 4090 的 MORCA 为 84.98 秒、实际 3.01 倍,PSNR 20.95。 论文 Table 2:Wan2.2 与 Wan2.1 在不同目标加速下的时延及相对无缓存输出保真度,粗体为最佳、下划线为次佳。PSNR、SSIM、LPIPS 用相同 prompt 与种子的无缓存视频作参考,不是现实视频真值;目标与实际加速略有差异。 批判点评:PSNR、SSIM、LPIPS 比的是同 prompt 与种子的无缓存输出,不是现实视频真值或人工偏好。不是免训练缓存法,离线数据与在线 rollout 都有成本;预算离散会留下加速误差。在约 2.4 倍的 Wan2.1 配置,LPIPS 未胜过全部基线。作者仓库当前只标 Coming soon,方法实现尚未公开。 8. JoyAI-Voice2.0:连续潜空间同时规划语义声学 JoyAI-Voice 2.0: A Full-Continuous Autoregressive Speech Generation Model with Semantic-Acoustic Joint Representation | 京东探索研究院 | arXiv:2610.08834 关键词:连续语音生成, 语义声学双编码, 局部扩散, 语音克隆 前序问题:连续语音生成避免量化损失,却可能把声学噪声传回自回归规划,长期输出不稳定;只保语义又会丢掉音色与微小韵律。 本文贡献:JoyAI-Voice 2.0 将 AudioVAE 连续潜变量分成 patch,双编码器分别抽取纯化语义与完整声学信息,融合后交给 1.5B 因果 Transformer 规划下一块。局部 DiT 以历史块为条件生成下一块,再解码为 48 kHz 波形;训练结合 flow matching、停止预测、SFT 与 DiffusionNFT。 论文 Figure 3:JoyAI-Voice 2.0 架构。原始波形由 AudioVAE 压缩为连续潜变量并分块,双编码器抽取纯化语义和声学表示,融合后由因果自回归 Transformer 规划;局部 DiT 生成下一块完整潜变量,最终解码为 48 kHz 波形。 实验效果:表 2 的 Seed-TTS,中文 CER 0.74%、英文 WER 1.27%、困难集 CER 5.53%;三个子集的平均识别错误率为 2.51%,相对 dots.tts 的 2.95% 降低 14.9%。说话人相似度平均 74.8,低于 dots.tts 的 79.2,内容正确不等于声线最像。 论文 Table 2:Seed-TTS 零样本语音克隆。中文及困难集用 CER,英文用 WER,SIM 为说话人相似度;错误率越低越好、SIM 越高越好。平均识别错误率混合不同子集口径,2.51% 不能当所有语言的统一 WER;粗体标注各列最佳。 批判点评:平均 2.51% 混合中文 CER 与英文 WER,不能统称所有语种 WER。MDVD-Eval 是作者的中文多属性集,并用模型裁判评分;不能外推任意语言与真实交互延迟。原文首发 9 月 29 日,本期从候选池补充这篇未读报告,未确认官方代码或权重公开。 9. SteerSpeech:用小向量调节说话情绪强度 Steerspeech: Activation Steering For Emotion Control In Generated Speech | 弗吉尼亚大学;Netflix | arXiv:2610.10415 关键词:语音情绪控制, 激活steering, 低秩变换, 多专家监督 前序问题:情绪 prompt 或参考语音难细调强度;直接加激活差向量又可能改掉说话人身份与文本内容。 本文贡献:SteerSpeech 冻结 Qwen3-TTS 主干,为每种情绪训练 33,793 参数的低秩变换。将情绪与中性激活差修正为 steering 向量,用情绪、身份和转录专家共同监督;生成后再 replay,并用直通估计器跨过离散语音 token 训练,推理时以强度 α 注入隐藏层。 论文 Figure 1:SteerSpeech 总览。冻结语音主干,只学习情绪 steering 的低秩变换;训练经生成与 replay,用情绪、身份和转录专家监督修正向量,推理以 α 调节注入强度。免主干微调不等于完全免训练。 实验效果:表 1 汇总:愤怒目标情绪分从朴素 steering 的 0.651→0.835,WER 6.0%→5.1%;快乐情绪分 0.487→0.524,但 WER 7.1%→9.7%。表 2 的代表性情绪 A/B 主观比较中,相对朴素 steering,情绪强度偏好为 78.1%。 论文 Table 2:代表性情绪的主观 A/B 偏好,三组比较分别列情绪强度、身份保留与自然度。SteerSpeech 相对朴素 steering 的情绪偏好 78.1%,但身份与自然度偏好为 41.2%、47.7%;相对情绪参考语音也并非全项占优。 批判点评:更强情绪并非所有属性都更好;表 2 相对参考语音,身份偏好仅 12.6%、自然度偏好 16.2%。因此不能把强度偏好称为整体音质胜率。需训练低秩变换,且仅在指定主干与情绪上验证;arXiv 注释明确 ICASSP 2027 在审,未接收,也未确认官方代码。 10. UltraText:检查整幅图里的长文本是否对 UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation | 西湖大学;蚂蚁集团;浙江大学;上海创智学院;香港科技大学;中科院自动化所;微信AI;MBZUAI;香港城市大学;北京大学 | arXiv:2610.09823 关键词:生成文字评测, 双语密集文本, 整图裁判, 保真度与清晰度 前序问题:一个招牌写对,不代表海报、菜单或网页里的所有区域都对。文字看起来清楚,也可能遗漏或改写指定内容。 本文贡献:UltraText Bench 提供 432 个英中文 prompt,覆盖 24 类场景、三个难度和每图 4–12 个文本区域;生成器只接收 prompt。完整结构化参考交给 Q-Judger,对整图六项评分映射为文字保真、清晰、空间与场景四维,并把失败覆盖率与有效图质量均值分开报告。 论文 Figure 4:任务与评分协议。生成器只接收 prompt,Q-Judger 读取完整参考与生成图,输出六项整图评分,再合成为四维与综合分;参考字段并非与分数逐项对应,网格只给粗位置,可共享格子。无效响应不评分并降低覆盖率;面包店示意简化自指定四区域记录。 实验效果:表 5 的 24 个模型配置:Z-Image-Turbo 相比 Base,清晰度 70.60→74.41,保真度 55.51→40.75;Qwen-Image-2512 的英文综合分由 L1 的 86.50 降到 L3 的 42.86。综合分权重为 60/30/5/5,分数在 0–100 范围。 论文 Table 5:24 个模型配置排行榜。VLM 评分 0–100,英中文 prompt 宏平均等权汇总;综合权重为保真、清晰、空间、场景 60/30/5/5。L1/L2/L3 为不同负载,Low/High 为 API 品质;失败影响覆盖率而不直接记零分,排名不等于字符正确率。 批判点评:这些是视觉语言模型评分,不是正确字符百分比;默认采样、分辨率和 API 设置不同,不能把 Base/Turbo 差异单独归因于加速。语言集独立编写且字符负载不同;报告没有置信区间,近分排名须谨慎。官方数据与评测仓库。 趋势观察 表示要为生成目标服务 GRACE 用 DiT 特征指导潜空间压缩,QuadTok 给复杂区域更多 token,JoyAI 把语义与声学分开再融合。重建指标、token 数和生成质量需要分别核对。 不同计算职责可以明确拆分 SGF+ 分开上下文写入与去噪,Position Forcing 从预测干净形状恢复位置,MORCA 按终点误差调度缓存。相似模块的职责不同,训练与部署成本也不同。 控制需要保留未编辑属性 CrossEdit 在组合指令中兼顾音画与内容,Tetris3D 条件化邻居关系,SteerSpeech 约束声线与转录漂移。控制强度或几何稳定单项更好,都不能代替整体质量。 把指标拆开才看得见代价 JoyAI 的低识别错误不代表最高说话人相似度;UltraText 的文字清晰不代表内容正确。总分与偏好都有边界,评估时要同时看分项、失败覆盖率和实验设置。 今日讨论 GRACE 用双潜变量在指定 A100 设置实现 11.1 倍提速,但重建 PSNR 下降;你会用哪些指标与逐帧证据,验证残差潜变量补回的信息足以满足上线画质要求? 人工智能炼丹君 整理 | 2026-10-09
-
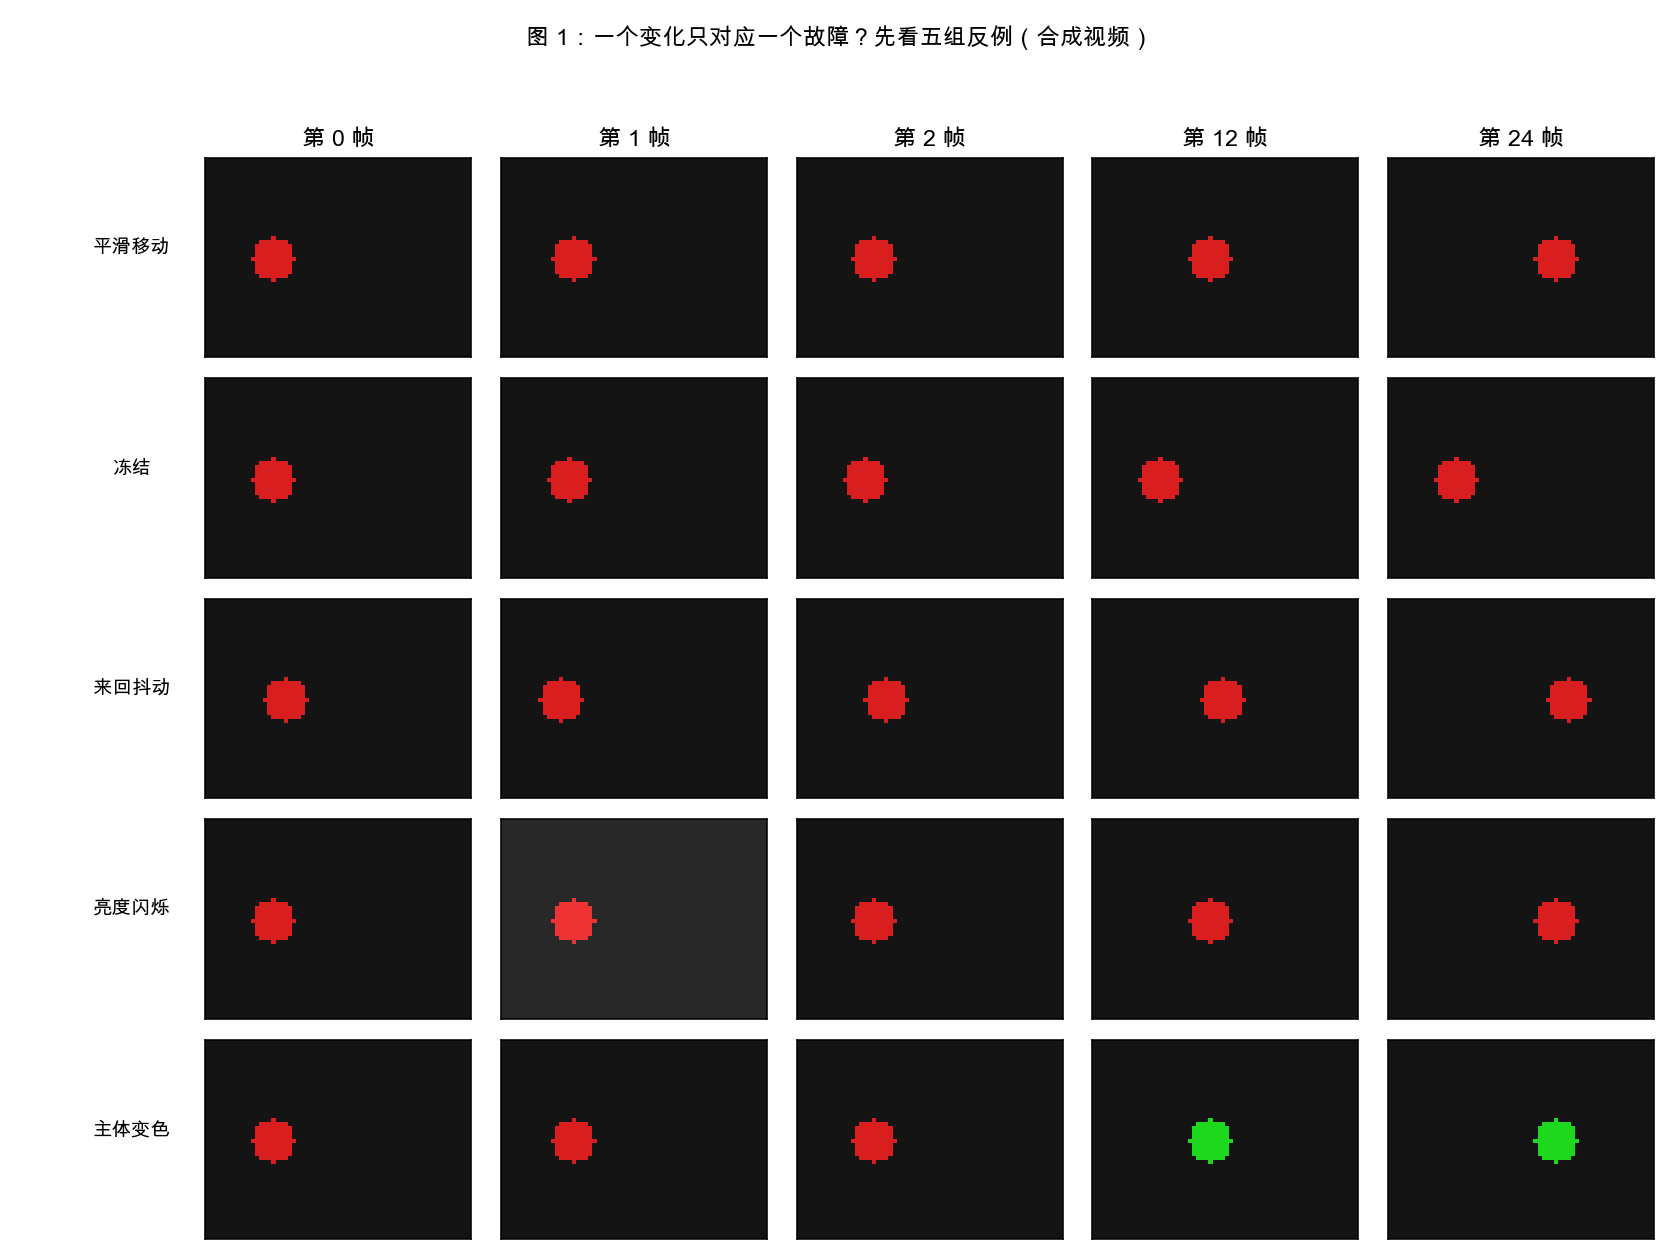
AIGC 基本功|视频生成评测:VBench 与人工验收-VBench AIGC 基本功|视频生成评测:VBench 与人工验收-VBench 所属方向:评测 | 难度:进阶 | 前置知识:FID / CLIP Score 到底测了什么 关键词:视频评测、VBench、时序一致性、运动幅度、成对比较、人工盲评、置信区间 01. 为什么需要它 假设你正在验收一个视频推理加速方案:运行时间降了,但角色走到一半换了脸,镜头运动变成小幅抖动。报告却写着“综合质量保持”。问题可能出在评测:更锐利的单帧补偿了变差的时序,多个维度压成一个数以后,故障被平均掉了。速度收益可以真实存在,质量结论也仍然可能不充分。 本文先给一组真正跑出的反例。把一张红色圆盘的图片复制成 25 帧,得到冻结视频;另一个视频让圆盘每帧向右移动 1 像素。我们自定义的轨迹平滑度在两者上都是 1.000000,但运动量分别是 0 与 1 像素/帧。冻结视频的相邻帧像素差还是 0,若验收只要求“变化小、足够平滑”,它会轻松过关,而“主体向右行走”的需求并没有完成。这些数字来自本文 CPU 合成实验,不是 VBench 分数,也不是任何真实生成模型的测量。 第二个反例更隐蔽:给平滑轨迹加上左右交替的位移,主体颜色始终一样,玩具身份一致性仍接近 1,运动量却升到 6 像素/帧,玩具平滑度降到约 0.000006。运动更多不代表运动更好,身份稳定也不代表时间连续。评测首先要把这些命题拆开,才有资格讨论“质量不变”。 视频比图像多了时间轴,而时间轴不能靠多算几张 FID 补齐。逐帧看起来漂亮的图像串,可能含有冻结、闪烁、速度突变、身份漂移和动作错误;看起来稳定的视频,也可能没有执行提示词要求的动作。接下来我们从可控反例推导几个量,再对照 VBench 的真实实现,最后把人工验收做成可以重复执行的协议。 02. 最小可用理解 第一句:视频质量至少包含“每一帧是否好看”“时间上是否连贯”“是否完成条件要求”三个问题,任何一个问题的代理指标都不能承担另外两个问题。 第二句:VBench 把问题细分为多个维度,维度对应特定提示词和评测器;它应当先被当作一组诊断结果,再被汇总成排名分数。原始 VBench 的 16 维可以分成 7 个视频质量维度和 9 个条件一致性维度,具体分组和权重以第 05 节固定版本的官方代码为准。 第三句:人工验收把自动指标漏掉的失败拿出来检查,但人的判断也需要控制提示词、抽样、展示顺序和统计单位;“我看了几条觉得不错”不能支持整个任务分布上的质量结论。 后面的 NumPy 实验只演示指标会如何混淆不同故障,不实现 DINO、RAFT 或 AMT,也不冒充官方榜单。把机制讲清楚与复现基准是两件不同的工作,读者可以在普通 CPU 上完成前者,再按正式协议组织后者。 03. 数学推导 3.1 相邻帧差为什么会惩罚正确运动 记视频为 $V=(X_0,\ldots,X_{T-1})$,每一帧 $X_t$ 是 $H\times W\times C$ 的像素数组。$T$ 是帧数,$H,W$ 是画面高度和宽度,$C=3$ 表示 RGB 通道;本文把像素映射到 $[0,1]$。最直接的时间变化量是相邻帧平均绝对误差: $$D_{\mathrm{pixel}}=\frac{1}{(T-1)HWC}\sum_{t=1}^{T-1}\sum_{h,w,c}|X_t(h,w,c)-X_{t-1}(h,w,c)|$$ 分母是参与比较的像素通道总数,所以不同尺寸可以在同一尺度上读数;绝对值避免亮暗变化抵消。可是圆盘平移时,进入圆盘的像素由背景变为红色,离开的像素由红色变为背景。即使纹理完全不闪烁,边缘也产生非零误差。因此 $D_{\mathrm{pixel}}$ 同时包含运动、外观变化、光照变化、噪声和遮挡,不是纯粹的闪烁量。 如果已知帧间位移 $u_t$,先把上一帧对齐到当前帧再比较,就得到运动补偿残差: $$R=\frac{1}{(T-1)HWC}\sum_{t=1}^{T-1}\|X_t-\mathcal{W}(X_{t-1},u_t)\|_1$$ $\mathcal{W}$ 是按位移重采样的算子,$\|\cdot\|_1$ 表示所有像素通道绝对值之和。在本文整数平移的场景中,它是数组平移;一般视频中需要光流、插值和可见性处理。正确平移而纹理不变时,残差可以为零;固定位置亮度跳变时,位移为零,残差保留亮度变化。这个对照说明为什么必须先辨别运动,才能谈闪烁。 残差仍不能直接等于闪烁。新露出的区域在上一帧没有对应点,光流可能算错,物体变色也会产生残差。实际使用时要考虑遮挡掩码、镜头切换和评测器误差。本文背景统一、圆盘远离边界,才允许用整幅图像的循环平移演示机制;真实画面不能直接照搬这个边界处理。 3.2 运动量与运动平滑度测的是不同阶差分 为了把运动单独拿出来,先用已知场景的阈值分割获得主体中心 $c_t\in\mathbb{R}^2$。位置的一阶差分是每帧位移,二阶差分是位移的变化: $$v_t=c_t-c_{t-1},\qquad a_t=c_{t+1}-2c_t+c_{t-1}$$ $v_t$ 的单位是像素/帧,$a_t$ 的单位是像素/帧平方;若希望比较物理时间中的速度和加速度,需要分别乘以帧率及其平方。本文所有样本用同一时间采样,因而直接使用帧单位。用欧氏范数去掉方向,再求平均: $$M=\frac{1}{T-1}\sum_{t=1}^{T-1}\|v_t\|_2,\qquad A=\frac{1}{T-2}\sum_{t=1}^{T-2}\|a_t\|_2$$ $M$ 测运动量,$A$ 测速度变化程度。为方便演示,把第二个量映射成“越高越平滑”的玩具分数 $S$: $$S=\exp(-A/\tau),\qquad \tau=1\ \text{像素/帧平方}$$ 指数的输入必须无量纲,所以 $\tau$ 与 $A$ 同单位。$A=0$ 时 $S=1$,$A$ 越大,$S$ 越低。这只是我们为反例选择的尺度,VBench motion smoothness 不使用这个公式。冻结与匀速移动的二阶差分都为零,因此两者的 $S$ 一样;左右抖动的一阶差分较大,二阶差分也很大,故 $M$ 大而 $S$ 小。 这里还有一个重要边界:正常动作会加减速,抛物运动有加速度,舞蹈动作可能刻意急停。低二阶差分不是通用的好视频标准。这个量适合解释“运动大小”和“运动变化”不能合并,是否自然还需要更强的视觉模型和具体任务判断。 3.3 身份一致性为什么要同时看首帧和邻帧 让 $f_t$ 表示第 $t$ 帧提取出的特征,先归一化成单位向量 $z_t=f_t/\|f_t\|_2$,于是余弦相似度就是内积 $z_t^\top z_s$。只比较邻帧时,一个主体可以每帧只改变一点,最后完全换成另一种外观,而每一步仍很相似。再增加与首帧的比较,可以让慢漂移受到惩罚。 $$I=\frac{1}{T-1}\sum_{t=1}^{T-1}\frac{\max(0,z_t^\top z_{t-1})+\max(0,z_t^\top z_0)}{2}$$ 两个相似度分别检验局部连续性和相对于最初外观的保持,等权平均。这个结构对应固定版本官方 subject_consistency 的逐视频计算;本文的特征却只是圆盘内平均 RGB,官方用的是 DINO 图像特征。相同的聚合式不代表相同的评测能力:颜色描述符无法识别人脸身份、衣服细节和类别语义,DINO 特征也不是专用的身份识别证明。官方 subject_consistency.py 亮度变化可能影响特征方向,镜头变化也可能让同一主体的图像特征改变。这个指标测的是所选特征空间里的外观稳定性,不能从高分推出“剧情中始终是同一个人”。更不能从高分推出“人物做了正确动作”:红色圆盘左右抖动时,颜色方向仍然不变。 3.4 FVD 把时间放进特征,但仍然是分布比较 前置文章中的 FID 先提取图像特征;FVD 使用视频特征,原始工作采用 I3D 相关视频表征。设真实与生成视频特征的均值为 $\mu_r,\mu_g$,协方差为 $\Sigma_r,\Sigma_g$,高斯近似下的距离仍然是: $$\mathrm{FVD}=\|\mu_r-\mu_g\|_2^2+\mathrm{Tr}(\Sigma_r+\Sigma_g-2(\Sigma_r^{1/2}\Sigma_g\Sigma_r^{1/2})^{1/2})$$ 这里 $r,g$ 标记真实与生成集合,$\mathrm{Tr}$ 是迹。时间信息是否保留、保留什么,取决于视频特征器和片段采样;公式本身只比较一阶与二阶统计。它可以衡量两组视频表征的分布差异,却不会逐条指出“第 12 帧换脸”,也不直接校验某个提示词是否完成。样本量、特征器、裁剪、长度和帧率不一致时,跨实验数值不宜直接比较。FVD 原始论文 3.5 成对比较的统计单位是任务,不是帧 比较方案 A 与 B 时,用相同 prompt 集合、匹配的 seed 编号和相同输出规范,得到分数 $q_{p,s}^{A},q_{p,s}^{B}$。$p$ 标记 prompt,$s$ 标记重复生成。先在同一任务内取差,再平均 seed: $$\delta_p=\frac{1}{K}\sum_{s=1}^{K}(q_{p,s}^{B}-q_{p,s}^{A}),\qquad \widehat{\Delta}=\frac{1}{P}\sum_{p=1}^{P}\delta_p$$ $K$ 是每个 prompt 的 seed 数,$P$ 是 prompt 数。这样困难任务在两组中共享,任务难度不会轻易掩盖方案差异。相同 seed 编号只是控制抽样的一部分,不保证不同架构生成完全相同的随机轨迹;报告仍应保留多次生成和失败样本。 视频中的帧高度相关,同一 prompt 的多个 seed 也共享任务难度。本文因此按 prompt 有放回抽样,每次保留该 prompt 的全部成对 seed,重新计算均值差,重复 10000 次,以 2.5% 和 97.5% 分位数得到 bootstrap 百分位区间。这是在已观测 seed 集合条件下,对任务抽样不确定性的近似,不完整刻画换一批 seed 的不确定性,也不包含协议偏差和未覆盖任务。这个过程本身不证明 prompt 具有代表性;若任务分层且样本比例预先固定,应在各层内部重采样,再按目标任务比例汇总。 04. 代码实现 4.1 一个可以逐项解释的 CPU 实验 文末完整脚本 video_metrics_lab.py 只依赖 NumPy。它生成 5 组形状为 (25, 48, 64, 3) 的浮点视频,正常样本像素范围 [0.08, 0.85]。背景为均匀灰色,圆盘半径为 5 像素,正常轨迹从横坐标 16 移到 40,保持在画面内部。固定半径和背景的目的,是把遮挡、变焦和复杂纹理先拿掉,留下容易检查的变化因素。 五组样本分别是:正常匀速移动、位置冻结、位置左右交替偏移 3 像素、全画面交替增加 0.08 亮度、圆盘在第 12 帧从红色变成绿色。颜色变化只是“外观改变”的合成代理,不宣称等价于真实人物换脸。所有位置都是整数,正文里运动补偿残差为零的结果才可以精确验证,而不是受双线性插值误差影响。 核心计算对应第 03 节的一阶与二阶差分: speed = np.linalg.norm(np.diff(centers, axis=0), axis=1) acceleration = np.linalg.norm(np.diff(centers, n=2, axis=0), axis=1) motion = speed.mean() smoothness = np.exp(-acceleration.mean()) 这里 centers 就是公式里的 $c_t$,acceleration 对应 $\|a_t\|_2$;指数默认采用 $\tau=1$ 的像素/帧平方尺度。主体阈值分割要求至少一个通道大于 0.35,这是为已知合成场景设计的,拿到真实视频不会自动获得可靠主体掩码。 4.2 实际输出应该怎样读 2026-10-08 在 CPU 上执行后,正常移动的 pixel_mae 为 0.002029080,aligned_mae 为 0,运动量为 1,玩具平滑度为 1。冻结样本的两个误差和运动量都为 0,玩具平滑度仍为 1。这组结果直接证明相邻像素差会处罚正确运动,而单独的平滑度又会放过冻结。 抖动样本的 pixel_mae 为 0.010329861,运动量为 6,二阶差分均值为 12,玩具平滑度为 0.000006144,玩具身份一致性约 1。原地或来回乱动同样能增加运动量,所以“更动态”不能独立成为加分目标。 亮度闪烁样本的 pixel_mae 为 0.081647135,对齐后残差为 0.08,运动量和玩具平滑度仍为 1。主体变色样本的玩具身份一致性降为 0.793119704,运动量和平滑度仍为 1。浮点余弦可能出现 $1+\epsilon$ 的末位误差,脚本保留原始计算,不把它解释成实际相似度超过 1。 看图时先沿行观察:前 3 列选用连续帧,冻结行的位置不变,抖动行在平移上叠加往返,闪烁行的背景与主体一起变亮,变色行从中段开始外观改变。若只等间隔抽到偶数帧,交替闪烁会被采样漏掉;同一故障可能影响多个量,而某些量对明显故障完全不敏感。 这张图的重点是冻结与正常移动同样平滑、抖动保持颜色身份却最动态。图中的三个量均为本文玩具指标,不是 VBench radar chart,也不能填进 VBench 报告。 4.3 真实运行的成对 bootstrap 为了只检验统计流程,脚本再创建 24 个合成任务、每任务 3 个成对 seed。每个任务共享一个轨迹难度,A 叠加正弦扰动,B 把同一扰动振幅乘以 0.65,然后计算第 03 节的玩具平滑度。这些任务没有自然语言语义,只是带 task ID 的受控轨迹实验;“prompt”在数组维度中代表统计上的任务组。 结果为 B − A = 0.089640896,以 prompt 为单位的 10000 次 bootstrap 得到 95% 百分位区间 [0.081229656, 0.098102901]。代码保存逐任务差值和 bootstrap 样本,读者可以检查区间是怎样产生的。区间排除了 0,只支持“这组受控扰动减弱后,玩具平滑度均值提高”这个命题,不支持真实视频质量或用户偏好提高。 左图每根柱子是一个任务内对 3 对 seed 求平均的差;右图按任务重采样,虚线是百分位区间。把 72 个视频当作 72 个独立 prompt,会改变估计的抽样层级;把所有帧当作独立样本会更严重地高估证据量。 05. 工业级实现对照 5.1 VBench 不是一个通用“视频好坏函数” 本节源码固定为 Vchitect/VBench,提交 fd18b3d055cb0fc6f066ca90fe2c3c8cbb698490,于 2026-10-08 核验。首先确定评测范围:这里讲原始 VBench 的 text-to-video 16 维路径;VBench++ 的 image-to-video、长视频和可信性扩展,以及 VBench-2.0 的内在真实性评测,具有各自入口,不能只因目录名字接近就混用分数。 质量组包括主体一致性、背景一致性、时间闪烁、运动平滑度、动态程度、美学质量和成像质量。条件一致性组包括物体类别、多物体、人类动作、颜色、空间关系、场景、外观风格、时间风格和整体一致性。每个名字背后都有适合它的测试提示词,而不是把任意业务视频塞给 16 个评测器后就获得同等有效的解释。官方维度与分组常量 VBench 的方法论文同时组织维度、提示词和人类偏好验证;自动分数与人的判断存在经验上的相关性,不等于对所有新模型和新业务场景都有校准保证。工程应用还要保留完整输入清单、逐视频结果与失败原因,才能知道一个平均分究竟来自哪些样本。原始 VBench 方法论文 5.2 三个时序维度各用了什么 vbench/subject_consistency.py#subject_consistency 对每帧提取并归一化 DINO 特征,计算与邻帧及首帧的非负余弦相似度,正是第 3.3 节的结构。它处理的是图像特征,不是本文的掩码 RGB,也不是人脸跟踪系统。在单进程代码中总体分数按实际帧对数累加;多进程汇总分支对逐视频分数取平均。各视频帧数相同时二者一致,变长样本时要额外核对聚合口径。 vbench/dynamic_degree.py#DynamicDegree 使用 RAFT 光流。对相邻抽样帧,取光流模长最大的 5% 像素的平均值,与按短边尺寸缩放的阈值比较;超过阈值的帧对数量达到与抽样帧数相关的要求,视频被判为动态。固定实现从 MP4 约按 8 fps 抽样,阈值为 $6\min(H,W)/256$,计数门槛为 $\mathrm{round}(4N/16)$,$N$ 是抽样后的帧数。最终对逐视频布尔值取平均,因此它更接近“被判为动态的视频比例”,不能当成平均光流速度或动作正确率。官方 dynamic_degree.py vbench/motion_smoothness.py#MotionSmoothness.motion_score 用 AMT 插帧:保留偶数索引帧,预测夹在中间的帧,再与原视频相应奇数索引帧比较像素绝对误差,并用 $1-\mathrm{MAE}/255$ 转成分数。它衡量插帧模型对时间连续性的解释程度,不是质心二阶差分。遮挡、大动作、风格变化及插帧模型能力都会影响分数。官方 motion_smoothness.py vbench/temporal_flickering.py#cal_score 直接对相邻帧像素差做归一化,并在代码中明确要求静态视频。这个前提解决了第 3.1 节的混淆:如果测试提示词本来允许大幅运动,移动的边缘会进入像素差,就不能把低分全部归因于闪烁。本文运动补偿实验是教学扩展,不是官方 temporal flickering 的计算方法。官方 temporal_flickering.py 5.3 总分先归一化,再分组加权 设第 $j$ 维原始分数为 $r_j$,官方常量给出的锚点为 $l_j,u_j$,该维权重为 $w_j$。固定版本的 get_nomalized_score 按下面的线性映射计算加权分数: $$n_j=\frac{r_j-l_j}{u_j-l_j},\qquad Q=\frac{\sum_{j\in\mathcal{Q}}w_j n_j}{\sum_{j\in\mathcal{Q}}w_j},\qquad C=\frac{\sum_{j\in\mathcal{C}}w_j n_j}{\sum_{j\in\mathcal{C}}w_j},\qquad F=\frac{4Q+C}{5}$$ $\mathcal{Q}$ 是上述 7 个质量维度,$\mathcal{C}$ 是上述 9 个条件维度;这里 $C$ 表示条件组分数,不是前文图像通道数。动态程度的 $w_j=0.5$,其余维度为 1;质量组总权重为 6.5,条件组为 9。锚点来自版本内固定常量,不是每次提交动态取最小最大值,也不是把 16 个原始百分数直接平均。官方总分函数 例如运动平滑度的锚点是 0.706 与 0.9975,外观风格的锚点是 0.0009 与 0.2855。相同的原始分数变化,经不同区间映射后幅度不同。这个版本没有把归一化结果截断到 [0,1];用合成原始输入 0.5 调用官方运动平滑度归一化路径,实际返回 −0.706689537。负值表示低于所用锚点,不表示执行错误,也不能擅自裁成零后仍称为同一协议。 我们把固定源码的四个纯聚合函数取出实际执行,同时构造两组“假想归一化维度向量”做反例:A 所有维度为 0.8;B 只把运动平滑度降低 0.08、成像质量提高 0.12,其余保持不变。官方聚合函数给出总分 0.800000 → 0.804923,虽然平滑度下降,总分仍上升。这些是合成输入上的权重算术验证,不是真实模型的 VBench 成绩。 这也给“总分不变”划出准确边界:它约束一个加权线性组合,不约束每个维度。若推理加速特别容易损伤时间连续性,就应预先把主体一致性、平滑度等相关维度设为单独验收项,不能等待总分出来后再挑对方案有利的指标解释。 06. 代价与边界 6.1 自动评测省了什么,又遗漏什么 自动化可以重复处理较多样本,给回归检查提供稳定入口,并把某些故障定位到相应维度;代价是依赖特征器、检测器或插帧模型。换权重、帧率、尺寸或解码方式,可能改变结果。镜头切换会影响一致性,运镜可能触发动态判定,插帧困难可能拉低平滑度,复杂画风可能影响检测,这些都需要回到视频和任务本身解释。 真实生成任务也不是所有维度都越高越好。静态产品展示不必追求动态比例,镜头切换不应被无条件当作背景故障,剧情里允许角色换装,恐怖题材可能需要闪光。这些需求应在测试集设计时分层,明确哪些维度适用。按官方任务跑公开基准时尊重官方协议;按业务任务做验收时明确命名为业务评测,不把自选提示词和改过阈值的数值混成官方榜单。 6.2 把人工验收写成可执行的协议 下面是一套建议协议,本文没有执行真人盲评,也没有声称获得人类偏好结果。先锁定目标任务,例如人物近景、复杂手部动作、运镜、长时身份保持;固定任务比例、提示词、生成次数、分辨率、帧率和时长。A、B 对同一 prompt 生成成对样本,全部纳入样本清单,失败和空视频也按预先规定计入,避免只挑好看的样本。 展示时隐藏模型名和方案信息,随机交换左右位置,并保存交换映射,确保统计时能恢复 A、B 身份。让标注者分别判断“身份保持”“运动自然”“动作符合提示词”和“整体可用”,提供 A 好、B 好、平局以及无法判断的选项。先用一小组示例统一判定标准,给正常播放速度与重复观看机会;不要用截帧替代视频,也不要把每个维度的问题写成“哪个更好看”。 定义一次成对判断 $y$:B 胜为 1,平局为 0.5,A 胜为 0。无法判断需要单独报告比例,不能事后当平局。对每个 prompt 的 seed 和标注者先按预先规则汇总,再按 prompt 计算偏好均值并进行分组 bootstrap。如果同一批标注者参与很多任务,还要承认跨任务的标注者相关性;可以采用按任务和标注者的双重重采样,或另作标注者层面的敏感性分析。 包含平局时,$y$ 不再是普通伯努利变量,所以不能把半胜计数直接塞进标准二项区间而不解释假设。应报告胜、负、平局、无法判断、任务数、标注者数与置信区间,结合具体失败类型读结果。多人标注可以减少单人的偶然判断,但“多数人同意”仍取决于任务代表性和问法;它不能替代目标用户的实际可用性要求。 6.3 “不退化”需要事先定义容忍幅度 若目标是证明加速后质量没有明显损失,应在实验前为重要维度定义最小可接受差值 $-\epsilon$。对越高越好的指标,只有差值区间下界高于 $-\epsilon$ 时,才有相应证据支持这个任务分布上的非劣结论。区间跨过零只说明优劣尚不清楚,不自动证明两者相等。本文合成实验只示范区间计算,不替任何真实产品选择 $\epsilon$。 同样,显著的小幅提升不一定有实际价值。验收应同时考虑效果大小、故障严重程度和速度收益。例如少量严重换脸不能被许多轻微清晰度改善完全抵消,应该设置单独的失败率或人工否决条件。自动维度、人工偏好和关键故障率共同提供证据,任何一个都不是最终业务决策的全权替代。 07. 经典论文脉络 Towards Accurate Generative Models of Video: A New Metric & Challenges,1812.01717:提出 FVD,用视频表征把时间信息引入分布比较;它延续了图像分布距离思路,但不能逐故障诊断。 Emerging Properties in Self-Supervised Vision Transformers,2104.14294:DINO 提供可用于相似度计算的自监督视觉表征,是理解主体一致性评测器的背景材料;它本身不是视频评测基准。 VBench: Comprehensive Benchmark Suite for Video Generative Models,2311.17982:把评测组织为细分维度、对应提示词及自动方法,并以人类偏好检验对齐,适合诊断早期视频生成的不同短板。 VBench++: Comprehensive and Versatile Benchmark Suite for Video Generative Models,2411.13503:扩展图生视频及更丰富的评测设置与可信性范围;使用时应核对适用任务和专门入口。 VBench-2.0: Advancing Video Generation Benchmark Suite for Intrinsic Faithfulness,2503.21755:关注更复杂的内在真实性问题,说明高基础技术质量仍不足以概括物理、常识和复杂动作能力。 这条脉络不是“新论文让旧指标作废”,而是不断增加可以提出的问题。FVD 适合分布层面的比较,原始 VBench 适合分维度诊断,新一代基准增加更深的能力检查;人工验收仍负责特定业务能否交付。 08. 常见误解 误解一:相邻帧差越小,视频越好。 冻结视频为零,正常平移却非零。只有在静态测试前提下,像素差才更接近闪烁诊断;不能用它无条件惩罚动态场景。 误解二:动态程度高就说明动作自然。 抖动、运镜和正确动作都可能产生运动;运动存在与运动是否符合要求是不同问题。本文最动态的样本,恰好是明显抖动的样本。 误解三:主体一致性高就说明人物身份可靠。 高分是所选特征器下的相似性证据,不能替代局部身份核验。本文颜色不变时,抖动样本照样接近满分;真实场景还会混入背景和视角因素。 误解四:VBench 总分是 16 维的简单平均。 固定版本先做锚点归一化,动态程度权重是 0.5,质量与条件组再以 4:1 合成。改变归一化范围或补上 clipping,都改变了协议。 误解五:置信区间跨过零,就证明加速没有损失。 没有检测出差异可能是数据不足;非劣结论还需要事前容忍幅度。扩大帧数不能代替扩大独立任务数。 误解六:玩具实验跑通,就复现了 VBench。 本文只验证数学机制与统计流程,没有运行官方深度模型评测器,也没有真实生成模型的分数;完整基准复现还需要指定权重、官方提示词和严格预处理。 09. 动手验证 从文末复制 video_metrics_lab.py 与 make_figures.py 到同一个 code/ 目录,安装 numpy matplotlib,依次运行: python code/video_metrics_lab.py python code/make_figures.py 脚本以所在文件推断文章目录,不依赖当前工作路径;放在 code/ 时输出保存在文章目录的 _evidence/,图片在 figures/;直接把两份脚本放在普通目录时,则统一写入该目录下的 video_metrics_results/。预期看到 assertions: passed、五组合成数据结果和上面的 bootstrap 区间。修改内容后数值自然会变化,应重新运行并保存新的输出,不能继续抄用旧数字。 做三个小实验:把冻结样本与正常移动交换查看,确认单独平滑度无法排序;加上 --jitter-amplitude 1,把抖动幅度从 3 改为 1,观察运动量与二阶差分的变化;加上 --repair-scale 1,让 A、B 完全同轨迹,确认成对差值与区间都变为零。最后这个构造验证的是代码自洽,不意味着真实实验的同等质量可以这样证明。脚本会保存本次参数;这些参数实验会更新输出文件,运行默认命令可以恢复正文的基线结果。 再把每任务 seed 数增加但保持任务数不变,思考它减少的是生成随机性还是任务覆盖误差。两种不确定性来自不同层级,应该分别设计样本量。要进一步复现官方分数,先安装固定版本官方仓库,核对 checkpoint、提示词集、视频清单与各维度预处理;本文 CPU 脚本不承担这一功能。 10. 延伸阅读 先读 FID / CLIP Score 到底测了什么,理解特征空间、分布距离和有限样本偏差;再回到 AIGC 基本功知识树,寻找视频自回归、世界模型和推理加速的相邻主题。 读视频加速论文时,把“质量保持”拆成可核对的问题:用了哪版基准、哪些任务、哪些维度、多少独立样本、什么聚合与区间;读世界模型时,增加动作可控性、长时记忆和因果响应,不能只沿用短视频的技术质量分数。评测的价值在于让失败可见,并让下一次改进有明确目标。 附录:完整代码 09 节用到的脚本全文如下(video_metrics_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 video_metrics_lab.py """CPU synthetic video diagnostics. These are NOT official VBench scores.""" import argparse import json from pathlib import Path import numpy as np SCRIPT_DIR = Path(__file__).resolve().parent ROOT = SCRIPT_DIR.parent if SCRIPT_DIR.name == "code" else SCRIPT_DIR / "video_metrics_results" def render_video(positions, colors, brightness=None): """Render integer-position disks into float RGB frames [T, H, W, C].""" positions = np.asarray(positions) colors = np.asarray(colors) t = len(positions) frames = np.full((t, 48, 64, 3), 0.08, dtype=np.float64) yy, xx = np.mgrid[:48, :64] for i in range(t): mask = (xx - positions[i, 0]) ** 2 + (yy - positions[i, 1]) ** 2 <= 25 frames[i, mask] = colors[i] if brightness is not None: frames = np.clip(frames + np.asarray(brightness)[:, None, None, None], 0, 1) return frames def measure_video(frames): """Known-scene segmentation and color features, with no learned model.""" yy, xx = np.mgrid[:frames.shape[1], :frames.shape[2]] centers, features = [], [] for frame in frames: mask = frame.max(axis=-1) > 0.35 if not mask.any(): raise ValueError("Synthetic object disappeared from the frame") centers.append([xx[mask].mean(), yy[mask].mean()]) color = frame[mask].mean(axis=0) features.append(color / np.linalg.norm(color)) centers = np.asarray(centers) features = np.asarray(features) adjacent = np.maximum(0, np.sum(features[1:] * features[:-1], axis=1)) anchored = np.maximum(0, features[1:] @ features[0]) speed = np.linalg.norm(np.diff(centers, axis=0), axis=1) acceleration = np.linalg.norm(np.diff(centers, n=2, axis=0), axis=1) residuals = [] for i in range(1, len(frames)): shift = np.rint(centers[i] - centers[i - 1]).astype(int) aligned = np.roll(frames[i - 1], (shift[1], shift[0]), axis=(0, 1)) residuals.append(np.abs(frames[i] - aligned).mean()) return { "pixel_mae": float(np.abs(np.diff(frames, axis=0)).mean()), "aligned_mae": float(np.mean(residuals)), "motion_px_per_frame": float(speed.mean()), "acceleration_px_per_frame2": float(acceleration.mean()), "toy_smoothness": float(np.exp(-acceleration.mean())), "toy_identity": float(((adjacent + anchored) / 2).mean()), }, centers def make_examples(jitter_amplitude=3): t = 25 positions = np.stack([np.arange(t) + 16, np.full(t, 24)], axis=1) red = np.tile([0.85, 0.12, 0.12], (t, 1)) jitter = positions.copy() jitter[:, 0] += jitter_amplitude * np.where(np.arange(t) % 2 == 0, 1, -1) changed = red.copy() changed[t // 2:] = [0.12, 0.85, 0.12] return { "smooth": render_video(positions, red), "freeze": render_video(np.tile(positions[0], (t, 1)), red), "jitter": render_video(jitter, red), "flicker": render_video(positions, red, 0.08 * (np.arange(t) % 2)), "identity_change": render_video(positions, changed), } def paired_bootstrap(a, b, seed=20261008, replicates=10000): """Resample prompts, retaining all paired seeds within each prompt.""" if a.shape != b.shape or a.ndim != 2: raise ValueError("Expected equally shaped arrays [prompts, paired_seeds]") delta = (b - a).mean(axis=1) rng = np.random.default_rng(seed) indices = rng.integers(0, len(delta), size=(replicates, len(delta))) boot = delta[indices].mean(axis=1) ci = np.quantile(boot, [0.025, 0.975]) return delta, boot, { "prompts": len(delta), "seeds_per_prompt": a.shape[1], "replicates": replicates, "mean_b_minus_a": float(delta.mean()), "percentile_95_ci": ci.tolist(), } def make_paired_metrics(repair_scale=0.65): """A controlled trajectory repair, with prompt-level difficulty shared.""" rng = np.random.default_rng(17) difficulty = rng.uniform(0.4, 1.2, (24, 1)) seeds = rng.uniform(0.8, 1.2, (24, 3)) t = np.arange(25) a = np.empty((24, 3)) b = np.empty_like(a) for p in range(24): for s in range(3): phase = rng.uniform(0, np.pi) wiggle = np.sin(0.9 * t + phase) * difficulty[p, 0] * seeds[p, s] for out, scale in [(a, 1.0), (b, repair_scale)]: trajectory = t + scale * wiggle acceleration = np.abs(np.diff(trajectory, n=2)).mean() out[p, s] = np.exp(-acceleration) return a, b def illustrative_weight_tradeoff(): """Use official aggregation weights on invented normalized vectors.""" quality_weights = np.array([1, 1, 1, 1, 1, 1, 0.5]) qa = np.full(7, 0.8) qb = qa.copy() qb[3] -= 0.08 qb[5] += 0.12 sa = sb = np.full(9, 0.8) score_a = (4 * np.average(qa, weights=quality_weights) + sa.mean()) / 5 score_b = (4 * np.average(qb, weights=quality_weights) + sb.mean()) / 5 return {"synthetic_normalized_only": True, "total_a": score_a, "total_b": score_b, "smoothness_delta": qb[3] - qa[3]} def main(): parser = argparse.ArgumentParser(description=__doc__) parser.add_argument("--jitter-amplitude", type=int, default=3) parser.add_argument("--repair-scale", type=float, default=0.65) args = parser.parse_args() if not 0 <= args.jitter_amplitude <= 8 or not 0 <= args.repair_scale <= 1: parser.error("Require jitter amplitude in [0,8] and repair scale in [0,1]") evidence = ROOT / "_evidence" evidence.mkdir(parents=True, exist_ok=True) videos = make_examples(args.jitter_amplitude) metrics = {name: measure_video(video)[0] for name, video in videos.items()} assert metrics["freeze"]["toy_smoothness"] == 1.0 assert metrics["freeze"]["motion_px_per_frame"] == 0.0 assert metrics["smooth"]["pixel_mae"] > 0 assert metrics["smooth"]["aligned_mae"] == 0 assert metrics["jitter"]["toy_identity"] > 0.999 if args.jitter_amplitude == 3: assert metrics["jitter"]["toy_smoothness"] < 0.01 assert metrics["identity_change"]["toy_identity"] < 0.9 a, b = make_paired_metrics(args.repair_scale) delta, boot, comparison = paired_bootstrap(a, b) if args.repair_scale < 1: assert comparison["percentile_95_ci"][0] > 0 else: assert np.all(delta == 0) and np.all(boot == 0) result = {"not_official_vbench": True, "experiment": {"jitter_amplitude": args.jitter_amplitude, "repair_scale": args.repair_scale}, "shape": list(videos["smooth"].shape), "range": [float(videos["smooth"].min()), float(videos["smooth"].max())], "examples": metrics, "paired_comparison": comparison, "weight_tradeoff": illustrative_weight_tradeoff()} payload = json.dumps(result, ensure_ascii=False, indent=2) (evidence / "lab_outputs.json").write_text(payload + chr(10), encoding="utf-8") np.savez(evidence / "bootstrap_samples.npz", a=a, b=b, delta=delta, boot=boot) print(payload) print("assertions: passed (mechanism checks on synthetic data)") if __name__ == "__main__": main() make_figures.py """Create diagrams from the CPU synthetic experiment, without model weights.""" import os import tempfile from pathlib import Path os.environ.setdefault("MPLCONFIGDIR", str(Path(tempfile.gettempdir()) / "vbench_mpl")) import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from video_metrics_lab import make_examples, measure_video, make_paired_metrics, paired_bootstrap SCRIPT_DIR = Path(__file__).resolve().parent ROOT = SCRIPT_DIR.parent if SCRIPT_DIR.name == "code" else SCRIPT_DIR / "video_metrics_results" plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 140 plt.rcParams["savefig.dpi"] = 140 def main(): folder = ROOT / "figures" folder.mkdir(parents=True, exist_ok=True) videos = make_examples() names = list(videos) labels = ["平滑移动", "冻结", "来回抖动", "亮度闪烁", "主体变色"] fig, axes = plt.subplots(5, 5, figsize=(12, 9)) for row, name in enumerate(names): for col, frame in enumerate([0, 1, 2, 12, 24]): axes[row, col].imshow(videos[name][frame]) axes[row, col].set_xticks([]) axes[row, col].set_yticks([]) if row == 0: axes[row, col].set_title(f"第 {frame} 帧") if col == 0: axes[row, col].set_ylabel(labels[row], rotation=0, labelpad=38) fig.suptitle("图 1:一个变化只对应一个故障?先看五组反例(合成视频)") fig.tight_layout(rect=(0.04, 0, 1, 0.95)) fig.savefig(folder / "counterexample_frames.png") plt.close(fig) fig, axes = plt.subplots(1, 3, figsize=(13, 4)) values = [measure_video(videos[name])[0] for name in names] for ax, key, label in zip(axes, ["motion_px_per_frame", "toy_smoothness", "toy_identity"], ["运动量:像素 / 帧", "玩具平滑度", "玩具身份一致性"]): ax.bar(labels, [v[key] for v in values], color=["#2872b8", "#8594a3", "#e79c3a", "#bd6684", "#7a69bc"]) ax.tick_params(axis="x", rotation=35) ax.set_title(label) ax.grid(axis="y", alpha=0.2) fig.suptitle("图 2:冻结最平滑,抖动最动态;三个量必须一起读(非 VBench)") fig.tight_layout() fig.savefig(folder / "metric_tradeoffs.png") plt.close(fig) a, b = make_paired_metrics() delta, boot, comparison = paired_bootstrap(a, b) fig, axes = plt.subplots(1, 2, figsize=(12, 4)) axes[0].bar(np.arange(len(delta)), delta, color="#2872b8") axes[0].set_xlabel("合成 prompt 编号;每个 prompt 保留 3 对 seed") axes[0].set_ylabel("玩具平滑度 B − A") axes[0].set_title("先配对,再对 prompt 求平均") axes[1].hist(boot, bins=40, color="#2872b8", alpha=0.8) for bound in comparison["percentile_95_ci"]: axes[1].axvline(bound, color="#e79c3a", linestyle="--") axes[1].set_xlabel("以 prompt 为单位的 bootstrap 均值差") axes[1].set_ylabel("重复次数") axes[1].set_title("虚线为 95% 百分位区间;仅对应这组合成数据") fig.suptitle("图 3:不把相关的 72 个视频当作 72 个独立任务") fig.tight_layout() fig.savefig(folder / "paired_bootstrap.png") plt.close(fig) print("figures: counterexample_frames.png, metric_tradeoffs.png, paired_bootstrap.png") if __name__ == "__main__": main()
-
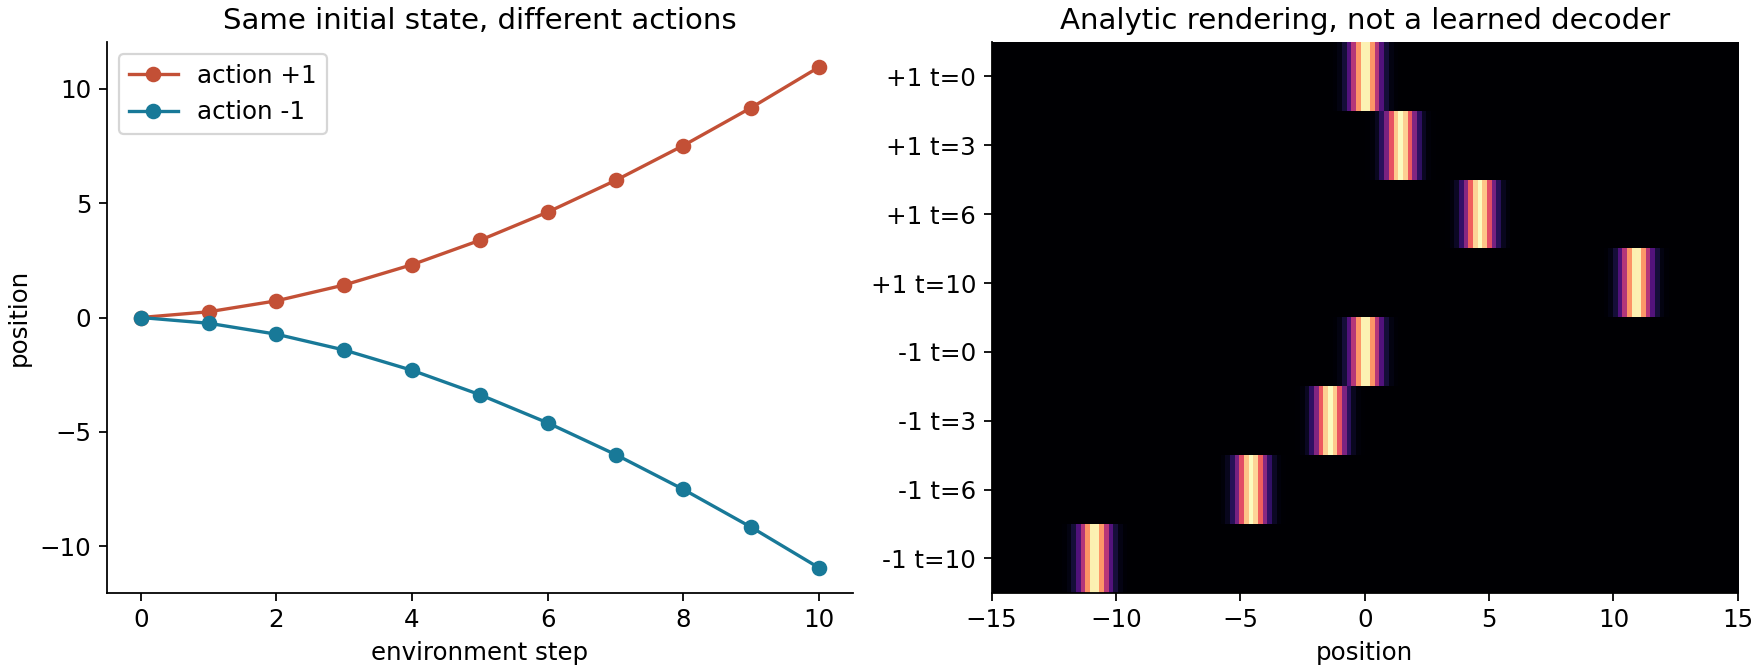
AIGC 基本功|世界模型:从视频生成到可交互环境-WorldModel AIGC 基本功|世界模型:从视频生成到可交互环境-WorldModel 从同一张画面出发,按左键和按右键,未来应该不同。本篇沿着动作条件、状态记忆、长程误差和模型内规划这条线,把「能生成视频」到「能当环境使用」之间的距离拆开。附录提供无需权重、只用 NumPy 与 matplotlib 的完整 CPU 实验;实验学习的是合成环境的二维状态动力学,不是训练好的视觉世界模型。 01. 为什么需要它 想象一个球正向墙壁运动。视频生成器看过很多相似片段,接下来画出球碰墙反弹,画面连贯,观看体验很好。现在给球一个向左的控制指令,生成器却继续播原来的反弹轨迹。它预测了「录像通常怎样继续」,但没有回答「我采取这个动作以后会怎样」。用于动画制作时,这可能只需要换提示词;用于训练控制器时,这是环境接口失效,因为动作与结果之间的联系已经被切断。 更隐蔽的失败是每一步都很准,连续走几十步却越来越离谱。本篇实际运行的小实验中,动作条件模型在独立测试集上的单步状态均方误差为 5.605065e-08,但连续预测到第 60 步时升到 0.492476。这些是二维合成动力系统、固定随机种子下的实测数值,不是任何论文的游戏成绩。误差增长还伴随着状态离开训练范围,后面会把两种原因分开解释。一个漂亮的单步损失,不能直接当作长程交互能力的证书。 世界模型要服务的用途很具体:让智能体在真正执行动作前,低成本地比较几种可能未来;让昂贵的机器人交互、稀缺的游戏样本被重复利用;或者让用户在生成的环境里逐帧改变行动。如果目标只是导出一段不可修改的短视频,动作接口、奖励预测、终止处理可能都不是必需组件。只有当未来要随行动改变,或者模型将被控制器反复调用,这些要求才变成核心问题。 02. 最小可用理解 第一,世界模型学习的是「给定过去和动作,未来的状态或观测如何变化」,一个常见形式是条件分布 $p_{\theta}(o_{t+1}\mid o_{\leq t},a_{\leq t})$。其中 $o$ 是观测,$a$ 是动作,$\theta$ 是模型参数,下标 $t$ 表示环境中的时间步。 第二,画面不一定等于状态:同一张球的位置图,可能对应向左或向右的速度。因此模型要从历史构造记忆,必要时还要表达不确定性;把过去压缩成潜变量只是实现方式之一。 第三,模型的使用方式会改变它需要满足的质量要求。拿它做视频续写,需要合理的观测序列;拿它做规划或训练策略,还需要动作响应、奖励与终止语义、长程误差和真实环境中的任务效果。本文用显式位置与速度替代视觉编码,先把这个闭环跑通,再对照真实扩散世界模型的接口。 可以把系统想成三个角色:表示模型保存当前可用信息,动力学模型回答动作后的变化,控制器根据目标选择动作。三个角色可以由不同网络实现,也可以在一个大型生成模型里合并。名字并不决定能力;是否能从相同历史分叉出可信、可控的未来,才是更有用的判断问题。 03. 数学推导 从环境状态到可用记忆 设真实状态为 $s_t$,动作是 $a_t$,环境转移规律为 $P(s_{t+1}\mid s_t,a_t)$,观测规律为 $P(o_t\mid s_t)$。状态包括影响未来的一切信息,例如物体位置、速度和遮挡后的位置;相机给出的图像只是其中一部分。所谓马尔可夫性,是在知道完整状态与当前动作后,更早的历史不再为下一步增加信息。实际智能体往往拿不到完整状态,所以需要保存历史 $H_t=(o_0,a_0,o_1,\ldots,a_{t-1},o_t)$。 理论上可以保留一个信念分布 $b_t(s)=P(s_t=s\mid H_t)$。新动作执行后,先用转移规律把每个可能状态推进一步,再用新观测筛掉不吻合的状态: $$b_{t+1}(s')\propto P(o_{t+1}\mid s')\int P(s'\mid s,a_t)b_t(s)ds.$$ 这里 $s'$ 是下一步候选状态,积分把当前所有可能状态的贡献相加,比例符号表示最后还要归一化。这个式子解释了为什么只记一张图片可能不够,也解释了「模型自己想象」与「看见真实新观测」的区别:前者只做预测,后者还能修正记忆。神经世界模型一般不会显式积分,而是用递归状态、历史 token 或有限帧堆叠近似这个信息更新过程。近似是否足够,要由具体任务判断。 假设用编码器或历史聚合器构造 $z_t=E_{\phi}(H_t)$,$z_t$ 就是模型可访问的表示,$\phi$ 是表示模块参数。动作条件动力学、观测生成、奖励与终止预测可以写成: $$z_{t+1}\sim p_{\theta}(z_{t+1}\mid z_t,a_t),\quad o_{t+1}\sim p_{\psi}(o_{t+1}\mid z_{t+1}),\quad (r_t,d_{t+1})\sim p_{\omega}(r_t,d_{t+1}\mid z_t,a_t,z_{t+1}).$$ $r_t$ 表示这次转移的奖励,$d_{t+1}$ 表示下一步是否结束,$\psi$ 与 $\omega$ 分别是解码和任务预测参数。这是一个便于分析的分解,不要求所有模型都采用这种条件独立结构;图像空间扩散模型也可以直接生成下一张图。奖励头不是定义世界模型的唯一条件,却是把模型作为强化学习环境使用时常见的必要接口。 为什么动作一定要进入条件 当训练数据由行为策略 $\mu(a\mid H_t)$ 收集,但预测器忽略动作时,它学到的是混合后的未来: $$P(o_{t+1}\mid H_t)=\sum_a P(o_{t+1}\mid H_t,a)\mu(a\mid H_t).$$ 求和把向左、向右和不动的后果混在一起。这个模型可能很好地复现旧策略拍出的录像,却无法直接回答指定动作的后果。如果下一帧预测采用平方误差,最优输出还是条件均值:两种互斥未来可能被平均成一个并不存在的中间结果。换成更强的生成器可以表达多个未来,但若缺少动作条件,它仍然不知道用户选中了哪个分支。 动作标签也不自动保证因果正确。若训练里「向左」只在道路左侧出现,模型可能同时利用背景位置推测动作效果;到了另一侧,控制就会错。要接近可干预的接口,需要覆盖相关的状态与动作组合、准确的时间对齐,并排查相机变化等混杂因素。这是数据与评估的要求,不能靠把动作 embedding 拼进网络就宣告解决。 用最简单的系统看清参数 本篇环境取 $s_t=(p_t,v_t)$,其中 $p_t$ 为位置,$v_t$ 为速度,动作 $a_t\in\{-1,0,1\}$ 是加速度指令。一步更新定义为: $$v_{t+1}=0.92v_t+0.25a_t,\quad p_{t+1}=p_t+v_{t+1}=p_t+0.92v_t+0.25a_t.$$ 系数 0.92 让旧速度逐渐衰减,0.25 决定控制力度,时间步长被定义为一个单位。先更新速度再更新位置,避免在公式与代码之间偷偷换成另一种积分顺序。虽然系统很小,它已经包含了惯性、动作后果以及位置累积。 把每条训练记录写成行向量 $\varphi_i=(p_i,v_i,a_i,1)$,最后的常数项让模型能够学习偏置。把所有 $N$ 条特征叠成 $\Phi\in\mathbb{R}^{N\times4}$,下一步状态叠成 $Y\in\mathbb{R}^{N\times2}$,待学习权重为 $W\in\mathbb{R}^{4\times2}$。于是预测是 $\widehat{Y}=\Phi W$。这只是线性动力学回归,不包含视觉编码器、神经网络或潜动作发现。 假设每个目标维度存在同方差高斯测量噪声,最大化条件似然等价于最小化平方误差。加入权重惩罚后,用以下目标拟合: $$L(W)=\|\Phi W-Y\|_F^2+\lambda\|W\|_F^2.$$ $\|\cdot\|_F^2$ 是矩阵中所有元素平方之和,$\lambda=10^{-4}$ 是本实验的岭惩罚强度。这个定义使用误差总和而不是平均值,所以换训练样本数时,保持相同的 $\lambda$ 不等于保持相同的相对正则强度。对 $W$ 求导,误差项给出 $2\Phi^{\top}(\Phi W-Y)$,惩罚项给出 $2\lambda W$;令梯度为零得到: $$\left(\Phi^{\top}\Phi+\lambda I\right)W=\Phi^{\top}Y.$$ $I$ 是四阶单位矩阵。左侧矩阵在正的岭惩罚下可逆,但代码用 np.linalg.solve 解方程,不显式求逆,以减少不必要的数值误差。W 的第一行对应位置、第二行对应速度、第三行对应动作、第四行对应常数;理想的无噪声权重分别是 (1,0)、(0.92,0.92)、(0.25,0.25)、(0,0)。 为什么一步误差会累积 真实动力学记为 $f$,学到的动力学记为 $\widehat f$。给它们相同动作序列,从同一初始状态出发。自由滚动误差定义为 $e_t=\|\widehat s_t-s_t\|$。在一步中加减 $f(\widehat s_t,a_t)$,再使用三角不等式: $$e_{t+1}\leq\|\widehat f(\widehat s_t,a_t)-f(\widehat s_t,a_t)\|+\|f(\widehat s_t,a_t)-f(s_t,a_t)\|.$$ 如果在滚动真正到达的区域内,模型误差上界为 $\varepsilon$,真实动力学对状态的 Lipschitz 常数为 $K$,第二项至多为 $Ke_t$,于是得到 $e_{t+1}\leq\varepsilon+Ke_t$。从 $e_0=0$ 递推: $$e_H\leq\varepsilon\sum_{j=0}^{H-1}K^j.$$ $H$ 是滚动长度。如果 $K<1$,上界趋向有限值;如果 $K=1$,上界线性增长为 $H\varepsilon$;如果 $K>1$,这个粗上界可能快速增长。这是带条件的范数上界,不是所有世界模型误差曲线的精确规律,也不能把实验中的均方误差直接代进去。训练集上的平均误差很小,并不说明离开训练分布后仍有同一个 $\varepsilon$。 Teacher forcing 每一步用真实状态作为输入,相当于不断把前面输入偏差清零;自由滚动把上一步预测当作下一步输入,偏差会反馈。两者可以用于同一个训练好的模型,但测量的风险不同。后面的误差图将把它们放在一起,让「独立单步测试」「沿真实轨迹逐步预测」「连续自己预测」三种条件不再混淆。 从预测到规划 模型能够回答后果后,还缺「哪个后果值得追求」。给定目标位置 $p^*=2$,定义一个有限长度动作序列的代价: $$J(a_{t:t+H-1})=\sum_{k=1}^{H}\left[(\widehat p_{t+k}-p^*)^2+0.5\widehat v_{t+k}^2+0.02a_{t+k-1}^2\right].$$ 第一项希望接近目标,第二项希望到达时不要带着很大的速度冲过去,第三项轻微惩罚控制力度。权重是教学实验的设计,不是论文超参数。动作离散且序列很多,我们用随机射击法:采样多条动作序列,在模型里逐条模拟,取代价最低的一条。 Model Predictive Control,也就是 MPC,不把这条计划全部执行完。它只执行最优候选的第一个动作,再读真实状态,用新的状态重新规划。每次与真实环境交互都给模型一次纠偏机会。这样的闭环通常能缓解长时间开环预测的问题,但无法消除模型对关键事件的系统性误判;如果短期内就把碰撞预测错,反复规划也可能反复犯错。 04. 代码实现 完整实现是附录中的 world_model_demo.py。只需 Python、NumPy 与 matplotlib,不需要下载数据、权重或游戏。脚本在运行时生成训练样本,拟合两个模型,执行长程滚动和 MPC,再生成三张图。随机种子为 20261008;本次环境为 NumPy 2.1.3 与 matplotlib 3.10.5,不同版本可能产生末位数值差异。 训练状态均匀采样在 [-1,1],动作在 -1、0、1 中随机选取。目标状态由真实动力学生成,再叠加标准差 0.01 的独立高斯噪声,模拟带噪监督记录。独立单步测试用另一批状态和动作,并以无噪声真实下一状态为目标,因此本文报告的测试误差不包含测量噪声的不可约下限。若直接拿有噪目标测试,这一误差的尺度会改变。 与前面的正规方程对应,核心拟合代码如下: import numpy as np def fit_model(s, a, next_s, use_action=True): action = np.asarray(a).reshape(s.shape[:-1] + (1,)) bias = np.ones(s.shape[:-1] + (1,)) columns = (s, action, bias) if use_action else (s, bias) phi = np.concatenate(columns, axis=-1) ridge = 1e-4 W = np.linalg.solve(phi.T @ phi + ridge * np.eye(phi.shape[-1]), phi.T @ next_s) return W s = np.array([[0.0, 0.0], [1.0, 0.2], [-1.0, -0.2], [0.5, -0.1]]) a = np.array([1, -1, 0, 1]) v_next = 0.92 * s[:, 1] + 0.25 * a next_s = np.stack((s[:, 0] + v_next, v_next), axis=-1) print("feature shape:", (len(s), 4)) print("W shape:", fit_model(s, a, next_s).shape) 这一小段可独立运行,输出特征 (4,4) 与权重 (4,2);它只示范拟合接口。下面的大样本数值来自完整脚本,不能用这四条示范记录替代。完整实验里,训练状态为 (4096,2),特征为 (4096,4),权重为 (4,2);128 条轨迹滚动 60 步,加上初始状态,得到 (61,128,2)。数组第一轴始终是环境时间,第二轴是轨迹,第三轴是位置与速度。 真实学习到的四行权重,保留六位小数为 (1.000380,0.000147)、(0.919667,0.920085)、(0.249902,0.249973)、(-0.000010,0.000090)。动作行接近理想值 0.25,说明模型学到了控制力度。位置行的速度输出却出现了一个很小的非零系数 0.000147,这会让位置反过来影响速度,而真实环境没有这种机制。看似无关紧要的参数泄漏,在长程位置越来越大时会被放大。 左图让两个模型副本从完全相同的初始位置与速度出发,分别连续接收 +1 与 -1;两条位置轨迹分开,动作改变了未来。右图把状态通过手写高斯亮点映射到图像,只用于显示分支。亮点图片既不是训练输入,也不是学习出来的解码结果,不能把它当作视觉生成质量证据。 无动作模型也用同一批训练记录拟合,但特征只保留位置、速度和常数。这次独立测试的动作条件单步 MSE 为 5.605065e-08,无动作单步 MSE 为 0.04053985。由于训练动作近似对称,忽略动作的最佳平方误差预测会接近「平均动作等于零」的未来。它不是完全不会动,而是无法可靠区分当前指令造成的偏移。 图的纵轴为状态 MSE,采用对数坐标,所以不同曲线的量级更容易比较。第 60 步,沿真实轨迹执行 teacher forcing 的误差为 3.021024e-05,自由滚动为 0.492476,无动作模型为 161.336796。图中还有一个专门的扰动对照:在学习后的速度特征行两个系数上都加 0.02,其第 60 步误差为 20.262952。这是人为破坏动力学参数的诊断实验,没有重新训练,也不是新的学习方法。 为什么 teacher forcing 的后期误差也高于独立单步测试?因为单步测试的位置仍在 [-1,1],长程真实轨迹的位置绝对值最大到了 52.139858。对真实输入预测消除了输入偏差反馈,却没有消除分布外外推。自由滚动还额外引入了预测状态反馈,因此更差。用同一个 MSE 名字展示指标时,必须同时交代输入分布和是否注入真实观测,否则读者会误以为是在测同一件事。 MPC 每步比较 512 条长度为 12 的动作序列,只执行最佳候选的第一个动作。35 次真实交互后,位置为 1.766138,速度为 -0.055751;执行过程中累计位置误差平方为 36.255730,一直不执行动作的同一指标为 560.0。这里后两个数只累计位置项,没有把规划目标中的速度与动作惩罚混进去。控制器明显接近了目标,但没有精确收敛;有限候选搜索与离散动作会留下残差,也可能出现左右切换。图上的偏差比把它描述为「成功到达」更诚实。 实验的价值是可定位:动作消融对应条件变量,参数扰动对应动力学误差,teacher forcing 对照对应输入分布,MPC 对应观测纠偏。完整输出还保存为 JSON 与 NumPy 数组,三张图直接由同一次运行生成,正文数字不依赖手工抄造的曲线。 05. 工业级实现对照 现实视觉世界模型不能直接读取位置与速度。本篇选择 DIAMOND 官方代码 做参照,并在 2026-10-08 实际下载、检查了提交 5bcd1599755b4f2fae8e5e079e02f0728e174965 的 Atari 主分支。以下链接固定到该提交,未来上游重构也不会改变它们指向的代码。这里只检查实现并验证了采样日程的算术;没有安装全套训练环境,也没有运行预训练 DIAMOND 游戏,因此不报告其推理速度、画面或任务分数。 最外层是 src/envs/world_model_env.py#WorldModelEnv。step 将当前动作写入动作缓存,再生成下一帧,预测奖励与结束标记,滚动观测缓存。如果回合结束或超过想象长度,还会重置对应环境。这里可以直接看到一个可交互生成器变成训练环境需要补上的工作:批量回合管理、终止与截断区别、重置条件、奖励和缓存对齐。仅把图像生成函数命名成环境,不会自动得到这些语义。 生成下一帧的是 src/models/diffusion/diffusion_sampler.py#DiffusionSampler.sample。它接收历史观测 prev_obs 与动作 prev_act,把历史帧的时间与通道合并,然后从噪声开始多次调用去噪器。这里有两个时间轴:一个是环境往前走一帧的 $t$,另一个是为这一帧逐步去噪的噪声尺度 $\sigma$。减少去噪步数可以减少每帧调用次数,但不等于环境历史变短。 为了验证源码中的数值约定,本次从固定版本提取了 build_sigmas 函数原样执行,只用 NumPy 适配其张量算术,没有加载网络。指定三步、最小噪声 0.002、最大噪声 5、幂指数 7 时,得到约 [5.0,0.283082,0.002,0.0];末尾的零是额外追加的终点。这只验证噪声日程计算,不能替代神经模型采样或证明三步足够完成任何任务。 真实默认配置 config/agent/default.yaml 中 num_steps_conditioning 为 4;这表示该配置用有限帧堆叠作为图像动力学的历史条件,不能据此宣称它具有任意长度的持久记忆。默认去噪组件也有自己的噪声缩放参数,它们与本文二维线性回归的岭惩罚不是同一个概念,不能把 toy 的超参数搬过去。 去噪器位于 src/models/diffusion/denoiser.py#Denoiser。compute_conditioners 随噪声尺度计算输入、输出和跳连缩放;compute_model_output 把噪声图、历史观测和动作传给内部网络。尤其值得读的是 forward:它复制观测序列,在每个训练位置生成去噪结果,并把结果写回 all_obs,让后续片段用到模型生成的上下文。这比只在真实前缀上优化独立下一帧,更直接面对自回归使用时的上下文偏差;具体训练流程仍要以该版本源码为准。 还有一个容易漏掉的细节:wrap_model_output 会裁剪并量化到 8 位图像尺度,再映射回归一化区间。因此模型输出、观测记录和下一轮输入的数值约定必须一致,不能把任意连续张量直接塞入缓存。本文状态模型没有像素量化,也没有卷积网络,它省略了视觉表示的损失、采样计算和多模态未来,只保留「动作进入预测」「预测反馈」「任务闭环」这三个结构。 为什么不用 Genie 的社区实现当工业锚点?本篇讨论的是 Genie 原论文 中的潜动作模型、视频 tokenizer 与动力学组合,没有将社区重写认定为官方复现。论文里的潜动作是从无动作标签视频中学习的离散接口;潜动作索引需要解释或映射,不能天然等同真实键盘动作。DIAMOND 的官方实现则给出了可检查的环境接口,适合把动作条件、去噪和回合管理连接起来阅读。 06. 代价与边界 世界模型把真实交互的一部分成本换成模型训练和想象计算。环境样本很昂贵时,这种交换可能有价值;如果已有便宜、精确的模拟器,增加一个有偏差的学习模型反而可能添负担。像素空间扩散能保留许多视觉细节,但每个环境步还要多次去噪;离散或连续潜空间更紧凑,但压缩可能漏掉任务关键细节。选择时要看任务需要的后果,而不能只根据生成画面是否细腻判断。 记忆也有账本。有限帧堆叠便宜,却可能忘记遮挡前出现的物体;递归状态节省历史存储,却可能因瓶颈丢信息;长上下文 token 保留更多过去,但推理延迟与缓存成本上升。检验记忆最直接的方法之一,是让两个状态具有相同当前画面、不同过去,并查看预测能否区分它们。例如球在遮挡物后从左侧进入还是从右侧进入,会改变重新出现的位置。只播放无长期遮挡的短片,不能证明这种记忆能力。 本实验还提示一个结构约束问题。真实系统的状态转移特征值为 1 与 0.92,学习后的值为 1.002029 与 0.918436。第一个值略微超过 1,和位置向速度泄漏一起,引入了真实系统没有的反馈。由这个现象可提出一个可检验的改进:强制速度更新不依赖绝对位置,把已知平移对称性写进模型。但「增加结构约束一定更好」不是通用结论;如果真实环境中有位置相关的力场,这个约束就会把需要学习的规律删掉。 随机性也要区分。观测里本来存在不可预测因素,是数据不确定性;模型没见过某类状态,是知识不足。前者需要合理的未来分布,后者更需要覆盖、估计和谨慎使用。每次采样出不同视频,不代表模型对分布外事件知道自己不确定。本文模型预测均值,没有学习方差,不能用它做风险敏感控制,也不能从它的多条随机动作轨迹估计模型置信度。 规划还有一个特别的风险:优化器会主动寻找模型中的漏洞。模型错误地相信「持续向右能穿过墙而不受罚」,控制器就可能偏爱这个在想象里得分很高的方案。预测误差要沿智能体真正访问的状态评估,任务成绩则必须回到真实环境检验。MPC 用新观测不断纠偏,策略在想象中训练后再真实测试,模型集成估计分歧,都是处理风险的工具;它们分别作用于不同环节,没有一个单独保证仿真到真实转移成功。 本文最小实现的边界应明确保留:状态完全可见、动力学线性、动作标注准确、无碰撞、无遮挡、无终止事件、奖励由作者手写。它证明这些接口能在一个小系统中相互配合,并展示失败如何出现;它没有证明在自然视频上自动学到物理规律,更没有证明模型拥有通用空间理解、完整因果模型或现实安全保证。 07. 经典论文脉络 World Models,1803.10122,2018。它用视觉压缩、时序概率模型与控制器连接感知和行动,并探索在模型生成的梦境里训练策略。值得带走的是表示、动力学、控制器的分工,以及模型漏洞会影响控制器这一问题;不要把特定环境里的转移结果泛化成任何生成器都能替代真实环境。 PlaNet:Learning Latent Dynamics for Planning from Pixels,1811.04551,2018 年首版。它把从图像学习潜动力学与在线潜空间规划连接起来,并关注多步预测。阅读时重点看「当前观测修正状态,然后再规划」的循环,它与本篇 MPC 的教学接口相邻;本文线性拟合不复现其神经潜状态模型。 Dreamer:Dream to Control,1912.01603,2019 年首版。它从潜空间想象轨迹学习行为,将价值与行为学习连接到世界模型。与每步重新搜索候选计划相比,这条路线关注如何把想象轨迹用于学习一个可快速执行的策略。两种用法都需要模型,不能因为有策略网络就把模型训练与策略训练混成一个目标。 Genie:Generative Interactive Environments,2402.15391,2024。它展示了从无真实动作标签的视频中学习潜动作接口,再通过视频 tokenizer 与动力学模型产生可交互观测的路线。这里新的问题是「如何从录像中发现可用控制变量」,并不意味着潜动作索引天然有真实操纵杆的语义。 DIAMOND:Diffusion for World Modeling: Visual Details Matter in Atari,2405.12399,2024。它把扩散预测用于世界模型,并提供官方可交互实现。这里的阅读重点是像素细节、条件遵循和逐帧采样怎样影响模型作为环境的使用;本篇不把论文发表时的排名描述为今天的最新水平,也不把不同任务与协议的分数横向混比。 这五篇可以按问题阅读,而不只是按年代记名词:先问是否有紧凑状态,再问如何从预测选动作,再问能否通过想象学习策略,接着问缺动作标签怎么办,最后问观测生成范式如何影响控制。大模型参数量、视频分辨率和推理帧率都是重要工程指标,但它们回答不了这条链上所有问题。 08. 常见误解 误解一:视频连续就是世界模型合格。 连续说明模型擅长某种观测分布;交互还需要在相同历史下响应不同动作。最小诊断是复制同一初始条件,控制随机性,分别施加两个动作,比较响应是否符合任务语义。变化太弱可能是条件被忽略,变化过强也可能是乱改场景,不能只看有没有差异。 误解二:单步 loss 很低,几十步一定准。 本文单步与长程实测已经给出反例。要同时检查是否持续注入真实观测、测试状态是否在训练范围内、预测误差是否影响下一个输入。否则「预测下一帧」和「自主滚动一整段」只是共用一个模型名,实际测试条件完全不同。 误解三:动作条件自动等于因果模型。 拼接动作提供了表达能力,没有替代数据覆盖、干预检验和时间同步。一个动作在数据里总伴随镜头移动时,模型可能只学会镜头响应,仍然忽略角色本身。潜动作学习还要额外确认潜变量表达的是可操控变化,而不是背景抖动。 误解四:潜变量越小,模型越高效越好。 压缩减少计算,但一个很小的目标、计分板变化或遮挡后的记忆都可能影响奖励。要检查任务相关信息能否从表示中恢复或影响预测;不能用重建图像整体看起来还行,代替对关键细节的测试。 误解五:梦境里得分高,真实环境自然也高。 控制器可能利用模型漏洞,数据分布也会随策略变化。应保持真实环境评估,并检查同一策略在真实与模型环境中的差距。本篇 MPC 的每个执行动作都通过手写真实动力学推进,报告的是这个合成真实环境里的轨迹,没有把模型内代价当实际成绩。 误解六:随机生成未来就等于估计了不确定性。 生成多样性、环境随机性和模型知识不足是不同问题。若模型对未见事件高度自信地生成错误画面,多次采样也未必暴露问题;需要专门的校准、覆盖和风险评估,不能只调采样温度。 09. 动手验证 把附录代码保存为 world_model_demo.py,安装 NumPy 与 matplotlib,然后运行以下命令。脚本会在指定目录创建 figures/ 与 _evidence/,输出 JSON 数值;无需联网即可重新生成三张图。 python -m pip install numpy matplotlib python world_model_demo.py --output-dir ./world_model_results 先原样运行一次,核对训练特征 (4096,4)、滚动状态 (61,128,2)、单步有动作误差约 5.61e-08、无动作误差约 0.04054。这些预期来自本文保存的实际运行;版本变化时允许末位差异。如果量级完全不同,先检查动作与目标是否按同一个时间步对齐,以及 true_step 的速度、位置更新顺序是否改了。 随后做三个独立改动,每次只改一个,并保留基准输出。第一,把训练目标噪声 0.01 改为零,观察学到的泄漏系数与长程误差是否下降;岭惩罚仍在,所以不应强求所有参数逐字等于理想值。第二,把训练状态的采样范围扩大,但保持测试协议与随机种子明确记录,观察 teacher forcing 后期误差与自由滚动误差怎样变化;不要预先假定二者会按相同比例改善。第三,把 MPC 里的候选条数从 512 改成 64,再改成 2048,比较实际执行轨迹与累计位置误差,同时记录运行耗时。候选数增加会增加计算,单个随机种子的成绩也不保证严格单调。 还可以做一个表示实验:让模型输入只有位置,不再提供速度,再用连续两帧的位置差构造速度估计。因为相同位置可能有不同速度,只有当前位置的预测会面对互斥未来;加入历史应改善可辨识性。这个扩展本篇没有运行,因此没有给出伪造数值;验证时要重新定义特征、拟合与测试,不能只删数组一列然后继续引用原文的结论。 读完图以后,写下四个答案:控制变量是否真的改变未来;误差增长来自输入反馈还是外推;真实新观测能纠正哪一部分;规划器怎样把模型误差变成错误选择。这四问比只核对脚本「能运行」更接近世界模型实验需要回答的问题。 10. 延伸阅读 回到 AIGC 基本功知识树,先读 自回归视频生成,理解时间因果掩码、逐帧生成和预测反馈,再把其中的条件变量从历史扩展到动作。 沿着树中的 VAE 与视觉 tokenizer 继续读,重点追问压缩是否保留控制相关信息;沿着 DDPM 与扩散数学继续读,区分噪声时间和环境时间,理解下一帧内部为何还要多步采样;沿着强化学习基础继续读,补齐奖励、折扣、终止与策略评估,再理解世界模型怎样参与行为学习。理解这三个接口后,阅读新的可交互生成论文,就能分辨它改进了观测生成、控制接口、记忆还是决策,而不会把所有能力都归到一个「世界模型」标签里。 附录:完整代码 09 节用到的脚本全文如下(world_model_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 world_model_demo.py """CPU toy: learn action-conditioned state dynamics, then roll out and plan. This is a synthetic state-space teaching experiment, not a visual world model. Run: python world_model_demo.py --output-dir ./world_model_results Dependencies: NumPy and matplotlib. No pretrained weights or network required. """ import argparse import json import os from pathlib import Path os.environ.setdefault("MPLCONFIGDIR", "/tmp/world_model_matplotlib") import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt def true_step(s, a): """s[..., 0] = position, s[..., 1] = velocity; a is acceleration command.""" velocity = 0.92 * s[..., 1] + 0.25 * np.asarray(a) position = s[..., 0] + velocity return np.stack((position, velocity), axis=-1) def features(s, a, use_action=True): action = np.asarray(a).reshape(s.shape[:-1] + (1,)) bias = np.ones(s.shape[:-1] + (1,)) columns = (s, action, bias) if use_action else (s, bias) return np.concatenate(columns, axis=-1) def fit_model(s, a, next_s, use_action=True): phi = features(s, a, use_action) ridge = 1e-4 regularizer = ridge * np.eye(phi.shape[-1]) W = np.linalg.solve(phi.T @ phi + regularizer, phi.T @ next_s) return W def model_step(s, a, W, use_action=True): return features(s, a, use_action) @ W def rollout(step, initial_s, actions): states = [np.asarray(initial_s).copy()] for action in actions: states.append(step(states[-1], action)) return np.stack(states) def evaluate_rollouts(W, W_no_action, rng): count, horizon = 128, 60 initial_s = rng.uniform(-1, 1, size=(count, 2)) actions = rng.integers(-1, 2, size=(horizon, count)) truth = rollout(true_step, initial_s, actions) learned = rollout(lambda s, a: model_step(s, a, W), initial_s, actions) no_action = rollout(lambda s, a: model_step(s, a, W_no_action, False), initial_s, actions) W_biased = W.copy() W_biased[1] += 0.02 biased = rollout(lambda s, a: model_step(s, a, W_biased), initial_s, actions) teacher = np.stack([model_step(truth[t], actions[t], W) for t in range(horizon)]) teacher_error = np.mean((teacher - truth[1:]) ** 2, axis=(1, 2)) curves = { "free_rollout": np.mean((learned[1:] - truth[1:]) ** 2, axis=(1, 2)), "teacher_forcing": teacher_error, "no_action": np.mean((no_action[1:] - truth[1:]) ** 2, axis=(1, 2)), "biased_velocity": np.mean((biased[1:] - truth[1:]) ** 2, axis=(1, 2)), } return truth, learned, curves def plan_action(s, W, candidates, target=2.0): imagined_s = np.repeat(s[None], len(candidates), axis=0) costs = np.zeros(len(candidates)) for t in range(candidates.shape[1]): a = candidates[:, t] imagined_s = model_step(imagined_s, a, W) costs += (imagined_s[:, 0] - target) ** 2 + 0.5 * imagined_s[:, 1] ** 2 + 0.02 * a ** 2 return int(candidates[np.argmin(costs), 0]) def run_mpc(W, rng): s = np.array([-2.0, 0.0]) states, actions = [s.copy()], [] for _ in range(35): candidates = rng.integers(-1, 2, size=(512, 12)) candidates[0] = 0 a = plan_action(s, W, candidates) s = true_step(s, a) states.append(s.copy()) actions.append(a) return np.array(states), np.array(actions) def make_figures(output_dir, W, curves, mpc_states, mpc_actions): fig_dir = output_dir / "figures" fig_dir.mkdir(parents=True, exist_ok=True) plt.rcParams.update({"font.size": 11, "axes.spines.top": False, "axes.spines.right": False}) colors = ["#c35036", "#187998", "#516c35", "#8d5aa5"] s0 = np.array([0.0, 0.0]) positive = rollout(lambda s, a: model_step(s, a, W), s0, np.ones(10)) negative = rollout(lambda s, a: model_step(s, a, W), s0, -np.ones(10)) fig, ax = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True) ax[0].plot(positive[:, 0], label="action +1", marker="o", color=colors[0]) ax[0].plot(negative[:, 0], label="action -1", marker="o", color=colors[1]) ax[0].set(xlabel="environment step", ylabel="position", title="Same initial state, different actions") ax[0].legend() grid = np.linspace(-15, 15, 160) strips = [] for branch in (positive, negative): for t in (0, 3, 6, 10): strips.append(np.exp(-0.5 * ((grid - branch[t, 0]) / 0.4) ** 2)) ax[1].imshow(np.stack(strips), aspect="auto", cmap="magma", extent=(-15, 15, 8, 0)) ax[1].set(xlabel="position", title="Analytic rendering, not a learned decoder") ax[1].set_yticks(np.arange(8) + 0.5, ["+1 t=0", "+1 t=3", "+1 t=6", "+1 t=10", "-1 t=0", "-1 t=3", "-1 t=6", "-1 t=10"]) fig.savefig(fig_dir / "action_branches.png", dpi=160) plt.close(fig) fig, ax = plt.subplots(figsize=(8, 4.8), constrained_layout=True) for color, (name, error) in zip(colors, curves.items()): ax.semilogy(np.arange(1, len(error) + 1), error, label=name.replace("_", " "), color=color) ax.set(xlabel="rollout horizon", ylabel="state MSE (128 trajectories)", title="One-step fit does not certify long-horizon accuracy") ax.legend() fig.savefig(fig_dir / "rollout_error.png", dpi=160) plt.close(fig) fig, ax = plt.subplots(2, 1, figsize=(8, 5), constrained_layout=True, sharex=True) ax[0].plot(mpc_states[:, 0], color=colors[1], label="MPC in true environment") ax[0].axhline(2, linestyle="--", color=colors[0], label="target") ax[0].axhline(-2, linestyle=":", color="gray", label="zero-action baseline") ax[0].set(ylabel="position", title="Replan after observing each real transition") ax[0].legend(loc="lower right") ax[1].step(np.arange(len(mpc_actions)), mpc_actions, where="post", color=colors[2]) ax[1].set(xlabel="real environment step", ylabel="executed action", yticks=[-1, 0, 1]) fig.savefig(fig_dir / "mpc_control.png", dpi=160) plt.close(fig) def main(): script_dir = Path(__file__).resolve().parent default_dir = script_dir.parent if script_dir.name == "code" else script_dir / "world_model_results" parser = argparse.ArgumentParser() parser.add_argument("--output-dir", type=Path, default=default_dir) args = parser.parse_args() args.output_dir.mkdir(parents=True, exist_ok=True) rng = np.random.default_rng(20261008) s = rng.uniform(-1, 1, size=(4096, 2)) a = rng.integers(-1, 2, size=4096) next_s = true_step(s, a) + rng.normal(0, 0.01, size=s.shape) W = fit_model(s, a, next_s) W_no_action = fit_model(s, a, next_s, False) test_s = rng.uniform(-1, 1, size=(2048, 2)) test_a = rng.integers(-1, 2, size=2048) test_target = true_step(test_s, test_a) action_mse = np.mean((model_step(test_s, test_a, W) - test_target) ** 2) no_action_mse = np.mean((model_step(test_s, test_a, W_no_action, False) - test_target) ** 2) truth, learned, curves = evaluate_rollouts(W, W_no_action, rng) mpc_states, mpc_actions = run_mpc(W, rng) results = { "seed": 20261008, "numpy_version": np.__version__, "matplotlib_version": matplotlib.__version__, "training_state_shape": list(s.shape), "training_feature_shape": list(features(s, a).shape), "W_shape": list(W.shape), "W": W.tolist(), "learned_transition_eigenvalues": np.linalg.eigvals(W[:2].T).tolist(), "rollout_max_absolute_position": float(np.max(np.abs(truth[:, :, 0]))), "rollout_shape": list(truth.shape), "one_step_action_mse": float(action_mse), "one_step_no_action_mse": float(no_action_mse), "error_horizon_1": {name: float(error[0]) for name, error in curves.items()}, "error_horizon_60": {name: float(error[-1]) for name, error in curves.items()}, "mpc_final_position": float(mpc_states[-1, 0]), "mpc_final_velocity": float(mpc_states[-1, 1]), "mpc_position_cost": float(np.sum((mpc_states[1:, 0] - 2.0) ** 2)), "zero_action_position_cost": float(35 * (-2.0 - 2.0) ** 2), "mpc_actions": mpc_actions.tolist(), } make_figures(args.output_dir, W, curves, mpc_states, mpc_actions) evidence_dir = args.output_dir / "_evidence" evidence_dir.mkdir(parents=True, exist_ok=True) (evidence_dir / "experiment_results.json").write_text(json.dumps(results, indent=2), encoding="utf-8") np.savez(evidence_dir / "experiment_arrays.npz", truth=truth, learned=learned, mpc_states=mpc_states, mpc_actions=mpc_actions, **curves) print(json.dumps(results, indent=2)) print("Figures: action_branches.png, rollout_error.png, mpc_control.png") if __name__ == "__main__": main()
-
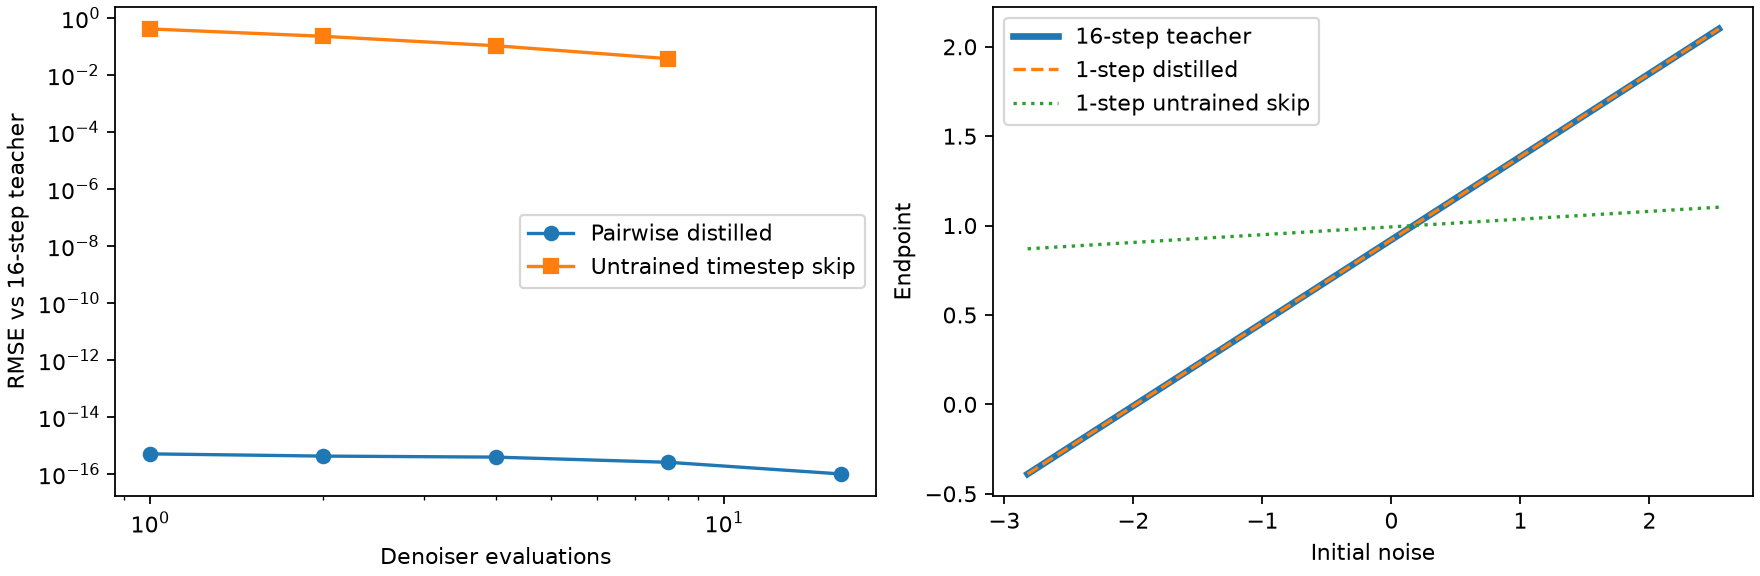
AIGC 基本功|少步蒸馏的目标、误差与采样-Distill AIGC 基本功|少步蒸馏的目标、误差与采样-Distill 所属方向:生成范式 | 难度:前沿 | 前置知识:DDIM 与采样器、CFG 关键词:少步生成、渐进蒸馏、一致性模型、LCM、DMD、教师目标 论文与源码核验日期:2026-10-08。本文的数值来自一维高斯教学问题的 CPU 实跑;没有训练图像模型,也没有复现论文的 FID 或 GPU 加速。 01. 为什么需要它 把一个原来需要反复去噪的模型改成少步,最容易想到的操作是删掉时间点。问题在于,原模型每次只学会在当前噪声水平上估计一个局部方向;跨得更远以后,这个方向未必仍然合适。采样器可以改善数值积分,却不能自动让已有网络学会一次完成一整段轨迹。蒸馏要解决的正是这部分能力缺口。 先看一个可以亲自检查的失败场景。本篇用同一批 512 个初始噪声,将一个确定性教师的 16 步结果当作参照。直接把时间表缩成 4 步,终点均方根误差为 0.105562;缩成 1 步,误差为 0.410312。逐级训练学生去模仿教师合成的转移后,4 步误差降到约 3.90e-16。这不是图像质量提升,而是一个极其简单的仿射系统中,目标改变确实改变了少步行为的证据。 现实里,用户需要的不只是较少的循环次数,而是尽快得到符合提示词的图像或视频。若少步结果丢了主体关系、文字或运动一致性,再小的耗时也未必可用。因此讨论蒸馏时,必须同时问:学生学的究竟是什么;少掉的是几次网络评估;新的分布与任务能力损失在哪里。 标题中的少步没有保证任意模型都能从某个固定步数降到另一个固定步数。Progressive Distillation 论文给出逐次减半的路线;LCM 论文讨论潜空间中的少步生成。它们使用不同模型与训练目标,不能用一张演示图推导出通用的质量结论。 02. 最小可用理解 三句话建立框架:教师负责提供可信的生成行为或分布信号;学生通过训练把这些信号压进更少次调用;推理时必须使用与学生训练匹配的时间表、参数化和条件方式。仅仅替换 scheduler,不会凭空产生蒸馏后的权重。 少步蒸馏可以按监督对象分成几条路线。渐进蒸馏让一步学生贴近两步教师的终点。一致性蒸馏要求同一条去噪轨迹上的不同状态映射到相同终点。分布匹配则关注学生生成样本整体是否接近教师分布,而非要求每一个噪声种子生成完全相同的样本。这些目标可以结合,但不是换个名字的同一个损失。 本文先把渐进蒸馏推到能跑,再解释一致性与分布匹配改变了什么。先修 DDIM 提供确定性转移公式,CFG 提醒我们条件引导本身也是教师行为的一部分。若教师使用某种引导强度,学生的目标就依赖它;训练时没有覆盖的强度,在推理时任意调整不一定可靠。 03. 数学推导 3.1 先把确定性 DDIM 写成两个系数 设干净数据为 $x_0$,时刻 $t$ 的带噪状态为 $x_t$。信号系数是 $\alpha_t$,噪声系数是 $\sigma_t$,教学问题使用保持方差的条件 $\alpha_t^2+\sigma_t^2=1$。标准高斯噪声为 $\epsilon$,前向状态写成: $$x_t=\alpha_t x_0+\sigma_t\epsilon.$$ 教师网络或解析预测器给出的干净样本估计记为 $\widehat x_0(x_t,t)$。它不是已知真值。用当前状态减去估计的信号,再除以噪声尺度,得到与该估计相容的噪声: $$\widehat\epsilon(x_t,t)=\frac{x_t-\alpha_t\widehat x_0(x_t,t)}{\sigma_t}.$$ 本文只讨论不额外注入随机噪声的 DDIM 转移,目标时刻 $s\lt t$。保留估计的干净样本与噪声方向,用目标时刻的系数组合: $$x_s=\alpha_s\widehat x_0+\sigma_s\widehat\epsilon.$$ 将上一式的噪声估计代入,把所有乘在 $x_t$ 前的系数归到一起,得到: $$x_s=A_{ts}x_t+B_{ts}\widehat x_0(x_t,t),\qquad A_{ts}=\frac{\sigma_s}{\sigma_t},\quad B_{ts}=\alpha_s-\frac{\sigma_s}{\sigma_t}\alpha_t.$$ 这一步只有代数整理,没有假设教师完美。$A_{ts}$ 表示直接保留当前状态的比例,$B_{ts}$ 表示干净样本估计对目标状态的贡献。分母要求当前噪声尺度非零,因此不能从零噪声端再向前执行这类转移。最后一步可以到达零噪声端,因为此时分子为零而当前分母仍非零。 3.2 两步教师怎样变成一步学生的监督 选择三个降序时刻 $t>u>s$。教师先从 $x_t$ 到 $x_u$,再在新的输入 $x_u$ 上重新预测并到达 $x_s^{\mathrm{teach}}$: $$x_u=A_{tu}x_t+B_{tu}\widehat x_0^{\mathrm{teach}}(x_t,t),\qquad x_s^{\mathrm{teach}}=A_{us}x_u+B_{us}\widehat x_0^{\mathrm{teach}}(x_u,u).$$ 第二次预测必须接收第一步输出,而不能继续拿原输入代替。否则监督的不是教师真实走过的两步。现在要求学生从同一个 $x_t$ 一次到达相同目标,其一步公式为: $$x_s^{\mathrm{student}}=A_{ts}x_t+B_{ts}\widehat x_0^{\mathrm{student}}(x_t,t).$$ 把学生终点设为教师终点,移项并除以非零的 $B_{ts}$,得到学生应该预测的干净样本目标: $$\widetilde x_0=\frac{x_s^{\mathrm{teach}}-A_{ts}x_t}{B_{ts}},\qquad L_{\mathrm{pair}}=\mathbb E\left[\left\|\widehat x_0^{\mathrm{student}}(x_t,t)-\widetilde x_0\right\|_2^2\right].$$ 波浪号表示“由教师转移反解出来的目标”,它一般不同于原训练数据的真实 $x_0$,也不必等于教师在时刻 $t$ 的第一次估计。蒸馏改变了监督:学生需要补偿较大跨度,让一步尽量承担教师两步的作用。若继续用旧的局部估计、只删时间点,就没有完成这个目标替换。 训练完一次,将学生固定为下一轮教师,再把时间点成对合并。本文走 16、8、4、2、1 步的减半链。真实模型可以在某一轮停止;继续压缩意味着更困难的函数逼近,不能由代数公式保证学习成功。 还要注意分母的条件数。$B_{ts}$ 很小时,教师终点中的数值误差会被放大到反解目标中。代码拒绝绝对值过小的分母。实际训练还要考虑噪声参数化、损失权重与时间采样,不能把一个没有报除零错误的实现当作稳定训练方案。 3.3 一致性目标怎样改变问题 渐进蒸馏贴近有限跨度的转移;一致性模型的函数 $f_\theta(x_t,t)$ 则尝试直接预测轨迹接近数据端的终点。若 $x_t$ 与 $x_u$ 位于同一条概率流 ODE 轨迹,理想情况是两者给出相同结果。一个示意的一致性蒸馏目标为: $$L_{\mathrm{cons}}=\mathbb E\left[d\left(f_\theta(x_t,t),\operatorname{stopgrad}\left(f_{\bar\theta}(x_u,u)\right)\right)\right].$$ $\theta$ 是当前学生参数,$\bar\theta$ 是目标网络参数,常通过指数滑动平均更新;$d$ 是比较两个输出的距离;$\operatorname{stopgrad}$ 表示右侧不参与此次反向传播。这里的低噪声状态由教师轨迹转移得到,不能任意选择一张无关带噪图。本文省略了论文具体的采样权重与离散化细节,所以这条式子用于解释监督关系,不是完整训练配方。 只要求两个输出相同还不够:无论输入是什么都输出常数,也会满足这种相等。为排除这一类没有生成意义的解,需要数据端边界条件。原一致性模型使用小的正端点 $\varepsilon$,要求: $$f_\theta(x,\varepsilon)=x,\qquad f_\theta(x,t)=c_{\mathrm{skip}}(t)x+c_{\mathrm{out}}(t)F_\theta(x,t).$$ $F_\theta$ 是可训练网络。若 $c_{\mathrm{skip}}(\varepsilon)=1$ 且 $c_{\mathrm{out}}(\varepsilon)=0$,边界就由结构保证,不依赖训练恰好学会恒等映射。本文代码演示满足该条件的一组连续系数,并用 512 个输入实际检查零误差。Diffusers 的离散 LCM 使用另一组时间缩放系数,不能将两套数值原样混用。 3.4 分布匹配为什么不等于逐样本复制 设生成器为 $G_\theta(z)$,初始随机变量是 $z$。学生生成的分布记为 $p_{\mathrm{student}}$,教师参考分布记为 $p_{\mathrm{teacher}}$。分布匹配路线关心的对象可概括为: $$L_{\mathrm{dist}}=D_{\mathrm{KL}}\left(p_{\mathrm{student}}\,\|\,p_{\mathrm{teacher}}\right).$$ 这里的式子只说明分布目标,并不是说能够直接计算两个完整图像分布的密度。DMD 在带噪空间利用真实参考与生成分布的 score 信息构造训练信号,原论文还结合回归约束。读者应把它理解为另一种监督来源,不要将本篇反解 DDIM 的闭式目标称为 DMD 实现。两个生成器可能在相同种子下输出不同样本,却具有相近整体分布;反过来,少量配对样本的均方误差很低,也不足以证明覆盖了所有模式。 04. 代码实现 完整脚本是文末的 distill_demo.py。依赖 NumPy 与 matplotlib,不需要下载模型权重。教学数据分布选择均值为 1、方差为 0.25 的一维高斯;时间表使用 $\alpha_t=\cos t$、$\sigma_t=\sin t$,从 1.4 弧度走到零。这里的 $t$ 是调度参数,不是秒,也不是 Diffusers 的整数时间索引。 高斯条件分布给出一个解析教师: $$\widehat x_0^{\mathrm{teach}}(x,t)=\mu+\frac{\alpha_t v}{\alpha_t^2v+\sigma_t^2}(x-\alpha_t\mu),\qquad \mu=1,\quad v=0.25.$$ 符号 $v$ 在这里是数据方差,不是扩散网络的 velocity 参数化。这个预测器是条件均值,并非声称每一个噪声对应已知干净样本。高斯条件均值对输入是仿射函数,DDIM 转移也是仿射函数;两步复合后仍然仿射。因此学生只要学习斜率与截距,就可以精确表示教师合成目标。这是实验误差接近机器精度的关键原因。 核心代码直接对应第 03 节的移项公式: alpha_t, sigma_t = schedule(t) alpha_s, sigma_s = schedule(s) a = sigma_s / sigma_t b = alpha_s - a * alpha_t x0_target = (target - a * train) / b design = np.column_stack([train, np.ones_like(train)]) slope, intercept = np.linalg.lstsq(design, x0_target, rcond=None)[0] print(slope, intercept) a 对应 $A_{ts}$,b 对应 $B_{ts}$,target 是教师两步终点。线性最小二乘只用于这个能够精确表示的教学系统;真实网络会用小批量优化,不能用两个系数取代图像生成器。各轮学生系数独立依赖对应的转移区间。真实模型通常以时间条件共享网络参数,本篇采用每个区间一个仿射预测器,是为了让目标与拟合误差完全可查。 运行固定随机种子 7,训练输入形状为 (256,),测试输入和输出形状均为 (512,),全部为 float64。测试输入与拟合输入分开采样。下面的数值直接取自本地 run_result.json: 网络评估次数 逐级蒸馏相对教师 RMSE 不训练只删时间点 RMSE 16 0 参照教师 8 2.56585e-16 0.0370682 4 3.90109e-16 0.105562 2 4.23841e-16 0.226265 1 5.06866e-16 0.410312 一阶段学生最终学到的斜率为 0.4646808695,截距为 0.9210195202。注意这是学生的干净样本预测器参数;由于最后转移到零噪声,终点恰好等于该预测。16 步教师终点的样本均值为 0.892840、标准差为 0.439749。这些数值也提醒我们:贴近教师终点不等于已经复原理论数据分布。初始噪声是标准正态,而我们的最高噪声端仍保留信号,有限步教师也不是连续过程的精确解。 图左看误差是否随压缩累积,纵轴使用对数尺度,参照教师的零误差仅为作图截到 1e-16。图右看同一初始噪声对应的终点:一步学生与 16 步教师重合,未训练的一步跳转则明显偏离。配图由完整脚本生成,不包含真实图像模型实验。 实验保存每轮的最小分母绝对值与全部拟合系数。第一次减半的最小分母绝对值约为 0.176679,最后一步为 1。若更改时间表导致分母逼近零,应先解决调度与参数化问题,不要靠把无穷值裁剪成有限数掩盖目标失效。 05. 工业级实现对照 本节以实际读取的 Diffusers v0.35.1 源码为准。固定版本与本地源码 SHA256 一起保存,可以避免将未来上游改动混进本次解释。知识树锚点是 scheduling_lcm.py 中的 LCMScheduler.step,训练对照是 train_lcm_distill_sd_wds.py。 首先,采样器要知道网络输出的语义。prediction_type 可以是噪声、干净样本或 velocity;代码先把它们转换成原始样本估计,再通过 c_out 与 c_skip 得到 denoised。若模型输出是 velocity 却按噪声解释,时间表看似正常,结果仍会错。最小代码从头到尾直接预测干净样本,省去了接口兼容层。 其次,LCM 多步采样不是照抄本文确定性 DDIM。该版本 step 在非末步将 denoised 按下一时刻的信号系数缩放,并加入新噪声;末步直接返回 denoised。随机数生成器、设备、dtype 和当前步索引都会影响实际行为。把一次生成的全部中间状态当成完全确定的同一轨迹,在这种采样模式下就需要重新说明随机性条件。 再看训练脚本,DDIMSolver.ddim_step 使用索引从累计信号系数中取对应时间点;教师进行条件与无条件预测后构造引导结果;目标学生在较低噪声状态上预测终点;当前学生与停止梯度的目标输出进行比较。滑动平均目标网络提供较平稳的监督。教师、当前学生、目标学生是不同角色,不能因为它们最初权重相同,就把三份输出混为一谈。 CFG 的参数约定也要逐行核对。训练脚本的注释明确区分 Imagen 约定与 LCM 约定的偏移。如果只看到变量名都叫 guidance scale 就直接复制数值,可能实际上改变教师目标。读代码时要沿着条件组合公式追踪,而不能凭参数名字推断语义。 本文还在本地实际执行了官方 LCMScheduler.step 与离散边界系数方法的源码片段,使用 CPU 张量核对末步和非末步的数值、形状与随机数分支。该验证覆盖采样方法的运算,未加载完整 pipeline、没有模型权重,也没有测 GPU 性能。它能支持本节对分支逻辑的说明,不能支持某个图像模型已达到论文质量的说法。 实际输入张量形状为 (1, 1, 2, 2),类型为 float64,随机种子为 19。非末步输出与单独按公式计算的最大差为 1.11022e-16,末步输出与 denoised 的最大差为 0;两步中仅非末步调用一次噪声生成。这些检查使用原方法与显式配置夹具,不等同于完整库的端到端测试。 工业训练还包含 VAE 编码、文本条件、混合精度、梯度裁剪、分布式数据流、训练状态恢复和验证集。最小实验刻意隔离这些因素,让读者先查明“损失是不是在教学生完成更大的跨度”。进入生产时,这些系统环节会重新成为质量与稳定性的约束,不能把教学脚本直接称为部署实现。 06. 代价与边界 少步节约的是推理阶段反复评估去噪器的成本,代价包括教师构造目标、学生训练与新增权重的管理。训练是否划算,取决于实际生成请求量、教师成本、学生维护周期和质量验收要求。不是所有偶尔使用的模型都值得蒸馏。 网络评估次数不等于端到端加速倍数。设固定开销为 $T_{\mathrm{fixed}}$,单次网络评估耗时为 $T_{\mathrm{eval}}$,评估次数为 $N$,一个仅用于预算的模型是: $$T(N)=T_{\mathrm{fixed}}+N T_{\mathrm{eval}}.$$ 这里固定开销包括可能的文本编码、VAE 解码、传输与后处理。该式假设每次评估成本相同,真实 CFG 批处理和内核行为可能打破假设。本文没有实测这些项,所以不报告墙钟加速。即使循环次数大幅下降,VAE 解码占比也会升高,随后要优化的瓶颈可能已经换了位置。 质量边界至少有三个层面。第一,学生近似教师时可能继承教师已有的偏差;第二,有限容量与优化误差会产生额外偏差;第三,训练条件以外的提示词、分辨率、长视频长度和引导强度可能引发分布外问题。高质量的平均评分不能自动证明每个困难场景都被保留。 本文的仿射教师让函数复合仍留在同一个表示族里,学生可以达到数值精度。真实神经网络的两步复合通常更复杂,一次调用不一定有足够容量表达。若将本实验的近零误差当成“一步生成原则上没有任何质量损失”的证明,就越过了实验边界。 还可以给误差积累一个有条件的上界。记第 $i$ 段教师转移为 $T_i$,学生转移为 $S_i$,两条轨迹进入该段时的状态差为 $e_i$。假设在实际经过的状态范围内,学生转移对输入变化的放大系数不超过 $K_i$,并且同一教师输入上的学生转移误差不超过 $\delta_i$。加减同一个学生转移项,再使用三角不等式,可得: $$e_{i+1}\leq K_i e_i+\delta_i.$$ 这是把两种误差拆开:旧状态差经过学生映射被放大,新转移近似又添加一项。由同样初始状态出发,初始误差为零,递推展开得到: $$e_m\leq\sum_{i=0}^{m-1}\delta_i\prod_{j=i+1}^{m-1}K_j.$$ 空乘积取一。该上界要求真的具有上述局部放大与误差界,本文没有测量真实网络的这些常数,因此不将它当作质量保证。它说明为什么只看训练样本上的单段误差不够:后续映射可能放大差异,而学生在前段产生的新状态也可能超出监督覆盖范围。推理验收需要完整走完轨迹,不能只展示教师输入上的一张损失曲线。 采样器的高阶积分、跨步缓存、量化和蒸馏可以一起考虑,但需要组合验收。缓存引入的时序近似、量化的数值误差、蒸馏的学习误差未必相互独立。不能把单独测试的加速倍数相乘,再宣称组合后同时保留各自的质量结果。 对于交互式编辑与可控生成,还要检查原模型所支持的控制插件、低秩适配和条件接口是否与学生兼容。某个模型在简单文生图上通过验收,不等于已有的编辑工作流可以直接迁移。这里是工程验收建议,而非对所有蒸馏模型作相同能力限制。 07. 经典论文脉络 下面五篇按它们改变的对象排列,并非所有方法都沿着单一继承链发展。没有标注会议、评分或硬件数字的地方,不应自行补上这些背书。 Denoising Diffusion Implicit Models,2010.02502:提供确定性采样等选择,让既有扩散训练目标能够配合更快的生成过程,是本文转移推导的起点。 Progressive Distillation for Fast Sampling of Diffusion Models,2202.00512:把确定性教师两步压成学生一步,再重复减半,是本文最小实验的直接概念来源;我们的解析高斯例子不是论文图像实验的复现。 Consistency Models,2303.01469:让轨迹上不同状态预测同一终点,并讨论蒸馏与独立训练;所以“一致性模型必须依赖预训练教师”并不是其完整定义。 Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference,2310.04378:将一致性路线用于潜空间与带引导的生成,是工业采样和训练源码对照的背景。 One-step Diffusion with Distribution Matching Distillation,2311.18828:引入分布匹配监督来训练一步生成器,原方法结合回归;它不是对本文逐级二步目标进行简单重命名。 读这一脉络时,先标记“没有改权重而改采样”、“学有限跨度转移”、“学轨迹终点”和“学分布”这几类对象,再比较成本与质量。否则容易把一篇论文的训练方式和另一篇论文的采样器拼成不存在的方法。 论文之间的评测设置也不同。某个数据集上的无条件 FID、某个文生图模型的人工偏好与视频的时序稳定性不是同一问题。本文保留论文身份与机制关联,避免把不同基准的数字排成一个貌似统一的排行榜。 08. 常见误解 误解一:把 50 个时间点改成 4 个就是蒸馏。 这只是删时间点或换采样设置。学生权重是否经过专门训练、目标是否考虑大跨度,才决定是否完成了蒸馏。本文的不训练跳步对照给出了明确反例。 误解二:学生预测的干净图必须等于训练数据真值。 在本文渐进目标里,学生预测的是为了重现教师两步终点而反解的量。它承担了有限步转移的补偿,不能机械套用原始去噪标签解释。 误解三:一致性只是任意两张带噪图输出一样。 输入之间需要相应的轨迹关系,数据端还需要边界约束。任意配对可能破坏监督;缺少边界约束则连常数输出都可能满足相等。 误解四:同种子图像不同说明分布蒸馏失败。 配对一致与分布一致是不同目标。判断 DMD 等路线需要分布与任务评测,同种子逐像素差异不能单独决定成功或失败。 误解五:scheduler 中的边界系数已经完成了一致性训练。 系数提供结构与采样规则,真正承载学到的生成映射的是权重。未蒸馏的网络接入一个 LCM scheduler,不会因为公式合法就拥有 LCM 能力。 误解六:本实验一步误差近零证明图像也能无损一步。 本实验的仿射表示族对复合封闭,且监督完全可计算。图像网络没有获得这项保证;还存在有限训练、数据覆盖和条件组合等问题。 09. 动手验证 从文末复制完整代码为 distill_demo.py,安装依赖后运行。脚本同时打印 JSON、生成 run_result.json 与原创配图。命令是: python -m pip install numpy matplotlib python distill_demo.py 先不改任何参数,对照表格中的四种压缩结果。不同 NumPy 与线性代数库可能使最后几位舍入误差不同;应检查数量级与断言通过,不要求每一个浮点字符串逐字相同。直接跳步的误差应明显大于机器精度,逐级拟合则在这个仿射问题中接近机器精度。 然后把教师预测器改成非线性函数,例如在原输出上加一项 0.05 * np.tanh(x)。仍只让学生拟合斜率和截距时,精确匹配断言很可能失败。这是预期的诊断:目标变复杂而学生表示能力没变。先打印误差观察问题,再设计更有容量的学生,不能把断言简单删除后宣布压缩成功。 第三个实验是故意构造重复时间点,使某次转移没有噪声水平变化。分母检查应拒绝退化区间。这帮助区分“训练效果差”和“监督本身没有定义”。如果只是把 NaN 替换成零,后面的均方误差会产生没有意义的数值。 最后单独检查一致性端点。本脚本已经实际调用边界函数,输出 boundary_max_error 为 0。若删除跳连系数或让输出系数在端点仍非零,恒等边界便不再由结构保证。这个实验不等于训练了一致性生成器,但能验证参数化究竟保证了哪一个性质。 10. 延伸阅读 先回到 DDIM 与高阶采样器,区分数值积分误差和网络误差;再读 CFG 的代价与调法,把教师的条件组合与学生条件输入接起来。若连教师在何种引导方式下产生目标都没确定,少步比较就缺少共同基准。 同在推理加速方向,扩散跨步缓存关注复用已有计算,量化关注数值表示的成本。它们与训练学生解决不同的成本来源,适合通过统一质量预算比较,而不是只排列循环次数。 知识树中的视频评测节点仍待撰写,后续应把少步生成的时序稳定性、主体保持和提示词遵循拆开验收。本文到这里建立的是监督目标与可复现代数实验,真正选择一个少步模型,还要回到自己的任务、条件范围和实际质量门槛。 附录:完整代码 09 节用到的脚本全文如下(distill_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 distill_demo.py """CPU teaching experiment: exact pairwise DDIM distillation for an affine teacher. Dependencies: numpy, matplotlib. No model weights or image-quality benchmark. """ import json from pathlib import Path import numpy as np import matplotlib matplotlib.use('Agg') import matplotlib.pyplot as plt def schedule(t): return np.cos(t), np.sin(t) def teacher_x0(x, t): # Posterior mean for one-dimensional N(mu, variance) data under VP noise. mu, variance = 1.0, 0.25 alpha, sigma = schedule(t) weight = alpha * variance / (alpha * alpha * variance + sigma * sigma) return mu + weight * (x - alpha * mu) def ddim(x, x0, t, s): alpha_t, sigma_t = schedule(t) alpha_s, sigma_s = schedule(s) a = sigma_s / sigma_t b = alpha_s - a * alpha_t if abs(b) < 1e-10: raise ValueError('Degenerate distillation interval') return a * x + b * x0 def sample(predictors, grid, x): x = x.copy() for i, predictor in enumerate(predictors): x = ddim(x, predictor(x, grid[i]), grid[i], grid[i + 1]) return x def distill(predictors, grid, train): new_grid = grid[::2] students, coefficients, denominators = [], [], [] for j in range(0, len(predictors), 2): t, u, s = grid[j:j + 3] middle = ddim(train, predictors[j](train, t), t, u) target = ddim(middle, predictors[j + 1](middle, u), u, s) alpha_t, sigma_t = schedule(t) alpha_s, sigma_s = schedule(s) a = sigma_s / sigma_t b = alpha_s - a * alpha_t x0_target = (target - a * train) / b design = np.column_stack([train, np.ones_like(train)]) slope, intercept = np.linalg.lstsq(design, x0_target, rcond=None)[0] def predictor(x, unused_t, slope=slope, intercept=intercept): return slope * x + intercept students.append(predictor) coefficients.append([float(slope), float(intercept)]) denominators.append(float(b)) return students, new_grid, coefficients, denominators def main(): rng = np.random.default_rng(7) train = rng.normal(size=256) test = rng.normal(size=512) grid = np.linspace(1.4, 0.0, 17) predictors = [teacher_x0] * 16 golden = sample(predictors, grid, test) rows = [{'steps': 16, 'max_error': 0.0, 'rmse': 0.0}] stages = [] while len(predictors) > 1: predictors, grid, coefficients, denominators = distill(predictors, grid, train) result = sample(predictors, grid, test) rows.append({'steps': len(predictors), 'max_error': float(np.max(np.abs(result - golden))), 'rmse': float(np.sqrt(np.mean((result - golden) ** 2)))}) stages.append({'steps': len(predictors), 'coefficients': coefficients, 'min_abs_denominator': float(np.min(np.abs(denominators)))}) assert np.allclose(result, golden, rtol=1e-11, atol=1e-11) skipping = [] for steps in [8, 4, 2, 1]: skip_grid = np.linspace(1.4, 0.0, steps + 1) result = sample([teacher_x0] * steps, skip_grid, test) skipping.append({'steps': steps, 'rmse': float(np.sqrt(np.mean((result - golden) ** 2)))}) # Boundary identity: f(x,t)=c_skip*x+c_out*F(x,t), sigma_data=0.5. eps, sigma_data = 0.002, 0.5 def consistency_boundary(x, t): delta = t - eps c_skip = sigma_data ** 2 / (delta ** 2 + sigma_data ** 2) c_out = sigma_data * delta / np.sqrt(t ** 2 + sigma_data ** 2) return c_skip * x + c_out * np.tanh(x) boundary_error = float(np.max(np.abs(consistency_boundary(test, eps) - test))) assert boundary_error == 0.0 result = {'seed': 7, 'dtype': str(test.dtype), 'train_shape': list(train.shape), 'test_shape': list(test.shape), 'output_shape': list(golden.shape), 'teacher_endpoint_mean': float(golden.mean()), 'teacher_endpoint_std': float(golden.std()), 'distilled': rows, 'untrained_skip': skipping, 'stages': stages, 'boundary_max_error': boundary_error, 'scope': 'affine Gaussian teaching teacher; no neural network or image-quality claim'} folder = Path(__file__).resolve().parents[1] (folder / 'figures').mkdir(parents=True, exist_ok=True) fig, axes = plt.subplots(1, 2, figsize=(11, 3.6), constrained_layout=True) axes[0].plot([r['steps'] for r in rows], [max(r['rmse'], 1e-16) for r in rows], 'o-', label='Pairwise distilled') axes[0].plot([r['steps'] for r in skipping], [r['rmse'] for r in skipping], 's-', label='Untrained timestep skip') axes[0].set(xscale='log', yscale='log', xlabel='Denoiser evaluations', ylabel='RMSE vs 16-step teacher') axes[0].legend() order = np.argsort(test) skip_one = sample([teacher_x0], np.array([1.4, 0.0]), test) one = sample(predictors, grid, test) axes[1].plot(test[order], golden[order], label='16-step teacher', lw=3) axes[1].plot(test[order], one[order], '--', label='1-step distilled') axes[1].plot(test[order], skip_one[order], ':', label='1-step untrained skip') axes[1].set(xlabel='Initial noise', ylabel='Endpoint') axes[1].legend() fig.savefig(folder / 'figures/distillation_error.png', dpi=160, metadata={'Software': 'PairwiseDistillationTeachingDemo'}) plt.close(fig) (folder / 'run_result.json').write_text(json.dumps(result, indent=2), encoding='utf8') print(json.dumps(result, indent=2)) if __name__ == '__main__': main()
-
AIGC 每日速读|2026-10-08|Stanford视频生成快3.53倍LoT 今日 AIGC 论文速览 今日共 10 篇 · 生成架构与后训练 3 篇 · 图像视频算力与量化 3 篇 · 多参考图与长视频记忆 2 篇 · 数字人与生成语音增强 2 篇 重点论文标题列表 LoT(Stanford):按细节分配视频生成算力 LiFT(阿姆斯特丹):共享主干多循环细化图像 MEND(得州奥斯汀):奖励收益够大才移动样本 RefRoute(达特茅斯):十六张参考图也能轻量合成 Keepsake(中佛罗里达):长视频只留难替代的历史帧 今日论文速览 1. LoT:按细节分配视频生成算力 Level-of-Token Diffusion | 斯坦福大学;Google | arXiv:2610.05816 关键词:多分辨率token, 图像视频生成, 算力分配, 不对称flow 前序问题:天空、虚化背景和人脸被分配同样密度的 token,生成时算力花在很多低细节区域。直接压缩 token 又会让预训练 DiT 只能输出低分辨率流场,难兼顾省计算与完整画面。 本文贡献:Level-of-Token 把框、语义掩码、纹理方差或景深转成大小和形状不同的矩形 token 布局。重要区域用细 token,其余区域合并;经分块不对称 flow、形状嵌入、与原网格对齐的 RoPE 及按形状区分的输出头,DiT 处理较短序列,但每步仍恢复完整分辨率速度场。需要微调预训练模型。 论文 Figure 3:LoT 流程。完整分辨率 token 网格 x_t 按 LoT 布局映射成较短序列,DiT 以 token 形状 s、时间步 t 与文本 c 为条件处理;按形状区分的输出头 h_e_i 恢复不对称速度 u,再转为完整秩速度用于 flow-matching 训练。 实验效果:表 2 的 Wan2.1 14B、三倍 token 压缩预算下,论文报告平均视频生成加速 3.530 倍;Aesthetic 为 0.5104、Imaging 为 0.5650,完整基座为 0.5518、0.6465。表 1 的 FLUX2 4B 对应预算最高加速 2.040 倍。数字代表不同预算下的速度与质量取舍。 论文 Table 2:视频生成量化比较。相同 token 预算下,与压缩基线相比,LoT 的 Aesthetic、Imaging 分数及加速更好;表内同时列出完整分辨率 Wan2.1 14B,压缩后这些质量分仍低于完整模型,不能把基线间优势读成全面无损。 批判点评:标题的 3.53 倍限于上述视频配置,不代表任意布局或所有模型。全画面都需要细纹理时,可减少的 token 很少;压缩过强仍损害细节。它不是只靠换采样器的免训练技巧。可从作者项目页核对布局及演示,本期未确认可下载的方法代码。 2. LiFT:共享主干多循环细化图像 LiFT: Loop Flow Transformers | 阿姆斯特丹大学;TNO | arXiv:2610.05538 关键词:循环DiT, flow matching, 推理深度, 参数共享 前序问题:生成质量通常随参数增长,模型存储预算有限时很难扩容。让同一主干循环多次,又常要求每次直接猜最终目标,训练深度之外未必继续改善。 本文贡献:LiFT 反复调用共享 DiT 核心,给每次循环连续深度坐标,并把各步预测监督到初始速度估计与 flow-matching 目标之间直线路径的对应位置。训练随机采样内部坐标,推理使用均匀网格;一个固定 checkpoint 可在不增加参数、不重新训练的情况下改变循环次数,并和外层积分步数共同分配计算。 论文 Figure 2:深度循环与时间 flow。(a)采样器沿生成时间推进,每步调用一次网络;(b)每次调用把共享核心运行 K 次,每次有自己的深度坐标 s_k,共享读出头给出预测 u_k;(c)训练把每个预测回归到从停止梯度的初始估计 b=sg(u_0) 到 u* 的路径对应点;(d)训练随机采样内部坐标,推理用均匀网格。各面板颜色标出同一循环,为清晰省略归一化及首次 h_0 重注入。 实验效果:表 2 的 ImageNet 256×256、50 个积分步设置:L/2 R10 在训练的两次循环时 FID 为 20.30,推理八次循环为 10.95。图 7 对应 dense L/2 的 250 步为 15.74,八次循环 LiFT 计算约少 30%。所有点均按五万张生成图评价。 论文 Figure 7:增加循环细化相同噪声的图像。展示 LiFT L/2 R10 在 50 个积分步与 dense L/2 在不同步数的选定配对样本,各行共享类别及初始噪声,列标题给每图 TFLOPs。第二列八次循环与末列 dense 的 250 步相比,计算少约 30%、FID 10.95 对 15.74;这些选定图不替代五万张量化评测。 批判点评:更深并非始终更好,八次后也有回退;B/2 小模型在所测预算下仍落后 dense 基线。实验为无 CFG 的类别条件图像生成,不能直接推广视频或文生图。FLOPs 是解析估计,未验证设备延迟、能耗或峰值显存;作者页中的代码入口仍标为 Coming Soon。 3. MEND:奖励收益够大才移动样本 MEND: RL For Flow Models via Proximal Velocity Matching | 得州大学奥斯汀分校;Google;科罗拉多大学博尔德分校 | arXiv:2610.05954 关键词:生成后训练, 可微奖励, 近端速度匹配, 多样性 前序问题:奖励重加权需要大量更新,直接沿奖励梯度推动所有样本又可能牺牲多样性。一个高分样本是否还该移动、移动多远,常由统一更新幅度决定。 本文贡献:MEND 在同一 prompt 组内给奖励设上限,已达上限的样本保持不动;其余样本沿奖励梯度提出三个不同长度的候选,只有截断后的奖励收益超过二次位移代价才接受。再把接受的位移转成存储状态处的速度回归目标。行为 adapter 随训练做 EMA,方法不使用冻结参考、KL 项或 advantage 权重。 论文 Figure 4:MEND 总览。(1)同一 prompt c 的组中,达到奖励上限 κ 的样本保持;(2)低于上限的样本沿奖励梯度得到三个提议,判据从截断奖励扣除位移代价并选最佳候选,示例选最短 y_1;(3)训练 adapter 在存储状态回归到行为预测加接受位移 d 的目标,即公式 5 的速度目标,行为模型随后用 EMA 跟随。 实验效果:表 2 的 DrawBench 200 个提示、每个五个种子:训练 PickScore 的 MEND 100 次更新得到 23.70,Flow-GRPO 约四千次为 23.52,两者到基座的距离同为 0.313;MEND 六个评价指标中五个更高。另一个等预算协议的表 7:PickScore 为 24.03,ReFL 23.92、DiffusionNFT 23.43,不能混成同一实验。 论文 Figure 3:SD3.5-M、Flow-GRPO、DiffusionNFT 与 MEND 的图像比较。每行共享同一提示与种子,各图标注 PickScore;这是配对示例而非整体成功率。 批判点评:更新次数差距不等于训练时间快四十倍,候选需解码和奖励评价。必须有可微奖励;目标选择的收益保证不等于模型每次更新保证,更无法识别错误奖励。长训练仍可能奖励投机;表 2 美学分数还低于 Flow-GRPO。作者项目页提供复现入口,实际代码状态按页面核验。 4. RefRoute:十六张参考图也能轻量合成 RefRoute: Decoupling Conditioning Cost from References via Compact Residual Conditioning and Spatial Routing | 达特茅斯学院 | arXiv:2610.07720 关键词:多参考图生成, 紧凑残差条件, 空间路由, 注意力加速 前序问题:多张参考图都编码成密集网格再全局注意力,计算随数量和分辨率上涨;不同参考的外观还会串到错误人物或物体上。 本文贡献:RefRoute 把每张参考图先降采样再 VAE 编码,用全分辨率像素残差编码器补回细节。条件路由与注意力路由把参考分配到目标区域,限制跨参考交互,同时允许区域外的选择性访问以处理反射、接触等场景关系。单张 1024×1024 参考的 token 从 4096 减为 256,仍需训练及多参考微调。 论文 Figure 2:RefRoute 总览。每张参考图先降采样并由 VAE 编码成紧凑 token,残差编码器从完整分辨率提取互补特征,在 DiT 输入投影后加到对应参考嵌入;增强嵌入与文本、带噪目标通过条件专用 adapter 和注意力路由联合处理。 实验效果:图 4 独立计算成本实验中,16 张参考图、50 步和四步配置分别比对应 FLUX 基线快 18.3、14.2 倍。表 2 的 ManyRef100 包含 10–17 张参考,多参考微调后的 Weighted-Ref-VIEScore 为 36.06,FLUX.2-Klein-9B 为 8.88;该分数不是成功率。 论文 Figure 4:参考数量与推理成本。与 FLUX.2-Klein 基线及相同主干上的 OminiControl2 参考分支实现相比,RefRoute 在所测配置中时延增长更慢、峰值分配显存接近恒定;分支实现比较不代表完整 OminiControl2 训练系统。 批判点评:加速实验和微调质量实验需分别理解。少参考 MICo-Bench 的 52.81 仍低于对应基座 55.67,不能宣传所有参考数量都更好。评分依赖多模态模型,自建数据有合成及筛选偏差。原文仅承诺发表后释放代码、配置和相关数据,不能写成当前已开源。 5. Keepsake:长视频只留难替代的历史帧 Keepsake: Selective Spatial Memory for Long-Horizon Video Generation | 中佛罗里达大学 | arXiv:2610.06588 关键词:长视频生成, 空间记忆, 固定容量, 免训练控制 前序问题:生成越久就保存越多历史帧,检索和存储持续增长;只保留最新帧又会忘掉刚离开的场景。历史帧价值随新视角出现而改变,一次性决定保留不够。 本文贡献:Keepsake 在每个视频块生成后,把已有和新增观察建成位姿—外观图,以相机距离及视觉相似度衡量替代关系。保留优先级同时看强替代帧数量与最近替代者相似度,优先留下难替代观察,逐步删除冗余直到满足固定容量。只修改持久记忆更新规则,宿主生成器、采样及检索规则保持原样,无需再训练。 论文 Figure 2:Keepsake 总览。上部将它插入长视频循环作为记忆更新模块,每个生成块后更新持久记忆,保持生成器及检索规则;下部把旧记忆和新观察汇集成位姿—外观图,边权结合相机邻近与视觉相似度。节点统计强替代者数量和最近替代者相似度,共同决定保留优先级;删除低优先级观察直到满足容量 B。缩略图与展示分数为说明示意。 实验效果:附录表 5 的十五条匹配 180 秒 MemCam 轨迹:完整记忆 5397 帧、FVD 734.2;Keepsake 留 32 帧、FVD 476.6,降低 35.1%,LPIPS 0.5980→0.5876。表 1 的另一组 60 秒 WorldMem:FVD 3077.6→1116.9,每次检索 77.92→4.54 ms。 论文 Table 5:长时 MemCam 结果。十五条匹配的 180 秒轨迹,有限记忆策略容量 B=32;比较完整保留、FIFO 与 Keepsake 的存储条目、LPIPS 和 FVD。Keepsake 的 32 帧相对完整 5397 帧仍改善质量,不能由检索收益推出完整生成时延。 批判点评:检索毫秒不是整段生成耗时,32 帧是记忆库容量而非视频长度。样本仅十五条匹配轨迹,几何与视觉相似度也未必代表未来所有重要事件;最优预算随任务变化。原文称策略代码在补充材料,本期未确认独立公开仓库,不能泛称无限长记忆已解决。 6. CentriQ:先去均值再做低比特量化 CentriQ: Calibration-Free Quantization of Diffusion Transformers via Exact Mean Centering | Tenstorrent;洛桑联邦理工学院 | arXiv:2610.06260 关键词:DiT量化, 无校准, 均值补偿, 四比特激活 前序问题:DiT 的条件归一化会重新引入逐 token 均值。Hadamard 旋转不一定能把这部分能量均匀摊开,单个大坐标会撑大量化范围;照搬语言模型的免校准量化会损伤图像。 本文贡献:CentriQ 先减去每个 token 的通道均值,再旋转与量化;减去的成分通过完整精度的 rank-1 分支精确补回线性层输出,因此不是丢掉均值。激活尺度由无数据规则得到,权重拟合使用抑制重尾影响的稳健目标。同一路径覆盖 PixArt-Σ、FLUX.1-schnell 和 SANA 的 adaLN 条件设计。 论文 Figure 3:CentriQ 的一个量化线性层。上部为在线逐 token 路径,下部为离线权重路径;每个 token 的均值 x̄_t 与权重行和向量 w_1 构成全精度 rank-1 分支,绕过权重与激活量化并补回均值分量。 实验效果:表 1 的 MJHQ、W4A4:FLUX.1-schnell 的 FID 为 18.8,带校准 SVDQuant 为 18.3,BF16 为 19.5;SANA-1.6B 为 16.2、19.3、16.0。表 2 的 FLUX W4A2 消融中,完整方法 FID 35.59,只有旋转为 455.30,二比特结果仍有明显质量差距。 论文 Figure 4:FLUX.1-schnell 在 W4A4、W4A2 与 W2A4 下的 GenEval 提示结果,同一行共享提示和种子;标记是 GenEval 检测器的判断,而非人工成功率。 批判点评:rank-1 补偿精确不代表整个量化模型无损。二比特激活采用模拟量化,没有支持它的融合 kernel;A100 整数张量核结果不能等同新 GPU 的 NVFP4。FID 单项改善也不是逐张更好。arXiv 注释明确代码及项目页将稍后发布,本期不放尚未确认的方法仓库。 7. BASA:标准注意力后端也能高效稀疏 Backend-Agnostic Sparse Attention for Fast High-Resolution Visual Generation | 上海交通大学;复旦大学;香港大学 | arXiv:2610.08772 关键词:稀疏注意力, 平移窗口, 全局KV池化, 高分辨率生成 前序问题:固定窗口算得快但边界易出方格伪影,细粒度滑窗质量较好却依赖复杂专用 kernel。理论注意力稀疏度并不保证实际加速。 本文贡献:BASA 在不同 DiT 层与去噪步交错平移空间窗口,让邻域跨边界交换信息;池化的全局 K/V 补长程上下文,标准 SDPA 完成本地与全局计算。视频窗口保留完整时间跨度,仅做空间稀疏。实验还用密集教师蒸馏注意力层,不应把全部结果写成免训练替换。 论文 Figure 3:BASA 总览。(a)稀疏注意力结合多个组件,在减少注意力成本时恢复局部及全局视觉交互;(b)作为 DiT 块视觉自注意力模块的替换,其余生成流水线保留。实验中的注意力蒸馏仍需训练。 实验效果:表 3 的单 A100、Wan2.1-T2V-1.3B,从 832×480 外推到 1664×960:窗口 10×10、池化 4×4 时,预热后注意力前向延迟 509.66→112.84 ms,加速 4.52 倍、稀疏度 90%。表 4 的一百段视频中,Imaging Quality 65.22%→67.02%,Aesthetic 57.53%→56.87%。 论文 Table 3:Wan2.1-T2V-1.3B 从 832×480 到 1664×960 的视频分辨率外推注意力效率。配置在 latent 网格上定义;时延为预热后的注意力前向耗时,加速相对 dense Wan,列出实现、稀疏度、TFLOPs、MFU 与 kernel 效率,不是端到端采样速度。 批判点评:4.52 倍限注意力前向,不能当端到端视频生成加速。各质量维度有升有降,表 1 的相似度还是与密集模型输出比较。窗口过小可能损伤保真度,标准后端兼容也不等于所有硬件都实测;未确认该方法独立代码链接。 8. TalkLikeYou:一步生成个人说话习惯 Talk Like You: Imitating How You Speak in Real-Time Talking Head Generation | 中国科学院自动化研究所;中国科学院大学;中科院香港创新研究院;澳门科技大学 | arXiv:2610.06658 关键词:数字人生成, 说话习惯, 一步flow, 运动空间 前序问题:同一发音,不同人露齿、张嘴和嘴角运动习惯不同。只保证音画同步与清晰度容易生成千人一面的表情,单人微调又增加部署成本。 本文贡献:TalkLikeYou 在隐式关键点运动空间建模说话习惯,用音频、源运动与可选习惯条件生成旋转和表情变化,再以冻结渲染模块合成视频。flow 模型预测干净运动,一步采样;两阶段学习先用预设 one-hot 习惯,再学习参考视频到统一习惯空间,并用 PLAD 评价相似性和多样性。 论文 Figure 2:TalkLikeYou 框架。flow 运动生成器从可选习惯来源一步采样习惯感知运动,再渲染视频;两阶段习惯学习增强泛化与稳定性。统一习惯空间中星号表示 one-hot 习惯编码、圆点为参考视频样本;第一阶段用对齐损失关联视频特征及对应习惯编码。 实验效果:表 1 的 HDTF:FID 7.71、FVD 112.94、身份相似度 CSIM 0.94,对应 Ditto 为 21.61、319.03、0.87。Sync-C 为 8.73,但 Sync-D 6.82 仍高于 Sonic 的 6.70,唇同步并非所有指标最优。推理运动采样为一步,训练两阶段在 RTX 3090 上分别 48、72 小时。 论文 Figure 3:三种选定说话习惯下与先进基线的视觉与唇同步比较。需放大观察细节,动态视频见作者补充材料;静态帧不单独证明完整时序质量。 批判点评:一步运动采样不代表整条视频流水线只做一次前向,静态图也无法证明时序同步或个人习惯完整复现。定制需参考视频或预设习惯,跨人物、姿态与口型应另测。作者项目页和官方仓库提供方法入口。 9. AuraSE:降噪时尽量不改词与声线 AuraSE: Low-Hallucination Generative Speech Enhancement via Multimodal Flow Matching and Inference Policy Optimization | 香港中文大学深圳;Microsoft Research | arXiv:2610.06632 关键词:生成语音增强, 多模态flow, 推理策略优化, 内容保真 前序问题:生成式降噪能让音频更干净,却可能改词或改说话人。即便输入转录文本,不同句子的最佳 guidance、温度和步数也不同。 本文贡献:AuraSE 用文本与声学双流再转单流的 MMDiT,保留退化音频的专门通路。IPO 从当前模型在多组解码配置下生成候选,按感知质量、词错误率、说话人相似度和语义保真组合奖励形成偏好对,周期刷新数据并优化。部署最终固定十步 ODE,不做逐句搜索,不使用 CFG。 论文 Figure 1:AuraSE 总览。左侧双流再转单流 MMDiT 以转录为条件增强退化 mel 并预测 flow 速度;中央双流块让 mel 与文本共同注意力但保持独立投影;右侧 IPO 用多样推理策略解码、评分、在缓冲中组成自生成偏好对,再闭环更新模型。 实验效果:表 3 每个合成测试集 824 句:有混响 WER 从 AuraSE 基础版 9.65% 降至 IPO 8.22%,无混响从 8.43% 降至 6.98%。表 4 的真实 DNS 盲测 OVRL 3.144→3.365,人类盲听综合分 3.60±0.13→3.74±0.13,区间为 95% 置信区间半宽。 论文 Table 3:合成主测试,有混响与无混响各 824 句;除 WER 外越高越好,粗体及下划线为增强系统中最佳与次佳,排除原始噪声音频参考。SIG、BAK、OVRL 是感知质量,SIM 是说话人相似度,SBS 是语义保真,不能只选一个维度宣称零幻觉。 批判点评:低 WER 不等于零幻觉,说话人相似度也并非所有系统最高。输入转录及评测依赖外部识别器,后训练还要多次声码器及奖励计算。结果限于论文的英语增强条件,不可直接外推所有语言、麦克风和音乐修复;本期未确认官方代码入口。 10. CoAl:对齐上下文token提升生成 Learning to Read the Contextual Tokens in Diffusion Transformers | 特拉维夫大学;康奈尔大学 | arXiv:2610.06844 关键词:多模态DiT, 上下文对齐, 全局语义, 生成表征 前序问题:多模态 DiT 会不断更新文本 token,但其内容与生成质量的关系不清楚。只对齐图像 token 的局部特征,可能忽略上下文中逐步形成的全局场景信息。 本文贡献:作者先用轻量瓶颈把多层上下文 token 映射给冻结语言模型,从隐表示询问生成图语义;再提出 Contextual Alignment(CoAl),把单个早期层的上下文表示通过小型 Q-Former 对齐到干净图的冻结 SigLIP 全局语义嵌入。空提示条件加权减少照抄 prompt 的捷径,额外对齐网络只在训练使用。 论文 Figure 6:Contextual Alignment。轻量 Aligner 把多模态 DiT 的上下文 token 映射成嵌入,以负余弦相似度损失对齐到冻结语义编码器从干净输入图得到的教师嵌入。 实验效果:表 1 的从零训练实验:REPA 加 CoAl 后 FID 4.95→4.29,Recall 0.338→0.407;另一个 SD3 在 Fine-T2I 上微调实验,基础 FID 19.30、常规 flow 微调 17.18、CoAl 16.75。两种协议数据与指标范围不同,不能直接排名。 论文 Table 1:与表征对齐基线的量化比较。(a)完整模型从零训练:给 REPA、HASTE、SRA 加 CoAl,分别列 FID、CLIP、HPS、Precision 与 Recall;(b)预训练模型微调:比较基础、常规 flow、视觉对齐及 CoAl 的 FID 和分布覆盖。两种实验使用不同协议,数字不能横向混排。 批判点评:读到语义及与偏好分相关,不等于模型能逐步逻辑推理或保证最终画面。Reader 训练集中于单个人物和十五类问题,标签来自 VLM;全局语义对齐也不能保证局部细节正确。这篇入选依据是实际改进生成的 CoAl,而非一般视觉问答;未确认方法代码已公开。 趋势观察 预算应跟随内容与条件 LoT 根据画面细节改变 token 布局,RefRoute 压缩参考条件并路由到指定区域,Keepsake 留下难替代视角。减少重复信息比统一压缩所有输入更值得先测。 计算位置和更新目标都能调整 LiFT 把计算放在共享主干循环,MEND 先检查样本移动是否值得,AuraSE 把多配置偏好训练进固定解码器。它们减少的是不同成本,不能用同一加速口径相互比较。 低比特与稀疏仍需保留关键通路 CentriQ 用精度较高的分支补回均值,BASA 用全局池化恢复长程信息。压缩不是简单删去内容,关键是被省略的部分如何表达及补偿。 可解释表征要落到生成验证 TalkLikeYou 用运动空间表示习惯,CoAl 对齐上下文全局语义。表征可读不等于可靠控制,仍须核对质量变化、数据范围与失败例。 今日讨论 你的生成内容中,哪些区域可以降低细节预算,哪些区域必须保持完整? 人工智能炼丹君 整理 | 2026-10-08
-
AIGC 每日速读|2026-10-07|腾讯原生2K音画训练快2.5倍Prism 今日 AIGC 论文速览 今日共 10 篇 · 音画与流式声音生成 2 篇 · 规则一致性与四维世界 2 篇 · 图像生成与连续编辑 2 篇 · 视频编辑与推理加速 3 篇 · 结构可控声音变形 1 篇 重点论文标题列表 Prism(腾讯):原生二千像素音画训练提速 S2PD(剑桥):先串行推演再并行修画面 PVD(港理工):两个半身专家接力生成图像 WorldSonus(港科大):世界画面逐段配上立体声音 ALIVE(罗切斯特):插入的物体跟着人物互动 今日论文速览 1. Prism:原生二千像素音画训练提速 Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training | 腾讯混元;复旦大学;浙江大学 | arXiv:2610.05416 关键词:联合音画生成, 原生2K训练, 动态稀疏注意力, 跨模态引导 前序问题:2K 视频的 token 数量让全注意力训练昂贵,先生成低分辨率再超分又难补回原生细节。固定稀疏块还可能把不同运动方向或关键发声区域混在一起,省了计算却损伤动作与声音对应。 本文贡献:Prism 在 MOVA 双分支 DiT 中替换视频自注意力,保留音频与跨模态注意力。先划分 8×8×8 时空宏区,结合视频特征通道方差和音频到视频交叉注意力范数,为各区选择 64、128 或 256 token 的块形状;再用 Top-k/Top-p 混合策略分配注意力预算。稀疏布局适应空间结构和音画耦合,而非统一删去固定区域。 论文 Figure 2:Prism 架构。把 token 序列划分为时空宏区,动态给各宏区指定适配的块形状,再以 Top-k/Top-p 混合块稀疏注意力把计算集中到信息量高的交互。 实验效果:作者在十万条 2K 视频上训练,报告原生 2K 联合音画训练加速 2.5 倍。表 2 的 95% 稀疏配置相对全注意力训练:cpCER 从 0.374 降到 0.187,DeSync 从 1.05 降到 0.63,MotionQ 从 0.53 升到 0.89。2K-Bench 为 300 条未见的十秒视频;训练吞吐与这些质量指标是两类证据。 论文 Figure 3:与此前开源方法的定性比较。音频必须参看项目演示视频,更多结果见附录 A.7;此静态图展示视频画面,不单独证明音频质量。 批判点评:2.5 倍不能移写成端到端生成速度,95% 稀疏也不等于整个模型少算 95%。静态截图无法核对音频,须结合项目音画演示。自建测试集和自动评价不代表所有镜头、说话人与低分辨率任务都同样获益。项目页与官方代码给出复现入口。 2. S2PD:先串行推演再并行修画面 S2PD: Serial-to-Parallel Diffusion for Physically and Logically Consistent Video Generation | 剑桥大学;丰田欧洲 | arXiv:2610.06847 关键词:视频扩散, 串并行采样, 物理一致性, 游戏规则 前序问题:即使不断采样程序生成的训练数据,并行视频扩散仍会生成违规棋步、错误碰撞或不连贯物体。问题可能在于模型缺少逐段协调事件的串行计算,而不只是数据不够。 本文贡献:Serial-to-Parallel Diffusion 在高噪声阶段按时间块自回归去噪,先协调相互依赖的事件;到较低噪声再切换为整段并行细化,减少纯串行采样的闪烁。训练使用多种块大小;实验在从零训练的 DiT-B 与 Wan-5B-LoRA 上,按匹配训练预算比较双向并行、因果 Diffusion Forcing 和 Block Causal。 论文 Figure 2:各方法的注意力模式与本文采样策略。(a–c)分别为双向、因果 Diffusion Forcing(cDF)与 Block Causal(BC)的注意力掩码及噪声水平;(d)先串行去噪再并行细化;(e)时间切片内部的 token 顺序;(f)训练使用多种块大小。 实验效果:表 2:DiT-B 的 2048 每次 rollout 非法转移从并行基线 47.9 降到 0.9,双摆动力学误差从 73.4 降到 1.1;Wan 的 Kubric MOVi-A CD-FVD 从 252.8 降到 137.0。国际象棋则为 51.0→12.3,仍逊于另两种串行方法的 4.6 和 6.8,不能写成全任务最优。 论文 Figure 6:Wan-5B-LoRA 架构的定性比较。在 MPMWorlds 与真实魔方数据集上,串行方法表现相近,相比双向基线生成更连贯的视频。 批判点评:程序世界中的规则错误减少,不是开放世界物理定律的保证。串行块越小通常越慢,表 4 显示质量和采样成本需一起调;混合方法相对纯并行也有额外串行开销。建议先检查自己的事件依赖是否需要串行推演。项目页可核验,本文不使用未经确认的会议接收背书。 3. PVD:两个半身专家接力生成图像 Two Halves are More than One: Phase-wise Velocity Distillation for Fast and High-Quality Image Generation | 香港理工大学;OPPO研究院 | arXiv:2610.08070 关键词:图像生成, 分阶段蒸馏, 平均速度, 显存压缩 前序问题:粗结构与细节生成发生在不同噪声区间,却常由同一个完整学生网络承担。压到一次完整主干计算预算时,统一学生容易兼顾不好两个阶段;少步模型也未必减少活跃参数或显存。 本文贡献:Phase-wise Velocity Distillation 从教师抽取约半深度主干,先用 flow matching 对齐初始化,再学习粗到细两个区间的平均速度;文生图采用共享冻结主干与阶段 LoRA,并加阶段判别器做对抗细化。两个半身专家依次执行,累计 FLOPs 约等于一次完整教师主干前向,但实际仍是两次专家调用。 论文 Figure 3:PVD 总览。(a)从教师抽取半身主干,经 flow matching 微调初始化局部学生;(b)分阶段 LoRA 专家在划分的时间区间上学习平均速度;(c)文生图任务使用分阶段判别器进行对抗细化。 实验效果:表 1 的 ImageNet 256×256、归一化计算预算 1.00 下,PVD FID-50K 为 1.48,iMF 为 1.72,多步 LightningDiT 为 1.35。表 3 的 Qwen-Image 蒸馏:活跃参数 20.43B→10.40B,峰值显存 38.42→19.84 GiB,减少 48.36%;GenEval 为 0.8720→0.8846。 论文 Figure 1:文生图结果。上排为教师:Stable Diffusion 3.5-Medium、FLUX.1-dev、Qwen-Image,分别使用 50×2、50、50×2 步;下排以两个半身分阶段专家顺序生成,累计计算约等于一次完整教师主干前向。这是计算预算比较,不能读成只调用一个专家。 批判点评:活跃参数不是所有权重总量,等 FLOPs 也不是已实测的一倍调用延迟。Qwen 的 DPG 从 89.10 降到 86.54,WISE 从 0.64 降到 0.59,质量没有全面超过教师;密集计数和罕见布局仍困难。可从官方仓库核对权重与实现,再按具体 GPU 测显存及延迟。 4. WorldSonus:世界画面逐段配上立体声音 WorldSonus: Bringing Sound to Worlds | 香港科技大学;Noiz AI;沐曦;上海交通大学 | arXiv:2610.08760 关键词:视频到音频, 因果流式生成, 立体声, 交互提示 前序问题:交互视频的未来画面尚未产生,双向配音不能等待整段视频再工作。声音还要随左右位置与用户文字控制变化,同时维持跨块连续性。 本文贡献:WorldSonus 用因果自回归 Transformer 与 rectified-flow 头,逐块输出 48 kHz 立体声。两种时间尺度的视觉 token 同时提供场景计划与帧级线索,环形 KV 缓存限制历史长度;提示词在块边界更新。训练用冻结 Synchformer 的 ShiftNCE 做时间对齐,结合真实立体声筛选和全景一阶 Ambisonics 的视角解码学习方向,教师只在训练使用。 论文 Figure 1:WorldSonus 总览。(a)因果流式流程:视频映射为两种时间尺度的视觉 token,条件化自回归 Transformer 和 rectified-flow 头;(b)训练专用 ShiftNCE:冻结 Synchformer 教师以对比窗口匹配指导时间对齐;(c)立体声空间监督:真实立体声筛选与全景一阶 Ambisonics 视角解码提供方向依据;(d)交互文字控制:在块边界动态更新提示,保留会话状态和声学连续性。 实验效果:表 1 的单 H100 设置中,100 ms 音频块计算为 41.2 ms,实时因子约 0.41。VGG 五秒测试 FAD 为 1.73,PrismAudio 为 2.09;交互五秒为 2.68 对 6.22。五秒与十秒拆分各 4096 条,三十秒拆分为 1024 条,跨时长结果分别统计。 论文 Figure 2:两个交互片段中,与双向基线比较立体声布局。红框标出声源;能量平衡曲线中负值表示左声道占优,正值表示右声道占优。 批判点评:41.2 ms 是模型块计算,不是含采集、传输、播放缓冲的完整交互延迟。时间同步并非全优:VGG 五秒 DeSync 为 0.686,PrismAudio 为 0.539,后者更低。因果音频表示和有限立体声数据仍构成限制,三十秒评测不足以保证无限长会话稳定。项目页可听原始演示。 5. ALIVE:插入的物体跟着人物互动 ALIVE: Interaction-Aligned Object Insertion for First-Frame-Guided Video Editing | 罗切斯特大学;Adobe Research | arXiv:2610.08779 关键词:视频编辑, 首帧引导, 物体插入, 时间局部条件 前序问题:给视频首帧加一本书很容易,随后让人拿起、翻开它却难:插入物体常留在原地或穿过手。只写物体名称,也缺少每个阶段该发生什么交互的描述。 本文贡献:ALIVE 把干净源视频 latent 与带噪目标 latent 沿通道拼接,编辑后的首帧保持干净,以 LoRA 训练 LTX-2.5 22B 编辑器。35,800 对数据混合渲染、真实、模型生成与通用编辑来源,并标注多级提示。可选 VLM 从原视频、编辑首帧和物体名称预测分段交互描述与帧区间,再通过时间局部交叉注意力路由到对应片段。 论文 Figure 3:ALIVE 总览。(a)源视频与带噪目标 latent 沿通道拼接(C),编辑首帧 latent 保持干净(金色);火焰表示编辑器及 VLM 的 LoRA 微调。(b)监督 VLM 从同样的视觉输入与物体名提示 P1 预测 P4 描述及帧区间,P4 文本独立编码;注意力图比较共享的 P0–P3 条件与时间局部 P4 条件。 实验效果:表 1 的 128 例交互插入测试中,0–100 的 VLM Overall:只给物体名的 ALIVE 为 86.71,Señorita 为 60.24;预测分段提示后为 87.66。103 例通用插入中,ALIVE 为 92.28,加入 VLM 后为 91.71,增强并非对所有任务有益。 论文 Figure 4:交互物体插入定性结果。(a)拿书,(b)提篮,分别展示首帧、视频 40% 和 90% 位置。AnyV2V 的方形帧以较窄宽度展示;† 表示按照各方法官方提示格式额外提供交互指导。 批判点评:这些是自动 VLM 判断与抽帧协议下的分数,不能当作接触力或真实物理正确率。区间预测错误、布料和物体旋转仍会造成伪影;编辑器也不是在线流式生成器。论文明确实现和实验在罗切斯特完成,署名 Adobe 合作不应改写为单一机构成果。项目页可查演示,未确认可下载的方法代码。 6. MC-Sparse:缓存稀疏布局再补注意力尾项 MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers | 腾讯混元;复旦大学;上海创智学院;香港中文大学;南开大学;北京大学;上海交通大学 | arXiv:2610.06801 关键词:视频生成加速, 稀疏注意力, 元数据缓存, 残差补偿 前序问题:稀疏注意力与完整注意力之间的差距不只来自删掉低权重连接,还来自块结构绑定和近似选择错误。每步重新精确筛选又可能吞掉节省的计算。 本文贡献:MC-Sparse 在锚点步骤精确选择 KV 索引,并用相似查询重排与 token 级选择减少结构误差;跨去噪步缓存查询分组、选择索引及完整减稀疏的残差,近似补回被丢弃尾项。Q、K、V 特征仍在当前步重新计算,因此不是复用旧视频 token。预热、锚点刷新和 CUDA 实现成本都需计入。 论文 Figure 6:MC-Sparse 流程总览,展示查询分组、精确选择及元数据复用、token 稀疏注意力和尾项补偿之间的连接;具体预算与刷新策略以正文为准。 实验效果:表 1 的 Minimax-H3-Base 768p 视频分支:15% 注意力密度下,DiT 去噪加速 1.80 倍,相对完整注意力输出 PSNR 为 27.30 dB;25% 密度为 1.61 倍、28.44 dB。15% 时 VBench ImgQual 从 69.20 变为 68.94,接近基线仍有质量差异。 论文 Figure 1:Minimax-H3-Base 768p 的质量和效率。左侧为质量指标及 DiT 去噪延迟:15%、25% 注意力密度分别相对 FA3 全注意力加速 1.80、1.61 倍;右侧为 15% 密度生成帧与完整注意力参考的逐段比较。接近参考不代表无损。 批判点评:这里的 PSNR 对齐完整模型输出,不是真实视频;1.80 倍也不包含 VAE 与条件编码。各任务约五十个评测样本、硬件并行设置和内部三维数据限制泛化与复现判断,不能宣传无损或全系统同幅提速。项目页已给出,未把未知代码状态写成开源完成。 7. CtrlCache:转向与动作变化决定是否复算 CtrlCache: Accelerating Interactive Video World Models with Control-Aware Caching | 奥克兰大学;新南威尔士大学 | arXiv:2610.08777 关键词:交互世界视频, 免训练加速, 控制感知, 残差缓存 前序问题:少步交互世界模型还要多次运行昂贵 DiT。只按内部特征相似度决定缓存,容易忽视用户突然转向或改变动作时需要及时刷新。 本文贡献:CtrlCache 先把输入控制分成初始、变化、持续转向与稳定状态:初始及动作变化块完整计算,转向和稳定块才在选定内部去噪步复用本块最近完整步的残差,首尾步骤始终完整。稳定交互时,再把上一块最后一帧的低频历史先验混入首步干净 latent 估计;无需重新训练,也不把所有历史特征无条件沿用。 论文 Figure 3:CtrlCache 总览。(a)按块自回归去噪,首尾步骤保持完整计算;(b)动作感知策略在转向与稳定块的选定内部步复用残差,在初始及动作变化块保留完整计算;(c)稳定交互中,频率混合历史先验把前一块最后干净帧的结构用于指导首步干净 latent 估计。 实验效果:表 1 的 WBench 导航、单 A100 设置:Matrix-Game 2.0 去噪时间 14.99→10.67 秒,加速 1.41 倍,Overall 0.6543→0.6786;LingBot-World v1 为 1.26 倍、0.7816→0.8127,v2 为 1.21 倍、0.8042→0.8201。使用相同提示、控制和初始帧比较。 论文 Figure 4:CtrlCache 与基线的定性比较。各方法使用相同初始条件和控制序列;蓝色虚线框用于比较布局、物体位置及运动细节,红框标出外观或结构失真,绿框标出本文保留较好的细节。控制字符串沿用 WBench:W/S/A/D 为平移,left/right/up/down 为视角变化。 批判点评:计时排除 KV 提交与更新,不能直接当完整交互延迟;TeaCache 与 EasyCache 在此表还更快,CtrlCache 选择了不同质量取舍。v2 的画质与交互分项略降,不能写成每项提升。复用步位置和控制规则依赖具体模型,移植时需要重新验证。项目页提供方法说明。 8. UniSlider:滑杆刻度对应感知变化 UniSlider: Perceptually Uniform Sliders for Continuous Image Editing | 巴塞罗那自治大学计算机视觉中心;Adobe Research | arXiv:2610.06831 关键词:连续图像编辑, 感知均匀性, LoRA, 自适应采样 前序问题:把编辑强度从 0.2 拉到 0.3,有时完全没变化,有时突然跳到另一种样子。现有强度参数并不对应均匀的可感知变化,界面有刻度却缺少稳定控制。 本文贡献:UniSlider 在冻结的 FLUX.2-klein-4B 上训练按强度缩放的 LoRA,完整运行少步采样,用 DreamSim 距离把中间图推向输入与满强度输出之间的相应感知位置。满强度目标只需缓存基座的默认编辑,不需人工中间图。推理再测量样本的感知曲线,自适应重映射滑杆参数,补偿残余不均匀。 论文 Figure 3:UniSlider 训练。采样强度 s,按公式 3 缩放可训练 LoRA 与冻结主干组合,完整运行 T 步得到 x_s;满强度 x_edit 在 s=1 时仅缓存一次。公式 4 的损失把 x_s 推向输入 x_src 与 x_edit 之间由 s 指定的感知位置。 实验效果:表 1 的 300 例基准:感知距离变异系数 CV-DSim 为 0.652,SliderEdit 为 1.199;LPIPS 单调性违例率为 0.016 对 0.251。表 3 中,只用均匀采样的 UniSlider 为 0.871,自适应采样后为 0.652,表明训练和参数重映射均有作用。 论文 Figure 2:训练缩小滑杆不均匀差距,自适应采样继续补偿。三行对同一图像执行同一指令:左侧为等滑杆刻度的 SliderEdit、仅用训练损失的 Vanilla、带强度重参数化的完整 UniSlider;右侧为每张图相对输入的 DreamSim 感知距离,以输入到完整编辑的总距离归一化。对角线表示理想均匀变化。 批判点评:DreamSim 上的匀速不等于每种语义属性都线性变化,原文失败例中颜色变化会掩盖球尚未膨胀的问题。编辑身份保持与 VQA 单调性也并非逐项最佳,基座本身的错误会沿滑杆传播。不同基座的比较需看附录同基座对照。作者项目站本次 TLS 验证失败,未降级访问,也不声称演示或代码已核验;本卡依据可访问的原论文全文。 9. ChronoWorld:用四维记忆回看修正世界 ChronoWorld: Camera-Controlled Consistent 4D World Generation via Spatiotemporal Cues and Geometric Reflections | 北京大学王选计算机研究所;加州大学默塞德分校 | arXiv:2610.06687 关键词:相机可控生成, 四维世界, 几何记忆, 反思修正 前序问题:按新相机轨迹生成视频时,动态物体在不同视角可能对不上,局部漂亮也不能保证整个时空场景一致。需要把生成结果放回可重建的几何状态,再检查历史视角。 本文贡献:ChronoWorld 的 Observation–State–Reflection 框架以相机条件 STC-DiT 生成视频,通过时空极线因果注意力联结视角约束和时间顺序;多头重建 decoder 预测颜色、几何与运动等四维属性。统一 4D 记忆用于检索和重渲染,几何反思再据不一致结果做校正,把视频观察转成可检查的世界状态。 论文 Figure 2:ChronoWorld 框架。相机轨迹条件化的时空线索 Diffusion Transformer(STC-DiT)去噪目标视频,多头重建 decoder 预测四维属性。 实验效果:表 1 的相同输入视频与目标相机轨迹设置:ChronoWorld 的 FVD-4D 为 177.41,Free4D 为 216.67;相对位姿旋转、平移误差为 0.95、2.34,对方为 1.73、3.28。表 2 的重建一致性 PSNR 为 18.87、SSIM 为 0.73。本次也核对 v2,相应主表数字一致。 论文 Figure 4:不同相机轨迹下 ChronoWorld 与基线的定性结果。作者提示放大查看局部细节;量化效果须结合 FVD-4D、相机误差和重建一致性表格。 批判点评:4D 同步、相机误差与重建一致性是不同指标,不宜合并为现实世界正确率。几何由生成和估计共同建立,回看改进仍可能继承错误;原文未给出足以验证无限场景或完整实时延迟的证据。训练使用八张 A100 80GB,推理单 A100;未确认官方项目或代码入口,不宣称已开源。 10. Smorph:换音色时保留节奏与音高 Smorph: Playable Sound Morphing with Diffusion Models | 美国西北大学;Adobe Research;Wizdom Music | arXiv:2610.06478 关键词:声音生成, 音色变形, 结构引导, 音乐交互 前序问题:从铜管变成弦乐、从鼓声变成气泡声时,音色与节奏结构常一起变化。音乐设计希望保持音高轮廓或响度包络,让声音身份沿连续路径变化。 本文贡献:Smorph 在扩散采样中组合文本或音频端点引导,并让所有中间状态共享固定的 RMS 或音高结构条件;支持提示到提示、音频到提示和音频到音频变形。SoundCanvas 预生成 5×5、共 25 个声音组成二维网格,鼠标在邻近样本间双线性交叉混音,MIDI 键盘触发当前音色。当前引导无需额外训练,但所用基座与音频条件模块已有预训练或适配。 论文 Figure 2:结构引导的组合指导,详见第 3.1 节。变形参数 α∈[0,1] 插值音频或文本端点条件 c_1…c_N;共享结构参考 c_S 为所有中间状态锚定时间包络或音高轮廓,并在全部 T 个去噪步保持固定。 实验效果:表 2 的 Clotho→Clotho、RMS 音频到提示设置:相对 SDEdit,结构控制分数 S_ctrl 从 0.356 升到 0.646,mel-L1 从 1.518 降到 1.027;目标音色相似度从 0.695 降到 0.646,KAD 从 4.420 升到 4.902。结构保留增强伴随目标变形及分布质量取舍。 论文 Figure 3:有显式结构控制(上排)与无显式控制(下排)的变形路径。每格为 mel 频谱,灰线为输入 RMS、橙线为生成 RMS;显式控制在展示的路径中更好保留预期时间包络。 批判点评:实时的是预生成样本间的演奏与混音,不是鼠标每次移动都实时运行扩散。感知路径也不保证处处线性;音乐人案例属于探索性反馈。机构由作者项目页核实,arXiv 注释和项目页标示 ISMIR 2026,但本期不把这一标示扩大为独立查证的接收结论;没有确认方法代码下载。 趋势观察 计算应随阶段与控制变化 S2PD 把高噪声串行推演和低噪声并行细化分开,PVD 把粗细生成交给不同专家,CtrlCache 在动作变化时刷新。减少计算之前,需要先识别哪些阶段或控制状态承载关键依赖。 缓存内容比缓存数量更关键 MC-Sparse 缓存布局与误差补偿,WorldSonus 限制流式历史,ChronoWorld 保存可重建的四维状态。缓存有不同语义,不能把索引、旧特征与几何记忆混为同一种技巧。 连续控制需要可测的约束 UniSlider 用感知距离修正滑杆,Smorph 用音高或响度结构锚定音色变化,ALIVE 用时间区间对齐交互。控制的意义要落到具体条件与失败例,而非只展示连续参数。 速度与质量必须分别核对 训练吞吐、DiT 去噪、单音频块计算和端到端响应是不同预算。自动质量分数的改善也常伴随其他维度退步,本期逐项写清测试条件,不拼成统一性能榜。 今日讨论 你的生成工作流更需要降低训练成本,还是让交互控制更稳定? 人工智能炼丹君 整理 | 2026-10-07
-
AIGC 基本功|视频稀疏注意力的误差与布局-SparseAttn AIGC 基本功|视频稀疏注意力的误差与布局-SparseAttn 所属方向:注意力与核心零件 | 难度:前沿 | 前置知识:FlashAttention、3D RoPE 关键词:视频生成、稀疏注意力、概率质量、块稀疏、时空布局、在线 profiling 本文以 2026-10-07 核验的论文与官方源码为准。全部实验来自 CPU 合成输入,不涉及模型权重、GPU 内核测速或生成视频质量评测。 01. 为什么需要它 视频的 token 数往往同时受帧数与每帧空间分辨率影响。把帧数翻倍,不只意味着多看一倍内容:若所有 token 两两计算注意力,配对数会变成四倍。这里的 token 指模型输入注意力层的潜空间 patch,不能直接用原视频像素数替代。VAE 的压缩率、patch 化方式和文本序列拼接,都会改变实际长度。 本篇先用一个能完全检查的小视频账本:4 帧,每帧 4×4 个位置,共 64 个 token。全注意力有 4096 对 query/key。只保留同帧配对,就剩 1024 对;只保留同一空间位置跨帧配对,就剩 256 对。上述数值由附录脚本实际构造布尔掩码并计数。小规模是为了看清算子,不能据此估算真实视频的显存占用。 真实论文也提醒我们,注意力可能占据很大一部分生成耗时。Sliding Tile Attention 论文在其 HunyuanVideo 实验设置中报告:基于 FlashAttention-3 的总耗时为 945 秒,其中注意力占 800 秒。这个数字带有论文的模型、分辨率和硬件条件,不是所有视频模型的固定比例。本文不将它移植到本地 CPU 实验,也不把论文的 GPU 加速当作已经复现的结果。 难点在于,少算配对同时改变信息来源。假设一个运动物体从左边移到右边,同一空间坐标跨帧未必一直指向同一物体。若硬性只保留原坐标,关键运动关联就可能被删掉。另一方面,即使保留的关联都正确,GPU 也可能仍然在混合计算块里做无效工作。理解稀疏注意力,必须同时回答两个问题:输出改变多少,保留下来的模式是否能让硬件真正少算。 02. 最小可用理解 用三句话建立框架:为每个 query 选一组允许读取的 key;在这组 key 上重新做 Softmax;把允许的配对组织成可以整块跳过或整块计算的布局。第一步决定信息损失,第二步保证权重重新归一化,第三步决定计算节约能否兑现。 稀疏注意力有两种常见来源。训练时就限定稀疏结构,模型能适应这种通信图;对已经训练好的全注意力模型做免训练稀疏替换,则需要评估替换误差。二者都可能用相同的掩码代码,但质量证据不能相互代用。本文重点讨论后者,同时保留训练适应这条路线的边界。 还要把它与已讲过的零件连起来。FlashAttention 在相同算子定义下优化读写与分块,目标是精确注意力,仍有浮点舍入差异。稀疏注意力一般删掉部分配对,因而改变算子。跨步缓存则复用不同去噪步骤之间的结果。三种方式的误差来源与可省成本不同,组合时要重新评测,不能把各自加速倍数直接相乘。 03. 数学推导 3.1 从全注意力到受限 Softmax 先只看一个头、一个样本,不含 dropout。设总长度为 $N$,query 和 key 维数为 $d$,value 维数为 $d_v$。矩阵 $Q,K$ 的形状都是 $N\times d$,$V$ 的形状是 $N\times d_v$。小写 $q_i,k_j,v_j$ 分别是第 $i$ 个 query、第 $j$ 个 key 与 value。它们是经过投影及位置处理后的向量;本文的掩码推导不要求投影矩阵采用某个具体模型。 缩放分数 $s_{ij}$ 和全注意力权重 $p_{ij}$ 为: $$s_{ij}=\frac{q_i^\top k_j}{\sqrt{d}},\qquad p_{ij}=\frac{\exp(s_{ij})}{\sum_{\ell=1}^{N}\exp(s_{i\ell})}.$$ 除以维数的平方根,是标准缩放点积注意力的定义。每一行权重为正且求和为一,因此输出 $y_i$ 是所有 value 的加权平均: $$y_i=\sum_{j=1}^{N}p_{ij}v_j.$$ 为第 $i$ 行定义保留集合 $S_i$。被删除的 key 分数设为负无穷,因为其指数为零。只要集合非空,受限权重 $\widetilde p_{ij}$ 可以直接写成原概率除以保留质量 $z_i$: $$z_i=\sum_{j\in S_i}p_{ij},\qquad \widetilde p_{ij}=\begin{cases}p_{ij}/z_i,&j\in S_i,\\0,&j\notin S_i.\end{cases}$$ 为什么可以这样写?原概率的分子是指数分数,分母是整行指数之和。把保留概率再求和,得到保留指数之和除以整行指数之和。二者相除时,原先的整行分母抵消,剩下的正是在保留 key 上做 Softmax。于是稀疏输出是: $$\widetilde y_i=\sum_{j\in S_i}\frac{p_{ij}}{z_i}v_j.$$ 这里的 $z_i$ 是概率质量,不是保留 token 的比例。保留四分之一 key,可能保住几乎全部质量,也可能丢掉大部分质量。空集合没有定义:所有分数为负无穷时,稳定 Softmax 的减最大值操作会产生无效值。代码必须拒绝空行或预先设计合法的保留策略,不能靠一个很小的 epsilon 假装集合有内容。 3.2 删除质量怎样进入误差 定义删除质量 $\alpha_i=1-z_i$。当删除集合非空时,令 $u_i$ 表示被删除 value 按原概率重新归一化后的平均;令 $r_i$ 表示保留集合的平均,即稀疏输出。原输出分成两部分: $$y_i=(1-\alpha_i)r_i+\alpha_i u_i,\qquad \widetilde y_i=r_i.$$ 相减时保留部分合并,得到一个精确恒等式: $$\widetilde y_i-y_i=\alpha_i(r_i-u_i).$$ 它解释了误差的两个因素:删除了多少概率,以及删除部分与保留部分的 value 有多不同。若所有 value 的欧氏范数都不超过 $M$,加权平均的范数也不超过 $M$。再用三角不等式,得到逐行上界: $$\lVert\widetilde y_i-y_i\rVert_2\leq\alpha_i(\lVert r_i\rVert_2+\lVert u_i\rVert_2)\leq2\alpha_i M.$$ 当全部 key 都保留时,删除质量为零、误差为零,不需要定义删除均值。这是条件明确的单层局部上界,不是最终视频画质保证。后续输出投影、残差连接和多次去噪可能传播这些差异;推导也没有给出整个模型的 Lipschitz 常数。更紧的估计需要观测两类 value 均值的距离,而不仅仅数被删掉的 token。 一个反例能直接检查条件:两项概率分别为 0.99 和 0.01,value 分别为 0 和 100。删掉第二项,保留质量仍有 0.99,但输出从 1 变成 0。脚本以 query 为 1、两个 key 为 log(99) 与 0 构造这个分布,并实际得到上述结果。概率质量高的确有帮助,然而不说明 value 尺度就不能宣称绝对误差很小。 3.3 时空模式与密度 设帧数为 $T$,每帧位置数为 $P=H W$,其中 $H,W$ 是 token 网格的高和宽。序列长度为 $N=TP$,先忽略文本等额外 token。按帧展平时,位置索引 $i=tP+p$,$t$ 表示帧,$p$ 表示帧内位置。教学空间掩码只保留同帧,时间掩码只保留同位置跨帧。 $$D_{\mathrm{full}}=T^2P^2,\qquad D_{\mathrm{spatial}}=TP^2,\qquad D_{\mathrm{temporal}}=PT^2.$$ 这里的 $D$ 表示允许的 query/key 配对数。空间模式中每个 query 可以读整帧的 $P$ 个 key,乘以 $TP$ 个 query;时间模式中每个 query 读 $T$ 个同位置 key。分别除以全配对数,密度为 $1/T$ 和 $1/P$。空间和时间取并集时,每行保留 $P+T-1$ 个 key,因为自己的 token 被两种集合各数了一次。 $$\rho_{\mathrm{union}}=\frac{P+T-1}{TP}.$$ 这组公式描述本文的简化掩码。SVG 论文的实际空间候选还可覆盖邻帧,时间候选也包含实现选择的带宽;模型还可能带文本上下文。不能把本文的同帧掩码称为完整 SVG 算法,更不能声称每个真实视频头都有密度 $1/T$。 3.4 布局重排为何不改变同一掩码的结果 令 $\Pi$ 是排列矩阵,对应重新编号 token;令 $A$ 是允许配对的布尔掩码。对 $Q,K,V$ 同步左乘排列矩阵,掩码的两个轴也同步重排,得到 $A'=\Pi A\Pi^\top$。分数的行列相应重排,逐行 Softmax 不受 key 顺序影响,因此: $$\operatorname{Attn}(\Pi Q,\Pi K,\Pi V,A')=\Pi\operatorname{Attn}(Q,K,V,A).$$ 最后乘逆排列,把输出放回原位置,就恢复同一稀疏算子的结果。成立的前提是位置编码已经正确关联原 token,Q/K/V 和掩码保持一致。若重排后用新序号重新生成 RoPE,却没有维护原来的时空坐标,就改变了分数,以上等价性不再适用。布局是存放方式,不能顺手改掉位置语义。 04. 代码实现 附录的 sparse_attention_demo.py 只需要 NumPy 与 matplotlib,读者可以先安装依赖,再运行脚本。它不下载权重、不调用 GPU。核心函数完整地实现同一公式,稳定 Softmax 先减每行最大值,掩码关闭的分数设为负无穷: def attention(q, k, v, mask): if not mask.any(axis=-1).all(): raise ValueError('Every query must retain at least one key') scores = q @ k.T / np.sqrt(q.shape[-1]) weights = softmax(np.where(mask, scores, -np.inf)) return weights @ v, weights 正文片段依赖附录里的 softmax 和 NumPy 导入;文末附录提供全部可运行代码。为了构造两个可解释的头,实验把第一个头的 Q/K 主信号放在帧的 one-hot 维度,第二个头放在帧内位置的 one-hot 维度,再加入标准差 0.15 的高斯扰动。主信号幅度为 6,随机种子为 7。这样主动造出一个偏空间、一个偏时间的分布,而不是从预训练视频模型测出来的头分工。 真实形状为 Q=(2,64,20)、V=(64,3),其中最前面的 2 是两个头,最后的 20 来自 4 个帧维度与 16 个位置维度。每头输出为 (64,3)。两个头共享同一 V,是为了让掩码误差可比较,未实现多头拼接及输出投影。相同输入与全掩码比较时,最大误差为零。 合成头 保留模式 配对密度 平均保留质量 对全注意力输出的 MSE 空间头 同帧 0.25 0.9989513131 6.1315309714e-08 空间头 同位置跨帧 0.0625 0.0680910956 0.9388219956 时间头 同帧 0.25 0.2703426737 0.6489679917 时间头 同位置跨帧 0.0625 0.9950700202 8.8294241814e-06 MSE 是对全部 64×3 个输出元素的平方误差求平均。它不是每行向量范数,也不是视频质量下降百分比。空间头用更激进的时间掩码时,虽然密度更低,却丢失了大部分概率质量;同一个稀疏比例换到另一个头,结果会完全不同。表格中的数值经过四舍五入,完整浮点输出由脚本打印并保存在运行结果中。 脚本还逐行检查数学上界。在空间头配合同帧掩码时,最大行误差为 0.0008639397,而这组行中的最大上界为 0.0117092274。断言比较的是每行误差与该行上界,不能把两个最大值的大小关系当成逐行证明。时间头配时间掩码同样通过断言;上界较松,是因为它使用整个 V 的最大范数,丢失了两类均值之间的具体方向。 并集掩码密度为 0.296875,两个头的 MSE 分别为 5.5294485880e-08 和 5.0711107889e-06。它在这组输入里比各自专用模式更接近全输出,但配对更多。这只是本次观测;增加保留集合同时改变归一化,误差并没有对任意输入都单调下降的定理。只看这张表,不能推出并集是通用最优选择。 图由同一实跑脚本生成。深色格子表示允许配对,细线每隔 4 个 token 划出计算块。中间与右侧保留完全相同的时间关联,但右侧把同位置的四帧放到一起,混合块变成完整小方块。它展示的是索引布局变化,不是视频内容或真实注意力热力图。 代码的 block_cost 假设每个 4×4 块只要有一个允许配对,就要计算整块。原时间掩码有 256 个有效配对,却分布在 64 个活跃块里,需要计算 1024 个位置,利用率为 0.25;重排后活跃块为 16 个、计算位置为 256 个、利用率为 1。重排再还原的最大绝对输出差为 2.2204460493e-16。这里的四倍是这个块账本中的工作量比例,未测延迟,真实内核可能采用不同块形状与融合策略。 05. 工业级实现对照 核验的官方代码为 svg-project/Sparse-VideoGen 的 Wan attention.py,关键位置是 WanAttn_SVGAttn_Processor2_0.sample_mse 与 sparse_head_placement;布局参考实现位于 placement.py。以上以 2026-10-07 下载的源码为准,快照与 SHA256 留在本地证据目录,分支 URL 将来可能重构。 sample_mse 抽取 query 行,分别计算全注意力和两个候选掩码的输出,随后以输出 MSE 评估候选。这比只比较注意力概率更贴近实际 value 聚合结果,但只看抽样行,仍有漏掉稀有困难 query 的风险。论文介绍随机采样约 1% 行的设置;当前 Wan 类里可以看到 num_sampled_rows=32 的类属性,实际采样数还会受序列长度限制。论文比例与某个源码默认值不是同一配置,部署时应查看运行参数的最终取值。 本次额外执行了官方函数体:保留数学运算,移除计时装饰器,以 CPU PyTorch 运行同一合成 Q/K/V,并配置 32 个采样行。官方 MSE 的输出形状为 (2,1,2),依次对应候选掩码、样本与头;argmin 选出的头类型为 [[0,1]],即空间头选空间候选、时间头选时间候选。这里只运行 profiling 和布局的参考函数,没有安装整套 SVG CUDA/Triton 扩展,也没有宣称完成视频推理复现。 实跑的两组采样 MSE 分别为 [6.8160804146e-08, 0.7533096337] 与 [1.0477995207, 7.9057440928e-06],列表中按空间头、时间头排列。它们与第 04 节对全部行计算的 MSE 不完全相同,因为这里随机抽取 32 行,而且官方函数使用带放回的 torch.randint,可能多次抽中同一个 query。不要把“抽了 32 行”直接理解成“覆盖 32 个不同位置”。这个细节不会改变本次选出的类型,却会影响评估样本覆盖程度。 sparse_head_placement 调用 ref_wan_sparse_head_placement,将时间头的视频部分从 frame-major 转为 token-major,保留末尾上下文 token 的位置。测试在视频的 64 个 token 后增加 2 个上下文 token,将官方参考结果与独立的 reshape/permutation 预期比较,Q/K/V 的最大差为零,上下文逐元素保持不变。这个上下文长度是测试参数,不能照搬为真实模型默认长度。 工业版本还提供 Triton 头布局与输出还原函数,处理批次、多头、步数及前若干层保留全精度等逻辑;当前仓库还包括后续 SVG2、SVG-EAR 路径。本文只分析已核验的 SVG1 候选模式与相关 Wan 参考函数,不把同一仓库中的所有更新归到原始论文。源码里的窗口、文本及图像条件处理,比同帧/同位置两个布尔条件复杂得多。 Sliding Tile Attention 则从计算块出发,让同一 query tile 共享一组 key tiles,尽量避免只保留少数元素的混合块。这与普通逐 token 滑窗有区别:二者的窗口边界不必完全相同。论文同时讨论无需训练与微调后的设置;更激进稀疏配置的结果若依赖微调,不能贴上免训练标签。选实现时要同时对照保留图的语义和实际 kernel 的结构,API 名称里带 sparse 并不足以保证收益。 06. 代价与边界 第一个代价是选择掩码的成本。若先算完整的全注意力,再从全部权重中寻找最重要连接,已经支付了最昂贵的部分。在线 profiling 通过抽样降低选择开销,但抽样误差也需要被监控。尤其是少数快速运动、镜头切换或长程交互 query,平均误差可能掩盖局部失败;候选集合里若根本没有合适模式,选出较小 MSE 也不代表它足够好。 可以把选择与验收分成两件事:先比较两个候选谁更好,再判断胜出的候选是否跨过允许误差的门槛。候选 MSE 都很高时,单纯的 argmin 仍然会返回一个类型,但它只表示相对更好。若要加入全注意力回退,应明确阈值用的是绝对误差、归一化误差还是其它指标,并记录每层、每步、每头的回退比例。本文没有为真实视频模型拟定通用阈值,也没有把教学输出范围当作部署标准。 同样,平均保留质量与最差行质量应分开记录。平均值接近一,仍可能存在少数严重失真的行;而即便删除质量相同,value 的方向分布也会让输出误差不同。检查局部误差时,可以同时看均值、最大值以及具体失败 query 的时空位置。这样的诊断有助于辨别错误来自窗口太小、头类型选错,还是位置编码与重排错配,避免把所有问题都归因于“稀疏率太高”。 第二个代价是布局、索引与数据搬运。布尔掩码的零不会自动让 NumPy 的 q @ k.T 少做乘法:本文最小实现先算完整分数,再应用掩码,所以它验证语义与误差,计算复杂度仍然是平方级。真正的稀疏内核必须提前知道活跃块,并跳过空块。若运行过程中每步重新排列 Q/K/V,排列本身的读写也要算入端到端时间。 第三个代价是全局交流能力。完全同帧的头不能直接读取其他帧;完全同位置的头不能直接读取别的位置。多头、残差与后续层可间接传播信息,但不能凭这种可能性认定某个被删除连接不重要。文本 token、首帧图像条件和特殊全局 token 常需要单独保留策略,训练时学习出的依赖不能任意删掉。 端到端收益可用成本模型先做量级检查。设全流程中注意力耗时比例为 $f$,稀疏后注意力加速倍数为 $r$,新增 profiling 与布局成本占原总耗时的比例为 $g$。在其它环节耗时不变的假设下: $$R_{\mathrm{total}}=\frac{1}{(1-f)+f/r+g}.$$ 若教学假设 $f=0.8$、$r=4$,不算新增开销时总加速为 2.5;再假设 $g=0.05$,就降为 2.2222222222。脚本实际计算这两个数值,然而参数是人为假设,既非本地测得的耗时,也非 SVG 的论文配置。这个模型的用途是防止把注意力内核四倍加速写成整段视频四倍加速。 还要看基线。对比普通全注意力,与对比优化后的 FlashAttention,收益可能差得很大。dtype、设备、分辨率、帧数、批量、是否计入编译与 warmup,都影响结论。本文只验证 float64 CPU 算子,没有 BF16/FP16 下的稳定性结论。某一精度的有限误差,不能推断另一精度的内核也会产生同样结果。 最后,稀疏模式的效果依赖去噪步和层。早期噪声状态、后期细节状态可能需要不同通信图;某些关键层适合全注意力回退。最终验收应固定同一模型、输入、随机种子与采样配置,同时看视频的运动连贯性、人物身份和提示词遵循。单层输出 MSE 是诊断信号,论文里的质量指标是其具体实验的证据,两者都不能替代待部署配置的实际验收。 07. 经典论文脉络 以下四篇提供不同层面的认识,英文标题与 arXiv 条目逐一核对。 Generating Long Sequences with Sparse Transformers(1904.10509):较早系统探索结构化稀疏连接,帮助理解通信图如何限制上下文路径;不能把训练得到的结果直接当作视频模型免训练剪枝证据。 FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(2205.14135):在算子不变时优化 IO 与分块,提供比较稀疏方法时需要的精确基线。 Sparse VideoGen: Accelerating Video Diffusion Transformers with Spatial-Temporal Sparsity(2502.01776):结合头的时空模式、在线选择和布局变换;摘要报告 CogVideoX-v1.5 与 HunyuanVideo 的最高端到端加速分别为 2.28×、2.33×,属于作者实验,本文未复现这些速度。 Fast Video Generation with Sliding Tile Attention(2502.04507):用 tile 组织局部注意力,减少混合块;其无需训练与微调设置应分开比较,说明稀疏结构和硬件块设计需要一起考虑。 这条脉络不是后一篇全面取代前一篇。精确 IO 优化回答怎样更高效地算相同注意力,稀疏连接回答哪些配对可以删,tile 与排列回答剩余配对怎样落到硬件。把三个问题分开,才看得懂方法之间有哪些可以组合、哪些只是比较口径不同。 08. 常见误解 误解一:掩码里有零,就已经省掉了对应乘法。 本文的 NumPy 路径是反例,它先产生完整分数。代码里存在掩码只说明语义受限;确认算力节约,需要看 kernel 是否跳过了整块,以及它为了识别和排列块支付了多少成本。 误解二:保留 99% 概率,输出误差必然不超过 1%。 百分比的分母没有定义,value 尺度也被忽略。本文反例的绝对误差为 1;若全输出接近零,相对误差还可能非常大。报告误差时应明确范数、聚合方式和参照量。 误解三:时间头等于把未来帧屏蔽掉。 本文时间模式连接同位置的全部帧,没有使用因果掩码。视频扩散常对一段视频同时去噪,不能直接套用自回归解码的因果约束;具体模型若确有因果设计,需要另行叠加并重新检查每行是否合法。 误解四:先重排 token,再随意换一下 position_ids 也等价。 等价的是一致的索引排列,原坐标语义必须保留。RoPE、条件 token 的边界及输出逆排列都参与正确性;只比较张量形状完全看不出这些错误。 误解五:低 MSE 的单层结果就能保证最终视频不变。 合成实验只证实给定输入上的局部性质。真实模型会反复调用注意力,误差可能叠加或放大,也可能被后续操作抑制。是否可以接受,要靠配置一致的端到端证据,不应将一个教学表格写成部署承诺。 09. 动手验证 把附录完整代码保存为 sparse_attention_demo.py,运行 python -m pip install numpy matplotlib 后执行 python sparse_attention_demo.py。脚本会输出 JSON 并在相邻目录生成运行结果和配图;随机种子固定为 7,使用 float64。不同 NumPy/BLAS 版本末位可能有微小差异,检查数量级和断言,不要求所有打印尾数逐字节相同。 第一步,确认三组形状、4096/1024/256 的配对计数及表格数值。把第一个头误用时间掩码,应该看到保留质量远低于同帧掩码,输出 MSE 明显变大。这验证“模式必须适配头”的逻辑,而不是观察任意真实模型头是否属于这两类。 第二步,检查时间掩码重排前后的块账本。有效配对始终为 256,活跃块分别为 64 与 16,逆排列输出最大差约为 2.22e-16。保持 Q/K/V 与掩码同步时,它们计算的是同一个算子;如果只重排 Q 而不重排 K/V,那是在故意制造错配,不能用它评估正常布局变化的误差。 第三步,查看 counterexample:保留质量 0.99、原输出 1、稀疏输出 0。再把 value 的 100 改成更大或更小的数,并重新运行;这是读者的扩展实验,本文没有预先声称改动后的实测输出。公式预言绝对误差随 value 尺度线性变化,可以用自己的运行验证。 第四步,脚本对空掩码执行捕获异常,empty_row_rejected 必须为 true。不要删掉这个检查后把 NaN 当成误差为零。若要研究更复杂窗口,先确认每个 query 至少有一个合法 key,再验证归一化、输出与块占用。最终准备换进模型时,还需要独立的 GPU 内核一致性测试及视频质量测试,本文的 CPU 演示只提供原理层的验算起点。 10. 延伸阅读 从 FlashAttention回看平方计算与 IO 成本的区别,再用 3D RoPE检查 token 重排是否保持原时空坐标。前者帮助建立正确的速度基线,后者帮助排查形状正确但位置语义错误的实现。 与 跨步缓存 DiffCache比较时,重点看复用轴:稀疏是在一次注意力调用内选择连接,缓存是在去噪步骤之间复用计算。若继续阅读 线性与循环记忆 LinearMem,则关注另一条路线如何改变聚合结构及历史状态的存储。这些零件能帮助组织性能问题,仍需在具体模型中各自验证,再评估组合误差与收益。 附录:完整代码 09 节用到的脚本全文如下(sparse_attention_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 sparse_attention_demo.py """CPU teaching experiment; pair counts are not hardware speed measurements.""" import json from pathlib import Path import numpy as np import matplotlib matplotlib.use('Agg') import matplotlib.pyplot as plt def softmax(scores): exp = np.exp(scores - scores.max(axis=-1, keepdims=True)) return exp / exp.sum(axis=-1, keepdims=True) def attention(q, k, v, mask): if not mask.any(axis=-1).all(): raise ValueError('Every query must retain at least one key') scores = q @ k.T / np.sqrt(q.shape[-1]) weights = softmax(np.where(mask, scores, -np.inf)) return weights @ v, weights def block_cost(mask, block=4): n = mask.shape[0] assert n % block == 0 tiles = mask.reshape(n // block, block, n // block, block) active = tiles.any(axis=(1, 3)) pairs = int(mask.sum()) computed = int(active.sum()) * block * block return {'useful_pairs': pairs, 'active_tiles': int(active.sum()), 'computed_pairs': computed, 'utilization': pairs / computed} def main(): rng = np.random.default_rng(7) t, height, width = 4, 4, 4 positions = height * width n, d = t * positions, t + positions frame = np.repeat(np.arange(t), positions) pixel = np.tile(np.arange(positions), t) full = np.ones((n, n), dtype=bool) spatial = frame[:, None] == frame[None, :] temporal = pixel[:, None] == pixel[None, :] masks = {'full': full, 'spatial': spatial, 'temporal': temporal, 'union': spatial | temporal} q = np.zeros((2, n, d), dtype=np.float64) q[0, np.arange(n), frame] = 6.0 q[1, np.arange(n), t + pixel] = 6.0 q += rng.normal(0, 0.15, size=q.shape) k = q.copy() v = rng.normal(size=(n, 3)) results = [] outputs = [] max_value_norm = np.linalg.norm(v, axis=-1).max() for head in range(2): golden, p = attention(q[head], k[head], v, full) head_outputs = {} for name, mask in masks.items(): y, p_sparse = attention(q[head], k[head], v, mask) retained = (p * mask).sum(axis=-1) removed = np.maximum(0, 1 - retained) error = np.linalg.norm(y - golden, axis=-1) bound = 2 * removed * max_value_norm assert np.all(error <= bound + 1e-12) assert np.allclose(p_sparse.sum(axis=-1), 1) results.append({'head': head, 'mask': name, 'density': float(mask.mean()), 'retained_mass_mean': float(retained.mean()), 'mse': float(np.mean((y - golden) ** 2)), 'max_row_error': float(error.max()), 'max_bound': float(bound.max())}) head_outputs[name] = y outputs.append(head_outputs) # Group tokens by spatial coordinate, then frame: an exact permutation. perm = np.argsort(pixel, kind='stable') permuted = temporal[np.ix_(perm, perm)] old_y, _ = attention(q[1], k[1], v, temporal) new_y, _ = attention(q[1, perm], k[1, perm], v[perm], permuted) restored = np.empty_like(new_y) restored[perm] = new_y permutation_error = float(np.max(np.abs(restored - old_y))) # A small deleted probability can matter when values have large magnitude. small_q = np.array([[1.0]]) small_k = np.array([[np.log(99.0)], [0.0]]) small_v = np.array([[0.0], [100.0]]) dense_y, dense_p = attention(small_q, small_k, small_v, np.array([[True, True]])) pruned_y, _ = attention(small_q, small_k, small_v, np.array([[True, False]])) try: attention(q[0], k[0], v, np.zeros_like(full)) except ValueError: empty_row_rejected = True else: raise AssertionError('An empty row was accepted') # Idealized cost model, not timings: 80% attention, 4x attention acceleration. f, r, profiling = 0.8, 4.0, 0.05 result = {'seed': 7, 'q_shape': list(q.shape), 'v_shape': list(v.shape), 'output_shape': list(old_y.shape), 'results': results, 'temporal_blocks_before': block_cost(temporal), 'temporal_blocks_after': block_cost(permuted), 'permutation_max_error': permutation_error, 'counterexample': {'retained_mass': float(dense_p[0, 0]), 'dense_output': float(dense_y[0, 0]), 'pruned_output': float(pruned_y[0, 0])}, 'empty_row_rejected': empty_row_rejected, 'assumed_amdahl_speedup_without_profile': 1 / ((1 - f) + f / r), 'assumed_amdahl_speedup_with_profile': 1 / ((1 - f) + f / r + profiling)} folder = Path(__file__).resolve().parents[1] (folder / 'figures').mkdir(parents=True, exist_ok=True) fig, axes = plt.subplots(1, 3, figsize=(12, 3.5), constrained_layout=True) for ax, mask, title in zip(axes, [spatial, temporal, permuted], ['Spatial: frame-major', 'Temporal: frame-major', 'Temporal: reordered']): ax.imshow(mask, cmap='Blues', vmin=0, vmax=1, interpolation='nearest') ax.set_title(title) ax.set_xlabel('Key index') ax.set_ylabel('Query index') for edge in range(3, n, 4): ax.axhline(edge + .5, color='#94a3b8', lw=.3) ax.axvline(edge + .5, color='#94a3b8', lw=.3) fig.savefig(folder / 'figures/sparse_layout.png', dpi=150, metadata={'Software': 'SparseAttentionTeachingDemo'}) plt.close(fig) (folder / 'run_result.json').write_text(json.dumps(result, indent=2), encoding='utf8') print(json.dumps(result, indent=2)) if __name__ == '__main__': main()
-
AIGC 基本功|线性、循环与记忆架构-LinearMem AIGC 基本功|线性、循环与记忆架构-LinearMem 长序列的瓶颈不只在注意力矩阵,还在不断增长的历史状态。本篇从可以手算的线性核出发,推到循环状态与 Delta 更新,再区分序列循环和深度循环。公式中的等价关系、代码中的误差、框架中的工程选择各有适用范围。 先修:自注意力机制的计算与显存账本。本文不训练视频模型,也不以随机张量实验推断视频画质;所有数值实验是 CPU 上的机制验证。论文与源码核验日期:2026-10-06。 01. 为什么需要它 假设一个流式生成器已经处理了 65536 个 token,单层单头的 key 和 value 维度都是 64。若两者均以 FP32 保存,历史 K、V 就要占 32 MiB。这还没有乘层数、头数和并发数,也没有算模型参数、工作区和训练激活。长视频若把时间与空间都展开成 token,状态增长会直接挤压服务容量。这个账本来自元素计数,不是某张 GPU 的实测峰值。 一种选择是保留历史,并用 FlashAttention 等方法减少中间矩阵和访存;另一种选择是把历史压进固定形状的状态。后者的单层单头状态可以只有 64×64 的矩阵,加一个长度 64 的归一化向量,共 16640 字节,约 0.015869 MiB。两者在这个设定下相差约 2016.49 倍,但这只是注意力历史存储的比例,不能写成模型显存节省或吞吐加速倍数。 压缩状态也会改变信息的组织方式。想象系统先记住“对象 A 的颜色是红”,随后收到“对象 A 的颜色改为蓝”。只做累加的记忆可能把两条记录混在一起,读出平均意见;具备纠错更新的记忆才有机会覆盖旧映射。省空间与能否可靠检索不是同一个问题,本文用这个更新场景把两者连起来。 这也是阅读长序列论文时最值得先问的三件事:保留了多少历史,允许怎样更新历史,训练时又如何并行。只看到“线性复杂度”就认为速度、记忆和生成质量一起改善,会把三个独立问题混成一个结论。 02. 最小可用理解 线性注意力先把 query 和 key 映射到特征空间,再利用矩阵乘法的结合律,把“每个 query 访问所有历史”改写成“每个 query 读取一个累积状态”。循环实现沿 token 方向更新这个状态;Delta 更新则把“直接写入新 value”改成“先读旧 value,再写纠正量”。深度循环共享同一计算块反复修改整段表示,它增加的是每个 token 的计算深度,不能由此推出历史缓存变成固定大小。 这里“线性”主要指固定特征维度时,时间随序列长度线性增长;整层仍包含非线性映射、归一化和前馈网络。这里“记忆”指输入驱动的隐藏状态,并非训练参数永久学到的知识,也不是数据库里逐条可寻址的记录。 把几个概念放在一起看,区别会更清楚: 机制 循环或聚合的轴 持续保留什么 要付的代价 Softmax 因果注意力 query 对历史位置检索 随前缀增长的 K、V 解码读取历史与缓存容量 核线性注意力 token 顺序 累积矩阵及归一化状态 核改变、信息混合 Delta 类记忆 token 顺序 可纠错的矩阵状态 更新依赖、key 干扰 深度循环 Transformer 表示的修订次数 整段表示及所需缓存 重复计算、停止机制 这张表是机制对比,不是性能排行榜。同一系统可以混用不同层;是否适合视频生成还取决于因果性、时间空间组织、条件输入和训练目标。 03. 数学推导 从检索权重开始 设序列长度为 $N$,当前位置为 $t$,历史位置为 $i$。列向量 $q_t,k_i\in\mathbb{R}^{d_k}$ 分别表示 query 和 key,$v_i\in\mathbb{R}^{d_v}$ 表示 value;$d_k$ 是匹配空间维度,$d_v$ 是读出空间维度。因果注意力只允许 $i\le t$,当前 token 可以看见自身。标准缩放点积注意力写成: $$a_{ti}=\frac{\exp(q_t^\top k_i/\sqrt{d_k})}{\sum_{j=1}^{t}\exp(q_t^\top k_j/\sqrt{d_k})},\qquad o_t=\sum_{i=1}^{t}a_{ti}v_i$$ $a_{ti}$ 是当前位置分给第 $i$ 条历史的非负权重,沿历史位置求和为一;$o_t$ 是输出。分母中的 $j$ 只是求和索引。指数作用在 query-key 配对上,因此不能把 Softmax 随意移到乘法外面。下面将换一种相似度,这是改变算子定义的步骤。 选择逐元素特征映射 $\phi:\mathbb{R}^{d_k}\to\mathbb{R}^{r}$,$r$ 是映射后的维度。本文用 $r=d_k$ 的 ELU+1:正输入加一,非正输入取指数。这样每个分量为正,两个映射向量的点积为正,归一化分母就有明确意义。定义核相似度: $$s(q,k)=\phi(q)^\top\phi(k),\qquad \phi(u)=\begin{cases}u+1,&u>0\\ \exp(u),&u\le0\end{cases}$$ 这并不等于原来的指数点积核。选择 ELU+1 是一个具体的建模选择;本文接下来验证的是这个新核内部的等价计算,不声称复现 Softmax。核线性化与循环视角的来源是 Linear Transformers。 把历史和移到 query 外面 用新核替换权重后,定义一个带数值保护项的输出。$\epsilon>0$ 是避免极小分母引发数值问题的常量;它会略微改变归一化,因而权重和不再严格等于一。实验的两种实现都会使用相同的 $\epsilon=10^{-6}$: $$o_t=\frac{\sum_{i=1}^{t}\bigl(\phi(q_t)^\top\phi(k_i)\bigr)v_i}{\sum_{i=1}^{t}\phi(q_t)^\top\phi(k_i)+\epsilon}$$ 分子中,$\phi(q_t)$ 对每个历史位置都相同,因此可以利用分配律先求历史外积的和。外积 $\phi(k_i)v_i^\top$ 的形状是 $r\times d_v$,它不是相似度矩阵。把这些外积累加成 $S_t$,把映射后的 key 累加成 $z_t$: $$S_t=\sum_{i=1}^{t}\phi(k_i)v_i^\top\in\mathbb{R}^{r\times d_v},\qquad z_t=\sum_{i=1}^{t}\phi(k_i)\in\mathbb{R}^{r}$$ 于是输出的转置可写成一行矩阵读取: $$o_t^\top=\frac{\phi(q_t)^\top S_t}{\phi(q_t)^\top z_t+\epsilon}$$ 维度检查很重要:分子是 $1\times d_v$ 的行向量,分母是标量,结果与 $o_t^\top$ 一致。代码里每个 token 都用一维数组表示,因此 fq[t] @ S 直接得到长度 $d_v$ 的数组,不需要显式转置。 历史状态天然有递推式,因为第 $t$ 步的和只比前一步多一项: $$S_t=S_{t-1}+\phi(k_t)v_t^\top,\qquad z_t=z_{t-1}+\phi(k_t),\qquad S_0=0,\ z_0=0$$ 先写入当前 token,再用当前 query 读取,才与 $i\le t$ 的因果定义一致。若先读后写,就变成严格只看过去的另一个算子。若先把整段所有 key 累进一个状态再逐个读取,则会泄露未来,不能拿来做因果生成。 固定 $r,d_v$ 时,每步更新和读取都需要约 $O(rd_v)$ 运算,整段是 $O(Nrd_v)$。解码期间可持续保留的状态是 $O(rd_v+r)$。这里没有把反向传播所需激活算进去;训练若朴素保存每一步状态,内存仍会随长度增长。前缀和、分块计算和反向重计算解决的是训练工程问题。 从累加改成纠错 归一化线性记忆会混合重复 key 的记录。现在单独讨论一个无分母归一化的关联记忆,不再沿用 ELU+1 权重解释:$k_t\in\mathbb{R}^{r}$ 是单位长度 key,$S\in\mathbb{R}^{r\times d_v}$ 是矩阵状态。它对 key 的预测是行向量 $k_t^\top S$。给定新 value 后,定义单步平方误差: $$\ell_t(S)=\frac12\left\|S^\top k_t-v_t\right\|_2^2$$ 若 $S$ 的第 $a,b$ 个元素变化,只会通过 $k_{t,a}$ 改变预测的第 $b$ 个分量。因此该元素的梯度是 key 的第 $a$ 分量乘以第 $b$ 分量的预测误差;把所有元素拼回去,得到: $$\nabla_S\ell_t=k_t\bigl(k_t^\top S-v_t^\top\bigr)$$ 用更新幅度 $\beta_t$ 做一次梯度步,得到本文方向约定下的 Delta 规则: $$S_t=S_{t-1}+\beta_t k_t\bigl(v_t^\top-k_t^\top S_{t-1}\bigr)$$ $\beta_t$ 控制新信息覆盖旧映射的程度。这是对输入状态的一次在线更新,不等同于对模型全部训练权重进行反向传播。外积写入只纠正当前 key 对应的预测,而不是无条件累加原始 value;这层解释来自 Fast Weight Programmers。 为什么单位 key 能精确覆盖?左乘 $k_t^\top$,利用 $k_t^\top k_t=1$,可得: $$k_t^\top S_t=(1-\beta_t)k_t^\top S_{t-1}+\beta_t v_t^\top$$ 当 $\beta_t=1$,当前 key 的读出就恰好等于新 value;若 key 未归一化,更新会额外乘上它的平方范数,这个覆盖结论就不成立。读另一个 key $h$ 时,它受到的变化是 $\beta_t(h^\top k_t)$ 乘以纠正量:正交 key 不受影响,相似 key 会受到干扰。Delta 规则能纠错,却没有让矩阵成为无碰撞字典。 再引入遗忘系数 $\alpha_t$,先衰减旧状态,再针对衰减后的预测做纠错: $$\widetilde S_{t-1}=\alpha_t S_{t-1},\qquad S_t=\widetilde S_{t-1}+\beta_t k_t\bigl(v_t^\top-k_t^\top\widetilde S_{t-1}\bigr)$$ 展开后是 $\alpha_t(I-\beta_t k_tk_t^\top)S_{t-1}+\beta_t k_tv_t^\top$,$I$ 是 $r\times r$ 单位矩阵。论文常把状态转置成 value-first 方向,式子于是从左乘变成右乘,两者只是布局约定。先遗忘再计算误差这一顺序不能随意改,否则得到另一个更新规则。该组合是 Gated DeltaNet 的核心机制。 深度循环沿另一个轴进行 设 $H^{(s)}\in\mathbb{R}^{N\times d}$ 是第 $s$ 次修订后的整段表示,$d$ 是隐藏维度,共享参数为 $\theta$。深度循环可以抽象成: $$H^{(s+1)}=F_\theta\bigl(H^{(s)},P^{(s)}\bigr),\qquad s=0,1,\dots,R-1$$ $P^{(s)}$ 提供位置与修订步信息,$R$ 是执行的修订次数,$F_\theta$ 可包含注意力与前馈网络。不同的 $s$ 重用同一套参数,但每次处理的仍是整段表示。若内部用全注意力,一轮的长度平方成本仍在,多轮修订也仍要付计算。它能改变参数复用和计算深度,却不能直接推出固定历史容量。这是 Universal Transformers 与 token 递推状态的关键区分。 04. 代码实现 完整脚本 linear_memory_demo.py 放在文末附录。只需 Python 3.10+、NumPy 和 matplotlib,保存后执行 python linear_memory_demo.py,会打印结果、写出 JSON,并生成原创图。在项目的 code/ 结构下输出到该文章目录;单独保存时输出到脚本所在目录。依赖安装可以用 python -m pip install numpy matplotlib;没有权重、数据集或 GPU 下载步骤。 先看循环读取的核心。fq 和 fk 是 $\phi(q)$ 与 $\phi(k)$,S 是 $S_t$,z 是 $z_t$。这里没有多头和 batch,目的是让一次状态更新的维度一眼可查: def recurrent_linear(q, k, v, eps=1e-6): fq, fk = phi(q), phi(k) S = np.zeros((fk.shape[1], v.shape[1]), dtype=np.float64) z = np.zeros(fk.shape[1], dtype=np.float64) out = np.zeros_like(v) for t in range(len(q)): S += np.outer(fk[t], v[t]) z += fk[t] out[t] = (fq[t] @ S) / (fq[t] @ z + eps) return out, S, z 脚本还写了一个刻意生成完整 $N\times N$ 权重矩阵的参考实现:先计算 phi(q) @ phi(k).T,再用下三角因果掩码去掉未来位置。这个版本不追求省内存,只作为独立计算路径验证结合律重排。循环版若不小心先读取再更新,或者漏掉 z,这个对照会立即暴露差异。 2026-10-06 在 CPU、NumPy float64、随机种子 7 下实际运行得到: q_shape = [8, 4] v_shape = [8, 3] output_shape = [8, 3] state_shape = [4, 3] normalizer_shape = [4] explicit_recurrent_max_error = 1.6653345369377348e-16 linear_softmax_max_difference = 0.9214427905350642 output_min = -1.088998885679583 output_max = 0.8987635397834051 first_two_outputs = [[-0.57930138, -0.19619590, 0.89876354], [0.32426122, -0.78686054, 0.01150493]] future_leak_error = 0.0 第一项误差在 float64 舍入量级,验证新核的两种求值路径。第二项差异是同一组 q、k、v 在新核与标准缩放 Softmax 下的最大绝对差,验证两者是不同算子;它不是精度下降百分比。输出出现负数并不矛盾:权重非负,而 value 本身可以为负。 “未来泄露”实验把最后一个 value 的每个分量加 100,前七个输出保持逐元素相同。因为循环计算先前输出时尚未看到最后一个 value,它对前面的结果没有作用。这个检查只检验该输入上的因果实现;一般的因果性质来自第 03 节的求和范围,而不是一次随机测试证明所有情况。 Delta 实现则用 decayed = alpha * S,随后计算 v - k @ decayed,最后写入 beta * np.outer(k, correction)。代码与前面的转置方向一致。它不使用 z,也不对输出套线性核分母;把两套归一化随意拼接,会失去上述精确覆盖结论。 脚本对同一个单位 key 先写 [1,0],再写 [0,1]。把普通外积累加后除以写入次数,读出是 [0.5,0.5];Delta 取 beta=1 后读出是 [0,1]。这里的平均是一个手工归一化的单 key 例子,不能当成前面随机 ELU+1 注意力实验的整体输出。 接着写入另一个单位 key,控制它与原 key 的内积 $\rho$。旧 key 的读出如下: 新旧 key 内积 $\rho$ 旧 value 的分量 新 value 的分量 0.0 1.0 0.0 0.5 0.75 0.5 0.9 0.19 0.9 这些数字可手算:先写原 key 后,第二次更新把旧分量减去 $\rho^2$,同时写入 $\rho$ 倍新分量。最后一行的 0.19 是按小数显示的舍入值,原始输出为 0.18999999999999995。干扰强度取决于 key 几何关系,不能只看状态矩阵是否足够大。 图左只比较单层单头 FP32 的历史状态元素:K、V 随前缀增长,矩阵状态保持固定。图右来自上述实际更新实验:key 越相似,旧映射受到的干扰越大。请把左右两幅一起看,省掉的历史位置并没有变成免费的精确记忆;两幅图都不是 GPU 吞吐测试。 05. 工业级实现对照 以下均以 2026-10-06 实际读取的官方源码为准,原文件及 SHA256 快照已随本地质检保存。上游分支链接可能变化,所以这里同时注明文件和符号,不把今天的布局当永久 API。 idiap/fast-transformers 的 LinearAttention 对 query、key 应用特征映射,用 einsum 聚合 KV,并计算归一化分母。这个文件实现的是无因果掩码版本,只接受全一注意力掩码;不能因为名字里有 Linear 就拿它直接替代因果解码器。它处理 padding 和 batch、多头,而最小代码只有一条序列。 实际 token 递推对应 RecurrentLinearAttention.forward。该实现保存 Si 和 Zi,分别是矩阵及归一化状态,并在推理时原位更新;存在梯度时换成非原位加法。全序列因果计算另在 CausalLinearAttention。训练接口与解码接口分开,是因为前缀扫描、梯度保存和单 token 状态更新需要不同执行方式。 框架中的状态形状还有 batch、head 两个轴。服务时某个请求结束,应只清掉对应请求的状态;若拼接多个样本而不重置,会让第二个样本读到第一个样本的信息。测试新架构时,这类状态边界比单次输出形状更值得核对。最小程序每次调用都新建零状态,因此不提供跨请求复用接口。 本次还用 CPU PyTorch 2.10.0 实跑下载源码中未改动的 RecurrentLinearAttention 类:同一输入与 NumPy 结果的最大误差为 2.220446049250313e-16,末状态也一致。运行时仅适配未使用的事件派发接口及 memory=None 的兼容接口,未测试整个包的可选编译扩展;这个证据验证递推方法的源码对照,不代表完整框架性能测试。 FLA 的 GatedDeltaNetBlock 负责模型层组合,实际记忆运算在 fla/layers/gated_deltanet.py#GatedDeltaNet.forward。源码调用 chunk_gated_delta_rule 或 fused_recurrent_gated_delta_rule,传入初始状态并按 use_cache 返回末状态。当前实现还把 q/k 的 L2 归一化、门与 beta 变换交给内核处理,并使用 value-first 状态布局;读公式时要先核对转置。 为什么不能用 Python token 循环评判 FLA 的速度?教学循环每步触发许多小运算,训练又有跨步依赖。分块内核把一段更新组织成适合 GPU 的计算,融合递推减少解码调用开销。框架同时管理短卷积状态、padding 和归一化,本文的一个矩阵不是完整层状态。因此“缓存不增长”也要说明指的是哪一种缓存。 UniversalTransformer 的修订逻辑可沿 universal_transformer_util.py#universal_transformer_basic 阅读:它对整段 state 做 step 预处理,再调用注意力和前馈单元;固定修订次数路径使用 num_rec_steps,另有 ACT 路径。这里的 step 是深度修订,不是缓存下一帧。这个历史 TensorFlow 实现适合解释机制,本文不把它当作今天的视频部署推荐。 06. 代价与边界 首先,有限状态保留的是叠加后的关联,不是每条历史的独立副本。在有限数值精度下,固定大小状态没有随输入长度增长的独立存储位置,因而不能保证对任意长序列中任意位置的任意内容都能精确恢复。这个说法是存储预算约束,不是“模型超过某个长度必然失效”的具体阈值预测。 其次,遗忘与纠错作用不同。$\alpha$ 衰减整个矩阵,包括与当前 key 正交的映射;$\beta$ 控制当前关联的覆盖。脚本先把状态设为单位矩阵,取 alpha=0.8 更新第一个 key,再读第二个正交 key,得到 [0,0.8]。它虽然没有受到 Delta 纠错项的干扰,仍被全局遗忘衰减。把所有变化都归因于“选择性删除”会误读机制。 再者,特征维度也是成本。线性复杂度的前提是 $r$ 不随 $N$ 增长;若为改善检索不断扩大 $r$,矩阵更新和读取也会变贵。短序列时,优化良好的精确注意力可能更合适。必须实测相同硬件、精度、batch、序列长度和质量约束下的端到端延迟,本文的状态元素图无法回答交叉点在哪。 训练与解码还要分别验收。固定解码状态不代表训练显存恒定,不代表单步就没有计算,也不代表批量 prefill 一定更快。工程实现会使用分块、扫描或重计算;其真正收益应由 profiler 以及完整训练步骤验证。把单 token 延迟、首 token 延迟和总生成时间混为一个数字,会掩盖需要付出的成本。 状态账本还应区分“元素数量”和“信息容量”。一个矩阵有固定数量的浮点元素,但这些元素可以用不同方向叠加许多关联,不能简单说它只能记住恰好多少个 token;反过来,也不能把可接受任意长度输入写成能保存任意数量的独立事实。实际检索能力要通过任务衡量:例如改变干扰 key 数量、重复更新次数、查询与写入的距离,以及输入精度,分别观察正确读出率和数值误差。 比较混合模型时,账本应按层拆开。部分层若保留窗口注意力,其显式缓存仍随窗口长度占空间;部分层若保留完整注意力,该部分历史仍会增长。短卷积还可能维护局部状态。只看到某一层用了 Delta 更新,就把整个模型都归为固定状态,会漏掉服务中真正占内存的部分。判断是否合适,应先列清每层状态、精度、并发请求数和最大长度,再用运行时内存测量核对。 落到视觉生成,时间因果性与空间交互必须分开设计。双向 DiT 在同一个去噪步内可以访问整个视频,不能只把注意力换成本文因果递推就声称等价;把空间 token 排成序列后,排列顺序也会影响递推的归纳偏置。自回归视频可以沿时间维护状态,但仍要验证运动、遮挡后对象恢复、长时一致性和跨片段条件变化。 最后,深度循环的参数复用不等于算力复用。执行 $R$ 次修订通常需要重复做 $R$ 次块计算,是否受益要看任务、停止规则与训练是否覆盖该次数。推理时随意把次数从四次加到八次,不保证答案或生成质量改善。本文只用抽象方程定位循环轴,没有提供训练过的深度循环模型或性能结论。 07. 经典论文脉络 这五篇不是同一条单向升级路线,而是围绕“历史怎么保存、计算怎么组织”形成的分支。阅读时先分清 token 轴与深度轴,再理解具体内核优化。 Universal Transformers,2018,1807.03819:在深度方向共享转移,并允许动态修订次数;它保留全局注意力交互,提供的是计算深度视角。 Transformers are RNNs,2020,2006.16236:用特征核与结合律把注意力改写成累积状态,连接全序列计算与因果递推。 Linear Transformers Are Secretly Fast Weight Programmers,2021,2102.11174:将外积状态解释为 fast weights,并引入 Delta 式纠错,针对加法记忆的映射更新问题。 Transformers are SSMs,2024,2405.21060:从结构化状态空间对偶组织 Mamba2 的计算,说明递推与并行矩阵形式可以共同设计。 Gated Delta Networks,2024,2412.06464:把遗忘门与 Delta 更新结合,并设计高效分块训练,让记忆管理和硬件执行协同。 本文没有直接比较这些论文的榜单分数:训练规模、数据和任务不同,把各自报告的提升并排当成架构优劣,会得出超出证据的结论。真正可迁移的基本功是识别状态、更新规则、归一化及并行形式,再按自己的任务设置对照实验。 08. 常见误解 “线性注意力只是换乘法顺序,数值应该和 Softmax 一样。” 换顺序之前已经换了相似度。显式线性核与递推线性核应一致;与 Softmax 的差异则是正常的算子差异。把两者的误差都叫“实现 bug”,会把建模选择误当工程问题。 “固定状态就是无限上下文精确记忆。” 固定状态能持续接收输入,但它叠加或纠正关联,没有为每条历史开辟新的独立位置。需要逐条引用、精确复制或回溯时,应明确测试检索能力,并考虑显式缓存、外部检索或混合结构。 “Delta 只更新当前 key,所以不会损伤其他信息。” 更新是否影响另一个 key 取决于内积。正交时纠错项不干扰,相似时会串扰;再加遗忘门,连正交映射也会衰减。第 04 节的三个内积点让这个限制可以直接看到。 “代码里的 beta 就是生产模型中的最终更新幅度。” 最小代码直接传最终标量;实际模型通常预测门控参数,再经过内核里的非线性或缩放。FLA 当前接口明确提供内核归一化和 sigmoid 选项。对照时不能只把同名变量代进公式,还要查它处在变换前还是变换后。 “深度循环减少了层数,因此执行成本也按同样比例下降。” 共享参数减少的是独立参数副本,重复执行仍付运算、激活及注意力成本。把参数量、执行深度和上下文状态分开计数,才能解释循环架构到底省了什么。 “对语言长序列有用,所以可以无训练替换视频 DiT。” 时间因果约束、空间邻接和扩散步条件都不同。替换需要训练或有依据的适配,再用视频维度的验收验证;随机 CPU 实验只能说明机制,不能证明视频生成可用。 09. 动手验证 先原样运行附录脚本,确认输出形状及两种线性求值误差低于 1e-12。不同 NumPy 版本可能改变最后几个浮点位,因此逐项复现应使用误差容限,而同 key 的 [0,1] 覆盖例子可以直接手算核对。 第一个改动是把 recurrent_linear 里的读取放到写入之前。第一步读出会变成零,之后只访问严格过去,显式参考实现若仍保留对角线就不再一致。修复不该“放宽误差阈值”,而应把两种实现的因果定义对齐。 第二个改动是把 memory_experiment 的 Delta 更新改成 beta=0.5。重复 key 先后写入两个 value 后,应读出 [0.25,0.5],不是 [0.5,0.5]:零初态到第一条信息本身也只走了半步。这个结果直接来自递推式,不要求训练模型。 第三个改动是去掉门衰减,取 alpha=1,再保留单位初始状态和正交 key 检查。第二个 key 应读出 [0,1];与 alpha=0.8 的 [0,0.8] 对照,就能隔离全局遗忘和关联纠错的作用。 第四个改动是把 q、k、v 的输入改成 float32,状态与掩码也保持输入 dtype,使两条路径都使用 float32。脚本末尾已经执行这组对照并打印 float32_explicit_recurrent_max_error。预期因乘加顺序不同而出现更大的舍入差异,不承诺跨版本固定数值;请同时记录误差、输入长度和状态范围。长度扩展时数值稳定性也应重新测量,而不是沿用短序列的阈值。 最后,可将序列长度加大,只比较状态元素计数,不运行显式平方矩阵版本到内存耗尽。若要做 GPU 性能结论,应该另建真实框架测试,包含同步、预热、完整模型和质量对照;本篇没有把教学脚本执行时间包装成生产加速结果。 10. 延伸阅读 先回到 自注意力,确认权重归一化、因果掩码和矩阵形状;再读 FlashAttention,理解保留精确算子时如何优化中间存储。两条路线可以比较,也可以组合,但证据边界不同。 结合 KV Cache 和 性能建模与 Profiling,分别量出历史容量、解码带宽、首 token 延迟与端到端时间,避免只看理论阶数。进入视频任务时,再对照 自回归视频生成与 Forcing 范式 的训练与推理条件。 知识树下一步可沿稀疏注意力、世界模型和视频评测继续学习。它们分别回答保留哪些显式交互、如何维护可交互环境状态,以及如何发现画质之外的退化;今天的固定状态推导并不能替代这些任务层面的验证。 附录:完整代码 09 节用到的脚本全文如下(linear_memory_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 linear_memory_demo.py """CPU teaching experiment: normalized linear attention and delta memory. Install numpy and matplotlib. Run with Python 3.10 or newer. No weights, GPU, dataset downloads, or training are required. """ import json from pathlib import Path import numpy as np import matplotlib matplotlib.use('Agg') import matplotlib.pyplot as plt def phi(a): return np.where(a > 0, a + 1, np.exp(np.minimum(a, 0))) def explicit_linear(q, k, v, eps=1e-6): n = len(q) weights = phi(q) @ phi(k).T weights *= np.tril(np.ones((n, n), dtype=weights.dtype)) return weights @ v / (weights.sum(axis=1, keepdims=True) + eps) def recurrent_linear(q, k, v, eps=1e-6): fq, fk = phi(q), phi(k) S = np.zeros((fk.shape[1], v.shape[1]), dtype=q.dtype) z = np.zeros(fk.shape[1], dtype=q.dtype) out = np.zeros_like(v) for t in range(len(q)): S += np.outer(fk[t], v[t]) z += fk[t] out[t] = (fq[t] @ S) / (fq[t] @ z + eps) return out, S, z def causal_softmax(q, k, v): logits = q @ k.T / np.sqrt(q.shape[1]) logits[np.triu_indices(len(q), k=1)] = -np.inf logits -= logits.max(axis=1, keepdims=True) weights = np.exp(logits) weights /= weights.sum(axis=1, keepdims=True) return weights @ v def delta_step(S, k, v, beta=1.0, alpha=1.0): decayed = alpha * S correction = v - k @ decayed return decayed + beta * np.outer(k, correction) def memory_experiment(): k = np.array([1.0, 0.0]) values = np.array([[1.0, 0.0], [0.0, 1.0]]) additive = sum((np.outer(k, v) for v in values), np.zeros((2, 2))) additive_read = k @ additive / 2.0 S = np.zeros((2, 2)) for v in values: S = delta_step(S, k, v) overwrite_read = k @ S half = np.zeros((2, 2)) for value in values: half = delta_step(half, k, value, beta=0.5) crosstalk = [] for rho in [0.0, 0.5, 0.9]: k2 = np.array([rho, np.sqrt(1.0 - rho ** 2)]) state = delta_step(np.zeros((2, 2)), k, values[0]) state = delta_step(state, k2, values[1]) crosstalk.append({'rho': rho, 'old_key_read': (k @ state).tolist()}) state = np.eye(2) decayed = delta_step(state, k, values[1], beta=1.0, alpha=0.8) return {'additive_same_key': additive_read.tolist(), 'delta_same_key': overwrite_read.tolist(), 'crosstalk': crosstalk, 'gated_unrelated_key': (np.array([0.0, 1.0]) @ decayed).tolist(), 'half_beta_read': (k @ half).tolist(), 'no_forgetting_unrelated_key': (np.array([0.0, 1.0]) @ delta_step(state, k, values[1])).tolist()} def main(): rng = np.random.default_rng(7) q = rng.normal(size=(8, 4)) k = rng.normal(size=(8, 4)) v = rng.normal(size=(8, 3)) direct = explicit_linear(q, k, v) recurrent, S, z = recurrent_linear(q, k, v) softmax = causal_softmax(q, k, v) future_v = v.copy() future_v[-1] += 100 future, _, _ = recurrent_linear(q, k, future_v) agreement = float(np.max(np.abs(direct - recurrent))) future_error = float(np.max(np.abs(future[:-1] - recurrent[:-1]))) q32, k32, v32 = q.astype(np.float32), k.astype(np.float32), v.astype(np.float32) direct32 = explicit_linear(q32, k32, v32) recurrent32, _, _ = recurrent_linear(q32, k32, v32) assert agreement < 1e-12 assert future_error == 0 report = {'seed': 7, 'dtype': str(q.dtype), 'q_shape': list(q.shape), 'v_shape': list(v.shape), 'output_shape': list(recurrent.shape), 'state_shape': list(S.shape), 'normalizer_shape': list(z.shape), 'explicit_recurrent_max_error': agreement, 'linear_softmax_max_difference': float(np.max(np.abs(recurrent - softmax))), 'output_min': float(recurrent.min()), 'output_max': float(recurrent.max()), 'first_two_outputs': recurrent[:2].tolist(), 'future_leak_error': future_error, 'float32_explicit_recurrent_max_error': float(np.max(np.abs(direct32 - recurrent32))), 'float32_output_dtypes': [str(direct32.dtype), str(recurrent32.dtype)], 'memory': memory_experiment()} folder = Path(__file__).resolve().parent if folder.name == 'code': folder = folder.parent figures = folder / 'figures' figures.mkdir(parents=True, exist_ok=True) (folder / 'run_result.json').write_text(json.dumps(report, indent=2), encoding='utf-8') lengths = np.array([256, 1024, 4096, 16384, 65536]) # Single batch/layer/head, FP32, d_k=d_v=r=64. State count only. kv_mib = lengths * 128 * 4 / 2 ** 20 fixed_mib = np.full(len(lengths), (64 * 64 + 64) * 4 / 2 ** 20) fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True) axes[0].loglog(lengths, kv_mib, 'o-', label='Explicit K,V history') axes[0].loglog(lengths, fixed_mib, 's-', label='Linear S,z state') axes[0].set(xlabel='Prefix tokens', ylabel='MiB, FP32, one layer/head', title='State storage, not total GPU memory') axes[0].legend() axes[0].grid(alpha=0.2) rhos = np.array([item['rho'] for item in report['memory']['crosstalk']]) reads = np.array([item['old_key_read'] for item in report['memory']['crosstalk']]) axes[1].plot(rhos, reads[:, 0], 'o-', label='Old value component') axes[1].plot(rhos, reads[:, 1], 's-', label='New value component') axes[1].set(xlabel='Key inner product', ylabel='Readout at old key', title='Delta updates still have crosstalk', ylim=(-0.05, 1.05)) axes[1].legend() axes[1].grid(alpha=0.2) fig.savefig(figures / 'memory_tradeoff.png', dpi=150) plt.close(fig) print(json.dumps(report, indent=2)) print('figure: figures/memory_tradeoff.png') if __name__ == '__main__': main()
-
AIGC 每日速读|2026-10-06|加州理工稳住镜头外场景LoGo 今日 AIGC 论文速览 今日共 10 篇 · 长视频一致性与定制 2 篇 · 一步图像生成与后训练 2 篇 · 视频蒸馏与加速 3 篇 · 配对动作生成 1 篇 · 语音与音乐生成 2 篇 重点论文标题列表 LoGo(加州理工):镜头绕一圈场景少变形 Depth as Time(普林斯顿):一步生成把去噪搬进深度 DuoMatching(港中文):图像老师帮视频补回细节 VDOT++(悉尼大学):四步蒸馏别硬配每个token Reward Composition(UCLA):审美加分先过提示词约束 今日论文速览 1. LoGo:镜头绕一圈场景少变形 LoGo: Local-Global Rewards for Consistent Long-Horizon Video Generation | 加州理工学院 | arXiv:2610.03636 关键词:长视频生成, 相机控制, 三维一致性, 局部奖励 前序问题:镜头绕过墙面再回来,门可能移位、墙上数字可能变形。给整段视频一个三维一致性分数,会让局部错误被大面积正确区域稀释;只强化局部几何,又可能鼓励模型把画面变灰、变糊来降低误差。 本文贡献:LoGo 将关键帧经 VGGT 重建到共享三维空间,以 voxel 聚合 RGB 和深度重投影误差,把奖励分配到出错区域。训练混合归一化后的局部与全局奖励,并交替使用美学和相机跟随奖励。它改善的是相机可控视频的后训练信号,而非新增一个持久世界记忆模块。 论文 Figure 4:(a)说明 voxel 奖励如何聚合:把关键帧重建到共享三维空间,按体素汇总局部误差。(b)把局部奖励投影回视频帧进行可视化,突出需要修正的区域。 实验效果:表 1 的 TrajectoryBench 上,Lingbot2 的 PSNR-D 从 16.0 提高到 18.2 dB,极线误差从 1.507 降至 1.111,约下降 26%。表 2 的 DL3DV 上,同一基座极线误差由 2.161 降至 1.365。三个基座均有三维一致性收益,但相机指标并非逐项变好;例如 UniWorld 在表 1 的旋转误差由 13.8 变为 14.0。 论文 Figure 3:LoGo 的动机。(a)只用全局奖励难改善三维一致性;局部奖励改善以 PSNR 衡量的一致性,却降低以 HPSv3 衡量的画质,因此要组合二者。(b)绿色 LoGo 曲线扩展一致性与质量的 Pareto 前沿。(c)训练中的奖励曲线及质量评估显示,局部奖励随训练损害画质,LoGo 在改善一致性的同时维持质量。 批判点评:作者明确限定静态场景,超过 400 帧仍困难;因此不能写成动态世界无限稳定。奖励依赖重建模型估计的几何,改善重投影指标也不等于恢复真实物理。建议优先看局部奖励与画质的消融,再判断自己的相机轨迹是否在测试范围内。代码与 benchmark 已给出官方仓库。 2. Depth as Time:一步生成把去噪搬进深度 Depth as Time in One-Step Generative Models | 普林斯顿大学 | arXiv:2610.03626 关键词:一步生成, 深度探针, 共享权重, 模型压缩 前序问题:一步生成只调用一次网络,但网络内部仍有许多层。多步扩散的逐步去噪到底消失了,还是被重排到网络深度里?仅看最终图像,无法区分一次直达和层内反复细化。 本文贡献:作者用模型自身输出头解码中间层,并用独立训练及随机探针做对照:时间条件 flow-map 模型呈现随深度去噪的规律,部分 MeanFlow 任务甚至先去噪再加噪。进一步用带内部时间区间条件的共享 block 拟合教师隐藏层,把层数与独立参数组数拆开。 论文 Figure 2:大规模一步图像生成器也呈现沿深度逐渐去噪的现象。FLUX-schnell 和 MeanFlow 的逐层终点预测逐渐显露清晰图像结构;不依赖 τ 的 Drifting 模型作为对照。对 FLUX-schnell,模型输出头与独立训练探针得到相似的归一化终点距离下降规律,随机探针不能复现。 实验效果:附录表 1 的 ImageNet 256×256 实验:MeanFlow SiT-L/2 从 459M 参数压到 27.6M,压缩 16.6 倍;经 FD-loss 后训练,FID-50k 为 4.87,教师为 4.01。两组独立 block 的学生用 46.5M 参数达到 4.04。附录表 2 中,另行训练的两组 block 学生将执行次数减半后 FID 为 5.25。 论文 Table 1:ImageNet 256×256 的参数压缩结果。在教师原始深度、固定 K 执行次数下,分别报告 FD-loss 后训练前后的 FID-50k,各行采用最优 CFG 强度 ω。压缩倍数相对教师参数量;高亮行使用单个共享 block,灰色行为教师。增加独立 block 数量可用更多参数换取质量。 批判点评:16.6 倍是参数压缩,单组 block 仍可执行 24 次,不能换算成 16.6 倍延迟加速。相似的深度轨迹也不等于逐点复现教师的采样轨迹;缺少时间索引任务的 Drifting 模型未呈现同样规律。公开代码适合研究内部计算,结论尚不是所有一步模型的普遍定理。 3. DuoMatching:图像老师帮视频补回细节 DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation | 香港中文大学;字节跳动;香港科技大学;香港交互感知研究中心 | arXiv:2610.03543 关键词:视频蒸馏, 联合边缘分布, 图像教师, 潜空间桥接 前序问题:视频教师能教会时间连贯,但少步学生仍可能丢掉 prompt 中的羽毛、毛发等细节。整段视频的联合分布匹配会受到周围帧制约,需要额外的单帧监督补足视觉与语义先验。 本文贡献:DuoMatching 在视频联合 DMD 上增加来自图像教师的边缘 DMD。LatentBridge 将视频 latent、前一片段与局部帧编号映射到图像 latent,避免直接套用不同 VAE 空间;Latent Variation Sampling 用相邻 latent 的差异切分时间区间,每段抽样一片,提高有限监督预算的覆盖。 论文 Figure 3:DuoMatching 总览。(a)用图像教师参考分布 P_i 补充联合分布匹配;每组表示一个视频,节点表示帧级分布。(b)LatentBridge 根据视频 latent z^l、前一片 z^(l−1) 和局部帧编号 i,通过 ℓ₁ 重建损失映射到对应图像 latent。(c)Latent Variation Sampling 用相邻 latent 的差异分段,并在段内随机抽样。 实验效果:表 1 按生成单位和 NFE 分组:两步逐帧设置的 VBench Total 从 Causal Forcing++ 的 80.67 到 83.53;四步 chunk 设置从 82.79 到 83.51。表 2 在同一 Wan2.1 教师下,对四个基线的整体偏好为 80.87%–94.35%;对 Causal Forcing++ 的时间与运动偏好为 49.57%,说明主要收益来自画质与语义。 论文 Figure 1:DuoMatching 的动机与结果。自回归模型的后续帧常退化,图中 Q-Align 曲线展示这一现象。联合 DMD 缓解漂移,但学生与视频教师仍有画质差距,示例中缺少 prompt 要求的羽毛。联合与边缘匹配的组合改善画质、补回羽毛,同时保留时间连贯性;这张示例不代替完整统计评估。 批判点评:Full、Frame、Chunk 的函数评估单位不同,不能跨组把 NFE 当作相同成本排序。图像教师与桥接模块也带来训练成本;更清晰的单帧不是所有运动指标都提高的保证。项目页提供代码,值得在相同生成模式与预算内复现。 4. VDOT++:四步蒸馏别硬配每个token VDOT++: Unified Few-Step Video Generation via Unbalanced Optimal Transport Distillation | 悉尼大学;上海人工智能实验室;香港科技大学;香港中文大学 | arXiv:2610.03221 关键词:少步视频生成, 非平衡最优传输, 跨规模蒸馏, 条件生成 前序问题:同一个文字或图像条件允许多种正确视频。把学生与教师每帧的空间 token 强制全量配对,可能把本来合理但位置不同的内容当作错误,并在分布重叠不足时给出不稳定指导。 本文贡献:VDOT++ 在 DMD 上加入非对称非平衡最优传输:放松学生侧质量约束,下调不可靠 token 的质量,同时保持教师侧覆盖。ℓ₁ 距离使聚合更接近加权中位数,减少远处匹配的影响;DMD 与对抗项分两次反传。相同训练配方分别训练三类任务的生成器,还研究大 score 网络指导小生成器。 论文 Figure 3:VDOT++ 总览。上方:给定条件,少步生成器同时使用 DMD score 差异、逐帧最优传输匹配和对抗损失,经两次顺序反传及一次优化更新。下方图示一对时间帧,为清楚省略扩散时间与帧索引 (t,q)。DMD 在对应时空坐标提供 score 差异;平衡 OTD 显式耦合空间 token,却强制全量匹配;对称 UOT 放松两侧。非对称 UOT 放松学生侧、保持教师侧约束,压低不可靠学生 token 质量并维持教师覆盖。 实验效果:表 III 的文生视频 VBench 中,Wan-14B 四次评估学生的归一化均分为 81.59,50×2 次评估教师为 77.70;表 IV 的图生视频对应为 78.38 和 77.92。表 II 的 flow 条件任务却是 80.29,对应教师 80.35,因此不是每个任务、每项指标都超过教师。 论文 Figure 4:可控视频生成的定性对比。比较 100 次函数评估的 VACE 教师与 4 次评估的 VDOT、VDOT++,任务为(a)flow 条件的视频到视频,(b)视频向外扩展,(c)多参考图像到视频。顶行给出输入条件,每种方法展示 0、2.5、5 秒的帧。 批判点评:“统一”指训练配方跨任务复用,并非一个 checkpoint 同时完成全部任务。NFE 降低也不能直接等同端到端加速倍数。正文提到 CVPR 2026 的是前作 VDOT,这个扩展版本未核实接收证据,不能借前作会议作本篇背书;本文未发现可核验的新代码仓库。 5. Reward Composition:审美加分先过提示词约束 Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards | 加州大学洛杉矶分校;Arena Intelligence | arXiv:2610.02967 关键词:图像后训练, 人类偏好, rubric奖励, 奖励投机 前序问题:优化审美奖励,模型可能擅自添加装饰、乱码或写实风格;只优化提示词完成度,又可能牺牲细节。把不同量纲的分数简单平均,无法处理“这个要求只对某类 prompt 生效”的情况。 本文贡献:这项图像后训练研究组合人类偏好、内容满足度和禁止内容 checklist。各奖励轴独立归一化;只有意图严格的 prompt 激活额外约束;适用的反投机检测发现问题后否决正向偏好加分。不同奖励配置得到的权重再做融合,使审美优化受到意图约束。Reward Composition 是本文的编辑短名。 论文 Figure 2:两类反复出现的奖励投机失败。左侧:prompt 要求不含文字,RL 策略却在餐巾上添加乱码。右侧:prompt 要求 Elsa Beskow 的故事书插画风格,基座保持该风格,而 RL 策略偏向照片写实。这些案例解释为何需要按 prompt 启用约束和否决。 实验效果:表 1 的 2026-09-04 Arena 快照中,FLUX.2-dev 从 1132.8±14 到 1202±13,约增加 69 Elo。表 2 在 1k 验证 prompt、五个候选 checkpoint 中选择最佳值,Stage 3 在 Gemini 评估配 Arena RM 的对比胜率为 0.660,单偏好为 0.507;这些自动评估与线上 Elo 不是同一个指标。 论文 Figure 1:奖励设计可视化。只用偏好训练会偏向通用装饰并忽略要求;只用满足度会洗掉细节并丢失风格和景物;Arena-T2I-Hard 能恢复要求元素但保留多余装饰;不加意图门控的禁止内容奖励,即使 prompt 允许细节也会将其压平。Stage 1 仅在意图严格时施加约束,示例中能满足要求而未明显损伤质量。 批判点评:只测试两个基座、单个随机种子,内容分解问题未经人工逐条审计。排行榜数字属于 9 月 4 日快照,不是今天的排名;多个 checkpoint 择优也需与固定预算评估区分。作者说释放 1k 训练子集,但本次项目页未提供可核验下载入口,因此不声称数据或代码已可下载。 6. PMD:冻结视频模型顺手生出动作 Parasitic Co-Denoising: Unlocking 3D Human Motion Generation in a Frozen Video Diffusion Model | 新加坡南洋理工大学 | arXiv:2610.03047 关键词:三维动作生成, 视频扩散, 共去噪, 多层特征融合 前序问题:视频模型学会了人怎么动,却没有显式输出可用于动画的三维动作。先生成视频再估计动作需要多阶段处理;从零训练动作生成器又受动作数据覆盖限制。 本文贡献:Parasitic Motion Decoder(PMD)附着在冻结的 Wan2.1 上。先对齐动作与视频 latent,再用轻量 flow-matching decoder 读取视频 DiT 多层特征,按噪声水平 σ 自适应融合,并与视频共享去噪日程。视频与动作的噪声独立,耦合来自同一日程和特征条件;一次联合采样流程得到配对输出。 论文 Figure 2:Parasitic Motion Decoder(PMD)的结构。先将动作与视频 latent 对齐,再让动作 decoder 与冻结视频宿主同步去噪;σ 自适应多层融合把宿主的中间特征送入动作流。 实验效果:表 1 的 MBench Protocol B:19M 可训练参数的 PMD,动作条件一致性 0.58、泛化 0.72;2B 可训练参数的 MotionVLA 对应 0.55、0.66。表 2 的 HumanML3D 上,PMD 的 R-Precision Top-1 为 0.537,FID 为 0.098;DisCoRD 的 FID 为 0.032,说明语义对齐优势没有覆盖全部分布质量指标。 论文 Figure 3:MBench prompt 上的定性比较,展示各动作生成方法对文字动作要求的可视化结果。图展示动作语义与轨迹外观;抖动、足部接触等质量仍应结合实验表分别判断。 批判点评:19M 是附加可训练模块,不包含冻结视频宿主,因此不是整个系统只有 19M 参数。冻结宿主没有接受本工作三维动作监督,但附加模块训练仍用配对动作数据。动作抖动、接触和 FID 也并非全面最佳;没有找到作者可核验代码链接,不把模板或会议样式当作接收证据。 7. Custom Forcing:两分钟视频保持同一个主体 Custom Forcing: Training-Free Subject Customization for Autoregressive Video Generation | 韩国庆熙大学;得克萨斯大学奥斯汀分校 | arXiv:2610.02914 关键词:视频个性化, 自回归生成, KV缓存, 免训练定制 前序问题:自回归视频能不断续写,却容易把用户给定的某只宠物或物品变成同类通用实例。固定参考帧只能提供初始锚点;文本的类别先验与后续漂移会逐步削弱主体身份。 本文贡献:Custom Forcing 将五张参考图和一张场景定制 anchor 一次写入持久 KV cache。DVA 根据当前主体相似度相对初始水平的下降增强参考 value;ACG 比较读取与不读取 anchor 的注意力输出,沿远离通用类别先验的方向引导。冻结基座,无需逐主体训练。 论文 Figure 3:Custom Forcing 总览。上方:参考图与 FLUX.2 [klein] 生成的定制 anchor 副本一次写入 KV cache。中间:冻结基座每层 self-attention 在 DVA 以 g(t) 放大参考 value 后,分别读取含及不含 anchor 的缓存,得到 z_+、z_-。左下:DVA 根据当前已完成 chunk 的相似度 s(t) 相对初始 μ_base 的下降设置 g(t)。右下:ACG 以 κ 沿远离 z_- 的方向外推,再与 z_+ 混合。 实验效果:表 1 的两分钟测试:固定 K/V 的首段与末段 DINO-I 为 0.583、0.415,Custom Forcing 为 0.622、0.578。表 2 在单 H100、30 秒、100 个案例上,相对 FramePack-F1、SkyReels-V2 DF、SkyReels-V3 的逐帧生成时间优势为 9.5、11.5、28.5 倍;这些基线架构和规模不同。 论文 Figure 4:两分钟生成示例。只使用定制 K/V 时,主体在第一分钟内发生漂移;Custom Forcing 在展示的两种主体案例中维持到两分钟。两种案例分别生成,并非证明一个视频同时控制两个主体。 批判点评:相对固定 anchor,DVA 与 ACG 增加 11%–13% 生成时间。测试为动物和物品、每段一个主体、最长两分钟,局部细节漂移和多个主体仍未解决。实际能力受冻结基座限制。作者项目页可访问,但没有找到该方法的可核验代码仓库。 8. SpectralCache:复用奇异子空间少算主干 SpectralCache: Accelerating Diffusion-Based World Models via Spectral Feature Caching | 史蒂文斯理工学院;美国东北大学;达姆施塔特工业大学 | arXiv:2610.02660 关键词:扩散加速, 世界视频生成, 频谱缓存, 特征近似 前序问题:世界视频模型每个去噪步都运行昂贵主干。直接复用完整特征没有利用结构:相邻步骤的主导奇异子空间相对稳定,变化更多体现在低维奇异值上。 本文贡献:SpectralCache 在完整步分解最终层特征,缓存最近两次的奇异子空间、奇异值和残差。近似步固定子空间,只线性外推奇异值;误差累积或间隔到阈值后,交替刷新主干和缩放奇异值,以进一步少算完整步骤。它是免训练近似,不是精确复用。 论文 Figure 4:SpectralCache 总览,区分完整主干计算与近似缓存步骤;稳定奇异子空间和残差被复用,奇异值通过外推或缩放更新,触发条件控制刷新。 实验效果:表 1 的 HunyuanVoyager-13B,512×768、49 帧设置下加速 5.22 倍;静态 WorldScore 从基线 66.28 变为 65.90,动态从 46.40 变为 46.13。Aether-5B 的 480×720、41 帧生成加速为 2.20 倍。不同模型与任务的收益应分别读,不能都写成 5.22 倍。 论文 Figure 1:SpectralCache 与基线在 HunyuanWorld-Voyager-13B 上的比较。(a)视觉效果,(b)延迟,(c)质量。在所测条件下加速约 5.22 倍,同时保持较高视频保真;接近原模型仍不代表逐像素无误差。 批判点评:频谱稳定和固定缩放系数来自所测模型的经验,强动态或采样日程改变时需重新验证。质量接近基线仍存在误差,不能写“无损”;PSNR 对齐基线生成也不是对齐真实视频的证明。当前原文没有可核验代码链接,工程复现还需要补足实现和预算测量。 9. DriftTTS:不用生成老师四步合成语音 DriftTTS: Few-Step Text-to-Speech Without Distillation via Distribution-Matching Drift | 马萨诸塞大学阿默斯特分校;伍斯特理工学院 | arXiv:2610.03390 关键词:语音合成, drifting模型, 分布匹配, 少步生成 前序问题:少步 TTS 往往依赖多步生成教师或预设噪声到数据轨迹。能否直接让真实和生成 mel 特征的分布接近,并让生成器学习自己实际会访问的中间状态? 本文贡献:DriftTTS 在原始 mel 与冻结 MelMAE 特征空间构造真实样本吸引、生成样本排斥的 drift 目标,训练文本条件 decoder。on-policy rollout 用模型自身中间状态学习少步更新;MelMAE 只用于训练。推理从高斯噪声逐步替换 mel 状态,再由 HiFi-GAN 转为波形,无生成教师蒸馏。 论文 Figure 1:DriftTTS 总览。文本条件高斯噪声经少步 drift decoder 迭代细化为 mel 频谱,再用 HiFi-GAN 转为波形。训练时在 mel 域特征空间使用真实与生成样本计算 on-policy 分布匹配 drift 目标,优化 decoder。 实验效果:表 1 在 LJSpeech、相同 HiFi-GAN 和 Whisper-medium 评估下,四步 DriftTTS 的 MCD 为 3.87 dB、WER 3.7%,Matcha-TTS 为 3.85 dB、3.4%。表 2 的 MOS 为 4.18±0.16,对方 3.96±0.18;配对检验按受试者聚合 p=0.31,按语句 p=0.044。 论文 Table 1:LJSpeech 评估。所有合成系统使用同一个 HiFi-GAN 声码器,WER 由 Whisper-medium 计算,听测统计另见 Table 2。四步 DriftTTS 的 WER 为 0.037、MCD 为 3.87、UTMOS 为 4.25、MOS 为 4.18;四步 Matcha-TTS 对应 0.034、3.85、4.36、3.96。NFE 是声学生成器的函数评估次数。 批判点评:更高 MOS 均分不能写成所有统计口径显著胜出,两个客观指标还略逊基线。无生成教师不等于没有预训练组件,仍用 MelMAE 与声码器;只报告单说话人数据。推理次数应不超过训练深度 K,训练两步的模型直接跑四步会退化。官方代码可访问。 10. Music Rubric:音乐奖励别只盯一个分数 Rubric-Based Optimization for Text-to-Music Generation | 华盛顿大学;艾伦人工智能研究所 | arXiv:2610.03589 关键词:文本到音乐, rubric奖励, 音频语言模型, 后训练 前序问题:提高某一个音乐自动评分,可能牺牲提示词符合度或其他听觉质量。让音频语言模型按多个维度打分是否更稳,也要区分“音乐听起来好”与“速度、调性、乐器确实正确”。 本文贡献:作者用七维自然语言 rubric 评价 prompt 对齐、风格乐器、旋律、节奏、结构、制作和音乐性。MusicGen-small 与 ACE-Step v1 将候选排名转为 DPO 偏好对;ACE-Step 另用 DiffusionNFT 在线优化标量奖励,并比较一次联合评分和逐维评分。Music Rubric 是本文编辑短名。 论文 Figure 1:MusicCaps 上 DPO 后各评估器分数相对未训练模型的百分比变化,正值为好。上排为 MusicGen-small,下排为 ACE-Step v1。每面板对应一个偏好来源:左三列斜线柱按单一自动指标排序,右三列实心柱按音频语言模型 rubric 排序。面板内三柱对应三个评估器,三柱皆正表示无这三项的取舍。各排尺度不同,上排最大柱使用断轴以保持小柱可读;绝对变化见附录表 1、2,基线分数见表 4。 实验效果:附录表 3:ACE-Step 用 Qwen3-Omni 逐维奖励训练 125 次更新后,相对原模型 CLAP、SongEval、Audiobox 分别增加 0.0180、0.1057、0.3385。第 5.4 节的小听测有 7 人、40 条 caption、52 次判断,36 次偏好训练后模型,即 69%,95% 区间 48%–89%;这些是不同口径的证据。 论文 Figure 2:ACE-Step v1 的 DPO 与 DiffusionNFT 比较,每个评分器一面板。面板内三组为 rubric 偏好 DPO(斜线)、一次请求评价全部维度的联合提示 DiffusionNFT、每维度独立请求的逐维提示 DiffusionNFT。每组三柱为与 Figure 1 同色的三个评估器,以相对未训练模型的分数变化百分比表示。所有面板同尺度,对 Qwen2-Audio 最大柱使用断轴;绝对变化见附录表 2、3,基线分数见表 4。 批判点评:评分器和提问方式决定信号是否有效:Music Flamingo 联合评分可出现奖励上涨而外部指标下降,rubric 也没有改善所测调性准确率。短音乐、少量听测与宽置信区间不足以承诺长曲或专家质量;直接属性测量与 rubric 更适合互补使用。本次未找到可核验的作者代码入口。 趋势观察 奖励要定位错误并尊重条件 LoGo 将几何错误定位到三维区域;图像奖励组合按 prompt 意图启用约束,音乐 rubric 则暴露评分器和提示方式的影响。更细的奖励有机会改善生成,但也需要防止对评分代理的过度优化。 一步调用仍包含内部迭代 Depth as Time 把压缩目标推进到网络深度,SpectralCache 从稳定子空间中减少重复计算。参数、执行次数与端到端延迟是三种预算,本文分别给出对应测试条件。 跨模态先验需要明确桥接 DuoMatching 把图像教师接到视频 latent,PMD 把视频宿主知识接到动作流。对齐接口是关键,但附加参数或少步采样不能抹去宿主与训练的成本。 质量应按维度报告 主观偏好、文字符合度、三维一致性和接触质量不一定同步上升。不同论文的 benchmark、生成单位与采样预算不同,这份日报不把分数拼成统一排行榜。 今日讨论 你会优先改善长视频的一致性,还是压缩少步生成的内部计算? 人工智能炼丹君 整理 | 2026-10-06
-
AIGC 基本功知识树 每日论文速读解决的是广度——今天世界上发生了什么。但读论文有个前提:你得先看得懂。 这里是另一条线:把视觉生成的底层零件一个个拆开讲透。每篇都给数学推导 + 能跑的代码 + 经典论文出处,并标注前置知识,你可以顺着依赖链一路读下来。 当前规划 38 个知识点,已发布 38 篇。 图例:● 已发布 · ◍ 已发布待更新 · ◐ 正在写 · ○ 计划中 数学与优化基础(2/2) 概率、变分推断、随机微分方程——读懂扩散模型公式的最小前置集合。 ● 变分下界与重参数化(ELBO) · 难度:入门前置 不理解 ELBO 就没法理解 VAE 的 KL 项为什么要加权,也没法理解扩散模型的训练目标从哪来。 ● 扩散过程的前向与反向推导(SDE) · 难度:入门前置 · 前置:ELBO 把 DDPM 的离散公式和 SDE 的连续视角对上,后面所有采样器的差异都能一句话解释。 注意力与核心零件(7/7) 注意力、位置编码、稀疏激活与循环记忆——视频生成里最吃显存、最难外推也最影响长程建模的部件。 ● 自注意力机制的计算与显存账本(MHA) · 难度:核心必修 先把 O(N²) 的常数项算清楚,才能判断后面各种稀疏/线性方案到底省在哪一项。 ● 旋转位置编码 RoPE 的原理与实现(RoPE) · 难度:核心必修 · 前置:MHA 许多现代视频 DiT 使用 RoPE;理解旋转和相对位置性质,才能区分坐标可计算与生成质量可外推。 ● FlashAttention 为什么不需要存下注意力矩阵(FlashAttn) · 难度:进阶 · 前置:MHA online softmax 这一个技巧撑起了整个长序列时代,值得把递推式一步步推一遍。 ● 视频 DiT 里的 3D RoPE 与分辨率外推(3D-RoPE) · 难度:进阶 · 前置:RoPE 换分辨率或帧数时,3D RoPE 的坐标、频率与轴分配是需排查的因素之一,还要检查训练分布、VAE 与注意力实现。 ● 混合专家 MoE:稀疏激活怎么省算力(MoE) · 难度:工程实战 · 前置:MHA 统一多模态模型开始普遍用 MoE 扛参数量,但路由不均衡带来的训练不稳定很少被讲清楚。 ● 线性、循环与记忆架构(LinearMem) · 难度:前沿 · 前置:MHA 长序列架构正在从保存完整注意力矩阵转向可更新状态和深度循环;把复杂度、记忆容量与并行性放进同一框架,才能判断它们何时真能替代 Softmax Attention。 ● 视频生成里的稀疏注意力(SparseAttn) · 难度:前沿 · 前置:FlashAttn、3D-RoPE 视频长序列的全注意力成本很高;稀疏化可以减少计算,但免训练部署的质量取舍需和精确 IO 优化、缓存等方案比较。 生成范式(9/9) 从 DDPM 到流匹配,以及把 50 步压到 4 步的蒸馏路线。 ● DDPM 训练目标与采样流程(DDPM) · 难度:核心必修 · 前置:SDE DDPM 是理解扩散模型的重要起点;先读懂其 loss 与采样循环,再比较其他生成路径和训练目标。 ● 分类器无关引导 CFG 的代价与调法(CFG) · 难度:核心必修 · 前置:DDPM CFG 让每步算两遍,是推理成本里最容易被忽视的 2×,也是蒸馏首先要干掉的对象。 ● 从 DDIM 到高阶采样器(DDIM) · 难度:进阶 · 前置:DDPM 采样器换一个、缓存策略就得重调——这是推理加速最常见的踩坑点。 ● 流匹配与 Rectified Flow(FlowMatching) · 难度:进阶 · 前置:SDE、DDPM 流匹配被许多近期生成模型采用;它与 DDPM 的概率路径、监督目标及采样方式值得系统比较。 ● 潜空间扩散与 Stable Diffusion 架构(LDM) · 难度:进阶 · 前置:DDPM、VAE 把扩散搬进潜空间这一步,直接决定了今天视觉生成的算力可行性。 ● DiT:用 Transformer 替掉 UNet(DiT) · 难度:进阶 · 前置:LDM、MHA adaLN-Zero 这个小设计是 DiT 能稳定训起来的关键,值得逐行对照公式看。 ● 自回归视频生成与 Forcing 范式(Forcing) · 难度:工程实战 · 前置:DDPM、DiT 双向扩散没法流式出帧,Forcing 系列是把视频生成变成可交互的关键一步,也是当下最活跃的范式。 ● 少步蒸馏:从 50 步到 4 步(Distill) · 难度:前沿 · 前置:DDIM、CFG 蒸馏是过去两年推理加速收益最大的一条线,也是最容易把质量搞崩的一条。 ● 世界模型:从视频生成到可交互环境(WorldModel) · 难度:前沿 · 前置:Forcing 视频生成正在从「出片」转向「可交互环境」,这是范式转变而不是又一个 SOTA 分数。 表征与压缩(4/4) VAE / Tokenizer——视频生成的「地基」,决定了上限和伪影形态。 ● VAE 结构与训练目标(VAE) · 难度:核心必修 · 前置:ELBO 潜空间扩散依赖编码器输出的统计尺度;像素空间扩散不使用 VAE,不能将 scaling_factor 推广到所有扩散模型。 ● 离散化表征:VQ-VAE 与 VQGAN(VQGAN) · 难度:进阶 · 前置:VAE 离散自回归视觉模型依赖 tokenizer,码本利用率是重要问题;连续潜变量自回归路线不适用这一前提。 ● 视频 VAE 的时空压缩结构(VideoVAE) · 难度:工程实战 · 前置:VAE 时间维压缩比和因果卷积的实现方式,直接决定了长视频能不能逐块解码而不接缝。 ● 视频 VAE 的常见 loss 组合(VAELoss) · 难度:工程实战 · 前置:VideoVAE L1 + KL + LPIPS + GAN 四项的权重配比是玄学重灾区,把每项在管什么讲透很有价值。 对齐与强化学习(4/4) 从 PPO 到 GRPO,以及怎么把 RL 用到扩散和视频生成上。 ● 策略梯度与 PPO 基础(PPO) · 难度:核心必修 PPO 是在线策略优化的重要基础;掌握优势估计和裁剪后,再区分 GRPO 与直接偏好优化等不同路线。 ● 从 DPO 到 GRPO:去掉价值网络(GRPO) · 难度:进阶 · 前置:PPO GRPO 用组内相对奖励省去 critic;净成本还取决于组采样、参考模型、奖励评估和显存,不能统一声称降低一个量级。 ● 把 RL 用到扩散模型上(DiffusionRL) · 难度:前沿 · 前置:GRPO、DDIM 把多步去噪当成一条 MDP 轨迹,是理解视频 RL 各种做法的统一视角。 ● 视频生成中的强化学习与奖励模型(VideoRL) · 难度:前沿 · 前置:DiffusionRL、FlowMatching 视频的奖励要同时管画质、运动和指令遵循,reward hacking 在这里表现得最明显。 分布式训练(4/4) 参数、数据、序列三个维度怎么切,以及切完之后通信量变成多少。 ● 数据并行与 ZeRO 显存切分(ZeRO) · 难度:进阶 先把「参数 + 梯度 + 优化器状态」的显存账算清楚,才知道该切哪一部分。 ● 混合精度与数值稳定性(AMP) · 难度:进阶 BF16、FP16 与 FP8 的范围、精度和缩放机制不同,排查异常时要区分前向溢出、梯度下溢与舍入误差。 ● 张量并行与流水线并行(TP-PP) · 难度:工程实战 · 前置:ZeRO TP 的通信量和 PP 的气泡率都能手算,算完就知道并行度该怎么配。 ● 序列并行与 Ring Attention(SP) · 难度:前沿 · 前置:TP-PP、FlashAttn 超长视频序列可能需要序列或上下文并行;是否值得使用取决于单卡容量、通信和计算重叠。 推理加速与部署(5/5) 先用性能模型定位算力、带宽和显存瓶颈,再用缓存、稀疏、量化与算子融合把生成时间从分钟压到秒。 ● 性能建模与 Profiling:算力、带宽与显存账本(Roofline) · 难度:进阶 · 前置:AMP 不先判断算力、带宽还是显存容量在卡住系统,量化、融合、缓存很容易做成负优化;这篇提供所有推理优化节点共同的测量方法。 ● KV Cache 与自回归视频生成(KVCache) · 难度:进阶 · 前置:MHA、Roofline 自回归视频模型正在把 LLM 的这套缓存工程整体搬过来,值得先打好底。 ● 算子融合与 CUDA Graph(Fusion) · 难度:工程实战 · 前置:MHA、Roofline 小算子多的模型往往卡在访存和 launch 开销上,融合的收益比换算法更确定。 ● 量化:从 INT8 到 FP4(Quant) · 难度:工程实战 · 前置:AMP、Roofline 激活里的离群值是量化掉点的主因,SmoothQuant 的迁移技巧值得逐步推演一遍。 ● 扩散模型的跨步缓存复用(DiffCache) · 难度:前沿 · 前置:DDIM、DiT、Roofline 相邻去噪步的特征高度相似,这是免训练加速里性价比最高的一类手段。 评测与指标(3/3) FID/CLIP/VBench 各自测的是什么,以及它们什么时候会骗人。 ● FID / CLIP Score 到底测了什么(FID) · 难度:核心必修 FID 对样本量和预处理极其敏感,不同论文的数字经常根本不可比。 ● 视频生成评测:VBench 与人工验收(VBench) · 难度:进阶 · 前置:FID 加速类工作最爱报 VBench 总分不变,但分维度看往往能发现明显退化。 ● 音频质量评测:MOS、PESQ 与 FAD 各测什么(AudioEval) · 难度:工程实战 音视频生成里音频质量几乎全靠几个数字说话,但这些数字测的根本不是一回事:SI-SDR 只管波形对齐、PESQ 只为通信语音设计、FAD 看的是分布而不是单条样本的保真度。选错指标会得到自欺欺人的结论——比如用波形指标验收 codec,数字很好听但高频毛刺全在。 最后更新:2026-10-26 09:17
-
AIGC 每日速读|2026-10-05|NeurIPS省七成token保孔洞SILSA 今日 AIGC 论文速览 今日共 10 篇 · 3D生成 1 篇 · 持久世界建模 2 篇 · 视频表征与3D控制 3 篇 · 个性化图像生成 1 篇 · 音频生成 2 篇 · 视频生成评测 1 篇 重点论文标题列表 SILSA(伊利诺伊大学):省七成token保住孔洞 Oneira(莫纳什大学):新物体能互动且留下后果 World Observer(KAIST):镜头外的物体也继续演化 SemanTok(Stability AI):小模型先学会视频语义 Tacit-TTS(杜比实验室):免转写克隆语音快十倍 今日论文速览 1. SILSA:省七成token保住孔洞 SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation | 伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02201 关键词:图像生成3D, 切片潜空间, Rectified Flow, 拓扑约束 前序问题:高分辨率 3D 生成常先预测活跃体素,再补局部几何;连续曲面被拆成大量局部 token,细杆、孔洞和远距离连接容易断裂。增加体素数能补细节,却同时推高序列长度与训练显存。问题不只是模型画得像不像,还包括生成的网格是否保留原有结构。 本文贡献:SILSA 沿 x、y、z 三轴使用重叠的滑动窗口切片,每个 token 概括一段局部深度窗口。Slice VAE 将带朝向的表面采样编码成切片潜变量,再通过稀疏体积解码器重建网格;Volumetric Anchor Lattice 给三组切片共享的 3D 工作空间。切片级持久同调与相邻切片 Betti 转变损失约束连通分量和孔洞,图像条件 Rectified Flow 则一次生成整组潜变量。 论文 Figure 2:SILSA 总览。沿 x、y、z 轴以重叠切片 latent 表示形状。拓扑感知 SliceVAE 将表面编码为固定的多轴切片 latent,再通过稀疏体积上采样解码为高分辨率网格。图像条件 Rectified Flow Transformer 生成 latent,并以 Volumetric Anchor Lattice 作为共享 3D 记忆协调不同轴。VAE 训练中的切片级持久同调与 Betti 转变损失监督连通分量、孔洞和拓扑一致性。 实验效果:表 3 中固定 384 个 token,对比最紧凑基线 Dora 的 1280 个减少 70.0%;batch size 4、单张 A100 下训练显存 8.7GB,对比 Dora 的 14.6GB 减少 40.4%,端到端推理 0.34 秒/形状,对比 0.82 秒减少约 58.5%。表 1 的 PSNR 为 32.74,SparseFlex 为 30.12;表 2 的 Betti-Err 为 1.582,对比 1.743。arXiv comments 明确标注 Accepted at NeurIPS 2026。 论文 Figure 3:自然场景输入图像的 image-to-3D 生成结果。图中展示 SILSA 从不同输入得到的 3D 形状;这是定性展示,不能仅凭样例推出分布外形状可靠性。 批判点评:这些数字来自不同对照:70% token、显存和延迟以 Dora 为参照,PSNR 与 Betti-Err 的强基线是 SparseFlex,不能拼成对同一模型的全面领先。切片拓扑监督改善结构,并不提供任意形状的拓扑保证;作者也承认分布外结构及信息不足的输入视角会降低保真。值得关注的是表示方式,而不是把单物体结果直接外推到完整场景。 2. Oneira:新物体能互动且留下后果 Oneira: From Open-Ended Generation to Open-World Interaction in Video World Models | 莫纳什大学;大连理工大学;香港中文大学(深圳);牛津大学;布里斯托大学 | arXiv:2610.01614 关键词:交互式视频生成, 显式世界状态, 状态持久性, 条件视频 前序问题:能生成新房间,不代表能持续与新房间里的东西互动。镜头发现一个新苹果,模型要把它变成可操作对象;把苹果拿走之后,再回头也应看到空桌面。纯视频续写往往把交互当作局部视觉效果,缺少记录事件后果并供后续片段查询的状态载体。 本文贡献:Oneira 用显式世界状态表把视频生成与交互闭环连接。coding agent 读取当前观察和目标,定位实体、规划动作并把结果写回表;探索中发现的新物体也会注册。渲染引擎沿相机轨迹把更新后的表转成粗条件视频,视频生成器结合首帧、可选记忆帧和分块 caption 补齐外观与动作;末帧和更新后的状态进入下一段。它的贡献落在生成可互动且状态连续的视频环境。 论文 Figure 2:Oneira 单片段流程。给定输入图像与目标,coding agent A 读取世界状态表并规划动作 P_k。引擎 E 将每个动作写入表,把更新结果 T_k 沿相机路径 C_k 渲染成粗条件视频 V_k(第 3.2 节)。交互表现为物体框的删除或重新着色;被移动物体的框暂时移除,静止后从生成帧重新注册,新露出的物体也如此。视频模型 G 结合首帧、可选记忆帧、V_k 与分块 caption c_k 生成片段(第 3.3 节),末帧与更新后的表启动下一段。球体仅为示意,条件与生成帧来自同一个 Oneira 片段。 实验效果:表 1 的 InteractionBench 包含 100 个交互案例和 50 条记忆链。Oneira 的交互成功率为 0.78、目标正确率 0.82,LingBot-World-V2 分别为 0.49、0.39;记忆部分 State 通过率 0.80,MiniMax-H3 Ref2VA 为 0.68。图 3 展示三个片段组成的 30 秒链,比较执行交互后转回原处的状态。 论文 Figure 3:三个片段组成的 30 秒链的定性比较。各列上方标出当时的动作,橙色单元格表示 caption 携带交互的 chunk,插图显示 Oneira 的条件视频。红色标签标注 baseline 帧中的失败。Oneira 在指定 chunk 控制两次交互,并在相机转回时维持改变后的状态。 批判点评:状态表使“后果被记住”更明确,却没有让底层视频模型成为物理仿真器。作者列出的动作空间仍是离散的,连续控制和精细接触并未解决;长时域视觉一致性仍受生成器能力限制。100 个交互案例与 50 条记忆链是作者的专用评测,不能等同于开放世界任意操作均可靠。 3. World Observer:镜头外的物体也继续演化 World Observer: Joint Actor-Observer Generation for Persistent World Modeling | 韩国科学技术院(KAIST)人工智能学院 | arXiv:2610.02162 关键词:视频世界模型, 全景观察者, 多视角生成, 镜头外动态 前序问题:视频世界模型通常只生成行动者当前看见的画面。汽车驶出视野之后,没有可见证据约束它继续前进;再次入镜时可能丢失、停住或变成别的车。仅保存旧图像能帮助记住外观,却不一定能维护镜头外持续发生的动态。 本文贡献:World Observer 把“行动”和“观察”拆成两个同步生成流:透视 actor 负责当前视角,全景 observer 持续观察选定区域,二者由共享 DiT 联合生成。共同全景源的 warping 建立几何对应;Observer Sink 从高分辨率初始全景取四个透视参考,帮助物体重返视野时恢复细节。观察者还能放在不同位置,或接收单独条件来控制画面外的事件。 论文 Figure 4:模型总览。(a)World Observer 使用共享 DiT 联合生成 actor 与全景 observer 两条流。(b)Observer Sink 将高分辨率初始全景转换为四个透视参考,以保留精细外观信息。 实验效果:表 1 的真实/合成 OOV 测试中,单观察者 2B 模型的 FVD 为 291.7/196.2,LingBot-World 为 420.0/333.3;OOV-D_gt 为 0.426/0.531,对方为 0.337/0.340。多观察者仅在合成集测试,FVD 为 147.0,但 OOV-D_gt 为 0.528,略低于单观察者 0.531。因此视角增加改善部分指标,并非所有动态指标同步上涨。 论文 Figure 7:与其他模型的定性比较。红框标出目标离开视野前与重新进入视野后的物体。已有模型常丢失物体、冻结其状态或不一致地重建它;World Observer 在视野外间隔后更好地保持物体身份与状态演化。 批判点评:方法目前需要全景条件,作者将从普通透视图补全全景列为后续方向;真实世界多观察者条件稀缺,多观察者优势只在合成集有证据。有限的观察者预算也无法覆盖整个世界。它更像把算力分配到感兴趣区域,而不是获得无限范围的世界记忆。 4. SemanTok:小模型先学会视频语义 SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation | Stability AI;卡尔斯鲁厄理工学院 | arXiv:2610.00686 关键词:视频tokenizer, 自回归生成, DINO语义监督, 可变长度token 前序问题:自回归视频生成需要先确定场景是什么,再补纹理细节。可变长度 tokenizer 虽能从粗到细输出,已有 decoder-REPA 对齐却可能利用带噪输入满足损失,未必迫使短 token 前缀本身承载语义;小 AR 模型因此仍可能生成类别不对或随时间漂移的画面。 本文贡献:SemanTok 保留 VideoFlexTok 的可变长度训练和 nested dropout,在编码端加入冻结 DINO 特征,并用轻量 Dense DINO 与 Class DINO 读出头,要求每个保留下来的 token 前缀单独预测教师语义。冻结 tokenizer 后,AR 模型按时间优先、由粗到细的顺序预测 token,再由扩散 decoder 还原视频。语义监督直接落在短前缀,而不只落在 decoder 的中间状态。 论文 Figure 2:方法总览。(1)tokenizer 训练:encoder、FSQ 与扩散 decoder 联合训练,nested dropout 使 decoder 能从任意 token 前缀重建视频。SemanTok 保留 VideoFlexTok 的训练方案(橙色),再加入冻结教师的语义监督:教师特征输入 encoder,每个保留的前缀都学习预测这些特征(紫色;细节见图 3)。(2)AR 训练与生成:冻结 tokenizer,AR 模型按时间优先、粗到细的顺序预测 token,步骤(1)的 decoder 将任意生成前缀渲染为视频。 实验效果:摘要与实验分析报告:201M 的 SemanTok AR 模型可匹配或超过约 3.4 倍规模的 VideoFlexTok AR 模型;附录表 4 中相应规模阶梯为 201M 和 679M。正文还报告在相同 AR 模型下,k=16 时每 token 预测约少用 32% 的 bits。图 7 比较同一 Kinetics-600 弹吉他类别的 rollout,201M 的 SemanTok 随时间退化更慢。 论文 Figure 7:SemanTok 在两种 AR 模型规模下保持优势。图中是同一 Kinetics-600 弹吉他类别的 class-to-video rollout。在 201M 模型下,SemanTok 随时间缓慢退化,而 VideoFlexTok 只在 t=1 时清晰。项目页提供视频。 批判点评:“小模型追上大模型”限定在作者的数据、token 预算与指标配置;参数量减少不等于端到端生成耗时同比减少。正文专门指出每帧仅 1 个 token 时不能兼顾全部目标,附录重建表也显示部分 PSNR/SSIM 逊于基线。语义更准和逐像素重建更准是两种目标,部署时仍需按预算权衡。 5. Tacit-TTS:免转写克隆语音快十倍 Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning | 杜比实验室 | arXiv:2609.38658 关键词:语音克隆, Masked LM, 非自回归生成, ReFlow蒸馏 前序问题:自回归 TTS 逐个预测语义 token,零样本音色克隆效果好但延迟高。非自回归系统更快,却常要求参考音频的转写;参考是陌生语言、婴儿咿呀或无意义发音时,ASR 生成的错误文本反而污染条件。目标是在不要求参考转写的同时降低生成耗时。 本文贡献:Tacit-TTS 从 IndexTTS2 蒸馏,将 text-to-semantic 阶段替换为 masked 非自回归生成,同时保留预训练的说话人和情绪条件。免训练长度估计结合参考音频语速与目标文本音节数,确定输出长度;连续潜表示和 ReFlow 蒸馏则加速下游 semantic-to-mel 的 flow-matching 渲染器,最后由 vocoder 合成波形。 论文 Figure 2:Tacit-TTS 流程总览。输入为参考音频与目标文本,encoder 提取条件表征;text-to-semantic 模型通过 masked-LM 生成语义 token,semantic-to-mel 模型将其转成 mel 频谱,最后由 vocoder 合成波形。 实验效果:单张 NVIDIA A100 上,作者对超过 5 秒的语音报告相对 IndexTTS2 超过 10 倍加速。图 3 的端到端测试包含参考条件计算:4 秒输出约 9.0 倍、31 秒附近最高约 14.9 倍、125 秒为 11.8 倍。表 1 中 LibriSpeech speaker similarity 为 0.875,教师为 0.870;但 WER 为 5.54,教师为 3.115。参考语言另测试了 8 种语言及非词汇声音。 论文 Figure 3:IndexTTS2 与 Tacit-TTS 的端到端生成时间(包含参考条件计算)随输出时长的变化。使用同一参考片段,以固定段落重复延长输出。虚线表示实时速度;Tacit-TTS 曲线上方数字是相对教师的加速比,插图放大 Tacit-TTS 曲线。4 秒、31 秒附近和 125 秒的示例加速比约为 9.0、14.9 和 11.8 倍,不能当作全数据平均。 批判点评:更快没有消除质量损失:普通中文测试上的音色相似度和内容准确度仍落后于教师。图 3 使用固定段落重复拉长输出,最高 14.9 倍不能写成所有语音平均加速;长序列的全注意力成本也开始侵蚀收益。四个常规数据集的其他基线质量数字来自教师论文,而跨语言与非词汇测试由作者重跑,比较范围应分开理解。 6. 4Director:完整网格让物体转身不丢脸 4Director: Controlling Video World Models with Rigid 3D Geometry | Stability AI;伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02160 关键词:可控视频生成, 4D场景, 刚体网格, Motion Adapter 前序问题:2D 框只能指定物体在屏幕上的位置,不能完整表达深度和转向;3D 点或 blob 也缺少完整表面。镜头与物体同时移动时,模型容易每帧重新猜未观测几何,导致物体转了一半、遮挡出错或身份变化。专业创作需要把相机和物体轨迹放进统一的 3D 坐标系。 本文贡献:4Director 从输入图为每个物体一次重建 canonical mesh,每帧只施加一个指定刚体变换。网格、背景点云与相机共享坐标系,用户编排轨迹后渲染成深度视频;可训练 Motion Adapter 将几何条件注入预训练视频模型,后者补充外观、光照与非刚体动态。团队构建含 20,774 个片段的 RealCOD-Rigid,并以身份判断门控 mask IoU,形成 IG-IoU 指标。 论文 Figure 3:4Director 总览。左侧:每个物体只重建一次为完整 canonical mesh,每帧用一次刚体变换移动;网格、背景点云与相机共享坐标系,用户在该坐标系指定物体与相机轨迹,并将场景渲染成深度视频(第 3.1 节)。右侧:可训练的 Motion Adapter 分支将刚体渲染注入预训练视频生成器,由后者补充外观、光照与非刚体动态(第 3.2 节);训练使用 RealCOD-Rigid(第 4 节)。 实验效果:表 1 中 4Director 的 FVD 为 370.4,SymphoMotion 为 405.4、VerseCrafter 为 484.7;IG-IoU 为 60.4,对应 52.9 和 54.8,camera RotErr 为 3.65°。图 5 对比共同相机与物体控制,显示其更完整地跟随指定转向;图 6 另展示物体离开视野后重返的定性案例。 论文 Figure 5:相机与物体共同控制的定性比较。每个片段顶行展示输入图像和规定的轨迹,其下为四个 baseline、4Director 以及源视频按时间对齐的帧。箭头表示物体朝向,源视频中为绿色、生成视频中为红色。该组案例里只有 4Director 完成源视频的转向;baseline 保留原朝向、只转了一部分、模糊或丢失主体。 批判点评:完整网格减少逐帧几何猜测,却会把错误重建固定进控制条件。论文失败案例中,倒立舞者被当作一个刚体平移,生成结果一直保持初始姿态而没有跳舞,说明刚体轮廓可能压制应有的非刚体动作。IG-IoU 还依赖视觉语言裁判判断身份;作者的 VBench 优势多数在 2 个点以内,应避免把图中单例写成稳定保证。 7. GenCine:相机与物体在3D里一起编排 Generative Cinematographer: Composing Camera and Object Motion in 3D | 约翰斯霍普金斯大学 | arXiv:2610.02180 关键词:视频运动控制, 3D运动handle, XYZ引导图, LoRA 前序问题:同一条 2D 拖拽轨迹可能对应完全不同的 3D 运动;相机和物体一起动时,屏幕坐标更难区分“物体真的转身”和“镜头绕过去”。另一方面,整物体刚体控制过硬,人体、动物或机械臂的不同部分需要分别编排,而不必为每类对象建立物理模型。 本文贡献:GenCine 把单张图提升为可编辑的 3D 场景 scaffold,艺术家在共同世界坐标系里设置相机路径,并以局部 3D handle 控制前景不同部分。背景 XYZ、前景 XYZ 和恒定前景身份颜色图分别表达静态位置、动态位置和跨帧对应;有效性 mask 标记缺失条件。轻量 guidance branch 与 Wan 模型的 LoRA 学习这些控制,从真实视频恢复轨迹并结合合成数据训练。 论文 Figure 3:GenCine 的 3D 控制流程。首先从 RGB 图估计深度与动态 mask,再提升为供动作编排的 3D 场景。艺术家通过 Blender 等 3D 界面,在共同世界坐标系指定相机和物体运动。控制转为背景 XYZ、前景 XYZ 和前景身份图,分别指示静态场景位置、移动 handle 的位置及身份。有效性 mask 区分可用条件与缺失值,动态 mask 标出初始前景。冻结的 Wan VAE 将图编码给视频模型;训练配对从视频运动恢复的条件,推理时同样的图表达艺术家编排的控制。 实验效果:表 1 的 Camera Shooting 上,GenCine 的 TransErr 为 1.00,Wan-Move 为 1.02;受控前景 R-LPIPS 为 0.18,对方为 0.19。Object Interactions 上整体 LPIPS 为 0.35,Wan-Move 为 0.37,但整体 PSNR 为 16.54,略低于 Go-w-Track 的 16.59。图 5 给出艺术家编排运动的定性对比,体现 3D 意图与 2D 投影控制的区别。 论文 Figure 5:艺术家编排运动的定性比较。自上而下为 Living room、Bus 和 Robotic arm;每组按行展示 Wan-Move、VerseCrafter、Go-with-the-Track 和 GenCine。第一列为 3D 控制(GenCine)或共享的 2D 投影(baseline),随后四帧采样各控制区间。实线与虚线分别表示已执行和剩余目标路径,圆点表示当前目标,半透明 mask 表示投影目标区域。 批判点评:主要价值是可表达的控制接口,数值优势相当局部,不支持“全指标碾压”的结论。多个 handle 只是分段刚体近似,不能可靠表示复杂形变;单图深度估计出错、遮挡和超出归一化范围的运动都会影响控制。它与 4Director 各有取舍:局部操作更灵活,但没有完整网格带来的全表面约束。 8. PEARL:从用户历史推理个性化画面 Personalized Image Generation with Reasoning and Reflection | 范德堡大学;Adobe;马里兰大学帕克分校;佐治亚大学 | arXiv:2610.00737 关键词:个性化图像生成, 用户历史, 推理反思, DPO 前序问题:个性化图像生成通常依赖挑选好的参考图片,而真实用户偏好分散在评论、帖子、图片和 metadata 中。把某件商品放到什么环境、某个主题应采用什么风格,需要综合历史线索;检索一张最像的图片并不能完整表达生活方式与审美。 本文贡献:PEARL 将多模态 planner、reflector 与冻结图像生成器串成 reason-reflect 循环:先从历史形成场景计划并渲染,再根据实际图像与历史的不匹配修订计划。训练先蒸馏 silver personalization trajectory,再采用交替策略 DPO,用与用户历史相关的检索奖励优化两种策略。配套 benchmark 区分电商商品的 Personalized Scene Generation 和社交媒体的 Personalized Creative Generation。 论文 Figure 2:Pearl 的训练流程。先用 Silver Personalization Trajectory 做 warm start,再通过 Render-in-the-Loop 优化两种策略。图左的教师产生推理与计划供 planner 和 reflector 蒸馏;图右把两种策略与冻结渲染器串接,按奖励给候选排序、构建偏好对并做交替 DPO 更新。 实验效果:表 1 的 Amazon 场景生成中,H@5 为 0.2297,PMG 为 0.2143;MLLM Overall 为 3.92,对方为 3.48。表 2 的 Instagram 创作生成中,跨类别 R@1 为 0.876,Pigeon 为 0.748,MLLM Overall 为 3.541,对方为 3.334。图 4 将两种任务的指标归一化后汇总,比较完整 PEARL 与移除 reflection 的版本。 论文 Figure 4:消融:Pearl 与 Pearl -Reflection 的比较。该可视化对两种任务的指标进行归一化和汇总,展示保留 reflection 前后的差异;坐标是汇总后的相对值,不是原始 benchmark 分数。 批判点评:用户“喜欢”不等于模型能识别出用户:检索与 MLLM 分数只是偏好对齐的代理指标。作者明确指出电商场景没有每个用户—商品组合的自然真实目标图,只能间接评估;策略训练也只做了一轮交替 DPO。Instagram 的 LPIPS 和 MS-SSIM 并非最优,因此不能把摘要中的平均个性化提升写成所有画质指标普遍提升。 9. PLACE:让双耳声像跟随多模态条件 PLACE: Positional Latent Adaptation via Conditioned Embeddings for Binaural Audio Generation | 杜比实验室;佐治亚理工学院 | arXiv:2610.00630 关键词:双耳音频生成, 空间条件, 低秩latent适配, ILD与ITD 前序问题:音频与画面语义一致,还不一定听得出声音来自左边还是右边。现有空间声音生成器的条件接口常较固定,难以同时接收文本、视频和可选音频。想让耳机中的声像随场景变化,需要条件中的空间信息真正改变生成 latent,而不是只描述声源类别。 本文贡献:PLACE 基于 AudioX,增加 Perception Encoder Core 视频特征,将文本与视频表征对齐以提取空间线索,再用依赖条件的低秩变换调整生成 latent。适配器通过解码音频上的耳间声级差 ILD 和时间差 ITD 损失训练;五个预训练 encoder 与 SAO decoder 冻结,AudioX 通过 LoRA 微调。系统支持不同模态条件组合,而非只处理视频输入。 论文 Figure 1:PLACE 框架总览,蓝色突出视频特征路径,橙色突出文本路径。(a)AudioX 生成 latent,空间条件在冻结 SAO decoder 之前驱动其变换;五个预训练 encoder 与 decoder 全部冻结,AudioX 用 LoRA 微调。(b)投影后的 PE Core 特征在 MAF 模块之前补充 CLIP 与 Synchformer 特征。(c)文本—视频 cross-attention 与联合 self-attention 产生空间特征 H_c-sp。 实验效果:表 1 的 FAIR-Play split 1 上,ITD 误差 0.1077ms、ILD 误差 2.0495dB,ViSAGe 分别为 0.1136ms、2.1306dB;split 2 的 ITD 却较差。表 3 的分布外 T2A 听测平均分为 55.5,SpatialSonic 为 44.8;域内 V2A 为 65.3,对方 ViSAGe 为 44.9。原文只写 Submitted to ICASSP 2027,不能称为会议接收。 论文 Table 3:主观听测表。评分范围为 1–100,越高越好;SC 为语义一致性,SI 为空间感,SP 为空间一致性,Sy 为同步性(T2A 不评此项),AR 为音频真实感,Avg 为所评维度的均值。GT 是真实音频参考,不参与最佳模型加粗;粗体表示每种条件各列最优模型。表中区分域内与分布外 T2A、域内与 Gemini 视频条件 V2A;n 统计评分数。PLACE 在域内 T2A 均分 40.5,分布外 T2A 为 55.5,域内 V2A 为 65.3,Gemini V2A 为 58.4。 批判点评:收益取决于模态与分布。域内 T2A 听测均分仅 40.5,低于 SpatialSonic 的 44.4 和 AudioX 的 41.1;BEWO-1M SS-set 上 FSAD、ITD、ILD 也逊于 SpatialSonic,优势集中在原文定义的 SpatialCLAP 差值指标。听测表中的 n 是评分数,不能当作独立听众人数。空间一致性进步不等于全面音质领先。 10. VTR-Bench:视频逼真了字却还常写错 VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation | 香港城市大学;香港科技大学(广州);香港科技大学;西湖大学;电子科技大学 | arXiv:2610.01499 关键词:视频生成评测, 视觉文字渲染, WER, 关键帧引导 前序问题:广告、科学演示和界面视频里的文字常承担核心信息。模型能把灯光与动作做得漂亮,招牌仍可能拼错、缺字或小字不可读;只评审美与物理合理性无法发现这些问题。需要把文本正确性与画面任务完成度分开衡量。 本文贡献:VTR-Bench 用 300 个 prompt 覆盖五类场景,对具体文字载体分别转写并计算 WER,同时用每条 prompt 的 20 问 checklist 检查场景与运动要求。作者另外提出关键帧引导生成流程,由 Director agent 根据视觉反馈反复调整图像、首帧及运动计划,再生成视频。主贡献是生成模型评测与改进,符合 AIGC 范围,而不是通用视频理解。 论文 Figure 2:VTR-Bench 总览。左侧:专家设计五种场景类别,引导场景 seed 生成与人工过滤;保留的 seed 用于构造 prompt,再通过参考图生成和 VLM 审查迭代完善,最后人工复核。右侧:生成视频在两个维度分别评估,Video Score 以 20 问 checklist 衡量场景与视频要求完成度,WER 比较针对具体文字载体的 VLM 转写与参考文字,衡量视觉文字保真。 实验效果:主表 1 比较 11 个视频模型,Wan3.0 的整体 WER 最低,为 0.250,Video Score 为 0.849;MiniMax H3 为 0.447/0.756,Seedance2.5 为 0.641/0.791。表 2 中 Qwen3.8-27B 对文字块 WER 的 Pearson 为 0.9541,视频级为 0.9842,支持其与人工转写的相关性。官方代码:VTR-Bench。 论文 Figure 1:即使视频视觉上可信,现有视频模型仍难正确渲染文字。上方是 Seedance2.5 生成的视频;Video Score 是 20 问 checklist 中满足要求的比例,WER 是相对参考文字的词错误率。左下展示视频中的四种文字渲染问题,右下展示 11 个模型在 VTR-Bench 上的整体 WER。 批判点评:WER 是词级编辑距离,0.250 不等于“25% 的视频失败”,也不能推出每个视频都错四分之一。不同模型的分辨率与生成管线不同,排行榜还受评审模型影响;相关性高不意味着每条转写都正确。关键帧 agent 的迭代成本也应单独核算,不能把更高预算的改进当作单次生成能力。 趋势观察 从像素记忆走向状态载体 Oneira 显式记录交互后果,World Observer 持续生成选定区域的视角;两条路线都让镜头外状态获得约束,但尚未证明无限时域或全面物理可靠性。 控制接口先解决几何歧义 4Director 用完整刚体网格,GenCine 用局部运动 handle;它们共同把相机和物体放进世界坐标系,分别在完整几何与形变灵活性之间取舍。 短序列必须携带可用信息 SILSA 的切片潜变量与 SemanTok 的短语义前缀都减少局部 token 负担;这是不同任务中的表示设计趋势,不能把各论文加速数字横向相乘。 评测拆开能力与代价 视频里的字、音频的空间感、用户历史匹配和端到端耗时都需要独立指标。各论文测试集、评分口径和硬件不同,本期不做跨论文统一排行榜。 今日讨论 SILSA 用切片拓扑监督改善单物体孔洞与连通性;面对输入视角不充分或分布外形状,你会优先增加多视角条件,还是设计可验证的拓扑约束? 人工智能炼丹君 整理 | 2026-10-05