首页
应用
关于
Search
1
Pytorch DDP
2,482 阅读
2
Pytorch 常见问题
1,515 阅读
3
视频时序切分
1,341 阅读
4
中文场景下的CLIP图文预训练
1,044 阅读
5
Semi-Supervised + Noisy Label
1,028 阅读
AIGC
AIGC Daily Papers
AIGC Fundamentals
其他
职场经验复盘
多模态理解
购房/投资
阅读
广告
Segmentation
LeetCode
Pytorch
Python
Shell
C++
常用链接
Search
标签搜索
AIGC
人工智能
论文速读
ai
视频生成
DiT
对齐
蒸馏
扩散模型
attention
transformer
视频编辑
图像生成
diffusion
基础知识
稀疏注意力
多模态
文生图
NVIDIA
llm
Jefxiong
累计撰写
203
篇文章
累计收到
8
条评论
首页
应用
栏目
AIGC
AIGC Daily Papers
AIGC Fundamentals
其他
职场经验复盘
多模态理解
购房/投资
阅读
广告
Segmentation
LeetCode
Pytorch
Python
Shell
C++
常用链接
页面
关于
首页
/
其他
/
正文
其他
基于LLM做多模态生成系列文章-Make-A-Scene
人工智能炼丹君
2024-04-05
/
0 评论
/
367 阅读
/
正在检测是否收录...
04/05
基于LLM做多模态生成系列文章-Make-A-Scene
Make a Scene (Meta-2022)
:
Make-A-Scene: Scene-Based Text-to-Image Generation with Human Priors
Motivation
提升生成的可控性:Make-A-Scene同期工作主要以文生图为主,生成结果的可控性低。(ControlNet之前的工作)
人类感知优化:人类对于人脸/人体显著物体的畸形容忍程度较低,生成图片需要增强这些方面的能力
主要贡献
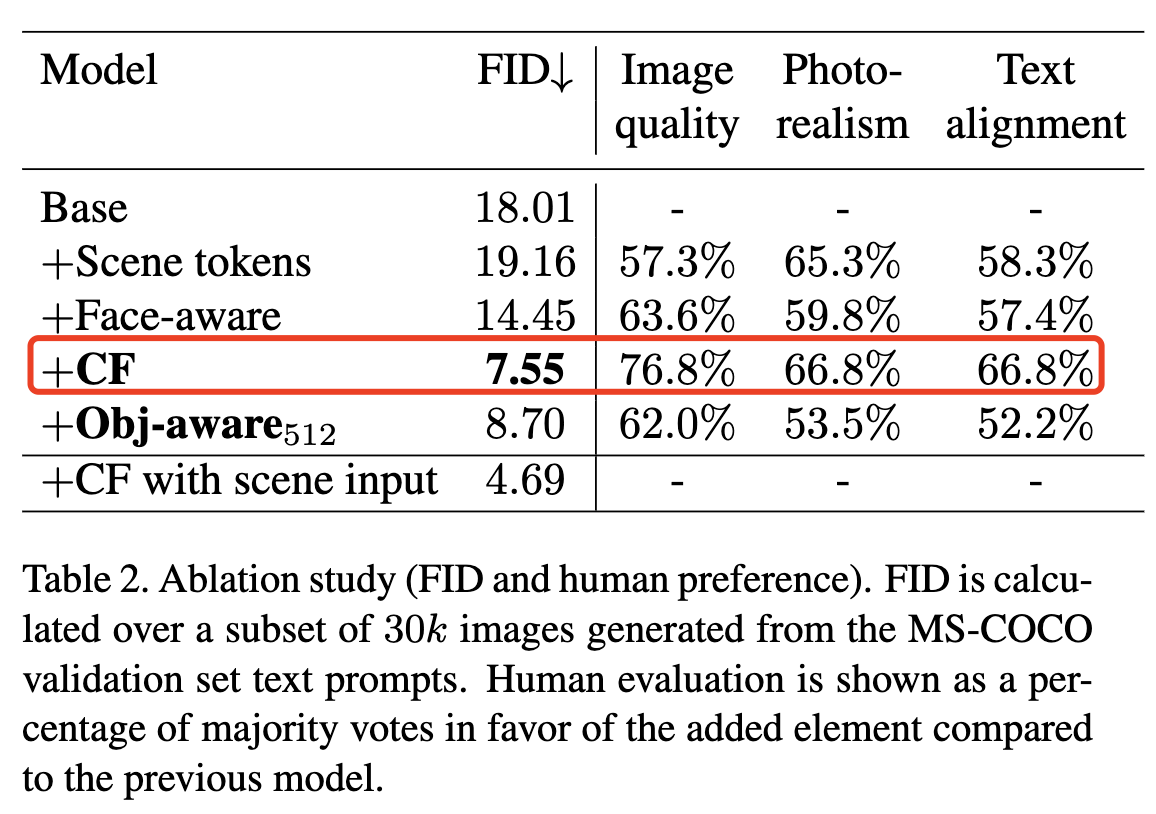
1. 可控生成:实现除文本控制外,增加图片分割图的可控生成,结构一致性 2. 压缩优化:优化图片tokenizer,增强对显著物体(人脸/人体等)的重建效果 3. 推理优化:提出针对自回归图片生成模型的CFG方案【可以舍弃CLIP rerank的环节】,极大提升FID和图文对齐
一些思考
分割图与类别相关,推理过程中有OOD的类别,有一定的限制性
提高对显著物体的重建效果,通过加入“感知Loss”实现,Face Embedding or Vgg Embedding进行约束
CFG对于提升图文一致性效果非常显著。
其中系数经验值取3-5
0
版权属于:
人工智能炼丹君
本文链接:
https://jefxiong.cn/index.php/archives/992.html
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权
上一篇
下一篇
评论 (0)
画图模式
文本模式
细
中
粗
取消
发表评论
粤ICP备2021042327号





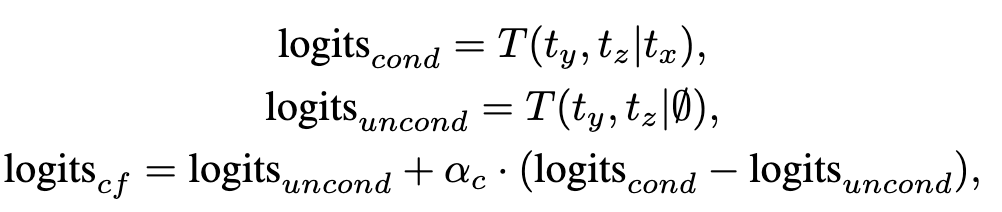
评论 (0)