今日 AIGC 论文速览
今日共 10 篇 · 图像生成接口与表征 3 篇 · 流式视频与效率 4 篇 · 语义图像编辑 1 篇 · 语音量化 1 篇 · 音乐生成评测 1 篇
重点论文标题列表
- InstantFusion(上海AI Lab):让不同图像模型接力去噪
- RG(阿里):让内部表征真正带动画图
- CoVA(南开):把VAE特征分阶段用好
- Memory Forcing(快手):固定缓存也保留中程历史
- ForcingBooster(港科大):简单区域提前停复杂区域多算
今日论文速览
1. InstantFusion:让不同图像模型接力去噪
InstantFusion: A Shared Latent Interface for Heterogeneous Image Generators | 上海人工智能实验室;复旦大学;上海交通大学;香港中文大学 | arXiv:2610.13944
关键词:跨模型图像生成, 共享潜空间, 动态对齐, 接力去噪
- 前序问题:不同生成器各有所长,但中间状态直接交给另一模型会出现伪影;为每对模型训练桥接器,又难随着模型数量扩展。
- 本文贡献:为每个冻结生成器训练轻量 Latent AutoEncoder,把中间状态编码到共享空间,再由目标模型解码。训练同时约束重建、同噪声状态对齐与局部去噪速度对齐;推理根据预测干净潜变量的变化选择交接点。同一接口支持模型组合、接力加速及跨架构蒸馏,不必为每对模型单独建映射。
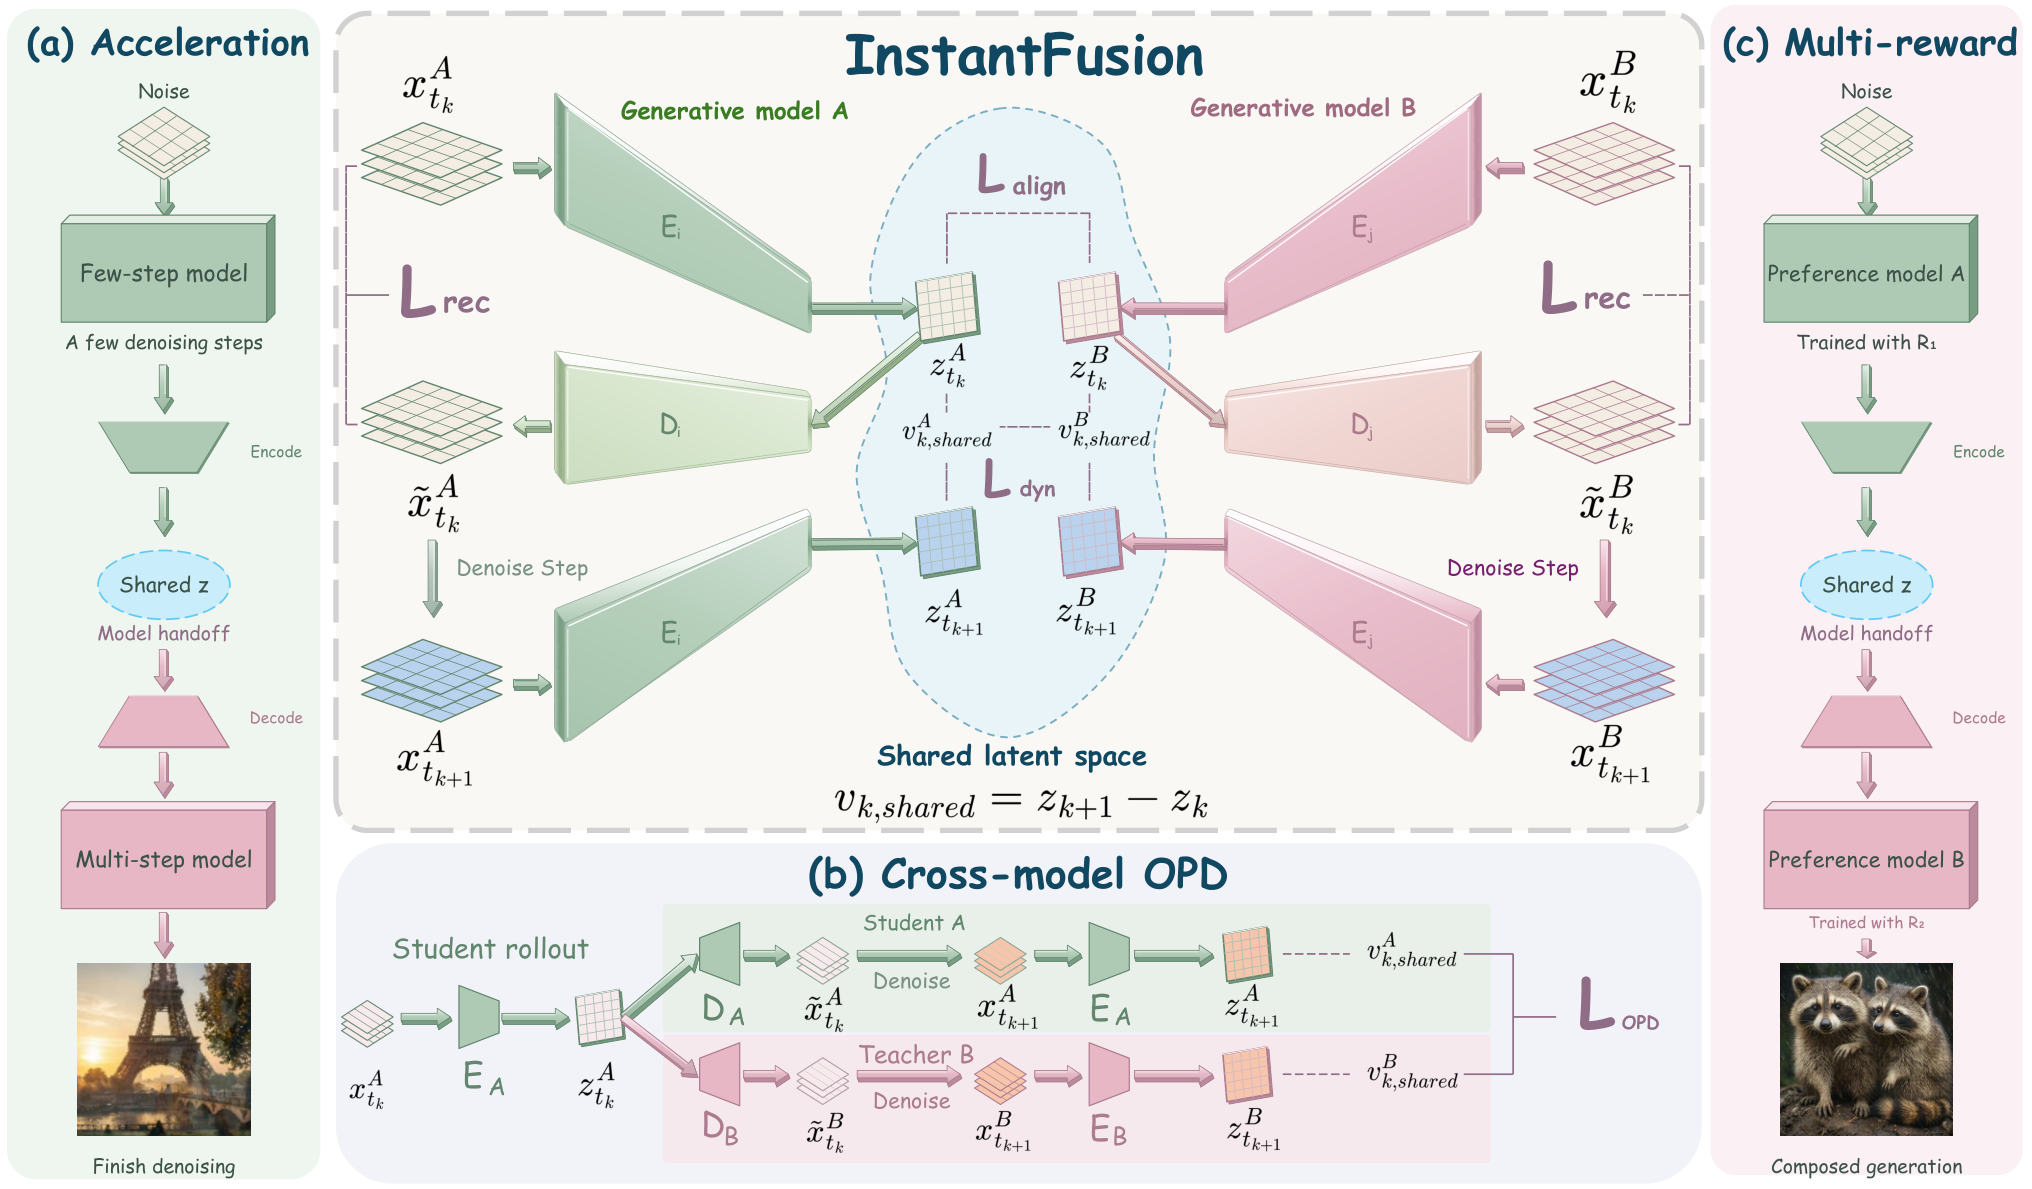 论文 Figure 1:InstantFusion 概览。训练时,每个冻结生成器的专用 LAE 把中间状态映射到共享表示空间,同时对齐潜状态与去噪动态。推理时,发送模型的状态经共享空间翻译到接收模型的潜空间,自适应准则决定接收模型何时接管去噪。图中接口、接力加速、偏好组合与蒸馏是不同用途。
- 实验效果:表 2:接入 Qwen-Image 后,SD3 的 GenEval-v2 从 22.14→35.06,FLUX.1 从 22.86→36.54,分别增加 12.92、13.68 分;OneIG-Bench 平均分为 0.4776、0.5007。SD3 组合的 CLIP 分 28.65→26.98、推理分 0.2770→0.2730,不能说所有指标同时提升。
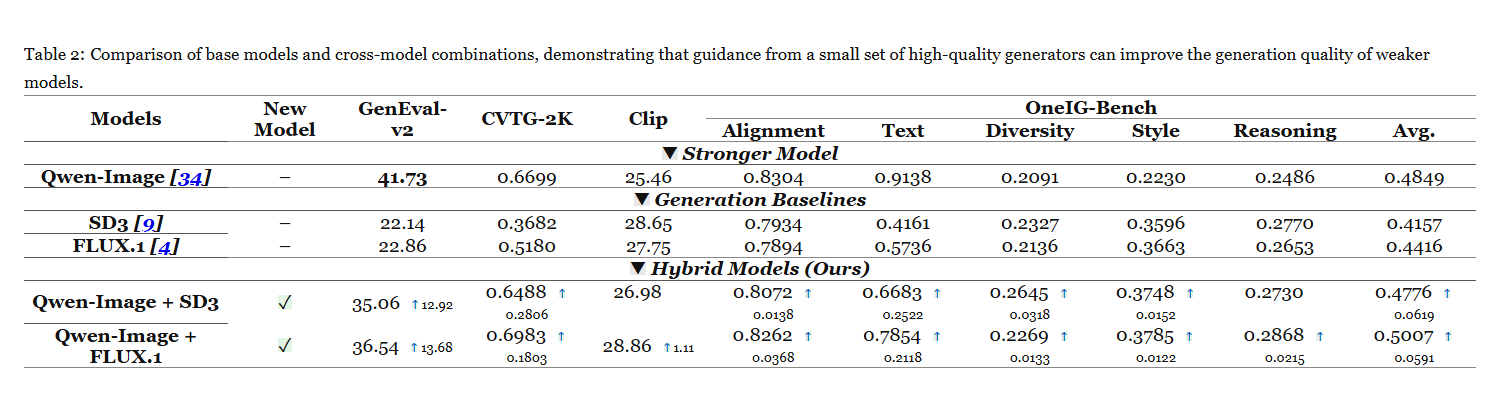 论文 Table 2:基础生成器与跨模型组合比较,展示少量高质量生成器如何帮助较弱模型。列含 GenEval-v2、CVTG-2K、CLIP 及 OneIG-Bench 的对齐、文字、多样性、风格、推理与平均分。Qwen-Image+SD3 的 GenEval-v2 为 35.06,+FLUX.1 为 36.54;各自增量为 12.92、13.68 分。部分 CLIP 与推理数值下降,原表增量箭头不能替代实际数值判断。
- 批判点评:当前方法要求共享 VAE 和兼容时间参数,不能任意拼接不同编解码器;同时装载多个主干增加显存与存储。冻结主干仍需训练接口,重复往返也会损伤保真度。表 3 不同接力对象有速度与质量取舍,不能把摘要加速范围外推所有组合。官方仓库可见 LAE/OPD 训练及 SD3/Qwen 推理实现,HuggingFace 可见接口权重;其他演示组合未逐一确认实现,未运行复现。
2. RG:让内部表征真正带动画图
Learning Representations to Guide Pixel Diffusion Transformers | 中山大学;阿里巴巴;香港大学;上海交通大学 | arXiv:2610.12978
关键词:像素空间生成, 表征引导, 低维瓶颈, 训练目标修正
- 前序问题:中间层对齐视觉教师后,语义可能被后续像素合成覆盖;更强表征或更复杂像素解码器,不一定换来更好的生成。
- 本文贡献:Representation Guidance 用低维瓶颈连接普通 Transformer 编码器与解码器;比较解码器有无内部表征时的预测速度差,把停止梯度后的差值加进 flow matching 训练目标,迫使生成使用表征。默认由 EMA 网络形成引导,训练仍叠加 DINOv2 的 REPA 对齐;内部引导不能说成完全不用外部表征监督。
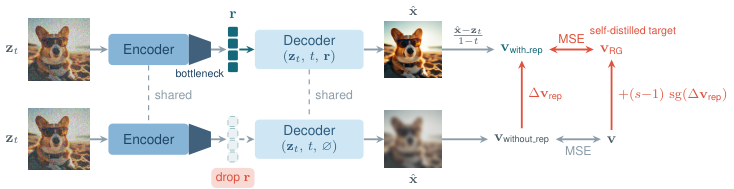 论文 Figure 6:Representation Guidance 训练。编码器把带噪输入 z_t 经瓶颈映射为 r;共享解码器在有 r 和无 r 两种条件下预测干净图像,再转成 v_with_rep 和 v_without_rep,其差为 Δv_rep。无表征分支由原 flow matching 目标 v=x−ε 监督,有表征分支由沿停止梯度偏移外推的 v_RG 监督。
- 实验效果:表 2:ImageNet 256×256,RG-XL/16 为 725M 参数、600 epochs,FID 1.55;RG-L/16 为 459M、同训练轮数,FID 1.79。表中的 PixelDiT-XL 为 797M、320 epochs、FID 1.61,JiT-G/16 为 2B、600 epochs、FID 1.82;训练预算与外部模型并不完全相同。
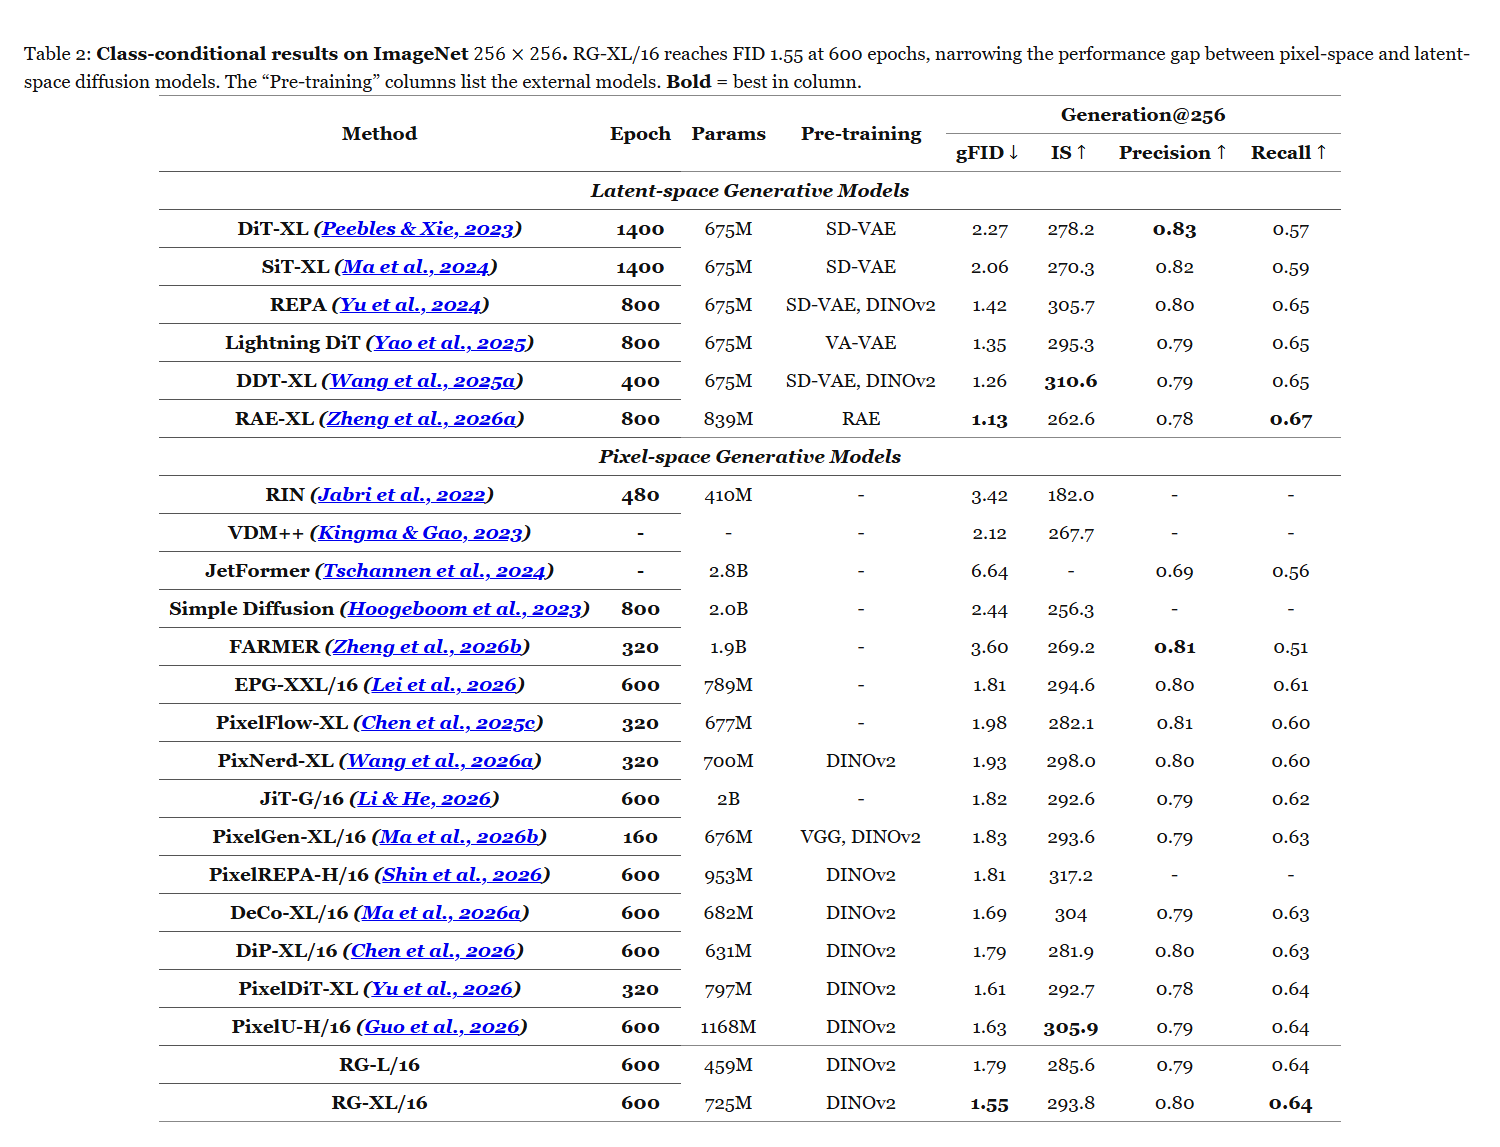 论文 Table 2:ImageNet 256×256 类别条件结果,比较潜空间与像素空间模型。预训练列列出额外使用的外部模型,粗体标示列内最佳。RG-XL/16 在 600 epochs 达 FID 1.55,725M 参数,外部表征列为 DINOv2;同时列出 IS、Precision、Recall。不同模型训练轮数及预训练组件不同,FID 排名不等于同成本比较。
- 批判点评:RG 增加两次无梯度 EMA 前向,推理无需这两次教师调用,但训练成本仍存在;低噪声区间、warm-up 和引导强度均属方法条件。现有实验聚焦图像,视频、3D、音频迁移尚未证实。官方仓库目前仅有 README 与展示素材,作者把代码和权重列为待发布,不能称已开源实现。
3. CoVA:把VAE特征分阶段用好
CoVA: Composing VAE Representations for Generative Learning | 极豪科技;南开大学 | arXiv:2610.13322
关键词:生成表征学习, VAE特征组合, 分阶段监督, 软标签幅值
- 前序问题:VAE 特征擅长重建,却不一定带来生成需要的语义结构;直接平均类别嵌入又会改变幅值,让 FID 改善与语义作用混在一起。
- 本文贡献:在线训练小型 latent composer,通过类别监督、掩码重建和水平翻转一致性整理 VAE 特征。前期用其密集特征对齐 SiT,中后期停止对齐,最后阶段使用停止梯度的类别后验软条件,并恢复硬标签嵌入的幅值,隔离方向语义与条件强度效应。辅助模块只在训练使用。
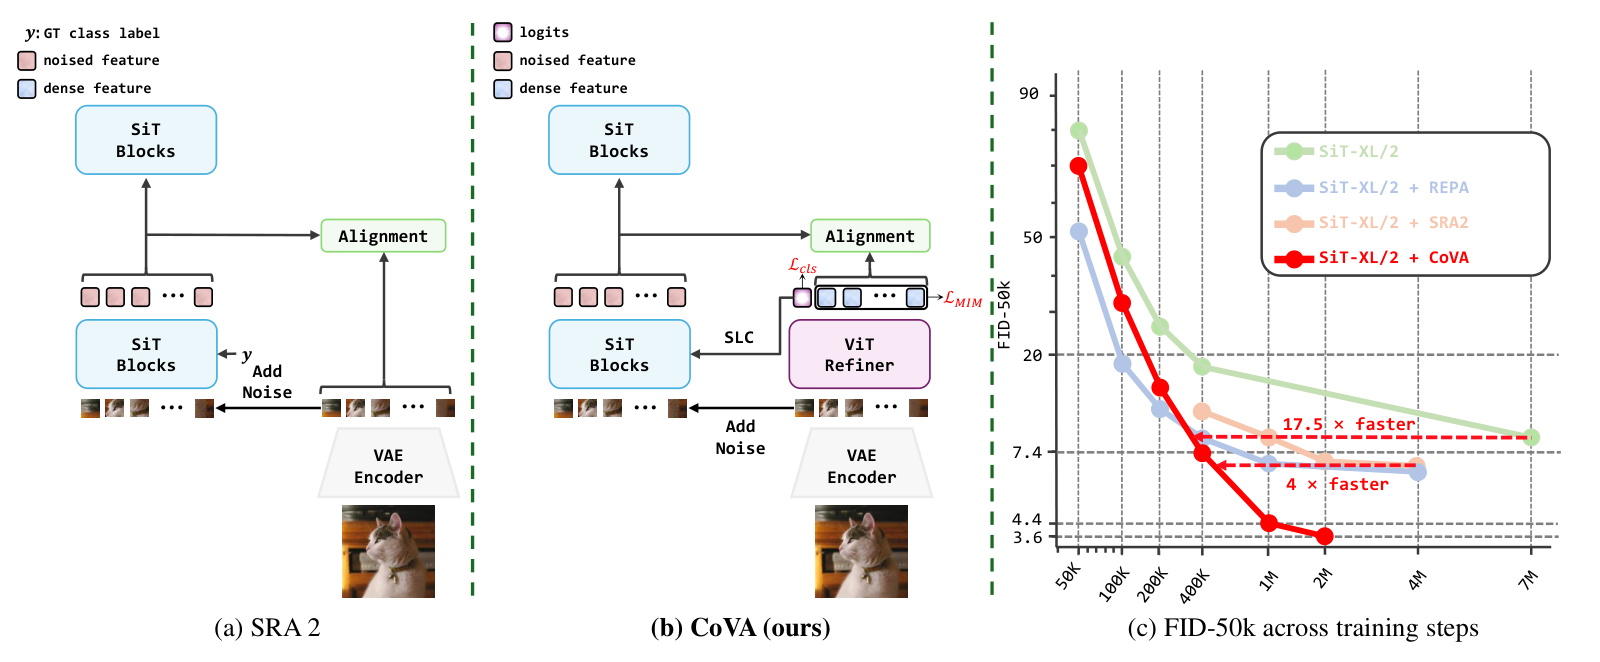 论文 Figure 3:SRA2 与 CoVA 比较。(a)SRA2 通过轻量投影与辅助对齐损失,把 SiT 中间特征对齐到 VAE 特征。(b)CoVA 在线组合干净 VAE 潜变量,语义及空间目标训练 composer,早期用密集特征作对齐,后期用停止梯度的类别后验作软条件。(c)分阶段从对齐转为软条件,使训练收敛更快、生成质量更好。
- 实验效果:表 1:ImageNet 256×256、batch 256、不开 CFG,同为 400K 次训练,SiT-XL/2 的 FID 从 17.2→7.4,REPA 为 7.9。表 3:增加 8.5M 辅助参数,训练吞吐从 8.1→7.0 iter/s,计算量 114.46→122.69 GFLOPs;改善收敛不等于单次训练更快。
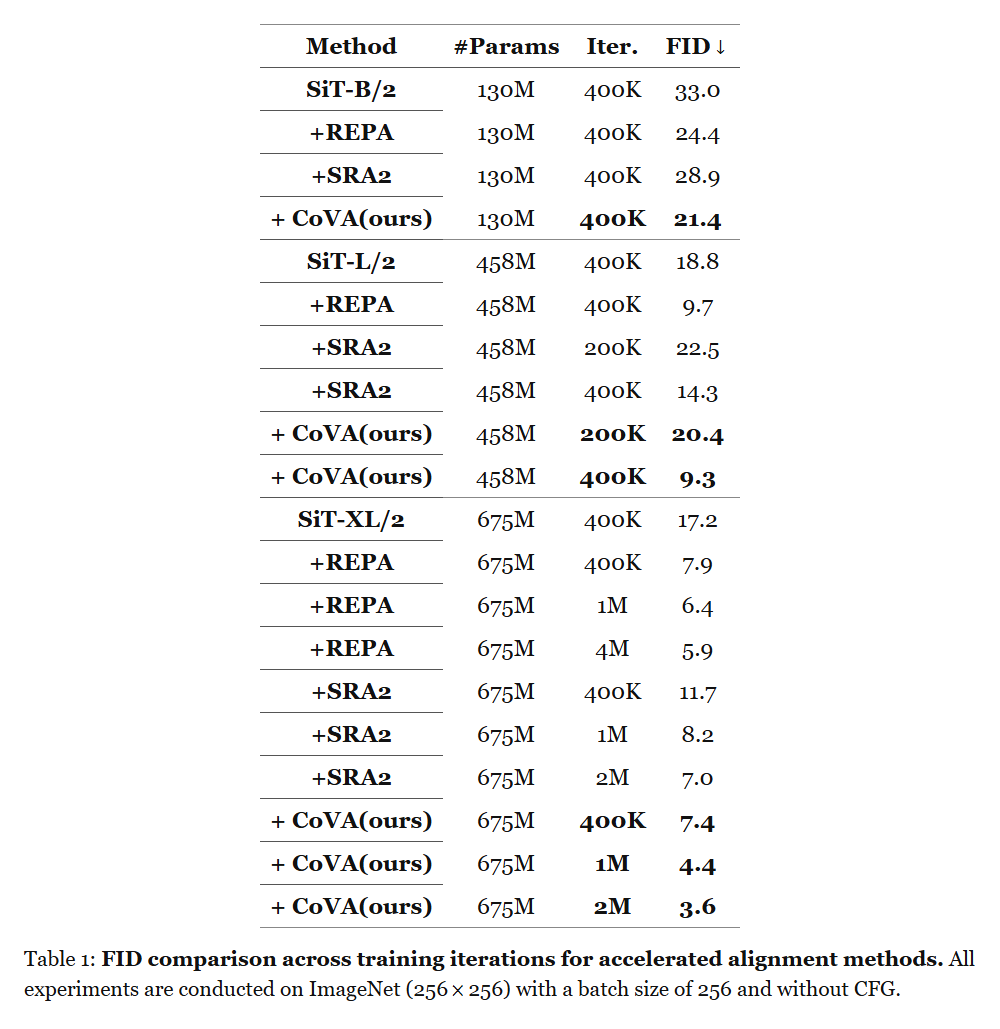 论文 Table 1:不同训练迭代数的 FID。全部在 ImageNet 256×256、batch 256、不开 CFG;列出 SiT-B/2、L/2、XL/2 的参数数目及 REPA、SRA2、CoVA。XL/2 同为 400K 时原 SiT 17.2、REPA 7.9、CoVA 7.4;CoVA 1M 为 4.4、2M 为 3.6,不能把不同迭代数当同预算结果。
- 批判点评:主实验是类别条件 ImageNet,不能外推开放域文生图。表 5 显示只缩小条件幅值就能降 FID,却损失 Recall,评估应一起看覆盖度。原文未给出可确认的 CoVA 官方方法代码入口。
4. Memory Forcing:固定缓存也保留中程历史
Memory Forcing: Attendable Mid-Horizon History for Streaming Video Generation | 南京大学;清华大学;快手可灵团队;上海人工智能实验室 | arXiv:2610.11756
关键词:流式视频生成, 固定KV缓存, 中程记忆, 分库RoPE
- 前序问题:只保留开头与最近帧的 KV 缓存,会忘掉已离开窗口的事件;人物离场再回来,身份和场景容易漂移。
- 本文贡献:把原有固定大小缓存分成 sink、archive、working 三区。近期区满时,将与新片段最不相似的旧片段移入档案区,档案满后按 FIFO 淘汰;所有 key 保持原始形式,在注意力时用 Bank-aware RoPE 重赋时间位置,使旧事件可被检索。继续沿用 Rolling Forcing 的滚动去噪和 DMD 训练。
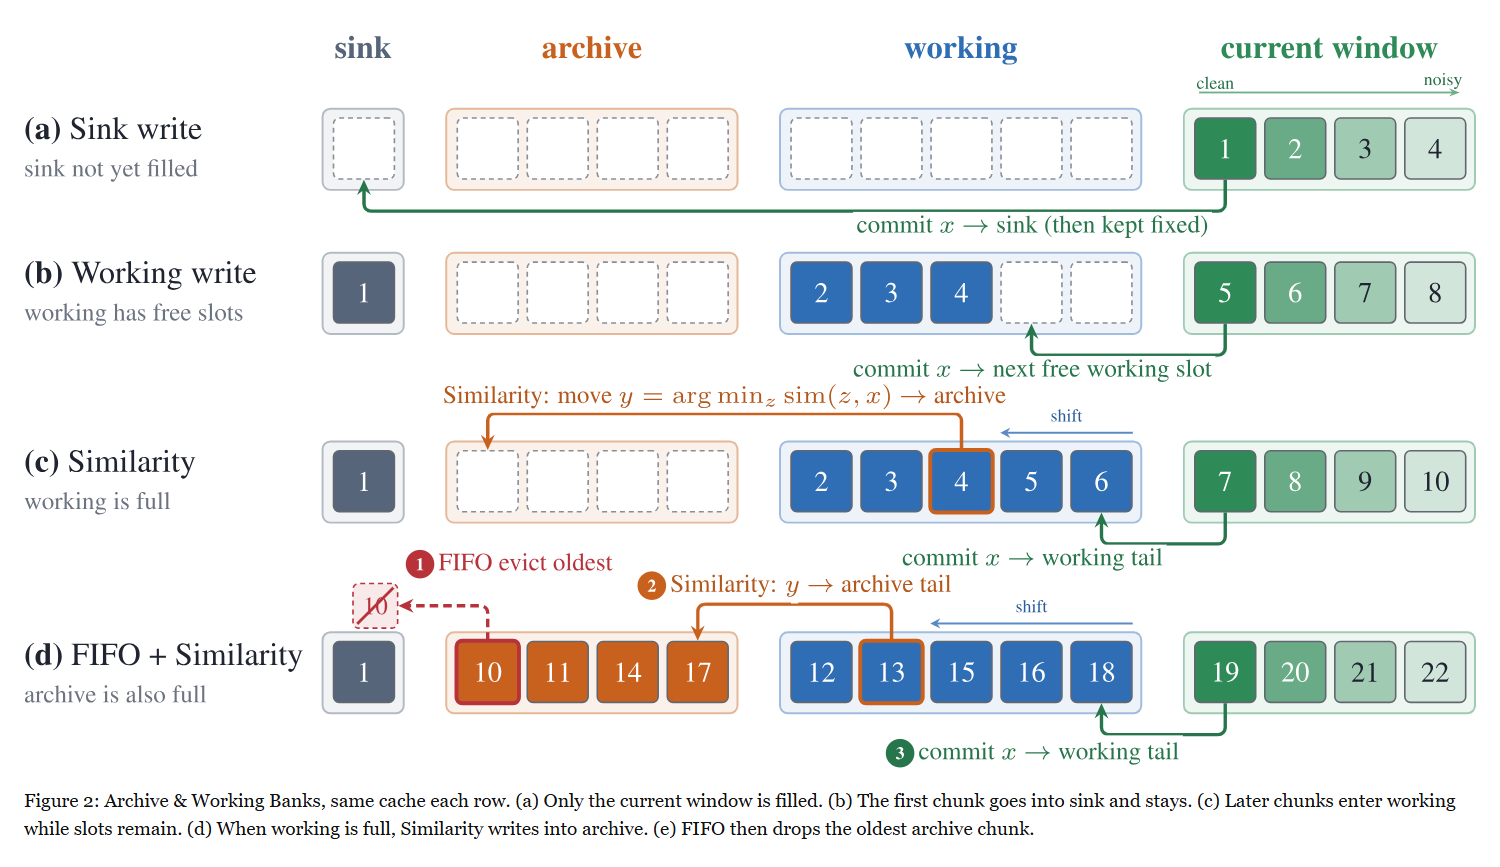 论文 Figure 2:Archive & Working Banks,每行缓存大小相同。(a)只有当前窗口被填满。(b)首个 chunk 进入 sink 并固定保留。(c)有空位时后续 chunk 写入 working。(d)working 满后,根据与新片段的相似度选历史写入 archive。(e)archive 满时由 FIFO 丢弃最旧 chunk。原 caption 分五步叙述,原图(d)合并相似写入与 FIFO 淘汰;颜色区分三类记忆,未增加独立历史存储。
- 实验效果:表 1:1.3B 模型,官方 VBench 总分 5 秒 83.88、60 秒 83.20,下降 0.68 分;LongLive 为 83.23→82.21,下降 1.02 分。表 2 的 30 秒消融中,working-only 总分 82.41,archive+working 为 83.58;60 秒 similarity 写入为 83.20,FIFO 为 82.96。
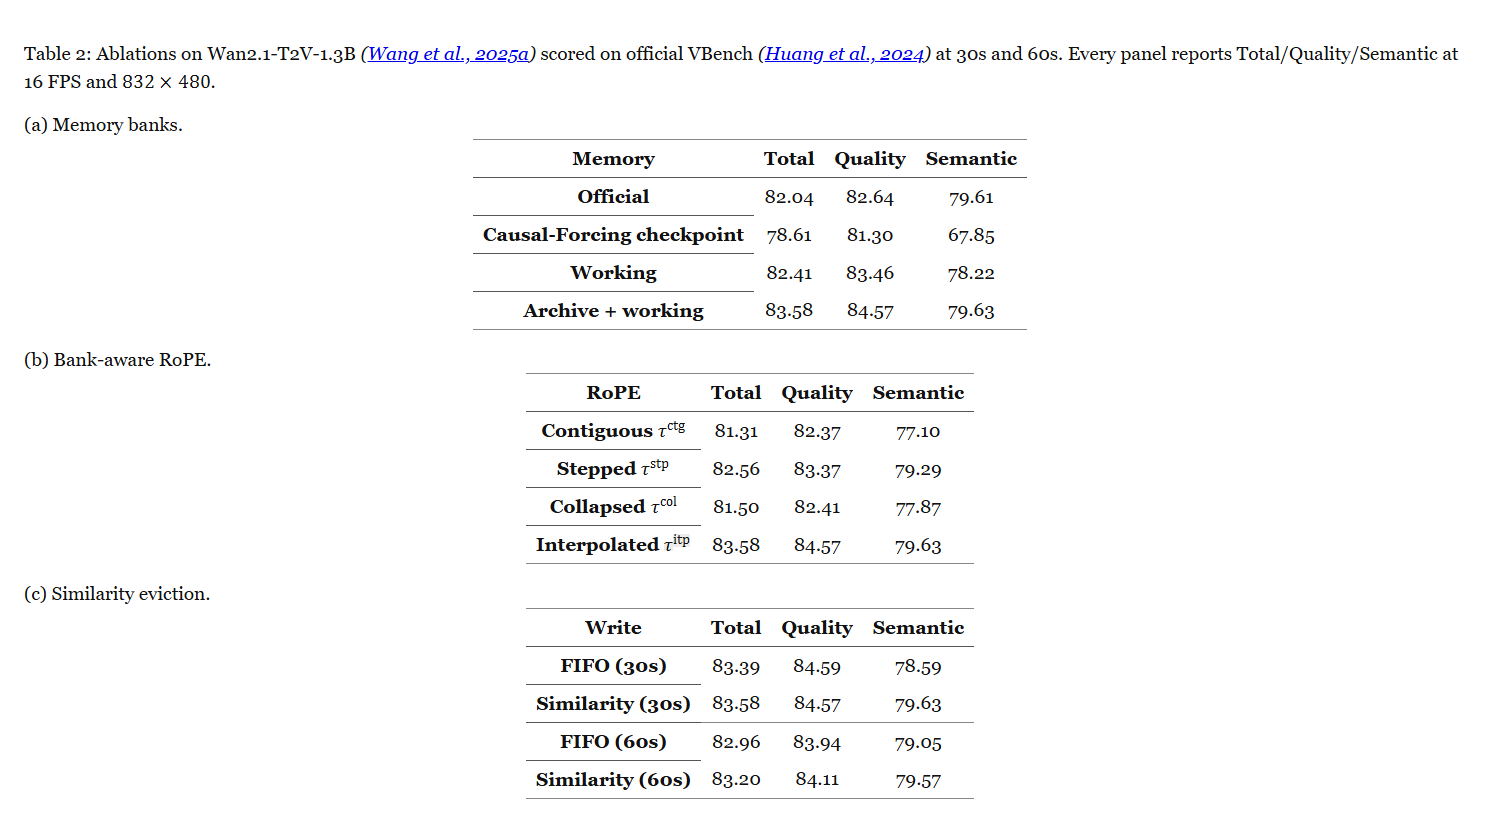 论文 Table 2:Wan2.1-T2V-1.3B 在官方 VBench 的 30秒及60秒消融,全部为16 FPS、832×480,报告总分、质量、语义。(a)记忆库;(b)Bank-aware RoPE 的连续、阶梯、折叠、插值分配;(c)相似度写入与 FIFO。30秒 archive+working 为83.58,working-only为82.41;60秒相似度写入为83.20、FIFO为82.96。
- 批判点评:缓存不增大不等于保存全部过去,档案仍会淘汰,最不相似也不必然等于最重要;分库和 RoPE 需要适配训练。论文对 Gen-Complex、MovieGen 等集合的结果不同,不能只用一个总分替代记忆验收。原文明确代码与权重拟在接收后发布,未确认会议接收或现已开源。
5. ForcingBooster:简单区域提前停复杂区域多算
ForcingBooster: Adaptive Patch-wise Denoising for Fast Autoregressive Video Diffusion | 香港科技大学;VAST;澳门科技大学 | arXiv:2610.12625
关键词:自回归视频加速, patch动态路由, 提前退出, on-policy训练
- 前序问题:每个 patch 都执行相同去噪步数,静态背景浪费计算;统一减步又让新区域与复杂细节得不到足够修正。
- 本文贡献:轻量 router 在每步预测各 patch 的停止概率,提前停止的干净预测及其 KV 作为仍在去噪区域的上下文。通过无梯度自身 rollout 记录退出并回放,以重建损失和计算成本训练路由概率;主干和时间表固定,首个 chunk 仍用四步。这里需要路由器训练,并非免训练加速。
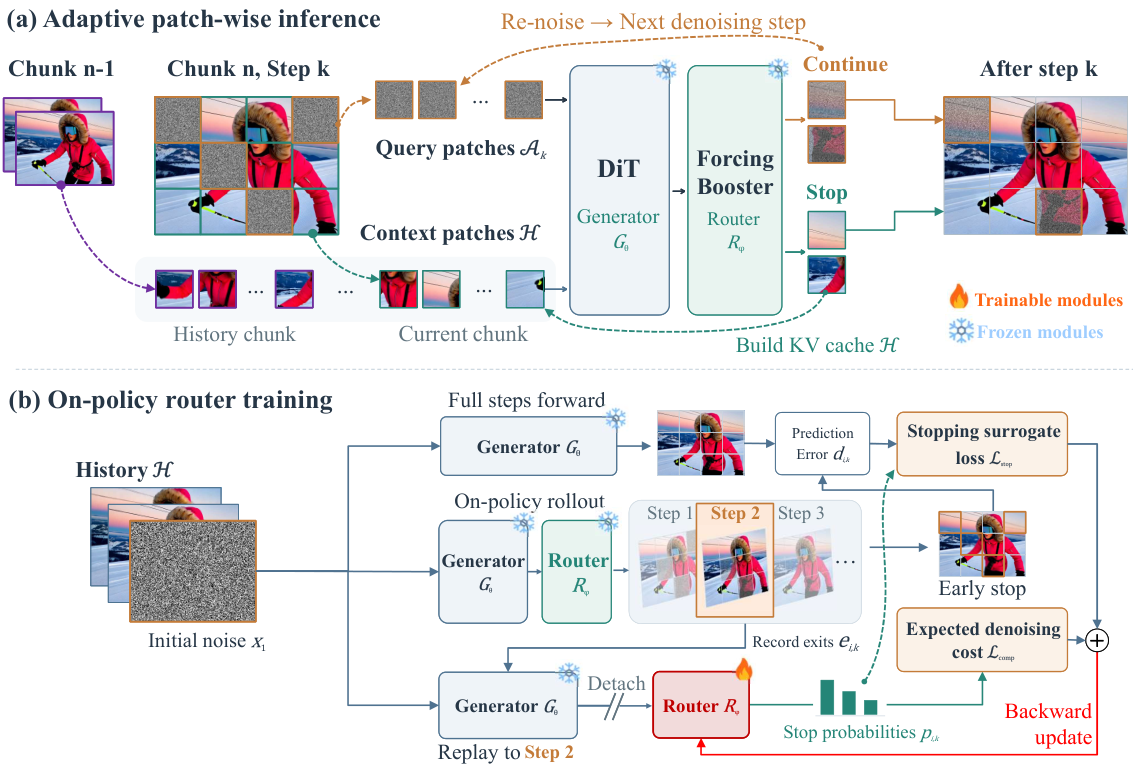 论文 Figure 2:自适应 patch 推理与 on-policy router 训练。(a)router 选择继续去噪的 patch,已停止 patch 的预测提供可复用 KV 上下文。(b)无梯度 rollout 记录退出位置用于回放,重建和计算成本通过停止概率训练 router。主干固定,路由模块仍需训练。
- 实验效果:表 1:Causal Forcing 1.3B、81 帧、480×832、16 FPS,单 A800、BF16、batch 1。含文本编码、router、KV 与 VAE 的平均端到端时间 11.15→8.56 秒,1.30 倍;patch-NFE 减少 50.19%,VBench 总分 82.08→81.55。减少一半 patch 更新不能叫两倍端到端加速。
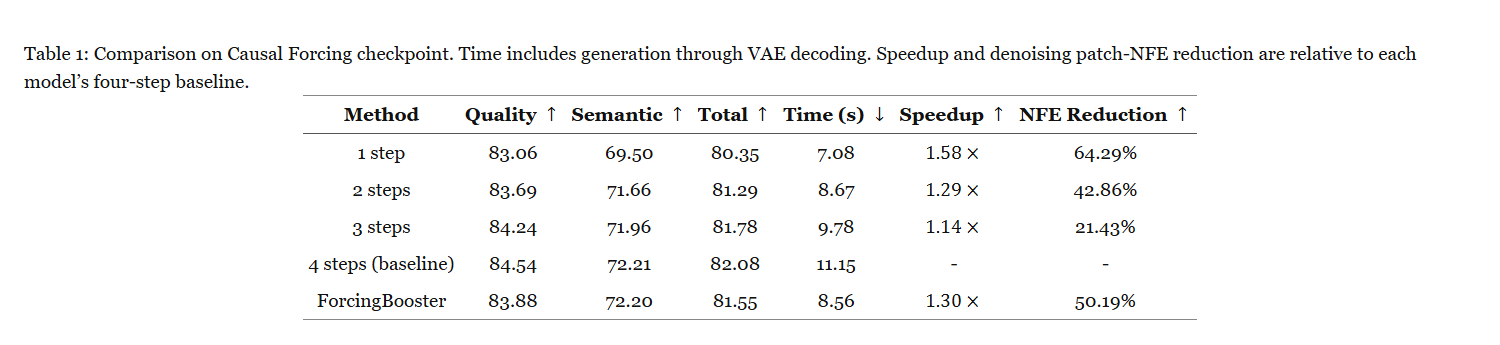 论文 Table 1:Causal Forcing checkpoint 上的比较,时间包括生成直至 VAE 解码。加速和 denoising patch-NFE 减少均相对该模型四步基线;列含质量、语义、总分、时间、加速及 NFE 减少。ForcingBooster 时间8.56秒、1.30倍、减少50.19%,总分81.55;四步11.15秒、总分82.08。首段统一四步,不能将 NFE 减少等同整体加速。
- 批判点评:保留质量是接近基线而非完全相同;路由误判会让尚未完成的细节早退,不同主干加速幅度也不同。文中路由器训练 500 steps,动态稀疏执行有开销。作者项目页及官方仓库可见 Wan 方法实现和权重入口,未运行复现。
6. CacheScope:把完整计算留给高风险步骤
CacheScope: Exact-Compute Allocation for Training-Free Diffusion Acceleration | 中山大学 | arXiv:2610.12530
关键词:扩散缓存加速, 轨迹归一化, 浅层探针, 完整计算调度
- 前序问题:浅层特征变化同时受到输入轨迹位移和网络响应影响;直接用变化量决定缓存更新,可能把计算花在错误步骤。
- 本文贡献:每步运行第一个 Transformer block,分别量出输入位移 Δx 与输出变化 Δy,用 s=Δy/(Δx+ε) 衡量沿当前轨迹的灵敏度。累计达到阈值才运行余下 blocks 并更新缓存,否则沿用同一有界一阶重建器;CFG 两分支分别累计。无需训练、梯度或辅助网络,改变的是完整计算落点。
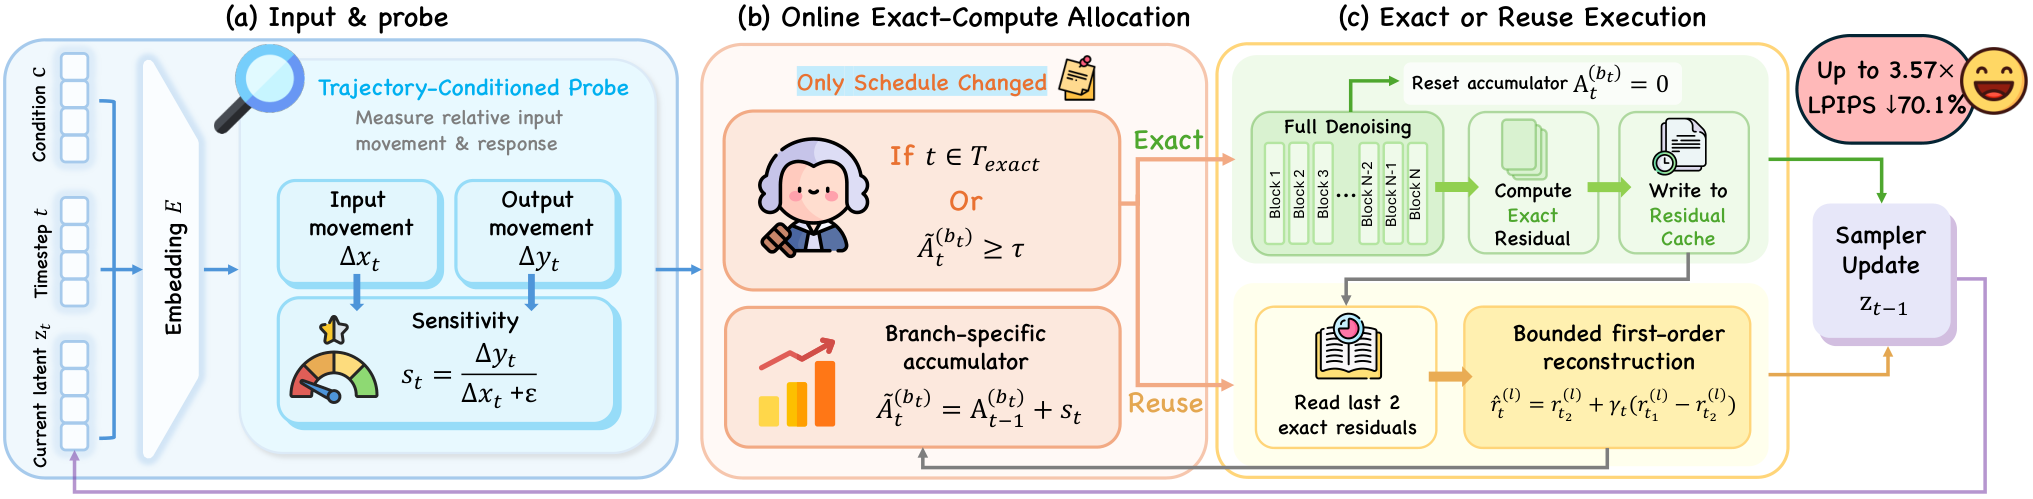 论文 Figure 2:CacheScope 概览。每步先运行第一个 Transformer block 为浅层探针,量出输入轨迹相对位移 Δx_t 和探针响应 Δy_t,累计 s_t=Δy_t/(Δx_t+ε)。超过阈值 τ 才精确计算其余 blocks 并刷新缓存,否则沿用不变的有界一阶重建器。这是相对原探针调度的唯一改动;CFG 的两分支维护独立累计量与缓存。
- 实验效果:表 2:32 个留出 prompt、各指标取中位数。Wan2.1 Moderate 的原始探针调度 D 与 CacheScope S 约为 2.492、2.493 倍加速,LPIPS 0.0772→0.0414;但 SSIM 0.8961→0.9220。FLUX Fast 下 S 为 3.566 倍、LPIPS 0.1246;数值需按同主干、速度区间和同一重建器解释。
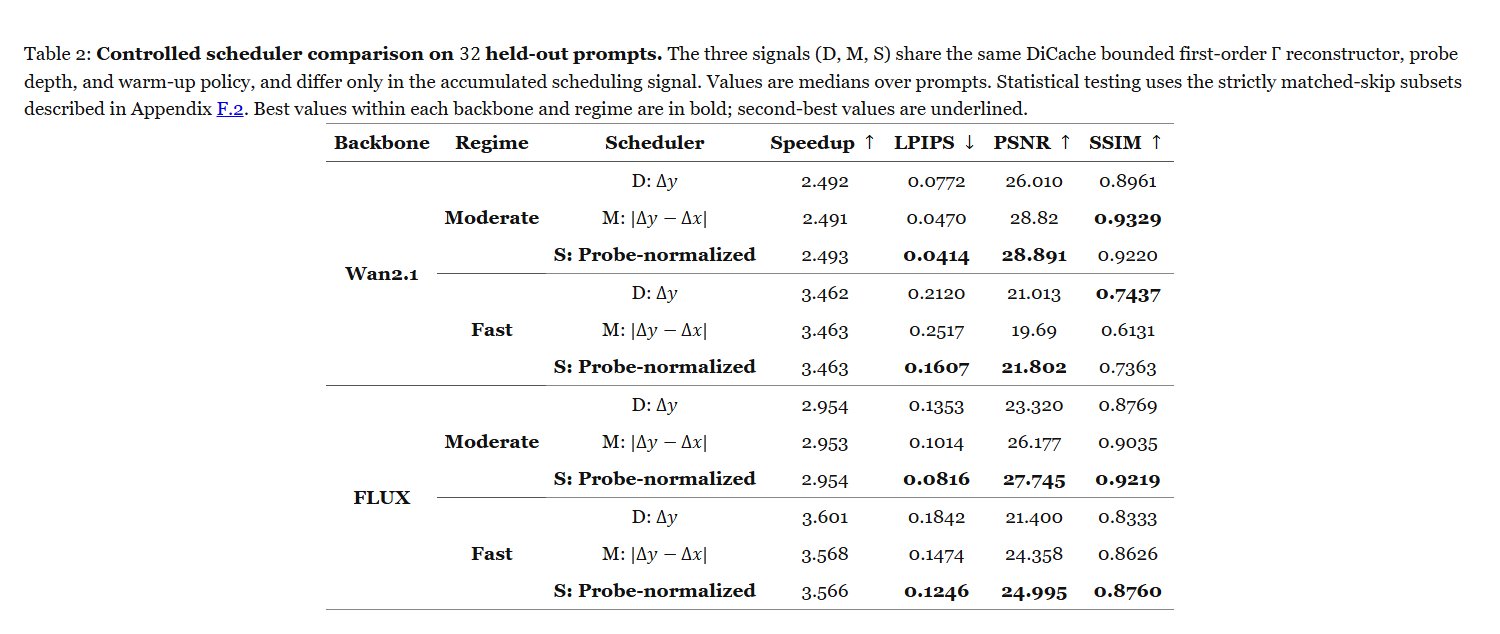 论文 Table 2:32个留出 prompt 的受控调度比较,指标为 prompt 中位数。D、M、S 信号共享同一个 DiCache 有界一阶 Γ 重建器、探针深度和 warm-up,只改变累积信号;统计检验使用附录F.2严格匹配跳步的子集。列含加速、LPIPS、PSNR、SSIM,粗体/下划线为主干和速度档内最佳/次佳。Wan Moderate 的D/S LPIPS为0.0772/0.0414,FLUX Fast 的S为3.566倍、0.1246。
- 批判点评:LPIPS、PSNR、SSIM 是相对密集生成输出的保真,不是真实图像真值。浅层探针不是完整误差证明,阈值与 warm-up 仍需选;快档可能出现细节偏差,不能称无损。原文未给出可确认的作者方法代码入口,部署价值需在自己的 prompt 与采样器上验证。
7. HD-VSR:消费卡靠关键帧与插帧做超分
High-Throughput Generative Video Super-Resolution on a Single Consumer GPU | Ethical AI Novelties;塞浦路斯理工大学 | arXiv:2610.13179
关键词:生成式视频超分, 稀疏关键帧, RIFE插帧, 邻域注意力
- 前序问题:逐帧运行扩散超分成本高;全局时空耦合虽能稳视频,却难在单张消费卡上兼顾吞吐和显存。
- 本文贡献:本文以 HD-VSR 作阅读简称。用预训练一步 AdcSR 增强稀疏关键帧,用 RIFE 从相邻高分辨率关键帧插出中间帧,再以运动门控决定是否回退生成;把部分高分辨率全局注意力替换为邻域注意力,语义关键低分辨率层保留全局。zero-shot 指推理时组合,不是组件从未训练。
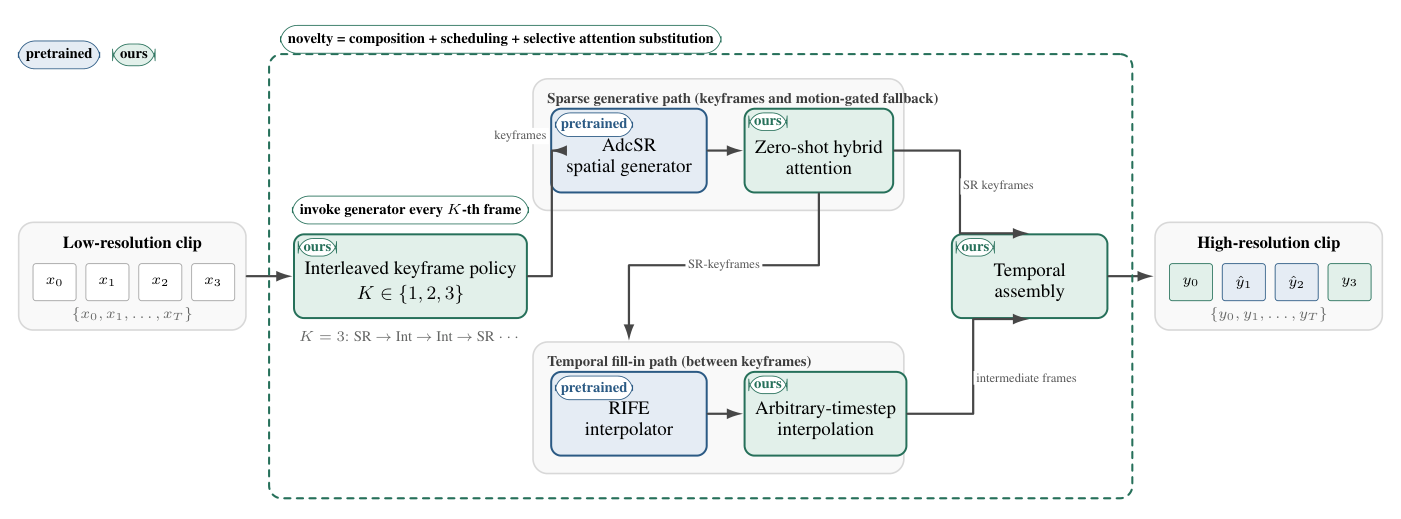 论文 Figure 2:所提流程。复用两个预训练组件:AdcSR 对稀疏关键帧做超分,RIFE 作时间插帧。新贡献在组合方式:运动感知交错关键帧策略决定何时调用生成主干,免微调的混合注意力加速空间生成器高分辨率层,时间装配把超分关键帧和插帧合并为完整序列。
- 实验效果:表 1:RTX 4090、1280×720、关键帧间隔 K=3、batch B=8,吞吐 32.66 FPS、峰值显存 8.99 GB;同 K、B=1 为 8.28 FPS、2.33 GB。表 4 的 4K、B=1,邻域注意力相对原实现 0.76→1.10 FPS,44.7% 提升,基线和口径不同。
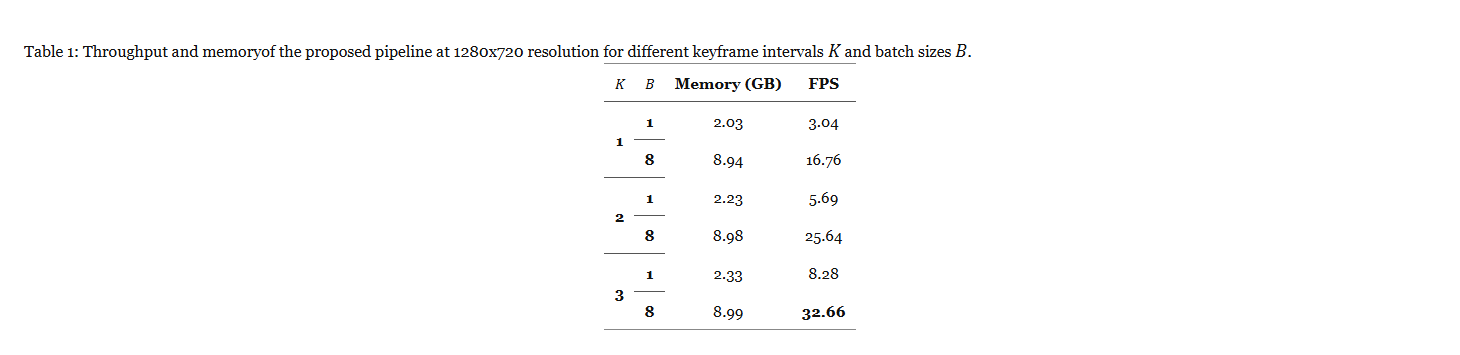 论文 Table 1:1280×720下不同关键帧间隔K和batch B的吞吐与显存。K=1、B=1为3.04 FPS、2.03 GB,K=3、B=1为8.28 FPS、2.33 GB;K=3、B=8为32.66 FPS、8.99 GB。K增大时更多帧来自插帧,B增大是吞吐批量,表格不能证明单流32.66 FPS的低延迟。
- 批判点评:32.66 FPS 是批量交错吞吐,不能当单段低延迟实时生成;插帧需要后一关键帧,高运动和遮挡会受影响。表 3 有感知分下降,作者明确以重建保真换效率,不能称超分质量全面领先。本文未提供可确认的整套框架官方代码入口,AdcSR 与 RIFE 本身也不是本文新模型。
8. ThinkDrag:先理解拖拽意图再改变图像
ThinkDrag: Semantic Drag-Based Image Editing with Visual Reasoning | 南洋理工大学S-Lab | arXiv:2610.13316
关键词:拖拽图像编辑, 视觉推理, 端点标记, 语义编辑评测
- 前序问题:把拖拽当几何位移,容易移动了像素却没有形成合理的姿态或物体变化;大结构改动也让特征点跟踪失准。
- 本文贡献:基于 BAGEL 训练统一理解与生成模型,用合成语义编辑对、拖拽点和推理轨迹监督 LoRA。Drag Endpoint Markers 为起终点建立图像空间对应,可直接生成,也可先输出显式推理。构建 145 例 DragBench++,以参考编辑与语义点跟踪补充原有几何距离评测。
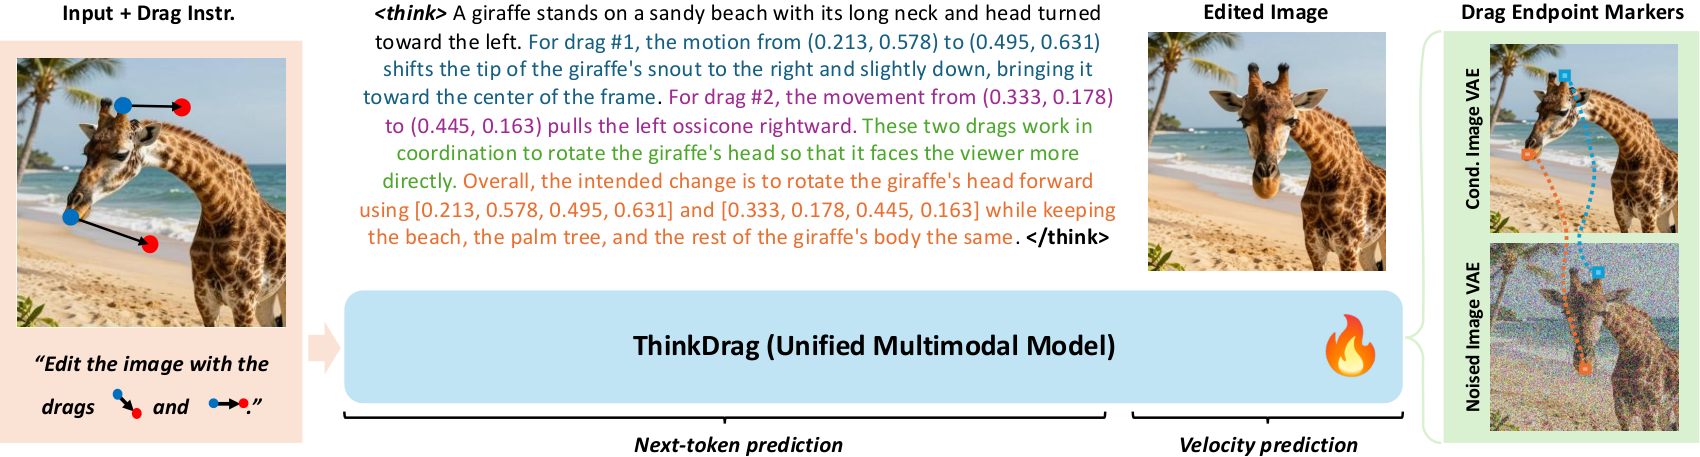 论文 Figure 4:ThinkDrag 统一多模态模型流程。源图像、文本化拖拽约束及 Drag Endpoint Markers 为图像生成提供空间对应;模型可直接编辑,或先产生解释拖拽意图的推理轨迹再编辑。图中两种模式共享理解与生成模型,端点标记区别于仅用于展示的箭头。
- 实验效果:表 1:DragBench++,ThinkDrag 参考图保真 IF* 为 0.905、MD_MLLM 为 34.24;LightningDrag 为 0.836、57.28。原 DragBench 上 ThinkDrag FID 30.05、MD 28.84,GeoDrag MD 22.77 更低。附录推理模式相对直接模式只赢 75/145,即 51.7%,不是稳定全面胜出。
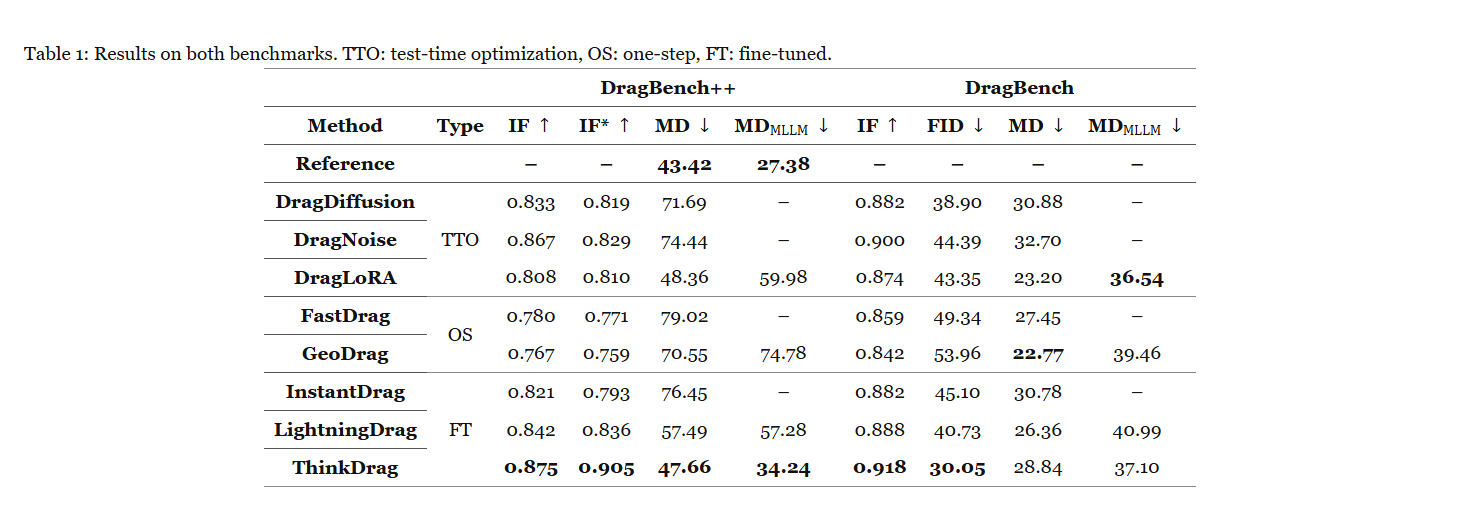 论文 Table 1:DragBench++与DragBench结果,TTO/OS/FT分别为测试时优化、一步方法、微调。IF对输入图像,IF*对参考编辑,MD为DIFT跟踪距离,MD_MLLM为语义跟踪距离,FID衡量分布差异;↑/↓标指标方向,缺测为横线。ThinkDrag主表为直接模式:++上IF*0.905、MD_MLLM34.24;原DragBench的MD28.84,GeoDrag22.77更低。
- 批判点评:数据和新评测含合成图像及模型裁判,参考编辑也不是唯一正确解。主表采用直接模式,不能把全部提升归给显式推理;推理增加串行生成时间,点跟随精度未处处最好。作者项目页与仓库已核验;当前仅 README/LICENSE/assets,数据、权重和推理代码均列 TODO,尚不能据此复现。
9. TTS-Q:把量化精度留给后期音色
TTS-Q: Perception-Guided Post-Training Quantization of Text-to-Speech Diffusion Transformers | Wyze;纽约市立大学城市学院;中科院计算所;台湾大学;清华大学 | arXiv:2610.12474
关键词:语音扩散量化, 音色保真, 任务匹配校准, 后期FFN精度
- 前序问题:低字词错误率不代表声音仍像目标说话人;四位语音扩散量化的音色损失集中在特定层与去噪阶段。
- 本文贡献:在任务匹配候选中选初始重建误差高的语音,取特定采样状态校准 FlatQuant;权重保持 W4,把末期 FFN 激活升为 A9,其余用 A3,匹配约四位的名义激活预算。该预算按参数加权,并不保证同样的实测时延;没有重新训练 TTS 主干,仍有离线校准优化。
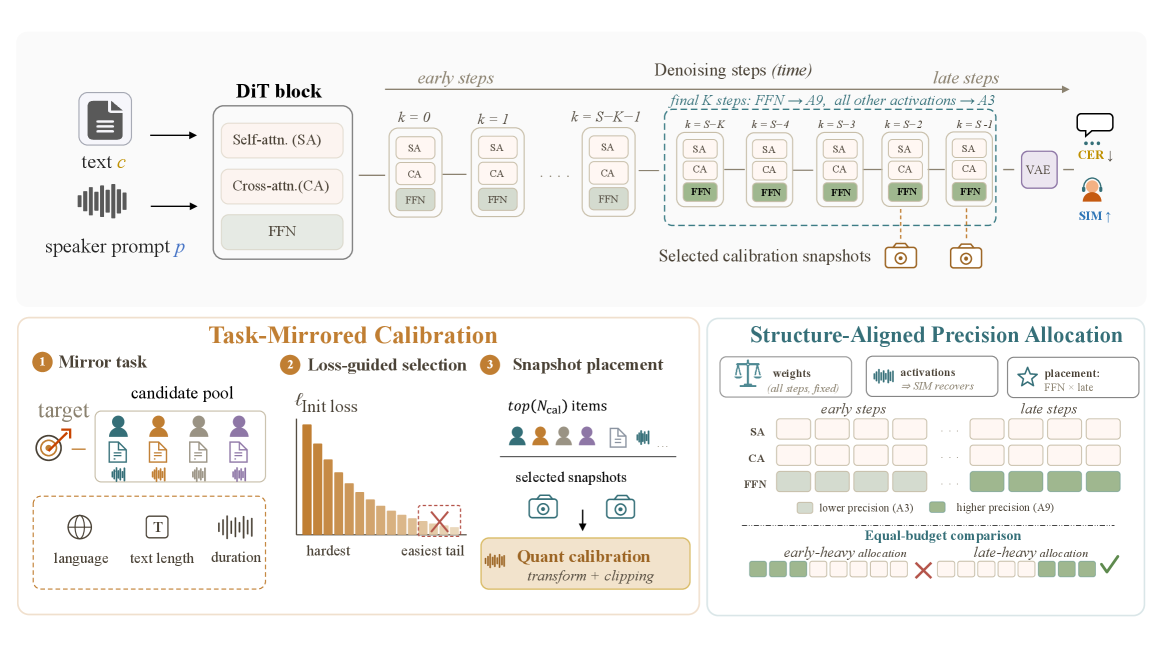 论文 Figure 1:TTS-Q。上方文本和说话人参考条件化TTS DiT,采样状态用于离线校准,阴影FFN为推理精度分配;CER/SIM为字符错误率/说话人相似度。左下按初始损失排序任务匹配候选,取语音-步数快照拟合均匀W4A4。右下权重W4,晚期FFN激活升精度、其他位置降精度;早晚示意在相同名义预算比较,名义预算不等于实测时延。
- 实验效果:表 1:Seed-TTS-eval 留出集,3.5B 英文,均匀 W4A4 参考 SIM 0.7796→TTS-Q 0.7829,全精度为 0.7834;WER 1.813%→1.918%,全精度 1.919%。各方案 32 条校准、steps {13,14}。附录 S11 的 15.83→4.44 GB 来自均匀 W4A4 部署,未测试混合 TTS-Q 路径。
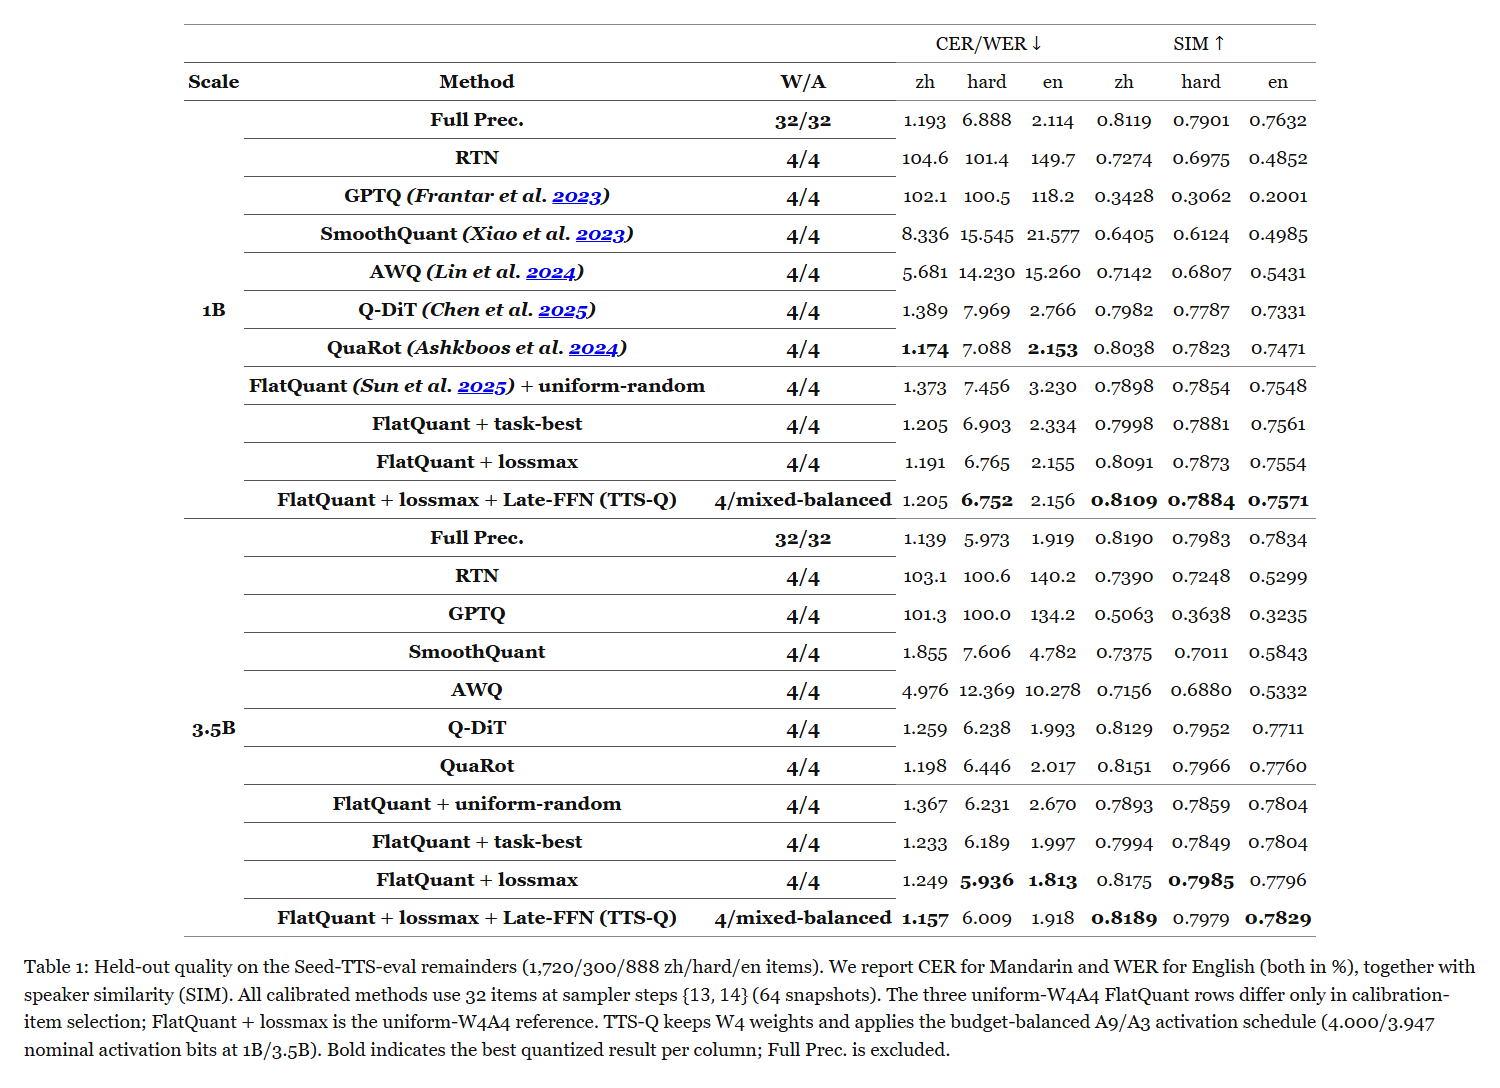 论文 Table 1:Seed-TTS-eval留出集,zh/hard/en为1720/300/888项;中文CER和英文WER均为百分数,另报SIM。校准均为32项、steps{13,14}、64快照;三个均匀W4A4行仅选择数据不同,lossmax为均匀参考。TTS-Q权重W4,A9/A3均衡预算在1B/3.5B为4.000/3.947位;粗体只在量化结果中按列比较,全精度不参与。3.5B英文SIM为0.7829、WER为1.918%。
- 批判点评:名义四位不等于全程 W4A4,更不能把均匀量化的显存和速度归给混合方案;1B 部署量化路径还可能更慢。原摘要与 PDF 均记首发 8月11日,本期是首次纳入,不能称10月新发。原文未给出可确认的方法官方仓库或权重入口。
10. MusicEval Probes:音乐裁判是否真的听了音频
What Do Audio-Language Judges of Generated Music Listen For? Four Probes with Controls from Expert Ratings | 华沙理工大学计算机科学研究所 | arXiv:2610.13247
关键词:音乐生成评测, 音频语言裁判, 位置偏差, 专家对照
- 前序问题:裁判评分与专家相关,不等于它真正听懂音乐质量;文本提示、候选位置和问法都可能改变生成模型排名。
- 本文贡献:以 MusicEval Probes 作阅读简称,审计五个开放音频语言裁判:去掉音频、同 prompt 换另一模型音乐、交换成对顺序、重写指令,并用专家评分计算相应对照。MusicEval 覆盖 2748 段音乐,后两项也测 SongEval,直接检验生成音乐评价是否可靠,而非提出音乐生成器。
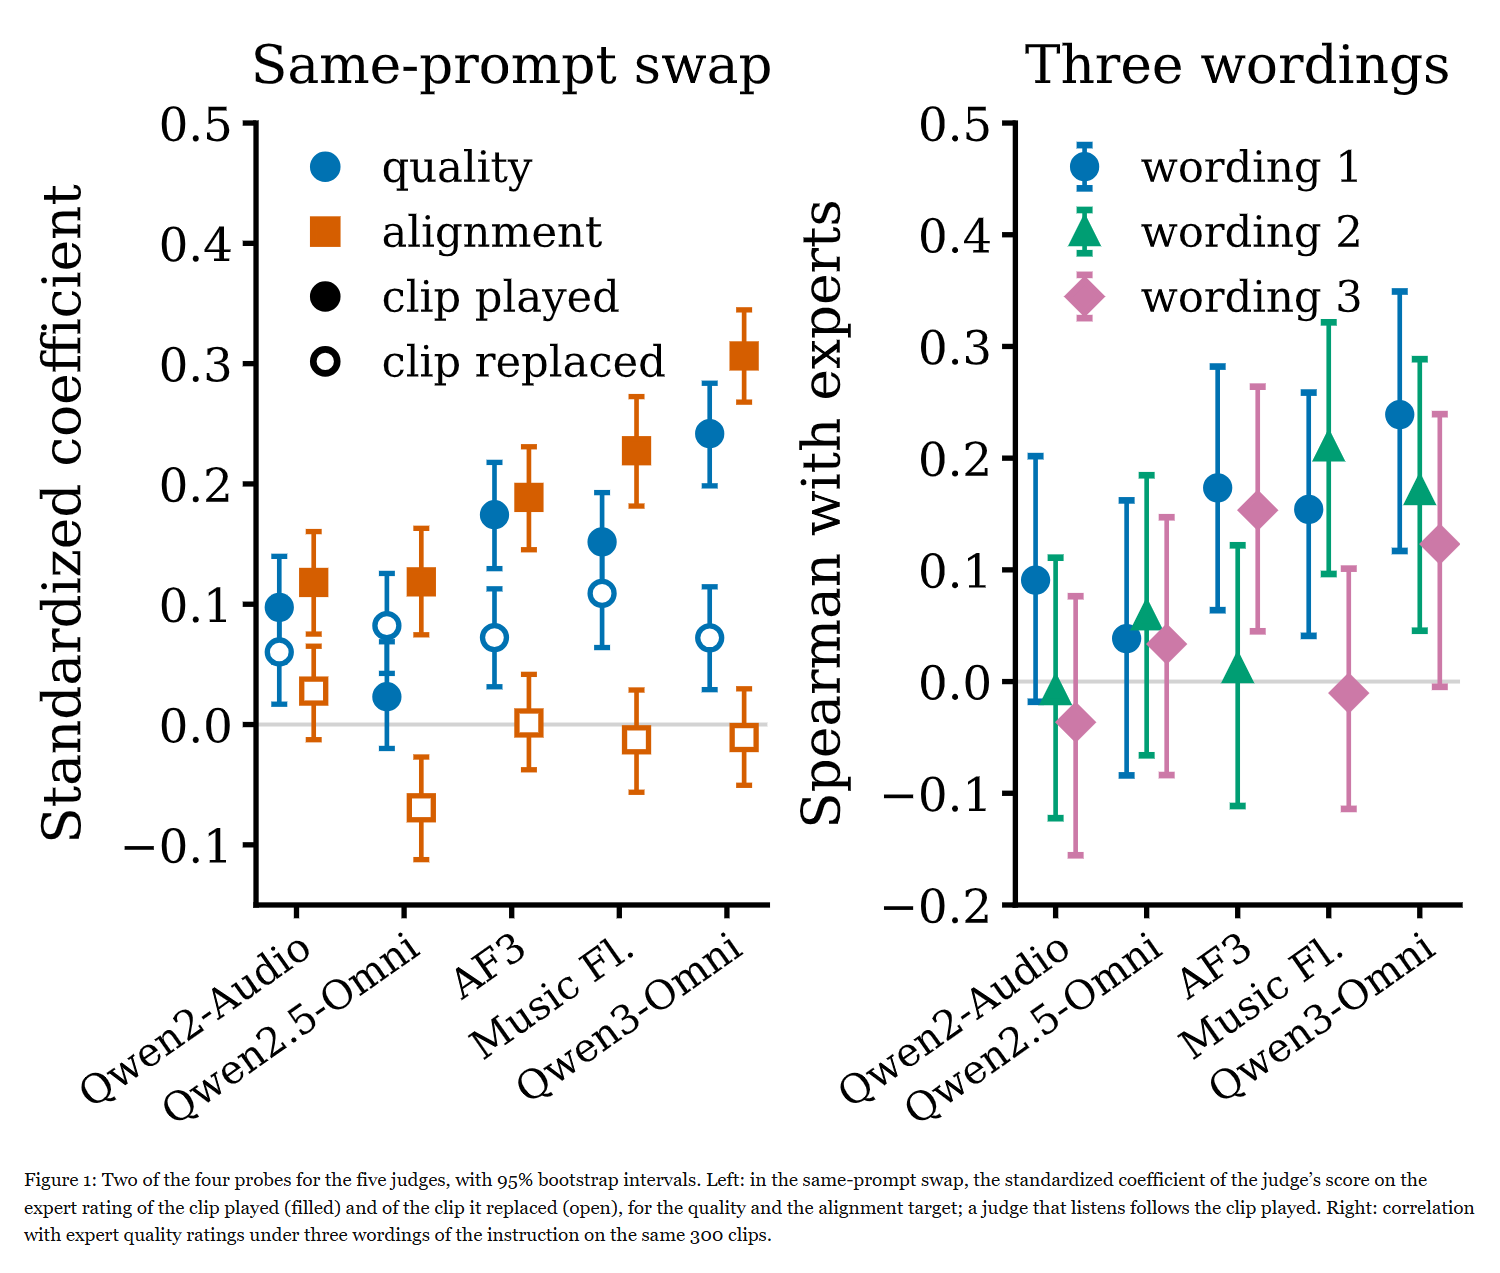 论文 Figure 1:五个裁判的四种探针中两种,附95% bootstrap区间。左侧同prompt换音乐,实心/空心为裁判分对实际播放片段/被替换片段专家分的标准化系数,分别看质量与对齐;真正听音频应追随播放片段。右侧在相同300段音乐上换三种指令问法,比较与专家质量分的相关。
- 实验效果:表 1:Qwen3-Omni 音乐质量 Spearman 相关为 0.31;去掉音频后为 0.04,专家构造的 prompt-only 对照为 0.08。表 2:600 对样本交换顺序,Music Flamingo 99% 仍选同一位置,Qwen3-Omni 为 25%;随机参照是 50%,同位置意味着优选音乐随交换改变。
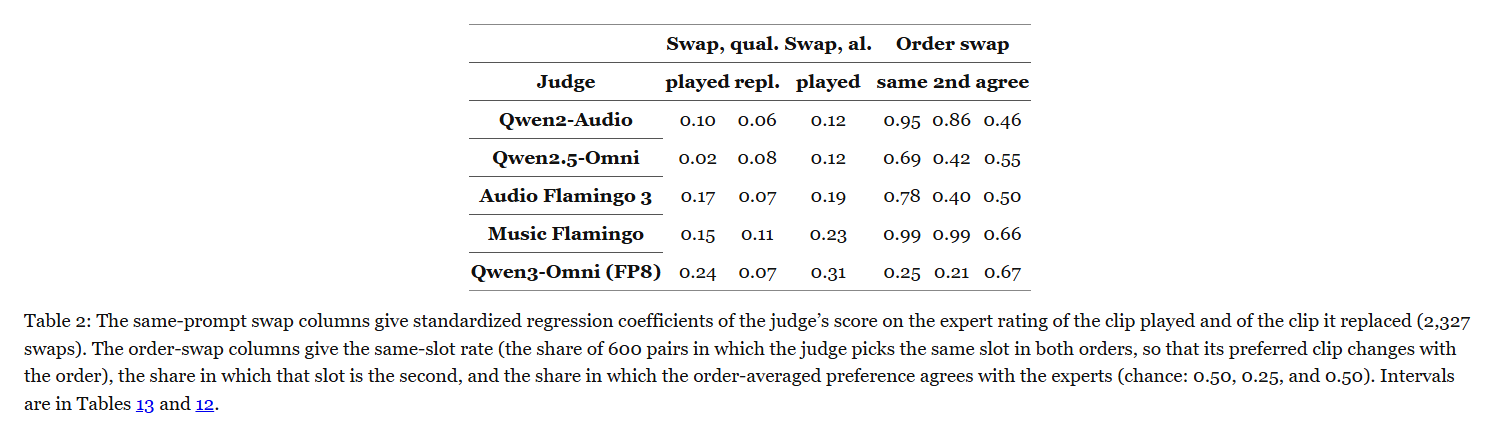 论文 Table 2:同prompt交换的列报告裁判分对实际播放与被替换片段专家分的标准化回归系数,共2327次交换。顺序交换列报告600对样本两种顺序下选同位置的比例、其中选第二位置的比例、顺序平均偏好与专家一致的比例;随机参照为0.50/0.25/0.50,区间见表13和12。Music Flamingo同位置0.99,Qwen3-Omni为0.25,不能把同位置率当音质准确率。
- 批判点评:相关系数不是准确率,位置偏差也不是总体音质差。问法实验使用固定 300 段片段,结论受裁判版本、prompt 和数据集约束。模型级相关与片段级相关不能混用,选音乐生成器时应同时做专家验证。原论文未提供可确认的本研究官方实现入口。
趋势观察
表征既要对齐也要服务生成
InstantFusion对齐中间状态与速度,RG直接改变内部表征对预测的影响,CoVA分阶段使用VAE特征。表征图看着更有语义,不等于最终生成收益。
预算应该落在最需要的位置
Memory Forcing决定缓存留下谁,ForcingBooster决定哪些patch继续去噪,CacheScope决定哪些步骤完整计算,TTS-Q把名义精度留给晚期FFN。预算口径不同,收益须配条件。
吞吐与训练收敛各有代价
HD-VSR高FPS依靠批量和插帧;CoVA单步训练更慢但同迭代FID更低。不能把batch吞吐叫单流低延迟,也不能把少训练轮数直接等同省时比例。
评测要拆开目标和对照
ThinkDrag的几何点距与语义合理性未必一致,MusicEval Probes检验音频、位置和问法的干扰。生成部署需要原始任务与人工验收共同决定。
今日讨论
InstantFusion把SD3的GenEval-v2从22.14提高到35.06,但仍要求共享VAE、兼容时间参数并装载多个主干;你需要哪些指标和显存证据,如何判断接力生成是否值得用在自己的图像工作流中?
人工智能炼丹君 整理 | 2026-10-13


评论 (0)