今日 AIGC 论文速览
今日共 10 篇 · 图像生成机制 2 篇 · 视频缓存、压缩与纠错 3 篇 · 原生三维编辑 1 篇 · 流式动作与长动作评测 2 篇 · 情绪语音生成 1 篇 · 视频文字评测 1 篇
重点论文标题列表
- SFG(斯坦福):减少图像对文本的错误反馈
- T2I Sinks(复旦):高注意力位置不能随手删
- CORAL-KV(AMD):跨层预测压小视频缓存
- UniGVC(中科大):同一码流选直播或高清回看
- PreCoG(港大):先看预览再修缓存轨迹
今日论文速览
1. SFG:减少图像对文本的错误反馈
Images Talk Back: Guiding MMDiTs by Suppressing Image-to-Text Feedback | 斯坦福大学;清华大学;纽约大学 | arXiv:2610.13941
关键词:多模态扩散, 语义反馈引导, 双向注意力, 推理期控制
- 前序问题:MMDiT 用联合注意力让当前图像更新内部文本表征;图像少画一个物体时,这条反馈可能把错误写回文本,并继续影响后续图像。
- 本文贡献:Semantic Feedback Guidance(SFG,语义反馈引导)在冻结模型中增加辅助分支:加强图像到文本反馈、减弱文本到图像条件,再让采样方向远离该分支。iSFG 则在正常条件前向内直接抑制前者、加强后者。修改位置在 softmax 与 value 聚合后,保留注意力归一化和模态内项;图像 SFG 只在前 20% 采样步启用额外分支。
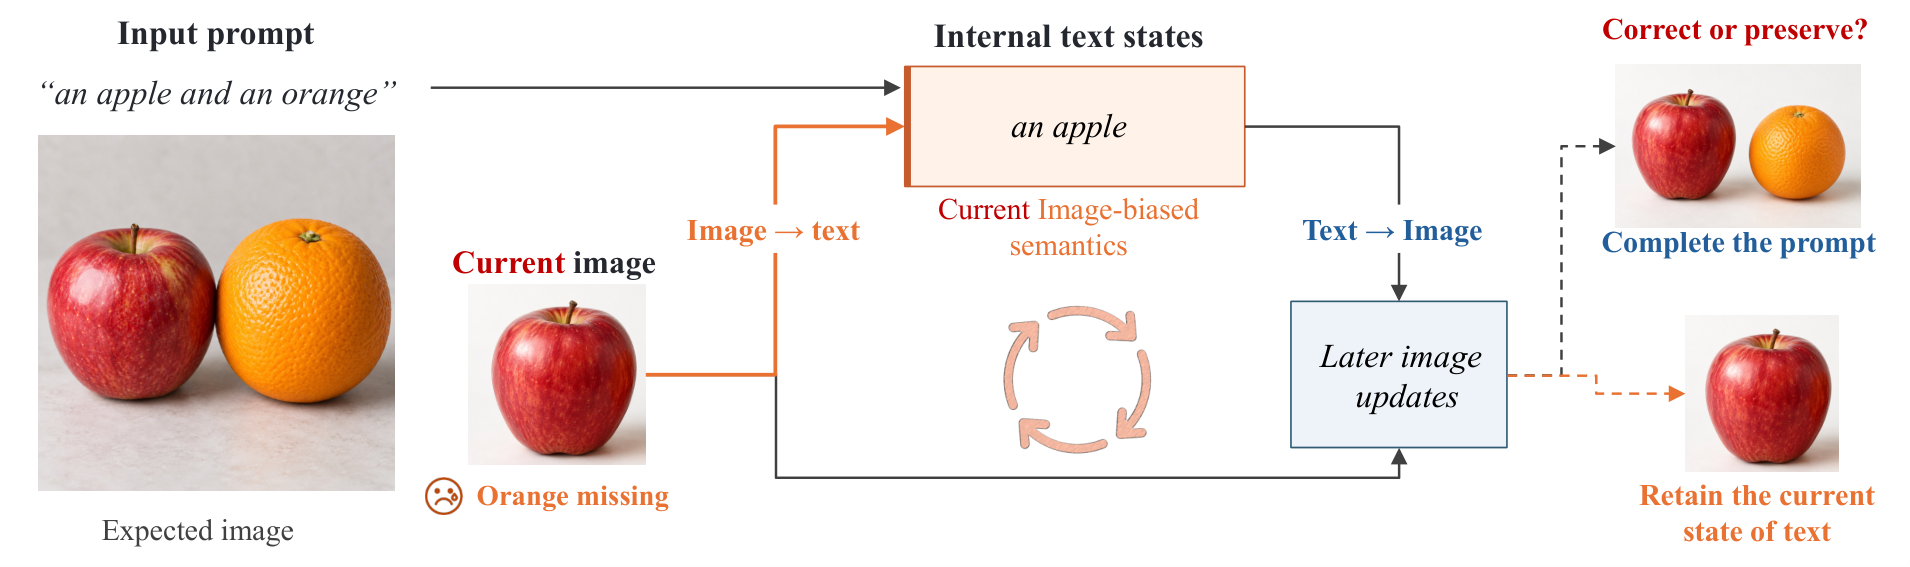 图2|图像对文本反馈路径:输入prompt保持不变,当前图像通过图像到文本消息写入内部文本状态,随后文本再指导图像更新。缺失橙子的中间图像可能被纠正,也可能把缺失状态延续;文本标签和AI生成水果仅示意可能状态。
- 实验效果:表 2:1024×1024 图像、相同 prompt 与 seed,FLUX 的 CFG→CFG+SFG,GenEval 0.6661→0.7479,HPSv2.1 30.96→31.66;SD3.5M 的 GenEval 0.6890→0.7110。表 3:SD3.5M 的 iSFG 为 0.7047、HPS 32.98,比 CFG 高 1.33,增益与 SFG 不相同。
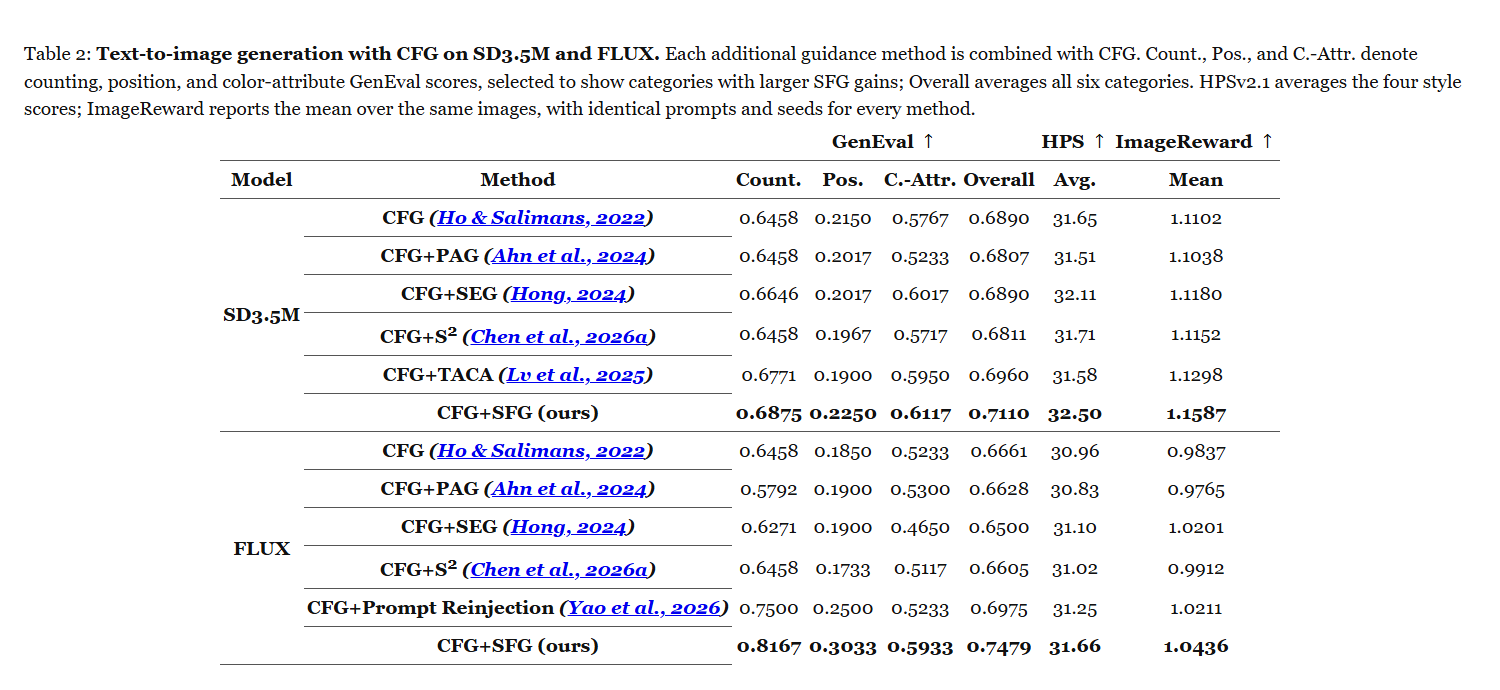 表2|有CFG的文生图比较:SD3.5M与FLUX上,各额外引导均叠加CFG。Count、Pos、C.-Attr分别为计数、位置、颜色属性,Overall为六类平均;HPSv2.1为四风格平均,ImageReward用同图像。各方法prompt与seed相同,FLUX的GenEval从0.6661至0.7479。
- 批判点评:SFG 无 CFG 时约用 1.2K 次模型评估,有 CFG 时约 2.2K;iSFG 零额外评估不等于零时延,也不能套用 SFG 的较大 GenEval 收益。干预支持反馈方向解释,尚不证明所有模型、场景都有效。官方仓库可见图像与视频推理源代码及配置,未运行复现。
2. T2I Sinks:高注意力位置不能随手删
Exploring Attention Sinks in Text-to-Image Transformers from Diffusion and Autoregressive Models | 复旦大学;上海创智学院;上海科学智能研究院 | arXiv:2610.13337
关键词:生成注意力分析, attention sink, 结构性位置, register探针
- 前序问题:某些 token 获得异常多的注意力,并不说明它们可有可无;把语言模型中对 attention sink 的直觉直接套给图像生成,可能损坏结构。
- 本文贡献:本文以 T2I Sinks 作阅读简称。对 FLUX.1、Z-Image 和 Infinity-2B 逐层逐头分析注意力,再以 logit 惩罚、value 清零、头剪枝及阶段性 token 移除作干预。扩散模型的 sink 常在模态边界、文本区和空间角落;自回归模型集中于首个全局 token。额外 register token 只作小范围探针。
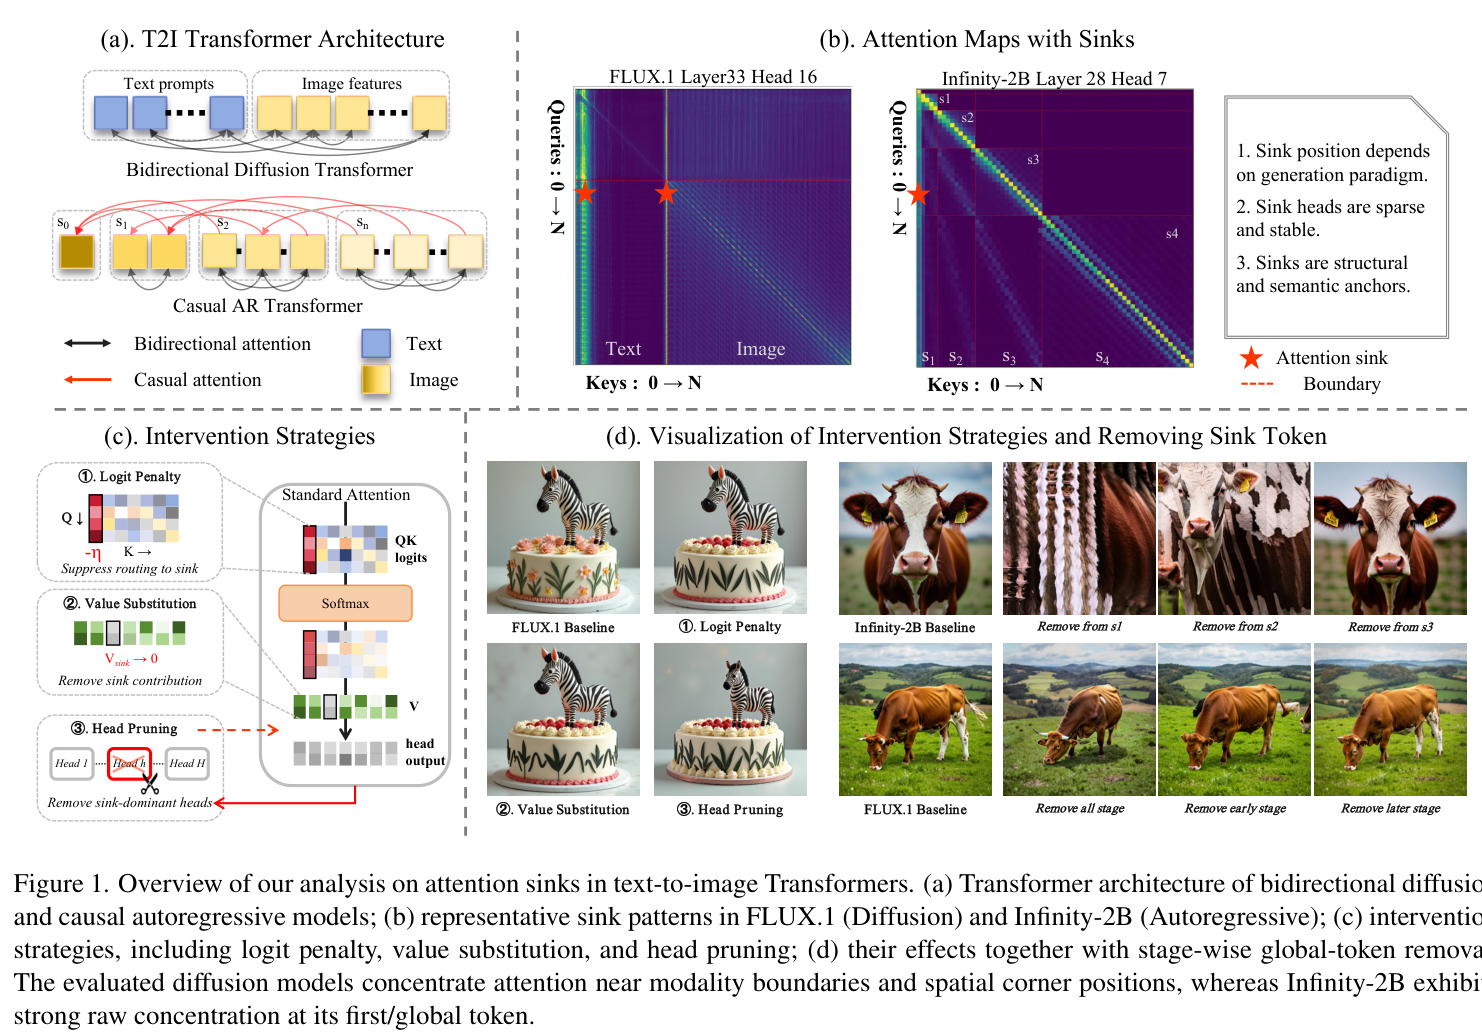 图1|图像生成attention sink研究总览:(a)双向扩散与因果自回归架构;(b)FLUX.1与Infinity-2B的代表性sink;(c)logit惩罚、value替换和头剪枝;(d)干预及分阶段全局token移除结果。扩散sink聚集在模态边界和空间角落,Infinity首个全局token明显集中。
- 实验效果:表 5:Infinity-2B 从首尺度起移除全局 token,GenEval 64.56→11.37;从第 4 尺度开始为 62.90。FLUX 全程移除结构位置则为 67.14→64.81。表 7:FLUX 加 register,GenEval 67.14→68.85、DPG 83.67→84.01,register 的 top-1 sink 比例仅 0.53%。
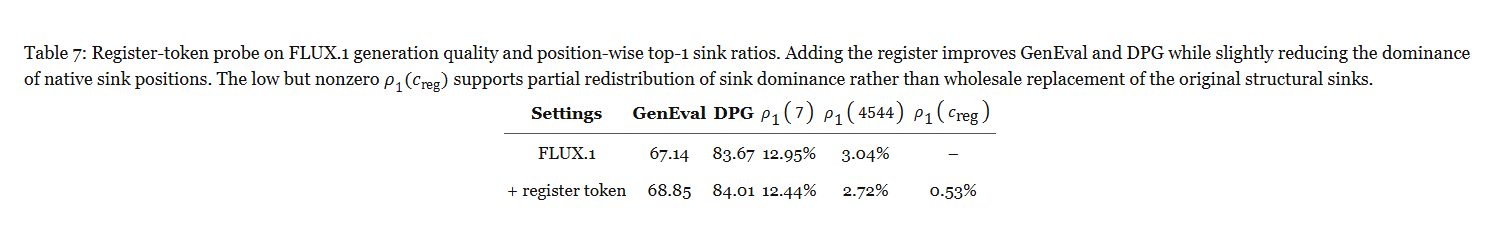 表7|FLUX的register token探针:加入register后GenEval和DPG改善,原生sink位置的top-1比例略降;register自身比例0.53%,说明部分重新分配,不能称完全取代结构性sink。
- 批判点评:结构角色依赖生成范式和阶段,不能把 sink 都称为坏注意力。register 的结果是单主干探针;部分位置干预影响小,但剪掉高 sink 头更伤,关注位置不能替代关注头。本文未提供可确认的作者方法代码入口,也未证明通用推理加速。
3. CORAL-KV:跨层预测压小视频缓存
CORAL-KV: Compact Cross-Layer Prediction and Residual Coding for Autoregressive Video KV Caches | AMD;威斯康星大学麦迪逊分校 | arXiv:2610.12514
关键词:视频KV压缩, 跨层预测, 低秩加分块, 残差量化
- 前序问题:长视频的历史 key/value 缓存不断增长;只在单层内聚类量化,残差误差会随生成累积,边界处还可能突然失真。
- 本文贡献:CORAL-KV 先用上一层重建缓存预测当前 key,再用当前重建 key 和上一层 value 预测当前 value,只量化预测残差。block-DPLR 用块对角项建模头内通道、低秩项建模跨头联系;可跨视频复用离线预测器,也可固定低秩项、为当前视频重拟合块对角项,以更大缓存换保真。
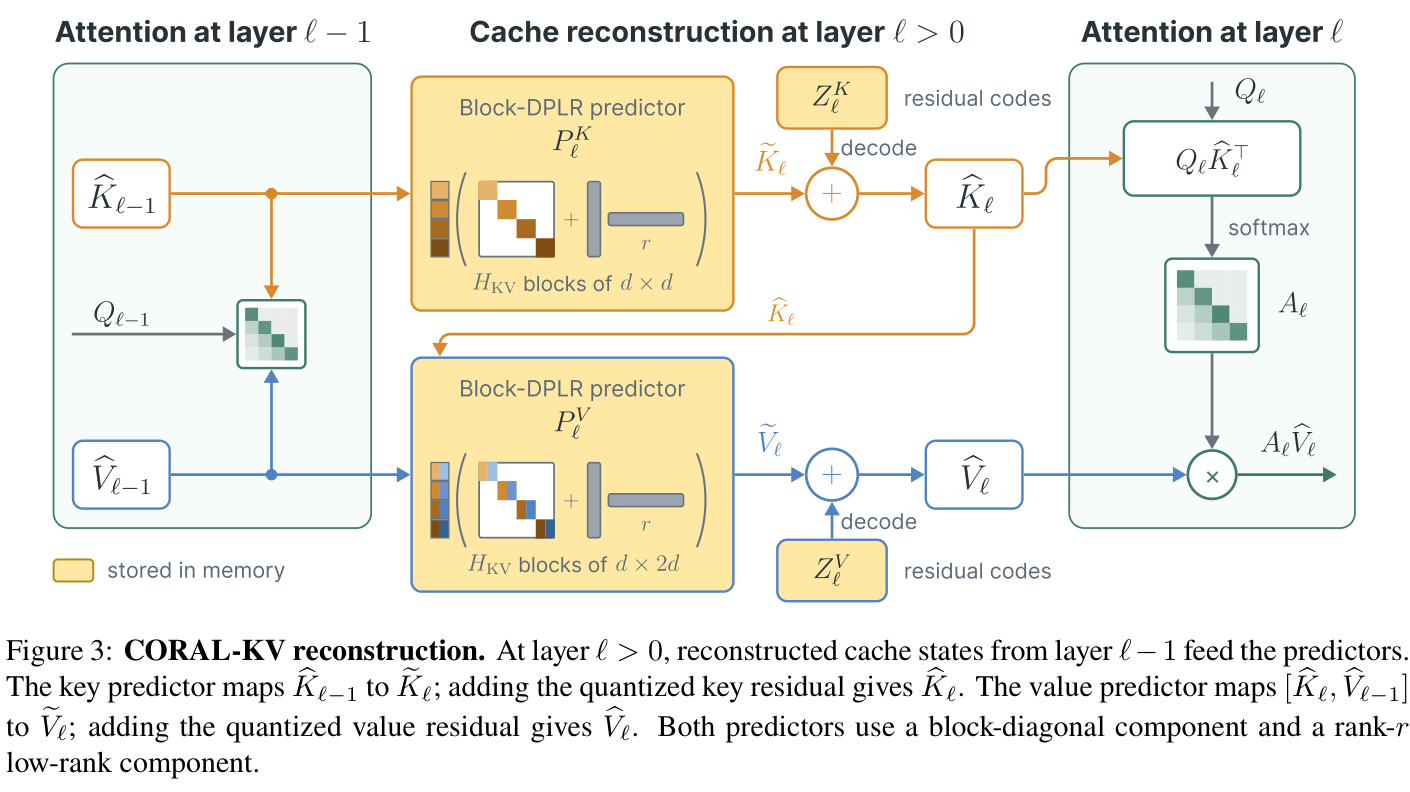 图3|CORAL-KV重建:第ℓ层由前一层重建缓存预测key,加量化key残差;再用当前重建key与上一层value预测value,加量化value残差。两预测器都由块对角与rank-r低秩部分组成,解码不取原始key/value。
- 实验效果:表 1:单视频 HY-WorldPlay 285 帧,QVG-4→复用 CORAL-KV,缓存 13.36→6.90 GB、相对 BF16 输出的 PSNR 16.66→16.98 dB;MAGI-1 192 帧为 1.58→0.99 GB、26.14→31.09 dB。视频适配版本 MAGI-1 为 1.15 GB、32.47 dB,相对 BF16 的生成时延增加 10.0%。
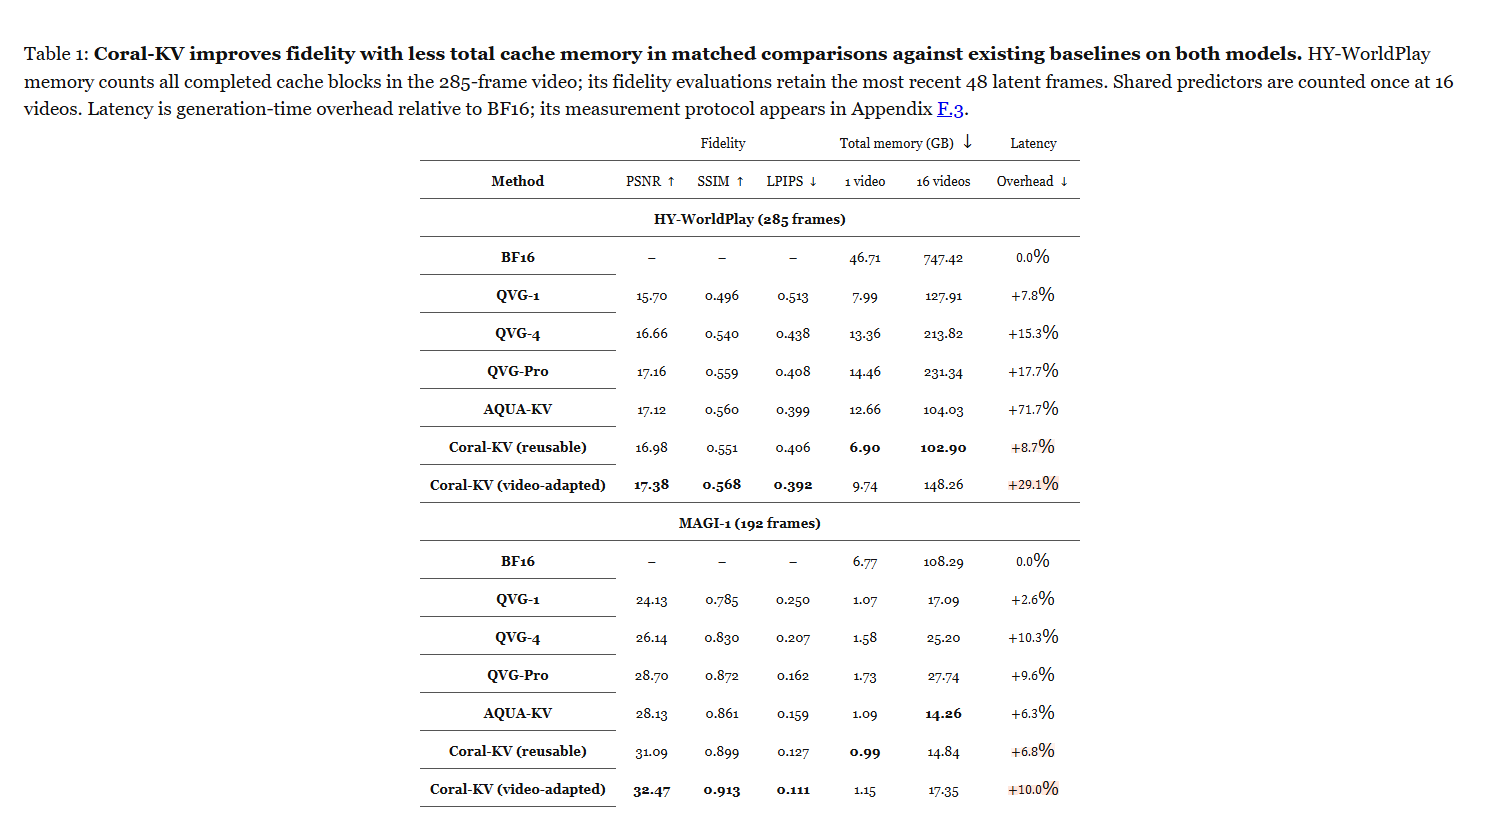 表1|匹配比较中的保真与总缓存:HY-WorldPlay含285帧的已完成缓存块,保真评估保留最近48个latent帧;16视频列把共享预测器只计一次。PSNR/SSIM/LPIPS相对BF16生成,时延列为相对BF16开销,协议见附录F.3,不是全进程峰值显存或并发吞吐。
- 批判点评:内存数字只涵盖存储缓存,不是整个进程峰值显存;16 视频数是共享参数核算,不是16路并发实测。时延在 MI355X 测量,HY-WorldPlay 适配版本开销达29.1%。保真对照是同 seed 的 BF16 输出,不能当真实视频准确率。只验证两个主干,本文未确认作者代码入口。
4. UniGVC:同一码流选直播或高清回看
Unified Generative Video Compression with Autoregressive and Bidirectional Video Diffusion | 中国科学技术大学;快手 | arXiv:2610.13023
关键词:生成式视频压缩, 共享码流, 双模式解码, 单步蒸馏
- 前序问题:双向扩散解码画质更好却需要整段视频;自回归解码适合流式播放,但上下文受限。同一视频直播和回看不应被迫存两份码流。
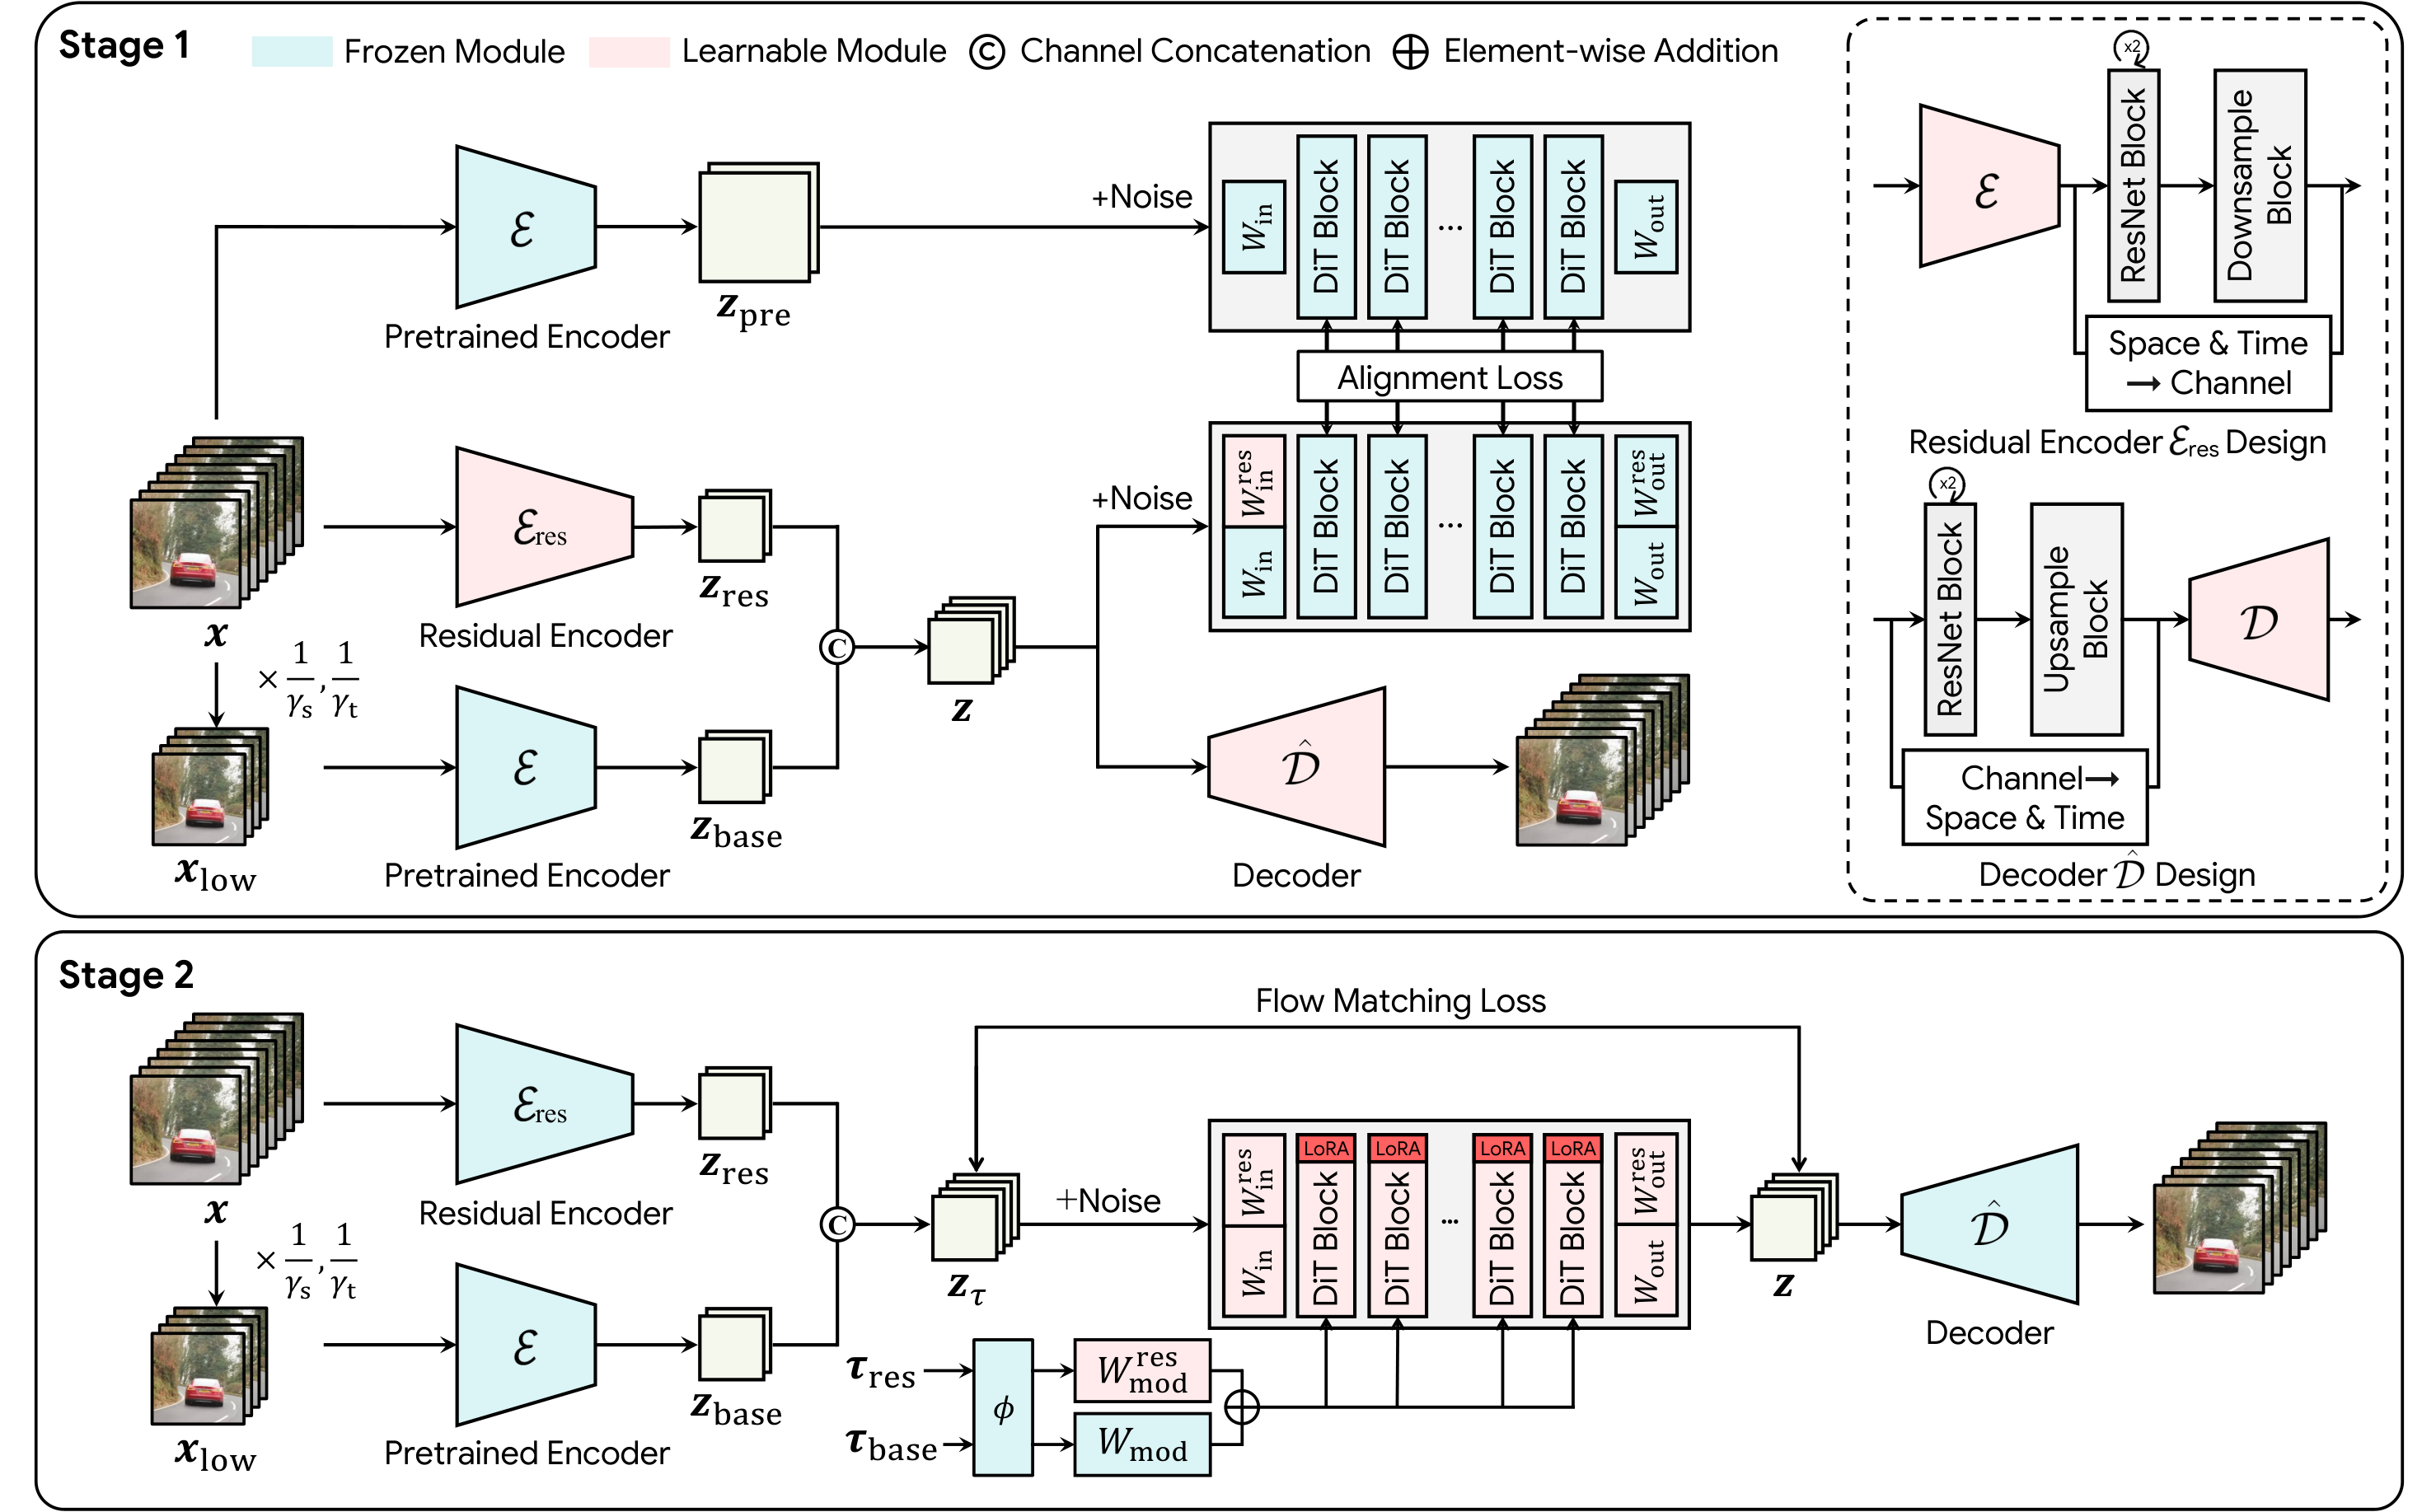
- 本文贡献:层次潜变量 codec 生成同一压缩码流和递归条件,分别驱动双向 BI-DiT 与窗口自回归 AR-DiT。先联合适配 codec 和两套 LoRA,再用双向模型作教师把 AR 蒸馏到一步,最后在像素空间微调并训练条件 tiny decoder。共享的是传输表示,解码端仍保留两套参数。
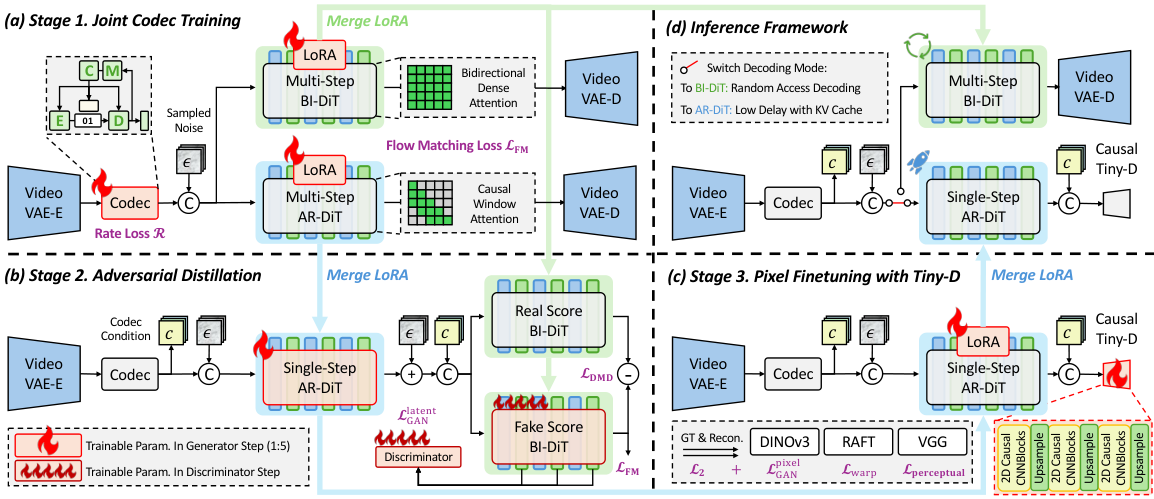 图1|UniGVC训练与推理:(a)共同适配共享latent codec和双向/窗口因果DiT的LoRA;(b)合并LoRA,在相同codec条件下用双向DiT的真实score、伪score及对抗监督将AR蒸馏为一步;(c)像素空间改进AR及条件tiny decoder;(d)同一codec条件选择回看或流式解码。
- 实验效果:表 2:HEVC-B 1080p、0.0005–0.004 bpp,50步双向+原VAE为0.14 FPS,一步AR+tiny decoder为36.85 FPS。每帧 codec、DiT、解码器分别7.42、16.10、3.62 ms;最终训练组合相对双向基线的 BD-LPIPS +0.001、BD-DISTS +0.017,仍有感知差距。
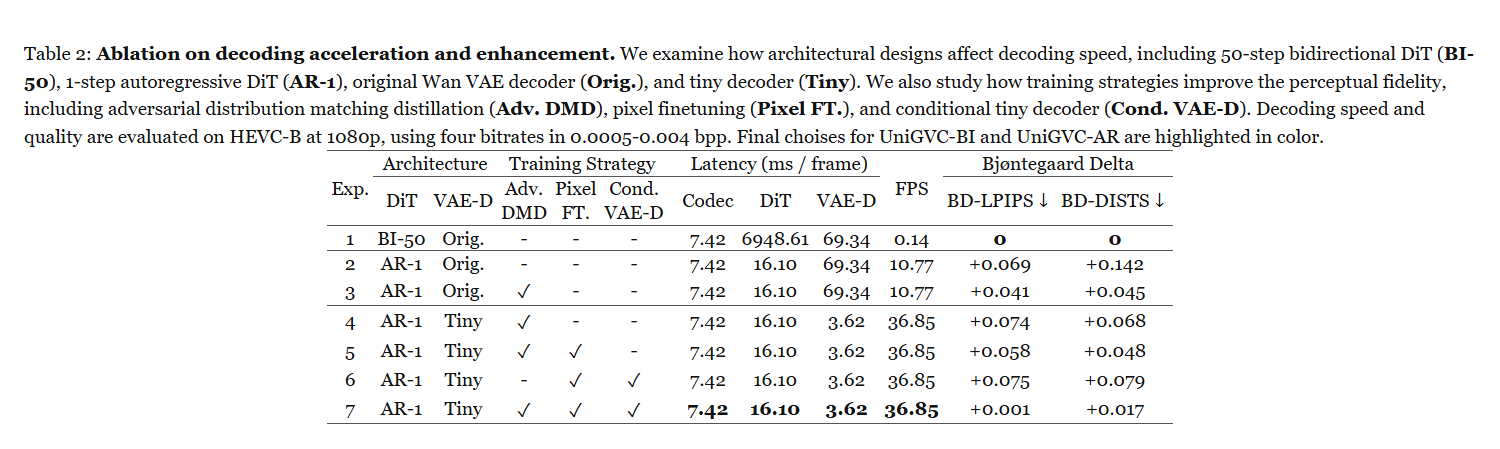 表2|解码加速和增强消融:BI-50为50步双向,AR-1为一步自回归,Orig为原Wan VAE,Tiny为轻量解码器;Adv.DMD、Pixel FT、Cond.VAE-D为不同训练组件。在HEVC-B 1080p与0.0005–0.004 bpp四码率测试,最终AR为36.85 FPS,BD-LPIPS和BD-DISTS仍高于双向基线。
- 批判点评:250倍左右是对该50步双向方案的解码速度比较,不能称比通用视频编码器快250倍。极低码率可能补出合理但非原视频的细节;高FPS依赖一步AR与tiny decoder,不能套给双向质量档。原文声明代码和模型以后发布,未确认已开放。
5. PreCoG:先看预览再修缓存轨迹
PreCoG: Preview-Edit for Efficient Video Correction in Generation-Time | 香港大学NICE Lab;北京邮电大学 | arXiv:2610.13174
关键词:视频生成纠错, 低成本预览, 缓存轨迹编辑, 反事实软投影
- 前序问题:每次查出漏物体、动作绑定或时序错误就重新完整生成,既重复计算,又可能把已正确的内容改坏。
- 本文贡献:PreQA 用规划、评估、修正三个步骤,将原 prompt 拆成固定要求并从低步数预览诊断失败;PreEdit 以目标与反事实条件的预测差编辑缓存轨迹,用分块软投影减弱无关方向变化。每次选要求覆盖率最高的预览继续改,只对最终选中候选完整渲染;无需额外训练视频主干。
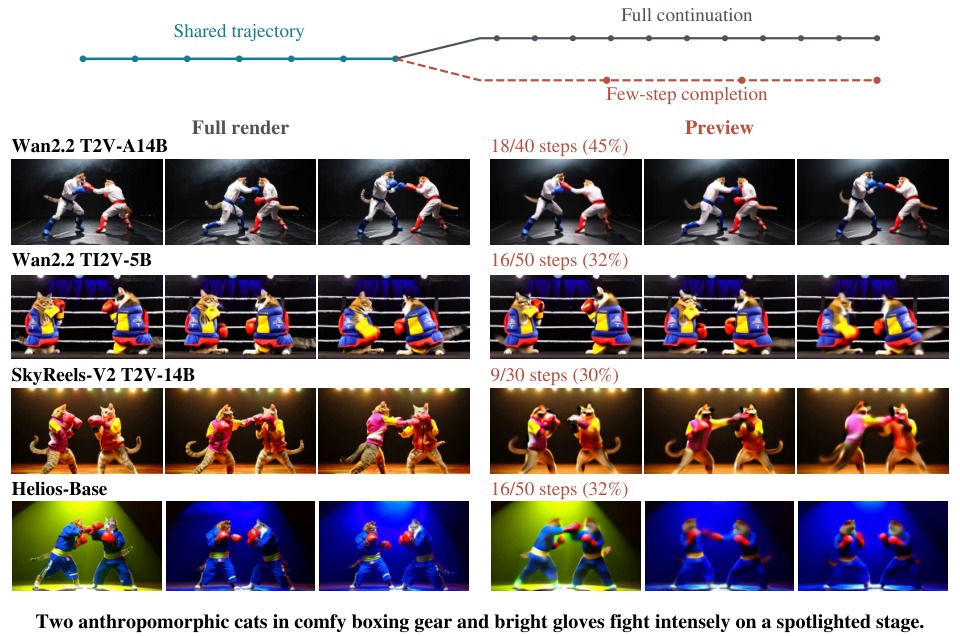 图1|共用轨迹的预览与完整渲染:成对视频具有相同prompt与seed,预览用少步完成。图中百分比是采样步数比例,不是实测耗时比例;主体与阶段大体对应,细节和姿态仍可能不同。
- 实验效果:表 1:Wan2.2-T2V-A14B、81帧、832×480、原40步,预览14+2+2步、最多4轮。直接生成→PreCoG,VBench 82.06→83.49、T2V-Comp 55.27→62.28、VS2 3.708→3.854;耗时895.0→2022.9秒,为2.26倍。相对VSR的3620.3秒更快,但VSR的VS2为3.973。
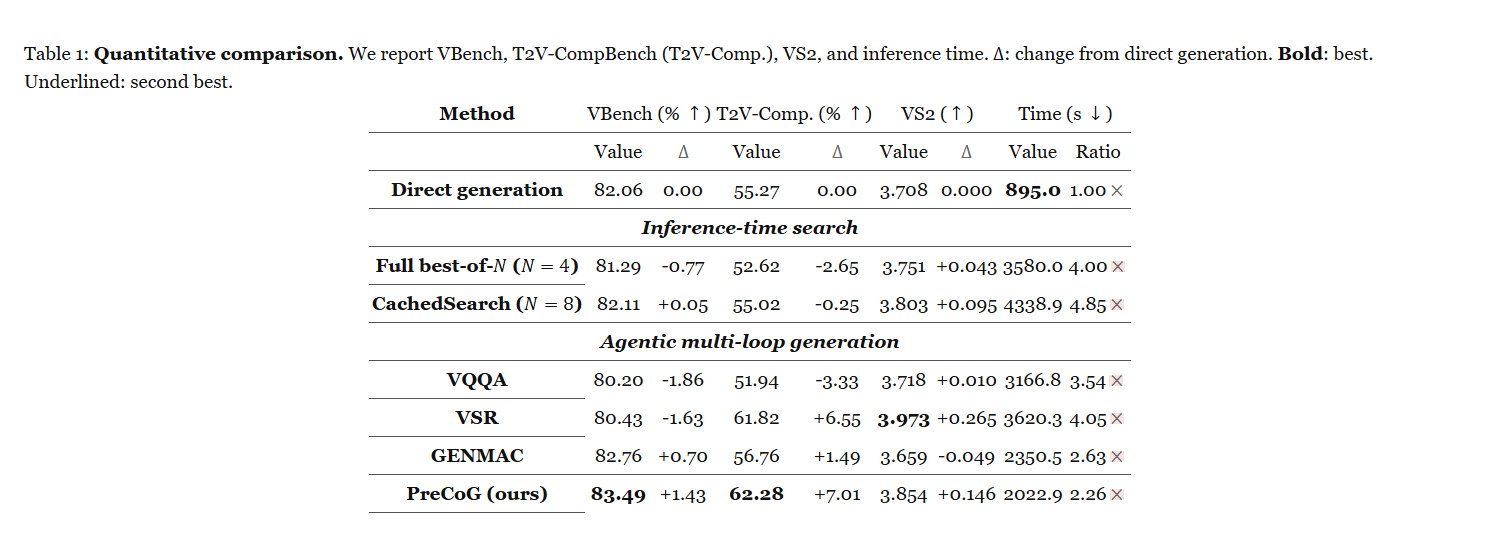 表1|视频纠错比较:列出VBench、T2V-CompBench、VS2及推理耗时,Δ为相对直接生成。PreCoG提高质量和对齐,耗时2022.9秒仍是直接生成的2.26倍;VS2 3.854低于VSR的3.973,不代表各项最高。
- 批判点评:这里的VBench是六维均值,不与其他论文全维总分直接比。98.24%预览一致性来自固定seed的初始候选诊断,不能保证任意纠错后续。规划和反馈依赖Qwen3.8-27B,多轮纠错仍有额外成本;人工评估仅4人。未确认作者完整框架代码入口。
6. 3DRAG:在原生三维潜空间拖动物体
3DRAG: 3D-Native Object Drag Editing with Generative Models | 上海科技大学 | arXiv:2610.13216
关键词:原生3D拖拽, 稀疏体素, 占用感知位移, logits级融合
- 前序问题:用2D扩散监督拖3D常有视角不一致,纯几何变形又容易破坏拓扑、纹理或未编辑区域。
- 本文贡献:在TRELLIS的稀疏3D潜空间构建弹性位移场,用占用感知winner-takes-all避免映射冲突;对结构和SLAT两阶段反演,缓存潜变量及Q/K/V。生成时搬移潜状态,在logits层融合目标与缓存源token,未编辑区域用缓存保留。无需训练或每次编辑优化,仍需反演与去噪。
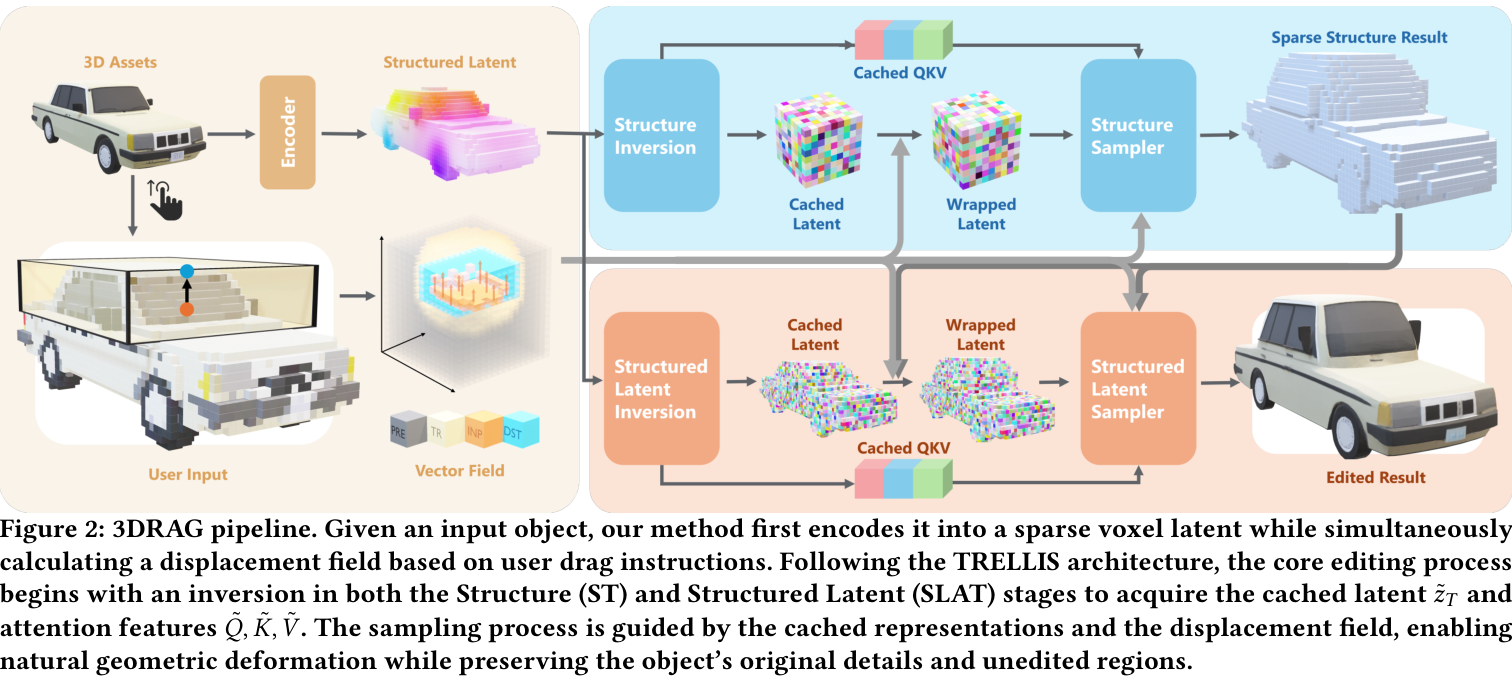 图2|3DRAG流程:输入物体编码到稀疏体素潜空间,同时由拖拽指令建立位移场。TRELLIS结构ST与SLAT阶段反演获取缓存潜变量和Q/K/V;采样时用缓存与位移场保持细节、产生自然变形并保留未编辑区域。
- 实验效果:表 1:100个3D物体、单H20、64³体素,反演及去噪各25步。3DRAG未编辑区域PSNR 31.50、拖拽MD 15.89、FID 21.99、耗时227.74秒;APAP为22.52、18.01、63.31、275.13秒。纯几何ARAP仅3.32秒,不能称全表最快或交互实时。
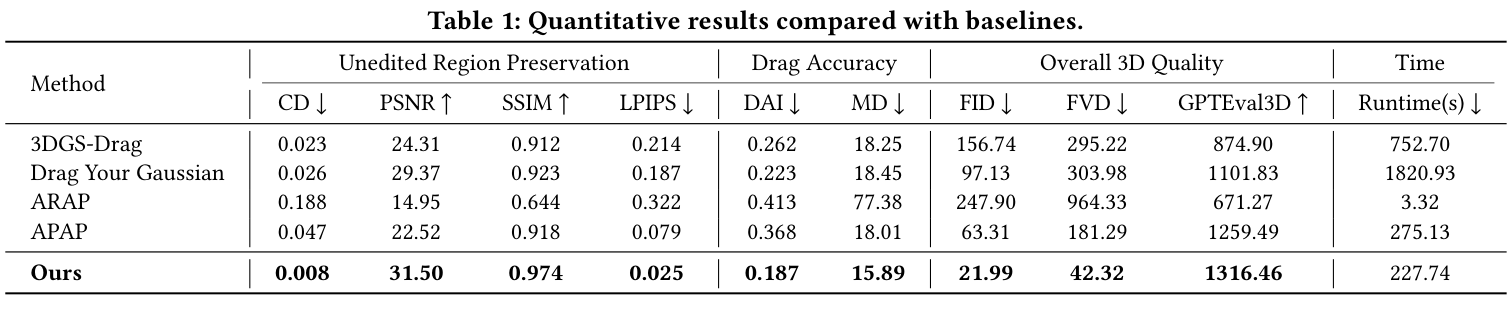 表1|3D拖拽比较:评估未编辑区域保留、拖拽准确、整体3D质量和运行时间,向上/下箭头标明优劣。3DRAG的PSNR为31.50、MD为15.89、耗时227.74秒;ARAP仅3.32秒,生成方法的质量收益不能当全表最快。
- 批判点评:64³限制细薄结构精度,TRELLIS的VAE仍带色偏;GPTEval3D由模型裁判给分,不能当独立人工真值。原文列MM ’26会议信息与DOI,未把其他稿件模板当接收。官方仓库可见编辑UI、推理及依赖配置,需另备TRELLIS权重,未运行复现。
7. Sonic-AMG:声音边来角色边做反应
Sonic-AMG: Streaming Human Motion Generation from Spatial Audio | 布朗大学;麻省理工学院;耶鲁大学;香港大学 | arXiv:2610.13300
关键词:空间音频动作生成, 因果flow, 自身rollout训练, 空间反馈
- 前序问题:离线模型先知道整段声音及真实身体位置,在线角色却要边听边动;生成姿态的误差又会改变声源相对位置,形成训练推理差异。
- 本文贡献:将声学内容与身体相对声源位置分成token,用因果Transformer和flow head生成动作潜变量,再以因果解码器还原四帧片段。rehearsal训练结合整段teacher forcing与短自身rollout;空间反馈根据生成root姿态重新计算声源相对位置,使训练和在线条件一致。
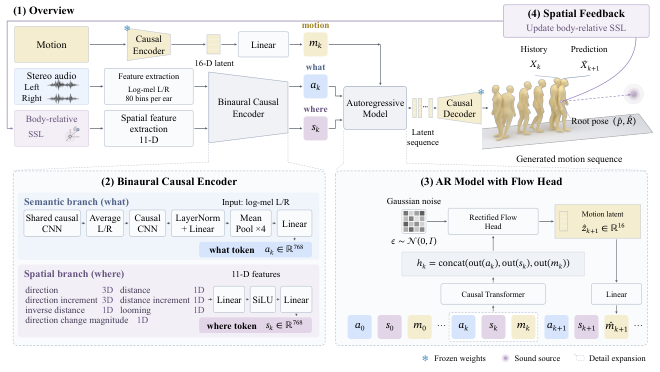 图2|Sonic-AMG架构:交错声学what、空间where与动作token,经因果Transformer与flow head生成动作latent;空间反馈从解码root姿态更新身体相对声源位置SSL。Xk、zk、mk分别为四帧动作块、latent及投影token。
- 实验效果:表 2:SAM,在真实身体位置GT条件下,MOSPA→Sonic-AMG,FID 8.242→6.505、R@1 0.942→0.957;实际Online条件下Sonic为FID 8.066、R@1 0.943。作者项目报告RTX A6000首帧184 ms,对照MOSPA为10846 ms;首帧时延不是长期稳定吞吐。
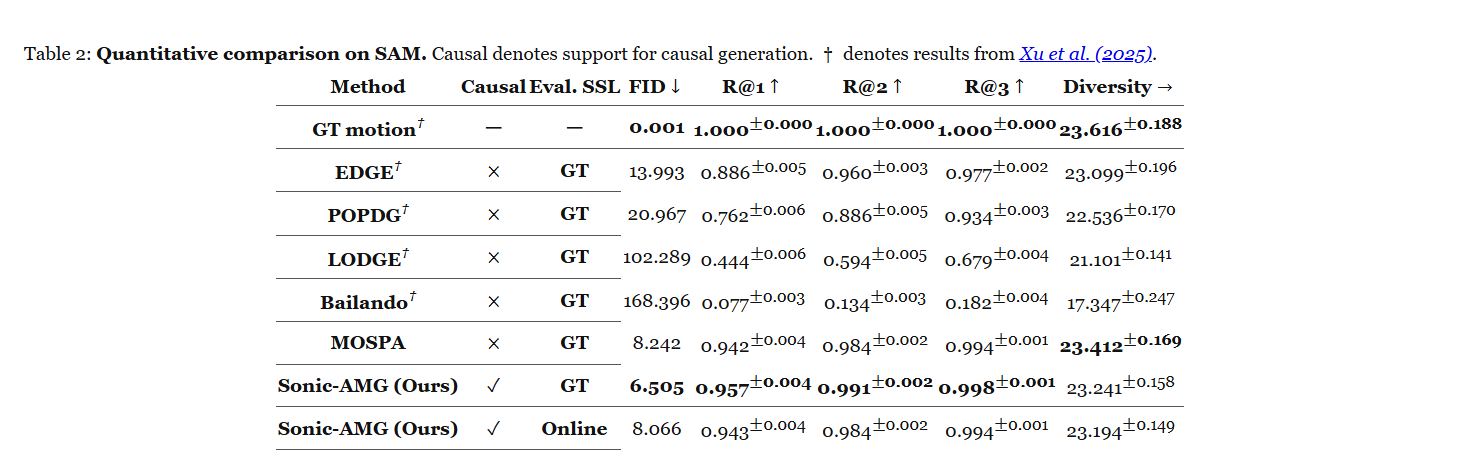 表2|SAM定量比较:Causal表示支持因果生成,†表示引用Xu等2025报告;GT使用真实身体的声源相对位置,Online由生成root姿态更新。Sonic-AMG GT的FID为6.505,Online为8.066;R-precision与Diversity含95%置信区间,不应混用协议。
- 批判点评:主实验仍假设已知世界声源位置,且给4帧真实初始动作;不能把GT最优数字当完全自主在线表现。长时连贯与多事件切换主要是定性证据,机器人演示是离线物理仿真。作者项目页已核验;原文称代码与模型将在接收后发布,未确认接收。
8. Emo-BPO:同时学目标情绪和反向情绪
Emo-BPO: Emotion Bidirectional Preference Optimization for Diffusion-based Emotional TTS | 威廉玛丽学院;埃默里大学;乔治梅森大学 | arXiv:2610.12958
关键词:情绪语音生成, 双向偏好优化, 对比扩散引导, 后期引导调度
- 前序问题:只奖励目标情绪,没有学习如何远离竞争情绪,CFG的正反预测容易缺少区分,细粒度语气控制不稳。
- 本文贡献:把同文本、不同情绪的音频对调换次序,训练情绪对齐与情绪对比两条score分支;推理用对比CFG强化目标、压低其他情绪,并把引导强度留给后期去噪。基于Grad-TTS,只微调扩散解码器,冻结文本编码器及时长预测器,波形用HiFi-GAN生成;仍依赖已有情绪标注。
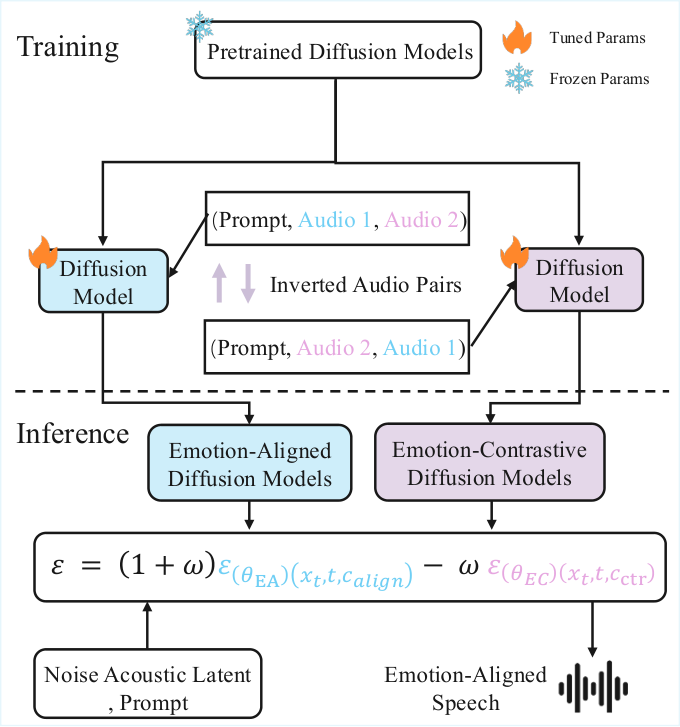 图1|Emo-BPO总览:训练调换同文本情绪对,部分微调预训练主干,同时学习情绪对齐EA与情绪对比EC扩散分支。推理在CFG内组合两路预测,强化目标情绪并抑制竞争情绪;训练仍利用已有情绪标注。
- 实验效果:表 1:英语ESD与EmoVoiceDB、三次运行均值,Emo-BPO的Emo SIM 99.23、UTMOS 4.52、平均情绪识别0.87;CosyVoice2为98.47、4.43、0.82。WER为3.84,略高于CosyVoice2的3.77,不能说可懂度也最佳。表 2的30人主观MOS为3.93、情绪MOS 4.25。
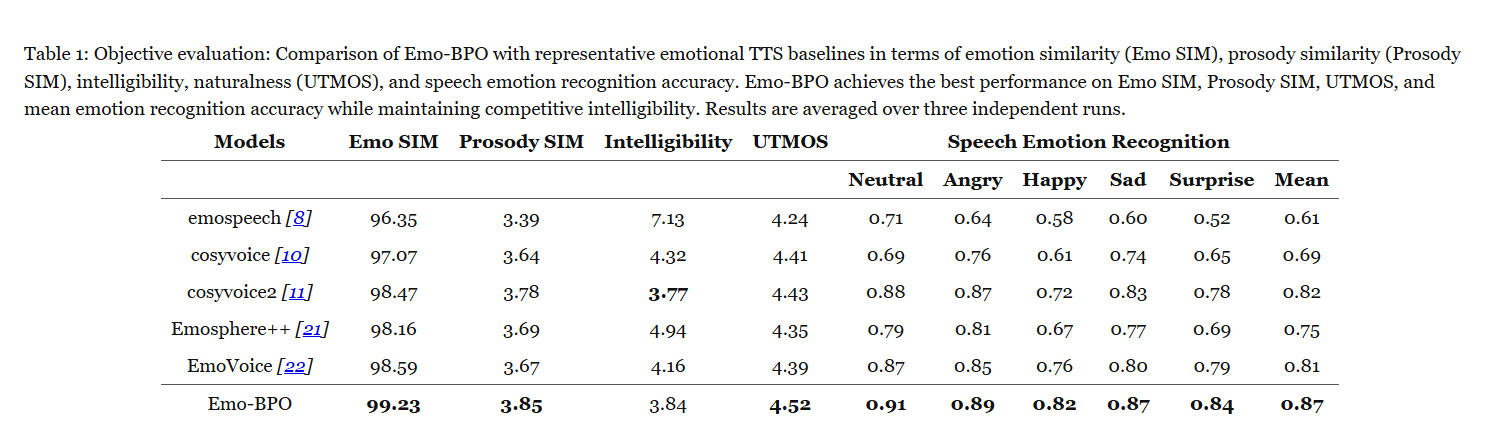 表1|客观情绪TTS评估:比较Emo SIM、韵律相似、可懂度、UTMOS及五类情绪识别,三次独立运行取平均。Emo-BPO的UTMOS为4.52、情绪识别均值0.87;可懂度列实为WER、越低越好,3.84不优于CosyVoice2的3.77。
- 批判点评:只有英语五类情绪,同文本配对与情绪标签是数据条件,免新增标注不等于无监督。自动MOS和情绪分类器可能有域偏差,没有给出完整部署时延。arXiv备注明确称Interspeech 2026接收;作者项目页可听样例,未确认完整训练代码开放。
9. ELMA:长动作要记住上一段约束
ELMA: Benchmarking Anaphoric Compositions for Long-Term Text-to-Motion Generation | 庆应义塾大学;庆应AI中心;索尼集团 | arXiv:2610.13549
关键词:长动作生成, 跨段指代, 连续数据集, 状态保持评测
- 前序问题:“继续敬礼并走路”要求保留上一段手势,只给各段独立字幕会让生成角色换动作时忘记约束。
- 本文贡献:从真实连续视频筛出30秒全身动作,以自动跟踪、姿态恢复和两阶段质量过滤构建ELMA,再生成带前文的六段字幕并标注指代依赖。数据含13.2k片段、110小时;ELMABench取测试集1k片段,每段5秒,只在指代目标段计分。A2M训练把当前与此前CLIP文本嵌入加权融合。
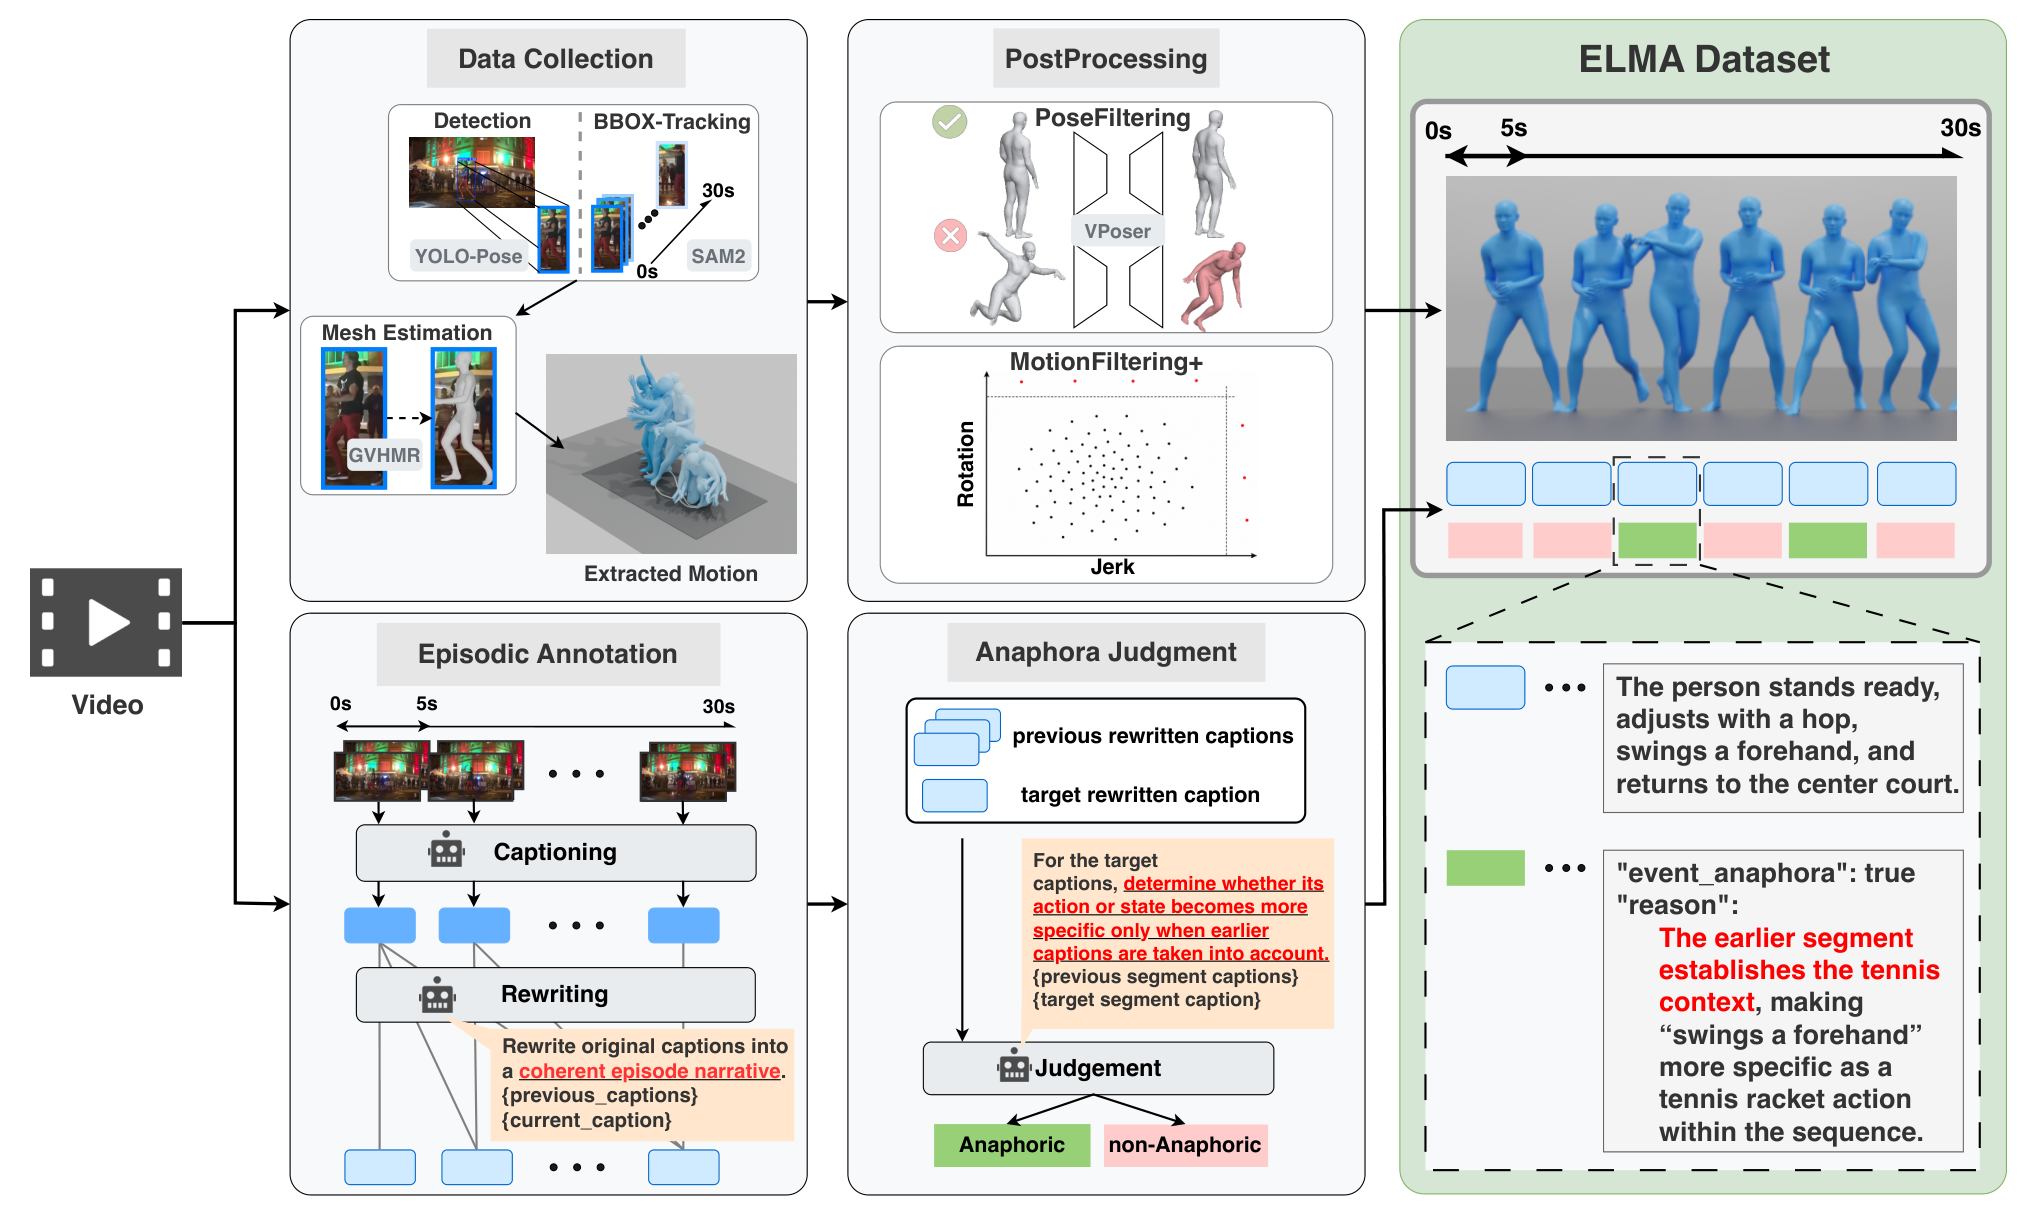 图3|ELMA数据构建:上部为动作收集,下部为字幕标注。SAM2人物跟踪与两阶段后处理筛出高质量动作,先生成连贯episode的分段字幕,再识别指代目标和跨段依赖;全部自动生成,仍有恢复和标注误差。
- 实验效果:表 2:FlowMDM在T2M训练→A2M推理时FID 1.9363、R-P@3 0.4211;A2M训练→A2M推理为1.5287、0.4662。但Matching Score 7.6015→8.1161变差;UniMotion的FID 18.3490→19.0050也未改善。不能把数据微调收益称跨模型普遍有效。
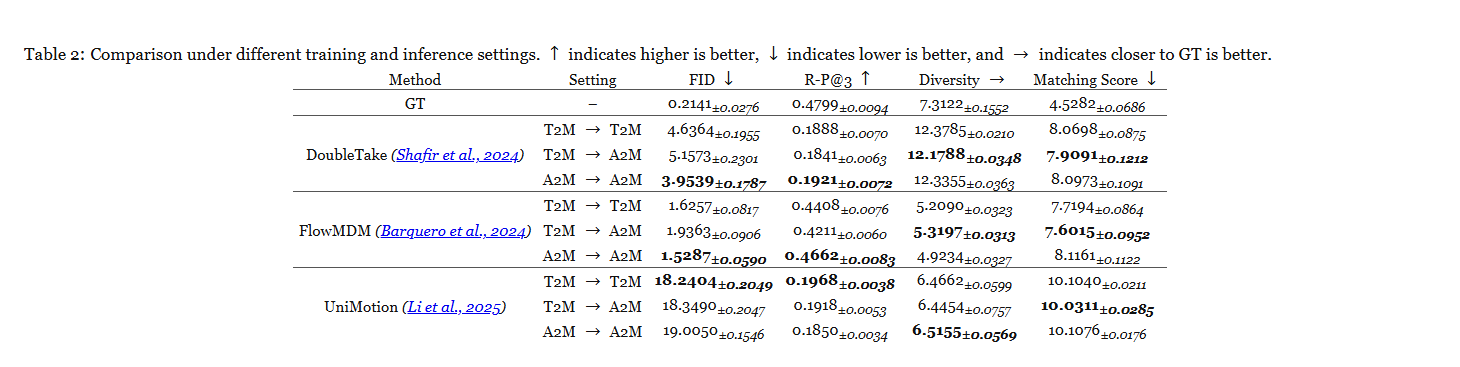 表2|不同训练推理设置:T2M为独立指令,A2M为带前文依赖指令;FID、Matching Score越低越好,R-P@3越高越好,Diversity应接近GT。FlowMDM的A2M训练改善FID与检索,但Matching Score变差,UniMotion也非统一改善。
- 批判点评:由视频恢复的动作和自动字幕有噪声,30秒及六段不能代表任意长流。依赖保持仍用分布与文本动作嵌入度量,需检查具体状态。arXiv备注与项目页称NeurIPS 2026 Evaluations & Datasets接收;作者项目页仍为Coming Soon,数据和代码未确认可下载。
10. TextVBench:分开测视频文字正确和稳定
TextVBench: Evaluating Text Rendering and Preservation in Video Generation | 中国科学技术大学 | arXiv:2610.13412
关键词:视频文字生成评测, OCR目标匹配, 时间一致性, 多参考文字保留
- 前序问题:视频里的字可能一直错但十分稳定,也可能每帧变;只看清晰度或OCR识别率,会混淆字符正确、跨帧保持与额外乱码。
- 本文贡献:分别构建300个中英T2V prompt和200个Ref2V参考,先把OCR候选关联到指定文字目标,再算空间字符保真S、同目标相邻观测的时间保真T,以长度加权聚合成TextVScore。多参考只在活跃视角匹配并处理重现;额外可读文字单列Extra,不混进主分。
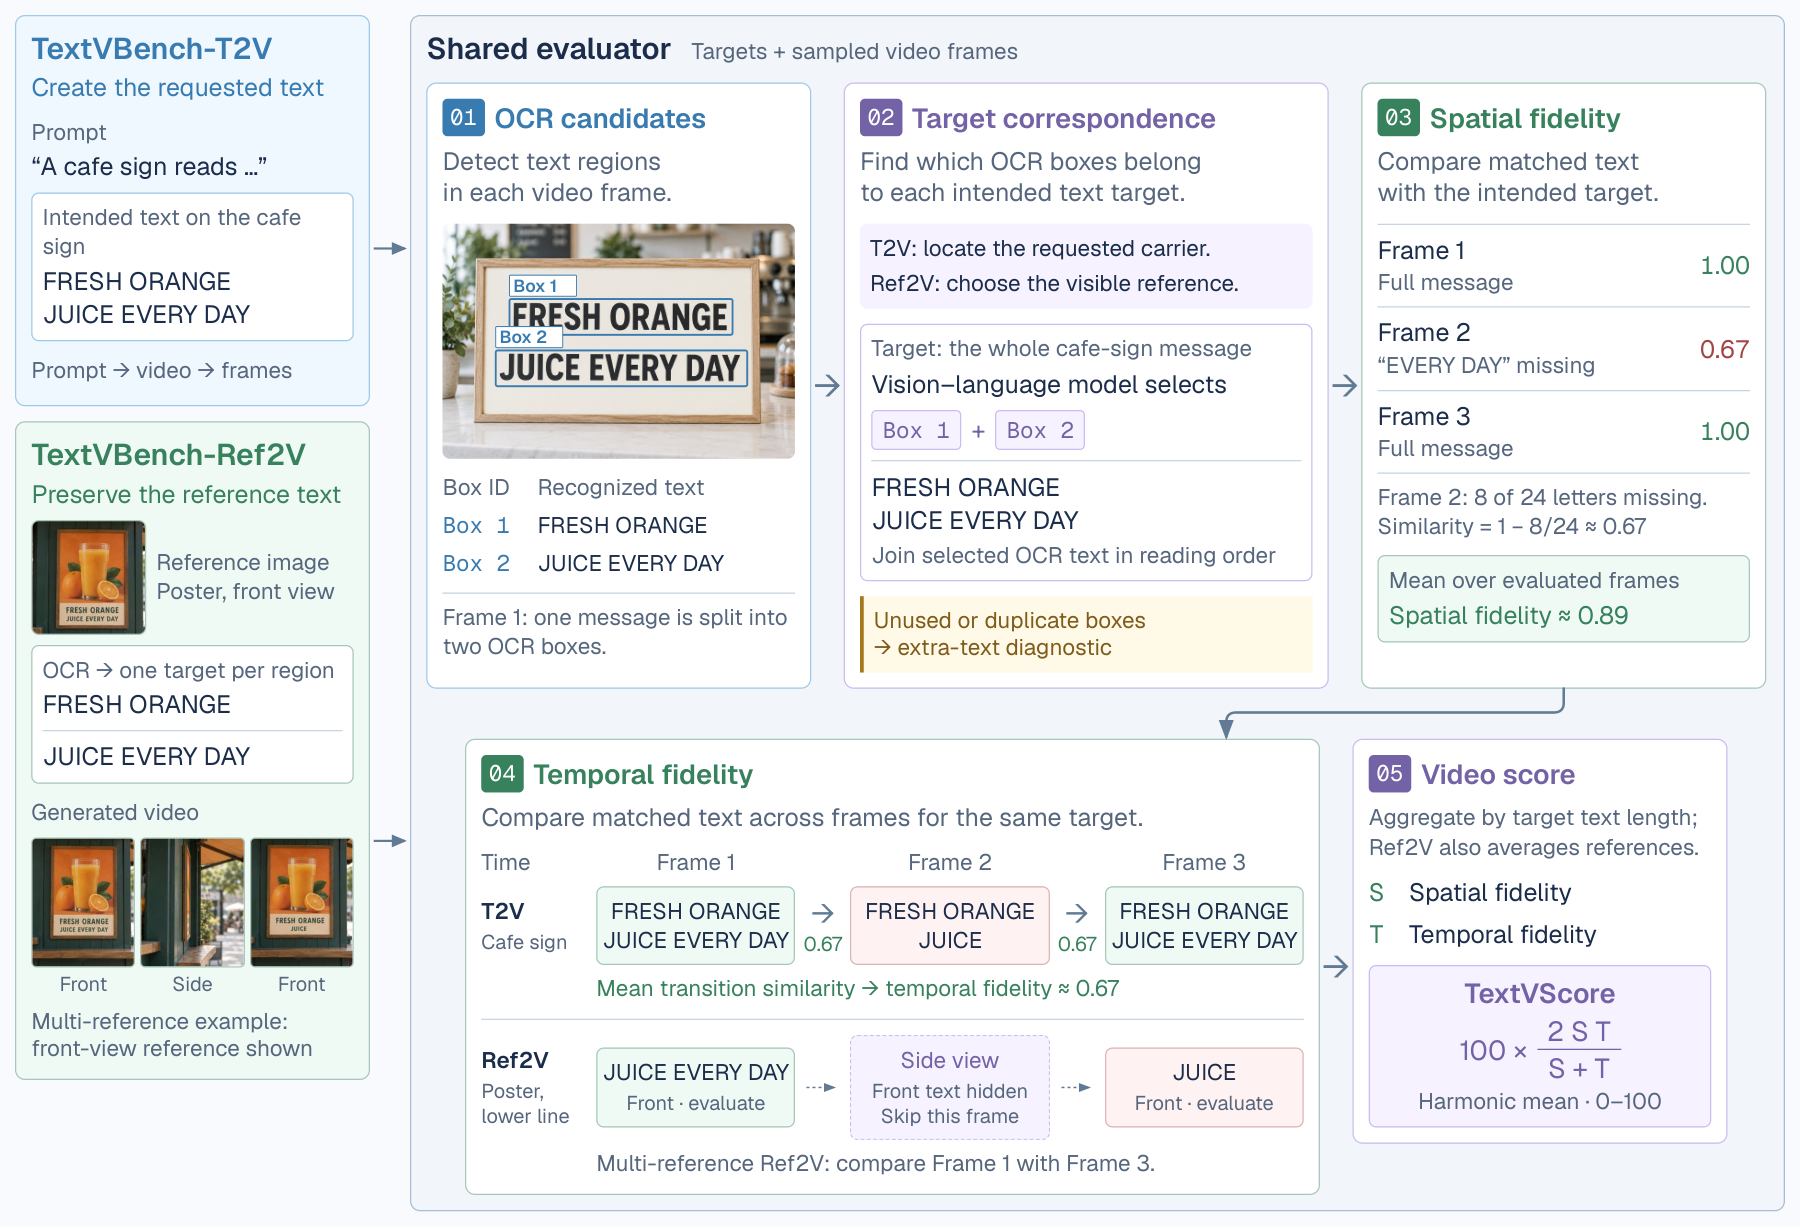 图2|TextVBench统一评估:目标来自T2V指定文本或Ref2V参考区,编号框为OCR观测;同目标可跨框拼接而不改写。空间保真对目标,时间保真对同目标前后观测;漏掉EVERY DAY是24个归一字符中的8个。多参考跳过不活跃视角并在重现时比较;长度加权得到S/T,额外文字独立报告。场景和数值是示意。
- 实验效果:表 1:八个T2V模型、六个Ref2V模型,共2400+1200视频,3FPS抽样、最多30帧、OCR置信阈值0.80。T2V中MiniMax-H3的TextVScore 68.320,Wan2.2-A14B为43.853;Ref2V头三名仅56.506、56.465、56.388,相差0.119分,不足以宣称可靠总排名。
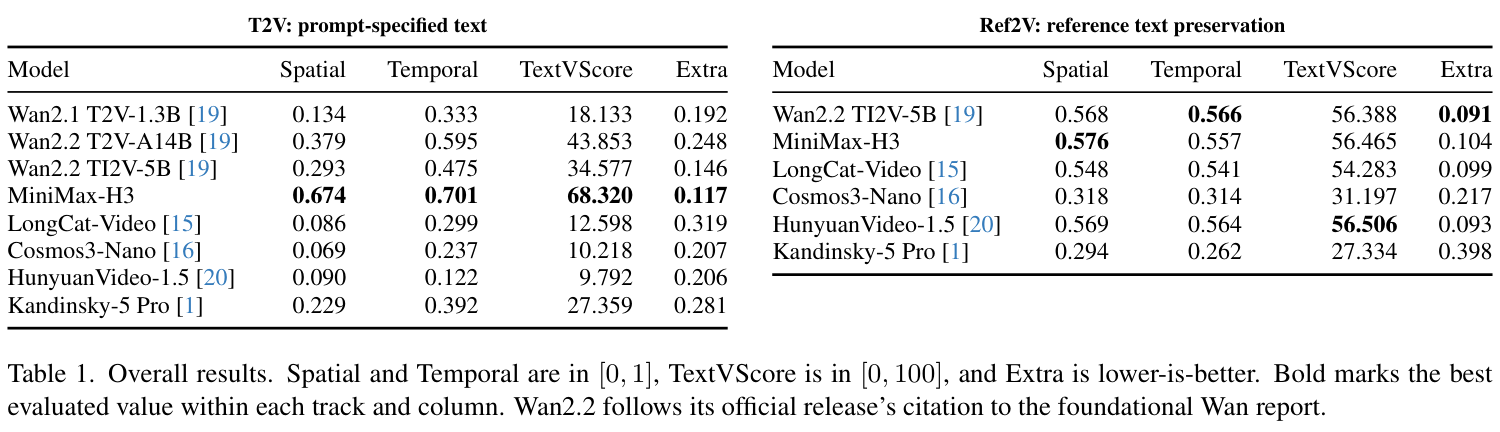 表1|总体结果:T2V测指定文字生成,Ref2V测参考文字保留;Spatial和Temporal范围0–1,TextVScore为0–100,Extra越低越好,粗体仅为各轨道列内最优。Ref2V前三名只差0.119分,不能将小差距看作可靠总排序。
- 批判点评:模型按各自推荐设置测试,不是算力对齐。未决OCR候选路由依赖Qwen3.8-27B;难度同时改变文字量、布局等属性,切片下降不证明单一原因。3FPS也会漏短暂闪烁,中文字形等OCR误差仍影响得分。本文未确认作者评测实现或数据下载入口。
趋势观察
信息流要看因果作用
SFG抑制错误回写,T2I Sinks显示高注意力token可能有结构作用。注意力数值、语义直觉和干预结果应分开看。
共享表示不消除部署成本
CORAL-KV共享预测器,UniGVC共享码流,PreCoG共享缓存轨迹;分别节省缓存、传输或重复渲染,仍有拟合、解码模型和反馈计算。
在线与长时条件各有门槛
Sonic-AMG在线重算空间位置,但主实验仍需声源坐标;ELMA测跨段依赖,部分指标和模型未改善。真实状态保持还要逐段验收。
可控性需要具体失败指标
3DRAG分别测未编辑区域与拖拽,Emo-BPO同时看情绪和WER,TextVBench分开正确文字与稳定文字。单一总分不能代替产品目标。
今日讨论
SFG把FLUX的GenEval从0.6661提高到0.7479,iSFG零额外模型评估但增益较小;如果你的图像任务更在意物体计数、偏好分或时延,会用哪些实测证据选择这两种控制?
人工智能炼丹君 整理 | 2026-10-14


评论 (0)