今日 AIGC 论文速览
今日共 10 篇 · 图像计算与自训练 3 篇 · 视频编辑与加速 3 篇 · 局部三维生成 1 篇 · 音视频与语音控制 2 篇 · 生成编辑评测 1 篇
重点论文标题列表
BudgetPix (Google):按细节分配可变token预算Data-space DMD (字节):不用时间表直接反复修图Rubric-CEPR (MBZUAI):只把核验通过的编辑教回模型VINCIE-NExT (字节):先编辑关键帧再把变化传给视频PTD (NVIDIA):让四步学生沿自己的曲线学
今日论文速览
1. BudgetPix:按细节分配可变token预算
BudgetPix: Compute-Adaptive Tokenization for Pixel-Space Image Diffusion | 伊利诺伊大学厄巴纳-香槟分校;Google | arXiv:2610.12307
关键词 :像素空间扩散, 四叉树, 可变token预算, 多尺度解码
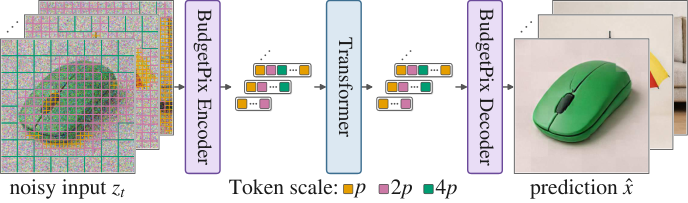
前序问题 :固定网格给平滑背景和复杂纹理相同的计算预算;直接减少 token 又容易破坏细节,难用一个模型适配不同推理预算。本文贡献 :BudgetPix 按图像强度直方图熵构造四叉树,复杂区域保留细 patch,平滑区域合并为粗 token;多尺度 Patch Aggregator 编码粗格,Refiner 恢复固定分辨率。训练时扰动布局与预算,推理按当前去噪预测重估布局。新增编解码路径需要训练,Transformer 从已有像素空间扩散模型初始化。
论文 Figure 3:BudgetPix 总览。编码器把固定大小图像变成不同尺度、可变数量的 token,解码器恢复固定分辨率,训练和推理都支持不同 token 数。紫色编码器与解码器从头训练,蓝色 Transformer 从已有主干初始化;图中三部分共同构成预算自适应像素空间扩散。
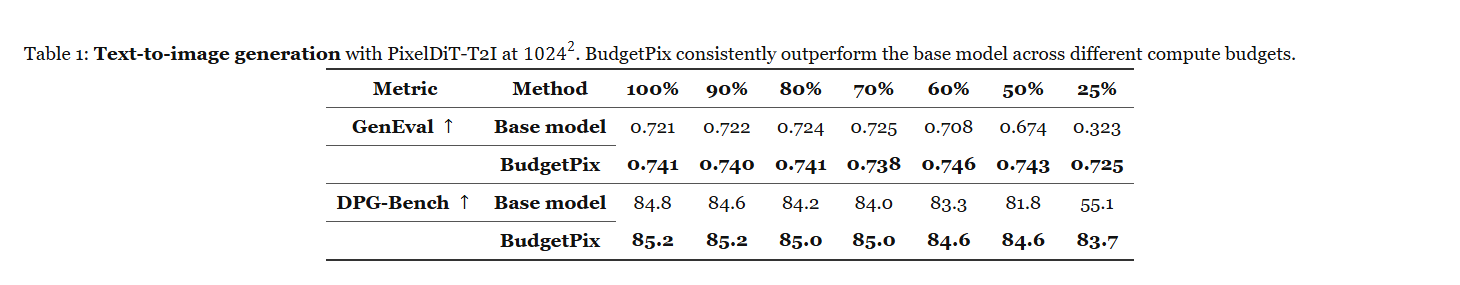
实验效果 :表 1:1024² PixelDiT-T2I,BudgetPix 在 25% token 预算下 GenEval 为 0.725、DPG-Bench 为 83.7;原模型全预算分别为 0.721、84.8。原模型同为 25% 预算时降至 0.323、55.1。不同指标说明保留指令遵循的程度,不能把 25% token 预算直接当四倍端到端加速。
论文 Table 1:1024² PixelDiT 文生图在 100%、90%、80%、70%、60%、50%、25% token 预算下的 GenEval 与 DPG-Bench。BudgetPix 各预算指标高于对应原模型;25% 时 GenEval 0.725、DPG 83.7,原模型全预算为 0.721、84.8。这里是预算与指标比较,未给出四倍端到端时延。
批判点评 :布局依据中间预测,尚未出现的小细节可能分不到 token;PixelDiT 的全分辨率像素阶段还形成计算下限。需先微调,不能视为免训练插件,也不能把一个指标接近说成画质无损。作者项目页 目前未提供可确认的方法代码或权重入口。
2. Data-space DMD:不用时间表直接反复修图
Few-Step Generation via Data-Space Iteration | 字节 Seed | arXiv:2610.12102
关键词 :少步图像生成, 数据空间迭代, DMD蒸馏, 自rollout
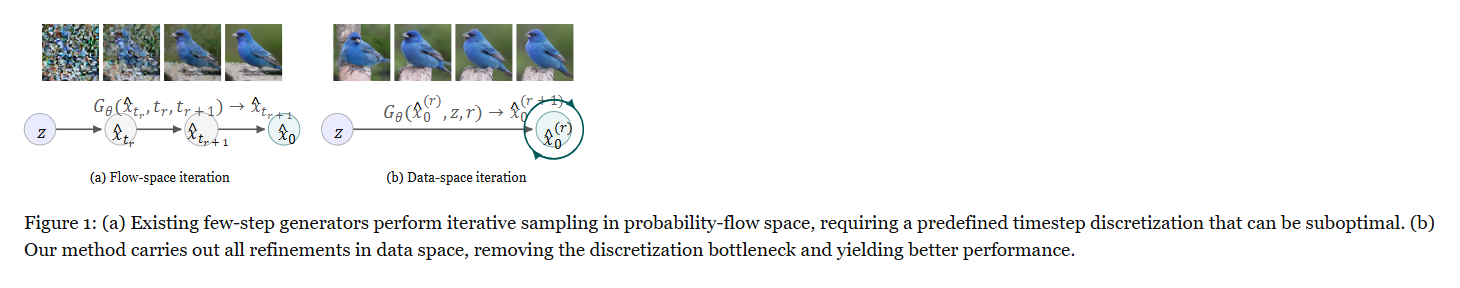
前序问题 :少步采样通常仍沿概率流选定几个时间点;难例和不同空间区域需要的修正次数不同,手工时间表未必适合。本文贡献 :共享生成器从噪声开始,直接把上一轮数据预测、原始噪声和迭代编号作为条件,反复修正干净样本,不再在每轮输出后按指定时间点重新加噪。通过分布匹配蒸馏 DMD 训练每一轮输出,并用自身 rollout 形成训练输入。它取消流时间离散化,仍需选择迭代次数与训练噪声采样。
论文 Figure 1:(a)现有少步生成沿概率流空间迭代,需要预定时间离散化,可能并不最优;图中从初始噪声经多个带噪状态到数据端点。(b)数据空间迭代直接修正每轮数据预测,以原始噪声和轮次作条件,取消流时间离散化瓶颈。两排小图用于示意各自迭代过程。
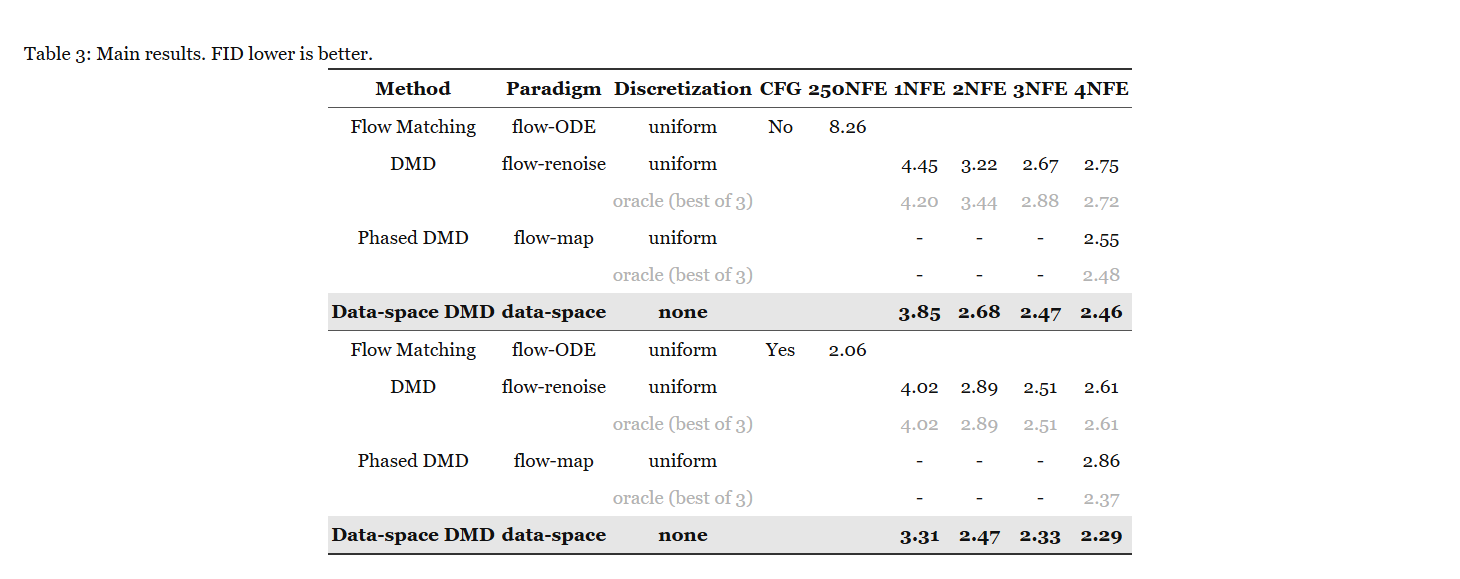
实验效果 :表 3:类别条件 ImageNet 256×256,四次网络评估、启用 CFG 时,Data-space DMD 的 FID 为 2.29,均匀时间表 DMD 为 2.61,搜索三种时间表后的 Phased DMD 为 2.37。250 次评估的流模型 FID 为 2.06,少步方案尚未达到该教师水平。
论文 Table 3:ImageNet 256×256 的主结果,FID 越低越好。上半不开 CFG,下半启用 CFG;比较 250 NFE 流模型、1–4 NFE DMD、4 NFE Phased DMD 与数据空间 DMD。oracle 仅取三种搜索时间表中的最佳结果;数据空间方法无需时间表,启用 CFG 的四步 FID 为 2.29,教师 250 NFE 为 2.06。
批判点评 :主结果是类别条件小图,文生图与其他模态仍属未来工作;自 rollout 有训练成本,不是把任何现有采样器换个循环就有效。不同训练权重与 CFG 需同时核对。作者在附录给出实现细节,未从论文入口确认独立代码仓库或权重。
3. Rubric-CEPR:只把核验通过的编辑教回模型
Rubric-CEPR: Self-Evolving Image Editing via Reward-Verified Self-Distillation | 穆罕默德·本·扎耶德人工智能大学;阿尔托大学 | arXiv:2610.12469
关键词 :图像编辑, 内部奖励, 可行性门控, 自蒸馏
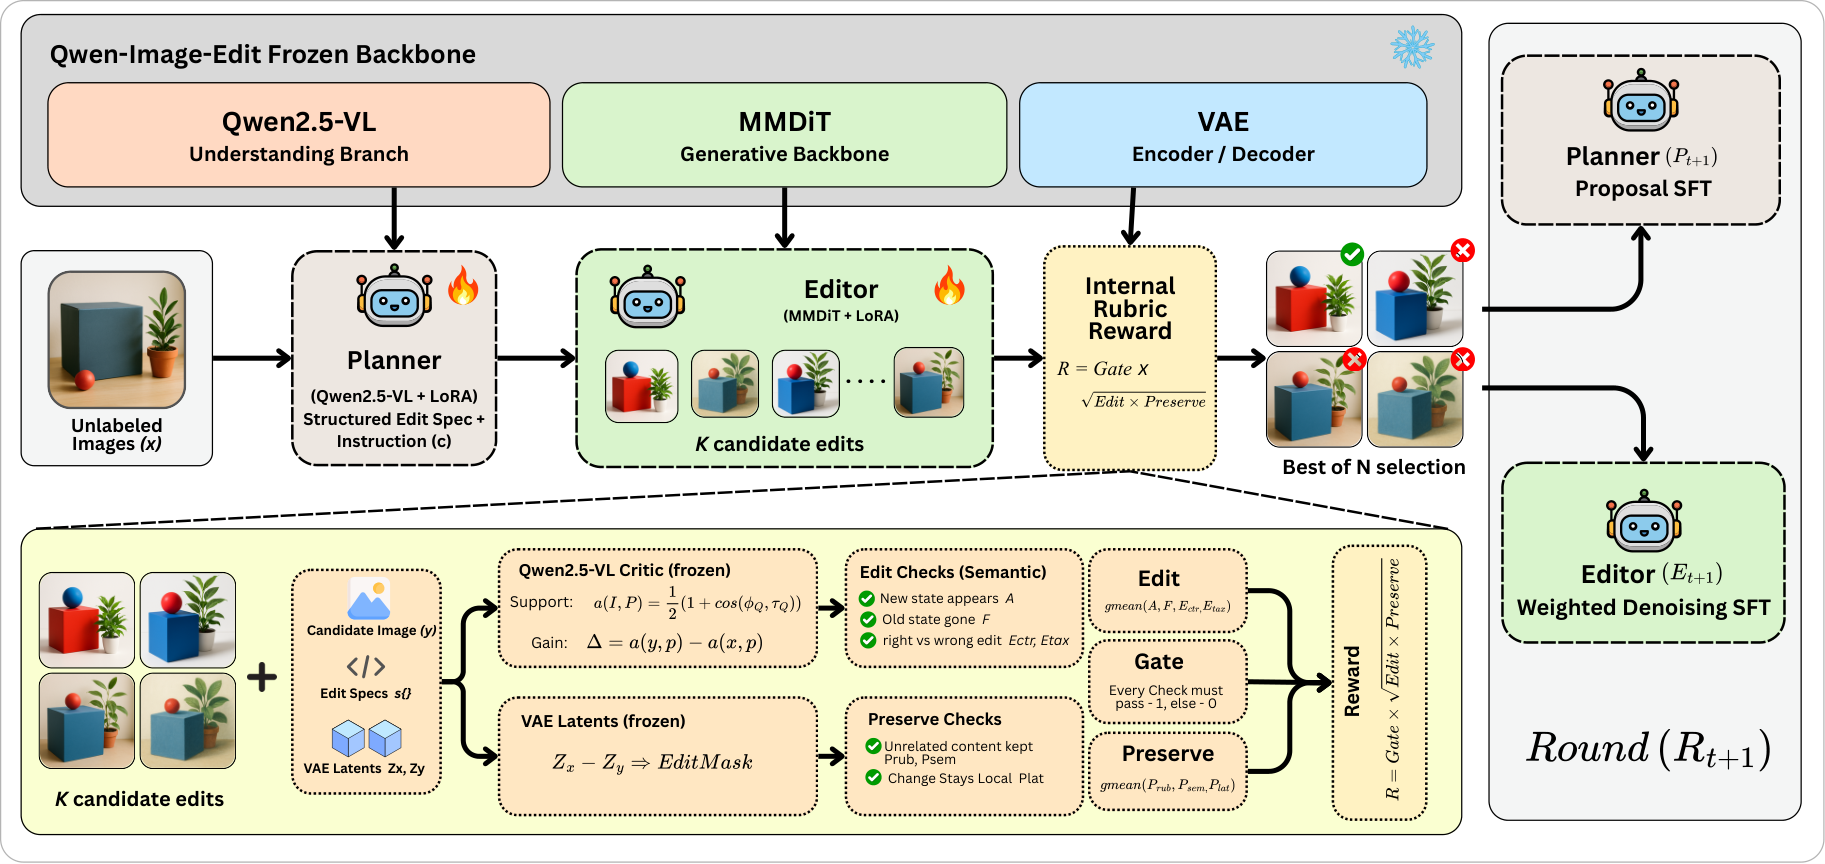
前序问题 :模型自己生成的编辑样本可能真实却没按指令改;单一奖励还可能让“保留得好”补偿“根本没编辑”,把失败教回模型。本文贡献 :Planner 从未标注图像提出结构化编辑要求,Editor 采样多个候选,冻结 Critic 利用原编辑器的视觉语言特征和 VAE 潜变量检查新状态、旧状态消除及局部保留。任何适用检查不通过就拒绝,再把最佳可行样本用于 LoRA 加权去噪训练;主要循环不查询外部奖励模型。
论文 Figure 2:Rubric-CEPR 的提出、编辑、核验与蒸馏循环。冻结 Qwen-Image-Edit 提供 Qwen2.5-VL 理解分支、MMDiT 与 VAE;Planner 的 LoRA 给出指令 c 和结构化要求 s,Editor 的 LoRA 采样 K 个编辑。冻结 Critic 以语义支持与增益、VAE 保留检查构成 R=Gate·√(Edit×Preserve),新状态、旧状态消除、正确操作、无关内容保留与局部性任一适用项失败即拒绝;最佳通过样本训练 Editor,难度带内提案轨迹训练 Planner,进入下一轮。主要循环不查询外部奖励模型。
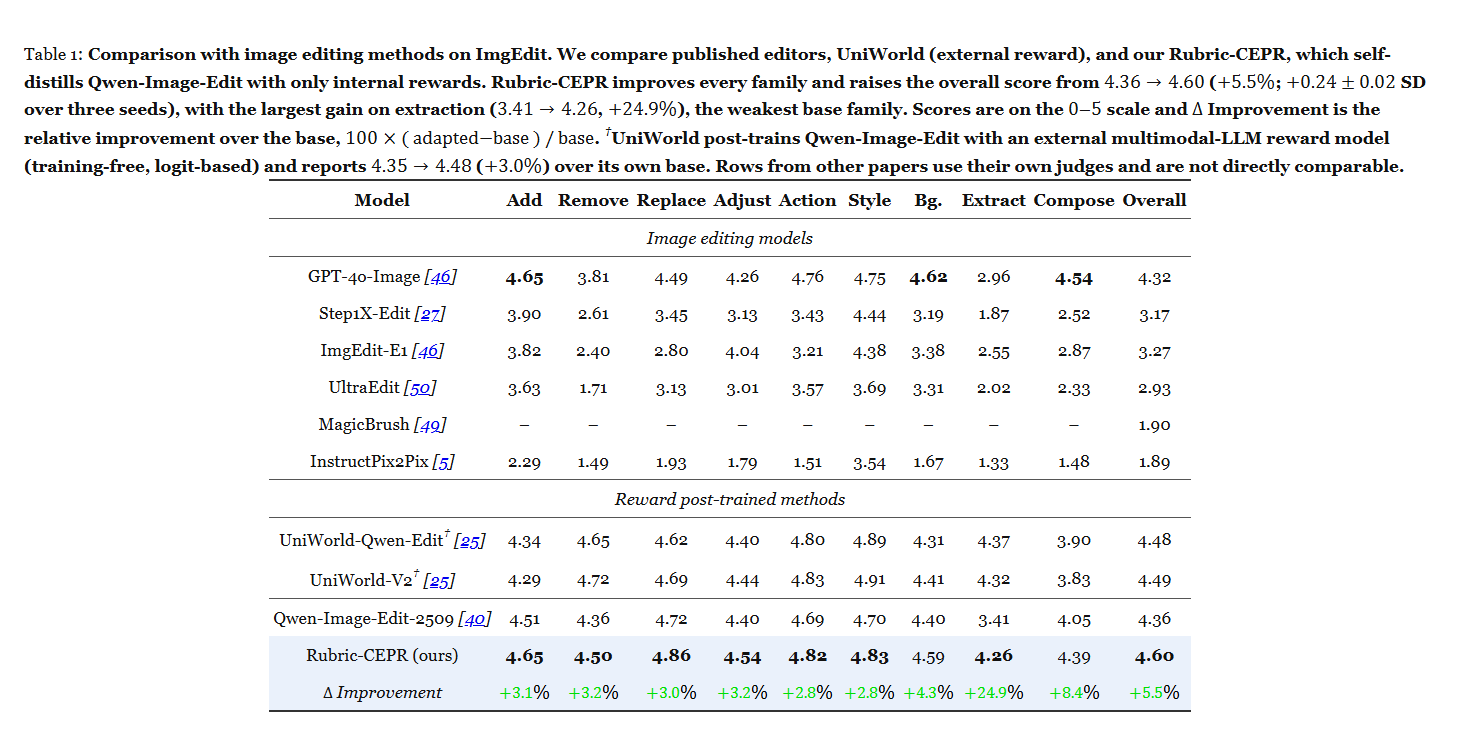
实验效果 :表 1:Qwen-Image-Edit-2509 在 ImgEdit 的 0–5 分制总分 4.36→4.60,相对提升 5.5%;物体分离 3.41→4.26,相对提升 24.9%。总分差为 0.24±0.02,报告的是三次训练种子的标准差。表 2 的 GEdit-Bench 总分 7.39→8.31。
论文 Table 1:ImgEdit 各编辑类别及总分,0–5 分制。内部奖励自蒸馏使 Qwen-Image-Edit-2509 总分 4.36→4.60,相对提升 5.5%,差值 0.24±0.02 为三种子标准差;物体分离 3.41→4.26,相对提升 24.9%。Δ 按 100×(适配分−原分)/原分计算;† UniWorld 使用外部奖励,其原模型与裁判协议不同,不能直接横向归因。
批判点评 :内部可检查的编辑更受益:若原模型完全采不到正确样本,多采样也找不到训练目标;调整类内部信号最多追回 30% 的 oracle 空间。主要结果是一次适配,不能称为持续多轮自进化。跨论文裁判协议不同。作者仓库 可访问,未运行复现。
4. VINCIE-NExT:先编辑关键帧再把变化传给视频
VINCIE-NExT: Unlocking Video Editing from Images via In-Context Modeling | 新加坡国立大学;字节 Seed;中国科学技术大学 | arXiv:2610.12104
关键词 :视频编辑, 图像示范, 共享空间位置, 编辑链
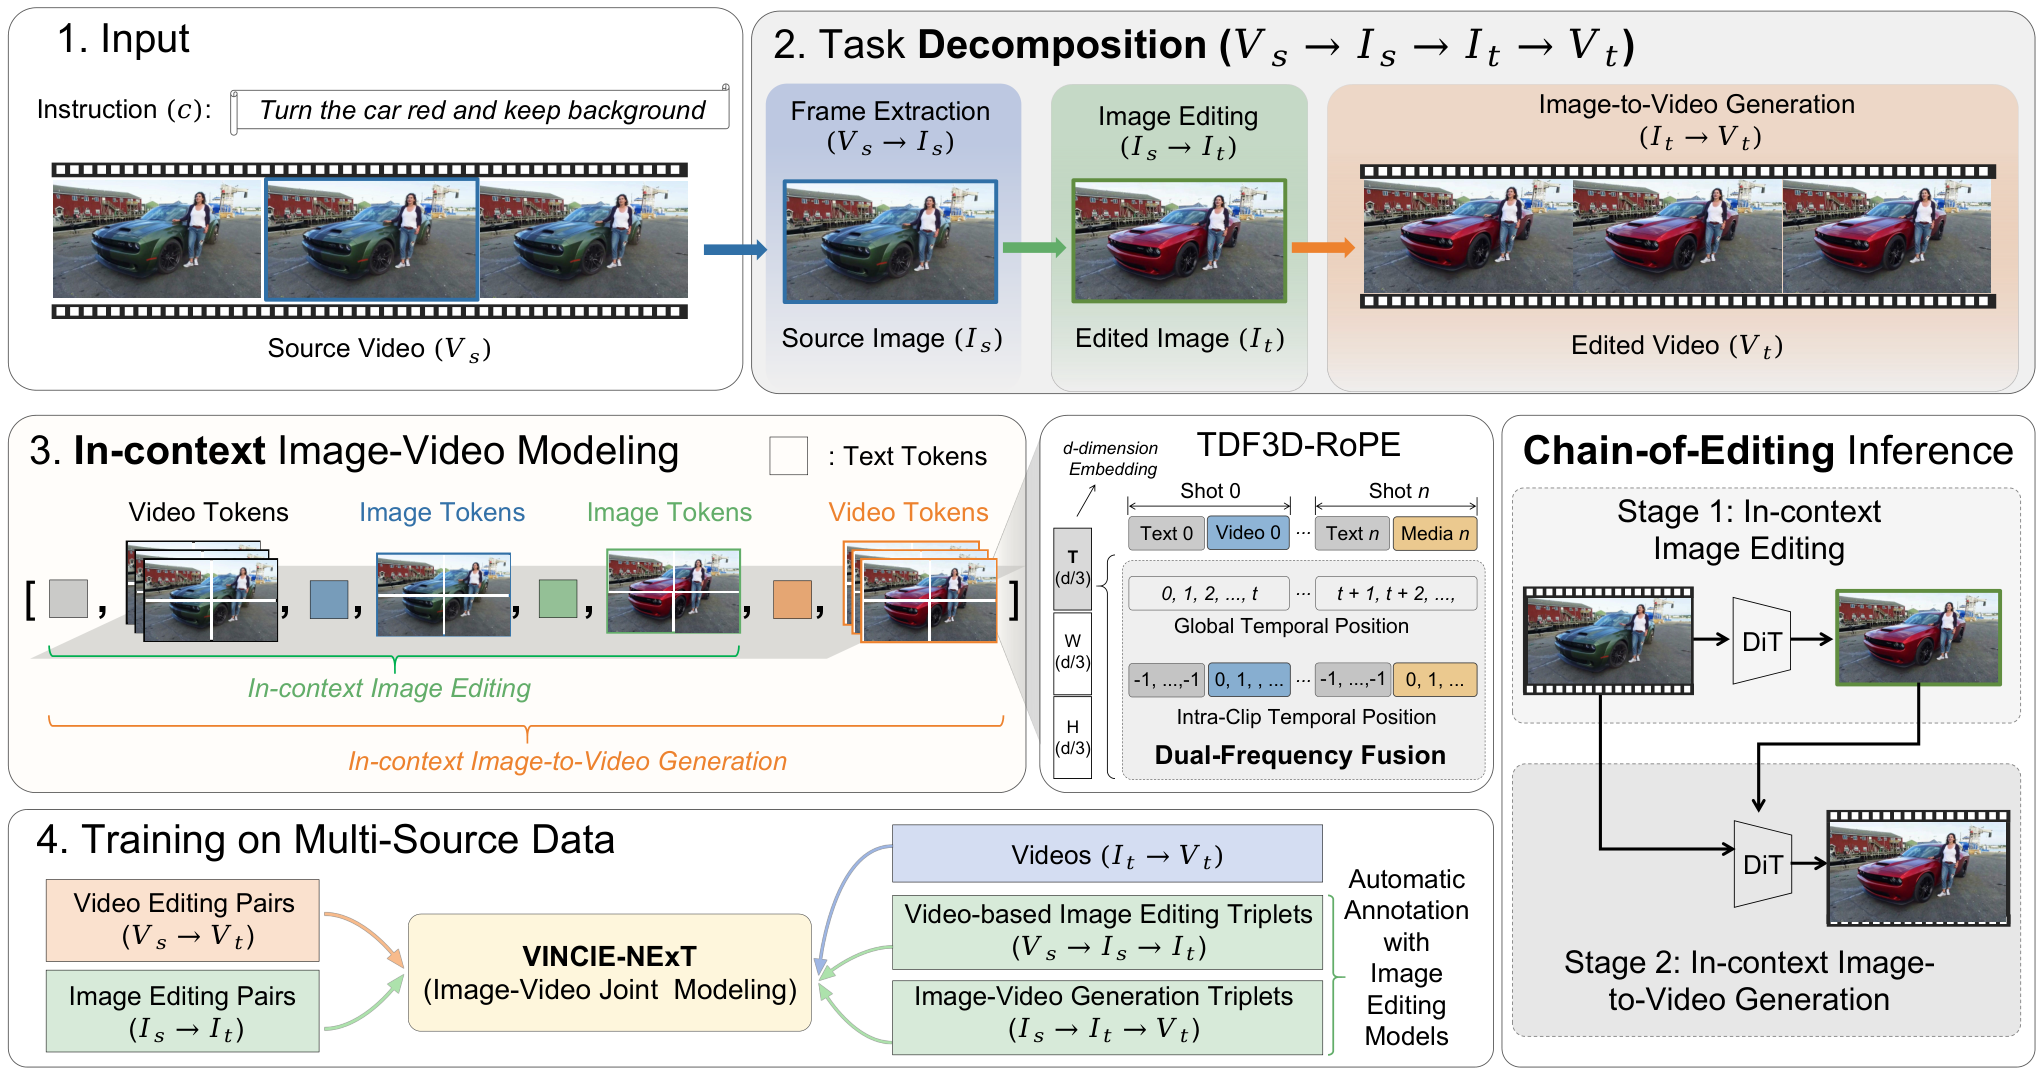
前序问题 :视频编辑三元组昂贵;成熟图像编辑数据很多,但改对一帧不代表变化能稳定传到所有视频帧。本文贡献 :把任务拆成视频→图像→编辑图像→视频,以源与目标图像对作为上下文示范;TDF3D-RoPE 将示范和视频帧放在共享空间坐标中,统一扩散主干联合学习各子链。Chain-of-Editing 在推理时先得到编辑图像,再生成编辑视频,也允许更强图像编辑器提供示范。
论文 Figure 2:VINCIE-NExT 总体架构。把视频编辑分成视频→图像→图像→视频子任务链,源图 Iˢ 与编辑图 Iᵗ 作为上下文视觉示范。统一扩散主干据此把成熟图像编辑先验迁移到视频帧;图中各段代表可组合子链,而非完全无需视频编辑训练数据。
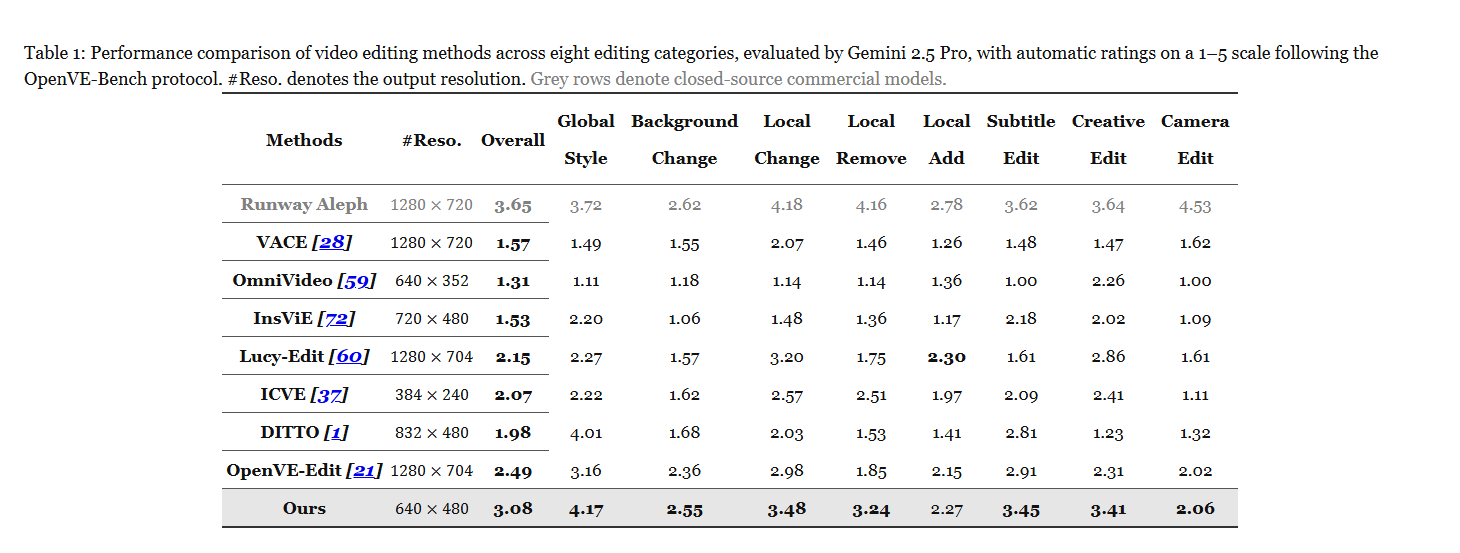
实验效果 :表 1:431 段 OpenVE-Bench,Gemini 2.5 Pro 按 1–5 分评分,VINCIE-NExT 总分 3.08,高于 OpenVE-Edit 的 2.49,但低于 Runway Aleph 的 3.65;输出分辨率分别为 640×480、1280×704、1280×720。表 2 的第一阶段 256×256 模型,全数据加 CoE 为 2.65,不是同条件的 3.08。
论文 Table 1:OpenVE-Bench 八类编辑比较,Gemini 2.5 Pro 按 1–5 分自动评分。#Reso. 为输出分辨率,灰行是闭源商业模型。VINCIE-NExT 在 640×480 总分 3.08,OpenVE-Edit 在 1280×704 为 2.49,Runway Aleph 在 1280×720 为 3.65;各类包括全局风格、背景、局部改删增、字幕、创意与相机编辑。
批判点评 :训练仍用了 OpenVE 视频编辑配对,不能叫完全不用配对视频;关键帧编辑错误会被传播,长视频与大相机运动仍待验证。CoE 增加串行扩散阶段。arXiv 注释明确已接收 NeurIPS 2026。作者项目页 有仓库入口,但当前仓库只有 LICENSE 和 README,方法实现与权重尚未公开。
5. PTD:让四步学生沿自己的曲线学
Parametric Trajectory Distillation for Few-Step Video Generation | 洛桑联邦理工学院;NVIDIA;斯坦福大学 | arXiv:2610.11498
关键词 :视频少步蒸馏, 参数化轨迹, 教师速度监督, 多样性
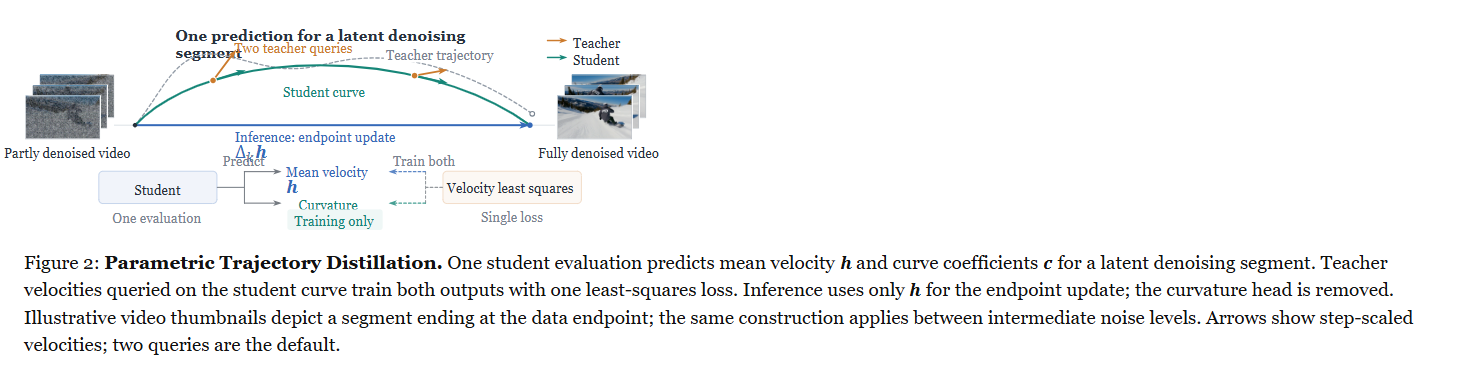
前序问题 :把高度弯曲的教师轨迹压成几次学生评估,学生容量可能学不动,导致细节变软或不同种子生成近似视频。本文贡献 :Parametric Trajectory Distillation 让学生预测片段的平均速度与多项式曲率,在学生当前曲线上查询教师速度,以最小二乘损失同时学位移和形状;部署时去掉曲率头,只用平均速度更新端点。MiniMax-H3 的最后一个较平滑片段采用教师积分目标,并非所有片段都同一种监督。
论文 Figure 2:参数化轨迹蒸馏。一次学生评估输出平均速度 h 与曲率系数 c,参数化潜变量去噪片段;在学生曲线上查询教师速度,以同一个最小二乘损失监督两者。推理只使用 h 更新片段端点,移除曲率头。小视频图示意片段终止于数据端点,同样构造适用于中间噪声层;箭头为步长缩放速度,默认每片段查询两次教师。
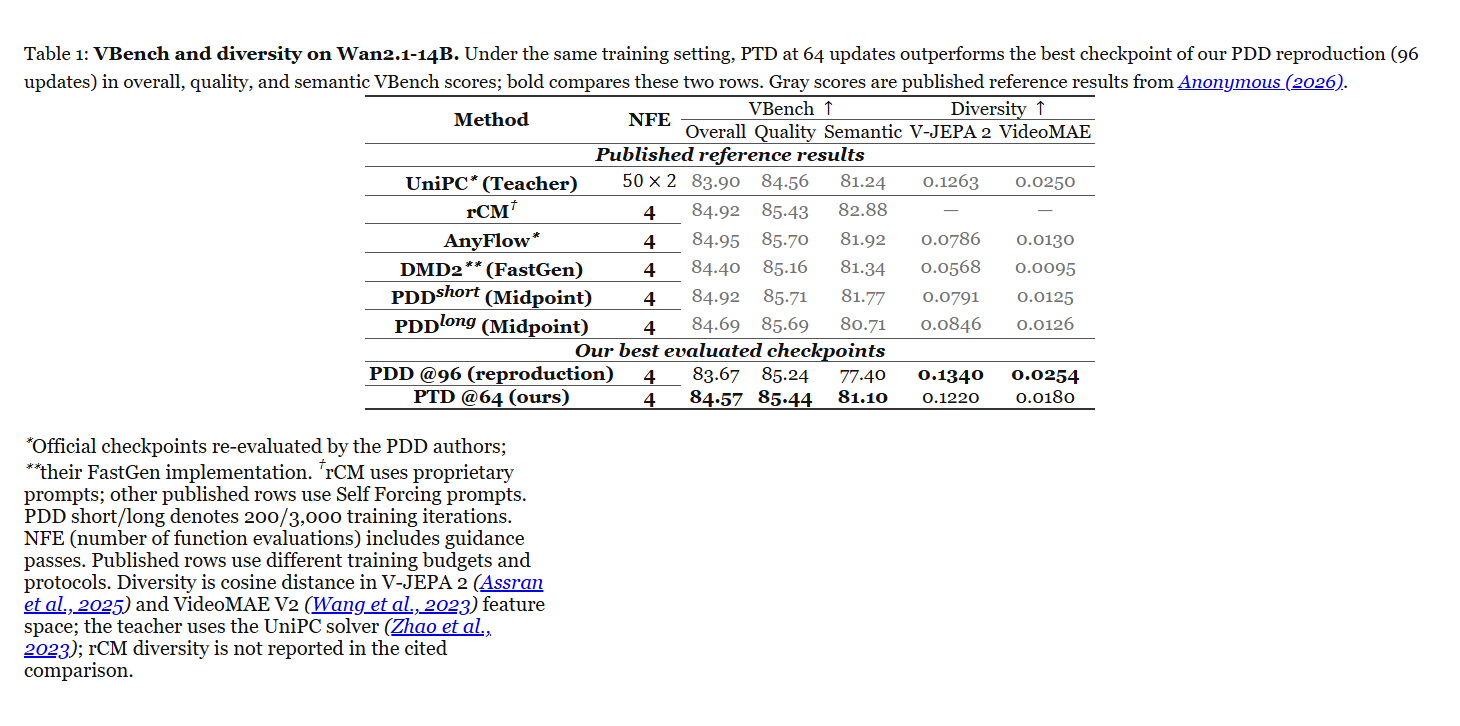
实验效果 :表 1:Wan2.1-14B 四次网络评估,匹配训练设置的 PDD 复现 VBench 总分 83.67→PTD 84.57,语义分 77.40→81.10。盲测人类偏好份额相对 PDD 为 55.1%,相对 MiniMax-H3 上的 LightX2V Turbo 为 63.4%。这是两项独立比较,不是所有基线的平均胜率。
论文 Table 1:Wan2.1-14B 的 VBench 与多样性。粗体只对比相同训练设置下 PDD 第96次更新与 PTD 第64次更新;灰色行是已发表参考,训练预算及协议不同。NFE 含引导评估,教师为 50×2;多样性是 V-JEPA 2 与 VideoMAE V2 特征余弦距离。PTD 总分和语义分提升,但这两项多样性不高于该 PDD 复现;rCM 用专有 prompt 且未报告多样性。
批判点评 :表 1 的 VideoMAE 多样性 0.0254→0.0180,改善并非所有指标同时成立;发表的参考行训练预算和协议不同。去掉训练曲率头不等于不用蒸馏,四次评估也不等于视频生成时延。作者项目页 有演示,未确认 PTD 方法权重公开。
6. iCATS:按交互与噪声动态稀疏注意力
iCATS: Fast Video Generation via Interaction-Aware Sparse Attention and Timestep-Adaptive Sparsity | 杭州师范大学;平头哥半导体;阿里巴巴 | arXiv:2610.11302
关键词 :视频DiT加速, 交互聚类, SNR稀疏调度, 尾部合并
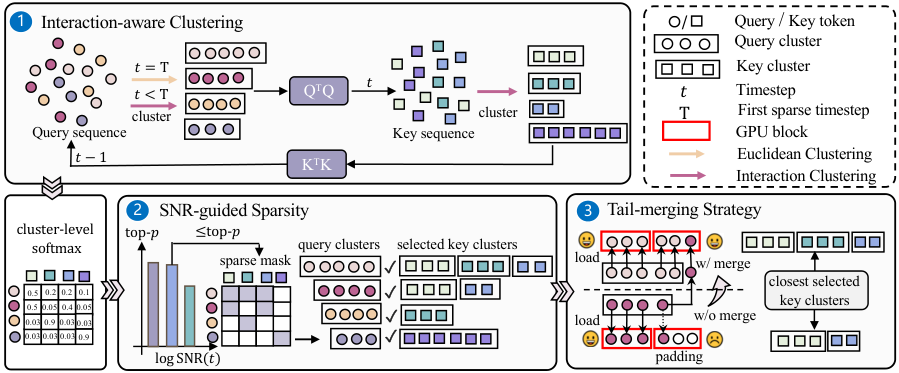
前序问题 :独立按特征距离聚类 query 与 key,未必保留实际注意力交互;固定稀疏度和不规则簇填充又会损伤画质与 GPU 利用率。本文贡献 :iCATS 用 query-key 点积交互定义聚类目标,并改写成低成本二次型;以信噪比 SNR 调整各去噪时间步的 top-p 稀疏掩码。执行时将不满计算块的尾部 token 重新分配,减少 padding。无需微调生成主干,但聚类、调度与稀疏 kernel 都有实际开销。
论文 Figure 3:iCATS 的稀疏注意力流程。①按 query-key 交互聚类,用簇中心估计簇级 softmax;②以 SNR 引导每个去噪步的 top-p 值并选注意力计算区域;③在稀疏 kernel 前重分配未对齐计算块的 query 簇尾部 token,减少不规则簇的 padding。图中 interaction clustering 为交互聚类,Euclidean clustering 仅用于首个稀疏步初始化 query 簇。
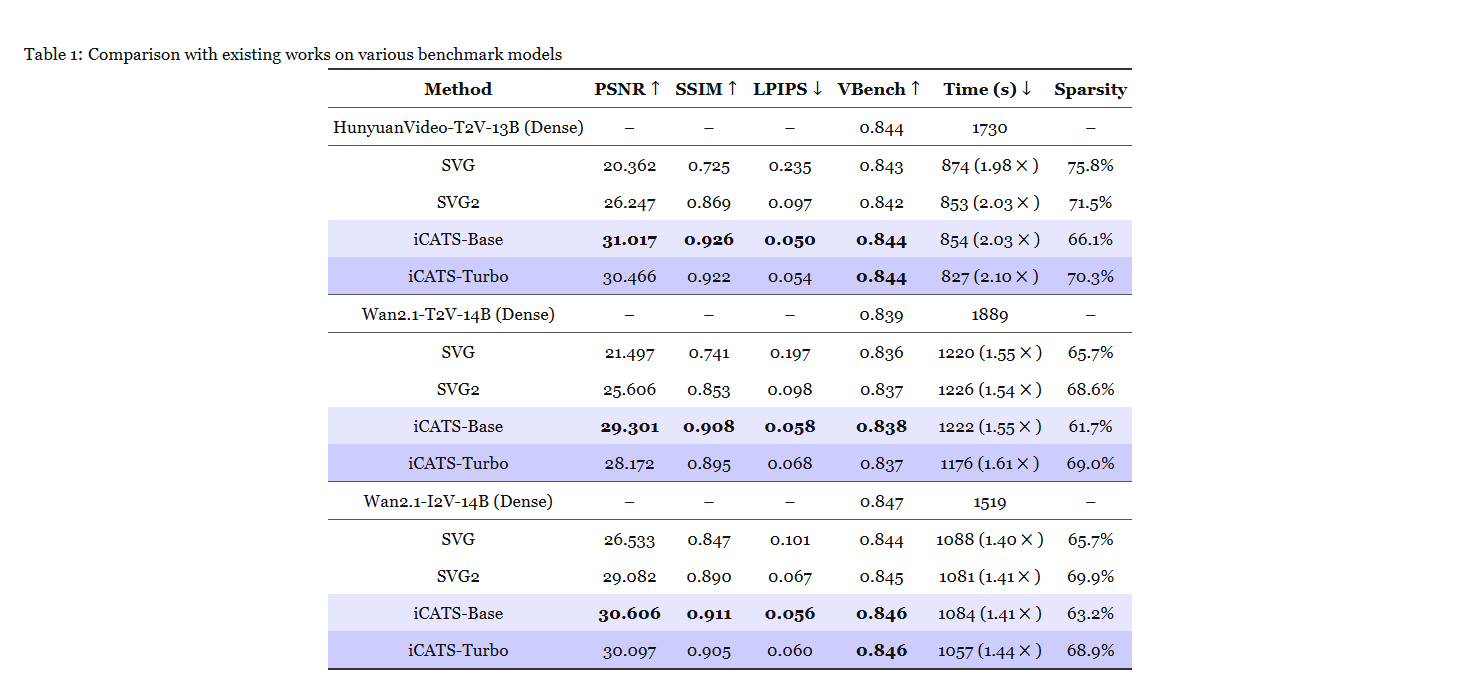
实验效果 :表 1:5 秒 720p、八张 H100,HunyuanVideo-T2V-13B 的 iCATS-Base 从 1730 秒降至 854 秒,2.03 倍,PSNR 31.017 dB;Wan2.1-T2V-14B 从 1889→1222 秒,1.55 倍,PSNR 29.301 dB。相应 VBench 为 0.844 与 0.838。
论文 Table 1:三种视频主干的密集、SVG、SVG2、iCATS-Base 与 Turbo 比较。PSNR、SSIM、LPIPS 衡量相对原模型输出的保真度,VBench 衡量视频质量,Time 是实测秒数,Sparsity 是理论注意力计算削减比例。5秒720p、八H100下,Hunyuan Base 为854秒、2.03倍、31.017dB,Wan文生视频 Base 为1222秒、1.55倍、29.301dB;不可把稀疏率当整体加速率。
批判点评 :PSNR 比的是相同配置的原密集模型输出,不是真实视频真值;理论稀疏率不能当实际整体加速率。八卡结果不能外推单卡,且聚类多卡并行和 token 级 kernel 仍待优化。未从论文作者入口确认代码或权重公开。
7. SpaceFlow:不同3D部位分配不同控制强度
SpaceFlow: Locally Controllable 3D Generation | 苏黎世联邦理工学院;斯坦福大学;Microsoft | arXiv:2610.12399
关键词 :3D生成, 局部几何控制, 部件条件路由, 自相似引导
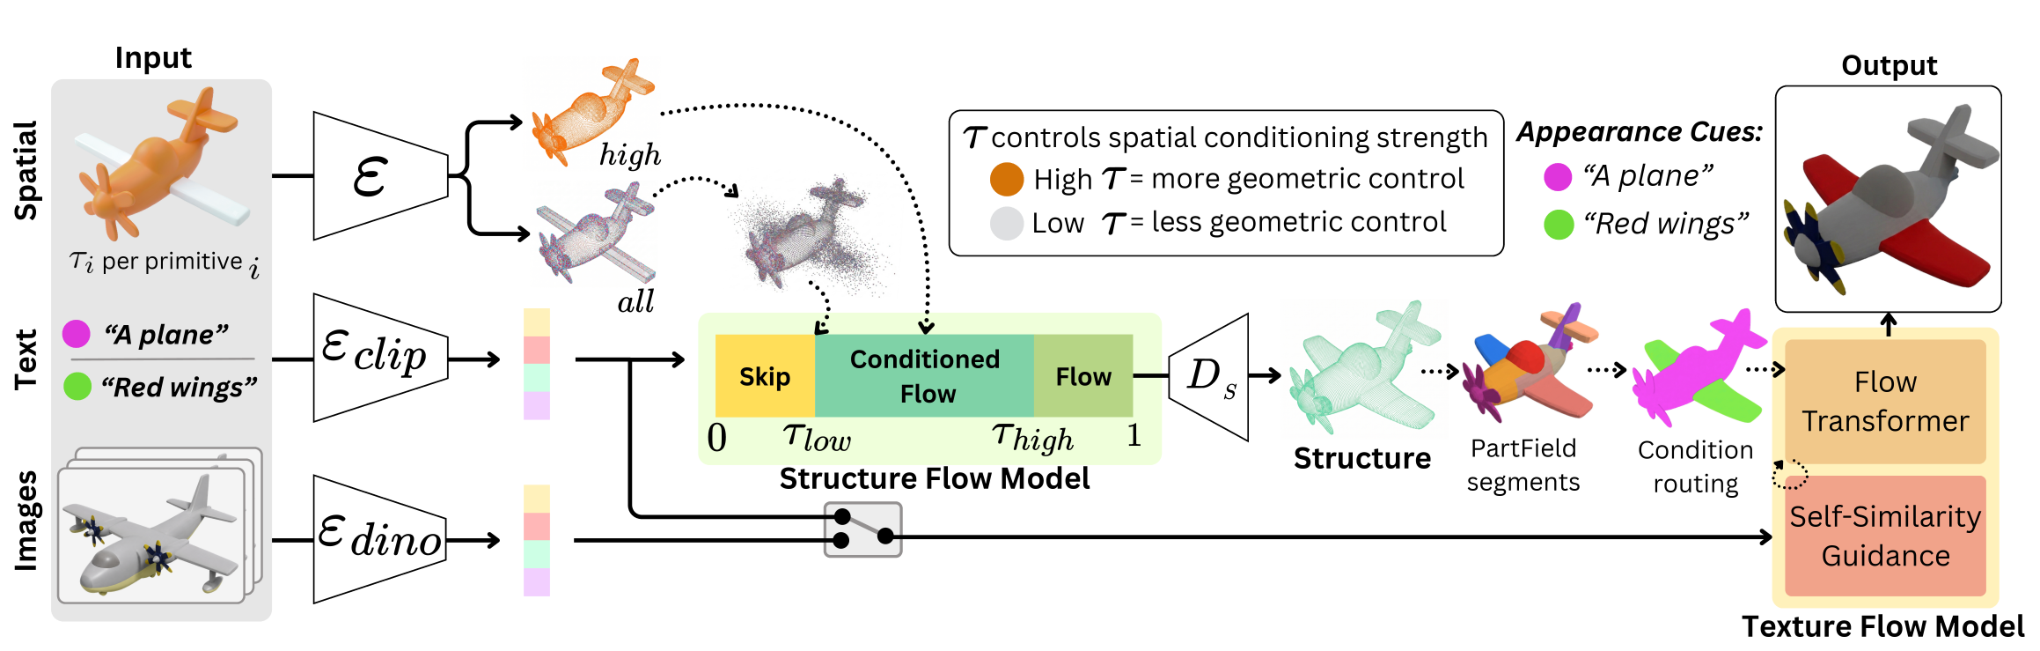
前序问题 :对整个物体统一控制强度,难同时保住指定结构并让其他部位自由生成;局部材质 prompt 还可能串到别的部件。本文贡献 :SpaceFlow 在 TRELLIS 推理中给每个几何 primitive 指定强弱控制,在受控时间段注入高控制区域;生成结构后用 PartField 划分部件,将局部文本或图像外观条件路由到对应区域,再用自相似引导细化外观。几何约束与外观条件分别作用,支持同一物体各部位不同自由度。
论文 Figure 2:SpaceFlow 流程。输入可编辑几何及局部控制强度 τᵢ,在受控时间段把高控制区域注入稀疏结构 flow;PartField 分割生成结构后,将每个部件的文字或图像条件只路由到该部件,再经外观 flow 与自相似引导得到局部几何和外观可控的3D资产。
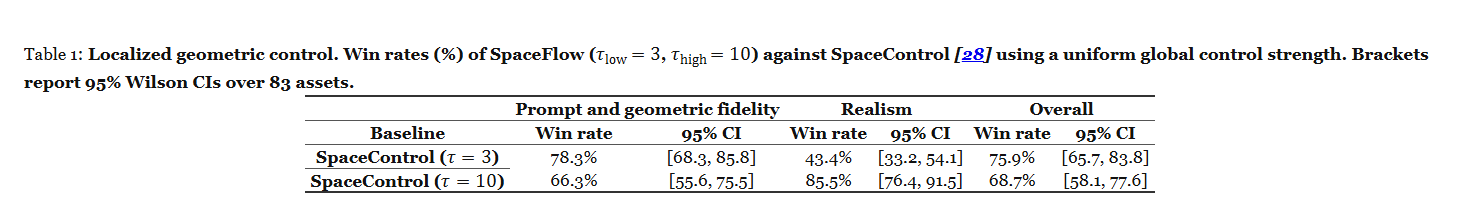
实验效果 :表 1:83 个资产,局部 τ=3/10 对比统一 τ=3,prompt 与几何保真胜率 78.3%、总体胜率 75.9%,但真实感胜率仅 43.4%;对比统一 τ=10,总体胜率为 68.7%。表 4 的外观总体评分 6.78,但纹理细节 6.49 低于 TRELLIS 的 6.87。
论文 Table 1:83个资产上局部几何控制胜率。SpaceFlow 低/高 τ 为3/10,与统一全局 τ=3及τ=10的 SpaceControl 比较 prompt与几何保真、真实感和总体偏好;括号为95% Wilson区间。对τ=3,总体75.9%但真实感43.4%;对τ=10,总体68.7%,说明保真与真实感存在条件相关取舍。
批判点评 :胜率来自指定视觉语言裁判与资产集,表中附 95% Wilson 区间,不能当任意3D对象的成功率。语义与强几何约束冲突时会变形;更多局部控制也未必提升纹理细节。原文给出推理设置,未确认作者已发布 SpaceFlow 实现。
8. SepGen:同次生成视频混音和两路分轨
SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model | 特拉维夫大学;Google | arXiv:2610.11361
关键词 :音视频生成, 分轨生成, 文本寻址, 混音噪声调度
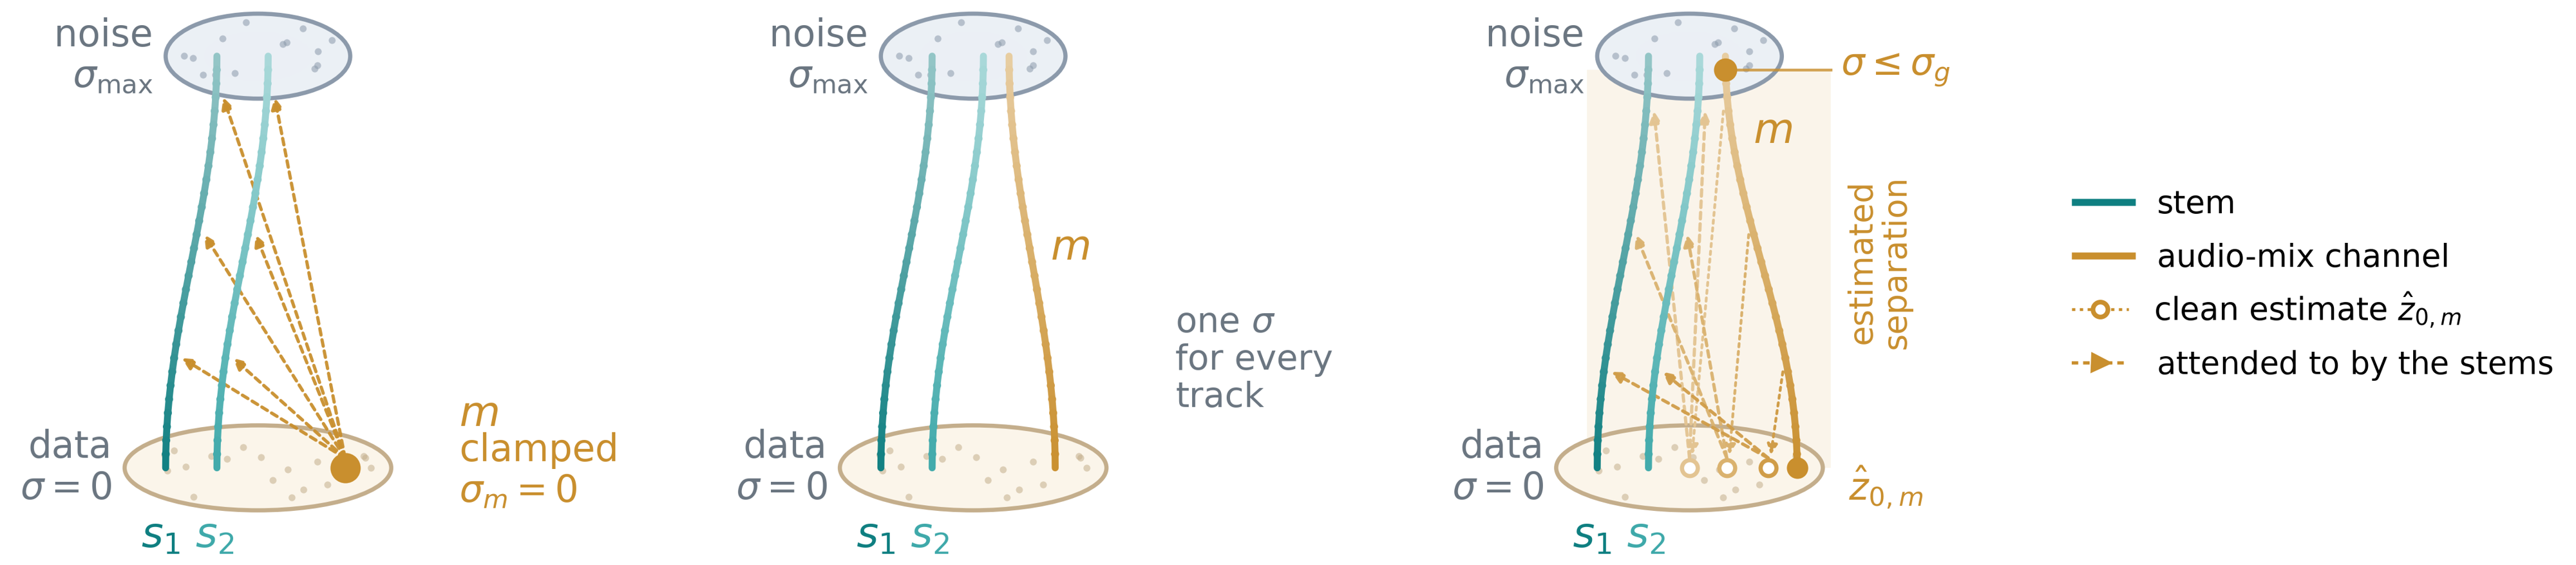
前序问题 :音视频模型通常只给一条混音;想换视角做空间音频,或单独编辑某个声源,就缺少可寻址的独立波形。本文贡献 :SepGen 在预训练音视频双流模型中增加分轨 adapter,每路由独立描述指定声源,在同次采样中生成视频、混音与分轨。分离模式保持输入混音干净;生成模式在高噪声读取带噪混音,低于阈值 σ_g 后读取其干净预测,减少分轨与混音错位。原混音主干保持不变。
论文 Figure 2:σ空间中的三种推理调度,从左到右:(a)分离模式保持混音 m 干净;(b)朴素共享噪声生成让分轨和混音处于同一噪声层;(c)SepGen 的分轨在 σ_g 以上读带噪混音,以下读其干净估计 ẑ₀,m,以改善生成时各声源与混音的对应。
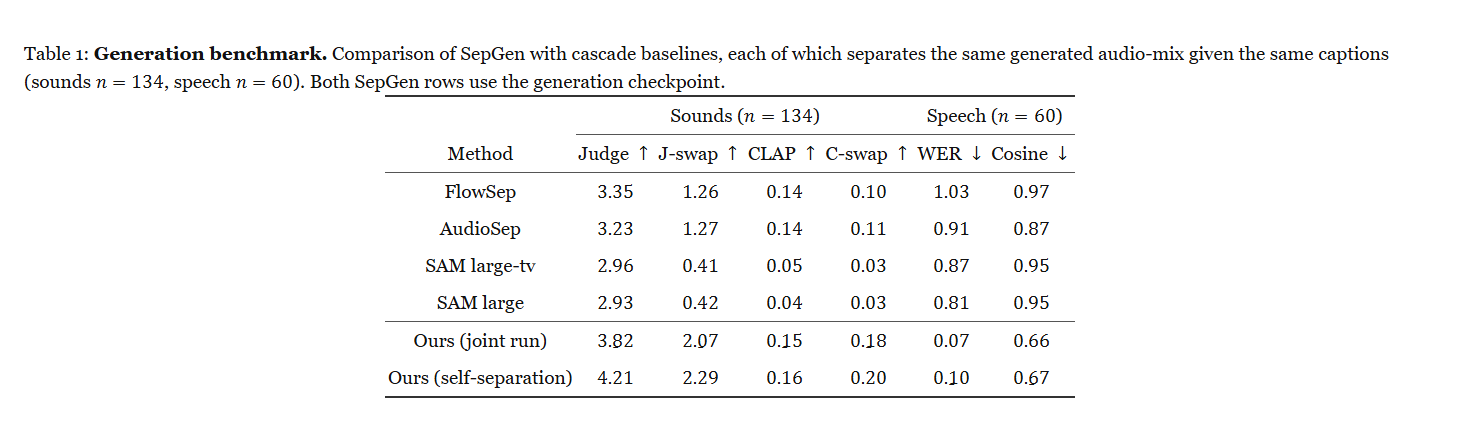
实验效果 :表 1:134 个声音案例和 60 个语音案例,联合生成的声音裁判分为 3.82,FlowSep 串行分离为 3.35;语音 WER 为 0.07,即 7%,FlowSep 为 1.03,即 103%。额外自分离声音分为 4.21,却使 WER 变为 0.10;这需要再运行一次,不能算同次采样。
论文 Table 1:生成评测,134个声音与60个语音案例;所有串行基线对同一生成混音和相同描述做分离,两行 SepGen 都使用生成 checkpoint。Judge/J-swap 为声音裁判及描述交换分,CLAP/C-swap为声音文本对齐及交换分,越高越好;语音WER与跨轨Cosine越低越好。联合采样WER0.07是7%,额外自分离WER0.10是10%;粗体与下划线是最好与次好,不代表额外自分离也是一次采样。
批判点评 :当前训练和评估固定两个声源,不能声称任意数量分轨;声源仍带原场景混响与距离线索,完整新视角空间渲染属于后续工作。codec 重合成相位还影响 SI-SDR 的解释。作者项目页 列出代码、模型和数据入口,未运行复现。
9. EDICT:全局改音色局部切换说话方式
Edit Who Speaks, Control How They Speak: Global Timbre Editing and Local Instruction Control for TTS | 新加坡国立大学;LIGHTSPEED;南洋理工大学;独立研究者 | arXiv:2610.11437
关键词 :语音生成, 音色编辑, 局部指令, KV缓存重建
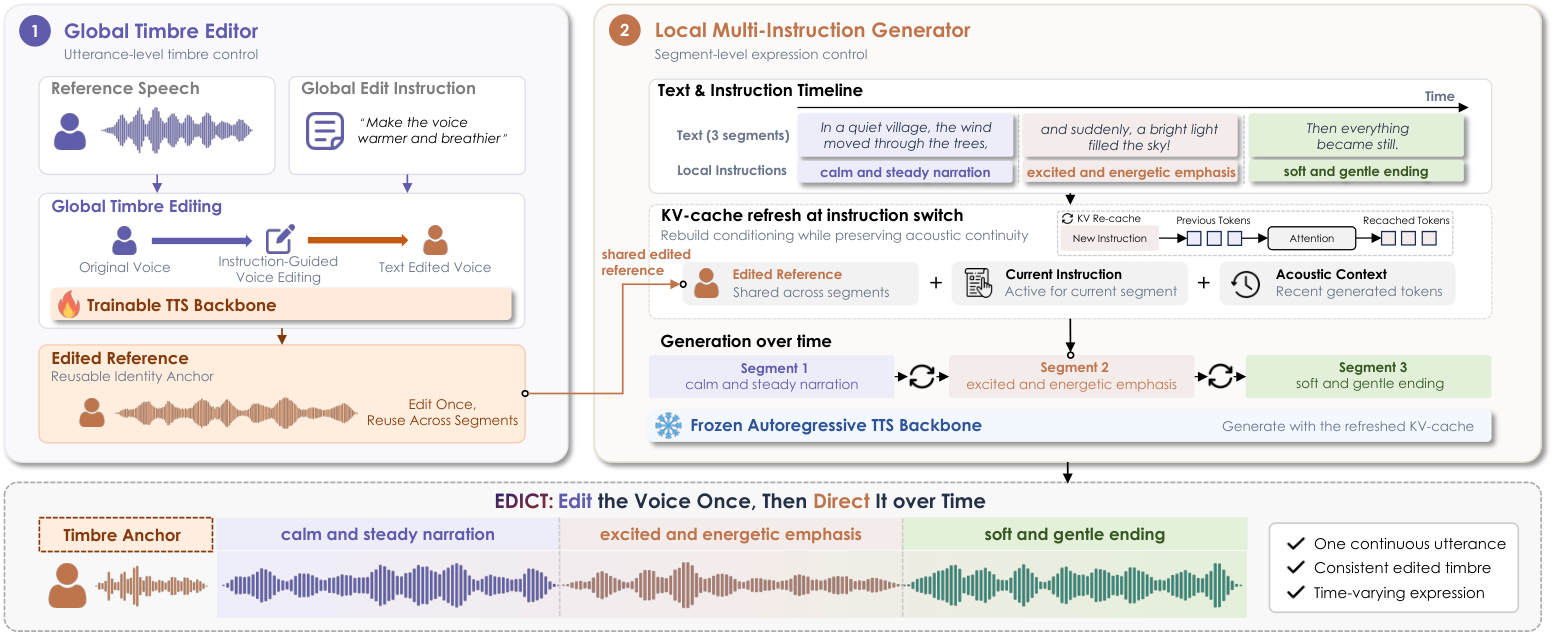
前序问题 :参考语音克隆保留旧音色,文字设计又难在同一参考上微改;整句表达指令无法准确控制每个文本片段的语气。本文贡献 :EDICT 先把参考语音和结构化属性编辑送入可训练音色编辑器,生成 codec token 参考,作为各段共享的身份锚。冻结 TTS 主干按分段指令连续生成,在每个边界重建 KV 缓存:换入新指令和文本,同时保留首段与最近一段选定声学上下文,让表达变化但声音身份连续。
论文 Figure 1:EDICT 联合全局音色编辑与局部表达控制。可训练编辑器读取源参考和全局编辑指令,输出共享codec参考;每段冻结TTS均使用它。在指令边界重建KV缓存,以选定历史声学上下文保持衔接,多个片段组成一条连续话语。
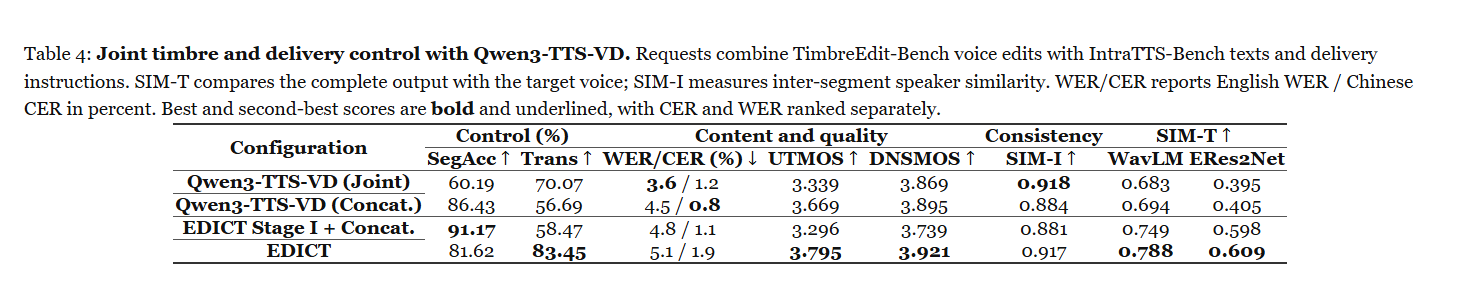
实验效果 :表 4:Qwen3-TTS-VD 联合控制,EDICT 的片段指令准确率 81.62%、过渡质量 83.45%;原 Joint 为 60.19%、70.07%。段间说话人相似度为 0.917、与原 0.918 接近;英文 WER 3.6%→5.1%,中文 CER 1.2%→1.9%,内容正确性付出代价。
论文 Table 4:Qwen3-TTS-VD上的联合音色及表达控制,请求结合TimbreEdit-Bench的音色编辑与IntraTTS-Bench的分段指令。SIM-T是整条语音与目标声线相似度,SIM-I是段间相似度;WER/CER分别为英文/中文百分数,粗体/下划线为最好/次好且分语种排名。EDICT的SegAcc81.62%、Trans83.45%、SIM-I0.917;错误率5.1%/1.9%,须与控制分共同看。
批判点评 :音色编辑器仍要训练,冻结 TTS 主干不等于全系统免训练;训练、指令构造和评测含合成数据与模型裁判。指令遵循更高不能代替低错误率,推广到更多声线还待验证。作者演示页 ,未确认官方方法代码与权重入口。
10. RISEBench++:检查图像编辑是否真的推理对
Reasoning-Informed Visual Editing | 上海交通大学;东南大学;华南理工大学;微软亚洲研究院;复旦大学;华东师范大学 | arXiv:2610.12343
关键词 :生成编辑评测, 隐式规则, 多轮一致性, 多图条件
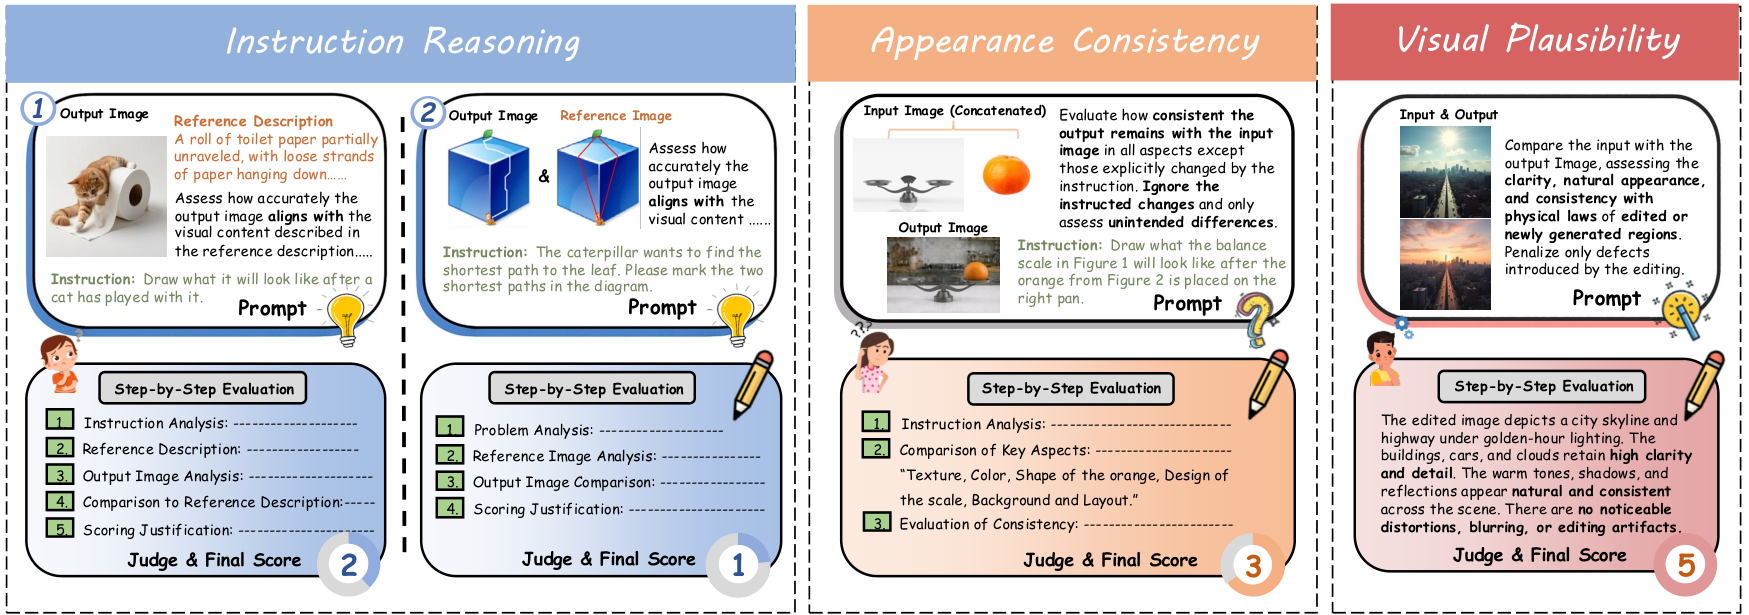
前序问题 :画得自然或保住外观,不代表模型从图中推断了正确状态;因果、空间规则和多轮条件经常在编辑图像中失效。本文贡献 :RISEBench++ 用六类推理、12 个子类和 65 种任务组织 1000 个英中文人工标注案例,覆盖单图、多图与多轮编辑。裁判分别评指令推理、外观一致性和视觉合理性,以任务条件检查生成图像;论文另研究带规划与核验的编辑执行流程,本期关注生成能力评测。
论文 Figure 3:RISEBench++的三维评测与流程。指令推理与外观一致性由Gemini-3-Flash按类别专用prompt评判,视觉合理性由Gemini-3.1-Flash-Lite评判;分别检查是否推理并执行正确、保留应保内容及画面是否合理,不能以自然外观替代推理正确性。
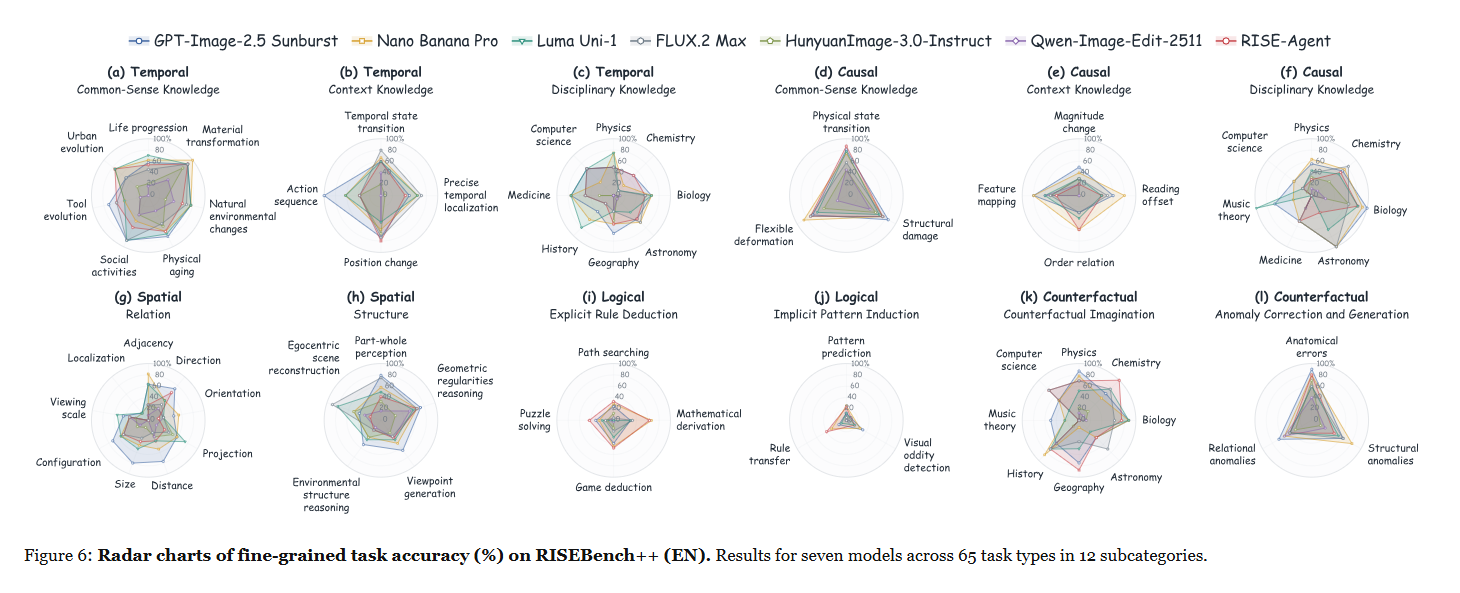
实验效果 :表 1、2:共评估 58 个视觉编辑方案。英文集 GPT-Image-2.5 Sunburst 总任务准确率 56.6%,逻辑类 27.0%、混合类 39.0%;Nano Banana Pro 总分 54.6%,逻辑类 36.0%。领先总分也可能有明显类别短板,不能从一个榜单分推断所有编辑能力。
论文 Figure 6:英文RISEBench++细粒度任务准确率雷达图,展示七个模型在12个子类的65种任务上的表现。各轴对应不同任务,局部短板与总分排名并不一致;数值是此评测协议的任务判定,不是所有真实编辑的通用成功率。
批判点评 :准确率是本数据集、指定模型版本和裁判协议下的任务判定;混合多轮错误会累积,英中文结果须分别看。不是纯视觉理解测验,产出要求确实编辑图像。官方仓库 提供评测说明与样例,完整千例数据链接已单独核查。
趋势观察
先定义计算预算再谈加速
BudgetPix分配token,Data-space DMD调整迭代位置,PTD匹配学生能学的曲线,iCATS兼顾注意力保真和kernel开销。token比例、网络评估次数和端到端时延是不同口径。
内部监督也要验证失败条件
Rubric-CEPR用不可互相补偿的门控筛目标;RISEBench++把推理执行与外观合理性分开。画面真实或自评高分都不够,仍要检查未编辑内容和真实任务约束。
把控制绑定到正确对象与时间
VINCIE-NExT绑定关键帧示范,SpaceFlow路由到局部部件,SepGen分配声源描述,EDICT在分段边界重建上下文。局部控制有效,还要验证全局一致性与连续性。
更高总分仍可能付出代价
EDICT内容错误率、SpaceFlow纹理细节、PTD部分多样性都揭示不同目标间的取舍。部署时应使用自己的分辨率、声源数、视频长度与硬件复核。
今日讨论
BudgetPix用四叉树按熵分配token,在25%预算下GenEval为0.725,但全分辨率像素阶段形成计算下限;你会用哪些细节证据与端到端时延测量,判断这种预算在自己的图像生成场景中是否值得采用?
人工智能炼丹君 整理 | 2026-10-12



评论 (0)