搜索到
92
篇与
视频生成
的结果
-
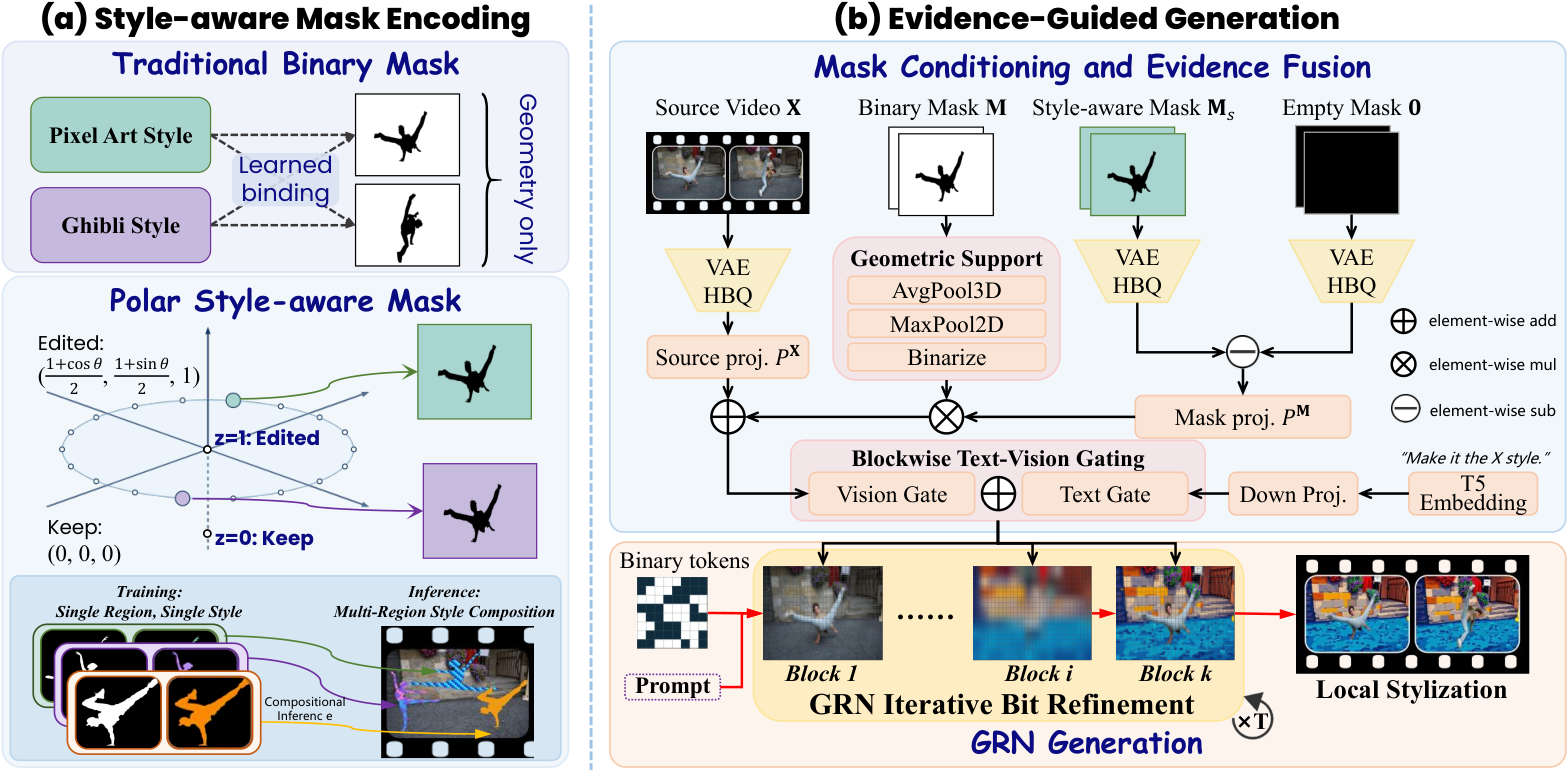
 AIGC 每日速读|2026-10-30|小米只给局部视频换画风LociArt 今日 AIGC 论文速览 今日共 10 篇 · 视频局部编辑与图像编辑防护 2 篇 · 物理外观编辑与视频记忆 2 篇 · 生成训练与表征 2 篇 · 少步生成安全 1 篇 · 图像与音乐编辑评测 2 篇 · 交互视频世界 1 篇 重点论文标题列表 LociArt(小米):只给选中区域换画风 CaD(普林斯顿):让编辑器照抄原图来防改 SREdit(西南大学):先看投影照得动哪里再改 VMem-Bench(可灵):旧参考能记住也能带错人 NTI(港大):训练别只认唯一下一块 选读入口:要给视频局部换画风,先读 LociArt 并确认风格已学、区域互不重叠;想保护照片免遭改动,读方向相反的 CaD。要把改图投回实体,读 SREdit 的额外 0.60 至 0.73 秒与完整系统成本;长故事换装或角色退场,读 VMem-Bench 的召回/错带实体取舍。训练视觉自回归看 NTI,选择压缩器先看 WithinVAE 的生成负结果。部署少步模型再读 DICE;手机预算读 MoI-Bench,编辑音乐读 SMEBench。最后用 BoxWorld 思考哪些互动规则应交给显式引擎。 今日论文速览 1. LociArt:只给选中区域换画风 LociArt: A Unified Paradigm for Free-Style Local Video Stylization | 小米 MiLM Plus;西安电子科技大学 | arXiv:2610.36456 关键词:局部视频风格化, 极坐标风格掩码, 区域几何约束, 风格扩展 前序问题:想让视频里的熊变成铅笔画,周围石头仍保留原色;整段换风格容易,局部换风格却会越界、闪烁。二值掩码只说改哪里,还没有把每个区域与它的风格绑在一起。 方法直觉:把风格当成单位圆上不同方向,直接写进要编辑的区域;再同时保留压缩后的上下文和原掩码的几何边界。模型既知道这里该换什么画风,也知道影响应停在哪里。 本文贡献:GRNStyle 基于 GRN 生成细化网络,以二进制视觉 token(压缩视觉单元)并行迭代生成。三通道风格掩码前两维存缩放后的极坐标,第三维存占用,不额外增加通道或 token。编码掩码减去空掩码编码,消除空条件偏置;池化的原掩码提供几何支撑,再与源视频特征经逐块视觉/文字门控注入。自动全局风格化、去物体、抠图与合成构造 10 万对视频;从预训练 GRNEdit 初始化 20 亿参数主干,8 张 H200 全量微调,训练 61 帧、20 帧/秒、18 种风格。 原文图 2|GRNStyle 总览。(a)极坐标风格掩码把风格绑定到区域,并支持多区域组合;(b)减去空掩码的锚定证据与原掩码几何支撑同源视频特征融合,经逐块门控引导局部视频风格化。 实验效果:80 条视频、84 个视频-物体掩码单元,前景/背景两协议共 168 例。对同数据微调的 VACE-1.3B,区域风格原型相似度 SPS 前景 0.386→0.407、背景 0.676→0.705;未编辑区域 PSNR 峰值信噪比 25.43→25.92、25.49→26.15 dB。相邻帧 CLIP 视觉特征余弦一致性 0.980→0.983,均越高越好,但不是像素级无闪烁保证。10 扩 15 风格且不回放旧数据,旧类 SPS 下降 0.022,对二值版 0.102。 原文表 1|LociArt 基准比较。fg/bg 为编辑目标掩码及其补集;FT 为局部风格微调,星号为免训练,剑号为直接合成掩码且非编辑区复制源像素,因此省略不可比 PSNR,双剑号为图像方法。SPS、区域文字相似、非目标保真和相邻帧一致性及风格/保留裁判分均越高越好,粗体和下划线分别标最优与次优。 批判点评:多区域组合只展示不相交区域及已学风格的定性案例,不能称任意参考图零样本编辑;旧风格仍遗忘。20 人、160 例的用户研究每例仅一人评分,不是每人评完全部。未给统一推理时延/峰值显存,新增条件不加 token 不等于零开销。项目有演示,本次未核到 GRNStyle 实现或权重。 2. CaD:让编辑器照抄原图来防改 Copying As Defense: Protecting Images from Editing By Eliciting Model Copying | 普林斯顿大学;Adobe Research | arXiv:2610.35566 关键词:图像编辑防护, 早层参考注意力, 逐token目标, 优化成本 前序问题:分享照片前加一层微小扰动,希望别人难以篡改。把编辑器对原照片的注意力压低,可能只让它凭文字重画另一个人,仍然完成了不希望发生的编辑。 方法直觉:反过来,让待生成区域过度关注原图。注意力总量归一化,原图占得越多,文字指令和新画布分到的越少,模型就更容易复制输入而不是执行改动。 本文贡献:CaD 是 Copying-as-Defense。对白盒可访问的扩散 Transformer 编辑器,优化输入像素扰动,逐目标 token、逐注意力头最大化早期双流块分给参考图的注意力质量。只对选定早层计算损失,前向与反向都在最后目标块截断。50 张受保护图来自 20 张筛选人像与 30 张合成人体图,每张 15 条指令,共 750 个编辑输出/配置;比较 FLUX Kontext 与 FIBO Edit。 原文图 2|在 Flux Kontext 早期双流块不断加深的前缀中累积干预。Target→Ref=0 移除参考注意力,=1 把所有目标查询注意力分给参考键。(a)压低参考仍能按指令生成,拉满则越来越复制自然图或黑参考;(b)10 张 BodyBench 图的 PickScore 文字图像匹配分,无干预和=0 保持高且近乎平坦,=1 随干预块增加而下降。这是机制诊断,不是 CaD 算法流程图。 实验效果:每像素最大扰动 12/255 时,FLUX Kontext 的 BodyBench 编辑成功率 81.6%→5.1%,DeContext 为 24.9%;成功由视觉语言模型同时判断改动、身份保留及伪影。FIBO 的人像为 80.0%→18.3%,但全身图 CaD56.4%反而高于 Diff-PGD47.6%。FLUX 每优化步 0.647 秒,对 DeContext1.232 秒;CaD1000 步共 10.78 分钟,对方 800 步 16.43 分钟,不能把每步约 1.9 倍当总耗时倍率。 原文表 1|最大扰动 12/255 下两个编辑器和两个数据集的保护。蓝色粗体/浅蓝标最好/次好;编辑成功、文字匹配和身份分越低代表防护越强,保护图 LPIPS 越低、PSNR 越高越不易察觉。运行时间分别是每步秒数与每图分钟数;基线 800 步、CaD1000 步,不能混为同预算。 批判点评:输出可能是有损复制或带伪影的失败图,防编辑不等于恢复干净原照;LPIPS 感知距离与 PSNR 还要核保护图是否可见改变。实验只 50 张且针对已知白盒编辑器,JPEG 压缩、缩放和去扰动会削弱保护,不能许诺跨平台永久有效。原文未给可核实的作者方法代码入口。 3. SREdit:先看投影照得动哪里再改 SREdit: Scene Response Guided Appearance Editing for Projection Mapping | 西南大学 | arXiv:2610.32792 关键词:投影外观编辑, 场景响应图, 早期源图锚定, 物理重现 前序问题:把雕像照片改成翡翠,再投回实体,屏幕上很亮的绿未必能照出来;编辑器还可能改了轮廓。后面的投影补偿只能调光,救不了已经偏离实物的目标图。 方法直觉:先估计各处表面对投影光的响应。照不动的地方多保留原色与明暗,能照动的区域再大胆修改;只在生成前段拉住结构,把后段留给纹理。 本文贡献:冻结已重建、已标定的高斯可微场景渲染器,从表面反射、法线及投影/观察方向求逐通道响应,再取均值并在物体支撑域归一化。采样前 20%用同噪声级的源图潜变量锚定,按响应和时间权重修正 Euler 更新,后段恢复原编辑器;不用训练或反传编辑器。Qwen 与 LongCat 分别 40/50 步,控制强度 2.5/3.0 由另一个场景选择。最后独立优化投影补偿图。 原文图 1|固定物理场景的外观编辑流程。前 r 比例采样用源外观保住配准,场景响应图让低响应区域保留更多源信息、高响应区域允许更大变化;剩余步骤由原编辑器完成,再迭代优化补偿图并进行实体投影。 实验效果:6 套固定实物-投影-相机装置、18 个文字任务,论文报告 64GB A100。LongCat 生成目标与实拍结果的 PSNR14.7231→20.6623 dB、LPIPS 感知距离 0.3369→0.2316,后者越低越好;耗时 58.50→59.10 秒,峰值 29.73GiB 不变。Qwen88.37→89.10 秒、57.94→57.95GiB。参考图编辑仅测 Qwen、4 场景 12 例,PSNR18.5257→21.7335;20 人 720 次判断整体偏好 72.4%。 原文表 1|6 套装置 18 个提示的实体投影质量与效率均值。PSNR、SSIM、LPIPS 及色差比较各自目标与相机实拍;CLIP、BLIP-ITM 评文字请求一致性。时间是单张目标生成墙钟秒数,VRAM 是生成期峰值分配显存,粗体/下划线标最好/次好,剑号为二维表面方法。 批判点评:PSNR 比较各方法自己的目标与实拍,目标难度不同,不能直接当编辑优劣;需结合文字一致性与人工评价。响应是软约束,过强会抹掉纹理;场景重建、标定和补偿成本不包含在新增不到 1 秒的编辑开销里。固定机位物体实验尚不覆盖动态表面;原文未给方法代码。 4. VMem-Bench:旧参考能记住也能带错人 More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation | 中国科学技术大学;可灵研究;清华大学;香港科技大学;香港城市大学 | arXiv:2610.35001 关键词:长视频视觉记忆, 参考检索, 当前状态正确性, 双轨诊断 前序问题:长故事里人物换了围巾,检索旧帧却把旧围巾带回来;已经离场的人也可能因同框参考再次出现。“长得像过去”与“符合现在剧情”并不是同一个目标。 方法直觉:把检查分成生成前与生成后:先问检索的证据是否合适,再问新视频真正保住了谁、错带了谁。这样能区分检索覆盖、历史相似和当前状态正确性。 本文贡献:Track-A 在 92 部真实影片的 16548 片段上,只从过去检索、随后揭示当前片段,不运行生成器。Track-B 为 30 条人工构思故事、2824 个 5 秒片段;共享 FLUX.2 关键帧合成与 Wan2.2-TI2V-5B,对四种检索策略各取 3 帧,再与无记忆及获得真值实体 ID 的最近出现参考对照。各策略从自己的输出继续写记忆,因此比较完整闭环策略;这里 causal 仅指不看未来,不是固定历史上的单参考因果干预。 原文图 2|(a)两轨按时间读当前指令与历史:A 轨在揭示真实下一片段前检索评分,随后用真实片段更新;B 轨先生成评分,再用自身输出更新。(b)B 轨故事与压力族覆盖统计,同一片段可以有多个压力标签。 实验效果:共享生成器下,必需人物/道具召回率 0.559→0.628 至 0.693,生成实体中真正需要的比例即精确率 0.977→0.915 至 0.938;禁止实体保持不出现的比例 0.968→0.845 至 0.898。检测到的回归实体与历史 DINOv3 视觉特征相似度 0.35→0.49 至 0.57,却可能奖励过时外观。62 次长间隔人物回归中 61 次已在提示写新外观,去掉外观描述后无记忆召回 0.984→0.565,揭示提示泄漏的混淆。 原文图 3|相对无记忆策略的整体取舍。点为策略差,横须为每故事一次生成条件下配对故事重采样 95%置信区间;标题给无记忆绝对分。(a,b)人物/道具召回及精确率,(c)禁止实体不出现,(d,e)人物短间隔/长间隔回归召回,前五项用百分点;长间隔 62 次中 61 次提示已写新外观。(f)历史 DINOv3 相似度使用独立余弦刻度,只取两次均检出的策略相关子集,越像过去不代表当前越正确。最近出现真值 ID 对照预算可变,检索策略固定 3 帧。 批判点评:每故事/策略只一次生成,置信区间反映故事间波动;第二裁判的无记忆召回变为 0.361,绝对分依赖裁判。与独立原生生成器的方法不能只归因记忆好坏;论文不是加速方案。代码有评测和共享生成工具,完整数据另取,原始生成视频及逐段评分包未包含。 5. NTI:训练别只认唯一下一块 Visual Autoregressive Generation with Next Token Imagination | 香港大学;萨里大学 | arXiv:2610.36793 关键词:视觉自回归训练, 上下文自适应软目标, 快照上下文, 训练预算 前序问题:自回归模型前面采出一块略不同的花纹,训练仍逼它接回唯一真值下一块,可能把合理的新组合也罚掉。但允许任意“想象”,又会越走越偏。 方法直觉:把相近视觉 token 当候选,再看当前上下文是否仍与真值上下文给出相似预测。接近时允许多种续写,分歧大或模型不自信时,把监督收回到真值附近。 本文贡献:NTI 即 Next Token Imagination。SCA 快照上下文近似定期用冻结模型在真值前缀下采样替换 token;CRI 上下文调节想象结合码本余弦相似度、真值/替换上下文预测的总变差距离及熵置信度,分配真值与非真值的软目标概率。真值序列与替换序列混入同批单次训练前向,保留原自回归损失。1024 项码本将 256×256 图压为 256 个 token,快照每 16 轮刷新,替换概率上限先升至 0.3,320 轮后归零,最后 80 轮只用真值。 原文图 2|NTI 训练总览:快照近似构造模型预测上下文;结合码本相似、真值与生成上下文预测进行上下文调节想象,给出不同合理 token 的软监督,再由自回归生成器与视觉解码器输出图像。 实验效果:ImageNet-1K 类条件、400 轮、5 万生成图:同 461M 即 4.61 亿参数 AR-L 主干,FID 图像分布距离 3.02→1.67,越低越好;IS 类别可辨性/覆盖代理 256.20→312.72,越高越好。8 张 A100 估算每轮含摊销快照成本 11.62→12.80 分钟,在线双前向 22.90 分钟;约 10%额外训练成本,不是免费监督。NTI-L 用 CFG 无分类器引导强度 14,推理流程不变。 原文表 1|ImageNet-1K 的 256×256 类条件生成比较。N/A 为无离散码本,N/R 为原文未报,横线为对应检查点未公开,剑号为作者自行训练实现;吞吐为每秒图数,FID 越低、IS 与吞吐越高越好。各家架构、训练轮数和引导设置不同,同 AR-L 的 3.02 到 NTI-L1.67 才是直接训练策略对照。 批判点评:主要证据限 ImageNet 类条件,不等于开放域文字生成或语义组合已解决;码本相近也不是有效图像的数学保证。较低 FID 不能证明更大分布覆盖。代码与权重已给训练/采样和 S/B/L 推理权重,权重不含优化器或回放状态,不能用于原位续训;本次未运行模型。 6. WithinVAE:压缩器自己教自己学语义 WithinVAE: Compact Visual Autoencoding with Self-Distilled Semantics | 上海交通大学;中国电信人工智能研究院 | arXiv:2610.36593 关键词:视觉自编码器, 自蒸馏语义, 有序压缩token, 生成负结果 前序问题:图像压缩器能还原纹理,却未必把“同一类物体”放在容易学习的位置。借识别模型的语义又可能丢掉外观细节:能否在重建任务内部组织语义? 方法直觉:让自编码器的滑动平均副本做老师,比较同图不同裁剪的表示;同时越靠后的压缩 token 越容易被丢掉,迫使主要信息先写在前面。能重建与有语义各自用独立实验检验。 本文贡献:主模型用 ViT-L 编码/解码、256 个查询,经逐 token VAE 变分自编码瓶颈变为 256×32 连续数值。后位 token 的独立屏蔽概率线性升至 0.5,解码器可只读前缀。全局 DINO 式自蒸馏对齐平均压缩 token,局部 iBOT 式遮挡预测约束图块编码;EMA 即参数指数滑动平均老师,观察干净视图且不反传。仍用 One-D-Piece 生成预训练初始化和 ConvNeXt 感知损失,“不用外部识别语义目标”不是整个系统从零。 原文图 2|WithinVAE 训练:ViT-L 图块与 256 查询经逐 token 变分瓶颈成为 256×32 有序序列,位置相关屏蔽后由像素解码器重建;全局 DINO 式分支匹配压缩 token 均值,局部 iBOT 式分支匹配学生遮挡图块,目标来自看干净视图的编码器/VAE 滑动平均副本。 实验效果:ImageNet256、5 万验证图,对 RPiAE 连续标量数 16384→8192,PSNR21.30→22.66 dB,重建 FID0.50→0.46;冻结线性分类准确率 65.404%→71.886%,同架构仅重建版 66.814%。8192 是 token 数乘通道数,不是压缩比特数。8 张 H100,自编码器训练 10 轮,下游 6.75 亿参数 LightningDiT 训练 80 轮;有引导生成 FID 却是 3.67,对 RPiAE1.51,越低越好。 原文表 3|6.75 亿参数 LightningDiT 训练 80 轮的 ImageNet 类条件生成。RPiAE 为其论文报告值,WithinVAE 为 5 万样本评测;引导按各自实现,只对开/关不声明数值完全相同。生成 FID 越低越好,IS 及生成精确率/召回率越高越好;WithinVAE 有引导 FID3.67 仍落后 RPiAE1.51,重建收益不能代替生成收益。 批判点评:重建和分类提升没有带来更好生成,是本文关键负结果;两种实现的引导细节并未声明完全相同,不把差值全归因表示。前缀 128token 重建 22.33dB 是主模型,另一个 512×96 潜变量模型的 25.63dB 不能混用。全局分类不证明每 token 具备对象分割语义;未给统一编解码时延、显存及作者代码入口。 7. DICE:少步出图也要重做概念擦除 Haste Makes Waste? Towards Safe Few-Step Text-to-Image Models | 特拉维夫大学 | arXiv:2610.36665 关键词:少步生成安全, 概念擦除, 直线路径重加噪, 自蒸馏保留 前序问题:把文生图蒸馏成一到四步后,原模型有效的概念擦除可能失灵;猛改权重又会毁掉正常图像。安全能力不能直接随老师的画质与速度一起继承。 方法直觉:不要只在少步采样恰好访问的高噪声点上训练。沿干净样本到高斯噪声的整条直线均匀取点,同时要求擦除后的速度场尽量贴近擦除前的少步模型。 本文贡献:DICE 即 Distillation-Integrated Concept Erasure,在已蒸馏的 FLUX Schnell、FLUX SCFM 和 SD3.5 Turbo 联合注意力层训练 LoRA 低秩适配。三项损失分别反向压低目标概念速度、抑制指向概念文字 token 的注意力、匹配冻结擦除前模型的速度。干净概念潜变量由原少步模型生成,再按均匀噪声级线性重加噪;保留项初始化为零,不需访问原全步老师或重跑蒸馏。 原文图 4|FLUX Dev 与 FLUX Schnell 速度场对潜变量扰动的经验局部敏感度,横轴为噪声级 sigma,误差棒为跨图样本标准差;Schnell 在高噪声区更敏感。这是设计直线路径重加噪的诊断证据,不是完整因果证明。 实验效果:NSFW-1k 提示集,FLUX Schnell 的 NudeNet 裸露检测阳性率 0.2348→0.0456,最好既有擦除对照 0.1608;四步 HPSv2 人类偏好代理 0.2909→0.2887,略降。@5 表示同提示五次采样至少一次被检出,DICE 仍 0.1700;不能把 0.0456 当所有违规内容的失败率。作者代码默认 100 步微调、秩 256;FLUX 配置需单张 80GB 卡,SD3.5 配置需两张,未据此推算训练耗时。 原文表 VI|NSFW-1k 少步模型的安全检测与正常生成偏好。NudeNet 和 SD-Checker 阳性率越低越好,@5 为五次采样至少一次阳性;一/四步 HPSv2 越高越好,各模型内粗体为该列最优。DICE 降低阳性但未清零,偏好分仍有下降,不能把检测器阳性等同所有有害概念。 批判点评:白盒对抗提示下 Schnell 阳性率仍 0.455,防线有明显剩余漏洞;实验限裸露/暴力及自动裁判,机制敏感度是诊断而非完整因果证明。IEEE S&P 2027 接收由 arXiv 评论明确支持。代码与LoRA 权重已给,本次只核文件/配置,不运行。 8. MoI-Bench:手机跑得快还得改得对 MoI-Bench: A Benchmark for Image Generation and Editing on Mobile Devices | 伦敦大学学院;南京大学;香港理工大学;华东师范大学 | arXiv:2610.37599 关键词:端侧生成编辑评测, 操作目标解耦, 任务覆盖率, 端到端实测 前序问题:手机能 3 秒出一张图,不代表能删对合照里的人,还保住其余人的脸。把文字替换与文字删除混成“文字编辑”,总分会掩盖真正缺失的能力。 方法直觉:把用户要求拆成“做什么操作×针对什么目标”,再分别问指令执行、画质与未改细节保留。另测手机上的时间、存储和峰值内存,让能力和部署成本各有坐标。 本文贡献:16 类操作、8 类目标形成 64 种适用子任务,共 1150 例,并非完整 128 格笛卡尔积。MoI-Eval 逐样本设问题,以 0/0.6/1 评未满足/部分/完全满足;组内均值、组间加权几何平均,避免好画质完全抵消没改对。总体质量按样本等权,覆盖率按 64 子任务等权,阈值为任务均分至少 0.6;不支持任务保留零分,确认执行错误剔除。19 模型的质量以 A100 参考实现或云 API 出图测,手机另测少于 40 亿总参数模型。 原文图 1|(a)从移动用户需求建立任务;(b)沿操作、目标与评价准则三轴结构化评估;(c)用质量-可部署二维坐标指导模型改进,区分速度够用与任务覆盖仍不足。 实验效果:手机共同任务是文生图,只有 DreamLite 成功部署编辑。各配置预热 1 次再测 3 次,DreamLite1024×1024、4 步在 iPhone17 Pro 为 3.22 秒/1305.7MiB 峰值,在小米 15 Pro 为 18.19 秒/2390.5MiB。Mobile-O512×512、20 步在 iOS2.81 秒,但任务覆盖 0.11,对 DreamLite0.64;分辨率、每步成本不同,不能按步数判快慢。内存分别是 iOS 物理占用和 Android 进程 PSS 比例分摊内存。 原文表 8|iPhone17 Pro 与小米 15 Pro 部署。参数含编码器/图像编解码等全部参数化部件,分辨率与步数不同;Size 为模型存储 MiB,E2E 为端到端秒数,Mem 为峰值应用内存 MiB,iOS 用物理占用、Android 用 PSS。Janus-Pro 的 Android 时延用预计算提示嵌入而排除准备时间;Ovis 的 D2 旁剑号指出可见伪影。 批判点评:质量来自参考配置,时延来自手机配置,二维图不证明量化后的每张手机图都保持同一质量;3 次平均也不覆盖热降频。iOS 与 Android 使用不同推理栈,差值不能简化成芯片优劣。数据与评测代码已给,模型推理适配器尚未提供;任务覆盖低也可能因为模型定位只生成。 9. SMEBench:换乐器别只听文字分数 SMEBENCH: Benchmarking Neural Music Editing with Synthetized MIDI Edits | Mila;拉瓦尔大学;梅努斯大学;康考迪亚大学;土伦大学;艾克斯马赛大学;CNRS LIS;CNRS ILLS | arXiv:2610.36715 关键词:成对音乐编辑评测, MIDI可控干预, 音源保留, 指标排名反转 前序问题:把弦乐换成铜管,音乐和文字很匹配,旋律却全换了。没有成对目标音频,很难区分“确实完成编辑”与“重新生成了一首像要求的曲子”。 方法直觉:先在 MIDI 音符事件里只改一个可记录的属性,再用同一音色库渲染原版与目标版。原音频衡量保留,目标衡量已知有效改法,文字衡量描述匹配,三条线分开比较。 本文贡献:从 MIDI 乐谱裁 10 秒,按实际存在的乐器筛可用编辑,覆盖换/删/提取/加倍乐器、连断奏、渐强渐弱与校音等 12 种操作;同一 SoundFont 采样音色库生成单声道 22050Hz 音频,再筛可听性与质量并核文字。共 11160 对,平衡测试 3600 例、每操作 300 例;另以真实分轨构造 416 例 SME-Real、来自 107 轨。比较 5 种共用 AudioLDM2 音乐底座的扩散编辑方法与不保源的 MusicGen 文字生成。 原文图 1|成对音乐编辑构造:分析 10 秒 MIDI 片段决定可用操作与目标,执行符号干预,用同一 SoundFont 渲染源/目标并筛听感和质量;从 MIDI、音频和编辑元数据提取事实形成四种文字描述,音频与文字检查通过后保存已知干预及成对目标。 实验效果:测试集用编辑后描述作条件:MusicGen 的 CLAP-T 文字-音频特征相似度 0.350 最高,但对成对目标的 CLAP-A 音频相似度仅 0.492,SteerMusic0.691;目标 LPAPS 感知距离 5.926 对 4.482,越低越好。换成命令式条件,文字分偏好 VCI、目标音频指标偏好 ZETA。17 人听 20 个抽样对、共 236 次评分,指令对齐 3.99/5;连奏、删乐器、换鼓三项未可靠超过量表中点,剔除后主感知汇总只含 9 操作。 原文表 3|SMEBench 测试集模型排名。编辑后描述和命令式输入分开,数值是均值及 95%重采样置信区间;CLAP 文字/音频相似度越高、LPAPS 目标感知距离越低越好,粗体为各条件/指标最好均值。文字排名与两种成对目标音频排名不同;目标仅是一种受控合法实现,非全部有效输出集合。 批判点评:目标仅代表一种合法实现,接近它不等于穷尽编辑正确性;MIDI 不覆盖人声、混音和母带处理,真实补集也不覆盖全部 12 类。论文没有给统一时延/显存排名,不能从音频指标推出部署速度。数据与构造代码已给,含 MIDI/真实分轨构造及指标工具;源 MIDI 与音色库须另取,本次未复现六个编辑系统。 10. BoxWorld:规则引擎决定视频里会发生什么 BoxWorld: Let World Engines Control and Video Generators Render | 不列颠哥伦比亚大学;Vector 人工智能研究所;华为加拿大 | arXiv:2610.36371 关键词:交互视频生成, 对象状态接口, 区域注意力, 自生成轨迹蒸馏 前序问题:没拿钥匙,生成世界却自己把门打开:视频模型擅长画常见后续,不一定严格执行条件规则。每改玩法就重训生成器,也不适合快速做交互世界。 方法直觉:把“事情该不该发生”交给显式规则引擎,把“看起来怎样”交给视频生成器。引擎持续发每个对象的位置、身份与当前状态,生成器照状态画下一段。 本文贡献:编码代理先按规则生成 Box World Engine,交互时不逐步调用代理。对象接口含二维框、固定外观属性、动态状态;逐帧掩码交叉注意力只允许视觉 token 读覆盖自己的框,零初始化门控注入每块。以 LongLive 为底座,先冻主干学布局,再用 4000 段游戏视频和秩 16 LoRA 学状态变化,最后秩 64 LoRA 在自身生成历史上做分布匹配蒸馏,恢复四步生成;三阶段 20000/10000/400 次更新。 原文图 3|(a)状态绑定模块把每物体二维框、外观属性和动态状态编码为 token,掩码交叉注意力让每个视觉 token 只读覆盖自己的对象;(b)模块插在渲染器每块自注意力和原交叉注意力之间。 实验效果:832×480、4 步,布局模块仅噪声级大于 0.8 启用;论文报告生成吞吐 20.7 帧/秒,与 LongLive 相同。PairedStateBench 含 16 场景族 87 例、37 对分支;两分支都满足目标的比例 13.5%→97.3%,完整多阶段任务 8.0%→83.9%。要求事件出现/禁止事件不出现分别 92.2%/90.5%,不是同一分母。对照模型输入接口不同;20.7 是生成吞吐,不等于用户动作到显示响应的延迟。 原文表 1|PairedStateBench 按整体及简单/中等/困难报告。剑号为仅公开相机控制的 LingBot-v2,Oracle 额外得到互动后果文字;FPS 为生成吞吐。Trigger、Suppress、成对分支成功、状态吻合、发生时机与完整任务成功各有分母,均越高越好,简单例不适用 Suppress。BoxWorld 获得对象状态,其他方法使用各自接口,不能当等条件纯生成器比较。 批判点评:规则正确性来自显式引擎,不能称生成器自己学会通用物理推理;二维框与状态文字也不能约束所有细粒度接触和遮挡。原文没有足以统一复核的 FPS 硬件与峰值显存账单,单机部署仍待实测。项目展示结果,本次未核到作者渲染器代码或权重。 趋势观察 保留与改动需要同一接口里的两条约束 LociArt把风格写进掩码又补原几何,SREdit按物理响应限制改动;CaD则用过强参考注意力阻断编辑。控制强弱不是越大越好,先明确任务要变化还是防变化。 评测要检查执行变化和保留什么 VMem-Bench的历史相似度能奖励旧围巾,SMEBench的文字匹配会偏好重写整首音乐;应把当前状态、目标改动和源内容保留分别计分。 表征更好与生成更好仍有距离 NTI在同AR主干降低FID,WithinVAE却出现重建和线性分类更好、生成更差。训练目标的收益必须落在真正的生成实验,不能只看中间表示。 速度账单包含模型外的条件 MoI-Bench分开参考画质与手机成本,DICE为少步模型额外做擦除微调,BoxWorld把规则交给引擎;推理步数、生成吞吐与端到端响应各自报告。 今日讨论 LociArt 从 10 扩到 15 种风格、不回放旧数据,旧类 SPS 仍下降 0.022,对二值掩码 0.102;多区域仅有已学风格的定性展示。如果剪辑任务要给熊和背景分别换画风,应在什么条件下启用这种组合?如何固定掩码并用多种子实验收集区域风格、边界外变化和旧风格遗忘的证据,确定可以接受的保留阈值? 人工智能炼丹君 整理 | 2026-10-30
-
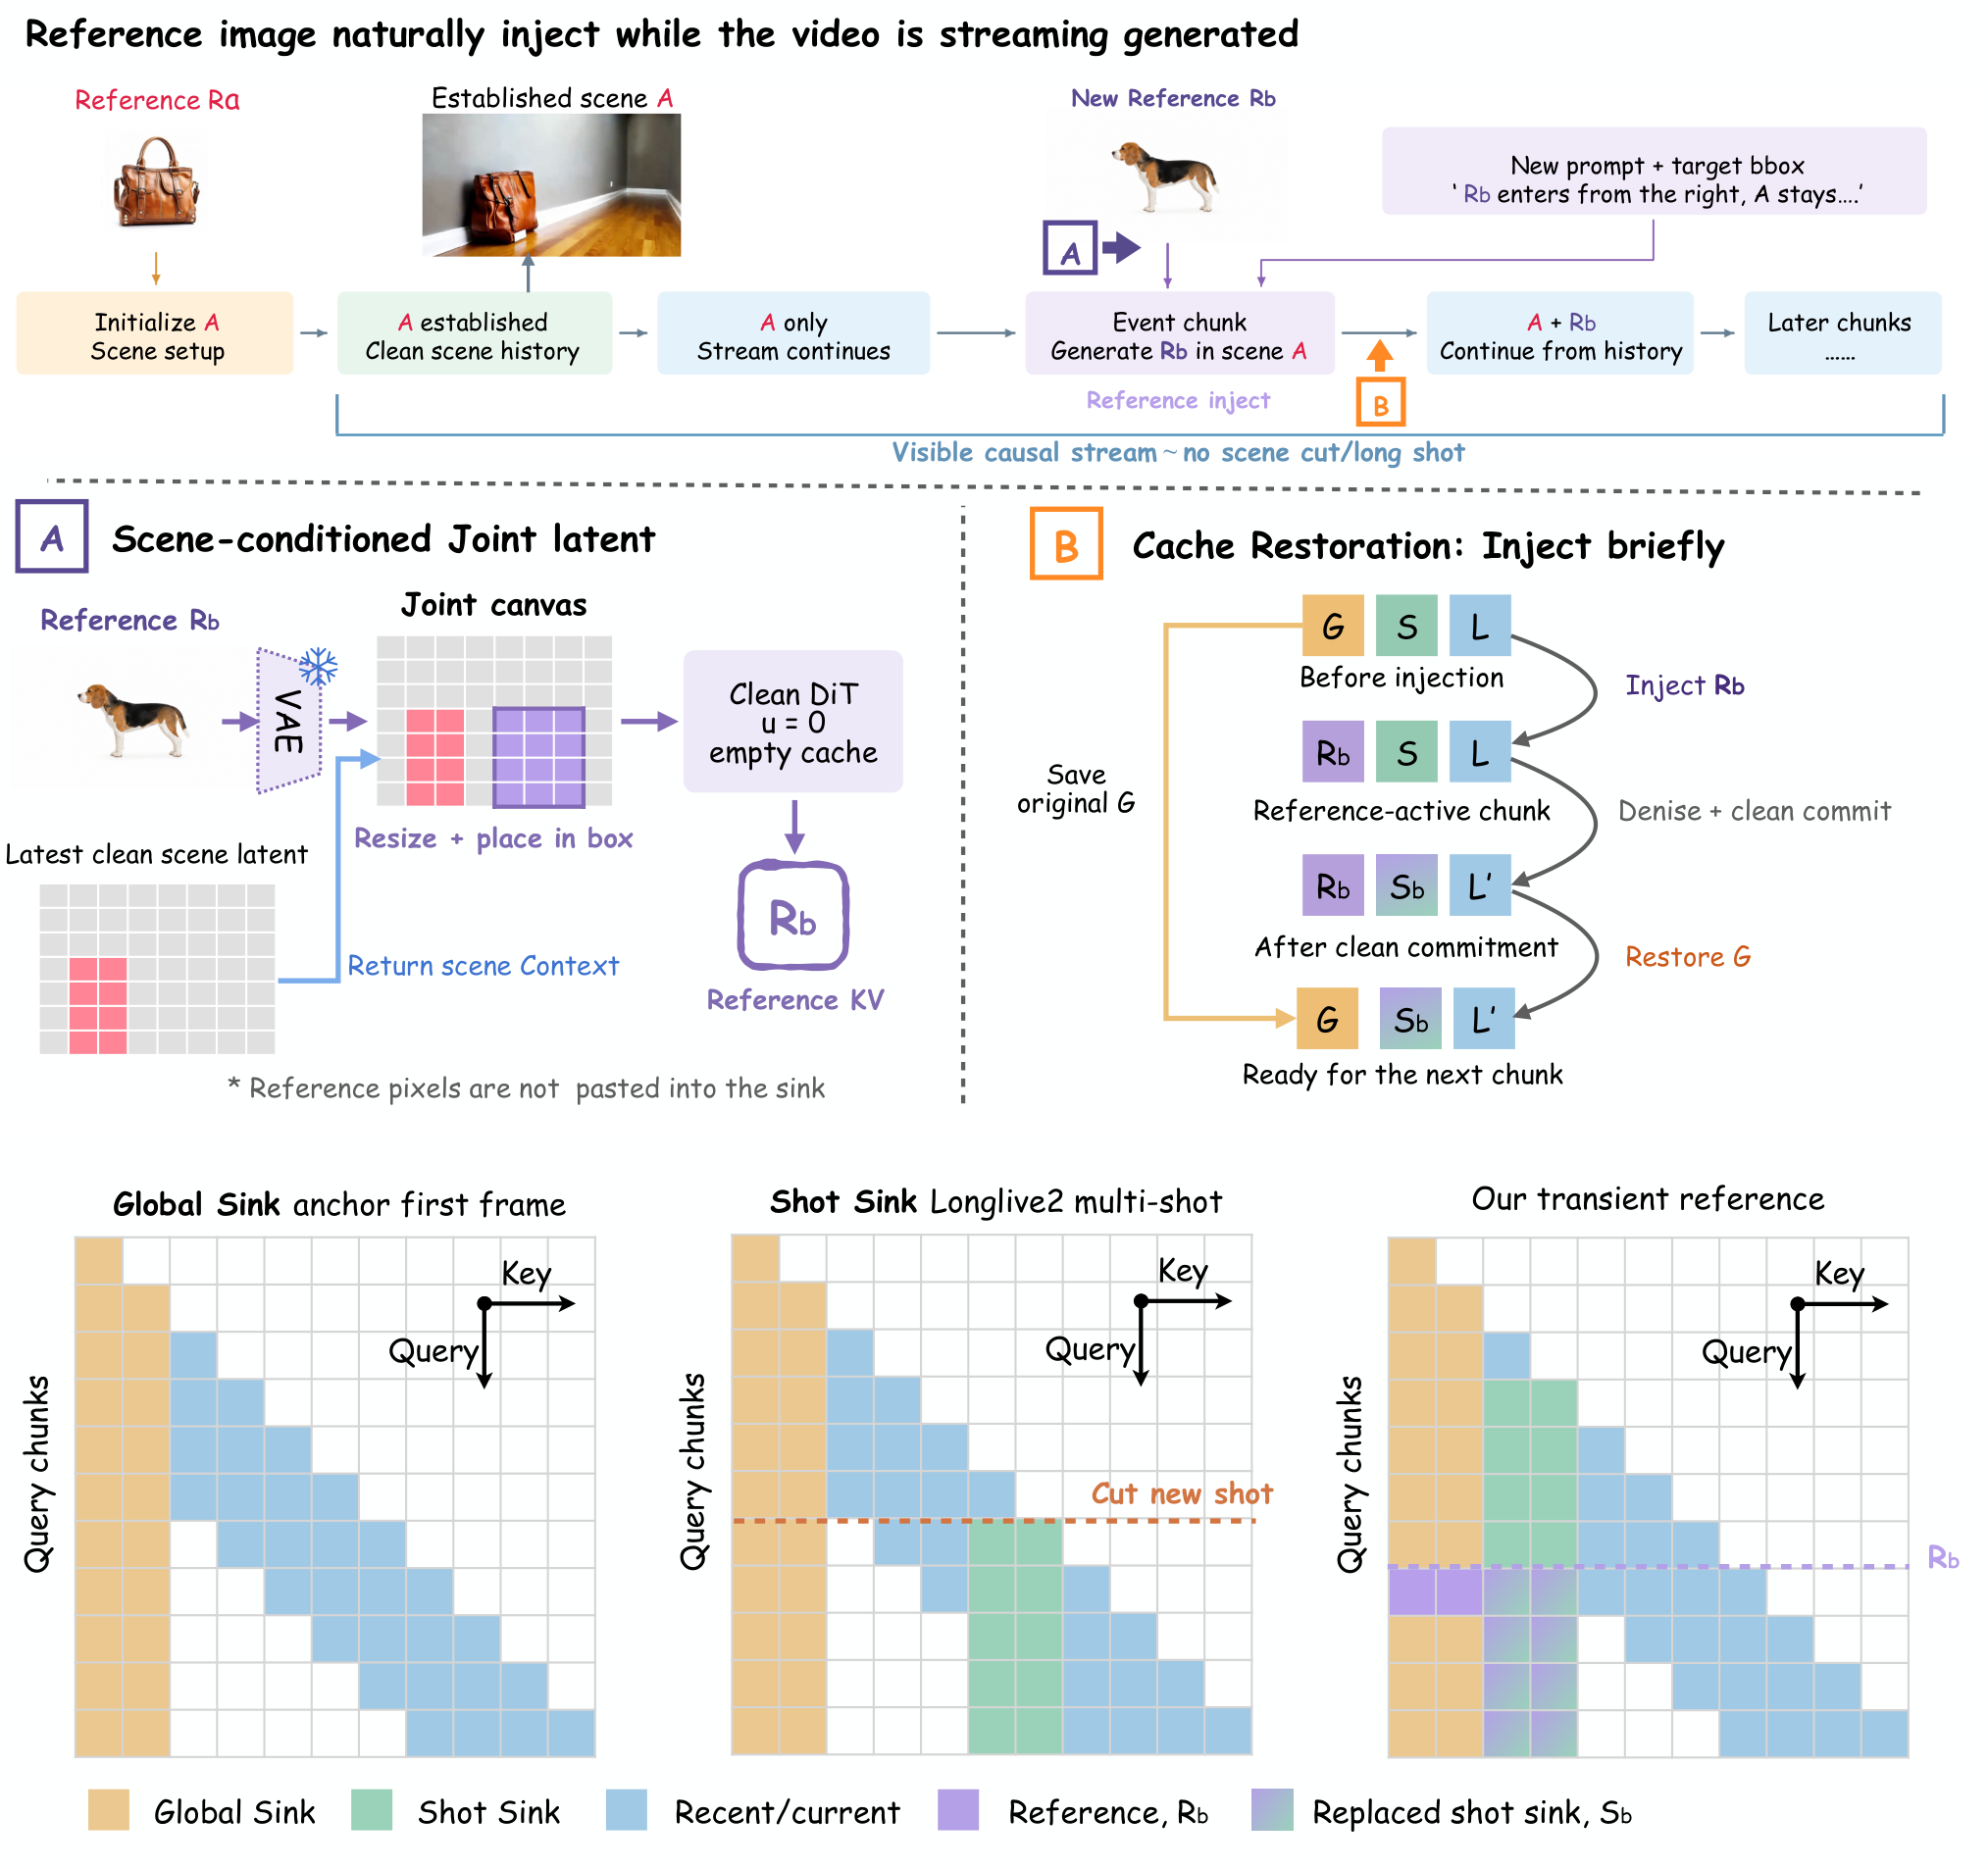
AIGC 每日速读|2026-10-29|新国大新角色入场保住原镜头ReferStream 今日 AIGC 论文速览 今日共 10 篇 · 流式视频参考注入与视频修复 2 篇 · 图像身份与统一编辑 2 篇 · 参考加速与多样性修复 2 篇 · 图像生成训练 2 篇 · 可控音乐合成 1 篇 · 原生三维生成 1 篇 重点论文标题列表 ReferStream(新国大):新角色入场保住原场景 TINDER(南洋理工):从坏帧反推噪声再去退化 ALADDIN(Sumsub):一步换身份保留表情姿态 FrameForge(中科大):用虚拟时间学不同图像改法 ToDoPro(港大):先小图探路再省参考计算 选读入口:视频正在生成、希望临时加入参考角色,先读 ReferStream;已有视频模糊或低清,接着读 TINDER 并比较 4 倍超分的保真与感知冲突。改人脸身份选 ALADDIN,兼顾主体/边缘/指令三类改图读 FrameForge。多参考服务卡显存读 ToDoPro,四步模型总重复构图读 ReSeed。训练预算分配读 KnowThenDraw,联合训练损失低却出图崩读 SpeeDiff。想编辑弯音和力度读 GuitarLFM;最后再用 GenSfM 理解四张未标机位照片如何联合生成三维。 今日论文速览 1. ReferStream:新角色入场保住原场景 ReferStream: Interactive Subject Injection for Streaming Video Generation | 伯恩茅斯大学;新加坡国立大学;浙江大学;香港科技大学;之江实验室 | arXiv:2610.37566 关键词:流式参考注入, 场景上下文, 临时缓存, 主体保留 前序问题:视频已经生成到雨伞镜头,这时才给一张黑猫照片,希望猫接着入场,伞还在。把照片长期塞进生成记忆,可能连伞和背景也改掉;已输出画面又不能重来。 方法直觉:先把参考放进当前场景的压缩画布,让模型在原场景里理解新角色;只在入场这一小段借用参考记忆,随后恢复原记忆。新角色继续依靠刚生成的视频历史留下来。 本文贡献:冻结 LongLive2-5B,无需额外训练。Joint Latent 将参考的 VAE(变分自编码器,将图像压缩并重建)的特征缩放到最新干净场景帧的指定矩形,再做一次干净前向,抽取注意力键/值 K/V。Cache Restoration 先备份全局缓存条目,注入参考,生成并提交当前 chunk(连续潜变量片段)后,仅恢复备份条目,保留新生成历史及推进的位置。默认每 chunk 8 个潜帧、4 个采样步;参考矩形不是前景分割,重叠处后写覆盖,位置只作软引导。 原文图 2|连续镜头入场示意。上:主体 A 已建立,参考 B 到达并约束下一片段。中 A:将参考与最新场景潜变量合成,干净 DiT 前向提取参考键值 R_j;中 B:备份全局 K/V、注入 R_j、去噪并提交后恢复备份,保留新局部历史 L′。S′为更新后的镜头锚点,无刷新时等于 S。下部是缓存访问示意,不是实测注意力;照片来自基准,后续生成是示意。 实验效果:自建基准 68 条脚本,48 条连续镜头、20 条可切镜头;有不一致参考的条目统一排除,按有效案例等权。整体对无视觉参考的 LongLive2,新主体相似度 39.99→52.86、旧主体相似度 42.29→73.18,目标类别计数准确率 73.90%→82.33%。相似度是原值乘 100,不是身份识别准确率。共同单种子消融中,去掉场景合成/完整方法的新主体相似度 63.10/51.31、旧主体相似度 70.56/72.17,保留与引入有取舍。 原文表 3|共同连续镜头集合、种子 0 的组件消融。粗体为各列最好点估计,完整方法为蓝行。新/旧主体相似度越高越好,新/旧重复率越低越好;场景合成和缓存恢复都改善原主体保留与重复指标,但代价是新主体相似度下降。 批判点评:这是生成中的参考注入,不能回改已输出帧。离线基线提前得到全部参考,输出分辨率和帧率也不同,不能据分数声称更快;额外干净前向和 K/V 备份尚无统一时延/显存账单。基准是开发型精选集合,检测漏检、自动时间对齐和单种子影响结论。项目 的仓库目前为网页与演示素材,未核到生成实现。 2. TINDER:从坏帧反推噪声再去退化 Taming Noise Initialization for Zero-shot Video Restoration with Image Diffusion Priors | 南洋理工大学;河北工业大学;瑞典皇家理工学院;深圳北理莫斯科大学 | arXiv:2610.37290 关键词:零样本视频修复, 噪声初始化, 自适应频域混合, 轨迹注意力 前序问题:用图像扩散器逐帧修模糊视频,单帧好看却会闪。独立噪声丢掉帧间关联,同一噪声又不反映物体运动;从坏帧反推噪声,还可能把模糊纹理一起带回去。 方法直觉:让初始化先记住原视频怎样连续变化,再保留较可靠的低频结构、用随机噪声替换受污染频率。恢复时让相邻帧中对应区域互相参照,同时约束结果符合已知退化测量。 本文贡献:原文称 TINDER:先做 20 步 DDIM 确定性扩散反演,将退化帧映射回相关初始噪声;按各帧频域能量选择高斯低通截止频率,以 η 表示保留能量比例,再混入高频高斯噪声。MGTA(测量引导轨迹注意力)从坏帧的邻帧 patch(局部图块)匹配建立对应,只在采样的 UNet(U 形多尺度去噪网络)解码层沿轨迹聚合特征;在反演时加入该注意力反而强化退化。DDS 或 DiffPIR 负责每步的数据一致性,无需再训练视频底座。 原文图 2|TINDER 总览:从退化视频做 DDIM 反演生成具有原时序关联的噪声,再用自适应噪声混合抑制反演中保留的退化、使噪声趋向高斯;采样过程中再以测量引导轨迹注意力利用帧间关联。 实验效果:DAVIS、REDS4、Set8 各取 100 段、每段 16 帧;测 13×13、标准差 2.0 高斯模糊、2/4 倍超分及随机 70%像素缺失。同 DDS 下 DAVIS 去模糊对同噪声基线,PSNR 峰值信噪比保真分 27.90→29.43 dB,LPIPS 感知距离 0.1873→0.1763,FVD 视频分布距离 72.26→63.42,后两者越低越好。RTX A5000 上整流程 9.67→20.18 秒/视频;MGTA 约多 1.94 秒和 500MB,采样另需 20 或 50 步。 原文表 I|DAVIS、REDS4、Set8 的视频去模糊、2 倍/4 倍超分与 70%随机缺失修补定量比较;PSNR 和 SSIM 越高越保真,LPIPS 感知距离和 FVD 视频分布距离越低越好,粗体为最优。4 倍超分保真略升而感知/视频距离变差;修补也非所有指标领先。 批判点评:4 倍超分的 DAVIS PSNR 26.89→27.09,却伴随 LPIPS 0.2538→0.2701、FVD 155.58→258.18 变差,不能写成全面修复领先。任务依赖已知退化和可靠对应,未证明真实未知混合退化同样有效。正文说 70%缺失,超参数表却标 10%,本稿沿主设置并披露冲突;arXiv 评论只列期刊名,不据此宣称已接收。原文未给可核实代码入口。 3. ALADDIN:一步换身份保留表情姿态 ALADDIN: Adversarial Latent Diffusion Distillation for One-Step Identity Swapping | Constructor 大学;Sumsub | arXiv:2610.37503 关键词:一步身份编辑, 对抗训练, 伪标签三元组, 独立身份评测 前序问题:换上参考人物的身份,还要保留目标照片的表情、头发和眼镜。多步扩散耗调用次数,纯对抗生成又容易损失真实感;如果训练与打分用同一个人脸编码器,指标还会偏向熟悉它的方法。 方法直觉:借预训练流模型的生成能力直接做一步修改,再借同一冻结模型的中间特征判断真假。先换成别人,再让学生换回本人,用原照片监督,获得真实感与身份强度之间可调的折中。 本文贡献:以 FLUX.1-Krea-dev 初始化,冻结 VAE 和底座,训练秩 64 LoRA 低秩适配及 PuLID 身份交叉注意力;目标潜变量按固定噪声级 0.2 做一次速度更新。判别器读取冻结扩散器四层特征,身份、姿态、50 维几何表情及脸外掩码损失约束输出。老师混合跨身份/同身份对训练,学生用老师在线生成的三元组伪目标与感知重建训练;这不是每步模仿老师轨迹的常规蒸馏。 原文图 2|ALADDIN 训练。左:老师接目标和冻结 PuLID 源身份,单步生成,由身份、姿态、表情和背景损失约束;生成/真实图的潜变量加相同噪声级后经冻结扩散器,中间特征供判别器判断真假。右:冻结老师将身份 B 移到 A 的目标图;学生从老师初始化,把 A 换回伪目标,用真实 A 目标图作重建监督。 实验效果:512×512、固定 1000 组 FFHQ,独立 WebFace-R50 评身份。学生重建权重 7 对 APPLE,身份相似度同为 0.40,CLIP 特征分布距离(文中称 FID)3.34/3.22,姿态误差 1.56/1.86、表情误差 0.60/0.63,误差越低越好。生成器 1 次网络评估对 28 次,不等于整流程快 28 倍。4 张 H100 上,老师 10 万图对约 4.5 小时,学生 1.5 万图对约 50 分钟;训练集本身有 410 万图像,不能写成只需 10 万张原始数据。 原文表 2|FFHQ 固定 1000 图对比较,FID 使用 CLIP ViT-B/32 特征;身份相似度与 Top-1/Top-5 检索率由 WebFace-R50 计算,检索率以百分数报告。组内按 FID 从差到好排列;粗体/下划线标领先值。InSwapper 用同一评分身份模型作条件;换独立 MS1M 编码器,学生权重 1 为 0.55,对 InSwapper0.56。姿态和表情误差越低越好。 批判点评:增大重建权重会削弱身份迁移:权重 1/7 相似度 0.50/0.40。大年龄差、少见身份和纹身保留仍失败;分布距离采用 CLIP 而非标准 Inception 特征,不能横比通用 FID。InSwapper 用评分编码器作条件,仍有例外。arXiv 明确写 Accepted to WACV 2027;未找到作者方法代码,不把引用的 FLUX 仓库当实现。 4. FrameForge:用虚拟时间学不同图像改法 FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation | 中国科学技术大学;FrameX.AI | arXiv:2610.36545 关键词:视频先验迁移, 虚拟时间路由, 中间潜变量, 统一图像编辑 前序问题:保留人物换背景、把边缘图画成照片、让猫换姿势,对输入的保留程度不同。把所有任务都当相同间隔的“前帧→后帧”,会让一个共享编辑器互相拖累。 方法直觉:借视频模型对不同幅度变化的经验,按输入与去噪阶段选择虚拟时间距离;再加一个中间特征状态,帮助传递“怎么变”。它输出的是图片,虚拟时间不是实际生成长视频。 本文贡献:冻结 HunyuanVideo1.5-T2V-720P 与 VAE,统一秩 32 LoRA。MoTE(时间专家混合)每步路由选择一套 RoPE 旋转位置编码,等效视频跨度 17/69/121 帧,实际只保留条件、目标与一个中间位置。CoTR(时间推理链)加无像素监督的噪声中间潜变量;训练中期以 0.5 概率屏蔽目标与文字/条件的直接注意力,迫使信息经中间状态,末期和推理恢复全注意力。三任务各 17 万样本,合计 51 万,512×512。 原文图 2|FrameForge 将不同条件图像任务建模成视频底座的目标帧预测。多模态扩散 Transformer 共同处理文字、条件、中间推理和带噪目标 token 并预测速度;MoTE 每步选虚拟间隔的 RoPE;CoTR 加入从噪声开始、经注意力更新的中间隐层状态。训练中期随机屏蔽条件/文字到目标的直接注意力,鼓励中间路径。 实验效果:GEdit 英文 606 例、11 类,GPT-4.1 评语义/画质/综合:动作修改综合 ChronoEdit 5.76→6.84,全类 5.08→6.12;但画质 6.88→6.52。DreamBench 30 主体×25 提示综合 0.739,对 ChronoEdit 0.729,主体一致性 0.739 低于 0.757。2 张 A800 训练 1.2 万更新约 6 天,1.82 亿可训练参数;推理 50 步及额外中间状态,未给统一单图延迟/显存。 原文表 3|GEdit 指令图像编辑,分别列动作修改及全类总体的语义一致、感知质量和综合分,均越高越好。闭源与开源分组,主干列不同。FrameForge 动作综合 6.84、全类 6.12 优于 ChronoEdit,但全类画质 6.52 低于 6.88,闭源总体仍更强。 批判点评:“推理链”是隐层通信设计,没有可读的逐步推理或中间图真值;全类综合仍低于闭源对照。主干、数据和任务接口与其他方法不同,不能把跨系统差距全归因路由。作者项目、推理代码及LoRA 权重均已核到;仓库含三专家/一个中间潜变量配置与三任务入口,权重未下载验证。会议接收未确认。 5. ToDoPro:先小图探路再省参考计算 ToDoPro: Faster and Better Reference-Based Generation: Early Token Reduction via Downsampled Self-Probing | 香港大学;南洋理工大学 | arXiv:2610.34782 关键词:参考生成加速, 低分辨率探测, 分层token裁剪, 激活显存 前序问题:同时给多张参考,模型把背景、无关小物和主体一起反复读,越加参考越慢、显存越高。直接缩小所有图又会丢主体纹理;外接重要性模型还会增加部署负担。 方法直觉:先让原模型在小图上走一趟便宜的探路,判断文字和待生成画面真正会读取哪里。重要区域保留细节,中等区域保留缩略全局,低价值区域再丢掉。 本文贡献:参考图长宽各缩 2 倍;FLUX.2-Klein-4B 先探 2 步再做原 4 步主采样,Qwen-Image-Edit/HiDream 分别探 10 步、主 40/50 步。用生成及文字查询对参考的注意力,在全部层平均为利用分数;Triton 内核兼容不显式保存注意力矩阵的 FlashAttention。每个原 2×2 token 块(模型特征单元)按高/中/低重要度做 4→4、4→1、4→0,中档坐标放在原块中心,无需训练或新参数。 原文图 5|空间与时间下采样的自探测裁剪。先用长宽各 2 倍下采样图及稀疏时间表做去噪,抽取参考利用分数;主采样前据此保留高重要度、丢弃低重要度、用低分辨率 token 替换中等重要度。例图用 4 步 FLUX.2-Klein-4B;探测和主采样是两个阶段。 实验效果:单 80GB H800、种子 42,FLUX.2-Klein-4B 在 MultiBanana 快速档,端到端 5.74→2.50 秒,2.30 倍;峰值激活显存 15.3→7.3GB,五维质量均值 4.70→4.72。MACRO 7.93→3.20 秒、24.7→11.5GB,四任务均分 6.18→6.20。慢档 MultiBanana 3.43 秒、9.8GB、均分 4.88。质量改善与速度是不同档位,不能拼成同一最优点。 原文表 1|FLUX.2-Klein-4B 在 MultiBanana 和 MACRO 的质量/效率。MultiBanana 五维为指令、参考、背景主体匹配、物理真实、视觉质量,MACRO 四任务为定制、插图、空间、时间;平均分越高越好。时延为端到端秒数,Speed 为对原模型倍率,Act.VRAM 为激活显存 GB,时延/显存越低越好。快慢档分开,不能拼成同一工作点。 批判点评:激活显存不含全部模型常驻权重,不能承诺 7.3GB 卡可运行。极高裁剪率会失去必要细节,小字/稀疏部件可能在探测时漏掉;新目标 token 占多数时收益缩小。参考一致性快速档 4.85 略低于原 4.86。作者仓库目前为空,“将开源”不等于代码已可用。 6. ReSeed:只补首步找回不同种子差异 A First-Step Bias Restores Lost Diversity in Diffusion Model Distillation | 格拉茨技术大学;奥地利复杂性科学中心;瑞士数据科学中心 | arXiv:2610.37110 关键词:少步蒸馏修复, 种子响应, 首步偏置, 多样性取舍 前序问题:四步模型出图很快,同一句提示换随机种子却总画出相似构图。究竟要重训整模型,还是某一个去噪区间把随机差异压掉了? 方法直觉:先替换老师的第一段轨迹定位瓶颈,再只给学生首步加小偏置,学老师在这段时间走了多远。偏置本身不携带种子,差异来自它改变了冻结网络对不同输入的响应。 本文贡献:冻结蒸馏学生,在每个 Transformer 块输出增加零初始化逐通道残差偏置,仅首步启用。监督目标是老师从相同噪声/提示出发、跨首个学生区间的平均速度,非终点瞬时速度;后 3 步仍用原学生。FLUX 学生增加 233472 参数,占去噪器 0.00196%,约 8000 提示-噪声对训练,不需目标图、解码或对抗网络。理论界只约束首步端点响应误差,不保证最终图像多样性。 原文图 3|ReSeed 概览。(a)首步收缩可能合并不同种子轨迹,老师和 ReSeed 保留替代路径;(b)冻结底座,把首步块输出偏置拟合到老师区间平均速度;(c)偏置在第 2 至 4 步关闭。示意说明干预位置,不是最终多样性的理论保证。 实验效果:FLUX 四步 SenseFlow,100 提示各 10 种子,DINOv3 视觉特征两两余弦距离 0.1575→0.2336,提升 48.3%;另 5000 张 COCO 图的 FID 为 40.22→34.65。Wan 四步 DMD2 在 320 条 VBench 提示每条 8 视频,DINOv2 视频多样性 0.3374→0.4290,但动态程度 0.531→0.329、文字匹配 0.2419→0.2365。采样网络评估次数不增;各模型实测时延多 0.14%至 0.41%,激活峰值至多多 1MiB。 原文表 2|FLUX 质量与多样性比较。NFE 为去噪器网络评估次数,DINO/CLIP 特征距离和 LPIPS 跨种子距离越高越多样;CLIP 文字匹配、PickScore/HPS 偏好代理、美学越高越好,FID 分布距离越低越好。ReSeed 保留 4 次评估并提高多样性、降低 FID,但偏好及美学略降;误差为跨适配训练种子波动。 批判点评:更分散的特征不等于更丰富且符合提示的内容;FLUX 人类偏好代理分与美学也略降。视频只一次适配训练,跨提示 bootstrap 不能代表跨训练波动;仅验证流匹配 Transformer。作者代码包含训练、生成和评测入口,但权重及完整提示库不在仓库,老师/学生另备。 7. KnowThenDraw:先学语义再让扩散画细节 Know, then Draw: A New Learning Paradigm for Visual Generation | 加州大学圣迭戈分校;Adobe Research | arXiv:2610.37626 关键词:自回归预训练, 语义token, 像素扩散渲染, 计算分配 前序问题:画得像不代表理解“两个物体、颜色和位置”。如果自回归阶段花大量精力还原像素纹理,能否反而挤占学习场景语义的预算? 方法直觉:把“知道该画什么”与“画得细腻”交给不同学习目标。先预测语义编码,随后冻结该骨干,让扩散模块把其表示渲染成像素;前一阶段的编码不必单独解码成好图。 本文贡献:AR 自回归按位置指令、随机顺序预测离散视觉 token。比较重建型、语义加重建型及 Semantic-LM 纯语言监督码本;后者量化冻结 Qwen2.5-VL 视觉特征,无图像解码器或重建损失。后训练复用冻结 AR 注意力投影,仅训练输入、时间和扩散专用前馈/归一化及像素输出模块。训练渲染用真图 token,推理改用 AR 生成 token,存在条件分布差异;分别拟合两阶段规模规律,主口径预算约 3:2。 原文图 2|学习分工:自回归预训练用离散 token 预测获取视觉知识;随后冻结预训练骨干,增加复用其注意力与表示的扩散模块,将知识渲染为高保真图片。自回归专注知识,扩散专注渲染。 实验效果:约 400M 最终参数、同累计图像曝光的控制实验:AR→像素扩散 GenEval 组合指令分 65.51、DPG 细粒度提示分 71.11;纯像素扩散 61.16/62.56。约 3B 最终版训练 6600 H100 GPU 小时,GenEval0.86、DPG87.78;前者 553 提示每条 1 图,后者 1065 提示每条 4 图。推理 AR 采样后再 50 步 Euler 像素渲染,带语义/文字双引导,未给统一整图延迟。 原文表 3|GenEval 与 DPG 文生图评测。模型大小以十亿参数计,各系统组件计数可能不同,横线为缺失结果。作者用大语言模型改写提示匹配训练分布。GenEval 分单物体、双物体、计数、颜色、位置与颜色属性,综合为六类均值;本方法约 3B,综合 0.86,DPG87.78。 批判点评:评测用大语言模型改写提示,并按固定种子评分选提示变体,不能当完全未触碰的测试协议。6600 小时没有计入所有外部预训练资产;3960/2640 是阶段预算分配,非各阶段独立计时。拟合损失下限是外推且混合真图条件影响,不能证明 AR 普遍胜扩散。原文未给作者方法代码入口。 8. SpeeDiff:像素回路拦住潜空间坍缩 SpeeDiff: Scalable Pixel-Anchored End-to-End Latent Diffusion Model | 字节跳动 Seed;加州理工学院;Meta | arXiv:2610.36419 关键词:端到端潜空间训练, 像素重建锚定, 双表示对齐, 训练成本 前序问题:同时训练图像压缩器和扩散器,损失下降却画不出东西:编码器可能把不同图压到几个狭窄峰,扩散预测常数就能拿低损失,像素语义却丢了。 方法直觉:不能只在压缩空间里自我打分,还要把去噪估计解码成图片,核对真的保留原图。让像素误差沿完整路径反传,堵住“把表示做简单就过关”的捷径。 本文贡献:TPR(Tweedie 像素重建)从中间噪声状态估计干净潜变量,送 VAE 解码器并与真图计算均方/感知误差,同时保留 VAE 重建和流匹配损失,不切断到编码器的梯度。全 Transformer VAE 与改进 DiT 联合缩放,REPA++同时将干净潜变量和早层扩散特征对齐到冻结 DINOv3 视觉表示。每训练步 1 次编码、1 次扩散和 2 次解码;256 图用空间 16 倍压缩、32 通道,512 图改 32 倍压缩。 原文图 2|SpeeDiff 四条训练分支:VAE 编码/解码重建;标准随机插值和速度预测的扩散损失;Tweedie 干净潜变量估计解码后与真图比较的 TPR 分支;潜变量和中间扩散特征同时对齐视觉底座的 REPA++分支。VAE 与扩散从零联合训练,梯度不截断;视觉特征底座冻结。 实验效果:ImageNet 类条件、无引导、5 万生成图评 gFID 生成图与真图视觉特征的分布距离。80 轮原始联合训练 33.95,加 TPR 为 5.79,加架构为 3.66,再加 REPA++为 1.69;XL200 轮在 256/512 分别 1.50/1.53。更实用的同 7.93FID 对照,16 张 H100、批 256,训练步 23.52 倍减少,计每步 0.16→0.31 秒后耗时加速 12.14 倍;峰值 57.34GB 对 26.97GB。默认采样 250 次网络评估。 原文表 1|80 轮 ImageNet256 生成、无引导 FID。上半部分扩散到 VAE 梯度截断,下半为真正端到端;原联合训练 33.95,加入 TPR 降 5.79,再加架构 3.66 和 REPA++1.69。两个组依次加组件,FID 越低越好,表示像素锚定使联合梯度有效。 批判点评:摘要 140/61 倍是特定收敛比较口径,不是逐步训练或出图速度;完整联合训练更费显存。最佳版依赖预训练 DINOv3,不能称整个系统从零;尚未证明开放域文字生成同样有效。arXiv 明确接收 CVPR 2026,本月上传不等于本月才完成研究;未给可核实方法代码。 9. GuitarLFM:先改每根弦的演奏再合成 Expressive Guitar Synthesis via Controllable Latent Flow Matching | 台湾大学 | arXiv:2610.36786 关键词:可控吉他合成, 逐弦音高包络, 跨弦注意力, 潜空间流匹配 前序问题:MIDI 乐谱写了哪个音、何时弹,却没写弯音和余音怎样变化。直接把乐谱变音频,即使音符正确,演奏细节也难以单独修改。 方法直觉:先预测每根弦的连续音高和响度曲线,把“怎么演奏”变成能编辑的中间控制;再让声音生成器负责音色和波形,不必同时猜演奏与合成。 本文贡献:六弦输入含音高、发声状态、音内相对位置、起音及力度。轴向 Transformer 分开沿时间/弦建模,跨弦门从零初始化;先出 f0 基频和 RMS 均方根振幅包络,再由条件编码器经 AdaLN 自适应归一化调制扩散 Transformer,流匹配生成 Stable Audio Open 压缩音频。逐弦解码,经各弦学习的脉冲响应滤波后混合;可再用仅 MIDI 的力度预测器替代音频提取力度。 原文图 2|逐弦声音合成器架构:音高 f0 及 RMS 振幅包络经条件编码,发声状态 s 和起音 o 提供额外提示;紫色圆是学习的弦身份嵌入。轴向 Transformer 特征经自适应归一化调制轴向扩散 Transformer,由常微分方程求解器生成压缩音频,Stable Audio Open 解码;每弦输出再用学习的各弦脉冲响应混合。 实验效果:GuitarSet 按录音 306/18/36 划训练/验证/测试,44.1kHz,训练裁 5.9 至 11.9 秒。真实音频力度条件下,对同结构单阶段,f0 平均绝对误差 33.53→26.52 音分(100 音分为半音),包络相关 0.63→0.88。32 人听 18 段 8 秒,1 至 5 分总体偏好 2.54→3.04;但多尺度频谱损失 8.79 高于 DDSP-Guitar8.27,越低越好。推理 50 个 Euler 步、引导强度 2,条件/无条件预测额外耗计算,未报统一实时率。 原文表 1|客观与主观结果。Ref 为各方法从音频提取的力度,Pred 为仅 MIDI 预测力度;MOS 听感仅比较真音频和三个 Ref 系统。Oracle synth 用真实控制作合成上界,横线表示不适用/未评。音高误差用音分、包络误差和 MSSL 越低越好,包络相关及内容正确/表现力/音质/偏好评分越高越好。 批判点评:听感分只评音频提取力度版本,不能移植给纯 MIDI 版;后者包络误差 0.61 对 0.30,听感未评。单数据集和逐弦专门录音限制泛化,项目长音频样例无对照。代码与模型页由项目给出,本次不运行音频模型。ICASSP 2027 只是投稿,非接收。 10. GenSfM:四张照片一起猜形状和机位 Generative Structure from Motion with Native 3D Diffusion | 香港大学;Transengram;腾讯 | arXiv:2610.35522 关键词:原生三维生成, 联合形状位姿, 紧凑机位编码, 逐体素图像条件 前序问题:四张没标相机的物体照片,既要补出没看到的背面,也要找准各照片从哪里拍。先估机位再生成,第一步错了,细节就会贴到错误表面。 方法直觉:把形状和每个机位一起放进同一去噪过程,相互校正;粗形状与机位对齐后,再按真实投影位置读取图像纹理,而不只靠整图语义猜细节。 本文贡献:基于 TRELLIS,粗阶段联合处理 4096 形状 token、四视图共 256 机位 token 及 128 共享 register 全局信息 token。UV 体积把每体素投到图像的二维坐标编码成 4×4×4 机位潜网格,较 16 立方网格少 64 倍 token,非全模型快 64 倍。DINOv2 语义加多尺度卷积特征作条件;细阶段按估计机位逐体素采样并跨视图平均。约 43 万资产、每资产 24 渲染视图,训练每次取 4 张。 原文图 2|GenSfM 粗到细总览:把未知位姿的多视图三维恢复化为联合生成;粗阶段用多模态形状-位姿扩散 Transformer 同时去噪稀疏结构与逐视图三维机位 token,恢复形状与相机;细阶段按恢复的机位为每体素采样图像条件,细化几何与外观并输出结构化潜变量。 实验效果:Toys4k/GSO 各前 400 物体、每物体两组互斥四视图,共各 800 物体-视图组。相似变换 ICP(迭代匹配点云)对齐后,对 TRELLIS-M,未见视图 PSNR24.01→28.54、22.28→25.50 dB;双向平方 Chamfer 点云距离的跨物体中位数 0.4329→0.1133、0.5200→0.1882,表中单位×0.001。原始相对旋转误差低于 5 度比例 97.23%/98.21%。粗/细各 25 步,机位/粗阶段各 8 张 H200、细阶段 4 张,均训练 100 万更新。 原文表 3|与三维生成方法比较:对无输入机位的标准化三维输出,两侧输出网格各采 10 万表面点,以相似变换 ICP 迭代对齐到真值坐标,再评价未见视图光度和几何。PSNR/SSIM/F 分越高越好,LPIPS 及双向平方 Chamfer 跨物体中位数越低越好;Toys4k 和 GSO 分开,不能混同另一表的点图最小二乘对齐。 批判点评:各能力族用不同对齐协议,不能跨表混用数字;未知侧仍是生成推断,非测量真值。只验证物体中心、四视图,场景和更多视图待证;细阶段训练用真值机位,推理误差会错贴特征。NeurIPS 2026 接收有 arXiv 评论证据;项目可查,尚未核到方法代码和统一推理时延/显存。 趋势观察 控制介入的位置决定保留边界 ReferStream临时替换全局缓存,TINDER改初始噪声与采样注意力;两者都处理视频连续性,但一个引入新主体,一个恢复已知退化。 借视频先验仍须先看实际输出 FrameForge借虚拟时间生成单张图,ReferStream才是流式视频。不能因为底座叫视频模型,就把任务和收益写成视频编辑。 首步与表征是两类不同修复 ReSeed在冻结学生首步补种子响应,SpeeDiff在训练期让像素误差约束潜空间;前者维持四步采样,后者默认250次网络评估。 可编辑中间表示需要协议兜底 GuitarLFM把每弦演奏曲线暴露出来,GenSfM把形状和机位一起生成;前者听感只评音频力度版,后者限四视图物体,控制接口不能代替泛化证据。 今日讨论 ReferStream 加入场景合成后,旧主体相似度 70.56→72.17,新主体 63.10→51.31。已输出画面不能重来时,如何固定参考到达时刻与目标框,用多种子实验分别收集主体还原、旧场景保留和重复率证据,决定何时启用场景合成或减弱注入? 人工智能炼丹君 整理 | 2026-10-29
-
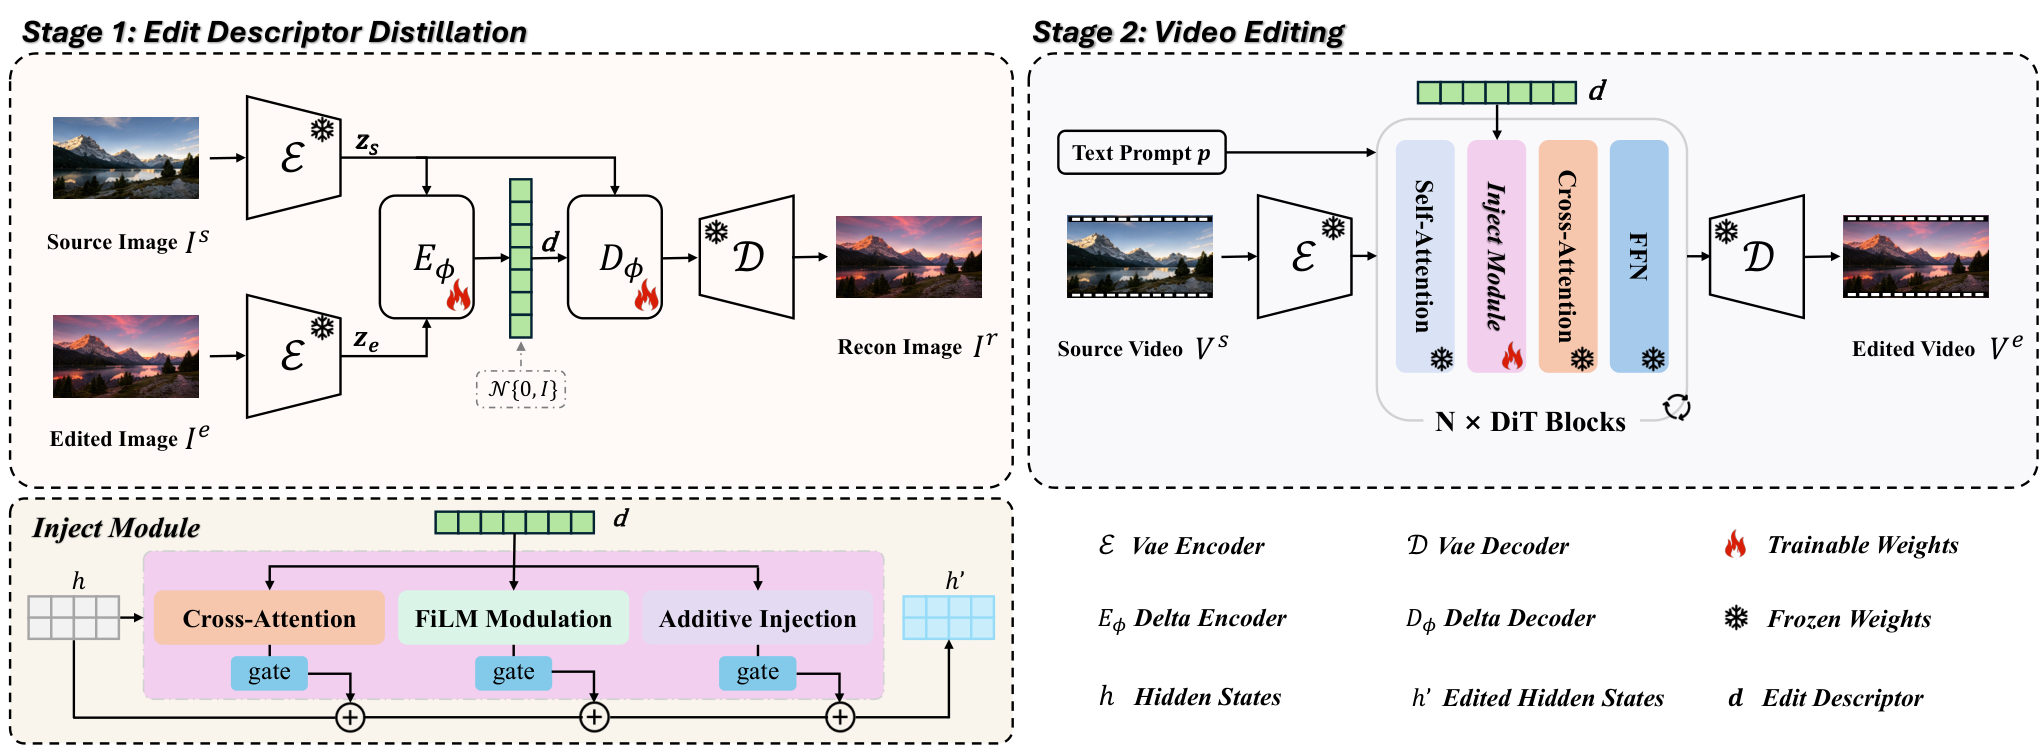
AIGC 每日速读|2026-10-28|浙大首帧改动带着整段走EditDistill 今日 AIGC 论文速览 今日共 10 篇 · 参考视频编辑 1 篇 · 参考图效果与变换迁移 2 篇 · 多视角视频生成 2 篇 · 视频蒸馏与推理加速 2 篇 · 语音与空间音频生成编辑 2 篇 · 三维场景编辑 1 篇 重点论文标题列表 EditDistill(浙大):首帧怎么改整段跟着走 KINESYS(工业光魔):借参考特效但少动原镜头 CrossPair(蚂蚁):示范一对图迁移同一种改法 WorldCast(小米):大幅绕拍时记住人物背面 OmniShowcase(KAIST):四面参考加法线转台稳绕拍 选读入口:已有视频想改衣服、照明或局部物体,先读 EditDistill,重点看首帧代表性和 CLIP-E 没有领先的边界。图像上借烟火等参考特效选 KINESYS,已有改前改后示范想迁移同一操作选 CrossPair。需要数字相机轨迹及人物多面锚点看 WorldCast;以四面照片做主体展示看 OmniShowcase。训练四步视频模型读 SF2,已有 Blackwell 推理服务读 Triage。研究图像先验能否跨到声音读 ImageTTS;要移动某个声音且保住其他音轨读 AMBIT。最后,需要把单视图修改落回可渲染三维资产时看 VidEdit3D,并核对逐场景拟合成本。 今日论文速览 1. EditDistill:首帧怎么改整段跟着走 EditDistill: Is It Possible to Guide Video Editing with Image Editing? | 浙江大学;浙江理工大学;清华大学;北京航空航天大学 | arXiv:2610.34303 关键词:首帧示范编辑, 编辑描述, 时序保留, 轻量条件注入 前序问题:把首帧里的人换上红围巾不难,难的是走动、转身后围巾还在,背景和动作也没被重画。逐帧调用图像编辑器会闪烁,单给修改后的首帧又可能把整个场景带偏。 方法直觉:从修改前后两张图里提炼“改了什么”,把它与图里原本的内容分开;让视频底座负责把这个变化安放到各帧。描述的是变化规则,而不是把某一帧像素贴满整段。 本文贡献:第一阶段在冻结 VAE(图像与压缩潜变量间的编解码器)空间,读取原图、改图及差分,以残差重建和 KL 相对熵分布约束学出 1024 维编辑描述;推理取分布均值。第二阶段冻结 Wan2.1-I2V-14B,隔三块插入融合器:交叉注意力定位局部,FiLM 特征缩放/平移调全局外观,加法分支补编辑偏置,零初始化门控制注入。训练除流匹配外,约束输出变化描述与示范一致,并用冻结 DINO 视觉特征保留源帧结构。两阶段用约 200 万图对、10 万筛选合成视频对及 OpenVid 重建样本;分别 20 万与 3 万次更新,16 张 80GB H800。 原文图 3|EditDistill 总览:第一阶段将修改前后图像对编码为编辑描述 d;第二阶段冻结 Wan2.1-I2V-14B,仅训练轻量融合注入模块,在选定 Transformer 块注入 d,引导源视频去噪成时间连贯的编辑视频。 实验效果:VACE-benchmark 统一 480×832、81 帧,推理 50 步;与 VACE 比,未编辑区域 DINO 相似度 0.701→0.738,光流对齐误差 Warp(越低越稳)3.42→2.97,FVD 视频特征分布距离 914.6→852.1。CLIP-E 编辑方向相似度 0.245,略低于 VACE 的 0.247;CLIP-T 文字匹配 0.282 也低于 0.302。注入模块约 480MB,原文称不足底座参数 4%;这是模块大小,不能当实际峰值显存或整片时延。 原文表 1|统一 480×832、81 帧比较。CLIP-E 和 CLIP-T 分别测编辑方向和文字匹配,DINO-sim 测非编辑区域保留,Temp.与 Warp 测时序相似和光流对齐误差,FVD 测视频分布距离;前四项越高越好,Warp/FVD 越低越好,粗体和下划线分别为最优和次优。EditDistill 在保留、时序和 FVD 领先,编辑匹配并非全部最优。 批判点评:主体一致性 0.942 低于 Omni-Video 的 0.964,首帧无法代表的大动作、遮挡和转场仍是弱点;局部注意力也可能溢到邻区。编辑描述可重复使用不等于已验证任意视频底座迁移。代码 已有推理入口及模块,权重可用性本次未下载验证。 2. KINESYS:借参考特效但少动原镜头 KINESYS: Test-Time Adaptation for Reference-Based Effect Editing in Images | 北卡罗来纳大学教堂山分校;工业光魔;费耶特维尔州立大学 | arXiv:2610.33292 关键词:参考特效编辑, 测试时适配, 双路反馈, 多候选搜索 前序问题:想给赛车加上参考照片里那种烟雾,编辑器却连车身和机位都改了。只问“烟像不像”会漏掉源图被破坏,只追求相似又可能什么都没改;作者研究的是图像特效编辑。 方法直觉:请两位分工不同的检查员指导调参:一位对照特效参考问形态和位置,另一位看原图、指令与结果,检查是否乱改。对几个随机起点分别优化,挑能在新噪声上也稳定工作的版本。 本文贡献:FLUX.2 Klein 4B 冻结底座,逐请求调秩 16 的 LoRA 低秩适配。Gemma 4 E4B-it 做参考问答,EditReward 给指令与质量反馈;每轮 3 个固定噪声候选共用一套适配权重,奖励加权抑制坏样本,早期排斥项维持多样性。五次独立搜索在第 16/31 次更新后保留 3/2 路,每路最多 100 次更新;用同一留出噪声评估中间权重,选择后再采样新变体。底座每次出图 4 步,参考长边上限 384 像素;用户还需指令、三条类别问题和可选掩码。 原文图 2|KINESYS 总览:参考问答 VQA 与看源图的 EditReward 提供互补反馈。K 次独立搜索各有自己的 LoRA 参数φ_k 和 N 个固定噪声候选;α_i 为候选目标权重,随时间衰减的λ_div(t)D 防止早期模式坍缩。横轴 0 到 T 为优化更新,弱搜索在剪枝点停止,留下的继续到后续权重检查点。 实验效果:81 请求、两随机种子中,各方法共同完成 156 例;八类包括烟雾、火焰、积雪、船尾浪。相对 Nano Banana 2,LPIPS 源图感知距离 0.429→0.377(越低越接近),TPIPS 文本条件感知相似度 0.696→0.731(越高越接近)。16 编辑的人评中,保留原图偏好 45%对 25%,特效转移 48%对 42%,其余为平局;前者 41 份答卷,多数非特效专家。多路反复出图并反传是每请求额外成本,论文未给统一耗时和峰值显存。 原文表 1|81 个请求、两种子中各方法共同完成的 156 例比较;开源权重方法按 Gemini 分排列,粗体/下划线为一/二名。匕首表示 EditReward 用于本方法优化和选择,并非独立裁判;双匕首表示 Nano Banana 2 与 Gemini 裁判同属一模型家族。LPIPS 距离越低、TPIPS 相似度越高越保留源图,其余为编辑质量模型评分。 批判点评:源图相似不等于特效成功;EditReward 既参与优化又选最终权重,不能把该分数当独立验证。人评样本小,156 例还排除了各服务未共同完成的 6 例;与闭源特效转移接近不能写成全面超越。项目 可查,本次未找到作者可确认的方法代码链接。 3. CrossPair:示范一对图迁移同一种改法 CrossPair: Unlocking Generalist Visual Transformation Learning in Image Editors | 浙江大学;蚂蚁集团 | arXiv:2610.34333 关键词:示例驱动编辑, 双路径条件, 关系方向对齐, 跨内容迁移 前序问题:给“这张改前→这张改后”的示范,再让模型处理另一张图,它可能复制示范人物而没学会改法。修复、换装、风格化看似不同,都需要把变换从示范内容中剥出来。 方法直觉:让一条路径理解操作含义,另一条保留颜色与纹理,再要求两组不同场景的“变化方向”一致。比较的是各场景内部怎样变,不是假设两张不相关照片的同位置就是同一个物体。 本文贡献:以 Qwen-Image-Edit-2511 为底座,把示范前、示范后、待改图按固定角色顺序送入 VLM 视觉语言编码和 VAE 外观编码。冻结 DINOv3 在训练时找每组图的变化区域,聚合特征差分并对齐方向;目标图只提供停止梯度的变化权重,预测分支保留梯度,低噪声时才加强该约束。只训练秩 128 LoRA,DINO 分支推理移除。Transform-360K 实际有 91010 条四图记录,360K 指记录级图像出现次数,非 36 万独立样本;含 8000 多细粒度关系。 原文图 2|CrossPair 总览:示范图对和待改图一起进入底座原有 VLM 语义及 VAE 外观路径,引导流预测。仅在训练时,正确目标提供停止梯度的变化定位权重,冻结 DINOv3 比较示范及预测查询的变化方向;VAE/VLM 编码器冻结,只训练生成器 LoRA。 实验效果:1095 个已见操作留出查询上,Relation252K 衍生训练版的 CLIP 目标图相似度 0.871、方向相似度 0.438,对照 RelationAdapter 为 0.777/0.355。450 个未见操作查询上,扩展数据版目标相似度 0.783、LPIPS 距离 0.402;原数据版为 0.744/0.440。GPT-5.5 一次匿名排序的未见操作首选率 43.5%,但保留源内容首选率仅 11.2%。训练图面积上限 262144 像素;额外 DINO 只增训练成本,论文未给统一部署时延/显存对照。 原文表 2|已见操作和未见操作的确定性指标及 GPT-5.5 单次排序首选率。R252K/T360K 表示不同训练混合。CLIP-I 对目标/源图相似度、CLIP-Dir 方向相似度越高越好,LPIPS 对目标距离越低越好;首选率分整体、操作与源内容保留三类,不能把整体首选率当编辑成功率。 批判点评:推理只给一对示范不等于训练只靠一对:训练另有待改图的正确结果,也有可指明操作的文字。新数据版同时改变数量和组成,不能把全部收益归因单一损失;系统对照保留各自原生采样器。源图保留弱于 LoRWeB,任务需权衡迁移力度;原文未提供可核实的项目或代码入口。 4. WorldCast:大幅绕拍时记住人物背面 WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control | 武汉大学;小米 | arXiv:2610.33135 关键词:相机轨迹控制, 多视角人物记忆, 几何对齐, 大角度视频 前序问题:镜头绕人物转半圈,正脸像本人,背面却换了发型和衣服。第一帧里根本没有这些信息;镜头走对路径,与人物每一面保持同一身份,是两个耦合问题。 方法直觉:把源图投影成沿相机轨迹的粗参考,明确哪里看不到;再把人物正背侧参考放进共同三维坐标,目标机位从对得上的参考里取细节,而不从所有照片无差别拼信息。 本文贡献:Wan2.1-I2V-14B 接收初始图、文字、目标内外参及补充人物视图。深度反投影后沿轨迹渲染 RGB 和覆盖掩码,Plücker 射线编码相机位置与方向;GAMA(几何对齐记忆注意力)先用前景掩码和多视图几何估计对齐参考,再在 20 处插入记忆块。第一阶段用 76698 条 SpatialVID 和 5 万 UE5 序列训练相机控制,第二阶段用 3 万 Blender 多视角样本训练记忆分支;81 帧、832×480,两个阶段分别 5/8 轮。 原文图 2|WorldCast 总览:把沿目标轨迹对齐的几何指导,与先在共同坐标系对齐的多视角人物记忆结合,使相机路径和人物补充外观共同指导视频生成。 实验效果:CLACT 评测含 42 场景(17 合成、25 真实)各六条轨迹。相对 Uni3C,ATE 绝对轨迹误差 0.098→0.065,相对旋转误差 1.069→0.896,跨视角几何差异 MEt3R(越低越一致)0.324→0.228,ArcFace 身份相似度 0.374→0.555。画质分 0.719,低于 Lyra 2.0 的 0.725;不是所有指标领先。增加多参考和 20 个记忆块需要计算与存储,原文没有统一实测时延账单。 原文表 1|CLACT 主比较,箭头表示越小/越大越好,Anchors 表示是否增加人物视图。ATE/RTE/RRE 为绝对轨迹、相对平移/旋转误差;MEt3R 为跨视角几何差异;Arcf./CLIP/DINO 为身份或视觉特征相似度,Subj./IQ 为主体稳定和画质。WorldCast 使用额外人物视图,画质和主体稳定未在所有对照中领先。 批判点评:方法用了额外人物参考,而大多数相机基线只给初始图;不能把信息增量全当架构收益。遮挡、前景分割和相机对齐失准仍会污染记忆。代码 有推理入口,README 明确专用权重仍待发布,不能据演示命令声称现在能完整复现;其推荐显存也不是论文峰值测量。 5. OmniShowcase:四面参考加法线转台稳绕拍 OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images | KAIST;仁荷大学;FLIPTION | arXiv:2610.35684 关键词:多视角主体生成, 法线转台, 三维一致性, 合成视频数据 前序问题:给了茶壶四面照片,视频绕拍时仍可能长出第二个壶嘴。照片分别告诉模型各面像什么,却没明确告诉它这些面属于怎样的同一件立体物体。 方法直觉:先由同样四张参考重建粗几何,转一圈记录表面朝向,作为独立的结构说明书;照片提供外观,法线提供形状。说明书不必逐帧对齐最终视频,镜头动作仍由文字指定。 本文贡献:构建 4000 条 Showcase-4K 视频,12 种相机运动、88 种轨迹配置。主体由真实三维资产渲染,视频修补只生成背景;条件也从四张参考重建,避免训练偷用真值网格。25 帧法线转台编码为 7 帧潜变量,80 帧目标编码为 20 帧,再加四张独立参考,共 31 个时间位置;token 即模型处理的特征单元。条件保持干净,仅目标加噪。Wan2.1-I2V-14B 只调秩 128 LoRA,四张 B200 训练 33000 次更新约 50 小时。 原文图 4|OmniShowcase 总览:从 N=4 张参考图重建几何并渲染法线转台。参考图及法线条件送入经 LoRA 调优的图生视频扩散 Transformer 参考路径;模型用照片外观与法线结构生成视频,无需针对每个新主体再优化。 实验效果:ShowcaseBench 的 50 主体、四条 360 度轨迹与训练资产隔离,另测 NAVI 的 35 主体,各方法均给同样四张图。相对 3DreamBooth,留出集 DINO 主体相似度 0.707→0.799,归一化并刚性对齐后的 GT-CD 双向点云距离 0.1717→0.0824;NAVI 相对 MV-S2V 为 0.1816→0.0975。留出集美学分 0.574 低于 MAGREF-MV 的 0.614。推理虽无需逐主体调优,仍要先重建与渲染转台,不能当作零预处理。 原文表 2|ShowcaseBench 的 50 主体与 NAVI 的 35 主体主比较,共九指标。DINO/CLIP 测身份,MEt3R、GT-CD 及 RotCov 测跨视图结构、对齐后点云距离及视点覆盖,ViCLIP 测文字匹配,Imaging/Aesthetic/Dynamic 测画质、美学与运动。相似度和画质类越高越好,三个结构/覆盖距离越低越好;粗体/下划线为最优/次优。美学指标未领先。 批判点评:它是多视图主体生成,不是对原视频逐帧重拍,也不是数字相机路径的严格控制。不同参考间主体非刚性变化处理不了,背景有合成感,几何分还依赖重建和对齐器。仓库 当前只有说明及素材,数据、推理、权重和训练代码均列为待发布。 6. SF2:少步视频还要学中间表征 Beyond Distribution Matching: Self-Supervised Representation Forcing for Few-Step Video Generation | 上海交通大学;腾讯混元;南洋理工大学 | arXiv:2610.35594 关键词:少步视频蒸馏, 表征自监督, 非对称噪声, 时空一致性 前序问题:把几十步视频压成四步,最终画面分布看着接近,人物关节仍会跳,倒掉的墙还会长回来。只约束出图结果,没有直接要求学生学会稳定的内部时空表示。 方法直觉:让学生看更破碎的噪声拼图,老师看同一生成轨迹上较干净的一刻;学生既要出好视频,也要预测老师中间层怎样理解它。老师来自学生参数的慢速平均,无需另请视觉大模型。 本文贡献:Self Flow Forcing(SF2)保留 DMD 分布匹配蒸馏目标,复用已有四步生成轨迹,取高/低噪声状态。学生混合两者,EMA 指数移动平均老师只看较干净状态;用投影器把学生 30%深度特征对齐老师 70%深度,余弦损失只更新学生。默认同一空间掩码跨帧复用,避免从相邻帧照抄;双向/因果最大比例设 0.4/0.2。EMA 动量 0.99,先 100 次仅训练投影器,再加入权重 0.5 的表征目标。 原文图 1|SF2 总览:学生去噪轨迹最干净预测继续承担标准 DMD 输出损失;两个中间状态 x_t/x_s(t>s)用空间掩码混成学生的高污染输入,EMA 老师只看较干净 x_s。通过可学习投影器和停止梯度的余弦损失对齐不同深度隐层,老师以指数平均更新,不引入外部预训练特征。 实验效果:Wan2.1-T2V-1.3B、四步、848×480,单 H100 同组比较:双向版 VBench 视频质量及语义评测总分 83.19→84.15,报告速度 16.2 FPS(帧/秒)、时延 4.22 秒不变;因果版相对 Causal-Forcing 总分 84.04→84.15,VisionReward 偏好模型均分 6.326→7.523,报告 17 FPS。一个训练周期定义为 1 次生成器和 5 次判别 score 模型更新,新增分支占周期 6.2%,不是训练总成本免费;推理不保留 EMA 或投影器。吞吐按表注为帧/秒,正文另写样本/秒有冲突,不能据此换算完整视频时延。 原文表 2|VBench 及 VisionReward 比较,分双向多步、蒸馏双向、自回归多步、蒸馏自回归四组,粗体只标各可比组最优;蒸馏组共享 Wan2.1-T2V-1.3B。吞吐量按表注为 FPS,时延为秒,单 H100;正文另一处写 samples/s,存在单位表述不一致,本稿沿表注且不跨组解释整片时延。Total/Quality/Semantic 和 VisionReward 均越高越好。 批判点评:不把内部特征对齐等同物理正确证明;三维重渲染探针也用了外部重建器,因果/双向速度及延迟口径不能混作整片首帧体验。arXiv 评论明确已接收 NeurIPS 2026。仓库 当前只有 README 并写代码将发布,不能称已可复现。 7. Triage:注意力每块分三档算 Triage: Skip, Skim, or Refine Attention Tiles in Video Diffusion Transformers | 首尔大学 | arXiv:2610.35706 关键词:视频推理加速, 注意力分块, 四位计算, 误差路由 前序问题:视频几万个 token 彼此做注意力,计算量随长度平方增长。统一砍掉一部分块会漏掉重要细节,保留块全用同一种低精度,又把算力花在了误差本就很小的地方。 方法直觉:像读长文:无关段落看摘要,普通段落略读,关键段落精读。根据每块近似造成的输出误差,把多花一次计算能换来多少精度算清楚,再按同一个预算价格选择。 本文贡献:先用聚类树把相似查询和键组成 tile 注意力块,统计均值、方差和键值协方差,预测三档误差。skip 以块均值贡献替代,非直接清零;skim 用 NVFP4 四位乘法;refine 再加量化残差乘法。价格π越大越节省,路由按误差下降与新增成本决定升级。单个融合内核在同一次 softmax 归一化中合并三档,利用 RTX Blackwell 的 FP4 计算单元,无需再训练生成器。 原文图 5|Triage 总览:规划阶段①聚类树将相似查询与键分块,②路由按预测误差分值 Ẽ_t=m̃_t(J_t+R_t)√w_h 选择略过、低精度或残差精修;m̃_t 为估计注意力质量,J/R 为近似误差项,w_h 为头输出权重。执行阶段③同一遍计算中,略过块用均值,普通块用一次 NVFP4 乘法,精修块用三次乘法计入残差。块图案仅作示意。 实验效果:五设置各 50 提示/图文对,只换视觉自注意力,首 20%步和第一块仍密集计算。RTX 5090、HunyuanVideo 540p/129 帧在π=0.3 时整段加速 2.32 倍、对密集视频 PSNR 像素信噪比 34.46 分贝;π=0.15 是 2.21 倍、36.37 分贝。同卡 Wan2.2 720p 只加速 1.38 倍;96GB RTX PRO 6000 的 LTX-2.5 为 1.84 倍。含预处理的单次注意力 4.1–8.6 倍,与不含预处理的内核最高 13.5 倍不同。 原文表 1|五设置各 50 提示的端到端结果:PSNR/SSIM 相对密集输出越高越好、LPIPS 距离越低越好;VBench 为五维平均质量,E2E 为整片相对密集版速度比。Density 是计算块占比,括号是全部块中的精修占比;Tokens 是每序列视觉 token,LTX 仅指阶段 2。π为误差与计算的价格。S/L/S+L 分别稀疏、四位及八位组合;粗体标最好方法,硬件分 32GB RTX 5090 和 96GB RTX PRO 6000。 批判点评:PSNR 衡量贴近密集输出,不是现实世界真值;VBench 画质也并非每组都超过密集版。收益依赖 Blackwell 硬件、序列长度与密集暖启,不能泛化为所有 GPU 或整套服务提速。原文没有作者方法仓库;其 CUTLASS 引用只是底层库,ICML 模板也不当接收证据。 8. ImageTTS:画图底座读频谱学说话 ImageTTS: Repurposing Pretrained Image Diffusion Transformers for Speech Synthesis | 武汉大学;微软;香港中文大学 | arXiv:2610.34807 关键词:跨模态生成迁移, 图像潜空间, 零样本语音, 风格指令 前序问题:图像生成器学到的东西能否帮助语音,而不只是借用同款网络?语音还要求字念对、短参考里是谁在说话,两类能力必须分开检验。 方法直觉:把频率随时间变化的声谱图当灰度图片复制成三通道,让图像编码器压缩;再比较同一结构从画图权重和随机权重起步,分清“表示能装下声音”和“生成先验真有帮助”。 本文贡献:100 频带的 log-mel 声谱插值到 512 高,时间补齐 16 倍数并归一化成伪 RGB;冻结 FLUX.2 VAE 和 Qwen3 文字编码器,微调 4B 图像 DiT 扩散 Transformer,做条件流匹配。零样本用参考语音前缀,指令版把文本内容与说话风格一起编码;生成声谱再经 BigVGAN-v2 声码器还原波形。规模版用 10 万小时 Emilia、64 张 40GB A100 训练 18 万次更新,指令版再用 9000 小时和零样本等量混合训 5 万次。 原文图 2|ImageTTS-base 架构:以流匹配 DiT 为主干,由双流块和单流块组成,并接受时间步σ条件。用 Euler 积分求解潜变量,经冻结 FLUX.2 VAE 解码器与 BigVGAN-v2 声码器合成语音。 实验效果:585 小时 LibriTTS 初始化实验,同为 10 万次更新,图像预训练/随机的 WER 词错误率 2.7%/4.2%;随机训 15 万次仍 3.8%。冻结 VAE 在 LibriTTS 重建 STOI 可懂度 0.99、说话人相似度 0.95,这是重建而非生成分。规模版 Seed-TTS 英文 WER1.12%、中文 CER 字错误率 1.68%,中文说话人相似度 0.72 低于 F5-TTS 的 0.76;CapSpeech 风格属性平均准确率 0.66。推理 50 个 Euler 求解步,文字/语音双引导需额外前向,非只调用网络 50 次。 原文表 2|同为 10 万次训练更新,交叉比较图像预训练/随机初始化及图像 VAE 潜空间/直接 mel 建模,粗体为各指标最优。WER 词错误率按百分数越低越好,SIM 说话人相似度、DNSMOS 预测感知质量越高越好;潜空间预训练 WER2.7%,随机 4.2%,直接 mel 保留说话人略强,表示选择存在取舍。 批判点评:正确发音与身份保持有取舍,不能把重建分数套给生成。更大私有数据系统不是同数据公平对照;只在约 10 万小时 Emilia 组比较优势。未给统一实时率或峰值显存,演示 自称 ICLR 2027 匿名投稿,不构成接收;本次未发现可确认的代码。 9. AMBIT:挪一个声源其他声音少受扰 Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion | 香港科技大学;Noiz AI;华盛顿大学 | arXiv:2610.34415 关键词:空间音频编辑, 可执行场景计划, 四通道表示, 在策略自蒸馏 前序问题:把狗叫从左边移到右边,背景音乐却变声或偏了方向。空间音频编辑既要执行哪条声源怎么动,也要保留其余声音的音色、响度与位置,只写一段目标描述不够。 方法直觉:先列完整目标场景:改谁、保留谁、何时响、沿哪里移动,再渲染声音。计划负责可说清的控制,原音频负责计划写不全的细节;两者共同约束,减少保留部分被重新想象。 本文贡献:FOA 一阶 Ambisonics 以 W 全向及三方向分量表达声场,非四个独立扬声器。共享 Transfusion Transformer 在自回归模式逐 token 产 ScenePlan,在流匹配模式生成音频潜变量;可执行计划含声源类型、文字、时间和三维直线路径。编辑同时用原始潜变量及 CLAP 对比音文特征;VAE 以共享解码器全向重建、分组 KL 和空间协方差保留通道关系。OPSD 在策略自蒸馏让老师纠正学生自己产生的计划前缀与采样状态,联合更新两模式。主干及接口 3.326 亿可训练参数,训练 160 万 FOA 例及 100 万编辑对。 原文图 2|AMBIT 总览:(a)共享 Transformer 预测可执行 ScenePlan 并以编译计划指导原生 FOA 潜空间流渲染;编辑在两模式使用源潜变量,在规划时加入 Ambit CLAP 特征。(b)OPSD 在学生前缀和实际访问状态上蒸馏 token 及干净潜变量预测,联合更新共享块及自回归/DiT 模块。(c)VAE 结合共享解码器的全向 W 辅助恢复、分组 KL 和空间协方差监督。 实验效果:8000 生成请求、5000 编辑对;相对 SwanWeave,基础版编辑配对 CLAP 音文相似度 0.68→0.84,FAD 音频特征分布距离 0.57→0.24;未编辑声源方向平均绝对误差 0.90→0.17 弧度,绝对响度变化 8.40→1.65 分贝。单声源指标只在带标注的孤立活动区间计算,不能覆盖所有重叠混音。联合 OPSD 的 FAD0.211,对继续监督训练为 0.232。计划最长约 15 秒,规划与连续渲染均耗计算,未提供统一端到端时延。 原文表 5|空间音频编辑:上部为混合声场指标,下部为孤立区间上的非编辑声源保留与目标声源方向。角度误差单位为弧度,响度变化为分贝;Direction MAE 为方向平均绝对误差,W NMSE 为全向通道归一化均方误差,Angular traj.RMSE 为角轨迹均方根误差,越低越好,wCS 方向加权余弦相似度越高越好。粗体为各列最好。保留原声需单独检查,不能用目标方向正确替代。 批判点评:长声景和连续多轮编辑的一致性仍待验证;语音自然度 UTMOS3.52 低于 Qwen3-TTS 的 4.18,不是音质全胜。方向误差弧度不能误写成角度。代码 有生成和编辑实现,但 README 明确预训练模型尚待发布,现有命令需要本地模型包。 10. VidEdit3D:先沿镜头改视频再改三维 VidEdit3D: Flexible 3D Gaussian Editing with Video Diffusion | 西湖大学;利兹大学;南洋理工大学;加州大学默塞德分校 | arXiv:2610.35756 关键词:三维高斯编辑, 轨迹组织, 视频先验, 区域选择优化 前序问题:给三维场景里的人戴上耳机,一张视图改好了,换角度耳机却不见了;逐视图编辑还可能动到邻近家具。目标既是跨角度一致,又允许局部形状真的改变。 方法直觉:把静态三维场景的绕拍渲染排成平滑视频,借视频模型的时序能力传播首视图编辑,再只把该改的区域拟合回三维。镜头移动造成的画面变化不应变成人物自己乱动。 本文贡献:输入已重建 3DGS(三维高斯点及颜色、透明度组成的可渲染场景)、标定视图、改过的锚点图及前后提示。TGR 选 4 或 7 关键视图,最远点覆盖后排成短闭环,样条插值成 61 帧片段,双向从同一锚点传播。FAVE 共享源/改状态噪声,用源结构校正限制漂移;ECG 在同一改后状态对比源/目标图条件,早期放大源条件拉开编辑信号。注意力差分给区域掩码;RS-GS 用跨视图掩码和深度剔除遮挡后背景,只更新选中高斯。 原文图 2|VidEdit3D 总览:将三维编辑转成沿轨迹的视频编辑。第一步 TGR 组织选中视图为平滑片段;第二步 FAVE 从用户修改锚点传播,借 ECG 增强语义对齐、注意力掩码保留背景;第三步 RS-GS 以逆渲染将二维结果抬升回三维,仅允许目标高斯更新。 实验效果:50 编辑案例、同场景同提示,参考条件方法还给同一锚点。相对 EditSplat,CLIP-D 图像变化与文字变化方向相似度 0.0813→0.1275;相对 GaussCtrl,跨视图几何差异 MEt3R0.1137→0.1126,改进幅度较小。底座 Wan2.1-I2V-14B-480P,50 步日程强度 0.9,即 45 个有效去噪步;每个接受片段都需传播,再做 3000 次高斯优化。免网络微调并不免三维拟合,论文未给统一整流程时延/显存。 原文表 1|编辑忠实度与多视图一致性比较:CLIP-D 为编辑方向对齐,CLIP-S 为目标语义匹配,DINO 为跨视图特征相似,前三项越高越好;MEt3R 为重叠相邻视角几何差异,越低越好。VidEdit3D 四项领先,粗体标最优,但 MEt3R 相对 GaussCtrl 的优势只有 0.0011,不夸大为几何完全正确。 批判点评:视图相似度过滤在首个不合格片段就停止该分支,覆盖不足或重遮挡仍可能留下未改区域;新对象还受选中高斯及增密范围限制。跨角度一致不能证明几何真值正确。仓库 当前仅说明和素材,方法代码标为即将发布。 趋势观察 示范变化比完整目标更适合传递编辑意图 EditDistill把图对提炼为变化描述,CrossPair把跨场景特征变化对齐;两者都在区分内容和操作,但前者用于视频时序,后者用于不同图像。 几何条件的对齐方式决定控制边界 WorldCast按相机几何读取人物锚点,OmniShowcase用独立法线转台给形状而不逐帧锁相机;不能将两种多视图方法当成同一种控制。 速度优化要标明省的是哪一步 SF2以额外训练换四步质量,Triage改注意力精度,KINESYS反而按请求多路调优;收益需要回到训练、推理和服务成本分别看。 保留能力需要单独测 KINESYS的源图保留、AMBIT的未编辑声源方向与响度、VidEdit3D的非目标高斯冻结,各自给出更具体的保持对象。 今日讨论 EditDistill 对比 VACE,未编辑区域 DINO 相似度 0.701→0.738、Warp 误差 3.42→2.97,但编辑方向 CLIP-E 为 0.245,仍低于 0.247。面对首帧无法代表的大动作,固定修改与生成预算后,如何用转身、遮挡的分级实验,收集证据区分“更稳地传播改动”和“编辑力度更弱”,分别衡量目标变化与非目标保留? 人工智能炼丹君 整理 | 2026-10-28
-
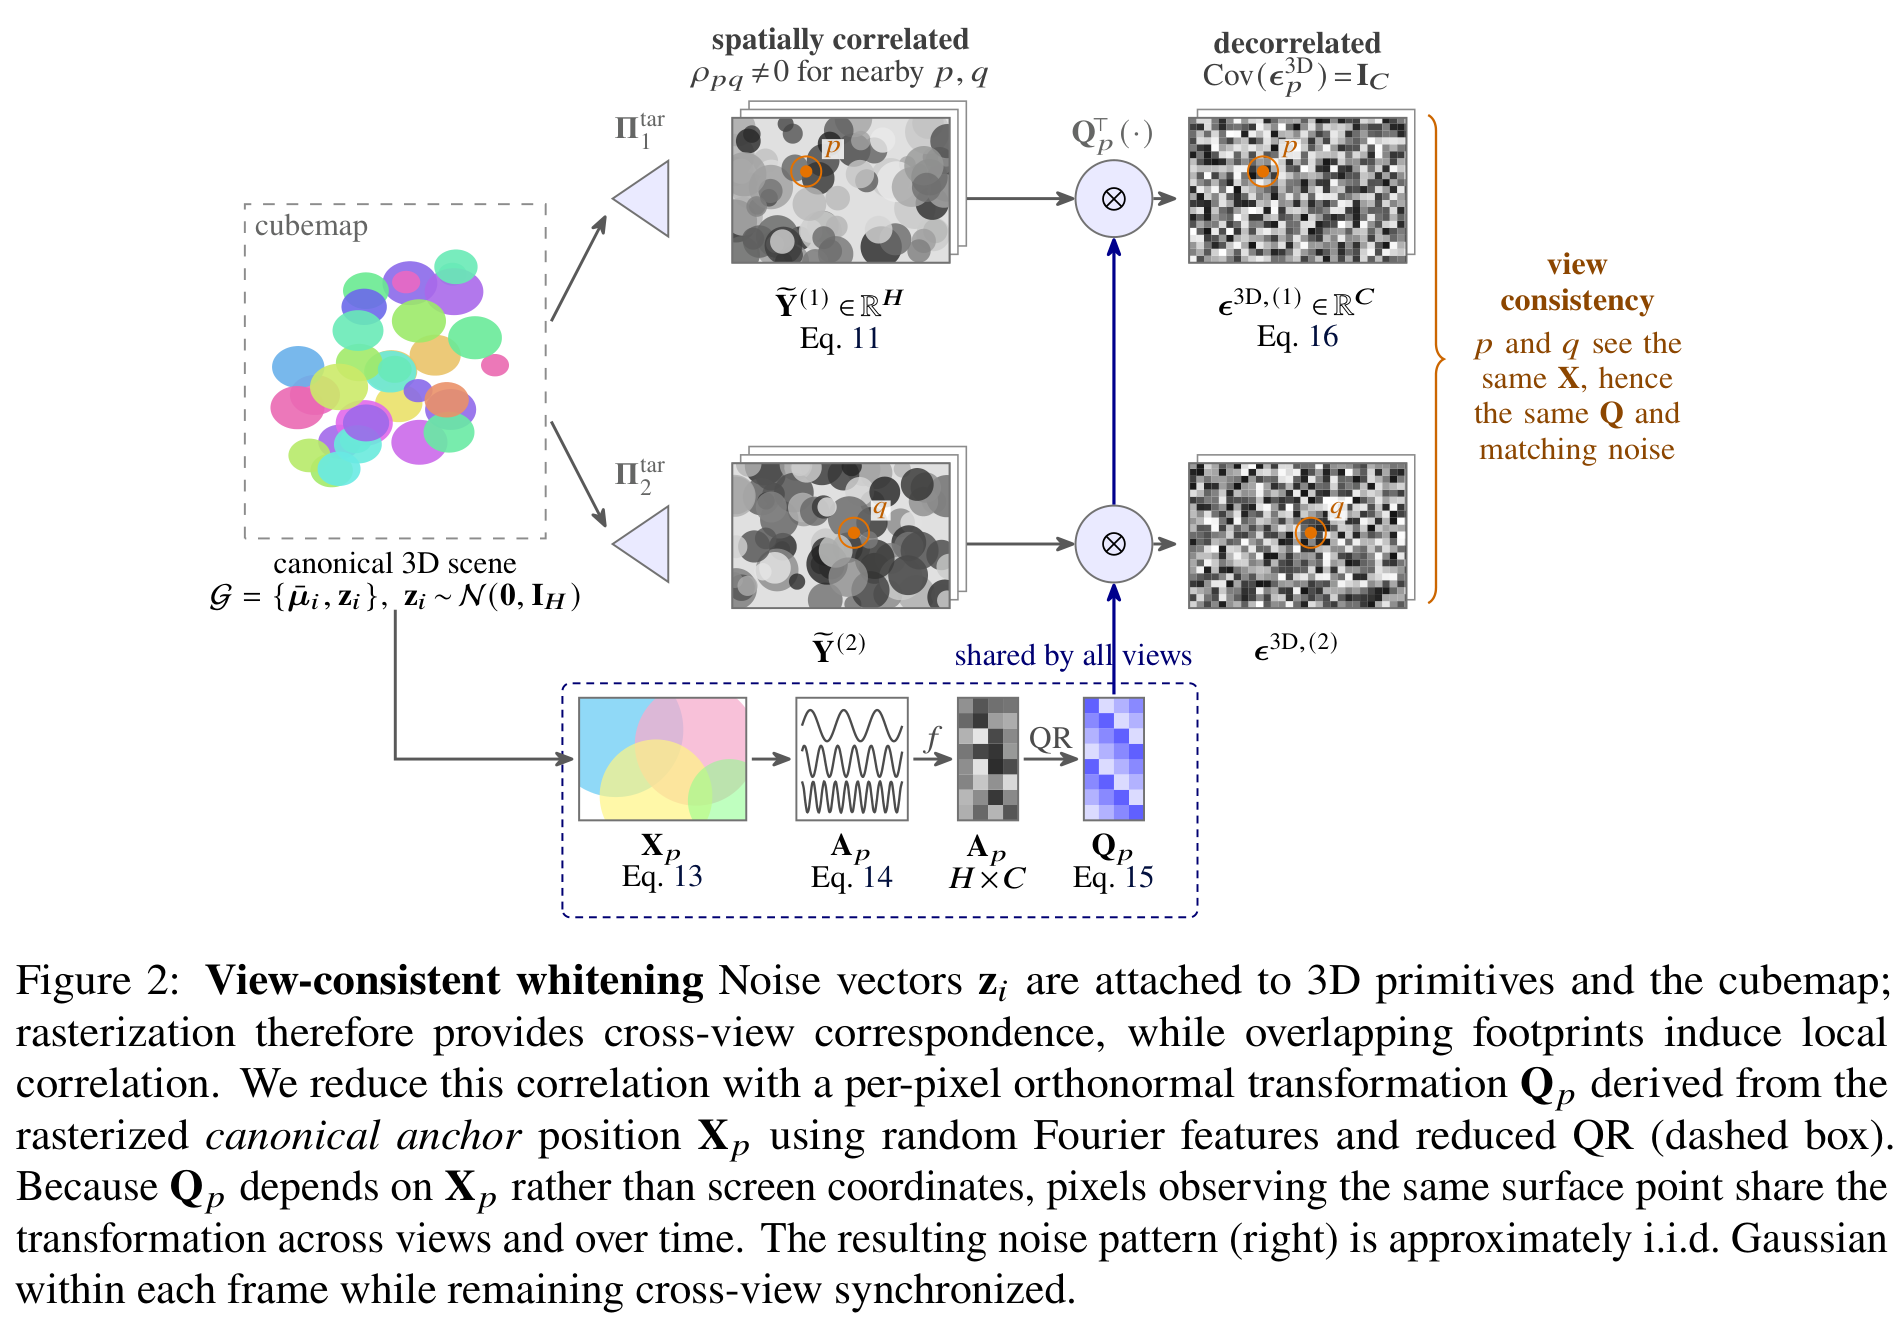
AIGC 每日速读|2026-10-27|高通换机位也让动作对齐SyncVid 今日 AIGC 论文速览 今日共 10 篇 · 参考视频重拍与相机控制 2 篇 · 图像编辑与透明素材 3 篇 · 图像生成模型 1 篇 · 旋律音频生成 1 篇 · 音频驱动三维头像 1 篇 · 多参考图生成评测 1 篇 · 城市三维生成 1 篇 重点论文标题列表 SyncVid(高通):换机位也让同一动作对齐 WorldForge V2(西湖大学):换镜头时少带进重建破绽 LOCI(Meta):同图每个人都有独立编辑旋钮 AlphaAnything(字节):透明素材不用另造一套潜空间 EditJev(北京大学):先挑合适的改图模型再开工 选读入口:要把已有视频换机位并对齐人物动作,先读 SyncVid,再读 WorldForge V2 比较噪声同步与轨迹参考两条路。合照里不同人改不同程度,读 LOCI;做玻璃、发丝等透明素材读 AlphaAnything。部署多个编辑器先看 EditJev 的路由与估算时延;想研究扩散之外的图像生成,读 TEM 并留意持续采样链。已有音频模型想跟旋律走,读 Melody Guidance;照片做可转头数字人,接 AudioLift。多张参考总串细节,借 MDMR-Bench 拆验收项;做可逐栋编辑的城市三维资产,再读 CityLift 及掩码和数据域边界。 今日论文速览 1. SyncVid:换机位也让同一动作对齐 SyncVid: World-Equivariant Diffusion for Synchronized Video Generation | 高通 AI Research | arXiv:2610.31765 关键词:参考视频重拍, 跨视角同步, 结构化噪声, 近似白化 前序问题:给同一段舞蹈换两个机位,人物可能在左视角抬手、右视角却已经转身。每个视角各自生成得通顺,不代表它们描绘的是同一时刻、同一个动作。怎样让遮挡后露出的部分也尽量一致? 方法直觉:别让各机位从互不相干的随机噪声开始:先给场景里的三维小颗粒各分配一份固定噪声,再按新机位投影。不同机位看见同一个颗粒,就拿到相关的随机起点;生成器负责把不完整的投影补成画面。 本文贡献:NoPo4D 将单目视频重建成随时间变化的高斯点,噪声绑定不随时间变化的规范坐标锚点;未观察背景用包围场景的立方体补足。投影会使邻像素过度相关,于是用规范三维位置的随机傅里叶特征及 QR 正交分解(构造正交方向的局部变换)做近似白化:降低局部相关,同时保留跨视角对应。源视频和渲染视频作为条件,以秩 256 的 LoRA 低秩适配微调 Wan2.2-14B;36000 组合成视频对,加 2000 条真实静态视频折叠出的约 13500 对,八张 H100 训练 10000 次更新。 原文 PDF 图 2|跨视角一致的近似白化:噪声向量绑定三维高斯点与背景立方体,栅格化使不同机位共享对应关系,但重叠足迹带来局部相关。虚线框用规范锚点 X 的位置经随机傅里叶特征及约化 QR 分解得到逐像素正交变换 Q;它依赖三维位置而非屏幕坐标,同一表面跨视角、跨时间共享变换。右侧噪声在帧内近似独立高斯,视角间仍同步;这种白化不是严格独立性保证。 实验效果:Multi-ViewBench 含 200 片段,统一 5 秒、15 帧/秒、480p,方法输出 75 帧。相对 Reshoot-Anything,动态区域可信匹配点 1268→1332,跨视角 FVD(视频特征分布距离,越低越好)202.22→146.99;跨视角 CLIP 相似度按百分制 89.96→91.66。相机旋转/平移误差 0.151/0.121,逊于 ArtiFixer 的 0.0780/0.0529。单 H100、480×832、50 步生成耗时 1203.1 秒,另有 4D 重建 4.18 秒、噪声渲染 6.44 秒、白化 0.53 秒;未报峰值显存。 原文表 1|Multi-ViewBench 上的视角同步、时间一致性及相机精度比较。Generation Length 为实际生成帧数,49 至 75 帧不等;Mat. Pix.为动态/静态区域的高置信匹配点数,越高越好;FVD-V 为跨视角视频分布距离,越低越好;CLIP-V、CLIP-F 分别为跨视角和时间相似度,越高越好;RotErr、TransErr 为相机旋转和平移误差,越低越好。SyncVid 输出 75 帧、动态匹配 1332、FVD-V146.99,但相机误差 0.151/0.121 未领先。 批判点评:三维跟踪或遮挡出错仍会破坏同步;白化仅近似,不能保证像素独立或真实世界几何正确。200 片段由视觉语言模型筛选,且不同对照输出长度不同,不能把匹配点当严格同帧数胜率。原文所列项目主页本次返回 404,未确认代码或权重已公开;机构由四位作者的高通公司邮箱及原 PDF 核验。 2. WorldForge V2:换镜头时少带进重建破绽 WorldForge V2: Eliciting Camera-Trajectory Alignment in Video Diffusion Models | 西湖大学;北京航空航天大学;新加坡管理大学 | arXiv:2610.31640 关键词:相机轨迹控制, 视频重渲染, 速度缓存, 轨迹低秩适配 前序问题:把一段实拍改成绕物体转动,深度重建的孔洞和错位很容易一起变成视频里的浮空结构。直接强塞参考帧会伤画质,完全交给模型又可能不按指定机位走。 方法直觉:先把画面按目标相机路径粗略投影,再挑适合承载运动信息的潜变量通道施加约束;保留原生成器的预测作校正。重拍指导可以带路,但不应把错误参考当成必须照抄的真值。 本文贡献:IRR(步内递归精修)在预测的干净潜变量中融合参考,再统一加噪;FLF(光流门控潜变量融合)比较位移、方向和异常流,筛选运动相关通道;DSG(双路径自校正引导)比较有无轨迹引导的预测,以角度自适应投影校正。v-cache 复用上一步速度预测,少算额外前向。进一步按 Shapley 贡献筛选网络块训练 Trajectory LoRA:LongCat 用 48 块中的 36 块、8 场景 50 视频、1200 次更新;H3 用 50 块中的 38 块、1 场景 50 视频、1500 次更新,均含 200 次锚点预热,再混合引导状态训练。 原文图 2|WorldForge V2 总览:单张图或视频帧与目标相机路径先经几何重建,渲染对齐轨迹的参考帧。无训练路径在预测干净潜空间依次执行 IRR 步内精修、FLF 运动通道筛选和 DSG 双路径校正;高效路径用 V-Cache 在带噪潜空间融合轨迹,结合对轨迹敏感块的轻量 LoRA,仅少量训练数据学习相机控制。目标是在沿指定路径变化时保留底座生成能力。 实验效果:无训练动态重渲染覆盖超过 30 源视频:相对 TrajectoryCrafter,FVD 视频分布距离 97.31→93.17,但 ATE(全局相机位置误差)0.431→0.527,反而更差。学习版在 40 个留出场景、200 条轨迹比较,统一 640×360 评分;H3 的 PSNR 像素信噪比 20.21 分贝、LPIPS 感知距离 0.2698,对照 UniWorld-View 为 17.15/0.3370。单 A100 估算均时 H3 为 707.3 秒,叠加公开加速 LoRA 后 139.0 秒;各方法使用原生配置,非严格等结构提速。 原文表 III|Trajectory LoRA 与相机控制方法对比。PSNR、SSIM 衡量目标视角像素和结构重建,越高越好;LPIPS 衡量感知距离,Vis/Disocc 分别限于可见与新露出区域,越低越好;ATE 为全局轨迹误差,RPE-T/R 为局部平移/旋转误差。两底座改善重建与新区域补全;H3 局部相机误差最低,但 ATE0.00685 仍高于 UniWorld-View0.00625。粗体和下划线分别标示最优与次优。 批判点评:无训练引导与学习版是两条路径,不能把单场景训练说成整个系统免训练;更新数不含底座预训练。单场景有泛化价值,但大幅度深度错误、人群遮挡仍会留下破绽;全局轨迹指标也非全胜。代码 含 Wan、LongCat 和 H3 相关实现,未实际运行模型。 3. LOCI:同图每个人都有独立编辑旋钮 LOCI: Localized Continuous Control for Multi-Subject Image Editing | Meta AI 研究团队 | arXiv:2610.31950 关键词:多主体图像编辑, 区域低秩适配, 注意力绑定, 连续强度控制 前序问题:合照里想让左边的人渐渐变老、右边的人只添胡须,调大某个编辑旋钮却可能把所有人一起改。只框定区域解决不了改多少,只调全局强度也解决不了改谁。 方法直觉:让每条指令只和自己的主体绑定,再把低秩适配器原来统一的强度拆成逐个图文片段(token)的强度。训练时先学会把指定编辑完全压回原图,推理时缩放这条抑制方向,得到连续的编辑幅度。 本文贡献:冻结 FLUX.1-Kontext,将文字、待编辑图及源图 token(模型处理的文字或图像片段)按主体分组;区域框或掩码决定写入范围,重叠区域取更强抑制值。IDAttn(主体解耦注意力)在中间块隔离主体,首尾块允许视觉信息互通以协调光照;训练和推理使用同样路由。α为抑制量:1 不改、0 为名义编辑、负数进一步外推。秩 16 适配器仅用 22482 个单区域例,八张 H200 训练 10000 次;不用针对多人数量再训练。 原文图 2|LOCI 架构。阶段 1 由用户提供源图、逐区域框 B、指令及独立控制α;阶段 2 把文字、目标与源图 token 分成主体分组 T/L/C,低秩残差按α逐 token 门控,背景 L_u/C_u 无适配残差。阶段 3 冻结 Flux.1-Kontext 的 19 个双流与 38 个单流块:0–9 及 47–56 块协调视觉信息,10–46 块隔离主体。插图为两种查询—键注意力矩阵;协调阶段主体图像 token 可读取所有视觉 token,补足背景连续性证据。 实验效果:128 个合成多主体场景、427 主体编辑对,每图 2–7 主体;统一 1024×1024、28 去噪步。双旋钮 7×7 网格中,相对事后拼接 SliderEdit 与 IDAttn,语义串扰 0.2776→0.2211,感知串扰 0.1909→0.1860;串扰是非目标变化相对目标变化的比值,越低越好。多区域同时编辑成功率 0.9099,略低于无连续控制的 IDAttn 单独版 0.9153。未报告额外墙钟时延和显存,单次联合编辑仍需要 28 步,不是一次网络调用。 原文表 2|协议 C 让各主体同时名义编辑,区域成功率及最差区域 CLIP 增益越高越好;协议 D 在双旋钮网格分别测目标响应和串扰,仅适用于有连续控制的方法。语义与 LPIPS 感知串扰越低越好。LOCI 区域成功率 0.9099,IDAttn 单独版 0.9153;LOCI 串扰 0.2211/0.1860,事后拼接 0.2776/0.1909。粗体、下划线为最优与次优,不能将无滑块方法当作协议 D 的零串扰。 批判点评:合成场景的框/掩码已提供,不能外推自动定位和任意拥挤合照。背景虽不写入适配器残差,注意力仍可能传播变化,不能保证背景完全不变。感知串扰相对事后拼接只小幅改善;若框重叠,最强抑制优先也会影响旋钮独立性。原文没有本方法代码入口,不把引用的 FLUX 仓库当 LOCI 代码。 4. AlphaAnything:透明素材不用另造一套潜空间 AlphaAnything: Extending Pretrained RGB Generators to RGBA | 清华大学;字节跳动;北京大学 | arXiv:2610.32413 关键词:透明图像生成, 共享潜空间, 单向特征传递, 透明度端点损失 前序问题:生成玻璃、烟雾或发丝后再抠图,边界容易灰一圈;重新训练透明图像编码器,又可能损失原模型的小字和颜色。能不能让原彩色生成器直接产生透明素材? 方法直觉:在原有 RGB 三色解码器旁加一条预测透明度的支路,支路只能读取彩色特征,不能改回彩色解码过程。同时把透明度误差传回生成器,让它生成的潜变量本身更适合解码透明边界。 本文贡献:RGBA 比 RGB 多一个 alpha 不透明度通道:0 全透明、1 全不透明,中间值半透明。冻结原 VAE(变分自编码器)的编码与 RGB 解码,训练生成 Transformer 的秩 64 LoRA 及 alpha 支路,固定同一潜变量时 RGB 解码严格不变。EA(端点感知)损失按前景/背景混合权重的 Fisher–Rao 弧长衡量误差,可精确表示 0 和 1,错误饱和时仍有梯度;再对前景与背景误差分别开方聚合,增强小片错误的影响。各变体 20000 次更新、全局批量 16,文字生成训练有 8963 份 RGBA 样本。 原文图 2|AlphaAnything 总览:Transformer 的 LoRA 与嵌在 VAE 中的 alpha 分支,仅经生成式训练学习 RGBA。RGB 到 alpha 的单向特征共享,使给定同一潜变量时 RGB 解码保持原样;透明度监督仍可通过冻结但可微的解码器回传生成器,因此最终生成的潜变量允许改变。 实验效果:图像转 RGBA 测试为 295 源图中的 735 目标层;Qwen-Image-Edit 底座相对 OmniAlpha,Soft IoU(软透明度交并比)0.6881→0.9223,LPIPS 感知距离 0.0911→0.0136。文字生成在白底/黑底合成图上平均评分;AlphaTest 的 FID 分布距离却不领先,例如 FLUX.2 版 75.1796,对照 Qwen-Image-2.1 为 72.2720。FLUX.2 隔离解码 0.148→0.249 秒,端到端附加 0.244%;2.299→2.386GiB 是 VAE 单独峰值,非完整模型显存。 原文表 3|RGBA-Image 的图像转 RGBA 比较。RGB L1 为颜色绝对误差;Soft IoU 为软透明度交并比,越高越好;SAD 为透明度绝对差总量;LPIPS 为合成图感知距离;Alpha Grad 与 Alpha Conn 分别评透明度边缘梯度与连通误差,后五类距离/误差越低越好。AlphaAnything 比较 FLUX.2 与 Qwen-Image-Edit 底座,不能把后者更高成绩完全归因于统一方法。 批判点评:固定潜变量的 RGB 解码不变,不保证适配后的生成结果与原模型逐像素相同,潜变量已经被训练改变。透明数据和指标仍有限,文字生成的分布质量未全面胜出。仓库 本次只有 README、素材和忽略文件,不能称实现或权重已开源。 5. EditJev:先挑合适的改图模型再开工 EditJev: System One Routing for Image Editing Models | 北京大学;清华大学 | arXiv:2610.32635 关键词:图像编辑路由, 偏好排序, 质量时延权衡, 单次评分 前序问题:换背景、提衣服、擦汽车,各家编辑器的强弱不同。所有请求都交给平均成绩最高的模型,既可能改错对象,也可能为简单操作等太久;每次先把所有模型都跑一遍又更贵。 方法直觉:先让一个小裁判只看源图和指令,预测五个编辑器谁更合适;把它的质量偏好与事先测好的速度分合起来,只执行被选中的一个。裁判直接输出五维分数,省去逐字生成模型名。 本文贡献:Qwen3-VL-4B 多模态底座冻结主参数,只训练 LoRA 与线性偏好头,读取最后一个非填充 token。候选为 FLUX.2 Klein 4B/9B、FLUX.1-Kontext、OmniGen2 及 Qwen-Image-Edit。离线对每条训练请求运行全部候选,分别评编辑、保留、自然度、伪影;前两项与后两项各取较差值,再取几何平均,仅用差至少 0.5 的模型对训练排序。推理用β权衡质量与归一化速度,ImgEdit 取 0.7、GEdit-En 取 0.02,测试无需看到生成结果。 原文图 2|EditJev 总览:原图注把离线候选出图、自动评估及路由器训练写作上半部,把质量时延推理写作下半部;实际图面顺序相反,上部为在线选择,下部为离线偏好训练,本稿按图面解读。离线阶段运行所有候选用于偏好监督,在线并非先把所有输出生成后再筛选。 实验效果:737 个 ImgEdit 与 606 个 GEdit-En 请求,按各自官方协议和 GPT-5.1 裁判评分;相对固定 Qwen-Image-Edit,总分 4.540→4.592、8.194→8.255。RTX PRO 6000 上候选各测 20 请求均时,按选中模型频率加路由开销,估算总时延 56.90→22.33 秒、56.90→38.88 秒;不是每条请求端到端重测。路由单独平均 0.094 秒,依据 5 次本地请求。20 案例、20 人共 400 次判断,人类选择一致 327 次,即 81.75%。 原文表 3|固定 Qwen-Image-Edit、GPT-5.5 路由和 EditJev 的时延比较,含路由推理与选中编辑器生成,越低越好。ImgEdit 分别 56.90/51.15/22.33 秒,GEdit-En 分别 56.90/53.55/38.88 秒;按各模型实测均时与选择频率估算平均总时延,不表示每条请求都做同样端到端重测。 批判点评:质量提升较小,依赖固定候选池和自动评判偏好;新增编辑器不等于现有评分头自动适配。离线全部候选出图及标注成本未消失,论文也未给完整多模型驻留显存账单。两数据集β不同,不能把省 60.8%时延直接套到任意负载;人评只覆盖 20 案例。原文未提供本方法代码地址。 6. TEM:让图像沿低能量方向慢慢成形 Scaling Transformer Energy-based Models For High Quality Image Synthesis | 麻省理工学院;伊利诺伊大学厄巴纳香槟分校;哈佛大学 | arXiv:2610.31889 关键词:能量图像生成, 多层能量头, 正样本表征对齐, 持续采样链 前序问题:能量模型给每张候选图打一个越低越合理的分数,再沿梯度修图,理论上很灵活;现实中高维采样费算力、训练不稳定,常只能做小图。怎样把这条路线带到现代图像生成规模? 方法直觉:在压缩后的潜空间里打分,让不同深度的评分头分别看纹理、结构和语义,最后加总。只给真实图像补上视觉教师的密集特征监督,避免把错误生成样本也强行拉向同一特征目标。 本文贡献:TEM(Transformer 能量模型)用视觉 Transformer 输出标量能量,多个中间层能量头求和。训练压低真实图能量、抬高自身 MCMC(马尔可夫链蒙特卡洛)负样本能量;采样匹配损失兼顾低能量和多样性,PRA(正样本表征对齐)只对真实图对齐冻结 DINOv2 特征。图像经 Stable Diffusion 自编码器压成 32×32×4 潜变量;训练每次 40 次 Langevin 梯度更新,批量 256,共 50000 次优化,训练缓冲区容量 16000、复用概率 0.99。 原文图 2|架构与训练:左边 TEM 用 Transformer 块处理 VAE 编码的潜变量 token,多层标量能量头相加成总能量;右边对比训练降低真实样本 x+能量、提高 MCMC 生成负样本 x−能量,PRA 只将真实样本内部表征对齐冻结视觉基础模型 VFM。不同深度能量头共同约束纹理、布局和语义。 实验效果:ImageNet 类别条件生成,6.09 亿参数 TEM-XL、60 次采样更新、50000 张图计算 FID(特征分布距离,越低越好):256×256 为 3.82,512×512 为 8.24。同尺寸 DiT-XL 无分类器自由引导为 9.62,有引导为 2.27,不能称全面超过扩散。评估前 5000 条链从高斯噪声起步,后续复用 40 步缓冲状态,再各追加 60 步。附录 256 图采样 14.48 万亿浮点操作/份,DiT 为 29.66 万亿;这是计算量,非墙钟或显存实测。 原文表 1|ImageNet 256×256 与 512×512 类别条件生成,FID 由 50000 样本计算、越低越好;Params 主要按 256 配置,NFE 是论文列出的采样网络评估口径,能量梯度更新成本需另参附录。CFG 列表示分类器自由引导,空线是未报告。TEM-XL 6.09 亿参数、60 步、FID3.82/8.24,主结果无 CFG;各 baseline 数字取原论文,不是全部同机重跑。 批判点评:步数包含能量梯度,不能与普通去噪前向调用一一等价。持续链复用是成绩协议的重要部分,不代表每图独立 60 步从纯噪声开始。多算未必让分布更好:60→80 步,FID3.82→4.72、召回 0.57→0.51,清晰度换来模式覆盖下降。项目 与代码 有训练、采样实现,未执行模型。 7. Melody Guidance:不用重训也能照旋律生成声音 Melody Guidance for Audio Diffusion Models Without Retraining | 德国埃尔朗根纽伦堡大学;International Audio Laboratories Erlangen | arXiv:2610.32211 关键词:旋律音频生成, 推理期引导, 可微音高估计, 三角波初始化 前序问题:手里有无条件音频扩散模型,想让它按一条旋律唱或弹,通常得重新准备旋律配对数据。只在推理时用音高误差硬拽,又容易得到音准对了、音色却变假的声音。 方法直觉:先用目标音高合成有泛音的三角波作草稿,再让生成器把草稿修成真实音色;每步用可求梯度的音高检测器纠偏。草稿减轻纠偏负担,扩散先验负责声音自然,两者要一起调。 本文贡献:F0 是基频、决定主音高;dSWIPE 是可微音高估计器,用候选音高相关性的 softmax 代替硬选最大值,使音高误差可反传。在每步预测的干净波形上计算误差,经解码器传回潜变量,并按噪声量和梯度范数归一化;波形模型可直接引导。λ为纠偏强度,t_init 为开始去噪的噪声位置;目标音高用标准差 50 音分平滑,100 音分为一个半音,保留颤音空间。唱声 LOUDAR 取λ=2.5、t_init=0.8;吉他为 2/0.7,两钢琴模型为 0.3/0.65。 原文图 1|旋律引导采样:目标 F0 基频曲线 y 先合成三角波热启动信号 x_init,按需编码成 z_init;反向扩散逐步细化,同时经 dSWIPE 可微音高检测器的似然梯度拉向目标旋律。热启动与梯度引导共同减少音准与真实音色的冲突。 实验效果:100 条 POP909 旋律、四个底座。唱声用 CREPE 独立提音高,RPA(发声帧原始音高准确率)0.91、OA(含清浊音判断的总体准确率)0.86,DiffSinger 为 0.76/0.85。吉他 OA0.79 低于 DDSP-Guitar0.84;钢琴 MR-CQT 的 OA0.78 优于 PianoKontext0.63,但同为 MAESTRO 训练的 FAD(音频特征分布距离)0.39 较 0.25 差。无需旋律专属重训仍要逐步反传,论文没给墙钟、采样步数总账和峰值显存。 原文表 1|唱声、吉他和钢琴分组结果。RPA 为发声帧原始音高准确率,OA 还计入清浊音识别;下标 C/S 分别指 CREPE/SWIPE 音高提取,准确率越高越好。KAD 与 FAD 分别为核音频距离、Fréchet 音频距离,越低越好;唱声和吉他对照训练数据不同,只能指示相对质量,钢琴同为 MAESTRO 才较可比。不同提音高器下准确率不应混写。 批判点评:唱声和吉他对照训练数据不同,不能按 FAD 或 KAD 音频分布距离直接排统一音质榜;钢琴对照同数据才较可比。音素、拨弦动作、音头和衰减仍由无条件先验决定,不能据旋律控制推断歌词或演奏法可控。试听项目 可访问,未确认本方法代码已公开。 8. AudioLift:一张照片先补五机位再成头像 AudioLift: Audio-Driven Single Image to Full-Head Gaussian Avatar via Multi-view Video Generation | 耶鲁大学;加州大学默塞德分校;卡内基梅隆大学 | arXiv:2610.31747 关键词:音频驱动头像, 多视角视频生成, 高斯重建, 后脑补全 前序问题:单张照片驱动数字人说话,正面看着不错,一转到侧后方就可能头颈断开、帽子消失。参数化人脸的运动空间也难覆盖夸张张嘴,能否借视频生成能力补全完整头部? 方法直觉:先让同一声音驱动五个同步机位,再把每个时刻的五张图拼成三维高斯头像。生成的机位不完全一致,所以重建器训练时就故意看些错位侧视图,学会以清晰正面作锚点。 本文贡献:第一阶段基于 13 亿参数 StableAvatar,四斜机位排成 2×2 画布,另加正面流;同一时刻的视觉 token 读取相同音频窗口,全局注意力共享五视角信息。第二阶段微调 FaceLift 逐帧前馈重建,侧视输入加网格畸变与相机扰动,正面保持干净;活动体积正则压低头部范围外高斯的不透明度,后方三个角度区间用冻结教师低权重蒸馏。训练 2641 条语音序列、328 身份,第二阶段 648 片段各 16 帧,共 10368 多视角场景;两阶段分别 6800 和 7328 次更新,八张 48GB RTX 6000 Ada。 原文图 2|AudioLift 两阶段:(a)音频驱动多视角生成,四个斜视角拼成 2×2 画布,另加正面流,同一时刻的五视角共享音频上下文及跨视角注意力;(b)三维高斯序列重建,微调的前馈重建器逐帧把生成的五机位提升为三维高斯头像,得到可从任意机位、任意时刻渲染的高斯序列。干净参考视图为去噪器提供条件,侧面与正面按时间交错成同一 token 序列,以共享自注意力连接各视角。 实验效果:RenderMe-360 测试 42 片段、21 身份,HDTF 另 21 对照片语音;81 帧、25 帧/秒,统一 512×512 白底计分。前者相对 SDTalk,正面 FID 分布距离 77.05→44.53,但 SSIM 结构相似度 0.710→0.678;新机位 PSNR 像素信噪比 10.99→12.27 分贝。新视角只评第 0 帧五个未见相机,正面评 1–80 帧,不能混成全动态新视角定量。第一阶段五视角各 416×608、30 步;未报端到端耗时与实际峰值显存。 原文表 1|RenderMe-360 端到端比较,(a)正面、(b)新视角。PSNR 像素信噪比、SSIM 结构相似度及 CSIM-ref 参考身份余弦相似度越高越好,LPIPS 感知距离与 FID 特征分布距离越低越好。正面评 1–80 帧,新视角仅第 0 帧五个未见相机;AudioLift 正面 FID44.53,但 SSIM0.678 低于 SDTalk0.710,不是所有指标都更优。 批判点评:后脑来自教师的合理补全,不能声称恢复照片未拍到的真实发型;逐帧前馈重建也不是对整段做显式时间优化。无逐人优化不等于无训练或实时。演示超过 20 秒,但主定量仅 3.24 秒窗口。项目 和所链接仓库 已列出,仓库含两阶段推理、配置与说明,未执行模型。 9. MDMR-Bench:多张参考图要逐项查有没有串 MDMR-Bench: A Multi-Dimensional Benchmark for Multi-Reference Image Generation | 南京大学;华为研究;香港大学 | arXiv:2610.32459 关键词:多参考生成评测, 检查清单, 非目标保留, 裁判一致性 前序问题:给三张人物、服装和场景参考,结果看着漂亮却把衣服纹理抄错,或者换衣时连脸也变。一个笼统美学分不容易指出是哪条约束没满足,多参考生成需要更细的验收。 方法直觉:把每个要求拆成可回答“是/否”的检查项,既问整体有没有完成,也问某个人、某个属性是否保留。任务家族等权汇总,避免数量最多的容易题把分数撑高。 本文贡献:2390 案例覆盖实体融合、属性转移、单图多元素提取、信息图操作与视觉推理;前两类各 936 和 982 例,常有 2–4 参考图。约 50 万图图库经模型打标签、任务分桶、自动验证及人工筛查;48.2%案例至少含一张合成参考。五维按指令/一致/组合/最小改动/质量分别权重 0.20/0.25/0.25/0.20/0.10,维内整体与原子问题等权;先按子任务平均,最后五任务家族等权。默认 Gemini-3-Pro 裁判,非把各样本简单平均。 原文图 1|MDMR-Bench 概览:多参考图生成覆盖实体融合、属性转移、多元素提取、信息图操作及视觉推理等挑战。五个评估方面均使用整体问题与原子细节问题组成的检查清单,分开诊断指令满足、参考保留、组合、额外修改及画质,而不是只给笼统总分。 实验效果:主榜百分制:GPT-Image-2 总分 88.8,Nano Banana Pro85.1,开源组 FLUX.2 为 51.3;这是本基准指定裁判和原生支持分辨率下的分数。GPT-Image-1.5 指令分 90.3,但最小改动仅 56.8,揭示过度编辑。200 案例 800 输出的人评形成 5924 项判断,默认裁判与人类一致率 0.853,Cohen κ(扣除随机一致后的指标)0.642。逐项裁判增加 API 调用成本,未报告统一评测时延或峰值显存。 原文表 2|默认 Gemini-3-Pro 裁判的主榜,百分制;GPT-5.4 裁判另列附录。Following/Consistency/Composition/Minimality/Quality 分别为遵循指令、参考一致、合理组合、最小额外改动和画质,Overall 按既定权重与任务家族等权汇总。闭源与开源模型分组,GPT-Image-2 为 88.8,FLUX.2 为 51.3;这些是指定协议下评分,不是普适成功率。 批判点评:合成参考、人工维度权重与裁判偏好会影响榜单;属性任务中参考数多的子集更难,不是同一案例只改参考数的因果实验。主榜与任务表对 GPT-Image-2 总分分别 88.8 和 88.7,本稿按主榜口径保留差异。arXiv 评论明确接收 NeurIPS 2026 评测与数据集轨道;代码 本次 404,数据 尚无法确认公开下载,不沿用摘要“已公开”的断言。 10. CityLift:一张城市图补成可拆分楼群 CityLift: Compositional 3D Urban Generation from a Single Image | 西安交通大学;中关村学院 | arXiv:2610.32728 关键词:城市三维生成, 场景骨架, 空间特征继承, 独立楼宇网格 前序问题:从城市斜拍图做三维资产,逐栋生成容易楼高不对、楼群互撞;整城一次生成又难单独编辑一栋。遮挡让完整几何与相对布局都难猜,怎样同时照顾? 方法直觉:先在同一坐标系搭一份楼群粗骨架,再给每栋楼分自己的细化空间。楼在哪里、有多大,以及从整体读到的三维特征,都随同一坐标变换送进局部生成器,最后按原变换放回。 本文贡献:输入除了单张图,还需要每栋楼实例掩码。共享参数的场景/单楼双流稀疏结构 Transformer 交互,生成 64³占用骨架和隐藏特征;确定性局部坐标映射同时用于占用、特征、训练目标与最终组装。TRELLIS 流模型从噪声重生成局部结构,再由预训练 SAM 3D 生成纹理网格;低噪声阶段另约束占用重叠、质心和轴向分布。CityLift-5K 有 4997 合成场景、36338 栋,训练 4497/验证 250/测试 250;训练用两张 80GB A100,局部模块 18000 次更新。 原文图 2|CityLift 总览:输入单张城市图与逐栋楼掩码,在共同坐标系生成可独立编辑网格。(a)共享的场景/单楼生成器联合预测粗占用,隐式包含位置、尺度和几何;(b)骨架坐标映射 T 把占用及上下文特征 F 重采样进单楼局部空间,得到对齐条件 A;(c)局部流模型依据 A 及楼图特征 e 从噪声重建细稀疏结构,指导网格生成,再沿继承变换放回场景。 实验效果:250 个留出场景平均 7.8 栋,楼与场景均隔离。CD(双向表面最近点平均距离,以网格单元计)单楼相对 Pixal3D 由 2.547→1.011;场景相对 SAM 3D 由 2.595→1.079,F@2(两格阈值内精确率召回率的调和平均)0.597→0.855。每场景 115 秒,比 Pixal3D1482.4 秒快,但慢于 SAM 3D83.7 秒和整场景 TRELLIS.2 的 39.2 秒;未报实际峰值显存。真实 InstanceBuilding 来源渲染测试场景 CD2.012→1.531,收益较合成集小。 原文表 1|CityLift-5K 的单楼与场景几何比较,距离以网格单元计。CD 为双向倒角距离,Acc 为生成到参考的单向距离,Comp 为参考到生成的完整性误差,均越低越好;F@1/F@2 为一格/两格阈值 F 分数,越高越好。横线表示没有独立楼输出;末列为秒/场景。CityLift 场景 CD1.079、F@2 为 0.855、115 秒,并非表中最快。 批判点评:外部真实来源也是从已重建网格再渲染 RGB 与掩码,不能说直接验证任意无人机实拍。外部数据单楼阈值 F 分数和单向精度仍落后 Pixal3D,改善主要来自覆盖与组装。不可见立面是生成性补全,不等于测量真值。项目 可查,本次未发现可确认的方法代码入口。 趋势观察 先定义哪些东西必须保持 SyncVid保持动作的跨机位对应,LOCI限制区域串扰,AlphaAnything只保证固定潜变量的RGB解码;三种保持各有不同对象。 控制常从表示入口开始 场景级噪声、逐token适配强度、原潜空间的透明度监督,比再加一段笼统指令更明确地约束干预位置。 省下的计算要按实际协议计 EditJev报告频率加权估算,TEM复用持续采样链,WorldForge叠加加速LoRA;它们的数字不是同一种时间账单。 完成感不能替代验收清单 MDMR-Bench分开指令与非目标保持,AudioLift区分正面动态与首帧新视角,CityLift分开单楼与整场景质量。 今日讨论 SyncVid 的跨视角 FVD 从 202.22 降到 146.99,相机旋转误差却比 ArtiFixer 更大。若同步收益主要来自把噪声绑定三维锚点,你会怎样用等帧数、同底座实验,分别改变遮挡程度和几何误差,收集哪些独立证据,区分动作同步、轨迹准确与新露出内容的真实一致性? 人工智能炼丹君 整理 | 2026-10-27
-
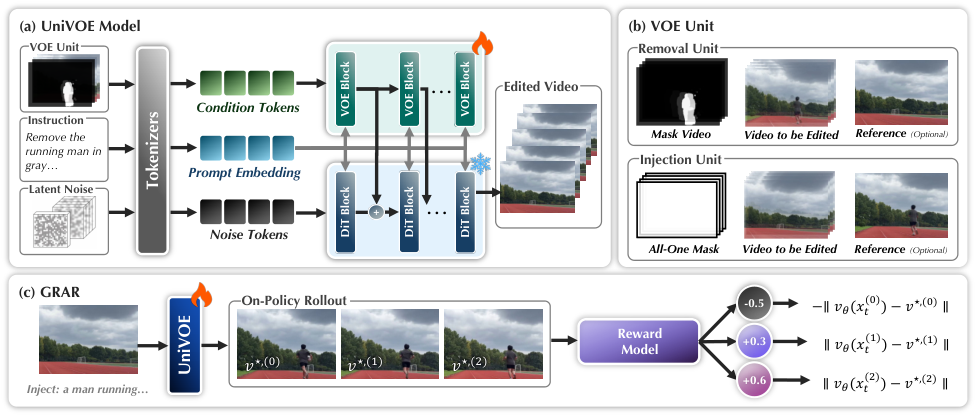
AIGC 每日速读|2026-10-26|腾讯混元删物添物连影一起改UniVOE 今日 AIGC 论文速览 今日共 10 篇 · 视频编辑与可控重渲染 4 篇 · 单步图像编辑 1 篇 · 视频训练与音视频加速 2 篇 · 场景语音生成 1 篇 · 全景与3D部件生成 2 篇 重点论文标题列表 UniVOE(腾讯混元):删物添物时连阴影一起改 FAPL(港科大):只换人物时别把动作也换了 Latent Space Jam(Lightricks):先按框走再补回视频质感 AnyGameRenderer(Alaya实验室):游戏换画风先数清每个小人 ECT(浙江大学):一个噪声时刻改图仍要校准 选读入口:真实视频删物或添物且要一起改阴影、倒影,先读UniVOE;只换人物却连动作也变,接FAPL。要规定每帧位置读Latent Space Jam,要把粗糙游戏录像换画风又数清角色读AnyGameRenderer。单张图低延迟局部改动读ECT;训练流式视频模型读Direct Forcing,已有声画联合生成服务再读CAVC,对照它们的步数与墙钟账单。做数字人口播读HeyGen Voice,看场景声音和音色如何拆开;全景接缝问题读CubeAtlas,图片转可编辑3D资产读FlexPart,注意提示粒度和遮挡边界。 今日论文速览 1. UniVOE:删物添物时连阴影一起改 UniVOE: A Removal-Driven Framework for Interaction-Aware Universal Video Object Editing | 腾讯混元;北京大学深圳研究生院;香港中文大学 | arXiv:2610.31641 关键词:视频对象编辑, 交互效应, 移除监督, 奖励后训练 前序问题:把视频里的烤箱删掉,披萨仍躺在烤箱留下的阴影里;往街道添辆车,地面却没有倒影。视频编辑不能只改物体轮廓,还要处理它对环境造成的光照、接触和反射变化。真实的有物体/无物体配对视频又很难拍到。 方法直觉:先学会把物体和它的痕迹擦干净,再把擦掉后的片段当输入、原始实拍当目标,倒过来教模型添物体。插入结果的运动与交互来自真实片段,减少完全合成监督的失真。 本文贡献:移除器先用超过63000段视频学习补洞,再用68000对视频微调交互效应;应用后筛得69000对,与原68000对合成137000对插入训练数据。两模型结构相同、分别训练,各230亿参数,含冻结140亿参数 Wan2.1 主干及30亿参数控制分支。移除输入膨胀对象掩码,插入用全一掩码允许全局修改;可追加由外部图像编辑器生成的首帧参考。GRAR(组相对优势回归)每个条件生成16份结果,以经人工偏好微调的 Qwen3-VL 奖励模型排序,按组内中位数分正负回归,不另存冻结参考策略。 原文图3|UniVOE流程。(a)移除器与插入器共享网络结构,指令与视频对象编辑单元不同。(b)移除输入源视频与膨胀二值掩码;插入用全一掩码,允许全局交互效应变化。两任务参考图均可选,由外部图像编辑模型生成以提供更明确指导。(c)GRAR组相对优势回归把预训练插入器向人类偏好调整,以改善物理真实感。 实验效果:训练片段为97帧、832×480;评测 VOR100对、ROSE56对且剔出训练集。移除仅给文字,插入给文字与参考图。VOR移除的 PSNR(像素信噪比)23.752分贝,EffectErase23.210;插入相对不做GRAR,FVD(视频分布距离,越低越好)361.286→234.562,LPIPS(感知距离,越低越好)0.307→0.237。移除由50步缩到12步,但未报完整推理时间及峰值显存,不能按步数直接宣称提速4倍。 原文表4|对象插入后训练消融。相同设置不做/做GRAR,DINO身份相似度0.353/0.390,CLIP指令相似度0.221/0.232,感知距离LPIPS0.307/0.237,视频分布距离FVD361.286/234.562;前两项越高越好、后两项越低越好。 批判点评:筛选仍会漏过移除器偏差,插入能力受保留配对与自有奖励模型上限约束;省去参考策略不意味着免除奖励偏移。论文称支持超过200帧编辑,但定量范围仍是97帧480p,不能外推长片稳定性。项目 可查,权重 可查;项目主页标出的代码地址本次返回404,尚未确认代码公开。未据会议模板推断接收。 2. FAPL:只换人物时别把动作也换了 Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation | 香港科技大学;腾讯视频;法国巴黎综合理工学院 LIX | arXiv:2610.30926 关键词:因子视频编辑, 多模态表征, 动作顺序, 多镜头一致性 前序问题:给视频系统接上多模态大语言模型,换个人物仍可能把动作和镜头一起改。原因可能更早:生成器依赖自己的文字和图像条件,根本没认真使用大语言模型的隐藏表征。怎样让这些表征既有用,又能按人物、场景、动作、相机分别控制? 方法直觉:先暂时关掉更容易走的条件捷径,让生成器必须读懂大语言模型的表征;再只换一个因素对应的片段,用成对视频教它哪些该变、哪些该保留。最后反过来固定生成器,让理解端学会提供能生成视频的信息。 本文贡献:FAPL即因子感知预测学习,基于 UniVideo 的130亿参数 DiT(用 Transformer 做视频扩散的生成器)。第一阶段冻结多模态模型及连接器,仅以其潜表征训练DiT;第二阶段在连接器输出后替换结构化描述中某个因子的完整token区间,监督双向编辑,区间可不同长,并不假定完全解耦。第三阶段冻结DiT,梯度经它更新多模态模型及连接器;仅文字、文字加完整视频两种观察以1:1抽样、共用目标。100000对视频每因素25000对,三阶段分别10000、15000、10000步。 原文图3|因子感知预测学习FAPL。阶段一冻结多模态大语言模型和原连接器,用其潜表征训练视频扩散Transformer;阶段二保留这一冻结配置,在成对样本间交换因子对应输出区间,监督特定因素改变;阶段三冻结训练好的生成器,以视频重建共同更新多模态模型与连接器,只有文字、文字加完整视频的观察共用一个生成目标。 实验效果:CineFactor-10K按源视频隔离:5000例仅文字生成、5000例因子编辑,另测100组多镜头。相对同底座,动作顺序正确率48%→61%,编辑交集准确率42%→58%;交集要求是非题与选择题同时通过。相机旋转误差1.54→1.02弧度,越低越好。等数据和优化预算下,第二阶段做因子替换比不替换48%→57%,较能隔离机制收益。推理50步、分类器自由引导系数5.0;未报墙钟时延或峰值显存,三阶段训练有额外成本。 原文表1|三个任务定量比较:稀疏输入生成评动作顺序与相机平移/旋转误差;因子编辑交集准确率要求两种问答检查都过;多镜头评主体、场景和ArcFace人脸相似度。FAPL对应61%、0.0586、1.02弧度、58%、0.516、0.471、0.523;不是同一指标的七次测量。 批判点评:第三阶段完整视频是训练观察,文字分支推理时并未偷看目标视频。多镜头仍独立生成,主要靠共享人物/场景参考,没有跨镜头记忆;隐藏区间受上下文混合,不能称四个因素已经数学解耦。实验支持这些受控任务的改进,尚非任意复杂剪辑都能准确保留。原文未给本方法代码入口。 3. Latent Space Jam:先按框走再补回视频质感 Latent Space Jam: Layout Guided Video Synthesis | Lightricks;独立研究者;莱赫曼大学 CANVAS 实验室 | arXiv:2610.30390 关键词:布局视频生成, 潜变量优化, 轨迹控制, 两阶段精修 前序问题:让山羊沿指定路线下山,只写“向左下走”常常不听;强压每帧目标框又会毁掉外观。位置必须准、动作还得连贯,能否把这两个要求放在不同阶段完成? 方法直觉:先生成一条画质粗但位置准的引导视频,再把它当草稿修清楚。草稿也由视频模型产生,保留运动和接触关系,比逐帧贴上独立生成的物体更合适。 本文贡献:冻结文生视频模型,优化潜变量而非模型权重;让指定文本token的交叉注意力分布贴近各帧二值框,使用 KL 散度衡量两分布差异。只在选定去噪时刻和早期三层做梯度优化。草稿可先时空上采样,再按当前噪声量加噪、插入第二次去噪的早期,恢复纹理。Wan2.2与LTX-2均有验证;静态/动态/多物体约40/40/20套布局,共约100套。 原文图2|无需训练的布局引导视频流程。输入文字与时空布局,先用交叉注意力布局损失优化冻结文生视频模型的潜变量,使指定token注意力对应目标框,生成粗糙但遵循布局的潜空间视频;可做空间和时间上采样,再在去噪早期注入引导视频。第二阶段保留布局与运动、改善外观细节,得到最终视频。 实验效果:多物体设置,同为Wan2.2并精修后,相对重实现的 TrailBlazer,IoU(预测与目标区域交并比,按百分制显示)13.86→25.83,目标中心距离32.47→21.87,越低越好;FVD视频分布距离204.73→198.57。这里比较的是同底座,不能把LTX与Wan差异全归方法。低分辨率草稿高160像素49帧,再精修到高480像素81帧,耗时36秒+5分58秒,底座6分20秒;高480像素81帧草稿自身要10分24秒,无训练仍有推理优化成本。 原文表1|静态、动态、多物体三类布局比较;IoU交并比与AP50重叠阈值精度评空间重合,CD是中心距离,I.为原始交叠面积、I-AP50基于该面积评轨迹;FVD视频分布距离越低越好、CLIP图文相似度越高越好。左为引导、右为精修;原图注总结Wan2.2引导较强、LTX-2精修相当或更强,但具体条目存在指标取舍,不能理解为每个格子全胜。 批判点评:框约束不区分物体移动和相机运动,拥挤、多物体交互仍困难;主结果动态场景的部分AP50分数没有胜过早期方法,不能沿用图注“全指标更好”的泛化表述。IoU与中心距离衡量位置,不证明物理正确。耗时表未明确卡型与显存,项目 与代码 可查,未执行;不能仅凭TOG排版认定接收。 4. AnyGameRenderer:游戏换画风先数清每个小人 AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark | Alaya 实验室 | arXiv:2610.31466 关键词:视频重渲染, 实体对应, 游戏生成, 低秩微调 前序问题:把满屏几何小人换成精致游戏人物,生成器可能留下方块、凭空多出敌人,或把俯视镜头改成正面。游戏的画面可换,角色数量、出场时刻与位置不能随意重写。 方法直觉:直接把粗糙游戏录像作为结构参考,再明确每种形状代表谁。训练描述故意列入没出现的角色,迫使模型根据视频判断实体存在,而不是见到名字就添一个。 本文贡献:基于330亿参数 MiniMax-H3 的参考视频编辑模式,仅训练秩128的 LoRA(低秩适配参数),关闭音频损失、推理丢弃音频。10330段配对由38个GEAR游戏、虚幻引擎和真实录像检测框重建三路组成;统一124帧、24帧/秒、1344×768。六段描述固定身份映射、位置、大小、时机和数量,首帧锚图可选。16张141GB H200训练约48小时;推理20步Euler采样,未报生成耗时或峰值显存。 原文图2|AnyGameRenderer。(a)三路配对:GEAR将完整游戏渲染与方块/语义图等多个粗糙流对齐,虚幻引擎配完整图与方块图,真实录像用检测3D框转粗糙图。(b)每例粗视频作输入,目标首帧可作锚点,六段描述明确粗形状与真实实体对应及保持要求。(c)文字、参考视频、锚图与带噪目标token构成冻结MiniMax-H3生成器输入,只训练自注意力和前馈层的LoRA低秩适配,按指定风格重渲染。 实验效果:59个隔离案例共753实体,同种子、步数和描述:时间匹配50.9%→62.9%,位置匹配57.1%→61.9%,漏掉数量变化34.7%→21.3%。时间匹配是“输入存在帧集合”和“输出在位帧集合”的交并比;活不足12帧的实体不计。数量统计只覆盖75次规定幅度变化,允许60帧窗口内达标;不是逐帧精确计数。真实录像子集时间匹配仅46.5%→51.1%,未渲染率还由2.6%升至2.9%。 原文表2|隔离测试集实体同步结果,单位%。左侧四主指标为时间匹配、位置匹配、未渲染率与幻觉率;右侧三辅助量为及时出场、从未出现及漏掉数量变化。灰色GT floor把真实RGB视频送进同一检测匹配流程,表示该评估器的可测上限/误差底,而不是人工标注完全无噪声。 批判点评:总体幻觉率仍46.0%,真值视频经过同一检测匹配流程也有34.1%,说明检测器本身存在误差,不能把46.0%直接当肉眼错画比例。24帧/秒是输出播放率,不是实时生成速度;跨域无锚图风格建议减LoRA系数至0.7,仍待用户实际验收。项目 与代码 、模型 可查;数据仓库 本次只有占位文件,尚未提供样本。未执行模型。 5. ECT:一个噪声时刻改图仍要校准 One Evaluation Is Enough: Inversion-Free Image Editing with Trajectory Correction | 浙江大学;蚂蚁集团;重庆邮电大学 | arXiv:2610.30827 关键词:单次图像编辑, 端点校准, 无需反演, 计数口径 前序问题:单步图像编辑看似只跑一次,但常在多个噪声时刻分别求源/目标指令差,再合成一步。能否只观察一个时刻,也保住没要求修改的背景? 方法直觉:同一个带噪状态下,源指令和目标指令的预测差同时提供“往哪改”和“干净结果差多少”;先按剩余噪声角度推一把,再用端点差收回过度外推。二者在同一编辑轴上调幅,不是凭空生成新方向。 本文贡献:ECT(端点校准输运)适用于预测噪声的 VP(方差保持)单步生成器。把两种文字条件打包进一次去噪批调用,得到角度切向量与干净端点位移;解析输运后做受约束投影,再更新一次潜变量。不反演、不中途积分、不迭代优化。默认噪声时刻t=0.75、校准系数ζ=0.7、编辑强度λ=1;t是噪声日程位置,ζ收缩外推幅度,λ控制整体编辑量。一个时刻、两条条件分支、一次批调用和一次更新,是四种不同计数。 原文图2|以马变斑马说明编辑流程。(a)FlowEdit沿多步路径累积源/目标场差。(b)ChordEdit把t与t−δ两时刻残差合成一次更新,含四条条件时间分支。(c)ECT在同一带噪状态只算两文字条件;同一预测确定角度残差gₜ与端点位移dₜ,先输运âₜ=−θₜgₜ,再校准u*ₜ=âₜ−ζdₜ,一次更新x_edit=x_src+λu*ₜ。θₜ为剩余噪声角、ζ为校准强度、λ为编辑强度;示意图只表示同一编辑轴调幅。 实验效果:H20、同SD-Turbo底座的PIE-Bench,相对ChordEdit,背景PSNR(像素信噪比)22.63→23.74分贝,LPIPS感知距离按1000倍显示122.64→109.04,越低越好;整图CLIP图文相似度按100倍显示30.60→30.20,编辑对齐略降。同步推理计时0.265→0.212秒,但排除文件读写和指标计算;峰值PyTorch预留显存7498→7480MiB,只省0.24%,不是内存大幅下降。 原文表3|PIE-Bench消融:(a)一步与两步ECT比较;(b)角度输运的作用;(c)额外神经网络评估NFE的作用。蓝色为ECT变体,粗体为较好值,橙色为资源减少;额外NFE是独立变体,不属于严格单时刻主结果。时间为秒、主机内存为MiB,CP/VQ/PC分别评内容身份保持、视觉质量、物理感知协调。 批判点评:同SwiftBrush-v2的PIE背景均方误差与感知距离有小幅退步;保持更好不等于指令全做对,例如加花仍未准确放到嘴里。主结果严格单时刻,附录额外网络评估变体另算,不能混写。推导尚不覆盖非VP日程、速度预测或空间自适应约束;原文未给本方法代码入口。 6. Direct Forcing:四步视频不再先做初始化 Direct Forcing: A Single-Stage Training Recipe for Few-Step Autoregressive Text-to-Video Generation | 北京航空航天大学;京东未来研究院 | arXiv:2610.30861 关键词:自回归视频, 单阶段训练, 分布匹配, 梯度平衡 前序问题:把双向视频扩散模型改成边看历史边出下一块,常先蒸馏因果初始化、再匹配生成分布。只做后者容易在块边界突然换物体,能否一次训练同时学会接得上和整体像真视频? 方法直觉:一组练习在真实历史上续写,约束相邻块;另一组让模型接着自己生成的历史走,检查整批视频的分布。两种练习的梯度强弱动态配平,避免续写损失压住分布学习。 本文贡献:从13亿参数Wan2.1双向底座出发。CCA(因果续写对齐)用冻结视频编码器对齐预测与参考的时空token余弦距离;噪声块只能看之前真块和自己,阻断未来泄漏。RDM(rollout分布匹配)用MMD(最大均值差异,比较特征分布的统计距离)匹配整条生成视频与参考,并用文字相似度配对;每条完整视频算一个分布样本。梯度先等范数,再按续写残差调权。八张B200、6505对参考视频、250次联合更新;每次128生成例做RDM、32参考对做CCA。 原文图3|Direct Forcing用共享少步因果生成器同时学习:在参考历史上做因果续写对齐CCA,在自生成历史上做rollout分布匹配RDM。冻结编码器提供配对余弦对齐及视频文字最大均值差异MMD;动态梯度平衡先匹配梯度范数,再按拟合误差加权CCA,合并为一次共享更新。 实验效果:832×480、81帧、每块3个潜帧且去噪4步;944提示各5份共4720视频。VBench总体/质量得分84.63/86.01,相比Elastic Forcing84.25/85.06,但语义79.08低于80.99。单B200吞吐20.63帧/秒、首帧0.25秒,与列出的其他四步模型相同;训练变化未增加推理结构。250次不含底座预训练、离线特征及数据准备,步数也不是统一GPU小时账单。 原文表2|VBench文生视频比较,按生成方式分组,分数用百分制。高亮行是250次更新模型;星号ViRDM不使用光流正则,本方法主模型也未使用这一辅助目标,另在附录消融。吞吐为帧/秒,延迟指首帧秒数,四步因果模型时延在单B200测量;其他时延与部分质量指标沿用原报告。 批判点评:所谓无在线扩散教师,仍用冻结Wan14B等编码器提取训练特征;不能说不依赖大模型。仅验证13亿参数及最多50秒视频,长视频六指标赢四项、动态与画质两项较差。不同公开baseline的质量得分并非全部本次同机重跑;原文未给本方法代码入口。 7. CAVC:缓存声音后还要重新对齐画面 CAVC: Convergence-Adaptive Audio-Visual Cache for Modality-Asymmetric Diffusion Generation | 浙江大学;蚂蚁集团 | arXiv:2610.30854 关键词:音视频生成, 非对称缓存, 末端重耦合, 推理加速 前序问题:声画联合生成每步都算音频、视频和交叉注意力,很费时。但把两边都缓存,视频动作会停住;只缓存声音又可能让敲击和音效对不上。哪些计算能省,哪些必须一直做? 方法直觉:声音中段偏了,末尾联合细化还能补回不少;视频中段少算丢掉的运动却难补。于是保留完整视频去噪,声音稳定后暂用旧预测,最后再让声画一起校准。 本文贡献:CAVC(收敛自适应音视频缓存)不训练模型:前段完整联合去噪,在线监测音频预测变化,默认阈值0.30、窗口3;触发后重用音频去噪输出、绕过音频分支和声画交叉注意力,但音频潜变量仍按调度器推进。末段恢复原生3步联合细化。基于LTX-2.3-22B-dev及官方蒸馏LoRA,全部方法启用CPU卸载、单样本单并发,在96GB H20测试;不是只删几条Python语句就可忽略传输成本。 原文图2|CAVC按模态收敛动态分配从T到0的去噪轨迹。(1A)高噪声初段完整运行音频、视频及交叉注意力,建立语义绑定;监测器在音频预测稳定的τ时触发缓存。(1B)中段复用音频预测,跳过音频分支和声画注意力,让视频继续独立细化时空结构,避免静态声音过度约束。(2)末尾数步恢复联合计算,解码前减少累计声画偏移、改善同步。 实验效果:AVGen-Bench/VABench为1280×704、241帧24帧/秒,General-80为1536×1024、121帧24帧/秒,报告墙钟加速1.10–1.35倍。General-80动态程度(光流超过阈值的片段占比)0.380→0.512;AVGen-Bench的AV-F1(起音匹配,容许正负3帧)0.5381→0.5650,但细粒度同步分数0.561→0.525,DNSMOS预测音质1.706→1.688。默认参数消融217.2→184.8秒,是该配置结果,不能把最大加速套到每个提示。 原文表2|三个基准的自动音频、视觉语言模型质量、声画对齐及物理性评估。AV-F1是起音事件匹配诊断分,越高越好;粗体为最优。DNSMOS为预测音质、CLAP为音频文字相似度;声画同步分是时间偏移的变换值,不是人工听评。AVGen-Bench同步分0.561降至0.525,起音F1改善不代表所有同步指标都改善。 批判点评:结尾重耦合只在测试设置补回约81.5%–91.3%的音频文本相似度缺口,不是数学保证完全恢复;同步分数也非人评。快速连续声学事件触发晚,收益趋近原采样;视频分支始终运行,加速上限受它限制,未报峰值显存下降。原文未给本方法代码入口。 8. HeyGen Voice:声音像本人也要像在这个房间 HeyGen Voice: Scene-Aware Voice Cloning for Talking Videos | HeyGen 研究团队 | arXiv:2610.30470 关键词:场景语音合成, 音色克隆, 声学锚点, 跨场景适配 前序问题:用手机录音克隆本人声音,画面换成录音棚或教堂,声音却仍像手机录的。说话人身份、说话方式和房间声学绑在一起,长稿分段还会一段一间房。 方法直觉:参考录音提供“谁在说”,图片与两段描述提供“怎么说、在哪说”;选定一段生成声音作锚点,后面各段都沿用这套声学状态,另外读取上一段结尾保持衔接。 本文贡献:冻结视觉、文字、音频编码器,分别把图片、说话人描述、环境描述与音色压成少量条件token;自回归Transformer按脚本预测离散声学码,再由流匹配及波形解码器输出44.1千赫声音。五阶段依次为多语种文字转语音预训练、模拟跨场景、真实同人跨场景、组相对策略优化GRPO、直接偏好优化DPO表达适配器。voice-clone保音色并随场景适配,full-clone更多沿用原录音;锚点一致性嵌入与滑动局部上下文分工不同。 原文图1|HeyGen Voice架构。冻结编码器把多模态输入池化为条件token;克隆策略决定延续状态来自为目标场景设计的声音锚点,还是原参考录音。条件前缀、脚本文字和声学码组成同一自回归序列。监督训练用交叉熵,GRPO组相对策略优化用可懂度及音色奖励,DPO直接偏好优化用偏好对;流匹配解码器以隐藏状态和参考音频合成波形。 实验效果:331个英语同人异源案例、155说话人簇,voice-clone目标音色相似度0.590,Cartesia0.582;音画嵌入相似度0.282对0.261。full-clone对原参考相似度0.757,高于voice-clone0.739,体现取舍。此测试额外给HeyGen目标图片、从真实目标录音生成的描述及信噪比,其他语音API没有这些输入,不能归结为纯模型同条件领先。报告单并发实时因子约0.1,即合成耗时/音频时长约十分之一;未报首包时延与峰值显存。 原文表5|331个跨场景配对案例,音色相似度分别参照真实目标录音和原参考录音,ImageBind两列为音频对音频、音频对目标图像的嵌入相似度。粗体最佳、下划线次佳。voice-clone偏目标场景,full-clone偏保留参考声学;HeyGen还接收目标图、由真实目标录音导出的描述与信噪比,不是各系统完全同输入。 批判点评:十语言文字错误率使用双评审都确认才计错的规则,分歧算零但保留分母,不能当常规自动转写错误率;因此这里主要关注场景迁移证据。听评与生产投票有不同样本池,报告中10月榜单名次也不是永久结论。产品与样例 可查,未见开放权重或本方法训练代码。 9. CubeAtlas:全景六个面放一张画布里生成 Squaring-the-Sphere: Distortion-Free and Seamless Panorama Generation via CubeAtlas | 腾讯 | arXiv:2610.31565 关键词:全景生成, 立方体表示, 稀疏注意力, 透视超分 前序问题:普通照片扩成全景,顶部被拉长;六个透视面分别生成,又在接缝处对不上。如何保留普通图像模型熟悉的透视几何,同时把一整圈场景连起来? 方法直觉:把四个侧面排成一带,上下极面旋转后各取一半,紧挨对应侧面,形成一张紧凑画布。接缝两边能一起去噪,再把互补极面融合回球面。 本文贡献:CubeAtlas是Squaring-the-Sphere的表示:侧面边长S,中央S×4S、上下各S/2×4S,合计2S×4S,S指潜空间边长;不算边缘padding时与ERP(经纬展开)token量相同。输入单张透视图与文字,无需给相机内外参;冻结图像编码器与变分自编码器,完整微调图像编辑DiT8000步。布局稀疏注意力保留目标间75%连接,文字和图像条件仍全连。解码后方向加权融合极面,基图1280×2560;六个92.79度重叠视图经冻结4倍超分得到5120×10240。 原文图3|Squaring-the-Sphere流程。输入透视图和文字,扩散Transformer在同一画布上联合去噪完整CubeAtlas;布局稀疏注意力保留带内连接、限制跨纬度交互。对每个极区,赤道面只关注能组成完整极面的两块同轴半极区;生成后融合拼接为ERP经纬展开全景。联合一次画布不表示只有一个去噪时间步。 实验效果:100自采图及三个公开集100/100/118例,主比较均在未超分基图。RealSee3D立方面边缘误差Seam-Cube从CubeDiff0.0229降至0.0064,越低越好;稀疏版同token量去噪时间为ERP的0.84倍,非端到端10K图总时间。相对密集CubeAtlas,立方接缝0.0143→0.0132,但ERP接缝0.0103→0.0142,不能称所有边界指标都更好。 原文表2|全景表示与效率设计消融。Tokens是目标token序列长度,Time为相同设置的去噪时间,均以ERP=1.00倍归一;Sparse Attn.为布局感知稀疏注意力。半极区CubeAtlas token量不变,稀疏版时间0.84倍;各接缝、赤道与极区质量及文字遵循列须分别看,不能把相对时间当完整超分总耗时。 批判点评:“一次生成”指六面同画布联合处理,不是一次网络评估就出图;10K由透视超分得到,不是原生10K去噪。质量/几何部分由视觉语言模型打分,30全景、各3人验证排序相关,仍是有限评审。SUN360的FID分布距离也未胜过全部对照;未报绝对墙钟或显存,原文未给本方法代码入口。 10. FlexPart:点一下也能指定要生成的部件 A Unified Framework for Image-to-3D Part Generation via Variable Granularity | 同济大学;Chongqing Afari Intelligent Drive Co., Ltd;华中科技大学 | arXiv:2610.31671 关键词:3D部件生成, 多粒度提示, 几何引导, 最优输运 前序问题:从图片造一把椅子,想分别改椅背和椅腿:有时愿意精描掩码,有时只想点一下。为点、框、掩码各训练一套模型费事,先分割再投到3D也可能把部件切碎。 方法直觉:让详细边界在训练时教会稀疏点击“这个点代表多大一块”,推理时用户再少画一点,也能借到学过的几何常识;详细提示仍可追加,控制精细度更灵活。 本文贡献:FlexPart用TripoSG预训练权重及3D变分自编码器,分别编码点、框、掩码,融合后以带门控的自适应层归一化调制DiT;DINOv2图像特征提供全局语义,部件注意力兼顾局部几何和整体关系。非对称几何引导用部分最优输运对齐点与框/掩码表征,强提示嵌入停止梯度,50次Sinkhorn归一化求匹配,缺失提示用可学习空向量。训练从1–8部件、每部件512token扩到2–16部件、每部件1024token,8张H20;推理至少需要点,框和掩码可逐级加上。 原文图2|FlexPart支持点、框、掩码,点是最低输入。带噪潜变量、部件ID及时间步共同接收提示编码,缺失提示由可学习空向量替代;融合条件经带门控的自适应层归一化调制每层3D扩散Transformer,生成部件。训练专用多粒度几何引导分支以最优输运对齐弱、强几何先验。 实验效果:PartVerseXL同掩码条件,部件CD(倒角距离,点集相互最近距离,越低越好)OmniPart0.3283→0.2938,降10.5%;换成框为0.3042,仅比掩码差约3.5%。统一训练相对仅点训练,点条件CD0.3550→0.3334。辅助分支只用于训练;H20的8部件1024token配置,前向8.9毫秒对DiT525毫秒约1.70%,不是整体训练吞吐代价。A800推理峰值约6–8GB,随部件数改变,未给正文可直接引用的统一总时延。 原文表1|部件结构评测,Cond.表示输入条件,PartPacker不需要几何条件。完整网格对照用SAM3D把多视角二维掩码提升到3D分割;Part IoU-V/B分别是体素与三维包围盒交并比,CD为倒角距离、越低越好;粗体/下划线为最优/次优。FlexPart的Mask/Box/Point仍按原文层级保留最低点输入,不能称三种完全孤立推理接口。 批判点评:点的位置很关键:另一个放点消融中中心改边缘,CD0.3302→0.4190,不能和主表0.3334混为同一协议。遮挡部件仍可能长到可见位置;部件质量改善不等于整体网格全指标最佳,PartObjaverse-Tiny整体CD0.1587也略差于OmniPart0.1585。arXiv评论明确接收NeurIPS 2026;代码 可查,未运行。 趋势观察 控制先要说清保持什么 UniVOE保护对象之外的交互合理性,FAPL检查非目标因素,AnyGameRenderer直接数实体;同叫保持,却需要不同验收对象。 无训练不等于免费 Latent Space Jam在推理时优化草稿,CAVC需要末段重新对齐;ECT批调用次数与条件分支数也不能互换。 监督的入口比接口数量重要 UniVOE倒用移除配对,FAPL关闭条件捷径,Direct Forcing同时看真实与自生成历史,FlexPart让强几何提示教弱提示。 统一表示仍有局部取舍 CubeAtlas减少跨面裂缝却不包办所有ERP边界指标;HeyGen两种克隆策略在目标场景与原录音相似度之间选择。 今日讨论 UniVOE加入GRAR后,VOR插入FVD由361.286降到234.562。若只对奖励模型高分样本做测试,这个改善还能代表真实使用吗?你会如何按移除残影强弱、参考图是否提供分层留出样本,需要哪些独立证据,同时检查非目标区域和阴影变化? 人工智能炼丹君 整理 | 2026-10-26
-
AIGC 每日速读|2026-10-23|南京大学腾讯ARC用未来块监督视频生成FCP 今日 AIGC 论文速览 今日共 10 篇 · 视频演化训练 1 篇 · 驾驶与人物视频编辑 2 篇 · 图像编辑与少步对齐 2 篇 · 视频几何纠偏 1 篇 · 长视频记忆与计算分配 2 篇 · 语音生成表征 1 篇 · 交互视频压缩 1 篇 重点论文标题列表 FCP(南京大学):别只接下一段还要预测更远 HorizonComposer(西蒙菲莎):换天气时保住车辆和车道 JointLight(中科院计算所):先滤掉几何伪影再给人物换光 ER-Chord(新加坡国立):单步改图把力气用在可靠位置 AdvFidelity(阿里淘天):少步奖励训练也盯住网格伪影 选读入口:想知道逐段视频生成为什么能接得顺、却未必学会场景如何演化,先读FCP:训练时增加未来块预测监督,推理仍按原流程逐块生成。若要编辑已有视频,再按场景选HorizonComposer的驾驶天气改写或JointLight的人物重打光;单张图局部编辑看ER-Chord,少步生成纹理瑕疵看AdvFidelity。镜头几何漂移读CausalAlign,一分钟视频忘前文读Attn-Forcing,稀疏算力分配读ALLOT;语音事件编码读RubatoCodec,交互视频压缩读CADRE。 今日论文速览 1. FCP:别只接下一段还要预测更远 Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation | 南京大学;腾讯互娱 ARC 实验室;浙江大学 | arXiv:2610.29989 关键词:自回归视频, 未来块预测, 物理合理性, 辅助监督 前序问题:前一秒画面没断,不代表后一秒运动合理。训练总给真实相邻历史,模型可能靠几乎不变的画面就完成去噪;怎样逼它学习更远的变化? 方法直觉:把中间几段挡住,让模型仅凭当前内部特征预测更远的片段。辅助预测器不能互相偷看未来,也不给文字捷径;主模型因此要在特征里留下时间演化信息。 本文贡献:Future Chunk Prediction 即未来块预测,在标准教师强制训练上增加独立辅助分支;教师强制指以真实历史而非生成历史作条件。Wan 主干抽取干净历史与带噪目标的多层特征,经多层感知机融合后逐 token 调制每个三层扩散Transformer预测器;token是网络处理的特征单元。各未来偏移并行、互不串接,省略文字跨注意力,辅助梯度回到主干。推理删除这些分支,仍按原流程逐块生成。 原文图1|未来块预测FCP概览。自回归主干的中间表征作为辅助Transformer块的条件,预测更远未来片段;训练梯度回到主干,推理移除辅助预测分支。 实验效果:匹配训练数据/设置的 Wan2.2-TI2V-5B 对照,Physics-IQ Verified 的总体 IQ 评分在图生视频30.4→33.8,视频续写40.6→44.4;这是与真实录像对比的物理合理性评分,不是成功率。1.3B消融中,监督干净/带噪特征兼用时30.9,仅干净28.8、仅带噪29.9、原训练27.6。达到 IQ=30 的估算训练计算比全历史特征辅助版少50.7%,不能写成比基础训练省50.7%。 原文表2|Wan2.2-TI2V-5B受控比较。图生视频I2V与视频续写V2V分别报告Physics-IQ Verified总体IQ及SP、ST、WS分项;灰色行列为默认配置与总体分。偏移是未来块的整数距离,chained表示串联预测,不能与彼此独立并行分支混同。 批判点评:5B训练首阶段32张GPU、25000步、121帧1024×576,另有后续阶段,辅助网络增加训练成本;推理路径相同不构成实测零时延。不同公开模型的数据和训练不同,横榜不用于归因;部分补充评测依赖视觉语言裁判,细微动力学未必敏感。项目 与代码 可查,未复现。 2. HorizonComposer:换天气时保住车辆和车道 HorizonComposer: Spatiotemporally Consistent Driving Video Editing with Enriched Traffic Semantics | 西蒙菲莎大学;NEC 美国研究院 | arXiv:2610.28829 关键词:驾驶视频编辑, 交通语义, 像素奖励, 参考帧过渡 前序问题:把晴天行车记录改成雪夜,车道线弯了、前车消失了,生成片就不能再用于验证原场景。天气和光线要变,车辆身份、位置与运动却必须尽量保留,怎样让编辑器分清这两件事? 方法直觉:不把整段训练视频一概判好坏,而是逐像素标出哪些变化可信;另外给参考图片与动态视频留一段内部过渡,先消化参考里错位的车,再输出正式片段。 本文贡献:在 Cosmos-Transfer2.5 上冻结深度控制分支、微调视觉分支。混合重复路线实拍配对与合成编辑配对,以场景变化检测、车道/车辆分割、光流及指令评分形成内容、时序、对齐三路奖励,转为逐像素二值条件;离线强化训练时以0.3概率丢弃它,推理设为全正。前置2个思考潜帧并镜像反转开头控制序列,完成后裁掉;按时间压缩4倍,它们对应8帧过渡,生成93帧后保留85帧。这里的思考指时序缓冲。 原文图3|细粒度奖励图生成。对每对视频,结合帧级编辑指标、像素级场景变化掩码和驾驶语义检查生成稠密奖励图;以可信外观修改为监督,同时保护车道和车辆等关键交通语义,具体实现见原文附录H。 实验效果:44位参与者给出429条准则级回答,内容保持偏好46%,SyntheticPip 为33%,约39%是相对增幅,不是增加39个百分点。SeRM 车道分割的平均交并比 mIoU 为37.48%→40.27%。BDD100K 从200真视频增补200生成视频,整体平均精度 mAP 为0.167→0.175;严格定位阈值0.75的 mAP@75 为0.154→0.165,才对应相对7.14%。训练2张80GB H100、48 GPU小时;推理35步,未报完整耗时/峰值显存。 原文表4|BDD100K下游多对象检测。真实200视频与同样真视频加200生成视频比较;mAP为跨交并比阈值平均精度,mAP@50/75分别在0.50/0.75阈值下计算。三项从0.167/0.316/0.154升至0.175/0.324/0.165,相对增幅4.79%/2.53%/7.14%,不是百分点。 批判点评:150例域内、150例域外评测中,结构保持有收益,但域外指令成功指标较 SyntheticPip 低4.52%,画质指标低3.10%。局部轨迹修改需先由 HorizonForge 完成,不是本模型直接控制任意车辆。额外8帧和外部参考编辑器有成本;86,614总视频与28,348合成训练片不是同一统计单位。原文未给本方法代码入口,不作会议接收推断。 3. JointLight:先滤掉几何伪影再给人物换光 JointLight: Human-Centric Video Relighting with Asynchronous RGB-Irradiance Joint Modeling | 中科院计算所;中国科学院大学;卡迪夫大学;快手 | arXiv:2610.29780 关键词:视频重打光, 辐照度, 异步去噪, 几何误差 前序问题:人物视频想把阳光从左边转到右边,改色调不等于改光照。先估几何再渲染光照虽可控制方向,网格孔洞和锯齿又会变成漏光,怎样用粗几何而不照搬其错误? 方法直觉:把粗光照加噪,让细碎伪影先消失,保留大尺度亮暗分布;再让彩色视频与光照图互相修复。二者处于不同噪声阶段,避免把不可靠光照当作干净真值。 本文贡献:逐帧从单目点云构网格,赋白色漫反射材质,在 Mitsuba 3 中用目标高动态范围环境图渲染辐照度,即表面接收的照明分布。Wan2.2-TI2V-5B 把源视频、带噪彩色视频与辐照度沿时间拼接,共享旋转位置编码、用模态嵌入区分。训练12000步,最后4000步以估计光照替换真值做域匹配。推理将光照固定在0.6T噪声阶段,T为完整去噪日程,彩色支路到该阶段后两路一起去噪。 原文图2|完整训练流程。带噪彩色视频、带噪辐照度视频及源视频编码后沿帧维拼接,输入全量微调的扩散Transformer;彩色与辐照度token分配各自噪声时间,支持异步推理。 实验效果:训练用UE5合成6.8万段、每段94帧、832×480视频及配对光照;测试静态光/旋转光各50例。旋转光下 PSNR 像素信噪比16.39分贝,对照 UniRelight14.90;LPIPS 感知距离0.263/0.303,越低越好。静态光结构相似度 SSIM 为0.656,低于对照0.661。单张 A800、81帧、50步完整流程223秒,含点云/深度22.8秒、网格38.2秒、渲染18.8秒、神经生成141.9秒;未报峰值显存。 原文表1|SynthStatic静态光、SynthDynamic动态光及用户评分。PSNR像素信噪比、SSIM结构相似度越高越好,LPIPS感知距离越低越好;VQ/LF分别是视觉质量/光照忠实度,13位用户对15例按1至5评分。粗体/下划线为最好/次好。静态SSIM仍由UniRelight领先。 批判点评:真实视频主要作定性和13人15例评分;HumanOLAT 独立测试是前景掩码后的静态图,不能当作真实动态视频定量证明。光照图只管漫反射,镜面、金属和玻璃的高光不保证正确,强运动及深度断层仍可能漏光,脸部细节也可能过平。论文首页给出 SIGGRAPH Asia 2026 会议及DOI证据;代码、数据仅承诺公开,未见本方法下载入口。 4. ER-Chord:单步改图把力气用在可靠位置 ER-Chord: Spatially Consistent One-Step Image Editing via Equal-Energy Reliability Redistribution | 新加坡国立大学;快手;大连理工;天津大学;哈尔滨工业大学;腾讯 | arXiv:2610.29248 关键词:单步编辑, 空间分配, 等能量, 无需训练 前序问题:只把沙发换颜色,单步编辑器却连墙面一起改。把整体编辑强度调小能保背景,但目标也改不动;能否总力度不减,只把它放到更可信的位置? 方法直觉:比较相邻噪声水平给出的编辑方向:局部越一致,越值得分配更新幅度。保留每处原方向和全图总能量,用一个共同的调节量重新分配幅度。 本文贡献:复用 ChordEdit 的两个端点预测,以端点差异相对局部控制幅度定义可靠度;它表示预测一致,不表示语义一定正确。目标是在接近原编辑场的同时惩罚低可靠位置,约束清理前控制向量平方和不变。强度参数小于1且原能量非零时有唯一方向保持解;用最多32次二分求共同标量,CPU开销小于0.01秒,不加去噪网络调用、训练、反演或反向传播。 原文图1|ER-Chord方法概览。从时间聚合的编辑控制场出发,测量局部端点一致性,在方向不变、总控制能量固定的前提下重新分配空间幅度;不需辅助引导、训练、反演、额外去噪评估或反向传播。 实验效果:PIE-Bench 全700例,SD-Turbo、相同目标文本/噪声/种子:背景 PSNR 为22.20→22.77分贝,LPIPS 感知距离按1000倍标度128.25→120.23,目标编辑区图文相似度22.96→23.16。完整法为1次输运更新加1次清理,网络评估次数 NFE=2;无清理 NFE=1,不能将单步写成全流程只调用网络一次。报告0.37秒/图,对照0.38,峰值均6988 MiB;所读原文未说明具体测速卡型。 原文表1|PIE-Bench编辑比较。MSE均方误差及LPIPS感知距离按1000倍显示;PSNR与整图/编辑区图文相似度越高越好。绿/黄/紫分别为前三名;T-/I-free表示无需训练/反演。Steps为输运步数,NFE为网络评估次数;完整ER-Chord还含清理,NFE=2。时间为秒,峰值内存MiB。 批判点评:外部 TEdBench 100例的方向相似度0.25与对照持平,不能概括为全指标上涨。等能量只约束清理前,不能证明最终图片改动量一样;低可靠点也不必全部减弱,约束在全图耦合。若底座方向就错,重新分力度仍救不了。代码 已有作者入口,本稿未运行模型。 5. AdvFidelity:少步奖励训练也盯住网格伪影 AdvFidelity: Unifying Preference Alignment and Few-Step Image Generation within Reinforcement Learning | 阿里淘天集团;上海交通大学 | arXiv:2610.29380 关键词:图像生成编辑, 少步强化学习, 对抗奖励, 参考配对 前序问题:图像符合文字、奖励得分也高,放大却满是网格和纹理噪点;先强化对齐再蒸馏加速,又可能丢掉对齐收益。怎样在少步训练里同时检查这些低层缺陷? 方法直觉:找高质量参考图,加适量噪声再由当前模型重建,做成内容接近、细节质量不同的一对。判别器不容易靠题材或色调取巧,而要学着分辨生成器眼下的伪影。 本文贡献:基于 LeapAlign,让任务奖励和在线保真奖励的梯度穿过实际4或8步采样轨迹,共同训练 LoRA 低秩适配器,不使用分布匹配蒸馏损失。判别器冻结 DINOv2 视觉主干,只训练全局特征上的多层感知机,并用随机裁块放大局部问题。参考加0.3或0.5噪声后用一两步重建负例;每次生成器更新后更新判别器,正负配对用排序损失。参考按任务选原底座样本、目标风格模型样本或真实训练图。 原文图2|AdvFidelity。(a)少步生成器从噪声采样,任务与保真奖励共同更新。(b)高质参考加中等噪声,由当前模型重建成内容匹配的负样本。(c)判别器按Bradley–Terry配对排序损失在线更新,再提供保真奖励。每轮先更新一次生成器,再重复构造配对及判别更新。 实验效果:FLUX.1-dev 在 GenEval553条提示、每条4图上,组合生成总分4步0.7535、8步0.7759,50步 LeapAlign0.7420。Qwen-Image-Edit-2511 换装124例,8步、无分类器自由引导 CFG,服饰特征相似度0.7929;40步且带CFG对照0.7874。外域四项1至10分由 Gemini 三次评价同一组生成图,误差条表示裁判重复波动,不是多次模型训练。训练新增参考重建及判别器更新,未给完整耗时显存账单。 原文表3|Qwen-Image-Edit-2511换装定量比较。域内用DINO服饰特征相似度,域外用真实感、一致性、对齐、协调性四项模型裁判评分;CFG标明是否用分类器自由引导,NFE为报告的采样网络评估口径。8步法不使用CFG;均值和标准差来自对同一组图三次裁判评分。 批判点评:不做显式蒸馏,不等于不用强模型参考:偏好任务准备5万张50步、已对齐模型样本;GenEval另用5000张底座参考,不能混为同一设置。消融按组件累加,尚非所有因素独立随机对照;奖励风格依赖所选参考,少步数也不能直接换算同倍加速。当前未核实方法代码链接,不宣称可立即复现。 6. CausalAlign:镜头运动别在去噪后段忘掉 CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion | 北京大学;北京通用人工智能研究院;英伟达;清华大学;威斯康星大学麦迪逊分校 | arXiv:2610.29915 关键词:视频几何, 相机运动, 因果诊断, 变化特征对齐 前序问题:视频刚开始镜头绕物体转得合理,越往后几何却漂移。模型内部能解码相机运动,不代表生成时真正使用或保留它,怎样找到该补强的层和去噪阶段? 方法直觉:既做读出测试,也主动遮掉、打乱、替换或注入运动特征,看生成是否受影响;只在运动信息开始衰退的位置,教模型保存前后帧的变化,而不是死记静态场景。 本文贡献:用冻结的 LingBot-Map 三维教师学习128维 delta token,即帧间变化特征,其中64维运动、40维几何、24维视觉。三阶段先训教师变化编码器,再训主干到该空间的投影器,最后冻结教师与投影器,只调目标层 LoRA。Wan2.2-14B-I2V 选14、10、12、20层和噪声索引398、799,以变化对齐及相对位姿监督训练;位置由线性探针和相同范数随机干预对照共同确定。推理只需首帧与文字,无额外三维缓存。 原文图2|CausalAlign三阶段训练。第一阶段把流式三维教师连续帧特征编码成帧间变化token;第二阶段用训练集小子集学习主干到变化空间的投影器,随后冻结;第三阶段用完整训练划分仅优化已诊断目标层的LoRA,投影器仍冻结。 实验效果:DL3DV、RealEstate10K 各90%训练/10%评测,同采样/种子:重投影误差8.4→6.5像素,降22.6%;深度-光流误差6.9→5.5像素,对照 FantasyWorld 为5.4,仍更低。视频分布距离 FVD 为182.4→182.7,越低越好,不能称画质全指标改善。迁移 Fast-WAM 后任务组平均成功43.5%→54.2%,提高10.7个百分点;原子已见任务703/900成功,对应78.1%。 原文表1|相机自身运动一致性,同划分、估计器及生成设置。无相机控制的方法只收首帧和文字,有控制的方法额外收轨迹及三维缓存。平移/角速度接近度、平滑度越高越好;重投影、深度-光流、极线误差单位像素,越低越好;Jerk度量加速度突变。CausalAlign七项均优于底座、六项列首。 批判点评:相机未来并非唯一,主榜评内部几何一致,不是逐帧命中给定轨迹;显式相机控制对照还拿到轨迹与三维缓存,输入条件不同。运动姿态与深度均由冻结估计器恢复,估计误差仍在。教师、干预诊断及三阶段适配有额外训练成本,未给完整耗时显存,推理移除辅助网络不代表已实测加速。核心是视频生成,机器人迁移只是补充;未核实方法代码入口。 7. Attn-Forcing:旧画面删掉后仍记住它的作用 Attn-Forcing: Learning Full-Context Attention Proxies for Streaming Video Generation | 同济大学;腾讯;南洋理工大学;香港科技大学 | arXiv:2610.30036 关键词:流式视频, 注意力代理, 历史压缩, 注意力监督 前序问题:流式生成一分钟视频,缓存旧帧会越来越贵,删掉又容易忘记前面。直接延长窗口还可能让运动变僵,怎样在固定内存里保住历史对当前画面的影响? 方法直觉:把将要移出窗口的内容交给少量可学习代理,并教代理回答“当前查询看旧历史会得到什么”,而不只要求它把旧画面压缩得像。 本文贡献:Wan2.1-T2V-1.3B 上保留3个起始潜帧、9个局部潜帧和3个代理潜帧;这些是压缩视频帧,不是3个标量或文本token。门控跨注意力用被移出的视觉潜变量更新代理,再经主干形成逐层键值缓存。128维随机特征在线累计历史键值统计,近似历史注意力响应,停止梯度后只作监督目标;最后6层的匹配损失仅优化代理参数。与分布匹配蒸馏联合训练,短初始化700步、60秒流式长训2300步,16张H20、总批量32。 原文图2|Attn-Forcing。训练时,把将从局部窗口移出的视觉潜变量经代理更新模块写入可学习代理。注意力匹配损失让代理响应接近由在线累积统计近似的历史响应;统计只作监督,推理用代理产生的正常键值。 实验效果:946条VBench提示各5种子评5秒/30秒,60秒另用128条 MovieGen 提示。60秒六维加权总分82.37,LongLive79.26,动态程度72.14/35.55;但主体一致性97.11/97.93、背景95.84/96.60,保持不是全胜。自有消融仅加代理总分80.03→80.16,再加注意力监督到82.37,收益主要在监督。每块4去噪步;H20端到端生成时间额外约13%,还多一次主干前向,未报完整峰值显存。 原文表2|官方MovieGen提示生成60秒视频,128条提示,用VBench-Long六维评总分、主体/背景一致性、运动平滑、动态程度、美学及画质,均越高越好。粗体/下划线为最好/次好;总分更高不等于每项一致性最好。 批判点评:固定大小历史统计只用于训练监督;推理直接使用该近似会逐渐模糊,不能把线性注意力替换与代理法混为一谈。LongLive窗口从12扩到120时总分79.26→75.01,可能受训练窗口失配影响,并非长上下文天然更差。动态指标上升也不能替代精确回忆任务,尚无无限时长证据;未核实作者方法仓库。 8. ALLOT:按最终视频误差分配稀疏预算 Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers | 中国科学院大学;中科院自动化所;快手可灵;北京大学 | arXiv:2610.29441 关键词:视频扩散加速, 稀疏注意力, 离线校准, 延迟预算 前序问题:视频注意力每层都删相同比例,某个关键层一稀疏就变形;只看本层误差,又低估早期小误差向最终视频传播的影响。怎样把有限的注意力时间花对位置? 方法直觉:先逐个测“层×去噪步”被简化后最终损失多少,再按真实计时分配预算。像给关键工序留全量检查,对容错位置多省一点,而不是只按理论算量平均删。 本文贡献:ALLOT 全称 Allocating Layer-step Latency by Output Tests。先单层稀疏探测一步速度预测误差,再用每5步一窗的稀疏完整生成,校准误差向最终画面的传播增益;四段真实探测视频、八条校准提示。测量部署内核在各密度下的延迟,二分拉格朗日权重求每格密度表,超出稀疏内核交叉点就保留密集计算。推理查表,保留既有块排序与内核,但密度截断替代原逐头/逐输入阈值自适应。 原文图3|ALLOT流程。(1)离线测逐层单步误差、去噪轨迹传播增益、不同稀疏密度的内核延迟,为每个延迟预算C求密度表。(2)推理逐层逐步查密度,密度1调用密集注意力,否则使用既有稀疏内核。 实验效果:XAttention、Wan2.1-1.3B、480p81帧、50步、32提示,同种子相对密集视频的 PSNR 为18.14→25.37分贝;耗时148.7→148.6秒,密集183.8秒。这是贴近密集输出,不是绝对生成质量。四类公开管线九设置,按成对95%区间与感知距离共同判六胜三平;并非九项都更好。离线测量约6至23 GPU小时,Wan2.2双专家超过30;换 Radial/HunyuanVideo 的探测另报57 GPU小时,调预算CPU重求约4秒。 原文表1|XAttention、Wan2.1-1.3B、480p81帧、32提示的分配比较。Default为公开配置;按墙钟时间分组,前两组各重求ALLOT表,第三组双方都使用HEART跨步掩码复用TMR。粗体为组内PSNR/SSIM/LPIPS最好,保真指标参照同种子密集输出,Speedup为密集总时间除以该行时间。 批判点评:输出误差可加与传播增益跨层共享都是近似,求解器最优只针对离散估计目标及对应预算,不保证真实视频全局最优。部分设置 VBench 或感知距离退步,例如 SVG2 感知距离0.151→0.156。更换模型、选择策略和部署硬件需重新核对探测与计时;多次生成才能摊薄校准成本。未核实作者代码入口。 9. RubatoCodec:语音token留给变化快的地方 RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding | 第三智能公司(Third Intelligence) | arXiv:2610.29434 关键词:语音生成, 自适应编码, 事件预算, 流式解码 前序问题:语音生成每秒只留少量token,停顿和爆破音却分到一样多位置,短音节容易丢。若每句话的token总数又任意浮动,生成长度更难预测,能否总量固定、局部分得灵活? 方法直觉:同样长的一句话给同样事件预算,变化快的地方切得密,近静音切得疏;每个事件同时存内容码和持续时间,生成器按事件而非固定时钟输出。 本文贡献:基于 X-Codec-2,将16千赫输入编码到50赫兹、每格20毫秒;用潜特征变化与频谱通量定边界,K=round(RT),T为编码格数、R为保留比例,默认R=0.25,即约12.5事件/秒。二分和单调校正保证恰好K个非空事件。聚合起始特征、区间均值和时长,默认每事件16层量化,每层4096个码值;事件不是单个码索引。内容与时长恢复50赫兹网格,因果解码输出44.1千赫音频。TTS先生成各码层,再生成时长,可逐事件解码。 原文图1|RubatoCodec,默认保留比例0.25,沿用X-Codec-2编解码主干。潜特征变化和波形频谱通量分配固定预算事件;聚合器把事件起点特征与由起点、区间均值、时长得到的可学习修正相加。量化内容和时长恢复50赫兹网格,再经受Inworld TTS启发的上采样提高合成特征率。 实验效果:匹配 Qwen3-0.6B 主干、8码本、12.5事件/秒,English seed-tts-eval1088句零样本音色克隆:逐句平均词错误率 WER 为3.20%→3.10%,音色余弦相似度均0.392,预测音质 UTMOS 为4.080→4.162,非人工听评分。H200上另测250个合成代码事件,解码平均11.07毫秒/事件,对应平均约80毫秒声音;不包含文本模型生成、首包等待及在线编码,不能称11毫秒端到端语音响应。 原文表18|English seed-tts-eval语音合成。两系统同为八码本、标称12.5事件/秒。WER为逐句平均词错误率,越低越好;SIM为参考音色余弦相似度;UTMOS/UTMOSv2为预测音质,越高越好,非听评。粗体为较优值,并列共同标记。 批判点评:全句归一化、双向语义编码和未来特征用于分配,当前编码不是在线因果;流式成立于已给事件的解码。TTS生成88.3%句子恰中预算、99.9%差不超过1事件,并非全数严格满足。长事件偶有不自然停顿;码层与时长都计入比特率,不能把12.5事件/秒当12.5索引/秒。代码 与权重 可查,未运行。 10. CADRE:静止镜头与移动镜头压法不同 Rethinking Video Autoencoders for Interactive World Models | Kyutai;巴黎路桥学院 LIGM、巴黎理工学院、法国国家科研中心、古斯塔夫埃菲尔大学;加州大学伯克利分校 | arXiv:2610.30129 关键词:视频自编码器, 交互生成, 时空压缩, 动作延迟 前序问题:交互视频模型帧率够高,按键后却等很久才有反应;重建图像看着清晰,手里小物体的运动又丢了。该压时间还是压空间,不能只凭单帧画质决定。 方法直觉:每多合并几帧,模型少算几次,但动作也要等这几帧凑齐。静止镜头的时间重复多,移动镜头每帧都见新内容,两者应把压缩预算放在不同轴。 本文贡献:冻结 DINOv3 逐帧特征,训练三维卷积瓶颈;用因果扩散解码器、空间自适应归一化和零初始化跳接恢复像素。自蒸馏让一次大步匹配两次小步,得到一或二步解码。七种自编码器只改变时间因子τ和空间因子s,τ×s×s分别表示合并帧数与两轴压缩;潜变量由同一12亿参数、动作条件世界模型生成。训练自编码器用7.6万小时混合视频,比较另含五种既有自编码器。 原文图3|CADRE。冻结DINOv3提取器与训练瓶颈按τ×s×s压缩,τ为时间帧数、s为空间压缩因子;因果扩散解码器在输入、逐层空间调制及零初始化跳接三处接收潜变量。仅瓶颈、升维及时间分块随压缩点变化;训练结合感知、三维小波、流匹配及自蒸馏目标。 实验效果:机器人/人体操作、驾驶/室内导航四环境,统一20帧/秒、288×512,每环境2048例;给40真帧后生成96帧,评最后16帧。相同2×32×32压缩,单步扩散解码相对回归版将 FVD 视频分布距离降低1.4至2.5倍,越低越好;回归版像素PSNR反而更高,可能来自模糊。单H100、世界模型8步,仅若干配置达到20帧/秒且动作延迟小于230毫秒,不是所有压缩点。 原文图7|时间压缩和空间token的取舍。绿色固定空间块尺寸增加时间合并τ,橙色固定token总预算,空间格随之变粗。静止视角允许更多时间合并,移动视角合并过多会伤运动质量;完整结果在原文图15,不能仅凭图像清晰度选择压缩。 批判点评:动作可恢复比 ARR 是冻结探针读回动作的决定系数,再除以真视频探针分数,不等于机器人成功率。固定约1100个token/16帧时,移动镜头偏2×32×32、操作偏8×16×16;粗空间格会使操作FVD变差2.4倍而图像分布几乎不变。相机运动只是主要解释,场景/动作也随域变化,不能当严格单因子因果结论。项目 与代码 可查,未复现。 趋势观察 辅助监督要阻断捷径 FCP不让未来分支串看并去掉文字条件;CausalAlign以干预诊断找层;Attn-Forcing直接约束历史注意力响应,训练目标决定留下何种信息。 保持不是把编辑力度调小 HorizonComposer把可靠监督细化到像素,ER-Chord固定清理前总能量,JointLight先处理几何提示的噪声;各自保护的对象不同。 收益必须和成本放在一起 Attn-Forcing约多13%推理时间,ALLOT需离线探测,JointLight完整223秒含几何与渲染;少步骤、少缓存都不直接等于端到端更快。 压缩的计数单位影响结论 RubatoCodec每事件有多个码层和时长;CADRE同时压时间与空间;HorizonComposer的2潜帧对应8输出过渡帧,先说明单位再读数字。 今日讨论 FCP在标准教师强制训练上增加未来块预测;匹配训练数据与设置的Wan2.2-TI2V-5B图生视频对照中,Physics-IQ总体评分从30.4提高到33.8。若要检验收益是否来自隔开中间画面的未来块监督,而不是额外分支容量或训练计算,哪些证据能说明等数据、等计算的消融成立,并同时排除推理质量与成本退步? 人工智能炼丹君 整理 | 2026-10-23
-
AIGC 每日速读|2026-10-22|快手换人换声一起对口型AVE 今日 AIGC 论文速览 今日共 10 篇 · 参考视频与统一编辑 2 篇 · 文字与生成轨迹编辑 2 篇 · 数值编辑评测 1 篇 · 视频渲染与计算分配 2 篇 · 语音合成训练 1 篇 · 骨架与四维生成 2 篇 重点论文标题列表 AVE(快手):换人换声一起对上口型 VitronEdit(新加坡国立):几何监督只加给多视角 TextRIRO(复旦):打乱真文字学会保留字形 Dancing Diffusion(中科院自动化所):接着同一生成过程改下半场 ABACUS(CEA LIST):加三个物体到底加对几个 选读入口:要把视频中的人连声音一起替换,先读AVE;图像、参考视频和多视角编辑想共用模型,接着读VitronEdit。真实招牌换字读TextRIRO,已生成图片想保留街景再改对象读Dancing Diffusion;验收“加三个”是否真加三个,用ABACUS。把灰模或骨架渲成视频读SolarRenderer,研究算力分配读MoDDiT。语音只错几个字时看LoCA的局部训练;三维资产需要可重放动作看JCA,生成场景需要换镜头和时间看AEON。 今日论文速览 1. AVE:换人换声一起对上口型 Edit in Sync: Unified End-to-End Audio-Visual Editing for Human-Centric Videos | 快手可灵;北京大学;香港中文大学;清华大学;香港大学;国防科技大学 | arXiv:2610.27947 关键词:参考视频编辑, 音画同步, 人物替换, 双向监督 前序问题:把视频里的人换成参考人物,外观对了,声音却还像原人,重新配音又对不上嘴。人物插入和删除也必须同时处理画面与声音,怎样保住原动作、说话时序和背景? 方法直觉:让声音和画面在每一层互相参考,而不是先换脸再配音;把源片、目标和参考放在共同时间轴,又用不同坐标标明它们的角色,避免把参考当成待生成内容。 本文贡献:以 Ovi 音视频联合主干为基础,自编码器将音画压到潜空间,两路扩散 Transformer 用双向跨注意力交换信息。Modality-Aware Sync-RoPE 是区分角色的旋转位置编码:源与目标共享时间坐标,空间轴偏移区分角色,参考隔开固定距离;音频时间频率按长度比缩放。先预热音频,再联合适配,最后精修高质子集;正向学合成编辑,反向以真实片为目标,降低合成痕迹。所有阶段用秩256的 LoRA 低秩适配器,基础权重冻结。 原文图4|AVE总览。模态感知同步旋转位置编码通过角色专属的三维坐标偏移,区分源、目标与参考特征,同时维持共同时间轴上的对应关系。 实验效果:评测192例,替换、插入、删除各64例;片长121帧、24帧/秒、480×832,音频16千赫。替换时,口型同步置信度 Sync-C 为5.39,对照 Wan2.2+音频后处理为5.02;同步特征距离 Sync-D 为8.53/8.76,越低越好。音色相似度 CAM++ 为0.682/0.665,人脸相似度 ArcFace 为0.647/0.634;原文正文曾把两项名称写反,此处按指标定义校正。替换背景像素信噪比 PSNR 为34.62,低于 VACE 对照35.37。 原文表1|AVE-Dataset-Bench三种编辑任务的定量比较。重建指标仅在背景区域计算,粗体标最好结果;+PA表示串联基线接入作者音频后处理。音色/人脸相似度以表头CAM++/Arc为准,正文有名称互换。 批判点评:无掩码指模型推理不要求空间掩码,数据合成与背景评分仍用分割。自建数据约10万对;阶段1约12万对含外部真实移除子集,不能混算。联合阶段用24张 H800,未报端到端推理耗时与峰值显存;背景保持并非全面领先。原文仅承诺后续开放代码、权重和基准,尚无核实的下载入口;不作会议背书。 2. VitronEdit:几何监督只加给多视角 VitronEdit: Universal Visual Editing across Images, Videos, and 3D Scenes | 新加坡国立大学;牛津大学 | arXiv:2610.27049 关键词:统一编辑, 参考视频, 几何后训练, 跨模态迁移 前序问题:图像、视频编辑有大量配对数据,三维场景却缺。把每个视角单独改好,转动镜头时颜色、材质又不一致;能否借图像和视频的编辑经验,再学会跨视角保持? 方法直觉:把图像看成静止序列、视频看成时间序列、三维看成多视角序列,用同一模型编辑;几何老师只管真正有多视角约束的三维样本,让共享主干吸收这种约束。 本文贡献:从 OmniWeaving 初始化,主干为 HunyuanVideo-1.5,Qwen2.5-VL 多模态语言模型编码指令与参考;用模态 token 即模态标记区分三类序列。先图像、再视频、后加入三维数据训练,约253万样本;秩32 LoRA 适配后再训练500步。冻结几何提取器从预测及目标潜变量估深度、相机,约束归一化深度、相对旋转及局部/全局位移。默认仅三维样本用几何损失。图像复制5帧,多视角首帧保留、其余各重复4次,减轻时间压缩损失。 原文图2|VitronEdit总览。几何后训练以冻结的三维解码器,从预测与目标潜变量估计深度和相机姿态,作为几何监督。 实验效果:消融中,仅三维加几何监督相比不加:跨视角编辑方向一致性73.98→74.34,图像感知距离 LPIPS 为14.88→14.86、视频34.20→33.78;距离越低越好,这些分数沿用原文100倍标度。三维主榜一致性74.34,对照 EditSplat 为66.30。视频指令/参考混合榜的整帧图文语义相似度26.95高于初始化26.50,但源内容 PSNR 为17.32低于19.57;不能称所有编辑指标提升。 原文表4|几何后训练消融。括号为相对仅三维加几何监督Geo-3D的变化,按指标上升/下降方向判优劣;红色表示移除后退步、灰色表示改善。3D Consist.为跨视角编辑方向一致性。 批判点评:三维评测16项任务,26个编辑视图经50步生成后重新训练三维高斯30000次;评分8视图来自重建训练视图,并非留出新视角。额外几何网络与序列复制有训练/内存代价,训练用8张 H200,缺完整推理账单。只覆盖静态场景多视角编辑。项目 与代码 可查,仓库内称UniVEdit,本稿未运行。 3. TextRIRO:打乱真文字学会保留字形 Real In, Real Out: What If We Only Use Real Data for Scene Text Editing? | 复旦大学可信具身智能研究院;上海市多模态具身智能重点实验室;腾讯微信视觉团队 | arXiv:2610.27592 关键词:场景文字编辑, 真实数据, 自配对, 长文本识别 前序问题:把招牌上的词换掉,字体、透视和灯光却像贴纸。真实的改字前后配对图很少,合成字训练又容易带来不自然风格,能否让一张真图自己提供监督? 方法直觉:沿文字长轴按字符数切条,打乱再裁一段:原来写什么被破坏,笔画、材质与局部弯曲仍在。模型拿这份残缺风格和目标文字,重建完整真实原图。 本文贡献:Shuffle&Crop 按概率先打乱字符列,再连续裁剪,也保留只裁剪分支。ViT 视觉 Transformer 提取多尺度风格,经 ControlNet 式零初始化卷积注入去噪 U-Net;文字编码器先在真实场景做下一字符预测,学习字符辨认。冻结 SD2.1 自编码器与文字编码器,训练 SD1.5 U-Net 和风格编码器。输入64×256;识别器过滤生成图,再与原图拼成长文字,构建 TextRIRO-3M。 原文图2|(a)训练时对一张真实目标图破坏文字内容但保留风格,构成伪源图;视觉Transformer风格编码器输出多尺度特征,经ControlNet式零卷积注入U-Net,真实文字识别预训练的文字编码器提供目标文字。(b)推理沿稳定扩散标准去噪日程。(c)轻量字符分词器与识别解码器共同做下一字符预测。(d)独立文字识别器检验编辑结果,通过后与原图拼成长文本。图标分别表示冻结和可训练。 实验效果:ScenePair 整词识别准确率85.23%,TextCtrl 为84.67%、RS-STE 为91.80%;FID 生成分布距离41.53,优于后二者43.78/49.59,越低越好。RIROCommon 六数据集平均,等长改字79.31%、不限长度47.64%,对照 RS-STE 为60.24%/11.73%。V100、20步、批量32报告平均0.20秒/图,是批处理摊销;文字预训练36 GPU小时、编辑微调180 GPU小时。 原文表2|RIROCommon结果,与三种场景文字编辑模型比较。E为等长替换,V为不限制文字长度的编辑;每个数据集分别统计,Avg为六集平均,不能把两类任务混算。 批判点评:不等于识别准确率全面最好;识别器偏好和图像真实感是两回事。混合打乱裁剪也未在每种曲线布局上胜出。长文本对称拼接产生偶数长度偏置,附录混入非对称拼接缓解;对极长文本仍应单验。arXiv 备注明确已被 NeurIPS 2026 接收。代码 已提供入口,本稿未运行模型。 4. Dancing Diffusion:接着同一生成过程改下半场 Dancing Diffusion: Learning Continuous Programs for Image Generation and Editing | 中国人民大学;中国科学院自动化研究所 | arXiv:2610.28003 关键词:图像编辑, 条件编译, 前缀复用, 保持取舍 前序问题:把生成的红公交改成红卡车,从噪声重画会连街道也换掉;太晚切换指令,背景保住了,车又改不动。能否把生成的前半段保存,再只改后续操作? 方法直觉:把一条指令编成按时间执行的连续条件块,像安排分段任务。保存已经走过的采样状态,再替换尚未执行的条件;前史相同,但未来像素仍可能改变。 本文贡献:冻结 SANA-600M 生成器,以2.731亿参数编译器输出3个条件块及有效位置掩码;总采样30步。训练时参考图与前缀状态停止梯度,固定视觉观察器同时评价目标变化与非编辑区保持,梯度穿过去噪后缀只更新编译器。上线不调用观察器。6/12/12 表示三块各执行6、12、12步;它含40次更新的联合热身,其他日程初始化不同,不能当严格单变量比较。 原文图2|训练已保存前缀之后的条件。参考路径给出停止梯度的采样状态和源图;目标编译器提供未来条件,后缀输出接受关于变化与保留的观察器反馈。仅优化编译器,源参考不能跟着移动降低损失;部署不含观察器和损失。 实验效果:24类请求、每类3个种子,在6/12/12日程第9步分支,背景 LPIPS 感知距离由重新生成的0.321降到0.227,越低越好;图文目标差值变化0.092→0.088,保持更多但编辑略弱。第21步分支距离0.033、语义变化0.029,编辑进一步受限。A800上4个后续版本,重算9.20秒、缓存7.18秒,省22.0%;不含加载和写文件,每份潜状态32 KiB。 原文图7|最终仅编辑目标检查点上的全部预先规定分支点。每条曲线表示背景保持与语义代理之间的取舍,并非已经验证的成功率前沿;背景均值只计有效源掩码,语义均值用全部尝试。 批判点评:三种日程各仅一次训练;背景均值只覆盖有效源掩码,语义均值用全部尝试。原生指令切换同样能缓存,省时不全来自学习。操作可寻址不证明语义完全解耦,类别替换也不等于完整指令成功。主要研究生成轨迹,未建立真实照片编辑或推理能力结论;原文无核实的方法代码入口。 5. ABACUS:加三个物体到底加对几个 ABACUS: A Benchmark for Image Editing Models to Assess Object Category and Counting Under Scene Conservation | 巴黎萨克雷大学;法国原子能与替代能源委员会LIST实验室 | arXiv:2610.28316 关键词:图像编辑评测, 对象计数, 场景保持, 实例核验 前序问题:让编辑器加三把椅子,画面很漂亮却只多两把,甚至把旧椅子挪过去充数。再找视觉语言模型打分,它自己也可能数错,该怎样验证新增了什么? 方法直觉:先把每个旧物体和编辑后的对应物匹配,再把保留对象遮掉,只数真正新增的;同时检查旧物体和背景是否被破坏,三件事缺一不可。 本文贡献:在 COCO 的80类可数物体上,经双检测器与人工检查构造3845张图、10944条加/删/改指令。评测用 SAM 分割定位、实例一一匹配、非生成式修补去掉保留内容,再由 RF-DETR 与 Co-DETR 双检测确认。仅6.4%的歧义实例交给 Qwen3.6-27B 回答类别是否正确,不让它计数。CF 为数量符合度,按实际数与请求数的调和口径;SC 为光流位移与多尺度结构相似度的背景保持;OC 为旧类别保留度。先分别取均值,再把三因子相乘。 原文图3|添加与删除共享四阶段管线:输入原图Io、编辑图Ie及全景分割真值,依次做新实例发现、干净图构建、双检测器检测与视觉语言模型歧义消解,输出确认新增数和未匹配原实例数;在添加/删除任务中,这两个输出互换用途。 实验效果:600张人工计数图上,精确计数一致率0.82,单视觉语言模型0.55、单检测器0.28;困难档0.76而非满分。七编辑器主榜 Seedream4.0 总分0.31,Gemini2.5为0.29、GPT-Image-1为0.26;这是三项均值的乘积,不是成功率,也不是各难度格子总分的平均。三个商业模型的95%自助采样区间重叠,不能据点估计断言显著排名。 原文表2|ABACUS编辑模型榜。E/M/H为易/中/难,每个操作与难度格先对数量CF、场景SC、旧类别OC分别取均值,再相乘;整体在10944次编辑上同样先均值后相乘,并非格子分数平均。粗体为列最好;三个商业模型95%自助采样区间重叠。 批判点评:只覆盖80类固定词表,不评艺术风格,也不约束“必须改哪一把”。检测与匹配有偏差,源图筛选偏向可检测对象;多工具评测另有运行成本,未报端到端时延显存。arXiv 明确 WACV 2027 数据集评测轨接收。代码与数据 可查,未在本稿重跑。 6. SolarRenderer:粗略结构四步变成写实视频 SolarRenderer: Few-Step Generative Reference Rendering | 新加坡国立大学;LIGHTSPEED;香港中文大学(深圳);SLAI;香港科技大学(广州) | arXiv:2610.28630 关键词:生成式渲染, 结构参考, 四步蒸馏, 流式视频 前序问题:游戏引擎给出灰模、骨架或深度,布局和动作是对的,缺少真实材质与灯光。生成模型把结构当宽松参考,又容易改镜头;怎样既听结构又少跑几十步? 方法直觉:让每个结构特征与要生成的那一帧占据相同位置,用文字说明该继承布局而不要继承灰色外观;先学会控制,再单独训练四步加速,避免速度目标毁掉控制。 本文贡献:冻结330亿参数 MiniMax-H3,结构视频进入原生参考通路,不加类型标记,旋转位置编码逐帧对齐;参考近干净、目标带噪,区分二者。秩384控制 LoRA 用流匹配训练后冻结;加速 LoRA 的前128秩取自 DMAD,扩到384秩。分布匹配教师比较有/无结构预测,以1.5倍方向引导加强结构,再监督学生;另有五次分布估计更新对应一次生成器更新。训练含13.6万片段、约243小时。 原PDF图2(HTML图1)|冻结扩散Transformer通过原生参考通路读结构视频,序列包含文字、可选首帧I、结构潜变量sk及带噪潜变量zk;sk使用对应zk的时间/空间旋转位置,首帧位置为0。(1)控制LoRA以流匹配训练。(2)加速LoRA向结构引导教师蒸馏,教师由有/无结构S预测差、按强度w外推。 实验效果:泛化集208例、57段结构视频、16种表示,其中11种训练未见;另有53段有真值测试。四步生成158帧约209秒,对照50步2562秒,为12.3倍;原文只注明单 GPU,未给该测速的具体卡型。泛化总体偏好 Elo 为1441,与 LynnReal-Omni 持平,结构评分1338高于1241;Elo 是成对模型裁判拟合,不是准确率。 原PDF表1|在泛化与分布内两测试集上比较四个问题的Gemini成对偏好Elo及自动分。因果版只与本法比较;某问题全部对局失利的方法共用一个评分。粗体与下划线斜体分别为最好和次好。不同测试集的评分分别拟合。 批判点评:分块因果版另报768p最高28帧/秒,具体硬件、首块延迟与峰值内存不完整,不能与209秒拼成同一配置。仓库另有4张B200的社区流式集成,不能反推论文测速条件。因果版偏好较低且颜色会漂移;快速镜头四步也不总胜50步。项目 与代码 含推理、权重及训练入口,未复现。网页与PDF图号不同,配图按PDF。 7. MoDDiT:把算力留给真正难画的块 MoDDiT: Simple Token Routing in Diffusion Transformers | BOLD(British Open-ended Learning and Discovery,英国开放式学习与发现团队) | arXiv:2610.28086 关键词:扩散Transformer, token路由, 动态计算, 视频蒸馏 前序问题:天空和背景很容易,细纹和运动边缘很难,扩散网络却让每个特征块经过同样多计算。能否绕过不需要更新的 token,把预算留给困难部分? 方法直觉:像分诊一样先给特征块打分:自注意力每图固定选一部分,前馈网络则让不同样本共享总预算;未选中的内容直接沿残差通路保留。 本文贡献:两层小网络为 token 即网络处理的特征单元打路由分;训练加 Gumbel 随机扰动探索,渐退为确定性选择。自注意力每样本选前K项,K是被选数量;MLP 多层感知机把批次与 token 合并分配预算,推理用训练跟踪阈值估计分配。图像模型从零训练100万步,交替把一层密集块换成两层稀疏块,因此12.5%容量不是只花12.5%总计算。 原文图2|上:自注意力逐样本固定选前K个特征,50%容量示例选四个中的两个。下:MLP前馈路由跨样本共享训练预算,选三个绿色和一个蓝色特征;颜色表示样本,条纹表示加性更新。漏斗收集被选特征并将更新散回原位置,路由门控先乘更新再做残差相加,未选特征保持原值。 实验效果:ImageNet 256×256、512次去噪更新、引导强度1.5、50000图:25%容量模型 FID 分布距离4.795,对照 DiT-L/2 为5.069;每图去噪算量129.888/165.380万亿浮点运算,含条件与无条件两支,不含解码。空间版 FID 为4.790/4.714,反而略差。视频四步学生 Funnel20 的 VBench 总分77.69低于密集82.07,算量省23.98%。 原文表2|512次DDPM去噪更新、无分类器引导强度1.5。质量用50000张图;算量估计平均1024张,含条件和无条件两支,不含自编码器解码;FID为生成分布距离,sFID为空间版,IS为Inception评分,Precision/Recall为生成精度和覆盖率。 批判点评:图像批量32只测得1.64对1.55图/秒,小批量反而更慢,收集/散回特征的开销抵消省算;未报硬件对应的全面延迟优势。1X视频预测的稀疏/密集训练批量256/217,等更新次数并非等数据量。BOLD 是PDF列出的机构,邮箱含牛津域名不能直接当牛津机构背书;未核实方法代码入口。 8. LoCA:一句话错在哪里就改哪里 LoCA: Local Credit Assignment for Reinforcement Learning of Autoregressive Flow-Matching TTS | 灵光乍现科技(上海) | arXiv:2610.28035 关键词:语音合成, 局部信用, 流匹配, 强化学习 前序问题:合成一句话只错一个词,整句奖励却一起惩罚,正确片段也被推走;负奖励持续排斥同一个输出,还可能把训练推得过头。怎样只针对可靠的局部错误调整? 方法直觉:先把识别出的错字对齐到声音时间段,给错误与未报错片段不同增量,未知尾部不判错;再给正向拟合和负向排斥各设停止线,够了就停。 本文贡献:在20亿参数 VoxCPM2 自回归流匹配语音主干上,每条件采8个候选,以识别内容误差和说话人相似度计算句级优势,即样本相对组内平均的好坏。自动语音识别 ASR 与强制对齐定位错误,映射到生成潜帧;已测标签在句内中心化,局部权重0.2,保持系数均值,未知帧增量为零。正负回归阈值相对冻结参考误差计算,另加参考锚定;只控制固定重放目标,不保证参数不会漂移。 原文图1|12个生成潜帧的局部信用示例,非离散语音token。6个未报错帧、4个错误帧的标签均值0.6,另2个未知尾帧排除;局部权重0.2、句级优势0.05时,错误/未报错/未知帧最终系数为-0.07/+0.13/+0.05。 实验效果:固定 CV3 子集3624条,含3500普通及124困难例;相同选定模型整行比较:内容错误率4.758%,原模型5.986%、GROW 5.553%;严重失败代理51/61/60条,音色余弦相似度乘100为69.137/67.168/67.562。中文按字符、其余语言按词算逐句错误率,再按样本数加权。均10个流匹配步、引导强度2、固定种子,无重试或多次挑最好。 原文表1|主模型比较,每行所有指标来自同一选定模型。Cases为严重失败代理数量,SIM为余弦相似度乘100;错误率/数量越低越好,相似度越高越好。CV3普通集3500条,加124条困难例组成完整选择集;困难中文60、英文64条按样本数加权。 批判点评:去阈值变体严重失败仅44条,比完整法少,但错误率及音色更差;不能称所有风险均下降。俄语未进本次强化训练池,错误率6.219%→4.723%,严重代理却5→6;不代表底座没见俄语。训练多候选、ASR和对齐有额外成本,缺完整耗时显存表。单主干单种子,严重代理不是人工听评;未核实方法代码入口。 9. JCA:视频动作也能导出骨架动画 Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs | NVIDIA;以色列理工学院;巴伊兰大学 | arXiv:2610.28632 关键词:运动视频联合生成, 任意骨架, 相机对齐, 交叉注意力 前序问题:视频里猴子跳得很自然,三维资产却拿不到可重放动作;先生成视频再估骨架,动作可能超出这只猴子的关节结构。能否从一开始就让指定骨架参与生成? 方法直觉:让懂视频的模型和懂骨架的模型一起去噪,相互通报动作进度;再找出每个三维关节投影到画面的哪里,拟合把两者对齐的相机。 本文贡献:图网络按关节名、静止几何、可选参考图二维位置和骨骼连接编码;每关节每帧18通道,含旋转、位置及变化。独立运动去噪器与 Wan2.2-I2V-A14B 图生视频主干通过零初始化双向跨注意力桥耦合,附加模块共1.78亿参数。定位头将关节对视频块的注意力加权成二维坐标,再拟合每片一台静态透视相机。数据约20万视频/运动对,含11.8万资产视频、6万人体、2.7万机器人;运动单独预训另用12.5万序列。 原文图2|输入文字、骨架及可选参考图,同时去噪视频潜变量Zv与运动特征Zm。图网络把骨架及图中关节二维位置编码成逐关节描述D;运动块沿骨骼边传播图注意力。零初始化双向跨注意力桥让两路交换特征,训练起点保留各自预训练行为。右侧定位头用关节查询视频块,按块坐标加权得到二维关节,与三维运动形成对应点以拟合相机。 实验效果:20资产×5指令共100对,模型裁判0至100分的指令遵循58.4,对照 ActionMesh43.4;网格边长相对变化中位数0.20%/7.07%,越低越好。人体250条指令,通用版对齐后平均关节位置误差114.8毫米,差于 EchoMotion97.7;专门人体微调10000步后72.3。引导每去噪步需4次前向,附加参数少不等于运行便宜。 原文表2|视频与人体运动联合生成。同步指标比较生成动作和GVHMR恢复的动作;视频与动态指标按VBench。PA-MPJPE为逐帧刚性对齐后关节位置误差,SA-MPJPE/MPJVE为全序列单旋转对齐后位置/速度误差;位置毫米、速度毫米/秒。通用版和人体微调版须区分。 批判点评:人体对照使用文本生成,本法有生成的参考图,输入条件不同;同步参考来自另一个恢复模型,并非动作捕捉。相机拟合假定静态,训练偏双足;模型不直接看到三维场景几何,接触与穿透没有硬约束,交互对象也未恢复三维。缺完整延迟显存表。作者项目页 展示结果,当前未见方法代码链接。 10. AEON:把生成视频解成持续四维场景 AEON: Unifying Video and 3D World Models | 清华大学软件学院 | arXiv:2610.28631 关键词:四维生成, 高斯场景, 潜空间适配, 持续表示 前序问题:生成视频能看,换个视角却容易变形;逐帧重建得到的三维结构也不一定属于同一个世界。怎样把视频生成先验变成可以反复换镜头的显式动态场景? 方法直觉:让生成模型先给出压缩视频,再翻译成一个持续存在、会移动和显隐的高斯集合;换镜头时渲染同一份场景,而不是重新猜一组画面。 本文贡献:4DGS 即带时间变化的三维高斯表示,每个基元含位置、形状、颜色、不透明度、线速度、角速度及可见持续时间。先训四维重建器,四个头估深度、外观、动态和相机;再用线性岭回归初始化的卷积支路与零门控 Perceiver 跨注意力支路,把 Wan 视频潜变量映射到 视觉表征模型 DINOv2 第4层特征空间。冻结重建教师监督基元、几何与特征,最后加可微渲染精修;蒸馏后两阶段可用无几何标注的视频。 原文图2|上(1):四维重建器4DRM用深度、高斯外观、动态演化和相机四头,把单目视频解成4DGS场景,再渲染RGB、深度和法线作端到端监督。下(2):冻结视频扩散模型(如Wan2.2)提供生成先验,教师重建器提供四维重建能力,经域适配器和可学习学生4DRM蒸馏,形成显式动态场景。 实验效果:30个图文场景的相同预设镜头上,Wan2.2版主体一致性0.875、运动平滑0.980、美学0.531,对照 Lyra 为0.864/0.974/0.459,均越高越好。视频转四维重建的 DaVis 结果:PSNR像素信噪比24.661,对照 NeoVerse23.929;LPIPS感知距离0.243/0.283,越低越好。生成、重建和新轨迹评测是三类任务,不混作同一组成绩。 原文表2|四维生成的定量比较。全部输出沿共同预设相机轨迹渲染,使用VBench主体参考相似度、主体一致性、运动平滑及美学评分;比较基于同一图文条件,不应当作任意视角几何真值。 批判点评:实时指已得到高斯后的渲染,不等于文本到四维场景实时;16张 H200 训练,未给完整生成延迟、显存预算。世界时长受视频窗口限制,未见区域会露洞,跨窗口融合只是未来方案;显式渲染不证明几何真实。arXiv 备注明确 NeurIPS 2026 接收。项目 与推理代码 可查,仓库目前列Wan2.1生成路线,不能据Wan2.2主榜声称全部版本已开放。 趋势观察 保留目标应进入机制 AVE共享时间轴,TextRIRO保风格破文字,Dancing Diffusion固定已执行状态;三者分别约束同步、样式与生成前史。 几何约束要放对位置 VitronEdit只对三维样本加几何监督,JCA显式读骨架,AEON输出持续高斯;一致性与物理正确仍需区分。 平均数字必须说清分母 ABACUS先均值后乘积,LoCA逐句误差按样本加权,SolarRenderer不同测试集Elo分别拟合,不能把评分写成成功率。 少算与更快需要两份证据 MoDDiT算量下降可能抵不过小批量路由开销;SolarRenderer四步整段与流式实时是两个版本,Dancing前缀省时也适用于原生切词。 今日讨论 AVE人物替换的Sync-C从Wan2.2串联对照5.02提高到5.39,Sync-D从8.76降到8.53,但背景PSNR为34.62,低于另一对照VACE的35.37。若你在做参考人物视频编辑,会收集哪些指标和失败样本,结合口型同步、参考身份、背景保持与实际耗时来决定联合编辑是否值得,而不把不同对照的最优数值拼成一次全面胜出? 人工智能炼丹君 整理 | 2026-10-22
-
AIGC 每日速读|2026-10-21|字节擦字幕保住原场景DeOverlay 今日 AIGC 论文速览 今日共 10 篇 · 视频编辑与透明素材 3 篇 · 多轮与分层图像编辑 2 篇 · 音视频联合创作 1 篇 · 多镜头布局生成 1 篇 · 文生图与推理效率 2 篇 · 可控歌曲翻唱 1 篇 重点论文标题列表 DeOverlay(字节):从原片出发擦掉遮挡字幕 Wan-Alpha++(天津大学):让透明特效从出现走到消失 ColorModern(延世大学):四格关键帧带动长片调色 MT Forcing(商汤):用单轮老师稳住八轮编辑 LayerEditor(华南理工):编辑完顺手交付可复用图层 选读入口:原片被字幕或标题遮住,先读DeOverlay;手头是单张透明素材、要做出现消失动画,读Wan-Alpha++。老彩色长片只想换色调,读ColorModern。连续改图漂移看MT Forcing,成品还要拆成可复用层看LayerEditor;只修声音或画面其中一条看UniAVC。需要人物按三维站位跨镜头转身看MeV;考虑训练预算读Halcyon,已有扩散模型要省推理读SpecKCast;想保留旋律却改速度和唱法读MuLaCover。 今日论文速览 1. DeOverlay:从原片出发擦掉遮挡字幕 DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal | 字节跳动;南方科技大学 | arXiv:2610.26081 关键词:视频编辑, 叠层移除, 流匹配, 场景保持 前序问题:擦掉字幕后,背景也被重新画了一遍;旁边帧能看到的细节没用上,始终被遮挡的区域又必须靠生成补全。怎样同时利用原片和生成先验? 方法直觉:从带字幕的原视频开始小步修正,每一步都重新参考同一份原片;局部只汇总没被遮住的位置,让字幕本身不混进背景线索。 本文贡献:以13亿参数 LingBot-Video 为主干,训练350000对叠层/干净片段,用秩256的 LoRA 低秩适配器微调。视频自编码器先压到潜空间,在原片与干净片之间学习流匹配,即预测沿两者连线移动的速度;遮挡区损失权重6、外部1。对前后共5个潜时间位置,在固定空间坐标排除掩码区并按可见数平均,另加全局源特征与编辑区域嵌入;逐元素相加维持一条视频token序列,token即网络处理的特征单元。推理共享同一网络反复更新,使用12像素无缝贴回。 原文图3|DeOverlay总览。(a)共享权重Euler更新从源潜变量开始,上方通路传当前状态,下方循环在固定源线索下更新状态与时间;(b)可见性感知源汇总VSA、全局源条件GSC与掩码嵌入组成源条件;(c)源线索先加到当前状态token,再联合处理视频与文字。张量网格和中间状态为示意,RGB为配对源片/输出。 实验效果:DVTE-Bench含8类、1631对视频,原干净目标经文字识别筛查;输入真值外接框掩码,评分用像素掩码。六步、引导强度2实际调用网络12次:遮挡区PSNR像素保真信噪比30.80,对照MiniMax-Remover为26.17,越高越好;LPIPS感知距离0.0408/0.0977,视频特征分布距离VFID为0.0835/0.2806,均越低越好。单A100另测8段650帧:四步端到端2.0712帧/秒、峰值12.236GiB,排除初始化;六步主榜没有对应速度行。 原文表2|全部1631条视频采用发布的像素掩码协议。(a)PSNR排除无限值,VFID为全局视频特征分布距离;(b)TWE Gap是预测与干净目标平均时间变形误差的绝对差,目标TWE为9.3228,诊断定义见原文附录I。粗体标(a)最佳值,(b)粗体/下划线标预测TWE最接近/次接近目标及其余诊断最低/次低值。 批判点评:适合已知叠层位置的场景,不能把合成叠层评测当真实遮挡全恢复。固定坐标汇总会混合运动物体;完全遮住的内容仍是推断。目标筛掉天然文字,保留路牌文字需另测;四步也慢于MiniMax-Remover的2.6405帧/秒。作者项目页 承诺开放基准与输出,尚未核实方法代码;不作会议接收背书。 2. Wan-Alpha++:让透明特效从出现走到消失 Wan-Alpha++: Animating a Single RGBA Asset into Controllable Transparent Video Effects | 天津大学;香港理工大学;大连理工大学;莫纳什大学;中国科学技术大学;独立研究者 | arXiv:2610.26189 关键词:参考动画, RGBA生成, 透明特效, 时间控制 前序问题:拿一张带透明度的火焰素材做“先出现、再消失”的动画,首尾都是全透明,传统首帧或首尾帧控制就看不到素材本身;先生成再抠像还会丢掉烟雾的半透明边缘。 方法直觉:把时间轴循环平移,让原来位于中间的可见素材跑到两端,借用已有首尾条件能力;生成后再移回时间轴,恢复出现到消失的过程。 本文贡献:RGBA是RGB颜色加alpha不透明度。共享视频潜空间分别编码颜色与alpha,通过透明感知双向扩散保持预训练颜色分布并区分alpha;透明度引导的噪声均值偏移控制粗略位置。新增图像条件路线先适配Wan2.1-I2V-14B,再用196条特效视频学习时间相位重参数化,把零/正/零alpha模式变为正/零/正。推理对指定透明区间做归一化梯度更新,再逆变换;同一参考RGBA图约束两端。 原文图4|时间相位重参数化的图像到RGBA视频推理。同一RGBA输入约束时间两端;透明状态引导对用户指定不可见区间施加归一化梯度更新,最后做时间变换,恢复需要的出现/消失特效。 实验效果:图像条件视频为81帧、480×832、40步;前32步每步另做2至3次梯度迭代,不能沿用文生版四步加速。文本训练/验证集为77237/4066条,基础图生路线另用429条,特效适配用196条。效果类评测对照Wan2.1-FLF2V加MatAnyone:DINO-I结构特征相似度0.9227/0.6679,CLIP-I语义外观相似度0.9368/0.7969,均越高越好;这类依赖外观的分数只统计足够可见的帧。 原文表IV|普通与特效两类图像到RGBA视频定量比较。DINO-I和CLIP-I衡量参考保持,其余指标衡量通用视频质量,均按原表方向解读;效果类DINO-I由0.6679到0.9227。 批判点评:收益主要针对透明出现/消失和输入素材保持,不等同修改任意既有视频。两阶段生成加抠像对照与端到端RGBA路线的能力不同;只用少量特效数据,复杂多阶段透明变化仍待验证。40步及梯度引导增加推理成本,论文未给完整耗时或峰值显存;尚无核实的方法代码入口。原Wan-Alpha会议版不代表本扩展已被接收。 3. ColorModern:四格关键帧带动长片调色 From Legacy to Contemporary: Scalable Color Modernization for Long Videos | 延世大学 | arXiv:2610.26391 关键词:视频调色, 关键帧编辑, 颜色传播, 镜头一致性 前序问题:老彩色视频偏色、灰暗,逐帧让生成模型重画会改脸、闪烁;每镜头各调各的,又可能让相邻镜头像来自两部电影。 方法直觉:先把相邻镜头的代表帧放到一张四格图里一起调色,再只把学到的颜色变换传播给原帧。生成模型负责审美参考,原片保住空间细节。 本文贡献:先检测并合并镜头,从每镜头16个候选中用Qwen3-VL-8B选关键帧。最多4张相邻关键帧拼成2×2,FLUX.1-Kontext-dev按同一自然现代色调指令编辑30步。拆开后估计每镜头的MKL(Monge–Kantorovitch线性)颜色映射:用完整3×3矩阵匹配RGB均值和协方差,保留颜色通道间关联;高亮处用平滑压缩防止硬截断,再固定应用于该镜头全部帧,无需训练新模型。 原文图1|长视频调色流程:先将输入分成镜头,各取代表关键帧,再联合现代化相邻镜头的关键帧,最后从原帧/编辑帧对估计每镜头颜色映射,应用于该镜头全部帧。 实验效果:100段1960至2000年代电影片段共3.9小时、3390镜头,每段2至4分钟。65人对15段作975份完整排序,平均名次2.31,对照CAP-VSTNet为3.02,越低越好;第一名占37.9%/17.6%。边缘结构相似度0.865,不及Neural Preset的0.886;相似源镜头的颜色变换差异SW-IGC为5.90/7.50,越低越好。H200颜色传播816帧/秒,只是末段;完整流程还需约13秒/镜头选帧、14秒/四格编辑,CPU含视频读写传播约80帧/秒;抽样10段端到端平均每段10.9分钟。 原文表1|Condensed Movies数据集100段视频的补充定量比较。灰色原视频仅供参考且不计排名;CDC以百分之一为单位。端到端方法缺可靠源/输出对应,故未报SW-IGC;FPS仅为H200上的颜色传播吞吐。 批判点评:它修改已有彩色视频的色调,不能补黑白片缺失颜色,也不处理划痕与几何修复。静态全局映射可能跟不上镜头内照明变化。SW-IGC用24标准色评估映射相似度,过度平滑能得更低4.46却产生不自然色彩,因此低分不等于审美最佳。作者代码仓库 可访问;未运行完整流程。 4. MT Forcing:用单轮老师稳住八轮编辑 MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion | 商汤研究院;香港科技大学;斯坦福大学;清华大学AIR | arXiv:2610.25404 关键词:多轮编辑, 分布蒸馏, 历史监督, 质量漂移 前序问题:一张图连续改八次,前面几轮还清晰,后来纹理变脏、先前保留的花纹也丢了。只用正确历史训练,模型上线后却只能接着自己的错误继续改。 方法直觉:让学生在自己生成的历史上练习,但老师每次都从最初原图执行累积指令,避免老师也越改越坏;再用一致的参考轨迹约束“哪些细节必须延续”。 本文贡献:Single-Turn DMD即单轮分布匹配蒸馏:把截至当前轮的指令合成一次编辑请求,由固定单轮老师从源图给出目标分布,监督学生自回归生成的每轮输出。仅匹配各轮分布不能保证前后同一细节,因此Teacher-Forcing Guidance先在参考轨迹上预热,之后仍用较小权重的流匹配监督历史到下一图的转移。它改训练过程,无需在每次用户编辑时再生成老师结果。 原文图2|MT Forcing。(a)单轮DMD将学生自生成轨迹的逐轮边缘分布匹配到单轮老师;(b)参考轨迹上用流匹配监督依赖历史的转移;(c)总体训练先teacher-forcing预热,之后DMD联合teacher-forcing正则,分别维护画质与跨轮一致性。 实验效果:在MTEdit-Bench的100条八轮逐步编辑会话,对同一SenseNova-U1.5前后比较:第八轮IF指令遵循4.52→9.17、CC累积内容一致性3.22→7.68,二者为Qwen3.5-Plus的0至10分;DRS抗画质漂移分3.03→4.35,取两个画质评分平均、0至5分。八轮平均匹配点位移Pixel为6.34→0.74像素;同时使用两项训练目标的消融均分IF/CC为9.66/8.40。 原文表2|SenseNova-U1.5在MTEdit-Bench逐步子集的八轮均分组件消融。完整方法在IF、CC、DRS和Pixel四指标均最好,分别为9.66、8.40、4.30及0.74像素。 批判点评:Pixel度量前后图像匹配点移动,只有本应保持的区域才宜越小越好,不能替代编辑是否正确。第一轮部分内容分下降,第八轮改善不等于每轮全面领先;DMD还需教师、生成器及分布估计网络,训练与参考轨迹成本没有完整账单。不同裁判或多轮指代任务仍需另验。作者项目与代码 可访问,本稿未复现实验。 5. LayerEditor:编辑完顺手交付可复用图层 Editing Images into Reusable Layers via Compositional Edit-Prior Distillation | 华南理工大学;清华大学;中国科学技术大学;鹏城实验室;京东 | arXiv:2610.24738 关键词:图像编辑, RGBA图层, 组合蒸馏, 图层控制 前序问题:改完电商海报只得到一张扁平图,下一次想单独移动商品或改字又要重画;先编辑再拆层还会把文字、边缘和半透明内容拆坏。 方法直觉:让模型一起画最终效果和按顺序排列的独立图层,再把图层合成回去请原编辑老师检查;这样“每层可用”与“合起来编辑正确”同时受约束。 本文贡献:基于FireRed-Image-Edit-1.1,把编辑画布以及有序图层的颜色/alpha特征放进一条序列;alpha是连续不透明度,单独解码以保住细边和半透明。C-EPD为组合编辑先验蒸馏,在学生实际走到的去噪状态查询冻结教师:直接画布接受速度监督,解码后的图层合成图接受像素监督,梯度能传回颜色与alpha。每5次更新做一次蒸馏,使用10节点轨迹、每次选2个查询;基础流匹配继续训练所有输出。 原文图2|LayerEditor同时生成直接编辑画布D及有序RGBA图层堆栈S。组合编辑先验蒸馏C-EPD使用冻结老师,同时监督直接预测与解码图层重新合成的图像。 实验效果:LayerEditor-100K提供约10万编辑/有序图层样本。独立Crello测试2994例、ScaleEdit测试1000例;后者合成图结构相似度SSIM为0.8839,对照Seedream5-Pro联合版0.8365,越高越好;alpha交并比IoU为0.6802/0.6583。Crello合成图FID分布距离33.86/55.33,越低越好。消融去C-EPD后编辑一致性评分6.14降至4.67,分数来自1至10分模型裁判。主干秩256适配,推理30步,另训练alpha解码器。 原文表1|两个基准上的编辑与图层质量。规则式模型评分针对合成输出,范围1至10;每列最佳与次佳标出。图像层指标分别检查直接输出和图层合成结果,图层指标检查RGBA误差及alpha重合。 批判点评:联合输出和可微解码增加训练与长序列成本,没有完整推理时延、峰值显存证明。重合图层先做一一匹配再算误差,不代表语义拆分唯一正确;完全被遮住内容仍靠逐层监督。Seedream有5例无有效输出被其指标排除,比较分母并非完全一致;模型裁判分也不是人类认可率。尚无核实的方法代码入口。 6. UniAVC:保留一条音画分支只改另一条 UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling | 香港科技大学;华为研究 | arXiv:2610.24791 关键词:音视频编辑, 联合生成, 非对称去噪, 分阶段训练 前序问题:只想换画面却把满意的声音也重做了;只想修音频,统一噪声进度又逼两种信息一起变化。稀缺音画配对数据还要从头教模型各自怎么生成,太浪费。 方法直觉:先分别练好视频和音频,再用配对数据只训练两者的交流通道;共享时间索引下各走各的去噪进度,想保留哪条就把哪条固定为干净条件。 本文贡献:从LTX-2.3初始化两套Transformer,以每层跨注意力桥交流,桥的调制读取对方噪声等级。参考潜变量与目标特征拼接,掩码禁止参考读取噪声目标。先独立训练两分支,再冻结分支、仅训练跨模态桥;视频/音频各消费3430万/5490万次样本,配对对齐消费67万次,次数不等于独立数据量。额外训练一条分支无噪声且不计损失的任务,支持单模态编辑及固定满意分支后的自修正。 原文图3|UniAVC。(a)音视频两套Transformer仅通过每块跨注意力桥交互,调制由对方噪声等级驱动;参考潜变量作为上下文token与目标拼接,掩码阻止参考在自/跨注意力中读取噪声目标。(b)先并行用单模态数据练好各自生成编辑,再冻结两分支,只用配对数据训练跨模态桥。 实验效果:720P、121帧、24帧/秒、16kHz单声道训练,推理30步,视频/音频噪声偏移参数9/2。InsAVE-80K测试集对照InstructAV2AV:FVD视频分布距离150.86/180.38、FAD音频分布距离1.99/2.75,均越低越好;但文本音频对齐27.36/34.96,越高越好,对照更佳。JAVEditBench指令一致性分4.42,对照MiniMax-H3为4.11;音画同步分0.2975却低于JAVEdit的0.3688。 原文表2|JAVEditBench与InsAVE-80K测试集联合音视频编辑比较。列名缩写各基准官方指标,剑号表示取自引用论文的结果;粗体/下划线分别为最好/次好。本法分布距离更低,但部分音画同步与文本音频对齐仍落后对手。 批判点评:它支持编辑既有音画,故放在创作效率部分;并非所有生成或同步指标最优。自修正需额外去噪,30步不能当全部请求的统一时延。分阶段节约的是配对样本消耗,3430万与5490万次单模态训练不能忽略;部分视频来自内部数据,且论文附录对InsAVE训练/测试划分表述有歧义,复现须核对划分。作者项目与代码 可访问,未跑模型。 7. MeV:先在三维里排好每个镜头 Mise-en-Video: Fine-Grained 3D Control for Multi-Shot Video Generation | 香港科技大学;可灵AI研究;香港中文大学;西北工业大学;大连理工大学 | arXiv:2610.26801 关键词:多镜头生成, 三维布局, 朝向控制, 分层注意力 前序问题:同一个人物跨镜头还在,却不按要求转身、位置也不对;一句长提示同时描述整片、每镜头和人物属性,信息容易串到别处。 方法直觉:先用三维盒子安排人物站位和朝向,再把整体剧情、镜头说明和人物属性分别送到该看的区域,让控制信号既有空间也有作用范围。 本文贡献:Mise-en-Video简称MeV。给有朝向的三维边界框涂NOCS标准物体坐标颜色,即用固定颜色编码物体自身坐标,投影成逐帧二维布局。控制分支复制主干前一半Transformer块,经零初始化卷积逐层注入。层级上下文注意力让全局文本对所有视频特征可见、镜头文本只对所属镜头可见、主体文本只对盒子覆盖区域可见。先训练层级文本,再冻结主干训练布局分支;16万条、每条2至6镜头、最多250帧,1B即10亿参数基础主干,使用32张GPU。 原文图2|MeV总览。创作者先设计三维场景并给分层描述;布局投影为NOCS标准物体坐标颜色编码,作为ControlDiT引导;文本分成全局、镜头、主体三级,通过层级上下文注意力融合,改善跨镜头叙事及主体一致性。 实验效果:100组多镜头提示比较中,MeV/EchoShot跨镜头主体一致性0.5499/0.4492,越高越好;对MultiShotMaster,平均朝向角误差0.2015/0.4094弧度,越低越好。去三维布局后同误差升到0.4194。14B即140亿参数HoloCine的主体一致性0.5955仍高于MeV,不能称跨规模全面领先;主表与层级注意力消融的完整模型数字也不同,不能混算。 原文表2|朝向估计定量比较:偏航、俯仰、翻滚角平均差及mAOE平均朝向误差以弧度计,越低越好;偏航朝向相似度OS Yaw越高越好。MeV的mAOE为0.2015,对照MultiShotMaster为0.4094。 批判点评:粗盒子便于导演控制,但不能表达手指等精细形变,额外半主干控制分支与布局制作均有成本,未给完整速度显存结果。去注意力掩码反而提高表面一致性,却让多镜头塌成连续镜头,说明指标必须结合叙事。作者项目页 标注SIGGRAPH Asia 2026,本稿仅将其作为作者声明;机构身份按原文;当前仓库开放数据标注与布局渲染管线,不能当完整视频生成权重已开放。 8. Halcyon:不用语言预训练也能学文生图 Text-to-Image Generative Modeling Without Language Pretraining | 斯坦福大学;Radical Numerics | arXiv:2610.26863 关键词:文生图, 从零训练, 早期融合, 训练预算 前序问题:训练文生图模型,是否必须先花大成本学一个通用语言模型?语言预测更强,并不保证更会把文字变成图像。 方法直觉:把文字和图像都切成离散token,在同一模型里直接学习“这段话之后应该出现哪些图像单元”,让图文配对负责教文字的视觉含义。 本文贡献:早期融合的自回归Transformer统一预测文字与图像序列。文本分词器、图像分词器及生成器均从头训练;256×256图像用8倍下采样得到32×32、共1024个图像token,文字/图像/特殊符号合计80640词表。GPIC约1亿图文对训练一轮。以图生文序列替换部分丢弃描述的样本,仍保留无条件图像前缀,可在相同预算附带学图像描述。另用固定计算预算和预训练初始化作受控实验。 原文图3|序列格式。纯文本预训练、描述和图像token与特殊符号共享词表;前两行是单模态,后两行是配对图文。图像I与图生文I2T共享图像开始/结束包围的图像前缀,文生图T2I丢弃描述作无分类器引导时也得到此前缀。序列补到固定长度,PAD填充不计训练损失;框宽仅示意,不代表token数量。 实验效果:GPIC测试50000条描述,每条一张256×256图;gFD为生成与真实图像特征的Fréchet分布距离,越低越好。16亿参数Halcyon为35.28,对照JiT-T2I-XXL/8++为40.97;总预训练运算量约少275倍,包含语言、分词器和图像生成器训练,非采样加速。5.2亿参数在额外语言预训后仍完整训练一轮图文、总预算1.5倍时gFD为49.22,未优于从头的48.02;构图问答GenEval在16亿参数时53.48,对照43.17,越高越好。 原文表6|Halcyon-0.52B固定预训练预算下,分配外部纯文本训练对文生图的影响。各语言阶段均超过每参数20文本token的Chinchilla参考量;剑号配置在额外语言训练后保留完整一轮文生图,总计算1.5倍,gFD仍未改善。token计数不含填充。 批判点评:结论限GPIC、256分辨率和已测模型;受控干预集中小型自回归模型,不能推广为所有生成任务都不需要语言。无语言模型权重预训不等于不用文字:文本分词还使用OpenWebText。1024token逐个生成的延迟没有端到端证明。项目页 提供模型集合,但代码标coming soon;网页模板仓库不是方法代码。 9. SpecKCast:预测不同频带何时需要重算 SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration | 多伦多大学;Vector研究所;三星电子多伦多AI中心 | arXiv:2610.26837 关键词:扩散加速, 频域预测, 卡尔曼滤波, 不确定性 前序问题:缓存上一去噪步能省算,但跳得越远越失真;画面大轮廓和细纹在不同阶段变化,整块特征用同一预测规则并不合适。 方法直觉:把去噪输出拆成低频轮廓与高频细节,各自记住数值和变化速度;预测越来越不确定时再真正调用大网络纠正,平稳时直接用预测。 本文贡献:二维离散余弦变换DCT把每个输出通道分解为空间频率,分7个频带。卡尔曼滤波作为递推状态估计器,为每个系数追踪值与速度,为频带共享不确定性;按噪声信噪比扭曲各带时间轴,阻尼外推避免越跳越远。实验先用12提示×50步轨迹校准频带功率,取后25步统计,参数不训练但校准有成本。跳过时逆变换得到采样器所需速度,不确定性过阈值才重算。 原文图2|去噪速度各空间频带轨迹不同。一次FLUX.1-dev生成的50次速度预测分别做PCA主成分投影,点间更大间隔表示变化更大。(a)完整速度采样分量;(b至d)径向DCT频带B0首步变化最大、B3较宽区间持续变化、B6在40步后最活跃。各面板分别拟合PCA与归一化,不能把跨面板距离直接比较;更多提示与Qwen-Image原文附录G提供。 实验效果:H100上,以50步为完整参考。Qwen-Image 1328×1328约8次有效求值配置,从52.22到8.70秒、6.00倍,额外0.01GiB;与参考图感知距离LPIPS为0.267,越低越好,绝非无损。Wan2.1-14B约14次配置由370到105.2秒、3.52倍,视频质量分80.86对参考81.11。NFE按论文表记有效去噪求值预算,是跨样本平均,单样本可变;使用双分支引导的模型每次实际还需条件/无条件两次Transformer前向。 原文表3|FLUX.1-dev约14次有效求值下的SpecKCast组件消融。频率分解、按频带扭曲时间和不确定性自适应调度共同带来最佳参考保真,完整模型PSNR24.28、LPIPS0.146、耗时3.45秒。 批判点评:PSNR、SSIM与LPIPS主要衡量贴近50步参考,不自动代表用户更喜欢;6倍是图像特定设置,不能套给全部视频。Wan额外内存表中约0.05GiB,摘要“低于0.05”不宜当所有模型严格上界。已计算步仍处理全部空间token;离线校准和自适应耗时需纳入部署预算,尚无核实方法代码入口。 10. MuLaCover:给旋律和弦换速度与唱法 MuLaCover: Flexible Cover Song Generation via Symbolic Tonal Control | 穆罕默德·本·扎耶德人工智能大学;北京大学;MuLa Labs Vera Praxis Lab;香港中文大学;南京艺术学院 | arXiv:2610.26684 关键词:歌曲生成, 符号乐谱, 翻唱控制, 部分参考 前序问题:想保留一首歌的旋律和和弦,却换成另一种风格、速度,逐帧音频条件容易把新版本也锁在原节拍上;只给一段副歌时更加受限。 方法直觉:保留“唱什么旋律、配什么和弦”的简谱骨架,把原录音时间先归一化;让文字指定新歌词与风格,生成器自己决定新版本如何铺开。 本文贡献:从参考录音抽取旋律与和弦,统一到每分钟120拍、十六分音符网格。旋律用128个音高各自的起音/延音状态共256维,和弦用12音级;投影后通过门控自适应跨注意力接入HeartMuLa-3B的28层中最后8层。先30秒片段预热,再全曲训练,最后用同一歌不同版本的“内容/歌词风格音频”交叉配对微调。掩蔽乐谱区间支持续写、向前后扩展和补副歌;前两阶段仅训新模块,最后加低秩适配。 原文图1|MuLaCover。(a)N层歌曲主干输入歌词l、风格s和音频token a,最后L层以GACA门控自适应跨注意力注入乐谱内容c;(b)c先经各层自注意力细化,再以tanh限制的可学门控合入隐藏状态;(c)前两阶段四信号取同版本,第三阶段c取同曲另一版本;颜色区分版本。(d)内容序列掩码支持部分参考:rho=0保留alpha T到beta T区间以向外生成,rho=1保留其补集以填内部,T为乐谱长度;默认alpha=0、beta=1、rho=0为全曲。 实验效果:约20万合成歌曲用于数据构造,16张A100 80GB训练,新增可训参数约3亿至4亿而非整个模型规模。完整翻唱任务在32首源歌检索库中,本法/Suno-v5.5的CSI首位找回率为0.97/0.98,越高越好;音素错误率0.13/0.11,越低越好,后者更佳。22名有效参与者对8首抽样歌给出95个完整人歌组合、1520次五分评分,本法整体音乐性3.75±0.22,对照3.88±0.21,区间为95%置信区间。 原文表1|全曲翻唱任务的客观评测,箭头标指标优劣方向,粗体为最好、下划线为次好。比较音频审美、歌词、风格和原曲检索;本法与商业对照各有优劣,不能用单列概括全部音乐性。 批判点评:可控性不等于逐音符精确复制,自动旋律和和弦转录错误会传递;小检索库与听评也不足证明所有风格等价商业系统。部分参考任务的SongEcho掩蔽与ACE-Step串联是作者适配,不能当原生能力公平等同。未报告完整推理时延显存,训练新模块也有成本。项目与代码 可访问,项目副标题写Lead Sheet Control,原文保留Tonal Control;仓库标权重与输出限非商业用途。 趋势观察 编辑应先想哪些信息不能丢 DeOverlay固定源引导,ColorModern只传播颜色,UniAVC固定满意分支;三者都把保留目标放进具体操作。 监督对象要对准失败阶段 MT Forcing练学生自己生成的历史,LayerEditor检查图层重新合成,Wan-Alpha++把可见参考搬到有效条件位置。 计算预算必须有分母 Halcyon的275倍算总预训练,SpecKCast的6倍是特定采样设置,ColorModern的816帧/秒仅末段传播。 多维指标共同决定是否可用 MuLaCover旋律检索与歌词精度不同步,MeV表面一致性不能取代分镜控制,UniAVC分布距离好也不保证所有同步指标领先。 今日讨论 DeOverlay同一检查点的四步/六步消融,遮挡区PSNR仅从32.461到32.467,相对时延却从1.00到1.25;速度表四步为2.0712帧/秒,主榜六步尚无对应端到端行。若你要做批量视频字幕移除,会收集哪些指标,结合遮挡区感知距离、运动边界残影、天然文字保留率与实际耗时,判断这两步是否值得,而不直接拿六步质量和一步3.0847帧/秒拼成一个配置? 人工智能炼丹君 整理 | 2026-10-21
-
AIGC 每日速读|2026-10-20|Adobe多参考视频编辑OmniXRef 今日 AIGC 论文速览 今日共 10 篇 · 多参考视频编辑 1 篇 · 多轮图像编辑 1 篇 · 视频几何纠错与视频配音 2 篇 · 像素生成与推理效率 2 篇 · 语音与个性化生成 2 篇 · 可控3D头像与世界模型 2 篇 重点论文标题列表 OmniXRef(Adobe):多段参考各取所需再改视频 MTEdit(商汤):先拼好编辑轨迹再拆训练对 VGC(加州默塞德):生成完再修镜头下的几何 MFlow(Adobe):按数据方向学该预测什么 Sink-Sparse(西安交大):保留重要注意力再补全局 选读入口:要用多段参考改视频,先读 OmniXRef;连续修图越改越脏读 MTEdit,生成视频已有几何变形读 VGC。训练像素生成器读 MFlow,长序列注意力慢读 Sink-Sparse;动作细节配错音读 SCR-V2A,语音首响预算紧读 DriftTTS。两图合成准备慢读 Kingfisher;表情带偏镜头读 VDAs,镜头回访忘场景读 PPMem。 今日论文速览 1. OmniXRef:多段参考各取所需再改视频 OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing | Adobe Research;布朗大学 | arXiv:2610.22744 关键词:视频编辑, 多模态参考, 属性迁移, 位置编码 前序问题:想让原视频沿参考片的镜头运动,再套另一段的灯光,模型却把参考人物也搬了进来。多个参考不仅要“都看到”,还要分清每段只允许借什么。 方法直觉:把每个参考做成一个带任务和编辑说明的小包,再给这些包预留固定位置。网络可同时比较全部输入,而不把参考数量改变误当成位置含义改变。 本文贡献:冻结 Qwen3-VL-8B 多模态语言模型提取交错文本/视觉上下文,视觉位置换成视频编码潜变量,单流扩散 Transformer 联合去噪。Mix-Patchify按任务压缩参考的空间 token,源/目标保持细粒度、参考时间轴不压缩。R²-RoPE 是预留参考槽的旋转位置编码:为参考预留8槽,训练随机分配不重复位置,避免增加参考时越出训练坐标范围。约1000万训练样本经272P单参考、272P双参考、480P精调逐级学习;主要文字编辑数据约700万为内部数据。 图2|OmniXRef-Model整体结构。参考包统一承载文本、图像和视频参考。多模态语言模型从交错输入提取语义上下文;单流扩散Transformer通过完整自注意力联合处理上下文文本、视觉token及噪声,使多个参考包同时约束编辑结果。下方Mix-Patchify将视频潜变量按所需粒度切块,再映射为扩散token。 实验效果:OmniXRef-Bench 共125例,覆盖镜头、动作、内容、风格、视觉特效五类,用 Gemini 3.8 Flash 裁判。RA参考遵循、VQ画质、SP源内容保留各按0至5分评估;综合分另惩罚参考泄漏,非简单均值。总体综合分OmniXRef/Seedance 2.5为3.78/2.73,SP为4.68/3.71;但VQ为3.68/3.70,画质并未胜过该商用对照。支持三参考的展示来自双参考训练后的组合泛化,不能据8槽宣称8参考质量已充分评测。 表2|OmniXRef-Bench视频参考属性迁移的逐类别语言模型裁判评估,含内容、风格、特效、镜头、动作及五类总体均值。RA为参考遵循,VQ为视觉质量,SP为源内容保留,三者均为0至5分且越高越好;Score按原协议综合并惩罚参考泄漏,不能按三分算术平均解释。商用模型为参考,粗体只标其余方法最优;横线表示缺少结果。 批判点评:训练与推理要付多参考 token 及全注意力开销;局部压缩并不消除随参考数增加的计算。有限125例及语言模型裁判适合看属性迁移趋势,非普遍产品排名。主表和消融表的完整模型数值略异,正文统一用主表;项目页 仍标Code Soon,没有已开源证据。 2. MTEdit:先拼好编辑轨迹再拆训练对 MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing | 商汤研究院;香港科技大学;斯坦福大学;清华大学AIR | arXiv:2610.23751 关键词:多轮编辑, 轨迹数据, 上下文学习, 质量漂移 前序问题:连续改八次图,第八次可能已经脏了;若训练数据本身也靠逐轮改图获得,模型会学到这种累积退化。怎样得到既遵循连续指令、又不越改越坏的训练链? 方法直觉:先在同一画布里共同生成多个编辑状态,再把画布拆成轨迹。共享视觉上下文让各状态互相约束,比每轮只承接上一次的误差更稳。 本文贡献:PTC(packed trajectory canvas,打包轨迹画布)流程先筛高分辨率美学种子图,再用视觉语言模型规划画布提示,让闭源图像模型一次生成多个状态。随后做坏例过滤、拆格、局部特征匹配与几何对齐,并补逐轮指令,得到50万条轨迹、269万次编辑,最多8轮、平均5.38轮。既包含只执行当前指令,也包含需记住历史的约束、指代和简短指令。用块因果注意力及交错位置编码联合训练多轮,微调 Qwen-Image-Edit-Causal。 图2|MTEdit数据构造。(a)筛选高分辨率与高美学质量种子图。(b)视觉语言模型依据种子图规划PTC画布提示,指导闭源图像模型在共享视觉上下文中共同生成多个编辑状态。(c)过滤坏例、生成逐轮提示,拆分画布并做局部特征匹配和几何对齐,将状态转换为含指令与目标图的多轮编辑轨迹。 实验效果:MTEdit-Bench 含100条8轮逐步编辑链,另有三类各50条4轮上下文任务。受控消融用相同图像/提示、相同教师,各造1万条8轮链,再让同一主干训练5000步:第8轮 PTC/逐轮生成的 IF 指令遵循分为5.06/4.26,CC 内容一致性分为4.44/3.84,DRS 抗画质漂移分为4.22/3.96。IF/CC 是视觉语言裁判0至10分,低于6的首次失败后后续轮置零;DRS是两种画质评分平均、0至5分,不随失败清零。 表3|逐步编辑子基准上的受控消融。Method表示训练数据用PTC共同生成还是逐轮生成;每种构造各1万条八轮轨迹、同主干同超参数训练5000步。逐轮报告IF指令遵循、CC内容一致性与DRS抗画质漂移,均越高越好,粗体标最优。IF/CC为0至10分且首个失败之后后续归零;DRS为0至5分并保留实际分数。 批判点评:结果支持数据构造方式,不代表闭源教师可被低成本替代;画布生成、筛选与对齐成本仍须支付。完整模型第8轮DRS为4.33,但指令遵循仍落后最强闭源模型,不能把画质稳定等同编辑正确。低分置零会放大早期失败影响,比较时应沿用同协议;未核实MTEdit专属代码或数据下载入口,也无会议接收证据。 3. VGC:生成完再修镜头下的几何 Learning to Correct Geometry in Generated Videos | 加州大学默塞德分校;南洋理工大学;北京大学;卡内基梅隆大学 | arXiv:2610.23856 关键词:视频修正, 几何一致性, 配对监督, 光流 前序问题:镜头移动时,灯杆变成两根、门框扭曲;换一个视频生成器又要重新解决。能否在成片后统一修正,而不修改原生成模型? 方法直觉:拿真实视频当正确答案,让现有补帧生成器制造“同场景但几何出错”的版本,再训练一个专门纠错的视频模型。难点是错片仍要走原镜头路线。 本文贡献:VG-Pairs按相机旋转和平移量决定分段数,在运动方向转折处选关键帧,分段用 Wan 2.1-Fun-InP 补中间帧并拼接,避免只给首尾时走捷径。VGC以 Wan 2.1-1.3B 做视频到视频去噪,输入错片、文本和从错片计算的光流;光流是相邻帧运动场,用于区分全局相机移动与局部物体运动,推理时同样可得。训练使用约8000条DL3DV及6.3万条SpatialVID视频,81帧、832×480,32张H100训练1万步。 图3|VGC流程。从真实视频中按相机运动选自适应关键帧,图生视频补全器合成有几何扭曲的片段作训练输入;纠错器学习还原几何一致的目标视频。光流由错片计算并作辅助条件,帮助区分镜头移动与场景动态。中央三维重建仅用于示意,实际流程不使用该重建。 实验效果:在200条保留DL3DV提示、CogVideoX-5B文生视频上,用独立三维重建再投影衡量一致性:PSNR由15.6668到16.6940,像素均方误差MSE由0.0333到0.0264,均改善;LPIPS感知距离却由0.5285升至0.5733,反而变差。图生视频的3DCS三维一致性误差亦由0.7944到0.8121,越低越好,不能宣称所有几何指标均提高。大模型14B扩展到动态场景和720P,属于另一配置。 表2|DL3DV中三种CogVideoX来源生成器的文生/图生视频几何修正。通过独立三维重建与再投影计算PSNR、结构相似度SSIM、感知距离LPIPS、均方误差MSE和三维一致性误差3DCS;前两者越高越好,后三者越低越好。括号是加VGC后的变化,亦展示与VideoGPA叠加。PSNR和MSE多改善,但LPIPS均变差,图生视频的部分SSIM、3DCS也退化,不能据原表概括所有指标改善。 批判点评:改进主要来自配对监督;加光流的增益有限,额外纠错生成、视频编码及光流计算均增加延迟,论文未给完整部署耗时。重投影自洽也不保证忠于真实场景。已核实NeurIPS 2026接收;代码 现释放14B无光流版,不能直接等同上述1.3B含光流实验。项目页作者与arXiv有一名作者差异,本稿保留arXiv原始名单与机构。 4. MFlow:按数据方向学该预测什么 Rethinking the design space of Vanilla Pixel Diffusion Transformers | Adobe Research;马里兰大学帕克分校 | arXiv:2610.23854 关键词:像素生成, 流匹配, 参数化, 高频细节 前序问题:直接在像素上生成时,预测干净图像有时比预测变化速度容易,但换大模型、换视频就未必。固定一种目标,还可能让整套训练都在迁就不合适的表示。 方法直觉:不同数据方向的难度不同:轮廓和细纹不必用同一种预测目标。让模型为每个方向学习“更像图像还是更像速度”,再统一还原成采样需要的速度。 本文贡献:先用 PCA 主成分分析计算固定的图像块或视频块正交方向,再学习各方向的系数 m_i,范围0至1。目标为 x₀−Mε:x₀是干净信号,ε是噪声,M按这些系数重加权噪声;m_i=0对应干净预测,1对应速度预测。将输出解析恢复为速度后计算流匹配损失,避免系数靠缩小目标投机。另加 ConvRefiner:冻结主干,用轻量卷积残差和对抗损失补细节,专门处理 JiT 类大图像块模型的高频缺失。 图3|MFlow预测参数化。按PCA数据主方向比较固定干净预测、固定速度预测、低秩二值分配的AsymFlow,以及连续可学习的MFlow。左侧曲线展示各方向的系数m_i,0偏向干净图像、1偏向速度;右侧用干净图像减去重加权噪声展示不同目标。黑色表示干净预测,白色表示速度预测。 实验效果:UCF-101 类别条件视频为16帧、128×128;各模型独立调采样参数,B级 MFlow/JiT/AsymFlow 的 FVD(视频特征分布距离,越低越好)为122/152/126。ImageNet 256×256、H级加相同感知损失时,FID(图像分布距离,越低越好)为1.81/1.82/1.79,并非全面最优。卷积细化器在冻结训练600轮的主干上另练30轮,恢复每像素0.5至0.7周期的径向高频能量,FID基本保持;文生图另有5000步细化训练。 表4|UCF-101类别条件视频生成B级模型比较。作者分别训练并独立调优每个模型的采样超参数,视频为16帧、128×128;FVD以1万生成视频估计分布距离,越低越好。潜空间基线为Wan视频编码器加latent-DiT;像素JiT、AsymFlow、MFlow分别为152、126、122。表内编码器名中的1.3B不是所比较生成器的参数规模。 批判点评:价值是减少人工选择预测子空间,不是推理必然更快。小模型、是否加入感知损失会改变排名;高频统计改善也不等同细节真实。大规模文生图用了内部预训练与微调数据,复现门槛需单算;额外卷积、训练和显存没有完整端到端量化。作者项目页 未提供方法代码入口,不能把网页模板仓库当代码;论文仍在审稿。 5. Sink-Sparse:保留重要注意力再补全局 Sink-Sparse Hybrid Attention for Efficient Inference in T2I/T2V Diffusion Transformers | 西安交通大学;厦门大学;上海交通大学 | arXiv:2610.22975 关键词:生成加速, 稀疏注意力, 离线校准, 全局补偿 前序问题:视频token越多,反复计算全连接注意力越慢;每一步再搜索该留哪些关联,也可能吃掉稀疏化收益。能否一次找好,以后重复利用? 方法直觉:同一层同一注意力头常反复关注相似位置。保留这个稳定骨架,再用低分辨率全局摘要补上弱关联,兼顾省算与上下文。 本文贡献:离线在每个主干分别跑4提示×2噪声种子的完整轨迹,汇总精确块级注意力概率质量;每行选能覆盖阈值τ的最少块,固定掩码跨步复用。在线稀疏分支保留重要块,补偿分支只将key/value(供查询读取的键和值)按30个token均值池化,query仍保持原长;依据两支归一化常数自适应融合。模型权重、采样步数不变,免训练不等于免校准。 图4|Sink-Sparse Hybrid Attention两阶段流程。离线对少量提示、种子及去噪步采集稠密注意力,精确汇总块级概率质量并按行覆盖阈值τ选出每层每头固定掩码。在线各步复用掩码,稀疏分支保留稳定高质量关联;全长query读取均值池化的key/value以补全局信息,最后按归一化常数融合两分支。 实验效果:单A800 80GB,Wan2.1-1.3B、832×480、81帧、50步:τ=0.85时由164.80降到106.73秒、1.54倍;VBench八维均分0.656到0.659,越高越好,非官方完整总分。τ=0.70可到94.57秒、1.74倍,但均分降为0.647。Z-Image-Turbo 2048×2048、8步由23.39到14.88秒、1.57倍;GenEval2中各属性问答软分的几何均值Soft-TIFA GM由16.38降至15.21,越高越好。计时排除初始化和写文件;默认离线校准约22分钟为按稠密耗时估算。 表1|Wan2.1-1.3B文生视频主比较,832×480、81帧、50步、单A800 80GB。Dense为同一优化算子栈的稠密基准164.80秒,加速倍数以它为分母;计时不含模型初始化和视频写入。τ=0.70/0.85为速度/质量档。八列分别评主体、运动平滑、动态幅度、背景、场景、美学、成像及总体一致性,均越高越好;八维均分由未四舍五入值计算,非完整VBench总分。 批判点评:这是已测两主干上的质量与速度取舍,图像设置并非无损。固定掩码可能遗漏罕见或分布变化下的关系,不应跨主干直接复用;稀疏率只统计主分支,不包含补偿分支。尚未核实作者代码入口,也未报告完整峰值显存,不把免训练写成零部署成本。 6. SCR-V2A:盯住真正发声的局部来配音 Semantic-Critical Regions for Video-to-Audio Generation | 悉尼大学 | arXiv:2610.23021 关键词:视频配音, 局部语义, 适配控制, 音画对齐 前序问题:画面里人和乐器都很大,真正发声的却是手与琴弦接触处。只用整帧语义,配音可能听着像那个场景,却错过细小动作和节奏。 方法直觉:先找“哪里最能解释声音”,把局部热图与原视频同时送入生成器:局部提示事件,全局保住场景,标签补声音类别。 本文贡献:SCR指语义关键区域。用MotionFormer视频编码器预测声音标签,只微调最后块与分类头;保留概率高于0.65、最多5个标签,通过类别梯度加权的激活图定位区域,跨标签取最大,再与原帧各占50%叠加。热图适配器弥合热图和自然视频的差别,二者由共享视觉编码器编码后拼接,经控制适配器注入预训练音频扩散U-Net(带跨层跳接的去噪网络),标签作辅助语义条件,最后解码频谱与波形。 图2|SCR-V2A整体结构。声音相关视觉定位预测标签并提取语义关键区域热图;原始视频与经热图适配器处理的热图由共享编码器编码,融合后经控制适配器注入冻结音频扩散U-Net,并联合声音标签的文本特征生成频谱与波形。彩色箭头区分视频、定位、融合、音频及文本路径,火焰/锁表示可训练/冻结组件。 实验效果:在VGGSound约20万条10秒片、310类上训练,并用CountixAV测跨域。域内SCR-V2A/MMAudio 的FAD(VGGish特征上的音频分布距离,越低越好)为1.07/1.84,DeSync音画时间不同步分为0.680/0.440、越低越好,后者更强。跨域FAD为2.16/2.22。30人对20视频的5秒音频作五分评价,本法总体音质3.93±0.94、语义对齐4.10±0.88、时间对齐3.50±0.97;MMAudio时间对齐3.87±0.94。195M指可训练参数,非整模型参数或推理内存。 表1|VGGSound域内和CountixAV域外客观比较。FD、FAD为不同音频特征空间的分布距离,KLD为类别概率分布差异,DeSync为时间不同步分,均越低越好;IS为音频质量/多样性分,IB为ImageBind音画语义相似度%,均越高越好。Seeing&Hearing直接在测试时优化IB,比较需注意该条件。#Params按文中说明计可训练参数,非总推理参数;粗体/下划线标最优/次优。 批判点评:局部区域有助分布质量和语义,不保证时序最佳。梯度热图、双路视觉编码和扩散本身均需计算,缺端到端时延与峰值显存证据,不能只凭可训练参数宣称部署轻。标签误判也会把注意力引向错处;这些差异不由小规模听评自动证明显著。arXiv明确写ACM Multimedia Asia 2026已接收,未核实专属代码入口。 7. DriftTTS:把迭代搬到训练来一步发声 DriftTTS: One-stage Single Step Text-to-Speech via Generative Drifting | 首尔市立大学人工智能系 | arXiv:2610.22960 关键词:语音生成, 生成漂移, 单步采样, 片段监督 前序问题:语音生成器要反复调用解码器,交互响应变慢;蒸馏虽能减步,却通常先付一遍多步教师训练。能否从头训练一个只调用一次的模型? 方法直觉:让生成结果在训练中靠近真实语音片段、远离当前错误分布,推理时就直接落到目标附近;片段一起比较还能避免单帧“对了、拼起来却不顺”。 本文贡献:沿用Matcha-TTS文本编码器和时长预测器,用MAS单调对齐搜索把每个文字token的表示按持续时间展开,形成接近目标梅尔频谱(声学能量随时间与频带变化)的先验。解码器接先验与随机噪声,一次预测频谱,无时间步嵌入。训练随机裁80帧约0.93秒片段,以掩码自编码器MAE提取特征;真实批次作吸引样本、生成批次作排斥样本且排除自身,三个温度共同计算漂移损失。 图1|DriftTTS训练流程。文本编码器与MAS单调对齐搜索依据每个token持续时间重复其表示,构造先验ε=μ;解码器单次把先验映为生成片段。片段漂移在MAE掩码自编码器的特征空间中比较生成与真实目标片段,将训练中的生成分布推向目标;推理无需重复该漂移优化。 实验效果:LJSpeech单说话人训练2000轮、4张A10,每GPU批量64;另训练MAE,波形仍由HiFi-GAN声码器合成。500条评测、单A10、批量1:NFE即解码器调用次数,DriftTTS为1;WER单词错误率1.80%,MOS五分听感均分4.43±0.08,对照Matcha-TTS十次调用为1.93%、4.38±0.08。RTF为模型推理秒数/音频秒数,排除声码器:0.00441对0.0187,约4.2倍;单步RapFlow为0.00419,仍略快。MOS来自153人290份响应。 表1|LJSpeech评测。NFE为推理解码器调用次数;WER为单词错误率%、越低越好;MOS为五分主观听感均值及所报区间、越高越好,来自153名听者的290份响应。单A10测RTF即推理秒数除音频秒数,表中单位10⁻³且不含声码器,越低越好。Ground truth为真实语音,Vocoded GT为声码器重建。 批判点评:“从头单阶段”限定TTS模型,不代表没有预训练声码器或额外特征网络。去MAE后WER升至20.03%,片段与特征空间是必要条件;训练大批量和2000轮的成本不能隐去。多说话人、零样本与长语音尚待验证,MOS区间重叠也不能声称听感显著胜过多步。作者音频页 可访问,尚无代码入口;机构是首尔市立大学,非首尔大学。 8. Kingfisher:重组前四级图码来换风格 Kingfisher: Fast Personalized Visual Autoregressive Generation via Scale-Aware Prompt-Conditioned Scale Decomposition | 越南胡志明市科学大学;越南国家大学胡志明市分校;日本国立情报学研究所 | arXiv:2610.23238 关键词:个性化生成, 视觉自回归, 风格迁移, 尺度分解 前序问题:想保留一张实拍的主体、借另一张的画风,逐对训练LoRA适配器太慢;直接混合图像表示又容易把主体和风格一起换掉。 方法直觉:视觉自回归生成先画粗结构再补细节。抓住最早几级里决定主体与外观的部分,拆开后重新组合,再让冻结的生成器补完后续。 本文贡献:在冻结的 Infinity 多尺度生成器上,只处理前四级残差码。用中性外观提示和物体提示查询生成器,SVD奇异值分解提取“中性外观仿射空间”与“物体内容子空间”,据此投影并联合优化内容、风格及残差。重组时前两级换外观、第三级保留内容语义锚、第四级补内容方向;其余级由原生成器按位自校正生成。无需更新模型权重,但每对图片仍有图码优化。 图3|Kingfisher整体流程。将内容图A和风格图B用冻结编码器变为多尺度残差码,通过中性与物体提示分别构造外观仿射空间、物体内容子空间;在选定早期尺度将图码拆为内容、风格和残差并优化约束,再重组成语义前缀。冻结Infinity生成器按位自校正补剩余尺度,保留A结构并引入B外观。 实验效果:CSD-100的100张图各配5张不同类别风格图,共500个有序组合,每法一图,固定种子2026。Kingfisher/UnZipLoRA 的内容相似度CSD-C为0.5519/0.5782,后者更好;风格相似度CSD-S为0.5222/0.3673,本法更好,二者均为特征余弦相似度。单A100每对准备23.54±1.86秒,对照CSD-VAR为171.65±11.82秒;准备后每图1.61±0.15秒,对照1.39±0.12秒。20人600次强制选择中获254票、42.3%,是相对偏好。 表2|单A100效率与人工偏好。Prep./pair是每对内容/风格图的准备优化秒数;Infer./image是准备完成后单张生成秒数,两者不可混用。数值为均值与所报告离散度。人工偏好来自20参与者共600次强制选择:Votes为票数、Pref.为占比;这不是开放用户群的绝对满意率。 批判点评:加速集中在准备阶段,并非每图推理最快。171.65除23.54约7.29倍,与摘要7.5倍和正文“超过10倍”不一致,本稿保留原秒数;也不沿用未明确分母的54倍宣传。仅单张内容/风格、固定种子协议,不足证明开放场景通用解耦;项目页 标代码即将开放。 9. VDAs:表情与镜头分开驱动头像 Video Diffusion Avatars: Taming Video Diffusion Models into Controllable 3D Avatars | 慕尼黑工业大学;Woven by Toyota;Toyota Motor Europe | arXiv:2610.23772 关键词:可控头像, 视频扩散, 表情解耦, 多视角 前序问题:拿一段正脸表情去驱动侧面头像,表情编码里夹带的原镜头会把新视角拉回去;仅靠传统三维脸模又难表达舌头与嘴内细节。 方法直觉:把“做什么表情”和“从哪儿看”分开,再用不同相机的参考、驱动和目标三元组训练,迫使模型不能偷用驱动镜头。 本文贡献:在 WAN-Animate-14B 上使用 X-NeMo 学习式表情码,经解耦器分成表情与相机部分,再翻译回原模型可接受的条件格式,相机部分取中性值。代理网格将头部/躯干局部坐标方向与明暗编码成图像,联合控制镜头、颈部及上身,三维骨架补姿态。冻结去噪主干,只微调条件相关组件;公开多视角数据上的相机三元组进一步去掉视角捷径。 图2|Video Diffusion Avatar结构。镜头、上身姿态与表情作为独立控制信号进入WAN-Animate-14B。解耦的X-NeMo表情码翻译成原生条件格式,并配视角中性相机码;代理网格渲染编码镜头和姿态。多视角数据的参考、驱动、目标相机三元组训练多视角一致性,主扩散块冻结而条件相关组件微调。 实验效果:单张A100训练34小时,推理20步。BecomingLit 的25条同人驱动测试中,VDAs/MVP4D 的脸部LPIPS感知距离为0.202/0.282,越低越好;JOD感知质量预测分为3.99,对照中最高CAP4D为2.40,越高越好。另测22条Multiface同人和13条BecomingLit跨人驱动。完整模型在单A100生成77帧、576×1024约12分钟;四步蒸馏原型改为288×512可达论文所报4.8帧/秒,但降低画质。 表2|定量结果:每格左/右依次为BecomingLit和Multiface;同人驱动各25和22例,跨人驱动仅BecomingLit的13例。MMDM为CAP4D的扩散组件。PSNR、JOD感知质量、ID身份相似度、Expr表情一致性越高越好;LPIPS和AKD平均关键点距离越低越好。跨人无逐像素真值,故仅评身份、表情及关键点;颜色在各数据集内部排序。 批判点评:完整模型适合离线制作,不能把34小时训练或低分辨率原型速度当作高清实时渲染能力。作者当前仓库对快速版写约3.5帧/秒,与论文4.8的原型口径分开;长序列仍可能漂移,光照烘在参考中。静态三维高斯重建只是多视角一致性探针,视频输出不等于直接交付可实时渲染的三维资产。代码 已有推理脚本与权重说明。 10. PPMem:把场景记成平面再转镜头 Persistent Planar Memory for Video World Models | 清华大学;蚂蚁集团;香港科技大学 | arXiv:2610.23795 关键词:视频生成, 世界模型, 平面记忆, 相机控制 前序问题:镜头绕回刚才的房间,墙和门却换了位置;只看最近几帧不够,逐像素累积三维点又让场景记忆膨胀。怎样在连续生成中保存可再投影的空间结构? 方法直觉:墙、地板和立面大多接近平面。把这些面记住,再从下一段的目标相机渲染深度,相当于让生成器沿着同一份场景草图继续画。 本文贡献:在 Wan 2.2 TI2V 5B 扩散 Transformer(用注意力网络逐步去噪的视频生成器)上,每段生成约25帧,并预测平面。每面用7个参数表示:中心深度、两个矩形尺度、四元数(四维旋转表示)。旧面通过遮挡投票删除,近邻按观测质量去重,再与新面合并。深度既作为输入通道,也经 DTF(把深度切成网络处理的特征单元token再融合)补入几何特征;先训练视频主干,再冻结主干训练几何头及 LoRA 低秩适配器。推理去噪后另做一次启用几何适配器的前向来提取平面。 图2|PPMem整体结构。带噪视频潜变量与源视图投影RGB、可见掩码、平面池渲染的部分深度按通道拼接,前序上下文帧在时间上前置。Wan扩散主干的两路token分别由视频解码器恢复RGB,或经几何LoRA及ViT深度token融合后解码成逐帧平面。平面合并进持久池,再按下一段目标相机渲染并回馈条件。 实验效果:主实验训练使用 DL3DV 与 RealEstate10K 超过8万片段,576×1024;两测试集各100场景。DL3DV 的121帧完整系统对照中,PPMem/Gen3C 的 PSNR(像素保真信噪比,越高越好)为13.98/13.59,LPIPS(感知距离,越低越好)为0.464/0.565。各模型按自身原生分辨率评测,不能把差异全部归给记忆。同主干、低分辨率消融中,预测深度/真值及其倒数均小于1.25的比例由无持久记忆64.0%升至70.3%。约400帧后10万个平面约5MB,仅为几何记忆;额外深度编码器约8700万参数,非零推理成本。 表2|DL3DV和RealEstate10K上的短程完整系统比较。两种帧预算N=49与N=121;N指输出帧数,VMem短档用48帧。49帧时多数基线只生成一段,121帧时Voyager、VMem、SPMem需自回归衔接。PSNR、CLIP语义及DINOv2结构相似度越高越好,LPIPS感知距离越低越好。每种方法按自身原生分辨率与画幅评测,输入及真值相应裁剪缩放。 批判点评:适合静态、平面丰富且相机路径已知的环境;作者亦承认动态内容与非平面细节受限。5MB不能当整机显存,作者仓库默认设置约需19GiB GPU内存。主榜是跨系统比较,消融才控制主干;深度 token 融合的阈值准确率也未优于仅通道拼接。已核实 NeurIPS 2026 接收;项目与代码 可访问,未运行模型。 趋势观察 控制先分清信息该进哪里 MTEdit共享画布防止训练轨迹漂移,OmniXRef按参考包限定属性,VDAs把表情与镜头分开;保持内容不能靠泛泛加大条件强度。 记忆与纠错处理不同时间点 PPMem把几何记忆带入下一段生成,VGC在视频生成后修正;前者不能代替后者的成片检查,后者也没有持久世界状态。 省算需要保留成本账 Sink-Sparse要离线校准并付全局补偿,Kingfisher要逐对优化图码,DriftTTS把多步推理的工作搬到训练;同叫免训练或一步,账本并不相同。 主指标无法代替全部验收 MFlow补高频而FID变化小,VGC重投影改善却有感知退化,SCR-V2A音频分布质量与时间对齐也有取舍。 今日讨论 OmniXRef 在125例多参考编辑测试中的综合分为3.78,Seedance 2.5为2.73;源内容保留分为4.68/3.71,但画质分为3.68/3.70,并未领先。如果要给真实剪辑流程选模型,你会用哪些指标同时检查参考属性迁移、源内容保留、参考泄漏、画质和参考数增加后的计算成本,而不只看综合分? 人工智能炼丹君 整理 | 2026-10-20
-
AIGC 每日速读|2026-10-19|Meta让图像token先学特征FeaTok 今日 AIGC 论文速览 今日共 10 篇 · 图像表征与统一生成 2 篇 · 图像编辑与蒸馏 2 篇 · 视频计算与采样加速 2 篇 · 视频时序控制 1 篇 · 三维材质生成 1 篇 · 音乐与长语音生成 2 篇 重点论文标题列表 FeaTok(Meta):图像token先学特征再画图 Intern Lumina U2(上海AI Lab):一个视觉位置装八本码表 ACEdit(特拉维夫大学):连续改十次也守住原图细节 FocusOPD(中科大):只在早期深层补蒸馏监督 Speculative Forcing(KAIST):画好的视频token提前交卷 选读入口:想重新训练图像表示,先读 FeaTok,关心统一图像理解与生成再接 Intern Lumina U2;连续改图会漂移,直接看 ACEdit,要合并多个教师看 FocusOPD。视频算得慢,按位置早停读 Speculative Forcing,按时间缓存读 SoftCache;事件先后不对读 TSG。商品三维小字丢失看 SUPRA-Tex,低预算文生音乐看 MIDI-REPA,语音超过50秒开始跳读或变声看 VoXtend。 今日论文速览 1. FeaTok:图像token先学特征再画图 FeaTok: Feature-Loss Tokenization for Image Generation | Meta FAIR;Mila;蒙特利尔大学;哥伦比亚大学;牛津大学;麦吉尔大学 | arXiv:2610.22060 关键词:图像生成, 特征重建, 离散编码, 全局条件 前序问题:把图片压成离散token后,重建得像,不代表后面的生成器容易学。逐像素还原会迫使编码器保留许多局部细节,却未必组织好物体与场景的关系;token就是供模型预测的离散视觉单元。 方法直觉:先教编码器抓住视觉特征中的结构,再单独教解码器把这些单元画回像素。生成器先决定全局内容,再补局部,减少每一步从零猜整幅画的负担。 本文贡献:FeaTok用冻结视觉编码器四个等间隔层的归一化特征均值作目标,通过特征重建训练编码器、量化器与特征解码器;像素解码器仍训练,但在输入处截断梯度,像素损失不能反过来塑造token。全局特征和局部图块各用一个量化器,生成时先预测全局token,再以其为条件预测图块。SigLIP、SigLIP2、DINOv2、DINOv3均做受控实验;只换特征目标时SigLIP2并不获益,加入全局token才超过像素版。 图2|FeaTok的编码及生成流程。蓝色为传统离散编码器,橙色为本方法:特征损失L_feat只训练特征解码器D_feat,从全局及局部图块token重建冻结编码器的多层目标y;像素损失L_pix仅训练像素解码器D_pix,输入的图块token已截断梯度。图中未画出的生成器联合建模全局量化器Q_global与图块量化器Q_patch的token。 实验效果:ImageNet-1k、256×256、五万张生成样本,无引导FeaTok-L-DINOv3的gFDr6为3.13,离散基线VFMTok2为4.38;它平均六种特征空间中以固定参考距离归一化的Fréchet距离比,越低越好。对连续RAEv2为3.13对3.95,采样运算量1.27对47.72 TFLOPs,TFLOPs指每图万亿次浮点运算,约38倍是算量比。单L40S、批量256、含像素解码的实测吞吐14.36对1.09图/秒,峰值22.0对13.4 GiB。 表2|ImageNet-1k 256×256上的连续特征基线对比。无引导时FeaTok以更低采样运算量取得所列模型最低gFDr6;Size为生成器参数量,TFLOPs为无引导每图采样浮点运算量。各指标列以粗体和下划线表示最优、次优。有引导连续基线转录自Singh等人2026论文;有引导RAEv2仍优于FeaTok,不能把无引导结论扩到整表。gFDr6为六特征空间归一化Fréchet距离比均值,越低越好。 批判点评:有引导RAEv2仍以2.17优于FeaTok的3.08,不能称全面超越连续模型。DINOv3特征监督使重建PSNR从20.61降至17.45,PSNR是逐像素重建信噪比、越高越好,说明细节存在代价。文生图还需预训练75000次后微调500次,不是从零500次。项目页明确代码与权重待开源审批。 2. Intern Lumina U2:一个视觉位置装八本码表 Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation | 上海AI Lab;华为;上海交大;大连理工;清华;上海创智学院;悉尼大学;港科大(广州);中科院深圳先进院;中科大;港中文 | arXiv:2610.20818 关键词:统一生成理解, 多码本, 掩码扩散, 稳定性感知采样 前序问题:统一模型既要读懂图片,又要生成纹理。一处画面只用一个离散编号,容量受限;直接把连续图像特征接入文本模型,又要协调不同表示和训练目标。 方法直觉:每个视觉位置用八个互补编号描述,主干同时推理所有位置,小预测头在每个位置内依次补齐八个编号,把空间并行与局部依赖分工。 本文贡献:冻结AToken编码器将图像、视频、三维输入转成统一离散表示,每处有8个码本、每码本4096项。各码本独立嵌入后在同一位置拼接、投影成一个主干token;掩码扩散主干预测缺失位置,多码本自回归头依次预测该位置的8个码。文本按块扩散生成,图像全画布迭代;MoE即混合专家,只激活部分参数。整机约16.9B参数、每token激活约1.4B,B为十亿。 图3|Intern Lumina U2整体结构:视觉输入由AToken编码成视觉token,文本编码为文本token;MoE混合专家扩散语言主干通过文本头恢复掩码文本、以块扩散生成回答,通过多码本自回归头恢复掩码视觉位置。每个视觉token的K个码按顺序预测;本模型K=8,不同位置由主干并行处理。 实验效果:主模型在1024张昇腾910B上训练,另有训练token预算不同的NVIDIA参考线。同一检查点、1024×1024、553条GenEval提示、每提示1图、引导强度4.0的加速实验,默认96个外层扩散步需159.9秒;PHV即Plateau-Halton sampling with V-verify,以置信度平台决定解掩码、Halton顺序选位置,再由验证器按隐状态漂移刷新缓存,合用后平均60.4步、35.9秒,4.45倍。主干前向次数由192降至121,含有条件和无条件两支;相应GenEval物体属性组合分86.6至89.3;原文该计时表未清楚注明卡型,不把35.9秒视作指定910B的单卡性能。 表4|同一检查点1024×1024文生图推理加速:553条GenEval提示,每条一图,引导4.0、温度0.9、随机种子42。Steps为实际外层扩散步数,平台自适应行随提示变化;BB fwd同时计有条件及无条件主干前向,括号为缓存命中率。时间为去掉首次内核预热后的每图墙钟时间,含缓存预热。选定PHV使用δ_p=0.18、f_p=0.005,其余缓存和验证参数固定。单图GenEval不能与表7四种子协议直接对比,所列配置均未低于production path。 批判点评:该加速表是单种子协议,不能与四种子主榜的89分混算;60.4步也不是60.4次主干前向。多码本头本身仍有解码开销。当前生成能力限图像生成和编辑,视频与三维是理解输入,尚未验证视频或三维生成。代码可访问,本次未运行模型。 3. ACEdit:连续改十次也守住原图细节 ACEdit: Stable Multi-Turn Image Editing via Asymmetric Conditioning | 特拉维夫大学 | arXiv:2610.22328 关键词:多轮图像编辑, 自生成轨迹, 非对称条件, 分数蒸馏 前序问题:先换衣服,再加道具,改到后面人脸和背景一起漂移。训练时看干净原图,使用时却不断编辑自己的输出;误差逐轮累积,用固定配对目标硬教也会错位。 方法直觉:学生照常在自己的上一轮结果上编辑,老师始终看干净原图与累计指令。学生走一条可能出错的长路,老师从源头判断现在该变成什么,避免把旧错误当成要保留的细节。 本文贡献:学生为四步FLUX.2-klein-9B,冻结教师与可训练辅助编辑器为同系列base版。教师和辅助器都看原图及合并指令,二者预测差形成分数蒸馏梯度,辅助器拟合学生当前输出分布。训练以10轮自生成编辑轨迹暴露真实输入,仅对抽中的当前轮当前去噪步回传梯度,轮间直接传潜变量,省去反复像素编解码。学生只训练rank16的LoRA低秩适配权重,共27.8M参数,M为百万。 图2|ACEdit方法。左:学生沿自身生成轨迹逐轮编辑,上一轮图像I_(e-1)和当前指令产生当前去噪步的干净估计。右:估计加噪至τ,同时送入冻结教师及可训练辅助编辑器;两者都以干净原图I_0和截至第e轮的累计指令为条件。教师表示期望的干净条件分布,辅助器拟合学生实际生成分布,二者预测差给出蒸馏梯度,把多轮输出推向不退化的目标分布。 实验效果:96张合成图、每图10条局部指令,共960条;单B200约4.4 GPU小时,505次迭代中只有100次学生更新,推理仍为4步。EdiVal-10测试252条真实照片编辑链,十轮末KRIS视觉语言裁判质量分2.73至3.19、一致性3.03至3.85,均为1至5分;指令遵循3.31至3.38未标显著差异。未编辑背景LPIPS感知距离由0.351降至0.254,越低越好;未编辑锚点DINOv2距离只在148条有效链统计。 表1|EdiVal-10定量对比。除锚点距离外,均在252条编辑链累计十轮后计算;锚点距离只统计148条锚对象大部分位于编辑区外的链。质量为KRIS视觉语言裁判的1至5分和第1至10轮HPSv3变化;保留性为同裁判一致性、未编辑锚点DINOv2距离及背景LPIPS距离;编辑性用第10轮指令遵循分检查是否偷懒不编辑。模型按主干分组,粗体及下划线为列最优和次优,星号表示与本方法配对差异超过两个标准误。 批判点评:稳定性改善不等于永不忘记旧编辑,论文仍出现“让登山者微笑”时抹掉先前墨镜的失败。Emu Edit的HPSv3质量变化-0.15还略优于本方法-0.17,不应每列都称第一。与30步MT-OPSD的主干和分辨率不同。作者项目代码仍标Coming soon。 4. FocusOPD:只在早期深层补蒸馏监督 FocusOPD: Structure-Guided On-Policy Distillation for Diffusion Models | 中科大;港科大(广州);华为诺亚方舟实验室 | arXiv:2610.21250 关键词:图像生成, 多教师蒸馏, 方向对齐, 监督预算 前序问题:把构图、画字和审美三个教师合进一个生成器,只匹配最后输出,学生内部特征仍可能接不住教师能力。全层全时刻强行对齐,又增加训练开销。 方法直觉:先定位差距集中在哪些层、哪些去噪阶段,再把额外监督花在那里。高噪声早期负责搭结构,深层负责落实语义,方向一致可能比把所有特征数值抄齐更有用。 本文贡献:在学生自己的10步轨迹上抽取并截断梯度的状态,让学生和同架构教师读取同一输入。保留原OPD即在策略分布上的输出蒸馏,再对选定深层和早期步骤的逐token特征归一化,最小化余弦方向差;只更新学生的LoRA适配权重。SD3.5-M受控配置选最后12层、前40%去噪段,推理只保留学生,不增加教师。 图4|FocusOPD流程:教师与学生读取来自学生轨迹的相同状态,输出监督遵循原有OPD协议,额外特征方向监督集中在早期去噪与深层。推理只使用训练后的学生,没有额外教师调用。 实验效果:512×512、训练至检查点1000,SD3.5-M加在DiffusionOPD上,GenEval组合正确率0.953至0.967,PickScore偏好奖励23.797至23.944,LAION审美分6.052至6.199,均越高越好。独立监督预算消融中,选择12层及早期40%的更新耗时18.99秒,全24层全轨迹21.77秒,纯输出监督16.54秒;每个并行进程的CPU教师缓存分别432、2160和0 MiB,不能说是GPU显存。 表3|SD3.5-M和DiffusionOPD上的特征监督消融。单次更新耗时统计第11至1000步;教师缓存是每个并行进程存于CPU的张量负载,不是GPU显存。特征变量都用余弦距离、权重λ=0.3;所有方法训练完整24层Transformer,Last-12只限制监督位置而非只训练12层。Time列标监督覆盖范围,Time/up为秒,缓存为MiB。 批判点评:主表与开发集消融数字不同,不能把消融的0.960当主榜0.967的同一运行。各指标并非单调:DanceOPD加监督后的文字识别准确率0.952降至0.945,STEP-OPD的PickScore也稍降。论文对两个主干选窗是否完全一致有文字出入;本期12层/40%只指明示的SD3.5-M配置。额外监督比纯输出训练更贵,未确认独立公开实现。 5. Speculative Forcing:画好的视频token提前交卷 Speculative Forcing for Efficient Autoregressive Video Generation | 韩国科学技术院(KAIST AI);NAVER AI Lab | arXiv:2610.22347 关键词:视频生成加速, token早停, 收敛验证, 上下文缓存 前序问题:少步视频模型仍让每个视觉token完整跑四步,即使静态背景早已接近最终结果,也要陪着运动区域继续算。把整块一起早停又会把未修好的细节带入后续视频。 方法直觉:逐个检查中途的干净估计,足够接近四步结果的token先定稿;后续只更新还没完成的部分。已交卷的内容仍能作为上下文被其他位置读取。 本文贡献:提供两种验证器:免训练版使用与干净历史内容的相似性及跨步稳定性;学习版读取冻结生成器的中间特征,用三层三维卷积预测每token相对完整结果的剩余误差,再做局部时空平滑。接受后冻结该token,只保留key/value供注意力匹配和取回内容。学习头分别用1000条提示或1000个初始场景的完整轨迹训练,阈值控制提前接受程度。 图3|Speculative Forcing:基线让每个token走完整去噪表;本方法把中间干净估计当草稿,验证器预测其相对完整结果的剩余差距rel_k(i)。预测已收敛者接受定稿,后续只作为注意力的key和value参与上下文,因此下一次去噪仅更新尚未接受的token。 实验效果:单H100、LongLive 1.3B、5秒VBench视频,学习版平均每token去噪1.68次,吞吐26.40至41.74帧/秒,总分83.08至83.21;这不是整机只调用1.68次。30秒VBench-Long为1.72次、24.5至37.8帧/秒。Lingbot-World 2.0相机运动测试200场景、每段253帧,平均2.55次、18.1至24.5帧/秒;质量随时间波动的Drift由3.094降至2.839,越低越好。 表1|LongLive生成5秒视频。Mean Steps是每个token平均实际去噪次数,不是完整网络调用次数;标准VBench的16个维度汇总为总分、质量与语义分,均越高越好,吞吐在单张H100上测量。TF为免训练验证器,H为学习头验证器;与1至4步统一采样分别对照。 批判点评:阈值放松并非免费:世界生成阈值从0.24提至0.32,虽到28.3帧/秒,Drift却升至3.398。定稿是不可撤回的,错误接受会影响后续上下文;训练版还要先采完整轨迹。它研究token去噪早停,与上期交付缓存的Speculative Sampling是不同机制。代码仓库当前仅说明内部审查后发布,尚未确认实现可用。 6. SoftCache:缓存还够用就往前多走一步 SoftCache: Adaptive Step Size Caching for Diffusion Transformers | 特拉维夫大学;莱赫曼大学 | arXiv:2610.22369 关键词:扩散加速, 自适应步长, 特征缓存, 网格重排 前序问题:缓存加速通常只决定“重算还是复用”,但一次刚刷新的缓存与即将过期的缓存,仍按相同步长前进,没把剩余精度余量用于减少采样节点。 方法直觉:缓存越新、估计误差越小,就允许走得远些;快到刷新阈值时收回原步长。跳到原网格之间后,还要同步调整后面的节点,否则会浪费一次计算走极短的路。 本文贡献:用输入廉价探针累计的陈旧信号与阈值之间的归一化余量设置复用步长;轨迹开始及探针突变时禁跳。为支持离网格时刻,用最近两次新算残差沿时间线性外推,并在大加速时阻尼;跳后将剩余节点重新均匀分布到终点。无需训练,但多保存一个历史残差张量,刷新阈值仍需按速度目标选择。 图2|刷新信号包含的不只是二值决定。(a)无缓存FLUX轨迹上,复用残差相对误差E_i的分箱中位数与四分位带随累计刷新信号A_i上升。(b)硬缓存只将A_i与阈值τ比较,并在缓存节点使用原步长Δ_i;SoftCache还读取距阈值的余量,A_i越低步长越长,上限JΔ_i。星号表示两面板同一A_i:低误差允许长跳,高误差只短跳,越过τ则重算刷新。 实验效果:FLUX.1-dev、1024×1024、DrawBench 200提示、原50步Euler、单H100 NVL,与同提示同随机种子的无缓存结果比较。最快档去噪环节15.49至2.24秒、6.91倍,PSNR18.58对SeaCache17.46,LPIPS0.327对0.409;PSNR信噪比越高、LPIPS感知距离越低表示更接近原采样。峰值分配内存均33.8 GB。混元视频65帧640×480、946提示最快档6.05倍;Wan2.1另在RTX A5000,不能跨设备比较绝对耗时。 表1|FLUX、DrawBench 200提示,每个分块对应一个速度档,逐行报告实际加速比。DrmSim为DreamSim感知距离;PSNR信噪比、SSIM结构相似度越高越好,LPIPS和DreamSim距离越低越好,四者均衡量与同提示同种子无缓存采样的保真度,不能读成绝对生成质量或人类偏好。 批判点评:6.91倍计同步后的去噪循环,不是含全部编解码的端到端服务时间。四个保真指标衡量接近无缓存结果,不能等同人类更喜欢;随预算收紧它自身也会变差,FLUX慢档PSNR23.20、快档18.58。需验证新主干的刷新信号是否仍可靠。代码入口可访问。 7. TSG:把视频先后顺序写成可执行约束 Temporal Specification Guidance for Text-to-Video Generation | 宾夕法尼亚大学;丰田北美研发 | arXiv:2610.20822 关键词:可控视频生成, 时序逻辑, 注意力引导, 生成验收 前序问题:要求红灯变绿,模型可能两种颜色都画到了,却顺序错了;要求一个物体先进入、另一个持续存在,文字出现不代表时序要求真的满足。 方法直觉:把“先发生、持续到、在某段时间出现”写成机器可检查的时间规则,再沿着增加规则满足度的方向调整生成过程。 本文贡献:TSG即Temporal Specification Guidance,用带时间区间的时序逻辑表达事件约束,从视频对文本的注意力提取每个概念随时间的证据。LogSTOP在对数空间计算可微满足分,将其对注意力的梯度改写为注意力偏置,额外条件前向得到引导方向,叠加CFG无分类器引导;CFG通过有条件和无条件预测差加强提示。无需外部概念分类器,也不对视频Transformer权重反向传播;默认前15采样步启用。 图2|时序规格引导TSG。额外条件前向中,逐注意力头对时序证据按规格评分,并应用由梯度得到的logit偏置,再以得到的预测扩充无分类器引导CFG。Transformer权重不接收梯度。示例视频由Wan2.2 5B生成。 实验效果:220提示、11类约束、5至6秒视频、五种主干,规则满足准确率提高9.5至20个百分点。单B200、Wan2.1-1.3B为15.9%至31.4%,时间1.39至2.35分钟,峰值30.48至30.52 GiB;画质分69.25降至67.39。A14B另用H200,满足率35.9%至46.8%,耗时24.28至35.18分钟。评测均匀抽21帧,Qwen2.5-VL-7B判概念是否存在后才按规则计分。 表1|220提示基准上的时序约束满足率、画质、时间和峰值内存。除Wan2.2 A14B在H200测量外,其余时间与内存均在B200测量;时间单位分钟,内存GiB。Base为仅CFG,TSG为加入规格引导;满足率变化应读为百分点,附带倍数为各自基线时间比,跨设备绝对时间不能直接排序。 批判点评:免训练也付出额外前向时延,低显存增量不能写成低计算代价。最强配置仍只有46.8%满足率,注意力只是概念代理,视觉语言裁判和21帧抽样也可能漏掉短事件。其优势是可检查的约束接口,还不能宣称视频已严格满足形式化保证;原文未确认可用独立代码入口。 8. SUPRA-Tex:三维表面也能保住小字纹理 SUPRA-TEX: 3D Generation with Super-Aligned Texture | 华为;上海交大;华中科大 | arXiv:2610.22352 关键词:三维纹理生成, 物理材质, 可见锚定, 不可见面补全 前序问题:给商品照片生成三维资产,正面标签变糊、背面纹理接不上;光照烘进颜色后,换个灯源就显得不真实。可见面细节与不可见面补全需要分开处理。 方法直觉:先把照片中可信的颜色和材质投到三维表面,当作固定参考;生成器集中补看不到的区域,再协调全表面,减少反复改写已经观察到的小字和图案。 本文贡献:二维编辑模型估计去光照的反照率、金属度、粗糙度,即物理渲染PBR材质;有效观测投到可见表面体素,未观察处不以虚构填充值冒充证据。冻结材质编码器将观测编码到目标生成潜空间,另附覆盖范围与边界距离;交错流Transformer把观测作为只读key/value,交替更新未观察单元与全表面。60层生成器在64张GPU训练,推理25步Euler、不用CFG。 图1|SUPRA-Tex。左:二维转换器从单参考图估计去光照的反照率、金属度、粗糙度。中:利用网格M与相机投影π将有效估计投到可见体素,部分PBR输入省略不可见体素;冻结材质编码器E_mat将其映到目标潜空间,连同覆盖与边界元数据组成观测C_o。右:以几何潜变量G为条件,交错流Transformer从噪声Z_1生成完整材质Z_0。插图中固定只读流O提供key/value,生成流X交替更新未观察单元U与全表面S;冻结解码器D_mat输出表面PBR材质,分别从左右打光展示。 实验效果:给定真实网格与单张参考图,在DTC-Tex的100个商品及Complex-Tex的110个网格,以同光照同相机渲染参考视角和15个新视角。新视角前景PSNR为22.134对Pixal3D的20.377、20.488对19.402,PSNR越高越接近真实像素。另在两者共享预测几何的端到端实验,DTC-Tex四视角PSNR28.65对26.88;几何生成与贴纹理协议必须分开看。 表2|在表1各方法各指标的有效对象上,分开报告一个参考视角及15个新视角的保真度;PSNR_fg使用真实前景掩码,PSNR越高、LPIPS感知距离越低越好。Shaded为带光照渲染,Albedo为反照率。新视角先对每个对象平均、再跨对象平均,包含已观察和未观察表面;缺少PBR输出的方法对应反照率为横线。 批判点评:新视角同时包含已见和未见表面,不能把它称为纯背面准确率。几何是固定条件,形状或相机错位无法靠纹理修复;二维金属度估错也会被保留下来。商业系统对比另用两视图,不能与此处单图实验混算。代码与权重入口已读,未实跑。 9. MIDI-REPA:用音符结构教小模型作曲 MIDI-REPA: Improving Text-to-Music Generation with Symbolic Representation Alignment | 台湾大学;加州大学圣迭戈分校 | arXiv:2610.20967 关键词:文生音乐, 符号监督, 表征对齐, 低成本训练 前序问题:音乐生成器直接从密集波形学旋律与节奏,有限预算下容易学到音色却抓不住音符结构。扩大参数并非唯一办法,训练目标本身也可以更明确。 方法直觉:先让现成转谱器把训练音频写成简化音符表,训练时要求生成器的中间特征也能读出这张表;推理时撤掉老师,仍按文本生成声音。 本文贡献:在122M参数FluxAudio-S上,用自动音乐转录AMT提取与音频潜变量时间对齐的MIDI音符目标,轻量时间卷积头以余弦相似度辅助流匹配训练。MuScriptor音符卷帘表是108时间帧×88音高的二值矩阵;与分7乐器族的立方目标、Basic Pitch目标对比。最稳配置对齐第L2层、覆盖完整去噪轨迹,冻结SAME-L音频编码器处理10秒44.1kHz立体声。 图1|MIDI-REPA框架:自动音乐转录AMT提取的符号目标通过轻量投影头与余弦相似度对齐损失监督中间音频表征,同时保留去噪目标。设计研究分别检查(a)对齐哪一种符号目标、(b)在主干哪一层对齐、(c)在流匹配轨迹的哪一段启用对齐。 实验效果:筛选后的JamendoMIDI有51077曲,排除验证及重叠参考后训练49034曲、约3161小时,30万次更新,单RTX3090约31.3 GPU小时;该时间未单独覆盖全量离线转谱成本。Song Describer Dataset(SDD)受控实验,Fréchet音频距离FAD从0.5275降至0.4947,越低越好;CLAP音频与文本嵌入相似度从0.2220至0.2686,越高越好。ATTM另80条提示为FAD0.497、CLAP0.315;推理25步Euler和4.5引导,不增加转谱器或对齐头。 表4|80条域内提示上的ATTM客观比较。Borda排名在17个官方系统加本方法的集合上重算,表中仅展示六个官方决赛系统和FluxAudio-S基线。训练成本按ATTM峰值FP16吞吐换算,A100-eq为等效GPU小时,不是实际设备时间;FAD音频分布距离越低、CLAP音频文本相似度和CCS字幕一致性分越高越好。重算Rank并非新增官方比赛名次。 批判点评:14.2 A100等效GPU小时是按峰值半精度吞吐换算,不是实际在A100训练;ATTM重算综合排名也不是比赛官方新名次。MIDI监督取决于转谱质量,Basic Pitch在同一测试FAD0.5363还差于基线。这里只验证短片段,未证明完整歌曲结构。arXiv明确Submitted to ICASSP 2027,不能写已接收。代码入口已核验。 10. VoXtend:短语音模型连续读到四分钟 Speaking Longer Than Learned: Training-Free Long-Form Generation for Full-Stream Text-to-Speech | 首尔市立大学 | arXiv:2610.19553 关键词:长语音合成, 窗口限制, 说话人保持, 免训练外推 前序问题:只见过50秒语音的流式模型,读长文时会跳音、越读越不像同一个人。持续保留开头的参考声音并清理旧缓存,也没有消除这种退化。 方法直觉:先让模型反复工作在熟悉的位置区间,再持续提醒它“声音像开头这个人”。缩短窗口解决发音位置偏差,给参考声音加注意力偏置解决身份漂移。 本文贡献:在VoXtream2上定位:把缓存重置推迟到900帧,发音加速仍在训练边界625帧附近出现,说明不是简单丢历史。于是把时间Transformer的缓存窗口W从625缩为375帧,帧率12.5Hz,相当50秒与30秒窗口;重置仍保留声学提示和近期帧并重算key/value。再向参考音频对应的注意力logit即归一化前分数加常量b=1.5,强化声纹条件,无需追加训练。 图2|音频生成的局部位置与每帧预期推进音素数,分别取窗口W=400、625、900帧。阴影为随机8段语句的标准误。把缓存重置推迟到900帧仍在625附近异常推进,用来区分位置范围问题与重置丢失历史;这是方法诊断图,非生成系统结构图。 实验效果:LibriSpeech-Long dev-clean的281段、15.89小时、最长约4分钟,平均7.88秒开头作声学提示。整体单词错误率WER8.63%至3.58%,越低越好;说话人嵌入余弦相似度SPK-SIM0.659至0.759,越高越好。158名听众评自然度,每模型325次评分,五分制MOS均4.03。仅缩窗口至375的RTX3090实时因子RTF由0.415至0.433,RTF是计算时长除音频播放时长、小于1表示快于播放;不是完整双改动的计时。 表1|长语音整体及分段表现。WER为单词错误率(%)、越低越好,SPK-SIM为说话人特征余弦相似度、MOS为五分主观评分,均越高越好。MOS按均值与95%置信区间报告;GT为真实语音,GT+Mimi为编解码重建。按0至210秒分段与整体分别比较,不能把单段变化当整段平均。 批判点评:Qwen3-TTS与MOSS-TTS错误率仍更低,不能称长语音整体最强。窗口太小至250帧,WER反升6.51%;声学提示占用和重置重算也构成成本。证据来自特定主干与英语朗读,未验证多人对话或跨语言;VoXtend是本期沿用作者项目域名的短标签。作者音频样例可访问,尚未确认公开代码。 趋势观察 先决定表示要服务谁 FeaTok限制像素梯度,Intern Lumina U2给每处八个码;重建、生成和理解的表示目标需要明确分工。 把监督花在实际输入上 ACEdit让学生面对自己的编辑输出,FocusOPD沿学生轨迹补早期深层监督,MIDI-REPA则在音乐中间特征补音符结构。 加速要区分计算粒度 Speculative Forcing按token早停,SoftCache按缓存余量跳时间节点;前者平均token次数、后者去噪循环加速都不能替代服务端到端计时。 保持与改变要有具体条件 TSG约束事件时间,SUPRA-Tex固定可信观测,VoXtend调整位置窗口并保留声纹条件;它们各有额外计算与失效场景。 今日讨论 FeaTok无引导采样为1.27 TFLOPs,对照RAEv2为47.72,但批量256的端到端吞吐是14.36对1.09图/秒,显存则22.0对13.4 GiB。若你要选择线上图像表示,哪种证据能够支持你在同显存预算、同质量目标且含像素解码的条件下采用FeaTok,并验证算量优势能兑现多少请求吞吐? 人工智能炼丹君 整理 | 2026-10-19
-
AIGC 每日速读|2026-10-16|首尔大学先修图再一步生成Priming 今日 AIGC 论文速览 今日共 10 篇 · 一步生成与表征训练 2 篇 · 视频蒸馏与交互服务 2 篇 · 视频缓存压缩 1 篇 · 原生高分辨率编辑 1 篇 · 三维场景生成 1 篇 · 语音驱动与语音合成 2 篇 · 生成视频物理评测 1 篇 重点论文标题列表 Priming(首尔大学):先学修复再学一步作画 RECON(澳国立):把语义送进生成器后半段 Glance Forcing(武汉大学):一条轨迹只负责初始化 Speculative Sampling(中科大):先画未来但别急着提交 TempoKV(上交):缓存只存难预测的残差 选读入口:训练一步图像模型先读 Priming,再读 RECON 理解语义如何传到后层;做少步视频看 Glance Forcing,搭交互产品再看 Speculative Sampling 的到显示时延,长视频显存紧张看 TempoKV。需要4K改图看 BluePixel 的背景保留,换相机重访同一场景看 SceneAE。语音驱动人像看 Kandinsky S2V,要研究解码能否改错看 Revise-TTS;最后用 PhyMetric 检查视频到底违反了什么物理现象。 今日论文速览 1. Priming:先学修复再学一步作画 Are We Overthinking One-Step Generation? | 首尔大学;哈佛大学 | arXiv:2610.20331 关键词:一步生成, 重建预训练, 分布后训练, 最优传输 前序问题:想把噪声一次变成图像,直接从零匹配整批生成图与真实图的分布,训练常很昂贵。模型还没学会物体结构,就要同时解决像什么、覆盖哪些样本的问题。 方法直觉:先练修复被噪声破坏的图像,再练从纯噪声作画。修复阶段有一一对应的正确答案,先教会网络图像长什么样;后训练再要求一批作品的整体分布接近真实数据。 本文贡献:Priming Models 两阶段使用同一生成网络。第一阶段在固定噪声水平 s=0.8 做像素重建,并加感知特征损失;s 表示混入噪声的水平,不是采样步数。第二阶段从高斯噪声一步生成,利用冻结图像编码器的特征做熵正则最优传输:在两批特征间分配匹配关系,并加入停止梯度的生成样本项,即该分支只作数值参照、不反向更新,以优化分布而非逐图照抄。默认不用额外可学习风格向量,也不需要多步扩散教师蒸馏。 图1|Priming 的训练投入与生成质量:左侧在ImageNet比较训练浮点运算量与FID,展示质量和训练成本的权衡;右侧说明简单重建预训练提供有效初始化,使后续分布后训练更高效。FID是生成与真实特征分布的距离,越低越好。 实验效果:ImageNet 的256×256类别条件生成中,约4.051亿参数的 Priming-L 先训练160遍数据,再后训练25000次更新,FID为1.19,总训练量238.95 EFLOPs;1 EFLOP代表10的18次方浮点运算。FID衡量生成与真实图像特征分布差异,越低越好。原表 W-Flow 为1.33、3744.43 EFLOPs,属于不同方法的训练账本比较。文生图的一步版本 GenEval 从一步 MeanFlow 的0.548提高到0.818;GenEval测物体、属性与空间组合正确率,但仍低于100步流模型的0.873。 表2|文生图对比:Priming优于一步MeanFlow,使用logit-normal噪声分布预训练的变体以较少训练运算接近四步MeanFlow;扩展到两步也具有竞争力。†标记的对照数值来自Wang等人2026a论文。GenEval衡量物体属性组合正确率,DPG-Bench衡量密集文本指令遵循,均越高越好;EFLOPs是训练浮点运算总量,不是秒数。 批判点评:摘要“约十分之一训练量”不能解释为同硬件快十倍;预训练、特征编码与批间传输计算仍要支付。训练特征选择也会改变排名:更换编码器可改善另一分布指标却恶化FID,说明单分数不足以验收。RT-1视频预测中,其FVD(视频特征分布距离,越低越好)为30.96,仍差于32步流模型的27.24,不能照搬表注称所有质量指标均胜。本文代码提供训练入口,本次未实跑模型。作者代码。 2. RECON:把语义送进生成器后半段 Representation Conditioning for Generation | 澳大利亚国立大学 | arXiv:2610.20608 关键词:表征条件, 语义注入, 训练加速, 扩散Transformer 前序问题:用视觉编码器监督生成器的前几层,前半段学到了物体语义,后半段却未必能用好。以往 REPA 表征对齐训练结束后,还会丢掉连接两种特征的投影头。 方法直觉:把已经学会的语义做成一张便签,直接交给后面的绘图层。训练时用真实图像提取的可靠便签;生成时没有真实图,就让保留下来的投影头估计这张便签。 本文贡献:Representation Conditioning(RECON,表征条件)将视觉编码器特征池化成默认1个语义 token,即供网络注意力读取的特征单元,与图像块特征拼接送入后续层。推理复用 REPA 的多层感知机投影头,因此不再调用真实图像编码器。为缓解训练用真特征、推理用预测特征的落差,只在归一化噪声时间 t<0.5 时注入;高噪声阶段不提供便签。默认大模型用零填充对齐维度,无新增参数;小模型若特征维度不足,仍可能增加线性映射。 图1|RECON把原先丢弃的表征用于后层条件:(a)REPA以冻结视觉编码器监督投影头gϕ,推理时丢弃该头;(b)RECON训练时将视觉编码器的token送往后层;(c)推理保留gϕ作为编码器代理,执行同样条件注入;(d)ImageNet 256×256、无引导的五万样本生成FID随训练步数变化,RECON更早达到SiT-XL/2与REPA最终质量。 实验效果:ImageNet 256×256、SiT-XL/2、批量256、无引导设置下,训练40万次更新后,RECON的生成FID为3.25,REPA为7.90;延长到240万次为2.21。该指标用5万生成样本估计,越低越好。摘要63倍对SiT、25倍对REPA指达到相近质量所需的训练收敛进度,不是推理速度。MS-COCO文生图在MMDiT、15万次训练、50次网络评估、引导强度1下,FID从9.85降到8.26,图文特征相似度CLIP从0.2273升到0.2313。 表3|MS-COCO文生图:MMDiT主干,常微分方程采样,50 NFE(网络函数评估次数),训练150000次;w是引导强度。FID越低越好,CLIP图文相似度越高越好;在展示的两种引导强度下RECON优于REPA。 批判点评:保留投影头、拼接语义token都需要运行,参数不增不代表零推理开销。ImageNet主协议仍用250步随机微分方程采样,文生图用50步常微分方程采样,不能称一步生成。不同引导方式会改变最终排名;有引导的系统对比还包含Autoguidance(以较弱生成模型作参照的引导),必须与无引导收敛图分开读。作者代码。 3. Glance Forcing:一条轨迹只负责初始化 Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance | 武汉大学;电子科技大学;中山大学;华盛顿大学;新加坡国立大学;中南大学 | arXiv:2610.20220 关键词:视频蒸馏, 慢快专家, 轨迹初始化, 分布匹配 前序问题:把能同时看前后帧的视频模型变成实时逐块生成器,通常先收集大量教师去噪轨迹。若只留一条轨迹,单个学生同时拟合布局和纹理,质量会明显崩塌。 方法直觉:先搭骨架和最后描细节,本来就不该由同一种步伐完成。把高噪声阶段的语义布局与低噪声阶段的细节交给不同适配器,减少它们争用同一表示的冲突。 本文贡献:Glance Forcing 使用慢、快两组 LoRA,即少量低秩可训练权重;预训练教师保持冻结。慢专家处理早期结构,快专家处理后期纹理,各自接受阶段目标。概率流常微分方程轨迹用于把少步路径拉直,之后的分布匹配蒸馏仍负责生成质量。单样本设置压缩的是轨迹监督,不是从零只看一个视频就学会所有内容;后续分布匹配仍使用25000规模的数据。 图3|慢快专家流程:逐块自回归扩散模型使用分阶段LoRA适配器完成去噪,Slow-LoRA在早期产生粗结构,Fast-LoRA在后期细化细节;专家各自的目标进一步改善时间连贯性与空间保真度。LoRA是以少量低秩权重适配原网络。 实验效果:Wan2.1-1.3B(13亿参数)、480×832、81帧,使用8张A100训练。逐块四步设置的完整模型 VBench 综合分84.33,Causal Forcing为84.04;VBench汇总视频质量与语义等维度,越高越好。单轨迹版本后训练后为84.22,但语义分79.11低于对照81.84。轨迹采集约1个A100 GPU小时,是初始化数据准备成本;不能把图示11600倍扩展成完整训练或推理收益。完整模型相对Causal Forcing人评胜率63.3%,来自50条提示、3名标注者、150票,不能套给所有单样本变体。 表1|与既有模型对比,生成质量与此前方法相当或更好。Data为训练数据规模,Dyn.为动态程度,Vision.为VisionReward视觉奖励分,Instruct.为指令遵循;*表示跨阶段沿用同组模型。吞吐与首段时延在H100上分别用每秒帧数与秒报告,不含VAE解码时间;轨迹初始化行与分布匹配后训练行应分开比较,单轨迹版语义分并非最优。 批判点评:单条轨迹的内容很敏感:低运动样本后训练总分79.81,而默认男孩样本84.22,差异远大于对照间的零点几分。两个专家也要按阶段切换,单轨迹并未消除冻结大教师、后训练和适配器成本。应先检查自己的运动分布和语义需求。作者项目页。 4. Speculative Sampling:先画未来但别急着提交 Speculative Sampling in Interactive Video Generation | 中国科学技术大学;香港中文大学;独立研究者 | arXiv:2610.20556 关键词:交互视频, 预测缓存, 可撤换未来, 端到端时延 前序问题:用户改变动作指令后,即使模型采样很快,也可能要等到整段视频播完才生效。缩小生成块能减少等待,却损失联合建模质量和GPU并行效率。 方法直觉:可以一次画出较长的未来,但每次只交付一小段;没交付的部分先放缓存。指令不变就继续用,指令变了就替换尚未承诺的未来,已经交付的前缀保持不动。 本文贡献:每次将接下来要交付的1个潜帧与额外噪声潜帧拼成较大的双向窗口,共同采样并缓存预测。潜帧是视频压缩空间中的时间单元,通常对应多个像素帧。有限状态机协调生成和缓存消费;新条件触发可行位置重规划,不强行打断正在执行的生成。作者把到显示的时延拆成生成前等待、首个可交付输出计算(含视频解码)、播放排队,避免只报Transformer单次前向时间。 图3|投机采样服务控制:(a)联合生成填充预测缓存,供细粒度交付及播放,按播放进度补充;(b)有限状态机在Produce生成与Consume复用之间协调,此例每次交付q=1个潜帧。新条件在可行位置重规划,不中断正在执行的生成,两种状态下播放均继续。 实验效果:每组服务臂使用30条配对的60秒交互轨迹。Wan1.3B的480p长块在低频更新下,响应时延中位数从3.23秒降到1.32秒,95百分位从4.64秒降到1.91秒;高频更新中位数从3.11秒降到1.35秒。长块设置用8张B300运行扩散主干,另有视频解码GPU;短块用4张,两种资源配置不能直接当同成本比较。LTX长块低频中位数4.82→2.39秒,但播放欠载比例0.069%→0.204%。 表3|Wan1.3B、LTX-2.3及Sol-H3的480p级在线服务实验。Baseline为整块承诺,投机采样为本方法;LTX括号内配置对扩散Transformer应用CUDA Graph录制与重放。普通执行下长短块隔离块大小,括号内外的短块隔离执行方式。L50、L95分别是响应时延中位数与95百分位,单位秒;GPU内核活跃度与播放欠载为百分比,GPU活跃度是所监测设备按时间加权的平均值,设备覆盖范围按各模型正文定义。 批判点评:缓存的未来可能被新指令废弃,因此要额外支付生成、存储及重规划成本。它移除了固定块边界的部分等待,却不保证所有模型和执行模式更好:LTX短块采用CUDA Graph时,低频中位时延反而从1.81升到2.01秒,欠载也增加。CUDA Graph是预录制并重放GPU工作以减少调度开销,不能与普通执行混成一个对照。作者项目页。 5. TempoKV:缓存只存难预测的残差 TempoKV: Predictive KV Cache Quantization for Autoregressive Video Generation | 上海交通大学;华南理工大学;阿里巴巴 | arXiv:2610.15324 关键词:视频缓存量化, 时序预测, 非对称KV, 低比特残差 前序问题:长视频逐段生成时,注意力要保存以往帧的key/value缓存,显存不断增长。直接套语言模型的量化方案,会忽略视频相邻帧的冗余,也可能使误差随时间放大。 方法直觉:能从历史猜到的部分不用完整抄一遍,只存猜错多少。key负责注意力匹配,value是按匹配结果取回的内容;先猜key,再用重建key帮助猜value,比两者各猜各的更准确。 本文贡献:TempoKV 用8条BF16校准提示离线收集缓存,线性回归拟合固定预测器。BF16是16位脑浮点格式。推理先从同位置历史key预测当前key,再从已重建当前key和短value历史预测value,只对预测残差做低位量化。默认key看前2帧、value看前1帧,并可让key获得更多比特;不更新生成模型权重,但并非无需校准或额外算子。 图2|TempoKV:(a)离线从8条校准提示采集干净BF16缓存轨迹,以线性回归拟合预测器;(b)在线由重建key历史预测当前key,再由对齐的重建key与value历史预测value,只存低位残差R。key用于注意力匹配,value用于内容聚合,BF16是16位脑浮点格式。 实验效果:MovieGen前128条提示、832×480、717帧的Causal Forcing实验中,key/value各2比特的k2v2达到6.71倍缓存压缩,六项VBench视觉分均值77.04,BF16为76.95;改用k4v2,压缩4.73倍、均值77.11。k4v2表示key4比特、value2比特。Self-Forcing同协议k2v2为73.32,仍低于BF16的74.23,说明高压缩在不同主干上代价不同。 表1|MovieGen上的Causal Forcing,832×480、717帧。每个精度组内最优与次优分别用粗体与下划线标记。压缩比仅针对缓存;k4v2表示key4比特、value2比特。PSNR/SSIM越高越接近BF16,LPIPS/FID越低越接近;Visual Quality是六种视频视觉维度均值,不能当作整机加速。 批判点评:6.71倍是缓存体积的压缩比,包含量化元数据等开销,不能换算整机显存减少6.71倍或推理快6.71倍。预测器、反量化和保留历史都有成本;必须与自己的注意力实现一起计时。论文称代码将发布,未给可核实的作者仓库,本期不补造代码链接。 6. BluePixel:原生4K编辑还要守住背景 BluePixel: Toward Native 4K Agentic Image Editing | vivo;南京大学;上海交通大学 | arXiv:2610.19882 关键词:原生4K编辑, 渐进VAE适配, 背景保持, 专家协作 前序问题:把图片中的字或衣服改对,背景也可能悄悄变化;到4K分辨率,微小漂移尤其明显。只提高分辨率,也不能让通用编辑器自动具备调色、虚拟试穿等专长。 方法直觉:先让模型承载大画布,再按任务学专长,最后提速。编辑处跟教师走,不编辑处锚定原图;精确调色等操作交给专用工具,系统再逐次检查。 本文贡献:BluePixel 把1K预训练编辑器通过渐进式VAE适配升到原生4K;VAE是将像素压缩到潜空间并重建的自编码器。后续以监督微调、持续学习和奖励优化兼顾能力与细节。少步蒸馏的SATP(源图锚定目标投影)按教师预测相对源图的编辑强度区分保留区域与变化区域,构造教师结果和原图潜变量的混合目标,补偿非编辑区漂移。配套系统分解指令、路由专家,以同一奖励模型验收并有限重试。 图2|第一阶段与最终模型对比:第一阶段检查点能够编辑但能力有限;经历第二阶段的渐进监督微调、按基准定向微调、持续学习与强化学习后,最终模型的编辑质量及细节保真度明显提高。此图是阶段结果对照,不是SATP模块架构。 实验效果:50步教师压到4步后,单张昆仑芯P800 XPU、BF16精度、无其他优化下完成一次4K编辑为8.7秒,正文称约4倍加速;这是编辑器,未包含任意多轮工具调用。VINS-4KEval++共3305例,七模型共同覆盖2513例的表8中,BluePixel综合8.62/10、成功率63.2%,GPT Image 2为9.15、74.8%;非编辑区一致性9.06,对照9.34。 表8|VINS-4KEval++七模型共同覆盖2513例,BluePixel综合排名第二,仅次GPT Image 2,非编辑区一致性也第二。采用BluePixReward裁判,BluePixel做提示改写并报告8个种子的均值,外部模型每例一个输出;每种子明细在原论文表4。分数0至10、越高越好,Success为同一裁判认定成功的比例;IF为指令遵循,NC为非编辑区一致性,VQ为视觉质量。 批判点评:本模型报8个随机种子的平均值并做提示改写,外部模型每例1个输出;同一自家奖励模型又用于训练与评测,排名应配合独立人评。完整系统会增加规划、验收和重试时延;8.7秒不能代表整套系统。SATP完整推导与训练配方另待配套论文,当前论文并非所有环节都可独立复现。作者代码。 7. SceneAE:存一个场景再换相机看 SceneAE: Scene Generation and Reconstruction in Queryable 3D-Anchored Latent Space | 北京邮电大学;加州大学伯克利分校;鉴智机器人;SynapX | arXiv:2610.19708 关键词:三维锚点潜空间, 场景生成, 几何内容解耦, 相机控制 前序问题:按视频帧存场景,同一个房间换一条相机路线就可能又生成一遍,还会把物体外观与观察角度绑在一起。记住了之前的画面,不等于有可重复查询的场景。 方法直觉:把场景记成稀疏的空间笔记:每条笔记有三维坐标和局部内容。相机移动时只查询这些笔记并渲染;生成时先安排几何,再给几何填外观。 本文贡献:SceneAE 以3000个显式三维锚点及其隐式内容特征表示场景。编码器借冻结的Depth Anything 3估深度并提特征,反投影成点云后选择锚点,聚合可见视角信息;解码器按目标相机输出RGB和深度。生成Transformer先按相机控制未来几何布局,再以几何为条件生成内容,避免每换轨迹都重新合成整段视频。 图3|几何与内容解耦的扩散Transformer:先以相机条件控制未来几何布局,再用几何布局控制纹理内容,因而更准确跟随相机。场景潜空间直接锚定三维位置,解码时可重复查询。 实验效果:DL3DV、RealEstate10K和ScanNet训练样本用9视角,分辨率518×376,8张A800训练10万次。RealEstate10K双视角条件下,像素重建信噪比PSNR为19.8、结构相似度SSIM为0.68,对照GLD为19.4、0.67,均越高越好;DL3DV同设置PSNR17.9却低于GLD的18.1。表1每步145毫秒,对照285毫秒,不能称完整视频仅145毫秒。往返轨迹记忆实验PSNR30.7,对照GEN3C29.8。 表1|外观生成定量对照:报告像素重建信噪比PSNR、结构相似度SSIM,以及VBench的主体、背景和多视角一致性,均越高越好;另报GFLOPs(十亿次浮点运算)与每步毫秒数衡量效率。单视角、双视角及两个数据集应分别看,不能把每步时间当整段端到端时间。 批判点评:重复查看同一表示很有吸引力,但几何质量依赖深度基础模型、相机位姿和可见性估计。几何对比中Gen3R采用VGGT生成评估参考,本方法与GLD采用DA3,参考源不同,不能简单当同一真实三维标尺。它主要展示相机驱动场景生成与重建,尚不能据此声称任意动态世界均稳定;未确认作者代码入口。 8. Kandinsky S2V:语音驱动人物且记住前情 Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation | Kandinsky 实验室(Kandinsky Lab) | arXiv:2610.19290 关键词:语音驱动视频, 多尺度记忆, 口型同步, 策略蒸馏 前序问题:单张照片配音生成长人物视频,既要嘴型跟得上声音,又要跨段保持身份、姿态和动作;只盯嘴部,容易丢掉整个人物的连贯表演。 方法直觉:声音与文字负责当下怎么说,参考图负责是谁,压缩记忆负责刚才怎么动。旧帧记粗略轮廓,最近帧保留细节,把记忆预算花在时间上更近的地方。 本文贡献:Kandinsky S2V 1.0 用冻结Qwen2.5-Omni的文本和音频特征,参考图经视频VAE编码,三尺度FramePack将过去30个潜帧按远到近分为24、4、2帧并逐级减小压缩;当前视频帧只注意对应时间段的音频。训练117万单说话人片段,结合参考记忆混合和按脸面积调整的损失。π-Flow蒸馏把每段策略的5个干净潜变量估计一次预测出来,再通过无需额外网络调用的子步积分,最终16个策略段、不用有无条件双分支引导。 图2|Kandinsky S2V架构:冻结Qwen2.5-Omni的Thinker文本特征及音频塔特征,分别进入扩散Transformer内Nt个文本块与Na个音频块。参考图经冻结Hunyuan三维VAE编码,其潜变量与带噪目标zt及多尺度FramePack历史记忆拼接,C表示拼接。每个块执行视觉自注意力V2V、文本交叉注意力V2T、按周期插入的音频交叉注意力V2A及前馈层;最后由冻结VAE解码回像素。交叉注意力使当前视觉特征读取相应条件。 实验效果:Lite与Pro是系列简称,实际参数约23亿和214亿。每段生成125帧、25 FPS,对应5秒播放时长。H100、512×768、单GPU上,Pro基础版每段914秒,蒸馏版173秒;8GPU时162秒与57秒。1280×768单GPU为3854秒与675秒,体现设备、分辨率不同不能只报一个速度。作者摘要给5.4倍端到端收益;80条俄语HD人评中,多数项目74%至100%打平,牙齿嘴部蒸馏版获38%偏好、基础版3%。 表5|发布推理代码在H100上对Lite与Pro逐块计时。每行GPU数量与耗时按位置一一对应;SD为512×768,HD为1280×768,时间单位秒。每块125帧、25 FPS,故播放时长5秒;单卡Pro蒸馏版SD为173秒、基础914秒,不能将输出帧率当生成速度。 批判点评:25 FPS是输出帧率,不是实时生成吞吐。Pro蒸馏后EMTD口型相关分8.03略低于基础8.05,Lite也出现同步下降,不能写蒸馏后所有指标都升。自回归长链还会累积误差,数据以单说话人为主,多人互动并非已验证能力。作者项目页。论文所列代码仓库及权重集合本次回读均为404,暂未确认可下载状态。 9. Revise-TTS:说错的声音token还能再改 Revise-TTS: A Non-Masking Refinement Framework for Masked Diffusion Models in Text-to-Speech | 谢菲尔德大学;HojoAI | arXiv:2610.19499 关键词:语音合成, 非掩码修正, 层级二值量化, 迭代自纠错 前序问题:掩码扩散语音模型像填空,一旦高置信度预测被提交,后续步骤通常不再改它。早期发错的声音单元会留在上下文里,继续影响后面。 方法直觉:允许已经写上的答案被擦掉重做。声音先编码成可从粗到细细化的二进制单元,模型既练补全缺失内容,也练从掺杂错误的整段内容里恢复正确声音。 本文贡献:HBQ是层级二值量化,每次把当前量化区间对半分,形成有粗细次序的位串,可打包成整数或逐位预测。GRN是生成式修正网络,训练输入混合真实和随机token;token是离散声音单元。模型预测完整序列,推理按余弦进度保留部分预测、把剩余位置换成随机token再修正,而非用专门掩码符号永久填空。一次重建训练目标不等于一次推理,主实验仍迭代32步。 图1|层级二值量化HBQ:每轮将选定量化区间对半分。连续值z=-0.113经过三轮产生位序列011,对应离散索引3;按正文重建值为-0.125。二值位可按整数或逐位提供给语音模型。 实验效果:主模型使用Emilia英语46800小时、中文49900小时,16张A100训练25万次;小规模消融另用4卡,不能混成主训练成本。LS-PC英语测试中,Revise-TTS单词错误率2.00%,OmniVoice为1.57%,说话人相似度0.519对0.697;Seed中文测试错误率1.19%对0.89%,中文这里按字符计错。32步修正保留了可用自然度,但没有全面超越基线。Higgs编码器的受控实验中,修正模式同样弱于掩码模式的说话人相似度。 表4|固定Higgs声音编码器,用8张GPU在Emilia英语/中文微调后,比较掩码与生成修正解码。Steps列100k指100000次训练更新,不是100000次推理;主推理协议是32次修正。SIM是说话人相似度、越高越好,英语WER为单词错误率、中文同列按字符计错,越低越好。修正并未在所有数据集和指标占优。 批判点评:这篇的价值是展示可撤回的解码机制及量化接口的限制。词错率越低越好,说话人相似度越高越好;二者要一起验收。换到HBQ的编码器重建本身就较差,不能把主系统的差距全归因于修正策略。作者明确Under review,不写会议接收;没有核实到作者代码和真实端到端计时,32步也不等于实时。 10. PhyMetric:别只问视频看起来合理吗 PhyMetric: Diagnosing Physical Plausibility in Text-to-Video Generation via Scene-Level QA | 内华达大学里诺分校 | arXiv:2610.19823 关键词:视频生成评测, 物理合理性, 场景诊断, 问答裁判 前序问题:生成的玻璃杯碰撞后没有正确反应,画面却很逼真;泛泛问“符合物理吗”,视觉语言模型可能高置信度说是。整体分数无法告诉开发者究竟哪一步坏了。 方法直觉:把验收改成观察清单:针对这个场景本应出现的现象逐项问是非题,再挑能回答问题的时间帧。问的是可见后果,而非让裁判凭印象打一个总分。 本文贡献:PhyMetric覆盖6类物理领域、50个细分类别、1115个场景,每场景8个平衡是非问题,共8920题,带12种诊断维度。为每个场景提供物理规律、预期时序、可见征象与常见失败的结构化先验,再按问题选择视频帧交给视觉语言模型作答,逐场景、维度与类别聚合;它评估生成结果,不是给生成器装物理仿真引擎。 图3|PhyMetric评估:给定物理场景s,文生视频模型按描述cs生成视频Vs。对每个场景是非问题,按问题抽取帧,并提供描述规律、预期后果和常见失败的结构化物理先验Ks;视觉语言模型结合帧与先验回答。问题正确率先聚成场景分S(s,Vs),再对全部场景平均成模型分,使整体印象转成可诊断的物理检查。 实验效果:完整1115场景、两种开源裁判的平均总体分,Wan2.2-14B为72.78,Cosmos-7B为72.59;数值接近,且会随裁判变化。受控消融中,Qwen3.5-9B裁判使用场景问题及先验为74.91,无先验72.75;换成泛化的整体问题时48.88,接近均衡是非题的50%机会水平。该受控结果不是完整榜单分数,也不是人类标注准确率。 表2|完整1115场景的开源视觉语言裁判结果。Average是两种裁判的平均分;Overall为总体聚合,Weighted按题目难度和诊断维度权重聚合,分数越高越好,不能与100场景受控实验混用。Wan2.2-14B平均Overall为72.78,Cosmos-7B为72.59,两个裁判下细微顺序会变化。 批判点评:先验并非越多越好:GPT-5.4裁判加入默认先验后受控分数从73.94降到72.25,尽管与人的相关性可能改善。问题构造、抽帧和裁判偏差仍影响结论;每场景8次问题判断还增加评估调用成本。接近0.2分的模型差距不应写成已证明的绝对物理优势。作者项目页。 趋势观察 先学什么影响后训练成本 Priming先做重建,RECON把语义送给后层,Glance按噪声区间分工;同样少步,不同初始化承担的责任不同。 交付与计算要分开计账 投机采样延后未来帧的承诺,TempoKV只压缓存,Kandinsky输出25 FPS但仍慢生成;吞吐、响应、存储和播放时长是四件事。 保留接口比追求单分数更难 BluePixel锚定未编辑背景,SceneAE解耦几何与内容,Revise-TTS暴露声音编码器质量瓶颈;模块相接处决定最终效果。 诊断问题需要足够具体 PhyMetric把整体合理性拆成场景问题;其不同裁判并非一致受益,BluePixel也用自家奖励判定成功,验收来源应明确。 今日讨论 Priming-L在ImageNet 256×256达到FID 1.19,但RT-1视频的FVD为30.96,仍高于32步流模型的27.24。若要判断“先重建再一步生成”能否替代你的少步模型,哪种实验能固定总训练算量,并同时检查图像分布、长时序一致性和特征编码器带来的评价偏差? 人工智能炼丹君 整理 | 2026-10-16
-
AIGC 每日速读|2026-10-15|微软把生成压到4次评估SMD 今日 AIGC 论文速览 今日共 10 篇 · 少步生成与高分辨率 2 篇 · 理解与编辑控制 2 篇 · 视频超分与运镜 2 篇 · 原生三维生成 1 篇 · 语音与歌声编辑 2 篇 · 音画同步评测与奖励 1 篇 重点论文标题列表 SMD(微软):把局部弯路留给训练 AReA(多伦多大学):大画布先看全局再看细节 DuplexBridge(中科大):先分清没听懂还是没画对 QK-Edit(字节):只换查询与键保住原结构 FlashVSR+(上海AI Lab):单张4090做完整4K超分 选读入口:如果你要缩短生成等待,先读 SMD,接着用 AReA 看大分辨率下如何省注意力;做视频修复再读 FlashVSR+ 的4090卸载条件。复杂编辑失败先读 DuplexBridge 的责任划分,需要保留原视频结构再读 QK-Edit,运镜控制看 GTL。三维贴图异常看 Channel Match;有现场噪声的改词看 AnyEdit,改变语气看 Prime-EVC,音画验收最后读 SyncReward。 今日论文速览 1. SMD:把局部弯路留给训练 Simplifying and Improving On-Policy Distillation for Few-Step Diffusion | 微软研究院;纽约大学;香港科技大学 | arXiv:2610.18472 关键词:少步蒸馏, 同策略回归, 代理路径, 教师排斥 前序问题:把几十次去噪直接缩成几次,常会遇到同一大步内教师方向不断变化:学生只预测一个方向,局部监督互相打架,视频训练还可能先变好再退化。 方法直觉:像用一条直线代替弯路:学生学习这一大段的平均方向,训练时另找一个能弯曲、但不改变起终点的辅助路径,接住局部变化。部署时只走学生的大步。 本文贡献:Simplified Matching Distillation(SMD,简化匹配蒸馏)沿学生当前生成路径查询冻结教师,回归速度。Pivot 辅助网络输出积分为零的残差,使区间内方向可变而终点不变;再用同一教师的弱引导或跳层预测作负参照,拉开与较差方向的距离。只在训练使用 Pivot 和教师,不依赖在线分数估计或对抗训练,也不改部署模型结构。 图10|对同策略回归的两项改进:(a)代理路径允许一个粗步长内的局部速度变化,但固定学生速度时保持起终点不变;(b)排斥同一教师较弱的预测,与模仿目标教师预测互补。两项改进为便于解释分别展示,均只用于训练。 实验效果:原论文 Qwen-Image 实验统一为 4 NFE;NFE 是生成网络前向调用次数,教师 50 步含有条件与无条件两分支,共 100 次。SMD 的 GenEval(物体及属性组合正确率)0.873,高于 Lightning 的 0.852,略低于教师 0.874;密集指令遵循分 DPG 为 88.7,教师 88.3。OneIG 综合分同为 0.540,但多样性 0.144 低于教师 0.195。 表2|Qwen-Image 文生图:NFE 计算网络前向评估次数,教师的 50×2 包括有条件与无条件两个 CFG 引导分支;粗体和下划线为少步方法中的第一、第二,不含教师。†是 PDD 原文表3及6–8的欧拉版本,未有公开 checkpoint。各项越高越好;综合分不等于每项都领先。 批判点评:少调用网络不能直接换算墙钟加速;训练仍要教师查询和 Pivot。Wan2.1-14B 视频的语义分 80.52 低于 AnyFlow 的 82.10,330亿参数(33B)的音画联合模型分别测 4/8 次调用,不能统称全任务四次且全面领先。作者代码含推理与训练入口,本次未执行模型复现。 2. AReA:大画布先看全局再看细节 AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers | 多伦多大学;Vector研究所 | arXiv:2610.17227 关键词:高分辨率生成, 自适应感受野, 跨尺度注意力, 局部窗口 前序问题:把原生约千像素的图像模型直接拉到四千像素,注意力计算猛增,还容易复制主体、扭曲布局。只改位置编码,不能同时处理关注对象数量暴涨的问题。 方法直觉:构图时看整幅画的缩略版,修细节时只看邻近区域。缩的是被查询的上下文,输出画布始终保持目标分辨率,因此不需要先生成小图再放大。 本文贡献:AReA 即自适应感受野注意力,无需训练。早期保留全分辨率 query(查询),对 key/value(供匹配与聚合的信息)按块取中心代表,统一到较粗坐标;后期改用逐渐收缩的窗口。稀疏全局信息桥维持远处联系,重叠边界缓解接缝,离散小波变换识别平滑区并进一步拆窗。切换按噪声水平设定,FLUX.1 前 8 步、Qwen-Image 前 20 步采用全局粗阶段。 图4|AReA 流程:在噪声水平阈值 σ⋆处从阶段一切换到阶段二。阶段一全分辨率查询访问每个 f×f 块选出的一个 key/value,f 随步数调整,坐标映射到接近训练分辨率的网格;阶段二逐渐缩小局部窗口,并进一步拆分离散小波变换图中平滑区域的窗口以降低计算。 实验效果:H100 上的 Aesthetic-4K 含 195 条提示。在 4096×4096 的 FLUX.1 设置,单图时间从全注意力 314 秒降至 151 秒;另用 1000 条复杂提示组成 HRGen-1K,图文对齐 CLIP 分从 23.36 到 29.89,偏好预测 PickScore 从 19.04 到 21.44,均越高越好。6144×6144 的最高加速 3.2 倍属于另一分辨率设置。 表1|Aesthetic-4K 上 FLUX.1 与 Qwen-Image 在不同分辨率和宽高比的对照,粗体为最佳、下划线为第二;时延单位秒、越低越好,奖励、美学、图文匹配和偏好分越高越好,整体与局部裁剪的 Fréchet 距离越低越好。收益随主干与分辨率变化。 批判点评:不增参数仍需实现窗口、信息桥与拆窗调度;切换阈值按主干经验选择。固定窗口消融虽有不错的美学或 CLIP 分,却出现布局破碎,因此这些分数不能替代主体数量和接缝检查。作者项目页提供演示及代码入口,未实跑其模型。 3. DuplexBridge:先分清没听懂还是没画对 DuplexBridge: Coordinating Understanding and Generation for Unified Image Editing | 中国科学技术大学;阿里巴巴Wan团队 | arXiv:2610.18819 关键词:统一图像编辑, 角色分工, 双向信任门控, 完整遵循评测 前序问题:让统一模型先理解指令再编辑,最终改错时却不知道该罚谁:可能理解阶段认错对象,也可能条件没错、生成阶段执行失误。共享一个奖励会把责任混在一起。 方法直觉:先把任务写成可验收的交接单:改哪个对象、最终变成什么、哪些内容必须保留。理解者对交接单是否忠实负责,绘图者对是否照交接单完成负责。 本文贡献:同一模型分别承担理解与生成角色,不另接外部理解模块。源图约束的结构化 bridge 传递目标、变化和不变量;理解的局部监督不看生成图,生成的局部监督检查实际收到的条件。只有伙伴可信时才接收相应全局任务反馈,同时保留有效局部反馈,交替训练两角色。 图3|伙伴互信门控:执行可信度控制理解者能否接收全局反馈,提示可信度控制生成者能否接收全局反馈;局部反馈仍各有独立有效性掩码。图将两角色的全局资格及局部奖励符号简写;路由矩阵假定判断可用,Yr 是基准编辑结果,与任务提供的参考图不同。 实验效果:CE-Bench 有 1200 个任务;CCR 指所有变化与保留要求同时通过的任务比例,区别于平均要求通过率。Wan-Image-7B 直接编辑的 CCR 为 53.83%,完整系统 77.08%,包括提示增强、监督微调及强化学习。共同监督初始化后,仅比较门控:无门控 70.92%,双门控 77.08%,不能把全系统增益都归给门控。 表10|Wan-Image 全局奖励门控消融:前四行只变化两项语义信任决策,保留局部监督与奖励有效性条件。oracle 使用额外标注;等数量随机门控与保留分组结构的随机门控是不同对照。CCR 为全部变化与保留要求同时通过的任务百分比,双门控为77.08,无门控为70.92。 批判点评:推理增加了原生理解及条件生成环节,训练还需奖励判断;文中奖励模型的相对时延不等于整套编辑端到端时延。自动裁判与人评仍有误差,公开任务类别构成也随要求数量变化,不能把要求越多分越低解读为单变量因果。未确认作者完整训练实现的公开入口。 4. QK-Edit:只换查询与键保住原结构 QK-Edit: Revisiting Attention-based Injection in MM-DiT for Image and Video Editing | 加州大学默塞德分校;字节跳动Seed;字节跳动智能创作;香港中文大学 | arXiv:2610.17829 关键词:图像视频编辑, 查询键替换, 多模态注意力, 无需训练 前序问题:给真实视频换主体时,直接套用旧图像编辑的注意力注入,可能保住原结构却不听新指令,或跟上指令却把动作与背景弄坏。 方法直觉:注意力里,query 像每个位置提出的问题,key 用于匹配位置,value 才是取回的内容。借用原视频的查询与键来固定布局,同时让新文本和当前内容负责改变外观。 本文贡献:在把文本与视觉合并处理的多模态扩散 Transformer 中,只替换视觉 query/key,保留目标文本特征与目标 value。生成素材可在原采样时缓存,真实素材先反演回噪声并记录特征;图像仅在前 30% 去噪步注入,视频为前 20%。不训练参数,但需要源特征缓存及真实素材的反演计算。 图6|查询与键操纵策略:替换注意力 Q 与 K 的视觉部分,在目标提示遵循和源结构保持之间取得平衡;Q 是查询特征,K 是用于匹配的键,文本部分及用于聚合内容的 value 保留目标分支。 实验效果:A100 上以 FLUX.1-dev 编辑图像、HunyuanVideo 编辑视频。真实 TGVE+ 视频中,帧间 CLIP 余弦一致性 0.921、偏好预测 PickScore 20.52,Flatten 为 0.887、19.91;但描述修改方向的 ViCLIP 分为 0.196,低于 Flatten 0.204。论文覆盖 65 至 129 帧、320×320 至 1280×720 的视频设置。 表3|TGVE+ 真实视频编辑:比较修改方向及输出整体的 ViCLIP 语义对齐、帧间 CLIP 一致性和 PickScore 偏好预测,箭头均向上。QK-Edit 的方向分0.196低于 Flatten 的0.204,其他展示列较高,不能解读为所有指标第一。 批判点评:结构保持不等于所有语义指标最佳,且不是每条基准样本都使用最大分辨率和帧数。缓存与反演使“免训练”仍有时间和显存成本,原文未给统一端到端开销数字。真实反演在复杂运动中易有误差,未改区域仍可能被轻微改动;文字渲染与体操等复杂运动也受主干限制。未确认作者方法仓库可用。 5. FlashVSR+:单张4090做完整4K超分 FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching | 上海人工智能实验室;香港中文大学;清华大学;CPII(InnoHK) | arXiv:2610.17552 关键词:生成式视频超分, 混合注意力, 奖励蒸馏, 缓存卸载 前序问题:视频超分即从低分辨率恢复高分辨率;即使把扩散压成一步,4K 时空注意力仍可能撑爆显存,切成小块又容易产生边缘瑕疵,普通蒸馏也未必保住文字。 方法直觉:大部分层只管附近像素和前面的帧,少数层负责远处联系;训练时多学习奖励高的教师轨迹,奖励模型只负责打分,无需把梯度穿过它。 本文贡献:每五个扩散 Transformer 块保留一个全局块,其余采用局部时空注意力,适配训练后再蒸馏。Ry-DMD(奖励收益分布匹配蒸馏)用奖励加权的教师轨迹修改目标分布估计,支持不可微的黑盒奖励。4090 上另用适配注意力算子,并把保留全局层的 key/value 缓存卸到 CPU 固定内存,异步预取回显卡。 图2|FlashVSR+ 三阶段训练:第一阶段用图像视频数据训练140亿参数的全注意力多步教师;第二阶段适配混合注意力学生获得强初始化;第三阶段用 Ry-DMD 蒸馏成一步生成器,奖励反馈修改教师项估计,无需奖励梯度。 实验效果:效率测 89 帧视频,含 1080p、2K、4K。最高约 2 倍是去噪主干加速,峰值显存约降 45%;单张 24GB RTX 4090 的 4K 运行还包含上述卸载优化。文字识别奖励实验中,识别准确指标从基线 0.624 到 0.776;像素保真 PSNR 从 23.94 到 24.86,感知差异 LPIPS 从 0.246 到 0.240,后者越低越好。 图6|89帧视频的效率对照:(a)H200同级 GPU 上的 GPU 计算时间与峰值显存;(b)RTX4090 的端到端墙钟推理时间,包含 CPU key/value 缓存卸载与异步预取开销。SeedVR2整帧运行显存不足,改用切块;H200同级设备上的Ours-Base与旧FlashVSR结构及流程相同,旧算子不支持4090。两个面板口径不同,主干加速不能直接当完整路径加速。 批判点评:一步不等于实时;CPU 传输、预取、编码解码仍占时间。真实 VideoLQ 上无参考质量 MUSIQ 为 47.64,低于旧 FlashVSR 的 49.70,不能宣称所有质量分都更好。项目与代码入口已核验,训练适配和高分辨率设备条件需要一起复现。 6. GTL:把运镜主体和焦点分开控 Gen Through the Lens: Camera-Controllable Video Generation via Cross-Coordinate Conditioning Fusion | 腾讯视频太阳系 | arXiv:2610.15900 关键词:可控视频生成, 三坐标条件, 三维框控制, 景深与变焦 前序问题:输入一张照片再让相机环绕人物,常分不清是相机动、人物动还是焦距变;只给相机轨迹,人物位置与景深也未必按要求走。 方法直觉:分别给摄影机设置、世界里的运动轨迹、主体的三维占位框,再让它们在同一几何空间中对齐,避免把所有摄影要求挤进一句模糊提示。 本文贡献:Gen Through the Lens(GTL)融合相机、世界、物体三个坐标空间:恢复有统一实际尺度的相机参数,以彩色世界网格编码运镜,以带深度的三维框编码主体位姿,并加入分层景深与变焦条件。Wan2.1-14B(140亿参数)的编码器、解码器与生成主干冻结,只训练上下文适配器,分运镜、主体及变焦、景深三阶段加入控制。 图3|GTL 总体架构:在相机、世界与物体坐标空间联合输入相机运动、物体运动及景深控制信号,引导视频生成,源图像和几何条件共同约束生成主干。 实验效果:训练基础集约 11 万段,另构建 8000 段变焦与 15000 段景深数据,统一 81 帧、480p;原文报告约 288 GPU 小时。1000 段独立测试中,GTL 的视频分布距离 FVD 为 86.54,RealCam-I2V 为 98.76,越低越好;相机平移误差 8.59 对 9.86,但旋转误差 4.89°高于对照 4.63°。 表2|与现有方法的定量比较:误差及分布距离越低越好,重叠及语义指标越高越好;屏幕空间误差按图像对角线的百分比报告。*列需谨慎,RealCam-I2V 与 GEN3C 不支持显式物体运动或目标定位,可能使它们的物体指标较差。GTL旋转误差并非最优。 批判点评:主体框训练以人为主,非人物泛化主要来自定性展示;部分对照不支持显式物体控制,物体指标并非同等功能比较。几何来自自动估计,误差会传到条件和评测,训练成本也不是单次生成时延;未提供可直接对照的推理显存或时间,未确认完整开源实现。 7. Channel Match:形状没坏也要校准纹理接口 Channel Match: Calibrating Shape Latents for Few-Step 3D Generation | 威廉玛丽学院;SparcAI公司 | arXiv:2610.15321 关键词:原生三维生成, 少步蒸馏, 通道统计校准, 几何纹理接口 前序问题:三维模型两步就生成了正确形状,贴上材质却出现黑斑,问题可能不是网格坏了,而是几何隐变量的统计分布偏离纹理模型训练时的输入。 方法直觉:几何与纹理像两道串联工序:前一道加速后输出格式没变,数值分布却变了。先把接口上每个通道的均值与波动尺度校准,再交给原来的纹理生成器。 本文贡献:在 TRELLIS.2 的 1024³ 分辨率设置,用连续自一致性与解析速度回归联合蒸馏几何模型,自适应平衡两种损失。自定义 JVP 注意力核计算沿教师方向的速度变化;JVP 是雅可比矩阵与向量之积,无需显式存整张雅可比矩阵。Channel Match 无需再训练,按通道标准差亏损检测分布塌缩,触发尺度或均值加尺度校准,保持生成器不变。 图1|少步分布偏移及 Channel Match 校准:从左到右是输入、未校准两步学生的无纹理网格与物理材质渲染,以及校准后网格与渲染。偏移的形状潜变量会让冻结纹理模型产生黑斑;校准后几何保持不变。示例选择几何简单、两步教师和学生都接近多步参考的样本,以隔离潜变量统计偏移而非几何重建错误,并非全部复杂物体的保证。 实验效果:单张 A800-80GB 上,几何采样从 5.29 秒到 1.18 秒,约 4.5 倍;图像到形状完整路径 11.51 秒到 7.55 秒,约 1.5 倍。72 个容易出材质伪影的演示资产,统一四视角、对照十二步教师渲染,完整校准将感知差异 LPIPS 从 0.0802 降到 0.0747;这是更接近教师,不是接近真实照片的直接测量。 表3|TRELLIS.2 的72个演示资产与十二步教师渲染作四视角比较。仅标准差和均值加标准差两种校准都使学生更接近教师,完整校准在这批材质伪影较多的资产上收益更大。下半部分为各指标改善的资产比例;它不代表完整 Toys4K 或真实纹理误差。 批判点评:3216 个较简单 Toys4K 资产中,单独校准标准差更稳,完整均值校准反而可能稍差。JVP 增加的是训练开销,纹理阶段保持不变限制总加速。原文的结构相似度 SSIM、像素保真 PSNR 在正文与表格有个别数值不一致,因此本文只采用一致的 LPIPS 与计时数据;尚未确认作者完整公开实现。 8. AnyEdit:改人声时留下现场的声音 AnyEdit: A Unified Framework for Speech and Singing Voice Editing with Real-World Environmental Consistency | 香港中文大学(深圳);华为媒体技术与体验设计研究所;澳门城市大学;Amphion公司 | arXiv:2610.15665 关键词:语音歌声编辑, 环境一致性, 抗噪韵律, 分阶段声学渲染 前序问题:在有伴奏、回声或街噪的录音里换一句话,常把环境声一并擦掉,或让没修改的词也变了音调。先做人声分离还会引入分离伪影。 方法直觉:先在干净的语义空间里决定说什么、怎么唱,再借周围原始声音还原现场感。这样编辑能力和噪声混响的处理不必在同一个步骤里互相干扰。 本文贡献:不显式分离人声:自回归模型生成韵律与内容风格 token(离散片段编码);教师学生训练从受损录音恢复干净韵律,50Hz 特征压成 6.25Hz token。流匹配声学模型再依据原音色及上下文渲染频谱。未修改区域加权监督稳定原有语气,并用歌曲重复段对齐挖出的真实配对做直接偏好优化;这仍依赖合适的重复结构。 图1|AnyEdit 总体架构:先在干净语义空间预测韵律与内容风格,再结合原声学上下文生成频谱并还原波形;NFE 为流匹配推理时的函数评估次数,图中按常微分方程积分步骤计,不包含全部前后处理。 实验效果:AnyEditBench 同时覆盖中英语音和歌声、干净/模拟/真实环境。真实英语语音中,单词错误率 WER 为 0.0616,Vevo2 为 0.0778;真实英语歌声 WER 为 0.1749,对照 0.2809,背景嵌入相似度为 0.7384,对照 0.5671,后者越高越好。但英语语音背景相似度 0.7705 低于 SSR-Speech 的 0.8729。 表2|AnyEditBench 真实环境子集,分语音与歌声两域。英语用单词错误率 WER、中文用字符错误率 CER,基频相关仅测歌声;粗体为各域最优,下划线指优于统一基线 Vevo2。另列说话人及背景相似度、混响时间误差与信噪比误差,不能仅以识别率概括环境保持。 批判点评:极端语音信噪比 0dB,即信号与噪声功率相当时,WER 为 0.386,差于 Vevo2 的 0.196,不能把平均收益当全条件保证。两阶段处理与多步声学解码仍有成本,未给统一时延。arXiv 备注明确称 NeurIPS 2026 接收;作者演示与公开评测集可访问,未确认完整训练代码。 9. Prime-EVC:情绪先配好再一步变声 Prime-EVC: One-Step Expressive Emotional Voice Conversion via Emotion-Primed Flow Matching | 九州大学;东华大学;腾讯混元;日本国立情报学研究所;东京大学;独立研究者 | arXiv:2610.16036 关键词:情绪语音转换, 一步流匹配, 韵律条件, 说话人保持 前序问题:想把同一句话由平静改成兴奋,直接把多步情绪转换模型砍成一步,往往只剩平滑的平均音色,目标情绪没真正进入音高和能量。 方法直觉:与其让一步采样临时猜出情绪,不如先预测“这个人表达这种情绪时”的逐帧音高与强弱,把难题移到条件端,再让解码器完成剩下的声学细节。 本文贡献:Prime-EVC 是情绪语音转换而非从文本直接生成。冻结 HuBERT 提取内容,通过 FiLM(按特征缩放和偏移)融合说话人与五类情绪;情绪方差适配器预测逐帧音高与能量,再施加情绪分类及频谱时间变化监督。扩散 Transformer 的条件流匹配解码器一步欧拉更新生成梅尔频谱,BigVGAN 将其转成波形。 图1|Prime-EVC 的编码、条件、渲染流程:从原语音取得内容,以说话人与情绪融合风格及逐帧韵律构造条件,再由一步条件流匹配解码器和声码器生成转换语音。一步指流解码更新,不是整条路径只有一次计算。 实验效果:ESD 英语十位说话人、五类情绪、16kHz,6000 次转换;16 位听者评每系统 100 条样本。自然度主观均分 3.77±0.03、情绪均分 3.90±0.04(±表示95%置信区间半宽),高于四步 DurFlex 的 3.63、3.79。A6000、批量 1,含声学模型及声码器的 RTF 为 0.038(耗时/音频时长),对照四步 0.132、百步 1.917。 表1|ESD 上整体比较,粗体仅在转换系统中排名;GT 为真实语音,vocoded 为声码器重建。自然度与情绪主观评分给均值及95%置信区间,自动质量、情绪与说话人相似度越高越好,字符及单词错误率、RTF越低越好;RTF包含声学模型及共享声码器,主干参数量并不相同。 批判点评:一步只计流解码器的网络评估,内容编码与声码器仍执行;模型约 9800 万参数,对照约 1.59 亿,也影响速度。说话人是训练过的十个嵌入,不是任意新音色克隆;去掉部分监督时 WER 还略好,情绪与可懂度需一起看。arXiv 标注在研预印本;作者样例可听,未确认训练代码。 10. SyncReward:声音对得上也得让人认同 SyncReward: Human-Aligned Synchronization Reward for Audio-Visual Generation | 中国人民大学;腾讯微信 | arXiv:2610.16338 关键词:音画同步奖励, 人类评分对齐, 时间对比学习, 生成后训练 前序问题:视频里的声音语义相关,却未在可见动作发生时响起;只奖励某个同步指标,模型可能把指标刷高,观众仍觉得嘴型或撞击声对不上。 方法直觉:先学习同一片段中哪个声音对应哪个时刻,再学人类如何判定“完全不同步、部分同步、同步”。内容匹配与时间对齐分别训练,避免只靠主题相似过关。 本文贡献:基于音画感知编码器,先用同片段错时负样本及跨片段语义负样本做对比学习,再冻结编码器,以人类 0/1/2 级评分训练交互 Transformer 与打分头,结合回归和成对排序。输出 0–2 的同步分。SyncReward-Data-80K 是约 8 万条评分;作者仓库说明为 80001 条评分覆盖 57099 个片段,不能把评分数直接写成独立片段数。 图3|SyncReward 两阶段训练:第一阶段以匹配音画片段、同视频错时负样本和同批跨视频语义负样本做对比学习;第二阶段冻结两种编码器,只训练跨模态 Transformer 与评分头,结合人类同步评分的回归和成对排序损失,输出0–2分。火焰与雪花分别表示训练和冻结。 实验效果:整体人评排序相关 Spearman ρ×100 为 78.2、成对排序准确率 83.6%,只做第一阶段为 60.5、74.6%。LTX-2.3 每提示生成 16 条再择优,人类偏好分为 63.67%,基模为 32.31%;用 DiffusionNFT 后训练为 65.78%。这些偏好分是基于基模比较的暂定估计,原文说明尚待完整两两评估,不能当全对全胜率。 表2|以同步分作奖励,分别比较十六选一与 DiffusionNFT 后训练;人类和 Gemini 偏好使用相同留出提示,自动指标也在同一批生成视频计算。当前偏好分为相对基模比较的暂定估计,作者说明将以完整两两评估替换;不同自动指标不构成统一胜率。 批判点评:十六选一要支付 16 次生成与打分成本;后训练有额外训练预算,未提供完整部署时延。模型可能提高嘴型同步却遗漏提示要求的乐器,同步奖励不能单独保证内容遵循。作者仓库提供打分、训练及基准入口,本次未复现;四类声音覆盖也不等于所有长视频场景。 趋势观察 把额外工作放到合适阶段 SMD的Pivot只留训练,AReA随去噪进度改感受野,Prime-EVC先把情绪放进条件。一步或少步的含义,要结合其余模块和前后处理判断。 编辑失败需要明确责任 DuplexBridge区分理解与执行,QK-Edit区分结构与内容。局部机制有效不保证所有语义指标都赢,验收要同时覆盖改变与保留。 接口分布同样影响最终质量 Channel Match的形状没坏但材质变差,AnyEdit把干净编辑与现场渲染分开。模块单独达标仍可能在连接处出错。 奖励与设备条件决定兑现方式 FlashVSR+依赖混合训练及4090缓存卸载,SyncReward十六选一需要额外生成。偏好分、去噪速度和完整产品耗时是不同账本。 今日讨论 SMD把Qwen-Image从教师100次网络评估压到4次,GenEval为0.873对0.874,但多样性从0.195降到0.144。训练仍要教师查询与Pivot,部署也有前后处理;你会用哪些指标和固定预算实验,验证减少网络调用后是否仍保住服务需要的变体覆盖? 人工智能炼丹君 整理 | 2026-10-15