搜索到
63
篇与
视频生成
的结果
-
 AIGC 每日速读|2026-08-29|字节斯坦福让视频记住走远的人RingForcing 今日 AIGC 论文速览 今日共 10 篇 · 长视频记忆与一致性 3 篇 · 实时流式生成与编辑 3 篇 · 单图世界建模 1 篇 · 后训练与奖励建模 2 篇 · 流式音视频评测 1 篇 重点论文标题列表 Ring Forcing(Stanford University、MIT、北京大学、UC Berkeley、字节跳动):环形训练把记忆拉到分钟级 EditaLive(澳门大学、vivo BlueImage Lab、大湾区大学 GVC Lab):两步采样做到14.47FPS直播换装 TetherMem(华中科技大学、小米 MiLM Plus):主体查身份场景查近景各走一路 RECAP-Forcing(UC San Diego):按外观新鲜度存而非按时间存 Magpie(Mogo AI、南京大学、南安普顿大学):引擎管规则生成模型只管画 今日论文速览 1. Ring Forcing:环形训练把记忆拉到分钟级 Ring Forcing: Towards Precise Long-Term Memory for Autoregressive Video Diffusion | Stanford University、MIT、北京大学、UC Berkeley、字节跳动 | arXiv:2608.26794 关键词:自回归视频扩散,长时记忆,物体恒存性,稀疏RoPE,历史压缩,字节跳动,Stanford 前序问题:视频生成往长时长走,真正的瓶颈不是画质而是记忆。作者把它拆成两个必须同时成立的能力:一是「物体恒存性」——一个人走出画面几十秒后再进来,长相要和原来一致,而不是换了个人;二是「记忆容量」——模型得能处理超长上下文,真正用上很久以前的信息。已有做法往往只顾一头:能精确复现细节的,可用的时间跨度很短;把上下文拉得很长的,又保不住身份。更棘手的是训练目标本身的矛盾——如果强迫模型严格照抄历史,生成会变得僵死、失去多样性;如果放松约束,它就干脆不去看远处的历史,因为预测邻近帧永远是更省力的捷径。 本文贡献:Ring Forcing 的核心是一个环形训练策略:把原视频与反转后的视频首尾相接成环,随机裁掉开头一段,再在中间「挖掉」一部分作为隐藏的真值(Hidden GT),同时施加 Ring Context Drop。这样一来,要预测的目标帧其内容只能从远距离历史里取回,模型没有走捷径的余地,从而在「严格遵循历史」与「保持生成多样性」之间取得平衡。为扩容记忆,作者用压缩加时间步组合的策略,在固定序列长度下把有效历史跨度推到分钟级,并让感受野覆盖整段历史。第三个部件是稀疏 RoPE:让位置编码可以灵活、可扩展地适配记忆条目,同时尽量复用预训练先验,实验显示它比标准按索引排布的 RoPE 收敛更快、重建质量更好。作者还设计了双流结构,在不增加序列长度的前提下让组合策略稳定优于两个单独基线。 Overview of the Ring-Structured Training Strategy. We construct a sequence ring by concatenating a linear raw video with its reversed counterpart. By unrolling the ring into a conditioning sequence, the target frames are naturally embedded into the distant history as the Hidden GT, which essentially forces the autoregressive generator to learn explicit long-range retrieval. To prevent trivial shortcuts, a Random Head Crop is applied to truncate boundary information leakage, while a Random Context Drop is used to balance history adherence and generation diversity. 实验效果:在作者构建的 A-D-R Benchmark(出现—消失—再现)与一分钟通用长视频基准上,Ring Forcing 在分钟级连贯性和物体恒存性上明显优于现有方法。定性对比里,同一段一分钟美术馆漫游,FramePack 的画面逐步漂移、LongCat 后半段结构开始崩坏、LongLive 的展品在切换中被替换,而 Ring Forcing 始终保持雕塑与展厅结构稳定;穿越遮挡后再出现的物体也能保持原有外观。人类偏好评测中它在美学、自然度与总体偏好上均取得最佳,说明记忆机制的增强没有以画质退化为代价。 Qualitative results of 60-second long video generation. The visualization demonstrates the model's capability to maintain overall consistency and visual quality throughout a 1-minute duration in general scenarios. 批判点评:这篇的价值在于把长视频一致性从「算力/上下文长度问题」重新定义成「检索问题」,而环形训练是一个相当巧妙的构造——它用数据组织方式强制模型放弃预测邻近帧的捷径,比单纯加损失项更根本。稀疏 RoPE 也和昨天 JoyAI-Echo-1.5 的「给记忆单独编址」思路撞在一起,可以认为这是当前的一个共识方向。需要保留的疑问有三点:一是自建 A-D-R Benchmark 虽然针对性强,但也意味着「恒存性」这个最关键指标缺少第三方基准交叉验证,作者说的 SOTA 主要在自家尺子上量出;二是环形训练依赖把视频反转,这对有明确因果方向的内容(倒水、物体破碎)是否引入了反物理先验,论文没有讨论;三是分钟级的说法建立在「压缩+时间步组合」之上,压缩必然有损,论文没有量化到底丢了什么、在多长时间尺度上开始失效。 2. EditaLive:两步采样做到14.47FPS直播换装 EditaLive! Unified Character Video Editing for Live Streaming | 澳门大学、vivo BlueImage Lab、大湾区大学 GVC Lab | arXiv:2608.27123 关键词:人像视频编辑,直播流式生成,少步蒸馏,稀疏注意力,Wan-Animate,vivo 前序问题:常规视频编辑关注的是整体场景,而直播场景真正在意的是人——观众盯着的是主播的脸和动作。把现有视频编辑方法直接搬到以人为主体的直播上有两个硬伤:一是面部表情容易失配,改完之后人物的微表情和原视频对不上,观感立刻失真;二是这些方法通常要多次离线推理,延迟根本不满足实时互动。一个看似可行的折中是「先用图像编辑器改首帧、再驱动动画」,但这条级联路径不是端到端的,延迟叠加,而且长序列下外观会持续漂移。此外这类任务还缺训练数据——成对的「编辑前后视频」几乎无法大规模构造。 本文贡献:EditaLive 从预训练的图像动画模型 Wan-Animate 出发,利用它天然把外观与动作解耦的特性,将其改造成指令驱动的人像视频编辑器:做法是只编辑参考帧、再重建视频,从而绕开成对视频数据的构造难题,配套自建了 CharEdit-50K 数据集(用 GPT 生成增删改与风格化四类互逆指令对,经 Qwen-Image-Edit 与 Nano Banana 2 合成候选,再做角色一致性、可逆性、编辑准确性等质量过滤)。为满足实时性,作者把模型从双向改为因果流式,并设计对齐的自 rollout 蒸馏,把模型压缩成两步采样器;其中 Align Forcing 与 Fixed RoPE 用来缩小训练与推理的差距,First-frame Preserved Sparse Attention(FPSA,稀疏率 75%)负责过滤冗余历史信息以抑制外观漂移。 Overview of the three-stage training pipeline of EditaLive. (a) Appearance--Motion Decoupled Editing reformulates character video editing as appearance editing with explicit body and facial motion preservation. (b) Causal Streaming Adaptation converts bidirectional modeling into causal generation using clean historical context and causal attention. (c) Aligned Self-Rollout Distillation compresses the model into a two-step sampler, where Align Forcing and Fixed RoPE align training with streaming inference, and FPSA improves long-term appearance stability. 实验效果:在单张 NVIDIA H100 上,EditaLive 端到端吞吐 14.47 FPS、平均块间延迟 0.829 秒,实现了亚秒级流式延迟。作者承认专用流式基线的原始速度更快,但那些基线的编辑成功率最高只有 0.428,而 EditaLive 达到 0.720;相较最快的双向基线 LucyEdit,它在吞吐与延迟上都有数量级改善。消融图显示去掉 Align Forcing 后风格化结果的色调与身份明显跑偏,去掉 FPSA 与 Fixed RoPE 则在第 900 帧附近出现可见的外观退化。 Ablation study on causal streaming adaptation and aligned self-rollout distillation. 批判点评:这篇的工程判断很清晰:直播编辑的真实约束是「实时」,所以宁可牺牲一点原始吞吐去换编辑成功率,这个取舍是对的——0.428 的成功率在产品里等于不可用。用「只编辑参考帧」绕开成对视频数据的构造,也是个聪明的降本设计。但有几处需要保持警惕:一是数据管线重度依赖闭源模型(GPT 5.5 生成指令、Nano Banana 2 与 Qwen-Image-Edit 合成图像),这意味着数据分布继承了这些模型的偏好和缺陷,复现成本也不低;二是它的能力边界被基座 Wan-Animate 框定,本质是「外观替换」,涉及大幅改变体型或需要新增遮挡关系的编辑恐怕难以胜任,论文的 limitation 图也暗示了这点;三是 FPSA 固定 75% 稀疏率是个经验值,在快速运镜或多人入画时是否仍然安全,缺少压力测试。 3. TetherMem:主体查身份场景查近景各走一路 Tether the Subject, Release the Scene: Query-Aware Memory Routing for Long-Horizon Autoregressive Video Generation | 华中科技大学、小米 MiLM Plus | arXiv:2608.26902 关键词:自回归视频生成,记忆路由,免训练,场景推进,长视频一致性,小米 前序问题:流式自回归视频模型逐块生成,靠历史记忆维持一致性。问题是现有方法对「主体查询」和「场景查询」用的是同一套访问策略——都同等地看历史。这确实稳住了主体身份,但副作用是把背景、视角和场景结构也一并锁死在此前的状态上:人物在走动,可街景却始终是同一条街,怎么走都走不出去。作者把这个失效模式命名为「记忆锚定的场景推进不足」,并指出它很容易被漏掉——因为常用的一致性指标和运动指标都不会报警,画面里确实有局部运动,一致性也确实很高,唯独缺了「场景在推进」这件事。 本文贡献:TetherMem 是一个免训练、面向冻结视频生成器的查询感知时空记忆路由器。它把主体查询与场景查询分开处理,并用「区域」和「新旧程度」两类先验来调制各自对历史的访问权重:主体查询保留承载身份的历史,场景查询则主动降低对主体历史和陈旧背景的依赖。具体实现上,用时间对齐的离线掩码区分主体区域与场景区域,再在归一化记忆路由中给不同年龄的记忆条目加上对数偏置,使得主体侧倾向「拴住」身份记忆、场景侧倾向「放开」并偏向近期背景。相比此前只做帧级时间筛选(选择保留哪些帧、粒度粗且不区分查询类型)的做法,它把筛选粒度下沉到了「哪类查询看哪块区域的哪段历史」。 Overview of TetherMem. (a) End-to-end routing preserves identity memory for subject queries and favors recent backgrounds for scene queries. (b) Prior methods select memory frames, whereas TetherMem routes query roles within the retrieved history. 实验效果:在来自 10 位标注者的 2400 次盲测成对比较中,TetherMem 在八个流式长视频基线里取得最高的期望偏好度:整体质量 0.780、场景推进 0.769。完整的 30 秒视频上,它能让背景、视角和场景状态持续变化,同时保住主体的可辨识度与时间连续性;架构图中的定性对比显示,基线要么表现为「场景冻结」(一直是同一条街),要么是「伪推进」(换了街景但布局照旧),而 TetherMem 能走出「街道→店面→广场」的真实推进。作者提供的证据散点图还显示它在「身份 EP × 场景推进 EP」平面上明显位于右上角,优于 LongLive-RAG 与 MemRoPE 等基线。 The evaluation landscape exposes two distinct gaps. (a) Identity EP versus scene-progression EP shows that strong identity can coexist with weak progression. (b) nT versus human progression shows that coherent translation is informative but incomplete: Causal Forcing has high nT and low human progression. Values are the method-level aggregates from Table. 批判点评:这篇最有价值的部分其实不是方法而是问题定义——它指出了一个被现有指标系统性掩盖的失效模式,并且说清了为什么「一致性高、有运动」还能是坏结果。这种把「指标满分但体验不对」显式化的工作,往往比再涨两个点更有意义。免训练、面向冻结模型也让它容易被复用。但要注意几点:一是核心结论几乎完全依赖人类偏好评测,没有自动指标佐证——这一方面是诚实的(作者自己论证了现有指标测不出场景推进),另一方面也让结果难以被独立复现和横向比较,作者若能顺势提出一个可自动计算的场景推进指标,贡献会大得多;二是方法依赖「时间对齐的离线掩码」来区分主体与场景,这个前置分割的质量直接决定路由效果,遇到多主体、主体与背景纠缠或分割失败时会怎样退化,论文没有充分交代;三是「主体拴住、场景放开」是一个人为设定的二分,对于「主体本身就该随场景改变」(如换装、光照剧变)的情形,这套先验可能反而成为约束。 4. RECAP-Forcing:按外观新鲜度存而非按时间存 RECAP-Forcing: Retaining Content Appearances for Long Video Generation | UC San Diego | arXiv:2608.26671 关键词:长视频生成,KV缓存,外观索引记忆,光流新颖度,免训练,UCSD 前序问题:长视频自回归生成面临一个根本的记忆取舍:注意力窗口有限,模型必须决定从不断膨胀的历史里留下什么。现有方法几乎都按时间来组织记忆——保留最近的帧,把更早的压缩或直接丢弃。作者认为这个索引方式本身就错了:一段长视频不只是帧的序列,而是一批不断登场的主体、物体和场景,它们的身份必须长期保持一致。按时间存有两个恶果:同一内容会被反复重复存储,且随时间衰减,最终导致信息永久丢失;同时记忆开销与视频长度成正比,越长越吃不消。 本文贡献:RECAP-Forcing 换了个索引轴:按「外观新颖度」组织记忆,而不是按时间。做法是在内容首次可见的那一刻,就把它对应的 KV 缓存留存下来——包括入画的新主体、被遮挡后重新露出的区域、新引入的场景,优先保留「新颖」而非「近期」。这样记忆规模与「新引入内容的总量」成正比,而不是与视频长度成正比,长程一致性因此变成记忆结构本身的显式属性。框架把两个机制统一在同一原则下:视频开头所有内容都是新的,此时用 attention sink 保住初始场景;随着视频推进,再用基于光流的新颖度库延续同一原则——用 RAFT 算前后帧光流,转成新颖度图,挑出新颖 patch,取其对应的逐层 KV 入队到记忆库。整套方法免训练、无额外可学习参数。 What should a long-term video memory store? The same rollout, indexed two ways. Top: the man is recorded at his first appearance ($t_1$); each later frame depicts something new: a passing car ($t_2$), a pedestrian ($t_3$), another passer-by ($t_4$). Bottom Left: frame-indexed memory re-stores old and new content alike at every step, then compresses or evicts it as time passes, so memory pressure grows with video length. Bottom Right: appearance-indexed memory (RECAP-Forcing) stores content when it newly appears, at canonical temporal position $0$, memory scales with the amount of newly appearing content, not with its duration. 实验效果:作为推理期免训练方法,RECAP-Forcing 在多个强基线上一致提升了视觉质量与语义保真度,并优于既有的记忆方法。一分钟长视频的定性对比很直观:基线在「第二个主体入画」的场景里逐渐丢失内容身份并开始漂移退化——尾随的 SUV 化成尘土并出现复制、岩石人裂开并偏离路径;而 RECAP-Forcing 在保住主体身份与视觉一致性的同时没有牺牲运动幅度。记忆可视化图显示,被选中留存的 patch 确实集中在新出现的角色与新露出的区域上,说明新颖度判据按预期工作。 Qualitative results on four one-minute prompts. Across all scenes, the baseline loses subject identity, style, scale, or background consistency. In contrast, RECAP-Forcing preserves the subject(s) and the full scene throughout the minute. 批判点评:「按外观索引而非按时间索引」是今天三篇记忆论文里最简洁、也最容易迁移的一个想法——免训练、无新增参数、可直接挂在现有模型上,这类工作的实际影响力往往比需要重训的方案更大。「记忆增长应当与新内容量成正比、而非与视频长度成正比」这句话本身就值得记下来。需要打折扣的地方也很明确:一是判据完全依赖光流的新颖度,而光流在快速运镜、大面积遮挡、剧烈光照变化下本就不可靠,此时「新颖」可能只是估计误差,论文没有给出失效分析;二是留存策略只进不出,若视频里持续引入新内容,记忆库会单调膨胀,论文声称规模与新内容量成正比,但没有交代长时间运行下的上限与淘汰机制;三是三位作者仅在自选基线上做相对比较,缺少与本文另两篇(Ring Forcing / TetherMem)这类同期方案的直接对话,读者难以判断三条路线的相对优劣。 5. Magpie:引擎管规则生成模型只管画 Magpie: Real-Time World Renderer for Interactive Games | Mogo AI、南京大学、南安普顿大学 | arXiv:2608.27168 关键词:实时世界渲染,交互式游戏,生成式渲染,白盒画面,游戏引擎解耦,Mogo AI 前序问题:现代游戏开发重度依赖传统图形管线:建模、材质、动画、灯光、特效、运行时优化,每一环都要人力,导致美术资产昂贵、原型周期漫长。视频基础模型已经开始改变影视制作,但游戏和线性媒体有本质区别——游戏不只要求画面连续真实,还要求玩法规则、物体状态和交互结果稳定且可复现。换句话说,同样的操作与状态在指定规则下必须保持稳定的含义,这一点是纯生成式方案最难保证的:一旦让生成模型接管世界状态,规则就变得不可控、不可复现,游戏也就不成立了。 本文贡献:Magpie 的关键设计是把玩法执行与视觉生成彻底分开。设计师照常在游戏引擎里定义场景与规则;运行时,游戏引擎负责解算玩家操作、维护世界状态,并输出「白盒画面」(只有几何、布局、遮挡与主要运动的灰模渲染);独立的 Render Server 再把白盒画面转成最终的高保真视觉,流式回传给客户端。初始化时用一段文本提示与首帧图像确定视觉风格,交互过程中白盒帧是唯一持续的去噪条件,相机位姿只用来检索相关的视觉历史。数据侧,作者在 Unreal Engine 里搭可控场景,由训练过的真人操作员而非脚本或自动智能体来玩,采集约 300 小时、30 多个场景的成对交互视频(1920×1080、60 FPS),并要求操作员刻意反复经过困难视角、交互边界、状态转换与静止间隔;除双路视频外还记录相机位姿、操作输入、碰撞、状态转换与事件信息,共享时间戳。 Magpie system overview. Designers define layouts, interactions, rules, and numerical parameters in the game engine. The User Client forwards player actions to the Game Engine, which executes gameplay and emits white-box observations. The independent Render Server converts those observations into generated video and streams the result back to the client. Gameplay state and rule execution remain inside the engine. 实验效果:Magpie 5B 的 Render Server 在单张 NVIDIA H100 上以块级自回归推理运行:每块含 5 个潜在帧,首块解码为 17 帧、后续每块 20 帧。作者提供的运行时时序图给出了完整的延迟构成——引擎录制约 830 毫秒(20 帧 / 24fps)、渲染约 620 毫秒,从用户输入到画面显示端到端约 1550 毫秒,块输出本身覆盖约 830 毫秒。系统层面,它保住了玩法的可设计性与可复现性,并降低了早期游戏原型对完整视觉资产的依赖。 Chunk-level interaction and rendering timeline. At 24 FPS, the Game Engine records 20 white-box frames in approximately 830 ms. After transfer, the Render Server generates the corresponding chunk in approximately 620 ms; transfer and buffering account for the short intervals between stages. The first action-aligned visual response therefore appears after roughly 1550 ms, while subsequent output chunks are displayed over approximately 830 ms. 批判点评:这篇的价值主要在系统架构而非模型创新,而它的克制恰恰是最值得学的地方——不追求端到端接管一切,而是承认「规则可复现」这条底线只有传统引擎守得住,把生成模型限定在渲染层。用真人操作员而非脚本采集数据、并刻意覆盖交互边界与困难视角,也是一个容易被忽视但对交互场景很关键的细节。不过必须实话实说:约 1550 毫秒的端到端延迟离真正可玩还有相当距离——它对回合制或慢节奏探索或许够用,但对任何需要即时反馈的玩法(动作、竞技)都不可接受,论文标题里的 real-time 更接近「流式」而非游戏工业界理解的实时。另外它是技术报告体裁,缺少与其他世界模型的量化横向对比,也没有交代白盒画面的抽象程度如何影响生成质量——白盒给得太粗,模型要猜的东西太多;给得太细,又回到了要做美术资产的老路,这个权衡点在哪,读者看不到答案。 6. SpatialCrafter:先出几何代理再补高频细节 SpatialCrafter: Single Image World Modeling with Generative 3D Proxies | 香港科技大学、阿里巴巴通义实验室、群核科技、吉林大学 | arXiv:2608.27073 关键词:单图场景生成,世界模型,3D代理,视频扩散,几何注入,港科大,通义 前序问题:从一张图生成可自由探索的三维场景,在游戏、机器人和 VR 里都是刚需。现有基于视频扩散模型的做法通常依赖不完整的条件信号——稀疏点云或二维全景图,由此带来三个连锁问题:模型要靠随机猜测填补缺失信息(幻觉)、长距离漫游时画面逐渐漂移、三维一致性不达标。根子在于条件信号本身没有提供完整可靠的几何约束,于是视频模型既要负责编造几何又要负责渲染外观,两件事互相干扰。 本文贡献:SpatialCrafter 引入一个全局 3D 代理,把生成过程拆成「代理生成」与「外观精修」两阶段。代理阶段用 Point-anchored Sparse Structure(PaSS)Flow 模块,从输入图与点云出发预测空间对齐、几何一致的稀疏体素结构,再经 SLAT 扩散得到粗糙 3D 场景。精修阶段把视频扩散模型重新定位为「生成式延迟渲染器」,只负责在代理给定的几何之上合成高频写实细节。为了让代理与预训练视频模型更好结合,作者提出 Parallel Geometry Injection(把粗糙 RGBD 视频经 VAE 编码后与噪声潜变量做宽度/通道拼接注入)和 Proxy-Aware Corruption 训练策略,提升对代理瑕疵的鲁棒性,同时避免破坏预训练的生成流形;视频 DiT 主体冻结、仅用 LoRA 微调。此外作者构建了 115K 场景的大规模数据集,称是首个面向图生场景任务的混合数据集。 Overview of SpatialCrafter. Given a single image and a camera trajectory, we first construct a global 3D proxy using a native 3D generator with Point-Anchored Sparse Structure (PaSS) Flow Matching. This proxy then serves as a reliable coarse 3D prior for the Generative Deferred Refiner, which transforms it into photorealistic RGB-D video sequences via Parallel Geometry Injection and Proxy-Aware Corruption. 实验效果:在 DL3DV 与 RE10K 等合成与真实数据集上,SpatialCrafter 大幅优于现有方法,消除了长程漂移,并在快速相机运动与极端视角变化下保持稳健一致。视觉质量以 FVD、PSNR、LPIPS、SSIM 对齐真值序列衡量,作者报告在三个基准上全面领先。定性对比图很能说明问题:同一输入下 Voyager 整体偏暗甚至近乎全黑、GEN3C 出现严重纹理糊化与结构错乱、ViewCrafter 把家具糊成一片,而 SpatialCrafter 的结果在几何结构与材质细节上都最接近 GT。 Qualitative comparison with SOTA methods. SpatialCrafter significantly surpasses the baseline methods under extreme challenging camera motions, yielding photorealistic and spatially consistent novel view synthesis. Please refer to the supplementary material for more comparison results. 批判点评:「先保几何、再补外观」的分工是这篇最扎实的判断——把视频扩散模型从「同时编造几何和外观」的双重负担里解放出来,长程漂移自然缓解,这与 Magpie 用白盒画面约束生成是同一个思路,可以看作今天的一条隐性共识。Proxy-Aware Corruption 这个细节也很实用:既然代理必然有瑕疵,训练时就主动注入瑕疵,比事后修补更合理。但要注意:一是整个链路的上限被第一阶段的代理质量锁死,稀疏体素代理在细长结构、透明与反射材质上先天薄弱,论文没有给出代理失败时的退化分析;二是两阶段串联意味着推理开销叠加,而论文对「可探索」这个卖点没有给出交互延迟或帧率数据,实际能否支撑实时漫游是未知的;三是 115K 场景数据集里合成数据占比与真实数据的配比没有充分交代,而「首个混合数据集」的说法需要这个信息才站得住。 7. LiveVVT:22.39FPS实时视频换装 LiveVVT: High-Fidelity Video Virtual Try-On in Real Time | 清华大学、中关村学院、华南理工大学、北京交通大学 | arXiv:2608.26714 关键词:视频虚拟试穿,流式扩散,滚动窗口,渐进蒸馏,全局外观记忆,清华 前序问题:基于扩散的视频虚拟试穿靠双向时空建模拿到了很高的视觉保真度,但代价是必须拿到完整片段才能推理,在需要持续输出的实际部署里延迟和算力开销都不可接受。直接把模型改成因果的又会破坏预训练的双向先验,画质明显下滑。于是形成一个两难:要画质就没法实时,要实时就保不住画质。此外流式场景还有长时程难题——服装细节和已穿着的整体外观必须在整段视频里稳定,不能越穿越走形。 本文贡献:LiveVVT 是一个滚动式流式扩散框架,在因果递归生成中保留有界的双向建模:在固定大小的窗口内,它对多个视频块联合去噪、只做有界的前瞻,从而保住局部双向交互,同时每次迭代吐出一个干净块。窗口之外用两套互补记忆维持长程一致性——有界的时间记忆负责传递近期动态与遮挡上下文(FIFO 队列,入新汰旧),持久的全局外观记忆只在开始时从目标服装与一张正面试穿关键帧构建一次,之后全程锚定服装细节与穿着后的整体外观。训练上采用三阶段渐进蒸馏:先做双向 VVT 学习,再用教师轨迹回归完成少步因果适配,最后用 Collaborative Matching Distillation 把教师分布匹配与真实视频上的滚动流匹配耦合起来,让优化目标与递归推理方式对齐。 Overview of LiveVVT. (a) Rolling streaming try-on emits one clean chunk per update from a staggered-noise window with persistent global appearance memory $\mathcal{A}=(\mathcal{A}_g,\mathcal{A}_f)$ and temporal memory $\mathcal{H}_k$. (b) Bidirectional VVT learning, teacher-trajectory regression, and CoMD progressively transfer offline bidirectional priors to few-step streaming generation. 实验效果:在成对与非成对的长序列基准上,LiveVVT 相比同规模模型取得更优的生成质量。效率对比图给出明确数字:LiveVVT 达到 22.39 FPS、单次更新延迟 1.56,而 MagicTryOn 为 1.97 FPS / 41.11、CatV2TON 1.69 FPS / 47.88、ViViD 1.44 FPS / 56.25、VACE 仅 0.31 FPS / 157.8;相对 MagicTryOn 吞吐提升 11.37 倍,延迟降低 26.35 倍。 Comparison of latency and throughput between LiveVVT and state-of-the-art methods. 批判点评:「有界窗口内保留双向性」是这类流式改造里比较务实的折中——完全因果化会丢掉预训练先验,完全双向又不能流式,在窗口内保留局部双向交互是个合理的中间态,这与今天 EditaLive 的思路高度一致,说明这已经成为流式视频生成的一种标准做法。把外观记忆做成「只构建一次、全程锚定」也很聪明:服装是整段视频里唯一恒定的东西,没必要反复重新编码。需要注意的是:一是效率数字来自作者自绘的对数坐标图且未标注硬件,22.39 FPS 是在什么分辨率、什么显卡上取得的并不清楚,与基线是否同配置也无从核对,这在以速度为主要卖点时是个明显缺口;二是「相比同规模模型更优」的措辞回避了与更大模型的直接比较;三是全局外观记忆依赖一张正面试穿关键帧,人物大幅转身、侧背面出现时服装的未见部分如何保持合理,论文没有给出针对性分析。 8. Self-OPD:去掉教师用自己分叉当监督 Self-OPD: On-Policy Distillation for Flow Matching Models without Teacher | 清华大学、浙江大学、阿里巴巴 | arXiv:2608.26872 关键词:on-policy蒸馏,流匹配,无教师,奖励对齐,多目标优化,阿里 前序问题:On-policy 蒸馏(OPD)靠一个预训练的专用教师提供稠密监督信号,在大语言模型上很成功,最近也被搬到流匹配模型上。但这套范式有两个明显负担:一是每换一个优化目标就得训一个对应的专用教师,算力成本高得离谱;二是教师与学生的分布存在差异,会让误差沿生成轨迹不断累积放大。也就是说,教师既贵又不完全可靠。 本文贡献:Self-OPD 是面向流匹配模型的无教师 OPD 框架,把学生自己的探索转化为逐步监督。在每个时间步,它把确定性的下一状态预测分叉成 K 条随机 SDE 候选,用 ODE 采样器把它们各自推演完,再拿各自的奖励与一个确定性的自参考基线比较,得到归一化后的优势。速度场用「全分支推拉」目标优化:高优势的分支吸引学生靠近,低优势的分支在方向感知衰减与 SDE 方差归一化下把学生推开。面对多目标对齐时,Self-OPD 在奖励层面融合归一化分数,从而避免不同目标的梯度直接冲突。 Self-OPD pipeline. Top: The student branches its prediction into $K$ SDE paths (blue), generates images via ODE rollouts (purple), and scores them ($r^+, r^{\mathrm{ref}}, r^-$). Bottom-left: Rewards define a self-referenced advantage $A_k$ that pulls toward high-reward velocities $v_+$ and pushes away from low-reward velocities $v_-$. Bottom-right: A direction-aware coefficient $d_k$ gates the push to prevent it from counteracting the pull, resulting in the multi-branch loss $\mathcal{L}_{\text{Self-OPD}}$. 实验效果:在单一奖励与混合奖励基准上,Self-OPD 均优于此前的强化学习与 OPD 方法,且不需要任何任务专用教师。作者提供的雷达图显示:单奖励设定下它在 GenEval(strict / cont.)、HPSv2、PickScore、OCR 五个维度上全面包住 SD3.5-Base、Flow-GRPO、GRPO-Guard、Flow-OPD(教师)与 DiffusionOPD(教师);混合奖励设定下它在七个维度上整体领先,仅在 HPSv2(sep.) 与 PickScore(sep.) 两项上略逊于 DiffusionOPD 教师方案。 Overview of Self-OPD. 批判点评:去掉教师这件事的意义主要在成本结构上——「每个新目标都要训一个专用教师」本来就是 OPD 落地的最大阻碍,用学生自己的随机分叉构造对照来替代,方向是对的,也和 RubricRM 的「让评价适配输入」共享同一种去中心化思路。在奖励层面而非梯度层面融合多目标,回避梯度冲突,也是个干净的工程选择。但这套方法的天花板明显受奖励模型限制:所有监督信号都来自奖励打分,一旦奖励有偏,自我强化会把偏差放大,而论文正是用 HPSv2、PickScore、GenEval 这些奖励来训练又用它们来评测,存在自我印证的风险,缺少人类偏好评测作为独立校验。另外每步分叉 K 条候选并各自完整推演,训练开销不会低,作者虽给了 training_efficiency 图,但与「省掉训练教师」的成本节约究竟净赚多少,没有算总账。混合奖励下两项指标落后于教师方案,也说明无教师并非全面免费。 9. RubricRM:先给指令定评分表再打分 RubricRM: Generative Reward Modeling via Dynamic Rubrics for Image Generation and Editing | 北京大学、阿里巴巴、阿里巴巴达摩院 | arXiv:2608.26956 关键词:奖励模型,动态评分细则,文生图,图像编辑,GRPO,EMNLP2026,阿里 前序问题:奖励模型是对齐视觉生成模型的关键部件,但现有视觉奖励模型大多只输出一个标量分数,或者依赖一套固定评价标准。这在文生图和指令图像编辑上尤其不合适——不同输入需要的评价维度本来就不同:一句要求渲染文字的提示,该看的是文字准确度;一句要求改背景的编辑指令,该看的是主体是否被保住。用同一把尺子量所有任务,既损失可解释性,也丧失任务敏感性。 本文贡献:RubricRM 是一个成对生成式奖励建模框架,把打分拆成两步:先针对具体输入生成专属的评分细则(包含评价维度、各维度权重与打分标准),再依照该细则为候选图像打分。作者为文生图与图像编辑分别训练专用模型,采用两阶段流程:监督微调让模型学会「基于细则打分」这一范式,随后用 GRPO 配合细粒度的维度级奖励(同时考虑方向与绝对误差)进一步提升打分质量。训练数据覆盖常见物体、风格、构图、推理、文字、世界知识等广泛类别;作者还引入了饱和过滤,从其训练曲线看,不做过滤时奖励均值会崩塌、熵急剧下降、回复长度暴涨,加入过滤后三者都保持平稳。 Inference and training pipeline of RubricRM. (A) RubricRM supports both text-to-image and image-editing preference selection. At inference time, the model first dynamically generates a rubric conditioned on the input, including scoring criteria and corresponding weights, and then scores each image along each dimension based on the rubric, all within a single inference pass. (B) Training is conducted in two stages. The model is first supervised fine-tuned on synthesized rubric data to learn the paradigm of rubric generation followed by scoring, and is then further optimized with GRPO using dimension-level rewards.-0.6cm 实验效果:在多个生成与编辑基准上,RubricRM 优于既有的专用奖励模型,并且在骨干模型更小的情况下仍能与强闭源 MLLM 裁判保持竞争力。模型、数据与代码已开源。论文被 EMNLP 2026 主会接收。作者给出的数据分布显示,文生图侧覆盖常见物体 92.9%、风格 69.4%、构图与透视 52.2%、世界知识 15.8%、逻辑推理 9.0%、文字渲染 6.4%;编辑侧以物体编辑 45.9%、属性编辑 25.7%、背景编辑 18.1% 为主。 批判点评:「先定标准再打分」在思路上是对的——把评价标准从固定尺子变成随输入生成,同时顺带解决了可解释性(读者能看到每个维度的得分构成),这比单纯堆一个标量分数进步明显。用维度级奖励做 GRPO 而不是只用最终偏好,也让训练信号更稠密。但有几个隐忧:一是评分细则本身由模型生成,谁来保证细则的合理性?如果细则生成偏了,后续打分再精确也是错的,论文没有对细则质量做独立评估;二是这类框架天然存在自我一致性偏好的风险——用同一个骨干生成细则又用它打分,容易系统性偏爱某类图像;三是数据分布明显长尾,文字渲染仅 6.4%、逻辑推理 9.0%,而这两项恰恰是当前文生图最容易出错、最需要奖励模型把关的能力,覆盖如此之低,实际把关效果值得怀疑。作者的饱和过滤消融倒是很有说服力,可惜这类训练稳定性细节在正文里份量偏轻。 10. StreamAV-Bench:13个系统流式音视频集体翻车 StreamAV-Bench: A Comprehensive Benchmark for Streaming Audio-Video Generation | 北京智源研究院、北京大学、可灵、清华大学、中国科学技术大学 | arXiv:2608.26336 关键词:流式音视频生成,评测基准,长时程稳定性,交互响应,状态保持,智源,可灵 前序问题:生成模型正把视频生成推向无边界的流式音视频生成,用于实时交互世界。但现有基准评的都是「已完成的序列」,抓不住流式特有的性质——比如生成过程中能否持续响应新指令、长时间跑下去质量是否漂移、交互后的状态能否被后续保持和复用。缺了这类评测,流式音视频模型的真实短板就是不可见的。 本文贡献:StreamAV-Bench 是首个专门面向流式音视频生成的综合基准,建立了统一评测框架,分两条赛道:渐进赛道测指令遵循与长时程稳定性(单一提示,生成 60/120/180 秒,考察描述全局状态的能力);交互赛道测交互响应与状态保持复用(初始提示 + 在 30/60/90/120/150 秒处陆续注入更新提示)。基准覆盖 32 个细粒度维度,含经专家验证的评测用例(渐进 160、专家验证 320、交互 160),在内容复杂度(实体/活动/音频复杂度)与更新复杂度(交互类型/更新模态/时间依赖)两轴上组织,场景-音频联合覆盖 8 个场景×5 个音频域,主体-风格 5 类×4 种视觉风格,并采用双人评审加裁决的流程保证质量。指标侧分渐进赛道(指令达成与漂移、质量漂移、音视频漂移、视觉一致性)、交互赛道(更新达成率、响应延迟、视听状态保持、历史依赖遵循)与共享指标(视觉/音频质量、跨模态对齐、原生边界连续性、FPS、首块时间)。 We present StreamAV-Bench, a comprehensive benchmark for streaming audio-video generation. (a) The benchmark includes a progressive track to assess instruction adherence and long-horizon stability, and an interactive track to measure interactive response alongside state retention and reuse. (b) The benchmark covers content complexity in both tracks and update complexity in the interactive track, with 320 expert-verified scenarios that span 8 scene domains, 5 audio domains, 5 subject categories, and 4 visual styles. (c) The evaluation is driven by a unified framework of 32 fine-grained dimensions, computed with expert models, MLLMs, and corresponding checklists. 实验效果:作者对 13 个代表性系统做了大规模评测,结论是当前模型普遍存在两类问题:渐进生成中出现时间漂移,交互控制时存在响应瓶颈。作者给出的失效分类图把问题拍得很清楚,共八类:指令漂移、质量退化、视觉不一致、音视频漂移、更新达成失败、基于提示的连续性失败、状态保持失败、历史复用失败——例如「一只灰猫」生成到后面变成暹罗猫,或指令要求关窗而输出毫无反应。时序演化曲线显示,视觉美学与视觉质量随时长(30→180 秒)单调下滑,而音频质量与音视频同步大致持平,说明退化主要发生在视觉侧。 Qualitative failure cases. Common failure modes in representative streaming generation models. 批判点评:评测类工作的价值取决于它能否暴露此前看不见的问题,这篇在这点上是合格的——八类失效模式的分类图信息密度很高,「视觉随时长单调退化、音频基本持平」这个观察也很有用,它提示流式生成的瓶颈主要在视觉侧而非音频侧,对后续研究是明确的指路。32 个维度加专家双评加裁决,工程量也扎实。但需要提醒:一是它与今天的 Ring Forcing、TetherMem、RECAP-Forcing 撞在同一天,而后三者解决的正是这里暴露的长时程漂移,遗憾的是本文的 13 个被测系统并未包含这些最新记忆方法,因此「普遍存在时间漂移」的结论可能已经部分过时;二是 32 个维度虽全面,但维度越多越容易稀释重点,论文没有交代哪些维度与人类整体观感相关性最高;三是渐进赛道最长只到 180 秒,而「无边界流式」的宣称需要更长时程才能验证,三分钟恐怕还不足以暴露真正的长程问题。 趋势观察 长视频记忆从「压缩历史」转向「给历史建索引」 — 今天有三篇同时冲向自回归长视频的记忆瓶颈,且给出了三种互不相同的索引方式:Ring Forcing 用环形训练强迫模型去远距离历史里检索,并给记忆配了稀疏 RoPE;TetherMem 按「查询是主体还是场景」分流,主体查身份记忆、场景查近期背景;RECAP-Forcing 干脆不按时间存,改按「外观是否新出现」存。共同前提是承认了一件事——固定注意力窗口下,决定成败的不是能塞多少历史,而是能否精准取回需要的那一条。值得注意的是三者都在弱化「时间近=更重要」这个默认假设。 少步蒸馏正在从「加速技巧」变成流式产品的入场券 — EditaLive 把编辑模型压到两步采样、LiveVVT 做三阶段渐进蒸馏并配 Collaborative Matching Distillation,两者的动机都不是刷速度榜,而是「不做到实时这个功能就不成立」——直播换装、直播换脸本质上不允许离线多步推理。它们也都撞上同一个矛盾:强行改成因果会破坏预训练的双向先验、画质掉档,于是解法趋同——在有界窗口内保留局部双向性,再用蒸馏把训练与流式推理对齐。 生成模型开始被当作「渲染器」嵌进既有工业管线 — Magpie 的做法很克制也很务实:不让生成模型接管游戏逻辑,而是把玩法执行留在游戏引擎里,引擎只输出白盒画面,再由独立 Render Server 生成最终视觉。这保住了游戏最不能丢的东西——规则可复现、状态可控。SpatialCrafter 也是类似思路,先出一个几何正确的 3D proxy,再让视频扩散模型只负责补高频细节。两者都在退一步:不追求端到端全能,而是把生成模型放在「渲染」这一层,让可控性由传统方法兜底。 后训练开始摆脱对「更强教师」的依赖 — Self-OPD 把 on-policy 蒸馏里的教师直接去掉,让模型自己分叉出 K 条 SDE 候选、用奖励算优势来自我监督;RubricRM 则让奖励模型先针对当前指令生成评分细则再打分,而不是套一把固定尺子。方向是一致的:监督信号从「外部权威给答案」转向「模型自己产生可比较的对照」。这条路的隐患也明显——自我对照的天花板受限于奖励模型本身的判别力,一旦奖励有偏,自我强化会把偏差放大。 人工智能炼丹君 整理 | 2026-08-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
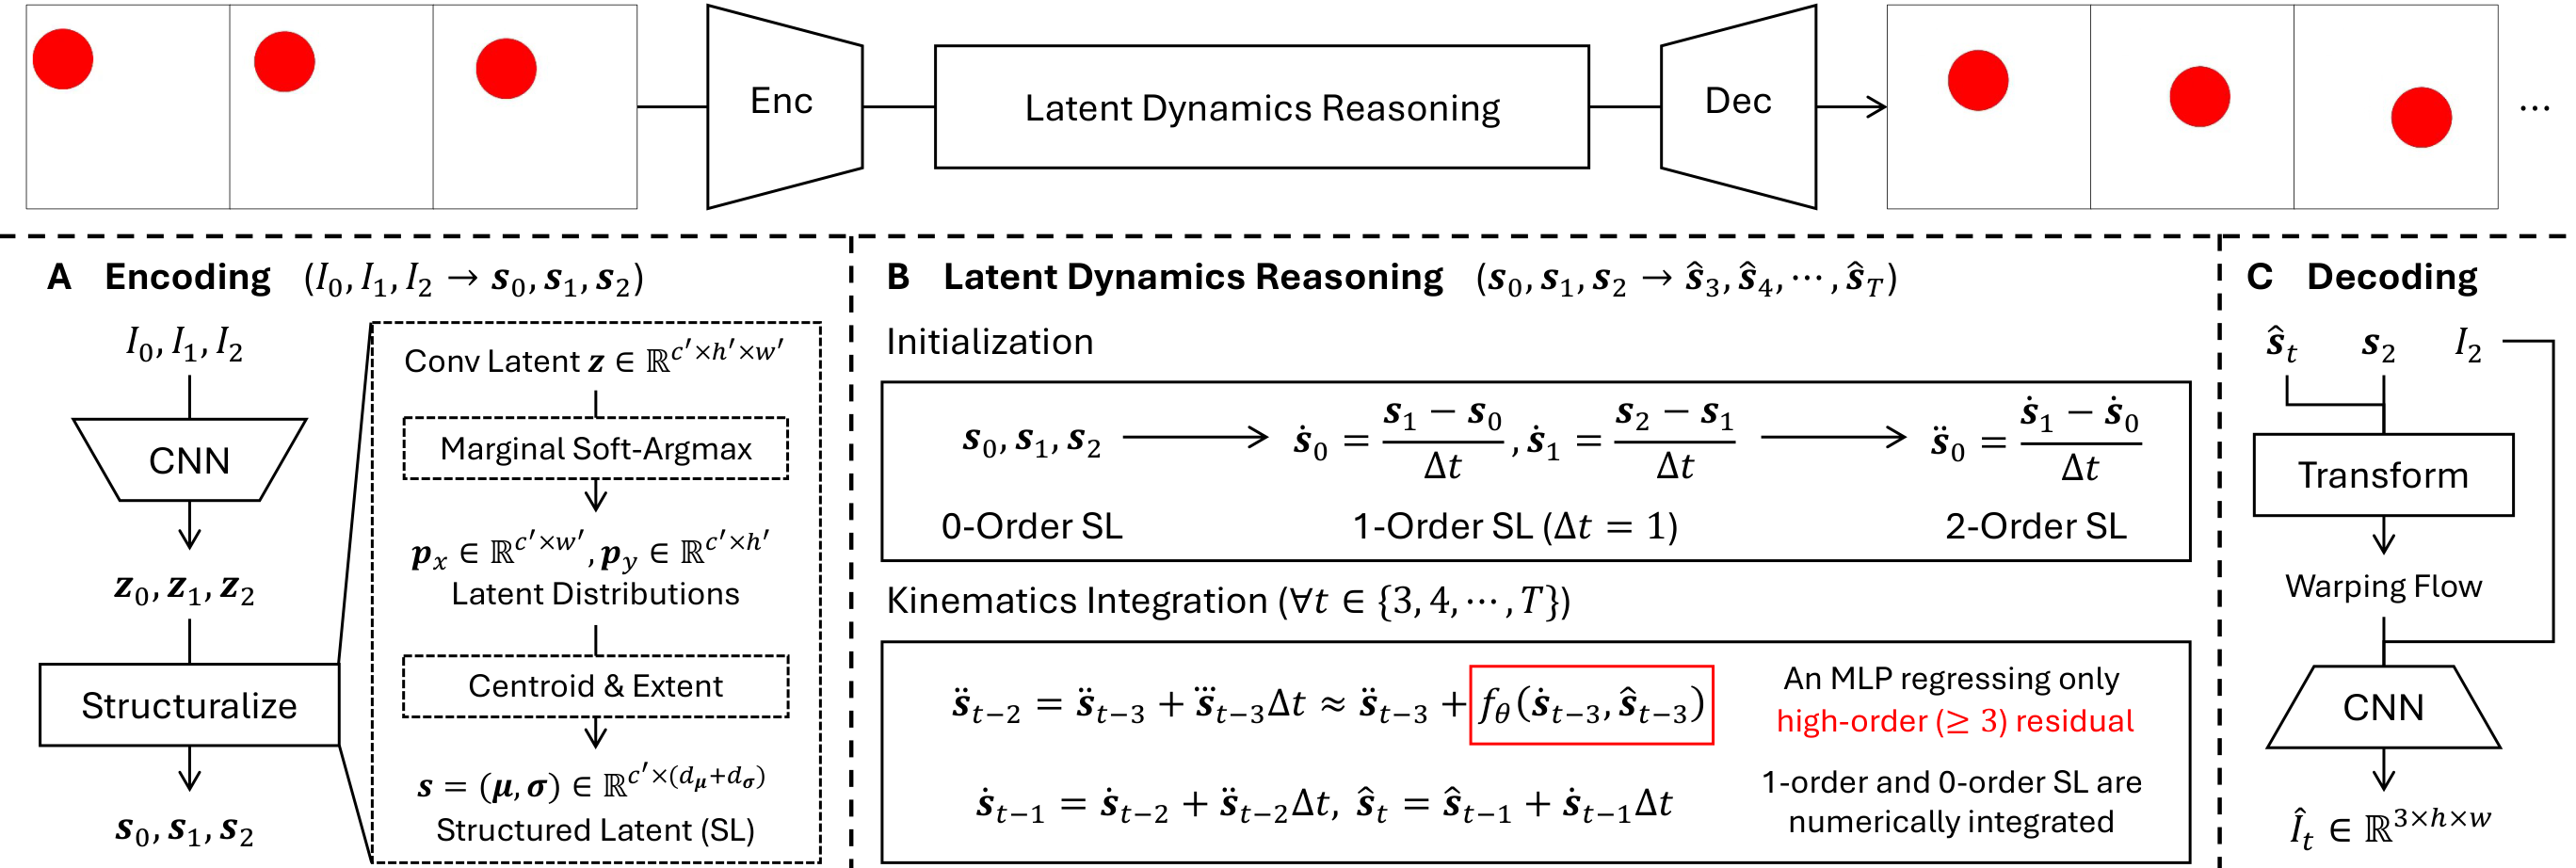
AIGC 每日速读|2026-08-28|京东JoyAI-Echo-1.5给长视频装上跨镜头记忆 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与世界模型 2 篇 · 视频编辑与剪辑规划 2 篇 · 自回归图像生成加速 1 篇 · 3D 资产纹理与物理化 2 篇 · 数字人与语音交互 2 篇 · 评测与度量审计 1 篇 重点论文标题列表 JoyAI-Echo-1.5(京东 Joy Future Academy):跨镜头记忆守住身份与音色 4DStreamCtrl(北京大学、腾讯混元):单卡 480p 20FPS 交互式 4D 控制 RefVideo-6M(中国电信 TeleAI、香港中文大学、中山大学、复旦大学、清华大学):600 万参考式编辑对反转构造 MTAR(佛山大学、香港大学、中山大学):训练时间砍 76% 推理零开销 RefineCut(香港中文大学(深圳)、vivo AI Lab、中国科学院大学、东南大学、北京大学):8B 开源规划器闭环出剪辑时间线 今日论文速览 1. JoyAI-Echo-1.5:跨镜头记忆守住身份与音色 Long-Horizon Audio-Visual Generation for Persistent Stories and Interactive Worlds | 京东 Joy Future Academy | arXiv:2608.23383 关键词:长视频生成,音视频联合生成,跨镜头记忆,世界模型,少步因果蒸馏,分离RoPE,京东 前序问题:视频生成正在从「几秒一个孤立片段」走向「长篇叙事」和「可进入的交互世界」,但这一步跨过去要同时满足三个互相拉扯的要求:跨越多个镜头保持人物长相和声音不漂移、持续响应用户的控制输入、以及在长时间 rollout 中不崩坏。已有做法各有短板——纯靠拉长注意力窗口的方案显存和算力随长度爆炸;单纯依赖首帧条件的方案在第二个镜头之后身份就开始跑偏;世界模型类方案能响应导航输入,却往往把控制信号编码成与几何脱节的抽象向量,导致视角变化不符合真实相机运动。更棘手的是音频:语音身份(音色)与画面身份必须同步维持,而长序列里音画一致性的退化通常比画面本身更早被听出来。 本文贡献:JoyAI-Echo-1.5 是一套统一的音视频生成系统,做成两个针对性变体,共享同一套记忆条件化设计。长视频变体的核心是可组合的跨镜头记忆:从多个此前镜头聚合视觉证据(单帧视觉记忆),同时从「语音过滤后的整镜头音频」中提取说话人线索(音频记忆),两类记忆与文本、图像条件可以任意组合。关键设计是分离的 RoPE 坐标——记忆条目不与当前生成窗口共用位置编码,而是各自分配独立的坐标基点(μ 依次取 500/550/600 且 σ=0),从而让模型把记忆当作「可检索的外部条目」而非「更长的上下文」。世界模型变体则把异构导航输入(键盘、轨迹等)统一换算为标定过的 6-DoF 公制相机轨迹,经几何感知的条件通路注入,使控制与操作设备无关。为支撑长时程效率,作者把双向音视频骨干改造成因果少步生成器:先用渐进 teacher forcing,再在自生成 rollout 上做短时程与长时程的 Self-Gradient Forcing;蒸馏侧采用音视频联合 DMD,视频分支全量微调、音频分支走 LoRA 的非对称优化,并给音频额外加 patch 判别器与 latent RMS 能量匹配做稳定化。 Overview of memory-conditioned long-form generation and few-step acceleration in JoyAI-Echo-1.5. 实验效果:长视频设定下,JoyAI-Echo-1.5 在跨镜头一致性、视觉质量、文本对齐与语音保真度四项上均优于既有长视频基线;与自家 1.0 版本的同故事对比可以看到人物长相在第 0/5/10/15/20/23 镜头间明显更稳。世界模型变体在 WBench 上取得平均 81.7 分排名第一,并在 SANA-WM-Bench 上拿到领先的视觉质量与长时程持久性。作者还展示了在 Director Agent 编排下生成 10 分钟连续音视频叙事的案例。代码与项目页已开源(jd-opensource/JoyAI-Echo)。 Qualitative comparison between JoyAI-Echo-1.5 and JoyAI-Echo-1.0 under the same long-form story. Frames sampled from temporally separated shots demonstrate the improved character consistency, scene stability, and visual rendering of JoyAI-Echo-1.5. 批判点评:这是今天最有系统完成度的一篇,把记忆、几何控制、rollout 感知训练三件事拧成了一条可交付的产线,「记忆用独立 RoPE 坐标编址」这个设计尤其值得借鉴——它把长时程一致性从算力问题重新定义成检索问题。但要清醒看待几点:一是作者自己的对比图(v1 vs v1.5)虽然显示身份更稳,但这是自家版本迭代的自证,跨镜头一致性缺少与外部强基线在同一故事下的逐镜头量化;二是 WBench 81.7 的第一名含金量取决于该榜单的竞争密度与提交时间窗口,且世界模型变体与长视频变体是两套权重,「统一系统」在部署时实际是双栈;三是 10 分钟叙事依赖 Director Agent 做镜头编排,这层是外部 agent 而非模型内生能力,把它算作模型的长时程能力会高估;四是音频分支只用 LoRA 而视频全量微调,这个非对称选择在论文里更多是稳定性权衡的结果,音频质量上限是否被 LoRA 限制没有充分消融。 2. 4DStreamCtrl:单卡 480p 20FPS 交互式 4D 控制 4DStreamCtrl: Interactive Video Generation with Online 4D Control | 北京大学、腾讯混元 | arXiv:2608.25479 关键词:视频生成,4D控制,3D point track,流式生成,因果蒸馏,相机控制,北大腾讯混元 前序问题:生成视频已经足够逼真,但要真正当成交互工具用,必须能精细指定「物体和相机随时间怎么动」——而现有方法各自只覆盖一角:相机参数类方法能调视角但搬不动物体;2D 轨迹类方法在图像平面上操作,忽略深度与遮挡,导致物体沿轨迹移动时尺度和前后关系失真;近期的 3D 方法补上了几何,却只能离线跑且视频长度固定。换句话说,没有一种方法同时做到「相机与物体都是 3D 一致可控」加「实时流式生成」。这两个要求还互相冲突:3D 一致性通常需要全序列联合优化,而流式生成要求因果、恒定显存。 本文贡献:作者的核心主张是:相机运动、物体轨迹、深度这三件事可以统一进单一的 3D point track 表征,一个模型在一次前向里就能同时做相机与物体的联合控制、深度编辑和运动迁移。为了规模化学到这个接口,他们从野外视频挖掘 3D 运动监督,构建 OpenVidHD-Motion3D 数据集,并用一个轻量的 Geometric Motion Head 把 3D tracks 与文本编码为 2D 与深度运动特征,与含噪 latent 融合后送入带 3D RoPE 的 DiT,再解码成视频——这个编码器插在预训练视频扩散模型上,不需要重训骨干。关键一步在于这个编码器是时序可分离的,因此可以把模型蒸馏成因果流式学生:生成任意长视频只需四步去噪,且显存与长度无关。 Overview of 4DStreamCtrl capabilities. (a) Motion transfer. Given a source video, we extract decomposed 4D representations of camera motion, human motion, and background structure, which transfer to a new scene via image style transfer while preserving the original motion. 实验效果:统一设计在运动控制精度上超过此前的相机专用、2D 轨迹和离线 3D 方法,同时覆盖了它们各自孤立支持的模态。4DStreamCtrl 在单张高端 GPU 上以 20 FPS 生成 480p 视频,在数百帧尺度上保持时序连贯,作者称这是首次实现交互式 4D 可控流式生成。控制点数量消融显示质量在训练时使用的 256 条 track 处达到峰值(PSNR 18.27、SSIM 0.64、LPIPS 0.23),点数过少(16)或过多(1024)都会明显掉点。 Effect of the number of control points on student model generation. PSNR, SSIM, LPIPS, and EPE as the inference-time track count varies from 16 to 1024. Quality peaks at the training count of 256. 批判点评:把相机、物体、深度三种控制统一到 point track 这一个表征上,是这篇最漂亮的地方——它让「一次前向多种控制」成为可能,而不是堆三个适配器。工程指标也扎实:单卡 20 FPS 加长度无关显存,确实够得上交互门槛。需要注意的是:一是 point track 的质量完全依赖上游 3D 追踪器,野外视频挖掘出的监督在遮挡、快速运动、低纹理场景下必然带噪,论文没有量化追踪误差如何传导到控制精度;二是 track 数量的敏感性不小(1024 点时 PSNR 从 18.27 掉回 16.21),说明模型对推理期配置的鲁棒性有限,实际部署需要把点数锁在训练值附近,这对「艺术家自由指定轨迹」的宣称是个约束;三是作者自己的失败案例图承认长时程下小人脸与背景物体会逐渐模糊、并出现因果不一致的交互(蛋糕莫名缺一块),说明四步因果学生在细节保真上仍有代价;四是 480p 分辨率对「交互式创作工具」偏低,抬到 720p/1080p 后 20 FPS 能否维持是未知数。 3. RefVideo-6M:600 万参考式编辑对反转构造 RefVideo-6M: A Reliable Reference-Based Dataset for Instructional Video Editing | 中国电信 TeleAI、香港中文大学、中山大学、复旦大学、清华大学 | arXiv:2608.26101 关键词:视频编辑,参考式编辑,数据集,Mixture-of-Tokens,指令编辑,TeleAI,中国电信 前序问题:指令式视频编辑这两年的进展主要靠大规模数据集推动,但现有数据集有两个硬伤。第一是「目标视频本身是生成的」:多数数据集的编辑后视频由自动编辑模型产出,本身就带伪影和瑕疵,拿它当监督信号等于教学生模仿一个不合格的老师,误差会被继承甚至放大。第二是「只有文字没有参考图」:大部分公开数据集依赖纯文本指令,而真实的精确编辑往往需要视觉参考——要把这件衣服换成那件、把人脸保持成这个身份、把材质换成这块纹理,光靠文字描述无法唯一确定目标,也无法保持身份一致。 本文贡献:RefVideo-6M 用一个反转技巧同时解决这两个问题:把无伪影的真实视频当作编辑「目标」,再用多个编辑专家反向生成质量筛选过的「输入」条件——也就是把原视频与编辑后视频的角色对调,从而保证监督端永远是真实画面。数据规模为 500 万视频编辑样本加 100 万图像编辑样本,覆盖 26 类视频编辑任务与 6 类图像编辑任务,并提供约 600 万个视觉参考,参考类型相当多样:圈选、边界框、光照方向、外扩掩码、背景图、风格、纹理、物体、人物、服装。构造管线除了八个开源专家外,作者还自训了四个专家来补覆盖。配套模型 RefMoT 采用 Mixture-of-Tokens 设计来高效吸收参考信息:视频/参考/文本/条件文本四路 token 各有独立的 QKV 投影与 FFN,但共享 AdaLN 与注意力,并用结构化掩码控制哪几路可以互相看见,从而在降低训练成本的同时提升参考引导编辑质量。 Overview of RefMoT. RefMoT adopts a Mixture-of-Tokens design to efficiently incorporate reference information, reducing training cost while improving reference-guided editing quality and preserving strong generalization. 实验效果:数据集覆盖 26 个视频编辑任务与 6 个图像编辑任务,视频长度以 81 帧和 129 帧两档为主,任务分布上物体添加/移除/换色/重纹理等局部编辑占主体。作者提供了有参考与无参考两种设定下的用户研究界面与对比,RefMoT 在参考引导编辑质量与泛化性上均有提升,同时训练成本低于将参考直接拼接进序列的朴素做法。 Statistics of RefVideo-6M. The dataset includes 26 editing tasks and 6 image editing tasks. 批判点评:「把真实视频当目标、反向合成输入」这个反转思路是本篇最有价值的部分,它绕开了「用生成数据训生成模型」的误差累积陷阱,思路干净且可复用到图像编辑之外的领域。RefMoT 的 Mixture-of-Tokens 也是务实设计——共享注意力省算力、独立 FFN 保模态特性。但几点必须打问号:一是反转策略只对「可逆」任务成立,物体移除反转成物体添加是自然的,但风格迁移、重打光这类反转后语义并不对称的任务,输入条件的真实性依然依赖那 12 个专家的质量,论文没有按任务类型拆开报告数据可靠性;二是「600 万参考」的口径包含圈选、边界框这类几何提示,与真正的图像参考混在一个数字里,容易高估视觉参考的规模;三是评测以用户研究为主,缺少在公开视频编辑基准上与其他数据集训练的同架构模型做控制变量对比,「数据集更好」的结论强度受限;四是 81/129 帧的长度上限意味着这套数据对长视频编辑基本无覆盖。 4. MTAR:训练时间砍 76% 推理零开销 Efficient Training with Foresight: Multi-Token Auxiliary Supervision for Autoregressive Image Generation | 佛山大学、香港大学、中山大学 | arXiv:2608.25386 关键词:自回归图像生成,多token预测,训练加速,对比正则,语义丢弃,DINOv3,ACM MM 2026 前序问题:自回归图像生成把图像当作离散 token 序列建模,扩展性好、保真度高,但传统的 next-token prediction(NTP)有三个连在一起的毛病:监督稀疏且近视——每步只预测紧邻的下一个 token,模型学不到稍远处的结构;表征区分度不足——采样得到的 token 表示彼此不够可分;训练成本高——必须在完整 token 序列上做密集计算,而图像 token 里有大量低信息量的背景与平坦区域,这些位置消耗了同等算力却贡献很少学习信号。已有加速手段多数动的是推理侧或架构,训练阶段「每一步梯度携带多少信息」这个维度反而少有人碰。 本文贡献:MTAR 是个纯训练期框架,三个组件全部只在训练时生效、推理时零额外开销。一是多 token 预测(MTP):在原有 NTP 头之外再加一个 MTP 头,对「当前 token 正下方」的 token 提供辅助监督,把稀疏近视的信号加密成对多个未来 token 的联合监督(论文记作 MTP(R₁,B) 配置)。二是 token 级对比正则(TCR):对采样到的 token 表示走共享权重的 MLP 得到相似度矩阵,同类拉近异类推远,显式提升表征可分性。三是语义丢弃(SD):用 DINOv3 为每张图提取 token 重要度图,丢掉低重要度 token 只保留语义显著的位置参与训练,保留 token 沿用其原始空间索引以免位置信息错乱——作者还对比了 SigLIP2,发现 DINOv3 的重要度图在 50% 保留率下更好地保住了 VQ 解码后的结构。 Overview of the proposed framework. (a) Overall framework under the MTP (R$_1$, B) setting: besides the original NTP (R$_1$) head, an additional MTP head is introduced to provide auxiliary supervision for the token directly below the current token. (b) TCR: Sampled token representations are projected by a shared MLP to compute a similarity matrix. 实验效果:在 ImageNet 上,相比 LlamaGen,MTAR 拿到最多 0.95 更低的 FID 与 39% 更快的训练;而在总量口径上(LlamaGen 训练 300 epoch,MTAR 只训 100 epoch),Base 模型训练时间从 115 小时降到 30 小时(降 74%)、显存从 45 GiB 降到 31 GiB(降 30%),Large 模型从 175 小时降到 42 小时(降 76%)、显存从 97 GiB 降到 73 GiB(降 25%)。即使只用 1/3 的训练迭代数,性能仍与基线相当或更好。 Comparison of total training time (hours) and total GPU memory usage across all training GPUs between LlamaGen and MTAR for the Base and Large models, along with the corresponding FID values. LlamaGen is trained for 300 epochs, whereas MTAR is trained for only 100 epochs. 批判点评:这篇的价值在于把优化战场从推理侧挪回训练侧,且三个组件都不污染推理路径——对工程落地非常友好,尤其 SD 用现成视觉基座的重要度图来分配算力,思路简单但有效。但读数字时必须小心口径:论文摘要里的「39% faster」与配图里的「降 74~76%」不是一回事,后者把 epoch 数从 300 砍到 100 一起算进去了,等于把「收敛更快」和「单步更省」混在同一个百分比里;如果只看同迭代数,真实加速是 39%。其次,MTP 只对「正下方」一个 token 加监督,比语言模型里成熟的多 token 预测要保守得多,为什么选这个方向、能否推广到更远距离缺少系统消融。第三,SD 引入了对 DINOv3 的外部依赖,重要度图的偏好会隐式塑造生成分布(比如系统性弱化背景细节),这个副作用没有被评估。最后,实验规模停在 ImageNet 256×256 与 LlamaGen Base/Large,能否在更大规模或文本条件生成上复现,仍是开放问题。 5. RefineCut:8B 开源规划器闭环出剪辑时间线 Plans You Can Check: Verifier-Grounded Learning of an Open-Weight Planner for Executable Video-Editing | 香港中文大学(深圳)、vivo AI Lab、中国科学院大学、东南大学、北京大学 | arXiv:2608.25622 关键词:视频剪辑规划,可执行时间线,验证器,开源规划器,DPO,EMNLP 2026,vivo 前序问题:实际的视频剪辑远不只是像素生成:剪辑师要把一份创作 brief、一个素材池、音乐元数据和一堆硬性约束,转成一条可执行的时间线——选哪些片段、怎么裁、怎么排、用什么转场、总时长和音乐怎么对齐。这个「决策层」此前基本被忽略,或者被简单包装成「给前沿大模型套个 workflow」的做法。这条路有三个问题:规划过程隐式不可复现、生成的方案无法被机器验证、也没法拿来训练自己的模型。更麻烦的是这个任务没有唯一正确答案——同一个 brief 有很多种合理剪法,所以直接模仿老师的输出并不合适。 本文贡献:RefineCut 把这件事定义为「可执行视频剪辑规划」,并训练一个紧凑的开源权重规划器而非包装前沿模型。规划器通过结构化补丁(patch)编辑一条带类型的时间线,覆盖片段选择、裁剪、排序、转场、时长与音乐对齐;每个补丁由一个确定性验证器实际应用并对照显式的约束账本(constraint ledger)逐条检查。因为不存在唯一正解,训练不直接模仿老师:作者把每个多老师分支都通过验证器重放一遍,只保留「验证器认为最好」的修复作为监督(verified SFT)。第二阶段 RefineCut-Evo 让学生用验证器加任务评分表给自己的修复打分,挑高边际的偏好对做 DPO 训练。最终这个 8B 规划器在推理时完全跑在闭合验证器回路里,不再需要调用任何老师模型。 Overview of RefineCut. Verifier replay and self-improvement turns noisy trajectories into an evolved planner. 实验效果:论文构建了 RefineCut-Bench(3578 条任务)用于评测。系统的实际形态是一个闭环编辑 agent:维护时间线状态与约束账本(时长边界、转场规则、步数预算 ≤3、禁用项、风格一致性),规划器输出 RefinePatch,验证后重算状态并接受或拒绝,循环不超过 3 次,最终产出可执行的 final_plan.json。作者用 GPT-5.4、DeepSeek-V4-Pro、Qwen3-Max 作为多老师来源,并明确展示了「老师选择 ≠ 验证器最优」的错配现象,这正是 verified SFT 的动机。 RefineCut learns an open-weight planning layer that turns editing intent into executable edit plans. 批判点评:把「剪辑决策」从像素生成里剥出来单独建模,并且用确定性验证器做监督筛选,这个问题定义本身就是贡献——它让一个原本靠 prompt 碰运气的环节变得可复现、可验证、可训练,「老师选择 ≠ 验证器最优」的观察也很有说服力。8B 能本地跑、推理期不依赖老师,对产品化是实打实的好处。但天花板明显被验证器框住了:验证器只能检查可形式化的约束(时长、转场规则、禁用项),而剪辑质量里最关键的节奏感、情绪曲线、镜头语言恰恰无法写成账本条目——所以「verifier-best」未必等于「人觉得好」,论文若没有充分的人工偏好评测,这个 gap 就是悬着的。其次多老师全是闭源前沿模型,数据构造成本与可复现性受制于这些 API,且学生的能力上限被老师分布圈定。第三,步数预算 ≤3 是个相当紧的约束,复杂 brief 下是否够用没有讨论。最后 RefineCut-Bench 由作者自建,缺少第三方基准交叉验证。 6. GLOSS:单形状自监督纹理刷进 Blender GLOSS: Geometric Local Self-Similarity Learning for Faithful Reference-Guided Texture Fill | NVIDIA、普林斯顿大学、多伦多大学 | arXiv:2608.25461 关键词:3D纹理生成,参考引导,几何自相似,PBR材质,Blender插件,SIGGRAPH Asia,NVIDIA 前序问题:纹理艺术家想为一个已有 3D 形状快速试多种外观,条件图像生成本来很合适,但当前最强的方法仍有两个缺口。一是保真度:生成整个物体纹理时很难同时贴合精细几何细节和单视图参考,留给艺术家引导的空间很小——模型倾向于按自己的全局理解重画,而不是老老实实跟随参考。二是灵活性:现有自动模型多数是「给个全局提示、一键出整体纹理」,艺术家无法从不同来源交互式、可控地探索多种纹理组合。这类方法通常还要在大规模 3D 数据集上训练,数据门槛高。 本文贡献:GLOSS 走了一条反直觉的路线:不追求在大 3D 数据集上学通用先验,而是针对单个 3D 形状训练一个「形状专属」的局部纹理生成与补全模型,利用自然与人造形状中普遍存在的几何自相似性以及几何-纹理相关性。具体做法是在该未贴图形状的大量单视图生成图像上训练网络,让它学会通过关注局部几何(比如鳞片走向)来为局部区域上色,并忠实跟随作为条件的纹理参考块。训练完成后,任何新参考都能通过逐块 inpainting 迁移成整个目标物体的纹理。作者还展示了批量多注意力可视化,说明目标图像中心 patch 如何跨批次关注参考图像的各个 patch。 We train a GLOSS network on many single-view generated images of one untextured 3D shape (left), allowing it to learn how to texture local shape regions by attending to local geometry (such as scales) and faithfully following conditional texture patches. 实验效果:质量上达到或优于强图像条件纹理生成基线,同时额外支持局部几何条件下的纹理修补(由艺术家挑选参考引导),并可泛化到 PBR 材质与未见网格做纹理迁移。作者把这个纹理填充能力做成 Blender 插件,与若干 3D 纹理专业人士做了试点,对模型的可控性、实用性与创作启发性反馈积极。论文也诚实给出失败案例:语义纹理错配,以及几何与纹理相关性低时的失效。 Data and Training: we use off-the-shelf models to generate training data for our local texture inpainting model. Steps A to F show the patch data generation pipeline. 批判点评:「per-shape 专属模型」这个取向很有意思——放弃泛化换取对单个资产的极致保真与可控,正好命中艺术家工作流里「这一个模型要做到位」的真实需求,而且大幅降低了数据门槛。做成 Blender 插件并请真实从业者试用,这种落地闭环在学术论文里不多见,值得加分。但代价也很直白:每换一个形状就要重新训练一个网络,论文摘要没有给出单形状训练耗时,这直接决定它是「可用工具」还是「demo」;如果一个资产要等数小时,交互式探索的价值就被抵消了。其次「几何自相似性」这个前提有明确适用边界——鳞片、砖墙、织物这类重复结构受益明显,而光滑无特征或语义强依赖(比如人脸、品牌标识)的表面会退化,作者的失败案例也承认了几何-纹理相关性低时失效。第三,专业人士试点是小样本主观反馈,缺少与现有商业工具的定量对照。最后,作者之一因会议地点原因撤出 SIGGRAPH Asia 2026 发表,属论文外信息,但说明该工作原定投向图形学顶会。 7. Gen2Physics:材质分割 mIoU 15.6 涨到 48.3 Gen2Physics: Grounding Generated 3D Meshes in Physics via Multi-View Material Decomposition | Google DeepMind、Google Research、布里斯托大学 | arXiv:2608.23869 关键词:3D生成,物理仿真,材质分解,多视图一致性,VLM精修,水密子网格,Google DeepMind 前序问题:生成式模型现在能产出高保真 3D 网格,但这些输出缺少交互仿真、游戏和机器人所需的物理属性——它们只是「看起来对」的壳,没有材质、密度、内部结构信息,扔进物理引擎里行为完全不对。此前的物理化工作大多针对体素或神经场等体表征,与标准物理引擎不兼容,需要额外转换;而且它们通常把整个网格当作单一均质物体处理,一把钳子的金属头和塑料柄被赋予同一个密度,自由落体和碰撞行为自然失真。 本文贡献:Gen2Physics 是一套统一自动的框架,直接在网格上操作以产出可立即仿真的资产。管线三段:先用微调过的 Vision Transformer(论文亦称 DPT)在多视图 2D 渲染上做稠密材质分割;再做稳健的 2D-to-3D 一致性投影——把资产每个面投影到各渲染视图上并考虑遮挡,按跨视图投票为每个面指定材质标签,从而把噪声大、视图间不一致的 2D 掩码聚合成一致的 3D 材质图;最后由视觉语言模型(VLM)引导精修,利用上下文推理分配物理属性并推断内部几何(实心还是空心)。通过把表面 patch 转成带不同密度的体,该方法让物理上合理的动力学仿真成为可能,并输出每种材质各自水密的子网格。作者同时构建了 PartNet-Material 数据集,通过人工为资产每个部件指定材质标签得到稠密分割掩码。 Process of our 2D-to-3D consistency projection. A fine-tuned ViT predicts material segmentation masks, which are possibly noisy and not consistent across views. We project each face of our asset onto the rendered views, taking into account occlusions. For each face, we assign a label corresponding to the cross-view vote. 实验效果:在 ABO-500 与 PartNet-Material 两个基准上,Gen2Physics 把此前物理化管线的材质分割精度提升一倍多(mIoU 从 15.6 提到 48.3),同时在质量估计精度上与体表征方法持平,并且是唯一能输出「每材质水密子网格」的方法。定性对比中可以看到 NeRF2Physics 与 PUGS 的材质分割碎片化严重(椅子、水壶、钳子上出现大片错误标签),而 Gen2Physics 的结果与人工标注的 GT 分割高度接近。 We compare Gen2Physics (Ours), NeRF2Physics, and PUGS on a material identification task. The visualizations show that the 2D-to-3D consistency projection and VLM refinement proposed in Gen2Physics ensure more coherent and accurate material segmentations. In contrast, NeRF2Physics and PUGS produce fragmented predictions. 批判点评:选题很实用:生成 3D 的下一个瓶颈确实是「能不能进引擎」,而不是「像不像」。直接在网格上做、输出每材质水密子网格这两个工程决策,让结果可以无缝喂给标准物理引擎,比一堆需要转换的体方法更贴近生产。mIoU 从 15.6 翻到 48.3 的幅度很大,定性图上与 GT 的接近程度也支持这个数字。但必须看清基线的起点极低——15.6 mIoU 本身已经接近不可用,翻一倍后的 48.3 也谈不上可靠,意味着仍有过半的面材质判错,直接用于精密仿真风险不小。其次「实心还是空心」由 VLM 上下文推理给出,这是一个没有视觉证据支撑的猜测(外观看不出内部),论文若未单独评估这一项的准确率,那么质量估计「持平体方法」的结论可能建立在互相抵消的误差上。第三,材质类别只覆盖木/金属/织物/玻璃/塑料/皮革/橡胶七类,复合材质、涂层、透明件这些真实资产里的常见情况无法表达。最后 PartNet-Material 是作者自建且人工标注,规模与标注一致性未披露。 8. Super Star:只用已生成语音在线出手势 Super Star: Towards Streaming Real-time Interactive Agents for Digital Humans | 上海科技大学、腾讯光子工作室(LIGHTSPEED) | arXiv:2608.24909 关键词:数字人,协同语音手势,流式生成,因果自回归,自演化数据,ACM MM 2026,腾讯光子 前序问题:协同语音手势生成(co-speech gesture)此前几乎都在离线设定下研究:拿到一整段完整语音,再合成配套手势。但真实场景里的交互式数字人必须在线生成——只能用当前已经产生的回复音频,还要满足严格的延迟约束。这让已有方法直接失效,因为它们要么依赖未来语音信息(离线双向建模),要么推理延迟太大。这是个结构性错配,不是调参能解决的:一旦不能看未来,手势与语音的同步就要靠因果预测完成,而手势的自然度恰恰很依赖对整句韵律的预判。 本文贡献:作者形式化了「面向交互式数字人的在线协同语音手势生成」这一任务,并提出一个实时交互框架,把流式语音回复模块与在线手势生成模块耦合起来。手势生成器设计为因果多模态自回归模型,从流式回复语音与运动历史预测身体动作,因此无需访问未来语音即可做到低延迟、语音对齐的手势合成——具体结构上,Omni 模型接收用户音频/查询文本/第一视角视觉,输出文本-音频 token 流,经流式 coder decoder 后与组合式身体 token 一起进入若干层因果自注意力加带音频注意力掩码的多头交叉注意力,最后由 motion decoder 输出动作。为支撑这个设定,作者还设计了面向虚拟陪伴场景的离线数据合成管线:用话题与情绪感知的主体语料库构造多样的人机对话,再针对 agent 回复生成协同语音手势(用到 TTS、动作捕捉与音色克隆,16 台相机加 50 个标记点)。为弥合离线构造与在线部署的差距,他们建立自演化训练回路,把线上交互中收集的用户反馈重新灌回数据生成流程,实现对用户偏好的持续适配。 Overview of Super Star. (a) Offline interactive data synthesis and self-evolving loop pipeline for constructing virtual-companion-oriented training data that continuously adapts to user preferences. (b) Online real-time interaction pipeline, where a streaming speech response module is coupled with an online gesture generator. 实验效果:实验显示该框架在延迟-质量权衡上更优,语音-动作同步性更强,用户偏好度高于有竞争力的既有基线。定性对比中,给定同一段流式回复语音,该方法比基线反应更及时、手势更自然同步。论文被 ACM Multimedia 2026 接收。 Qualitative comparison of online co-speech gesture generation. Given the same streaming response speech, our method reacts more promptly and generates more natural and synchronized gestures than existing baselines. 批判点评:把任务从离线搬到在线并明确「不能看未来语音」这个约束,是这篇的主要贡献——它承认了产品场景的真实限制,而不是在离线设定里继续刷指标。自演化回路(线上反馈回灌数据生成)也是个务实的工程闭环,配合腾讯光子的背景,看得出是冲着实际数字人产品去的。但论文的量化披露偏弱:摘要通篇是「更优」「更强」「更高」,没有给出延迟的毫秒数、同步性指标的具体数值,而延迟恰恰是这个任务的核心卖点,缺了数字就无法判断是否真达到交互门槛。其次训练数据完全由自建管线合成(LLM 造对话 + TTS + 音色克隆 + 动捕),合成数据的分布偏差会直接塑造手势风格,且「虚拟陪伴」场景的定向语料使结论难以外推到其他交互类型。第三,自演化回路依赖线上用户反馈,存在偏好漂移与正反馈放大的风险,论文未讨论如何防止手势风格被少数活跃用户带偏。最后,评测以用户研究为主,缺少与工业级数字人系统的端到端延迟对照。 9. CSAVocoder:因果流式空间音频恒定显存 CSAVocoder: A Causal Spatial Audio Vocoder Towards Real-Time Spatial Audio Generation | 浙江大学 | arXiv:2608.25404 关键词:空间音频,声码器,因果流式,GAN,通道间线索,实时生成,浙江大学 前序问题:空间音频声码器负责把生成模型产出的梅尔谱转成空间音频波形,是沉浸式内容链路的最后一环。问题是绝大多数神经声码器是为单声道设计的,直接扩展到空间音频会损害空间质量——因为它们逐通道独立重建,完全忽略了通道间线索(inter-channel cues),而人耳判断声源方位恰恰依赖左右耳的时间差与强度差。此外实时应用还要求严格因果与恒定显存,这与常见的非因果、看全局上下文的声码器架构直接冲突。 本文贡献:CSAVocoder 是一个因果的 GAN 空间音频声码器,把波形保真度与空间渲染联合优化。框架引入两个针对性设计:一是 Spatial Adaptor,把多通道梅尔谱与动态的声源-听者位姿信息融合,让声码器知道当前的空间关系而不只是频谱内容;二是空间一致性判别器,专门监督通道间线索是否被正确重建,而不是只看单通道波形像不像。为满足实时要求,作者设计了严格因果、带状态的生成器,支持高效流式推理且显存开销恒定——这一点对长时间连续渲染尤其关键。 Overview of our model architecture. 实验效果:在大规模空间音频数据集上,CSAVocoder 的空间类指标全面超过所有对照声码器(含扩散类声码器),同时在常规音频质量指标上保持有竞争力,并达到实时性能。评测同时走客观与主观两条轨:客观侧除常规音频指标外,还把音频切成 1 秒片段、计算预测与真值嵌入的余弦相似度再平均,得到空间一致性分数;主观侧设计了 MOS-Q(音质,关注清晰度/自然度/有无金属噪声与毛刺,明确要求评分者忽略空间定位)与 MOS-P(空间感知,关注左右声道强度变化的声像准确度、远近距离感、以及空间效果与文字描述的匹配度,明确要求忽略音质因素)两套独立的听测量表,把「音质」与「定位」解耦打分。定性上,本方法在左右(L/R)双通道的梅尔谱重建上比 HiFi-GAN、WaveFM、Vocos、CarGAN、FarGAN 更接近 Ground Truth,高频谐波结构的保留差距可见。 Qualitative comparison of mel-spectrogram reconstruction on left (L) and right (R) channels against Ground Truth and baseline vocoders. 批判点评:补的是一个真实且常被忽视的缺口:整条空间音频生成链路的研究重心都在声学场建模和方位控制上,最后落地成波形这一环却长期沿用单声道声码器,通道间线索的损失会把前面所有的空间建模努力打折。架构上三处设计都对得上问题:Cross-Channel Attention 显式建模通道关系而非逐通道独立重建、空间位姿经 FiLM 动态调制进骨干、以及 PixelShuffle1d 配 State Cache 实现严格因果加恒定显存的流式推理。评测设计也比同类工作用心——把 MOS-Q 与 MOS-P 拆成两套量表、并在指导语里互相排除干扰因素,这是空间音频主观评测中容易被偷懒省掉的一步。不足在于:一是摘要层面量化信息极少,「competitive audio quality」这种措辞通常意味着单通道音质并未领先,实际是拿一部分单声道保真度换空间保真度,这个权衡的具体幅度要看正文表格;二是对比基线(HiFi-GAN、Vocos、CarGAN、FarGAN)多为单声道声码器的直接扩展,缺少与专门设计的空间音频声码器的正面对照,「空间指标全面超越」的含金量因此受限;三是空间一致性用「1 秒片段嵌入余弦相似度」来度量,这个代理指标是否真的对应人耳定位误差没有被验证,而它恰恰是论文的主打客观指标;四是覆盖范围止于 FOA/双通道,更高阶 Ambisonics 的可扩展性未知。 10. AV-Sync Audit:四个同步度量互相不一致 What Do Audio-Visual Synchronization Metrics Actually Measure? | 弗吉尼亚理工大学、Accenture | arXiv:2608.25157 关键词:音视频同步,度量审计,可靠性,Kendall tau,Krippendorff alpha,ECCV 2026 Workshop 前序问题:自动音视频同步度量被广泛用来给音视频生成模型排名、甚至直接当训练目标,但它们本身很少被当作「测量仪器」来审计——我们默认分数高就是同步好,却没检验过这些分数在受控扰动下是否单调、对预处理是否敏感、彼此之间是否一致。这是个基础但危险的盲区:如果度量本身不可靠,那么基于它的模型选择和训练优化都可能在优化噪声。 本文贡献:作者在统一的可靠性协议下联合审计四个常用度量——AV-Align、ImageBind AV-relevance、JavisScore、Synchformer/DeSync,检查六个维度:受控扰动下的单调性、预处理敏感性、排名不确定性、度量间一致性、与 PEAVS 人类对齐代理的一致性,以及学习式融合能否改善。结论不是「某个度量胜出」,而是一次坐标轴分裂:不同度量测的根本不是同一件事。基于此,作者主张报告方式应改为「可靠性卡片」(Reliability Card)——给出按度量家族拆分的结果与置信区间,而不是一个赤裸的同步分数。 Kendall tau against known desynchronization for four AV-sync metrics under controlled distortion families. 实验效果:Synchformer/DeSync 是最强的时间偏移追踪器(τ=0.84),在 Shift 与 Speed 两类扰动上明显领先;ImageBind/JavisScore 则更贴合 PEAVS 人类对齐代理(τ=0.20)与内容破坏类扰动,在 Mute 扰动上反超;AV-Align 是最弱的独立度量,在 Speed 与 Shuffle 上 Kendall τ 几乎为零甚至落到负区间。四个度量互相之间严重不一致(Krippendorff α=0.066),跨度量相关矩阵显示 ImageBind 与 JavisScore 高度相关(0.78),而 Synchformer 与两者近乎零相关(-0.00/0.00),AV-Align 与所有其他度量均为轻微负相关。线性与简单 kNN 融合都没能在 PEAVS 一致性上超过最佳单一度量。 Cross-metric correlation matrix among the four audio-visual synchronization metrics. 批判点评:这是今天最该被从业者读到的一篇,尽管它既没有新模型也没有新数据集。把度量当仪器做体检、并给出「坐标轴分裂而非单一赢家」的结论,直接质疑了当前音视频生成领域一大批论文的评测有效性——尤其 α=0.066 这个数字,意味着四个度量对同一批样本的排序几乎相互独立,那么「我们在 X 度量上 SOTA」的说法可信度非常有限。融合也救不了,这个负面结果同样有价值。局限要说清楚:一是这只是 ECCV Workshop 的非归档 poster,作者仅两人且一位来自咨询公司,实验规模与审稿强度都远低于主会论文;二是「人类对齐」用的是 PEAVS 代理而非新采集的人工标注,代理本身的有效性成为整个结论链的单点依赖,若 PEAVS 有偏,τ=0.20 的解读会翻转;三是审计只覆盖四个度量与四类受控扰动(Shift/Speed/Shuffle/Mute),真实生成模型的失效模式(如语义不匹配、口型错位)未必落在这四类里;四是文章给出了「可靠性卡片」的建议格式,但没有推动出可直接调用的工具或标准实现,落地阻力不小。 趋势观察 「记忆」成为长时序生成的一等公民,而不再是上下文窗口的副产品 — 今天两篇最重的视频工作给出了同一个判断:把长视频做长,靠的不是把注意力窗口拉宽,而是显式设计要记什么、以什么坐标记。JoyAI-Echo-1.5 把跨镜头记忆拆成「单帧视觉记忆 + 语音过滤后的音频记忆」两路,并用分离的 RoPE 坐标给记忆条目单独编址(μ=500/550/600),让身份与音色能跨任意镜头组合被检索;4DStreamCtrl 则把记忆压进 3D point track 这一几何表征里,使显存与视频长度解耦。两者都放弃了「全序列自注意力」的暴力路线,转向「结构化外部条件」——这与前两周 On-Policy 蒸馏、长视频记忆一致性专题里看到的趋势完全一致,说明长时程一致性已经从「算力问题」被重新定义成「表征与检索问题」。 少步蒸馏从「加速手段」升级为长视频的可行性前提 — 值得注意的是,今天两篇长视频工作都不是先做好质量再顺手蒸馏,而是把因果化少步生成写进了主线设计。JoyAI-Echo-1.5 用渐进 teacher forcing 加短/长时程 Self-Gradient Forcing,把双向骨干直接改造成因果少步生成器;4DStreamCtrl 蒸馏出四步因果学生,才换来单卡 480p、20 FPS 的交互式流式生成。逻辑很清楚:长视频天然要求流式、要求恒定显存、要求可交互,这三条都无法在多步双向采样上成立。蒸馏因此不再是「便宜版」,而是「唯一能跑的版本」——这与 08-27 TurboT2VA 把少步蒸馏与工程推理栈捆绑交付是同一条脉络的延续。 训练效率的抓手从「改架构」转向「改监督信号密度」 — MTAR 提供了另一个角度:不动推理架构、不加推理开销,纯粹在训练阶段动刀。多 token 预测把稀疏近视的 next-token 监督加密,token 级对比正则提升表征可分性,语义丢弃按 DINOv3 的重要度图砍掉低信息 token 的冗余计算——三者叠加拿到相比 LlamaGen 训练时间降 74~76%、显存降 25~30%、FID 最多低 0.95 的结果,而且只用 1/3 迭代数就追平基线。这个思路值得关注:当推理侧的优化空间被少步蒸馏和量化榨得差不多之后,训练侧「每一步梯度携带多少信息」正在成为新的效率战场。 评测层的自省开始追上生成层:度量本身需要被审计 — 今天有两篇工作在往同一个方向使劲,却站在生成与评测的两端。AV-Sync Audit 把四个常用音视频同步度量当作「测量仪器」逐一体检,结论相当刺眼:Synchformer 追时间偏移最强(τ=0.84),但 ImageBind/JavisScore 更贴合人类偏好代理(τ=0.20),四者互相之间几乎不一致(Krippendorff α=0.066),线性与 kNN 融合都没能超过最佳单一度量。MatReplace、VGA-BenchV2 这类基准同日出现也在补同一块短板。这提示一个容易被忽略的风险:如果我们一直用互相矛盾的单一分数去排名和训练生成模型,那么榜单进步与真实体验提升之间的相关性可能远比想象中脆弱。 人工智能炼丹君 整理 | 2026-08-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-26|京东开源世界模型边走边生720p视听EchoWM 今日 AIGC 论文速览 今日共 10 篇 · 交互式世界模型 1 篇 · 视频生成与编辑统一 2 篇 · 3D 渲染修复与新视角合成 2 篇 · 生成理解一体化 1 篇 · 图像编辑与强化学习 1 篇 · 数字人压缩 1 篇 · 生成评测与审计 2 篇 重点论文标题列表 EchoWM(京东 Joy Future Academy、港科大、北大、清华、港大、中科大、复旦、北航、斯坦福大学):导航即生成的720p视听世界模型 EditStream(Adobe Research、罗切斯特大学):六任务一模型的少步流式视频编辑 FixAnything(卡内基梅隆大学 (CMU)):一个视频先验修四种3D表示 Loopy(天津大学、香港理工大学、腾讯):锚定层位置编码把时间轴掰成圆 Object-Uni(中科院自动化所、国科大、清华大学、蚂蚁集团):物体位姿当显式变量贯通理解生成 今日论文速览 1. EchoWM:导航即生成的720p视听世界模型 EchoWM: Open and Enterable Omnimodal World Models | 京东 Joy Future Academy、港科大、北大、清华、港大、中科大、复旦、北航、斯坦福大学 | arXiv:2608.23189 关键词:世界模型,全模态生成,相机意图,6-DoF轨迹控制,音视频同步,自回归后训练,京东 前序问题:现有的世界模型基本都停在「视频生成器 + 一个控制信号」的形态上,有三处结构性缺口。第一是模态不全:绝大多数只出画面,声音要么完全没有,要么靠后期单独配一条音轨,长时程下环境声、音乐、语音与画面的同步无从保证。第二是控制接口碎片化:第一人称场景(相机就是观察者)和第三人称场景(相机与角色各动一套)通常需要各训一个视角专用控制器,两套接口在数据、训练和推理上都无法复用,用户切换视角等于换一个模型。第三是运动幅度不可比:不同来源的数据(游戏录屏、第一人称采集、影视素材)标注的相机运动尺度天差地别,直接混训会让模型学到一个平均化、无物理尺度的运动先验,用户按同样的键在不同场景里位移距离完全不一致。这些问题合起来的后果是:模型能生成好看的片段,但不能被「进入」和持续操作。 本文贡献:EchoWM 把交互统一组织在「相机意图」这一个抽象上——第一人称下相机意图就是观察者运动,第三人称下相机与角色的动力学耦合直接从数据里学出来,不再为每种视角单独设计控制器,两类交互共享同一个接口。离散按键命令和连续位姿都被映射到同一个带公制尺度的相对 6-DoF 轨迹表示上,再做数据集级校准,使异构数据源之间的运动幅度保持一致,这是让「按同样的键走同样远」成立的前提。生成侧是联合音视频骨干:视频流与音频流各有自注意力,轨迹只在交叉注意力之前注入视频流(音频流不做轨迹注入),再经 AV 交叉注意力耦合,从而在一个前向里同时产出 720p 视频与环境声/音乐/语音。轨迹注入用的是相对 UCPE 分支(QKV 投影 + ray-local UCPE + 零初始化输出投影),零初始化保证接入时不破坏预训练骨干。训练分四阶段渐进:AV 持续预训练 → 冻结骨干只训动作 → 联合微调 → 自回归后训练(teacher forcing + SGF + 因果续写),最后一阶段是长时程能力的来源;多轮推理时用尾窗条件化下一轮,实现可持续导航。代码与模型已在 jd-opensource/JoyAI-Echo 开源。 Overview of EchoWM. Media context, structured text, and user controls share a unified camera-intent interface. Discrete controls or metric poses are converted into globally calibrated relative 6-DoF trajectories and serialized as an event stream. A relative UCPE branch injects this trajectory into video self-attention before audio--visual cross-attention, while the audio stream receives no direct trajectory condition. Four progressive training stages yield synchronized audio--visual generation and support multi-turn inference through synchronized tail-window conditioning. 实验效果:在公开世界模型基准上,EchoWM 同时取得了强轨迹跟随与高视觉质量,第一人称与第三人称交互都支持,且长时程生成中环境声与语音保持同步。固定全局平移尺度带来的收益在与 LingBot-World-v2 的成对对比里最直观:两者接收完全相同的参考观测与导航条件,当相机朝前景角色或场景结构推近时,LingBot-World-v2 的主体表观尺度变化过大、位移响应难以预测——补光灯场景直接从人像冲到相机机身特写,游戏门框场景推近到结构解体,烛光工坊场景越过工作台变成齿轮特写,越野场景则冲过摩托只剩落日空景;EchoWM 在同样的轨迹上呈现的是渐进、可预期的尺度变化,主体始终留在画面里。这条定性证据与论文的公制尺度、速度响应消融互为补充:固定全局平移尺度让不同片段之间「请求的位移幅度」可比,推近行为因此变得可控。推理侧的赛车导航序列也显示,同一条弯道在连续推进中赛道几何、栅栏与草地纹理保持稳定。 Qualitative scale-control comparison. LingBot-World-v2 and EchoWM receive matched reference observations and navigation conditions. When the camera approaches a foreground character or scene structure, LingBot-World-v2 exhibits larger changes in apparent subject scale and less predictable displacement response, whereas EchoWM preserves a more gradual scale change across the trajectory. This qualitative comparison complements the metric-scale and speed-response ablations: a fixed global translation scale keeps requested displacement amplitudes comparable across clips and makes approach behavior more controllable. 批判点评:最需要打折扣的是「open」这个词的适用范围——论文声称开源,但摘要与图表里没有交代模型参数量、训练数据总时长,也没给出可复现的训练配方细节,公开的更可能是推理权重而非完整训练链路。轨迹跟随的量化结果只以「strong」概括,缺少与 Genie 类闭源系统的直接数字对比,而后者恰恰是读者最想知道的参照。音频侧的评估同样偏薄:说「保持同步」,但没有报告音画同步的客观指标(如 AV-Sync offset 分布),环境声/音乐/语音三类音频各自的质量也没有拆开评。第三人称下「相机-角色耦合从数据里学」是个漂亮的设计,但代价是可控性变弱——用户无法像显式相机装配那样精确指定构图,论文没有讨论这个权衡。此外 LingBot-World-v2 是唯一的定性基线,且这组对比只针对尺度/位移响应这一个维度,画面里基线失控得相当彻底(推近直接越过主体),让人怀疑两者是否在同等推理预算下运行,论文没有给出步数与分辨率的对齐说明;真正需要的长时程身份一致性、音画同步等维度都没有配对应的定性证据。最后,作者列表横跨 8 家单位、共同一作 5 人,这类大团队技术报告的工程细节往往难以被外部独立复现。 2. EditStream:六任务一模型的少步流式视频编辑 EditStream: A Unified Autoregressive Framework for Interactive Video Generation and Editing | Adobe Research、罗切斯特大学 | arXiv:2608.21424 关键词:统一视频编辑,自回归少步生成,速度矩匹配VMM,自回归unrolling,KV-cache,交互式创作,Adobe 前序问题:交互式视频创作在工程上一直被两层割裂卡住。第一层是任务割裂:文生视频、图生视频、视频转视频、编辑传播、参考图引导编辑、相机位姿变更这六件事,各家通常各训一个模型或各挂一套适配器,创作工具里要串起来意味着维护六套权重与六套推理路径。第二层是速度割裂:高质量的扩散视频模型要几十步采样,根本进不了交互式工作流;而把它蒸馏成少步自回归模型时,已知的 Self-Forcing 类做法会带来一串顽疾——过饱和、运动退化(画面几乎静止)、时序不稳定,以及训练流程本身很复杂。运动退化尤其致命:交互式编辑的用户改的往往就是运动,如果蒸馏后的模型只会输出近似静止的画面,统一带来的便利就毫无意义了。 本文贡献:EditStream 的第一步是把六种任务折进单个 DiT:通过通道拼接把 mask token、条件视频 VAE token 与输出视频 VAE token 拼在一起,用一个 Conv3D 把新增通道并进原有通道(C_new = C_old + C_cond),不同任务只是这套拼接模式的不同配置——文生视频只留输出分支,编辑传播额外接条件视频,参考图引导编辑再拼一路参考帧,显式相机控制则加入学习到的降采样 mask。第二步是两阶段蒸馏,核心是 Velocity Moment Matching:与 Self-Forcing 在教师轨迹上做整段视频级 DMD 匹配不同,VMM 在「学生自己走到的中间状态」上采样一次局部转移,用教师速度与辅助网络速度的残差(v_T − v_A)作为监督信号,逐块(block-wise)沿因果 KV-cache 展开;首块单独做 VMM 更新,后续块通过 unrolling loss mask 只在展开步上更新。这样做的直觉是:学生的误差分布只有在学生自己的状态上才能被正确纠正,而在教师轨迹上匹配等于永远在纠正一个不会遇到的分布。 Overview of VMM-forcing unrolling. During training, we fully unroll streaming inference: the causal student generates each temporal block from noise with the target few-step schedule, commits the denoised block to the KV cache as history, and proceeds to the next block. At a sampled local transition for each selected block/rollout, we query the bidirectional teacher and auxiliary model at the student-induced states, and supervise the student by matching the teacher--auxiliary residual velocity moments under the same autoregressive context. The student-generated first-block condition is also fed into the teacher and auxiliary model. 实验效果:从文生视频对比图可以直接读出蒸馏质量的差距。Self-forcing 版本在四组场景里几乎全部退化成静止:三只金毛四帧内姿态几乎不变、狼群原地踏步、龙灯只有轻微摆动、沙漠中两人搬椅子的动作停在同一姿态。VMM-forcing 版本则有真实的位移与形变——金毛从雪堆里跑出并跨出画面、狼群沿小径实际前进、龙灯完成翻卷、沙漠场景里沙子被扬起并落下。首帧编辑 + HOI(手物交互)消融显示,不加 HOI 训练时锅盖编辑在后续帧丢失、遮阳帽戴不到头上;加了之后锅盖被手放到锅上、帽子正确落到头顶并随手部动作保持贴合。论文将这些归因于 VMM 与 unrolling 共同缓解了过饱和、运动退化与时序不稳定三类问题。 Qualitative Text-to-Video (T2V) results on frequent user prompts. We compare the Self-forcing conversion and the proposed VMM-forcing pipeline. VMM-forcing produces richer motion dynamics and scene evolution while maintaining texture realism and temporal coherence, whereas Self-forcing often yields over-sharpened, plastic-like appearances and reduced temporal diversity. 批判点评:这是一篇 report 而非常规论文,量化结果的呈现相当克制——摘要里没有给出任何具体的 FVD/VBench 数字,也没有报告蒸馏后的步数与实测帧率,而「fast, few-step」和「efficient streaming」正是它的核心卖点,缺少数字就很难判断它离真正的交互式实时还有多远。六项任务统一后,每项任务相对各自的专用 SOTA 是否有质量损失也未见系统对比,统一的代价没有被量化。VMM 引入了一个辅助网络 A,训练成本相对 Self-Forcing 增加多少、辅助网络如何初始化与更新,摘要层面没有交代。定性图上还有一个诚实的观察:VMM-forcing 的金毛在第三、四帧出现了明显的运动模糊与主体截断,说明追求运动幅度的同时清晰度是有让步的,论文没有讨论这个权衡。最后,Adobe 内部数据与训练栈的依赖较重(数据一节单列),外部复现难度不小。 3. FixAnything:一个视频先验修四种3D表示 FixAnything: 3D-Consistent Rendering Refinement via Video Generative Priors | 卡内基梅隆大学 (CMU) | arXiv:2608.23549 关键词:渲染伪影修复,视频生成先验,3DGS,NeRF,几何感知DPO,视频到视频翻译,ECCV 2026 前序问题:3DGS、NeRF、网格甚至点云在输入视角稀疏、或目标视角离输入较远时都会渲染出伪影,这是三维重建落地的通用痛点。已有工作确实在用扩散生成先验来修,但几乎都是「一种表示一套方案」:给 3DGS 修伪影的模型改用到 NeRF 上要重设计架构,点云的稀疏空洞和网格的几何错误又是另外两类退化模式。结果是工程上要维护多条专用修复管线,每条都要单独设计架构并大规模重训。更深一层的问题是,多数修复方法逐帧独立处理,修出来的结果虽然单帧好看,但跨帧不一致,无法反过来喂给下游重建——这就失去了「修复」最重要的用途。 本文贡献:FixAnything 的关键洞察很朴素:即使是噪声很大的渲染序列,也仍然保留了相机运动与粗略场景结构,因此清理伪影可以被直接表述成「视频到视频翻译」,从而复用预训练视频生成模型隐含的多视角先验,只需极少改动与轻量微调。落地是两阶段。Stage I 监督微调:输入退化视频经冻结的 VAE 编码器得到条件 latent,与噪声、以及一张标记「哪些像素是干净的」的二值 mask 一起送入冻结的 DiT,只训练 LoRA,再由冻结 VAE 解码器出目标视频。这张 binary mask 是可控性的来源——它让模型把输出锚定在高质量输入(例如训练视角)上,只精修其余部分,而不是把整段视频重画一遍。Stage II 几何感知偏好优化:用同一条输入视频跑多个随机种子的 rollout,把每次输出送进 structure-from-motion 恢复相机位姿,与 GT 位姿比较,位姿误差大的判为负样本、误差小的判为正样本,用 DPO 更新 LoRA。换言之,它把「几何一致性」这个原本难以微分的目标转成了可直接优化的偏好信号,而不是再加一堆手工正则。 实验效果:跨四种不同的 3D 表示,FixAnything 都用轻量微调稳定提升了渲染质量,证明单个通用视频先验可以替代多条专用精修管线。最直观的是点云与稀疏输入的修复结果:游乐场攀爬架序列中,输入的中间三帧几乎只剩黑底上的散点(点云稀疏到看不出结构),输出恢复出完整的金属管架、地面绿漆与远景树木,与 GT 高度接近;亭子序列里输入帧被大面积黑洞和撕裂纹理占据,输出补出了完整的木构屋檐、栏杆、石阶与背景树林,逆光帧的光晕也被合理重建。mask 感知条件的消融显示,不加 mask 时干净的训练视角也会被模型重画而丢失细节。框架的简洁性还带来一个附加好处:将来出现更强的视频模型可以直接换上,不需要重新设计架构。 FixAnything generalizes across input representations. The same model cleans up sparse COLMAP point clouds (top) and meshes (bottom), producing photorealistic output despite minimal visual input except for the clean first and last views. 批判点评:摘要通篇用「consistently improves」描述结果,没有给出任何 PSNR/LPIPS 的具体数字,也没说明四种表示各自提升了多少,这在一篇已被 ECCV 2026 接收的论文里显得异常保守,读者无法判断增益是显著还是边际。用 SfM 恢复的位姿精度当 DPO 奖励是个聪明设计,但 SfM 本身在纹理稀疏或强逆光场景就会失败,此时奖励信号的可靠性存疑,论文没有讨论这个失效模式。定性结果里输出与 GT 存在明显的「生成味」——亭子序列中输出的树木纹理和光晕分布与 GT 并不一致,说明模型在补全时引入了幻觉内容;对于测绘、数字孪生这类要求忠实度的场景,这种「好看但不忠实」的修复是风险而非收益,而位姿一致性奖励只约束几何、约束不到外观真实性。此外全部实验用的都是同一个预训练视频骨干,「通用性」的结论究竟来自方法还是来自这个特定骨干的能力,缺少交叉验证。 4. Loopy:锚定层位置编码把时间轴掰成圆 Loopy: Seamless Video Loop Generation via Anchored Looping Shift of Positional Embedding | 天津大学、香港理工大学、腾讯 | arXiv:2608.23090 关键词:循环视频生成,RoPE位置编码,分层时序控制,锚定层,免训练,RGBA视频,ACM TOG 前序问题:循环视频在网页动效、游戏素材和社交媒体里需求很实在,但现有做法质量普遍不行,根因在于大家都绕过了一个基础问题:视频生成模型究竟如何感知时间顺序,这种感知又如何决定首尾能否接得上。常见的两条路各有硬伤——直接在提示词里写「scene looping seamlessly」,模型基本不理解,生成出来的首尾差异巨大(鲨鱼从侧身游到正面怼镜头,根本接不上);用首尾帧到视频(FLF2V)把首帧复制给尾帧作为参考,虽然强制首尾一致了,但模型为了同时满足两端约束会把中间的运动压得几乎静止,得到的是「能循环但不动」的伪循环。两条路都没有触及 DiT 内部时序表示这一层。 本文贡献:论文首次揭示:DiT 内不同注意力层的位置编码对时序顺序的控制强度差异很大,其中最强的那一层可以视为「锚点」。他们把这个锚定层设为循环视频的参考点,为其余层提供强上下文先验。基于此提出锚定位置编码偏移策略——按每层实际的时序控制效应给出层特定的偏移长度,把 DiT 对时间的感知从「一条直线」变成「一个圆」。实现上极简:在每个 DiT block 的自注意力里,Q/K 除了原始 RoPE R_{t,h,w},再并行算一份偏移后的 RoPE,偏移量为 (t − δ_l) mod T',其中 δ_l 是第 l 层的时间偏移,两者按层组合后再进 attention 与交叉注意力+FFN。整个过程不改权重、不需重训,是纯推理期干预,因此可以直接挂在 Wan2.1/2.2、HunyuanVideo 1.5 等现成基座上,并同时支持 RGB 与 RGBA 视频,还能叠加身份控制与风格迁移这类 AIGC 能力。 Comparison of Wan2.2 14B and HunyuanVideo 1.5 outputs when shifting RoPE at the layers with the first- and second-largest $\alpha_l$, relative to the original generated videos. 实验效果:逐层分析图给出了机制的直接证据:Wan2.2 14B 的 α_l 曲线在第 0 层达到峰值约 0.31、第 1 层约 0.22,之后迅速衰减到 0.05~0.15 区间;HunyuanVideo 1.5 的峰值落在第 2 层(约 0.31)与第 6 层(约 0.21)。在 α_l 最高的层做偏移会破坏内容(墨滴场景出现整帧粉紫色偏色与结构错乱),在次高层偏移则能保持内容正确并实现循环,这正是「按层给不同偏移量」这一设计的来源。定性对比中,T2V 基线生成的鲨鱼首尾姿态完全不同、无法循环;FLF2V 虽首尾一致但四帧几乎静止;Loopy 既保持首尾可接,中间又有真实的尾部摆动与身体位移。论文报告循环视频的时序一致性与视觉保真度都有显著提升,用户研究在运动连贯性等维度上给出更高评分,模型已在项目主页发布。 Comparison with Wan2.2 in text-to-video (T2V) and first-last-frame-to-video (FLF2V) modes. FLF2V and our method use the same prompt. Although the prompt explicitly requests a looping scene, T2V fails to produce a seamless loop, while FLF2V degenerates to a nearly static video. Neither mode generates a looping video with vivid motion. 批判点评:最实际的限制是这套策略与基座强绑定:α_l 的峰值层因模型而异(Wan2.2 在第 0/1 层、HunyuanVideo 1.5 在第 2/6 层),换一个基座就要重新做逐层扫描来定位锚点和标定每层偏移量 δ_l,论文没有给出自动化的标定流程,这在工程上是一笔隐性成本。δ_l 的具体取法只描述为「按每层时序控制效应」,缺少可复用的公式或搜索预算说明。效果侧全部以「significantly improves」和用户研究箱线图呈现,没有报告循环质量的客观指标(例如首尾帧感知距离),而这恰恰是最容易量化的一项。另外从 α_l 曲线看,中后层存在若干局部尖峰(Wan2.2 在 20~30 层、HunyuanVideo 在 30~40 层附近),论文只利用了全局最强的一两层,这些次级峰是否也参与时序控制、忽略它们是否留下了改进空间,没有讨论。最后,能循环的内容类型边界不清——鲨鱼游动、墨滴扩散这类准周期运动天然适合循环,而有明确起止语义的动作(如开门、倒水)能否成立,未见说明。 5. Object-Uni:物体位姿当显式变量贯通理解生成 Object-Uni: A Unified Model for Object-Centric Spatial Understanding and Controllable Generation | 中科院自动化所、国科大、清华大学、蚂蚁集团 | arXiv:2608.22757 关键词:统一多模态模型,物体位姿,视角化朝向抽象,可控生成,新视角合成,UniSpatial-80K,蚂蚁集团 前序问题:统一理解与生成的模型这两年进展很快,但有一项能力始终缺位:理解并操纵物体实例的空间状态。现有模型能用自然语言把物体描述得很好(「一把红色的椅子在桌子旁边」),却做不到两件事——精确表示连续的物体位姿,以及在指定目标视角下生成几何一致的图像。根子上的原因是位姿在现有工作里的地位错了:要么被当成一个待预测的标签(理解侧的输出),要么被当成一个外部控制信号(生成侧的输入),两侧各用一套表示、互不相通。而多模态大语言模型天然处理离散 token,连续的旋转矩阵/四元数很难直接塞进语言空间并保持可推理性,这是把位姿变成「理解与生成共享变量」的主要技术障碍。 本文贡献:Object-Uni 把物体级空间智能重新表述成一个统一问题,把位姿感知、空间推理、位姿条件生成、物体级新视角合成四件事连起来,并把物体位姿当作理解与生成共享的显式几何变量。为了让 MLLM 能真正用上位姿,他们提出视角化朝向抽象:把朝向映射为结构化的视角描述(便于语言模型推理),同时保留连续的几何监督(不丢精度)。架构上,理解分支里输入图像经视觉编码器、文本经 tokenizer、物体裁剪图额外经 DINO 编码器进入冻结的 MLLM,MoE 中激活一组可训练 expert,输出侧除常规 NTP loss 外加一路 orient head 承担 orientation loss;生成分支复用同一 MLLM(此处 expert 冻结),用可学习 query 经 connector 送入可训练的 Diffusion Transformer,与图像 latent、目标位姿 latent 一同去噪。此外构建了物体级空间基准 UniSpatial-80K,并用「物体 token 锚定的位姿锚」把每个实例与其位姿状态绑定,避免多物体场景下位姿串位。 Overview of Object-Uni. Our model unifies object-centric spatial understanding and orientation-controllable generation. The dotted modules denote object-centric novel view synthesis. 实验效果:实验显示物体级位姿理解与位姿可控生成都有提升,把统一模型从「描述物体」推进到「操纵空间状态」。定性对比中,单物体位姿控制上 Object-Uni 能在保持参考物体外观身份的同时把收割机、叉车、板车、越野摩托转到目标视角,而对照的 SceneDesigner 虽然也换了视角但常常改掉物体本身(收割机换成另一款红色机型、叉车变成挖掘机、板车上多出一个南瓜)。多物体场景下差距更明显:书本、相机、沙发、鞋子四组里 Object-Uni 保持了实例数量与相对布置(两本书叠放、两台相机并排、鞋子一双朝向一致),SceneDesigner 则出现物体简化、颜色改变与朝向不一致。 Evaluation of pose-controllable generation in single- and multi-object scenarios. The reference image in the first row serves as the source for the input text and 9D pose annotations. Object-Uni shows better text alignment and pose consistency under diverse pose conditions. 批判点评:「视角化朝向抽象」在把连续朝向离散成结构化视角描述时必然有精度损失,论文没有报告这个抽象带来的角度误差上界,而它直接决定了这套表示能支撑多细的位姿控制——如果分辨率只到「高角度视角/侧视」这一级,就谈不上真正的连续位姿操纵。效果全部以「improves」概括,摘要层面没有一个具体数字(角度误差、位姿准确率、生成一致性指标均缺),UniSpatial-80K 上与其他统一模型的横向对比也未见。基准由作者自建、模型也在其上训练与评测,存在自证循环的风险,缺少在第三方物体位姿数据集上的迁移验证。架构上依赖冻结 MLLM + MoE expert + DINO 编码器 + 可训练 DiT 四个部件,训练与推理开销显著高于纯 MLLM 方案,论文未给出代价核算。定性对比只选了 SceneDesigner 一个基线,说服力有限。最后,从生成结果看 Object-Uni 输出的图像在背景与光照上与参考图差异较大(收割机的麦田、摩托的赛道都被重画),说明「保持物体身份」是靠牺牲场景一致性换来的。 6. Next-Scale NVS:下一尺度自回归单次出多视角人脸 Photorealistic Novel View Synthesis of Human Faces using Next-Scale Transformers | 洛桑联邦理工 (EPFL)、Meta | arXiv:2608.23410 关键词:新视角合成,下一尺度自回归,多尺度VQVAE,跨视角一致性,GS-LRM,合成数据训练,Meta 前序问题:人物的照片级新视角合成在高分辨率、多目标相机的设定下仍然很难:既要保住身份,又要保住细微的外观细节(皮肤纹理、发丝、衣物褶皱),还要让多个视角之间几何自洽。主流做法是扩散模型,但它有两处结构性代价。一是必须依赖大规模 2D 预训练才能有可用的先验,这决定了它对数据量的胃口。二是多视角一般靠逐视角独立采样再想办法约束一致性,跨视角自洽是「事后补」而非「内生」,分辨率越高、目标相机越多,不一致就越明显。对于真人数据难以大规模合法采集的人脸场景,「必须靠海量任务数据才能收敛」本身就是一个卡点。 本文贡献:作者不走扩散,而是把下一尺度自回归(next-scale autoregressive)范式适配到以人为中心的视角合成上,使其支持更高分辨率、多视角输出与更强的跨视角一致性,且全部在单次前向里完成。管线是:N 张 512×512 输入图经多尺度 VQVAE 编码器得到逐尺度 token(i_1 为 N×1×32、i_2 为 N×4×32、i_3 为 N×9×32,依次加密),与 CLIP 特征、目标相机外参 (R_1,T_1)…(R_M,T_M) 组成的全局条件一同经 word embedding 进入 Causal Next-Scale Transformer,自回归产出 M 组目标视角的逐尺度 token r_1/r_2/r_3,再由多尺度 VQVAE 解码器一次性解出 M 张 512×512 视角;训练时目标视角走 teacher forcing。这个范式的关键红利是训练数据经济性:不需要 2D 预训练,且低分辨率、通用的预训练可以直接复用,只在最后几个训练阶段才用到全尺寸的任务专用图像,因此用一个更小但更真实的数据集就能收敛。他们在覆盖多样身份与服饰的合成人脸数据集上训练,并把输出接到已有的 GS-LRM 上做像素对齐的 3D 高斯提升,最终得到人脸的 3D 模型。 Our architecture: input images are encoded into multi-scale features by the VQ-VAE encoder and used as inputs for the transformer. They are also embedded into a global conditioning along with the camera-pose RT matrix, used both in the AdaLN layers and the SOS tokens. The transformer outputs one scale at a time for every output view simultaneously, up to the final scale. The output features are decoded by the VQ-VAE decoder to produce the final RGB images, which can be lifted to 3D gaussians by an off-the-shelf GS-LRM model. During training, previous scales are teacher-forced, while during inference the model is auto-regressive. The architecture is the same for all our models, with the only difference being the number of input and output views. 实验效果:模型输出锐利且真实的视角图,并可选择同时合成多个新视角以提升视角间的一致性。论文报告在人物主体上感知保真度与跨视角连贯性均有增益,说明下一尺度自回归可以作为可扩展、多输出的人物视角合成骨干。与 FaceLift 的六视角对照能看出差距落在身份保持上:FaceLift 把发色提亮成偏灰金、发型改成盖头式,侧脸轮廓被压扁、后脑呈现出与真值完全不同的整齐发块,肤色整体偏白;本文方法在六个视角上的脸型、下颌线、肤色与颈部阴影都贴近真值,仅在后脑一列把稀疏的头发画得略密。与 GS-LRM 串联后,从多视角人脸输入可得到准确且照片级的三维人脸模型,完成了「多视角生成 → 3D 高斯提升 → 渲染」的闭环。多尺度 VQVAE 的微调与不同 patch 划分方式的消融(256/512 分辨率、normal 与 diff patchify)表明适配到 512 分辨率时 VQVAE 微调是必要的。 批判点评:最大的问题是训练数据全部为合成人脸,论文自己也强调「a smaller but more realistic training dataset」,但合成到真实的域差距未见量化评估,模型在真实拍摄人脸上的表现是空白,而这才是实际用途所在。量化结果同样只以「we observe gains」表述,没有 PSNR/LPIPS/身份相似度的具体数字,也没和 FaceLift、Splatter-Image 这些明确出现在其定性对比目录里的基线给出表格化比较。分辨率停在 512×512,对影视级人脸资产而言偏低,而下一尺度自回归的 token 数随尺度平方增长,往 1024 走的代价论文没有交代。第一作者的贡献声明为「在 Meta Reality Labs 实习期间完成」,且 LaTeX 源里仍留有多处 TODO FINAL: Replace with your institution list 未清理的模板注释,说明这是一版尚未定稿的投稿,结论宜谨慎引用。此外整套流程依赖外部 GS-LRM 做 3D 提升,端到端的几何误差如何在两个模型之间分摊也没有分析。 7. Lever-Edit:不用编辑奖励也能做编辑在线RL Can We Perform Online RL for Image Editing without Editing Rewards? | 北京大学 | arXiv:2608.22780 关键词:图像编辑,在线强化学习,T2I奖励迁移,反事实目标描述,奖励对齐caption,北京大学 前序问题:用强化学习直接优化图像编辑的人类偏好,前提是有可用的编辑专用奖励模型,而这一块恰恰很薄——训练编辑奖励需要昂贵的三元组监督(原图、指令、编辑结果),还要按任务做复杂的标定。反观文生图(T2I)这一侧,奖励生态已经相当成熟且多样:语义对齐、美学、真实性、字形形状等各类视觉偏好都有现成模型。把这套生态迁移到编辑上,能大幅拓宽 RL 可优化的偏好维度。但迁移有一个本质错配:编辑指令描述的是「相对变化」(把狗变成大理石雕像),而 T2I 奖励要求的是「自包含的目标描述」(一只大理石雕像的狗,立在基座上)。而且通用视觉语言模型给出的 caption 虽然语义正确,却可能与被冻结的奖励模型不兼容——奖励模型对措辞、句式有自己的偏好,语义对但表述不对,打出来的分就是噪声。 本文贡献:作者先论证标准的图像编辑维度是可以映射到 T2I 奖励空间的:图像质量可以直接迁移;提示遵循可以通过「对期望视觉状态的描述」来对齐;参考一致性则可以通过把需保留的源内容编码进描述里做粗粒度语义转换。在此基础上提出 Lever-Edit 两阶段框架。Stage 1 是 T2I query 对齐:训练一个奖励对齐的 captioner,它接收系统提示与编辑指令(各有可学习的 embedding 权重),经 VLM 解码出「反事实目标描述」——即编辑成功后画面应该是什么样的自包含描述;训练时 VLM 冻结、只学 reward-aligned query embedding,用聚合的多个 T2I 奖励作为信号,让 captioner 学会说奖励模型「听得懂」的话。Stage 2 是奖励对齐微调:把 captioner 冻结,只用迁移来的 T2I 奖励优化编辑策略本身(此时编辑骨干解冻、query embedding 冻结)。两阶段的冻结/解冻是交替的,这个设计避免了 captioner 与策略互相追逐导致的奖励崩塌。 Overall two-stage T2I reward transfer pipeline in Lever-Edit. 实验效果:实验显示 Lever-Edit 在编辑对齐度与源内容保持上都能与基于编辑奖励微调的方法竞争,同时明显优于几种直观的迁移基线。定性对比按提示遵循、美学、一致性、自然度四组维度组织,八个编辑任务里可以看到:不做对齐(w/o Alignment)时「把狗变成大理石雕像」只是把狗漂白、「换成极简白背景」直接把人像退化成线稿;Lever Pure Edit 与 Lever Pure VLM 各有偏差(前者美学不足,后者出现主体改变,如冲浪板换成桨板时人物姿态被重画);Lever Offline SOTA 在自然度上仍有塑料感;完整的 Lever-Edit 在四组维度上综合最好——大理石雕像有正确的石材质感与基座、红色跑车放到建筑前方且透视正确、热气球加入天空且尺度合理、白色背景替换保留了人物细节。 Qualitative analysis of different methods. Lever-Edit successfully edits the images with strong prompt following and high aesthetics, while maintaining both semantic and source consistency with naturalness. Zoom in for better visualizations. 批判点评:「competitive against editing-reward-based fine-tuning」这个表述值得留意——它说明本方法并未超越用真正编辑奖励训练的上界,价值在于省掉三元组标注成本,而不是效果更好;如果编辑奖励模型未来变得容易获得,这条路径的必要性会下降。摘要没有给出任何数字(编辑对齐、源保持的具体指标与基线差距均缺),也没说明用了哪几个 T2I 奖励模型及其聚合权重,而这直接决定结果可复现性。方法引入的 captioner 是新的失效点:反事实目标描述如果写错(把「移除」理解成「替换」),策略就会被系统性地引向错误方向,论文未讨论 caption 错误率及其对训练的影响。「参考一致性靠粗粒度语义转换」是全流程最薄弱的一环——T2I 奖励天生不看源图,无法真正惩罚身份改变,从定性图里也能看到 Lever Pure VLM 出现主体被重画的情况;这类结构性缺陷不是靠 captioner 能补齐的。另外两阶段交替冻结的训练配方对超参可能较敏感,稳定性未见报告。 8. SACHA:2.23MB存下动态高斯头像 SACHA: Semantic-Aware Compression for 3D Gaussian Head Avatars | 香港城市大学、阿里巴巴达摩院 | arXiv:2608.23133 关键词:3D高斯头像,语义感知密度控制,外观-运动解耦压缩,率失真优化,头部先验参数,阿里达摩院 前序问题:可驱动的 3D 高斯头像渲染质量高、控制灵活,但高斯基元数量庞大,存储和传输成本都很重,这是它进入视频会议、VR 社交、移动端这些实际场景的主要障碍。现有的高斯头像方法有两处共同盲区。第一,忽视了头部不同语义区域的视觉显著性差异——眼睛、嘴唇这些高频且被注意力集中的区域和后脑、脖颈这类低频区域,如果按同样的密度分配高斯基元,就是把预算浪费在看不出差别的地方。第二,几乎没人做训练完成后的头像序列压缩:一段动态头像在时间维度上高度冗余(外观基本不变、只有表情和姿态在动),但主流做法仍然逐帧存储完整的高斯参数。 本文贡献:SACHA 把两件事合起来做。语义感知密度控制在训练阶段按头部区域自适应分配高斯基元,做区域自适应的稠密化与剪枝,把预算集中到显著区域;配套的语义感知标准高斯训练管线负责产出这个紧凑的标准(canonical)表示。外观-运动解耦压缩针对序列冗余:编码端对每一帧先用头部先验模型提取形状 β、表情 ψ_t、姿态 θ_t 三组头部先验参数,单独编成参数码流;高斯本体则拆成绑定索引 {b_i} 与标准高斯 {g_i},各经坐标排序后编成索引码流与高斯码流。解码端拿到三路码流后,由头部先验模型驱动「头部先验引导的形变」,把标准高斯变形到当前帧。关键在于:外观(标准高斯 + 绑定索引)只需传一次,运动只传头部先验参数——参数量比逐帧全量高斯小几个数量级,这就是时间冗余被吃掉的地方。 Overview of the proposed appearance-motion decomposed compression framework for 3D Gaussian head avatars. 实验效果:率失真性能优于现有的高斯头像表示与压缩方法,同时保持高质量的新视角与新表情渲染。单被试(Subject 264)的主观对比给出了很具体的数字:SACHA 只用 2.23 MB 就达到 PSNR 29.9984 dB,而 G-PCC 需要 10.50 MB 才拿到 29.9856 dB(约 4.7 倍体积换来几乎相同的质量);TGA 用 20.69 MB 只有 28.7186 dB,SACHA 在体积小约 9 倍的同时质量还更高。质量更高的两个基线代价极大——SVG-Head 84.12 MB / 31.2910 dB、TexAvatars 69.67 MB / 31.0862 dB,都比 SACHA 大 30 倍以上。HEVC 在 21.49 MB 下只有 21.49 dB 级别的可见退化(脸部结构明显扭曲)。新视角合成的 RD 曲线(PSNR/SSIM/LPIPS 三张图,横轴为对数尺度的 MB)显示 SACHA 的绿色曲线整体位于 1.5~3 MB 区间,而全部基线分布在 10~105 MB。 Subjective comparisons with G-PCC, HEVC, CompactSTG, GA, SVG-Head, TexAvatars, and TGA on subjects 074 and 264 from the NeRSemble dataset. 批判点评:从 RD 曲线看结论要更克制一些:SACHA 在自己的码率区间内 PSNR 大致在 28.8 dB 附近,明显低于 SVG-Head 的约 29.95 dB 与 TexAvatars 的约 29.85 dB,也就是说它换来极小体积的代价是质量上限被压低了——单被试上 29.9984 dB 的漂亮数字并不代表平均水平。LPIPS 一栏尤其值得注意:SVG-Head 约 0.045、TexAvatars 约 0.048,而 SACHA 约 0.11~0.12,感知质量差距比 PSNR 体现的更大,对于强调面部细节的应用未必可接受。方法整体强依赖头部先验模型(形状/表情/姿态参数化),先验拟合失败的情况(夸张表情、被遮挡、佩戴眼镜或头发遮挡面部)会直接让形变解码出错,论文没有报告这类失效。语义分区如何获得、分区错误的鲁棒性也未见交代。此外全部实验只在头部这一类目标上,方法名里的语义感知密度控制是否能推广到全身或一般物体,缺少验证。 9. DefaultShift:加速后颜色默认最多漂移0.303 DefaultShift: Auditing Semantic Default Shift in Accelerated Text-to-Image Models | 悉尼大学 | arXiv:2608.21784 关键词:少步加速模型,语义默认漂移,成对审计,VLM评估,离线校准,分布偏移,推理加速代价 前序问题:少步文生图模型正在大规模替换慢速生成器,但加速可能悄悄改变那些提示里没有指定的属性的分布——每一张输出看起来都合理、也都与提示对齐,可整体分布已经变了。作者把这类分布称为语义默认(semantic defaults),把替换导致的变化称为语义默认漂移。问题在于现有评测完全测不出它:质量指标只看单图好坏,偏好指标只看人更喜欢哪张,多样性指标只看整体是否单调,三者都不检验「替换模型是否保留了参考模型的语义默认」。后果是实践中的隐性风险——用少步模型批量生成训练数据时,颜色、背景、光照、视角的默认分布已经偏移,下游模型会继承这个偏差,而流水线里没有任何一环会报警。 本文贡献:DefaultShift 是一套成对审计流程。上半部分 Default Shift-Audit 分三段:成对采样阶段,对同一提示(如「a photo of a helicopter」)分别用参考模型 T(多步扩散)和加速替换模型 S 各生成一批图;语义默认阶段,用 VLM 评估器按封闭语义词表(颜色、背景、光照、视角等,每类若干离散取值)给每张图打标,得到两个直方图;漂移审计阶段,用 TV 距离等指标算概率质量的移动,并做教师自举校正(TV_adj = TV(T,S) − η_T)以剔除参考模型自身的采样噪声,再经 q=32 筛查、q=64 确认两级预算与 cell-level bootstrap,输出按配方排序的结果和方向性签名(偏暖还是偏灰)。下半部分 Default Shift-Select 是离线校准:给定参考直方图模板与 CLIP 质量下限,从 M=128 的候选池里做分布匹配(min TV),挑出 N=32 张既满足质量门槛、又让语义分布贴近参考模型的图。方法把「解释性排序」与「确证性的 cross-fit 推断」分开,避免用同一批数据既选又证。 Overview of DefaultShift. The audit generates matched samples from a declared reference and accelerated replacement, maps each image to a closed semantic vocabulary, and compares their conditional distributions. Cell-level discrepancies are aggregated for recipe ranking and directional analysis. DefaultShift-Select uses reference statistics and a quality-filtered replacement pool to construct a distribution-matched offline subset. 实验效果:在 14 组参考/替换配对上,调整后的颜色差异从 0.054 到 0.303,且方向随加速配方而异。统一 q=64 审计的排序里 NitroFusion-4 最严重(约 0.30),Turbo 约 0.25、DMD2 约 0.23、NitroFusion-1 约 0.23、FLUX-schnell 约 0.20,而 LCM 与 Lightning 最轻(约 0.05)。多属性画像显示颜色是最大的漂移源(0.20~0.30),背景 0.06~0.12、光照 0.05~0.09、视角仅 0.01~0.03。方向性指纹图给出定性结论:DMD2、Turbo、Lightning、LCM 都朝「暖色质量增加」方向移动(DMD2 的 Δ暖色质量约 +0.16 最显著),FLUX 则相反,朝灰色方向漂移(Δ暖色质量约 −0.07)。1000 张图的人工审计复现了同样的排序。DefaultShift-Select 在 Turbo、DMD2、FLUX 上把人工测得的漂移降低了 10.3% 到 35.1%,且没有实质的质量损失;在均衡评测下,经校准的数据相比未校准的替换数据恢复了 4.3 个准确率点和 7.5 个最差组点。 Acceleration recipes differ in magnitude, attribute, and direction. a The unified $q=64$ audit covers all 14 replacement pairs. Lines are 95% object-cluster intervals. b Color dominates the four-attribute profile, while viewpoint shifts are small. c Replacement-minus-reference changes in gray and warm mass reveal opposing recipe fingerprints. 批判点评:整套审计建立在 VLM 评估器加封闭语义词表之上,两处都会引入偏差:VLM 自身对颜色、光照的判断有系统性倾向,论文虽给出了人类与 VLM 的混淆矩阵,但那只覆盖「clear case」,模糊样本上的一致性未知;封闭词表则把连续属性强行离散化,词表粒度直接决定测出多大的 TV 距离,换一套词表数值不可比。「颜色差异 0.054 到 0.303」是 TV 距离而非人眼可感差异,缺少感知尺度上的锚定,读者很难判断 0.2 究竟意味着轻微偏暖还是明显变色。DefaultShift-Select 只是事后筛选,本质是丢弃不合分布的样本来贴近参考分布,代价是有效产出下降(128 选 32,即弃掉 75%),这个吞吐损失论文没有和「干脆用慢速模型」做成本对比。审计限定在提示未指定的属性上,但「未指定」的边界本身依赖提示写法,作者用的是「a photo of a {object}」这类极简模板,真实业务里的长提示会指定更多属性,结论的外推性有限。最后,下游 4.3/7.5 点的增益只在其自建的均衡评测设定下成立,任务范围较窄。 10. FIRM-Video:先核查再打分的8B视频奖励模型 FIRM-Video: Check Before You Score for Reliable Text-to-Video Reward Modeling | 上海交通大学、腾讯优图实验室、同济大学 | arXiv:2608.21839 关键词:视频奖励模型,清单驱动,先核查再打分,指令遵循,世界一致性,感知质量,腾讯优图 前序问题:可靠的奖励模型是文生视频评测与对齐的基础,但评测准确性与推理效率之间的权衡,把压力全压回了训练监督的质量上。现有做法分两类,各有各的毛病。一类是固定评分细则的整体式评判:一个提示进来,模型按几条固定维度直接给总分,检查必然不完整——提示里明确要求的细节(红色狐狸、镜头右摇、雪地森林)不会被逐条核对。另一类是开放式推理:让模型自由生成一段分析再打分,问题是理由与分数经常不一致(unfaithful justification),而且多个维度的归因彼此纠缠(entangled attribution),分低了到底是因为没跟指令、还是因为画面糊,说不清。归因不清的奖励用来做 RLHF 或 Best-of-N,优化方向就是模糊的。 本文贡献:FIRM-Video 提出统一的清单驱动数据构造框架,核心是「先核查再打分」原则:构造维度专属清单 → 逐条对着时序视觉证据核验 → 只聚合被验证过的判断。三个维度各有各的清单构造方式。指令遵循(IF)把提示拆成带权重的原子需求(「红狐是否在场」「狐狸是否跃过木头」「场景是否下雪」「镜头是否右摇」),逐条验证满足与否,按权重加权求和得 1~5 分。世界一致性(WC)构造经提示校准的、针对具体目标的检查项,锚定在可见实体与动作上(「狐狸身份是否稳定」「解剖结构是否合理」「落地是否符合物理」),只对检测到违反的项计分。感知质量(PQ)用一套通用视觉缺陷分类(清晰度、模糊、色彩稳定性、闪烁、压缩伪影、局部畸变)做缺陷验证。三路验证过的判据与分数再被转成自然语言分析,用于端到端奖励建模的理由综合。数据上构造了 FIRM-Video-90K(29,348 个视频、3,012 个提示、3 个维度、88,044 条维度专属实例),并发布 FIRM-Video-Bench(250 个视频、750 条点式人工标注)。 Overview of the FIRM-Video data construction framework and reward model training. Given a prompt and its generated video, FIRM-Video applies a unified check-before-score pipeline to construct fine-grained supervision for instruction following, world coherence, and perceptual quality. The resulting dimension-specific analyses and scores form FIRM-Video-90K, which is then used to train the FIRM-Video-8B reward model. 实验效果:基于 Qwen3-VL 的 FIRM-Video-8B 在 FIRM-Video-Bench 上取得最优的总体 MAE,同时在三个视频生成器上的 Best-of-8 采样中稳定给出最高的 VBench Total、Quality 与 Semantic 分数。teaser 的案例很有说服力:一段工业车间里工人挥锤的视频存在三处问题(手柄颜色不对——提示要求纯黑却是浅棕、手柄形变、手柄畸形),人工标注给出 IF 3 / WC 2 / PQ 5;GPT-5 给 4/5/5、Qwen3-VL-8B 给 5/5/5,都严重高估了世界一致性;只有 FIRM-Video-8B 给出 3/2/5,与人工完全一致。模型输出的理由也指向了正确位置(「锤柄是浅棕而非指定的纯黑」「严重的解剖形变与锤柄融合」)。 Qualitative evaluation case of FIRM-Video-8B, illustrating its improved alignment with human judgments. 批判点评:清单本身是用 LLM 从提示里自动拆出来的,这就把可靠性问题往上游推了一层——如果原子需求拆错或漏拆(比如把「镜头右摇」漏掉),下游再严格的核验也补不回来,论文没有报告清单构造的召回率与准确率。权重同样如此:IF 分数是原子需求的加权和,权重怎么定、对结果多敏感,摘要层面没有交代。核验环节仍然由 MLLM 执行,「对着时序视觉证据核查」只是把一次大判断拆成多次小判断,单次判断的错误率并未消除,只是被平均了;对细粒度物理违例(手柄形变这类)MLLM 的检测能力本身就是瓶颈。FIRM-Video-Bench 由作者构建、模型也在同源数据上训练,报「最优 MAE」存在数据分布同源的优势,跨基准(如 VideoScore、VBench-Reward)的迁移结果缺失。Best-of-8 只测了三个生成器,且未说明是哪三个、覆盖是否有代表性。另外三个维度分别打分虽然解开了归因纠缠,但如何聚合成单一奖励用于 RL 训练,论文未给出方案,这一步没有解决的话,可靠归因的价值就还停留在评测阶段。 趋势观察 世界模型的竞争焦点从「画面好不好」转向「进得去、走得动、听得见」 — 今天最值得注意的信号是京东 Joy Future Academy 开源了 EchoWM,它把三件此前分开做的事塞进了一个模型:连续导航响应、720p 视频生成、以及环境音/音乐/语音的同步生成。过去一年世界模型的论文大多在比 FVD 和画面保真度,控制接口则各家各造——第一人称用一套相机控制器,第三人称再单独训一个角色控制器。EchoWM 的做法是把「相机意图」抽象成唯一接口:第一人称下它就是观察者运动,第三人称下相机与角色的耦合关系直接从数据里学,不额外设计视角专用控制器。离散按键和连续位姿统一映射到带公制尺度的相对 6-DoF 轨迹,再做数据集级校准,让不同来源的数据保持一致的运动幅度。这套设计的价值在于它承认了一个现实:世界模型最终要交到用户手上被「玩」,而不是被离线打分。同一天他们还放出了姊妹工作 JoyAI-Echo-1.5(arXiv:2608.23383),专攻跨镜头记忆的长视频叙事,两篇合起来是一次完整的系统级发布。值得留意的是「音频」这一路终于被当成一等公民而非后期配音——长时程下环境声与语音能否保持同步,正在成为区分「视频生成器」和「世界模型」的一条硬指标。 少步蒸馏正在从「加速技巧」长成「交互能力的前提条件」 — Adobe 的 EditStream 把这个转变说得很清楚:它先用灵活的任务条件把文生视频、图生视频、视频转视频、编辑传播、参考图引导编辑、相机位姿变更六件事统一到一个 DiT 里,然后才做少步自回归蒸馏——因为不做蒸馏,这个统一模型就没法用于交互式创作。他们提出的 Velocity Moment Matching 值得关注:不是在教师的采样轨迹上做匹配,而是在学生自己走到的中间状态上匹配条件速度矩,再叠加自回归 unrolling 让学生暴露在自己的预测误差里。从 T2V 的对比图能直接读出差异——Self-forcing 版本几乎是把首帧复制了四遍(狗和狼都原地不动、龙灯几乎静止),VMM-forcing 才有真实的位移和形变。这条线索和 Loopy 是呼应的:Loopy 发现 DiT 内不同注意力层的位置编码对时序顺序的控制力差异极大,最强的那层可以当锚点,按层给不同的偏移量就能把「直线」时间感知掰成「圆」,从而无需训练地生成无缝循环。两篇一起看,说明视频 DiT 的时序机制还有相当多可被显式操纵的结构,不必事事回到重训。 评测这一侧开始追问「加速和对齐到底悄悄改掉了什么」 — DefaultShift 提了一个此前几乎没人测的问题:少步模型替换慢速模型时,那些提示里没指定的属性(颜色、背景、光照、视角)的分布会不会被悄悄改掉?他们把这个现象命名为语义默认漂移,并给出成对审计流程。结果相当刺眼——14 组参考/替换配对里,调整后的颜色差异从 0.054 到 0.303,且方向因加速配方而异:DMD2、Turbo、Lightning 整体偏暖,FLUX-schnell 反而偏灰。1000 张图的人工审计复现了同样的排序。这提示一个容易被忽略的成本:蒸馏的代价不止是画质,还有分布层面的偏移,而现有的质量/偏好/多样性指标都测不出来。FIRM-Video 则从奖励模型一侧收紧标准,用「先核查再打分」替代整体式打分——先把提示拆成带权重的原子需求,逐条对着时序视觉证据核验,只聚合被验证过的判断。它的 teaser 很有说服力:同一段有明显手柄形变的视频,GPT-5 给 4/5/5、Qwen3-VL-8B 给 5/5/5,人工标注是 3/2/5,只有 FIRM-Video-8B 对上了。当生成能力持续走高,能否可靠地「说出哪里错了」正在成为比刷分更稀缺的能力。 人工智能炼丹君 整理 | 2026-08-26 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-24|快手可灵证明奖励劫持源于流形漂移ThermoDPO 今日 AIGC 论文速览 今日共 10 篇 · 奖励对齐与偏好优化 1 篇 · 推理加速 1 篇 · 音频驱动与语音生成 3 篇 · 数字人与 4D 生成 1 篇 · 新视角合成 1 篇 · 视频身份保持 1 篇 · 设计与版式生成 1 篇 · 生成评测 1 篇 重点论文标题列表 ThermoDPO(西湖大学、浙江大学、快手可灵团队):奖励劫持的根因是流形漂移 AViTS(上海交通大学、阿里云终端智能计算部、山东大学、吉林大学、西安交通大学(ECCV 2026)):选对token省下9倍算力 SingDance(快手可灵团队、香港科技大学、清华大学):训练没见过的唱跳被组合出来 K5 声音克隆(Kandinsky Lab(俄罗斯莫斯科)):加一层线性层换来声音克隆 VoiceDesigner(约翰霍普金斯大学、Adobe Research):用文字描述设计并改写音色 今日论文速览 1. ThermoDPO:奖励劫持的根因是流形漂移 Manifold Drift in Flow Preference Optimization: A Root Cause of Reward Hacking | 西湖大学、浙江大学、快手可灵团队 | arXiv:2608.20011 关键词:流形漂移,偏好优化,流匹配,奖励劫持,DPO,快手可灵 前序问题:偏好优化(DPO 那一套)已经是对齐生成模型的标准做法,但把它搬到流匹配这种连续时间动力学上并不是换个损失函数那么简单。流匹配的训练目标是学一个把噪声搬运到数据分布的速度场,而奖励驱动的更新会直接修改这条搬运轨迹——问题是,没有任何机制约束修改后的轨迹终点仍然落在预训练数据流形上。实践中这表现为大家熟悉的「奖励劫持」:打分器给的分越来越高,生成的图却越来越不像正常图片。此前的讨论多停留在现象描述和经验缓解(加 KL 惩罚、早停、混拒绝采样),没人说清这究竟是调参问题还是结构问题。 本文贡献:作者把这个失效模式命名为流形漂移(manifold drift),并给出了它的判据。理论侧证明了两件事:最优的流匹配确实能恢复终点数据分布;而一次偏好更新只要其诱导的终点位移带有非零法向分量,采样支撑集就会离开预训练流形——也就是说漂移是偏好更新的结构性后果,不是训练不充分。对策是 ThermoDPO:一个带温度控制的目标函数,把成对偏好优化锚定在被偏好的样本上。这个设计有个漂亮的性质——在不同温度区间下,它分别退化为拒绝采样微调(RFT)和 FlowDPO,也就是说它把这两种此前被当作不同方法的做法统一在一条温度轴上,同时控制一个基于重建的逐点代理量来间接约束流形距离。低温时偏好信号会被削弱,作者又补了一个加权变体 ThermoDPO-weighted 来补偿。 Core intuition of ThermoDPO. Flow Matching (gray) transports noise to the pretrained data manifold. FlowDPO (green) may reach preferred regions through an off-manifold displacement, whereas ThermoDPO (red) adds a winner-side anchor intended to keep the redirected mass closer to the pretrained manifold. The formal statements and their assumptions are summarized in tab:notation_theory_map; the behavior is evaluated in the toy study (Fig.) and real-image study (Fig.). 实验效果:玩具基准上 ThermoDPO-weighted 的 StrictScore 达到 0.899,对比 FlowDPO 的 0.629 和 FlowDPO+RFT 的 0.857。真实模型上,在 SD3.5-M、CFG=4.5 的设定下,OCR 指标提升 47.5%,四项指标平均提升 16.0%。人工成对评测的结果更能说明问题:在文字准确性上 ThermoDPO 对 FlowDPO 的胜率是 40.0% 对 16.7%,视觉质量上对 FlowDPO 是 36.7% 对 6.7%——注意三个对比中「平局」的比例都在 46%~93% 之间,说明改进是稳定的方向性提升而非把生成结果整体改头换面。 Pairwise human evaluation of ThermoDPO-weighted against different baselines on text accuracy and visual quality over 30 prompts. Each stacked bar reports the percentage of prompts for which ThermoDPO-weighted is preferred, tied, or dispreferred relative to the corresponding baseline. ThermoDPO-weighted shows consistently stronger performance on visual quality while remaining competitive on text accuracy. 批判点评:这篇的贡献重心明确在理论刻画,实证部分则偏薄。主结果跑在玩具基准上,真实模型只验证了 SD3.5-M 单个骨干、且核心提升集中在 OCR 这一个指标上(47.5% 相对提升听起来大,但文字渲染是 SD3.5 的已知短板,基线本身偏低)。四项指标平均 16.0% 的提升没有拆开给出每一项,读者无法判断是均匀改善还是被 OCR 一项拉高。人工评测的样本量看柱状图应为 30 对,规模偏小。另外把 RFT 和 FlowDPO 统一到温度轴上是个优雅的结论,但也意味着 ThermoDPO 在实践中多了一个需要调的超参,而论文对温度如何选择只给了区间性的定性讨论。视频生成——快手可灵最关心的场景——完全没有实验。 2. AViTS:选对token省下9倍算力 AViTS: Adaptive Spatiotemporal Token Selection for Efficient Dynamic-Resolution Generation | 上海交通大学、阿里云终端智能计算部、山东大学、吉林大学、西安交通大学(ECCV 2026) | arXiv:2608.17995 关键词:token选择,动态分辨率,DiT加速,时空重要性,ECCV 2026,阿里云 前序问题:扩散 Transformer 的成本来自迭代采样。一个已知的省法是动态分辨率:早期时间步在低分辨率下去噪,后期再升到高分辨率,因为早期主要确定构图、不需要细节。但现有做法在分辨率切换点会把所有 latent token 一起升采样,这里有两重浪费——很多 token 对应的是背景或平坦区域,根本不需要高分辨率计算;而统一升采样还可能损害细节一致性。已有的部分升采样策略要么只看局部 latent 的结构线索,要么只用单步统计量,两者都难以同时刻画「token 与文本的语义相关性」和「token 表示在扩散步之间的动态变化」。 本文贡献:AViTS 把「该给哪个 token 升分辨率」建模成一个时空重要性问题,两个信号分开算再融合。空间重要性来自 latent 与文本的注意力:把自注意力的 Query 与文本 Key 的注意力图沿头维度平均,得到每个 token 的空间分数,语义上与 prompt 更相关的 token 分数更高。时间重要性来自 token 级特征在扩散时间步之间的方差——变化剧烈说明这个位置还没收敛、仍在被主动塑形。两者融合后做重要性感知的选择性升采样:关键 token 优先精化分辨率,次要 token 延后处理,从而砍掉冗余的高分辨率计算。整个方法不需要重训模型。 Overview of AViTS and spatiotemporal importance estimation. (a) Three-stage dynamic-resolution sampling: Stage~1 low-res denoising with signal collection over the last $N_T$ steps, Stage~2 selective upsampling of top-$K$ tokens, and Stage~3 full-res refinement. (b) Temporal importance from token-wise step variance across the collected snapshots. (c) Spatial importance from aggregated latent--text cross-attention (averaged over heads/blocks and collection steps); fused scores guide prioritization. 实验效果:FLUX 上最高 6.34 倍加速;Qwen-Image-Edit 和 FLUX.1-Kontext-dev 上接近 9 倍 FLOPs 削减;叠加蒸馏模型后达到 14.76 倍。作者强调该方法与蒸馏、量化、特征缓存三条主流加速路线正交,可以叠乘。图像编辑任务上的定性对比给出的是 5.24 倍加速档位(这一档下与 Ralu 的 4.55 倍、ToCa 的 3.59 倍、TaylorSeer 的 5.00 倍同台):三组编辑指令中 AViTS 的结果与原始 1.00 倍输出最接近,而同倍率的 TaylorSeer 出现了明显的材质与结构偏移(陶瓷羊的例子里羊的形态直接变了)。 Qualitative comparison on GEdit-Bench with Qwen-Image-Edit. AViTS achieves superior semantic preservation and visual quality at a higher acceleration ratio (5.24$\times$) compared to state-of-the-art baselines. 批判点评:加速比的报法需要读者留心:摘要里的「近 9 倍」和「14.76 倍」是 FLOPs 削减,而定性图里用来跟同类方法比画质的是 5.24 倍这一档——FLOPs 削减与实际墙钟加速之间通常有不小的落差,尤其是这套方法引入了额外的注意力统计与 token 选择开销,论文摘要没有给出对应的实测延迟。另外空间重要性依赖 latent-text 注意力,这对文本条件较弱或无文本条件(如纯图像编辑的结构保持部分、无分类器引导关闭时)的场景是否还成立,需要更多验证。方法本身只作用于「动态分辨率采样」这个前提之上,如果模型本来不走 coarse-to-fine,收益无从谈起。 3. SingDance:训练没见过的唱跳被组合出来 SingDance: Compositional Zero-Shot Singing-and-Dancing Video Generation with Role-Aware Audio Conditioning | 快手可灵团队、香港科技大学、清华大学 | arXiv:2608.16220 关键词:唱跳视频,组合零样本,角色条件,音频注入,快手可灵 前序问题:给定一张参考图、一段文本和一条音轨生成个性化舞蹈视频,需要模型把音乐映射到身体动作。但「边唱边跳」多了一个要求:画面里的人不仅要跟上节拍,嘴还得对上歌词。现有方法在这里正好分成两个互不搭界的阵营——音乐驱动的方法只管编舞,不管口型;语音驱动的方法则默认画面里的人就是发声者,从没考虑过「跳舞的人同时在唱这首歌」这种组合。而直接收集「唱跳」配对数据成本极高。 本文贡献:SingDance 的核心设计是把「是否发声」抽象成一个语义角色:画面主体要么是 source(声音由他发出),要么是 listener(声音来自画外的另一个人)。这样一来,「对口型」就不再绑定在语音这个模态上,而变成一个可以被显式切换的条件。架构上用硬路由(hard-compact routing)从语音、音乐、角色三路条件里挑出与当前任务相关的部分,再通过逐帧的联合音频注入送进 DiT 块——关键是 source 和 listener 共享同一条语音通路,这保证了两种角色下的表征是可比的。训练用非对称监督:屏幕内说话的视频与精心筛选的画外对话回应视频负责建立角色控制,纯器乐和歌曲伴舞视频负责建立音乐驱动的身体动作。真正巧妙的是目标配置 Song/Source(发声者在唱歌)在训练中从未出现过——推理时把 source 角色指派给一首歌,就把分别学到的「发声」和「随歌跳舞」两种能力组合出来了,实现组合零样本。 Training architecture of SingDance. The first video frame is separately encoded as a clean reference latent, while subsequent frames are temporally compressed and noised in latent space. Wav2Vec~2.0 and MuQ features, together with the vocal-role condition, are selected by hard-compact routing and supplied to frame-wise joint audio injection. The repeated block is schematic: joint audio injection is applied immediately after each of 10 selected blocks in the 30-block DiT backbone. The denoised latents are decoded into output frames. Snowflakes and flames denote frozen and trainable modules, respectively. 实验效果:实验显示强的动作-节拍对齐与视觉保真度,口型同步与最强的语音驱动基线高度竞争,但生成时参数量显著更少。角色切换的效果在定性图里最直观:同一段视频在 Lip-on 和 Lip-off 两种设定下,人物的身体动作与背景几乎完全一致(帧号相同),差别只在嘴部——Lip-on 时嘴张开在发声,Lip-off 时嘴闭合,说明发声控制被干净地从身体运动中解耦出来,切换一个条件不会牵动其他部分。 Qualitative paired vocal-role switching on two SingDance examples. Each Lip-on/Lip-off pair shares all role-independent inputs and inference settings; only the vocal role changes. 批判点评:论文只有 9 页 5 图,实验体量偏小,且摘要中的结论多为定性表述(「强的对齐」「高度竞争」),缺少可对照的绝对数字——口型同步到底是 Sync-C 多少、跟哪个基线差多少,需要读正文才能确认。组合零样本是个漂亮的设定,但它成立的前提是「发声」与「音乐驱动运动」这两种能力在表征上足够独立;一旦歌曲的节奏与歌词的发音在时间上强耦合(比如快嘴 rap),这种解耦假设是否还站得住是个开放问题,而这恰恰是唱跳场景里最难的一类。另外角色只有 source/listener 两档,多人同框、轮唱、和声这类真实短视频里常见的情形不在建模范围内。 4. K5 声音克隆:加一层线性层换来声音克隆 Adding Voice Cloning to Text-to-Audio-Video Models with a Single Zero-Initialised Layer | Kandinsky Lab(俄罗斯莫斯科) | arXiv:2608.15690 关键词:声音克隆,文生音视频,零初始化,T2AV,Kandinsky 前序问题:文生音视频(T2AV)模型能从一段文字同时生成画面和配乐配音,但没有任何机制控制「说话的是谁」——你要一个特定音色,只能碰运气。给这类模型加声音克隆的常规思路是接一个说话人编码器、改架构、重训,代价不小,而且改动大了容易伤到已有的音视频生成能力。 本文贡献:作者给出的是一个近乎最小的改法:在音频主干上加一个零初始化的线性层,短周期微调,推理时给一段短参考录音即可。零初始化是关键——增强后的模型在训练开始时就是原模型的一个功能副本,不会破坏已有能力,这个思路和 ControlNet 的零卷积同源。参考信息通过两路互补信号注入:一是把参考音频的扩散 latent 拼接(prepend)到音频流前面,提供细粒度的时序音色信息;二是用一个全局说话人嵌入去调制目标音频的 token,提供说话人层面的整体约束。方法在自家两个模型上验证:K5(5B)和 K5-lite(0.6B),底座是开源 Kandinsky 5.0 的 CrossDiT 架构——音频与视频两条流各自做自注意力,再在每个融合块内通过跨模态注意力交互,文本条件由两条流共享。 实验效果:在 30 个说话人、674 条说话人-文本配对的基准上,对比五个强声音克隆 TTS 基线(含 XTTS-v2、IndexTTS2、NAVA 等),增强后的 5B 模型在三个独立验证网络(ECAPA-TDNN、WavLM-SV、Resemblyzer)上都取得最高的说话人编码器余弦相似度 SECS,且相对每一个基线都具备统计显著性。架构上还有个意外收获:因为音频路径可以独立评估,推理时能只跑音频、跳过整个音视频扩散循环,带来约 30 倍加速,而声音克隆行为不受影响。 批判点评:评测口径偏窄是最明显的问题:主指标只有说话人相似度 SECS 一项,而声音克隆的质量至少还要看可懂度(WER)和自然度(MOS)——只优化相似度很容易换来音质或发音的退化,论文摘要里没有给出这两项与基线的对照。基准规模也不大(30 个说话人),且没有说明是否覆盖跨语言、口音、非常规音色这些真正考验泛化的情形。30 倍加速的说法需要正确理解:它是「只跑音频路径 vs 跑完整音视频循环」的对比,本质上是省掉了视频生成,而不是音频生成本身变快了——对于真正需要音视频一起出的场景,这个加速并不存在。另外整套方法绑定在自家 Kandinsky 5.0 底座上,对其他 T2AV 架构的可迁移性未验证。 5. VoiceDesigner:用文字描述设计并改写音色 VoiceDesigner: Text-to-Voice Generation and Editing via Unified Diffusion Modeling and Data Augmentation | 约翰霍普金斯大学、Adobe Research | arXiv:2608.13613 关键词:文生音色,语音编辑,统一扩散,数据增强,Adobe 前序问题:文生音色(TTV)让人可以用一段文字描述直接合成对应的嗓音,这在配音、游戏角色、有声书里价值很高。但现有系统卡在两处:一是音色多样性不足,尤其是虚构角色(怪物、机器人、卡通形象)这类现实中不存在的嗓音,模型基本合成不出来——因为训练数据里就没有;二是缺乏鲁棒且灵活的编辑能力,比如按参考音克隆、或者只改情绪和语气而保持音色。 本文贡献:两条线同时下手。数据侧做了一个混合流水线:用数字信号处理手段(变调、共振峰变换、时域拉伸这类)配合语音生成模型,人工构造出覆盖真实人声与虚构角色的多样音色数据集——本质上是用增强绕开「虚构嗓音没有真实录音」这个死结。模型侧提出 VoiceDesigner,一个统一处理生成与编辑的扩散 Transformer。架构上四路输入各配一个 Local-DiT 前端:参考音频与目标音频走 VAE 编码器,指令走语言模型,转写文本走 tokenizer,四路 token 拼接后过共享的 DiT 块栈。DiT 块内部用 RMS-Norm 加 Scale/Gate 的调制结构(自注意力和前馈各一组),条件通过调制系数注入。另配一个时长预测器先定长度,再由 DiT 从噪声 latent 出发去噪、VAE 解码出波形。这样生成(无参考音)与编辑(有参考音)就是同一套权重下的不同输入配置。 An overview of framework design of VoiceDesigner. 实验效果:主客观评测显示,VoiceDesigner 在与音色描述和编辑指令的对齐度(prompt alignment)上优于当前最好的 TTV 模型,同时在感知质量与音色可用性上保持竞争力。架构消融给出的证据比较扎实:作者按条件注入位置分 Early / Early-Mid / Late-Mid / Late 四档对比三代架构,最终版 VD-DiT-v3 在声音克隆相似度 SIM-o 上于所有四档都稳定最高(约 0.58),而基线 CapSpeech-NAR 在 Early 档的 WER 高达 0.76、Early-Mid 档 0.20,v3 则把 WER 压在 0.04 附近——说明架构改进的收益主要来自把条件注入做得更鲁棒,而非单纯堆容量。 Ablation study on the model architecture. 批判点评:「优于 SOTA 的 prompt 对齐、竞争力的感知质量」这个表述值得警惕:竞争力通常意味着没有更好。也就是说这套方法换来的是描述控制力,代价可能是音质并未提升。虚构音色靠 DSP 增强构造是个务实的工程解,但增强出来的样本与真实录音在统计上必然有差异——模型学到的「怪物嗓音」有多大程度是在拟合变调伪影而非真正的音色概念,论文没有正面回答,而这直接决定了它在真实创作中够不够用。消融图里 SIM-o 最高约 0.58 这个绝对水平在声音克隆任务里并不算高(专门做克隆的系统通常更高),说明统一模型在克隆这一子任务上确实付了代价。另外情绪、语气这类编辑属性的评测只提到 Style-Acc 一个指标,粒度较粗。 6. AvatarDynamizer:静态数字人补上衣服褶皱 AvatarDynamizer: From Static to Dynamic Human Avatars via Generative Dynamic Textures | 马普信息学研究所、VIA Research Center、EPFL | arXiv:2608.19900 关键词:4D数字人,动态纹理,3D高斯,视频扩散先验,马普所 前序问题:全身数字人要跨过恐怖谷,表面动态是关键——衣服的褶皱、布料的甩动,这些细节缺失时人眼立刻觉得假。但现有两条路各有硬伤:通用方法能从单张图、单目视频或文本提示重建静态 3D 数字人,可它们的动画是骨骼驱动的,衣服跟着骨头刚性变形,没有真实的表面动态;专用方法(为单个人训一套)渲染质量和动态都好,代价是每个人都要一套昂贵的多视角采集。近期的通用动态方法则难以把表面动态嵌进表示里,结果要么多视角不一致,要么动态表现力不足。 本文贡献:核心想法是把「数字人的表面动态」转成「纹理生成问题」,从而可以直接借用预训练视频扩散模型的先验。具体做法:设计一个纹理空间的表面动态嵌入,用编码器-解码器把姿态相关的动态编码进动态纹理图(dynamic texture map)——纹理图是二维的,天然与视频扩散模型的输入格式兼容;解码时再把纹理解成 3D 高斯,由高斯渲染器出图,多视角一致性因此得到保证。整条流水线的输入端很宽:多视角图、单目图、单目视频、文本提示、随机采样、3D 扫描都能作为静态数字人来源,经身份拟合得到身份纹理,再与用户指定动作产生的运动纹理一起送进动态纹理生成器,最后由通用高斯解码器渲染出自由视角结果。由于现有数据集在规模、序列长度或动作多样性上都不够,作者还自采了一个大规模多视角长序列数据集。 Overview. Given a static human avatar reconstructed from multimodal inputs, e.g. multi-view images, we first perform identity fitting to obtain its coarse shape and identity texture. Our Dynamic Texture Generator predicts dynamic texture maps conditioned on identity and novel pose. Then, our Generalized Gaussian Decoder recovers Gaussian splats for faithful and view-consistent renderings. 实验效果:实验表明该方法能给静态数字人赋予可信的表面动态,在视觉保真度上优于同类通用方法,尤其在动态训练数据有限时优势更明显。定性对比图给出的证据比较清楚:以 LHM 和 MV 两种静态数字人来源为起点,逐行对比 Static Avatar、+GAS、+VAP 与 +Ours——前三者在胸前印花和裤腿区域(图中红框)都出现了纹理糊掉或褶皱缺失,本方法(绿框)则保留了印花细节并给出了随姿态变化的布料褶皱,与 GT 行的表现最接近。 Qualitative Comparison on DynaHuman. Given a static avatar reconstructed from a monocular image using LHM or from multi-view images (MV), we compare our method with state-of-the-art generalizable surface dynamics methods. Our AvatarDynamizer produces faithful wrinkles while preserving both 3D geometry and identity consistency. 批判点评:把动态压进纹理空间是个聪明的降维,但它同时划定了能力边界:纹理是贴在几何表面上的,因此这套方法能表达「表面看起来在动」,却难以表达真正需要几何位移的动态——宽松裙摆的大幅甩动、外套的开合、长发的飘动,这些超出纹理可表达范围的情形论文没有讨论。「优于同类通用方法」的对照对象是通用方法,而质量天花板仍是专用方法(per-subject 训练),两者的差距有多大摘要没有交代。另外方法依赖自采的大规模多视角数据集才训得起来,这与「通用、低成本」的初衷之间存在张力——数据成本从推理侧转移到了训练侧,对复现者不算友好。 7. GenRec:该重建的别幻觉该幻觉的别糊 GenRec: Knowing Where to Reconstruct and Where to Generate | 苏黎世联邦理工、Google、Microsoft、KAIST | arXiv:2608.17832 关键词:新视角合成,流匹配,观测掩码,重建与生成分区,ETH 前序问题:从稀疏输入图做生成式新视角合成,本质上是两个性质完全不同的任务混在一起:在某个源视图里可见的像素有唯一正确的值(只受视角相关的着色调制),而落在遮挡区或超出拍摄范围的像素则允许一整个分布的合理补全。现有方法用一个统一的损失同时处理这两种情形,结果是几何保真与创造性幻觉的界限被抹平——即便通过 warp 的点云或投影深度把场景几何注入进去,可见区域该被精确重建的地方也会被生成先验带糊。 本文贡献:GenRec 的做法是把这个分区直接写进架构、监督和梯度流三处。首先由源相机加一个单目深度估计器导出观测掩码(observation mask),明确标出哪些像素是「被看到过的」。主干是一个多视角流匹配模型,同时对 RGB 和场景坐标图(scene-coordinate map)在所有目标视图上联合去噪——两个模态各有编码器,通过跨视角注意力与跨模态注意力交互,解码侧接 LoRA。然后是一个像素空间的精化阶段(重建分支),用稀疏 3D 交叉注意力与自注意力,专门在已观测像素上恢复被 latent 压缩丢掉的高频细节,且不扰动未观测区域的生成先验。关键在于同一个掩码还用来门控监督信号——回归损失被限制在观测区域内,不会污染生成先验;反过来生成损失也不会去干扰该被精确重建的部分。 Overview of GenRec. Given posed input views and target poses, monocular depth and forward warping produce per-target observation masks and warped renders. These condition a (I) multi-view flow matching backbone, which jointly denoises RGB and scene-coordinate latents through cross-view and cross-modal attention. A (II) reconstruction branch then refines only the observed pixels via sparse 3D attention guided by the predicted scene coordinates, while the observation mask gates gradients so the generative prior is preserved in unobserved regions. 实验效果:在 RealEstate10K、DL3DV-10K、Mip-NeRF 360 三个数据集上,单视图外推与双视图插值两种设定下,GenRec 在观测区域取得最好的重建保真度,同时在未观测区域的感知质量上超过纯生成式基线——也就是说没有用一头的退化去换另一头。定性对比中与 Gen3C 的差别很明显:Gen3C 的结果在家具边缘、地面纹理上出现明显的糊化与结构漂移(教室场景的桌椅、客厅场景的家具轮廓都有溶解感),GenRec 则保持了清晰的边界与合理的几何。论文还特意把重建指标分观测/未观测区域分别汇报,而非只给全图平均——这个报法比现有工作更诚实。 Comparative qualitative results. Single-view extrapolation against our strongest baseline, Gen3C. Each row shows the input view, ground-truth target, GenRec, and Gen3C. 批判点评:整套方案的正确性建立在观测掩码的准确性上,而掩码来自单目深度估计器——深度估计在无纹理区、反射面、细结构上的失效是众所周知的,一旦掩码把「其实没看清」的像素标成已观测,回归损失就会强行去拟合一个错误的目标,这类失效模式论文没有展开分析。方法把两条支路、两个模态、两套损失叠在一起,复杂度不低(流匹配主干 + 稀疏 3D 注意力精化 + LoRA),推理开销与训练成本相对单一模型的对照没有交代。评测集中在室内场景为主的三个数据集上,大尺度室外、动态物体等情形未涉及。 8. KeyID:免训练把身份注入到关键帧 KeyID: Decoupled Drafting and Keyframe Editing for Identity-Preserving Video Generation | 广东工业大学(ACM MM 2026) | arXiv:2608.16154 关键词:身份保持,视频生成,免训练,关键帧编辑,ACM MM 2026 前序问题:身份保持视频生成(IPVG)要求合成的视频既忠于参考主体的长相,又贴合文本提示。现有方法两头受限:一类靠微调,调参成本高;一类只在输入层做增强,能力有限。共同的困难是在复杂、长序列动作中维持刚性的身份一致——人一动起来,脸就开始漂。更本质的矛盾是「提示遵循」与「身份保真」之间存在容量冲突:模型的表达能力被两个目标同时争夺,密集的逐帧身份监督会压制动作的自由度。 本文贡献:KeyID 是一个免训练框架,思路是把视频动态的合成与身份的注入彻底解耦成两步。第一步 Reference-Aware Video Generation:先用大语言模型把全局提示扩写成带细节的增强提示,经 T2I 出首帧、ImgEdit 编辑、再由 I2V 展开成视频草稿(并有 Prompt Relay 机制传递时序提示)——注意这个草稿是身份无关(identity-agnostic)的,只对齐多个参考的粗略属性,因此动作可以放开生成。第二步 Identity-Preserved Keyframe Editing:对草稿做分组帧采样挑出关键帧,只在这些稀疏关键帧上做身份修正,再通过运动插值把修正传播到中间帧。从密集的帧级监督换成稀疏的关键帧级精化,容量冲突就被绕开了。模块化设计还带来一个好处:扩展到多主体参考和复杂连续动作不需要额外训练。 Overview of KeyID. (a) Reference-Aware Video Generation. A global prompt, optional temporal prompts, and a face reference are fused by GPT-5 into an enhanced prompt, from which a first frame is generated and optionally edited with non-human objects. The edited frame and the global prompt, along with optional temporal prompts, drive I2V to produce a video draft. (b) Identity Preserved Keyframe Editing. Keyframe windows are uniformly sampled in groups along the video draft, optimal keyframes are selected in keyframe identity refinement, and motion interpolation produces the final temporally coherent video with preserved identity and prompt adherence. 实验效果:自动与人工评测均优于此前工作,并在 ACM Multimedia 2026 IPVG 大挑战赛 Track 2(Sequential Action)中拿到亚军。定性对比里与 Concat-ID、Stand-In 的差距集中在长序列动作上:跑步、足球、医院三组场景中,两个基线在人物快速移动时脸部出现明显变形与身份漂移(足球场景里 Stand-In 的人物在远景中几乎不可辨识),KeyID 则在整段动作里保持了一致的面部特征,同时动作幅度与场景细节(跑道、球场、走廊)都没有被压制。 Qualitative comparison. Four evenly sampled frames are shown for each video. KeyID better preserves identity consistency and prompt adherence across complex actions. 批判点评:免训练是真实优势,但这套流水线的代价是把复杂度转移到了推理链上——LLM 扩写、T2I、ImgEdit、I2V、关键帧编辑、运动插值,六个环节串联,每一环的失败都会传导下去,且整体延迟必然远高于单模型端到端方案,论文没有给出推理成本的量化。稀疏关键帧修正加运动插值的组合在动作平滑时应该工作良好,但在快速非线性运动、遮挡后重现这类情形下,插值能否维持身份一致性是个疑问——而这恰恰是 Track 2「连续动作」最难的部分。竞赛拿的是亚军而非冠军,说明方法仍有明显差距。评测依托竞赛官方基准,跨基准的泛化性未验证。 9. Mise-en-Scène:版式不用预测而是自己长出来 Mise-en-Scène: Implicit Layout Emergence in Diffusion Transformers for Human-AI Design Co-Creation | Canva Research(ECCV Human-AI Co-Creation Workshop 最佳论文) | arXiv:2608.19000 关键词:版式生成,平面设计,隐式布局,LoRA,Canva 前序问题:从用户给定的素材自动做平面设计,要同时满足两件互相拉扯的事:整体构图协调,以及每个素材被精确保留(logo 不能变形、文字不能糊)。现有做法是先用语言模型预测显式的边界框坐标,再把素材贴进去。这种「先规划再合成」的分离带来两个后果:布局与视觉呈现脱钩,生成的构图往往僵硬、缩放失当;而且产物是一张扁平的图,设计师没法继续改。 本文贡献:作者换了个问法:布局能不能在一个预训练的图像编辑扩散 Transformer 内部隐式地涌现出来?两阶段实现。第一阶段用一个经过 knockout 筛选的小 LoRA 适配预训练 DiT,让它直接起草一份完整设计——元素的排布与渲染出的画布是联合涌现的,而不是先定坐标再填充。输入侧文本简述过文本编码器,背景图与各个元素分别过冻结的 VAE,所有 token 拼接后进 DiT 块栈。草稿里的文字和 logo 会有可见的失真,但位置关系是对的。第二阶段是确定性的 match-and-place:借一个 VLM grounder 逐个定位草稿中的元素位置,再把原始高分辨率素材搬到对应位置——这一步保证了素材的像素级保真,且产物是可编辑的分层设计而非扁平图,设计师能接着改。作者特别强调,对预训练 Transformer 做最小适配就够了,不需要多元素生成任务里常见的那套专门的条件注入机制。 Mise-en-Sc`ene. The method runs in two stages. In Stage~1 (simplified layout generation), a text brief, a background canvas, and the visual elements are mapped by frozen encoders into a joint token sequence and processed by a flow-matching Diffusion Transformer adapted only through a knockout-selected LoRA, which produces a layout-aware draft design. Because the draft comes from stochastic sampling, it still contains rendering artifacts such as distorted text and warped logos. In Stage~2 (deterministic match-and-place), a VLM grounder locates each original element in the draft independently, and the original high-resolution layers are alpha-composited at the grounded boxes to yield the final design, which keeps the emergent layout while restoring exact, pixel-faithful, editable assets. 实验效果:在大规模 PrismLayersPlus 基准上,Mise-en-Scène 生成的设计在感知质量上最接近真值,且大幅领先 LLM 版式规划器与专用版式 Transformer 两类方法;match-and-place 阶段把剩余的保真度差距也补到了接近真值合成图的水平。消融数据佐证了第二阶段的必要性:直接对扩散草稿而非 match-and-place 合成结果打分,会让 Qwen3-VL 上的美学保真度差距 |ΔGT| 从 0.046 恶化到 0.248。定性对比中与 FlexDM、LaDeCo 的差别很直观——两个基线普遍把元素缩得过小或叠在一起(FlexDM 尤其明显,文字常糊成一团),本方法的排布则接近 GT 的构图逻辑。 Qualitative comparison on the PrismLayersPlus test set. Each row shows, from left to right, the input design elements provided without spatial context, followed by the composites from FlexDM, LaDeCo, our Mise-en-Sc`ene, and the ground truth. Every method is rendered from its own predicted layout; our column is the match-and-place output. Our designs follow the ground-truth arrangement most closely; see text for a per-row discussion. 批判点评:第二阶段能保证素材保真,但它同时暴露了第一阶段的局限:草稿里文字和 logo 是失真的(框架图里明确标注了 text distortion、brand/logo distortion、detail inconsistency 三类问题),也就是说 DiT 学到的其实是「大致该放哪」而非真正理解了排版规则,match-and-place 是必要的补丁而非可选增强——一旦草稿里某个元素的位置判断错了,第二阶段只会把原始素材精确地搬到一个错误的位置上。评测的主指标是与真值的感知接近度,这个口径隐含假设了 PrismLayersPlus 的真值就是好设计,但平面设计本身允许多解,「接近真值」和「设计得好」并不等价,而论文没有人工设计师的偏好评测。另外基准单一,元素数量、语种、画布比例的覆盖范围未交代。 10. BeyondMasks:删掉物体也要删掉它的影子 BeyondMasks: Evaluating Causal and Physical Consistency in Video Object Removal | Bilkent 大学、Koç 大学、Hacettepe 大学(ECCV 2026) | arXiv:2608.20107 关键词:视频物体移除,因果一致性,评测基准,VLM评测,ECCV 2026 前序问题:生成式视频模型让物体移除的视觉真实度大幅提升,但评测协议还停在「掩码区域像素保真度」上,本质上把移除当成了局部修补。现实场景里移除一个物体是一次因果干预:抹掉物体本身之外,它引起的物理效应——影子、反光、光照变化、半透明遮挡、以及运动留下的痕迹——也必须一并消除。而这些效应恰恰落在掩码之外,现有指标完全看不到。现有基准要么没有对齐的干净参考,要么局限于简化的合成设定,无法系统评估因果一致性。 本文贡献:BeyondMasks 是一个配对基准:提供时序对齐的合成与真实视频对,每对都带干净背景参考。构造方式是反向的——先有干净背景,再插入物体与其应有的效应,从而天然拿到对齐的「移除前/移除后」真值:合成侧用 Veo 3 生成背景视频再插入物体与效应(90 条),真实侧用三脚架实拍背景再通过受控编辑引入目标物体(90 条)。数据覆盖光度、几何、体积、动态四类交互,标注上刻意只给「物体本体」的二值掩码而不标注次生效应,逼模型自己去推理该消除什么。作者还整理了次生效应的分类体系并给出各类样本数(影子 127、反光 61、半透明 46、水汽 20、光源 38、随意痕迹 37)。配套提出 CORE,一个基于视觉语言模型的结构化评测协议,同时度量物体消失程度与次生效应一致性,与人类判断的吻合度高于现有指标。 Overview of the BeyondMasks construction pipeline. Top: Paired intervention-based generation, where an object-present video is derived from a clean background video, ensuring temporal alignment. Bottom: Representative categories of object-induced causal after-effects, including illumination, reflection, volumetric, and dynamic interaction effects. 实验效果:对当前最好的方法做基准测试后暴露出系统性失效:掩码区域保真度很高,但次生效应普遍没被移除——视觉上的合理性与因果上的正确性之间存在明确的鸿沟。定性结果把这个鸿沟量化得很清楚:三组场景(结冰湖面的倒影、木板上的杯子阴影、路面上的瓶子与其投影)里,ProPainter 与 Minimax 的 LPIPS 分数与最好的方法几乎持平(0.065~0.098 区间,差异极小),但 CORE 的两项打分差距明显——ProPainter 的 CORE-AES 只有 1~2 分,Rose 能到 4~5 分;肉眼看图也能确认前两者留下了明显的残影与阴影残迹。也就是说 LPIPS 这类指标对次生效应几乎不敏感,换个指标才能把差距照出来。 Pixel metrics fail to capture causal correctness. Although LPIPS scores are similar across methods, their ability to remove object-induced effects (e.g. shadows or reflections) differs substantially. CORE separates these failure modes by evaluating object removal (CORE-OS) and elimination of causal after-effects (CORE-AES). $\downarrow$ better for LPIPS; $\uparrow$ better for CORE scores. 批判点评:180 条视频(合成 90 + 真实 90)的规模对一个基准来说偏小,各效应类别的样本数更少(水汽只有 20 条),据此得出的类别级结论统计强度有限。合成侧用 Veo 3 生成背景再插入物体,这引入了一层生成模型自身的偏置——被评测的方法与构造数据的模型属于同一技术谱系,是否存在系统性的相互适配值得警惕。CORE 依赖 VLM 打分,而 VLM 对影子、反光这类细微物理线索的敏感度本身就是个未知量,论文虽报告了与人类判断的吻合度更高,但「更高」的基线是本就不敏感的 LPIPS,这个对照并不严格;用 VLM 评测生成结果也天然继承了 VLM 的失效模式。作为纯评测工作,它指出了问题却没有给出改进移除方法的方向。 趋势观察 奖励对齐的失效终于被写成了数学 — 过去一年大家都在抱怨「奖励劫持」:模型学会了讨好打分器,图却越来越怪。今天快手可灵与西湖大学合作的 ThermoDPO 第一次把这件事在流匹配框架里形式化了——他们定义了「流形漂移」(manifold drift)这个概念,并证明只要偏好更新引起的终点位移带有非零法向分量,采样结果就必然离开预训练数据流形。换句话说,奖励劫持不是调参没调好,而是把 DPO 直接搬到连续时间动力学上时的结构性后果。这个视角的价值在于它把一个玄学问题变成了可度量的量:论文用「重建距离」作为流形距离的代理,于是「有没有漂移」可以被直接监控,而不是等到生成结果看起来不对才回头查。今天另一篇 BeyondMasks 走的是同一条路的另一半——它说视频物体移除的评测一直在算掩码区域的像素误差,可现实中删掉一个物体还要删掉它的影子、反光和水汽,这些恰恰落在掩码之外。两篇论文一个从理论、一个从评测,指向同一件事:生成模型的对齐问题正在从「效果好不好」进入「我们究竟在优化什么」的阶段。 加速的粒度从「步」下探到「token」 — 扩散模型加速的主流路线过去是减步数(蒸馏)、缓存特征(TeaCache 一类)、或者降精度(量化)。上交与阿里云的 AViTS 在今天给出了一个正交的第四条:动态分辨率采样时,不要把所有 latent token 一起升采样。它用「latent 与文本的注意力」度量空间重要性、用「token 特征跨时间步的变化量」度量时间重要性,融合后只对关键 token 优先做分辨率精化,其余延后。在 Qwen-Image-Edit 和 FLUX.1-Kontext-dev 上拿到接近 9 倍 FLOPs 削减,叠加蒸馏模型后到 14.76 倍。值得注意的是作者明确强调这条路与蒸馏、量化、特征缓存正交——这意味着推理加速正在从「选一条路线」变成「几条路线叠乘」,而叠乘的前提是每条路线作用在不同的冗余维度上。AViTS 挖的是空间分辨率这一维,此前基本没人系统做过。 音频侧的改造正在变得越来越「轻」 — 今天有三篇论文都在音频生成上,但共同点不是模型更大,而是改动更小。Kandinsky Lab 的做法最极端:给一个文生音视频模型加声音克隆能力,只需在音频主干上加一个零初始化的线性层,短周期微调即可,且因为零初始化,增强后的模型起点就是原模型的功能副本,不破坏已有能力。副产品是推理时可以只跑音频路径而跳过视频路径,拿到约 30 倍加速。快手可灵的 SingDance 也是类似哲学——它没有为「唱跳」这个新任务收集数据(Song/Source 这个目标配置在训练时从未出现过),而是把发声主体建模成一个语义角色(source 或 listener),让训练时分别学到的「发声」与「随歌跳舞」两种能力在推理时组合起来。这种「靠结构设计换数据」的思路在数据获取越来越贵的今天格外有价值。 人工智能炼丹君 整理 | 2026-08-24 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|视频生成中的强化学习与奖励模型-VideoRL 视频生成中的强化学习与奖励模型 所属方向:对齐与强化学习 | 难度:前沿专题 | 前置知识:DiffusionRL、FlowMatching 关键词:视频强化学习、奖励模型、Flow-GRPO、时序一致性奖励、人类偏好、reward hacking 01. 为什么需要它 先看一个用于说明奖励投机的假设场景;下面的“两千步”不是本文实际运行的视频实验记录。 你有一个文生视频模型,想用 RL 把它对齐到人类偏好。你手上有个打分器,在图像上验证过效果不错——清晰度、细节、构图都能打分。你把它接上视频,跑 GRPO,训了两千步。奖励曲线漂亮地往上走。 然后你去看生成结果:画面几乎不动了。 人物站在原地,衣角不飘,背景纹理纹丝不动。prompt 明明写着 "a person walking across the street",模型给你一张会呼吸的照片。 这不是 bug,是模型算得比你清楚。静止画面有一系列白拿的好处: 形状永远不会崩——因为它不变 帧间没有闪烁——因为帧之间完全一样 细节可以做到极精细——不用分算力去渲染运动模糊 而它放弃的只有「动态性」这一项。如果静止带来的加分超过动态性与指令遵循等全部损失,那么静止可能比运动拿到更高奖励,RL 会毫不犹豫地找到它。 视频奖励增加了运动与时序一致性维度。在有限模型能力下,运动幅度与形变、闪烁等伪影可能存在经验权衡;这不是“运动必然降低画质”的物理定律。图像的清晰度、构图、语义也可能冲突,不能假设图像奖励天然相容。 后面几节会把这笔账算成具体数字——用 VisionReward 真实发布的 29 个权重。 02. 最小可用理解 三句话: 采一组。对同一个 prompt 采样 $G$ 条视频(比如 8 条),用奖励模型给每条打一个分。 组内比。把这组分数减去组内均值、除以组内标准差,得到每条的优势(advantage)——比同组平均好就是正,差就是负。 按优势推。优势为正的往上推概率,为负的往下压。不需要训练价值网络(critic),组内均值就当基线用了。 这概括了 GRPO 的组内优势机制;完整目标还包含后文的概率比、裁剪和可选 KL。它省掉 critic 的代价是必须一次采一组,好处是少训一个网络、少一堆调不动的超参。 如果只记一件事:RL 不会给你「更好的视频」,只会给你「奖励更高的视频」。这两者的差距全部藏在奖励模型里。本文一半篇幅在讲奖励模型,不是跑题。 03. 数学推导 3.1 从策略梯度到组内基线 目标很直白:最大化生成样本的期望奖励。 $$J(\theta) = \mathbb{E}_{x \sim \pi_\theta} [r(x)]$$ 其中 $\pi_\theta$ 是生成模型(策略),$x$ 是一条采样出来的视频,$r(x)$ 是奖励模型给的分。对参数求梯度,用对数导数技巧: $$\nabla_\theta J = \mathbb{E}_{x \sim \pi_\theta} [r(x) \nabla_\theta \log \pi_\theta(x)]$$ 这个式子能用,但方差大得没法训。原因是 $r(x)$ 的绝对值直接乘在梯度上:假如所有样本的奖励都在 8.0 到 8.2 之间,那么每个样本都在说「往我这边推」,只是力度略有差别。真正有用的信息是「谁比谁好」,而不是「绝对分多高」。 标准解法是减一个基线 $b$: $$\nabla_\theta J = \mathbb{E}[(r(x) - b) \nabla_\theta \log \pi_\theta(x)]$$ 只要 $b$ 与 $x$ 无关,这个替换是无偏的(因为 $\mathbb{E}[b \nabla_\theta \log \pi_\theta] = b \nabla_\theta \mathbb{E}[1] = 0$)。PPO 那一路用一个学出来的价值网络当 $b$,GRPO 的选择更省事——同一个 prompt 采一组,用组内均值当基线: $$A_i = \frac{r_i - \mathrm{mean}(r_1, \dots, r_G)}{\mathrm{std}(r_1, \dots, r_G)+\varepsilon}$$ 这里不能直接套用上面的无偏证明:组均值含有 $r_i$,依赖当前样本。固定 prompt、独立同分布采样且不除标准差时, $$E[(r_i-\bar r)\nabla\log\pi_\theta(x_i)]=(1-1/G)\nabla J.$$ 使用不含自身的 leave-one-out 均值可消除该缩放;除以随机组标准差还会改变样本及 prompt 的相对权重。$\varepsilon>0$ 防止同分组除零,同分组的奖励优势为零。标准化是有用的工程选择,不能据此宣称完整 GRPO 无偏;奖励均值高本身也不等于期望梯度大。 这张图要看什么:左图是同一个 prompt 采出的 8 条视频的奖励,全挤在 8.0 到 8.2 之间——如果直接把 $r_i$ 乘在梯度上,8 条样本会一起喊「往我这边推」,有用的信息全被绝对值淹没(箭头方向完全一致)。右图减掉组内均值、除以组内标准差之后,同样的 8 个数字变成了有正有负的优势:绿的往上推、红的往下压。这就是 GRPO 不用 critic 也能训的原因——基线是从同组样本里白捡的(图由 code/make_figures.py 生成,下同)。 GRPO 出自 DeepSeekMath(arXiv:2402.03300),原本是给语言模型的数学推理用的,后来被搬到视觉生成上。 3.1.1 完整目标里还有两个护栏 上面那个式子是骨架。真实的 GRPO 目标还包着两层保护,后面 04 节的最小实现会把它们省掉,这里先说清省的是什么。 第一层是重要性采样比的截断(沿用 PPO 的做法): $$\mathcal{L} = -\mathbb{E}\left[ \min\left( \rho_i A_i, \ \mathrm{clip}(\rho_i, 1-\epsilon, 1+\epsilon) A_i \right) \right]$$ 式子里的 $\rho_i$ 是新旧策略的概率比,$\rho_i = \pi_\theta(x_i) / \pi_{\theta_{\text{old}}}(x_i)$。采样用的是旧策略 $\pi_{\theta_{\text{old}}}$,更新的是新策略 $\pi_\theta$,$\rho_i$ 修正这个偏差。clip 截断的是朝有利方向继续外推的收益,不保证每个 ratio 都在区间内,也不是 KL 的硬约束。神经网络共享参数,仍可能越界;需结合 KL 和梯度日志监控。视觉去噪实现通常按每个随机转移计算 ratio,不能把这里的整段视频记号误当成可直接算出的边缘密度。 第二层是对参考模型的 KL 惩罚: $$\mathcal{L}_{\text{total}} = \mathcal{L} + \beta \, \mathrm{KL}\left[ \pi_\theta \, \| \, \pi_{\text{ref}} \right]$$ $\pi_{\text{ref}}$ 通常是 RL 开始前的初始模型。这一项把策略拴在原始分布附近,是对付 reward hacking 最基础的护栏——因为大多数 hack(比如 01 节那个静止画面)都要求策略跑到离原始分布很远的地方去。$\beta$ 调的就是「允许它跑多远」。 代价是 $\beta$ 很难调:太大则学不动,太小则护栏形同虚设,而合适的值随任务和奖励模型变化。这也是为什么 04 节要先把护栏拆掉看清裸的优化行为——理解 hacking 怎么发生,比直接套护栏更重要。 3.2 flow matching:怎样得到随机转移的似然 Flow matching 的 ODE 为 $dx_t/dt=v_\theta(x_t,t)$。本文用 $t=1$ 表示噪声、$t=0$ 表示数据:给定初始噪声,逐步转移是确定性的条件 delta,不能直接代入高斯转移 log-prob 做 PPO/GRPO。 这不等于输出没有概率分布。随机初值经正则、可逆的 ODE 流仍可产生具有边缘密度的输出,CNF 可用散度积分计算密度;可微奖励还可以沿 ODE 用路径导数优化,确定性策略梯度也有自己的适用条件。受限的是本文这条“随机逐步转移似然 + score function”的路线。 Flow-GRPO 第 4.2 节 为它构造反向时间 SDE: $$dx_t=\left[v_\theta(x_t,t)-\frac{\sigma_t^2}{2}\nabla\log p_t(x_t)\right]dt+\sigma_t\,d\bar W_t,\qquad dt<0.$$ 由于时间从 1 向 0 走,score 修正前是减号;离散噪声标准差为 $\sigma_t\sqrt{-dt}$。若改用从噪声出发递增的时间坐标,漂移和 score 符号必须一起变换。准确 score、匹配的速度场与连续时间求解条件下,SDE 和 ODE 共享边缘分布;近似网络、有限步长及 RL 更新会带来偏差,不能保证实现后精确不变。 这使被训练的非退化转移具有可计算的高斯 log-prob。终步若噪声为零,仍要排除或另行处理,不能对零方差求对数密度。Flow-GRPO 还用 Denoising Reduction 减少训练采样步数、保留完整推理步数;这是论文所测任务上的经验结果,需在视频任务重新验证。 3.3 奖励从哪来:把打分变成一串是非题 现在缺的是 $r(x)$。视频的「好」是多维的,而人类偏好数据通常只有「A 比 B 好」这种成对比较,信息量很稀疏。 VisionReward(arXiv:2412.21059)的做法是把打分拆成一串可解释的是非题,再线性加权: $$r(x) = \frac{1}{K} \sum_{k=1}^{K} w_k \cdot a_k(x), \quad a_k(x) \in \{+1, -1\}$$ 其中 $a_k$ 是一个视觉语言模型对第 $k$ 个问题的回答(yes 记 $+1$,no 记 $-1$),$w_k$ 是该问题的权重。视频版一共 $K = 29$ 个问题,从「是否满足 prompt 的全部要求」到「细节是否精细」。 这个设计有两个好处。可解释:分低的时候能看出是哪一维拖的,不是一个黑盒数字。可控:想让模型更重视某一维,直接改 $w_k$ 就行。 代价是它把「好」压成了一个线性组合。而线性组合最容易被套利——下一节就用它真实发布的权重,把套利空间算出来。 04. 代码实现 4.1 先把奖励函数照抄一遍 VisionReward 的打分逻辑短到可以完整贴出来。这是它仓库里 inference-video.py 的核心两行(2026-08 的 main 分支): answers = np.array([1 if answer == 'yes' else -1 for answer in answers]) return np.mean(answers * weight).item() 有个细节值得停一下:no 记的是 $-1$,不是 $0$。这让答错变成实打实的扣分,而不只是「没拿到加分」。同一个维度上,yes 和 no 之间差了 $2 w_k$ 而不是 $w_k$——算套利空间时这个因子 2 不能漏。 29 个权重是仓库里 VisionReward_Video/weight.json 直接给出的。先看看它们长什么样(code/reward_hacking.py): 29 个维度,权重总和 6.2772,均值 0.2165 最高 1.1418(指令-未完全失败) 最低 0.0085(细节-不粗糙) 最高/最低 = 134 倍 指令遵循三档合计 2.3486,占总权重 37.4% 构图+色彩合计 0.0924,占总权重 1.5% 两个数字值得盯着看。最高和最低差 134 倍——这不是一个「各维度都重要」的均衡奖励,而是有着强烈倾向的。指令遵循三档占了 37.4%,构图加色彩只占 1.5%:在真实的人类偏好数据里,指令三档的权重合计是构图与色彩权重合计的约 25 倍。但这不是人类把指令遵循看得比整体美感重 25 倍的因果结论:其他维度也反映画质,且题目相关性、回答频率与权重尺度会影响解释。 这个结构反直觉但合理——观众要的是他要的东西,不是一张漂亮但无关的图。 这张图要看什么:左图把 29 个权重从低到高排开——最高的「指令-未完全失败」1.1418,最低的「细节-不粗糙」0.0085,相差 134 倍(红色是指令遵循三档,灰色是构图加色彩)。右图按语义归堆后更刺眼:指令遵循合计 2.3486、一家吃掉 37.4%,构图加色彩只有 0.0924、占 1.5%。指令三档的权重合计是构图与色彩这两组的二十多倍——记住这个比例,4.2 和 4.4 节的套利与翻转全是从它推出来的。 4.2 静态套利的账 回到 01 节那个静止画面。它能白拿哪些分、要放弃哪些分,现在可以精确算: 静止能白拿:全程形状保持+不混乱+画质稳定 = 0.7166 静止要放弃:镜头高度动态+不微弱 = 0.1634 净收益 +0.5532 (yes/no 相差 2 个单位,实际影响 ×2 = +1.1064) 上述 +1.1064 是未除以 $K$ 的加权和变化;score() 实际变化是 $1.1064/29\approx0.03815$。权重总和 6.2772 对应分数上限 0.2165,分数全范围宽度约 0.4329,因此这笔差额约占全范围 8.8%。这只是所选维度的局部账,不能省略指令等其他维度后宣称静止全局最优。 那它会不会因为违背 prompt 而被罚回来?我构造了两个视频画像对比(prompt 要求「人物走过街道」): 视频 A(几乎静止的精致画面,没照做 prompt) +0.1220 视频 B(照做了 prompt,但有形变和抖动) +0.1144 奖励模型更偏好:A(静态) 差值 0.0076 静态那个赢了。 拆开看差异来自哪: -1.9088 指令-全部满足 +0.8586 细节-非常精细 +0.5372 画质-非常稳定 +0.5272 全程形状-不混乱 -0.5048 指令-大部分满足 +0.3688 全程形状-完美保持 静态视频在指令遵循上亏了 2.41(这是权重最高的维度!),但靠画质那几项一点点堆回来,最后反超 0.0076。 需要说清楚:这两个 yes/no 画像是我按各维度语义人工假设的,不是真实模型的输出,所以这个结论说明的是「权重结构允许这样的套利」,不是「VisionReward 实际会这么判」。差值只有 0.0076 也说明它非常接近临界——是否会被优化器实际找到,还取决于策略可达性、采样噪声与正则约束,不能由这一对假设画像推断必然收敛。 4.3 让 GRPO 自己去找套利 手工构造画像终究不如让算法自己找。下面是完整的单参数 GRPO(code/grpo_minimal.py),策略只有一个参数:运动强度 $m$。 维度压到 1 维是刻意的——才能看清 GRPO 究竟把策略推向哪里。玩具概率按人为假设设定:$m$ 越大,指令遵循和动态性越容易拿 yes,形状保持、画质稳定、细节精细越容易拿 no。 def grpo(steps=400, group=32, lr=0.35, sigma=0.15, theta0=0.0, seed=0, weight=None): rng = np.random.default_rng(seed) theta = theta0 for step in range(steps): # 策略:m = clip(sigmoid(theta) + noise),高斯探索 mu = 1 / (1 + np.exp(-theta)) eps = rng.normal(0, sigma, group) ms = np.clip(mu + eps, 0.0, 1.0) rs = np.array([reward(m, rng, weight) for m in ms]) # 组内相对优势:减均值除标准差(3.1 节那个式子) adv = (rs - rs.mean()) / (rs.std() + 1e-8) # ∂mu/∂theta = mu(1-mu) grad = float(np.mean(adv * eps / sigma ** 2) * mu * (1 - mu)) theta += lr * grad return 1 / (1 + np.exp(-theta)) m_final = grpo() print(f"GRPO 收敛到 m = {m_final:.4f}") # GRPO 收敛到 m = 0.9657 十几行,没有 critic,也刻意去掉了 3.1.1 节那两层护栏(clip 和 KL)——保留的是组标准化 REINFORCE 示意,不是完整 PPO/GRPO 更新。代码中的高斯 score 对应裁剪前潜在动作 $a=\mu+\epsilon$,环境再执行 $m=\mathrm{clip}(a,0,1)$;不能把它当成裁剪后混合分布的普通高斯 log-prob。用完整的 29 个权重跑: step 运动强度 m 组内平均奖励 0 0.5000 -0.0238 80 0.9227 +0.0395 160 0.9420 +0.0346 320 0.9649 +0.0452 399 0.9660 +0.0370 GRPO 收敛到 m = 0.9657 → 策略选择:动态(照做了 prompt) 没有 hack。 策略从中性的 0.5 一路推到 0.966,选择了照做 prompt。换三个不同初值(0.27 / 0.50 / 0.73)出发,都收敛到 0.977 附近,说明这不是初值凑巧。 原因就是 4.1 节那个 37.4%:指令遵循的权重足够大,压住了画质维度的全部诱惑。这是玩具里的结果,不能验证 Flow-GRPO 的视频表现。Flow-GRPO 在其图像实验中他们报告「very little reward hacking occurred」,奖励涨上去了而画质和多样性没有明显退化。 4.4 关键对照:把指令遵循拿掉 那 01 节那个失败场景怎么发生的?答案在奖励模型上,不在算法上。 01 节的设定是「手上有个在图像上验证过的打分器」——图像打分器很可能根本不看时序,或者对指令遵循的权重远没有这么高。把三个指令遵循维度的权重置零,模拟这种情况,同一个 GRPO 再跑一遍: step 运动强度 m 组内平均奖励 0 0.5000 -0.0016 80 0.0305 +0.0269 160 0.0178 +0.0363 320 0.0099 +0.0396 399 0.0084 +0.0324 收敛到 m = 0.0084(完整权重下是 0.9657) 从 0.966 翻转到 0.008。 策略选择了几乎完全静止。注意中间那列奖励——它一路从 $-0.0016$ 涨到 $+0.04$,总体上也比初始值高,但逐步有明显随机波动。这就是 01 节说的:奖励曲线不能告诉你模型学到了什么。 奖励曲面看得更清楚——同一组物理约束,两种权重下的形状完全相反: m 完整权重 去掉指令遵循 0.0 -0.0393 +0.0393 0.3 -0.0298 +0.0228 0.5 +0.0006 -0.0006 0.8 +0.0446 -0.0322 1.0 +0.0379 -0.0394 → 完整权重的最高点在 m = 0.8(+0.0446) → 去掉指令遵循后最高点在 m = 0.0(+0.0393) 完整权重下曲面在 $m = 0.8$ 处见顶;去掉指令遵循后,在这一玩具设定下整体偏向低运动强度;表格是每点 4000 次随机采样的估计,不能仅凭稀疏网格确立精确单调性或全局最优。 这张图要看什么:左图是同一组物理约束下的奖励曲面——完整权重(蓝实线)在 $m=0.8$ 附近见顶,去掉指令遵循三档后(红虚线)整条曲线翻转成单调递减,最高点直接落到 $m=0$。右图是同一个 GRPO、同一个初值跑 400 步:蓝线冲到 0.966(照做 prompt),红线掉到 0.008(躺平)。而两条浅色细线是各自的组内平均奖励——二者总体奖励改善,但都有采样噪声,不能靠奖励曲线判断是否符合需求。奖励曲线不能告诉你模型学到了什么。 结论落在这里:reward hacking 不是算法出了毛病,而是它精确地最大化了你真正写下来的那个目标。 同一个 GRPO、同一个物理约束,只改奖励的权重结构,行为就翻转了。查 hacking 该去查奖励函数,而不是调 RL 的超参。 还要区分两种目标:图中的曲面是在固定运动强度 $m$ 上的采样均值,策略优化的却是高斯探索后再裁剪的期望奖励。$\mu=0.966$ 是裁剪前策略均值参数,不是实际运动强度的期望;它与网格中 $m=0.8$ 的峰值不能直接比较。因此这些数字不能证明“策略梯度过冲”,更不能归因为探索噪声必然造成方向性偏置。 05. 工业级实现对照 参考实现(以 2026-08 的 main 分支为准,上游会重构): THUDM/VisionReward → inference-video.py:score、compare_two_videos THUDM/VisionReward → VisionReward_Video/weight.json:29 个线性权重 上面的最小实现把奖励当成一个现成函数,生产上它是个 VLM,差别都在这。 5.1 打分要跑 29 次前向 score() 的实际流程是:抽帧、对每个问题拼一次 prompt、让 VLM 输出 yes/no。29 个问题就是 29 次 VLM 前向。 这直接决定了 RL 训练的成本结构。GRPO 每步要采一组(比如 8 条视频),每条视频要 29 次 VLM 前向,也就是每个训练步 232 次前向——而这还没算生成那 8 条视频本身的去噪开销。奖励计算不是附带开销,它经常是训练循环里最贵的一环。这也是 Flow-GRPO 要做 Denoising Reduction 的现实压力来源。 5.2 两套问题清单,别拿错 仓库里有两个文件长得很像: VisionReward_video_qa.txt:64 个问题,用于细粒度查询(问模型某一项如何) VisionReward_video_qa_select.txt:29 个问题,用于打分 inference-video.py 顶部读的是 _select 那个: QUESTIONS_PATH = "VisionReward_Video/VisionReward_video_qa_select.txt" WEIGHT_PATH = "VisionReward_Video/weight.json" 29 条问题对应 29 个权重,一一对齐。拿 64 个那份去乘权重会直接维度不匹配——这算好事,至少会报错。 5.3 比较两个视频不是比分数 想判断 A 和 B 哪个好,直觉是各算一次 score() 再比大小。它没这么做——compare_two_videos() 的结尾是: answers1 = np.array([1 if answer == 'yes' else -1 for answer in answers1]) answers2 = np.array([1 if answer == 'yes' else -1 for answer in answers2]) diff = answers1 - answers2 return np.sum(diff * weight).item() > 0 先求两个答案向量的逐维差 diff,再加权求和判正负。 只要两次打分使用同一组答案与权重,这与比较两个 score() 完全等价(仅差正的常数 $K$),并不能阻止不同维度相互抵消。VisionReward 论文的“多维一致性”另指偏好优化时筛选在各语义维度都一致占优的样本对;不是把减法移到加权和里面。 5.4 那些数字:这套设计到底有多少提升 VisionReward 报告的两个结果: 偏好预测准确率比 VideoScore 高 17.2% 用它做奖励的文生视频模型,pairwise win rate 比用 VideoScore 高 31.6% 这两个百分比对应不同指标与实验,不能相除推断“奖励改进被 RL 放大了”。VisionReward 的偏好优化还包括 DPO 等流程;本文引用的是论文报告结果,不是视频 GRPO 的对照实测。 06. 代价与边界 杠杆是双向的。 持续优化可能放大奖励偏差,但幅度不是由 5.4 节的两个异质指标决定的。奖励模型里一个不起眼的偏见——比如偏爱暖色调、偏爱中心构图——在评测里可能只是一两个百分点,但 RL 会把它当成目标,训几千步之后就是全部输出都发黄。奖励模型的偏见不会被平均掉,会被放大。 优化的是奖励,不是质量。 这句话看着像废话,但它有个实践推论:奖励曲线上升不能作为训练成功的证据。4.4 节那次 hack 的奖励曲线($-0.0016 \to +0.04$)和 4.3 节那次成功训练长得一模一样。 那怎么才能发现?三个手段,按性价比排: 盯住奖励模型看不见的指标。 挑几个不参与奖励计算的量化指标定期记录,比如帧间光流的平均幅度、逐帧 LPIPS 差异。静态 hack 在这类指标上一眼就露馅(光流幅度趋近 0),而奖励模型完全不看它们。这个办法便宜、能自动化,应该默认开着。 看奖励的维度分解,不只看总分。 VisionReward 这种线性结构的好处正在这里——把 29 维的得分分别记下来。总分涨、但某几维在持续下跌,就是套利正在发生。4.4 节第 5 段那张表就是这么读的。 固定一批 prompt 定期人眼看。 最贵但不可替代。前两个手段只能发现你预料到的失效模式,人眼能发现你没预料到的。 至于用第二个奖励模型交叉验证——听起来对称,实际有个陷阱:如果两个奖励模型是用同源的偏好数据训的,它们很可能共享同样的盲区,交叉验证会一起点头。要用就得选训练数据和架构都不同的。 成本很实在。 按 5.1 节的账,每个训练步是「$G$ 条视频的完整采样+ $29G$ 次 VLM 前向」。视频采样本身就比图像贵一个量级(多了时间维度),再乘上组大小,这是 RL 在视频上落地慢的主要原因。Denoising Reduction 这类工程手段不是优化项,是可行性前提。 线性加权是双刃剑。 它带来可解释性,也带来可套利性——线性函数没有交互项,意味着「这一维差到极点」不会拖累其他维度的加分。真实的人类判断不是这样的:一个完全静止的「视频」在人眼里直接不合格,不管它多精细。线性模型表达不了这种否决关系,所以 04 节那个套利在数学上成立。 什么时候不该用 RL。 如果你的问题能用更直接的手段解决,就别上 RL。想让输出更清晰——去修数据和 VAE;想让它听懂 prompt——先确认是不是文本编码器或者标注质量的问题。RL 适合的是「说得清好坏、但写不出损失函数」的目标,比如整体美感、运动自然度这类只能靠比较来表达的偏好。上 RL 之前先问一句:我的奖励模型真的比我的损失函数更懂这件事吗? 07. 经典论文脉络 这条线分两支:怎么优化和拿什么当奖励。两支交替推进。 奖励这一支: ImageReward(arXiv:2304.05977,2023-04)第一个规模化的文生图人类偏好模型,确立了「收集成对偏好数据训一个打分器」这个范式。它是个黑盒标量,可解释性问题从这里就留下了。 VideoScore(arXiv:2406.15252,2024-06)把细粒度人类反馈搬到视频上,成为视频奖励模型的常用基线——也就是 VisionReward 那两个数字(17.2% / 31.6%)超越的对象。 VisionReward(arXiv:2412.21059,2024-12)用分层是非题 + 线性加权换来可解释性,图像和视频统一处理。代价是线性结构本身可被套利(06 节)。 优化这一支: DDPO(arXiv:2305.13301,2023-05)把去噪过程当成多步决策,第一次让 policy gradient 在扩散模型上跑通。 DPOK(arXiv:2305.16381,2023-05)同期工作,补上了 KL 正则——防止策略为了刷奖励跑离原始分布太远。这是对付 hacking 最基本的护栏。 Diffusion-DPO(arXiv:2311.12908,2023-11)绕开 RL:直接用成对偏好数据做监督式优化,省掉在线采样。简单稳定,代价是只能利用已有的偏好数据,没有探索。 GRPO(arXiv:2402.03300,2024-02)出自 DeepSeekMath,本是给语言模型数学推理用的。用组内相对优势替掉 critic,把 RLHF 的工程复杂度砍掉一大块。 Flow-GRPO(arXiv:2505.05470,2025-05)第一个把在线 policy gradient 接进 flow matching 的工作,靠 ODE→SDE 转换取得随机逐步转移的可计算似然(3.2 节)。在文生图上把 GenEval 从 63% 拉到 95%、视觉文字渲染从 59% 到 92%。 需要说明:Flow-GRPO 的实验是在文生图上做的(SD3.5-M),不是视频。它之所以是视频 RL 的关键前置,是因为主流视频模型也是 flow matching 训的,ODE→SDE 那套推导可以直接搬过来——但视频上的实证还远没有图像充分。 08. 常见误解 「奖励涨了就是训好了」。 01 节整节都在讲这件事。奖励是你自己写的目标函数,模型最大化它是本分。奖励上升唯一证明的是优化在工作,不是效果在变好。 「reward hacking 是 RL 算法的问题,换个算法就好了」。04.4 节那个对照实验就是为了拆掉这个想法:同一个 GRPO,只改奖励权重,行为从 $m = 0.966$ 翻到 $m = 0.008$。算法只是执行者。出了 hacking 该去审奖励函数。 「GRPO 比 PPO 好」。 它主要是更省——不用训 critic,少一个网络和一堆超参。省掉 critic 的代价是必须一次采一组样本才能估出基线,采样开销更大。在视频这种采样极贵的场景里,这个权衡并不是无脑赚。 「多加几个奖励维度就能防 hacking」。 加维度确实提高了套利难度,但只要还是线性加权,套利空间就存在——4.2 节那个例子里有 29 个维度,静态依然套出了 1.1 的净收益。真正起作用的是权重结构(指令遵循占 37.4% 才压住了它),以及 DPOK 那种把策略拴在原始分布附近的 KL 护栏。 「flow matching 模型可以直接套用扩散模型的 RL 方法」。按随机转移似然做 PPO/GRPO 时,需要先定义非退化随机转移,例如 3.2 节的 ODE→SDE 路线。确定性 ODE 的输出边缘密度、可微奖励路径导数等另有方法,并不是所有 RL 都必须给每一步加噪。 09. 动手验证 三个实验,用到的脚本全文都在文末附录,纯 NumPy,没有 GPU 依赖,复制存成同名文件就能跑。 实验一:给自己的奖励函数算套利空间。 跑 reward_hacking.py,看第 2 段那笔账。然后把你自己项目里奖励各维度的权重填进 DIMS,重算一遍「静止能白拿 / 要放弃」的净收益。预期结论是:只要净收益为正,你的模型早晚会发现它。 实验二:找出翻转的临界点。 跑 grpo_minimal.py,把指令遵循的三个权重乘一个系数 $c$(改 weight_without_instruction 为按比例缩放),从 $c = 1.0$ 逐步降到 $0$,看收敛的 $m$ 在哪一步从 0.97 掉到 0.01。预期是个比较陡的转折而不是平滑过渡——这意味着奖励权重的微小改动可能导致行为质变,调权重时值得扫一遍而不是只试一个值。 实验三:验证组大小对方差的影响。 还是 grpo_minimal.py,把 group 从 32 改成 4、8、64,各跑三个不同 seed。预期看到组越小、收敛点越不稳定——因为组内均值和标准差是用这几个样本估的,样本太少基线就不可靠。还要一起权衡采样成本、同分组概率、奖励稀疏度和并行吞吐。 本文三张配图由 make_figures.py 生成(这个需要额外装 pip install matplotlib,其余脚本只要 NumPy)。想复现就把权重换成你自己的:左边的权重账本换成你的 29 维,右边的曲面和 GRPO 轨迹会直接告诉你你的奖励函数在纵容哪种躺平。 10. 延伸阅读 这篇在知识树里是 L4(前沿专题),前面还有三级台阶。如果 03 节读起来吃力,按下面顺序补更省时间: 策略梯度与 PPO 基础——3.1 节那个对数导数技巧、为什么要减基线、clip 是干什么的,都属于那一篇 从 DPO 到 GRPO:去掉价值网络——GRPO 本身的完整讨论在那篇。本文只用到它「组内相对优势」这一个机制,没有展开和 PPO、DPO 的对比 把 RL 用到扩散模型上——DDPO 那套「把去噪当多步决策」的建模 流匹配与 Rectified Flow——3.2 节 ODE→SDE 转换的前提 读完这篇可以继续看: 人类偏好数据怎么收(还没写)——4.1 节那 29 个权重是怎么从成对比较数据里拟合出来的 视频质量评测指标(还没写)——06 节说的那三个检测手段该怎么落实,尤其是「奖励模型看不见的指标」具体该记哪些 附录:完整代码 09 节用到的脚本全文如下(make_figures.py、reward_hacking.py、grpo_minimal.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「视频生成中的强化学习与奖励模型」的三张解释图。 数值一律从同目录两个脚本里取(reward_hacking 的 29 个真实权重、 grpo_minimal 的奖励曲面与 GRPO 轨迹),这里只负责画——那边改了这里要重跑, 免得图和正文数字打架。 三张图分别回答: 1. 29 个奖励权重的账本长什么样(为什么「有没有照做」压过「好不好看」) 2. 组内优势到底把什么信息抽出来了(原始奖励看着都一样,标准化后才有正负) 3. 只改奖励权重、不动算法,GRPO 为什么会从「照做」翻转成「躺平」 只依赖 numpy + matplotlib。跑法:python make_figures.py """ import textwrap from pathlib import Path import matplotlib.pyplot as plt import numpy as np import grpo_minimal as G from reward_hacking import NAMES, WEIGHT ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.bbox": "tight", }) INK = "#1f2937" MUTE = "#6b7280" C_INSTR = "#d1495b" # 指令遵循:红 C_OTHER = "#2f6fb0" # 其余维度:蓝 C_AES = "#c9ced6" # 构图/色彩:灰 C_FULL = "#2f6fb0" # 完整权重 C_NOIN = "#d1495b" # 去掉指令遵循 C_POS = "#2f9e6f" # 优势为正 C_NEG = "#d1495b" # 优势为负 # 维度分组(下标对应 reward_hacking.DIMS 的顺序) GROUPS = [ ("指令遵循", [0, 1, 2], C_INSTR), ("构图+色彩", [3, 4, 6], C_AES), ("光照", [7, 8, 9, 10, 11, 12], C_OTHER), ("形状保持", [13, 14, 15, 16, 17], C_OTHER), ("运动", [5, 18, 19, 20, 21], C_OTHER), ("画质+细节", [22, 23, 24, 25], C_OTHER), ("文字+内容", [26, 27, 28], C_OTHER), ] def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left") if xlabel: ax.set_xlabel(xlabel, fontsize=10, color=MUTE) if ylabel: ax.set_ylabel(ylabel, fontsize=10, color=MUTE) ax.tick_params(colors=MUTE, labelsize=9) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#d1d5db") ax.grid(alpha=0.25, linewidth=0.6, axis="y") ax.set_axisbelow(True) def footer(fig, text, width=118): """把「这张图要看什么」放到坐标轴下方。 必须放在 y<0:bbox_inches="tight" 会把负坐标的 artist 一起收进来, 放在 0~0.05 之间会和 x 轴标签叠在一起。 """ wrapped = "\n".join(textwrap.wrap(text, width=width)) fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE, va="top", ha="left", linespacing=1.6) # ────────────────────────────────────────────────────────────────────── # 图 1:29 个奖励权重的账本 # ────────────────────────────────────────────────────────────────────── def fig_weight_ledger(): order = np.argsort(WEIGHT) # 从小到大,画出来是升序 colors = [C_INSTR if i in (0, 1, 2) else C_AES if i in (3, 4, 6) else C_OTHER for i in order] labels = [NAMES[i] for i in order] fig, axes = plt.subplots(1, 2, figsize=(12.6, 6.4), gridspec_kw={"width_ratios": [1.45, 1]}) fig.subplots_adjust(wspace=0.34) ax = axes[0] ax.barh(np.arange(29), WEIGHT[order], color=colors, height=0.72) ax.set_yticks(np.arange(29)) ax.set_yticklabels(labels, fontsize=7.6) ax.set_xlim(0, WEIGHT.max() * 1.18) ax.tick_params(axis="y", length=0) style(ax, "29 个维度的权重(升序)", "权重 $w_k$", None) # 最高 / 最低标注 ax.text(WEIGHT[order][-1] + 0.02, 28, f"{WEIGHT.max():.4f} 最高", fontsize=8.5, color=INK, va="center") ax.text(WEIGHT[order][0] + 0.02, 0, f"{WEIGHT.min():.4f} 最低", fontsize=8.5, color=MUTE, va="center") # 图例:红=指令遵循,灰=构图色彩,蓝=其余 from matplotlib.patches import Patch ax.legend(handles=[ Patch(color=C_INSTR, label="指令遵循(3 维)"), Patch(color=C_AES, label="构图+色彩(3 维)"), Patch(color=C_OTHER, label="其余(23 维)"), ], fontsize=8.2, frameon=False, loc="lower right") ax = axes[1] gcolor = {name: c for name, _, c in GROUPS} gs = [(name, float(WEIGHT[idx].sum())) for name, idx, _ in GROUPS] gs.sort(key=lambda t: -t[1]) total = WEIGHT.sum() ys = np.arange(len(gs)) # 颜色必须按排序后的名字取:按 GROUPS 顺序 zip 会跟排序后的柱子错位 ax.barh(ys, [v for _, v in gs], color=[gcolor[n] for n, _ in gs], height=0.7) ax.set_yticks(ys) ax.set_yticklabels([n for n, _ in gs], fontsize=9) ax.tick_params(axis="y", length=0) for i, (_, v) in enumerate(gs): ax.text(v + 0.03, i, f"{v:.3f} ({v / total * 100:.1f}%)", fontsize=8.2, color=INK, va="center") ax.set_xlim(0, max(v for _, v in gs) * 1.45) style(ax, "按语义归堆:谁在主导总分", "权重合计", None) fig.suptitle("图 1 VisionReward 的 29 个权重不是均衡的:" "指令遵循一家占了 37.4%,构图加色彩只有 1.5%", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图是 29 个权重从低到高排开——最高的「指令-未完全失败」1.1418," "最低的「细节-不粗糙」0.0085,相差 134 倍,根本不是「各维度都重要」的均衡奖励。" "右图把它们按语义归堆后更刺眼:指令遵循三档合计 2.3486,一家吃掉 37.4%;" "而构图加色彩只有 0.0924、占 1.5%。真实人类偏好数据里," "「有没有照着 prompt 做」比「好不好看」重要二十多倍——这个结构是后面所有套利的源头。") fig.savefig(OUT / "reward_weight_ledger.png") plt.close(fig) print(f"[图1] 29 维权重合计 {total:.4f};最高 {WEIGHT.max():.4f}/最低 {WEIGHT.min():.4f}" f" = {WEIGHT.max() / WEIGHT.min():.0f} 倍;指令遵循占 " f"{WEIGHT[[0, 1, 2]].sum() / total * 100:.1f}%") # ────────────────────────────────────────────────────────────────────── # 图 2:组内优势把「谁比谁好」抽出来 # ────────────────────────────────────────────────────────────────────── def fig_group_advantage(): rng = np.random.default_rng(2024) rs = 8.0 + rng.random(8) * 0.2 # 同一个 prompt 采 8 条,分都挤在 8.0~8.2 adv = (rs - rs.mean()) / (rs.std() + 1e-8) idx = np.arange(1, 9) fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.6)) fig.subplots_adjust(wspace=0.26) ax = axes[0] ax.bar(idx, rs, color=C_OTHER, width=0.62) ax.set_ylim(0, 8.9) ax.set_xticks(idx) style(ax, "原始奖励:8 条都在 8.0~8.2 之间", "组内第 i 条", "奖励 $r_i$") for i, v in zip(idx, rs): ax.arrow(i, v + 0.42, 0, 0.30, width=0.055, color=INK, length_includes_head=True, head_width=0.16, head_length=0.12) ax.text(0.99, 8.72, "每一条都在说:往我这边推(只是力度略有差别)", fontsize=8.6, color=MUTE, ha="right", va="top") ax.text(0.02, 0.30, f"极差只有 {rs.max() - rs.min():.2f}", fontsize=8.6, color=INK, transform=ax.transAxes) ax = axes[1] cols = [C_POS if a >= 0 else C_NEG for a in adv] ax.bar(idx, adv, color=cols, width=0.62) ax.axhline(0, color=INK, lw=1.0) ax.set_xticks(idx) ax.set_ylim(-2.0, 2.0) for i, v in zip(idx, adv): ax.text(i, v + (0.09 if v >= 0 else -0.09), f"{v:+.2f}", ha="center", va="bottom" if v >= 0 else "top", fontsize=8, color=INK) style(ax, "减均值除标准差后:谁该推、谁该压,一眼分清", "组内第 i 条", "优势 $A_i$") ax.text(0.98, 0.94, "绿的往上推,红的往下压;组内均值自动当基线", fontsize=8.6, color=MUTE, ha="right", va="top", transform=ax.transAxes) fig.suptitle("图 2 GRPO 的组内基线:把「绝对分多高」换成「谁比谁好」", fontsize=12, color=INK, x=0.012, ha="left", y=1.04) footer(fig, "要看什么:左图是同一个 prompt 采出的 8 条视频的奖励,全挤在 8.0 到 8.2 之间——" "如果直接把 $r_i$ 乘在梯度上,8 条样本会一起喊「往我这边推」,只是力气略有差别," "有用的信息被绝对值淹没了(箭头方向完全一致)。右图减掉组内均值、除以组内标准差之后," "同样的 8 个数字变成了有正有负的优势:一半往上推、一半往下压。" "这就是 GRPO 不用 critic 也能训的原因——基线是从同组样本里白捡的。") fig.savefig(OUT / "group_advantage.png") plt.close(fig) print(f"[图2] 8 条奖励 {rs.min():.3f}~{rs.max():.3f}(极差 {rs.max() - rs.min():.3f});" f"优势 {adv.min():+.2f}~{adv.max():+.2f}") # ────────────────────────────────────────────────────────────────────── # 图 3:只改奖励权重,同一个 GRPO 翻转 # ────────────────────────────────────────────────────────────────────── def _trace_grpo(weight=None, seed=0, steps=400, group=32, lr=0.35, sigma=0.15): """复刻 grpo_minimal.grpo 的循环,只是把每步的 m 和组内平均奖励记下来。 抽随机的顺序必须和原函数完全一致,否则数字对不上正文。 """ rng = np.random.default_rng(seed) theta = 0.0 ms, rr = [], [] for _ in range(steps): mu = 1 / (1 + np.exp(-theta)) eps = rng.normal(0, sigma, group) m_clip = np.clip(mu + eps, 0.0, 1.0) r = np.array([G.reward(m, rng, weight) for m in m_clip]) adv = (r - r.mean()) / (r.std() + 1e-8) grad = float(np.mean(adv * eps / sigma ** 2) * mu * (1 - mu)) theta += lr * grad ms.append(mu) rr.append(float(r.mean())) return np.array(ms), np.array(rr), 1 / (1 + np.exp(-theta)) def fig_surface_flip(): w_no = G.weight_without_instruction() # 奖励曲面:与 grpo_minimal.main 同口径(rng=7,每点 4000 次采样) rng = np.random.default_rng(7) grid = np.linspace(0, 1, 21) surf_full, surf_no = [], [] for m in grid: surf_full.append(float(np.mean([G.reward(m, rng) for _ in range(4000)]))) surf_no.append(float(np.mean([G.reward(m, rng, w_no) for _ in range(4000)]))) surf_full = np.array(surf_full) surf_no = np.array(surf_no) # 正文引用的那张 11 点表,峰值标注以它为准 rng2 = np.random.default_rng(7) tbl = np.linspace(0, 1, 11) tf, tn = [], [] for m in tbl: # 抽随机顺序与 grpo_minimal.main 完全一致(逐点交错),否则峰值数字对不上正文 tf.append(float(np.mean([G.reward(m, rng2) for _ in range(4000)]))) tn.append(float(np.mean([G.reward(m, rng2, w_no) for _ in range(4000)]))) tf, tn = np.array(tf), np.array(tn) pk_f, pk_n = tbl[int(tf.argmax())], tbl[int(tn.argmax())] ms_full, rr_full, m_end_full = _trace_grpo(weight=None, seed=0) ms_no, rr_no, m_end_no = _trace_grpo(weight=w_no, seed=0) fig, axes = plt.subplots(1, 2, figsize=(12.6, 5.0)) fig.subplots_adjust(wspace=0.30) ax = axes[0] ax.plot(grid, surf_full, lw=2.4, color=C_FULL, label="完整 29 维权重") ax.plot(grid, surf_no, lw=2.4, color=C_NOIN, ls="--", label="去掉指令遵循三档") ax.axhline(0, color="#9ca3af", lw=0.8) ax.scatter([pk_f], [tf.max()], s=70, color=C_FULL, zorder=5) ax.scatter([pk_n], [tn.max()], s=70, color=C_NOIN, zorder=5) ax.annotate(f"最高点 m={pk_f:.1f}", (pk_f, tf.max()), textcoords="offset points", xytext=(10, -30), fontsize=8.6, color=C_FULL, arrowprops=dict(arrowstyle="->", color=C_FULL, lw=1.0)) ax.annotate(f"最高点 m={pk_n:.1f}", (pk_n, tn.max()), textcoords="offset points", xytext=(18, 26), fontsize=8.6, color=C_NOIN, arrowprops=dict(arrowstyle="->", color=C_NOIN, lw=1.0)) ax.legend(fontsize=8.6, frameon=False, loc="lower center") style(ax, "同一组物理约束,两种权重下的奖励曲面形状完全相反", "运动强度 $m$", "期望奖励 $r$") ax = axes[1] ax.plot(ms_full, lw=2.4, color=C_FULL, label="m(完整权重)") ax.plot(ms_no, lw=2.4, color=C_NOIN, ls="--", label="m(去掉指令遵循)") ax.set_ylim(-0.05, 1.05) ax.set_xlabel("训练步", fontsize=10, color=MUTE) ax.set_ylabel("运动强度 $m$", fontsize=10, color=MUTE) ax2 = ax.twinx() ax2.plot(rr_full, lw=1.1, color=C_FULL, alpha=0.45) ax2.plot(rr_no, lw=1.1, color=C_NOIN, alpha=0.45, ls="--") ax2.set_ylabel("组内平均奖励(浅色细线)", fontsize=9, color=MUTE) ax2.tick_params(colors=MUTE, labelsize=8.5) ax2.spines["top"].set_visible(False) h1, l1 = ax.get_legend_handles_labels() ax.legend(h1, l1, fontsize=8.6, frameon=False, loc="center right") style(ax, "同一个 GRPO 跑 400 步:一条冲到 0.97,一条躺到 0.01", None, None) ax.set_ylabel("运动强度 $m$", fontsize=10, color=MUTE) ax.set_xlabel("训练步", fontsize=10, color=MUTE) ax.text(0.02, 0.06, f"完整权重收敛 m={m_end_full:.3f}\n" f"去掉指令遵循收敛 m={m_end_no:.3f}", fontsize=8.4, color=INK, transform=ax.transAxes, va="bottom", bbox=dict(fc="white", ec="#d1d5db", lw=0.7, pad=4)) fig.suptitle("图 3 奖励曲线一样漂亮,学到的东西完全相反", fontsize=12, color=INK, x=0.012, ha="left", y=1.03) footer(fig, "要看什么:左图是同一组物理约束下的奖励曲面。完整权重(蓝实线)在 m=0.8 附近见顶," "去掉指令遵循三档后(红虚线)整条曲线翻转成单调递减,最高点直接落到 m=0——彻底不动才是最优解。" "右图是同一个 GRPO、同一个初值跑 400 步:蓝线冲到 0.966 选择照做 prompt," "红线掉到 0.008 选择躺平。而两条浅色细线是各自的组内平均奖励——它们都在稳步上涨," "形状和一次成功的训练没有任何区别。奖励曲线不能告诉你模型学到了什么。") fig.savefig(OUT / "reward_surface_flip.png") plt.close(fig) print(f"[图3] 曲面峰值:完整 m={pk_f:.1f} ({tf.max():+.4f})," f"去掉指令 m={pk_n:.1f} ({tn.max():+.4f});" f"GRPO 收敛 {m_end_full:.4f} vs {m_end_no:.4f}") def main(): fig_weight_ledger() fig_group_advantage() fig_surface_flip() print(f"[OK] 三张图已写入 {OUT}") for f in sorted(OUT.glob("*.png")): print(f" {f.name} {f.stat().st_size / 1024:.0f} KB") if __name__ == "__main__": main() reward_hacking.py """用 VisionReward 的真实权重,算一遍「静态视频能不能骗到高分」。 权重与问题取自 THUDM/VisionReward(2026-08 的 main 分支): VisionReward_Video/weight.json 29 个线性权重 VisionReward_Video/VisionReward_video_qa_select.txt 29 个 yes/no 问题 打分公式同 inference-video.py 的 score():yes=+1,no=-1,乘权重后取均值。 注意:下面两个视频的 yes/no 画像是**按各维度语义做的人工假设**, 不是真实模型的输出。它用来说明权重结构本身允许什么样的套利, 不构成对 VisionReward 实际表现的评测。 运行 `python reward_hacking.py`。 """ import numpy as np # (权重, 维度简称) —— 顺序与上游 weight.json 严格一致 DIMS = [ (0.9544, "指令-全部满足"), (0.2524, "指令-大部分满足"), (1.1418, "指令-未完全失败"), (0.0350, "构图-美观"), (0.0252, "构图-无明显缺陷"), (0.1260, "镜头运动-无明显缺陷"), (0.0322, "色彩-不难看"), (0.1629, "光照-完全准确"), (0.2167, "光照-无明显错误"), (0.0197, "光照-存在"), (0.1360, "光照-极美"), (0.0965, "光照-美"), (0.1549, "光照-不难看"), (0.1294, "首帧形状-完全准确"), (0.0989, "首帧形状-无明显错误"), (0.1884, "首帧形状-不混乱"), (0.1844, "全程形状-完美保持"), (0.2636, "全程形状-不混乱"), (0.1117, "镜头运动-高度动态"), (0.0517, "镜头运动-不微弱"), (0.0256, "物体运动-非常平滑"), (0.4390, "物体运动-完全真实"), (0.2686, "画质-非常稳定"), (0.4293, "细节-非常精细"), (0.0085, "细节-不粗糙"), (0.1276, "细节-不显著粗糙"), (0.0580, "文字-全部正确"), (0.1446, "文字-存在"), (0.3942, "内容-属于物理世界"), ] WEIGHT = np.array([w for w, _ in DIMS]) NAMES = [n for _, n in DIMS] Y, N = 1, -1 # 视频 A:几乎静止的精致画面。prompt 要求「人物走过街道」,它只给了个站着的人。 STATIC = [ N, N, Y, # 指令:没走,但也不算完全没关系 Y, Y, # 构图:精心构图 Y, # 镜头运动无缺陷(没动,自然没缺陷) Y, # 色彩 Y, Y, Y, Y, Y, Y, # 光照:静态画面容易做好 Y, Y, Y, # 首帧形状:完美 Y, Y, # 全程形状:不动=完美保持 N, N, # 镜头动态:没有 Y, Y, # 物体运动:平滑(无运动可挑)、真实(无违反物理) Y, # 画质稳定:不动=极稳 Y, Y, Y, # 细节:静态可以渲染很精细 Y, Y, # 文字 Y, # 属于物理世界 ] # 视频 B:真的走起来了,但运动带来形变、抖动和轻微模糊。 DYNAMIC = [ Y, Y, Y, # 指令:确实照做了 N, Y, # 构图:运动中构图一般 Y, # 镜头运动无明显缺陷 Y, # 色彩 N, Y, Y, N, Y, Y, # 光照:运动中光照没那么完美 Y, Y, Y, # 首帧形状:还行 N, N, # 全程形状:走动中有形变 ← 运动的代价 Y, Y, # 镜头动态:有 Y, Y, # 物体运动:平滑且真实 N, # 画质稳定:运动带来抖动 ← 运动的代价 N, Y, Y, # 细节:动态模糊,不够精细 ← 运动的代价 Y, Y, # 文字 Y, # 属于物理世界 ] def score(answers): """复刻 inference-video.py 的 score()。""" a = np.array(answers) assert len(a) == len(WEIGHT), f"维度不匹配: {len(a)} vs {len(WEIGHT)}" return float(np.mean(a * WEIGHT)) def main(): print("=== 1. 权重结构 ===") print(f" 29 个维度,权重总和 {WEIGHT.sum():.4f},均值 {WEIGHT.mean():.4f}") print(f" 最高 {WEIGHT.max():.4f}({NAMES[int(WEIGHT.argmax())]})") print(f" 最低 {WEIGHT.min():.4f}({NAMES[int(WEIGHT.argmin())]})") print(f" 最高/最低 = {WEIGHT.max() / WEIGHT.min():.0f} 倍") instr = WEIGHT[0] + WEIGHT[1] + WEIGHT[2] print(f"\n 指令遵循三档合计 {instr:.4f},占总权重 {instr / WEIGHT.sum() * 100:.1f}%") aes = WEIGHT[3] + WEIGHT[4] + WEIGHT[6] print(f" 构图+色彩合计 {aes:.4f},占总权重 {aes / WEIGHT.sum() * 100:.1f}%") print("\n=== 2. 静态套利的账 ===") shape_stable = WEIGHT[[16, 17, 22]].sum() motion = WEIGHT[[18, 19]].sum() print(f" 静止能白拿:全程形状保持+不混乱+画质稳定 = {shape_stable:.4f}") print(f" 静止要放弃:镜头高度动态+不微弱 = {motion:.4f}") print(f" 净收益 {shape_stable - motion:+.4f}" f" (yes/no 相差 2 个单位,实际影响 ×2 = {(shape_stable - motion) * 2:+.4f})") print("\n=== 3. 两个视频的实际得分 ===") s_static, s_dynamic = score(STATIC), score(DYNAMIC) print(f" 视频 A(几乎静止的精致画面,没照做 prompt) {s_static:+.4f}") print(f" 视频 B(照做了 prompt,但有形变和抖动) {s_dynamic:+.4f}") winner = "A(静态)" if s_static > s_dynamic else "B(动态)" print(f" 奖励模型更偏好:{winner} 差值 {abs(s_static - s_dynamic):.4f}") print("\n=== 4. 差异来自哪几个维度 ===") diff = (np.array(STATIC) - np.array(DYNAMIC)) * WEIGHT order = np.argsort(-np.abs(diff)) print(" (正值=这一维让静态视频占便宜)") for i in order[:8]: if diff[i] != 0: print(f" {diff[i]:+.4f} {NAMES[i]}") if __name__ == "__main__": main() grpo_minimal.py """GRPO 的最小可运行实现,跑在 VisionReward 的真实权重上。 策略只有一个参数:运动强度 m。这是刻意的——把维度压到 1 维, 才能看清 GRPO 到底把策略推向哪里,而不是被高维噪声淹没。 人为设定的玩具权衡(不是视频物理定律或真实 VLM 的测量): m 越大 → 指令遵循、动态性维度更容易拿 yes m 越大 → 形状保持、画质稳定、细节精细更容易拿 no(运动带来形变/抖动/模糊) prompt 明确要求运动("a person walking across the street"), 所以「照做」在语义上就等于 m 要大。看 GRPO 最后选了什么。 运行 `python grpo_minimal.py`。 """ import numpy as np from reward_hacking import WEIGHT, NAMES # 各维度对运动强度 m 的敏感方向 # +1: m 越大越容易 yes -1: m 越大越容易 no 0: 与 m 无关 SENSITIVITY = np.zeros(29) SENSITIVITY[[0, 1, 2]] = +1.0 # 指令遵循(prompt 要求运动) SENSITIVITY[[18, 19]] = +1.0 # 镜头动态 SENSITIVITY[[20, 21]] = +0.3 # 运动平滑/真实:要有运动才谈得上,但过猛会假 SENSITIVITY[[16, 17]] = -1.0 # 全程形状保持 SENSITIVITY[22] = -1.0 # 画质稳定 SENSITIVITY[[23, 24, 25]] = -0.7 # 细节精细(动态模糊) SENSITIVITY[[7, 8, 10, 11]] = -0.3 # 光照准确/美观:运动中更难保持 def yes_prob(m): """给定运动强度 m∈[0,1],各维度答 yes 的概率。 基线 0.5 表示「说不准」,敏感度把它往两边拉。 """ return np.clip(0.5 + SENSITIVITY * (m - 0.5) * 1.6, 0.02, 0.98) def sample_video(m, rng): """按概率采一个 yes/no 画像,yes=+1 no=-1。""" return np.where(rng.random(29) < yes_prob(m), 1, -1) # 指令遵循的三个维度。把它们置零就得到一个「只看画质」的奖励模型, # 用来对照权重结构对 reward hacking 的影响。 INSTRUCTION_DIMS = [0, 1, 2] def reward(m, rng, weight=None): """复刻 inference-video.py 的 score():np.mean(answers * weight)。""" w = WEIGHT if weight is None else weight return float(np.mean(sample_video(m, rng) * w)) def weight_without_instruction(): w = WEIGHT.copy() w[INSTRUCTION_DIMS] = 0.0 return w def grpo(steps=400, group=32, lr=0.35, sigma=0.15, theta0=0.0, seed=0, weight=None, verbose=False): """单参数 GRPO,返回收敛后的运动强度 m。 每步采 group 个动作,用组内均值/标准差做 baseline 得到 advantage, 再按 advantage 加权更新——不需要 critic,这是 GRPO 的核心简化。 为了看清裸的优化行为,这里省掉了 PPO 式的 clip 和对参考模型的 KL 惩罚。 """ rng = np.random.default_rng(seed) theta = theta0 for step in range(steps): # 策略:m = clip(sigmoid(theta) + noise),高斯探索 mu = 1 / (1 + np.exp(-theta)) eps = rng.normal(0, sigma, group) ms = np.clip(mu + eps, 0.0, 1.0) rs = np.array([reward(m, rng, weight) for m in ms]) # 组内相对优势:减均值除标准差 adv = (rs - rs.mean()) / (rs.std() + 1e-8) # 潜在动作 a = mu + eps 的高斯 score,m=clip(a) 只是环境映射。 # 这不是含边界原子质量的裁剪后 m 分布的逐点 log-density。 # ∂mu/∂theta = mu(1-mu) grad = float(np.mean(adv * eps / sigma ** 2) * mu * (1 - mu)) theta += lr * grad if verbose and (step % 80 == 0 or step == steps - 1): print(f" {step:>4} {mu:.4f} {float(rs.mean()):+.4f}") return 1 / (1 + np.exp(-theta)) def main(): print("=== 1. 优化前后的运动强度 ===") print(" step 运动强度 m 组内平均奖励") m_final = grpo(verbose=True) print(f"\n GRPO 收敛到 m = {m_final:.4f}") verdict = "静态(放弃了 prompt 要求的运动)" if m_final < 0.35 else \ "动态(照做了 prompt)" if m_final > 0.65 else "折中" print(f" → 策略选择:{verdict}") print("\n=== 2. 从不同初值出发是否都收敛到同一处 ===") for name, t0 in (("偏静态 (m≈0.27)", -1.0), ("中性 (m=0.50)", 0.0), ("偏动态 (m≈0.73)", 1.0)): mf = grpo(theta0=t0, seed=1) print(f" 初值 {name:<18} → 收敛 m = {mf:.4f}") print("\n=== 3. 奖励曲面:各运动强度的期望得分 ===") rng = np.random.default_rng(7) w_no_instr = weight_without_instruction() print(" m 完整权重 去掉指令遵循 (每点 4000 次采样)") best, best_no = (-9e9, None), (-9e9, None) for m in np.linspace(0, 1, 11): r = float(np.mean([reward(m, rng) for _ in range(4000)])) r2 = float(np.mean([reward(m, rng, w_no_instr) for _ in range(4000)])) best = max(best, (r, m)) best_no = max(best_no, (r2, m)) print(f" {m:.1f} {r:+.4f} {r2:+.4f}") print(f" → 完整权重的最高点在 m = {best[1]:.1f}({best[0]:+.4f})") print(f" → 去掉指令遵循后最高点在 m = {best_no[1]:.1f}({best_no[0]:+.4f})") print("\n=== 4. 对照:奖励模型不看指令遵循时,GRPO 选什么 ===") print(" step 运动强度 m 组内平均奖励") m_hack = grpo(weight=w_no_instr, seed=0, verbose=True) print(f"\n 收敛到 m = {m_hack:.4f}" f"(完整权重下是 {m_final:.4f})") print(" → 同一个算法、同一个物理约束,只改奖励的权重结构," "\n 策略就从「照做」翻转成「静止不动」。这就是 reward hacking 的来源:" "\n 不是算法坏了,是它精确地最大化了你真正写下来的那个目标。") print("\n=== 5. 两个收敛点在各维度上的差别 ===") p_ok, p_hack = yes_prob(m_final), yes_prob(m_hack) gap = (p_hack - p_ok) * WEIGHT order = np.argsort(np.abs(gap))[::-1] print(" (正值=hack 后的策略在这一维更容易拿 yes)") for i in order[:6]: print(f" {gap[i]:+.4f} {NAMES[i]}" f" (yes 概率 {p_ok[i]:.2f} → {p_hack[i]:.2f})") if __name__ == "__main__": main()
-
AIGC 每日速读|2026-08-22|阿里6B小模型编辑分反超20B的Swift-Image 今日 AIGC 论文速览 今日共 10 篇 · 统一图像生成与编辑 3 篇 · 视频生成与世界模型 1 篇 · 4D 人体与数字人 2 篇 · 3D 生成加速 1 篇 · 音频与动作生成 2 篇 · 生成评测 1 篇 重点论文标题列表 Swift-Image(阿里巴巴集团):6B编辑分4.33反超20B模型 Stream4D(UCLA、清华大学):3DGS奖励会奖励画面冻结 4DAnyone(浙江大学 CAD&CG 国家重点实验室、Robbyant、港中文、蚂蚁集团):手机随手拍重建4D人体 WithEveryone(复旦大学、腾讯混元、香港大学):十人合影身份不互串 ear-VAE2(阿里巴巴通义千问团队、Monash University):波形自编码器缺一根频率轴 今日论文速览 1. Swift-Image:6B编辑分4.33反超20B模型 Swift-Image: Exploring the Performance Frontier of Compact Unified Image Generation Models | 阿里巴巴集团 | arXiv:2608.20334 关键词:统一图像生成,图像编辑,单流DiT,多教师蒸馏,少步生成,DiffusionNFT 前序问题:统一图像生成模型(同时做文生图、单图编辑、多图编辑)目前的主流路线是把参数量往上堆,20B 级别已经是常态。但对大多数团队来说,这个规模既训不起也推不动。真正的问题是:在受限的计算预算下,一个相对小的视觉生成器到底能被系统性的训练工程推到什么位置?这里有两重困难。一是三类任务的目标彼此干扰——文生图要的是语义覆盖与美学,编辑要的是身份/布局保持,直接混合训练会互相拖累。二是要做少步推理就得蒸馏,而蒸馏一个已经在多任务上打了折扣的模型,误差会继续累积。所以「小而全」在实践中通常意味着「小而每项都差一点」。 本文贡献:Swift-Image 用 6B 的单流 DiT 打底,架构上把 Qwen3-VL 作为文本/图像理解侧的编码器,VAE embedding 与加噪 VAE embedding 分别经 projector 进入主干;每个 Single-Stream Parallel Block 内部把注意力和 MLP 并行放置,Q/K 各带 RmsNorm 与 RoPE,出口用一个受时间步 t 调制的 Zero-Init Gate 控制残差写入,Scale&Shift 也由 t 驱动。训练侧是渐进式管线:从广覆盖语义起步,逐步提高分辨率、强化视觉质量,最后加入生成-编辑统一监督。后训练是这篇的重头戏,共四段。第一段用任务专属教师(T2I-RL 与 Edit-RL,均为 6B 多步)分别做多步强化学习,提供互补监督;第二段做任务专属 few-step 蒸馏,以 DMD2 为骨架并叠加动态反向模拟、后期偏置停止、解耦噪声匹配、教师锚定对抗损失四个机制,把两个多步专家各自压成 6B few-step 专家;第三段是多教师 on-policy 蒸馏(OPD),让统一学生在自己的策略下同时向 T2I 专家和 Edit 专家学习,从而把两个专家合成一个模型而不是简单加权;第四段用 DiffusionNFT 做 few-step 强化学习,混合 T2I 奖励(对齐、质量)与编辑奖励(身份、布局)做 MixRL 精修。整套设计的核心思路是「先让专家各自强,再在学生策略下合并,最后混合奖励收口」,用流程隔离替代损失加权来缓解目标干扰。 Unified visual backbone for T2I generation and image editing. Semantic conditions from Qwen3-VL and image latents from FLUX.2 AE are jointly processed by parallel single-stream Transformer blocks. 实验效果:参数量-编辑得分的帕累托图给出的对比最直接:Swift-Image-6B-PE 的 Overall Edit Score 为 4.33,3B-PE 为 4.32,而横轴 20B 附近的 FireRed-Image-Edit 是 4.11、Qwen-Image-Edit-2511 是 4.07,9B 的 FLUX.2-klein 为 4.06、4B 版本为 3.89,15.7B 左右的 JoyAI-Image-Edit-Plus 只有 3.72。也就是说 3B/6B 两档都稳定位于图的左上角,用约三分之一到七分之一的参数量取得更高的编辑分。3B 与 6B 几乎打平这一点尤其值得注意——说明在这套后训练管线下,收益主要来自训练策略而非模型容量。 Comparison for parameter and overall edit score with open-source models. The overall edit score is computed as the average across three public editing benchmarks and our benchmarks. 本方法 achieves leading performance with only 6B and 3B parameters. 批判点评:这篇的价值在于它把「小模型能不能靠训练工程赢」这个问题做成了一个可复现的配方,而不是又一次架构宣称。四段式后训练里最有意思的是 OPD:用 on-policy 蒸馏来合并两个任务专家,比传统的多任务损失加权更能规避「学生在教师分布外的行为无人监督」这个老问题,思路是对的。帕累托图也画得诚实,把同期主要开源模型都摆进来了。但几点要保留。第一,Overall Edit Score 是论文自选的综合指标,4.33 与 4.11 的差距落在 5 分制里只有 0.22,缺少置信区间或多次评测的方差,很难判断这是稳定领先还是评测噪声——尤其 3B 的 4.32 与 6B 的 4.33 相差 0.01,几乎不可能是真实差异,反过来也提示这个指标在高分段的分辨力有限。第二,图上只有编辑分一个维度,文生图能力与多图编辑能力没有在同一张图里对照,「统一模型」的另两条腿表现如何需要翻正文。第三,四段后训练每一段都引入了额外的教师模型与奖励模型,总训练成本很可能远超「受限算力预算」的字面印象,论文若不给出与 20B 直接训练的总 FLOPs 对比,「省算力」的结论就只对推理侧成立。第四,DMD2 叠四个机制、DiffusionNFT 再叠 MixRL,组件数量偏多而消融只能覆盖其中一部分,哪几个是真正的关键路径并不清楚,复现者容易在超参上踩坑。 2. Stream4D:3DGS奖励会奖励画面冻结 Stream4D: 4D-Consistency for Streaming Autoregressive Diffusion Video Models | UCLA、清华大学 | arXiv:2608.19556 关键词:流式自回归扩散,长视频生成,4D一致性,3DGS奖励,几何漂移,reward hacking 前序问题:流式自回归扩散模型是实时长视频生成的主流路线,但它的训练目标优化的是局部帧预测,而不是一个连贯世界的几何与动力学。后果是长 rollout 会累积几何漂移,最终退化成静止或不自然的运动。近期有一类双向方法试图用 3D Gaussian Splatting 重建构造的奖励来解决这个问题——让模型生成的视频能被 3DGS 稳定重建,间接逼它学会几何一致。作者指出这条路有一个根本性缺陷:单个刚性 3D 重建无法建模动态场景,于是这个 critic 会把真实的物体运动当成重建误差来惩罚,而它的最大化解恰恰是「把视频冻住」。在自回归设定下这个捷径尤其危险,因为每个 chunk 都可能把上一个 chunk 已经衰减的运动继续传播放大。 本文贡献:论文的第一贡献是把这个 reward hacking 模式明确暴露出来,并给出跨场景的可视化证据:在机甲战斗、赛车穿行、水下鱼群三个动态强度差异很大的场景里,逐帧对比 Base、VideoGPA、World-R1 与本方法在 t=0/0.50/1.00 的输出,用 MOVES / FROZEN / KEEPS MOTION 三个标签直接标注运动状态。同时也给了另一组更长时程(t=0s 到 10s,间隔 2.5s)的猫叼鱼跑动对比,可以看到 World-R1 与 VideoGPA 在后半段几乎不再有位移,而本方法保持了跑动姿态的连续变化。方法层面,Stream4D 的思路是把奖励从「静态刚性重建」升级到「4D 一致性」,即在允许场景本身随时间演化的前提下约束几何与动力学的连贯,从而让 critic 不再把合法运动误判为误差,同时保留对几何漂移的惩罚能力。这也让约束能适配自回归的分块推进结构,而不是只能在双向全序列设定下使用。 Static-3D rewards freeze the scene; a 4D reward keeps it moving. Five uniformly-spaced frames from a $10.3$,s LongLive rollout (“a cat running away with a fish while people chase behind”). The distilled base contains large motion but the cat and fish drift across frames; the static-3DGS rewards World-R1 and VideoGPA reduce the scene to a more rigid, low-motion configuration. Stream4D keeps the cat running with clear forward motion while preserving a coherent subject and scene. 实验效果:定性结果是这篇最有力的部分:三场景 × 三时刻的对比图里,两个基于 3DGS 奖励的基线(VideoGPA、World-R1)在全部三个场景都被判定为 FROZEN,而 Stream4D 在全部场景保持 KEEPS MOTION;十秒时长的长程对比进一步显示基线在 t=5s 之后主体位移基本停滞。原始 Base 模型虽然 MOVES,但可以看到画面结构在后续帧出现明显漂移与内容突变。也就是说 Base 有运动但没有几何一致性,3DGS 奖励方法有一致性但杀掉了运动,Stream4D 试图同时拿住两者。 批判点评:这篇最值得记的不是方法而是那张 FROZEN 标签图。它把「用静态重建指标当动态生成 critic」这个设计错误做成了可以一眼看懂的反例,而这类奖励设计在过去一年的世界模型工作里被大量采用——凡是拿单次 3D 重建误差当监督的方案,都应该拿这张图自查一遍。与昨天 DynaForcing 揭示的 DMD 反向 KL 偏好静止放在一起看,可以归纳出一条更一般的规律:动态生成任务里任何不显式建模时间演化的奖励,静止都是合法捷径。但要清醒几点。第一,论文给出的主要证据是定性对比图,MOVES/FROZEN/KEEPS MOTION 这三个标签是作者判定的,缺少像 Dynamic Degree、光流幅度这类可量化的运动指标表格来支撑「基线冻结、我们不冻结」的强论断,读者只能相信示例的代表性。第二,示例场景都是运动幅度较大的(战斗、赛车、鱼群),恰恰是最容易凸显冻结问题的设定;在运动本就轻微的场景里,4D 一致性约束是否会反过来引入不必要的抖动,论文没有讨论。第三,作者团队没有公开 comment 信息(无会议接收、无项目页),代码与权重是否开放不明,而这类涉及奖励设计细节的工作可复现性高度依赖实现细节。第四,「4D 一致性」如何具体参数化、计算开销相对 3DGS 奖励增加多少,是评估这套方案能否落到实际训练里的关键,需要读正文确认。 3. 4DAnyone:手机随手拍重建4D人体 4DAnyone: Create Anyone in 4D from a Casual Monocular Video | 浙江大学 CAD&CG 国家重点实验室、Robbyant、港中文、蚂蚁集团 | arXiv:2608.20335 关键词:4D人体重建,单目视频,多视角一致性,视频扩散,4DGS,有界注意力上下文 前序问题:从一段没有标定的手机随手拍视频里重建出可自由换视角的 4D 人体,最自然的路径是先用相机可控的视频扩散模型合成多个新视角视频,再把它们抬到 4D Gaussian Splatting。但这条路在实践中卡住了:现有的相机可控视频扩散能生成看起来合理的新视角视频,一旦把目标视角数量扩到 4DGS 重建所需要的数十个,一致性就崩了。作者把这个失效精确归因为「有界注意力上下文」问题——当目标视角数超过单次 DiT 前向能容纳的容量,就必须把视角分成若干组分批生成,而这一分组同时打开了两个互相耦合的瓶颈:参考上下文侧,如果让每一组都以此前生成的全部视角为条件,代价随视角数呈 O(N²) 增长;不这么做,则组与组之间失去共同参照,跨组一致性无从保证。 本文贡献:4DAnyone 的框架从源视频出发,一路 VAE 编码得到 Src Tokens,另一路过 HMR 模型估计人体,把目标视角的骨架渲染图经可训练的 Skel Enc 编码为 Skeleton Tokens。参考上下文侧维护一组 Ref Tokens 并配合 Pack Ref Context 机制压缩,与 Noise Tokens、Skeleton Tokens 一起拼接后送入 Diffusion Transformer。主干里每个 block 包含三种注意力,其中 Video Attention 与 Cross Attention 保持冻结、只有 Multiview Attention 可训练,作用维度上前者按 v(f h w) d 组织、后者按 f(v h w) d 组织——也就是说把「同一视角内跨帧」和「同一帧内跨视角」两种一致性显式分离到不同的注意力上,训练成本集中在真正需要新增的多视角一致性上。生成的多组目标视角视频最后统一用来训练 4DGS,得到可自由视角渲染的动态人体。 Overview of 本方法. Given a source video, we extract a 3D skeleton sequence via GVHMR and render skeleton videos and skeleton depths for $v$ target viewpoints. The 3D-aware skeleton encoder injects skeleton tokens into the DiT via residual addition. The source video is encoded by the pretrained VAE and concatenated with noisy target latents along the view dimension. The DiT denoises the target latents via Target Context Routing and the decoded target videos are packed into the Reference Context Packing module as references for subsequent generation rounds. The final 4DGS model is reconstructed from the generated multi-view videos using FreeTimeGS. 实验效果:论文的定位是生成「重建级别」的多视角一致视频,即质量足以直接支撑 4DGS 优化,而不只是看起来合理。配套的定性素材覆盖较广:既有工作室级的舞蹈/戏服序列,也有十余段真实户外手机视频(wild_demo)以及游戏角色多视角样本(supp_mvgamehuman),另有专门的挑战性案例与失败案例分析。核心主张是在目标视角数扩展到数十个的规模下,跨组一致性不再随视角数增加而崩溃,从而让单目随手拍视频到 4D 可渲染人体这条链路真正跑通。 Qualitative comparison with baselines. We show target-view generated videos (Gen.) and their corresponding 4DGS renderings (Rend.) across diverse human-centric videos. 本方法 produces geometrically accurate and visually detailed results across viewpoints, while the baselines suffer from inaccurate camera control (our fine-tuned ReCamMaster$^\dagger$) or geometric distortions (MV-Performer). See the project page for dynamic results. 批判点评:把问题归因到「有界注意力上下文」是这篇最扎实的部分——它不满足于说「一致性不够好」,而是指出根因是单次前向容量限制迫使分组,并把分组带来的两个瓶颈(参考上下文 O(N²)、跨组失参照)明确拆开,这种诊断方式让后续工作有明确的攻击面。架构上冻结 Video/Cross Attention、只训 Multiview Attention 也是有品位的选择:既复用了预训练视频先验,又把新增能力限定在真正缺失的维度上。但要注意几点。第一,整条链路对 HMR 人体估计的精度有硬依赖——骨架 token 是多视角生成的主要几何条件,一旦源视频里出现严重自遮挡或快速运动导致 HMR 失准,误差会直接传导到所有目标视角,论文提供了 failure case 但未量化这一依赖的敏感度。第二,casual monocular video(随手拍)的边界很模糊:wild_demo 里的素材多为竖屏高分辨率、主体居中、光照良好的短片段,与真正随手拍摄的抖动、遮挡、逆光场景差距不小。第三,工程成本不透明——生成数十个视角视频再优化 4DGS,单个对象的端到端耗时与显存需求是决定这套方案能否实用的关键,摘要与图里都没有交代。第四,方法涉及浙大、Robbyant、港中文、蚂蚁四方合作且投向 ACM 会议格式,属工程完成度较高的工作,但也意味着复现需要相当规模的算力与数据。 4. WithEveryone:十人合影身份不互串 WithEveryone: Unified Planning and Identity Grounding for Group Image Generation | 复旦大学、腾讯混元、香港大学 | arXiv:2608.20336 关键词:身份保持生成,群体图像,布局规划,身份接地,ID Loss,统一骨干 前序问题:身份保持的图像生成在单人场景已经比较成熟,但一旦场景里要出现多个指定的人,可靠性就迅速下降。难点不止是「每张脸都要像」,还要把每个参考身份绑定到画面里一个特定的人和特定的位置——模型很容易把 A 的脸特征渗到 B 身上,或者干脆漏掉某个参考。更棘手的是训练侧:常用的身份损失需要在若干张噪声预测出来的人脸之间建立对应关系,而在多人场景下这个对应本身就是模糊的,监督信号会被错配稀释,等于用一个不可靠的目标去训一个本就困难的任务。 本文贡献:WithEveryone 支持最多十个参考身份,把整件事组织成统一骨干上的一条多阶段序列。流程按阶段推进:先读用户提示与参考图,Reason 阶段做语义理解并输出 NTP 损失;接着 ID_IN 把身份 embedding 注入,Rep Forcing 阶段用 pred_emb 与 id_emb 之间的表征强制损失确保身份信息被真正吸收(而非被主干忽略);然后再一次 Reason 与 Layout Reason 阶段,以离散坐标 token(形如 <|x_130|><|y_288|>)的形式预测结构化的身份-布局规划;Layout Render 把这份规划渲染成一张可视条件图;最后 Denoise 阶段在 Flow Matching 与 ID Loss 联合监督下出图。关键设计是 Layout-Grounded ID Loss——利用标注的人脸区域,直接在正确的空间位置上监督对应的身份,绕开了多张噪声人脸之间建立对应关系这一模糊环节。整套方案把身份注入、布局规划、渲染约束串成一条链,每个环节都有明确的监督形态。 Overview of 本方法. The model loads selected reference identities as ID tokens, predicts structured Layout CoT, renders a visual layout condition, and predicts identity representations before generating the target group image. Modality-switch tokens that mark the boundaries between autoregressive reasoning and flow-based image generation are used in the sequence but omitted from the figure. 实验效果:方法支持最多十个参考身份的群体图像生成,配套的画廊素材(gallery1-3、quality)展示了多身份合影场景下的生成结果与质量对比,另有单步预测可视化与数据构造流程说明。消融部分覆盖较全:人脸尺寸的绝对/相对影响、高分辨率下的身份与规划表现、ID Loss 的布局项与权重设置、Rep Forcing 的余弦相似度与损失曲线,都各有独立分析图,说明作者对每个组件的作用边界做了系统检验。 Qualitative comparison with proprietary models. mark faces that reproduce a person already generated elsewhere in the image, that are not recognizable as their bound reference, and that appear transplanted without adapting to the pose, lighting, or viewpoint of the scene. These author annotations are illustrative; their quantitative counterparts are the duplicate rate, Sim(Ref), and Copy-Paste. 批判点评:这篇抓住的痛点很实在:多人身份保持的真正瓶颈不在人脸编码器强不强,而在「参考-人物-位置」这个三元绑定关系没有被显式监督。把布局作为中间产物先规划出来、再用人脸区域标注把 ID Loss 接地到具体位置,是对症的解法,比在损失里加更多身份约束更有希望。用离散坐标 token 让统一骨干直接输出布局规划,也避免了外挂一个布局模型带来的接口割裂。但几点需要保留判断。第一,整条链路依赖人脸区域标注来提供 Layout-Grounded ID Loss 的监督,这类标注在训练数据规模化时成本不低,且标注质量直接决定接地的准确性,论文的数据构造流程需要仔细看清楚这一步是人工还是自动、错误率多少。第二,「最多十个身份」是个上限声明而非能力曲线,实际效果在 2 人、5 人、10 人时大概率显著不同,摘要没有给出随身份数变化的量化衰减,而这恰恰是读者最关心的。第三,Rep Forcing 引入了额外的表征对齐损失,其权重与 ID Loss、NTP 损失、Flow Matching 损失之间的平衡是四项损失的调参问题,消融给了曲线但整体的调参难度可能被低估。第四,项目页与代码标注为「will be released」,当前无法验证,多阶段序列的实现细节(尤其坐标 token 的词表设计)对复现影响很大。 5. ear-VAE2:波形自编码器缺一根频率轴 Fourier is Frontier: Frequency-Aware Autoencoding for High-Fidelity Music Reconstruction | 阿里巴巴通义千问团队、Monash University | arXiv:2608.19843 关键词:音乐重建,复数STFT,音频自编码器,相位一致性,立体声,频段分工 前序问题:潜空间音乐生成模型的底座是连续潜表示的音频自编码器,而这些自编码器在高压缩率下普遍暴露三个失效:高频丢失、相位不连贯、立体声声像塌陷。以往这三个问题往往被分别当作独立缺陷来打补丁。作者提出一个结构性的共同根因:波形自编码器没有显式的频率轴,因此根本不存在一个可以做「按频段定向修正」的抓手——你想单独修高频或单独修相位,在波形域里没有对应的操作面。这个视角把三个看似不同的症状收敛到同一个表示选择问题上。 本文贡献:作者先在等预算条件下比较了五种表示,结论是复数 STFT 在全频带与高频谱距离上都最低,且能在每个频点上直接访问幅度与相位——也就是提供了那根缺失的频率轴。据此提出 ear-VAE2:立体声复谱经 Spec Encoder(Conv2d 与 Spec-Act 交替)压到 25 Hz 潜表示,Spec Decoder 还原出缺 Nyquist 的复谱,再由 Duplex-Aware Refiner 补齐为全频带复谱,最后 iSTFT 回到波形。两个核心部件各司其职:Spec-SnakeBeta 是频率相关的周期激活,对高/中/低频学习不同形状的非线性响应;Duplex-Aware Refiner 以 ConvNeXt-1D 为骨架,把输入复谱 X = M·e^{jφ} 按频段分工修正——高频(>4 kHz)只加幅度修正 δM,中频(1.5–4 kHz)同时加 δM 与相位修正 δφ,低频(<1.5 kHz)只加 δφ,并额外预测 Nyquist bin,整体带 bypass 残差。这个分工直接对应三个失效模式的物理成因:高频主要是幅度衰减,低频人耳对相位更敏感,中频两者都重要。 Architecture of 本方法. Stereo audio is transformed via STFT into a complex spectrogram; a Spec Encoder compresses it to a 25,Hz continuous latent and a Spec Decoder reconstructs a coarse complex spectrogram; the highest-frequency (Nyquist) STFT bin is removed to facilitate frequency downsampling. The subsequently applies band-specific complex corrections and restores the Nyquist bin to produce the full-bin spectrogram, which the iSTFT resynthesizes into a waveform. 实验效果:五种等预算表示的对比给出了方法选择的量化依据:复数 STFT 在全频带与高频谱距离两项上均为最低。系统层面的验证素材覆盖了各个组件的作用:输入表示的六面板频谱对比、潜空间频率探针、声学截止频率示例、STFT 漂移与波形对比、Spec-SnakeBeta 的二维响应可视化、refiner 前后对比,以及梯度范数稳定性与幅度损失的 A/B 消融曲线。训练在单节点 8 卡 A100 上完成,各阶段之间重置优化器状态。 Latent temporal-frequency probe for one track (Track 1004034; temporal split at 0.5). Rows (top to bottom): ground-truth audio; full reconstruction; low-temporal-frequency latent half decoded; high-temporal-frequency latent half decoded. Columns (left to right): 本方法, LeVo~2, SAME-L, and Stable Audio Open. For 本方法, the rapidly varying (high) latent half decodes to audio with a lower spectral centroid, matching Table. 批判点评:这篇的论证结构很干净:先指出三个症状共享一个结构性根因(没有频率轴),再用等预算的表示对比证明复数 STFT 是那根轴,最后按频段的物理特性设计分工修正。按频段拆分修正目标——高频补幅度、低频补相位、中频兼顾——是有听觉心理学依据的设计,不是拍脑袋的分段。作者来自通义千问团队,音乐生成底座的工程需求是真实的,方法的实用动机可信。但要注意几点。第一,摘要与配图里没有给出与主流音频自编码器(如 DAC、Encodec、Stable Audio VAE)在同一压缩率下的完整客观指标表格,「最低谱距离」只是五种表示之间的内部比较,跨方法的对照需要翻正文确认。第二,频段分工的三个边界(1.5 kHz、4 kHz)是硬编码的超参,不同音乐类型(电子、古典、人声)的能量分布差异很大,这套固定切分是否需要按内容自适应,论文未讨论。第三,25 Hz 潜帧率是个相当激进的压缩设定,在这个帧率下瞬态(鼓点、拨弦起振)的保真度是最容易出问题的地方,而给出的证据多为稳态频谱对比,缺少瞬态专项分析。第四,评估以客观谱距离为主,音乐重建的最终裁判是听觉,主观 MUSHRA 类测试的规模与结论需要核实。 6. VGI-Bench:27任务测视频模型会不会推理 VGI-BENCH: Probing Visual Intelligence in Video Generation Models | UIUC、清华大学、滑铁卢大学、MIT、UBC、Vector Institute、微软研究院 | arXiv:2608.19583 关键词:视频生成评测,视觉推理,零样本,任务分类体系,Seedance,MiniMax-H3 前序问题:已经有研究提示视频生成模型可能通过生成帧展现某种零样本视觉推理能力,但要可靠地评测这件事很难,原因有三。第一,输入必须与当前视频模型的视觉先验对齐,否则模型失败的原因是看不懂输入而不是不会推理。第二,评测必须要求一个有效的演化过程,而不是只看最终状态是否合理——否则模型可以靠猜一个看似正确的结果画面来蒙分。第三,任务难度需要标定在「有挑战但部分可行」的区间,太难则所有模型一起零分、太易则区分不出差异。这三条约束下的评测设计,比单纯堆任务数量困难得多。 本文贡献:VGI-Bench 包含 27 个任务、810 个实例,按「任务领域 × 技能标签」的两级分类体系组织,从而支持对视觉推理能力做细粒度拆解而非给一个总分。技能维度覆盖七项:规划(Planning)、空间(Spatial)、时序(Temporal)、属性接地(Attribute Grounding)、物理(Physics)、可供性(Affordance)、拓扑(Topology)。任务形态包括迷宫路径(线型迷宫、方格迷宫)等结构化推理场景,并配有专门的标注界面来保证判定一致。评测覆盖当前主要的商业与开源视频模型:Seedance-2.0、Kling-v3.0、MiniMax-H3、Gen-4.5、Sora-2、Wan2.7、Veo-3.1、Wan2.2 与 HY-1.5,商业模型走 API、开源模型本地在 H20 上跑,并给出了访问与算力预算说明。 Per-model performance across the skill tags. 实验效果:七维技能雷达图给出了清晰的能力画像:Affordance 是所有模型表现最好的维度,多数模型都能接近外圈;Topology 上 MiniMax-H3 反而领先 Seedance-2.0 与 Kling-v3.0;而 Spatial、Temporal、Attribute Grounding 三个维度整体收缩明显,多数模型落在 30 分以内的内圈。Seedance-2.0 与 Kling-v3.0 构成第一梯队且在 Planning 与 Physics 上拉开身位,Wan2.2 与 HY-1.5 作为较早的开源版本明显位于内圈。这幅图的信息量在于它显示当前视频模型的「视觉智能」是高度不均衡的——物体可供性这类偏静态语义的能力已经不错,而涉及多步空间/时序推演的维度仍是普遍短板。 Performance comparison in oracle prompting and in varying input visual styles. 批判点评:这份评测最有用的产出是那张雷达图,它把「视频模型会不会推理」这个含糊的问题拆成七个可分别观察的维度,并且直接暴露了能力结构的不均衡:Affordance 普遍高、Spatial/Temporal 普遍低。这个结构性结论比任何单一排行榜分数都更有指导意义——它告诉后续工作该往哪个维度投入。三条设计约束(对齐视觉先验、要求有效演化过程、难度标定在部分可行区间)也说明作者对评测方法学有认真思考,不是简单堆任务。但要保留几点。第一,810 个实例分摊到 27 个任务,平均每任务只有 30 例,而生成模型的输出方差很大,单任务 30 例的统计功效偏弱,雷达图上相近的两条线(如 Gen-4.5 与 Sora-2)差异是否显著难以判断。第二,视频生成模型的评测天然依赖判定器,迷宫这类任务尚可自动判定,但物理合理性、可供性这类维度的判定标准与判定者一致性论文需要交代清楚,否则维度间分数不可直接比较。第三,作者机构跨十家单位、参与者众多,评测规模与工程量可观,但也意味着不同任务的标注标准可能存在异质性。第四,商业模型走 API 意味着版本会持续变动,这份榜单的时效性有限,需要配套的持续更新机制才能长期有参考价值。 7. TextRefine:海报改字要避开商品主体 TextRefine: Improving Textual Fidelity, Spatial Placement, and Glyph Rendering for Text Editing in Product Posters | 快手科技、中国科学院大学人工智能学院 | arXiv:2608.19637 关键词:文字编辑,商品海报,字形渲染,空间放置,奖励优化,罕见汉字 前序问题:商品海报里的文字编辑(插入新文字或替换已有文字)看着像通用图像编辑的子集,实际上有三个通用模型都做不好的具体要求:文字内容必须准确(不能漏字或写错,中文尤其困难)、放置位置必须合理(不能压在商品主体或已有内容上)、字形必须结构正确且与画面视觉一致(不能糊、不能变形、不能字重突变)。当前指令式编辑模型在这个场景下的失效是复合的:经常漏掉或错误渲染目标文字,把文字放到显著商品上,产出结构扭曲或视觉突兀的字形。三种失效原因不同,用一个笼统的编辑目标很难同时治。 本文贡献:TextRefine 是任务对齐的后训练框架,把监督微调与针对具体操作的奖励优化结合起来,分别对准上述三类失效。数据构造是这篇的重头,两条线并行。文字插入线:网络图像 → EasyOCR 检测文字 → Qwen-Image-Edit 移除文字 → 配对过滤与文字恢复(Qwen3VL-8B)→ 文字属性推断(相对位置、颜色效果、字体描述)→ 构造简单模板提示与描述式提示两种监督形态,形成训练对。文字替换线专门针对罕见汉字:同样先检测再移除,然后做罕见字替换与文字颜色推断(Qwen3VL-8B),从 50 种中文字体库中选字体,把目标文字渲染出来,再生成两种替换指令表述(「把『变』换成『蠹』」与「把『耐高温不变形』改成『耐高温不蠹形』」)。方法侧对插入操作采用基于文字跨度的奖励设计,配合有效跨度过滤与字形奖励信号;RL 阶段还做了难度感知的数据选择,优先挑信息量高的样本。训练用混合精度、全局 batch 8、学习率 1e-5,约 20 epoch,在 48 张 A800 上完成。 Overview of the data construction pipeline for text insertion and text replacement in OpenTextEdit. 实验效果:配套的验证素材覆盖了三类失效各自的改善情况:定性对比图、失败模式分析、SFT 训练样例,以及三组文字添加奖励曲线(FireRed、Qwen、TextRefine 各自一组)与两组文字替换对比(Qwen-FireRed 替换、TextRefine 替换),可以横向看到奖励优化在不同底座上的效果差异。评测样例图与有效跨度过滤、字形奖励信号的可视化则分别说明评测口径与奖励构造的合理性。 Comparison of binary OCR correctness and the proposed graded glyph signal. Whereas a binary reward retains only the final correctness decision, the target-glyph CTC posterior preserves continuous recognition evidence and provides a more informative signal for optimizing glyph fidelity. 批判点评:这是一篇工业味道很浓的论文,来自快手,解决的是电商海报本地化改字这个有明确商业价值的问题。它最扎实的地方是数据构造:用「检测→移除→恢复→属性推断→提示构造」这条流水线,从无标注网络图像里自动造出高质量训练对,而且专门为罕见汉字设计了字体渲染分支——中文文字编辑的长尾字形问题在英文为主的研究里几乎没人管,这个补位是实在的。把奖励按操作类型分开设计(插入用文字跨度奖励,字形另设信号)也比一个笼统的编辑奖励更对症。但几点需要注意。第一,整条数据流水线深度依赖 Qwen-Image-Edit 做文字移除、Qwen3VL-8B 做恢复与属性推断,这意味着训练数据的质量上限被这两个外部模型锁定,而且模型的失效模式可能被继承——如果 Qwen-Image-Edit 在某类背景上移除文字会留下痕迹,这些痕迹会作为「干净背景」进入训练集。第二,摘要与配图没有给出定量的文字准确率/位置合理率/字形质量三项指标表,改善程度只能从定性图判断。第三,48 张 A800 训 20 epoch 的成本对多数团队不现实,而论文没有交代更小规模下方法是否仍有效。第四,场景高度特化在商品海报,字体库限定 50 种中文字体,迁移到其他版式(如长图文、视频字幕)需要重新造数据,通用性有限。 8. Block3D:形状token切块自回归去噪 Block3D: Efficient Text-to-3D Generation via Block-Wise Diffusion | 浙江大学 ZipLab、西安交大、UC Berkeley、武汉大学、Monash、University of Adelaide | arXiv:2608.19567 关键词:文生3D,块状扩散,形状token,自回归,几何保真,生成加速 前序问题:文生 3D 已经推进得很快,但「高几何保真 + 低推理成本」这个组合仍然难拿。现有方法分两派,各有结构性缺陷。一派把离散形状 token 自回归解码出来,问题是严格串行、且一旦某个 token 错了就没有修正机会。另一派用扩散或流匹配迭代精修一个全局 3D 表示,问题是每一步都要处理完整表示,想要更高质量就得付更多步数,成本随质量线性甚至更快地涨上去。两派的共同困境是:生成粒度要么太细(逐 token 串行)要么太粗(全表示反复迭代),都没有落在效率与质量的合适折中点上。 本文贡献:Block3D 的做法是重新选择生成粒度:把离散形状 token 序列切成若干连续的块,块之间按自回归顺序生成、块内部联合去噪。这样既保留了自回归带来的顺序条件性(后面的块能看到前面已定的几何),又在块内获得了扩散的并行修正能力(一个块里的 token 可以互相纠错,不再是一锤定音)。相比逐 token 自回归,串行步数从 token 数降到块数;相比全表示扩散,每步只需处理一个块而不是整个表示,单步成本大幅下降。作者还给出了注意力可见性的可视化来说明块内/块间的信息流组织方式。 Block3D overview. Text and optional bounding-box conditions guide left-to-right block generation. Completed blocks form a frozen causal prefix, while M2T and T2T edit only the active block before the frozen decoder maps the completed codes to a mesh. 实验效果:端到端生成时间在 100 条 TRELLIS-500K 提示上测量,硬件为单张 A100 80GB,对照方法包括 ShapeLLM-Omni 与 TRELLIS 系列。生成质量方面给出了较丰富的定性素材:人形雕像、维纳斯像、王座人物、戒指、棋子、卡通角色、双头狮鹫、穹甲龟等多类几何,每个都配有原始文字描述并展示多视角结果,可以看出对复杂结构描述(「三颗八边形宝石对称镶嵌的戒指」「两个头、两条脖子、两条后腿、两条前腿和两条长尾的双头狮鹫」)有较好的服从度。另有场景级的复合结果(栅栏围合的院落)与大批量资产网格展示(40+ 个独立生成资产),说明方法在批量资产生成场景下的可用性。 Additional Block3D text-to-shape results. Each group contains multiple viewpoints of a single generated mesh, with its complete text prompt shown directly below. 批判点评:块状生成这个思路本身很自然——它就是在「逐 token 串行」和「全表示并行」这两个极端之间插入一个可调的中间点,用块大小当旋钮同时控制串行深度和单步成本。从工程角度这是个稳妥的改进,也容易与现有的形状 token 化方案组合。定性结果里对复杂组合描述(多部件、对称约束、计数约束如「两个头两条尾」)的服从度看起来不错,这类计数与对称约束恰恰是纯自回归容易翻车的地方,块内联合去噪的纠错能力在这里应该确实有帮助。但要保留几点。第一,块大小是核心超参,它直接决定效率-质量权衡的位置,论文若不给出块大小扫描曲线,读者无法判断报告的结果是在一个精心挑选的甜点上还是普遍成立。第二,效率对比表只给了端到端生成时间,缺少显存占用与质量指标的同表对照——单看时间快了但质量掉了多少,需要交叉验证。第三,块间自回归意味着误差仍会沿块序列累积,只是粒度变粗了,长序列(高分辨率形状)下这个累积是否可控,论文未专门检验。第四,作者机构跨六家单位,实验在单张 A100 上完成,规模适中;与工业级 3D 生成系统(如商业 3D 资产工具)的差距如何,缺少对照。 9. EfficientSync:口型编辑别再重绘整张下半脸 EfficientSync: Real-Time Lip Synchronization via Deformation-Based Reference Texture Mixing | 华南理工大学、罗切斯特大学 | arXiv:2608.18832 关键词:唇形同步,实时推理,参考纹理混合,形变对齐,口内细节,数字人 前序问题:音频驱动的唇形同步任务是把说话视频的嘴部区域改成匹配驱动音频,同时保持头部姿态、身份和背景不变。这在定义上是一个局部编辑任务,但主流做法却是用重型的 GAN 或扩散解码器把整个下半脸重建出来。代价有两层:一是延迟高,难以实时;二是更要紧的,重建式解码器会「幻觉」出口内细节——牙齿、唇纹这些高频结构被生成器凭先验编出来,而不是保留原视频里真实存在的纹理,结果是身份感和真实感都受损。作者的判断是,身份保持的瓶颈并不在参考帧数量不够,而在缺一个能把参考帧里已有的真实纹理忠实搬运过来的机制。 本文贡献:EfficientSync 由三个部件组成。STAR 采样(图中标注为 STAR Sampling)在拓扑特征空间 F_topo 里为当前目标选取合适的参考帧——驱动音频经 F_a 得到 e_a、源图像经 E_s 得到 e_s 与特征 F_s,参考图像经 F_r 编码后由注意力引导的 Warp 做形变对齐得到 F_r。动态纹理混合器(Dynamic Texture Mixer)把参考纹理 e_w 与 e_a、e_s 一起过自注意力,再在通道维度上学习一组打分曲线 R_1..R_N,据此对通道做加权混合,得到融合特征 F_mix——这一步是「混合真实纹理」而非「生成纹理」的关键。STAM 策略处理背景与遮罩的训练-推理差异:训练时用邻近帧配自适应遮罩,推理时用源帧配自适应遮罩,背景经 F_bg 与 Conv/Warp 分支处理后与 F_mix 相加,最后由 Spade 出图。整体是形变+混合的路线,绕开了重解码器。 The framework or our EfficientSync. (a) STAR Sampling first selects, from the source video, a reference pool that is both sharp and topologically diverse, supplying high-quality material for deformation at no inference cost. (b) The Dynamic Texture Mixer then aggregates the spatially aligned references into a high-fidelity mouth feature through a context-aware, channel-wise selection mechanism. (c) The Spatio-Temporal Shifted Adaptive Masking strategy finally composites the synthesized mouth back into the source frame, blending it seamlessly with the preserved background. 实验效果:效率对比在单张 A100 上进行,给出 FPS 等指标的完整表格,与主流唇形同步方法横向对照,主张达到实时。质量侧配有与 SOTA 的定性对比(vssota)、路由策略对比(comparison_routing)、动态纹理混合器的动机说明(dtm_motivation)与用户研究结果。核心主张是:在保持实时性的同时,口内细节来自真实参考纹理而非生成幻觉,因此在身份保真与真实感上优于重建式方法。这篇为期刊格式(含作者简介),实验组织相对完整。 Qualitative comparisons with state-of-the-art works under the cross-audio setting. EfficientSync preserves sharp, identity-consistent intra-oral textures, whereas competing methods either blur the mouth region or hallucinate teeth that deviate from the source identity. 批判点评:这篇的问题重述很有价值:把「口型同步身份不像」从「参考信息不足」重新归因为「缺少纹理搬运机制」,进而否掉了「重建整个下半脸」这条主流路径。用形变对齐加通道级纹理混合来替代生成式解码,在物理上更合理——真实牙齿纹理本来就在参考帧里,没必要让网络重新编一遍,这也顺带解释了为什么它能同时改善速度和真实感(不生成 = 不需要大解码器 = 更快)。三个部件(选帧、混合、训推一致)分别对准三个不同环节,设计不冗余。但几点要注意。第一,形变+混合路线的天花板受参考帧覆盖度限制:如果驱动音频要求的口型在所有参考帧里都没出现过(比如源视频从未张大嘴、或缺少特定音素口型),没有真实纹理可搬,这时方法要么退化要么产生不自然过渡,论文需要交代这个边界。第二,STAR 采样依赖拓扑特征空间的构造质量,这个空间怎么学、对新身份是否需要重新适配,是实用性的关键。第三,效率表是在 A100 上测的,「实时」在消费级显卡或移动端是否成立不明。第四,作者标注为 under review 的期刊投稿,方法组件较多(STAR/DTM/STAM 三件套加 Spade 解码),消融是否足以厘清各自贡献需要看正文;另外文中出现的 NVIDIA A100 仅为实验硬件,与机构归属无关。 10. DrumMotion:打鼓动作要精确到鼓面落点 Generalized Audio-Driven Synthesis of Precise Drummer Motion | Disney Research Studios、特拉维夫大学、ETH Zürich(SCA 2026 最佳论文) | arXiv:2608.19055 关键词:音频驱动动作生成,扩散模型,双目标损失,击打精度,SCA 2026 最佳论文,迪士尼 前序问题:音乐驱动的角色动画在娱乐与互动教育里有明确应用,但打鼓这个具体任务格外难:它要求高加速度的爆发式动作与极高的时空精度同时成立——鼓槌必须在正确的时刻落在正确的鼓面位置上,早几十毫秒或偏几厘米都会立刻显得假。现有方法多依赖动作匹配(motion matching)或 MIDI 输入,前者泛化到真实世界的多样音频很差,后者要求结构化输入而非原始音频。还有一个更基础的缺口:这个领域缺少能区分「精确打鼓」与「大致在动但不准」的标准化评测指标,导致方法之间无法有效比较。 本文贡献:系统分三段。数据获取段:动作捕捉采集鼓手动作,同时录 MIDI;数据增强用随机鼓组合成音频、再叠加随机音频滤波,从一份 MIDI 派生出多条音频(Audio 1..m),从而让模型见过大量音色与录音条件,这是「泛化到真实世界音频」的关键设计。动作合成段:音频先提取可解释音频特征(explainable audio features),与输入噪声 x_T 一起送入 Transformer Decoder 做扩散去噪,预测动作 x̂_0;姿态表示显式拆成 x = {r_body, r_sticks, p_sticks},即身体旋转、鼓槌旋转与鼓槌位置。核心是双目标损失 L(x, x̂) = L_body(r, r̂) + L_sticks(p_sticks, p̂_sticks),把「身体动作自然」与「鼓槌落点精确」两个诉求解耦到不同的监督项上——身体走旋转空间保自然,鼓槌单独走位置空间提精度。评测段提出两个新指标:Impact Point Deviation 衡量空间精度(鼓面落点偏差),Percussive Alignment Score 衡量时序对齐。长段落动作合成在推理时用滑动窗口拼接。训练用 Adam、学习率 3e-4、batch 128、6000 epoch,在单张 RTX 3090 上约 48 小时。 Overview. We augment the audio in our dataset resulting in motion sequences aligned with multiple audio variations to ensure generalization. Raw audio is then processed into explainable features to condition a diffusion-based Transformer Decoder. We employ a hybrid pose representation, using joint rotations for the body and Cartesian positions for drumsticks. The model is trained via a dual-objective loss to balance natural body dynamics with high-precision stick impacts. Finally, performance is evaluated using Impact Point Deviations and Percussive Alignment Scores to assess spatial and temporal fidelity. 实验效果:两个新指标给出的量化结果可以直接对照:Percussive Alignment Score 的小提琴图显示 GT 的平均 DAS 为 0.91,本方法 0.82,而仅旋转版本 0.69、两个消融档位分别为 0.59 与 0.80;数据增强的消融同样清楚——非增强版平均 DAS 0.70,增强版 0.84。也就是说双目标损失里的鼓槌位置项把 0.69 提到 0.82(向 GT 的 0.91 靠近),而随机鼓组+随机滤波的音频增强单独贡献了 0.70→0.84。另有击打点聚类影响分析、MIDI 对照、增益 0 vs -10dB 的鲁棒性测试、速度-加速度-MIDI 时序对照与用户研究。这篇获得第 25 届 ACM SIGGRAPH / Eurographics 计算机动画研讨会(SCA 2026)最佳论文奖。 Our model achieves temporal alignment comparable to ground-truth data. PAS distributions as violin plots for GT (leftmost, black), noisy GT (second and fourth, red), rotations-only model (middle, purple), and our model (rightmost, orange), when applied to our test dataset. Each sample is one-second long. Noisy GT is obtained by adding Gaussian noise with standard deviation $\sigma$=50 ms and $\sigma=25$ ms to every motion onset time. When noise is added to the data, PAS decreases, indicating that the metric successfully discriminates audio-motion alignment quality. 批判点评:这是今天最「小而完整」的一篇:问题定义清晰(高加速度 + 高时空精度的内在张力)、方法设计对症(双目标损失把自然性与精度解耦)、评测缺口自己补上(两个新指标)、消融给出了每个设计的独立贡献(位置项 0.69→0.82、音频增强 0.70→0.84)。用随机鼓组和随机滤波从一份 MIDI 派生多条音频这个增强设计尤其巧妙——它精准针对「泛化到真实录音」这个痛点,且成本极低。迪士尼研究院加 SCA 最佳论文的组合也说明工程完成度经得起图形学社区检验。要注意的是适用范围。第一,任务高度特化于打鼓,双目标损失的「身体走旋转、末端走位置」这个拆法虽然可以推广到其他需要末端精度的动作(弹奏、击剑、乒乓),但论文只验证了打鼓一种。第二,方法仍达不到 GT 水平(0.82 vs 0.91),这个差距在专业观众眼里是否可察觉,用户研究需要看具体设计。第三,训练依赖动捕数据加同步 MIDI,这类配对数据的采集成本很高,换一个乐器就要重新采集,数据门槛限制了推广速度。第四,48 小时单卡 3090 的训练成本很友好,但 6000 epoch 也提示数据量不大,泛化性主要靠音频增强撑起来,视觉侧(不同体型、不同鼓组布局)的泛化未见专门检验;文中提到的 RTX 3090 仅为实验硬件。 趋势观察 奖励函数写错了,模型就学会「什么都不做」 — 今天有两篇论文从完全不同的方向撞到了同一堵墙:当你用一个静态的重建指标去当动态生成的 critic,模型的最优策略往往是让画面停下来。Stream4D 把这件事说得最透——用 3D Gaussian Splatting 的重建误差当奖励,本意是逼视频模型学会几何一致,但单个刚性 3D 重建根本描述不了动态场景,于是真实的物体运动会被记成重建误差,而让整段视频冻结反倒能把这个 critic 刷满分。论文的对比图把三个场景摊开摆着:Base 模型 MOVES,VideoGPA 和 World-R1 两个用 3DGS 奖励训出来的方法双双标着 FROZEN,只有加了动态几何约束的版本 KEEPS MOTION。这个失效模式在自回归流式生成里尤其致命,因为每个 chunk 都会把上一个 chunk 的静止倾向继续放大。往回看昨天 DynaForcing 报告的「DMD 蒸馏后数字人变木头人」,会发现两者本质同源:一个是反向 KL 偏好低运动模式,一个是刚性重建 critic 惩罚真实运动,路径不同但都指向同一件事——凡是拿静态度量当动态目标的奖励设计,静止都是一个数学上合法的捷径。这也解释了为什么评测里必须单列动态幅度指标:只看画质分,两种崩塌都完全不可见。 小模型开始靠训练工程而不是参数量抢位置 — Swift-Image 的定位很直接:不比谁的参数多,比在受限算力预算下能把一个小生成器推到什么位置。它的 6B 单流 DiT 在统一编辑得分上拿到 4.33,而 20B 的 FireRed-Image-Edit 是 4.11、Qwen-Image-Edit-2511 是 4.07;更极端的是 3B 版本也有 4.32,几乎和 6B 打平。真正撑起这个结果的不是架构创新,而是一条堆到四层的后训练管线:任务专属教师做多步 RL、few-step 蒸馏、多教师 on-policy 蒸馏把 T2I 和编辑两个专家合成一个学生、最后再用 DiffusionNFT 做混合奖励精修。Block3D 走的是另一条省算力的路——把离散形状 token 序列切成块,块间自回归、块内联合去噪,避开了全表示反复迭代的开销。两篇放一起看,信号是清楚的:在开源生成模型这一层,参数规模的边际收益正在快速衰减,而蒸馏链路设计、专家合并策略、生成粒度切分这些「工程」变量的杠杆反而变大了。对算力有限的团队,这比追着堆参数更现实。 生成模型正在被拆开当几何编码器和信号处理器用 — 今天有几篇论文的共同动作是:不把生成模型当采样器,而是当一个特征提取或信号修正的组件。4DAnyone 把问题诊断为「有界注意力上下文」——当目标视角数超过单次 DiT 前向的容量,就必须分组,而分组会同时暴露参考上下文 O(N²) 增长和跨组不一致两个瓶颈;它的解法不是换模型,而是重新组织注意力的上下文结构,让视频扩散模型能稳定吐出数十个重建级一致视角,再抬到 4DGS。ear-VAE2 的思路更彻底:把音乐自编码器的失效(高频丢失、相位不连贯、立体声塌陷)归因到「波形自编码器根本没有显式频率轴」这个结构性缺陷,于是直接换到复数 STFT 表示,并按频段分工修正——高频只补幅度、中频补幅度和相位、低频只补相位。EfficientSync 则拒绝用重解码器重建整个下半脸,认为身份保持的瓶颈不是参考帧不够,而是缺一个把参考帧里已有真实纹理搬过来的机制。三篇的共性是把生成模型内部结构与任务的物理/几何先验对齐,而不是简单增大模型或加数据。 人工智能炼丹君 整理 | 2026-08-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-21|中科大揪出蒸馏后数字人变木头人DynaForcing 今日 AIGC 论文速览 今日共 10 篇 · 推理加速与蒸馏 3 篇 · 奖励模型与偏好对齐 1 篇 · 语音与音频驱动生成 2 篇 · 3D 与部件级生成 1 篇 · 视频编辑 2 篇 · 生成评测 1 篇 重点论文标题列表 DynaForcing(中国科学技术大学、南京大学、合肥工业大学、清华大学(ACM MM 2026)):蒸馏后数字人静止的真凶是反向KL VA-Judger(复旦大学、上海创智学院、华为诺亚方舟实验室):拼指标当奖励就是在教模型作弊 ⚡ SparsePR(Texas A&M University):22%密度换2.61倍加速靠残差回填 MDD(南京理工大学、华为):轻量模型管幅度缓存管方向 FireRedTTS3(小红书):冻结音频编码器当语义老师稳住自回归 今日论文速览 1. DynaForcing:蒸馏后数字人静止的真凶是反向KL DynaForcing: Overcoming Dynamic Collapse in Self-Forcing Distillation for Streaming Avatar Generation | 中国科学技术大学、南京大学、合肥工业大学、清华大学(ACM MM 2026) | arXiv:2608.17707 关键词:动态崩塌,DMD蒸馏,自强制,数字人,反向KL,ACM MM 2026 ⚠️ 前序问题:音频驱动数字人要同时满足三件事:口型对得上、表情有起伏、还能实时流式出帧。近期的做法是用自强制(self-forcing)配合分布匹配蒸馏(DMD)把多步教师压成少步学生,实时性确实拿到了,但这条路上藏着一个此前没人系统刻画过的失效模式:学生模型会收敛到一个近乎静止的最优解——单帧看上去画质很好,时序动态却被严重压制。这对数字人是致命的,因为哪怕只丢一点点运动幅度,口型同步和表情自然度就跟着崩。更麻烦的是常规评测发现不了:感知质量指标在这个过程中甚至还在上升,只有专门看动态幅度的指标才会暴露问题。 本文贡献:作者先把病因拆成两条。第一条来自 DMD 的目标函数本身——反向 KL 具有模式寻求(mode-seeking)倾向,会主动偏向低运动模式,因为静止解在分布上更「安全」。第二条来自无锚点的自条件:学生用自己上一步的输出继续往下推,一旦运动开始衰减,这个反馈回路会把衰减不断放大。对应地,DynaForcing 在三个不同层面下药。数据层的 Hybrid Forcing 把 rollout 按概率锚定到真实动态上,切断反馈回路;损失层的 Dynamics-Aware Reward Regularization 借 DMD 的强化学习解释引入显式运动奖励(用 Sync-C 和关键点方差构造 R_dyn,以 exp(α·R_dyn) 缩放 DMD 损失),直接对冲反向 KL 的偏置;条件层的 Reference Perturbation 用 Qwen-Edit 加 ArcFace 过滤造出五档相似度的扰动参考图,把身份从静态细节里解耦出来,逼模型只能靠音频去驱动运动。工程上还额外贡献了计算图剪枝与梯度重放,把自强制训练的显存开销压掉一个数量级以上。 Overview of . Three strategies intervene at different levels of the self-forcing training pipeline: (a) Hybrid Forcing at the input level, (b) dynamics-aware reward regularization at the loss level, and (c) reference perturbation at the conditioning level. 实验效果:动态幅度从崩塌状态恢复到与教师相当的水平:Dyn-Deg 从 0.31 提到 0.73,唇音同步 Sync-C 从 7.03 提到 7.68,而视觉质量指标同时改善,也就是说质量与动态的权衡在整个训练过程中被解开了,不再需要靠早停去凑一个折中点。训练曲线图给出的证据更直观:原始自强制方案在 T2V 和 Avatar 两个设定下,Dynamic Degree 都在 4000 步左右骤降到接近 0(Avatar 上 Sync-C 先冲到 7.8 再一路滑到 5 以下),而同期 Imaging Quality 和 Aesthetic Quality 几乎是平的甚至微升——这正是「只看画质指标会完全漏掉崩塌」的实证。作为对照,教师强制版的 CausVid 动态维持在 0.4-0.7 区间波动而不崩。 Dynamic collapse in self-forcing distillation. (a)~Text-to-video (Self-Forcing~huang2025self): VBench~huang2023vbench dynamic degree drops from 0.80 to 0.00 while visual quality improves. (b)~Audio-driven avatar (LiveAvatar~huang2025liveavatar): Sync-C and ExpVar degrade while IQA and ASE improve. (c)~Comparing self-forcing with CausVid~yin2025slow (GT-anchored): CausVid's dynamic degree fluctuates around 0.43 without collapsing, confirming that unanchored self-conditioning, not DMD distillation itself, drives the collapse. 批判点评:这篇的价值主要在诊断而非疗法。把「蒸馏后数字人变木头人」这个从业者都遇到过但说不清的现象,明确归因到反向 KL 的模式寻求性质加上无锚自条件的正反馈,并且用训练曲线证明感知质量指标对此完全不敏感——这个洞察本身就值得记下来,它意味着任何做少步蒸馏的团队都该在评测里补一个动态幅度指标,否则等于在盲飞。三条策略也确实分别对准三个不同层面,不是同质化的堆料。但要清醒几点。第一,Dyn-Deg 0.31→0.73 这个数字很漂亮,但 Dynamic Degree 本身是 VBench 系的粗粒度指标,它变高既可能是恢复了有意义的表情运动,也可能是引入了额外抖动,论文没有给出区分二者的证据(比如人眼评测里对「运动是否自然」的单独打分)。第二,Dynamics-Aware Reward 用 exp(α·R_dyn) 缩放损失,α 的取值必然敏感——给太大就变成鼓励乱动,论文对这个超参的鲁棒区间交代不足。第三,Reference Perturbation 依赖 Qwen-Edit 生成扰动参考图,这引入了对外部编辑模型能力的隐性依赖,换一个编辑器扰动分布就变了,结论的可迁移性未验证。第四,实验主要在 Avatar 场景,通用 T2V 上只给了崩塌现象的展示而非完整修复效果,「这套方法是否同样适用于一般视频蒸馏」仍是开放问题。 2. VA-Judger:拼指标当奖励就是在教模型作弊 VA-Judger: Reward Modeling from Human Preference Feedback for Joint Video-Audio Generation | 复旦大学、上海创智学院、华为诺亚方舟实验室 | arXiv:2608.18607 关键词:视听联合生成,奖励模型,人类偏好,思维链,维度级GRPO,LTX-2 ⚠️ 前序问题:要用强化学习后训练视听联合生成模型,第一件事是得有奖励信号。现在的通行做法是把音质、画质、音画同步度这几个单项指标加权拼成一个总分。问题在于这些指标各自只看一个感知维度,谁都没有捕捉到「文本提示、视频、音频三者之间的整体语义与时序连贯性」——而恰恰是后者决定了人类会不会觉得这段内容好。用拼出来的指标当优化目标,模型很快学会 reward hacking:每一项分数都刷得很高,成品放给人看却依然割裂、不忠于提示。这是奖励建模里的经典陷阱,只是在视听双模态下更隐蔽,因为可选的单项指标更多,堆起来看着更「全面」。 本文贡献:作者先补数据:构建 VAPref-10K,包含 9K 条提示和 10.3K 组细粒度成对比较,样本来自多个开源生成模型,标注由人类完成。再补评测:提出 VA-Judger-Bench,同时设置域内和域外的模型对比,专门检验奖励模型是否真的与人类偏好对齐,而不是只在训练分布上过拟合。核心方法 VA-Judger 是一个带思维链的 omni 奖励模型,训练分三段推进:第一段格式蒸馏,从质量差距明显的对子里学会结构化输出(提示对齐、音画一致性、音质、画质、完整度五个维度先想再答);第二段人类对齐,对质量接近的难例用拒绝采样,只保留与人类标注结论一致的解释链,再做 SFT;第三段维度级 GRPO,把人类反馈拆解到各个质量维度上分别给奖励,比单一二元偏好标签提供的信号密度高得多。三段的设计逻辑是从易到难、从格式到判断、从粗到细。 Overview of the VA-Judger training pipeline. Stage 1 cold-starts the model on easy preference pairs. Stage 2 aligns the model on harder pairs through human rejection sampling. Stage 3 performs GRPO using answer-level and dimension-level rewards grounded in human reasons. 实验效果:在域内和域外两套评测上,VA-Judger 预测人类偏好的准确率都超过拼指标的基线。更有说服力的是下游验证:用它的奖励去后训练视听生成模型,人类偏好率从 LTX-2 原始模型的 10.08%、OmniNFT 后训练的 27.63%,提升到 62.3%——三者相加正好 100%,说明这是一次三方对比的人类投票,而不是各自独立打分,62.3% 意味着在超过六成的对局里人类选了 VA-Judger 后训练的结果。 Human preference rates over 200 three-way comparisons. For each prompt, participants select the best video-audio output among LTX-2, LTX-2 post-trained with OmniNFT, and LTX-2 post-trained with VA-Judger. 批判点评:这篇把奖励建模里那个人人都懂但很少被正面处理的问题挑出来讲清楚了:单项指标线性加权不是「近似人类偏好」,而是「定义了一个可被刷分的新目标」。用 CoT 结构强制模型先在五个维度上给出理由再下结论,配合拒绝采样只保留结论正确的解释链,这套做法在文本奖励模型上已被验证过,搬到视听双模态并补上维度级 GRPO 是合理的推进。下游 10.08%/27.63%/62.3% 这个三方对比也比单看奖励模型准确率更有说服力,因为它证明奖励确实能转化成生成质量。但几点需要打问号。第一,训练数据的 CoT 由 Gemini 3.1 生成,这意味着奖励模型的判断风格与偏好倾向被教师模型的先验深度塑造,「与人类对齐」这个说法实际上是「与被人类标注筛选过的 Gemini 解释对齐」,两者不完全等价。第二,10.3K 组成对比较放在双模态偏好建模里并不算多,尤其还要覆盖 9K 条不同提示,平均每条提示只有约一组比较,难以刻画同一提示下的偏好分布。第三,下游验证只在 LTX-2 一个模型上做,而奖励模型最怕的就是与特定生成器的失效模式耦合——换一个音画同步机制不同的底座还能否维持 62.3% 的领先,论文没有回答。第四,域外评测虽然设置了,但「域外」仅指未见过的生成模型对比,提示分布仍来自同一批,真正的分布外泛化并未检验。 3. SparsePR:22%密度换2.61倍加速靠残差回填 Partition the Support, Reconstruct the Residual: Training-Free Sparse Attention for Video Generation and World Models | Texas A&M University | arXiv:2608.18484 关键词:免训练稀疏注意力,块稀疏,残差重建,响应耦合分块,视频生成,世界模型 ⚠️ 前序问题:免训练的块稀疏注意力是给视频 transformer 加速的主流手段,但作者指出这条路上有两个被含糊处理的前提。第一,「注意力按行高度集中」这个观察本身并不能直接给出一个可执行的稀疏算子——共享同一块路由的多个查询,它们各自真正需要的 key 支撑集可能重叠得很差,池化后的并集会被撑得很大,稀疏度名义上高、实际执行的键值对并不少。第二,「保留了多少注意力质量」这个常用判据也不足以决定被跳过的交互会带来多大的 softmax 后误差,因为 softmax 是非线性的,丢掉的 logit 质量与输出偏差之间没有简单对应。换句话说,现有方法在「怎么分块」和「丢了多少」这两个关键环节上都在用代理指标做决策。 本文贡献:SparsePR 由两个部件组成。响应耦合分块(Response-Coupled Partitioning)不再对查询向量本身做 K-means,而是对采样查询的 key 响应做聚类,形成配对的 K/V 组,用组质心诱导出「查询-响应」坐标系再共享路由——这样落到同一路由的查询在支撑集上真正是相似的,图里给出的对比很直观:语义聚类下五个块的支撑集并集大小为 5,响应耦合聚类下降到 2。探针拟合残差重建(Probe-Fitted Residual Reconstruction)则拿一小批精确计算的查询行做探针,测出稠密输出与稀疏输出之差,在探针残差张成的输出子空间里拟合一个逐调用的仿射修正(b, B),再把这个修正加回稀疏输出上。整套流程免训练、逐调用自适应,不需要改模型权重。 Overview of SparsePR. Response-Coupled Partitioning builds executable K/V and query groups, and Probe-Fitted Residual Reconstruction uses exact probe rows to correct the sparse output. 实验效果:在四个异构的视频生成与世界模型上,SparsePR 一致降低了注意力重建误差。误差-密度权衡曲线显示,在 HunyuanVideo、Wan2.2、Cosmos-Predict2.5、Cosmos3-Nano 上,响应耦合分块的均值误差与 p99 误差都稳定低于语义分块,且优势在低密度端更明显。消融给出的归因是:探针拟合贡献了误差下降的主要部分,响应耦合分块主要负责降低硬丢弃误差、并在探针预算有限时改善重建质量。端到端上,在实际执行的键值对密度 22.0%-26.0% 时保持生成质量,取得 1.48 倍到 2.61 倍的整体加速。 Cross-model density sensitivity. Mean (top) and p99 (bottom) normalized attention-output error versus total executed-pair density for semantic and response-coupled partitioning under the same residual-repair configuration. The dashed line marks the (22%) reference density. 批判点评:这篇的问题定义比方法更值得读。「行稀疏集中不等于可执行稀疏算子」和「保留注意力质量不等于输出误差小」这两句话,把大量免训练稀疏注意力工作的隐含假设直接点破了,而且给出了可量化的反例——支撑集并集从 5 降到 2 这个数字,说明分块几何本身就能带来一倍以上的实际计算量差异,这是纯靠调稀疏率调不出来的。探针拟合仿射修正的思路也务实:既然误差主要落在一个低维子空间里,那就用少量精确行把它估出来补回去,成本可控。不过要注意几点。第一,1.48x-2.61x 的区间跨度很大,论文没有清楚交代这个区间对应的模型与分辨率组合,读者无法判断自己的场景落在哪一端;22.0%-26.0% 的密度区间同理。第二,探针本身要精确计算若干查询行,这部分开销随探针预算线性增长,而重建质量又依赖探针数量,端到端加速比与重建质量之间存在一个论文未充分暴露的权衡曲线。第三,评估以注意力重建误差为主,生成质量只说「保持」,缺少 VBench 之类的完整对照表,「误差降低」到「人眼看不出差别」之间还差一层证据。第四,作者机构在视频生成方向积累有限,四个模型的实验规模也不算大,工业级长视频场景下响应耦合聚类的开销是否仍可忽略,值得实测后再判断。 4. MDD:轻量模型管幅度缓存管方向 Magnitude-Direction Decoupling for Fast Video Generation with Flow Matching Models | 南京理工大学、华为 | arXiv:2608.17695 关键词:流匹配加速,幅度方向解耦,缓存复用,CFG复用,Wan2.1,华为 ⚠️ 前序问题:流匹配视频生成的效果已经很好,但迭代去噪带来的算力开销极高。一个自然的想法是:并非每一步都需要完整的大模型,有些步骤可以换成更便宜的替代品。现实中的两种替代手段各有毛病——直接缓存复用上一步的输出,或者直接换一个轻量模型来预测,都会让采样轨迹偏离原始去噪路径,最终画质和内容丰富度都掉下来。问题的症结在于,此前的加速工作把「用便宜的东西替代」当成一个整体决策,而没有去问:模型输出这个向量里,究竟哪一部分是轻量模型能可靠给出的,哪一部分必须靠别的机制补。 本文贡献:作者的实证分析给出了一个干净的拆分:把去噪输出看作幅度与方向两个分量,轻量模型能稳健地捕捉幅度分量,而缓存则能提供可靠的方向指引。基于这个观察,MDD 让方向校准后的轻量模型去替代原模型完成部分步骤——轻量模型负责出幅度,缓存负责纠方向,从而在加速的同时把轨迹偏移修正回来。此外 MDD 还在 classifier-free guidance 上做了进一步节省:CFG 需要跑条件和无条件两路,而作者发现两路的幅度信息可以复用,于是只算一路幅度,进一步压掉推理开销。整套方案不改模型权重,属于即插即用的采样器级加速。 实验效果:在多个基准上 MDD 优于既有加速方法,在 Wan2.1 上最高取得 2.95 倍加速,同时保持较高的视觉保真度与内容丰富度。支撑「幅度可替代、方向靠缓存」这一判断的实证曲线显示:在整个扩散过程中,大模型与残差复用、大模型与小模型两条余弦相似度曲线的走势差异明显(方向上小模型不可靠),而幅度比值曲线则长期贴近 1.0(幅度上小模型可靠);CFG 的条件/无条件两路幅度曲线在大部分时间步高度重合,只在末段分离,这是幅度复用可行的直接依据。 批判点评:把加速的替代决策从「整体换不换」细化到「幅度换、方向不换」,这个拆分角度是这篇最有价值的部分——它给后续工作提供了一个可复用的分析框架:先看输出向量的哪个分量对替代鲁棒,再决定用什么机制补另一个分量。CFG 幅度复用也是顺手捡的一笔便宜,工程上很容易落地。但这篇的呈现有明显短板。第一,论文的核心框架图用 TikZ 绘制、正文只有一个 tex 文件,可提取的图仅剩分析曲线,方法结构的可读性偏弱。第二,2.95 倍是「最高」值且限定在 Wan2.1 上,其他模型上的加速比与质量代价没有在摘要层面交代,实际收益范围不明。第三,「保持高视觉保真度」缺少人眼评测支撑,而幅度/方向解耦这类近似最容易在长时序上累积出细微的运动不连贯,这恰恰是自动指标最不敏感的地方。第四,方向来自缓存意味着对相邻步的相似性有隐含假设,在采样步数被压得很少(比如 4-8 步)的场景下相邻步差异变大,这套解耦是否还成立,论文未做低步数极限的验证。 5. FireRedTTS3:冻结音频编码器当语义老师稳住自回归 FireRedTTS3: Unified Speech Generation and Editing with Semantically Enriched Speech Representations | 小红书 | arXiv:2608.17492 关键词:连续自回归TTS,语音编辑,语义蒸馏,零样本音色克隆,指令控制,小红书 ⚠️ 前序问题:新一代连续自回归 TTS 直接在连续语音表征上工作,好处是保留了丰富的声学细节,同时能吃到文本 LLM 的指令跟随能力,音色克隆、指令化音色设计、语音编辑这些能力一下都打开了。代价是自回归固有的误差累积——生成越长,偏移越大,吐字和音色都可能跑偏。既有的缓解方案要么额外挂语义模块,要么搞多阶段 tokenizer 训练流程,要么把自回归架构改得很复杂,都是在系统复杂度上付账。作者想要的是在表征层面而不是架构层面解决这件事。 本文贡献:做法相当简洁:拿一个在多种语音理解任务上训练好的、冻结的音频编码器当语义教师,用它去正则化音频特征空间。这样做的效果是文本-语音对齐变好、自回归生成更稳定,而整个系统结构保持简单,不需要额外语义模块也不需要多阶段 tokenizer 流程。架构上分三块:RedAE tokenizer 把 24kHz 音频经 50Hz 序列压到 25Hz 潜表征,同时受重构损失和语义蒸馏损失双重约束;FireRedTTS3-Base 是 Backbone Transformer 加 Flow Head 与 Stop Predictor,做多语言多方言的零样本音色克隆;FireRedTTS3-Instruct 在此之上支持统一的音色克隆、指令化音色设计和语音编辑(例如「删除第一个词」这类编辑指令直接以文本形式输入)。代码与模型已开源。 An overview of FireRedTTS3, including (a) the RedAE Tokenizer with semantic supervision, (b) FireRedTTS3-Base for multilingual and multi-dialect voice cloning, and (c) FireRedTTS3-Instruct for voice cloning, instruction-controlled voice design, and speech editing. 实验效果:FireRedTTS3-Base 在 Seed-TTS-Eval 和 MiniMax-MLS-Test 上取得对比系统中最好的平均语音可懂度与说话人相似度;FireRedTTS3-Instruct 在 InstructTTSEval 和 Ming-Freeform-Audio-Edit 上超过竞争系统。作者据此论证:语义信息丰富的连续语音表征配上简单架构,就足以支撑稳定、可控、高保真的语音生成与编辑。 批判点评:这篇的取向很对我的胃口——不加模块、不加阶段,只在表征约束上动手,用一个现成的冻结理解模型当语义锚。这个思路的可迁移性其实超出 TTS:任何连续自回归生成任务,只要该模态存在成熟的理解侧编码器,都可以照这个套路给特征空间加语义正则。小红书把 Base 和 Instruct 两个变体分开发布也很实用,前者专注克隆质量,后者覆盖指令与编辑。但要注意的地方不少。第一,「简单」是相对的——冻结音频编码器本身就是一个在多任务上训过的大模型,把它算进系统开销后,与「额外挂语义模块」的复杂度差距没有摘要说得那么大,只是训练流程更短。第二,效果论证全部依赖自动指标(可懂度、说话人相似度),而语音生成里最关键的自然度、韵律合理性与情感恰当性都必须靠 MOS 类主观评测,摘要层面完全没提。第三,语音编辑的评测只在 Ming-Freeform-Audio-Edit 上做,这个基准的覆盖广度和难度分布尚未被社区充分检验,单一基准上的领先说服力有限。第四,论文只给出一张架构图,缺少可视化的实验对照,无法判断误差累积到底被压住了多少——「更稳定」这个说法需要长句合成的失败率曲线来支撑。 6. MegaParts:300部件3D生成靠离散token压出来 MegaParts: Scaling Part-Aware 3D Object Generation to 300 Parts via Token-Efficient Autoregressive Modeling | 香港大学、上海人工智能实验室、复旦大学、同济大学、浙江大学 | arXiv:2608.14783 关键词:部件级3D生成,自回归,向量量化,自适应长度tokenizer,256k上下文,上海AI Lab ⚠️ 前序问题:可控建模、编辑、关节化这些图形学应用都需要把物体表示成语义部件的有机组合,所以部件感知的 3D 生成很重要。但现有方法扩不上去:部件数一多,生成精细几何所需的 token 长度和显存就贵得离谱,于是大家只能停在几个到十几个部件的量级,而真实的复杂物体——一台钢琴、一架投石机——动辄上百个部件。这是一个纯粹的规模瓶颈,不是质量瓶颈。 本文贡献:MegaParts 把结构化序列建模和一个 token 高效的向量量化形状 tokenizer 结合起来。tokenizer 的目标函数是「在保证高保真重建的前提下最小化 token 用量」,因此学到的离散潜表征长度能随几何复杂度自适应——简单部件少花 token,复杂部件多花。在这个紧凑表征之上训一个大语言模型,在统一的结构化序列里依次生成物体包围盒、部件包围盒和部件形状 token,配合高效长上下文训练策略,支持最多 300 个部件、序列长度最长 256k token。架构图显示生成分两级:全局布局 token 负责规划(chain of thought 形式给出各部件的 bbox 与 token 预算),局部形状 token 负责逐部件生成几何,最后通过 SDF 与 Marching Cubes 出网格。 Overview of MegaParts. Our framework consists of two stages. Top: we learn a token-efficient vector-quantized representation for part geometry. Bottom: we train a part-aware autoregressive generator that represents a 3D object as a structured sequence conditioned on a text prompt and optional object- and part-level bounding boxes. If bounding boxes are absent, the model first predicts the object box and part boxes, followed by autoregressive generation of local shape tokens for each part. The decoded part geometries are then assembled into the final part-aware 3D asset. 实验效果:网格质量高于自回归与扩散基线,作者据此论证压缩后的离散部件 token 不仅解决了可扩展性,还提升了可达到的几何保真度。teaser 图给出的四个例子分别是 164、300、287、159 个部件的复杂物体(机械人形、投石机、伞状结构、三角钢琴),每个部件都以独立颜色区分且保持了可分离的语义结构,直观说明了「上百部件」这个量级不是统计口径而是真的能生成出来。 批判点评:「先把 token 压到极致,再让 LLM 原生自回归」这条路径在 3D 生成里的说服力正在变强,这篇把部件数推到 300、上下文推到 256k,是个实打实的规模跃升,而且顺手给出一个反直觉结论——压缩不但没损失保真度,反而提升了可达到的几何质量。两级生成(全局布局规划 + 局部形状填充)的分工也很自然,本质上是把 3D 建模里「先摆结构再抠细节」的人类流程编码进了序列顺序。需要冷静看的地方:第一,「网格质量高于基线」缺少具体数值,而部件级生成的基线本身就少,对比的公平性(同等算力、同等训练数据)无从判断。第二,300 部件是上限而非常态,论文没有交代部件数从 10 增到 300 过程中质量与耗时的退化曲线,实用价值主要取决于这条曲线的形状。第三,256k 上下文的训练成本必然可观,「高效长上下文策略」具体省了多少、单次生成的推理延迟是多少秒级还是分钟级,摘要层面没有回答,而这直接决定它是产品可用还是仅供研究。第四,部件的语义划分质量依赖训练数据里的部件标注,而高质量部件级 3D 数据本身稀缺,这套方法在标注体系之外的物体类别上泛化如何,是个真实的隐忧。 7. VicEdit:40万条数据把编辑指令从文字换成示例 VicEdit: Learning to Edit Videos from Visual In-Context Examples | 上海交通大学、腾讯优图实验室、浙江大学 | arXiv:2608.16745 关键词:视觉上下文编辑,视频编辑,模态自适应语义蒸馏,双上下文注入,VicEdit-400K,腾讯优图 ⚠️ 前序问题:指令式视频编辑已经做得不错了,但纯文本指令有个绕不过去的瓶颈:细腻纹理和复杂动态很难用语言讲清楚。你可以说「把花瓶涂成深番茄红」,但「深番茄红」到底是哪个红、光泽如何、材质反射怎样,文字给不出精确答案;「转成雪天」这类全局风格更是如此。这个感知鸿沟导致模型要么改得不够(干脆不动),要么改得过头(风格漂移、结构崩坏)。 本文贡献:作者提出视觉上下文编辑这一范式,把编辑条件从文本指令升级为多模态视觉引导,支持单张图像、图像对、视频对三种参考形式。配套造了 VicEdit-400K——首个大规模视觉上下文视频编辑数据集,用自动化流程生成 40 万条高质量样本、覆盖十类任务,并做了多维度过滤保证视觉保真与语义一致。方法上 VicEdit 要解决的核心问题是异构参考的统一:模态自适应语义蒸馏(Modality-Adaptive Semantic Distillation)从不同形式的视觉参考里抽出模态特定的语义 token,双上下文注入(Dual-Context Injection)再把这些视觉 token 与文本指令 token 拼接后送进 DiT 的交叉注意力,让生成同时受视觉与文本两路信号约束。MLLM 侧用 LoRA 微调,DiT 的自注意力冻结、交叉注意力可训。 . It consists of 1) MASD modulates base queries $Q_{base}$ with modality embeddings $E_m$ to distill visual tokens $T_{vis}$; 2) DCI applies a semantic shift to calibrate instruction extraction, yielding dual-context tokens. These unified embeddings are injected into a Video DiT to steer the generation process. All examples presented in the figure are collected from the open-source OpenVE~he2025openve. 实验效果:在 VicEditBench 上,VicEdit 在基础指令编辑和视觉上下文编辑两类任务上都取得最优。定性对比很直观:三个案例分别是局部风格(把花瓶涂成深番茄红)、全局风格(转成雪天)、局部移除(去掉时钟及其阴影)。基线们的失败模式各异——Lucy-Edit 和 NovaEdit 大量出现 No Change(干脆没动),VideoCoF 出现 Flat Coloring(上色平板无质感),Kiwi-Edit 则是 Severe Artifacts 和 Inpainting Failure;VicEdit 在三个案例上分别达到自然编辑、和谐风格化与完全移除。 Comparison with baselines on visual in-context editing tasks. All examples presented in the figure are collected from the open-source OpenVE~he2025openve and Senorita~zisenorita. 批判点评:「文字讲不清纹理和动态」这个判断本身没有争议,用视觉示例当条件也是图像编辑那边已经验证过的路子,这篇的贡献主要在于把它系统地搬到视频域并且把数据这一环补齐——40 万条、十类任务的规模在视频编辑数据集里是可观的,光这一项就有实际价值。技术上把三种异构参考(单图/图对/视频对)统一成模态特定语义 token,再与文本双路注入,设计是干净的。但要注意几点。第一,VicEdit-400K 由自动化流程生成,也就是说训练数据的编辑效果上限被生成流程所用的模型决定,「高质量」是过滤后的相对高质量,模型很可能继承了造数据时那些模型的偏好与瑕疵。第二,评测在自建的 VicEditBench 上进行,而这个基准与训练数据同源,域内优势难以排除——同组作者另一篇 PersonaShot 就明确指出现有视频评测在跨镜头连续性上普遍失灵,自建基准的覆盖面同样需要外部检验。第三,定性图里基线大面积出现 No Change 这个失败模式值得警惕:这更像是基线在该提示形式下未被正确调用,而非能力缺失,公平性存疑。第四,三种参考形式的相对贡献没有拆开,实际使用中「给一张图」和「给一对视频」的成本差异巨大,读者需要知道最便宜的那档能拿到多少收益。 8. MSEditor:多视角数据改造成跨镜头监督信号 MSEditor: Toward Consistent Multi-Shot Video Editing | 香港科技大学(广州)、香港科技大学、百度、清华大学(ECCV 2026) | arXiv:2608.17559 关键词:多镜头视频编辑,跨镜头一致性,监督适配器,跨镜头打包,ECCV 2026,百度 ⚠️ 前序问题:对一整条多镜头视频做统一修改,难点不在单镜头编辑本身,而在镜头之间。多镜头视频由时序上不连续的片段拼成,视角、机位尺度、主体姿态在切镜处大幅跳变,逐镜头独立编辑会导致严重的身份漂移,误差还会沿序列累积放大。要做到连贯,模型必须建立可靠的跨镜头语义感知,在这些断裂的边界之间维持主体外观稳定与视觉连续。而这类任务的高质量训练数据几乎不存在——没人专门去拍「同一编辑在多镜头下的前后对照」。 本文贡献:MSEditor 是首个专门面向一致性多镜头视频编辑的框架。数据这一环用了个巧办法:把现成的多视角视频数据集改造过来提供跨镜头监督——多视角天然就是「同一主体在不同视角下」,正好对应多镜头的核心难点。架构上引入监督适配器(Supervisory Adapter)把跨镜头信息注入扩散骨干,让模型学到身份一致的表征;这个适配器块与冻结的 DiT 块并行,只有适配器的 patchify、cross attention 与 FFN 可训。为了压住累积误差并保证长程时序连贯,还设计了跨镜头打包(Cross-Shot Packing)策略,在自注意力窗口内动态聚合语义相关的镜头,而非只看相邻帧。推理时先编辑首帧,再连同编辑掩码一起驱动整条多镜头序列。 Overview of our method. Top: Given an input multi-shot video and corresponding editing masks, our method first trains a Supervisory Adapter to inject multi-shot information into the diffusion backbone. We also introduce two key strategies: Cross-Shot Packing and Sparse Cross-Attention to keep the consistency during training. Bottom: During inference, editing is performed on the first frame and produces coherent and identity-preserving multi-shot video output. 实验效果:在作者整理的多镜头视频编辑基准上,MSEditor 在身份保持、时序稳定性和整体视觉质量上显著优于既有方法。四镜头编辑的定性对比(把黄色跑车改成蝙蝠车 Tumbler)显示:TokenFlow 基本没改动,Ins2V2 出现严重色偏和结构失真,VACE 在近景轮胎镜头里编辑出了完全不同的车,Ditto 在多个镜头间外观不统一,而 MSEditor 在四个镜头(含远景、轮胎特写、逆光剪影)里保持了一致的车身形态与材质。 Qualitative comparison results with the state-of-the-art methods. We compare our multi-shot approach against leading single-shot video editing baselines on a four-shot editing task. The results show that our method successfully executes the complex subject replacement, demonstrating superior cross-shot temporal consistency. 批判点评:「拿多视角视频数据集当多镜头编辑的监督来源」是这篇最聪明的一步——它把一个数据不存在的问题,转化成一个已有数据的重新解释问题,成本几乎为零而监督信号的语义正好对上。跨镜头打包按语义相关性而非时间邻近去聚合上下文,也比简单扩窗口更贴合多镜头的结构特点。ECCV 2026 接收和港科大+百度的组合也说明这套方案经过了同行审视。但几点需要留意。第一,多视角与多镜头并不完全等价:多视角是同时刻不同机位,主体姿态与光照基本一致;真实多镜头往往跨时间、跨场景、主体状态本身在变化。用前者监督后者,在「状态确实应该变化」的镜头切换上可能反而过度约束。第二,评测基准由作者自行整理,规模与构成细节不明,「显著优于」缺少可核对的数值。第三,推理链路依赖首帧编辑质量,首帧一旦有瑕疵会被跨镜头传播机制放大到全序列,这个失效模式论文未讨论。第四,定性对比里 TokenFlow 出现「基本没改动」的结果,与 VicEdit 那篇里基线的 No Change 现象类似,都提示当前多镜头编辑的基线调用方式尚未标准化,横向对比结果需要谨慎解读。 9. AnyTalk:零动画数据给任意角色配口型 AnyTalk: Speech Animation for Arbitrary Characters Leveraging a Video Generation Model | KAIST(TVCG 接收) | arXiv:2608.16143 关键词:3D语音动画,视频扩散先验,零动画数据,blendshape优化,蒸馏实时化,KAIST ⚠️ 前序问题:给 3D 角色做音频驱动的语音动画,现有方法要么依赖该角色专属的动画训练数据,要么需要费力的绑定与重拓扑。这两条路都把成本卡在了「每来一个新角色就得重做一遍」上,风格化角色尤其吃亏——它们的面部拓扑和 blendshape 配置千差万别,几乎不可能有现成动画数据。作者想问的是:既然视频扩散模型已经在海量真人说话视频上学到了强大的运动先验,能不能把这份先验直接借给任意 3D 角色,从而完全绕开动画数据这一环。 本文贡献:AnyTalk 分两步走。第一步是角色专属微调(Character-specific Fine-tuning, CsF):拿目标 3D 角色的渲染图配上置零的音频嵌入(代表「无运动」)去微调预训练视频扩散模型——用零音频教模型「这个角色静止时长什么样」,从而在不需要任何动画数据的前提下把角色外观注入模型,同时保住大规模视频扩散模型原有的运动先验。第二步是把生成的说话头视频提升回 3D:通过一个优化过程估计 blendshape 参数,得到真正可用的 3D 语音动画。架构上用 ReferenceNet 加去噪 UNet 的双塔结构,音频经交叉注意力分别产出 pose、expression、lip 三路控制信号再经 adapter 注入。为了实用性,作者还把 AnyTalk 蒸馏成一个精简网络 AnyTalk_RT,实现实时性能。代码已开源。 Finetuning process of $D_{CsF}$. The rendered images of the target 3D character and the zero condition $C_{zero}$ are used to form a pair for fine-tuning the model. To preserve the motion prior, only the spatial residual network of denoising UNet is trained (flame icon), while the other layers remain frozen. 实验效果:方法可在多样的面部网格与 blendshape 配置上生成口型同步的动画,显著降低人工投入与数据需求。定性对比在同一个风格化卡通角色上进行,逐词展示九个时间点的口型:ScanTalk、DiffSpeaker+NFR、CodeTalker+NFR 三个基线在整段发音里嘴部开合幅度都很小、近乎静止,而 AnyTalk 在 child/native/grace/beauty/attire 等词上给出了明显区分的口型(含张口、圆唇等不同形状),这在风格化角色上尤为关键,因为这类角色缺乏专属训练数据、基线只能靠迁移硬套。 Comparison with baselines on Morphy. Each phoneme and its corresponding frame are presented for comparison. Ours best follows the given audio with wider mouth opening and precise lip closure, while ScanTalk, DiffSpeaker + NFR, and CodeTalker + NFR exhibit only subtle movement. 批判点评:用「置零音频嵌入」来做外观注入而不污染运动先验,这个技巧很聪明——它等价于告诉模型「这是该角色的静态基底」,剩下的运动能力完全交还给预训练先验,从而实现零动画数据。把视频生成的 2D 结果再优化回 blendshape 参数,也让产出物真正落在图形学生产管线里可用(能改、能复用、能接绑定),而不只是一段像素视频,这一点比多数 talking-head 工作更务实。TVCG 接收和额外蒸馏出实时版本也说明工程完成度不低。不过限制很明显。第一,整条链路依赖一次角色专属微调,也就是说「任意角色」的代价是每个角色都要微调一次,虽然免了动画数据但没免掉 per-character 训练,与真正的零样本仍有距离。第二,2D 视频再反解 blendshape 会引入两层误差(视频生成本身的误差 + 参数拟合误差),细微的唇形细节容易在这个过程中被平滑掉。第三,定性对比中基线普遍表现为「几乎不动」,这更可能是基线在风格化非人角色上的固有失效,而非同等条件下的公平比较——在真人网格上的对比才更能说明方法上限。第四,蒸馏版 AnyTalk_RT 的质量损失没有在摘要层面量化,实时与保真之间的取舍不明。 10. PersonaShot:16指标测出画质与叙事的断层 PersonaShot: Benchmarking Person-Centric Narrative Continuity in Multi-Shot Video Generation | 上海交通大学、腾讯优图实验室、浙江大学 | arXiv:2608.16717 关键词:多镜头评测,叙事连续性,物理连续性,情感动态,电影语法,腾讯优图 ⚠️ 前序问题:视频生成正从单镜头片段走向多镜头叙事,而人物角色是这类叙事的核心锚点。但现有基准主要评角色外观或单镜头质量,没人去量「人物的物理状态与情绪状态在切镜之后是否还连贯」。另一个被忽略的问题是评测方法的针对性:物理连续性、面部动态、电影关系这三类判断所需的证据完全不同——一个要看视觉空间关系,一个要看时序面部变化,一个要看镜头之间的关系逻辑,用一套通用打分器同时应付三者必然失准。 本文贡献:PersonaShot 是首个以人物为中心的多镜头叙事连续性基准,含约 1000 个多镜头片段和 16 项指标,覆盖三个维度:因果物理连续性(空间布局连续性 SLC、物体状态持久性 OSP、几何尺度一致性 GSC)、情感动态(表情自然度 EN、面部动作时序连贯 FATC、情绪-叙事对齐 ENA、情绪弧连贯 EAC)、电影语法(导演叙事排序 DNS、镜头切换恰当性 ST、切换节奏对齐 TRA、180 度规则遵守 180R、视线匹配正确性 EM)。评估分三个时间层级:镜头内状态、跨镜头转换、序列级轨迹。方法上把大型多模态教师的推理蒸馏成轻量的、按指标定制的专家评估器,每个评估器只依赖其指标所需的那类证据(视觉/时序/关系),再与专家人工判断做对齐。 Overview of PersonaShot evaluation framework. Given generated multi-shot videos and prompts, PersonaShot extends conventional quality assessment with three specialist dimensions for narrative-level evaluation: causal physical continuity, affective dynamics, and cinematic grammar. 实验效果:评测揭示不同 SOTA 模型呈现出各异的能力剖面,并暴露出感知质量与跨镜头叙事连续性之间存在明显落差——视觉上很有说服力的视频,仍频繁出现物理状态重置、情绪突变和电影关系断裂。雷达图对比 Seedance、HoloCine、EchoShot 三个模型:Seedance 在物体状态、几何尺度、表情自然度、180 度规则上明显领先,HoloCine 在物理连续性维度接近但在情绪弧和视线匹配上落后,EchoShot 整体最弱且在电影语法一侧塌陷严重。失败案例图给出的典型问题包括空间布局漂移(人物与电话亭的相对位置在三个镜头间跳变)。人类研究表明作者的评估器与专家判断高度一致。 Overview of PersonaShot's person-centric evaluation. Top: Qualitative examples illustrating our three core dimensions: physical continuity, affective dynamics, and cinematic grammar. Bottom: Quantitative comparison across fine-grained metrics for specific state-of-the-arts, revealing their distinct capability profiles. 批判点评:这篇最有价值的产出是那句结论:画质好和叙事连续没有必然关系,视觉惊艳的多镜头视频依然会出现物理状态重置和越轴。这对做多镜头生成的团队是个直接警告——现有的 VBench 类指标测不出这些问题,模型在这些维度上的退化是完全隐形的。把 16 个指标按证据类型分派给不同的专家评估器,而不是用一个通用 VLM 打全部分,是方法上的正确取舍;把电影语法(180 度规则、视线匹配、切换节奏)纳入自动评测也是此前少见的尝试。不过也有几点要保留。第一,约 1000 个多镜头片段对 16 项指标来说样本偏薄,尤其电影语法这类指标本身依赖具体拍摄语境,样本不足容易让排名不稳。第二,评估器由大型多模态教师蒸馏而来,因此整套基准的判断上限被教师模型的理解能力封顶——它测不出教师本身看不懂的问题,而电影语法恰恰是当前 MLLM 较弱的一环。第三,「与专家判断高度一致」的一致性数值、标注者数量与信度系数在摘要层面缺失。第四,与同组的 VicEdit 共享大部分作者,两篇分别造基准与造方法,需要留意后续是否出现自家基准上自家方法领先的循环论证。 趋势观察 蒸馏加速的代价终于被摆到台面上 — 今天有三篇论文从不同角度谈同一件事:把大模型压成快模型,损失的到底是什么。DynaForcing 给出了最锋利的答案——DMD 自强制蒸馏里的反向 KL 天然偏向低运动模式,学生模型会收敛到一个「画面精美但几乎不动」的伪最优解,作者把这个现象命名为动态崩塌,并且用训练曲线证明它不是偶发而是系统性的:Dynamic Degree 一路掉到 0.31,而感知质量指标反倒还在涨,所以只看 FID/IQA 的评测体系根本发现不了。SparsePR 从另一头切入,指出「保留了多少注意力质量」这个常用指标并不能决定被跳过的交互带来多大的 softmax 后误差,于是干脆用少量精确行拟合一个仿射修正把残差补回来。MDD 则把加速拆成幅度和方向两个分量,发现轻量模型能可靠承担幅度、缓存能可靠提供方向。三篇的共同信号是:加速研究正在从「跑得多快」转向「快的同时到底丢了哪一维」,而这一维往往不在主流指标里。 评测正在从「像不像」转向「成不成」 — PersonaShot 和 VA-Judger 都在推同一件事:单帧或单镜头的画质分数已经不足以区分模型好坏。PersonaShot 用 16 个指标覆盖物理连续性、情感动态和电影语法三层,结论直接而尴尬——视觉上很惊艳的多镜头视频,经常出现人物物理状态在切镜后被重置、情绪突变、越轴违规,也就是说画质和叙事连续性之间存在明显断层。VA-Judger 则指出把音质、画质、同步度三个单项指标线性加权当奖励,本身就是在鼓励 reward hacking:模型学会了把每项刷高,但整体听起来看起来仍然不连贯。它的解法是训一个带思维链的 omni 奖励模型,先从质量差距明显的对子里学格式,再用拒绝采样对齐人类对难例的解释,最后做维度级 GRPO。两篇一前一后,说明生成评测的重心正在从感知保真度移向任务完成度与跨镜头一致性。 视频编辑的条件通道从文字扩到了视觉 — VicEdit 提出的判断很直白:文字讲不清细腻纹理和复杂动态。所以它把编辑指令从纯文本升级为单图、图对、视频对三种视觉参考,并配了 40 万条数据的 VicEdit-400K。MSEditor 面对的则是另一个维度的难题——多镜头视频天然由视角、机位、姿态都不连续的片段拼成,逐镜头编辑必然身份漂移。它的做法是把多视角视频数据集改造成跨镜头监督信号,再用跨镜头打包策略在自注意力窗口内聚合语义相关的镜头。两篇一起看能发现视频编辑正在同时向两个方向扩张:条件端从文本扩到视觉示例,时序端从单镜头扩到整条多镜头序列,而这两个扩张都倚赖新造的数据而非新造的架构。 人工智能炼丹君 整理 | 2026-08-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-19|阿里像素空间T2I反超潜空间Z-Image-Pixel 今日 AIGC 论文速览 今日共 10 篇 · 图片生成与编辑 4 篇 · 视频生成与加速 3 篇 · 音视频生成 2 篇 · 统一修复与智能体路由 2 篇 重点论文标题列表 Z-Image-Pixel(阿里 Token Hub·港科大·南京大学·UC San Diego):像素空间T2I首个能打的配方 SQuad(Qualcomm AI Research):注意力FLOPs降67倍且VBench不掉 Qwen-Video-Edit(Reve·UT Austin):帧排成一张大图就能改视频 PixRestore(港理工 视觉计算实验室·OPPO 研究院):50M参数无VAE一步修复 EqF(UC San Diego·Harvard):去掉噪声条件换来闭环采样 今日论文速览 1. Z-Image-Pixel:像素空间T2I首个能打的配方 An Empirical Study of Training Pixel-Space Text-to-Image Diffusion Models | 阿里 Token Hub·港科大·南京大学·UC San Diego | arXiv:2608.16887 前序问题:文生图这几年几乎被潜空间扩散垄断,原因很实在:VAE 先把 1024×1024 压成几十倍小的潜表示,注意力算力才降到可承受的范围。但这笔交易的代价一直存在——VAE 是有损压缩,高频细节、小面积结构、文字边缘都会在编解码往返中被磨掉,而且 VAE 本身还得单独训练、单独维护,成了管线里一个没人愿意碰的黑盒。像素空间扩散能绕开这一切,直接在原始像素上做去噪,此前也不断有人尝试,但研究几乎全停留在小规模或类别条件的玩具设定里。真正的问题从来不是「像素空间能不能生成图」,而是「在大规模文生图这个真实战场上,像素空间到底怎么训才能追上潜空间」——这个配方一直是空白。 本文贡献:这篇给出了那份缺失的配方。作者先做了一个关键的负面观察并把它坐实:直接在像素空间做大规模预训练,收敛速度显著慢于潜空间——这不是调参不到位,而是像素空间预训练的固有劣势。既然如此,就不要硬碰硬。他们提出 latent-to-pixel 策略:先在潜空间高效地把生成先验学到手,再在后训练阶段迁移到像素空间。真正的贡献密度在于对这次「迁移」做了系统性的设计空间扫描,逐项确定了五个关键选择——权重初始化怎么做、数据配比怎么调、预测目标选什么、解码器架构如何设计、噪声调度如何安排。最终固化出一套可复现的实践配方,并放出 Z-Image-Pixel 模型。这是一篇典型的「把方向从可行推到可用」的工程实证工作。 Qualitative samples over training iterations. The latent space model consistently demonstrates faster image structure learning and superior final image quality in pre-training progress. 实验效果:按该配方训出的像素空间模型,在质量上匹配或超过对应的潜空间同行,同时端到端推理速度提升 3.18 至 4.75 倍——去掉 VAE 编解码环节的收益在这里被兑现成了实打实的吞吐。收敛性对比图显示,纯像素空间预训练在 GenEval 上到 150K 步仍停在 0.54 附近,而潜空间 50K 步就已达到 0.73 并趋于饱和,两条曲线的差距直观解释了为什么必须先借潜空间起步。 Evaluation curves over training steps. The model trained in the latent space consistently achieve superior results (measured by GenEval~geneval and DPG~dpg) and faster convergence compared to those trained in the pixel space. 批判点评:这类经验性研究的价值往往被低估。它没有提出新架构、新损失,但把一个「大家都觉得应该可行、却没人跑通」的方向变成了可落地的配方,而且诚实地把负面结果——像素空间直接预训练更慢——放在了论证链条的开头,这比藏起来只报好消息的做法可信得多。3.18 到 4.75 倍这个加速区间也给得克制,说明作者知道加速比依赖分辨率和采样步数配置。不过要清醒看待几点。第一,latent-to-pixel 意味着它并没有真正摆脱 VAE,只是把 VAE 从推理期挪到了训练期——你仍然需要一个训好的潜空间模型作为起点,声称的「无 VAE」只在部署侧成立,训练侧的依赖链其实变长了。第二,「匹配或超过潜空间同行」这个表述里的「匹配」占多大比重、在哪些指标上真正超过,摘要没有拆开,而 GenEval/DPG 这类指标对细节保真其实不敏感——恰恰是像素空间最该发力的地方缺少针对性证据。第三,五个设计维度的扫描是在什么规模下做的没有说明,小规模上得出的最优选择在更大模型上是否还成立,是这类经验配方的通病。第四,作者团队来自阿里 Token Hub,模型命名 Z-Image-Pixel 暗示其属于 Z-Image 系列,是否会开放权重和完整训练细节,决定了这份配方的实际社区价值——配方类论文如果不放代码,复现门槛会高得离谱。 2. SQuad:注意力FLOPs降67倍且VBench不掉 SQuad: Sub-Quadratic Attention Distillation for Efficient Video Generation | Qualcomm AI Research | arXiv:2608.16585 前序问题:视频 DiT 的算力几乎全被自注意力吃掉,而它的成本随 latent token 数 n 呈 O(n²) 增长。视频的 token 数天生就大——Wan 2.2 5B 在 81 帧 704×1280 下 n 就到 18480——于是这一项直接主导了运行时与显存,成为分辨率和时长的硬天花板。学界的常规解法是把满 softmax 的 QK^T 换成更便宜的核:线性注意力 O(n) 或低秩近似 O(nk)。这些替身确实便宜,但几乎从没真正恢复原始注意力的表达力,留下一道顽固的质量鸿沟。问题的本质是效率与表达力之间的取舍被推到了极端——要么二次成本,要么掉点。 本文贡献:SQuad 选了取舍曲线上一个被忽略的中间点:O(n√n)。做法是把注意力拆成两段——先在局部窗口内做精细注意力,再以窗口为单位做全局注意力,两段复合出 n√n 的复杂度,天然平衡效率与表达力。更务实的是训练路径:从零训一个自己的视频 DiT 成本高到不现实,所以他们直接把预训练的满 softmax DiT 蒸馏成 SQuad-Attention 版本,分两阶段进行——先做 Flow-Matching 有监督微调对齐行为,再用改进的分布匹配蒸馏 DMD2,后者额外让采样本身也变少步。也就是说这套方法同时压了单步成本和总步数两个乘数。 % attention. Left: full softmax Self-Attention at $\mathcal{O}(n^2)$ complexity. Right: factorizes it into a local pass within $\mathcal{O}(\sqrt{n})$ windows followed by a global pass across the windows, giving a full receptive field at $\mathcal{O}(n\sqrt{n})$ complexity with a true softmax throughout.% 实验效果:在 Wan 2.2 5B 文生视频上,SQuad 的 VBench 达到 83.20,二次复杂度教师为 83.08——质量基本持平甚至略优。同时每步每块的注意力 FLOPs 降低约 67 倍,注意力延迟同步大幅下降。FLOPs 缩放曲线在三个模型规模上都做了验证:Wan 2.2 5B(n=18480)从 4.2 降到 0.063 TFLOPs/block 即 67 倍,Wan 2.1 1.3B(n=32760)为 90 倍,Wan 2.1 14B 为 88 倍,且实测点与理论 O(n√n) 曲线吻合良好——说明这个复杂度改善不是纸面推导,且在 1.3B 到 14B 的规模区间内稳定成立。 Wan 2.2 5B 批判点评:这是今天这批里工程收益最锋利的一篇。67 倍注意力 FLOPs 削减配合 VBench 不掉分,而且理论复杂度和实测曲线对得上,说服力比单纯报几个基准数字强得多。局部加全局的两段结构也不新奇——Swin 那一脉早有类似思路——但把它作为蒸馏目标而不是从头训练的架构,这个选择很关键:它让方法能直接嫁接到已有的强基座上,这才是工业界真正用得上的形态。不过 67 倍需要精确解读:这是「每步每块注意力」这一层的削减,不等于端到端加速 67 倍。DiT 里还有 FFN、cross-attention、归一化和 VAE 解码,注意力占比再高也不是 100%,Amdahl 定律在这里毫不留情——摘要给的注意力延迟改善才是更接近真相的数字,而端到端墙钟时间完全没披露,这是最该补的一格。其次值得肯定的是 FLOPs 缩放在 1.3B/5B/14B 三个规模上都验证了(分别为 90×/67×/88×),削减倍率没有随规模崩塌,这比只测单一规模有说服力;但质量侧的 VBench 只在 5B 上报了一个数,14B 上蒸馏后是否同样不掉分并没有交代——FLOPs 省得下来不等于质量守得住,这两件事需要分别举证。第三,VBench 对长程时序一致性和复杂运动的分辨力有限,而局部窗口注意力最可能损伤的恰恰是跨远帧的关联,只报 VBench 总分难以排除这类退化。最后 DMD2 蒸馏本身会带来多样性收缩的已知副作用,论文把它与注意力替换打包在一起评估,两者各自的贡献和代价被混在了一个数字里。 3. Qwen-Video-Edit:帧排成一张大图就能改视频 Qwen-Video-Edit: Instruction-Based Video Editing by Repurposing an Image Editing Model | Reve·UT Austin | arXiv:2608.14790 前序问题:指令式视频编辑的主流做法是拿视频预训练的生成基座开刀:找一个视频 DiT,让它同时条件于源视频和编辑指令,然后花很大代价适配。这条路的成本结构很不友好——视频基座本身训练昂贵,适配又要构造视频编辑三元组数据,而高质量视频编辑数据的稀缺程度远超图像。于是整个方向被卡在「数据不够、算力不够」的双重瓶颈里,而同期图像编辑模型早已相当强大。一个自然但少有人认真验证的问题是:能不能不要视频基座,直接让图像编辑模型去改视频? 本文贡献:作者证明这条捷径真的走得通,而且用一串「零训练观察」把设计逻辑铺得很干净。核心操作是把 Wan 2.1 视频 VAE 的 latent 帧当成一张大虚拟图像的若干 tile 平铺,然后对每个 tile 复用图像编辑器原有的位置编码——也就是说,从模型视角看这压根不是视频,就是一张它早就熟悉的拼贴图。两个 latent 空间之间用一对轻量输入输出投影桥接,且这对投影从编辑器自己的 patchify/unpatchify 层热启动,使得初始化时一段静态视频被嵌入的方式与一张图像完全一致。整体在公开的 Ditto-1M 编辑三元组上微调,再可选地用 Wan 2.2 跑几步去噪作为时序增强器。支撑这套设计的观察链很有说服力:原装图像编辑器已经能编辑以联络表形式呈现的视频;它不在乎 token 来自一次联合编码还是逐帧编码后在 latent 空间缝合;它甚至能零样本编辑真实视频 latent 到明显可辨识的程度——微调要补的只剩保真度那一段。 Overview. Video latent frames are embedded as tiles of a virtual image grid and edited by the image editing transformer; only the two projections (warm-started from the editor's own patchify/unpatchify layers) and the transformer weights (LoRA or full) are trained. 实验效果:从 Qwen-Image-Edit 出发,无需任何视频生成预训练即可完成指令式视频编辑。流程图显示除 In-Proj 与 Out-Proj 两个轻量投影和 DiT 本体外,Wan 2.1 VAE 编解码与 Wan 2.2 增强器全程冻结,可训练部分被压到极小。定性结果覆盖全局风格迁移与局部主体替换等任务,人物换成机器人这类大幅编辑仍保持了动作与场景的连贯。 批判点评:这篇最漂亮的地方不是结果而是论证方式:那条零训练观察链把「为什么这样可行」讲成了一个可验证的递进过程,而不是先做完再编故事。把视频摊成联络表这个操作听起来近乎取巧,但作者恰恰用它揭示了一个有意思的事实——强图像编辑模型内部已经隐含了相当程度的跨帧一致性能力,只是从没被这样调用过。投影层从 patchify 热启动的设计也很讲究,保证了初始化即合理。但取巧的代价必须点明。第一,把帧铺成 tile 意味着帧间关系只能靠二维位置编码隐式表达,模型没有任何显式的时间轴概念,短片段可能侥幸过关,帧数一多、运动一快,这种隐式关联大概率崩塌——而 tile 数量还直接受图像编辑器分辨率上限约束,这是个硬天花板,摘要没说能处理多少帧。第二,需要 Wan 2.2 做「可选时序增强」这件事本身就是自证:如果时序一致性真的够好,为什么还要额外几步去噪来补?这个「可选」组件在多少比例的案例里其实是必需的,是关键信息。第三,训练数据是公开的 Ditto-1M,编辑类型分布决定了能力边界,超出分布的指令表现如何未知。第四,全文只报了定性结果和「结果表明」,没有与专门视频编辑模型的定量对比——考虑到这是一份 report 而非完整论文,可以理解,但也意味着现在还无法判断它离 SOTA 有多远。 4. PixRestore:50M参数无VAE一步修复 PixRestore: Unified Image Restoration via Pixel Diffusion Transformer | 港理工 视觉计算实验室·OPPO 研究院 | arXiv:2608.16793 前序问题:统一图像修复想用一个模型处理各种退化——模糊、噪声、低分辨率、压缩失真等——从低质图恢复高质内容。近来主流做法是挪用大型预训练文生图潜扩散模型,借它的容量和生成先验。但这条路有两处结构性别扭。一是潜扩散里的 VAE 会丢掉对修复最敏感的细节——修复任务的评判标准恰恰是细节保真,而 VAE 的有损压缩正好打在痛点上。二是文生图先验是开放式合成的,它倾向于「编」出看起来合理但与原图内容不符的东西,在修复语境下这就是伪影。换句话说,借来的能力和任务的要求存在方向性冲突。 本文贡献:PixRestore 索性不借了:一个无 VAE 的像素空间 DiT,扩散骨干完全从零训练,不依赖任何文生图预训练。它直接在 patch 化的像素上做 flow matching,既保住细粒度细节,又把 token 序列长度控制在可处理范围。为适配不同退化类型,模型学会用低质与高质图的 DINO 特征相似度来预测各层特征的可靠性:可靠层的特征被融合为稠密条件注入,不可靠层则接受更强的高质特征监督以促使其学会去除退化——这是个挺聪明的自适应机制,让同一套参数能对不同退化做出不同的内部路由。训练用大规模多场景多退化语料,最后再用基于 DINO 的对抗目标把它微调成一步生成器。 Overview of PixRestore. A frozen vision encoder extracts multi-layer features from the LQ image, and an adaptive layer router predicts per-layer weights to fuse them into a single conditioning feature. The LQ image and the noisy state $x_t$ are patchified, then processed by $N$ DiT blocks, and finally decoded into the HQ output. 实验效果:仅约 50M 参数,在公开基准与真实世界测试集上取得有竞争力的结果,且推理为一步生成,效率优势明显。框架图显示 LQ 图像经 Vision Encoder 提取多层特征后由 Adaptive Layer Router 产生逐层权重,门控加权求和为 Fused Feature,再通过 Pixel DiT 的 cross-attention 注入——整条路径无 VAE 参与。 PixRestore achieves the best overall performance in terms of restoration quality, model size, and inference speed. Top-left: radar charts comparing PSNR, LPIPS, and degradation removal performance across eight degradation types. Top-right: GFLOPs versus inference latency, where the bubble size denotes the number of parameters. Bottom: visual comparisons on eight restoration tasks. With only about 50M parameters and single-step inference, PixRestore achieves the best overall restoration quality while being the most efficient among diffusion-based methods. 批判点评:50M 参数加一步推理这个组合在修复领域相当有竞争力,尤其对照那些动辄搬 SD 全量权重的方案,参数量差了两个数量级。用 DINO 特征相似度来判定层可靠性是这篇最有想法的设计:它把「哪些层可信」从人工先验变成了数据驱动的预测,而且 DINO 特征对退化的敏感度确实适合做这个裁判。从零训练而非微调 T2I 的选择也自洽——既然认定 T2I 先验方向不对,就不该半信半疑地用。但几处需要留意。第一,从零训练意味着放弃了大模型先验带来的语义理解能力,在极端退化、需要「猜」出内容的场景下,50M 从零模型很可能力不从心——摘要只说「有竞争力」而非超越,这个措辞值得注意。第二,一步生成器是用对抗目标蒸出来的,GAN 训练的稳定性和模式覆盖问题不会因为换成 DINO 判别器就消失,对分布外退化的鲁棒性存疑。第三,「大规模多场景多退化语料」是自建的,覆盖哪些退化、按什么比例混合,直接决定了泛化边界,而这恰恰是统一修复模型最容易过拟合评测集的地方。第四,团队来自港理工与 OPPO,考虑到 50M 和一步推理的组合,这个模型的真实目标场景大概是手机端 ISP 后处理,那么就该给出移动端实测延迟——公开基准上的 GFLOPs 说明不了端侧的真实表现。 5. EqF:去掉噪声条件换来闭环采样 Equilibrium Forcing: Adaptive Video Generation Without Noise Conditioning | UC San Diego·Harvard | arXiv:2608.14706 前序问题:基于扩散和 flow matching 的自回归视频生成,有两个被当作理所当然的设定:训练目标是刚性的,采样调度是静态的。模型在训练时被告知当前噪声水平是多少,推理时则按一张预先排好的时间表逐步去噪。这套组合的后果是推理过程完全无法根据数据本身做调整——不管当前这一帧生成得好还是烂,采样器都按同一张表往下走。对自回归视频生成来说这尤其致命,因为误差会沿时间轴累积,而一个不会看反馈的采样器没有任何自我纠正的机会。 本文贡献:EqF 的切入点相当反直觉:把噪声水平条件整个去掉。作者提出一个简化框架,让视频去噪生成模型不再接收噪声水平作为输入,从而把「学习去噪场」和「如何采样」这两件事彻底解耦。这个解耦是关键——一旦模型不再绑定于特定噪声水平,推理时就可以自由设计算法,包括闭环运行:根据当前样本反馈动态调整后续采样行为,而不是照表执行。作者还给出了较为深入的分析,解释移除噪声条件为何能让模型获得数据相关的推理性质,并进而超过标准的噪声条件方法。图 1 把这件事讲得很清楚:训练得到的均衡传输去噪场乘上一个推理期的 attractor warp η,共同诱导出最终的采样地形——去噪场与采样调度在数学形式上被分成了两个可独立操作的因子。 Equilibrium Forcing Overview. is trained with a simple unmodulated equilibrium denoising objective (left), which can be shaped at inference time through the $\eta$ warp (middle). The sampling landscape here is shaped to be an attractor, with the magnitude decreasing as the sample descends and converges (right). 实验效果:在有挑战性的自回归视频生成基准上提升了视频质量与一致性。固定算力缩放实验显示,EqF 配合 NAG 采样在 100 步时 FVD 已降至约 74,250 步时进一步降到 60 以下,而标准 flow matching 从 50 步到 250 步始终在 102 至 122 区间徘徊几乎不随算力改善——说明闭环采样确实把额外算力换成了质量,而静态调度做不到这一点。 批判点评:这篇的价值在于挑战了一个几乎没人质疑过的默认设定。噪声水平条件从 DDPM 起就是标配,大家默认它是必需的,EqF 反过来论证它其实是一种约束——因为它把去噪场和采样调度绑死了,而解绑后能换来推理期自适应。图 1 那个「去噪场 × attractor warp = 采样地形」的分解也把抽象主张落成了可理解的几何图像。固定算力缩放曲线是全文最有力的证据:FM 的曲线几乎水平,意味着多给算力也白给,而 EqF 能持续下降,这个对比比任何单点 FVD 数字都更能说明问题。但要保持警惕。第一,摘要通篇没有具体的基线名称、数据集名称和绝对指标,只说「有挑战性的基准」和「超过标准方法」,这种表述在视频生成领域的可比性极低——FVD 对分辨率、帧数、特征提取器都极度敏感,脱离配置的数字无法横向对照。第二,最好的曲线来自 EqF+NAG 组合,而 NAG 是额外的采样技巧,那么增益中有多少来自「去掉噪声条件」这个核心主张、多少来自 NAG,图里 EqM 系列的存在暗示做了消融,但摘要没给结论。第三,闭环采样意味着推理时要评估反馈信号,这必然带来额外计算,而「固定算力」的口径是按采样步数还是按实际 FLOPs 对齐,直接影响结论成立与否。第四,去掉噪声条件对训练稳定性和收敛速度的影响未提,这类架构级简化往往在别处付出代价。第五,方法在视频上验证,是否迁移到图像生成没说——如果这个洞察真的普适,图像上应该更容易验证,没做反而值得琢磨。 6. ConceptEdit:1200万编辑对与稠密监督 Unlocking the Potential of Image Editing via Concept Scaling and Dense Supervision | 上海交通大学·蚂蚁集团 | arXiv:2608.16812 前序问题:现有图像编辑框架基本沿用文生图扩散模型的训练范式,但把这套范式挪到编辑任务上会暴露两处内在错配。第一是对编辑概念的粒度关注不足——文生图关心的是「画出什么」,编辑关心的是「精确改动什么而不动其余」,后者需要远为细致的概念划分,而现有数据集的标签粒度远远不够。第二是监督信号过于稀疏导致训练低效:一对图像通常只承载一个编辑操作,模型每看一对样本只学到一件事,样本效率极低。这两个问题叠加,使得编辑模型的能力增长严重受制于数据的组织方式而非模型容量。 本文贡献:两条线同时发力。数据侧建立了一套超过 1000 个细粒度编辑概念的分层分类体系,并基于改进的合成框架构建 ConceptEdit-12M,一千二百万高质量编辑对。这里的关键设计是「库驱动」——先有概念库再据此合成,从而有效纠正了生成数据常见的分布坍缩问题,同时保住数据保真度;这是合成数据工作最容易翻车的地方,作者显然意识到了。训练侧提出稠密监督策略:把多个互不干扰的编辑概念合成到单对图像里,让一次前向承载多个学习信号,从而同时提升训练效率与最终性能。此外还发布 ConceptEdit-Bench,一个细粒度评测套件,用于诊断模型在大量真实场景下的能力分布。四阶段流程图显示,概念库构建后由 VLM 生成指令与 VQA 检查清单,经 Flux.2 / Qwen-Image-Edit / Nano Banana2 等多模型执行编辑,最后由 VLM 结合思维链做通过、重写或拒绝的三态判决。 Overview of the improved synthesis framework. Stage 1: Library Construction leveraging LLM world knowledge. Stage 2: Semantic Matching and Instruction Generation including VQA checklists. Stage 3: Image Synthesis using various editing models. Stage 4: Instance Specific Verification using VQA. 实验效果:训练结果显著超越先前工作,验证了稠密监督策略的有效性。配套的 ConceptEdit-Bench 支持按概念维度做细粒度诊断,而非只给一个整体分数。 (a) Edit Concept Scaling. Left: The previous paradigm is restricted by coarse categories and limited diversity. Right: Our approach scales up to 1,000+ fine-grained concepts to ensure a balanced and rich distribution. (b) Dense Supervision. Left: Conventional training relies on single edit pairs with sparse supervision signals. Right: Our composite edit strategy provides dense supervision, enhancing training efficiency. 批判点评:这是一篇典型的「数据即方法」论文,而且把数据工程做得比多数同类扎实。1000+ 概念的分层体系加 1200 万编辑对,规模上足以改变下游模型的能力上限;四阶段管线里那个 VQA 检查清单 + 思维链判决的设计尤其值得学——它把「这次编辑成功了吗」拆成若干可验证的具体问题(文字是否清晰、眼睑是否变形、脸型是否保持),而不是笼统打分,这才是合成数据质量能立住的原因。稠密监督的思路也很直接有效:既然一对图只学一件事太浪费,那就塞进多个互不干扰的概念,本质是在提升每单位算力的信息密度。但要打几个问号。第一,全部数据由 Flux.2、Qwen-Image-Edit、Nano Banana2 等现成模型生成,这意味着 ConceptEdit-12M 的能力天花板被这些教师模型锁定——学生能学到的编辑质量原则上不会超过教师,「显著超越先前工作」更可能是超越了那些数据更少的工作,而非超越数据生产者本身。第二,「互不干扰」的判定标准是什么没有说明,编辑概念之间的干扰往往是隐性的(改表情可能牵动脸型),判定不严会引入标签噪声,而这种噪声在稠密监督下会被放大。第三,评测基准由数据生产方自己发布,与训练数据共享概念体系和合成管线,同分布优势难以排除——ConceptEdit-Bench 上的领先有多少能迁移到真实用户指令上是个悬念。第四,摘要只说「显著超越」,没有任何具体数字或基线名称,这在一篇以规模为核心卖点的论文里偏弱。第五,12M 数据的合成算力成本未披露,而这直接决定了这条路径是否可被社区复现。 7. SyncSparse:稀疏化不能牺牲音画同步 Efficient Audio-Visual Generation via Synchrony-Aware Cross-Modal Sparse Attention | 上海交通大学·阿里 Token Hub·阿里云 | arXiv:2608.15522 前序问题:音视频联合生成模型能在统一扩散过程里同时合成同步的画面与声音,但推理开销一直很高——长视频 token 序列要在每个去噪步反复算注意力。视频生成领域已经积累了不少加速手段:低比特量化、注意力稀疏化、特征缓存。麻烦在于这些方法都是为纯视频模型设计的,直接搬到音视频模型上会忽略音频与视频两个分支之间的交互,进而破坏音画同步——而同步性恰恰是音视频生成的核心价值,画面再清晰、声音再干净,只要唇形和语音对不上,整个结果就废了。这是一个典型的「加速方法对模态盲视」的问题。 本文贡献:作者的关键观察是:双向音视频交叉注意力揭示了两个分支之间的结构化交互模式,高响应往往集中在少数与声音相关的视觉与时间位置上。也就是说,同步性并非均匀分布在所有 token 上,而是由一小撮关键 token 承载。据此提出受保护的稀疏注意力策略——对同步关键的 token 保留高保真的完整计算,只对冗余的注意力部分做稀疏化。整套框架是同步感知的:通过在加速过程中显式考虑跨模态依赖,在提效的同时守住音画对齐。框架图显示五步流水线:双流输入、交叉注意力显著性计算、Top-k 音频 query 保护性选择、受保护稀疏注意力、以及同步感知指示器,后者用 Δ_sync = max(Δ_v, Δ_a, λ_pΔ_p, λ_sΔ_s) 决定当前时间步是复用缓存还是重新计算。 Overview of the proposed synchronization-aware acceleration framework. Cross-modal interactions between audio and video branches are used to guide protected sparse attention and cache reuse. 实验效果:在提升推理效率的同时保持了视频质量、音频质量与音画同步三项指标。缓存策略图显示去噪时间步被自适应地划分为 Cached、Reused (Skip) 与 Recompute (Update) 三类,仅在同步信号变化剧烈时才触发重算。 Qualitative comparison of dense inference, unprotected acceleration, and our protected acceleration. The protected computation path better preserves salient visual structures and reduces local artifacts under acceleration. 批判点评:这篇的问题意识比方法本身更值得称道:它指出了一个正在发生但少有人明说的隐患——加速方法的迁移往往是模态盲视的,在纯视频上验证过的稀疏化和缓存策略被直接用到音视频模型上,而评测指标里如果没有同步性这一项,退化会完全隐形。「同步性集中在少数 token 上」这个观察也很自然地导出了保护式稀疏化,逻辑闭环。Δ_sync 取四路信号最大值的设计偏保守但合理——宁可多算几步也不冒同步崩掉的风险。不过整份摘要在效果层面几乎是零信息量:只说「提升效率」「保持质量」,没有任何加速倍率、没有基线名称、没有具体指标数值,这在一篇以效率为核心卖点的论文里是硬伤——读者无法判断它是快了 1.5 倍还是 5 倍,而这个区间决定了方法有没有实用价值。其次,Top-k 保护的 k 如何选择、保护比例与加速比之间的权衡曲线长什么样,是这类方法最核心的超参问题,摘要完全没碰。第三,方法建立在「能拿到双向交叉注意力图」的前提上,这对某些架构(如把音频当额外 token 拼进同一序列做自注意力的设计)并不成立,适用范围有限制。第四,摘要文本里出现了多处 this http URL 的替换残留,说明投稿时的自动化处理出了问题,虽然不影响技术内容,但反映出打磨程度。第五,与 SQuad 那种把加速做成蒸馏目标的思路相比,这里仍是训练无关的推理期启发式,上限受限于原模型。 8. GenRouter:按需路由省95%执行成本 GenRouter: Unified Workflow Routing for Agentic Image Generation | 港科大(广州)·港中文·Google DeepMind | arXiv:2608.16721 前序问题:文生图模型已经基本解决了原始像素合成这个基础难题,社区注意力转向如何满足越来越复杂的用户请求。为此出现了各种智能体式图像生成工作流,给静态推理加上外部知识检索、迭代推理等高级能力。但这些工作流大多各自为政,采用固定的一刀切拓扑——不管请求是「画一只猫」还是「按照这三张参考图合成一个符合物理规律的复杂场景」,都走同一条重型管线。结果是严重的算力错配:简单查询被强行推过昂贵的流水线,成本和延迟全花在不需要的环节上。 本文贡献:GenRouter 是第一个统一的智能体图像生成工作流路由框架。第一步是 GenCanvas,把各种异构的智能体管线标准化为一组通用基础原语和可执行模板——rewrite、decompose、search、reason、skill、verify、refine、sketch 等,这一步的意义在于把「不同工作流」变成「同一空间里的不同组合」,否则路由无从谈起。在这个统一空间上,GenRouter 通过三个机制把异构 prompt 自适应地路由到最优工作流:需求画像分析请求特征,经验匹配复用历史轨迹,帕累托过滤在质量、成本、延迟等多目标间取舍。系统还能通过累积经验持续自我演化。框架图显示 prompt 先被编码为雷达图形式的 Task Signature,经 Trajectory Memory 与 Route Memory 双记忆匹配后,在帕累托平面上按质量-成本-延迟三轴筛出最终路由。 Overview of our proposed (Left) and (Right) . 实验效果:在多个基准上取得更优的视觉对齐,同时相比重型静态管线降低执行成本超过 95%、延迟降低 65%。系统还能通过累积经验实现零样本泛化能力的持续提升。 Qualitative comparison. Left side shows cost (scaled by $0.01$); right side shows latency. 批判点评:这篇抓住的痛点很真实:智能体式生成的成本失控问题在实际部署里比论文里严重得多,而「所有请求走同一条重型管线」几乎是当前所有 agentic 图像生成工作的默认形态。GenCanvas 那层标准化抽象是全文最有价值的部分——把异构管线归约到统一原语空间,路由才有了数学基础,这个工程判断是对的。帕累托过滤而非单目标优化也符合真实场景,因为质量、成本、延迟的权衡本来就该交给使用方而不是硬编码。95% 成本削减听起来夸张,但如果基线真是无差别走重型管线,这个数字反而说明了原方案有多浪费——它衡量的是「浪费被消除了多少」而非「效率被提升了多少」。也正因如此,这个数字高度依赖测试集里简单请求的占比:如果基准里大部分是简单 prompt,95% 几乎是自动达成的,而真实流量分布未必如此,论文应当给出按请求复杂度分层的成本曲线。第二,路由器本身也要跑推理——需求画像、经验匹配、帕累托过滤都不免费,这部分开销是否计入了「执行成本」的统计口径,直接影响结论的诚实度。第三,「自我演化」依赖经验累积,冷启动阶段的表现和收敛所需的请求量没有交代,而这决定了它在新部署环境里多久才能变得有用。第四,路由错误的代价不对称——把复杂请求误路由到轻量工作流会直接产出劣质结果,摘要说「更优的视觉对齐」,但没给误路由率,这才是用户实际会感知到的风险。 9. StructFlow:让噪声也带上空间结构 Spatially-Grounded Flow Matching: Structured Source Distributions for Image Generation | 马里兰大学·Netflix | arXiv:2608.15452 前序问题:当前 flow matching 模型学的是把源分布——独立同分布的高斯噪声——传输到自然图像的目标分布。但这个源分布完全不含任何空间结构的概念,而图像本质上是局部相关的:邻近像素强相关。作者的假设很有意思:正因为噪声是独立采样的,模型在训练时被隐式地鼓励去利用「噪声较小的邻居」作为上下文,从而部分绕开了真正学习图像局部结构这件事。换句话说,源分布的设计与图像域的归纳偏置是相互对抗的——我们给了模型一个走捷径的机会,它就不会好好学结构。 本文贡献:StructFlow 把空间局部性直接编码进源分布:让一个小区域内的像素共享一个公共噪声成分。这个改动很轻,但改变了传输路径的几何性质——路径变得与图像区域在几何上对齐,从而带来通用 flow matching 难以提供的三个性质:天然尊重边界的细粒度局部编辑、稳健的结构保持、以及图像之间平滑的语义插值。作者还证明这些好处能延伸到大型预训练模型上,通过一个轻量的后训练阶段即可植入,不必从零重训。噪声构造图清楚展示了机制:图像先被划分为超像素,每个超像素分配一个 anchor 分量,区域内部再叠加噪声,最终得到的相关噪声在去噪轨迹上使得结构从早期就开始显现,而标准 flow matching 的不相关噪声则要到很晚才浮现结构。 modelname Noise Construction. introduces locality in the source distribution sampling instead of i.i.d gaussian sampling in normal flow matching. % 实验效果:在多个数据集上、无条件、类别条件与文本条件三种设定下、使用不同架构验证有效。类别条件 ImageNet 256×256 上 FID 从 18.50 改善到 17.24、sFID 从 14.04 改善到 10.03;但无条件 FFHQ 256×256 上 Precision 从 0.250 提升到 0.350、ImgReward 从 0.500 提升到 0.720 的同时,FID 反而从 22.68 退到 25.80、Recall 从 0.200 掉到 0.160。结构保持实验显示,给定同一组超像素划分、更换随机种子时,生成结果的构图与主体轮廓保持一致而颜色、材质、身份等属性自由变化——说明超像素划分确实成了一个可控的结构句柄。 Comparison with baseline. Evaluated across a diverse set of metrics for robust assessment, performs on par with standard flow matching and outperforms it in some cases. 批判点评:这是今天这批里最优雅的一篇:改动只在源分布,不动架构、不动损失、不动采样器,却换来局部编辑、结构保持、语义插值三个下游能力,而且能通过轻量后训练植入已有大模型。那个「独立噪声让模型偷懒依赖低噪邻居」的假设也相当锐利,属于对训练动力学的真实洞察,而不是拍脑袋的启发式。结构保持图的说服力很强——固定超像素、换种子,构图不变而属性变化,这直接证明了源分布的结构确实被继承到了输出。不过要留意几处。第一,超像素划分本身成了新的输入依赖:生成时需要一份划分,无条件生成场景下这份划分从哪来?如果是随机生成的,那它的分布就成了新的隐式先验,可能引入难以察觉的偏置;如果要用户提供,那这就从「更好的生成」变成了「另一种条件生成」,可比性发生了变化。第二,让区域内共享噪声成分本质上降低了源分布的熵,理论上会压缩可生成的多样性——而这个担心在论文自己的数据里就被证实了:无条件 FFHQ 上 Recall 从基线 0.200 掉到 0.160、FID 从 22.68 退到 25.80、FID-DINO 从 232.4 退到 267.3,同时 Precision 从 0.250 冲到 0.350。这是一组非常典型的「保真度换多样性」权衡信号,说明 StructFlow 生成的样本更精致但覆盖面更窄。摘要只说「有效」,把这个方向性代价藏进了图里,读者若不看 baseline_comparison 这张图很容易被误导。类别条件 ImageNet 上表现则相反(FID、sFID、Recall 全面改善),说明这个代价与是否有强条件信号高度相关——条件越弱,熵损失越致命。第三,「轻量后训练即可植入大模型」这个结论只说了成立,没给成本量化和在哪个模型上验证,而这是该方法能否被采纳的关键。第四,超像素的粒度是一个新超参,粒度过粗会锁死构图、过细则退化为独立噪声,最优粒度是否依赖数据集和分辨率未讨论。第五,作者两人分属马里兰大学与 Netflix,工作在 Netflix 实习期间完成,考虑到 Netflix 的业务场景,这套方法在视频生成上的表现是个自然的下一步,但本文未涉及。 10. CineDub:免裁脸免分离的多人配音 CineDub: Scaling End-to-End Video Dubbing to Multi-Speaker Dialogues with Coherent Sound Effects | 中科大·蚂蚁集团·莫纳什大学 | arXiv:2608.15734 前序问题:真实场景下的自动视频配音被两个互相矛盾的约束卡住。层级式方法依赖脆弱的多阶段预处理——人脸裁剪、说话人分离等——这些前置步骤严重限制了数据可扩展性和实际部署:任一环节出错,后面全崩。整体式方法直接在未裁剪视频上操作,避开了预处理,但代价是时序对齐薄弱,而且在多说话人场景下会出现说话人-话语归属的歧义:模型不知道这句话该由画面里哪个人说。于是配音这件事在「脆弱但精确」和「鲁棒但混乱」之间左右为难,而影视配音恰恰是多说话人、多轮对话的典型场景。 本文贡献:CineDub 是一个统一的扩散模型,能直接从未裁剪视频完成精确的多说话人对话配音,既不需要人脸裁剪也不需要说话人日志。核心是隐式耦合整体条件化范式:整体视觉表示与一种语义捆绑的转写格式被独立编码,却通过跨模态训练隐式耦合起来,从而解决说话人歧义并支持精确的多人多轮对话配音。基于整体视觉特征捕获的统一时序线索,作者进一步把 CineDub 扩展到语音与音效的联合生成,为此引入环境音到语言的课程学习以缓解子任务退化,并设计解耦的文本分支控制机制来解决同时生成时的跨提示词干扰。同时发布两个真实场景基准。框架图显示视觉侧分为 Dense Temporal(Synchformer)、Global Semantic(CLIP)与 Transcription(Gemma-T5)三支冻结编码器,转写格式用 / 标记切分不同说话人的语句,音频与转写元 token 分别经交叉注意力注入主干。 Overview of CineDub under the ICHC paradigm. The holistic visual condition $\mathbf{c}_v$ (left), extracted by SynchFormer (Sec.~sec:visual_condition), encodes both event-level audio-visual correspondences and fine-grained lip-sync alignment. To address the speaker assignment ambiguity in $\mathbf{c}_v$, the semantic-bundled transcription $\mathbf{c}_t$ (right) provides per-segment speaker-utterance grounding cues, implicitly coupling with $\mathbf{c}_v$ via multi-conditional training (Sec.~sec:text_condition). CineDub adopts a unified DiT backbone that supports both joint video-to-speech-and-audio generation and each subtask. $\mathbf{c}_t$ and $\mathbf{c}_a$ are routed through decoupled textual branches to prevent cross-prompt interference, with learnable meta-tokens replacing inactive branches during single-task inference (Sec.~sec:decoupled_attn). 实验效果:实现了从未裁剪视频直接进行多说话人多轮对话配音,并扩展到语音与音效的联合生成。同时释出 CineDub-Multi(多说话人对话配音)等两个真实场景基准。论文已被 ACM MM 2026 接收。 Visualization of SynchFormer self-attention maps (magenta: active speaker; white: inactive speaker). (a)~Single-speaker setting: attention concentrates on the lip region. (b)~Two-speaker setting: attention dynamically shifts to the active speaker across turns. (c)~Failure cases: attention drifts to a non-speaking face during overlapping speech or becomes ambiguous at shot boundaries. 批判点评:「不需要人脸裁剪和说话人日志」是这篇最实在的卖点。做过配音管线的人都知道,那些预处理步骤是主要的故障源和数据规模瓶颈,能去掉它们,工程价值立刻显现。用带 / 标记的语义捆绑转写格式来消解说话人归属歧义,是个巧妙的取舍——把「谁在说」这个视觉难题部分转移到了文本侧的结构化表示上,绕开了视觉说话人定位的老大难。三支冻结编码器分工也清晰:Synchformer 管密集时序、CLIP 管全局语义、Gemma-T5 管文本,各司其职且都不训练,成本可控。ACM MM 2026 接收提供了一定的同行评议背书。但几点需要审视。第一,转写格式承担了消歧的主要负担,意味着推理时需要一份带说话人切分标记的高质量转写——这份输入从哪来?如果需要人工标注或依赖 ASR 加日志,那么「不需要说话人日志」只是把它从视觉管线挪到了文本管线,端到端的依赖并没有真正消除,摘要在这一点上表述得偏乐观。第二,同时生成语音与音效带来的「跨提示词干扰」用解耦文本分支来解决,但音效与语音在时间上天然重叠(说话时门在响),这种物理层面的耦合能否靠表示层解耦干净,值得怀疑。第三,两个基准都由作者团队自建,与训练数据的分布关系未说明,同分布优势难以排除。第四,摘要没有任何定量结果——没有同步性指标、没有音质指标、没有与层级式方法的对比数字,一篇声称解决多说话人歧义的论文却不给说话人归属准确率,是明显的缺口。第五,环境音到语言的课程学习是为缓解子任务退化而引入的,说明联合生成确实存在能力互斥,那么相比两个独立模型分别生成再混音,联合方案的净收益有多大并不明确。 趋势观察 像素空间正在夺回 VAE 让出的地盘 — 今天有四篇论文从不同角度指向同一个结论:VAE 潜空间不是免费的午餐。阿里的 Z-Image-Pixel 给出了首个能与潜空间掰手腕的像素空间 T2I 训练配方,港理工的 PixRestore 干脆不要 VAE 从零训像素 DiT,PixelControl 指出潜空间压缩会削弱细结构控制信号。VAE 换来的是算力,代价是细节与保真度——当算力配方被打通后,这笔交易开始被重新审视。 注意力加速从「手工稀疏」走向「蒸馏出来的结构」 — Qualcomm 的 SQuad 不再手写稀疏模式,而是把满 softmax 教师蒸馏成 O(n√n) 的局部+全局两段注意力,在 Wan 2.2 5B 上 VBench 83.20 对 83.08 基本无损而注意力 FLOPs 降 67 倍。上交与阿里的 SyncSparse 则说明:稀疏化不能对模态盲视,音视频模型直接套用视频加速方法会破坏音画同步。 「不训新模型」成为一种正当的方法论 — Qwen-Video-Edit 直接把图像编辑模型当视频编辑器用(帧排成一张大图),KeyID 走训练无关路线,EqF 把噪声条件整个去掉换来推理期自适应,MLLM 语义纠偏在采样循环里插反馈。视频基座训练成本高企之后,研究重心明显从「造模型」转向「榨干已有模型的隐含能力」。 人工智能炼丹君 整理 | 2026-08-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-18|港科大数字人比LTX-2快33倍还能连说一分钟Omni… 今日 AIGC 论文速览 今日共 10 篇 · 实时流式数字人与音视频联合生成 1 篇 · MLLM 与 DiT 融合的视频生成架构 1 篇 · 视频生成推理加速 3 篇 · 个性化与可控图像生成 2 篇 · 生成式渲染与视频编辑 2 篇 · 图像编辑评测基准 1 篇 重点论文标题列表 Omni-LiveAvatar(港科大 iComAI Lab·Vivix Group):比LTX-2快33倍的分钟级流式数字人 BiVidGen(中科院·Microsoft Research·中山大学·浙大·西交·上海AI Lab):MLLM先写视觉token再交DiT渲染 SCOPE:免训练稀疏注意力提速1.99倍 ForgeWM:世界模型压到1步还听懂键鼠 CRAFT(SIGGRAPH Asia 2026):1万张参考图干掉200万配对数据 今日论文速览 1. Omni-LiveAvatar:比LTX-2快33倍的分钟级流式数字人 Omni-LiveAvatar: Minute-Level Real-Time Streaming Joint Audio-Video Avatar Generation | 港科大 iComAI Lab·Vivix Group | arXiv:2608.13602 前序问题:音视频联合生成模型是沉浸式数字人的底座,但现有模型几乎都依赖双向注意力加多步去噪,这两件事凑在一起决定了它只能生成很短的片段。双向注意力要求看到完整序列才能算,天生做不了流式;多步去噪又让单块延迟压不下来。于是「实时交互」和「长时长」这两个数字人最需要的属性,在当前架构下同时缺失——你要么生成几秒的高质量片段然后卡住,要么牺牲质量去换速度,而且一旦想连续说上一分钟,全局一致性(人物长相、音色、场景)就开始飘。 本文贡献:提出 Omni-LiveAvatar,第一个做到分钟级、实时、流式的音视频联合数字人生成框架,三个部件各解一个问题。一是渐进式自回归蒸馏管线,把一个大的双向音视频联合扩散模型转成少步自回归生成器,关键点是整个过程不需要额外的稳定化机制——同类工作常要靠各种辅助 trick 才能压住自回归的误差累积。二是同步的音视频长短期记忆,在有界显存预算下保住全局一致性,这是长时生成不漂的直接原因。三是分层滚动提示词规划策略,让语义可以连贯演进、提示词之间平滑切换,而不是每换一句话画面就跳一下。 Overview of Omni-LiveAvatar. The proposed progressive autoregressive distillation pipeline converts a large bidirectional audio-video diffusion model into a few-step causal generator without any auxiliary stabilization mechanism (top). At inference, the synchronized audio-video long-short-term memory preserves global consistency while retaining recent context within a bounded memory budget for minute-level streaming inference (middle), and the hierarchical rolling prompt planning organizes global and local prompts for smooth long-form semantic evolution (bottom). 实验效果:单张 NVIDIA H200 上,相对其教师模型 LTX-2 拿到 33 倍生成加速,且能实时产出分钟级、音视频同步的高质量数字人。质量维度上全面超过同期的加速类基线,具体覆盖视觉质量、音频质量、跨模态同步性和人物保真度四个方面。代码已开源。 Qualitative comparison of 5-second avatar generation. Omni-LiveAvatar generates realistic and temporally consistent avatars with visual quality comparable to Ovi and LTX-2, whereas OmniForcing exhibits noticeable realism degradation and Hallo-Live suffers from facial and hand artifacts as well as color drift. 批判点评:这篇的工程完成度是今天这批里最高的,33 倍加速加分钟级流式,两个指标同时拿下不容易,而且「不需要额外稳定化机制」这句如果站得住,实际价值比加速倍率本身更大——自回归视频生成的误差累积一直是靠各种补丁压住的,能去掉补丁说明蒸馏管线的设计确实抓住了主要矛盾。教师选 LTX-2 也是个务实选择,那是当前公开可用的强音视频联合模型之一。不过 33 倍这个数字要放在正确的语境里读:它是相对教师的加速比,而教师本身是多步双向模型,基数很慢,所以这个倍率更多说明「双向多步这条路在实时场景下浪费有多大」,而不等于绝对性能领先。真正该问的是绝对延迟——摘要只说「实时」,没给单块生成耗时和端到端首帧延迟,而数字人交互对这两个数字极其敏感,300 毫秒和 800 毫秒是完全不同的产品体验。分辨率和帧率也没披露,H200 是顶配卡,换到消费级或推理卡上还剩多少余量不清楚。另外「分钟级」和真正的开放式交互仍有距离:长短期记忆是有界预算,那就必然有遗忘边界,跑到第五分钟、第十分钟时人物一致性掉多少,论文只展示了分钟级。最后,音视频联合生成最难的其实是音画同步在长序列上的累积误差,摘要报了同步性优于基线,但没说这个优势是否随时长衰减。 2. BiVidGen:MLLM先写视觉token再交DiT渲染 Beyond Text Conditioning: A Systematic Study of MLLM-DiT Fusion for Video Generation | 中科院·Microsoft Research·中山大学·浙大·西交·上海AI Lab | arXiv:2608.14043 前序问题:DiT 已经是高保真视频生成的主流范式,但它做高层语义规划的能力一直很弱——给一句复杂提示词,它能画得很好看,却常常没把因果关系、动作顺序、多物体交互理清楚。图像生成那边已经证明把 MLLM 和扩散骨干混起来有明显优势,可这套思路在视频上基本没被认真研究过。更关键的是,现有少数尝试几乎都把 MLLM 当成一个冻结的特征编码器用,取它的隐层表示喂给 DiT,而 MLLM 最核心的能力——自回归地「生成」内容——完全没被调用。这就等于请了个会规划的大脑,却只让它当传感器。 本文贡献:系统性地拆解「MLLM 该怎么和 DiT 融合做视频生成」这个问题,明确拆成三问:什么样的中间表示适合做 MLLM 与 DiT 之间的桥梁、MLLM 该如何产出这个表示、DiT 在扩散渲染时该如何吸收它。三个发现:其一,由 EMA-based tokenizer 产出的离散语义视觉 token 提供了既稳定又有表达力的接口;其二,自回归因果建模适合生成这些 token;其三,显式的视觉 token 条件化比改写提示词(prompt refinement)或隐空间桥接(latent bridging)都更有效。基于这三点提出 BiVidGen 这一混合架构,让 MLLM 真正承担语义规划、DiT 负责扩散渲染。 Overview. BiVidGen consists of three main components. First, an EMA-based vision tokenizer provides discrete visual representations. Then, an MLLM predicts semantic visual tokens. Finally, the DiT renders high-fidelity videos conditioned on these planned tokens. 实验效果:论文以系统性对照实验为主体,逐一验证三个设计维度上的选择,最终 BiVidGen 在语义规划相关的生成任务上优于把 MLLM 当冻结编码器的既有做法。三条发现分别对应中间表示形式、生成方式、条件注入方式的消融结论。 Qualitative Comparisons. MLLM+DiT yields better causal transitions, temporal consistency, and semantic alignment than the DiT-only baseline in these examples. 批判点评:这篇的价值主要在「把问题问清楚」而不是「刷了个 SOTA」。它把 MLLM-DiT 融合这个此前靠直觉拼装的设计空间,拆成三个正交维度逐一做对照,最后给出的三条结论——离散语义 token 做接口、自回归生成、显式 token 条件化——对后续做这个方向的人是实打实的省时间,尤其「显式 token 条件化优于 prompt refinement 和 latent bridging」这条,直接排除了两条看起来很自然但实际次优的路径。EMA tokenizer 提供稳定接口这个发现也有说服力,离散化在生成任务里通常被担心信息损失,这里反而因为稳定性赢了。但摘要在最关键的地方留了空白:没有任何具体数字,没说在哪些 benchmark 上、相对哪些基线提升多少,也没交代 MLLM 和 DiT 各自的规模、训练数据量和总训练成本。对一篇以「系统性研究」自我定位的工作,这些恰恰是判断结论泛化性的关键——三条结论是在某个特定尺寸组合下成立,还是随规模稳定?其次,引入自回归 MLLM 生成视觉 token 必然带来额外推理延迟,视频生成本来就慢,这个代价有多大、值不值得,论文没有权衡分析。最后一个更根本的隐忧:既然 MLLM 现在承担了语义规划,那它规划错的时候会怎样?DiT 是有能力纠正一个错误的视觉 token 序列,还是会忠实地把错误渲染出来?这个失败模式没有讨论,而它直接决定了这套架构在实际产品中的鲁棒性。 3. SCOPE:免训练稀疏注意力提速1.99倍 SCOPE: Subspace Clustering with Online Per-Head Top-K Estimation for Sparse Video Attention | arXiv:2608.12780 前序问题:DiT 在时空 token 上的自注意力是二次复杂度,视频一长、分辨率一高就成为主要瓶颈。现有免训练稀疏注意力方法普遍用块级或簇级的代理分数来构造稀疏掩码,问题是这种粗粒度代理会把 key 之间的细微差异抹平,在激进稀疏率下高贡献的 key 就被漏掉了。还有一个更隐蔽的失败模式:代理分数容易产生过度集中的 softmax 分布,导致 Top-p 策略对某些 query 簇只保留极少的 key。用一个固定的 Top-k 下限可以缓解,但不同注意力头、不同输入的稀疏容忍度本来就不一样,共享一个固定值必然有头被切得太狠。 本文贡献:提出 SCOPE,免训练稀疏注意力框架,把 3D-RoPE 对齐的 key 子空间聚类和在线逐头 Top-k 估计结合起来。具体做法是把过了 RoPE 的 key 按时间、高、宽三个子空间分别独立聚类,再通过查找表聚合对应的质心分数,为每个 query 簇得到逐 key 的代理分数——粒度从块/簇细化到单个 key。在既有的 Top-p 与固定 Top-k 混合选择策略之上,SCOPE 在线推导每个头专属的 Top-k 值:对每个头,按 query 簇大小加权平均其初始保留 key 数,只对那些初始保留数低于该均值的 query 簇补充选取额外 key。最终稀疏注意力在选中的原始 key/value 上计算。 Overview of SCOPE. Queries are clustered in the full feature space, while each post-RoPE key is represented by temporal, height and width subspace assignments. Query-centroid slices score the corresponding subspace centroids to form lookup tables, and indexed summation reconstructs a proxy logit for every key. Hybrid Top-$p$/fixed-Top-$k$ selection produces the initial key counts, from which SCOPE estimates an online per-head Top-$k$ value. Sparse attention is computed using the selected original $K$ and $V$. 实验效果:在六种模型-任务配置上,SCOPE 在保真度和延迟两个维度上都稳定优于现有免训练基线。720p HunyuanVideo 上端到端加速最高 1.99 倍,同时相对稠密注意力保持 28.46 dB PSNR。 Attention recall and PSNR under matched attention density. SCOPE consistently achieves higher attention recall and PSNR than competing sparse attention methods at the same retained density. 批判点评:这篇的两个改动都很对症。按 RoPE 的三个物理维度分别聚类,比在混合后的高维空间里做一次聚类更合理——时间、高、宽三个方向的相似性结构本来就不同,混在一起聚必然互相干扰,这个设计有明确的几何动机而不是调参调出来的。逐头在线估计 Top-k 也踩在了痛点上:稀疏注意力的工程实践里,「哪个头能切多狠」向来是最难统一的,用全局固定值本质上是在拿最脆弱的那个头的容忍度当上限,牺牲了其余头的加速空间。1.99 倍加速配 28.46 dB PSNR 是个体面的组合,六种配置的覆盖也说明不是单点调优。但要注意几个尺度问题。28.46 dB 是相对稠密注意力的重建保真度,这个量级在图像上属于「肉眼可辨差异」的边缘,视频上更麻烦的是误差会沿时间累积——单帧 PSNR 达标不代表时序闪烁可接受,而摘要没给任何时序一致性指标。1.99 倍是「最高」值且只在 720p HunyuanVideo 上,其余五个配置的加速比没披露,实际期望值应该往下调。更根本的是,SCOPE 自己引入了聚类和查找表两层额外开销,这部分成本随 token 数如何增长、在什么序列长度以下会反而变慢,论文没给出盈亏平衡点,而这直接决定它能否用在短视频或低分辨率场景。最后,逐头 Top-k 用「簇大小加权均值」作为阈值是个启发式,为什么均值是对的、换成分位数会怎样,缺少分析。 4. ForgeWM:世界模型压到1步还听懂键鼠 ForgeWM: Progressive Causal Training for Few-Step Action-Conditioned Video World Models | arXiv:2608.14022 前序问题:动作条件视频世界模型要同时满足低延迟因果生成和对游戏原生控制信号的可靠响应。因果蒸馏已经能做到一步或少步视频合成,但把它扩展到交互式世界模型很难,症结在于离散的键盘状态和连续的鼠标运动必须在因果训练和自回归 rollout 的全过程中,始终与被时间压缩过的隐空间 chunk 保持对齐。视频 VAE 在时间维做了压缩,一个隐 chunk 对应多帧,而用户的按键是逐帧发生的——这个错位在多步生成里还能靠冗余步数糊过去,压到一两步就直接暴露成「动作响应不准」。 本文贡献:提出 ForgeWM,一个渐进式框架,通过四个阶段把双向的动作条件视频生成器转成高效的少步世界模型:域适应、teacher-forced 因果训练、因果一致性蒸馏、以及与双向教师做 on-policy 分布匹配。产出的是「按预算特化」的学生模型,分别在 1、2、4 步的稳态去噪预算下工作。ForgeWM 还支持一种双路径部署协议,把延迟敏感的交互与可选的回放期精修结合起来——一步学生先出草稿保存,之后再重新加噪并精修这份草稿,等于把「交互时要快」和「回放时要好」两个矛盾需求拆到了不同时间点。 Overview of ForgeWM. (A) Frame-aligned keyboard and mouse controls condition latent chunks. (B) A shared base yields a bidirectional teacher and budget-specialized causal students through four-stage training. (C) Deployment separates low-latency interaction from optional Replay-Time Refinement (Figure~fig:replay-refinement). 实验效果:在配对的 Minecraft 轨迹上,ForgeWM 在成像质量、参考对齐的运动指标上领先所评估的各系统,学生模型可在 1、2、4 步预算下运行。 Qualitative comparison. Rollouts at frames 0, 25, 51, and 76. Rows show the reference and three models. Controls are annotated once on the reference: each overlay shows dominant WASD and accumulated mouse-look to the next frame; the final frame has no outgoing control overlay. Left/right: daytime forest stream/rainy riverbank at night. 批判点评:把「动作对齐」识别为少步世界模型的核心障碍,这个判断是准的,而且它指出的错位很具体——时间压缩的隐 chunk 与逐帧动作信号之间的粒度不匹配,这不是靠加数据能解决的结构问题。四阶段渐进管线(域适应→teacher-forced→一致性蒸馏→on-policy 分布匹配)的顺序也有内在逻辑:先让模型适应域,再在有监督信号下学因果,最后用 on-policy 修正暴露出的分布偏移。双路径部署是全篇最有产品意识的设计——交互时用一步出草稿保延迟,回放时再加噪精修提质量,直接承认了「同一个模型不必在所有时刻都做同样的权衡」,这个思路可以迁移到很多实时生成场景。但实验范围是明显的短板:只在 Minecraft 上验证。Minecraft 的视觉复杂度低、纹理规整、物理规则简单且完全确定,是世界模型最友好的测试场,在这里报 SOTA 与在真实感游戏或真实视频上的可用性之间有很大鸿沟。「领先所评估的各系统」这个表述也偏保守,说明对比范围可能有限,具体的 FID/FVD 数值和延迟数字摘要都没给。一步学生的绝对质量损失多少同样没交代——1、2、4 步三档特化模型之间的质量-延迟曲线是这篇最该给的图,缺了它就无法判断「压到一步」是真可用还是仅仅可跑。另外双路径协议要为每次交互保存草稿,显存和存储开销在长会话下如何增长,也没有讨论。 5. CRAFT:1万张参考图干掉200万配对数据 CRAFT: Constrained Reward via Attention Fine-Tuning for Subject Personalization without Composed Targets | SIGGRAPH Asia 2026 | arXiv:2608.14403 前序问题:主体驱动的图像个性化——生成新图像同时保持一个或多个参考主体的身份——是视觉内容创作的基础能力。当前主流做法是在几十万到几百万组「参考图-合成目标」配对样本上微调预训练的 MMDiT,而每组合成目标都是主体出现在新场景中的一张合成图。造这些目标需要一条昂贵的多阶段流水线:LLM 生成提示词、T2I 合成目标图、参考主体抠取、VLM 质量过滤、对应关系标注。除了贵,这条路还有个隐性代价——方法被紧紧绑在某个特定的目标合成器和某一套数据清洗策略上,换个合成器结论就不一定成立。 本文贡献:提出 CRAFT,一个单步 ReFL 框架,用 LoRA 适配器微调预训练的「参考感知」MMDiT,训练数据只需 1 万张参考图加主体 mask,完全不需要合成目标监督。核心是「看哪里」原则:注意力级奖励把噪声 token 与短语 token 的注意力对齐到正确的参考主体上,由此得到的逐主体注意力 mask 再去门控一个像素级身份奖励,从而让图像空间的监督与学到的注意力路由保持一致。这等于把监督信号从「像素该长什么样」换成了「注意力该看哪个主体」,后者可以从参考图本身直接构造。 Overall pipeline of CRAFT. The denoising prefix is rolled out without gradients up to the reward step $t^\ast$, where two forward passes are performed: the frozen backbone $f_\text{base}$ produces $\mathbf{v}_\text{base}$, while the LoRA-adapted model $f_\text{LoRA}$ produces $\mathbf{v}_\text{LoRA}$ together with the cross-modal attention sub-blocks $\mathbf{A}_{N2R_k}$, $\mathbf{A}_{N2P_k}$, and $\mathbf{A}_{P_k 2 R_k}$. Following the Where to look principle, $\mathcal{R}_\text{ref}$ and $\mathcal{R}_\text{cons}$ shape noise- and phrase-token attention toward each reference subject (sec:method:attn_rewards); the resulting per-subject mask $\mathbf{m}^\text{noise}_k$ then gates the pixel-level identity reward $\mathcal{R}_\text{id}$ on the VAE-decoded pre-image $\hat{\mathbf{I}}$ (sec:method:pixel). Auxiliary terms $\mathcal{R}_\text{CLIP-T}$, $\mathcal{R}_\text{AES}$, and a velocity-space regularizer $\mathcal{L}_\text{anchor}$ are added for prompt fidelity, aesthetics, and stability (sec:method:loss). A single backward pass updates only the LoRA parameters. 实验效果:应用在 FLUX.2-klein-9B 上,CRAFT 在 XVerseBench 上达到 SOTA,且只用 1 万条纯参考数据,而此前的通用方法需要 15 万到超过 200 万组合成目标配对。同一套配方迁移到其他参考感知骨干上也能稳定提升性能。已被 ACM SIGGRAPH Asia 2026 接收。 Qualitative comparison with state-of-the-art subject-driven personalization models. 批判点评:1 万对 200 万,两个数量级的数据量差距还能拿 SOTA,这是今天最有冲击力的数字,而且它的说服力不在倍数本身,而在于它质疑的东西:如果两百万组精心合成的配对数据能被一万张参考图替代,那说明此前的数据流水线在很大程度上是在用外部监督重新教模型一些它内部已经编码好的东西。把监督从像素空间挪到注意力空间是关键一步——「主体身份」这个概念在 MMDiT 里本来就是通过注意力路由实现的,直接在这一层加约束比绕一圈从像素反推更直接。用注意力 mask 去门控像素奖励也很巧,避免了两种监督各说各话。迁移到其他参考感知骨干仍有效,说明不是单一模型上的过拟合。SIGGRAPH Asia 的接收也是一层背书。不过前提条件要看清楚:它要求骨干必须是「参考感知」的 MMDiT,也就是说模型本身已经具备处理参考图的结构,CRAFT 是在这个基础上做对齐微调,而不是从零赋予个性化能力——所以严格说它省掉的是「对齐阶段」的数据,而非全部。评测只报了 XVerseBench 一个基准,主体个性化的评测口径分歧很大,单一 benchmark 上的 SOTA 需要更多交叉验证,尤其是多主体组合、罕见物体这些困难设定。注意力级奖励依赖短语 token 与主体的正确对应,当提示词里出现代词、隐含指代或多个同类物体时这个对应如何建立,摘要没说。最后 1 万张参考图仍需主体 mask 标注,这部分成本虽远低于合成目标流水线,但并非零。 6. XYZFlow:不靠蒸馏拿到7.2倍教师加速 XYZFlow: Scaling Multi-dimensional Shortcut Flows for Efficient Generative Modeling | ICML 2026 | arXiv:2608.12276 前序问题:高保真图像生成始终卡在速度与质量的取舍上。扩散模型视觉效果强,代价是昂贵的迭代采样。现有的高效方法主流是把预训练模型蒸馏成少步采样器,但蒸馏本身是个难做的过程,而且质量上限严重依赖教师模型——教师有的毛病学生躲不开,教师没有的能力学生也长不出来。这意味着加速路线被绑死在「先有一个好教师」这个前提上,而且每换一个基础模型就要重跑一遍蒸馏。 本文贡献:提出 XYZFlow,从流匹配的多维度缩放这个角度重新思考高效生成,而不是走蒸馏路线。核心主张是:相比单步映射,通过结构化的多维条件化可以让概率路径更可辨识、更易学习,从而提升表达力。论文把自回归建模看作一种隐式的流直化——上下文越丰富,轨迹的歧义就越小。XYZFlow 用两个正交维度实现这个想法:时间维缩放,即在完整去噪历史上做非马尔可夫条件化;空间维缩放,通过「下一捷径预测」(Next Shortcut Prediction)顺序生成图像块,把已生成块的去噪轨迹当作后续块的先验。 Next Shortcut Prediction in XYZFlow. (Top-Left) Flow diagram showing the generation sequence, where a blue curve represents progressively strengthening constraints. (Top-Right) Visualization of a non-uniform patch-based denoising process: the first image patch undergoes the most denoising steps, while subsequent patches are generated with fewer steps (“shortcuts”). This forms a long autoregressive sequence where the denoising flow from prior patches (green and blue arrows) guides the denoising of subsequent ones. 实验效果:达到 SOTA 性能,相对教师模型实现 7.2 至 8.5 倍加速,同时 FID 保持竞争力。其中 Next Shortcut Prediction 在质量-延迟权衡上优于单纯的模型放大或步数削减两种做法。已被 ICML 2026 接收(16 页 5 图)。 Randomly selected examples of generated images from XYZFlow. XYZFlow shows high-quality generative modeling abilities. 批判点评:「自回归建模是隐式的流直化」这个视角是这篇最有价值的部分。流匹配领域一直在琢磨怎么把概率路径拉直,主流手段是改路径设计或加正则;这篇指出提供更丰富的条件上下文本身就在减少轨迹歧义,等于把自回归和流直化两条此前平行的技术线接上了,这个洞察比 7.2 倍这个数字更耐读。时间和空间两个正交维度的划分也干净——非马尔可夫地用完整去噪历史,加上按块顺序生成用已完成块当先验,两者确实互不重叠,可以独立叠加。绕开蒸馏这一点尤其实在,摆脱了对教师质量的依赖,ICML 2026 的接收说明理论部分经过了同行检验。但代价需要说清楚:空间维的 Next Shortcut Prediction 是顺序生成图像块,这天然引入了块间的串行依赖,跟扩散模型全图并行去噪的优势正好相反。摘要报的 7.2-8.5 倍加速想必已经包含这部分开销,但在什么分辨率下测的、块数增加时加速比如何衰减,是判断可扩展性的关键,而这些没披露。「FID 保持竞争力」这个措辞比「达到 SOTA」弱,暗示纯质量指标上可能有小幅让步,具体差多少应该给出。时间维的非马尔可夫条件化要保存完整去噪历史,显存开销随步数线性增长,与少步生成的初衷存在张力。另外全文以图像生成为主,视频这种时空 token 量级大得多的场景下,块间串行的代价会被放大多少,是个开放问题。 7. RGBX-Next:把DiT改造成可控生成式渲染器 RGBX-Next: Towards Realistic Generative Rendering from G-Buffers | NVIDIA·UCSB·UCSD·MBZUAI | arXiv:2608.13929 前序问题:扩散模型在图像、视频和流式生成上效果已经很好,但和传统 3D 渲染相比,它对生成结果缺乏精确控制。传统渲染管线里你能精确指定几何、材质、光照,改一个参数就得到可预期的变化;扩散模型给的是「大致符合描述」,无法承担需要确定性控制的生产任务。反过来传统渲染又缺少生成模型的真实感先验,物理正确不等于看起来像照片。这两条路各有各的强项,一直没能真正打通。 本文贡献:主张一条可行路径是把生成模型当作以传统渲染的 G-buffer 为条件的「学习型渲染器」。提出 RGBX-Next,一个统一的前向与逆向渲染生成框架:既能从图像、视频、流中估计 G-buffer(逆向),也能从 G-buffer 渲染出真实的图像、视频、流(前向)。核心贡献是给出了一套把扩散 Transformer(DiT)模型微调成生成式前向渲染器与逆向渲染器的通用配方。作者承诺公开全部模型。 High-level overview of our paper. We first describe a simple version of image and video models in sec:initial-rgbx, followed by an improved version using our QK type embedding and clean input tokens techniques in sec:improved-rgbx. We estimate G-buffers from real video data with our model in sec:dataset, and train models with X-patchify in sec:xpatchify. We discuss conditioning dropout and lighting control in sec:dropout-blurring,sec:lighting. We introduce streaming extensions of our models in sec:streaming. 实验效果:所得模型在真实感生成式渲染与内在分解(intrinsic decomposition)两个方向上都达到高质量。论文强调其提出的设计原则将有利于后续可控生成式前向与逆向渲染的研究。团队来自 NVIDIA 与 UCSB 等,作者包含多位实时渲染与逆向渲染方向的资深研究者。 The overall design of our $1/N$ streaming models. For each chunk, the model receives $N$ current input frames and one stitching frame from the previous chunk, whose input and output are already known, then produces the $N$ new output frames through a diffusion process. Optional long-context tokens provide a clean reference frame for long-term memory. For simplicity, the figure illustrates the rgbtox case with albedo as xx. 批判点评:把 G-buffer 当作生成模型的条件接口,这个设计的聪明之处在于它直接复用了图形学几十年积累下来的中间表示。G-buffer(法线、深度、albedo、粗糙度这些)本来就是渲染管线里为了解耦几何与着色而设计的,它天然是结构化、可编辑、语义明确的——比文本提示词或隐向量都更适合做精确控制的入口。前向和逆向统一在一个框架里也很自然,两者本质是同一映射的两个方向,共享表示能互相提供约束。作者阵容是这篇的隐性背书:Marco Salvi、Jan Novák、Ravi Ramamoorthi、Ling-Qi Yan、Miloš Hašan 都是渲染和逆向渲染方向的资深研究者,NVIDIA 主导加上承诺开源模型,落地可能性比多数学术工作高。但摘要的表述相当克制,也确实缺东西:全篇没有一个量化指标,「高质量」「有利于后续研究」这类措辞在一篇声称做 SOTA 级渲染的工作里偏软,无法与 RGB↔X 等前作直接比较。「通用配方」的具体内容摘要没展开——微调哪些层、G-buffer 如何编码注入、训练数据从何而来(合成渲染数据的域间隙如何处理),这些恰恰是能否复现的关键。前向渲染方向还有个绕不开的问题:生成模型对 G-buffer 的响应是否单调可预期?如果微调 albedo 一个通道会引起画面其他部分的连带变化,那「精确控制」这个卖点就打折了,而摘要没有这类可控性验证。流式(streams)支持被反复提及但没有延迟数字,实时渲染场景下这是硬门槛。 8. InstructVVT:视频试衣扔掉mask和pose先验 InstructVVT: Instruction-Driven Video Virtual Try-On without Auxiliary Spatial Priors | 南京大学·中国移动九天 | arXiv:2608.14070 前序问题:视频虚拟试衣是个约束极强的编辑任务:既要精确替换目标人物的衣服,又要严格保住原视频的空间结构和时序动态。现有方法严重依赖手工的辅助空间先验(mask、pose 等)来实现编辑控制,可这些先验在无约束的真实视频里很容易失效——遮挡、快速运动、罕见姿态都会让 pose 估计或分割崩掉。更本质的问题是,这类先验把丰富的视觉上下文压缩成了不完整的结构信号,信息通道太窄。此外标准的重建目标也无法充分刻画试衣任务特有的人类偏好(衣服贴合是否自然、褶皱是否合理)。 本文贡献:提出 InstructVVT,基于 DiT 的指令驱动、参考引导的视频试衣框架,推理时完全不需要空间先验。核心是双层参考条件化:一方面由 MLLM(挂可训练 LoRA)经 Connector 推断语义编辑 token,用于目标消歧与结构保持——也就是搞清楚「要换谁的哪件衣服、哪些部分不能动」;另一方面用一条轻量条件化通路把参考服装的细粒度外观显式注入,与源视频 latent 一起拼成多模态 DiT 输入。训练分两阶段:Stage 1 监督微调,Stage 2 用 DiffusionNFT 做强化学习——策略 DiT 采样 K 个候选视频,由冻结的 MLLM 奖励模型打分,经 NFT 损失更新策略并以 EMA 回写,以此对齐标准重建目标无法刻画的试衣偏好(贴合是否自然、褶皱是否合理)。 Overview of our InstructVVT framework. In the supervised training, the source video, reference garment, and instruction are encoded by a frozen MLLM with trainable query tokens $Q_e$, LoRA adapters~lora, and an MLP connector to produce MLLM edit tokens $C_e$. We adopt two embedding layers with identical architecture but independent parameters to encode video cue tokens $X_t$ and reference garment tokens $C_g$, respectively. The MLLM edit tokens $C_e$, video cue tokens $X_t$ and reference garment tokens $C_g$ are injected into each DiT block through cross-attention. The post-training stage applies DiffusionNFT~diffusionnft: a frozen EMA policy samples $K$ videos, a tailored reward model based on MLLM assigns score-token rewards, and the NFT loss updates the trainable DiT. 实验效果:在无约束真实视频上不依赖推理期空间先验即可完成试衣编辑,同时保持源视频的空间结构与时序动态。定性对比覆盖 ViViD、CatV2TON、MagicTryOn、TripVVT、UniVideo 五个基线,在领口结构、腰带细节与裙摆轮廓的保真度上更接近目标服装。论文 23 页 10 图,Dingbao Shao 与 Song Wu 为共同一作,Zili Yi 为通讯作者。 Qualitative comparisons on ViViD-S. The examples show that InstructVVT transfers the reference garment while preserving the source video appearance and temporal structure, complementing the quantitative ViViD-S results in Table~tab:vivid_s. 批判点评:去掉推理期空间先验这个方向是对的,理由比「少一步预处理」更深:mask 和 pose 本质是把高维视觉信息压成低维结构信号的有损投影,在真实视频里既容易估错,又丢掉了大量对编辑有用的上下文。用 MLLM 推断语义编辑 token 做目标消歧,思路上与今天 BiVidGen 那篇同源——都是让 MLLM 承担「理解要改什么」的规划角色,而非只做特征编码器。第二阶段引入 DiffusionNFT 强化学习也踩在了实处:试衣好不好看是典型的「重建损失说不清、人一眼能判断」的任务,用 MLLM 当奖励模型去对齐这类偏好,比继续堆重建监督更对症,而且 NFT 这条路线比 DPO 类方法更适合扩散模型的训练形态。不过摘要通篇没有任何量化结果,没有 benchmark 名称、没有与 ViViD/TripVVT 等的对比数字,也没说清基座 DiT 是哪个、训练数据规模多大——对一篇 23 页的工作,摘要层面的信息密度偏低。「不需要推理期空间先验」这个措辞要留意「推理期」三个字:训练阶段是否仍用 mask/pose 做监督没有交代,若训练仍需要,省下的是部署成本而非数据成本。服装细节保真是视频试衣最难的部分,logo、纹理、褶皱在人物运动中的一致性只笼统说保持时序动态,缺少针对细粒度纹理漂移的量化证据。MLLM 既参与推理条件生成、又在训练时充当奖励模型,两处都是重计算,逐块处理长视频时开销会被放大,但没有效率数字。RL 阶段还有个隐忧:MLLM 奖励模型自身的偏好偏差会被策略学去,而摘要没有讨论奖励过优化(reward hacking)的防护。 9. Concept Guidance:跳过特定层就能连续调美感 Concept Guidance: Precise, Training-Free Latent Control for Text-to-Image Generation | GCPR 2026 Oral·慕尼黑大学 CompVis | arXiv:2608.14172 前序问题:文生图扩散模型有两个严重限制实用性的短板。一是标准模型缺少内在机制来做连续的、概念特定的引导——比如想精确控制「这张图有多好看」,你没有一个可以平滑调节的旋钮,只能改提示词然后重新抽卡。二是在需要高局部连贯性的任务上不可靠,典型就是生成文字和人手,这两样几乎是扩散模型的经典失败案例。现有的可控生成方案大多要额外训练、外部模型或梯度回传,成本高且不通用。 本文贡献:引入「概念级互信息」(concept-wise mutual information)这一新概念,并发现不同层之间存在很大的、依赖于概念的差异——这说明特定结构的生成是局部化在网络的不同部分的。基于这个洞察提出 Concept Guidance(CoG):先量化每一层对特定概念的影响,然后用「跳过概念相关层后生成的预测」的加权组合来引导去噪。整套方法开箱即用,不需要额外训练、外部模型、梯度或提示词工程。 Concept Guidance precisely approximates the target direction by combining per-layer skip predictions using concept-relevant layers ($\alpha,\beta,\gamma$). It computes individual skip-layer noise predictions ($\epsilon_{[\theta\setminus \alpha]}, \epsilon_{[\theta\setminus \beta]}, \epsilon_{[\theta\setminus \gamma]}$) and extrapolates over them to precisely estimate the target direction. 实验效果:在多种目标和主流模型上都取得性能提升,覆盖 PixArt-alpha、SD3、SD3.5 与 FLUX.1-dev。代码已开源。被 GCPR 2026 接收为 Oral 报告,论文 28 页含补充材料。 Uncurated Comparison of Classifier-Free Guidance (CFG) ho2022classifier_free_guidance, Naive Skip-Guidance as found in Stable Diffusion 3 huggingfaceSD3, Spatio-Temporal Skip Guidance hyung2025spatiotemporal and Concept Guidance for Aesthetics (FLUX.1-dev). 批判点评:「概念的生成是按层局部化的」这个发现本身就有独立价值,它给扩散模型的可解释性提供了一个可操作的抓手:不是笼统地说某些层管结构、某些层管风格,而是用概念级互信息把「哪一层对哪个概念负责」量化出来。基于此的 CoG 走了一条很轻的路——通过跳过概念相关层来构造对比预测,再加权组合去引导,完全不需要训练、外部模型或梯度,这在实践中意味着可以直接挂到任何现成模型上。在 PixArt-alpha、SD3、SD3.5、FLUX.1-dev 四个架构上都有效,说明层级概念局部化不是某个模型的偶然特性,这个跨架构验证做得比较扎实,Ommer 组(Stable Diffusion 原作团队)在这个方向的判断力也值得信任,GCPR Oral 加开源代码进一步加分。但方法本身的边界需要看清。「跳过层」是个粗粒度干预,一层往往同时参与多个概念的生成,跳过它拿到的对比信号必然混入了对其他概念的扰动——摘要提到美感和局部连贯性(文字、手)两类目标,但没说多个概念同时引导时会不会互相冲突,而实际使用中「既要好看又要手正确」才是常态。「性能提升」缺少具体数字和评测口径,美感这类主观目标尤其需要说明是用自动指标(如 aesthetic predictor)还是人工评测,两者结论经常不一致,而且用某个 aesthetic 模型打分再优化它容易陷入自我强化。跳过层还意味着每步要多跑若干次前向来构造对比预测,推理成本的增加倍数摘要没给,这对本来就慢的扩散采样是实际负担。每个概念都需要先做一轮层影响量化,这个前置校准的成本和是否需要按模型重做,也没交代。 10. CPI-Bench:首个纳入多图编辑的评测基准 CPI-Bench: A Comprehensive, Practical and Intelligent Benchmark for Real-World Image Editing | arXiv:2608.14546 前序问题:图像编辑模型进展飞快、应用铺得越来越广,把这些能力直接部署到真实场景的需求越来越急。但现有基准仍局限在简单的单图任务上,覆盖维度有限,而且区分不开不同模型的性能差异——大家分数都挤在一起,看不出谁真的更强。结果就是它们无法可靠评估模型在复杂多图编辑、高要求推理指令、以及实际部署设定下的表现,而这三项恰恰是真实业务里最常遇到的。 本文贡献:提出 CPI-Bench,面向真实世界图像编辑的综合、实用、智能基准,由三个核心子集构成。CPI-General-Bench 全面覆盖多样的编辑任务,并首次把多图编辑评估纳入进来;CPI-Practical-Bench 聚焦高频真实用户应用场景;CPI-Intelligent-Bench 专门评估高要求的推理型编辑能力。三个子集分别对应「覆盖广度」「实用贴近度」「推理深度」三个此前被忽略的维度。 The overview of CPI-Bench. CPI-Bench decomposed into three distinct dimensions: CPI-General-Bench for comprehensive editing performance, CPI-Practical-Bench for real-world deployment efficacy, and CPI-Intelligent-Bench for reasoning-based editing tasks. 实验效果:论文给出主流图像编辑模型在该基准上的评测结果,13 页基准报告。最有说服力的是与 Arena 人类偏好排名的一致性对比:CPI-Bench 的 Spearman 相关系数达 0.994、平均绝对误差 0.12,而 GEdit-Bench 仅 0.548(MAE 1.50)、ImgEdit-Bench 0.814(MAE 0.88)、REDEdit-Bench 0.976(MAE 0.25)。评测覆盖 GPT-Image-2、Seedream5 Pro、Nano Banana Pro、Qwen-Image 2.0 Pro、Seedream4.5、Qwen-Image-Edit-2511、FLUX.2-klein-9B/4B 等主流模型。 Left: Model ranking trends across benchmarks compared against the Arena Image Edit Leaderboard~lmarena2024leaderboard. CPI-Bench we proposed demonstrates the closest alignment with Arena. Right: Spearman correlation coefficients and Mean Absolute Error (MAE) with Arena rank. CPI-Bench outperforms other benchmarks, achieving the highest correlation and the lowest error margin. 批判点评:把多图编辑正式纳入基准是这篇最实在的贡献。真实用户的编辑需求里,「把这张图的人放到那张图的场景里」「参照这张图的风格改那张」这类跨图操作占比很高,而现有基准几乎全是单图进单图出,评测口径和真实用法之间存在结构性错位。三子集的切分逻辑也清楚——覆盖广度、实用场景、推理深度,分别对应三种不同的失败模式。更关键的是它给出了一个可验证的自证方式:用与 Arena 人类偏好排名的 Spearman 相关性来衡量基准自身的有效性。0.994 对 GEdit-Bench 的 0.548,这个差距说明现有部分基准的排序与人类判断几乎脱节,而「基准该不该被信任」本来就该用这种方式检验,这个方法论比基准本身更值得借鉴。不过要注意几个问题。与 Arena 对齐这件事是双刃剑——相关性做到 0.994 意味着它高度拟合了当前 Arena 的偏好分布,但 Arena 本身有其偏差(用户构成、提问分布、审美倾向),过度对齐等于把这些偏差一并继承,而且一个与现有人类榜单几乎重合的基准,额外信息量到底有多少是可以追问的。评测模型只有 8 个且集中在头部闭源与 FLUX 系列,样本量偏小时 Spearman 系数本身就不稳定,换一批模型是否还有 0.99 需要验证。评测指标的具体实现(用 VLM 打分还是人工标注、多图编辑正确性如何自动判定)摘要没交代,而这决定了基准能否被独立复现;13 页篇幅对一个三子集基准来说偏紧,样本规模、任务分布、标注一致性检验都未见披露。「Intelligent」子集尤其需要说明「高要求推理」的操作化定义,否则容易变成难题集合而非能力维度。机构信息缺失也值得留意,基准类工作的中立性与作者团队是否同时在造编辑模型有直接关系。作为今天唯一的评测工作,它排在末位,但指出的评测盲区和自证方法都有实际价值。 趋势观察 今天的加速不再是「砍步数」,而是重新决定每一步该看什么 — SCOPE、ForgeWM、Omni-LiveAvatar 是今天最值得对读的一组,三篇都在做加速,但切入的层次完全不同,合起来正好画出视频生成推理优化的三层地图。SCOPE 动的是注意力内部:它不改模型、不训练,只是质疑现有免训练稀疏注意力用「块级/簇级代理分数」筛 key 这件事——粗粒度代理会把 key 之间的细微差异抹平,高贡献的 key 在激进稀疏下就被漏掉了。它的做法是把过了 RoPE 的 key 按时间、高、宽三个子空间分别聚类,再用查找表聚合质心分数,让代理分数细到单个 key;同时把 Top-k 的下限从「全局固定值」改成「每个头在线估计」,因为不同注意力头的稀疏容忍度本来就不一样,共享一个值必然有头被切狠了。ForgeWM 动的是采样步数,把双向生成器蒸成 1/2/4 步的学生。Omni-LiveAvatar 动的是生成范式,把双向扩散整体换成自回归流式。三者的加速倍率也恰好逐层放大:SCOPE 端到端 1.99 倍,ForgeWM 压到 1 步,Omni-LiveAvatar 相对教师 LTX-2 拿到 33 倍。这说明一件事——单靠某一层的优化很快会触顶,真正的量级提升来自换范式,但换范式的代价是要重训,而 SCOPE 这类免训练方法的价值恰恰在于它能直接叠加到任何已有模型上。值得注意的是三篇的适用边界完全不重叠,理论上可以叠乘,但没有任何一篇验证了叠加后的保真度损失是否线性累积,这大概是这个方向下一步最该做的实验。 MLLM 在生成管线里的角色正在从「编码器」升级为「规划器」 — BiVidGen 与 InstructVVT 从两个尺度上指向同一个转变。过去把 MLLM 接进扩散模型,绝大多数做法是拿它当一个更聪明的文本编码器——冻住权重,取最后一层特征喂给 DiT,MLLM 的自回归生成能力完全没被用到。BiVidGen 系统地拆了三个问题:中间表示该是什么、MLLM 怎么产出它、DiT 怎么吸收它,结论是离散语义视觉 token(EMA tokenizer 产出)作为接口最稳定,自回归因果建模是生成这些 token 的有效方式,而显式的视觉 token 条件化比改写提示词或隐空间桥接都更有效。这三条结论合起来等于说:MLLM 应该真的去「生成」一个视觉计划,而不是被动地提供特征。InstructVVT 在视频试衣这个具体任务上做了同样的事——它砍掉了对 mask、pose 这类手工空间先验的依赖,改由 MLLM 推断语义编辑 token 来做目标消歧和结构保持。这个转变的意义在于,手工先验在真实无约束视频里本来就容易失效,而且把丰富的视觉上下文压成了不完整的结构信号;让 MLLM 直接理解「要改什么」,信息通道宽得多。不过要注意,两篇都还没回答一个关键问题:MLLM 规划出错时,DiT 有没有能力纠正,还是会把错误的语义计划忠实地渲染出来。这个失败模式的分析在两篇里都缺失。 监督信号在变便宜:从「配对目标」退到「参考图 + 注意力对齐」 — CRAFT 这篇的数字值得单独拎出来看:主体个性化的主流做法要 15 万到 200 万组「参考图-合成目标」配对数据,而每一组目标都得靠 LLM 生提示词、T2I 合成、主体抠取、VLM 质检、对应关系标注这条多阶段流水线造出来,成本高,而且方法会被死死绑在某一个目标合成器和某一套数据清洗策略上。CRAFT 只用 1 万张参考图加主体 mask,完全不要合成目标,就在 XVerseBench 上做到了 SOTA。它的思路是把监督从像素空间挪到注意力空间——用注意力级奖励把噪声 token 和短语 token 的注意力对准正确的参考主体,再用得到的逐主体注意力 mask 去门控像素级身份奖励。往大了看,这跟 Concept Guidance 是同一个方向的两种表达:CoG 发现不同层对不同概念的贡献差异很大,于是通过跳过概念相关层来做引导,同样不需要额外训练、外部模型或梯度。两篇合起来提示一个判断——扩散模型内部其实已经有相当结构化的、按概念/主体组织的表示,过去我们花大钱造配对数据,某种程度上是在用外部监督重新教模型一些它内部已经编码好的东西。如果这个判断成立,个性化和可控生成的数据成本还有明显的下降空间。 人工智能炼丹君 整理 | 2026-08-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-14|阿里14B数字人实时跑三分钟LiveAnimate 今日 AIGC 论文速览 今日共 10 篇 · 实时流式数字人与人体动画 3 篇 · 统一音频场景生成与语音合成 2 篇 · 视频扩散推理加速 2 篇 · 可编辑 3D 世界状态与预演 1 篇 · 生成模型安全与概念擦除 1 篇 · 统一多模态模型评测 1 篇 重点论文标题列表 LiveAnimate(港中文·阿里Qwen·Liblib AI):14B 数字人首次实时流式跑三分钟 Avatar-Forever(港理工·字节跳动·AMD):22B 数字人单卡 27.2 FPS 无限时长 ⚡ MiDashengLM-Gen(小米 MiLM Plus·上海交大 X-LANCE):统一音频生成把语音错词率砍到 2.79% LoSA(悉尼大学·CSIRO):锁死 99% 注意力质量换 3.2 倍加速 UniSwap(港中文·阿里Qwen):单模型同时换脸换声还能流式 今日论文速览 1. LiveAnimate:14B 数字人首次实时流式跑三分钟 LiveAnimate: Stable Long-Form Streaming Human Animation in Real-Time | 港中文·阿里Qwen·Liblib AI | arXiv:2608.11745 ⚠️ 前序问题:姿态驱动的人体动画要从一张参考图加一路驱动姿态流合成目标人物视频,直播、远程呈现、虚拟主播这类交互场景天然要求实时出画。但扩散类系统生成一个片段动辄几分钟到几小时,响应式交互根本无从谈起。更麻烦的是长时段:即便勉强加速,流式生成一路推下去,外观和身份会随时间漂移,KV 缓存也会随时长无限膨胀,导致延迟越跑越高。 本文贡献:提出 LiveAnimate,作者称是首个在十亿参数量级上同时做到实时流式与稳定长时生成的动画系统,底座是 14B 参数的视频扩散 Transformer。两阶段训练先用 Reference-Anchored Teacher-Forcing Adaptation 把预训练的双向 DiT 改造成块因果自回归生成器,再用 Block-wise Self-Forcing Distillation 把采样预算压到 3 步。关键设计是 Pose-Retrieval Sink Attention(PR-Sink)——一个有界 KV 缓存机制:Static Sink 永久锚定首个生成块,Dynamic Sink 保留一个按姿态检索出的历史块,外加三槽滚动窗口。姿态复现时 PR-Sink 直接取回相关外观上下文,无需保留整条序列,因此显存与单块延迟不随流长增长。工程侧再叠 Ulysses 序列并行与算子融合。 Overview of ours. Given a reference image and streaming pose signals, our system generates video blocks autoregressively. Each block undergoes 3-step denoising followed by a clean KV update. PR-Sink augments a three-block rolling window with the first generated block and a pose-matched historical block selected from a compact memory bank. Ulysses sequence parallelism distributes attention computation across GPUs. 实验效果:在两张 NVIDIA H100 上达到 19.63 FPS 流式推理。在三分钟基准上,从最初 30 秒到最后一分钟,感知质量与身份一致性几乎保持恒定,而此前系统在同样的 rollout 长度上要么显著退化,要么需要数小时离线计算。 Quality and identity over a three-minute rollout. Metrics are computed on a 0--10,s prefix, the 0--30,s initial window, and three subsequent temporal segments. The full model is highlighted in red. Flat trajectories indicate resistance to accumulated degradation. Higher is better for ASE, IQA, and DINO-S; lower is better for FID and V-MAE. 批判点评:这篇的价值不在某个单点数字,而在它把「实时」「长时」「大模型」这三个此前互相拆台的约束第一次同时满足了。以往路线要么把模型缩到 1B 级换实时、要么牺牲长时稳定性,LiveAnimate 直接在 14B 上硬啃,靠的是把长时漂移问题重新定义为缓存管理问题——PR-Sink 的姿态检索思路很聪明:人体动画的驱动信号本身是周期性、可索引的,姿态复现时把对应的历史外观取回来,比无脑保留全序列或粗暴丢弃都更划算,而且天然给出了「显存恒定」这个硬保证。这也是它敢报三分钟基准的底气。但必须把期待校准:19.63 FPS 是两张 H100 的成绩,单卡折半后离消费级部署仍隔着代际,成本上更接近云服务而非端侧;3 步蒸馏在人体动画这种强条件任务上损失可控,不代表能平移到弱条件的开放域生成。三分钟也还不是「长时」的终点,直播场景动辄数小时,Static Sink 永久锚首块的设计在超长 rollout 下是否会因首帧与当下姿态相关性衰减而变成噪声源,论文没给出压力测试。另外姿态检索依赖驱动信号的可复现性,遇到几乎不重复的自由舞蹈或大幅视角变化,Dynamic Sink 可能长期取不到有用的历史块,退化为纯滚动窗口。它是一个扎实的工程胜利,但把它读成「数字人已经解决」会误判。 2. Avatar-Forever:22B 数字人单卡 27.2 FPS 无限时长 Avatar-Forever: Decoupled Parallel Training for High-Quality Real-Time Infinite Avatars | 港理工·字节跳动·AMD | arXiv:2608.12107 ⚠️ 前序问题:现有流式视频系统普遍依赖以蒸馏为核心的串行训练管线来实现少步长视频生成,这个范式有两处硬伤。第一,前面阶段引入的失败或分布偏移会污染后续优化,让整个训练很难收敛;第二,蒸馏式目标天生偏向短程生成,一旦自回归误差在长 rollout 上累积,质量会明显退化。换句话说,「生成效率」和「长时鲁棒性」被强行塞进同一条串行流水线里,两个目标互相打架。 本文贡献:提出 Avatar-Forever,把上述两种能力当成两个独立能力并行训练,而不是串行耦合。一个分支做全参数蒸馏,训出一个视觉质量高的高效生成器;另一个分支通过 Recovery-oriented Rollout Training(RRT)训练一个轻量长程适配器,专门提升长时推理条件下的生成鲁棒性。解耦并行的设计简化了整体训练流程,也避免了少步生成与长程适配之间不必要的目标冲突。推理侧再引入 ForeverCache——一种分块特征缓存机制,大幅削减流式推理中对历史的冗余重算。整套方案构建在 22B 视频基础模型之上。 Overview of Avatar-Forever. Top: Existing streaming avatar systems employ sequential distillation pipelines, leading to stage-wise dependence and objective interference. Bottom: Avatar-Forever learns few-step efficiency and long-horizon robustness in parallel. A lightweight adapter is trained under accumulated rollout errors, and it is merged with the distilled generator in inference. In addition, ForeverCache is proposed to reuse historical features for efficient streaming inference. 实验效果:支持无界的音频驱动数字人生成,同时保持身份一致性、动作连贯性与视觉保真度;在单张 H100 上实现 768×512 高分辨率视频端到端 27.2 FPS 吞吐。 Visual results of extended-duration generation. We uniformly sample frames from a continuous video generated for more than 11 minutes. Avatar-Forever maintains stable identity, facial structure, and scene content while producing natural expressions, coherent head and body motion, and accurate audio--visual synchronization throughout the extended autoregressive rollout. The bottom row shows the corresponding driving-audio waveform. 批判点评:和 LiveAnimate 同天出现、目标高度重叠,但方法论切入点完全不同,两篇并读信息量最大。LiveAnimate 是在推理侧动手术(PR-Sink 管缓存),Avatar-Forever 是在训练侧动手术——它指出的「串行蒸馏管线中前序阶段污染后序优化」是个被长期容忍的隐性成本,把少步高效与长程鲁棒拆成两条并行分支各自优化、最后组合,是很清晰的解耦思路,也顺带解决了「蒸馏目标偏爱短程」这个结构性偏见。RRT 显式面向恢复能力训练,比单纯加长训练序列更对症。数字上它比 LiveAnimate 更漂亮:22B 更大的底座、单卡 27.2 FPS、且声称无界时长。但正因为漂亮,几处要打问号:分辨率是 768×512,低于 LiveAnimate 的对照设定,FPS 之间不能直接横比;「无限时长(infinite)」是个很强的措辞,摘要只给了机制性论证(ForeverCache 削冗余 + 长程适配器)而没有报出具体跑了多久的实测曲线,而长 rollout 的退化通常是缓慢累积而非突然崩溃,缺时长轴上的量化曲线就难以证伪。解耦并行还带来一个未被讨论的问题:两个分支各自最优,组合后是否仍最优?论文把「避免目标冲突」当成优点,但也意味着两者之间的协同信号被切断了,轻量适配器能否完全兜住全参数蒸馏生成器在长程上的所有失效模式,缺少消融就只能存疑。它是很有说服力的工程范式提案,但「无限」二字值得读者自己打个折。 3. MiDashengLM-Gen:统一音频生成把语音错词率砍到 2.79% MiDashengLM-Gen: Unified Audio Scene Generation via LLM-Driven Autoregressive Flow Matching | 小米 MiLM Plus·上海交大 X-LANCE | arXiv:2608.11804 ⚠️ 前序问题:要生成同时混合语音、音乐与音效的连贯音频场景一直很难。现有做法普遍是拼装式管线:一个冻结、解耦的文本编码器喂给一个独立的音频解码器。这种结构限制了跨模态联合优化,最直接的代价是语音清晰度很差——统一模型能生成「听起来像有人说话」的音频,但说的词经常是糊的,这让它们在需要真正传达内容的场景里没法用。 本文贡献:提出 MiDashengLM-Gen,一个端到端框架,把预训练大语言模型与逐 token 的条件流匹配(per-token conditional flow matching)耦合起来,做自回归、变长的混合音频场景生成。作者称这是首个用单一端到端训练模型完成通用文本到音频生成的方案——不再是「冻结编码器 + 独立解码器」的拼装,而是让 LLM 的语义能力与流匹配的声学生成能力在同一次训练中联合优化。框架也自然扩展到多语言设定。代码与检查点均已开源。 实验效果:在 Seed-TTS 基准上,英文词错误率(WER)从 12.15% 降到 2.79%,逼近专用 TTS 系统的 1.24%;多语言 WER 相比现有基线也很有竞争力;同时在 MECAT 基准上保持了有竞争力的混合音频生成质量。 Training loss and STFT L2 distance curves for different DiT width/depth configurations. Topline denotes DashengTokenizer encode-to-decode reconstruction. 批判点评:这篇最值得看的是它把「统一模型的语音清晰度」这个长期被含糊掉的短板量化成了一个能被追打的数字。此前统一音频生成的评测常聚焦整体音频质量或文本一致性,语音是否真的能听清则被稀释在综合分里——12.15% 的 WER 意味着每八个词就错一个,这个水平在演示视频里听起来可能还行,实际上完全无法承载信息。降到 2.79% 是 4.4 倍的收敛,把统一模型从「不可用」拉进「可用」的门槛内,而且没有牺牲混合音频质量,说明端到端联合训练确实解决了拼装管线里跨模态优化被切断的根因。开源也让结论可验证。但离终点仍有距离:2.79% 对 1.24% 是 2.25 倍的差距,专用 TTS 依然明显更清晰,「逼近」的措辞略微乐观;在有背景音乐和音效叠加的真实混合场景下,WER 是否还能守住 2.79%,摘要没有拆分报告——而这恰恰是统一模型相对专用 TTS 唯一的存在理由,也是最该给出的数字。MECAT 上「有竞争力」是个偏保守的表述,暗示混合音频质量可能并未超越专门的音频生成模型,那么这套统一方案的定位就更像「一个模型够用」而非「一个模型更好」。逐 token 流匹配的推理开销也未见报告,自回归叠流匹配在长音频上的延迟表现是落地的关键变量。方向正确、增益扎实,但别把它当成统一音频生成已经追平专用系统。 4. LoSA:锁死 99% 注意力质量换 3.2 倍加速 LoSA: Near-Lossless Sparse Attention for Training-Free Video Diffusion Acceleration | 悉尼大学·CSIRO | arXiv:2608.12032 ⚠️ 前序问题:视频扩散 Transformer 采样成本极高:每个去噪步都要在很长的 3D token 序列上做自注意力,这是二次复杂度,分辨率和时长一涨就成为绝对瓶颈。稀疏注意力能在不重训的前提下削减这笔开销,但现有方法普遍追求激进稀疏度——越往后每多榨一点加速,付出的注意力保真度代价越不成比例,质量塌得比速度涨得快。 本文贡献:LoSA 反向切入这条权衡曲线:先用构造方式把保真度锁死在近无损,再在这个约束允许的范围内尽可能多地砍计算。两个观察让这个区间变得可行——大约 40% 的块交互可以被移除而仍保留 99% 的注意力质量(attention mass),且高质量支撑集在各去噪步之间是稳定的。于是 LoSA 固定的是「保留质量阈值 99%」而不是稀疏率:在某个早期稠密步测出精确的块注意力质量,为每个 head 和 query 块保留满足该阈值的最小 key/value 块集合,然后把冻结的块索引复用到其余所有步。整套方法无需训练。 Overview of . Left: video diffusion attention contains a low-mass tail, allowing approximately $40\%$ of the block area to be removed while retaining approximately $99\%$ of the attention mass. Right: after a dense warm-up, measures exact block masses at $t_0$ and constructs the mask $\Omega$ by retaining, for each layer, head, and query block, the smallest prefix whose cumulative mass reaches $\theta$. The same frozen mask is reused at all remaining steps, while Q/K/V and attention weights are recomputed from the current hidden states. Bottom: with optional feature caching, the cache selects which steps are computed, while accelerates self-attention within every computed step. 实验效果:在 Wan2.1-1.3B 上,仅 LoSA 单独使用即带来 1.36 倍加速,VBench Overall 仅降 0.06 分。组合收益最大:与特征缓存叠加后,在 HunyuanVideo 上达到 3.2 倍加速、质量仅降 0.02 分,而同等速度下最强稀疏基线要降 0.32 分(差距 16 倍)。在三个视频扩散 Transformer 与最高 3.2 倍加速的范围内,LoSA 始终给出最好的无训练速度-质量权衡。 Speed--quality trade-off on Wan2.1-1.3B. Each point reports VBench Overall versus end-to-end speedup. and its cached variants form the entire Pareto frontier: every baseline configuration is matched or dominated by a configuration, showing that near-lossless sparse attention preserves quality better than aggressive sparsity or cache-only acceleration. 批判点评:这篇的贡献是把加速方法的接口从「设一个稀疏率」换成「设一个质量阈值」,这个换位比它的加速倍数更有价值。稀疏率是手段侧参数,用户真正关心的是质量损失上界;以往调稀疏率本质是盲调——不同模型、不同分辨率下同一个稀疏率对应的质量损失完全不同,只能试。LoSA 直接把用户可控量改成「保留 99% 注意力质量」,让加速变成有保证的操作,这是工程可用性上的实质进步。两个观察也很干净:40% 块交互可删且高质量支撑跨步稳定,后者尤其重要——正因为稳定,才能只在一个早期步测量、后续全部复用,把测量开销摊薄到近乎为零。3.2 倍下 0.02 对 0.32 分的差距(16 倍)比任何单点加速数字都更能说明方法优越。但要看清它的适用边界:注意力质量守恒并不等于生成质量守恒,99% 的 mass 保留是个代理指标,VBench 分数掉得少也只说明主流评测捕捉不到差异,细粒度的运动连贯与细节纹理是否有肉眼可辨的损失需要看实际样本。「索引冻结」这个核心简化建立在支撑集跨步稳定的经验观察上,一旦遇到运动剧烈、场景切换的内容,早期步测出的支撑集对后期步的代表性会下降,论文没报按内容类型拆分的结果。另外 1.36 倍的单独加速其实不算高,3.2 倍是叠加特征缓存后的复合结果,意味着大部分加速红利来自另一个正交方法,LoSA 更准确的定位是「一个不拖后腿、可安全叠加的稀疏化组件」,而非独立的加速引擎。 5. UniSwap:单模型同时换脸换声还能流式 UniSwap: Streaming Audio-Visual Identity Swapping for Talking Videos | 港中文·阿里Qwen | arXiv:2608.11752 ⚠️ 前序问题:说话视频的角色替换要求同时迁移外观与声音,还得保住源视频的动作、场景、语言内容和音视频时序对齐。现有方法用两个分别优化的模型处理视觉和音频,音视频一致性很难强制约束——脸换了、声音换了,但两者的匹配关系和口型同步会松掉。更现实的障碍是数据:跨身份的对齐训练对本身极其稀缺,没有成对样本就没法直接监督。 本文贡献:提出 UniSwap,作者称是首个做流式联合音视频身份替换的框架。给定源视频、参考图像和一段参考语音,UniSwap 在单个音视频扩散 Transformer 内同时迁移参考外观与音色,同时保住源内容与动态。为解决对齐数据稀缺,设计 swap-and-reconstruct 管线:从真实片段中剥离视觉与声音身份,再用原片段作为重建目标。从双向骨干出发逐步适配——In-context Pretraining 学联合替换,Conditional Streaming Adaptation 转为块因果 KV 缓存生成,Efficient Self-forcing DMD 缓解暴露偏差并把每块采样从 30 步压到 3 步。Efficient Multi-LoRA Switching 让 DMD 的三个角色共享同一个冻结骨干;Feature-RoPE Decomposition 把缓存位置保持在训练范围内,支撑稳定长时推理。 Overview of UniSwap. The three-stage pipeline comprises (a) In-Context Pretraining for joint audio-video replacement, (b) Conditional Streaming Adaptation with block-causal masking and KV-cached inference, and (c) Efficient Self-Forcing DMD, which reduces denoising to 3 steps per block. Feature-RoPE Decomposition bounds cached positions while preserving cross-modal physical-time alignment. 实验效果:实验显示强音视频同步性、有竞争力的身份保持、高效流式与稳定长时生成;单张 H100 上块式自回归 3 步采样达到 13.6 FPS,支持小时级长时生成。 Qualitative comparison on the long-video benchmark. Frames are sampled every 10 seconds from 1-minute generations. The baselines exhibit identity drift and visual artifacts as generation progresses (highlighted in red), while UniSwap preserves the reference identity throughout the full duration. Zoom in for details. 批判点评:把换脸和换声塞进同一个扩散 Transformer,最直接的收益是音视频一致性从「事后对齐」变成「联合建模的内生属性」,这在口型同步上是结构性优势——两个独立模型无论怎么后处理,都难保证音色变化和面部动态的耦合关系正确。swap-and-reconstruct 的自监督构造也很实用,把「没有跨身份成对数据」这个死结转化为可重建的代理任务。Multi-LoRA 共享冻结骨干让三个 DMD 角色不必各存一份权重,是很务实的显存优化。但这篇要额外提一句风险:联合音视频身份替换在能力上等价于「更难被察觉的深度伪造」——单独换脸或单独换声都留有模态间不一致的破绪,而联合替换恰恰把这个最有效的检测线索抹掉了。摘要通篇未提任何水印、溯源或滥用防护机制,这在同一天还有 PEAK(概念擦除)和 SafeCA(T2V 越狱防御)在做安全侧工作的语境下,对比格外刺眼。技术层面也有保留:身份保持只说「有竞争力」,是个偏弱的措辞,暗示相比专用换脸模型可能并不占优,联合建模换来的一致性可能以单模态精度为代价;13.6 FPS 低于同天 LiveAnimate 的 19.63(两卡)和 Avatar-Forever 的 27.2(单卡),联合音视频的算力代价是实打实的;「小时级」的稳定性同样缺少时长轴上的量化曲线。方法扎实,但这是一篇技术评价和伦理评价必须分开打分的论文。 6. Luna-TTS:扩散语言模型 TTS 首块延迟 41.6 毫秒 Luna-TTS Family Technical Report | VUI Labs·上海交大 | arXiv:2608.11593 ⚠️ 前序问题:现代 TTS 被自回归编解码语言模型主导,但左到右解码带来三重结构性代价:延迟随语句长度增长、错误沿已提交前缀累积、以及在残差矢量量化(RVQ)的 token 网格上强加了一个人为的生成顺序——RVQ 网格本身并不存在这样的顺序。这三点在需要低延迟、长语句、高稳定性的场景里都是硬伤。 本文贡献:提出 Luna-TTS Family,基于扩散语言模型的 TTS 系统,在中英日韩四语种、100 万小时语音上预训练。整个家族由一个预训练自回归文本 LLM 渐进适配而来:从因果注意力到双向、最终到块因果,两个变体共享同一套 tokenizer、数据管线与 0.6B 骨干血统。Luna-TTS 完全非自回归,用固定步数的并行细化生成整个 RVQ token 网格,零样本音色克隆与语音编辑天然表现为 infilling 任务;Luna-TTS Realtime 由继续训练得到,在 32 个编解码帧(1.28 秒)的块上自回归、块内并行去噪,支持 KV 缓存的块式生成与增量音频交付。退火微调阶段加入对情绪与非言语声(NVV)的显式控制,强化学习阶段用 GRPO、策略比在实际去噪轨迹上计算。 实验效果:Realtime 变体端到端 RTF 0.0240、本地首块延迟 41.6 毫秒(预热服务协议下)。Seed-TTS-Eval 上在对比的开源与商业系统中四项指标全部最优:test-zh 达 0.73 CER / 79.7 SIM,test-en 达 1.49 WER / 76.8 SIM;更难的野外 CV3-Eval 上中英错误率均为对比中最低。对比领先商业系统,在 NVV 与情绪控制的多数客观、模型评分与人工评分指标上取得最好结果。 批判点评:这篇的路线选择值得单独拎出来看。当前 TTS 的主流叙事是「自回归 LLM + 编解码 token」,Luna 反过来论证这条路存在结构性错配:RVQ 的 token 网格是二维的(时间 × 码本层),左到右强加一维顺序纯属人为,而扩散语言模型的并行细化天然匹配这种结构。这个论点不只是效率优化,而是对生成顺序这一建模假设的直接质疑——首块延迟 41.6 毫秒、RTF 0.0240 的数字则是对该论点的支撑证据。更聪明的是它不从零训练,而是把预训练的自回归文本 LLM 渐进适配(因果→双向→块因果),复用了文本 LLM 的语义能力,这也解释了 0.6B 这么小的骨干能打赢商业系统。NAR 与 Realtime 两个变体共享血统、覆盖离线高质量与流式低延迟两种场景,产品化考量很完整。需要保留的地方:41.6 毫秒明确标注在「预热服务协议」下测得,真实服务的冷启动、并发排队与网络往返都不在这个数字里,别直接当端到端体验延迟读;Seed-TTS-Eval 上四项全优的对照集是「我们对比的系统」,商业系统版本迭代很快,这类横评的时效性通常只有几个月;机构标注为 VUI Labs Research,是相对新的团队,1 万小时级以上的数据来源与许可情况未在摘要说明,这在 100 万小时规模下是个不可忽略的合规问题。技术报告体裁也意味着消融相对薄——渐进适配的三个阶段各自贡献多少、GRPO 那一步的实际增益有多大,都需要正文细读才能判断。 7. GeoFlow:别再从纯高斯噪声重画已知场景 GeoFlow: Efficient Driving Video Generation via Geometry-Aligned Priors | 北航 (ECCV 2026) | arXiv:2608.12203 ⚠️ 前序问题:扩散模型与流匹配能合成高保真驾驶视频,但受制于大量采样步带来的高推理延迟。作者把低效归因到一个被普遍默认的选择:标准高斯源分布——连续帧各自初始化为独立的高斯噪声。这忽略了驾驶视频里极强的时空相关性,逼着模型把上一帧里已经确定的场景结构从噪声里重新生成一遍,既算得冗余,又容易产生几何不一致。 本文贡献:提出 GeoFlow,用显式几何先验实现高效驾驶视频生成。不再从标准高斯噪声采样,而是利用多视图几何与空间自适应的噪声注入,构造一个 Geometry-Aligned Prior(GAP)分布作为起点。这个初始化拉近了源分布与数据分布的距离,从而得到明显更直、更短的采样轨迹——流匹配的核心成本正来自轨迹的曲折程度,把起点挪近就等于直接砍掉了大部分传输代价。 Schematic of the proposed GeoFlow framework. % Instead of initializing from an uninformative noise, % Our method leverages multi-view geometry to bridge the gap between the source and target manifolds. % The pipeline projects visual features into a latent point cloud, which is rendered to the target view to form a geometric prior. To bridge the gap between the source and target manifolds, we leverage multi-view geometry to construct a Geometry-Aligned Prior Distribution, where an Spatially-Adaptive Noise Injection strategy is introduced to reduce error accumulation due to depth and rendering artifacts. Bottom Panel: As visualized in the sampling trajectory comparison, our initialization significantly shortens and straighten the flow, % yielding a nearly straight generation path (green) compared to the highly curved trajectory of the standard Gaussian baseline (red), thereby enabling high-fidelity synthesis within several inference steps. 实验效果:训练与推理效率均显著提升:在基线模型上仅需数小时微调即可明显提升少步生成质量;完全收敛训练后,大幅削减了达到当前最优视频生成质量所需的推理步数。ECCV 2026 接收。 Ablation of Noise Injection. 批判点评:这篇的洞察很干净,也很容易被低估:整个扩散/流匹配社区把「从标准高斯出发」当成了公理,但对结构高度冗余的视频而言,这个起点其实是在浪费——上一帧已经确定的道路、建筑、车道线,凭什么要从纯噪声里重新长一遍?GeoFlow 把加速的着力点从「怎么走得快」(蒸馏、缓存、稀疏化)挪到了「从哪儿出发」,这是与主流加速路线正交的维度,理论上可以叠加。用多视图几何构造先验也很合理:驾驶场景的相机内外参和多视图关系是已知的,这些确定性信息本该被直接利用而不是让网络去猜。「仅需数小时微调」意味着它可以作为补丁挂到现有基线上,落地摩擦很小。但适用面要看清楚:这套方法吃的是驾驶场景「几何强先验 + 时空强冗余」的红利,多视图标定、连续帧结构高度重叠都是自动驾驶数据的特殊性质,换到开放域视频(镜头切换、剧烈运动、无标定)里,GAP 能否构造得出来是个大问号,所以别把它读成通用视频加速方案。效果描述也偏定性——「大幅削减推理步数」「显著提升」都没给出具体倍数或 FVD 数字,摘要层面无法判断它相比同类少步方法的量化位置。另有一个方法内在张力值得注意:先验越强,采样轨迹越短越直,但生成多样性也越受约束;驾驶视频生成常被用于仿真罕见场景(corner case),如果先验把输出往「几何上像前一帧」的方向拽得太紧,恰恰会削弱它在最有价值场景上的表达能力,这个权衡摘要没有讨论。 8. StateFlow:给视频创作补一个持久 3D 状态层 StateFlow: Building, Evolving, and Accessing 3D World States for Previsualization | 北京交大·北大·BAAI·Mootion AI | arXiv:2608.12314 ⚠️ 前序问题:预演(previsualization)是影视、游戏、建筑与城市设计中连接想法与制作的中间层,创作者要在这一层反复打磨场景、动作、镜头与时空动态。但现有生成方法靠简单提示词、用一次性图像或视频合成去联合控制所有这些因素,可控性很弱,也几乎不支持迭代编辑——改一处就得整体重生成,上一版的结果全丢。作者点出问题的根子:一个世界由多个带几何、外观和其他属性的元素加上相机组成,不同帧其实是这份共享状态的局部修改或重组,绝大部分内容是被复用的。缺失的组件是一个显式且持久的工作状态。 本文贡献:提出 StateFlow,以状态为中心的生成式预演框架。不做一次性视频生成,而是用一个可编辑的 3D 世界来组织场景结构、演化与相机,需要更高保真时再让现成视频模型来增强画质。这个世界被维护为场景元素与相机配置的持久结构化 3D 状态,作为预演的核心工作表示。三个阶段:State construction 通过先验引导、冲突感知的双视图初始化,把生成的 2D 内容抬升为连贯 3D 世界;State evolution 把用户意图翻译成结构化的状态转移并保留世界记忆,避免每次编辑都全场景重生成;State access 用渲染反馈反思机制把相机方案细化为视觉上可行的轨迹,而不是只依赖 VLM 的语义判断。 Qualitative comparison on Scene Generation 实验效果:实验显示 StateFlow 能为视频创作与类游戏原型制作产出高质量 3D 世界。 Qualitative comparison on previsualization applications. Case~1 and Case~3 showcase video creation, while Case~2 shows 3D game prototyping. Video-generation baselines consistently suffer from spatial--temporal inconsistency, identity drifting, and restricted camera motion, whereas StateFlow operates on a persistent and interactive 3D world, yielding precise, highly controllable, and geometry--appearance-consistent results. 批判点评:这篇提的问题比它给的方案更重要。当前视频生成的交互范式基本是「抽奖」——改一个词,整段重出,上一版的所有满意之处一并丢失,这在需要迭代收敛的专业创作流程里是致命的。StateFlow 把矛头指向缺少持久状态,这个诊断很准:把「视频」当作输出、把「3D 世界状态」当作可编辑的真源,编辑就从重新生成变成状态转移,世界记忆得以保留,这才是专业工具该有的形态。三阶段拆分也各有对症之处,尤其 State access 用渲染反馈来验证相机轨迹的物理可行性、不轻信 VLM 的语义判断,是个务实的清醒设计——VLM 说「镜头从这里推过去很好」和这条轨迹真的不穿墙是两件事。但这篇的实验部分是明显短板:摘要只给了「能产出高质量 3D 世界」这种定性结论,没有任何量化指标、没有与一次性视频生成基线的可控性对比、也没有用户研究,而「可控性」和「迭代效率」恰恰是它的核心主张,最该被量化。方案本身也把难题转移而非消除了:把 2D 内容抬升为连贯 3D 世界(单视图/双视图 3D 重建)本身就是未解问题,「冲突感知的双视图初始化」听起来是在缓解不一致而非解决它,一旦初始状态几何有误,后续所有编辑都建在歪地基上。它还依赖现成视频模型做画质增强,那么最终输出的一致性又部分回到了那个不可控的黑箱里。作为范式提案很有启发,作为可用工具还需要更硬的证据。 9. PEAK:擦概念把攻击成功率从96.5%压到5.6% PEAK: Precise and Persistent Concept Erasure via k-Sparse Autoencoders | 合肥工大·中科大·澳门大学 | arXiv:2608.10985 ⚠️ 前序问题:从大规模文生图扩散模型中擦除概念因版权侵权、隐私侵犯与不良内容的顾虑而愈发关键,但现有方法很难同时做到精确与持久:概念相关表征定位不准会造成意外的语义干扰(擦掉一个概念顺带损伤无关生成能力),而底层概念知识删除不彻底又让对抗性恢复成为可能——攻击者用精心构造的提示词就能把「已擦除」的概念重新召回。 本文贡献:提出 PEAK,通过 k-稀疏自编码器(kSAE)实现精确且持久的概念擦除。先在扩散去噪网络的内部激活上训练一个 kSAE,把稠密表征分解为可解释的稀疏特征;再对比目标提示与非目标提示诱发的稀疏激活,按激活强度与激活频率两个维度识别出一小组目标特有特征。随后用这些定位到的特征做参数优化,选择性抑制目标相关激活,同时相对原模型保留互补的非目标激活。这种特征引导的优化把概念擦除直接嵌入扩散参数,因而不需要任何推理时干预,也让擦除对对抗攻击具备有效的持久性。代码与模型已开源。 The main pipeline of the proposed PEAK. (a) A frozen kSAE encodes diffusion-model activations induced by matched target and non-target prompts, and target-specific features are selected by contrasting their activation scores. (b) The selected target features are suppressed during fine-tuning, and the other features are aligned with those of the original model. 实验效果:在 I2P 基准上,PEAK 把 NudeNet 检测数从 582 降到 6,平均攻击成功率(ASR)从 96.52% 降到 5.63%,同时在 MS-COCO 上以近零的 KID 保持了通用生成质量。 Qualitative evaluation of PEAK across different diffusion architectures. PEAK consistently erases target concepts while preserving non-target semantics in both SDXL and FLUX models. 批判点评:这篇把可解释性研究的工具真正用出了实效,路径值得注意:kSAE 本是机制可解释性领域用来把稠密激活拆成人类可读稀疏特征的手段,PEAK 把它当作「定位手术刀」——先分解再靠激活强度和频率双重筛选出目标特有特征,比在稠密表征上直接调参精确得多,这也直接对应上了「精确」与「持久」两个诉求:定位准则不伤及无辜(COCO 近零 KID 佐证),删得彻底则抗对抗恢复(ASR 96.52%→5.63%)。把擦除烧进参数、不需推理时干预,工程上也更可靠——任何依赖推理时过滤的方案都能被绕过或直接关掉。开源让结论可复现。但要清楚它的边界:5.63% 的 ASR 不是零,意味着约二十次尝试里仍有一次能召回目标概念,对真正的滥用防护而言这个残余风险并不小,而攻击方法是持续演进的,今天的 5.63% 在更强的新攻击下会退化多少不可知。NudeNet 582→6 的评测面也偏窄——I2P 加 NudeNet 主要覆盖裸露类内容,版权风格、特定人物身份这些擦除需求的难度分布完全不同(风格是弥散的,很难在稀疏特征里被干净地切出来),摘要未给出跨概念类型的分解结果。同时擦除多个概念时特征之间是否干扰、KID 是否会累积恶化,也没有报告。另外这类方法有个绕不开的现实前提:它要求模型权重可改,对已经分发到用户手上的开源权重毫无追溯力——真正的擦除必须发生在发布之前。技术质量很高,但别把它当成安全问题的终点。 10. SGU:让统一模型对自己画的图做推理 Do You See What You Draw? A Semantic Closed-Loop Framework for Holistic Evaluation of Unified Multimodal Models | 浙江大学 | arXiv:2608.11907 ⚠️ 前序问题:大视觉语言模型越来越追求把视觉生成与理解统一进同一套参数空间,但如何连贯地评估这种结构性统一仍是关键难题。当前评测协议基本把生成能力和判别能力当成两个独立任务分别打分,缺的是面向统一多模态模型(UMM)的系统级评估——两项单独都很高,不代表它们在同一套参数里真的打通了。 本文贡献:提出 Self-Generative-Understanding(SGU),一个无需标注的评测框架,用语义闭环挑战来探测统一模型的整合能力。它不需要任何新标注,而是利用 UMM 自身兼具理解与生成的双重能力:先让模型感知一张图并产出文本描述,接着基于该描述重建视觉上下文,最后对自己生成的输出做推理。这条闭环管线提供了一个零成本测试床,产出专门用于把 UMM 当作统一系统来评估的整合性能分数。 Illustration of traditional UMM evaluation and our Self-Generative-Understanding (SGU) framework. (a) Existing evaluations often assess generation ($\mathcal{M}_G$) and understanding ($\mathcal{M}_U$) separately, producing capability-specific scores such as $s_g$ and $s_u$. These metrics remain valuable for component-wise diagnosis but do not directly provide a system-level view of how a UMM behaves when understanding and generation are jointly involved. (b) SGU provides a complementary closed-loop evaluation framework tailored to UMMs. It requires the model to understand an input image, generate a textual representation, reconstruct a visual context from that representation, and reason over the reconstructed image, yielding an outcome-based system-level score $s_{\text{umm}}$. 实验效果:大量实验显示,即便是表现很好的 UMM 也常常无法对自己生成的上下文进行推理,暴露出理解或生成各自单独评测都捕捉不到的局限。 批判点评:「让模型对自己画的图做推理」这个设计的巧妙之处在于零标注:闭环把模型自己的输出当成下一步的输入,评测信号完全内生,不需要人工标注也就不需要为每个新模型准备新数据。它探测的东西也确实是现有评测的盲区——理解分和生成分各自很高,只说明两个模块都能干活,不说明它们共享的表征是自洽的;如果模型看图能说出 A、按 A 画图、却对画出来的图推理不出 A,那所谓「统一」就只是参数共享而非语义打通。「高性能 UMM 常常无法对自己生成的上下文推理」这个发现本身就值得整个统一模型社区认真对待。但这个框架有个结构性弱点:闭环里的误差会复合传播,最终分数低到底是理解错了、生成偏了,还是推理跳了,很难归因,而缺乏归因能力的指标对改进模型的指导价值有限。零标注同时也意味着没有绝对基准——闭环失败可能只是因为文本描述天然不可能完整承载一张图的全部信息(描述必然有损,重建必然有偏),这部分损失是任务内在的,不该全算成模型缺陷,摘要没有说明如何区分内在信息损失与真实的能力缺口。另外闭环分数在不同模型间是否可比也需要论证:一个描述更啰嗦的模型可能因为传递了更多信息而闭环得分更高,但这未必意味着它更「统一」。它作为诊断性探针很有价值,作为排行榜指标则要谨慎。 趋势观察 实时数字人今天出现了两条互不知情的技术路线,答案不唯一 — 今天最值得对读的是 LiveAnimate 与 Avatar-Forever——同一天投出、目标几乎完全重叠(大模型底座上的实时流式长时数字人),但动手的位置完全相反。港中文与阿里 Qwen 的 LiveAnimate 在推理侧做手术:它把「长时外观漂移」重新定义为一个缓存管理问题,PR-Sink 用 Static Sink 永久锚定首块、Dynamic Sink 按姿态指纹检索历史块、外加三槽滚动窗口,使显存与单块延迟不随流长增长,14B DiT 在两张 H100 上跑到 19.63 FPS,三分钟基准上从前 30 秒到最后一分钟质量近乎水平。港理工与字节的 Avatar-Forever 则在训练侧动刀:它指出以蒸馏为核心的串行管线有个被长期容忍的隐性成本——前序阶段的失败与分布偏移会污染后续优化,且蒸馏目标天生偏爱短程,于是把「少步高效」和「长程鲁棒」拆成两条并行分支各自训练(后者用 Recovery-oriented Rollout Training),推理再叠 ForeverCache,22B 底座上单卡 27.2 FPS、实测跑到 11 分 44 秒身份不崩。两条路线都成立,且正交——一个管缓存怎么用,一个管模型怎么练,理论上可以叠加。这也说明实时数字人已经从「能不能做到」进入「怎么做更划算」的工程竞速阶段,港中文那一组更进一步,同天还投了 UniSwap 把同一套流式技术栈迁移到音视频联合身份替换上,13.6 FPS 单卡、小时级长时。要留一分清醒:三篇的分辨率、卡数、时长口径各不相同,FPS 数字之间不能直接横比;「无限」「小时级」这类措辞普遍缺少时长轴上的量化退化曲线,而长 rollout 的失效通常是缓慢累积而非突然崩溃。 加速研究开始把「用户该拧哪个旋钮」当成一等问题 — LoSA 和 GeoFlow 都在做视频扩散加速,但两篇最有价值的东西都不是加速倍数。悉尼大学与 CSIRO 的 LoSA 把稀疏注意力的可控参数从「稀疏率」换成了「保留 99% 注意力质量」——这是接口层面的改动,却直接解决了一个长期的盲调问题:同一个稀疏率在不同模型、不同分辨率下对应的质量损失完全不同,用户只能试,而用户真正关心的从来是质量损失的上界。锁死阈值再反推能砍多少计算,加速就从赌博变成了有保证的操作;配合「高质量支撑集跨去噪步稳定」这个观察,只在一个早期步测量、后续全部复用冻结索引,测量开销被摊薄到近乎为零,最终在 HunyuanVideo 上 3.2 倍加速仅降 0.02 分,同等速度下最强稀疏基线要降 0.32 分。北航的 GeoFlow(ECCV 2026)换了另一个维度:整个社区把「从标准高斯噪声出发」当成公理,但对结构高度冗余的驾驶视频而言,上一帧已经确定的道路和建筑凭什么要从纯噪声里重新长一遍?它用多视图几何与空间自适应噪声注入构造 Geometry-Aligned Prior,把起点直接挪到数据分布附近,采样轨迹变得更直更短。这是与蒸馏、缓存、稀疏化都正交的加速维度,且只需数小时微调就能挂到现有基线上。两篇的边界也要看清:LoSA 的 1.36 倍单独加速并不高,3.2 倍是叠加特征缓存后的复合结果,它更准确的定位是「一个不拖后腿、可安全叠加的组件」;GeoFlow 吃的是驾驶场景「几何强先验 + 时空强冗余」的特殊红利,换到无标定、镜头切换剧烈的开放域视频未必构造得出这个先验,而且先验越强、多样性越受约束,用于仿真罕见场景时这个权衡值得警惕。 统一模型的评价标准正在从「各项都高」转向「内部是否自洽」 — 今天有三篇论文从不同角度指向同一件事:把能力拼在一起不等于打通了。浙大的 SGU 提出一个零标注的语义闭环评测——让统一多模态模型先描述一张图、再按自己的描述重建图像、最后对自己生成的图做推理。发现是扎实的:即便理解分和生成分都很高的模型,也常常无法对自己生成的上下文正确推理,图中模型对原图答「猫朝左」、对自生成图答「猫朝前」,这类失效在分离式评测里完全看不到;六个模型的闭环排名与孤立排名折线明显交叉,说明分开打分预测不了统一系统的整合表现。小米 MiLM Plus 与上交的 MiDashengLM-Gen 则给出了「不自洽」的具体代价:以往统一音频生成靠冻结文本编码器加独立音频解码器的拼装管线,跨模态优化被切断,最直接的后果是语音清晰度崩坏——Seed-TTS 上英文 WER 高达 12.15%,每八个词错一个,演示视频里听着还行,实际完全无法承载信息;改成 LLM 与逐 token 条件流匹配端到端联合训练后降到 2.79%,4.4 倍收敛,且混合音频质量没掉。北京交大与北大的 StateFlow 从交互侧提出另一种自洽:当前视频生成的编辑范式基本是抽奖,改一个词整段重出、上一版的满意之处全丢,它主张缺的是一个显式且持久的 3D 世界状态,把编辑从重新生成变成状态转移。三篇合起来看,「统一」这个词正在被要求兑现更硬的东西:不只是参数共享,而是表征自洽、跨模态联合优化、以及状态可持久。当然也别过度乐观——SGU 的闭环误差难以归因,文本描述天然有损这部分内在损失不该全算成模型缺陷;MiDashengLM-Gen 的 2.79% 对专用 TTS 的 1.24% 仍有 2.25 倍差距,且未拆分报告有背景音乐音效叠加时的 WER,而那恰恰是统一模型唯一的存在理由;StateFlow 的实验只给了定性结论,可控性与迭代效率这两个核心主张最该被量化却没有量化。 人工智能炼丹君 整理 | 2026-08-14 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-13|Adobe视频世界模型首次外推物理定律LDR 今日 AIGC 论文速览 今日共 10 篇 · 世界模型与物理外推 2 篇 · 全模态对话与数字人 1 篇 · 生成训练目标与对抗后训练 1 篇 · 流式与自回归视频生成加速 2 篇 · 图像超分与编辑 2 篇 · 语音合成细粒度控制 1 篇 · 视频生成评测基准 1 篇 重点论文标题列表 LDR(UCSD·Adobe):首个能外推物理定律的视频世界模型 Ex-Omni-2D(香港中文大学(深圳)·腾讯光子):四卡四步推理让对话模型有形象 ⚡ AdvFD(北京大学·快手可灵(KlingAI Research)):对抗表征治好FD指标刷分症 Stream Forcing(华中科技大学·地平线·Anyverse Dynamics):统一训练轨迹让流式视频FVD降36.6% SparSTAR(西江大学(Sogang University)):免训练块稀疏注意力720p提速1.6倍 今日论文速览 1. LDR:首个能外推物理定律的视频世界模型 Learning How the World Evolves: Extrapolative Video World Models via Latent Dynamics Reasoning | UCSD·Adobe | arXiv:2608.09926 ⚠️ 前序问题:世界按自身的动力学(运动定律)演化,但主流视频扩散模型基本是在拟合像素,而没有建模像素如何随时间转移。结果是它们能渲染出视觉上合理的帧,却未必真的遵守物理定律——尤其在分布外场景中,模型是真学到了底层动力学,还是只记住了训练集里的表观模式,此前很难分辨,也几乎没有模型能把学到的动力学外推到训练分布之外。 本文贡献:提出 Latent Dynamics Reasoning(LDR),纯粹从像素中捕获动力学:把潜空间的状态转移显式改写成运动学积分——低阶动力学用数值积分直接算出,网络只回归驱动 rollout 的三阶及以上残差项。为了让这套积分具备更好的外推能力,LDR 不在稠密卷积特征上做,而是运行在结构化潜变量(Structured Latent)之上。沿用 PhyWorld 的设定,在匀速运动、抛物线、碰撞、弹跳、逼近五个任务的白盒物理基准上验证,重点考察能暴露模型是否真正习得动力学的分布外场景。 Overview of LDR. Given three conditioning frames $I_0,I_1,I_2$, LDR predicts the future frames $\hat{I}_3,\hat{I}_4,\dots,\hat{I}_T$ in three stages. (A) LDR first encodes each input frame into a structured latent (SL). (B) LDR measures the low-order time derivatives of the given SL, then rolls out by regressing only the high-order residual with $f_\theta$ and numerically integrating the lower orders to the next latent $\hat{\boldsymbol{s}}_t$ ($t\in\{3,4,\cdots,T\}$). (C) LDR finally decodes each predicted latent to an RGB frame $\hat{I}_t$. 实验效果:在 256² 分辨率下,无论单任务还是联合任务训练,LDR 的分布内与分布外误差之差比视频扩散基线小 20 倍以上,同时参数量少 26 倍、运行速度快 143 倍。它在剧烈分布偏移下依然成立:仅用「红球从左向右」训练,却能正确预测蓝色方块从右向左的运动。作者称这是据其所知首个能把学到的动力学外推到训练分布之外的视频世界模型。 Stress test under severe OOD shift. Trained only on red balls but tested on an unseen object (e.g., “earth”), LDR still predicts the correct motion, while the others fail. 批判点评:这篇的方法论姿态比数字更值钱。它没有把「物理一致性」当成一个再加些数据、再加个 loss 就能改善的软指标,而是直接在架构层面把低阶运动学变成不可学的确定性计算,只留高阶残差交给网络——这等于把归纳偏置从「祈祷模型学到」改成「结构上直接给定」,也顺带解释了参数量能少 26 倍:本来大量容量就是被用来重新发明积分。20 倍的分布内外误差差距收窄,比任何 FVD 分数都更能说明泛化。但必须把庆祝的音量调低:验证完全落在 PhyWorld 式白盒基准上,五个任务都是刚体质点级的简单动力学,与真实视频里的流体、布料、多物体接触、遮挡完全不在一个复杂度量级;红球到蓝方块的泛化确实漂亮,但那本质上是「外观换了、动力学同构」,并未证明它能外推到没见过的动力学类型。运动学积分假设状态可以被少数低阶导数良好描述,一旦遇到碰撞、断裂这类不可微事件,残差项还能不能兜住是未知的。此外它与主流视频扩散模型不是同类可替换品——143 倍加速的对照物是在白盒任务上的基线,不代表能接管开放域视频生成。它更应被读作一个强有力的存在性证明:外推是可能的,前提是别再让网络从零学积分。 2. Ex-Omni-2D:四卡四步推理让对话模型有形象 Ex-Omni-2D: Expressive Omni-Modal Dialogue Models with Native Visual Presence | 香港中文大学(深圳)·腾讯光子 | arXiv:2608.10720 ⚠️ 前序问题:全模态对话模型已经能理解多模态输入并合成语音回复,但这些回复在视觉上是「无身体」的——只有声音没有形象。要补上形象通路,最直接的做法是端到端监督,可这需要大规模的「查询-文本-语音-视频」四元组数据,现实中几乎无法收集。另一方面,流式增量生成还面临后段块质量累积退化的问题。 本文贡献:提出 Ex-Omni-2D,给定多模态查询、参考图像和参考音频,协同生成文本、个性化语音与参考条件视频三位一体的回复。模型先预测一个结构化的 Visual Thought Plan(VTP)描述场景、情绪与动作,再生成回复文本和原生多码本语音单元;这些语音单元构成共享的声学-时间接口,既解码为语音又与视频帧在线对齐。正是这个接口让回复通路与形象通路能各自从异质的语音、对话、形象视频数据中学习,从而绕开四元组大规模监督。全序列 Video Generator 作为主教师,进一步蒸馏成少步的块因果 Streaming Student,其 Prefix Streaming 机制把干净潜变量跨相邻块携带,抑制后段块的累积退化。 Overview of Ex-Omni-2D. Speech, text, and vision encoders provide multimodal context to the Large Language Model, which produces a non-user-facing Visual Thought Plan (VTP) and the user-facing response. The Speech Generator uses reference audio for voice conditioning and generates speech in a native multi-codebook space. The Video Generator encodes the reference image and VTP, and reuses the generated speech representation to synthesize the synchronized video response. It is instantiated as a full-sequence Teacher for primary realization and a distilled Prefix-Streaming Student for efficient incremental deployment. 实验效果:四步推理下,完整的四 GPU 流水线在 400×720 / 720×400 分辨率上达到端到端 RTF 1.293,提供了一个实用的质量-效率操作点。 Prefix-Streaming analysis. Top: representative later-chunk examples; each row shows the reference image, a no-prefix frame, and its Prefix-Streaming counterpart. Bottom: full-duration DINO curves over 200 paired CommonEval videos. Markers denote chunk means and shaded regions denote bootstrap uncertainty. Prefix is mixed over early chunks but degrades more slowly and is consistently better from chunk~9 onward, supporting a reduction in cumulative late-chunk subject drift rather than a uniform per-chunk improvement. 批判点评:这篇真正的巧劲不在多模态本身,而在于用「多码本语音单元」当作声学与时间的共享接口——这一步把数据需求从不可能的四元组降解成三堆各自都存在的现成数据,是全篇最具工程判断力的设计,也是同类工作最容易卡死的地方。VTP 显式写出场景/情绪/动作,等于把风格控制从隐式条件变成可检查的中间产物,调试友好。Prefix Streaming 承载干净潜变量以抑制后段退化,说明作者清楚流式生成的病根是误差累积而非单块质量。但要泼几盆冷水:RTF 1.293 意味着生成 1 秒内容需要约 1.29 秒,仍未跨过实时门槛,而这是在四张 GPU 上取得的——按单卡折算的成本相当高,离真实的交互式数字人部署还有距离;论文摘要只给了 RTF 这一个硬数字,语音自然度、唇音同步、身份保持、指令遵循等关键质量维度均无量化对照,「Expressive」这个卖点因此缺乏支撑;分辨率停在 400×720 这类竖屏小尺寸,也暗示更高分辨率下的开销尚未解决。此外教师-学生蒸馏引入的质量损失有多大、四步是否已是下限,摘要层面都没有交代。 3. AdvFD:对抗表征治好FD指标刷分症 AdvFD: Boosting Visual Generation via Adversarial Fréchet Distance Loss | 北京大学·快手可灵(KlingAI Research) | arXiv:2608.11205 ⚠️ 前序问题:Fréchet 距离近来成为生成器后训练中有效的分布级目标,可以补充传统的逐样本扩散与流匹配损失。但直接优化 Fréchet 目标会引发「Fréchet hacking」:目标指标持续改善,而视觉质量以及在其他特征空间下的 Fréchet 对齐却可能停滞甚至恶化。作者把这一失效归因于现有 Fréchet 损失所依赖的静态预训练特征空间——它对真实与生成分布之间的差异只提供了不完整且固定的视角,生成器于是学会往这个固定视角的盲区里钻。 本文贡献:提出 Adversarial Fréchet Distance(AdvFD),用一个经过校准的对抗学习表征来补充 FD-Loss 中的静态表征目标。AdvFD 在原有静态 Fréchet 目标之外增加一个可学习表征:该表征对抗性地最大化真实与生成样本之间的 Fréchet 差异,而生成器则在由此产生的自适应特征空间中最小化同一差异。为防止对抗表征通过特征幅值放大来平凡地抬高目标,作者进一步引入真实特征白化(real-feature whitening),归一化其尺度与协方差几何,稳定这一 min-max 优化。 Overview of our adaptive training. (a) In the G-step, the generator is updated to minimize the static Fréchet objective together with the adaptive Fréchet discrepancy, while both the static and adversarial representations are frozen. (b) In the D-step, the generator is frozen, and the adversarial representation is updated to maximize the Fréchet discrepancy between real and generated distributions. The two steps alternately improve the generator and adapt the representation to discrepancies missed by the fixed encoder. 实验效果:大量实验表明 AdvFD 在 JiT 与 pMF 两种骨干、以及不同模型规模上,都能一致提升一步生成器的后训练效果。 AdvFD mitigates Fréchet hacking in one-step generation. Top: Compared with JiT-L trained using the static FD loss, AdvFD generates cleaner and more coherent images under the same 1-NFE sampling budget. Bottom: AdvFD consistently reduces FD-r3 and FD-r6 across JiT-L and JiT-H, with relative improvements of 41.4%/38.0% and 34.0%/32.1%, respectively, showing that the gains persist as the generator scales up. These results demonstrate improved perceptual quality and generalization across evaluation representations. Lower is better for all metrics. 批判点评:这篇最有价值的贡献是把一个大家隐约感觉到但很少被正面命名的问题定义清楚了:指标一旦进入训练回路,就会被优化压力反向利用。「静态特征空间提供固定且不完整的视角」这个归因很到位——它解释了为什么 FD 越刷越好而人眼看着没变好,也顺带把「刷 FID 即进步」的行业习惯拖到了聚光灯下。real-feature whitening 这个细节尤其体现作者对 min-max 训练的实战理解:不加约束的对抗表征最省力的作弊方式就是把特征整体放大,白化直接封掉了这条路。局限也不难看出:引入对抗表征等于把一个稳定的分布级损失换成了 GAN 式的 min-max 优化,训练稳定性与超参敏感性天然变差,白化只是缓解而非根治,论文对失败模式与调参代价的交代不足;「一致提升」这类措辞在摘要中缺少具体数字支撑,读者无法判断增益是显著还是边际;验证骨干限于 JiT 与 pMF、场景限于一步生成器后训练,对多步扩散或视频生成是否同样奏效未知;更微妙的是,用对抗表征衡量的「改善」本身也是一个可被 hack 的目标,这个套娃问题论文并未回答。 4. Stream Forcing:统一训练轨迹让流式视频FVD降36.6% Stream Forcing: Constructing Unified Training Trajectory for Robust Streaming Video Generation | 华中科技大学·地平线·Anyverse Dynamics | arXiv:2608.10439 ⚠️ 前序问题:流式视频生成对世界建模潜力巨大——未来帧必须在线逐步推断以形成连续视频流。但流式视频扩散模型存在一个根本性的训推不匹配:推理遵循一种特化的去噪顺序,而先进的训练策略通常需要多样的噪声级配置。于是训推一致性与训练覆盖面成了一对只能二选一的矛盾。 本文贡献:把视频扩散采样重新表述为一个以帧为索引、在噪声级上的随机过程。在这个随机过程空间内构造一条连续的训练轨迹,沿该轨迹采样调度从独立采样逐步演化到与推理一致的采样,从而不再需要在两端之间做取舍。作者进一步引入联合校准算法与时间相关采样算法,以保证轨迹平滑性与跨帧相关性。基于这些设计提出 Stream Forcing,一个兼顾训练充分性与推理效率的流式视频生成统一训练框架。 Overview of the curriculum training. Our method builds a continuous curriculum transition between independent training and inference-aligned training that balances full distribution coverage with consistency at inference time. 实验效果:UCF-101 基准上 FVD 改善 36.6%;方法还能稳健地零样本外推到长时程视频生成,在 UCF-101 上 FVD 改善 27.9%。 Visualization of unconditional video generation on UCF-101 dataset. DF: Diffusion Forcing df. AR-D: AR-Diffusion ardiff. Our method presents higher visual quality and more robust long-horizontal extrapolation. 批判点评:把「训推一致性 vs 训练覆盖」这对二元对立改写成一条连续轨迹上的渐变,是个漂亮的问题重构——它承认两端都有价值,用课程式过渡取代硬性选边,本质上和退火、课程学习属于同一族智慧,但用在噪声级调度这个具体位置上是新的。36.6% 的 FVD 改善幅度不小,长时程零样本外推还能保住 27.9%,说明训练轨迹确实带来了泛化性而非仅仅拟合了评测设置。不过要打的折扣不少:UCF-101 是分辨率低、类别有限的老基准,在它上面的 FVD 增益能否迁移到 720p 开放域文生视频,完全无法从这篇推断,而流式生成的真实战场恰恰在后者;「联合校准」与「时间相关采样」两个算法被摘要一笔带过,它们各自贡献多少增益、引入多少训练开销,没有消融交代;连续轨迹意味着需要设计演化时间表,这又是一组新超参,敏感性未知。此外流式生成最该报的延迟、首帧时间、单帧算力等在线指标一个都没出现,「推理效率」的主张目前只有结构性论证而无实测支撑。 5. SparSTAR:免训练块稀疏注意力720p提速1.6倍 SparSTAR: Sparse Attention for SpaceTime AutoRegressive Video Synthesis | 西江大学(Sogang University) | arXiv:2608.10519 ⚠️ 前序问题:InfinityStar 通过图像金字塔与片段金字塔的序列把视觉自回归生成扩展到视频,但它不断变化的尺度与跨片段上下文让后期尺度的注意力开销高昂,也使得从扩散模型或图像 VAR 模型直接搬来的稀疏模式变得不可靠。 本文贡献:提出 SparSTAR,一种为该设定量身定制的免训练块稀疏注意力方法。在每个高开销尺度与每个注意力头上,SparSTAR 依据当前的 query 与 key 激活对连续的 key block 打分,保留必需的条件上下文,并通过一条仅前向的稀疏路径执行选中的块。作者系统分析了片段内的跨尺度一致性、跨片段边界的模式持续性,以及复用跨越越来越远尺度时的质量退化。这些分析一致表明重要 key block 会发生漂移,因此在每个目标尺度重新计算块选择比复用迁移来的 mask 更可靠。 Overview of SparSTAR, a training-free block-sparse attention framework for video autoregressive generation that reduces attention latency while maintaining video quality. 实验效果:在 720p 文生视频与图生视频上,SparSTAR 保留了全部 token 与精修尺度,提供约 1.6 倍端到端加速,同时 VBench 分数与配对输出重建保真度接近稠密的 InfinityStar。 PSNR--latency trade-off for recalibration frequency on 720p T2V. Error bars denote 95% confidence intervals for PSNR across five seeds. 批判点评:这篇的贡献首先是一个诚实的否证:它没有先摆出方法再补实验,而是先系统测量「从别处迁移来的稀疏 mask 在变尺度自回归结构下到底能不能用」,得到的答案是不能——重要 key block 会随尺度漂移。这个结论比方法本身更有传播价值,因为当前有相当多加速工作默认稀疏模式具备跨设定可迁移性。免训练、仅前向、保留全部 token 与全部精修尺度这几条约束定得很克制,意味着它可以直接挂到现成模型上而不牵动生成质量的责任边界,工程可用性高。但天花板也被这份克制锁死了:1.6 倍加速对视频生成的实际体感改善有限,距离能改变产品形态的量级尚远;方法与 InfinityStar 的金字塔结构深度绑定,对当下更主流的视频 DiT 是否适用没有讨论,通用性存疑;每个尺度重新打分本身要花算力,摘要只说「保真度接近」,这类模糊表述掩盖了具体的质量损失幅度,而稀疏注意力最该担心的正是长时程一致性这种在 VBench 上不易暴露的退化。此外单一机构、无顶会标注、缺少与 SVG、SpargeAttn 等同类稀疏注意力方法的横向对比,也让它的相对位置不好判断。 6. Latent-to-4D:绕过RGB用视频潜变量直出4D Beyond Pixels: From Video Priors to 4D Worlds | 浙江大学 ReLER·CCAI | arXiv:2608.10744 ⚠️ 前序问题:4D 生成要从文本或图像等条件合成动态 3D 场景。现有方法分两派:一派把生成好的 RGB 视频再用一个独立的 4D 模型去重建,另一派改造某个特定视频生成器让它直接预测几何。前者受分布不匹配与误差传播之苦——视频生成器的输出分布并非 4D 重建模型所期望的输入分布;后者则把 4D 预测绑死在特定生成器上,生成器或条件方式一变就可能要重训。 本文贡献:作者提出一个新问题:共享同一个 VAE 的视频模型,其最终去噪潜变量能否充当通往显式 4D 预测的可复用接口?基于这一洞察提出直接的潜变量到 4D 生成,并实例化为 Latent-to-4D:它绕过 RGB,把视频潜变量与预训练 4D 解码器的 token 网格对齐,再通过逐帧与全局时空注意力加以精修。仅用约 1K 现有重建片段训练,单个 checkpoint 就能在同一 VAE 家族内的多个视频扩散 Transformer 之间原样迁移,无需重训。 Latent-to-4D training pipeline. A frozen video VAE encodes an observed video into a VAE-space latent. L4AR aligns the latent grid through a learned 3D convolution, reuses frozen camera and time tokens, and refines the representation through alternating frame-wise and global attention. The 4D decoder predicts cameras and dynamic world-space geometry. 实验效果:在 Text4D-200 与 I4D-200 上,Latent-to-4D 在基于投影的 DINO-F1 指标上分别超过同潜变量的 Wan+4RC 级联 2.88–3.45 与 5.81 点,并在几何、时间稳定性与整体质量上更受人类评审者青睐。 Image-to-4D comparison. Each row shows the input condition and 4D results. RGB baselines reconstruct the decoded video, whereas Ours consumes its terminal latent directly. 批判点评:「把共享 VAE 的潜变量当作跨模型可复用接口」这个提法很有工程审美——它没有再造一个更大的 4D 生成器,而是在既有生态里找到一个天然存在却被忽视的对接面,顺手解决了级联方案的分布不匹配和专用方案的绑定问题。约 1K 训练片段、单 checkpoint 跨多个视频 DiT 原样迁移,这个数据效率与复用性在 4D 生成里相当难得,也说明潜变量确实承载了足够的几何信息,RGB 那一步真的是多余的信息瓶颈。但边界必须说清楚:可迁移性严格限定在「同一 VAE 家族」内,一旦 VAE 换代或换厂,接口即失效,这与其宣称的通用性之间存在张力,且视频模型的 VAE 恰恰是迭代很快的部件;2.88–5.81 点的 DINO-F1 增益是相对同潜变量的 Wan+4RC 级联,属于自设对照,未与更强的专用 4D 生成方法正面比较;投影域的 DINO-F1 本身是间接指标,无法直接反映几何精度,人类偏好评测又缺样本量与统计显著性说明。此外训练依赖预训练 4D 解码器,其能力上限就是整套方案的上限,动态范围、拓扑变化剧烈的场景表现如何未见交代。 7. MeanSR:一步超分免蒸馏直接学平均速度场 MeanSR: Restoration Trajectory Learning for One-Step Perceptual Super-Resolution | 西北工业大学 | arXiv:2608.09405 ⚠️ 前序问题:基于扩散的超分能获得强感知质量,但需要昂贵的迭代去噪。现有一步蒸馏方法虽然压缩了推理时间,却依赖昂贵的预训练教师模型;代表性方法 CTMSR 通过 PF-ODE 一致性训练避开了蒸馏,但它只是约束网络行为,并没有显式建模从低分辨率输入到高分辨率图像的那个修复动力学过程。 本文贡献:提出 MeanSR,一种一步感知超分方法:学习一个以低分辨率图像为条件的平均速度场,直接刻画从退化或带噪输入到合理高分辨率输出的有限时间转移。平均速度与瞬时速度之间的关系本身即提供直接的训练信号,同时保留单步推理。作者进一步把分布轨迹匹配目标重新表述以适配平均速度生成,并引入阶段感知的时间采样(Stage-Aware Temporal Sampling)策略改进轨迹学习。 Overview of the proposed MeanSR framework. Stage 1 estimates an LR-conditioned restoration trajectory by predicting its average velocity under the MeanFlow formulation, while Stage 2 further aligns the generated restoration trajectory with the real HR trajectory through distribution trajectory matching. The proposed Stage-Aware Temporal Sampling (SATS) assigns different temporal distributions to trajectory estimation and trajectory alignment, respectively. 实验效果:在合成与真实世界基准上,MeanSR 在 CLIPIQA、MUSIQ、MANIQA 三项感知指标上均优于 CTMSR,同时显著降低 FLOPs 与推理延迟;重建出的结构更锐利、纹理更真实,感知伪影更少。 Comparison of representative one-step super-resolution methods. The x-axis denotes CLIPIQA, the y-axis denotes inference runtime, and the bubble size represents FLOPs. MeanSR achieves a favorable trade-off between perceptual quality and computational efficiency. 批判点评:这篇的定位很清楚:把 MeanFlow 那套「学平均速度场」的思路搬到超分,从而在免蒸馏的前提下把修复过程本身建模出来,而不是像 CTMSR 那样只用一致性去间接约束网络行为。这个区分是有实质的——显式的有限时间转移让训练信号直接指向「从退化态到清晰态该怎么走」,也自然解释了为何能同时改善质量并降低 FLOPs。摆脱教师模型对下游落地的意义同样实在,省掉的是一整套预训练成本。但它的贡献属于路径迁移而非原理创新,MeanFlow 的核心恒等式并非本文所出,主要工作是条件化与采样策略适配。评估层面问题更明显:三项指标 CLIPIQA/MUSIQ/MANIQA 全是无参考感知指标,众所周知偏好锐利与高对比,缺少 PSNR/SSIM/LPIPS 的配套报告,无法排除「感知分上去了但保真度掉了」这种典型的一步超分退化;主要对照仅 CTMSR 一家,未与 OSEDiff、SinSR 等一步扩散超分做完整横比;论文标注为投稿 AAAI 2027、仅 7 页,尚未经同行评审,Stage-Aware Temporal Sampling 的消融强度也难以从摘要判断。 8. ATDEdit:免掩码异步解码编辑达27.44dB Diffusion Image Editing via Asynchronous Token Decoding | 广东工业大学·香港浸会大学·北京大学·惠州学院 | arXiv:2608.09322 ⚠️ 前序问题:文本引导的扩散图像编辑要在修改语义属性的同时保住身份、布局与背景。但采样过程中简单地切换文本条件往往引起全局漂移——去噪动力学会把改动沿 token 传播开,进而破坏本不该改的区域。现有方案通常依赖外部或用户提供的空间掩码,或者需要微调模型。 本文贡献:提出 ATDEdit(Asynchronous Token Decoding Edit),一个推理期框架:把采样器的每一步视为对一个全局耦合 token 矩阵的并行更新,从而支持按 token 索引切换条件并施加差异化的更新策略。它不对所有 token 同步施加目标条件更新,而是用逐 token 的条件意外度(conditional surprisal)估计可编辑位置,仅对选中的 token 集合施加目标条件修正;在保留 token 位置提供源 key/value 记忆,并把选中的保留 token 潜变量行回投到其源值。这些操作促进背景保持,但作者明确声明其不构成像素级不变性保证。整套方法无需外部或用户提供的空间掩码,也无需模型微调。 Overview of ATDEdit for transforming a fox into a dog. (Top) Same-state source/target evaluations produce Token-wise Conditional Surprisal and an editable-token mask. (Bottom) Target-conditioned corrections are applied to editable tokens, while source key/value memory and hard projection constrain selected keep-token rows. 实验效果:在 PIE-Bench 上,ATDEdit 取得该基准上已报告的最强保持性指标,包括 27.44 dB PSNR 与 0.055 LPIPS,同时保持有竞争力的语义对齐。已被 ACM MM 2026 接收。 Comparison of edited results. Real images are in the first column. 批判点评:用「条件意外度」在推理期自动划定可编辑 token,是这篇最漂亮的一笔——它把「哪里该改」从需要人工掩码或额外分割模型的外部输入,转成模型自身条件响应差异的内生信号,免训练、免掩码这两个属性叠加起来带来的实用性相当高。更值得称赞的是学术诚实度:论文明确写出这些操作「促进背景保持但不构成像素级不变性保证」,在一个惯于把机制性偏好包装成理论保证的领域,这种自我设限反而提升了可信度,也准确点出了本方法的性质——它是软偏置而非硬约束。27.44 dB / 0.055 LPIPS 的保持性数字确实扎实。但需要警惕保持性与编辑力度的天然此消彼长:保持性做到基准最强,而语义对齐只被描述为「有竞争力」,这个措辞差异很可能意味着在需要大幅改动的编辑任务上它偏保守;意外度阈值 ρ(t) 是核心超参,其跨图像稳健性与失败模式摘要未交代,若阈值偏保守则编辑区域覆盖不全,偏激进则退回全局漂移;PIE-Bench 单一基准也不足以覆盖真实编辑意图的多样性,尤其是涉及大范围结构变化或多对象组合的情形。 9. CtrlSpeech:音素级控制音高音量与时长 CtrlSpeech: Coarse-to-Fine Control for Expressive Speech Synthesis | 德克萨斯大学奥斯汀分校·Amazon | arXiv:2608.08362 ⚠️ 前序问题:近来的 TTS 系统已实现很强的自然度与零样本音色克隆,但在词级或音素级上对富有表现力的语音做细粒度控制仍然困难——用户能换音色,却很难精准指定某个字要更重、更高或拖得更长。 本文贡献:提出 CtrlSpeech,一个具备由粗到细控制能力的可控表现力 TTS 框架。它构建在 DiTAR 架构之上,把全局说话人条件与音素对齐的音高、音量、时长信号结合起来,从而在保留目标说话人音色的同时实现局部韵律控制。这一设计让用户能在很细的时间粒度上调整表现力属性,使语音精修更灵活可控。 The architecture of . 实验效果:实验表明 CtrlSpeech 在零样本 TTS 上取得有竞争力的表现,并改善了对表现力属性的可控性,验证了其在灵活实用的表现力语音合成上的有效性。已被 Interspeech 2026 接收,Demo、代码与模型权重均已公开。 Coarse-to-fine speech control pipeline. 批判点评:把控制信号锚定在音素级的音高、音量、时长三元组上,是个务实到近乎朴素的选择,但恰好对上了配音、有声书这类真实生产流程的操作直觉——从业者要的正是「这个字重读一点」,而不是再来一个模糊的情绪标签。全局说话人条件与局部韵律控制解耦,保证了调韵律不串音色,工程上很关键。Demo、代码、权重三件套齐放,在 TTS 这个复现门槛偏高的方向里是实打实的加分项。但这篇的定位应当被诚实地看作扎实的增量工作而非突破:音素级韵律控制在 FastSpeech 2 时代就是标准配置,本文的实际贡献更像是把这套显式控制接口迁移并适配到 DiTAR 这个较新的自回归-扩散混合架构上;摘要通篇没有一个具体数字,「有竞争力」与「改善了可控性」这类表述无法支撑与 CosyVoice、F5-TTS 等主流系统的强弱判断;控制粒度也仍停在音高/音量/时长这些声学低层属性,对情绪、语气、口音等更高层表现力维度没有覆盖。此外六页的 Interspeech 短文体量,注定其消融与主观评测的深度有限。 10. Sci-VBench:16个前沿模型科学因果全线不及格 Sci-VBench: Evaluating Knowledge- and Reasoning-Intensive Video Generation in Science Domains | 浙江大学·中国科学院大学·同济大学·耶鲁大学 | arXiv:2608.09873 ⚠️ 前序问题:视频生成模型的视觉真实度进步很快,但它们是否真的掌握了科学知识与因果动力学,一直缺少有效的衡量方式。现有评测大多停留在表层视觉合理性,无法区分「画面看起来对」与「物理与科学过程真的对」。 本文贡献:提出 Sci-VBench,一个评测跨科学领域的知识密集与推理密集视频生成的综合基准。它包含 1,253 条专家标注样例,覆盖自然科学、健康医疗、人文社科、工程四大学科下的 60 个学科方向。每条样例都要求模型生成在时间上信息丰富、需要科学推理与知识落地的视频,而非仅有表层视觉合理性。作者进一步建立了基于评分细则(rubric)的评测协议,并验证在该协议下非专家人类评审者与 MLLM-as-Judge 系统都能与专家判断达成较高一致,从而支撑可规模化的可复现评测。 Overview of the dataset. Top left: distribution of the expert-annotated examples over subjects across core disciplines. Remaining panels: representative prompt--video examples from each discipline, generated by Gemini-Omni-Flash, where faithful generation requires grounding in the underlying scientific mechanism. 实验效果:对 16 个前沿闭源与开源模型的评测显示:自动感知质量分数在各系统间挤成一团,而在提示词落地(Prompt Grounding)以及科学与因果正确性上的表现差异显著,闭源与开源之间存在明显差距。这表明视觉真实度的进步尚未转化为对科学与因果动力学的可靠建模。已被 COLM 2026 接收。 Overview of the benchmark construction process. 批判点评:这篇的核心发现极具诊断价值:感知质量分数在 16 个模型间几乎无法区分,而科学与因果正确性上分差巨大——这直接说明当前主流视频生成评测已经饱和失效,大家在一个分辨不出好坏的维度上继续内卷。rubric 协议加上「非专家与 MLLM-as-Judge 都能对齐专家判断」的验证,是这类主观性强的基准最该做却常被省略的一步,它把可规模化评测的成本问题真正解决了。1,253 条专家标注、60 个学科的覆盖面也称得上扎实。作为评测工作,它的价值恰好与今天的 LDR 形成呼应:一个证明外推是可能的,一个证明现有模型普遍做不到。局限主要在方法论固有处:MLLM-as-Judge 与人类专家「较高一致」是在这套 rubric 下成立,一旦作为主要评分手段大规模使用,就存在被针对性优化的风险,届时它会重演今天感知指标的命运;四大学科 60 方向的样例分布必然不均,摘要未交代各领域样本量,跨领域分数可比性存疑;「科学正确性」在很多场景下需要专业判断,rubric 能否覆盖领域细微差别仍待检验。此外基准只能揭示差距而不提供改进路径,闭源领先的具体成因(数据、规模还是后训练)无法从中推断。 趋势观察 世界模型的评判标准从「像不像」转向「外推得出来吗」 — 今天最值钱的一篇是 UCSD 与 Adobe 的 LDR。它把一个长期被含糊处理的问题摆到台面上:主流视频扩散模型是在拟合像素,而不是在建模像素如何随时间转移,所以它们能渲染出视觉上合理的帧,却未必真的遵守运动定律。LDR 的做法很硬核——把潜空间的状态转移显式写成运动学积分,低阶动力学(速度、加速度)直接数值积分算出来,网络只负责回归三阶及以上的残差项。这等于把物理先验从「希望模型自己学到」变成「架构层面直接给定」。效果上,分布内与分布外误差的差距比视频扩散基线小了 20 倍以上,参数量少 26 倍、速度快 143 倍;只用红球从左往右运动训练,却能正确预测蓝色方块从右往左的运动。作者称这是首个能把学到的动力学外推到训练分布之外的视频世界模型。这条线索的意义在于,它把世界模型的验收标准从「生成质量」拽回到「泛化到没见过的物理配置」,也预示配套评测会跟着变——同一天浙大与耶鲁的 Sci-VBench 正好给出了另一个佐证:视觉真实度分数在 16 个前沿模型间挤成一团,而「提示词落地」与「科学因果正确性」的分差却很大,说明画面变好并没有自动带来对科学与因果动力学的可靠建模。 生成模型的训练目标本身正在被重新审计 — 北大与快手可灵的 AdvFD 指出一个很扎心的现象——「Fréchet hacking」:用 Fréchet 距离做生成器后训练时,目标指标一路走高,但视觉质量和在其他特征空间下的 Fréchet 对齐却可能停滞甚至变坏。根因是现有 FD-Loss 依赖静态的预训练特征空间,它对真实与生成分布之间差异的观察视角是固定且不完整的,于是生成器学会了往这个固定视角的盲区里钻。AdvFD 的解法是给静态目标补一个对抗学出来的表征:判别侧最大化该表征下的 Fréchet 差异、生成侧最小化同一差异,并用真实特征白化把它的尺度与协方差几何归一,防止对抗表征靠单纯放大特征来虚增目标。这类工作和「刷 FID 就等于变好」的旧习惯正面冲突,提醒我们指标一旦进入训练回路就会被优化压力反向利用。今天的 ATDEdit 从另一头呼应了同一种审慎——它明确声明自己的 KV 记忆与潜变量回投「促进背景保持,但不构成像素级不变性保证」,在一个人人爱声称 SOTA 的领域里,把话说到这个精度反而更可信。 视频推理加速开始区分「训练-推理对不齐」和「算力花在哪」两类病 — 今天有两篇从不同层面攻视频生成的效率。华科与地平线的 Stream Forcing 处理的是流式视频扩散的结构性顽疾:推理必须按一个特化的去噪顺序逐帧在线推进,而先进训练策略又需要多样的噪声级配置,两者天然冲突——训练覆盖面和训推一致性只能二选一。它把视频扩散采样重写成一个以帧为索引的、在噪声级上的随机过程,然后在这个过程空间里构造一条连续训练轨迹,让采样调度从独立采样平滑演化到与推理一致的采样,UCF-101 上 FVD 改善 36.6%,长视频零样本外推再改善 27.9%。Sogang 大学的 SparSTAR 走的是另一条路——不动训练,只在推理时省算力:它发现从扩散或图像 VAR 模型搬来的稀疏注意力模式在 InfinityStar 这种「图像金字塔 + 片段金字塔」的变尺度结构下并不可靠,重要的 key block 会随尺度漂移,所以每到一个目标尺度就重新算一次块选择,比复用迁移来的 mask 稳得多,720p 端到端约 1.6 倍加速且不丢 token 与精修尺度。一个改训练轨迹、一个改推理时的块选择,共同点是都先诚实地承认了「照搬别处的经验在这里会失效」。 少步化从图像生成蔓延到修复类任务,路径也从蒸馏转向直接学速度场 — 西北工业大学的 MeanSR 是个值得注意的信号:一步感知超分不再依赖昂贵的预训练教师做蒸馏,而是学一个以低分辨率图像为条件的平均速度场,直接刻画从退化/带噪输入到合理高分辨率输出的有限时间转移。这条路子承自 MeanFlow 一脉——平均速度与瞬时速度的关系本身就能提供训练信号,从而在保留单步推理的同时绕开教师模型。它对标的 CTMSR 虽然也免蒸馏,但只靠 PF-ODE 一致性约束网络行为,并没有显式建模支配修复过程的那个场。结果是 CLIPIQA/MUSIQ/MANIQA 全面超过 CTMSR,同时 FLOPs 与延迟大幅下降。把它和 AdvFD 放在一起看会更有意思:两者都在追问「我们到底该让生成器拟合什么」——一个说该拟合自适应的分布差异,一个说该拟合有限时间的平均速度场,而不只是逐样本的去噪方向。 端到端多模态交互的落地瓶颈,正从「能不能生成」变成「能不能流着出」 — 香港中文大学(深圳)与腾讯光子的 Ex-Omni-2D 挑明了当前全模态对话模型的一个体感缺陷:它们能理解多模态输入、能合成语音回复,但回复在视觉上是「无身体」的。它让模型先产出一个描述场景、情绪、动作的结构化 Visual Thought Plan,再生成回复文本与原生多码本语音单元,而这些语音单元同时充当共享的声学-时间接口,一边解码成语音、一边在线对齐视频帧——这个设计的实际价值是让回复通路与形象通路可以各自从异质的语音、对话、形象视频数据中学习,避开了「查询-文本-语音-视频」四元组大规模标注这个几乎不可能满足的前提。真正的工程含金量在流式那一步:把全序列视频教师蒸馏成少步的块因果 Streaming Student,用 Prefix Streaming 把干净潜变量跨块携带下去,抑制后段块的累积退化,四步推理、四卡在 400×720 下达到端到端 RTF 1.293。RTF 略大于 1 说明还不算真正实时,但已经把这条链路推到了可以谈产品化的操作点上。 人工智能炼丹君 整理 | 2026-08-13 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-12|阿里DUET两步视频质量多样性双赢 今日 AIGC 论文速览 今日共 10 篇 · 视频生成加速与少步蒸馏 3 篇 · 统一多模态表征与理解生成一体化 1 篇 · 音频与音乐生成 3 篇 · 扩散架构机理与图像编辑 2 篇 · RGBA 视频与资产生成 1 篇 重点论文标题列表 DUET(阿里巴巴·北京大学·清华大学深圳国际研究生院):两步视频生成质量多样性双赢 UniSpace(美团):8B统一模型扔掉VAE通路 SonicWeave(快手可灵团队·香港中文大学·清华大学深圳国际研究生院):一套权重生成全类音频场景 FullDiT(复旦大学·阿里巴巴 Token Foundry):音乐生成胜过五家商业系统 adaLN-Gaussian(北京大学·百度·UC Berkeley):零初始化才是DiT的真功臣 今日论文速览 1. DUET:两步视频生成质量多样性双赢 DUET: A Diversity-Quality Duet of Distillation Experts for Two-Step Video Generation | 阿里巴巴·北京大学·清华大学深圳国际研究生院 | arXiv:2608.09637 关键词:两步视频生成,少步蒸馏,质量多样性权衡,专家分工,流匹配 前序问题:扩散模型能生成高质量视频,但迭代采样的开销让实际部署很难受。少步蒸馏是主流解法,却暴露出一个绕不开的质量-多样性权衡:轨迹级蒸馏(如 sCM)倾向保住多样性但质量偏弱,分布级蒸馏(如 DMD)质量强但生成结果的结构多样性大幅塌缩。此前的工作大多试图在 loss 层面把两类目标混合调和,结果总是按下一头翘起另一头,且混合目标本身的优化难度还额外增加了训练成本。 本文贡献:面向极端的两步视频生成,提出 DUET,把权衡改造成噪声层面的专家分工:sCM 专家接管高噪声那一步,负责铺开多样的结构布局;DMD 专家接管低噪声那一步,负责精修外观细节。两个专家各自按原生目标独立训练,因此完全绕开了 loss 级组合的优化困难,质量与多样性是联合获得而非互相交换。作者进一步指出剩下的瓶颈在于「接力界面」和高噪声阶段本身,用 RL 引导的专家自适应加以解决,得到 DUET+。 实验效果:在 Wan2.1-T2V-1.3B 骨干上,DUET 把 sCM 的两步质量拉到接近 DMD 的水平,同时几乎完整保留其结构多样性——约为 DMD 的两倍;DUET+ 在保住这一多样性优势的同时进一步提升整体质量。 批判点评:这篇的洞察很值钱:把「质量 vs 多样性」从一个需要折中的标量权衡,重新表述成「不同噪声区间需要不同归纳偏置」的分工问题,从而让两个专家都能按最适合自己的目标训练。这比在 loss 里加权重系数干净得多,也解释了为什么此前的混合方案总在原地打转。局限也很清楚:两步生成需要同时维护两个专家权重,显存与部署复杂度是单模型方案的两倍,论文对这部分成本交代不足;「接力界面」被承认是瓶颈,说明高噪声专家交给低噪声专家的中间状态存在分布不匹配,DUET+ 用 RL 打补丁而非从原理上解决;此外骨干只验证了 1.3B 的 Wan2.1,在 14B 级别模型上噪声分工的最优切分点是否仍在同一位置,完全未知。 2. UniSpace:8B统一模型扔掉VAE通路 UniSpace: Unified Visual Representation and Scalable Multimodal Modeling | 美团 | arXiv:2608.08676 关键词:统一多模态,视觉表征,Patch重参数化,理解生成一体化,MoE 前序问题:语义视觉编码器已成为多模态理解和图像生成语义条件化的核心接口,但它的最终 token 会丢弃细粒度视觉细节,导致像素重建能力很差,因此无法直接用在图像生成、编辑这类对重建敏感的任务上。业界的通行做法是另外挂一条 VAE 通路专门负责重建,代价是架构分裂、两套表征空间难以对齐。 本文贡献:作者先做了一个反直觉的诊断:语义 ViT 的冻结 Transformer 块并非本质上无法保留视觉细节,真正把表征推向语义抽象、让细粒度信息难以从最终 token 恢复的,是原始的 patch 参数化方式。基于此提出 Patch Reparameterization——保留原有语义通路不动,另加一条重建感知的 patch embedding,把细粒度视觉信息送进同一批冻结 ViT 块。由此得到的统一表征既保住多模态理解能力,又能做高保真图像重建,重建-生成权衡曲线更优。作者进一步把这套表征放大成 UniSpace,一个 8B 的 Mixture-of-Transformer-Experts 模型,在同一个视觉空间里完成理解、生成和编辑,完全不需要独立的 VAE 通路。 实验效果:系统级评测显示模型具备可用的文生图能力与指令式图像编辑能力,验证了「重参数化后的预训练 ViT 可以充当可扩展多模态建模的统一视觉接口」这一主张。 批判点评:把矛头指向 patch 参数化而非 Transformer 块本身,这个归因方向是这篇最有价值的部分——它意味着大量「语义编码器保不住细节」的结论可能都是参数化方式的问题,而不是架构的固有缺陷,从而打开了「保留冻结语义骨干、只改输入侧」的低成本改造空间。去掉 VAE 通路对统一模型的架构简化意义很实在。但也要冷静看:论文用「practical text-to-image generation」这类措辞而非硬指标对比,说明生成质量距离专用 T2I 模型仍有明显差距,8B MoTE 的规模也不小;「重建-生成的有利权衡」是相对自身消融而言,缺少与 VAE 方案在同等算力下的正面对照;另外冻结 ViT 的容量上限是否会在更大规模上成为瓶颈,文中没有给出 scaling 证据。 3. SonicWeave:一套权重生成全类音频场景 SonicWeave: Chunk-Routed Mixture-of-Experts for Unified Audio Scene Generation | 快手可灵团队·香港中文大学·清华大学深圳国际研究生院 | arXiv:2608.09571 关键词:统一音频生成,Chunk路由MoE,流匹配,音频场景合成,专家专业化 前序问题:文本条件的通用音频生成正从孤立的语音、音乐、音效合成,走向用单个模型把它们组合成可控、连贯的音频场景。这个统一设定格外棘手:异质成分对共享骨干提出互相冲突的结构要求,而一个复杂混合场景内部还可能包含局部不同甚至相互重叠的内容,需要在同一段音频里做细粒度自适应。现有音频 MoE 大多在领域级别做路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。 本文贡献:提出 SonicWeave,一个面向统一音频场景生成的流匹配模型,核心是带冲突门先验-证据路由机制的 chunk 级 MoE(CPE-MoE)。它按连续的声学 chunk 做路由,把编码结构化文本条件与扩散阶段的全局先验,和来自演化中声学状态的局部证据结合起来;一个学出来的冲突门在局部状态不可靠时倾向采信全局先验,只在某区域明显偏离全局场景语境时才让局部证据主导路由。单套权重即支持语音、音乐、音效、歌声及其细粒度混合。 实验效果:在 TTS、TTA、TTM 三类基准上一致优于受控的 Dense 与 Base-MoE 基线;复杂场景评测进一步显示组合质量提升,路由分析揭示出跨扩散阶段的内容相关专家专业化现象。 批判点评:「按 chunk 路由」这个粒度选择切中了要害:语音的音素、音乐的节拍、音效的事件都是有时间跨度的结构,逐 token 决定专家等于在同一个声学事件内部反复换脑,chunk 级正好对上声学连续性。冲突门的设计也挺聪明——扩散早期局部状态本来就是噪声,此时强行采信局部证据只会引入路由抖动,用全局先验兜住是对的。不足在于对比强度:论文的对照是自己控制的 Dense 与 Base-MoE 基线,而非各领域的 SOTA 专用模型,所以「统一模型是否已经不输专精模型」这个最关键的问题没有回答;chunk 长度作为一个关键超参,其敏感性分析在摘要层面没有体现;此外 MoE 的实际激活参数量与推理开销未交代,工业落地时的性价比无法评估。 4. FullDiT:音乐生成胜过五家商业系统 Beyond Reconstruction: Full-Context Generative DiT for Music Generation | 复旦大学·阿里巴巴 Token Foundry | arXiv:2608.08787 关键词:音乐生成,暴露偏差,条件DiT,RVQ编解码,分类器无关引导 前序问题:混合式音乐生成器把自回归语言模型的长程规划能力,和扩散/流模型渲染器的高保真结合起来。但存在一个被忽视的部署错配:渲染器是用干净的、从目标推导出的 codec token 训练的,上线时却要接收语言模型的不完美预测,这就形成了 codec 接口层面的暴露偏差——训练时没见过的错误 token 分布,在推理时成了常态。 本文贡献:作者不再把渲染当成简单的重建任务,而是把它重新表述为「从一个不完美离散计划出发的全上下文生成」。为此提出 FullDiT:一个条件 DiT,融合八路帧对齐的 RVQ 流与独立编码的歌词、caption,并在完整声学隐序列上做非因果自注意力。训练阶段引入 Error-Matched Distractor Conditioning(EMDC),把每个 codebook 的替换率匹配到教师强制下的 top-1 错误率,并从余弦 KNN 邻域中采样「近似错答」token,同时不改变声学目标。推理阶段用四路 classifier-free guidance(4-CFG)独立缩放 codec、歌词、caption 三类引导增量。 实验效果:匹配消融显示 EMDC 在合成扰动下把 ViSQOL 提升 0.77,且在非并列比较中明显更受偏好;进一步消融验证了全曲上下文与渲染器侧文本条件各自的增益。完整系统在 18 项自动指标中的 15 项上超过五个商业系统,并在 Artificial Analysis 带唱音乐榜单上进入前三。 批判点评:EMDC 是这篇最扎实的一笔:不是随机加噪,而是把干扰率精确对齐到教师强制的真实 top-1 错误率,并从 KNN 邻域取「像是对的错答」,这让训练分布真正逼近推理时会遇到的错误结构,比通用数据增广讲得通得多。渲染器侧也吃歌词和 caption 这一点也很合理——语言模型的 plan 一旦出错,渲染器至少还有文本可以校正。质疑点在于评测:「18 项中的 15 项超过五家商业系统」这类表述缺少商业系统的具体版本与调用时间,商业模型迭代极快,可复现性存疑;ViSQOL 提升 0.77 是在「合成扰动」这一人造条件下测得的,真实语言模型错误分布是否同构未验证;八路 RVQ 加全序列非因果注意力意味着相当高的显存与延迟开销,论文未给出与主流方案的推理成本对照。 5. adaLN-Gaussian:零初始化才是DiT的真功臣 Unveiling the Secret of AdaLN-Zero in Diffusion Transformer | 北京大学·百度·UC Berkeley | arXiv:2608.09438 关键词:扩散Transformer,adaLN-Zero,零初始化,条件化机制,TPAMI 前序问题:扩散 Transformer(DiT)已成为图像生成的主流架构,围绕它的性能改进层出不穷,但社区对它的理解仍然停留在表面。一个典型例子是 adaLN-Zero:所有人都知道它比 adaLN 效果好,也都在用,但到底是哪一部分设计在起作用,一直没人系统回答过。 本文贡献:本文深入拆解 DiT 中的关键条件化机制 adaLN-Zero,把它的性能来源分解为三个候选要素——类似 SE 的结构、零初始化、以及「渐进式」更新顺序,并逐一做受控验证,最终证明零初始化是其中最具决定性的因素。基于这一理解,提出分析导向的初始化策略 adaLN-Gaussian:它既是对上述分析的经验验证,也是一个能稳定改善优化效率的实用初始化方法。另一方面,受 SE 式结构启发,提出改进的条件化机制 SE-adaLN-Zero。 实验效果:遵循 DiT 设置在四个数据集上做了充分实验,尤其在 ImageNet1K 上验证了 adaLN-Gaussian 与 SE-adaLN-Zero 的有效性和泛化性;除类别到图像生成之外,还在文生图任务上评估了两种改进方法的泛化能力。论文已被 IEEE TPAMI 2026 接收。 批判点评:这是今天最「不性感但最有长期价值」的一篇。当整个领域都在往上堆模块时,回头把一个被默认使用了数年的组件拆开做归因,得到的是可迁移的设计原则而不是又一个刷分技巧——「零初始化主导」这个结论对任何做残差式条件注入的架构都有参考意义,adaLN-Gaussian 作为一行初始化改动,落地成本几乎为零。局限在于实验尺度:遵循原始 DiT 设置意味着规模偏小,ImageNet1K 类别到图像生成与今天动辄十亿参数的 T2I/T2V 训练环境差距不小,零初始化的主导地位在大规模、长训练下是否依然成立需要更强证据;文生图上的泛化验证在摘要中只是一笔带过,没有给出具体量级;此外 SE-adaLN-Zero 作为结构改动会带来额外参数与算力,论文未讨论其与收益的性价比。 6. REST:把RL副产物直接当蒸馏监督 RL-Native Distillation: Exploiting Scored Trajectories for Few-Step Image Generation | 上海交通大学·阿里巴巴淘天集团 | arXiv:2608.09226 关键词:少步图像生成,RL蒸馏协同,优势调制,奖励对齐,无CFG推理 前序问题:高效文生图既需要基于强化学习的奖励对齐,也需要少步蒸馏,但这两个流程通常被串行执行:先 RL 对齐、再压缩步数。这不仅推高训练成本,还有一个隐患——压缩过程可能把前一阶段辛苦对齐来的奖励收益又丢掉。 本文贡献:作者提出一个 RL 原生视角:扩散 RL 本身就在生成带奖励分数的有限步轨迹,这些中间状态是天然的蒸馏监督来源,而不是采样过程的一次性副产物。基于此提出 REST(Reward-Enhanced Scored-Trajectory Distillation),一个单阶段的 RL-蒸馏协同训练框架,把一个解耦的学生挂到任意 RL 教师上:学生从教师不断演化的 rollout 轨迹中分段学习,而教师原本的优化过程完全不受干扰。为避免无差别模仿把教师的低奖励行为也一并保留,进一步提出 Advantage-Modulated Distillation(AMD),把 rollout 的优势值转换为基础蒸馏损失上的带符号权重——强化来自优选轨迹的监督,并轻度排斥低奖励轨迹。整个框架轻量且即插即用,不需要额外的图像 rollout、独立蒸馏数据集或对抗训练。 实验效果:在组合式生成、视觉文字渲染、人类偏好对齐三类任务上,REST 使无 CFG 的少步推理能够追平甚至超越其 40 步的 RL 教师,而额外训练成本低于纯 RL 的 25%。在 DrawBench 上 PickScore 比 RTDMD 高 0.82,且只需其五分之一的训练迭代数。 批判点评:这篇的核心洞察属于「看见了别人扔掉的东西」:RL 阶段每一步 rollout 都自带奖励分数和完整中间状态,串行流水线却把它们当垃圾清掉,然后再花一遍算力重新造蒸馏数据——指出这点之后,单阶段协同几乎是自然结论。AMD 用带符号权重区分优劣轨迹也很关键,否则蒸馏会连教师的坏习惯一起继承。落地友好度高:不改教师、不加 rollout、不用对抗训练,额外成本 25% 以内。需要打问号的地方:学生学的是教师「演化中」的轨迹,教师早期还没对齐好时的轨迹质量偏低,论文没说清如何避免学生被早期噪声带偏(是否需要 warmup 或权重退火);「追平甚至超过 40 步教师」中的「超过」很可能来自 AMD 对低奖励轨迹的排斥效应,本质上是奖励模型上的进一步过拟合,是否真正提升人类感知质量存疑;此外三类任务均偏重可自动打分的能力,对开放域美学的影响未评估。 7. EditMod:1K图编辑仅需1.57秒 Model the Edit, Not the Image: Visual Autoregressive Editing from a Source-Centric Perspective | 北京理工大学·浙江大学·腾讯·深圳大学 | arXiv:2608.09057 关键词:视觉自回归,图像编辑,源为中心,多尺度残差,免反演 前序问题:下一尺度视觉自回归模型(VAR)通过由粗到细的高效预测生成高质量图像,已是一条强有力的生成范式,但它在文本引导图像编辑上的潜力基本没被开发。现有的免训练 VAR 编辑方法大多把编辑表述为「以源图为引导或约束的目标条件重新生成」,还往往依赖反演、测试时优化、注意力控制或用户提供的掩码。这种生成为中心的表述没有充分利用 VAR 天然提供的多尺度源表征,还引入了额外计算或人工干预。 本文贡献:作者转向源为中心的 VAR 编辑视角:把编码后的源图像 token 当作主要视觉状态,编辑过程只聚焦于条件诱发的变化量。基于这一视角提出 EditMod——在共享的自回归上下文下,对比源条件预测与目标条件预测,把两者之差视为逐尺度的编辑方向,再把它作为残差更新施加到选定尺度的源 token 上。整条链路不需要反演、不需要测试时优化、也不需要用户掩码。 实验效果:实验显示 EditMod 在源图保真度上处于领先水平,同时保持很强的文本对齐能力;在单张 A100 上完成 1K 分辨率图像的端到端编辑仅需 1.57 秒,且无需任何逐图预处理准备。 批判点评:「建模编辑量而不是重建整张图」这个转向非常对症:编辑任务本来就只有小部分内容需要变,让模型从零重新生成整图,既浪费算力又让未编辑区域无谓漂移。用源条件与目标条件预测之差作为逐尺度编辑方向,思路上和 classifier-free guidance 的差分同源,但落在 VAR 的多尺度 token 上更自然,也顺带解释了为什么能免反演、免掩码。1.57 秒完成 1K 编辑的数字对交互式应用相当有吸引力。局限在于:残差更新施加在「选定尺度」上,哪些尺度该动、动多少,摘要没交代选择准则,很可能是需要调的超参数,直接影响可用性;差分方向对提示词写法的敏感度未讨论——目标提示与源提示措辞差异过大时,差分可能失控;此外 VAR 生态目前的基座模型数量与质量都远不如扩散系,方法再好也受限于骨干天花板。 8. BAG:缓存复用改由门控网络决策 BAG: Budget-Aware Gating for Diffusion Caching | 浙江大学·西湖大学 AGI Lab | arXiv:2608.09231 关键词:扩散缓存,预算感知,门控网络,调度蒸馏,DiT加速 前序问题:扩散缓存是加速 DiT 的轻量手段——在去噪步之间复用中间特征,但现有范式面临一个根本权衡:在线启发式规则缺乏全局预算意识,不知道整体算力还剩多少;静态调度表则缺乏实例自适应能力,也无法灵活适配运行时变化的预算约束。 本文贡献:提出 BAG(Budget-Aware Gating),一种把全局预算节奏控制与动态、实例自适应的特征复用统一起来的缓存策略。它不再依赖手工规则,而是用一个轻量门控网络,在每一步同时以预算状态和局部轨迹反馈为条件,动态决定「执行完整计算」还是「复用缓存特征」。该策略通过离线到在线的调度蒸馏训练得到——把离线搜索出的调度表所包含的决策能力,迁移进一个紧凑的在线门控。 实验效果:在 FLUX.1-dev 与 Wan2.1 上的大量实验表明,BAG 在各个加速档位上一致优于当前最好的缓存方法,并且在不同分辨率、随机种子和引导强度下都保持稳健。代码将开源。 批判点评:把「算还是复用」这个决策交给一个同时看全局预算和局部轨迹的小门控,方向是对的:静态表不知道当前这张图难不难,在线启发式不知道预算还剩多少,两者的盲区正好互补。离线搜索调度表再蒸馏成在线门控,也是一种务实的工程折中——离线搜索能看到全局最优,在线门控只需继承其决策模式。可疑之处在于泛化边界:门控网络是学出来的,训练时的预算区间、分辨率和模型骨干一旦超出,决策是否还成立没有交代;论文强调在不同分辨率、种子、引导强度下稳健,但这些都属于同骨干内的扰动,换到未见过的 DiT 上是否需要重新蒸馏是关键问题。另外门控本身的推理开销虽称轻量,但在高加速档位下相对总算力的占比会被放大,摘要未给出具体数字。 9. CuteTTS:首音延迟直降23.3% CuteTTS: Efficient and High-Quality Speech Synthesis via Autoregressive Modeling of Continuous Latents | 复旦大学·上海创智学院 | arXiv:2608.08638 关键词:零样本TTS,连续自回归,流匹配,引导步蒸馏,低延迟 前序问题:零样本文本转语音已经在支撑交互式助手、个性化媒体和无障碍工具,所有 TTS 系统都要同时满足三件事:忠实的语言渲染、一致的说话人身份、以及低延迟响应。但紧凑的流式系统必须在一个可预测的低码率隐序列里保住足够的声学细节,而迭代式扩散采样与 classifier-free guidance 又会在每个自回归步上把推理成本乘上一遍。 本文贡献:提出 CuteTTS,一个紧凑的连续自回归 TTS 系统:把语义对齐的因果 VAE 隐变量、patch 级自回归、显式说话人条件化与双向流匹配头结合起来。进一步提出 guidance-step distillation,把 classifier-free guidance 与多步求解器一起吸收进单个区间条件化的学生模型,从而在推理时不必再为引导和多步求解重复付费。 实验效果:在 LibriSpeech 与 Seed-TTS-Eval 上,零样本音色克隆的可懂度与说话人相似度具备竞争力;蒸馏使首音延迟相对基础模型降低 23.3%、实时率降低 40.8%,而客观与主观质量保持相当。 批判点评:把 CFG 和多步求解一起蒸进「区间条件化」的单个学生,这一手比单纯做步数蒸馏更实用:交互式 TTS 的痛点是首音延迟,而 CFG 意味着每步都要跑两遍前向,属于纯粹的常数倍开销,能一并吸收掉收益很直接。走连续隐变量而非离散 token,也规避了码本容量对声学细节的硬约束。不足在于对比强度不够:「competitive」这种措辞通常意味着没有在可懂度或相似度上取得优势,仅是持平,而真正的卖点全在效率数字上;23.3% 和 40.8% 都是相对自身基础模型的相对提升,没有给出与主流流式 TTS 的绝对延迟对照,工业选型时价值有限;双向流匹配头与因果 VAE 的组合在流式场景下的前瞻依赖长度也没交代,这直接决定能否真正做到低延迟流式。 10. GameAlpha:透明区域跳算省35%token Alpha as an Efficiency Signal: Visibility-Routed RGBA Image-to-Video Generation | 北京大学·字节跳动·清华大学 | arXiv:2608.09355 关键词:RGBA视频生成,游戏素材,可见性路由,流匹配,DiT加速 前序问题:RGBA 视频把 RGB 外观与 alpha 通道结合,让动画素材能贴到任意背景上,游戏行业用量极大。但高质量游戏 RGBA 动画生成有两个卡点:一是现有 RGBA 视频数据集以写实内容为主,游戏素材覆盖很少;二是传统的先生成再抠像流水线在 RGB 合成之后才估计 alpha,半透明区域常被背景糊掉,导致抠像输出不稳定。近期开始有工作联合建模 RGB 与 alpha,但大多是文本条件的,效率与质量上仍有未解问题。 本文贡献:构建 GameAlpha-2.4K,一个 2.4K 片段的游戏风格 RGBA 视频数据集,用抠像友好的合成、多假设 alpha 恢复和基于合成的质量门筛选制成。在此之上训练一个参考图条件的 RGBA 视频生成器,单次前向同时产出 RGB 帧与 alpha 遮罩。为提升效率,提出 visibility router:在早期阶段就识别出透明 token,跳过它们后续的 DiT 更新;同时用 x_0-lock 让这些 token 沿原始流匹配调度朝自预测终点前进,避免被跳过后偏离轨迹。 实验效果:模型的 FVD 低于传统两阶段流水线;visibility router 在最后两个 DiT 去噪步中跳过 35% 的 token 评估,带来 1.2 倍骨干加速,质量退化可忽略。 批判点评:「把 alpha 当效率信号」这个提法很巧:alpha 通道本身就明确标出了哪些区域是透明的、几乎不含内容,这等于免费拿到一张算力分配图,不需要额外训预测器去猜哪里重要——这是本文最讨巧也最合理的一点。x_0-lock 的补充也必要,否则被跳过的 token 会脱离流匹配轨迹造成边缘伪影。但工业价值需要打折看:1.2 倍加速且仅作用于最后两个去噪步,这个收益相当有限,与今天另外两篇(BAG、DUET)动辄数倍的加速不在一个量级;GameAlpha-2.4K 只有 2.4K 片段,对视频生成而言规模偏小,是否足以支撑通用游戏素材生成存疑;FVD 低于两阶段流水线是个较弱的基线选择,未与近期联合建模 RGBA 的方法正面比较;此外游戏风格数据训出的模型跨美术风格泛化能力完全未讨论。 趋势观察 少步蒸馏从「二选一」走向「按噪声分工」 — 阿里与北大的 DUET 把长期困扰少步蒸馏的质量-多样性权衡拆成了一个分工问题:轨迹级蒸馏(sCM)保多样性、分布级蒸馏(DMD)保质量,此前所有工作都在试图用一个 loss 把两者调和,结果总是牺牲一方。DUET 干脆让 sCM 专家接管高噪声那一步负责铺开结构,DMD 专家接管低噪声那一步负责精修细节,两个专家各按自己的原生目标独立训练,绕开了 loss 组合的优化困难。两步视频生成上质量逼近 DMD、结构多样性保住 sCM 水平(约为 DMD 的两倍)。这是今天最干净的一个「把权衡改造成分工」的范式样本。 推理加速的重心从「压缩步数」转向「花掉的算力值不值」 — 今天有三篇从不同角度攻同一件事。上交与淘天的 REST 指出 RL 对齐与少步蒸馏被串行执行是纯粹的浪费——扩散 RL 本身就在生成带奖励分数的有限步轨迹,那些中间状态是天然的蒸馏监督,不该当采样副产品扔掉;单阶段协同训练后,无 CFG 的少步推理能追平甚至超过 40 步的 RL 教师,额外训练成本不到纯 RL 的 25%。浙大与西湖的 BAG 则戳破缓存策略的两难:在线启发式没有全局预算意识、静态调度又缺乏实例自适应,改用一个轻量门控网络同时看预算状态和局部轨迹反馈来决定「这一步算还是复用」。字节与北大的 GameAlpha 走的是第三条路——不去改调度,而是让 alpha 通道直接充当算力分配图,透明 token 早早识别出来后跳过后续 DiT 更新。三条路线的共同指向是:加速的下一程不在「少走几步」,而在算力分配的精细化——按训练流程、按实例难度、按空间区域,各有各的省法。 统一模型开始拆掉 VAE 这根拐杖 — 美团的 UniSpace 提出一个反直觉的观察:语义 ViT 的冻结 Transformer 块并非天生保不住视觉细节,真正把表征推向语义抽象的是原始的 patch 参数化方式。于是它做 Patch Reparameterization——保留原语义通路,另加一条重建感知的 patch embedding,把细粒度信息喂给同一批冻结 ViT 块,最终把理解、生成、编辑装进同一个视觉空间,8B 的 Mixture-of-Transformer-Experts 全程不需要独立的 VAE 通路。这条路子如果站得住,意味着统一多模态模型的架构可以显著简化:一个预训练 ViT 即可充当通用视觉接口。 音频生成开始追求「一套权重装下所有声音」 — 快手可灵团队与港中文的 SonicWeave 把语音、音乐、音效、歌声以及它们的细粒度混合塞进单个流匹配模型。它的技术判断很具体:现有音频 MoE 大多在领域级别路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。SonicWeave 改按连续声学 chunk 路由,并用一个冲突门在局部状态不可靠时倾向全局先验、在区域偏离全局场景时才让局部证据说话。复旦与阿里 Token Foundry 的 FullDiT 则捅破混合式音乐生成的一个部署真相:渲染器用干净的目标 codec token 训练,上线却要吃语言模型的不完美预测,这是典型的暴露偏差;把渲染重新定义为「从不完美离散计划出发的全上下文生成」,并按教师强制下的 top-1 错误率匹配干扰替换率,最终在 18 个自动指标中的 15 项上超过五家商业系统。 扩散架构的「知其所以然」终于开始补课 — 北大与百度的 adaLN-Zero 研究(TPAMI 2026)值得单独一提:DiT 已被用了几年,但 adaLN-Zero 为什么比 adaLN 好,社区一直只有直觉。这篇把候选解释拆成三条——SE 式结构、零初始化、渐进式更新顺序,逐一做消融,最终证明零初始化才是主导因素,并顺势给出 adaLN-Gaussian 初始化与 SE-adaLN-Zero 改进结构。在基座模型迭代如飞的当下,这类回头做机理归因的工作反而更稀缺:它给出的是可迁移的设计原则,而不是又一个刷分技巧。 人工智能炼丹君 整理 | 2026-08-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注