Qualitative comparison between JoyAI-Echo-1.5 and JoyAI-Echo-1.0 under the same long-form story. Frames sampled from temporally separated shots demonstrate the improved character consistency, scene stability, and visual rendering of JoyAI-Echo-1.5.
批判点评:这是今天最有系统完成度的一篇,把记忆、几何控制、rollout 感知训练三件事拧成了一条可交付的产线,「记忆用独立 RoPE 坐标编址」这个设计尤其值得借鉴——它把长时程一致性从算力问题重新定义成检索问题。但要清醒看待几点:一是作者自己的对比图(v1 vs v1.5)虽然显示身份更稳,但这是自家版本迭代的自证,跨镜头一致性缺少与外部强基线在同一故事下的逐镜头量化;二是 WBench 81.7 的第一名含金量取决于该榜单的竞争密度与提交时间窗口,且世界模型变体与长视频变体是两套权重,「统一系统」在部署时实际是双栈;三是 10 分钟叙事依赖 Director Agent 做镜头编排,这层是外部 agent 而非模型内生能力,把它算作模型的长时程能力会高估;四是音频分支只用 LoRA 而视频全量微调,这个非对称选择在论文里更多是稳定性权衡的结果,音频质量上限是否被 LoRA 限制没有充分消融。
2. 4DStreamCtrl:单卡 480p 20FPS 交互式 4D 控制
4DStreamCtrl: Interactive Video Generation with Online 4D Control | 北京大学、腾讯混元 | arXiv:2608.25479
关键词:视频生成,4D控制,3D point track,流式生成,因果蒸馏,相机控制,北大腾讯混元
前序问题:生成视频已经足够逼真,但要真正当成交互工具用,必须能精细指定「物体和相机随时间怎么动」——而现有方法各自只覆盖一角:相机参数类方法能调视角但搬不动物体;2D 轨迹类方法在图像平面上操作,忽略深度与遮挡,导致物体沿轨迹移动时尺度和前后关系失真;近期的 3D 方法补上了几何,却只能离线跑且视频长度固定。换句话说,没有一种方法同时做到「相机与物体都是 3D 一致可控」加「实时流式生成」。这两个要求还互相冲突:3D 一致性通常需要全序列联合优化,而流式生成要求因果、恒定显存。
本文贡献:作者的核心主张是:相机运动、物体轨迹、深度这三件事可以统一进单一的 3D point track 表征,一个模型在一次前向里就能同时做相机与物体的联合控制、深度编辑和运动迁移。为了规模化学到这个接口,他们从野外视频挖掘 3D 运动监督,构建 OpenVidHD-Motion3D 数据集,并用一个轻量的 Geometric Motion Head 把 3D tracks 与文本编码为 2D 与深度运动特征,与含噪 latent 融合后送入带 3D RoPE 的 DiT,再解码成视频——这个编码器插在预训练视频扩散模型上,不需要重训骨干。关键一步在于这个编码器是时序可分离的,因此可以把模型蒸馏成因果流式学生:生成任意长视频只需四步去噪,且显存与长度无关。
Overview of 4DStreamCtrl capabilities. (a) Motion transfer. Given a source video, we extract decomposed 4D representations of camera motion, human motion, and background structure, which transfer to a new scene via image style transfer while preserving the original motion.
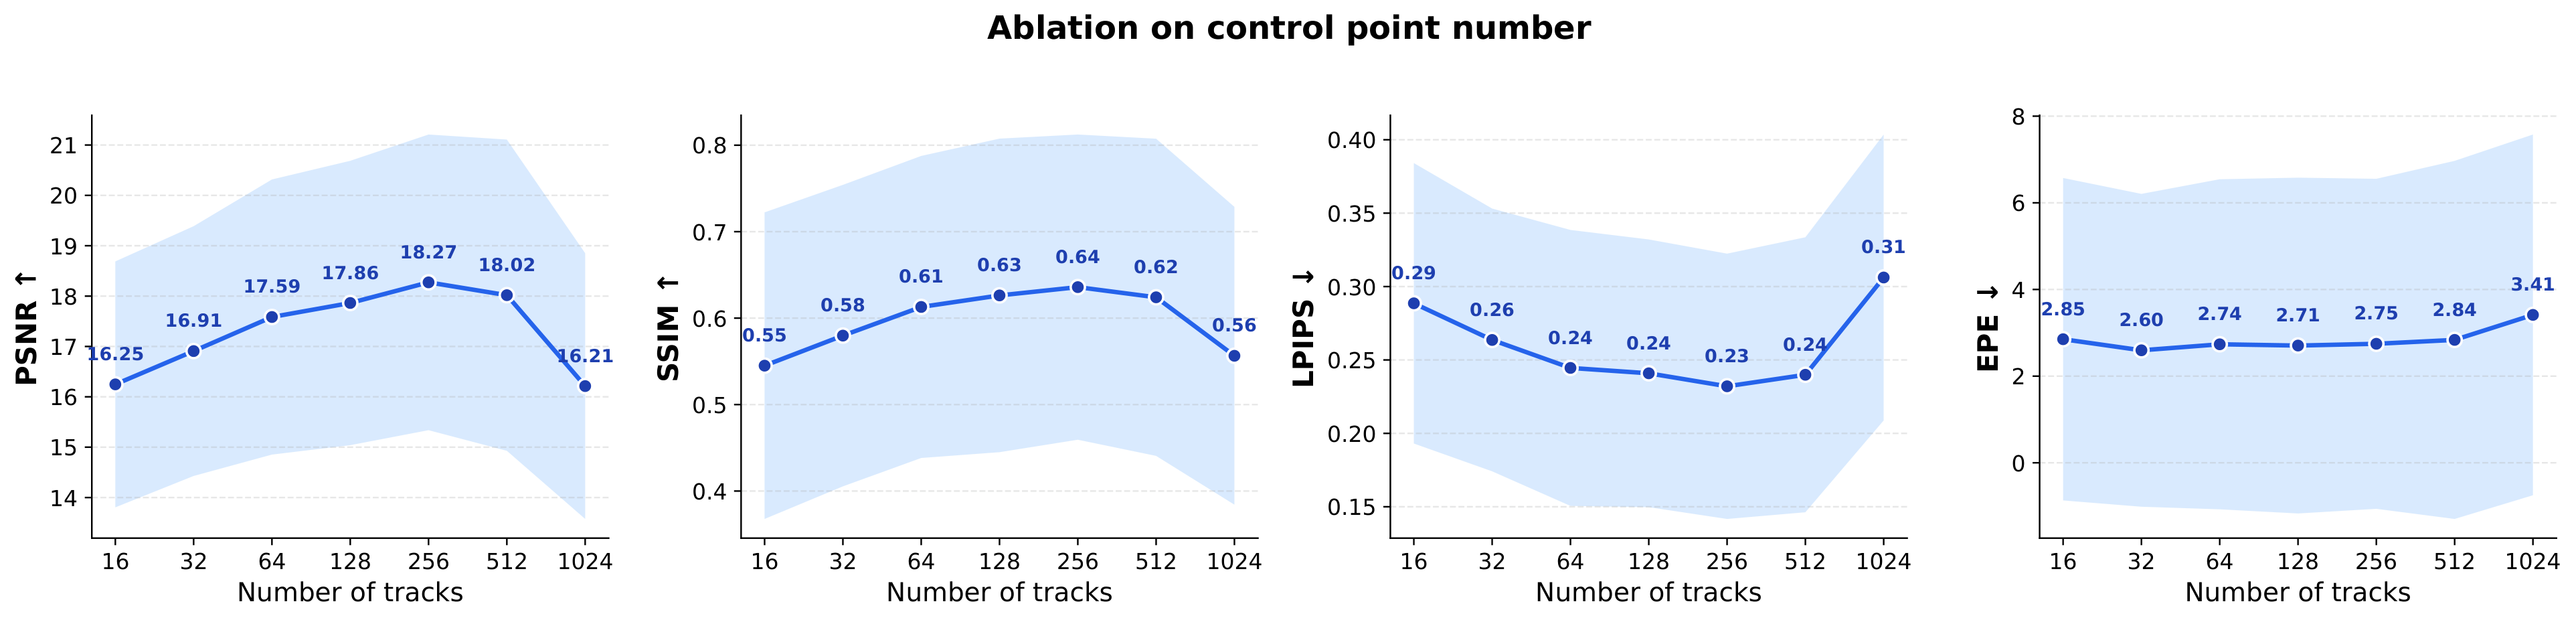
Effect of the number of control points on student model generation. PSNR, SSIM, LPIPS, and EPE as the inference-time track count varies from 16 to 1024. Quality peaks at the training count of 256.
批判点评:把相机、物体、深度三种控制统一到 point track 这一个表征上,是这篇最漂亮的地方——它让「一次前向多种控制」成为可能,而不是堆三个适配器。工程指标也扎实:单卡 20 FPS 加长度无关显存,确实够得上交互门槛。需要注意的是:一是 point track 的质量完全依赖上游 3D 追踪器,野外视频挖掘出的监督在遮挡、快速运动、低纹理场景下必然带噪,论文没有量化追踪误差如何传导到控制精度;二是 track 数量的敏感性不小(1024 点时 PSNR 从 18.27 掉回 16.21),说明模型对推理期配置的鲁棒性有限,实际部署需要把点数锁在训练值附近,这对「艺术家自由指定轨迹」的宣称是个约束;三是作者自己的失败案例图承认长时程下小人脸与背景物体会逐渐模糊、并出现因果不一致的交互(蛋糕莫名缺一块),说明四步因果学生在细节保真上仍有代价;四是 480p 分辨率对「交互式创作工具」偏低,抬到 720p/1080p 后 20 FPS 能否维持是未知数。
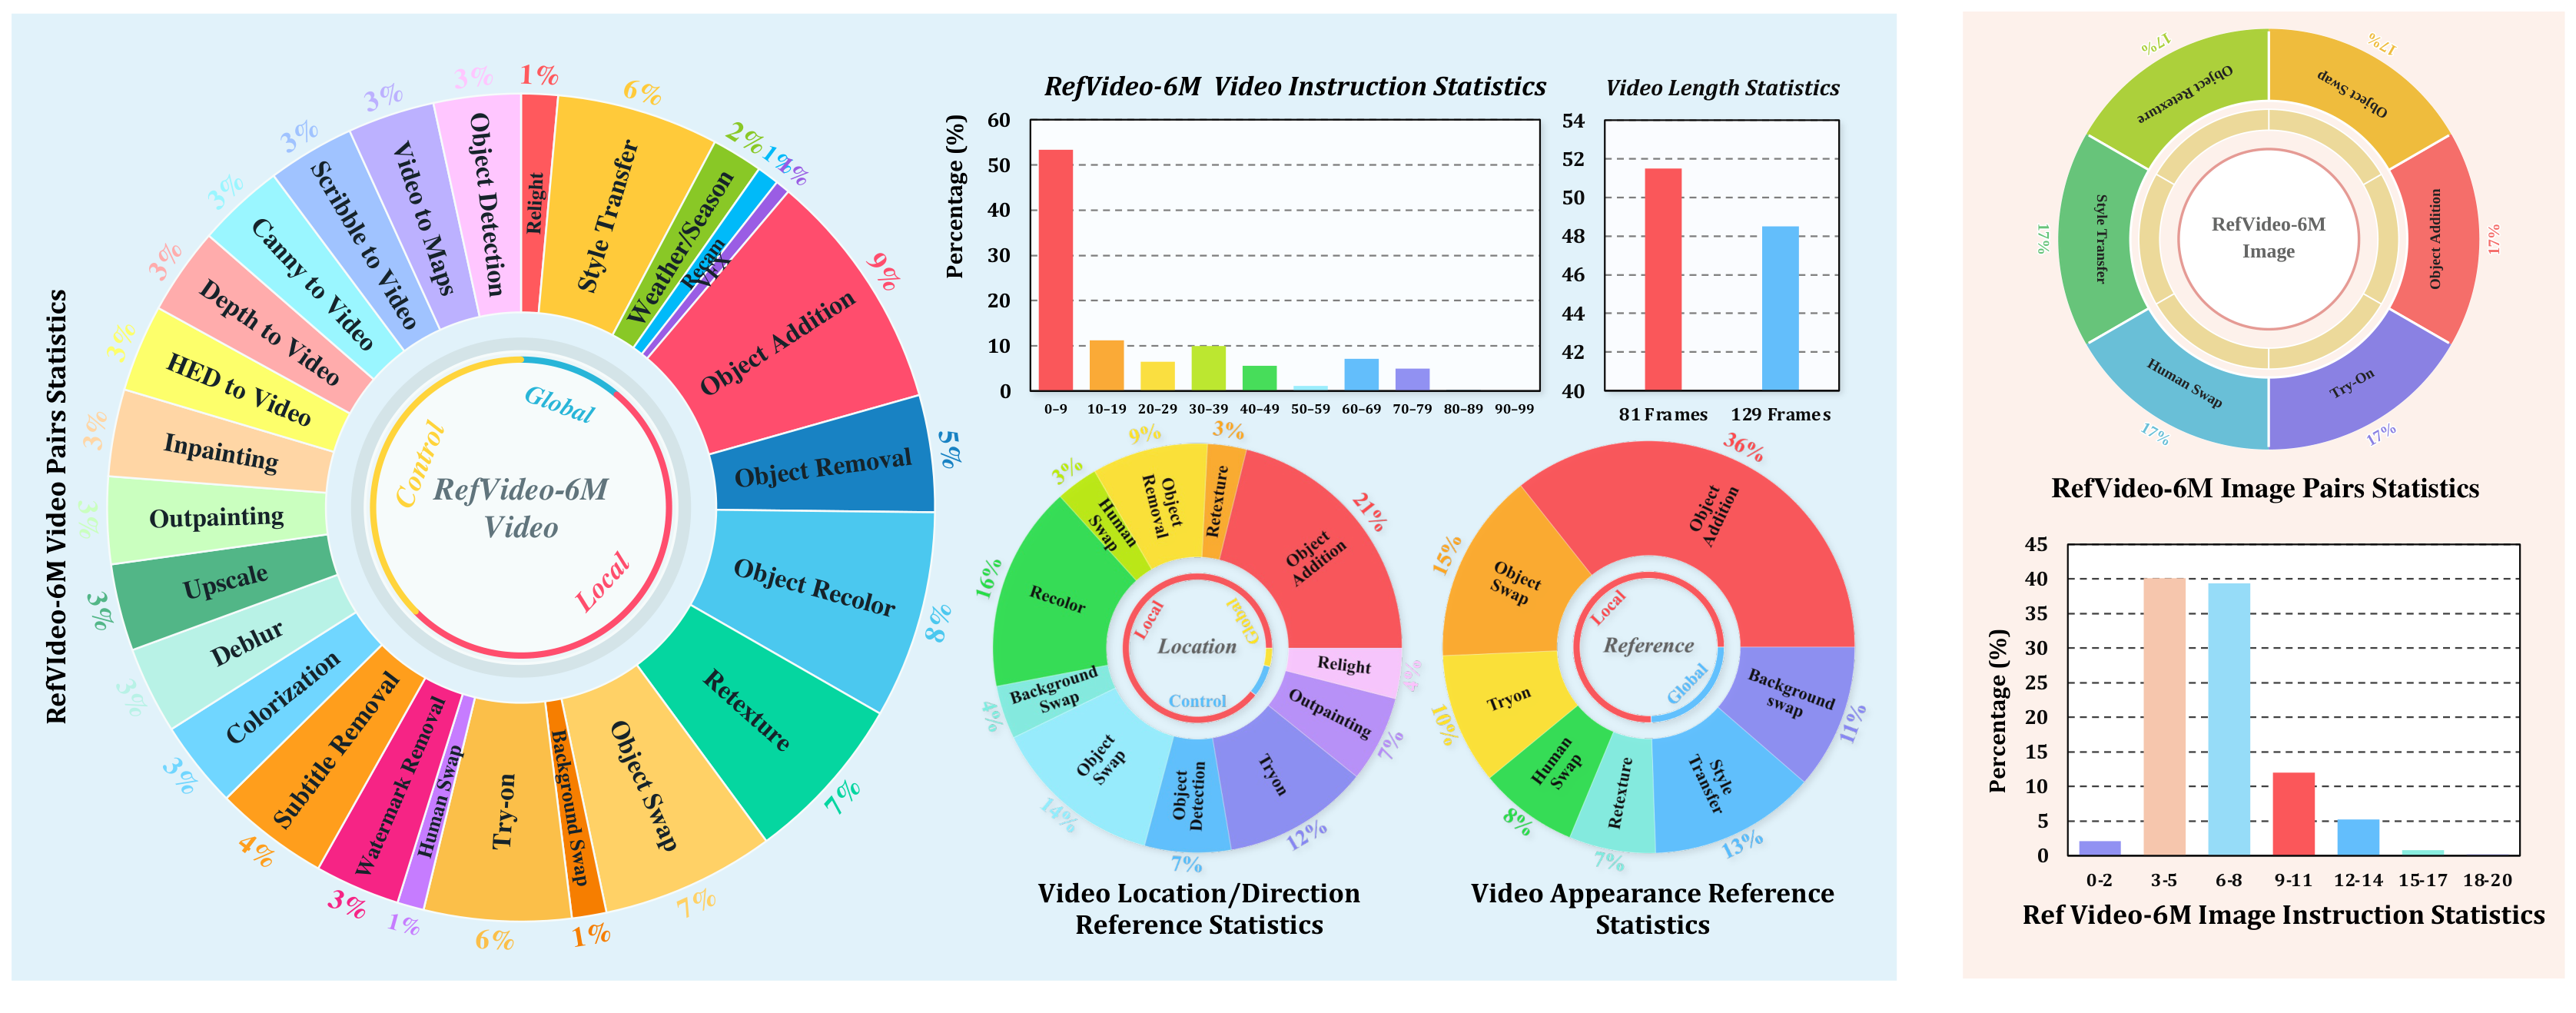
3. RefVideo-6M:600 万参考式编辑对反转构造
RefVideo-6M: A Reliable Reference-Based Dataset for Instructional Video Editing | 中国电信 TeleAI、香港中文大学、中山大学、复旦大学、清华大学 | arXiv:2608.26101
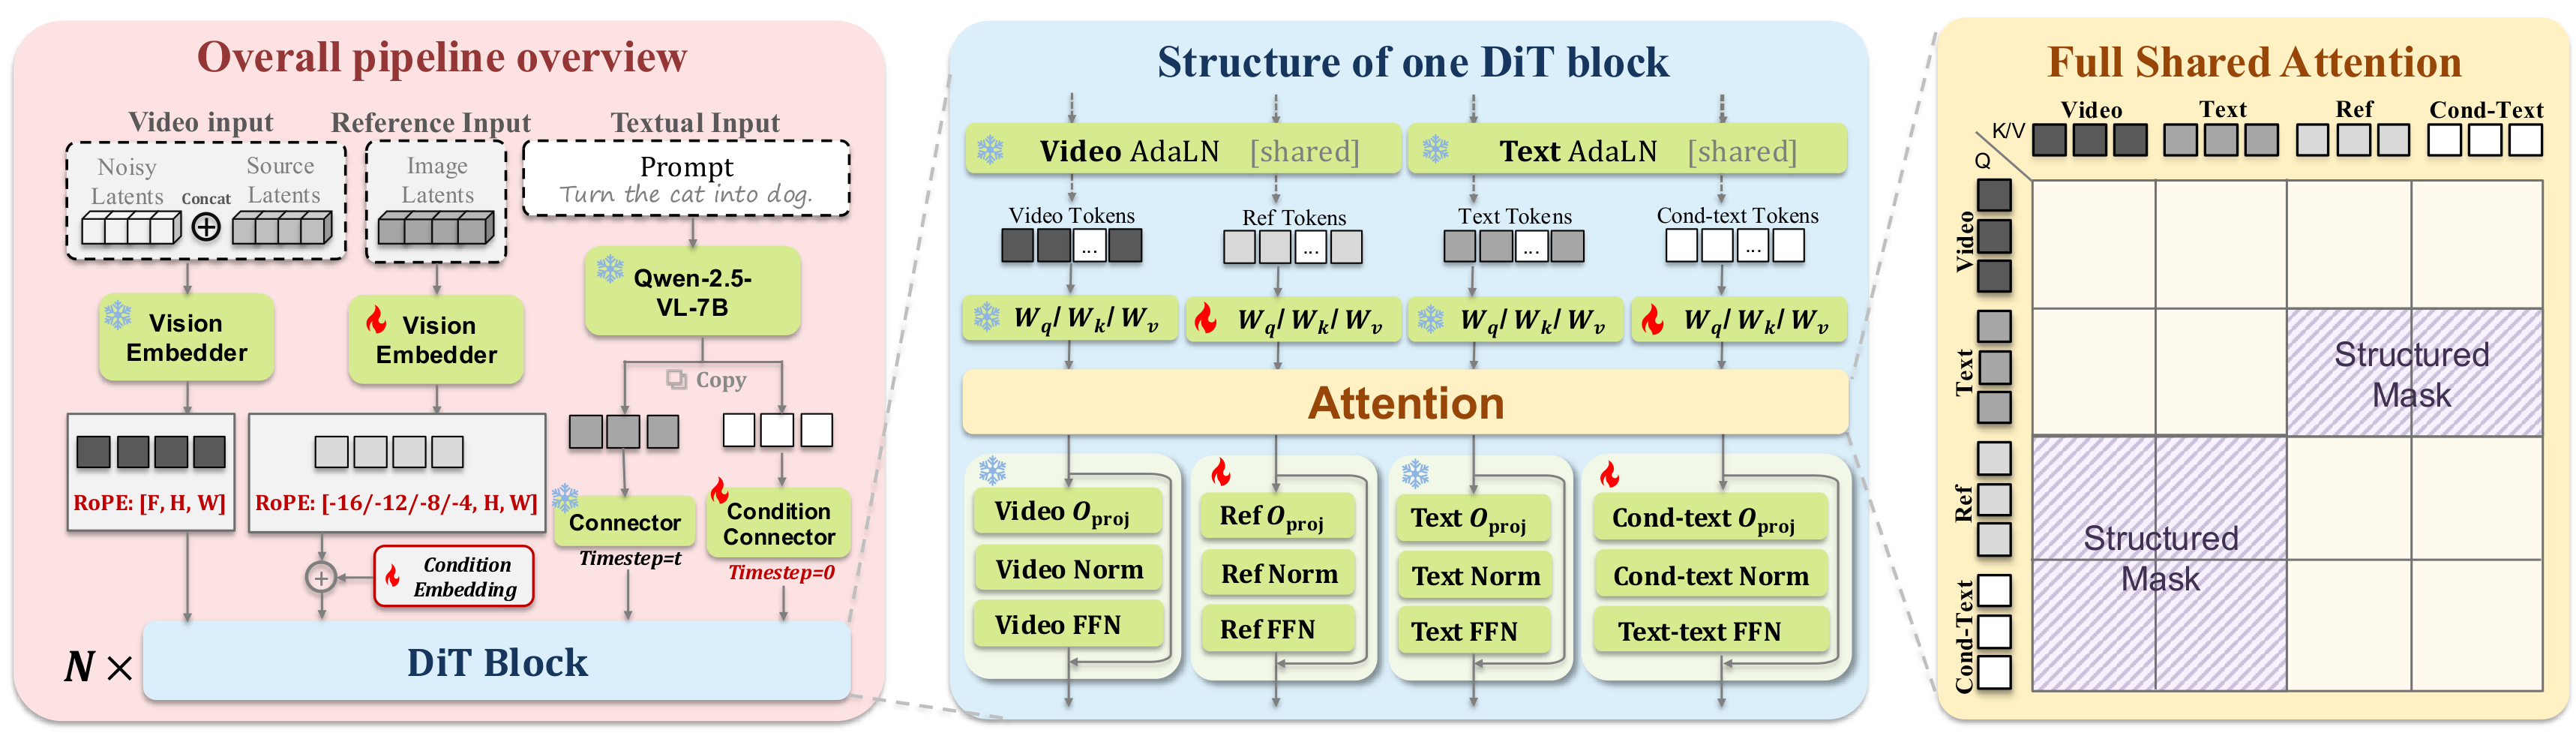
Overview of RefMoT. RefMoT adopts a Mixture-of-Tokens design to efficiently incorporate reference information, reducing training cost while improving reference-guided editing quality and preserving strong generalization.
Overview of the proposed framework. (a) Overall framework under the MTP (R$_1$, B) setting: besides the original NTP (R$_1$) head, an additional MTP head is introduced to provide auxiliary supervision for the token directly below the current token. (b) TCR: Sampled token representations are projected by a shared MLP to compute a similarity matrix.
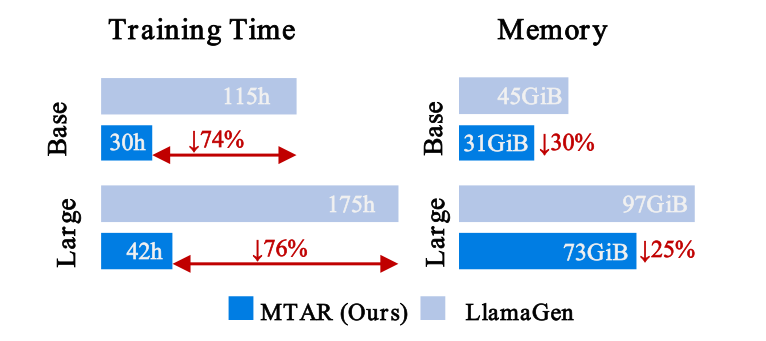
Comparison of total training time (hours) and total GPU memory usage across all training GPUs between LlamaGen and MTAR for the Base and Large models, along with the corresponding FID values. LlamaGen is trained for 300 epochs, whereas MTAR is trained for only 100 epochs.
Plans You Can Check: Verifier-Grounded Learning of an Open-Weight Planner for Executable Video-Editing | 香港中文大学(深圳)、vivo AI Lab、中国科学院大学、东南大学、北京大学 | arXiv:2608.25622
前序问题:纹理艺术家想为一个已有 3D 形状快速试多种外观,条件图像生成本来很合适,但当前最强的方法仍有两个缺口。一是保真度:生成整个物体纹理时很难同时贴合精细几何细节和单视图参考,留给艺术家引导的空间很小——模型倾向于按自己的全局理解重画,而不是老老实实跟随参考。二是灵活性:现有自动模型多数是「给个全局提示、一键出整体纹理」,艺术家无法从不同来源交互式、可控地探索多种纹理组合。这类方法通常还要在大规模 3D 数据集上训练,数据门槛高。
本文贡献:GLOSS 走了一条反直觉的路线:不追求在大 3D 数据集上学通用先验,而是针对单个 3D 形状训练一个「形状专属」的局部纹理生成与补全模型,利用自然与人造形状中普遍存在的几何自相似性以及几何-纹理相关性。具体做法是在该未贴图形状的大量单视图生成图像上训练网络,让它学会通过关注局部几何(比如鳞片走向)来为局部区域上色,并忠实跟随作为条件的纹理参考块。训练完成后,任何新参考都能通过逐块 inpainting 迁移成整个目标物体的纹理。作者还展示了批量多注意力可视化,说明目标图像中心 patch 如何跨批次关注参考图像的各个 patch。
We train a GLOSS network on many single-view generated images of one untextured 3D shape (left), allowing it to learn how to texture local shape regions by attending to local geometry (such as scales) and faithfully following conditional texture patches.
实验效果:质量上达到或优于强图像条件纹理生成基线,同时额外支持局部几何条件下的纹理修补(由艺术家挑选参考引导),并可泛化到 PBR 材质与未见网格做纹理迁移。作者把这个纹理填充能力做成 Blender 插件,与若干 3D 纹理专业人士做了试点,对模型的可控性、实用性与创作启发性反馈积极。论文也诚实给出失败案例:语义纹理错配,以及几何与纹理相关性低时的失效。
Data and Training: we use off-the-shelf models to generate training data for our local texture inpainting model. Steps A to F show the patch data generation pipeline.
批判点评:「per-shape 专属模型」这个取向很有意思——放弃泛化换取对单个资产的极致保真与可控,正好命中艺术家工作流里「这一个模型要做到位」的真实需求,而且大幅降低了数据门槛。做成 Blender 插件并请真实从业者试用,这种落地闭环在学术论文里不多见,值得加分。但代价也很直白:每换一个形状就要重新训练一个网络,论文摘要没有给出单形状训练耗时,这直接决定它是「可用工具」还是「demo」;如果一个资产要等数小时,交互式探索的价值就被抵消了。其次「几何自相似性」这个前提有明确适用边界——鳞片、砖墙、织物这类重复结构受益明显,而光滑无特征或语义强依赖(比如人脸、品牌标识)的表面会退化,作者的失败案例也承认了几何-纹理相关性低时失效。第三,专业人士试点是小样本主观反馈,缺少与现有商业工具的定量对照。最后,作者之一因会议地点原因撤出 SIGGRAPH Asia 2026 发表,属论文外信息,但说明该工作原定投向图形学顶会。
7. Gen2Physics:材质分割 mIoU 15.6 涨到 48.3
Gen2Physics: Grounding Generated 3D Meshes in Physics via Multi-View Material Decomposition | Google DeepMind、Google Research、布里斯托大学 | arXiv:2608.23869
前序问题:生成式模型现在能产出高保真 3D 网格,但这些输出缺少交互仿真、游戏和机器人所需的物理属性——它们只是「看起来对」的壳,没有材质、密度、内部结构信息,扔进物理引擎里行为完全不对。此前的物理化工作大多针对体素或神经场等体表征,与标准物理引擎不兼容,需要额外转换;而且它们通常把整个网格当作单一均质物体处理,一把钳子的金属头和塑料柄被赋予同一个密度,自由落体和碰撞行为自然失真。
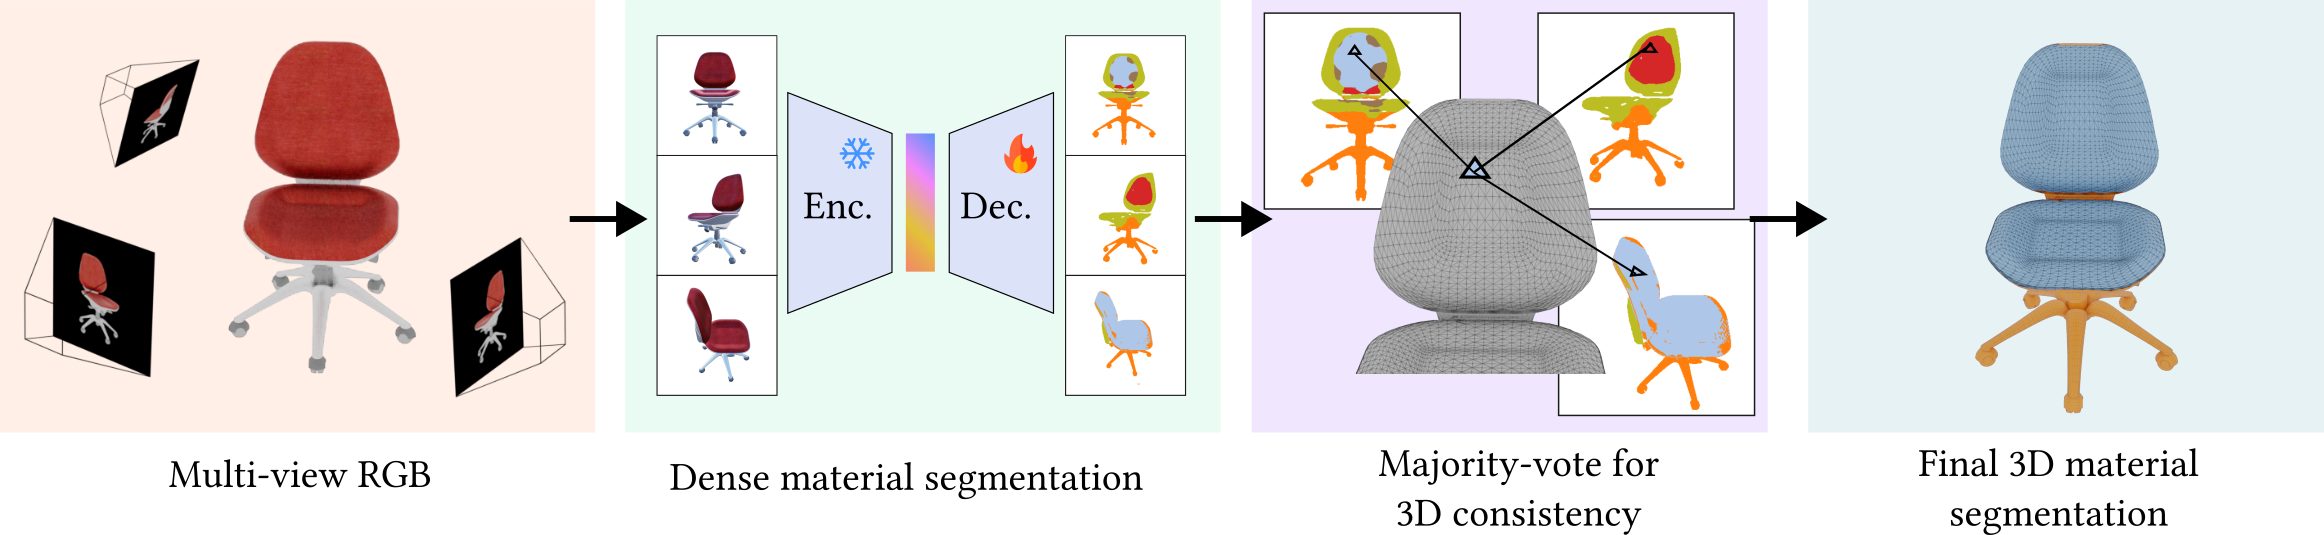
Process of our 2D-to-3D consistency projection. A fine-tuned ViT predicts material segmentation masks, which are possibly noisy and not consistent across views. We project each face of our asset onto the rendered views, taking into account occlusions. For each face, we assign a label corresponding to the cross-view vote.
We compare Gen2Physics (Ours), NeRF2Physics, and PUGS on a material identification task. The visualizations show that the 2D-to-3D consistency projection and VLM refinement proposed in Gen2Physics ensure more coherent and accurate material segmentations. In contrast, NeRF2Physics and PUGS produce fragmented predictions.
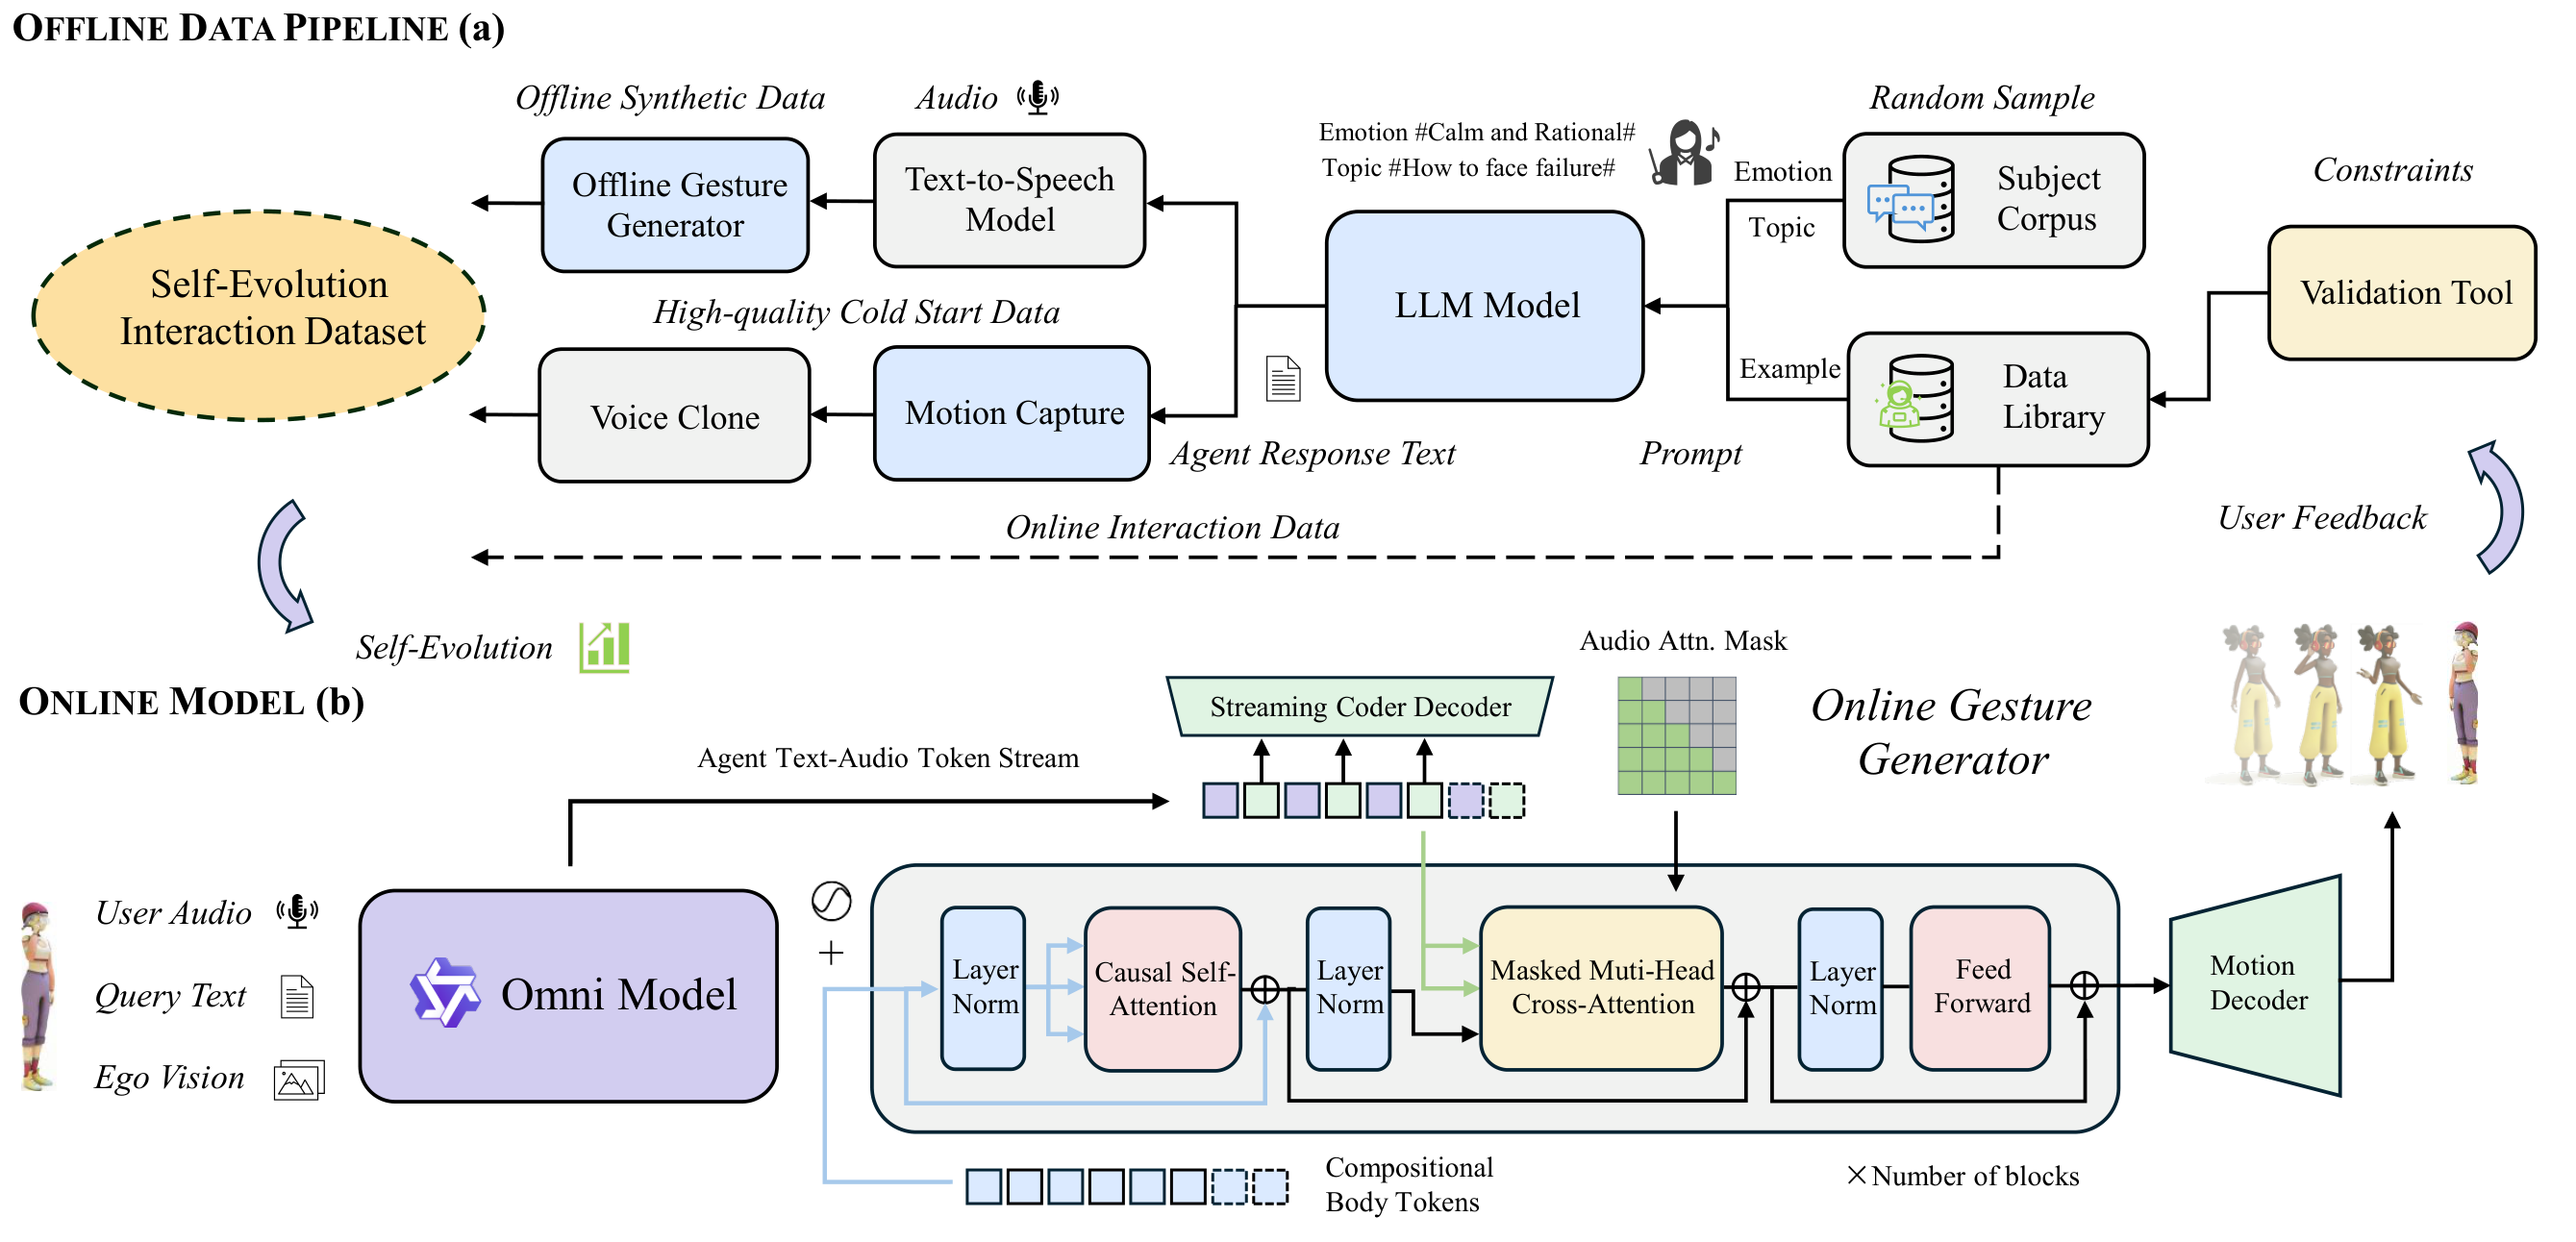
Overview of Super Star. (a) Offline interactive data synthesis and self-evolving loop pipeline for constructing virtual-companion-oriented training data that continuously adapts to user preferences. (b) Online real-time interaction pipeline, where a streaming speech response module is coupled with an online gesture generator.
Qualitative comparison of online co-speech gesture generation. Given the same streaming response speech, our method reacts more promptly and generates more natural and synchronized gestures than existing baselines.
















评论 (0)