搜索到
92
篇与
视频生成
的结果
-
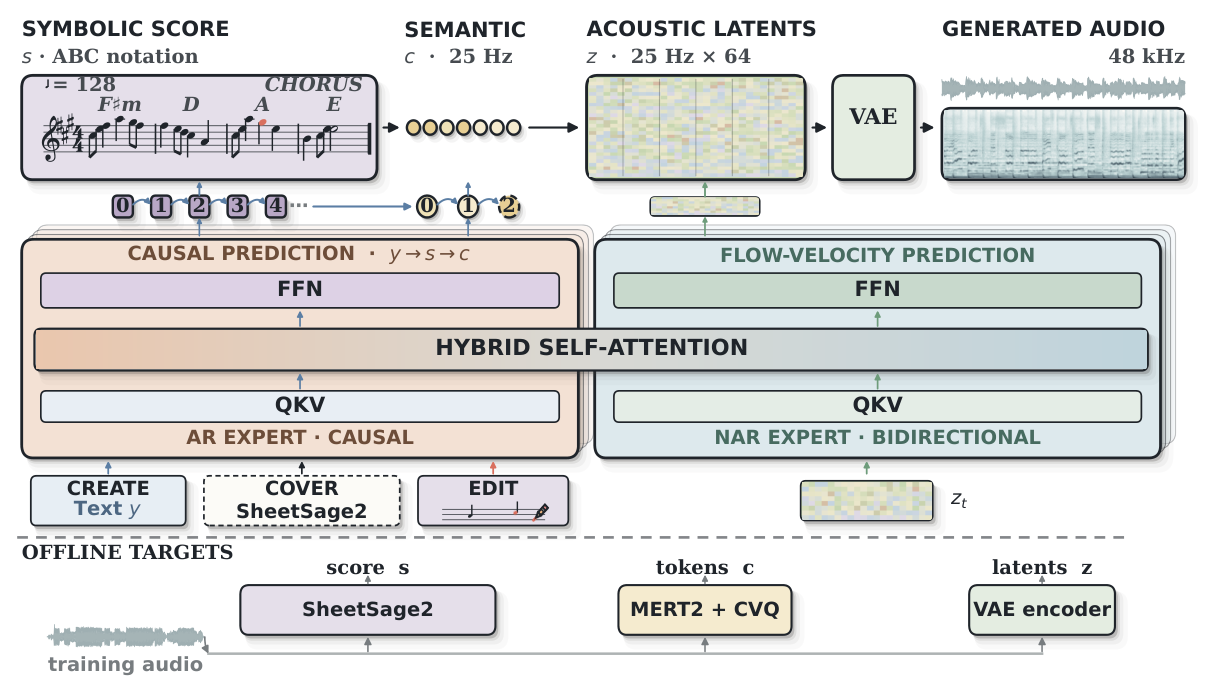
 AIGC 每日速读|2026-09-30|港科大先写谱再唱,YuE2 逼近 Suno 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 蒸馏与一步生成 3 篇 · 统一模型与自我反思 1 篇 · 音乐与音频生成 1 篇 · 数据集与评测 1 篇 重点论文标题列表 YuE2(港科大):先写谱再唱出来,49.3%胜 WorldAttention(阿里巴巴达摩院):单卡22帧,内核快14倍 PDMD(加州大学圣迭戈分校):一行代码,VBench 涨 1.03 GeoShrink(香港科技大学(广州)):两行代码换五倍,PSNR+3.10 MGFlow(清华大学):一步打赢四步,FDr 1.45 今日论文速览 1. YuE2:先写谱再唱出来,49.3%胜 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality | 香港科技大学;M-A-P;HKGAI;Tokenwave.AI;纽约大学;斯坦福大学;MBZUAI;Noiz;ACE Studio | arXiv:2609.33757 关键词:音乐生成, 符号音乐, 音频生成, 可控创作, 多模态 前序问题:符号音乐模型把旋律、和声、节奏、曲式写得很清楚,但通常停在「谱」这一步,出不了成品录音;音频模型能吐出完整歌曲,作曲过程却完全隐式,用户没法改。真正可用的创作工具要的是「先看懂谱、再决定怎么唱」。更麻烦的是训练数据:现成录音没有对齐的乐谱,符号监督和语义监督双双缺失。 本文贡献:用一个 AR-NAR 混合的 Mixture-of-Transformers 把两件事接成一条链:先写出可读的乐谱(指定旋律与和声),展开成 25 Hz 语义音乐 token,最后落成 25 Hz 连续声学 latent,由 48 kHz 立体声 VAE 解码成整首歌。为从「没有对齐乐谱的录音」里学会这套流程,配套提出 MERT2 提供语义监督、SheetSage2 提供符号监督。由于中间产物是人类可读的乐谱,同一 checkpoint 能跟着谱面编辑改动并保住未改动部分,还能零样本翻唱,外部大模型也可把反馈译成谱面修订,实现 agentic 改曲。 Composing in symbols, performing in audio. 实验效果:同一 checkpoint 下,专家对「带符号规划」的整体偏好为 49.3%,不规划只有 34.6%。WildSongBench 上 SongBench Global Avg 得 6.73,超过所有受评公开基线;best-of-8 取 6.96,是全部受评系统中的最高均值。专家听测中 best-of-8 优于 Suno v4.5,对 v5 接近持平。MERT2 在 MARBLE 的 15 项指标中 14 项刷新最佳;SheetSage2 在 lead-sheet 转录对比的 15 组指标对中 12 组领先。 Expert preferences for YuE2 versus six proprietary song generators across all six criteria. 批判点评:49.3% 对 34.6% 看着是压倒性优势,其实只是同一套系统的两种采样策略互相比,净增益不到 15 个百分点。真正硬的对标是 Suno v6:论文自己给的专家偏好里对 v6 的 overall 胜率只有 31.6%、败率 59.3%,是明显劣势——「frontier quality」只在 v4.5 / v5 这一档站得住。另外 best-of-8 的 6.96 需要 8 倍采样成本,56 页技术报告也没有同行评审背书。 2. WorldAttention:单卡22帧,内核快14倍 WorldAttention: An Efficient Attention Architecture for Interactive Video World Models | 阿里巴巴达摩院;浙江大学;香港科技大学;湖畔实验室;阿里巴巴 TRE | arXiv:2609.34606 关键词:视频世界模型, 稀疏注意力, KV 缓存, 推理加速, 长视频生成 前序问题:交互式视频世界模型要按文本指令持续生成长时间、时间连贯的视频。滑动窗口能把计算量封住,代价是历史上下文被直接砍掉,长程交互能力塌掉;而保留全历史 KV 缓存在计算和显存上都不可行——注意力的二次复杂度让开销爆掉,KV 缓存的线性增长迟早把显存吃满。两条路都不通,问题落在「既要长历史,又要低延迟」上。 本文贡献:提出系统级协同设计的注意力架构,两手一起改:一是 Hybrid Sparse Attention(HSA),把线性全局注意力和头自适应稀疏注意力并在双分支里,按注意力头动态决定稀疏度;二是 Hierarchical KV Cache(HKV),把历史 KV 组织成跨多层存储的语义索引页,先做 prompt 级检索再做 page 级检索,粗到细地把需要的页取回并控制 GPU 驻留量。两项设计都配了定制 kernel,把理论上的效率真正落到硬件上。 Overall architecture of WorldAttention. 实验效果:定制 kernel 相对 FlashAttention-3 带来 14.02 倍 kernel 级加速,叠加 HKV 后端到端加速 2.21 倍;单张 NVIDIA H100 上维持 22.0 FPS。VBench-Long 上质量得分 86.55 且吞吐最快,主体一致性 0.9472;InterVBench 上主体一致性 0.9668。B200 上跨模型规模与分辨率的端到端加速为 2.06 到 2.46 倍。 Attention kernel speedup. 批判点评:14.02 倍是 attention kernel 这一层的数字,端到端只剩 2.21 倍,落差本身就是论文的自我交代:HSA 单次执行 633 微秒里,稀疏 block 注意力 kernel 只占 11.78 微秒(1.86%),大头是 KV 连续拷贝(31.00%)和线性分支(39.78%)。也就是说 kernel 做得再快,杠杆也被内存搬运和线性分支吃掉。另外质量侧的「超越此前 SOTA」只给了主体一致性等少数几项,没有给出相对最强基线的完整指标表。 3. PDMD:一行代码,VBench 涨 1.03 PDMD: Projected Distribution Matching Distillation for Video Diffusion Models | 加州大学圣迭戈分校;字节跳动 | arXiv:2609.35768 关键词:视频生成, 扩散蒸馏, 分布匹配, 少步生成, 批评者误差 前序问题:视频扩散模型动辄要几十次去噪评估,DMD 能把 NFE 压到个位数,但蒸馏出来的样本会在训练过程中逐步退化:画面越来越过饱和、纹理出现不自然的伪影。作者把根因定位到 critic 误差——它混进学生更新之后会随训练步数累积,而 DMD 本身没有任何机制把这个误差拦下来。 本文贡献:提出 PDMD:把 DMD 更新中「与学生-critic 端点残差平行」的那个分量投影掉。作者证明,在固定噪声查询点上,这个残差正是 critic 端点误差的无偏估计;在高维假设下,投影能移除恒定比例的 critic 误差,同时只丢掉可忽略比例的 ideal DMD 信号。整个改动对 DMD 只动一行代码,不引入额外损失、额外网络、额外数据、额外模型前向,也不需要多阶段训练。 2D comparison of projection directions (20-point moving average). 实验效果:Wan2.1 上 4 NFE 取得 VBench 总分 83.73,比对齐设置的 DMD 高 1.03 分。MiniMax-H3 音视频联合生成上,VideoGen-Eval 视觉总分 83.17,比最强蒸馏基线高 0.41 分,且在受评的 4-NFE 模型中 6 项音频指标全部拿到最好成绩。定性对比与用户研究在视觉质量、运动、音频质量上都偏向 PDMD。 Quality, semantic, and total scores on the 387 VideoGen-Eval prompts. 批判点评:1.03 和 0.41 都是小数点后两位的量级提升,放在 VBench 总分 80 多的量级上更像「修退化」而不是「提上限」——它的价值本来就在于 DMD 已经开始崩的那段区间,基线越健康收益越小。MiniMax-H3 的 0.41 分是相对「最强蒸馏基线」而非 teacher,论文没给与未蒸馏模型的差距。另外投影只保证移除「恒定比例」误差,这个结论建立在高维假设之上,实际有限维下的常数有多大并未量化。 4. GeoShrink:两行代码换五倍,PSNR+3.10 GeoShrink: Accelerating Diffusion Transformers with Two Lines of Code | 香港科技大学(广州);格里菲斯大学;CSIRO Data61;JITRI 深度感知研究所 | arXiv:2609.33723 关键词:推理加速, 扩散Transformer, 免训练, 采样求解器, 特征预测 前序问题:扩散 Transformer 的推理成本几乎全部来自沿采样轨迹反复调用模型。已有的免训练加速多走特征缓存路线,在不同去噪步之间复用或预测中间表示;但这类方法动的是模型内部结构,接入成本高,而且缓存什么、什么时候更新都要重新调。能不能完全不碰模型,只在求解器接口上做文章。 本文贡献:提出 GeoShrink:保留原始求解器网格,只在预先规定的一组锚点上真正调用模型。被跳过的阶段,它把「最近一次观测到的增量」按几何保留比例加回最近的精确输出,作为求解器要的那个场。这个规则从弦切线传输和往返线投影推出来,并给出一条几何锚间距原则:在固定覆盖率和首段跨度下,让相邻最大间隔的扩张最小。误差分析刻画了预测误差的几何闭合与传播,全程不假设能拿到未来模型输出。改动只需两行代码。 Overview of GeoShrink. 实验效果:在约 5 倍加速下,FLUX 的 PSNR 比所列最强基线高 3.10 dB。HunyuanVideo 上报告 4.99 倍加速,ChronoMagic-Bench-150 的 PSNR 比最强保真基线高 5.44 dB。在固定评估预算下对比,运动、音频、音乐、3D 生成上也都有明显增益,实验覆盖图像、视频、动作、音频以及适配后的 3D 后端。 Speed-quality trade-off: GeoShrink yields a better Pareto frontier on SD3.5 Medium. 批判点评:全文主打指标是 PSNR,这是保真度指标而不是感知质量指标——5.44 dB 的 PSNR 增益可以对应肉眼几乎无差别的画面,也可以对应明显更糊的结果,论文没有补 FID 或人类偏好。另外「比所列最强基线高」里的基线集合是作者自选的,到底是跟哪些缓存类方法比、有没有包含最新的同类工作,从摘要看不出来。锚间距原则也只在给定覆盖率和首段跨度这组约束下最优。 5. MGFlow:一步打赢四步,FDr 1.45 Unifying Distributional Training for One-Step Visual Generation | 清华大学;复旦大学;西安交通大学;北京大学;浙江大学;DeepSeek;字节跳动 Seed;加州大学伯克利分校;智源研究院 | arXiv:2609.35763 关键词:一步生成, 分布匹配, 高斯混合, Wasserstein梯度流, 文生图 前序问题:一步生成器的分布训练有很多条彼此看起来不相干的路线:FD-Loss 用高斯矩匹配,Drifting 用核密度做 KL 匹配,各自都能work,但没人说清楚它们之间的关系是什么,也说不清「分布建模」和「匹配差异」这两件事哪一件在起作用。缺少统一视角的直接后果是,新方法只能靠试,无法判断某一处改动到底改的是哪一环。 本文贡献:给出一个统一的理论框架:把「分布建模」与「匹配差异度」拆开,再用 Wasserstein 梯度流把全局目标和逐点特征更新连起来。在这个框架下,FD-Loss 和 Gaussian-kernel Drifting 分别被还原为高斯最优传输和基于核密度的 KL 匹配两个特例。框架进一步催生 MGFlow:用高斯混合来建模特征分布,粒度可调,介于全局矩和逐样本表示之间;它同时支持最优传输和基于分数的匹配,并用带质量约束的样本分配配成对分量更新,专门解决「混合模型表达力提升」本身解决不了的 mode collapse。 A unified view of distributional training. 实验效果:ImageNet 256×256 上大幅超过 FD-Loss 基线,pMF-H 取得 FDr⁶ 1.45、JiT-H 取得 1.64,均为当前最佳。文生图方面,把 FLUX.2 [klein] 4B 后训练成一步生成器,在 GenEval 和 PickScore 两个指标上都超过了原始的四步模型。 One-step text-to-image samples from FLUX.2 [klein] 4B post-trained with MGFlow. 批判点评:FDr⁶ 是论文自报指标,对比表里的基线也是作者自己跑的,跨论文可比性存疑;ImageNet-256 是类条件生成的老基准,没有在更大规模或更高分辨率上验证。文生图部分只报了 GenEval 和 PickScore 两个自动指标,没给人类偏好,而「一步超过四步」这种反直觉结论恰恰最需要人工评测背书。另外九家机构联合署名,真正的方法贡献集中在统一框架和高斯混合这两点上,工程验证面其实偏窄。 6. REPI:16万步追平700万步 Scaffold Then Internalize: Representation Injection for Diffusion Transformers | 中山大学;Video Rebirth;香港理工大学 | arXiv:2609.35292 关键词:扩散Transformer, 表示对齐, 训练加速, 表示注入, 图像生成 前序问题:REPA 类方法靠「把扩散 Transformer 的隐状态投影到预训练视觉编码器空间」来加速训练,方向是单向的:扩散模型被迫去迎合编码器。反过来那条路没人走过——让编码器表示直接参与去噪过程。问题在于直接注入会破坏扩散模型自身的表示结构,注入之后模型到底学到了什么、推理时还要不要带着编码器,都没人回答。 本文贡献:提出 REPI(REPresentation Injection),走 scaffold-then-internalize 两段式:第一阶段「搭脚手架」,用投影后的编码器 K/V 临时替换扩散 Transformer 原生的 K/V,只保留它自己的 Query,让外部表示先替模型把去噪这件事撑起来;第二阶段「内化」,模型恢复到使用自己的 K/V,同时用一个内化目标把自身 K/V 对齐到投影后的编码器表示。推理时编码器和投影层全部丢掉,不留下任何额外开销。 Overview of REPI. (a) Scaffold. (b) Internalization. 实验效果:在 SiT-B、SiT-L、SiT-XL 等多种骨干上一致优于 REPA,且两者高度互补——叠加后收益远超任一单独使用。SiT-XL 上,REPI + REPA 训练 200K 步就已经超过 REPA 训练 400K 步的结果。最亮眼的是:仅用 160K 步,REPI + REPA 就能匹配 vanilla SiT 训练 7M 步的效果,相当于 43.5 倍以上的提速。 REPI accelerates diffusion transformer training across model scales. 批判点评:43.5 倍的对照物是「什么都不加的 vanilla SiT」,这个基线本身不含任何加速手段,比值因此被放大;更有信息量的是和 REPA 的等步数对比,那部分增益要小得多。另外从 FID-步数曲线看,REPI 做的是把曲线「提前」,并没有把收敛上限抬高——训练足够久之后差距会收窄。论文也明确指出最大收益来自与 REPA 叠加,单独用 REPI 的绝对提升要看主表才清楚。代码目前标注为即将开源。 7. UMM-Reflection:自己改自己图,GenEval+12 Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning | 南洋理工大学;上海交通大学;东京大学 | arXiv:2609.35767 关键词:统一多模态模型, 强化学习, 自我反思, 图像编辑, 文生图 前序问题:统一多模态模型既能看图又能画图,理论上应该能自己修自己的输出:先诊断这张图错在哪,再改,看着改完的结果继续诊断。但「这次修改到底有没有用」只有渲染出来才知道,所以反思文本和图像生成必须沿着整条回路联合学习。SFT 冷启动能学会走流程却找不到高成功率的修复路径;而只优化渲染器或只优化某一个头的朴素 RL,又把大部分收益留在桌上。 本文贡献:提出 UMM-Reflection,在同一个统一模型内部对完整反思轨迹做 RL。关键设计是 sibling trajectories 共享同一张初始图像,这样 group-relative advantage 比较的就是不同「反思策略」而不是不同起点;再用一个轨迹级 advantage 同时更新反思 token 和基于 flow 的修订,避免逐轮信用分配带来的组合爆炸。信用跨轮次流动、同时流向同一模型的两种角色,推理时不需要任何 verifier。 UMM-Reflection RL. 实验效果:在 BAGEL 上相对 SFT 把 GenEval 提升 12.05 分,且增益能迁移到训练中完全没用过的 WISE(+10.97)、OneIG-Bench(+3.48)、T2I-CompBench++(+4.63)。 Learning dynamics of the 1,000-update RL run. 批判点评:+12.05 分是相对 SFT 冷启动版本,不是相对原始 BAGEL 或当前 SOTA 生成模型,绝对值要在主表里才看得清。整套实验只在一个统一模型(BAGEL)上做,换骨干是否成立未知。训练侧每条轨迹最多三轮反思、每组 16 条 rollout,为了拿到稳定的 group-relative advantage 开销不小;而三轮上限本身就意味着更长链条的迭代修复能力没有被验证——尽管推理免 verifier 是实打实的优势。 8. Elastic Forcing:扔掉两个打分模型,84.64 From Scores to Samples: Elastic Forcing for Autoregressive Video Generation | 清华大学人工智能学院;西安交通大学 IAIR;复旦大学相辉研究院;北京大学 | arXiv:2609.35491 关键词:视频生成, 自回归生成, 蒸馏, MMD, 后训练 前序问题:少步自回归视频生成基本都挂在 DMD 上,而 DMD 需要两样重资产:一个双向扩散 teacher,和一个在线更新的 fake-score 模型。前者限制了「能学什么」——必须有一个现成的目标分布 teacher;后者让后训练的内存和计算开销居高不下,模型一大就跑不动。两者的存在使得「直接向参考视频学」这条路一直没走通。 本文贡献:提出 Elastic Forcing:不学 teacher 给出的真假分数,而是直接从参考视频学 rollout 分布,后训练阶段两个 score model 全部去掉。做法是在冻结的自监督视频表示空间里最小化 MMD(最大均值差异),并用 Nyström–Monte Carlo 混合估计器在近似偏差与采样方差之间取平衡;再配合省内存的 replay 和梯度子采样让这个目标变得可训练。移除辅助 score model 之后,14B 后训练可以放进 8 张 H200。 Demonstration of Elastic Forcing. 实验效果:在与 Self-Forcing 完全相同的架构和初始化下,1.3B 模型把 VBench 总分从 83.80 提到 84.64,同时保持 17 FPS。去掉辅助 score model 使 14B 规模的后训练在 8 张 H200 GPU 上成为可能。除了蒸馏,直接从参考视频学习还能在没有目标专用扩散 teacher 的情况下习得新的视觉风格、语义概念和空间先验。 Additional demonstrations of our 14B model. 批判点评:83.80 到 84.64 只有 0.84 分,而且这个对照是与 Self-Forcing 同架构同初始化的自体基线,不是与当前最强少步方法比。14B 那部分论文只说「使后训练成为可能」,没有给出 14B 的量化评测结果,也没有和带 score model 的同等规模方案做效率对比——省下来的显存到底换来多少质量,读者看不到。MMD 估计器本身还需要在 Nyström 近似偏差和 Monte Carlo 方差之间调参,这个权衡的敏感度没在摘要里交代。 9. GEAR:几何只当地址,12项全第一 Geometry as Address: Routing Attention to Visual Memory for Long-Horizon Camera-Controlled Video Generation | 浙江大学 CAD&CG 国家重点实验室;香港科技大学(广州);LIGHTSPEED | arXiv:2609.34722 关键词:视频生成, 相机控制, 长程记忆, 几何先验, 记忆检索 前序问题:长程相机可控视频生成要从不断膨胀的视觉历史里把之前看过的内容取回来。现有做法要么在历史上下文里隐式检索,要么把历史重建成持久的 3D 记忆:前者检索低效、token 越堆越多,后者会因为全局融合不断累积几何误差,跑几十秒之后画面就漂了。矛盾在于几何信息到底该被用来「解释场景」还是只用来「定位」。 本文贡献:核心洞察是:几何不需要解释场景,它只需要决定「视觉记忆该从哪里读」,而「该恢复什么」交给注意力去判断。GEAR 据此把几何当作视觉记忆的显式 token 级地址——不把历史观测融进一个持久的全局 3D 表示,而是保留为逐帧 latent,只用逐帧几何与目标视角建立 token 级对应关系,从而避开全局融合的误差累积。由这些对应关系引导,Geometric Correspondence Attention(GCA)在去噪时把几何匹配上的历史特征选择性注入到噪声目标 patch。另外用 Invisible Octree 累积可见性证据,把几何上合理但实际被遮挡的对应关系剔掉。 System overview. 实验效果:在 DL3DV 与 WorldScore 的全部 12 项指标上取得最佳:SSIM 0.3645、LPIPS 0.4459、FVD 837.59、TransErr 0.0116、RotErr 0.1228、ATE 0.0436、Content Alignment 0.7423、Photo Consistency 0.9732、Style Consistency 0.8700、主观分 0.5018、Revisit SSIM 0.6489、Revisit LPIPS 0.2019。支持沿高难度轨迹生成分钟级视频。 Out-of-domain qualitative comparison for minute-long generation. 批判点评:主观分只有 0.5018,刚过一半,说明「12 项全第一」里最贴近人的那一项优势最薄。FVD 837.59 的绝对值也谈不上低。对比集合是「带 memory 机制的近期方法」,没有与不带记忆的强基线在同等时长下对照,因此无法判断这套地址机制相对「干脆不记忆」的净收益。此外整套方法依赖每帧几何(位姿与深度)可用,相机轨迹是外部给定的,几何估计本身的误差如何传导到地址精度只做了定性讨论。 10. ORAV:380题9种角色,人机86% ORAV: Benchmarking Audio-Video Generation from Multimodal Contexts | 清华大学人工智能学院;腾讯混元 | arXiv:2609.34843 关键词:音视频生成, 多模态参考, 基准评测, 组合式生成, 评测协议 前序问题:用异构多模态参考(图、视频、音频混着给)去生成音视频成了一个新课题,它同时要求两件事:对生成结果有组合式控制,对多模态上下文有 grounded 理解。但现有基准基本只覆盖单参考或同构参考,评测协议也沿用通用视频质量指标,无法判断「模型有没有照着指令把指定参考里的指定内容取出来并正确组合」。没有基准,就没法追踪这一方向的进展。 本文贡献:提出 ORAV Bench,包含 380 个任务实例,每个实例带 2 到 10 个参考,覆盖 9 种语义角色和 30 种角色组合;指令负责说明各参考之间的关系,媒体本身提供要被落实的身份、动态和音频特征。评测上设计了一套参考感知的成对比较协议:先分别准备视觉和听觉证据,再逐个比较每个参考「本应贡献什么」,最后在两种呈现顺序下核对总体裁决,以消解顺序偏差。 Omni-reference audio-video generation requires selectively composing information from heterogeneous references. 实验效果:在留出实例上,该协议与人类判断的有效一致率达到 86.08%。对 5 个前沿系统的评测显示,总体排名掩盖了各系统在不同参考组合上的能力差异;暴露出的一个反复出现的失败模式是:模型生成了与某个参考高度相似、但并非指令所要求的内容。可复现的逐点诊断在质量、参考亲和度、语音三个维度上揭示出彼此独立的行为差异。 Performance across composition signatures. 批判点评:86.08% 是「有效一致率」,已经剔除了不可用判断和顺序冲突的样本,分母比全部配对要小,实际一致性更接近的下界没有给出。5 个受评系统在摘要里被匿名处理为 frontier systems,读者无法核对评测对象;380 个实例摊到 30 种角色组合后每种只剩十几个,论文也承认只有共享实例数不少于 8 个的 14 个 signature 才重拟合了胜率。作为纯基准工作,它不提供任何模型或训练方案,落地价值取决于社区是否跟进。 趋势观察 加速的战场从算法层下移到系统层 今天十篇里有三篇在跟计算成本较劲,但下手的层级完全不同:WorldAttention 直接写定制 kernel 并重排 KV 的内存层级,GeoShrink 干脆绕开模型、只在求解器接口上抠掉五分之四的调用,Elastic Forcing 则是把两个 score model 整个删掉换来 14B 后训练的可行性。共同点是单纯改注意力数学已经不够,谁把内存搬运和调用次数一起管起来谁才拿到真实收益。 「先搭脚手架再拆掉」成了训练范式的共识动作 REPI 用编码器 K/V 临时替换扩散 Transformer 的原生 K/V,等模型内化之后在推理时把编码器整体丢弃;PDMD 只对 DMD 动一行代码、不加任何额外网络或损失;UMM-Reflection 在训练时用冻结 verifier 打分、推理时一个 verifier 都不需要。三篇方向毫不相干,却都在做同一件事:把复杂度全部留在训练期,交付一个结构不变、开销不增的推理模型。 人工智能炼丹君 整理 | 2026-09-30 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
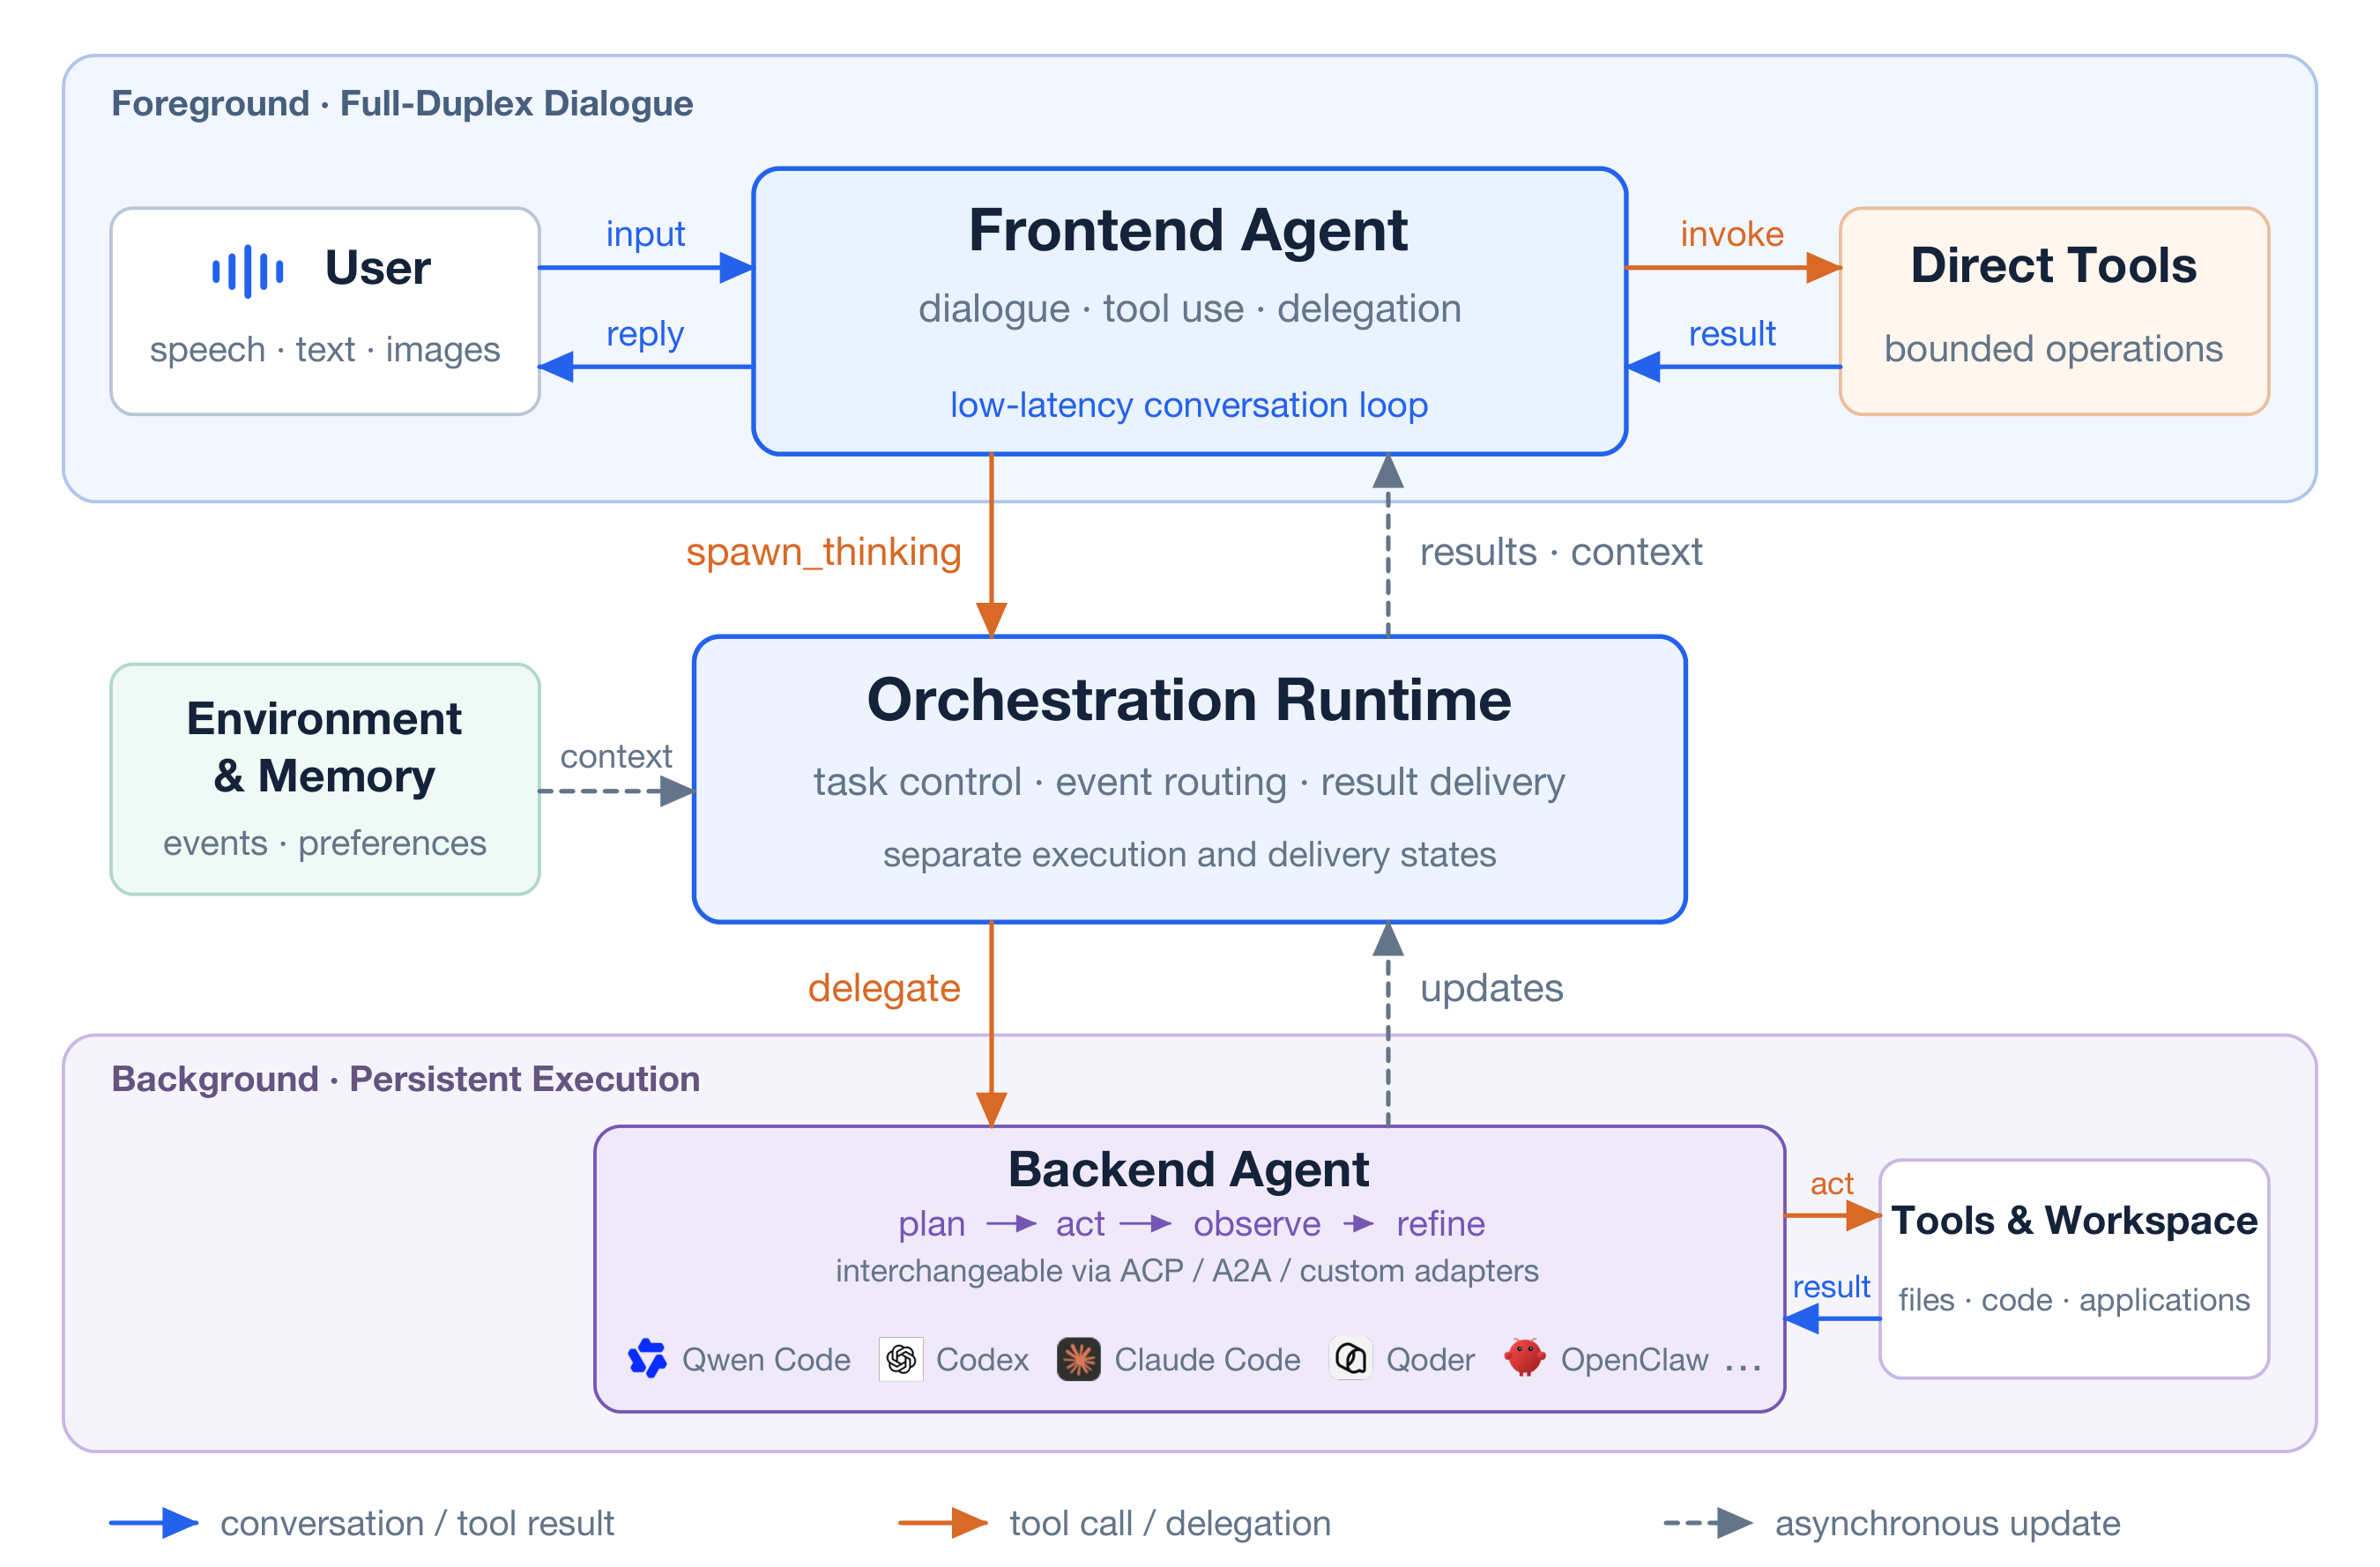
AIGC 每日速读|2026-09-29|阿里双Agent语音涨10.4分,Qwen-Audio 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 图像生成与编辑 3 篇 · 语音与动作生成 2 篇 · 数据集与评测 1 篇 重点论文标题列表 Qwen-Audio-Agent(阿里巴巴 Token Foundry):双Agent并行,座舱91.04% DyMD(北航):14B 压成 1.3B 四步 HetA-DiT(高通 AI 研究院):两成 token 走全注意力 Routed Forcing(清华大学):动力学+45%,嘴部不动 RWTD(字节跳动 Seed):一步模型 GenEval 0.80 今日论文速览 1. Qwen-Audio-Agent:双Agent并行,座舱91.04% Qwen-Audio-Agent Technical Report | 阿里巴巴 Token Foundry | arXiv:2609.25195 关键词:全双工语音, 智能体架构, 任务委派, 语音助手, 异步执行 前序问题:全双工语音助手要一边聊天一边干活,但一段对话里既混着「马上能答」的即时操作,也混着「要跑好几步」的长任务。现有做法要么让前台模型自己把工具全调完(长任务把对话卡死),要么整段委托给后台(用户干等,中途插一句还会把任务一起取消)。语音打断与任务取消、执行完成与结果回传被绑成一根绳,是这套系统要解决的核心矛盾。 本文贡献:提出前后台双 Agent 架构:Frontend Agent 只负责对话,并判断这一步是直接调工具还是委派出去;Backend Agent 在独立上下文里跑被委派的任务;Orchestration Runtime 负责维护任务状态、协调向用户要授权,并把结果排回对话。关键设计是把「语音打断」和「任务取消」解耦,把「执行完成」和「结果投递」解耦,所以后台在跑的时候对话还能继续往下聊。独立适配器让前台模型、后台 Agent、客户端可以分别替换,已在桌面助手、智能座舱、语音客服三类场景落地。 Foreground-background architecture of Qwen-Audio-Agent. 实验效果:内部座舱基准 134 个用例上,混合执行的任务成功率 91.04%,直接执行 72.39%、全部委派 80.60%。另在「三种配置都成功」的同一批轮次上做延迟评测,混合执行的平均任务执行延迟比这两个基线分别低 26.73% 和 30.91%。 Illustrative timeline of a delegated task. 批判点评:两个数字其实来自两个不同的评测集合:成功率是 134 个座舱用例,延迟只统计三种配置都跑成功的轮次——也就是说最难的那批(只有混合执行成功、基线直接失败)根本没进延迟统计,26.73% 的降幅是在对自己有利的子集上算出来的。另外 91.04% 比的是同一套系统的两种退化配置,没有跟任何外部语音智能体对照,报告也没给后台任务的绝对耗时。 2. DyMD:14B 压成 1.3B 四步 DyMD: Preserving Interaction Dynamics through Distribution Matching Distillation in Few-Step Video World Models | 北京航空航天大学;京东未来学院 | arXiv:2609.31349 关键词:视频世界模型, 分布匹配蒸馏, 少步生成, 具身智能, 交互动力学 前序问题:大视频扩散模型是很强的具身预测先验,但多步采样对交互式下游太贵。DMD 能把采样压到几步,代价却是机器人与物体之间的交互运动被抹掉:画面看着没问题,机械臂却基本不动,生成出来的世界对规划毫无用处。 本文贡献:从 teacher 信号和 fake-score 信号两头定位问题:弱重加噪让 teacher 后验一直集中在「没动作」的 rollout 附近,而动作更强的 rollout 又带来更大的 fake-score 拟合误差,反过来拖住生成器学动力学。DyMD 给两个自适应机制——temporal affinity 条件下的重加噪采样,按每条 rollout 当前交互保真度混合基础时间步表与 teacher 先验;dynamics-guided fake-score tracking,用噪声条件预测器估计每条 rollout 的拟合难度并上调其 critic 权重。14B teacher 蒸成 4 步 1.3B 学生,推理时不加任何辅助模块。 Overview of DyMD. 实验效果:具身视频基准上,相对 Base DMD 把 R-Bench 任务遵循度提 9.6 个百分点、PAI-Bench-G 的 Domain 分提 5.1 分,视觉质量基本持平。作为下游动作规划骨干,在两个 WorldArena 任务上平均成功率 34%,Base DMD 为 16%。 Visual comparison of interaction dynamics between Base DMD and DyMD at four NFE. 批判点评:34% 对 16% 看着翻倍,但绝对值仍只有三分之一,而且只在两个任务上测;全文反复验证的其实是主表那两个更朴素的数(9.6 / 5.1)。另外整套收益建立在「先用 V-JEPA 类特征算 temporal affinity」之上,这个额外前向的开销并没有计进推理成本。 3. HetA-DiT:两成 token 走全注意力 Where Compute Matters: Heterogeneous Attention for Efficient Video Diffusion | 高通 AI 研究院;波恩大学 | arXiv:2609.31050 关键词:视频扩散, 稀疏注意力, 推理加速, token 路由, DMD 前序问题:视频扩散的自注意力在长时空 token 序列上是二次开销。现有高效注意力基本对所有 token 一视同仁,但去噪难度在不同视频区域、不同时间步上差异极大,均匀省算力必然在最难的地方翻车。 本文贡献:提出 HetA-DiT:一个轻量不确定度分支预测每个 token 的去噪难度,据此把不确定的 token 送进稠密全局注意力、把更可信的 token 交给便宜的局部注意力。路由同时随内容和时间步自适应,并保留全局上下文,还留了一个参数控制质量-效率权衡。关键工程点是推理时不新增 Transformer 前向——不确定度估计直接复用上一个去噪步的结果,也因此能和少步 DMD 蒸馏兼容。 HetA-DiT. Heterogeneous self-attention computation assigned to tokens with different denoising complexities. 实验效果:在 DMD 蒸馏后的 Wan2.2-5B 与 Wan2.1-1.3B 上评测,VBench、VBench-2.0 和人工偏好上质量与基线可比,但只有约 20% 的 token 走稠密注意力。 Qualitative comparison of HetA-DiT to baseline DMD. 批判点评:摘要只说「维持可比质量」,没给 VBench 总分的具体差值;而「约 20% 走稠密」是路由比例、不是端到端加速比,局部注意力在真实硬件上能兑现多少要看实现,论文里也没有 wall-clock 延迟表。此外不确定度复用上一步估计,意味着第一个去噪步的路由其实是盲的。 4. Routed Forcing:动力学+45%,嘴部不动 Where and When to Force: Routed Forcing for Streaming Avatars | 清华大学;京东未来学院;东南大学 | arXiv:2609.30963 关键词:流式数字人, 蒸馏, DMD, 多样性塌缩, 区域路由 前序问题:Self Forcing 用 DMD 把双向视频扩散模型蒸成因果、少步的流式生成器,但 DMD 最小化的是 reverse KL,本质是 mode-seeking:学生会丢掉高动态模态、塌到静止输出上,把生成视频的动态和多样性一起压扁。 本文贡献:先把这种塌缩量化成一张区域异质图:人物区域(姿态、手势)多样性损失最大,音频驱动的嘴部损失很小,背景几乎不变。据此提出两维路由——Where:人物区域改用 Data-Forcing Distillation(拿真实视频当监督),嘴部与背景保留 DMD 以保口型和场景稳定;When:高噪声阶段开 DFD 注入真实动态,低噪声阶段切回 DMD 修细节,避免真实视频与学生 rollout 的空间差异带来模糊与伪影。 Routed Forcing routes distillation by semantic region and noise stage. 实验效果:相对 Self Forcing,动态最高提升 45%,多样性提升 7–25%,视频质量与口型同步基本保持。 Qualitative comparison of different training strategies. 批判点评:45% 是「最高」值,7–25% 的多样性区间跨了不同指标,主表里并不是每项都赢。更重要的是整套方法依赖先用分割模型对学生 rollout 抽人物 mask、用面部关键点抽嘴部 mask,这些前处理在流式实时场景里的开销没有被计入收益。 5. RWTD:一步模型 GenEval 0.80 Aligning One-Step Generative Models with Reward-Weighted Transport Distillation | 字节跳动 Seed;加州大学伯克利分校 | arXiv:2609.30840 关键词:一步生成, 奖励对齐, 最优传输, 蒸馏, 后训练 前序问题:一步生成器推理便宜,但后训练极难:通用隐式生成器既没有可算的似然,也没有去噪轨迹可借,而 GenEval、HPSv2 这类奖励往往根本不可导,梯度类方法又容易把图改得过度风格化。 本文贡献:提出 Reward-Weighted Transport Distillation,只要采样和标量奖励分数。它没有直接对齐常规的 reward-tilted 参考分布,而是构造自适应目标:把「当前分布」与「参考分布」分别倾斜后再混合——当前项吸收训练中已发现的改进,参考项把目标锚回预训练生成器。实现上用特征空间最优传输加不动点回归完成对齐。理论分析表明其不动点分布在 off-policy 倾斜参考与 on-policy 倾斜当前模型之间插值,给出了「适应奖励」与「保留先验」的权衡解释。 SANA Sprint 1.6B comparisons. RWTD improves alignment on difficult position prompts. 实验效果:把一步模型 SANA Sprint 1.6B 的 GenEval 从 0.73 提到 0.80;单独的偏好对齐实验显示跨奖励泛化良好,HPSv2 后训练在涨分的同时基本保住了组合能力与真实感。 Effect of mixed reward tilting on GenEval and held-out PickScore / diversity. 批判点评:0.73→0.80 是 GenEval 单项,摘要没说明其他指标是否同步变好。论文自己指出梯度类基线 FAV、DRaFT 在 HPSv2 上出现明显风格化、属于奖励过优化,而 RWTD 只是「大体保留真实感」——这说明 RWTD 同样在往奖励方向偏,只是偏得慢。另外最优传输做在特征空间,编码器选谁会直接影响结论。 6. SAP-DMD:两步采样救回高频细节 Spectral Amplitude Purification in Distribution Matching for Diffusion Distillation | 浙江大学;加州大学伯克利分校 | arXiv:2609.29116 关键词:扩散蒸馏, DMD, 频域分析, 一步生成, 细节恢复 前序问题:DMD 能让扩散模型几步出图,但优化动态长期被低频信号主导:方向误差的幅度谱高度集中在低频,弱的中高频信号被压住,细结构和纹理迟迟回不来。 本文贡献:提出 SAP-DMD,一个即插即用模块:自适应地调制 DMD 方向场的幅度谱,压掉幅度谱的支配性长尾,削弱低频主导,让中高频结构更快恢复。改动只在方向场上做,不替换骨干、不加参数。 2-step performance evolution during training on SD3.5 Medium. 实验效果:在 PixArt-α、SD3、SD3.5 上,2 步与 4 步采样下都更快收敛、生成质量更好。 Qualitative comparison of 4-step (top) and 2-step (bottom) generation. 批判点评:摘要通篇是定性表述——「更快收敛」「质量更好」,没有给任何一个具体数字,FID/CLIP 的实际对比全在正文表里。所谓「即插即用」也只在这三个文生图模型上验过,视频与编辑类任务没测。另外压低频本身是经验操作,压到什么程度靠阈值超参,论文没有给出选参依据。 7. FuseReg:换解码器 gFID 降 27% FuseReg: Regularizing Layer Fusion Mitigates the Reconstruction-Generation Gap in Representation Autoencoders | 布朗大学;南加州大学;莱斯大学;阿伯丁大学;圣母大学;马里兰大学;宾夕法尼亚大学 | arXiv:2609.31620 关键词:表征自编码器, 层融合, 正则化, 图像生成, 重建生成鸿沟 前序问题:表征自编码器(RAE)直接把预训练视觉编码器的特征当重建与扩散潜变量用。但要选哪些编码器层组成这个共享潜空间是个两难:浅层保像素细节更好,深层生成指标更好。固定启发式的层融合把两个本该分开优化的目标硬绑在了一起。 本文贡献:提出 FuseReg:不挑层,改为在随机采样的编码器层子集上训练。理论分析给出机制解释——子集采样显式惩罚了对跨层不一致的敏感性。结果是同一个解码器可以不重训地同时处理完整、稀疏、单层三种融合方式。 Cosine-similarity maps of decoder intermediate-block features under different layer fusions. 实验效果:ImageNet-256 + DINOv3-L 上,单个 FuseReg 解码器在三种融合下的 PSNR 都高于为固定融合专门训的解码器;只换解码器、生成器完全不动,RAEv2 DiT-XL 的无引导 gFID 降 27%;生成与扩散两阶段一起正则化,DiT-Base 的 gFID 降 29%。 One FuseReg decoder supports both sparse and single-layer fusions. 批判点评:27% 和 29% 都是相对自身基线的相对降幅,不是 gFID 绝对值,也没跟非 RAE 路线(如 SD-VAE)的潜空间横向比。另外随机子集训练要求训练时多跑几种融合,成本靠「一次训练多处可用」摊平——这个账只在论文自己的设定下成立。 8. Timo:40K 动作片段六维评测 Timo: $\textbf{T}$aming Mult$\textbf{i}$modal Diffusion Transformer for Human $\textbf{Mo}$tion Generation | 逐际动力 | arXiv:2609.30761 关键词:人体动作生成, MMDiT, flow matching, 运动学监督, 评测基准 前序问题:现有人体动作生成大多用 cross-attention 注入文本语义,忽略了动作与文本 token 之间的双向建模。直接把视觉生成里好用的 MMDiT 搬过来也不行:关节运动时间上连贯、跨关节相关性却很弱,MMDiT 配 flow matching 直接上会产出不协调、抖动严重的动作。 本文贡献:提出 kinematics-aware 的 MMDiT 框架 Timo:用全共享的多模态注意力做文本-动作双向建模,配合 flow matching、几何与旋转运动学监督(直接比较真实旋转及其随时间的变化),以及从「广泛动作学习」到「细节字幕对齐」的两阶段课程。同时构建了 6 个公开数据集、40,025 条留出片段的基准,在同一评测器与评分协议下测六个互补维度。 Kinematics-aware multimodal generation with a shared 24-block stack. 实验效果:定量与定性均明显超过现有方法,在六个维度中的五个上超过 Kimodo,基准平均分相对提升 40.8%。并在 LimX Luna、LimX Oli 两台实体人形机器人上完成重定向与跟踪执行。 Qualitative comparison across models and prompts. 批判点评:40.8% 是「基准平均分」的相对提升,而这个基准的作者就是本论文自己:六个维度、统一评测器都是他们定的,被比较的四个系统是「重新评测而非引用原文数字」,训练数据与表示各不相同,文中也承认自家数据含内部采集。机器人演示只做到重定向跟踪,没有闭环控制指标。 9. HyperErase:超网络一次前向出 LoRA HyperErase: Scale-Calibrated Hypernetwork for Multi-Concept Erasure in Text-to-Image Models | 哈尔滨工业大学(深圳);清华大学深圳国际研究生院;吉林大学;鹏城实验室;华南理工大学 | arXiv:2609.31154 关键词:概念擦除, 超网络, LoRA, 文生图, 模型安全 前序问题:概念擦除的主流做法是静态权重:训一个冻结的 adapter,遇到不同 prompt 变体就不好使,多概念叠加时还会发生参数互相干扰。 本文贡献:把概念擦除重构成「prompt 条件的参数摊销」:训一个超网络,把文本描述直接映射为该 prompt 专属的 LoRA 更新,不需要逐 prompt 做梯度优化,也免去手工合并 LoRA。为了让合成出的 adapter 稳且准,又提出 decoupled rectification——把 LoRA token 拆成 pattern 与 scale 两个子空间,对 scale 用平方根变换抑制乘性过缩放,并在推理时用教师给出的规范先验做校正。 Overview of HyperErase: hypernetwork-driven prompt-conditioned parameter synthesis. 实验效果:在主要概念类别上,擦除有效性、图像质量、语义对齐三者的权衡全面改善,性能接近「金标准」的单概念基线;一次前向就能为每个 prompt 变体产出专属 LoRA,推理期无需梯度更新。 Visual results of artist style erasure. 批判点评:摘要里「接近金标准单概念基线」是自我定位,实际是在 I2P / NudeNet 这类检测指标上逼近,而 FID、CLIP 的对比分散在不同概念类别的表里,没有一张表把三个维度同时摆在一起。另外超网络本身要先跑完 gold baseline 的擦除流程、收集 checkpoint-prompt 对,这个前置成本并没有被算进「免优化」的收益里。 10. TrafficImag:31K 样本的反事实路口 TrafficImag: A Benchmark for Counterfactual Roadside Traffic Video Generation | 德克萨斯大学奥斯汀分校;杜克大学 | arXiv:2609.30722 关键词:反事实生成, 路侧交通, 视频生成, 评测基准, 世界模型 前序问题:现成路侧交通数据集支持感知、预测和视觉问答,但不评「反事实视频生成」:改掉某一个交通参与者的行为之后,生成的未来既要符合道路拓扑,又不能扰动其余交通参与者。 本文贡献:TrafficImag 把大规模路侧数据(9,022 张标注图、7,043 段去重视频、31,145 条以参与者为中心的历史-未来样本)和一套可执行协议绑在一起,覆盖行为推理、干预感知的图像编辑、条件视频生成三类任务。每次干预都用「参与者级程序」来描述:目标参与者、意图行为、合法路线、交互顺序、时间约束,从而给异构基础模型提供统一评测接口。评测四个互补的有效性维度,端到端反事实只有四项全过才算成功。 Overview of the TrafficImag benchmark. 实验效果:在多个 SOTA 基础模型上,最强推理器的 macro F1 为 80.4%;完整条件接口把最好生成器的端到端成功率从 23.3% 拉到 55.0%。Oracle 研究显示条件视频执行仍是剩余的主要瓶颈。 Matched 8-second rollouts for a programmed left-turn counterfactual. 批判点评:55.0% 已经是最好的数,意味着接口给全后仍有近一半反事实做不成;而 20 个场景 × 3 次重复对百分比类指标来说置信区间很宽。论文自己也承认瓶颈在视频执行,也就是说这个基准当下更多是在给生成器记分,还没真正定位到路侧场景的语义难题。 趋势观察 少步蒸馏开始为「丢掉的东西」买单 今天十篇里有四篇在修蒸馏的副作用:DyMD 修的是机器人不再和物体交互,Routed Forcing 修的是数字人塌成静态,SAP-DMD 修的是低频把高频细节吃掉,RWTD 则换了个方向——先承认一步生成器的后训练很难做,再用最优传输把奖励塞进去。共同点是 NFE 已经不是瓶颈,蒸馏完之后「还剩什么」才是。 「对所有东西一视同仁」正在被放弃 HetA-DiT 只让约两成 token 走稠密注意力,Routed Forcing 按人物、嘴部、背景分区域换监督信号,FuseReg 干脆不挑层而是在随机层子集上训练。三篇方法毫不相干,但都在拒绝均匀处理——按 token、按区域、按层做差异化分配,成了这一批论文共享的默认动作。 人工智能炼丹君 整理 | 2026-09-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
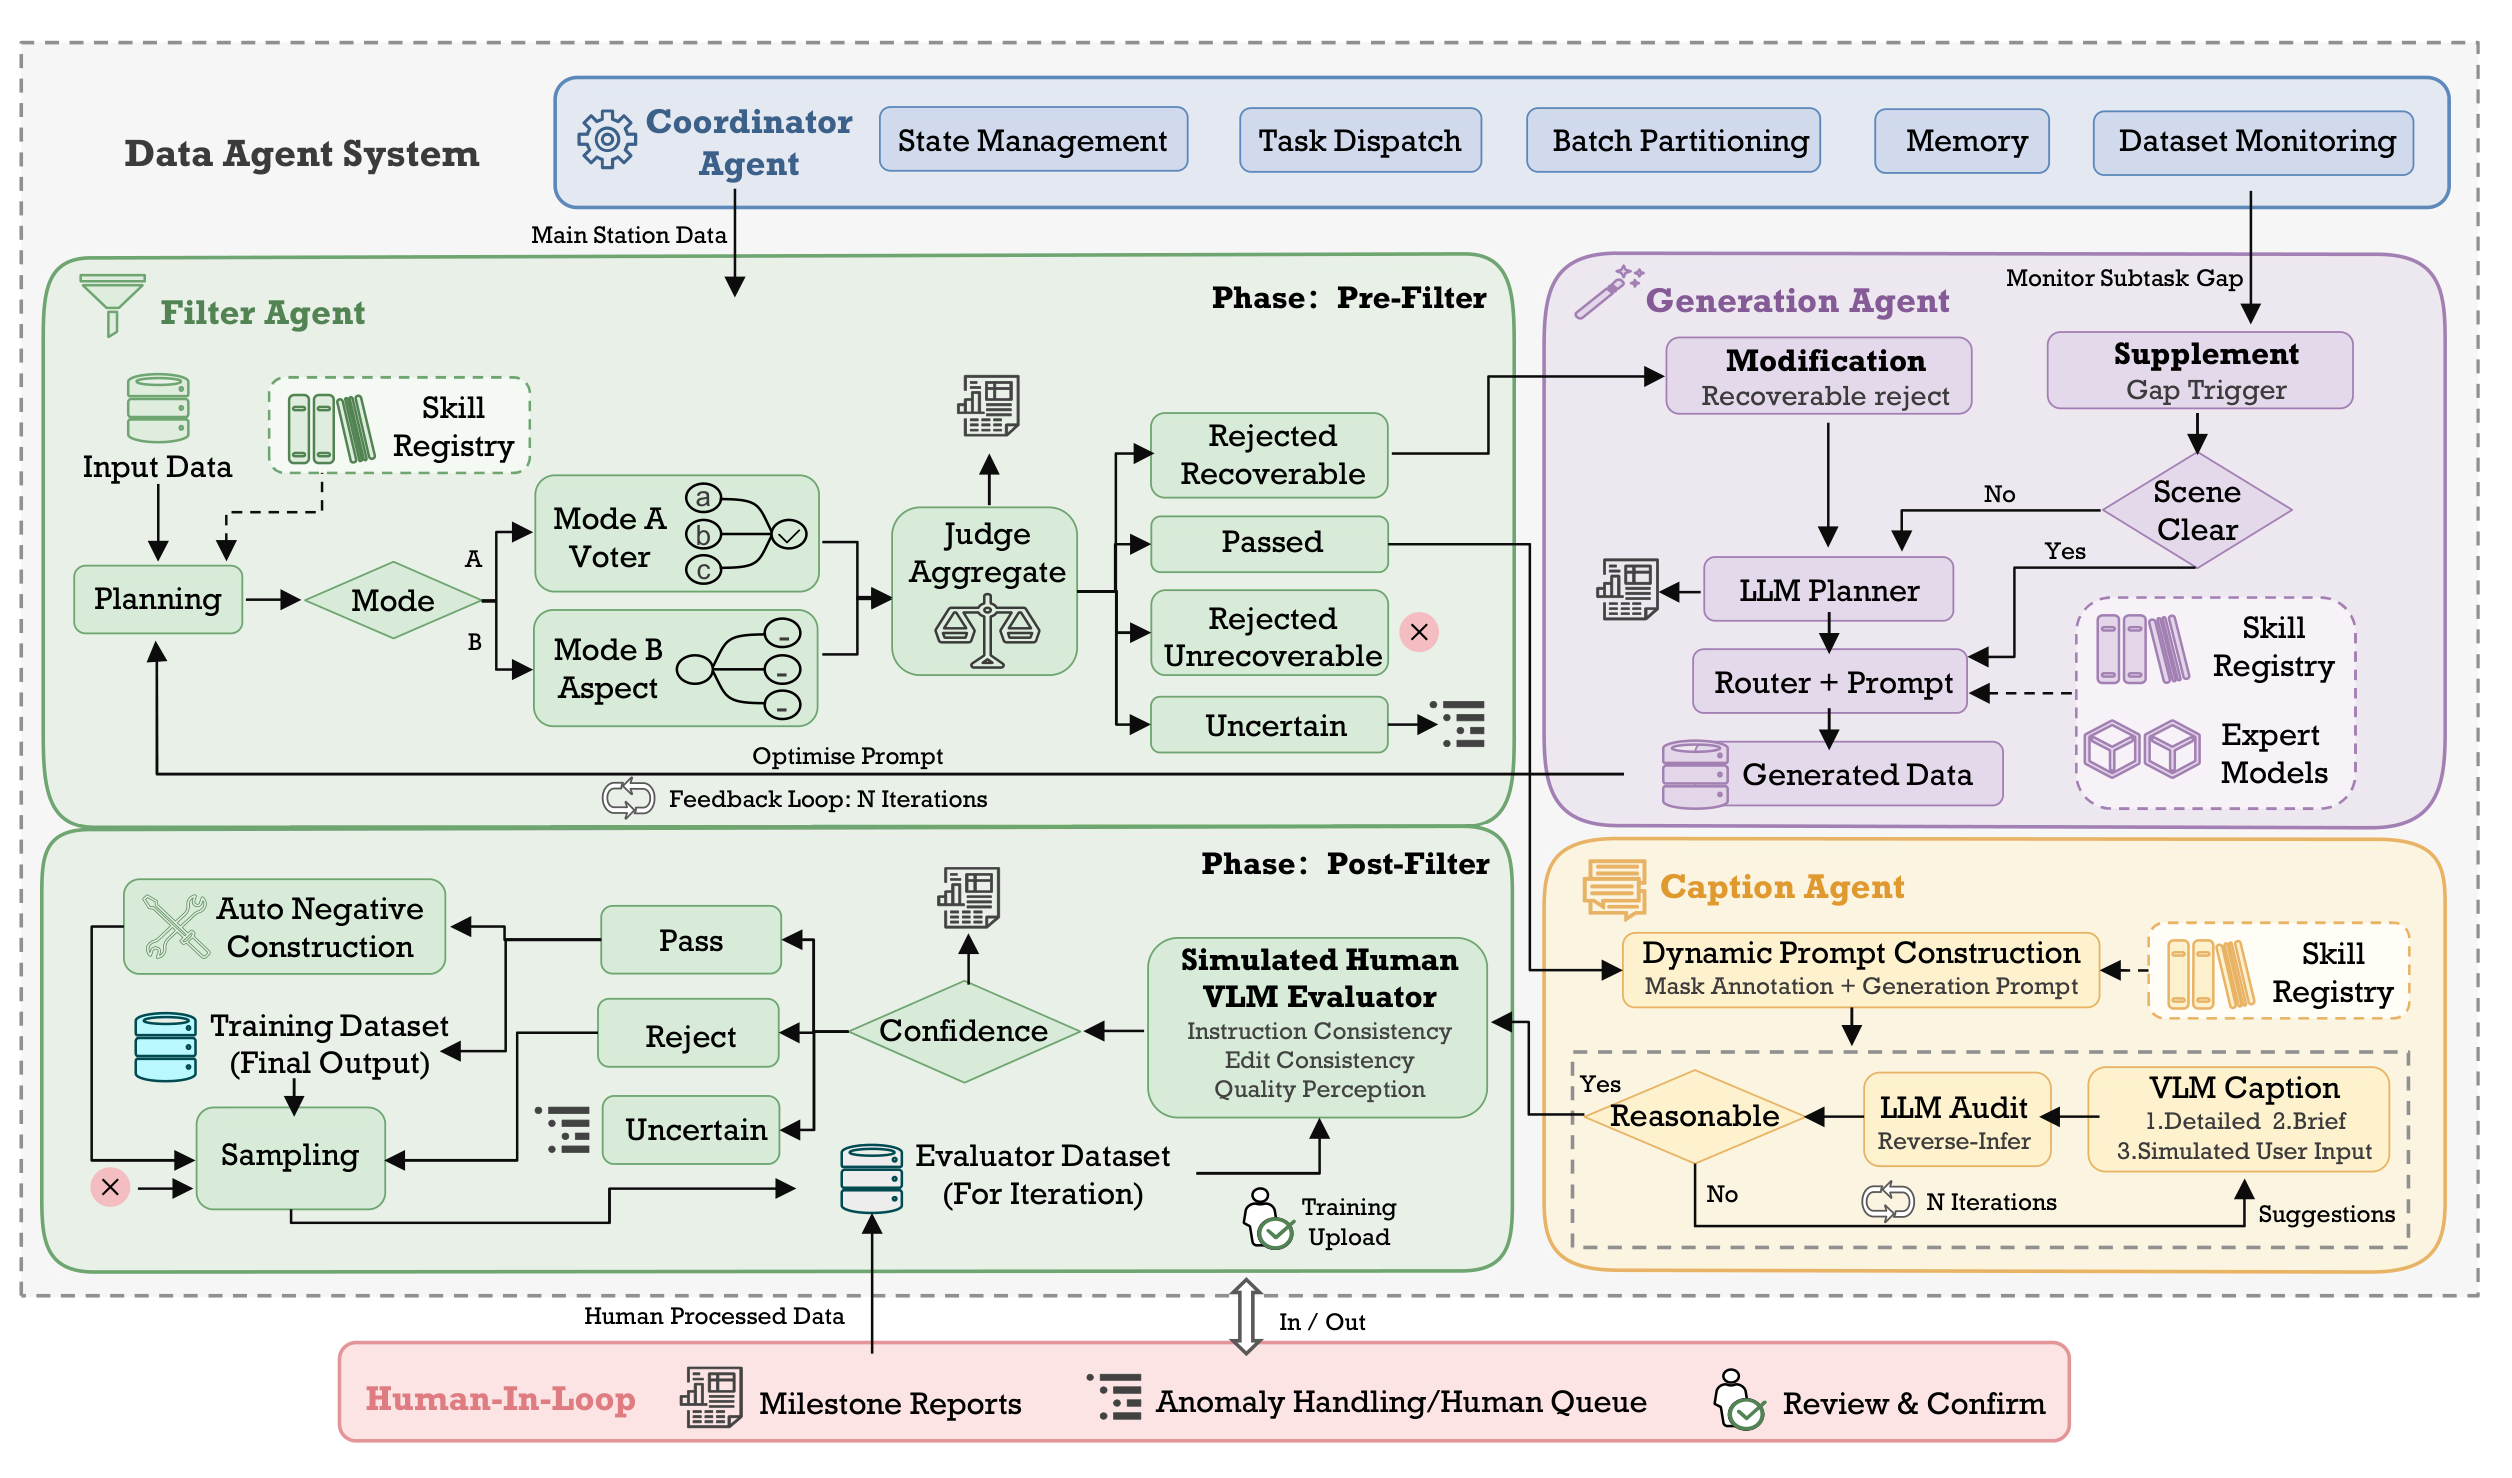
AIGC 每日速读|2026-09-25|快手开源修图登顶,GEdit仍输GPT 今日 AIGC 论文速览 今日共 10 篇 · 图像编辑与生成安全 2 篇 · 统一预训练与视频运动 2 篇 · 多模态联合生成 2 篇 · 音频生成与后训练 2 篇 · 推理加速与视频评测 2 篇 重点论文标题列表 KwaiMind(快手):180万对数据炼电商修图 UVU(清华大学):视觉监督前移,RefCOCO涨7.7 ⚡ Unite-Audio(东京科学大学):117M音频生成,CLAP登顶 MotionSpec(卡迪夫大学):频谱轨迹约束视频运动 RecCAR(巴伊兰大学):反向注意力补齐,音画更同步 今日论文速览 1. KwaiMind:180万对数据炼电商修图 KwaiMind Technical Report | 快手 | arXiv:2609.26375 关键词:图像编辑,电商,CTR奖励,Ecom-Bench,在线强化学习 ⚠️ 前序问题:电商修图不是通用编辑:商品主体要一模一样、促销文字要渲染准确、图还得有点击欲。通用编辑模型在这三件事上都没专门优化,而电商数据的采集清洗又贵又杂,缺一套能稳定产出高质量配对数据的流水线。 本文贡献:快手发布 KwaiMind:多模态 DiT 底座,Agent 数据引擎维护约 180 万高质量编辑对;继续预训练加 SFT 后走偏好优化与在线 RL,用 VLM 通用裁判加 CTR、文字渲染、商品一致性三类专用奖励训练专精策略,再经 on-policy 蒸馏合并成单一模型;配套发布覆盖 11 类商业编辑任务的 Ecom-Bench。 Overview of the end-to-end data pipeline. Coordinator Agent routes samples through filtering, generation, captioning, and post-filtering with bounded feedback loops and human review. 实验效果:开源编辑器里综合最强:ImgEdit 4.15、GEdit 5.79、REDEdit 英/中 3.75/3.73,Ecom-Bench 视觉质量第一;CTR 引导优化把生成图预测 CTR 超过原图的比例从 12.16% 提到 37.41%,线上 A/B 实际 CTR 相对提升约 2.44%。 Overall comparison on general image editing benchmarks: ImgEdit, GEdit, and the English and Chinese splits of REDEdit. Hatched bars denote closed-source models. 批判点评:最强的限定词是开源:图上闭源模型全面更高——ImgEdit 被 Seedream 4.0 的 4.27 和 GPT-Image-2 的 4.20 压着,GEdit 上 Nano Banana 2 拿 7.02、GPT-Image-2 拿 7.10,比 KwaiMind 的 5.79 高出一大截,REDEdit 两个语种同样如此。真正立住的卖点其实是 CTR 这条商业指标,而不是编辑质量本身。 2. UVU:视觉监督前移,RefCOCO涨7.7 UVU: Improving Multimodal Understanding via Vision-Language Unified Autoregressive Paradigm | 清华大学;腾讯优图实验室;南京大学;格拉斯哥大学 | arXiv:2609.27915 关键词:统一自回归,像素级codebook,连续视觉编码,视觉监督,预训练 ⚠️ 前序问题:多模态大模型的细粒度视觉理解长期靠稀疏文本监督撑着,已有的视觉监督大多加在后训练阶段,那时视觉表征已基本定型,监督信号只能当辅助约束。要重塑感知骨干,得把视觉监督搬进预训练。 本文贡献:提出 UVU 视觉语言统一自回归范式:不用向量量化,SigLIP-2 连续视觉特征直接进 LM 解码器做下一 token 预测;设计大规模迭代层次聚类算法构建 20 万词表的像素级视觉 codebook,让图像 patch 与文本 token 在预训练期共享统一监督,模型由此内化视觉重建能力。 Overview of the UVU vision-language unified autoregressive framework. Continuous visual features from SigLIP-2 are projected and integrated with textual embeddings for autoregressive next-token prediction in an LM decoder, generating pixel-level image tokens. 实验效果:同为 3B/Qwen2.5 底座,RefCOCO 从 84.1 涨到 91.8、LISA 57.4→71.7、CVBench-3D 71.9→76.6、BLINK 46.9→52.8;相对去掉视觉监督的自版 UVU*,RefCOCO +6.2、LISA +12.1。注意力热图显示 UVU 更聚焦目标区域。 Comparison of visual attention heatmaps under three paradigms: from left to right, without visual supervision, AR + VQ, and UVU (Ours). 批判点评:对手没输干净:SEEDB 74.1 仍低于 LLaVA-OV 的 75.4,MMStar 55.0 输给 56.7,ScienceQA 91.3 远低于 GLM-4v 的 96.7;MME 2201.9 对 LLaVA-OV 2146.3 的领先也只有 2.6%。统一目前只覆盖理解侧,生成侧数据还没进训练,作者自己也在文中承认。 3. Unite-Audio:117M音频生成,CLAP登顶 UNITE-AUDIO: Joint Learning of Continuous Tokenization and Latent Flow Matching for Text-to-Audio Generation | 东京科学大学;清华大学;武汉大学;东京大学;蚂蚁集团 | arXiv:2609.28206 关键词:文本生成音频,联合训练,flow matching,Flow-GRPO,连续表征 ⚠️ 前序问题:文本生成音频的主流做法是两阶段:先训重建导向的音频 tokenizer 再冻结,然后在固定隐空间训生成模型。但为重建优化的表征未必适合生成,生成目标无法反过来塑造隐空间。 本文贡献:首个把连续音频表征学习和隐空间 flow matching 联合训练的 TTA 系统:掩码波形过在线编码器,EMA 编码器提供停止梯度的目标特征,重建与自监督生成预测耦合,让生成目标直接塑造隐空间;再用 Flow-GRPO 后训练强化文本条件对齐。 Overview of the proposed framework: (a) the reconstruction path and (b) the generation path. Blue denotes regions with gradient propagation, while gray denotes regions without gradient propagation. 实验效果:117M 隐空间生成模型(不含编解码器)在 AudioCaps-886 上 CLAP 0.534 全表最高(EzAudio 0.496、TangoFlux-RL 0.480),KL 1.057 最低,RTF 0.062;NFE 压到 4 时 RTF 仅 0.009 仍保 CLAP 0.512。 Comparison between conventional separate tokenizer-generator training and our joint single-stage training. 批判点评:分布指标难看:FD_OpenL3 84.76 是 EzAudio 38.26 的两倍多,FD_16k 43.25 也落后 GenAU 的 31.94,IS 11.34 不及 TangoFlux-RL 的 12.20——语义对齐赢了,音频分布保真还差得远;首个联合训练的含金量取决于你更看重 CLAP 还是 FD。 4. MotionSpec:频谱轨迹约束视频运动 MotionSpec: Spectral Trajectory Supervision for Motion-Consistent Video Generation | 卡迪夫大学;中国科大;华东师范大学 | arXiv:2609.28095 关键词:视频生成,运动一致性,傅里叶谱,光流,微调目标 ⚠️ 前序问题:文生视频单帧越来越真,运动却常失真:动作推进不一致、复杂动作下结构崩坏。标准生成目标对运动本身几乎没有专门约束,运动演化处于欠约束状态。 本文贡献:提出 MotionSpec 运动监督:谱轨迹一致性 STC 构造锚点相对的稠密运动轨迹,经时间傅里叶变换成运动谱体积,对齐幅度与相位同时约束运动强度和时序组织;辅以局部光流一致性 LFC 稳定相邻帧过渡,两者随时间步加权加进微调目标。 Overview of the pipeline. At each training step, the video generative model takes the prompt, timestep, noise level, and real data as inputs. 实验效果:在 Wan2.1 上微调,VMBench 均分 61.57→65.07,其中物体完整性 OIS 48.34→56.53、时序一致性 TCS 97.09→98.82;VideoJAM-Bench 运动分 85.3→93.61。定性对比里 Wan2.1 的骑车段后半程自行车几乎消失,MotionSpec 保留完整。 Qualitative Results. On the left are the results of Wan2.1, and on the right are the results of ours. 批判点评:外观分几乎没动:App 仅 81.95→82.20(+0.25);PAS 上单独用 LFC(24.27)反而高于完整版(23.74),说明两个目标存在拉扯。评测全部在 Wan2.1 一个底座上做,换模型的泛化性未知。 5. RecCAR:反向注意力补齐,音画更同步 All modalities are equal, but video is more equal: Closing the Cross-Attention Gap in Joint Video Generation | 巴伊兰大学;NVIDIA | arXiv:2609.27901 关键词:联合视频生成,跨模态注意力,KL正则,音画同步,人体解剖 ⚠️ 前序问题:联合视频-动作/视频-音频生成的扩散 Transformer 里存在不对称:伴随模态到视频的对应很强,但反过来约束视频生成的对应路始终弱——视频听动作指令的能力远弱于动作看视频的能力,人体解剖崩坏、音画不同步由此而来。 本文贡献:把两个方向的跨模态对应表示成视频 token 上的分布,定义反向对应差距;提出 RecCAR,KL 正则把弱方向对齐到以视频到模态对应为固定参考的强方向,即插即用地微调 EchoMotion 这类联合生成模型。 Illustration of asymmetric reciprocal cross-modal correspondence. For a motion token corresponding to the head, the VM correspondence correctly localizes the head region in the video, while the reciprocal MV correspondence is dispersed. 实验效果:视频-动作联合生成 Human Anatomy 0.69→0.75,VMBench 多数指标超 EchoMotion、CoMoVi、FlowMo;视频-音频生成音画失同步从 0.804 降到 0.752。散点图上每个 prompt 的反向差距在微调后一致下降。 Qualitative comparison of RecCAR against EchoMotion, CoMoVi, and FlowMo across three representative scenes. 批判点评:增益以自家基线为参照:0.75 的解剖分意味着仍有约四分之一样本不达标,音频侧 0.752 的失同步也谈不上小;teaser 里对比的 LTX-2 只做了定性展示,未给出与闭源模型在同一协议下的量化差距。 6. GestureFAR:9.3毫秒每token的流式手势 GestureFAR: Streaming Co-Speech Gesture Generation with Flow Autoregression | 罗切斯特大学;东京大学;加州大学圣克鲁兹分校;加州大学洛杉矶分校;Meta | arXiv:2609.21576 关键词:手势生成,流式,flow自回归,蒸馏,实时交互 ⚠️ 前序问题:流式陪聊手势生成此前靠离散运动 token 自回归,把高维连续运动压进有限 codebook,真实感和多样性都受损;而连续方法又难以保证逐 token 因果,实时交互卡在延迟上。 本文贡献:提出流式手势生成框架 GestureFAR:因果 VAE 把全身动作编码成可流式的连续隐变量,Transformer 对音频-运动上下文自回归,每 token 配 flow-matching 头从连续分布采样下一潜变量;再冻结因果骨干,用一致性加分布匹配目标把多步 flow 头蒸馏成单步前向。 Overview of GestureFAR. GestureFAR generates co-speech gestures from streaming audio by autoregressing over continuous motion latents. 实验效果:BEAT2 流式组 FGD 3.08 全面最佳(LiveGesture 4.57、MIBURI 8.06),BC 0.741 接近离线最优;1 步蒸馏后每 token 9.3ms,是教师 8 步 24.4ms 的 2.6 倍速、MIBURI 62.9ms 的 6.8 倍速。 Qualitative comparison on BEAT2. We visualize generated full-body gestures from different methods under the same speech inputs, with the semantically salient words highlighted in red. 批判点评:BC 0.741 仍低于 MIBURI 的 0.790 和 LiveGesture 的 0.794,多样性 13.24 也略逊离线系;单步蒸馏换速度后 FGD 反而比教师还好(3.08 vs 3.17),这个反常更像评测协议的产物而非能力证明,文中未解释。 7. DeltaS:状态漂移选KV,六个基准+2.1 DeltaS: Reading the Gated Linear Attention State for KV Cache Eviction in Streaming Video | Maum AI;首尔大学;延世大学 | arXiv:2609.27470 关键词:KV缓存淘汰,流式视频,线性注意力,混合架构,训练无关 ⚠️ 前序问题:视频语言模型转向线性/全注意力混合架构后,线性注意力状态固定大小,但全注意力 KV 缓存仍随流式视频无限增长;流式场景下问题还没来就得决定淘汰谁,现有基于位置、注意力或 KV 本身的信号都拿不到这个先验。 本文贡献:提出训练无关的 DeltaS:读门控 delta 线性注意力的循环状态,用一块帧内状态的归一化变化量(状态漂移)衡量该块带来多少新信息,漂移大的块对应 KV 留存;信号计算只占前向的 1.9%,无需代理查询。 Overview of DeltaS. Each video chunk updates the recurrent linear-attention states, whose normalized changes yield a shared score for retaining the corresponding KV entries across full-attention layers. 实验效果:预算与留存策略对齐的受控比较里,状态漂移信号全面胜过位置/注意力/KV 三类基线;六个长视频基准平均超最强无查询基线 2.1 分,最长基准 LVBench 超 5.6 分。 Performance margin as a function of KV retention rate. DeltaS generally shows larger margins at lower retention rates. 批判点评:增益随留存率升高而收窄:留存 token 超过约四成后在 EgoS 上反而落后基线 0.7 分,高预算场景收益有限;hybrid 架构前提也把它限死在门控 delta 线性注意力这一类骨干上。 8. DriftAudio:一步生成后训练FAD降34% DriftAudio: Marginal Drifting for Distributional Post-Training of One-Step Text-to-Audio Generators | 悉尼科技大学 | arXiv:2609.27598 关键词:一步生成,分布后训练,文本生成音频,Drifting,FAD ⚠️ 前序问题:一步文本生成音频模型把推理成本打下来之后,生成分布仍欠火候;常规后训练依赖逐条件配对的真实样本,自由文本条件下一个 prompt 往往只有一两条真实参考,逐条件 Drifting 根本做不了。 本文贡献:提出 DriftAudio 边缘分布后训练:把 Drifting 从逐条件搬到边缘音频分布上做,在冻结的 PANNs 特征空间里用重采样真实样本、滚动生成的 FIFO 样本库和当前批次共同估计漂移场,得到 detached 训练目标只更新生成器,一步推理流程原样保留。 Overview of DriftAudio. The one-step generator remains text-conditioned, while Drifting is performed on the marginal audio distribution in feature space. 实验效果:从 MeanAudio 出发 FAD 降 33.9%、FD 降 17.6%,KL 与 CLAP 同步改善;从 FdAudio 出发 FAD 1.22→0.99,一步生成的分布质量明显抬升。 Mean and covariance components of FAD for the four evaluated models. Numbers above the bars denote total FAD. 批判点评:不是白捡的:从 FdAudio 出发时 IS 和 CLAP 出现回退,说明边缘分布对齐和条件保真之间存在交换;方法绑定冻结的 PANNs 特征空间,换更强的音频评价骨干是否还成立未验证。 9. InGuard:嵌入层安检,省一半去噪步 InGuard: Towards Generalized Inner Guardrail for Safe Text-to-Image Generation | 阿里巴巴 AAIG | arXiv:2609.27620 关键词:文生图安全,内嵌护栏,嵌入改写,潜空间检测,RevGen ⚠️ 前序问题:T2I 的安全护栏都装在外面:前置 prompt 分类器加后置图像分类器,两者不用模型自身表征——prompt 检查准头有限,图像检查要等全量去噪烧完才跑,而且违规 prompt 只能一刀切拒绝,本可改写成安全输出的也被扔掉。 本文贡献:提出 InGuard 内嵌护栏:文本编码器嵌入上直接做风险三级分类(不安全/风险/良性),SAGE 对风险 prompt 做嵌入空间软门控改写使其输出安全图而非拒答,去噪中途用一步干净潜变量估计做潜空间检测,发现风险即刻提前终止;配套 RevGen Safety 基准,1 万条 prompt 由真实图反生成并注入受控 IP 角色。 Overview of our InGuard framework. Three complementary components work in sequence: prompt embedding risk classification, SAGE embedding-space safety enhancement, and latent detection with early termination. 实验效果:五个开源 T2I 模型上安全率 97.9%-98.8%,追平或超过外置护栏;良性扰动少 57.5%-73.5%,参数少约 3.7 倍,50%-55.6% 的去噪步被跳过;潜空间检测在 44%-50% 计算量处就逼近图像级 F1。 Pretraining effects on Avg F1 across five LDMs; latent detection vs denoising-step fraction used as a compute proxy. 批判点评:SAGE 改写不是万能的:论文自己承认增强失败时只能靠潜空间检测兜底拦截,等于承认存在漏改样本;RevGen 由自家反生成流水线构造,跨基准的代表性有待第三方复检。 10. CineGuard:11种运镜的抄袭检测 Did You Steal My Shot? Pioneering Camera Motion Plagiarism Detection in Generative Videos | 河海大学 | arXiv:2609.22267 关键词:运镜抄袭,生成视频,涡度,基准,版权保护 ⚠️ 前序问题:运镜是影视级 IP,但生成视频用一句 prompt 就能复刻高价值运镜;现有相似度检测都盯着画面内容,训练数据把运镜和内容缠在一起,传统光流又表达不了复杂相机运动——运镜抄袭至今无人管。 本文贡献:构建首个运镜分析基准 CineFlow:11 种运镜风格的模拟数据集把运镜与内容解耦;提出 CineGuard 检测网络,在光流上叠加流体力学涡度作为平移不变线索,3D 卷积提 tubelet 嵌入后过 ViT 主干加全局相机适配器,对比学习聚拢同运镜视频。 Architecture of the motion plagiarism detection network. The input flow is first augmented with vorticity, then a 3D convolution extracts tubelet embeddings. 实验效果:抄袭检测超最强基线 3.02 倍;在 Veo 3.1 与即梦的商业生成视频上,余弦相似度 0.56-0.83,基线全部落在 0.35 以下,Precision@5 最高 0.73 对基线约 0.27。 Performance of plagiarism detection on generative videos. Left: cosine similarity between videos. Right: Precision@5 for retrieving videos with the same motion label. 批判点评:局限写在图里:FPV Drone 这类复合运镜相似度掉到 0.56,是全表最低,混合运镜仍是软肋;基准是简单几何场景模拟出来的,真实影视素材上的迁移只有商业视频小样本佐证。 趋势观察 编辑模型的主战场从通用能力挪向行业指标 KwaiMind 把 CTR 预测直接做成奖励信号训进编辑模型,线上 A/B 实测 +2.44%;InGuard 则把安全检查搬进生成管线内部,省下一半去噪步。两条线指向同一件事:图像生成的竞争正在从「生成质量」转向「商业约束下的生成质量」,奖励函数和护栏的构造方式开始比骨干网络更值钱。 视觉监督正在从后训练前移到预训练 UVU 用像素级 codebook 把视觉监督直接塞进预训练,RefCOCO 一项涨 7.7 分;MotionSpec 则在视频微调里用频谱约束补上运动监督的缺口。共同逻辑:等表征定型再补监督太晚了,感知质量的上限在预训练阶段就被决定。 一步生成与流式生成进入质量补课期 DriftAudio 给一步 TTA 做边缘分布后训练,FAD 降三分之一;GestureFAR 用单步蒸馏把手势生成压到每 token 9.3ms;Unite-Audio 把去噪步数压到 4 还能保住 CLAP。速度战的下一程是质量战——谁能在一步、几步的预算里把分布差距补回来,谁就拿到实时产品化的门票。 混合架构的两组记忆开始学会协作 DeltaS 证明线性注意力的循环状态可以反过来指挥全注意力 KV 缓存的淘汰,六个长视频基准平均 +2.1;Unite-Audio 则让生成目标直接塑造 tokenizer 隐空间,打破「先冻结表征再训生成」的铁律。两篇都在挑战模块化管线里各训各的默认假设。 人工智能炼丹君 整理 | 2026-09-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-24|阿里Qwen3.8-Omni发布,视频推理输Gemini 今日 AIGC 论文速览 今日共 10 篇 · 全模态基座与语音智能体 2 篇 · 视频编辑与生成智能体 2 篇 · 生成推理加速与量化 2 篇 · 视觉Tokenizer与音视频生成 2 篇 · 奖励模型与生成安全评测 2 篇 重点论文标题列表 Qwen3.8-Omni(Qwen Team, Alibaba Group):原生全模态智能体,百万上下文 VideoX-Qwen(Nanjing University):120万对指令视频编辑数据 QuantWM(Harbin Institute of Technology (Shenzhen)):2比特KV量化压住时序闪烁 Flash-dLLM(VILA Lab, MBZUAI):扩散LLM提速五倍且不伤精度 VideoGen-Agent(Princeton University):RL教会智能体用工具做视频 今日论文速览 1. Qwen3.8-Omni:原生全模态智能体,百万上下文 Qwen3.8-Omni: Towards Native Omni-Modal Agents | Qwen Team, Alibaba Group | arXiv:2609.25611 关键词:全模态智能体,稀疏MoE,百万上下文,视频剪辑,插件框架 前序问题:全模态模型此前主要强调感知和交互,真正的长程智能体任务——调工具、跑多步、把一段素材剪辑成片——要靠外挂 harness 拼,而现有 agent harness 对音频和视频没有原生支持。缺一个在多模态上原生 co-training、又不丢文本能力的底座。 本文贡献:发布 Qwen3.8-Omni-Flash:Thinker 继承 Qwen3.8-Next 的稀疏 MoE 骨干(GDN 与交错注意力混合),上下文扩到 100 万 token;原生多模态 co-training 把文本侧的智能体能力迁移到音视频任务,再经多教师蒸馏合并领域专精策略;配套开源 Qwen-MM-Plugins 插件框架与 Qwen-Live-Harness 实时交互框架。 Qwen3.8-Omni-Flash is a unified end-to-end model capable of processing multiple modalities 实验效果:WildClawBench-MM 从上代 34.5 涨到 71.0(+36.5)、AgenticVBench 14.5→36.8、OmniGAIA 57.2→74.0;Video-MME-v2 47.9→65.0。开智能体模式后 LVOmniBench 63.3→73.6,OmniVideoBench 单次 query 消耗 token 从 14.6 万降到 7.9 万(约 -45.7%)。 The overview of Qwen3.8-Omni-Flash-Realtime and Qwen-Live-Harness 批判点评:摘要口气很大,但表格里对手没输干净:Gemini 3.8 Flash 在三个视频推理基准的静态设置上全面更高,开智能体后 OmniVideoBench(70.1 vs 67.8)和 Video-MME-v2 仍被压着;teaser 图的 OmniCap-IF 一栏 Flash 拿 20.2,落在上代 Plus 的 28.3 和 Muse Spark 1.2 的 26.8 之后。所谓「领先」主要立在自己参与的新评测上。 2. VideoX-Qwen:120万对指令视频编辑数据 VideoX-Qwen: Data-Centric Instruction-Based Video Editing | Nanjing University;Jiutian Research | arXiv:2609.26015 关键词:指令视频编辑,数据合成,Qwen3-VL,Wan,成对监督 前序问题:通用视频编辑缺的不是模型而是监督:编辑要在执行指令的同时保住无关主体、场景结构和时序连续性,而成对(源视频、指令、目标视频)数据的规模和任务覆盖都远远不够,指令视频编辑长期落后于图像编辑。 本文贡献:一条可扩产的数据流水线:Qwen3-VL-235B 做源视频筛选与目标解析,加/删走 SAM3 加 Minimax-Remover,替换/属性走 Qwen-Image-Edit 首帧编辑加 WanAnimate 传播,自动通过率 89%,产出 120 万条方向性编辑对(每组任务超 40 万条)。模型侧统一 Qwen-Wan 编辑器:多模态语义条件加稠密源视频 latent 引导,图像-视频三阶段渐进训练。 Paired-video construction pipeline 实验效果:100 例对比 UniVideo 和 Kling O1:11 项指标里 9 项均值最优,覆盖指令遵循、编辑质量、内容保持、结构与感知相似度和视频分布质量。 Qualitative comparisons on compound and attribute editing 批判点评:「9/11 最优」的另一面是 11 项里输了 2 项,且对比规模只有 100 例;加/删两条数据路线直接复用 Minimax-Remover 和 WanAnimate,编辑对质量上限被这些现成生成器封顶。论文把「逐条校验富化后的指令」画成 proposed extension(虚线框),等于承认 120 万对里指令与实际编辑的一致性还没有被逐一验证。 3. QuantWM:2比特KV量化压住时序闪烁 QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for World Models and Video Generation | Harbin Institute of Technology (Shenzhen);National University of Singapore | arXiv:2609.26425 关键词:KV cache量化,视频生成加速,世界模型,注意力补偿,训练无关 前序问题:视频生成和世界模型的 KV cache 是部署瓶颈,已有 2-bit 量化方法在 VBench 这类指标上「几乎无损」,但作者实测发现:指标没掉,画面却在闪——逐帧指标天生看不见时序问题。 本文贡献:训练无关、严格因果的 2-bit KV 量化框架。诊断先行:Key 的量化重建误差比 Value 小,输出退化却更大,因为小扰动就能改变 QK^T 注意力 logits、挪走 Query 选中的时序-空间 token。对症两招:QSAC 聚类联合历史 Query 敏感度与残差范围选 INT2 友好的 Key 质心;PSAC 用低秩投影沿 Query 主子空间补偿残余 Key 误差。 Overview of QuantWM's inference system 实验效果:Causal-Forcing、LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video 五个底模上,KV cache 最高压缩 6.20×,图像与视频质量指标全面超过现有 2-bit 方法,额外开销有限,且保持严格因果可流式推理。 Visual comparison of BF16, K16V2, K2V16 and K2V2 on world models 批判点评:这篇最值钱的是诊断而不是方法:它解释了为什么「VBench 几乎无损」的结论靠不住——逐帧指标对时序闪烁盲。但时序改善的验收仍以看图为主,论文没给出时序稳定性的量化指标;6.20× 的压缩上限是在 93 帧生成这一档测的,更长序列的收益未报告。 4. Flash-dLLM:扩散LLM提速五倍且不伤精度 Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs | VILA Lab, MBZUAI | arXiv:2609.26796 关键词:扩散语言模型,KV cache,并行解码,Triton,推理加速 前序问题:扩散 LLM 靠并行去噪生成文本,但双向注意力让自回归那套 KV cache 直接失效;已有加速工作把 KV cache 和并行解码分开研究,两者合用时 GPU 显存 I/O 反而成了主要瓶颈。 本文贡献:训练无关两件套。Flash-Cache:把 QKV 投影、RoPE、cache 写入、注意力计算融进一个 I/O 感知的融合 Triton 核,砍掉冗余访存;Flash-Verify:让 dLLM 自己既当 drafter 又当 verifier 做草稿-验证式并行解码,不挂辅助模型。 Overview of Flash-dLLM 实验效果:LLaDA-1.5 上对此前最强的 Elastic-Cache 在 GSM8K/HumanEval 分别提速 5.1 倍和 11.0 倍;Flash-Cache 加 Flash-Verify 达到精度 83.02%、吞吐 210.6 tokens/s(Elastic-Cache 为 82.79%、41.7);batch 16 显存约 26GB,对照 Fast-dLLM 的 50GB 降约 48%,后者在 batch 24 直接 OOM。 Throughput and peak memory versus batch size on GSM8K 批判点评:赢面都在 dLLM 阵营内部:可扩展性图里自回归的 Llama3 在 batch 32 的吞吐仍高于 Flash-dLLM,「扩散 LLM 加速后追平 AR」还没有发生。精度与吞吐是硬权衡(80.2% 到 83.2% 对应 278 降到 186 tokens/s),宣传里 81 倍是对无 cache 基线的倍数,直接引用容易被误读成对 SOTA 的提速。 5. VideoGen-Agent:RL教会智能体用工具做视频 VideoGen-Agent: Reinforcing Video Generation Agents | Princeton University;Stanford University;UC Davis;MMLab, CUHK;BenchFlow;GWU | arXiv:2609.24997 关键词:生成智能体,强化学习,工具调用,视频生成,VABench 前序问题:视频生成模型面对需要专业知识、特定身份、物理一致或时序事件的 prompt 经常直接翻车:太极招式做不对、指定角色画不像、物理参数乱来。单靠扩大底模收益有限,缺一个会检索、仿真、检测来补信息的生成智能体。 本文贡献:六类任务上训一个共享策略:先在教师轨迹上 SFT 建立工具使用习惯(检索文本/图像、仿真、目标检测、深度估计等),再用类别感知混合奖励(工具调用合法性、任务适配度、视频质量)做 RL。配套 VABench:600 条 held-out prompt,覆盖程序知识、单/多实体身份、物理一致、场景合成、多镜头时序。 Overview of VideoGen-Agent 实验效果:VABench 上从底模 56.5 提到 75.6(+19.1 分);把生成工具换成更强的 Seedance 2.0 后,不重训智能体就到 86.1;人评 84.3% 偏好升级配置而非最强独立基线。 Qualitative comparison on Procedural Knowledge generation 批判点评:86.1 这档数字藏着归因问题:从 75.6 到 86.1 的增量完全来自换生成工具,智能体一行代码没动——agent 框架的收益上限被底模和工具质量强绑定,这一段「白捡的分」其实是底模的分。混合奖励里「视频质量」一项依赖 VLM 裁判打分,裁判偏差会直接写进策略,论文未讨论防 reward hacking 的机制。 6. Vorch-Human:一个模型统一说话人与歌声视频 Vorch-Human: Unified Multi-Task Human-Centric Generation via Long-Horizon Continuation | Vorch Team;Harbin Institute of Technology, Shenzhen;Tongji University | arXiv:2609.26117 关键词:音视频统一生成,数字人,扩散transformer,长视频,身份保持 前序问题:以人为核心的音视频生成被拆成好几个模型:语音驱动数字人、参考音色合成说话视频、外观加声音参考生成场景,各自训练各自维护。它们本质上是同一组模态、只是条件不同的任务。 本文贡献:双流音视频扩散 transformer,在传统 noisy 音频/视频接口之外增加 clean 条件 token 组,用 per-token 任务嵌入、时间位置类型、条件掩码和共享多模态 prompt 编码器,把驱动语音、音色样本、首帧、主体图统一进一个模型;两级数据管线做说话人聚类与跨片段身份串联;长视频靠冻结 latent 前缀递归、每段只生成新后缀。 Role-aware unified human-centric architecture 实验效果:5 分钟长生成保持身份一致与音画同步;GSB 人评对 LongCat-Video-Avatar-1.5:动作/姿态/表情净偏好 +46.9%,口型准确度 +47.5%,单人音视频驱动整体净偏好 +27.1%。 Raw GSB breakdown for LongCat-Video-Avatar-1.5 批判点评:同一张 GSB 图的另一半:视觉质量净偏好 -13.1%,多人场景再输 -9.2%——赢的两项全在「跟音频对齐」上,纯画质反而输给 LongCat,摘要里 strong identity preservation 的措辞没覆盖这个短板。署名主体写作「Vorch Team」,机构披露不完整,技术报告性质明显。 7. StableVQ:三招治住VQ码本训练崩溃 StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training | Huazhong University of Science and Technology;KlingAI Research;South China Normal University | arXiv:2609.26774 关键词:VQ tokenizer,码本利用率,训练稳定,自回归生成,ImageNet 前序问题:共享投影 codebook 把 VQ tokenizer 的利用率推上去之后,训练稳定性成了新瓶颈:码本利用长期趴在低位、出现永久死码、甚至在 26 万步附近突然崩到 0。现有方法各打各的补丁,缺少对根因的解释。 本文贡献:把根因归结为 Encoder-Decoder 与 Codebook 的「纠缠训练」:两个子系统各自都无法独立完成任务,只能靠碰巧合作维持。三个零参数改动:Dynamic STE 按量化距离压低不可靠梯度;Region VQ Loss 让激活码向邻近未激活码按比例传播目标;Decoupled Schedule 给两个子系统各配独立学习率调度。 Three characteristic failure modes of VQ training 实验效果:ImageNet 256 重建:262k 码本 120 epoch rFID 0.92(对照 FVQ 1.29、SimVQ 3.16),16k 码本 1.13;鲁棒性指标 UR-AUC 60.59,比 FVQ 的 8.08、SimVQ 的 2.17 高一个量级;只用单个线性投影层就追平需要 ViTBlock 投影器的 FVQ。 Qualitative reconstruction comparison with a 16k codebook 批判点评:主张是「治崩溃」,但主表里 FVQ 和 SimVQ 在各自标准配置下利用率本来就是 100%,差距全在故意制造码本-token 分布错配的鲁棒性测试里拉开——这三招买的更像「最坏情况的保险」,常态训练收益主要是 rFID 那 0.2 到 0.4。下游生成只给「competitive」,FID 全表在附录。 8. Qwen-Audio 3.1:全双工误答率从73%压到13% Qwen-Audio-3.1-Realtime: Towards Reliable Agentic Voice Interaction | Alibaba Token Foundry, Alibaba Group | arXiv:2609.25176 关键词:全双工语音,语音智能体,GRPO,在线蒸馏,工具调用 前序问题:实时语音助手要同时干三件互相打架的事:理解还在演化的请求、执行动作、遵守对话规则(何时说、何时闭嘴、是否插话)。上一代在背景有人说话时 73% 的轮次会错误应答,全双工的「闭嘴」比「会说」更难。 本文贡献:Think/Act/Speak and Coordinate 三层:Core-Cocktail SFT 加 M2-OPD 多教师在线策略蒸馏迁移文本能力;自进化可执行环境加多粒度 rollout 的 GRPO 教工具调用与参数落地;全双工决策模型独立管「说不说」。另给 Voice Harness 前后台原型:对话在前台、任务在后台异步跑。 Qwen-Audio-3.1-Realtime model framework for continuous spoken interaction 实验效果:tau-Voice 半双工改编任务成功 78.4%→82.0%(Airline 64.0%→74.0%);Full-Duplex-Bench v1.5 背景语音应答率 73.0%→13.0%、恢复率 0.26→0.87;FLEURS 宏平均 WER 9.01→3.98;WebSearch1K 检索调用从 4.37 次降到 1.05 次(-76%)。 Qwen-Audio-3.1-Realtime post-training pipeline 批判点评:两个回撤写在正文里:EVA-A 的 Mean 分从 70.50 掉到 66.26,WebSearch1K 的 F1 从 60.87% 降到 58.61%——少说话、少调用是把双刃剑;Daily Chat 和 persona 交互的 Spoken 分也在微跌。摘要只报提升项,回撤要翻到结果表才看得见,读技术报告别只读开头。 9. RULER:六项Rubric奖励治SVG生成 RULER: Instance-aware Rubric Rewards for SVG Generation | Ant Group;The Hong Kong University of Science and Technology (Guangzhou);Independent Researcher;University of Oxford | arXiv:2609.25270 关键词:SVG生成,Rubric奖励,GRPO,reward hacking,视觉裁判 前序问题:自然语言生成 SVG 是没有绝对真值的开放任务:CLIP、Aesthetic 这些在自然图像上标定的标量指标迁到风格化矢量图上会误判,直接拿来当 RL 奖励还会触发 reward hacking——评测和优化同时失去可靠信号。 本文贡献:实例化 rubric 奖励:每条指令由前沿模型生成六项 rubric(语义、视觉、风格三轴),裁判 VLM 逐项给渲染 rollout 打分,加权满意度经 GRPO 优化。rubric 只从文本推导,不需要配对 SVG 真值、也不需要人类偏好标注。训练用 Qwen3-VL-8B 做裁判,与评测用的 GPT-5-mini 分开。 Qualitative comparison of scalable vector graphics generation between RULER and four baselines 实验效果:MMSVG-Illustration/Icon 上 rubric 分从 0.432/0.395 提到 0.693/0.683,超过专用 SVG 模型、追平大得多的 DeepSeek-V3;人评盲测对自家 Qwen3-8B 骨干胜率 89.7%、对 Qwen3-32B 66.1%;消融显示去掉语义轴掉 10.1%、换静态 rubric 掉 22.7%。 Ablation of rubric design on MMSVG-Illustration and MMSVG-Icon 批判点评:「追平 DeepSeek-V3」在可视化图里并非全赢:五个示例里同心圆靶一栏 DeepSeek-V3 的 0.94 高于 Ours 的 0.92;Ours 的 CLIP 分(0.28-0.35)与基线几乎无差,说明传统指标确实分不出好坏,但反过来也意味着 rubric 分数与人类直觉的对应完全押在裁判 VLM 上。人评规模只有 150 条 prompt。 10. Moderation Gap:三成有害视频骗过逐帧审核 The Temporal Moderation Gap: Text-to-Video Safety Filters Are Blind to Harm in Motion | National University of Singapore;University of New South Wales;Fuzhou University | arXiv:2609.26233 关键词:文生视频,安全审核,帧序,红队测试,评测方法 前序问题:T2V 服务的安全栈是从图像生成继承的:关键词过滤加随机抽 8 帧逐帧检查。这套栈对「伤害只存在于帧序」的视频天然失明——闯红灯、往转动的车床里伸手、误服药片,每一帧单看都无害。 本文贡献:理论上证明:任何忽略帧序的审核器只要放行某片段,就必然放行其良性重排。实测未修改的基准 prompt 就能让 32.7% 的 Sequential-Action 目标落入审核盲区,改写、拆场景、反馈式搜索都无显著改善(McNemar p≥0.12)——不需要任何 prompt 技巧就能触发。修复方向是读帧序:时序感知检测器 AUC 0.74,逐帧检查等于抛硬币。 The temporal moderation gap 实验效果:对 97 帧全部打分发现:约三分之一的交付片段只是把不安全帧藏起来,其余按帧序整体看仍有害,尽管每一帧都通过了审核;用户实验确认人能区分片段与其重排的安全性。 Three Sequential-Action gap clips 批判点评:论文顺带揭了一个测量陷阱:在搜索出的 prompt 上用它自己的渲染种子打分,会把 7.5% 的单次生成率虚标成 46.7%——这个坑对所有做安全评测的人都成立。但修复方案的 AUC 0.74 离可用尚远,且全部证据来自 Sequential-Action 一类动作伤害,跨帧累积的暗示性内容等其他类型未覆盖。 趋势观察 全模态模型开始从「能听会说」转向「能干活」 Qwen3.8-Omni 把上下文推到 100 万 token 并配好插件与实时 harness,Qwen-Audio-3.1-Realtime 则把「何时闭嘴」当成一等公民单独训练。两条线指向同一件事:多模态模型的竞争正在从感知指标挪向任务成功率,模型外面的 harness、插件和记忆管理层开始决定产品形态。 视频编辑与视频生成的瓶颈,先卡在数据而不是模型 VideoX-Qwen 用 120 万对合成编辑数据喂出一个统一编辑器,VideoGen-Agent 则用六类任务的教师轨迹加 RL 教模型调用工具。两者都在补同一个洞:指令视频任务缺少可靠的监督与反馈信号,谁的流水线能稳定产出高质量配对数据,谁就拿到上限。 加速这条线在「省显存」和「省访存」上分头推进,且都是训练无关 QuantWM 发现 2-bit KV 量化的真正受害者是时序稳定性而非单帧指标,用注意力补偿把闪烁压回去;Flash-dLLM 则把瓶颈定位到 GPU 显存 I/O,用融合核加自验证并行解码把吞吐推到 210.6 tokens/s。共同点是都不动训练,靠推理系统层的重新安排。 评测开始把「裁判本身」当成被审对象 RULER 证明静态标量指标在 SVG 上失灵,改用逐指令生成的 rubric 当奖励;Moderation Gap 则证明逐帧安全审核对帧序盲。两者都在说同一件事:在开放生成任务里,裁判的构造方式本身就是被评测对象,默认信任任何单一打分器都危险。 人工智能炼丹君 整理 | 2026-09-24 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
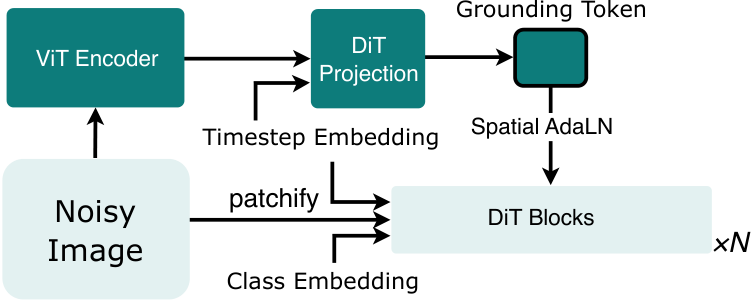
AIGC 每日速读|2026-09-23|NVIDIA像素扩散FID 1.46,仍输latent 今日 AIGC 论文速览 今日共 10 篇 · 图像生成与像素扩散 2 篇 · 视频世界模型与 3D 一致 2 篇 · 视频生成加速与流式编辑 2 篇 · 动作与音频生成 2 篇 · 音视频因果与奖励评测 2 篇 重点论文标题列表 PixelDiT2(NVIDIA):像素扩散 FID 压到 1.46 WorldCrafter(ARC Lab, Tencent IEG):分钟级探索重访 PSNR 18.0 ⚡ GAE(HKUST):相机轨迹误差砍半 FVD 降 23% SparkDiffusion(Peking University, Melon Group):97% 稀疏下 265 倍单卡加速 MixiMotion(PTIT, Hanoi):一步动作对齐 0.835 逼近教师 今日论文速览 1. PixelDiT2:像素扩散 FID 压到 1.46 PixelDiT2: Representation-Grounded Pixel Diffusion Transformers | NVIDIA;University of Rochester | arXiv:2609.24919 关键词:像素空间扩散,表征先验,表示对齐,DINOv3,ImageNet ⚠️ 前序问题:像素空间扩散不用自编码器、直接在 RGB 上去噪,省掉了 latent 重建瓶颈,代价是收敛慢、最终画质长期落后 latent 扩散。作者的判断是缺一个显式表征先验:latent 扩散天然在紧凑结构化的隐空间里去噪,像素扩散却要一边学「好去噪的表征」一边学「怎么生成像素」,两件事挤在同一次训练里互相拖累。 本文贡献:提出 representation grounding:用一个冻结的预训练视觉基座模型在整个去噪过程里持续提供 per-patch 表征监督。带噪图像走像素去噪通路,同时冻结编码器产出 per-patch 特征,一个时间步条件化的 DiT 块 P_g 把它映射成 scaffold,再通过空间 AdaLN 调制扩散 transformer;REPA 只作为训练期辅助目标。另提出延迟 grounding dropout:训练初期保留 grounding,到 epoch 160 再开启 dropout。 PixelDiT2 at ImageNet-512x512: samples, architecture, and convergence. 实验效果:ImageNet-256×256 上 H/16 模型 600 epoch 达 FID 1.46、IS 301.6;512×512 上 680 epoch 达 FID 1.48、IS 295.7,两档都是像素侧最好(同表其余像素方法 1.61–3.94 / 1.78–3.95)。论文强调 epoch 预算:512 档 epoch 200 就超过 PixelDiT 850 epoch 的 FID,预算低 4.25 倍。 PixelDiT2 reaches FID 1.78 at epoch 200 and 1.48 at epoch 680. 批判点评:「补上表征先验」在像素侧成立,但把两张表横着读是另一面:256 上 latent 侧 RAE-XL FID 1.13、REPA-XL 1.29 都优于 1.46,512 上 RAE-XL 1.13 同样压过 1.48,IS 也不及 REPA-XL 306.3 与 JiT-G 306.8。也就是说「追平」只在像素扩散内部成立,跨阵营仍差约 0.3 FID,摘要里 narrowed the gap 的措辞容易被读成已经追平。另外延迟 dropout 的开启时机是在 512 档上调出来的,256 档用的是从头独立 dropout,两档训练协议并不一致,跨分辨率可比性打了折扣。 2. WorldCrafter:分钟级探索重访 PSNR 18.0 WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory | ARC Lab, Tencent IEG;Peking University | arXiv:2609.24984 关键词:视频世界模型,隐式3D记忆,长程一致性,相机可控,流式生成 ⚠️ 前序问题:视频世界模型做交互式探索时,长程一致性一直是硬伤:走出一段距离再回头,场景常常「认不出」是刚才那个地方。难点在于历史观测越来越多,而视频生成器的 token 预算是固定的,怎么把历史压进有限 token、又不依赖显式深度对应,是个两难——显式 3D 重建重且脆,简单堆历史帧则 token 直接爆掉。 本文贡献:核心洞察是「让被请求的视角来决定历史怎么压缩」。一个与视频生成器联合训练的 memory encoder 把历史观测编成紧凑的 3D-aware 表示,再由 pose-conditioned readout 按当前目标相机位姿读出固定数量的、目标视角专属 token,在去噪前注入,全程不需要显式深度对应。配合 max-coverage 历史检索、最近时间上下文和 few-step 蒸馏,实现从单张图或文本出发的流式分钟级探索。 Overview of the WorldCrafter pipeline. 实验效果:VBench 自建输入模式 725 段视频上 Overall 81.910 为全表第一(Alaya-EVOKE 81.406、SANA-WM 80.841、Echo-WM 80.211),主体一致性 82.695、背景一致性 90.589、运动平滑 98.787、整体一致性 26.745 均为第一。长程重访一致性上 MEt3R 0.166、PSNR 18.016、SSIM 0.517,相对次优 Lyra 2.0(0.334 / 14.050 / 0.390)近乎翻倍。 Qualitative long-horizon revisit comparison in a static scene. 批判点评:重访那张表真正的第一不是 WorldCrafter 而是它的加速版 WorldCrafter-fast(MEt3R 0.129、PSNR 20.868、SSIM 0.616)——少步蒸馏的变体反而在一致性上更好,这暗示「更多步数」本身可能带来累积漂移,论文没有就这条给出解释。视觉质量上也不是全胜:美学质量 AQ 61.432 只排第四,不及 SANA-WM 63.467;动态程度 DD 96.893 是全表最低(其余 97.087–100),说明换来的一致性里有一部分是靠画面动得更少买到的。评测均在自建输入模式下完成,未与公开榜单协议对齐。 3. GAE:相机轨迹误差砍半 FVD 降 23% GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation | The Hong Kong University of Science and Technology;ARC Lab, Tencent IEG;The University of Hong Kong;The University of Texas at Austin | arXiv:2609.24981 关键词:几何原生隐空间,3D一致性,自编码器表征,相机轨迹,感知生成统一 ⚠️ 前序问题:视觉生成器能出逼真画面,却保不住一个前后一致的 3D 场景。作者认为这不只是建模问题,更是表征问题:生成器演化的是外观为中心的隐空间,感知模型恢复几何用的是语义丰富、编码跨视角结构的空间,两者不在同一坐标系上。常见补丁是「再输出一个几何头」,等于把几何当副产品,治标不治本。 本文贡献:不把几何当额外输出,而是直接把一个几何基座模型的特征重参数化成紧凑、可扩散的隐空间——几何原生自编码器 GAE,其 latent 同时可解码到外观、深度、相机和点图。训练分两阶段:先训 codec 把冻结的多层几何特征压进 latent,再用条件流只在「待生成视角」的 latent 上做流匹配,参考视角 latent、相机射线和文本作为控制,让感知与生成共用同一个隐空间接口。 Overview of Geometry-Native Autoencoder (GAE). 实验效果:在固定生成器与训练协议的控制对比下:重建侧 GAE-128 用比原始几何特征少 24 倍的通道,PSNR 28.76 / LPIPS 0.036 / rFID 5.4(RealEstate10K)反而略优于原始 L0 特征;生成侧 GAE-64 最优,RealEstate10K FVD 225.7、PSNR 20.02、SSIM 0.711,DL3DV FVD 287.0、PSNR 18.00,相对最好的非 GAE 受控 latent 分别降 FVD 12.7% 与 23.1%;ATE 在 RealEstate10K 降 52.8%、DL3DV 降 23.3%,MEt3R 取到受控组最佳 0.1208 / 0.1347。 Multi-frame RGB, geometry, and camera-pose comparison across RealEstate10K scenes. 批判点评:最有价值的是控制变量设计,但同一张表也留了口子:受控组之外还列了 Gen3R 与 GLD 两个参考方法,其中 Gen3R 在 RealEstate10K 的 MEt3R 是 0.1157,优于 GAE-64 的 0.1208——「最佳」限于受控 latent 这个口径。DL3DV 的重投影误差上 GAE 只有 0.0028–0.0029,反而不如 WAN2.1 VAE 的 0.0019,说明几何原生 latent 在像素级回投影精度上并不占优。另外通道数选择本身就不一致:128 在重建上最好、64 在生成上最好,论文没给选择依据,实际部署还得自己再权衡一次。 4. SparkDiffusion:97% 稀疏下 265 倍单卡加速 SparkDiffusion: Mitigating the High-Sparsity Trap --- A Unified Framework for up to $265\times$ Single-GPU Acceleration of Visual Generation | Peking University, Melon Group;Tsinghua University;Alibaba Group;University of Electronic Science and Technology of China;Harbin Institute of Technology | arXiv:2609.23153 关键词:稀疏注意力,推理加速,少步蒸馏,FP8量化,视频扩散 ⚠️ 前序问题:视频扩散 transformer 贵在注意力要处理超长时空 token 序列,做稀疏注意力是自然的加速思路。但作者发现一个「高稀疏陷阱」:稀疏度推到极致时,逐步训练损失还在稳步下降,最终生成质量却停滞甚至倒退。诊断指出这是监督问题——主要误差来自高噪声的结构生成阶段,逐步局部训练修不动它,只有对齐终态的训练才修得动。 本文贡献:由此给出一条分阶段原则:先把稀疏架构适配成粗粒度先验,再校正终态分布。SparkDiffusion 按此串起三件事——短程稀疏 warm-up、少步 trajectory-mixed 蒸馏、FP8 量化配融合 kernel,并把三者做成可乘的加速因子。覆盖 Wan2.1/Wan2.2 骨干、T2V/I2V 任务、480P/720P 分辨率,以及 H100 与 RTX 5090 两种 GPU。 Overview of the SparkDiffusion framework. 实验效果:3 步无 CFG 推理下,Wan2.1-T2V-14B-720P 在单张 RTX 5090 上端到端 265× 加速(H100 上 220×);Wan2.1-T2V-1.3B-480P 端到端 1.3 秒出片。长序列 720P 上维持 97% 注意力稀疏,1.3B-480P 上 90%。VBench 总分从 dense 的 83.69 到 83.15,掉 0.54 分;同表延迟与显存项均为最好(18.0 / 8.0)。 End-to-end latency and speedup of SparkDiffusion over Full Attention on NVIDIA H100 and RTX 5090 GPUs. 批判点评:265× 是三个因子相乘的结果,其中大部分来自 3 步蒸馏而非稀疏本身,读标题很容易把功劳全记在稀疏上——论文在图表里做了分解,但正文强调的仍是合成后的倍数。质量代价是实打实的:83.15 低于 dense 83.69,且稀疏度从 90% 提到 97% 时分数从 83.42 掉到 83.15,说明高稀疏陷阱只是被缓解、没被消除。另外源码里仍能看到若干未清理的 TODO 占位注释(作者元数据、BF16 两列标注为占位),作为预印本部分数值还需等正式版复核。 5. MixiMotion:一步动作对齐 0.835 逼近教师 MixiMotion: One-Step Text-to-Motion Generation via Asymmetric Set Distillation | Posts and Telecommunications Institute of Technology, Hanoi, Vietnam | arXiv:2609.23010 关键词:文本到动作,一步生成,集合蒸馏,运动学监督,推理延迟 ⚠️ 前序问题:文本到动作生成质量上来了,但迭代采样要几十上百次网络评估,延迟高,交互式动画、游戏这类场景用不了。压缩成严格一步模型有两大障碍:一是文本条件下的动作天然多模态,同一提示对应多个合理动作,固定的教师-学生一一对应会把多种有效模式平均掉;二是只在归一化表征空间里对齐,解码后可能出现明显运动学瑕疵。 本文贡献:MixiMotion 用离线集合蒸馏:对每个提示让冻结的多步教师先生成 K=4 个动作存进离线教师库,学生训练与推理时都不再查教师;学生从独立噪声采样 M=8 个一步样本,用非对称双向集合匹配训练——教师到学生方向鼓励覆盖教师支持的多样动作,学生到教师方向抑制不被支持的生成,两侧权重 α=(1, 0.20) 故意不对称。再叠加解码空间的端点、轨迹与身体分组运动学监督。 MixiMotion: offline asymmetric set distillation for one-step text-to-motion generation. 实验效果:ViMoGen 上语义对齐 0.835,一步方法里第一(MotionLCM-1 0.825、naive 一步教师 0.711),逼近 50 步 HY-Motion-1.0-Lite 教师的 0.858;六个类别中有四类超过 MotionLCM-1。25 人盲评总体 4.33 对教师 4.50,同为一步/少步里最高(MotionHiFlow 4.20、MotionLCM-1 3.98)。单次网络评估延迟从 829.58 ms 降到 9.30 ms。 Qualitative comparisons between HY-Motion-1.0-Lite and MixiMotion. 批判点评:摘要里的 89.2× 是单次网络评估口径,正文自己给出的端到端加速是 6.75×——差了十几倍,文本编码与渲染等开销没算进去,读者很容易把 89.2× 当成真实提速。另外 0.835 其实仍略低于多步的 MLD 0.840(与 MDM 0.833 基本持平),「逼近教师」成立,但严格说还没超过最好的多步基线。消融里非对称权重只带来 0.829→0.835 的 0.006 增益,解码空间监督贡献 0.832→0.835,各组件边际收益都很小;学生从教师热启动、460M 参数与教师同量级,并没有变小。语义分数由 Qwen3-VL-30B 判 yes/no 问题自动给出,非人类标注。 6. SVEET:双向模型改流式 15 FPS Streaming Video Editing with Easy Adaptation | Shanghai Jiao Tong University | arXiv:2609.24788 关键词:流式视频编辑,双向转自回归,特征解耦,正交解耦训练,实时生成 ⚠️ 前序问题:预训练的双向视频扩散模型编辑质量好,但它需要看完整段视频,做不了逐帧自回归的流式编辑。直接改造会撞上两个矛盾:双向骨干的特征在时间上互相依赖,而流式推理要求条件帧彼此独立;可控性与因果性两个优化目标还会互相拉扯,联合训练通常顾此失彼。 本文贡献:先系统复盘已有 video-to-video 扩散方案,归纳出流式适配的两条原则:骨干特征解耦、条件帧独立。据此给预训练双向模型加一条辅助控制分支,用时间独立自注意力编码源视频,中间特征注入对应骨干块;为弥合双向与流式的特征空间差异,再提出解耦训练 ODT,显式约束「视频可控性」与「模型因果性」两个优化方向正交,使二者在推理时兼容,并实现跨异构骨干的零样本迁移。 Our proposed SVEET. 实验效果:视频风格迁移上 VLM 编辑准确率 7.4322 为全表第一(LiveEdit 5.8672、DayDream+CF 5.2321、SDV2 4.2297),CLIP 文本对齐 0.2287、主体一致性 0.9447、背景一致性 0.9298、运动平滑 0.9898、美学质量 0.5550 均为第一。消融中 ODT 把 2D 版从 7.1898 提到 7.4322、3D 版从 7.0653 提到 7.3315,推理期投影(6.4250)与两阶段 teacher forcing(7.0927)都不如它。单张 H100 上 15 FPS,未用任何额外加速手段。 Qualitative comparison results on stylization. 批判点评:唯一没拿第一的一列是整体一致性(0.1123 第二),而拿下这列的 Channel concat 编辑准确率只有 1.8902——几乎没在编辑,说明这个指标在这组对比里更接近「越不改越高分」,拿它当唯一失分项反而暴露了指标本身失效。实验只在风格迁移这一个任务上给了完整数字,其余编辑任务的优势主要靠定性图支撑。15 FPS 是在 H100 上测的,离真正的端侧实时还有距离,且论文没有给出不同分辨率或时长下的 FPS 曲线。 7. COT-TTS:听对话推断语气 MOS 4.15 COT-TTS: Audio Context-Aware Text-to-Speech with Chain-of-Thought Reasoning | The Hong Kong University of Science and Technology;Nanjing University;JIUTIAN Research, China Mobile;Peking University;China Mobile (Hong Kong) Innovation Research Institute | arXiv:2609.22697 关键词:上下文感知语音合成,链式推理,可编辑风格,级联对比,时长一致性 ⚠️ 前序问题:语音合成的说话方式现在基本靠用户显式下指令,但自然对话里该怎么说本应从上下文推断出来。现有系统要么让用户逐句指定,要么把 ASR、LLM、TTS 串成级联——参数动辄 30B 以上,而且级联转换会把原始语音里的副语言信息(非语言发声、节奏、情绪强度)丢掉。 本文贡献:把「上下文感知推理式 TTS」定义成新任务:给定历史对话音频、目标文本和参考语音,先理解上下文,再显式推理出一段中间 CoT,最后按指定音色合成目标语音,且这段 CoT 可被检查与编辑。配套建了大规模双语对话语音数据集(900 万训练样本,含 100 万高质量子集)和 800 条人工核验、源不重叠的评测基准,并给出 0.6B / 1.7B 端到端自回归模型,直接产出带情绪标注的转写、可编辑风格推理和语音 token。 Overview of the end-to-end CoT-guided autoregressive model. 实验效果:英文基准上 COT-TTS-0.6B 拿到 Human MOS 4.150 全表第一(级联 3.050–3.500),情绪一致性 0.954 第一,时长误差 1.155 秒远优于级联的 5.1–12.5 秒;中文基准上 0.6B Human MOS 4.200 同样第一。可编辑 CoT 变体在中文上拿到最高的 LLM 综合分 3.461 与历史理解 4.079。参数量只有级联系统(34–39B)的几十分之一。 Distributions of the normalized audio quality score, naturalness score, target-audio effective-speech ratio, and emotional expression intensity over 50K randomly sampled examples. 批判点评:「参数少几十倍、效果相当」要看是哪一列:UTMOSv2 2.943 低于 two-a3b-fish 的 3.138,DNSMOSPro 3.180 明显不及 two-qwen3omni-seedvc 的 4.240,WER 0.041 也高于 three-dia-a3b-fish 的 0.012;LLM 评测的 CoT 逻辑 4.558 不及 4.836,综合分 2.304 不及 3.601。真正领先的是人类整体评分、情绪一致性和时长误差三项。更值得注意的是两个反常:0.6B 的人类评分(4.150 / 4.200)高于 1.7B(4.050 / 4.150),规模变大反而变差;开启可编辑 CoT 后推理分数上去了,英文 Human MOS 却从 4.150 掉到 3.500——论文把这解释为改动把分布推离训练域,等于承认「可编辑」目前要付音质代价。 8. Common Cause:灰度视频让音频翻车 62% Common Cause, Not Cross-Attention: Blocking Visual Shortcuts in Audio-Video Generation | RIKEN iTHEMS;RIKEN AIP;South China University of Technology;Columbia University | arXiv:2609.22361 关键词:音视频生成,因果推断,反事实不变性,视觉捷径,共享表征失效 ⚠️ 前序问题:音视频联合生成器的训练数据里,「看起来是什么」和「听起来是什么」高度相关——某种材质、纹理或物体外观总与某种声音同时出现。这种相关往往是虚假的:模型可以只从外观预测声音,完全不碰「是什么事件」这个因果变量。一旦测试时外观与事件的关联被打破,模型就会直接合成错误事件的声音。 本文贡献:这是一篇受控的因果研究而非又一个模型。先建音视结构因果模型,让音频在构造上独立于视频的干扰外观,再系统检验流行解法——直接 cross-attention、共享 latent、bottleneck、无监督 shared/private 分解、忠实共享先验,证明这些「走公共因」的做法全都抓不住要害,因为共享 latent 不是干预,模型照样拿得到外观代理变量。真正堵住捷径需要对干扰变量做干预:在 SCM 与干预假设下,论文证明反事实不变性是识别因果预测器的充要条件。 The counterfactual intervention do(v:=v') made concrete (Colored-MNIST). 实验效果:在特征向量 SCM、程序化像素视频、真实图像配频谱音频、移动真实数字、条件生成器五个场景验证。反事实惩罚随因果线索变强从 263× 平滑坍缩到 2.7×,说明捷径只在因果线索难读时才被采用;Moving-MNIST 上直接模型 OOD 准确率 0.21 而本文方法 0.995。对真实预训练视频转音频模型 MMAudio 做输入干预:灰度化让 top-1 声音类别翻转 62%、色彩旋转 54%,最小编辑只翻 22%。 The failure, made audible. 批判点评:最尖锐的一段是「修不好」:作者用重着色一致性项把 MMAudio 的速度网络微调 1500 步,色彩旋转翻转率基本没动(62.5% → 63.9%),真正下降的是通用 OOD 敏感度(高斯噪声 83.3% → 70.8%)——这次微调买到的是整体更鲁棒,而不是论文想修的外观捷径,恰好反证诊断与修复之间还有距离。另外结论高度依赖 SCM 与干预假设成立,真实数据上的干预只能做「改写外观」这类近似;MMAudio 实验只有 24 条真实视频、其中 18 条用于微调,样本量偏小。 9. RewardVerse:先写准则再打分 PLCC 0.52 RewardVerse: Rubric-Guided Policy Optimization for Video Reward Modeling | Institute of Automation, Chinese Academy of Sciences;University of Chinese Academy of Sciences;The Hong Kong University of Science and Technology;Tencent | arXiv:2609.22947 关键词:视频奖励模型,评分准则中介,标量漂移,RGPO,强化学习奖励 ⚠️ 前序问题:用强化学习优化视频生成模型时,奖励模型是地基,但现有视频奖励模型直接把复杂主观质量映射成一个标量,没有显式评分准则,于是出现标量漂移:分数尺度在不同提示之间坍缩或整体平移,RL 拿这种奖励训练并不稳。 本文贡献:借鉴人工标注工程,在「评测请求」和「打分器」之间插入一个动态评分准则 rubric 作为中间表示:先显式生成评测标准,再按准则打分,给标量一个语义锚点。为训练这条协作流水线提出两阶段 RGPO:阶段一用自演化的种子 rubric 预热打分器(偏好奖励 + 格式奖励 + 校准损失),阶段二联合优化 rubric 生成器、产出随请求自适应的准则,同时持续把打分器对齐人类评分。 Overview of RewardVerse and its two-stage RGPO training. 实验效果:16 维 EvalVerse 基准上 Joint(Ours) 在 14 个维度取得最高 PLCC,宏平均 PLCC 0.520、SRCC 0.493 均为第一(次优 Q-Scorer 0.467 / 0.354);Logic 维度 PLCC 0.750 对次优 0.593,Action 0.566 对 0.390。漂移诊断上 RGPO 把均值偏差从 +0.610 降到 +0.164,PLCC/SRCC 从 0.240/0.222 提到 0.505/0.458,预测标准差从 0.457 扩到 1.332,被压缩的分数区间被重新拉开。换到闭源 Gemini-3.1-Pro 上,加 rubric 仍让 PLCC 从 0.490 提到 0.593。 Score distributions of six reward models on the shared 10-dimensional test subset. 批判点评:「14/16 维最高」是真的,但剩下两维恰好是最容易被低层画质解释的:Temporal 那列 Ours 0.538 不及 VideoScore2 的 0.697,SRCC 侧也有两列被 Q-Scorer 与 Raw-rubric 超过。也就是说在偏感知质量而非认知/时序的维度上,rubric 中介的优势会收窄——论文自己也点出 Q-Scorer 在光照、逻辑这类与低层画质相关的维度上仍有竞争力。Gemini 实验只对比了有/无 rubric 两个变体,且受限于 API 只能读自然语言浮点输出,无法与开源模型在同一训练协议下横比。此外 rubric 由模型自生成,其质量评估仍依赖同一套 VLM 裁判,存在自证循环的风险。 10. IMPLICIT-Bench:5493 条中性提示词测隐式偏见 IMPLICIT-Bench: Measuring Implicit Bias in Text-to-Image Models under Neutral Prompts | The University of Melbourne | arXiv:2609.24228 关键词:文生图偏见评测,隐式偏见,知识图谱三元组,中性提示,去偏见权衡 ⚠️ 前序问题:文生图模型的偏见评测大多用「一张 [职业] 的照片」这类槽位模板,只能孤立地探显性人口属性(性别、肤色)。它漏掉了更隐蔽的一类:在自然提示里,当与刻板印象相关的属性没有被指定时,模型仍然默认输出刻板结果——这种隐式偏见现有评测基本看不见。 本文贡献:用结构化知识图谱构造受控提示三元组:中性、刻板、反刻板三个变体只在单一偏见维度上不同,其余场景语义保持一致,从而能把偏见效应精确归因到模板类基准做不到的粒度。最终发布 5,493 条提示、覆盖 11 个偏见类别,并用多模型一致性、CLIP 验证和人工评测三重校验。基于它评测现有去偏见方法,揭示出偏见降低与语义保真之间的基本权衡。 Four-stage KG-grounded benchmark pipeline. 实验效果:过滤后保留的中性图显著偏向刻板端:VLM 均值从 1.75 升到 3.40(Qwen3-VL)、1.26 升到 2.65(Gemma-4),未参与筛选的 CLIP 验证器同向移动。最终基准上 CLIP 判定 67.7% 的 Δx 为正(Cohen's d = +0.39),Qwen3-VL 71.6%(d = +0.85),三个裁判在 Δx 层面正相关(Pearson r = 0.22–0.44)。12 名人工评审在 100 个样例上复现了同样排序:刻板 3.78 > 中性 3.17 > 反刻板 1.60,75.9% 的 KG 被认为确实反映社会刻板印象。 Cross-model qualitative comparison, set 1. 批判点评:三个裁判的一致性是这个方法最脆弱的一环:Gemma-4 的倾向比例只有 48.7%,几乎等于抛硬币,d 也只有 +0.29,与 CLIP 的 67.7%、Qwen3-VL 的 71.6% 不在一个量级;裁判间 Pearson r 仅 0.22–0.44,CLIP 与两个构建裁判的逐图相关性也只有 0.42 / 0.55。人工侧同样不完美:VLM 相对人类均值的 MAE 接近 0.97–0.99,且 12%–16% 的样例把刻板与反刻板的方向判反。样本分布也不均衡——physical-appearance 类只有 14 条,人工研究里 sexual-orientation 一行只落在单个样例上。作者自列的局限同样实在:KG schema 单轴、源数据带 WEIRD 偏斜、去偏见实验只在 Qwen-Image 上做过。 趋势观察 世界模型这一轮在比「记得住」,不是在比「画得好」 WorldCrafter 让目标相机位姿去决定历史怎么压成固定数量的 token,GAE 则干脆把几何基座的特征重参数化成生成用的隐空间。两者承认的是同一件事:分钟级的一致性不是把模型做大就能换来的,而是取决于历史和几何以什么形式存在。有意思的是 WorldCrafter 的加速版在重访一致性上反超了标准版,说明步数与一致性之间未必是正相关。 像素扩散与 latent 扩散的差距,正被「表征」而不是「架构」填平 PixelDiT2 不引入自编码器,而是让一个冻结的视觉编码器在整个去噪过程里持续提供 per-patch 表征,把表征学习和像素生成拆成两件事。不过两张主表横着读会发现,1.46 是像素侧最好、却仍不及 latent 侧 RAE-XL 的 1.13,IS 也不及 REPA-XL 的 306.3——差距在缩小,但没有消失。 加速方案的瓶颈已经从「算力」挪到了「监督」 SparkDiffusion 指出高稀疏下逐步损失在降、终态质量却不涨,根因是监督没有对齐终态;SVEET 则指出双向改流式的瓶颈不在算力而在两个优化方向互相干扰,于是显式约束它们正交。两者都不是靠新算子取胜,而是重新安排了训练时究竟该优化什么。 评测类工作开始把「裁判本身」当成被审对象 IMPLICIT-Bench 的三个裁判一致性只有 Pearson r = 0.22–0.44,其中一个几乎等于抛硬币;RewardVerse 则发现外部打分器在认知类维度上可以是负相关(VideoScore-v1.1 在 Logic 上 PLCC −0.245)。当奖励模型和偏见裁判都开始被自己的盲区反噬,评测可信度就成了需要单独论证的事,而不是默认前提。 人工智能炼丹君 整理 | 2026-09-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
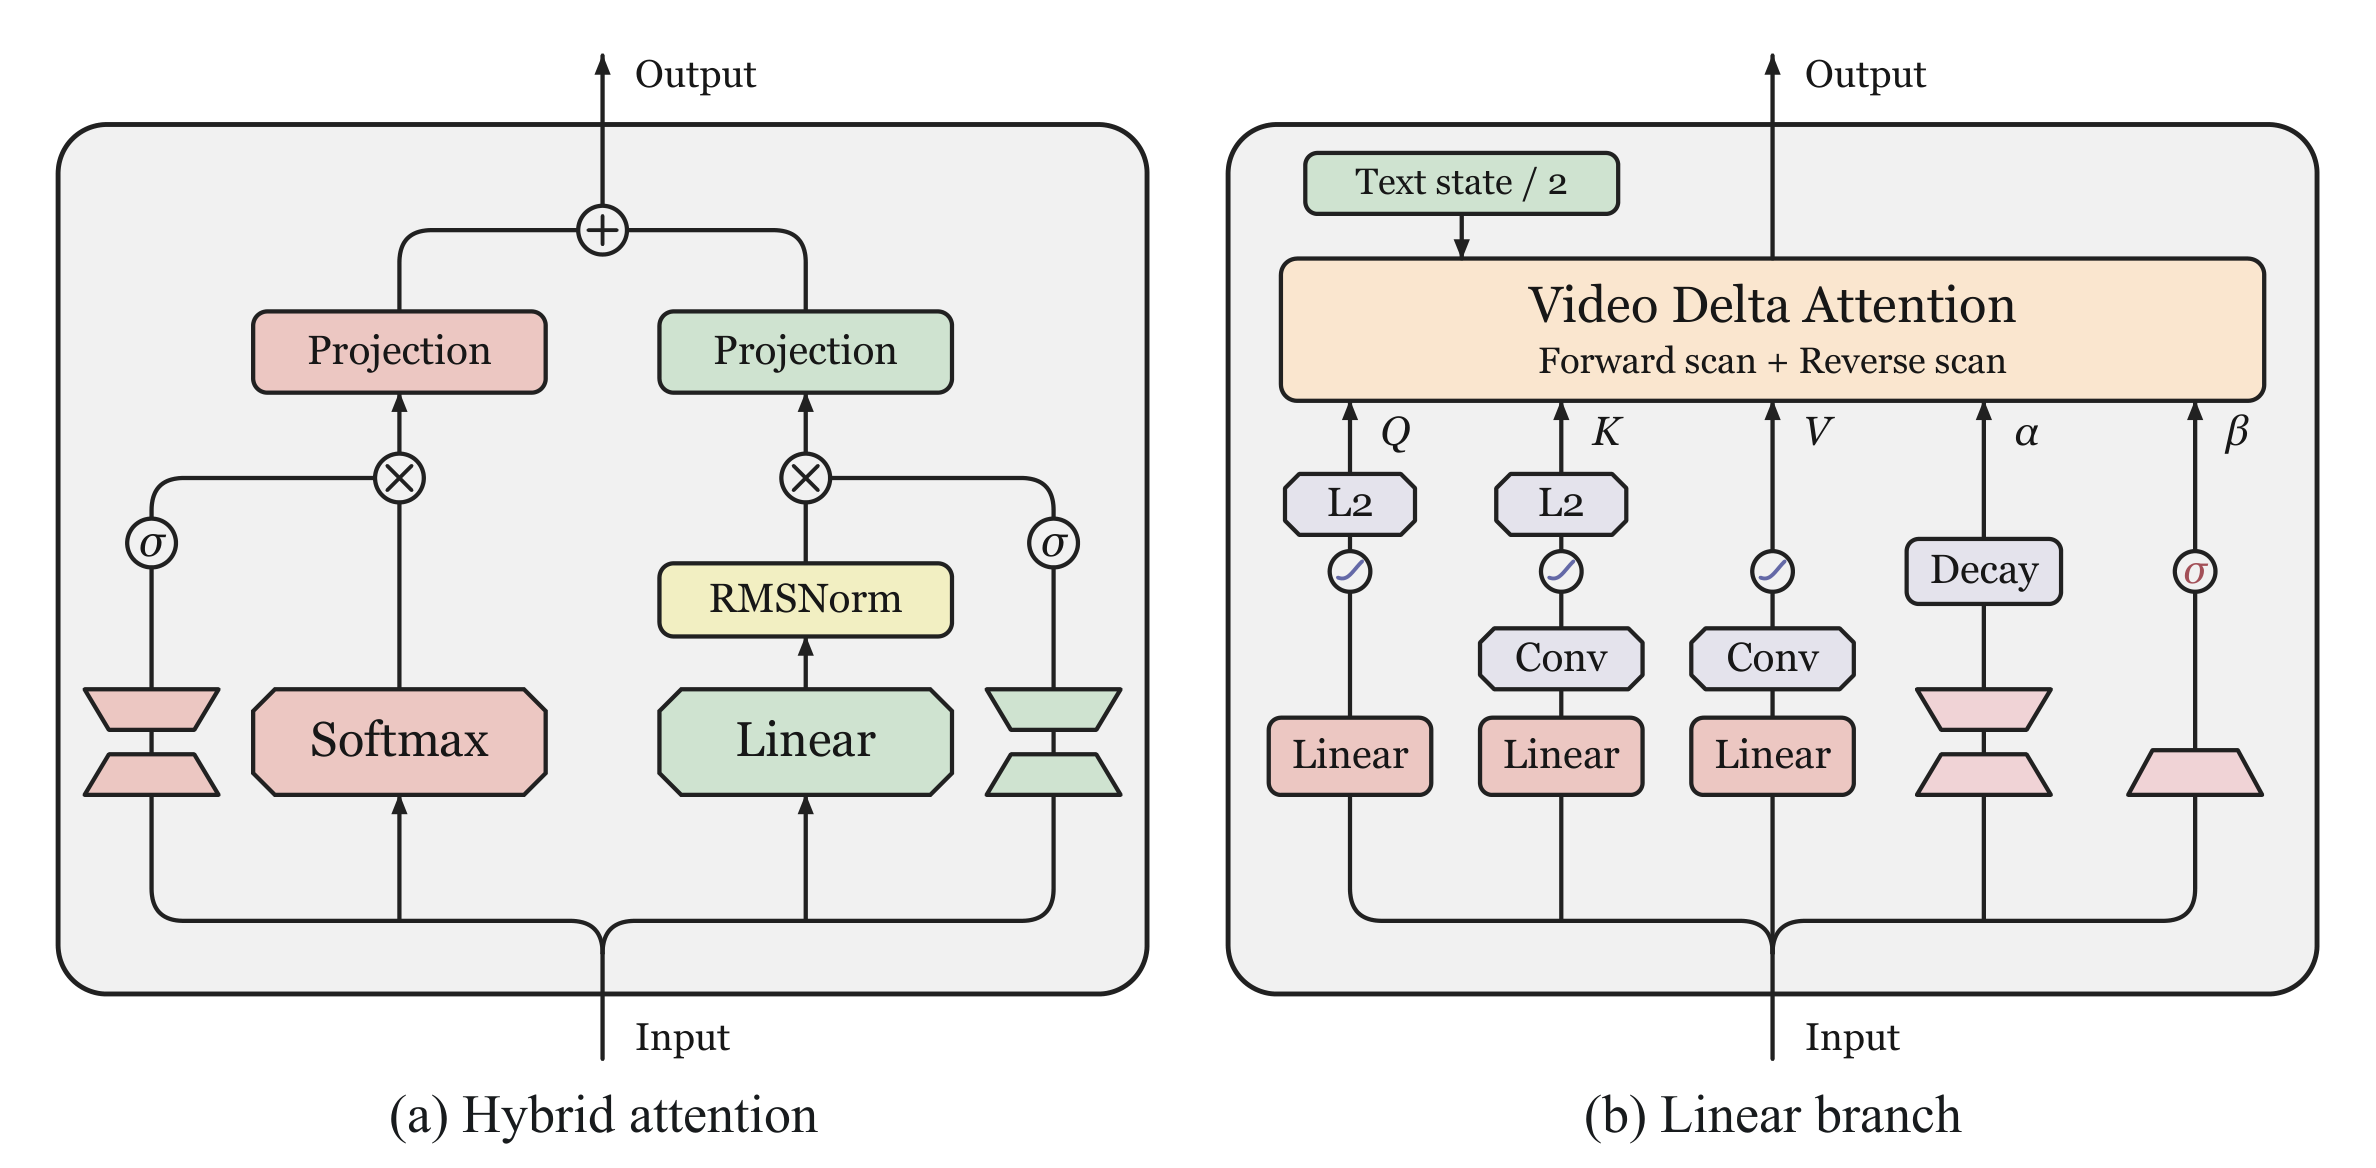
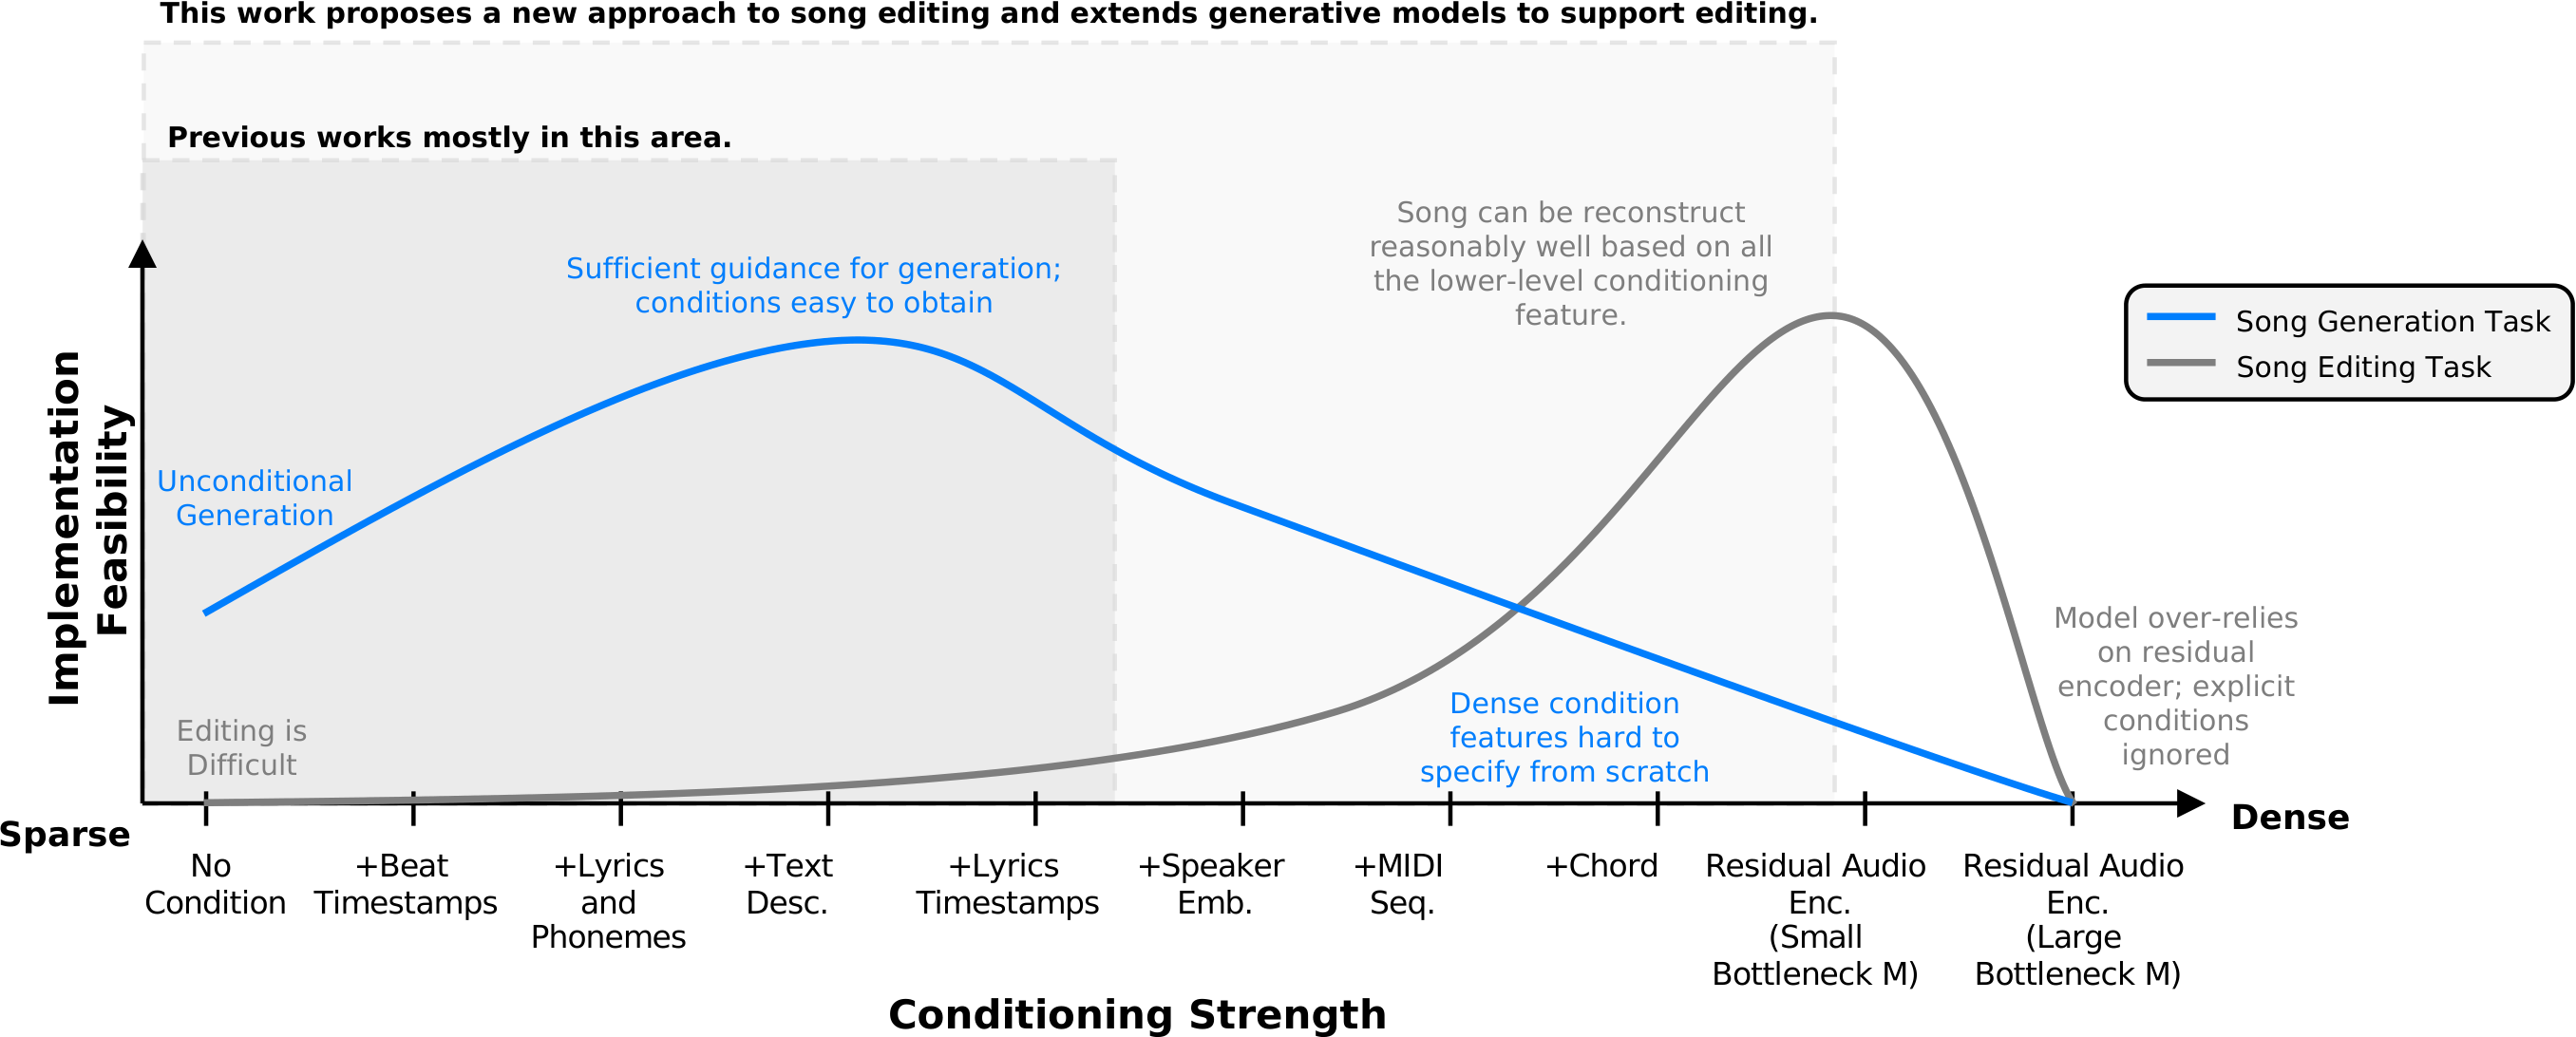
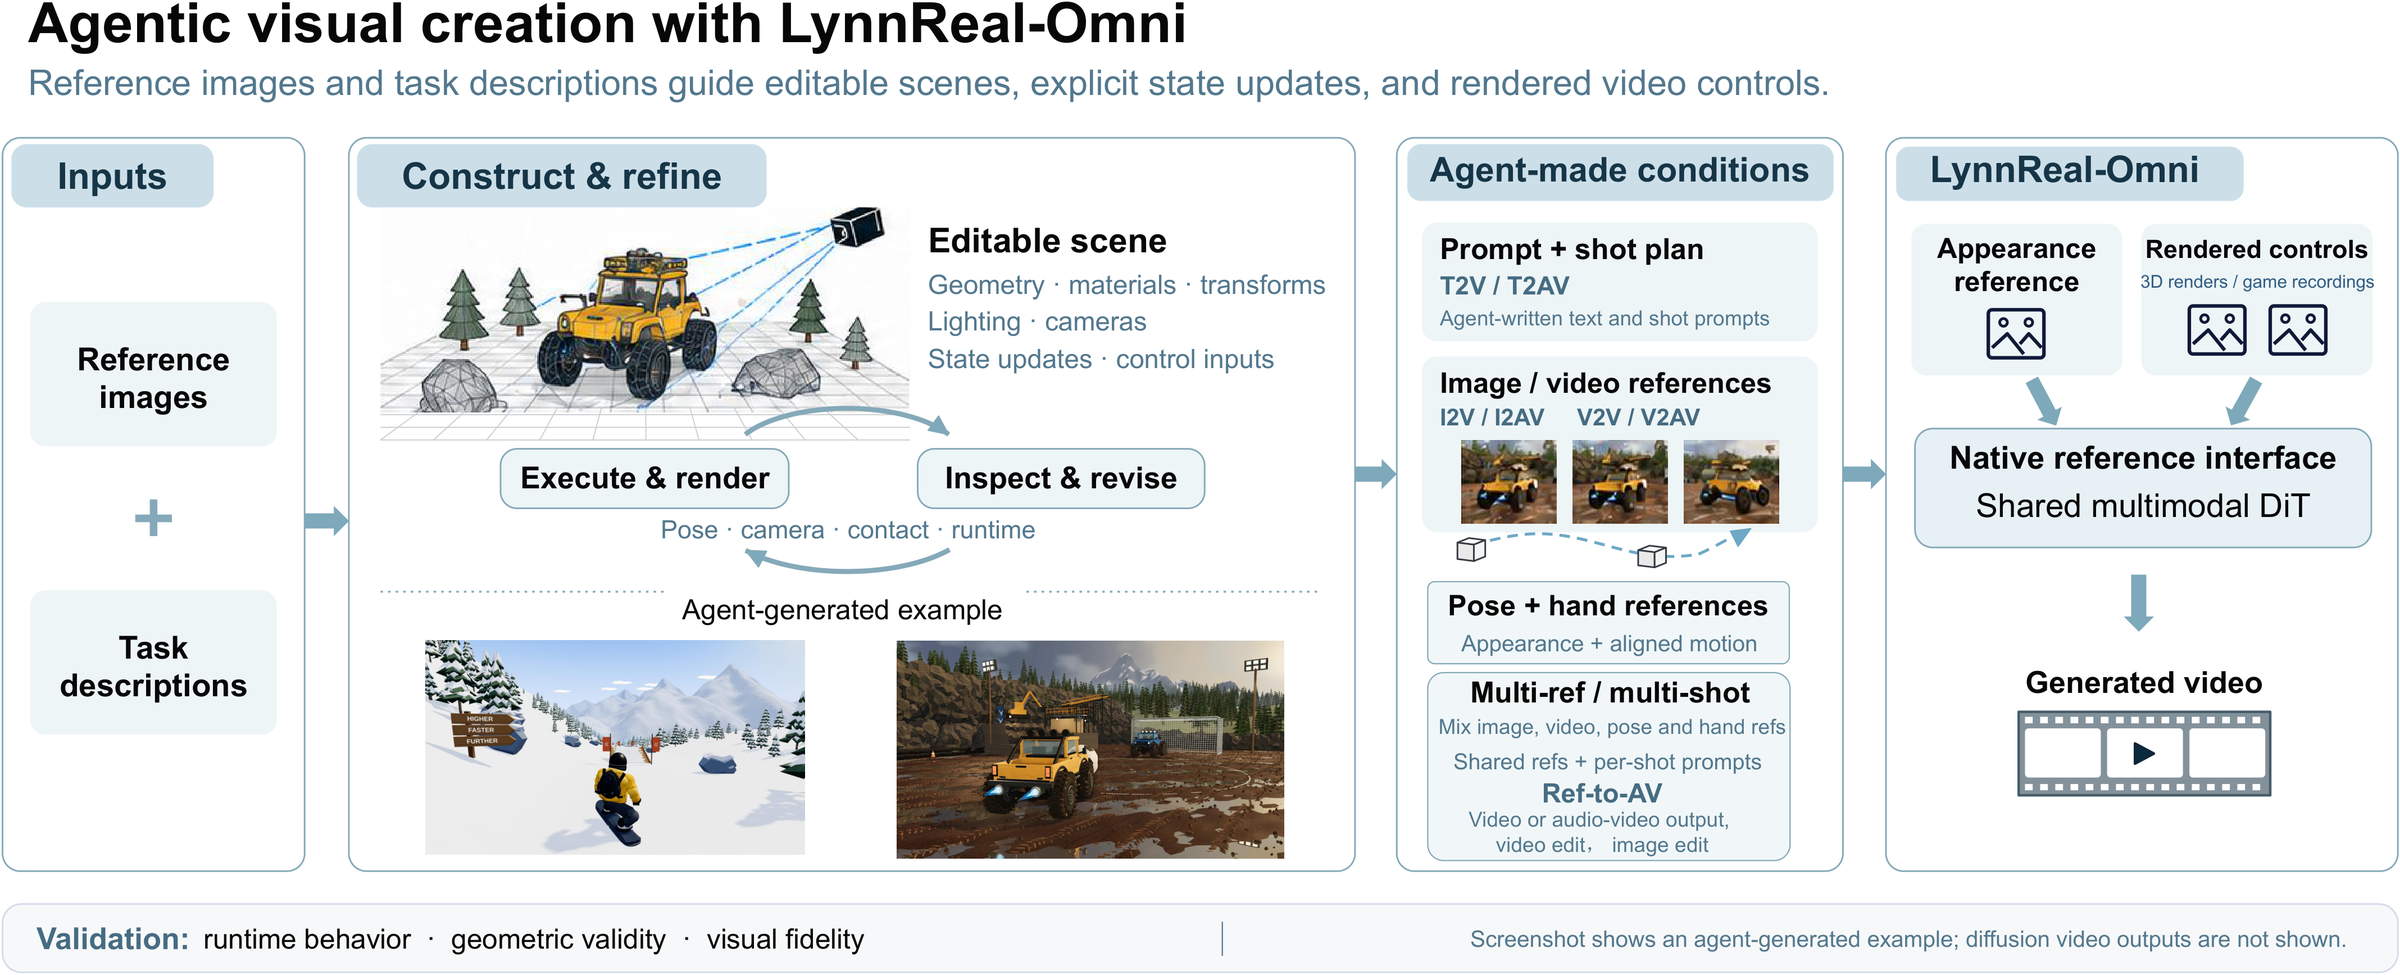
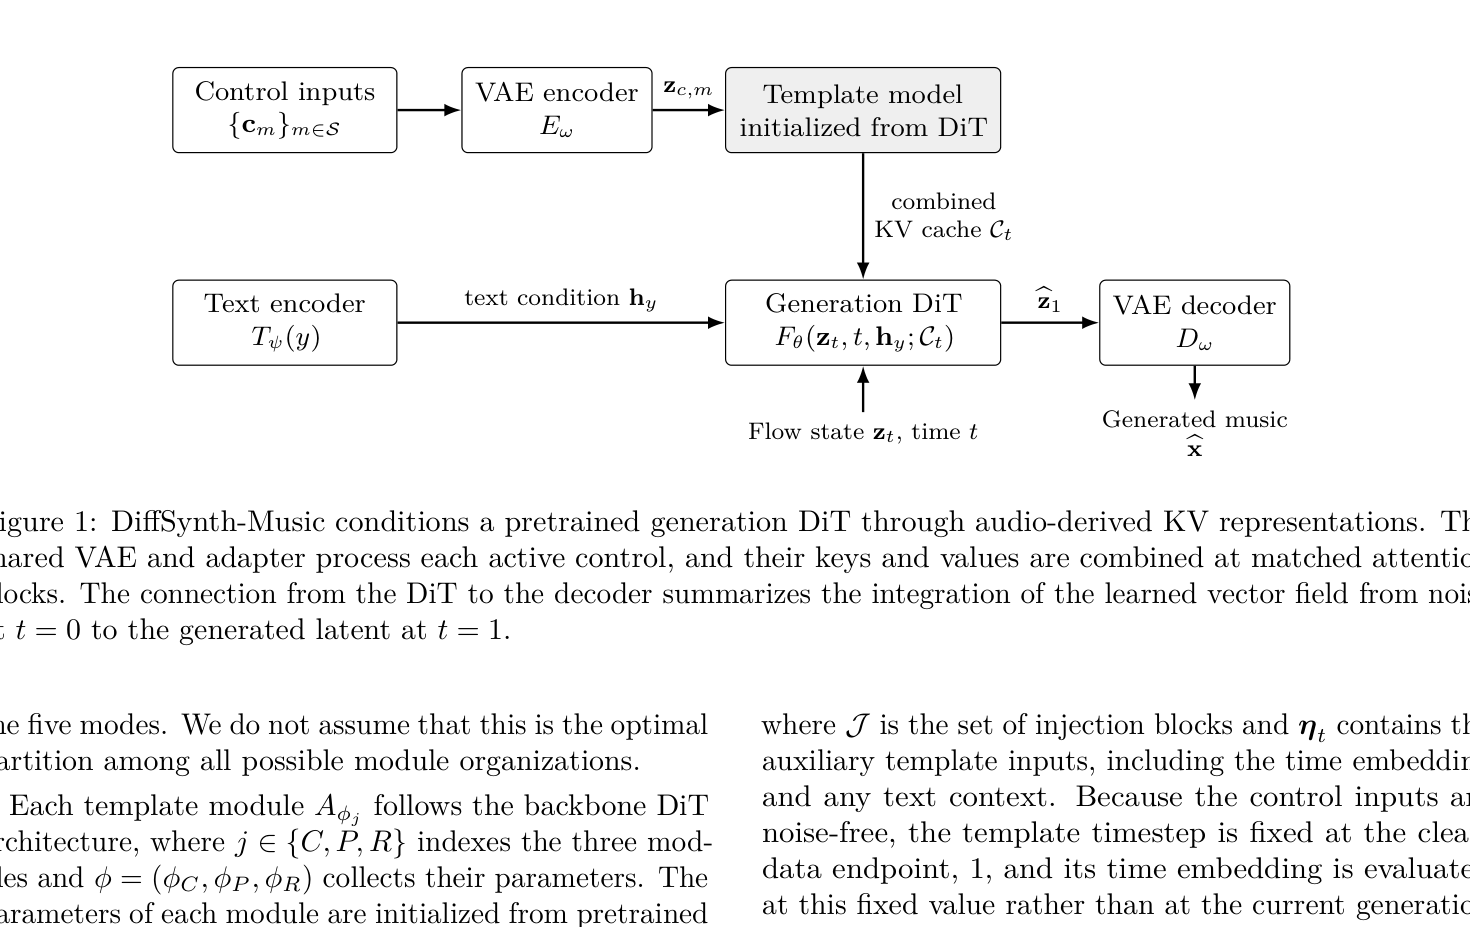
AIGC 每日速读|2026-09-21|伯克利线性注意力让H3视频快14.5倍-VDN 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 Video DeltaNet(UC Berkeley × Impossible Inc. × UT Austin):线性注意力让H3快14.5倍 dQwen3.5(University of Texas at Austin):混合骨干省一半适配token Edit-VAR(中山大学 × 华南理工大学 × 清华大学 × 山东大学 × 南开大学 × 湖南大学):免训练免反演改视频 Paint-Anything(ByteDance Seed × 浙江大学 × 南京大学):写个十六进制就能上色 StepAudio 3 Music(StepFun(阶跃星辰)× ACE × 香港中文大学 × UC San Diego):先写ABC谱再生成5分半歌 今日论文速览 1. Video DeltaNet:线性注意力让H3快14.5倍 Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation | UC Berkeley × Impossible Inc. × UT Austin | arXiv:2609.20744 关键词:视频扩散模型,线性注意力,混合注意力,推理加速 前序问题:视频扩散模型每一步去噪都要把又长又宽的时空 token 序列过一遍注意力,算力全压在这里。线性注意力在大语言模型里已经被验证好用,但直接搬到视频模型上会丢掉细粒度交互,画面质量跟着掉——于是「省算力」和「保质量」一直是二选一。 本文贡献:论文提出 Video DeltaNet(VDN),不做纯替换而是双分支并存:局部 Softmax 注意力管近处的细粒度交互,双向线性记忆管长程视频上下文。线性分支的核心是 Video Delta Attention(VDA),它不按 token 逐个更新记忆,而是以「帧」为单位、把该帧的全部空间 token 一起吸收进去,一帧只更新一次。两个分支各有独立的输出投影和可学习门控来校准配比;适配则走分阶段的教师对齐配方(Stage A1 先单独对齐每个线性分支,A2 再端到端训练组装后的混合层),把新通路渐进地塞进已预训练的模型里。作者把 VDN 落在 MiniMax H3 上,只对 video-to-video 这类交互用混合注意力,凡是牵涉文本或音频的交互仍然保留 Softmax。 实验效果:配合八步蒸馏和优化过的 SGLang 服务栈,VDN-H3 在 8 张 NVIDIA B200 上生成 14.3 秒 768p 视频,DiT 去噪只用 6.70 秒,相对同样 8 卡、50 步的 dense H3 基线提速 14.5 倍。质量方面:50 步时 Stage B 后的 VDN-H3 与蒸馏前的 Dense H3 基本持平(美学、技术、学习质量、FIRM 各项接近,仅两个端点保真度指标略降);八步时在五项无参考质量指标上全部最高,VQA_T 比 FastH3 v2 高 10.78 分;四步时同样在五项上超过 Dense H3 加 Larry 适配器与 FastH3 v1,VQA_T 领先 FastH3 v1 达 12.64 分。 批判点评:这篇的价值在于把「线性注意力用于视频」从整体替换改成了按交互类型分流:视频与视频之间用线性,涉及文本、音频的跨模态交互留给 Softmax,承认了不同交互对精度的敏感度本就不一样,比一刀切务实得多。以帧为单位更新记忆也和视频 tokenizer 的时间结构对齐(H3 的 VAE 按五个连续潜帧为一个时间块解码,窗口顺着它走以免 Softmax 边界切断 tokenizer 的自然时间单元)。要留意的是 14.5 倍里混进了八步蒸馏和服务栈优化的贡献,架构本身的净收益要看 50 步那组对照;论文也明确说八步那组的显著性标记是各变体与 Dense 50 比,并非 VDN-H3 直接对 FastH3。另外全部结论都长在 MiniMax H3 这一个骨干上,换模型是否还成立尚无证据。 2. dQwen3.5:混合骨干省一半适配token dQwen3.5: Hybrid-Attention Diffusion Language Models | University of Texas at Austin | arXiv:2609.20751 关键词:扩散语言模型,混合注意力,模型适配,并行解码 前序问题:把预训练好的自回归模型改造成扩散语言模型(DLM)是条省钱路线,但几乎所有现成改造都从全注意力 Transformer 出发。问题是自回归这边早就转向了注意力与 RNN 层交错的混合架构,而 RNN 结构上就是因果的,要把它双向化并不容易——骨干和目标范式对不上。 本文贡献:作者索性直接试:以 Qwen3.5 为起点,在 0.8B、2B、4B、9B 四个规模上做自回归到扩散的适配,得到 dQwen3.5 系列,并拿一个全注意力模型做对照,专门回答两个问题——混合骨干是否是高效的适配起点,适配出来的模型还保不保留定义 DLM 的并行与任意序解码行为。评测统一用同一套解码方案(默认画布 1024)而非各家自带的推理配方,并用 trunk(去掉 embedding 与输出头)参数量作为容量口径对齐比较组。 实验效果:混合骨干确实更省:达到同一训练 loss 所需的 token 量大约只要全注意力对照的一半,配图上逐个 loss 档位统计的中位数是 2.21 倍 token 效率差。跨规模看,dQwen3.5 在任意序解码行为上与全注意力 DLM 相似,并行解码下表现强劲——HumanEval 与 MBPP 上 1× 到 8× 加速区间基本压住全注意力对照。 批判点评:结论有用且反直觉:结构上「不适合」双向化的混合骨干,反而是更划算的 DLM 起点,这对想复用现成混合架构权重的人是直接的好消息。但配图暴露了摘要没提的代价——在 MATH500 上,100B token 档的混合版明显落后全注意力对照(1× 时约 9.3% 对 15.8%),数学推理这一块的损失不小,只有在 4× 以上高加速区间才靠后者衰减更快而追平。作者自己在注释里也怀疑退化可能来自训练数据混合不如 Qwen3/Qwen3.5 原始配方,这等于承认「骨干差异」和「数据差异」还没被干净地分离。另外全部比较都在基座 checkpoint 上做,后训练被明确排除在外,而后训练对下游表现影响很大,所以这套结论离「能直接上线」还有距离。 3. Edit-VAR:免训练免反演改视频 Edit-VAR: Taming Visual Autoregressive Model for Precise Video Editing | 中山大学 × 华南理工大学 × 清华大学 × 山东大学 × 南开大学 × 湖南大学 | arXiv:2609.21268 关键词:视频编辑,视觉自回归,免训练,token替换 前序问题:文本引导的视频编辑要改对目标内容,同时保住没被编辑区域的外观和时间连贯。训练型方法控制力强但吃数据吃算力;免训练方法分两条路,免反演的不用恢复轨迹,可它那套保源引导会限制编辑强度、让语义改动做不彻底;反演型先恢复潜轨迹再重生成,近似误差会累积,导致源内容漂移和时间不一致。 本文贡献:Edit-VAR 是第一个基于预训练视觉自回归视频模型、既免训练又免反演的文本引导视频编辑框架。它把源视频直接编码成多尺度离散 token,用概率引导的条件 token 替换来保源;再用注意力引导的 token 级与尺度感知调制,只在与编辑相关的位置和生成阶段选择性放松源约束。Scale-Decoupled Generation 以「晚期尺度解除约束」的形式实现,负责重新生成运动一致的细节、减少纹理碎裂。另有残差引导的 token 剪枝,利用最后两个高分辨率尺度上的冗余来压推理开销。 实验效果:大量实验加一项盲测用户研究显示,Edit-VAR 在编辑保真度、源内容保持、时间连贯性和推理效率上整体优于现有免训练视频编辑方法。定性对比里,同样把「red boat hull」改成「dark blue boat hull」、把「tree frog」改成「poison dart frog」,VACE 会连船型和背景一起改,RAVE 整片色调偏移、青蛙变成纯绿,Edit-VAR 则只换掉目标物的颜色与纹理,港口的其他船、水面倒影和叶片细节都留住了。 批判点评:把编辑搬到离散多尺度 token 上做,绕开了连续扩散反演的误差累积,这个切换是这篇最实在的地方——问题定位在「反演」而不是泛泛的「一致性」,配套的概率引导替换也把「保源还是接受编辑」变成了可按 token 判定的显式比较。但摘要通篇只给「整体优于」的定性结论,没有一个具体数字,编辑保真与源保持之间的权衡到底移动了多少无从判断;残差剪枝说是降推理成本,省了多少、掉不掉质量也没披露。更根本的限制是它绑在视觉自回归视频模型上,而这类骨干的开源生态和画质上限目前都不如主流扩散视频模型,方法再好也受骨干天花板约束。 4. Paint-Anything:写个十六进制就能上色 Paint-Anything: Unified Any-Color Control for Image Generation and Editing | ByteDance Seed × 浙江大学 × 南京大学 | arXiv:2609.20816 关键词:图像生成,图像编辑,颜色控制,数据管线 前序问题:专业设计需要的是任意颜色控制:用任一 24 位十六进制值指定某个物体的目标颜色,生成和编辑都得听话。以往工作在颜色生成、编辑、上色上各做一块,却往往依赖专门的颜色表示或特制的推理流程,不通用。而大语言模型这边提供了一个更简单的起点——连小模型都已经能把十六进制值和颜色语义对上。 本文贡献:Paint-Anything 直接把十六进制写进文本提示(包在 color 标签里)由文本编码器编码,通过物体级颜色监督学出一套生成与编辑共享的 hex-prompt 接口。配套数据管线从真实图像构建 Paint-500K:经 VLM 定位、SAM3 掩码、CIE 空间颜色提取、编辑对合成、过滤与重新描述而成。关键设计是:真实图像有阴影,标签只能算近似颜色,所以再补一批纯色锚点——它们的像素与配对的十六进制严格一致;而这些锚点只在高噪声时间步参与训练,低噪声阶段仍交给自然图像,避免把纯色的平坦质感带进成品。论文还提出 Any Color Benchmark(ACBench),含 ACBench-T2I 与 ACBench-Edit 两部分,专门量物体级十六进制颜色保真度。 实验效果:在 FLUX.2-4B 上,Paint-Anything 把 ACBench-T2I 和 ACBench-Edit 分数相对基座分别提升 85.3% 和 28.3%,并在参与比较的方法中取得最高的平均 CompColor 分。消融实验支持这套训练配方。定性对比里基座 FLUX.2-4B 常给出「语义上说得通但数值上离要求很远」的颜色——要 #FF5634 的车身给成偏红、要 #000080 的沙漠绿洲给成亮蓝,Paint-Anything 则能贴住指定色值。 批判点评:「纯色锚点只在高噪声时段用」这个细节是全文最值得抄的一笔:它承认了监督信号在不同噪声尺度上的可信度不同,用时间步做分工而不是简单混数据,比多数「加一路干净监督」的做法更讲究。把十六进制塞进文本提示、不引入专门颜色编码器,也让它能直接挂在现成模型上。但 85.3% 是相对基座的提升,基座本身在这项上分数低,相对增幅容易放大;编辑侧只有 28.3%,两者差距说明编辑任务里颜色约束和内容保持的冲突还没解决好。更要紧的是 ACBench 是作者自建的评测,「在自家基准上提升最多」这件事需要外部复现才能定性。另外全部结果都在 FLUX.2-4B 上,跨骨干的可迁移性未验证。 5. StepAudio 3 Music:先写ABC谱再生成5分半歌 StepAudio 3 Music Technical Report | StepFun(阶跃星辰)× ACE × 香港中文大学 × UC San Diego | arXiv:2609.16034 关键词:音乐生成,音频tokenizer,MoE,流匹配DiT 前序问题:长篇音乐生成要同时满足两件事:既能按开放域文本指令走,又得让和声、节奏、旋律结构立得住。以重建为导向的音频 tokenizer 会把音乐结构和精细声学细节混在一起,产出高熵 token 不好建模;而模型若只是端到端硬生,编曲结构就成了隐式的、不可控的副产物。 本文贡献:StepAudio 3 Music 走离散与连续混合的设计。StepAudio Music Tokenizer 把音频表示成 50 Hz 的单码本流(码本 65536 条),靠语义引导的自监督与多任务训练同时保住音乐结构和重建所需信息;论文用受控对比(统一 25 Hz 帧率)比较了单码本 VQ、Semantic RVQ、Acoustic RVQ 三种离散瓶颈,以及不同 DiT 配置,才定下这个方案。渲染侧由流匹配 DiT 预测连续的 StepAudio VAE 潜变量,再由 VAE 解码器还原 48 kHz 音频。显式规划则交给一个 MoE 自回归模型:它先用 ABC 记谱法产出中间编曲方案(ABC-CoT),再去预测音乐 token,让和声、节奏、旋律结构成为生成上下文的一部分。渐进式训练课程加监督微调支撑歌曲与纯器乐生成、由干声生成伴奏、翻唱合成,最长 5 分 30 秒。 实验效果:经 DPO 强化学习后,模型在 AudioBox 的 Content Enjoyment、Content Usefulness、Production Quality 三项以及 MuQ-MuLan 相似度上取得所评系统中的最高分,SongBench 结果具备竞争力。在 Artificial Analysis Music Arena Vocals 初步榜上 Quality Elo 为 1105。 批判点评:「先写 ABC 谱再生成音频」把编曲从隐式副产物提成了显式可读的中间态,这既是可控性抓手也是可调试性抓手,是这篇最有辨识度的设计;单码本 50 Hz 加流匹配 DiT 的分工,也把「离散好建模」和「连续好还原」各自的长处分开用了。但榜单要看细账:Vocals 榜上它实际是第 4 名(前面是 Suno V5.5 的 1170、Mureka V9 的 1159、Mureka V8 的 1140),摘要里「仅次于 Suno V5.5 和 Mureka」的说法把 Mureka 两个版本折叠了,读起来比实际名次靠前。更关键的是它的投票样本只有 2119,而同榜 Suno、MiniMax 等都在 1 万以上,95% 置信区间也宽到 ±14,和第 5 名 Suno V5(1097,±6)的差距在统计上并不稳。论文自己也说明这些评测衡量的是生成质量,并不直接度量对单个 ABC 音符、和弦、小节的遵循程度——也就是说 ABC-CoT 到底被执行得多准,目前没有直接证据。 6. PhysStream:边生成边推物理的流式视频 PhysStream: Streaming Physics-Grounded Video Generation with Structured Scene Memory and Fine-Grained Motion Control | University of Pennsylvania × Snap Inc. × KAUST | arXiv:2609.17521 关键词:视频生成,物理一致性,自回归,交互控制 前序问题:视频生成的交互控制正从粗糙提示走向对动态场景做细粒度、物理上有意义的操纵。但现有可控方法要么要求生成开始前就给出完整控制时间表,要么用像素空间信号去规定物体位置——那是在指派位置,而不是在指定物理动力学。 本文贡献:PhysStream 是面向物理接地的图生视频的自回归模型,带两样东西。一是结构化场景记忆:位置图与物体跟踪图都从已生成的帧里在线导出,边生成边更新。二是用稀疏的速度增量信号做细粒度运动控制,这些信号编码的是物理量,让模型去学底层动力学而不是背位置。训练分两阶段:先用运动控制条件微调一个双向模型,再训练一个因果自回归模型并额外接入结构化场景记忆,进一步提升物理一致性。 实验效果:PhysStream 支持对多物体桌面刚体场景做交互式的、生成中途的控制——这是此前方法不具备的能力。合成基准上运动分布距离(FVMD)比最强基线降低 33%,轨迹误差降低 12%;野外对比中超过 85% 的情况被人类评估者更偏好。长时程上,配图里一只玉色茶杯在桌面随机走动,从 t=0 一路走到 t=180 帧,远超 49 帧的训练窗口,仍持续跟随随机注入的速度增量交互并保持外观不崩。 批判点评:「控制信号编码物理量而非像素位置」这个取舍是关键:它把可控性问题从「让模型听话地摆物体」改成「让模型学会动力学然后自己推演」,这也是它能支持生成中途插入交互、而不需要预先排好完整控制表的根因。结构化场景记忆从已生成帧在线导出,避免了额外的外部状态追踪,工程上干净。但作者自己单列了一张图说明一致性指标的局限——FlashMotion 的一致性分数和本方法相当,却有明显伪影和幻觉物体,DragStream 生成近乎静止的画面也能拿高分,这等于承认 33% 和 12% 这两个提升所依赖的指标体系本身可信度有限,真正支撑结论的是那 85% 的人类偏好。适用范围也偏窄:主战场是多物体桌面刚体,非刚体只给了弹跳球和布料两个微调后的演示,离通用物理场景还远。 7. DeepSeek-V4.1-Flash:每token只留890字节KV DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression | DeepSeek-AI | arXiv:2609.19969 关键词:KV cache压缩,MoE,长上下文,推理成本 前序问题:长时程智能体大规模铺开后,模型负载越来越偏输入重。尽管此前工作已大幅降低长上下文计算成本,prefill 仍然很贵,而庞大的 KV cache 继续挤占 HBM 与 SSD 容量、吃掉数据传输带宽。算力、存储、带宽这三份需求合起来,构成了进一步压低部署成本的主要瓶颈。 本文贡献:DeepSeek-V4.1-Flash 是一个多模态 MoE 模型,骨干 552B 参数,支持最长 100 万 token 上下文。它采用因果编码器-解码器(CED)架构:解码时每 token 激活 16B 参数,prefill 时只激活 8B,这对智能体这类输入重负载显著改善成本效率。为把 KV cache 压缩推到极限,模型把 Compressed Sparse Attention 2(CSA2)里的跨层 KV cache 复用与 FP4 KV 缓存结合起来,使常驻 HBM 的全局 KV cache 降到每 token 890 字节,约为 DeepSeek-V4-Flash 的四分之一。再通过名为 SWA Bounded Replay 的部署优化,把常驻 SSD 或主机内存的持久 KV cache 压到约八分之一。论文另外精简了 V4 架构并引入若干高效扩展,在 45T token 的多模态语料上预训练并做了完整后训练。 实验效果:KV cache 占用大幅缩小的同时,性能明显好于基线。单 token decode FLOPs 随上下文增长的曲线上,V4.1-Flash 到 1024K 仍基本持平在 25 GFLOPs 上下,而 V4-Flash 已升到约 55、V3.2 约 600、V1 超过 3000。预训练阶段在自建留出集上,V4.1-Flash-Base 的 BPB 在所有任务上均低于 V4-Flash-Base 与 V4-Pro-Base。代码智能体基准上性能随 RL 训练规模持续提升,把最大上下文进一步扩到 1M token 后,在极长时程任务上还能继续涨。模型权重已在 HuggingFace 放出。 批判点评:890 字节每 token 这个数字值得记住:它把长上下文的讨论从「模型记不记得住」彻底拽到了「cache 放不放得下、搬不搬得动」,而 prefill 8B、decode 16B 的非对称激活更是直接冲着智能体负载「输入远大于输出」的真实形状去的,属于按负载画像改架构。但 FLOPs 曲线也显示,在约 100K 以下的上下文里 V4.1-Flash 反而略高于 V4-Flash(约 23 对 19 GFLOPs),这套设计是拿短上下文的一点效率换长上下文的大幅收敛,主要跑短请求的场景未必划算。另外 FP4 KV 缓存在什么任务上会先露出精度问题、SWA Bounded Replay 对首 token 延迟的影响如何,摘要都没交代;593 位作者的技术报告里工程优化与架构贡献高度耦合,外部想复现出同样的 890 字节与同等质量,难度不低。 8. The Weight Is Over:12GB显卡跑亚秒出图 The Weight Is Over - Interactive Diffusion on Consumer GPUs | Adobe × NVIDIA | arXiv:2609.21849 关键词:端侧推理,扩散加速,文本编码器蒸馏,显存预算 前序问题:端侧推理正在爆发,但势头几乎全在语言模型那边。扩散管线吃显存、对延迟敏感,还要编排文本编码器、Transformer、解码器以及后处理若干环节,这套流程远没有大模型推理循环那么标准化,落到消费级设备上格外难办。 本文贡献:论文在性能、质量、模型体积这个三角里找可落地的点,给出三项贡献:一个嵌入翻译器,把小文本编码器映射到大编码器的表示空间,从而砍掉权重与延迟;一套可复现的扫参配方,用来在扩散管线的速度/质量/显存三角里做导航;以及一个端侧交互式图像生成编辑器,在较新的 GPU 上实现亚秒级首图时间(TTFI)。 实验效果:跨设备扫参结果最能说明问题。RTX 4070 Ti(12 GB,可用约 11.2 GB)上,只要常驻权重预算没超出可用显存,每步延迟稳定在数百毫秒量级;一旦越过 11.2 GB 就触发 host-paging、必须从主机流式取权重,每步延迟直接跳到 10^4 毫秒级,相当于一个断崖。工作站级 RTX PRO 6000 Blackwell(96 GB)上「什么都放得下」,此时主导排序的就变成精度——NVFP4 最快,FP8 次之,FP16/BF16 落后。嵌入翻译器的容量门槛也量出来了:187M 的翻译器能紧跟 4B 参考编码器,29M 就会漂到「看着合理但内容不对」(要狐狸给猫、要拉面给黄色玩偶),3.5M 则塌缩成一种同质的暗黑森林风格。 批判点评:这篇的实用价值不在某个新模块,而在把「显存预算」立成了一等约束并画出了那条断崖:越过可用显存的惩罚不是线性变慢而是一到两个数量级,这意味着端侧调优的第一目标应该是「压进预算」而不是「提高吞吐」,顺序搞反了后面全是白做。把翻译器容量与语义保真的关系摸到 187M/29M/3.5M 三个档,也给了很实际的选型下界。但工作偏工程报告:只有两位作者、两台设备,没有跨更多消费级显卡的统计;质量评价主要靠定性图,缺少 FID 之类的量化指标,「187M 紧跟 4B」到底差多少无法量化。亚秒 TTFI 也限定在「较新的 GPU」上,对更老的消费级卡是什么表现没有交代。 9. MuSeC:语义声学分流的音乐codec Rethinking Music Tokenization: A Semantic Codec toward High-Fidelity LLM Music Generation | 西北工业大学 ASLP × 吉利汽车研究院(宁波) | arXiv:2609.21240 关键词:音乐tokenizer,语义codec,残差量化,音乐信息检索 前序问题:离散音频 tokenization 已成为原始波形与自回归建模之间的关键接口,所以音乐 tokenizer 得同时做到两件互相拉扯的事:支持高保真重建,又要产出适合语言建模的离散序列。以重建为导向的 tokenizer 常把音乐结构和精细声学细节混在一起,产出高熵 token 难建模;而语义引导的替代方案本是为语音设计的,套到音乐上不合身,往往还伤重建质量。 本文贡献:论文先把「音乐语义内容」重新定义成一个可度量的概念——以下游音乐信息检索(MIR)任务表现为锚。循着这个定义提出 MuSeC:一个音乐语义 codec,直接从混合信号里把语义与声学内容解耦,不需要做源分离。结构上,冻结的 SSL 编码器加 k-means 提供语义 token,另一路声学 RVQ 流捕捉细粒度声学信息,两路拼接后送解码器做高保真重建,训练时还有判别器提供对抗损失。 实验效果:MuSeC 在保住高保真重建所需信息的同时,产出对语言模型更友好的离散单元,重建质量有提升,token 序列也更可预测,为高保真 LLM 音乐生成提供了实际基础。MIR 任务上的自消融显示,完整 MuSeC(S1A16)在 GuitarSet/Chords(0.3648 对 0.1713)、EMO/R2A(0.6520 对 0.6110)、EMO/R2V(0.3696 对 0.3578)等任务上明显好于纯 k-means 量化版本,也普遍好于只有声学的 A16 变体。 批判点评:把「语义」从形容词变成以 MIR 任务表现为锚的可测量量,是这篇方法论上最扎实的一步——有了口径,语义与声学的分流才有得优化,而不是凭感觉设计码本。不做源分离直接从混合信号解耦,也省掉了一个容易引入误差的前置环节。但消融图显示优势并不一致:GTZAN/Genre 上 MuSeC-S1A16 是 0.5345,反而低于 k-means 的 0.6034,Lyrics 上两者基本持平(0.4903 对 0.4993);更重要的是全部设置都明显低于连续 LeVo BEST-RQ 这条语义上限(多数任务差 0.1 以上),说明离散化的语义损失远未补齐。另外论文标题指向「高保真 LLM 音乐生成」,但实际只做到 codec 这一层,接上语言模型后端到端能好多少并没有验证,「更可预测的 token 序列」目前也缺少熵或困惑度之类的直接数字支撑。 10. OmniVBench:1.2万条清单查参考跑没跑偏 OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation | 腾讯 × 香港科技大学(广州) | arXiv:2609.22069 关键词:视频生成评测,参考到视频,数据集,因子级评估 前序问题:参考到视频(R2V)生成正朝着越来越通用、越来越多样的参考控制演进,催生了所谓全模态 R2V 这一范式。但现有基准跟不上:测试用例覆盖的参考类型与组合都有限,评估协议大多只看整体参考一致性,忽略了参考因子是否被正确保留、解耦并路由到对应目标。同时全模态 R2V 训练数据构建成本高,合适的训练资源很稀缺。 本文贡献:论文同时给出 OmniVBench 与 Omni-R2V Dataset,一个管评测一个管训练。OmniVBench 把 R2V 评测扩展到更广的参考类型、更细的控制任务和更丰富的参考组合,覆盖 7 个任务族、18 个细粒度任务,横跨内容、运动、风格、结构、叙事与多参考设定,共 813 个评测用例。核心是因子级评估:用 12172 条针对具体用例的检查清单条目,逐条判断意图中的参考因子是否被忠实保留、是否被正确解耦并绑定到目标、是否按指令实现。Omni-R2V Dataset 主要取材于大规模专业视频素材库,包含 34 万条处理好的训练样本,覆盖多种参考类型与多参考组合,并给出各任务专用的参考-目标配对构建管线。 实验效果:对先进的开源与闭源 R2V 模型做的大范围评测显示,各任务族和各评估维度上都存在明显性能差距,暴露了当前 R2V 模型的残留局限。配图给出的多参考用例里,RF(参考保真)/IR(指令遵循)两项分数分化极大:UniVideo 只有 33.2/14.8,LoomVideo 43.1/36.7,OmniWeaving 48.0/56.0,Kling 3.0 Omni 62.9/100,Bernini 85.2/69.7,Gemini Omni 91.2/100,而 MiniMax H3、Seedance 2.0 与 Seedance 2.5 在该用例上拿到 100/100。 批判点评:把「参考一致性」拆成保留、解耦、路由三件事,是这套基准最有价值的判断——多参考场景真正容易错的不是「像不像」,而是把 A 参考的属性贴到了 B 目标上,而整体一致性分数恰恰看不出这类串台。12172 条逐用例清单让这种错误变得可指认。数据侧 34 万条专业素材样本对社区也是实打实的补给。但代价是清单法对判定器的依赖很重:谁来回答这 1.2 万条问题、判定器自身的偏差和一致性如何,摘要没有交代,而这直接决定分数可信度。813 个评测用例摊到 18 个细粒度任务上平均每任务仅四十余例,统计功效对细分结论偏弱;配图那个用例里三个模型同时打满 100/100,也提示清单在强模型区间容易饱和、区分度下降。另外基准与数据集同源、且出自同一团队,用该数据训练的模型在该基准上的成绩需要额外小心解读。 趋势观察 注意力的省法,从「换掉它」变成「按交互类型分流」 Video DeltaNet 只在视频与视频之间用线性注意力,凡涉及文本或音频的交互仍留给 Softmax;dQwen3.5 则把注意力与 RNN 交错的混合骨干当成扩散语言模型的适配起点。两篇的共同前提是承认不同交互对精度的敏感度本来就不同,一刀切替换必然在某处付出代价。 长上下文的成本,已经从算力转到显存和带宽 DeepSeek-V4.1-Flash 把常驻 HBM 的全局 KV 压到每 token 890 字节、持久部分再压到八分之一,并用 prefill 8B、decode 16B 的非对称激活去贴合智能体负载的真实形状;The Weight Is Over 则量出消费级显卡越过可用显存后延迟跳升两个数量级的断崖。两者都在说:放不放得下、搬不搬得动,已经比算得快不快更决定部署成本。 生成过程正在被拆出显式的中间态 StepAudio 3 Music 先用 ABC 记谱产出编曲方案再预测音乐 token,PhysStream 把位置图与跟踪图作为结构化场景记忆在线维护,Edit-VAR 缓存源概率与交叉注意力图再逐 token 决定保源还是改。把过去隐含在权重里的东西显式化,换来的是可控性与可调试性。 评测开始追问「参考有没有被放对位置」 OmniVBench 把参考一致性拆成保留、解耦、路由三件事,用 1.2 万条逐用例清单指认把 A 的属性贴到 B 上的串台;Paint-Anything 自建 ACBench 专量物体级十六进制色值保真;MuSeC 干脆把「音乐语义」定义成下游 MIR 任务表现。三者都不再满足于一个整体相似度分数。 人工智能炼丹君 整理 | 2026-09-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-18|高通揪出长视频KV错配-Recency Forcing 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与长时程一致性 2 篇 · 生成模型评测与审计 2 篇 · 推理与采样加速 2 篇 · 语音与音乐生成 2 篇 · 视频修复与图像应用 2 篇 重点论文标题列表 Recency Forcing(Qualcomm AI Research):按距离衰减注意力救长视频 MiniMax-H3-Reason(National University of Singapore;Fudan University;Tencent):全模态模型物理推理仅四成 ⚡ Diagonal Sparsity(KAIST;Agency for Defense Development;Seoul National University):对角稀疏把吞吐拉到3.1倍 VibeAvatar(Peking University):口型与美感分阶段各管各的 AVR(New York University;University of Technology Sydney):能抄就抄抄不到才让扩散补 今日论文速览 1. Recency Forcing:按距离衰减注意力救长视频 Recency Forcing: Bridging the Long-Horizon Gap in Autoregressive Video Generation | Qualcomm AI Research | arXiv:2609.19729 关键词:自回归视频生成,长时程一致性,KV cache,注意力偏置 ⚠️ 前序问题:自回归视频生成一拉长就退化。论文把根因定位到一处被忽视的训练-推理不一致:训练时短片段的全部上下文帧都在 KV cache 里,推理时显存约束却会把远处帧逐出 cache,等于抽走了模型当初赖以生成的上下文。作者称之为 KV 淘汰错配(KV eviction mismatch)。 本文贡献:思路不是用截断上下文去模拟淘汰——那会连模型仍需要的时间信息一起丢掉、破坏运动连贯——而是保留上下文,同时让远处帧的影响逐步衰减,等它们真被淘汰时影响已可忽略。论文先用扰动式敏感度指标 positional response R(Δ, t_denoise) 量出上下文影响随时间距离陡峭衰减、且在不同去噪步上系统性变化;据此提出 Temporal Response Bias(TRB),把一个非正的、随时间步变化的偏置直接加在 softmax 之前的注意力 logits 上。配套的 Biased Attention Reparameterization(BAR)是个等价改写,把偏置移到 softmax 之外,使 TRB 退化成一次标准 FlashAttention 调用。 实验效果:在 VBench 与 VBench-Long 上取得长时程生成的 state-of-the-art 质量,且不增加推理成本。60 秒视频的定性对比里,Self-Forcing 出现色彩漂移,LongLive 产生场景重复,DeepForcing 引入模糊,Recency Forcing 则保持了画面稳定与运动连贯。方法不改动上下文长度与训练目标,免训练与训练两种模式都能用,BAR 的等价改写让偏置的额外开销为零。 批判点评:把长视频退化归到 KV cache 淘汰这个具体的工程约束上,而不是笼统归因于「误差累积」,定位比多数同类工作清晰,BAR 让它零开销落地也务实。但摘要只给 state-of-the-art 的结论、未披露具体分数,免训练与训练两种模式的增益差距、TRB 偏置形状换骨干后是否还成立,都要看正文;VBench 系列本身偏重视觉质量,长时程的叙事与物体持久性未必能被它完全反映。 2. MiniMax-H3-Reason:全模态模型物理推理仅四成 Can MiniMax-H3 Reason About the Physical World? An Evaluation of Omni-Modal Generative Model | National University of Singapore;Fudan University;Tencent | arXiv:2609.18323 关键词:全模态生成模型,物理世界推理,跨模态整合,评测基准 ⚠️ 前序问题:全模态生成模型把文本、图像、视频、音频统一建模,MiniMax-H3 正是在共享潜空间里同时做多模态理解与音视频联合生成的代表。但多模态对齐到底有没有提升模型的世界推理能力?现有面向视频生成与世界模型的评测大多受限于单一输入模态,且提示词与目标视频内容高度重合,回答不了这个问题。 本文贡献:论文构建了围绕物理世界推理四个互补维度的评测框架,专门为全模态输入设计任务:隐式提示搭配多帧、音频-图像、前缀视频、音频-视频四类场景。关键设计是每一路模态只提供事件的部分证据,模型必须跨模态整合互补线索,才能推断出潜在的事件状态与未来动态。 实验效果:517 个评测实例上,MiniMax-H3 总体成功率 41.97%。分维度看,基于视频的决策推理最高、为 56.00%,基于音频的消歧推理最弱、只有 27.40%。作者据此认为要真正吃到多模态输入的红利,关键仍在有效的跨模态整合。 批判点评:用「每种模态只给部分证据」的设定逼出跨模态整合能力,比提示词与目标高度重合的常规评测更有区分度,音频维度 27.40% 也确实点出了当前全模态模型的短板。但全文只评了 MiniMax-H3 一个模型,没有同代横向对比,41.97% 这个绝对值究竟是模型不行还是任务过难无从判断;517 个实例摊到四个维度上,每个维度的样本量也偏薄。 3. Diagonal Sparsity:对角稀疏把吞吐拉到3.1倍 Understanding and Exploiting Diagonal Attention Sparsity in Autoregressive Image Generation | KAIST;Agency for Defense Development;Seoul National University | arXiv:2609.19702 关键词:自回归图像生成,稀疏注意力,KV cache,推理加速 ⚠️ 前序问题:自回归图像生成因为能直接复用基于 transformer 的 LLM 服务设施而成为多模态系统的一种范式,但每次请求要吐出上千个视觉 token,解码越来越被注意力计算中的 KV cache 访问卡住。稀疏注意力在文本 LLM 推理上已被充分研究,可它的稀疏性假设能不能迁移到自回归图像生成,此前没人说得清。 本文贡献:论文首次系统刻画了自回归图像生成中的注意力稀疏性,覆盖多种负载与代表性开源模型,发现三个和文本场景不一样的性质:prefill 与 decode 阶段存在明显不对称、注意力强烈集中在 prompt token 与局部 token 上、以及视觉 token 的空间局部性带来一种独特的对角稀疏模式。据此提出对角感知稀疏注意力,在最近窗口内沿对角方向选择性跳过 KV 条目。 实验效果:基于 FlexGen、FlashAttention-2 与自定义 kernel 实现在 GPU 服务系统上,相比稠密推理最高取得 3.1 倍吞吐与 1.19 倍延迟改善,质量损失低于 2%。 批判点评:把稀疏模式追到「视觉 token 的空间局部性」这一来源、而不是照搬文本 LLM 的稀疏假设,是这篇最扎实的地方,3.1 倍吞吐也有工程说服力。但「质量损失低于 2%」用的是哪个指标、在哪些负载上成立,摘要没交代;对角模式依赖光栅扫描式的 token 排布,换扫描顺序或改分辨率后是否还成立同样存疑。 4. VibeAvatar:口型与美感分阶段各管各的 VibeAvatar: Aligning Phonetic Kinematics and Human Aesthetics for High-Fidelity Talking Avatar Synthesis | Peking University | arXiv:2609.18632 关键词:说话人视频合成,语音驱动,GRPO,流匹配 ⚠️ 前序问题:多模态说话人视频合成要从一张参考肖像加一段语音生成逼真视频。扩散类方法进步很快,却始终难以同时拿到准确的唇部发音、符合人类偏好的运动美感和高效推理这三样。 本文贡献:论文的判断是:发音准确性和运动美感来自根本不同的源头,应该在互补的阶段分别处理,而不是塞给单个生成器隐式地一起学。VibeAvatar 因此把两个目标解耦——条件阶段用 Phonetic Kinematics Adapter(PKA)把面向识别的语音特征转成发音-运动条件;后训练阶段用 Aesthetic Motion Policy(AMP),以 GRPO 优化一个流一致的随机采样策略。运动生成器本身是轻量流模型,工作在紧凑的一维 warp 潜空间里。 实验效果:客观指标与用户研究上,发音、美感、效率三项均达到 state-of-the-art;生成 10 秒 512px 视频耗时不到 10 秒,显存占用约 3GB。 批判点评:「发音归条件阶段、美感归后训练」是个干净的分工,把 GRPO 用在采样策略而不是生成器权重上也省掉了重训成本,约 3GB 显存意味着消费级显卡能跑。但美感由 GRPO 所对齐的偏好定义,口味会不会过拟合到特定标注群体值得警惕;摘要只给了效率数字,发音与美感的具体分数、以及更长时长下的身份漂移都得看正文。 5. AVR:能抄就抄抄不到才让扩散补 Copy What Is Seen, Generate What Is Not: Training-Free Anomaly-Aware Video Restoration | New York University;University of Technology Sydney | arXiv:2609.18836 关键词:视频修复,异常检测,免训练方法,扩散修补 ⚠️ 前序问题:监控系统检测到异常后往往还得把画面修好,但这两件事一直被分开研究:免训练的异常检测止步于一个分数或标签,免训练的视频编辑则只听用户提示词、不听检测器。 本文贡献:AVR 只用冻结的预训练模型就把两端接上,而且只在画面确实没有证据可抄的地方才生成内容。先由运动证据把开放词表提案收敛成时空掩码;再用片段自身算出的背景先验,填掉异常曾经遮挡过的每一个像素,只把「任何一帧都没出现过」的部分交给扩散合成;最后一个冻结的验证器逐片段决定该信任经典修复、先验锚定修复还是背景条件修复。 实验效果:三个监控数据集上、覆盖全参考异常注入与真实异常两种设定:oracle 掩码下 AVR 的全帧保真度领先,在编辑区域内与三个训练过的视频 inpainting 方法持平,用自己产出的掩码时优于「先检测再生成」的流水线,同时压住了残留异常与自由扩散带来的闪烁。 批判点评:「能抄就抄、抄不到才生成」的取舍很贴监控取证的需求——少生成一分就少一分臆造风险,全程冻结模型也免了训练成本。但它靠运动证据圈定异常,静止或缓慢的异常可能整个漏掉;oracle 掩码下的领先说明上限不错,自产掩码下的成绩才是实际水平,三个监控数据集的场景多样性也仍有限。 6. CPR:作曲演奏精修三段渲染钢琴 CPR: Combining global composing, local performing and full-sequence refining in piano rendering with continuous autoregressive modelling | The Chinese University of Hong Kong, Shenzhen | arXiv:2609.18216 关键词:钢琴渲染,连续自回归,流匹配,音乐生成 ⚠️ 前序问题:提示词条件下的钢琴 MIDI-to-Music 渲染,要在忠实还原目标音符的同时复现参考录音的音色。现有方法分两条路:离散 codec 的自回归模型有因果时序建模能力,但量化会丢掉声学细节;流匹配更能保住声学结构,代价是全序列注意力开销大、语义结构反而更差。 本文贡献:连续自回归模型直接在连续表示上工作,既兼有自回归的条件跟随能力与流匹配的分布建模能力,又绕开量化瓶颈、计算成本更低。CPR 据此拆成三段:Composer 自回归预测连续隐状态,Performer 经局部流匹配生成 24kHz 声学潜变量,Refiner 再把波形上采样到 48kHz。论文另引入 Bottlenecked Representation Alignment(BREPA)与 Modality-Time RoPE(MT-RoPE),分别强化 Composer 隐状态里的音乐语义结构和跨模态时间对齐。 实验效果:P-MUSE-eval 上,CPR 只用 4 步(NFE=4)就输出 48kHz 音频,onset F1 78.4 与 FAD_clap 0.129 均为最佳;音色相似度 89.3 略低于需要 25 步的 P-MUSE(90.6),但明显优于 MIDI-VALLE 的 83.4。另有 13 位听众对 14 个样本的 MOS 主观评测。 批判点评:三段分工把「写什么音」「怎么弹出来」「采样率补齐」拆开,绕过离散量化这个老瓶颈,4 步出 48kHz 相对 P-MUSE 的 25 步是实打实的效率优势。但音色相似度并未超过 P-MUSE,说明连续表示在音色保真上还没占到便宜;MOS 只有 13 位听众评 14 个样本,样本量偏小,评测也集中在钢琴单一乐器上。 7. Self-Distilled TTS:模型自己教自己念生词 Self-Distilled Pronunciation and Accent Control for Neural Text-to-Speech | Independent Researcher;KOWRO Inc. | arXiv:2609.17234 关键词:语音合成,自蒸馏,发音控制,口音标注 ⚠️ 前序问题:直接读原始文本的 TTS 没有词典,碰上生僻词只能靠猜。已有的补救要么拿录音训练一条专门的发音与口音通道,要么从示例里一个词一个词地改。 本文贡献:这篇两样都不做。让冻结的骨干去读一个含有它本来就念得对的常见词的句子,再把它自己的输出当作同一句话的教师——只是把那个词替换成带标注的、指定口音的读法。这一对训练样本就是方法的全部。 实验效果:Sarashina2.2-TTS 上,经筛选的评测者(Fleiss' kappa = 0.85)在 0.89 的未见词上听出了指定口音,而无法表达口音的假名方案只有 0.57、没有赢下任何一组对比,自然度没有可测量的损害。未经调整迁移到自回归、扩散和编码器-解码器骨干后,319 个词上的读法正确率比不做编辑高出 0.25 到 0.47;CosyVoice 2 上三个词里有两个能带上口音,但在 Irodori 上不行,论文分析了原因。 批判点评:用模型自己的输出当教师、只换一个词构成训练对,简洁到几乎没有额外数据成本,跨骨干迁移也说明思路不绑架构。但它天然受限于「骨干本来就念得对的常见词」这个起点,词表外的音素组合未必覆盖得到;Irodori 上失效说明迁移并非无条件成立,日语音高重音之外的语言是否同样奏效也还没有证据。 8. JewelTry:免掩码珠宝试戴还管尺寸 JewelTry: Mask-Free Scale Aware Jewelry Virtual Try-On | Amazon | arXiv:2609.16626 关键词:虚拟试戴,免掩码扩散,尺寸感知,评测基准 ⚠️ 前序问题:虚拟试穿让顾客看到上身效果,已是网购的重要技术。服装类进展很大,珠宝却因为体积小、结构刚性、对细节高度敏感而一直是难啃的品类:既要忠实迁移外观,还得相对佩戴者有正确的尺寸和位置。现有珠宝试戴多依赖掩码引导,而免掩码方法又缺乏建模产品尺寸的显式引导。 本文贡献:论文先建了 JVTO-Bench,提供带真实产品尺寸标注的「参考-源-目标」三元组,覆盖四大珠宝品类。在此之上提出免掩码扩散框架 JewelTry:尺寸适配器把产品实际尺寸编码成一个 scale token,让模型在上下文中学到珠宝与人体解剖结构之间的尺寸关系;再用单向条件注意力与注意力精修损失,同时保住参考珠宝的粗粒度几何与细粒度结构细节。 实验效果:实验显示 JewelTry 在视觉保真度、背景保持、物体一致性与尺寸准确性之间取得平衡,为免掩码、尺寸感知的珠宝虚拟试戴立了一个较强基线。 批判点评:把「尺寸对不对」变成可编码的条件而不是靠掩码兜底,抓住了珠宝区别于服装的真正难点,配套放出带真实尺寸标注的 benchmark 也补上了这一方向的评测空白。但摘要通篇没给量化指标,「取得平衡」这类表述无法判断相对现有方法的实际差距;四个品类对珠宝这种长尾品类而言覆盖面也偏窄。 9. MSR:多张参考图各占一个 slot MSR: Multiple Subject Reference for Video Generation | Licon Studio | arXiv:2609.18393 关键词:多主体视频生成,参考图条件,LoRA,流匹配 ⚠️ 前序问题:让视频生成器同时吃多张参考图时,既要保住每个主体的外观,又要把每张图和它该扮演的角色对上,否则属性就会串到别的对象身上。 本文贡献:MSR 是面向 LTX 视频生成的 slot 感知条件方案:每张参考图被独立编码成一段静态片段、对应一组单独的潜 token;一个紧凑的傅里叶特征 MLP 给它加上数值化的 slot 嵌入,再用随 slot 变化的时间偏移改写这组 token 的旋转位置坐标。这些参考组被前置到带噪的目标 token 之前,在仅针对目标的流匹配训练中充当干净上下文。整套方案用 LoRA 实现,权重与推理工作流已开源。 实验效果:论文给的是定性结果:示例展示了包含不同角色与参考环境的写实及风格化场景组合;开发过程中的观察显示,相对更早的连续参考基线,参考混淆有所减少,但相似服装、复杂衣物和视角变化仍然困难。另有一个补充实验在冻结视觉参数的前提下加入了语音参考条件。 批判点评:用独立 token 组加 slot 嵌入来绑定「哪张图对应哪个角色」,思路直接,靠 LoRA 就能低成本落地,开源权重与工作流对想复现的人友好。但这更像一份技术报告而非完整论文:全文没有定量实验,「参考混淆减少」只是开发观察而非受控对比,缺少与基线的可比指标;作者自己也承认相似服装与视角变化仍未解决。 10. Newer Is Not Fairer:新版文生图并没有更公平 Newer Is Not Fairer: Gender Stereotyping in Text-to-Image AI Across Model Generations | Northeastern University | arXiv:2609.18007 关键词:文生图,性别偏见,模型审计,公平性评测 ⚠️ 前序问题:文生图模型已经在专业与创意场景里广泛使用,但它们如何呈现不同职业的性别、以及更新的模型是不是更公平,跨代际地看仍缺乏系统证据。 本文贡献:论文评测了 20 个职业、5 种提示词模板、4 代 Stable Diffusion(SD 1.5、SD 2.1、SDXL、SD 3 Medium),每个「职业×模型」单元生成 100 张、共 8000 张图,全部用 DeepFace 判定性别,并与美国劳工统计局(BLS)的真实劳动力数据对照,所有显著性检验都做了 Benjamini-Hochberg 多重校正。 实验效果:8000 张开源模型图像中 76.4% 为男性(95% CI [75.1%, 78.7%]);更扎眼的是历史上女性主导的职业里仍有 57.6% 生成男性。相对 BLS 数据,模型平均低估女性 20–46 个百分点,本就接近性别均衡的职业偏差最大——科学家 BLS 女性占 48%、模型输出 82–99% 为男性,清洁工 BLS 女性占 46%、模型输出 80–92% 为男性。代际并非稳步改善:偏差从 SD 1.5 一路恶化到 SDXL,到 SD 3 Medium 才部分回落。与 GPT-image-1 在五个职业上的初步对比显示商业模型偏差更低,但实际效应很小(Cramér's V = 0.080)且属探索性。没有任何一个模型达到性别均衡。 批判点评:8000 张图、多重检验校正、对照 BLS 真实就业数据,这套设计让结论比常见的偏见讨论扎实得多,「更新不等于更公平」的代际发现尤其有价值。但性别判定依赖 DeepFace 的二元分类,本身有误差且无法涵盖非二元表达;20 个职业、5 个模板的提示词空间偏窄,与 GPT-image-1 的对比作者也标注为探索性,撑不起开源与商业模型孰优孰劣的强结论。 趋势观察 长上下文的瓶颈,从「记不记得住」变成「cache 放不放得下」 Recency Forcing 把长视频退化追到 KV cache 淘汰这一工程约束,Diagonal Sparsity 直接冲着自回归图像生成的 KV 访问瓶颈去。两篇都不再泛泛谈误差累积,而是把注意力的显存与访存代价当成一等问题来解。 生成质量的定义权,正在交给后训练与采样策略 VibeAvatar 把运动美感交给 GRPO 在后训练阶段对齐,而不是让生成器隐式地学;CPR 用连续自回归绕开量化,再分三段把语义结构、局部声学与采样率分工。共同前提是承认单个生成器学不好多个互相冲突的目标。 评测开始审问模型「到底懂不懂」,而不只是「像不像」 MiniMax-H3 的评测让每种模态只给部分证据,逼模型跨模态整合才能答对;Newer Is Not Fairer 用 8000 张图对照真实就业数据,把「新版是否更公平」变成可证伪的问题。两者都不满足于保真度分数。 免训练与轻量适配,正在成为落地的默认路径 AVR 全程冻结预训练模型、只在没有证据可抄的地方才生成;MSR 用 LoRA 给现成视频模型加多主体条件;Self-Distilled TTS 让模型自己的输出当教师。共同动机都是避开重训成本。 人工智能炼丹君 整理 | 2026-09-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-17|Meta一个模型既写歌又改歌-SongCraft 今日 AIGC 论文速览 今日共 10 篇 · 音乐与歌曲生成 2 篇 · 视频生成与世界模型 2 篇 · 视频编辑与采样效率 2 篇 · 长语音稳定生成 2 篇 · 生成评测与溯源 2 篇 重点论文标题列表 SongCraft(Meta AI):一套模型统一歌曲生成编辑 SlotDiT(University of Bonn):用 slot 潜空间省算力提成功率 AlayaVista(Alaya Lab;Beijing Institute of Technology;The University of Tokyo):全景状态驱动流式世界模型 MDN-Control(Wuhan University):掩码深度噪声协同视频编辑 ADSC(SAP;National University of Singapore;A*STAR I2R):按样本收敛动态缩短采样 今日论文速览 1. SongCraft:一套模型统一歌曲生成编辑 SongCraft: Unified Song Generation and Editing with Reconstructive Learning | Meta AI | arXiv:2609.16315 关键词:歌曲生成,音频编辑,流匹配,重建预训练 前序问题:歌曲生成与歌曲编辑通常由两套系统完成:生成只接收歌词等稀疏条件,编辑却需要保留人声、旋律和结构等稠密属性,分别训练会重复成本且难共享能力。 本文贡献:SongCraft用重建式预训练随机切换稀疏生成分支和稠密编辑分支,共享潜空间流匹配主干;编辑时抽取歌词时间戳、MIDI、和弦、歌手等属性并只改目标条件,生成时仅保留歌词、节拍和描述。 实验效果:统一模型的歌词WER为0.133;主观A4平均分7.45、SongEval为3.62。它的可懂度领先,但SongEval整体质量仍低于Levo的3.95;瓶颈加长还会同时降低音高、歌手和歌词可编辑性。 批判点评:统一生成与属性级编辑是实用方向,重建预训练减少成对编辑数据依赖;但质量与可编辑性存在明显折中,当前主要针对有限时长与条件类型,更长歌曲和复杂编曲仍是后续工作。 2. SlotDiT:用 slot 潜空间省算力提成功率 SlotDiT: Object-Centric Representations for Diffusion Transformers | University of Bonn | arXiv:2609.17414 关键词:扩散Transformer,对象中心表示,潜空间设计,机器人控制 前序问题:视频DiT通常在像素或稠密视觉潜空间中预测,容易把大量算力花在背景纹理上,也难以显式跟踪承担动作的对象;机器人控制真正关心的是对象状态及其随指令发生的变化。 本文贡献:SlotDiT 让文本条件 DiT 直接在 slot 潜空间里工作:先把场景分解成一组对象级的 slot,再依据指令与已观测上下文自回归去噪未来的 slot 轨迹。论文的落点是系统性比较潜空间设计——在统一 DiT 框架下把 slot 表示与 VAE 式、语义对齐式潜空间放在一起对照。 % Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines. 实验效果:每帧只需 10 个 token(VAE 类基线为 256)。CLIPort 的 PutInBowl 任务上成功率 73.0%,次优的 TextOCVP 为 50.0%,VAE 类基线仅 0.5%–10.0%;LT-syn 的六种设置下为 17.0%–74.5%,均居首。生成 39 帧的吞吐 9.33 FPS,快于最快基线的 6.71 FPS,相对 SD-VAE 基准提速 5.68 倍(单卡 A6000)。 % Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines. 批判点评:论文自己点明了一个反直觉结论:视觉质量指标好不等于任务能完成——VAE 基线的感知分更高,指令跟随与任务成功率却大幅落后。代价是 slot 数量固定、外观细节受限,视频生成质量只能算与基线持平而非更优;评测也集中在 CLIPort 与 LT-syn 两类机器人环境,开放世界泛化尚无证据。 3. AlayaVista:全景状态驱动流式世界模型 AlayaVista: Streaming World Modeling from Panoramic States to Perspective Video | Alaya Lab;Beijing Institute of Technology;The University of Tokyo | arXiv:2609.14462 关键词:世界模型,视频生成,相机控制,全景状态 前序问题:相机连续移动时,普通视频生成模型只看局部视口,离开画面的区域容易被遗忘,重新转回时场景会漂移;直接维护高分辨率全景又会让生成和渲染成本过高。 本文贡献:AlayaVista把360度全景作为持续演化的全局状态,再按相机轨迹选择视口、渲染低分辨率透视潜变量,并用局部视频细化器恢复高清画面;全景状态和当前视角因此分离更新,支持流式相机控制。 实验效果:在 MUGEN-HQ 上,AlayaVista 的跨视角一致性 0.9240、旋转误差 2.132 均为最优,平移误差 0.03312 优于 HY-World 2.0 的 0.03885,但仍高于带显式 3D 高斯支架的 MoVerse(0.02746);动态性 0.9200 偏低,作者认为是长时漫游中局部运动被衰减所致。 批判点评:全景记忆能减少回看漂移,但系统包含全景生成、潜空间渲染和局部细化三段,训练与部署都较重;评测集中在合成式或精选全景数据,长时间真实街景中的几何稳定性仍需验证。 4. MDN-Control:掩码深度噪声协同视频编辑 MDN-Control: Mask-Depth-Noise Guided Region Control for Multi-Subject Video Editing | Wuhan University | arXiv:2609.16475 关键词:视频编辑,多主体控制,遮挡建模,免训练方法 前序问题:多主体视频编辑时,目标人物常被邻近主体或遮挡区域干扰,属性会串到无关对象;只靠文本和掩码也难以同时保持身份、边界与背景。 本文贡献:MDN-Control不再训练新模型,而是组合掩码引导定位、深度感知遮挡软门控和噪声潜变量检索:前者锁定主体,中间模块随去噪阶段调整遮挡约束,后者从候选噪声中选择更匹配指令的初始化。 实验效果:在MSVBench上,方法取得Warp-Err 2.87、CLIP-T 27.09、CLIP-F 95.72、Q-Edit 9.43与CM-Err 2.75;实验在单张NVIDIA L40上完成,并包含20段视频的用户研究。 Overview of MDN-Control. Mask-guided localization localizes the target, depth-aware occlusion control guides editing near occlusions, and noise latent prompting initializes appearance generation. Denoising uses mask-depth guidance at early steps and mask-only guidance thereafter. 批判点评:免训练组合便于迁移到现有DiT,但噪声检索的增益不大,部分固定随机种子甚至更好;20段主观测试规模也偏小,复杂相机运动和长遮挡下的稳定性还未充分覆盖。 5. ADSC:按样本收敛动态缩短采样 Efficient Text-to-Image Generation: An Adaptive Step Schedule Controller for Diffusion Models | SAP;National University of Singapore;A*STAR I2R | arXiv:2609.16572 关键词:文生图,扩散采样,自适应步数,推理加速 前序问题:文生图扩散模型通常给所有提示词使用同一去噪步数,但简单样本早已收敛仍继续计算,复杂样本又可能因固定短计划而欠采样。 本文贡献:ADSC 准备一组步长不同的采样日程,在每个时间步评估误差项的差异,据此在日程之间动态切换,让简单提示词早收敛早停、复杂提示词保留更多步数;控制器无需额外训练,也不改动基础扩散模型。 Effect of text prompt and seed combinations on diffusion steps for generating visually sufficient images. Step counts shown are examples; optimal steps may vary. 实验效果:在COCO的DDIM实验中平均18.89步、0.79秒/图;与固定19步的0.78秒几乎相同,但CLIP-I为95.70,高于固定19步的92.40,CLIP-T均为31.4,优势主要来自按样本分配步数。 The denoising process begins with the longest schedule (e.g. 40 steps in the example) and transitions to shorter schedules (20 followed by 10) upon detecting convergence. 批判点评:方法实现简单且可插拔,不过同等平均步数下墙钟时间没有加速,控制器判断还增加少量开销;论文比较的不同基线并非始终严格等算力,效率结论应区分步数、质量和实际延迟。 6. LACI:回滚重生成压住长语音失败 Taming Long-form Text-to-Speech | Argmax, Inc.;University of Virginia;Bilkent University | arXiv:2609.16989 关键词:长文本语音合成,推理期干预,错误回滚,语音克隆可靠性 前序问题:自回归TTS在超长文本上会突然跳过整段内容或重复、幻觉;平均WER掩盖了少数灾难性失败,而重新训练模型对已有开源系统成本很高。 本文贡献:LACI(Localized Attention-Constrained Inference,局部注意力约束推理)是纯推理期方法,不改动模型权重:近实时检测 TTS 生成错误,回滚到错误起点,再施加临时护栏重新生成,额外开销可忽略。论文另提出滑窗版说话人相似度 wSIM,用来暴露常规 SIM measure 不到的失败模式。 实验效果:Qwen3-TTS-0.6B 在超过 1500 词的提示上,10 个随机种子里的最差 WER 从 35.2% 降到 3.4%,甚至优于它在 500 词以内短文本上 5.4% 的可靠性;120 秒参考音频下最差 wSIM 从 0.01 升到 0.47;WER 超过 30% 的灾难性生成比例从 26% 降到 1% 以下。 批判点评:推理期干预能给现成开源模型直接止损,不必重训,这是它最实用的地方;但前提是错误可被近实时检出,回滚重生成也会推高长文本的尾部延迟。更值得注意的是超过 1300 词之后失败开始抗拒重生成,LACI 只把失败比例从 70% 压到 57%,反而不及对照方法 ACI 的 34%,作者认为这是模型自身的连贯性上限而非检测不到。 7. DiTAR+:扩张上下文抑制长语音漂移 DiTAR+: Dual Optimization for Robust Autoregressive Diffusion Speech Synthesis | ASLP@NPU, Northwestern Polytechnical University | arXiv:2609.13909 关键词:语音生成,扩散Transformer,长上下文,说话人一致性 前序问题:连续潜变量自回归扩散语音模型在长序列中会逐块积累误差,出现说话人漂移、重复或无法终止;简单扩大历史上下文又让局部声学细节成为捷径。 本文贡献:DiTAR+用扩张上下文采样跨更远的历史块建模宏观一致性,同时在浅层对历史声学块做分层掩码,把语义对齐与声学渲染分开,减少模型复制局部声学模式。 The overall architecture of the proposed DiTAR+ framework. (a) The standard two-stage DiTAR baseline. (b) Hierarchical Acoustic Masking (HAM), which masks historical acoustic context in shallow layers to decouple semantic alignment and acoustic rendering. (c) Dilated Context Sampling (DCS), which expands the macro-receptive field via dilated sampling while preserving temporal continuity. 实验效果:在SeedTTS评测中,DiTAR+的Seed-EN WER为1.672、Seed-ZH为0.985;中文困难集WER为9.893,低于DiTAR的12.478;25至35秒长语音WER从2.778降至2.173,说话人相似度从0.741升至0.759。 Chunk-level speaker similarity over continuous generation steps (3.0,s per chunk). The standard baseline experiences severe speaker drift in the long tail, whereas DCS effectively stabilizes the temporal coherence. 批判点评:DCS与HAM直接针对长尾漂移,消融也显示两者互补;但困难集和长语音集为内部构造,论文没有充分量化扩张上下文带来的吞吐、显存和首音延迟成本。 8. CMA-OT:课程式多尺度舞蹈配乐对齐 CMA-OT: Hierarchical Expert Supervision for Dance-to-Music Generation | HKUST(GZ);Tencent | arXiv:2609.13118 关键词:舞蹈配乐,多尺度对齐,最优传输,音乐生成 前序问题:舞蹈配乐既要踩准局部节拍,又要匹配段落级风格;单尺度动作特征或固定对齐损失容易顾此失彼,尤其在动作与音乐结构非一一对应时。 本文贡献:CMA-OT从预训练Jukebox专家提取底层、中层和高层音乐知识,课程式地由局部节奏过渡到全局语义,并用尺度感知的Fused Gromov-Wasserstein最优传输对齐舞蹈与音乐表示。 实验效果:在AIST++上,CMA-OT取得BCS 99.14、BHS 99.12、F1 99.12、FADp 12.50、FADc 0.26;MotionComposer的FADp/FADc为27.52/0.49。TikTok上FADp/FADc为27.53/0.38,也优于30.61/0.81。 批判点评:多尺度课程把节拍和风格监督组织得较清楚,但系统依赖Jukebox专家与额外最优传输计算;AIST++和TikTok仍是较窄的数据分布,指标提升不等同于真实音乐审美或版权可用性。 9. VOR-Bench:细粒度评测视频对象移除 VOR-Bench: A Human Perception-Driven Benchmark for Video Object Removal | Beijing University of Posts and Telecommunications;China Telecom AI Technology;Xi'an Jiaotong University | arXiv:2609.16878 关键词:视频对象移除,评测基准,视觉语言模型,主观一致性 前序问题:视频对象移除常用有缺陷的参考视频或逐帧图像指标,既可能把错误参考当真值,也难以判断对象是否删净、背景是否连续以及结果是否符合常识。 本文贡献:VOR-Bench 由三部分组成:VORD 数据集提供 150 对配对编辑视频与涂鸦式掩码,覆盖模型生成、工具渲染与相机实拍三类来源,另构建 300 对的扩展集验证规模是否足够;rMPAF 流程把图像级对象移除与微调后的视频生成模型结合,自动产出运动连贯的配对视频;VOR-MDSM 则是按三个评价维度微调的 VLM 打分模型。 实验效果:论文报告VOR-MDSM三项偏好判断与人工评分的Spearman相关系数均超过0.9,整体高于VideoLLaMA3、Qwen3-VL-8B和Gemini-3.1-Pro;基准覆盖相机采集、模型生成和工具渲染三类视频。 批判点评:细粒度维度比单一PSNR更接近真实观感,但150/300对数据仍小,VLM裁判也在相近任务分布上训练和验证;论文中的数据与模型发布仍带未来时态,可复现性要看正式开放程度。 10. RAIN:区域感知一跳提取语义水印 RAIN: Region-Aware Inversion Network for Semantic Watermark Extraction | Independent Researcher | arXiv:2609.14856 关键词:生成水印,扩散反演,鲁棒提取,模型归属 前序问题:Gaussian Shading等语义水印把信息埋在扩散初始噪声里,传统提取要多步反演大模型,代价高且在压缩、裁剪、噪声等失真后容易累积误差。 本文贡献:RAIN把终端噪声恢复改写为高信噪比端点上的条件回归,用小型双分支NAFNet一次预测水印决策所需的噪声区域;训练时加入有限集合的最坏失真样本,强化区域边界而非逐点精确重建。 Extraction pipeline used in our implementation. 实验效果:在1000条COCO样本的SD 2.1匹配评测中,干净图比特准确率99.99%;JPEG Q=25为98.15%,缩放到0.25为98.93%。其一次提取仅14.394 GFLOPs、15.468M参数,FARI为682.675 GFLOPs、868.469M参数。 Redrawn from Tables 3 and 4 of RAIN: extraction backbone cost and bit accuracy under matched SD 2.1 distortions. 批判点评:把目标从精确噪声恢复改成区域判别很契合水印任务,但盐椒噪声下93.11%的比特准确率低于OSI的99.71%,极端亮度下也非最优;当前证据绑定Gaussian Shading与特定Stable Diffusion设置。 趋势观察 生成系统开始压缩“状态”而非只压缩网络 SlotDiT 把视频压成少量 slot,AlayaVista把漫游场景压成持续全景状态,MDN-Control则把编辑约束拆成掩码、深度与噪声。共同方向是先确定任务真正需要保存的状态,再把DiT算力集中到这些变量。 推理时控制器成为低成本升级路径 ADSC按样本切换去噪日程,LACI检测跳读后回滚,MDN-Control组合现成控制信号。三者都尽量不重训主模型,把可靠性或效率问题移到可观测、可干预的推理环节。 评测从单一保真度转向任务与失败尾部 VOR-Bench用三维主观语义评分替代单一图像指标;LACI报告最差采样和灾难性失败率;SlotDiT直接看机器人完成率。平均分仍重要,但能否解释具体失败正成为更强的证据。 音频生成继续争夺长程结构控制 DiTAR+扩张历史上下文,SongCraft统一稀疏生成与稠密编辑条件,CMA-OT以多尺度音乐专家监督舞蹈配乐。不同任务都在处理局部声学质量与长程语义结构之间的矛盾。 人工智能炼丹君 整理 | 2026-09-17 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-16|22帧视频377毫秒-LynnReal-Omni 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与交互 2 篇 · 视频算子与少步蒸馏 2 篇 · 图像生成、编辑与超分 3 篇 · 视频重建评测与动作建模 2 篇 · 语音合成与文本对齐 1 篇 重点论文标题列表 LynnReal-Omni(LynnReal AI):22帧视频377毫秒生成 VC-Attention(Nunchux AI、MIT、NVIDIA):低位注意力提速视频生成 Logit Refiner(CompVis @ LMU Munich · ECCV 2026):补回同尺度token依赖 BVB(罗切斯特大学、Sony、卡内基梅隆大学、华盛顿大学):让智能体用Blender复刻视频 CrossDistill(北京大学、清华大学、阿里巴巴集团):分段蒸馏兼顾画质与多样性 今日论文速览 1. LynnReal-Omni:22帧视频377毫秒生成 LynnReal-Omni: Native multi-modal Video Generation for Agentic Visual Workflows | LynnReal AI | arXiv:2609.15863 关键词:多模态视频生成,可控视频,实时渲染,智能体创作 前序问题:扩散视频采样具有随机性,人物外观和长场景连续性难以精确控制;代理提供3D场景、游戏录像等明确约束,但单靠这些结构化输入又不足以保证真实感。 本文贡献:LynnReal-Omni 用32B共享多模态扩散Transformer统一文生视频、参考图驱动、结构控制、编辑与长视频;另训练27B Flash版本,接收3D渲染和游戏录像等异构条件,并以轻量VAE加速解码。 Agent workflows. Image-based scene reconstruction and agent-written low-poly games produce distinct visual-control streams. Prompt refinement, image generation, and first-frame editing provide appearance controls. The video model receives these controls through its native reference interface. 实验效果:论文报告在单张H100上,预热状态下生成并解码22帧540p视频,标准版需843毫秒,Flash版需377毫秒;这是特定帧数、分辨率和硬件条件的延迟,不代表任意长视频都可实时生成。 An example of generated-video artifact repair with LynnReal-Omni. Top: corrupted candle video. Bottom: independently repaired frames at identical timestamps, including both endpoints. Full frames are displayed at the same scale. Each source-frame edit uses four denoiser evaluations, for 480 evaluations across this 120-frame example. The accompanying demo plays both complete videos synchronously. 批判点评:统一的控制接口便于代理组合素材,但32B/27B模型的训练与部署成本很高;公开的22帧预热延迟也不能直接推出长片段的端到端吞吐或多轮主体一致性。 2. VC-Attention:低位注意力提速视频生成 VC-Attention: Value Smoothing and Softmax Casting for Low-bit Attention | Nunchux AI、MIT、NVIDIA | arXiv:2609.15810 关键词:视频生成,低比特注意力,FP8,算子优化 前序问题:视频DiT的时空token序列很长,低比特乘法虽快,V值离群点使量化误差扩大,softmax的高精度指数计算又成了新的延迟瓶颈。 本文贡献:VC-Attention 无需重新训练模型:V-Smooth先在线聚类并重排V token,减去块均值后量化残差;ExpCast-FP8把对数域分数直接编码为E4M3概率,替代FP32指数与格式转换。 VC-Attention writes the byte the conventional path writes. (a) Both paths take the same log-domain score $z$. The standard path evaluates an FP32 exponential and casts the result to E4M3; VC-Attention replaces both steps with one fused multiply-add, because an E4M3 byte is an affine function of the log of the value it stores. Reading the result as E4M3 costs no instruction: those bits already are the byte the $PV$ matrix multiply consumes. (b) The byte each path writes, and the relative error of the probability it decodes to. The two write the same byte on most of the interval and are one code apart on the rest. Every unit interval of $z$ looks the same, so one is enough. 实验效果:在所测B200/B300/H200上,注意力核相对BF16 FlashAttention-4快1.46–1.59倍,工作站卡快2.3–3.6倍;所测视频模型端到端加速为1.13–1.19倍或1.36–1.70倍,核加速不能当作整段视频加速。 Video diffusion leaves two bottlenecks that QK-centric low-bit attention does not touch. (a) Output error on Wan2.2. A Hadamard rotation of $QK$ shrinks the probability term, but leaves the larger value term exactly where it was: the value quantizer, not the $QK$ quantizer, is what bounds fidelity. (b) Even once both matrix products are low-bit, softmax's FP32 exponentiation and its cast still sit on the critical path between them. 批判点评:需要专门融合算子和在线token分组,不同GPU、序列长度及模型分布会影响收益;重排与量化误差应在具体视频模型上逐一核验。 3. Logit Refiner:补回同尺度token依赖 Logit Refiner: Improving Visual Autoregressive Models via Intra-Scale Dependency Modeling | CompVis @ LMU Munich · ECCV 2026 | arXiv:2609.11804 关键词:视觉自回归,图像生成,同尺度依赖,解码优化 前序问题:视觉自回归模型在每个尺度内并行采样token,忽略它们彼此的空间依赖;即便增大主干参数,也可能产生局部不连贯的图像。 本文贡献:Logit Refiner 冻结预训练VAR主干,增加轻量自回归模块,依次采样同尺度token并利用主干特征恢复局部联合依赖;接到已有checkpoint时无需重训主干。 Logit Refiner Overview. (a) The VAR backbone processes all previous scales and produces hidden states for the current scale in a single parallel forward pass, finally sampling from pointwise posteriors in parallel. As sampling is done independently within each scale, this can lead to mismatched tokens, affecting generation quality. (b) Our logit refiner takes these hidden states and samples tokens autoregressively within the scale, conditioning each prediction on previously sampled tokens. The refiner is a lightweight causal transformer, incurring only a small overhead during generation, while significantly improving sample quality. 实验效果:论文称新增参数约为主干的10%,训练计算不足主干的5%;在ImageNet 256×256类别条件实验中,1.1B参数的加装模型质量超过约两倍规模的对照主干,且在文生图设置中仍有提升。 VAR Failure Cases vs. Refiner. Our Logit Refiner can address a range of typical failures of VAR. Each column shows a paired sample (same class, same seed). Top: samples covering various failure modes from VAR-d30. Bottom: with refiner. 批判点评:顺序采样补回依赖也可能增加推理时的串行开销;论文中的参数和质量比较限定于所测VAR主干与任务,不能直接外推到所有生成架构。 4. BVB:让智能体用Blender复刻视频 BVB: Benchmarking Agentic Video Understanding via Programmatic Reconstruction in Blender | 罗切斯特大学、Sony、卡内基梅隆大学、华盛顿大学 | arXiv:2609.15478 关键词:视频理解,Blender,程序化重建,智能体评测 前序问题:现有视频理解基准多靠问答;模型即使答对部分问题,也不一定能生成同时保留动作、镜头和对象关系的可执行场景。 本文贡献:BVB要求智能体在统一沙箱与成本上限内编写Blender动画,渲染后分别用Dual VQA评价时空事实保留率、用Latent Similarity评价视觉相似度,并以平方根均值综合评分。 Controlled reconstruction and evaluation. A model alternates between viewing source frames and running Python code in a Docker sandbox under a cost limit, then saves an animated Blend scene. Dual VQA measures how well the rendered video retains answers the judge gets right on the source, and Latent Similarity compares layout and motion using frozen V-JEPA features. 实验效果:论文测试10个模型家族的51种配置;最优配置的潜空间相似度达到88.6,但仅保留源视频中53.7%的正确时空问答,说明看起来像与事实还原之间仍有差距。 BVB reveals shared task difficulty and model-specific variation. The left panel shows retention across eleven representative configurations. The right panel shows the full range, interquartile range, and mean over all 51 configurations for each task. Purple boxes mark the best shown value in each task. 批判点评:程序化重建比问答更能暴露空间和时间推理缺陷,但Blender建模、工具调用预算及渲染质量也会影响分数;不能把结果简单当作通用视频理解能力排名。 5. CrossDistill:分段蒸馏兼顾画质与多样性 CrossDistill: Balancing Quality and Diversity via Trajectory-Level Hybrid Few-Step Distillation | 北京大学、清华大学、阿里巴巴集团 | arXiv:2609.14725 关键词:扩散蒸馏,少步采样,视频生成,多样性 前序问题:扩散模型少步蒸馏常在画质与多样性之间取舍:轨迹蒸馏保留模式覆盖,分布匹配提升细节却可能让不同随机种子收敛到相似画面。 本文贡献:CrossDistill 沿噪声轴设置交叉点:高噪声阶段保持教师轨迹以保留全局分支,低噪声阶段做分布匹配以锐化局部细节,再用交叉状态耦合两段目标。 2D toy manifold distillation setting. From left to right: original teacher, trajectory-based distillation (TD), distribution matching (DM), loss-level mixture of TD and DM, and trajectory-level hybrid distillation (CrossDistill; ours). All models are trained on the same gray data manifold, and each student is trained to convergence. Colored curves denote denoising trajectories of 12 seeds, and black dots denote final generated samples. 实验效果:文生视频实验与图生视频定性展示显示,方法在少步设置下保留种子级差异,同时获得有竞争力的视觉质量;摘要没有给出可跨基准引用的统一加速倍数。 Diversity--quality trade-off. For each of three prompts (rows) we sample four independent initial noise seeds (columns) and show the same frame per generated video. AnyFlow and DMD show reduced seed-level variation, while rCM is diverse but lower in visual quality. In these examples, CrossDistill improves the trade-off, maintaining competitive diversity and visual quality. 批判点评:交叉点选择与两类目标的平衡需要按模型、任务调整;目前的图生视频证据以定性结果为主,读者应区分画质展示与可复现的综合指标。 6. DiVA:锚点续接让数字角色多轮互动 DiVA: Enabling Interactive Digital Life Simulation via Video Models | 蚂蚁集团、南洋理工大学、A*STAR | arXiv:2609.13830 关键词:交互视频,数字人,视频续接,多轮生成 前序问题:数字角色连续互动时,等待、动作与下一轮切换容易造成姿态跳变、镜头抖动和身份漂移;只拼接长视频难以稳定维持可交互状态。 本文贡献:DiVA 用多模态语言模型路由动作和语音响应,再把等待视频、动作视频和两者过渡拆成耦合模块;Anchored Video Continuation根据前一动作返回稳定锚点状态,支持语音与空间点击输入。 Given a text prompt defining the character's role, an MLLM acts as a router, processing user inputs (e.g. clicks and dialogue) and translating them into character responses and behavioral prompts for the audio-text conditional action model. Our video generation component starts with a waiting video, followed by iterative action videos based on the MLLM output. Finally, the anchored video continuation (AVC) module, conditioned on the prior action, targets preset, high-quality anchor frames that represent distinct character states (e.g. sitting or leaning back). Guided by the MLLM state assessment, AVC transitions to the appropriate anchor state. This mechanism smoothly restores the sequence to a stable, high-quality condition and enables expressive transitions between states, significantly expanding the character's motion range. 实验效果:论文对长视频、续接和插帧替代方案做比较,并报告多轮视觉质量与真实感的改善;摘要未给出统一的绝对延迟或显著性数字,因此不宜宣称“无限无衰减”。 Qualitative comparison on long-term digital life simulation. Our method successfully generates high-quality, expressive, and drift-free results, accurately performing state transitions (e.g. the 3rd to 4th transition in both examples). In contrast, all baselines suffer from severe drift and fail to execute precise state transitions; for instance, InfiniteTalk's subject only partially stands up in the second example. Notably, all baselines exhibit severe drift in fewer than 10 interaction rounds (marked in the bottom-right of each image), whereas our method remains stable indefinitely. Best viewed zoomed in. 批判点评:锚点策略对角色常见姿态有效,但复杂、非周期动作可能难找合适状态;实时交互还依赖生成延迟、音视频同步和对用户点击的空间理解。 7. Open-UniMo:64K动作token接入语言模型 Open-UniMo: Towards Unified Motion-Language Understanding and Generation in the Open World | 清华大学、香港中文大学(深圳)、南洋理工大学 | arXiv:2609.14615 关键词:动作生成,动作理解,具身智能,统一token 前序问题:动作语言模型往往把动作当作文本的辅助输入,跨模态互动不足;长动作序列逐token生成还容易积累误差。 本文贡献:Open-UniMo 在约150K文本token之外增加64K动作token,用一致的动作思维链连接语言语义与动作动态;先监督微调建立双向映射,再用GRPO提高语义对齐。 Overview of the Open-UniMo framework. Open-UniMo is trained in two stages with CoT reasoning. In the SFT stage, the model learns CoT-guided bidirectional motion-language mappings for both T2M and M2T tasks. In the GRPO stage, reinforcement learning further refines format compliance and motion-language alignment through multiple reward signals. 实验效果:论文在传统指标和自建Open-MoBench上报告领先结果,并通过消融指出动作到文本理解的瓶颈不主要在词表大小;没有单一数字可以概括所有动作任务。 Qualitative comparison on Open-MoBench for the T2M task. Compared with existing representative approaches, Open-UniMo generates motions that better capture semantic details and natural dynamics. 批判点评:64K动作词表与大规模开放数据意味着训练和部署成本;自建基准依赖VLM评判,实际机器人动作与物理环境中的泛化还需独立测试。 8. IABEdit:语义梯度教编辑器只改该改处 Semantically Aligned Gradient-Driven Context-Preserving Image Editing | 印度理工学院焦特布尔分校 | arXiv:2609.12691 关键词:图像编辑,语义对齐,视觉语言模型,局部保持 前序问题:指令式图像编辑的训练通常只看重建和文字条件,没有显式检查生成结果是否完成指令,因此容易漏改目标或波及无关区域。 本文贡献:IABEdit 用冻结的视觉语言模型提取目标编辑图的空间语义描述,再由可训练对齐器从生成图重建描述,利用残差梯度教生成器同时判断改什么、改哪里;推理时无需VLM。 IABEdit enables instruction-based image editing through a semantic-supervised distillation mechanism. A frozen Descriptive Anchor extracts rich guidance from the instruction and ground-truth edit, while an Instruction Aligner learns to align the generated image with this guidance. The alignment is enforced via backpropagation, guiding the diffusion model toward faithful and controllable edits. 实验效果:在MagicBrush上,DINO-I相对最佳扩散基线提高3.49、相对最佳总体基线提高1.26;在遮挡较重的D-LORD设置中,DINO-P比论文比较的Gemini代理高5.13。 Qualitative results on RealEdit dataset showing comparisons across various editing methods. The instruction adherence can be visualized at the fine-grained level. The non-targeted regions remain preserved, showcasing precise instruction-aligned editing generations. 批判点评:指标提升反映所测数据集的结构和语义保持,不等于所有编辑指令都能被精准执行;训练额外依赖VLM表征,需警惕其偏差与评测模型重合。 9. DNF-SR:双输入保住一步超分细节 DNF-SR: Dual-Input and Negative-Aware Feature Fine-Tuning for Real-World Image Super-Resolution | 南开大学 · CVPR 2026 | arXiv:2609.15120 关键词:真实图像超分,一步扩散,双输入,负样本微调 前序问题:低清图直接送入一步扩散模型会与其训练输入分布错位;只给低清图加噪虽能缩小分布差异,却可能抹掉原始内容。 本文贡献:DNF-SR 把原始低清图与加噪低清图一起送入Flux-Kontext编辑主干:噪声提供生成先验,原图维持内容条件;随后把多次生成结果分为正负样本,在图像和特征空间做负样本感知微调。 Overview of the DNF-SR framework. (a) The model structure adopts a dual-input design: noisy LR latents ($z_{mix}$) and original LR latents ($z_{LR}$) are concatenated with text tokens (encoded from image captions) and fed into fine-tuned DiT blocks of the Flux-Kontext pretrained model. We employed multiple loss functions to ensure the performance of the model. (b) The post-training process of Negative-aware Feature Fine-Tuning: multiple restored results are generated with different input noises, evaluated by combined full-reference (FR) and no-reference (NR) IQA metrics to obtain reward scores, and divided into positive and negative subsets. By constructing positive and negative optimization directions within both the image and the feature spaces, the quality of the restored images is improved. 实验效果:论文报告在真实图像超分实验中优于所比方法,并强调一步推理;arXiv摘要没有统一的绝对速度或画质数字,具体收益取决于论文内各数据集和指标。 Visual comparisons of different Real-ISR methods. Please zoom in for a better view. 批判点评:一次前向降低采样步数,但双输入增加token和内存;负样本分组依赖奖励模型,细节“更好看”时也可能偏离真实纹理。 10. AlignDPO:严重语音幻觉率降至0.6% AlignDPO: Preference-Gated Alignment for Reducing Hallucination in Decoder-Only TTS | ConnexAI · IEEE SLT 2026 | arXiv:2609.12855 关键词:语音合成,文本语音对齐,DPO,内容幻觉 前序问题:纯解码器语音合成在自回归输出时可能漏词、重复或编造内容;注意力对齐过弱不行,但一味把对齐压得很尖也会降低鲁棒性。 本文贡献:AlignDPO 在DPO偏好优化中只对被选中的语音样本加入轻量CTC对齐项,引导少数承担文本语音对齐的注意力头到适度锐化区间,推理时无需改模型结构。 Per-head $L_{CTC}$ distribution (log scale, teacher-forced over 100 utterances) for the four systems, sharing the x-axis. Colored dots are the identified AEAMs ($L_{CTC} < 2$); gray dots are the remaining heads. 实验效果:在Seed-TTS-Eval英语集上,论文报告严重内容幻觉率由4.4%降到约0.6%;正文还给出相对强DPO基线的幻觉率15.0%降至11.3%,两种统计口径不能混为一个数字。 ACI's effect is non-monotone (U-shaped) in attention sharpness, on both an in-domain and a hard out-of-domain set: hallucination vs. free-running entropy $C_E$ for five models. Left to right (soft to sharp): Base ($C_E{=}1.01$), DPO ($0.84$), DPO+M ($0.48$), Base+M ($0.08$), and DPO+M from Base+M ($0.07$). Seed-TTS reports HAL ($n{=}706$); Hard-500 reports SEV-HAL. 批判点评:结果基于特定英语语音数据和纯声学单码本主干;多语言、长句及噪声输入能否维持相同收益仍需独立验证,CTC权重过大会过度锐化。 趋势观察 视频模型走向可组合控制 LynnReal-Omni统一参考图、3D渲染和游戏录像等条件,DiVA把角色等待、动作与过渡拆开管理。可控生成的重点正从单段采样转到素材接口和跨轮状态保持。 加速要拆解真实瓶颈 VC-Attention同时处理V值离群点和softmax成本,LynnReal-Omni-Flash以独立模型和轻量解码器压缩短片段延迟;核提速、模型延迟和长片段吞吐需分别衡量。 生成质量不只是增加参数 Logit Refiner补回同尺度token依赖,CrossDistill按噪声阶段分别保多样性与细节,DNF-SR用原图条件减少一步超分的内容漂移;三者都调整了生成过程中的信息流。 评测从单一画质走向任务事实 BVB用程序化重建拆分视觉相似和时空事实,IABEdit显式检查编辑语义与局部保持,Open-UniMo同时评估动作生成和理解;分项指标比一个综合分更容易定位失败。 人工智能炼丹君 整理 | 2026-09-16 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-15|阿里五路音频控制-DiffSynth-Music 今日 AIGC 论文速览 今日共 10 篇 · 可控与统一音频生成 2 篇 · 长时音视频与可控视频生成 2 篇 · 图像编辑与画质修复 2 篇 · 3D 资产生成 1 篇 · 流式交互与语音评测 2 篇 · 高效长上下文 1 篇 重点论文标题列表 DiffSynth-Music(阿里巴巴集团、上海交通大学):五路音频控制锁住节拍 StepAudio 3 Gen(阶跃星辰 StepFun-Audio 团队):一套模型生成所有声音 Encore(百度、北京理工大学 · SIGGRAPH Asia 2026):三十秒音画同步不跑偏 DIAL(阿里巴巴集团、北京大学):调一个旋钮控人物像不像 Omni-Streaming Thinking(香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学):流式多模态会主动改口 今日论文速览 1. DiffSynth-Music:五路音频控制锁住节拍 DiffSynth-Music: Audio-Conditioned KV-Cache Adapters for Controllable Music Generation | 阿里巴巴集团、上海交通大学 | arXiv:2609.12774 关键词:可控音乐生成,音频条件,KV缓存,扩散Transformer 前序问题:文字与歌词能规定歌曲主题和唱词,却难以精确约束节拍、旋律、伴奏、演唱韵律和参考风格;把多种音频条件逐步送进扩散模型又会反复增加计算。 本文贡献:DiffSynth-Music 从同一音乐 DiT 初始化 Control、Prosody、Reference 三个模板模型,先由共享 VAE 编码控制音频,再把逐层 KV 缓存注入生成主干。模板端固定在干净数据端点,每种控制只前向一次,五类条件还能组合使用。 实验效果:相对冻结主干,节拍条件把 Beat-F1 从 0.3031 提到 0.8496;人声条件把 V-MSE 从 0.0158 降到 0.0006,伴奏条件把 A-MSE 从 0.0221 降到 0.0023;参考条件的 MuLan-A 从 0.6836 升到 0.8088。 批判点评:一次缓存让多条件控制更便宜,但三个模板模型仍带来额外参数和训练维护成本。实验以单条件为主,真正创作常同时叠加节拍、人声、伴奏与参考音频,组合冲突和听感质量仍需更大规模人评。 2. StepAudio 3 Gen:一套模型生成所有声音 StepAudio 3 Gen Technical Report | 阶跃星辰 StepFun-Audio 团队 | arXiv:2609.12945 关键词:通用音频生成,语音合成,声音设计,RVQ 前序问题:语音、歌声、音乐与音效通常使用不同生成器和离散表示,混合声音任务很难在一套模型里保持文本能力、说话人一致性与声学细节。 本文贡献:StepAudio 3 Gen 以 12.5 Hz 的 16×2048 共享 RVQ 空间直接自回归建模通用音频:主干沿时间预测首码本,轻量因果 Transformer 再沿码本轴补齐其余十五层;渐进预训练与 RVQ Adaptor 缓解音频能力对语言能力的干扰。 实验效果:TTS 人类偏好 Elo 达 1755.33,对五个商业系统的汇总胜率为 82.0%;声音设计 Elo 为 1668.5、汇总胜率 75.5%;风格一致性中文平均 85.2%,英文平均 77.7%。 批判点评:统一离散建模简化了产品管线,但十六层 RVQ 的级联预测仍可能积累误差。报告覆盖多类声音,公开复现仍取决于训练数据、偏好标注与完整模型权重。 3. Encore:三十秒音画同步不跑偏 Encore: Infinite Audio-Video Generation with Adaptive Signal Routing | 百度、北京理工大学 · SIGGRAPH Asia 2026 | arXiv:2609.04249 关键词:音视频联合生成,长视频生成,自适应信号路由,跨模态同步 前序问题:现有音视频生成能做出同步良好的短片,但时长受限;长视频方法靠分块迭代延长时长,却完全没有音频。联合生成长音视频比单做任何一边都难:每一块都要同时保住视频时序连贯、音频时序连贯和跨模态同步,而这三路条件信号进入模型的通路各不相同。 本文贡献:Encore 把难题拆成两层:局部连续性交给带显式跨块上下文传播的迭代生成,全局一致性交给带位移位置编码的参考音视频信号。在此之上提出自适应信号路由(ASR),在自注意力内加逐层逐头可学习偏置、在交叉注意力输出上加可学习缩放,让模型自行调节每路条件信号的影响强度。端到端联合训练后,推理时全程以真值模态为条件即可支持无限长的音频转视频与视频转音频。 实验效果:扩展后的 VerseBench 长音视频评测上,身份一致性 ID 为 0.86、音画同步 LSE-C 为 2.36、AV-A 为 0.88,三项均为最佳;误差累积 ΔAS 0.02、ΔID 0.07,明显低于次优的 0.06 与 0.22。短片设置下 LSE-C 为 3.46,对 LTX-2.3 的 2.36。 批判点评:把长音视频拆成局部续接加全局参考,确实压住了 30 秒级的身份漂移与场景突变。但 ASR 的逐层逐头可学习参数把调参负担转移到了训练侧,消融显示去掉任一路缩放都会让同步指标明显掉档。画面美学仍落后于 OVI 与 LTX2.3,且所谓无限长目前只验证到 30 秒量级,更长时长的累积行为没有给出。 4. DIAL:调一个旋钮控人物像不像 Harnessing Intrinsic Subject-Aware Attention for Controllable Multi-Subject Video Generation | 阿里巴巴集团、北京大学 | arXiv:2609.11507 关键词:多主体视频生成,注意力定位,保真强度控制,偏好优化 前序问题:多主体视频生成卡在两件事上:保真强度不可调——模型要么因训练数据偏置产生生硬的贴图感,要么对输入敏感到无法控制;以及语义漂移——主体中途消失、属性出错、多个参考身份互相串味。 本文贡献:作者发现 DiT 内部某些注意力块天然形成内在空间定位图(ISGM),能准确定位参考主体。DIAL 据此双阶段复用这一内部信号:低噪声阶段用 ISGM 构造注意力偏置矩阵,推理时逐主体调节引导强度 γ 即可控制身份保真度,无需重训;高噪声阶段用同一张图零成本构造偏好对做强化学习,把注意力锚定到参考主体上抑制漂移。 实验效果:OpenS2V-Eval 上,Kaleido 主干总分从 56.00 提到 γ=16 时的 61.14,人脸相似度从 31.81 升到 60.64,双双超过最强通用基线 SkyReels-v3 的 59.26 与 VACE-14B 的 55.09。第二阶段单独作用(γ=0)把主体出现率从 155/320 提到 163/320。 批判点评:把控制接口接到模型自带的注意力结构上、省掉外挂模块,这个思路很干净。但 ISGM 出现在哪一层依赖对具体主干的经验观察,换骨干要重新找;保真度提升伴随真实感与美学分下滑,γ 给多少仍靠人工判断。第二阶段的偏好对由 ISGM 自评构造,评判标准与被优化对象同源,存在自我确认的风险。 5. Omni-Streaming Thinking:流式多模态会主动改口 Omni-Streaming Thinking | 香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学 | arXiv:2609.15128 关键词:流式多模态,音视频推理,状态修正,幻觉抑制 前序问题:流式音视频模型常在声音尚未说完时依据画面提前下结论;一旦错误判断写入记忆,后续音频即使否定它,模型仍会沿着旧状态回答。 本文贡献:OST 把输出拆成已见证据、未来证据预测和待验证主张,并为主张绑定验证时间窗。音频与视觉证据分开保存;遇到矛盾后,反驳过程削弱旧主张及其依赖状态,回答门控只在关键主张满足条件时放行。主干冻结为 Qwen3-Omni-30B-A3B,仅做轻量适配。 实验效果:在五个流式与音视频基准上,OST 相对最强开放基线平均提升超过 10%;OST-DiagBench 的 d′ 达 2.95,而开放基线最高 1.38。SOVBench-O 平均准确率由 81.6 提至 87.8,SOVBench-T F1 由 90.5 提至 92.4。 批判点评:显式状态与反驳链能减少过早承诺,却依赖主张拆分、模态归因和验证时间窗都足够准确。复杂直播中矛盾可能长期不闭合,额外结构化输出也会增加延迟和训练标注成本。 6. Overpainting:灰色地带让模型自己发挥 Overpainting: Localized Context-aware Diffusion Image Editing | Adobe Research、威廉与玛丽学院 | arXiv:2609.10811 关键词:图像编辑,三值遮罩,扩散模型,注意力dropout 前序问题:图像编辑要么给定二值遮罩、严格只改框内,结果生硬且边界突兀;要么纯靠文字提示,改哪里完全不受控。用户真正想表达的「这块必须改、这一圈可以顺带调、其余别动」没有对应接口。 本文贡献:Overpainting 用白/灰/黑三值 trimap 表达这三档意图:白色必须编辑、灰色允许编辑、黑色不得改动。实现上在预训练图像编辑扩散模型外挂 LoRA,用联合注意力在源图、遮罩与噪声三路输入间传信息,并以注意力 dropout 平衡信息流。配套的自动数据流水线先用语言编辑模型造候选图像对,筛掉过度编辑、编辑不足与整体偏移的失败样本,再从可用样本反解出 trimap。 实验效果:遮罩估计网络微调后 F1 达 0.955、IoU 0.916,对比阈值像素差的 0.733 与 0.607。MISATO@1K 补全评测上 LPIPS 0.189、FID 20.58,远好于 FLUX-Kontext 的 0.372 与 92.09。180 个人工整理的例子上,50% 注意力 dropout 在遮罩遵循与编辑质量之间取得平衡点。 批判点评:三值 trimap 比二值遮罩更贴近真实修图意图,把「顺带调一下」这件事显式化了。但灰区给模型多大自由度只能靠 dropout 率这一个全局参数调,用户画的灰区宽窄也会显著改变结果,论文自己的遮罩变体实验就显示同一提示词能得到差异很大的输出。训练数据由 FLUX.1 Kontext 自动生成再筛选,模型学到的编辑分布因此被上游模型的偏好圈住。 7. PLSR:3D网格切块做超分省显存 PLSR: Progressive and Localized Super-Resolution of 3D Objects via Localized Latent Voxel Diffusion | 香港中文大学、广东工业大学、香港城市大学、莫纳什大学 | arXiv:2609.06436 关键词:3D资产生成,超分辨率,体素扩散,渐进式生成 前序问题:扩散式 3D 生成模型被固定分辨率卡住,细节上不去;直接把分辨率整体拉高,显存与算力又会爆掉。 本文贡献:PLSR 在已有 3D 生成基座上做超分,把全局超分拆成关联式的局部子任务:粗网格编码成低分辨率条件,上采样出高分辨率隐变量的稀疏体素骨架后切成固定大小 patch,每个 patch 关联裁剪对应的低分辨率条件与输入图像,逐 patch 去噪再聚合成全局预测。整轮结果还能当作下一轮的低分辨率条件,渐进逼近更高分辨率,基座只需低成本微调。 实验效果:伪真值几何评测上 LPIPS 0.109、FID 55.89、Chamfer 距离 0.0139、F1 0.145,四项全面优于 TRELLIS.2 在 1536 与 2560 两档分辨率下的结果;纹理评测 LPIPS 0.125、FID 59.89。开放世界 ELO 评分中几何总体质量 1855、纹理 1633,高于 TRELLIS.2(1536) 的 1790 与 1599。 批判点评:把全局超分拆成局部 patch 换来了显存友好,重叠推理与渐进式两个消融也都验证有效。但逐 patch 去噪要遍历所有 patch,分辨率越高调用次数越多,省的是显存不是时间。接缝主要靠低分辨率条件当锚点加重叠区抑制,论文也承认无重叠时仍有残留。开放世界评测依赖模型打分,与人工审美的一致性没有交叉验证。 8. SAS:稀疏注意力直接听损失 SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking | 腾讯混元、香港科技大学(广州)、香港科技大学 | arXiv:2609.13141 关键词:稀疏注意力,长上下文,上下文排序,端到端优化 前序问题:可训练稀疏注意力通常用硬 Top-K 选上下文,语言模型损失无法穿过离散选择,只能蒸馏稠密注意力权重;有限预算因此可能保留“像教师”却不真正影响最终预测的块。 本文贡献:SAS 在训练时把选择器连续分数以对数门的形式注入注意力 softmax,让语言模型损失直接更新上下文排序;归一化门校准历史块与始终保留的当前块,Triton 内核把这一机制嵌入 FlashAttention 风格计算。 实验效果:在 2048 token 预算、Qwen3-4B 上,AIME24 比 SeerAttention-R 高 13.02 分(68.85 对 55.83);Qwen3-14B 的 LongBench 8K+ 为 53.9 对 51.5。SGLang 解码在 512K、batch 1 最多降延迟 5.6 倍,batch 8、64K 最多约 13 倍加速。 批判点评:端到端损失对下游任务更直接,但选择器只在数学数据上训练,跨领域稳定性仍受主干与查询分布影响;预填充仍采用稠密注意力,因此长输入首 token 成本没有同时消失。 9. Mi-Ripple:修掉反复AI编辑的涟漪 Mi-Ripple: Restoring Images Degraded by Iterative AI Editing | 弥阳科技、中国科学院软件研究所、上海交通大学、天津大学 | arXiv:2609.11317 关键词:图像修复,迭代编辑,频域伪影,配对再生成 前序问题:图像被生成模型反复编辑后会积累低频起伏、色带与周期纹理,内容看似正确却越来越“塑料”;普通锐化或去噪可能同时损伤真实边缘。 本文贡献:Mi-Ripple 先在频域用陷波定位并抑制迭代编辑形成的周期分量,再通过配对再生成构造更干净的参考,对剩余伪影做修复;流程把可测量的频谱异常与生成式细节恢复结合。 实验效果:14 次只做陷波的测试中,整图 CIELAB 亮度残差标准差为 0.08–0.44;配对再生成把参考中的碎屑密度降低 45%。三个示例的尺度纹理指数分别从 25.3%、41.1%、20.0% 降至 11.1%、12.1%、0.0%。 批判点评:方法针对可见的周期性退化更有解释性,但配对再生成可能改动原图身份与细节。若伪影频率与真实重复纹理重合,陷波也可能误删内容,仍需要区域级保真检查。 10. Duplex Cue:会说会停还要边听边改 Continue, Adapt, or Yield: In-Turn Adaptation to Overlapping Speech in Full-Duplex Agents | Besimple AI | arXiv:2609.13117 关键词:全双工语音,重叠语音,对话适应,语音评测 前序问题:全双工语音评测常把模型行为简化为继续说或停下来,却漏掉人类常用的第三种反应:保留话轮,同时吸收听者补充的词、纠正或澄清。 本文贡献:Duplex Cue 把听者意图区分为回应、协作与打断,把说者行为标成原样继续、话内适应或让出话轮。研究从无脚本英语对话中提取 300 个经人工确认的提示,并在相同提示下比较人类录音与 PersonaPlex 延续。 实验效果:保留 208 对活跃且可评分样本;66 个协作提示中,人类话内适应率为 68.2%,PersonaPlex 为 34.8%,相差 33.4 个百分点。模型更多原样继续(42.4%)或让出话轮(22.7%);自动评分与人工在 142 项中一致 108 项,κ=0.641。 批判点评:三分法比“停没停”更接近自然对话,但判断适应需要理解语义依赖,自动评审本身可能偏向表面复述。要成为训练目标,还需扩展语言、说话风格、噪声与真实网络延迟。 趋势观察 控制接口前移到模型内部 控制不再靠外挂模块,而是接到主干已有的结构上:DiffSynth-Music 用可复用 KV 缓存组合五路音频,StepAudio 3 Gen 用共享离散码本统一语音、歌声、音乐与音效,DIAL 干脆直接复用 DiT 自带的注意力定位图。 长时序生成靠显式上下文传播续命 Encore 把长音视频拆成局部连续性与全局一致性两层,用跨块上下文传播加参考信号压住 30 秒后的身份漂移,误差累积指标 ΔID 从次优的 0.22 降到 0.07——长程生成的胜负手不在单帧画质,而在误差累积。 编辑控制从硬遮罩转向软约束 Overpainting 用白灰黑三值 trimap 区分「必须改、可以改、不能改」,Mi-Ripple 用频域陷波只删周期分量,都在回答「哪里该动、动多少」,而不是一刀切地框定编辑区域。 算力不够时预算分配成为核心问题 PLSR 把全局 3D 超分拆成可迭代的局部 patch 去噪换显存,SAS 在固定注意力预算下端到端学上下文排序——两条线都承认资源有限,转而研究怎么把预算花在刀刃上。 人工智能炼丹君 整理 | 2026-09-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-11|阿里13模型不会专业剪辑-CutCraft 今日 AIGC 论文速览 今日共 10 篇 · 音视频创作评测与安全 2 篇 · 可编程世界与物理视频 2 篇 · 生成后训练与统一多模态 2 篇 · 图像编辑与多视角生成 2 篇 · 设计自动化与合成数据 2 篇 重点论文标题列表 CutCraft(阿里巴巴、上海交通大学、复旦大学等):13模型不会专业剪辑 Programmable World Model(Alaya Lab):规则状态准确率98% ⚡ DIVA(Peng Li 等(ACM MM 2026)):参考图放大越狱风险 GGF(上海交通大学、中国电信人工智能研究院、中国科学技术大学):模型用自绘图反哺理解 FlowCPO(西湖大学、浙江大学、快手可灵团队):离线对齐GenEval达0.84 今日论文速览 1. CutCraft:13模型不会专业剪辑 Beyond Coherence: Benchmarking Professional Editing-Technique Execution in Multi-Shot Audio-Video Generation | 阿里巴巴、上海交通大学、复旦大学等 | arXiv:2609.08275 关键词:音视频生成,多镜头,剪辑评测,生成智能体 ⚠️ 前序问题:多镜头音视频模型已经能做出连贯、电影感强的片段,但现有评测多看画质、同步和物理合理性,无法判断模型是否真的执行了 J-cut、L-cut、转场时机和蒙太奇等专业剪辑指令。看起来像电影,不代表遵守了剪辑语法。 本文贡献:CutCraft 把结构化多镜头提示扩展为显式剪辑规格,并用镜头结构对齐、专家模型指标、工具化多模态判断和规则问答构成分层评测。作者还给出一个生成智能体基线:先规划镜头,再逐镜生成,最后做后期合成,使剪辑语义变成可执行步骤。 实验效果:对 13 个闭源与开源音视频生成模型的测试显示,当前系统普遍能维持内容连贯,却经常错过规定镜头数、转场关系和高阶蒙太奇;美学质量与剪辑指令遵循只有弱相关。智能体基线说明把剪辑拆成规划、生成和合成后更容易显式执行专业语法。 批判点评:混合评测仍依赖专家模型和多模态裁判,复杂剪辑意图可能被评分器误读。后期拼接能提升指令遵循,却可能掩盖底层生成模型不会原生控制镜头的问题;基准对真实剪辑师工作流、版权素材和长叙事的覆盖仍有限。 2. Programmable World Model:规则状态准确率98% Programmable World Model | Alaya Lab | arXiv:2609.10540 关键词:世界模型,视频生成,可编程状态,交互游戏 ⚠️ 前序问题:交互式视频世界模型能生成逼真的下一帧,却通常把角色生命值、阵营、库存和任务进度隐含在像素历史里。实体离开画面后,模型容易忘记它是否存活;自然语言提示也只能描述结果,无法保证规则在长时间交互中被稳定执行。 本文贡献:Programmable World Model 把世界状态演化与视觉生成拆开。编码智能体把自然语言规则写成可执行程序,轻量引擎维护包含屏外实体和非视觉属性的权威状态;状态增强的 3D 定向包围盒再经确定性编译器投影成身份、语义和运动方向控制图,预训练视频模型只负责把状态渲染成画面。 实验效果:在作者新建的 CombatStateBench 上,系统的存活角色数量准确率达到 94%,状态准确率达到 98%,并能在长时战斗交互中维持实体状态。它还支持用户预先编写游戏机制、逐个控制实体,并在镜头移开后继续保存世界事实。 批判点评:显式引擎让规则可验证,但也把开放世界压缩成包围盒、离散属性和手写转移规则;复杂物理、细粒度姿态与不可预设事件仍交给生成器补全。论文基准集中于战斗场景,面对大规模地图、多玩家并发和长期程序错误时的扩展性仍待验证。 3. DIVA:参考图放大越狱风险 The Price of Consistency: Exploiting Visual Anchors for Multimodal Jailbreaking in Video Generation | Peng Li 等(ACM MM 2026) | arXiv:2609.07216 关键词:视频生成,安全评测,多模态越狱,参考图控制 ⚠️ 前序问题:图生视频用参考图锁住主体和场景,提高时空一致性,但安全系统往往只重点审查文字。模型原本可能把危险提示漂移成无害内容,视觉锚点却会把生成过程拉回参考图中的危险意图,形成一致性越强、逃逸空间越小的安全悖论。 本文贡献:DIVA 是一个免训练多模态越狱框架,把危险意图拆成静态参考图和看似普通的运动提示,并用双重标准筛选兼顾隐蔽性与语义保真度的组合。论文同时提出 TI2VSafetyBench,用于专门评测多条件视频生成中的视觉锚定风险。 实验效果:作者在多家主流商业平台和开源视频模型上测试,DIVA 的攻击成功率显著高于纯文本攻击,说明只过滤提示词不足以覆盖图像与运动描述共同表达的风险。论文已被 ACM MM 2026 接收。 批判点评:攻击依赖先获得合适的危险参考图,现实系统还可能在上传、编码和输出阶段做二次视觉审核。公开越狱流程有双重用途风险;防御评估需要同时覆盖输入图、运动文本、跨模态组合和生成结果,且必须在平台更新后持续重测。 4. GGF:模型用自绘图反哺理解 Dreaming in Flow: Generative Grounding Feedback for Self-Evolving Unified Multimodal Models | 上海交通大学、中国电信人工智能研究院、中国科学技术大学 | arXiv:2609.08282 关键词:统一多模态,自训练,流模型,图像生成 ⚠️ 前序问题:统一多模态模型把理解和生成放进同一网络,却仍把两种能力当作独立任务训练。直接用模型自生成图像做自训练又会放大漏物体、属性错误和空间关系失真,缺少一种让生成经验反哺理解、再由理解修正生成的闭环。 本文贡献:生成接地反馈 GGF 只使用文本提示和模型自己的视觉梦境。流级反馈在同一噪声潜变量上比较文本、图像与修复条件的预测方向,把图像接地信息传回文本条件;梦境回放则通过描述和再想象,让可验证事实在两次生成间保持一致,并分离无关经验。 实验效果:在采用不同理解—生成融合设计的统一模型上,GGF 都带来一致的文生图提升,同时让视觉理解获得幅度较小但稳定的增益。方法不依赖额外成对图文数据,说明模型自身生成的图像可以成为双向训练信号。 批判点评:自生成经验仍受初始模型能力上限约束,流级一致不保证图像事实正确。回放和修复增加训练计算,如何过滤系统性偏见、避免错误闭环以及在闭源生成器上复现,仍是落地障碍。 5. FlowCPO:离线对齐GenEval达0.84 FlowCPO: A Unified Divergence View of Preference Alignment for Flow Models | 西湖大学、浙江大学、快手可灵团队 | arXiv:2609.09905 关键词:流模型,偏好对齐,离线优化,前向KL ⚠️ 前序问题:流与扩散模型的偏好对齐分成在线强化学习和离线偏好优化两派:前者必须不断从当前模型采样,成本高;后者常用正样本微调或似然比近似,既难解释与在线目标的关系,简化回归损失还可能无下界。 本文贡献:FlowCPO 用散度视角统一这些方法,并提出无需在线回滚的离线前向 KL 目标,同时利用偏好和拒绝样本。在线性插值及明确正则条件下,作者把前向 KL 上界化为可在固定数据上优化的对比流匹配损失,并证明该损失非负。 实验效果:在域内实验、CFG=3.0 时,FlowCPO 的平均 GenEval 与 OCR 分数分别为 0.84 和 0.87,高于 FlowDPO 的 0.81 和 0.74。域外测试中它取得最佳 GenEval,但多项奖励分数低于 RFT,结果并非全面领先。 批判点评:理论上界依赖线性插值和正则条件,真实大模型训练是否满足需要验证。离线数据省掉采样,却继承偏好数据覆盖与标注偏差;负样本权重、参考先验和插值系数也会带来额外调参成本。 6. PhysFlow:5万物理视频教会运动 PhysFlow: Physics-Aware Optical Flow for Motion Controllable Video Generation | 中科院自动化所、中国科学技术大学、北京航空航天大学、中关村学院 | arXiv:2609.08215 关键词:视频生成,物理一致性,光流,运动控制 ⚠️ 前序问题:视频生成器能做出漂亮纹理,却常出现碰撞错误、非刚体变形失真和前景背景接触不合理。完整物理引擎依赖准确 3D 重建和材料参数,文字或稀疏轨迹又不足以描述像素级形变,需要一种介于模拟状态和最终外观之间的密集运动表示。 本文贡献:PhysFlow 把生成拆成两步:PA-Flow 根据速度、加速度、密度和杨氏模量生成物理感知光流,分别建模全局运动与局部形变;FlowRender 再以光流视频为条件合成纹理。配套 PhysVideo 用物理引擎与 3D Gaussian Splatting 构建显式监督。 实验效果:PhysVideo 包含 1 万个前景物体和 5 万段带运动、材料属性标注的视频。实验显示 PhysFlow 在保持视觉质量的同时提升物理合理性,并能从单图处理非刚体运动、物体交互及前景背景接触。 批判点评:光流适合二维位移,却无法显式表达遮挡后的三维结构、拓扑变化和长期守恒量;两阶段误差也会累积。方法仍需用户或数据提供材料与运动属性,开放世界里这些参数通常难以可靠获得。 7. MIEdit:千组编辑基准无需调参 Multi-History-Step SDE Inversion for Image Editing with Superior Regional Awareness | 中科院自动化所、国科大(ECCV 2026) | arXiv:2609.06602 关键词:图像编辑,SDE反演,语义遮罩,免训练 ⚠️ 前序问题:免训练扩散编辑要在重建原图与服从新提示之间取舍。现有 ODE/SDE 反演步数多、编辑幅度受限,增大 CFG 还可能产生伪影;非编辑区域保护通常需要额外遮罩输入或独立分支。 本文贡献:MIEdit 用预测—校正的多历史步 SDE 反演,在每一步复用至少两个历史项,以更少步数提高稳定性和编辑可塑性;同时调整噪声日程缓解大幅编辑冲突。IASM 在反演早期借助 CFG 方向自动生成语义角度遮罩,并贯穿后续采样约束区域。 实验效果:作者构建 EditEval++,覆盖 30 个细粒度任务和超过 1,000 组图像—文本—遮罩三元组。实验显示 MIEdit 在无需微调、无需外部遮罩的条件下超过所比较方法,并能把输入重建到数值精度范围。论文已被 ECCV 2026 接收。 批判点评:多历史项会增加缓存与实现复杂度,自动遮罩质量仍依赖基础模型的 CFG 响应。论文主要围绕扩散 SDE 编辑,迁移到流匹配模型、超高分辨率和多对象关系编辑时是否稳定还未充分验证。 8. StreetDiff:全景约束街景多视角 StreetDiff: Multi-view Street Scenes Generation via Cross-view Consistent Multi-view Stable Diffusion with Structure Prompts | 深圳大学 | arXiv:2609.09890 关键词:多视角生成,街景,全景图,结构控制 ⚠️ 前序问题:多视角扩散在室内或简单自然场景表现不错,面对道路、建筑和动态目标密集的城市街景时,镜头旋转后容易重复物体、扭曲建筑和破坏布局。相邻视角注意力缺少球面几何对应,难维持全局结构。 本文贡献:StreetDiff 让全景分支负责全局布局、透视分支负责局部细节,并用 Panorama Alignment Module 按球面投影建立跨视角注意力约束。结构提示可来自分割图、轮廓或草图;作者还构建带文本和密集结构标注的 HDR 城市全景数据集 Street360。 实验效果:实验显示 StreetDiff 在街景生成质量和多视角几何一致性上超过所比较基线,尤其改善纯文本条件下的建筑与道路结构;它无需修改扩散骨干即可注入几何对齐。 批判点评:球面全景是有效的全局脚手架,但真实街区包含强遮挡、动态交通和大范围深度变化,二维投影约束仍可能失效。Street360 的地域与天气覆盖、从合成多视角到可导航 3D 场景的差距也需要检验。 9. LoGAN:少量字形扩展27种语言 LoGAN: Multilingual Font Localization with Generative Agents | Netflix(ECCV 2026) | arXiv:2609.07029 关键词:字体生成,多语言,VLM智能体,扩散模型 ⚠️ 前序问题:把一个品牌字体或电影 Logo 本地化到新语言,不只是生成单个字形,还要保留笔画风格、纹理、颜色、字距和字偶距。通用生图模型常改乱排版,传统字体生成又难从拉丁字母跨到结构复杂的中日韩字符。 本文贡献:LoGAN 用 VLM 智能体协调字形级扩散、少样本风格微调、字距与字偶距迁移以及纹理扩展模块。输入少量原字体字形或 Logo 字母后,系统分别解决结构、排版和材质,再组合成目标语言的完整字符集。 实验效果:论文覆盖超过 27 种语言,包括拉丁、希腊、西里尔与中日韩文字;在字体和真实 Logo 数据上,相比字体专用模型及 FLUX、Nano-Banana 等编辑模型取得更高字形保真度,并更好保持风格、纹理和字距。400 个电影 Logo 样本中有 44% 基于字体制作。 批判点评:多模块流水线提升可控性,也放大任一环节的误差和运行成本。少数字形可能不足以覆盖复杂脚本的部件组合、书写规范与文化设计语义;字体版权、人工修字和完整字符编码支持仍是商业落地条件。 10. AnomalyCraft-700K:4万异常视频70万标注 AnomalyCraft-700K: Component-Level Controllable and Verifiable Synthetic Anomalies for Fine-Grained Video Anomaly Understanding | 西北工业大学、新加坡管理大学 | arXiv:2609.06978 关键词:视频生成,异常检测,合成数据,多模态理解 ⚠️ 前序问题:真实异常视频稀少、难控制,已有合成数据通常只按类别或整句提示生成,提示与画面细节不一定一致,也缺少靠近正常—异常边界的困难正常样本,模型容易根据表面线索而非事件语义判断。 本文贡献:AnomalyCraft 把异常事件拆成场景、背景、主体、物体和有向交互五类组件,通过三阶段生成逐步放松非关键约束。相同组件同时作为核验单元,定位并人工修正视频—文本偏差;每个异常类别还配套语义接近但实际正常的困难反例。 实验效果:数据集包含超过 4 万段视频和 70 万条任务级文本标注,覆盖从异常检测、检索、描述到细粒度推理的六类任务。传统模型和多模态大模型评测都显示,它能为异常检测与理解提供有效监督。 批判点评:合成器的视觉偏差可能成为捷径,组件级人工修正也带来高成本和主观性。模型在该数据上提升不代表真实监控、开放场景和未见异常同样受益,需与真实数据混合训练并做跨域验证。 趋势观察 生成评测开始检查专业过程 CutCraft不再只看画质和连贯性,而是逐项检查镜头、转场和音画剪辑语法,说明创作模型的评价对象正在从结果扩展到过程执行。 世界模型从像素记忆走向权威状态 Programmable World Model把规则与实体状态交给可执行引擎,生成模型退回渲染器角色;可验证状态开始成为长期交互的一等公民。 条件越强,跨模态安全面越大 DIVA揭示参考图既提升一致性也会固定危险意图;安全策略需要联合审查图像、文字运动条件与输出,而不能只过滤提示词。 生成模型用结构中间态换取控制 从PhysFlow的光流、StreetDiff的全景几何到MIEdit的语义角度遮罩,低维且可解释的中间表示正在连接高层意图与像素生成。 人工智能炼丹君 整理 | 2026-09-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-10|90%稀疏视频DiT加速2.63倍-RoLA 今日 AIGC 论文速览 今日共 10 篇 · 高效与流式视频生成 3 篇 · 可控动作与手语生成 2 篇 · 生成基础设施与评测 3 篇 · 图像生成与编辑 2 篇 重点论文标题列表 RoLA(北京大学、清华大学、电子科技大学、阿里巴巴等):90%稀疏视频DiT加速2.63倍 Mask Forcing(香港科技大学(广州)、香港科技大学、加州大学圣迭戈分校等):给自回归蒸馏注入干净令牌 FlexMoGen(布朗大学、Epic Games、加州大学戴维斯分校、犹他大学):文字定内容,参考动作定风格 Decoupled SF(Yanru An 等):流式数字人15.4FPS且延迟1.3秒 Miles v0.1(RadixArk):744B模型异步RL跑上64张GB300 今日论文速览 1. RoLA:90%稀疏视频DiT加速2.63倍 RoLA: Rotary-Positioned Low-Rank Linear Attention for Efficient Diffusion Transformers | 北京大学、清华大学、电子科技大学、阿里巴巴等 | arXiv:2609.06712 关键词:视频生成,稀疏注意力,线性注意力,扩散Transformer 前序问题:视频扩散 Transformer 的时空令牌很长,稠密自注意力随序列长度平方增长。稀疏分支可以省计算,却会丢掉维持场景、运动和语义一致性的远程联系;现有低秩全局补偿又难同时保留 3D RoPE 的相对位置结构与可复用的线性摘要。 本文贡献:RoLA 将注意力拆成固定稀疏局部分支与低秩全局分支。它先把查询和键投影到低秩空间并通过非线性,再施加截断后的预训练 3D RoPE;这样旋转不会被非线性打乱,全局键值摘要可对所有查询复用。令牌级门控负责把局部尖峰与平滑全局背景重新融合,无需新增位置参数。 Architecture overview of the proposed method. (a) Dense 3D-RoPE attention decomposes into sparse top-$k$ spikes and a residual background. (b) The method replaces dense attention in pre-trained DiT blocks with sparse--low-rank branches and gated fusion, reusing backbone RoPE without additional positional embeddings. The right part shows the rotary low-rank branch and distribution-aware gated fusion. 实验效果:在 Wan2.1-14B 的 720p、81 帧设置上,RoLA 在 90% 稀疏率下仍保持有竞争力的生成质量,并在单张 NVIDIA H100 上取得 2.63 倍端到端推理加速。机制实验中,截断秩 r=64 的时间与高度相对位置余弦相似度都达到 0.93。 Deployment-oriented efficiency summary on RTX 5090 (different from the benchmark evaluation setting). Panel (a) shows representative fixed-setting deployment latency, panel (b) shows theoretical self-attention FLOPs per denoising step, and panel (c) shows long-sequence deployment latency. 批判点评:RoLA 需要对替换注意力后的完整骨干做单阶段全参数微调,部署收益并非零训练获得。低秩分支只解决高稀疏率下的全局补偿,稀疏局部分支本身沿用既有方案;更长视频、不同 RoPE 划分和消费级 GPU 上的质量—速度曲线仍需验证。 2. Mask Forcing:给自回归蒸馏注入干净令牌 Mask Forcing: Improving Autoregressive Video Diffusion Distillation via Dual-Noise Masking Rollout | 香港科技大学(广州)、香港科技大学、加州大学圣迭戈分校等 | arXiv:2609.09123 关键词:视频生成,自回归扩散,分布匹配蒸馏,模式坍塌 前序问题:用反向 KL 的分布匹配蒸馏把双向视频扩散教师压成因果学生时,目标偏向追逐少数高概率模式。学生在自回滚中容易越来越饱和、平滑,并把早期误差持续传给后续片段。 本文贡献:Mask Forcing 在学生自回滚期间沿空间和时间轴随机遮罩,用更干净、较低噪声的令牌替换部分高噪声输入。扰动让学生探索教师分布中尚未覆盖的区域,同时干净令牌给邻近噪声令牌提供去噪参照,从而缓解模式坍塌与长时误差积累。方法可插入多种 DMD 自回归蒸馏流程,不需要真实视频或额外后训练阶段。 实验效果:在 30 秒 LongLive 设置上,加入 Mask Forcing 后 HPSv3 从 8.44 提升到 9.11,VBench 总分从 83.91 提升到 84.51,语义分从 80.70 提升到 81.44。论文还报告它在逐帧和分块设置下普遍改善视觉质量与指令遵循。 批判点评:收益依赖遮罩比例、噪声窗口和更新粒度,表明它仍是一套需要按骨干与任务调参的训练策略。论文主要在既有因果视频蒸馏管线上验证,尚未说明对完全不同教师、极长序列或交互式状态更新是否同样稳定。 3. FlexMoGen:文字定内容,参考动作定风格 Flexible Motion Generation from Language and Style References | 布朗大学、Epic Games、加州大学戴维斯分校、犹他大学 | arXiv:2609.08032 关键词:人体动作生成,文本到动作,风格迁移,潜扩散 前序问题:文本很适合描述“做什么”,却难精确表达节奏、肢体发力和情绪动态;离散风格标签又无法覆盖未见风格、长动作或同一序列里的风格切换。 本文贡献:FlexMoGen 同时输入自然语言与风格动作片段,用无风格标签监督的变分编码器提取连续风格,再通过轻量适配模块调制文本到动作的潜扩散模型。统一预训练、相对位置编码和时变风格控制使模型可以合成长序列、多风格过渡以及未见过的文本—风格组合。 Overview of our style-adapted text-to-motion framework. The input content motion $x_c$ is encoded by a pretrained motion encoder, and Gaussian noise is added to its latent embedding. The text-to-motion (T2M) model (top right) consists of $7$ Transformer encoder layers that take motion, text, and time embeddings as inputs. Each self-attention block incorporates relative positional encoding into the key and value projections. During style finetuning, the T2M backbone is frozen, and only the weight matrices $W_s^{K}$ and $W_s^{V}$ in the Style Adaptation Module (SAM) are trained. SAM encodes a style example $x_s$ and injects its outputs as additive biases to the $K$ and $V$ vectors in the attention layers, guiding the network to preserve the semantics of $x_c$ while reflecting the style of $x_s$. 实验效果:22 名参与者给出 330 次成对判断。相对 SMooDi,FlexMoGen 在内容保持、风格反映和整体动作质量上的偏好率分别为 61.1%、67.7% 和 71.3%;相对 T2M+MP,内容和质量偏好率达到 82.1% 与 94.0%。 User study results (pairwise preference, % favoring ours). Left: FlexMoGen vs. T2M+MP. Middle: FlexMoGen vs. SMooDi. Right: FlexMoGen vs. LoRA-MDM. Criteria are content preservation, style reflection, and motion quality. 批判点评:风格参考本身可能同时携带动作内容,编码器是否真正解耦仍难完全证明。用户研究规模较小,长序列测试只含一次风格过渡;快速连续切换、接触物理和手部细节还需要更严格评测。 4. Decoupled SF:流式数字人15.4FPS且延迟1.3秒 Decoupled Self-Forcing Distillation for Streaming Talking Head Generation | Yanru An 等 | arXiv:2609.10317 关键词:说话人视频,流式生成,自强制蒸馏,动作潜变量 前序问题:端到端音频驱动视频扩散把音频条件融合到整幅视频潜变量,而身份、背景和外观大多与音频无关,既浪费容量也容易模糊细节。便宜的两阶段方法先生成动作,再渲染视频,却常因动作空间监督不足而损失画质。 本文贡献:该方法先在与身份解耦的低维动作空间里融合音频和动作字幕,由小型因果自回归 Transformer 生成动作潜变量,再交给预训练扩散渲染器。解耦自强制蒸馏用同一个冻结视频教师监督两条流:有动作条件时蒸馏因果渲染器,无条件时以真实视频给渲染回滚打分,反向约束动作生成器。 Overview of Motar. (a) An AR motion transformer models causal dependencies over motion latents, with an efficient diffusion head producing continuous-valued latents; a user-written motion caption and the driving audio are fused into a global condition query by a Q-Former projector. (b) Hierarchical conditioning: the global query is injected by full cross-attention for coarse, sequence-level control, while raw audio embeddings are injected by windowed cross-attention for frame-level lip articulation. (c) Decoupled self-forcing distillation: the frozen bidirectional teacher $G$ supervises both branches by distribution matching. Conditioned on motion, it distills $G$ into a block-causal student $G_\phi$; unconditionally, it matches the rendered motion rollout against the distribution of real talking videos. 实验效果:动作生成与视频渲染两条因果流并行运行,论文报告达到 15.4 FPS、首段延迟 1.3 秒,并称相对非流式教师没有质量退化。 Qualitative comparison with Wan-based end-to-end methods. For each result we show five frames with the spoken word beneath; the phoneme being articulated is highlighted in red (e.g. the “oo” in “look”), so that lip shape can be checked against the sound at each frame. Our method produces the tightest audio--lip alignment and the sharpest facial detail. 批判点评:动作空间没有天然的双向教师,论文借渲染结果间接监督,效果会受动作表示和渲染器上限共同影响。身份解耦在极端表情、遮挡与头部大幅运动下是否成立,以及跨语言口型和长时间漂移,仍需更大规模验证。 5. Miles v0.1:744B模型异步RL跑上64张GB300 Miles v0.1: Production-Level Post-Training | RadixArk | arXiv:2609.08368 关键词:大模型后训练,强化学习,SGLang,分布式训练 前序问题:前沿模型的强化学习已经包含多轮工具调用、超长回滚和异步环境,生成、训练与权重同步任一环节的不一致都会让 on-policy 假设失效;现有框架往往只覆盖某种后端或缺少生产级可观测性。 本文贡献:Miles 以 SGLang 负责回滚,训练端可选 Megatron-LM 或 PyTorch FSDP,并提供点对点、共享桶和磁盘增量等三类权重同步路径。系统统一支持全参数与 LoRA 强化学习、on-policy 蒸馏、SFT、真正的 rollout—training 对齐,并把同一架构扩展到扩散模型。 实验效果:端到端案例在 64 张 NVIDIA GB300 上对 GLM-5.2 744B-A40B 做终端编码任务的全异步智能体强化学习,前 30 个统计步骤的中位耗时为 263 秒。项目已开源代码与部署文档。 批判点评:64 张 GB300 的案例展示了规模上限,也意味着复现门槛很高。异步回滚会带来策略陈旧度、环境版本和样本重放偏差,系统提供校正机制,但不同任务下的稳定边界仍需独立验证。 6. VI-Bench:反推视频提示词最高仅得0.632 VI-Bench: Benchmarking Prompt Inversion from AIGC Videos | 中国科学院自动化研究所、弗吉尼亚大学、新加坡国立大学等 | arXiv:2609.08079 关键词:视频理解,提示词反演,生成评测,多模态模型 前序问题:视频描述只需说出画面内容,能够复现的提示词还要恢复风格、镜头运动和多镜头结构。现有视频理解基准没有测试“反推提示词后重新生成,能否回到原视频”,也难评估提示泄露风险。 本文贡献:VI-Bench 从 1610 万条真实用户提示中清洗出约 390 万条,构建 900 个经人工核验的 AIGC 视频,覆盖单镜头语义、风格与镜头控制、多镜头组合三档难度。它让 18 个视觉语言模型反推提示,再用原生成器回放,并联合原提示对齐与回放视频保真计算 Inversion Score。 实验效果:最强模型的总体 Inversion Score 只有 0.632;难度从单镜头升到多镜头后表现明显下降。主题与风格的“文本看似正确、回放却不像”差距最大,说明视频字幕能力不能替代可执行的生成控制恢复。 批判点评:提示反演同时涉及创作复用与隐私攻击,分数更高并非在所有场景都更好。基准把开放式提示压成五个维度,仍可能漏掉负面提示、采样器与种子等无法从画面稳定恢复的控制因素。 7. RelightFormer:9万物体训练多视角直接换光 RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting | 香港理工大学 | arXiv:2609.07414 关键词:图像重光照,多视角生成,生成Transformer,环境光照 前序问题:逆渲染要从图像分解几何、材质和光照,是高度欠定的优化问题;单图生成式重光照又忽略跨视角线索,难以在镜面、透明和毛发材质上保持一致。 本文贡献:RelightFormer 从视频基础模型改造出前馈生成 Transformer,用光照交叉注意力把目标环境贴图动态注入空间特征,并用对输入顺序不敏感的位置编码对称处理无序多视角。训练数据 LOD 包含 9 万个 Objaverse 物体与 3.9 万种独特光照,不显式估计法线、反照率等内在属性。 Architecture of RelightFormer. Input modalities (noise, reference images, and an environment map) are first patchified into token sequences, with ray embeddings added to encode stereo geometric priors. Noise and reference tokens are concatenated and processed through two parallel attention pathways: a multi-view self-attention module for intra- and cross-view feature aggregation, and an illumination attention module that dynamically injects lighting cues into spatial features. The outputs of both branches are element-wise summed and passed through an FFN. After the final layer, reference tokens are discarded, and the updated noise tokens are used to predict the flow-matching velocity field. For clarity, VAE encoding and decoding stages are omitted. 实验效果:在真实 OLATverse 材质分组上,RelightFormer 在多数类别取得最高前景指标;例如金属物体 sPSNR/PSNR 为 22.84/19.88,毛发物体为 17.75/14.28,并支持单视角、多视角和新视角的零样本重光照。 Qualitative results for multi-view image relighting in real-world OLATverse Dataset. 批判点评:绕过显式物理分解提升了易用性,却也降低了光照与材质参数的可解释性。9 万合成物体的材质分布与真实拍摄存在域差,复杂遮挡、非刚体和未知相机标定下的多视角一致性仍是风险。 8. AV-SafetyBench:只看视频会漏掉近半音画风险 AV-SafetyBench: A Safety Benchmark for Text-to-Audio-Video Generation | Suah Choi 等 | arXiv:2609.06991 关键词:音视频生成,安全评测,跨模态风险,生成基准 前序问题:文字到音视频模型同时生成画面、语音、音效和环境声,危险内容可能只藏在音轨,或由无害画面与无害声音组合后产生。只评视频或只评音频会系统性漏检。 本文贡献:AV-SafetyBench 建立四个轴、13 类风险的分类体系与 5200 条人工复核提示,分别从完整音画、仅视频、仅音频三种视角判定输出,再把完整音画风险归因到视频、音频、双模态各自危险或跨模态组合危险。 实验效果:五个开源音视频生成模型的完整音画不安全率为 25.1% 至 49.4%。在四个模型中,音频独有与音画联合风险占可归因不安全样本的 41.6% 至 48.3%;跨模态伤害类别中,87.5% 来自音画组合后才出现的风险。 批判点评:风险比例依赖提示集分布、生成拒答策略和裁判阈值,不应直接解释成真实产品事故率。基准主要覆盖公开模型与英语语境,多语言语音、方言暗示和长时叙事风险仍可能不足。 9. Concept Brittleness:用稀疏特征定位生图概念盲点 Interpreting Object-Dependent Concept Brittleness in Text-to-Image Diffusion Models | 复旦大学、深圳大学等 | arXiv:2609.09909 关键词:文生图,可解释性,稀疏自编码器,推理时修复 前序问题:同一风格或属性在大多数对象上能生成,却会对少数对象稳定失败。这类“对象依赖的概念脆弱性”不是换随机种子就能解释,也难从原始去噪特征中定位缺失了哪一条概念证据。 本文贡献:作者把逐步去噪轨迹投到稀疏自编码器空间,对比成功与失败样本,寻找缺失、变弱或出现过晚的概念维度,并从同类成功样本建立概念原型。推理时把失败样本的特征轻量插值到原型方向,用修复效果反证诊断是否抓住了真实缺口。 实验效果:跨多个扩散骨干的风格与属性失败案例中,原型插值显著改善概念一致性、文本保真和修复成功率。分析还显示越深层的去噪表示概念结构越清晰,而越早期介入通常有更强纠正作用。 批判点评:方法先要收集可靠的同类成功样本来构造原型,对长尾概念或没有清晰成功对照的情况较弱。SAE 的稀疏特征并不天然等于人类可读因果概念,插值改善结果也不能完全排除其他相关方向共同起作用。 10. SignRefine:局部适配器把手语手部精度提高30% SignRefine: Adapting Foundational Video Models for Sign Language Generation | 萨里大学 | arXiv:2609.08496 关键词:手语生成,视频扩散,局部适配器,关键点控制 前序问题:通用视频扩散模型主要在口语人物视频上训练,能生成自然人物,却经常把手指、嘴形和眉眼做错;对手语而言,这些小区域正承载语言信息,画质好但动作错仍不可理解。 本文贡献:SignRefine 冻结预训练视频 DiT 主干,只为左手、右手和脸部分别加入带空间掩码的局部适配器,把高分辨率区域条件注入指定 Transformer 层。系统只需二维关键点与一张人物参考图,并使用原生手语视频数据集 NVSign 训练区域控制。 实验效果:相对最强基线,SignRefine 的手部姿态精度指标最高提升 30%;手语用户在视觉质量与可理解性成对比较中超过 80% 的情况下选择 SignRefine。模型还展示了跨人物外观与视觉条件的泛化。 批判点评:二维关键点没有完整编码手形、接触关系和非手部语法,生成可理解性仍取决于关键点质量。当前数据的语言种类、地区变体和签署者覆盖决定了泛化边界,必须持续由聋人社群参与评测。 趋势观察 视频效率开始补齐全局结构 RoLA在90%稀疏下保留旋转位置全局分支,Mask Forcing则从训练分布侧减少自回滚模式坍塌;速度优化正在从少算注意力扩展到稳定学生分布。 条件控制向低维与局部区域收缩 Decoupled SF把音频先落到动作潜变量,SignRefine只强化手脸区域,说明让条件作用于真正相关的表示比全图注入更节省容量。 生成评测进入可回放和跨模态阶段 VI-Bench要求反推提示后重新生成,AV-SafetyBench同时检查画面、音轨及其组合;只看文本相似或单一模态已不足以评价生成系统。 基础设施成为算法可信度的一部分 Miles把回滚、训练和权重同步放在同一套可验证系统里,提醒大规模后训练的算法结论必须连同 on-policy 对齐与运行拓扑一起审查。 人工智能炼丹君 整理 | 2026-09-10 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注