AIGC 每日速读|2026-11-11|南京大学给长视频扩画找回旧镜头-LongSCOP

人工智能炼丹君
2026-11-11 / 0 评论 / 3 阅读 / 正在检测是否收录...

今日 AIGC 论文速览

今日共 10 篇 · 视频扩画与分场景控制 3 篇 · 视频生成与推理系统 4 篇 · 图像与音频编辑 2 篇 · 物理三维场景 1 篇

重点论文标题列表

  • LongSCOP(南京大学):给长视频扩画找回旧镜头
  • SceneShifter(悉尼大学):换场景却不换人
  • ⚡ OneReel(伊利诺伊大学):多镜头共用四帧记忆
  • MPEG-Diffusion(Roblox):三成全分辨率 token 生成视频
  • V2C-Edit(台湾大学):图像改动由 VLM 逐步导航

选读入口:要给长片补画左右画面,先读 LongSCOP 的参考帧条件与时间代价;要按音频和台词切换人物所在场景,读 SceneShifter;多分镜同人并想缩短生成时间,读 OneReel。只想降低高清视频去噪成本,读 MPEG-Diffusion;图像指令常被忽略,读 V2C-Edit;物理运动失真,读 PhysOPSD。多轮续写与回退读 ReelCache;混音里只改一个声源读 STEER;去噪特征缓存读 FADE;布料家具三维场景读 SoftPAT3D。


今日论文速览

1. LongSCOP:给长视频扩画找回旧镜头

LongSCOP: Semantically Consistent Long Video Outpainting | 南京大学;香港大学;中国科学院深圳先进技术研究院;香港中文大学;深圳理工大学;索非亚大学 INSAIT | arXiv:2611.12445

关键词:视频扩画, 长视频编辑, 参考帧检索, 自强制训练

  • ⚠️ 前序问题:给长视频向画面外扩出内容时,按块生成容易在块与块之间闪烁、坍塌,人物和背景也会逐渐变样。只看当前几帧,可能错过前后已经露出的缺失区域。
  • 方法直觉:若待补的画面区域在别的时刻出现过,就把那个时刻作为参照;训练时让模型接触自己的前一块预测,减少训练时用真帧、推理时用生成帧造成的误差积累。
  • 本文贡献:LongSCOP 联合 self-forcing(自强制:以前一步生成帧作为训练条件)、潜变量校准和未来参考帧稳定逐块扩画;用配准分数筛候选,再由 Qwen3.5-VL-27B 推断缺失内容、选关键参考帧。作者还构建 6.2 万段训练视频和长视频扩画基准 LVO-Bench。
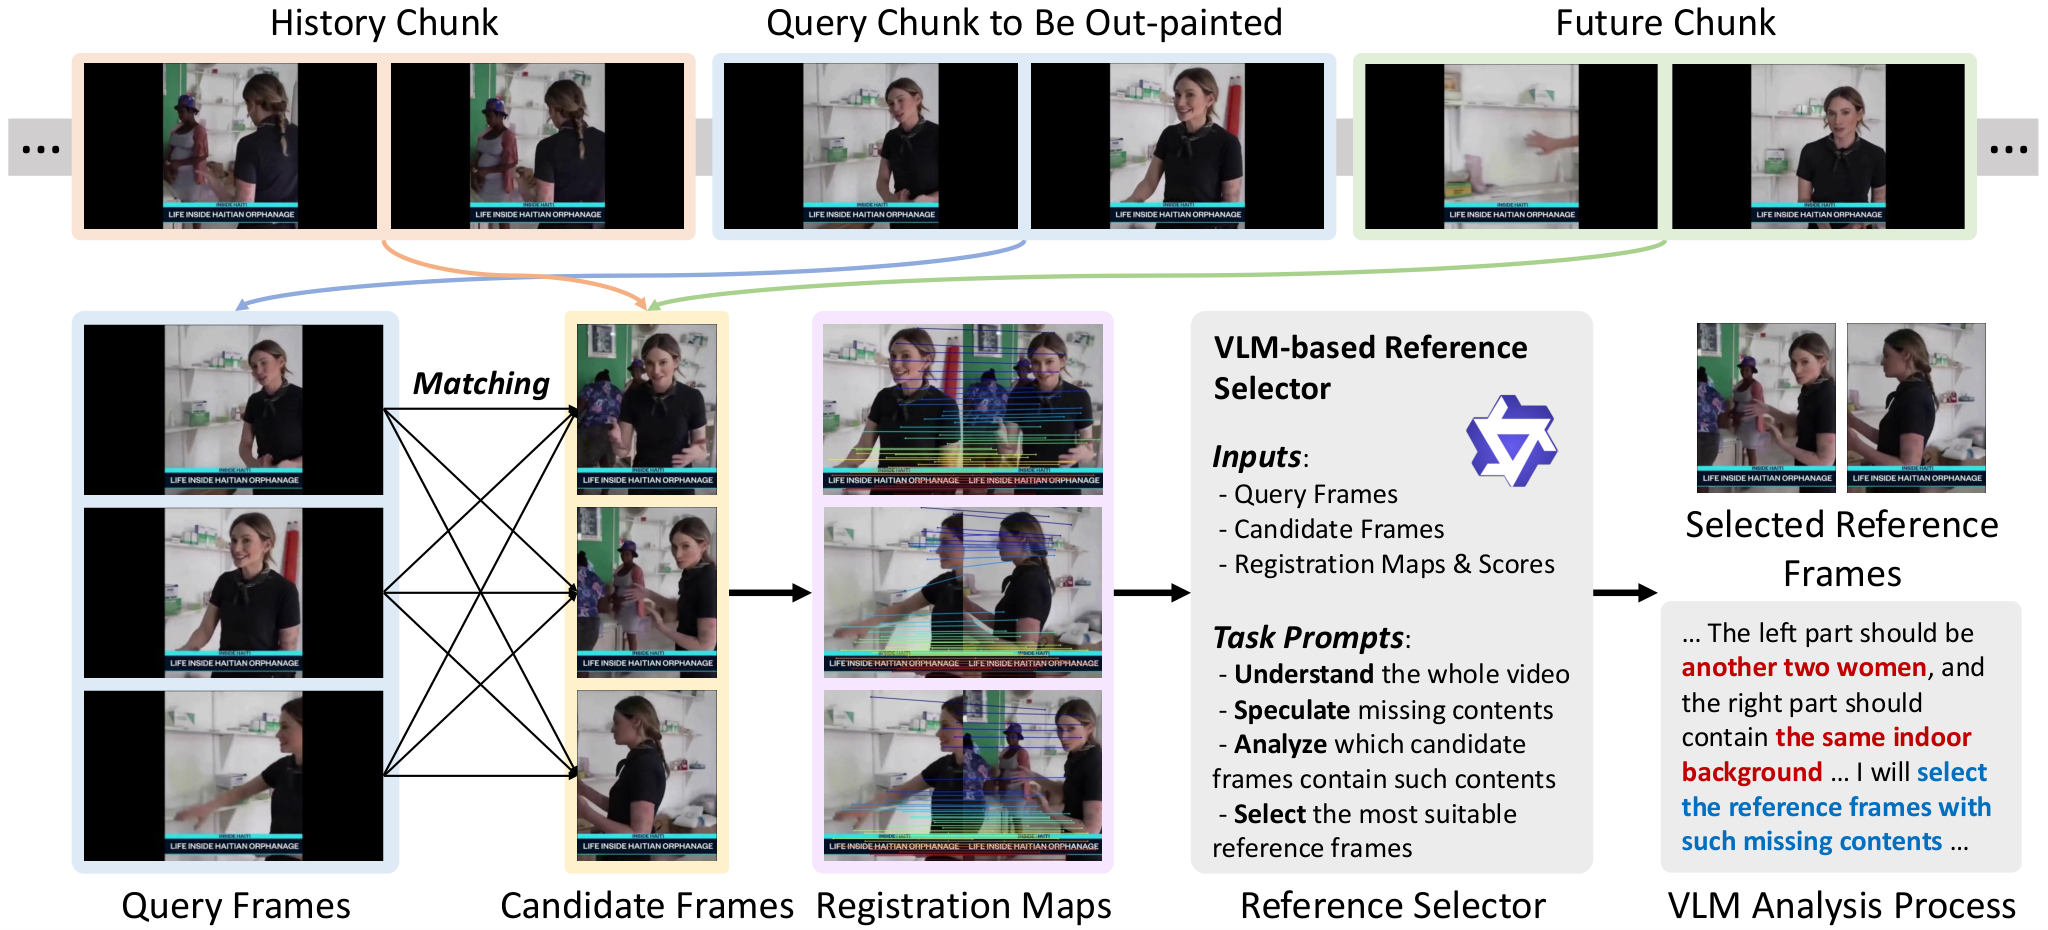
图 4|关键参考帧检索框架。当前待扩画块提供查询帧,历史块和未来块提供候选帧;目标是找到适合补全当前块的参考帧。先计算所有查询—候选配对的配准图与分数,再交给 Qwen3.5-VL-27B [32]。视觉语言模型理解整段视频、推断缺失内容(示例中的两名女性与室内背景),分析哪些候选帧含有这些内容,最后选出最合适的参考帧。
Figure 4: Illustration of key reference frame retrieval framework. Given query frames from current query chunk to be out-painted and candidate frames from both history chunk and future chunk, we aim to find the most suitable reference frames to out-paint current chunk. Specifically, we calculate the registration maps and scores for all query-candidate pairs, and then input them into a VLM, Qwen3.5-VL-27B [ 32 ] . The VLM is requested to understand the whole video, speculate the missing contents ( i.e. , contents to out-paint like the two women and the indoor background), analyze which candidate frames may contain such missing contents, finally select the most suitable reference frames.
  • 实验效果:在 LVO-Bench 上,对照 VACE,结构相似度 SSIM 由 0.725 升至 0.749,峰值信噪比 PSNR 由 18.59 升至 19.87 dB,生成视频分布距离 FVD 由 225.5 降至 197.3(越低越好)。但以 Mast3R 检索处理 15 秒视频时,9B 版本由 VACE 的 13.5 分钟增至 16.5 分钟;27B 版本为 20.1 分钟。
图 5|定性对照。LongSCOP 在长时段扩画中保持生成稳定与语义一致;黄色框圈出的区域为原始输入区域。放大可查看细节。
Figure 5: Qualitative comparison. Our LongSCOP could achieve stable video out-painting results and maintain the semantic consistency over a long time horizon. The region circled by the yellow box indicates the original input region. Zoom in for better views.
  • 批判点评:收益依赖长视频里确实有可借的参考帧;遮挡区域从未露出时,检索无法提供缺失外观。短片 DAVIS 上 LongSCOP 的 PSNR 20.04 dB 低于 Infinite-Canvas 的 20.80 dB,不能把长视频优势泛化为所有扩画。

2. SceneShifter:换场景却不换人

SceneShifter: Training-free Multi-Scene Temporal Control for Audio-driven Human Animation | 悉尼大学;南洋理工大学;威斯康星大学麦迪逊分校 | arXiv:2611.09960

关键词:音驱人物动画, 多场景控制, 前景一致性, 稀疏注意力

  • ⚠️ 前序问题:一张人物参考图配一段音频,想让背景按指定时间从街道切到车站,人物却常跟着变脸、变衣服,或背景根本不切。
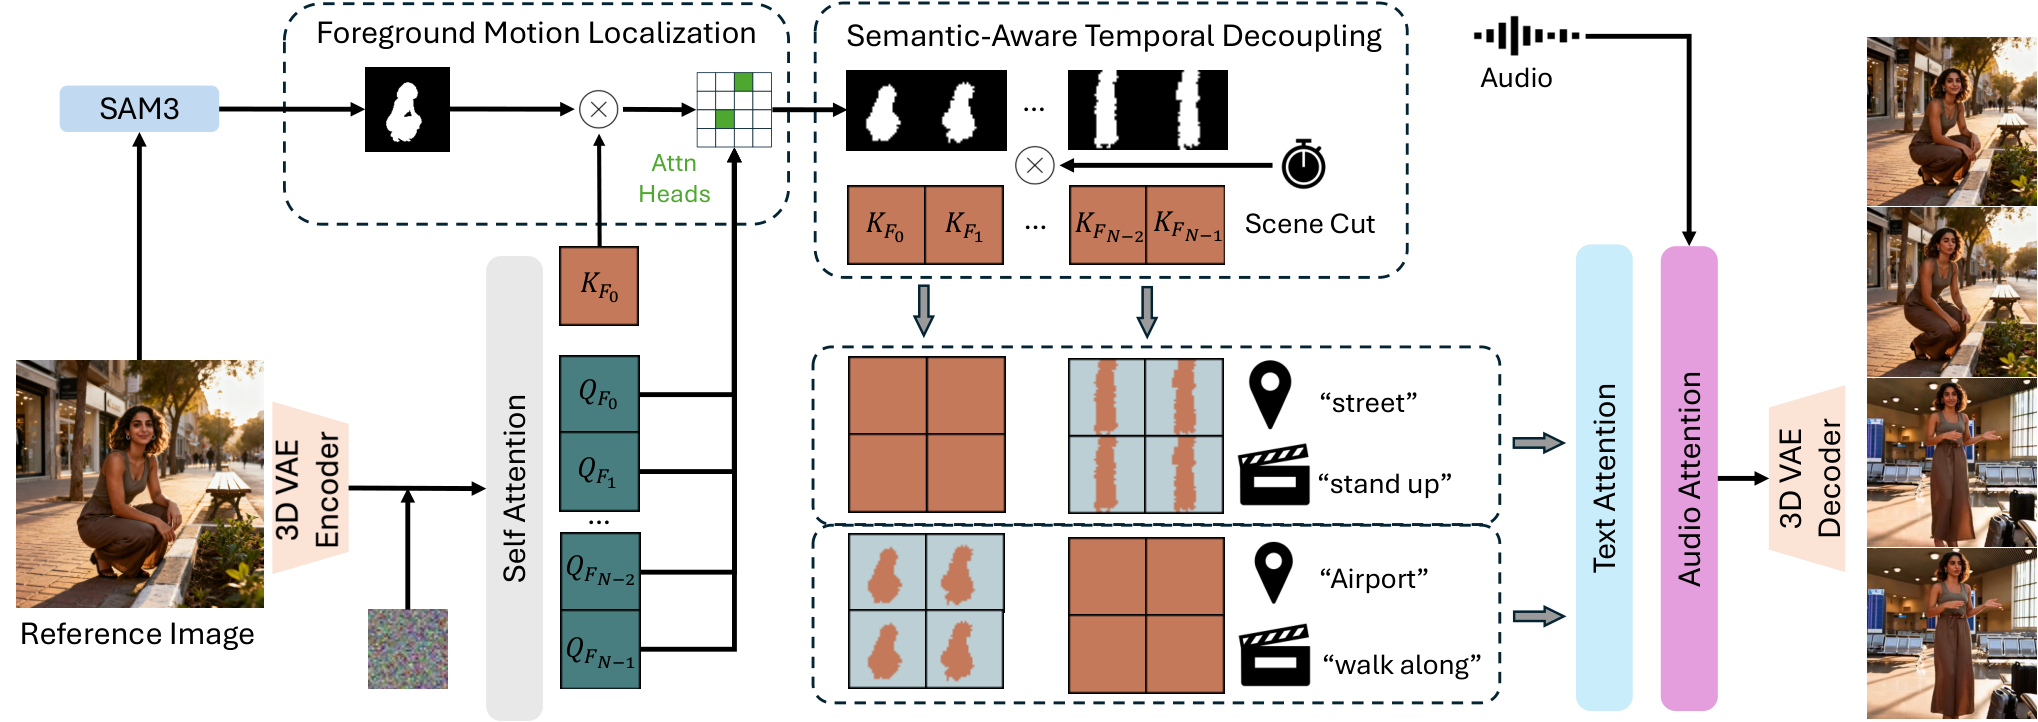
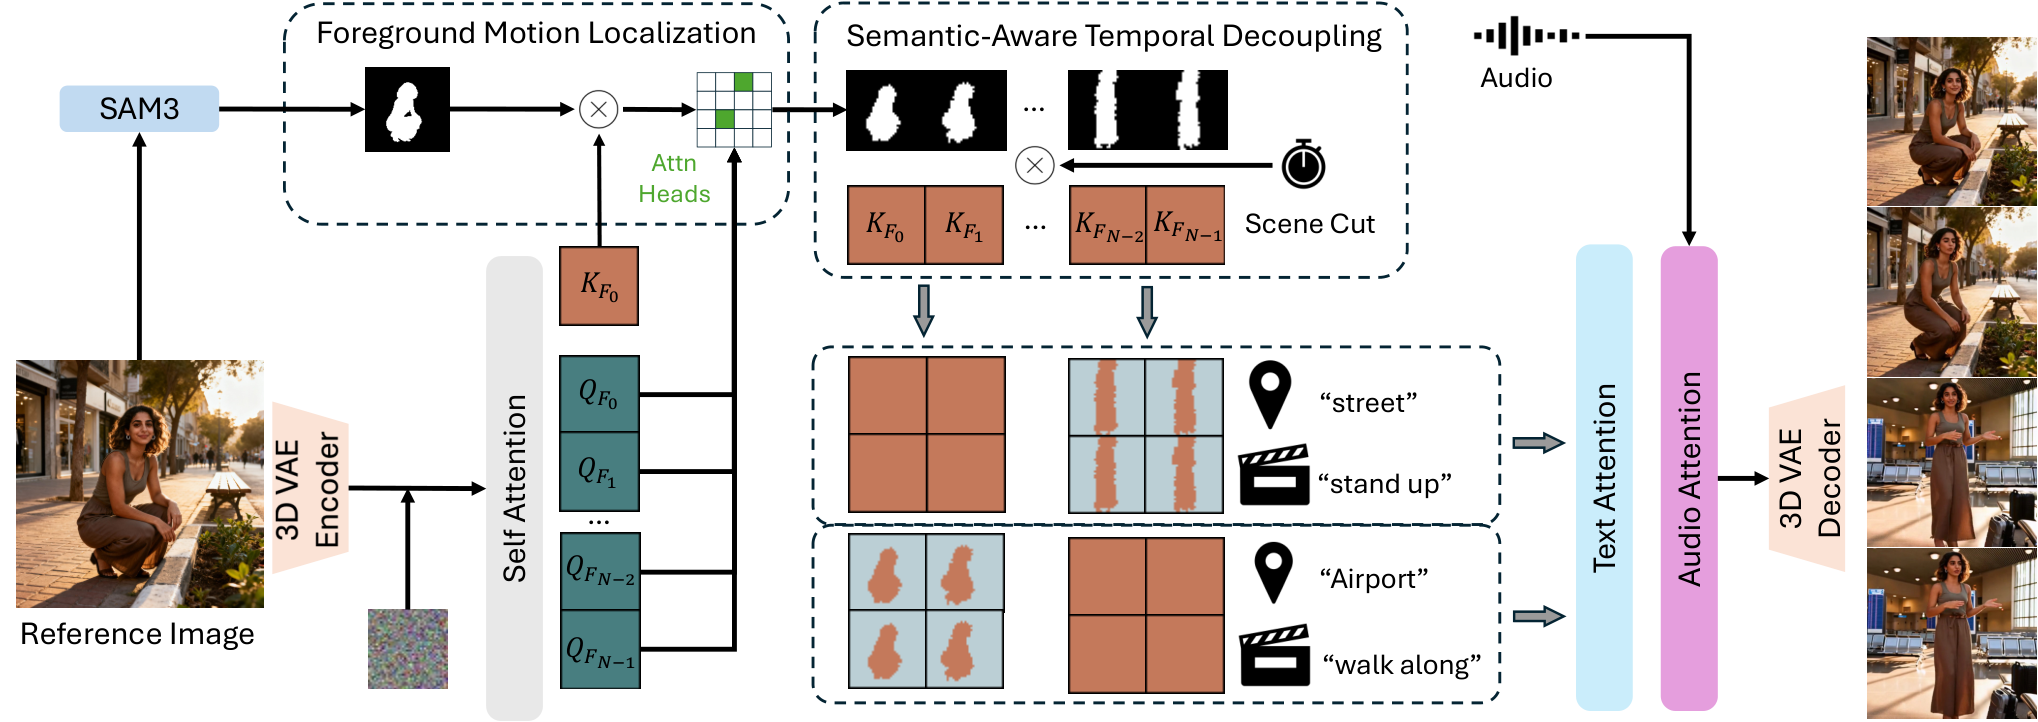
  • 方法直觉:把同一场景内部的背景联系保留,切断不同场景背景之间的注意力;让前景人物跨场景继续互相看见,并从能追踪主体运动的注意力头提取动态前景掩码。
  • 本文贡献:SceneShifter 无需重训,在时空自注意力中抑制跨场景背景 token 互看,保留跨场景人物联系;动态前景定位和转场上下文窗口分别处理大动作与切换边界,并建立 SceneShifterBench 测试切场时间、人物保持和画质。
图 3|所提出的 SceneShifter 框架流程。
Figure 3 : Pipeline of the proposed SceneShifter framework.
  • 实验效果:在 MultiTalk 主干的 SceneShifterBench 上,场景切换成功率由基础模型 38.7% 升至 99.3%,切换时点准确率由 17.5% 升至 98.1%;对照 DiTCtrl 的时点准确率为 96.6%,但其衣着保持只有 31.7%,SceneShifter 为 100.0%。14 人、每准则 140 次盲评中,人物一致性获得 65.7% 偏好票。
图 4|在 MultiTalk 主干上,基础模型、DiTCtrl、SwitchCraft 与本文方法的定性生成结果。
Figure 4 : Qualitative results generated by the base model, DiTCtrl, SwitchCraft, and our method using the MultiTalk backbone.
  • 批判点评:方法无法让基础模型生成本来不会的大幅姿态动作;短于主干训练片长的场景,背景画质会下降。多主体互相遮挡时掩码可能合并,人物离开再进入后外观漂移。

3. OneReel:多镜头共用四帧记忆

OneReel: Efficient Multi-Scene Video Generation with Scene-Structured Attention | 伊利诺伊大学厄巴纳-香槟分校;得克萨斯大学奥斯汀分校;斯坦福大学 | arXiv:2611.10594

关键词:多场景视频生成, 场景结构注意力, 共享帧记忆, 推理加速

  • ⚠️ 前序问题:把多个分镜一起生成能让角色连续,却让所有镜头互相注意,成本随总长度快速增长;分镜各自生成又容易换人。
  • 方法直觉:一个镜头保留内部完整注意力,只从其他镜头读少量代表帧。分镜提示和时长已给出边界,无须在去噪早期再猜哪里该跨镜头连接。
  • 本文贡献:OneReel 用场景范围限定注意力,每步按潜帧聚类更新有界共享记忆;把本场景及共享 K/V(注意力键和值)打包成可高效执行的变长密集运算,并在多 GPU 上均衡分镜负载。固定共享帧数时,跨场景注意力成本随镜头数近似线性增长。
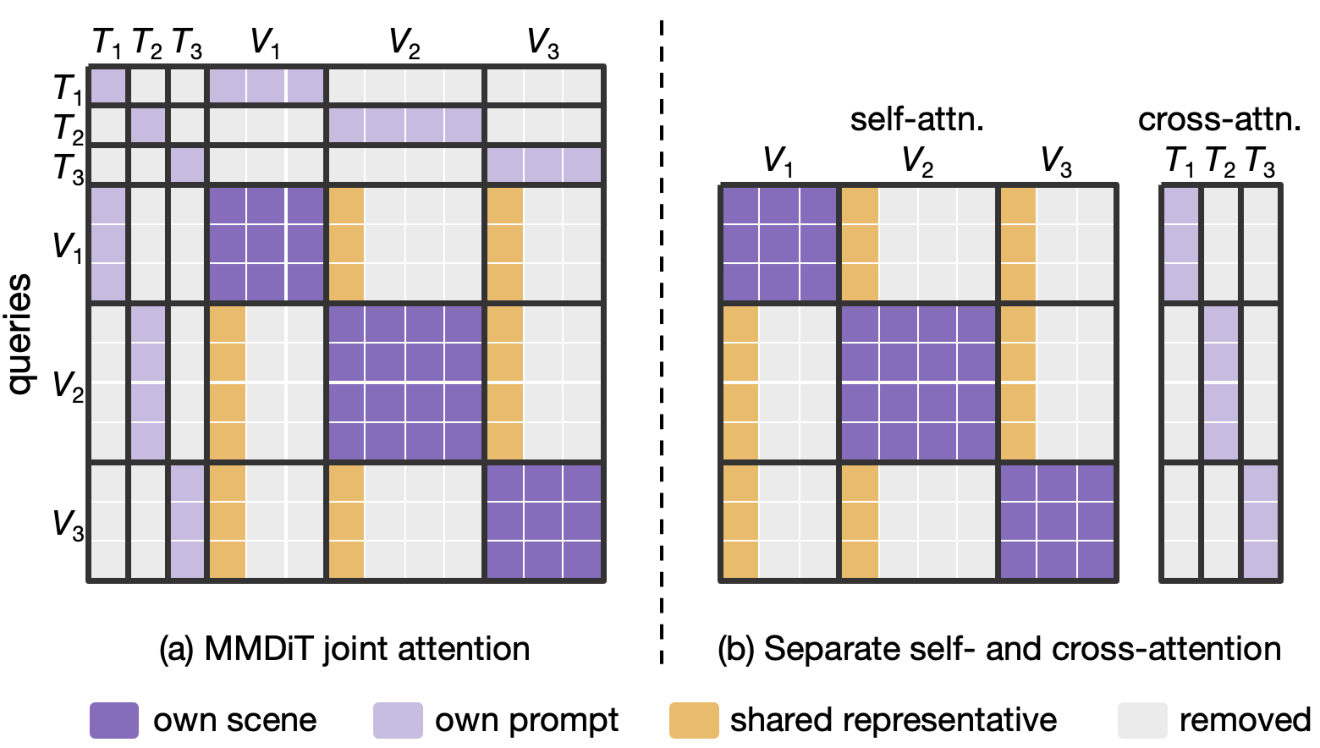
图 5|不同模型架构中的场景结构注意力:行表示查询,列表示键;紫色为场景内部交互,橙色为从共享记忆挑选的其他场景视频 K/V。示例展示一个注意力头,文本查询仍局限于本场景。
Figure 5: Scene-structured attention across model architectures. Rows denote queries and columns denote keys. Purple denotes scene-local interactions; orange denotes selected foreign video K/V from a shared memory. The example shows one head; text queries remain local.
  • 实验效果:四种视频生成模型上的端到端加速相对密集注意力为 1.7–4.9 倍,相对已有稀疏方法为 1.2–2.2 倍。40 条多场景请求、HunyuanVideo-1.5 480p 下,CLIP 文本跟随分(自动图文匹配,越高越好)由密集方案 27.7% 升至 61.9%。默认四帧共享记忆相对不共享把 Text+ID(文本与人物身份联合分)由 17.0% 升至 24.3%,同时延迟增加 19%。
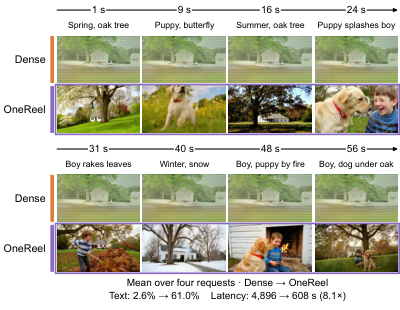
图 10|用 HunyuanVideo-1.5 生成一分钟视频;OneReel 呈现请求中的场景变化,而密集生成在视觉上重复。
Figure 10: Minute-long generation with HunyuanVideo-1.5. OneReel captures the requested scene changes, while dense generation remains visually repetitive.
  • 批判点评:收益以明确分镜提示和时长为前提;四帧共享是质量与延迟的折中,继续加至八帧只多 2.3 个百分点的 Text+ID,却再添 15% 延迟。跨场景一致性不能只凭文本跟随分推断,需看同一角色在镜头间是否稳定。

4. MPEG-Diffusion:三成全分辨率 token 生成视频

MPEG-Diffusion: Mixed-Resolution Video Generation | 得克萨斯大学奥斯汀分校;Roblox | arXiv:2611.12069

关键词:视频生成, 混合分辨率, 扩散 Transformer, 推理加速

  • ⚠️ 前序问题:视频扩散模型全画面高分辨率去噪昂贵;把主体裁为高清、背景低清,容易在交界处出现鬼影,还得事先知道主体在哪里。
  • 方法直觉:让高清查询读高清键值、低清查询读低清键值,避免一个低清 token 强行代替多个高清 token;在解码前先把两种潜变量融合,让边界邻域一起解码。
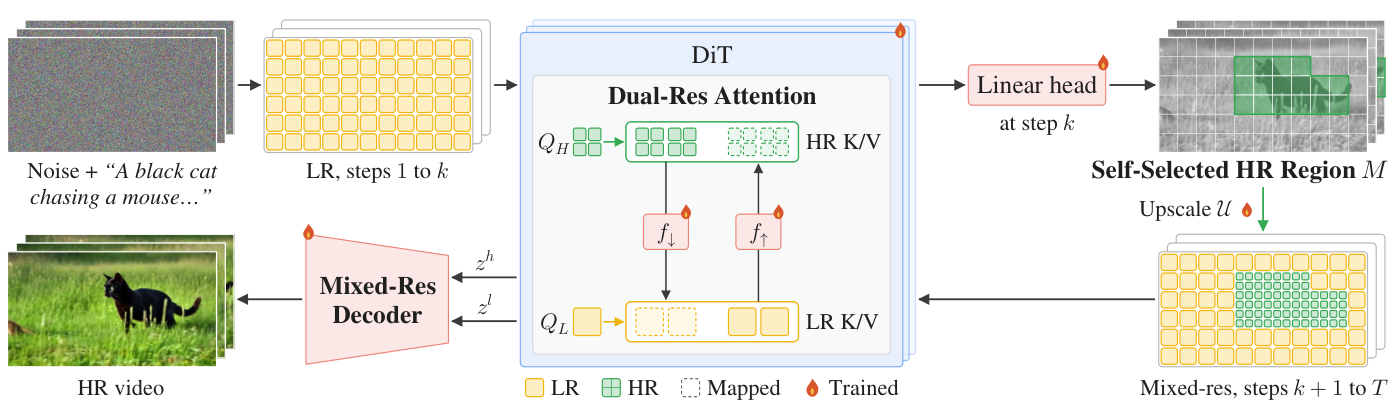
  • 本文贡献:MPEG-Diffusion 先以低分辨率跑前 k 步,再用冻结主干特征训练的线性头选高清区域;双分辨率注意力填补缺失键值,混合分辨率解码器合并潜变量。k 是开始分辨率分叉的去噪步,不是生成帧数。
图 2|MPEG-Diffusion 概览。总共 T 步中前 k 步在低分辨率 LR 运行;到第 k 步,线性头选出高分辨率 HR 区域 M(第 2 部分),余下步骤在 M 上用 HR、其他区域用 LR 去噪。双分辨率注意力(第 1 部分)让每个查询读取同分辨率的 K/V,缺失条目(虚线)由另一分辨率经线性映射补齐。混合分辨率解码器(第 3 部分)把 HR 与 LR 潜变量合成一个 HR 视频。火焰图标标出训练的部分。
Figure 2 : Overview of MPEG-Diffusion. The first k k of T T steps run at LR. At step k k , a linear head selects the HR region M M (part 2), and the remaining steps denoise M M at HR and the rest at LR. In dual-resolution attention (part 1), each query reads the K/V of its own resolution, with missing entries (dashed) filled from the other resolution by linear maps. The mixed-resolution decoder (part 3) merges the HR and LR latents into one HR video. Flames mark trained parts.
  • 实验效果:Wan2.1 14B、720p、k=40 且总 token 预算相当于全高清的 30% 时,去噪阶段相对全高清加速 4.8 倍;同预算 Foveated Diffusion 为 5.2 倍,但 DOVER 自动质量分(越高越好)为 0.743,本文 0.794。k=25 的 38% token 设置下,本文为 3.3 倍、DOVER 0.803;750 次左右双视频投票中,对 Foveated Diffusion 的平局折半胜率为 90.1%。
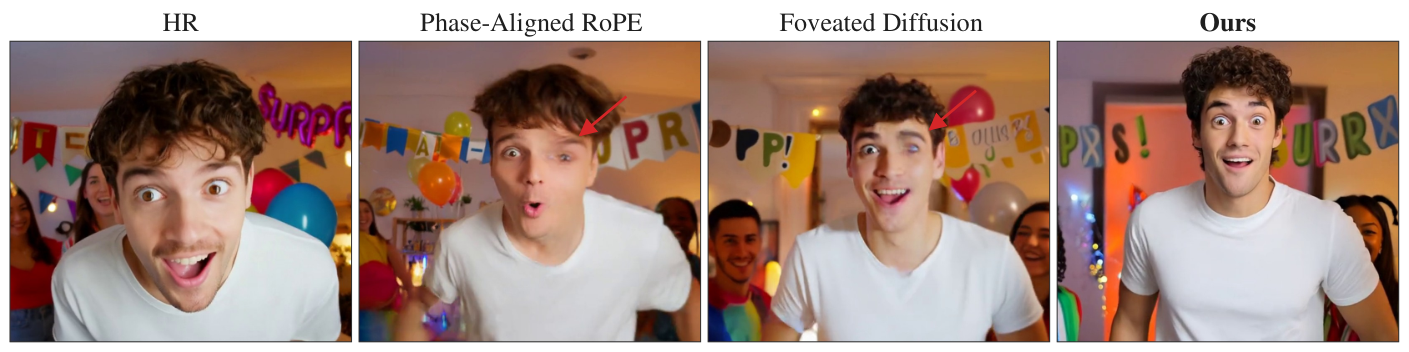
图 8|人脸定性比较:Wan2.1 14B、k=25、相同随机种子,提示词为一名年轻男子走进惊喜派对。两个基线在 HR/LR 边界有明显伪影,一只眼清晰而另一只出现重影(箭头);本文方法没有可见退化,接近全 HR。更多示例见附录 A。
Figure 8 : Qualitative comparison on faces (Wan2.1 14B, k = 25 k=25 , same seed). Prompt: a young man steps into a surprise party. Both baselines show clear artifacts where the HR and LR regions meet, with one eye sharp and the other ghosted (arrows). Ours shows no visible degradation and is close to HR (more examples in Appendix A ).
  • 批判点评:4.8 倍指去噪时间,不是包含编码、解码的整条视频产线。质量未完全回到全高清:k=40 时 Wan2.1 14B 的 VBench 视频生成质量分为 83.9,高清基线 85.3;选高清区域的线性头也需要训练。

5. V2C-Edit:图像改动由 VLM 逐步导航

VLM as an Editing Pilot: VLM-Steered Velocity Control for Flow-Based Image Editing | 台湾大学;加州大学戴维斯分校;台湾清华大学;台湾中央研究院 | arXiv:2611.10066

关键词:图像编辑, 流匹配, VLM 引导, 无反演编辑

  • ⚠️ 前序问题:用 FlowEdit 改图时,源图约束过紧会出现零编辑:背景保住了,请求的变化却没有发生。固定的源图耦合时序无法适应不同改动。
  • 方法直觉:每个去噪时间步备好不同强度的编辑速度,让视觉语言模型比较候选结果是否真正执行指令;指令已基本实现时,再用空间掩码保护无需改动的区域。
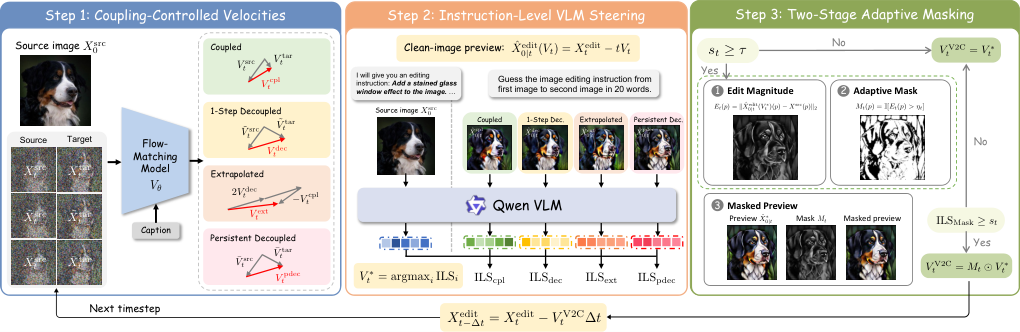
  • 本文贡献:V2C-Edit 是免训练的流式编辑控制:构造四种源图耦合速度,用 ILS(Instruction-Level Similarity,指令级相似度)逐步选方向,采用两阶段自适应掩码;ILS 评估改动本身,而非只比目标文案与整图的 CLIP 相似度。
图 3|V2C-Edit 流程:(1) 耦合控制速度:构造四种耦合行为不同的编辑速度;(2) 指令级 VLM 引导:每一步用 ILS 选最合适的速度;(3) 两阶段自适应掩码:语义对齐足够且掩码更新不损害 ILS 时才施加空间掩码。VLM 查询模板见附录 F。
Figure 3 : Overview of the proposed V2C-Edit pipeline. (1) Coupling-Controlled Velocities: Construct four editing velocities with different coupling behaviors. (2) Instruction-Level VLM Steering: Select the optimal velocity at each timestep using ILS. (3) Two-Stage Adaptive Masking: Apply spatial masking when semantic alignment is sufficient and the masked update maintains ILS. The VLM query templates are provided in Appendix F .
  • 实验效果:FLUX 上的 MagicBrush 数据集,对照 FlowEdit,GPT 指令对齐分 5.56→6.07,Gemini 分 4.76→5.36;未编辑区域的 PSNR(峰值信噪比,越高越接近源图)为 17.48→17.44 dB,略降。H100 80GB 上 50 张图平均每张 26.44 秒、峰值 53GB;基础 FlowEdit 为 4.00 秒、36GB。
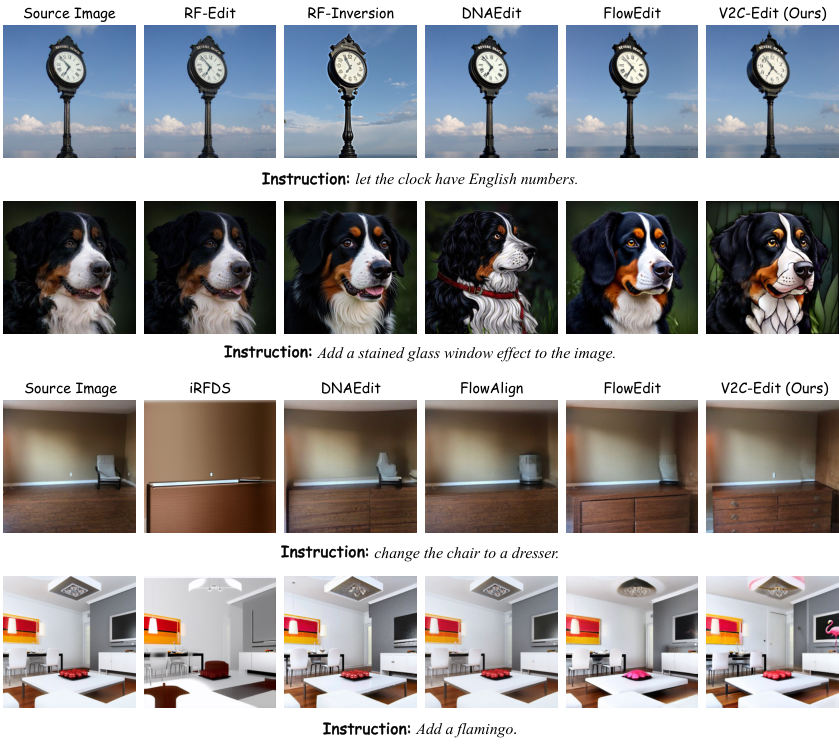
图 4|文本引导图像编辑的定性对照。本文方法更符合编辑指令,同时较好保持源图背景一致性。
Figure 4 : Qualitative comparisons of text-based image editing methods. Our method achieves the highest fidelity to the editing instruction while maintaining strong background consistency with the source image.
  • 批判点评:更强的指令完成度换来约 6.6 倍单图耗时和 17GB 额外峰值显存,非实时编辑方案;PSNR 也显示背景保留并未同步改善。ILS 依赖 VLM 逐步评估,在不同编辑指令和 VLM 上的稳定性要另验。

6. PhysOPSD:物理代码教视频动起来

PhysOPSD: Code as Privilege for Physically Plausible Video Generation | 香港科技大学;阿里巴巴 Token Hub | arXiv:2611.12411

关键词:视频生成, 物理一致性, 自蒸馏, 可执行模拟

  • ⚠️ 前序问题:视频模型能画出逼真画面,仍会把摆锤、接触或流体运动画错。单靠文字很难给出可控制的物理过程,离线视频示例又把物理规律与外观混在一起。
  • 方法直觉:用可执行模拟程序生成可调物理过程,作为训练期特权信息;对同一场景只改变一个物理参数,并保持生成噪声一致,让模型看到动态变化的原因。
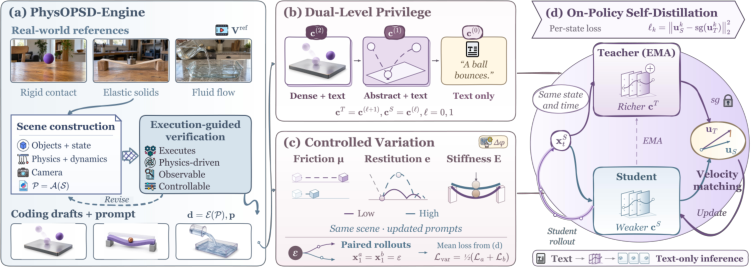
  • 本文贡献:PhysOPSD 用 PhysOPSD-Engine 把真实物理情境转成可验证模拟,构造密集与抽象两级物理草稿;在 on-policy self-distillation(模型用自己生成的样本接受教师纠正)中提供配对物理变体。代码是训练用物理条件,最终目标是生成视频。
图 3|所提出的 PhysOPSD 方法概览。
Figure 3: Overview of our proposed PhysOPSD .
  • 实验效果:用 3K 物理样本后,8.3B 主干在 PhyGround 的 Overall 从原 HunyuanVideo-1.5 的 66.3 升至 68.3;同规模 80K 样本 SFT 为 66.1,21K 样本 PhysHPO 为 67.0。VideoPhy-2 的 All 指标为 67.0,对照 PhysHPO 为 66.0。这里 K 表示千条训练实例。
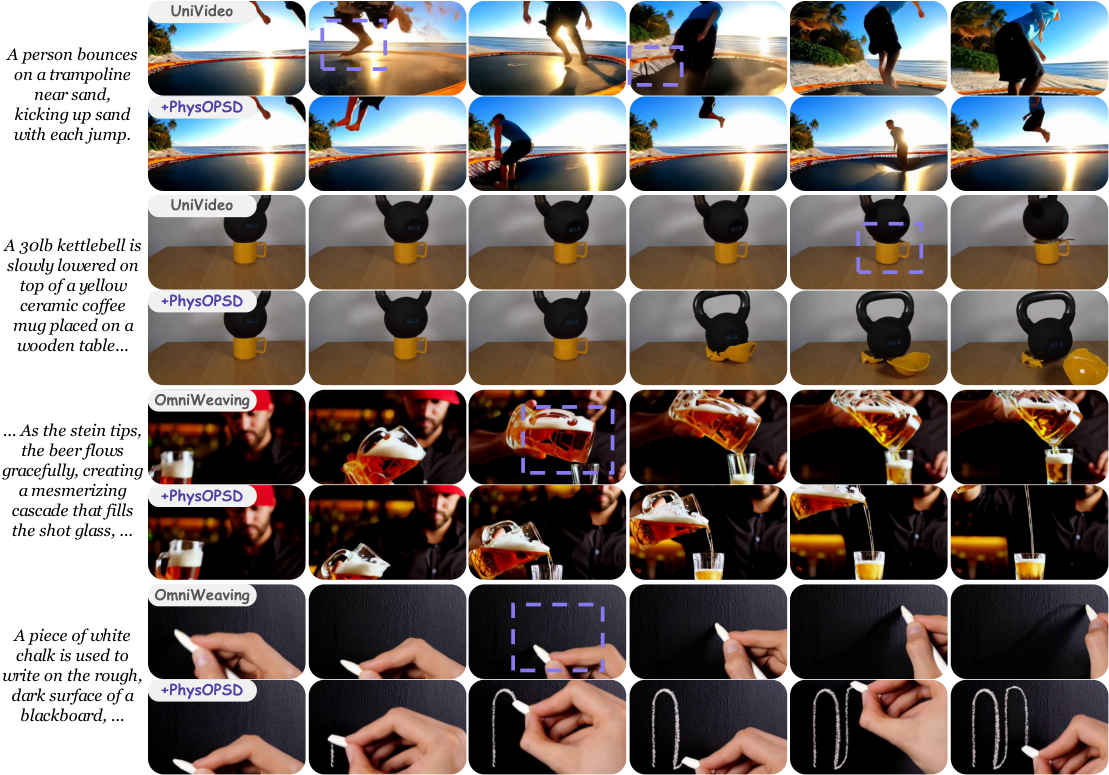
图 5|PhysOPSD 的定性结果;更多结果见图 14、15、16 和 17。
Figure 5: Qualitative results of PhysOPSD . More results are shown in Figures 14 , 15 , 16 and 17 .
  • 批判点评:改善仍依赖模拟程序覆盖目标物理现象,镜头外观与真实互动的泛化要单独测。表中 3K 只表示训练实例数;建立可执行模拟程序的成本、推理耗时与真实世界失败率仍需另验。

7. ReelCache:续写视频压住历史缓存

ReelCache: An Efficient KV Cache Compression and Management System for Multi-Round Video Generation | 匹兹堡大学;Google | arXiv:2611.09973

关键词:视频续写, KV 缓存压缩, 分块生成, 推理系统

  • ⚠️ 前序问题:逐块续写视频要保存旧块的注意力 K/V 缓存;用户回退、分叉时保留所有版本耗显存,删掉后重算又拖慢下一块。
  • 方法直觉:同一块的缓存既有通道冗余,也有时空相关性;相邻块还共享部分基向量。先低秩分解,再像编码视频那样压系数,并把分叉历史组织成树。
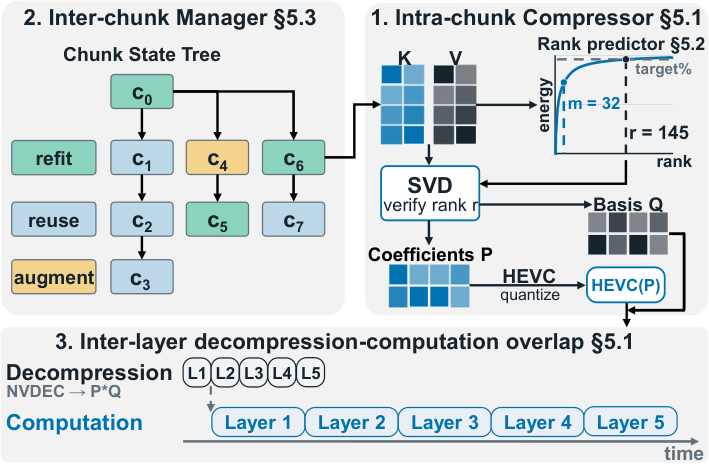
  • 本文贡献:ReelCache 在每层预测满足保留能量目标的秩,再压缩注意力缓存;跨块共享低秩基,树形管理恢复、回退和分叉。KV 是注意力的键和值,压缩的是生成过程的历史状态,不是最终视频文件。
图 9|ReelCache 系统概览。
Figure 9: Overview of ReelCache .
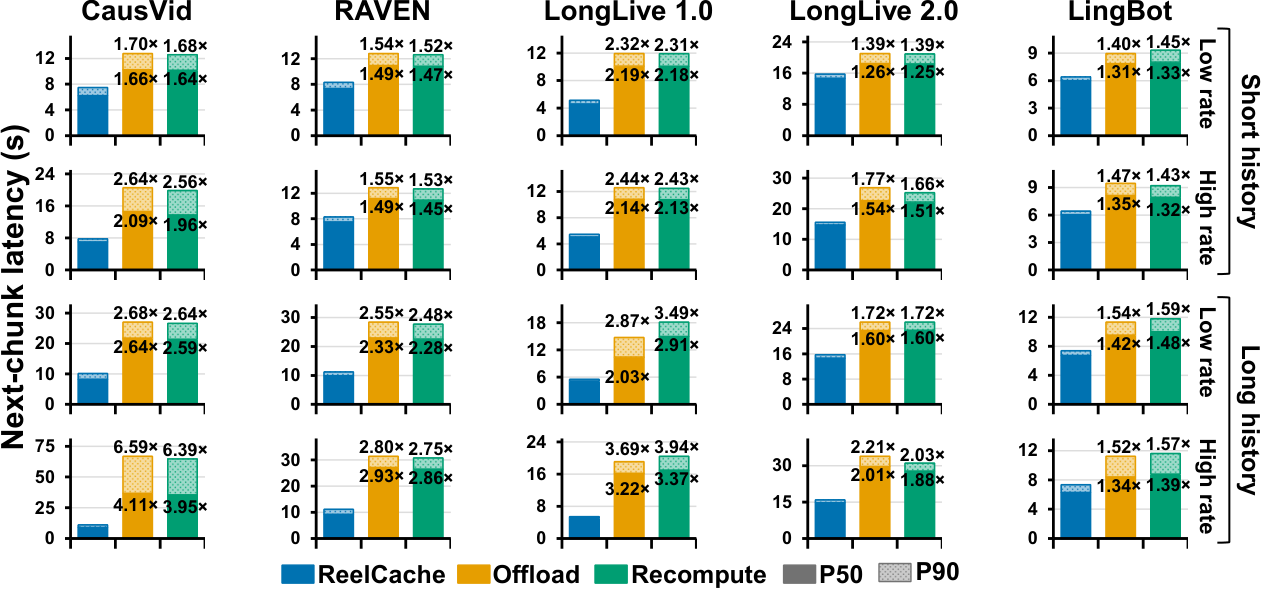
  • 实验效果:五种视频模型上,对照文中缓存基线,KV 存储缩小 14.46–21.13 倍,下一块生成加快 1.25–3.36 倍,六项代表性 VBench 视频生成指标下降小于 1%。CausVid 上额外压缩开销约 0.2%,解压开销 3.2%;RAVEN 分别 0.8% 和 4.2%。
图 15|在不同模型与工作负载上,ReelCache 相对基线的下一块生成延迟 P50 与 P90;P50 是中位数,P90 是 90% 请求不超过的延迟。
Figure 15: P50 and P90 next-chunk latency of ReelCache compared to baselines across models and workloads.
  • 批判点评:这项收益集中在长历史、多轮恢复和分叉;短片一次生成时,树形缓存管理的收益较小。VBench 的六项平均跌幅低于 1% 不代表每条视频完全无可见变化,仍需对关键主体做逐帧检查。

8. STEER:音频编辑先找对声源

Steer Unified Audio Editing Toward Reliable Source Selection | 中国人民大学;腾讯;香港大学;香港中文大学 | arXiv:2611.10630

关键词:音频编辑, 声源选择, 去噪轨迹, 后训练

  • ⚠️ 前序问题:混合音里说“只删掉狗叫”,统一音频编辑器可能误删说话声,或把所有声音一起变了。错误声源往往在早期去噪就选定,后续难纠正。
  • 方法直觉:训练时多看决定声源的早期状态;再让模型从自身跑偏的中间状态继续去噪,学会把选错的声源拉回来。
  • 本文贡献:STEER(Source-selection Training via Early-trajectory Emphasis and Recovery)分两阶段后训练:Emphasis 强化早期关键状态,Recovery 用自生成轨迹学习纠错;得到 SteerSound,并建立同时检查目标改到位和非目标保留的 Selective Audio Editing Benchmark。
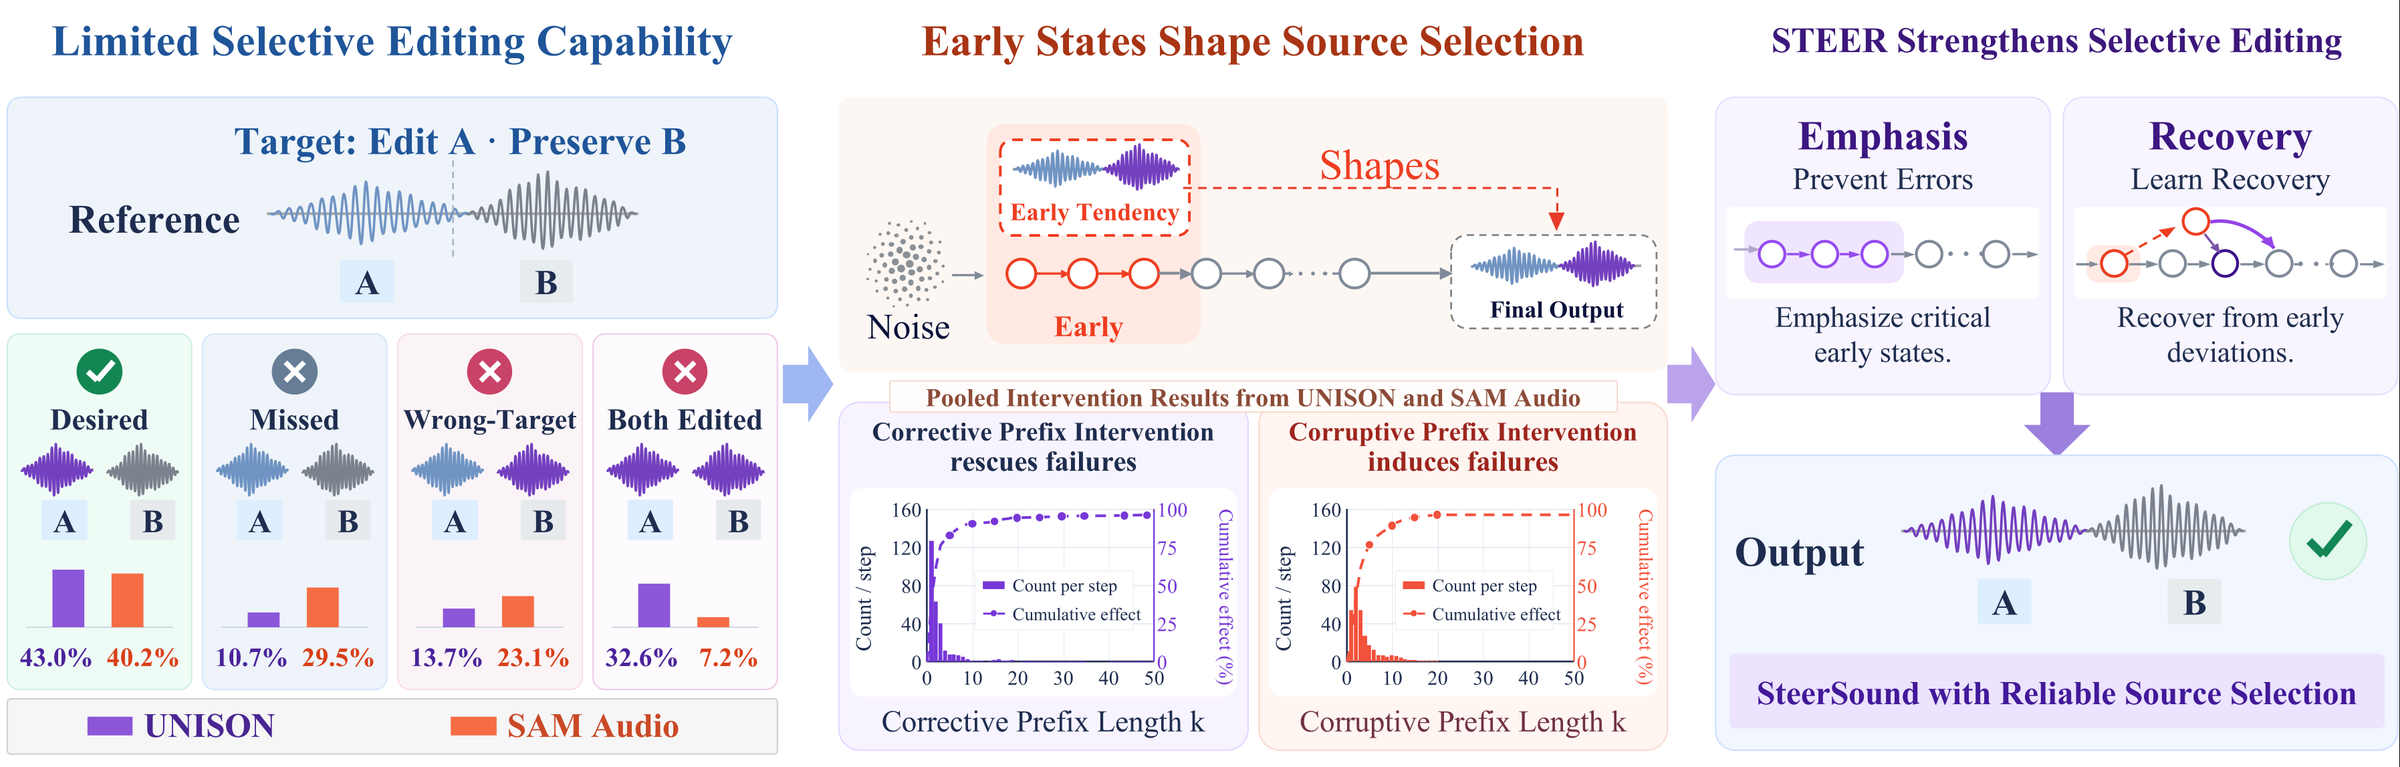
图 1|STEER 强化选择性音频编辑。左:已有编辑器可能让目标声源原样保留,或误改非目标声源。中:早期状态塑造最终声源选择,后续去噪通常沿既定编辑方向继续,而不会回头修正。右:STEER 用早期轨迹强调(Emphasis)与恢复训练(Recovery)处理这些错误,得到声源选择更可靠的 SteerSound。
Figure 1: Strengthening selective audio editing with STEER. Left: Existing editors may leave the target unchanged or modify non-target content. Middle: Early states shape final source selection, while later denoising tends to follow the established editing direction rather than revise it. Right: STEER addresses these failures through early-trajectory emphasis (Emphasis) and recovery training (Recovery), yielding SteerSound with more reliable selective editing.
  • 实验效果:在自建选择性音频编辑基准上,原始基础编辑器的整体成功率 70.42%、选择性错误率 28.48%;两阶段后为 85.78% 和 8.45%。但在复杂音频编辑测试集,SteerSound 的生成 CLAP 音文匹配分(越高越好)从基础模型 0.223 略降到 0.220,KL 分布距离(越低越好)由 1.915 升到 2.133;选择性提升不等于所有生成指标齐升。
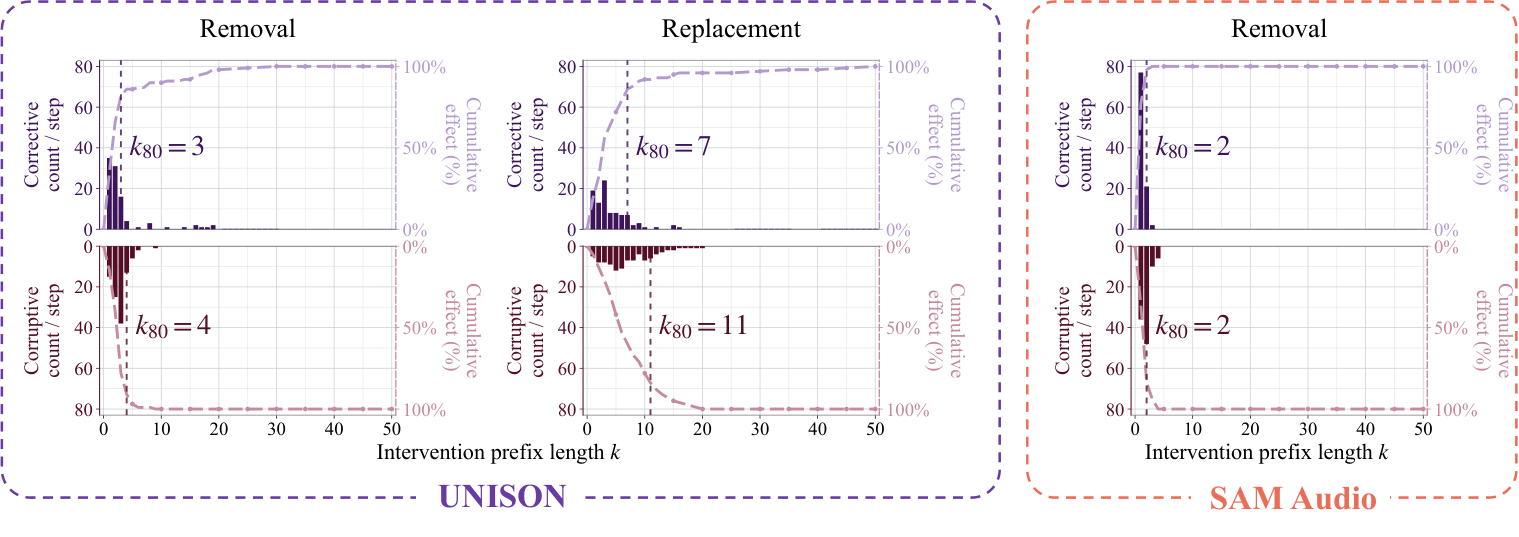
图 3|对声源选择施加双向早期轨迹干预:上排为纠正干预,下排为扰乱干预。每项任务用 100 个验证例;柱形表示逐步被纠正或扰乱的个数,曲线为累计效果。每项任务的 k80 是累计效果达到 80% 的最短干预前缀长度;移除任务的 k80 始终短于替换任务。
Figure 3 : Bidirectional early-trajectory interventions on source selection. Corrective (top) and corruptive (bottom) prefix interventions are evaluated on 100 validation examples per task. Bars show per-step corrective or corruptive counts, while curves show the corresponding cumulative effects. For each task, k 80 k_{80} denotes the shortest intervention prefix length at which the cumulative effect reaches 80%. Removal consistently exhibits a shorter k 80 k_{80} than replacement.
  • 批判点评:结果依赖作者构造的编辑任务与基准;不同声源重叠、指令模糊时仍需人工听感。两阶段后训练有额外数据和训练成本,论文摘要未给可直接推广的推理加速结论。

9. FADE:分数阶预测少算视频去噪

FADE: Fractional Anomalous Dynamics Extrapolation for Training-Free Diffusion Transformers Acceleration | 四川大学 | arXiv:2611.10514

关键词:扩散加速, 视频生成, 特征缓存, 分数阶动力学

  • ⚠️ 前序问题:扩散 Transformer 的中间特征随去噪步非线性变化,简单缓存或线性外推在弯曲轨迹处会积累误差,导致生成细节和运动失真。
  • 方法直觉:先离线测不同层、步和位置适合的分数阶变化率,推理时按查找表选阶数,在完整计算步之间预测特征;分数阶算子允许比整数阶外推更灵活地贴近弯曲轨迹。
  • 本文贡献:FADE(Fractional Anomalous Dynamics Extrapolation)离线建立多维阶数 LUT(查找表),在线交替执行完整计算与 Mittag–Leffler 分数阶特征预测;无需重新训练生成主干。
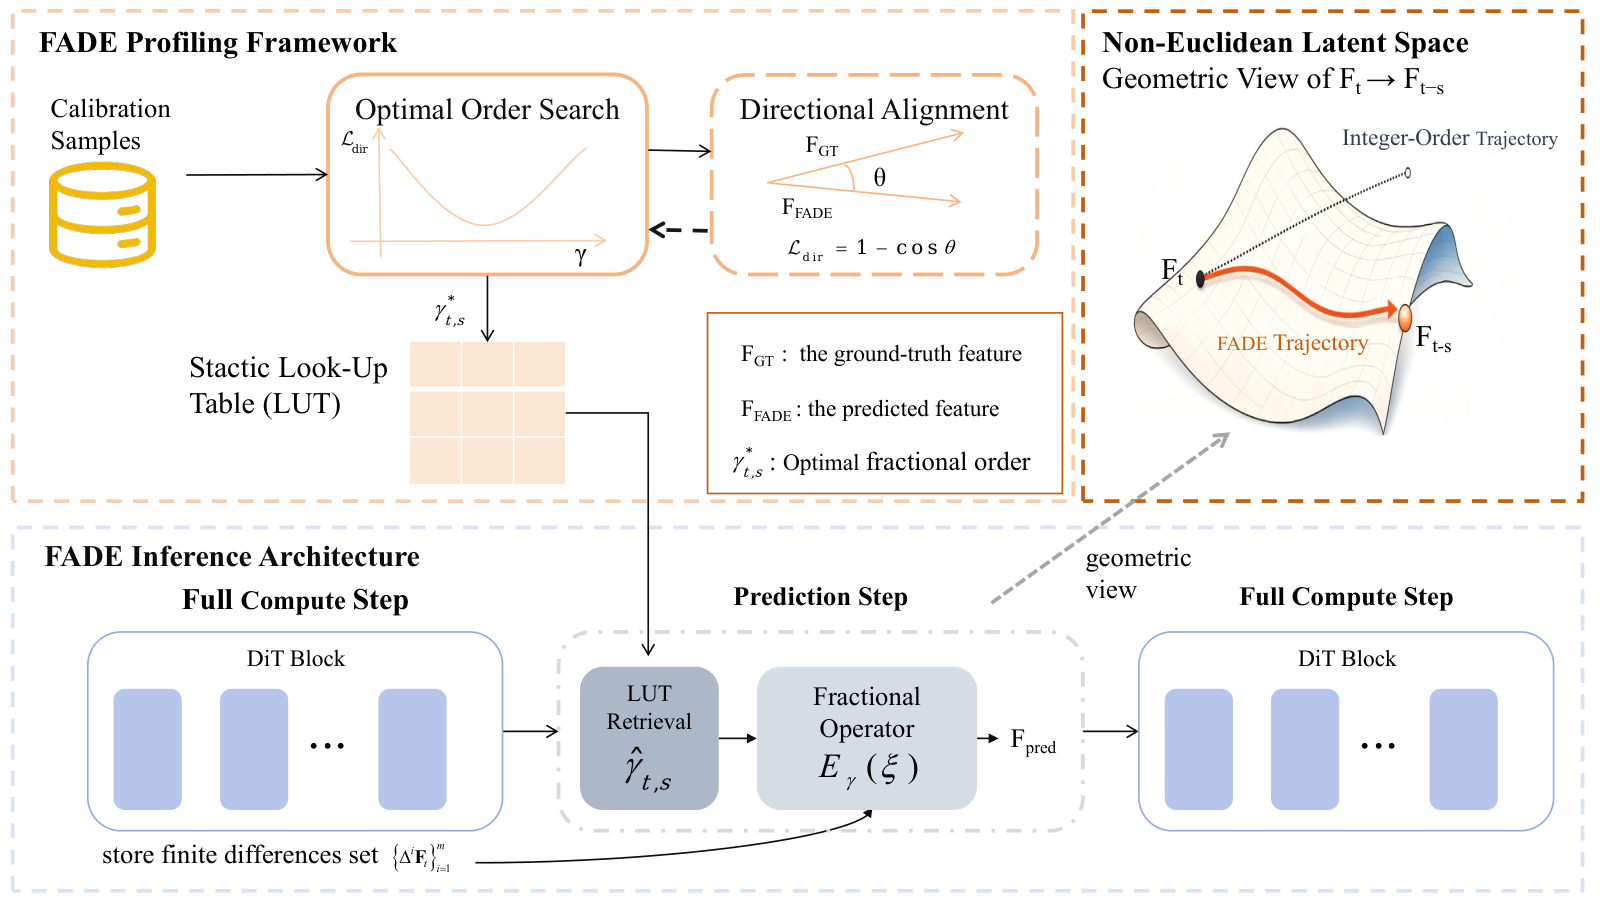
图 2|FADE 总体框架包含离线 profile 与在线推理。离线阶段校准最佳分数阶并存入静态 LUT;在线阶段以 LUT 查到的阶数预测特征,在完整计算步与预测步之间交替。右上角对比潜空间中 FADE 轨迹与整数阶轨迹的几何形状。
Figure 2 : Overall framework of FADE. FADE consists of an offline profiling stage and an online inference stage. The offline stage calibrates and stores the optimal fractional orders in a static LUT, while the online stage alternates between full-compute and prediction steps using LUT-retrieved orders for feature forecasting. The upper-right panel illustrates the geometric contrast between the FADE trajectory and the integer-order trajectory in the latent space.
  • 实验效果:HunyuanVideo 文生视频、原始 50 步设置,完整推理为 190.2 秒、VBench 视频生成分 80.68%;同为 5359T FLOPs(T 为万亿次浮点运算估计)预算下,FADE 为 37.9 秒、80.12%,HiCache 为 37.8 秒、79.93%。表中 5.56 倍是 FLOPs 口径,按实际秒数约 5.0 倍。
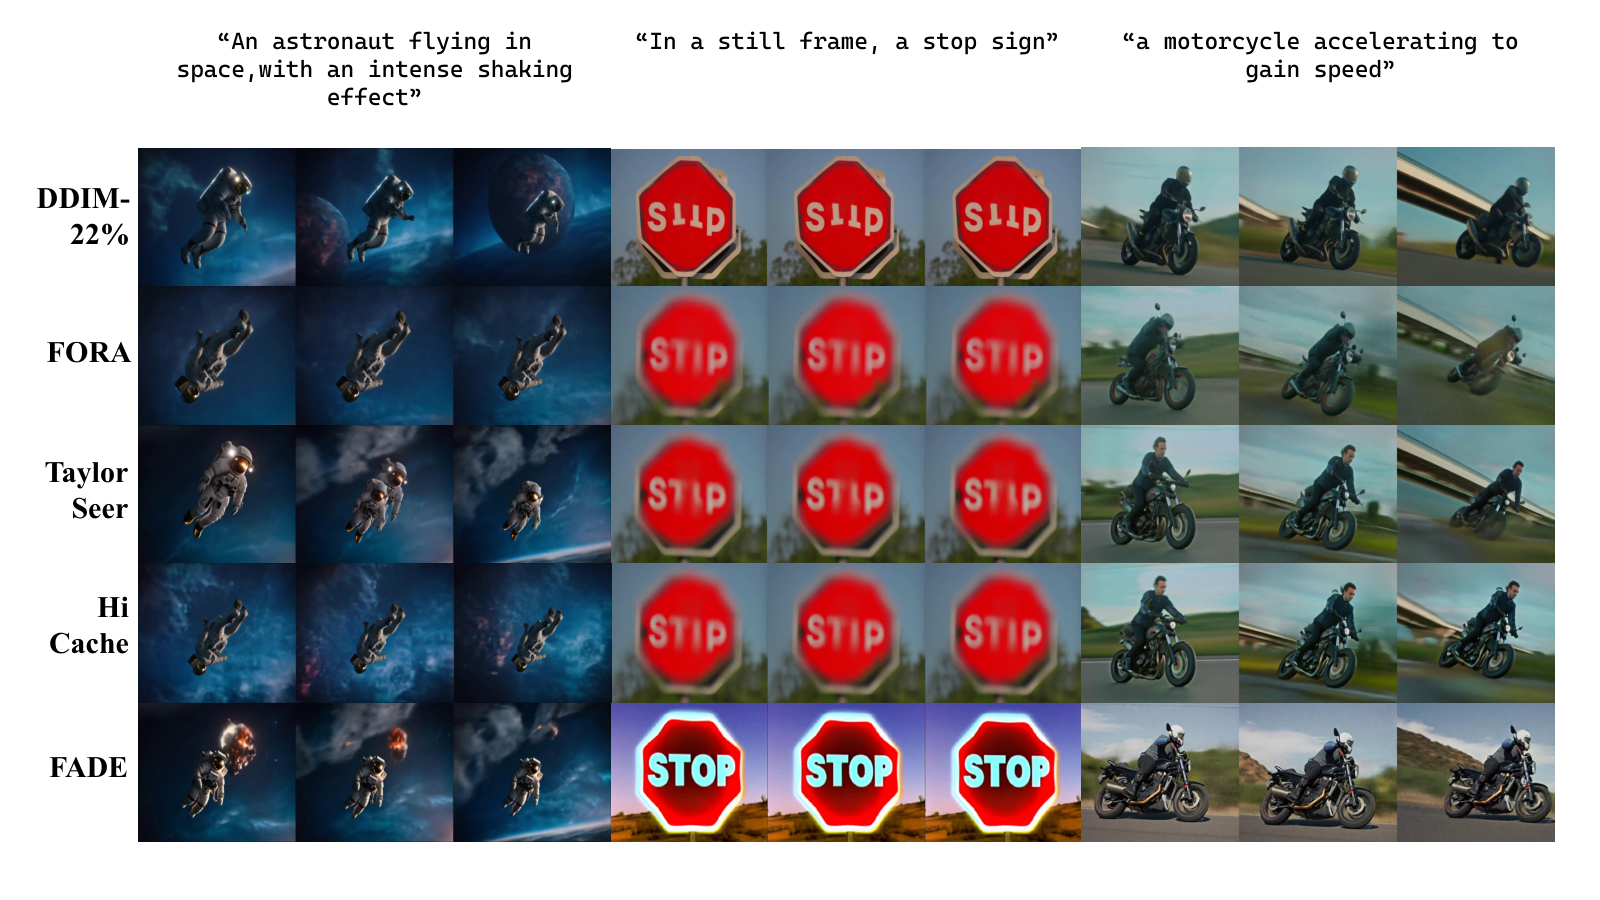
图 5|文生视频生成的定性比较。
Figure 5 : Qualitative comparison on text-to-video generation.
  • 批判点评:离线 profile 与查找表构建有前置成本,跨模型或分辨率可能需重做;输出 VBench 仍比完整 50 步低 0.56 分,且表中同预算延迟几乎与 HiCache 持平,优势主要是质量。

10. SoftPAT3D:让布料玩具稳稳落座

SoftPAT3D: Physics-Augmented Text-to-3D Scene Generation with Deformables | 斯坦福大学 | arXiv:2611.11087

关键词:文本到3D, 可变形物体, 物理仿真, 场景生成

  • ⚠️ 前序问题:文本生成的三维房间里,布料可能穿过椅面、玩具悬空;把软物体当刚体摆放,无法给后续仿真一个有效的静止初态。
  • 方法直觉:先为布料、绳索等构造制造过程对应的自然形状和材料,再让它们与家具一起在统一接触求解器里落到平衡;失败时优化摆放位置。
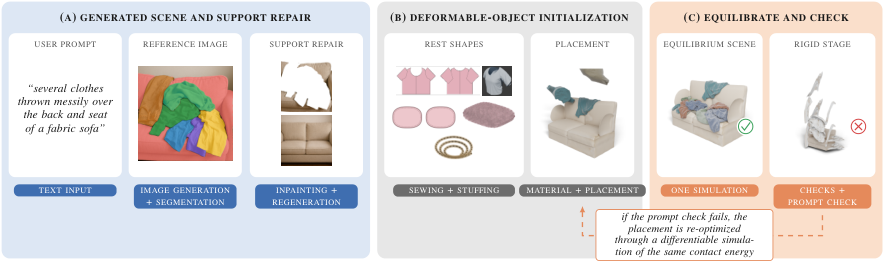
  • 本文贡献:SoftPAT3D 在文本到三维场景流程中,补全遮住的承托表面并建碰撞网格,为软体指定 rest shape(无外力自然形状)和材料,统一仿真接触、检查几何与提示符合度,再用可微仿真调整初始摆放。
图 2|SoftPAT3D 总流程;每张卡片是同一提示在某一步后的状态,标签标明产生它的步骤。(a) 提示扩展为参考图,按 PAT3D 分割并提升为三维;补画每个可变形物下被遮住的支撑面,再重建成碰撞网格(第 3.4 节)。(b) 按制造方式和尺寸先验为软体给出自然形状(第 3.2 节),从材料库指定材料,并放在提示所说的支撑位置上方(第 3.4 节)。(c) 单次仿真在统一接触屏障下使场景达到平衡(第 3.3 节),再通过几何与提示检查(第 3.5 节);失败场景进入摆放优化(第 3.6 节)。
Figure 2 : Overview of SoftPAT3D. Each card shows the state of one prompt at that point of the pipeline, and its label names the step that produced it. (a) The prompt is expanded into a reference image, segmented and lifted as in PAT3D, and the support hidden under each deformable object is inpainted, regenerated and converted into a collision mesh (Sec. 3.4 ). (b) Each deformable object receives a rest shape from its manufacturing process under a size prior (Sec. 3.2 ), a material from the material library and a placement above the part the prompt names (Sec. 3.4 ). (c) One simulation brings the scene to equilibrium under a single contact barrier (Sec. 3.3 ), and the result passes the geometric checks and the prompt check (Sec. 3.5 ); a scene that fails enters placement optimization (Sec. 3.6 ).
  • 实验效果:主实验表的 34 个场景里,SoftPAT3D 生成 43 个软体,接触穿越为每千条边 0、穿透 0 mm,完成 21 个场景;对照刚体流程完成 2/32。共同的 13 个可渲染场景上,GPT-5.4 物理合理性评分从刚体流程 43 升至 90(0–100),CLIP 图文匹配分由 23.9 升至 28.2。
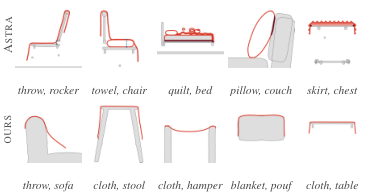
图 5|垂直剖面:布料为红色、家具为灰色,穿入家具的布料呈深红色;虚线标出布料悬浮在承托物上方的位置。上排为 GPT-6 Astra:毯子和毛巾悬在座面上,棉被穿过床垫,枕头嵌入靠背,裙摆悬空起伏。下排为本文方法:布料落在支撑面上、包住边缘并从边缘垂下。
Figure 5 : Vertical sections, cloth in red, furniture in grey, cloth inside the furniture in dark red, and a dashed line where the cloth floats above its support. Top: GPT-6 Astra; the blanket and the towel hang above their seats, the quilt runs through the mattress, the pillow sits inside the backrest, and the skirt ripples in mid-air. Bottom: ours; the cloth rests on the support, wraps its edges and hangs from them.

  • 批判点评:这些几何与评分结果依赖作者的场景集、碰撞建模和求解预算;34 个场景仍有 13 个未达到完整通过。模型处理的是静态平衡,不能直接推断复杂布料动态也正确。

趋势观察

长视频更需要选对历史

LongSCOP 检索前后帧补画缺失区域;OneReel 跨镜头只分享代表帧;ReelCache 压缩并恢复分叉历史。三者操作对象不同,分别是像素参考、注意力范围和缓存状态。

速度收益要看时间口径

MPEG-Diffusion 的 4.8 倍是去噪阶段;OneReel 报端到端 1.7–4.9 倍;FADE 表中 5.56 倍是 FLOPs,实际秒数约五倍。不同指标不可横比。

控制精度有代价

V2C-Edit 提高指令对齐却使单图耗时从 4.00 增至 26.44 秒;LongSCOP 的 VLM 参考帧检索也将 15 秒片处理从 13.5 增至 16.5 分钟。


今日讨论

LongSCOP 在 LVO-Bench 把 FVD 从 VACE 的 225.5 降到 197.3,却使 15 秒视频处理由 13.5 分钟增至 16.5 分钟。如何验证参考帧检索在遮挡区域从未露出的长视频上是否仍有收益,并用同一组输入比较扩画稳定性与时间成本?


人工智能炼丹君 整理 | 2026-11-11


更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」

每日更新 · 论文精选 · 深度解读 · 技术脉络

微信搜索 人工智能炼丹君 或扫描下方二维码关注

扫码关注「人工智能炼丹君」

0

评论 (0)

取消
粤ICP备2021042327号