


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

人工智能炼丹君 | 2026年11月14日(周六)
覆盖时间:2024-11-14 至 2026-11-14(仅收录此期间首发的研究或产品版本)
本期 AIGC 周末专题聚焦面向 Agent 的视频生成:代码、Blender白模与虚幻引擎方向,精选 10 项代表工作进行深度解读。
2026 年 11 月,Fable 5.2 发布时,Ethan Mollick 给了它一个开放式任务:做出一件能嵌入文章、迅速吸引读者、展示模型能力的作品。他随后在文章中展示了一段用代码制作的影片,并表示自己只给了初始要求,没有追加反馈。一个原本需要创意、动画和制作工具共同参与的任务,被交给了通用 Agent。这个案例值得追问的,是从一句创作要求到一段可播放作品,中间的制作过程如何组织起来。
理解这件事,可以先看 Fable 5.2 在流程中的位置。官方规格列出的输出是文字;它可以生成代码、组织工具调用,把场景、相机、动画和声音的要求落实到可执行工程,再由浏览器或三维引擎渲染画面。这里,Agent 负责把创意转化为制作步骤,渲染工具负责把这些步骤变成视频。Mollick 的展示提供了一个具体入口,也把问题引向更广的范围:哪些视频适合这样做,哪些环节又需要生成模型参与?
沿着这个问题,会遇到几条不同的路线。数学讲解、信息图和品牌动画,可以把文字、图形与时间安排写成代码;需要稳定几何和连续机位的作品,可以让 Agent 操作三维场景、资产与时间轨道;希望保留动作和镜头、再丰富材质与风格的作品,可以先渲染白模,再用 diffusion 等生成模型重绘;面向更开放的叙事和画面探索,也可以由 Agent 拆分剧本、组织分镜,调用视频模型并审阅结果。它们都能产出视频,却把控制权放在不同的地方。
这种差别在修改第二版时最具体:字幕向左移一点,能否只改一个坐标?产品换成侧面镜头,能否保留同一套几何和材质?角色的动作已经满意,能否只换外观?答案取决于创作要求保存在代码、场景、时间轨道、运动条件,还是提示词与参考图里。选择路线时,需要同时考虑画面效果、哪些内容必须保持不变,以及一次局部修改会牵动多少制作环节。
本期从 Fable 5.2 的代码制作案例出发,选取近两年的十项代表工作,梳理代码渲染、三维片场、白模加生成式编辑,以及视频模型制片与审片之间的联系。下面先用路线图和时间线建立全局,再逐项讨论它们的机制、控制能力、制作成本与失败场景。
方向分布:
2024-11-14—2026-11-14:8项研究与2项产品/工具链,比较可控性、制作成本与适用任务
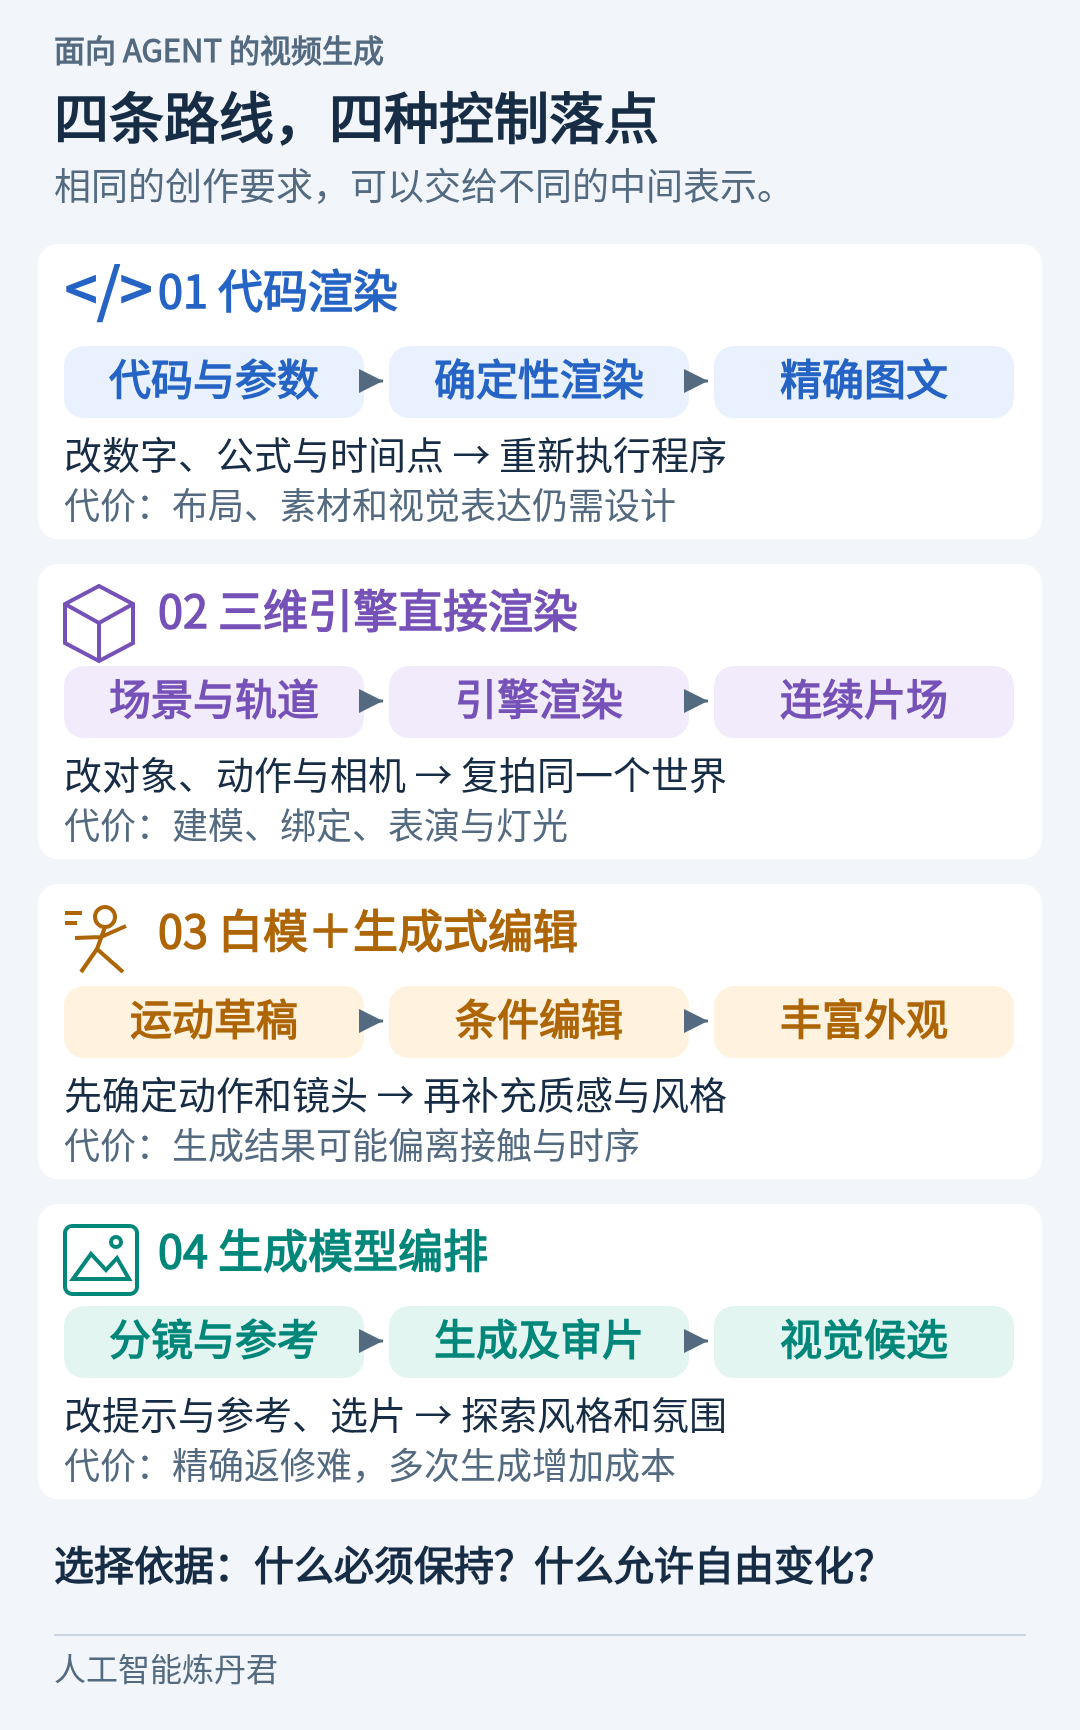
四条路线按 Agent 修改的对象区分:代码参数、三维场景、运动草稿、分镜与参考。图中同时标出输出优势与主要代价;它们可在同一作品中组合。
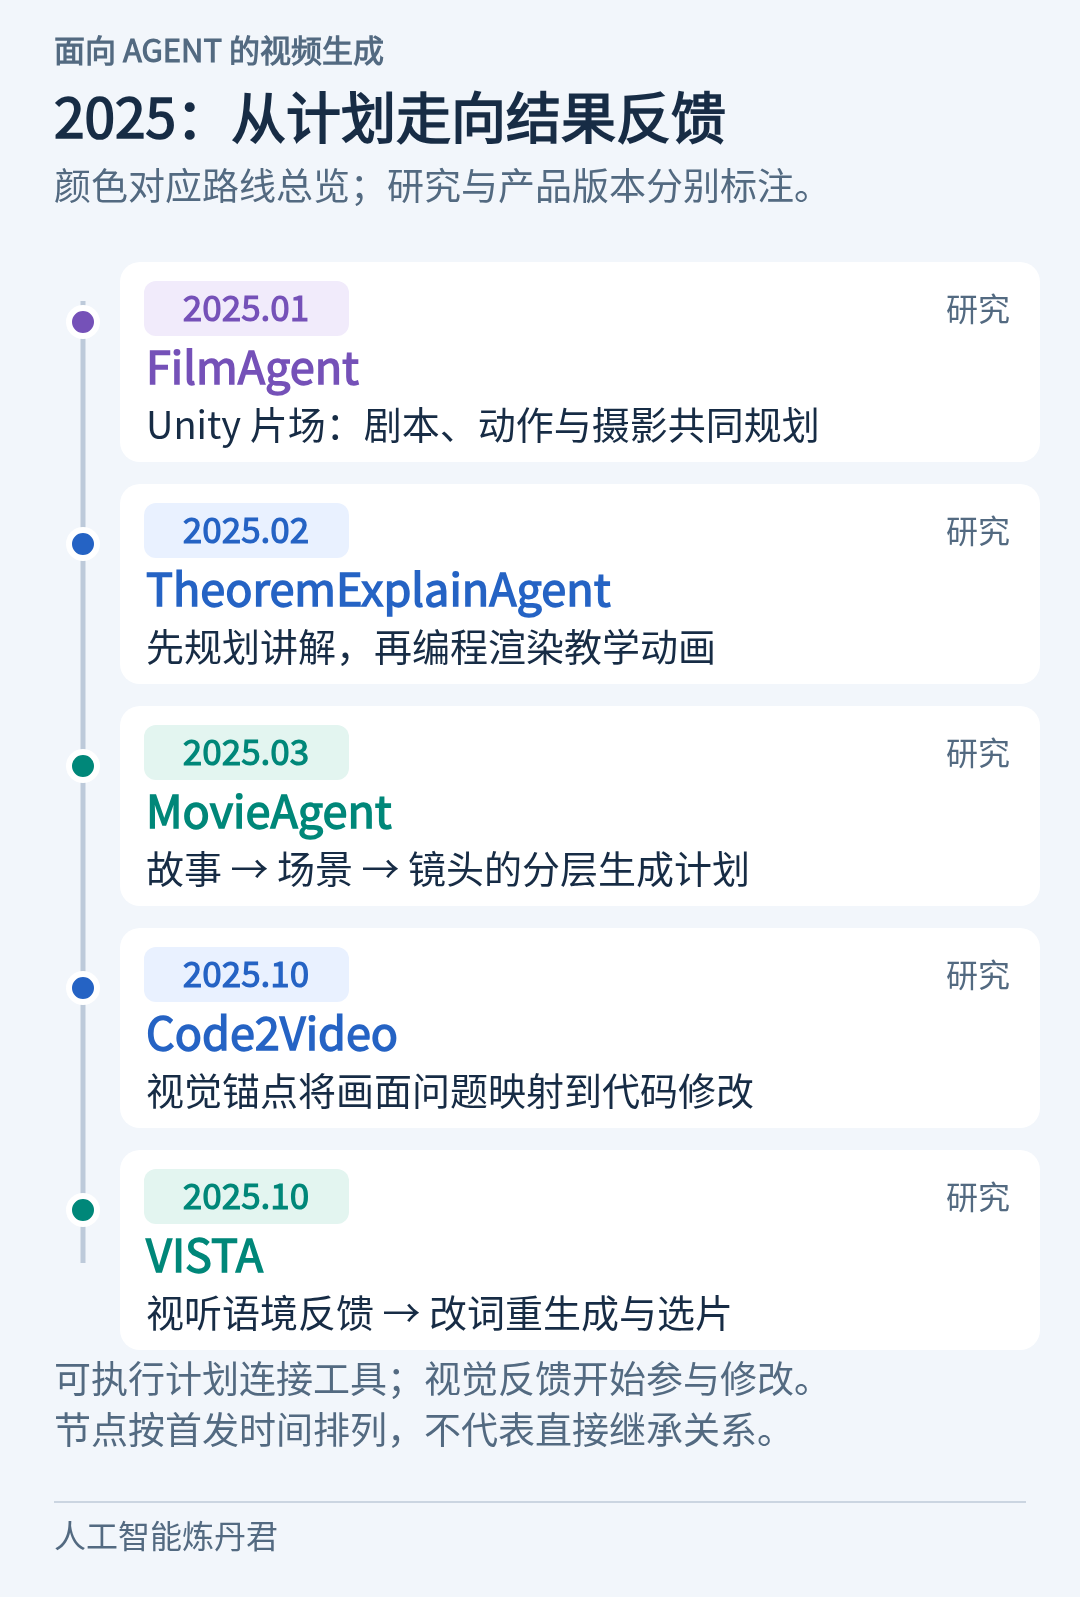
2025 年的五项工作展示了两种进展:先把创意拆成可执行计划,再让画面或视听反馈参与修改。颜色对应前图路线;节点按首发月份排列,不代表直接继承。FilmAgent 使用 Unity 片场。
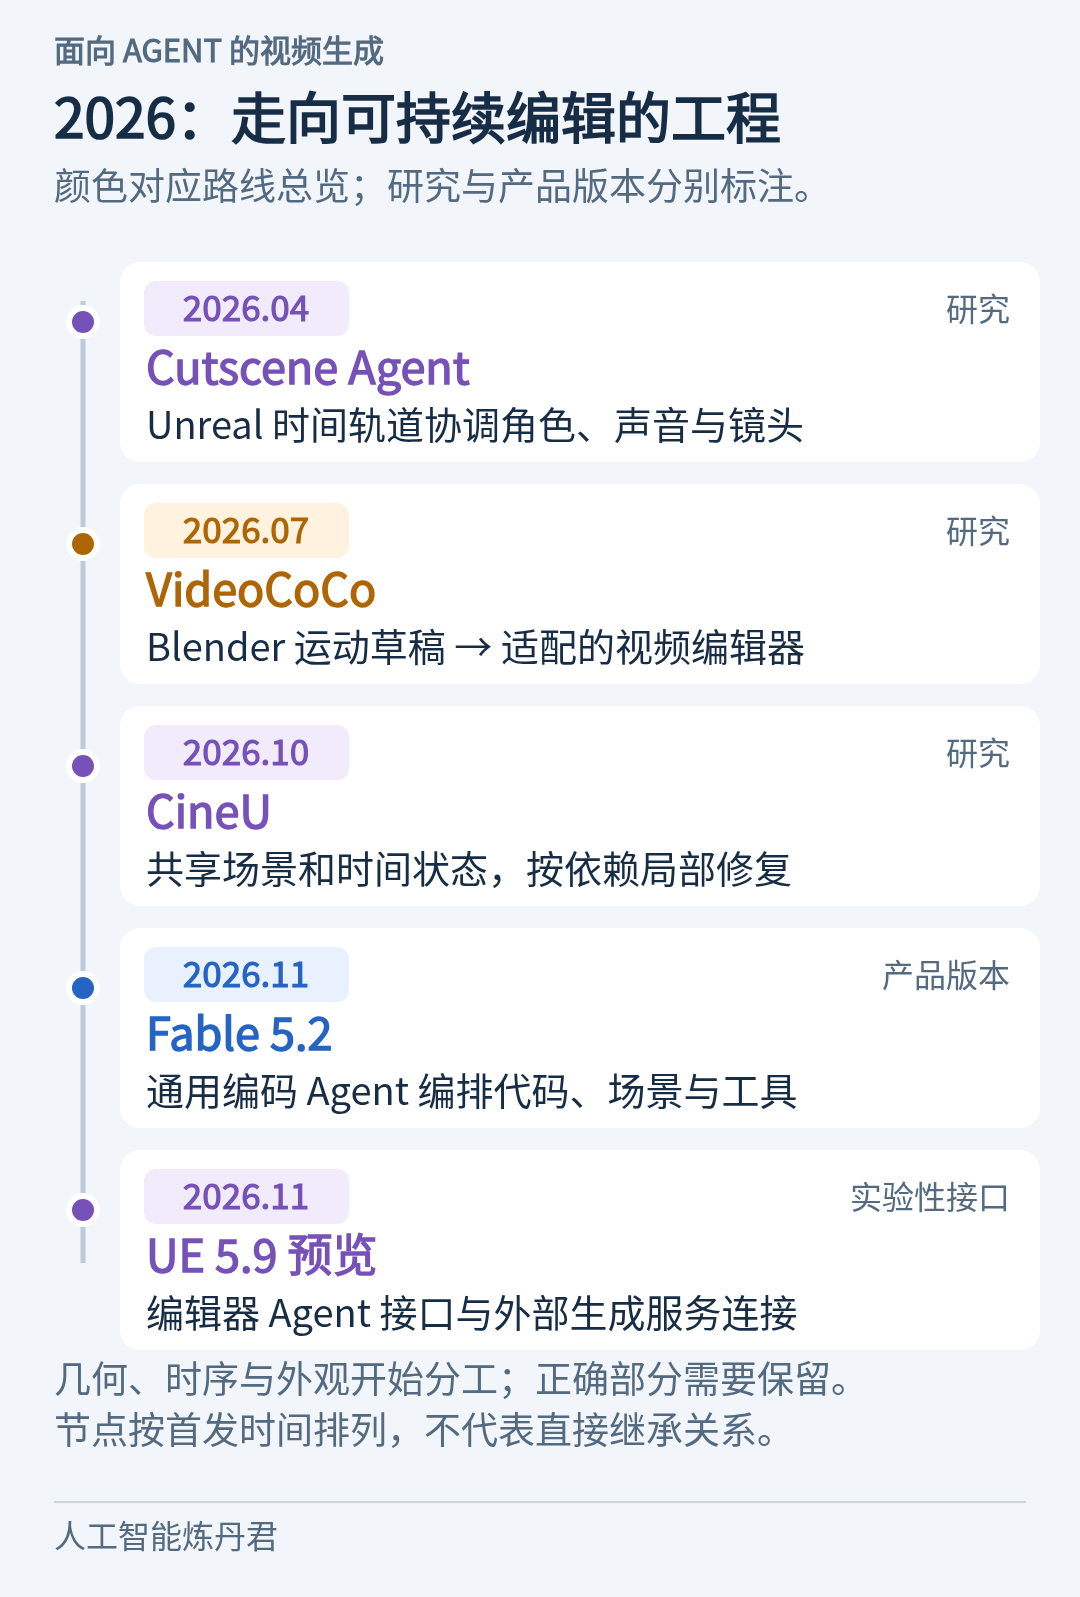
2026 年的五项工作进一步强调时间轨道、运动与外观分工、共享状态和局部修复。研究、产品版本与实验性工具接口分别标注;UE 5.9 为预览版。
工作: Claude Fable 5.2
来源: Fable 5.2 官方发布与代码视频案例
机构: Anthropic
关键词: 代码视频, 编码Agent, Three.js, 渲染工程, 场景编排
相关资料: Anthropic官方发布:2026-11-09 · Fable官方:代码动画与三维设计能力 · 官方平台规格:文字与图像输入,文字输出 · Ethan Mollick代码影片与场景工程 · Mollick公开Portals工程(独立于开场影片) · Portals第三方依赖声明
核心问题: 怎样把一个视听创意组织成可以持续修改的代码工程?
讲解一段算法、制作品牌动画或演示三维结构时,创作者往往既要控制文字和几何,又要反复修改节奏。把这些要求交给通用编码 Agent,意味着它可以把创意落实为可执行工程:改一句文案、一个参数或一段时间安排,再由渲染器重新出画面。Fable 5.2 的案例展示了这条路线正在从短小动画走向更完整的视听制作。
前序工作及局限:
与前序工作的本质区别: 用通用编码 Agent 编排场景、动画与音轨,将运行反馈和画面检查用于修改工程。
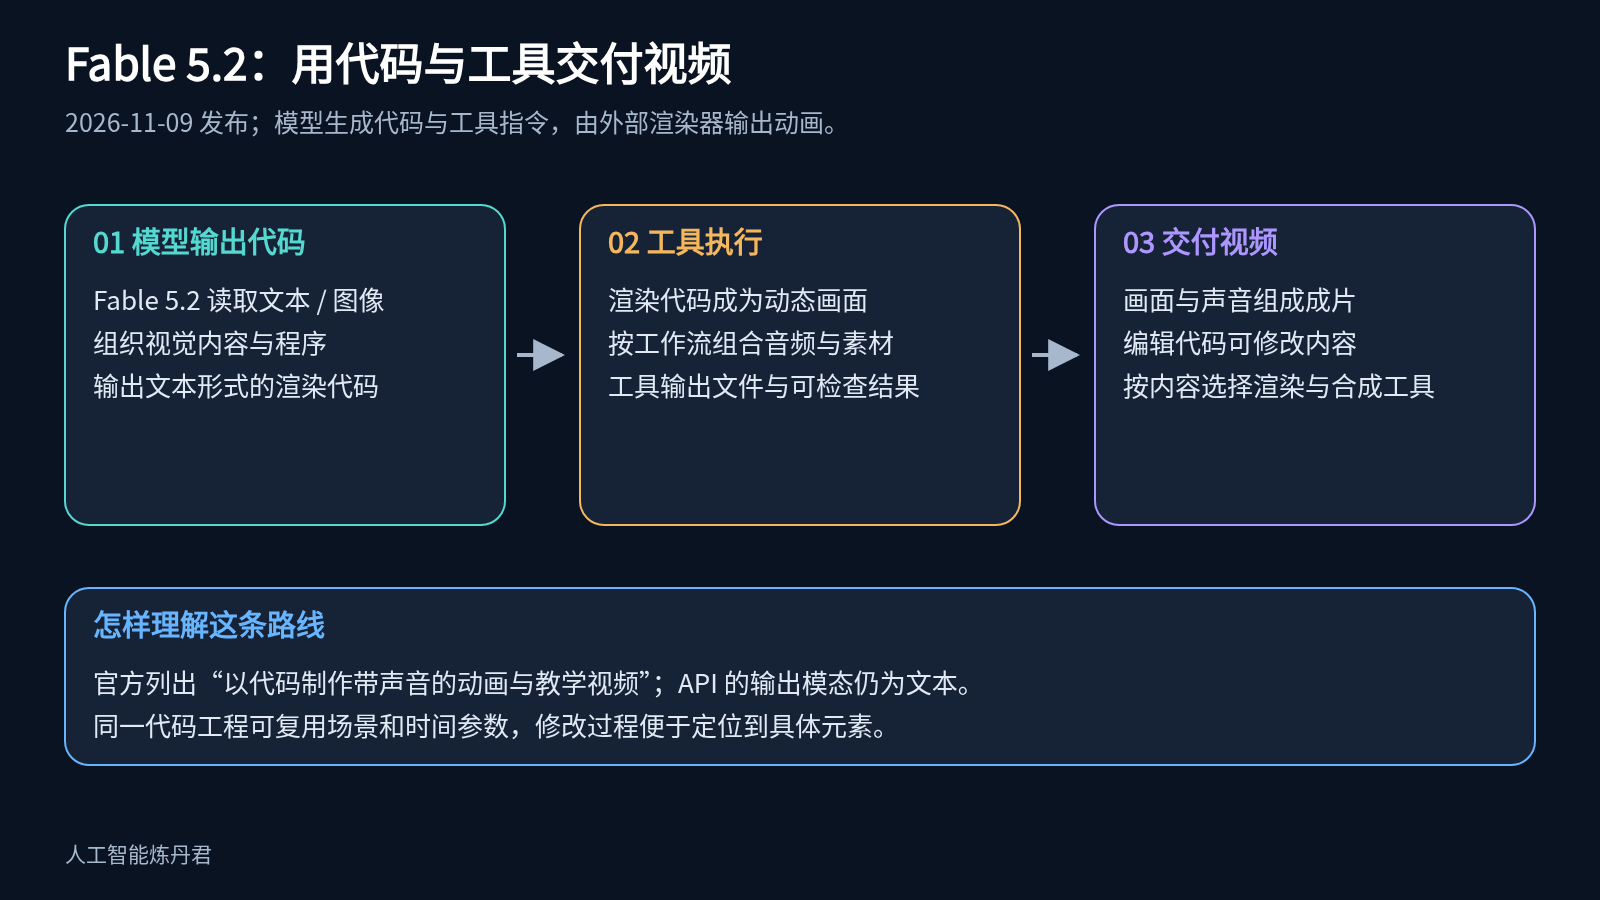
图表详解:Fable 5.2:用代码与工具交付视频
Fable 5.2生成代码与工具指令,渲染器执行场景、动画和音轨,最终组合为视频。代码控制内容与时间参数,素材和渲染后端决定可实现的视觉风格。
1. 用程序表示画面和时间。 Fable 5.2 于 2026 年 11 月 9 日发布,官方规格为文字与图像输入、文字输出。它通过代码和工具指令组织几何、材质、相机、动画与声音,再由浏览器或三维引擎生成画面。视频的可控性来自工程中的对象与时间参数。
2. 让通用编码能力承担制作编排。 一个完整任务可以拆成场景搭建、动画、镜头、音轨和导出;代码执行和画面检查为下一轮修改提供反馈。相较专用视频网络,这种方式更容易接入已有字体、绘图库和工程资产,但模型也必须处理依赖、运行环境与跨模块协调。
3. 从 Portals 理解可复用的场景结构。 Mollick 公开的这一独立三维漫游项目使用 Three.js:场景模块返回三维场景、相机路径和时长,由公共引擎驱动播放,声音在浏览器中合成。把场景内容与播放逻辑分开后,可以替换一个世界而复用相机调度和界面。Portals 是三维工程案例;同文的开场代码影片是另一件作品。
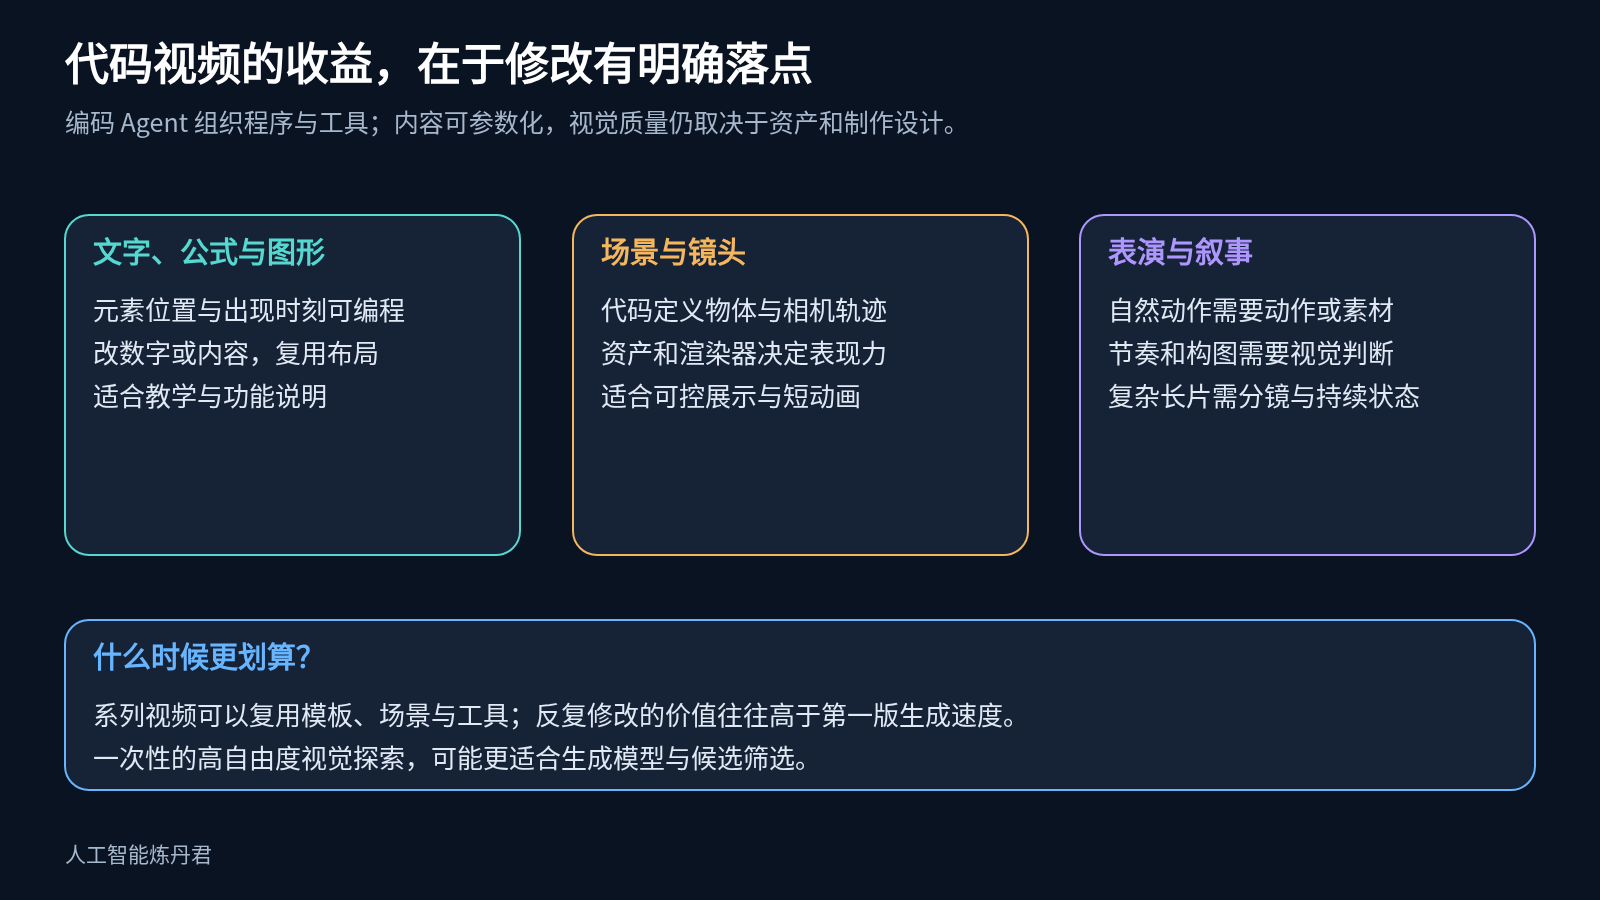
图表详解:代码视频的收益:修改有明确落点
文字、公式与图形适合参数化修改;场景与镜头可以复用代码和资产;自然表演与叙事仍需要动画资源和视觉判断。系列内容能摊薄模板制作成本,一次性的高自由度探索则未必值得建立同样复杂的工程。
技术演进定位: 通用代码生成 → 可运行的场景与动画工程 → 工具执行和画面反馈。Fable 5.2 代表通用编码 Agent 进入视听制作的产品路线,可与专用动画框架、Blender 或游戏引擎组合;其价值取决于工程控制与审阅能力。
可能的后续方向:
工作: TheoremExplainAgent: Towards Video-based Multimodal Explanations for LLM Theorem Understanding
来源: ACL 2025 主会论文
机构: University of Waterloo;Votee AI;Vector Institute
关键词: 教学视频, Manim, 规划与编码, 执行反馈, TheoremExplainBench
相关资料: ACL 2025正式论文 · ACL 2025论文全文 · 官方项目及生成视频 · OpenAlex 学术引用记录(2026-11-14)
核心问题: 怎样把长篇知识解释拆成可执行、可修复的动画制作步骤?
解释勾股定理时,模型可以把文字说得很流畅,却在动画里画错对应边,或让公式变化快于旁白。教学视频把抽象推理变成了一组必须相互吻合的对象:讲解步骤、数学符号、几何图形和播放时间。TheoremExplainAgent 用这个更具体的任务检验模型:能否把自己声称理解的定理,转成别人可以跟着看懂的长篇解释?
前序工作及局限:
与前序工作的本质区别: 将讲解计划与动画编码分开,以真实运行错误驱动有限次修复。
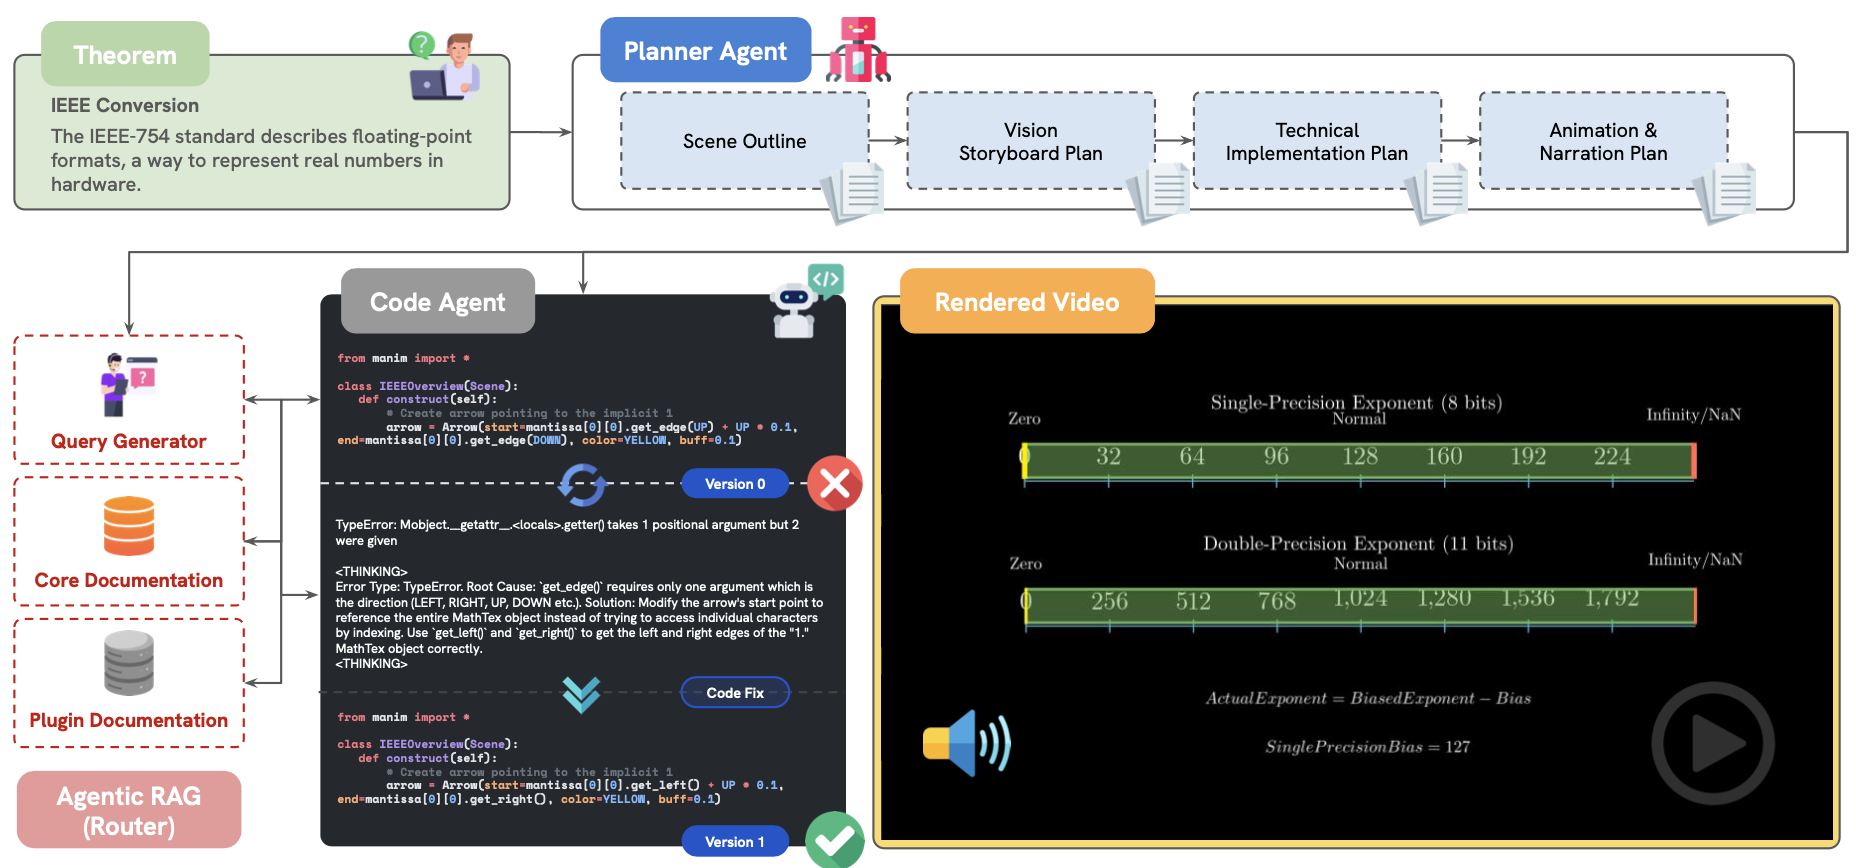
图表详解:方法框架(原论文图 2)
TheoremExplainAgent 由两个大语言模型 Agent 组成。输入一个定理后,规划 Agent 制定执行计划,编码 Agent 随后生成用于制作视觉内容与音频的 Python 脚本。
先决定怎样讲,再决定怎样画。 Planner 把定理与背景组织成多个场景,为每个场景安排概念、可视化、动画、转场与旁白。这样,编码者面对的是有边界的讲解任务,而不是一次生成整部视频的长程序。
把表达落到 Manim 代码。 Coder 将场景计划写成 Python 动画,语音合成负责旁白;公式、图形和出现顺序成为可执行指令。渲染器实际运行这些指令,异常会返回编码者,最多进行五次修复尝试。
闭环首先解决“做得出来”。 执行错误提供了具体反馈:哪个调用无效、哪里缺少对象、程序为何中断。但一个公式盖住另一个公式,或者动画说明了错误的数学关系,未必触发异常。因此,程序修复保证的是进入成片阶段的机会,教学质量仍取决于前面的解释计划和画面表达。
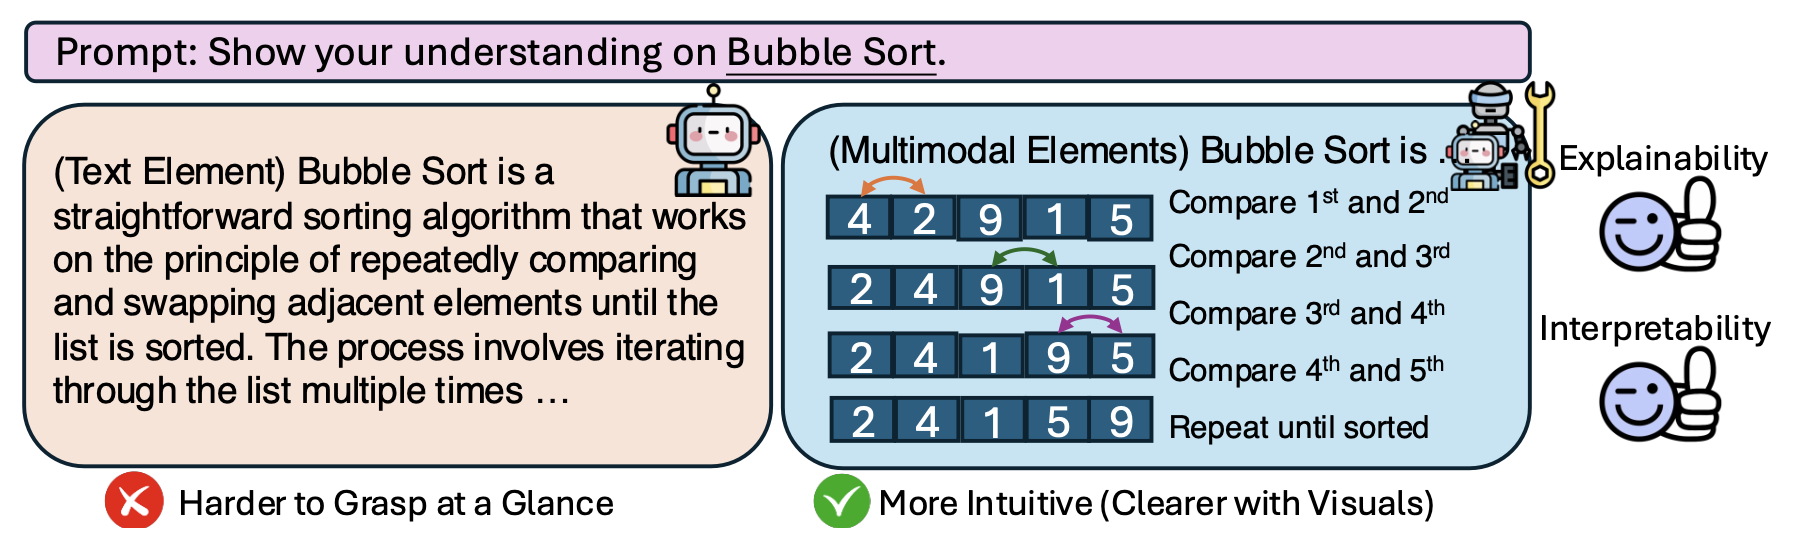
图表详解:可视化结果(原论文图 1)
结构化视觉解释可以让复杂概念更直观,同时把文字解释中不易发现的推理错误暴露出来;图中以排序过程展示文字描述与逐步可视化的区别。
技术演进定位: 代码视频从工具调用走向长篇教学流程:首先解决内容组织与执行可靠性。
可能的后续方向:
工作: Code2Video: A Code-centric Paradigm for Educational Video Generation
来源: 2025 arXiv;2026 ICML
机构: Show Lab, National University of Singapore
关键词: 代码视频, 视觉反馈, Manim, 布局锚点, TeachQuiz
相关资料: arXiv摘要 · arXiv v1全文 · ICML 2026正式论文集(标题为Educational Video Creation) · 官方生成案例 · OpenAlex 学术引用记录(2026-11-14)
核心问题: 程序执行成功之后,怎样根据观众实际看到的画面继续修复?
让动画代码运行起来以后,下一道难题是让观众跟得上:字幕不能压住示意图,公式需要在解释到它时出现,几个章节也不能各用一套符号。Code2Video 直接处理这种“程序成功、表达失败”的落差,把讲解结构、画面布局和渲染后的视觉反馈纳入同一条制作流程。
前序工作及局限:
与前序工作的本质区别: 以视觉锚点和占用表连接画面元素与代码位置,把审片意见落实到可编辑区域。
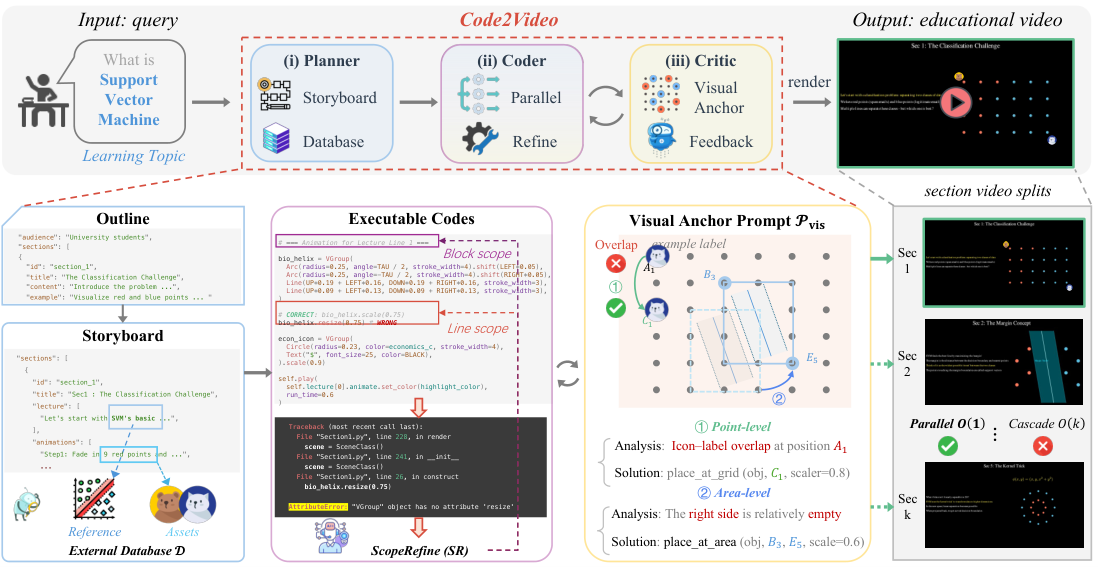
图表详解:方法框架(原论文图 4)
Code2Video 的整体流程。给定用户问题,Planner 将学习主题转成分镜并检索视觉素材;Coder 并行合成代码并进行作用域引导的修复,以保证效率和时间一致性;Critic 使用视觉锚点提示反复调整空间布局与清晰度,生成可复现、结构化的教学视频。
用提纲维持讲解顺序。 Planner 根据主题和受众安排章节,再细化成逐句旁白与配套动画;图片和图标放入共享素材缓存,使不同片段沿用同一套视觉资源。
并行制作,逐步扩大修复范围。 各章节独立生成 Manim 程序。遇到错误时,ScopeRefine 先修出错行附近的代码,再扩展到对应讲解块,最后才重写整节。这个顺序尽量保住已经正确的部分。
让视觉意见能找到代码。 系统把画布离散成 6×6 锚点网格,为小元素分配点位,为大元素分配区域,并记录占用位置、缩放和代码行。Critic 同时看渲染视频和程序,发现遮挡或布局失衡后,通过这份对应关系调整局部代码。关键不是简单增加一个“打分模型”,而是让“公式挡住图了”变成可执行的修改。
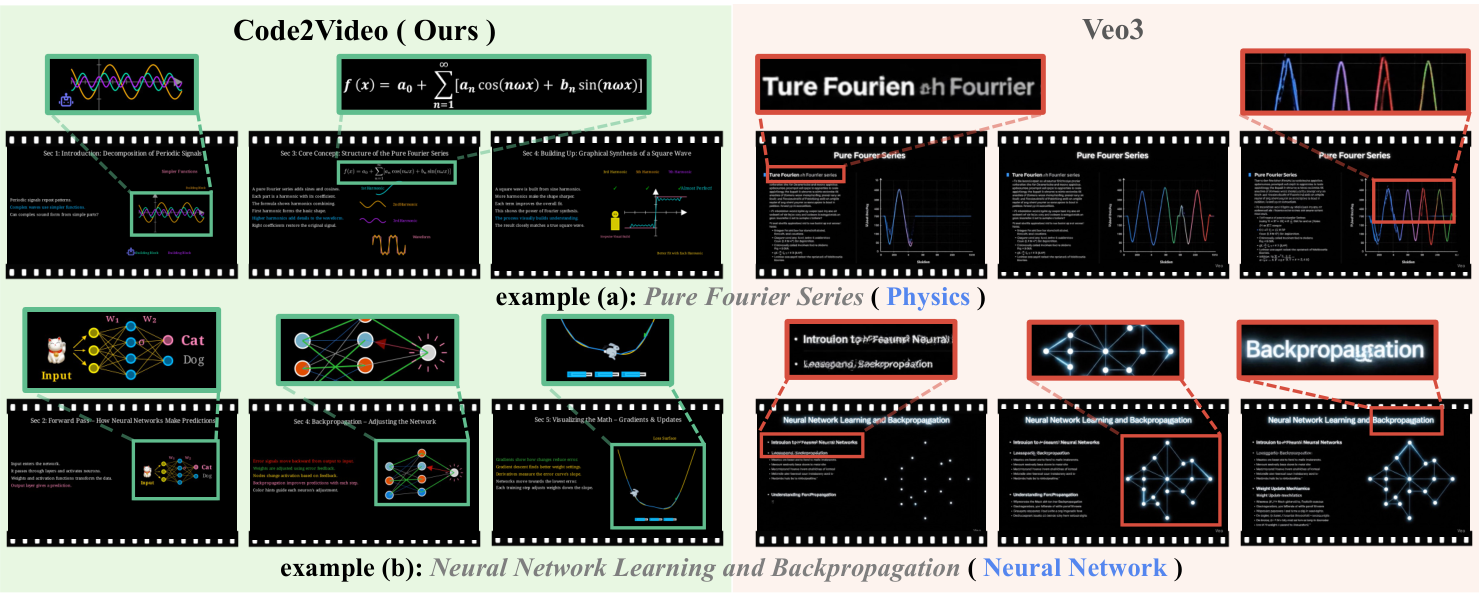
图表详解:可视化结果(原论文图 6)
Code2Video 与 Veo3 的定性比较。作者展示代码路线在所选教学案例中保持连贯的逻辑顺序、语义一致性和可解释布局的能力;这是论文所选案例,不是所有视频任务的统一排名。
技术演进定位: 代码视频从执行修复走向视觉返修,并进一步评价知识传递效果。
可能的后续方向:
工作: VideoCoCo: Code-as-CoT for Physically-Consistent Video Generation via an Agentic Dual-Engine System
来源: 2026-07 首发,2026-08 修订
机构: CUHK、USTC 等联合团队
关键词: Blender, 白模, Code-as-CoT, 视频编辑, 物理一致性
相关资料: VideoCoCo 原论文 · VideoCoCo 官方代码与示例 · BlenderMCP 社区工具入口
核心问题: 怎样既保留动作过程的可控性,又获得生成模型的写实外观?
一个物体先受撞击再破裂,与先破裂再被碰到,单帧都可能逼真,视频表达的因果却完全不同。VideoCoCo 把这种过程先写成 Blender 程序并渲染成白模,让生成模型主要负责外观。它试图降低一个模型同时猜测运动过程和生成写实画面的负担。
前序工作及局限:
与前序工作的本质区别: 以 Blender 程序生成连续白模草稿,再由适配的编辑器处理外观,让过程控制与外观生成分工。
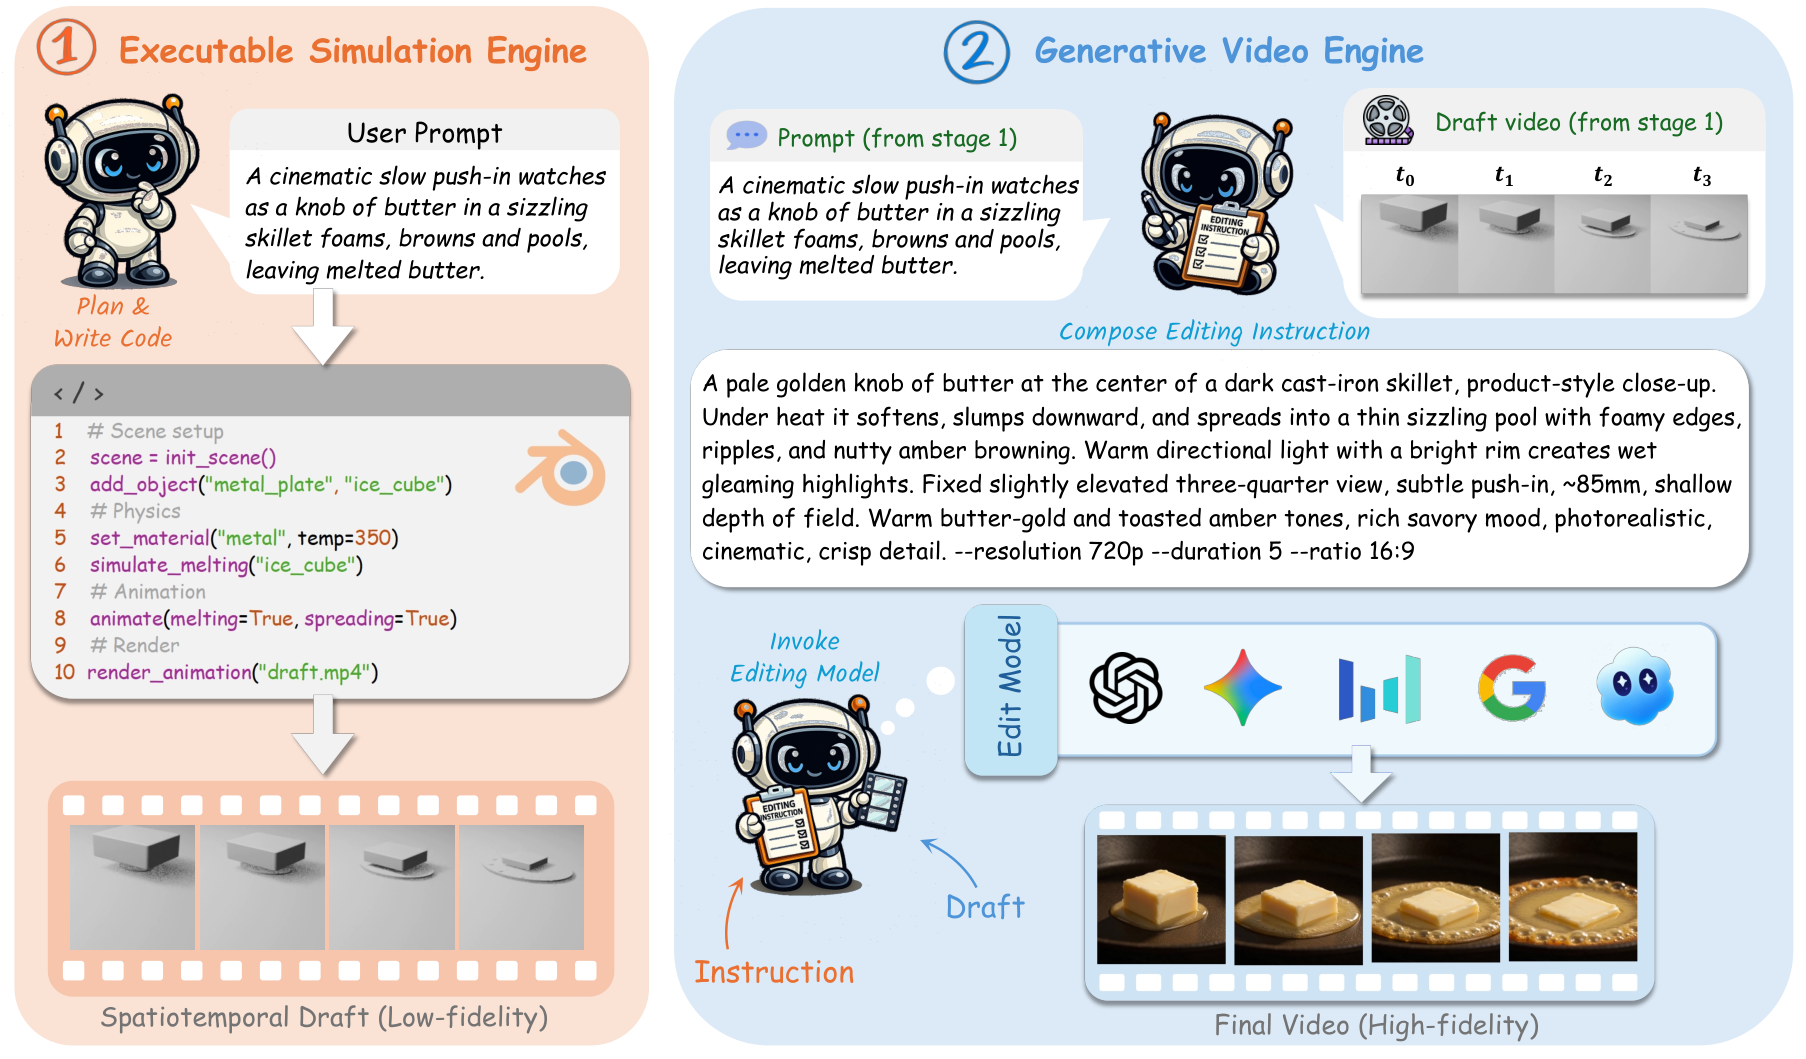
图表详解:VideoCoCo:Blender白模到生成视频(原论文图2)
VideoCoCo 双引擎流程。第一阶段中,代码 Agent 根据提示规划并编写独立 Blender 程序,规定场景及其时间演化,在沙箱执行后得到低保真的时空草稿。第二阶段中,指令 Agent 根据原始提示和草稿生成编辑指令,与草稿一起输入视频编辑模型,得到最终高保真视频;草稿提供动态过程,编辑模型提供写实外观。
1. 先固定完整过程。 编码 Agent 根据提示编写 Blender Python,声明物体、属性及随时间的变化,再执行程序得到低保真白模视频。相较文字分镜或稀疏关键帧,每一帧都有明确的场景状态,动作先后和相机运动可以在上色前调整。
2. 再补外观。 指令 Agent 同时读取原提示和白模,描述材质、光照与视觉风格,避免重新定义已有运动。视频编辑器以白模和指令为条件生成成片。为弥合白模与真实视频的外观差异,论文用 VideoCoCo-3K 的 3,000 组三元组适配 OmniWeaving;Seedance 2.0 用于构造训练目标。
3. 分清 Blender 的两种出口。 直接渲染保留三维工程对对象和镜头的控制;白模加生成式编辑用部分确定性换取更丰富的外观。BlenderMCP 是让 Agent 执行 Python、读场景和看视图的社区接口,不是完整视频方法。作者工程用预览检查过程、修改脚本,交互检查与最终批量渲染也各有职责。
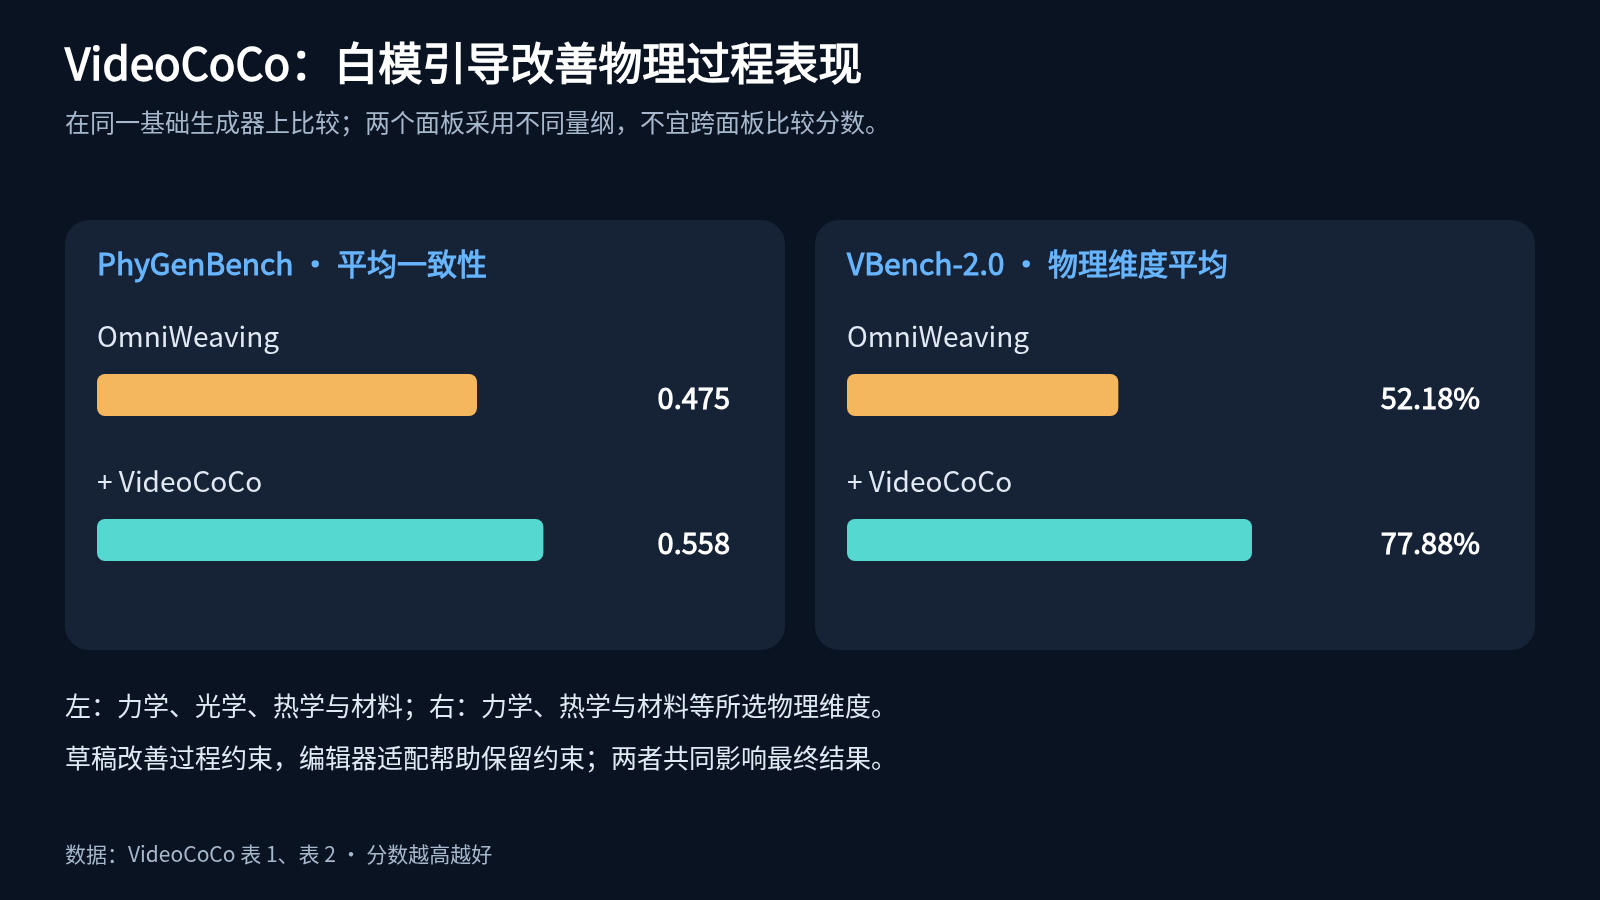
图表详解:VideoCoCo:过程约束与编辑器适配的物理任务收益
数据:论文表 1、表 2。橙色为基础生成器,青色为加入VideoCoCo后的结果。左图采用0到1的一致性量表;右图为选定物理维度的百分制结果,未包括VBench的全部评价维度。两个面板分别读数,关注各自基线到完整方法的变化。
技术演进定位: 文字分镜或关键帧规划 → 可执行的连续白模视频 → 针对白模条件适配的生成式编辑。VideoCoCo 连接代码控制与扩散外观,但最终成片对时序和接触的忠实程度仍受编辑器约束能力影响。
可能的后续方向:
工作: Unreal Engine 5.9 MegaJam Preview
来源: 2026-11 Epic 官方预览发布与渲染文档
机构: Epic Games
关键词: Unreal Engine, MCP, Level Sequence, Movie Render Graph, Agent工具链
相关资料: Epic 2026-11-09 UE 5.9 MegaJam Preview · Epic Movie Render Graph 脚本与完成回调
核心问题: 怎样让创作指令持续对应到三维场景、镜头和动画轨道?
如果一个项目要持续修改角色、机位和剪辑,生成一段视频还不够,制作系统需要保留这些对象的身份和相互关系。Unreal 的作用是提供可编辑的场景与时间线,让 Agent 的操作落到具体资产、轨道和渲染任务上,而不是每轮重新猜测整段画面。
前序工作及局限:
与前序工作的本质区别: 把编辑器中的对象与渲染能力交给 Agent 操作,在同一工程内保留资产和时空关系。
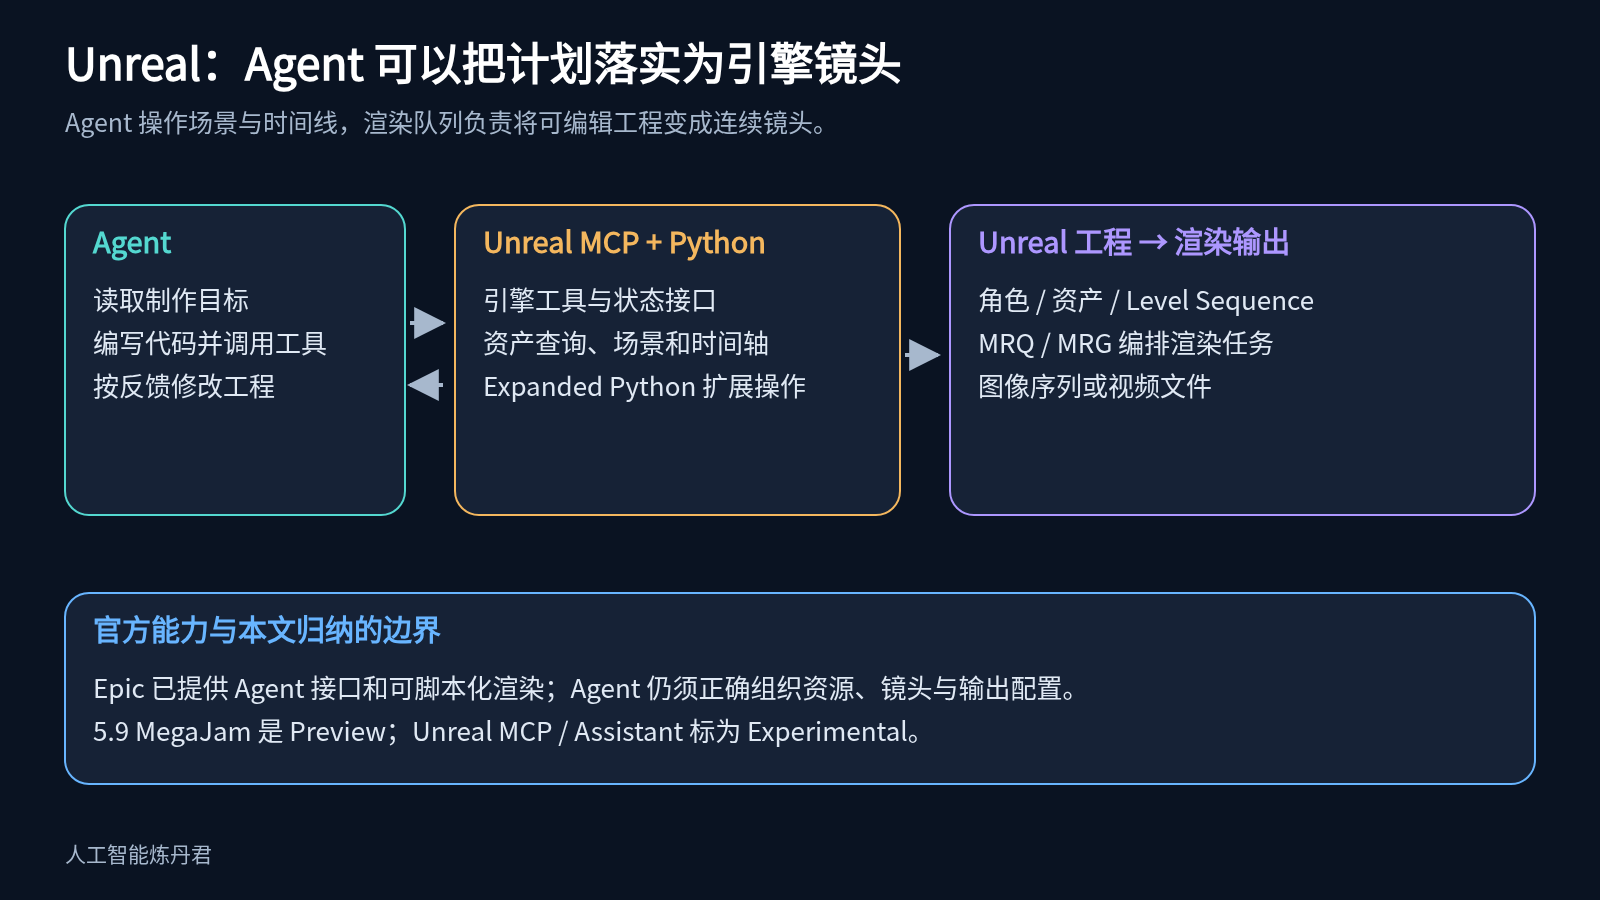
图表详解:Unreal:Agent 可以把计划落实为引擎镜头
Agent通过Unreal工具与Python接口处理资产、场景和时间轴,再把渲染任务交给MRQ/MRG。创作目标需要对应到具体对象与轨道;UE5.9预览中的相关Agent能力仍为实验功能。
1. 把操作落到编辑器对象。 2026 年 11 月 9 日发布的 UE 5.9 MegaJam Preview 扩展了 Unreal MCP、编辑器内的 Unreal Assistant 及 Python API。Agent 可通过工具操作场景、资产、动画与渲染;MCP 和 Assistant 等相关功能仍标为 Experimental。
2. 用场景和时间线维持一致性。 Level 保存场景,Level Sequence 保存角色、相机与动画轨道。相机位置、焦距、角色运动和切镜时间都是独立的修改对象;换一个机位时,同一角色与布景可以继续使用。
3. 让渲染配置也可编排。 Movie Render Graph 用图管理渲染设置,脚本可修改暴露参数并接收执行完成回调。它负责将既定场景转成输出画面,创作规划和视觉审阅仍需上层系统完成。
4. 按任务选择画面后端。 实验性的 Unreal Canvas 可用提示、参考图或已有场景连接外部模型,生成图像、网格和视频。引擎渲染从几何生成像素,外部视频模型根据条件合成像素;二者可以互补,但具有不同的控制强度和误差来源。
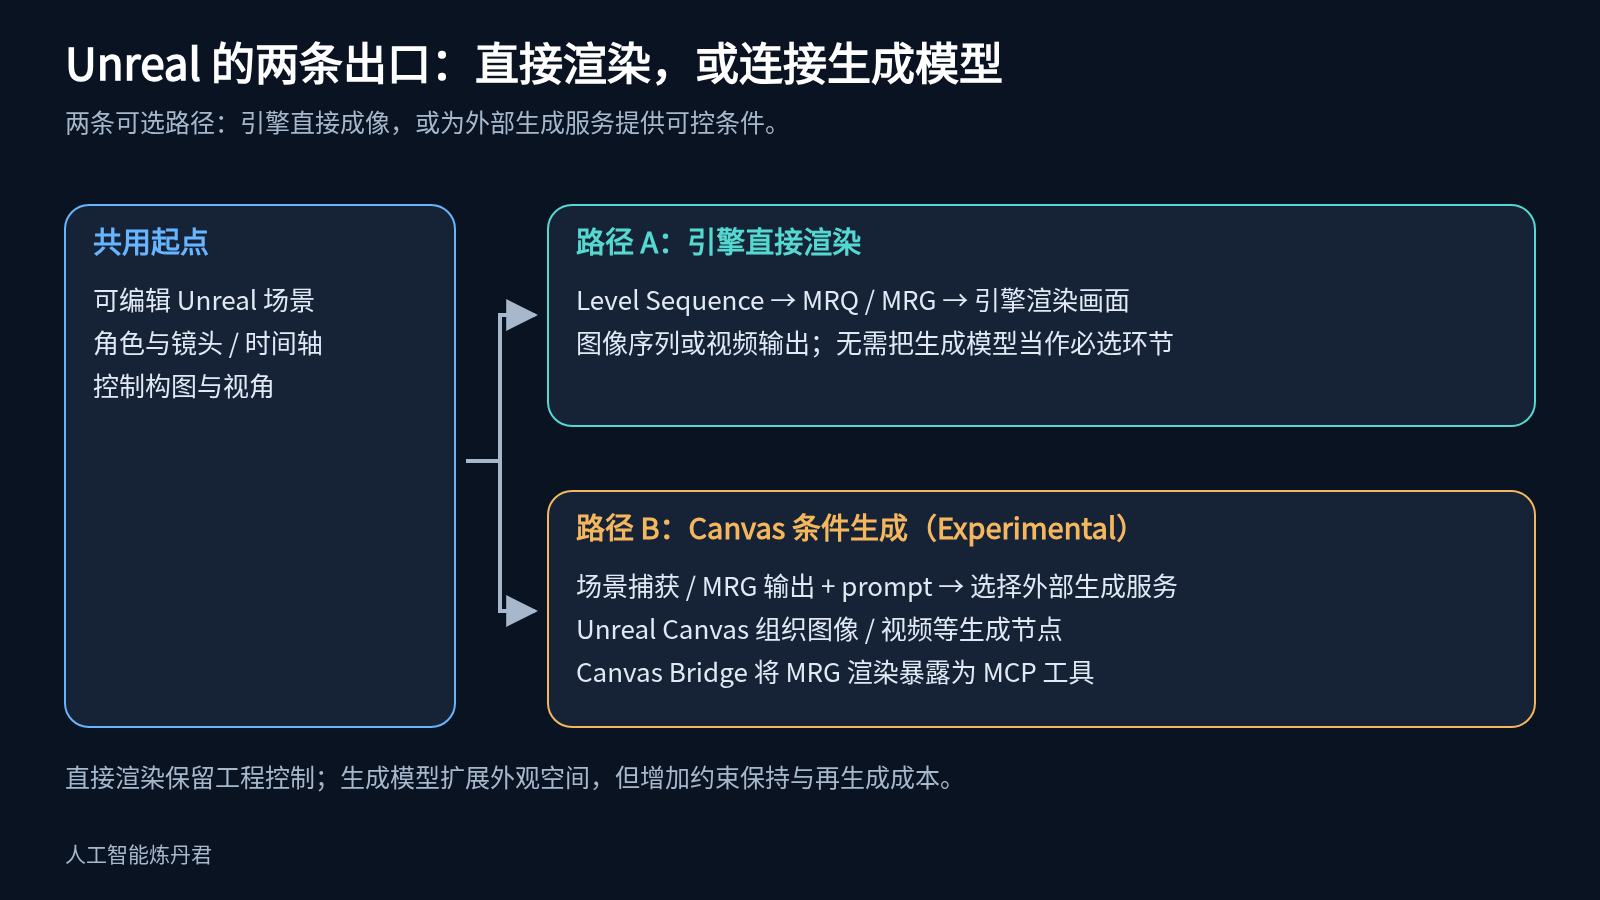
图表详解:Unreal 的两条出口:直接渲染,或连接生成模型
同一场景有两条输出路径:直接渲染保留对几何、镜头和时间的工程控制;通过实验性Unreal Canvas连接外部模型,可以扩展外观变化,但增加生成约束保持与再生成成本。
技术演进定位: 传统三维编辑器与脚本 → Agent 可调用的对象、时间线和渲染接口 → 引擎与外部生成模型协同。它提供制作基础设施;具体的规划、反馈和返修策略由 Cutscene Agent、CineU 等系统进一步实现。
可能的后续方向:
工作: Cutscene Agent: An LLM Agent Framework for Automated 3D Cutscene Generation
来源: 2026 技术报告、官方项目与代码
机构: Kuaishou GameMind Lab
关键词: 视频生成Agent, Unreal Engine, MCP, Level Sequence, 视觉反馈, Cutscene Agent
相关资料: arXiv v1:体系、CutsceneBench 与限制 · 官方项目:演示资产与美术参与说明 · 官方代码与 UE 5.6 环境说明 · Photographer:已实现截图反馈循环 · 视角工具实际调用:编辑器视口相机
核心问题: 怎样把对白、表演和摄影协调到可以继续精修的同一条时间线上?
对白从三秒变成五秒后,嘴型、动作、对方的反应和切镜点都可能需要调整。Cutscene Agent 把这类对白型三维过场落到 Unreal 的原生时间轴中,让角色、表演、声音和镜头能够协同修改,也为动画师继续加工保留入口。
前序工作及局限:
与前序工作的本质区别: 让导演和专门角色共同编排原生轨道;视口反馈用于观察场景,成片摄影由时间线中的相机轨道控制。
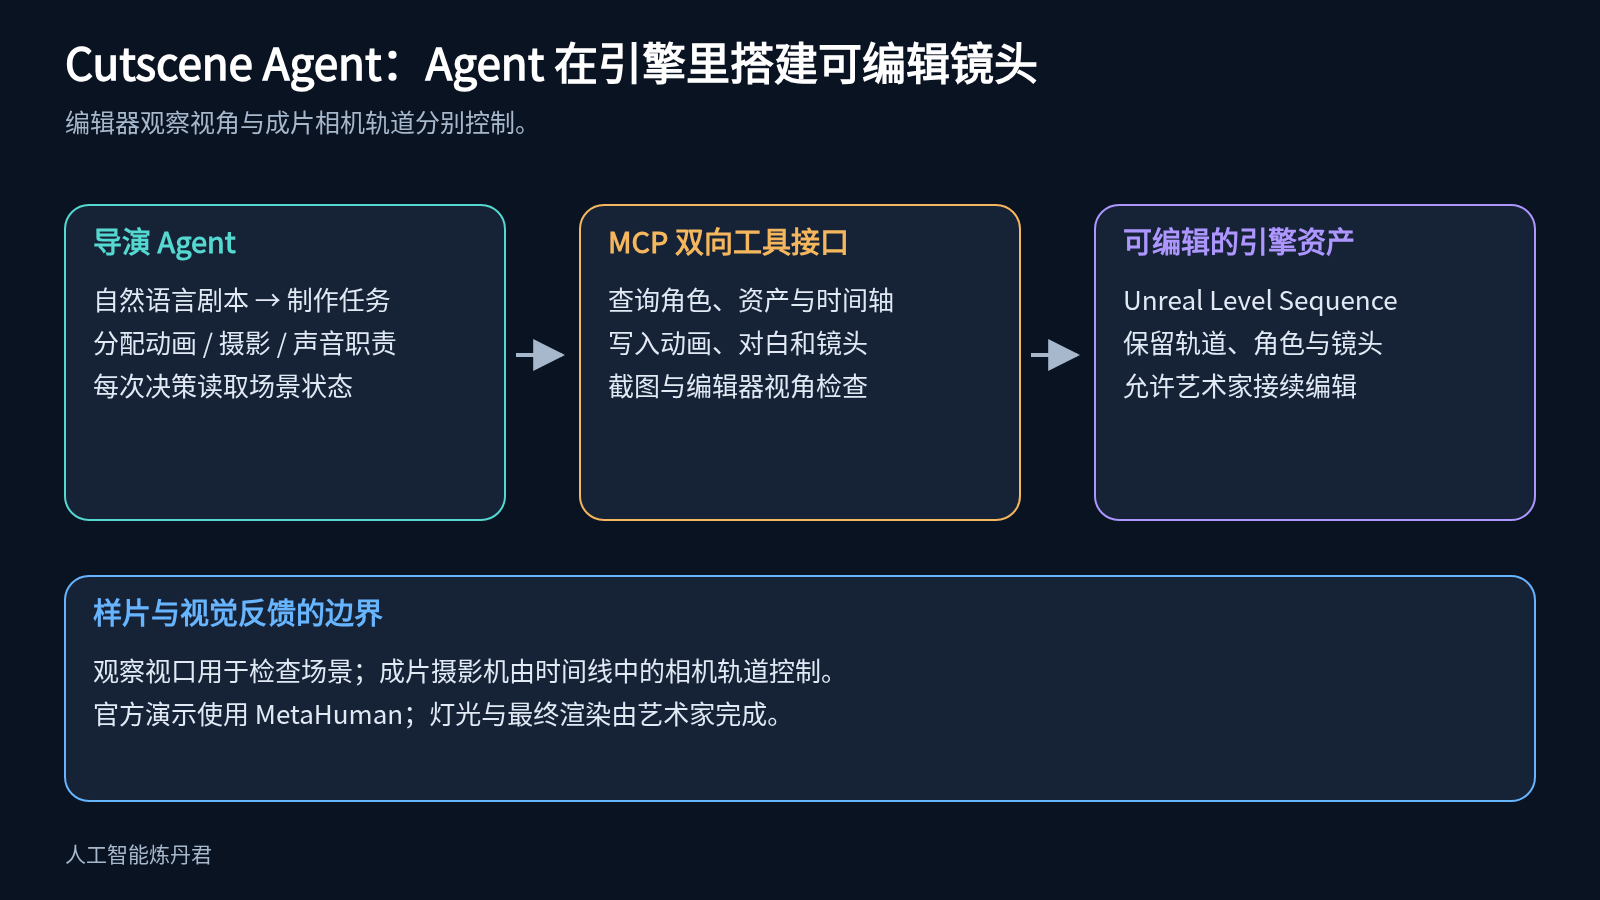
图表详解:Cutscene Agent:Agent 在引擎里搭建可编辑镜头
导演分配动画、摄影与声音任务,在Unreal中组织可编辑的Level Sequence。每轮读取时间轴状态,协调角色动作、音轨和镜头。Photographer通过视口截图调整观察视角;成片摄影由时间线中的相机轨道控制。
1. 先读真实场景,再做下一步。 导演 Agent 通过 Cutscene Toolkit 查询角色、动画和音频资源,每轮决策前重新读取 Level Sequence 的轨道与时间段,减少文字计划与实际工程脱节。
2. 围绕同一时间轴分工。 场景、动画、摄影和声音专家分别处理站位、表演、机位以及对白和面部动画。语音生成、音轨挂载、面部动画生成与挂载有明确先后;相机模板以角色骨骼位置为参照,初始化过肩、主观、推拉和环绕等机位。
3. 区分观察与拍摄。 Photographer 根据视口截图调整编辑器观察视角,帮助看清对象和空间关系;成片机位由 Level Sequence 的相机轨道控制。这种局部视觉反馈有用,但不能等同于审阅整片并自动重写拍摄方案。
4. 留下可编辑的表演工程。 输出是原生角色、动画、声音和相机轨道,可继续渲染与加工。官方演示使用 MetaHuman,灯光和最终渲染由美术完成。
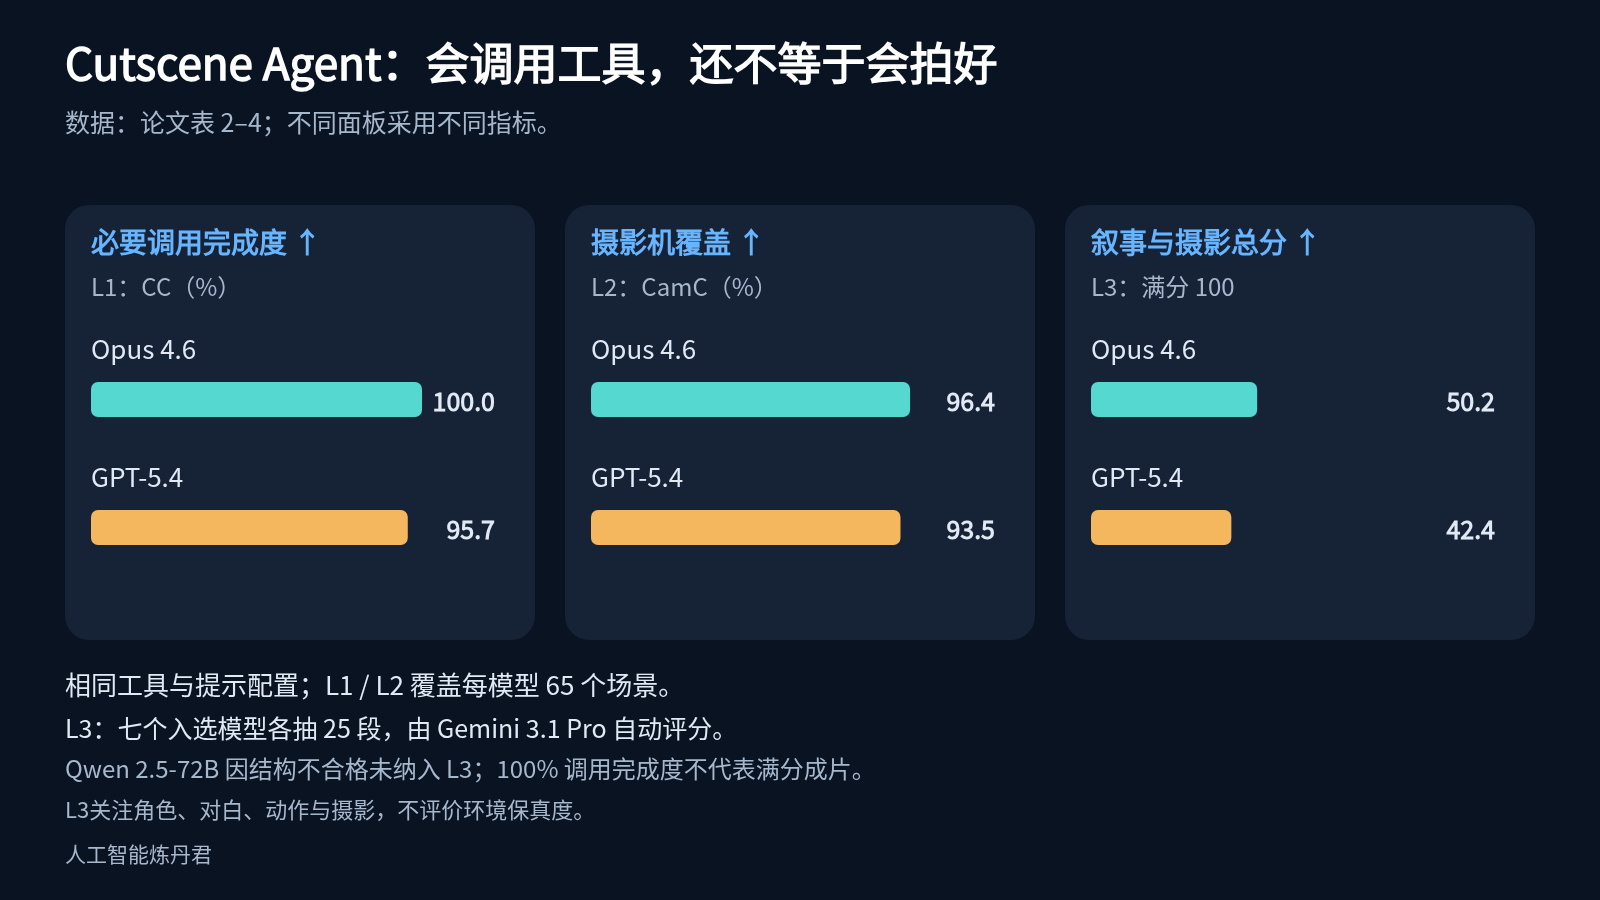
图表详解:Cutscene Agent:会调用工具,还不等于会拍好
Opus 4.6 / GPT-5.4 的调用完成度为 100.0 / 95.7,摄影机覆盖为 96.4 / 93.5,叙事与摄影总分为 50.2 / 42.4。L1/L2 在每模型 65 场景上评价;L3 仅覆盖七个入选模型,每个抽取 25 段视频(五个层级各五段),由 Gemini 3.1 Pro 自动评分、满分 100。Qwen 2.5-72B 因结构完整性不足未纳入 L3;该分数不是人工偏好或成功率。 成片评分忽略环境保真度,重点在角色、对白、动作与摄影。
技术演进定位: 对白脚本与角色分工 → 引擎原生时间轴 → 真实状态回读与局部视口反馈。它承接虚拟制片的资产复用思路,把自动化重点放在表演编排及多轨道协调。
可能的后续方向:
工作: Cinematize from Unreal: Agentic Choreography for Controllable World Simulation
来源: 2026 技术报告
机构: Tongji University;Microsoft Research Asia
关键词: 视频生成Agent, Unreal Engine, Sequencer, 多镜头编排, 局部修复, CineU
相关资料: arXiv 首发、作者与准确标题 · arXiv v1:方法、定性多镜头结果与消融
核心问题: 修改一个对象或镜头时,怎样保留已有场景中仍然正确的部分?
“让角色在屋顶行走,同时推拉变焦,再切到远景”包含空间、动作、镜头和时间的多重依赖。即使每个操作单独能执行,组合后也可能角色滑行、站位悬空或镜头错拍。CineU 把 Unreal 工程作为持续存在的世界状态,并围绕依赖关系安排执行和局部返修。
前序工作及局限:
与前序工作的本质区别: 使用持续的世界状态、时间线与依赖关系定位失败,把修改限制在相关函数、对象与轨道。
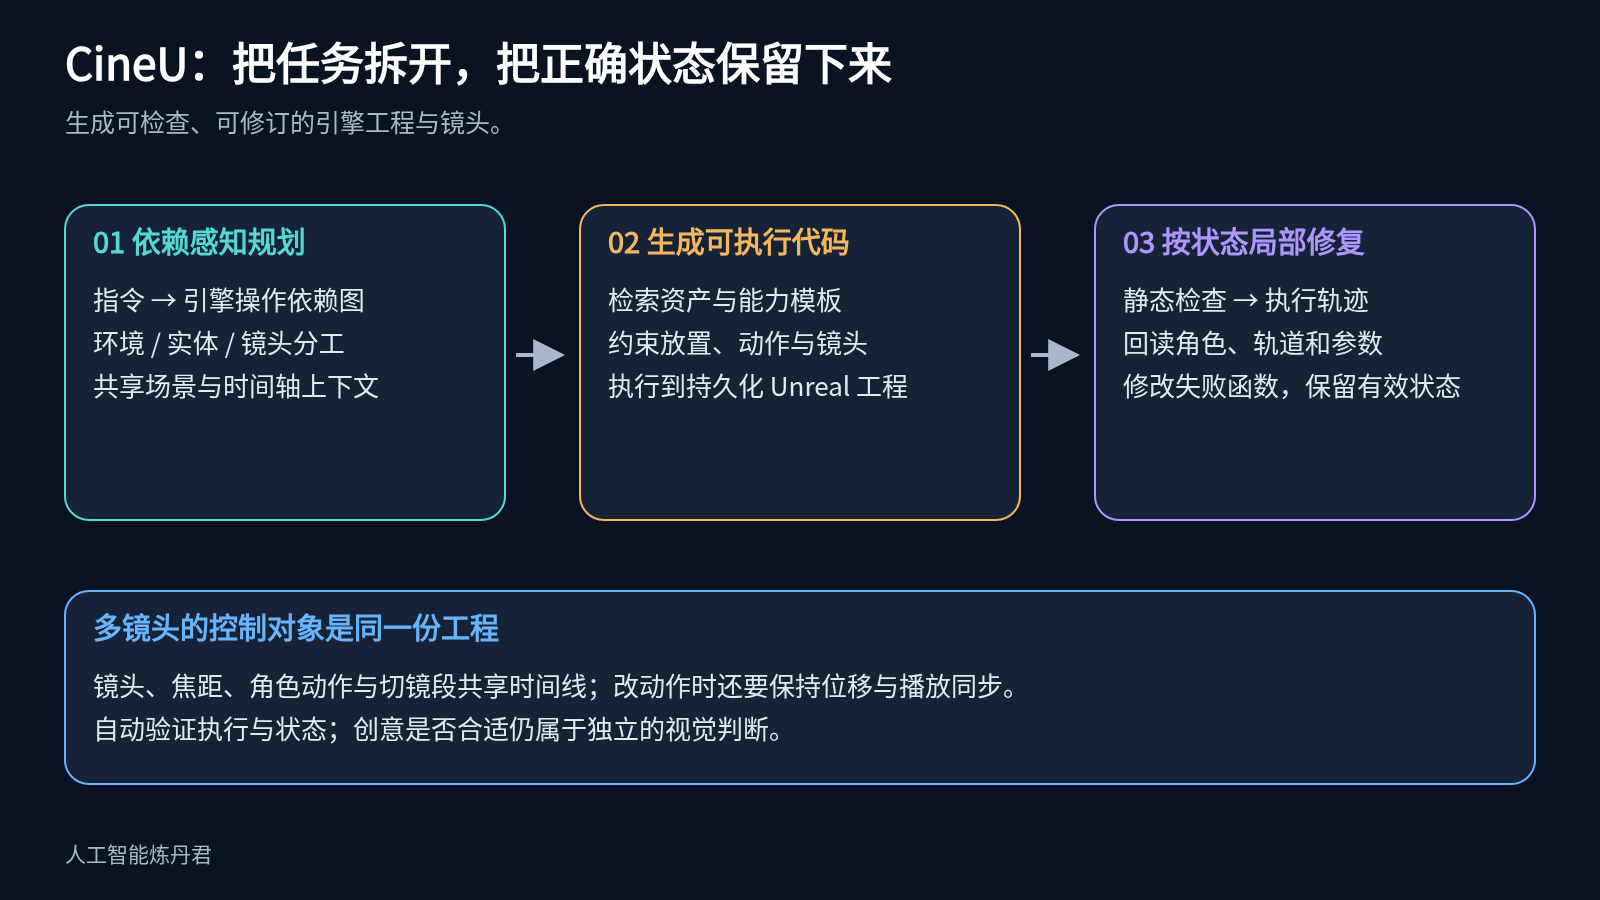
图表详解:CineU:把任务拆开,把正确状态保留下来
CineU 将指令拆成有依赖的引擎操作,分工检索资产并生成代码。静态检查、执行轨迹和状态回读共同定位失败,再局部修订函数。多镜头共享场景与时间轴,保留正确资产和时序;创意判断不等同于自动验证。
1. 把需求拆成有关联的任务。 编排 Agent 管理环境、实体、摆放、动画和镜头;Sequencer 专家提供共同时间轴,让相机、动作和位移共享时长与轨道引用。
2. 在已有能力内构造操作。 论文配置有 300 多个验证资产和 60 多个代码模板。资源先从本地检索,再查外部市场;各专家只读取与自身任务相关的模板,减少误用 API 与不兼容资产的机会。
3. 把镜头意图转成关系约束。 包围盒近似支持“在屋顶上”“在旁边”等放置关系;推拉变焦同步相机距离与焦距,移动轨道与行走动画共享时间,避免对象只平移而不迈步。
4. 根据失败位置修复依赖范围。 系统依次检查程序、执行完成情况及引擎实际状态,修改导致失败的函数并保留已完成部分。换贴图通常只影响外观,换实体可能影响支撑几何,换动作则需重新同步位移;局部修改的范围由这些关系决定。
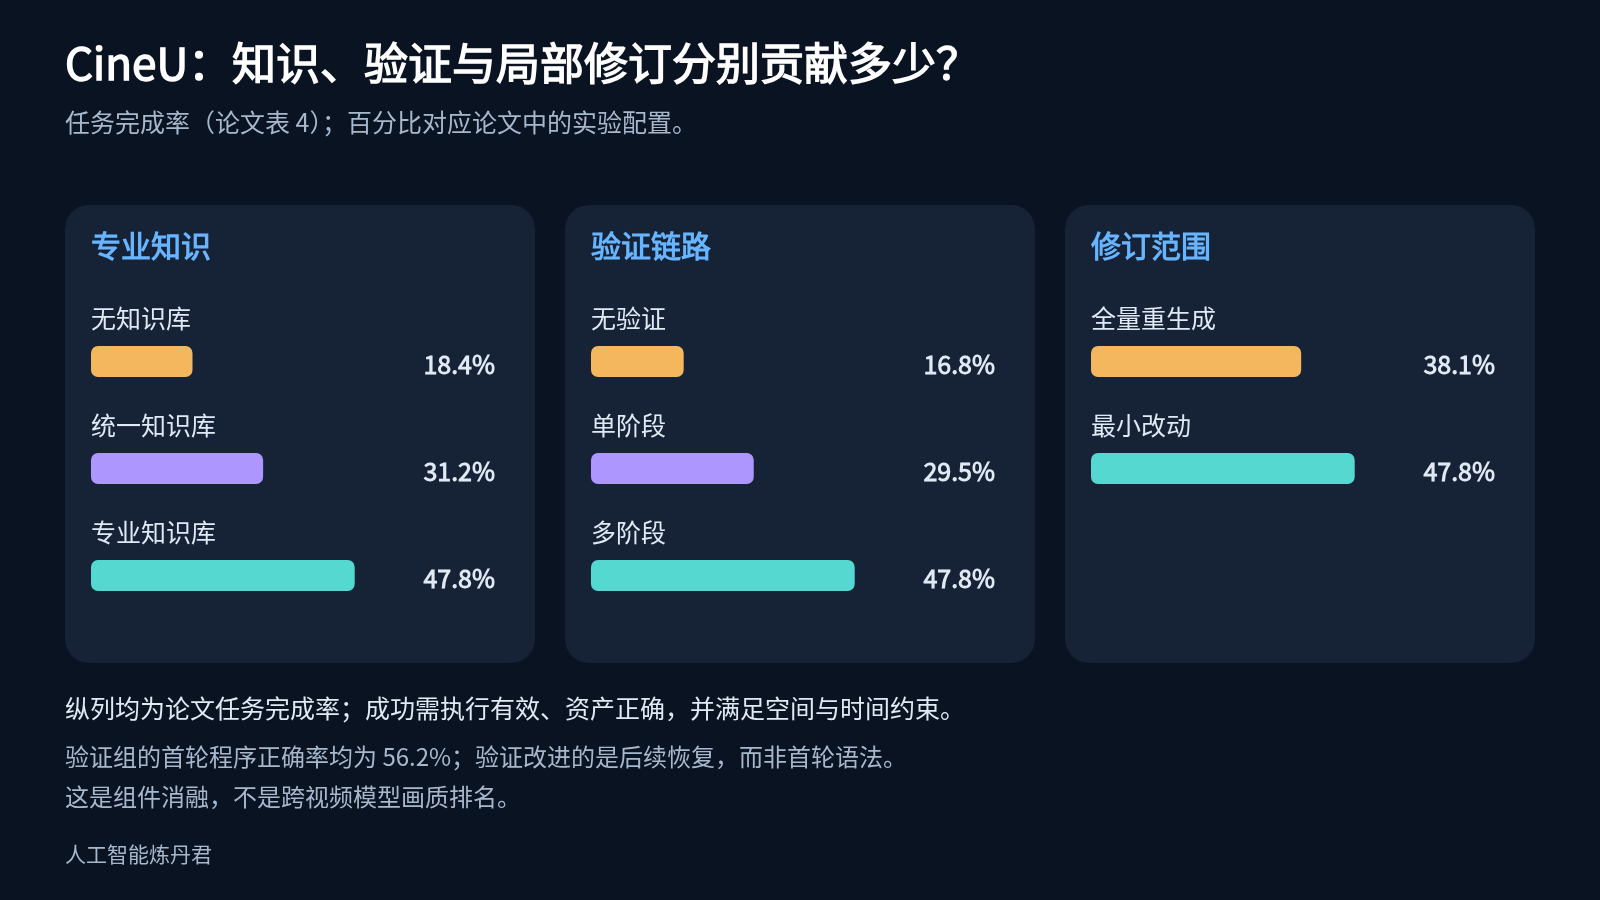
图表详解:CineU:知识、验证与局部修订分别贡献多少?
任务完成率:无/统一/专业知识为 18.4%/31.2%/47.8%;无/单阶段/多阶段验证为 16.8%/29.5%/47.8%;全量重生成/最小改动为 38.1%/47.8%。成功需执行、资产和时空约束同时满足;验证组首轮程序正确率均为 56.2%。不同配置的完成率不能代替视频美学评分。
技术演进定位: 语言驱动三维操作 → 持久场景与多镜头时间轴 → 能力检索、关系检查和局部返修。相较对白型过场编排,CineU 更强调空间与时间依赖下的持续修改。
可能的后续方向:
工作: FilmAgent: A Multi-Agent Framework for End-to-End Film Automation in Virtual 3D Spaces
来源: 2025 论文与官方 Unity 演示
机构: Harbin Institute of Technology (Shenzhen);Tsinghua University
关键词: 虚拟制片, Unity, 多Agent协作, 镜头规划, 角色连续性
相关资料: arXiv v1全文 · 官方项目与Unity视频 · OpenAlex 学术引用记录(2026-11-14)
核心问题: 怎样协调剧本、演员与摄影,让拍摄计划在同一个三维片场执行?
同一句台词,用近景拍表情,还是用中景交代肢体动作,会改变观众对剧情的理解。人物站位、动作、对白和摄影无法各自独立决定。FilmAgent 把这类相互约束放进一个共享的 Unity 虚拟片场,让导演、编剧、演员和摄影 Agent 围绕同一场戏协作。
前序工作及局限:
与前序工作的本质区别: 用编剧修改、演员反馈和摄影讨论协调制作决策,再将计划映射为 Unity 的具体站位、动作与镜头。
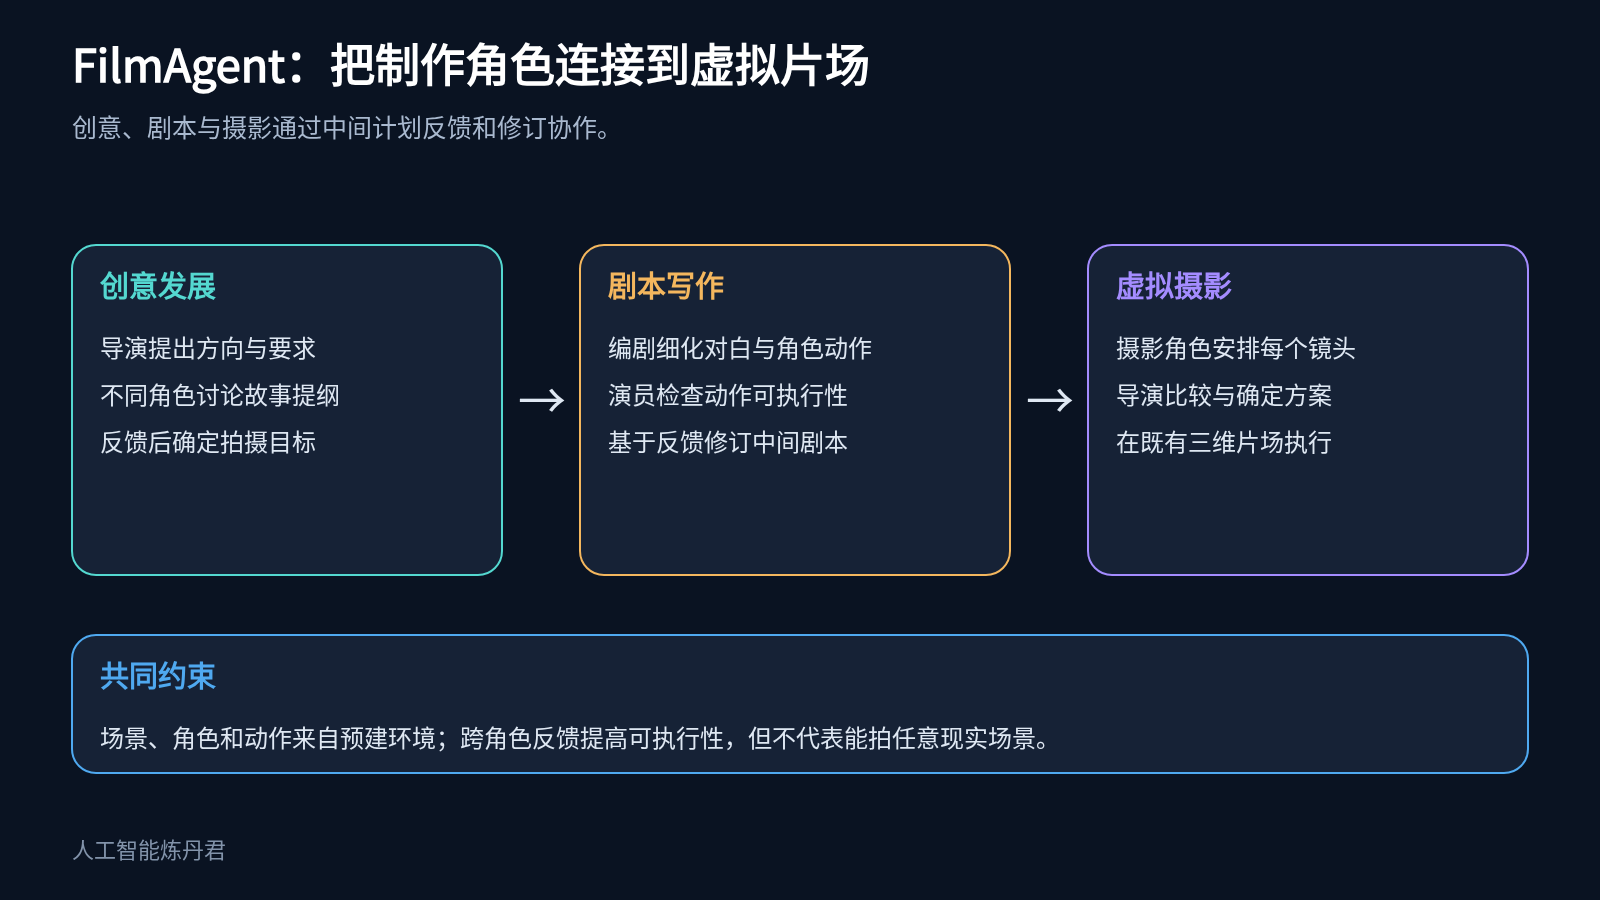
图表详解:FilmAgent 的制作角色与三阶段流程
创意发展阶段把创作目标变成故事提纲;剧本阶段具体安排对白与角色动作,通过反馈检查动作能否在既有环境中实现;摄影阶段由摄影角色提出镜头,导演比较并确定拍摄方案,最后在虚拟三维片场执行。角色通过中间结果反馈和修订协作。流程依赖预建片场和动作库,复杂场景仍需要额外的资产准备。
先给剧组一个能拍摄的世界。 系统提供预建场景、站位、动作与摄影选项。Agent 的计划必须落到这些可执行的选择上,而不是只写出听起来专业的镜头描述。
剧本经历有分工的修改。 导演从创意组织角色与场景;编剧补充台词、站位和动作。导演检查情节与动作是否合理,演员从角色性格出发提出意见,再由编剧修改、导演确认。
摄影讨论服务叙事。 两个摄影 Agent 分别提出镜头方案,讨论分歧,再由导演裁决。最后,每句台词都绑定演员位置、动作和摄影机选项;语音长度决定对应片段的时间,在 Unity 中执行成片。这里的反馈主要发生在剧本和拍摄计划上,实际画面的视觉错误仍需要另外检查。

图表详解:可视化结果(原论文图 2)
FilmAgent 在 Unity 中搭建的客厅俯视图。环境预先设置演员位置与摄影机方案,包含多种距离的静态镜头,以及跟随或环绕角色的动态镜头;完整摄影配置见论文附录图8。
技术演进定位: 多 Agent 协作与持久三维片场结合的代表,主要优化生成前的拍摄组织。
可能的后续方向:
工作: Automated Movie Generation via Multi-Agent CoT Planning
来源: 2025 技术报告与官方演示
机构: Show Lab, National University of Singapore
关键词: 多镜头生成, 分层规划, 角色参考, 工具编排, MoviePrompts
相关资料: arXiv v1全文 · 官方项目与视频 · 官方代码
核心问题: 怎样把全片故事拆成彼此关联的场景与镜头,而不是孤立生成多个短片?
多镜头视频的困难常出现在两段之间:上一镜人物刚拿起杯子,下一镜杯子不见了;每段都好看,观众却不知道故事为什么这样发展。MovieAgent 尝试把全片的叙事关系先组织成层次清楚的计划,再让不同生成工具完成镜头。它处理的核心是长目标如何变成一串彼此有关的生成请求。
前序工作及局限:
与前序工作的本质区别: 通过故事、场景和镜头三级计划传递角色资料与叙事要求,再调用图像、视频和音频工具。
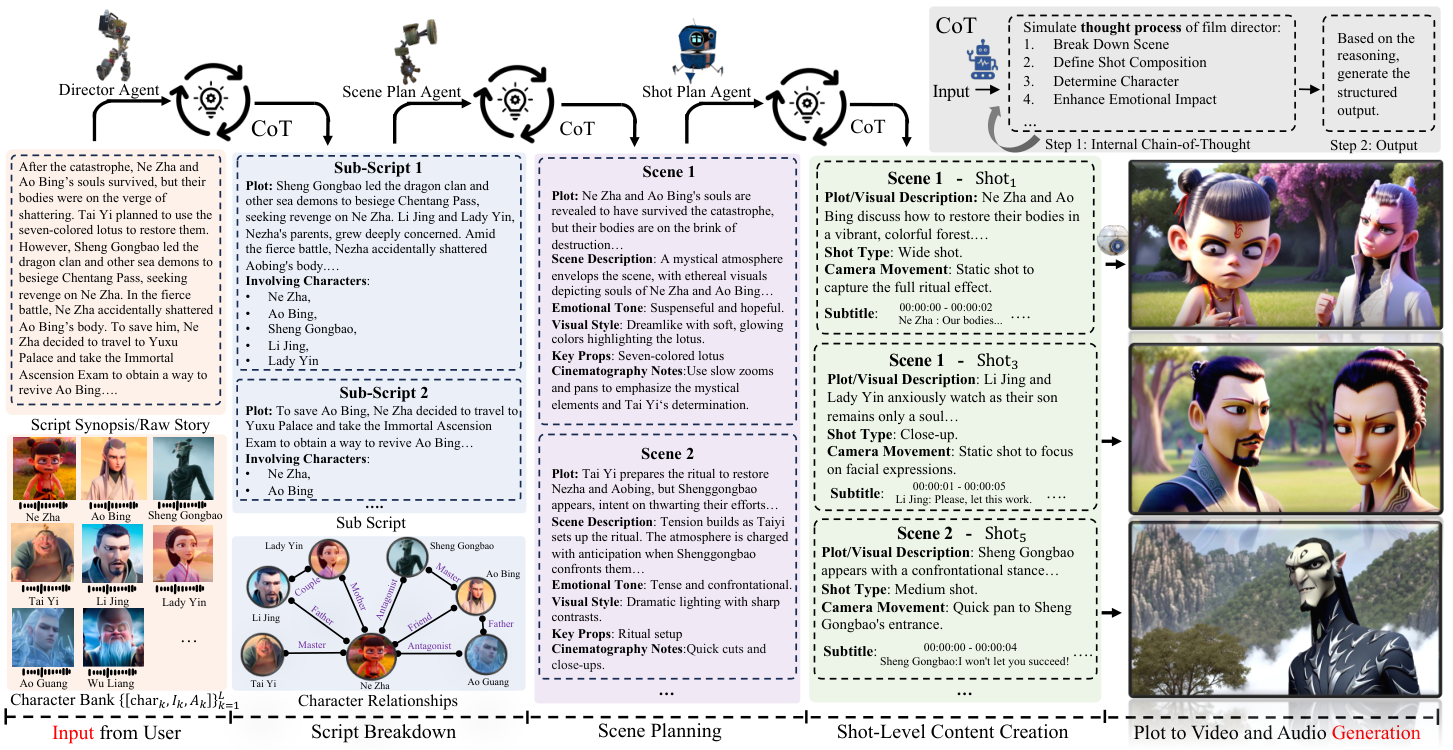
图表详解:方法框架(原论文图 2)
MovieAgent 整体流程。框架使用导演、场景规划和镜头规划 Agent,通过分层推理自动组织长视频,再将结构化镜头要求交给后续生成工具。
角色资料贯穿全片。 输入包括故事梗概与角色库,角色库保存名字、参考图,需要对白时还提供声音样本,让后续镜头有共同的身份依据。
按叙事层次逐级细化。 Director Agent 先划分关键故事单元;Scene Plan Agent 依据地点、时间和冲突变化确定场景;Shot Plan Agent 再指定每镜中的人物、动作、景别、运镜与对白。每一级都把上一层的叙事意图转成更具体的制作要求。
用计划驱动不同后端。 系统可先生成角色定制的关键帧,再生成视频,也可调用一阶段定制视频模型;对白镜头还要组合语音和说话人动画。最终按计划拼接镜头。分层计划为生成提供上下文,但像素、动作和口型仍取决于各个后端是否遵循这些条件。
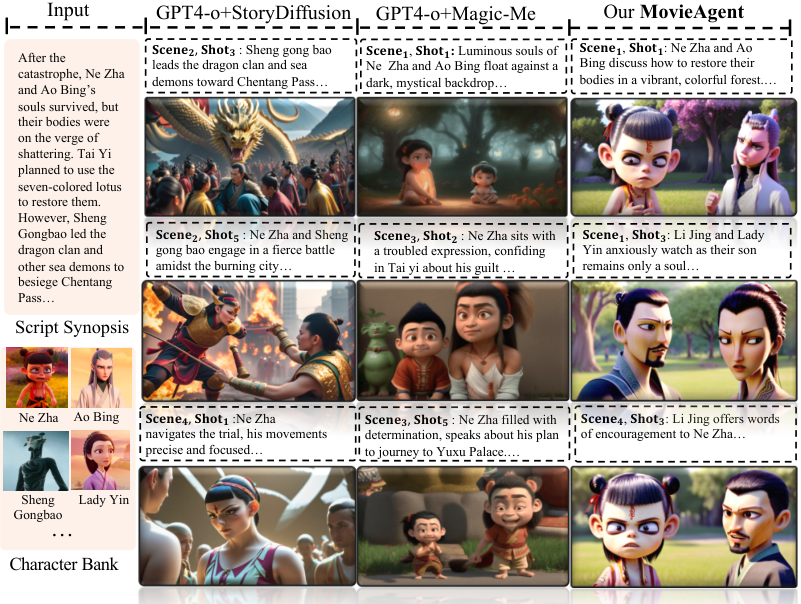
图表详解:可视化结果(原论文图 6)
不同方法的生成结果可视化比较。图中展示角色、场景和镜头连续性的案例差别;应结合论文指定的模型组合与测试集解读,不将样例当作普遍保证。
技术演进定位: 生成模型之上的长视频组织层,重点是拍什么以及镜头如何相连。
可能的后续方向:
工作: VISTA: A Test-Time Self-Improving Video Generation Agent
来源: 2025 技术报告与官方演示
机构: Google;National University of Singapore
关键词: 视频生成Agent, 多模态审片, 提示优化, 推理时计算, VISTA
相关资料: arXiv v1 全文与实验口径 · 官方项目与生成示例 · OpenAlex 引用记录(2026-11-14)
核心问题: 怎样用已经生成的视频发现错误,并让下一轮生成更有方向?
同一条视频提示采样几次,可能一版动作正确但声音混乱,另一版画面漂亮却偏离故事。生成之前写得再详细,也看不到这些实际错误。VISTA 把问题改成一个迭代任务:先看片,指出最值得修正的地方,再调整下一次生成请求。
前序工作及局限:
与前序工作的本质区别: 把候选比较、视觉与声音等多维批评、提示优化和重生成串成反馈闭环。
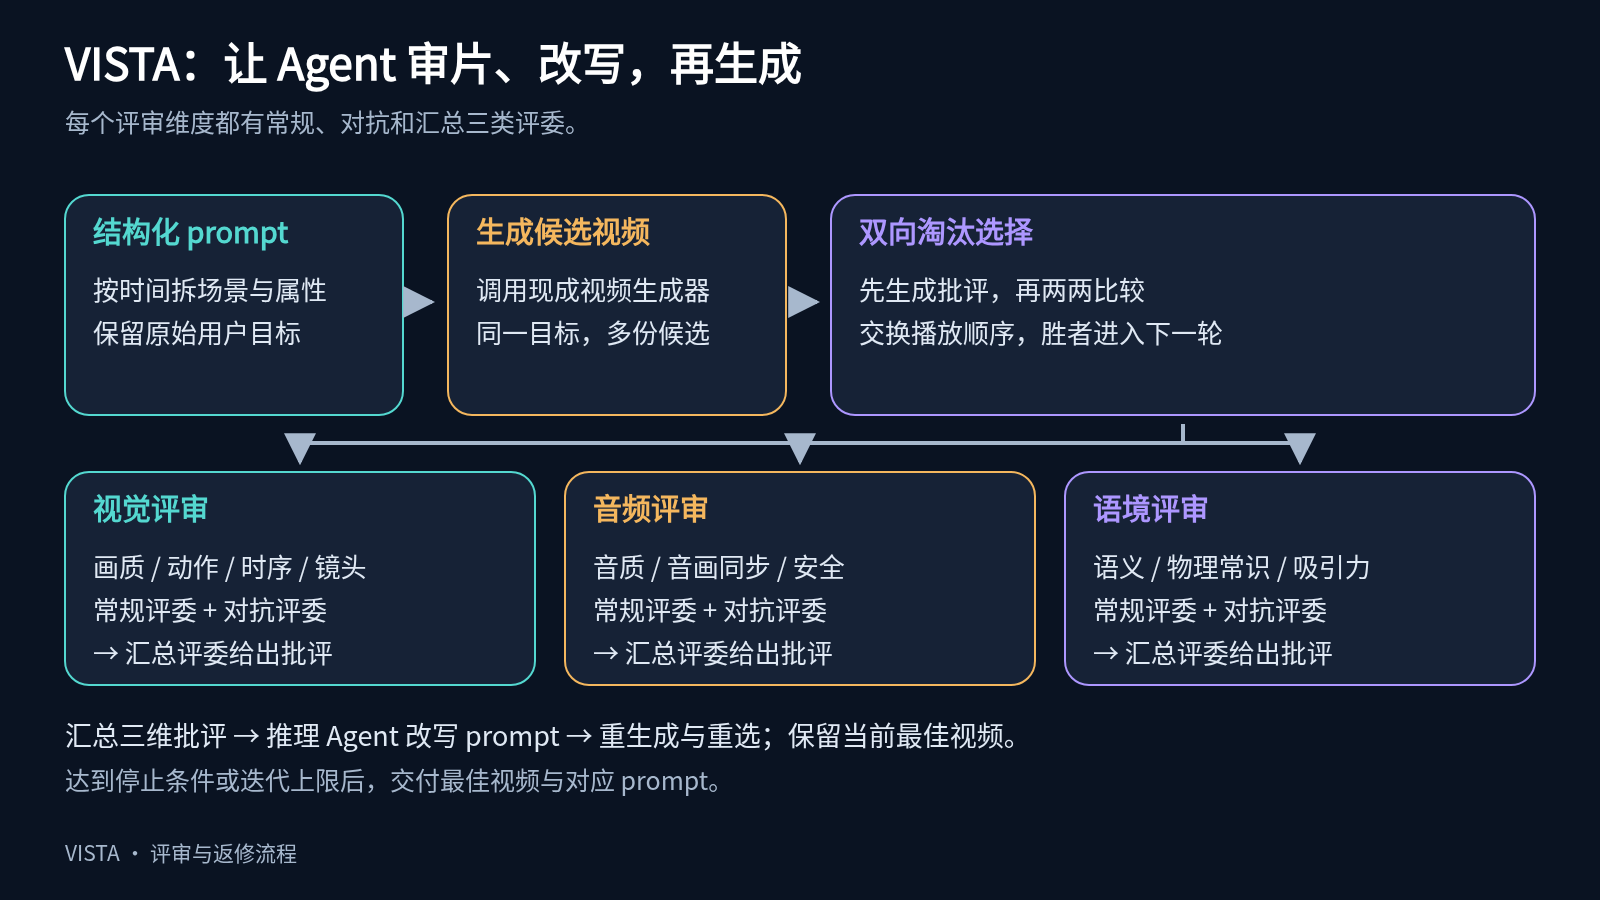
图表详解:方法框架(论文图 1)
原 Figure 1 展示 VISTA 多 Agent 框架,图例区分多模态 LLM Agent、对抗式多模态 LLM Agent 与视频生成 Agent。根据第 2 节,本图显示先将用户意图改写成结构化场景 prompt,生成多个候选;以交换顺序的双向两两比较进行淘汰,选择最佳视频。随后在视觉、音频和语境三个维度分别由常规评委、对抗评委和汇总评委给出批评,推理 Agent 据此改写 prompt,重生成并与当前最佳结果重选;满足停止条件或迭代上限后交付最佳视频及其 prompt。
先产生可以比较的候选。 规划者将目标展开成带时间、人物、动作、镜头和声音的场景,也保留原始提示作为候选。多个视频生成后,通过交换左右顺序的两两比较选出当前最佳结果,减少单次比较的位置偏好。
把模糊的“不够好”拆开。 视觉、声音和语境各自设普通评委、对抗评委与裁决者,检查实际视频。这样可以分别讨论画面是否成立、声音是否匹配,以及成片是否遵循用户意图,而不是让一个总分掩盖不同问题。
修改请求,重新生成。 推理 Agent 汇总批评,改写提示,再调用视频模型,与保留的最佳候选比较,直到达到轮次或停滞条件。闭环作用于生成请求:新一轮会重新采样视频,并不是直接在原片上修改出错的某个对象。
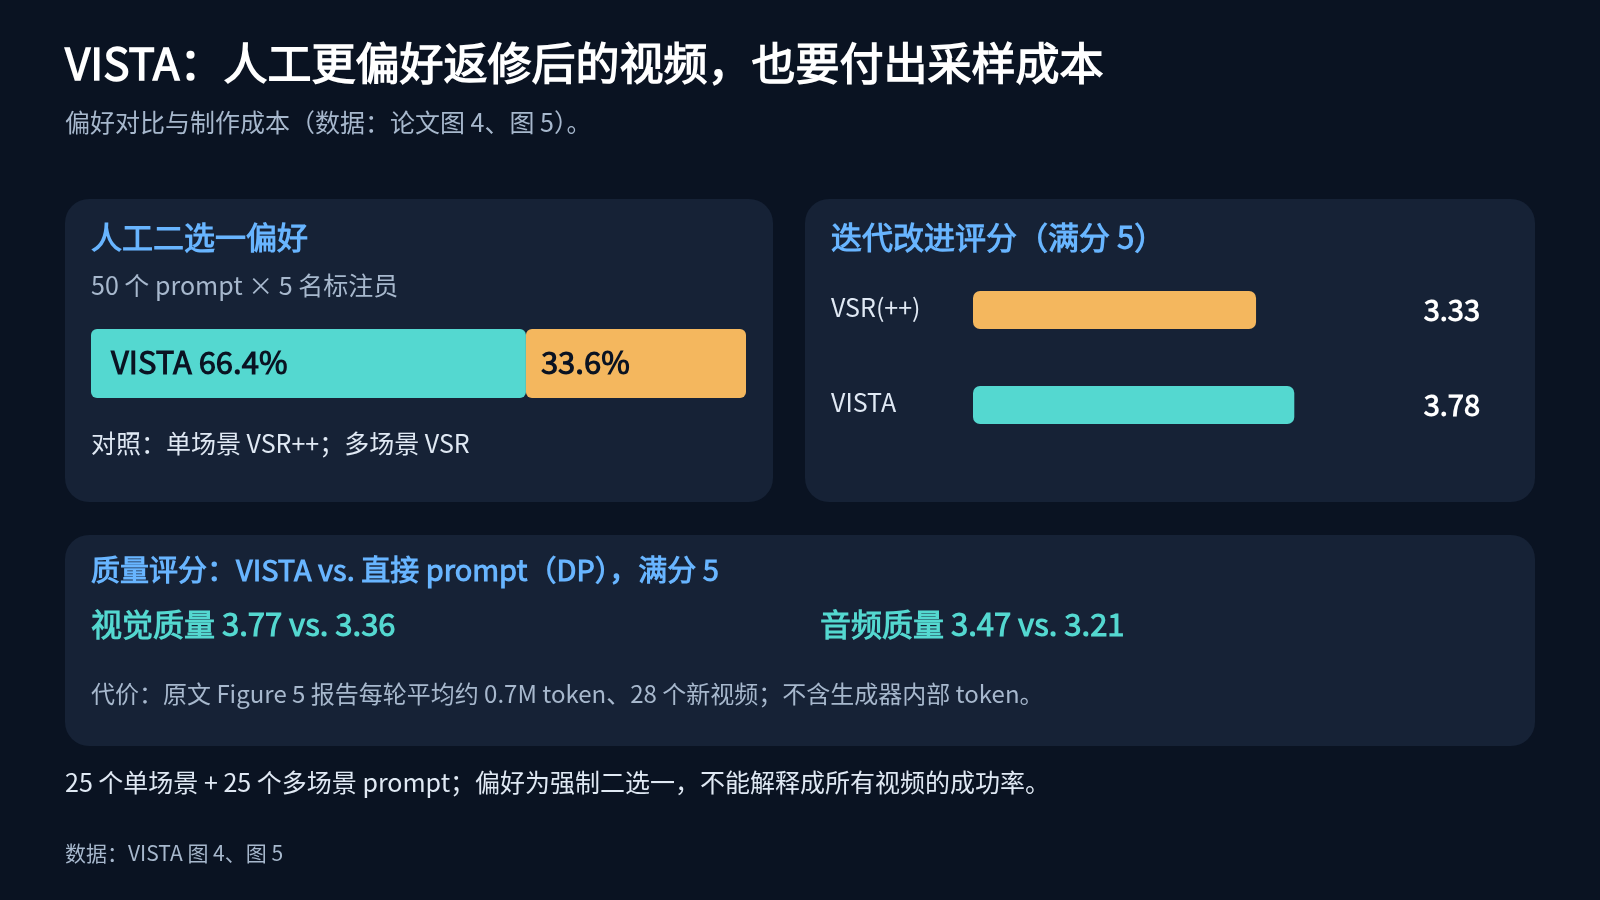
图表详解:结果对比(论文图 4)
原图汇总人工评估,个人结果见附录表 7。第 4.2 节抽取 50 个 prompt,25 个单场景将 VISTA 与 VSR++ 比较,25 个多场景与 VSR 比较;5 位有 prompt 优化经验的标注员强制二选一,VISTA 获得 66.4% 偏好,对照为 33.6%。另外 3 位专家对完整迭代轨迹给出满分 5 分的改进评分:VISTA 为 3.78,VSR(++) 为 3.33;与直接 prompt(DP)比较,视觉质量为 3.77 对 3.36,音频质量为 3.47 对 3.21。补充成本来自 Figure 5:跨两个数据集的每轮均值约 0.7M 输入输出 token、28 个新采样视频,不含视频生成器内部 token。人工偏好不等于任务成功率,结果仅适用于论文设置。
技术演进定位: 黑盒视频生成器之上的结果优化层,以更多推理与采样预算换取成片偏好的提升。
可能的后续方向:
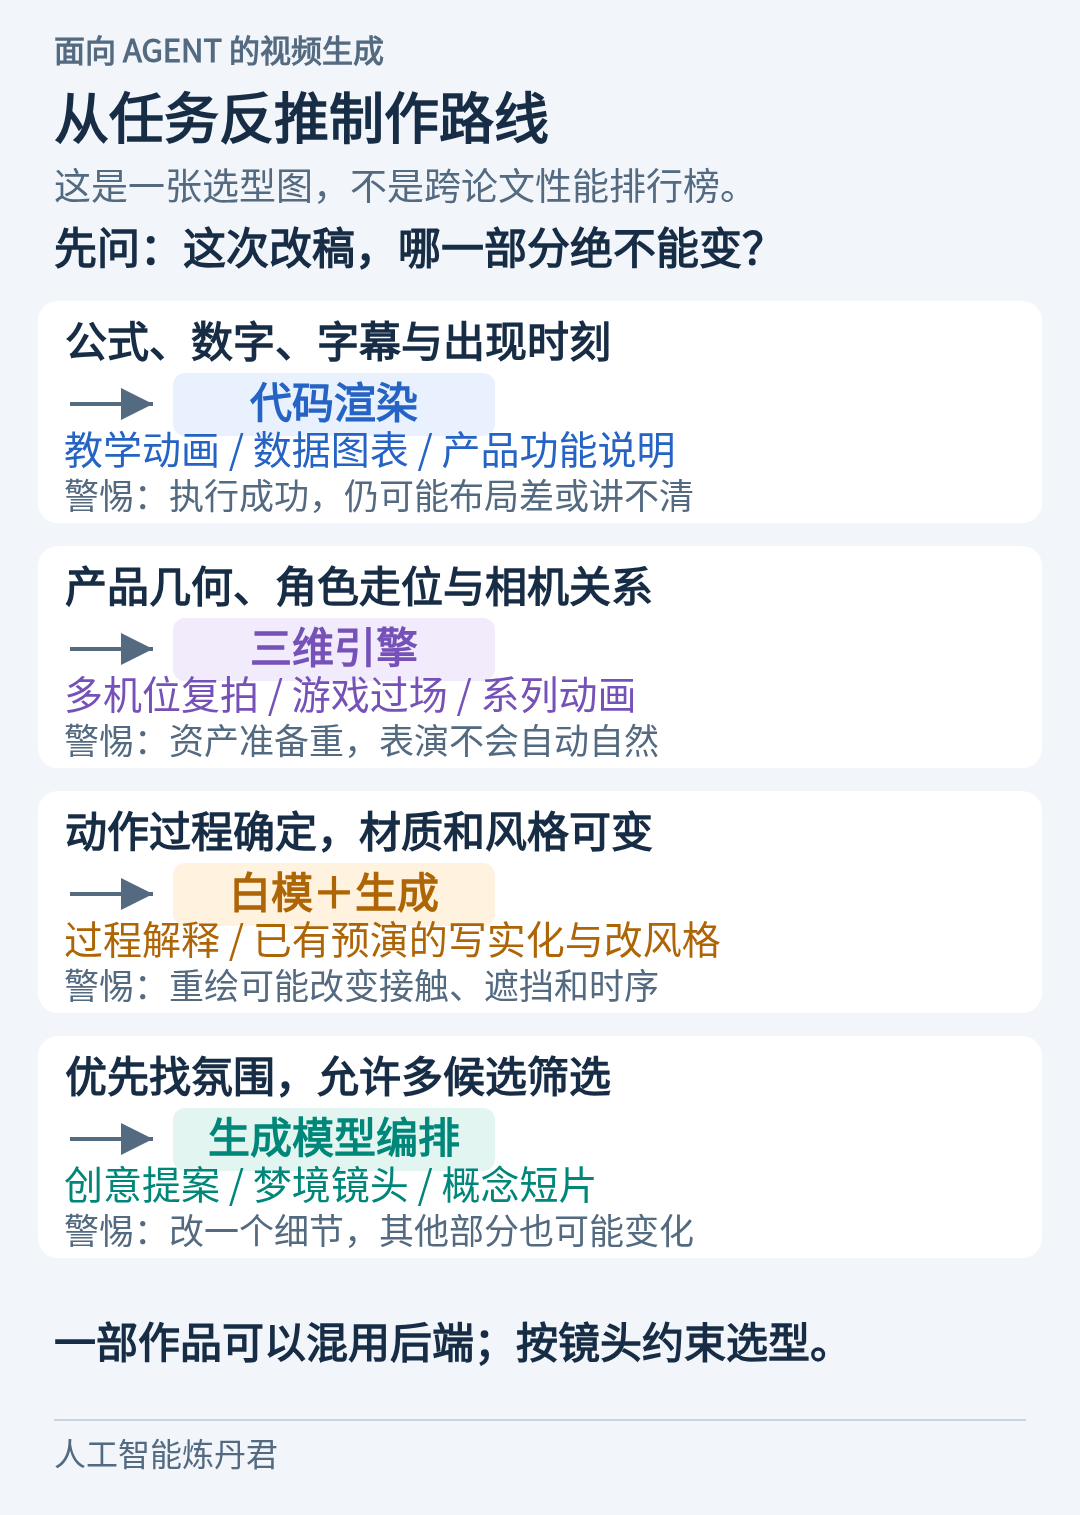
选型取决于必须保持的内容、修改频率与资产条件。精确图文、多机位几何、运动与外观分工、氛围探索对应不同的优势,也各有制作成本和失败模式。
从自然语言要求走向可编辑的场景与时间约束
同一个角色、物体和动作需要跨镜头保持对应关系。更有用的中间表示应连接脚本、场景对象、轨道和生成条件,让空间与时间要求能被执行、修改和追踪。
把精确过程与丰富外观分开处理
引擎保存几何、动作与相机,生成模型提供外观变化。发展重点是让生成条件真正保留关键约束,同时给材质、光照和细节留下自由度。
从整段重生成走向理解依赖的局部修改
修改台词、动作或角色尺寸会影响不同轨道。更可信的返修流程应知道变化会传到哪里,并尽量保留其他正确结果。
用分层反馈分配制作预算
先检查脚本、布局和粗动画,再投入最终渲染与生成,最后评价音画、表演和叙事。成本应覆盖候选筛选、返修与人工介入,并落到最终采用的成片上。
四条路线的差别,在第二版和第十版里尤其明显。下面比较的是修改的落点与代价,而不只是第一版画面是否漂亮。
代码渲染:精确表达可以复用,感染力仍需设计。 TheoremExplainAgent把讲解规划接到 Manim,Code2Video进一步把画面问题映射到代码位置。公式出现时间、箭头指向和数据都能直接修改,系列内容可以摊薄模板成本;但程序能执行,不等于讲解顺序合理或动画自然。复杂质感与表演仍依赖素材、动作和美术设计,通用编码 Agent 也绕不开这些制作工作。
三维引擎:复拍同一个世界,成本先花在资产上。 FilmAgent在预建片场安排拍摄,Cutscene Agent把分工落到原生时间轴,CineU强调共享状态与局部修复。产品换五个机位,可以复用几何;但延长台词会牵动口型、动作和反应镜头,改变角色身高会影响接触与构图。已有合适资产时复用收益较大,从零建模、绑定、布光时,准备工程可能比渲染更费力。
白模+生成:省下精细资产,不等于省下约束检查。 VideoCoCo先用 Blender 程序表达过程,再由适配的编辑器丰富外观。约束弱,模型可能重写动作;约束强,粗糙轮廓和僵硬运动也可能被保留。因而需要分别检查草稿运动是否合理,以及重绘是否保留接触、遮挡与时序;草稿错误可能向后传递,外观编辑还可能引入新的偏差。
生成模型编排:探索外观方便,精确返修更不确定。 MovieAgent分层规划故事与镜头,VISTA用视听语境反馈调整请求与候选。它们适合不值得先建完整三维世界的创意探索;但“动作再快一点”也可能同时改变脸、衣服或背景。多轮筛选的成本应按最终采用的成片计算,计入废弃候选、等待和人工精修。
实际制作可以按镜头混用:商标和字幕交给代码,产品特写保留三维几何,运动明确的镜头尝试白模重绘,开放的氛围镜头采用生成模型。核心问题是哪些内容必须保持,以及下一轮修改能否只动该动的部分。
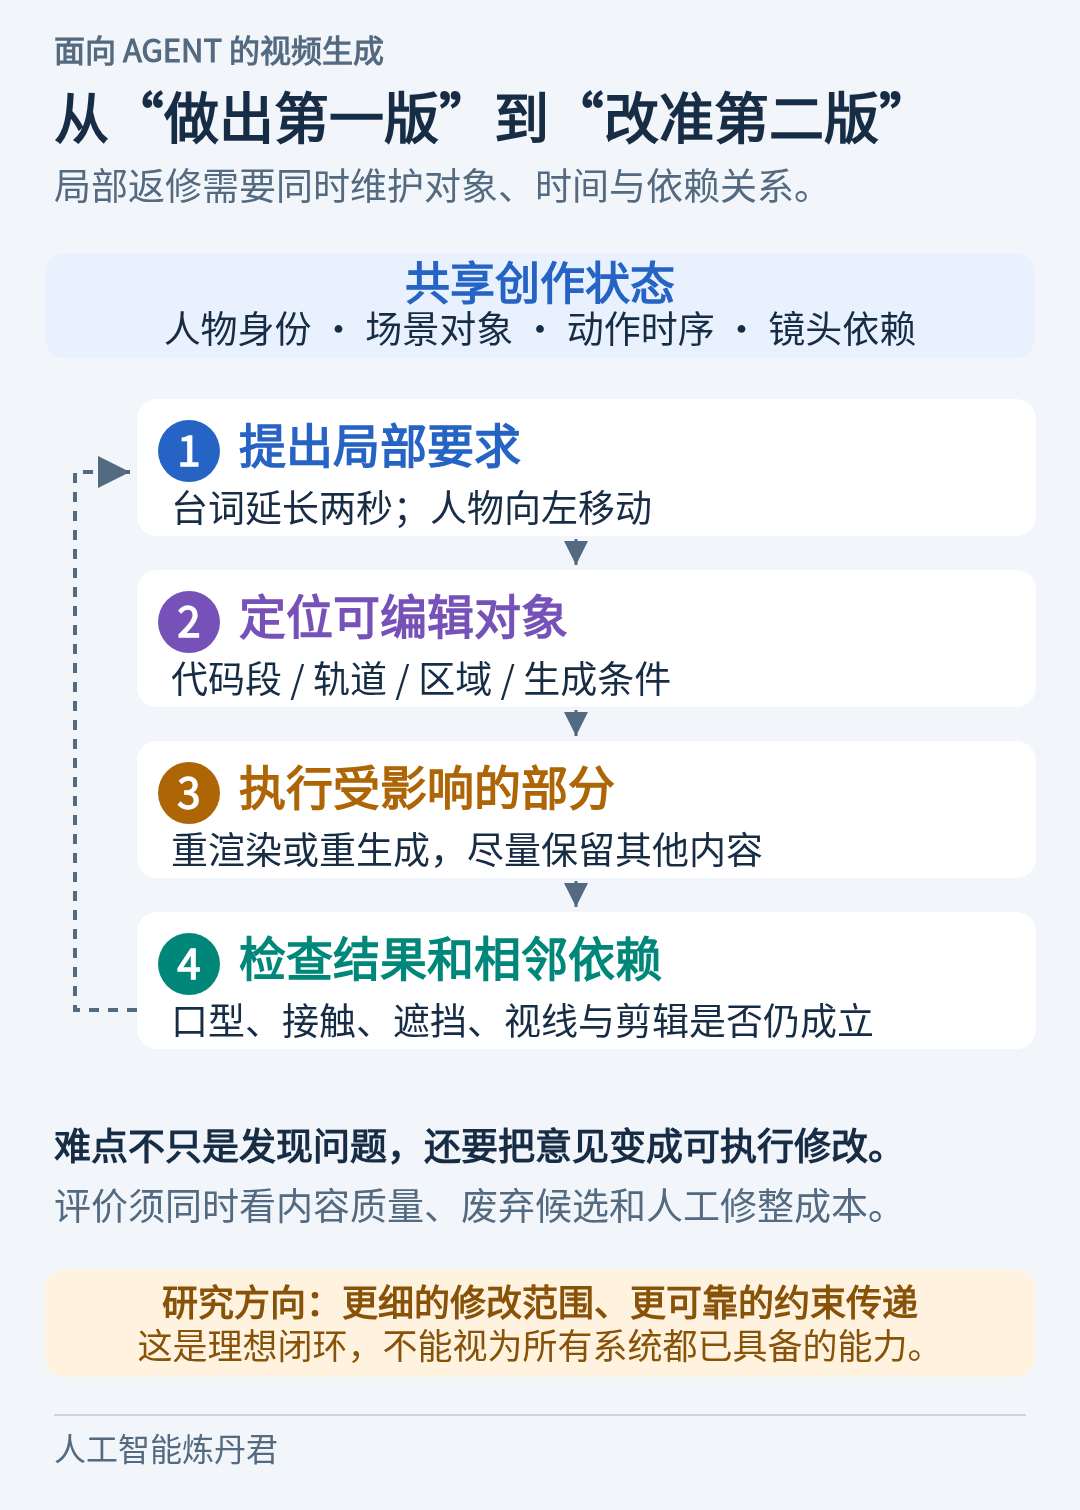
完整的局部返修仍需将对象、时序与依赖检查连接成闭环。
1. 创作意图怎样落到可执行约束? “更有压迫感”涉及景别、运动、节奏与声音;“站在台阶上”涉及几何接触。前者需要观看结果和理解叙事,后者可以检查空间关系。Agent 必须区分这些要求,选择对应的表示与反馈,不能用同一个评分替代所有判断。
2. 多镜头怎样维护持续状态? 同一张角色参考图不足以记录刚拿起的杯子、视线方向或动作进度。场景工程能保存对象状态,仍需把剧本事件、时间轴与生成片段连接起来,否则换镜头后仍可能出现连续性错误。
3. 反馈怎样变成正确的局部修改? 遮挡可能来自站位、相机或剪辑时机;改站位又可能破坏接触。执行检查、场景验证、视觉判断和叙事理解各有作用。有效返修要定位对象、时间段和修改操作,并复查依赖,而不只是增加评委或重试次数。
4. 结构到外观怎样避免信息损失? 白模重绘可补充纹理,也可能改变边界、遮挡和接触。条件接口必须区分哪些约束不可变、哪些外观允许探索;仅凭泛化提示,很难同时做到保留运动和自由换风格。
5. 怎样衡量真正的交付质量与成本? 教学片看解释,产品片看外形和标识,叙事片看表演与剪辑;漂亮的单镜头不保证连起来成立。成本也应覆盖建模、废弃候选、重试与人工修整。只比单次调用价格,无法回答哪条路线更适合一部反复改稿的作品。
共同的创作表示。 将剧本中的人物、道具和事件对应到场景实体、时间段与生成条件,让不同后端接续处理同一镜头。需要共享的是身份、动作和依赖关系,不要求所有后端具有相同内部结构。
约束下的局部编辑。 代码与三维工程已有明确的修改对象,生成模型还需要更强的区域、身份和时间保持能力。将编辑限制在指定对象或片段,并检查相关依赖,才能逐步接近实际剪辑和动画制作中的可控返修。
分阶段分配预算。 先用草图、白模和低分辨率视频解决故事、布局与时序,再精细渲染入选镜头。在创意分歧大或失败代价高的节点引入人工判断,由 Agent 承担可检验的执行与修复。系统的价值会越来越取决于能否稳定保留满意部分,完成第二版、第三版。
假如同一产品短片要反复更换卖点、机位和画风,你会把哪些内容保存在代码或三维工程中,哪些交给生成模型?你最希望下一版修改时保持哪一部分不变?
人工智能炼丹君 | 2026-11-14
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注


评论 (0)