搜索到
224
篇与
人工智能炼丹君
的结果
-
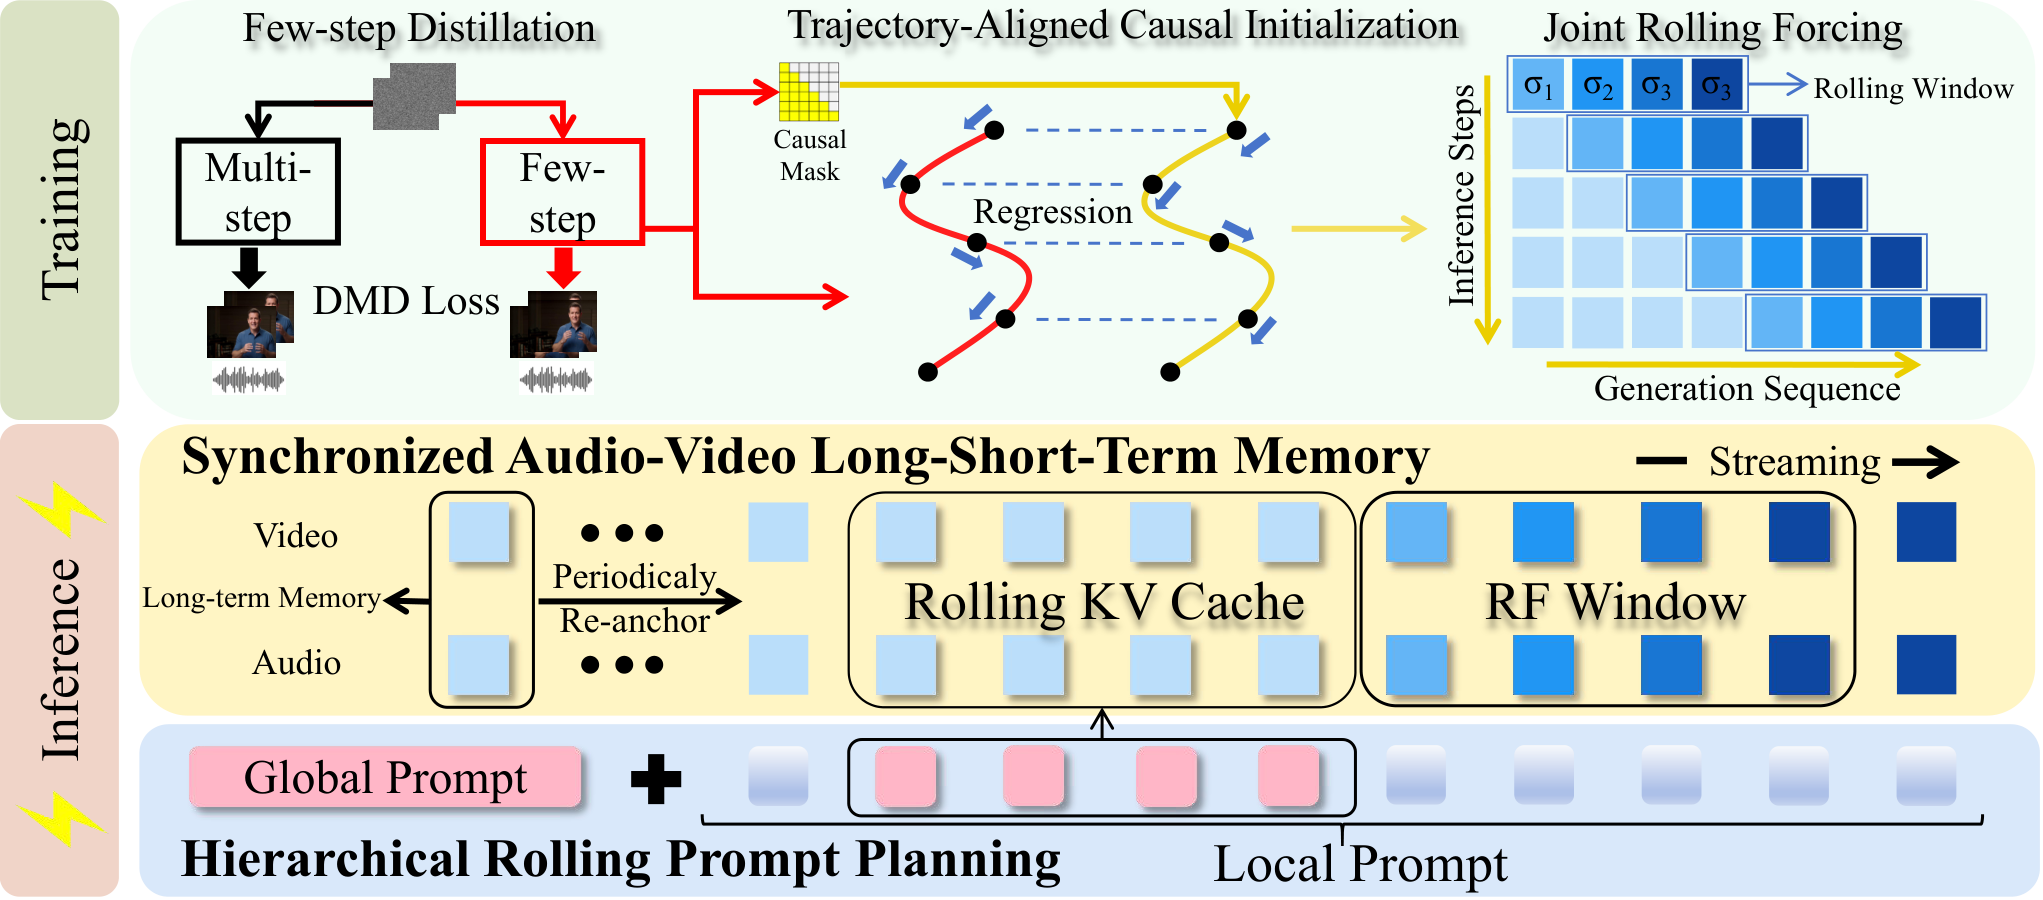
 AIGC 每日速读|2026-08-18|港科大数字人比LTX-2快33倍还能连说一分钟Omni… 今日 AIGC 论文速览 今日共 10 篇 · 实时流式数字人与音视频联合生成 1 篇 · MLLM 与 DiT 融合的视频生成架构 1 篇 · 视频生成推理加速 3 篇 · 个性化与可控图像生成 2 篇 · 生成式渲染与视频编辑 2 篇 · 图像编辑评测基准 1 篇 重点论文标题列表 Omni-LiveAvatar(港科大 iComAI Lab·Vivix Group):比LTX-2快33倍的分钟级流式数字人 BiVidGen(中科院·Microsoft Research·中山大学·浙大·西交·上海AI Lab):MLLM先写视觉token再交DiT渲染 SCOPE:免训练稀疏注意力提速1.99倍 ForgeWM:世界模型压到1步还听懂键鼠 CRAFT(SIGGRAPH Asia 2026):1万张参考图干掉200万配对数据 今日论文速览 1. Omni-LiveAvatar:比LTX-2快33倍的分钟级流式数字人 Omni-LiveAvatar: Minute-Level Real-Time Streaming Joint Audio-Video Avatar Generation | 港科大 iComAI Lab·Vivix Group | arXiv:2608.13602 前序问题:音视频联合生成模型是沉浸式数字人的底座,但现有模型几乎都依赖双向注意力加多步去噪,这两件事凑在一起决定了它只能生成很短的片段。双向注意力要求看到完整序列才能算,天生做不了流式;多步去噪又让单块延迟压不下来。于是「实时交互」和「长时长」这两个数字人最需要的属性,在当前架构下同时缺失——你要么生成几秒的高质量片段然后卡住,要么牺牲质量去换速度,而且一旦想连续说上一分钟,全局一致性(人物长相、音色、场景)就开始飘。 本文贡献:提出 Omni-LiveAvatar,第一个做到分钟级、实时、流式的音视频联合数字人生成框架,三个部件各解一个问题。一是渐进式自回归蒸馏管线,把一个大的双向音视频联合扩散模型转成少步自回归生成器,关键点是整个过程不需要额外的稳定化机制——同类工作常要靠各种辅助 trick 才能压住自回归的误差累积。二是同步的音视频长短期记忆,在有界显存预算下保住全局一致性,这是长时生成不漂的直接原因。三是分层滚动提示词规划策略,让语义可以连贯演进、提示词之间平滑切换,而不是每换一句话画面就跳一下。 Overview of Omni-LiveAvatar. The proposed progressive autoregressive distillation pipeline converts a large bidirectional audio-video diffusion model into a few-step causal generator without any auxiliary stabilization mechanism (top). At inference, the synchronized audio-video long-short-term memory preserves global consistency while retaining recent context within a bounded memory budget for minute-level streaming inference (middle), and the hierarchical rolling prompt planning organizes global and local prompts for smooth long-form semantic evolution (bottom). 实验效果:单张 NVIDIA H200 上,相对其教师模型 LTX-2 拿到 33 倍生成加速,且能实时产出分钟级、音视频同步的高质量数字人。质量维度上全面超过同期的加速类基线,具体覆盖视觉质量、音频质量、跨模态同步性和人物保真度四个方面。代码已开源。 Qualitative comparison of 5-second avatar generation. Omni-LiveAvatar generates realistic and temporally consistent avatars with visual quality comparable to Ovi and LTX-2, whereas OmniForcing exhibits noticeable realism degradation and Hallo-Live suffers from facial and hand artifacts as well as color drift. 批判点评:这篇的工程完成度是今天这批里最高的,33 倍加速加分钟级流式,两个指标同时拿下不容易,而且「不需要额外稳定化机制」这句如果站得住,实际价值比加速倍率本身更大——自回归视频生成的误差累积一直是靠各种补丁压住的,能去掉补丁说明蒸馏管线的设计确实抓住了主要矛盾。教师选 LTX-2 也是个务实选择,那是当前公开可用的强音视频联合模型之一。不过 33 倍这个数字要放在正确的语境里读:它是相对教师的加速比,而教师本身是多步双向模型,基数很慢,所以这个倍率更多说明「双向多步这条路在实时场景下浪费有多大」,而不等于绝对性能领先。真正该问的是绝对延迟——摘要只说「实时」,没给单块生成耗时和端到端首帧延迟,而数字人交互对这两个数字极其敏感,300 毫秒和 800 毫秒是完全不同的产品体验。分辨率和帧率也没披露,H200 是顶配卡,换到消费级或推理卡上还剩多少余量不清楚。另外「分钟级」和真正的开放式交互仍有距离:长短期记忆是有界预算,那就必然有遗忘边界,跑到第五分钟、第十分钟时人物一致性掉多少,论文只展示了分钟级。最后,音视频联合生成最难的其实是音画同步在长序列上的累积误差,摘要报了同步性优于基线,但没说这个优势是否随时长衰减。 2. BiVidGen:MLLM先写视觉token再交DiT渲染 Beyond Text Conditioning: A Systematic Study of MLLM-DiT Fusion for Video Generation | 中科院·Microsoft Research·中山大学·浙大·西交·上海AI Lab | arXiv:2608.14043 前序问题:DiT 已经是高保真视频生成的主流范式,但它做高层语义规划的能力一直很弱——给一句复杂提示词,它能画得很好看,却常常没把因果关系、动作顺序、多物体交互理清楚。图像生成那边已经证明把 MLLM 和扩散骨干混起来有明显优势,可这套思路在视频上基本没被认真研究过。更关键的是,现有少数尝试几乎都把 MLLM 当成一个冻结的特征编码器用,取它的隐层表示喂给 DiT,而 MLLM 最核心的能力——自回归地「生成」内容——完全没被调用。这就等于请了个会规划的大脑,却只让它当传感器。 本文贡献:系统性地拆解「MLLM 该怎么和 DiT 融合做视频生成」这个问题,明确拆成三问:什么样的中间表示适合做 MLLM 与 DiT 之间的桥梁、MLLM 该如何产出这个表示、DiT 在扩散渲染时该如何吸收它。三个发现:其一,由 EMA-based tokenizer 产出的离散语义视觉 token 提供了既稳定又有表达力的接口;其二,自回归因果建模适合生成这些 token;其三,显式的视觉 token 条件化比改写提示词(prompt refinement)或隐空间桥接(latent bridging)都更有效。基于这三点提出 BiVidGen 这一混合架构,让 MLLM 真正承担语义规划、DiT 负责扩散渲染。 Overview. BiVidGen consists of three main components. First, an EMA-based vision tokenizer provides discrete visual representations. Then, an MLLM predicts semantic visual tokens. Finally, the DiT renders high-fidelity videos conditioned on these planned tokens. 实验效果:论文以系统性对照实验为主体,逐一验证三个设计维度上的选择,最终 BiVidGen 在语义规划相关的生成任务上优于把 MLLM 当冻结编码器的既有做法。三条发现分别对应中间表示形式、生成方式、条件注入方式的消融结论。 Qualitative Comparisons. MLLM+DiT yields better causal transitions, temporal consistency, and semantic alignment than the DiT-only baseline in these examples. 批判点评:这篇的价值主要在「把问题问清楚」而不是「刷了个 SOTA」。它把 MLLM-DiT 融合这个此前靠直觉拼装的设计空间,拆成三个正交维度逐一做对照,最后给出的三条结论——离散语义 token 做接口、自回归生成、显式 token 条件化——对后续做这个方向的人是实打实的省时间,尤其「显式 token 条件化优于 prompt refinement 和 latent bridging」这条,直接排除了两条看起来很自然但实际次优的路径。EMA tokenizer 提供稳定接口这个发现也有说服力,离散化在生成任务里通常被担心信息损失,这里反而因为稳定性赢了。但摘要在最关键的地方留了空白:没有任何具体数字,没说在哪些 benchmark 上、相对哪些基线提升多少,也没交代 MLLM 和 DiT 各自的规模、训练数据量和总训练成本。对一篇以「系统性研究」自我定位的工作,这些恰恰是判断结论泛化性的关键——三条结论是在某个特定尺寸组合下成立,还是随规模稳定?其次,引入自回归 MLLM 生成视觉 token 必然带来额外推理延迟,视频生成本来就慢,这个代价有多大、值不值得,论文没有权衡分析。最后一个更根本的隐忧:既然 MLLM 现在承担了语义规划,那它规划错的时候会怎样?DiT 是有能力纠正一个错误的视觉 token 序列,还是会忠实地把错误渲染出来?这个失败模式没有讨论,而它直接决定了这套架构在实际产品中的鲁棒性。 3. SCOPE:免训练稀疏注意力提速1.99倍 SCOPE: Subspace Clustering with Online Per-Head Top-K Estimation for Sparse Video Attention | arXiv:2608.12780 前序问题:DiT 在时空 token 上的自注意力是二次复杂度,视频一长、分辨率一高就成为主要瓶颈。现有免训练稀疏注意力方法普遍用块级或簇级的代理分数来构造稀疏掩码,问题是这种粗粒度代理会把 key 之间的细微差异抹平,在激进稀疏率下高贡献的 key 就被漏掉了。还有一个更隐蔽的失败模式:代理分数容易产生过度集中的 softmax 分布,导致 Top-p 策略对某些 query 簇只保留极少的 key。用一个固定的 Top-k 下限可以缓解,但不同注意力头、不同输入的稀疏容忍度本来就不一样,共享一个固定值必然有头被切得太狠。 本文贡献:提出 SCOPE,免训练稀疏注意力框架,把 3D-RoPE 对齐的 key 子空间聚类和在线逐头 Top-k 估计结合起来。具体做法是把过了 RoPE 的 key 按时间、高、宽三个子空间分别独立聚类,再通过查找表聚合对应的质心分数,为每个 query 簇得到逐 key 的代理分数——粒度从块/簇细化到单个 key。在既有的 Top-p 与固定 Top-k 混合选择策略之上,SCOPE 在线推导每个头专属的 Top-k 值:对每个头,按 query 簇大小加权平均其初始保留 key 数,只对那些初始保留数低于该均值的 query 簇补充选取额外 key。最终稀疏注意力在选中的原始 key/value 上计算。 Overview of SCOPE. Queries are clustered in the full feature space, while each post-RoPE key is represented by temporal, height and width subspace assignments. Query-centroid slices score the corresponding subspace centroids to form lookup tables, and indexed summation reconstructs a proxy logit for every key. Hybrid Top-$p$/fixed-Top-$k$ selection produces the initial key counts, from which SCOPE estimates an online per-head Top-$k$ value. Sparse attention is computed using the selected original $K$ and $V$. 实验效果:在六种模型-任务配置上,SCOPE 在保真度和延迟两个维度上都稳定优于现有免训练基线。720p HunyuanVideo 上端到端加速最高 1.99 倍,同时相对稠密注意力保持 28.46 dB PSNR。 Attention recall and PSNR under matched attention density. SCOPE consistently achieves higher attention recall and PSNR than competing sparse attention methods at the same retained density. 批判点评:这篇的两个改动都很对症。按 RoPE 的三个物理维度分别聚类,比在混合后的高维空间里做一次聚类更合理——时间、高、宽三个方向的相似性结构本来就不同,混在一起聚必然互相干扰,这个设计有明确的几何动机而不是调参调出来的。逐头在线估计 Top-k 也踩在了痛点上:稀疏注意力的工程实践里,「哪个头能切多狠」向来是最难统一的,用全局固定值本质上是在拿最脆弱的那个头的容忍度当上限,牺牲了其余头的加速空间。1.99 倍加速配 28.46 dB PSNR 是个体面的组合,六种配置的覆盖也说明不是单点调优。但要注意几个尺度问题。28.46 dB 是相对稠密注意力的重建保真度,这个量级在图像上属于「肉眼可辨差异」的边缘,视频上更麻烦的是误差会沿时间累积——单帧 PSNR 达标不代表时序闪烁可接受,而摘要没给任何时序一致性指标。1.99 倍是「最高」值且只在 720p HunyuanVideo 上,其余五个配置的加速比没披露,实际期望值应该往下调。更根本的是,SCOPE 自己引入了聚类和查找表两层额外开销,这部分成本随 token 数如何增长、在什么序列长度以下会反而变慢,论文没给出盈亏平衡点,而这直接决定它能否用在短视频或低分辨率场景。最后,逐头 Top-k 用「簇大小加权均值」作为阈值是个启发式,为什么均值是对的、换成分位数会怎样,缺少分析。 4. ForgeWM:世界模型压到1步还听懂键鼠 ForgeWM: Progressive Causal Training for Few-Step Action-Conditioned Video World Models | arXiv:2608.14022 前序问题:动作条件视频世界模型要同时满足低延迟因果生成和对游戏原生控制信号的可靠响应。因果蒸馏已经能做到一步或少步视频合成,但把它扩展到交互式世界模型很难,症结在于离散的键盘状态和连续的鼠标运动必须在因果训练和自回归 rollout 的全过程中,始终与被时间压缩过的隐空间 chunk 保持对齐。视频 VAE 在时间维做了压缩,一个隐 chunk 对应多帧,而用户的按键是逐帧发生的——这个错位在多步生成里还能靠冗余步数糊过去,压到一两步就直接暴露成「动作响应不准」。 本文贡献:提出 ForgeWM,一个渐进式框架,通过四个阶段把双向的动作条件视频生成器转成高效的少步世界模型:域适应、teacher-forced 因果训练、因果一致性蒸馏、以及与双向教师做 on-policy 分布匹配。产出的是「按预算特化」的学生模型,分别在 1、2、4 步的稳态去噪预算下工作。ForgeWM 还支持一种双路径部署协议,把延迟敏感的交互与可选的回放期精修结合起来——一步学生先出草稿保存,之后再重新加噪并精修这份草稿,等于把「交互时要快」和「回放时要好」两个矛盾需求拆到了不同时间点。 Overview of ForgeWM. (A) Frame-aligned keyboard and mouse controls condition latent chunks. (B) A shared base yields a bidirectional teacher and budget-specialized causal students through four-stage training. (C) Deployment separates low-latency interaction from optional Replay-Time Refinement (Figure~fig:replay-refinement). 实验效果:在配对的 Minecraft 轨迹上,ForgeWM 在成像质量、参考对齐的运动指标上领先所评估的各系统,学生模型可在 1、2、4 步预算下运行。 Qualitative comparison. Rollouts at frames 0, 25, 51, and 76. Rows show the reference and three models. Controls are annotated once on the reference: each overlay shows dominant WASD and accumulated mouse-look to the next frame; the final frame has no outgoing control overlay. Left/right: daytime forest stream/rainy riverbank at night. 批判点评:把「动作对齐」识别为少步世界模型的核心障碍,这个判断是准的,而且它指出的错位很具体——时间压缩的隐 chunk 与逐帧动作信号之间的粒度不匹配,这不是靠加数据能解决的结构问题。四阶段渐进管线(域适应→teacher-forced→一致性蒸馏→on-policy 分布匹配)的顺序也有内在逻辑:先让模型适应域,再在有监督信号下学因果,最后用 on-policy 修正暴露出的分布偏移。双路径部署是全篇最有产品意识的设计——交互时用一步出草稿保延迟,回放时再加噪精修提质量,直接承认了「同一个模型不必在所有时刻都做同样的权衡」,这个思路可以迁移到很多实时生成场景。但实验范围是明显的短板:只在 Minecraft 上验证。Minecraft 的视觉复杂度低、纹理规整、物理规则简单且完全确定,是世界模型最友好的测试场,在这里报 SOTA 与在真实感游戏或真实视频上的可用性之间有很大鸿沟。「领先所评估的各系统」这个表述也偏保守,说明对比范围可能有限,具体的 FID/FVD 数值和延迟数字摘要都没给。一步学生的绝对质量损失多少同样没交代——1、2、4 步三档特化模型之间的质量-延迟曲线是这篇最该给的图,缺了它就无法判断「压到一步」是真可用还是仅仅可跑。另外双路径协议要为每次交互保存草稿,显存和存储开销在长会话下如何增长,也没有讨论。 5. CRAFT:1万张参考图干掉200万配对数据 CRAFT: Constrained Reward via Attention Fine-Tuning for Subject Personalization without Composed Targets | SIGGRAPH Asia 2026 | arXiv:2608.14403 前序问题:主体驱动的图像个性化——生成新图像同时保持一个或多个参考主体的身份——是视觉内容创作的基础能力。当前主流做法是在几十万到几百万组「参考图-合成目标」配对样本上微调预训练的 MMDiT,而每组合成目标都是主体出现在新场景中的一张合成图。造这些目标需要一条昂贵的多阶段流水线:LLM 生成提示词、T2I 合成目标图、参考主体抠取、VLM 质量过滤、对应关系标注。除了贵,这条路还有个隐性代价——方法被紧紧绑在某个特定的目标合成器和某一套数据清洗策略上,换个合成器结论就不一定成立。 本文贡献:提出 CRAFT,一个单步 ReFL 框架,用 LoRA 适配器微调预训练的「参考感知」MMDiT,训练数据只需 1 万张参考图加主体 mask,完全不需要合成目标监督。核心是「看哪里」原则:注意力级奖励把噪声 token 与短语 token 的注意力对齐到正确的参考主体上,由此得到的逐主体注意力 mask 再去门控一个像素级身份奖励,从而让图像空间的监督与学到的注意力路由保持一致。这等于把监督信号从「像素该长什么样」换成了「注意力该看哪个主体」,后者可以从参考图本身直接构造。 Overall pipeline of CRAFT. The denoising prefix is rolled out without gradients up to the reward step $t^\ast$, where two forward passes are performed: the frozen backbone $f_\text{base}$ produces $\mathbf{v}_\text{base}$, while the LoRA-adapted model $f_\text{LoRA}$ produces $\mathbf{v}_\text{LoRA}$ together with the cross-modal attention sub-blocks $\mathbf{A}_{N2R_k}$, $\mathbf{A}_{N2P_k}$, and $\mathbf{A}_{P_k 2 R_k}$. Following the Where to look principle, $\mathcal{R}_\text{ref}$ and $\mathcal{R}_\text{cons}$ shape noise- and phrase-token attention toward each reference subject (sec:method:attn_rewards); the resulting per-subject mask $\mathbf{m}^\text{noise}_k$ then gates the pixel-level identity reward $\mathcal{R}_\text{id}$ on the VAE-decoded pre-image $\hat{\mathbf{I}}$ (sec:method:pixel). Auxiliary terms $\mathcal{R}_\text{CLIP-T}$, $\mathcal{R}_\text{AES}$, and a velocity-space regularizer $\mathcal{L}_\text{anchor}$ are added for prompt fidelity, aesthetics, and stability (sec:method:loss). A single backward pass updates only the LoRA parameters. 实验效果:应用在 FLUX.2-klein-9B 上,CRAFT 在 XVerseBench 上达到 SOTA,且只用 1 万条纯参考数据,而此前的通用方法需要 15 万到超过 200 万组合成目标配对。同一套配方迁移到其他参考感知骨干上也能稳定提升性能。已被 ACM SIGGRAPH Asia 2026 接收。 Qualitative comparison with state-of-the-art subject-driven personalization models. 批判点评:1 万对 200 万,两个数量级的数据量差距还能拿 SOTA,这是今天最有冲击力的数字,而且它的说服力不在倍数本身,而在于它质疑的东西:如果两百万组精心合成的配对数据能被一万张参考图替代,那说明此前的数据流水线在很大程度上是在用外部监督重新教模型一些它内部已经编码好的东西。把监督从像素空间挪到注意力空间是关键一步——「主体身份」这个概念在 MMDiT 里本来就是通过注意力路由实现的,直接在这一层加约束比绕一圈从像素反推更直接。用注意力 mask 去门控像素奖励也很巧,避免了两种监督各说各话。迁移到其他参考感知骨干仍有效,说明不是单一模型上的过拟合。SIGGRAPH Asia 的接收也是一层背书。不过前提条件要看清楚:它要求骨干必须是「参考感知」的 MMDiT,也就是说模型本身已经具备处理参考图的结构,CRAFT 是在这个基础上做对齐微调,而不是从零赋予个性化能力——所以严格说它省掉的是「对齐阶段」的数据,而非全部。评测只报了 XVerseBench 一个基准,主体个性化的评测口径分歧很大,单一 benchmark 上的 SOTA 需要更多交叉验证,尤其是多主体组合、罕见物体这些困难设定。注意力级奖励依赖短语 token 与主体的正确对应,当提示词里出现代词、隐含指代或多个同类物体时这个对应如何建立,摘要没说。最后 1 万张参考图仍需主体 mask 标注,这部分成本虽远低于合成目标流水线,但并非零。 6. XYZFlow:不靠蒸馏拿到7.2倍教师加速 XYZFlow: Scaling Multi-dimensional Shortcut Flows for Efficient Generative Modeling | ICML 2026 | arXiv:2608.12276 前序问题:高保真图像生成始终卡在速度与质量的取舍上。扩散模型视觉效果强,代价是昂贵的迭代采样。现有的高效方法主流是把预训练模型蒸馏成少步采样器,但蒸馏本身是个难做的过程,而且质量上限严重依赖教师模型——教师有的毛病学生躲不开,教师没有的能力学生也长不出来。这意味着加速路线被绑死在「先有一个好教师」这个前提上,而且每换一个基础模型就要重跑一遍蒸馏。 本文贡献:提出 XYZFlow,从流匹配的多维度缩放这个角度重新思考高效生成,而不是走蒸馏路线。核心主张是:相比单步映射,通过结构化的多维条件化可以让概率路径更可辨识、更易学习,从而提升表达力。论文把自回归建模看作一种隐式的流直化——上下文越丰富,轨迹的歧义就越小。XYZFlow 用两个正交维度实现这个想法:时间维缩放,即在完整去噪历史上做非马尔可夫条件化;空间维缩放,通过「下一捷径预测」(Next Shortcut Prediction)顺序生成图像块,把已生成块的去噪轨迹当作后续块的先验。 Next Shortcut Prediction in XYZFlow. (Top-Left) Flow diagram showing the generation sequence, where a blue curve represents progressively strengthening constraints. (Top-Right) Visualization of a non-uniform patch-based denoising process: the first image patch undergoes the most denoising steps, while subsequent patches are generated with fewer steps (“shortcuts”). This forms a long autoregressive sequence where the denoising flow from prior patches (green and blue arrows) guides the denoising of subsequent ones. 实验效果:达到 SOTA 性能,相对教师模型实现 7.2 至 8.5 倍加速,同时 FID 保持竞争力。其中 Next Shortcut Prediction 在质量-延迟权衡上优于单纯的模型放大或步数削减两种做法。已被 ICML 2026 接收(16 页 5 图)。 Randomly selected examples of generated images from XYZFlow. XYZFlow shows high-quality generative modeling abilities. 批判点评:「自回归建模是隐式的流直化」这个视角是这篇最有价值的部分。流匹配领域一直在琢磨怎么把概率路径拉直,主流手段是改路径设计或加正则;这篇指出提供更丰富的条件上下文本身就在减少轨迹歧义,等于把自回归和流直化两条此前平行的技术线接上了,这个洞察比 7.2 倍这个数字更耐读。时间和空间两个正交维度的划分也干净——非马尔可夫地用完整去噪历史,加上按块顺序生成用已完成块当先验,两者确实互不重叠,可以独立叠加。绕开蒸馏这一点尤其实在,摆脱了对教师质量的依赖,ICML 2026 的接收说明理论部分经过了同行检验。但代价需要说清楚:空间维的 Next Shortcut Prediction 是顺序生成图像块,这天然引入了块间的串行依赖,跟扩散模型全图并行去噪的优势正好相反。摘要报的 7.2-8.5 倍加速想必已经包含这部分开销,但在什么分辨率下测的、块数增加时加速比如何衰减,是判断可扩展性的关键,而这些没披露。「FID 保持竞争力」这个措辞比「达到 SOTA」弱,暗示纯质量指标上可能有小幅让步,具体差多少应该给出。时间维的非马尔可夫条件化要保存完整去噪历史,显存开销随步数线性增长,与少步生成的初衷存在张力。另外全文以图像生成为主,视频这种时空 token 量级大得多的场景下,块间串行的代价会被放大多少,是个开放问题。 7. RGBX-Next:把DiT改造成可控生成式渲染器 RGBX-Next: Towards Realistic Generative Rendering from G-Buffers | NVIDIA·UCSB·UCSD·MBZUAI | arXiv:2608.13929 前序问题:扩散模型在图像、视频和流式生成上效果已经很好,但和传统 3D 渲染相比,它对生成结果缺乏精确控制。传统渲染管线里你能精确指定几何、材质、光照,改一个参数就得到可预期的变化;扩散模型给的是「大致符合描述」,无法承担需要确定性控制的生产任务。反过来传统渲染又缺少生成模型的真实感先验,物理正确不等于看起来像照片。这两条路各有各的强项,一直没能真正打通。 本文贡献:主张一条可行路径是把生成模型当作以传统渲染的 G-buffer 为条件的「学习型渲染器」。提出 RGBX-Next,一个统一的前向与逆向渲染生成框架:既能从图像、视频、流中估计 G-buffer(逆向),也能从 G-buffer 渲染出真实的图像、视频、流(前向)。核心贡献是给出了一套把扩散 Transformer(DiT)模型微调成生成式前向渲染器与逆向渲染器的通用配方。作者承诺公开全部模型。 High-level overview of our paper. We first describe a simple version of image and video models in sec:initial-rgbx, followed by an improved version using our QK type embedding and clean input tokens techniques in sec:improved-rgbx. We estimate G-buffers from real video data with our model in sec:dataset, and train models with X-patchify in sec:xpatchify. We discuss conditioning dropout and lighting control in sec:dropout-blurring,sec:lighting. We introduce streaming extensions of our models in sec:streaming. 实验效果:所得模型在真实感生成式渲染与内在分解(intrinsic decomposition)两个方向上都达到高质量。论文强调其提出的设计原则将有利于后续可控生成式前向与逆向渲染的研究。团队来自 NVIDIA 与 UCSB 等,作者包含多位实时渲染与逆向渲染方向的资深研究者。 The overall design of our $1/N$ streaming models. For each chunk, the model receives $N$ current input frames and one stitching frame from the previous chunk, whose input and output are already known, then produces the $N$ new output frames through a diffusion process. Optional long-context tokens provide a clean reference frame for long-term memory. For simplicity, the figure illustrates the rgbtox case with albedo as xx. 批判点评:把 G-buffer 当作生成模型的条件接口,这个设计的聪明之处在于它直接复用了图形学几十年积累下来的中间表示。G-buffer(法线、深度、albedo、粗糙度这些)本来就是渲染管线里为了解耦几何与着色而设计的,它天然是结构化、可编辑、语义明确的——比文本提示词或隐向量都更适合做精确控制的入口。前向和逆向统一在一个框架里也很自然,两者本质是同一映射的两个方向,共享表示能互相提供约束。作者阵容是这篇的隐性背书:Marco Salvi、Jan Novák、Ravi Ramamoorthi、Ling-Qi Yan、Miloš Hašan 都是渲染和逆向渲染方向的资深研究者,NVIDIA 主导加上承诺开源模型,落地可能性比多数学术工作高。但摘要的表述相当克制,也确实缺东西:全篇没有一个量化指标,「高质量」「有利于后续研究」这类措辞在一篇声称做 SOTA 级渲染的工作里偏软,无法与 RGB↔X 等前作直接比较。「通用配方」的具体内容摘要没展开——微调哪些层、G-buffer 如何编码注入、训练数据从何而来(合成渲染数据的域间隙如何处理),这些恰恰是能否复现的关键。前向渲染方向还有个绕不开的问题:生成模型对 G-buffer 的响应是否单调可预期?如果微调 albedo 一个通道会引起画面其他部分的连带变化,那「精确控制」这个卖点就打折了,而摘要没有这类可控性验证。流式(streams)支持被反复提及但没有延迟数字,实时渲染场景下这是硬门槛。 8. InstructVVT:视频试衣扔掉mask和pose先验 InstructVVT: Instruction-Driven Video Virtual Try-On without Auxiliary Spatial Priors | 南京大学·中国移动九天 | arXiv:2608.14070 前序问题:视频虚拟试衣是个约束极强的编辑任务:既要精确替换目标人物的衣服,又要严格保住原视频的空间结构和时序动态。现有方法严重依赖手工的辅助空间先验(mask、pose 等)来实现编辑控制,可这些先验在无约束的真实视频里很容易失效——遮挡、快速运动、罕见姿态都会让 pose 估计或分割崩掉。更本质的问题是,这类先验把丰富的视觉上下文压缩成了不完整的结构信号,信息通道太窄。此外标准的重建目标也无法充分刻画试衣任务特有的人类偏好(衣服贴合是否自然、褶皱是否合理)。 本文贡献:提出 InstructVVT,基于 DiT 的指令驱动、参考引导的视频试衣框架,推理时完全不需要空间先验。核心是双层参考条件化:一方面由 MLLM(挂可训练 LoRA)经 Connector 推断语义编辑 token,用于目标消歧与结构保持——也就是搞清楚「要换谁的哪件衣服、哪些部分不能动」;另一方面用一条轻量条件化通路把参考服装的细粒度外观显式注入,与源视频 latent 一起拼成多模态 DiT 输入。训练分两阶段:Stage 1 监督微调,Stage 2 用 DiffusionNFT 做强化学习——策略 DiT 采样 K 个候选视频,由冻结的 MLLM 奖励模型打分,经 NFT 损失更新策略并以 EMA 回写,以此对齐标准重建目标无法刻画的试衣偏好(贴合是否自然、褶皱是否合理)。 Overview of our InstructVVT framework. In the supervised training, the source video, reference garment, and instruction are encoded by a frozen MLLM with trainable query tokens $Q_e$, LoRA adapters~lora, and an MLP connector to produce MLLM edit tokens $C_e$. We adopt two embedding layers with identical architecture but independent parameters to encode video cue tokens $X_t$ and reference garment tokens $C_g$, respectively. The MLLM edit tokens $C_e$, video cue tokens $X_t$ and reference garment tokens $C_g$ are injected into each DiT block through cross-attention. The post-training stage applies DiffusionNFT~diffusionnft: a frozen EMA policy samples $K$ videos, a tailored reward model based on MLLM assigns score-token rewards, and the NFT loss updates the trainable DiT. 实验效果:在无约束真实视频上不依赖推理期空间先验即可完成试衣编辑,同时保持源视频的空间结构与时序动态。定性对比覆盖 ViViD、CatV2TON、MagicTryOn、TripVVT、UniVideo 五个基线,在领口结构、腰带细节与裙摆轮廓的保真度上更接近目标服装。论文 23 页 10 图,Dingbao Shao 与 Song Wu 为共同一作,Zili Yi 为通讯作者。 Qualitative comparisons on ViViD-S. The examples show that InstructVVT transfers the reference garment while preserving the source video appearance and temporal structure, complementing the quantitative ViViD-S results in Table~tab:vivid_s. 批判点评:去掉推理期空间先验这个方向是对的,理由比「少一步预处理」更深:mask 和 pose 本质是把高维视觉信息压成低维结构信号的有损投影,在真实视频里既容易估错,又丢掉了大量对编辑有用的上下文。用 MLLM 推断语义编辑 token 做目标消歧,思路上与今天 BiVidGen 那篇同源——都是让 MLLM 承担「理解要改什么」的规划角色,而非只做特征编码器。第二阶段引入 DiffusionNFT 强化学习也踩在了实处:试衣好不好看是典型的「重建损失说不清、人一眼能判断」的任务,用 MLLM 当奖励模型去对齐这类偏好,比继续堆重建监督更对症,而且 NFT 这条路线比 DPO 类方法更适合扩散模型的训练形态。不过摘要通篇没有任何量化结果,没有 benchmark 名称、没有与 ViViD/TripVVT 等的对比数字,也没说清基座 DiT 是哪个、训练数据规模多大——对一篇 23 页的工作,摘要层面的信息密度偏低。「不需要推理期空间先验」这个措辞要留意「推理期」三个字:训练阶段是否仍用 mask/pose 做监督没有交代,若训练仍需要,省下的是部署成本而非数据成本。服装细节保真是视频试衣最难的部分,logo、纹理、褶皱在人物运动中的一致性只笼统说保持时序动态,缺少针对细粒度纹理漂移的量化证据。MLLM 既参与推理条件生成、又在训练时充当奖励模型,两处都是重计算,逐块处理长视频时开销会被放大,但没有效率数字。RL 阶段还有个隐忧:MLLM 奖励模型自身的偏好偏差会被策略学去,而摘要没有讨论奖励过优化(reward hacking)的防护。 9. Concept Guidance:跳过特定层就能连续调美感 Concept Guidance: Precise, Training-Free Latent Control for Text-to-Image Generation | GCPR 2026 Oral·慕尼黑大学 CompVis | arXiv:2608.14172 前序问题:文生图扩散模型有两个严重限制实用性的短板。一是标准模型缺少内在机制来做连续的、概念特定的引导——比如想精确控制「这张图有多好看」,你没有一个可以平滑调节的旋钮,只能改提示词然后重新抽卡。二是在需要高局部连贯性的任务上不可靠,典型就是生成文字和人手,这两样几乎是扩散模型的经典失败案例。现有的可控生成方案大多要额外训练、外部模型或梯度回传,成本高且不通用。 本文贡献:引入「概念级互信息」(concept-wise mutual information)这一新概念,并发现不同层之间存在很大的、依赖于概念的差异——这说明特定结构的生成是局部化在网络的不同部分的。基于这个洞察提出 Concept Guidance(CoG):先量化每一层对特定概念的影响,然后用「跳过概念相关层后生成的预测」的加权组合来引导去噪。整套方法开箱即用,不需要额外训练、外部模型、梯度或提示词工程。 Concept Guidance precisely approximates the target direction by combining per-layer skip predictions using concept-relevant layers ($\alpha,\beta,\gamma$). It computes individual skip-layer noise predictions ($\epsilon_{[\theta\setminus \alpha]}, \epsilon_{[\theta\setminus \beta]}, \epsilon_{[\theta\setminus \gamma]}$) and extrapolates over them to precisely estimate the target direction. 实验效果:在多种目标和主流模型上都取得性能提升,覆盖 PixArt-alpha、SD3、SD3.5 与 FLUX.1-dev。代码已开源。被 GCPR 2026 接收为 Oral 报告,论文 28 页含补充材料。 Uncurated Comparison of Classifier-Free Guidance (CFG) ho2022classifier_free_guidance, Naive Skip-Guidance as found in Stable Diffusion 3 huggingfaceSD3, Spatio-Temporal Skip Guidance hyung2025spatiotemporal and Concept Guidance for Aesthetics (FLUX.1-dev). 批判点评:「概念的生成是按层局部化的」这个发现本身就有独立价值,它给扩散模型的可解释性提供了一个可操作的抓手:不是笼统地说某些层管结构、某些层管风格,而是用概念级互信息把「哪一层对哪个概念负责」量化出来。基于此的 CoG 走了一条很轻的路——通过跳过概念相关层来构造对比预测,再加权组合去引导,完全不需要训练、外部模型或梯度,这在实践中意味着可以直接挂到任何现成模型上。在 PixArt-alpha、SD3、SD3.5、FLUX.1-dev 四个架构上都有效,说明层级概念局部化不是某个模型的偶然特性,这个跨架构验证做得比较扎实,Ommer 组(Stable Diffusion 原作团队)在这个方向的判断力也值得信任,GCPR Oral 加开源代码进一步加分。但方法本身的边界需要看清。「跳过层」是个粗粒度干预,一层往往同时参与多个概念的生成,跳过它拿到的对比信号必然混入了对其他概念的扰动——摘要提到美感和局部连贯性(文字、手)两类目标,但没说多个概念同时引导时会不会互相冲突,而实际使用中「既要好看又要手正确」才是常态。「性能提升」缺少具体数字和评测口径,美感这类主观目标尤其需要说明是用自动指标(如 aesthetic predictor)还是人工评测,两者结论经常不一致,而且用某个 aesthetic 模型打分再优化它容易陷入自我强化。跳过层还意味着每步要多跑若干次前向来构造对比预测,推理成本的增加倍数摘要没给,这对本来就慢的扩散采样是实际负担。每个概念都需要先做一轮层影响量化,这个前置校准的成本和是否需要按模型重做,也没交代。 10. CPI-Bench:首个纳入多图编辑的评测基准 CPI-Bench: A Comprehensive, Practical and Intelligent Benchmark for Real-World Image Editing | arXiv:2608.14546 前序问题:图像编辑模型进展飞快、应用铺得越来越广,把这些能力直接部署到真实场景的需求越来越急。但现有基准仍局限在简单的单图任务上,覆盖维度有限,而且区分不开不同模型的性能差异——大家分数都挤在一起,看不出谁真的更强。结果就是它们无法可靠评估模型在复杂多图编辑、高要求推理指令、以及实际部署设定下的表现,而这三项恰恰是真实业务里最常遇到的。 本文贡献:提出 CPI-Bench,面向真实世界图像编辑的综合、实用、智能基准,由三个核心子集构成。CPI-General-Bench 全面覆盖多样的编辑任务,并首次把多图编辑评估纳入进来;CPI-Practical-Bench 聚焦高频真实用户应用场景;CPI-Intelligent-Bench 专门评估高要求的推理型编辑能力。三个子集分别对应「覆盖广度」「实用贴近度」「推理深度」三个此前被忽略的维度。 The overview of CPI-Bench. CPI-Bench decomposed into three distinct dimensions: CPI-General-Bench for comprehensive editing performance, CPI-Practical-Bench for real-world deployment efficacy, and CPI-Intelligent-Bench for reasoning-based editing tasks. 实验效果:论文给出主流图像编辑模型在该基准上的评测结果,13 页基准报告。最有说服力的是与 Arena 人类偏好排名的一致性对比:CPI-Bench 的 Spearman 相关系数达 0.994、平均绝对误差 0.12,而 GEdit-Bench 仅 0.548(MAE 1.50)、ImgEdit-Bench 0.814(MAE 0.88)、REDEdit-Bench 0.976(MAE 0.25)。评测覆盖 GPT-Image-2、Seedream5 Pro、Nano Banana Pro、Qwen-Image 2.0 Pro、Seedream4.5、Qwen-Image-Edit-2511、FLUX.2-klein-9B/4B 等主流模型。 Left: Model ranking trends across benchmarks compared against the Arena Image Edit Leaderboard~lmarena2024leaderboard. CPI-Bench we proposed demonstrates the closest alignment with Arena. Right: Spearman correlation coefficients and Mean Absolute Error (MAE) with Arena rank. CPI-Bench outperforms other benchmarks, achieving the highest correlation and the lowest error margin. 批判点评:把多图编辑正式纳入基准是这篇最实在的贡献。真实用户的编辑需求里,「把这张图的人放到那张图的场景里」「参照这张图的风格改那张」这类跨图操作占比很高,而现有基准几乎全是单图进单图出,评测口径和真实用法之间存在结构性错位。三子集的切分逻辑也清楚——覆盖广度、实用场景、推理深度,分别对应三种不同的失败模式。更关键的是它给出了一个可验证的自证方式:用与 Arena 人类偏好排名的 Spearman 相关性来衡量基准自身的有效性。0.994 对 GEdit-Bench 的 0.548,这个差距说明现有部分基准的排序与人类判断几乎脱节,而「基准该不该被信任」本来就该用这种方式检验,这个方法论比基准本身更值得借鉴。不过要注意几个问题。与 Arena 对齐这件事是双刃剑——相关性做到 0.994 意味着它高度拟合了当前 Arena 的偏好分布,但 Arena 本身有其偏差(用户构成、提问分布、审美倾向),过度对齐等于把这些偏差一并继承,而且一个与现有人类榜单几乎重合的基准,额外信息量到底有多少是可以追问的。评测模型只有 8 个且集中在头部闭源与 FLUX 系列,样本量偏小时 Spearman 系数本身就不稳定,换一批模型是否还有 0.99 需要验证。评测指标的具体实现(用 VLM 打分还是人工标注、多图编辑正确性如何自动判定)摘要没交代,而这决定了基准能否被独立复现;13 页篇幅对一个三子集基准来说偏紧,样本规模、任务分布、标注一致性检验都未见披露。「Intelligent」子集尤其需要说明「高要求推理」的操作化定义,否则容易变成难题集合而非能力维度。机构信息缺失也值得留意,基准类工作的中立性与作者团队是否同时在造编辑模型有直接关系。作为今天唯一的评测工作,它排在末位,但指出的评测盲区和自证方法都有实际价值。 趋势观察 今天的加速不再是「砍步数」,而是重新决定每一步该看什么 — SCOPE、ForgeWM、Omni-LiveAvatar 是今天最值得对读的一组,三篇都在做加速,但切入的层次完全不同,合起来正好画出视频生成推理优化的三层地图。SCOPE 动的是注意力内部:它不改模型、不训练,只是质疑现有免训练稀疏注意力用「块级/簇级代理分数」筛 key 这件事——粗粒度代理会把 key 之间的细微差异抹平,高贡献的 key 在激进稀疏下就被漏掉了。它的做法是把过了 RoPE 的 key 按时间、高、宽三个子空间分别聚类,再用查找表聚合质心分数,让代理分数细到单个 key;同时把 Top-k 的下限从「全局固定值」改成「每个头在线估计」,因为不同注意力头的稀疏容忍度本来就不一样,共享一个值必然有头被切狠了。ForgeWM 动的是采样步数,把双向生成器蒸成 1/2/4 步的学生。Omni-LiveAvatar 动的是生成范式,把双向扩散整体换成自回归流式。三者的加速倍率也恰好逐层放大:SCOPE 端到端 1.99 倍,ForgeWM 压到 1 步,Omni-LiveAvatar 相对教师 LTX-2 拿到 33 倍。这说明一件事——单靠某一层的优化很快会触顶,真正的量级提升来自换范式,但换范式的代价是要重训,而 SCOPE 这类免训练方法的价值恰恰在于它能直接叠加到任何已有模型上。值得注意的是三篇的适用边界完全不重叠,理论上可以叠乘,但没有任何一篇验证了叠加后的保真度损失是否线性累积,这大概是这个方向下一步最该做的实验。 MLLM 在生成管线里的角色正在从「编码器」升级为「规划器」 — BiVidGen 与 InstructVVT 从两个尺度上指向同一个转变。过去把 MLLM 接进扩散模型,绝大多数做法是拿它当一个更聪明的文本编码器——冻住权重,取最后一层特征喂给 DiT,MLLM 的自回归生成能力完全没被用到。BiVidGen 系统地拆了三个问题:中间表示该是什么、MLLM 怎么产出它、DiT 怎么吸收它,结论是离散语义视觉 token(EMA tokenizer 产出)作为接口最稳定,自回归因果建模是生成这些 token 的有效方式,而显式的视觉 token 条件化比改写提示词或隐空间桥接都更有效。这三条结论合起来等于说:MLLM 应该真的去「生成」一个视觉计划,而不是被动地提供特征。InstructVVT 在视频试衣这个具体任务上做了同样的事——它砍掉了对 mask、pose 这类手工空间先验的依赖,改由 MLLM 推断语义编辑 token 来做目标消歧和结构保持。这个转变的意义在于,手工先验在真实无约束视频里本来就容易失效,而且把丰富的视觉上下文压成了不完整的结构信号;让 MLLM 直接理解「要改什么」,信息通道宽得多。不过要注意,两篇都还没回答一个关键问题:MLLM 规划出错时,DiT 有没有能力纠正,还是会把错误的语义计划忠实地渲染出来。这个失败模式的分析在两篇里都缺失。 监督信号在变便宜:从「配对目标」退到「参考图 + 注意力对齐」 — CRAFT 这篇的数字值得单独拎出来看:主体个性化的主流做法要 15 万到 200 万组「参考图-合成目标」配对数据,而每一组目标都得靠 LLM 生提示词、T2I 合成、主体抠取、VLM 质检、对应关系标注这条多阶段流水线造出来,成本高,而且方法会被死死绑在某一个目标合成器和某一套数据清洗策略上。CRAFT 只用 1 万张参考图加主体 mask,完全不要合成目标,就在 XVerseBench 上做到了 SOTA。它的思路是把监督从像素空间挪到注意力空间——用注意力级奖励把噪声 token 和短语 token 的注意力对准正确的参考主体,再用得到的逐主体注意力 mask 去门控像素级身份奖励。往大了看,这跟 Concept Guidance 是同一个方向的两种表达:CoG 发现不同层对不同概念的贡献差异很大,于是通过跳过概念相关层来做引导,同样不需要额外训练、外部模型或梯度。两篇合起来提示一个判断——扩散模型内部其实已经有相当结构化的、按概念/主体组织的表示,过去我们花大钱造配对数据,某种程度上是在用外部监督重新教模型一些它内部已经编码好的东西。如果这个判断成立,个性化和可控生成的数据成本还有明显的下降空间。 人工智能炼丹君 整理 | 2026-08-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
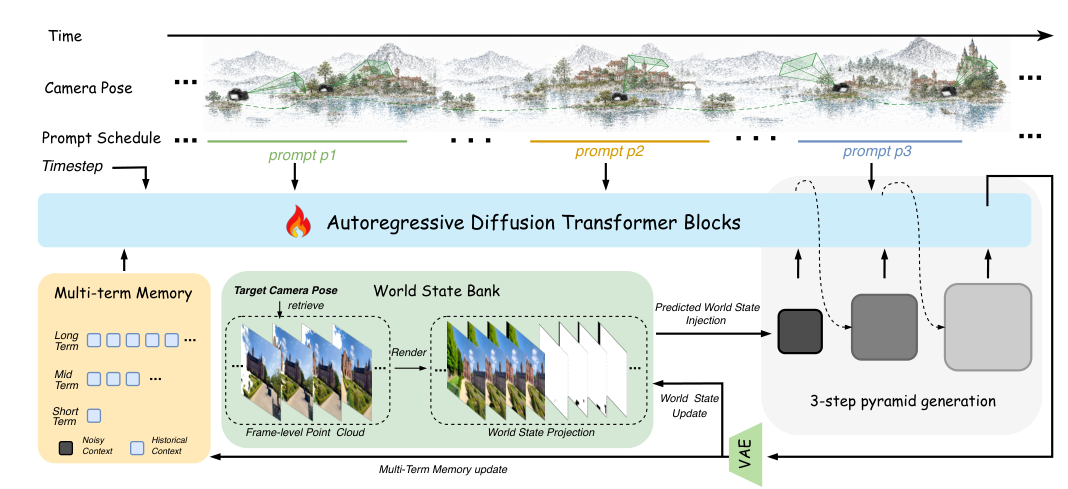
AIGC 每日速读|2026-08-17|AlayaLab世界模型连跑两小时画面不塌Evoke 今日 AIGC 论文速览 今日共 10 篇 · 长时交互式世界模型与外部记忆 1 篇 · 音频生成与零样本语音合成 2 篇 · 视频隐空间与超分重建 2 篇 · 可控图像生成与编辑 3 篇 · 文生 3D 优化机理 1 篇 · 生成质量奖励模型 1 篇 重点论文标题列表 Evoke(Alaya Lab·上海AI Lab·中科大):世界状态外置连跑两小时不塌 VoxAudio(浙江大学):台词与音景端到端一次生成 Phoenix TTS(滴滴·厦门大学):字错率低于真人录音本身 V-RAE(新加坡国立大学):冻结语义特征当隐空间快6倍 Princigram(上海AI Lab·上海交大):物理思维链治好受力方向画错 今日论文速览 1. Evoke:世界状态外置连跑两小时不塌 Alaya-EVOKE: From Linear-Scaling Supervision to Endless World | Alaya Lab·上海AI Lab·中科大 | arXiv:2608.13546 前序问题:交互式世界模型要同时满足三件事:持久记忆、即时响应、长程生成。可这三者在现有架构里互相拆台——把历史留在去噪器上下文或 KV 缓存里,成本随时长一路往上涨,于是「会话能开多久」和「能记住多少」变成一道零和题;而低延迟交互又依赖少步生成,少步学生的能力上限被它的教师死死压住。结果是长跑一段时间后画面开始漂移,而且这种漂移在短窗口内看起来还挺合理,很难被及时发现。 本文贡献:提出 Evoke,做法是把持久世界状态从模型里搬出去,同时重新设计教师。场景几何维护在一个外部的、按相机位姿索引的世界状态库(World State Bank)中,去噪器每步只检索与当前视角相关的信息,因此会话再长上下文也保持有界。教师不再被当成一个固定的生成器,而是专门为长程监督重新设计:它的稀疏注意力组合了块级分组、对选定远端帧的检索、以及一路线性注意力全局状态,让显存与计算随时长线性增长的同时支持长程监督。这种监督恰好能暴露那种「短窗口内看着合理」的内容漂移,而逐块条件化又让提示词切换和事件控制可以贯穿整个序列。最后用 30 秒的分布匹配目标在自强制 rollout 下训练,把这两项能力一起迁移给一个三步学生,且该学生不需要 classifier-free guidance。 With bounded retention, per-step cost does not grow with session length. The camera pose reads the world state bank into the target view; the student injects that render at the coarsest of its three coarse-to-fine evaluations, alongside a short parametric history and the current text condition. The emitted chunk then updates the store and the history. 实验效果:单张 H200、384×640 分辨率下,每个 1.5 秒块的生成耗时 2.11 秒。作为三步世界模型在 WBench 上达到 SOTA,同时在 VBench-Long 与 VBench-2.0 上保持竞争力。论文给出了长达 65.5 分钟的连续 rollout,饱和度、亮度、对比度全程稳定在合理区间而非逐渐冲淡或变暗,与 0-30 秒片段的余弦相似度也保持在真实视频 60 秒间隔的水平;观测到的漂移量明显低于「定向漂移正比于 i」和「扩散式漂移正比于 i 的平方根」两条参考曲线。 An hour-long session stays bounded rather than degrading. One continuous $65.5$,min Evoke rollout, three steps per chunk without classifier-free guidance ($2619$ chunks; faint per-chunk, bold two-minute mean). (a) Color is flat over the hour. (b) Scene identity plateaus at cosine $0.523$, the level real footage scores against itself $60$,s apart. (c) Opening-window shift stays far below unrelated-scene drift. A stability claim, not fidelity ($n=1$). 批判点评:这篇真正的贡献是把问题重新问了一遍。主流做法默认历史必须以某种形式驻留在注意力里,于是所有工程努力都花在「怎么把 KV 压得更狠」上,而压缩必然有损,长跑必然漂移,这条路的天花板是结构性的。Evoke 说历史不该放在注意力里——场景几何本质上是可以用相机位姿索引的空间数据结构,那就外置成检索库,去噪器只管当前视角。这一步跨出去之后,「上下文有界」就不是优化目标而是架构保证了,两小时 rollout 敢报出来正是这个底气。教师侧的设计同样值得注意:它承认了少步学生的上限由教师决定这件事,于是不是去改进蒸馏算法,而是先把教师改造成能提供长程监督的形态,这个因果链梳理得比多数同类工作清楚。不过要把期待校准好。2.11 秒生成 1.5 秒内容,意味着它还没到实时——是 1.4 倍的实时余量缺口,交互体验上属于「可用但有延迟感」,跟同期那些报 20 FPS 以上的数字人工作不在一个口径上,后者的场景约束也弱得多。分辨率 384×640 偏低,放大到 720p 以上时几何检索与渲染路径的开销是否还只占去噪器的 38%,论文没给。更关键的是外部世界状态库依赖相机位姿这个索引键,这在自由视角漫游里成立,但遇到大幅动态物体、场景本身发生不可逆变化(东西被打碎、被拿走)时,一个以几何为中心的状态表示能不能承载这些语义级变更是没有验证的——论文展示的多是相机运动下的场景重访。最后,两小时 demo 是精心挑选的连续 rollout,中途没有剧烈的提示词冲突,这跟真实交互里用户随时想推翻场景的用法差距不小。 2. VoxAudio:台词与音景端到端一次生成 VoxAudio: Vocalized Audio Synthesis via Multi-Reward Autoregressive Flow Matching | 浙江大学 | arXiv:2608.12951 前序问题:很多真实需求其实是「有人在某个环境里说话」——播客制作、视频配音都是这个形态,术语叫发声化音频合成。但现有文生音频系统面对引号里的台词只有两条烂路可选:要么把台词退化成一段听不清的人声嘟囔,要么甩给一个独立 TTS 模型生成后再做后期混音。后者的代价常被低估:一旦拆成两段,你就失去了对「台词什么时候出现」以及「它和场景声怎么互动」的控制权,时间轴对不齐、响度失衡、整体不连贯这三个问题会一起冒出来。 本文贡献:提出 VoxAudio,一个因果自回归流匹配模型,从三个层面同时下手。架构层面用块级因果分解,每块带独立噪声水平,使音频可以经滑动窗口流式推理配合 KV 缓存输出,且支持可变目标时长;为了能在任意块粒度上推理,预训练阶段刻意用随机化的块边界。偏好层面用多奖励的 Negative-aware FineTuning(NFT),联合优化语义保真度、语言准确性、听感质量与时间对齐四项。数据层面为补上发声内容缺失的监督信号,构建了 VoxCorpus——一个大规模语料库,其字幕直接引用嵌入语音的逐字转录并标注时间区间,同时给出带区间标注的 VoxBench 基准与一个时间对齐度量指标。 Comparison of Audio Generation Paradigms. Decoupled Pipeline: Conventional methods synthesize soundscapes and speech independently, requiring post-hoc mixing. VoxAudio: A unified system for vocalized audio synthesis from single prompts. 实验效果:在覆盖通用音频、语音、以及统一发声化音频三类任务的四个基准上验证了有效性与效率。代码与 demo 已公开。 Detailed architecture and attention mechanism of the Causal Diffusion Transformer. (a) The causal joint block facilitates interaction between audio latents and conditioning features; (b) The causal fused block refines integrated representations through deep self-attention; (c) The chunk-wise causal attention mask, where shaded regions indicate masked-out tokens, ensuring that each temporal chunk only attends to current and historical context. 批判点评:这篇的价值在于它拒绝了一个被行业默认了很久的妥协。「音效模型 + TTS + 后期混音」这套流水线之所以能长期存在,是因为它在多数场景下勉强够用,于是没人去问「为什么台词和环境声必须分两次生成」。VoxAudio 指出这个拆分恰好牺牲了最难补回来的那部分能力——时间上的因果关系。混音是后置操作,它能调响度、能对齐波形,但无法让环境声「因为有人说话」而改变,也无法让说话时机被场景事件驱动。端到端建模才能拿回这层控制。三个层面的设计也不是堆料:随机化块边界预训练是为了让推理时的块粒度可以自由选,这直接服务于流式;四路奖励里那个时间对齐项是专门补时间控制这个短板的,跟 VoxBench 的区间标注指标形成闭环,说明作者清楚自己在优化什么。但摘要在关键数字上相当吝啬——四个基准只说「验证了有效性与效率」,既没给具体分数,也没跟解耦流水线做量化对比,这让人很难判断端到端到底赢了多少、在哪些条件下会输。这类工作最需要回答的问题恰恰是:当台词很长、语义复杂时,端到端模型的语音清晰度能不能持住专用 TTS 的水平?摘要里没有正面交代。另外 VoxCorpus 的规模只说「大规模」,语言覆盖、说话人多样性、场景类型分布这些决定泛化能力的信息全部缺失,而这类需要逐字转录加时间区间标注的数据,标注成本高、容易在特定域上过拟合。多奖励 NFT 同时优化四个目标也存在标准的调权难题,摘要没提四项之间是否出现此消彼长。 3. Phoenix TTS:字错率低于真人录音本身 Phoenix TTS: High-Fidelity Synthesis and Voice Conversion via Flow-Matching-Driven Speech Tokenization | 滴滴·厦门大学 | arXiv:2608.11737 前序问题:零样本 TTS 系统里的语义 tokenizer,通常用有监督 ASR 或自监督目标来训练。但语音的语义与声学信息本质上无法彻底解耦,ASR 类目标为了聚焦语言内容会主动丢掉声学细节,依赖这类 tokenizer 的模型往往在音色相似度上难以做到最优。更根本的问题是这些 tokenizer 都是独立优化的,拿不到下游声学生成任务的任何直接监督,于是离散 token 与声学模型所需的连续空间之间横着一道特征鸿沟,把合成质量的上限提前焊死了。 本文贡献:提出 Phoenix TTS,一个把表示学习与生成式声学建模紧密耦合的统一框架。具体做法是:语音 tokenizer 一方面被优化去重建自监督特征以保持语义丰富度,另一方面同时接受来自 Flow Matching 训练损失的直接监督。通过这种联合训练范式,抽出的离散 token 既保留了必要的语义信息,又天然与下游 Flow Matching 模型的特征空间对齐,跨过了那道特征鸿沟。 UniSpeechTokenizer 实验效果:在 11 万小时数据上训练,字错率稳定低于真实录音本身(说明合成语音的可懂度已超过原始录音水平),同时保持稳健的零样本说话人相似度,与若干知名大规模基线相当或更优。作为统一训练的额外收获,学到的 tokenizer 可以无需任务特定微调直接迁移到零样本音色转换任务。 UniSpeechTokenizer 批判点评:这篇干的是修地基的活,不性感但要紧。语音合成这几年的注意力几乎全在声学模型和声码器上,tokenizer 被当成一个先训好就不动的预处理模块,很少有人回头问它的训练目标是否与下游需求一致。Phoenix TTS 把这个断层点了出来:ASR 目标天生要丢声学细节,因为对识别任务而言音色是噪声——可对合成任务而言音色恰恰是目标。目标函数错位,下游怎么优化都有个焊死的天花板。让 Flow Matching 损失直接回传到 tokenizer,本质是把「表示该长什么样」交给最终任务来定义,而不是让一个代理任务替它决定。音色转换能力免费掉出来,也从侧面印证了这个表示确实同时抓住了语义与声学两侧。不过「字错率低于真人录音」这个说法要小心读——它更可能说明合成语音吐字过于清晰规整、少了真人的口误连读与含混,在 ASR 眼里反而更好识别。这是可懂度的胜利,但不等于自然度更高,某种意义上甚至暗示了一种「过度清晰」的机器感;论文若不配 MOS 主观听测,这个数字容易被误读成全面超越真人。11 万小时的数据量也把复现门槛拉得很高,联合训练的收益里有多少来自方法本身、多少来自数据规模,摘要没有拆开;tokenizer 与 Flow Matching 联合训练还引入了耦合代价——换下游声学模型就得重训 tokenizer,牺牲了模块化,这个成本对工业迭代不算小。另外说话人相似度只说「相当或更优」,没给具体对比对象与数值,跨语言、带口音、低资源音色这些真实难点是否覆盖也未交代。 4. V-RAE:冻结语义特征当隐空间快6倍 V-RAE: Rethinking Video Latent Spaces for Generation | 新加坡国立大学 | arXiv:2608.13556 前序问题:隐空间视频生成依赖自编码器来定义一个紧凑空间供生成模型工作。视频自编码器的架构这几年演进了很多,但它们的隐空间基本还是围绕像素级重建来优化的,缺乏高层语义组织。问题在于——一个重建最优的隐空间,未必适合做生成建模。这两个目标长期被混为一谈,几乎没人认真区分过。 本文贡献:提出 V-RAE,一个视频表示自编码器,把紧凑的生成式隐变量直接构建在冻结的视觉基础模型表示之上。一个轻量的时序池化模块负责消除时间冗余同时保留语义结构,再由一个视频解码器从压缩特征中重建连续运动。作者用四个有代表性的冻结编码器在视频重建、语义探测、类别条件生成三类任务上做了评估。此外还提出 tFVD——一个时序一致性诊断指标,用来补上「重建质量不足以刻画生成效用」这个缺口。 V-RAE architecture. A frozen visual representation encoder produces temporally dense features, which are compressed by a lightweight temporal pooling module. The figure depicts the chunk-wise causal decoder used with image encoders. 实验效果:在 K600 上取得 2.13 rFVD,超过所有评测过的大规模预训练视频 VAE。其隐变量保留的语义信息显著多于常规视频 tokenizer 的隐变量。在匹配的生成设置下,最优变体在 UCF101 与 K600 上分别取得 117.86 与 19.16 的 gFVD,同时收敛速度最快达到 6 倍提升。论文还证明 tFVD 与下游生成质量的相关性比重建指标更可靠。此外在 Cityscapes 未来视频预测任务上,V-RAE 也在匹配预测设置下优于 Wan 2.2 VAE 的隐空间。 Temporal Reconstruction Error Difference (TRED) for RAEv2, Wan2.2 VAE, OmniTokenizer, and V-RAE on K600 validation examples. The heatmaps visualize temporally averaged TRED within high-frequency regions of interest, while the curves show spatially averaged TRED over consecutive frame transitions. 批判点评:这篇最有价值的是它把一个被默认了很久的等式拆开了:重建好 ≠ 适合生成。整个视频 VAE 社区的迭代逻辑基本是「刷低 rFVD,然后假定生成模型会因此受益」,而 V-RAE 直接指出这个传导链未经验证,还顺手给了 tFVD 作为更靠谱的代理指标——这个贡献可能比模型本身更持久,因为它改的是大家的评估习惯。用冻结视觉基础模型特征当隐空间底座这个做法也很省:既然 DINOv3、SigLIP2 这些编码器已经在海量数据上学到了良好组织的语义空间,那生成模型没必要从像素重建目标里重新长出语义结构。收敛快 6 倍这个数字最能说明问题——它说的不是生成质量上限更高,而是优化路径更顺,因为隐空间的语义组织已经替生成模型做掉了一部分工作。不过要注意实验口径。gFVD 报的是类别条件生成,数据集是 UCF101 与 K600,这是学术基准里的小规模设定,跟当下真正在跑的文生视频(大规模文本条件、开放域、高分辨率、长时序)距离相当远。冻结编码器天然带来分辨率与预训练域的双重约束——基础模型在图像域上训练,对高速运动、剧烈形变这类视频独有的内容是否还保有良好表示,摘要没给压力测试。「四个代表性冻结编码器」的结果也只报了最优变体,编码器选择对结果的敏感度有多大不清楚,如果换一个就掉很多,那这套方法的鲁棒性要打折。另外语义丰富的隐空间可能反过来损失细粒度纹理与高频细节,这在类别条件生成里不易暴露,但在真实应用里是硬指标。 5. Princigram:物理思维链治好受力方向画错 Towards Physics-Faithful Generation of Scientific Diagrams | 上海AI Lab·上海交大 | arXiv:2608.13112 前序问题:文生图早已做到照片级真实,但顶尖系统在生成科学示意图这件事上依然不可靠——因为示意图的价值不在好看,而在物理上是否成立:受力方向对不对、坐标系是否有效、热力学状态是否自洽、方程与所画场景是否匹配。这些模型训练用的是网络图像加物理内涵浅薄的配文,产出的示意图看起来合理但物理上是错的,用在教育与科学传播场景里是净负值。更麻烦的是现有评测器也不可靠:CLIP 打分器会把摩擦力方向画错的图打出更高分,开放词表检测器则完全抓不到物理量之间的几何关系。 本文贡献:提出 Princigram,一个物理保真的科学示意图生成器,以及配套数据管线。核心进展是结构化物理思维链(SP-CoT):一套按子学科划分的 schema,把一张物理示意图分解成横跨六个子学科的显式多步推理链,从场景识别、参数、受力或过程分析,到支配定律与综合。与自由形式思维链不同,SP-CoT 遵循固定 schema 并带严格保真规则,把视觉可见事实与物理推断结论分开,所有数学一律符号化表达;它既作为密集训练监督,也在推理时充当结构化的「思考」提示。据此整理并结构化标注了 430 万张物理图像,其中 115037 张带专家级标注,并适配了一个统一多模态骨干。另外提出 VeriphyT2IBench,其问题由每张留出示意图自身的结构化标注派生:每张图变成一组针对其对象、受力、状态的二元问题库,使评判模型的分数可以分解为一条条具名物理事实而非一个笼统总分。 Several challenges to physics-faithful scientific-diagram generation, and our approach. (a)~State-of-the-art multimodal generators produce diagrams that violate basic physics, such as mislabeled forces or incorrect circuit topology. (b)~The failure is generative rather than perceptual: a model that correctly describes the physics of a scene still generates it incorrectly. (c)~Appearance-based evaluation is unreliable in this setting, a CLIP-style scorer prefers the physically incorrect image (c.1), and an open-vocabulary detector cannot verify the geometric relations that determine correctness (c.2). (d)~Structured Physical Chain-of-Thought () addresses both problems by keeping data construction, annotation, training, and evaluation structured, finitely describable, and extensible. 实验效果:在 GenExam 的物理子集与 VeriphyT2IBench 上,Princigram 表明显式的物理结构化监督确实提升了生成科学示意图的物理保真度。数据侧完成 430 万张物理图像的整理与结构化标注,其中 115037 张达到专家级标注质量。 Overview of : data construction, structured supervision, and training--evaluation. % (a)~Data-curation pipeline. Four complementary sources---a manually curated seed, OpenDataLab~opendatalab, public web archives, and a textbook-procurement stream---are aggregated into a raw pool, then de-duplicated, resolution-filtered, and routed by a subdiscipline classifier into a structurally annotated corpus of ${\sim}4.3$M physics diagrams; a high-quality expert-level subset is split into training and held-out test data, and a balanced subset of the test split forms . % (b)~Corpus composition. Distribution of the corpus across the six physics subdisciplines and their sub-categories, showing a strongly long-tailed profile in which mechanics and quantum mechanics dominate while optics is rare. % (c)~ and how it is used. From a diagram and its prompt, a fixed five-step schema (scene; parameters; force or process analysis; coordinate systems and governing laws; and synthesis) makes the underlying physics explicit. These structured annotations drive three stages: pre-training on the ${\sim}4.2$M corpus-level pairs, supervised fine-tuning on the $109$K human-verified expert-level pairs, and evaluation on , where each generation is scored by answering the binary questions compiled from its own annotation (Local, Global, and Strict accuracy). 批判点评:这篇挑的是一个价值被严重低估的场景。T2I 的评价体系几乎全建立在「像不像真的」上,而科学示意图恰好是一类外观正确性无关的图像——一张受力箭头画反的斜面示意图可以渲染得极其精美,但它在教学里传递的是错误知识,负效用比不生成更大。作者把这一点说得很直白,也顺手戳破了评测环节的窘境:CLIP 打分器给错误图打高分这个例子相当有说服力,说明整条评估链条此前是失效的。SP-CoT 的设计有两点比较克制:固定 schema 而非自由思维链,是因为物理推理有确定结构,放开只会引入更多幻觉;严格区分「视觉可见事实」与「物理推断结论」,则避免了把模型的推断误当成图上真有的东西——这个区分是很多 CoT 类工作栽跟头的地方。VeriphyT2IBench 把分数拆成具名物理事实,也把「这张图错在哪」变成了可定位的信息而不是一个模糊总分。不过效果段的表述明显偏软——只说「提升了物理保真度」,没有任何具体分数或与基线的量化差距,这在一篇同时提出新基准的论文里是个显眼的空白,读者无法判断是从 40% 提到 70% 这种量级,还是只有几个点的边际改善。430 万张图像里仅 11.5 万带专家标注,占比 2.7%,剩下 97% 的语料级标注质量如何、噪声会不会反向污染物理保真度,没有交代。六个子学科的 schema 是人工设计的,这既是优点(结构可靠)也是天花板(覆盖范围受限),遇到跨学科题目或 schema 未涵盖的场景如何退化是未知的。最后,VeriphyT2IBench 由留出图自身标注派生,问题与训练数据同源,评判又依赖一个判官模型,存在既当裁判又当选手的风险,第三方独立验证仍然必要。 6. MotionCraft:视频超分做成世界状态预测 MotionCraft: Latent World Modeling with Sparse Attention for Visual Upscaling | 独立研究者团队·澳门大学 | arXiv:2608.08553 前序问题:视频超分要从低分辨率输入恢复高保真高分辨率视频,手机拍摄、流媒体、档案修复都靠它。但现有路线在局部细节保真、长程时空建模、感知真实感、效率这四项上互相拉扯:卷积对齐类方法能守住局部结构,可一遇大幅运动或复杂退化就崩;Transformer 类方法能抓长程依赖,但要在架构或算法上做适配才跑得动;近期的隐空间或扩散类生成器能合成丰富纹理,却需要专门的时序约束才能维持连贯。 本文贡献:提出 MotionCraft,一个可控的视频超分框架,把复原任务重新表述为受世界模型启发的运动感知隐状态预测,并把自适应稀疏注意力与一个用户可直接操作的显式控制接口整合进来。系统由三部分组成:稳健的运动融合(外部运动编码器与内部运动估计器并行,经光度一致性检查与置信度门控融合,再由残差校正器补偿偏差)、一个在局部性与定向非局部交互之间取平衡的隐空间世界 Transformer(LWT,内含自适应稀疏注意力与键值记忆缓存),以及一个紧凑的条件解码器,在流式约束下输出时序一致的高质量重建。 Overview of the MotionCraft framework for high-fidelity visual upscaling. The system initiates with Robust Motion Encoding and Fusion, where external motion signals and internal image-driven estimates are gated by a Photometric Inconsistency confidence map to compensate for systematic biases. The core Latent World Transformer (LWT) processes low-resolution latents using Adaptive Sparse Attention, which employs a differentiable soft top-$k$ selection to maintain locality while capturing long-range dependencies. Temporal persistence is managed through a Key-Value Memory Cache ($\mathcal{M}_{t-1}$). The Controllability Interface modulates the latent state via global scalars $\gamma$ and spatial gating maps $g_t$ to balance temporal smoothness and reconstruction fidelity. Finally, a Tiny Conditional Decoder performs distillation-based refinement to produce the high-resolution output $\hat{X}_t$. 实验效果:实证评估显示 MotionCraft 在重建与感知性能上都表现强劲,同时能在时序平滑度与重建保真度之间提供可预测的权衡。控制敏感度实验给出了这条权衡曲线:随着控制参数 γ 从 0.1 增至 2.0,运动平滑度评分从约 0.15 单调升至约 0.95,而 PSNR 从 29.00 dB 平缓降至 27.20 dB——下降幅度不到 2 dB,说明权衡是渐进可控而非断崖式的。 Control sensitivity. As $\gamma$ increases, motion smoothness rises monotonically while PSNR decreases gracefully, indicating a predictable trade-off between smoothness and fidelity. 批判点评:这篇的思路转换值得留意:把超分从「逐帧复原」重新表述为「运动感知的隐状态预测」,等于承认视频超分本质上是个时序建模问题而非图像问题的批量重复。世界模型的框架此前主要用在生成与决策上,挪到复原任务上是个不算显然的迁移。真正把它跟同类工作区分开的是那个显式控制接口——绝大多数超分方法把「时序平滑 vs 细节保真」这个取舍固化在训练里,用户拿到的是一个既定折中;MotionCraft 把这个旋钮交出来,且用 γ 曲线证明它单调可预测。对档案修复这类需求分化的场景(有人要平滑观感,有人要最大细节)这是实用的产品化设计,不只是刷指标。双运动路径加光度一致性检查的做法也务实,承认了外部光流在大运动与遮挡下会失效,用内部估计器与置信度门控做兜底而非盲信单一信号。但作者列为「独立研究者团队」这一点需要读者自行加权——12 位作者集体标注独立研究者,缺少机构算力与工程背书,可复现性与规模化能力都要打问号。效果段也偏定性:「强劲」「可预测的权衡」这类表述背后没给出与主流基线(如扩散类超分)的并列数值对比,无法判断它在绝对质量上处于什么位置;γ 曲线的 PSNR 区间落在 27-29 dB,在标准 VSR 基准上属于中等而非领先水平。「流式约束」被反复提及但未给出延迟或吞吐的具体数字,自适应稀疏注意力节省了多少计算也没量化——对一篇把效率列为核心动机的论文,这是关键缺口。 7. PixSDS:latent干净像素却在偷偷跑偏 PixSDS: Why Latent SDS Makes Noisy Pixels | 独立研究者 | arXiv:2608.12997 前序问题:分数蒸馏采样(SDS)通过用预训练扩散先验优化渲染图像来实现文生 3D,但在隐空间里做 SDS 常常产出结构化的色彩伪影与高频纹理噪声。这个现象长期被当作调参问题绕过,很少有人追问它的机理到底是什么。 本文贡献:识别出隐空间 SDS 的一个失效模式,成因是 VAE 诱导的像素漂移:被优化的图像可以沿着「VAE 编码器约束很弱」的像素空间方向移动,于是它的隐变量表示始终保持干净且语义合理,而图像本身却在悄悄累积可见伪影。作者用受控的 2D SDS 实验、VAE-only 优化实验,以及一份简化分析共同支撑这个诊断——分析表明当到像素的逆映射欠约束时,编码器式的隐空间目标会放大图像空间噪声。据此提出 PixSDS,一个轻量的 VAE 一致性梯度修复方法:解码一次隐空间 SDS 的前瞻步,把解码得到的图像作为像素空间优化的干净方向,从而减少沿 VAE 不一致方向的移动,且无需重训扩散模型、无需更换渲染器、无需替换 SDS 目标。 VAE-only optimization. Column 1 shows the target image $X$. Columns 2--7 show optimized images $Z_i$ from two different random initializations, with their decoded latents $\dec(\enc(Z_i))$ shown in the bottom-right inset. Even without a diffusion model, optimizing only through the VAE encoder produces structured noise in $Z_i$, while the decoded latents remain clean. 实验效果:在 2D 优化与文生 3D 生成上的实验表明,PixSDS 大幅减少了结构化伪影,同时保留了语义内容。集成到 DreamGaussian 第二阶段优化后,与原始 SDS 相比纹理更干净;接入 LucidDreamer 后,浮动的噪声高斯与结构化纹理伪影都有减少。代码已公开。 DreamGaussian comparison. We apply in the second optimization stage of DreamGaussian~tang2024dreamgaussian. Compared with SDS, produces cleaner textures and fewer structured artifacts. 批判点评:这是一篇教科书式的诊断型论文,全程一个人完成。它的方法论比结论更值得学习:先用 VAE-only 优化把「latent 干净、像素脏」这个反直觉现象单独隔离出来复现——这一步很关键,因为它证明了伪影的来源与扩散先验、与渲染器都无关,纯粹是 VAE 编码器的欠约束逆映射造成的;再用简化分析给出数学上的解释;最后修法极轻,不动扩散模型、不动渲染器、不动 SDS 目标,只补一个 VAE 一致的干净方向。「latent 看起来完全正常所以问题很难被发现」这个洞察尤其有意思——它意味着任何只监控隐空间指标的优化流程都会对这类退化完全失明,这个教训可以外推到所有在隐空间做优化的任务,不限于文生 3D。修补的普适性也已用两个不同的 3D 框架(DreamGaussian 与 LucidDreamer)交叉验证。局限同样清楚。单作者、无机构支持,实验规模注定有限:文生 3D 只验证了两个开源框架,对闭源或更大规模的 3D 生成系统是否同样适用未知。效果全部以定性描述给出——「大幅减少」「更干净」,没有任何量化指标(如 CLIP 分数、用户偏好率、伪影强度度量),这在 3D 生成领域虽属常见,但让改进幅度无法与其他去伪影方法横向比较。前瞻步需要额外解码一次,带来的计算开销未报告;超参数 β 虽做了敏感性分析但最优值如何随任务变化没有指导。最后,这个方法治的是 VAE 欠约束这一个特定失效模式,而 SDS 还有过饱和、Janus 多面等其他老问题,它对那些完全无效——读者不应把它理解为 SDS 的通用改进。 8. GST:学整个画家而非几张名作 Through Van Gogh's Eyes: Global Style Transfer with Diffusion Model | KIST·成均馆大学 (ECCV 2026) | arXiv:2608.11546 前序问题:艺术图像合成想复现的是某位艺术家的整体视觉身份,但现有方法往往抓不住这个「全局风格」。传统风格迁移是一对一的——把一张或少数几张参考画作的风格搬到内容图上,做作品级风格化有效,却无法代表一位艺术家更广的风格分布。而用艺术家名字作条件的文生图扩散模型(比如「……梵高风格」)虽然灵活,却受文本诱导偏差影响,往往只复现那几幅最出名作品的图案,把梵高简化成《星月夜》的漩涡。 本文贡献:提出全局风格迁移(GST)这一多对一的艺术图像合成范式,聚合目标艺术家的多幅作品,把它们共有的全局风格迁移到单张内容图上。为此提出全局风格引导(GSG),在扩散模型的中间特征空间(h-space)中学习一个残差的全局风格偏移量,且在固定提示词下进行——通过纯粹从视觉统计中学习艺术家级风格语义,GSG 规避了文本依赖带来的艺术偏差。另外提出内容对齐引导(CAG),一个免训练的感知引导机制,在允许艺术家特有的几何形变的同时保留内容图的语义结构。 Overall framework of Global Style Transfer (GST). (Left) Global Style Guidance (GSG) trains a lightweight Style Extraction Function $f_t$ on multiple artworks under the fixed prompt `A painting', learning a residual global style offset $\Delta \mathbf{h}_t$ that modulates the U-Net bottleneck representation $h_t$ in a text-independent manner. During reverse diffusion, $\Delta \mathbf{h}_t$ steers the denoising trajectory toward the artist's global style distribution. (Right) Content Alignment Guidance (CAG) first maps the content image $I_c$ into a noisy latent via DDIM inversion, then applies CLIP-based perceptual guidance at each timestep to align the semantic structure of the generated image with the content while permitting style-driven deformation, yielding artist-level stylization. 实验效果:在 WikiArt 上的实验表明,相比现有风格迁移与扩散式艺术合成方法,GST 在风格保真度、内容保留、输出多样性三项上都更优。论文展示了同一张内容图迁移到梵高、达利、塞尚、罗列赫、莫奈、希什金、库斯托季耶夫、雷诺阿八位艺术家风格的结果,各艺术家的笔触与色彩体系区分明显。 Global Style Transfer results across multiple artists for the same content image. Given the same content images $I_c$, our framework transfers the images into the global styles of eight different painters. All images are generated using a text-independent prompt (``A painting”) to eliminate stylistic bias in the diffusion model. For each content image $I_c$ (left column), our framework applies Global Style Guidance (GSG) to capture artist-specific global semantics and Content Alignment Guidance (CAG) to preserve flexible, style-based deformation of content. The results show that a single content image is rendered into distinctly different artistic styles across various artists, demonstrating our framework’s ability to synthesize artist-faithful images. 批判点评:这篇的问题定义比方法更有意思。风格迁移长期默认「风格」等于某张参考图的纹理统计,于是一对一是天然设定;而 GST 指出艺术家的风格其实是一个分布,任何单张作品都只是这个分布的一次采样,用一张画代表梵高在概念上就是错的。这个重新定义直接催生了多对一范式。它同时点出了 T2I 路线的一个隐性缺陷:文本条件下的「梵高风格」并非从画作学来,而是从图文配对数据里那几幅高频出现的名作学来,因此模型学到的是《星月夜》而不是梵高——这个「文本诱导偏差」的诊断很准。在 h-space 学残差偏移的做法也选得聪明:中间特征空间比 latent 更贴近语义,学偏移量而非重训模型让方法保持轻量,且完全绕开文本通道。CAG 免训练、允许几何形变这一点也符合艺术直觉——真正的风格迁移不该只换纹理,梵高会重画物体的形状。至于代价:论文自己给出的失败案例已经说明,当艺术家的数据集内容高度偏斜时方法会失灵(如罗列赫作品几乎全是山景,学到的「风格」里混进了山这个内容先验)——这是多对一范式的结构性弱点,风格与内容在聚合统计里本就纠缠。评测停在 WikiArt 且以风格保真度、内容保留、多样性三项定性对比为主,摘要未给具体数值;而艺术风格评估本身缺乏公认的客观指标,「更优」的可信度依赖主观实验设计的严谨程度。方法需要目标艺术家有足够多的作品,对小众或早逝艺术家不适用。最后必须提一句:这类工作把「批量复刻在世艺术家风格」的门槛进一步降低,版权与创作伦理的争议只会更尖锐,论文对此没有讨论。 9. SketchSense:看懂潦草草图再动笔补图 SketchSense: Learning to Interpret Imperfect Sketch Guidance for Image Inpainting | 独立研究者 | arXiv:2608.13186 前序问题:草图引导的图像补全提供了直观的结构控制,但真实草图往往混杂着可靠的全局意图与局部糟糕的笔画——过于密集、位置偏移、残缺不全,或者干脆是刻意不合常规的画法。现有方法基本二选一:要么整个去噪过程都把输入草图当固定条件,要么先把它精修成干净结构再合成 RGB。前者假设所有笔画一样可靠,局部错误会一路传播污染整张图;后者则必须在外观与语义上下文尚未浮现之前就把结构的歧义解决掉,属于信息不足时强行决策。 本文贡献:提出 SketchSense,通过同步去噪两条相互作用的 RGB 流与结构流来解读不完美的草图引导。双向注意力融合(Bidirectional Attention Fusion)把外观生成与结构恢复耦合起来,产出一个精修后的结构,这个结构同时暴露了模型对草图的动态理解过程;实现上复用 FLUX 块族的原生 QKV 作为共享基底,再由专门的联合注意力 QKV LoRA 产生增量。一个短语级目标负责对齐两条流的语义落地。草图感知空间调控(Sketch-Aware Spatial Regulation)进一步根据局部生成状态调整草图的使用方式,对注意力与融合过程做调制;另有一个可选的带符号先验,把「保留 vs 修正」的意图注入特征表示与注意力行为。 Motivation and overview of SketchSense. Fixed-sketch conditioning can propagate locally degraded strokes. SketchSense synchronously denoises RGB and structure, regulates sketch use through learned attention modulations and an optional signed prior, and exposes its interpretation as refined structure. 实验效果:在自然图像与结构复杂图像上的实验显示,在复原质量与结构保真度两方面都显著优于现有方法。论文以中国壁画补全为例,展示了在笔画密集、结构复杂的场景下,SketchSense 相比固定草图条件方法在细节上的改善。 Bidirectional Attention Fusion with adapted QKV reuse. Native QKV provides the shared base, and a dedicated joint-attention QKV LoRA produces fusion-specific $\Delta QKV$. Directional messages pass through a zero-initialized projection, split into $\Delta H_x^l$ and $\Delta H_e^l$, and enter their receiving branches through $g_x^l$ and $g_e^l$. 批判点评:这篇抓的痛点很真实:用户画的草图从来不是均匀可靠的,通常整体意图对、局部笔画烂。而现有两条路线都建立在一个错误前提上——固定条件假设笔画一致可靠,先精修则要求在信息不足时提前把歧义决断掉。SketchSense 的解法在时序安排上更合理:让结构解读与外观生成同步演进、互相喂信息,去噪早期外观尚模糊时不强行定结构,随着 RGB 逐渐清晰再反过来修正结构理解。「精修后的结构暴露了模型对草图的动态理解」这一点还带来了额外的可解释性——用户能看到模型把哪一笔当成了什么,这在交互式创作工具里是实打实的价值,比一个黑箱输出有用得多。可选的带符号先验也务实,它承认「这笔要保留还是要改」有时只有用户知道,那就把这个意图开放给用户显式指定,而不是让模型猜。但这篇是单作者工作,实验规模与工程完备度需要留意。效果段只有「显著优于现有方法」这类定性表述,没有任何量化指标或基线名单,而复原质量与结构保真度都有成熟的客观度量(FID、LPIPS、边缘一致性等),不给数值让改进幅度无从核实。方法本身叠了四个组件——双向注意力融合、短语级目标、草图感知空间调控、可选带符号先验,摘要未提消融,无法判断收益主要来自哪一处,也存在过度设计的可能。绑定 FLUX 块族的 QKV 复用意味着与特定架构耦合,迁移到其他 DiT 骨干需要重新适配。双流同步去噪必然增加计算量,开销未报告。最后,「刻意不合常规的笔画」与「画错的笔画」在模型看来可能无法区分,这个歧义如何处理是这类方法的固有难题。 10. MuseCritic:先写乐评再打分准度飙升 MuseCritic: Learning Multi-Aspect Song Rewards through Natural-Language Aesthetic Critiques | 复旦大学 | arXiv:2608.11755 前序问题:长篇歌曲生成模型在时长、结构完整性、声学复杂度上不断进步,让可靠的审美奖励对于对齐人类偏好变得越来越重要。但面向完整歌曲的奖励模型仍然很少,且现有评估器通常一次前向就直接吐出分数,不给任何可读的解释——既难以调试,也无法告诉生成模型究竟哪里不好。 本文贡献:提出 MuseCritic,一个半标量奖励模型:它先生成一段覆盖五个审美维度的自然语言评论,再把这段评论作为中间表示来预测连续的奖励分数。训练分两阶段:先由教师模型(Gemini-3-Pro)针对歌曲、评分细则与专家评分产出高质量评论用于监督微调;随后让微调后的模型生成自己的评论再做奖励学习,以缓解训练与推理之间的分布偏移。推理时同一骨干挂两个头,LM head 输出五维评论,RM head 给出五维分数。 Overview of the two-stage training and inference pipeline of method. In Stage~I, Gemini-3-Pro generates aesthetic critiques from songs, evaluation rubrics, and expert mean ratings to construct $\mathcal{D}_{\mathrm{off}}$, which is used to fine-tune a pretrained large language model into an SFT critique generator. In Stage~II, the SFT model replaces the teacher critiques with one self-generated five-aspect critique per song to construct $\mathcal{D}_{\mathrm{on}}$; a scalar reward head is then initialized, and is trained using expert mean ratings as regression targets. At inference time, first generates a five-aspect critique and then predicts five continuous aesthetic scores conditioned on the song, rubric, and self-generated critique. 实验效果:在 200 首 SongEval 歌曲组成的域内测试集上,宏平均均方误差从 0.2875 降到 0.2316,宏平均 LCC、SRCC、Kendall's tau 分别提升到 0.9068、0.8838、0.7178。在包含 733 组偏好对的域外 Music Arena 基准上取得 71.35% 的最高准确率。此外用 MuseCritic 配合 GRPO 训练,让 Muse-0.6B 在 SongEval 与 Audiobox Aesthetics 的全部九项审美指标上都获得提升。 Effect of natural-language aesthetic critiques on five-dimensional score distributions. Curves show expert ratings, full predictions, and predictions from the no-critique variant on the fixed SongEval test set. Coherence, Musicality, Memorability, Clarity, and Naturalness correspond to the five aesthetic dimensions. Without critiques, predictions cluster in a narrow high-score region; the full model more closely matches the range of expert ratings. 批判点评:这篇把「先说理由再打分」这个在 LLM 评判里已经验证过的思路,落到了音乐审美这个更主观的领域上,而且没有停在「评论只是副产品」的层面——评论被显式当作预测分数的中间表示,等于强制模型把打分依据外显出来再据此定分,这跟事后补一段解释有本质区别。第二阶段用模型自己生成的评论做奖励学习也处理得细:如果一直用教师评论训练,推理时喂的是自产评论,中间表示的分布就对不上,这个偏移点被明确指出并修掉了。可解释性在这里不只是锦上添花——生成模型拿到「和声设计缺少标志性钩子」这样的具体反馈,比拿到一个 3.7 分有用得多,而 GRPO 实验里九项指标全面提升,说明这个信号确实能反向优化生成质量,闭环是通的。域外 Music Arena 上 71.35% 的偏好准确率也比域内指标更能说明泛化。要留一分冷静的地方:域内 200 首、域外 733 组偏好对,规模都偏小,音乐风格与语言的覆盖面无从判断,长篇歌曲的审美又高度依赖文化语境,跨风格泛化能力存疑。域内 LCC 高到 0.9068 需要警惕——SongEval 的专家评分本身可能存在标注者一致性上限,逼近这个上限更多说明拟合了该标注体系的偏好,而非掌握了普适审美。71.35% 这个数字放在偏好判断任务里其实不算高,随机是 50%,说明近三成的人类偏好它判反了,作为 RLHF 奖励信号会引入可观噪声。教师用 Gemini-3-Pro 也意味着整套评论体系继承了该模型的审美倾向与盲区,五个审美维度同样是人工设定,未必覆盖音乐性的全部面向。MSE 从 0.2875 降到 0.2316 是约 19% 的相对改善,扎实但非量级突破。 趋势观察 今天的主线不是把模型做大,而是把「上下文」从模型里搬出去 — Evoke 与 V-RAE 是今天最值得对读的一组,它们从两个方向指向同一个判断:真正卡住长时生成的不是参数量,而是模型该记住什么、以什么形式记住。Alaya Lab 的 Evoke 把场景几何整体搬进一个相机位姿索引的外部世界状态库(World State Bank),去噪器每步只检索与当前视角相关的那一小块,于是上下文长度被彻底钉死——会话跑到两小时,单块生成时间仍是 2.11 秒,显存不涨。这跟主流做法正好相反:主流是把历史往 KV cache 里堆,堆到显存爆掉为止,于是「记得多久」和「能跑多久」变成一道零和题。Evoke 的答案是这道题本身出错了,历史不该放在注意力里。V-RAE 走的是另一条路但逻辑同源:它质疑视频 VAE 长期以来只为像素重建服务这件事,直接把冻结的视觉基础模型特征当作隐空间底座,只加一个轻量时序池化模块压掉冗余。结果是重建拿到 K600 上 2.13 rFVD 超过所有评测过的大规模视频 VAE,而生成侧收敛快了最多 6 倍——说明「重建最优的隐空间」和「适合生成的隐空间」本来就不是一回事,这个区分此前基本被行业忽略。两篇合起来给的信号很清楚:接下来一段时间的增量可能更多来自表示与记忆的重新设计,而不是继续堆 DiT 层数。 音频这边今天补的是「语音和音效终于长在一起」这个缺口 — VoxAudio 与 Phoenix TTS 都来自音频方向,但补的是产业链上两个不同的洞。浙大的 VoxAudio 针对的是一个被长期用胶带粘住的流程:要生成「有人在环境里说话」的音频,现有系统要么把台词退化成听不清的嘟囔,要么交给独立 TTS 生成再后期混音——后者的代价是彻底失去对「什么时候说、和场景怎么互动」的控制权。它用块因果自回归流匹配把二者合成一件事做,配上带逐字转录与时间区间标注的 VoxCorpus 语料,还能滑窗流式出音。滴滴与厦大的 Phoenix TTS 则往回追一层,质疑语音 tokenizer 的训练方式:传统 tokenizer 用 ASR 或自监督目标独立训练,为了抓语言内容会主动丢掉声学细节,于是下游声学模型的音色相似度天花板被提前焊死。它的做法是让 tokenizer 同时接受自监督特征重建和下游 Flow Matching 损失的直接监督,11 万小时数据训出来的系统字错率稳定低于真人录音,且免费附赠零样本音色转换能力。一个在往上做端到端整合,一个在往下修表示层的地基,共同点是都不满足于「拼几个现成模块」。 越来越多论文在做「诊断」而不是「刷分」,这是领域成熟的信号 — PixSDS 和 Princigram 今天都不是在原有指标上抢名次,而是先把一个大家默认能用的东西拆开看它为什么不对。PixSDS 追查文生 3D 里 latent SDS 那些结构化色斑与高频噪点,给出的诊断相当漂亮:VAE 诱导的像素漂移——优化中的图像可以沿着「VAE 编码器几乎不约束」的像素方向自由跑,于是它的 latent 看起来始终干净且语义正确,图像本身却在悄悄累积可见瑕疵。它用 VAE-only 优化实验把这个机理单独复现出来,修法也轻:解码一次 latent 前瞻步,拿解码图像当像素空间的干净方向,不重训扩散模型、不换渲染器。Princigram 则指出一个更尴尬的事实——T2I 早就做到照片级真实,但画科学示意图依然满是错的受力方向、无效坐标系,因为训练数据里的网图配文根本不含物理约束,生成出来「看着像、物理上全错」,用在教学与科学传播上是净负值。它的解法是结构化物理思维链(SP-CoT),把示意图按六个子学科拆成固定 schema 的多步推理,既当训练监督又当推理提示,并配 VeriphyT2IBench 把评分拆成一条条具名物理事实而不是一个笼统总分。这类工作短期不好看,长期决定了这个方向能不能被信任。 人工智能炼丹君 整理 | 2026-08-17 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 周末专题|2026-08-16|NVIDIA领衔 On-Policy 蒸馏让学生反超教师 AIGC 周末专题深度解读:On-Policy 蒸馏:生成模型后训练从「模仿终点」转向「纠正过程」 人工智能炼丹君 整理 | 2026年8月16日(周日) 覆盖时间:2026-08-07 ~ 2026-08-15 本期概述 本期 AIGC 周末专题聚焦On-Policy 蒸馏:生成模型后训练从「模仿终点」转向「纠正过程」方向,精选 7 篇代表性论文进行深度解读。 方向分布: 少步视频蒸馏的策略与因果对齐 2 篇 (HPSD, CMD) 超越教师的外推式后训练 2 篇 (DreOPD, FlowErase-OPD) 特权信息蒸馏与 LUPI 范式 2 篇 (TRACE-GS, HPSD) 免训练缓存加速的另一条路线 2 篇 (GCache, GeoCache) 含 NVIDIA × 1、上海AI Lab × 1、港中文/复旦 × 1 技术路线与时间线 离线蒸馏时代(2022.06 — 2024.06) 描述:监督来自教师预先生成的轨迹或终点,学生做纯回归。范式简洁、可预计算,但从设计上就不覆盖学生自己会走到的状态。 关键节点: 2022.06:Progressive Distillation:渐进折半采样步数 2023.03:Consistency Models:端点一致性映射 2023.11:LCM / LCM-LoRA:少步生成走向实用 2024.05:DMD2:分布匹配蒸馏成为主流框架 On-Policy 萌芽(2024.07 — 2026.03) 描述:研究者开始意识到 exposure bias,把学生 rollout 引入监督环路,同时 RL 后训练(DPO/GRPO 系)为生成模型提供了另一条突破教师上界的路径。 关键节点: 2024.09:扩散模型 DPO 系列:偏好对齐后训练兴起 2025.01:Self-Forcing 类方法:自回归视频引入 on-policy rollout 2025.08:GRPO 等 RLVR 方法迁入视觉生成 2026.02:OPD/SDPO:on-policy 稠密监督在 agent 与 LLM 上验证 OPD 集中爆发(2026.08.07 — 2026.08.13) 描述:一周内 9 篇以 on-policy 蒸馏为核心的论文横跨视频、图像、3D、安全对齐四个任务,且共同转向「修正教师自身缺陷」这一更深的问题层次。 关键节点: 08.07:FlowErase-OPD:OPD 用于多概念安全擦除 08.10:DreOPD / TRACE-GS:外推超越教师 + 特权几何 08.13:HPSD / CMD:混合策略自蒸馏 + 因果教师对齐 08.13:LOPD:把特权上下文本身做成可学习隐 token 免训练加速并行线(2026.08.13 — 未来) 描述:缓存加速同期给出另一种答案:不改模型权重,只优化推理时的计算复用决策,且同样强调「对齐最终目标而非局部代理」。 关键节点: 08.13:GCache:双层优化对齐画质的缓存策略 08.13:GeoCache:跨视角几何搬运替代时间跳步 待观察:蒸馏与缓存能否叠加,仍是开放问题 1. HPSD:混合策略自蒸馏让 TI2V 模型把「看过首帧」的能力内化进纯文生视频:上海AI Lab 与上交、NTU S-Lab 联手,用同一个模型分别当师生,T2V 与 TI2V 双双提升 论文: HPSD:混合策略自蒸馏让 TI2V 模型把「看过首帧」的能力内化进纯文生视频 arXiv: 2608.13205 机构: 上海AI Lab, 上海交通大学, NTU S-Lab, 复旦大学, Adobe Research, 港中文 1.1 研究动机 核心问题: TI2V 模型在特权条件(高质量首帧+增强提示词)下质量明显更好,但这份能力无法在纯 T2V 模式下被调用 TI2V(文本+图像到视频)是新兴的统一架构:一个模型同时支持 T2V 和 I2V。实践中人们发现,给它一张高质量首帧或一段精细提示词,生成质量会明显好于纯 T2V 模式。这就引出一个很自然的问题——这种被「特权条件」激发出来的能力,能不能内化成模型自己的基础生成能力?最直接的做法是自蒸馏(self-distillation),但监督微调这条路是 off-policy 的:监督只覆盖教师生成的终点,来自固定的离线分布,而非学生实际访问的状态,缺乏针对演化策略的精确纠正。而现有 on-policy 蒸馏方法又有条件-状态不匹配(condition-state mismatch)的毛病:监督被给定的首帧牵着走,而不是对准学生真正生成的内容,反而误导了纠正方向。 前序工作及局限: Off-Policy SFT 自蒸馏:监督只覆盖教师终点,不对准学生演化中的策略 On-Policy 蒸馏:监督位置对了但被首帧条件带偏,产生条件-状态不匹配 与前序工作的本质区别: 混合策略:学生继承教师轨迹点作锚点,再向自身策略局部精修 K 步,最后在自生成 roll-out 上做速度级监督 1.2 方法原理 Introduction to HPSD. (a) Off-policy SFT supervises on fixed teacher endpoints, which drift from the evolving student policy. (b) On-policy distillation queries the teacher at student-visited states, yet suffers from condition-state mismatch in TI2V models. (c) HPSD anchors the student on the teacher trajectory and supervises roll-outs evolved under its own policy. (d) HPSD substantially boosts the base generation quality of TI2V models (WAN-2.2-TI2V-5B in this figure), especially in cinematic lighting, fine details, and balanced composition. Prompts in the Appendix. HPSD 要解决的核心矛盾是:off-policy 的监督位置不对,纯 on-policy 的监督方向不对。它的折中方案是「锚点 + 局部精修」。具体来说,教师在特权条件(增强提示词 + T2I 生成的高质量首帧)下 rollout 出一条完整轨迹,学生不直接回归这条轨迹的终点,而是把轨迹上的点当作起始锚点,从锚点出发用自己的策略走 K 步,得到一段「混合策略子轨迹」——起点来自教师(off-policy 成分),路径来自学生(on-policy 成分)。监督加在子轨迹末端:此时把模型切回 TI2V 模式获得教师预测,与学生在 T2V 模式下的预测做速度级(velocity)匹配。这样监督既落在学生真实会访问的状态附近,又通过锚点继承了教师的高质量先验。教师权重由学生 EMA 更新,整个流程只需一个模型,不引入额外参数。 1.3 核心创新 提出 Hybrid-Policy Self-Distillation(HPSD),核心设计是让单个 TI2V 模型在不同条件下同时扮演师生两角:教师跑 TI2V 模式,拿到高质量首帧和增强后的提示词;学生跑基础 T2V 模式,只有原始提示词。关键在「混合策略」这个折中——学生先继承教师的 off-policy 轨迹点作为锚点(anchor),再在锚点附近向自己的策略做局部精修(locally refines),最后在这些自生成的 roll-out 上接受速度级(velocity-level)监督。这样既吸收了教师的特权先验,又保留了 on-policy 的精确策略纠正,避开了纯 off-policy 的分布错位和纯 on-policy 的条件-状态不匹配。 1.4 实验结果 Overview of HPSD. (a) Offline Stage: Privileged conditions (enhanced prompt and first frame) are synthesized using auxiliary models. (b) Online Stage: The student evolves hybrid-policy sub-trajectories starting from the teacher's off-policy anchor states. Distillation on these states provides the student with precise policy correction anchored by the teacher's privileged content priors. Varying gray shading denotes the noise level over time, while solid white indicates clean frames. 实验显示 HPSD 显著提升 T2V 性能,同时 TI2V 模式也获得可观增益——这一点值得注意,说明它不是简单地把 TI2V 的能力搬到 T2V(那样 TI2V 应该持平或下降),而是整体强化了模型的基础生成能力。论文提供了项目主页与代码。定性对比(teaser 图 d 部分)显示,原始 T2V 结果在光影、材质、动态细节上明显平淡,HPSD 后的结果在火光、烟雾、金属反射等高频细节上有实质改善。 1.5 关键洞察 「内化特权信息」的机理未澄清 — 如果高质量首帧带来的是模型本不具备的新信息,理论上无法通过自蒸馏内化;如果只是激发了模型已有却未被普通提示词充分调用的能力,那本质是条件空间的对齐而非能力提升。论文用 T2V/TI2V 双提升来佐证后者,但缺少直接的表征层面证据 计算开销未与 off-policy 基线做等算力对比 — 每个训练步都要教师 rollout 完整锚点轨迹 + 学生走 K 步 + 教师再前向一次,成本远高于离线预计算轨迹的 SFT。论文报告了效果增益,但没给出相同 GPU 时预算下与 off-policy 自蒸馏的对比曲线 依赖外部 T2I 与 LLM 改写器 — 特权首帧由外部 T2I 模型生成、增强提示词由 LLM 改写,最终 T2V 质量的天花板部分由这两个外部组件决定。若 T2I 模型本身有风格偏好,可能被一并蒸馏进 T2V 模式 技术演进定位: TI2V 统一架构上的自蒸馏方案,T2V 与 TI2V 双双提升 可能的后续方向: 锚点比例自适应调度 扩展到音视频联合生成的多模态特权条件 2. CMD:NVIDIA 让因果教师给因果学生打分,堵住自回归视频蒸馏的「未来信息泄漏」:NVIDIA 指出双向教师评分让学生偷看未来帧,改用因果教师后长视频与相机控制双双 SOTA 论文: CMD:NVIDIA 让因果教师给因果学生打分,堵住自回归视频蒸馏的「未来信息泄漏」 arXiv: 2608.13391 机构: NVIDIA, SketchX CVSSP 萨里大学 2.1 研究动机 核心问题: 少步因果视频学生被「能看到完整 clip」的双向教师监督,教师评分依赖了学生生成时不存在的未来帧与未来控制 交互式自回归视频生成有两个硬约束:低延迟 rollout 和精确的在线控制。少步蒸馏负责前者,而在线控制施加了一条因果约束——每一帧、每一块都只应依赖生成时已经拿到的历史和控制信号。问题在于,现有的视频分布匹配蒸馏(DMD)流水线普遍用「双向教师给完整 clip 打分」的方式来监督因果少步学生。这就出现了信息集错位:教师给某个目标块的评分,可能依赖了学生生成它时根本还不存在的未来帧和未来控制信号。学生因此在训练时被一个「能看到未来」的评委打分,推理时却只能看历史,两者的信息边界不一致。 前序工作及局限: DMD / DMD2:提供分布匹配蒸馏的评分函数框架,但为双向设定 Self Forcing:把 on-policy rollout 引入自回归视频,仍用双向教师全 clip 打分 与前序工作的本质区别: 因果教师逐块条件评分 s_real(Bt|B<t, I_0) + Prefix Scoring 对准学生真实缓存前缀 + Prefix Corruption 稳定早期训练 2.2 方法原理 Context-Matched Distillation. A causal student first generates an autoregressive rollout. Self-Forcing scores its complete noised rollout with a bidirectional teacher, allowing the score of a target to depend on future blocks. CMD instead uses a causal teacher: Base CMD conditions on preceding noised DMD blocks, Prefix Scoring uses the cached clean student prefix that produced the target, and Prefix Corruption perturbs this prefix to stabilize supervision when early rollouts are unreliable. CMD 的技术核心是把 DMD 的评分函数改造成因果形式。原本 Self Forcing 一类方法让双向教师对完整 clip B_1:4 打分,再取其中第 3 块的梯度,此时该梯度实际上依赖了 B_4(未来块)。CMD 换成因果教师,直接计算条件评分 s_real(B3 | B<3, I_0),未来块完全不参与。在此基础上,Prefix Scoring 进一步要求评分所用的前缀就是学生 rollout 时实际缓存的那个前缀(而非重新加噪的独立样本),实现「上下文匹配」。由于训练早期学生生成的前缀质量差,直接用会让教师评分不可靠,因此引入 Prefix Corruption:对前缀施加扰动(图中的 Corrupted Prefix / Prefix Corruption 分支),既避免教师被劣质前缀带偏,又不破坏目标与上下文的对应关系。因为整个公式化只依赖「历史可见」这一条约束,它天然适配帧级和块级生成、长视频蒸馏,以及相机等时变控制条件的蒸馏。 2.3 核心创新 提出 Context-Matched Distillation(CMD),一个因果 DMD 框架,核心原则是让教师监督与「每个目标被生成时可获得的信息」严格对齐。三个层次的设计:(1) 用因果教师替代双向全 clip 评分,教师评估每个目标时不访问未来帧与未来控制;(2) 用同一个因果教师初始化少步学生,让教师训练、学生蒸馏、推理三个阶段共享一致的因果公式化;(3) Prefix Scoring——不只对齐时间信息边界,还把监督对准学生真实 rollout 的上下文,即在「产生该目标的那个缓存学生前缀」下评估它;(4) Prefix Corruption——训练早期学生前缀不可靠,对其加扰动来稳定训练,同时保持目标-上下文对齐。 2.4 实验结果 Efficient Prefix Scoring. The causal student first generates an on-policy rollout and caches the clean prefix used to produce each block. Corrupted prefixes and their corresponding noised DMD targets are then packed under a block-causal attention mask, allowing all targets to be scored in parallel. Finally, the real and fake scores are evaluated under the same prefix--target context to form the context-matched DMD update. 在短视频和长视频基准上,CMD 在自回归方法中取得 SOTA 综合性能,同时对时变相机控制的遵循度有大幅改善(substantially improved adherence to time-varying camera controls)。论文包含 chunk1 vs chunk4 的用户研究偏好对比。相机控制这一项的提升尤其能佐证方法动机——正是因为原来的双向教师会泄漏未来的控制信号,学生才学不好「只根据当前控制做出反应」这件事。 2.5 关键洞察 因果教师本身能力弱于双向教师 — 换成因果教师意味着教师评分时可用的信息更少,其分数估计的绝对质量必然低于双向教师。CMD 赌的是「信息集一致」的收益大于「教师变弱」的损失,论文用最终指标证明了净收益,但没有拆解这两个相反作用各自的量级 Prefix Corruption 的扰动强度是新的调参负担 — 扰动太弱则教师被劣质前缀带偏,太强则破坏上下文对齐。论文提出该机制但对扰动 schedule 的敏感性分析有限,实际迁移到新模型时可能需要重新搜索 延迟收益未量化 — 论文主打质量与控制遵循度,但交互式生成的核心诉求是延迟。Prefix Scoring 需要缓存并复用学生前缀,训练开销明确增加,推理端的 FPS/首帧延迟数字在摘要中未给出 技术演进定位: 自回归视频蒸馏中因果信息集对齐的系统性方案,相机控制遵循度大幅改善 可能的后续方向: 刻画因果教师容量损失与信息对齐收益的相对量级 扩展到动作/音频/文本流等多种时变控制 3. DreOPD:用「降质参考」造出排斥方向,让学生在多数指标上超过它的所有教师:哈工深与浙大把隐式奖励外推转成闭式速度回归,多教师设定下超越各专精教师 论文: DreOPD:用「降质参考」造出排斥方向,让学生在多数指标上超过它的所有教师 arXiv: 2608.09233 机构: 哈尔滨工业大学(深圳), 浙江大学, 哈尔滨工业大学 3.1 研究动机 核心问题: 传统 on-policy 蒸馏的教师匹配本质是模仿,学生上界被教师锁死;而 RL 虽能超越却有高方差梯度与跨任务干扰 流匹配模型已是图像生成主流,但适配到多样的下游场景通常依赖后训练,而不同任务的优化目标之间会互相冲突。强化学习可以直接优化任务奖励、突破原模型上限,但轨迹级优化带来高方差梯度和跨任务干扰。On-policy 蒸馏(OPD)能在学生 rollout 上提供稠密稳定的监督,可惜传统的教师匹配本质仍是模仿(imitation-based)——学生的上界就是教师,无法超越。于是问题变成:能不能既保留 OPD 的稳定性,又获得 RL 那种「超越原模型」的外推能力? 前序工作及局限: OPD:学生 rollout 上的稠密监督,稳定但只能插值到教师之间 DPO / 隐式奖励:用偏好对隐式定义奖励方向,但走轨迹级策略梯度 与前序工作的本质区别: 引入轻度降质参考构成排斥区,吸引与排斥合力指向教师之外;把隐式奖励外推写成闭式速度回归而非策略梯度 3.2 方法原理 Conceptual comparison in the multi-task setting. Left: Standard OPD regresses a shared student toward task-specific teacher velocities, encouraging interpolation among the teachers. Right: DreOPD uses a shared degraded reference to construct targets that extrapolate through each task-specific teacher. Joint regression toward these targets moves the student beyond each teacher along the corresponding teacher-reference directions. DreOPD 的核心几何图景可以从论文的示意图直接读出:左图是常规多教师 OPD,学生被 OCR/美学/GenEval 三个教师同时吸引,结果只能落在教师围成的凸包内(Interpolated Student,Between Teacher);右图加入降质参考后,空间被划分成排斥区(Repulsive Zone)与吸引区(Attractive Zone),学生一方面被各教师吸引,另一方面被降质参考排斥,两股力合成的总方向(图中黄色箭头)指向教师之外,得到 Extrapolated Student(Beyond Teachers)。技术上,这套外推没有走 RL 的策略梯度,而是把隐式奖励差转写成速度场的闭式回归目标,因此保留了 OPD 逐状态稠密监督、低梯度方差的特性。降质参考只需「轻度」降质——降得太狠会让排斥方向脱离有意义的语义流形,降得不够则对比度不足、外推方向不清晰。 3.3 核心创新 提出 DreOPD(Degraded-reference extrapolative OPD),把两个范式桥接起来。关键有两点:(1) 把隐式的奖励外推转化为闭式的速度回归(closed-form velocity regression),使外推式后训练能享受 OPD 的稳定性,不必走高方差的策略梯度;(2) 引入一个「轻度降质的参考」(mildly degraded reference)来强化教师-参考之间的对比,从而得到更清晰的外推方向。直观理解就是:只知道「好的方向」时学生最多插值到教师之间;同时知道「差的方向」后,学生可以沿着差→好这条向量继续往外走,抵达教师本身都没到过的区域。 3.4 实验结果 Visualization of multi-task DreOPD performance. We compare the student trained by DreOPD with the corresponding task-specific teachers across metrics. 在单教师和多教师两种设定下,DreOPD 的平均表现都优于 OPD 和多任务 RL 基线,并在多数指标上超过各个专精教师。论文的雷达图很直观:学生(红色)在 GenEval 0.968、OCR 0.936、Aesthetic 6.29、PickScore 24.04、HPSv2.1 0.349、ClipScore 0.296、ImageReward 1.52、Average 0.994 这八个维度上几乎完全包住了 GenEval 教师、OCR 教师、美学教师三条曲线,而每个专精教师只在自己擅长的那一到两个轴上突出、其他轴明显凹陷。 3.5 关键洞察 外推的线性假设在目标冲突时可能失效 — 「远离差的方向 ≈ 靠近好的方向」在奖励地形平缓处成立。但当多个目标本身互斥(如 OCR 精度与美学评分),合成的外推方向可能指向两者都退化的区域。论文展示了成功的雷达图,未展示外推步长过大时的失效模式 降质参考的构造缺乏原则性 — 「轻度降质」的程度直接决定排斥方向的质量,但如何选择降质方式与强度,论文未给出可迁移的准则,实际应用中可能需要针对每个任务重新调 评测集中在自动指标 — 八项指标全部是自动奖励模型或规则评测。奖励模型本身可被过拟合,「超越教师」的结论若无人类偏好实验佐证,存在 reward hacking 的解释空间 技术演进定位: 流匹配 on-policy 蒸馏中首个让学生突破教师上界的外推式方案 可能的后续方向: 外推步长自适应控制与失效检测 结合人类偏好数据以减少对自动奖励模型的依赖 4. TRACE-GS:把「多看几个视角」的特权几何蒸馏进稀疏视图学生,推理时只留学生:Concordia 与 Mila、上交提出首个用特权几何做 on-policy 监督的稀疏视图 3DGS 修复框架 论文: TRACE-GS:把「多看几个视角」的特权几何蒸馏进稀疏视图学生,推理时只留学生 arXiv: 2608.10286 机构: Concordia University, Mila 魁北克 AI 研究所, 上海交通大学 4.1 研究动机 核心问题: 稀疏视图下欠约束几何让扩散从一开始就偏,偏差沿 rollout 累积;而监督加在独立加噪状态上,不覆盖推理真正到达的状态 稀疏视图 3D 高斯泼溅(3DGS)修复的常规思路是不断堆更复杂的修复架构,但这篇论文指出了一个更根本的共性缺陷:基于扩散先验的方法,其监督发生在独立加噪的状态上,而这些状态并不覆盖推理时真正到达的状态。在稀疏视图场景下这个问题被放大——欠约束的几何从一开始就让去噪产生偏差,而这些偏差沿 rollout 逐步累积(compound along the rollout)。这正是本期专题的理论根基:off-policy 监督位置错了,误差就永远得不到纠正。 前序工作及局限: 扩散先验稀疏视图重建:off-policy 监督导致 accumulated drift LUPI(Vapnik):训练时用特权信息、推理时丢弃的经典框架 与前序工作的本质区别: 教师以额外训练视角的丰富几何为条件,沿学生 rollout 在每个访问状态上对齐去噪方向与跨视角响应;部署只留学生 4.2 方法原理 Off-policy mismatch in sparse-view 3DGS restoration. Top: supervision at independently forward-noised states misses rollout states, letting deviations accumulate; on-policy supervision covers visited states. Bottom: on-policy restoration recovers sharper detail from 6 views. TRACE-GS 的技术叙事非常干净。它的 teaser 图把 off-policy 与 on-policy 的差别画得比大多数论文清楚:off-policy 一侧,监督状态(supervision states)与学生实际访问状态(visited states)是两条平行的点列,中间用虚线标注 mismatch,学生沿 rollout 走向的终点被标为 accumulated drift;on-policy 一侧,监督状态与访问状态重合,rollout 箭头直接连在被监督的状态上。落到实现,教师的「特权」是额外训练视角提供的几何约束——这在训练集上是免费的(数据本来就有更多视角),但在推理时按定义不可得。监督不只对齐单视角的去噪方向,还对齐跨视角响应(cross-view responses),这对 3D 一致性尤其关键。最终产物是一个只吃稀疏视图的学生,它的输出被当作额外观测送进 3DGS 优化,从而绕过稀疏视图下 3DGS 本身欠约束的问题。 4.3 核心创新 提出 TRACE-GS,做 on-policy 轨迹蒸馏(on-policy trajectory distillation):教师以额外训练视角带来的更丰富几何为条件,沿稀疏视图学生自己的 rollout 提供目标,在每个访问过的状态上对齐去噪方向和跨视角响应。这份额外几何只在训练时可用,因此 TRACE-GS 属于 LUPI(learning using privileged information)设定;部署时只保留稀疏视图学生,其修复后的渲染结果作为伪观测(pseudo-observations)反哺 3DGS 精化。论文声称这是首个从特权几何导出 on-policy 监督用于稀疏视图 3DGS 修复的工作。 4.4 实验结果 Qualitative comparison on DL3DV. GSFixer blurs reflective and under-observed regions (zoomed), whereas TRACE-GS restores sharper detail closer to the GT. 论文报告在多个数据集和多种稀疏视图设定下都有一致增益(consistent gains)和较强的泛化性(strong generalization),包含 DL3DV、Mip-NeRF 等数据集上的定性对比与消融。teaser 的下半部分给出直观对比:off-policy 修复结果在细杆状物体(栏杆、阀门手柄)上出现明显模糊与结构断裂,TRACE-GS 的结果在同一区域保持了清晰边缘,与 GT 更接近。 4.5 关键洞察 特权视角的数量与选择策略未充分探讨 — 教师能看到「额外训练视角」,但额外多少个视角、如何挑选,直接决定教师的几何优势大小,也决定师生差距是否过大导致蒸馏困难。摘要层面未见这方面的系统消融 增益来源存在混淆项 — 最终质量提升同时来自 (a) on-policy 监督位置的修正与 (b) 教师拥有更好几何这两个因素。要证明前者的贡献,需要一个「同样特权几何但 off-policy 监督」的对照组,摘要中未明确提及 伪观测的误差会进入 3DGS 优化 — 学生修复结果作为伪观测参与 3DGS 精化,若学生在某些视角系统性产生幻觉几何,误差会被固化进 3D 表示,且比 2D 层面的错误更难察觉 技术演进定位: 首个用特权几何导出 on-policy 监督的稀疏视图 3DGS 修复框架 可能的后续方向: 特权几何的自适应选择与课程式调度 扩展到动态场景 / 4D 重建 5. FlowErase-OPD:把多个单概念擦除模型蒸成一个 LoRA,用保留教师守住生成能力:哈工深与清华深研院、鹏城实验室用锚定多教师蒸馏解决多概念擦除的擦-保权衡 论文: FlowErase-OPD:把多个单概念擦除模型蒸成一个 LoRA,用保留教师守住生成能力 arXiv: 2608.07620 机构: 哈尔滨工业大学(深圳), 清华大学深圳国际研究生院, 鹏城实验室 5.1 研究动机 核心问题: 流匹配模型的多概念擦除中,各概念擦除目标互相干扰,且擦得越狠正常生成能力损失越大 流匹配模型让文生图质量大幅提升,同时也带来了安全隐忧——它们可能生成有害或不期望的内容。现有针对流匹配模型的概念擦除方法大多只处理单个概念,而同时有效擦除多个概念仍然困难:不同概念的擦除目标会互相干扰,而且擦得越狠、模型的正常生成能力损失越大,这个「擦除 vs 保留」的权衡是核心难点。 前序工作及局限: ESD / UCE 等概念擦除:主要面向单概念,多概念同时擦除仍困难 多教师蒸馏 + LoRA 合并:提供把多个专精模型合成单一模块的路径 与前序工作的本质区别: AMTD 把多个单概念擦除教师蒸进统一 LoRA 并加保留教师;ARC 动态调节各擦除教师的采样频率、损失权重与擦-保配比 ρ 5.2 方法原理 Overview of FlowErase-OPD. (a) illustrates the framework of our approach. Each mini-epoch we input a prompt contain a specific target concept to the student, corresponding teachers, and the anchor teacher. Then we compute the KL divergence and employ ARC to calculate the final loss and update the weight of each teacher models for the current mini-epoch. (b) details the Adaptive Retention Control. RAC dynamically adjusts the mini-epoch occupancy ratios between each concept erasure teachers and the anchor teacher based on the erasure efficacy for each individual concept. 从框架图可以看清 FlowErase-OPD 的结构:左侧是共享文本编码器,学生是一个带 LoRA 适配器的流匹配主干(Double Stream Blocks + Single Stream Blocks);中间是 n 个概念擦除教师(各自也是 LoRA 适配器,分别对应「梵高星空」「裸体」等概念);下方是锚点教师(以「a child playing soccer」这类正常提示词为条件),负责界定不该被破坏的生成行为。学生输出 μ_θ 与各教师输出 μ_φ 逐一计算 KL 散度,得到 ℓ_1..ℓ_n 与 ℓ_anchor。右半部分是 Adaptive Retention Control 的计算逻辑:每个擦除损失乘以权重 w_i、乘以采样概率 si、再乘以 (1-ρ),锚点损失乘以 w{n+1} 与 ρ,最后取期望合成总目标。ρ 即擦除与保留的动态配比,w 与 s 则让训练过程能自动把算力分配给当前还没擦干净的概念,避免某个概念主导优化。 5.3 核心创新 提出 FlowErase-OPD,基于 on-policy 蒸馏做多概念擦除。两个关键组件:(1) Anchored Multi-Teacher Distillation(AMTD)——先把多个单概念擦除模型蒸馏进一个统一的 LoRA 模块,并额外引入一个保留教师(retention teacher)来缓解擦除与生成能力保留之间的权衡;(2) Adaptive Retention Control(ARC)——动态调整每个擦除教师的采样频率和损失权重,同时动态调节擦除教师与保留教师之间的相对贡献,从而协调多个擦除目标。 5.4 实验结果 Visual results of Van Gogh erasure results. 在裸体、物体、艺术风格三类擦除任务上,FlowErase-OPD 一致改善了「擦除效果 - 图像质量 - 语义对齐」三者的权衡,在多种多概念擦除设定下达到 SOTA。此外得到的模型对对抗攻击表现出较强鲁棒性。论文据此主张 on-policy 蒸馏可以作为流匹配模型安全可控生成的一个有原则的框架(principled framework)。 5.5 关键洞察 教师数量线性增长带来的成本 — 每个待擦概念都需要先训练一个单概念擦除教师,概念数增加时前置成本线性上升。面向真实内容安全场景(数百个敏感概念)时这套流程的可扩展性存疑 鲁棒性评测的攻击面有限 — 论文称对对抗攻击鲁棒,但概念擦除的攻防是快速演进的领域,针对性的越狱提示词、LoRA 权重回退等攻击手段是否覆盖,摘要层面无法判断 ρ、w、s 三组超参的交互复杂 — ARC 引入三组动态量共同决定损失配比,虽然自适应减轻了手工调参,但三者的交互动力学缺乏分析,训练不稳定时难以定位是哪一路失衡 技术演进定位: on-policy 蒸馏作为流匹配模型安全可控生成的统一框架 可能的后续方向: 免单概念教师的直接多概念擦除 与更强的越狱攻击基准联合评测 6. GCache:缓存复用不该看局部相似度,应该直接对齐最终画质:港中文与复旦用双层优化搜缓存策略,Wan2.1 上 2.17 倍加速还把 LPIPS 从 0.1095 降到 0.0316 论文: GCache:缓存复用不该看局部相似度,应该直接对齐最终画质 arXiv: 2608.13043 机构: 香港中文大学, 复旦大学 6.1 研究动机 核心问题: 现有缓存策略用局部特征相似度决定是否复用,但该启发式与最终生成质量显著错位,因为误差沿轨迹的传播累积是非均匀的 扩散模型在视觉生成上性能占优但推理开销巨大。基于缓存的加速是一条有希望的路线,但现有策略都依赖局部相似度启发式——看当前步与上一步的特征差异是否够小来决定是否复用缓存。论文指出这类局部指标与最终生成质量存在显著错位(significantly misaligned with final generation quality),根源在于误差沿去噪轨迹的传播和累积是非均匀的:同样大小的局部误差,发生在不同时间步对最终画面的影响可能差好几倍。 前序工作及局限: DeepCache / FasterDiffusion:开创特征缓存复用加速 TeaCache / ERTACache:基于局部相似度的自适应缓存,仍是局部代理指标 与前序工作的本质区别: 先推误差传播严格上界,再用 Bernstein 形式重参数化传播指数放松保守性,最后把策略搜索写成双层优化对齐画质损失 6.2 方法原理 % Comparison between local mismatch and global impact (lower is better). % We conduct a series of independent experiments in which a cached residual is reused at exactly one specific timestep. % For each timestep, the blue marker (Rel-L1) measures the local discrepancy between the ground-truth residual and the cached residual from the preceding step, while the red marker (LPIPS) reflects the resulting impact on final generation quality. % As shown, local mismatch is not a reliable proxy for global impact, as large Rel-L1 values around step~19 and in the final denoising stages correspond to only minor increases in LPIPS, i.e., a relatively small degradation in final output quality. % Note that the prominent Rel-L1 spike around step~19 is a known characteristic of Flux-dev~1.0 when using the Euler ODE solver. % Similar spike behaviors in different diffusion models have also been reported in prior work~DBLP:conf/cvpr25:TeaCache. % GCache 的动机由两张分析图支撑,值得单独说明。第一张图把逐步的局部 Rel-L1 与最终 LPIPS 画在同一横轴上:可以看到 Rel-L1 在第 21 步附近出现一个尖锐峰值,而同一位置的 LPIPS 几乎没有波动;反过来在去噪末段(timestep 5→0),Rel-L1 明显回升但 LPIPS 依然平稳。这直接证伪了「局部特征变化大 = 不能复用」的启发式。第二张图从另一个角度验证:在不同时间步注入等量噪声,特征偏差(Feature Deviation)的最终累积量差异显著——早期注入(timestep 50)的偏差一路放大到最高,晚期注入(timestep 10)的影响则小得多。既然影响非均匀,缓存决策就应该按「全局影响」而非「局部相似度」来做。技术实现上,GCache 先推严格上界,再用 Bernstein 形式重参数化传播指数以避免上界过于保守,最后把策略搜索写成双层优化:内层解「给定误差权重下的最优复用策略」,外层学「让误差权重与真实画质损失对齐」。 6.3 核心创新 提出 Global-Impact Cache(GCache)。技术路径分三层:(1) 先给误差传播建立严格的理论上界刻画;(2) 意识到这个上界对复杂高度非凸的扩散模型过于保守,于是用 Bernstein 形式重参数化传播指数;(3) 把缓存策略搜索重构为双层优化(bilevel optimization)问题——内层目标寻找最优复用策略,外层目标让误差加权函数与生成质量损失对齐。这样既保留了理论严谨性,又贴合实证表现,学会把算力优先投给最影响视觉保真度的地方。 6.4 实验结果 Comparison of different cache policies. 在视频与图像生成上,GCache 一致优于此前的缓存策略。最亮眼的数字在 Wan2.1 视频扩散模型上:保持 2.17 倍加速的同时显著提升生成质量,LPIPS 从 0.1095 降到 0.0316(降低约 71%)。论文的策略对比图显示,GCache 优化后的策略(绿线)在整个去噪过程中累积误差都明显低于 ERTACache(蓝线),甚至低于理论上界(橙线)——后者正说明原始上界确实过于保守,Bernstein 重参数化是必要的。 6.5 关键洞察 策略搜索的离线成本未披露 — 双层优化需要在目标模型上做策略搜索,这笔一次性成本有多大、换模型或换分辨率后是否需要重搜,摘要未说明。若每个新模型都要重搜,实用性会打折 外层目标依赖 LPIPS 一类代理指标 — 外层把误差权重对齐到「生成质量损失」,实际实现大概率用 LPIPS。LPIPS 本身是感知代理而非人类偏好,过度对齐单一指标存在指标过拟合风险,而报告的主结果恰好也是 LPIPS 与少步蒸馏的关系未讨论 — 缓存加速与少步蒸馏是两条竞争路线。在已经蒸馏到 4 步的模型上,缓存还有多少可复用冗余?两者能否叠加?这个问题对实际选型很关键但未涉及 技术演进定位: 首个把缓存决策与最终画质显式对齐的策略搜索框架 可能的后续方向: 把离线策略搜索改为免搜索的在线自适应 与少步蒸馏模型联合优化 7. GeoCache:多视角纹理生成跳步会毁一致性,那就沿几何对应搬运更新:免训练插件在 Hunyuan3D-2.1 上取得 2.21 倍加速,MV-PSNR 33.60 dB 为 2 倍以上最佳保真度 论文: GeoCache:多视角纹理生成跳步会毁一致性,那就沿几何对应搬运更新 arXiv: 2608.13255 机构: 亚利桑那大学, 东卡罗来纳大学, 加州州立大学长滩分校 7.1 研究动机 核心问题: 多视角纹理扩散中跳过去噪步会同时跳过跨视角交互,而正是该交互在持续对齐同一表面的不同观测,一致性因此快速退化 几何条件下的多视角扩散能生成高质量 3D 纹理,但要对每个视角反复评估去噪器,计算开销很大。现有免训练加速器主要利用时间冗余——跨去噪步复用计算。可是在多视角纹理生成里,跳过一步同时也跳过了跨视角交互,而正是这种交互在持续对齐同一表面的不同观测;结果就是一致性与保真度快速退化。换句话说,通用的时间缓存方法在这个任务上水土不服。 前序工作及局限: DeepCache 系列:只利用时间维冗余,在多视角任务上破坏跨视角一致性 SyncMVD / MVPainter / Hunyuan3D:几何条件多视角纹理生成管线,本就提供位置图 与前序工作的本质区别: 发现几何对应表面点的预测干净信号具有可迁移演化;每步只算轮换锚视角,再用位置图把 Δx_0 搬运到非锚视角,周期性全量控误差 7.2 方法原理 The attachment point of , and one cached step. The denoising loop is 14.7% of the paint stage and the only component a neural cache can act on. Views occupy the batch axis, so restricting the forward to the $a$ anchor rows is the natural unit of saving; the anchors' per-step change in $\xz$ is transported through correspondence and added to each other view's own previous $\xz$. GeoCache 的方法图分三层,把设计讲得很清楚。(a) 生成管线:形状生成 21.7 秒 → 预处理 13.8 秒 → 多视角去噪循环 6.5 秒 → 上采样 2.5 秒 → 烘焙 20.9 秒,其中 paint 阶段占端到端 67%,去噪循环是 GeoCache 的作用点。(b) 去噪调度:10 个采样步里 4 步是全量(开头两步 head、中间一步 refresh、末尾一步 tail),其余 6 步只跑轮换的锚视角对({0,3}、{1,4}、{2,5} 循环),使去噪器前向次数从 10N 降到 4N+6α(6 视角下即 60→36)。(c) 单个缓存步的细节:以锚对 {0,3} 为例,批切片去噪器只对锚视角计算,得到 per-step 变化量 Δx0^(A)(t),再通过位置图定义的几何映射 G{A→v} 搬运到每个非锚视角 v,即 x_0^(v)(t) = x0^(v)(t-1) + G{A→v}[Δx_0^(A)(t)]。这个式子的关键性质是:非锚视角保留自己的内容与噪声,只继承共享表面的演化——搬运后的视角在采样器自身的参数化下被重新合成,因此多步历史保持一致。 7.3 核心创新 论文的分析找到了一个互补的冗余来源:尽管中间特征是视角特有的,但几何上对应的表面点,其预测的干净信号(predicted clean signals)呈现出可迁移的演化。基于这一观察提出 GeoCache——一个免训练插件,每步只评估一个轮换的锚视角子集(rotating subset of anchor views),再把它们几何对齐的逐步 x_0 更新搬运(transport)到其余视角。周期性的全视角计算控制累积误差,采样器一致的重建(sampler-consistent reconstruction)保持去噪轨迹不被破坏。它不需要重训练也不改架构,用的只是几何条件纹理管线里本就有的位置图(position maps)。 7.4 实验结果 Speed--fidelity ladders on the three backbones leads. Shading marks ${\geq}2\times$; the bottom right is best. Table~tab:main_results carries the headline rows. 在 Hunyuan3D-2.1、SyncMVD、MVPainter 三个管线上,GeoCache 在 2 倍以上的工作点取得比时间缓存和减步法更好的速度-保真权衡。Hunyuan3D-2.1 上实现 2.21 倍去噪循环加速,MV-LPIPS 0.0293、MV-PSNR 33.60 dB,是所有测试方法在 2 倍以上区间的最佳保真度。同一套迁移配置在 SyncMVD 上取得最高加速比与最低 FLOPs,在 MVPainter 上则在被加速方法中取得最低 FLOPs 与最佳保真度。论文由此主张跨视角几何是多视角纹理扩散的一条有效加速轴。 7.5 关键洞察 加速比受限于管线其他阶段 — 方法图自己给出的数字显示,去噪循环只有 6.5 秒,而形状生成 21.7 秒、烘焙 20.9 秒。即使去噪循环加速 2.21 倍,端到端收益也被非去噪阶段严重摊薄,论文主打的是循环内加速比 依赖几何条件管线提供的位置图 — 几何搬运的前提是有准确的位置图建立跨视角对应。对无几何条件的多视角生成(如纯图像域的一致性生成)方法不适用,适用范围比通用时间缓存窄 锚视角轮换策略是固定的 — 调度中锚对按 {0,3}/{1,4}/{2,5} 固定轮换,未考虑不同视角的纹理复杂度差异。纹理细节集中的视角可能需要更高的全量计算频率,固定调度留下了自适应空间 技术演进定位: 把加速冗余从时间维拓展到跨视角几何维的免训练插件 可能的后续方向: 自适应锚视角选择与全量步调度 扩展到视频生成中的跨帧几何对应 横向对比与技术脉络总结 横向对比:本期 On-Policy 蒸馏与加速路线技术对比 论文 任务领域 教师的「特权」/信息优势 核心机制 能否超越教师 关键数字 机构 HPSD 文生视频 (T2V/TI2V) 高质量首帧 + LLM 增强提示词 锚点继承 + 局部精修 + 速度级监督 自蒸馏,目标是内化而非超越 T2V 与 TI2V 双双提升 上海AI Lab / 上交 / NTU CMD 自回归视频蒸馏 无(反而主动削弱教师为因果) 因果教师评分 + Prefix Scoring/Corruption 对齐优先,不追求超越 短/长视频 AR 方法 SOTA,相机遵循度大幅提升 NVIDIA / 萨里大学 DreOPD 流匹配图像后训练 多个专精教师 + 降质参考 闭式速度回归实现奖励外推 是,多数指标超过各专精教师 GenEval 0.968 / OCR 0.936 / Aes 6.29 哈工深 / 浙大 TRACE-GS 稀疏视图 3DGS 修复 额外训练视角的几何 (LUPI) 沿学生 rollout 对齐去噪方向与跨视角响应 内化特权几何,不超越 多数据集一致增益 + 强泛化 Concordia / Mila / 上交 FlowErase-OPD 文生图概念擦除 n 个单概念擦除教师 + 保留锚点教师 AMTD 多教师蒸进单 LoRA + ARC 动态配比 目标是擦-保权衡最优 裸体/物体/风格三类擦除 SOTA + 抗攻击 哈工深 / 清华深研院 / 鹏城 GCache 扩散推理加速 (图像+视频) 不适用(免训练) 误差传播上界 + Bernstein 重参数 + 双层优化 不适用 Wan2.1 上 2.17× 加速,LPIPS 0.1095→0.0316 港中文 / 复旦 GeoCache 多视角纹理扩散加速 不适用(免训练) 轮换锚视角 + 位置图几何搬运 Δx_0 不适用 Hunyuan3D-2.1 上 2.21×,MV-PSNR 33.60 dB 亚利桑那 / 东卡罗来纳 / CSULB 核心技术趋势 监督对象从「终点」转向「轨迹」 本周 7 篇工作无一例外地把监督信号从教师生成的终点,改到学生自己 rollout 访问过的状态上。TRACE-GS 明确指出 off-policy 监督不覆盖推理状态,HPSD 称之为「缺乏针对演化策略的精确纠正」,CMD 则叫「监督与学生的因果信息集错位」。三个不同任务、三套不同术语,指向的是同一个诊断。 教师不再被当作正确答案,而是被当作有偏的参考 过去蒸馏的隐含假设是「教师是对的,学生模仿就行」。本周多篇工作正面质疑这一点:CMD 指出双向教师给因果学生打分时泄漏了未来帧;HPSD 指出以首帧为条件的教师会把监督引向给定图像而非学生实际内容;ADOPD 指出教师可能凭语言先验而非真实视觉证据给出「看似合理」的回答。识别并绕开教师自身的偏差,成了本周的共同技术动作。 从「逼近教师」到「外推超越教师」 DreOPD 是本周最具范式意义的一篇:它引入一个「轻度降质的参考」构成排斥方向,把隐式奖励外推转化为闭式速度回归,让学生在多数指标上超过各个专精教师。FlowErase-OPD 的锚点保留教师本质也是同一思路——用额外教师定义学生该远离/该保留的方向,而不只是该靠近的目标。蒸馏的上界不再是教师。 特权信息(LUPI)成为通用的教师构造手法 本周至少 4 篇工作采用同一模板:给教师一些学生在推理时拿不到的「特权条件」,再把这份能力内化进学生参数。HPSD 的特权是高质量首帧+增强提示词,TRACE-GS 是额外训练视角的几何,ADOPD 是参考图像,LOPD 更进一步把特权上下文本身做成可学习的隐 token。这套 LUPI(Learning Using Privileged Information)范式正在成为生成模型自蒸馏的标准配方。 免训练缓存是同一目标下的另一条路线 与蒸馏并行,本周还有两篇缓存加速工作,思路上形成有趣的呼应:GCache 指出局部特征相似度这种启发式与最终画质严重错位,改用双层优化直接对齐生成质量损失;GeoCache 指出多视角纹理生成中跳步会破坏跨视角交互,转而利用几何对应做跨视角搬运。二者都在说同一件事——加速决策必须对齐最终目标,而不是局部代理指标。 核心技术难点与开放问题 四大核心难点 1. on-policy 的算力账没人算 on-policy 蒸馏要求教师在学生 rollout 的每个访问状态上前向打分,训练开销远高于离线预计算轨迹的 off-policy 方案。本期 5 篇蒸馏工作全部只报告效果增益,无一给出等 GPU 时预算下与 off-policy 基线的对比。当师生都是 14B 级视频模型时,这笔开销可能吃掉方法收益。LOPD 声称用不到 GRPO 30% 的 rollout 预算就能超过它,但那是 agent 任务的结论,未必迁移到视频扩散。 2. 外推的失效边界未知 外推式后训练缺一套失效检测机制。DreOPD 的排斥方向由「降质参考 → 教师」这条向量决定,但论文既没给降质强度的选择准则,也没有在训练中监控外推是否已经越界——学生一旦走出有效语义流形,自动指标可能还在涨(因为奖励模型本身可被过拟合),画质却已崩坏。对比来看,RL 后训练至少有 KL 约束把策略拉回参考分布附近,而闭式速度回归形式的外推目前没有等价的正则项。这是把「超越教师」做成可靠工程手段之前必须补上的一环。 3. 自蒸馏能内化多少信息 特权信息蒸馏缺少「特权强度」与「可内化上限」的量化关系。本期 4 篇 LUPI 类工作各自选定了一种特权(首帧、额外视角、参考图、隐 token),但都没有回答一个可操作的问题:特权信息给得越多,学生能内化的比例是单调上升还是先升后降?直觉上师生差距过大时蒸馏反而更难,存在一个最优特权强度。TRACE-GS 的额外视角数、HPSD 的首帧质量都是天然的调节旋钮,却都没做扫描实验。缺了这条曲线,LUPI 在新任务上只能靠试。 4. 教师变弱与信息对齐的净收益难拆解 CMD 把双向教师换成因果教师,代价是教师本身可用信息变少、评分质量下降,收益是信息集与学生一致。最终指标证明净收益为正,但这两个相反作用各自的量级没有被拆开测量。同理 TRACE-GS 的增益同时来自 on-policy 位置修正与教师更好的几何,缺少「同特权几何但 off-policy」的对照组。 5. 蒸馏与缓存两条加速路线互不对话 GCache/GeoCache 通过优化推理时计算复用来加速,HPSD/CMD 通过压缩采样步数来加速,两者解的是同一个开销问题,但论文之间互不引用。关键的实际问题无人回答:在已经蒸馏到 4 步的模型上还剩多少可复用冗余?两条路能否叠加,还是会互相抵消? 今日讨论 On-Policy 蒸馏这一周的集中爆发,本质上是生成模型后训练在补一门早该补的课:监督必须发生在模型真正会去的地方。但把这批工作放在一起看,会浮现几个尚未解决的问题。 第一,on-policy 的代价是什么?每一步监督都要教师在学生 rollout 上前向一次,训练成本远高于离线预计算轨迹。LOPD 声称用不到 GRPO 30% 的 rollout 预算就能超过它,但这是在 agent 任务上测的;视频扩散上的 HPSD、CMD 都没有给出与 off-policy 基线的等算力对比。当教师和学生都是 14B 级模型时,这笔开销可能吃掉方法本身的收益。 第二,「超越教师」的边界在哪里?DreOPD 用降质参考构造外推方向,本质是假设「远离差的方向 ≈ 靠近好的方向」。这个线性假设在奖励地形平缓处成立,但在多目标冲突时(比如 OCR 精度与美学评分互斥)外推方向可能指向两者都差的区域。论文的雷达图很漂亮,但没有展示外推步长过大时的失效模式。 第三,自蒸馏的信息从哪来?HPSD 让同一个 TI2V 模型分别以 TI2V 和 T2V 模式充当师生,声称把特权条件下的能力「内化」进基础能力。这在信息论上需要解释——如果首帧带来的是模型本身不具备的新信息,那它无法被内化;如果只是激发了模型已有但未被 T2V 提示词充分调用的能力,那本质是在做提示词/条件空间的对齐,而非能力提升。这个区分决定了自蒸馏的天花板,本周几篇工作都绕开了它。 你更看好哪条路线:把教师做得更聪明(特权条件、因果对齐),还是把学生的探索做得更自由(外推、RL)?欢迎在评论区讨论。 人工智能炼丹君 整理 | 数据来源:arXiv 2026-08-07 ~ 2026-08-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-14|阿里14B数字人实时跑三分钟LiveAnimate 今日 AIGC 论文速览 今日共 10 篇 · 实时流式数字人与人体动画 3 篇 · 统一音频场景生成与语音合成 2 篇 · 视频扩散推理加速 2 篇 · 可编辑 3D 世界状态与预演 1 篇 · 生成模型安全与概念擦除 1 篇 · 统一多模态模型评测 1 篇 重点论文标题列表 LiveAnimate(港中文·阿里Qwen·Liblib AI):14B 数字人首次实时流式跑三分钟 Avatar-Forever(港理工·字节跳动·AMD):22B 数字人单卡 27.2 FPS 无限时长 ⚡ MiDashengLM-Gen(小米 MiLM Plus·上海交大 X-LANCE):统一音频生成把语音错词率砍到 2.79% LoSA(悉尼大学·CSIRO):锁死 99% 注意力质量换 3.2 倍加速 UniSwap(港中文·阿里Qwen):单模型同时换脸换声还能流式 今日论文速览 1. LiveAnimate:14B 数字人首次实时流式跑三分钟 LiveAnimate: Stable Long-Form Streaming Human Animation in Real-Time | 港中文·阿里Qwen·Liblib AI | arXiv:2608.11745 ⚠️ 前序问题:姿态驱动的人体动画要从一张参考图加一路驱动姿态流合成目标人物视频,直播、远程呈现、虚拟主播这类交互场景天然要求实时出画。但扩散类系统生成一个片段动辄几分钟到几小时,响应式交互根本无从谈起。更麻烦的是长时段:即便勉强加速,流式生成一路推下去,外观和身份会随时间漂移,KV 缓存也会随时长无限膨胀,导致延迟越跑越高。 本文贡献:提出 LiveAnimate,作者称是首个在十亿参数量级上同时做到实时流式与稳定长时生成的动画系统,底座是 14B 参数的视频扩散 Transformer。两阶段训练先用 Reference-Anchored Teacher-Forcing Adaptation 把预训练的双向 DiT 改造成块因果自回归生成器,再用 Block-wise Self-Forcing Distillation 把采样预算压到 3 步。关键设计是 Pose-Retrieval Sink Attention(PR-Sink)——一个有界 KV 缓存机制:Static Sink 永久锚定首个生成块,Dynamic Sink 保留一个按姿态检索出的历史块,外加三槽滚动窗口。姿态复现时 PR-Sink 直接取回相关外观上下文,无需保留整条序列,因此显存与单块延迟不随流长增长。工程侧再叠 Ulysses 序列并行与算子融合。 Overview of ours. Given a reference image and streaming pose signals, our system generates video blocks autoregressively. Each block undergoes 3-step denoising followed by a clean KV update. PR-Sink augments a three-block rolling window with the first generated block and a pose-matched historical block selected from a compact memory bank. Ulysses sequence parallelism distributes attention computation across GPUs. 实验效果:在两张 NVIDIA H100 上达到 19.63 FPS 流式推理。在三分钟基准上,从最初 30 秒到最后一分钟,感知质量与身份一致性几乎保持恒定,而此前系统在同样的 rollout 长度上要么显著退化,要么需要数小时离线计算。 Quality and identity over a three-minute rollout. Metrics are computed on a 0--10,s prefix, the 0--30,s initial window, and three subsequent temporal segments. The full model is highlighted in red. Flat trajectories indicate resistance to accumulated degradation. Higher is better for ASE, IQA, and DINO-S; lower is better for FID and V-MAE. 批判点评:这篇的价值不在某个单点数字,而在它把「实时」「长时」「大模型」这三个此前互相拆台的约束第一次同时满足了。以往路线要么把模型缩到 1B 级换实时、要么牺牲长时稳定性,LiveAnimate 直接在 14B 上硬啃,靠的是把长时漂移问题重新定义为缓存管理问题——PR-Sink 的姿态检索思路很聪明:人体动画的驱动信号本身是周期性、可索引的,姿态复现时把对应的历史外观取回来,比无脑保留全序列或粗暴丢弃都更划算,而且天然给出了「显存恒定」这个硬保证。这也是它敢报三分钟基准的底气。但必须把期待校准:19.63 FPS 是两张 H100 的成绩,单卡折半后离消费级部署仍隔着代际,成本上更接近云服务而非端侧;3 步蒸馏在人体动画这种强条件任务上损失可控,不代表能平移到弱条件的开放域生成。三分钟也还不是「长时」的终点,直播场景动辄数小时,Static Sink 永久锚首块的设计在超长 rollout 下是否会因首帧与当下姿态相关性衰减而变成噪声源,论文没给出压力测试。另外姿态检索依赖驱动信号的可复现性,遇到几乎不重复的自由舞蹈或大幅视角变化,Dynamic Sink 可能长期取不到有用的历史块,退化为纯滚动窗口。它是一个扎实的工程胜利,但把它读成「数字人已经解决」会误判。 2. Avatar-Forever:22B 数字人单卡 27.2 FPS 无限时长 Avatar-Forever: Decoupled Parallel Training for High-Quality Real-Time Infinite Avatars | 港理工·字节跳动·AMD | arXiv:2608.12107 ⚠️ 前序问题:现有流式视频系统普遍依赖以蒸馏为核心的串行训练管线来实现少步长视频生成,这个范式有两处硬伤。第一,前面阶段引入的失败或分布偏移会污染后续优化,让整个训练很难收敛;第二,蒸馏式目标天生偏向短程生成,一旦自回归误差在长 rollout 上累积,质量会明显退化。换句话说,「生成效率」和「长时鲁棒性」被强行塞进同一条串行流水线里,两个目标互相打架。 本文贡献:提出 Avatar-Forever,把上述两种能力当成两个独立能力并行训练,而不是串行耦合。一个分支做全参数蒸馏,训出一个视觉质量高的高效生成器;另一个分支通过 Recovery-oriented Rollout Training(RRT)训练一个轻量长程适配器,专门提升长时推理条件下的生成鲁棒性。解耦并行的设计简化了整体训练流程,也避免了少步生成与长程适配之间不必要的目标冲突。推理侧再引入 ForeverCache——一种分块特征缓存机制,大幅削减流式推理中对历史的冗余重算。整套方案构建在 22B 视频基础模型之上。 Overview of Avatar-Forever. Top: Existing streaming avatar systems employ sequential distillation pipelines, leading to stage-wise dependence and objective interference. Bottom: Avatar-Forever learns few-step efficiency and long-horizon robustness in parallel. A lightweight adapter is trained under accumulated rollout errors, and it is merged with the distilled generator in inference. In addition, ForeverCache is proposed to reuse historical features for efficient streaming inference. 实验效果:支持无界的音频驱动数字人生成,同时保持身份一致性、动作连贯性与视觉保真度;在单张 H100 上实现 768×512 高分辨率视频端到端 27.2 FPS 吞吐。 Visual results of extended-duration generation. We uniformly sample frames from a continuous video generated for more than 11 minutes. Avatar-Forever maintains stable identity, facial structure, and scene content while producing natural expressions, coherent head and body motion, and accurate audio--visual synchronization throughout the extended autoregressive rollout. The bottom row shows the corresponding driving-audio waveform. 批判点评:和 LiveAnimate 同天出现、目标高度重叠,但方法论切入点完全不同,两篇并读信息量最大。LiveAnimate 是在推理侧动手术(PR-Sink 管缓存),Avatar-Forever 是在训练侧动手术——它指出的「串行蒸馏管线中前序阶段污染后序优化」是个被长期容忍的隐性成本,把少步高效与长程鲁棒拆成两条并行分支各自优化、最后组合,是很清晰的解耦思路,也顺带解决了「蒸馏目标偏爱短程」这个结构性偏见。RRT 显式面向恢复能力训练,比单纯加长训练序列更对症。数字上它比 LiveAnimate 更漂亮:22B 更大的底座、单卡 27.2 FPS、且声称无界时长。但正因为漂亮,几处要打问号:分辨率是 768×512,低于 LiveAnimate 的对照设定,FPS 之间不能直接横比;「无限时长(infinite)」是个很强的措辞,摘要只给了机制性论证(ForeverCache 削冗余 + 长程适配器)而没有报出具体跑了多久的实测曲线,而长 rollout 的退化通常是缓慢累积而非突然崩溃,缺时长轴上的量化曲线就难以证伪。解耦并行还带来一个未被讨论的问题:两个分支各自最优,组合后是否仍最优?论文把「避免目标冲突」当成优点,但也意味着两者之间的协同信号被切断了,轻量适配器能否完全兜住全参数蒸馏生成器在长程上的所有失效模式,缺少消融就只能存疑。它是很有说服力的工程范式提案,但「无限」二字值得读者自己打个折。 3. MiDashengLM-Gen:统一音频生成把语音错词率砍到 2.79% MiDashengLM-Gen: Unified Audio Scene Generation via LLM-Driven Autoregressive Flow Matching | 小米 MiLM Plus·上海交大 X-LANCE | arXiv:2608.11804 ⚠️ 前序问题:要生成同时混合语音、音乐与音效的连贯音频场景一直很难。现有做法普遍是拼装式管线:一个冻结、解耦的文本编码器喂给一个独立的音频解码器。这种结构限制了跨模态联合优化,最直接的代价是语音清晰度很差——统一模型能生成「听起来像有人说话」的音频,但说的词经常是糊的,这让它们在需要真正传达内容的场景里没法用。 本文贡献:提出 MiDashengLM-Gen,一个端到端框架,把预训练大语言模型与逐 token 的条件流匹配(per-token conditional flow matching)耦合起来,做自回归、变长的混合音频场景生成。作者称这是首个用单一端到端训练模型完成通用文本到音频生成的方案——不再是「冻结编码器 + 独立解码器」的拼装,而是让 LLM 的语义能力与流匹配的声学生成能力在同一次训练中联合优化。框架也自然扩展到多语言设定。代码与检查点均已开源。 实验效果:在 Seed-TTS 基准上,英文词错误率(WER)从 12.15% 降到 2.79%,逼近专用 TTS 系统的 1.24%;多语言 WER 相比现有基线也很有竞争力;同时在 MECAT 基准上保持了有竞争力的混合音频生成质量。 Training loss and STFT L2 distance curves for different DiT width/depth configurations. Topline denotes DashengTokenizer encode-to-decode reconstruction. 批判点评:这篇最值得看的是它把「统一模型的语音清晰度」这个长期被含糊掉的短板量化成了一个能被追打的数字。此前统一音频生成的评测常聚焦整体音频质量或文本一致性,语音是否真的能听清则被稀释在综合分里——12.15% 的 WER 意味着每八个词就错一个,这个水平在演示视频里听起来可能还行,实际上完全无法承载信息。降到 2.79% 是 4.4 倍的收敛,把统一模型从「不可用」拉进「可用」的门槛内,而且没有牺牲混合音频质量,说明端到端联合训练确实解决了拼装管线里跨模态优化被切断的根因。开源也让结论可验证。但离终点仍有距离:2.79% 对 1.24% 是 2.25 倍的差距,专用 TTS 依然明显更清晰,「逼近」的措辞略微乐观;在有背景音乐和音效叠加的真实混合场景下,WER 是否还能守住 2.79%,摘要没有拆分报告——而这恰恰是统一模型相对专用 TTS 唯一的存在理由,也是最该给出的数字。MECAT 上「有竞争力」是个偏保守的表述,暗示混合音频质量可能并未超越专门的音频生成模型,那么这套统一方案的定位就更像「一个模型够用」而非「一个模型更好」。逐 token 流匹配的推理开销也未见报告,自回归叠流匹配在长音频上的延迟表现是落地的关键变量。方向正确、增益扎实,但别把它当成统一音频生成已经追平专用系统。 4. LoSA:锁死 99% 注意力质量换 3.2 倍加速 LoSA: Near-Lossless Sparse Attention for Training-Free Video Diffusion Acceleration | 悉尼大学·CSIRO | arXiv:2608.12032 ⚠️ 前序问题:视频扩散 Transformer 采样成本极高:每个去噪步都要在很长的 3D token 序列上做自注意力,这是二次复杂度,分辨率和时长一涨就成为绝对瓶颈。稀疏注意力能在不重训的前提下削减这笔开销,但现有方法普遍追求激进稀疏度——越往后每多榨一点加速,付出的注意力保真度代价越不成比例,质量塌得比速度涨得快。 本文贡献:LoSA 反向切入这条权衡曲线:先用构造方式把保真度锁死在近无损,再在这个约束允许的范围内尽可能多地砍计算。两个观察让这个区间变得可行——大约 40% 的块交互可以被移除而仍保留 99% 的注意力质量(attention mass),且高质量支撑集在各去噪步之间是稳定的。于是 LoSA 固定的是「保留质量阈值 99%」而不是稀疏率:在某个早期稠密步测出精确的块注意力质量,为每个 head 和 query 块保留满足该阈值的最小 key/value 块集合,然后把冻结的块索引复用到其余所有步。整套方法无需训练。 Overview of . Left: video diffusion attention contains a low-mass tail, allowing approximately $40\%$ of the block area to be removed while retaining approximately $99\%$ of the attention mass. Right: after a dense warm-up, measures exact block masses at $t_0$ and constructs the mask $\Omega$ by retaining, for each layer, head, and query block, the smallest prefix whose cumulative mass reaches $\theta$. The same frozen mask is reused at all remaining steps, while Q/K/V and attention weights are recomputed from the current hidden states. Bottom: with optional feature caching, the cache selects which steps are computed, while accelerates self-attention within every computed step. 实验效果:在 Wan2.1-1.3B 上,仅 LoSA 单独使用即带来 1.36 倍加速,VBench Overall 仅降 0.06 分。组合收益最大:与特征缓存叠加后,在 HunyuanVideo 上达到 3.2 倍加速、质量仅降 0.02 分,而同等速度下最强稀疏基线要降 0.32 分(差距 16 倍)。在三个视频扩散 Transformer 与最高 3.2 倍加速的范围内,LoSA 始终给出最好的无训练速度-质量权衡。 Speed--quality trade-off on Wan2.1-1.3B. Each point reports VBench Overall versus end-to-end speedup. and its cached variants form the entire Pareto frontier: every baseline configuration is matched or dominated by a configuration, showing that near-lossless sparse attention preserves quality better than aggressive sparsity or cache-only acceleration. 批判点评:这篇的贡献是把加速方法的接口从「设一个稀疏率」换成「设一个质量阈值」,这个换位比它的加速倍数更有价值。稀疏率是手段侧参数,用户真正关心的是质量损失上界;以往调稀疏率本质是盲调——不同模型、不同分辨率下同一个稀疏率对应的质量损失完全不同,只能试。LoSA 直接把用户可控量改成「保留 99% 注意力质量」,让加速变成有保证的操作,这是工程可用性上的实质进步。两个观察也很干净:40% 块交互可删且高质量支撑跨步稳定,后者尤其重要——正因为稳定,才能只在一个早期步测量、后续全部复用,把测量开销摊薄到近乎为零。3.2 倍下 0.02 对 0.32 分的差距(16 倍)比任何单点加速数字都更能说明方法优越。但要看清它的适用边界:注意力质量守恒并不等于生成质量守恒,99% 的 mass 保留是个代理指标,VBench 分数掉得少也只说明主流评测捕捉不到差异,细粒度的运动连贯与细节纹理是否有肉眼可辨的损失需要看实际样本。「索引冻结」这个核心简化建立在支撑集跨步稳定的经验观察上,一旦遇到运动剧烈、场景切换的内容,早期步测出的支撑集对后期步的代表性会下降,论文没报按内容类型拆分的结果。另外 1.36 倍的单独加速其实不算高,3.2 倍是叠加特征缓存后的复合结果,意味着大部分加速红利来自另一个正交方法,LoSA 更准确的定位是「一个不拖后腿、可安全叠加的稀疏化组件」,而非独立的加速引擎。 5. UniSwap:单模型同时换脸换声还能流式 UniSwap: Streaming Audio-Visual Identity Swapping for Talking Videos | 港中文·阿里Qwen | arXiv:2608.11752 ⚠️ 前序问题:说话视频的角色替换要求同时迁移外观与声音,还得保住源视频的动作、场景、语言内容和音视频时序对齐。现有方法用两个分别优化的模型处理视觉和音频,音视频一致性很难强制约束——脸换了、声音换了,但两者的匹配关系和口型同步会松掉。更现实的障碍是数据:跨身份的对齐训练对本身极其稀缺,没有成对样本就没法直接监督。 本文贡献:提出 UniSwap,作者称是首个做流式联合音视频身份替换的框架。给定源视频、参考图像和一段参考语音,UniSwap 在单个音视频扩散 Transformer 内同时迁移参考外观与音色,同时保住源内容与动态。为解决对齐数据稀缺,设计 swap-and-reconstruct 管线:从真实片段中剥离视觉与声音身份,再用原片段作为重建目标。从双向骨干出发逐步适配——In-context Pretraining 学联合替换,Conditional Streaming Adaptation 转为块因果 KV 缓存生成,Efficient Self-forcing DMD 缓解暴露偏差并把每块采样从 30 步压到 3 步。Efficient Multi-LoRA Switching 让 DMD 的三个角色共享同一个冻结骨干;Feature-RoPE Decomposition 把缓存位置保持在训练范围内,支撑稳定长时推理。 Overview of UniSwap. The three-stage pipeline comprises (a) In-Context Pretraining for joint audio-video replacement, (b) Conditional Streaming Adaptation with block-causal masking and KV-cached inference, and (c) Efficient Self-Forcing DMD, which reduces denoising to 3 steps per block. Feature-RoPE Decomposition bounds cached positions while preserving cross-modal physical-time alignment. 实验效果:实验显示强音视频同步性、有竞争力的身份保持、高效流式与稳定长时生成;单张 H100 上块式自回归 3 步采样达到 13.6 FPS,支持小时级长时生成。 Qualitative comparison on the long-video benchmark. Frames are sampled every 10 seconds from 1-minute generations. The baselines exhibit identity drift and visual artifacts as generation progresses (highlighted in red), while UniSwap preserves the reference identity throughout the full duration. Zoom in for details. 批判点评:把换脸和换声塞进同一个扩散 Transformer,最直接的收益是音视频一致性从「事后对齐」变成「联合建模的内生属性」,这在口型同步上是结构性优势——两个独立模型无论怎么后处理,都难保证音色变化和面部动态的耦合关系正确。swap-and-reconstruct 的自监督构造也很实用,把「没有跨身份成对数据」这个死结转化为可重建的代理任务。Multi-LoRA 共享冻结骨干让三个 DMD 角色不必各存一份权重,是很务实的显存优化。但这篇要额外提一句风险:联合音视频身份替换在能力上等价于「更难被察觉的深度伪造」——单独换脸或单独换声都留有模态间不一致的破绪,而联合替换恰恰把这个最有效的检测线索抹掉了。摘要通篇未提任何水印、溯源或滥用防护机制,这在同一天还有 PEAK(概念擦除)和 SafeCA(T2V 越狱防御)在做安全侧工作的语境下,对比格外刺眼。技术层面也有保留:身份保持只说「有竞争力」,是个偏弱的措辞,暗示相比专用换脸模型可能并不占优,联合建模换来的一致性可能以单模态精度为代价;13.6 FPS 低于同天 LiveAnimate 的 19.63(两卡)和 Avatar-Forever 的 27.2(单卡),联合音视频的算力代价是实打实的;「小时级」的稳定性同样缺少时长轴上的量化曲线。方法扎实,但这是一篇技术评价和伦理评价必须分开打分的论文。 6. Luna-TTS:扩散语言模型 TTS 首块延迟 41.6 毫秒 Luna-TTS Family Technical Report | VUI Labs·上海交大 | arXiv:2608.11593 ⚠️ 前序问题:现代 TTS 被自回归编解码语言模型主导,但左到右解码带来三重结构性代价:延迟随语句长度增长、错误沿已提交前缀累积、以及在残差矢量量化(RVQ)的 token 网格上强加了一个人为的生成顺序——RVQ 网格本身并不存在这样的顺序。这三点在需要低延迟、长语句、高稳定性的场景里都是硬伤。 本文贡献:提出 Luna-TTS Family,基于扩散语言模型的 TTS 系统,在中英日韩四语种、100 万小时语音上预训练。整个家族由一个预训练自回归文本 LLM 渐进适配而来:从因果注意力到双向、最终到块因果,两个变体共享同一套 tokenizer、数据管线与 0.6B 骨干血统。Luna-TTS 完全非自回归,用固定步数的并行细化生成整个 RVQ token 网格,零样本音色克隆与语音编辑天然表现为 infilling 任务;Luna-TTS Realtime 由继续训练得到,在 32 个编解码帧(1.28 秒)的块上自回归、块内并行去噪,支持 KV 缓存的块式生成与增量音频交付。退火微调阶段加入对情绪与非言语声(NVV)的显式控制,强化学习阶段用 GRPO、策略比在实际去噪轨迹上计算。 实验效果:Realtime 变体端到端 RTF 0.0240、本地首块延迟 41.6 毫秒(预热服务协议下)。Seed-TTS-Eval 上在对比的开源与商业系统中四项指标全部最优:test-zh 达 0.73 CER / 79.7 SIM,test-en 达 1.49 WER / 76.8 SIM;更难的野外 CV3-Eval 上中英错误率均为对比中最低。对比领先商业系统,在 NVV 与情绪控制的多数客观、模型评分与人工评分指标上取得最好结果。 批判点评:这篇的路线选择值得单独拎出来看。当前 TTS 的主流叙事是「自回归 LLM + 编解码 token」,Luna 反过来论证这条路存在结构性错配:RVQ 的 token 网格是二维的(时间 × 码本层),左到右强加一维顺序纯属人为,而扩散语言模型的并行细化天然匹配这种结构。这个论点不只是效率优化,而是对生成顺序这一建模假设的直接质疑——首块延迟 41.6 毫秒、RTF 0.0240 的数字则是对该论点的支撑证据。更聪明的是它不从零训练,而是把预训练的自回归文本 LLM 渐进适配(因果→双向→块因果),复用了文本 LLM 的语义能力,这也解释了 0.6B 这么小的骨干能打赢商业系统。NAR 与 Realtime 两个变体共享血统、覆盖离线高质量与流式低延迟两种场景,产品化考量很完整。需要保留的地方:41.6 毫秒明确标注在「预热服务协议」下测得,真实服务的冷启动、并发排队与网络往返都不在这个数字里,别直接当端到端体验延迟读;Seed-TTS-Eval 上四项全优的对照集是「我们对比的系统」,商业系统版本迭代很快,这类横评的时效性通常只有几个月;机构标注为 VUI Labs Research,是相对新的团队,1 万小时级以上的数据来源与许可情况未在摘要说明,这在 100 万小时规模下是个不可忽略的合规问题。技术报告体裁也意味着消融相对薄——渐进适配的三个阶段各自贡献多少、GRPO 那一步的实际增益有多大,都需要正文细读才能判断。 7. GeoFlow:别再从纯高斯噪声重画已知场景 GeoFlow: Efficient Driving Video Generation via Geometry-Aligned Priors | 北航 (ECCV 2026) | arXiv:2608.12203 ⚠️ 前序问题:扩散模型与流匹配能合成高保真驾驶视频,但受制于大量采样步带来的高推理延迟。作者把低效归因到一个被普遍默认的选择:标准高斯源分布——连续帧各自初始化为独立的高斯噪声。这忽略了驾驶视频里极强的时空相关性,逼着模型把上一帧里已经确定的场景结构从噪声里重新生成一遍,既算得冗余,又容易产生几何不一致。 本文贡献:提出 GeoFlow,用显式几何先验实现高效驾驶视频生成。不再从标准高斯噪声采样,而是利用多视图几何与空间自适应的噪声注入,构造一个 Geometry-Aligned Prior(GAP)分布作为起点。这个初始化拉近了源分布与数据分布的距离,从而得到明显更直、更短的采样轨迹——流匹配的核心成本正来自轨迹的曲折程度,把起点挪近就等于直接砍掉了大部分传输代价。 Schematic of the proposed GeoFlow framework. % Instead of initializing from an uninformative noise, % Our method leverages multi-view geometry to bridge the gap between the source and target manifolds. % The pipeline projects visual features into a latent point cloud, which is rendered to the target view to form a geometric prior. To bridge the gap between the source and target manifolds, we leverage multi-view geometry to construct a Geometry-Aligned Prior Distribution, where an Spatially-Adaptive Noise Injection strategy is introduced to reduce error accumulation due to depth and rendering artifacts. Bottom Panel: As visualized in the sampling trajectory comparison, our initialization significantly shortens and straighten the flow, % yielding a nearly straight generation path (green) compared to the highly curved trajectory of the standard Gaussian baseline (red), thereby enabling high-fidelity synthesis within several inference steps. 实验效果:训练与推理效率均显著提升:在基线模型上仅需数小时微调即可明显提升少步生成质量;完全收敛训练后,大幅削减了达到当前最优视频生成质量所需的推理步数。ECCV 2026 接收。 Ablation of Noise Injection. 批判点评:这篇的洞察很干净,也很容易被低估:整个扩散/流匹配社区把「从标准高斯出发」当成了公理,但对结构高度冗余的视频而言,这个起点其实是在浪费——上一帧已经确定的道路、建筑、车道线,凭什么要从纯噪声里重新长一遍?GeoFlow 把加速的着力点从「怎么走得快」(蒸馏、缓存、稀疏化)挪到了「从哪儿出发」,这是与主流加速路线正交的维度,理论上可以叠加。用多视图几何构造先验也很合理:驾驶场景的相机内外参和多视图关系是已知的,这些确定性信息本该被直接利用而不是让网络去猜。「仅需数小时微调」意味着它可以作为补丁挂到现有基线上,落地摩擦很小。但适用面要看清楚:这套方法吃的是驾驶场景「几何强先验 + 时空强冗余」的红利,多视图标定、连续帧结构高度重叠都是自动驾驶数据的特殊性质,换到开放域视频(镜头切换、剧烈运动、无标定)里,GAP 能否构造得出来是个大问号,所以别把它读成通用视频加速方案。效果描述也偏定性——「大幅削减推理步数」「显著提升」都没给出具体倍数或 FVD 数字,摘要层面无法判断它相比同类少步方法的量化位置。另有一个方法内在张力值得注意:先验越强,采样轨迹越短越直,但生成多样性也越受约束;驾驶视频生成常被用于仿真罕见场景(corner case),如果先验把输出往「几何上像前一帧」的方向拽得太紧,恰恰会削弱它在最有价值场景上的表达能力,这个权衡摘要没有讨论。 8. StateFlow:给视频创作补一个持久 3D 状态层 StateFlow: Building, Evolving, and Accessing 3D World States for Previsualization | 北京交大·北大·BAAI·Mootion AI | arXiv:2608.12314 ⚠️ 前序问题:预演(previsualization)是影视、游戏、建筑与城市设计中连接想法与制作的中间层,创作者要在这一层反复打磨场景、动作、镜头与时空动态。但现有生成方法靠简单提示词、用一次性图像或视频合成去联合控制所有这些因素,可控性很弱,也几乎不支持迭代编辑——改一处就得整体重生成,上一版的结果全丢。作者点出问题的根子:一个世界由多个带几何、外观和其他属性的元素加上相机组成,不同帧其实是这份共享状态的局部修改或重组,绝大部分内容是被复用的。缺失的组件是一个显式且持久的工作状态。 本文贡献:提出 StateFlow,以状态为中心的生成式预演框架。不做一次性视频生成,而是用一个可编辑的 3D 世界来组织场景结构、演化与相机,需要更高保真时再让现成视频模型来增强画质。这个世界被维护为场景元素与相机配置的持久结构化 3D 状态,作为预演的核心工作表示。三个阶段:State construction 通过先验引导、冲突感知的双视图初始化,把生成的 2D 内容抬升为连贯 3D 世界;State evolution 把用户意图翻译成结构化的状态转移并保留世界记忆,避免每次编辑都全场景重生成;State access 用渲染反馈反思机制把相机方案细化为视觉上可行的轨迹,而不是只依赖 VLM 的语义判断。 Qualitative comparison on Scene Generation 实验效果:实验显示 StateFlow 能为视频创作与类游戏原型制作产出高质量 3D 世界。 Qualitative comparison on previsualization applications. Case~1 and Case~3 showcase video creation, while Case~2 shows 3D game prototyping. Video-generation baselines consistently suffer from spatial--temporal inconsistency, identity drifting, and restricted camera motion, whereas StateFlow operates on a persistent and interactive 3D world, yielding precise, highly controllable, and geometry--appearance-consistent results. 批判点评:这篇提的问题比它给的方案更重要。当前视频生成的交互范式基本是「抽奖」——改一个词,整段重出,上一版的所有满意之处一并丢失,这在需要迭代收敛的专业创作流程里是致命的。StateFlow 把矛头指向缺少持久状态,这个诊断很准:把「视频」当作输出、把「3D 世界状态」当作可编辑的真源,编辑就从重新生成变成状态转移,世界记忆得以保留,这才是专业工具该有的形态。三阶段拆分也各有对症之处,尤其 State access 用渲染反馈来验证相机轨迹的物理可行性、不轻信 VLM 的语义判断,是个务实的清醒设计——VLM 说「镜头从这里推过去很好」和这条轨迹真的不穿墙是两件事。但这篇的实验部分是明显短板:摘要只给了「能产出高质量 3D 世界」这种定性结论,没有任何量化指标、没有与一次性视频生成基线的可控性对比、也没有用户研究,而「可控性」和「迭代效率」恰恰是它的核心主张,最该被量化。方案本身也把难题转移而非消除了:把 2D 内容抬升为连贯 3D 世界(单视图/双视图 3D 重建)本身就是未解问题,「冲突感知的双视图初始化」听起来是在缓解不一致而非解决它,一旦初始状态几何有误,后续所有编辑都建在歪地基上。它还依赖现成视频模型做画质增强,那么最终输出的一致性又部分回到了那个不可控的黑箱里。作为范式提案很有启发,作为可用工具还需要更硬的证据。 9. PEAK:擦概念把攻击成功率从96.5%压到5.6% PEAK: Precise and Persistent Concept Erasure via k-Sparse Autoencoders | 合肥工大·中科大·澳门大学 | arXiv:2608.10985 ⚠️ 前序问题:从大规模文生图扩散模型中擦除概念因版权侵权、隐私侵犯与不良内容的顾虑而愈发关键,但现有方法很难同时做到精确与持久:概念相关表征定位不准会造成意外的语义干扰(擦掉一个概念顺带损伤无关生成能力),而底层概念知识删除不彻底又让对抗性恢复成为可能——攻击者用精心构造的提示词就能把「已擦除」的概念重新召回。 本文贡献:提出 PEAK,通过 k-稀疏自编码器(kSAE)实现精确且持久的概念擦除。先在扩散去噪网络的内部激活上训练一个 kSAE,把稠密表征分解为可解释的稀疏特征;再对比目标提示与非目标提示诱发的稀疏激活,按激活强度与激活频率两个维度识别出一小组目标特有特征。随后用这些定位到的特征做参数优化,选择性抑制目标相关激活,同时相对原模型保留互补的非目标激活。这种特征引导的优化把概念擦除直接嵌入扩散参数,因而不需要任何推理时干预,也让擦除对对抗攻击具备有效的持久性。代码与模型已开源。 The main pipeline of the proposed PEAK. (a) A frozen kSAE encodes diffusion-model activations induced by matched target and non-target prompts, and target-specific features are selected by contrasting their activation scores. (b) The selected target features are suppressed during fine-tuning, and the other features are aligned with those of the original model. 实验效果:在 I2P 基准上,PEAK 把 NudeNet 检测数从 582 降到 6,平均攻击成功率(ASR)从 96.52% 降到 5.63%,同时在 MS-COCO 上以近零的 KID 保持了通用生成质量。 Qualitative evaluation of PEAK across different diffusion architectures. PEAK consistently erases target concepts while preserving non-target semantics in both SDXL and FLUX models. 批判点评:这篇把可解释性研究的工具真正用出了实效,路径值得注意:kSAE 本是机制可解释性领域用来把稠密激活拆成人类可读稀疏特征的手段,PEAK 把它当作「定位手术刀」——先分解再靠激活强度和频率双重筛选出目标特有特征,比在稠密表征上直接调参精确得多,这也直接对应上了「精确」与「持久」两个诉求:定位准则不伤及无辜(COCO 近零 KID 佐证),删得彻底则抗对抗恢复(ASR 96.52%→5.63%)。把擦除烧进参数、不需推理时干预,工程上也更可靠——任何依赖推理时过滤的方案都能被绕过或直接关掉。开源让结论可复现。但要清楚它的边界:5.63% 的 ASR 不是零,意味着约二十次尝试里仍有一次能召回目标概念,对真正的滥用防护而言这个残余风险并不小,而攻击方法是持续演进的,今天的 5.63% 在更强的新攻击下会退化多少不可知。NudeNet 582→6 的评测面也偏窄——I2P 加 NudeNet 主要覆盖裸露类内容,版权风格、特定人物身份这些擦除需求的难度分布完全不同(风格是弥散的,很难在稀疏特征里被干净地切出来),摘要未给出跨概念类型的分解结果。同时擦除多个概念时特征之间是否干扰、KID 是否会累积恶化,也没有报告。另外这类方法有个绕不开的现实前提:它要求模型权重可改,对已经分发到用户手上的开源权重毫无追溯力——真正的擦除必须发生在发布之前。技术质量很高,但别把它当成安全问题的终点。 10. SGU:让统一模型对自己画的图做推理 Do You See What You Draw? A Semantic Closed-Loop Framework for Holistic Evaluation of Unified Multimodal Models | 浙江大学 | arXiv:2608.11907 ⚠️ 前序问题:大视觉语言模型越来越追求把视觉生成与理解统一进同一套参数空间,但如何连贯地评估这种结构性统一仍是关键难题。当前评测协议基本把生成能力和判别能力当成两个独立任务分别打分,缺的是面向统一多模态模型(UMM)的系统级评估——两项单独都很高,不代表它们在同一套参数里真的打通了。 本文贡献:提出 Self-Generative-Understanding(SGU),一个无需标注的评测框架,用语义闭环挑战来探测统一模型的整合能力。它不需要任何新标注,而是利用 UMM 自身兼具理解与生成的双重能力:先让模型感知一张图并产出文本描述,接着基于该描述重建视觉上下文,最后对自己生成的输出做推理。这条闭环管线提供了一个零成本测试床,产出专门用于把 UMM 当作统一系统来评估的整合性能分数。 Illustration of traditional UMM evaluation and our Self-Generative-Understanding (SGU) framework. (a) Existing evaluations often assess generation ($\mathcal{M}_G$) and understanding ($\mathcal{M}_U$) separately, producing capability-specific scores such as $s_g$ and $s_u$. These metrics remain valuable for component-wise diagnosis but do not directly provide a system-level view of how a UMM behaves when understanding and generation are jointly involved. (b) SGU provides a complementary closed-loop evaluation framework tailored to UMMs. It requires the model to understand an input image, generate a textual representation, reconstruct a visual context from that representation, and reason over the reconstructed image, yielding an outcome-based system-level score $s_{\text{umm}}$. 实验效果:大量实验显示,即便是表现很好的 UMM 也常常无法对自己生成的上下文进行推理,暴露出理解或生成各自单独评测都捕捉不到的局限。 批判点评:「让模型对自己画的图做推理」这个设计的巧妙之处在于零标注:闭环把模型自己的输出当成下一步的输入,评测信号完全内生,不需要人工标注也就不需要为每个新模型准备新数据。它探测的东西也确实是现有评测的盲区——理解分和生成分各自很高,只说明两个模块都能干活,不说明它们共享的表征是自洽的;如果模型看图能说出 A、按 A 画图、却对画出来的图推理不出 A,那所谓「统一」就只是参数共享而非语义打通。「高性能 UMM 常常无法对自己生成的上下文推理」这个发现本身就值得整个统一模型社区认真对待。但这个框架有个结构性弱点:闭环里的误差会复合传播,最终分数低到底是理解错了、生成偏了,还是推理跳了,很难归因,而缺乏归因能力的指标对改进模型的指导价值有限。零标注同时也意味着没有绝对基准——闭环失败可能只是因为文本描述天然不可能完整承载一张图的全部信息(描述必然有损,重建必然有偏),这部分损失是任务内在的,不该全算成模型缺陷,摘要没有说明如何区分内在信息损失与真实的能力缺口。另外闭环分数在不同模型间是否可比也需要论证:一个描述更啰嗦的模型可能因为传递了更多信息而闭环得分更高,但这未必意味着它更「统一」。它作为诊断性探针很有价值,作为排行榜指标则要谨慎。 趋势观察 实时数字人今天出现了两条互不知情的技术路线,答案不唯一 — 今天最值得对读的是 LiveAnimate 与 Avatar-Forever——同一天投出、目标几乎完全重叠(大模型底座上的实时流式长时数字人),但动手的位置完全相反。港中文与阿里 Qwen 的 LiveAnimate 在推理侧做手术:它把「长时外观漂移」重新定义为一个缓存管理问题,PR-Sink 用 Static Sink 永久锚定首块、Dynamic Sink 按姿态指纹检索历史块、外加三槽滚动窗口,使显存与单块延迟不随流长增长,14B DiT 在两张 H100 上跑到 19.63 FPS,三分钟基准上从前 30 秒到最后一分钟质量近乎水平。港理工与字节的 Avatar-Forever 则在训练侧动刀:它指出以蒸馏为核心的串行管线有个被长期容忍的隐性成本——前序阶段的失败与分布偏移会污染后续优化,且蒸馏目标天生偏爱短程,于是把「少步高效」和「长程鲁棒」拆成两条并行分支各自训练(后者用 Recovery-oriented Rollout Training),推理再叠 ForeverCache,22B 底座上单卡 27.2 FPS、实测跑到 11 分 44 秒身份不崩。两条路线都成立,且正交——一个管缓存怎么用,一个管模型怎么练,理论上可以叠加。这也说明实时数字人已经从「能不能做到」进入「怎么做更划算」的工程竞速阶段,港中文那一组更进一步,同天还投了 UniSwap 把同一套流式技术栈迁移到音视频联合身份替换上,13.6 FPS 单卡、小时级长时。要留一分清醒:三篇的分辨率、卡数、时长口径各不相同,FPS 数字之间不能直接横比;「无限」「小时级」这类措辞普遍缺少时长轴上的量化退化曲线,而长 rollout 的失效通常是缓慢累积而非突然崩溃。 加速研究开始把「用户该拧哪个旋钮」当成一等问题 — LoSA 和 GeoFlow 都在做视频扩散加速,但两篇最有价值的东西都不是加速倍数。悉尼大学与 CSIRO 的 LoSA 把稀疏注意力的可控参数从「稀疏率」换成了「保留 99% 注意力质量」——这是接口层面的改动,却直接解决了一个长期的盲调问题:同一个稀疏率在不同模型、不同分辨率下对应的质量损失完全不同,用户只能试,而用户真正关心的从来是质量损失的上界。锁死阈值再反推能砍多少计算,加速就从赌博变成了有保证的操作;配合「高质量支撑集跨去噪步稳定」这个观察,只在一个早期步测量、后续全部复用冻结索引,测量开销被摊薄到近乎为零,最终在 HunyuanVideo 上 3.2 倍加速仅降 0.02 分,同等速度下最强稀疏基线要降 0.32 分。北航的 GeoFlow(ECCV 2026)换了另一个维度:整个社区把「从标准高斯噪声出发」当成公理,但对结构高度冗余的驾驶视频而言,上一帧已经确定的道路和建筑凭什么要从纯噪声里重新长一遍?它用多视图几何与空间自适应噪声注入构造 Geometry-Aligned Prior,把起点直接挪到数据分布附近,采样轨迹变得更直更短。这是与蒸馏、缓存、稀疏化都正交的加速维度,且只需数小时微调就能挂到现有基线上。两篇的边界也要看清:LoSA 的 1.36 倍单独加速并不高,3.2 倍是叠加特征缓存后的复合结果,它更准确的定位是「一个不拖后腿、可安全叠加的组件」;GeoFlow 吃的是驾驶场景「几何强先验 + 时空强冗余」的特殊红利,换到无标定、镜头切换剧烈的开放域视频未必构造得出这个先验,而且先验越强、多样性越受约束,用于仿真罕见场景时这个权衡值得警惕。 统一模型的评价标准正在从「各项都高」转向「内部是否自洽」 — 今天有三篇论文从不同角度指向同一件事:把能力拼在一起不等于打通了。浙大的 SGU 提出一个零标注的语义闭环评测——让统一多模态模型先描述一张图、再按自己的描述重建图像、最后对自己生成的图做推理。发现是扎实的:即便理解分和生成分都很高的模型,也常常无法对自己生成的上下文正确推理,图中模型对原图答「猫朝左」、对自生成图答「猫朝前」,这类失效在分离式评测里完全看不到;六个模型的闭环排名与孤立排名折线明显交叉,说明分开打分预测不了统一系统的整合表现。小米 MiLM Plus 与上交的 MiDashengLM-Gen 则给出了「不自洽」的具体代价:以往统一音频生成靠冻结文本编码器加独立音频解码器的拼装管线,跨模态优化被切断,最直接的后果是语音清晰度崩坏——Seed-TTS 上英文 WER 高达 12.15%,每八个词错一个,演示视频里听着还行,实际完全无法承载信息;改成 LLM 与逐 token 条件流匹配端到端联合训练后降到 2.79%,4.4 倍收敛,且混合音频质量没掉。北京交大与北大的 StateFlow 从交互侧提出另一种自洽:当前视频生成的编辑范式基本是抽奖,改一个词整段重出、上一版的满意之处全丢,它主张缺的是一个显式且持久的 3D 世界状态,把编辑从重新生成变成状态转移。三篇合起来看,「统一」这个词正在被要求兑现更硬的东西:不只是参数共享,而是表征自洽、跨模态联合优化、以及状态可持久。当然也别过度乐观——SGU 的闭环误差难以归因,文本描述天然有损这部分内在损失不该全算成模型缺陷;MiDashengLM-Gen 的 2.79% 对专用 TTS 的 1.24% 仍有 2.25 倍差距,且未拆分报告有背景音乐音效叠加时的 WER,而那恰恰是统一模型唯一的存在理由;StateFlow 的实验只给了定性结论,可控性与迭代效率这两个核心主张最该被量化却没有量化。 人工智能炼丹君 整理 | 2026-08-14 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
深度解读|NVIDIA Sol-Engine|Agent自动调栈视频推理快2.77倍 Sol-Engine 深度解读:NVIDIA 让 Agent 自己调出视频推理加速栈,端到端 2.27~2.77 倍 论文:Sol Video Inference Engine: Agent-Native Full-Stack Acceleration Framework for Efficient Video Generation 机构:NVIDIA Research(Efficient AI Team & Singapore Lab)· 港大 · MIT 人类作者:Yitong Li、Junsong Chen、Haopeng Li、Haozhe Liu、Jincheng Yu、Ligeng Zhu、Ping Luo、Song Han、Enze Xie 论文首页署名:NVIDIA SANA Team*、Codex*、GPT-Image2(* 同等贡献) 日期:2026-06(arXiv 2606.23743) 代码:论文给出 GitHub Code 与 Project Page 链接入口,截至发稿未见公开可跑的完整仓库 论文类型:技术报告 / 系统工程论文(非新算法论文) 01 先说说这东西是干嘛用的 先说一个容易被忽略的细节:这篇论文的署名里,Codex 和 GPT-Image2 是和 NVIDIA SANA Team 并列的"同等贡献作者"。arXiv 页面还专门单独列了一栏 "Human authors",把 9 位人类作者和 AI 分开标注。 这不是行为艺术。论文的主张就是"让 agent 来干加速工程这件活",所以把干活的 agent 署名进去,逻辑上是自洽的。 回到技术本身。Sol Video Inference Engine(下面简称 Sol-Engine)解决的问题很具体: 视频扩散模型的推理加速,没有通用配方。 现在业界已经攒了一大堆免训练加速手段——跨步缓存、稀疏注意力、token 剪枝、低比特量化、算子融合。每一个单独看都有效。但真到部署时会发现一件很烦的事: 在 Cosmos3-Super 上调好的缓存策略,搬到 LTX-2.3 上就崩,因为后者用的是 res_2s 二阶采样器,不是 Euler; 在 544×960 分辨率下管用的稀疏模式,换到 1088×1920 就掉质量; 在 B200 上收益明显的 NVFP4 量化,换张不支持 FP4 的卡就基本白干。 于是每换一个「模型 × 硬件 × 推理配置」组合,就得重新调一遍。而这三个维度一乘起来是个组合爆炸。NVIDIA 的做法是:别让人一个个调了,把这五类技术做成"技能"暴露给 agent,让 agent 自己搜。 具体产出是三个真实部署的加速栈: 模型 参数量 SGLang 基线 Sol-Engine 加速 Cosmos3-Super 64B(4 卡 SP) 99.6 s 43.9 s 2.27× LTX-2.3 22B 97.8 s 41.0 s 2.38× SANA-Video 2B 29.4 s 10.6 s 2.77× VBench 平均分变化在 ±0.54% 以内。全程免训练,不动模型权重。 (图片来源:论文 Figure 1。左侧是传统模式:kernel 组、算法组、推理服务组各管一段,最后人工集成调试,迭代周期长、沟通成本高、易出错;右侧是 Sol-Engine 模式:五类加速技能暴露给 agent,agent 做局部搜索和栈集成,人只负责验收和迭代) 02 主要亮点,以及需要冷静看的地方 值得关注的地方: 把"加速"这件事重新定义为逐实例调优问题,而不是"发明一个更好的方法"。这个问题重构本身比具体数字更有价值; 三个模型跨越 2B 到 64B,架构差异极大(MoT 混合专家、两阶段推理、线性注意力),同一套流程都拿到了 2× 以上,说明不是过拟合到单一 backbone; 用并行技能 agent + 集成 agent两层结构规避了单 agent 搜全局空间的成本问题,工程上是合理设计; 明确指出 PSNR 这类相似度指标和人类感知不对齐,并给出了反例图(详见第 07 段)——这个观察对整个视频加速评测圈都有价值; 附录 A 的超参配置写得非常细,细到 TeaCache 阈值 1.15、起始第 10 步、LTX 跳过的具体 call 索引 [13,14,16,...,27]。这部分是全文最能直接抄走用的资产; 量化不是一刀切,而是按去噪步选择性施加:Cosmos3-Super 的前 3 步和后 3 步保持高精度,只在中间步走 NVFP4。这个经验规则很实用。 需要冷静看的地方: "agent 比人快"这个核心主张没有对照实验。论文说"with little human effort",但没给 agent 用的是什么模型、搜了多少轮、花了多少 GPU 小时或 token 成本,也没有"人工调优需要 N 人周 vs agent 需要 M 小时"的量化对比; 没有消融证明 agent 搜索优于随机搜索或网格搜索。这是最大的方法论空白——如果把同样的搜索预算给随机搜索也能找到差不多的配置,那"agentic"就更多是包装而不是贡献; 人工验收仍在环里,所以这不是全自动流程。而"人觉得可以接受"本身是主观且不可复现的判断标准; 只在 B200 / B300 上做了实测,而这两张卡正好是 NVFP4 的主场。论文 Figure 3 把 H200 和 RTX 5090 画进了"硬件空间",但没有给这两张卡的任何实测数字; VBench 平均分几乎不变,但单维度有明显退化被平均分抹平了:成像质量在 Cosmos3-Super 上掉 1.35%、在 SANA-Video 上掉 1.64%,LTX-2.3 的美学质量掉 2.09%; 只报单请求延迟,没有吞吐量和显存峰值数据。生产部署更关心并发下的 QPS; Cosmos3-Super 是 NVIDIA 自家模型,有"自家模型自家调"的信息优势; 没有和 TeaCache、Sparse VideoGen2 等单点方法做同环境端到端对比——这些方法在论文里是"技能库的候选项",不是"被击败的基线"。 03 视频加速这条赛道现在什么样 在看 Sol-Engine 怎么组合之前,先把它调用的这些"技能"各自的来路说清楚。视频扩散加速大致分三层打: 算法层:缓存。 相邻去噪步算出来的东西很像,那就别重复算。代表工作是 TeaCache(用 timestep 嵌入预测输出变化量,变化小就复用缓存残差)、TaylorSeer(ICCV 2025,用泰勒展开预测未来特征,而不只是复用旧特征)、EasyCache(运行时自适应调整复用策略)。 模型层:稀疏注意力 + token 剪枝。 视频的时空 token 序列很长,注意力矩阵里大量连接贡献很小。稀疏注意力方向有 PISA(分块稀疏 + 一阶泰勒补偿)、Sparse VideoGen 1/2、SpargeAttention、Radial Attention、VSA。token 剪枝方向有 ToMe-SD、Astraea、TAPE、CoReDiT。 Kernel 层:量化 + 算子融合。 量化有 PTQ4DiT、Q-DiT、SVDQuant、SageAttention 1/2/3。融合有 CUTLASS epilogue、ByteTransformer、CODA(把 transformer block 重写成 GEMM + epilogue 程序)。 另一条相关线索是"agent 做系统优化":CUDA-LLM 和 CudaForge 已经证明 agent 配上编译检查、正确性验证、profiling 反馈,可以自动生成或优化 CUDA kernel。The AI Scientist 则证明 agent 能跑完整的科研闭环。 Sol-Engine 站的位置很清楚:它不发明上面任何一层的新方法,它做的是"怎么把这些方法组合起来并调对参数"的自动化。 这个定位决定了它的价值和局限——价值在于把学术界攒的一堆单点技术真正落到部署;局限在于它本身没有新的算法贡献。 04 为什么"通用加速配方"这件事不成立 这是全文论证最扎实的一段,也是理解 Sol-Engine 为什么要用 agent 的关键。 论文先把冗余拆成三层,然后给了一个很有说服力的数据。 (图片来源:论文 Figure 2。左:未加速推理路径中算法级、模型级、kernel 级三层冗余的分布,30 步去噪中 GEMM 约占 40%、Softmax 约 20%,剩下是 RoPE、norm 等碎片算子;右:同一个 LTX-2.3、同一张卡,仅改变分辨率后的时间分布对比) 看右边那两条: LTX-2.3 在 544×960、token 长度 15,810 时:GEMM 38.8% / Softmax 19.9% / 逐元素+norm 41.3% 同一个模型在 1088×1920、token 长度 63,240 时:GEMM 24.8% / Softmax 47.6% / 逐元素+norm 27.6% 分辨率翻一倍,Softmax 占比从 19.9% 直接涨到 47.6%,GEMM 从 38.8% 掉到 24.8%。 瓶颈换了个位置。 低分辨率下你该去优化碎片算子和 GEMM,高分辨率下你该去优化注意力。同一个模型、同一张卡,只改了分辨率,最优的优化方向就完全不同了。 这就是"instance-specific"的实证。再把模型架构和硬件两个维度乘进来: (图片来源:论文 Figure 3。模型维度:Cosmos3-Super 64B 混合 Transformer、LTX-2.3 22B 两阶段推理、SANA-Video 2B 线性注意力;硬件维度:B200 192GB/FP4·8·16/约 9000 TFLOPS、H200 141GB/FP8·16·BF16/约 1979 TFLOPS、RTX 5090 32GB/FP4·8·16/约 3352 TOPS;配置维度:480p~1080p 分辨率、5~30 秒时长、16~48 fps 帧率) 论文的具体论证是: 模型决定数值敏感性:不同 backbone 对量化的鲁棒性、注意力冗余度、缓存跨步稳定性、token 剪枝容忍度都不一样; 硬件决定瓶颈暴露在哪:在 B200 这种高算力卡上,大 GEMM 快到一定程度后,小算子的启动开销和访存受限的 epilogue 就占了更大比例;换到算力弱的卡上,密集计算仍然主导,那些启动开销反而看不见; 配置决定 token 数和运行时平衡:注意力随 token 数平方增长,FFN 大致线性增长,所以分辨率一变,注意力和 FFN 的时间占比就会大幅移动。 结论是两句话:部署实例太多,穷举人工调优不可扩展;但每个实例内部的优化问题结构是清晰的——目标(延迟)和约束(质量不掉)都明确,这恰好适合交给 agent 自动化。 05 五个加速技能,每一个在干什么 (这段偏技术,只想看结果的可以直接跳到 08。) Sol-Engine 的技能库里有五样东西。每一样都不是新发明,但 agent 需要为每一样决定"用哪个方案 + 怎么调参"。 1. 跨步缓存(Cross-Step Cache) 高质量生成通常要 30~50 步去噪。相邻步之间模型反复执行结构相似的计算,隐状态变化缓慢。缓存就是跳过一些步的计算,用之前的结果补上。 Agent 要决定的事:选哪个缓存策略(TeaCache / EasyCache / TaylorSeer)、跳步时间表、缓存什么(特征还是残差)、补偿规则、warmup 多少步、最多允许连续跳几步。 2. 稀疏注意力(Sparse Attention) 视频 token 在时间上跨帧冗余、空间上帧内冗余,很多注意力边对最终输出贡献极小。稀疏注意力砍掉这些边,把平方复杂度压下来。 Agent 要决定的事:用哪个稀疏后端(PISA / SpargeAttention / SVG2)、哪些层可以安全稀疏化、哪些层必须保持 dense、稀疏模式、补偿策略。 3. Token 剪枝(Token Pruning) 不是砍注意力边,而是直接砍序列本身——跳过、合并或重建冗余的 latent token。序列短了,后面的注意力和 FFN 都跟着省。 Agent 要决定的事:剪枝准则、剪枝比例、层调度、时间步调度、重建规则。论文特别强调这里的验证重点是时序连贯性和后期步的细节保真——剪枝最容易破坏的就是运动的稳定性。 4. 量化(Quantization) 论文对量化的判断很清醒:量化能带来多少实际加速,取决于隐藏层维度、token 数和硬件特性;而模型对量化噪声的敏感度,取决于它自己的训练参数分布。所以加速潜力和质量代价都会随部署实例剧烈变化。 Agent 要决定的事:profiling 各层敏感度和张量形状,然后调逐层精度分配、权重/激活位宽、随时间步变化的缩放。 5. 算子融合(Kernel Fusion) Transformer 推理会在 GEMM 周围反复启动一堆算术强度很低的算子:bias 加法、残差更新、归一化、激活函数、缩放、layout 转换。融合就是趁中间结果还在寄存器或共享内存里就把后续算子做完,而不是写回 HBM 再启一个 kernel。 Agent 要决定的事:融合哪些算子序列、用手写 kernel 还是编译器生成、怎么匹配当前的张量形状和精度格式。典型候选是 GEMM + GELU、GEMM + residual、RoPE + norm。 论文把融合定位成后期任务——要等前面几层加速做完、瓶颈重新暴露之后再来做,因为融合的收益完全取决于"此刻什么在拖后腿"。 06 Agent 工作流怎么转起来 (图片来源:论文 Figure 5。① 加速技能库:缓存/token 剪枝/稀疏注意力/算子融合/量化;② 并行适用性执行器:每个技能一个 agent 独立判断是否适用并给出最优实现,图中示例显示 token 剪枝被判定为"不适用,会造成不可忽略的损失";③ 集成 agent:组合已选技能、全局参数调优、端到端质量检查、生成栈补丁;④ 人工验收:效率面板看延迟/吞吐/显存,质量面板看一致性/视觉保真/对齐,最后决定接受还是修订策略。论文脚注注明各方法的适用性在不同模型上会变,图中实现仅作示意) 整个流程分三段: 第一段:并行技能 agent 做局部搜索。 不让单个 agent 去搜整个全局空间——技能太多,联合搜索空间太大,成本和耗时都不划算。改成每个技能族一个独立 agent,各自在自己的小空间里并行搜。 比如缓存 agent 去搜跳步时间表和补偿规则,算子融合 agent 去 profile 每个 kernel 的耗时然后试 GEMM + GELU、RoPE + norm 这些组合。 有意思的是图里显示 agent 会主动报告"不适用"——token 剪枝在那个模型上被判定为损失不可忽略,直接出局。这比强行把五个技能都堆上去要合理。 第二段:集成 agent 做全局组合。 这一段是真正的难点。论文说得很直白: 这些方法不是独立的,最终端到端加速不等于各自局部收益的直接乘积。而且很多技术是有损的,直接把局部最优选择堆起来会累积近似误差,产出不可接受的结果。 所以集成器不是简单汇总第一阶段的结果,而是要重新做全局优化。它要解决的具体问题包括:缓存和稀疏注意力这两个有损方法叠加之后还能不能接受?量化和算子融合在同一个部署目标下有没有兼容的实现? 第三段:人工验收给质量反馈。 用固定的验证集看每个集成候选,判断视觉质量是否可接受。这个反馈决定下一轮 agent 是可以往更激进的加速推,还是要收敛回保守一点。 07 为什么人还必须留在环里 这一段是我认为全文最有洞察的部分,而且它的价值超出这篇论文本身。 问题是:既然要自动化,为什么不把质量判断也自动化?用 PSNR 做约束不就闭环了吗? 论文给了反例。 (图片来源:论文 Figure 6。上排为经过人工验收的结果——PSNR 更差但视觉质量更好;下排为未经人工验收的结果——PSNR 更好但视觉质量更差。左侧瀑布场景中,下排的水流细节糊成一片;右侧机器人场景中,下排的面部和城市结构出现明显退化) 看左边那组瀑布:上排(人工验收通过的)PSNR 分数更差,但水流的岩石细节清晰;下排(PSNR 分数更好的)水流糊成一团。右边机器人那组同理,下排的脸部和背景建筑明显退化。 原因是 PSNR 这类逐像素相似度指标有个结构性缺陷: 当加速后的输出只是改变了一些无害的视觉细节(比如水花的具体形状变了,但一样清晰合理),PSNR 会判定距离很大——虽然人看着完全能接受; 反过来,当输出出现模糊、时序抖动、运动不连贯这类真正致命的退化时,它在数值上反而可能离基线更近——因为模糊本身就是向均值收敛。 所以如果拿 PSNR 当优化目标,agent 会被引导向"生成模糊但数值安全"的方向。这正好是最不该要的结果。 论文的处理是老实承认这一点,把人留在环里做最终把关,并把"建立更强的端到端视觉质量评估器"列为未来工作——具体设想包括学习式视频偏好模型、伪影检测器、物理一致性检查、VLM 端到端质量判断。 这个观察对做视频生成评测的人来说值得单独拿出来看:只要自动指标和人类感知的错位没有解决,任何"全自动加速搜索"都会朝着指标漏洞的方向优化。 08 加速数字逐级拆解 这是全文最硬的一张图,把每一层技术各自贡献了多少秒都标出来了。 (图片来源:论文 Figure 4。绿色为去噪/DiT 阶段,灰色为 VAE 解码阶段,每一行代表叠加一层加速技术后的耗时构成,红色箭头标注累积加速倍率) 先看总表(NVIDIA B200,三种部署延迟与两套加速倍率): 模型 官方 pipeline SGLang 基线 Sol-Engine vs SGLang vs 官方 Cosmos3-Super 64B(4 卡 SP) 108.3 s 99.6 s 43.9 s 2.27× 2.47× LTX-2.3 22B 118.1 s 97.8 s 41.0 s 2.38× 2.88× SANA-Video 2B 34.2 s 29.4 s 10.6 s 2.77× 3.23× 论文主表用 SGLang 归一化,同时也给出了官方 pipeline 的延迟供参考,这点算诚实——毕竟 SGLang 本身已经比官方实现快了一截(比如 LTX 从 118.1 s 降到 97.8 s),拿官方版当基线会让倍率凭空好看一截。 Cosmos3-Super(64B,4 卡序列并行) 拆解路径:99.6 s(去噪 94.5 + VAE 4.8)→ 缓存后 52.4 s(去噪 47.3,1.90×)→ 加 kernel 融合与量化后 43.9 s(去噪 39.1,2.27×) 这个模型的加速几乎全靠缓存吃下来了——单缓存一项就 1.90×。原因是 64B 的 MoT 架构里 transformer block 极大,跳过一次去噪步省下的绝对时间非常可观。 缓存 agent 选的是 TeaCache 风格策略。量化则是按去噪步选择性施加,这是很值得抄的经验: 前 3 步和后 3 步保持高精度——早期步决定全局结构,晚期步细化高频细节,这两头用低精度分别会导致结构偏移和高频伪影; 中间那些"比较规整"的步走 NVFP4,作用在算术密度高的 GEMM 层:FFN 的 gate-up 和 down 投影、注意力的 QKV 和输出投影。 LTX-2.3(22B,两阶段) 拆解路径:97.8 s → 缓存后 70.3 s(1.39×)→ 加 token 剪枝和稀疏注意力后 58.5 s(增量 1.20×,累积 1.67×)→ 加算子融合和量化后 41.0 s(2.38×) 分阶段看更清楚(第一阶段 / 第二阶段 / VAE): 配置 一阶段 二阶段 VAE 总计 SGLang 基线 60.8 s 28.2 s 8.8 s 97.8 s + 缓存 33.3 s 28.2 s 8.8 s 70.3 s + token 剪枝 & 稀疏注意力 33.3 s 16.4 s 8.8 s 58.5 s + 算子融合 & 量化 24.6 s 11.0 s 5.4 s 41.0 s 这张表把"分工"说得很明白:缓存只砍了一阶段,稀疏注意力和 token 剪枝只砍了二阶段。 原因是 LTX-2.3 的流水线本身是两段式的——一阶段用 res_2s 二阶采样器跑 15 步生成 544×960 的 latent,二阶段上采样到 1088×1920 再精修 3 步,最后 VAE 解码 241 帧。二阶段的 token 数是一阶段的 4 倍,注意力成本占大头,所以稀疏化和剪枝的收益都在这里。 值得注意的是缓存在这个模型上只拿到 1.39×,明显低于 Cosmos3-Super 的 1.90×。论文解释了原因:res_2s 是二阶采样器,而市面上大部分缓存启发式规则是按 Euler 类调度假设设计的,直接套不上。Agent 最后是靠固定步跳过策略而不是在线阈值判断绕过了这个问题。 SANA-Video(2B,线性注意力) 拆解路径:29.4 s(去噪 28.2 + VAE 1.2)→ 缓存后 19.8 s(去噪 18.6,1.48×)→ 加 kernel 优化后 10.6 s(去噪 9.4,2.77×) 这个模型的情况反过来了:因为 SANA-Video 本身就是效率导向设计的(用线性注意力替掉平方复杂度的标准注意力),模型层已经没什么可榨的了,所以完全不用稀疏注意力和 token 剪枝,收益全来自算法层缓存和 kernel 层优化。 缓存 agent 选的是 EasyCache,50 步里跳掉约 16 步。kernel 层的三个改动都很朴素但有效(详见第 10 段)。 一个需要提醒的点:2.77× 是三个模型里最高的倍率,但它的绝对基数最小(29.4 s → 10.6 s)。小模型的 kernel 启动开销占比高,torch.compile 这类图优化的相对收益天然更大。别把 2.77× 直接理解成"这套栈在大模型上也能到 2.77×"。 09 质量到底掉没掉 论文用 VBench 做质量把关。先看结论表: 配置 平均分 主体一致性 背景一致性 时序闪烁 运动平滑 美学质量 成像质量 整体一致性 Cosmos3-Super 64B 基线 0.7759 0.9687 0.9301 0.9859 0.9923 0.6134 0.7276 0.2133 Sol-Engine 0.7775 0.9723 0.9382 0.9877 0.9935 0.6197 0.7178 0.2133 Δ +0.21% +0.37% +0.87% +0.18% +0.12% +1.03% -1.35% +0.00% LTX-2.3 22B 基线 0.7646 0.9010 0.9245 0.9675 0.9871 0.6234 0.7012 0.2474 Sol-Engine 0.7605 0.9006 0.9137 0.9704 0.9840 0.6104 0.7013 0.2429 Δ -0.54% -0.04% -1.17% +0.30% -0.31% -2.09% +0.01% -1.82% SANA-Video 2B 基线 0.7864 0.9730 0.9648 0.9626 0.9843 0.6650 0.6892 0.2660 Sol-Engine 0.7847 0.9750 0.9654 0.9646 0.9842 0.6624 0.6779 0.2637 Δ -0.21% +0.21% +0.06% +0.21% -0.01% -0.39% -1.64% -0.86% 平均分变化确实很小:+0.21% / -0.54% / -0.21%。论文的说法是"加速来自消除冗余和低效操作,而不是牺牲感知上关键的计算",从平均分看站得住。 但平均分掩盖了两个细节: 第一,成像质量(imaging quality)这一维在 Cosmos3-Super 上掉了 1.35%,在 SANA-Video 上掉了 1.64%,是这两个模型各自跌幅最大的维度(LTX-2.3 是唯一例外,这一维基本没动,+0.01%)。成像质量衡量的正是单帧的清晰度和伪影水平,也就是有损加速最容易伤到的地方。平均分之所以没动,是因为主体一致性、背景一致性、时序闪烁这些维度绝对值都在 0.9 以上且波动极小,把跌幅稀释掉了。 第二,LTX-2.3 的美学质量掉了 2.09%,是全表最大的单项跌幅,同时整体一致性掉 1.82%。这个模型是三个里唯一叠满了缓存+稀疏注意力+token 剪枝+量化四层的,有损方法堆得最多,代价也最明显。 还有一点值得说:VBench 的"整体一致性"(overall consistency,衡量文本-视频对齐)绝对值只有 0.21~0.27,本身分辨力就有限,在这个区间讨论 ±1.8% 的变化意义不大。 定性对比图看着确实还行: (图片来源:论文 Figure 7。每组上排为未加速的 SGLang 结果,下排为 Sol-Engine 加速结果,标注了各自的加速倍率。Cosmos3-Super 是机械臂刷盘子,LTX-2.3 是老人织渔网,SANA-Video 是热气球飞越麦田。场景布局、主体排布和运动结构基本保持) 论文自己的表述是"加速后的输出在精细视觉细节上可能有轻微差异,但整体视觉质量、运动质量和物理保真度仍然很强"。这个说法和数据是一致的——要的是"部署可接受",不是"逐像素一致"。 10 三个模型的具体配置(最能直接抄的部分) (这段是纯工程细节,不打算自己动手的可以跳到 13。) 附录 A 的信息密度非常高。如果你手上正好有这几个模型要部署,这些参数可以直接当起点用。 共性原则(论文明确说三个模型只在实现范围和超参上不同,方法层面原则一致): 缓存始终作为免训练的去噪步复用策略,但具体时间表按模型走; 稀疏注意力只在注意力图有足够结构性时才引入,否则不动; token 剪枝只在中间 token 冗余到"丢一部分不会有可见伪影"时才用; 量化选择性施加,数值脆弱的阶段留高精度,稳定的 GEMM 密集区域降精度; kernel 优化包括 epilogue 融合、QKV 路径融合、归一化路径融合、编译器图融合,只在对目标工作负载稳定时才启用。 Cosmos3-Super 缓存:TeaCache 风格残差重放,阈值 1.15,起始第 10 步,最多 3 次连续命中。判据是测量生成隐状态跨去噪步的相对 L1 变化并累积,累积值低于阈值就跳过生成路径的 transformer block,否则重算并刷新缓存残差; 量化:前 3 步 + 后 3 步走 dense/高精度路径,中间步用 NVFP4,作用于 FFN gate-up / down 投影和注意力 QKV / 输出投影。 LTX-2.3 两阶段结构:一阶段 res_2s 采样器 15 步 @544×960,二阶段上采样精修 3 步 @1088×1920,VAE 解码 241 帧; 缓存:用固定步跳过而非在线 TeaCache 阈值。预设名 8of15_last_29calls——一阶段共 29 次 denoiser 调用,在调用索引 [13, 14, 16, 17, 18, 19, 20, 21, 22, 24, 25, 26, 27] 复用上次计算结果(reuse_mode=last、max_skip_steps=30)。也就是 29 次里跳掉 13 次,约 45%; 稀疏注意力:PISA 只用于二阶段的高分辨率精修 transformer。稀疏度 0.9(密度 0.1),block size 64,只替换 video self-attention,一阶段稀疏调度关闭;二阶段 layer 0~1 保持 dense,之后的层用分块稀疏 + 近似余项 + 打分路由 + FlashAttention dense 兜底; token 剪枝:也只在二阶段。精修调用中按 feat_norm 显著性保留 50% video token,只在 refinement call 1 和 2 上做; 量化:NVFP4 只用于 video FFN 的输入/输出投影,NVFP4 融合的 proj_in+GELU 与 proj_out+bias+gate 路径关闭; 无损融合开关(这一串很长,照抄):block-0 self-attention 共享、guidance-prefix 共享、QK+RoPE 融合、RMS-AdaLN 融合、AdaLN 融合、QKNorm+RoPE 融合、双调制融合、cross-attention 双调制融合、Ada values 融合、残差门融合、FFN proj_in+GELU 融合、gate-to-output 编译、audio QKVG 融合、全局 QKNorm+RoPE 融合、tiled VAE 解码编译; 蒸馏 LoRA 强度:一阶段 0.25、二阶段 0.5;二阶段 sigmas 为 [0.909375, 0.725, 0.421875, 0.0]。 SANA-Video 测试配置:81 帧、50 步、480p(832×480); 不用稀疏注意力、token 剪枝、NVFP4 FFN 量化; 缓存:EasyCache,阈值 0.1,warmup 3 步,空间下采样步长 8。判据是从下采样隐状态估计在线的输入-输出变换率,累积估计的相对输出变化,低于阈值就跳过整个 transformer block 栈。缓存残差在未 batch 的 CFG 分支间共享,避免注入过期的 guidance;50 步里约跳 16 步; 三个 kernel 级改动:① 线性注意力的 K/V 聚合保持 BF16 tensor-core 执行,不提升到 FP32;② Q/K/V 投影权重加载后拼接,合并成一个 GEMM;③ DiT block 栈用 torch.compile 编译,max-autotune 模式用 max-autotune-no-cudagraphs + 子进程 autotuning + 持久化 TorchInductor 缓存; 低比特线性注意力 kernel 额外贡献约 1.2× kernel 级加速,重建损失很小(PSNR 高于 30 dB)。 从这三份配置里能提炼出的通用直觉: 模型越大,缓存的相对收益越高(64B 拿到 1.90×,2B 只有 1.48×); 本身已经做过效率优化的架构(线性注意力),模型层加速基本没戏,要往算法层和 kernel 层找; 多阶段流水线要分阶段施策,高分辨率阶段才值得上稀疏注意力和剪枝; 量化不要一刀切,首尾去噪步和数值脆弱模块留高精度; 非标准采样器(二阶、多阶)会让主流缓存启发式失效,退化成固定步跳过反而更稳。 11 换硬件会怎样 论文额外做了单卡 Cosmos3-Super 在 B200 和 B300 上的对比: 配置 延迟 加速 B200 × SGLang 353.5 s 1.00× B200 × Sol-Engine 143.8 s 2.46× B300 × SGLang 351.9 s 1.00× B300 × Sol-Engine 137.6 s 2.56× B300 相对 B200 的 BF16 算力差不多,但 NVFP4 算力更高。结果符合预期: Cosmos3-Super 依赖 NVFP4 执行较多,所以在 B300 上拿到更明显的端到端收益(2.46× → 2.56×); LTX-2.3 和 SANA-Video 对 NVFP4 依赖较轻,单卡场景下换到 B300 端到端几乎没变化。 这个实验本意是展示框架的硬件适应性,但反过来读出的信息更重要:这套栈的收益里有相当一部分绑定在 FP4 硬件支持上。 如果部署环境是 H100/H200 这类只有 FP8 的卡,或者更老的 A100,量化这一层的贡献会大幅缩水,2× 这个数字就不能直接搬。 论文 Figure 3 把 H200 和 RTX 5090 都画进了硬件空间图,但正文和附录都没有给这两张卡的任何实测数据。这是一个明显的缺口——一个号称"解决硬件异构性"的框架,只在同代同架构的两张卡上验证了硬件维度。 顺便注意单卡 Cosmos3-Super 的绝对延迟:353.5 s 基线,加速后 143.8 s。而 4 卡序列并行版本是 99.6 s → 43.9 s。64B 模型单卡出一段视频要两分半,这个量级离交互式使用还很远。 12 想自己复现要注意什么 能不能直接跑起来? 论文在摘要末尾给了 "Github Code" 和 "Project Page" 的链接入口,但截至发稿我没有找到公开可跑的完整仓库。所以现实的用法是:把附录 A 当配置说明书,在自己的推理栈上手动复刻。 好消息是所有依赖的技术都有公开实现: 缓存:TeaCache、EasyCache、TaylorSeer 都有开源仓库; 稀疏注意力:PISA、SpargeAttention、Sparse VideoGen 2 都开源; 量化:SVDQuant、SageAttention 系列开源; 融合:CUTLASS epilogue 是官方文档,torch.compile 是现成的。 运行时基座是 SGLang。 论文明确说部署接口组织成"dense 基线路径"和"组合后的 fullopt 路径"两条,所以测出来的对比是端到端服务栈,不是孤立的 kernel 微基准。这个做法值得学——很多加速论文只报 kernel 级数字,端到端一测就缩水。 硬件门槛不低:主实验在 B200 上,Cosmos3-Super 用了 4 卡序列并行。如果只有单卡,参考第 11 段的单卡数字。 如果要复刻 agent 部分:论文没有公开 agent 的实现细节——用什么模型、prompt 怎么写、搜索循环怎么组织、每个技能 agent 的工具接口长什么样,全都没有。想复现这一层,参考 CudaForge 和 CUDA-LLM 这两篇会更实际。 一个务实的建议:如果你的目标只是把某个视频模型的推理跑快一倍,没必要先搭 agent 框架。直接照抄第 10 段的经验规则(缓存优先、首尾步留高精度、高分辨率阶段才上稀疏、torch.compile 兜底),手工调两三轮大概就能吃到大部分收益。Agent 的价值在于你要同时维护很多个部署实例,而不在于单个实例能调得更好。 13 需要留意的限制 前面零散提过一些,这里集中说。 1. 核心主张缺对照实验。 论文反复强调"with little human effort"、"in a fraction of the usual human effort",但通篇没有任何量化:agent 用的什么模型?搜了多少轮?消耗多少 GPU 小时和 token?人工调优同样的目标要多久?没有这组对比,"agent 省人力"就只是一个断言。 2. 没有搜索策略的消融。 这是我认为最要紧的空白。Agent 相比随机搜索、网格搜索、贝叶斯优化的优势在哪?论文没做这个对比。考虑到每个技能的搜索空间其实不大(缓存阈值、稀疏度、剪枝比例这些都是低维连续或离散参数),传统超参搜索方法完全可能达到同样效果。如果是这样,"agentic" 的贡献就主要在"自动化编排和写补丁代码",而不在"搜得更好"。 3. 不是全自动。 人工验收在环,且论文自己承认这是当前的主要限制。而"人觉得可接受"是主观标准——换一批验收人,加速激进程度的上限就会变。这也意味着结果不完全可复现。 4. 硬件验证面太窄。 只有 B200 和 B300,同代同架构。Figure 3 承诺的 H200、RTX 5090 都没有实测。而 NVFP4 量化的收益强烈依赖 FP4 硬件,这一层在非 Blackwell 卡上会显著缩水。 5. 质量评测的选择性。 VBench 平均分变化在 ±0.54% 内,但成像质量维度三个模型有两个跌超过 1.3%,LTX-2.3 的美学质量跌 2.09%。论文正文只讨论平均分"基本持平",没有专门解释这些单维退化。另外定性对比图是作者挑的,Figure 7 加附录 B 的 18 组对比里没有失败案例。 6. 没有吞吐和显存数据。 全文只有单请求端到端延迟。生产部署要看的是并发下的吞吐、显存峰值、以及加速后能否提高 batch size。稀疏注意力和 token 剪枝理论上能省显存,但论文没量化。 7. 缺少与单点方法的端到端对比。 TeaCache、SVG2、SVDQuant 这些在论文里是"技能库候选",没有"单独用某一个方法能到多少倍"的完整对照。Figure 4 的分层拆解某种程度上补上了这个信息(比如 Cosmos3 单缓存 1.90×),但那是在 Sol-Engine 自己调参下的结果,不是各方法原始实现的公平对比。 8. 自家模型的信息优势。 Cosmos3-Super 是 NVIDIA 自己的模型,团队对它的架构、数值特性、训练分布都有外部研究者拿不到的信息。这不影响结果的真实性,但会影响"这套流程对任意第三方模型都同样有效"这个推论的强度。 9. 论文类型的定位。 署名(把 Codex 和 GPT-Image2 列为作者)、结构(大量篇幅在描述工程配置)、缺少方法论消融——这些都指向它更像一份高质量工程实践报告,而不是一篇方法论文。按技术报告的标准看,它的信息密度很高;按方法论文的标准看,它的验证是不完整的。 14 横向对比表格 下面这张表是我按公开信息整理的,不是论文原表。需要特别说明:Sol-Engine 没有和这些方法做同环境的端到端对比,所以加速倍率跨行不可直接比较(模型、硬件、分辨率、基线都不同)。 方案 覆盖层级 自动化程度 免训练 论文报告的加速 质量代价 硬件绑定 Sol-Engine 算法 + 模型 + kernel 全栈 Agent 并行搜索 + 集成 + 人工验收 是 端到端 2.27~2.77×(B200) VBench 平均 ±0.54% 较强(NVFP4 依赖 Blackwell) TeaCache 算法(缓存) 手工调阈值 是 本文实测单项 1.39~1.90× 中等,跳步越多越明显 无 EasyCache 算法(运行时自适应缓存) 在线自适应 是 本文实测单项 1.48× 中等 无 PISA 模型(分块稀疏注意力) 手工选层与稀疏度 是 本文中作为二阶段组件 小(有泰勒补偿) 无 Sparse VideoGen 2 模型(语义感知稀疏) 在线 profiling 是 注意力级为主 小 需定制 kernel SVDQuant kernel(4bit 量化) 手工 是(PTQ) 显存与访存收益为主 小 需低比特支持 SLA2 模型(稀疏 + 线性混合) 可学习 Router 否,需 QAT 微调 端到端 2.30~4.35×(RTX 5090) 需微调,作者称可超 full attention 无 CudaForge kernel(CUDA kernel 生成) Agent + 硬件反馈 是 单 kernel 级 无(要求数值正确) 无 几点解读: Sol-Engine 的差异化不在"加速比更高",而在"覆盖层级最全 + 调参过程自动化"。单看倍率,SLA2 在 Wan2.1-14B-720P 上报出 4.35×,比 Sol-Engine 的任何一个数字都高——但那需要 QAT 微调,不是免训练,且模型和硬件都不同; 免训练这一栏很关键。Sol-Engine 全程不动权重,这让它可以直接套到任何已发布的模型上,工程摩擦远小于需要微调的方案; 硬件绑定这一栏是 Sol-Engine 相对吃亏的地方。它的 kernel 层收益有相当部分来自 NVFP4,换卡就要重新评估。 15 总结感受 我觉得这篇论文真正的价值不在那几个 2× 的数字,而在它把问题重新框了一遍。 过去两年视频加速方向的论文,主流叙事是"我提出了一个新的缓存/稀疏/量化方法,比前人快 X 倍"。这类工作攒到今天已经足够多了,多到出现了一个新的瓶颈:没人知道该怎么把它们组合起来用在自己的部署上。 Sol-Engine 承认了这个现实,并给出一个务实的回答:这是个组合优化和调参问题,人工做不划算,交给 agent。Figure 2 那组数据(同一个模型同一张卡,分辨率翻倍后 Softmax 占比从 19.9% 涨到 47.6%)是全文最有说服力的论证——它证明"通用最优配方"这个东西压根不存在。 但作为一篇方法论文,它的验证是不完整的。 缺 agent vs 传统超参搜索的对照,缺人力成本的量化,硬件维度只验证了同代两张卡。这些不是小瑕疵,而是直接关系到"agentic 到底贡献了什么"这个核心问题。以现在的证据,我倾向于认为 agent 在这里的主要价值是自动化了编排和代码补丁生成,而不是搜到了人搜不到的解。 所以我给不同人的建议不一样: 如果你是工程师,正要部署这几个模型——直接去看附录 A,第 10 段我已经整理好了。那些经验规则(缓存优先、首尾步留高精度、多阶段流水线分阶段施策、非标准采样器退化成固定步跳过)比 agent 框架有用得多,手工调两三轮就能吃到大部分收益。 如果你是研究者——最值得跟进的不是 agent 框架本身,而是它暴露的那个空洞:缺一个和人类感知对齐的自动视频质量评估器。 论文的人工验收环节之所以拆不掉,根子就在这。谁把这个问题解决了,"全自动加速搜索"才真的能闭环,而且这个能力的价值远超加速这一个场景。 如果你在做技术决策——记住 2× 是在 B200 上、免训练、单请求延迟的数字。换硬件要重新评估(尤其没有 FP4 支持的卡),关心吞吐的话论文没给数据,而且你自己的模型需要重新跑一遍搜索流程。 最后说回开头那个细节。把 Codex 和 GPT-Image2 署名成作者,arXiv 用 "Human authors" 单独一栏来区分——这件事本身可能比论文的技术内容更值得记一笔。 它标记了一个开始:AI 参与科研产出的程度已经到了需要在署名规范上做制度性区分的地步。至于这算进步还是隐忧,各人判断不同,但趋势看起来是不可逆的。 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-13|Adobe视频世界模型首次外推物理定律LDR 今日 AIGC 论文速览 今日共 10 篇 · 世界模型与物理外推 2 篇 · 全模态对话与数字人 1 篇 · 生成训练目标与对抗后训练 1 篇 · 流式与自回归视频生成加速 2 篇 · 图像超分与编辑 2 篇 · 语音合成细粒度控制 1 篇 · 视频生成评测基准 1 篇 重点论文标题列表 LDR(UCSD·Adobe):首个能外推物理定律的视频世界模型 Ex-Omni-2D(香港中文大学(深圳)·腾讯光子):四卡四步推理让对话模型有形象 ⚡ AdvFD(北京大学·快手可灵(KlingAI Research)):对抗表征治好FD指标刷分症 Stream Forcing(华中科技大学·地平线·Anyverse Dynamics):统一训练轨迹让流式视频FVD降36.6% SparSTAR(西江大学(Sogang University)):免训练块稀疏注意力720p提速1.6倍 今日论文速览 1. LDR:首个能外推物理定律的视频世界模型 Learning How the World Evolves: Extrapolative Video World Models via Latent Dynamics Reasoning | UCSD·Adobe | arXiv:2608.09926 ⚠️ 前序问题:世界按自身的动力学(运动定律)演化,但主流视频扩散模型基本是在拟合像素,而没有建模像素如何随时间转移。结果是它们能渲染出视觉上合理的帧,却未必真的遵守物理定律——尤其在分布外场景中,模型是真学到了底层动力学,还是只记住了训练集里的表观模式,此前很难分辨,也几乎没有模型能把学到的动力学外推到训练分布之外。 本文贡献:提出 Latent Dynamics Reasoning(LDR),纯粹从像素中捕获动力学:把潜空间的状态转移显式改写成运动学积分——低阶动力学用数值积分直接算出,网络只回归驱动 rollout 的三阶及以上残差项。为了让这套积分具备更好的外推能力,LDR 不在稠密卷积特征上做,而是运行在结构化潜变量(Structured Latent)之上。沿用 PhyWorld 的设定,在匀速运动、抛物线、碰撞、弹跳、逼近五个任务的白盒物理基准上验证,重点考察能暴露模型是否真正习得动力学的分布外场景。 Overview of LDR. Given three conditioning frames $I_0,I_1,I_2$, LDR predicts the future frames $\hat{I}_3,\hat{I}_4,\dots,\hat{I}_T$ in three stages. (A) LDR first encodes each input frame into a structured latent (SL). (B) LDR measures the low-order time derivatives of the given SL, then rolls out by regressing only the high-order residual with $f_\theta$ and numerically integrating the lower orders to the next latent $\hat{\boldsymbol{s}}_t$ ($t\in\{3,4,\cdots,T\}$). (C) LDR finally decodes each predicted latent to an RGB frame $\hat{I}_t$. 实验效果:在 256² 分辨率下,无论单任务还是联合任务训练,LDR 的分布内与分布外误差之差比视频扩散基线小 20 倍以上,同时参数量少 26 倍、运行速度快 143 倍。它在剧烈分布偏移下依然成立:仅用「红球从左向右」训练,却能正确预测蓝色方块从右向左的运动。作者称这是据其所知首个能把学到的动力学外推到训练分布之外的视频世界模型。 Stress test under severe OOD shift. Trained only on red balls but tested on an unseen object (e.g., “earth”), LDR still predicts the correct motion, while the others fail. 批判点评:这篇的方法论姿态比数字更值钱。它没有把「物理一致性」当成一个再加些数据、再加个 loss 就能改善的软指标,而是直接在架构层面把低阶运动学变成不可学的确定性计算,只留高阶残差交给网络——这等于把归纳偏置从「祈祷模型学到」改成「结构上直接给定」,也顺带解释了参数量能少 26 倍:本来大量容量就是被用来重新发明积分。20 倍的分布内外误差差距收窄,比任何 FVD 分数都更能说明泛化。但必须把庆祝的音量调低:验证完全落在 PhyWorld 式白盒基准上,五个任务都是刚体质点级的简单动力学,与真实视频里的流体、布料、多物体接触、遮挡完全不在一个复杂度量级;红球到蓝方块的泛化确实漂亮,但那本质上是「外观换了、动力学同构」,并未证明它能外推到没见过的动力学类型。运动学积分假设状态可以被少数低阶导数良好描述,一旦遇到碰撞、断裂这类不可微事件,残差项还能不能兜住是未知的。此外它与主流视频扩散模型不是同类可替换品——143 倍加速的对照物是在白盒任务上的基线,不代表能接管开放域视频生成。它更应被读作一个强有力的存在性证明:外推是可能的,前提是别再让网络从零学积分。 2. Ex-Omni-2D:四卡四步推理让对话模型有形象 Ex-Omni-2D: Expressive Omni-Modal Dialogue Models with Native Visual Presence | 香港中文大学(深圳)·腾讯光子 | arXiv:2608.10720 ⚠️ 前序问题:全模态对话模型已经能理解多模态输入并合成语音回复,但这些回复在视觉上是「无身体」的——只有声音没有形象。要补上形象通路,最直接的做法是端到端监督,可这需要大规模的「查询-文本-语音-视频」四元组数据,现实中几乎无法收集。另一方面,流式增量生成还面临后段块质量累积退化的问题。 本文贡献:提出 Ex-Omni-2D,给定多模态查询、参考图像和参考音频,协同生成文本、个性化语音与参考条件视频三位一体的回复。模型先预测一个结构化的 Visual Thought Plan(VTP)描述场景、情绪与动作,再生成回复文本和原生多码本语音单元;这些语音单元构成共享的声学-时间接口,既解码为语音又与视频帧在线对齐。正是这个接口让回复通路与形象通路能各自从异质的语音、对话、形象视频数据中学习,从而绕开四元组大规模监督。全序列 Video Generator 作为主教师,进一步蒸馏成少步的块因果 Streaming Student,其 Prefix Streaming 机制把干净潜变量跨相邻块携带,抑制后段块的累积退化。 Overview of Ex-Omni-2D. Speech, text, and vision encoders provide multimodal context to the Large Language Model, which produces a non-user-facing Visual Thought Plan (VTP) and the user-facing response. The Speech Generator uses reference audio for voice conditioning and generates speech in a native multi-codebook space. The Video Generator encodes the reference image and VTP, and reuses the generated speech representation to synthesize the synchronized video response. It is instantiated as a full-sequence Teacher for primary realization and a distilled Prefix-Streaming Student for efficient incremental deployment. 实验效果:四步推理下,完整的四 GPU 流水线在 400×720 / 720×400 分辨率上达到端到端 RTF 1.293,提供了一个实用的质量-效率操作点。 Prefix-Streaming analysis. Top: representative later-chunk examples; each row shows the reference image, a no-prefix frame, and its Prefix-Streaming counterpart. Bottom: full-duration DINO curves over 200 paired CommonEval videos. Markers denote chunk means and shaded regions denote bootstrap uncertainty. Prefix is mixed over early chunks but degrades more slowly and is consistently better from chunk~9 onward, supporting a reduction in cumulative late-chunk subject drift rather than a uniform per-chunk improvement. 批判点评:这篇真正的巧劲不在多模态本身,而在于用「多码本语音单元」当作声学与时间的共享接口——这一步把数据需求从不可能的四元组降解成三堆各自都存在的现成数据,是全篇最具工程判断力的设计,也是同类工作最容易卡死的地方。VTP 显式写出场景/情绪/动作,等于把风格控制从隐式条件变成可检查的中间产物,调试友好。Prefix Streaming 承载干净潜变量以抑制后段退化,说明作者清楚流式生成的病根是误差累积而非单块质量。但要泼几盆冷水:RTF 1.293 意味着生成 1 秒内容需要约 1.29 秒,仍未跨过实时门槛,而这是在四张 GPU 上取得的——按单卡折算的成本相当高,离真实的交互式数字人部署还有距离;论文摘要只给了 RTF 这一个硬数字,语音自然度、唇音同步、身份保持、指令遵循等关键质量维度均无量化对照,「Expressive」这个卖点因此缺乏支撑;分辨率停在 400×720 这类竖屏小尺寸,也暗示更高分辨率下的开销尚未解决。此外教师-学生蒸馏引入的质量损失有多大、四步是否已是下限,摘要层面都没有交代。 3. AdvFD:对抗表征治好FD指标刷分症 AdvFD: Boosting Visual Generation via Adversarial Fréchet Distance Loss | 北京大学·快手可灵(KlingAI Research) | arXiv:2608.11205 ⚠️ 前序问题:Fréchet 距离近来成为生成器后训练中有效的分布级目标,可以补充传统的逐样本扩散与流匹配损失。但直接优化 Fréchet 目标会引发「Fréchet hacking」:目标指标持续改善,而视觉质量以及在其他特征空间下的 Fréchet 对齐却可能停滞甚至恶化。作者把这一失效归因于现有 Fréchet 损失所依赖的静态预训练特征空间——它对真实与生成分布之间的差异只提供了不完整且固定的视角,生成器于是学会往这个固定视角的盲区里钻。 本文贡献:提出 Adversarial Fréchet Distance(AdvFD),用一个经过校准的对抗学习表征来补充 FD-Loss 中的静态表征目标。AdvFD 在原有静态 Fréchet 目标之外增加一个可学习表征:该表征对抗性地最大化真实与生成样本之间的 Fréchet 差异,而生成器则在由此产生的自适应特征空间中最小化同一差异。为防止对抗表征通过特征幅值放大来平凡地抬高目标,作者进一步引入真实特征白化(real-feature whitening),归一化其尺度与协方差几何,稳定这一 min-max 优化。 Overview of our adaptive training. (a) In the G-step, the generator is updated to minimize the static Fréchet objective together with the adaptive Fréchet discrepancy, while both the static and adversarial representations are frozen. (b) In the D-step, the generator is frozen, and the adversarial representation is updated to maximize the Fréchet discrepancy between real and generated distributions. The two steps alternately improve the generator and adapt the representation to discrepancies missed by the fixed encoder. 实验效果:大量实验表明 AdvFD 在 JiT 与 pMF 两种骨干、以及不同模型规模上,都能一致提升一步生成器的后训练效果。 AdvFD mitigates Fréchet hacking in one-step generation. Top: Compared with JiT-L trained using the static FD loss, AdvFD generates cleaner and more coherent images under the same 1-NFE sampling budget. Bottom: AdvFD consistently reduces FD-r3 and FD-r6 across JiT-L and JiT-H, with relative improvements of 41.4%/38.0% and 34.0%/32.1%, respectively, showing that the gains persist as the generator scales up. These results demonstrate improved perceptual quality and generalization across evaluation representations. Lower is better for all metrics. 批判点评:这篇最有价值的贡献是把一个大家隐约感觉到但很少被正面命名的问题定义清楚了:指标一旦进入训练回路,就会被优化压力反向利用。「静态特征空间提供固定且不完整的视角」这个归因很到位——它解释了为什么 FD 越刷越好而人眼看着没变好,也顺带把「刷 FID 即进步」的行业习惯拖到了聚光灯下。real-feature whitening 这个细节尤其体现作者对 min-max 训练的实战理解:不加约束的对抗表征最省力的作弊方式就是把特征整体放大,白化直接封掉了这条路。局限也不难看出:引入对抗表征等于把一个稳定的分布级损失换成了 GAN 式的 min-max 优化,训练稳定性与超参敏感性天然变差,白化只是缓解而非根治,论文对失败模式与调参代价的交代不足;「一致提升」这类措辞在摘要中缺少具体数字支撑,读者无法判断增益是显著还是边际;验证骨干限于 JiT 与 pMF、场景限于一步生成器后训练,对多步扩散或视频生成是否同样奏效未知;更微妙的是,用对抗表征衡量的「改善」本身也是一个可被 hack 的目标,这个套娃问题论文并未回答。 4. Stream Forcing:统一训练轨迹让流式视频FVD降36.6% Stream Forcing: Constructing Unified Training Trajectory for Robust Streaming Video Generation | 华中科技大学·地平线·Anyverse Dynamics | arXiv:2608.10439 ⚠️ 前序问题:流式视频生成对世界建模潜力巨大——未来帧必须在线逐步推断以形成连续视频流。但流式视频扩散模型存在一个根本性的训推不匹配:推理遵循一种特化的去噪顺序,而先进的训练策略通常需要多样的噪声级配置。于是训推一致性与训练覆盖面成了一对只能二选一的矛盾。 本文贡献:把视频扩散采样重新表述为一个以帧为索引、在噪声级上的随机过程。在这个随机过程空间内构造一条连续的训练轨迹,沿该轨迹采样调度从独立采样逐步演化到与推理一致的采样,从而不再需要在两端之间做取舍。作者进一步引入联合校准算法与时间相关采样算法,以保证轨迹平滑性与跨帧相关性。基于这些设计提出 Stream Forcing,一个兼顾训练充分性与推理效率的流式视频生成统一训练框架。 Overview of the curriculum training. Our method builds a continuous curriculum transition between independent training and inference-aligned training that balances full distribution coverage with consistency at inference time. 实验效果:UCF-101 基准上 FVD 改善 36.6%;方法还能稳健地零样本外推到长时程视频生成,在 UCF-101 上 FVD 改善 27.9%。 Visualization of unconditional video generation on UCF-101 dataset. DF: Diffusion Forcing df. AR-D: AR-Diffusion ardiff. Our method presents higher visual quality and more robust long-horizontal extrapolation. 批判点评:把「训推一致性 vs 训练覆盖」这对二元对立改写成一条连续轨迹上的渐变,是个漂亮的问题重构——它承认两端都有价值,用课程式过渡取代硬性选边,本质上和退火、课程学习属于同一族智慧,但用在噪声级调度这个具体位置上是新的。36.6% 的 FVD 改善幅度不小,长时程零样本外推还能保住 27.9%,说明训练轨迹确实带来了泛化性而非仅仅拟合了评测设置。不过要打的折扣不少:UCF-101 是分辨率低、类别有限的老基准,在它上面的 FVD 增益能否迁移到 720p 开放域文生视频,完全无法从这篇推断,而流式生成的真实战场恰恰在后者;「联合校准」与「时间相关采样」两个算法被摘要一笔带过,它们各自贡献多少增益、引入多少训练开销,没有消融交代;连续轨迹意味着需要设计演化时间表,这又是一组新超参,敏感性未知。此外流式生成最该报的延迟、首帧时间、单帧算力等在线指标一个都没出现,「推理效率」的主张目前只有结构性论证而无实测支撑。 5. SparSTAR:免训练块稀疏注意力720p提速1.6倍 SparSTAR: Sparse Attention for SpaceTime AutoRegressive Video Synthesis | 西江大学(Sogang University) | arXiv:2608.10519 ⚠️ 前序问题:InfinityStar 通过图像金字塔与片段金字塔的序列把视觉自回归生成扩展到视频,但它不断变化的尺度与跨片段上下文让后期尺度的注意力开销高昂,也使得从扩散模型或图像 VAR 模型直接搬来的稀疏模式变得不可靠。 本文贡献:提出 SparSTAR,一种为该设定量身定制的免训练块稀疏注意力方法。在每个高开销尺度与每个注意力头上,SparSTAR 依据当前的 query 与 key 激活对连续的 key block 打分,保留必需的条件上下文,并通过一条仅前向的稀疏路径执行选中的块。作者系统分析了片段内的跨尺度一致性、跨片段边界的模式持续性,以及复用跨越越来越远尺度时的质量退化。这些分析一致表明重要 key block 会发生漂移,因此在每个目标尺度重新计算块选择比复用迁移来的 mask 更可靠。 Overview of SparSTAR, a training-free block-sparse attention framework for video autoregressive generation that reduces attention latency while maintaining video quality. 实验效果:在 720p 文生视频与图生视频上,SparSTAR 保留了全部 token 与精修尺度,提供约 1.6 倍端到端加速,同时 VBench 分数与配对输出重建保真度接近稠密的 InfinityStar。 PSNR--latency trade-off for recalibration frequency on 720p T2V. Error bars denote 95% confidence intervals for PSNR across five seeds. 批判点评:这篇的贡献首先是一个诚实的否证:它没有先摆出方法再补实验,而是先系统测量「从别处迁移来的稀疏 mask 在变尺度自回归结构下到底能不能用」,得到的答案是不能——重要 key block 会随尺度漂移。这个结论比方法本身更有传播价值,因为当前有相当多加速工作默认稀疏模式具备跨设定可迁移性。免训练、仅前向、保留全部 token 与全部精修尺度这几条约束定得很克制,意味着它可以直接挂到现成模型上而不牵动生成质量的责任边界,工程可用性高。但天花板也被这份克制锁死了:1.6 倍加速对视频生成的实际体感改善有限,距离能改变产品形态的量级尚远;方法与 InfinityStar 的金字塔结构深度绑定,对当下更主流的视频 DiT 是否适用没有讨论,通用性存疑;每个尺度重新打分本身要花算力,摘要只说「保真度接近」,这类模糊表述掩盖了具体的质量损失幅度,而稀疏注意力最该担心的正是长时程一致性这种在 VBench 上不易暴露的退化。此外单一机构、无顶会标注、缺少与 SVG、SpargeAttn 等同类稀疏注意力方法的横向对比,也让它的相对位置不好判断。 6. Latent-to-4D:绕过RGB用视频潜变量直出4D Beyond Pixels: From Video Priors to 4D Worlds | 浙江大学 ReLER·CCAI | arXiv:2608.10744 ⚠️ 前序问题:4D 生成要从文本或图像等条件合成动态 3D 场景。现有方法分两派:一派把生成好的 RGB 视频再用一个独立的 4D 模型去重建,另一派改造某个特定视频生成器让它直接预测几何。前者受分布不匹配与误差传播之苦——视频生成器的输出分布并非 4D 重建模型所期望的输入分布;后者则把 4D 预测绑死在特定生成器上,生成器或条件方式一变就可能要重训。 本文贡献:作者提出一个新问题:共享同一个 VAE 的视频模型,其最终去噪潜变量能否充当通往显式 4D 预测的可复用接口?基于这一洞察提出直接的潜变量到 4D 生成,并实例化为 Latent-to-4D:它绕过 RGB,把视频潜变量与预训练 4D 解码器的 token 网格对齐,再通过逐帧与全局时空注意力加以精修。仅用约 1K 现有重建片段训练,单个 checkpoint 就能在同一 VAE 家族内的多个视频扩散 Transformer 之间原样迁移,无需重训。 Latent-to-4D training pipeline. A frozen video VAE encodes an observed video into a VAE-space latent. L4AR aligns the latent grid through a learned 3D convolution, reuses frozen camera and time tokens, and refines the representation through alternating frame-wise and global attention. The 4D decoder predicts cameras and dynamic world-space geometry. 实验效果:在 Text4D-200 与 I4D-200 上,Latent-to-4D 在基于投影的 DINO-F1 指标上分别超过同潜变量的 Wan+4RC 级联 2.88–3.45 与 5.81 点,并在几何、时间稳定性与整体质量上更受人类评审者青睐。 Image-to-4D comparison. Each row shows the input condition and 4D results. RGB baselines reconstruct the decoded video, whereas Ours consumes its terminal latent directly. 批判点评:「把共享 VAE 的潜变量当作跨模型可复用接口」这个提法很有工程审美——它没有再造一个更大的 4D 生成器,而是在既有生态里找到一个天然存在却被忽视的对接面,顺手解决了级联方案的分布不匹配和专用方案的绑定问题。约 1K 训练片段、单 checkpoint 跨多个视频 DiT 原样迁移,这个数据效率与复用性在 4D 生成里相当难得,也说明潜变量确实承载了足够的几何信息,RGB 那一步真的是多余的信息瓶颈。但边界必须说清楚:可迁移性严格限定在「同一 VAE 家族」内,一旦 VAE 换代或换厂,接口即失效,这与其宣称的通用性之间存在张力,且视频模型的 VAE 恰恰是迭代很快的部件;2.88–5.81 点的 DINO-F1 增益是相对同潜变量的 Wan+4RC 级联,属于自设对照,未与更强的专用 4D 生成方法正面比较;投影域的 DINO-F1 本身是间接指标,无法直接反映几何精度,人类偏好评测又缺样本量与统计显著性说明。此外训练依赖预训练 4D 解码器,其能力上限就是整套方案的上限,动态范围、拓扑变化剧烈的场景表现如何未见交代。 7. MeanSR:一步超分免蒸馏直接学平均速度场 MeanSR: Restoration Trajectory Learning for One-Step Perceptual Super-Resolution | 西北工业大学 | arXiv:2608.09405 ⚠️ 前序问题:基于扩散的超分能获得强感知质量,但需要昂贵的迭代去噪。现有一步蒸馏方法虽然压缩了推理时间,却依赖昂贵的预训练教师模型;代表性方法 CTMSR 通过 PF-ODE 一致性训练避开了蒸馏,但它只是约束网络行为,并没有显式建模从低分辨率输入到高分辨率图像的那个修复动力学过程。 本文贡献:提出 MeanSR,一种一步感知超分方法:学习一个以低分辨率图像为条件的平均速度场,直接刻画从退化或带噪输入到合理高分辨率输出的有限时间转移。平均速度与瞬时速度之间的关系本身即提供直接的训练信号,同时保留单步推理。作者进一步把分布轨迹匹配目标重新表述以适配平均速度生成,并引入阶段感知的时间采样(Stage-Aware Temporal Sampling)策略改进轨迹学习。 Overview of the proposed MeanSR framework. Stage 1 estimates an LR-conditioned restoration trajectory by predicting its average velocity under the MeanFlow formulation, while Stage 2 further aligns the generated restoration trajectory with the real HR trajectory through distribution trajectory matching. The proposed Stage-Aware Temporal Sampling (SATS) assigns different temporal distributions to trajectory estimation and trajectory alignment, respectively. 实验效果:在合成与真实世界基准上,MeanSR 在 CLIPIQA、MUSIQ、MANIQA 三项感知指标上均优于 CTMSR,同时显著降低 FLOPs 与推理延迟;重建出的结构更锐利、纹理更真实,感知伪影更少。 Comparison of representative one-step super-resolution methods. The x-axis denotes CLIPIQA, the y-axis denotes inference runtime, and the bubble size represents FLOPs. MeanSR achieves a favorable trade-off between perceptual quality and computational efficiency. 批判点评:这篇的定位很清楚:把 MeanFlow 那套「学平均速度场」的思路搬到超分,从而在免蒸馏的前提下把修复过程本身建模出来,而不是像 CTMSR 那样只用一致性去间接约束网络行为。这个区分是有实质的——显式的有限时间转移让训练信号直接指向「从退化态到清晰态该怎么走」,也自然解释了为何能同时改善质量并降低 FLOPs。摆脱教师模型对下游落地的意义同样实在,省掉的是一整套预训练成本。但它的贡献属于路径迁移而非原理创新,MeanFlow 的核心恒等式并非本文所出,主要工作是条件化与采样策略适配。评估层面问题更明显:三项指标 CLIPIQA/MUSIQ/MANIQA 全是无参考感知指标,众所周知偏好锐利与高对比,缺少 PSNR/SSIM/LPIPS 的配套报告,无法排除「感知分上去了但保真度掉了」这种典型的一步超分退化;主要对照仅 CTMSR 一家,未与 OSEDiff、SinSR 等一步扩散超分做完整横比;论文标注为投稿 AAAI 2027、仅 7 页,尚未经同行评审,Stage-Aware Temporal Sampling 的消融强度也难以从摘要判断。 8. ATDEdit:免掩码异步解码编辑达27.44dB Diffusion Image Editing via Asynchronous Token Decoding | 广东工业大学·香港浸会大学·北京大学·惠州学院 | arXiv:2608.09322 ⚠️ 前序问题:文本引导的扩散图像编辑要在修改语义属性的同时保住身份、布局与背景。但采样过程中简单地切换文本条件往往引起全局漂移——去噪动力学会把改动沿 token 传播开,进而破坏本不该改的区域。现有方案通常依赖外部或用户提供的空间掩码,或者需要微调模型。 本文贡献:提出 ATDEdit(Asynchronous Token Decoding Edit),一个推理期框架:把采样器的每一步视为对一个全局耦合 token 矩阵的并行更新,从而支持按 token 索引切换条件并施加差异化的更新策略。它不对所有 token 同步施加目标条件更新,而是用逐 token 的条件意外度(conditional surprisal)估计可编辑位置,仅对选中的 token 集合施加目标条件修正;在保留 token 位置提供源 key/value 记忆,并把选中的保留 token 潜变量行回投到其源值。这些操作促进背景保持,但作者明确声明其不构成像素级不变性保证。整套方法无需外部或用户提供的空间掩码,也无需模型微调。 Overview of ATDEdit for transforming a fox into a dog. (Top) Same-state source/target evaluations produce Token-wise Conditional Surprisal and an editable-token mask. (Bottom) Target-conditioned corrections are applied to editable tokens, while source key/value memory and hard projection constrain selected keep-token rows. 实验效果:在 PIE-Bench 上,ATDEdit 取得该基准上已报告的最强保持性指标,包括 27.44 dB PSNR 与 0.055 LPIPS,同时保持有竞争力的语义对齐。已被 ACM MM 2026 接收。 Comparison of edited results. Real images are in the first column. 批判点评:用「条件意外度」在推理期自动划定可编辑 token,是这篇最漂亮的一笔——它把「哪里该改」从需要人工掩码或额外分割模型的外部输入,转成模型自身条件响应差异的内生信号,免训练、免掩码这两个属性叠加起来带来的实用性相当高。更值得称赞的是学术诚实度:论文明确写出这些操作「促进背景保持但不构成像素级不变性保证」,在一个惯于把机制性偏好包装成理论保证的领域,这种自我设限反而提升了可信度,也准确点出了本方法的性质——它是软偏置而非硬约束。27.44 dB / 0.055 LPIPS 的保持性数字确实扎实。但需要警惕保持性与编辑力度的天然此消彼长:保持性做到基准最强,而语义对齐只被描述为「有竞争力」,这个措辞差异很可能意味着在需要大幅改动的编辑任务上它偏保守;意外度阈值 ρ(t) 是核心超参,其跨图像稳健性与失败模式摘要未交代,若阈值偏保守则编辑区域覆盖不全,偏激进则退回全局漂移;PIE-Bench 单一基准也不足以覆盖真实编辑意图的多样性,尤其是涉及大范围结构变化或多对象组合的情形。 9. CtrlSpeech:音素级控制音高音量与时长 CtrlSpeech: Coarse-to-Fine Control for Expressive Speech Synthesis | 德克萨斯大学奥斯汀分校·Amazon | arXiv:2608.08362 ⚠️ 前序问题:近来的 TTS 系统已实现很强的自然度与零样本音色克隆,但在词级或音素级上对富有表现力的语音做细粒度控制仍然困难——用户能换音色,却很难精准指定某个字要更重、更高或拖得更长。 本文贡献:提出 CtrlSpeech,一个具备由粗到细控制能力的可控表现力 TTS 框架。它构建在 DiTAR 架构之上,把全局说话人条件与音素对齐的音高、音量、时长信号结合起来,从而在保留目标说话人音色的同时实现局部韵律控制。这一设计让用户能在很细的时间粒度上调整表现力属性,使语音精修更灵活可控。 The architecture of . 实验效果:实验表明 CtrlSpeech 在零样本 TTS 上取得有竞争力的表现,并改善了对表现力属性的可控性,验证了其在灵活实用的表现力语音合成上的有效性。已被 Interspeech 2026 接收,Demo、代码与模型权重均已公开。 Coarse-to-fine speech control pipeline. 批判点评:把控制信号锚定在音素级的音高、音量、时长三元组上,是个务实到近乎朴素的选择,但恰好对上了配音、有声书这类真实生产流程的操作直觉——从业者要的正是「这个字重读一点」,而不是再来一个模糊的情绪标签。全局说话人条件与局部韵律控制解耦,保证了调韵律不串音色,工程上很关键。Demo、代码、权重三件套齐放,在 TTS 这个复现门槛偏高的方向里是实打实的加分项。但这篇的定位应当被诚实地看作扎实的增量工作而非突破:音素级韵律控制在 FastSpeech 2 时代就是标准配置,本文的实际贡献更像是把这套显式控制接口迁移并适配到 DiTAR 这个较新的自回归-扩散混合架构上;摘要通篇没有一个具体数字,「有竞争力」与「改善了可控性」这类表述无法支撑与 CosyVoice、F5-TTS 等主流系统的强弱判断;控制粒度也仍停在音高/音量/时长这些声学低层属性,对情绪、语气、口音等更高层表现力维度没有覆盖。此外六页的 Interspeech 短文体量,注定其消融与主观评测的深度有限。 10. Sci-VBench:16个前沿模型科学因果全线不及格 Sci-VBench: Evaluating Knowledge- and Reasoning-Intensive Video Generation in Science Domains | 浙江大学·中国科学院大学·同济大学·耶鲁大学 | arXiv:2608.09873 ⚠️ 前序问题:视频生成模型的视觉真实度进步很快,但它们是否真的掌握了科学知识与因果动力学,一直缺少有效的衡量方式。现有评测大多停留在表层视觉合理性,无法区分「画面看起来对」与「物理与科学过程真的对」。 本文贡献:提出 Sci-VBench,一个评测跨科学领域的知识密集与推理密集视频生成的综合基准。它包含 1,253 条专家标注样例,覆盖自然科学、健康医疗、人文社科、工程四大学科下的 60 个学科方向。每条样例都要求模型生成在时间上信息丰富、需要科学推理与知识落地的视频,而非仅有表层视觉合理性。作者进一步建立了基于评分细则(rubric)的评测协议,并验证在该协议下非专家人类评审者与 MLLM-as-Judge 系统都能与专家判断达成较高一致,从而支撑可规模化的可复现评测。 Overview of the dataset. Top left: distribution of the expert-annotated examples over subjects across core disciplines. Remaining panels: representative prompt--video examples from each discipline, generated by Gemini-Omni-Flash, where faithful generation requires grounding in the underlying scientific mechanism. 实验效果:对 16 个前沿闭源与开源模型的评测显示:自动感知质量分数在各系统间挤成一团,而在提示词落地(Prompt Grounding)以及科学与因果正确性上的表现差异显著,闭源与开源之间存在明显差距。这表明视觉真实度的进步尚未转化为对科学与因果动力学的可靠建模。已被 COLM 2026 接收。 Overview of the benchmark construction process. 批判点评:这篇的核心发现极具诊断价值:感知质量分数在 16 个模型间几乎无法区分,而科学与因果正确性上分差巨大——这直接说明当前主流视频生成评测已经饱和失效,大家在一个分辨不出好坏的维度上继续内卷。rubric 协议加上「非专家与 MLLM-as-Judge 都能对齐专家判断」的验证,是这类主观性强的基准最该做却常被省略的一步,它把可规模化评测的成本问题真正解决了。1,253 条专家标注、60 个学科的覆盖面也称得上扎实。作为评测工作,它的价值恰好与今天的 LDR 形成呼应:一个证明外推是可能的,一个证明现有模型普遍做不到。局限主要在方法论固有处:MLLM-as-Judge 与人类专家「较高一致」是在这套 rubric 下成立,一旦作为主要评分手段大规模使用,就存在被针对性优化的风险,届时它会重演今天感知指标的命运;四大学科 60 方向的样例分布必然不均,摘要未交代各领域样本量,跨领域分数可比性存疑;「科学正确性」在很多场景下需要专业判断,rubric 能否覆盖领域细微差别仍待检验。此外基准只能揭示差距而不提供改进路径,闭源领先的具体成因(数据、规模还是后训练)无法从中推断。 趋势观察 世界模型的评判标准从「像不像」转向「外推得出来吗」 — 今天最值钱的一篇是 UCSD 与 Adobe 的 LDR。它把一个长期被含糊处理的问题摆到台面上:主流视频扩散模型是在拟合像素,而不是在建模像素如何随时间转移,所以它们能渲染出视觉上合理的帧,却未必真的遵守运动定律。LDR 的做法很硬核——把潜空间的状态转移显式写成运动学积分,低阶动力学(速度、加速度)直接数值积分算出来,网络只负责回归三阶及以上的残差项。这等于把物理先验从「希望模型自己学到」变成「架构层面直接给定」。效果上,分布内与分布外误差的差距比视频扩散基线小了 20 倍以上,参数量少 26 倍、速度快 143 倍;只用红球从左往右运动训练,却能正确预测蓝色方块从右往左的运动。作者称这是首个能把学到的动力学外推到训练分布之外的视频世界模型。这条线索的意义在于,它把世界模型的验收标准从「生成质量」拽回到「泛化到没见过的物理配置」,也预示配套评测会跟着变——同一天浙大与耶鲁的 Sci-VBench 正好给出了另一个佐证:视觉真实度分数在 16 个前沿模型间挤成一团,而「提示词落地」与「科学因果正确性」的分差却很大,说明画面变好并没有自动带来对科学与因果动力学的可靠建模。 生成模型的训练目标本身正在被重新审计 — 北大与快手可灵的 AdvFD 指出一个很扎心的现象——「Fréchet hacking」:用 Fréchet 距离做生成器后训练时,目标指标一路走高,但视觉质量和在其他特征空间下的 Fréchet 对齐却可能停滞甚至变坏。根因是现有 FD-Loss 依赖静态的预训练特征空间,它对真实与生成分布之间差异的观察视角是固定且不完整的,于是生成器学会了往这个固定视角的盲区里钻。AdvFD 的解法是给静态目标补一个对抗学出来的表征:判别侧最大化该表征下的 Fréchet 差异、生成侧最小化同一差异,并用真实特征白化把它的尺度与协方差几何归一,防止对抗表征靠单纯放大特征来虚增目标。这类工作和「刷 FID 就等于变好」的旧习惯正面冲突,提醒我们指标一旦进入训练回路就会被优化压力反向利用。今天的 ATDEdit 从另一头呼应了同一种审慎——它明确声明自己的 KV 记忆与潜变量回投「促进背景保持,但不构成像素级不变性保证」,在一个人人爱声称 SOTA 的领域里,把话说到这个精度反而更可信。 视频推理加速开始区分「训练-推理对不齐」和「算力花在哪」两类病 — 今天有两篇从不同层面攻视频生成的效率。华科与地平线的 Stream Forcing 处理的是流式视频扩散的结构性顽疾:推理必须按一个特化的去噪顺序逐帧在线推进,而先进训练策略又需要多样的噪声级配置,两者天然冲突——训练覆盖面和训推一致性只能二选一。它把视频扩散采样重写成一个以帧为索引的、在噪声级上的随机过程,然后在这个过程空间里构造一条连续训练轨迹,让采样调度从独立采样平滑演化到与推理一致的采样,UCF-101 上 FVD 改善 36.6%,长视频零样本外推再改善 27.9%。Sogang 大学的 SparSTAR 走的是另一条路——不动训练,只在推理时省算力:它发现从扩散或图像 VAR 模型搬来的稀疏注意力模式在 InfinityStar 这种「图像金字塔 + 片段金字塔」的变尺度结构下并不可靠,重要的 key block 会随尺度漂移,所以每到一个目标尺度就重新算一次块选择,比复用迁移来的 mask 稳得多,720p 端到端约 1.6 倍加速且不丢 token 与精修尺度。一个改训练轨迹、一个改推理时的块选择,共同点是都先诚实地承认了「照搬别处的经验在这里会失效」。 少步化从图像生成蔓延到修复类任务,路径也从蒸馏转向直接学速度场 — 西北工业大学的 MeanSR 是个值得注意的信号:一步感知超分不再依赖昂贵的预训练教师做蒸馏,而是学一个以低分辨率图像为条件的平均速度场,直接刻画从退化/带噪输入到合理高分辨率输出的有限时间转移。这条路子承自 MeanFlow 一脉——平均速度与瞬时速度的关系本身就能提供训练信号,从而在保留单步推理的同时绕开教师模型。它对标的 CTMSR 虽然也免蒸馏,但只靠 PF-ODE 一致性约束网络行为,并没有显式建模支配修复过程的那个场。结果是 CLIPIQA/MUSIQ/MANIQA 全面超过 CTMSR,同时 FLOPs 与延迟大幅下降。把它和 AdvFD 放在一起看会更有意思:两者都在追问「我们到底该让生成器拟合什么」——一个说该拟合自适应的分布差异,一个说该拟合有限时间的平均速度场,而不只是逐样本的去噪方向。 端到端多模态交互的落地瓶颈,正从「能不能生成」变成「能不能流着出」 — 香港中文大学(深圳)与腾讯光子的 Ex-Omni-2D 挑明了当前全模态对话模型的一个体感缺陷:它们能理解多模态输入、能合成语音回复,但回复在视觉上是「无身体」的。它让模型先产出一个描述场景、情绪、动作的结构化 Visual Thought Plan,再生成回复文本与原生多码本语音单元,而这些语音单元同时充当共享的声学-时间接口,一边解码成语音、一边在线对齐视频帧——这个设计的实际价值是让回复通路与形象通路可以各自从异质的语音、对话、形象视频数据中学习,避开了「查询-文本-语音-视频」四元组大规模标注这个几乎不可能满足的前提。真正的工程含金量在流式那一步:把全序列视频教师蒸馏成少步的块因果 Streaming Student,用 Prefix Streaming 把干净潜变量跨块携带下去,抑制后段块的累积退化,四步推理、四卡在 400×720 下达到端到端 RTF 1.293。RTF 略大于 1 说明还不算真正实时,但已经把这条链路推到了可以谈产品化的操作点上。 人工智能炼丹君 整理 | 2026-08-13 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-12|阿里DUET两步视频质量多样性双赢 今日 AIGC 论文速览 今日共 10 篇 · 视频生成加速与少步蒸馏 3 篇 · 统一多模态表征与理解生成一体化 1 篇 · 音频与音乐生成 3 篇 · 扩散架构机理与图像编辑 2 篇 · RGBA 视频与资产生成 1 篇 重点论文标题列表 DUET(阿里巴巴·北京大学·清华大学深圳国际研究生院):两步视频生成质量多样性双赢 UniSpace(美团):8B统一模型扔掉VAE通路 SonicWeave(快手可灵团队·香港中文大学·清华大学深圳国际研究生院):一套权重生成全类音频场景 FullDiT(复旦大学·阿里巴巴 Token Foundry):音乐生成胜过五家商业系统 adaLN-Gaussian(北京大学·百度·UC Berkeley):零初始化才是DiT的真功臣 今日论文速览 1. DUET:两步视频生成质量多样性双赢 DUET: A Diversity-Quality Duet of Distillation Experts for Two-Step Video Generation | 阿里巴巴·北京大学·清华大学深圳国际研究生院 | arXiv:2608.09637 关键词:两步视频生成,少步蒸馏,质量多样性权衡,专家分工,流匹配 前序问题:扩散模型能生成高质量视频,但迭代采样的开销让实际部署很难受。少步蒸馏是主流解法,却暴露出一个绕不开的质量-多样性权衡:轨迹级蒸馏(如 sCM)倾向保住多样性但质量偏弱,分布级蒸馏(如 DMD)质量强但生成结果的结构多样性大幅塌缩。此前的工作大多试图在 loss 层面把两类目标混合调和,结果总是按下一头翘起另一头,且混合目标本身的优化难度还额外增加了训练成本。 本文贡献:面向极端的两步视频生成,提出 DUET,把权衡改造成噪声层面的专家分工:sCM 专家接管高噪声那一步,负责铺开多样的结构布局;DMD 专家接管低噪声那一步,负责精修外观细节。两个专家各自按原生目标独立训练,因此完全绕开了 loss 级组合的优化困难,质量与多样性是联合获得而非互相交换。作者进一步指出剩下的瓶颈在于「接力界面」和高噪声阶段本身,用 RL 引导的专家自适应加以解决,得到 DUET+。 实验效果:在 Wan2.1-T2V-1.3B 骨干上,DUET 把 sCM 的两步质量拉到接近 DMD 的水平,同时几乎完整保留其结构多样性——约为 DMD 的两倍;DUET+ 在保住这一多样性优势的同时进一步提升整体质量。 批判点评:这篇的洞察很值钱:把「质量 vs 多样性」从一个需要折中的标量权衡,重新表述成「不同噪声区间需要不同归纳偏置」的分工问题,从而让两个专家都能按最适合自己的目标训练。这比在 loss 里加权重系数干净得多,也解释了为什么此前的混合方案总在原地打转。局限也很清楚:两步生成需要同时维护两个专家权重,显存与部署复杂度是单模型方案的两倍,论文对这部分成本交代不足;「接力界面」被承认是瓶颈,说明高噪声专家交给低噪声专家的中间状态存在分布不匹配,DUET+ 用 RL 打补丁而非从原理上解决;此外骨干只验证了 1.3B 的 Wan2.1,在 14B 级别模型上噪声分工的最优切分点是否仍在同一位置,完全未知。 2. UniSpace:8B统一模型扔掉VAE通路 UniSpace: Unified Visual Representation and Scalable Multimodal Modeling | 美团 | arXiv:2608.08676 关键词:统一多模态,视觉表征,Patch重参数化,理解生成一体化,MoE 前序问题:语义视觉编码器已成为多模态理解和图像生成语义条件化的核心接口,但它的最终 token 会丢弃细粒度视觉细节,导致像素重建能力很差,因此无法直接用在图像生成、编辑这类对重建敏感的任务上。业界的通行做法是另外挂一条 VAE 通路专门负责重建,代价是架构分裂、两套表征空间难以对齐。 本文贡献:作者先做了一个反直觉的诊断:语义 ViT 的冻结 Transformer 块并非本质上无法保留视觉细节,真正把表征推向语义抽象、让细粒度信息难以从最终 token 恢复的,是原始的 patch 参数化方式。基于此提出 Patch Reparameterization——保留原有语义通路不动,另加一条重建感知的 patch embedding,把细粒度视觉信息送进同一批冻结 ViT 块。由此得到的统一表征既保住多模态理解能力,又能做高保真图像重建,重建-生成权衡曲线更优。作者进一步把这套表征放大成 UniSpace,一个 8B 的 Mixture-of-Transformer-Experts 模型,在同一个视觉空间里完成理解、生成和编辑,完全不需要独立的 VAE 通路。 实验效果:系统级评测显示模型具备可用的文生图能力与指令式图像编辑能力,验证了「重参数化后的预训练 ViT 可以充当可扩展多模态建模的统一视觉接口」这一主张。 批判点评:把矛头指向 patch 参数化而非 Transformer 块本身,这个归因方向是这篇最有价值的部分——它意味着大量「语义编码器保不住细节」的结论可能都是参数化方式的问题,而不是架构的固有缺陷,从而打开了「保留冻结语义骨干、只改输入侧」的低成本改造空间。去掉 VAE 通路对统一模型的架构简化意义很实在。但也要冷静看:论文用「practical text-to-image generation」这类措辞而非硬指标对比,说明生成质量距离专用 T2I 模型仍有明显差距,8B MoTE 的规模也不小;「重建-生成的有利权衡」是相对自身消融而言,缺少与 VAE 方案在同等算力下的正面对照;另外冻结 ViT 的容量上限是否会在更大规模上成为瓶颈,文中没有给出 scaling 证据。 3. SonicWeave:一套权重生成全类音频场景 SonicWeave: Chunk-Routed Mixture-of-Experts for Unified Audio Scene Generation | 快手可灵团队·香港中文大学·清华大学深圳国际研究生院 | arXiv:2608.09571 关键词:统一音频生成,Chunk路由MoE,流匹配,音频场景合成,专家专业化 前序问题:文本条件的通用音频生成正从孤立的语音、音乐、音效合成,走向用单个模型把它们组合成可控、连贯的音频场景。这个统一设定格外棘手:异质成分对共享骨干提出互相冲突的结构要求,而一个复杂混合场景内部还可能包含局部不同甚至相互重叠的内容,需要在同一段音频里做细粒度自适应。现有音频 MoE 大多在领域级别做路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。 本文贡献:提出 SonicWeave,一个面向统一音频场景生成的流匹配模型,核心是带冲突门先验-证据路由机制的 chunk 级 MoE(CPE-MoE)。它按连续的声学 chunk 做路由,把编码结构化文本条件与扩散阶段的全局先验,和来自演化中声学状态的局部证据结合起来;一个学出来的冲突门在局部状态不可靠时倾向采信全局先验,只在某区域明显偏离全局场景语境时才让局部证据主导路由。单套权重即支持语音、音乐、音效、歌声及其细粒度混合。 实验效果:在 TTS、TTA、TTM 三类基准上一致优于受控的 Dense 与 Base-MoE 基线;复杂场景评测进一步显示组合质量提升,路由分析揭示出跨扩散阶段的内容相关专家专业化现象。 批判点评:「按 chunk 路由」这个粒度选择切中了要害:语音的音素、音乐的节拍、音效的事件都是有时间跨度的结构,逐 token 决定专家等于在同一个声学事件内部反复换脑,chunk 级正好对上声学连续性。冲突门的设计也挺聪明——扩散早期局部状态本来就是噪声,此时强行采信局部证据只会引入路由抖动,用全局先验兜住是对的。不足在于对比强度:论文的对照是自己控制的 Dense 与 Base-MoE 基线,而非各领域的 SOTA 专用模型,所以「统一模型是否已经不输专精模型」这个最关键的问题没有回答;chunk 长度作为一个关键超参,其敏感性分析在摘要层面没有体现;此外 MoE 的实际激活参数量与推理开销未交代,工业落地时的性价比无法评估。 4. FullDiT:音乐生成胜过五家商业系统 Beyond Reconstruction: Full-Context Generative DiT for Music Generation | 复旦大学·阿里巴巴 Token Foundry | arXiv:2608.08787 关键词:音乐生成,暴露偏差,条件DiT,RVQ编解码,分类器无关引导 前序问题:混合式音乐生成器把自回归语言模型的长程规划能力,和扩散/流模型渲染器的高保真结合起来。但存在一个被忽视的部署错配:渲染器是用干净的、从目标推导出的 codec token 训练的,上线时却要接收语言模型的不完美预测,这就形成了 codec 接口层面的暴露偏差——训练时没见过的错误 token 分布,在推理时成了常态。 本文贡献:作者不再把渲染当成简单的重建任务,而是把它重新表述为「从一个不完美离散计划出发的全上下文生成」。为此提出 FullDiT:一个条件 DiT,融合八路帧对齐的 RVQ 流与独立编码的歌词、caption,并在完整声学隐序列上做非因果自注意力。训练阶段引入 Error-Matched Distractor Conditioning(EMDC),把每个 codebook 的替换率匹配到教师强制下的 top-1 错误率,并从余弦 KNN 邻域中采样「近似错答」token,同时不改变声学目标。推理阶段用四路 classifier-free guidance(4-CFG)独立缩放 codec、歌词、caption 三类引导增量。 实验效果:匹配消融显示 EMDC 在合成扰动下把 ViSQOL 提升 0.77,且在非并列比较中明显更受偏好;进一步消融验证了全曲上下文与渲染器侧文本条件各自的增益。完整系统在 18 项自动指标中的 15 项上超过五个商业系统,并在 Artificial Analysis 带唱音乐榜单上进入前三。 批判点评:EMDC 是这篇最扎实的一笔:不是随机加噪,而是把干扰率精确对齐到教师强制的真实 top-1 错误率,并从 KNN 邻域取「像是对的错答」,这让训练分布真正逼近推理时会遇到的错误结构,比通用数据增广讲得通得多。渲染器侧也吃歌词和 caption 这一点也很合理——语言模型的 plan 一旦出错,渲染器至少还有文本可以校正。质疑点在于评测:「18 项中的 15 项超过五家商业系统」这类表述缺少商业系统的具体版本与调用时间,商业模型迭代极快,可复现性存疑;ViSQOL 提升 0.77 是在「合成扰动」这一人造条件下测得的,真实语言模型错误分布是否同构未验证;八路 RVQ 加全序列非因果注意力意味着相当高的显存与延迟开销,论文未给出与主流方案的推理成本对照。 5. adaLN-Gaussian:零初始化才是DiT的真功臣 Unveiling the Secret of AdaLN-Zero in Diffusion Transformer | 北京大学·百度·UC Berkeley | arXiv:2608.09438 关键词:扩散Transformer,adaLN-Zero,零初始化,条件化机制,TPAMI 前序问题:扩散 Transformer(DiT)已成为图像生成的主流架构,围绕它的性能改进层出不穷,但社区对它的理解仍然停留在表面。一个典型例子是 adaLN-Zero:所有人都知道它比 adaLN 效果好,也都在用,但到底是哪一部分设计在起作用,一直没人系统回答过。 本文贡献:本文深入拆解 DiT 中的关键条件化机制 adaLN-Zero,把它的性能来源分解为三个候选要素——类似 SE 的结构、零初始化、以及「渐进式」更新顺序,并逐一做受控验证,最终证明零初始化是其中最具决定性的因素。基于这一理解,提出分析导向的初始化策略 adaLN-Gaussian:它既是对上述分析的经验验证,也是一个能稳定改善优化效率的实用初始化方法。另一方面,受 SE 式结构启发,提出改进的条件化机制 SE-adaLN-Zero。 实验效果:遵循 DiT 设置在四个数据集上做了充分实验,尤其在 ImageNet1K 上验证了 adaLN-Gaussian 与 SE-adaLN-Zero 的有效性和泛化性;除类别到图像生成之外,还在文生图任务上评估了两种改进方法的泛化能力。论文已被 IEEE TPAMI 2026 接收。 批判点评:这是今天最「不性感但最有长期价值」的一篇。当整个领域都在往上堆模块时,回头把一个被默认使用了数年的组件拆开做归因,得到的是可迁移的设计原则而不是又一个刷分技巧——「零初始化主导」这个结论对任何做残差式条件注入的架构都有参考意义,adaLN-Gaussian 作为一行初始化改动,落地成本几乎为零。局限在于实验尺度:遵循原始 DiT 设置意味着规模偏小,ImageNet1K 类别到图像生成与今天动辄十亿参数的 T2I/T2V 训练环境差距不小,零初始化的主导地位在大规模、长训练下是否依然成立需要更强证据;文生图上的泛化验证在摘要中只是一笔带过,没有给出具体量级;此外 SE-adaLN-Zero 作为结构改动会带来额外参数与算力,论文未讨论其与收益的性价比。 6. REST:把RL副产物直接当蒸馏监督 RL-Native Distillation: Exploiting Scored Trajectories for Few-Step Image Generation | 上海交通大学·阿里巴巴淘天集团 | arXiv:2608.09226 关键词:少步图像生成,RL蒸馏协同,优势调制,奖励对齐,无CFG推理 前序问题:高效文生图既需要基于强化学习的奖励对齐,也需要少步蒸馏,但这两个流程通常被串行执行:先 RL 对齐、再压缩步数。这不仅推高训练成本,还有一个隐患——压缩过程可能把前一阶段辛苦对齐来的奖励收益又丢掉。 本文贡献:作者提出一个 RL 原生视角:扩散 RL 本身就在生成带奖励分数的有限步轨迹,这些中间状态是天然的蒸馏监督来源,而不是采样过程的一次性副产物。基于此提出 REST(Reward-Enhanced Scored-Trajectory Distillation),一个单阶段的 RL-蒸馏协同训练框架,把一个解耦的学生挂到任意 RL 教师上:学生从教师不断演化的 rollout 轨迹中分段学习,而教师原本的优化过程完全不受干扰。为避免无差别模仿把教师的低奖励行为也一并保留,进一步提出 Advantage-Modulated Distillation(AMD),把 rollout 的优势值转换为基础蒸馏损失上的带符号权重——强化来自优选轨迹的监督,并轻度排斥低奖励轨迹。整个框架轻量且即插即用,不需要额外的图像 rollout、独立蒸馏数据集或对抗训练。 实验效果:在组合式生成、视觉文字渲染、人类偏好对齐三类任务上,REST 使无 CFG 的少步推理能够追平甚至超越其 40 步的 RL 教师,而额外训练成本低于纯 RL 的 25%。在 DrawBench 上 PickScore 比 RTDMD 高 0.82,且只需其五分之一的训练迭代数。 批判点评:这篇的核心洞察属于「看见了别人扔掉的东西」:RL 阶段每一步 rollout 都自带奖励分数和完整中间状态,串行流水线却把它们当垃圾清掉,然后再花一遍算力重新造蒸馏数据——指出这点之后,单阶段协同几乎是自然结论。AMD 用带符号权重区分优劣轨迹也很关键,否则蒸馏会连教师的坏习惯一起继承。落地友好度高:不改教师、不加 rollout、不用对抗训练,额外成本 25% 以内。需要打问号的地方:学生学的是教师「演化中」的轨迹,教师早期还没对齐好时的轨迹质量偏低,论文没说清如何避免学生被早期噪声带偏(是否需要 warmup 或权重退火);「追平甚至超过 40 步教师」中的「超过」很可能来自 AMD 对低奖励轨迹的排斥效应,本质上是奖励模型上的进一步过拟合,是否真正提升人类感知质量存疑;此外三类任务均偏重可自动打分的能力,对开放域美学的影响未评估。 7. EditMod:1K图编辑仅需1.57秒 Model the Edit, Not the Image: Visual Autoregressive Editing from a Source-Centric Perspective | 北京理工大学·浙江大学·腾讯·深圳大学 | arXiv:2608.09057 关键词:视觉自回归,图像编辑,源为中心,多尺度残差,免反演 前序问题:下一尺度视觉自回归模型(VAR)通过由粗到细的高效预测生成高质量图像,已是一条强有力的生成范式,但它在文本引导图像编辑上的潜力基本没被开发。现有的免训练 VAR 编辑方法大多把编辑表述为「以源图为引导或约束的目标条件重新生成」,还往往依赖反演、测试时优化、注意力控制或用户提供的掩码。这种生成为中心的表述没有充分利用 VAR 天然提供的多尺度源表征,还引入了额外计算或人工干预。 本文贡献:作者转向源为中心的 VAR 编辑视角:把编码后的源图像 token 当作主要视觉状态,编辑过程只聚焦于条件诱发的变化量。基于这一视角提出 EditMod——在共享的自回归上下文下,对比源条件预测与目标条件预测,把两者之差视为逐尺度的编辑方向,再把它作为残差更新施加到选定尺度的源 token 上。整条链路不需要反演、不需要测试时优化、也不需要用户掩码。 实验效果:实验显示 EditMod 在源图保真度上处于领先水平,同时保持很强的文本对齐能力;在单张 A100 上完成 1K 分辨率图像的端到端编辑仅需 1.57 秒,且无需任何逐图预处理准备。 批判点评:「建模编辑量而不是重建整张图」这个转向非常对症:编辑任务本来就只有小部分内容需要变,让模型从零重新生成整图,既浪费算力又让未编辑区域无谓漂移。用源条件与目标条件预测之差作为逐尺度编辑方向,思路上和 classifier-free guidance 的差分同源,但落在 VAR 的多尺度 token 上更自然,也顺带解释了为什么能免反演、免掩码。1.57 秒完成 1K 编辑的数字对交互式应用相当有吸引力。局限在于:残差更新施加在「选定尺度」上,哪些尺度该动、动多少,摘要没交代选择准则,很可能是需要调的超参数,直接影响可用性;差分方向对提示词写法的敏感度未讨论——目标提示与源提示措辞差异过大时,差分可能失控;此外 VAR 生态目前的基座模型数量与质量都远不如扩散系,方法再好也受限于骨干天花板。 8. BAG:缓存复用改由门控网络决策 BAG: Budget-Aware Gating for Diffusion Caching | 浙江大学·西湖大学 AGI Lab | arXiv:2608.09231 关键词:扩散缓存,预算感知,门控网络,调度蒸馏,DiT加速 前序问题:扩散缓存是加速 DiT 的轻量手段——在去噪步之间复用中间特征,但现有范式面临一个根本权衡:在线启发式规则缺乏全局预算意识,不知道整体算力还剩多少;静态调度表则缺乏实例自适应能力,也无法灵活适配运行时变化的预算约束。 本文贡献:提出 BAG(Budget-Aware Gating),一种把全局预算节奏控制与动态、实例自适应的特征复用统一起来的缓存策略。它不再依赖手工规则,而是用一个轻量门控网络,在每一步同时以预算状态和局部轨迹反馈为条件,动态决定「执行完整计算」还是「复用缓存特征」。该策略通过离线到在线的调度蒸馏训练得到——把离线搜索出的调度表所包含的决策能力,迁移进一个紧凑的在线门控。 实验效果:在 FLUX.1-dev 与 Wan2.1 上的大量实验表明,BAG 在各个加速档位上一致优于当前最好的缓存方法,并且在不同分辨率、随机种子和引导强度下都保持稳健。代码将开源。 批判点评:把「算还是复用」这个决策交给一个同时看全局预算和局部轨迹的小门控,方向是对的:静态表不知道当前这张图难不难,在线启发式不知道预算还剩多少,两者的盲区正好互补。离线搜索调度表再蒸馏成在线门控,也是一种务实的工程折中——离线搜索能看到全局最优,在线门控只需继承其决策模式。可疑之处在于泛化边界:门控网络是学出来的,训练时的预算区间、分辨率和模型骨干一旦超出,决策是否还成立没有交代;论文强调在不同分辨率、种子、引导强度下稳健,但这些都属于同骨干内的扰动,换到未见过的 DiT 上是否需要重新蒸馏是关键问题。另外门控本身的推理开销虽称轻量,但在高加速档位下相对总算力的占比会被放大,摘要未给出具体数字。 9. CuteTTS:首音延迟直降23.3% CuteTTS: Efficient and High-Quality Speech Synthesis via Autoregressive Modeling of Continuous Latents | 复旦大学·上海创智学院 | arXiv:2608.08638 关键词:零样本TTS,连续自回归,流匹配,引导步蒸馏,低延迟 前序问题:零样本文本转语音已经在支撑交互式助手、个性化媒体和无障碍工具,所有 TTS 系统都要同时满足三件事:忠实的语言渲染、一致的说话人身份、以及低延迟响应。但紧凑的流式系统必须在一个可预测的低码率隐序列里保住足够的声学细节,而迭代式扩散采样与 classifier-free guidance 又会在每个自回归步上把推理成本乘上一遍。 本文贡献:提出 CuteTTS,一个紧凑的连续自回归 TTS 系统:把语义对齐的因果 VAE 隐变量、patch 级自回归、显式说话人条件化与双向流匹配头结合起来。进一步提出 guidance-step distillation,把 classifier-free guidance 与多步求解器一起吸收进单个区间条件化的学生模型,从而在推理时不必再为引导和多步求解重复付费。 实验效果:在 LibriSpeech 与 Seed-TTS-Eval 上,零样本音色克隆的可懂度与说话人相似度具备竞争力;蒸馏使首音延迟相对基础模型降低 23.3%、实时率降低 40.8%,而客观与主观质量保持相当。 批判点评:把 CFG 和多步求解一起蒸进「区间条件化」的单个学生,这一手比单纯做步数蒸馏更实用:交互式 TTS 的痛点是首音延迟,而 CFG 意味着每步都要跑两遍前向,属于纯粹的常数倍开销,能一并吸收掉收益很直接。走连续隐变量而非离散 token,也规避了码本容量对声学细节的硬约束。不足在于对比强度不够:「competitive」这种措辞通常意味着没有在可懂度或相似度上取得优势,仅是持平,而真正的卖点全在效率数字上;23.3% 和 40.8% 都是相对自身基础模型的相对提升,没有给出与主流流式 TTS 的绝对延迟对照,工业选型时价值有限;双向流匹配头与因果 VAE 的组合在流式场景下的前瞻依赖长度也没交代,这直接决定能否真正做到低延迟流式。 10. GameAlpha:透明区域跳算省35%token Alpha as an Efficiency Signal: Visibility-Routed RGBA Image-to-Video Generation | 北京大学·字节跳动·清华大学 | arXiv:2608.09355 关键词:RGBA视频生成,游戏素材,可见性路由,流匹配,DiT加速 前序问题:RGBA 视频把 RGB 外观与 alpha 通道结合,让动画素材能贴到任意背景上,游戏行业用量极大。但高质量游戏 RGBA 动画生成有两个卡点:一是现有 RGBA 视频数据集以写实内容为主,游戏素材覆盖很少;二是传统的先生成再抠像流水线在 RGB 合成之后才估计 alpha,半透明区域常被背景糊掉,导致抠像输出不稳定。近期开始有工作联合建模 RGB 与 alpha,但大多是文本条件的,效率与质量上仍有未解问题。 本文贡献:构建 GameAlpha-2.4K,一个 2.4K 片段的游戏风格 RGBA 视频数据集,用抠像友好的合成、多假设 alpha 恢复和基于合成的质量门筛选制成。在此之上训练一个参考图条件的 RGBA 视频生成器,单次前向同时产出 RGB 帧与 alpha 遮罩。为提升效率,提出 visibility router:在早期阶段就识别出透明 token,跳过它们后续的 DiT 更新;同时用 x_0-lock 让这些 token 沿原始流匹配调度朝自预测终点前进,避免被跳过后偏离轨迹。 实验效果:模型的 FVD 低于传统两阶段流水线;visibility router 在最后两个 DiT 去噪步中跳过 35% 的 token 评估,带来 1.2 倍骨干加速,质量退化可忽略。 批判点评:「把 alpha 当效率信号」这个提法很巧:alpha 通道本身就明确标出了哪些区域是透明的、几乎不含内容,这等于免费拿到一张算力分配图,不需要额外训预测器去猜哪里重要——这是本文最讨巧也最合理的一点。x_0-lock 的补充也必要,否则被跳过的 token 会脱离流匹配轨迹造成边缘伪影。但工业价值需要打折看:1.2 倍加速且仅作用于最后两个去噪步,这个收益相当有限,与今天另外两篇(BAG、DUET)动辄数倍的加速不在一个量级;GameAlpha-2.4K 只有 2.4K 片段,对视频生成而言规模偏小,是否足以支撑通用游戏素材生成存疑;FVD 低于两阶段流水线是个较弱的基线选择,未与近期联合建模 RGBA 的方法正面比较;此外游戏风格数据训出的模型跨美术风格泛化能力完全未讨论。 趋势观察 少步蒸馏从「二选一」走向「按噪声分工」 — 阿里与北大的 DUET 把长期困扰少步蒸馏的质量-多样性权衡拆成了一个分工问题:轨迹级蒸馏(sCM)保多样性、分布级蒸馏(DMD)保质量,此前所有工作都在试图用一个 loss 把两者调和,结果总是牺牲一方。DUET 干脆让 sCM 专家接管高噪声那一步负责铺开结构,DMD 专家接管低噪声那一步负责精修细节,两个专家各按自己的原生目标独立训练,绕开了 loss 组合的优化困难。两步视频生成上质量逼近 DMD、结构多样性保住 sCM 水平(约为 DMD 的两倍)。这是今天最干净的一个「把权衡改造成分工」的范式样本。 推理加速的重心从「压缩步数」转向「花掉的算力值不值」 — 今天有三篇从不同角度攻同一件事。上交与淘天的 REST 指出 RL 对齐与少步蒸馏被串行执行是纯粹的浪费——扩散 RL 本身就在生成带奖励分数的有限步轨迹,那些中间状态是天然的蒸馏监督,不该当采样副产品扔掉;单阶段协同训练后,无 CFG 的少步推理能追平甚至超过 40 步的 RL 教师,额外训练成本不到纯 RL 的 25%。浙大与西湖的 BAG 则戳破缓存策略的两难:在线启发式没有全局预算意识、静态调度又缺乏实例自适应,改用一个轻量门控网络同时看预算状态和局部轨迹反馈来决定「这一步算还是复用」。字节与北大的 GameAlpha 走的是第三条路——不去改调度,而是让 alpha 通道直接充当算力分配图,透明 token 早早识别出来后跳过后续 DiT 更新。三条路线的共同指向是:加速的下一程不在「少走几步」,而在算力分配的精细化——按训练流程、按实例难度、按空间区域,各有各的省法。 统一模型开始拆掉 VAE 这根拐杖 — 美团的 UniSpace 提出一个反直觉的观察:语义 ViT 的冻结 Transformer 块并非天生保不住视觉细节,真正把表征推向语义抽象的是原始的 patch 参数化方式。于是它做 Patch Reparameterization——保留原语义通路,另加一条重建感知的 patch embedding,把细粒度信息喂给同一批冻结 ViT 块,最终把理解、生成、编辑装进同一个视觉空间,8B 的 Mixture-of-Transformer-Experts 全程不需要独立的 VAE 通路。这条路子如果站得住,意味着统一多模态模型的架构可以显著简化:一个预训练 ViT 即可充当通用视觉接口。 音频生成开始追求「一套权重装下所有声音」 — 快手可灵团队与港中文的 SonicWeave 把语音、音乐、音效、歌声以及它们的细粒度混合塞进单个流匹配模型。它的技术判断很具体:现有音频 MoE 大多在领域级别路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。SonicWeave 改按连续声学 chunk 路由,并用一个冲突门在局部状态不可靠时倾向全局先验、在区域偏离全局场景时才让局部证据说话。复旦与阿里 Token Foundry 的 FullDiT 则捅破混合式音乐生成的一个部署真相:渲染器用干净的目标 codec token 训练,上线却要吃语言模型的不完美预测,这是典型的暴露偏差;把渲染重新定义为「从不完美离散计划出发的全上下文生成」,并按教师强制下的 top-1 错误率匹配干扰替换率,最终在 18 个自动指标中的 15 项上超过五家商业系统。 扩散架构的「知其所以然」终于开始补课 — 北大与百度的 adaLN-Zero 研究(TPAMI 2026)值得单独一提:DiT 已被用了几年,但 adaLN-Zero 为什么比 adaLN 好,社区一直只有直觉。这篇把候选解释拆成三条——SE 式结构、零初始化、渐进式更新顺序,逐一做消融,最终证明零初始化才是主导因素,并顺势给出 adaLN-Gaussian 初始化与 SE-adaLN-Zero 改进结构。在基座模型迭代如飞的当下,这类回头做机理归因的工作反而更稀缺:它给出的是可迁移的设计原则,而不是又一个刷分技巧。 人工智能炼丹君 整理 | 2026-08-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-11|NVIDIA免训练治好世界模型失忆WorldTrace 今日 AIGC 论文速览 今日共 10 篇 · 世界模型长时一致性与物理保真 2 篇 · 可控图像生成与区域编辑 4 篇 · 生成效率与免训练适配 2 篇 · 语音与数字人生成 2 篇 重点论文标题列表 WorldTrace(NVIDIA·普林斯顿大学·多伦多大学):免训练治好世界模型失忆 InsertFuse(上海交通大学·上海创智学院·西安交通大学·武汉大学):先训专家再蒸馏成一个 MOSAIK(华为加拿大):砍70%算力质量不掉 ControlRef(中山大学·清华大学·北京理工大学):稀疏布局延迟砍掉八成 HRDiT(兰卡斯特大学·华南理工·NVIDIA AI Tech Centre):现成DiT免训练出高清 今日论文速览 1. WorldTrace:免训练治好世界模型失忆 Addressable Memory for Video World Models | NVIDIA·普林斯顿大学·多伦多大学 | arXiv:2608.07408 关键词:视频世界模型,长时记忆,RoPE外推,KV cache压缩,免训练 前序问题:交互式视频世界模型依赖不断增长的 KV cache 当视觉记忆,来承接已生成的帧。但作者发现,一旦 rollout 超出训练时长,模型就无法可靠地寻址已存内容——因为时间维度的 RoPE 偏移跑到了训练时从未见过的范围之外,注意力检索不到相关视觉信息。更麻烦的是,天真地在 RoPE 旋转后的空间里压缩 cache 会直接破坏记忆,相当于把互不兼容的位置相位平均在一起。 本文贡献:提出免训练的记忆框架 WorldTrace:给每个摘要槽位分配一个互不相同、且落在训练分布内的虚拟位置,让压缩后的记忆保持「可寻址」。在这个可寻址 cache 之上研究两条压缩路线——WorldTrace-Field 压缩历史以维持时序连贯,WorldTrace-Landmark 在检测到的场景转换处保存原样场景轨迹以支持情节式回忆。同时提出 LoopBench,专门评测「绕一大圈之后能否重建先前访问过的场景」。 实验效果:WorldTrace-Field 把时序一致性提升 15.5%;WorldTrace-Landmark 在 LoopBench 上把情节式回忆提升 19.5%。全程无需重新训练,即扩展了视觉持久生成的长度。 批判点评:这篇的价值主要在诊断而非方法:把「世界模型跑长了会失忆」从模糊的「容量不够」精确归因到 RoPE 外推越界加旋转空间压缩相位冲突,并指出必须让虚拟位置落回训练分布内,这个洞察干净且可迁移——长上下文语言模型里的同类问题同样适用。免训练、可直接挂到现成模型上,落地成本几乎为零。局限是它本质在给外推能力打补丁而非根治:虚拟位置复用意味着不同时刻的记忆共享位置编码,冲突在更长 rollout 上迟早重现;Field 与 Landmark 两条路线各优化一个指标(时序连贯 vs 情节回忆),说明还没找到统一解;LoopBench 是作者自建的,绝对难度和外部可比性有待其他团队验证。 2. InsertFuse:先训专家再蒸馏成一个 InsertFuse: A Unified Framework for Multi-Category Reference-Guided Image Insertion | 上海交通大学·上海创智学院·西安交通大学·武汉大学 | arXiv:2608.06490 关键词:图像插入,On-Policy蒸馏,流匹配,区域平衡,参考引导 前序问题:参考引导的图像插入(把一个参考物体自然地放进目标场景)要同时处理人物、服饰、家具、logo 等多种类别,而不同类别的插入行为差异很大。直接联合训练一个通用模型会产生跨类别干扰——学插家具的能力会把插人物的能力带偏;而分别训练多个专用模型又无法统一部署。此外插入区域通常远小于背景,直接做流匹配会让监督信号被背景主导,且对物体尺度敏感。 本文贡献:提出 InsertFuse,核心思路是把「类别专属能力的学习」与「跨类别能力的整合」解耦:先为不同插入类别各训一个专家,再用 Insertion On-Policy Distillation(IOPD)把它们的能力合并进单个学生模型——在学生实际访问到的状态上去查询匹配的那个专家,从而保住类别专属的插入行为,又避免了直接联合训练的跨类别干扰。为改善空间控制,提出 Token 对齐的几何条件(TAGC),把掩码导出的几何线索映射到视觉 token 网格;以及区域平衡流匹配,对插入区域内外的预测误差分别归一化,防止背景主导和尺度依赖的监督失衡。另引入 Reference CFG,在固定场景与几何条件下隔离并强化视觉参考带来的引导,再由 IOPD 把这份增强监督迁移进统一学生。 实验效果:在公开的 AnyInsertion benchmark 和作者自建的多类别测试集上,多数指标达到最优,在多样插入类别上都表现出很强的参考保真度与生成质量。 批判点评:「先训专家、再 on-policy 蒸馏成一个」这条路子在大语言模型里已被验证,搬到图像插入上很对症——插入任务的类别差异确实大到会互相拖累,而 IOPD 在学生自己走到的状态上查专家(而非离线蒸馏固定数据),能避免分布错位,这是关键细节。区域平衡流匹配也点出一个容易被忽视的工程真相:插入区域只占画面一小块,不做归一化,损失基本被背景吃掉。不足在于成本:要先训 N 个专家再蒸馏,整体训练开销远高于单模型方案,论文没交代专家数量和总算力,实用性判断打折;「多数指标最优」的措辞意味着有指标不占优,具体哪些没说;此外自建测试集与公开 benchmark 混合汇报,容易掩盖在标准集上的真实位次。 3. MOSAIK:砍70%算力质量不掉 MOSAIK: Multi-Patch Content-Aware Spatial Allocation of Image Tokens for Efficient Generation | 华为加拿大 | arXiv:2608.05450 关键词:像素空间扩散,异构patch,推理加速,token预算,华为 前序问题:像素空间扩散模型避开了潜空间扩散的重建天花板,但 token 数量高得多,在自注意力的二次复杂度下生成成本高昂。已有的效率方法通过在选定的去噪步使用更大 patch 来减少 token,但每一步都在整张图上用同一个 patch 尺寸,忽略了不同区域被粗化时的保真损失其实差别很大。 本文贡献:提出 MOSAIK,一个「损伤引导」的框架,让 patch 尺寸同时随区域和去噪步变化。改造 PixelDiT 骨干使其能生成任意异构的 patch 布局,并用一个轻量预测器基于中间去噪特征估计每个区域被粗化会造成多大保真损失。在给定 token 预算下,损伤引导的布局预测器把细 patch 分给敏感区域、粗 patch 分给其余区域。 实验效果:在 FLOPs 减少 70%、token 数减少 83% 的同时,GenEval 与全算力 PixelDiT 持平,DPG-Bench 仅下降 1.0 分。与包括时序 patch 调度、特征缓存在内的多种效率范式相比,在中等预算下极具竞争力,在算力极度受限的场景下持续超越这些基线。 批判点评:「不同区域被粗化的代价不一样」这个观察太朴素了,以至于之前的 patch 调度工作集体忽略——把逐步的时间维调度扩展到空间维,并且用一个学出来的损伤预测器而非手工启发式来分配预算,思路正确且数字漂亮:砍 70% FLOPs 而 GenEval 持平,这个性价比在效率方向里属于第一梯队,尤其在算力受限区间超越特征缓存类方法,说明它不是靠预算宽松堆出来的。风险在于:异构 patch 布局需要改造骨干(PixelDiT),无法像特征缓存那样零成本挂到现成模型;损伤预测器本身要跑,在极小预算下它的开销占比会上升;此外评测集中在 GenEval/DPG 这类文图对齐指标,异构 patch 边界在高频纹理和小字上是否留下可见接缝,摘要没有交代。 4. ControlRef:稀疏布局延迟砍掉八成 ControlRef: Efficient Layout-Guided Multi-Instance Generation via Anchored 4D-RoPE | 中山大学·清华大学·北京理工大学 | arXiv:2608.06878 关键词:布局引导生成,多实例合成,4D-RoPE,MM-DiT,推理加速 前序问题:布局引导的多实例生成对多模态扩散 Transformer(MM-DiT)的可控合成很关键,但要把这个能力整合进统一架构一直很难。此前框架依赖冗余的全分辨率画布填充加 Shifted-RoPE 来管理多张参考图:这套机制在稀疏布局下把计算开销急剧放大,又破坏了关键的低频 RoPE 特征,形成严重的空间-频率折损,把绝对空间对应关系搞模糊。 本文贡献:提出 ControlRef。用统一实例-布局控制(UILC)注意力掩码严格解耦实例间的语义交互,强制精确的区域绑定。为进一步促进区域级空间对齐,提出 Anchored 4D-RoPE:把 token 直接锚定到它们的绝对几何中心——先把参考图预对齐到对应边界框的分辨率,再把布局 token 和参考 token 都物理锚定到绝对几何中心,并让参考沿 z 轴堆叠,从而原生保留空间先验,无需有损位移就缓解了空间-频率折损。 实验效果:在视觉保真度和定位准确率上达到最优,同时把稀疏布局下的推理延迟削减 80% 以上,稠密场景下的显存开销降低 50%。 批判点评:这篇把「Shifted-RoPE 用位移换对齐」这个隐性代价揭示得很清楚——位移破坏低频分量,而低频恰恰承载绝对空间信息,于是控制精度和算力两头同时受损。改成把 token 物理锚定到绝对几何中心、参考沿 z 轴堆叠(这也是 4D 的来源),是从坐标系层面而非加约束层面解决问题,延迟降 80%、显存降 50% 属于工程上很实在的收益。需要留意的是:稀疏布局的 80% 提速本质来自不再做全分辨率填充,收益高度依赖布局稀疏程度,稠密场景下只剩 50% 显存收益,宣传口径要打折;把参考预对齐到边界框分辨率意味着参考图会被重采样,小物体的细节保真如何没有交代;此外方法与 MM-DiT 的位置编码强耦合,迁移到其他架构的成本未知。 5. HRDiT:现成DiT免训练出高清 HRDiT: Training-Free High-Resolution Image Generation with Off-the-Shelf Diffusion Transformer Models (ECCV 2026) | 兰卡斯特大学·华南理工·NVIDIA AI Tech Centre | arXiv:2608.07003 关键词:免训练,高分辨率生成,Diffusion Transformer,空间错乱,ECCV2026 前序问题:免训练的文本到高分辨率图像生成正获得越来越多关注,但已有研究主要集中在把现成的 U-Net 扩散模型适配到高分辨率;对现成 Diffusion Transformer(DiT)的适配进展有限——尽管 DiT 在有限分辨率下的文生图能力本来更强。 本文贡献:指出两个特别阻碍现成 DiT 免训练做高分辨率合成的关键挑战——空间错乱(spatial disorder)与生成时间过长,并针对性提出一套专门适配现成 DiT 的方法。代码已公开。 实验效果:大量实验验证了方法的有效性。论文已被 ECCV 2026 接收。 批判点评:问题定位很到位:社区做免训练超高分辨率的技巧大多是 U-Net 时代的遗产,而主力基座早已换成 DiT,这个空档确实值得补;免训练、直接用现成权重、代码开源,落地门槛几乎为零,ECCV 2026 接收也算一层同行背书。但这条摘要是今天十篇里写得最含糊的:只说「有两个挑战」和「提出一种新方法」,具体机制、能撑到多高分辨率、加速比多少、与 ScaleCrafter/DemoFusion 这类前作差多少,一个数字都没给。即使实验部分扎实,这种写法也会让读者在信息筛选阶段先流失一批——对一篇主打「免训练即插即用」的工作来说,是很可惜的自我设限。 6. MaskFlow:掩码写进流匹配目标 MaskFlow: Precise, Consistent and Seamless Regional Image Editing | 商汤研究院·北京航空航天大学·南洋理工大学 | arXiv:2608.06929 关键词:区域图像编辑,流匹配,掩码条件,边界融合,商汤 前序问题:区域图像编辑因为空间可控性受到关注。但即便基于指令和基于掩码参考的方法都能做到不错的语义对齐,可靠的区域控制仍然困难——编辑必须被准确定位,并且与被保留的上下文自然融合,而现有方法常在边界留下痕迹或污染背景。 本文贡献:提出训练框架 MaskFlow,同时追求精确定位、一致的背景保持和无缝的边界过渡。关键做法是把掩码直接纳入概率路径和流匹配目标,让可编辑区域内的生成与区域外的源保持协同优化,而不是事后拼接。另提出 Soft-Poisson 去缝合模块,在训练和采样两个阶段都对预测的向量场做精修,改善编辑前景与保留背景的平滑融合。同时设计数据合成管线构建 MEData——面向区域图像编辑训练的掩码数据集。 实验效果:在自然场景和信息图(infographic)图像上的实验显示,定量与定性评测均相对竞争方法取得一致提升。 批判点评:把掩码写进概率路径和流匹配目标、而不是当成后处理的贴回操作,这是方法论上的正解——边界不自然的根源就是训练目标里从来没有「区域内外要协同」这一条。Soft-Poisson 在训练和采样两侧都介入也考虑得比较周全;选信息图当评测场景很实用,因为文字和线条对缝合痕迹最不宽容。不足在于它是训练框架而非免训练插件,接入成本比同类高;效果描述停留在「一致提升」,缺具体数字和基线对比,而区域编辑的差异往往只体现在边界几十个像素上,这类主观性强的改进尤其需要量化和用户研究支撑;MEData 由合成管线构造,与真实用户涂抹掩码的分布是否一致也需要验证。 7. EmoWorld:情感拆成三路分别调 EmoWorld: A Decoupled Affective Field for Controllable Emotional Video Generation | 香港科技大学(广州)等 | arXiv:2608.06231 关键词:情感视频生成,可控生成,冻结DiT,残差操控,Wan2.2 前序问题:情感决定观众如何解读一个场景,但现有视频生成器把全局氛围、承载情感的语义线索、以及情绪的时间推进这三件事全都揉在同一条文本条件里,导致无法分别控制——想调暗氛围就连带改了画面内容,想加一个悲伤的道具又连带改了整体色调。 本文贡献:提出 EmoWorld,在冻结的流匹配视频扩散 Transformer(Video DiT)内部解耦这三个因素。一次性准备阶段从「几何保持的中性全景图」与「情感编辑后的全景图」中提取逐层的情感方向和一个可复用的线索库。推理时:视觉氛围操控(VAS)把氛围方向注入隐藏状态;语义情感操控(SAS)为语义线索单独隔离出一个可独立缩放的 prompt 残差;时间情感操控(TAS)在去噪时间与视频时间两个维度上插值端点残差场。全程不更新生成器参数。 实验效果:在 Wan2.2 上,VAS 把目标情绪对齐度提升 19%、同时把时序波动代理指标降低 48%;SAS 把目标情绪对齐度提升 37%、检测到的承载情感线索增加 36%;TAS 相对最强基线把过渡单调性提升 15%。覆盖 27 个情绪类别的文生视频与图生视频设定,可跨多个 Video-DiT 骨干移植,并支持相机条件下的构图。 批判点评:把「情感」这个含混的条件拆成氛围、语义线索、时间推进三路分别注入,是这篇最漂亮的地方——它把一个说不清的美学需求变成了三个可分别缩放的旋钮,而且完全不动生成器权重、能跨骨干移植,工程友好度很高;用几何保持的中性/情感全景图对来抽取情感方向,也是个巧妙的构造。要谨慎的是评测指标的自定义程度偏高:「时序波动代理」「过渡单调性」都是作者自拟的量,19%/37%/48% 这些百分比缺少公认基线的对照,跨论文可比性差;情绪这类主观维度最终仍需人类评测,摘要未提及用户研究;此外方法依赖一次性准备阶段产出的线索库,换主题域或换骨干后是否需要重建,成本没有交代。 8. GAUGE:方程对了加速度还是错 GAUGE: A Measurement-Grounded Benchmark for Physical Fidelity in Simulation Engines and Video World Models | 上海人工智能实验室·香港大学·上海交通大学·浙江大学 | arXiv:2608.05948 关键词:物理保真度,视频世界模型,物理引擎,诊断基准,上海AI Lab 前序问题:物理引擎支撑着具身智能的大规模训练与评估,而生成式视频世界模型正在成为未来状态与交互的隐式模拟器。但现有的物理保真度评估往往各自孤立进行,且严重依赖感知相似度或人工判断,几乎无法告诉你到底是哪条物理原理、哪个参数被违反了。 本文贡献:提出 GAUGE,一个以真实世界为基准的诊断性 benchmark,联合评估数值模拟器与生成式视频世界模型对真实物理的复现与偏离。包含 22 个受控任务族,覆盖刚体、柔性线缆、织物和体积可变形物体;以真实世界轨迹为基准,配套标定过的物理元数据、不确定性标注和任务专属可观测量,涵盖碰撞、摩擦、动量传递、振荡、自接触、形变等基本物理过程。 实验效果:用广义轨迹误差在 14 个任务族上评测 Isaac Sim、Genesis 与 Newton,并在 5 个刚体任务上评测 6 个图生视频模型的物理定律一致性与推断参数的时序稳定性。结果显示没有任何一个物理引擎在全部任务上保真,最大偏差出现在冲击性接触、织物快速运动和体积形变;更值得警惕的是,视频世界模型能产出「方程形式符合预期」的轨迹,但恢复出的加速度、动量传递和振荡时序全是错的。 批判点评:把物理引擎和生成式视频模型放进同一套以真实轨迹标定的尺子下衡量,这个设计本身就是贡献——此前两个社区各说各话,一边比轨迹误差一边比感知相似度,根本无法对话。最有价值的结论是「方程形式对但加速度错」:这精确刻画了视频模型的物理是表层拟合而非机制正确,对所有把视频世界模型当具身智能模拟器用的团队都是一记警钟,而这种可归因到具体物理量的诊断,是感知相似度指标永远给不出的。局限在于覆盖不平衡:物理引擎评了 14 个任务族,视频模型只评了 5 个刚体任务,柔性和形变这些最难的场景恰恰没测到生成模型;真实轨迹的标定精度与不确定性标注本身也会引入误差上限;22 个任务族的构造和评分细节能否被外部团队稳定复现,要等数据与代码放出后才能判断。 9. SemBridge:语义token只在训练时用 SemBridge: Semantic Token Anchoring for Continuous-Latent Autoregressive Speech Generation | 西北工业大学·Soul AI Lab | arXiv:2608.07462 关键词:自回归语音生成,连续潜表示,语义token监督,零样本TTS,歌声合成 前序问题:连续潜表示的自回归语音生成通过避免量化损失、保留更丰富的声学信息,成为离散 token 建模之外一条有前景的路线。但连续声学目标并不把语言结构暴露成显式的 token 级预测目标,结果自回归语言模型只能通过预测声学来间接获得语言结构,这会损害生成语音的内容保真度——说白了就是音色和韵律很好,但字容易念错。 本文贡献:提出 SemBridge,一个仅在训练阶段生效的语义 token 锚定框架。用离散语义 token 直接监督自回归 LM 的状态,并采用语义对齐的声学 VAE,把连续目标空间组织在同一个语义参照系之下。语义监督只在训练时使用,推理阶段完全保持连续,因此不引入量化损失。在零样本文本转语音(TTS)和乐谱条件的歌声合成(SVS)两个任务上评估。 实验效果:在多个基准上,SemBridge 改善了以词错误率和字错误率(WER/CER)衡量的内容准确率,同时保持有竞争力的说话人相似度和感知质量。结果表明,对自回归状态施加显式语义 token 监督,是连续语音生成的一个有效且通用的方向。模型代码与 checkpoint 将开源。 批判点评:「训练时用离散语义 token 当拐杖、推理时完全撤掉」这个设计非常讨巧——它精准命中连续潜表示路线的软肋(音质好但内容易错),又不把量化损失带回推理阶段,属于两头好处都要的正确姿势,而且同时在 TTS 和歌声合成上验证,说明不是针对单一任务的技巧。不足是收益描述偏保守:内容准确率提升、说话人相似度和感知质量「保持有竞争力」,这个措辞通常意味着后两项略有折损,具体折多少要看正文;语义 token 的质量高度依赖所用的语义编码器,换一个编码器结论是否稳定没有交代;此外 16 位作者的大团队工作却只给出相对提升而无绝对 WER 数字,可比性打了折扣。 10. SubtleTalk:眉毛眨眼终于不再呆滞 SubtleTalk: Generating Controllable Weakly-correlated Facial Dynamics for 3D Talking Heads via Residual Flow Matching | 上海交通大学·腾讯 | arXiv:2608.06408 关键词:3D说话人,弱相关动态,残差流匹配,Valence-Arousal,腾讯 前序问题:音频驱动的 3D 面部动画要从语音合成真实且时序连贯的运动。尽管唇形同步已有显著进展,但眉毛运动、眨眼、头部动作这些「弱相关动态」——对照片级真实感恰恰至关重要——仍然难以忠实建模,常常表现得僵死或不自然地重复。作者归因于三点:一是弱相关动态的条件信息不足;二是确定性回归难以捕捉多样的运动模式;三是上半脸伪标签不可靠、数据集多样性有限造成的数据瓶颈。 本文贡献:提出 SubtleTalk,通过多条件建模与残差流匹配生成自然可控的弱相关面部动态。第一,针对单靠语音引导不足,引入可解释的控制信号——韵律、区域强度、Valence-Arousal(效价-唤醒度),显式刻画弱相关动态的时机、幅度和情感变化。第二,针对确定性回归表达力有限,在稳定的语音驱动运动先验之上构建残差流匹配,让模型捕捉超出确定性预测的随机偏差。第三,为缓解数据瓶颈,构建 SubtleTalk-Face 数据集,约 3900 个身份、74 小时数据,通过简单可扩展的伪标注管线构建,改进了上半脸追踪并带有帧级 VA 标注。 实验效果:大量实验表明,该方法在显著提升弱相关面部动态的真实感和多样性的同时,保持了准确的唇形同步。 批判点评:问题诊断分层很清楚:条件不足、回归表达力不足、数据不足,三条各配一个对策,而不是笼统地上一个更大的模型。「弱相关动态」这个提法本身就抓住了数字人恐怖谷的真正来源——唇形对了但眉眼呆滞,观众立刻觉得假;用残差流匹配在确定性先验之上叠随机偏差,是承认这类动作本质多模态、不该被回归到均值,方向正确;3900 身份、74 小时并带帧级 VA 标注的数据集也是实打实的贡献。局限是上半脸标注仍来自伪标注管线,而上半脸恰恰是原问题里「伪标签不可靠」的部分,这在方法论上有一点自我循环的味道;效果只给了「显著提升真实感和多样性」的定性说法,而多样性和真实感之间通常是权衡(动得多容易动得怪),缺少量化取舍曲线;此外三路控制信号的调参空间不小,实际使用的易用性有待验证。 趋势观察 长时一致性的病根被重新定位到「位置编码的可寻址性」 — NVIDIA 与普林斯顿的 WorldTrace 指出,视频世界模型跑超训练时长后失忆,真正原因不是 KV cache 装不下,而是 RoPE 的时间偏移跑出了训练分布,模型根本「找不到」存进去的内容;更糟的是在 RoPE 旋转后的空间里直接压缩,等于把相位不兼容的记忆平均成糊状。给每个摘要槽位分配一个落在分布内的虚拟位置,免训练就把时序一致性提了 15.5%、情节回忆提了 19.5%。这是今天最典型的「诊断比方法更值钱」。 生成效率的战场从「少走几步」转到「每一块像素值不值得花算力」 — 华为加拿大的 MOSAIK 指出,此前的 patch 调度都是在时间维上做手脚——某几个去噪步换大 patch,但整张图仍用同一个尺寸,完全忽略了不同区域被粗化时保真损失差别巨大。它训了一个轻量预测器估计每个区域的「损伤程度」,把细 patch 分给敏感区、粗 patch 分给其余,FLOPs 砍 70%、token 砍 83% 而 GenEval 与全算力持平、DPG 只掉 1.0 分,并且在算力极度受限时持续超越特征缓存类方法。空间维的自适应预算分配,是这条路上被漏掉的一整个维度。 免训练与训练后处理,仍然是投入产出比最高的一档工作 — HRDiT(ECCV 2026)把免训练高分辨率生成从 U-Net 时代搬到现成 DiT 上,只需解决空间错乱和生成耗时两个卡点;WorldTrace 完全不动权重就修好长时记忆;EmoWorld 在冻结的 Video DiT 上做三路情感操控,27 类情绪、跨多个骨干可移植,全程不更新生成器参数。当基座模型迭代速度远快于论文周期时,「不碰权重」正在成为一种务实的方法论选择。 可控生成的瓶颈从「像不像」转向「位置对不对、别处别动」 — 中山大学与清华的 ControlRef 发现前作用全分辨率画布填充加 Shifted-RoPE 管多张参考图,既在稀疏布局下浪费大量算力,又破坏低频 RoPE 特征、模糊了绝对空间对应;改成把 token 锚定到绝对几何中心的 Anchored 4D-RoPE,稀疏布局延迟砍掉 80% 以上、稠密场景显存省一半。商汤的 MaskFlow 把掩码直接写进概率路径和流匹配目标,从训练目标层面保证「区域内生成、区域外保源」;上交的 InsertFuse 则用区域平衡流匹配,对插入区域内外分别归一化误差,防止小目标的监督被背景吃掉。三篇都在说同一件事:控制不是往外加约束,而是改坐标系和目标函数。 评测正在从「打分」走向「诊断违反了哪条物理定律」 — 上海 AI Lab 联合港大、上交、浙大的 GAUGE 用真实世界轨迹做基准,22 个受控任务族覆盖刚体、柔性线缆、织物和体积可变形物,同时评物理引擎(Isaac Sim、Genesis、Newton)和 6 个图生视频模型,结论相当刺眼:没有一个引擎在全部任务上物理保真;而视频世界模型能生成「方程形式看起来对」的轨迹,但加速度、动量传递和振荡时序全是错的。这种可归因到具体物理量的评测,比再多一个感知相似度分数有用得多。 人工智能炼丹君 整理 | 2026-08-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-10|阿里Wan-Animate-2角色动画冲进实时24FPS 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与人物编辑 4 篇 · 图像生成与扩散训练范式 1 篇 · 世界模型与 3D 生成 3 篇 · 评测基准与音频编解码 2 篇 重点论文标题列表 Wan-Animate-2(阿里巴巴通义实验室):14B角色动画实时到24FPS Vorch-IR(美团 Vorch Team·复旦大学):双人换脸拉到分钟级 UniVVT(清华大学·天津智能创新研究院):扔掉掩码姿态快38倍 EG-FM(京东·中科院自动化所):让终点自己动收敛快2.7倍 EffectLearner(清华大学深圳国际研究生院):擦人连影子涟漪一起擦掉 今日论文速览 1. Wan-Animate-2:14B角色动画实时到24FPS Wan-Animate-2: Pushing the Application Boundaries of Character Animation | 阿里巴巴通义实验室 | arXiv:2608.06009 关键词:角色动画,实时流式生成,Self-Forcing蒸馏,视角控制,阿里通义 前序问题:角色图像动画目前有三条路线,每条都有硬伤:基于显式运动表征(骨架、关键点、SMPL)的方法受制于提取误差,一旦姿态估计出错就带着身份一起漂移;基于隐式运动特征的方法把驱动信号压缩成低维向量,手指、微表情这类细粒度动态在压缩里被抹平;上下文学习(in-context learning)路线干脆不要中间表征,直接把驱动视频喂进注意力,质量最好但算力开销高到无法接受。更要命的是,现有系统全部是离线合成,数字人主播、直播换装这类交互场景要求边算边出,而当前方法连准实时都做不到。 本文贡献:端到端重构 DiT,让模型直接消费驱动视频,彻底删掉中间运动提取器。四个部件撑起 Base 版:双分支 DiT 共享 QKV 投影,参考分支锚定在扩散时间步 t=0 提供无噪运动先验,只训共享投影层、主干权重冻结;Time-Align RoPE 把参考视频 token 逐帧前置拼接,用H_t×W_t 的空间偏移避免位置索引撞车;Sparse-Ref Attention 让每个 latent query 只看时间上对应的参考 K/V,把跨分支注意力从 O((N_r+N_l)²) 压到 O(N_l);Viewpoint LoRA 只注入 cross-attention 投影矩阵,用「right 60-degree view」这类自然语言而非旋转矩阵来控视角,把输出机位和驱动视频解耦。Lite 版靠三段式训练做到实时:教师强制预训练把全局去噪模型改造成chunk-wise 因果生成器;Error Buffer 把单步预测与真值latent 的残差以滑动估计维护,训练时加回 clean context 来对冲 exposure bias,不用跑完整自回归 rollout;Self-Forcing 蒸馏为 14B 规模设计分块反向传播,rollout 阶段无梯度算完整序列分数,梯度阶段逐 chunk 累积并 detach,峰值显存从与全序列成正比降到与单 chunk 成正比。 实验效果:Lite 版在 4 张 H100 上以流水线并行(1 卡 VAE 编码、2 卡序列并行跑 3 步 DiT 去噪、1 卡 VAE 解码)达到 400×720 分辨率 24 FPS,推理 chunk 为 8 帧,跨过实时阈值;得益于 error buffer,长时间自回归里观察不到误差累积或质量退化。视角空间离散为 12 个方位角×4 个俯仰角共 48 档,大幅换机位时周围环境仍保持高度一致。盲测用户研究覆盖视觉质量、动态自然度、身份保持、动作准确度、面部表情五维加总体质量:对开源 Wan-Animate 全指标领先,总体质量在超过 70% 的成对比较中被偏好;对闭源商业产品 Dreamina 多数比较中胜出,对可灵 Kling-MotionControl 打成平手——而后两者建立在更大的闭源视频基座上,Wan-Animate-2 完全基于开源基座。训练数据用 Wan-Animate 自动合成配对视频,参考图由 Qwen-Image-Edit / Qwen-Image / Z-Image 生成,覆盖全身/半身/特写;多视角数据由 Unreal Engine 渲染,仅用于训Viewpoint LoRA。团队承诺开源 Base 权重。 批判点评:这篇最扎实的地方不是又一个动画框架,而是把「实时」这件事真正做进了 14B 视频 DiT:Error Buffer 用一次前向的残差近似替代完整 rollout,Self-Forcing 的chunk-wise 反传把显存与序列长度解绑,这两招是可以直接搬去做其他流式视频生成的通用工程手艺。Viewpoint LoRA 用自然语言而非相机参数控视角,也切中了普通用户拿不到标定内参的实际痛点。但要冷静看几处:全文没有一张定量指标表,FVD/FID/身份相似度一个都没报,评估只有定性图和盲测胜率,而用户研究连参与人数、样本量、分维度百分比都没披露,「超过 70% 偏好」这种数字缺乏可复核性;对比只挑了 Wan-Animate、Dreamina、Kling 三家,AnimateAnyone/Champ/UniAnimate 等经典基线全部只在引言里被引用而未实测。所谓 24 FPS 是 4 卡 H100 加 400×720 的成绩,折算成单卡或 1080p 就不再是实时,「开放部署新场景」的说法离消费级还有距离。另外 Lite 是蒸馏产物、Base 才开源,最能落地直播的那一版权重反而没承诺放出。 2. Vorch-IR:双人换脸拉到分钟级 Vorch-IR: Long-Form Unified Multimodal Identity Replacement Video Generation | 美团 Vorch Team·复旦大学 | arXiv:2608.05648 关键词:视频身份替换,长视频生成,时间重叠推理,LTX2,美团 前序问题:视频身份替换要把一到多个主体的身份换掉,同时保住驱动视频的动作、表情和时序结构。现有方法几乎只做单人,而且普遍依赖任务专属的结构控制——掩码、姿态图之类,这让它们很难塞进一个通用的多模态编辑系统里。多人替换更是被配对训练数据的稀缺卡死:你很难找到「同一段舞蹈、同样的动作、但换了两个人」的真实配对素材。另一个长期痛点是长度,短片段模型要拉长通常靠自回归续写,误差会一路累积成身份漂移。 本文贡献:一个模型同时支持单人替换、双人替换,以及可选的背景替换,四种设置共享同一套参数,没有任务专属分支或输出头。基于 LTX2 的 48 层 DiT,联合条件化于驱动视频、有序参考图集合和一句文本编辑指令;参考图不需要和驱动视频的姿态、布局、空间构型对齐,谁替换谁完全由指令文本说明(比如「参考1换左边的人,参考2换右边的人,参考3换背景」)。密集视觉条件走自注意力融合——驱动视频与目标视频用同时间原点、同帧率的独立 RoPE 网格,每张参考图分配独立位置网格,从而不对参考图与目标施加坐标级对应;语义对应关系则通过 Gemma 视觉语言编码器的 cross-attention 建立,参考-目标的绑定被学成语义关系而非显式定位模块。条件 token 始终保持 clean 并赋时间步 0,只有目标 token 加噪与监督。配套一条全自动数据构建流水线:先编辑首帧身份(合成参考涵盖真人、动漫角色、其他类人形象),可选再编辑背景,由 LLM 生成替换指令,再用运动引导动画模型沿源运动轨迹传播,最后由 VLM 过滤肢体畸形、主体缺失、身份不匹配等失败样本。长视频靠时间重叠推理:8 秒窗口、2 秒重叠、线性 cross-fade 融合,所有窗口读同一份 latent、融合后对整段施加单次 Euler 步,全视频保持单一去噪轨迹,因此不需要自回归续写。 实验效果:训练只用了 15,571 个clip、总时长约 13 小时(91% 的clip 在 2-4 秒),32 张 H20Z、有效 batch 96、2000 次优化步的checkpoint。在自建 benchmark 上主体一致性 0.9096 与背景一致性 0.9332 双项第一,DINOv2 主体相似度 0.5613 第一(次优 SCAIL-2 为 0.5470),CLIP-I 0.7767 第二仅差 0.0068;跨数据集 XDance 上运动平滑度 1.4286 第一,DINOv2 0.6040、CLIP-I 0.7953 均为第二。GSB 人工成对评测覆盖 4 个对手×4 个维度共 16 组,Vorch-IR 在全部 16 组中 Good 占比都高于 Bad:对 Wan-Animate 身份一致性 77.0% Good 对 11.5% Bad,对 MoCha 运动一致性 50.0% Good 对 0.0% Bad、身份一致性 69.2% 对 3.9%,对 HunyuanCustom 身份一致性 65.4% 对 23.1%。推理用 8 步蒸馏采样器单阶段完成,完整驱动视频只编码一次,短片段训练的模型直接扩展到分钟级。 批判点评:这是Vorch 系列本周的第四篇(8 月 7 日那期已推过 Omni、Streamer、Director),从「一套权重覆盖 30 多种音视频配置」走到「一套权重覆盖单人/双人/背景四种替换设置」,路线是连贯的:把任务差异从架构里赶出去,全部推给指令文本和 token 角色分配。最实用的一招是时间重叠推理——用完整驱动视频本身作为稠密逐帧条件,所有窗口共享同一份 latent 再做单次全局 Euler 步,绕开了自回归续写的误差累积,这个思路对任何「有完整条件序列」的长视频任务都能复用。但要看清代价:训练数据只有 13 小时、15,571 个clip,而且监督信号全部由「图像编辑首帧 + 运动传播」合成,本质是在蒸馏现成编辑器与动画模型的能力,天花板受限于那两个工具;论文也没报 FVD,视频级分布距离缺一个公认口径。更关键的是定量对比只在「单人替换」这一共同设置下做——双人和背景替换恰恰是它宣称的核心增量,却只有项目页的定性结果,无法核验。时序闪烁 0.9680 低于 HunyuanCustom 的 0.9781,DWPose 误差 0.0976 也不及 Wan-Animate 的 0.0614,说明身份保真的提升是拿姿态精度和时序平滑换来的。最后,这类换脸能力的滥用风险是实打实的,论文对此几乎没有讨论。 3. UniVVT:扔掉掩码姿态快38倍 UniVVT: A Unified End-to-End Framework for High-Fidelity Video Virtual Try-on | 清华大学·天津智能创新研究院 | arXiv:2608.05745 关键词:视频虚拟试穿,端到端生成,MLLM语义条件,预处理加速,清华 前序问题:视频虚拟试穿要合成一段「这个人穿上这件目标服装」的视频,同时保住身份、动作和场景动态。主流做法把它当成掩码条件下的视频修补,于是必须挂一串独立模块:人体解析、姿态估计、服装变形。这套多阶段设计不只部署麻烦,更要命的是显式几何先验一旦出错,误差会不可逆地传进生成结果——掩码估计歪了,衣服就换不干净。而且这些预处理开销随视频长度近线性增长,90 帧就要一百多秒。 本文贡献:把视频试穿从「掩码条件视频修补」重新定义为「语义条件视频生成」,推理时彻底不需要掩码、姿态和变形场。核心判断是:「换什么」和「换到哪、怎么换」可以由多模态语义隐式编码,不必显式规定。三个组件:场景-任务感知器用 Qwen3-VL-2B-Instruct 把源视频、目标服装图、文本指令联合编码,前置 512 个可学习 task query 通过自注意力聚合任务信息,取的是 MLLM 的 hidden states 而非解码出的文本,因此同时捕获服装属性、场景上下文、人体-服装对应关系与时序编辑意图;语义桥是个轻量 MLP,只做维度与分布的适配,不学新的生成先验;视频生成模块基于 Wan2.1-Fun-Control 的 DiT,源视频 latent 与噪声沿通道维拼接以保留身份动作背景,服装 latent 沿序列维追加作为静态外观参考,每个 block 通过 cross-attention 注入任务语义与冻结CLIP 的服装外观特征。训练走三阶段渐进:先冻结生成器只对齐语义,再联合端到端适配,最后在256p-1024p 随机分辨率上精调。掩码与 DensePose 只出现在离线数据构建阶段(从真实的服装-视频对反向合成源输入),训练和推理都不吃这些输入。 实验效果:最有说服力的是效率:显式几何预处理在 30 帧要 36.36 秒、90 帧要 111.39 秒且近线性增长,UniVVT 的隐式任务编码分别只要 2.06 秒和 2.92 秒,加速 17.7 到 38.1 倍,90 帧场景直接省掉 108.47 秒。质量上也没让步——ViViD-S 视频基准 paired VFID_I 8.3623、VFID_R 0.1934、LPIPS 0.0456、unpaired VFID_I 12.3640、VFID_R 0.1876 五项里四项最优(SSIM 0.8922 次于 MagicTryOn 的 0.9011),unpaired VFID_R 相比次优 DreamVVT 的 0.4285 几乎腰斩。图像基准同样领先:DressCode paired FID 2.734、KID 0.4154、LPIPS 0.0349、unpaired FID 4.900、KID 0.960全为最优;VITON-HD paired FID 5.348、KID 0.3667 也是第一,并明显优于 Qwen-Image-Edit(14.269)与 FLUX.2-klein(11.503)这类通用图像编辑模型。消融很干净:去掉场景-任务感知器后 unpaired VFID_R 从 0.1876 恶化到 0.4424翻倍以上,定性上会把短裙错误地贴到上半身;语义桥若用 12 层 Transformer(1260M 参数、571G FLOPs)反而不如 41.96M 的 MLP,说明这一层只需做紧凑的分布变换。8 张 A100、LoRA rank 32、每阶段 30k 步。 批判点评:这篇给「能不能把一堆预处理模块直接删掉」提供了一个相当有力的答案,而且删的理由讲得通:掩码和姿态本质是在告诉模型「改哪里」,但一个足够强的 MLLM 看完视频和指令后本来就知道该改哪里,交叉注意力可视化也确实显示注意力集中在上半身并沿手臂持续跟随、人脸和背景响应明显更弱。17.7-38.1 倍的预处理加速对电商这种要批量跑的场景是硬收益,比多零点几个 SSIM 实在得多。轻量 MLP 打败重型 Transformer 那组消融也很有价值——提醒大家适配层不该无脑堆容量。但几处需要打折:训练三元组的「源视频」全部是用 inpainting 模型合成出来的,真实数据只提供服装图与目标视频,也就是说模型学的是「从合成劣化态恢复到真实态」,真实用户上传的视频未必落在这个分布里;in-the-wild 只在 TikTok 舞蹈上做了定性展示,没有数值。评测统一在 512×384 这个偏低的分辨率下进行,而试穿最挑剔的恰恰是布料纹理与 logo 这类高频细节,Stage 3 在 832p上 LPIPS 反而退到 0.0586 也暗示高分辨率并非无痛。论文既没有 FVD 也没有用户主观评测,视频级的时序观感缺少直接证据。SSIM 输给 MagicTryOn 也说明「端到端」在结构保真上还有欠账。 4. EG-FM:让终点自己动收敛快2.7倍 Energy-Guided Flow Matching | 京东·中科院自动化所 | arXiv:2608.05811 关键词:像素空间扩散,Flow Matching,频谱调度,收敛加速,京东 前序问题:像素空间生成模型绕开了 VAE 的有损压缩,代价是要在极高维空间里同时学全局结构和细粒度纹理。标准 flow matching 把噪声笔直插值到一个固定的干净图像终点,从低频轮廓到高频细节的整条频谱演化只能由网络隐式摸索,没有任何机制告诉模型「先把大形状定下来,再补纹理」。结果就是收敛慢、epoch 烧得多,像素扩散一直被认为训不动。 本文贡献:把固定终点换成会动的终点。用热核频率响应 R(h,ρ)=exp(−aħρ²) 对干净图做低通滤波,得到随时间平滑演化的终点 y_t(x):h=1 时最强低通只剩轮廓,h=0 时恢复全频谱等于原图,边界条件与标准 FM 完全一致。关键是高频释放节奏不写死,而是按每张图自己的频谱能量自适应:用 Parseval 定理算出总缺失能量与已恢复能量,令所有样本在同一时刻 t 完成相同比例的频谱能量恢复(release clock q(t) 用五次smootherstep),再用 16 次二分求出该图的热时间 h。速度目标因此多出一项终点自身运动项 t·∂_t y_t,通过隐式微分求导,无需对求根器反传。默认 σ₀=3.5,所有频谱运算在 FP32 下执行,t 与 1−t 接近 0 时解析赋值保证端点稳定。不改backbone、不改训练数据、不改采样器。 实验效果:ImageNet 256×256 类条件生成上做成收敛加速器:HyperDiT-H 只训 220 epoch 就拿到 FID 1.51,优于基线 600 epoch 的 1.56,约 2.7 倍加速;DeCo-XL/16 440 epoch 达 1.63 优于基线 600 epoch 的 1.69;PixelDiT-XL 200 epoch 的 1.55 已经超过基线 320 epoch 的 1.61,600 epoch拉到 1.45 优于基线 800 epoch 的 1.54(torch-fidelity 协议下为 1.39)。512×512 上从256 检查点仅微调 40 epoch,240 epoch 得 FID 1.68,而标准 PixelDiT 多训 530 epoch 才 1.81。迁到文生图,1.3B 的 EG-FM-T2I 把 PixelDiT-T2I 的 GenEval 从 0.78 提到 0.85、DPG 83.7→83.9(DPG 为全表最佳),GenEval 分项里Position 0.53→0.72、Color attribute 0.65→0.77 提升最猛。开销几乎为零:额外 FLOPs 最多 +0.026%/样本,每步墙钟时间增幅除 PixelDiT-B/16 的 4.81% 外均在 1% 以内,推理阶段完全零开销(不需 FFT、不需求根,与标准 FM 同 solver 同 NFE)。消融证明「逐样本自适应」是关键:共享线性释放 FID 2.48、数据集级 2.11、类级 2.03、逐样本 1.99。 批判点评:在一堆「加个新模块涨点」的论文里,这种改训练目标而不动网络、推理零开销的路子性价比极高,尤其「同一时刻所有样本释放相同比例频谱能量」这个归一化视角很干净——它把粗到细这件一直靠 noise schedule 玄学调的事,变成了可解析求解的能量约束。消融也做得诚实:取消量化、换释放时钟、改热时间粒度都摆了数字,还坦白 x-prediction 扩展在 JiT 上只从 2.37 到 2.33几乎无效,并解释了原因(早期 solver 的 x̃ 频谱不可靠)。不足同样清楚:σ₀ 呈 U 形曲线且最优值 3.5 是搜出来的,换数据分布或分辨率是否还成立没有验证,σ₀=1000 时 FID 崩到 66.08 说明这条路径对超参并不宽容;全部结果限于像素空间 backbone(DeCo/HyperDiT/PixelDiT),latent 空间主流模型上有没有增益完全空白,而作者也承认没在 Flux、Qwen-Image 量级基座上测过;GenEval 0.85 虽亮眼,但 DeCo-XXL/16 用 1.1B 参数拿了 0.86,说明这套增益并非在所有对手面前都成立。视频与跨模态更是明确列为未来工作。 5. EffectLearner:擦人连影子涟漪一起擦掉 EffectLearner: World-Aware Object-Effect Reasoning for Real-World Video Object Removal | 清华大学深圳国际研究生院 | arXiv:2608.05565 关键词:视频物体移除,效果推理,VLM引导,DiT擦除,清华 前序问题:视频物体移除不只要抹掉目标本身,还要连带清掉它引起的影子、反光、涟漪、尾迹、扬尘这些次生效果,同时保证补出来的背景高保真且时序连贯。现有方法把物体-效果对应关系隐式地从预定义效果类别和固定数据分布里学,一旦遇到真实场景里的组合效果(影子叠反射)、空间上与物体分离或弱相关的效果(远处水面的涟漪)、长尾物理现象、以及随时间演化的动态交互,就统统失效——把人擦了,地上的影子还在。 本文贡献:把语义推理塞进擦除管线:VLM 物体-效果推理器(Qwen2.5-VL-3B-Instruct)接收「目标高亮视频」(红色叠加α=0.15、黄色描边)与结构化效果分析提示,通过可学习效果查询做跨模态推理,聚合目标身份与运动、诱发效果及其时序演化、期望的移除后状态、需保留的场景内容,投影成紧凑的 effect-aware context tokens,直接替换 DiT 交叉注意力里原有的文本条件;DiT 视频擦除器基于 Wan2.2-TI2V-5B(从 Kiwi-Edit 初始化)在通道维拼接源视频 latent 与下采样掩码。两个运动感知机制补最后一公里:时间维掩码并集防止 causal 3D VAE 的时间压缩把快速运动目标的短时位置丢掉,运动一致性损失匹配运动补偿后的潜变量时序残差来压闪烁。配套自建 EffectWorld:Unreal Engine 5 渲染,每个目标 20 条随机化序列、每场景 3 条时空对齐序列(source/target/mask),共 11,092 组有效三元组,加 ROSE 的 16,663 组共 27,711 训练样本,配三阶段渐进课程(基础擦除→提高组合/动态/分离样本比例→长尾物理与快速运动精修)。 实验效果:EffectWorld-Eval 上 5 项指标全线最优:PSNR 29.521(次优 ROSE 25.955,领先 3.57 dB)、SSIM 0.934、LPIPS 0.044(次优 0.111,降 60%)、MAE 6.839、FVD 69.184(次优 EffectErase 238.521,降 71%)。ROSE-Bench 上拿到最佳 LPIPS 0.054 与最佳 FVD 81.866——注意 ROSE 虽然 PSNR 30.468领先,但 FVD 高达 803.722,几乎是本文的 10 倍,说明它的像素分领先建立在视频级不连贯之上。EffectWorld-Wild(70 组无配对真值)的 VBench 指标里背景一致性 0.958 与动态程度 0.400 双项最优。GPT-5.4 作评委的四维打分(1–4)总分 3.389 领先 EffectErase 的 3.270,20 人人工评测总分 3.675 对 3.213,其中效果移除 3.900 对 3.000、背景保持 3.950 对 3.000;人工与 LLM 评测的总分 Pearson r=0.9837。消融显示运动一致性损失最关键:去掉后 PSNR掉 4.818、LPIPS 恶化 3.25 倍、FVD 恶化 4.26 倍。 批判点评:这篇的价值在于把「效果」从枚举类别变成了可推理的语义变量——ROSE 那套预定义五类副作用(阴影/光源/反射/镜面/半透明)在真实视频里根本不够用,而让 VLM 先看一遍再告诉 DiT「哪些像素是这个物体造成的」是很自然的解法,评测设计也难得地把 ROSE 的高 PSNR 低 FVD 矛盾摆出来,说明作者清楚像素指标会骗人。人工与 LLM 评测 r=0.9837 也为 LLM-as-a-Judge 在这个任务上提供了一次有说服力的校验。但几处要打折:训练数据 11,092 组全部来自 Unreal Engine 渲染,虽然规避了肖像权问题,合成到真实的域差距只靠 ROSE 那 16,663 组真数据和课程学习来弥合,EffectWorld-Wild 上的优势主要体现在无参考指标和主观分而非硬指标;评测集规模偏小(Eval 仅 33 对、Wild 70 组、ROSE-Bench 60 组),单个难例就能明显搅动均值;人工评测只有 20 名志愿者且分数密集落在 3.9这种接近满分的区间,区分度有限。作者自己列的失败案例也很实在:大面积遮挡加高纹理背景会补得过度平滑,复杂运动下甚至把本该保留的细杆结构误删——这两类恰好是电商与影视后期最常遇到的。 6. HelloWorld:按一下键角色回头打招呼 HelloWorld: Enabling Socially Interactive Characters in Video World Models | 东京大学·Alaya Lab | arXiv:2608.05070 关键词:视频世界模型,社交交互,自蒸馏,时序注意力掩码,东京大学 前序问题:视频世界模型这两年进步很快,但里面的角色始终是「背景板」——你只能看,不能和它们互动。用户按个键让屏幕里的角色转过来朝你挥手、点头、说句问候,这件事目前没有任何世界模型支持。难点有两层:一是要让交互看起来自然,二是要控制交互发生的时机,而不是角色在整段视频里随机做动作。 本文贡献:在 LTX-2.3 基础上做了一个能社交互动的视频世界模型:按一下 F 键,屏幕里的角色就会朝镜头做出回应。关键是不采集任何外部数据、不做人工标注,而是用自蒸馏——先用精心设计的 prompt 让冻结的基座模型自己生成「同时含社交交互和相机运动」的片段,再用 Pi3X 从这些自产片段里恢复首帧点云与逐帧相机轨迹,按轨迹把点云重投影渲染成 warp video作为历史条件。warp video 天然带空洞(遮挡区和视野外),正好只提供几何引导、缺失部分交给模型补全,训练时用 visible-token selection 丢掉无有效源观测的 token,并刻意把相机文本从损失条件里排除,确保相机跟随完全由 warp video 而非文本控制。时机控制则是一个完全免训练的技巧:推理时给 cross-attention 加时序掩码,让交互窗口之外的帧无法 attend 到交互文本token,于是角色只在按键窗口内响应观众、窗口外表现为环境行为,开销可忽略。同时配套 HelloWorldBench,用 120 张图扩成 400 个评测样本、覆盖 264 个角色实例与 101 种交互类型,并设计ActAcc/TimeAcc/GazeDev 三个指标分别回答「做的是不是指定动作、有没有在指定时刻发生、是不是朝着观众」。 实验效果:训练成本低到有点惊人:156 条自生成视频、2000 步、LoRA rank 32、单张 H200。时机控制是最大增益——TimeAcc 81.7%,而所有基线在 30.9 到 41.2 之间,多数贴近 33.3% 的随机猜测水平,相比最强基线 WorldPlay 的 41.2 提升 40.5 个百分点;消融显示仅加视频流掩码就把 TimeAcc从 36.7拉到 80.9,再加音频流掩码让语音落在窗口内的比例从 52.5% 升到 69.1%。相机可控性 82.9 为全表最优,比次优 SANA-WM 的 70.0 高 12.9、比基座 LTX-2.3 的 31.4 高 51.5,同时背景一致性 96.9 与美学分 5.27 也都是最高,说明自蒸馏没有损伤基座画质。自蒸馏数据的价值也被量化了:相比用真实视频(不含社交交互)训练,ActAcc 从 36.4 升到 41.4、视线偏差从 51.3 度改善到 40.2 度——因为无交互的真实视频只教会模型填warp video 的空洞,角色会做动作但不朝向观众。30 人用户研究覆盖 4 个对手×3 个问题共12 组,偏好率71.7% 到 91.2%,所有置信区间下界都高于 66%。开销为基座的 +20% 时间、+36% FLOPs,10 秒 1280×704 片段耗时 60.2 秒、每帧 0.26 秒。 批判点评:这篇的巧劲在于两处都绕开了「需要更多数据」这个惯性答案:交互能力靠让基座模型自己生成训练数据来激活(156 条视频、2000 步就够),时机控制干脆完全免训练、只加一个 cross-attention 掩码。TimeAcc 从接近随机的 36.7 跳到 80.9 这组数字尤其说明问题——大家一直以为「控制时机」要靠时序建模,实际上只是没人去屏蔽窗口外的文本注意力。三个指标拆成「做什么/何时做/是否朝向观众」也比笼统的偏好分更有诊断力。但最需要说清的是标题里那个「interactive」目前名不副实:论文明确承认尚不支持实时交互,世界生成由预先指定的相机轨迹与交互脚本驱动,也就是说你并不能真的按一下键就看到反应,60.2 秒才出10 秒视频,离交互式体验差着一个数量级,作者把自回归架构列为未来工作。ActAcc 41.4 还输给 LingBot-World 的 50.5,且绝对值只有四成——意味着六成情况下角色做的并不是你指定的那个动作,这个基础准确率撑不起产品化。自蒸馏也有天花板:能被激活的只是基座里本来就有的社交先验,基座不会的动作蒸馏不出来。评测的 VLM 裁判与真人研究都指向同一个模型家族的偏好,跨基座泛化性未验证。 7. WorldClaw:一句话生成可编辑开放世界 WorldClaw: Agentic 3D Open-World Generation at Scale | 腾讯混元 Hunyuan3D | arXiv:2608.05248 关键词:3D世界生成,Agentic流水线,程序化地形,Hunyuan3D,腾讯 前序问题:从一句开放文本生成能自由漫游的大规模 3D 世界,难点是三件事必须同时成立:全局空间连贯(山脉、河流、聚落的相对关系不能乱)、局部内容丰富(走近了要有细节而不是一块糊墙)、以及产出显式可编辑可复用的资产(下游要能改材质、换模型、接进引擎)。现有路线各缺一角:分块潜变量方法长程组织弱、区域过渡突兀且不暴露独立资产;单视图高保真方法相机一走远就露出离散高斯基元和畸变几何;城市导向方法偏重实例排布而缺大尺度地貌。 本文贡献:全agentic 的粗到细三阶段流水线。规划阶段两个 agent 分工:意图分析 agent 只抽取并归一化 prompt 里显式表达的约束、绝不擅自补内容,场景规划 agent 才按schema 补齐下游必需的缺失字段,输出区域、地形、物体三类结构化规格。全局地形阶段先由地形规划 agent(可调搜索工具、必要时生成概念图)产出布局、资产、材质与世界尺度等参数,再用 GPT-Image-2 生成语义布局图和资产原型图、经 Hunyuan3D 的图生3D 转成可复用原型;核心是区域感知高度场H(x)=Σ_r m̃_r(x)·[h_r+Σk w{r,k}N_{r,k}(x)+Σj α{r,j}G_{r,j}(x)],用区域软权重混合基准高程、多频噪声与山峰/沙丘/阶地/侵蚀四类地貌算子,同一套权重复用于材质分配;地形资产按区域亲和性与目标密度在布局掩码内采样,再用局部高程、坡度、法线过滤,减少悬浮与穿模。区域物体阶段三个可复用 skill:Region Composition 渲染已有地形并生成合成图作为 2D 布局先验,Object Generation 用文本引导 SAM3 分割(全图加重叠滑窗提召回)后 SAM3D 重建网格并做非对称容差的图像空间尺度校准,Object Placement 用双射线对应恢复 3D 放置、以底部体素与地形的接触率为终止条件联合搜索锚点深度与等比尺度。两处渲染驱动精修循环经 BlenderMCP 连回引擎,维护「诊断渲染图+状态报告」任务队列,修区域突变、纹理比例失配、悬浮穿模,并做物体-地形协同变形(修改严格限制在支撑区内以保全全局地貌)。 实验效果:在 4 张 H20 上用 Blender 5.1.1跑通,agent 底座为 Opus 4.8,基础模型套件为 GPT-Image-2 + SAM3 + SAM3D + Hunyuan3D,大物体 PBR 纹理 2048×2048、小物体 1024×1024。正文 4 个加附录 7 个共展示 11 个完整世界,主题跨热带海盗岛、河谷部落聚落、沙漠战场、雪山未来设施、中世纪村庄、日式小镇岛屿、火山巢穴、宝石矿场等,每个都给出全局视图、区域视图、漫游视图,并附实例/深度/法线三种渲染。与 SynCity、Marble、MajutsuCity、WorldGen、GPT-5.6 Sol 五个基线在同一「中世纪村庄」主题下做定性对比:SynCity 长程组织弱且不暴露可控资产,Marble 远移后远处几何不完整并露出离散高斯基元,MajutsuCity 保留可控资产但被规则城市布局强约束,WorldGen 输出显式带纹理网格但展示视图地形平坦均质(作者称其为下游可用性上最接近的基线),GPT-5.6 Sol 能搭出完整布局但地形用简单几何形体、呈 blockout 外观。本文同时给出显式全局地形与独立重建放置的物体网格,兼顾大尺度地貌、局部填充与实例级可编辑性。 批判点评:这篇最有参考价值的不是某个模型,而是它证明了一件事:3D 开放世界生成可以不做成一个端到端大模型,而是拆成「LLM 写程序化地形参数 + 图像模型出布局图 + 分割重建做实例 + 渲染 agent 反复自查」的解耦流水线,且产物天然是引擎可用的显式网格与可编辑实例——这比一坨不可编辑的高斯点云对游戏和影视工业实用得多。区域感知高度场把地貌做成可解析的加权叠加,也让「换个世界尺度重跑」成为改参数而非重训。但必须说清它的实证水准:全文没有任何定量指标,没有 FID、CLIP-Score、几何误差,没有消融,也没有用户研究,全部结论建立在作者挑选的定性图上,这个证据强度撑不起「at Scale」的标题——连场景到底多少平方公里、放了多少资产都没披露。作者自陈的三条局限相当致命:整条链强依赖 Opus 4.8、GPT-Image-2 这类闭源强模型,换开源 LLM 常常生成不可执行的地形程序、换开源图像模型出不了可用布局图;LLM 写 Blender 节点图容易在尺度估计和节点连接上出错,需要多轮渲染-检查-修复;逐物体生成加多轮 agentic 精修导致延迟和成本随物体数与迭代次数增长,简单场景下甚至不如整体式方法。 8. MASS:1024人同屏世界只算一次 MASS: Multiplayer World Models with Authoritative Shared State | Alaya Lab·北京大学·东京科学大学 | arXiv:2608.06257 关键词:多人世界模型,类型化状态,权威服务器,可扩展渲染,北大 前序问题:当前视频世界模型在多人场景里必然失效,因为它们把世界状态和依赖视角的视觉潜变量纠缠在一起:同一份共享内容要为每个观看视角独立编码一遍,算力冗余;各视角的循环历史各自漂移,导致跨视图矛盾(同一个位置一个玩家看到食物、另一个看到空地);最要命的是模拟成本被绑死在「有多少人在看」上,视角数一涨算力线性爆炸,根本无法扩展。 本文贡献:把多人在线游戏的权威服务器架构搬进学习式世界模型:世界只模拟一次,与观看人数无关。Game Schema 声明式定义实体种类、字段与实例数,状态是有序 typed record 集合并做规范化序列化(字段固定位置区间、类型标签互斥 token 区间、可选字段显式 present/absent、有界列表带长度与canonical padding、空间桶排序去重)。Logic Engine 是唯一推进共享状态的学习组件,仅 5.66M 参数的 decoder-only Transformer(宽 256、6 层、8 头),自注意力严格限制在单条 record 内部、record 之间无注意力,因此可自由批处理并支撑千实体世界;物体交互靠预测前从共享状态算出的邻域上下文窗口传入;schema 派生 mask 只约束输出位置的合法词表,移动、碰撞、生长、拾取、死亡、奖励全部是学出来的而非写死的规则。Rendering Engine 按需渲染:把相机局部投影成 16 通道张量(可见占据、语义角色、玩家身份、深度、相机几何),经几何感知残差 U-Net 输出 RGB,只读投影后的 typed state 与相机、不读 RGB 历史,因此相机可在rollout 中随意增删移动、分辨率材质光照可变而无需重训动力学。服务端每tick 开销 T_server=T_logic(N)+C·t_sync(S):学习式转移只跑一次,分发对接收方线性,渲染在客户端本地。网络卡顿时客户端用同一个 Logic Engine 从最新权威版本本地推进,新版本到达后直接替换 typed state,不需要单独的纠正网络或隐藏 RGB latent。 实验效果:matched 多人 Snake(48×48、最多 8 人)上 128 tick、2 路同步相机评测,7 项指标里 6 项领先:LPIPS 0.098(次优 B-UN 0.123、MultiWorld 0.277)、状态恢复 0.764(最强视频基线 B-PV 仅 0.128,约 5.9 倍)、实体计数 0.234、位置 0.355、事件 F1 0.552,而跨视图不一致率为 0.000——所有视图从同一份预测 typed state 解码,一致性是构造性保证,对照 MultiWorld 的 0.984 与 B-PV/B-SL 的 1.000。注意 B-UN 是绝佳反例:LPIPS 有竞争力0.123 但状态恢复归零、事件 F1 仅 0.007,证明像素级好看不等于世界状态可恢复。直接状态预测层面对比更悬殊:所有密集预测器(独立头 CNN、Joint U-Net、RSSM)一步语义准确率都超过 91%,但位置准确率没有一个超过 2.7%、且每个预测 tick 都结构矛盾(100%);typed 载体位置准确率 99.1%、矛盾率 0%,H=32 时位置仍有 90.2%。可扩展性实测 1,024 个玩家 record + 4,096 个食物桶 record 共 5,121 record/tick,推进 10,000 个循环 tick;单张 H100 上渲染请求从 1 个视图 189.6 ms 到 1,024 个视图 842.4 ms,仅 4.4 倍而视图数增加了 1024 倍,世界转移成本完全不变。客户端预测实验中oracle 联合输入下缺失 1–8 次服务器更新的视内一致性恒为 1.000、本地角色位移恒为 0 格,即约 400 ms 窗口内学习式转移不引入任何视内偏差。八个游戏的渲染重建PSNR 五个超过 32 dB(Frogger 40.24),SSIM 全部超过 0.97。 批判点评:这篇的洞察很值钱:多人世界模型真正的瓶颈不是画质而是「循环载体选错了」。密集预测器语义准确率 91% 却位置准确率不到 2.7%、100% 结构矛盾这组对照数据极具说服力——网格表示无法跨 tick 保持实体身份,同一格子在不同步必须编码不同实体,U-Net 没有任何显式追踪机制,所以看起来对但状态全错。把权威状态、状态复制、客户端呈现三者分离,让模拟负载与观众数脱钩,这个架构迁移几乎是把二十年的netcode 经验直接兑换成了世界模型的可扩展性,1024 视图仅 4.4 倍渲染开销的数字很硬。但要注意评测场域的局限:主实验是 48×48 网格的 Snake,附带 Breakout 与 Tile Merger,全部是 2D 离散网格游戏,作者也承认扩展到 3D 环境与更丰富实体交互属未来工作——真实的多人 3D 世界里typed schema 该怎么声明连续几何和物理接触,是完全没碰的难题。延迟上typed-token Transformer 需 45.55 ms,明显高于密集基线的 3–4 ms,虽然刚好卡在 20 Hz tick 预算内但余量很小。Tile Merger 这类随机网格游戏 full-state exact 全程为 0,SRSC 显示 Crate Pusher 的 Logic 分数在 H=100 后跌到 10–17 区间,说明长时程可靠性远未解决。还有一点:MultiWorld 用 5.60B 可训练参数被 5.66M 的MASS 击败,这个对比虽然亮眼,但两者的能力边界本就不同——MASS 需要一份人工声明的 schema,视频世界模型不需要。 9. VideoArgus:给每条输入现场出评分细则 VideoArgus: Agentic Rubric-Grounded Unified Evaluation for Video Generation and Editing | 罗切斯特大学 | arXiv:2608.05485 关键词:视频生成评测,动态评分细则,Agentic评估,VideoArgus-Bench,罗切斯特 前序问题:评测生成视频有三个老毛病:评测内容是固定的(一套 prompt 打天下,模型很容易过拟合到榜单)、覆盖面是残缺的(要么只测文生视频、要么只测编辑,五种设置没人统一)、给出的分数是不可追溯的(一个数字下来,你不知道它为什么扣分、也没有证据链)。结果是榜单排名和人类观感经常脱节,尤其文生视频这一档,源基准评测器与人工判断的实例内 Spearman 只有 0.162,图生视频那档甚至是 −0.060,等于负相关。 本文贡献:把「固定指标」换成「现场生成的评分细则」。对每条输入实例,先在完全不看任何模型输出的前提下(output-blind)生成一次 sample-specific rubric,然后冻结、复用于该输入的全部候选视频——这样既是样本自适应的,又保证了跨模型的公平。rubric 从统一的 22 个维度池实例化,每条准则包含具体要求、hard/soft 约束类型、三档重要性权重、0–10 整数评分规则、预期失败模式、可选的 hard cap,以及一份evidence plan(目标实体/事件、参考源、有序工具序列)。评估阶段由 evidence plan 驱动工具调用:vlm_qa 做通用语义问答,专用工具负责目标定位跟踪、参考引导裁剪、DINOv3 视觉相似度、OCR、深度与空间关系、时间闪烁检测、感知质量评估,plan-normalization 层会检查工具参数与依赖、把不可用操作映射为替代方案,专用工具失败时回退到 criterion-specific vlm_qa 并把回退决策记进报告。最终分 S=(1−α)B+α·min(B,κ),α=0.5,B 为重要性加权基础分、κ 为最严格 hard cap,且重要性、失败阈值、hard cap 对打分模型隐藏,只在聚合时生效。覆盖 T2V/TI2V/TS2V/TV2V/TSV2V 五种设置。 实验效果:VideoArgus-Bench 含 1,026 条输入实例(653 张图、416 条视频,素材来自 Pixabay 并经质量过滤),指令平均约 26 词,平均 11.9 条准则/实例(范围 6–17),全部 rubric 预生成、冻结并开源,评测了 55 个 model–task 对。在独立的 210 实例、1,260 视频(每输入 6 个模型输出、15 名标注者 0–10 打分)人类对齐集上,实例内 Spearman 与 Kendall 在全部五个任务上都超过源基准评测器:T2V 从 0.162 提到 0.496(+0.334),TI2V 从 −0.060 提到 0.605(+0.665),TS2V 0.524→0.631,TV2V 0.548→0.608,TSV2V 0.686→0.749。骨干鲁棒性上,固定评估 VLM 换 rubric 生成器(Claude Opus 4.8 / GPT 5.6 Sol / Gemini 3.1 Pro)平均排名一致性 0.909,固定 rubric 换评估 VLM(Qwen3.6-27B / Gemma4-31B)平均 0.931。生成 rubric 的准则数是人工标注的 2.33倍(11.68 对 4.98)而 hard 准则数相当(2.09 对 2.27),说明是覆盖更广而非一味更严。成本上 rubric 生成一次性平均 $0.231/case,评估全程本地推理约 0.033 H100 GPU 小时/视频、无按次API 费用。附带榜单里Seedance 2.0 五项任务全冠,可灵 Kling v3 Omni 在四项任务排第二,开源最优分别是 HunyuanVideo-1.5(T2V/TI2V)、OmniWeaving(TS2V)、Kiwi-Edit(TV2V)、Aurora(TSV2V)。 批判点评:这套设计击中了视频评测最尴尬的现实:固定 prompt 集正在被刷榜,而单一维度分数无法解释扣分原因。「output-blind 先出细则、冻结后复用」是很聪明的一步——它同时解决了样本自适应与跨模型公平这对矛盾,而把重要性权重和 hard cap 对打分模型隐藏也有效防止了 judge 顺着权重自我合理化。TI2V 上从负相关 −0.060 翻到 0.605 这个数字尤其说明现有基准的失效程度之深。但要清楚它换来了什么代价:整套流水线依赖闭源 Claude Opus 4.8 生成 rubric、Qwen3.6-27B 做评估,评测本身变成了一个需要 GPU 集群和 API 预算的系统工程,$0.231/case 加0.033 H100 小时/视频,规模化打分并不便宜,而「用大模型评大模型」的循环偏见也没有被真正消解。人类对齐集只有 210 实例且 TSV2V 一档仅 10 条,这一档 0.749 的领先统计意义有限。工具消融显示 Full 相对纯 VLM 在实例内相关性上 5/5 胜出,但 pooled Spearman 在 T2V、TV2V、TSV2V 三项上反而不如纯 VLM 或源基准,说明专用工具的收益并不一致。附带榜单虽然吸引眼球,却只能读作「按VideoArgus 口径」的排名。 10. LILAC:解码再编码token一位不改 LILAC: An Idempotent Neural Speech Codec | 首尔国立大学 | arXiv:2608.05727 关键词:神经语音编解码,幂等性,可逆变换,低码率,首尔国立大学 前序问题:神经音频编解码器已经是语音生成与编辑的标准 token 接口,但它们全都不幂等:把token 解码成音频、再重新编码回 token,token 会变。论文实测的十二个基线配置,单次 decode–re-encode 平均至少重写 15% 的 token,最差的 FocalCodec 重写 89.1%、DualCodec 80.2%。这在任何会发生「重编码解码输出」的管线里都是灾难——级联编辑、迭代生成、多轮处理都会让 token 流不断漂移,100 轮循环后 FocalCodec 与 Mimi 的 token 一致率已趋近于 0,dWER 从 0.07 涨到 1.34。 本文贡献:不靠训练、靠架构把幂等性证出来。设可逆分析变换 A 把输入分成保留坐标 z 与丢弃坐标 f,编码为 E(x)=q(Π_z A(x))、解码为 D(z_q)=A⁻¹(z_q, φ(z_q)),则对任意 z_q 与任意 fill 网络 φ 恒有 E(D(z_q))=z_q,与权重、收敛程度、重建质量完全无关——证明只需三步:可逆性保证投影后取回z_q,FSQ 由 clamp+round 组成故幂等,两者复合即得。工程上用两类可逆基本块:源自 Glow 的可逆 1×1 卷积(正交参数化,逆即转置核)与源自 NICE 的加性耦合块(逆只需减法,对应小波 lifting steps,名字由此而来),f/g 用 ConvNext1D 堆叠、按时间维奇偶索引切分、合并时按通道拼接实现「时间减半通道加倍」。整条路径无任何除法,避免浮点溢出,整体保体积;唯一例外是可逆 1×1 卷积强制全精度执行以保证 round-trip 精确。通道演进为 reshape 到 5 通道 → stem 缓解多相伪影 → 四次 squeeze-and-mix 到 80 通道 → 五次projection 逐步切掉丢弃坐标,最终 20 通道。推论很有意思:证明对 φ 无任何约束,因此可以构造随机解码器 φ(z_q,ω)在保持幂等的同时输出多样结果。 实验效果:24 kHz 全带宽、帧率 9.375 Hz、每通道 4 bit×20 通道 = 80 bits/frame,码率 0.75 kbit/s,总参数 58.5M(分析变换 43.1M 共享 + fill 网络 15.4M)。解码并重编码 LibriSpeech 与 LibriTTS-R 全部 7,457 个测试样本,每一个都重编码为完全相同的 token 流;100 轮循环token 一致率恒为 1.0000,dWER 恒为定值,说话人 EER 恒为 4.00%——而同期DAC 的 EER 从 0.00涨到 46.00、FocalCodec 从 3.00 涨到 41.00。质量上 UTMOS 在 LibriSpeech test-clean 达 4.141、LibriTTS-R 达 4.238,均高于真值音频的 4.072 与 4.194;sub-1 kbit/s 组内 PESQ 2.60、STOI 0.935/0.944、SI-SNR +2.2/+6.0 dB 三项全部第一,且是唯一未在评测集上训练的编解码器(训练用 HiFiTTS-2 并按 reader-ID 排除全部 146 个 LibriSpeech/LibriTTS 说话人)。消融很实在:仅加 anti-imaging stem 会恶化 LibriTTS-R(dWER 0.121→0.252),必须配合带宽衰减增广;解开编解码共享权重、加宽隐层、加深卷积堆叠都无有意义提升;改用连续潜变量(取消量化)每个指标都变差;40 通道×1 bit 的 BSQ 变体 UTMOS 略升但 dWER 崩到 0.46–0.48。 批判点评:这是一篇少见的「先证明、后调参」的 codec 论文:幂等性不是训出来的性质而是构造出来的定理,与权重无关这一点意味着它不会因为换数据、换训练轮次而失效,这种保证在工程上比多零点几个 UTMOS 值钱得多。作者的坦诚也值得记一笔——明确写了「It does not push the pareto frontier」,把单程下游迁移面板里 LILAC dWER 9.90% 在五个学习型 codec 中垫底的数据也照实登出来,MUSHRA 主观分 51.4 落后DualCodec 的 74.8 且相对最接近的 FocalCodec 领先 2.9 分并不显著(p=0.077),这些都没被藏进附录。局限同样明确:dWER 与 SCOREQ 处于中游,纯卷积却因大量小通道卷积导致 GPU 上 RTF 反而落后于其他 codec,「不更好也不更快,只是永不漂移」。最关键的一条作者自己点出来了——幂等性的下游收益(用其 token 训练的生成模型更稳定)目前仍是理论推断,没有任何训练好的下游模型来实证,也就是说这篇提供的是一个有严格保证的接口,但它到底能给TTS 或语音编辑带来多少实际增益,还是空的。另外比特分配消融显示只有真正提高码率才能无副作用地改善性能,说明 0.75 kbit/s 这档已经被榨干。 趋势观察 人物视频生成的战场全面转向「实时 + 长时+ 多主体」 — 阿里通义的 Wan-Animate-2 用教师强制预训练、Error Buffer 与 chunk-wise 反传的 Self-Forcing 蒸馏,把 14B 角色动画在 4 卡 H100 上推到 400×720 分辨率 24 FPS,长时程自回归无可观测误差累积;美团 Vorch-IR 用 8 秒窗口、2 秒重叠的时间重叠推理,让短片段训练的模型直接扩展到分钟级,且一套权重同时吃单人、双人与背景替换。两者的共同判断是:画质早已不是瓶颈,延迟与时长才是数字人、直播换装这类场景真正的门槛。 「把预处理模块删掉」正在成为一条明确的降本路线 — UniVVT 把视频试穿从掩码条件修补改写为语义条件生成,推理时不要掩码、不要姿态、不要变形场——显式几何预处理在 90 帧要 111.39 秒且近线性增长,它的隐式任务编码只要 2.92 秒,加速 17.7 到 38.1 倍,同时 ViViD-S 上五项指标拿下四项最优。Vorch-IR 同样宣称推理不需要空间对齐的参考图、不需要 mask 或 pose。共同逻辑是:掩码和姿态本质在告诉模型「改哪里」,而一个足够强的 MLLM看完视频和指令后本来就知道。 训练目标与推理策略,比换个更大的骨干更划算 — EG-FM 不改 backbone、不改数据、不改采样器,只把 flow matching 那个固定终点换成按每张图频谱能量自适应演化的热核滤波终点,HyperDiT-H 就用 220 epoch 达到 FID 1.51、优于基线 600 epoch 的 1.56,额外 FLOPs 最多 +0.026%、推理零开销。HelloWorld 更极端:时机控制完全免训练,只给cross-attention 加一个时序掩码,就把 TimeAcc 从接近随机的 36.7拉到 80.9。不是每个提升都需要重训一个大模型。 世界模型开始承认「循环载体选错了,画质再好也白搭」 — MASS 的对照数据最刺眼——密集预测器(CNN、U-Net、RSSM)一步语义准确率都超 91%,位置准确率却没一个过 2.7%,且每个 tick 都结构矛盾;换成类型化状态后位置 99.1%、跨视图不一致率降到 0.000,1024 个视图的渲染开销只有单视图的 4.4 倍。HelloWorld 则用 warp video 把相机控制从文本里剥离出来,相机可控性 82.9 对基座 31.4。WorldClaw 干脆放弃端到端大模型,用 agentic 流水线产出引擎可用的显式网格与可编辑实例。三者都在说:让状态显式、可评估、与下游对齐,比在像素上继续堆生成能力更有效。 评测与接口的可信度,正在被当作一等问题对待 — VideoArgus 对每条输入 output-blind 生成一次评分细则再冻结复用,把文生视频与人类判断的实例内Spearman 从 0.162 拉到 0.496、图生视频从负相关 −0.060 拉到 0.605——现有基准的失效程度比想象中深。LILAC 则从架构上证明编解码幂等:对任意权重恒有 E(D(z))=z,7457 个测试样本重编码 token 一位不差,100 轮循环说话人 EER 恒为 4.00%,而同期 DAC 从 0.00 涨到 46.00。一个修评测、一个修接口,指向同一件事:能不能被信任地接进管线,正在成为比榜单名次更硬的约束。 人工智能炼丹君 整理 | 2026-08-10 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
深度解读|Sand.ai MAGI-2|114B视频MoE把token切12份挑专家 MAGI-2 Preview 深度解读:114B 视频 MoE,把一个 token 切成 12 份去挑专家 模型:MAGI-2 Preview 机构:Sand.ai 发布时间:2026-08-03(权重上传);2026-08-05(技术博客与模型卡定稿) 资料:技术博客 | GitHub 推理代码 | HuggingFace 权重 协议:Apache 2.0,代码与权重都是,可商用 说明:本文分析对象是官方博客、模型卡、configs/ 配置和 inference/ 全部源码,没有下载 307GB 权重、也没有跑过 8 卡 H100。文中凡是"推算"字样的数字都是我按 config 与源码算出来的,不是官方公布值。 (图片来源:本文根据 configs/magi2_preview.json 与 inference/model/magi2_preview.py 推算绘制) 01 先说这次开源的到底是什么 一句话:Sand.ai 开了一个 114B 总参数、每 token 只激活约 6B 的统一音视频生成模型,权重和推理代码全是 Apache 2.0。 它能干的事其实很窄: 文生视频(T2V)和图生视频(I2V),只支持首帧图,不支持尾帧、不支持视频续写; 视频自带声音,对白、环境声、音效由同一个模型和画面一起生成,最后用 ffmpeg 混进 mp4; 时长只有 10 秒,这是模型当前唯一支持的长度,不是默认值而是硬约束; 交付分辨率 1080p,但真实生成的是 1088×1920,因为 VAE 下采样要求每个维度是 16 的倍数。 真正值得注意的不是"又一个视频模型",而是它在赛道里的位置:这是目前少数把百亿级 MoE 用在视频生成主干上、并且把权重和训练系统设计一起公开的工作。Sand.ai 自己也把话说得很克制——这是一次 intermediate research release,用来验证"架构、系统、数据能不能一起 scale 到 100B",不是用来宣称画质 SOTA。 所以读这篇东西的正确姿势是:把它当一份系统论文看,而不是当一份效果报告看。 02 亮点,以及必须先说清的短板 亮点: Ultra-Fine-Grained MoE:每个稀疏层有 12 头 × 256 专家 = 3072 个专家单元,每 token 激活 12 × 6 = 72 个。这个粒度在公开的视频模型里没有先例。 通信量与 Top-k 解耦:走 Head Parallel,跨节点通信量是 O(NH),和每头选几个专家无关;收发形状在路由之前就由头划分静态确定,buffer 可以预分配。 架构与系统同步公开:Hierarchical Head Parallel、MagiMoE 融合算子、MagiMuon 优化器三件套都写进了博客,配套 MagiAttention 与 MagiCompiler 也是开源的。 音画在同一序列里联合去噪:文本、视频、音频进同一个 Transformer,只用 self-attention,没有 cross-attention 塔。音频 latent 频率被刻意定成 25Hz,和 25fps 视频帧一对一。 Apache 2.0,代码 + 权重都是。这一点比 MiniMax H3 的自定义社区协议干净。 推理代码的工程质量相当高:Triton 融合算子、Ulysses 上下文并行、四个组件独立的 offload 策略、MAGI2_DETERMINISTIC=1 可开位级确定性,注释里连"为什么这里必须先 draw 音频噪声"这种 RNG 顺序坑都写了。 必须先说清的短板: 没有任何 scaling 曲线,没有任何消融,没有任何 benchmark 表。 博客通篇是架构与系统论述,"我们观察到跨镜头身份更一致"这类能力描述明确写着 remain qualitative observations。一份讲 scaling 的技术报告里没有 scaling 曲线,这是最大的空白。 两个 transformer 都没做步数蒸馏,官方原话是 denoising step count is where most of the wall-clock time goes。base 版就是 100 + 5 步硬跑,蒸馏版 coming soon。 第三方盲测里它排第 6:Artificial Analysis I2V Arena Elo 1105,落后 33B 稠密的 MiniMax H3 整整 85 分。114B 总参数没有直接换来更好的画面。 硬件门槛是 8 张 Hopper,权重 307GB,而且 preview 和 refiner 默认都得 roundtrip 换进换出,因为 1080p 时两个模型在 80GB 卡上放不下彼此的激活。 能力面很窄:没有音频编码器,所以不能做音频驱动、音色参考、配音替换;refiner 阶段音频 token 直接置零,也就是说声音的质量完全由 512×896 那一阶段决定。 默认 8 卡配置里 12 个路由头分不进 8 张卡,代码补齐到 16 个槽位,结果有 2 张卡在 MoE 层纯陪跑(详见第 07 节)。 03 赛道位置:开放权重这一档现在怎么排 2026 年中的音视频联合生成赛道,大致分三层。 闭源第一梯队:字节 Dreamina Seedance 2.0、Google Gemini Omni Flash。这一档拿 API 卖,Elo 在 1190 以上。 开放权重梯队:MiniMax H3(33B 稠密、自定义社区协议)、Wan 系列(阿里,Apache 2.0)、SkyReels、以及现在的 MAGI-2 Preview。 MAGI-2 Preview 的特别之处是它选了一条别人没选的路:别人加参数靠把稠密模型做大(H3 是 33B 稠密),或者做粗粒度 MoE(Wan 2.2 用高噪/低噪两专家切换,27B 总参 14B 激活);MAGI-2 直接把 FFN 拆成三千多个低维小专家。 (数据来源:Artificial Analysis Image-to-Video Arena,2026-08-07 快照。盲测投票 Elo,不是逐维度指标) 这张图是全文唯一的第三方数字,值得多看两眼:MAGI-2 Preview 以 1105 排第 6,在 Wan 2.7(1094)和 Veo 3.1(1085)之上,但被同为开放权重的 MiniMax H3(1190)拉开 85 分。 需要给它留的余地也有两条:一是 base 版没蒸馏、100 步硬跑,Arena 用的是哪个配置无从核实;二是 Elo 反映的是"人类更喜欢哪个",而 MAGI-2 的卖点本来就不在这里。 04 从 MAGI-1 到 MAGI-2:为什么把自回归分块扔了 MAGI-1 是 24B 稠密模型,核心卖点是按 24 帧一个 chunk 自回归去噪,噪声水平随时间单调递增,最多 4 个 chunk 并发,因此支持流式生成、视频续写,而且峰值显存与视频总长无关。 MAGI-2 把这套东西整个放弃了。博客给的理由很直白:自回归分块引入额外的时序依赖和更复杂的生成调度,再叠加统一音视频建模和 100B 级分布式训练,系统变量会爆炸。 这个取舍的代价是实打实的: MAGI-1 MAGI-2 Preview 生成方式 分块自回归去噪 整段一次性去噪 时长 可延长(4M token 上下文) 固定 10 秒 流式 / 续写 支持 不支持 峰值成本 与总长无关 与总长成正比 音频 无 联合生成 所以 MAGI-2 不是 MAGI-1 的功能超集。如果你在用 MAGI-1 做长视频续写,MAGI-2 Preview 替代不了它,Sand.ai 也还在维护 MAGI-1.1-24B。 MAGI-2 保留的是另一篇工作的建模接口——《Speed by Simplicity》里 MagiHuman 的单流架构:文本、视频、音频拼成一条 token 序列,只用 self-attention。理由也讲得通:文本、口型、肢体动作、环境声、音乐、镜头节奏本来就是同一个事件的不同侧面,塞进一条序列可以在整个主干里持续交换信息,而不是只在几个预定义接口上握手。 05 架构核心:路由的单位从"整个 token"变成了"12 个子空间" (这段是全文最技术的一节,不感兴趣可以直接跳到 06 看结论。) 常规 MoE 是这样:路由器看整个 token 的隐藏状态,选出 Top-k 个专家,然后把完整的 H 维表示发到持有这些专家的设备上。每层通信量约为 N·k·H——选的专家越多,通信越贵。 更麻烦的不是量,而是形状不确定:发到哪些设备、每个 rank 收多少 token、收包 buffer 多大,全部由当前 batch 的路由结果决定。于是你会同时吃到三种痛:慢 rank 拖住全局吞吐(straggler)、各 rank 显存峰值不齐导致局部 OOM、以及为了对齐动态 token 数而产生的 GPU-CPU 同步。 视频 latent 的序列比文本长得多,而且一条统一音视频序列里混着不同模态、不同噪声水平、不同空间位置、不同运动状态的 token——异质性更强,动态路由带来的抖动更容易变成一阶系统开销。 Multi-Head LatentMoE 的做法是换掉路由单位。 (图片来源:Sand.ai 技术博客 §2.1 配图) 先用一个投影 W_in 把 3072 维隐藏状态映射成"路由表示",再切成 12 个 256 维子空间。每个子空间有自己独立的路由器和独立的专家池,各自从 256 个专家里选 6 个,算完再拼回去、过 W_out 映射回 3072 维。 关键收益在通信:既然要发的是"某几个头的全部子 token",那么通信量是 N·M·H_head = N·H,和每头选几个专家无关,而且跨设备收发形状由头划分静态决定,可以提前分配 buffer。路由依然是数据相关的,但这份不规则性被关在了每个 head owner 内部,不再决定跨设备的通信形状。 代进 MAGI-2 的实际数字,差距很直观: 常规 MoE 若按整 token 路由、Top-6,每层每 token 要发 6 × 3072 = 18,432 个数值; Head Parallel 每层每 token 只发 12 × 256 = 3,072 个数值,正好是 1/6。 省下的这个 6 倍恰好就是 Top-k,所以这套方法越是往"超稀疏、多专家、小专家"的方向走,收益越大——而 Ultra-Fine-Grained MoE 正是这个方向的极端。反过来它也有上限:Head Parallel 的并行度被头数卡住,12 个头就意味着这一维最多切 12 份。 有两件事这里需要讲清楚,博客说得比较含蓄: 第一,这不是 Sand.ai 原创。 多头路由的思路来自微软亚研的 Multi-Head Mixture-of-Experts(那一版里不同头还共享路由器和专家池),"每个头独立路由器 + 独立专家集 + Head Parallel"来自亚利桑那州立大学 kerner-lab 的 Multi-Head LatentMoE and Head Parallel。后者在 4B 语言模型上报的数字是:k=4 时通信量降到 EP 的 25%,训练最快 1.61× 加速。Sand.ai 的贡献是把一个 4B 规模验证过的学术方法,扛到 114B 的视频模型上——这个工程量本身很值钱,但署名要说清楚。 第二,那 3072 个"专家"不是 3072 个宽 FFN。 每个专家单元只在一个 256 维子空间上工作,结构是 256 → 1280 → 256 的 SwiGLU。所以 MAGI-2 加的不是一堆必须整体调用的大 FFN,而是一堆可以被独立挑选、自由重组的低维变换。同一个 token 的不同表示子空间可以形成完全不同的专家组合——这是它和常规 MoE 最本质的差别。 官方给的完整配置: 组件 MAGI-2 Preview 配置 主干层数 40 层 稀疏核心 中间 36 层(第 2–37 层)用 Multi-Head MoE,首尾 4 层保持稠密 模型宽度 3072 路由表示 12 头 × 256 维 专家池 每头 256 个专家 激活专家 每头 Top-6 专家 FFN 256 → 1280 → 256,融合 SwiGLU7 配置文件里还有几个博客没提的参数:路由打分用 sigmoid(不是 softmax),Top-6 概率归一化后再乘 route_scale = 4.9,路由分数在 FP32 下算、专家权重和主计算走 BF16。 06 把 114B 算给你看 博客说 114B 总参、6B 激活,但没给拆解。用 config 里的数字可以自己算,而且算得相当准。 单个稀疏层的路由专家池:12 头 × 256 专家 ×(W_gate 256×1280 + W_up 256×1280 + W_down 1280×256)= 12 × 256 × 983,040 ≈ 3.02B。乘 36 层 = 108.7B。 也就是说,114B 里有 95% 是那 110,592 个(36×12×256)小专家单元,其余全部加起来不到 6B: 部分 总参数 每 token 激活 路由专家池(36 层 × 12 头 × 256) 108.72B 2.55B(每层 72 个单元) 模态专属专家 + 共享专家(36 层) 1.70B 0.85B 注意力 QKVO(40 层,边界层 ×3 模态) 1.81B 1.51B 边界稠密层 FFN(第 0/1/38/39 层) 0.91B 0.30B split / merge 投影(36 层) 0.68B 0.68B 合计(推算) ≈113.8B ≈5.9B 两个官方数字都对上了,说明这个拆法没跑偏。但拆完会看到一件博客没强调的事: "每 token 激活 6B"里,只有 43% 来自路由专家,注意力占了 26%,剩下 31% 是恒定激活的稠密件。 稀疏化只作用在 FFN,注意力是全量参与的。而视频生成的瓶颈恰恰在注意力——预览阶段五万多个 token 的全注意力,压根不吃 MoE 的红利。 博客里其实也承认了这点,只是一句话带过:MoE does not remove attention cost, and the number of activated parameters is not equivalent to end-to-end FLOPs。看完这张拆解表,你会明白这句话的分量。 07 系统三件套:让三千个小专家真的跑得动 (这段偏基础设施,做应用的可以跳。) Multi-Head LatentMoE 只定义了路由架构,扛到 114B 要同时解决三个问题。 Hierarchical Head Parallel——把两级网络分开用。 单张 GPU 装不下一个头的完整专家库,而训练集群有两档带宽:节点内 NVLink,跨节点 InfiniBand。MAGI-2 把两件事分别映射到两档网络上。 (图片来源:Sand.ai 技术博客 Figure 2) 跨节点走 InfiniBand,只交换固定形状的头切片——[N, M, H_head] 按头维度分发,收发量由头划分静态推出,和 Top-k 产生的动态 token 拷贝无关。节点内走 NVLink,用 ZeRO/FSDP 式全分片存专家权重、梯度和优化器状态,当前层的参数按需 materialize、算完立刻 reshard。 一句话概括:InfiniBand 只管规整的激活交换,NVLink 管专家状态的高带宽聚合与重分片,负责某个头的 GPU 不需要常驻这个头的整个专家库。 MagiMoE——从路由到输出合并的整条路径都融合。 标准 MoE runtime 会按路由结果重排 token,然后用 Grouped GEMM 跑不同大小的专家矩阵。这套在常规 MoE 上没问题,但 MAGI-2 每个稀疏层有 3072 个窄专家单元:每个单元收到的 token 更少,GEMM 形状更小更不规则,于是排序、kernel launch、中间张量读写反而变成主要开销——足以把稀疏计算省下的算力全吃回去。 MagiMoE 的做法是把 融合路由与 Top-K → 紧凑的按专家 token 布局 → 融合 grouped 专家 FFN → 按路由权重合并输出 整条链一起优化,并把 up、gate 投影和 SwiGLU7 融在一起以减少中间结果落地和显存流量。负载均衡用 DeepSeek 那套 auxiliary-loss-free 专家偏置,不往主目标里塞额外的均衡损失;每个路由头独立应用,专家负载统计放在单独的 CUDA stream 上异步聚合,避免干扰主计算流。 推理仓库里能直接看到这条路径的落地:inference/flash_mh_moe/ 下的 route.py 和 Triton kernel mh_moe_fwd.py。 MagiMuon——让优化器认识 head × expert 结构。 稠密 Transformer 里一个权重就是一个大矩阵;MAGI-2 的专家权重天然是"按 head × expert 索引的一大批小矩阵"。MagiMuon 保留这个结构:路由门按头分组成矩阵批,专家的 up/gate/down 投影把 head 和 expert 展平进 batch 维,Muon 正交化对每个矩阵独立做,矩阵批跨 rank 分布以均衡优化器计算——而不是把所有头和专家拼成一个人造的大矩阵。 不是所有参数都用同一套更新规则:adapter、mHC、attention sink、门控相关参数走 Adam 风格,主矩阵参数走 MagiMuon。 博客还专门提了一句同期工作 Kimi K3 的 Per-Head Muon:那个是沿注意力头维度切 Q/K/V 动量矩阵,和 MagiMuon 针对的结构不同,但体现的是同一个设计原则——模型有显式的 head 结构,优化器就该用上这个结构。 顺手说一个发布配置里的小尴尬:12 个头分不进 8 张卡。 上面那句"并行度被头数卡住"在默认推理配置里就已经咬人了。configs/magi2_preview.json 写的是 ep_size = 8,而路由头是 12 个,12 % 8 ≠ 0。CoreMultiHeadMoE.__init__ 的处理方式是补齐到 8 的倍数: self.padded_num_heads = math.ceil(self.num_heads / self.ep_size) * self.ep_size # 16 self.ep_pad_heads = self.padded_num_heads - self.num_heads # 4 my_head_start = ep_rank * (self.padded_num_heads // self.ep_size) # ep_rank * 2 self.has_real_moe_heads = my_head_start < self.num_heads # rank 6/7 → False 12 头被补成 16 个槽位,每张卡分 2 个。算下来 rank 0–5 拿到真实的头 0–11,rank 6 和 rank 7 的 has_real_moe_heads 是 False——它们持有全零的 dummy 权重,照样参与 all-to-all,但输出直接丢掉,_forward_impl 里走的是 out = torch.zeros_like(x_heads)。 也就是说,官方 8 卡默认配置下,MoE 层的专家计算只有 6 张卡在干活,另外 2 张纯陪跑(注意力那部分它们还是照常参与,因为走的是 Ulysses 上下文并行)。要让 12 整除,得用 4 卡或 12 卡的 EP,但整个 pipeline 又硬绑在 8 卡上。这不影响正确性,是官方为了兼容才写的 pad 分支,但对着"高效 scaling"的标题看,这个 25% 的槽位浪费还是有点扎眼。 08 代码里有博客没写的东西 这是我读源码收获最大的一节。有三样东西在 configs/magi2_preview.json 和 magi2_preview.py 里实现得很完整,博客里一个字都没提。 一、mHC:DeepSeek 的流形约束超连接,MAGI-2 全层都在用。 配置里有这么一段: "mhc_config": { "enable": true, "num_stream": 4, "alpha_init": 0.01 } MHCHandler 的实现里是 num_sk_iters=20 的 Sinkhorn-Knopp 迭代,还配了专门的 Triton 算子 magi2::mhc_sinkhorn_knopp_affine_fwd。这对应的是 mHC: Manifold-Constrained Hyper-Connections(DeepSeek,ICML 2026 Spotlight):Hyper-Connections 把残差流从单股拓宽成多股、连接方式可学,效果有提升但破坏了恒等映射性质,大规模训练会信号发散;mHC 用 Sinkhorn-Knopp 把可学的残差混合矩阵投影到双随机矩阵构成的 Birkhoff 多胞体上,让信号传播变成特征的凸组合,从而在保留多股表达力的同时恢复范数保持性。 MAGI-2 把残差流拓宽成 4 股,每层在 attention 前后、MLP 前后各挂一组 mHC 参数。一篇讲"如何稳定地把模型 scale 上去"的报告,把训练稳定性的关键组件整个漏掉了,这个遗漏挺可惜的。 二、每个稀疏层还有两条恒定激活的稠密通路。 博客把稀疏层描述成"路由 + 专家",但 MultiHeadMoELayer.forward 实际是这样: moe_out = self.merge_linear(self.moe_mlp(self.split_linear(norm_output))) return moe_out + self._shared_expert_forward(norm_output, modality_dispatcher) 那个 _shared_expert_forward 里有两个 FFN:一个是所有 token 共用的 shared expert(3072 → 1280 → 3072),另一个是 modality-specific shared expert——视频、音频、文本各有一份独立权重,按 token 的模态选用。加上按模态分组的 MultiModalityRMSNorm,等于每层都留了一条"不经过路由的模态专属通路"。 这解释了一个疑问:既然音频只有 250 个 token、文本只有几百个,混在五万多视频 token 里做 Top-k 路由,凭什么保证音频不被视频专家的分布淹没?答案是——它不完全靠路由,模态差异有一部分是硬编码进权重的。这个设计比博客里"三个模态进同一个主干"的说法要务实得多。 三、注意力侧的两个小改动。 attn_sinks 开启,每层 1 个 sink token;attn_gating 开启。前者是 attention sink 那套(给每个头一个可学的"垃圾桶"logit,缓解 softmax 必须把注意力分配出去导致的伪高激活),后者给注意力输出加了门控。这两个都是 2025-2026 年 LLM 侧被验证有效的稳定性 trick,被搬到了视频 DiT 上。 顺带一个细节:num_query_groups = 24,而 num_heads_q = 3072/128 = 24。两者相等,说明预览阶段没用 GQA,是标准的多头注意力。 首尾 4 层的 QKVO 还是按 3 个模态各存一份。 09 数据方法论:博客最有想法的一节 抛开架构,博客里我觉得最值得抄进笔记本的是"数据过滤陷阱"这个提法。 早期视频生成模型大多在 7B 左右。小模型表达复杂分布的能力有限,而人对视觉错误又极其敏感,于是社区自然形成了一套以过滤为中心的数据策略:保留主体清晰、运动简单、镜头稳定的视频,把模型学不动的样本删掉。 对小模型有效,但会锁死后续 scaling: 当训练数据被持续简化以适配当前模型时,数据本身就成了更强模型的能力上限。 MAGI-2 的转向是从"过滤为中心"改成"高吞吐生产 + 精确标注"。必要的数据治理(安全、合规、隐私、严重损坏、去重)保留,但"当前模型是否容易生成"不再是准入标准。复杂运动、多人交互、镜头切换、长尾主体、字幕、屏幕文字、复杂音频关系——尽可能都留下来。 减少过滤只是第一步。一段复杂视频如果只配一句泛泛的 caption,里面的身份、动作、镜头和音频关系仍然无法变成有效监督。所以新 pipeline 把主体与场景、动作与交互、镜头与时序结构、对白与歌曲、环境声与音乐、屏幕文字与字幕全部纳入可扩展的多模态标注。 这也给"数据质量"换了个定义:先保留有用的复杂度,再把这份复杂度准确描述出来。在这个定义下,标注不再是过滤之后的附加步骤,而是数据 scaling 的核心基础设施。 博客声称的"涌现"是两条:多镜头数据留下后,人物身份跨镜头更容易保持一致;字幕数据留下后,能看到对白/歌曲与对应字幕特效同时出现的样本。但作者自己加了限定——these remain qualitative observations and require more systematic controlled experiments。这个诚实值得肯定,但也意味着这两条目前只是 cherry-picked 样例,不能当结论用。 10 提示词模板反推训练 caption:全文最硬的旁证 上面那套数据说法有多少是真的?推理仓库里有一份间接但很强的证据:prompt enhancement 的模板和 JSON schema。 官方明确说模型训练用的 caption 又长又结构化(long and structured),手写短 prompt 会浪费模型能力,所以配了 PE 步骤:拿一个指令模型按模板把用户 prompt 改写成结构化 JSON caption,再喂给 pipeline。那么这份 schema 的形状,就近似等于训练标注的形状。 T2V 模板(prompts/t2v.md,1543 行)要求输出两层结构: global_layer(整段不变的部分):美学(风格/对比/饱和度/配色/视效/氛围)、音频基线(环境声 + 对白语言与说话人标签)、静态物体列表(形状颜色/材质/相对大小/位置/朝向)、光照基线(条件/方向/阴影/光源一致性)、静态活体主体(性别/族裔/年龄段/面部特征/服装/外观细节)、镜头风格(整体风格/景深/焦段)。 dynamic_layer(按时间切段):每个 timeline_segment 里带镜头增量(对焦/机位/构图/运镜类型方向强度)、光照增量、物体动态状态、活体主体的动作(主要动作/身体姿态/运动细节/交互/面部表情)、屏幕文字渲染(文字/时间戳/位置/字号/颜色/字体)、因果事件(触发/结果/物理)、音频(对白逐句带 speaker 与 delivery、环境声变化、特殊音效带 visual_sync 说明与画面如何对齐)。 I2V 模板则是镜头制的:reference_bank + shot_timeline(每个镜头带时间区间、镜头 caption、镜头光照构图、运动与物理逻辑、引用的参考对象、关联的音频事件)+ audio_event_timeline + visible_text + generation_requirements。 这份 schema 把博客的说法验证得很扎实: causal_events 里专门有 physics 字段 → 对应"物理合理性"的诉求; text_render 和 visible_text 独立成项 → 字幕和屏幕文字确实没被过滤掉,而且是逐条带时间戳标注的; I2V 的 shot_timeline 允许多个镜头 → 多镜头数据确实保留,跨镜头身份一致靠 reference_bank 的 identifier 串起来; 音频事件带 visual_sync 和 synchronization_note → 音画同步是显式标注出来的,不是指望模型自己对齐。 顺着这个思路还能看出音画同步的另一半是架构层面做的:配置里 audio_latent_fps = 25.0,视频也是 25fps,一个视频帧配一个音频 latent token。代价是 Stable Audio Open 1.0 的 VAE 原生 latent 频率是 44100/2048 ≈ 21.53Hz,21.53 × 512/441 = 25.0,所以解码之后必须做一次 441/512 的 sinc 重采样把时长掰回来。为了 token 级 1:1 对齐,宁愿在解码端补一次重采样——这个取舍很能说明他们对音画同步的重视程度。 11 两阶段推理:100 步预览 + 5 步精修 生成分两段,magi2_preview 在低分辨率去噪,magi2_refiner 把结果拉到 1080p。 (图片来源:本文根据两份 config 与 inference/pipeline/inference_engine.py 推算绘制) 预览阶段跑 512×896。按 vae_stride = (8,16,16) 和 10 秒推算,latent 是 32 × 32 × 56 = 57,344 个视频 token,加 250 个音频 token 和文本 token。100 步 UniPC,每步 batch=2 同时算条件与无条件分支(等价 200 次单样本前向),CFG 强度视频 5.0、音频 7.0,负面提示词是一段写死的长串——视觉、音质、播音腔三段拼起来,光"AI voice / synthetic / TTS / 念稿感"就列了十几个词。上下文并行用 Ulysses,cp_size = 8,ep_size = 8。 精修阶段换成一个约 6.7B 的稠密 DiT(30 层、宽 4096、num_query_groups = 8 走 GQA),做的事比"超分"多: 把预览 latent 三线性插值到 63 × 68 × 120——时间维 32 → 63,等于顺手做了 2× 时间插帧,最终输出 25fps; 按 σ[220] 部分加噪,latent × σ + noise × √(1-σ²),是 SDEdit 那个套路; 5 步 UniPC 重新去噪,CFG 降到 2.0。 这一阶段的视频 token 是 63 × 68 × 120 = 514,080 个,比预览阶段多 9 倍。50 万 token 显然不能全注意力,所以 30 层全部走滑窗:8×4×4 分块、块半径 2,也就是每个查询块看周围 5×5×5 的块邻域。 有两个数字对不上直觉,值得单独拎出来: 算力分配极不均衡:预览阶段用 5.7 万 token 跑 200 次 114B 前向,精修阶段用 51 万 token 只跑 10 次 6.7B 前向。绝大部分 wall-clock 都花在预览阶段,官方也承认瓶颈就是没蒸馏的步数。 refiner 完全不管声音:magi2_refiner_audio_noise_scale = -1.0,代码注释写得很直接——the refiner is asked to improve the video and nothing else。音频 token 直接置零,最终音质完全由 512×896 那一阶段决定。 解码用的是蒸馏过的 turbo_vae(TurboV3-Wan22-TinyShallow),时间滑窗,每个视频只在一个 rank 上跑。视频 VAE 本身来自 Wan2.2-TI2V-5B,48 通道;文本编码器是 Qwen3.5-27B,56GB,输出 5120 维。 12 评测:只有一个第三方数字,官方一个都没给 这一节短,因为实在没什么可写。 官方材料里没有任何量化评测。 没有 VBench,没有内部人评,没有和 Wan / Veo / Kling 的对比表,甚至没有 loss 曲线。博客里两处"能力涌现"的描述都标注为 qualitative observations。 唯一可查的第三方数字是上面那张图:Artificial Analysis Image-to-Video Arena,Elo 1105,95% 置信区间 ±9,5650 张盲测投票,排第 6,API 价格栏写着 Coming soon。 所以现在能下的判断只有: 画面质量落在"开放权重里可用、但不是最好"这一档,被 MiniMax H3 明显拉开; 作为架构与系统的研究物料,它的价值和 Elo 排名基本无关; 想知道这套 Ultra-Fine-Grained MoE 到底值不值,得等 Sand.ai 补 scaling 曲线和受控消融,或者等社区自己做。 一份标题叫 Scaling Video Generation Models Efficiently 的报告,没有 scaling 曲线——这句吐槽我在第 02 节说过一次,这里还得再说一次。 13 本地跑起来要什么,以及你大概不该跑 硬件与环境: NVIDIA Hopper × 8(H100/H800 这一档)。发布配置把 cp_size 和 ep_size 都写成 8,想换卡数得自己改 config 并承担形状对不上的风险; Python 3.12 + 较新 CUDA toolkit; ffmpeg 必须在 PATH 上,否则视频照样出,但是静音的; 还需要 MagiAttention 和 MagiCompiler,pin 的版本记在 Dockerfile 的 build args 里。 权重 307GB。按 HuggingFace API 返回的文件大小统计,89 个文件的构成是:preview 228.1GB(56 个 safetensors 分片)、text_encoder 55.6GB、refiner 13.5GB、stable-audio-open-1.0 4.9GB、vae 2.8GB、turbo_vae 1.9GB。 最省事的路是 Docker: docker pull sandai/magi-2-preview:latest docker run --gpus all -it -v /path/to/ckpt:/workspace/ckpt sandai/magi-2-preview:latest 顺手提一句官方的好习惯:镜像有 per-commit tag,报告结果时应该写 sandai/magi-2-preview:<commit> 而不是 latest,镜像里 /etc/magi2-build-info 也记着构建来源。 下权重和跑 demo: hf download sand-ai/MAGI-2-preview --local-dir ckpt bash scripts/run_demo.sh 单条生成直接调 entry point: torchrun --nproc_per_node=8 inference/pipeline/entry.py \ --prompt "a red fox in snow" --output output/ 显存策略要留意:MAGI2_TEXT_ENC_OFFLOAD_MODE、MAGI2_PREVIEW_OFFLOAD_MODE、MAGI2_REFINER_OFFLOAD_MODE、MAGI2_VAE_OFFLOAD_MODE 四个环境变量分别控制四个大组件在阶段之间放哪,取值 cpu / gpu / roundtrip。preview 和 refiner 默认都是 roundtrip——1080p 时这两个模型在 80GB 卡上放不下彼此的激活,只能进出倒腾。这也意味着每次生成都要吃一轮 CPU↔GPU 搬运的时间。 我的建议: 做视频生成研究的:值得下,但重点看的应该是 inference/flash_mh_moe/、MultiHeadMoELayer 和两份 config,而不是生成效果。这是目前唯一能读到的百亿级视频 MoE 实现。 做业务落地的:现在不要上。10 秒固定时长、100 步未蒸馏、8 卡 Hopper 起步、Elo 落后同档开放权重模型,这四条里任意一条都够劝退。等蒸馏版和 API。 想学 MoE 工程的:这份代码质量很高,Triton 融合算子、静态形状通信、offload 编排、确定性开关都是能直接抄的范式,而且 Apache 2.0。 14 横向对比 模型 参数量 架构 音频 时长 分辨率 硬件 开放程度 I2V Arena Elo MAGI-2 Preview 114B 总 / 6B 激活 单流 Multi-Head MoE + 稠密 refiner 联合生成,含对白/环境声 固定 10s 1088×1920 Hopper × 8 权重 + 代码 Apache 2.0 1105(第 6) MiniMax H3 33B 稠密 单流 Omni Transformer 联合生成,32kHz 立体声 4–15s 768p 开放 / 2K 需闭源链路 — 权重开放,自定义社区协议 1190(第 3) MAGI-1 / 1.1 24B 稠密 分块自回归去噪 无 可延长,支持续写 720p H100 × 8(4.5B 版单卡 4090) Apache 2.0 — Wan 2.7 — DiT(2.2 起用高噪/低噪双专家 MoE) 部分版本支持 5s 起 720p/1080p 消费级可跑小版本 Apache 2.0 1094(第 7) Dreamina Seedance 2.0 未公开 未公开 支持 — 720p 云端 闭源,$9.07/min 1198(第 1) Veo 3.1 未公开 未公开 支持 — — 云端 闭源,$24.00/min 1085(第 10) (Elo 与价格取自 Artificial Analysis I2V Arena 2026-08-07 快照;"—"表示官方未公布或该榜未收录。) 这张表里最扎人的一行对比是前两行:114B 总参对 33B 稠密,输了 85 分 Elo。 这不能说明 Ultra-Fine-Grained MoE 路线错,因为 MAGI-2 明说自己是 intermediate release、没蒸馏、没调够;但它确实说明总参数量在这个赛道不是可以直接换成画质的硬通货。 15 总结感受 先说我最欣赏的地方:这是一份诚实的技术报告。 Sand.ai 没把 MAGI-2 Preview 包装成"新 SOTA",从标题到结论都在说这是路径验证。博客最后那句话我觉得写得相当好—— 模型架构决定容量如何组织,数据决定这份容量能学到什么,系统决定这份容量能否被可靠地训练和部署。 三者必须一起 scale,缺一个都不行。这个框架比"我们把模型做大了"要清晰得多。 然后说我觉得可惜的地方,主要是三条: 第一,最该有的东西没有。 一份讲 scaling 的报告,没有 scaling 曲线、没有受控消融、没有能力边界分析。作者把这三样列进了 next stage 的优先事项,但"下一步会做"和"这次做了"对读者的价值差得很远。现在社区能验证的只有"这套东西跑得起来",验证不了"这套东西比稠密/常规 MoE 更好"。 第二,代码比博客诚实。 mHC、共享专家、模态专属专家、attention sink——这些真正影响训练稳定性和多模态平衡的设计,配置和源码里实现得完完整整,博客里一个字没提。反过来,博客花很大篇幅讲的 Head Parallel 通信优势,其实主要来自一篇 ASU 的 4B 规模工作。该署名的没说清,该自夸的没说出来,这个信息分布挺奇怪的。 第三,能力面收得太紧了。 固定 10 秒、只支持首帧、没有音频编码器、refiner 不管声音、不支持续写——比 MAGI-1 少了流式和长视频,比 MiniMax H3 少了尾帧、音色参考、动作参考。可以理解(要控制系统变量),但这也意味着它现在只能是研究物料,不是生产工具。 最后回到那个真问题:把 token 切成 12 份、每份从 256 个小专家里挑 6 个,这个方向对吗? 我的看法是:方向值得追,但这次没被证明。 值得追的理由是那张参数拆解图——它让人看清了一个反直觉的事实:114B 里 95% 的参数是专家池,可"每 token 激活 6B"里却有 57% 是注意力和恒定稠密件。MoE 把 FFN 的容量-算力解耦做到了极致,但视频生成真正贵的是长序列注意力,那部分一点都没省。 所以在视频上继续堆专家池,边际收益到哪一层会掉下来,这是个必须靠实验回答的问题,而这次没答。 如果 Sand.ai 下一版能补上"同算力预算下,Ultra-Fine-Grained MoE 对稠密、对常规 MoE 的对比曲线",这套东西的分量会完全不同。在那之前,MAGI-2 Preview 最大的价值是:它让一个百亿级视频 MoE 的架构、路由行为和推理特性,第一次可以被外面的人直接读、直接跑、直接质疑。 就一次开源来说,这已经不算小。 本文只依据公开博客、模型卡、配置文件与推理源码分析,未下载权重、未实际运行推理。文中"推算"的参数量与 token 数为作者根据 config 与源码计算所得,可能与官方口径存在差异,欢迎指正。 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-07|Meta实测视觉懒惰生成数据只留5%反而更强 今日 AIGC 论文速览 今日共 10 篇 · 统一多模态预训练与Tokenizer 2 篇 · 统一音视频生成 3 篇 · 生成后训练与奖励对齐 3 篇 · 自回归与长视频生成 2 篇 重点论文标题列表 MM-Pretraining Physics(Meta FAIR·Reality Labs·牛津大学):生成数据只留5%反而更强 Vorch-Omni(Vorch Team):一个模型吃下30种音视频配置 Vorch-Streamer(Vorch Team·同济大学·哈工大深圳·上海交大):27.12FPS边说边生成数字人 Vorch-Director(Vorch Team·浙江大学):22个镜头分钟级不掉线 KVAE(Kandinsky Lab):音图视三件套PSNR多涨1dB 今日论文速览 1. MM-Pretraining Physics:生成数据只留5%反而更强 Towards Physics of Multimodal Pretraining: Knowledge Flow, Modality Synergy, Early Unification, and Recipes | Meta FAIR·Reality Labs·牛津大学 | arXiv:2608.05000 关键词:统一多模态预训练,视觉懒惰,MoE,数据配方,Meta FAIR 前序问题:统一多模态预训练已经成为共识路线,但语言、视觉理解、视觉生成三种能力在联合训练时到底怎么互相传递知识、什么时候协同什么时候打架、视觉数据该在训练的哪一刻加入,业界基本靠经验和直觉,公开的对照实验很少。 本文贡献:用严格的单变量控制实验系统拆解统一预训练,给出四条结论:一是知识流动高度不对称,语言是万能助推器、视觉理解是生成的强先验,而生成几乎不反哺前两者;二是数据复杂度决定模态是协同还是竞争,共享注意力与归一化、拆开前馈层的架构最有利于协同,且换视觉 tokenizer 结论不变;三是必须早期统一、同步联训,晚接视觉会触发作者命名的「视觉懒惰」;四是把这些结论合成非对称数据配方 L70/U25/G5(语言 70%、理解 25%、生成 5%)。 实验效果:在 13.5B MoE(256 专家、每 token 激活 16 个、其中 2 个模态专属,激活参数 1.5B)上用 2T token 做单变量对照:非对称配方相比均衡配方 L50/U25/G25,语言准确率 54.31% 对 52.86%,视觉理解均值 43.08 对 41.42,GenEval 从 0.467 升到 0.482、DPG 从 0.676 升到 0.689——生成 token 少了五倍,文图对齐反而更好,5 万张图的 FID 5.234 与均衡配方的 5.131 基本持平。视觉懒惰有四路机械证据:语言预热从 0B 拉到 800B token 后,视觉 FFN 的训练态与推理态激活幅度、图像包裹 token 的嵌入范数、推理时落在图像 token 上的注意力占比全线下滑。 批判点评:这类「控制变量做到底」的实证研究比又一个新架构更稀缺,尤其「生成数据只给 5%、生成指标反而更好」直接冲击了「想让模型会画就多喂图」的直觉,而视觉懒惰给「强 LLM 接视觉后仍然看图犯低级错误」提供了可测量的解释。局限也明显:结论建立在 Meta 自有数据与 RAE 编码器体系上,2T token 的对照跑一次成本极高,外部团队几乎无法复现;L70/U25/G5 是在这套设定下搜出来的,换数据分布未必照搬;GenEval 0.482 本身离商用文生图还有距离,说明配方优化的是预训练起点而非最终生成力。 2. Vorch-Omni:一个模型吃下30种音视频配置 Vorch-Omni: Multi-Task Orchestration of Sight and Sound | Vorch Team | arXiv:2608.05803 关键词:统一音视频生成,任意条件到任意输出,LTX-2.3,流匹配DiT,多任务 前序问题:文生视频、参考图生成、视频续写、指令编辑、视频配音这些能力今天大多各自训一个模型。一旦把目标视频、源视频、参考图、参考音频塞进同一条序列,模型就分不清哪段该生成、哪段要原样保留、哪段只提供身份或风格;加上音频既可能是条件又可能是输出,任务空间会成倍膨胀。 本文贡献:把所有任务统一成「任意条件到任意输出」的一次条件去噪:每个任务由视频目标、视频条件、音频目标、音频条件四个集合描述,token 级条件掩码决定谁保持干净、谁被去噪,任务标识区分目标/源/主体参考/音频参考/编辑条件,位置类型再区分「与目标共享连续时间轴」(如续写)和「独立参考网格」。视觉条件走两条互补通路——视觉语言模型读采样帧加文本指令给语义,视频 VAE 把完整条件编码成干净 latent 保结构。底座是单个 LTX-2.3 音视频流匹配 DiT(48 层,视频流 32 头×128 维、音频流 32 头×64 维),新任务只改配置不改结构。 实验效果:同一套权重覆盖 10 类以上任务、30 多种条件—输出组合,包括文生视频、文生音视频、图像与参考驱动生成、时间续写、音频驱动生成、视频转换以及单模态和跨模态编辑。人评部分组织 527 组样本、11361 条维度级判断与 Wan 2.7 盲测:81.4% 的判断认为两者相当,Good 与 Bad 各占 7.7% 和 8.0%,总体净胜率 -1.9%;但在最考验统一能力的维度上净胜率为正——音频指令遵循 +7.1%、参考一致性 +6.6%、音画同步 +5.9%、音频质量 +3.3%。 批判点评:把任务差异全部下沉到「token 角色 + 位置类型」的配置层、而不是每个任务加一个分支,是目前统一音视频模型里比较干净的一种抽象,作者也没有粉饰总体净胜率是负的这一点。但代价同样清楚:底座是别人的 LTX-2.3,全参数微调 5 万步,单卡 batch 只有 1;总体 -1.9% 意味着「统一」眼下换来的是特定维度的优势而非全面超越;作者自己也承认长时程一致性、精细局部编辑和多语言多说话人语音仍未解决。Vorch Team 未公开所属机构,权重与代码也没给出时间表。 3. Vorch-Streamer:27.12FPS边说边生成数字人 Vorch-Streamer: Extending Human Audio-Visual Generation to Real-Time Long-Form Streaming | Vorch Team·同济大学·哈工大深圳·上海交大 | arXiv:2608.05663 关键词:实时流式生成,数字人,Self Forcing,DMD蒸馏,语音规划token 前序问题:实时数字人要求边生成边播放,模型只能看历史不能看未来。把预训练的双向音视频扩散模型改成因果流式有两个坎:一是自回归复用自己生成的块会累积曝光偏差,几十秒后身份漂移、画面糊掉;二是给定一整段要说的话,因果生成器在只有局部上下文时并不知道当前这一块该说到哪一句。 本文贡献:在 22B 的 LTX2.3 音视频底座上做三阶段后训练。先用同一个底座合成 8 万条 12–21 秒的数字人音视频语料,保证监督信号与初始化同源;再以样本级混合 Teacher Forcing 与 Diffusion Forcing 训出 20 步因果短流式模型;最后做长时程 Self Forcing,让因果学生在完整 12–21 秒时域上自我 rollout,冻结的原双向模型作为 real-score 教师做 DMD 蒸馏,把双向模型的画质迁移到因果长轨迹上,同时把去噪压到 4 步。语音进度用外部语言模型预测 25 Hz 的离散「说话规划 token」——与 LTX 音频 latent 同频率,因此每个因果块都能拿到属于自己那一秒的语音内容。 实验效果:768×512、24 FPS 设定下,单张 H200 上端到端 DiT 吞吐 27.12 FPS,是评测中唯一越过 24 FPS 实时播放线的原生 T2AV 方法,且不需要外部音频或参考首帧。约两分钟的连续 rollout 在 0/30/60/90 秒采样帧上仍保持身份与场景一致,音唇同步 Sync-C/Sync-D、词错率、VBench2 身份与人体结构指标均有竞争力。推理用 3+1 因果窗口(三个常驻前缀块加最近一块)。训练侧第二阶段 64 张 H200 跑 6000 步,第三阶段 32 张 H200 跑 1000 步。 批判点评:「实时」这次是有明确定义的:24 FPS 播放线、单卡、四步去噪、有界上下文,比笼统说加速可信得多,25 Hz 说话规划 token 也确实解决了因果生成器不知道该说哪句的具体问题。但 27.12 FPS 建立在 H200 和 768×512 这个不算高的分辨率上,换消费级显卡或上 1080p 结论就不成立;训练语料是底座自己合成的 8 万条,风格和多样性都受限于教师,真人视频上的泛化没有验证;两分钟的 rollout 也还不是「无限长」。 4. Vorch-Director:22个镜头分钟级不掉线 Vorch-Director: Interactive World Story Model via Noise-Aware Error Rectification | Vorch Team·浙江大学 | arXiv:2608.05776 关键词:长视频续写,曝光偏差,噪声感知残差,多镜头故事,ST-Bench 前序问题:分钟级音视频靠自回归续写实现:把长视频切段,第 t 段以前面已生成的画面和声音为条件。但训练时喂的是干净的真值历史,推理时喂的是模型自己带着漂移、模糊和音画错位的输出,误差一段段滚雪球,最终身份跑偏、画面变平、声画不同步。已有做法把预测残差当作合成噪声注入历史来缩小这个落差,但都用一个与噪声水平无关的固定强度。 本文贡献:作者观察到残差修正是否有效,关键取决于残差是在流匹配的哪个噪声水平上产生的。于是把每条残差连同它产生时的噪声水平 σ 一起存下来,训练某个 σ 步时只采样同一噪声区间的残差并缩放到该区间,让注入的错误和去噪过程真正对齐;这样既保留了 teacher forcing 的训练效率,又造出接近推理分布的历史。配套设计包括始终不加噪的干净锚定窗口(clean sink),以及区分历史视频、参考图像、目标视频的任务嵌入,支持多镜头、多主体、参考引导的长时音视频生成。 实验效果:在 30 个用例、每例约 10 个镜头的多镜头故事基准 ST-Bench 上,用统一评测器重跑全部方法(不混用已发表数字),四项跨镜头一致性指标全面领先,ViCLIP 达 0.7887 而最强基线只有 0.5900,两项长程指标 ARC 与 Reappear 同样领先;对比对象包括 StoryDiffusion+Wan、StoryMem、HoloCine、Memento。另在 200 例的 UnityShots 上跑了 T2V 与 R2V 两种设定,并自建带同步语音、音乐和音效的长音视频基准,每例连续 22 个镜头达到分钟级,配套提出质量漂移和锚定相对一致性两个长程退化指标。 批判点评:「残差要按噪声水平配对注入」是个很具体也很容易被忽略的细节,作者还老老实实用同一评测器重跑所有基线,避免了各家用各自设定报数字的常见问题,新增的长程漂移指标也补上了平均分掩盖退化的缺口。但基线的画质与文本一致性其实并不输,领先主要集中在跨镜头一致性这一类指标上;ViCLIP 0.7887 对 0.5900 的巨大差距有多少来自方法本身、多少来自 LTX-2 底座与基线不同,论文没有拆开;自建基准由自己定义、自己评测,说服力要等第三方复现。 5. KVAE:音图视三件套PSNR多涨1dB KVAE: Family of Tokenizers for Multimodal Generative Models | Kandinsky Lab | arXiv:2608.05798 关键词:视觉tokenizer,VAE,音频编解码,因果压缩,开源 前序问题:潜空间扩散的天花板一半压在 tokenizer 上:压缩率、通道数、因果性直接决定生成模型的学习速度和最终画质。但开源社区里 tokenizer 的训练细节、选型方法和设计取舍几乎都藏在大模型报告的角落,后来者只能反复踩坑。 本文贡献:一次性放出覆盖三种模态的 KVAE 全家桶并开源:KVAE-Audio 是 48 kHz 全带宽连续音频 tokenizer,latent 帧率 50 Hz、64 通道;KVAE-3D 是两个因果视频 tokenizer,压缩率分别为 4×16×16(64 通道)和 4×8×8(16 通道);KVAE-2D 是空间 8 倍压缩、32 通道的图像模型。视频侧刻意做成无注意力的纯 Conv3D 结构,配合缓存机制可以处理任意长序列,归一化用空间 RMSNorm 以便推理时调整分段大小,上下采样把时间和空间操作拆成先后两步。编码器解码器故意不对称:4×8×8 的解码器约为编码器的 1.3 倍,4×16×16 直接做到 5.3 倍,把容量押在需要生成能力的解码侧。 实验效果:在 MCL-JCV 720p 重建评测上,同压缩率分组内平均比 Wan-2.1(PSNR 34.3)、Wan-2.2(34.2)和 HunyuanVideo 高出 1 dB 以上 PSNR,LPIPS 损失可以忽略。生成侧用统一的 2B CrossDiT(Qwen-2.5VL 文本编码器、流匹配损失、同一批数亿图文数据和超参)只换 tokenizer 做对照:KVAE-4×16×16 与指标完全一致,相比 Wan-2.2 让出一点视觉观感换来更好的提示词遵循,对 HunyuanVideo-1.5 则在全部类别上被更多人选中;有意思的是 KVAE-4×8×8 出现客观指标与人评打架的情况——PSNR 不占优,盲测却名列前茅。整体对标 Wan-2.2、HunyuanVideo-1.5、FLUX.2、MovieGen、StableAudio、MMAudio,代码已在 GitHub 公开。 批判点评:肯把训练细节、选型方法和消融一起交出来的 tokenizer 报告非常少,这份等于给中小团队省掉一轮昂贵的试错,「客观指标与人评打架」的坦白也比一味报 PSNR 有价值。但要注意重建指标只在 MCL-JCV 一个数据集上测,生成对照又只用 2B 模型和数亿量级图文数据,能否外推到十亿级视频数据和更大生成骨干是未知数;1 dB PSNR 的领先在下游生成里究竟折算成多少可感知收益,论文自己的人评已经说明关系并不线性。 6. Latent Reward Register:寄存器读奖励省33倍GPU时 Latent Reward Registers for Diffusion Preference Alignment | 快手可灵Kling Team·中科大 | arXiv:2608.03929 关键词:偏好对齐,latent奖励模型,寄存器token,on-policy蒸馏,可灵 前序问题:扩散模型对齐人类偏好,通常只在最终生成图上算一个稀疏的终点奖励,几十步去噪要共享这一个分数,时序信用分配极其困难。想改成稠密奖励,又绕不开把中间 latent 解码回像素空间的高昂代价。 本文贡献:提出 Latent Reward Register:在冻结的 DiT 输入序列前面挂一串可学习、无位置的寄存器 token(实验用 K=32),让它们从中间带噪 latent 里直接读出终点偏好。关键在于这是一条独立读出通路,不改动生成器的隐藏状态和速度场,因此拿到的是贯穿整个去噪过程、可微分的稠密奖励。基于它给出两种用法:训练侧的 RG-OPD 沿 on-policy 轨迹蒸馏奖励引导的更新,绕开标准策略梯度里昂贵的完整 rollout;推理侧的 RGS 用量级匹配的奖励梯度直接引导采样轨迹,一个参数都不用改。 实验效果:在 ImageReward、HPDv2、HPDv3、GenAI-Bench 合计 54170 对样本上,把 latent 前向加噪到高噪声区 u=0.8 打分,寄存器在所有 latent 奖励模型中成对偏好准确率最高。训练侧 SD3-Medium 上 RG-OPD 的 HPSv3 达 11.57,高于 AlignProp 的 11.20、ReFL 的 10.84 和 Flow-GRPO 的 10.26,MUSIQ 74.9、CLIP-IQA 0.726 同时领先,GPU 时最多省到原来的三十三分之一;FLUX.1-dev 上 HPSv3 12.38 同样第一。推理侧 RGS 在免训练方法里刷新 SOTA,SD3-Medium 上 HPSv3 10.70 对 DNO 的 8.85、Demon 的 9.09,且 MUSIQ 与 CLIP-IQA 一并提升而非以画质换分数。代码与权重已开源。 批判点评:「不动生成器、只挂一串寄存器 token 去读奖励」是个很轻的接口设计,33 倍 GPU 时的差距对预算有限的团队几乎是能不能做在线对齐的分水岭,而且训练和免训练两条路复用同一套读出器。需要警惕的是奖励是从生成器自己的特征里读出来的,两者共享盲区时容易一起自我强化,论文报的 MUSIQ 与 CLIP-IQA 都是无参考指标,扛不扛得住长时间优化下的奖励攻击没有给出曲线;实验也集中在 SD3-Medium 和 FLUX.1-dev 两个文生图骨干,视频扩散上还是空白。 7. SURE:让奖励先说自己有多不确定 Sample-Adaptive Latent Rewards for Uncertainty-Guided Diffusion Post-Training | 中国电信TeleAI·上海交大 | arXiv:2608.06125 关键词:latent奖励,不确定度,奖励攻击,扩散后训练,TeleAI 前序问题:latent 奖励模型能在不解码回像素的前提下监督扩散模型,效率很高,但它们只吐一个标量分数。生成器无从判断这次反馈到底可不可信,一旦在模型本就没把握的样本上照单全收,优化方向就会跑偏,进而演变成奖励攻击。 本文贡献:让奖励模型同时输出「打多少分」和「这个分有多不确定」。SURE-LRM 为每个带噪 latent 预测一个高斯效用:均值是奖励分数,方差是预测的不确定度,且完全从成对偏好中学出来,不需要额外人工标注。SURE-REFL 再把这份不确定度用起来——在选定的去噪转移点上查询冻结的 SURE-LRM,把 detach 后的方差换算成同一转移点内样本之间的可信度权重,每个加权奖励只沿本地转移回传。整条链路留在 latent 空间,既不需要像素解码,也不需要展开完整去噪图。 实验效果:偏好预测上跨三个骨干的均值从 DiNa-LRM 的 70.51 提升到 72.14,FLUX.1-dev 上单点最大提升 2.30。不确定度确实有信息量:排错的样本残差方差平均高 24.26%,用方差识别排序错误的 AUROC 为 0.6941,只保留方差最低的一半样本可把成对准确率从 79.40% 抬到 90.10%。视频侧 VisionRewardDB 72.31%、T2V Ranking 71.70%,均为最好。图像后训练在三个生成器、九个骨干—指标组合里拿下八项第一;视频用 Wan2.1-480P-T2V-14B 后训练,VBench 质量、语义、总分均为评测中最高。作者还给出对照曲线:DiNa-LRM-REFL 的优化奖励持续上升而独立的 HPSv3 已经开始下跌(典型奖励攻击),SURE-REFL 两条曲线则能同步更久。 批判点评:把「奖励可不可信」显式建模出来,比事后加正则更对症,方差—错误率的诊断也做得实在。但不确定度是无监督学出来的,AUROC 0.6941 说明它只是弱信号,离可靠的置信度校准还有距离;作者自己也承认「保留低方差一半准确率涨到 90.10%」这组样本训练时见过,属于分布内诊断而非留出校准。更根本的是,可信度只在同一转移点内做相对比较,如果整个时间步的奖励模型集体偏了,加权也救不回来。 8. LC-GRPO:动态度从12.5救回45.8 LC-GRPO: Bridging Train-Inference Gap for Flow-Based GRPO with Langevin Correction | 普林斯顿大学·加州大学圣地亚哥分校 | arXiv:2608.05600 关键词:Flow-GRPO,Langevin修正,训练推理错配,奖励攻击,强化学习 前序问题:流匹配模型推理时解确定性 ODE,而在线强化学习需要随机 rollout 来探索,于是现有 GRPO 训练时把 ODE 换成 SDE。连续时间下两者边缘分布相同,但有限步离散化后差别很大:探索噪声一大,SDE rollout 就发糊,拿这些糊掉的样本算奖励去训练,和最终 ODE 采样器生成的东西对不上号。 本文贡献:每一步 rollout 先走一步与推理对齐的 ODE Euler,再补一步针对该时刻边缘分布的随机 Langevin 修正。修正需要的 score 直接从流速度里换算出来,不用额外训练 score 模型;修正后的转移仍是各向同性高斯,似然可解析,能直接喂给策略优化。理论上作者证明:在合适条件下一步 Langevin 修正能降低不完美 ODE Euler 步的 Wasserstein 误差;在随机性水平匹配时,该转移比反向 SDE 的标准 Euler–Maruyama 离散更准确。 实验效果:SD3.5-Medium 上文字渲染 OCR 奖励做到 0.960,高于 Flow-GRPO 的 0.914 和 CPS 的 0.935,且 ImageReward 1.00、CLIP 0.291 等旁路质量指标不掉;人类偏好对齐 HPS-v2.1 达 0.393 对 0.381。FLUX.1-Dev 上 HPS-v2.1 0.384、PickScore 23.28 均第一。最刺眼的是视频:HunyuanVideo 用 VideoAlign 视觉质量做奖励,DanceGRPO 把 VBench 动态程度从原模型的 52.8 压到 12.5(画面几乎不动来骗高分),LC-GRPO 保住 45.8,同时 VideoAlign 视觉质量从 -0.205 提到 0.063、VBench 总分 79.10。计算上并不占便宜:Langevin 每步两次前向,作者让基线跑同样和两倍的 rollout 步数取更好结果。 批判点评:指出「训练用 SDE、推理用 ODE」这个人人默认却没人细究的错配,还给了 Wasserstein 误差的理论支撑,而不是纯经验 trick,视频那组动态程度 12.5 对 45.8 更是把奖励攻击拍在明面上——很多 GRPO 的涨分其实是靠画面变静态换来的。要留意每步两次前向的开销是实打实的,作者靠给基线加倍步数来对齐算力,但这不完全等价于同等 wall-clock;实验只覆盖 512×512 分辨率和 HPS、CLIP、OCR 这几类可打分奖励,更主观的美学或叙事奖励是否同样受益尚不清楚。 9. In-Context Forcing:上下文加噪反而提速82% In-Context Forcing: Uncovering Context Effects in Autoregressive Video Diffusion | 上海科技大学·腾讯优图·浙江大学 | arXiv:2608.05237 关键词:自回归视频扩散,噪声上下文,跨帧并行,推理加速,Self Forcing 前序问题:少步自回归视频扩散在生成当前帧的每一个去噪步时,都拿前面已经彻底去噪的干净帧当上下文。干净帧泄露了太多局部细节,模型顺手抄过来就行,结果时序语义被削弱、画面越生成越静止。而如果简单地给上下文加同样强度的噪声,引导又不够,时序一致性会崩。 本文贡献:借「扩散即掩码」的视角重新设计上下文:让上下文帧带上递减的噪声水平——离得远的帧掩得少、紧挨着的帧掩得多,形成渐进式自回归范式,既保住时序一致性又留出帧间动态。更实际的收益是,一旦不再严格依赖「前面必须是干净帧」,跨帧就能并行去噪,推理不再是一条串行长链。训练上以 Wan2.1-T2V-14B 为教师、其因果版 1.3B 为学生,batch 64 跑 1900 步。 实验效果:VBench 上视觉保真度和推理速度双双超过现有方法。逐帧设定下吞吐从 Self Forcing 的 8.9 FPS 提到 16.2 FPS,相对提速 82%,总推理时间减少 45.1%;即便在本已优化过的分块设定下也还能再省 9.3% 时间。30 秒长视频差距最明显:动态程度 86.40 对 Rolling Forcing 的 40.63——后者训练测试不一致的问题会随着滚动窗口反复传播,越长越静止。盲测 A/B 用户研究中相对 Wan2.1、CausVid、Self Forcing 三个基线均获偏好。 批判点评:「给上下文加噪反而更好」违反直觉但解释得通:干净帧提供的是模型可以偷懒复制的捷径。更漂亮的是解开干净帧依赖后顺带解锁跨帧并行,质量和速度不再是二选一。不过 82% 提速是在逐帧这个本身效率最差的设定下取得的,切到实际常用的分块设定就只剩 9.3%,标题数字有挑好看的成分;学生模型只有 1.3B,是否能迁移到 14B 级别未验证;动态程度高也不等于运动合理,86.40 里有多少是有意义的运动仍需人眼确认。 10. Diff-VF:免训练把短视频拉长4倍 Diff-VF: Training-free High-quality Long Video Generation via Diffusion Model | 上海交大·上海人工智能实验室 | arXiv:2608.05976 关键词:免训练长视频,窗口融合,噪声初始化,VBench-Long,即插即用 前序问题:现有视频扩散模型基本都用 10 秒以内的短视频训练,直接外推到长视频就会崩:要么长程语义漂移,要么为了保一致性把画面拍成几乎静止。而重新训练长视频模型既缺数据也缺算力。 本文贡献:提出免训练、即插即用、与骨干无关的 Diff-VF,全部操作只在噪声 latent 上做,因此不挑空间时间建模方式。三招配合:混合噪声初始化用第一段噪声锚定全局语义、后续段追加噪声补充内容多样性;加权窗口采样给每个窗口内的帧按到窗口中心的距离分配权重,让重叠区平滑过渡而不是简单平均出接缝;时间扩展采样把视频按固定间隔抽成若干等距子片段分别去噪再还原顺序,用随时间步变化的融合建立长程依赖。此外用跳跃残差引导把框架扩展到长视频增强,在保真与真实感之间做时间步相关的平衡。 实验效果:在 LaVie 上做 VBench-Long 评测,相比基座模型(主体一致性 0.8546、动态程度 0.9722)和免训练基线,Diff-VF 主体一致性升到 0.9164、动态程度 0.7208,高于 FreeNoise 的 0.6958 和 FreeLong 的 0.5625;整体一致性 0.2795 与人物动作 0.9580 均为最好,运动平滑度 0.9529 也居首。换到 HunyuanVideo 同样有效,说明对 2D+1D 与 3D 注意力两种结构都适用,生成长度是基座原生输出的 4 倍。对比对象包括 FreeNoise、FreeLong 和 RIFLEx。 批判点评:一行权重都不改就把短视频骨干拉长 4 倍,这类方法的部署成本几乎为零,权重函数和等距采样的设计也确实比简单平均更讲究,作者跨两种注意力结构验证了通用性。但要看清代价:基座原本 0.9722 的动态程度被压到 0.7208,只是压得比 FreeLong 的 0.5625 少而已,「一致性—动态性」的跷跷板并没有被打破,只是挪了个位置;评测停在 LaVie 和 HunyuanVideo,没碰 Wan、CogVideoX 这些主流骨干;4 倍长度对分钟级叙事而言仍然偏短。 趋势观察 统一多模态预训练开始有可复现的经验定律 — Meta 用 13.5B MoE、2T token 做单变量对照,得出语言 70%、理解 25%、生成 5% 的非对称配方,生成 token 少五倍反而把 GenEval 从 0.467 抬到 0.482;早期统一还是晚期对齐也不再是口味问题,晚接视觉会留下可测量的「视觉懒惰」。 音视频不再是先出画面再配音,而是同一条序列里的角色分配 — Vorch 三连发把目标、源、参考、历史统一成 token 角色与位置类型:Omni 一套权重覆盖 30 多种条件—输出组合,Director 用噪声配对的残差注入把 22 镜头的分钟级故事撑住,Streamer 在单张 H200 上把文本直出音视频推到 27.12 FPS。 奖励模型集体搬进 latent 空间,并开始交代自己的可信度 — 可灵的 Latent Reward Register 在冻结 DiT 上挂 32 个寄存器 token 直接读奖励,GPU 时最多省 33 倍;TeleAI 的 SURE 让奖励同时输出方差,把不确定的反馈自动降权。稠密、可微、带置信度的中间奖励,正在取代只看最终成图的稀疏打分。 强化学习和自回归都在补同一个洞:训练与推理不一致 — LC-GRPO 用 Langevin 修正让 rollout 与推理时的 ODE 采样对齐,把 DanceGRPO 压到 12.5 的 VBench 动态程度救回 45.8;In-Context Forcing 让上下文带递减噪声以匹配测试分布,30 秒长视频动态程度 86.40 对 Rolling Forcing 的 40.63。两者都说明:很多所谓的涨分,只是模型学会了让画面别动。 Tokenizer 和免训练技巧仍是被低估的杠杆 — Kandinsky Lab 把音频、图像、视频三套 tokenizer 连同训练细节与选型方法一起开源,重建 PSNR 平均比 Wan-2.2、HunyuanVideo 高 1 dB 以上;Diff-VF 不动一行权重,仅靠噪声初始化、加权窗口和等距采样就把短视频骨干拉长 4 倍。不是每个提升都需要重训一个大模型。 人工智能炼丹君 整理 | 2026-08-07 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-06|京东22B音画同修让百年老片复活OmniVR 今日 AIGC 论文速览 今日共 10 篇 · 音视频联合生成与修复 2 篇 · 实时与交互视频创作 2 篇 · 多模态Token高效压缩 2 篇 · 生成后训练与条件对齐 2 篇 · 评测与专业可控生成 2 篇 重点论文标题列表 OmniVR(中科大·京东探索研究院):22B让百年老片音画一起复活 JoyAI-Video-Edit(京东Joy Future Academy):16B单卡30FPS实时剪视频 ContextMaster(清华·南京大学·快手可灵·上科大·港科大):固定预算多镜头创作跑16.74FPS OmniPack(西北工业大学·北大·阿里·清华):无训练6.8%算力保住92.9% STEP-OPD(上海交大·阿里):蒸馏学生越过教师得分0.961 今日论文速览 1. OmniVR:22B让百年老片音画一起复活 OmniVR: Joint Video-Audio Conditional Generation for Restoring Degraded Historical Films | 中科大·京东探索研究院 | arXiv:2608.04224 关键词:音视频联合修复,历史影像,LTX-2,多模态DiT,京东 前序问题:历史影像往往同时存在模糊、噪声、闪烁、曝光不足,以及嘶声、削波、掉音和带宽缺失。现有修复器通常把视频与音频拆开处理,不仅留下单模态质量短板,还可能破坏口型、动作和声音之间的同步。 本文贡献:提出首个音视频联合生成式老片修复模型 OmniVR。系统从 22B 参数 LTX-2 音视频骨干出发,把低质音频和视频编码成联合条件,在统一多模态 DiT 中同步去噪;以联合退化管线模拟真实老片损伤,用近零初始化通道拼接与提示词退火把 T2AV 平滑改造成 AV2AV,再以首帧锚定、模态损失重加权和波形监督支持跨 121 帧窗口的长视频修复。 实验效果:在 200 段真实历史片组成的 OmniVRBench 上,真实轨 MUSIQ 达 61.87,显著高于次优 RealBasicVSR 的 52.38;DNSMOS 从退化输入的 2.04 提升至 2.43,FAD 从 15.93 降至 8.32。12 名标注者给出 80.0% 综合偏好。模型输出 1920×1088,作者还报告在独立 RTN 老片基准的六项无参考视觉指标上全部第一。 批判点评:把“修画面”和“修声音”变成一次联合条件生成,方向比串联两个修复器更完整,指标和人评也有说服力。但 22B 骨干以 rank-384 LoRA 在 64 张 H200 上训练约 5 天,成本很高;强生成先验可能补出原片不存在的纹理与颜色,历史档案、司法取证等场景仍需要真实性约束。代码和权重目前只是承诺公开。 2. JoyAI-Video-Edit:16B单卡30FPS实时剪视频 JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion | 京东Joy Future Academy | arXiv:2608.03974 关键词:实时视频编辑,自回归扩散,两步蒸馏,720p,京东 前序问题:直播和视频通话中的编辑必须边接收边输出,不能偷看未来帧,也不能让显存和计算随视频时长不断增长。把离线编辑器简单切成小段会产生边界跳变,自回归地反复使用生成历史又会累积色偏、身份漂移和背景幻觉。 本文贡献:提出 16B 自回归扩散编辑框架:MLLM 条件编码器理解指令和参考,因果 VAE 与分块双向、跨块因果注意力负责流式输出,滑动窗口加首块全局 sink 把历史状态限制在固定预算。Source-Anchored DMD 将多步扩散蒸馏为两步,并用当前源视频块约束教师目标;长程自回归蒸馏则在分段 rollout 上直接学习累积误差。 实验效果:结合两步生成、固定历史 KV 缓存、FP8 量化和优化 VAE 管线,完整系统在单张 NVIDIA B200 上实现端到端 720p 约 30 FPS。自动指标和人评均显著超过现有流式编辑器,在短视频与长视频上可与强离线系统竞争;代码已经公开。 批判点评:这是今日最硬的工业数字:16B 模型把开放式编辑真正推到实时帧率,而且处理时无需预知视频总长度。但单卡指的是昂贵的 B200,30 FPS 不能外推到消费显卡;两步扩散和 FP8 的细节损失、长达数小时的稳定性以及输入输出延迟分布,还需要独立复现。 3. ContextMaster:固定预算多镜头创作跑16.74FPS ContextMaster: Interactive Multi-Shot Video Creation via Fixed-Budget Sparse Context Routing | 清华·南京大学·快手可灵·上科大·港科大 | arXiv:2608.04956 关键词:多镜头视频,交互创作,稀疏路由,上下文缓存,可灵 前序问题:真实视频创作会在多轮中交替生成新镜头、引用人物或场景、编辑已有素材,并持续继承历史。若每个去噪步都密集读取不断增长的上下文,延迟会随会话变长;若只保留短窗口,又会忘掉早期角色与约束。 本文贡献:提出交互式多镜头视频创作 IMVC 与统一模型 ContextMaster。角色感知 RoPE 区分参考图、历史镜头、源视频和待生成目标;可缓存的干净上下文只预填一次,块稀疏路由在固定预算内检索相关历史,ConstraintSink 强制保留参考和逐帧编辑约束。两阶段特权上下文蒸馏先用稠密教师做一致性蒸馏,再用分布匹配修复少步 rollout 的细节。 实验效果:在单张 H200、匹配分辨率与帧数的设置下,五镜头任务平均达到 16.74 FPS;跨镜头一致性由强基线的 0.808 提升到 0.836,并在文本生成、参考生成和视频编辑三类任务中取得最强综合表现。固定 6-FE 读取预算接近质量与速度最佳点。 批判点评:这项工作把多镜头创作从一次性提示升级为有状态工作流,并让每轮上下文读取保持定额,产品形态很清晰。但 16.74 FPS 仍依赖 H200;路由器漏掉关键旧镜头会造成不可逆遗忘,角色一致性也不等于剧情因果一致。训练阶段还使用 64 张 H200,复现门槛不低。 4. OmniPack:无训练6.8%算力保住92.9% OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models | 西北工业大学·北大·阿里·清华 | arXiv:2608.03812 关键词:全模态大模型,Token压缩,免训练,音视频理解,推理加速 前序问题:全模态大模型同时接收长视频与音频时,视觉和声音 token 数远超文本。现有压缩要么在进入 LLM 前过早丢掉分散在长时间轴上的证据,要么进入 LLM 后只听文本指令,没有充分利用已经对齐的音视频交互。 本文贡献:提出免训练两阶段压缩框架 OmniPack。LLM 前按模态重要性、全局覆盖和相似度合并结构冗余,把被删除信息回收到代表 token;多模态充分交互后,再用文本问题引导和音视频协作做第二次语义压缩。不同阶段分别处理“结构重复”和“任务相关性”,无需改权重。 实验效果:在 Qwen2.5-Omni-7B 上仅用原始 16.7% FLOPs 即保留 98.0% 性能;极限设置只用 6.8% FLOPs 仍保留 92.9%。15%/7.5% 两阶段保留率下,FLOPs 降低 10 倍、prefill 加速 4.5 倍,同时保留 95.6% 性能,并跨三种骨干、五项基准保持最佳效率折中。 批判点评:无需训练且跨 Qwen 与 MiniCPM 骨干有效,工程接入成本很低;把“先保全局结构、后按问题精炼”拆开也比统一打分更合理。不过结果主要来自 H20 上的 prefill,端到端对话延迟和 KV 缓存收益未完全等同;极低预算仍损失约 7% 综合性能,稀有短暂事件可能最先被压掉。 5. STEP-OPD:蒸馏学生越过教师得分0.961 STEP-OPD: Rethinking Output Targets and Internal Dynamics in On-Policy Distillation for Diffusion Models | 上海交大·阿里 | arXiv:2608.04887 关键词:扩散蒸馏,On-policy,超越教师,表示对齐,图像生成 前序问题:扩散模型的 on-policy 蒸馏通常只让学生在自己的去噪轨迹上拟合教师速度,理论最优点就是“和教师一样”,无法主动超过教师;只看最终输出还会放任各 Transformer Block 的内部表示以错误方式相互抵消。 本文贡献:提出 STEP-OPD:把任务教师相对共享基础模型的速度差视为能力提升方向,将缩放后的差值继续加到教师目标上,构造“教师之外”的输出外推目标;同时不直接硬对齐隐藏状态,而是匹配相邻 Block 表示变化的方向和幅度,让学生学习能力在网络内部如何逐层形成。 实验效果:在组合对齐、文字渲染与人类偏好三组能力上统一超过标准 DiffusionOPD,并使 GenEval 从 0.927 提升到 0.961;统一学生在三类能力上分别超过对应的单任务教师,证明多教师能力整合不必以教师上限为终点。 批判点评:“教师减基础模型”的差向量能否稳定代表可继续外推的能力,是很有启发性的假设,内部变化对齐也补上了只看终点的盲区。但外推系数依赖任务调参,走得太远可能放大教师偏差;目前只验证图像生成,扩展到视频等更长序列后,中间层监督的显存和计算成本会更突出。 6. TD-V2A:帧间差分让视频配音FAD降至0.53 Visual Representation Matters: Exploiting Temporal Differences in Video-to-Audio Generation | 清华·南洋理工等 | arXiv:2608.04902 关键词:视频配音,帧间差分,音频扩散,时间对齐,视觉表征 前序问题:视频配音区别于看图配音的核心不是多看几张静态图,而是捕捉帧间运动变化。现有方法常外挂音视频对比模型、声学结构预测器或多模态大模型,系统复杂,且可能把真正决定声音时机的低层运动细节压掉。 本文贡献:提出 TD-V2A,直接把相邻帧差分作为额外视觉条件。作者比较像素帧差与编码后特征差,发现编码前差分保留的细粒度运动更有效;训练时以文本到音频预训练、原始视频条件、差分增强条件三阶段持续学习,采样时用退火差分引导在早期先确定全局声音动态,后期逐渐回到原始视觉语义。 实验效果:在约 1.5 万段 VGGSound 测试片上,FAD 达 0.53,优于 MMAudio 的 0.81;IS 达 16.9、ImageBind Score 达 33.8,均明显高于对比方法,时间对齐准确率 89.1。它甚至超过需要额外训练的 CAVP 音视频表示,且没有新增预测网络。 批判点评:把“视频比图片多出来的信息”直接定义为帧差,简单而有效,指标也说明低层运动不应过早被语义编码器抹掉。但逐帧差分对镜头切换、抖动和光照闪烁同样敏感,可能把无关变化误当声源;其时间对齐 89.1 仍略低于专门以对齐目标训练的 Diff-Foley 89.9。 7. CAPE-T2V:训练推理两头对齐提示词 CAPE-T2V: Captioner-Anchored Prompt Enhancement toward Two-Sided Conditioning Alignment in Text-to-Video Generation | 复旦·快手可灵 | arXiv:2608.03046 关键词:文生视频,提示增强,训练推理对齐,Caption,可灵 前序问题:视频 DiT 训练时看到的是详尽视频 caption,线上却由 Prompt Enhancer 把用户短句改写后再喂给模型。即使双方使用同一字段模板,细节选择、组织方式、粒度和措辞仍不同,形成残余 PE-Caption 分布缺口。 本文贡献:提出两步 Captioner-Anchored 对齐:先用外部视频描述器产生统一目标,把简短描述、详细描述和伪用户提示都训练成同一种 Anchored PE 输出;再让这个已经冻结的 PE 重写视频训练 caption 并微调 DiT,部署时仍由同一个 PE 改写用户提示,使训练侧与推理侧真正共享同一文本算子。 实验效果:在 Wan2.2 与 LTX-2.3、StoryEval/VBench-2.0/T2V-CompBench 的六个组合上全部超过只做 schema 对齐的基线。Wan2.2 分别提升 1.6、1.12、0.30 分,LTX-2.3 提升 1.4、0.92、0.65 分;caption 到推理改写的 MMD² 从 0.0764 降至 0.0682。 批判点评:工作指出“字段相同不等于分布相同”,并把 Prompt Enhancer 正式视作生成模型接口,诊断很贴近真实部署。但绝对增益多数只有 0.3–1.6 分,StoryEval 又使用 GPT-5.5 判定;一旦线上 PE 更新,就要重新改写训练 caption 并适配 DiT,维护成本仍然存在。 8. Two-Stage Token Pruning:只留10%视频Token还涨7分 Adaptive Two-Stage Visual Token Pruning for Efficient Inference in Video-Language Models | Amazon | arXiv:2608.03112 关键词:视频语言模型,Token剪枝,免训练,自适应预算,Amazon 前序问题:视频语言模型每帧可产生数百视觉 token,数分钟视频很快进入万 token 区间。现有图像剪枝方法既忽略跨帧重复,又对所有视频使用固定保留率;静态访谈和高速运动显然不该被压成相同预算。 本文贡献:提出完全后处理的两阶段自适应剪枝:先在时间轴选择差异最大的代表帧,再在保留帧内做 token 级裁剪。第二阶段对 token 相关矩阵做特征值分解,用谱衰减速度估计当前视频冗余度,并据此动态决定保留比例,无需训练或微调原模型。 实验效果:在三种 VLM、五项视频基准上持续增益;平均仅保留 10% token 时,VideoDC 准确率达到 76.75%,比同预算 DivPrune 的 68.47% 高 8.28 分,论文摘要按跨设置概括为约 +7%;同时 TFLOPs 降低约 95%,其他问答基准基本保持。 批判点评:把“删哪些帧”和“每帧删多少 token”分开,并让谱结构决定预算,符合视频冗余的实际差异。代价是特征值分解本身有额外开销,当前实验以短视频理解基准为主;突发但关键的一帧或小目标,仍可能在两轮剪枝中被不可逆丢失。 9. OmniEdit-Bench:五赛道揭穿视频编辑假高分 OmniEdit-Bench: A Comprehensive Benchmark for Instruction-based Video Editing | 港大·阿里通义万相·浙大·北大 | arXiv:2608.05049 关键词:视频编辑评测,音频编辑,时间编辑,推理编辑,通义万相 前序问题:很多视频编辑评测沿用图像编辑任务,只看逐帧空间变化;模型即使没有执行指令,只要保留原视频的高画质和一致性,也可能得到高分。音频、时间操作、参考条件和隐式推理因此长期缺席。 本文贡献:构建覆盖空间 240、时间 200、参考 200、音频 100、推理 50 个案例的五赛道基准,并区分显式与隐式指令。评测把质量拆成准确性、保留度、真实感和一致性,再以准确率作为门控缩放后三项,避免“看起来很好但改错了”获得虚高总分。 实验效果:商业与开源模型整体都远未过关:KlingV3-Omni 综合最高也仅 38.3/100,Seedance 2.0 为 37.3;时间赛道最好 Wan2.7-Edit 只有 29.0,推理赛道最好 Seedance 2.0 也只有 29.8。商业模型在空间编辑领先,但优势在音频、时间和推理任务明显收窄。 批判点评:把准确性设为其他质量分的前提,能有效纠正原视频先验造成的假高分;五赛道也比图像式评测更接近真实需求。不过大量评分仍依赖 VLM,门控权重是人为设计;部分商业模型因功能或版权限制没有覆盖全部赛道,横向平均并非完全同条件。 10. CSGen:2.4万样本守住血管道路裂缝 CSGen: A Multi-Domain Curvilinear Structure Generation Model via Hierarchical Multimodal Diffusion | ACM MM 2026·海南大学·广东海洋大学 | arXiv:2608.04655 关键词:可控生成,曲线结构,拓扑保持,专业数据,ACM MM 前序问题:血管、道路、叶脉和裂缝只占图像极少像素,却要求细长分支持续连通。通用扩散模型更擅长生成大物体,普通 MSE 又被背景像素主导,容易把这些稀疏结构画断或偏离控制图。 本文贡献:提出基于 SD3.5 的层次多模态扩散模型 CSGen,并汇集 24678 个样本,覆盖血管、冠脉、混凝土裂缝、叶脉和道路五域及七类标注。分阶段注入 CLIP 拓扑属性与 T5 场景描述,先锁定结构再补环境;稀疏感知损失按等效直径提高细小脆弱分支的权重。 实验效果:相同提示下 FID 达 98.525,优于 SD3.5-ControlNet 的 131.256;完整模型将拓扑 clDice 从基线 0.628 提升到 0.766。合成数据用于下游分割时,道路域 mIoU 最高增加 4.73 分,说明生成结果不只视觉像真,也能补充结构学习。 批判点评:这是 ACM MM 2026 已接收工作,数据、代码和结构指标较完整,说明专业生成不能只看通用审美分。但五个领域仍共享相对简单的二值拓扑先验,跨域统一性有限;合成图提升分割不等于临床或基础设施诊断可靠,专业场景还需真实分布验证。 趋势观察 音视频联合模型开始从内容生成反向进入修复 — OmniVR 直接复用 22B 音视频生成骨干,同时恢复老片画面、声音与同步关系;统一生成先验正在吞并过去彼此独立的增强管线。 视频编辑从固定短片走向实时、有状态和开放时长 — JoyAI 用两步自回归扩散在单 B200 达到 720p 约 30 FPS,ContextMaster 则以固定预算上下文支撑多轮多镜头创作,视频模型正从一次生成器变成持续工作的创作系统。 Token压缩从固定比例升级为内容与问题共同决定 — OmniPack 先保全局音视频结构、再按问题做语义精炼,Amazon 两阶段方案先删重复帧、再按谱冗余决定每帧预算;高效推理正在告别一刀切剪枝。 生成后训练不再满足于复刻教师或单边修补接口 — STEP-OPD 沿教师相对基础模型的能力方向继续外推,CAPE-T2V 则让同一个 Prompt Enhancer 同时定义训练与推理文本分布,优化目标从局部模仿转向端到端系统对齐。 视频能力评测开始补齐时间、声音与隐式推理 — OmniEdit-Bench 的五赛道显示最强商业编辑模型综合仍不足 40 分;TD-V2A 也证明只看语义无法评价配音,时间差分与同步指标将成为音视频系统的基本维度。 人工智能炼丹君 整理 | 2026-08-06 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注