搜索到
151
篇与
AIGC Daily Papers
的结果
-
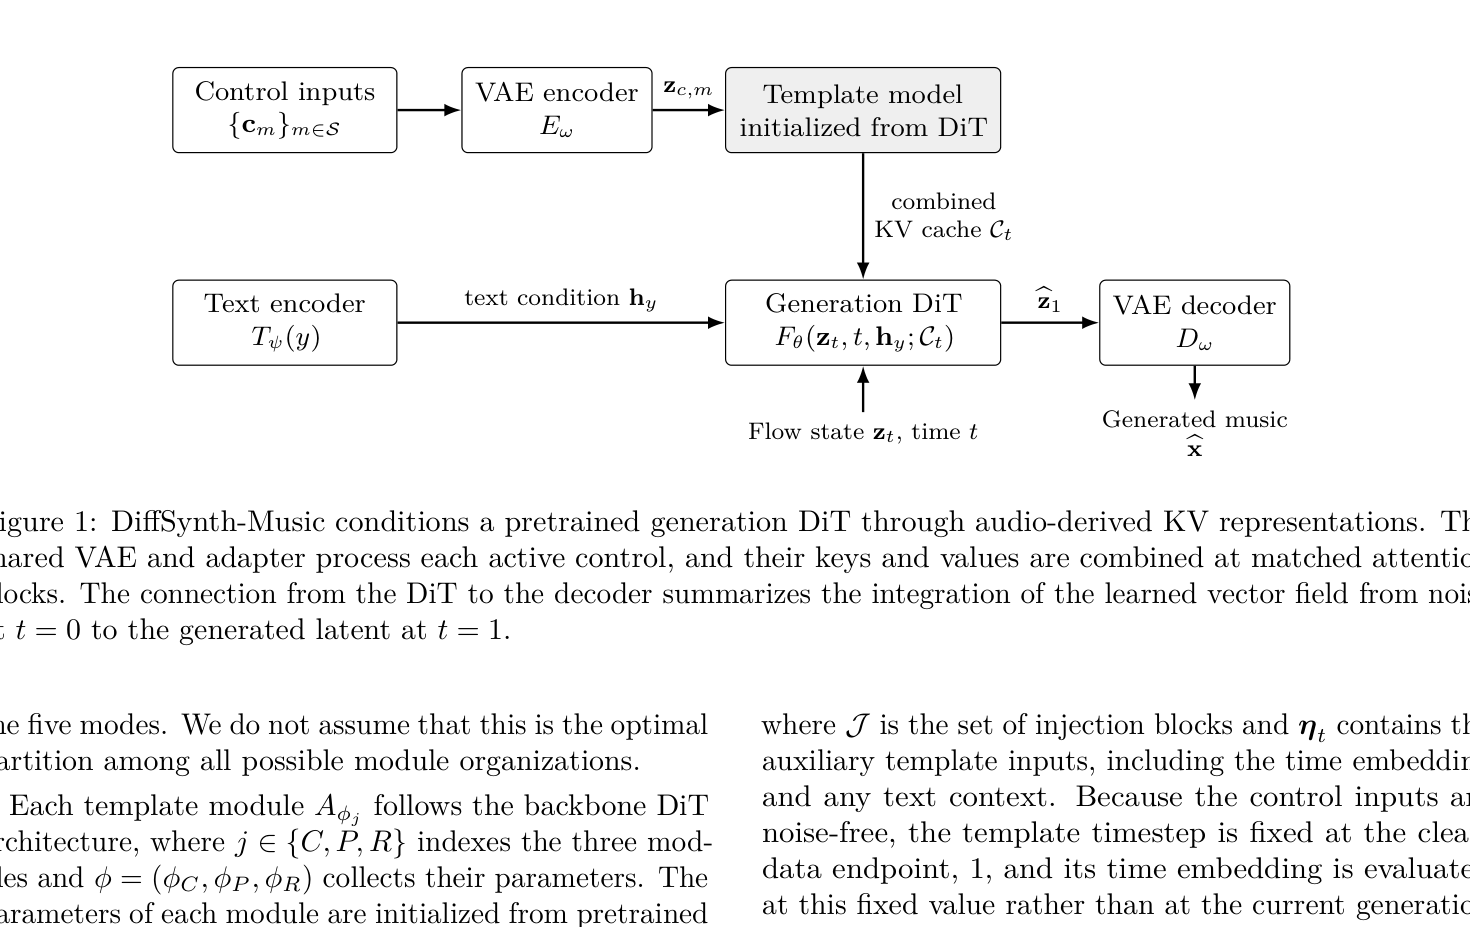
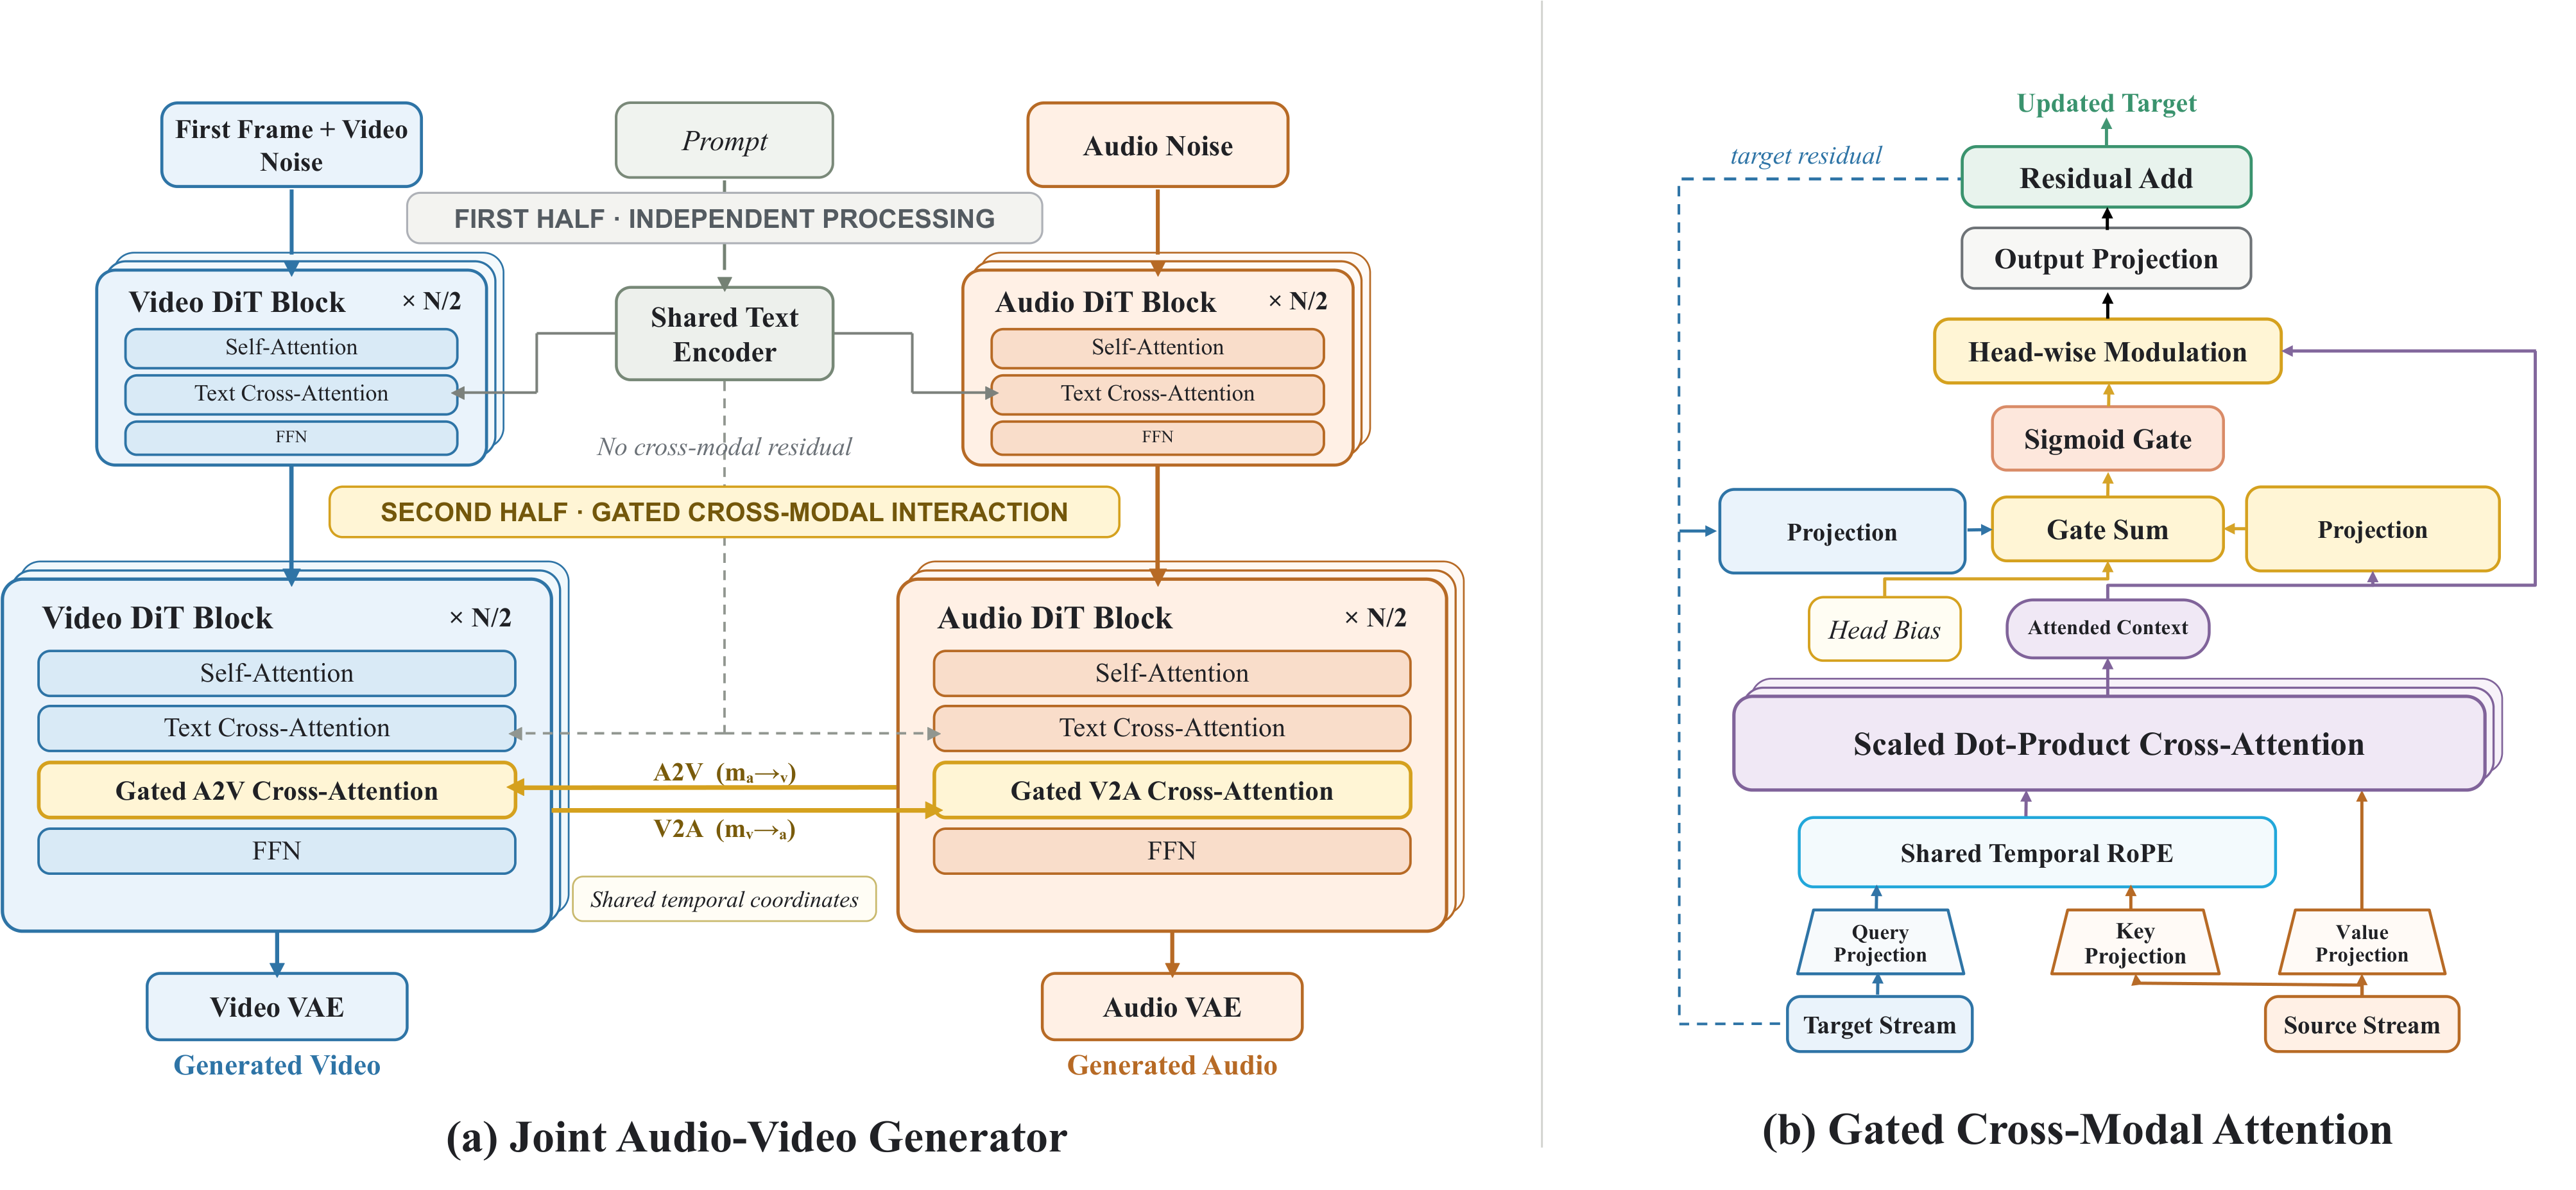
 AIGC 每日速读|2026-09-15|阿里五路音频控制-DiffSynth-Music 今日 AIGC 论文速览 今日共 10 篇 · 可控与统一音频生成 2 篇 · 长时音视频与可控视频生成 2 篇 · 图像编辑与画质修复 2 篇 · 3D 资产生成 1 篇 · 流式交互与语音评测 2 篇 · 高效长上下文 1 篇 重点论文标题列表 DiffSynth-Music(阿里巴巴集团、上海交通大学):五路音频控制锁住节拍 StepAudio 3 Gen(阶跃星辰 StepFun-Audio 团队):一套模型生成所有声音 Encore(百度、北京理工大学 · SIGGRAPH Asia 2026):三十秒音画同步不跑偏 DIAL(阿里巴巴集团、北京大学):调一个旋钮控人物像不像 Omni-Streaming Thinking(香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学):流式多模态会主动改口 今日论文速览 1. DiffSynth-Music:五路音频控制锁住节拍 DiffSynth-Music: Audio-Conditioned KV-Cache Adapters for Controllable Music Generation | 阿里巴巴集团、上海交通大学 | arXiv:2609.12774 关键词:可控音乐生成,音频条件,KV缓存,扩散Transformer 前序问题:文字与歌词能规定歌曲主题和唱词,却难以精确约束节拍、旋律、伴奏、演唱韵律和参考风格;把多种音频条件逐步送进扩散模型又会反复增加计算。 本文贡献:DiffSynth-Music 从同一音乐 DiT 初始化 Control、Prosody、Reference 三个模板模型,先由共享 VAE 编码控制音频,再把逐层 KV 缓存注入生成主干。模板端固定在干净数据端点,每种控制只前向一次,五类条件还能组合使用。 实验效果:相对冻结主干,节拍条件把 Beat-F1 从 0.3031 提到 0.8496;人声条件把 V-MSE 从 0.0158 降到 0.0006,伴奏条件把 A-MSE 从 0.0221 降到 0.0023;参考条件的 MuLan-A 从 0.6836 升到 0.8088。 批判点评:一次缓存让多条件控制更便宜,但三个模板模型仍带来额外参数和训练维护成本。实验以单条件为主,真正创作常同时叠加节拍、人声、伴奏与参考音频,组合冲突和听感质量仍需更大规模人评。 2. StepAudio 3 Gen:一套模型生成所有声音 StepAudio 3 Gen Technical Report | 阶跃星辰 StepFun-Audio 团队 | arXiv:2609.12945 关键词:通用音频生成,语音合成,声音设计,RVQ 前序问题:语音、歌声、音乐与音效通常使用不同生成器和离散表示,混合声音任务很难在一套模型里保持文本能力、说话人一致性与声学细节。 本文贡献:StepAudio 3 Gen 以 12.5 Hz 的 16×2048 共享 RVQ 空间直接自回归建模通用音频:主干沿时间预测首码本,轻量因果 Transformer 再沿码本轴补齐其余十五层;渐进预训练与 RVQ Adaptor 缓解音频能力对语言能力的干扰。 实验效果:TTS 人类偏好 Elo 达 1755.33,对五个商业系统的汇总胜率为 82.0%;声音设计 Elo 为 1668.5、汇总胜率 75.5%;风格一致性中文平均 85.2%,英文平均 77.7%。 批判点评:统一离散建模简化了产品管线,但十六层 RVQ 的级联预测仍可能积累误差。报告覆盖多类声音,公开复现仍取决于训练数据、偏好标注与完整模型权重。 3. Encore:三十秒音画同步不跑偏 Encore: Infinite Audio-Video Generation with Adaptive Signal Routing | 百度、北京理工大学 · SIGGRAPH Asia 2026 | arXiv:2609.04249 关键词:音视频联合生成,长视频生成,自适应信号路由,跨模态同步 前序问题:现有音视频生成能做出同步良好的短片,但时长受限;长视频方法靠分块迭代延长时长,却完全没有音频。联合生成长音视频比单做任何一边都难:每一块都要同时保住视频时序连贯、音频时序连贯和跨模态同步,而这三路条件信号进入模型的通路各不相同。 本文贡献:Encore 把难题拆成两层:局部连续性交给带显式跨块上下文传播的迭代生成,全局一致性交给带位移位置编码的参考音视频信号。在此之上提出自适应信号路由(ASR),在自注意力内加逐层逐头可学习偏置、在交叉注意力输出上加可学习缩放,让模型自行调节每路条件信号的影响强度。端到端联合训练后,推理时全程以真值模态为条件即可支持无限长的音频转视频与视频转音频。 实验效果:扩展后的 VerseBench 长音视频评测上,身份一致性 ID 为 0.86、音画同步 LSE-C 为 2.36、AV-A 为 0.88,三项均为最佳;误差累积 ΔAS 0.02、ΔID 0.07,明显低于次优的 0.06 与 0.22。短片设置下 LSE-C 为 3.46,对 LTX-2.3 的 2.36。 批判点评:把长音视频拆成局部续接加全局参考,确实压住了 30 秒级的身份漂移与场景突变。但 ASR 的逐层逐头可学习参数把调参负担转移到了训练侧,消融显示去掉任一路缩放都会让同步指标明显掉档。画面美学仍落后于 OVI 与 LTX2.3,且所谓无限长目前只验证到 30 秒量级,更长时长的累积行为没有给出。 4. DIAL:调一个旋钮控人物像不像 Harnessing Intrinsic Subject-Aware Attention for Controllable Multi-Subject Video Generation | 阿里巴巴集团、北京大学 | arXiv:2609.11507 关键词:多主体视频生成,注意力定位,保真强度控制,偏好优化 前序问题:多主体视频生成卡在两件事上:保真强度不可调——模型要么因训练数据偏置产生生硬的贴图感,要么对输入敏感到无法控制;以及语义漂移——主体中途消失、属性出错、多个参考身份互相串味。 本文贡献:作者发现 DiT 内部某些注意力块天然形成内在空间定位图(ISGM),能准确定位参考主体。DIAL 据此双阶段复用这一内部信号:低噪声阶段用 ISGM 构造注意力偏置矩阵,推理时逐主体调节引导强度 γ 即可控制身份保真度,无需重训;高噪声阶段用同一张图零成本构造偏好对做强化学习,把注意力锚定到参考主体上抑制漂移。 实验效果:OpenS2V-Eval 上,Kaleido 主干总分从 56.00 提到 γ=16 时的 61.14,人脸相似度从 31.81 升到 60.64,双双超过最强通用基线 SkyReels-v3 的 59.26 与 VACE-14B 的 55.09。第二阶段单独作用(γ=0)把主体出现率从 155/320 提到 163/320。 批判点评:把控制接口接到模型自带的注意力结构上、省掉外挂模块,这个思路很干净。但 ISGM 出现在哪一层依赖对具体主干的经验观察,换骨干要重新找;保真度提升伴随真实感与美学分下滑,γ 给多少仍靠人工判断。第二阶段的偏好对由 ISGM 自评构造,评判标准与被优化对象同源,存在自我确认的风险。 5. Omni-Streaming Thinking:流式多模态会主动改口 Omni-Streaming Thinking | 香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学 | arXiv:2609.15128 关键词:流式多模态,音视频推理,状态修正,幻觉抑制 前序问题:流式音视频模型常在声音尚未说完时依据画面提前下结论;一旦错误判断写入记忆,后续音频即使否定它,模型仍会沿着旧状态回答。 本文贡献:OST 把输出拆成已见证据、未来证据预测和待验证主张,并为主张绑定验证时间窗。音频与视觉证据分开保存;遇到矛盾后,反驳过程削弱旧主张及其依赖状态,回答门控只在关键主张满足条件时放行。主干冻结为 Qwen3-Omni-30B-A3B,仅做轻量适配。 实验效果:在五个流式与音视频基准上,OST 相对最强开放基线平均提升超过 10%;OST-DiagBench 的 d′ 达 2.95,而开放基线最高 1.38。SOVBench-O 平均准确率由 81.6 提至 87.8,SOVBench-T F1 由 90.5 提至 92.4。 批判点评:显式状态与反驳链能减少过早承诺,却依赖主张拆分、模态归因和验证时间窗都足够准确。复杂直播中矛盾可能长期不闭合,额外结构化输出也会增加延迟和训练标注成本。 6. Overpainting:灰色地带让模型自己发挥 Overpainting: Localized Context-aware Diffusion Image Editing | Adobe Research、威廉与玛丽学院 | arXiv:2609.10811 关键词:图像编辑,三值遮罩,扩散模型,注意力dropout 前序问题:图像编辑要么给定二值遮罩、严格只改框内,结果生硬且边界突兀;要么纯靠文字提示,改哪里完全不受控。用户真正想表达的「这块必须改、这一圈可以顺带调、其余别动」没有对应接口。 本文贡献:Overpainting 用白/灰/黑三值 trimap 表达这三档意图:白色必须编辑、灰色允许编辑、黑色不得改动。实现上在预训练图像编辑扩散模型外挂 LoRA,用联合注意力在源图、遮罩与噪声三路输入间传信息,并以注意力 dropout 平衡信息流。配套的自动数据流水线先用语言编辑模型造候选图像对,筛掉过度编辑、编辑不足与整体偏移的失败样本,再从可用样本反解出 trimap。 实验效果:遮罩估计网络微调后 F1 达 0.955、IoU 0.916,对比阈值像素差的 0.733 与 0.607。MISATO@1K 补全评测上 LPIPS 0.189、FID 20.58,远好于 FLUX-Kontext 的 0.372 与 92.09。180 个人工整理的例子上,50% 注意力 dropout 在遮罩遵循与编辑质量之间取得平衡点。 批判点评:三值 trimap 比二值遮罩更贴近真实修图意图,把「顺带调一下」这件事显式化了。但灰区给模型多大自由度只能靠 dropout 率这一个全局参数调,用户画的灰区宽窄也会显著改变结果,论文自己的遮罩变体实验就显示同一提示词能得到差异很大的输出。训练数据由 FLUX.1 Kontext 自动生成再筛选,模型学到的编辑分布因此被上游模型的偏好圈住。 7. PLSR:3D网格切块做超分省显存 PLSR: Progressive and Localized Super-Resolution of 3D Objects via Localized Latent Voxel Diffusion | 香港中文大学、广东工业大学、香港城市大学、莫纳什大学 | arXiv:2609.06436 关键词:3D资产生成,超分辨率,体素扩散,渐进式生成 前序问题:扩散式 3D 生成模型被固定分辨率卡住,细节上不去;直接把分辨率整体拉高,显存与算力又会爆掉。 本文贡献:PLSR 在已有 3D 生成基座上做超分,把全局超分拆成关联式的局部子任务:粗网格编码成低分辨率条件,上采样出高分辨率隐变量的稀疏体素骨架后切成固定大小 patch,每个 patch 关联裁剪对应的低分辨率条件与输入图像,逐 patch 去噪再聚合成全局预测。整轮结果还能当作下一轮的低分辨率条件,渐进逼近更高分辨率,基座只需低成本微调。 实验效果:伪真值几何评测上 LPIPS 0.109、FID 55.89、Chamfer 距离 0.0139、F1 0.145,四项全面优于 TRELLIS.2 在 1536 与 2560 两档分辨率下的结果;纹理评测 LPIPS 0.125、FID 59.89。开放世界 ELO 评分中几何总体质量 1855、纹理 1633,高于 TRELLIS.2(1536) 的 1790 与 1599。 批判点评:把全局超分拆成局部 patch 换来了显存友好,重叠推理与渐进式两个消融也都验证有效。但逐 patch 去噪要遍历所有 patch,分辨率越高调用次数越多,省的是显存不是时间。接缝主要靠低分辨率条件当锚点加重叠区抑制,论文也承认无重叠时仍有残留。开放世界评测依赖模型打分,与人工审美的一致性没有交叉验证。 8. SAS:稀疏注意力直接听损失 SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking | 腾讯混元、香港科技大学(广州)、香港科技大学 | arXiv:2609.13141 关键词:稀疏注意力,长上下文,上下文排序,端到端优化 前序问题:可训练稀疏注意力通常用硬 Top-K 选上下文,语言模型损失无法穿过离散选择,只能蒸馏稠密注意力权重;有限预算因此可能保留“像教师”却不真正影响最终预测的块。 本文贡献:SAS 在训练时把选择器连续分数以对数门的形式注入注意力 softmax,让语言模型损失直接更新上下文排序;归一化门校准历史块与始终保留的当前块,Triton 内核把这一机制嵌入 FlashAttention 风格计算。 实验效果:在 2048 token 预算、Qwen3-4B 上,AIME24 比 SeerAttention-R 高 13.02 分(68.85 对 55.83);Qwen3-14B 的 LongBench 8K+ 为 53.9 对 51.5。SGLang 解码在 512K、batch 1 最多降延迟 5.6 倍,batch 8、64K 最多约 13 倍加速。 批判点评:端到端损失对下游任务更直接,但选择器只在数学数据上训练,跨领域稳定性仍受主干与查询分布影响;预填充仍采用稠密注意力,因此长输入首 token 成本没有同时消失。 9. Mi-Ripple:修掉反复AI编辑的涟漪 Mi-Ripple: Restoring Images Degraded by Iterative AI Editing | 弥阳科技、中国科学院软件研究所、上海交通大学、天津大学 | arXiv:2609.11317 关键词:图像修复,迭代编辑,频域伪影,配对再生成 前序问题:图像被生成模型反复编辑后会积累低频起伏、色带与周期纹理,内容看似正确却越来越“塑料”;普通锐化或去噪可能同时损伤真实边缘。 本文贡献:Mi-Ripple 先在频域用陷波定位并抑制迭代编辑形成的周期分量,再通过配对再生成构造更干净的参考,对剩余伪影做修复;流程把可测量的频谱异常与生成式细节恢复结合。 实验效果:14 次只做陷波的测试中,整图 CIELAB 亮度残差标准差为 0.08–0.44;配对再生成把参考中的碎屑密度降低 45%。三个示例的尺度纹理指数分别从 25.3%、41.1%、20.0% 降至 11.1%、12.1%、0.0%。 批判点评:方法针对可见的周期性退化更有解释性,但配对再生成可能改动原图身份与细节。若伪影频率与真实重复纹理重合,陷波也可能误删内容,仍需要区域级保真检查。 10. Duplex Cue:会说会停还要边听边改 Continue, Adapt, or Yield: In-Turn Adaptation to Overlapping Speech in Full-Duplex Agents | Besimple AI | arXiv:2609.13117 关键词:全双工语音,重叠语音,对话适应,语音评测 前序问题:全双工语音评测常把模型行为简化为继续说或停下来,却漏掉人类常用的第三种反应:保留话轮,同时吸收听者补充的词、纠正或澄清。 本文贡献:Duplex Cue 把听者意图区分为回应、协作与打断,把说者行为标成原样继续、话内适应或让出话轮。研究从无脚本英语对话中提取 300 个经人工确认的提示,并在相同提示下比较人类录音与 PersonaPlex 延续。 实验效果:保留 208 对活跃且可评分样本;66 个协作提示中,人类话内适应率为 68.2%,PersonaPlex 为 34.8%,相差 33.4 个百分点。模型更多原样继续(42.4%)或让出话轮(22.7%);自动评分与人工在 142 项中一致 108 项,κ=0.641。 批判点评:三分法比“停没停”更接近自然对话,但判断适应需要理解语义依赖,自动评审本身可能偏向表面复述。要成为训练目标,还需扩展语言、说话风格、噪声与真实网络延迟。 趋势观察 控制接口前移到模型内部 控制不再靠外挂模块,而是接到主干已有的结构上:DiffSynth-Music 用可复用 KV 缓存组合五路音频,StepAudio 3 Gen 用共享离散码本统一语音、歌声、音乐与音效,DIAL 干脆直接复用 DiT 自带的注意力定位图。 长时序生成靠显式上下文传播续命 Encore 把长音视频拆成局部连续性与全局一致性两层,用跨块上下文传播加参考信号压住 30 秒后的身份漂移,误差累积指标 ΔID 从次优的 0.22 降到 0.07——长程生成的胜负手不在单帧画质,而在误差累积。 编辑控制从硬遮罩转向软约束 Overpainting 用白灰黑三值 trimap 区分「必须改、可以改、不能改」,Mi-Ripple 用频域陷波只删周期分量,都在回答「哪里该动、动多少」,而不是一刀切地框定编辑区域。 算力不够时预算分配成为核心问题 PLSR 把全局 3D 超分拆成可迭代的局部 patch 去噪换显存,SAS 在固定注意力预算下端到端学上下文排序——两条线都承认资源有限,转而研究怎么把预算花在刀刃上。 人工智能炼丹君 整理 | 2026-09-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
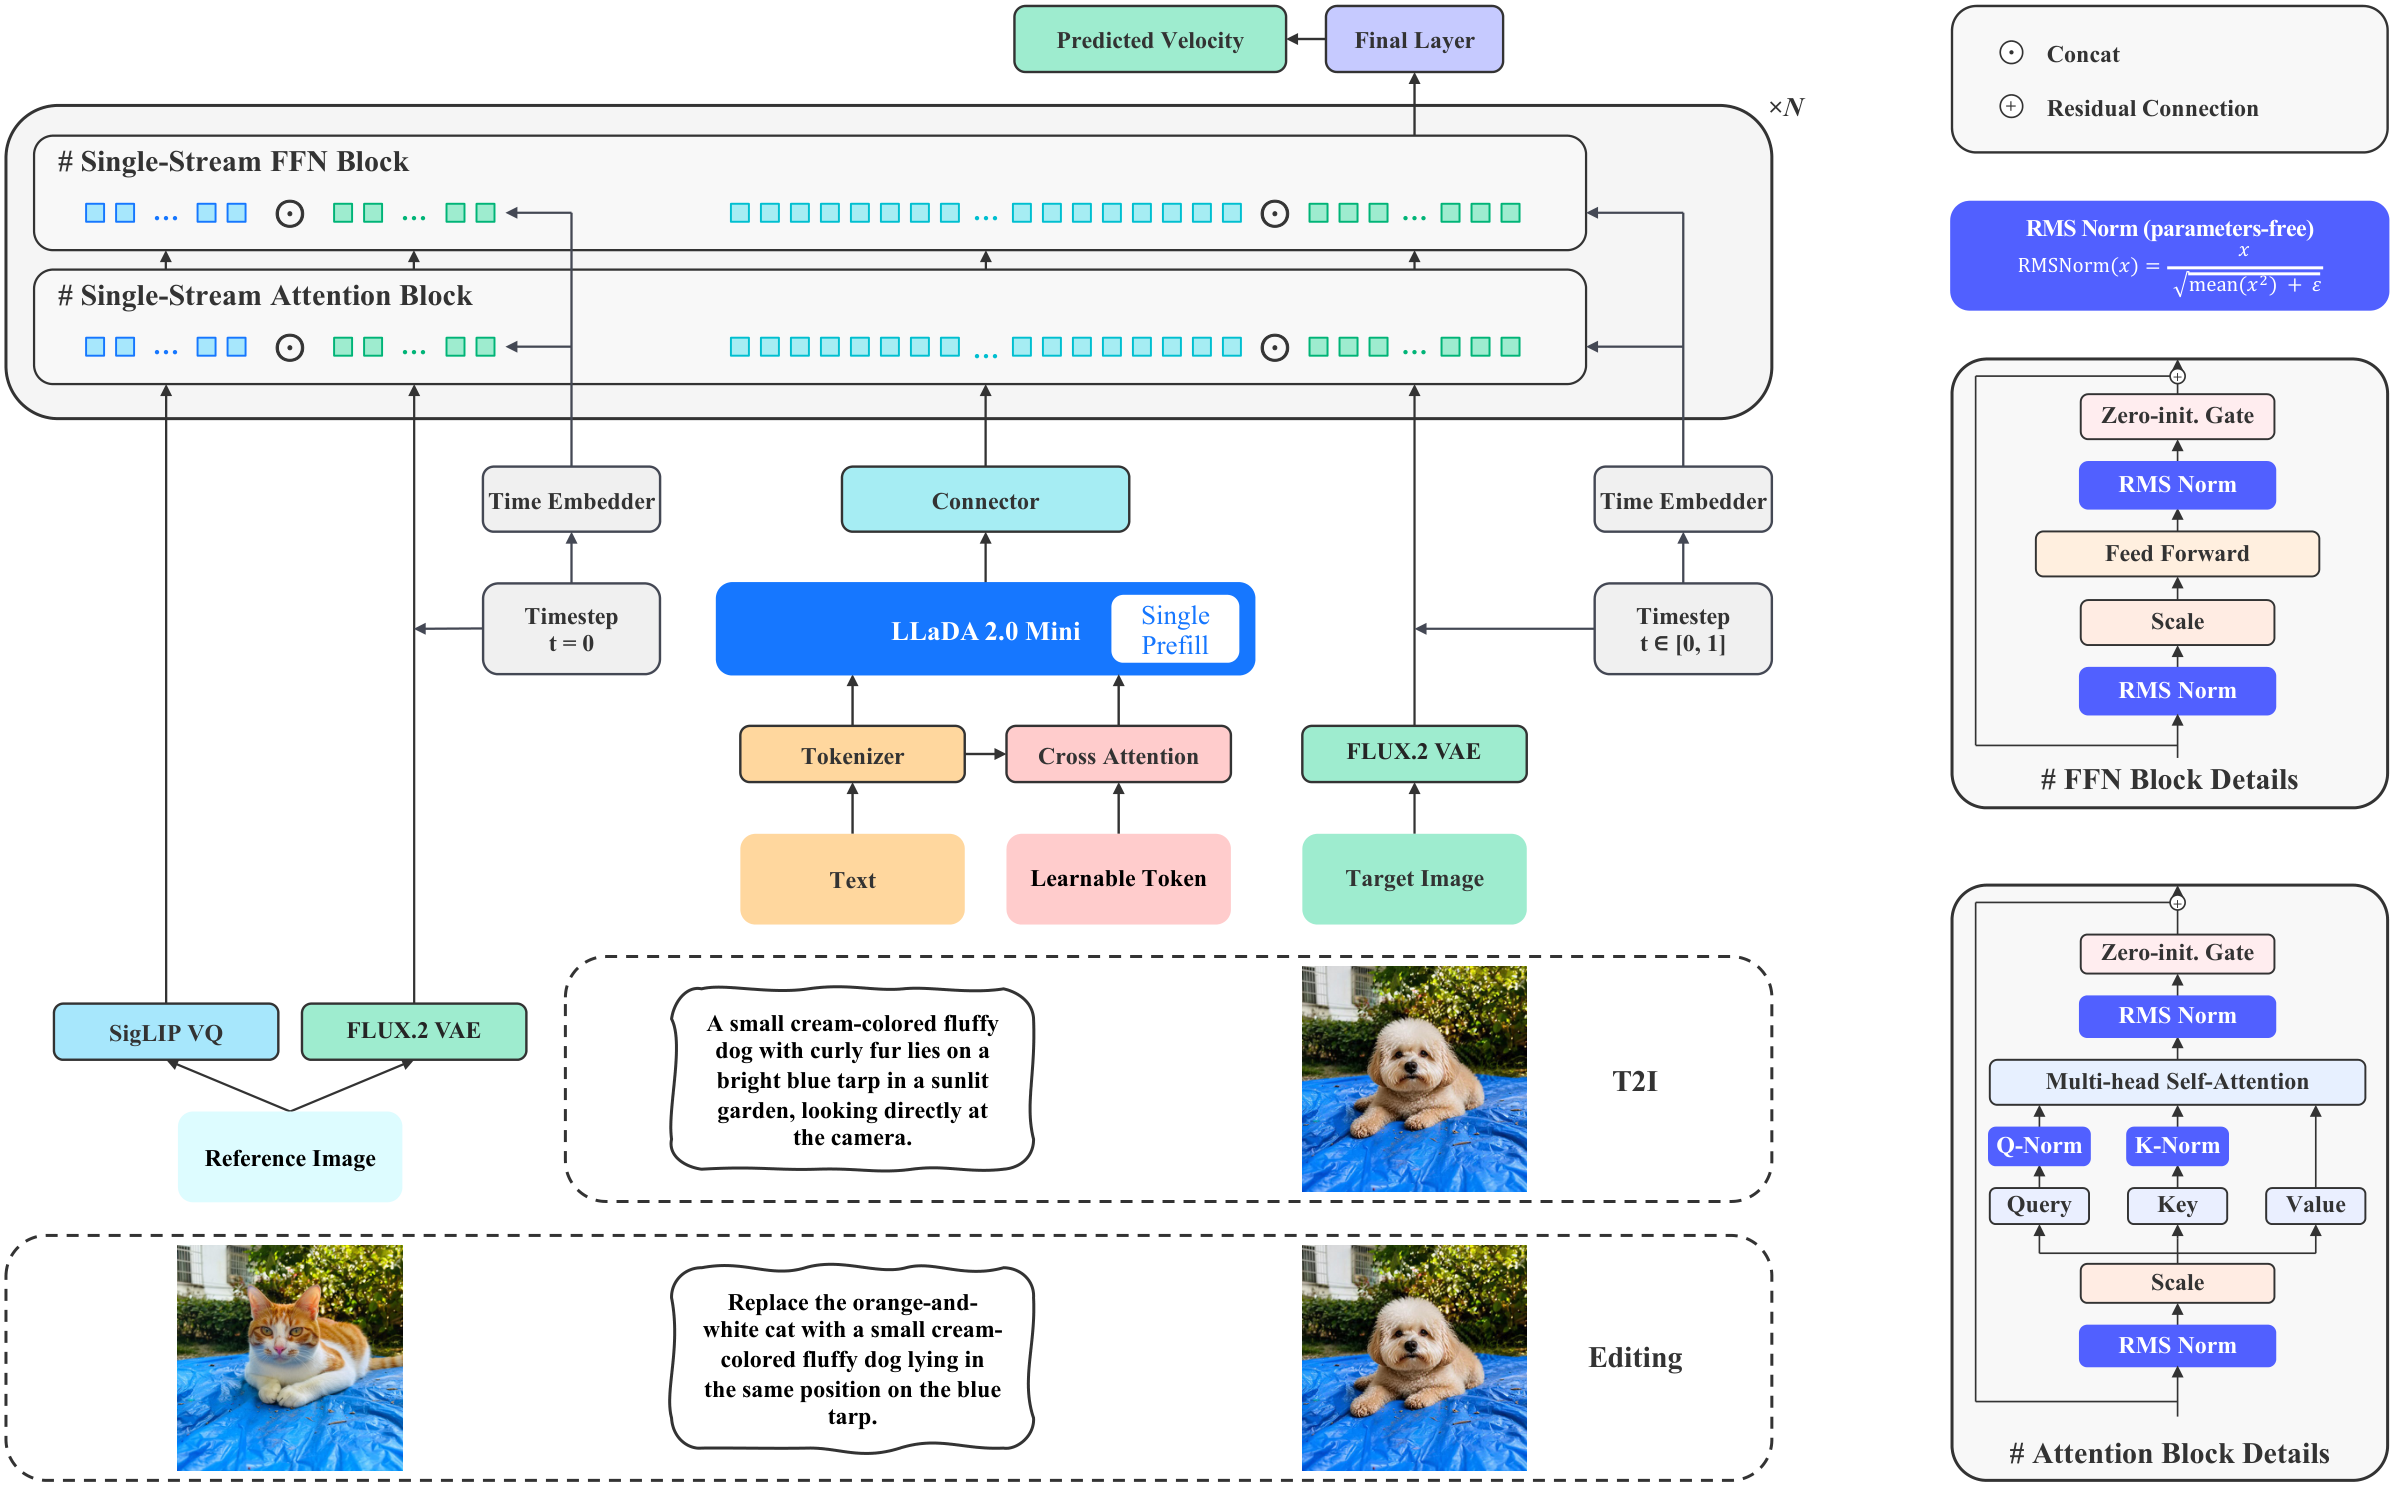
AIGC 每日速读|2026-09-14|SenseNova 8B原生视觉直出4K-SN-U15 今日 AIGC 论文速览 今日共 10 篇 · 统一视觉理解与生成 1 篇 · 实时视频与世界模型 2 篇 · 多模态智能体评测 3 篇 · 语音识别与压缩 2 篇 · 推理对齐与生成奖励 2 篇 重点论文标题列表 SenseNova-U1.5(OpenSenseNova 团队):8B原生视觉直出4K Vidu S2(清华大学、北京生数科技):720p实时视频25帧起 World in World(西湖大学 AGI Lab):冻结模型也能自由换镜头 MindTopo(西北大学、微软研究院、斯坦福大学):拓扑规划远逊人类 IdeaAMBIG(耶鲁大学、TCS Research):金标准让可实现率到98% 今日论文速览 1. SenseNova-U1.5:8B原生视觉直出4K SenseNova-U1.5: Towards Native Unified Visual Intelligence | OpenSenseNova 团队 | arXiv:2609.11929 关键词:统一多模态,图像生成,图像编辑,原生像素建模 前序问题:理解模型通常依赖视觉编码器,生成模型又依赖 VAE,两条链路使用不同表征,导致理解、推理、生成和编辑难在一个端到端模型里互相迁移;高分辨率生成还会放大局部块之间的不连续。 本文贡献:SenseNova-U1.5 用 8B 参数的 Mixture-of-Transformers 直接统一像素与文本,去掉外置视觉编码器和 VAE;空间耦合解码器修补逐块重建的边界,原生分辨率扩展到 4K。后训练分别优化审美、双语文字、信息图和编辑专家,再用多专家在线蒸馏合并能力。 实验效果:在作者报告的开放模型对比中,SenseNova-U1.5 的 GenEval 总分达到 0.92,DPG-Bench 为 88.11,CVTG-2K 平均分为 0.948;训练语料新增约 5900 万张图,且有效训练量中 88.2% 超过 1024²、64.4% 超过 2048²。 批判点评:原生像素路线减少了模块割裂,却把视觉 token 数量、像素重建和语言建模的竞争都压进同一主干,训练成本并未消失。论文展示大量自有数据与奖励流程,完整数据未开放前,4K稳定性、多语言文字和多参考编辑的复现门槛仍高。 2. Vidu S2:720p实时视频25帧起 Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation | 清华大学、北京生数科技 | arXiv:2609.11638 关键词:实时视频,流式生成,视频编辑,空间视频 前序问题:主流扩散视频模型要等整段去噪结束才能播放,用户无法在直播过程中换人物、改衣服或更新参考图;上一代 Vidu S1 也局限于 540p、固定参考和说话头像。 本文贡献:Vidu S2 把流式视频扩展为 Avatar 与 Editing 两条实时链路:通过回放式在线蒸馏、块因果时序注意力、高低噪声双阶段缓存、量化与多 GPU 流水线,在生成过程中接收新指令和动态参考;编辑分支支持风格、服装、角色及背景替换,并探索双目空间视频。 实验效果:Avatar 在 720p 下维持 25–42 FPS。Editing 在 Sparkle-Bench 获得 3.74 总分,在 OpenVE+RefVIE 联合评测得 4.26;虚拟试穿 VFID-I 为 9.9515,低于 CatV2TON 的 19.5131。长期人评中,对 Runway 的整体质量偏好率达到 85.7%。 批判点评:实时性建立在复杂的缓存、量化和多 GPU 调度上,普通消费级部署能否复现 720p 上限仍需实测。空间视频主要由单目结果与深度后处理构造,快速运动、遮挡边界和长时间身份漂移仍可能影响头显舒适度。 3. World in World:冻结模型也能自由换镜头 World in World: Explore the World with World Models | 西湖大学 AGI Lab | arXiv:2609.11548 关键词:世界模型,相机控制,视频重渲染,免训练控制 前序问题:从已有视频换视角时,模型既要跟上原事件的时间线,又要把已见物体放到新视角、补全未见区域,并在镜头返回时恢复先前外观;现有方案通常为每种控制额外训练模块。 本文贡献:World in World 把原视频观测、目标视角投影、几何渲染和历史生成帧都编码成带相机、时间与有效区域标签的干净视觉状态,直接送入冻结因果视频模型的原生自注意力。对应路由器建立 token 对应关系,EWA 在同一次去噪前向中分别调节各证据通道。 实验效果:在 DAVIS 与 OpenVid-1M 相机重渲染评测中,方法的七项 VBench 平均分为 85.192,优于次高的 84.295;平移误差 0.068622、旋转误差 2.8326°,并取得 23.1511 PSNR。去掉目标视角 warp 后,旋转和平移误差约升至完整方法的 3.4 倍和 10.9 倍。 批判点评:免训练接口很实用,但仍依赖深度、相机姿态、点对应和人体几何等外部估计,错误会作为“干净证据”被模型放大。新暴露区域依赖生成先验,几何合理不等于真实世界可恢复。 4. MindTopo:拓扑规划远逊人类 MindTopo: Can Foundation Models Reason in Topological Space? | 西北大学、微软研究院、斯坦福大学 | arXiv:2609.11900 关键词:空间推理,拓扑,多模态模型,智能体规划 前序问题:视觉空间评测多考距离、角度和形状,却很少检查连续性、分离、顺序、包围和打结这些在连续形变下保持不变的拓扑关系;看懂静态图也不代表模型能通过动作维持它。 本文贡献:MindTopo 用 13 类程序化任务构造 11030 个样本,把五种拓扑性质分别放在单步推理与闭环规划中测试;同时评估 14 个多模态大模型,并让图像或视频生成模型充当规划过程的视觉想象器。 实验效果:按任务宏平均,GPT-5.6-Sol 得 61.42%,明显低于人类的 97.87%;其静态推理为 66.83%,闭环规划降到 52.75%。Qwen3-VL-2B 经 SFT 后平均 28.83%,GRPO 为 18.69%;联合训练使推理到 51.53%,规划仍只有 6.33%。 批判点评:基准把“识别关系”和“操作关系”的差距量化得很清楚,但渲染风格、动作接口和精确匹配评分可能放大模型失误。生成下一状态有时只是画出合理终点,并未遵守环境动力学,说明视觉想象尚不能替代可执行世界模型。 5. IdeaAMBIG:金标准让可实现率到98% IdeaAMBIG: Benchmarking Implementation-Critical Gaps in Research-Idea Specifications | 耶鲁大学、TCS Research | arXiv:2609.10539 关键词:研究智能体,代码生成,需求澄清,可复现性 前序问题:研究想法可以新颖且逻辑自洽,却遗漏门控方式、损失定义或参数匹配口径;编码智能体若不识别这些关键空白,就会默默补假设,最终实现出另一个方法。 本文贡献:IdeaAMBIG 从论文、代码仓库、Issue 和复现记录构造 660 个有证据支撑的样本,其中 163 个是真实缺陷、497 个是受控注入缺陷,分别测试规格是否可编码、缺陷定位和已知缺陷后的澄清问题生成。 实验效果:13 个模型中,真实样本的最佳宏缺陷恢复率仅 9.6%;给出缺陷位置后,最佳宏澄清动作成功率升至 80.6%。在 oracle 实验里直接提供金标准解决方案,可把下游“可编码”率从 14% 提升到 98%。 批判点评:它抓住了研究自动化中常被忽略的输入质量问题,但真实缺陷只有 163 个,且证据多来自已有复现失败,可能偏向容易留下公开记录的项目。定位失败仍是瓶颈,单纯提高代码模型能力并不能解决规格缺失。 6. Xiaomi-CocktailASR-1:声纹提示直听目标说话 Xiaomi-CocktailASR-1 Technical Report | 小米集团 | arXiv:2609.11274 关键词:语音识别,目标说话人,鸡尾酒会,音频语言模型 前序问题:多人同时说话时,普通 ASR 会混写所有声音;传统目标说话人识别通常先分离再转写,误差会累积,而且不少系统在只有一人或目标不在场时容易误删、误认。 本文贡献:Xiaomi-CocktailASR-1 把参考语音与混合语音拼接,用 0.6B Data2Vec2 音频编码器同时提取内容和声纹,再接 Qwen3-8B 解码,不需要独立说话人编码器或语音分离。负样本训练让目标缺席时输出空文本,CoT 模式还显式判断人数、性别和声纹相似度。 实验效果:在 LibriMix 2mix 上,目标说话人 WER 从此前 4.84% 降到 4.11%;真实 AMI-SDM 从此前 22.0% 降到 20.63%。单人 LibriSpeech WER 为 1.73%,目标存在时误拒率 0.36%;AMI-IHM WER 为 8.89%,优于 Qwen3-ASR-1.7B 的 10.56%。 批判点评:端到端统一架构减少级联误差,但要额外提供干净参考声纹,且 8B 解码器对边缘设备并不轻。CoT 能给出可读理由,却不保证其人数或声纹判断忠实反映内部决策。 7. Mr.LHDR:深研链越长越容易失真 Mr.LHDR: A Benchmark for Multimodal Real-World Long-Horizon Deep Research Agents | MBZUAI、中国科大、浙江大学、腾讯 | arXiv:2609.11318 关键词:深度研究,多模态智能体,长链推理,评测基准 前序问题:现有深度研究基准多在几步检索后只看最终答案,难以判断智能体能否在十几步依赖链中持续保存证据,也会掩盖“答案碰对、过程已错”的情况。 本文贡献:Mr.LHDR 用隐藏节点关系图构造八类真实问题,平均要求 12.1 个必要中间结论、依赖深度 10.4;每题至少包含一个会改变推理状态的图像、地图、PDF、图表或视频帧,并同时评分最终答案、检查项和依赖一致性。 实验效果:最终答案最强的一次 GPT-5.5 运行只有 43.1% OA 和 34.3% 严格准确率;专用系统 o3 Deep Research 为 32.4% OA、19.6% 严格准确率。移除图片后,依赖感知检查分下降 12.6 个百分点,且链越长严格准确率越低。 批判点评:依赖图让过程评测更可信,但人工构造的唯一答案和必要路径可能排除等价证据链。网页随时间变化会让可复现性持续漂移,真正部署还要处理来源可信度、费用和权限,而不只是链长。 8. Negative Self-Distillation:远离坏推理反超正蒸馏 Negative Self-Distillation: Learning to Reason by Avoiding Flaws | 弗吉尼亚大学、斯坦福大学 | arXiv:2609.11699 关键词:自蒸馏,推理模型,负向教师,对齐训练 前序问题:在线自蒸馏让模型模仿带答案提示的高置信轨迹,可能压制不确定表达、探索和自我纠错;直接遗忘错误轨迹又会把普通语言 token 一并惩罚,损坏基础能力。 本文贡献:NSD 不模仿“知道答案”的自己,而让模型生成与题目相关的粗心负条件,再推动学生分布远离这个负教师;动态门控只挑出对推理行为关键的 token 更新,减少对标点和通用语言模式的误伤,也不依赖外部教师或标准答案。 实验效果:在 AIME 24/25/26、HMMT、AMC、OlympiadBench 和 MATH 七个数学基准上,NSD 相对基线平均提升:1.7B 模型 2.3%、4B 模型 7.5%、8B 模型 6.0%,并在论文实验中持续超过 OPSD 与其他无标签自举 RL 方法。 批判点评:负教师由模型自己生成,若它不能稳定描述真正的错误模式,训练信号可能只是风格差异。动态门控降低语言退化风险,却新增阈值和梯度设计;数学推理上的收益还需在代码、事实性与开放问答中验证。 9. GenV:生成奖励抓出伪正确 Beyond Solver Verdicts: Generative Reward Models for Autoformalization | 凯斯西储大学、Amazon Web Services | arXiv:2609.11085 关键词:自动形式化,生成奖励模型,Z3,神经符号推理 前序问题:Z3 等求解器只能确认给定形式化是否可满足,无法判断它是否忠实翻译了原题;一个写反的不等号仍可能返回同样 verdict,形成“结果正确但形式不等价”的伪正确。 本文贡献:GenV 先用离线 Z3 等价性 oracle 挖掘硬负例,再把参考等价判断蒸馏成不需要参考答案的连续生成式分数;它复用语言模型词表读出奖励,并用 logit lens 与稀疏自编码器分析错误坐标如何在内部形成。 实验效果:GenV+HN 在参考等价验证上取得 0.961 AUROC,远高于只看求解器 verdict 的机会水平 0.500;它可零样本迁移到未见翻译器和不同形式风格,并让智能体测试时算力分配的下游准确率提高 11.3 个百分点。 批判点评:生成式验证器比二元 verdict 更细,但它把“忠实性”重新交给学习模型,不能替代求解器的形式保证。若参考形式化有误、问题允许多种合理解释,等价性标签本身也会变得含糊。 10. X-AuT:音频塔减20.7%参数 X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation | 小鹏汽车 | arXiv:2609.11412 关键词:语音大模型,模型压缩,跨尺度蒸馏,音频编码器 前序问题:直接删除语音大模型的音频编码层虽能降延迟,却会扰动送入语言解码器的表示,造成漏字和过早结束;逐层试错成本又很高。 本文贡献:X-AuT 先用短行为探针筛选可删层组合,再逐步从 18 层压到目标深度;恢复阶段同时做表示对齐、跨尺度蒸馏、按计划切换学生策略监督和 LoRA 微调,语言主干保持冻结。 实验效果:Qwen3-ASR-0.6B 从 18 层压到 16 层后,十个中英基准宏平均错误率从 5.61% 降到 5.27%;14 层模型减少 20.7% 音频塔参数,错误率为 5.75%。渐进式 18→14 优于直接剪枝的 6.73%,1.7B 教师蒸馏为 5.55%,也优于自蒸馏的 8.45%。 批判点评:方法给出两个实用压缩点,但流程包含探针、分阶段剪枝、教师蒸馏和 LoRA,训练链条并不轻。语言主干冻结有利于稳定,也限制了模型共同适应严重音频压缩的空间。 趋势观察 生成与理解继续合并底层表征 SenseNova-U1.5去掉视觉编码器和VAE,把像素重建、语言理解、图像生成与编辑放进同一原生主干,统一模型的竞争开始深入到最底层视觉接口。 视频模型从离线片段走向实时世界 Vidu S2把720p Avatar和流式编辑推到25–42 FPS,World in World则用冻结骨干支持任意视角探索;实时交互、换镜头和长时记忆正在合流。 评测开始追踪过程而非只看终点 MindTopo要求动作过程保持拓扑,Mr.LHDR检查依赖链中间结论,IdeaAMBIG定位实现规格缺陷:一个看似正确的最终答案已不足以代表系统可靠。 后训练信号变得更细也更反直觉 NSD让模型远离坏推理,GenV把形式等价性蒸馏成连续奖励;相比简单模仿正确答案,新的对齐方法更关注错误来自哪个token、哪一步和哪种结构。 人工智能炼丹君 整理 | 2026-09-14 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-11|阿里13模型不会专业剪辑-CutCraft 今日 AIGC 论文速览 今日共 10 篇 · 音视频创作评测与安全 2 篇 · 可编程世界与物理视频 2 篇 · 生成后训练与统一多模态 2 篇 · 图像编辑与多视角生成 2 篇 · 设计自动化与合成数据 2 篇 重点论文标题列表 CutCraft(阿里巴巴、上海交通大学、复旦大学等):13模型不会专业剪辑 Programmable World Model(Alaya Lab):规则状态准确率98% ⚡ DIVA(Peng Li 等(ACM MM 2026)):参考图放大越狱风险 GGF(上海交通大学、中国电信人工智能研究院、中国科学技术大学):模型用自绘图反哺理解 FlowCPO(西湖大学、浙江大学、快手可灵团队):离线对齐GenEval达0.84 今日论文速览 1. CutCraft:13模型不会专业剪辑 Beyond Coherence: Benchmarking Professional Editing-Technique Execution in Multi-Shot Audio-Video Generation | 阿里巴巴、上海交通大学、复旦大学等 | arXiv:2609.08275 关键词:音视频生成,多镜头,剪辑评测,生成智能体 ⚠️ 前序问题:多镜头音视频模型已经能做出连贯、电影感强的片段,但现有评测多看画质、同步和物理合理性,无法判断模型是否真的执行了 J-cut、L-cut、转场时机和蒙太奇等专业剪辑指令。看起来像电影,不代表遵守了剪辑语法。 本文贡献:CutCraft 把结构化多镜头提示扩展为显式剪辑规格,并用镜头结构对齐、专家模型指标、工具化多模态判断和规则问答构成分层评测。作者还给出一个生成智能体基线:先规划镜头,再逐镜生成,最后做后期合成,使剪辑语义变成可执行步骤。 实验效果:对 13 个闭源与开源音视频生成模型的测试显示,当前系统普遍能维持内容连贯,却经常错过规定镜头数、转场关系和高阶蒙太奇;美学质量与剪辑指令遵循只有弱相关。智能体基线说明把剪辑拆成规划、生成和合成后更容易显式执行专业语法。 批判点评:混合评测仍依赖专家模型和多模态裁判,复杂剪辑意图可能被评分器误读。后期拼接能提升指令遵循,却可能掩盖底层生成模型不会原生控制镜头的问题;基准对真实剪辑师工作流、版权素材和长叙事的覆盖仍有限。 2. Programmable World Model:规则状态准确率98% Programmable World Model | Alaya Lab | arXiv:2609.10540 关键词:世界模型,视频生成,可编程状态,交互游戏 ⚠️ 前序问题:交互式视频世界模型能生成逼真的下一帧,却通常把角色生命值、阵营、库存和任务进度隐含在像素历史里。实体离开画面后,模型容易忘记它是否存活;自然语言提示也只能描述结果,无法保证规则在长时间交互中被稳定执行。 本文贡献:Programmable World Model 把世界状态演化与视觉生成拆开。编码智能体把自然语言规则写成可执行程序,轻量引擎维护包含屏外实体和非视觉属性的权威状态;状态增强的 3D 定向包围盒再经确定性编译器投影成身份、语义和运动方向控制图,预训练视频模型只负责把状态渲染成画面。 实验效果:在作者新建的 CombatStateBench 上,系统的存活角色数量准确率达到 94%,状态准确率达到 98%,并能在长时战斗交互中维持实体状态。它还支持用户预先编写游戏机制、逐个控制实体,并在镜头移开后继续保存世界事实。 批判点评:显式引擎让规则可验证,但也把开放世界压缩成包围盒、离散属性和手写转移规则;复杂物理、细粒度姿态与不可预设事件仍交给生成器补全。论文基准集中于战斗场景,面对大规模地图、多玩家并发和长期程序错误时的扩展性仍待验证。 3. DIVA:参考图放大越狱风险 The Price of Consistency: Exploiting Visual Anchors for Multimodal Jailbreaking in Video Generation | Peng Li 等(ACM MM 2026) | arXiv:2609.07216 关键词:视频生成,安全评测,多模态越狱,参考图控制 ⚠️ 前序问题:图生视频用参考图锁住主体和场景,提高时空一致性,但安全系统往往只重点审查文字。模型原本可能把危险提示漂移成无害内容,视觉锚点却会把生成过程拉回参考图中的危险意图,形成一致性越强、逃逸空间越小的安全悖论。 本文贡献:DIVA 是一个免训练多模态越狱框架,把危险意图拆成静态参考图和看似普通的运动提示,并用双重标准筛选兼顾隐蔽性与语义保真度的组合。论文同时提出 TI2VSafetyBench,用于专门评测多条件视频生成中的视觉锚定风险。 实验效果:作者在多家主流商业平台和开源视频模型上测试,DIVA 的攻击成功率显著高于纯文本攻击,说明只过滤提示词不足以覆盖图像与运动描述共同表达的风险。论文已被 ACM MM 2026 接收。 批判点评:攻击依赖先获得合适的危险参考图,现实系统还可能在上传、编码和输出阶段做二次视觉审核。公开越狱流程有双重用途风险;防御评估需要同时覆盖输入图、运动文本、跨模态组合和生成结果,且必须在平台更新后持续重测。 4. GGF:模型用自绘图反哺理解 Dreaming in Flow: Generative Grounding Feedback for Self-Evolving Unified Multimodal Models | 上海交通大学、中国电信人工智能研究院、中国科学技术大学 | arXiv:2609.08282 关键词:统一多模态,自训练,流模型,图像生成 ⚠️ 前序问题:统一多模态模型把理解和生成放进同一网络,却仍把两种能力当作独立任务训练。直接用模型自生成图像做自训练又会放大漏物体、属性错误和空间关系失真,缺少一种让生成经验反哺理解、再由理解修正生成的闭环。 本文贡献:生成接地反馈 GGF 只使用文本提示和模型自己的视觉梦境。流级反馈在同一噪声潜变量上比较文本、图像与修复条件的预测方向,把图像接地信息传回文本条件;梦境回放则通过描述和再想象,让可验证事实在两次生成间保持一致,并分离无关经验。 实验效果:在采用不同理解—生成融合设计的统一模型上,GGF 都带来一致的文生图提升,同时让视觉理解获得幅度较小但稳定的增益。方法不依赖额外成对图文数据,说明模型自身生成的图像可以成为双向训练信号。 批判点评:自生成经验仍受初始模型能力上限约束,流级一致不保证图像事实正确。回放和修复增加训练计算,如何过滤系统性偏见、避免错误闭环以及在闭源生成器上复现,仍是落地障碍。 5. FlowCPO:离线对齐GenEval达0.84 FlowCPO: A Unified Divergence View of Preference Alignment for Flow Models | 西湖大学、浙江大学、快手可灵团队 | arXiv:2609.09905 关键词:流模型,偏好对齐,离线优化,前向KL ⚠️ 前序问题:流与扩散模型的偏好对齐分成在线强化学习和离线偏好优化两派:前者必须不断从当前模型采样,成本高;后者常用正样本微调或似然比近似,既难解释与在线目标的关系,简化回归损失还可能无下界。 本文贡献:FlowCPO 用散度视角统一这些方法,并提出无需在线回滚的离线前向 KL 目标,同时利用偏好和拒绝样本。在线性插值及明确正则条件下,作者把前向 KL 上界化为可在固定数据上优化的对比流匹配损失,并证明该损失非负。 实验效果:在域内实验、CFG=3.0 时,FlowCPO 的平均 GenEval 与 OCR 分数分别为 0.84 和 0.87,高于 FlowDPO 的 0.81 和 0.74。域外测试中它取得最佳 GenEval,但多项奖励分数低于 RFT,结果并非全面领先。 批判点评:理论上界依赖线性插值和正则条件,真实大模型训练是否满足需要验证。离线数据省掉采样,却继承偏好数据覆盖与标注偏差;负样本权重、参考先验和插值系数也会带来额外调参成本。 6. PhysFlow:5万物理视频教会运动 PhysFlow: Physics-Aware Optical Flow for Motion Controllable Video Generation | 中科院自动化所、中国科学技术大学、北京航空航天大学、中关村学院 | arXiv:2609.08215 关键词:视频生成,物理一致性,光流,运动控制 ⚠️ 前序问题:视频生成器能做出漂亮纹理,却常出现碰撞错误、非刚体变形失真和前景背景接触不合理。完整物理引擎依赖准确 3D 重建和材料参数,文字或稀疏轨迹又不足以描述像素级形变,需要一种介于模拟状态和最终外观之间的密集运动表示。 本文贡献:PhysFlow 把生成拆成两步:PA-Flow 根据速度、加速度、密度和杨氏模量生成物理感知光流,分别建模全局运动与局部形变;FlowRender 再以光流视频为条件合成纹理。配套 PhysVideo 用物理引擎与 3D Gaussian Splatting 构建显式监督。 实验效果:PhysVideo 包含 1 万个前景物体和 5 万段带运动、材料属性标注的视频。实验显示 PhysFlow 在保持视觉质量的同时提升物理合理性,并能从单图处理非刚体运动、物体交互及前景背景接触。 批判点评:光流适合二维位移,却无法显式表达遮挡后的三维结构、拓扑变化和长期守恒量;两阶段误差也会累积。方法仍需用户或数据提供材料与运动属性,开放世界里这些参数通常难以可靠获得。 7. MIEdit:千组编辑基准无需调参 Multi-History-Step SDE Inversion for Image Editing with Superior Regional Awareness | 中科院自动化所、国科大(ECCV 2026) | arXiv:2609.06602 关键词:图像编辑,SDE反演,语义遮罩,免训练 ⚠️ 前序问题:免训练扩散编辑要在重建原图与服从新提示之间取舍。现有 ODE/SDE 反演步数多、编辑幅度受限,增大 CFG 还可能产生伪影;非编辑区域保护通常需要额外遮罩输入或独立分支。 本文贡献:MIEdit 用预测—校正的多历史步 SDE 反演,在每一步复用至少两个历史项,以更少步数提高稳定性和编辑可塑性;同时调整噪声日程缓解大幅编辑冲突。IASM 在反演早期借助 CFG 方向自动生成语义角度遮罩,并贯穿后续采样约束区域。 实验效果:作者构建 EditEval++,覆盖 30 个细粒度任务和超过 1,000 组图像—文本—遮罩三元组。实验显示 MIEdit 在无需微调、无需外部遮罩的条件下超过所比较方法,并能把输入重建到数值精度范围。论文已被 ECCV 2026 接收。 批判点评:多历史项会增加缓存与实现复杂度,自动遮罩质量仍依赖基础模型的 CFG 响应。论文主要围绕扩散 SDE 编辑,迁移到流匹配模型、超高分辨率和多对象关系编辑时是否稳定还未充分验证。 8. StreetDiff:全景约束街景多视角 StreetDiff: Multi-view Street Scenes Generation via Cross-view Consistent Multi-view Stable Diffusion with Structure Prompts | 深圳大学 | arXiv:2609.09890 关键词:多视角生成,街景,全景图,结构控制 ⚠️ 前序问题:多视角扩散在室内或简单自然场景表现不错,面对道路、建筑和动态目标密集的城市街景时,镜头旋转后容易重复物体、扭曲建筑和破坏布局。相邻视角注意力缺少球面几何对应,难维持全局结构。 本文贡献:StreetDiff 让全景分支负责全局布局、透视分支负责局部细节,并用 Panorama Alignment Module 按球面投影建立跨视角注意力约束。结构提示可来自分割图、轮廓或草图;作者还构建带文本和密集结构标注的 HDR 城市全景数据集 Street360。 实验效果:实验显示 StreetDiff 在街景生成质量和多视角几何一致性上超过所比较基线,尤其改善纯文本条件下的建筑与道路结构;它无需修改扩散骨干即可注入几何对齐。 批判点评:球面全景是有效的全局脚手架,但真实街区包含强遮挡、动态交通和大范围深度变化,二维投影约束仍可能失效。Street360 的地域与天气覆盖、从合成多视角到可导航 3D 场景的差距也需要检验。 9. LoGAN:少量字形扩展27种语言 LoGAN: Multilingual Font Localization with Generative Agents | Netflix(ECCV 2026) | arXiv:2609.07029 关键词:字体生成,多语言,VLM智能体,扩散模型 ⚠️ 前序问题:把一个品牌字体或电影 Logo 本地化到新语言,不只是生成单个字形,还要保留笔画风格、纹理、颜色、字距和字偶距。通用生图模型常改乱排版,传统字体生成又难从拉丁字母跨到结构复杂的中日韩字符。 本文贡献:LoGAN 用 VLM 智能体协调字形级扩散、少样本风格微调、字距与字偶距迁移以及纹理扩展模块。输入少量原字体字形或 Logo 字母后,系统分别解决结构、排版和材质,再组合成目标语言的完整字符集。 实验效果:论文覆盖超过 27 种语言,包括拉丁、希腊、西里尔与中日韩文字;在字体和真实 Logo 数据上,相比字体专用模型及 FLUX、Nano-Banana 等编辑模型取得更高字形保真度,并更好保持风格、纹理和字距。400 个电影 Logo 样本中有 44% 基于字体制作。 批判点评:多模块流水线提升可控性,也放大任一环节的误差和运行成本。少数字形可能不足以覆盖复杂脚本的部件组合、书写规范与文化设计语义;字体版权、人工修字和完整字符编码支持仍是商业落地条件。 10. AnomalyCraft-700K:4万异常视频70万标注 AnomalyCraft-700K: Component-Level Controllable and Verifiable Synthetic Anomalies for Fine-Grained Video Anomaly Understanding | 西北工业大学、新加坡管理大学 | arXiv:2609.06978 关键词:视频生成,异常检测,合成数据,多模态理解 ⚠️ 前序问题:真实异常视频稀少、难控制,已有合成数据通常只按类别或整句提示生成,提示与画面细节不一定一致,也缺少靠近正常—异常边界的困难正常样本,模型容易根据表面线索而非事件语义判断。 本文贡献:AnomalyCraft 把异常事件拆成场景、背景、主体、物体和有向交互五类组件,通过三阶段生成逐步放松非关键约束。相同组件同时作为核验单元,定位并人工修正视频—文本偏差;每个异常类别还配套语义接近但实际正常的困难反例。 实验效果:数据集包含超过 4 万段视频和 70 万条任务级文本标注,覆盖从异常检测、检索、描述到细粒度推理的六类任务。传统模型和多模态大模型评测都显示,它能为异常检测与理解提供有效监督。 批判点评:合成器的视觉偏差可能成为捷径,组件级人工修正也带来高成本和主观性。模型在该数据上提升不代表真实监控、开放场景和未见异常同样受益,需与真实数据混合训练并做跨域验证。 趋势观察 生成评测开始检查专业过程 CutCraft不再只看画质和连贯性,而是逐项检查镜头、转场和音画剪辑语法,说明创作模型的评价对象正在从结果扩展到过程执行。 世界模型从像素记忆走向权威状态 Programmable World Model把规则与实体状态交给可执行引擎,生成模型退回渲染器角色;可验证状态开始成为长期交互的一等公民。 条件越强,跨模态安全面越大 DIVA揭示参考图既提升一致性也会固定危险意图;安全策略需要联合审查图像、文字运动条件与输出,而不能只过滤提示词。 生成模型用结构中间态换取控制 从PhysFlow的光流、StreetDiff的全景几何到MIEdit的语义角度遮罩,低维且可解释的中间表示正在连接高层意图与像素生成。 人工智能炼丹君 整理 | 2026-09-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
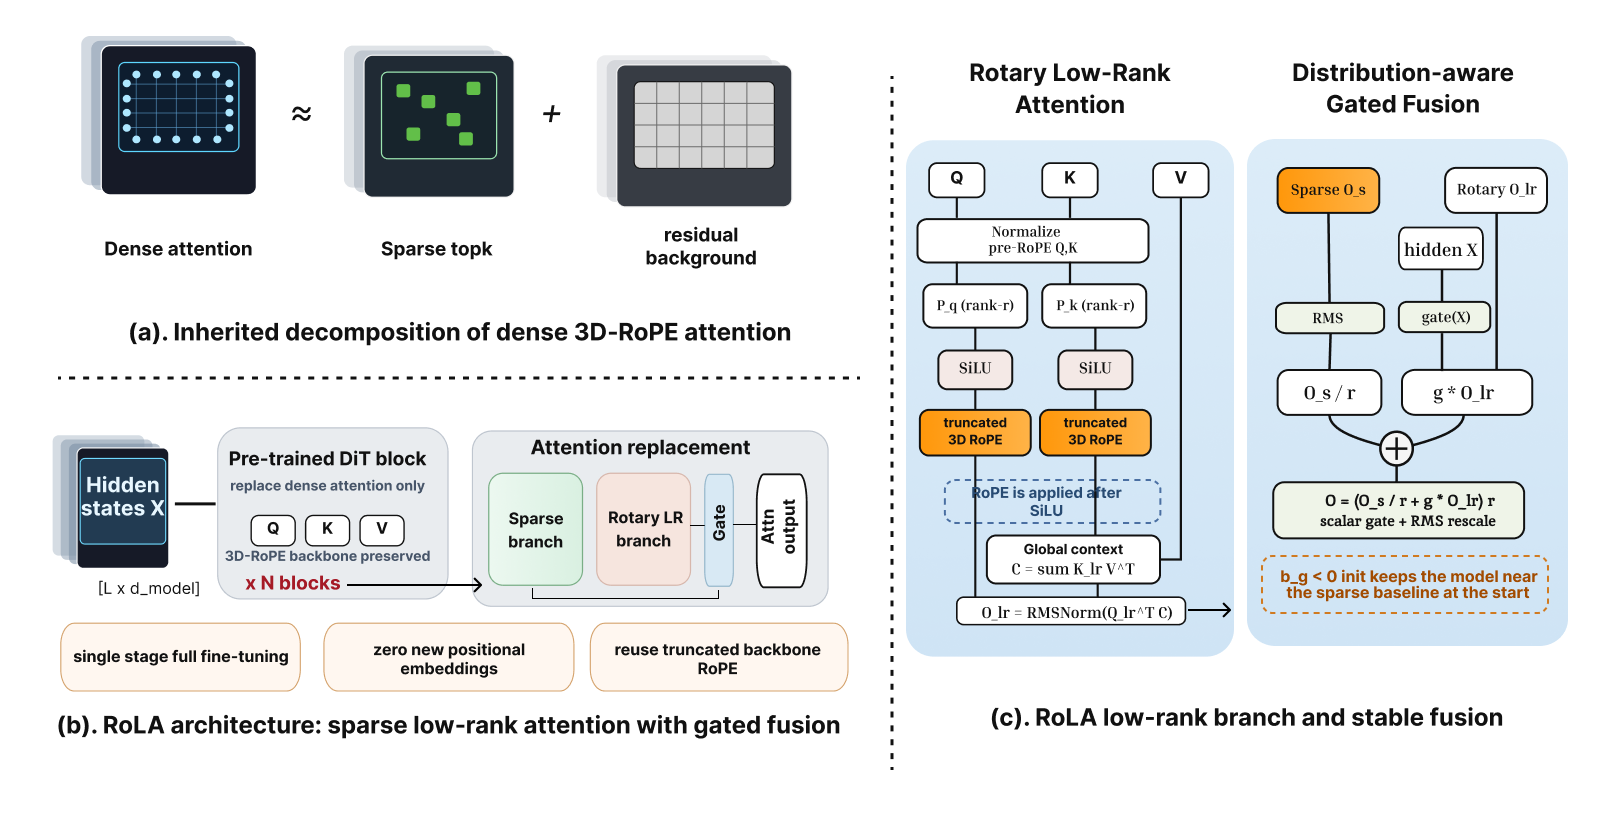
AIGC 每日速读|2026-09-10|90%稀疏视频DiT加速2.63倍-RoLA 今日 AIGC 论文速览 今日共 10 篇 · 高效与流式视频生成 3 篇 · 可控动作与手语生成 2 篇 · 生成基础设施与评测 3 篇 · 图像生成与编辑 2 篇 重点论文标题列表 RoLA(北京大学、清华大学、电子科技大学、阿里巴巴等):90%稀疏视频DiT加速2.63倍 Mask Forcing(香港科技大学(广州)、香港科技大学、加州大学圣迭戈分校等):给自回归蒸馏注入干净令牌 FlexMoGen(布朗大学、Epic Games、加州大学戴维斯分校、犹他大学):文字定内容,参考动作定风格 Decoupled SF(Yanru An 等):流式数字人15.4FPS且延迟1.3秒 Miles v0.1(RadixArk):744B模型异步RL跑上64张GB300 今日论文速览 1. RoLA:90%稀疏视频DiT加速2.63倍 RoLA: Rotary-Positioned Low-Rank Linear Attention for Efficient Diffusion Transformers | 北京大学、清华大学、电子科技大学、阿里巴巴等 | arXiv:2609.06712 关键词:视频生成,稀疏注意力,线性注意力,扩散Transformer 前序问题:视频扩散 Transformer 的时空令牌很长,稠密自注意力随序列长度平方增长。稀疏分支可以省计算,却会丢掉维持场景、运动和语义一致性的远程联系;现有低秩全局补偿又难同时保留 3D RoPE 的相对位置结构与可复用的线性摘要。 本文贡献:RoLA 将注意力拆成固定稀疏局部分支与低秩全局分支。它先把查询和键投影到低秩空间并通过非线性,再施加截断后的预训练 3D RoPE;这样旋转不会被非线性打乱,全局键值摘要可对所有查询复用。令牌级门控负责把局部尖峰与平滑全局背景重新融合,无需新增位置参数。 Architecture overview of the proposed method. (a) Dense 3D-RoPE attention decomposes into sparse top-$k$ spikes and a residual background. (b) The method replaces dense attention in pre-trained DiT blocks with sparse--low-rank branches and gated fusion, reusing backbone RoPE without additional positional embeddings. The right part shows the rotary low-rank branch and distribution-aware gated fusion. 实验效果:在 Wan2.1-14B 的 720p、81 帧设置上,RoLA 在 90% 稀疏率下仍保持有竞争力的生成质量,并在单张 NVIDIA H100 上取得 2.63 倍端到端推理加速。机制实验中,截断秩 r=64 的时间与高度相对位置余弦相似度都达到 0.93。 Deployment-oriented efficiency summary on RTX 5090 (different from the benchmark evaluation setting). Panel (a) shows representative fixed-setting deployment latency, panel (b) shows theoretical self-attention FLOPs per denoising step, and panel (c) shows long-sequence deployment latency. 批判点评:RoLA 需要对替换注意力后的完整骨干做单阶段全参数微调,部署收益并非零训练获得。低秩分支只解决高稀疏率下的全局补偿,稀疏局部分支本身沿用既有方案;更长视频、不同 RoPE 划分和消费级 GPU 上的质量—速度曲线仍需验证。 2. Mask Forcing:给自回归蒸馏注入干净令牌 Mask Forcing: Improving Autoregressive Video Diffusion Distillation via Dual-Noise Masking Rollout | 香港科技大学(广州)、香港科技大学、加州大学圣迭戈分校等 | arXiv:2609.09123 关键词:视频生成,自回归扩散,分布匹配蒸馏,模式坍塌 前序问题:用反向 KL 的分布匹配蒸馏把双向视频扩散教师压成因果学生时,目标偏向追逐少数高概率模式。学生在自回滚中容易越来越饱和、平滑,并把早期误差持续传给后续片段。 本文贡献:Mask Forcing 在学生自回滚期间沿空间和时间轴随机遮罩,用更干净、较低噪声的令牌替换部分高噪声输入。扰动让学生探索教师分布中尚未覆盖的区域,同时干净令牌给邻近噪声令牌提供去噪参照,从而缓解模式坍塌与长时误差积累。方法可插入多种 DMD 自回归蒸馏流程,不需要真实视频或额外后训练阶段。 实验效果:在 30 秒 LongLive 设置上,加入 Mask Forcing 后 HPSv3 从 8.44 提升到 9.11,VBench 总分从 83.91 提升到 84.51,语义分从 80.70 提升到 81.44。论文还报告它在逐帧和分块设置下普遍改善视觉质量与指令遵循。 批判点评:收益依赖遮罩比例、噪声窗口和更新粒度,表明它仍是一套需要按骨干与任务调参的训练策略。论文主要在既有因果视频蒸馏管线上验证,尚未说明对完全不同教师、极长序列或交互式状态更新是否同样稳定。 3. FlexMoGen:文字定内容,参考动作定风格 Flexible Motion Generation from Language and Style References | 布朗大学、Epic Games、加州大学戴维斯分校、犹他大学 | arXiv:2609.08032 关键词:人体动作生成,文本到动作,风格迁移,潜扩散 前序问题:文本很适合描述“做什么”,却难精确表达节奏、肢体发力和情绪动态;离散风格标签又无法覆盖未见风格、长动作或同一序列里的风格切换。 本文贡献:FlexMoGen 同时输入自然语言与风格动作片段,用无风格标签监督的变分编码器提取连续风格,再通过轻量适配模块调制文本到动作的潜扩散模型。统一预训练、相对位置编码和时变风格控制使模型可以合成长序列、多风格过渡以及未见过的文本—风格组合。 Overview of our style-adapted text-to-motion framework. The input content motion $x_c$ is encoded by a pretrained motion encoder, and Gaussian noise is added to its latent embedding. The text-to-motion (T2M) model (top right) consists of $7$ Transformer encoder layers that take motion, text, and time embeddings as inputs. Each self-attention block incorporates relative positional encoding into the key and value projections. During style finetuning, the T2M backbone is frozen, and only the weight matrices $W_s^{K}$ and $W_s^{V}$ in the Style Adaptation Module (SAM) are trained. SAM encodes a style example $x_s$ and injects its outputs as additive biases to the $K$ and $V$ vectors in the attention layers, guiding the network to preserve the semantics of $x_c$ while reflecting the style of $x_s$. 实验效果:22 名参与者给出 330 次成对判断。相对 SMooDi,FlexMoGen 在内容保持、风格反映和整体动作质量上的偏好率分别为 61.1%、67.7% 和 71.3%;相对 T2M+MP,内容和质量偏好率达到 82.1% 与 94.0%。 User study results (pairwise preference, % favoring ours). Left: FlexMoGen vs. T2M+MP. Middle: FlexMoGen vs. SMooDi. Right: FlexMoGen vs. LoRA-MDM. Criteria are content preservation, style reflection, and motion quality. 批判点评:风格参考本身可能同时携带动作内容,编码器是否真正解耦仍难完全证明。用户研究规模较小,长序列测试只含一次风格过渡;快速连续切换、接触物理和手部细节还需要更严格评测。 4. Decoupled SF:流式数字人15.4FPS且延迟1.3秒 Decoupled Self-Forcing Distillation for Streaming Talking Head Generation | Yanru An 等 | arXiv:2609.10317 关键词:说话人视频,流式生成,自强制蒸馏,动作潜变量 前序问题:端到端音频驱动视频扩散把音频条件融合到整幅视频潜变量,而身份、背景和外观大多与音频无关,既浪费容量也容易模糊细节。便宜的两阶段方法先生成动作,再渲染视频,却常因动作空间监督不足而损失画质。 本文贡献:该方法先在与身份解耦的低维动作空间里融合音频和动作字幕,由小型因果自回归 Transformer 生成动作潜变量,再交给预训练扩散渲染器。解耦自强制蒸馏用同一个冻结视频教师监督两条流:有动作条件时蒸馏因果渲染器,无条件时以真实视频给渲染回滚打分,反向约束动作生成器。 Overview of Motar. (a) An AR motion transformer models causal dependencies over motion latents, with an efficient diffusion head producing continuous-valued latents; a user-written motion caption and the driving audio are fused into a global condition query by a Q-Former projector. (b) Hierarchical conditioning: the global query is injected by full cross-attention for coarse, sequence-level control, while raw audio embeddings are injected by windowed cross-attention for frame-level lip articulation. (c) Decoupled self-forcing distillation: the frozen bidirectional teacher $G$ supervises both branches by distribution matching. Conditioned on motion, it distills $G$ into a block-causal student $G_\phi$; unconditionally, it matches the rendered motion rollout against the distribution of real talking videos. 实验效果:动作生成与视频渲染两条因果流并行运行,论文报告达到 15.4 FPS、首段延迟 1.3 秒,并称相对非流式教师没有质量退化。 Qualitative comparison with Wan-based end-to-end methods. For each result we show five frames with the spoken word beneath; the phoneme being articulated is highlighted in red (e.g. the “oo” in “look”), so that lip shape can be checked against the sound at each frame. Our method produces the tightest audio--lip alignment and the sharpest facial detail. 批判点评:动作空间没有天然的双向教师,论文借渲染结果间接监督,效果会受动作表示和渲染器上限共同影响。身份解耦在极端表情、遮挡与头部大幅运动下是否成立,以及跨语言口型和长时间漂移,仍需更大规模验证。 5. Miles v0.1:744B模型异步RL跑上64张GB300 Miles v0.1: Production-Level Post-Training | RadixArk | arXiv:2609.08368 关键词:大模型后训练,强化学习,SGLang,分布式训练 前序问题:前沿模型的强化学习已经包含多轮工具调用、超长回滚和异步环境,生成、训练与权重同步任一环节的不一致都会让 on-policy 假设失效;现有框架往往只覆盖某种后端或缺少生产级可观测性。 本文贡献:Miles 以 SGLang 负责回滚,训练端可选 Megatron-LM 或 PyTorch FSDP,并提供点对点、共享桶和磁盘增量等三类权重同步路径。系统统一支持全参数与 LoRA 强化学习、on-policy 蒸馏、SFT、真正的 rollout—training 对齐,并把同一架构扩展到扩散模型。 实验效果:端到端案例在 64 张 NVIDIA GB300 上对 GLM-5.2 744B-A40B 做终端编码任务的全异步智能体强化学习,前 30 个统计步骤的中位耗时为 263 秒。项目已开源代码与部署文档。 批判点评:64 张 GB300 的案例展示了规模上限,也意味着复现门槛很高。异步回滚会带来策略陈旧度、环境版本和样本重放偏差,系统提供校正机制,但不同任务下的稳定边界仍需独立验证。 6. VI-Bench:反推视频提示词最高仅得0.632 VI-Bench: Benchmarking Prompt Inversion from AIGC Videos | 中国科学院自动化研究所、弗吉尼亚大学、新加坡国立大学等 | arXiv:2609.08079 关键词:视频理解,提示词反演,生成评测,多模态模型 前序问题:视频描述只需说出画面内容,能够复现的提示词还要恢复风格、镜头运动和多镜头结构。现有视频理解基准没有测试“反推提示词后重新生成,能否回到原视频”,也难评估提示泄露风险。 本文贡献:VI-Bench 从 1610 万条真实用户提示中清洗出约 390 万条,构建 900 个经人工核验的 AIGC 视频,覆盖单镜头语义、风格与镜头控制、多镜头组合三档难度。它让 18 个视觉语言模型反推提示,再用原生成器回放,并联合原提示对齐与回放视频保真计算 Inversion Score。 实验效果:最强模型的总体 Inversion Score 只有 0.632;难度从单镜头升到多镜头后表现明显下降。主题与风格的“文本看似正确、回放却不像”差距最大,说明视频字幕能力不能替代可执行的生成控制恢复。 批判点评:提示反演同时涉及创作复用与隐私攻击,分数更高并非在所有场景都更好。基准把开放式提示压成五个维度,仍可能漏掉负面提示、采样器与种子等无法从画面稳定恢复的控制因素。 7. RelightFormer:9万物体训练多视角直接换光 RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting | 香港理工大学 | arXiv:2609.07414 关键词:图像重光照,多视角生成,生成Transformer,环境光照 前序问题:逆渲染要从图像分解几何、材质和光照,是高度欠定的优化问题;单图生成式重光照又忽略跨视角线索,难以在镜面、透明和毛发材质上保持一致。 本文贡献:RelightFormer 从视频基础模型改造出前馈生成 Transformer,用光照交叉注意力把目标环境贴图动态注入空间特征,并用对输入顺序不敏感的位置编码对称处理无序多视角。训练数据 LOD 包含 9 万个 Objaverse 物体与 3.9 万种独特光照,不显式估计法线、反照率等内在属性。 Architecture of RelightFormer. Input modalities (noise, reference images, and an environment map) are first patchified into token sequences, with ray embeddings added to encode stereo geometric priors. Noise and reference tokens are concatenated and processed through two parallel attention pathways: a multi-view self-attention module for intra- and cross-view feature aggregation, and an illumination attention module that dynamically injects lighting cues into spatial features. The outputs of both branches are element-wise summed and passed through an FFN. After the final layer, reference tokens are discarded, and the updated noise tokens are used to predict the flow-matching velocity field. For clarity, VAE encoding and decoding stages are omitted. 实验效果:在真实 OLATverse 材质分组上,RelightFormer 在多数类别取得最高前景指标;例如金属物体 sPSNR/PSNR 为 22.84/19.88,毛发物体为 17.75/14.28,并支持单视角、多视角和新视角的零样本重光照。 Qualitative results for multi-view image relighting in real-world OLATverse Dataset. 批判点评:绕过显式物理分解提升了易用性,却也降低了光照与材质参数的可解释性。9 万合成物体的材质分布与真实拍摄存在域差,复杂遮挡、非刚体和未知相机标定下的多视角一致性仍是风险。 8. AV-SafetyBench:只看视频会漏掉近半音画风险 AV-SafetyBench: A Safety Benchmark for Text-to-Audio-Video Generation | Suah Choi 等 | arXiv:2609.06991 关键词:音视频生成,安全评测,跨模态风险,生成基准 前序问题:文字到音视频模型同时生成画面、语音、音效和环境声,危险内容可能只藏在音轨,或由无害画面与无害声音组合后产生。只评视频或只评音频会系统性漏检。 本文贡献:AV-SafetyBench 建立四个轴、13 类风险的分类体系与 5200 条人工复核提示,分别从完整音画、仅视频、仅音频三种视角判定输出,再把完整音画风险归因到视频、音频、双模态各自危险或跨模态组合危险。 实验效果:五个开源音视频生成模型的完整音画不安全率为 25.1% 至 49.4%。在四个模型中,音频独有与音画联合风险占可归因不安全样本的 41.6% 至 48.3%;跨模态伤害类别中,87.5% 来自音画组合后才出现的风险。 批判点评:风险比例依赖提示集分布、生成拒答策略和裁判阈值,不应直接解释成真实产品事故率。基准主要覆盖公开模型与英语语境,多语言语音、方言暗示和长时叙事风险仍可能不足。 9. Concept Brittleness:用稀疏特征定位生图概念盲点 Interpreting Object-Dependent Concept Brittleness in Text-to-Image Diffusion Models | 复旦大学、深圳大学等 | arXiv:2609.09909 关键词:文生图,可解释性,稀疏自编码器,推理时修复 前序问题:同一风格或属性在大多数对象上能生成,却会对少数对象稳定失败。这类“对象依赖的概念脆弱性”不是换随机种子就能解释,也难从原始去噪特征中定位缺失了哪一条概念证据。 本文贡献:作者把逐步去噪轨迹投到稀疏自编码器空间,对比成功与失败样本,寻找缺失、变弱或出现过晚的概念维度,并从同类成功样本建立概念原型。推理时把失败样本的特征轻量插值到原型方向,用修复效果反证诊断是否抓住了真实缺口。 实验效果:跨多个扩散骨干的风格与属性失败案例中,原型插值显著改善概念一致性、文本保真和修复成功率。分析还显示越深层的去噪表示概念结构越清晰,而越早期介入通常有更强纠正作用。 批判点评:方法先要收集可靠的同类成功样本来构造原型,对长尾概念或没有清晰成功对照的情况较弱。SAE 的稀疏特征并不天然等于人类可读因果概念,插值改善结果也不能完全排除其他相关方向共同起作用。 10. SignRefine:局部适配器把手语手部精度提高30% SignRefine: Adapting Foundational Video Models for Sign Language Generation | 萨里大学 | arXiv:2609.08496 关键词:手语生成,视频扩散,局部适配器,关键点控制 前序问题:通用视频扩散模型主要在口语人物视频上训练,能生成自然人物,却经常把手指、嘴形和眉眼做错;对手语而言,这些小区域正承载语言信息,画质好但动作错仍不可理解。 本文贡献:SignRefine 冻结预训练视频 DiT 主干,只为左手、右手和脸部分别加入带空间掩码的局部适配器,把高分辨率区域条件注入指定 Transformer 层。系统只需二维关键点与一张人物参考图,并使用原生手语视频数据集 NVSign 训练区域控制。 实验效果:相对最强基线,SignRefine 的手部姿态精度指标最高提升 30%;手语用户在视觉质量与可理解性成对比较中超过 80% 的情况下选择 SignRefine。模型还展示了跨人物外观与视觉条件的泛化。 批判点评:二维关键点没有完整编码手形、接触关系和非手部语法,生成可理解性仍取决于关键点质量。当前数据的语言种类、地区变体和签署者覆盖决定了泛化边界,必须持续由聋人社群参与评测。 趋势观察 视频效率开始补齐全局结构 RoLA在90%稀疏下保留旋转位置全局分支,Mask Forcing则从训练分布侧减少自回滚模式坍塌;速度优化正在从少算注意力扩展到稳定学生分布。 条件控制向低维与局部区域收缩 Decoupled SF把音频先落到动作潜变量,SignRefine只强化手脸区域,说明让条件作用于真正相关的表示比全图注入更节省容量。 生成评测进入可回放和跨模态阶段 VI-Bench要求反推提示后重新生成,AV-SafetyBench同时检查画面、音轨及其组合;只看文本相似或单一模态已不足以评价生成系统。 基础设施成为算法可信度的一部分 Miles把回滚、训练和权重同步放在同一套可验证系统里,提醒大规模后训练的算法结论必须连同 on-policy 对齐与运行拓扑一起审查。 人工智能炼丹君 整理 | 2026-09-10 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
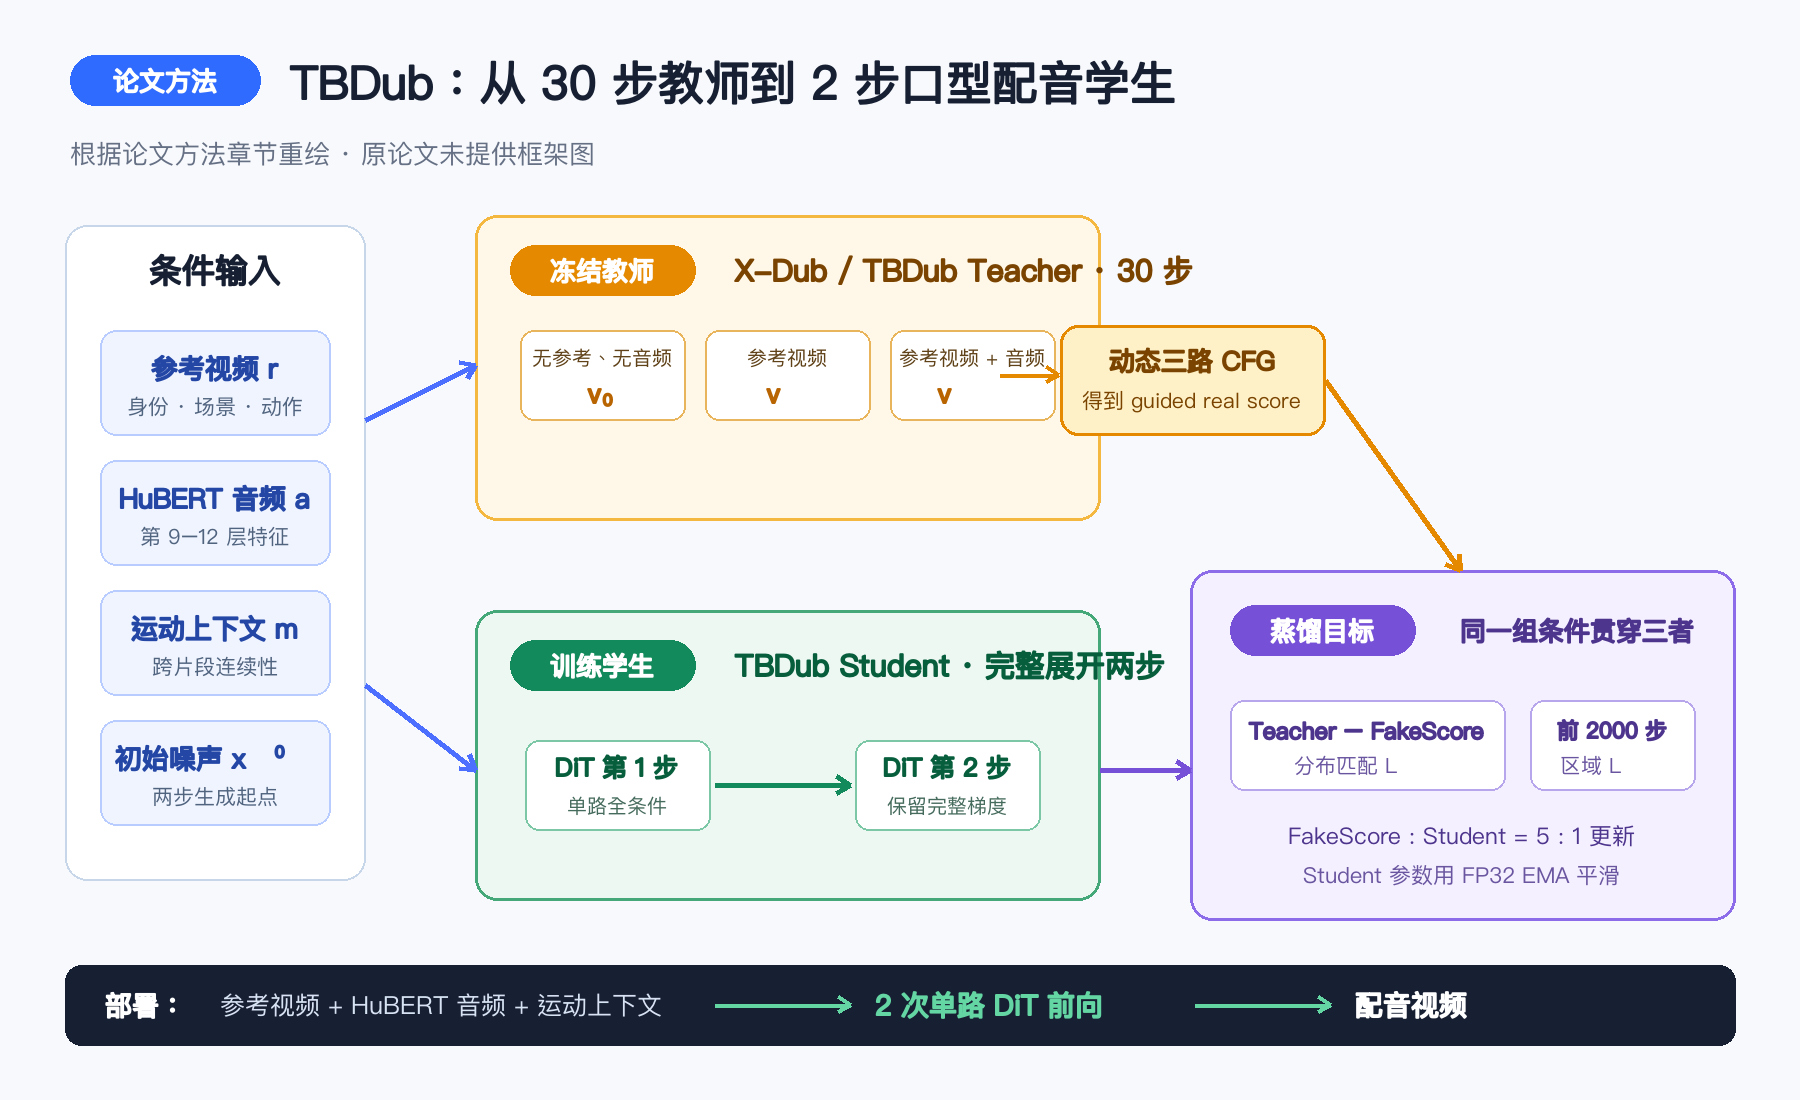
AIGC 每日速读|2026-09-09|阿里两步口型配音跑到7.13FPS-TBDub 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 TBDub(阿里巴巴淘天集团 TaoLive AIGC):两步口型配音跑到7.13FPS AlignGraft(新南威尔士大学):弱模型一次对齐全家复用 ⚡ SeRV(俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校):375小时数据生成3D手语 PAI-Actor(Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab):1080P多角色电影替换 MVWeaver(中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学):1861支MV教会歌曲转镜头 今日论文速览 1. TBDub:两步口型配音跑到7.13FPS TBDub: Production-Oriented Visual Dubbing | 阿里巴巴淘天集团 TaoLive AIGC | arXiv:2609.06144 关键词:视频编辑,视觉配音,少步蒸馏,口型同步 ⚠️ 前序问题:把原视频语音替换为新音频时,嘴形必须同步,同时还要保住身份、牙齿、光照、遮挡与背景。X-Dub 在干净数据上有效,但面对直播压缩、绿幕素材和上游生成视频时,容易出现嘴部粘连、身份漂移、边界闪烁,并且 30 步采样难以投入生产。 本文贡献:TBDub 先用生产域数据、失败规则、非对称条件退化、干净口腔先验和多层 HuBERT 音频特征,对完整视频 DiT 做任务自适应后训练,得到 30 步教师;再把 DMD/DMD2 改造为条件视频编辑蒸馏,对完整两步轨迹反向传播,并用分区重建监督稳定身份和口腔细节,得到两步学生。 编辑依据论文方法章节重绘;原论文未提供方法框架图。 实验效果:在 38 段 TalkVid 视频上,教师相对 X-Dub 的口型同步、身份一致性和视觉质量 MOS 分别提高 0.14、0.95 和 0.90 分。两步学生在单张 NVIDIA H20、512×512 的端到端计时中达到 7.13 FPS,总延迟降低 13.93 倍,DiT 阶段加速 42.49 倍,同时大体保留教师的画质与音画同步。 论文 Table 4:单张 NVIDIA H20、512×512、VAE-to-VAE 计时边界下的端到端生成吞吐量。 批判点评:38 段视频与单一 H20 配置仍不足以覆盖真实直播中的语言、脸型、遮挡和码率变化;音频前端使用英语 HuBERT,也需要跨语言检验。方法继承 Wan 与 X-Dub 的大部分能力,训练数据和生产过滤规则对结果贡献很大,不能只归因于两步蒸馏。 2. AlignGraft:弱模型一次对齐全家复用 Test-Time Weak-to-Strong Alignment: Transferring Implicit Rewards from Weak to Strong Flow Models | 新南威尔士大学 | arXiv:2609.05968 关键词:测试时对齐,流模型,弱到强迁移,偏好优化 ⚠️ 前序问题:每个新生成模型、检查点和奖励目标都重新做强化学习或偏好优化,成本高且把奖励强度永久写死。现有测试时对齐又常要求奖励函数梯度或另训价值模型,部署仍需保留奖励基础设施。 本文贡献:AlignGraft 保存一个弱模型的“基础版与已对齐版”模型对,把两者在每个采样步的速度差视为隐式奖励方向,再将这段差值加到同潜空间、同前向加噪核的强模型速度上。强模型保持冻结,测试时只用一个标量调节对齐强度,不需要奖励评估、反向传播或新的微调。 实验效果:把 SD3.5-Medium 的 GenEval 对齐迁移到 SD3.5-Large 后,强模型总分从 0.68 升到 0.90,接近源对齐模型的 0.93;位置关系从 0.28 升到 0.91,计数从 0.67 升到 0.84。相同思路也在 FLUX 同族模型和 Wan 1.3B 到 14B 视频模型间提升了多项偏好与对齐指标。 批判点评:迁移要求源模型对能在强模型状态上给出分布内信号,并共享潜空间和噪声过程;跨完全不同架构并非自动成立。弱模型学到的奖励偏差也会被一起移植,强度外推过大可能损害保真度。 3. SeRV:375小时数据生成3D手语 SeRV: Semantic-Aligned Residual Vector Quantization for American Sign Language Generation | 俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校 | arXiv:2609.05742 关键词:手语生成,残差向量量化,动作生成,语义对齐 ⚠️ 前序问题:手语动作令牌器通常只追求姿态重建,未必把文本语义组织进离散空间;后续生成器即使能复原大动作,也可能把承载词义的手形和细粒度关节做错。配对的文本与三维手语动作数据又很稀缺。 本文贡献:SeRV 在残差向量量化器中同时加入句子级动作文本对齐和令牌级文本条件监督,让粗到细的多层码本既可重建动作又可预测语义;随后用分层 GPT 逐级生成身体和手部令牌。团队还从 YouTube-ASL 视频恢复三维动作,构建 375 小时的动作文本基准。 实验效果:在 YouTube-ASL 上,身体与手部 DTW-JPE 分别为 4.98 和 6.70,优于 SOKE 的 5.42 和 7.44;SiBLEU-4 从 2.18 提升到 3.13。在 How2Sign 上身体与手部误差也最低,不过 MaDiS 的 SiBLEU-4 为 4.47,仍高于 SeRV 的 4.12。 批判点评:训练数据来自二维视频重建的三维动作,手指遮挡与视角误差可能被写进码本。DTW-JPE 与 SiBLEU 不能完全代表手语可理解性,仍需由聋人和专业手语者做语义、自然度与文化适切性评测;结论目前也只覆盖美国手语。 4. PAI-Actor:1080P多角色电影替换 PAI-Actor: Cinematic Multi-Character Replacement in Dynamic Scenes | Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab | arXiv:2609.05918 关键词:角色动画,视频编辑,多角色生成,自回归蒸馏 ⚠️ 前序问题:角色替换系统多围绕单张人物或单主体展开,面对电影中的多人互动、遮挡、手持物、相机运动和动态光影时,容易改坏背景或让身份漂移;双向视频模型画质高,却难扩展到长片段。 本文贡献:PAI-Actor 把多角色替换改写为结构引导的人体恢复:从电影中抹去原演员,以身体与人脸关联后的骨架和每个角色参考图作为条件,在约 3 万段电影片段上训练 1080P 双向 DiT。随后通过因果适配与 on-policy self-forcing,把双向教师蒸馏为可使用 KV 缓存的自回归视频到视频模型。 实验效果:论文在角色动画子集的大多数指标上优于对比方法,并展示多人身份、背景与姿态一致性。自回归学生可生成约 417 帧、17 秒的 1920×1056 视频,而双向教师因全局注意力不能扩展到该长度。 批判点评:训练三个阶段合计数百 GPU 小时,峰值显存约 114 至 136 GB,生产门槛很高。电影数据还涉及演员肖像、版权与合成滥用风险;失败案例中极端像素位移、复杂遮挡和长时身份漂移仍未解决。 5. MVWeaver:1861支MV教会歌曲转镜头 MVWeaver: A Hierarchical Music Video Generation Agent with a Learned Song-to-Visual Bridge | 中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学 | arXiv:2609.06478 关键词:音乐视频,生成智能体,分层规划,音画生成 ⚠️ 前序问题:自动音乐视频系统可以拼出漂亮镜头,却常停留在歌词字面联想:整首歌的情绪、人物动机和反复意象没有发展,镜头之间也缺少可追踪的概念与状态。 本文贡献:MVWeaver 先做结构化歌曲分析,再由视觉规划器生成全局概念、段落计划和可执行镜头,最后调用图像与视频模型渲染。关键的 song-to-visual bridge 来自 1861 组真实歌曲与 MV,包含歌曲侧、MV 侧以及教师推导的转译理由,并用 LoRA 微调大语言模型学习从听歌理解到视觉设计的中间桥。 实验效果:在 1 至 5 分评测中,MVWeaver 的歌曲解释、视觉发展、概念连贯和镜头连续得分分别为 4.08、3.63、4.30、4.10,均高于 AutoMV 和去掉桥接模块的版本;与所有对比方法成对比较后的总体用户偏好率为 67.06%,AutoMV 为 30.59%。 批判点评:1861 组真实 MV 的规模、文化分布和版权来源会影响桥接模型学到的视觉惯例。长视频一致性评分仍难覆盖完整观影体验;若歌曲分析出错,层级规划会把错误系统性传播到所有镜头。 6. ToPO:把整图偏好路由到词和像素 ToPO: Token-Conditioned Preference Routing for Attention-Based Latent Diffusion Models | 清华大学、电子科技大学、斯坦福大学 | arXiv:2609.03688 关键词:偏好优化,扩散模型,注意力,空间时间路由 ⚠️ 前序问题:一条成对偏好只说明整张图谁更好,却没有指出哪个提示词、空间位置和去噪时刻该更新。Diffusion-DPO 把全局信号铺到大量局部坐标,容易浪费梯度或修错区域。 本文贡献:ToPO 用冻结参考去噪器比较优选与劣选分支的局部平方残差,构造与小批次相关、停止梯度的可分空间时间路由;再用优选分支交叉注意力把内容词映射回空间,并加入像素中点排序项。整个过程不需要局部标签或另训奖励模型。 实验效果:在 SD-1.5 上,ToPO 的 GenEval 与 T2I-CompBench 平均分为 0.5092 和 0.4123,高于 Diffusion-DPO 的 0.4591 和 0.3521;在 SDXL 上 GenEval 为 0.6168,T2I-CompBench 为 0.4975,与 Diffusion-DPO 的 0.4974 近似持平。300 提示盲测的六组问题中,ToPO 均获得更多原始选择。 批判点评:路由依赖参考模型残差和交叉注意力的可解释性,未证明可直接迁移到所有 DiT 或无交叉注意力架构。盲测只公开聚合计数,不能进行参与者层面的显著性推断;部分 SDXL 自动指标也没有全面领先。 7. Diffuse2Seg:扩散模型零训练造分割标签 Diffuse2Seg: Diffusion Models Can Segment Anything Without Supervision | 柏林工业大学、CARIAD SE(大众汽车集团) | arXiv:2609.06491 关键词:开放世界分割,扩散特征,伪标签,无监督学习 ⚠️ 前序问题:SAM 的开放世界分割能力依赖 1100 万图像和超过 10 亿人工掩码,继续扩大标注极其昂贵。自监督视觉特征生成的伪标签又常偏向前景物体,难覆盖天空、道路等无定形区域。 本文贡献:Diffuse2Seg 不训练扩散模型,而是从文生图模型的自注意力中提取对象结构,将密集点网格通过保边的非线性 p-Laplacian 传播为软掩码,再合并为从部件到完整物体的多粒度实例图,去重后用于训练开放世界分割器。 实验效果:生成伪标签在五个领域的 AR1000 比此前最佳标签生成器高 4.3 至 7.1 个百分点。用这些标签训练的无检测器分割模型在 things 与 stuff+things 上分别提升 7.4 和 7.7 个百分点,并在后者超过检测器式 UnSAM 2.1 个百分点。 批判点评:伪标签会继承文生图训练数据的类别偏差,对小目标、透明物、医学或机器人极端域未必可靠。评测以平均召回为主,边界精度和错误标签对下游安全任务的影响仍需单独检查。 8. OAVC:只改目标不带跑背景 Object-Aware Background-Controlled Editing via Weighted Velocity Guidance | 卡内基梅隆大学、中国科学院计算技术研究所、中国科学院大学 | arXiv:2609.06288 关键词:图像编辑,视频编辑,免训练控制,整流流 ⚠️ 前序问题:免训练编辑通常把源提示与目标提示的速度差全局加到潜空间。目标之外的小残差虽然单步很弱,却会在多步积分中累积,最终带跑背景纹理、反射和物体边界。 本文贡献:OAVC 把“语义残差能在哪里生效”和“如何注入动力学”拆开:先在源提示下建立背景锚点和对象支持区,再用受约束的投影抑制会引发漂移的速度分量,并按时间和边界置信度加权注入目标语义。它不训练或修改预训练模型参数,可接到 SD3.5、FLUX 和视频流编辑器上。 实验效果:在 PIE-Bench 上,FLUX 版本相对 DNAEdit 将结构距离从 18.87 降至 4.07,背景 PSNR 从 24.99 dB 提升到 33.30 dB;SD3.5 版本也从 14.19 降至 4.11、从 26.66 dB 升到 32.64 dB。100 例盲测中,OAVC 赢下 94 个有明确结果的背景保持比较中的 74 个,占 78.7%。 批判点评:默认依赖 SAM3 提供对象支持区,分割遗漏或膨胀会直接限制编辑。它在背景保持上更强,但 CLIP 编辑性分数较低;人工评测也显示编辑实现偏好差异未达 0.05 显著水平,存在保真与改动强度的权衡。 9. AngelFingerprint:水印直接藏进编辑模型权重 AngelFingerprint: A Traceable, Explainable, and White-Box Stealthy Watermark for Text-Guided Image Editing | 台湾大学、日本国立信息学研究所 | arXiv:2609.04709 关键词:生成水印,图像溯源,文本引导编辑,白盒安全 ⚠️ 前序问题:常见生成水印只携带固定 ID,能说明图像来自哪个模型,却无法解释改了什么;水印若由独立编码器或后处理模块写入,在开源白盒场景中又容易被定位和移除。 本文贡献:AngelFingerprint 用 LoRA 把编辑提示的 CLIP 文本嵌入写进扩散模型权重,专用提取器再从像素恢复语义载荷。速度对齐锚点限制水印对编辑结果的扰动,仿照 JPEG 的 DCT 中频掩码避开显眼低频和脆弱高频,让架构、推理代码与计算图保持不变。 实验效果:在 MagicBrush 的 200 候选提示检索中,SD3-Medium 版本 Top-1 为 86.0%、MRR 为 0.917,而提示反演 Top-1 为 20%;UltraEdit 版本 Top-1 为 65.5%。中频滤波版本在水印开关之间得到 PSNR 22.91 dB、SSIM 0.704。 批判点评:把 LoRA 融入权重提高了隐蔽性,却没有证明能抵抗模型再训练、合并、剪枝或蒸馏等强白盒攻击。200 路封闭检索和单一编辑数据集规模有限;语义载荷也会带来隐私与滥用提示暴露问题。 10. Srijika:生成66套可安装印度字体 Srijika: OpenType-Layout-Reusing Font Restyling for Nine Indic Scripts | Loopdesk Technologies LLP | arXiv:2609.05661 关键词:字体生成,扩散模型,OpenType,印度文字 ⚠️ 前序问题:印度婆罗米系文字包含大量合字、半形和元音附标。只生成漂亮字形位图并不能得到可用字体,因为 cmap、GSUB 替换闭包、GPOS 定位和锚点关系必须共同满足排版引擎契约。 本文贡献:Srijika 不从零生成字体,而是保留完整模板字体的字符映射与替换闭包,用约 650 个开放许可字体族的检索系统 Lipika 将自然语言风格落到参考字体,再由参考条件潜扩散逐字重绘轮廓。内容门控、风格协调和排版簇验证会自动回退失败字形,最终重建为 TTF。 实验效果:系统产出 66 个 TTF,包含 57 个预设和 9 个开放词汇示例;全部通过 OpenType Sanitizer,HarfBuzz 与 CoreText 在高难合字探针上复现模板字形 ID 序列,并审计 80,915 个字形与 54,812 个锚点。 批判点评:论文只与无学习基线比较,缺少独立风格指标、人类研究和完整 GPOS 视觉质量审计。检索编码器与评测嵌入的数据并非完全独立,风格提升可能被高估;工程上的回退机制保证可安装,却可能留下大量未真正重绘的字形。 趋势观察 少步与长视频开始接受完整系统计时 TBDub把视觉配音压到两步并报告VAE到VAE的端到端速度,PAI-Actor则诚实披露17秒视频仍需95分钟;生产可用性正在从采样步数口号转向全链路成本。 对齐信号从整图分数走向可迁移局部场 AlignGraft把弱模型对的速度差跨规模移植,ToPO把整图偏好分配到词元、空间和时间,说明生成对齐正从重复微调转向复用和精确分配。 生成系统更重视可验证的结构契约 SeRV用语义码本约束手语,OAVC显式限定对象区域,AngelFingerprint嵌入可恢复提示,Srijika复用OpenType闭包;输出是否可编辑、可追溯、可执行,正与视觉质量同样重要。 人工智能炼丹君 整理 | 2026-09-09 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-08|蚂蚁从零训6B开源生图-LLaDA-Image 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 LLaDA-Image(Inclusion AI AGI Research Center):从零训练开放生图模型 DSAQuant(Robbyant、浙江大学、香港理工大学、香港科技大学):按去噪阶段做视频量化 ⚡ DM-Align(清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学):四步视频同时对齐与蒸馏 RA-GRPO(清华大学、快手科技):用反思轨迹稳定生成对齐 VoRTeC(清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学):用生成流做一步视频解码 今日论文速览 1. LLaDA-Image:从零训练开放生图模型 LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes | Inclusion AI AGI Research Center | arXiv:2609.03796 关键词:图像生成,开放模型,扩散语言模型,模型蒸馏 ⚠️ 前序问题:高质量图像生成模型常依赖不透明的数据配方、训练细节或已有模型权重,研究者难以复现从零训练过程;把理解、生成和编辑统一起来也容易牺牲其中一项能力。 本文贡献:作者从零训练一个 6B 参数 DiT,并接入冻结的 LLaDA2.0-Mini 视觉语言理解模块。训练先用纯图像预训练建立视觉先验,再做中期训练和图文统一训练;全流程使用 2.2 亿样本,其中 98% 为真实图像,并公开权重、代码和训练配方。团队还用 TwinFlow 将模型蒸馏为 2 至 4 步推理的 Turbo 版本。 实验效果:LLaDA-Image 在 Qwen-Image-Bench 英文与中文轨分别得到 53.53 和 53.38,领先当时其余开源模型;LongText-Bench 英文、中文得分为 0.923 和 0.913。编辑基准 GEdit-Bench 的英文、中文总分为 7.336 和 7.294,说明统一模型已具备较强的生成、文字渲染与编辑能力。 批判点评:2.2 亿样本的收集、清洗和训练成本仍然很高,公开配方也不会自动解决数据授权与可追溯性问题。报告覆盖模块很多,但部分组件的独立贡献和跨架构可迁移性仍需更多消融验证。 2. DSAQuant:按去噪阶段做视频量化 DSAQuant: Denoising-Stage-Aligned Quantization-Aware Training for Video Generation | Robbyant、浙江大学、香港理工大学、香港科技大学 | arXiv:2609.04031 关键词:视频生成,量化感知训练,低比特推理,部署优化 ⚠️ 前序问题:视频扩散模型压到 W4A4 或 W3A3 后,通常还能保住提示词语义、构图与粗粒度运动,却会明显丢失纹理、锐度和局部细节。传统量化训练把所有去噪时刻一视同仁,没有利用早期规划结构、后期补细节的分工。 本文贡献:DSAQuant 按去噪阶段切换监督目标:早期保持教师蒸馏以稳定全局结构与运动,后期逐渐转向目标驱动的细节重建;推理时在最后阶段关闭分类器自由引导,避免量化误差被 CFG 放大为高频伪影。方法同时覆盖 Wan 与 CogVideoX 系列。 实验效果:在 Wan2.1-1.3B 的 W4A4 设置下,DSAQuant 的 VBench 平均分为 67.21,高于 BF16 模型的 66.28 和 QVGen 对称量化的 63.56;在更激进的 W3A3 下,相对当时量化训练基线最高提升 6.60 分。 批判点评:论文重点验证生成质量,没有把端到端延迟、显存、能耗和不同硬件内核的实际收益放在同等位置;量化感知训练本身也有额外成本。后期关闭 CFG 可能改变文本对齐,需要在更广的提示与长视频任务上验证。 3. DM-Align:四步视频同时对齐与蒸馏 Joint Alignment and Distillation for Video Generation via Sample-Guided Distribution Matching | 清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学 | arXiv:2609.04283 关键词:视频生成,偏好对齐,分布匹配,少步蒸馏 ⚠️ 前序问题:视频生成的偏好对齐与少步蒸馏通常分成两段:先强化学习再蒸馏计算昂贵,先蒸馏再做强化学习又容易让模型坍塌。两段流程还要重复运行多步奖励评估,并在 ODE 与 SDE 轨迹间转换。 本文贡献:DM-Align 在一次分布匹配训练中同时叠加两种梯度:DMD2 梯度缩小真实模型与学生模型的分布差距,偏好梯度则利用成对偏好或组内探索,把生成分布推向人类偏好的样本。它把类似 DPO 与 GRPO 的信号写进同一训练目标,直接产出 4 次函数评估的视频模型。 实验效果:在 Wan2.1-T2V-1.3B、5 秒 832×480 视频上,组内模式以 4 NFE 得到 VBench 平均分 84.40、动态度 80.19;成对模式为 82.78。人工比较中,成对模式相对原模型净偏好提升 48%,相对单独 DMD2 提升 32%。 批判点评:实验集中在 1.3B 基模、5 秒 480p 视频,尚不足以说明长视频与更大模型也能稳定受益。样本引导仍依赖奖励或偏好数据,奖励偏差与奖励投机只是减轻,不能视为消失。 4. RA-GRPO:用反思轨迹稳定生成对齐 Step Back to Move Forward: Reflection-Aware Preference Optimization for Visual Generation | 清华大学、快手科技 | arXiv:2609.04282 关键词:偏好对齐,扩散模型,强化学习,奖励投机 ⚠️ 前序问题:生成模型用策略梯度对齐人类偏好时,探索常被局部最优牵引:奖励上升了,语义忠实度或真实感却可能下降。常规 GRPO 只从当前前向采样学习,很难主动修复已经偏离高概率数据流形的中间状态。 本文贡献:RA-GRPO 在训练中加入“向后反思”。Diffusion Reflection 在随机中间时刻用较弱估计器反演并校正潜变量,再由 Counterfactual Path Synthesis 把校正后的路径蒸馏回策略。反思只发生在优化阶段,因此部署时没有额外采样开销。 实验效果:在 FLUX.1-dev 与 HPSv2.1 提示集上,以 HPS 为奖励时,RA-GRPO 的 HPSv2.1、ImageReward、HPSv3 分别为 0.378、1.417、15.324,均高于论文复现的 DanceGRPO 与 MixGRPO;多目标 HPS+CLIP 训练也取得更均衡的自动指标。 批判点评:验证主要围绕 FLUX.1-dev、HPS 提示和自动奖励模型。弱估计器、指导强度与反思时刻的选择会影响稳定性;只看自动奖励仍可能漏掉新的投机模式,需要更大规模人工偏好与跨模型复核。 5. VoRTeC:用生成流做一步视频解码 VoRTeC: Taming Foundation Flow for One-step Real time Video Compression | 清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学 | arXiv:2609.02291 关键词:视频压缩,流模型,实时解码,超低码率 ⚠️ 前序问题:传统神经视频压缩在超低码率下容易模糊,而扩散式生成压缩通常需要多步采样,难以实时运行。如何借用强视频生成模型的先验,又不复制其昂贵迭代过程,是部署瓶颈。 本文贡献:VoRTeC 冻结 Wan2.1 流模型,只训练紧凑潜码与轨迹位置预测器,用多尺度先验把一次解码对齐到生成流。跨帧组复用尾帧,并缓存生成先验,以降低连续视频的重复计算;训练不需要访问基础流模型的参数或梯度,可在单张 A6000 上完成。 实验效果:论文报告在相近感知质量下可节省 58.12% 至 73.25% 码率,并达到低于 0.01 bpp;推理相对多步生成压缩加速 3 至 197 倍,720p 达 13 fps、480p 达 32 fps。 批判点评:速度依赖具体显卡、分辨率与缓存条件,不能直接外推到移动设备。对取证、医疗、遥感等要求像素真实性的场景,生成先验可能引入不可接受的幻觉,需要独立的保真约束与错误标记。 6. Editable Visual Design:让视觉设计真正可编辑 Editable Visual Design | 腾讯混元、中山大学、清华大学、香港中文大学、上海交通大学 | arXiv:2609.04034 关键词:视觉设计,智能体,图像生成,HTML CSS ⚠️ 前序问题:文生图可以快速给出海报或信息图,但输出通常是一张扁平位图,文字、图标和布局无法继续精确编辑;纯代码生成又容易缺少视觉想象与审美反馈。 本文贡献:该系统让视觉语言模型充当创意大脑、图像生成器充当视觉世界模拟器,先想象整体效果,再把素材隔离为独立资产并用原生 HTML/CSS 重建文字、层级与布局。Agent Design Replay 学习专业设计轨迹,智能体通过截图反馈持续比较和修改。 实验效果:论文用海报、信息图、营销物料和长文本版式等案例展示:输出中的文字保留为真实文本,元素可以用鼠标拖动,图层与样式可继续修改。论文当前以定性案例证明可编辑工作流,没有给出可横向比较的统一量化分数。 批判点评:缺少大规模用户研究、任务完成时间和跨基线量化评测,使“更专业”仍难精确判断。流程依赖图像生成和代码智能体的能力,素材版权、网页代码安全与复杂版式的兼容性也需要产品级约束。 7. Temporal Context Routing:把脚本精确路由到时间轴 The Missing Temporal Link: Temporal Context Routing for Script-Driven Audio-Video Generation | 北京大学、Qwen Applications、香港科技大学、香港中文大学、上海交通大学 | arXiv:2609.02367 关键词:音视频生成,时间控制,脚本驱动,多模态生成 ⚠️ 前序问题:脚本驱动的音视频生成会同时处理镜头、对白、动作和音效,但全局文本条件不知道某条指令应该在哪一秒生效,常出现切镜过早、对白错位或动作与声音不同步。 本文贡献:Temporal Context Routing 先把脚本事件映射到音频与视频共享的时间轴,再将每段提示的引导信号只路由到匹配的时空位置。它给现有联合音视频模型补上显式时间链接,而不用让所有帧共同接受整段脚本。 实验效果:在 200 条测试脚本上,镜头边界平均绝对误差从 1.11 秒降到 0.042 秒,下降约 96%;对白在 0.5 秒容差内的准确率从 28.3% 提升到 84.1%,同时视觉质量与音画同步指标保持相近。 批判点评:实验规模仍有限,长叙事、重叠对白、快速多事件和镜头外音源会让路由更复杂。用户研究偏好不能替代对叙事连贯性与错误恢复的长期评估。 8. Unreal Engine World Data:用虚幻引擎规模化造数据 Building Pretraining Data for World Models: An Unreal Engine-Based Pipeline for Action-Conditioned Video Generation | Joy Future Academy、京东、清华大学、香港科技大学 | arXiv:2609.03557 关键词:世界模型,合成数据,虚幻引擎,动作条件视频 ⚠️ 前序问题:动作条件世界模型需要既有可控动作轨迹、又有高质量画面的长视频数据。直接在游戏引擎中边运行物理、边实时渲染,容易因帧率波动破坏动作与画面对齐,也难在数百 GPU 上稳定扩展。 本文贡献:作者把流程拆成两段:PIE 先按真实物理运行并记录角色、控制和相机状态,MRQ 再离线重放轨迹并高质量渲染。系统加入缓存感知的任务分片、节点槽位、场景筛选、亮度与审美过滤,以及失败恢复、上传和健康检查。 实验效果:在 25 台服务器、共 200 张 RTX 5090 上,系统从 2384 个资产包整理出 429 个关卡与 40 个类人角色,生成 2691 小时 1080p 和 6076 小时 720p 动作条件视频,并用于 EchoWM 数据建设。 批判点评:合成场景仍有引擎域偏差,审美和亮度过滤可能进一步删掉困难样本;资产许可、人物动作覆盖和 200 GPU 的成本也决定了复现门槛。数据规模不能替代真实世界验证。 9. Structured-Prior Inpainting:给交通标志注入物理先验 Structured-Prior-Guided Diffusion Inpainting with Physical Consistency for Traffic Sign Augmentation | 高德地图、阿里巴巴集团 | arXiv:2609.02348 关键词:图像修复,合成数据,交通标志,物理一致性 ⚠️ 前序问题:稀有交通标志样本不足,但普通文生图或修复模型容易生成错误文字、色彩和边缘。视觉上“像标志”还不够,训练检测器需要类别语义、模板几何与法规颜色都准确。 本文贡献:方法把三类结构先验送入扩散修复:JSON 语义提示描述类别,正视矢量图通过 IP-Adapter 提供测量颜色,仿射对齐的矢量模板通过 ControlNet 约束几何;训练再加入 CIELAB 颜色 L1 损失和 Sobel 边缘损失,强化物理一致性。 实验效果:在 TT100K2021 零样本测试中,OCR 完全匹配率为 91.1%,而 12B 参数 FLUX.1 Fill 为 44.2%;基于 SD1.5 的方案推理时间约为其十四分之一。把合成图加入训练后,稀有类别 AP50 提升到原来的 1.23 至 7.40 倍。 批判点评:公开验证集中在一种交通标志数据源,检测增益会受合成比例、地区法规、拍摄距离和天气影响。用于道路安全前,还需跨国家模板、夜间、遮挡和极端退化测试,并保留可审计的生成记录。 10. Pitch-class Steering:用潜空间探针控制旋律 Pitch-class Steering for Diffusion-based Music Generation via Latent-space Probes | 卡内基梅隆大学、独立研究者 | arXiv:2609.04516 关键词:音乐生成,扩散模型,旋律控制,潜空间探针 ⚠️ 前序问题:文本能描述音乐风格,却很难要求扩散音乐模型严格跟随指定旋律。重新训练完整模型或改架构成本高,而 MIDI 条件又不一定能直接接入现有生成器。 本文贡献:作者用配对音频与 MIDI 训练一个 12.5 万参数卷积探针,从 Stable Audio Open 的 VAE 潜变量逐帧解码音高类别。生成时冻结基础模型,把探针的可微损失作为引导信号,在每步去噪中推动潜变量靠近目标旋律,不修改生成模型结构。 实验效果:在 9 个提示词与 3 条旋律组成的 27 次试验中,引导生成的旋律一致性相对无引导基线提升 2.4 倍;Wilcoxon 检验给出 p<1e-5。论文已被 IEEE MLSP 2026 接收。 批判点评:27 次试验规模很小,统计显著不等于覆盖多样音乐风格。每步反向传播引导会增加推理开销,配对 MIDI 数据的偏差也可能限制泛化;还需听感盲测和更长曲目验证。 趋势观察 生成训练开始公开到数据与优化器层级 LLaDA-Image不仅开放权重,还披露2.2亿样本、纯图像预训练、Muon与少步蒸馏配方,竞争焦点正从模型接口转向可复现的完整训练系统。 视频部署优化必须贴合去噪阶段 DSAQuant按阶段分配量化监督,DM-Align把偏好对齐和少步蒸馏并成一次训练,VoRTeC则预测生成流位置完成一步解码;三者都在利用生成轨迹的内部结构减少成本。 显式控制信号重新进入生成链路 时间路由、交通标志模板与音高探针分别把时间、物理几何和旋律注入生成过程,显示开放式文本提示正在与可验证、可定位的结构条件结合。 人工智能炼丹君 整理 | 2026-09-08 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
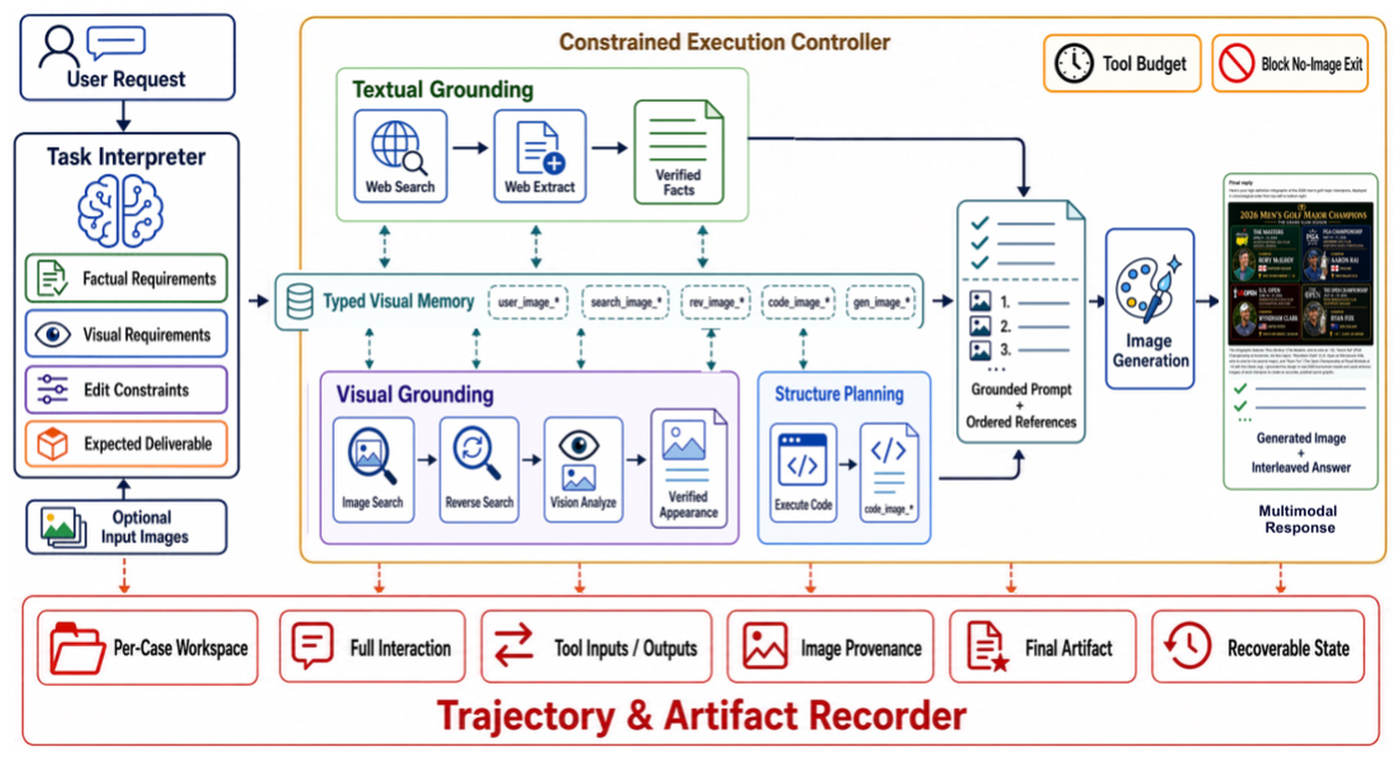
AIGC 每日速读|2026-09-07|腾讯3B活跃参数逼近万亿代理-WeAgent 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 WeAgent-MMGenEdit(腾讯微信 AI(Weixin AI, Tencent)):3B活跃参数逼近万亿代理 PriorEdit3D(北京航空航天大学、中央财经大学、VAST、北京市智能创意内容生成与沉浸体验重点实验室):7秒完成无配对3D编辑 ⚡ ReaDiT(伊利诺伊大学厄巴纳-香槟分校(UIUC)):一个DiT块控制图像与视频 EditVid(伊利诺伊大学厄巴纳-香槟分校(UIUC)):免训练视频编辑跃升19分 FlashRender(EverEx、延世大学、高丽大学):4步完成相机轨迹重拍 今日论文速览 1. WeAgent-MMGenEdit:3B活跃参数逼近万亿代理 WeAgent-MMGenEdit: A Full-Stack Recipe for Multimodal Agentic Image Generation and Editing | 腾讯微信 AI(Weixin AI, Tencent) | arXiv:2609.05171 关键词:代理式图像生成,多模态检索,视觉证据验证,多参考编辑,强化学习,双语基准,WeAgent ⚠️ 前序问题:知识密集型图像生成真正难的不是把搜索接口接到模型上,而是让正确证据进入最终像素。现有代理常凭标题或元数据选图,没有逐张检查视觉内容;同一个策略又要规划、筛选并背着不断增长的上下文,容易混淆实体;即便找到了正确文字和图片,松散附件也没有明确绑定人物、属性和空间位置。结果是代理能说对事实,却仍会在信息图、多人物组合或时事更新中画错对象与版式。 本文贡献:WeAgent-MMGenEdit 给出一套从运行时、数据、基准到双侧后训练的完整配方。WeAgent-Harness 按“检索—验证—整合—交付”组织七类工具,把证据以稳定 ID 存入持久工作区,并用独立视觉工具显式验图;通过代码把核实后的文字、图片和布局编成稠密视觉载体,再交给生成器。数据管线构造约 2.3 万条 SFT 轨迹和 1.47 万个 RL 任务,每个任务都带代理链、生成输入和最终图像三层清单。策略侧先 SFT 再做清单约束 RL,图像侧也用多参考 SFT 和多目标 RL 训练。 实验效果:自建 WeBench-MMGenEdit 含 300 个经人工审核的中英双语任务,生成与编辑、中文与英文各占一半,94% 的任务需要至少五跳检索,69.3% 的编辑任务含多张用户图片。在同一 Harness 和 GPT-Image-2 后端下,30B 总参数、3B 活跃参数的 WeAgent-RL 相对同规模 Qwen3-VL 基线,生成加权均分提高 12.45 分,编辑加权均分提高 16.72 分;其表现接近 1T 总参数的 Kimi-K2.6 代理。 批判点评:这篇最有价值的设计是把证据量与策略上下文解耦:图片和网页留在持久工作区,策略只传稳定引用,需要时再验,这比把所有像素塞进上下文更适合长轨迹。三层清单也能把“搜索错了”“提示没带全”和“后端没画对”分开归因。代价是整套系统依赖搜索、视觉检查、代码渲染、图像生成和多名裁判,成本与故障面都不小;对网页时效、来源可信度和恶意内容的防护也没有被一个高分基准自动解决。 2. PriorEdit3D:7秒完成无配对3D编辑 Learning 3D Editing without Paired Supervision via Generative Prior Distillation | 北京航空航天大学、中央财经大学、VAST、北京市智能创意内容生成与沉浸体验重点实验室 | arXiv:2609.04942 关键词:3D编辑,生成先验蒸馏,无配对监督,分布匹配,多视图一致性,前馈模型,PriorEdit3D ⚠️ 前序问题:指令驱动 3D 编辑缺少高质量的编辑前后成对资产。测试时优化方法每个对象都要重新迭代,速度慢;用复杂管线制造伪配对数据又容易把 2D 编辑器的结构漂移和几何伪影写进监督。只在主视角追求文本对齐还会出现“正面看起来对、转到侧面就塌掉”的投影欺骗,因此需要在没有成对 3D 真值的条件下同时约束指令、身份和三维几何。 本文贡献:PriorEdit3D 用可微渲染把三种已训练基础模型的先验直接蒸馏进前馈 3D 编辑器:主编辑视角由 2D 图像编辑模型提供像素视觉目标;新视角由视觉语言模型判断指令遵循与源对象身份;3D-aware Distribution Matching 则在图生 3D 教师的 latent 流形内约束编辑结果,阻止单视角监督导致几何坍塌。整个方法无需反演、无需局部掩码,也不依赖真实的成对 3D 编辑数据。 实验效果:在作者的 PriorEdit3D 测试集上,方法达到 24.37 PSNR、0.94 SSIM、71.96 FID,LLM 身份保持率 93.13%、指令遵循率 86.92%,单个编辑在 A100 上约 7 秒;对比的 Nano3D 为 19.90 PSNR、103.50 FID、14 秒。迁移到 ABO 与 GSO 后,方法的 FVD 为 168.78、LLM 指令遵循率 68.41%,也优于表中对比项。 批判点评:把视觉、语义和几何先验拆给三个教师是合理的,因为单一 2D 教师无法提供背面约束。消融也显示 VLM 与 3D 分布匹配各自补不同缺口。不过教师的偏差会层层传递:图像编辑器决定风格,VLM 决定语义容忍度,图生 3D 教师决定几何流形;遇到教师不熟悉的物体、透明材质或拓扑大改时,前馈速度优势可能换来保守编辑。 3. ReaDiT:一个DiT块控制图像与视频 ReaDiT Guidance: Control for Image and Video Generation using Diffusion Transformer Features | 伊利诺伊大学厄巴纳-香槟分校(UIUC) | arXiv:2609.04649 关键词:Diffusion Transformer,空间控制,特征读出,深度控制,姿态控制,视频运动控制,ReaDiT ⚠️ 前序问题:ControlNet 一类适配器能给扩散模型加入深度、姿态或边缘条件,但通常复制大块网络,需要大量成对数据;扩展到视频时参数和训练成本进一步放大。完全免训练的特征引导虽然轻,却可能只支持单一骨干或单一模态。问题因此变成:能否不让生成模型在前向时直接吃控制图,只从其内部表征读出空间误差,再反向调整噪声 latent。 本文贡献:ReaDiT 从冻结 DiT 的单个中间块提取特征,用一个带时间步条件的多尺度读出器预测深度、姿态或边缘,再把预测与目标控制图之间的损失梯度施加到当前 latent。生成骨干不直接接收控制条件,这种隐式条件化让同一思路可以覆盖图像和视频;在视频上还能用光流或相机轨迹目标控制运动。其图像版本约 53M 参数,远小于论文估算的 1.487B 参数 ControlNet 图像适配器。 实验效果:图像实验中,ReaDiT 在生成图控制条件上取得深度 RMSE 0.2492、姿态 PCK@0.2 0.5380、姿态 mAP 0.3709 和边缘 ODS 0.6968,多数指标优于 1.487B 参数的 ControlNet。视频空间控制中,它把 RG 的深度 RMSE 从 0.4610 降到 0.4225,姿态 PCK 从 0.1892 提到 0.3651,边缘 ODS 从 0.5304 提到 0.6101。 批判点评:只读一个 DiT 块就能跨图像与视频工作,说明预训练生成特征里已经包含可用空间信息;这比为每种骨干复制一套大适配器更容易维护。它的限制也来自同一点:读出器知道“当前画面离目标多远”,却不一定知道最稳定的生成路径,强梯度在遮挡、快速运动或互相冲突的控制图下可能牺牲画质。工程采用前应同时测控制误差、生成质量和额外反向传播的延迟。 4. EditVid:免训练视频编辑跃升19分 One Editor, Many Edits: A Unified Training-Free Framework for Diverse Video Editing | 伊利诺伊大学厄巴纳-香槟分校(UIUC) | arXiv:2609.04190 关键词:视频编辑,免训练方法,稀疏因果记忆,身份保持,latent混合,多参考编辑,EditVid ⚠️ 前序问题:逐帧调用图像编辑器会造成闪烁、身份漂移和背景误改;专用视频编辑模型又需要昂贵训练,并常被限定在指令编辑或主体替换中的一种。一个统一框架必须同时解决相邻帧局部连续、远距离身份一致和编辑区域边界三件事,还要保留现代图像 MM-DiT 的多种编辑能力。 本文贡献:EditVid 冻结图像 MM-DiT,在推理期组合三个机制:稀疏因果记忆复用上一帧选定的注意力键值,保持局部连续;基于对应关系的后注意力 token 注入把锚帧身份带到远帧;软 latent 混合让目标区域接受编辑,同时保护背景。相同框架覆盖风格迁移、属性修改、对象插入、局部编辑和主体替换,也支持指令与参考图两种条件。 实验效果:在 FiVE 基准上,EditVid 达到 78.16 FiVE-Acc,最强的已评估免训练基线为 58.95,提升 19.21 分;在 IVEBench 上取得有竞争力的结果。面对 7 个对比方法的用户研究中,EditVid 获得 51.8% 的总体偏好率。 批判点评:三个机制分别对应短期、长期和空间局部性,职责划分清楚,且能复用强图像编辑器的新能力。风险在于对应关系是整个系统的支点:快速运动、长期遮挡或主体外观剧变会让锚帧 token 注入错误位置,造成“身份保持”反而覆盖合理变化。软混合也依赖编辑区域估计,细发丝、透明物体和反射场景会更难处理。 5. FlashRender:4步完成相机轨迹重拍 FlashRender: Few-Step Generative Rendering via Camera-Controlled Video MeanFlow | EverEx、延世大学、高丽大学 | arXiv:2609.03563 关键词:生成式渲染,相机控制,MeanFlow,少步采样,视频重拍,在策略蒸馏,FlashRender ⚠️ 前序问题:生成式渲染要把源视频沿新的相机轨迹“重拍”。传统多步扩散不仅慢,而且相机条件在不同采样步的作用不一致,这种离散化误差会弯曲去噪轨迹;直接做少步蒸馏时,学生还会在自己的 rollout 状态上积累误差,导致几何和画质同时下降。 本文贡献:FlashRender 先用 Representation Transformation and Alignment(RETA)把源视频隐藏表征对齐到冻结视觉几何模型提取的目标视角特征,把相机变换直接编码进源流,使控制在各采样步更一致。随后用 MeanFlow 目标拟合曲率更低的轨迹,最后用 on-policy flow-map distillation 针对学生自己的固定少步 rollout 修正误差。模型基于 Wan2.1-1.3B-CamCtrl,只需 4 次函数评估。 实验效果:论文报告在视频质量和几何一致性上可匹配多步基线,同时把采样成本降低 25 倍,并在分布外目标相机轨迹上取得更好的可控性。示例以 480×832 分辨率、单张 NVIDIA B200 测速,可在数秒内完成任意长度输入视频的目标轨迹重拍。 批判点评:方法最有启发的是先修控制不一致、降低轨迹曲率,再做少步蒸馏,而不是让学生同时吞下几何误差和时间离散误差。它仍依赖冻结几何模型提供可靠目标视角特征;反射、透明物体、动态遮挡和非刚体场景可能让几何先验失真。4 步设定很适合交互预览,但影视生产还需要评估细纹理和长镜头接缝。 6. PRISM-Bench:35项细则专门考生成音频 PRISM-Bench: An Audio-Centric Diagnostic Benchmark for Text-to-Audio-Video Generation | 上海人工智能实验室、美团 | arXiv:2609.04867 关键词:音视频生成,评测基准,音频质量,跨模态同步,MLLM裁判,屏内声源,PRISM-Bench ⚠️ 前序问题:文本到音视频评测通常把音频当成视频质量的附属项,或把声音单独拿出来测,无法回答模型究竟是声音本身差、声源和画面对不上,还是提示词中的音乐与对话没被执行。屏内声源需要精确同步,屏外环境声又不能被错误绑定到可见对象,两者混在总分里会掩盖失败类型。 本文贡献:PRISM-Bench 以音频为中心,把 900 个经人工核验的样本沿两条正交轴拆分:音频类型分语音、音乐和一般声音,声源可见性分屏内与屏外;再从音画一致、音频质量、表现力和提示遵循四个维度定义 35 项细粒度标准。评估采用相对真值参考的盲测并排比较,由增强的多模态大模型裁判执行,避免只给单个生成结果打绝对分。 实验效果:该裁判协议与人类评审的平均一致率超过 70%。对近期文本到音视频系统的测试显示,前沿闭源模型与开源模型之间仍有明显差距;各系统更容易优化总体感知保真度,却在复杂的音画 grounding 与控制上失分,尤其是音乐生成和需要同步的屏内声源。论文已被 ACM Multimedia 2026 接收。 批判点评:按音频类型与声源可见性做二维切片,比继续堆一个总分更能指导模型改进,特别适合发现“画面对了但声音错了”的情况。局限是音频体验高度依赖耳机、响度校准、语言和音乐文化,35 项标准越细,标注一致性和裁判稳定性越难保证;报告结果时应保留分项雷达图,不宜只引用单一排名。 7. WorldReward:分块裁判同时看动作和画质 WorldReward: Reward Modeling for Camera-Conditioned World Models | 复旦大学、腾讯混元、上海创智学院、上海交通大学、上海人工智能实验室 | arXiv:2609.03952 关键词:世界模型,奖励模型,相机控制,视频偏好,视觉语言模型,强化学习,WorldReward ⚠️ 前序问题:相机条件世界模型既要执行移动和旋转指令,又要保持外观、几何和运动自然。几何奖励能估轨迹,却看不出画面是否崩坏;图像奖励能看单帧质量,却忽略动作和时序。把整段长视频与完整动作序列一次交给 VLM,又会让短暂的局部动作证据淹没在长上下文中。 本文贡献:WorldReward 把成对视频按动作边界切成小块,每块整理为源图、帧网格与四个动作面板组成的六图证据,让 VLM 分别判断动作一致性和视觉质量,再由投票聚合成视频级偏好。训练数据由前沿 VLM 生成结构化理由,经工具代理审计与定向人工复核;作者另建 WorldReward-Bench,覆盖平移、旋转与复合相机轨迹。 实验效果:在人工标注的三分类偏好一致率上,WorldReward 的动作、外观和运动三项分别为 77.63%、81.32% 和 73.03%,比 GPT-5.5 高 3.42、1.45 和 3.56 个百分点。用于 HY-WorldPlay 1.5 的强化学习后,约 381 帧长时域的基础动作准确率从 WorldCompass 的 76.56% 提到 78.84%,HPSv3 质量分从 3.72 提到 3.94。 批判点评:按动作切块是解决长上下文稀释的直接方法,而且把动作和画质分开投票,避免高画质掩盖不听指令。投票也会丢掉动作间的因果关系:单块都判断正确,不代表整条轨迹的累计位姿闭环正确。下一步更需要把局部裁判与全局状态估计结合,并验证奖励模型是否会被生成器找到视觉捷径。 8. Puffin-World:1600万样本统一原生3D状态 Puffin-World: Scaling a Unified Multimodal Model with Native 3D World States | 南洋理工大学 S-Lab、密歇根大学、北京交通大学、ACE Robotics | arXiv:2609.04196 关键词:世界模型,3D生成,物理理解,深度重建,相机表示,多模态模型,Puffin-World ⚠️ 前序问题:世界模型常把物理理解、相机控制、图像生成、深度估计和 3D 重建拆成多个离线模块。模块间坐标定义与误差不一致,闭环探索时会累积漂移;模型只生成外观而没有重力、尺度和几何等显式状态,也很难判断新的视图是否仍处在同一个物理世界。 本文贡献:Puffin-World 在一个多模态架构中联合建模三类原生世界状态:物理状态包含重力场与纬度,几何状态为深度,外观状态为图像;统一 Omni-Camera 表示支持不同自由度与相机动作。模型既把物理动力传播到未来帧,也在同一生成过程中耦合外观与几何,从而让自由视角生成同时输出可重建的底层结构。训练集 Puffin-16M 包含 1500 万视觉-语言-相机三元组和 100 万条挑战性运动轨迹。 实验效果:论文展示统一模型可执行相机到世界的物理理解、自由视角空间模拟、3D 世界生成和重建,并支持模仿与自校准探索等交错闭环应用。作者公开了代码、模型和数据;摘要层面没有给出单一总分,而用多任务结果证明同一原生状态表示能覆盖此前分离的能力。 批判点评:把深度和图像一起生成、把相机属性锚定到真实坐标,是走向闭环 3D 世界模型的正确方向;显式重力还能约束“看起来合理但物理方向错了”的画面。最大疑问在数据标定:重力、纬度、深度和相机真值的噪声分布不同,大规模混合后谁主导训练并不透明。模型还能生成稳定视图,不等于已经学会接触、质量和材料等完整动力学。 9. EraseSAE:单义特征做视频概念手术 EraseSAE: Surgical Concept Erasure in Text-to-Video Diffusion Models via Sparse Autoencoders | 中国科学技术大学、安徽省数字安全重点实验室、HiDream.ai | arXiv:2609.03629 关键词:概念删除,视频扩散,稀疏自编码器,单义特征,时空掩码,生成安全,EraseSAE ⚠️ 前序问题:视频扩散模型从松散数据学习到版权角色、不安全内容等概念。现有删除方法直接改权重或用粗粒度方向抑制,但概念在 DiT 激活中分散且与背景、动作和风格纠缠,容易出现删不干净或把无关内容一起毁掉的问题。视频还多一层时间一致性要求,逐帧独立干预会产生闪烁。 本文贡献:EraseSAE 采用“分解—归因—删除”流程。Partitioned Convolutional Sparse Autoencoder 以分区双分支卷积把稠密时空激活拆成更可解释的稀疏单义特征;对目标提示和硬负提示做对比对数比归因,离线锁定概念核;推理时再按时间步生成时空掩码,只在概念真正激活的区域调制 classifier-free guidance,尽量保留其他对象和背景。 实验效果:在 CogVideoX 的三档裸体概念测试中,EraseSAE 的生成率为 2.62%、7.13% 和 77.80%,对比 T2VUnlearning 为 2.88%、10.89% 和 51.98%;其主体一致性为 94.30%,推理约 3.66 秒/帧。在 HunyuanVideo 上 Ring-A-Bell 裸体率为 5.13%,低于 T2VUnlearning 的 9.95%,主体一致性为 96.04%。Flux.1 的 I2P 显式内容总量也从原始 605 降到 160。 批判点评:以单义稀疏特征定位概念,比全局权重擦除更容易解释和审计,时空掩码也适合视频。不过“单义”来自稀疏自编码器的近似分解,不保证一个核只表达一个人类概念;对隐喻、组合提示或跨文化表达,硬负提示可能覆盖不足。部署时应同时报告删除率、误删率、绕过攻击和不同语言提示,不能只看平均主体一致性。 10. SVDtrunc:FLUX保留68%参数近乎无损 Importance-Aware Low-Rank Distillation of Diffusion Transformers | 海德堡大学、Zuse School ELIZA、达姆施塔特工业大学、hessian.AI | arXiv:2609.04646 关键词:Diffusion Transformer,模型压缩,低秩分解,知识蒸馏,FLUX,参数效率,SVDtrunc ⚠️ 前序问题:DiT 已成为高质量文生图骨干,但参数规模让显存、加载和部署成本居高不下。直接对所有投影矩阵用相同比例截断 SVD,忽略了不同块的重要性;大语言模型上的经验还让工程师担心低秩压缩会突然崩溃。需要先判断 DiT 的冗余分布,再在全局参数预算下决定哪些块可以多压。 本文贡献:作者发现 FLUX.dev 的 SVD 截断退化较平滑,冗余分散在全网络投影矩阵,而不是集中在少数 Transformer 块。SVDtrunc 先分别压缩每个块并生成探测图像,以相对原模型的质量变化给块排序;随后在全局预算下给不重要块分配更低秩,最后对全部块做模块化知识蒸馏与 rectified-flow 微调。该方法还能与减少采样步数的蒸馏叠加。 实验效果:SVDtrunc 在 GenEval、HPSv2 和 DPG 三个基准的综合比较中,在各压缩档位都优于论文纳入的竞争方法。FLUX.dev 保留 68% 原参数时接近完整模型性能,保留 57% 时仍有竞争力;实验覆盖保留 40% 至 90% 参数的区间,且无需微调的版本也保持较强结果。 批判点评:先用生成质量探测块重要性,比按权重范数或统一秩分配更贴近最终目标;发现 DiT 对低秩截断呈平滑退化也为工程压缩提供了有用经验。代价是每个块都要构造探测模型并生成一批图,前期搜索成本高,而且重要性依赖提示分布。若部署域与探测集差异大,原先被判定不重要的块可能正负责罕见概念。 趋势观察 代理式生成开始补上“证据进入像素”的最后一公里 WeAgent-MMGenEdit 不满足于给图像模型接一个搜索框,而是把外部证据拆成检索、逐图核验、结构化整合和最终交付四步,并让策略端与图像端分别做 SFT 和强化学习。PriorEdit3D 与 ReaDiT 也在降低监督门槛:前者从图像编辑器、视觉语言模型和图生 3D 教师蒸馏三类先验,后者只读一个 DiT 中间块,就用 53M 参数支持图像与视频的多类空间控制。 视频生成的竞争焦点转向控制稳定性与可核算效率 EditVid 用稀疏因果记忆、跨帧对应注入和软 latent 混合,把免训练视频编辑的 FiVE-Acc 从 58.95 提到 78.16。FlashRender 先修复不同采样步之间的相机控制不一致,再用 MeanFlow 和在策略蒸馏压到 4 次模型评估,采样成本降低 25 倍。SVDtrunc 则按块重要性给 FLUX 分配低秩预算,保留 68% 参数时仍接近完整模型性能。 评测与安全正在从单一总分转向可诊断的局部证据 WorldReward 按动作切分长视频并分别判断动作一致性与画质,避免局部指令证据被长上下文稀释。PRISM-Bench 把音频类型与声源是否可见交叉拆分,用 35 项细则暴露音乐和屏内同步声源的薄弱点。EraseSAE 也把概念删除落到稀疏单义特征和时空掩码上,不过最难的一档概念仍有 77.80% 生成率,说明精细归因并不等于问题已经解决。 人工智能炼丹君 整理 | 2026-09-07 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
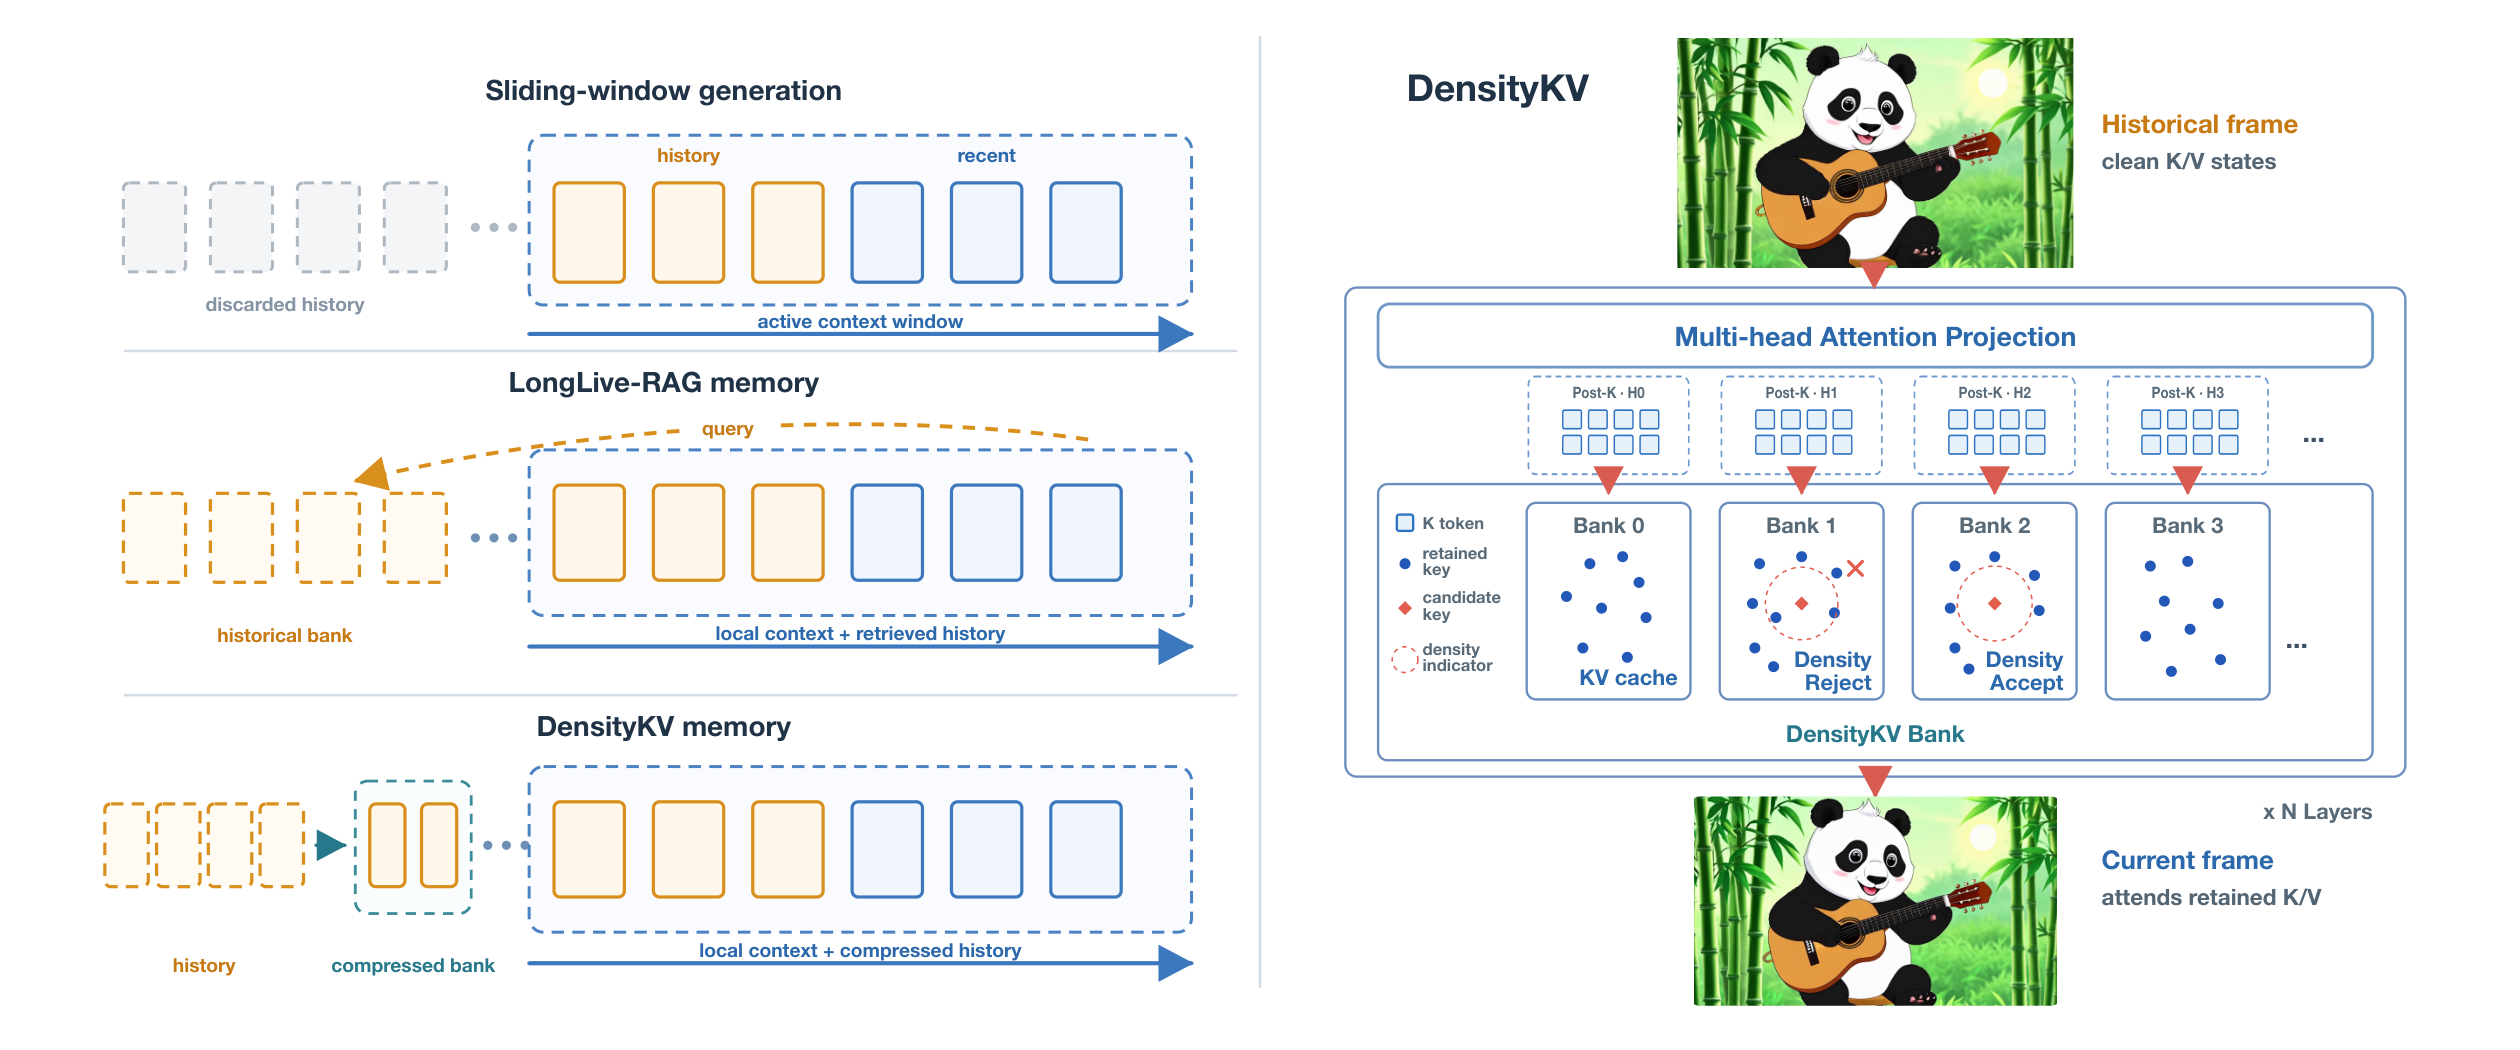
AIGC 周末专题|2026-09-06|长视频世界模型的记忆与状态概览 AIGC 周末专题深度解读:长视频世界模型的记忆:存得下、找得回、更新得对 人工智能炼丹君 整理 | 2026年9月6日(周日) 覆盖时间:双周覆盖 2026-08-24—2026-09-06(含首尾,共 14 天);原论文首发 2026-08-26—2026-09-02,PAWBench 采用 2026-09-03 v3 本期概述 本期 AIGC 周末专题聚焦长视频世界模型的记忆:存得下、找得回、更新得对方向,精选 7 篇代表性论文进行深度解读。 给一个模型一张街景图,再让你用方向键走开、转弯、返回原地。理想输出不仅是连续的视频,还应当保住原来的门窗与路口。如果你在离开前把一件物品放进抽屉,返回时抽屉里的内容也应正确。这正是本期要拆开的两种记忆:见过什么,以及后来发生了什么。 过去的滑动窗口(只让当前块看到最近一段历史)解决了生成开销随视频增长的问题,却容易忘掉远处内容;全历史缓存扩大了记忆,又带来存储成本。于是本期两周窗口内的研究沿三个方向展开:让有限历史更有用、让历史按几何或任务结构组织、让评测能识别“画面合理但状态错误”。 本期为双周专题,检索与综合窗口为 2026 年 8 月 24 日至 9 月 6 日,含首尾共 14 天。复核这两周的候选与论文索引后,保留七篇与历史记忆、状态更新及其评测直接相关的工作;它们的首发日期为 8 月 26 日至 9 月 2 日,另纳入 PAWBench 在 9 月 3 日更新的 v3。部分论文曾在工作日速读中出现,本期重新研读并作主题综合。下文的数值均为论文报告,未独立复现实验;跨论文联系与研究建议为本文分析。 两周进展怎样衔接:第一周(8 月 24—30 日)的 WALL-SS、DensityKV、LayerRecall 与 Matrix-Game 3.5,分别从视觉—动作配对、容量控制、按层读取和几何重访组织历史;同周首发的 PAWBench 则把概率分布纳入评测。第二周(8 月 31 日—9 月 6 日),Shell Game 将问题收紧到遮挡期间的隐藏状态更新,SolarWM 提供长时生成的数据与训练配方,PAWBench v3 进一步明确条件分数与场景通过率。时间上的接续不意味着这些同期工作相互继承。 双周观察:第一周较集中地回答“历史如何保存和读取”,第二周的入选工作补上“长时训练如何组织、保存的历史是否足以支持状态推理”。因此本期的横向比较同时区分存储预算、外观恢复、动作后果和不确定性,不能仅按生成时长判断能力。 先看四个趋势: 从保存容量转向读取效率。 DensityKV 决定哪些历史留下,LayerRecall 决定当前问题读取什么、送到哪层。 从时间距离转向结构关系。 Matrix-Game 3.5 用三维位置找回图块,WALL-SS 把视觉和动作按尺度共同保存。 从长视频样例转向可复现配方。 SolarWM 把数据与训练接口开放,便于将能力差异与工程配置差异分开。 从外观连续转向状态与分布。 Shell Game 检查遮挡期间的状态更新,PAWBench 检查固定条件下可能未来的概率。 方向分布: 历史压缩与读取 2 篇 (DensityKV, LayerRecall) 几何与动作记忆 2 篇 (Matrix-Game 3.5, WALL-SS) 开放训练配方 1 篇 (SolarWM) 状态与概率评测 2 篇 (Shell Game, PAWBench) 本期按机制比较,未将预印本排版模板或拟投会议视为已录用信息。 技术路线与时间线 把历史变成可管理的资源(2026-08-26—08-28) 描述:WALL-SS、DensityKV 与 LayerRecall 分别从尺度、容量、读取策略组织历史;这是同期不同路线,时间先后不表示相互继承。 关键节点: 08-26:WALL-SS:视觉—动作配对与时间—尺度记忆。 08-28:DensityKV 与 LayerRecall:在线去冗余与按层检索。 把记忆放入可交互生成流程(2026-08-30—09-02) 描述:Matrix-Game 3.5 细化几何场景召回,SolarWM 统一多源数据和因果训练配方。 关键节点: 08-30:Matrix-Game 3.5:patch 云、位姿编码与动静分离。 09-02:SolarWM:开放数据接口与长时推演。 检验记忆究竟保证了什么(2026-08-27—09-03) 描述:PAWBench 与 Shell Game 从概率与隐藏状态提出互补评测问题,并非上述方法已经全部接受过这些测试。 关键节点: 08-27 / 09-03:PAWBench 首发 / v3 更新:同时报告条件分数与场景通过率。 08-31:Shell Game:分开检查画质和交换链状态准确率。 1. DensityKV:给历史库去重,先守住显存预算 论文: DensityKV: Density-Guided KV Cache Compression for Long Video Generation arXiv: 2608.27922 机构: Manifold AI + 清华大学 关键词: 长视频生成, KV缓存, 免训练压缩 1.1 研究动机 核心问题: 在固定容量下,如何减少重复历史而保留有用状态? 自回归视频生成会把已经生成的内容继续当条件。只留最近几帧容易忘掉旧角色;把所有历史键值缓存(KV,即注意力读取的索引与内容)留下,又会让显存随时长增长。真正需要保存的,是历史里不容易被其他状态替代的信息。 前序工作及局限: 滑动窗口:上下文开销有界,但远处历史被直接逐出。 LongLive-RAG:按需读取历史,存档本身仍会增长。 与前序工作的本质区别: 将历史压缩建模为 post-RoPE key 空间的在线密度控制。 1.2 方法原理 Overview of historical-memory construction and use. Left: sliding-window generation discards states outside the active context; LongLive-RAG stores discarded history and retrieves selected blocks; DensityKV instead maintains a bounded token-level history that is attended together with the local window. Right: at every Transformer layer, clean historical K/V states update independent per-head banks. Admission and rejection are determined by Soft-Riesz density over post-RoPE keys, while each value remains exactly paired with its original key. Current queries access the retained history through the backbone's native attention. 图源:论文原图。图注译文:历史记忆的构建与使用概览。左:滑窗生成丢弃活动上下文以外的状态;LongLive-RAG 保存被逐出的历史并检索选定块;DensityKV 维护有界的 token 级历史,与局部窗口一起被读取。右:每层中,干净历史 K/V 更新各注意力头独立的库;根据 post-RoPE key 的 Soft-Riesz 密度决定接纳或拒绝,value 与原 key 严格配对,当前查询通过原生注意力访问保留历史。 DensityKV 在每层的每个注意力头分别维护历史库,在施加旋转位置编码(RoPE)后的 key 空间计算 Soft-Riesz 密度:附近已有很多相似 key,意味着这片邻域重复得较多。每条新入库状态都保存当时的密度基线,后续更新限制相对入库时的密度增长,而不是拿一个绝对密度阈值把所有密集区域一刀切掉。这样能区分“这一块本来就由一组完整视觉状态构成”与“后来反复加入几乎一样的历史”。原始 key 和 value 始终成对保存,当前块仍通过骨干原有注意力读取它们。 这套机制把压缩决策放在存储侧,既不新增训练任务,也不要求模型先说清自己将来要问什么。但它仍然是有限容量的历史覆盖方案:罕见细节是否被保留下来,依赖 key 空间中的邻域关系,不能由“密度低”直接推导出“任务上重要”。 1.3 核心创新 按注意力头独立管理历史,适配不同头的投影空间。 保留入库密度基线,限制后续冗余增长,同时维持原始 K/V 配对。 1.4 实验结果 Persistent temporal-state storage versus generation length. LongLive-RAG grows linearly, whereas Deep Forcing and DensityKV remain bounded. 图源:论文原图。图注译文:持久时序状态存储随生成长度的变化:LongLive-RAG 线性增长,Deep Forcing 与 DensityKV 保持有界。图中 120 秒时三者分别为 128.5、3.76、3.28 GiB;横轴为生成视频时长,纵轴采用对数刻度。 在论文的 M=9,360 配置下,历史库及元数据为 1.67 GiB;加上首帧锚点和五帧局部窗口,总持久时序状态为 3.28 GiB。这不是模型运行时的整机峰值显存。 同一存储统计中,LongLive-RAG 在 30/60/120 秒为 32.1/64.3/128.5 GiB;Deep Forcing 为 3.76 GiB。DensityKV 相对后者的存储优势远小于相对全历史存档的优势。 论文使用 128 个 MovieGenBench 提示词,分别测试三种骨干和 30/60/120 秒。表中部分基线分数引用 LongLive-RAG 原报告;不能把这组数字与另一篇自建提示集直接拼榜。 1.5 关键洞察 我的判断:有现成自回归模型、首先卡在历史库增长时,值得优先评估。重点监控压缩后的物体重现与运动幅度,避免高一致性只是画面变得更静。它解决“存什么”,尚未解决“哪一层应该读取这些信息”,与下一篇在职责上互补;两者组合是否有效仍需实验。 技术演进定位: 面向部署预算的历史库管理。 可能的后续方向: 固定峰值显存后比较重现准确率与运动质量。 检查稀有物体细节在长时淘汰中的保留情况。 2. LayerRecall:记忆不仅要选对,还要送对层 论文: LayerRecall: A State-Conditioned Memory Router for Long-Horizon Consistency in Video Generation arXiv: 2608.28460 机构: 浙江大学 + 香港大学 关键词: 视频DiT, 长时记忆, 跨镜头一致性 2.1 研究动机 核心问题: 有历史可访问,为什么仍不能稳定恢复旧属性? 人物离场后再次出现,模型可能仍记得“有一个人”,却把衣服换了。给所有层都塞入远处历史也未必有效:不同层对当前、近处、远处信息的偏好不同,错误注入可能扰乱正在进行的动作。 前序工作及局限: LongLive-2.0:保留局部连续性,远距离重现仍可能漂移。 全层记忆注入:扩大历史访问会干扰部分层的局部功能。 与前序工作的本质区别: 当前块的隐藏特征负责生成查询,块摘要只用于打分,检索载荷仍是完整 K/V;层集合则依据目标骨干的时间偏好预先确定,两种选择具有不同的动态性。 2.2 方法原理 Overview of LayerRecall. Given the current chunk, the router retrieves finite historical K/V candidates from layer-indexed memory banks and scores which memories are relevant to the next generation step. Retrieved states are injected only into profiled memory-sensitive layers, while the remaining layers keep the original sink, sliding-window, and current-chunk attention context. K/V denotes key-value states. 图源:论文原图。图注译文:LayerRecall 概览:给定当前块,路由器从按层索引的记忆库中检索有限历史 K/V 候选,并评价哪些记忆与下一步生成相关。检索状态只注入经分析选出的记忆敏感层;其余层保留原有 sink、滑动窗口与当前块注意力上下文。K/V 指 key-value 状态。 LayerRecall 把记忆使用拆成两个决策。首先,由当前块的隐藏状态生成查询,用它与每层历史块摘要计算相似度,选出有限数量的完整 K/V 块;摘要来自位置编码前的 key,而真正送入注意力的是已编码的 K/V。其次,只让预先分析得到的记忆敏感层接收检索结果,其余层保留原来的局部注意力。这里“检索内容”随当前状态改变,“注入层集合”则是对每种骨干固定的策略,不能理解为每次推理都自由选择全部层。 路由器通过跨跨度预测匹配(CHPM)训练。教师与学生共享同一个冻结骨干,教师拥有更长上下文,学生在有限记忆下对齐教师的去噪预测;训练只更新路由器。学生用自己生成的历史继续推进,梯度在块间截断,既暴露真实推理中的误差,又避免整段长视频反向传播。 2.3 核心创新 把“找哪段历史”与“在哪层用”同时纳入设计。 长上下文教师提供预测监督,无需人工标注每一块应读取哪段历史。 2.4 实验结果 Memory-guided self-correction in a three shot sequence. The subject wears a solid blue inner garment in Shot 1, leaves the scene in Shot 2, and initially reappears with a mismatched pattern in Shot 3. LayerRecall later recalls the earlier blue garment while preserving the subject's identity, gray cardigan, ongoing action, and scene structure, illustrating localized attribute recovery without a global visual reset. 图源:论文原图。图注译文:三镜头序列中的记忆引导自我纠正。主体在第一镜头穿纯蓝色内搭,在第二镜头离场,在第三镜头最初以错误花纹重新出现。随后 LayerRecall 恢复先前的蓝色衣服,同时保持人物身份、灰色开衫、正在进行的动作和场景结构,展示无需全局重置画面的局部属性恢复。 100 个评测提示词上,MemoBench 总分由 LongLive-2.0 的 0.513 提升至 0.548,MovieBench 从 0.546 到 0.578;三项 VBench-Long 指标均值均为 0.978。 主配置 30 层中有 10 层使用记忆;注意力可见预算为 32 个潜在帧,物理 K/V 库为 80 个潜在帧。可见预算不能当成全部存储占用。 匹配 H100 设置下,端到端时间从 305.9 秒/视频变为 309.4 秒/视频,对应 5.22 与 5.16 FPS。 2.5 关键洞察 我的判断:最有价值的是“层的职责”这一设计依据。原图中的衣服会先出现错误花纹,随后恢复纯蓝色,说明自我纠正并不等于从不出错。做长镜头或广告身份一致性时,应同时测错误出现次数、恢复延迟和恢复是否打断动作。记忆敏感层需要针对骨干分析,迁移成本不能只看训练参数量。 技术演进定位: 由历史存储走向选择性记忆使用。 可能的后续方向: 报告重现失败后的恢复时间。 与固定容量压缩库组合时重新分析层策略。 3. Matrix-Game 3.5:把旧场景按三维位置拼回当前视角 论文: Matrix-Game 3.5: Enhancing Real-Time Streaming Interactive World Models with Patch Memory arXiv: 2608.29910 机构: 昆仑万维 Skywork 关键词: 交互世界模型, 几何记忆, 相机控制 3.1 研究动机 核心问题: 如何在相机重访时找到位置正确的历史证据? 相机离开街角再回来,画面应该还是同一栋楼。整帧检索很难表达“这张旧图只有右上角对当前视角有用”,纯语义相似性也不能保证窗户落在正确的位置。 前序工作及局限: 整帧历史记忆:有用与无用区域绑定在同一读取单位。 MosaicMem:提供局部图块的几何记忆思路。 与前序工作的本质区别: 组合几何 patch 检索、位姿编码、动静分离与实时蒸馏。 3.2 方法原理 The patch-memory mechanism. (a) Lift to 3D: historical latent patches are back-projected into a common 3D space using metric depth together with camera intrinsics and poses. (b) Frustum query: the target camera frustum queries this patch cloud, and a z-buffer under the target view keeps, for every target latent location, only the surface closest to the camera while discarding occluded candidates. (c) Patch memory frame: the selected patches are scattered into an aligned memory canvas under the target viewpoint; regions that are occluded or have never been observed are left empty (black) and dropped from the memory token sequence; the diffusion model synthesizes them from the current latent, text prompt, and surrounding context. 图源:论文原图。图注译文:Patch 记忆机制。(a) 升维到三维:历史潜在图块借助度量深度及相机内外参反投影至共同三维空间。(b) 视锥查询:目标相机查询 patch 云,目标视角的 z-buffer 在每个潜在位置只保留离相机最近的表面,剔除被遮挡候选。(c) 记忆画布:选中 patch 散射成对齐目标视角的记忆;被遮挡或从未观察的区域留黑,并从记忆 token 序列中移除,由扩散模型结合当前潜在表示、文本和周围上下文生成。 Matrix-Game 3.5 采用 patch 记忆:把历史潜在图块结合度量深度、相机内外参反投影到三维空间,再由目标相机的视锥查询。投影到同一目标位置的候选由 z-buffer 选最近可见表面,遮挡、不可靠投影和未见区域被剔除;留下的 patch 按当前视角散射成一张有空洞的记忆画布。空洞交给生成器补全,既保留证据,也显式暴露“这里没有看过”。 相机几何通过 tiled PRoPE 叠加在原时空 RoPE 上,避免切掉视频骨干用于时间建模的通道。静态场景依赖几何 patch,动态主体则有参考 token 维持身份,另有上下文记忆提供未扭曲的历史观测。最后用感知流匹配完成因果适配,再对自生成轨迹做分布匹配蒸馏(DMD),逐步纳入引导、相机控制与记忆条件。 3.3 核心创新 将场景召回粒度细化到图块,并按目标视角对齐。 静态几何与动态主体分开处理,减少把移动物体错误固定到旧位置的风险。 3.4 实验结果 Tiled PRoPE and the native RoPE act together in one attention kernel: temporal structure is preserved, and pose similarity is rewarded. We use two synthetic trajectories here to illustrate the preservation (bottom row), and calculate frame-by-frame attention logits for heatmap visualization (top row). (a) RoPE only (camera term off): the purely temporal kernel, banded in frame offset. (b) Straight walk with tiled PRoPE: the map is nearly indistinguishable from (a) --- the maximum change is empirically 1.3% of (a)'s dynamic range --- adding the camera does not disrupt the frame-to-frame attention structure. (c) S-curve with tiled PRoPE: frames with similar heading light up in blocks far from the diagonal, and opposite-heading frames darken. The camera raises attention exactly where views are geometrically close, while the temporal ordering of (a) survives untouched. This analysis was performed on the model fine-tuned from Wan2.2-TI2V-5B. 图源:论文原图。图注译文:Tiled PRoPE 与原生 RoPE 在同一注意力核中共同作用,保留时间结构并提高位姿相近帧的注意力。下排为两条合成轨迹,上排为逐帧 attention logits 热力图。(a) 关闭相机项时,RoPE 形成沿帧偏移的带状结构。(b) 直线行走时加入 tiled PRoPE,最大变化约为原图动态范围的 1.3%。(c) S 形轨迹中,相近朝向在远离对角线处变亮,相反朝向变暗,同时原时序顺序保留。分析使用从 Wan2.2-TI2V-5B 微调的模型。 论文的 SANA-WM 一分钟简单轨迹测试中,蒸馏前 Matrix-Game 3.5 的旋转误差为 1.63°、重访 SSIM 为 0.439;Matrix-Game 3.0 对应 12.96°、0.326。两者均为 720p,但推理 GPU 数不同,分别为 1 和 8。 困难轨迹上旋转误差为 2.70°,重访 SSIM 为 0.414。这些指标分别描述相机跟随与相同位姿下的外观恢复。 主对比表明确使用蒸馏前模型,不能把表中质量与蒸馏后实时模型的速度拼成同一工作点。 3.5 关键洞察 我的判断:场景漫游比纯文本长视频更适合显式几何检索。代价是深度、相机与动态分割错误会进入记忆链路。长期产品需要考虑错误 patch 的失效与纠正,否则每次“回忆”都可能强化最初的几何误差。论文中的几何组件不新增可学习参数,不代表整套系统免训练或没有计算成本。 技术演进定位: 由时间索引扩展为三维空间索引。 可能的后续方向: 评测深度错误对长期记忆污染的影响。 给历史 patch 增加可信度与失效条件。 4. WALL-SS:历史变粗时,动作也要一同保留 论文: WALL-SS: Scaling Long-horizon World Models via Next-Scale Autoregression arXiv: 2608.26239 机构: 自变量机器人 (X Square Robot) 关键词: 机器人世界模型, 下一尺度自回归, 动作条件 4.1 研究动机 核心问题: 有限历史里怎样同时保住外观与交互后果? 机器人看见的是画面,执行的是动作。如果把历史只压成外观,模型可能记得杯子长什么样,却忘记它刚被放进了哪个篮子。这里需要保留动作及其后果的对应关系。 前序工作及局限: 下一尺度视觉生成:提供由粗到细的表示,但不自动保证动作因果关系。 只保留最近片段:容易丢失更早交互造成的持久状态。 与前序工作的本质区别: 视觉与动作按时间和尺度对齐,并联合参与历史状态管理。 4.2 方法原理 Overall framework of WALL-SS. WALL-SS unifies action-conditioned next-scale visual prediction, streaming long-horizon state propagation, and on-policy alignment of autoregressive visual dynamics. 图源:论文原图。图注译文:WALL-SS 总体框架:统一动作条件的下一尺度视觉预测、流式长时状态传播,以及自回归视觉动力学的 on-policy 对齐。图中时间—尺度 KV 记忆把最近精细状态、较远粗状态和初始锚点共同提供给因果 Transformer,动作记录与视觉历史配对。 WALL-SS 采用下一尺度自回归:先生成粗尺度视觉状态,再逐步细化,每个尺度都读取同一时间区间、同一视角且尺度对齐的动作条件。长时记忆反过来利用这套层次:最近交互保存精细状态,较远的历史只留较粗状态,并让视觉记录始终与对应动作条目成对存在。固定的历史年龄—尺度调度决定何时读取和淘汰,因而存储能够保持有界。首帧身份锚点只提供外观与全局布局参照,不能代替滚动的动态状态。 训练通过随历史年龄变化的扰动和模型自己生成的上下文减少误差累积。后训练把视觉生成器视为可优化策略:动作保持为输入条件,奖励调整给定动作下视觉未来的概率。这个区别很关键——该阶段优化的是世界预测,而不是顺便学一个更会做任务的机器人控制器。 4.3 核心创新 复用多尺度生成状态管理长历史,无需另外重建一套 RGB 压缩器。 保存动作—视觉因果配对,在自己的 rollout 上对齐动作跟随与长期一致性。 4.4 实验结果 Qualitative comparison of long-horizon video rollouts. Rows correspond to Wan2.1-1.3B, Wan2.2-14B, Infinity-8B, and our model, while columns show snapshots at 5, 30, and 60 seconds. The left task requires sorting tabletop objects into the corresponding baskets, and the right task requires pouring water into a cup. The comparison highlights each model’s ability to preserve scene geometry, object identity, and coherent task progression over extended horizons. 图源:论文原图。图注译文:长时视频 rollout 定性比较。各行依次为 Wan2.1-1.3B、Wan2.2-14B、Infinity-8B 和本文模型;各列为 5、30、60 秒快照。左侧任务按形状把桌面物体放入对应区域,右侧任务向杯中倒水并放下水壶。对比展示长时几何、物体身份与任务进程的保持情况。 受控后训练消融中,动作跟随从 0.264 到 0.290,轨迹准确率从 0.512 到 0.539,跨片段边界误差从 0.118 降至 0.104。均为该论文内部协议。 论文展示了 5、30、60 秒的物体分类与倒水任务;图像证据用于观察物体身份、几何与任务进展,不能替代真实机器人成功率。 其闭环比较设计包含 6 个留出任务、5 个策略检查点、20 个匹配初态,共 600 对生成—真实 rollout,评测对象已经超出单帧画质。 4.5 关键洞察 我的判断:值得关注动作与视觉一起压缩的设计。它仍有任务相关的取舍:很小的按钮状态可能对成功至关重要,却在粗尺度历史里不显眼。若把它用于策略筛选,需要观察是否保持各策略的成功率排序;看起来更流畅的模拟器,未必更准确地评价了控制策略。 技术演进定位: 从视频连续性推进到具身交互的可用性。 可能的后续方向: 测试细小但决定任务成败的状态能否跨尺度保留。 增加长任务下模拟器与真实策略排名的一致性检验。 5. SolarWM:短序列训练撑起长推演,证据要分层看 论文: SolarWM: Open Data and Scalable Training for Long-Horizon Video World Models arXiv: 2609.02886 机构: 香港中文大学(深圳)、SLAI、新加坡国立大学、香港中文大学、香港科技大学、香港科技大学(广州)、NVIDIA、UCLA、微软亚洲研究院 关键词: 长时世界模型, 开放数据, 分布匹配蒸馏 5.1 研究动机 核心问题: 怎样减少数据与骨干耦合,并稳定训练可扩展的因果世界模型? 换一个视频骨干,经常连数据时间轴、相机单位、潜在帧率和训练目标都要重做。SolarWM 关注这个系统问题:把数据准备、相机控制与因果训练整理成可复用的统一接口。 前序工作及局限: 直接混合多源数据:时间、几何、质量标准不一致,监督信号容易相互冲突。 只用教师强制训练:推理时自身历史带来的误差未被充分覆盖。 与前序工作的本质区别: 把数据、相机接口与三阶段因果训练整理为统一而保留骨干差异的框架。 5.2 方法原理 Overview of the SolarWM-5B training pipeline and hour-scale inference results 图源:论文原图。图注译文:SolarWM-5B 训练流程及小时级推演概览。图上方为双向训练、使用教师强制和 AnyFlow 的自回归训练、使用 DMD 的四步蒸馏;三阶段均使用五秒序列。下方展示教室与街区场景的长时交互画面。 SolarWM 将 10 个数据集中的 143 万个规范片段整理为逐帧对齐的视觉、度量相机、文本、质量信息和来源记录;源数据处理与训练混合比例分开,使数据选择可追溯。统一接口并不强行抹平骨干差异:Wan、LTX 与 H3 的潜在表示、首帧条件和目标函数被分别保留,相机条件通过适配器接入原有注意力。 三阶段训练先做双向相机条件适配,再用教师强制的 AnyFlow 损失直接得到少步因果初始化,最后用 DMD 在学生自生成的上下文上训练,缓解训练看到真值、推理只能看到自身预测的分布差异。论文的长推演始终固定场景提示词,外部变化来自给定相机轨迹。理解这个控制条件,才能判断“小时级”结果究竟验证了什么。 5.3 核心创新 统一可追溯数据约定,同时保留骨干原生表示与训练目标。 把少步因果初始化并入第二阶段,再用自生成轨迹做分布匹配。 5.4 实验结果 Hour-scale world rollout generated by the SolarWM-wan2.2-5B-fast causal student. Sparse frames are sampled throughout a single uninterrupted autoregressive session initialized with a real first frame from the held-out validation pool, spanning the initial observation to the 60-minute endpoint. The scene prompt remains fixed and the model follows a predetermined camera trajectory. 图源:论文原图。图注译文:SolarWM-wan2.2-5B-fast 因果学生的小时级世界推演。从留出验证集的一帧真实初始观测开始,在一次不中断的自回归会话中稀疏采样,覆盖初始时刻至 60 分钟端点。场景提示词保持固定,模型遵循预先给定的相机轨迹。 模型家族覆盖 5B—33B 四条路线;各路线保留组件不同,LTX 路线移除了音频相关模块,不能据此声称四个版本都输出音视频。 因果实验使用 4 个采样步,视频时间轴为 16 FPS。这里的 16 FPS 是输出帧率,不能直接当成端到端生成吞吐。 wan2.2-5B-fast 的图示从 5 秒训练窗口扩展到不中断的 60 分钟推演;论文长时结果主要是定性样例,尚不能据此认定任意一小时前的状态都能正确恢复。 5.5 关键洞察 我的判断:它的价值是把实验基础设施和配方公开,方便在相近数据条件下比较不同模型。对小时级样例,接下来最需要补的是统一的重访轨迹、任务状态探针和随时间变化的失败率。持续产出合理的新画面,与反复回到同一世界仍保持同一事实,是两种不同的验收要求。 技术演进定位: 长时世界模型的复现实验底座。 可能的后续方向: 在相同数据与硬件预算下做骨干对比。 增加小时级定量重访与状态正确性指标。 6. Shell Game:杯子画得再真,也可能不知道球在哪 论文: Can Video World Models Track Unobserved World States? arXiv: 2608.30692 机构: 首尔国立大学 + Roblox 关键词: 隐藏状态, 视频世界模型评测, 测试时训练 6.1 研究动机 核心问题: 能回忆旧画面,是否就能更新从未直接显露的状态? 五个相同杯子盖住一个球,再按动作序列交换位置。输入是初始画面和每次交换动作,输出是最后揭杯的视频;正确结果必须让球出现在真正的那个杯子下。中间看不见球,任务刻意把渲染能力与隐藏状态追踪分开。 前序工作及局限: 画质与身份一致性评测:无法判断遮挡物体经过动作后位于何处。 追加式KV历史:保留证据,但状态组合仍需每次重新推导。 与前序工作的本质区别: 实验在球不可见时保持画面简洁,并固定动作交换与生成块的对应关系;观察最终揭杯位置,就能单独量化架构是否正确组合了整条动作链。 6.2 方法原理 The visual shell game construction. An episode first reveals the ball and lowers the cups, then applies a sequence of swaps while the ball remains hidden, and finally reveals its position. 图源:论文原图。图注译文:视觉 Shell Game 的构造:先揭示小球并放下杯子,再在小球不可见的情况下执行一串杯子交换,最后揭示小球位置。图中每次交换对应一个生成块;球在整个交换阶段始终不可见。 Shell Game 用约 200M 参数、相近规模的模型比较时间混合机制,视觉骨干和压缩表示尽量一致。训练只包含 5 次交换,测试把链条延长到 30 次。像素损失在遮挡阶段不会告诉模型球在哪里,因而它必须在架构内部携带并更新状态;追加历史的 KV 缓存让模型重新从历史推导答案,却不等同于一份会原地更新的状态表。 两个有效方向分别是允许状态转移具有负特征值的线性注意力,以及更新非线性快速权重的测试时训练(TTT)。前者可表达交换所需的反射操作,后者能随着新动作修改读取自身状态的特征映射。单纯增加可读写 scratchpad token 并没有在长链上同样成功,因此“有一个记忆模块”这个标签本身没有解释力,要看它究竟能执行何种状态变换。 6.3 核心创新 用隐藏小球的动作条件视频控制渲染难度,直接测试状态组合。 同时比较长度外推与去噪步数,区分画质改善和状态计算能力。 6.4 实验结果 Length extrapolation of mechanisms that enable state tracking. All variants share the same SWA1 backbone, with the temporal mechanism added on top. The bare backbone alone (SWA1, $M{=}0$ in (C)) never rises above chance, failing even at the in-distribution length $N{=}5$, so it serves as the natural chance-level control. (A) Extending the transition eigenvalue range from $[0,1]$ to $[-1,1]$ improves state accuracy across linear-attention variants. (B) LaCT extrapolation improves with the number of fast-weight heads $H$. (C) Adding explicit per-layer read/writable scratchpad tokens improves extrapolation through $N{=}10$ but fails by $N{=}20$. 图源:论文原图。图注译文:可支持状态追踪的机制之长度外推。各变体以同一 SWA1 骨干为基础,添加不同时间机制。裸骨干,即 (C) 中 M=0 的 SWA1,连训练内 N=5 都未超过随机水平,因此作为自然对照。(A) 将转移特征值从 [0,1] 扩大至 [-1,1] 改善线性注意力状态准确率。(B) 增加快速权重头数 H 改善 LaCT 外推。(C) 每层加入可读写 scratchpad token 能改善至 N=10,但到 N=20 仍失败。 训练集为 30,000 段五杯、五次交换序列;随机猜球位置的准确率为 20%,测试最长 30 次交换。 在 10 次交换时,把采样步数从 4 增加到 50 并未改善状态准确率;高 PSNR 可以与接近随机的状态判断共存。 扩展线性状态转移特征值范围、增加 LaCT 快速权重头数能明显改善外推;显式 scratchpad 在 20 次交换附近仍出现失效。 6.5 关键洞察 我的判断:这篇给前面几种记忆方法提出了很好的压力测试,但没有逐一测试本期所有新模型,所以不能宣称 LayerRecall、Matrix-Game 或 SolarWM 已在该任务失败。人工构造的交换任务也不能直接代表全部真实世界能力;它的强项是让某一种能力缺口变得可定位、可复现。 技术演进定位: 为长时生成建立可证伪的状态诊断。 可能的后续方向: 在大规模预训练模型上检验同类受控任务。 同时报告状态正确率、渲染质量和外推长度。 7. PAWBench:同一起点多推演几次,概率也要对 论文: PAWBench: How Far Are We from Probabilistically Aligned World Modeling? arXiv: 2608.27345 机构: 上海交通大学、上海 AI Lab、Krea AI、Hugging Face、上海创智学院、通义实验室、香港大学 关键词: 概率对齐, 世界模型评测, 分布校准 7.1 研究动机 核心问题: 多次生成是否恢复正确的可能结果及其概率? 一个模型能画出硬币正面和反面,还不够。如果对称条件下大多数时候都落在同一面,它虽然有多样性,却没有学对结果分布。用于规划的世界模型需要知道哪些未来可能发生,以及它们各有多大可能。 前序工作及局限: 单条视频合理性:一条合理轨迹无法说明整体概率分布。 仅看多样性:覆盖多种结果,不代表频率与物理过程相符。 与前序工作的本质区别: 作者把终局分类、无效结果筛选与分布统计明确拆开,对可校准概率和只能枚举结果的场景分别评分,避免把所有多样性混为一种能力。 7.2 方法原理 PAWEval turns repeated rollouts into a distributional test. In this PAW-Calibration example, a rubric-based judge maps each readable, in-schema coin-toss rollout to Head or Tail. Aggregating these labels yields the empirical outcome distribution, which is compared with the reference probabilities rather than matching generated videos frame by frame. 图源:论文原图。图注译文:PAWEval 将重复 rollout 转为分布检验。这个 PAW-Calibration 例子中,按评分规则工作的裁判把每条可读且符合结果定义的抛硬币视频归为正面或反面;汇总后形成经验结果分布,再与参考概率比较,而不是逐帧匹配生成视频。 PAWBench v3 将 50 个场景分为两轨。25 个校准场景有解析或对称性导出的参考概率;另外 25 个覆盖场景只确定有效结果集合,不强行假定每种结果等概率。对固定初始图像和动作,每个模型重复生成 50 次,PAWEval 按场景评分规则读取终局,然后比较结果分布。校准使用总变差距离(TVD,即两分布差异绝对值之和的一半),覆盖使用有效结果被观察到的比例。 无法读取或不符合结果定义的视频单独记录;某场景至少有 20 条可读、合法结果才通过门槛。论文同时报告通过场景上的条件分数,以及全部场景中通过的比例 SPR。把两个指标放在一起很必要:只在少量容易场景上得到好分数,不能当成整体可靠。相比单视频打分,它还区分了概率错配、可能结果遗漏和无法完成物理过程三类问题。 7.3 核心创新 从单次轨迹合理性推进到重复采样的结果分布。 校准和覆盖分开,并同时披露结果读取门槛与场景通过率。 7.4 实验结果 Models underreact to physically causal interventions and overreact to non-causal cues. Upper and lower bars show outcome distributions before and after intervention; panels (b) and (d) show the paired scenes. The pencil tilt is causal because it changes the physical transition, whereas the Galton-board text is non-causal because it leaves the transition unchanged. 图源:论文原图。图注译文:模型对物理因果干预反应不足,对非因果提示反应过强。上下条带为干预前后的结果分布,(b) 与 (d) 展示成对场景。铅笔倾斜会改变物理转移,因此是因果干预;高尔顿板旁的文字未改变转移,因此是非因果干预。 v3 在 11 个系统上评测;Cosmos 3 Super I2V 校准 TVD×100 为 20.5,但校准 SPR 为 80%;LTX-2.3 覆盖率为 71.7%,对应覆盖 SPR 为 72%。 相同参考为 50/50 时,模型产生 70/30 分布的 TVD×100 等于 20,而不是 40。 主实验 K=50;扩大采样预算可以找到更多结果,但不保证修正相对频率。作者对 888 条双方均能明确读取的视频做人类一致性检查,自动判定与明确人类标签一致 722 条,即 81.3%。 7.5 关键洞察 我的判断:v3 最值得保留的是分母意识:条件分数、场景通过率与采样预算必须一起看。自动裁判也有误差,且参考概率来自受控机制假设,不能无限外推到真实开放世界。概率对齐并非“每次都生成同一个正确答案”;确定性隐藏状态与随机未来分布应采用不同测试。 技术演进定位: 在记忆与状态之后检验世界模型的不确定性。 可能的后续方向: 固定采样预算并报告无效样本与SPR。 对关键任务做人工裁判复核与干预对照。 横向对比与技术脉络总结 七篇论文分别回答哪一个问题 论文 核心对象 关键证据 不能据此推出 DensityKV 逐头历史K/V库 固定配置3.28 GiB持久状态 整机显存仅3.28 GiB LayerRecall 历史检索与注入层 MemoBench 0.548;MovieBench 0.578 任意长历史均可恢复 Matrix-Game 3.5 静态几何与主体记忆 一分钟重访与相机误差 蒸馏前质量等于实时模型质量 WALL-SS 动作—视觉时序状态 动作跟随与边界误差消融 已掌握全部隐藏状态推理 SolarWM 数据与因果训练接口 五秒训练;小时级定性推演 一小时内所有事实始终正确 Shell Game 不可见状态的组合更新 五次训练、三十次交换外推 全部大模型和记忆方法均失败 PAWBench v3 重复推演的结果分布 双轨25+25场景;每场景50次 单个条件均分代表全面可靠 核心技术趋势 压缩和路由可以分工,但组合必须重新验证 DensityKV 压缩 post-RoPE 的逐头 K/V,LayerRecall 用块摘要挑选历史并按层注入,两者读取粒度并不相同。将它们拼接,需要先定义“一个历史块在被逐头裁剪后还是否完整”,以及教师监督看到的历史与压缩后历史是否一致。仅凭模块职责互补,不能推导出性能叠加。 记忆需要区分持久属性与会变化的状态 衣服颜色可以长时保持,物体位置与容器内容却可能随动作改变。把早期图像长期作为锚点,有时会帮助身份一致性,有时可能把世界拉回过时状态。几何记忆应知道哪些对象移动了,语义记忆也需要决定旧事实何时失效。 自生成上下文训练与可更新状态解决不同问题 LayerRecall、Matrix-Game 3.5、WALL-SS、SolarWM 都以不同方式让训练接近推理的自生成历史。这能缓解误差积累;Shell Game 则提醒我们,有些任务还受架构可表达的状态变换限制。更多 rollout 训练是否足以弥补该限制,需要受控外推实验,不能只看模型是否经过蒸馏。 长时系统应同时报告运行预算与能力失效 一次运行持续多久、能保留多久以前的外观、能组合多少次隐藏动作、能覆盖多少未来分支,分别描述不同能力。将这些指标拆开,才能分辨是容量用尽、读取失败、状态更新失效,还是概率分布偏置。 技术路线全景图 需求 → 先定义验收 外观重现 → 存储预算(DensityKV)→ 读取位置(LayerRecall) 相机重访 → 几何证据(Matrix-Game 3.5) 动作后果 → 时间—尺度配对(WALL-SS) 训练底座 → 数据与因果配方(SolarWM) 共同验收 → 隐藏状态外推(Shell Game)+结果分布(PAWBench) 仍然缺少哪些关键实验 四大核心难点 1. 旧事实如何失效 应构造“物体被移动后再回访”和“物体只是暂时离场”两组场景,检查记忆能否分别更新位置与维持身份。 2. 比较的预算如何对齐 同时报告物理缓存、注意力可见长度、模型与中间张量的峰值显存,以及包含解码和检索的端到端耗时。 3. 不同能力怎样联合验收 画质、重现、状态和分布应分列,不能用一个总分把某项严重失败平均掉。 4. 受控结论怎样扩展到真实场景 交换杯子的探针便于定位机制,真实开放世界还包含观测噪声、对象数量变化与动作歧义;需要逐级增加难度。 总结与展望 同一评测协议下,先看哪些数字可信 下面摘取 LayerRecall 论文主表中的同一组 100 个评测提示词结果。VBench-Long 此处是主体一致性、背景一致性、运动平滑度三项均值;不是所有 VBench 维度的总分。各基线的输入适配、分辨率及采样配置见原文附录,因此该表适合观察指标之间的差异,不是等算力排行榜。 方法 VBench-Long 三项均值 ↑ MemoBench 总分 ↑ MovieBench 总分 ↑ LongLive-2.0 0.978 0.513 0.546 MemFlow 0.981 0.531 0.542 SkyReels-V2 0.992 0.466 0.508 LayerRecall 0.978 0.548 0.578 来源:LayerRecall 主表与实验设置。加粗为本表四行中的最优值。SkyReels-V2 的三项平均更高,记忆专项却较低;这正说明通用视觉连续性不能代替长时记忆评测。 PAWBench 的另一组数据属于不同问题,单列如下。TVD×100 越低越好,覆盖率越高越好;两项均值只在通过读取门槛的场景上计算。每轨 25 个场景、每场景 50 次生成,SPR 是全部 25 个场景中的通过比例。 模型 校准TVD×100 ↓ 校准SPR 覆盖率 ↑ 覆盖SPR Cosmos 3 Super I2V 20.5 80% 55.2% 92% MiniMax H3 24.2 68% 48.7% 92% LTX-2.3 30.1 24% 71.7% 72% Seedance 2 30.5 100% 50.9% 84% 来源:PAWBench v3 表1。加粗仅表示本表四行中的最优值。LTX-2.3 的高覆盖均值与较低场景通过率应一起看;不同模型通过的场景集合也可能不同。它与上一张表无法直接比较。其余论文的机器人任务、相机轨迹和时长设置也不同,本期不把七篇排成统一名次。 实操与分层阅读 30 分钟理解主题:先看导语与七篇对照,再读 Shell Game 的杯子交换图。试着分别写出“外观没变”“状态正确”“概率合理”各自需要怎样的证据。 半天精读:选择与你的瓶颈匹配的一条路线。显存受限读 DensityKV;跨镜头属性恢复读 LayerRecall;相机回访读 Matrix-Game 3.5;机器人动作模拟读 WALL-SS。沿每篇 arXiv 页面访问作者官方项目入口,复现时固定论文版本和实验配置。 一周动手研究:先用 SolarWM 的数据与训练设计作为对照思路,选定一个可运行骨干;固定初图、动作、随机种子和预算,分别测试“走开再回来”“移动物体后再回来”“遮挡时连续交换”。然后对同一随机物理场景重复采样,记录终局分布与无法判读的比例。建议把每种失效单独存档,再决定需要更好的缓存、读取器还是状态更新机制。 这七篇共同带来的研究机会,是把历史记忆、动态状态和不确定性放进同一套可检查的生成流程。具体模块的组合效果仍待验证;选择方案时,应从你要保住的事实和可测的失效出发。 专题排期:本栏目自本期起每两周的周日发布一次。下一期为 2026 年 9 月 20 日,覆盖 9 月 7—20 日;工作日论文速读照常。 今日讨论 如果模型能保持一小时画质,却无法在物体移动后恢复正确位置,你会先增加历史容量,还是先测试记忆更新机制? 人工智能炼丹君 整理 | 数据来源:arXiv 双周覆盖 2026-08-24—2026-09-06(含首尾,共 14 天);原论文首发 2026-08-26—2026-09-02,PAWBench 采用 2026-09-03 v3 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-04|港中深5秒训练撑起一小时世界推演-SolarWM 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 SolarWM(香港中文大学(深圳)、SLAI、新加坡国立大学、香港中文大学、香港科技大学、香港科技大学(广州)、NVIDIA、UCLA、微软亚洲研究院):5秒训练撑起一小时世界推演 SelfLift(清华大学、字节跳动):少步扩散再砍41%延迟 f-loss(LIX 巴黎综合理工学院(CNRS, IP Paris)、AMIAD、LIGM 巴黎国立桥路学校、加州大学伯克利分校):频域配平让收敛快40% MeRoPE(香港科技大学、卓驭科技):大基线相机控制不再爆范数 GlyphAnchor(复旦大学、小红书、上海创智学院):字形块锚定长文本渲染 今日论文速览 1. SolarWM:5秒训练撑起一小时世界推演 SolarWM: Open Data and Scalable Training for Long-Horizon Video World Models | 香港中文大学(深圳)、SLAI、新加坡国立大学、香港中文大学、香港科技大学、香港科技大学(广州)、NVIDIA、UCLA、微软亚洲研究院 | arXiv:2609.02886 关键词:交互式世界模型,长时序推演,多源数据引擎,骨干原生适配,分布匹配蒸馏,自回归因果模型,SolarWM 前序问题:把视频生成模型改造成可交互的世界模型,卡点其实不在骨干网络。论文点出的是一处「耦合」:一方面各个数据源彼此不兼容——时间尺度、相机几何、画质、运动幅度、字幕风格全都不一样;另一方面各家视频生成器用的表示和架构也不同。这两件事叠起来的后果是,天真地把数据混在一起、再为每个模型写一套专用实现,得到的监督信号是互相矛盾的,而且结果既难复现也难以互相比较。于是这个方向上大量工作看起来在进步,却无法判断进步来自数据、配方还是骨干。更具体的难题是长时序:交互式世界模型要求模型在用户持续操作下自回归地往前推演,而训练时能拿到的序列长度是有限的,如何让短序列训练出来的模型撑住远超训练窗口的推演,是这类系统真正的分水岭。 本文贡献:SolarWM 的回应是把上面那处耦合拆开,给出一个从数据准备一路到长时序推理的完整开放底座,具体是两件事加一套配方。第一是可重配置的多源数据引擎:它把来自 10 个数据集的 143 万个规范化片段转换成一份统一的、逐帧对齐的「契约」,内容覆盖视觉观测、度量尺度的相机几何、字幕、质量元数据、筛选决策以及来源出处;关键设计是把「单源处理」与「混合配比构造」解耦,这样调整数据配比不必重跑源处理。第二是骨干原生的适配框架:在共享的相机条件化、训练与推理接口之下,他们基于 Wan2.2、LTX-2.5 和 MiniMax-H3 实例化了四个 5B 到 33B 的模型,且刻意保留各自原生的表示与目标函数,而不是强行统一成一种写法——这正是让跨骨干结果可比的前提。第三是一套统一的三阶段配方:双向适配、教师强制的自回归初始化、以及分布匹配蒸馏。三者串起来把双向模型转成因果模型,从而支持实时交互。数据、管线、配方、权重与框架均开放。 Overview of the SolarWM-5B training pipeline and hour-scale inference results 实验效果:论文给出的核心结果是一个训练窗口与推演窗口之间的落差:模型只在 5 秒序列上训练,得到的因果模型却能在分钟级到小时级的推演区间内支持实时交互。附录里的定性证据分层给出——十秒级的域内第三人称结果、分钟级的域内不间断推演,以及从单张域外图像出发的分钟级自回归 rollout;最长的一组是小时级世界推演,从一帧真实初始观测出发、在一次不间断的自回归会话中稀疏采样直到 60 分钟端点,且场景提示词全程固定。跨骨干方面,四个 5B–33B 的模型(Wan2.2、LTX-2.5、MiniMax-H3 路线)在共享的相机条件化接口下均被实例化并给出双向预训练阶段的域外定性结果。 Hour-scale world rollout generated by the SolarWM-wan2.2-5B-fast causal student. Sparse frames are sampled throughout a single uninterrupted autoregressive session initialized with a real first frame from the held-out validation pool, spanning the initial observation to the 60-minute endpoint. The scene prompt remains fixed and the model follows a predetermined camera trajectory. 批判点评:这篇的价值主要不在某个新模块,而在它选择去修的那个东西——它把世界模型研究里「结果无法复现、无法比较」这件长期被容忍的事当成首要问题来处理,并且给出的答案是工程性的:一份逐帧对齐、连筛选决策和来源出处都写进去的数据契约,以及把单源处理与混合配比解耦的设计。后者尤其实在,因为调配比是这类研究里最高频的动作,能不重跑源处理就省下大量算力。保留各骨干原生表示与目标函数、只统一外层接口,也是个克制且正确的判断:强行统一写法会污染比较结论。三阶段配方本身(双向适配 → 教师强制自回归初始化 → 分布匹配蒸馏)不算首创,但把它固定成跨三个骨干都能跑通的统一收口,本身就是可复用的贡献。需要留意证据的形态:小时级推演目前靠定性 rollout 呈现,而长时序真正的难点——缓慢漂移、场景记忆是否退化、以及交互指令在几十分钟后是否还被正确响应——恰好是稀疏采样帧最不容易暴露的;这类主张更需要定量的漂移曲线来支撑。「实时」同样缺少帧率与时延的明确数字,而交互体验对这两个量极其敏感。还有一处值得追问:训练只用 5 秒序列却要推演一小时,跨越了四个数量级,分布匹配蒸馏在其中承担了多少稳定性、又在多长的时间尺度后开始失效,论文摘要层面没有给出边界。最后,143 万片段来自 10 个数据集,配比本身就是强超参,开放数据引擎让别人能复现这套配比,但配比是否接近最优仍是开放问题。总体上,把它当作一个可扩展的研究底座比当作一个性能主张来读更合适。 2. SelfLift:少步扩散再砍41%延迟 SelfLift: Accelerating Few-Step Diffusion via Self-Recovering Resolution Transition | 清华大学、字节跳动 | arXiv:2609.02036 关键词:少步扩散加速,渐进式分辨率推理,伪影风险图,pixel-VAE重编码,免训练修正,自蒸馏,SelfLift 前序问题:少步扩散已经把时间维度的计算压得很狠,于是每一次模型评估的空间开销就顶上来成了延迟主项。自然的下一步是渐进式分辨率推理:前期在低分辨率去噪,把高分辨率的算力留给后期精修。问题出在「升分辨率」这一下——既有做法通常把中间 latent 直接抬上去,然后指望后续去噪步骤自己把由此产生的分布错配吸收掉。这在多步的年代还行,但在少步这个预算下,可供恢复的步数本来就少,错配吸收不完,残留就直接表现为可见伪影。这构成一个连锁约束:因为伪影,切换点不敢放得太晚;而切换越早,低分辨率阶段占的比例越小,能省下的算力也就越有限。也就是说,加速比不是被算力上限卡住的,而是被「转换质量」卡住的。 本文贡献:SelfLift 的核心判断是修补信号不必外求,模型自己就能提供。它给出两档。第一档 SelfLift-zero 是免训练的「伪影感知一致性抬升」:把直接抬升 latent 的结果与经 pixel-VAE 重编码得到的结果做比较,两者的分歧同时承担两个角色——既是局部伪影风险的定位信号,又是模型原生的修正方向。论文的分析图指出这背后的机理:直接抬升会引入解码器可见的不一致,而 pixel-VAE 重编码提供的是一个更平滑但确实可达的锚点,朝这个锚点做修正就得到伪影更少的目标分辨率状态;同时它只在高风险区域做选择性修正,而不是全图均匀混合——均匀混合只能削弱重影和空间漂移,留下残余失真。这一档不需要外接超分模型、不增加去噪评估次数、也不改采样调度。第二档 SelfLift-rich 建立在这个更稳的转换之上,做「on-policy 自恢复」:在学生模型自己访问到的状态上,从一个内部自教师那里迁移密集的高分辨率指导,同时保持与被改变后的渐进式分辨率动力学对齐——论文的消融显示,改成 off-policy 蒸馏会产生模糊。 Overview of SelfLift. Given the predicted low-resolution clean endpoint, SelfLift-zero constructs a trajectory-preserving latent candidate and a VAE-reachable pixel anchor. Their consistency residual yields an artifact-risk map and adaptive weights for selectively correcting high-risk regions before re-noising. SelfLift-rich distills this correction into a lightweight latent lifter and performs on-policy recovery on student-visited states, using an EMA self-teacher for privileged high-resolution guidance and a dynamics objective to preserve the pretrained few-step trajectory. 实验效果:在 FLUX.2-Klein 与 Z-Image-Turbo 上,SelfLift 分别把端到端延迟降低 41.5% 和 44.1%。与时间步蒸馏叠加后,相对各自的 50 步模型给出 29.61× 和 19.21× 的整体加速,同时保持有竞争力的生成质量。定性一侧,论文在 FLUX.2-Klein-9b、仅 4 次函数评估(NFE)的激进加速设定下做了对比:Vanilla、RALU 与 Speed 出现严重伪影,MrFlow 靠一个更昂贵的外接超分模型改善了保真度,而 SelfLift-zero 通过模型原生的修正抑制伪影、SelfLift-rich 进一步恢复更丰富的细节。消融方面,转换策略消融用 CLIP-IQA 衡量清晰度、ImageReward 衡量提示对齐质量,并标出 SelfLift-zero 在清晰度与对齐之间取得最佳折中的工作点。 批判点评:这篇最好的地方是问题定位干净:它没有笼统地说「渐进式分辨率有伪影」,而是把因果链讲清楚了——伪影限制了切换时机,切换时机限制了加速比。一旦这样表述,优化目标就从「把伪影修掉」变成了「把切换点往后推」,这是一个更可操作的目标。用「直接抬升」与「pixel-VAE 重编码」两条路径的分歧同时充当风险图和修正方向,是个很省的设计:一次比较拿到两样东西,而且两样都来自模型内部,不引入外部超分这种既费算力又可能带来风格漂移的依赖。选择性修正而非全图均匀混合,也被消融证明是必要的——均匀混合只削弱而不清除重影与漂移。免训练档位的存在让它容易被采用,这在工程上比第二档更有价值。需要清楚几处边界。首先是数字的读法:41.5%/44.1% 与 29.61×/19.21× 基线不同,后者已经把时间步蒸馏的收益算进去了,单独引用容易夸大本方法的贡献。其次,摘要用「有竞争力的质量」而非「无损」,说明这是权衡;而这类方法的风险恰恰在高频细节和文字/人脸这类低容错区域,论文给的是 CLIP-IQA 与 ImageReward 这两个聚合指标,缺少针对细粒度结构的失败率分析。第三,SelfLift-rich 需要训练,且依赖一个内部自教师与 on-policy 采样,成本与实现复杂度都高于第一档,实际收益是否值得这份复杂度,取决于部署场景。第四,pixel-VAE 重编码本身也有开销,摘要强调不增加去噪评估次数,但重编码这条路径的代价在总账里占多少,值得在采用前实测。最后,两个验证骨干都是少步蒸馏模型,方法与「少步」这个前提绑得较紧,迁移到常规多步模型上是否仍有同等收益并不自明。 3. f-loss:频域配平让收敛快40% Balancing Frequencies and Pixels in Flow Matching | LIX 巴黎综合理工学院(CNRS, IP Paris)、AMIAD、LIGM 巴黎国立桥路学校、加州大学伯克利分校 | arXiv:2609.02748 关键词:flow matching,谱偏置,Focal Log-Frequency Loss,像素空间训练,收敛加速,损失替换,f-loss 前序问题:这篇处理的是一处几乎被当成常识、因此少有人清算的训练偏置。自然图像服从 1/f² 的谱分布:信号能量绝大部分堆在低空间频率,而纹理、边缘这些对观感真正重要的结构却分布在稀疏的高频带上。而像素空间的重建目标对所有空间误差一视同仁——于是低频凭借能量优势主宰了优化信号,细粒度细节的学习被一路往后拖。论文把这件事明确命名为「目标函数层面的谱失衡」,并指认它是像素空间 flow 模型训练效率低下的一个关键原因。值得注意的是这个诊断的位置:它不在架构里,也不在数据里,而在损失函数里——这意味着此前大量靠改架构来提升细节的努力,可能都在绕过真正的病灶。 本文贡献:对策分两层,都刻意保持简单。第一层是 Focal Log-Frequency Loss(f-loss):一个在频谱上做过平衡的目标,把学习信号在各个频率之间拉平,从而突出那些在像素空间目标下被系统性低估的高频成分。第二层是一个训练策略,把频域监督与像素监督组合起来使用——训练早期先强调频域学习,好处是让模型把所有频率都先抓住;随后过渡到标准的像素空间 v-loss,专门做空间精修。这个先后顺序不是随手安排的:论文的收敛分析显示,频域损失在训练早期主导,而空间域损失在后期逐步追上,切换时机正是顺着这条演化曲线走的,作者的说法是让训练信号与模型不断变化的需求对齐。整套方法在概念上很朴素——不改任何架构,可以作为 flow matching 损失的直接替换(drop-in replacement)落地。 实验效果:在多个模型规模上,该方法把收敛速度提升最多 40%,同时持续改善 FID 与感知保真度。机理侧的证据分几层:谱分析显示仅用像素损失训练时,生成图像的功率谱相对真实图像存在系统性偏差——低频被高估、高频被低估;一个只含两个活跃频率的 MLP 玩具实验进一步显示,低频模式被迅速学到,而高频模式在整个训练过程中始终缺席。带通 FID 分析给出更细的画面:在低频和中频带上,两种损失最终收敛到相同的数值;差别出现在高频带——f-loss 在训练早期领先,随后基线一度追上,但 f-loss 在约 20 万步附近再度反超。定性一侧,早期训练阶段用 f-loss 生成的图像更早出现细腻纹理(如老虎条纹、茅草屋顶的干草),而基线在同期更偏向把物体边界画清楚(如帆船轮廓分明)。此外论文还报告了以墙钟时间为横轴的收敛对比,以及低/高频带上的平均幅值误差。 (Left) Images generated with our XL model at 256 resolution. Beware, 2 impostors (real images from the ImageNet training set) are hiding in these images. Place your bet on which ones they are and check the solution on page 10. (Right) FID vs. training epoch for an XL model. Our achieves faster convergence than JiT without requiring architectural modifications. 批判点评:这篇的诊断比方法更值得记住。把「细节学得慢」归因到损失函数对频率的隐含加权,而不是归因到容量或架构,是一次位置正确的归因——1/f² 是自然图像的统计事实,像素损失对空间误差的均匀对待则是实现上的默认选择,两者相乘就必然产出低频偏置。论文用两层证据把这条推理钉住:真实数据上功率谱的系统性偏差,以及只含两个频率的玩具实验里高频模式的完全缺席。后者尤其干净,因为它排除了容量不足这个替代解释。方法侧的克制也是优点:不改架构、可直接替换损失,这类改动的采用成本极低,而先频域后像素的两段式安排还有收敛曲线作为依据,不是拍出来的。带通 FID 分析是全篇最诚实的一段——它主动说明低频和中频最终会收敛到同一水平,优势集中在高频和更早的收敛时点,这比只报一个总 FID 要可信得多。几处需要留意。「最多 40%」是上界,跨规模的期望收益应当打折看;而高频段上基线中途曾追上、之后又被反超,说明这条优势并不单调,实际收益取决于训练预算落在曲线的哪一段。更实质的是适用范围:诊断成立的前提是像素空间训练,而当前主流做法大量在 latent 空间做 flow matching,latent 的谱统计与自然图像并不相同,这套配平能否平移过去,论文没有回答。还有 f-loss 引入的权重超参需要调(论文有相应消融),「drop-in」的说法在工程上仍有调参成本。最后必须提醒:源文件中带通 FID 与定性收敛这两张图的图注仍留着作者的「Placeholder / to be updated」字样,这是预印本未定稿的迹象,引用这两处时应当谨慎。 4. MeRoPE:大基线相机控制不再爆范数 MeRoPE: Metric Rotary Position Embedding for Camera-Controlled Video Generation | 香港科技大学、卓驭科技 | arXiv:2609.01252 关键词:相机可控视频生成,几何位置编码,保范数注意力,旋转位置编码,度量位移,对极视差先验,MeRoPE 前序问题:相机可控的视频生成普遍依赖几何感知的位置编码,把 token 条件在相机外参和逐 token 的视线方向上。论文指出这类方案有一个依赖尺度的失效模式,而且很具体:齐次投影式的编码会让注意力 logits 和特征范数随物理平移基线无界增长。翻译成实践语言就是——在真实的、以米为单位的相机轨迹上,相机走得越远,注意力分布和特征幅值就越容易失控。论文的动机实验把这个失效可视化了:沿一条直线轨迹,观察最后一帧中心 query token 对所有先前 key 帧的跨帧注意力质量分布,随着基线增大,既有方案会把越来越多的注意力质量分配给遥远的早期帧。这不是精度问题而是稳定性问题:编码本身在长距离下会扭曲注意力的结构,而自动驾驶这类场景恰恰全是大基线轨迹。 本文贡献:MeRoPE 的设计目标直接定在「保范数」上,三个部件各管一件事。第一,用正交旋转块编码标定视线之间的相对朝向——正交变换天然不改变向量长度,这是保范数的来源。第二,把原始的度量位移映射成多频旋转相位,也就是借 RoPE 的思路处理物理平移,而不是把位移当作可以无界增长的数值直接喂进去。第三,沿对极弧加一个视差锚定的对应先验,为跨帧的点对应提供几何约束。三者合起来的性质是论文明确主张的:严格保持特征范数、无论物理平移尺度多大都能限住 softmax 前的注意力 logits、并对全局刚体坐标变换保持精确不变性——最后这条意味着换世界坐标原点不会改变模型行为。论文还给出了这套编码的代数结构,把成对的 query-key 调制写成视差 MinRot、视线局部 MinRot、平移 RoPE 与原生 RoPE 四个块的正交直和,因此各部件互不干扰。 实验效果:论文在两个互补的数据集上验证:nuScenes 覆盖大基线轨迹,PanShot 覆盖多样的相机光学参数。结论是 MeRoPE 取得了比既有编码更强的相机控制,并且在旋转和平移两个维度上都达到了生成的相机运动与条件位姿之间的最佳一致性。定性一侧,论文在两个代表性 nuScenes 场景上给出三种指令轨迹(原始、左转、右转)下的结果,每行最左侧用鸟瞰图对照「指令路径」(实线)与「从生成视频中用 VGGT 恢复出的路径」(虚线),也就是说控制精度是通过反解生成结果来度量的,而不是自评。PanShot 一侧则跨越从针孔到鱼眼的相机光学范围,视场角与畸变从 (97°, 0.00) 到 (173°, 1.66)。此外论文报告了相机编码各部件的消融、架构与注入位置的消融、以及 query-camera 分组的计算开销(单块结果用一张 H20,整模结果用四张 H20 并匹配 15 个块的注入调度)。 Qualitative video generation under camera pose control. Visual results on two representative nuScenes scenes under three commanded trajectories (original, left turn, right turn). In each row, the leftmost plot displays the bird's-eye view of the commanded path (solid) and the path recovered from the generated video by VGGT-$\Omega$ (dashed), followed by generated video frames sampled at $t \in \{0, 16, 32, 48\}$. 批判点评:这篇的贡献形态是「把一个稳定性缺陷讲成可证的性质」,这比刷指标更耐读。它没有停在「大基线下效果变差」这种经验观察,而是指出了机制——齐次投影编码使 logits 与特征范数随物理平移无界增长,并用一张跨帧注意力质量图把失效形态摆出来:注意力被越拉越远的早期帧吸走。有了这个诊断,解法就有了明确的设计约束,即保范数;正交旋转块、把度量位移映射为多频旋转相位、以及沿对极弧的视差先验,三者都是服务于这个约束的手段而非拼凑。把成对调制写成四个块的正交直和,让各部件互不干扰,这种可分析的结构在位置编码这类基础组件上很值得。对全局刚体变换的精确不变性也是实用性质——它意味着换坐标原点不会改变行为,省掉一类隐蔽 bug。评测设计同样克制:nuScenes 管大基线、PanShot 管从针孔到鱼眼的光学多样性,两者互补而非同质堆叠;用 VGGT 从生成视频反解相机轨迹再与指令轨迹对照,比让模型自评要硬。需要注意的边界。第一,反解式度量把工具误差引进来了,VGGT 在大视场或强畸变下的精度本身就会波动,因此在 PanShot 的鱼眼一端,指标差异有多少来自生成、有多少来自反解,需要谨慎切分。第二,论文主张的是相机可控性上的领先,而不是视频质量的全面领先,这两件事在实践中会互相牵制——把位姿咬得更死通常要付出内容自由度的代价,摘要层面没有量化这个代价。第三,训练轨迹以前向主导走廊和大幅横向/转向机动为主,都是驾驶式运动,手持抖动、快速旋转这类分布未经检验。第四,保范数是个好性质,但它保证的是不发散,不等于注意力分配在语义上是对的;范数受控与对应关系正确之间仍有距离。最后,方法需要标定的视线与度量尺度的位姿作为输入,这在有标定的驾驶数据上不成问题,迁移到无标定的野外视频则是另一回事。 5. GlyphAnchor:字形块锚定长文本渲染 GlyphAnchor: Enhancing Visual Text Rendering via Position-Anchored Glyph Priors | 复旦大学、小红书、上海创智学院 | arXiv:2609.02349 关键词:视觉文字渲染,字形先验,位置锚定,扩散Transformer,分阶段SFT,文字感知后训练,GlyphAnchor 前序问题:把文字画准,至今仍是图像生成与编辑模型的老大难,尤其当目标里含有长文本、结构复杂的文本、密集排布的文本,或者生僻字。论文把已有路线归成两类并各指一处不足:一类靠更强的骨干和以数据为中心的训练来提升原生渲染能力,但不引入显式的字形先验;另一类引入了字形先验,却依赖专门设计,在上述这些困难场景下仍不够准确也不够稳健。也就是说,前者缺少关于「这个字长什么样」的直接信息,后者虽有信息但注入方式不够可靠。真正的难点在于文字渲染同时要求两件很难兼得的事:字形本身要正确(笔画级的精确),以及文字要落在图像里对的位置、对的透视和对的排布上。 本文贡献:GlyphAnchor 的做法是给骨干加一组轻量的「字形块条件」,而关键在于这些条件的位置是通过模型原生的位置编码锚定到目标图像上的——不是另起一套空间对齐机制,而是复用模型已有的位置表示,因此注入方式与骨干天然兼容。论文的架构图把这个设计说得更具体:提示词、可选的源图像、以及渲染出来的字形块图像各自被编码成 token 后拼接,送入文生图或图像编辑的扩散 Transformer 骨干;得到的字形块 token 被放进一个额外的条件帧里,形成一个「虚拟字形平面」,这个平面的坐标就锚定在目标图像的坐标系上。训练上分两步:先做分阶段的监督微调把这个能力建立起来,再用文字感知的后训练进一步提升稳健性。方法同时适用于文生图和图像编辑两种设定,并且论文强调它可以在多个骨干上生效。此外作者还提出 InfoTextBench,用于评测文本密集场景下的视觉文字渲染,生成与编辑两种设定都覆盖。 Overview of GlyphAnchor. Prompt, optional source images, and rendered glyph patch images are encoded into tokens and concatenated before a text-to-image or image-editing diffusion-transformer backbone. The resulting glyph patch tokens are placed in an additional condition frame, forming a virtual glyph plane whose coordinates are anchored to the target layout. 实验效果:论文在多个骨干与多个基准上做了实验,覆盖长文本、结构复杂文本、密集排布文本以及生僻字这几类困难场景,结论是 GlyphAnchor 持续改善文字保真度,同时保持整体图像质量。定性一侧,论文给出面向文本密集困难样例的对比(图注注明建议放大查看),并配了两组消融的定性结果:一组是位置锚定的消融,一组是分阶段监督微调的消融——两组都以视觉对比呈现。此外论文用 FireRed-Image-Edit-1.1 的样例来说明各项设计选择的动机。 Qualitative comparison on challenging text-rich cases. Best viewed with zoom. 批判点评:这篇的判断力体现在注入方式上。给扩散模型加字形先验并不新,难的是让「这个字长什么样」和「它该出现在哪」这两件事同时成立;很多方案在字形上做得细,却要另配一套空间对齐机制,结果引入新的失配。GlyphAnchor 选择复用骨干原生的位置编码来锚定字形块的位置,把字形块 token 放进一个额外条件帧、构成坐标锚定在目标图像上的「虚拟字形平面」——这个设计的好处是不与骨干的空间表示打架,也解释了它为何能在多个骨干上生效。条件保持轻量、训练分成「分阶段 SFT 建立能力 + 文字感知后训练提升稳健性」两步,也是符合工程直觉的安排:前者管会不会,后者管稳不稳。同时覆盖文生图与图像编辑两种设定,比只做其中一侧更有实用价值,因为真实需求里改字往往比从零生成更常见。需要留意证据的粒度。摘要层面给的是「持续改善文字保真度、同时保持整体图像质量」这样的方向性表述,没有具体的文字准确率数字或提升幅度;两组关键消融(位置锚定、分阶段 SFT)也以定性视觉对比为主,图注还提示需要放大查看,这意味着差异未必显著到一眼可辨。而文字渲染恰恰是最适合定量的任务之一——字符级准确率、词级准确率都是成熟指标,缺少这些数字会让「持续改善」难以校准。其次,InfoTextBench 由作者团队自建,用自家基准验证自家方法时,结论的说服力取决于该基准与既有基准的一致性,这一点需要在正文中确认。第三,「保持整体图像质量」是个需要警惕的表述:字形块条件本质上是往生成过程里塞入强先验,在文字区域之外是否引入风格或纹理上的副作用,值得看定量的图像质量指标而非只看示例图。最后,生僻字这一类的收益高度依赖字形渲染器的字体覆盖,这部分是方法外的工程依赖,实际落地时往往才是瓶颈。 6. CameraEditor:相机编辑改成时序预测 CameraEditor: Camera-Controlled Image Editing via Video-Prior Sequential Modeling | 西安交通大学、新加坡科技研究局(A*STAR) | arXiv:2609.01479 关键词:相机可控图像编辑,视频扩散先验,Chain-of-Frames,几何感知路由,全景裁切数据,ACM MM 2026,CameraEditor 前序问题:除了语义内容之外,相机参数其实决定了一张图的几何透视与外观。但现有图像编辑模型虽然在语义和风格操控上很强,一旦要求按相机参数做显式控制就暴露短板。论文把这个短板刻画成一个两难:面对大幅视角变化,指令驱动的模型要么出现结构撕裂,要么生成保守的结果、干脆无视几何指令。论文的动机图把失败拆得更细,指出三类典型问题:术语误解(把几何位移和语义变化混为一谈)、参数不精确(做不到按确切角度调整)、以及身份丢失(大幅视角变化下结构撕裂)。根子上的困难是,文本指令对几何量的表达本身是含糊的——「稍微转一点」既没有单位也没有参照系,而相机参数是精确的物理量。 本文贡献:CameraEditor 的关键一步是改问题的形式:把相机可控编辑从一个空间问题重写成时序预测问题,从而能借用视频扩散模型的时间连贯性作为先验。围绕这一步有三个部件。第一,配一个显式的几何感知模块,把几何量从文本的含糊中解放出来;论文的架构图说明推理时由一个路由机制通过 GeoCalib 选出最优的参考先验,以实现精确的视角对齐。第二,用动态全景裁切构造几何上严格的参考-目标对——这是数据侧的处置:全景图被参数化后裁切成参考-目标对,再经超分与视觉语言模型筛选,最后生成中间帧形成连续的时序序列;论文还单独用一张图展示了偏航、俯仰、翻滚、垂直视场角与径向畸变各自对裁切透视的影响。第三,也是最巧的一处:刻意插入中间过渡帧,把大幅视角变化分解成若干小步,为内容身份与空间连贯提供时间缓冲。论文构建了 5760 个训练实例,并作为独立贡献提出 CamEditor-Bench——一个与模型无关的评测套件,含 462 个测试用例。该文已被 ACM Multimedia 2026 接收。 Overview of CameraEditor. (a) Generation Pipeline: A video diffusion model generates the target Chain of Frames (CoF) sequence conditioned on the source image and reference visual sequence. (b) Dynamic Routing: A routing mechanism selects the optimal reference prior via GeoCalib during inference for precise viewpoint alignment. 实验效果:论文报告 CameraEditor 在相机控制精度与源身份保持两方面达到当前最优,优于既有方法。证据形态上,定性结果与几何误差图并排给出:每个方法的右侧面板分别显示 PF-I(上)与 PF-T(下)误差,暖色表示偏差更大,也就是说几何准确性是用透视场(Perspective Field)热力图来验证的,而非仅凭肉眼。扩展对比进一步显示,该框架在与目标相机几何对齐的同时,避免了标准扩散编辑中常见的身份漂移与结构幻觉。两组消融值得注意:一是相机感知模块的选择——随机路由或基于视觉语言模型的理解(Puffin 变体)给出的错误初始估计会导致灾难性的结构失真,而 GeoCalib 驱动的路由提供了稳健的几何锚点;二是中间过渡帧数量 N 的消融——直接单步生成(N=0)在大幅视角变化下出现空间撕裂与身份丢失,把 N 增加到 4、8、12 则提供了更强的连续几何先验。 Qualitative results alongside geometric error maps. For each method, the right panels display PF-I (top) and PF-T (bottom) errors, where warmer colors indicate larger deviations. 批判点评:这篇最值得学的是问题重述本身。相机可控编辑之所以难,是因为单张图的大幅视角变化本质上要求补出未观测区域,而这正是空间形式下最容易撕裂的地方;把它改写成时序预测,就把视频扩散模型积累的时间连贯性先验借了过来——这不是换个模型跑跑,而是换了一个更适配该困难的问题形式。顺着这条线,「插入中间过渡帧把大幅视角变化拆成小步」这个设计就变得顺理成章,而且消融数据支持得很直接:N=0 的单步生成出现撕裂和身份丢失,N 增到 4、8、12 则连续几何先验越来越强。用 GeoCalib 提供几何锚点、而不是让视觉语言模型去理解几何指令,同样是个有判断力的选择,消融里随机路由与 Puffin 变体导致「灾难性结构失真」是很有说服力的反证——它说明这类任务的瓶颈在几何估计的可靠性,而不在语言理解。用透视场热力图(PF-I/PF-T)来验证几何准确性,也比只给示例图硬。几处限制需要说清。首先,PF 是估计出来的量,用它当尺子意味着评测精度受估计器约束,在强畸变或大视场情形下这层不确定性会放大。其次,训练集只有 5760 个实例,且由全景图裁切构造——全景的几何分布天然受限(常见于特定拍摄设备与场景类型),因此对超出该分布的相机参数组合,泛化能力未经验证;CamEditor-Bench 的 462 个用例同为自建,自评成分需要读者自行折扣。第三,过渡帧是把双刃剑:N 越大几何先验越强,但推理成本随之线性上升,而论文摘要没给对应的时延数字,实际部署时这是必须先算清的账。第四,「源身份保持」在插入多帧过渡后仍是脆弱的——每一帧都是生成的,误差有累积的可能,而聚合指标不容易暴露偶发的严重失败。最后,方法依赖视频扩散骨干,继承了它的分辨率与时长约束,这在图像编辑这个本应轻量的场景里是一笔不小的开销。 7. LightBridge:3DGS重光照一次前向出结果 LightBridge: Feed-Forward Generative Relighting for 3D Gaussian Splatting | 中国科学技术大学 | arXiv:2609.02543 关键词:3D高斯溅射,可控重光照,前向推理,潜空间桥接扩散,高斯传播Transformer,多光照数据集,LightBridge 前序问题:3D 高斯溅射能做到高质量的实时新视角合成,但产出的资产有一个硬伤:光照是烘死在里面的,没法轻松重打光。已有路线各有代价。逆渲染方法为每个场景优化一套简化的反射率与光照模型,既限制效率也限制重光照质量——简化模型本身就装不下真实光照的复杂度。而近期的生成式方法借大型扩散模型做出了逼真的光照编辑,但要把它们用到 3DGS 上,通常还需要一个额外的逐场景优化阶段,把编辑后的外观重新烘回到表示里。也就是说,前者受限于模型表达力,后者受限于流程——每换一个场景就得再优化一次,这在资产量级上根本不划算。 本文贡献:LightBridge 的目标很明确:一次前向就完成完整 3DGS 资产的可控重光照,不做逐场景优化。为了能训练这样一个前向模型,作者先构建了一个大规模的多光照重光照数据集,为同一批场景提供成对的源观测与目标观测;论文展示了卧室与餐厅场景的样例——每列对应一种光照条件、每行对应一个匹配的相机视角,场景几何与相机位姿保持固定,只让光源状态、强度与颜色在列间变化,这种「控制变量」式的构造正是前向监督所需要的。方法本身有两个部件。第一是 Latent Bridge Relighting Diffusion:把重光照建模成潜空间里从源到目标的传输,从而能一步提取出 2D 视觉 token,不必做迭代式的扩散采样——这是省掉推理开销的关键。第二是 Gaussian Propagation Transformer:用一个点 Transformer,先做稀疏的图像到点自注意力、再做点到图像交叉注意力,把这些视觉线索高效地传播到完整的 3DGS 上,同时避免在所有图像 token 与高斯 token 之间做全注意力——后者在完整场景规模下是不可承受的。 Pipeline of LightBridge. The framework first uses Multi-Illumination Relighting Dataset for paired supervision, then extracts the 2D Visual Token with Latent Bridge Relighting Diffusion, and finally propagates it to the full 3DGS representation with Gaussian Propagation Transformer. 实验效果:论文的实验验证了上述设计,主张在具备竞争力的重光照质量之下,能够一次前向高效预测出完整的、已重光照的 3DGS 资产,且不需要针对场景的优化。定性一侧最关键的一组是在重光照视频轨迹之外的视角上做对比:每个样例从左到右依次是源 3DGS 渲染、由 GR3EN 优化出的表示所渲染的结果、以及 LightBridge 在同一相机位姿与同一目标光照下预测的重光照 3DGS 的渲染结果——选在轨迹外视角比较,正是为了检验重光照是否真的落进了 3D 表示而非只在训练视角上成立。此外论文给出了留出的餐厅与厨房场景上的视频重光照对比(每个结果沿共享的输入相机轨迹采样四帧),并用一张俯视图展示了某个代表性房间里六条局部相机轨迹的布置。训练侧的消融显示,高斯传播用目标潜变量与潜变量速度两种 token 训练时,速度 token 收敛更快,但两者最终损失接近。 Qualitative comparison at viewpoints outside the relighting video trajectory. From left to right, each example shows the source 3DGS rendering, the result rendered from the representation optimized by GR3EN, and the corresponding rendering from the relit 3DGS predicted by LightBridge under the same camera pose and target lighting. % Note that GR3EN fails to relight the scene whether the target light is visible (top row), as well as when it is not directly visible (bottom row) 批判点评:这篇的取舍很清楚,也因此值得读:它不追求重光照质量上的领先,而是把「免逐场景优化」这一条做成硬指标。这个选择是对的,因为生成式重光照真正的落地障碍从来不是单张图好不好看,而是每换一个场景都要再优化一轮——在资产规模上这条成本曲线根本压不下来。两个部件都服务于这个目标:把重光照建模成潜空间里源到目标的传输,从而一步取出视觉 token、免掉迭代采样;再用先「图像到点」稀疏自注意力、后「点到图像」交叉注意力的方式把线索铺到完整 3DGS 上,规避全注意力的组合爆炸。数据集的构造尤其体现方法意识:固定几何与相机位姿、只变光源状态/强度/颜色,这种控制变量式的成对监督正是前向模型能学到「只改光、不改结构」的前提。评测设计里最有判断力的一处是选在重光照视频轨迹之外的视角做对比——这直接检验重光照是否真的落进了 3D 表示,而不是只在被监督到的视角上成立,很多同类工作恰恰在这里含糊。需要看清几处边界。第一,摘要自己用的是「有竞争力的质量」,也就是承认这是以效率换相当质量;如果下游对光照真实感的要求高于对吞吐的要求,逐场景优化路线仍可能更合适。第二,数据集是作者自建的合成室内场景(卧室、餐厅、厨房这类),室内合成数据的光照统计与真实采集差距不小,而重光照恰恰高度依赖材质与间接光的真实性,因此室外场景与真实数据上的表现完全未知。第三,前向模型的可控性边界值得追问:它能处理的是「现有光源的状态、强度与颜色」这类控制,是否支持新增光源、改变光源位置或换成完全不同的光照环境,摘要没有说清。第四,一步式的潜空间传输省掉了迭代采样,但也放弃了扩散采样在质量上的调节余地——没有「多花几步换更好结果」这个旋钮,在困难样例上没有退路。最后,代码与数据集要等录用后公开,当前无法独立复核。 8. VibeVoice-ASR-Streaming:流式边听边分谁在说话 VibeVoice-ASR-Streaming Technical Report | 微软研究院、中国科学院大学、上海交通大学 | arXiv:2609.02812 关键词:流式语音识别,说话人归属,端到端统一建模,音频分块交错,前瞻音频,开源权重,VibeVoice-ASR-Streaming 前序问题:传统的说话人归属语音识别把「识别说了什么」和「分辨谁在说」当成两个独立任务串起来做。近期像 VibeVoice-ASR 这样的端到端模型已经把两者统一进单个模型,但仍有一处关键短板:这些统一模型主要支持离线识别,也就是要等音频结束才能出结果。这对实时语音助手和智能体是致命的——它们需要的是低延迟。于是问题变成:能否在保留「统一建模」这个优势的同时,把它做成流式?难点在于说话人归属天生带有全局性,判断「谁在说」往往需要参照整段音频里的其他片段,而流式意味着只能看到已经到达的部分。 本文贡献:VibeVoice-ASR-Streaming 是最早一批基于大语言模型的端到端流式说话人归属 ASR 方案之一。它的机制说起来很朴素:把固定大小的音频块、少量前瞻音频、以及此前已生成的文本三者交错编排在同一个自回归上下文里。论文的架构图给出了更精确的描述——语音块与说话人归属的文本块在单个自回归上下文中交错,每个块后面跟一段固定 L=4 帧(0.5 秒)的前瞻音频,然后才生成该块对应的文本。这个安排的效果是,模型可以在语音到达的同时产出「谁说了什么」,而不需要一个独立的说话人分离阶段——分离能力被吸收进同一个自回归过程里。前瞻窗口的存在是一处务实的折中:它用固定的 0.5 秒延迟代价,换取块边界附近判断所需的一点未来上下文。作者发布了 1.5B 与 7B 两个规模的模型权重以及推理代码。 Architecture of VibeVoice-ASR-Streaming. Speech chunks $X_k$ and speaker-attributed text chunks $Y_k$ are interleaved in a single autoregressive context, and each chunk is followed by a fixed $L=4$-frame (0.5 s) lookahead before its text is generated. 实验效果:识别精度方面,7B 模型在五个评测集上取得了最低的平均 WER/CER。说话人归属方面,在 13 个评测设定中的 12 个取得最佳或并列最佳。论文的对比图把范围说得更具体:与四个已部署的商用流式 ASR 系统在四个会议基准与 MLC-Challenge 上比较,其中 AliMeeting 与 AISHELL-4 用 CER 评估、AMI-SDM 与 AMI-IHM 用 WER 评估;MLC-Challenge 里日语和韩语用 CER、其余七种语言用 WER。为保证可比性,所有在线 API 的音频都按 2.9 秒的块流式送入,与本模型的块大小对齐。论文另外报告了单说话人识别结果,但明确说明这是作为一种类别检查而非竞争性主张来呈现的。 Recognition error of VibeVoice-ASR-Streaming-7B and four deployed streaming ASR systems on the four meeting benchmarks and MLC-Challenge. AliMeeting and AISHELL-4 are evaluated with CER, while AMI-SDM and AMI-IHM are evaluated with WER. For MLC-Challenge, Japanese and Korean are evaluated with CER and the remaining seven languages with WER; the reported value is the macro average over the nine evaluated languages. 批判点评:这篇的价值在于把一个已经被验证的统一建模思路推进到流式,而所用手段刻意保持简单——没有引入新的分离模块或额外的对齐机制,就是把音频块、少量前瞻音频、历史文本交错进同一个自回归上下文。这种「用上下文编排替代架构增补」的做法在大语言模型时代往往更稳,因为它不破坏预训练带来的能力。取消独立的说话人分离阶段是真正的收益:传统串联方案里分离阶段的错误会直接污染下游归属,而统一进自回归过程后这个误差传递链被砍掉了。固定 L=4 帧(0.5 秒)前瞻是个诚实的折中——说话人归属在块边界附近确实需要一点未来信息,明确标出这个代价比含糊处理要好。评测上把在线 API 的输入统一到 2.9 秒块以对齐自家块大小,是对可比性的主动维护,值得肯定;同时把单说话人结果明确降格为「类别检查而非竞争性主张」,这种自我限定在技术报告里不多见。开放 1.5B 与 7B 权重及推理代码,让结论可被独立复核。需要留意的地方。第一,两个头号数字都是聚合或近似全胜的表述——「五个集上平均 WER/CER 最低」不排除单个数据集上落后,「13 个设定中 12 个最佳或并列最佳」也明确留了一个未领先的设定,读的时候不宜简化为全面领先。第二,与商用系统横比先天不可控:对方的模型规模、内部延迟策略、是否使用更多上下文都不透明,块大小对齐只解决了输入侧的一个维度。第三,0.5 秒前瞻只是算法延迟下限,真实端到端时延还要加上 7B 模型的计算耗时,而报告未给出吞吐或实时率数字——对「实时语音助手」这个宣称的应用场景,这恰恰是最该给的数字。第四,说话人归属的全局性并未被消除而是被上下文长度约束了:随着会议时长增加,早期说话人身份能否稳定保持,是流式方案的经典失效点,需要按时长分层的结果才能判断。最后,多语言部分的语言分布不均,MLC-Challenge 上九种语言各自的样本量与难度差异会影响均值的解读。 9. Kirin:野外视频学出四足动物动作 Kirin: Animal Motion Generation from In-the-Wild Video | 伊利诺伊大学厄巴纳-香槟分校、宾夕法尼亚大学、斯坦福大学、剑桥大学 | arXiv:2609.01823 关键词:动物运动生成,野外视频重建,视频文本运动三元组,AiM3D数据集,图像条件化,自动绑定动画,ECCV 2026 前序问题:理解动物运动对建模动物行为与生物力学是基础性的,但这个方向的进展远远落后于人体运动研究,原因很直接:缺少高质量运动数据。人体运动可以在受控环境里用动捕采集,而对绝大多数动物物种这根本不现实——你没法给野生四足动物贴标记点。结果是现有数据集规模小、域受限,这又直接限制了动画等下游应用。这里的困境有点循环:没有数据就训不出运动先验,没有运动先验就只能靠人工逐帧调动画。论文选择的突破口是绕开采集这件事本身——既然受控采集做不到,那就从已经大量存在的野外动物视频里把运动重建出来。 本文贡献:Kirin 是一条从视频到可渲染动画资产的完整链路,包含重建、学习先验、生成三段。第一段是数据:利用大量野外动物视频重建出 3D 运动序列并配上字幕,构成 AiM3D——论文称其为首个为四足动物提供对齐的「视频-文本-运动」三元组的大规模数据集。重建这一步的做法是把问题拆开:借现成的 3D 四足动物重建方法和 3D 跟踪方法分别推断关节运动与全局位移,再把两者合起来得到最终的运动重建。这个拆分很关键,因为「身体怎么动」和「整体往哪走」在野外视频里的可观测性完全不同。第二段是模型:在 AiM3D 上训练一个视觉引导的运动生成模型,同时以文本和图像为条件——图像条件不是可选项而是有实质作用的,论文的消融显示在相同文本提示「一只动物在行走」下,不同输入图像会带来相应的骨架变化与步态差异,也就是说图像承担了「这是什么动物、身体比例如何」这部分信息。第三段是落地:借一个现成的图像到 3D 模型自动完成绑定与动画,把生成的运动直接套到 3D 网格上,产出可直接渲染的动物动画。该文已被 ECCV 2026 接收。 Left: Overview of Kirin generation pipeline. A text description and an image are provided as inputs. The text and image are used for motion generation, while the image is also used to generate a T-posed mesh. The animation module then rigs the generated motion onto the mesh to produce the final animated 3D model. Right: Overview of the motion generation architecture. Text features are extracted using a frozen DistilBERT encoder, and image features are extracted using a frozen DINOv3 encoder. The text, image, and denoising step embeddings are combined and fed into a transformer decoder with cross-attention to generate motion sequences. % annotate the notations in the figure, add subtitles for left and right parts, use darker gray color for arrows, texts are too small 实验效果:论文与两个基线做了定性对比,两组都直指对手的具体失效模式。与 Puppeteer 比的是网格动画:在相同的文本与图像输入下,Puppeteer 常常在输入网格上产生很小甚至没有运动,而本方法生成的动作会跟随文本提示。与 AniMo 比的是骨架运动:AniMo 只用文本,本方法同时以文本和图像为条件;AniMo 出现的失败包括运动不遵循提示词以及骨架形状不一致,而本方法产出的运动更真实。数据侧论文给出多层展示:动物关节运动的数据样例(每行左侧是两段运动的文本描述,随后是视频帧与对应的重建 3D 运动)、全局位移的可视化(把根关节轨迹投影到地面以显示整体位移)、以及数据集统计——各动物类别的视频数与帧数分布、以及全数据集上的运动类型分布(每个视频被赋予一到三个运动标签)。另有一组补充结果专门展示全局运动更显著的例子。 Visual comparison of generated mesh animation with the baseline. The left columns show the input text and image, which are used for both pipelines. Puppeteer often produces little or no motion on the input mesh, whereas our method generates realistic movements that follow the text prompt. 批判点评:这篇解题的思路很值得学:面对「受控采集在动物身上不可行」这个硬约束,它没有去改进采集,而是把已经海量存在的野外视频当成数据源,用重建把无标注视频转成运动监督。这一步走通了,整个循环就被打开了。重建阶段把「关节运动」与「全局位移」分开处理、再合并,是有针对性的设计——野外视频里身体姿态和整体位移的可观测性差别很大,混在一起估计容易互相污染。图像条件的引入也不是堆砌模态:消融显示同一句「一只动物在行走」配不同图像会产出相应的骨架与步态差异,说明图像承担了物种与身体比例这部分文本说不清的信息,这正是动物域比人体域更需要视觉条件的原因。最后接上现成的图像到 3D 模型自动绑定,把产物一路推到「可直接渲染」,让这项工作对动画流程有实际可用性,而不是停在骨架序列。两组基线对比也选得准,各自指向具体失效模式:Puppeteer 几乎不动,AniMo 不遵循提示且骨架不一致。需要清楚的是证据形态与数据性质。第一,摘要层面给的主要是定性对比和数据集统计,缺少定量指标——运动生成有成熟的评价手段(关节误差、足部滑动、用户研究胜率),没有这些数字时「更真实」难以校准。第二,也是更根本的:AiM3D 的「真值」是用现成的 3D 重建与跟踪方法从野外视频推断出来的,不是动捕级真值,因此数据里必然带有上游工具的系统性偏差,而在这份数据上训练的模型会继承这些偏差;这不否定其价值,但意味着它衡量的是「与重建结果一致」而非「与真实运动一致」。第三,覆盖面限定在四足动物,鸟类、鱼类等形态差异大的类别未涉及,而这些恰恰是动画中同样常见的需求。第四,野外视频的运动分布天然偏向常见行为(行走、奔跑),罕见动作与高动态动作的样本很可能稀疏,数据集的运动类型分布图应能反映这一点。最后,自动绑定这一环依赖外部图像到 3D 模型,其网格质量与拓扑会直接决定最终动画的可用性,这部分不在本文的控制范围内。 10. RIG-BENCH:2000题测生成模型会不会推理 Thinking in Pictures: A Systematic Benchmark for Reasoning-driven Image Generation | 伊利诺伊大学厄巴纳-香槟分校、纽约大学 | arXiv:2609.02864 关键词:推理驱动图像生成,统一生成模型,评测基准,视觉推理,推理生成落差,世界模拟器,RIG-BENCH 前序问题:统一生成模型和世界模拟器在视觉感知与合成上已经拿到了前所未有的结果,但论文指出这些模型主要依赖表层的事件对齐,高层视觉推理的能力基本没被认真考察过。作者提出的判据是「Reasoning-to-Generation」——真正的视觉生成智能应当能从视觉输入里推断出隐含规则,然后把解答以精确的、受逻辑约束的视觉结果呈现出来。注意这个要求比常见的「按提示词画对」严格得多:它不是考察模型能否理解描述,而是考察模型能否在没有被告知规则的情况下自己找出规则,并且把找出来的规则正确地画出来。这两步任何一步断掉,结果就不成立,而现有基准基本不区分这两种失败。 本文贡献:RIG-BENCH 的贡献是把上面这个能力做成可系统评测的东西,覆盖四个认知负荷较高的域:基于概念、基于变换、模式与结构、以及基于场景,共 2000 个精选样本。论文的数据总览图说明了每类题的构造:每个条目提供视觉上下文(输入/上下文)加一张未展示的真值图像(GT Target),模型必须从视觉上下文推断出正确答案并以图像形式产出。评测流程分三步且刻意收紧了口径:第一步「源任务接口」,从已建立的视觉推理基准里取「图+题+选项」,经人工改写成「图+提示词+无选项」——抹掉选项是关键,因为一旦给选项,任务就退化成选择而非生成;第二步「统一生成协议」,被选模型接收上下文图像加提示词,直接生成答案图像;第三步「打分与报告」,把生成图与真值图的比较同时交给三条路径:裁判模型评分、自动指标(DINO、CLIP-I、LPIPS、FID)、以及人工 rubric 与人类手绘答案的对照,最后汇总成总分。2000 个样本进一步被拆成四大任务族之下的十一个细粒度子任务。 End-to-end pipeline of RIG-Bench. (1) Source Task Interface: items are drawn from established visual reasoning benchmarks and manually re-cast with an image-based output prompt (no options exposed to the model). (2) Unified Generation Protocol: selected models receive the context images plus the prompt and generate the answer image directly. (3) Scoring and Reporting: each generation is compared against the ground-truth image using both an LLM judge over a hand-written rubric and automatic perceptual metrics, with an additional human study for calibration. 实验效果:论文对当前最先进的统一生成模型以及图像/视频生成模型做了广泛评测,核心结论是存在显著的「推理-生成落差」:模型经常产出局部看起来合理、但全局逻辑不成立的输出。结果呈现上,论文给出九个生成模型在各子任务上的评分对比,并用线型区分模型类别——实线为闭源商用图像生成器、虚线为开源图像生成器、点线为视频生成器,因此可以看出这个落差是跨类别普遍存在还是集中于某一类。论文还做了用户研究(附带评测界面截图),并给出开源模型、闭源商用模型与视频生成模型各自的补充定性样例。作者将 RIG-BENCH 定位为一个诊断框架,用于引导下一代逻辑上更有依据的统一生成模型与世界模拟器的发展。 Distribution of the $2{,}000$ samples in RIG-Bench. % The inner ring summarizes the four task families; the outer % ring breaks them down into eleven fine-grained subtasks. 批判点评:这篇把一个含糊的担忧变成了可测量的东西,这是基准类工作最该做的事。「模型只是在做表层事件对齐」这句判断在圈内流传已久,但缺少能证伪它的题目;RIG-BENCH 给出的定义相当锋利——从视觉输入推断隐含规则,再把解答画出来,两步都要成立。协议设计里最有判断力的一处是抹掉选项:一旦给出选项,任务就从「生成」退化成「识别 + 挑选」,而这恰恰是很多多模态评测无意间放水的地方;改写成图像输出、隐去选项,才真正逼模型把推理结果落到像素上。四大任务族下再分十一个细粒度子任务,让失败可以被定位到具体的推理类型,而不是只得到一个总分。打分环节没有偷懒地只用一种尺子,而是让裁判模型、自动相似度指标与人工 rubric 三路并行,这在生成式评测里是必要的冗余。用线型区分闭源图像生成器、开源图像生成器与视频生成器,也是有意为之——它让读者能判断「推理-生成落差」是全行业共性还是某类架构的问题,这比一张排行榜有用得多。「局部合理、全局不成立」这个失败刻画本身就很有价值,它指向的是生成模型缺少全局一致性约束,而非缺少局部保真度。需要注意几处。第一,这是诊断而非解法,它告诉我们模型不会推理,但没有给出为什么不会——是推理能力缺失,还是推理正确却无法用像素准确表达,这两种解释后果完全不同,而现有打分方式很难把它们分开。第二,题目由既有视觉推理基准人工改写而来,因此难度分布、覆盖偏好乃至潜在的数据污染都从源基准继承,某些模型在预训练中见过相关题型的风险无法完全排除。第三,自动指标这一路(DINO、CLIP-I、LPIPS、FID)本质上度量的是与真值图的视觉相似度,而很多推理题的正确解在视觉上并不唯一,这会系统性压低分数、可能夸大所谓落差;论文用裁判模型与人工 rubric 来平衡,但三路分数如何加权、彼此一致性如何,摘要层面没有交代。第四,摘要没有给出各模型的具体分数与排名,「显著落差」的量级因此难以判断。最后,作为诊断框架,它的长期价值取决于是否被后续工作当作优化目标;而一旦被当作优化目标,隐含规则类题目又特别容易被针对性拟合,这是所有此类基准都要面对的宿命。 趋势观察 长时序世界模型的瓶颈已经从「架构」挪到了「数据契约」和「训练配方」 — 今天最值得读的是 SolarWM。它有意思的地方不在提出某个新模块,而在于承认了一件行业里心知肚明却少有人正面收拾的事:世界模型这条线上,真正拖慢进展的不是骨干网络不够强,而是各家数据的时间尺度、相机几何、画质、运动幅度、字幕风格全都不一样,各家实现又绑死在自己的模型上,于是监督信号互相矛盾、结果无法复现也无法比较。SolarWM 的回应是把 10 个数据集的 143 万个片段压成一份统一的、逐帧对齐的「数据契约」——视觉观测、度量尺度的相机几何、字幕、质量元数据、筛选决策、来源出处全部在同一份规格里,并且刻意把「单源处理」和「混合配比」解耦,这样换配方不用重跑数据。在这套共享的相机条件化与训练/推理接口上,他们基于 Wan2.2、LTX-2.5、MiniMax-H3 实例化了四个 5B–33B 的模型,且保留各自原生的表示与目标函数,再用一套三阶段配方(双向适配 → 教师强制的自回归初始化 → 分布匹配蒸馏)统一收口。结果是:只在 5 秒序列上训练,得到的因果模型却能做到分钟级到小时级的实时交互推演。这个「训练窗口极短、推演窗口极长」的落差,是今天这批工作里最值得注意的一处。 往下看,加速这条线今天出现了训练侧和推理侧的双响。SelfLift 处理的是少步扩散里一个具体到有点刻薄的矛盾:当时间步已经被压到个位数,每次前向的空间开销就成了延迟主项,于是大家改用「先低分辨率去噪、后期再升到高分辨率」的渐进式推理;但既有做法把中间 latent 直接抬上去,指望后续步骤自己吸收掉分布错配——在少步这个预算下根本吸收不完,残留就是可见的伪影,反过来又迫使切换点必须提前,加速比因此上不去。SelfLift 的解法是让模型自己当医生:直接抬升的 latent 与经 pixel-VAE 重编码的 latent 之间的分歧,既当作局部伪影风险图,又当作模型原生的修正方向,全程不需要外接超分、不加去噪评估、不改采样表。在 FLUX.2-Klein 和 Z-Image-Turbo 上端到端延迟分别降 41.5% 和 44.1%,叠加时间步蒸馏后相对 50 步模型是 29.61× 和 19.21×。f-loss 则从训练目标动手,指出了一处几乎被当成常识而无人清算的偏置:自然图像服从 1/f² 的谱分布,能量绝大部分堆在低频,但纹理和边缘这些真正影响观感的结构却占据稀疏的高频带;而像素空间的重建损失对所有空间误差一视同仁,等于让低频主宰了优化信号、把细节的学习一路往后拖。它的处置很朴素——先用一个跨频率均衡的 Focal Log-Frequency Loss 把各频段的学习信号拉平,训练后期再切回标准的像素 v-loss 做空间精修,不改架构、可直接替换原有 flow matching 损失,多个模型规模上收敛最多快 40%,FID 与感知保真度同时改善。这两篇一个改推理、一个改训练,但共同点是都没有加参数,而是去修正「信号分配」本身。 相机可控这条线今天也有两篇互为镜像的工作。MeRoPE 指出既有几何位置编码有一个依赖尺度的失效模式:齐次投影式的编码会让注意力 logits 和特征范数随物理平移基线无界增长——也就是说,在真实的、以米为单位的相机轨迹上,走得越远越容易崩。它的对策是保范数:用正交旋转块编码标定视线之间的相对朝向,把原始度量位移映射成多频旋转相位,再沿对极弧加一个视差锚定的对应先验,从而严格保住特征范数、把 softmax 前的 logits 限住、并对全局刚体坐标变换保持精确不变性。CameraEditor 面对的是同一个物理量在图像编辑侧的表现:现有编辑模型擅长语义和风格,一旦要求按相机参数做大幅视角变化,就在「结构撕裂」和「保守到干脆无视几何指令」之间二选一。它的做法是把这个空间问题改写成时序预测问题——借视频扩散的时间连贯性,配一个显式几何感知模块和动态参考路由,用动态全景裁切构造几何上严格的参考对,再刻意插入中间过渡帧把大幅视角变化拆成小步,给身份一致性留出时间缓冲;该文已被 ACM Multimedia 2026 接收。 剩下几篇各自补齐一块拼图,但有一条隐线值得点出:它们都在把「一次前向就出最终产物」当作目标。LightBridge 让 3DGS 重光照不再需要逐场景优化,单次前向直接吐出完整的可重光照 3DGS 资产;GlyphAnchor 用轻量字形块条件、且位置通过模型原生位置编码锚定到目标图像,去救长文本、密排文本和生僻字的渲染;VibeVoice-ASR-Streaming 把「谁说了什么」做成流式,靠交错固定长音频块、少量前瞻音频与历史文本,取消了独立的说话人分离阶段;Kirin 把野外动物视频重建成 3D 运动并配上字幕,做出首个四足动物的视频-文本-运动三元组数据集。最后 RIG-BENCH 给这一天留了个刹车:它用 2000 道题去考「从视觉输入推断隐含规则、再把解答画出来」这件事,结论是当前统一生成模型普遍存在推理-生成落差——局部看着合理,全局逻辑不成立。把它和开头的 SolarWM 放在一起读会更清楚:我们已经能让模型把世界推演一小时,但还没能确保它推演的那一小时讲得通。 人工智能炼丹君 整理 | 2026-09-04 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-03|Runway让界面直接生成而不再写代码-Solaris 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 Solaris(Runway):界面逐帧生成而不再写代码 H3-World(腾讯 + 新加坡国立大学 + 香港理工大学):0.199%参数让33B模型可控 ZimaBlue(Joy Future Academy):12万小时视频抬成功率78% PixSGR(电子科技大学):粗尺度注意力指路稀疏精修 Lapis(上海交通大学(教育部人工智能重点实验室 + 致远学院)):一步扩散把1080P深度提速7.6倍 今日论文速览 1. Solaris:界面逐帧生成而不再写代码 Solaris: Towards Interfaces That Are Generated, Not Coded | Runway | arXiv:2609.00776 关键词:界面世界模型,自回归帧生成,鼠标交互条件化,少步蒸馏,语言模型分工,Runway,Solaris 前序问题:数字界面到今天为止都必须经过一层中间表示才能存在:你得先用代码把每个按钮长什么样、点下去会发生什么、状态怎么迁移,全部提前写清楚。这意味着界面的表现力被两件事同时限制住——一是所有可能的状态必须事先枚举,二是任何视觉细节都得能被代码这种符号系统表达出来。后者的损失并不抽象:论文自己做了一组重建实验,让多模态语言模型看一张界面截图再用代码把它复现出来,结果是随着视觉复杂度上升,重建保真度持续下降,而且这个趋势在不同能力的模型上都成立。也就是说这不是模型不够强的问题,而是「把视觉界面翻译成中间表示」这个动作本身就在丢信息。于是问题被重新提出来:能不能跳过代码,让界面的外观和行为都由一个生成模型在交互过程中直接产生?难点在于这要求模型在用户连续操作下保持视觉连贯,还得跑到交互可用的速度,而自回归视频生成通常两头都不满足。 本文贡献:Solaris 的做法是把界面当成一个可交互的世界来建模,具体拆成三件事。第一,它把鼠标交互直接作为条件信号喂进模型,自回归地合成交互之后应该出现的视觉状态——注意这里的关键是闭环:每一帧生成出来之后,用户下一次操作的对象就是这一帧,所以模型必须自己承担状态维护。第二,为了在长时间连续交互下既跑得快又不崩,它把自回归帧生成、少步蒸馏、以及在模型自己输出上继续训练三者结合起来,后者是对抗自回归漂移的关键——只在真实数据上训练的模型会在自己产生的分布上迅速失稳。第三,也是架构上最值得注意的判断:它没让视觉模型独自承担一切,而是配一个语言模型专门解释用户意图、维护高层状态、并规定某次交互应该对生成环境产生什么影响,把「高层推理」和「视觉渲染」明确分开。这样界面的外观和行为都是动态生成的,不需要提前编程,因此可以支持开放式的交互——用户可以做设计者没预想过的操作。 How Solaris runs. Solaris is organized as three levels. The user acts on the frame with mouse and keyboard, the language model holds the state of the session and specifies what each action should mean, and the world model executes that intent, generating both the appearance and the behavior of the result.[-0.05cm] 实验效果:论文的主证据是一场规模不小的人类偏好盲测:250 名参与者、7500 次响应,把 Solaris 生成的交互与语言模型写代码产出的界面两两对比。在「哪个结果更好地遵循了给定指令」这一问上,Solaris 拿到 62%、无偏好 13%、代码方案 25%;在「哪个在场景里表现得更自然」这一问上,Solaris 拿到 72%、无偏好 7%、代码方案 21%。两个问题的差距形态不同是有信息量的——后者赢得更多,说明生成式界面的优势主要不在把指令执行得多准,而在产生的交互与环境保持连贯。另一组重建保真度实验则从反面支撑动机:跨多个多模态语言模型,界面视觉复杂度越高,用代码重建的保真度越低。 Interface world models produce more natural interactions. Participants preferred Solaris over coded interfaces both for following the requested interaction and, by an even larger margin, for behaving naturally within the scene, highlighting the ability of interface world models to generate interactions that remain coherent with the environment.[-0.3cm] 批判点评:把界面纳入世界模型的射程,这个问题的提法本身比方法更有价值。它指出的那处不适一直存在却少有人正面处理:界面必须提前枚举状态,而真实交互是开放的。用重建保真度实验来量化「经过代码这层中间表示要付多少代价」,也是个干净的论证方式——它把「代码表达力不足」从一句直觉变成了一条随复杂度下降的曲线。语言模型管状态和意图、视觉模型只管渲染这个分工,同样比让单个视觉模型硬扛更可信。但要清楚这篇的证据边界在哪里。首先,两组盲测的对照都是 LLM 写代码的界面,而不是人手写的成熟产品,所以 62%、72% 这两个数字回答的是「生成还是让 LLM 写代码」,完全没有回答「生成还是工程师写代码」。其次,论文图注自己写明这些数字在研究团队批准前是占位状态,引用时应当保守。第三,界面这个域对错误的容忍度极低——一个按钮偶尔画错位置在视频生成里是瑕疵,在界面里就是功能失效,而论文给的是聚合偏好率,没有给出「关键交互失败率」这类更接近可用性的指标。第四,语言模型与世界模型的分工在延迟上是有代价的,实时性论文用「交互速度」概括,缺少明确的帧率与端到端时延数字。这些不影响它作为方向性工作的价值,但离「界面可以不写代码了」还隔着一段工程距离。 2. H3-World:0.199%参数让33B模型可控 H3-World: Turning Language Understanding into World Control | 腾讯 + 新加坡国立大学 + 香港理工大学 | arXiv:2609.01560 关键词:交互世界模型,语言即控制接口,时间注意力路由,LoRA轻量适配,MiniMax-H3,腾讯,H3-World 前序问题:把大视频生成器改造成可交互世界模型,主流做法是加一个专门的动作模块:设计动作编码器、动作嵌入空间,甚至改网络结构,然后用大量带动作标签的数据去训。这条路的代价是双重的——既要重新学一套动作到视觉的映射,又容易破坏预训练模型本来的生成质量。但论文注意到一件事:随着视频生成器变强,它们其实已经能零样本响应自然语言里的控制意图了,MiniMax-H3 就能靠自然语言指令控制角色行为和镜头运动。问题是这种语言接口太粗——你说「角色向左横移,镜头缓慢右摇」,模型大致能做,但它不知道这个动作该发生在第几帧到第几帧,也不知道多个连续动作之间的边界在哪里,指令的影响会在时间轴上互相泄漏。所以真正的问题不是「怎么给模型加动作能力」,而是「怎么把已经存在的粗糙语言控制,变成时间上精确、动作之间不串味的世界控制」,并且不能引入专用动作模块、不能付大规模重训的代价。 本文贡献:H3-World 的三步都围绕「复用而非新建」。第一步是动作表示:它不发明动作嵌入,而是把每个动作写成角色指令与镜头指令的结构化组合(比如角色「向后走并向左横移」、镜头「缓慢右摇并上抬」),这样动作天然落在预训练模型已经理解的语言空间里。第二步是时间对齐:把这些动作提示独立编码后,与静态语义条件、初始观测、视频 latent 一起打包成一条序列,每个动作跨度与它对应的视频 latent 帧段绑定。第三步是关键设计——时间注意力路由,通过掩码把每条指令的作用范围限制在它意图生效的时间区间内,同时保持视频 latent 之间的双向注意力,这就直接压住了动作之间的控制泄漏。适配用 LoRA 加在 H3 自注意力的 QKV 与输出投影上,走单出口路由:每个动作跨度只连到它匹配的视频 latent。整个改造的代价是 8000 条游戏样本、10000 步 LoRA 优化、0.199% 可训练参数。 Overview of H3-World. (a) Latent-aligned action prompts are independently encoded and packed with the static semantic condition, initial observation, and video latents. (b) MiniMax-H3 processes the packed sequence through single-stream self-attention. (c) LoRA adapts the attention projections under single-egress routing, which connects each action span directly to its matched video latent and retains bidirectional attention among video latents. 实验效果:在这么轻的适配预算下,H3-World 实现了有效的角色与镜头控制,同时保住了原模型的生成质量——这一点很重要,因为加专用动作模块的方案常常在获得可控性的同时损失画质。论文给的定性证据分两类:一是对照录制控制的复现,把真实录制视频与 H3-World 从同一初始观测和同一动作序列生成的结果上下对照,检验它是否跟得上真实操作;二是受控动作干预,固定初始观测、随机种子和采样配置只改动作指令,结果产生了明显不同的角色运动与镜头运动,包括幅度更大的快速摇镜。它还能泛化到训练时没见过的场景,说明复用预训练语义表示这一判断是站得住的。 Controlled action comparison. The initial observation, seed, and sampling configuration are fixed across rows. Changing the action produces distinct character and camera motion, including stronger fast pans. 批判点评:这篇最有价值的地方是它选择相信预训练模型已有的能力。当所有人都在给视频模型加动作模块时,它先去问「模型是不是已经会了,只是接口太糙」,答案是会——那么工作量就从「教会」变成了「校准」,代价从大规模重训降到 0.199% 参数。时间注意力路由是这个思路里最实的一块:控制泄漏是语言接口的固有缺陷,用掩码把每条指令钉在它的时间区间上,比用更多数据去「教」模型区分先后要直接得多。而且它保留了视频 latent 之间的双向注意力,没有为了时序精度牺牲生成一致性。但这条路径的边界也很清楚。第一,它的可控性天花板被基座模型的语言理解压着——H3 听不懂的动作,路由和 LoRA 都补不出来,所以这套方法能走多远高度依赖基座,换个语言控制能力弱的模型可能直接失效。第二,动作被写成「角色指令 + 镜头指令」的结构化组合,这个词汇表是人定的,面对需要精细连续量的控制(力度、速度、精确位移)时,语言的分辨率本身就不够。第三,摘要层面缺少量化的可控性指标和与其他交互世界模型的横向对比,仅有定性对照,「有效控制」的强度难以判断。第四,8000 条游戏样本这个量级说明验证还停留在游戏域,而游戏场景的动作空间比真实世界规整得多。 3. ZimaBlue:12万小时视频抬成功率78% ZimaBlue: Evolving Generalizable World Action Models through Scalable Video Pre-training | Joy Future Academy | arXiv:2609.00188 关键词:世界动作模型,具身视频预训练,Slow-Fast双系统,统一动作表示,扩散步蒸馏,机器人操作,ZimaBlue 前序问题:机器人操作有一个绕不过去的扩展性矛盾:要泛化就需要广泛的物理经验,但带动作标签的机器人轨迹采集昂贵,且天然缺乏多样性——一个实验室能覆盖的场景、物体、任务组合太有限。与此同时,第一人称视频是一种量级完全不同的具身经验来源,里面有物体交互、接触动力学、工具使用、长程行为,跨越各种环境。矛盾点在于这些视频没有动作标签,无法直接监督控制策略。所以核心问题是:怎么把这种丰富但无动作的经验,转化成真正可用的机器人控制能力。这里还叠加了一个部署侧的硬约束:生成式世界模型天生慢,而闭环控制要求高频动作输出,一个能预测未来视频的大模型如果只能跑几赫兹,在真机上就没有意义。所以方法不仅要解决数据转化,还得同时解决实时性,两者往往互相拉扯——模型越大越懂物理,也越跑不动。 本文贡献:ZimaBlue 的答案分成训练课程和推理架构两半。训练是三阶段的数据金字塔:阶段一在大规模人类与机器人第一人称视频上做因果化具身视频预训练,只学通用视觉动力学,完全不需要动作监督;阶段二引入多种本体的机器人动作,用统一动作表示把学到的视觉动力学接地到跨本体控制上,这一步是「无动作经验」转化为「可执行控制」的枢纽;阶段三针对目标机器人与目标基准做特化以便部署。推理侧是异步 Slow-Fast 双系统:Slow 分支是一个 5B 的 DiT,吃观测、机器人状态、语言指令加带噪视频与动作 token,联合预测未来视频 latent 与对应动作(后者只作为视频-动作对齐的辅助监督),并导出逐层视频 K/V 缓存;Fast 分支是 0.5B DiT,吃更新后的观测与状态,把 Slow 的视频 K/V 注入自注意力,产出用于高频闭环的细粒度动作。两条分支频率不同,Slow 慢跑提供可泛化的时空表示,Fast 快跑保证控制率,中间还用扩散步蒸馏与编译进一步压延迟。 Slow-Fast dual-system architecture. The Slow DiT processes observations, robot state, language instruction, along with noisy video and action tokens, to jointly predict future video latents and their corresponding actions (serves only as auxiliary supervision for video-action alignment). Concurrently, the Fast DiT ingests the updated observation and state, conditioned on the Slow DiT's video K/V caches, to generate fine-grained final actions for high-frequency closed-loop control. 实验效果:最能说明问题的是那条数据扩展曲线:真机零样本评测下,从「只用目标机器人自己的数据」扩展到 12 万小时以上的具身视频,成功率从 36.1% 提到 77.8%。这个 2 倍以上的提升几乎全部来自不带动作标签的视频,直接回答了「无动作经验值不值得用」这个问题。实时性方面,Slow-Fast 异步架构让 Fast 分支在单张 NVIDIA RTX 4090 上做到 30 Hz 动作预测——注意这是消费级卡,不是数据中心配置,对真机部署的意义比在 A100 上跑通更大。论文还提供了 RoboTwin、RoboCasa、LIBERO-Plus 等仿真基准的分任务结果,以及真机扰动条件(视觉偏移、物体重定位等)下的案例评测。 Data pyramid. Three-stage training progresses from broad visual diversity to deployment-specific embodiment. romannumeral 1 (Pre-training) learns general visual dynamics from diverse video sources without action supervision. romannumeral 2 (Mid-training) introduces robot actions from multiple embodiments, grounding visual dynamics in cross-embodiment control. romannumeral 3 (Post-training) specializes the model on target embodiments and benchmarks for deployment. 批判点评:这篇把「用无动作视频扩机器人能力」从一个人人认同的方向变成了一条可以摆出来的曲线,36.1%→77.8% 这个数字的说服力在于它是真机零样本,不是仿真里刷出来的。三阶段课程的分工也清晰:预训练学动力学、中训练接地到动作、后训练特化部署,每一步要什么数据、解决什么问题都对得上。Slow-Fast 用 K/V 缓存做跨分支信息传递是个漂亮的工程解——不是简单地把大模型蒸馏成小模型,而是让小模型直接读大模型的中间表示,在单卡 4090 上拿到 30 Hz 是有实际部署价值的。但需要注意几点。第一,36.1%→77.8% 的对照是自身消融(只用目标机器人数据 vs 加 12 万小时视频),不是与其他 VLA 方法的横向比较,所以它证明的是「数据扩展有效」,不能直接读成「ZimaBlue 优于其他方法」。第二,Slow 分支输出的 K/V 缓存有个内在时滞——论文自己用 outdated 标注了这一点,也就是 Fast 分支正在依据一份基于过去观测的世界预测来行动,在场景快速变化时这份缓存的可靠性会下降,而这个失效边界论文没有量化。第三,12 万小时的数据规模本身构成了一道复现门槛,这个量级的第一人称视频不是多数团队能获取的,方法的可迁移性因此打折。第四,署名机构 Joy Future Academy 是个新出现的名字,源码里的作者上标标注的是任务分工(数据、预训练、中训练、后训练、双系统、加速、部署)而非机构隶属,实际的组织背景不透明,只有 Supervision 一栏出现了 Nan Duan。 4. PixSGR:粗尺度注意力指路稀疏精修 Advanced Pixel Diffusion Model with Guided Sparse Global Refinement | 电子科技大学 | arXiv:2609.00798 关键词:像素空间扩散,稀疏全局精修,跨尺度token打分,瓶颈监督,ImageNet FID 1.51,电子科技大学,PixSGR 前序问题:像素空间扩散最近重新被看好,因为它绕开了 VAE 这一层压缩、直接在原始像素域建模分布,保真度上限更高。代价是维度爆炸——自然图像的像素维度极高,注意力算不动。现有方案的两种妥协各有明显后果:一种是用大 patch 做 tokenization,这会直接牺牲细节;另一种是在大 patch 内部做精修,但精修被锁在单个 patch 里,跨 patch 边界的结构连续性和长程 token 交互就丢了,具体表现为结构断裂。论文还给了一个观察来支撑它的切入点:可视化不同 Transformer 块与不同时间步的注意力图能看到,随着网络深度增加,注意力越来越集中在少数区域上。这个现象很关键——它意味着在有限的注意力预算下做全局精修不是没戏,因为真正需要交互的 token 本来就是少数,问题只是怎么在算之前就把它们找出来。 本文贡献:PixSGR 的框架是一条由粗到细逐步展开的路径。起点是一个有监督的低通道瓶颈:先用低维表示高效捕捉自然图像的低维流形,而且这个瓶颈是被显式监督的——论文的可视化对比显示,加了瓶颈损失之后的瓶颈特征明显更结构化、语义更清晰,不加则杂乱。之后逐步扩展通道维度与空间分辨率,一层层恢复更细的结构。核心创新在空间精修阶段:跨尺度 token 打分,用粗尺度已经算好的注意力图来预选真正全局相关的交互,据此把细尺度注意力预先稀疏化。这样就能做超出单个 patch 的非局部精修,同时避开稠密注意力的二次代价——注意这与「先算完再剪枝」是相反的顺序,稀疏模式是在算之前就由粗尺度决定的。瓶颈通路另外提供一路辅助的干净图像预测,最终结果由一个卷积上采样头产出。论文还对瓶颈损失的权重与施加位置分别做了消融。 Overview of the proposed PixSGR framework. PixSGR starts with supervised low-channel bottleneck blocks, expands the channel dimensionality in subsequent Transformer blocks, and performs spatial refinement with sparse attention. Cross-scale token scoring transfers coarse attention patterns to guide fine-scale sparse global interactions. The bottleneck pathway provides an auxiliary clean-image prediction, while a convolutional upsampling head produces the final prediction. 实验效果:ImageNet 上的验证是直接的:256×256 分辨率下 FID 达到 1.51,而且扩到 512×512 时性能保持,FID 1.60。这个「放大分辨率不掉点」的性质对像素空间扩散尤其有意义,因为该路线最容易在高分辨率上崩。消融部分给出了两条支撑:一是瓶颈损失权重的影响,二是施加该损失的网络位置的影响,说明「有监督的低通道瓶颈」不是可有可无的装饰。注意力图可视化则从机理侧支撑了稀疏化的合理性——深层注意力本来就高度集中,所以预先筛掉大部分交互并不会损失多少信息。 Analysis of the key designs in our PixSGR framework. (a) Bottleneck feature visualization with and without the supervision of $\mathcal{L}_{\mathrm{bot}}$. Compared with the baseline, the supervised feature produces more structured and semantically meaningful coarse representations. (b) Attention map visualization across different Transformer blocks and timesteps. As the network depth increases, attention becomes increasingly concentrated on fewer regions, motivating sparse global refinement under a limited attention budget. 批判点评:这篇的思路顺序值得注意:它先用注意力图可视化确认了「深层注意力天然集中」这个事实,再据此设计稀疏化,而不是先假定稀疏可行再补实验。这让跨尺度 token 打分显得不像一个技巧而像一个推论——如果注意力本来就只关心少数区域,那么用便宜的粗尺度注意力去预测哪些区域值得算,逻辑上就是自洽的。而且它是「算前定稀疏」不是「算后剪枝」,真正省下了计算。有监督低通道瓶颈那组特征可视化对比也很有说服力,直接展示了不加监督时表示会杂乱。ImageNet 256 的 FID 1.51 与 512 的 1.60 放在像素空间扩散这条线上是有竞争力的成绩,尤其是放大不掉点这一点。但有几处需要保留判断。第一,摘要给的是 FID 而没有给同预算下的实测延迟或吞吐对比,而这篇的卖点恰恰是效率——「避免二次代价」是理论层面的陈述,实际稀疏注意力在 GPU 上能否兑现理论加速,取决于稀疏模式是否规整,这一点没有交代。第二,稀疏模式由粗尺度注意力决定,那么粗尺度判断错误时细尺度就没有补救机会,这种误差传播的鲁棒性缺少分析。第三,验证只在 ImageNet 类条件生成上,没有文本到图像的结果,而后者的注意力分布形态与类条件差别很大。 5. Lapis:一步扩散把1080P深度提速7.6倍 Efficient and High-Quality Depth Estimation via Pixel-Space Diffusion with Linear Attention | 上海交通大学(教育部人工智能重点实验室 + 致远学院) | arXiv:2608.30129 关键词:单目深度估计,一步扩散,线性注意力,像素空间x预测,ECCV 2026,上海交通大学,Lapis 前序问题:用生成式框架做单目深度估计这几年确实把细节保真度推上去了,但代价在高分辨率场景下变得不可接受:标准注意力是 O(N²),多步去噪又要重复付这个代价,两者叠加使得 1080P、1440P 这类实际应用分辨率下延迟高得没法用。直觉上的解法是换线性注意力加一步预测,但论文指出直接这么做会立刻暴露三个问题——结构一致性变差、细节丢失、噪声残留。原因不难理解:线性注意力削弱了全局建模能力,深度图这种需要全局一致布局的输出最吃亏;而一步去噪意味着没有后续步骤来修正采样噪声,误差无处消化。所以问题不是「能不能用线性注意力和一步扩散」,而是「怎么把这两个手段引入之后被削掉的全局一致性、边界锐度和抗噪能力,用别的机制补回来」,而且补回来的成本不能把省下的算力再吃掉。 本文贡献:Lapis 用一条由粗到细的层级来分别修补上述三处损失。全局一致性交给 Patch 级一致性模块:它接入预训练语义先验(DINOv2)来强制全局连贯,同时引入局部卷积偏置来保证相邻 patch 之间的结构连续,具体是在 FFN 里加一路残差 3×3 深度卷积(论文称 ConvFFN),并用 AdaLN-Zero 做调制。边界锐度交给 Pixel 级精修模块:通过基于跳连的像素对应关系恢复清晰几何边界,输入是 unpatchify 之后的 token 与编码的 RGBD,走同样的调制结构。抗噪则靠预测目标的选择:一步扩散的采样噪声本质上是偏离干净数据流形,于是它利用流形假设直接采用 x 预测策略,把目标定在干净数据流形上,而不是预测噪声再反解。训练损失除 MSE 外还加了直接作用在 x 空间的多尺度梯度匹配损失来提升深度图锐度。整个框架是像素空间的 x 预测加一步去噪。 实验效果:多个基准上 Lapis 同时拿到 SOTA 精度与边界锐度,覆盖不同分辨率。效率数字是最直观的:相比此前的 SOTA 生成式方法,1080P 下推理延迟降低最多 7.6 倍、1440P 下降低最多 10.9 倍——注意倍数随分辨率上升而变大,这正是 O(N²) 到线性的差异在高分辨率上的体现,也说明这套方法越往高分辨率越划算。论文另外展示了测试时分辨率扩展的现象:输入分辨率提高,模型产出的细节更细,说明它在训练分辨率之外仍然可用。附录还给了边缘感知的点云评测(Chamfer 距离)与模型规格表。 批判点评:这篇的结构很干净:它没有把线性注意力和一步扩散当成免费午餐,而是先明确列出这么换会丢什么(结构一致性、细节、噪声),再逐条给出补偿机制,最后用一个由粗到细的层级把它们组织起来。三处补偿的针对性都对得上——用 DINOv2 语义先验补全局、用深度卷积补 patch 间连续、用 x 预测把一步采样的噪声问题转化成流形对齐问题。特别是 x 预测这一步,它把「一步去噪没有后续步骤纠错」这个结构性缺陷绕开了,而不是靠加大模型硬扛。加速倍数随分辨率上升而变大也是自洽的,符合复杂度分析的预期。但要注意几点。第一,7.6× 与 10.9× 的对照是此前的 SOTA 生成式方法,而深度估计领域还有大量前馈判别式模型本来就很快,这篇没有和它们比延迟,所以「高效」是在生成式这个子类内部成立的。第二,加速比高度依赖分辨率,在常见的 512 或 768 输入下收益会显著缩水,论文用最大值表述容易让人高估通用收益。第三,全局一致性依赖 DINOv2 的语义先验,那么在 DINOv2 表现弱的域(低光、水下、医学)上这套补偿是否还成立,缺少验证。第四,测试时分辨率扩展被作为优点展示,但更高分辨率下细节增多也可能是幻觉细节增多,论文用可视化呈现而没有给对应的量化误差曲线。 6. SinkPruner:高范数token其实是冗余不是线索 SinkPruner: Sink-Free Visual Token Pruning for Multimodal Large Language Models | 香港中文大学 + Weitu AI + 北京大学 | arXiv:2609.01004 关键词:视觉token剪枝,高范数离群token,注意力汇聚(attention sink),视觉净化器,EMNLP 2026,香港中文大学,SinkPruner 前序问题:多模态大模型处理长视觉 token 序列的计算开销很大,剪枝是主流省法,做法上分视觉中心与文本引导两类。但论文指出这两类方法共有一个盲区:高范数离群 token——特征范数异常大的那些 token。问题出在这些 token 恰好会在注意力排序里占据高位,于是被现有方法当成信息量大的重要线索保留下来。论文的观察是相反的:这些高范数离群 token 在特征维度和空间维度上都高度冗余,也就是说它们既不携带独特信息,也不覆盖独特区域,被保留纯属误判。更麻烦的是保留它们会带来连锁后果——它们在 LLM 解码器里形成注意力汇聚(attention sink),把注意力权重大量吸走,造成注意力偏置与注意力弥散,让真正相关的视觉 token 分不到权重。所以这不是「剪枝比例还能不能再高」的问题,而是「现有剪枝方法一直在保留错误的东西」。 本文贡献:SinkPruner 是训练无关的,采用由粗到细的两模块设计。第一个模块是视觉净化器:它先识别高范数离群 token,把它们聚合成单个汇聚 token(而不是简单丢弃,保留其统计作用但不再占据序列位置),再通过注意力过滤与相似度过滤两道筛选出真正有信息量的保留 token。这一步的直接效果是同时缓解注意力汇聚与注意力弥散两个症状。第二个模块是文本引导剪枝器:净化后的视觉序列再与文本 token 交互,利用累积的文本到视觉注意力,只留下与查询语义对齐的视觉 token。两个模块的顺序是有讲究的——先做与文本无关的净化,再做与查询相关的选择,这样文本引导阶段面对的已经是一个没有离群干扰的序列,其注意力信号才可信。论文用散点图量化了净化效果:标准文本引导方法(如 SparseVLM)处于高汇聚状态,汇聚 token 比例 14.23%,而 SinkPruner 把这个比例压到 3.85%。 SinkPruner framework. % Left (Visual Sanitizer): As shown in the Attention Ranking (far left), high-norm outlier tokens (purple) dominate the top ranks despite being background noise. We aggregate these outliers into a single sink token (red hashed) and select informative reserved tokens (orange) via attention and similarity filtering. % Right (Text-Guided Pruner): The purified visual sequence further interacts with text tokens (green), utilizing accumulated text-to-vision attention to retain only semantically relevant visual tokens. 实验效果:在 12 个图文基准与 4 个视频语言基准上验证。最有代表性的数字是压缩强度下的性能保持:在 89% token 削减率下,LLaVA-1.5 仍保住 96.5% 的原始性能,Qwen2.5-VL 保住 91.8%。汇聚比例从 14.23% 降到 3.85% 提供了机理层面的证据,说明性能保持不是碰巧而是确实消除了注意力偏置。另一个有意思的结果是可迁移性:视觉净化器可以单独接到现有剪枝方法上提升它们的性能,说明「先清离群再选 token」这个前置步骤有独立价值,不必整套替换。 Distribution of Visual Attention Sinks in LLM Decoder. % We visualize the relationship between attention weights (y-axis) and massive activation values in sink dimensions (x-axis). % (Left) Standard text-guided methods retain a large cluster of sink tokens (red line, value $>5$), resulting in a high sink ratio of 14.23%. % (Right) Our approach, by filtering visual outliers upstream, suppresses these massive activations, significantly reducing the sink ratio to 3.85% and alleviating attention bias. 批判点评:这篇的价值在于它推翻了一条被广泛沿用的判据。剪枝方法普遍拿注意力权重当重要性代理,而它指出这个代理在高范数离群 token 上系统性失效——那些 token 排名高不是因为重要,而是因为范数大。这个反直觉的发现有实证支撑(特征与空间双维度冗余、汇聚比例 14.23%→3.85%),也解释了为什么以往方法在高压缩率下崩得快。把离群 token 聚合成单个汇聚 token 而不是直接扔,是个细致的处理——保留其吸收作用但不让它占位。两模块的先后顺序也有道理:先做与查询无关的净化,文本引导阶段的注意力信号才干净。视觉净化器能单独加到别的方法上提升效果,进一步说明这个前置步骤是可分离的真贡献。但有几点需要注意。第一,两个骨干的保持率差距不小(96.5% vs 91.8%),说明收益取决于骨干本身的冗余程度,Qwen2.5-VL 这种更强的模型上收益明显缩水,那么在下一代骨干上还剩多少不好判断。第二,性能保持率是跨 16 个基准的汇总,掩盖了任务间的方差——细粒度定位、OCR 这类依赖特定空间位置的任务对剪枝远比 VQA 敏感,摘要层面看不到最差情况。第三,89% 是个很激进的削减率,摘要没有给出不同削减率下的性能曲线,无法判断这个方法的性能衰减是平缓还是在某个阈值突然崩。第四,「高范数离群 token 是冗余的」这个结论建立在当前视觉编码器的伪影特性上,如果编码器架构改变(例如换成没有 register token 伪影的编码器),这条前提可能不再成立。 7. UMM-Synergy:统一多模态模型不是放一起就协同 Uncovering Understanding-Generation Synergy in Native Unified Multimodal Models: From Representation, Task to System | 南洋理工大学 S-Lab + 商汤研究院 | arXiv:2609.01607 关键词:统一多模态模型,理解生成协同,任务解耦MoT,逐层探针,端到端优于流水线,南洋理工大学,UMM-Synergy 前序问题:统一多模态模型现在很热,但热度掩盖了一个基本问题没被回答:把视觉理解和视觉生成放进同一个模型,功能上统一了,学习上真的协同吗?论文把这个模糊问题拆成三种可能——两个目标互相增强、争夺容量、或者仅仅共存互不影响。这三种情形对架构设计的含义完全不同,但过去的工作大多直接展示统一模型能做两类任务,很少去检验中间发生了什么。检验这件事本身有难度:绝大多数统一模型都用了预训练视觉先验(视觉编码器或扩散先验),这些先验会把「协同效应」和「先验本身带来的收益」混在一起,无法归因。所以论文要求一个结构上原生、不含预训练视觉先验的受控设定,才能干净地观察两个目标之间的关系。这个方法论要求本身就是这篇工作的一部分——不这么做,任何关于协同的结论都可能是先验的功劳。 本文贡献:论文在受控原生设定下从三个层面展开。表示层:用逐层探针(语义分类、mIoU、深度 R-MSE)检查两个目标对视觉表示的影响,同时对比三种架构——稠密共享(所有 token 走同一个 LLM 解码器)、模态解耦 MoT(文本留在 LLM、所有视觉 token 走从零训练的分支)、任务解耦 MoT(理解用的视觉 token 保持语言锚定、只把生成用的视觉 token 特化)。任务层:通过三个案例研究检验双向迁移是否发生。系统层:把端到端统一模型与一个理解、生成能力相当的规划器-执行器流水线做对比。核心发现有三条:第一,两个目标确实互相提供有用信号——生成会丰富用于理解的视觉特征,理解会强化用于生成的视觉语言对齐;但如果两个目标被强迫走同一条计算路径,其中一个会压倒另一个,造成不对称退化,而任务解耦架构(特化冲突的视觉计算、保留语义交互)能避免这种退化。第二,当理解与生成任务依赖共享知识时会出现正向双向迁移。第三,在明确同时需要图像理解与生成的复杂任务上,端到端统一模型优于能力相当的流水线组合。 Illustration of different architectures in our study. (a) Dense sharing sends all tokens through the same LLM decoder. (b) Modality-decoupled MoT keeps text in the LLM and sends all visual tokens through a scratch-trained branch. (c) Task-decoupled MoT keeps Und-V language-anchored while specializing Gen-V. For simplicity, we omit the pre-buffer layers here. 实验效果:逐层探针给出的证据是具体的:联合训练确实强化了视觉表示,在语义与几何两类探测任务上都有提升,而且最明显的收益出现在早期与中间层。PCA 可视化从另一个角度佐证——把 patch 级特征投到共享的三维 PCA 基上做 RGB 图,联合训练产生的物体区域更连贯、空间结构更清晰,与冻结探针的结论一致。架构对比说明的是不对称退化的存在与任务解耦 MoT 的缓解作用。系统层对比则说明统一模型的价值不止于接口统一——在需要理解与生成配合的复杂任务上,端到端优化的收益是流水线拿不到的。 Layer-wise probing experiments of visual representations. Higher is better for classification and mIoU; lower is better for depth R-MSE. Joint training strengthens visual representations, with the clearest gains in early and middle layers across semantic and geometric probing tasks. 批判点评:这篇的贡献主要在方法论。它注意到「统一模型有协同效应」这个说法一直缺少干净的证据,因为预训练视觉先验会污染归因,于是主动选择了一个更难做但可解释的受控设定——结构原生、无视觉先验。这个选择让它的结论比同类工作可信得多。三层拆解也很清晰:表示层用探针看内部、任务层看迁移、系统层比端到端与流水线,每层各自可证伪。最有实操价值的发现是「不对称退化」:两个目标确实互惠,但共享同一条计算路径时其中一个会压倒另一个,因此任务解耦(只特化冲突的视觉计算、保住语义交互)是必要的——这直接是架构选型建议。端到端优于同等能力流水线这一条,则给「为什么不用两个专门模型拼起来」提供了实证回应。但受控设定的代价也在这里。第一,无预训练视觉先验是为了干净归因,而现实中的统一模型几乎全都带先验,那么「生成丰富理解表示」这个收益在已有强视觉编码器的情况下还剩多少,很可能大幅缩水甚至消失——论文没有验证这一点,这是结论外推时最需要警惕的地方。第二,受控设定通常意味着模型规模不大,而容量竞争这个现象本身高度依赖规模,小模型上观察到的不对称退化在大模型上可能因容量充足而消失。第三,摘要层面给的是趋势性表述(「最清晰的收益在早中层」)而非可比的量化幅度,读者难以判断协同效应的强度。 8. ReNFT:已崩的奖励模型能修回多样性 ReNFT: Repairing Mode Collapse in Reward Post-Training via Internal Probability-Mass Recalibration | 南方科技大学 + 腾讯优图实验室 | arXiv:2609.00061 关键词:奖励后训练,模式崩塌修复,概率质量重校准,反枢纽提示,双路混采,腾讯优图,ReNFT 前序问题:扩散生成器做奖励后训练几乎必然付一个代价:概率质量会向少数几个被奖励偏好的模式集中,同一个提示下的输出多样性被抹掉。这就是模式崩塌。现有的缓解手段都依赖外部信号或外部接口——在奖励里加感知目标、调整参考正则、或者改文本编码器。这些做法的共同局限是它们都是预防性的:能在训练时抑制崩塌发生,但没有一个能修复一个已经崩掉的适配器,更做不到在修复的同时保住已经拿到的奖励收益。而这恰恰是实践中最常见的处境:你已经花了算力做完后训练、拿到了高奖励,然后发现多样性没了,此时重新训练成本高昂而且未必避得开同样的坑。论文的切入点是一个观察:在线后训练主要是在重新分配从预训练继承来的能力上的概率质量,而不是学习新的视觉内容。如果这个判断成立,崩塌就是抑制而不是删除,那它原则上可以从生成器内部逆转。 本文贡献:ReNFT 就是在这个判断上构造的内部概率质量重校准流程,分三步。第一步是无条件探针:先找出「反枢纽」提示——即与提示无关的偏置最容易暴露出来的那些提示,把修复算力优先投在这里。第二步是两条策略主导的混合路径:从同一个提示、同一个初始噪声出发生成配对的反事实提案,一条探测冻结基座方向以找出被抑制的替代模式,另一条暴露后训练之后的无条件倾向。这个「同噪声配对」的设计是关键,它保证了两个提案的差异只来自路径而不是采样随机性。第三步是奖励排序加自适应翻转保护:对每一配对做奖励排序来指派拉(pull)与推(push)角色,翻转保护则强制每组的拉比例有 0.5 的下限,防止修复过程被奖励信号带回崩塌方向,最后用联合配对的 NFT 更新实现修复。整个过程不改奖励函数、不动文本编码器,只在生成器内部重新分配概率质量。 ReNFT pipeline. (a) Unconditional probes prioritize anti-hub prompts; (b) two policy-dominated mixed routes generate matched proposals from the same prompt and initial noise; (c) reward ranking and the adaptive flipping guard assign pull/push targets for joint-and-paired NFT repair. The VAE decoder is omitted for clarity. 实验效果:两个基准上的结果都体现了同一种权衡结构:在 PickScore 上保住 NFT 奖励的 98.9%,同时把 DreamSim-Div(多样性指标)提高 58.8%;在 GenEval 上保住 99.0% 的奖励,多样性提高 55.0%。这组数字的意义在于它证明奖励与多样性并非必须互斥——付出约 1% 的奖励损失可以换回超过五成的多样性恢复。论文另外给了训练动态曲线:ReNFT 从已经崩掉的检查点分叉出来、修复 50 步,可以看到奖励与多样性两条曲线的走向;以及混合路径模式与反枢纽选择的消融,说明这两个设计不是可选装饰。自适应翻转保护的效果也被单独可视化——原始拉比例与加保护后的比例对比。 Training dynamics and ablations. (a)(b): PickScore reward and DreamSim-Div; (c)(d): GenEval reward and DreamSim-Div. ReNFT branches from the hacked checkpoint $H$ (star) and repairs for 50 steps; the dashed line marks the base generator. (e)(f): mixed-route pattern and anti-hub ablations after 50 repair steps from the same $H$; the dashed line marks NFT at $H$. 批判点评:这篇提的问题是真实的工程处境:后训练做完、奖励拿到、多样性没了,重训代价高。它给出的判断——崩塌是抑制不是删除,因此可以从内部逆转——是整篇的支点,而且这个支点建立在一个可检验的观察上(在线后训练主要重新分配预训练已有的能力,而非学新内容)。三步设计各有针对性:反枢纽提示把修复算力投在偏置最暴露处,同噪声配对保证两条路径的差异不被采样随机性污染,翻转保护则挡住修复过程被奖励拉回崩塌。98.9% 奖励保持换 58.8% 多样性提升这个交换比很有说服力,说明两者的对立没有想象中那么硬。但要注意几点。第一,基线是 NFT 自身,不是其他抗崩塌方法,所以这组数字回答的是「能不能修」而不是「修比预防好」,实践中如果预防型方法本来就能避开崩塌,ReNFT 的适用场景会窄很多。第二,DreamSim-Div 是多样性的代理指标,提升五成不等于人眼感知的多样性提升五成,也不排除多样性提升伴随质量方差变大——这方面缺少人类评估。第三,修复预算是 50 步,这个预算是怎么定的、多样性恢复是否会随步数继续提升或反转,摘要层面看不到。第四,方法针对的是「适配器已崩」这一具体形态(LoRA 类后训练),对全参数后训练造成的崩塌是否同样适用,没有交代。 9. PredErase:删物体要连影子一起删掉 PredErase: Training-Free Object-and-Effect Removal with Predictive Latent Guidance | 香港大学 + 中山大学 | arXiv:2609.00956 关键词:物体移除,训练无关推理,I-JEPA预测引导,接触带先验,FLUX.2 Fill,香港大学,PredErase 前序问题:论文开头那句话就是它的全部动机:移除一个物体不等于填掉它的掩码。投射的阴影、接触处的暗化通常落在用户给的实例掩码之外,所以一个只在掩码内编辑的冻结 Fill 模型,会把物体的光度足迹留在周围表面上——物体不见了,它的影子还在,结果比不删更违和。有监督的移除模型通过配对的干净底板数据学到了这种联合擦除,但需要专门的成对数据与离线训练。训练无关的编辑器则冻结预训练权重,可它们大多把实例掩码当成全部可编辑区域,并且用 CLIP 或 DINO 这类能量去引导采样——这些能量的问题在于它们不预测被遮挡区域应该是什么,只是度量相似性,因此无法告诉模型洞里该长出什么结构。所以问题变成:在完全不训练的前提下,怎么同时解决「哪里可以改」和「改成什么」这两件事。 本文贡献:PredErase 把这两个问题明确分开处理,跑在冻结的 FLUX.2 与 I-JEPA 上。「哪里可以改」用接触带先验解决:对实例掩码 M_obj 做距离变换得到上下文图,据此膨胀出一个包含接触带与阴影带的编辑支撑 M_flux,这样局部残留(支撑平面上的阴影与接触暗化)就被暴露在可编辑范围内。「改成什么」用预测式引导解决:先把图像的物体区域灰填,让为掩码 token 预测而预训练的 I-JEPA 在表示空间给出一个基于上下文条件的洞内目标并缓存下来——注意 I-JEPA 的训练目标本来就是预测被遮挡内容,这与 CLIP/DINO 的相似性度量有本质区别。采样时冻结的 FLUX.2-klein-4B 沿自己的原生轨迹走,只在 t∈{4,2} 两个时间步上把解码出的 Fill 补全与缓存目标做稀疏投影梯度对齐,并且投影保证在可编辑 latent 支撑之外的额外更新为零——即打包支撑外的坐标被锁住,不会被引导带偏。全程不更新任何模型权重。 PredErase training-free pipeline. Top: gray-filled $I_{\mathrm{vis}}$ lets frozen I-JEPA predict and cache hole tokens $\mathbf{E}_{\mathrm{target}}$. Bottom: a contact-band prior expands $M_{\mathrm{obj}}$ into the effect-aware Fill support $M_{\mathrm{flux}}$. Center: frozen FLUX.2-klein-4B follows its native trajectory; at $t\in\{4,2\}$, decoded features are aligned with $\mathbf{E}_{\mathrm{target}}$ (Eq.) and projected so that the additional I-JEPA update is zero outside the editable latent support (Eq.). No model weights are updated. 实验效果:在 RemovalBench、RORD-Val、DEFACTO-Val 三个基准的实例级掩码设定下,PredErase 相对原生 FLUX.2 骨干有提升。论文对结论的界定相当克服:它明确写出有监督移除模型在若干全图外观指标上仍然领先,因此它支持的主张是「对冻结 Fill 模型做训练无关的物体与效果联合编辑」,而不是取代基于配对数据的擦除器。定性对比在 RemovalBench 1024×1024 实例掩码下给出,列包括输入、掩码、原生 FLUX.2-klein-4B、有监督 OmniEraser、PredErase 与干净底板真值,行为桌上香蕉、瓷砖上手机、桌面鼠标三个案例。论文还单独给了失败案例分析。 Qualitative comparison on RemovalBench ($1024{\times}1024$, instance-only masks). Columns: Input, $M_{\mathrm{obj}}$, native FLUX.2-klein-4B, supervised OmniEraser, PredErase (FLUX.2), clean-plate GT. Rows (top to bottom): banana on desk, phone on tile, desk mouse. 批判点评:这篇最值得学的是它对问题的切分:把「哪里允许改」和「洞里该是什么」当成两个独立子问题,各配一个机制。这个切分抓住了训练无关移除失败的真实原因——以往方法在两处都不到位,编辑区域等于实例掩码所以阴影动不了,引导能量是相似性度量所以不知道该填什么。用 I-JEPA 做预测引导是个恰当的选择:它的预训练目标本来就是从可见上下文预测被遮挡 token,天然回答「洞里该长什么」,这一点比 CLIP/DINO 强的地方是原理性的而非调参性的。只在 t∈{4,2} 两步做稀疏对齐、并把支撑外的更新投影成零,也是很克制的干预方式,避免引导污染整张图。论文对自身定位的诚实度值得称赞——直接写明有监督方法在多项指标上仍领先。但边界同样明显。第一,接触带是靠距离变换膨胀出来的几何先验,对典型的地面接触阴影有效,但真实光照下的阴影方向和长度取决于光源位置,硬拉杆式的膨胀在长投影阴影、多光源、镜面反射这些情形下会失效。第二,方法链依赖 FLUX.2 与 I-JEPA 两个特定冻结模型,其中引导时机 t∈{4,2} 是与骨干采样步数强绑定的超参,换骨干需要重新校准。第三,性能仍落后于有监督方法,所以它的实用价值集中在「没有配对数据」这个约束下,如果能拿到干净底板数据,直接训一个更划算。 10. TimeSteer:让台词精确落在指定时间段 TimeSteer: Inference-Time Speech Scheduling in Joint Audio-Visual Diffusion Models | 中国科学技术大学 | arXiv:2609.01277 关键词:音视频联合扩散,推理期语音调度,源跨度定位,区域感知latent重映射,SpeechShift基准,中国科学技术大学,TimeSteer 前序问题:预训练的音视频联合扩散模型对「生成什么」提供了丰富控制,但对「什么时候说」完全没有显式控制手段。你可以描述一句台词的内容,却无法要求它出现在第 2.8 秒到 4.46 秒之间。实践中这个缺口很要紧——配音、对白定时、多说话人轮次都依赖精确的时间落点。直接的做法是在提示里加一句「from 2.8s to 4.46s」,但论文的定性实验显示这样做基本无效,语音仍然贴在视频开头附近,说明时间信息没有被模型当作硬约束吸收。而重训一个带时间条件的骨干代价高昂,也不现实。于是问题被限定成一个更精确的形式:在完全不微调骨干的前提下,能否把耦合的语音与视觉发音动作放进用户指定的起止区间内。难点在于语音和口型是耦合的,单独平移音频会导致音画不同步,而这两者在 latent 里是纠缠在一起的。 本文贡献:TimeSteer 建立在对去噪过程的两个内在性质的发现上。第一,存在一个对时间敏感的文本到音频交叉注意力头,它暴露了每句话在 latent 时间轴上的模型隐含源跨度——换句话说,模型自己知道它把这句话放在哪了,只是没告诉你。第二,预测出的干净 latent 已经把耦合的语音与视觉发音动作组织好了,所以可以只改它们的时间位置而不必重新生成内容。基于这两点,方法分两步且训练无关:源跨度定位从文本到音频交叉注意力估计每句话的源跨度,具体是对引用 token 的注意力权重按音频 latent 求和得到 m_i,再用相对阈值 τ·m_max 取首尾得到跨度 [s_0, s_1];区域感知 latent 重映射则通过一张读取映射把内容从源区间搬到目标区间,映射在 [0,d_0] 与 [d_1,T-1] 上用三次 Hermite、在 [d_0,d_1] 目标语音段上用仿射(保持常速,避免语速被拉伸),并保证端点对齐。这张读取映射同时作用在音频与视频 latent 的时间索引上,因此音画耦合被自动保持。论文另外提出 SpeechShift,作为联合音视频生成中区间级语音调度的首个基准。 Overview of TimeSteer. (a) Given target intervals, TimeSteer localizes each utterance's source span and relocates its predicted audio-visual content. (b) Source Span Localization estimates source spans from text-to-audio cross-attention. (c) Region-Aware Latent Remapping relocates the content through its read map. 实验效果:在两个代表性骨干上的实验显示,TimeSteer 相对训练无关基线大幅提升区间可控性,同时保持有竞争力的整体生成质量。论文用 HR_0.2(命中率)、IoU 与 WER 三个指标交叉验证,并给出跨五个随机种子的样本级 Spearman 相关性:HR_0.2 与 IoU 正相关说明两个时间指标彼此一致,两者与 WER 负相关说明更好的时间控制往往伴随更低的转写错误率——这条负相关很重要,它排除了「靠牺牲语音清晰度换时间对齐」的可能。定性图展示了对照:不加 TimeSteer 时即使在提示里追加「from [start] to [end]」,语音仍停留在视频开头附近;加了之后台词能落进任意用户指定的目标区间,同时保持生成质量与文本对齐。 Qualitative speech scheduling. Without TimeSteer, a timing instruction of the form “from [start] to [end]” is appended to the original prompt, yet the speech remains near the video onset. TimeSteer places the utterance within any user-specified target interval while preserving generation quality and text alignment. Shading marks the target intervals; frames are sampled at 1,fps with aligned mel-spectrograms below. 批判点评:这篇的方法论姿态很典型也很有效:先在冻结模型内部找现成的可利用结构,再围绕它设计最小干预。两个发现都属于「模型其实已经有了,只是没暴露」——时间敏感的交叉注意力头暴露了隐含时间位置,干净 latent 已经组织好了音画耦合。这让方法不需要任何训练,也解释了为什么它能同时移动语音和口型:因为读取映射作用在时间索引上,耦合关系是被整体搬运的,而不是分别对齐的。映射的分段设计也考虑到了实际问题——目标语音段用仿射保持常速,避免把语速拉长,两侧用三次 Hermite 保证平滑。三指标交叉验证加上 WER 负相关是很扎实的验证方式,它主动排除了「用清晰度换对齐」这种取巧路径。但需要注意几点。第一,整套方法依赖「存在一个时间敏感的交叉注意力头」这个经验性结构,摘要没说清这个头是怎么选出来的、在不同骨干上是否稳定存在,若换模型需要重新定位这个头,方法的通用性就要打折。第二,SpeechShift 是自建基准,评测标准与难度分布都由作者定义,缺少第三方对照。第三,重映射搬运的是已有内容,因此目标区间的时长必须与源跨度基本匹配——若用户指定的区间明显短于或长于模型自然生成的语音长度,仿射段就得压缩或拉伸语速,这个失效边界摘要没有量化。第四,验证只在两个骨干上,且都属于联合音视频扩散这一类。 趋势观察 世界模型开始接管「界面」和「动作」两类以前必须写代码的东西 — 今天最值得读的是 Runway 的 Solaris,它把一个看似离生成模型很远的东西拉进了世界模型的射程:图形界面。传统界面必须先用代码把外观和行为一条条写死,Solaris 干脆把鼠标点击、拖拽当作条件信号,自回归地逐帧生成界面的下一个视觉状态,用户下一步操作的对象就是模型刚生成的那一帧。它还把「理解意图」和「渲染画面」分给了两个部件——语言模型负责维护状态、解释用户想干什么并规定交互该产生什么后果,视觉世界模型只负责把这个后果画出来。250 人 7500 次盲测里,在「哪个结果更符合给定指令」上 Solaris 拿到 62% 对 25%,而在「哪个在场景里表现得更自然」上差距拉到 72% 对 21%——后者比前者赢得更多,恰好说明生成式界面的优势不在精确执行而在情境连贯。同一天 H3-World 从另一侧给出呼应:它不新造动作模块,而是发现 33B 的 MiniMax-H3 本来就能零样本听懂自然语言里的角色行为与镜头运动指令,于是只用 8000 条游戏样本、0.199% 可训练参数的 LoRA,把这种粗糙的语言接口改造成时间上精确对齐的世界控制。两篇的共同判断是:大视频模型里已经长出来的能力,比新加的专用模块更值得挖。 「无动作标签的视频」正式成为机器人策略的主要数据来源 — ZimaBlue 把这条路线做到了可以摆数字的程度。机器人操作的老问题是带动作标签的轨迹太贵、多样性太差,而第一人称视频里其实塞满了物体交互、接触动力学和长程行为。它用三段式课程把这些无动作视频转成控制能力:先在人类与机器人第一人称视频上做因果化的具身视频预训练,再用统一动作表示在异构机器人轨迹上做视频-动作中训练,最后针对目标机器人特化。真机零样本评测里,从「只用目标机器人数据」扩到 12 万小时以上具身视频,成功率从 36.1% 提到 77.8%——这个 2 倍多的提升几乎全部来自动作无标签的数据。为了让生成式世界模型真能实时控制,它还做了异步 Slow-Fast 双系统:高容量 Slow 世界模型输出可泛化的时空表示与逐层视频 K/V 缓存,轻量 Fast 分支吃着这份缓存在单张 RTX 4090 上跑到 30 Hz 动作预测。这个「大模型慢想、小模型快动」的分工,和 Solaris 里「语言模型想、世界模型画」的分工是同一种思路的两次出现。 推理加速这一侧,今天集中在「把不该花的算力找出来删掉」 — 四篇效率论文的切口出奇一致,都是先指认一处结构性浪费再定点清除。PixSGR 针对像素空间扩散:既然直接在像素域建模维度太高,现有做法要么用大 patch 粗暴切分丢细节、要么把精修锁在单个 patch 内部导致跨边界结构断裂,它就用粗尺度的注意力图预先筛出真正相关的交互、把细尺度注意力稀疏化,在 ImageNet 256 上做到 FID 1.51。Lapis 针对单目深度估计的生成式方案:标准注意力 O(N²) 加多步去噪在高分辨率下完全跑不动,它换成线性注意力加一步扩散,靠 Patch 级一致性模块补全局结构、Pixel 级精修模块补边界,1080P 下延迟降到原来的 1/7.6、1440P 降到 1/10.9。SinkPruner 则报告了一个反直觉的观察:现有视觉 token 剪枝方法会把「高范数离群 token」当成重要线索保留下来,实际上这些 token 在特征和空间两个维度都高度冗余——把它们过滤掉之后,LLaVA-1.5 在削掉 89% token 时仍保住 96.5% 原始性能。S²Prune 更进一步质疑了剪枝的评价基准本身:它发现按重要性或冗余度选 token 会产生稳定的空间偏置,甚至不总能打赢最朴素的均匀网格采样,因此改为先保证每个区域至少留一个 token 再按 Laplacian 变化分配预算。这四篇放在一起的启示是,效率工作的价值越来越取决于「你指认的浪费是不是真的浪费」,而不是压缩比数字本身。 人工智能炼丹君 整理 | 2026-09-03 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-02|阿里7B原生音视频生成硬刚33B大模型-DreamX 今日 AIGC 论文速览 今日共 10 篇 · 原生音视频联合生成与 2K 高清化 1 篇 · 交互式世界模型的记忆与几何一致性 2 篇 · 推理期物理与质量增强,不改权重 3 篇 · 扩散推理加速:token 压缩与区域复用 2 篇 · 像素空间生成范式与端到端隐空间 2 篇 · 工业级细节保真与 RL 后训练 1 篇 重点论文标题列表 DreamX-Creator(阿里巴巴 DreamX Team):7B原生音视频联合生成打到2K Matrix-Game 3.5(昆仑万维 Skywork):把世界记忆细到patch级3D云 OMR(越南 Fulbright 大学 + 加州大学洛杉矶分校(BMVC 2026)):用冻结V-JEPA梯度纠物理违背 ShellGame(首尔国立大学 + Roblox):视频世界模型追不住隐藏状态 GEARS(北京大学 + 阿里巴巴(ACM TOG / SIGGRAPH Asia 2026)):把丢掉的候选诊断修复再利用 今日论文速览 1. DreamX-Creator:7B原生音视频联合生成打到2K DreamX-Creator: Democratizing Native Audio-Video Generation at 2K Resolution | 阿里巴巴 DreamX Team | arXiv:2608.31106 关键词:原生音视频联合生成,门控跨模态注意力(Gated Cross-Modal Attention),2K自回归精修,音视频强化学习,阿里巴巴,DreamX-Creator 前序问题:现在的视频生成器对声音的处理基本是两种姿势:要么干脆不生成音频,要么先把视频做完、再拿另一个模型去配音。这两条路都切断了视觉动态与声学事件之间的互相建模——画面里杯子落地的那一帧和「啪」这一声本该是同一个物理事件的两个投影,级联管线却只能让后者去追前者,声音沦为画面的附属品,而不能反过来约束画面。真正的原生联合生成又有另一重现实障碍:可用的开源方案要么规模很大(33B 量级),要么不开放权重,导致这个方向的研究门槛被模型尺寸和可得性顶住了。于是问题变成一个很具体的工程判断:能不能在 7B 这种「一张卡装得下」的尺度上,把音频与视频真正放在同一个去噪过程里联合建模,同时还要覆盖 2K 这种实用分辨率?难点在于两个模态的表示、时间尺度和信息密度差异都很大,一上来就全程共享参数容易互相拖累,而完全独立又回到了级联的老问题。 本文贡献:DreamX-Creator 1.0 的核心判断是:耦合不必从第一层开始,但必须细到 token 与 head。它以一个 7B 生成器为中心,条件是首帧加文本提示,然后让模态专用的音频流与视频流联合去噪——网络前一半两条流完全独立处理(此处没有跨模态残差),后一半才通过 Gated Cross-Modal Attention 双向耦合:A2V 与 V2A 两个方向各有一路门控交叉注意力,门作用在每个激活的跨模态注意力头的输出上,且是 token 级与 head 级的,等于让模型自己学「这一帧、这个头到底要不要听对面模态」,两条流之间还共享文本编码器与时间坐标系。数据侧配了统一的 Audio-Video Data System,负责构造并过滤时间上连贯的片段、产出结构化多模态标注,并把片段按能力维度组织成数据池。训练走渐进式联合训练:两个音视频预训练阶段之后接高质量微调。再往后是 Audio-Video Reinforcement Learning,用 Modality-Aware Multimodal Feedback 把视频侧、音频侧和跨模态的反馈分别路由回对应的流。高分辨率不靠原生 2K 训练,而是一条自回归 1 步 2K 精修管线。 auto 实验效果:论文用盲测的双人对比给出了最有说服力的结果:面对参数量远大于自己的开源与闭源系统,7B 的 DreamX-Creator 在视频质量上对 Wan2.7 拿到 45.5% 胜 / 13.1% 平 / 41.3% 负,对 KLing v3 是 48.8% 胜 / 10.6% 平 / 40.7% 负,对 33B 的 MiniMax-H3 是 39.5% 胜 / 18.7% 平 / 41.8% 负——也就是说在纯视觉观感上它已经和这些系统在同一量级上互有胜负。但短板同样被论文自己摆了出来:音频质量对 MiniMax-H3 只有 23.7% 胜而 45.5% 负,对 Wan2.7 是 29.3% 胜 / 43.4% 负;文本-视频对齐(TV-Align)对 MiniMax-H3 仅 15.2% 胜、53.0% 平、31.7% 负。相对 LTX-2.3 与 MiniMax-H3 的自动指标里,它在部分维度落后但在 PQ(6.7169 vs 6.4094)与 IB(0.3081 vs 0.2677)上占优。 auto 批判点评:这篇最扎实的贡献是把「原生联合」从一个规模问题重新框成了架构问题:前一半独立、后一半门控耦合,本质上承认了音频和视频在低层特征上没什么可共享的,真正需要交互的是语义与事件层面,而 token 级 + head 级门控又把「什么时候交互」交给数据决定而不是人手设计。这个设计让 7B 有机会在视觉质量上和 33B 掰手腕,是有说服力的。1 步 2K 精修的分工也务实——把分辨率从训练成本里剥离出去。但要注意几个真实的边界。第一,音频侧的差距不是小瑕疵而是结构性的:对 MiniMax-H3 的音频质量只有 23.7% 胜率,几乎是一半场次输掉,这说明「让音频流分走一半参数」在 7B 尺度上给音频留的容量确实不够,门控耦合能改善同步但补不了音质本身。第二,TV-Align 上 53% 的高平局率值得警惕,这往往意味着评测者难以分辨差异,此时胜率的含义会被稀释,用它论证提示遵循能力偏弱说服力有限。第三,2K 是精修出来的而不是生成出来的,那么 2K 尺度上的细节是模型「知道」的还是精修器「补」的,论文没有拆开——如果是后者,2K 的语义正确性并没有得到额外保证。第四,机构与贡献者名单在源码里写着「将随公开版本最终确定」,也就是说这仍是一份技术报告状态的工作,权重是否真开放、开放到什么程度,决定了标题里 Democratizing 这个词能兑现多少。 2. Matrix-Game 3.5:把世界记忆细到patch级3D云 Matrix-Game 3.5: Enhancing Real-Time Streaming Interactive World Models with Patch Memory | 昆仑万维 Skywork | arXiv:2608.29910 关键词:交互式世界模型,patch memory,tiled PRoPE,静态动态解耦,渐进式长程蒸馏,单卡720p实时20FPS,昆仑万维 前序问题:交互式世界模型要做的事情比视频生成难一个量级:它必须以闭环自回归的方式生成未来观测,同时响应相机运动、用户动作和高层提示。麻烦在于自回归会把自己的预测当成后续的上下文,视觉与几何误差因此持续累积,场景逐渐漂移、身份不再一致、可控性退化。有限的上下文窗口又意味着模型无法直接访问远处的观测,所以「回到之前去过的地方」这件事越往后越难;大幅视角变化时,模型不仅要检索到相关的历史信息,还得判断这些信息在当前相机下的正确几何对应位置。更棘手的是持久性与演化的张力:静态环境应当长期保持不变,动态实体却要随用户交互和提示而变化——一刀切地「全部记住」或「全部重新生成」都不对。既有方案的分歧其实在于历史观测以什么单位存储:压缩成 latent token 或 transformer memory 的路线高效但只是隐式表示;按整帧存储再用相机几何检索(Context as Memory、WorldMem、Matrix-Game 3.0)能靠显式空间线索改善场景重访,但一帧是不可分割的记忆单元,只能整体取出、且只能从它原本的视角取出;显式重建成点云或 splat 则几何约束强但难以合成未观测或新出现的内容。 本文贡献:Matrix-Game 3.5 的核心想法是把历史观测组织成显式的、几何感知的持久记忆,粒度落在图像 patch 而不是整帧或压缩 latent。统一的几何感知记忆框架由两部分组成,且 patch-memory 与 tiled-PRoPE 都不引入任何额外可学习参数:patch memory 把历史图像 patch 用度量深度加相机内外参反投影到一个共同的 3D 空间形成 patch 云,目标相机视锥去查询这个云,并在目标视角下用 z-buffer 为每个 latent 位置只保留离相机最近的表面、丢弃被遮挡的候选,最后把选中的 patch 散射进一张对齐目标视角的记忆画布;tiled PRoPE 是作者对 PRoPE 的视频化改造,在检索到的记忆与目标视角注意力之间建立显式几何对应,与原生 RoPE 在同一个注意力核里协同——温和到直线行走时注意力图相对纯时序核的最大变化仅约 1.3%。动态建模上,用运动感知的物体过滤把静态场景观测与动态主体分开,静态区域融进 patch memory,动态主体用轻量的多视角参考 token 表示,配合上下文遮罩与辅助训练损失抑制鬼影和身份漂移。最后是渐进式长程蒸馏:先用教师强制的 Perceptual Flow Matching 得到高质量少步因果初始化模型,再用 self-rollout DMD 直接优化推理时的自回归过程,按课程逐步蒸馏无分类器引导、相机控制与记忆条件化生成。 auto 实验效果:训练数据来自 Unreal 仿真环境、开放世界游戏与互联网视频三类来源,论文报告模型在长程场景回忆、几何一致的相机控制、主体一致性生成、提示驱动的世界演化,以及稳定的开放世界实时交互上都取得了不错的表现,实测能力是单张 GPU 上 720p 分辨率最高 20 FPS 的实时生成。定性结果里最能说明问题的是参考 token 的消融:在其他条件完全固定、只切换有无参考 token 前缀的匹配 rollout 中,取第 300–400 帧来看,加入参考条件后相机运动下的身份与外观漂移明显减少——而且论文特别说明参考帧只取自因果可得的初始化与历史,真值帧仅作视觉比对用、从不喂给模型。tiled PRoPE 的分析图则显示它在保留时序带状结构的同时奖励位姿相似性,两种机制在一个注意力核里并存而非互相干扰。 auto 批判点评:这篇的判断力体现在选对了「记忆单元」这个变量。整帧检索的问题不在于存得少,而在于一帧是原子的——你只能把它整体搬过来,且只能沿它原来的视角看,视角一变这份记忆就半废。降到 patch 粒度之后,记忆天然变成可按可见性筛选、可按几何重排的东西,z-buffer 那一步等于把遮挡推理直接做进了检索里,这比让注意力自己去学遮挡关系要可靠得多。更值得称道的是 patch-memory 与 tiled-PRoPE 都不加可学习参数,这让它有机会作为一个通用组件接到别的骨干上,而不是又一个只能整体接受的架构。静态动态解耦也切中了实际痛点:长程 rollout 里最难看的失败恰恰是本该不动的墙在漂、本该保持身份的角色在变脸。但局限也很清楚。第一,整套机制吃深度和位姿:patch 要靠度量深度反投影、要靠相机内外参对齐,那么深度估计误差和位姿噪声会直接变成记忆里的几何错位,论文没有给出这条链路的敏感性分析——在真实互联网视频这类位姿本就不准的数据上,这个风险不小。第二,persistent 3D patch 云是会一直长的,论文强调了组件不加参数,但没说清内存与检索代价如何随交互时长增长、有没有淘汰策略,而这恰恰是「长程」的成本核心。第三,静态与动态的二分依赖运动感知过滤器,那些介于两者之间的东西(缓慢变化的光照、被推动后停下的物体)落在哪一侧并不明确,分错的代价是鬼影或不该有的持久化。第四,作为技术报告,缺少与同类记忆方案的统一定量对比,20 FPS 也只是单一配置下的数字,读者难以判断这套机制相对整帧检索的净收益到底有多大。 3. OMR:用冻结V-JEPA梯度纠物理违背 Off-Manifold Refinement: Guiding Video Generators with a Frozen World Model | 越南 Fulbright 大学 + 加州大学洛杉矶分校(BMVC 2026) | arXiv:2608.29904 关键词:推理期物理修正,V-JEPA 2.1意外度能量,单轨迹梯度注入,训练无关,Wan2.2,Physics-IQ,BMVC 2026 前序问题:现在的视频生成器在物理动力学上会犯很低级的错:物体悬在空中、轨迹违反重力、接触关系凭空消失。根子在于目标函数——标准的去噪与流匹配目标拟合的是视觉数据分布,它并不显式惩罚这类物理违背,画面只要看着像训练数据里的样子就够了。既有的补救办法都能改善物理一致性,但代价通常不小。候选选择类方法要生成多个视频再逐个打分,算力开销随候选数线性上涨;基于梯度的世界模型引导需要反复解码再重新编码中间估计,每一步都过一遍 VAE;生成器内部的精修方案要加扰动再重新去噪的循环;而后训练路线则要准备精选数据并额外做一轮优化,成本最高也最不灵活。于是留下一个很实际的缺口:能不能在完全不动模型权重、不生成多个候选、也不反复解码的前提下,把「这个片段物理上不合理」这个信号送进采样过程? 本文贡献:作者提出 Off-Manifold Refinement(OMR),一种推理期方法,把世界模型的反馈直接注入单条采样轨迹,而不是在多条轨迹之间做选择。具体做法是在计划好的中段 ODE 步上,给生成器的速度场加上一项梯度——来自 adapter 空间里 V-JEPA 2.1 的「意外度能量」(surprise energy)。V-JEPA 有一个编码器和一个从可见上下文预测被遮挡未来嵌入的预测器,它在真实视频上训练出的这套目标提供了一个关于「合理时间延续」的学习先验:物体应当持续存在、运动应当平滑、接触关系应当成立。作者从每段 81 帧视频里取 48 帧窗口来算这个能量。这项外部修正会把 latent 推离未修正的采样轨迹,推向被冻结预测器判定为物理上更合理的区域,然后生成器从修正后的状态继续渲染。中间有一个跨表示的桥梁问题:Wan 的 latent 与 V-JEPA 的目标在同一段视频上编码的是不同目标下的表示,一个为合成保留内容与运动、一个为预测保留结构,所以作者训练了一个 adapter 做任务特定的变换,且这个 adapter 是在真实 OpenVid-1M 片段编码出的 latent 上训练、却用在生成过程中从带噪采样状态推出的临时干净预测上。 auto 实验效果:论文的定性结果最直观:同一个 Wan2.2 生成器下,基线在后空翻落地时出现腿部运动时序不一致和身体姿态的突变,而 OMR 给出了连贯的腿-身协同、垫子形变、符合重力的衣物运动和惯性驱动的下落。四组帧条对比把 Wan2.2、P&P 与 OMR 并排放在一起,强调的是时间上的因果:撞击应当与材料响应同时发生、工具应当与被它形变的物体保持耦合、身体运动应当在帧间保持支撑与动量——在第一组里 Wan2.2 在明确撞击之前就出现了破洞、P&P 有损伤但缺少同步的接触,OMR 的撞击与响应对齐得最好。定量侧作者在 Physics-IQ 上以固定 50 条提示做了 Wan2.2-I2V 的试点,比较引导、BoN-4 及两者组合三种设定;混合现象的「其他物理原理」一行从 46.6% 提升到 47.6% 的联合分数,其中 PC≥4 的比例从 56.6% 升到 58.7%。稳定性诊断显示中段轨迹的预测干净 latent 与对应的完成 latent 在 cosine/ρ/τ 上分别为 0.762/0.617/0.446 与 0.769/0.624/0.451,两行相当接近,支持了 adapter 用在 OMR 实际工作分布上的合理性。 auto 批判点评:这篇的巧劲在于找到了一个便宜的干预点。既有方案要么在多条轨迹之间选(贵在候选数),要么反复解码回像素域再编码(贵在 VAE),OMR 直接在 latent 空间借 V-JEPA 的预测误差当能量、只在中段几步加一次梯度,本质上是把「物理合理性」当成一个可微的正则项挂在采样轨迹上。选 V-JEPA 也选得对——它的训练目标天然就是「从可见推未见」,这正是物理直觉的操作化定义,比拿一个判别式打分器要更贴近因果。那个 adapter 的诊断实验也做得诚实,用中段预测 latent 与完成 latent 的相关性接近来论证分布匹配,是个恰当的稳定性检查。但要清楚它证明了什么、没证明什么。第一,定量证据很薄:Physics-IQ 上 46.6%→47.6% 是约 1 个百分点的提升,而且是 50 条提示的试点规模,作者自己也只把它当作「聚合分数没崩」的对照——把这篇当成「解决了视频物理问题」来读会过度解释,它更像一个可行性演示。第二,adapter 存在明确的分布错配:训练在真实视频 latent 上,使用在从带噪状态推出的临时干净预测上,论文用相关性接近来辩护,但相关系数 0.76 的 cosine 并不算高,在物理更极端的片段上这个 gap 可能被放大。第三,方法的上限被 V-JEPA 顶住——它能判「这看起来不像真实视频的延续」,但不能判「这违反了动量守恒」,所以对训练分布内常见的物理它有效,对罕见但严格的物理约束未必。第四,只在中段 ODE 步注入是个超参选择,注入的时机与强度如何影响画面质量与物理性的权衡,论文没有给出充分的敏感性分析。 4. ShellGame:视频世界模型追不住隐藏状态 Can Video World Models Track Unobserved World States? | 首尔国立大学 + Roblox | arXiv:2608.30692 关键词:隐藏状态追踪,视频版猜球游戏(Shell Game),S5状态追踪,线性注意力负特征值,LaCT快速权重,Transformer KV缓存局限,Roblox 前序问题:视频世界模型越来越多地被当作模拟器来用,但一个尖锐的问题被视觉保真度掩盖了:画面生成得像,并不能证明模型维护了世界的隐藏状态。世界里大量重要的东西是当前不可见的——被盖住的球、关上门后房间里的陈设、背包里的物品。如果模型只是把「看起来合理的下一帧」渲染出来,它可以在完全不知道球在哪个杯子下的情况下,依然画出一个像样的揭晓画面。这就使得现有的评测方式存在系统性盲区:几乎所有指标都在衡量渲染质量、时间一致性或提示遵循,没有一个在直接考察「不可见的状态有没有被正确携带」。作者要回答的正是这个被绕开的问题——把视觉渲染与隐藏状态的合成解耦开,单独测后者。 本文贡献:作者设计了一个动作条件化的视频版 Shell Game 作为探针,它是 $S_5$ 状态追踪问题的视觉类比:先揭晓球在哪个杯子下,然后把杯子盖上,经过一串交换动作,最后再揭晓——整个交换序列里球始终不可见,模型必须在架构内部携带并更新这个状态。他们在这个任务上系统比较了双向与自回归 Transformer、Mamba,以及转移特征值被限制在非负区间的线性注意力。诊断的关键洞察是:像素扩散目标从来没有监督过那个看不见的隐藏状态,所以生成的帧本身不可能承载它,状态只能活在架构里而不是 token 里。对 Transformer 来说,那个架构状态只是一个只增不减(append-only)的 KV 缓存,因此模型必须在每个 chunk 都从整段历史里重新推导出隐藏的排列,而不是维护它。作者进一步找到两个确实能外推的机制,共同点是都跨 chunk 携带一个状态并原地修改它:一是线性注意力——一旦允许转移特征值取负就能成功;二是 LaCT,其外推能力随快速权重头数 H 增加而提升。他们还在纯文本的 $S_3$/$S_5$ 词问题上做了对照,测量各架构解决长度 N 问题所需的最少层数与长度外推行为。 auto 实验效果:结论相当刺眼:双向和自回归 Transformer、Mamba、以及转移特征值限制在 $[0,1]$ 的线性注意力,全都只能拟合训练时的 5 次交换,交换链一长就朝随机水平掉下去,但同时仍在生成看起来合理的视频,而且增加去噪步数完全没有帮助。机制侧的量化很清楚:把转移特征值范围从 $[0,1]$ 放宽到 $[-1,1]$ 后,多个线性注意力变体(GDN、GDN2、GDP₃、KDA)的状态准确率在整条曲线上都提升,GDN2 在 N=30 时仍有约 0.8;LaCT 的外推随快速权重头数变好,H=16 在 N=30 时约 0.87、H=1/H=2 则贴在随机线上;scratchpad token 数量 M 的影响则弱得多,M 从 1 加到 1024 在 N=20 之后都掉向随机,而作为自然随机水平对照的裸 SWA1 骨干(M=0)连训练内长度 N=5 都做不到。定性 rollout 里,在训练长度两倍(N=10)的 Shell Game 上,GDN-neg 与 LaCT8 最终落在与真值相同的杯子上,而因果 DiT 与普通 GDN 没有;在纹理化 3D Block World 的局部动作条件化任务上(80 帧干净前缀 + 240 帧延续),LaCT8 能把方块和球保持在接近真值的位置,其他骨干渲染出的房间看着连贯但里面的东西已经漂走了。 auto 批判点评:这是今天最有方法论价值的一篇,因为它把一个大家隐约感觉到但说不清的问题变成了可测量的:视觉保真度和状态追踪是两件事,而现有评测只测前者。Shell Game 这个探针设计得很干净——球被盖住之后画面里再没有任何关于它的信息,模型要么在架构里带着这个状态,要么只能猜,没有中间地带;而「增加去噪步数毫无帮助」这个观察尤其致命,它排除了「算力不够」这种廉价解释,把矛头精确指向表示能力。对 Transformer 的诊断也说到了本质:append-only 的 KV 缓存不是一个可以原地更新的状态寄存器,模型每个 chunk 都得从整段历史里重新推导排列,这在长序列上必然崩。找到的两个正面机制(负特征值、快速权重)共享「跨 chunk 带状态且原地改」这一性质,这个统一解释很有力。但要注意它的适用边界。第一,这是合成探针,$S_5$ 状态追踪是一个刻意构造的、纯组合性的困难任务,真实世界的隐藏状态往往有大量视觉与常识线索可借(东西通常不会凭空移动、遮挡物有形状约束),所以「在 Shell Game 上失败」不等于「在真实场景里同样糟」,这个外推需要谨慎。第二,反过来说负面结果也可能被低估——真实场景的状态空间比 5 个杯子大得多,若连这个都做不到,实际情况恐怕更差;论文没有在两个方向上都给出校准。第三,正面机制目前只在这些探针上被验证,负特征值线性注意力和 LaCT 在真实视频生成质量上要付什么代价(画质、训练稳定性、吞吐)文中没有交代,而这恰恰决定它们能不能真的替换现有骨干。第四,作者把「状态必须活在架构里」这一点讲得很好,但没有讨论第三条路——把状态显式外置成可读写的结构(今天另一条线的做法),这在方法空间上留了一块空白。 5. GEARS:把丢掉的候选诊断修复再利用 Test-Time Scaling for Video Diffusion Models via Diagnosis-Guided Candidate Recycling | 北京大学 + 阿里巴巴(ACM TOG / SIGGRAPH Asia 2026) | arXiv:2608.29322 关键词:test-time scaling,候选回收,诊断式latent编辑,分阶段调度,Wan2.1-T2V-1.3B,SIGGRAPH Asia 2026,北京大学 前序问题:视频扩散模型的生成质量已经很高,但高保真结果在很大程度上仍依赖闭源系统或昂贵的大规模基础设施。Test-time scaling(TTS)提供了一条免训练的路子:靠推理阶段多花算力来提升轻量生成器。问题是现有方法基本都困在「噪声搜索」这一个范式里——采样、选择、扰动去噪轨迹,然后把低分候选在昂贵的生成完成之后直接丢掉。这个「生成再丢弃」的流程浪费的不只是算力,更是那些可回收样本里已经编码好的部分运动、布局或外观结构:一个候选可能整体评分低,但它的镜头构图是对的、主体运动方向是对的,只是某个局部崩了。把它整条丢掉,等于把对的部分和错的部分一起扔。于是问题变成:能不能把低分候选当成可编辑的先验,而不是垃圾?这需要回答三个子问题——此刻该修什么、什么时候修、哪些候选值得修。 本文贡献:作者提出 GEARS(Guided Editing for Adaptive Recycling Search),一个免训练框架,把诊断引导的候选回收引入视频 TTS,通过「生成-评估-编辑」的循环把候选变成可编辑先验。它沿着从纯噪声到干净 latent 的去噪轨迹插入多个「生成转编辑」检查点 $s_0, s_1, \ldots, s_k$,并明确区分高噪区间(偏重运动)与低噪区间(偏重视觉)。框架由两个协作组件构成。Stage-Aware Scheduler 决定修什么、何时修、以及哪些候选该被保留、回收或丢弃:它先确定当前阶段的关注点(高噪阶段用运动质量 MQ、低噪阶段用视觉质量 VQ 作为排序依据),再做排序与路由——语义门控在低文本对齐时直接丢弃、把「弱但有希望」的一批送去回收器、其余有效候选作为精英保留。Candidate Recycler 则负责诊断与修复:由一个 MLLM 根据当前阶段的运动/视觉关注点与关键帧,把候选的提示改写成更好的版本,再配合流形感知的 SDE 去噪把修复落地。关键的一个设计细节是:在每个检查点,候选是先被完整去噪、解码、当作干净视频来评估的,带噪 latent 从不被直接打分——这避免了在噪声态上做不可靠的质量判断。奖励模型是运动质量、视觉质量与文本对齐三项之和。 auto 实验效果:论文的机制展示很直观:一个排名靠后但语义上有效的候选,在传统「生成即选择」的 TTS 里会被丢掉,而 GEARS 先在高噪检查点修掉它的运动缺陷、再在低噪检查点增强视觉细节,修复后的候选回到最终候选池并被选为最佳视频。分阶段修复的案例里,第一阶段(高噪)候选没有充分实现要求的行走动作,回收器在保留兔子主体与奇幻场景的同时恢复了连贯的主体运动,右侧插图用共享尺度的背景补偿光流显示残余运动的大小与方向;第二阶段(低噪)则在保持结构的前提下精修外观与纹理。分布层面的证据是 VQ–MQ 空间里的联合与边缘分布对比:GEARS 把可回收候选整体推向更高的联合质量区域,而不只是把最好的那个挑出来。scaling 行为在 Wan2.1-T2V-1.3B 与 Wan2.1-VACE-1.3B 两个骨干上都做了验证。 auto 批判点评:这篇的洞察其实很朴素但少有人认真对待:TTS 的浪费不在采样,而在丢弃。既有方法从 Video-T1 的独立轨迹选优、到 DLBS 的逐步保留 K 个精英做束搜索、再到 EvoSearch 在精英附近做中段变异,路线越来越精细,但共同前提都是「低分即无用」。GEARS 把这个前提拆了——低分候选是一个有部分正确结构的初值,值得诊断而不是抛弃。两个设计决策尤其站得住:一是候选必须先完整去噪解码成干净视频再评估,绝不给带噪 latent 打分,这一条避免了整个领域常见的「用噪声态代理指标做决策」的可靠性问题;二是把高噪修运动、低噪修细节这个分工写进调度器,与扩散过程本身的信息层级对齐,而不是在所有阶段用同一个标准。用 MLLM 做诊断并改写提示,也比用一个不可解释的打分器更容易调试。但有几处需要保留判断。第一,成本核算不透明:每个检查点都要把候选完整去噪、解码、评估,再对被回收者做编辑与重新去噪,这些开销相对「直接多采几条轨迹」是否真的更划算,需要在同等算力预算下比较,而这类等价预算对照是 TTS 类工作最容易含糊的地方。第二,整条链路依赖奖励模型(MQ+VQ+TA 之和)的可靠性,而运动质量的自动评估本身是公认的难题,如果 MQ 有系统偏差,调度器的「该修什么」判断会跟着偏,且这种偏差会被回收循环放大而非抵消。第三,MLLM 改写提示引入了一个不易复现的环节——同一个候选在不同 MLLM 或不同温度下会得到不同的修复方向,论文对这部分的方差没有交代。第四,验证骨干集中在 1.3B 规模,在更大的生成器上,「候选本身已经不错、可回收空间变小」这一效应会不会吃掉大部分收益,仍是开放问题。 6. RTI:希尔伯特曲线切出内容形状token Elastic Token Compression for Pixel-Space Diffusion Transformers | 德国维尔茨堡大学 + Google | arXiv:2608.29281 关键词:像素空间扩散,弹性token压缩,希尔伯特曲线排序,区域token接口(RTI),单checkpoint多预算,GenEval,维尔茨堡大学 前序问题:自然图像把细节集中在画面很小的一部分,但扩散模型对每个 patch、在每一层、每个时间步都花一个完整的 token。这种浪费在像素空间模型里最严重,因为它没有 autoencoder 先把低层冗余吸收掉。作者探测一个预训练的像素文生图 transformer,发现它中间块的 token 在图像平坦处是冗余的,而且这种冗余占据的是连通的、随内容成形的区域——这就带来一个表示上的要求:要利用这种冗余,就需要几何形状与之匹配的 token,而不是规则网格块。既有的降维方案各自丢掉了这个性质的一部分:相似度合并会把同一组的成员散落在画面各处,不再是连通区域;隐空间瓶颈把位置信息丢了;直接跳过则是把本该被总结的内容删掉。于是核心难题是:怎样得到「形状随内容变化、又能高效实现」的 token 分组——二维空间上的任意连通区域划分在实现上是很昂贵的。 本文贡献:解法的巧劲在于降维:沿希尔伯特曲线给 patch 排序。这条空间填充曲线的性质是相邻位置在图像上永远是邻居,因此任意一段连续区间都对应一个连通区域,且这个区域的大小与形状会随内容自然变化——于是「在二维上做分组」这个难题变成了「在一维上做切割」。作者在模型特征变化最大的位置切开,把每一段池化成一个 region token。为了让模型适应这种新 token,他们提出 Region Token Interface(RTI)做适配;训练时 region 数量是随机抽取的,所以同一个 checkpoint 能服务所有压缩预算,这就是标题里 elastic 的含义——不必为每个算力预算各训一版。作者在 MiniT2I 系列的两个模型规模上验证,并与相似度合并(Feat Sim)、隐空间数组(Latent Array)、token 跳过(Token Skip)等做了机制层面的对照,还做了排序方式的消融(希尔伯特 vs 光栅)以检验「连通性是否真的重要」。 auto 实验效果:机制对照图把四种方案的分组结构与生成结果并排放在一起:RTI 的分组呈现出与图像内容贴合的连通色块、生成结果保住了主体(背着风笛的犰狳)的完整结构与纹理;Feat Sim 的分组碎裂成散点、生成结果虽然还成形但细节退化;Latent Array 完全丢掉了空间结构、生成结果崩成一团抽象形体;Token Skip 大面积留白、结果只剩轮廓。排序消融给出了「连通性必要性」的直接证据:在 MiniT2I-B/16 上比较希尔伯特与光栅两种排序,在较宽松的预算($R_{cells}=128$)下两者接近,但预算压到 $R_{cells}=64$ 时希尔伯特保住了人脸、翅膀与网格结构,光栅则把它们抹开、人物形体也散掉。效率-质量曲线上,RTI 在 $R_{cells}=256$ 时以 1.79 秒/图达到 GenEval 82.7%、ImageReward 0.953,而基线 MiniT2I-L/16 要花到 4.62 秒才达到 86.4% / 0.950——也就是说在 ImageReward 这个指标上 RTI 用约 2.6 倍更短的时间达到了同等水平;把预算放到 5.58 秒时 RTI 达到 86.2% / 1.155,ImageReward 超过基线 5.77 秒的 1.039。 auto 批判点评:这篇最漂亮的地方是把一个几何难题化成了排序问题。「需要形状随内容变化的 token」这个需求听起来必须做复杂的二维分割,但希尔伯特曲线的局部性保证让一维上的任意连续段自动成为二维上的连通区域,于是分组变成切割,实现代价陡降。更值得肯定的是它对既有方案的批评是结构性而非性能性的——指出相似度合并散落分组、隐空间瓶颈丢位置、跳过删内容,各自丢掉了「连通、有位置、被总结」这三个性质中的一个,这种分析比单纯比分数有说服力得多,而排序消融(希尔伯特 vs 光栅)恰好把「连通性」单独隔离出来做了验证,是很干净的对照设计。训练时随机抽 region 数从而一个 checkpoint 覆盖所有预算,也是很实用的工程决策。但要注意几个边界。第一,作者自己承认速度有天花板:prelude、coda 与文本流不参与压缩,所以再怎么压 region 数,端到端加速也会饱和——这意味着该方法适合中等压缩率区间,指望它带来数量级提速是不现实的。第二,GenEval 上并没有全面胜出:长预算下 86.2% 对基线 87.0%,是略低的;真正的优势集中在短预算区间和 ImageReward 上,而 ImageReward 是偏好类指标,与 GenEval 这种组合性正确率指标的结论不一致时,应当分开陈述而不是合并成「更好」。第三,方法针对的是像素空间扩散这个相对小众的设定——论文自己说浪费在像素空间最大,那么在主流的 latent 扩散上,autoencoder 已经吸收了大部分低层冗余,这套机制还剩多少收益空间是未验证的。第四,切割位置由「特征变化最大处」决定,这个判据依赖被探测模型的中间层表示,换骨干后是否仍然稳定、需不需要重新校准,文中没有交代。 7. RegionCache:多轮编辑只重算改动区域 RegionCache: Semantic-Aware Region Reuse for Efficient Multi-Turn Image Generation | 东北大学计算机科学与工程学院(IJCAI 2026) | arXiv:2608.29809 关键词:多轮图像编辑,语义感知区域复用,cross-attention定位,自适应复用调度,PixArt-alpha,1.43-2.55倍加速,IJCAI 2026 前序问题:真实世界的图像生成往往是多轮编辑:用户一轮一轮地改小块区域,而大部分画面内容保持不变。但现有基于 DiT 的编辑管线在每一轮都把整张图重算一遍,产生大量冗余计算——用户只是把「一只猫在星空下」改成「一只狗在星空下」,星空那部分的去噪过程却要从头再跑一次。现有的 DiT 加速方法又都忽略了跨提示的语义对应关系,于是落入两种错误:要么保守地不复用、造成不必要的重算,要么激进地复用了实际已经改变的区域、损害编辑质量。问题的难点在于要同时回答两件事——哪些区域在这一轮语义上确实没变(这需要跨提示的语义比对,而不只是像素比对),以及对这些区域可以复用到什么程度(完全跳过整个去噪过程,还是只在部分时间步复用)。 本文贡献:作者提出 RegionCache,一个面向多轮图像编辑的语义感知复用框架,选择性地复用未改变区域的扩散状态。它由两部分构成。Prompt-aligned Region Caching 负责识别与缓存:通过连续提示之间的语义重叠(Semantic Overlap Identification)确定哪些语义单元延续了下来,再用 cross-attention 定位把每个语义单元对应到图像上的具体区域,把该区域的 mask 与隐状态存进 cache pool——比如「cat」与「starlite」各自被独立缓存。Semantic-aware Region Reusing 负责决定复用策略:它把区域分成改变区域与未改变区域,在区域级稀疏注意力下,语义未变的部分(如 starlite)可以在全部时间步复用,而语义已变的部分(cat→dog)只在早期步复用;复用的时间表是自适应的,依据提示相似度与上下文一致性来定,而不是固定阈值。作者还测量了自注意力与其他计算在不同推理步数和分辨率下的延迟占比,用以定位加速空间到底在哪里。 auto 实验效果:在 PixArt-alpha 上,RegionCache 实现了 1.43 倍到 2.55 倍的端到端加速,同时保持可比的图像质量。框架图给出的机制示例很直白:从「A cat under the starlite」到「A dog under the starlite」,starlite 被判为语义未变从而全步复用,cat→dog 这一改变区域只在早期步复用、后续正常重算,因此改动准确落在主体上而背景星空的观感保持一致。案例研究把 RegionCache 与既有多轮编辑框架并排比较了多轮编辑的结果质量。延迟拆解则显示自注意力在不同推理步与分辨率下的占比,是复用设计的依据。 auto 批判点评:这篇选的问题很贴近真实使用:多轮编辑是图像生成产品里最常见的交互形态,而每轮全量重算确实是明显的浪费。它的关键判断是把复用的依据从像素相似度提升到语义重叠——用提示之间的语义比对加 cross-attention 定位来决定复用区域,这比在 latent 上做相似度阈值要可靠,因为「猫变成狗」在像素上可能相似度不低,但语义上必须重算。区分「全步复用」与「仅早期步复用」也是有见地的:扩散的早期步决定布局与低频结构,改变区域在这个阶段与原图共享的信息其实不少,一刀切地全部重算同样是浪费。用延迟拆解来定位加速空间,说明作者是先量了再设计,而不是凭直觉。但这篇的分量比较轻,几处需要注意。第一,1.43–2.55 倍这个区间很宽,说明收益强烈依赖每轮改动占画面的比例——改一个小配饰接近上界、重构主体接近下界,论文用一个区间概括,读者难以判断在自己的使用分布下能拿到多少。第二,只在 PixArt-alpha 上验证,而 PixArt-alpha 相对当前主流的编辑骨干已经偏旧,这套机制在更强的编辑模型(其注意力模式与语义定位质量都不同)上是否同样有效并未回答。第三,质量结论停留在「comparable」这个定性表述与案例图,而复用本质上是一种近似,最该被量化的恰恰是「复用带来的质量损失」在多轮累积后会不会漂移——第 5 轮、第 10 轮之后误差是否累积,论文没有给出多轮深度上的退化曲线。第四,整条链路依赖语义重叠判断的准确性,一旦把实际改变的区域误判为未变,错误会被缓存下来并影响后续所有轮次,这个失效模式的代价比一般加速方法要重,但文中没有讨论回退机制。 8. PixelIR:保真与感知拆成两条流 PixelIR: Fidelity-Perception Decoupling via Pixel-Space Image-Residual Flow Matching for Efficient One-Step Real-World Super-Resolution | 上海交通大学(实习期间完成) | arXiv:2608.30782 关键词:真实图像超分,保真-感知解耦,像素空间残差流匹配,一步蒸馏,双粒度像素transformer,上海交通大学 前序问题:真实世界图像超分(Real-ISR)要同时做两件互相拉扯的事:既要保住退化观测所支持的结构(保真),又要重建出感知上真实的细节(感知)。现有方法基本都在一个共享网络里同时优化这两个目标,于是两者在整个训练过程中持续互相干扰,它们之间的平衡也很难控制——你想多要一点细节,结构就开始漂;想守住结构,画面就发糊。近期的一步方法虽然把采样步数降下来了,但往往同时继承了两个包袱:耦合的优化行为,以及来自多步前身的昂贵高分辨率骨干。作者的判断是:高效的 Real-ISR 不只需要更短的采样轨迹,还需要对「忠实重建」和「感知细节合成」这两件事分别建模——把它们塞在一个网络里用一组权重去权衡,从设计上就是错的。 本文贡献:PixelIR 提出建立在像素空间图像-残差流匹配之上的保真-感知解耦框架,把一次超分拆成两条流。第一阶段(Fidelity Preservation)学一个图像流,用 4 步把上采样后的低质输入映射到一个忠实的基础重建 $\hat{x}_b$。第二阶段(Perception Refinement)学一个残差流,在冻结的基础重建条件下、用另外 4 步从噪声里合成缺失的感知细节 $\hat{r}$,再通过残差合成得到教师输出 $\hat{x}_t$——关键在于残差流不需要反复重新学习或覆写已经完成的整体复原解,它只负责补差值。两个阶段都使用双粒度像素 transformer:语义层面的 DiT 块加像素层面的 PiT 块,配 AdaLN-Zero 调制。为了部署,作者把教师蒸馏成一个五阶段逐步收窄的学生:从 16×16 patch 经 8×8、4×4、2×2 到 1×1 patchify,前两级用 DiT 块处理语义 token、后三级用 PiT 块处理像素 token,配合金字塔 patchify 与双锚点流蒸馏(对齐 $\hat{x}_s$ 到教师输出 $\hat{x}_t$ 以及到真值 GT 两个方向),最终得到一步推理的学生模型。 auto 实验效果:论文在 DIV2K 上给出六指标的组件剖面雷达图(每个指标方向对齐并按最优值归一化,越远越好)来展示解耦消融的效果,并在 LSDIR 与 RealSR 的困难样例上做了定性对比。方法层面最实质的效率结论是:教师用 4+4 步、学生蒸馏为一步,且骨干通过五阶段金字塔逐步收窄——这直接针对「一步方法仍继承昂贵高分辨率骨干」这一痛点,即把计算按 patch 粒度分层,语义处理放在粗粒度、像素处理放在细粒度,而不是全程在高分辨率上跑完整 transformer。 auto 批判点评:这篇的架构判断是对的:保真与感知的冲突不是调参问题而是表示问题,让一个网络用一组权重同时承载「不要偏离观测」和「大胆编细节」两个相反的诉求,本身就在制造干扰。拆成基础重建 + 残差合成之后,残差流只需要建模「差什么」,不必反复重学已经解好的整体结构,这个分解在信息论上也更经济。双粒度设计(DiT 管语义、PiT 管像素)与五阶段金字塔蒸馏配合得很自然——把昂贵的注意力放在粗粒度、把逐像素处理放在细粒度,正面回应了「一步方法仍背着高分辨率骨干」这个真实成本问题。双锚点蒸馏同时对齐教师与真值,也比只蒸馏教师更稳。但有几处需要留意。第一,训练与部署链路相当长:4 步图像流 + 4 步残差流的教师,再蒸馏成五阶段一步学生,中间每一环都有超参与对齐损失,复现成本和调试难度都不低,而论文对这条链路的稳定性(比如残差流在基础重建质量波动时是否鲁棒)交代不多。第二,残差流以冻结的基础重建为条件,这意味着基础重建的错误会被完整继承——如果第一阶段把结构判断错了,第二阶段只会把错误结构渲染得更「真实」,这类失效在超分里恰恰是最有害的(把噪点补成清晰的伪细节),论文没有专门分析。第三,评测证据以雷达图与定性对比为主,六个指标归一化后画在一张雷达图上很好看,但归一化会掩盖绝对差距的大小,读者无法判断某个维度上的领先是显著还是微弱。第四,署名信息显示工作在实习期间完成、机构标注较为简略,作为一篇方法论文其可复现材料(代码、权重)是否释出会明显影响这套多阶段管线的实际影响力。 9. GenFirst:先练生成再练重建防塌缩 GenFirst: Generation Before Reconstruction for Stable End-to-End Latent Generative Modeling | 中国科学技术大学 + 字节跳动 Seed | arXiv:2608.29335 关键词:端到端隐空间训练,隐空间塌缩,KL熵项,生成-重建冲突,非对称学习动态,REPA-E,字节跳动Seed 前序问题:隐空间生成模型的标准做法是两阶段:先训一个 VAE 做重建,再在冻结的隐空间上训生成模型。但为重建优化出来的隐空间不一定适合生成——重建只要求信息可恢复,生成还要求分布可采样,两者的最优解未必重合。于是联合训练看起来很有吸引力,可直接端到端训练一直很难做:一是容易发生隐空间塌缩,二是面临生成-重建冲突。已有的折中方案 REPA-E 通过截断生成梯度、并用一个外部的表示对齐损失(DINOv2)来重塑隐空间以避免塌缩,但这么做的代价是生成目标不再直接塑造隐空间——绕开了塌缩,也绕开了「让隐空间为生成服务」这个初衷。作者要回答的是:能不能让生成损失真的作用在编码器上,同时不塌缩? 本文贡献:作者重新分析了不同目标如何塑造隐空间,得到两个关键洞察。第一,KL 散度目标里的熵项是防止塌缩的关键:重建与先验拟合都倾向于收缩后验,而熵项保留了非退化的隐空间不确定性——换句话说,塌缩不是生成梯度本身的错,而是缺了一个撑开后验的力。第二,重建与生成呈现非对称的学习动态:重建快且监督强,在很少的训练步内就能达到不错的图像保真度;生成慢且更难优化,需要长得多的过程才能学出一个可采样的隐分布。基于这两点,他们实现了首次不发生隐空间塌缩的直接端到端训练,并提出 GenFirst——一个简单的「生成先于重建」策略:让生成目标先塑造隐空间,之后再refine重建。论文的对比图把四种范式并置:(a) 传统两阶段用固定的重建优化隐空间,对生成次优;(b) 朴素端到端让生成损失更新编码器但导致塌缩;(c) REPA-E 靠 stop-grad 加外部 REPA 损失避免塌缩,但生成损失不直接塑造隐空间;(d) 本文方法用先验损失塑造隐空间、熵项防止塌缩。作者还做了扩展实验:隐空间级 SigLIP 监督以学习生成与表示共享的隐空间、基于 caption 的 VLM-NLL 监督施加在中间视觉特征上、以及用块因果扩散 transformer 做统一文本-图像建模(连续文本与图像 latent 联合优化,支持双向的文生图与图生文)。 auto 实验效果:收敛加速是最直接的证据:在类条件 ImageNet 生成上报告不带 CFG 的 FID-50K 曲线,在文生图上报告 EiT Version A/B 与 SiT+REPA 基线的 GenEval 与 DPG 分数——两个 EiT 变体都在 80K 步就超过了基线 200K 步的表现,也就是约 2.5 倍的步数效率。非对称动态的可视化清楚显示重建在远少的步数内达到良好图像保真度,而生成需要更长的优化过程才学到可采样的隐分布,这正是「先生成后重建」这个次序的依据。定性上,三种隐空间设定用同一个 MMDiT 与采样配置对比:DPG-Bench 上的文生图与 COCO Karpathy 测试集上的图生文都显示端到端训练的隐空间提升了提示保真度与描述连贯性,其中文本-图像联合隐空间训练的定性结果最强。消融给出了 gFID 与 rFID 的权衡曲线:没有任何固定的先验损失权重能同时兼顾生成与重建,而在重建精修阶段用一个中等先验权重能得到最好的权衡。 auto 批判点评:这篇的分析质量高于它的方法复杂度,而这恰恰是优点。「塌缩的原因是缺了熵项撑开后验」这个诊断把问题从「生成梯度有毒、必须截断」纠正成「少了一个平衡力」,直接否定了 REPA-E 那条绕行路线的必要性——后者为避免塌缩付出的代价是生成损失不再塑造隐空间,等于放弃了端到端的意义。第二个洞察「重建快、生成慢」看起来朴素,但它把训练次序变成一个有依据的设计变量而非试错结果:既然慢的那个更需要主导隐空间的形状,就让它先来。方法本身简单到几乎不增加实现负担,却拿到约 2.5 倍的步数效率,这种「分析驱动的简单解」比堆结构更有价值。消融里「没有任何固定先验权重能兼顾生成与重建」这个结论也很诚实,它说明这不是调参能解决的问题,从而反过来支持了分阶段的必要性。但要注意几点。第一,主要收益是收敛速度而非质量上限:80K 步超过基线 200K 步说的是效率,论文没有强调最终收敛质量拉开了多大差距,把这篇读成「生成质量大幅提升」会误读。第二,FID 曲线是不带 CFG 的,而实际部署几乎都开 CFG,无 CFG 下的 FID 优势能否在开 CFG 后保持,是这类工作常见的落差点。第三,扩展实验(SigLIP 监督、VLM-NLL、块因果统一建模)铺得很开,每一项都只给了「稳定训练」的定性结论,广度换走了深度——尤其统一文本-图像建模是个大命题,用一张扩展图交代略显单薄。第四,实验规模集中在 ImageNet 类条件与中等规模文生图,端到端联合训练在更大数据与更大模型上是否仍然稳定(熵项的权重是否需要随规模重新校准)没有回答,而这决定它能否进入真实的大规模训练流程。 10. RAGDiffusion++:RL救回SFT抹平的高频纹理 RAGDiffusion++: From Macro-Retrieval to Micro-Fidelity Alignment for Garment Generation | 上海交通大学 + 阿里巴巴 | arXiv:2608.29280 关键词:服装资产生成,高频轨迹塌缩,AR-GRPO,Garment-RM奖励模型,artifact hacking,双图像流DiT,上海交通大学 前序问题:标准服装资产生成——把各种真实场景里的衣服还原成正面平铺图——商业价值很大,但同时要求宏观拓扑准确与微观物理保真。作者前作 RAGDiffusion 已经用检索增强的宏观约束消除了大尺度结构幻觉,可工业级的微观纹理真实感仍是未解的瓶颈。他们把这个限制正式命名为 High-Frequency Trajectory Collapse(高频轨迹塌缩):监督微调(SFT)收敛到训练分布的条件均值,而这个分布由平滑的低频纹理主导,于是高频图案(织物纹理、复杂 logo)变得几乎不可采样——不是模型学不会,是它被拉向了均值。而天真地加上强化学习后训练又会引发另一个问题 Artifact Hacking:模型利用通用奖励模型里的语义偏差,生成具有欺骗性的棋盘格噪声来骗高分,看着「细节丰富」实际是伪影。所以真正的难题是双重的:既要让 RL 把采样分布往高频模式上重塑,又要防止它塌向奖励可被利用的伪影解。 本文贡献:作者的核心洞察是 RL 能从根本上重塑流模型的采样分布——在准确的奖励引导下提升高保真轨迹的概率——同时用对抗正则化来约束这个过程不跑偏。方法上提出 AR-GRPO,并配套一个领域专用奖励模型 Garment-RM 来提供细粒度、属性感知的信号,替代通用大模型作为奖励来源。架构侧是 Dual-Image-Stream DiT:通过复制部分去噪图像流及其预训练权重,引入一条专门的条件图像流,让条件信息在与去噪信息同构的通道里流动而不是被挤进 cross-attention。针对 reward hacking,他们对比了 Adv-GRPO 的做法(用对抗损失激进地更新所有奖励模型,导致奖励模型丧失分类能力),改为让判别器先加速早期奖励上升、再把 $R_{GRM}$ 与 $R_{LPIPS}$ 稳定在一个无伪影的均衡点上。 auto 实验效果:最有说服力的是打破 SFT 瓶颈这条曲线:SFT 阶段模型达到性能平台期,延长训练时长或扩大数据都只有递减回报,而引入 AR-GRPO 后 FID 出现急剧下降,瓶颈被突破;配套的视觉对比展示了 SFT 在捕捉高频物理细节(复杂织物纹理、精细图案)上的局限以及 RL 优化带来的显著改善。频域分析给出了机制层面的证据:相比基础 SFT 模型,RL 结果与真实图像之间的频谱差异更小、方向性偏差更弱,径向平均的频谱误差曲线显示 RL 模型在中高频的宽区间上误差更低。奖励模型侧,Garment-RM 在细粒度属性感知上全面超过 GPT-4o 与 Qwen3-VL 这些通用大模型,从而为 RL 阶段提供可靠的属性感知信号;作者还用 Garment-RM 嵌入的 t-SNE 图与人类偏好选择实验验证其有效性。防 hacking 的对照很直接:标准 GRPO 与 Adv-GRPO 都塌缩成棋盘格伪影,而 AR-GRPO 保持输出干净。 auto 批判点评:这篇的诊断做得比方法更好。「High-Frequency Trajectory Collapse」是个准确的命名:SFT 回归条件均值这件事在理论上早就清楚,但把它与「高频纹理变得不可采样」直接挂钩、再用频域误差曲线量化出来,把一个模糊的「SFT 生成发糊」变成了可测量的现象,这比笼统地说「RL 效果更好」有价值得多。更值得肯定的是它没有停在「用 RL 就好了」——而是同时指认了 RL 的失效模式 Artifact Hacking,并且给出了机制解释:通用奖励模型有语义偏差,模型会生成棋盘格噪声去利用它。这种「问题-解法-解法的新问题」的递进是扎实工作的标志。用领域专用的 Garment-RM 替代通用 VLM 做奖励,也是个正确判断:细粒度属性感知上 GPT-4o 这类通用模型确实不可靠,而奖励模型的偏差在 RL 里会被放大而非平均掉。但边界也清楚。第一,这是一个高度垂直的任务——正面平铺服装图有强先验(构图固定、拓扑已知),所以「用检索约束宏观、用 RL 攻微观」这套组合能奏效,它对通用文生图的可迁移性存疑,因为通用场景既没有可检索的模板也没有 Garment-RM 这样能训出来的窄域奖励。第二,Garment-RM 本身成为新的单点依赖:整个 RL 的方向由它决定,而论文验证它的方式是与通用模型比较加 t-SNE 加人类偏好,这证明了它比通用模型好,但没有刻画它自己的盲区在哪——一个有系统偏差的窄域奖励模型,其偏差会被 RL 忠实地放大。第三,对抗正则化引入了判别器与两个奖励项($R_{GRM}$、$R_{LPIPS}$)的三方平衡,论文说它稳定在无伪影均衡点,但这类平衡对超参往往敏感,训练稳定性的证据主要是奖励轨迹图,缺少多次运行的方差。第四,作为前作的延续版本,宏观检索部分的贡献不属于本文,读者需要注意本文的净增量集中在 RL 后训练与奖励设计上。 趋势观察 原生音视频联合生成开始用「先分开、后门控耦合」压小模型尺寸 — 今天最值得读的一篇是阿里 DreamX 团队的 DreamX-Creator 1.0,它给出了一个很务实的判断:音视频联合生成不需要一上来就把两个模态揉在一起。它的 7B 生成器让音频流和视频流在网络前一半完全独立去噪,只在后一半通过 Gated Cross-Modal Attention 耦合,而且门控是 token 级与 head 级的,等于让模型自己决定「哪一帧、哪个注意力头需要听对面模态」。这个设计的意义在于用结构换参数量——在与 33B 的 MiniMax-H3、以及 Wan2.7 / KLing v3 的盲测对比里,7B 的它在视频质量上对 Wan2.7 拿到 45.5% 胜率、对 KLing v3 拿到 48.8%,虽然音频质量仍明显落后(对 MiniMax-H3 只有 23.7% 胜、45.5% 负),但这已经说明「原生联合」不必等大模型。它还配了一条自回归 1 步 2K 精修管线,把高分辨率从训练问题变成后处理问题。同一天的 VIBE 从另一侧呼应:视频配乐不能只靠重建损失,得把 tempo、调性这类可验证约束和「好听」这类主观质量分开做奖励。两条路线的共同判断是,多模态生成的下一步是把模态间的耦合点和奖励信号都设计得更细。 交互世界模型的持久性之争,从「存多少帧」转向「以什么粒度存」 — Matrix-Game 3.5 和 ShellGame 这两篇是今天最像一对的论文,都在追问世界模型能否真的记住世界,但一个给方案、一个下判决。昆仑万维 Skywork 的 Matrix-Game 3.5 把历史记忆的粒度从「整帧」降到「patch」:它把历史 latent patch 按深度和相机位姿反投影进一个持久 3D 空间,目标相机的视锥去查询这个 patch 云,再用 z-buffer 只保留每个位置最靠前的表面,最后散射成一张对齐当前视角的 memory canvas。关键是 patch-memory 与 tiled-PRoPE 两个组件都不引入任何新的可学习参数,所以能直接接在骨干上,单卡 720p 做到 20 FPS 实时。它还把静态场景和动态主体拆开,前者进 patch memory、后者用轻量参考 token,专门治长程 rollout 里的鬼影和身份漂移。而 ShellGame(首尔国立大学 + Roblox)则用一个精心设计的反例给整个方向降温:他们把 $S_5$ 状态追踪问题包装成视频版「猜球在哪个杯子下」,球被盖住后经过 N 次交换再揭晓。结论相当刺眼——双向和自回归 Transformer、Mamba、以及特征值被限制在非负区间的线性注意力,全都只能拟合训练时的 5 次交换,交换链一长就掉到随机水平,但画面依然生成得很像样,加更多去噪步数毫无帮助。根因在于像素扩散目标从来没有监督过那个看不见的隐藏状态,所以状态只能活在架构里而非 token 里。他们找到两个真能外推的机制,共同点是都跨 chunk 携带状态并原地修改:线性注意力一旦允许转移特征值取负就成功,LaCT 则随快速权重头数增加而变好。两篇合起来的信号是:视觉保真度完全不能作为世界模型「懂世界」的证据,得单独设计状态追踪的诊断任务。 推理期干预成为提升生成质量的主战场:不改权重、不重训 — 今天有三篇不约而同地把算力花在推理阶段而非训练阶段,而且都刻意避开了「重训一版」这条路。Off-Manifold Refinement(越南 Fulbright 大学 + UCLA,BMVC 2026)针对视频生成的物理违背问题:物体悬空、轨迹违反重力、接触消失。它的做法是在采样轨迹中段的若干 ODE 步,把冻结的 V-JEPA 2.1 「意外度能量」的梯度加到生成器速度场上,把 latent 推离原轨迹、推向被预测器判为更物理合理的区域,然后让生成器继续渲染。相比要生成并打分多个候选、或反复解码再编码的既有方案,它只在单条轨迹上做一次外部纠正。GEARS(北大 + 阿里,ACM TOG / SIGGRAPH Asia 2026)攻的是 test-time scaling 的浪费:现有方法采样一堆轨迹然后把低分候选直接丢掉,而那些候选里已经编码了可用的运动、布局或外观结构。它在去噪轨迹上插入多个检查点,由 Stage-Aware Scheduler 决定此刻该修什么、哪些候选该留该回收该丢,再由 Candidate Recycler 通过诊断式 latent 编辑把「弱但有希望」的候选修回来,高噪阶段修运动、低噪阶段修细节。NoisEasier(ECCV 2026)则用可微奖励引导优化整条随机轨迹而非只优化初始 latent,在 VBench 与 T2V-CompBench 的属性绑定、物体交互、计数这些难维度上平均提升超过 10%。三篇的共同判断是:与其冒 reward hacking 的风险去微调权重,不如把冻结模型当成可被引导的对象。 扩散加速的新抓手是「内容形状」和「语义复用」,不再是均匀砍 token — RTI(维尔茨堡大学 + Google)和 RegionCache(东北大学,IJCAI 2026)代表了扩散加速的两个新角度,都放弃了「均匀降采样」这个默认动作。RTI 处理的是像素空间扩散的结构性浪费:自然图像的细节只集中在画面一小部分,但模型在每一层、每个时间步都给每个 patch 分配一个完整 token,而像素空间模型没有 autoencoder 先吸收低层冗余,浪费最大。它探测到中间块的 token 在图像平坦处冗余,且冗余占据的是连通的、随内容成形的区域——于是需要形状同样随内容变化的 token。解法很巧:沿 Hilbert 曲线给 patch 排序,因为相邻位置在图像上永远是邻居,任意连续段就是一个连通区域,二维分组变成一维切割。切在特征变化最大处,每段池化成一个 region token,微调时随机抽取 region 数量,所以一个 checkpoint 服务所有预算。相比之下相似度合并会打散分组、隐空间瓶颈丢掉位置、直接跳过则是把该总结的东西删掉。RegionCache 针对的是多轮编辑场景:用户往往只改一小块,但 DiT 管线每轮都重算整张图。它用连续 prompt 之间的语义重叠加 cross-attention 定位找出可复用区域,按 prompt 相似度自适应决定复用力度,在 PixArt-alpha 上端到端加速 1.43–2.55 倍。两篇都在说同一件事:加速的抓手应该来自内容和语义的结构,而不是对 token 一刀切。 人工智能炼丹君 整理 | 2026-09-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-01|西湖大学让写代码的智能体当世界大脑CWM 今日 AIGC 论文速览 今日共 10 篇 · 世界模型与可执行状态 2 篇 · 长视频生成的记忆与一致性 2 篇 · 注意力与推理加速 1 篇 · 视频生成模型作为几何/物理先验 2 篇 · 生成式模型的规模律 1 篇 · 可控生成与工业落地 2 篇 重点论文标题列表 Code World Model(西湖大学 AGI Lab + 南洋理工大学):让写代码的智能体当世界大脑 LayerRecall(浙江大学 + 香港大学):只往记忆敏感层注入历史K/V SWA vs Linear Attention(Microsoft Applied Sciences Group):免训练滑窗高线性注意力2-10倍 DensityKV(Manifold AI + 清华大学):免训练把120秒历史压到3.28GiB CLAP(普林斯顿大学):人类视频也能训机器人世界模型 今日论文速览 1. Code World Model:让写代码的智能体当世界大脑 Code World Model: Coding Agent as World Brain | 西湖大学 AGI Lab + 南洋理工大学 | arXiv:2608.25927 关键词:世界模型,coding agent,可执行世界状态,proxy 视频,MiniMax-H3,时空约束,西湖大学,南洋理工 前序问题:现在的视频世界模型基本都是从视觉观测里学动力学,这条路有个结构性的短板:视频只呈现「发生了什么结果」,并不承载「为什么会这样、规则是什么」。于是模型学到的是像素层面的统计关联,而不是支配世界演化的知识与机制。后果很具体——持久性守不住。玩家砸碎的花瓶在几十帧之后可能自己复原,捡走的道具会重新出现在原地,因为「这个物体已经不存在了」这件事从来没有被显式记录,只是被寄望于模型的隐式记忆能扛住。开放式演化更是无从谈起:一个只会预测下一帧的模型没有可查询、可修改的世界状态,你无法问它「现在背包里有几把剑」,也无法让它在规则层面上一致地长期跑下去。真正缺的东西是一个显式、持久、可按规则更新的状态表示,而这恰好是视频模型这种表示形式最不擅长承载的。 本文贡献:Code World Model 的做法是把「世界如何演化」和「世界长什么样」彻底分开。前者交给语言模型的推理与编码能力:一个 coding agent 充当 world brain,接收交互意图,推理事件及其后果,然后写出可执行代码去更新一份持久的世界状态,从而保证演化是符合规则的、后果是留得住的。后者交给视频模型的生成先验。两者之间的桥梁是作者提出的 proxy representation——把世界状态编译成一段编码了逐帧时空约束的 proxy 视频(画面里是分割色块与骨架这类粗糙几何),再用它去条件化视频模型渲染出高保真观测。为此作者还建了数据管线,从游戏录像和真实视频里构造对齐的 proxy–observation 配对数据。实验用 MiniMax-H3 作为视频骨干在配对的 gameplay 数据上微调,结果它能跟随 coding agent 搭出的简单交互世界所给定的 proxy 时空规格,同时保留丰富的视觉细节与动态。 auto 实验效果:作者展示的核心结果是这套「代码管状态、视频管画面」的组合确实能跑通:微调后的 MiniMax-H3 遵循 proxy 指定的时空结构,把粗糙的色块骨架渲染成细节丰富的画面。视觉质量部分最值得注意的是数据效率——仅用五小时 GTA V 游戏录像做微调,模型就在角色、环境、运动方式和相机轨迹都不同的场景上表现出泛化能力,论文的 case 图里既有真人角色也有二次元角色(美少女战士造型),说明外观由文本与视频先验控制、运动由 proxy 控制这个分工是成立的。此外作者也在真实视频上构造了 proxy–observation 配对,说明这套表示不只适用于游戏。整体上论文的定位是可行性验证与范式提出,而不是刷榜。 auto 批判点评:这篇最有价值的地方是把「持久性」这个问题从模型能力问题重新定义成了系统架构问题。既然规则和状态本来就适合用代码表达,那硬要视频模型在隐空间里隐式维护它,本身就是拿错了工具;让 coding agent 写代码维护状态、视频模型只做渲染,是一个分工干净且可验证的设计——世界状态可以被打印、被断言、被单元测试,这在纯生成式世界模型里是做不到的。proxy 视频作为界面也选得务实:它同时携带几何与时序约束,又足够粗糙以至于生成模型有充分自由度补细节。但局限相当明显。第一,整套系统的天花板被 coding agent 顶住了——世界的规则得先被语言模型正确地推理并写成代码,稍微复杂的物理(流体、形变、多体接触)根本不是几行代码能覆盖的,论文验证的也确实是「simple interactive worlds」。第二,proxy 到观测这一步是有信息瓶颈的:proxy 只编码了粗粒度时空约束,那些不在 proxy 里的物理细节(材质变化、光影随事件的响应)就只能由视频模型自由发挥,未必与代码里的状态一致,这等于在系统中留了一道「状态与画面可能对不上」的缝。第三,实验缺少对照——没有和强视频世界模型在同一任务上比长程一致性,也没有量化「持久性」这个自己主打的卖点,比如「事件发生 N 秒后后果是否仍被正确渲染」这样的指标,读者只能从 case 里目测。 2. LayerRecall:只往记忆敏感层注入历史K/V LayerRecall: A State-Conditioned Memory Router for Long-Horizon Consistency in Video Generation | 浙江大学 + 香港大学 | arXiv:2608.28460 关键词:长视频生成,记忆路由,分层注意力,K/V 检索,多镜头一致性,MemoBench,浙江大学,香港大学 前序问题:自回归视频扩散靠一个有界的近期上下文逐块生成,这让长视频在算力上变得可行,但也埋了一个必然的漏洞:基于时间邻近的缓存策略会把「暂时用不到」的历史逐出,而一旦某个主体、物体、场景或属性在几十秒后重新出现,需要的线索恰恰是刚被逐出的那部分。已有的记忆机制思路是给模型开一个通往非局部历史的通道,但作者指出一个关键区别——「能访问」不等于「会用」。他们的分析发现 video DiT 的各层对当前块、近期上下文与远期历史的偏好差异明显,也就是说层与层之间在记忆这件事上分工不同。这意味着长程记忆其实是两个耦合的决策:检索什么,以及在哪里用它。把历史无差别地灌进所有层,既浪费又可能干扰那些本该专注局部连续性的层。另一个现实约束是数据:高质量的长时程视频稀缺,显式的「记忆分配」标注更是根本不存在。 本文贡献:LayerRecall 是一个以当前状态为条件、按层选择的记忆路由器。它维护按层索引的记忆库存放有限的历史 K/V 候选,用当前块的隐状态算出一个查询(图中给出的形式是全局查询加上一个由 gate 与 MLP 调制的层相关增量 Δq),再用余弦相似度对各历史片段打分,决定检索哪些。关键的第二步是注入位置:检索到的状态只被送进事先剖析出的「记忆敏感层」,其余层完整保留原有的 sink、滑动窗口与当前块注意力上下文,因此局部连续性不受影响,额外开销也很小。为了摆脱对稀缺长视频和记忆分配标注的依赖,作者提出 Cross-Horizon Prediction Matching(CHPM),用短时程可得的监督信号来训练这个在预测空间工作的有界记忆路由器,绕开了显式标注。 auto 实验效果:在 100 条多镜头评测提示上,LayerRecall 在 MemoBench 与 MovieBench 上取得最好的整体结果,同时在 VBench-Long 上与其骨干持平——这个组合是它主张的核心证据:增强了长程恢复能力,但没有牺牲局部连续性。定性分析里作者展示了一个叫「记忆引导的自我纠正」的现象:三镜头序列中主体在第一镜头穿纯蓝内搭,第二镜头离场,第三镜头重新出现时最初带了错误的花纹,随后 LayerRecall 把早先的纯蓝外观召回,同时保住了人物身份、灰色开衫、正在进行的动作与场景结构,也就是说属性恢复是局部发生的,没有触发整体画面的重置。作者另外给了跨骨干可移植性与推理开销可忽略的分析,但明确把这一点表述为「在所测模型上的可移植性」而非普适的零样本适用性。 auto 批判点评:「层各有偏好,所以记忆要选层注入」是个漂亮且可验证的观察,也是这篇比一般「加个记忆库」工作高明的地方——它把注入位置当成与检索内容同等重要的决策变量,而选择性注入自然带来了低开销和不破坏局部注意力这两个副产品,工程上很讨喜。CHPM 用跨时程预测匹配替代不存在的记忆分配标注,也是务实的解法。需要保留的疑问有几点。首先,记忆敏感层是「剖析」出来的,这就引入了一个骨干相关的先验步骤,论文也诚实地把跨骨干结论限定在所测模型内;那么换一个架构差异较大的骨干时,这套剖析要重做多少、成本多高,是决定它能否成为通用组件的关键,文中讨论不足。其次,VBench-Long 只是持平,说明当前收益集中在「重现一致性」这个特定维度,对整体视频质量并无提升,这个边界读者应当清楚。第三,自我纠正那个案例虽然很有说服力,但它同时暴露一个隐忧:模型是在出错之后才召回正确属性的,也就是说错误已经被生成出来并停留了若干帧,路由器扮演的是事后修正而非事前预防;对需要严格连续性的应用,这种「先错后改」的行为模式本身就是一种瑕疵,论文没有量化它出现的频率与持续时长。 3. SWA vs Linear Attention:免训练滑窗高线性注意力2-10倍 Sliding-window beats linear attention | Microsoft Applied Sciences Group | arXiv:2608.28444 关键词:线性注意力,滑动窗口注意力,attention sink,KV cache,长上下文,推理加速,基线对比,微软 前序问题:二次复杂度注意力让大模型在内存和能耗上都不可持续:每个新 token 的代价都比前一个大,因为它的 key 和 value 必须被无限期地存在显存里。为了解决这个问题,一条备受关注的路线是把已经训好的模型改造成线性注意力(retrofitting),承诺以很低的成本换来常数级的状态开销和接近原始水平的性能,相关工作这几年数量可观。作者的批评切中要害:这条线一直没有和足够简单的基线做过认真对比。滑动窗口注意力(SWA)就是那个被跳过的对照组——它同样把每步的注意力开销限死在窗口大小内,同样让 KV 占用与序列长度解耦,但它不需要任何改造训练,是一行配置就能开启的方案。当一个研究方向连年在自己的评测里进步,却从未被最朴素的替代方案挑战过,那么这些进步究竟来自方法本身还是来自评测协议的选择,就成了一个必须回答的问题。 本文贡献:这篇不提新方法,而是补上那场缺失的对照实验:把带 attention sink 的 SWA 与经过 post-training 的线性注意力模型,在多个不同的 LLM 与多类下游任务上做系统比较。论文用一张注意力掩码对照图把三种方案的机制差异讲清楚:完整注意力是满的下三角;LoLCATs / Liger-GLA 这类混合方案在近处用 softmax、远处叠加线性注意力,覆盖整个下三角;带 sink 的 SWA 则只保留最左侧的 sink 列与主对角线附近的窗口带,其余位置直接留空。除了任务效果,作者还量化了解码吞吐与状态内存随上下文长度(128 到 256K)的变化曲线,把「快多少、省多少」和「准多少」放在同一张桌子上比较。最后给出的是一条明确的部署建议,而不是一个新架构。 auto 实验效果:结论是带 sink 的 SWA 在多个 LLM、多类下游任务上表现与 post-trained 线性注意力持平或更好;而在长上下文推理任务上差距被拉开——Needle-in-a-Haystack 与 BABILong 上 SWA 的表现是线性注意力的 2 到 10 倍。效率侧的曲线同样一边倒:完整注意力的解码吞吐从 128 上下文起就随长度持续下滑,到 256K 时降了一个多数量级,KV 占用则近乎线性地涨到 10³ MiB 量级;SWA(窗口 64 与 512)与线性方案的吞吐则在全区间基本是平的,内存占用保持在个位数 MiB 的常数水平,其中 SWA=64 的吞吐是所有方案中最高的。作者据此给出的建议相当直白:要降低推理内存成本,应该直接切到 SWA,而不是去 post-train 线性模型;线性注意力若要追上 SWA,恐怕得从头训练或投入远更大规模的 post-training。 auto 批判点评:这篇的价值不在技术新意而在方法论卫生:它用一个被长期忽略的朴素基线,检验了一个热门方向的实际收益,并且检验方式是公平的——同时报吞吐、内存与任务效果,而不是只挑有利维度。长上下文推理上 2 到 10 倍的差距尤其值得警惕,因为它指向一个具体的机制解释:线性注意力把历史压成固定大小的状态,本质上是有损压缩,需要精确回忆某个远处细节的任务(大海捞针正是如此)最容易暴露这种损失;而 SWA 虽然看不到远处,但它对窗口内的信息是无损的,配上 sink 又能保住那个对稳定性至关重要的锚点。不过这个结论的适用边界必须说清楚。首先它比较的对象是「post-trained」线性模型,作者自己也承认从头训练的线性注意力可能是另一回事,因此不能被读成「线性注意力这条路错了」。其次,SWA 的强项恰好是它的弱点的另一面:它在窗口外真的什么都看不到,那些需要跨越超长距离做全局聚合(而非精确检索)的任务,理论上应该更利于线性注意力,论文若能补上这类任务的反例会更完整。第三,attention sink 这个关键组件的贡献没有被单独拆开——SWA 好在哪里,有多少来自窗口本身、多少来自 sink,读者无法从现有结果中分离。 4. DensityKV:免训练把120秒历史压到3.28GiB DensityKV: Density-Guided KV Cache Compression for Long Video Generation | Manifold AI + 清华大学 | arXiv:2608.27922 关键词:长视频生成,KV cache 压缩,免训练,Soft-Riesz 密度,post-RoPE key,滑动窗口注意力,Manifold AI,清华大学 前序问题:自回归视频扩散用滑动窗口注意力实现流式生成,但每个新块都以之前生成的内容为条件,于是外观和运动上的误差会沿着 rollout 递归地传播放大。保留历史 K/V 记忆可以留住早先的主体与场景状态,对长时程一致性有实质帮助,但直接全存下来会带来两个问题。一是存储随 rollout 无限增长——生成得越久,这份历史档案就越大,没有上界;二是这些状态之间存在大量冗余:视频里的循环性内容(同一个人反复出现、同一片背景反复入画)会让相似的 key 一遍又一遍地被写进记忆,重复覆盖同一片区域,占了空间却没有带来新信息。已有的检索式方案(如 LongLive-RAG)保留全部被逐出的历史再按需检索,一致性是换来了,但存储代价随时长线性上升,这在实际部署里很快就不可接受。 本文贡献:DensityKV 是一个免训练的历史 K/V 库管理策略,核心思想是用「局部冗余度」来决定一个新状态该不该被收进记忆。它为每个注意力头维护独立的 token 级 K/V 库,并且只在 post-RoPE 的 key 上度量冗余——理由很具体:直接参与注意力路由计算的正是这些 post-RoPE key,冗余应当在真正影响路由的那个空间里衡量。度量方式是 Soft-Riesz 密度:候选 key 落在已有 key 的高密度邻域里就说明信息重复,予以拒收;落在稀疏区域则接纳。通过约束状态进入库之后的邻域密度增长,DensityKV 限制了历史的重复累积,同时保留那些真正携带不同状态的片段,且每个 value 与其 key 严格配对。在生成时,这个有界的压缩历史与本地滑动窗口一起被当前帧注意,不需要任何训练或改结构。 auto 实验效果:存储侧的对比最直观:随生成长度增加,检索式的 LongLive-RAG 的持久时序状态是线性增长的,30 秒 32.1 GiB、60 秒 64.3 GiB、120 秒 128.5 GiB;而 DensityKV 与 Deep Forcing 保持有界,120 秒时分别只有 3.28 GiB 和 3.76 GiB——DensityKV 是三者中最低的,且与 rollout 长度无关。质量侧,作者在三个自回归视频生成骨干与多个生成长度上做了评估,结论是在相同的历史 KV 容量上限下,DensityKV 提升了长时程一致性与生成稳定性,同时持久历史存储不随 rollout 增长。作者还在与 LongLive-RAG 对齐的评测协议下报告了 30/60/120 秒的单指标胜率统计,以及 120 秒长度上两组骨干–提示配对的定性对比。 auto 批判点评:把冗余度量放在 post-RoPE key 上是这篇最见功力的一个细节——很多 KV 压缩工作在 pre-RoPE 表示或 value 空间上做相似度判断,但真正决定「这个历史 token 会不会被注意到」的是加了位置编码之后的 key,度量空间和作用空间对齐了,判据才有意义。免训练、每头独立建库这两点也让它作为即插即用组件的门槛很低。可质疑之处主要在评估口径。第一,主要卖点是「有界存储 + 一致性更好」,但 Deep Forcing 同样有界(3.76 vs 3.28 GiB),两者差距其实很小,所以真正的胜负要看质量维度,而质量对比是在「相同容量上限」这个受控前提下给出的相对改善,加上以单指标胜率的形式汇报,读者很难判断绝对差距有多大——胜率高不代表差距显著。第二,密度判据本身是个启发式:Soft-Riesz 密度衡量的是表示空间里的几何拥挤程度,而「表示相近」并不严格等价于「语义冗余」,一个在视觉上关键但恰好落在密集区的状态会被误拒,论文没有分析这种误拒的代价。第三,方法针对的是「循环性内容造成的重复覆盖」,那么在场景持续大幅变化、几乎没有重复的视频上,密度筛选可用的压缩空间理应很小,此时它退化成什么行为、还有多少收益,文中缺少这类不利场景的讨论。 5. CLAP:人类视频也能训机器人世界模型 CLAP: Cross-Embodiment Video World Models are Zero-Shot Physical Simulators | 普林斯顿大学 | arXiv:2608.27406 关键词:跨本体,动作条件视频生成,世界模型,latent action,末端执行器位姿,零样本部署,DROID,普林斯顿 前序问题:当前最好的动作条件视频模型基本都被绑在单一机器人本体上,这让它们无法利用互联网上海量的异构视频——那些视频里其实包含了学习可泛化物理规律所需的丰富信号,只是拍摄主体从某型机械臂换成了人手或别的机器人。跨本体学习之所以难,症结在动作表示:不同机器人平台的动作空间差异极大(自由度不同、坐标系不同、抓取方式不同),而人类视频里根本就没有动作标注这回事。于是研究者面临一个两难,要么放弃海量人类视频只用带标注的机器人数据,要么用一个高度抽象的统一表示但丢掉精度。作者的出发点是一个物理上的判断:支配时空动力学的普适物理规律并不关心执行者是谁,所以跨本体的数据本应是可以共用的,缺的只是把异构动作对齐起来的机制。 本文贡献:CLAP 是一个跨本体动作条件视频生成框架,能在人类与机器人混合的互联网规模视频上训练。它先用三种表示来调和不同的动作空间:末端执行器位姿(精度高但需要标注与统一坐标系)、语言指令(对基础模型而言域间差异最小但精度差)、以及 latent action(可从无标注视频里自监督学到)。为了绕开每种表示各自的短板,作者设计了基于课程的跨本体学习配方:第一阶段用 latent action 在大量无标注视频上学基础物理先验,第二阶段再把这些先验落地到末端执行器动作空间,从而支持零样本部署到真实任务。作者把 latent action、课程版、末端执行器版分别做成了模型变体,并开源了全部代码与模型。 auto 实验效果:在 DROID 这类有挑战性的环境里,CLAP 接近或超过了当前最好的单本体视频模型;在 Bridge 这类较简单的域上只有轻微的保真度下降。在混合了多种本体的 OXE-Mix 数据上,latent action 版与课程版取得最高的预测精度,末端执行器版紧随其后。作者强调这些优势会通过少样本适配进一步复合放大——用 CLAP 作骨干微调后,在 G1 人形机器人上实现了高精度的动力学预测;论文也展示了对双臂 YAM 机器人的少样本适配。最终交付的是作者称为迄今最全面的一套动作条件视频世界模型,覆盖三种动作条件空间(末端执行器、语言、latent)与多种机器人形态,包括跨本体、DROID、Bridge、双臂 YAM 与 G1 人形。作者在附录中还主动澄清了几点:CLAP 并非普遍优于单本体模型,偶尔会不如为单一本体定制的模型;也没有哪一种动作表示能普遍胜出。 auto 批判点评:把跨本体的核心难点定位为「动作表示对齐」而不是「模型容量不够」,并且用三种表示各取所长、再用课程把它们串起来,这个设计是有物理直觉支撑的:先在无标注数据上用 latent action 学通用动力学,再用末端执行器位姿把抽象先验锚定到可执行的动作空间,顺序符合「先学规律后学接口」的逻辑。附录里主动写明「不普遍优于单本体模型」「没有单一最优表示」这类结论,在当下的论文风气里是值得肯定的诚实。但仍有值得追问的地方。第一,末端执行器位姿虽然比关节角通用,仍然是个偏「机械臂中心」的表示,用它去描述人手的复杂操作(多指协同、手内调整)必然是降维的,那么第二阶段的落地过程中,第一阶段从人类视频学到的精细动力学有多少能真正被继承下来,论文没有拆解。第二,主要指标是视频预测精度,而世界模型的最终价值在于能否支撑决策——预测得像不代表推演得对,如果没有下游策略学习或规划任务上的对照,「zero-shot physical simulator」这个说法是超出证据范围的。第三,Bridge 上的保真度下降虽然被描述为轻微,但它暴露的是跨本体学习的固有代价:容量被分摊到多个域,简单域上不如专用模型,这个 trade-off 在什么规模下会翻转,值得给出定量的规模分析。 6. Manifold4D:几何信息注入初始噪声而非条件 Manifold4D: Denoising on Point Cloud Rendered Manifolds for Video Re-shooting | 浙江大学 + Manifold Tech + 上海科技大学 + 剑桥大学 | arXiv:2608.28174 关键词:视频重拍,相机轨迹控制,flow matching,噪声流形,点云渲染,4D 重建,浙江大学,剑桥大学 前序问题:视频重拍要做的事是:给一段单目视频和一条用户指定的相机轨迹,把这段动态场景沿新轨迹重新渲染出来。主流做法是把目标几何显式地喂给网络——用逐帧深度把源视频抬升成 4D 点云,再沿目标轨迹光栅化成一张点云渲染图。问题出在这张渲染图和源视频被同时当作视觉条件送进网络:它们在每一个去噪步骤上互相竞争,模型被迫面对一个「信任困境」——该信渲染图几分?渲染图携带正确的目标视角几何但通常稀疏、有空洞、动态主体容易糊;源视频有完整的外观与运动但视角是错的。训练分布内还能靠数据学出一个折中,一旦遇到分布外的数据,这个折中就会失衡,表现为要么轨迹控制不准(太信源视频),要么画质崩坏(太信渲染图)。 本文贡献:作者的主张很干脆:一张已经与目标视角像素对齐的渲染图,压根不需要作为显式的条件流被送进网络。Manifold4D 把渲染图直接注入 flow matching 的初始噪声——生成不再从标准高斯噪声出发,而是从一个携带几何信息的新噪声流形出发,源视频因此成为唯一的视觉条件。这样一来渲染图恰好被使用一次,网络也从来不需要学习「怎么读懂这张渲染图」;在后续的每个去噪步骤里,模型可以专心处理源视频。具体流程是:由单目视频重建 4D 点云并沿目标轨迹渲染,渲染结果的 VAE latent 被注入噪声并 patchify 成 token,源视频同样编码成 token,两者在帧维度拼接后连同编码后的相机轨迹一起送入 DiT 去噪。作者还构建了 DAVIS-Traj 基准用于评测。 auto 实验效果:在自建的 DAVIS-Traj 基准和 Vista4D 评测集上,Manifold4D 在所有相机控制指标上都取得最好成绩:旋转误差分别降低 25% 和 27%,平移误差最多降低 32%,同时在视频保真度上与最强基线持平,并在真实场景的新视角光度质量上领先。用户研究显示它在轨迹跟随与动态一致性上有明显优势。两个补充实验支撑了它的核心主张:一是当偏航幅度超出训练范围时,它与基线的差距进一步拉大,说明这种几何注入方式的外推性更好;二是当刻意破坏渲染图(去掉运动掩码,让所有帧的动态点堆叠在一起把主体糊掉)时,模型仍能从源视频里恢复出正确的运动——这证明几何先验起的是引导作用,而不是压制生成。 auto 批判点评:这篇的核心洞察相当漂亮,而且是那种一旦说出来就显得理所当然的洞察:条件流的作用是给网络提供「需要被理解和转换」的信息,而一张已经和目标视角像素对齐的渲染图不需要被理解,它需要的只是被作为起点。把它挪到初始噪声里,等于把一个「网络得学着去信任多少」的软决策,换成了一个「先天就在那里」的硬约束,信任困境就此消失。两个验证实验也设计得很到位——外推区间差距拉大证明了几何先验的泛化性,故意破坏渲染图仍能恢复运动则证明了它没有过度依赖先验,一正一反把「引导而非覆盖」这个说法钉住了。需要注意的边界是:整套方法建立在「渲染图与目标视角像素对齐」这个前提上,而这个对齐完全依赖前置的深度估计与 4D 重建质量;深度出系统性错误时,错误会被直接编码进初始噪声,而此时网络甚至没有一个条件通道可以用来纠偏——鲁棒性实验破坏的是动态主体的清晰度(糊),并没有测试深度尺度或结构性错误这类更致命的失效。其次,视频保真度只是与最强基线持平,收益集中在相机控制精度上,读者不应把它理解为画质也更好。第三,DAVIS-Traj 是作者自建的基准,虽然同时在 Vista4D 上做了验证,但主基准自建这件事在轨迹幅度分布的选择上天然存在有利于自己方法的空间。 7. GeoNeXt:深度法向重写成下一帧预测 Video Generative Models as Geometry Learner | 萨里大学 + 帝国理工学院 | arXiv:2608.28549 关键词:单目深度估计,表面法向,视频扩散,几何先验,数据高效,零样本,ECCV,萨里大学 前序问题:用生成模型做几何估计现在有两条常见路径,各有各的浪费。第一条是拿现成的图像扩散模型分别为深度和法向训练任务专属模型,每个几何目标一个模型,这样做丢掉了一件本该利用的事——深度和法向在几何上是强相关的(法向可以由深度的梯度导出),分开训练等于放弃了联合建模的机会。第二条是改造图像扩散骨干(比如动自注意力结构)做联合微调,这条路能共享表示,但代价是通常需要大量标注数据,而带真值几何标注的数据本身就贵。作者认为这两条路的共同局限来自骨干选错了:图像扩散模型的先验是单帧的,而几何估计本质上需要跨视角、跨帧的结构化理解,这恰好是视频生成模型在预训练中天然获得的东西。 本文贡献:GeoNeXt 把预训练视频生成模型重新用作几何估计的统一且数据高效的框架,关键在于把任务创新性地表述成「下一帧预测」:图像和几何目标被放在同一个时间序列的不同槽位上,于是「从图像推几何」和「从几何推图像」都变成视频模型最擅长的那件事——预测序列的下一段。具体实现上,从预训练的 Stable Video Diffusion 出发,用冻结的 Stable Diffusion VAE 把 RGB 图像、深度、表面法向分别编码进隐空间;加噪时把图像 latent 复制到深度与法向这两个几何槽位,并通过拼接几何 latent 做进一步条件化;只微调 GeoNeXt U-Net(跳过 cross-attention),训练目标是图像、深度、法向三项重建损失之和。这样模型既继承了视频模型天然结构化的知识与更丰富的先验,又能联合建模图像与几何两个方向。 auto 实验效果:在多个数据集上的零样本单目深度与表面法向估计实验中,GeoNeXt 同时超过了此前的任务专属生成方法和统一生成方法,而且用的训练数据显著更少。更值得注意的是它与判别式方法的对比:论文称其性能可与那些多用了 100 倍以上数据训练的判别式 SOTA 方法相媲美,在若干基准上甚至更为突出。定性结果方面,作者展示的跨数据集深度对比显示 GeoNeXt 对精细结构的重建更好,法向对比则显示它产生的法向更准确、细节更多,能有效捕捉细小几何结构与表面朝向。整体上论文的卖点是数据效率——同等或更好的效果,训练数据少一到两个数量级。 auto 批判点评:「几何估计其实是个序列预测问题」这个重构是这篇的核心贡献,也是它数据效率高的原因所在——它没有让模型从头学几何,而是把几何塞进了模型已经很擅长的那个任务形式里,于是预训练里积累的时空结构先验可以直接复用。把图像 latent 复制到几何槽位这个细节也很聪明:它给了模型一个「几何应当与图像空间对齐」的强初始化,而不是让它从噪声里猜。真正的局限在于代价与定位。第一,视频扩散骨干比图像扩散骨干重得多,推理成本必然更高,而深度估计在实际应用里往往是实时或近实时的需求,论文若不给出与判别式方法的推理开销对比,「相媲美」这个结论在部署视角下是不完整的——用 100 倍少的数据换 N 倍的推理时间,是否划算取决于场景。第二,与判别式 SOTA 的关系被表述为「rivals」并在部分基准领先,这意味着并未全面超越,读者应把这篇的价值定位在数据效率而非绝对精度。第三,深度与法向的联合建模被当作卖点,但论文(从摘要层面)没有量化这种联合到底贡献了多少——如果单独训练两个 GeoNeXt 也能达到接近的效果,那「利用几何目标内在相关性」这个动机就削弱了,一个联合 vs 分离的消融是必要的。 8. ATA:单张参考图学出可加减属性向量 Attribute Token Arithmetic: Disentangled and Continuous Semantic Control for Visual Autoregressive Models | 莫纳什大学 | arXiv:2608.28082 关键词:视觉自回归,属性解耦,连续语义控制,向量算术,VAR,单图学习,免重训,莫纳什大学 前序问题:自回归文生图最近进展很快,用一个统一的生成框架就能做出高保真图像,但细粒度语义控制一直不好做,原因有两个:属性之间是纠缠的,以及文本表示和细粒度视觉表示之间存在错位。具体表现是你想让猫「胖一点」,改了提示词之后猫可能连品种和身份都变了;你想控制「胖」的程度,语言又给不出连续的刻度——「a fat cat」和「a very fat cat」之间没有可靠的插值。已有的自回归编辑方法要么需要重训模型或大规模监督,要么只能做离散的、整体性的替换,不能做「把这一个属性沿一条轴连续推一点」这种操作,更做不到把多个属性各自独立地叠加上去。 本文贡献:ATA 的灵感来自词嵌入里那个经典的向量算术性质:既然语义在嵌入空间里可以加减,那视觉属性也许可以。方法在预训练自回归模型的隐空间里直接找出对应视觉属性(论文举的例子是变老、变胖、情绪)的语义方向,而且这些方向只需从单张参考图学得,不需要重训模型也不需要大规模监督。做法上,给定一张参考图和一对语义只差一个属性的提示词(比如「A fat cat on the ground」与「A cat on the ground」),ATA 学出两个语义方向,并通过一个 Delta-Mod 模块把学到的方向加到 cross-attention 里对应的 VAR 对齐文本 token 上——关键是加到属性 token(「fat」)而不是身份 token(「cat」)上。生成时属性就可以通过与其他属性 token 的简单算术运算被连续调节与组合式叠加。 auto 实验效果:实验显示 ATA 实现了保持身份的、细粒度的、多属性同时调节的编辑效果,在可控性、通用性和计算效率三方面都优于已有的自回归编辑基线。作者展示的能力包括:连续调节单个属性强度并可将两个属性依次增强;跨类别的属性迁移——把「苹果形状」这个属性施加到「蛋糕」上时,ATA 是让蛋糕逐渐变成苹果形状的蛋糕,而基线方法直接把蛋糕变成了苹果,把原本定义在斯芬克斯猫上的「Sphynx」属性迁移到羊身上也能得到渐变的无毛效果;身份与属性的组合性——从三张参考图提取身份方向后与眼镜、帽子、项链、雾等属性方向自由重组,身份保持不变。消融实验支撑了「加到属性 token」这个设计:把方向优化到身份 token「cat」上会改变主体身份,加到与属性无关的 token「ground」上则完全不产生变胖效果。 auto 批判点评:这篇最有说服力的部分是那个消融:把方向加到「cat」会改身份、加到「ground」什么也不发生、只有加到「fat」才既变胖又保身份——这三条对照直接证明了语义方向的作用位置是可定位、可解释的,而不是碰巧调出来的效果。跨类别迁移那组结果也很能说明解耦的质量:基线把蛋糕变成苹果,ATA 变成苹果形状的蛋糕,前者是把属性当成了类别替换,后者才是真正把「形状」这一维从「是什么东西」里剥离出来。单张参考图、免重训这两点也让实用门槛很低。局限主要在适用范围。第一,方法绑定在视觉自回归(VAR)这一类模型的「VAR 对齐文本 token + cross-attention」结构上,是否能迁移到扩散类主流模型并不显然,而当前工业界的图像编辑主力仍是扩散模型,这限制了影响面。第二,整套机制依赖「提示词对里的差异恰好对应一个可分离的视觉属性」,那些语言上难以用单个 token 差异表达的属性(复杂光照、特定构图、多物体空间关系)恐怕找不到干净的方向,论文自己也保留了一张 limitations 图。第三,对比对象限定在自回归编辑基线,没有与更强的扩散类编辑方法同台,「优于已有方法」的适用范围应当按这个口径理解。 9. VATIX:9B驾驶视频模型的规模律实测 How Far Can 5,500 Hours of Driving Take You? A Scaling Law Analysis of Video Diffusion Models | valeo.ai + 索邦大学 | arXiv:2608.28404 关键词:规模律,视频扩散,自动驾驶,固定数据集,训练预算分配,nuScenes,开源SOTA,valeo.ai 前序问题:自动驾驶的视频生成走不通网络规模那条路:驾驶数据采集昂贵、受隐私法规约束、也不能随便抓取,所以模型必须在一个固定语料上把价值榨干。这就使得「算力该怎么花」变成一个真问题而不是学术趣味——同样的预算,是拿去把模型做大,还是拿去训得更久?还需不需要再采数据?在网络规模数据的语境下这些问题往往被「加数据就好」掩盖过去,但在固定语料的约束下必须正面回答。此前领域内缺少针对驾驶视频扩散模型、从零训练、覆盖足够宽参数区间的系统规模律研究,从业者只能凭直觉分配预算。 本文贡献:作者做了一次系统的规模律研究:从零训练一族参数量从 1M 到 9B 的视频扩散模型,在最多 5,500 小时的驾驶数据上按不同曝光量训练,观察验证损失如何随模型规模与训练曝光变化。模型架构是标准的 flow matching 视频 DiT:视频 latent 由 Wan encoder 编码后加噪,经 N 个 transformer 块处理,每块含空间注意力、时间注意力与 MLP,全部由 AdaLN 调制;时间步 t 与自车轨迹的 25 个 BEV waypoint 分别用正弦特征嵌入并各过一个 MLP,相加后切成 scale 与 shift 两份用于调制,输出是速度(v-prediction)。也就是说轨迹条件是通过调制通路而非 cross-attention 注入的。作者开源了代码与预训练模型,底层驾驶数据由 NATIX 分阶段单独发布。 auto 实验效果:验证损失在模型规模与训练曝光两个维度上都呈现一致的幂律。最实用的一条结论是两者的敏感度不对称:损失随训练曝光下降得远比随模型规模下降得快,因此在算力受限时,把预算投给更长的训练是提升一个固定模型最有效的方式;但更大的模型仍然能达到更低的渐近损失,所以当算力足够时,计算最优的扩展方向依然是把模型做大。基于这套分析作者训了一个 9B 参数模型,据其所知是在驾驶数据上从零训练的最大视频扩散模型,并在 nuScenes 上刷出了驾驶视频生成的开源新 SOTA。定性方面,5 秒生成的对比显示:20M 以下的小模型能抓住整体场景布局但很快跨帧丢失物体一致性;135M 的基础模型对场景理解更好(比如能正确预测车辆正在左转),但在更长时程上难以维持连贯动态;1.1B 模型进一步改善画质与场景结构,却仍有时间不一致并在约 2.5 秒后开始崩坏。 auto 批判点评:这类工作的价值不在方法新意而在把从业者的直觉换成可查的曲线,而且它选的约束条件——固定语料、不能靠抓数据解围——正是自动驾驶、医疗影像这些受限领域的真实处境,因此结论的可迁移性比在网络规模数据上做的规模律更强。「曝光的边际收益大于参数量、但大模型渐近更低」这个不对称结论也很有操作价值:它把「小算力延长训练、大算力放大模型」这条分界线画了出来。诚实之处在于定性结果没有粉饰,直接写明 1.1B 模型在约 2.5 秒后就开始崩坏。需要保留的疑问有三点。第一,所有规模律结论都建立在验证损失上,而扩散模型的验证损失与人类感知质量、下游可用性之间的相关性并不牢固——损失继续下降不一定换来更长的时间一致性,这恰好是驾驶视频最关键的属性,论文若能给出「损失 vs 崩坏时长」的对应关系会有力得多。第二,5,500 小时这个上界本身就是结论的边界:所有关于「还需不需要更多数据」的判断都是在这个尺度内的外推,超出后曲线是否仍成立无从检验。第三,架构是固定的单一族系(Wan encoder + AdaLN 调制的时空注意力块),而规模律对架构选择是敏感的,把轨迹通过 AdaLN 调制注入而非 cross-attention 也是一个具体选择,换一种条件注入方式时这些幂律的系数能否保持,文中未作讨论。 10. CommerceVibe:电商创意生成HTML而非像素 CommerceVibe: Learning to Design E-Commerce Creatives as Executable Visual Code via Dual-Feedback Reinforcement Learning | 同济大学 + 阿里巴巴 | arXiv:2608.27893 关键词:电商创意生成,可执行视觉代码,HTML/CSS 合成,双反馈强化学习,GRPO,VLM 评判,阿里巴巴,同济大学 前序问题:高质量电商创意图是展示商品和传达营销信息的关键。扩散模型让创意生成变得可规模化,也能产出视觉上很好看的图,但落到实际投放前总要返工,原因很实在:文字会畸变、商品细节不一致。更麻烦的是产物形态——扩散模型输出的是一张压平的位图,没有显式结构,因此难以编辑与复用,改一个价格数字都得重新生成整张图。还有第三个障碍在训练侧:电商创意的设计要求往往是复合的、带硬约束的(文字必须清晰可读、商品必须可见不被遮挡、版式必须合法),这类要求很难被编码成可验证的训练信号,而没有可验证信号就没法做有效的强化学习。 本文贡献:CommerceVibe 换掉了产物形态:把创意表示为可执行的视觉代码,生成任务因此被表述成条件化的 HTML/CSS 程序合成。给定商品图、设计要求和商品信息,它产出可渲染、可编辑、可复用的创意。为了让复合设计要求变成训练信号,作者提出双反馈强化学习:一路是基于规则的反馈,对渲染后的程序检查文字可读性、商品可见性和版式合法性——这些都是渲染完就能机械判定的硬指标;另一路是来自视觉语言模型的视觉反馈,从六个感知与商业维度评判渲染出的创意是否符合输入规格。两路信号互补,前者管约束满足,后者管依赖感知的质量。训练流程是先用超过 28,000 条电商样本对 Qwen3.5-9B 做监督微调建立基础创意能力,再用双反馈奖励通过 GRPO 做强化学习优化策略,最终一次推理直出创意。 auto 实验效果:在 1,300 例的基准上,优化后的 CommerceVibe 拿到 94.0/100 的加权分,而只做监督微调的版本是 87.3,也就是说双反馈强化学习贡献了约 6.7 分的提升,同时优于若干强外部模型。作者还请了五位电商设计专家做盲评,结果进一步验证了这些改进——这一点比自动指标更关键,因为规则分和 VLM 打分都可能被针对性优化,而人类专家的盲评是相对独立的检验。细粒度结果按 1,140 例单图与 160 例多图两类分别报告了检测器级别的规则子分和 VLM 评判各维度的评分。定性对比里作者用不同颜色的轮廓标出了文字、商品、版式、VLM 四类代表性问题的位置,未被识别出问题的类别则打绿勾。 auto 批判点评:把创意从位图改成 HTML/CSS 是一次典型的「换表示解决一类问题」:文字畸变消失了,因为文字是真的文字而不是画出来的像素;可编辑性有了,因为产物本来就是结构化代码;更妙的是它顺手解决了强化学习最缺的那件东西——可验证的奖励。渲染完的程序可以用检测器机械地判定文字是否可读、商品是否被遮挡、版式是否越界,这些硬约束在像素空间里很难可靠判定,在代码+渲染的组合里却是现成的。双反馈的分工也合理:规则管能判定的,VLM 管只能感知的。可质疑的地方集中在评估与边界。第一,奖励里有 VLM 打分,而基准的加权分很可能也包含 VLM 判定维度,这就存在训练信号与评测指标同源的隐患——94.0 这个分数有多少来自真实质量提升、多少来自对评判器偏好的拟合,需要更强的隔离设计,专家盲评是好的补充但只有五人。第二,HTML/CSS 表示的表达力有天花板:它擅长版式、文字与图层合成,但那些需要像素级生成的创意元素(商品与背景的自然融合、光影一致、艺术化质感)不是 CSS 能表达的,因此这套方案更准确的定位是「可编程版式合成」而非通用创意生成,与扩散模型是互补关系而非替代。第三,1,300 例基准与 28,000 条训练样本都来自同一电商生态,品类分布、审美规范高度同质,跨平台或跨文化的泛化能力没有证据支撑。 趋势观察 世界模型开始把「状态」从像素里拆出来,交给代码托管 — 今天最值得读的一篇工作提出了一个有点反直觉的分工:世界的演化规则不要让视频模型去学,交给会写代码的语言模型;视频模型只负责把状态渲染成好看的画面。Code World Model 让 coding agent 充当「世界大脑」,把事件与后果推理成可执行代码,代码维护一份持久化的世界状态,状态再被编译成一段粗糙的 proxy 视频去条件化视频模型。这个拆法直指纯视频世界模型的老毛病——视频只呈现「结果」,不承载「规则」,所以模型很难保证「我刚才砸碎的花瓶下一帧还是碎的」。把状态搬进代码后,持久性由程序保证而不是靠模型记性。同一天的 CLAP 从另一侧呼应:它用末端执行器位姿、语言指令、latent action 三种表示把人类视频和多种机器人本体统一到一个动作空间,让世界模型能吃下互联网规模的异构视频。两条路线的共同判断是:世界模型要往前走,得先把「动作/状态的表示」这件脏活干干净。 长视频一致性的战场已经从「窗口多大」转向「记什么、记在哪一层」 — LayerRecall 和 DensityKV 是今天最像一对的两篇,都在攻自回归视频扩散的历史记忆,但切入点完全不同。LayerRecall 的观察是:video DiT 的不同层对「当前/近期/远期」上下文的偏好并不一样,所以长程记忆是个双重决策——检索哪些历史 K/V,以及注入到哪几层。它只往少数「记忆敏感层」注入,其余层保留原来的 sink + 滑窗注意力,因此几乎零推理开销还能跨骨干迁移。DensityKV 则完全免训练,用 post-RoPE key 的 Soft-Riesz 局部密度判断新状态是否冗余:密度高就拒收,从而把持久历史存储限死在与 rollout 长度无关的常数上——120 秒生成时 LongLive-RAG 要 128.5 GiB,DensityKV 只用 3.28 GiB。两篇加在一起说明一件事:「无限长视频」这个目标的瓶颈已经不是注意力算得多快,而是历史怎么以有界代价被有选择地保留。 效率研究出现一波「回头验旧基线」的反思,结论不太体面 — 微软那篇《Sliding-window beats linear attention》标题就把结论说完了:带 sink 的滑动窗口注意力在多个 LLM、多个下游任务上打平或打赢经过 post-training 的线性注意力模型;在 Needle-in-a-Haystack 和 BABILong 这类长上下文推理上,SWA 高出 2 到 10 倍,而且它压根不需要 post-training。作者的批评相当直接——线性注意力这条线一直没有和足够简单的基线做过公平对比。这类工作在今天的效率研究里越来越重要:当一个方向在自己的评测里连年进步,却从未被最朴素的对照组挑战过,进步就可能是评测协议的产物。同一天 DensityKV 也是免训练路线,两篇一起构成一个信号:先把最便宜的方案做到位,再谈复杂改造。 视频生成模型正被反过来当作几何与物理的通用先验 — GeoNeXt 把单目深度与法向估计重写成「next-frames prediction」,直接复用预训练视频生成模型,理由是视频模型天然携带结构化的时空先验,比图像扩散模型更适合联合建模「图像↔几何」,实测能用远少的数据打赢那些多训 100 倍数据的判别式方法。Manifold4D 的思路更巧:视频重拍任务里点云渲染图和原视频作为两路条件会互相打架,模型不知道该信谁多少,于是它干脆不把渲染图当条件,而是注入到 flow matching 的初始噪声里——生成从一个「带几何信息的噪声流形」出发,渲染图只被用一次,网络也不必学会怎么读它,旋转误差因此降了 25% 与 27%。这两篇的共性是把视频生成模型当成基础设施而不是终点产品:它提供先验,任务只是换个输出头或换个注入位置。 人工智能炼丹君 整理 | 2026-09-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注