搜索到
135
篇与
AIGC Daily Papers
的结果
-
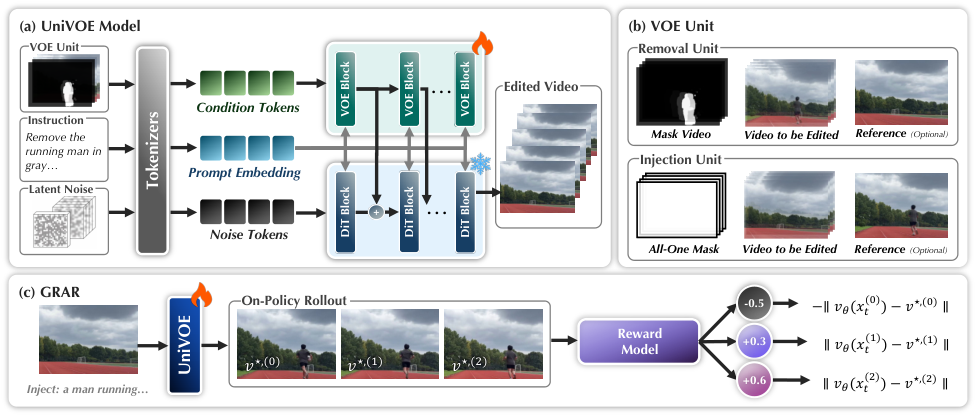
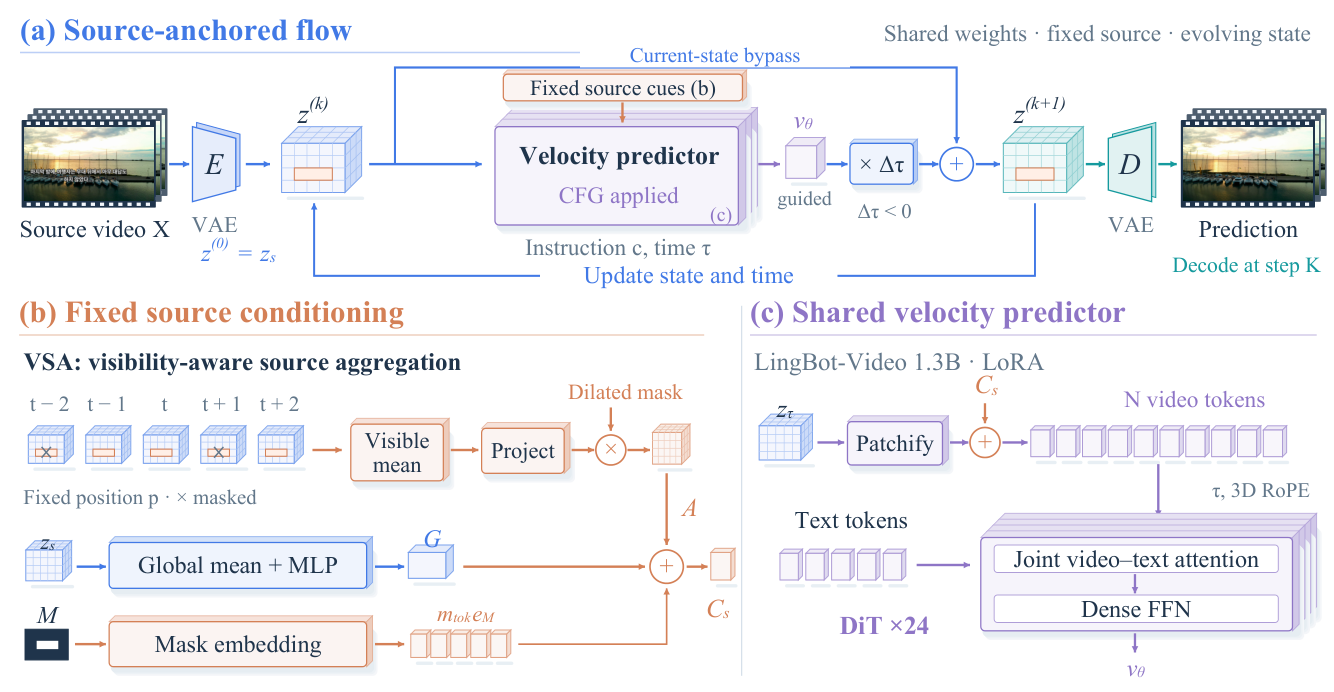
 AIGC 每日速读|2026-10-26|腾讯混元删物添物连影一起改UniVOE 今日 AIGC 论文速览 今日共 10 篇 · 视频编辑与可控重渲染 4 篇 · 单步图像编辑 1 篇 · 视频训练与音视频加速 2 篇 · 场景语音生成 1 篇 · 全景与3D部件生成 2 篇 重点论文标题列表 UniVOE(腾讯混元):删物添物时连阴影一起改 FAPL(港科大):只换人物时别把动作也换了 Latent Space Jam(Lightricks):先按框走再补回视频质感 AnyGameRenderer(Alaya实验室):游戏换画风先数清每个小人 ECT(浙江大学):一个噪声时刻改图仍要校准 选读入口:真实视频删物或添物且要一起改阴影、倒影,先读UniVOE;只换人物却连动作也变,接FAPL。要规定每帧位置读Latent Space Jam,要把粗糙游戏录像换画风又数清角色读AnyGameRenderer。单张图低延迟局部改动读ECT;训练流式视频模型读Direct Forcing,已有声画联合生成服务再读CAVC,对照它们的步数与墙钟账单。做数字人口播读HeyGen Voice,看场景声音和音色如何拆开;全景接缝问题读CubeAtlas,图片转可编辑3D资产读FlexPart,注意提示粒度和遮挡边界。 今日论文速览 1. UniVOE:删物添物时连阴影一起改 UniVOE: A Removal-Driven Framework for Interaction-Aware Universal Video Object Editing | 腾讯混元;北京大学深圳研究生院;香港中文大学 | arXiv:2610.31641 关键词:视频对象编辑, 交互效应, 移除监督, 奖励后训练 前序问题:把视频里的烤箱删掉,披萨仍躺在烤箱留下的阴影里;往街道添辆车,地面却没有倒影。视频编辑不能只改物体轮廓,还要处理它对环境造成的光照、接触和反射变化。真实的有物体/无物体配对视频又很难拍到。 方法直觉:先学会把物体和它的痕迹擦干净,再把擦掉后的片段当输入、原始实拍当目标,倒过来教模型添物体。插入结果的运动与交互来自真实片段,减少完全合成监督的失真。 本文贡献:移除器先用超过63000段视频学习补洞,再用68000对视频微调交互效应;应用后筛得69000对,与原68000对合成137000对插入训练数据。两模型结构相同、分别训练,各230亿参数,含冻结140亿参数 Wan2.1 主干及30亿参数控制分支。移除输入膨胀对象掩码,插入用全一掩码允许全局修改;可追加由外部图像编辑器生成的首帧参考。GRAR(组相对优势回归)每个条件生成16份结果,以经人工偏好微调的 Qwen3-VL 奖励模型排序,按组内中位数分正负回归,不另存冻结参考策略。 原文图3|UniVOE流程。(a)移除器与插入器共享网络结构,指令与视频对象编辑单元不同。(b)移除输入源视频与膨胀二值掩码;插入用全一掩码,允许全局交互效应变化。两任务参考图均可选,由外部图像编辑模型生成以提供更明确指导。(c)GRAR组相对优势回归把预训练插入器向人类偏好调整,以改善物理真实感。 实验效果:训练片段为97帧、832×480;评测 VOR100对、ROSE56对且剔出训练集。移除仅给文字,插入给文字与参考图。VOR移除的 PSNR(像素信噪比)23.752分贝,EffectErase23.210;插入相对不做GRAR,FVD(视频分布距离,越低越好)361.286→234.562,LPIPS(感知距离,越低越好)0.307→0.237。移除由50步缩到12步,但未报完整推理时间及峰值显存,不能按步数直接宣称提速4倍。 原文表4|对象插入后训练消融。相同设置不做/做GRAR,DINO身份相似度0.353/0.390,CLIP指令相似度0.221/0.232,感知距离LPIPS0.307/0.237,视频分布距离FVD361.286/234.562;前两项越高越好、后两项越低越好。 批判点评:筛选仍会漏过移除器偏差,插入能力受保留配对与自有奖励模型上限约束;省去参考策略不意味着免除奖励偏移。论文称支持超过200帧编辑,但定量范围仍是97帧480p,不能外推长片稳定性。项目 可查,权重 可查;项目主页标出的代码地址本次返回404,尚未确认代码公开。未据会议模板推断接收。 2. FAPL:只换人物时别把动作也换了 Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation | 香港科技大学;腾讯视频;法国巴黎综合理工学院 LIX | arXiv:2610.30926 关键词:因子视频编辑, 多模态表征, 动作顺序, 多镜头一致性 前序问题:给视频系统接上多模态大语言模型,换个人物仍可能把动作和镜头一起改。原因可能更早:生成器依赖自己的文字和图像条件,根本没认真使用大语言模型的隐藏表征。怎样让这些表征既有用,又能按人物、场景、动作、相机分别控制? 方法直觉:先暂时关掉更容易走的条件捷径,让生成器必须读懂大语言模型的表征;再只换一个因素对应的片段,用成对视频教它哪些该变、哪些该保留。最后反过来固定生成器,让理解端学会提供能生成视频的信息。 本文贡献:FAPL即因子感知预测学习,基于 UniVideo 的130亿参数 DiT(用 Transformer 做视频扩散的生成器)。第一阶段冻结多模态模型及连接器,仅以其潜表征训练DiT;第二阶段在连接器输出后替换结构化描述中某个因子的完整token区间,监督双向编辑,区间可不同长,并不假定完全解耦。第三阶段冻结DiT,梯度经它更新多模态模型及连接器;仅文字、文字加完整视频两种观察以1:1抽样、共用目标。100000对视频每因素25000对,三阶段分别10000、15000、10000步。 原文图3|因子感知预测学习FAPL。阶段一冻结多模态大语言模型和原连接器,用其潜表征训练视频扩散Transformer;阶段二保留这一冻结配置,在成对样本间交换因子对应输出区间,监督特定因素改变;阶段三冻结训练好的生成器,以视频重建共同更新多模态模型与连接器,只有文字、文字加完整视频的观察共用一个生成目标。 实验效果:CineFactor-10K按源视频隔离:5000例仅文字生成、5000例因子编辑,另测100组多镜头。相对同底座,动作顺序正确率48%→61%,编辑交集准确率42%→58%;交集要求是非题与选择题同时通过。相机旋转误差1.54→1.02弧度,越低越好。等数据和优化预算下,第二阶段做因子替换比不替换48%→57%,较能隔离机制收益。推理50步、分类器自由引导系数5.0;未报墙钟时延或峰值显存,三阶段训练有额外成本。 原文表1|三个任务定量比较:稀疏输入生成评动作顺序与相机平移/旋转误差;因子编辑交集准确率要求两种问答检查都过;多镜头评主体、场景和ArcFace人脸相似度。FAPL对应61%、0.0586、1.02弧度、58%、0.516、0.471、0.523;不是同一指标的七次测量。 批判点评:第三阶段完整视频是训练观察,文字分支推理时并未偷看目标视频。多镜头仍独立生成,主要靠共享人物/场景参考,没有跨镜头记忆;隐藏区间受上下文混合,不能称四个因素已经数学解耦。实验支持这些受控任务的改进,尚非任意复杂剪辑都能准确保留。原文未给本方法代码入口。 3. Latent Space Jam:先按框走再补回视频质感 Latent Space Jam: Layout Guided Video Synthesis | Lightricks;独立研究者;莱赫曼大学 CANVAS 实验室 | arXiv:2610.30390 关键词:布局视频生成, 潜变量优化, 轨迹控制, 两阶段精修 前序问题:让山羊沿指定路线下山,只写“向左下走”常常不听;强压每帧目标框又会毁掉外观。位置必须准、动作还得连贯,能否把这两个要求放在不同阶段完成? 方法直觉:先生成一条画质粗但位置准的引导视频,再把它当草稿修清楚。草稿也由视频模型产生,保留运动和接触关系,比逐帧贴上独立生成的物体更合适。 本文贡献:冻结文生视频模型,优化潜变量而非模型权重;让指定文本token的交叉注意力分布贴近各帧二值框,使用 KL 散度衡量两分布差异。只在选定去噪时刻和早期三层做梯度优化。草稿可先时空上采样,再按当前噪声量加噪、插入第二次去噪的早期,恢复纹理。Wan2.2与LTX-2均有验证;静态/动态/多物体约40/40/20套布局,共约100套。 原文图2|无需训练的布局引导视频流程。输入文字与时空布局,先用交叉注意力布局损失优化冻结文生视频模型的潜变量,使指定token注意力对应目标框,生成粗糙但遵循布局的潜空间视频;可做空间和时间上采样,再在去噪早期注入引导视频。第二阶段保留布局与运动、改善外观细节,得到最终视频。 实验效果:多物体设置,同为Wan2.2并精修后,相对重实现的 TrailBlazer,IoU(预测与目标区域交并比,按百分制显示)13.86→25.83,目标中心距离32.47→21.87,越低越好;FVD视频分布距离204.73→198.57。这里比较的是同底座,不能把LTX与Wan差异全归方法。低分辨率草稿高160像素49帧,再精修到高480像素81帧,耗时36秒+5分58秒,底座6分20秒;高480像素81帧草稿自身要10分24秒,无训练仍有推理优化成本。 原文表1|静态、动态、多物体三类布局比较;IoU交并比与AP50重叠阈值精度评空间重合,CD是中心距离,I.为原始交叠面积、I-AP50基于该面积评轨迹;FVD视频分布距离越低越好、CLIP图文相似度越高越好。左为引导、右为精修;原图注总结Wan2.2引导较强、LTX-2精修相当或更强,但具体条目存在指标取舍,不能理解为每个格子全胜。 批判点评:框约束不区分物体移动和相机运动,拥挤、多物体交互仍困难;主结果动态场景的部分AP50分数没有胜过早期方法,不能沿用图注“全指标更好”的泛化表述。IoU与中心距离衡量位置,不证明物理正确。耗时表未明确卡型与显存,项目 与代码 可查,未执行;不能仅凭TOG排版认定接收。 4. AnyGameRenderer:游戏换画风先数清每个小人 AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark | Alaya 实验室 | arXiv:2610.31466 关键词:视频重渲染, 实体对应, 游戏生成, 低秩微调 前序问题:把满屏几何小人换成精致游戏人物,生成器可能留下方块、凭空多出敌人,或把俯视镜头改成正面。游戏的画面可换,角色数量、出场时刻与位置不能随意重写。 方法直觉:直接把粗糙游戏录像作为结构参考,再明确每种形状代表谁。训练描述故意列入没出现的角色,迫使模型根据视频判断实体存在,而不是见到名字就添一个。 本文贡献:基于330亿参数 MiniMax-H3 的参考视频编辑模式,仅训练秩128的 LoRA(低秩适配参数),关闭音频损失、推理丢弃音频。10330段配对由38个GEAR游戏、虚幻引擎和真实录像检测框重建三路组成;统一124帧、24帧/秒、1344×768。六段描述固定身份映射、位置、大小、时机和数量,首帧锚图可选。16张141GB H200训练约48小时;推理20步Euler采样,未报生成耗时或峰值显存。 原文图2|AnyGameRenderer。(a)三路配对:GEAR将完整游戏渲染与方块/语义图等多个粗糙流对齐,虚幻引擎配完整图与方块图,真实录像用检测3D框转粗糙图。(b)每例粗视频作输入,目标首帧可作锚点,六段描述明确粗形状与真实实体对应及保持要求。(c)文字、参考视频、锚图与带噪目标token构成冻结MiniMax-H3生成器输入,只训练自注意力和前馈层的LoRA低秩适配,按指定风格重渲染。 实验效果:59个隔离案例共753实体,同种子、步数和描述:时间匹配50.9%→62.9%,位置匹配57.1%→61.9%,漏掉数量变化34.7%→21.3%。时间匹配是“输入存在帧集合”和“输出在位帧集合”的交并比;活不足12帧的实体不计。数量统计只覆盖75次规定幅度变化,允许60帧窗口内达标;不是逐帧精确计数。真实录像子集时间匹配仅46.5%→51.1%,未渲染率还由2.6%升至2.9%。 原文表2|隔离测试集实体同步结果,单位%。左侧四主指标为时间匹配、位置匹配、未渲染率与幻觉率;右侧三辅助量为及时出场、从未出现及漏掉数量变化。灰色GT floor把真实RGB视频送进同一检测匹配流程,表示该评估器的可测上限/误差底,而不是人工标注完全无噪声。 批判点评:总体幻觉率仍46.0%,真值视频经过同一检测匹配流程也有34.1%,说明检测器本身存在误差,不能把46.0%直接当肉眼错画比例。24帧/秒是输出播放率,不是实时生成速度;跨域无锚图风格建议减LoRA系数至0.7,仍待用户实际验收。项目 与代码 、模型 可查;数据仓库 本次只有占位文件,尚未提供样本。未执行模型。 5. ECT:一个噪声时刻改图仍要校准 One Evaluation Is Enough: Inversion-Free Image Editing with Trajectory Correction | 浙江大学;蚂蚁集团;重庆邮电大学 | arXiv:2610.30827 关键词:单次图像编辑, 端点校准, 无需反演, 计数口径 前序问题:单步图像编辑看似只跑一次,但常在多个噪声时刻分别求源/目标指令差,再合成一步。能否只观察一个时刻,也保住没要求修改的背景? 方法直觉:同一个带噪状态下,源指令和目标指令的预测差同时提供“往哪改”和“干净结果差多少”;先按剩余噪声角度推一把,再用端点差收回过度外推。二者在同一编辑轴上调幅,不是凭空生成新方向。 本文贡献:ECT(端点校准输运)适用于预测噪声的 VP(方差保持)单步生成器。把两种文字条件打包进一次去噪批调用,得到角度切向量与干净端点位移;解析输运后做受约束投影,再更新一次潜变量。不反演、不中途积分、不迭代优化。默认噪声时刻t=0.75、校准系数ζ=0.7、编辑强度λ=1;t是噪声日程位置,ζ收缩外推幅度,λ控制整体编辑量。一个时刻、两条条件分支、一次批调用和一次更新,是四种不同计数。 原文图2|以马变斑马说明编辑流程。(a)FlowEdit沿多步路径累积源/目标场差。(b)ChordEdit把t与t−δ两时刻残差合成一次更新,含四条条件时间分支。(c)ECT在同一带噪状态只算两文字条件;同一预测确定角度残差gₜ与端点位移dₜ,先输运âₜ=−θₜgₜ,再校准u*ₜ=âₜ−ζdₜ,一次更新x_edit=x_src+λu*ₜ。θₜ为剩余噪声角、ζ为校准强度、λ为编辑强度;示意图只表示同一编辑轴调幅。 实验效果:H20、同SD-Turbo底座的PIE-Bench,相对ChordEdit,背景PSNR(像素信噪比)22.63→23.74分贝,LPIPS感知距离按1000倍显示122.64→109.04,越低越好;整图CLIP图文相似度按100倍显示30.60→30.20,编辑对齐略降。同步推理计时0.265→0.212秒,但排除文件读写和指标计算;峰值PyTorch预留显存7498→7480MiB,只省0.24%,不是内存大幅下降。 原文表3|PIE-Bench消融:(a)一步与两步ECT比较;(b)角度输运的作用;(c)额外神经网络评估NFE的作用。蓝色为ECT变体,粗体为较好值,橙色为资源减少;额外NFE是独立变体,不属于严格单时刻主结果。时间为秒、主机内存为MiB,CP/VQ/PC分别评内容身份保持、视觉质量、物理感知协调。 批判点评:同SwiftBrush-v2的PIE背景均方误差与感知距离有小幅退步;保持更好不等于指令全做对,例如加花仍未准确放到嘴里。主结果严格单时刻,附录额外网络评估变体另算,不能混写。推导尚不覆盖非VP日程、速度预测或空间自适应约束;原文未给本方法代码入口。 6. Direct Forcing:四步视频不再先做初始化 Direct Forcing: A Single-Stage Training Recipe for Few-Step Autoregressive Text-to-Video Generation | 北京航空航天大学;京东未来研究院 | arXiv:2610.30861 关键词:自回归视频, 单阶段训练, 分布匹配, 梯度平衡 前序问题:把双向视频扩散模型改成边看历史边出下一块,常先蒸馏因果初始化、再匹配生成分布。只做后者容易在块边界突然换物体,能否一次训练同时学会接得上和整体像真视频? 方法直觉:一组练习在真实历史上续写,约束相邻块;另一组让模型接着自己生成的历史走,检查整批视频的分布。两种练习的梯度强弱动态配平,避免续写损失压住分布学习。 本文贡献:从13亿参数Wan2.1双向底座出发。CCA(因果续写对齐)用冻结视频编码器对齐预测与参考的时空token余弦距离;噪声块只能看之前真块和自己,阻断未来泄漏。RDM(rollout分布匹配)用MMD(最大均值差异,比较特征分布的统计距离)匹配整条生成视频与参考,并用文字相似度配对;每条完整视频算一个分布样本。梯度先等范数,再按续写残差调权。八张B200、6505对参考视频、250次联合更新;每次128生成例做RDM、32参考对做CCA。 原文图3|Direct Forcing用共享少步因果生成器同时学习:在参考历史上做因果续写对齐CCA,在自生成历史上做rollout分布匹配RDM。冻结编码器提供配对余弦对齐及视频文字最大均值差异MMD;动态梯度平衡先匹配梯度范数,再按拟合误差加权CCA,合并为一次共享更新。 实验效果:832×480、81帧、每块3个潜帧且去噪4步;944提示各5份共4720视频。VBench总体/质量得分84.63/86.01,相比Elastic Forcing84.25/85.06,但语义79.08低于80.99。单B200吞吐20.63帧/秒、首帧0.25秒,与列出的其他四步模型相同;训练变化未增加推理结构。250次不含底座预训练、离线特征及数据准备,步数也不是统一GPU小时账单。 原文表2|VBench文生视频比较,按生成方式分组,分数用百分制。高亮行是250次更新模型;星号ViRDM不使用光流正则,本方法主模型也未使用这一辅助目标,另在附录消融。吞吐为帧/秒,延迟指首帧秒数,四步因果模型时延在单B200测量;其他时延与部分质量指标沿用原报告。 批判点评:所谓无在线扩散教师,仍用冻结Wan14B等编码器提取训练特征;不能说不依赖大模型。仅验证13亿参数及最多50秒视频,长视频六指标赢四项、动态与画质两项较差。不同公开baseline的质量得分并非全部本次同机重跑;原文未给本方法代码入口。 7. CAVC:缓存声音后还要重新对齐画面 CAVC: Convergence-Adaptive Audio-Visual Cache for Modality-Asymmetric Diffusion Generation | 浙江大学;蚂蚁集团 | arXiv:2610.30854 关键词:音视频生成, 非对称缓存, 末端重耦合, 推理加速 前序问题:声画联合生成每步都算音频、视频和交叉注意力,很费时。但把两边都缓存,视频动作会停住;只缓存声音又可能让敲击和音效对不上。哪些计算能省,哪些必须一直做? 方法直觉:声音中段偏了,末尾联合细化还能补回不少;视频中段少算丢掉的运动却难补。于是保留完整视频去噪,声音稳定后暂用旧预测,最后再让声画一起校准。 本文贡献:CAVC(收敛自适应音视频缓存)不训练模型:前段完整联合去噪,在线监测音频预测变化,默认阈值0.30、窗口3;触发后重用音频去噪输出、绕过音频分支和声画交叉注意力,但音频潜变量仍按调度器推进。末段恢复原生3步联合细化。基于LTX-2.3-22B-dev及官方蒸馏LoRA,全部方法启用CPU卸载、单样本单并发,在96GB H20测试;不是只删几条Python语句就可忽略传输成本。 原文图2|CAVC按模态收敛动态分配从T到0的去噪轨迹。(1A)高噪声初段完整运行音频、视频及交叉注意力,建立语义绑定;监测器在音频预测稳定的τ时触发缓存。(1B)中段复用音频预测,跳过音频分支和声画注意力,让视频继续独立细化时空结构,避免静态声音过度约束。(2)末尾数步恢复联合计算,解码前减少累计声画偏移、改善同步。 实验效果:AVGen-Bench/VABench为1280×704、241帧24帧/秒,General-80为1536×1024、121帧24帧/秒,报告墙钟加速1.10–1.35倍。General-80动态程度(光流超过阈值的片段占比)0.380→0.512;AVGen-Bench的AV-F1(起音匹配,容许正负3帧)0.5381→0.5650,但细粒度同步分数0.561→0.525,DNSMOS预测音质1.706→1.688。默认参数消融217.2→184.8秒,是该配置结果,不能把最大加速套到每个提示。 原文表2|三个基准的自动音频、视觉语言模型质量、声画对齐及物理性评估。AV-F1是起音事件匹配诊断分,越高越好;粗体为最优。DNSMOS为预测音质、CLAP为音频文字相似度;声画同步分是时间偏移的变换值,不是人工听评。AVGen-Bench同步分0.561降至0.525,起音F1改善不代表所有同步指标都改善。 批判点评:结尾重耦合只在测试设置补回约81.5%–91.3%的音频文本相似度缺口,不是数学保证完全恢复;同步分数也非人评。快速连续声学事件触发晚,收益趋近原采样;视频分支始终运行,加速上限受它限制,未报峰值显存下降。原文未给本方法代码入口。 8. HeyGen Voice:声音像本人也要像在这个房间 HeyGen Voice: Scene-Aware Voice Cloning for Talking Videos | HeyGen 研究团队 | arXiv:2610.30470 关键词:场景语音合成, 音色克隆, 声学锚点, 跨场景适配 前序问题:用手机录音克隆本人声音,画面换成录音棚或教堂,声音却仍像手机录的。说话人身份、说话方式和房间声学绑在一起,长稿分段还会一段一间房。 方法直觉:参考录音提供“谁在说”,图片与两段描述提供“怎么说、在哪说”;选定一段生成声音作锚点,后面各段都沿用这套声学状态,另外读取上一段结尾保持衔接。 本文贡献:冻结视觉、文字、音频编码器,分别把图片、说话人描述、环境描述与音色压成少量条件token;自回归Transformer按脚本预测离散声学码,再由流匹配及波形解码器输出44.1千赫声音。五阶段依次为多语种文字转语音预训练、模拟跨场景、真实同人跨场景、组相对策略优化GRPO、直接偏好优化DPO表达适配器。voice-clone保音色并随场景适配,full-clone更多沿用原录音;锚点一致性嵌入与滑动局部上下文分工不同。 原文图1|HeyGen Voice架构。冻结编码器把多模态输入池化为条件token;克隆策略决定延续状态来自为目标场景设计的声音锚点,还是原参考录音。条件前缀、脚本文字和声学码组成同一自回归序列。监督训练用交叉熵,GRPO组相对策略优化用可懂度及音色奖励,DPO直接偏好优化用偏好对;流匹配解码器以隐藏状态和参考音频合成波形。 实验效果:331个英语同人异源案例、155说话人簇,voice-clone目标音色相似度0.590,Cartesia0.582;音画嵌入相似度0.282对0.261。full-clone对原参考相似度0.757,高于voice-clone0.739,体现取舍。此测试额外给HeyGen目标图片、从真实目标录音生成的描述及信噪比,其他语音API没有这些输入,不能归结为纯模型同条件领先。报告单并发实时因子约0.1,即合成耗时/音频时长约十分之一;未报首包时延与峰值显存。 原文表5|331个跨场景配对案例,音色相似度分别参照真实目标录音和原参考录音,ImageBind两列为音频对音频、音频对目标图像的嵌入相似度。粗体最佳、下划线次佳。voice-clone偏目标场景,full-clone偏保留参考声学;HeyGen还接收目标图、由真实目标录音导出的描述与信噪比,不是各系统完全同输入。 批判点评:十语言文字错误率使用双评审都确认才计错的规则,分歧算零但保留分母,不能当常规自动转写错误率;因此这里主要关注场景迁移证据。听评与生产投票有不同样本池,报告中10月榜单名次也不是永久结论。产品与样例 可查,未见开放权重或本方法训练代码。 9. CubeAtlas:全景六个面放一张画布里生成 Squaring-the-Sphere: Distortion-Free and Seamless Panorama Generation via CubeAtlas | 腾讯 | arXiv:2610.31565 关键词:全景生成, 立方体表示, 稀疏注意力, 透视超分 前序问题:普通照片扩成全景,顶部被拉长;六个透视面分别生成,又在接缝处对不上。如何保留普通图像模型熟悉的透视几何,同时把一整圈场景连起来? 方法直觉:把四个侧面排成一带,上下极面旋转后各取一半,紧挨对应侧面,形成一张紧凑画布。接缝两边能一起去噪,再把互补极面融合回球面。 本文贡献:CubeAtlas是Squaring-the-Sphere的表示:侧面边长S,中央S×4S、上下各S/2×4S,合计2S×4S,S指潜空间边长;不算边缘padding时与ERP(经纬展开)token量相同。输入单张透视图与文字,无需给相机内外参;冻结图像编码器与变分自编码器,完整微调图像编辑DiT8000步。布局稀疏注意力保留目标间75%连接,文字和图像条件仍全连。解码后方向加权融合极面,基图1280×2560;六个92.79度重叠视图经冻结4倍超分得到5120×10240。 原文图3|Squaring-the-Sphere流程。输入透视图和文字,扩散Transformer在同一画布上联合去噪完整CubeAtlas;布局稀疏注意力保留带内连接、限制跨纬度交互。对每个极区,赤道面只关注能组成完整极面的两块同轴半极区;生成后融合拼接为ERP经纬展开全景。联合一次画布不表示只有一个去噪时间步。 实验效果:100自采图及三个公开集100/100/118例,主比较均在未超分基图。RealSee3D立方面边缘误差Seam-Cube从CubeDiff0.0229降至0.0064,越低越好;稀疏版同token量去噪时间为ERP的0.84倍,非端到端10K图总时间。相对密集CubeAtlas,立方接缝0.0143→0.0132,但ERP接缝0.0103→0.0142,不能称所有边界指标都更好。 原文表2|全景表示与效率设计消融。Tokens是目标token序列长度,Time为相同设置的去噪时间,均以ERP=1.00倍归一;Sparse Attn.为布局感知稀疏注意力。半极区CubeAtlas token量不变,稀疏版时间0.84倍;各接缝、赤道与极区质量及文字遵循列须分别看,不能把相对时间当完整超分总耗时。 批判点评:“一次生成”指六面同画布联合处理,不是一次网络评估就出图;10K由透视超分得到,不是原生10K去噪。质量/几何部分由视觉语言模型打分,30全景、各3人验证排序相关,仍是有限评审。SUN360的FID分布距离也未胜过全部对照;未报绝对墙钟或显存,原文未给本方法代码入口。 10. FlexPart:点一下也能指定要生成的部件 A Unified Framework for Image-to-3D Part Generation via Variable Granularity | 同济大学;Chongqing Afari Intelligent Drive Co., Ltd;华中科技大学 | arXiv:2610.31671 关键词:3D部件生成, 多粒度提示, 几何引导, 最优输运 前序问题:从图片造一把椅子,想分别改椅背和椅腿:有时愿意精描掩码,有时只想点一下。为点、框、掩码各训练一套模型费事,先分割再投到3D也可能把部件切碎。 方法直觉:让详细边界在训练时教会稀疏点击“这个点代表多大一块”,推理时用户再少画一点,也能借到学过的几何常识;详细提示仍可追加,控制精细度更灵活。 本文贡献:FlexPart用TripoSG预训练权重及3D变分自编码器,分别编码点、框、掩码,融合后以带门控的自适应层归一化调制DiT;DINOv2图像特征提供全局语义,部件注意力兼顾局部几何和整体关系。非对称几何引导用部分最优输运对齐点与框/掩码表征,强提示嵌入停止梯度,50次Sinkhorn归一化求匹配,缺失提示用可学习空向量。训练从1–8部件、每部件512token扩到2–16部件、每部件1024token,8张H20;推理至少需要点,框和掩码可逐级加上。 原文图2|FlexPart支持点、框、掩码,点是最低输入。带噪潜变量、部件ID及时间步共同接收提示编码,缺失提示由可学习空向量替代;融合条件经带门控的自适应层归一化调制每层3D扩散Transformer,生成部件。训练专用多粒度几何引导分支以最优输运对齐弱、强几何先验。 实验效果:PartVerseXL同掩码条件,部件CD(倒角距离,点集相互最近距离,越低越好)OmniPart0.3283→0.2938,降10.5%;换成框为0.3042,仅比掩码差约3.5%。统一训练相对仅点训练,点条件CD0.3550→0.3334。辅助分支只用于训练;H20的8部件1024token配置,前向8.9毫秒对DiT525毫秒约1.70%,不是整体训练吞吐代价。A800推理峰值约6–8GB,随部件数改变,未给正文可直接引用的统一总时延。 原文表1|部件结构评测,Cond.表示输入条件,PartPacker不需要几何条件。完整网格对照用SAM3D把多视角二维掩码提升到3D分割;Part IoU-V/B分别是体素与三维包围盒交并比,CD为倒角距离、越低越好;粗体/下划线为最优/次优。FlexPart的Mask/Box/Point仍按原文层级保留最低点输入,不能称三种完全孤立推理接口。 批判点评:点的位置很关键:另一个放点消融中中心改边缘,CD0.3302→0.4190,不能和主表0.3334混为同一协议。遮挡部件仍可能长到可见位置;部件质量改善不等于整体网格全指标最佳,PartObjaverse-Tiny整体CD0.1587也略差于OmniPart0.1585。arXiv评论明确接收NeurIPS 2026;代码 可查,未运行。 趋势观察 控制先要说清保持什么 UniVOE保护对象之外的交互合理性,FAPL检查非目标因素,AnyGameRenderer直接数实体;同叫保持,却需要不同验收对象。 无训练不等于免费 Latent Space Jam在推理时优化草稿,CAVC需要末段重新对齐;ECT批调用次数与条件分支数也不能互换。 监督的入口比接口数量重要 UniVOE倒用移除配对,FAPL关闭条件捷径,Direct Forcing同时看真实与自生成历史,FlexPart让强几何提示教弱提示。 统一表示仍有局部取舍 CubeAtlas减少跨面裂缝却不包办所有ERP边界指标;HeyGen两种克隆策略在目标场景与原录音相似度之间选择。 今日讨论 UniVOE加入GRAR后,VOR插入FVD由361.286降到234.562。若只对奖励模型高分样本做测试,这个改善还能代表真实使用吗?你会如何按移除残影强弱、参考图是否提供分层留出样本,需要哪些独立证据,同时检查非目标区域和阴影变化? 人工智能炼丹君 整理 | 2026-10-26
-
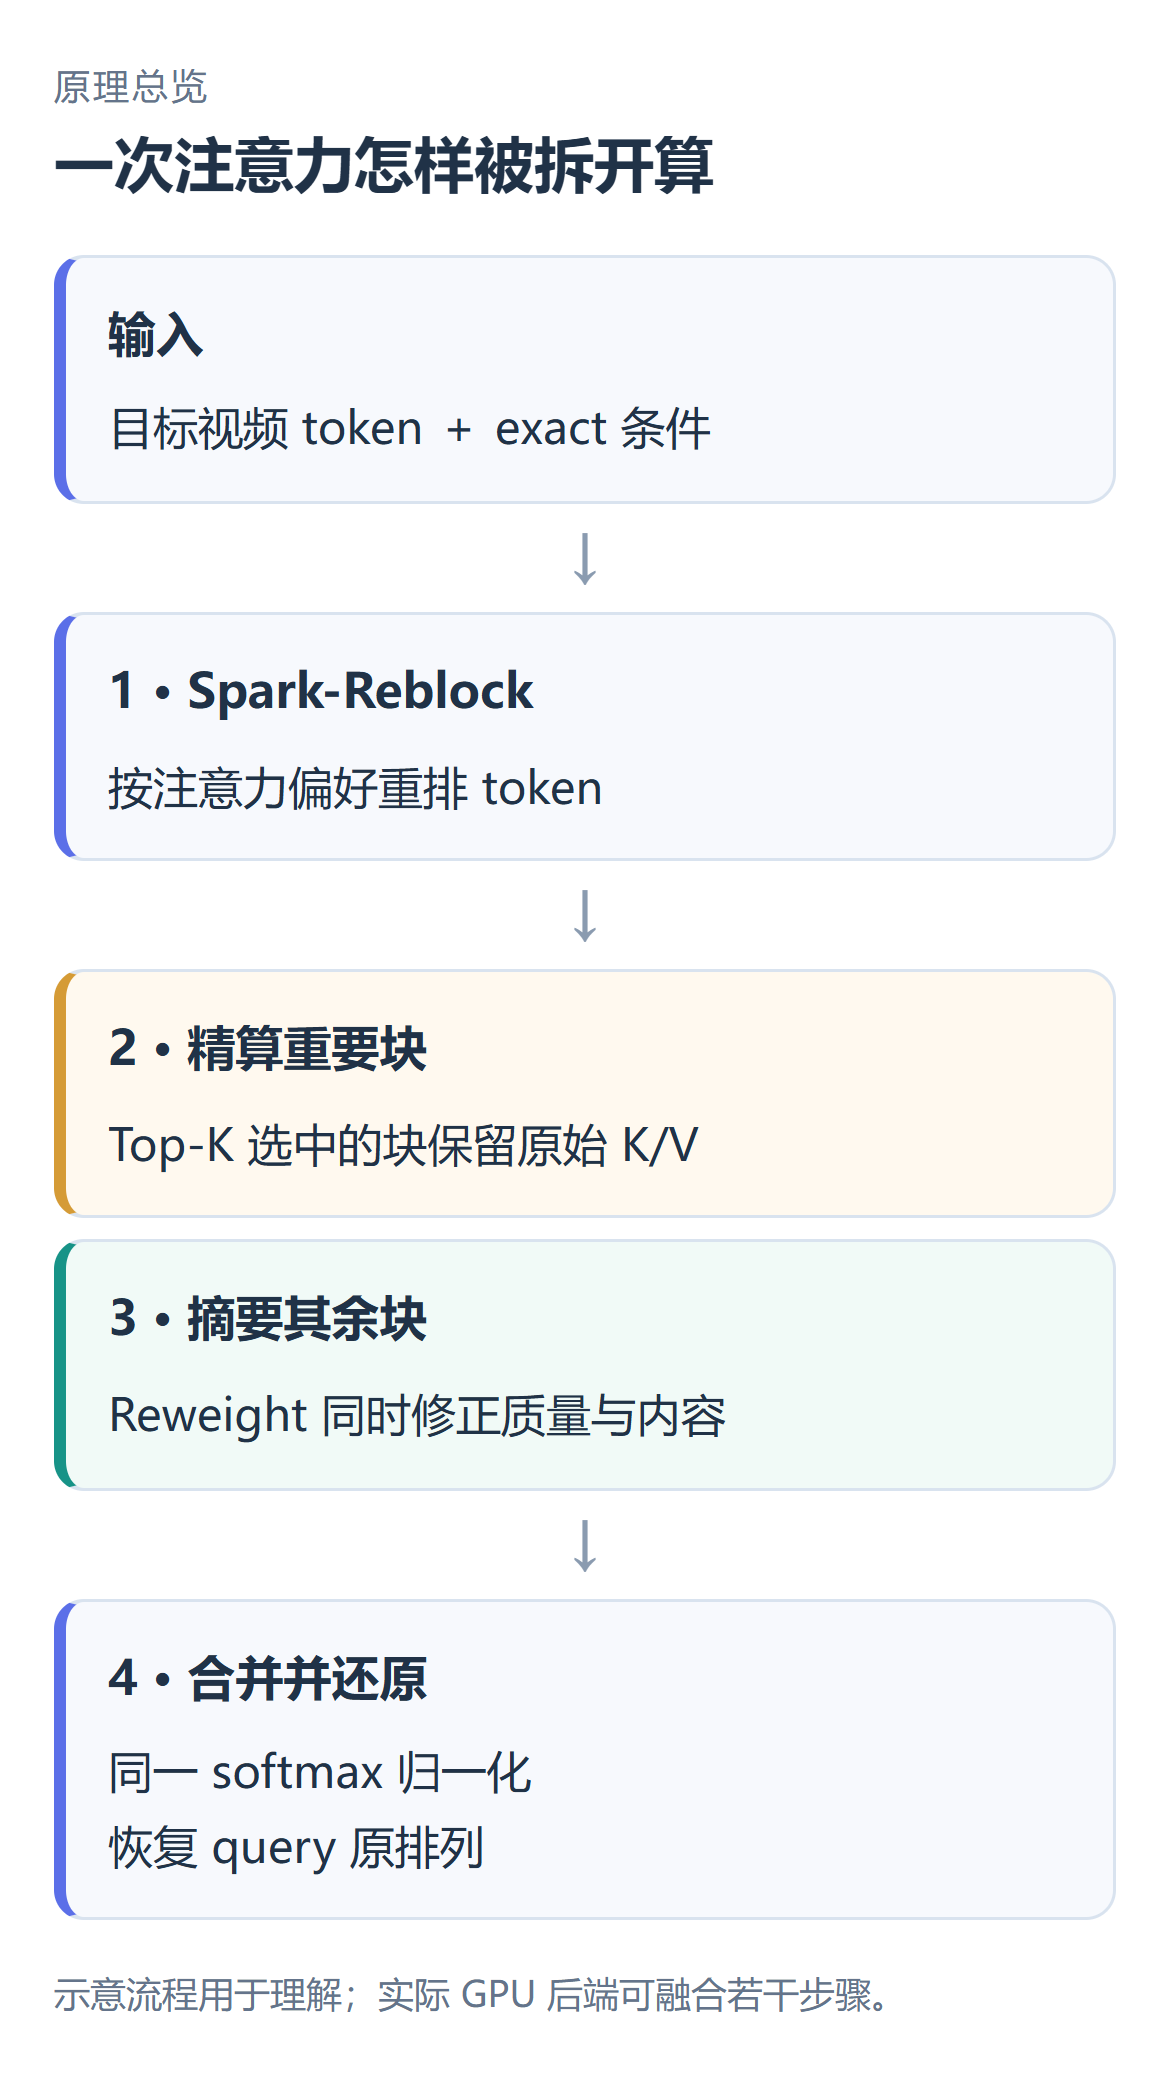
深度解读|Spark-H3:从注意力几何到稀疏内核代码 原文:Spark-H3: Adaptive Block Sparse Attention for MiniMax-H3 作者署名:SparkH3 Team。项目博客首发于 2026-09-23,技术正文更新于 2026-10-08。 阅读与代码核对日期:2026-10-24。源码固定在 502ef356,避免后续版本变化影响理解。 代码:Spark-H3 仓库。仓库标注 Apache-2.0;模型权重及依赖的许可应分别查看。 阅读提示:先建立整体直觉,再推导 Reblock 与 Reweight,最后对照源码和运行实验。文中自制实验只验证数学性质,未在本机复现 H3 视频质量或 GPU 加速比。 01 先把问题说清楚:少算哪些注意力,才能让视频保持原样 自制原理图:Reblock 改善布局,Top-K 选择精算块,Reweight 覆盖其余块,最后统一归一化并恢复 query 顺序。 Spark-H3 给 MiniMax-H3 视频生成模型替换了一段计算量很大的注意力运算。它保留模型已有权重,在推理时选择一部分 token 之间的交互精确计算,再用便宜的近似覆盖剩余交互。 视频生成会把时空内容编码成 latent token。每一层、每一个注意力头,都要让 query 判断应当从哪些 key 对应的 value 取信息。token 数变长,所有两两关系的数量按平方增长。 降低采样步数可以少运行几次模型;Spark-H3 则降低每次运行内部的注意力成本,两者可以叠加。 这里的目标包含两个层次。一个是输出视频看起来合理;另一个是尽可能接近同一 prompt、同一 seed 下的 dense 原始输出。 后者更严格:即使两段视频都很好看,人物姿态或镜头轨迹不同,逐像素保真指标也会下降。 这篇博客最有价值的地方,是把近似误差拆成了两个可以分别改进的问题。 分组误差:固定把相邻 token 装进同一个块,块均值可能代表不了内部成员,导致重要块没有被选中。 压缩误差:没被精算的块如果只取 K/V 均值,会错误估计它应当分到多少注意力,以及应当贡献什么内容。 Spark-Reblock 处理前者,Spark-Reweight 处理后者。把这两条线分开,后面的公式和代码就容易读了。 02 先读实验:10% 预算到底换来了什么 据原博客 Benchmark Results 数据重绘:1344×768、240 帧、24 fps、19 次去噪。只计 DiT;Spark 与 Lite 均为 10% 视频块精算密度,非本机实测。 原博客 Benchmark Results 使用 1344×768、240 帧、24 fps、VBench prompts,以及 20 个调度点对应的 19 次去噪。 质量比较采用相同 prompt、seed 的 dense 输出作为参考。以下只摘出支持主要判断的几行。 方法 视频块精算密度 DiT 时间 相对 dense 加速 PSNR / LPIPS Dense 100% 583.3 秒 1.00× ∞ / 0.00 Sol-H3 动态选择 355.4 秒 1.64× 20.36 / 0.20 Spark-H3 10% 337.4 秒 1.73× 23.30 / 0.14 Spark-H3 20% 371.1 秒 1.57× 25.38 / 0.09 Spark-H3 30% 404.1 秒 1.44× 27.07 / 0.07 Spark-H3-Lite 10% 330.2 秒 1.77× 23.34 / 0.14 来源:原博客 Benchmark Results。这是作者报告的数据,未在本机重跑。 博客的集成实验明确写了 RTX PRO 6000 Blackwell Server Edition 96GB 与 per-block compile;主表段落没有完整重述全部硬件和 warmup 条件,不能自行把另一组实验配置全部搬过来。 10% 是候选视频 K/V 块的精算预算。 它不表示只保留 10% 的视频 token,不表示总 FLOPs 下降 90%,也不表示整条视频生成流程提速十倍。文本、音频等 exact 内容、warmup、分组、摘要和 MLP 仍然有成本。 PSNR 越高、LPIPS 越低,表示相对 dense 参考更接近;SSIM 则主要衡量结构相似。它们回答“改动有多大”,无法单独回答“哪个视频更好”。 VBench 的一致性、平滑度和画质指标补充另一个视角,但也不能证明所有 prompt 上没有损失。 例如作者报告 Spark-H3 10% 的 VBench imaging quality 为 71.81,dense 为 72.14;aesthetic quality 为 68.22,dense 为 67.59。 几个维度接近且互有高低,适合表述为“这些已测维度整体接近”,不应扩写成全面无损。 03 从 dense attention 推到“精算加摘要” 自制原理图:两条分支先合并未归一化分子与指数质量,再得到输出;不能把两个独立 softmax 输出直接相加。 这一节开始进入推导。只想了解部署的读者,可以先读第 11 节源码地图和第 13 节使用说明。 记一个 query 为 q,块 B 内的 key、value 为 k 和 v,head dimension 为 d。注意力先算缩放点积,再指数化,最后统一归一化。 $$s_j(q)=q^T k_j/\sqrt{d}$$ $$Z_B(q)=\sum_{j\in B}e^{s_j(q)}$$ $$U_B(q)=\sum_{j\in B}e^{s_j(q)}v_j$$ Z 是这个块的注意力总质量,U 是还没归一化的内容贡献。全体块的 U 相加,再除以全体块的 Z 相加,得到最终输出。这里把“分子”和“分母”分开,是理解压缩分支的关键。 对精算集合内的块,逐 token 计算 Z 和 U。对剩下的块,用一个 key、一个 value 和一个质量修正项近似整块。这样,昂贵的 token 对 token 交互只发生在少量选中块中。 朴素均值压缩会取块内平均 key 和平均 value。块内有 m 个 token 时,摘要 logit 还要加 log(m)。 原因很直接:把同一个均值重复 m 次,指数质量就乘 m;改成一个虚拟 token 后,必须补回这个数量。 $$\widehat{Z}_B(q)=m e^{q^T\bar{k}_B/\sqrt{d}}$$ 因此,把一整个块压成一个 token,却不给它 log(m),会额外漏掉块大小这一项。 这个问题和 Jensen gap 是两回事,应先保证数量语义正确,再讨论怎样让近似更准。 两条分支最终共享同一套分母。不能分别算两个 softmax 输出,再直接加起来,或者各乘 0.5。正确合并时,哪一条分支带来更多指数质量,哪一条就分到更多权重。 实际内核通过 online softmax 维护行最大值、指数和、加权输出。这避免显式生成完整注意力矩阵,也让精算 token 与压缩摘要可以在同一个归一化过程中合并。 04 为什么固定时空块会把 Top-K 选错 来源:SparkH3 Team 原博客的 Spark-Reblock 动画。截取末帧;16 个 token、每叶 4 个 token 及图中召回数值均为动画玩具示例,不是 H3 消融实验。手机端将原图的分组与矩阵区域纵向排列;博客保留完整帧。 块稀疏注意力需要规则块:GPU 擅长计算整齐的矩阵 tile,不擅长逐个处理四散的 token。但“地址相邻”与“应该一起被注意”不总是一回事。 同一个视频里,一个人物可能跨帧移动。两个空间相近的位置,也可能分别属于人物和背景。扩散早期噪声更强,干净画面里的局部相似性会进一步减弱。 固定时空分组仍然有工程价值,只是未必符合当前层、当前 head 的注意力偏好。 假设一个块里混有几个极重要 token 和大量无关 token。均值打分会把重要成员稀释。预算有限时,整个块可能排不到 Top-K;即使入选,也花了大部分计算在无关成员上。 Reblock 的做法是改变打包方式:把注意力偏好相近的成员放在一起。这样块均值更有代表性,选中一块时,“整块都值得算”的概率更高。 图 1:自制教学实验。左图为交错排列的合成 token,右图按二阶矩特征做等容量二叉分组;亮区域更集中。这里只演示分组几何,未使用作者的 landmark/fanout-16 生产算法,也不代表真实 H3 的质量收益。 单纯重排不会丢信息。对 Q 重新排序,对 K/V 使用同一套 key 排列,计算后恢复 query 顺序,dense attention 的输出在精确算术下保持一致。 真正引入近似的是后续块选择和摘要替代,而不是 permutation 本身。 这也解释一个实现要求:Q 和 K 可以独立分组;但 K 与 V 必须绑定重排,输出必须按 Q 的逆排列恢复。哪怕公式写对,只要其中一处索引错位,就会把别人的内容写到当前 token 上。 05 核心原理一:为什么用“对侧二阶矩”衡量相似 自制原理图:Q 的分组由 K 的非中心化二阶矩诱导,K 的分组则参考 Q;对应比较的是打分模式的相似性。 直接比较两个 query 的欧氏距离,不一定能判断它们对 key 的偏好是否相近。更合理的办法,是比较它们对所有 key 打出的分数模式。 把 query 的完整打分向量写成 Kq。对两个 query,打分向量的内积可以改写为: $$\langle Kq_i,Kq_j\rangle=q_i^T K^T Kq_j$$ 定义 key 的非中心化二阶矩: $$M_K=K^T K/N$$ 于是两个打分向量的 cosine,可以不用真的构建长度为 N 的打分向量,转而在变换后的 d 维空间计算。博客把对应距离写成: $$d_Q(i,j)=1-\cos(M_K^{1/2}q_i,M_K^{1/2}q_j)$$ 这不是凭空添加的“统计技巧”:它来自对 attention logit profile 的比较。 某个方向如果在 key 分布里几乎不出现,query 在这个方向上的差异,对打分影响就很小;key 经常变化的方向,则应得到更多关注。 对 key 做分组时,同理使用 query 的二阶矩。Q 的分组看 K,K 的分组看 Q。 源码中的交叉命名容易绕晕,抓住这个关系就不会读反。 这里有三处边界要说明。 第一,M 是 E[kkᵀ],没有减均值,不能随手改成协方差 Cov(k)。后者会改变几何含义。源码还引入采样、ridge 等数值处理,因此数学等式与实际估计器要分开看。 第二,这是对原始打分模式的 cosine,不是对 softmax 后概率分布的精确距离。cosine 会忽略向量整体尺度,但尺度可能改变 softmax 的尖锐程度。 它是有依据的分组标准,不能宣称“同组 query 的注意力分布完全相同”。 第三,不需要显式求一个对称平方根。只要找到因子 L,使 LLᵀ 近似 M,对行向量使用 qᵀL 就能得到同一内积几何。 不要把“Mahalanobis”习惯性理解成必须乘逆协方差;这里采用的是对侧二阶矩诱导的度量。 06 从几何到硬件:为什么还需要等容量层次划分 自制教学图:16 个 token 逐级分成容量相等的子组,最终每叶 4 个 token。真实生产路径通常使用 64-token 叶块,图中分叉仅用于解释容量约束。 知道相似度,还不足以得到 GPU 好用的稀疏块。普通 k-means 的簇大小会不相等:有的簇很多 token,有的很少。如果再硬切成固定块,边界可能切断簇,或者混入别的簇。 Spark-Reblock 通过层次划分处理容量约束。从整组 token 开始,按指定子节点容量分配成员,然后在子组内继续细分,直到叶子是目标块大小。当前生产路径通常面向 64-token 叶块。 固定版本的默认设置包括 fanout 16、32 个 midpoint landmarks、group size 1,以及 power-of-two fanout 调度。 landmarks 帮助估计节点内划分方向,再用容量约束产生规则块。它不是对每一对 token 都计算相似度,也不是全局最优聚类的保证。 博客给出的分组复杂度是 O(N log N),这个判断需要把 head dimension、landmark 数量和分叉数视为固定参数。 每一层处理当前 token,层数随序列长度对数增长,因而避免直接枚举所有 token 对。 但 Spark 整套注意力不因此变成 O(N log N)。 如果始终精算固定比例 ρ 的视频块,精算部分仍有约 ρN² 个交互。逐 query 消费 N/64 个尾部摘要,也保留二次量级,只是常数更小。Reblock 的复杂度与整个注意力的复杂度必须分开说。 源码还有一个值得注意的优化:ComfyUI 当前默认 reblock_layout=q_reuse_k,只构建 K 布局,让 Q 复用;independent 则分别构建两侧布局。 两者会带来不同的布局成本与分组结果,不能只凭博客的抽象描述推断当前节点必然独立分组。 原博客 Spark-Reblock 消融在 10% 预算下,把 attention-mass recall 从 68.66% 提升到 81.54%,增加 12.88 个百分点;PSNR 从 18.61 提升到 22.41 dB。 这个实验只替换分组,其他设置保持不变,因而支持“更好的块布局有帮助”这一判断。 attention-mass recall 统计选中交互覆盖了 dense 的多少概率质量。它不是视频语义召回率,也不表示丢掉了其余概率:压缩分支仍会近似剩余部分。 07 核心原理二:均值压缩为什么会低估注意力质量 来源:SparkH3 Team 原博客的 reweight_correction 图。蓝色为先平均再 exp,橙色为先 exp 再平均,绿色表示修正后的等效 logit。原图用 x₁=−1、x₂=2;手机端按相同数据重绘并配中文说明。这张图解释质量偏差,完整加权 K/V 构造见第 08 节。 注意力是先 exp,再求和。均值压缩把一组不同的 logit 替换成平均值,再 exp。由于指数是凸函数,这两个顺序通常不等价。 $$E[e^x]\ge e^{E[x]}$$ 这就是博客提到的 Jensen gap。同一块内部的 logit 越分散,先平均再指数化就越容易遗漏高分成员带来的质量。 压缩块与 exact 块放在一个 softmax 中竞争时,压缩块可能因此被系统性压低。 拿一个只有两个 token 的块看得最清楚。令 d=1、q=1、key 为 −2 和 2,value 为 0 和 1。两个 logit 就是 −2 和 2。 真实指数质量:exp(−2)+exp(2)=7.524391。 均值 key 为 0;补了两个 token 的数量后,近似质量仍只有 2。 均值 value 为 0.5;真实块内加权 value 则为 0.982014。 所以需要补的有两件事:这个块该分到多少权重,以及它拿到权重后应当输出什么内容。只修分母、不修 value,仍可能把块的主要内容算错。 Reweight 采用一个代表 query,为每个块重新计算摘要。默认代表点是当前 head 内所有目标视频 query 的均值。 只用一个代表点给所有 K 打分,新增摘要构建可保持线性复杂度;若每个 query 都重新生成专属摘要,就回到了昂贵的全量交互。 08 完整推导:加权 K、加权 V 与 log-mass bias 来源:SparkH3 Team 原博客的 Spark-Reweight 动画。截取末帧;四个玩具 token 的 logit 为 −2、−1、1、2,图示依次修正压缩质量与加权 value,并与固定 exact 分支联合归一化。它展示代表 query 处的匹配,不表示任意 query 都精确。手机端将两侧面板纵向排列。 记代表 query 为 a。先在块内计算相对 a 的 softmax 权重: $$p_j(a)=\operatorname{softmax}_j(a^T k_j/\sqrt{d})$$ 再同时加权 K 和 V: $$\widetilde{k}_B=\sum_{j\in B}p_j(a)k_j$$ $$\widetilde{v}_B=\sum_{j\in B}p_j(a)v_j$$ 最后构造质量修正。为了手机阅读,把它拆成两条短式子: $$\ell_B=\log Z_B(a)$$ $$b_B=\ell_B-a^T\widetilde{k}_B/\sqrt{d}$$ 对于实际 query q,用如下一个虚拟 token 近似整块: $$\widehat{z}_B(q)=q^T\widetilde{k}_B/\sqrt{d}+b_B$$ $$\widehat{U}_B(q)=e^{\widehat{z}_B(q)}\widetilde{v}_B$$ 在 q=a 时,这个摘要能恢复整块的真实 Z 和 U。 将 q=a 代入,第一项正好被 bias 中的减法消掉,留下 log Z;再乘加权 value,就回到原始未归一化分子。多个压缩块与任意 exact 块一起合并时,这个性质仍然成立。 这是理想精确算术下的性质,真实 BF16/FP32 实现会有舍入误差。 当前源码默认还会用存储后的 BF16 摘要 key 计算 bias 中的减项,使下游实际消费的 key 与质量校正相配合;可选 pre_round 是不同的数值消融。 回到上面的两-token 例子,a=1 时,加权 key 为 1.928055,加权 value 为 0.982014,bias 为 0.090095。 虚拟 logit 为 2.018150,指数后正好是 7.524391。 这里容易出现一个反直觉的误读:bias 比 log(2) 小,不意味着补偿方向错了。 加权 key 已经提高了 logit,bias 必须扣除这部分变化。 不能保留均值 key,却直接套用加权 key 对应的 bias;也不能换了加权 key,还继续无条件加 log(m)。 事实上,在未舍入的数学定义下,这个 b 就是代表点块内权重的熵 H(p),介于 0 和 log(m) 之间。全块近似均匀时,它接近 log(m);权重集中到一个成员时,它接近 0。 补偿的含义取决于“key 和 bias 的组合”。 09 更深一层:Reweight 可以看成 log-mass 的切线 下面这一层是根据定义推导出的解释,原博客并未把它写成完整定理。 把一个块的精确 log-mass 记为 f(q)=log Z_B(q)。它对 q 的梯度就是按当前注意力加权的 key,再除以 √d。 $$\nabla f(a)=\widetilde{k}_B/\sqrt{d}$$ 所以 Spark 的虚拟 logit 等价于 f 在 a 处的一阶展开: $$\widehat{z}_B(q)=f(a)+(q-a)^T\nabla f(a)$$ 这样可以看清它为什么比均值更贴近局部真实分布:它同时对齐了代表点上的函数值和梯度。也可以看清它的局限:q 走远了,一条切线无法描述整个曲面。 log-sum-exp 是凸函数,因此理想算术下,这条切线不会高于真实块 log-mass。局部二阶误差由注意力权重下 key 的协方差控制,方向上越分散,偏离代表点时误差越大。 这个性质只讨论单块质量,不意味着最终视频误差有同样简单的单调关系。 value 的限制更直接:摘要 value 对所有 q 固定,而真实块内加权 value 会随 q 改变。就算某处质量近似得不错,内容贡献也可能不准。 图 2:自制两-token 实验,key 为 −2 和 2,value 为 0 和 1,代表点 a=1。左图显示 log-mass 在代表点相切;右图显示固定加权 value 无法跟随全部 query。远离代表点时,Reweight 也可能比均值更差,应按实际分布评估。 这也解释了 Reblock 与 Reweight 为什么互补。前者让需要一起处理的成员更集中,也改善重要块的选择;后者尽量提高剩余块的摘要质量。 但不能由此推出它们误差必然相加,或者任何输入下组合都严格更优。 原博客 Reweight 单独消融保持固定分组,将绝对 log-mass 误差从 3.86 降到 2.78 nats,约下降 28%;PSNR 从 18.61 到 19.17 dB。 它的独立收益小于 Reblock 那组,但它修的是另一处误差,不能拿两组数字直接做联合归因。 10 先写一个能跑的实现,再看 GPU 优化 下面是独立编写的 NumPy 教学实现,采用稳定 softmax,输入一个块的 K/V 和代表 query。它与作者内核的数学目标对应,省略了多 head、混合布局和 GPU 调度。 import numpy as np def softmax(x): z = np.exp(x - np.max(x, axis=-1, keepdims=True)) return z / z.sum(axis=-1, keepdims=True) def summary(anchor, keys, values): scale = keys.shape[-1] ** -0.5 logits = keys @ anchor * scale weights = softmax(logits) key = weights @ keys value = weights @ values peak = logits.max() lse = peak + np.log(np.exp(logits - peak).sum()) bias = lse - anchor @ key * scale return key, value, bias def mixed(query, keys, values, exact_ids, block=4, anchor=None): logits, vals = [], [] scale = keys.shape[-1] ** -0.5 for bid, start in enumerate(range(0, len(keys), block)): kb = keys[start:start + block] vb = values[start:start + block] if bid in exact_ids: logits.extend(query @ kb.T * scale) vals.extend(vb) else: if anchor is None: ak, av = kb.mean(0), vb.mean(0) bias = np.log(len(kb)) else: ak, av, bias = summary(anchor, kb, vb) logits.append(query @ ak * scale + bias) vals.append(av) return softmax(np.asarray(logits)) @ np.asarray(vals) rng = np.random.default_rng(20261024) k = rng.normal(size=(32, 8)) v = rng.normal(size=(32, 5)) a = rng.normal(size=8) dense = softmax(a @ k.T / np.sqrt(8)) @ v out = mixed(a, k, v, {1, 5}, anchor=a) print(np.max(np.abs(out - dense))) assert np.allclose(out, dense, atol=1e-12, rtol=0) exact_ids 是本例手动指定的精算块集合;生产代码会由路由生成。选中块只贡献原始 token;未选中块只贡献摘要,避免重复记账。 最后只有一次 softmax,这一行承担了分子与分母的正确合并。 运行最后一段,最大绝对误差约为 1.25×10⁻¹⁶。同样随机输入与 exact 集合下,将尾部改成均值摘要,最大绝对误差约为 0.240925。 这个数字用于检验构造,不能当作 H3 指标或普适收益。 配套实验还做了三个独立检查:全部块精算时回到 dense;Q/K 重排后恢复输出保持不变;对侧二阶矩空间的 cosine 与完整打分向量 cosine 一致。三个最大误差均低于 1.1×10⁻¹⁵。 完整脚本位于本项目 tools/spark_h3_lab.py,会保存实验数字和两张图。它的等容量二叉 PCA 分组仅用于解释 Reblock 直觉,不冒充作者的分区算法。 复现生产性能需要跑真实 H3、正确的 CUDA 后端和相同评测协议。 11 源码地图:把每个公式对应到文件和调用路径 自制源码路线图;文件与当前解读固定的 502ef356 版本对应。图中的顺序用于阅读理解,实际后端可以融合若干步骤。 固定版本源码中,公开入口、布局、路由与内核分得比较清楚。阅读时建议沿着下面的顺序走,避免从一个叫 Spark 的辅助实验文件误入非默认路径。 第一站:公开入口。 spark.py 把 spark_reblock 直接别名到 recursive_landmark_tree_v2_blocks,把 spark_reweight 别名到 virtual_summaries。后者只构建加权 K/V 与 bias,不负责生成代表点、路由、精算或合并输出。 第二站:模型安装器。 processor.py 的 install_h3_spark_attn 构建控制器,安装 attention processors 和布局 hook。上下文退出时恢复原状态;同一个安装上下文中再次调用 pipeline 前,需要 reset,避免沿用上一次去噪计数与缓存。 第三站:二阶矩与分组。 landmark_direction.py 中的 landmark_direction_factors 处理交叉度量;landmark_tree_v2.py 构建等容量层次与 permutation。指标估计、landmark 策略和树分割是独立选择,别把它概括成一次普通 sort。 第四站:Top-K。 spark_integration.py 的 _sol_topk_policy_scores 提供了很直观的参考路径:计算 query 块均值与 key 块质心点积,再按候选视频块数确定预算。它不是先构建全 token 注意力矩阵再取 Top-K。 相邻位置的强制 exact 带,在重排默认设置下关闭。独立排列 Q/K 后,块号相邻已不表示原时空邻近。exact context 则单独加入,不挤占候选视频块预算。 spark_route.py 明确标为 experimental,不能仅凭名字把它当作默认路由。 第五站:摘要。 sol_numerator_virtual_q.py 的 _summaries 和 virtual_summaries 对应第 8 节。核对重点是三个输出:加权 key、加权 value、log-mass;它们必须来自同一套权重和尺度。 底层用 exp2/log2,是 GPU 数值实现选择。点积先乘 1/√128,再换到以 2 为底的指数单位,写回 bias 时再换回自然对数。 看到 1.442695... 与 0.693147...,不要误以为模型换了定义;它们分别是 log₂e 和 ln2。 第六站:融合计算。 spark_reweight_sm120.py 包含路由 mask、online softmax 与摘要质量合并等实现。生产路径还包含 packed route 导出,尽量避免在注意力内核里再次算路由 QK。 整体数据流可以理解为:QKV 投影与位置处理 → 确认 packed token 范围 → 重排规划 → 块路由和尾部摘要 → exact 与近似联合归一化 → 恢复 query 排列 → 输出投影。 某些后端将其中几步融合,未必存在对应的中间大张量。 12 为什么 Python 与 ComfyUI 要分开理解 根据固定版本源码整理:算法思想相通,安装方式、内核与默认值分别核对。ComfyUI 的 producer_chunk 是 QKV 生产端分块,不是 64-token 注意力块。 Diffusers/Python 与 ComfyUI 是两条集成路径。它们共享算法思想,但 hook 位置、内核、默认参数和布局实现会变化。 不能在 Python 路径复现一个结果,就认为 ComfyUI 所有配置都会逐位一致。 ComfyUI 的 comfyui_nodes.py 在原生 dit/double_block patch 结构接入;comfyui_backend.py 连接 architecture-specific comfy-kitchen CUDA 后端。 它没有在运行时调用研究路径的 Triton/CuTe attention 内核。 一个很实在的优化,是把排列索引直接交给前后处理:读入 Q/K/V 时按布局消费,输出时按逆排列 scatter,减少四次实体 gather 带来的额外显存读写。 数学上等价的流程,在长序列下可能有完全不同的内存成本。 固定版本节点的默认参数还包括:topk_ratio=0.2、dense_layers=0、min_tokens=12288、tail_granularity=query、producer_chunk=16384。 其中 producer chunk 是 QKV 生产端分块大小,不是 attention block size;后者仍通常为 64。较早文档出现的 4096 不能当成当前默认值。 tail_granularity=query 保留每一条真实 q 来消费摘要;block 则同一个 query 块共享近似结果。exact 分支仍使用真实 query。 只看“都有 Reweight”无法判断这两种配置的误差是否相同。 默认 sparse_scope=target-video,目标视频以外的参考视频、图像、文本和音频按 exact 条件处理。 Ref2VA 可以显式选择 joint-video,将目标与参考视频共同放入稀疏域;静态参考图、文本和音频仍 exact。这是功能范围变化,应独立评价参考一致性。 混合尾块也需要小心。视频边界如果不是 64 的倍数,不能把后面的文本 token 当成视频一起聚类。默认 dense-tail 路径把这一段按 exact 处理。 布局来自模型提供的元数据,比猜测 token span 可靠。 13 如何开始使用,哪些参数先别混着改 自制调度图:19 次真实去噪、20% warmup 向上取整为 4 次 dense;随后 15 次启用 Spark。调度器另含最终 σ=0 端点。 截至核对日期,作者 v0.1.5 发布说明 提供 Linux/Windows x86_64、SM86/SM89/SM120 的 CUDA 13.0 安装包,并增加 ComfyUI 0.42.x 的 comfy-kitchen 0.2.39 支持;包内同时提供面向 0.38.x–0.40.x 的 wheel。 Python 3.12+、PyTorch CUDA 13.0+ 等要求应以当前安装包为准。 SM86、SM89、SM120 大致对应这批发布包中的 RTX 30、RTX 40、RTX 50/相关 Blackwell 设备。 不要把研究代码中的 SM90/SM100 dispatch 分支,等同于这些架构已完成生产验证。硬件支持、融合实现完成度和发布包可用性,是三项不同事实。 如果走 ComfyUI,先下载符合操作系统与 GPU 架构的 ZIP,连同 SHA256SUMS 校验;将节点目录放到 custom_nodes,用启动 ComfyUI 的同一个 Python 执行安装器,再重启。 权重和 LoRA 不包含在节点包中。 参数建议从 fidelity、20% Top-K 和默认 exact 条件范围开始。 fidelity 在前 20% 模型调用使用 dense;speed 从第一次调用起稀疏;dense 用于旁路对照。 这三个模式不是博客主表里按 10%/20%/30% 密度命名的同一组标签。 模式控制 warmup,Top-K 控制活跃阶段的精算预算,需要分别记录。 例如 19 次真实去噪调用,20% warmup 按向上取整得到 4 次。 MiniMax-H3 的调度器还包含最终 σ=0 端点,因此 Python pipeline 的 num_inference_steps=20 对应 19 次真实去噪;安装器的 num_denoise_steps 应传 19。 少步 LoRA 的调度规则则按各自官方说明处理。 Python 集成可以写成下面的最小改动。这里假定 pipe、模型权重和 inputs 已按 MiniMax-H3 官方流程准备完成;它不是一份独立模型加载脚本。 from h3_sparse_attention import install_h3_spark_attn n_denoise = 19 with install_h3_spark_attn( pipe.transformer, num_denoise_steps=n_denoise, warmup_mode="warmup_steps", warmup_steps=4, dense_layers=0, topk_ratio=0.2, ) as attention: result = pipe( **inputs, num_inference_steps=n_denoise + 1, ) stats = attention.summary() 调参时先固定模型、prompt、seed、scheduler、帧数与分辨率,对比 dense 和 fidelity。 然后只改变 Top-K,观察脸部细节、快速运动、跨镜头一致性与参考保持;确认误差可接受,再减少 warmup。 计时至少同时记录模型去噪时间与整条 pipeline 时间。第一次编译、模型加载、权重 offload、VAE 解码和音频处理应明确计入或排除。 RTX 4090 与 96GB Blackwell 上的显存策略不一样,不能直接平移博客中的秒数。 若配合 KJNodes 低显存节点,作者建议模型连接顺序为:加载器 → Low VRAM Attention → Chunk FeedForward → Spark → 采样器。 小 chunk 可以降低临时显存,但会增加调用开销。双阶段 LBH 工作流中,高分辨率第二阶段应按作者说明关闭 dense warmup,避免再次支付预热成本。 14 如何判断“更快”与“更好”的证据 先看 Amdahl 定律。设原始流程里可被这项优化影响的比例为 p,该部分加速 r 倍,那么整体加速由两部分共同决定: $$S=1/((1-p)+p/r)$$ 原主表 Spark-H3 10% 的 attention 加速是 2.33×,DiT 加速是 1.73×。 将两者粗略代入简化模型,可反推出约 74% 的可加速占比;这只帮助理解未加速部分的约束,不是作者提供的 profiler 分解,更不能据此精确拆出 Reblock、MLP 各用了多少时间。 Spark-H3-Lite 在博客中被描述为重排延迟减半,主表 10% 时比标准版快 7.2 秒。 不要仅凭这个描述,把源码里的任意 q_reuse_k 或相邻层复用开关直接认定为 Lite 的唯一实现;复现实验还需要相应配置与完整记录。 再看与 Video DeltaNet 的比较。 博客在 345 帧、14.4 秒设置下报告,无 warmup 的 Spark-H3 达到 BF16 2.49×、FP8 2.86× 的每步 DiT 加速;相应 VDN 为 2.28×、2.60×。 这组数字不能证明 Spark 在同质量下胜过 VDN。两者没有可直接对齐的相同 dense 权重;作者也明确把无 warmup 结果看成乐观速度上界。 采用旨在保真度的 warmup 时,VDN 仍更快。FP8 行还必须与 FP8 dense 比,不能拿 BF16 dense 做分母放大加速。 Few-step LoRA 和 Spark 可以分别减少“运行几次”与“每次算多少”,但组合收益通常不是两个宣传加速倍数直接相乘。 warmup、第一层保留 dense、CPU–GPU 传输以及 latent 分辨率变化都会改变结果。 技术定位可以这样对照: 方法 改进重点 剩余内容如何处理 使用代价与边界 固定布局 BSA 规则分块与选择精算块 取决于具体实现;博客消融带均值尾部 易接内核,分组可能不匹配当前内容 Sol-Attn 动态阈值选择与融合归一化 均值压缩分支 稀疏率随内容变化 Veda 训练更准确的块选择评分 博客讨论的方案丢弃未选块 需要相应训练或适配权重 Spark-Attn 自适应布局与加权尾部摘要 代表 query 条件下的加权 K/V 加 bias 重排成本、代表点近似与后端兼容 Video DeltaNet 精算局部规则加训练适配的 DeltaNet 通过学习的线性分支覆盖其余关系 模型适配与权重不能直接等同 dense BSA 在不同项目里可能只表示一个宽泛的算子家族。有些实现丢弃尾部;这篇博客的消融基线保留均值尾部。讨论横向比较前,应先确认具体算子,避免同名不同义。 15 我对这项工作的判断 Spark-H3 最值得学习的地方,是它把三个常常混在一起的层次接上了:先定义注意力偏好的几何,再构造 GPU 能消费的规则块,最后为未精算部分建立同时考虑质量与内容的摘要。 Reblock 的对侧二阶矩有明确的打分向量解释;Reweight 的摘要可以推导出代表点匹配和 log-mass 切线性质;内核再把这些运算融合进真实推理流程。 读懂其中任意一层,都能回头检查另两层是否实现了同一件事。 工程上也要保留几个现实判断。 当前证据主要围绕 MiniMax-H3,不能外推到所有 DiT;单代表点会有结构性误差;保真度和主观质量不能互相替代;长序列的节省要抵消重排与摘要成本,短序列可能更适合 dense。 作者博客尚不能替代完整可复现实验报告。 如果你已经在做 H3 工作流,这是一条值得实测的推理替换路径。若做稀疏注意力研究,更值得跟进的是代表点怎样选择、块质量误差怎样界定,以及能否让路由预算随层和内容变化,同时保留高效内核。 读代码时可以一直带着三个检查:这个块为什么值得精算?这个摘要的质量和内容是否配套?这些优化最终有没有省下真实墙钟时间? 这三个问题,比单看一个稀疏率更接近方法是否可用。 来源与复现实验 技术博客与原始结果 固定版本源码与 README 注意力内核与集成说明 ComfyUI v0.1.5 安装包与版本要求 MiniMax-H3 官方项目 Sol-Attn 官方项目 原理图与数值验证为本次独立编写的 CPU 实验;原博客实验值均已注明来源和条件。未运行模型权重、未测本机 GPU 性能。解读与推导:人工智能炼丹君,2026-10-24。
-
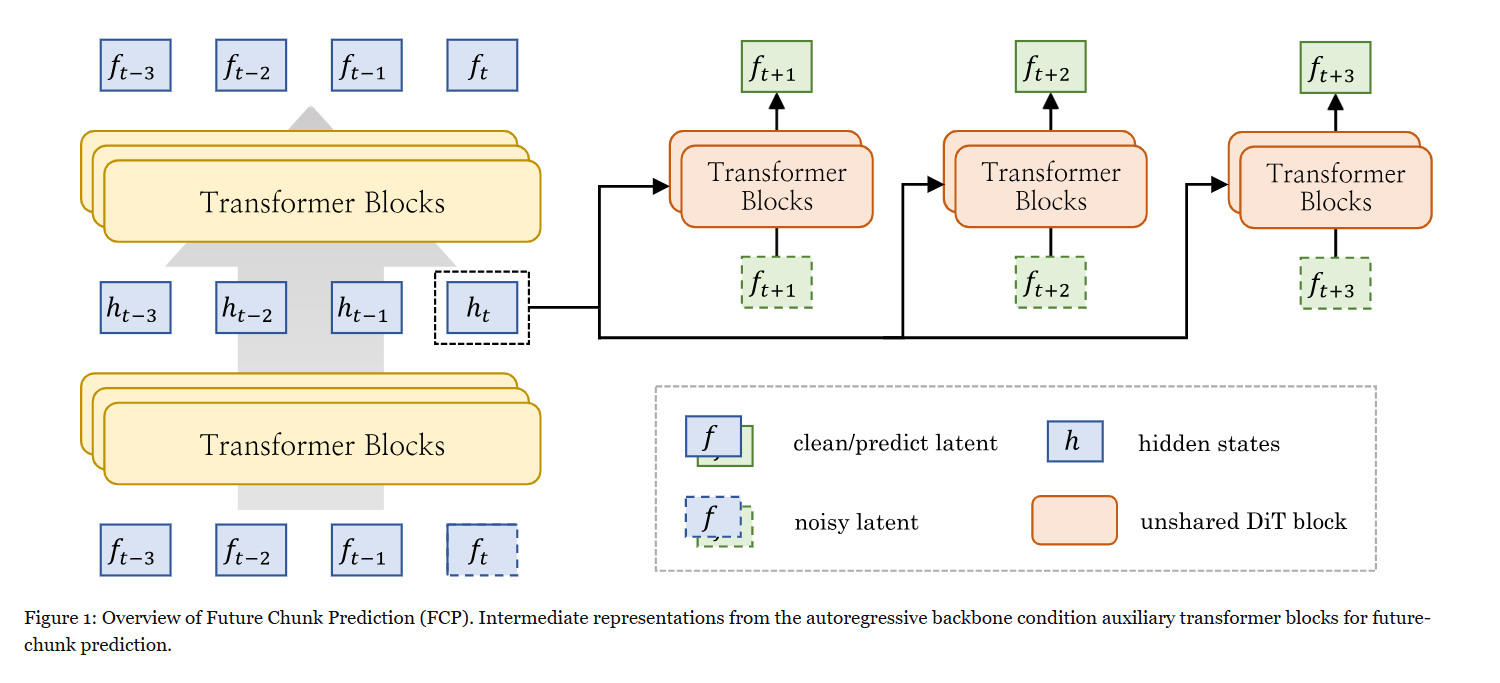
AIGC 每日速读|2026-10-23|南京大学腾讯ARC用未来块监督视频生成FCP 今日 AIGC 论文速览 今日共 10 篇 · 视频演化训练 1 篇 · 驾驶与人物视频编辑 2 篇 · 图像编辑与少步对齐 2 篇 · 视频几何纠偏 1 篇 · 长视频记忆与计算分配 2 篇 · 语音生成表征 1 篇 · 交互视频压缩 1 篇 重点论文标题列表 FCP(南京大学):别只接下一段还要预测更远 HorizonComposer(西蒙菲莎):换天气时保住车辆和车道 JointLight(中科院计算所):先滤掉几何伪影再给人物换光 ER-Chord(新加坡国立):单步改图把力气用在可靠位置 AdvFidelity(阿里淘天):少步奖励训练也盯住网格伪影 选读入口:想知道逐段视频生成为什么能接得顺、却未必学会场景如何演化,先读FCP:训练时增加未来块预测监督,推理仍按原流程逐块生成。若要编辑已有视频,再按场景选HorizonComposer的驾驶天气改写或JointLight的人物重打光;单张图局部编辑看ER-Chord,少步生成纹理瑕疵看AdvFidelity。镜头几何漂移读CausalAlign,一分钟视频忘前文读Attn-Forcing,稀疏算力分配读ALLOT;语音事件编码读RubatoCodec,交互视频压缩读CADRE。 今日论文速览 1. FCP:别只接下一段还要预测更远 Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation | 南京大学;腾讯互娱 ARC 实验室;浙江大学 | arXiv:2610.29989 关键词:自回归视频, 未来块预测, 物理合理性, 辅助监督 前序问题:前一秒画面没断,不代表后一秒运动合理。训练总给真实相邻历史,模型可能靠几乎不变的画面就完成去噪;怎样逼它学习更远的变化? 方法直觉:把中间几段挡住,让模型仅凭当前内部特征预测更远的片段。辅助预测器不能互相偷看未来,也不给文字捷径;主模型因此要在特征里留下时间演化信息。 本文贡献:Future Chunk Prediction 即未来块预测,在标准教师强制训练上增加独立辅助分支;教师强制指以真实历史而非生成历史作条件。Wan 主干抽取干净历史与带噪目标的多层特征,经多层感知机融合后逐 token 调制每个三层扩散Transformer预测器;token是网络处理的特征单元。各未来偏移并行、互不串接,省略文字跨注意力,辅助梯度回到主干。推理删除这些分支,仍按原流程逐块生成。 原文图1|未来块预测FCP概览。自回归主干的中间表征作为辅助Transformer块的条件,预测更远未来片段;训练梯度回到主干,推理移除辅助预测分支。 实验效果:匹配训练数据/设置的 Wan2.2-TI2V-5B 对照,Physics-IQ Verified 的总体 IQ 评分在图生视频30.4→33.8,视频续写40.6→44.4;这是与真实录像对比的物理合理性评分,不是成功率。1.3B消融中,监督干净/带噪特征兼用时30.9,仅干净28.8、仅带噪29.9、原训练27.6。达到 IQ=30 的估算训练计算比全历史特征辅助版少50.7%,不能写成比基础训练省50.7%。 原文表2|Wan2.2-TI2V-5B受控比较。图生视频I2V与视频续写V2V分别报告Physics-IQ Verified总体IQ及SP、ST、WS分项;灰色行列为默认配置与总体分。偏移是未来块的整数距离,chained表示串联预测,不能与彼此独立并行分支混同。 批判点评:5B训练首阶段32张GPU、25000步、121帧1024×576,另有后续阶段,辅助网络增加训练成本;推理路径相同不构成实测零时延。不同公开模型的数据和训练不同,横榜不用于归因;部分补充评测依赖视觉语言裁判,细微动力学未必敏感。项目 与代码 可查,未复现。 2. HorizonComposer:换天气时保住车辆和车道 HorizonComposer: Spatiotemporally Consistent Driving Video Editing with Enriched Traffic Semantics | 西蒙菲莎大学;NEC 美国研究院 | arXiv:2610.28829 关键词:驾驶视频编辑, 交通语义, 像素奖励, 参考帧过渡 前序问题:把晴天行车记录改成雪夜,车道线弯了、前车消失了,生成片就不能再用于验证原场景。天气和光线要变,车辆身份、位置与运动却必须尽量保留,怎样让编辑器分清这两件事? 方法直觉:不把整段训练视频一概判好坏,而是逐像素标出哪些变化可信;另外给参考图片与动态视频留一段内部过渡,先消化参考里错位的车,再输出正式片段。 本文贡献:在 Cosmos-Transfer2.5 上冻结深度控制分支、微调视觉分支。混合重复路线实拍配对与合成编辑配对,以场景变化检测、车道/车辆分割、光流及指令评分形成内容、时序、对齐三路奖励,转为逐像素二值条件;离线强化训练时以0.3概率丢弃它,推理设为全正。前置2个思考潜帧并镜像反转开头控制序列,完成后裁掉;按时间压缩4倍,它们对应8帧过渡,生成93帧后保留85帧。这里的思考指时序缓冲。 原文图3|细粒度奖励图生成。对每对视频,结合帧级编辑指标、像素级场景变化掩码和驾驶语义检查生成稠密奖励图;以可信外观修改为监督,同时保护车道和车辆等关键交通语义,具体实现见原文附录H。 实验效果:44位参与者给出429条准则级回答,内容保持偏好46%,SyntheticPip 为33%,约39%是相对增幅,不是增加39个百分点。SeRM 车道分割的平均交并比 mIoU 为37.48%→40.27%。BDD100K 从200真视频增补200生成视频,整体平均精度 mAP 为0.167→0.175;严格定位阈值0.75的 mAP@75 为0.154→0.165,才对应相对7.14%。训练2张80GB H100、48 GPU小时;推理35步,未报完整耗时/峰值显存。 原文表4|BDD100K下游多对象检测。真实200视频与同样真视频加200生成视频比较;mAP为跨交并比阈值平均精度,mAP@50/75分别在0.50/0.75阈值下计算。三项从0.167/0.316/0.154升至0.175/0.324/0.165,相对增幅4.79%/2.53%/7.14%,不是百分点。 批判点评:150例域内、150例域外评测中,结构保持有收益,但域外指令成功指标较 SyntheticPip 低4.52%,画质指标低3.10%。局部轨迹修改需先由 HorizonForge 完成,不是本模型直接控制任意车辆。额外8帧和外部参考编辑器有成本;86,614总视频与28,348合成训练片不是同一统计单位。原文未给本方法代码入口,不作会议接收推断。 3. JointLight:先滤掉几何伪影再给人物换光 JointLight: Human-Centric Video Relighting with Asynchronous RGB-Irradiance Joint Modeling | 中科院计算所;中国科学院大学;卡迪夫大学;快手 | arXiv:2610.29780 关键词:视频重打光, 辐照度, 异步去噪, 几何误差 前序问题:人物视频想把阳光从左边转到右边,改色调不等于改光照。先估几何再渲染光照虽可控制方向,网格孔洞和锯齿又会变成漏光,怎样用粗几何而不照搬其错误? 方法直觉:把粗光照加噪,让细碎伪影先消失,保留大尺度亮暗分布;再让彩色视频与光照图互相修复。二者处于不同噪声阶段,避免把不可靠光照当作干净真值。 本文贡献:逐帧从单目点云构网格,赋白色漫反射材质,在 Mitsuba 3 中用目标高动态范围环境图渲染辐照度,即表面接收的照明分布。Wan2.2-TI2V-5B 把源视频、带噪彩色视频与辐照度沿时间拼接,共享旋转位置编码、用模态嵌入区分。训练12000步,最后4000步以估计光照替换真值做域匹配。推理将光照固定在0.6T噪声阶段,T为完整去噪日程,彩色支路到该阶段后两路一起去噪。 原文图2|完整训练流程。带噪彩色视频、带噪辐照度视频及源视频编码后沿帧维拼接,输入全量微调的扩散Transformer;彩色与辐照度token分配各自噪声时间,支持异步推理。 实验效果:训练用UE5合成6.8万段、每段94帧、832×480视频及配对光照;测试静态光/旋转光各50例。旋转光下 PSNR 像素信噪比16.39分贝,对照 UniRelight14.90;LPIPS 感知距离0.263/0.303,越低越好。静态光结构相似度 SSIM 为0.656,低于对照0.661。单张 A800、81帧、50步完整流程223秒,含点云/深度22.8秒、网格38.2秒、渲染18.8秒、神经生成141.9秒;未报峰值显存。 原文表1|SynthStatic静态光、SynthDynamic动态光及用户评分。PSNR像素信噪比、SSIM结构相似度越高越好,LPIPS感知距离越低越好;VQ/LF分别是视觉质量/光照忠实度,13位用户对15例按1至5评分。粗体/下划线为最好/次好。静态SSIM仍由UniRelight领先。 批判点评:真实视频主要作定性和13人15例评分;HumanOLAT 独立测试是前景掩码后的静态图,不能当作真实动态视频定量证明。光照图只管漫反射,镜面、金属和玻璃的高光不保证正确,强运动及深度断层仍可能漏光,脸部细节也可能过平。论文首页给出 SIGGRAPH Asia 2026 会议及DOI证据;代码、数据仅承诺公开,未见本方法下载入口。 4. ER-Chord:单步改图把力气用在可靠位置 ER-Chord: Spatially Consistent One-Step Image Editing via Equal-Energy Reliability Redistribution | 新加坡国立大学;快手;大连理工;天津大学;哈尔滨工业大学;腾讯 | arXiv:2610.29248 关键词:单步编辑, 空间分配, 等能量, 无需训练 前序问题:只把沙发换颜色,单步编辑器却连墙面一起改。把整体编辑强度调小能保背景,但目标也改不动;能否总力度不减,只把它放到更可信的位置? 方法直觉:比较相邻噪声水平给出的编辑方向:局部越一致,越值得分配更新幅度。保留每处原方向和全图总能量,用一个共同的调节量重新分配幅度。 本文贡献:复用 ChordEdit 的两个端点预测,以端点差异相对局部控制幅度定义可靠度;它表示预测一致,不表示语义一定正确。目标是在接近原编辑场的同时惩罚低可靠位置,约束清理前控制向量平方和不变。强度参数小于1且原能量非零时有唯一方向保持解;用最多32次二分求共同标量,CPU开销小于0.01秒,不加去噪网络调用、训练、反演或反向传播。 原文图1|ER-Chord方法概览。从时间聚合的编辑控制场出发,测量局部端点一致性,在方向不变、总控制能量固定的前提下重新分配空间幅度;不需辅助引导、训练、反演、额外去噪评估或反向传播。 实验效果:PIE-Bench 全700例,SD-Turbo、相同目标文本/噪声/种子:背景 PSNR 为22.20→22.77分贝,LPIPS 感知距离按1000倍标度128.25→120.23,目标编辑区图文相似度22.96→23.16。完整法为1次输运更新加1次清理,网络评估次数 NFE=2;无清理 NFE=1,不能将单步写成全流程只调用网络一次。报告0.37秒/图,对照0.38,峰值均6988 MiB;所读原文未说明具体测速卡型。 原文表1|PIE-Bench编辑比较。MSE均方误差及LPIPS感知距离按1000倍显示;PSNR与整图/编辑区图文相似度越高越好。绿/黄/紫分别为前三名;T-/I-free表示无需训练/反演。Steps为输运步数,NFE为网络评估次数;完整ER-Chord还含清理,NFE=2。时间为秒,峰值内存MiB。 批判点评:外部 TEdBench 100例的方向相似度0.25与对照持平,不能概括为全指标上涨。等能量只约束清理前,不能证明最终图片改动量一样;低可靠点也不必全部减弱,约束在全图耦合。若底座方向就错,重新分力度仍救不了。代码 已有作者入口,本稿未运行模型。 5. AdvFidelity:少步奖励训练也盯住网格伪影 AdvFidelity: Unifying Preference Alignment and Few-Step Image Generation within Reinforcement Learning | 阿里淘天集团;上海交通大学 | arXiv:2610.29380 关键词:图像生成编辑, 少步强化学习, 对抗奖励, 参考配对 前序问题:图像符合文字、奖励得分也高,放大却满是网格和纹理噪点;先强化对齐再蒸馏加速,又可能丢掉对齐收益。怎样在少步训练里同时检查这些低层缺陷? 方法直觉:找高质量参考图,加适量噪声再由当前模型重建,做成内容接近、细节质量不同的一对。判别器不容易靠题材或色调取巧,而要学着分辨生成器眼下的伪影。 本文贡献:基于 LeapAlign,让任务奖励和在线保真奖励的梯度穿过实际4或8步采样轨迹,共同训练 LoRA 低秩适配器,不使用分布匹配蒸馏损失。判别器冻结 DINOv2 视觉主干,只训练全局特征上的多层感知机,并用随机裁块放大局部问题。参考加0.3或0.5噪声后用一两步重建负例;每次生成器更新后更新判别器,正负配对用排序损失。参考按任务选原底座样本、目标风格模型样本或真实训练图。 原文图2|AdvFidelity。(a)少步生成器从噪声采样,任务与保真奖励共同更新。(b)高质参考加中等噪声,由当前模型重建成内容匹配的负样本。(c)判别器按Bradley–Terry配对排序损失在线更新,再提供保真奖励。每轮先更新一次生成器,再重复构造配对及判别更新。 实验效果:FLUX.1-dev 在 GenEval553条提示、每条4图上,组合生成总分4步0.7535、8步0.7759,50步 LeapAlign0.7420。Qwen-Image-Edit-2511 换装124例,8步、无分类器自由引导 CFG,服饰特征相似度0.7929;40步且带CFG对照0.7874。外域四项1至10分由 Gemini 三次评价同一组生成图,误差条表示裁判重复波动,不是多次模型训练。训练新增参考重建及判别器更新,未给完整耗时显存账单。 原文表3|Qwen-Image-Edit-2511换装定量比较。域内用DINO服饰特征相似度,域外用真实感、一致性、对齐、协调性四项模型裁判评分;CFG标明是否用分类器自由引导,NFE为报告的采样网络评估口径。8步法不使用CFG;均值和标准差来自对同一组图三次裁判评分。 批判点评:不做显式蒸馏,不等于不用强模型参考:偏好任务准备5万张50步、已对齐模型样本;GenEval另用5000张底座参考,不能混为同一设置。消融按组件累加,尚非所有因素独立随机对照;奖励风格依赖所选参考,少步数也不能直接换算同倍加速。当前未核实方法代码链接,不宣称可立即复现。 6. CausalAlign:镜头运动别在去噪后段忘掉 CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion | 北京大学;北京通用人工智能研究院;英伟达;清华大学;威斯康星大学麦迪逊分校 | arXiv:2610.29915 关键词:视频几何, 相机运动, 因果诊断, 变化特征对齐 前序问题:视频刚开始镜头绕物体转得合理,越往后几何却漂移。模型内部能解码相机运动,不代表生成时真正使用或保留它,怎样找到该补强的层和去噪阶段? 方法直觉:既做读出测试,也主动遮掉、打乱、替换或注入运动特征,看生成是否受影响;只在运动信息开始衰退的位置,教模型保存前后帧的变化,而不是死记静态场景。 本文贡献:用冻结的 LingBot-Map 三维教师学习128维 delta token,即帧间变化特征,其中64维运动、40维几何、24维视觉。三阶段先训教师变化编码器,再训主干到该空间的投影器,最后冻结教师与投影器,只调目标层 LoRA。Wan2.2-14B-I2V 选14、10、12、20层和噪声索引398、799,以变化对齐及相对位姿监督训练;位置由线性探针和相同范数随机干预对照共同确定。推理只需首帧与文字,无额外三维缓存。 原文图2|CausalAlign三阶段训练。第一阶段把流式三维教师连续帧特征编码成帧间变化token;第二阶段用训练集小子集学习主干到变化空间的投影器,随后冻结;第三阶段用完整训练划分仅优化已诊断目标层的LoRA,投影器仍冻结。 实验效果:DL3DV、RealEstate10K 各90%训练/10%评测,同采样/种子:重投影误差8.4→6.5像素,降22.6%;深度-光流误差6.9→5.5像素,对照 FantasyWorld 为5.4,仍更低。视频分布距离 FVD 为182.4→182.7,越低越好,不能称画质全指标改善。迁移 Fast-WAM 后任务组平均成功43.5%→54.2%,提高10.7个百分点;原子已见任务703/900成功,对应78.1%。 原文表1|相机自身运动一致性,同划分、估计器及生成设置。无相机控制的方法只收首帧和文字,有控制的方法额外收轨迹及三维缓存。平移/角速度接近度、平滑度越高越好;重投影、深度-光流、极线误差单位像素,越低越好;Jerk度量加速度突变。CausalAlign七项均优于底座、六项列首。 批判点评:相机未来并非唯一,主榜评内部几何一致,不是逐帧命中给定轨迹;显式相机控制对照还拿到轨迹与三维缓存,输入条件不同。运动姿态与深度均由冻结估计器恢复,估计误差仍在。教师、干预诊断及三阶段适配有额外训练成本,未给完整耗时显存,推理移除辅助网络不代表已实测加速。核心是视频生成,机器人迁移只是补充;未核实方法代码入口。 7. Attn-Forcing:旧画面删掉后仍记住它的作用 Attn-Forcing: Learning Full-Context Attention Proxies for Streaming Video Generation | 同济大学;腾讯;南洋理工大学;香港科技大学 | arXiv:2610.30036 关键词:流式视频, 注意力代理, 历史压缩, 注意力监督 前序问题:流式生成一分钟视频,缓存旧帧会越来越贵,删掉又容易忘记前面。直接延长窗口还可能让运动变僵,怎样在固定内存里保住历史对当前画面的影响? 方法直觉:把将要移出窗口的内容交给少量可学习代理,并教代理回答“当前查询看旧历史会得到什么”,而不只要求它把旧画面压缩得像。 本文贡献:Wan2.1-T2V-1.3B 上保留3个起始潜帧、9个局部潜帧和3个代理潜帧;这些是压缩视频帧,不是3个标量或文本token。门控跨注意力用被移出的视觉潜变量更新代理,再经主干形成逐层键值缓存。128维随机特征在线累计历史键值统计,近似历史注意力响应,停止梯度后只作监督目标;最后6层的匹配损失仅优化代理参数。与分布匹配蒸馏联合训练,短初始化700步、60秒流式长训2300步,16张H20、总批量32。 原文图2|Attn-Forcing。训练时,把将从局部窗口移出的视觉潜变量经代理更新模块写入可学习代理。注意力匹配损失让代理响应接近由在线累积统计近似的历史响应;统计只作监督,推理用代理产生的正常键值。 实验效果:946条VBench提示各5种子评5秒/30秒,60秒另用128条 MovieGen 提示。60秒六维加权总分82.37,LongLive79.26,动态程度72.14/35.55;但主体一致性97.11/97.93、背景95.84/96.60,保持不是全胜。自有消融仅加代理总分80.03→80.16,再加注意力监督到82.37,收益主要在监督。每块4去噪步;H20端到端生成时间额外约13%,还多一次主干前向,未报完整峰值显存。 原文表2|官方MovieGen提示生成60秒视频,128条提示,用VBench-Long六维评总分、主体/背景一致性、运动平滑、动态程度、美学及画质,均越高越好。粗体/下划线为最好/次好;总分更高不等于每项一致性最好。 批判点评:固定大小历史统计只用于训练监督;推理直接使用该近似会逐渐模糊,不能把线性注意力替换与代理法混为一谈。LongLive窗口从12扩到120时总分79.26→75.01,可能受训练窗口失配影响,并非长上下文天然更差。动态指标上升也不能替代精确回忆任务,尚无无限时长证据;未核实作者方法仓库。 8. ALLOT:按最终视频误差分配稀疏预算 Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers | 中国科学院大学;中科院自动化所;快手可灵;北京大学 | arXiv:2610.29441 关键词:视频扩散加速, 稀疏注意力, 离线校准, 延迟预算 前序问题:视频注意力每层都删相同比例,某个关键层一稀疏就变形;只看本层误差,又低估早期小误差向最终视频传播的影响。怎样把有限的注意力时间花对位置? 方法直觉:先逐个测“层×去噪步”被简化后最终损失多少,再按真实计时分配预算。像给关键工序留全量检查,对容错位置多省一点,而不是只按理论算量平均删。 本文贡献:ALLOT 全称 Allocating Layer-step Latency by Output Tests。先单层稀疏探测一步速度预测误差,再用每5步一窗的稀疏完整生成,校准误差向最终画面的传播增益;四段真实探测视频、八条校准提示。测量部署内核在各密度下的延迟,二分拉格朗日权重求每格密度表,超出稀疏内核交叉点就保留密集计算。推理查表,保留既有块排序与内核,但密度截断替代原逐头/逐输入阈值自适应。 原文图3|ALLOT流程。(1)离线测逐层单步误差、去噪轨迹传播增益、不同稀疏密度的内核延迟,为每个延迟预算C求密度表。(2)推理逐层逐步查密度,密度1调用密集注意力,否则使用既有稀疏内核。 实验效果:XAttention、Wan2.1-1.3B、480p81帧、50步、32提示,同种子相对密集视频的 PSNR 为18.14→25.37分贝;耗时148.7→148.6秒,密集183.8秒。这是贴近密集输出,不是绝对生成质量。四类公开管线九设置,按成对95%区间与感知距离共同判六胜三平;并非九项都更好。离线测量约6至23 GPU小时,Wan2.2双专家超过30;换 Radial/HunyuanVideo 的探测另报57 GPU小时,调预算CPU重求约4秒。 原文表1|XAttention、Wan2.1-1.3B、480p81帧、32提示的分配比较。Default为公开配置;按墙钟时间分组,前两组各重求ALLOT表,第三组双方都使用HEART跨步掩码复用TMR。粗体为组内PSNR/SSIM/LPIPS最好,保真指标参照同种子密集输出,Speedup为密集总时间除以该行时间。 批判点评:输出误差可加与传播增益跨层共享都是近似,求解器最优只针对离散估计目标及对应预算,不保证真实视频全局最优。部分设置 VBench 或感知距离退步,例如 SVG2 感知距离0.151→0.156。更换模型、选择策略和部署硬件需重新核对探测与计时;多次生成才能摊薄校准成本。未核实作者代码入口。 9. RubatoCodec:语音token留给变化快的地方 RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding | 第三智能公司(Third Intelligence) | arXiv:2610.29434 关键词:语音生成, 自适应编码, 事件预算, 流式解码 前序问题:语音生成每秒只留少量token,停顿和爆破音却分到一样多位置,短音节容易丢。若每句话的token总数又任意浮动,生成长度更难预测,能否总量固定、局部分得灵活? 方法直觉:同样长的一句话给同样事件预算,变化快的地方切得密,近静音切得疏;每个事件同时存内容码和持续时间,生成器按事件而非固定时钟输出。 本文贡献:基于 X-Codec-2,将16千赫输入编码到50赫兹、每格20毫秒;用潜特征变化与频谱通量定边界,K=round(RT),T为编码格数、R为保留比例,默认R=0.25,即约12.5事件/秒。二分和单调校正保证恰好K个非空事件。聚合起始特征、区间均值和时长,默认每事件16层量化,每层4096个码值;事件不是单个码索引。内容与时长恢复50赫兹网格,因果解码输出44.1千赫音频。TTS先生成各码层,再生成时长,可逐事件解码。 原文图1|RubatoCodec,默认保留比例0.25,沿用X-Codec-2编解码主干。潜特征变化和波形频谱通量分配固定预算事件;聚合器把事件起点特征与由起点、区间均值、时长得到的可学习修正相加。量化内容和时长恢复50赫兹网格,再经受Inworld TTS启发的上采样提高合成特征率。 实验效果:匹配 Qwen3-0.6B 主干、8码本、12.5事件/秒,English seed-tts-eval1088句零样本音色克隆:逐句平均词错误率 WER 为3.20%→3.10%,音色余弦相似度均0.392,预测音质 UTMOS 为4.080→4.162,非人工听评分。H200上另测250个合成代码事件,解码平均11.07毫秒/事件,对应平均约80毫秒声音;不包含文本模型生成、首包等待及在线编码,不能称11毫秒端到端语音响应。 原文表18|English seed-tts-eval语音合成。两系统同为八码本、标称12.5事件/秒。WER为逐句平均词错误率,越低越好;SIM为参考音色余弦相似度;UTMOS/UTMOSv2为预测音质,越高越好,非听评。粗体为较优值,并列共同标记。 批判点评:全句归一化、双向语义编码和未来特征用于分配,当前编码不是在线因果;流式成立于已给事件的解码。TTS生成88.3%句子恰中预算、99.9%差不超过1事件,并非全数严格满足。长事件偶有不自然停顿;码层与时长都计入比特率,不能把12.5事件/秒当12.5索引/秒。代码 与权重 可查,未运行。 10. CADRE:静止镜头与移动镜头压法不同 Rethinking Video Autoencoders for Interactive World Models | Kyutai;巴黎路桥学院 LIGM、巴黎理工学院、法国国家科研中心、古斯塔夫埃菲尔大学;加州大学伯克利分校 | arXiv:2610.30129 关键词:视频自编码器, 交互生成, 时空压缩, 动作延迟 前序问题:交互视频模型帧率够高,按键后却等很久才有反应;重建图像看着清晰,手里小物体的运动又丢了。该压时间还是压空间,不能只凭单帧画质决定。 方法直觉:每多合并几帧,模型少算几次,但动作也要等这几帧凑齐。静止镜头的时间重复多,移动镜头每帧都见新内容,两者应把压缩预算放在不同轴。 本文贡献:冻结 DINOv3 逐帧特征,训练三维卷积瓶颈;用因果扩散解码器、空间自适应归一化和零初始化跳接恢复像素。自蒸馏让一次大步匹配两次小步,得到一或二步解码。七种自编码器只改变时间因子τ和空间因子s,τ×s×s分别表示合并帧数与两轴压缩;潜变量由同一12亿参数、动作条件世界模型生成。训练自编码器用7.6万小时混合视频,比较另含五种既有自编码器。 原文图3|CADRE。冻结DINOv3提取器与训练瓶颈按τ×s×s压缩,τ为时间帧数、s为空间压缩因子;因果扩散解码器在输入、逐层空间调制及零初始化跳接三处接收潜变量。仅瓶颈、升维及时间分块随压缩点变化;训练结合感知、三维小波、流匹配及自蒸馏目标。 实验效果:机器人/人体操作、驾驶/室内导航四环境,统一20帧/秒、288×512,每环境2048例;给40真帧后生成96帧,评最后16帧。相同2×32×32压缩,单步扩散解码相对回归版将 FVD 视频分布距离降低1.4至2.5倍,越低越好;回归版像素PSNR反而更高,可能来自模糊。单H100、世界模型8步,仅若干配置达到20帧/秒且动作延迟小于230毫秒,不是所有压缩点。 原文图7|时间压缩和空间token的取舍。绿色固定空间块尺寸增加时间合并τ,橙色固定token总预算,空间格随之变粗。静止视角允许更多时间合并,移动视角合并过多会伤运动质量;完整结果在原文图15,不能仅凭图像清晰度选择压缩。 批判点评:动作可恢复比 ARR 是冻结探针读回动作的决定系数,再除以真视频探针分数,不等于机器人成功率。固定约1100个token/16帧时,移动镜头偏2×32×32、操作偏8×16×16;粗空间格会使操作FVD变差2.4倍而图像分布几乎不变。相机运动只是主要解释,场景/动作也随域变化,不能当严格单因子因果结论。项目 与代码 可查,未复现。 趋势观察 辅助监督要阻断捷径 FCP不让未来分支串看并去掉文字条件;CausalAlign以干预诊断找层;Attn-Forcing直接约束历史注意力响应,训练目标决定留下何种信息。 保持不是把编辑力度调小 HorizonComposer把可靠监督细化到像素,ER-Chord固定清理前总能量,JointLight先处理几何提示的噪声;各自保护的对象不同。 收益必须和成本放在一起 Attn-Forcing约多13%推理时间,ALLOT需离线探测,JointLight完整223秒含几何与渲染;少步骤、少缓存都不直接等于端到端更快。 压缩的计数单位影响结论 RubatoCodec每事件有多个码层和时长;CADRE同时压时间与空间;HorizonComposer的2潜帧对应8输出过渡帧,先说明单位再读数字。 今日讨论 FCP在标准教师强制训练上增加未来块预测;匹配训练数据与设置的Wan2.2-TI2V-5B图生视频对照中,Physics-IQ总体评分从30.4提高到33.8。若要检验收益是否来自隔开中间画面的未来块监督,而不是额外分支容量或训练计算,哪些证据能说明等数据、等计算的消融成立,并同时排除推理质量与成本退步? 人工智能炼丹君 整理 | 2026-10-23
-
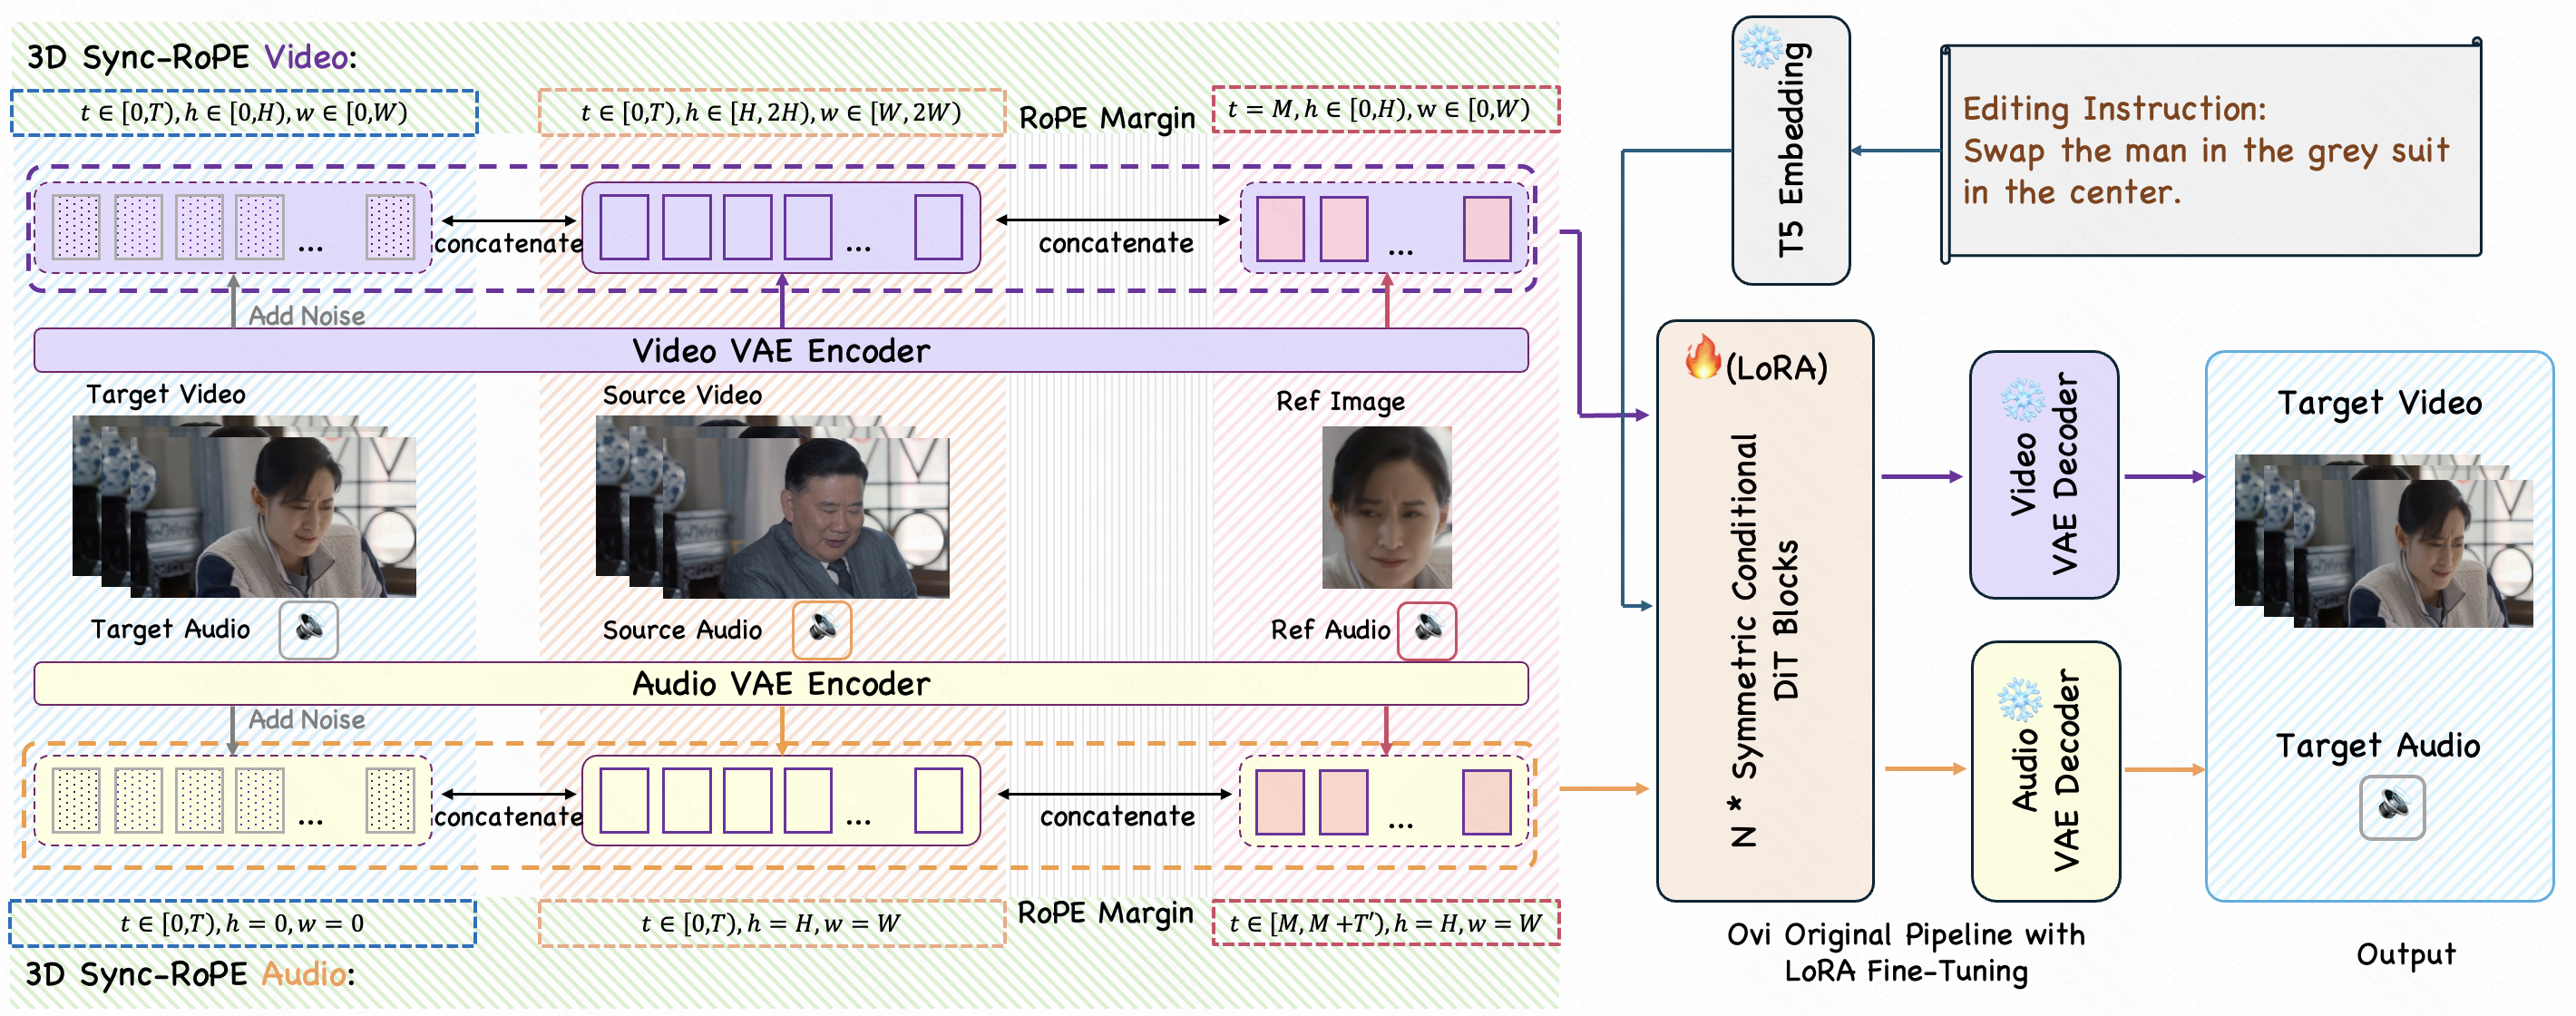
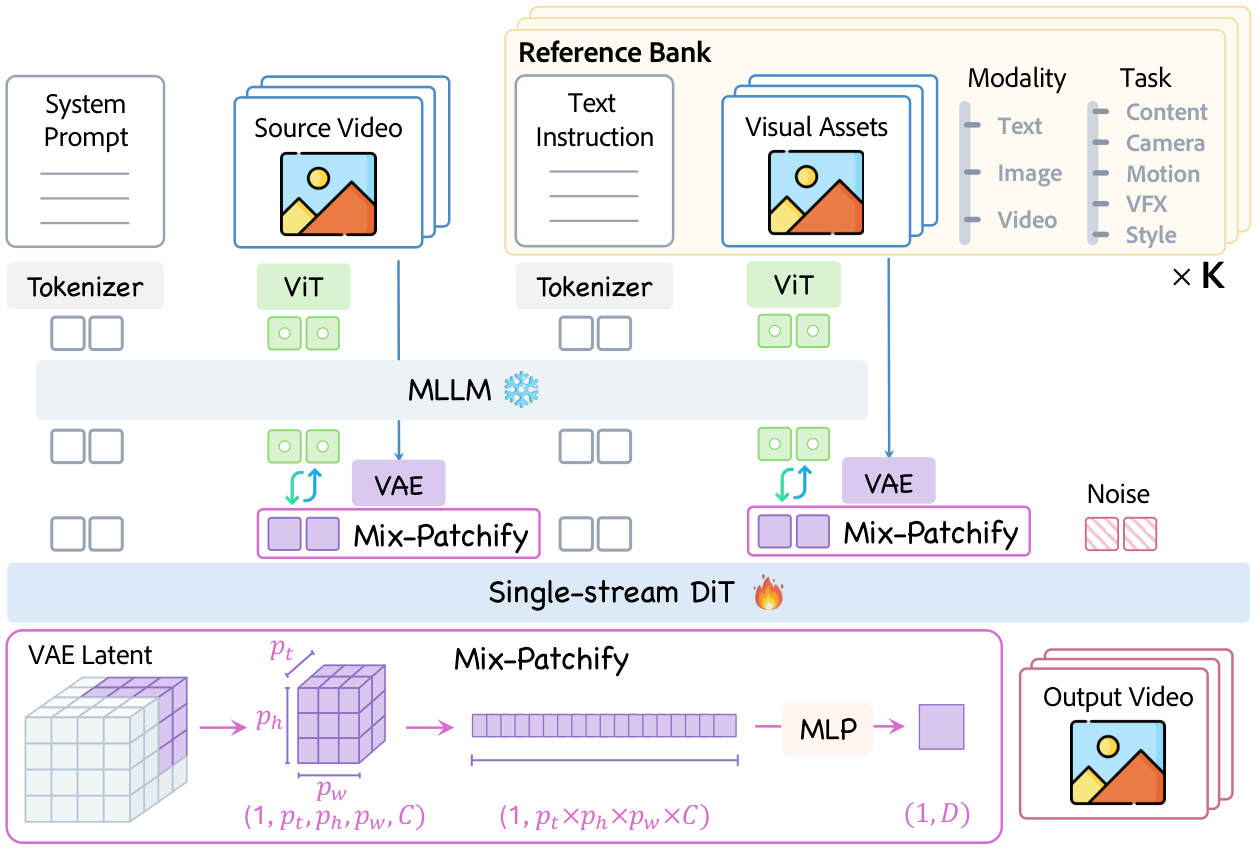
AIGC 每日速读|2026-10-22|快手换人换声一起对口型AVE 今日 AIGC 论文速览 今日共 10 篇 · 参考视频与统一编辑 2 篇 · 文字与生成轨迹编辑 2 篇 · 数值编辑评测 1 篇 · 视频渲染与计算分配 2 篇 · 语音合成训练 1 篇 · 骨架与四维生成 2 篇 重点论文标题列表 AVE(快手):换人换声一起对上口型 VitronEdit(新加坡国立):几何监督只加给多视角 TextRIRO(复旦):打乱真文字学会保留字形 Dancing Diffusion(中科院自动化所):接着同一生成过程改下半场 ABACUS(CEA LIST):加三个物体到底加对几个 选读入口:要把视频中的人连声音一起替换,先读AVE;图像、参考视频和多视角编辑想共用模型,接着读VitronEdit。真实招牌换字读TextRIRO,已生成图片想保留街景再改对象读Dancing Diffusion;验收“加三个”是否真加三个,用ABACUS。把灰模或骨架渲成视频读SolarRenderer,研究算力分配读MoDDiT。语音只错几个字时看LoCA的局部训练;三维资产需要可重放动作看JCA,生成场景需要换镜头和时间看AEON。 今日论文速览 1. AVE:换人换声一起对上口型 Edit in Sync: Unified End-to-End Audio-Visual Editing for Human-Centric Videos | 快手可灵;北京大学;香港中文大学;清华大学;香港大学;国防科技大学 | arXiv:2610.27947 关键词:参考视频编辑, 音画同步, 人物替换, 双向监督 前序问题:把视频里的人换成参考人物,外观对了,声音却还像原人,重新配音又对不上嘴。人物插入和删除也必须同时处理画面与声音,怎样保住原动作、说话时序和背景? 方法直觉:让声音和画面在每一层互相参考,而不是先换脸再配音;把源片、目标和参考放在共同时间轴,又用不同坐标标明它们的角色,避免把参考当成待生成内容。 本文贡献:以 Ovi 音视频联合主干为基础,自编码器将音画压到潜空间,两路扩散 Transformer 用双向跨注意力交换信息。Modality-Aware Sync-RoPE 是区分角色的旋转位置编码:源与目标共享时间坐标,空间轴偏移区分角色,参考隔开固定距离;音频时间频率按长度比缩放。先预热音频,再联合适配,最后精修高质子集;正向学合成编辑,反向以真实片为目标,降低合成痕迹。所有阶段用秩256的 LoRA 低秩适配器,基础权重冻结。 原文图4|AVE总览。模态感知同步旋转位置编码通过角色专属的三维坐标偏移,区分源、目标与参考特征,同时维持共同时间轴上的对应关系。 实验效果:评测192例,替换、插入、删除各64例;片长121帧、24帧/秒、480×832,音频16千赫。替换时,口型同步置信度 Sync-C 为5.39,对照 Wan2.2+音频后处理为5.02;同步特征距离 Sync-D 为8.53/8.76,越低越好。音色相似度 CAM++ 为0.682/0.665,人脸相似度 ArcFace 为0.647/0.634;原文正文曾把两项名称写反,此处按指标定义校正。替换背景像素信噪比 PSNR 为34.62,低于 VACE 对照35.37。 原文表1|AVE-Dataset-Bench三种编辑任务的定量比较。重建指标仅在背景区域计算,粗体标最好结果;+PA表示串联基线接入作者音频后处理。音色/人脸相似度以表头CAM++/Arc为准,正文有名称互换。 批判点评:无掩码指模型推理不要求空间掩码,数据合成与背景评分仍用分割。自建数据约10万对;阶段1约12万对含外部真实移除子集,不能混算。联合阶段用24张 H800,未报端到端推理耗时与峰值显存;背景保持并非全面领先。原文仅承诺后续开放代码、权重和基准,尚无核实的下载入口;不作会议背书。 2. VitronEdit:几何监督只加给多视角 VitronEdit: Universal Visual Editing across Images, Videos, and 3D Scenes | 新加坡国立大学;牛津大学 | arXiv:2610.27049 关键词:统一编辑, 参考视频, 几何后训练, 跨模态迁移 前序问题:图像、视频编辑有大量配对数据,三维场景却缺。把每个视角单独改好,转动镜头时颜色、材质又不一致;能否借图像和视频的编辑经验,再学会跨视角保持? 方法直觉:把图像看成静止序列、视频看成时间序列、三维看成多视角序列,用同一模型编辑;几何老师只管真正有多视角约束的三维样本,让共享主干吸收这种约束。 本文贡献:从 OmniWeaving 初始化,主干为 HunyuanVideo-1.5,Qwen2.5-VL 多模态语言模型编码指令与参考;用模态 token 即模态标记区分三类序列。先图像、再视频、后加入三维数据训练,约253万样本;秩32 LoRA 适配后再训练500步。冻结几何提取器从预测及目标潜变量估深度、相机,约束归一化深度、相对旋转及局部/全局位移。默认仅三维样本用几何损失。图像复制5帧,多视角首帧保留、其余各重复4次,减轻时间压缩损失。 原文图2|VitronEdit总览。几何后训练以冻结的三维解码器,从预测与目标潜变量估计深度和相机姿态,作为几何监督。 实验效果:消融中,仅三维加几何监督相比不加:跨视角编辑方向一致性73.98→74.34,图像感知距离 LPIPS 为14.88→14.86、视频34.20→33.78;距离越低越好,这些分数沿用原文100倍标度。三维主榜一致性74.34,对照 EditSplat 为66.30。视频指令/参考混合榜的整帧图文语义相似度26.95高于初始化26.50,但源内容 PSNR 为17.32低于19.57;不能称所有编辑指标提升。 原文表4|几何后训练消融。括号为相对仅三维加几何监督Geo-3D的变化,按指标上升/下降方向判优劣;红色表示移除后退步、灰色表示改善。3D Consist.为跨视角编辑方向一致性。 批判点评:三维评测16项任务,26个编辑视图经50步生成后重新训练三维高斯30000次;评分8视图来自重建训练视图,并非留出新视角。额外几何网络与序列复制有训练/内存代价,训练用8张 H200,缺完整推理账单。只覆盖静态场景多视角编辑。项目 与代码 可查,仓库内称UniVEdit,本稿未运行。 3. TextRIRO:打乱真文字学会保留字形 Real In, Real Out: What If We Only Use Real Data for Scene Text Editing? | 复旦大学可信具身智能研究院;上海市多模态具身智能重点实验室;腾讯微信视觉团队 | arXiv:2610.27592 关键词:场景文字编辑, 真实数据, 自配对, 长文本识别 前序问题:把招牌上的词换掉,字体、透视和灯光却像贴纸。真实的改字前后配对图很少,合成字训练又容易带来不自然风格,能否让一张真图自己提供监督? 方法直觉:沿文字长轴按字符数切条,打乱再裁一段:原来写什么被破坏,笔画、材质与局部弯曲仍在。模型拿这份残缺风格和目标文字,重建完整真实原图。 本文贡献:Shuffle&Crop 按概率先打乱字符列,再连续裁剪,也保留只裁剪分支。ViT 视觉 Transformer 提取多尺度风格,经 ControlNet 式零初始化卷积注入去噪 U-Net;文字编码器先在真实场景做下一字符预测,学习字符辨认。冻结 SD2.1 自编码器与文字编码器,训练 SD1.5 U-Net 和风格编码器。输入64×256;识别器过滤生成图,再与原图拼成长文字,构建 TextRIRO-3M。 原文图2|(a)训练时对一张真实目标图破坏文字内容但保留风格,构成伪源图;视觉Transformer风格编码器输出多尺度特征,经ControlNet式零卷积注入U-Net,真实文字识别预训练的文字编码器提供目标文字。(b)推理沿稳定扩散标准去噪日程。(c)轻量字符分词器与识别解码器共同做下一字符预测。(d)独立文字识别器检验编辑结果,通过后与原图拼成长文本。图标分别表示冻结和可训练。 实验效果:ScenePair 整词识别准确率85.23%,TextCtrl 为84.67%、RS-STE 为91.80%;FID 生成分布距离41.53,优于后二者43.78/49.59,越低越好。RIROCommon 六数据集平均,等长改字79.31%、不限长度47.64%,对照 RS-STE 为60.24%/11.73%。V100、20步、批量32报告平均0.20秒/图,是批处理摊销;文字预训练36 GPU小时、编辑微调180 GPU小时。 原文表2|RIROCommon结果,与三种场景文字编辑模型比较。E为等长替换,V为不限制文字长度的编辑;每个数据集分别统计,Avg为六集平均,不能把两类任务混算。 批判点评:不等于识别准确率全面最好;识别器偏好和图像真实感是两回事。混合打乱裁剪也未在每种曲线布局上胜出。长文本对称拼接产生偶数长度偏置,附录混入非对称拼接缓解;对极长文本仍应单验。arXiv 备注明确已被 NeurIPS 2026 接收。代码 已提供入口,本稿未运行模型。 4. Dancing Diffusion:接着同一生成过程改下半场 Dancing Diffusion: Learning Continuous Programs for Image Generation and Editing | 中国人民大学;中国科学院自动化研究所 | arXiv:2610.28003 关键词:图像编辑, 条件编译, 前缀复用, 保持取舍 前序问题:把生成的红公交改成红卡车,从噪声重画会连街道也换掉;太晚切换指令,背景保住了,车又改不动。能否把生成的前半段保存,再只改后续操作? 方法直觉:把一条指令编成按时间执行的连续条件块,像安排分段任务。保存已经走过的采样状态,再替换尚未执行的条件;前史相同,但未来像素仍可能改变。 本文贡献:冻结 SANA-600M 生成器,以2.731亿参数编译器输出3个条件块及有效位置掩码;总采样30步。训练时参考图与前缀状态停止梯度,固定视觉观察器同时评价目标变化与非编辑区保持,梯度穿过去噪后缀只更新编译器。上线不调用观察器。6/12/12 表示三块各执行6、12、12步;它含40次更新的联合热身,其他日程初始化不同,不能当严格单变量比较。 原文图2|训练已保存前缀之后的条件。参考路径给出停止梯度的采样状态和源图;目标编译器提供未来条件,后缀输出接受关于变化与保留的观察器反馈。仅优化编译器,源参考不能跟着移动降低损失;部署不含观察器和损失。 实验效果:24类请求、每类3个种子,在6/12/12日程第9步分支,背景 LPIPS 感知距离由重新生成的0.321降到0.227,越低越好;图文目标差值变化0.092→0.088,保持更多但编辑略弱。第21步分支距离0.033、语义变化0.029,编辑进一步受限。A800上4个后续版本,重算9.20秒、缓存7.18秒,省22.0%;不含加载和写文件,每份潜状态32 KiB。 原文图7|最终仅编辑目标检查点上的全部预先规定分支点。每条曲线表示背景保持与语义代理之间的取舍,并非已经验证的成功率前沿;背景均值只计有效源掩码,语义均值用全部尝试。 批判点评:三种日程各仅一次训练;背景均值只覆盖有效源掩码,语义均值用全部尝试。原生指令切换同样能缓存,省时不全来自学习。操作可寻址不证明语义完全解耦,类别替换也不等于完整指令成功。主要研究生成轨迹,未建立真实照片编辑或推理能力结论;原文无核实的方法代码入口。 5. ABACUS:加三个物体到底加对几个 ABACUS: A Benchmark for Image Editing Models to Assess Object Category and Counting Under Scene Conservation | 巴黎萨克雷大学;法国原子能与替代能源委员会LIST实验室 | arXiv:2610.28316 关键词:图像编辑评测, 对象计数, 场景保持, 实例核验 前序问题:让编辑器加三把椅子,画面很漂亮却只多两把,甚至把旧椅子挪过去充数。再找视觉语言模型打分,它自己也可能数错,该怎样验证新增了什么? 方法直觉:先把每个旧物体和编辑后的对应物匹配,再把保留对象遮掉,只数真正新增的;同时检查旧物体和背景是否被破坏,三件事缺一不可。 本文贡献:在 COCO 的80类可数物体上,经双检测器与人工检查构造3845张图、10944条加/删/改指令。评测用 SAM 分割定位、实例一一匹配、非生成式修补去掉保留内容,再由 RF-DETR 与 Co-DETR 双检测确认。仅6.4%的歧义实例交给 Qwen3.6-27B 回答类别是否正确,不让它计数。CF 为数量符合度,按实际数与请求数的调和口径;SC 为光流位移与多尺度结构相似度的背景保持;OC 为旧类别保留度。先分别取均值,再把三因子相乘。 原文图3|添加与删除共享四阶段管线:输入原图Io、编辑图Ie及全景分割真值,依次做新实例发现、干净图构建、双检测器检测与视觉语言模型歧义消解,输出确认新增数和未匹配原实例数;在添加/删除任务中,这两个输出互换用途。 实验效果:600张人工计数图上,精确计数一致率0.82,单视觉语言模型0.55、单检测器0.28;困难档0.76而非满分。七编辑器主榜 Seedream4.0 总分0.31,Gemini2.5为0.29、GPT-Image-1为0.26;这是三项均值的乘积,不是成功率,也不是各难度格子总分的平均。三个商业模型的95%自助采样区间重叠,不能据点估计断言显著排名。 原文表2|ABACUS编辑模型榜。E/M/H为易/中/难,每个操作与难度格先对数量CF、场景SC、旧类别OC分别取均值,再相乘;整体在10944次编辑上同样先均值后相乘,并非格子分数平均。粗体为列最好;三个商业模型95%自助采样区间重叠。 批判点评:只覆盖80类固定词表,不评艺术风格,也不约束“必须改哪一把”。检测与匹配有偏差,源图筛选偏向可检测对象;多工具评测另有运行成本,未报端到端时延显存。arXiv 明确 WACV 2027 数据集评测轨接收。代码与数据 可查,未在本稿重跑。 6. SolarRenderer:粗略结构四步变成写实视频 SolarRenderer: Few-Step Generative Reference Rendering | 新加坡国立大学;LIGHTSPEED;香港中文大学(深圳);SLAI;香港科技大学(广州) | arXiv:2610.28630 关键词:生成式渲染, 结构参考, 四步蒸馏, 流式视频 前序问题:游戏引擎给出灰模、骨架或深度,布局和动作是对的,缺少真实材质与灯光。生成模型把结构当宽松参考,又容易改镜头;怎样既听结构又少跑几十步? 方法直觉:让每个结构特征与要生成的那一帧占据相同位置,用文字说明该继承布局而不要继承灰色外观;先学会控制,再单独训练四步加速,避免速度目标毁掉控制。 本文贡献:冻结330亿参数 MiniMax-H3,结构视频进入原生参考通路,不加类型标记,旋转位置编码逐帧对齐;参考近干净、目标带噪,区分二者。秩384控制 LoRA 用流匹配训练后冻结;加速 LoRA 的前128秩取自 DMAD,扩到384秩。分布匹配教师比较有/无结构预测,以1.5倍方向引导加强结构,再监督学生;另有五次分布估计更新对应一次生成器更新。训练含13.6万片段、约243小时。 原PDF图2(HTML图1)|冻结扩散Transformer通过原生参考通路读结构视频,序列包含文字、可选首帧I、结构潜变量sk及带噪潜变量zk;sk使用对应zk的时间/空间旋转位置,首帧位置为0。(1)控制LoRA以流匹配训练。(2)加速LoRA向结构引导教师蒸馏,教师由有/无结构S预测差、按强度w外推。 实验效果:泛化集208例、57段结构视频、16种表示,其中11种训练未见;另有53段有真值测试。四步生成158帧约209秒,对照50步2562秒,为12.3倍;原文只注明单 GPU,未给该测速的具体卡型。泛化总体偏好 Elo 为1441,与 LynnReal-Omni 持平,结构评分1338高于1241;Elo 是成对模型裁判拟合,不是准确率。 原PDF表1|在泛化与分布内两测试集上比较四个问题的Gemini成对偏好Elo及自动分。因果版只与本法比较;某问题全部对局失利的方法共用一个评分。粗体与下划线斜体分别为最好和次好。不同测试集的评分分别拟合。 批判点评:分块因果版另报768p最高28帧/秒,具体硬件、首块延迟与峰值内存不完整,不能与209秒拼成同一配置。仓库另有4张B200的社区流式集成,不能反推论文测速条件。因果版偏好较低且颜色会漂移;快速镜头四步也不总胜50步。项目 与代码 含推理、权重及训练入口,未复现。网页与PDF图号不同,配图按PDF。 7. MoDDiT:把算力留给真正难画的块 MoDDiT: Simple Token Routing in Diffusion Transformers | BOLD(British Open-ended Learning and Discovery,英国开放式学习与发现团队) | arXiv:2610.28086 关键词:扩散Transformer, token路由, 动态计算, 视频蒸馏 前序问题:天空和背景很容易,细纹和运动边缘很难,扩散网络却让每个特征块经过同样多计算。能否绕过不需要更新的 token,把预算留给困难部分? 方法直觉:像分诊一样先给特征块打分:自注意力每图固定选一部分,前馈网络则让不同样本共享总预算;未选中的内容直接沿残差通路保留。 本文贡献:两层小网络为 token 即网络处理的特征单元打路由分;训练加 Gumbel 随机扰动探索,渐退为确定性选择。自注意力每样本选前K项,K是被选数量;MLP 多层感知机把批次与 token 合并分配预算,推理用训练跟踪阈值估计分配。图像模型从零训练100万步,交替把一层密集块换成两层稀疏块,因此12.5%容量不是只花12.5%总计算。 原文图2|上:自注意力逐样本固定选前K个特征,50%容量示例选四个中的两个。下:MLP前馈路由跨样本共享训练预算,选三个绿色和一个蓝色特征;颜色表示样本,条纹表示加性更新。漏斗收集被选特征并将更新散回原位置,路由门控先乘更新再做残差相加,未选特征保持原值。 实验效果:ImageNet 256×256、512次去噪更新、引导强度1.5、50000图:25%容量模型 FID 分布距离4.795,对照 DiT-L/2 为5.069;每图去噪算量129.888/165.380万亿浮点运算,含条件与无条件两支,不含解码。空间版 FID 为4.790/4.714,反而略差。视频四步学生 Funnel20 的 VBench 总分77.69低于密集82.07,算量省23.98%。 原文表2|512次DDPM去噪更新、无分类器引导强度1.5。质量用50000张图;算量估计平均1024张,含条件和无条件两支,不含自编码器解码;FID为生成分布距离,sFID为空间版,IS为Inception评分,Precision/Recall为生成精度和覆盖率。 批判点评:图像批量32只测得1.64对1.55图/秒,小批量反而更慢,收集/散回特征的开销抵消省算;未报硬件对应的全面延迟优势。1X视频预测的稀疏/密集训练批量256/217,等更新次数并非等数据量。BOLD 是PDF列出的机构,邮箱含牛津域名不能直接当牛津机构背书;未核实方法代码入口。 8. LoCA:一句话错在哪里就改哪里 LoCA: Local Credit Assignment for Reinforcement Learning of Autoregressive Flow-Matching TTS | 灵光乍现科技(上海) | arXiv:2610.28035 关键词:语音合成, 局部信用, 流匹配, 强化学习 前序问题:合成一句话只错一个词,整句奖励却一起惩罚,正确片段也被推走;负奖励持续排斥同一个输出,还可能把训练推得过头。怎样只针对可靠的局部错误调整? 方法直觉:先把识别出的错字对齐到声音时间段,给错误与未报错片段不同增量,未知尾部不判错;再给正向拟合和负向排斥各设停止线,够了就停。 本文贡献:在20亿参数 VoxCPM2 自回归流匹配语音主干上,每条件采8个候选,以识别内容误差和说话人相似度计算句级优势,即样本相对组内平均的好坏。自动语音识别 ASR 与强制对齐定位错误,映射到生成潜帧;已测标签在句内中心化,局部权重0.2,保持系数均值,未知帧增量为零。正负回归阈值相对冻结参考误差计算,另加参考锚定;只控制固定重放目标,不保证参数不会漂移。 原文图1|12个生成潜帧的局部信用示例,非离散语音token。6个未报错帧、4个错误帧的标签均值0.6,另2个未知尾帧排除;局部权重0.2、句级优势0.05时,错误/未报错/未知帧最终系数为-0.07/+0.13/+0.05。 实验效果:固定 CV3 子集3624条,含3500普通及124困难例;相同选定模型整行比较:内容错误率4.758%,原模型5.986%、GROW 5.553%;严重失败代理51/61/60条,音色余弦相似度乘100为69.137/67.168/67.562。中文按字符、其余语言按词算逐句错误率,再按样本数加权。均10个流匹配步、引导强度2、固定种子,无重试或多次挑最好。 原文表1|主模型比较,每行所有指标来自同一选定模型。Cases为严重失败代理数量,SIM为余弦相似度乘100;错误率/数量越低越好,相似度越高越好。CV3普通集3500条,加124条困难例组成完整选择集;困难中文60、英文64条按样本数加权。 批判点评:去阈值变体严重失败仅44条,比完整法少,但错误率及音色更差;不能称所有风险均下降。俄语未进本次强化训练池,错误率6.219%→4.723%,严重代理却5→6;不代表底座没见俄语。训练多候选、ASR和对齐有额外成本,缺完整耗时显存表。单主干单种子,严重代理不是人工听评;未核实方法代码入口。 9. JCA:视频动作也能导出骨架动画 Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs | NVIDIA;以色列理工学院;巴伊兰大学 | arXiv:2610.28632 关键词:运动视频联合生成, 任意骨架, 相机对齐, 交叉注意力 前序问题:视频里猴子跳得很自然,三维资产却拿不到可重放动作;先生成视频再估骨架,动作可能超出这只猴子的关节结构。能否从一开始就让指定骨架参与生成? 方法直觉:让懂视频的模型和懂骨架的模型一起去噪,相互通报动作进度;再找出每个三维关节投影到画面的哪里,拟合把两者对齐的相机。 本文贡献:图网络按关节名、静止几何、可选参考图二维位置和骨骼连接编码;每关节每帧18通道,含旋转、位置及变化。独立运动去噪器与 Wan2.2-I2V-A14B 图生视频主干通过零初始化双向跨注意力桥耦合,附加模块共1.78亿参数。定位头将关节对视频块的注意力加权成二维坐标,再拟合每片一台静态透视相机。数据约20万视频/运动对,含11.8万资产视频、6万人体、2.7万机器人;运动单独预训另用12.5万序列。 原文图2|输入文字、骨架及可选参考图,同时去噪视频潜变量Zv与运动特征Zm。图网络把骨架及图中关节二维位置编码成逐关节描述D;运动块沿骨骼边传播图注意力。零初始化双向跨注意力桥让两路交换特征,训练起点保留各自预训练行为。右侧定位头用关节查询视频块,按块坐标加权得到二维关节,与三维运动形成对应点以拟合相机。 实验效果:20资产×5指令共100对,模型裁判0至100分的指令遵循58.4,对照 ActionMesh43.4;网格边长相对变化中位数0.20%/7.07%,越低越好。人体250条指令,通用版对齐后平均关节位置误差114.8毫米,差于 EchoMotion97.7;专门人体微调10000步后72.3。引导每去噪步需4次前向,附加参数少不等于运行便宜。 原文表2|视频与人体运动联合生成。同步指标比较生成动作和GVHMR恢复的动作;视频与动态指标按VBench。PA-MPJPE为逐帧刚性对齐后关节位置误差,SA-MPJPE/MPJVE为全序列单旋转对齐后位置/速度误差;位置毫米、速度毫米/秒。通用版和人体微调版须区分。 批判点评:人体对照使用文本生成,本法有生成的参考图,输入条件不同;同步参考来自另一个恢复模型,并非动作捕捉。相机拟合假定静态,训练偏双足;模型不直接看到三维场景几何,接触与穿透没有硬约束,交互对象也未恢复三维。缺完整延迟显存表。作者项目页 展示结果,当前未见方法代码链接。 10. AEON:把生成视频解成持续四维场景 AEON: Unifying Video and 3D World Models | 清华大学软件学院 | arXiv:2610.28631 关键词:四维生成, 高斯场景, 潜空间适配, 持续表示 前序问题:生成视频能看,换个视角却容易变形;逐帧重建得到的三维结构也不一定属于同一个世界。怎样把视频生成先验变成可以反复换镜头的显式动态场景? 方法直觉:让生成模型先给出压缩视频,再翻译成一个持续存在、会移动和显隐的高斯集合;换镜头时渲染同一份场景,而不是重新猜一组画面。 本文贡献:4DGS 即带时间变化的三维高斯表示,每个基元含位置、形状、颜色、不透明度、线速度、角速度及可见持续时间。先训四维重建器,四个头估深度、外观、动态和相机;再用线性岭回归初始化的卷积支路与零门控 Perceiver 跨注意力支路,把 Wan 视频潜变量映射到 视觉表征模型 DINOv2 第4层特征空间。冻结重建教师监督基元、几何与特征,最后加可微渲染精修;蒸馏后两阶段可用无几何标注的视频。 原文图2|上(1):四维重建器4DRM用深度、高斯外观、动态演化和相机四头,把单目视频解成4DGS场景,再渲染RGB、深度和法线作端到端监督。下(2):冻结视频扩散模型(如Wan2.2)提供生成先验,教师重建器提供四维重建能力,经域适配器和可学习学生4DRM蒸馏,形成显式动态场景。 实验效果:30个图文场景的相同预设镜头上,Wan2.2版主体一致性0.875、运动平滑0.980、美学0.531,对照 Lyra 为0.864/0.974/0.459,均越高越好。视频转四维重建的 DaVis 结果:PSNR像素信噪比24.661,对照 NeoVerse23.929;LPIPS感知距离0.243/0.283,越低越好。生成、重建和新轨迹评测是三类任务,不混作同一组成绩。 原文表2|四维生成的定量比较。全部输出沿共同预设相机轨迹渲染,使用VBench主体参考相似度、主体一致性、运动平滑及美学评分;比较基于同一图文条件,不应当作任意视角几何真值。 批判点评:实时指已得到高斯后的渲染,不等于文本到四维场景实时;16张 H200 训练,未给完整生成延迟、显存预算。世界时长受视频窗口限制,未见区域会露洞,跨窗口融合只是未来方案;显式渲染不证明几何真实。arXiv 备注明确 NeurIPS 2026 接收。项目 与推理代码 可查,仓库目前列Wan2.1生成路线,不能据Wan2.2主榜声称全部版本已开放。 趋势观察 保留目标应进入机制 AVE共享时间轴,TextRIRO保风格破文字,Dancing Diffusion固定已执行状态;三者分别约束同步、样式与生成前史。 几何约束要放对位置 VitronEdit只对三维样本加几何监督,JCA显式读骨架,AEON输出持续高斯;一致性与物理正确仍需区分。 平均数字必须说清分母 ABACUS先均值后乘积,LoCA逐句误差按样本加权,SolarRenderer不同测试集Elo分别拟合,不能把评分写成成功率。 少算与更快需要两份证据 MoDDiT算量下降可能抵不过小批量路由开销;SolarRenderer四步整段与流式实时是两个版本,Dancing前缀省时也适用于原生切词。 今日讨论 AVE人物替换的Sync-C从Wan2.2串联对照5.02提高到5.39,Sync-D从8.76降到8.53,但背景PSNR为34.62,低于另一对照VACE的35.37。若你在做参考人物视频编辑,会收集哪些指标和失败样本,结合口型同步、参考身份、背景保持与实际耗时来决定联合编辑是否值得,而不把不同对照的最优数值拼成一次全面胜出? 人工智能炼丹君 整理 | 2026-10-22
-
AIGC 每日速读|2026-10-21|字节擦字幕保住原场景DeOverlay 今日 AIGC 论文速览 今日共 10 篇 · 视频编辑与透明素材 3 篇 · 多轮与分层图像编辑 2 篇 · 音视频联合创作 1 篇 · 多镜头布局生成 1 篇 · 文生图与推理效率 2 篇 · 可控歌曲翻唱 1 篇 重点论文标题列表 DeOverlay(字节):从原片出发擦掉遮挡字幕 Wan-Alpha++(天津大学):让透明特效从出现走到消失 ColorModern(延世大学):四格关键帧带动长片调色 MT Forcing(商汤):用单轮老师稳住八轮编辑 LayerEditor(华南理工):编辑完顺手交付可复用图层 选读入口:原片被字幕或标题遮住,先读DeOverlay;手头是单张透明素材、要做出现消失动画,读Wan-Alpha++。老彩色长片只想换色调,读ColorModern。连续改图漂移看MT Forcing,成品还要拆成可复用层看LayerEditor;只修声音或画面其中一条看UniAVC。需要人物按三维站位跨镜头转身看MeV;考虑训练预算读Halcyon,已有扩散模型要省推理读SpecKCast;想保留旋律却改速度和唱法读MuLaCover。 今日论文速览 1. DeOverlay:从原片出发擦掉遮挡字幕 DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal | 字节跳动;南方科技大学 | arXiv:2610.26081 关键词:视频编辑, 叠层移除, 流匹配, 场景保持 前序问题:擦掉字幕后,背景也被重新画了一遍;旁边帧能看到的细节没用上,始终被遮挡的区域又必须靠生成补全。怎样同时利用原片和生成先验? 方法直觉:从带字幕的原视频开始小步修正,每一步都重新参考同一份原片;局部只汇总没被遮住的位置,让字幕本身不混进背景线索。 本文贡献:以13亿参数 LingBot-Video 为主干,训练350000对叠层/干净片段,用秩256的 LoRA 低秩适配器微调。视频自编码器先压到潜空间,在原片与干净片之间学习流匹配,即预测沿两者连线移动的速度;遮挡区损失权重6、外部1。对前后共5个潜时间位置,在固定空间坐标排除掩码区并按可见数平均,另加全局源特征与编辑区域嵌入;逐元素相加维持一条视频token序列,token即网络处理的特征单元。推理共享同一网络反复更新,使用12像素无缝贴回。 原文图3|DeOverlay总览。(a)共享权重Euler更新从源潜变量开始,上方通路传当前状态,下方循环在固定源线索下更新状态与时间;(b)可见性感知源汇总VSA、全局源条件GSC与掩码嵌入组成源条件;(c)源线索先加到当前状态token,再联合处理视频与文字。张量网格和中间状态为示意,RGB为配对源片/输出。 实验效果:DVTE-Bench含8类、1631对视频,原干净目标经文字识别筛查;输入真值外接框掩码,评分用像素掩码。六步、引导强度2实际调用网络12次:遮挡区PSNR像素保真信噪比30.80,对照MiniMax-Remover为26.17,越高越好;LPIPS感知距离0.0408/0.0977,视频特征分布距离VFID为0.0835/0.2806,均越低越好。单A100另测8段650帧:四步端到端2.0712帧/秒、峰值12.236GiB,排除初始化;六步主榜没有对应速度行。 原文表2|全部1631条视频采用发布的像素掩码协议。(a)PSNR排除无限值,VFID为全局视频特征分布距离;(b)TWE Gap是预测与干净目标平均时间变形误差的绝对差,目标TWE为9.3228,诊断定义见原文附录I。粗体标(a)最佳值,(b)粗体/下划线标预测TWE最接近/次接近目标及其余诊断最低/次低值。 批判点评:适合已知叠层位置的场景,不能把合成叠层评测当真实遮挡全恢复。固定坐标汇总会混合运动物体;完全遮住的内容仍是推断。目标筛掉天然文字,保留路牌文字需另测;四步也慢于MiniMax-Remover的2.6405帧/秒。作者项目页 承诺开放基准与输出,尚未核实方法代码;不作会议接收背书。 2. Wan-Alpha++:让透明特效从出现走到消失 Wan-Alpha++: Animating a Single RGBA Asset into Controllable Transparent Video Effects | 天津大学;香港理工大学;大连理工大学;莫纳什大学;中国科学技术大学;独立研究者 | arXiv:2610.26189 关键词:参考动画, RGBA生成, 透明特效, 时间控制 前序问题:拿一张带透明度的火焰素材做“先出现、再消失”的动画,首尾都是全透明,传统首帧或首尾帧控制就看不到素材本身;先生成再抠像还会丢掉烟雾的半透明边缘。 方法直觉:把时间轴循环平移,让原来位于中间的可见素材跑到两端,借用已有首尾条件能力;生成后再移回时间轴,恢复出现到消失的过程。 本文贡献:RGBA是RGB颜色加alpha不透明度。共享视频潜空间分别编码颜色与alpha,通过透明感知双向扩散保持预训练颜色分布并区分alpha;透明度引导的噪声均值偏移控制粗略位置。新增图像条件路线先适配Wan2.1-I2V-14B,再用196条特效视频学习时间相位重参数化,把零/正/零alpha模式变为正/零/正。推理对指定透明区间做归一化梯度更新,再逆变换;同一参考RGBA图约束两端。 原文图4|时间相位重参数化的图像到RGBA视频推理。同一RGBA输入约束时间两端;透明状态引导对用户指定不可见区间施加归一化梯度更新,最后做时间变换,恢复需要的出现/消失特效。 实验效果:图像条件视频为81帧、480×832、40步;前32步每步另做2至3次梯度迭代,不能沿用文生版四步加速。文本训练/验证集为77237/4066条,基础图生路线另用429条,特效适配用196条。效果类评测对照Wan2.1-FLF2V加MatAnyone:DINO-I结构特征相似度0.9227/0.6679,CLIP-I语义外观相似度0.9368/0.7969,均越高越好;这类依赖外观的分数只统计足够可见的帧。 原文表IV|普通与特效两类图像到RGBA视频定量比较。DINO-I和CLIP-I衡量参考保持,其余指标衡量通用视频质量,均按原表方向解读;效果类DINO-I由0.6679到0.9227。 批判点评:收益主要针对透明出现/消失和输入素材保持,不等同修改任意既有视频。两阶段生成加抠像对照与端到端RGBA路线的能力不同;只用少量特效数据,复杂多阶段透明变化仍待验证。40步及梯度引导增加推理成本,论文未给完整耗时或峰值显存;尚无核实的方法代码入口。原Wan-Alpha会议版不代表本扩展已被接收。 3. ColorModern:四格关键帧带动长片调色 From Legacy to Contemporary: Scalable Color Modernization for Long Videos | 延世大学 | arXiv:2610.26391 关键词:视频调色, 关键帧编辑, 颜色传播, 镜头一致性 前序问题:老彩色视频偏色、灰暗,逐帧让生成模型重画会改脸、闪烁;每镜头各调各的,又可能让相邻镜头像来自两部电影。 方法直觉:先把相邻镜头的代表帧放到一张四格图里一起调色,再只把学到的颜色变换传播给原帧。生成模型负责审美参考,原片保住空间细节。 本文贡献:先检测并合并镜头,从每镜头16个候选中用Qwen3-VL-8B选关键帧。最多4张相邻关键帧拼成2×2,FLUX.1-Kontext-dev按同一自然现代色调指令编辑30步。拆开后估计每镜头的MKL(Monge–Kantorovitch线性)颜色映射:用完整3×3矩阵匹配RGB均值和协方差,保留颜色通道间关联;高亮处用平滑压缩防止硬截断,再固定应用于该镜头全部帧,无需训练新模型。 原文图1|长视频调色流程:先将输入分成镜头,各取代表关键帧,再联合现代化相邻镜头的关键帧,最后从原帧/编辑帧对估计每镜头颜色映射,应用于该镜头全部帧。 实验效果:100段1960至2000年代电影片段共3.9小时、3390镜头,每段2至4分钟。65人对15段作975份完整排序,平均名次2.31,对照CAP-VSTNet为3.02,越低越好;第一名占37.9%/17.6%。边缘结构相似度0.865,不及Neural Preset的0.886;相似源镜头的颜色变换差异SW-IGC为5.90/7.50,越低越好。H200颜色传播816帧/秒,只是末段;完整流程还需约13秒/镜头选帧、14秒/四格编辑,CPU含视频读写传播约80帧/秒;抽样10段端到端平均每段10.9分钟。 原文表1|Condensed Movies数据集100段视频的补充定量比较。灰色原视频仅供参考且不计排名;CDC以百分之一为单位。端到端方法缺可靠源/输出对应,故未报SW-IGC;FPS仅为H200上的颜色传播吞吐。 批判点评:它修改已有彩色视频的色调,不能补黑白片缺失颜色,也不处理划痕与几何修复。静态全局映射可能跟不上镜头内照明变化。SW-IGC用24标准色评估映射相似度,过度平滑能得更低4.46却产生不自然色彩,因此低分不等于审美最佳。作者代码仓库 可访问;未运行完整流程。 4. MT Forcing:用单轮老师稳住八轮编辑 MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion | 商汤研究院;香港科技大学;斯坦福大学;清华大学AIR | arXiv:2610.25404 关键词:多轮编辑, 分布蒸馏, 历史监督, 质量漂移 前序问题:一张图连续改八次,前面几轮还清晰,后来纹理变脏、先前保留的花纹也丢了。只用正确历史训练,模型上线后却只能接着自己的错误继续改。 方法直觉:让学生在自己生成的历史上练习,但老师每次都从最初原图执行累积指令,避免老师也越改越坏;再用一致的参考轨迹约束“哪些细节必须延续”。 本文贡献:Single-Turn DMD即单轮分布匹配蒸馏:把截至当前轮的指令合成一次编辑请求,由固定单轮老师从源图给出目标分布,监督学生自回归生成的每轮输出。仅匹配各轮分布不能保证前后同一细节,因此Teacher-Forcing Guidance先在参考轨迹上预热,之后仍用较小权重的流匹配监督历史到下一图的转移。它改训练过程,无需在每次用户编辑时再生成老师结果。 原文图2|MT Forcing。(a)单轮DMD将学生自生成轨迹的逐轮边缘分布匹配到单轮老师;(b)参考轨迹上用流匹配监督依赖历史的转移;(c)总体训练先teacher-forcing预热,之后DMD联合teacher-forcing正则,分别维护画质与跨轮一致性。 实验效果:在MTEdit-Bench的100条八轮逐步编辑会话,对同一SenseNova-U1.5前后比较:第八轮IF指令遵循4.52→9.17、CC累积内容一致性3.22→7.68,二者为Qwen3.5-Plus的0至10分;DRS抗画质漂移分3.03→4.35,取两个画质评分平均、0至5分。八轮平均匹配点位移Pixel为6.34→0.74像素;同时使用两项训练目标的消融均分IF/CC为9.66/8.40。 原文表2|SenseNova-U1.5在MTEdit-Bench逐步子集的八轮均分组件消融。完整方法在IF、CC、DRS和Pixel四指标均最好,分别为9.66、8.40、4.30及0.74像素。 批判点评:Pixel度量前后图像匹配点移动,只有本应保持的区域才宜越小越好,不能替代编辑是否正确。第一轮部分内容分下降,第八轮改善不等于每轮全面领先;DMD还需教师、生成器及分布估计网络,训练与参考轨迹成本没有完整账单。不同裁判或多轮指代任务仍需另验。作者项目与代码 可访问,本稿未复现实验。 5. LayerEditor:编辑完顺手交付可复用图层 Editing Images into Reusable Layers via Compositional Edit-Prior Distillation | 华南理工大学;清华大学;中国科学技术大学;鹏城实验室;京东 | arXiv:2610.24738 关键词:图像编辑, RGBA图层, 组合蒸馏, 图层控制 前序问题:改完电商海报只得到一张扁平图,下一次想单独移动商品或改字又要重画;先编辑再拆层还会把文字、边缘和半透明内容拆坏。 方法直觉:让模型一起画最终效果和按顺序排列的独立图层,再把图层合成回去请原编辑老师检查;这样“每层可用”与“合起来编辑正确”同时受约束。 本文贡献:基于FireRed-Image-Edit-1.1,把编辑画布以及有序图层的颜色/alpha特征放进一条序列;alpha是连续不透明度,单独解码以保住细边和半透明。C-EPD为组合编辑先验蒸馏,在学生实际走到的去噪状态查询冻结教师:直接画布接受速度监督,解码后的图层合成图接受像素监督,梯度能传回颜色与alpha。每5次更新做一次蒸馏,使用10节点轨迹、每次选2个查询;基础流匹配继续训练所有输出。 原文图2|LayerEditor同时生成直接编辑画布D及有序RGBA图层堆栈S。组合编辑先验蒸馏C-EPD使用冻结老师,同时监督直接预测与解码图层重新合成的图像。 实验效果:LayerEditor-100K提供约10万编辑/有序图层样本。独立Crello测试2994例、ScaleEdit测试1000例;后者合成图结构相似度SSIM为0.8839,对照Seedream5-Pro联合版0.8365,越高越好;alpha交并比IoU为0.6802/0.6583。Crello合成图FID分布距离33.86/55.33,越低越好。消融去C-EPD后编辑一致性评分6.14降至4.67,分数来自1至10分模型裁判。主干秩256适配,推理30步,另训练alpha解码器。 原文表1|两个基准上的编辑与图层质量。规则式模型评分针对合成输出,范围1至10;每列最佳与次佳标出。图像层指标分别检查直接输出和图层合成结果,图层指标检查RGBA误差及alpha重合。 批判点评:联合输出和可微解码增加训练与长序列成本,没有完整推理时延、峰值显存证明。重合图层先做一一匹配再算误差,不代表语义拆分唯一正确;完全被遮住内容仍靠逐层监督。Seedream有5例无有效输出被其指标排除,比较分母并非完全一致;模型裁判分也不是人类认可率。尚无核实的方法代码入口。 6. UniAVC:保留一条音画分支只改另一条 UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling | 香港科技大学;华为研究 | arXiv:2610.24791 关键词:音视频编辑, 联合生成, 非对称去噪, 分阶段训练 前序问题:只想换画面却把满意的声音也重做了;只想修音频,统一噪声进度又逼两种信息一起变化。稀缺音画配对数据还要从头教模型各自怎么生成,太浪费。 方法直觉:先分别练好视频和音频,再用配对数据只训练两者的交流通道;共享时间索引下各走各的去噪进度,想保留哪条就把哪条固定为干净条件。 本文贡献:从LTX-2.3初始化两套Transformer,以每层跨注意力桥交流,桥的调制读取对方噪声等级。参考潜变量与目标特征拼接,掩码禁止参考读取噪声目标。先独立训练两分支,再冻结分支、仅训练跨模态桥;视频/音频各消费3430万/5490万次样本,配对对齐消费67万次,次数不等于独立数据量。额外训练一条分支无噪声且不计损失的任务,支持单模态编辑及固定满意分支后的自修正。 原文图3|UniAVC。(a)音视频两套Transformer仅通过每块跨注意力桥交互,调制由对方噪声等级驱动;参考潜变量作为上下文token与目标拼接,掩码阻止参考在自/跨注意力中读取噪声目标。(b)先并行用单模态数据练好各自生成编辑,再冻结两分支,只用配对数据训练跨模态桥。 实验效果:720P、121帧、24帧/秒、16kHz单声道训练,推理30步,视频/音频噪声偏移参数9/2。InsAVE-80K测试集对照InstructAV2AV:FVD视频分布距离150.86/180.38、FAD音频分布距离1.99/2.75,均越低越好;但文本音频对齐27.36/34.96,越高越好,对照更佳。JAVEditBench指令一致性分4.42,对照MiniMax-H3为4.11;音画同步分0.2975却低于JAVEdit的0.3688。 原文表2|JAVEditBench与InsAVE-80K测试集联合音视频编辑比较。列名缩写各基准官方指标,剑号表示取自引用论文的结果;粗体/下划线分别为最好/次好。本法分布距离更低,但部分音画同步与文本音频对齐仍落后对手。 批判点评:它支持编辑既有音画,故放在创作效率部分;并非所有生成或同步指标最优。自修正需额外去噪,30步不能当全部请求的统一时延。分阶段节约的是配对样本消耗,3430万与5490万次单模态训练不能忽略;部分视频来自内部数据,且论文附录对InsAVE训练/测试划分表述有歧义,复现须核对划分。作者项目与代码 可访问,未跑模型。 7. MeV:先在三维里排好每个镜头 Mise-en-Video: Fine-Grained 3D Control for Multi-Shot Video Generation | 香港科技大学;可灵AI研究;香港中文大学;西北工业大学;大连理工大学 | arXiv:2610.26801 关键词:多镜头生成, 三维布局, 朝向控制, 分层注意力 前序问题:同一个人物跨镜头还在,却不按要求转身、位置也不对;一句长提示同时描述整片、每镜头和人物属性,信息容易串到别处。 方法直觉:先用三维盒子安排人物站位和朝向,再把整体剧情、镜头说明和人物属性分别送到该看的区域,让控制信号既有空间也有作用范围。 本文贡献:Mise-en-Video简称MeV。给有朝向的三维边界框涂NOCS标准物体坐标颜色,即用固定颜色编码物体自身坐标,投影成逐帧二维布局。控制分支复制主干前一半Transformer块,经零初始化卷积逐层注入。层级上下文注意力让全局文本对所有视频特征可见、镜头文本只对所属镜头可见、主体文本只对盒子覆盖区域可见。先训练层级文本,再冻结主干训练布局分支;16万条、每条2至6镜头、最多250帧,1B即10亿参数基础主干,使用32张GPU。 原文图2|MeV总览。创作者先设计三维场景并给分层描述;布局投影为NOCS标准物体坐标颜色编码,作为ControlDiT引导;文本分成全局、镜头、主体三级,通过层级上下文注意力融合,改善跨镜头叙事及主体一致性。 实验效果:100组多镜头提示比较中,MeV/EchoShot跨镜头主体一致性0.5499/0.4492,越高越好;对MultiShotMaster,平均朝向角误差0.2015/0.4094弧度,越低越好。去三维布局后同误差升到0.4194。14B即140亿参数HoloCine的主体一致性0.5955仍高于MeV,不能称跨规模全面领先;主表与层级注意力消融的完整模型数字也不同,不能混算。 原文表2|朝向估计定量比较:偏航、俯仰、翻滚角平均差及mAOE平均朝向误差以弧度计,越低越好;偏航朝向相似度OS Yaw越高越好。MeV的mAOE为0.2015,对照MultiShotMaster为0.4094。 批判点评:粗盒子便于导演控制,但不能表达手指等精细形变,额外半主干控制分支与布局制作均有成本,未给完整速度显存结果。去注意力掩码反而提高表面一致性,却让多镜头塌成连续镜头,说明指标必须结合叙事。作者项目页 标注SIGGRAPH Asia 2026,本稿仅将其作为作者声明;机构身份按原文;当前仓库开放数据标注与布局渲染管线,不能当完整视频生成权重已开放。 8. Halcyon:不用语言预训练也能学文生图 Text-to-Image Generative Modeling Without Language Pretraining | 斯坦福大学;Radical Numerics | arXiv:2610.26863 关键词:文生图, 从零训练, 早期融合, 训练预算 前序问题:训练文生图模型,是否必须先花大成本学一个通用语言模型?语言预测更强,并不保证更会把文字变成图像。 方法直觉:把文字和图像都切成离散token,在同一模型里直接学习“这段话之后应该出现哪些图像单元”,让图文配对负责教文字的视觉含义。 本文贡献:早期融合的自回归Transformer统一预测文字与图像序列。文本分词器、图像分词器及生成器均从头训练;256×256图像用8倍下采样得到32×32、共1024个图像token,文字/图像/特殊符号合计80640词表。GPIC约1亿图文对训练一轮。以图生文序列替换部分丢弃描述的样本,仍保留无条件图像前缀,可在相同预算附带学图像描述。另用固定计算预算和预训练初始化作受控实验。 原文图3|序列格式。纯文本预训练、描述和图像token与特殊符号共享词表;前两行是单模态,后两行是配对图文。图像I与图生文I2T共享图像开始/结束包围的图像前缀,文生图T2I丢弃描述作无分类器引导时也得到此前缀。序列补到固定长度,PAD填充不计训练损失;框宽仅示意,不代表token数量。 实验效果:GPIC测试50000条描述,每条一张256×256图;gFD为生成与真实图像特征的Fréchet分布距离,越低越好。16亿参数Halcyon为35.28,对照JiT-T2I-XXL/8++为40.97;总预训练运算量约少275倍,包含语言、分词器和图像生成器训练,非采样加速。5.2亿参数在额外语言预训后仍完整训练一轮图文、总预算1.5倍时gFD为49.22,未优于从头的48.02;构图问答GenEval在16亿参数时53.48,对照43.17,越高越好。 原文表6|Halcyon-0.52B固定预训练预算下,分配外部纯文本训练对文生图的影响。各语言阶段均超过每参数20文本token的Chinchilla参考量;剑号配置在额外语言训练后保留完整一轮文生图,总计算1.5倍,gFD仍未改善。token计数不含填充。 批判点评:结论限GPIC、256分辨率和已测模型;受控干预集中小型自回归模型,不能推广为所有生成任务都不需要语言。无语言模型权重预训不等于不用文字:文本分词还使用OpenWebText。1024token逐个生成的延迟没有端到端证明。项目页 提供模型集合,但代码标coming soon;网页模板仓库不是方法代码。 9. SpecKCast:预测不同频带何时需要重算 SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration | 多伦多大学;Vector研究所;三星电子多伦多AI中心 | arXiv:2610.26837 关键词:扩散加速, 频域预测, 卡尔曼滤波, 不确定性 前序问题:缓存上一去噪步能省算,但跳得越远越失真;画面大轮廓和细纹在不同阶段变化,整块特征用同一预测规则并不合适。 方法直觉:把去噪输出拆成低频轮廓与高频细节,各自记住数值和变化速度;预测越来越不确定时再真正调用大网络纠正,平稳时直接用预测。 本文贡献:二维离散余弦变换DCT把每个输出通道分解为空间频率,分7个频带。卡尔曼滤波作为递推状态估计器,为每个系数追踪值与速度,为频带共享不确定性;按噪声信噪比扭曲各带时间轴,阻尼外推避免越跳越远。实验先用12提示×50步轨迹校准频带功率,取后25步统计,参数不训练但校准有成本。跳过时逆变换得到采样器所需速度,不确定性过阈值才重算。 原文图2|去噪速度各空间频带轨迹不同。一次FLUX.1-dev生成的50次速度预测分别做PCA主成分投影,点间更大间隔表示变化更大。(a)完整速度采样分量;(b至d)径向DCT频带B0首步变化最大、B3较宽区间持续变化、B6在40步后最活跃。各面板分别拟合PCA与归一化,不能把跨面板距离直接比较;更多提示与Qwen-Image原文附录G提供。 实验效果:H100上,以50步为完整参考。Qwen-Image 1328×1328约8次有效求值配置,从52.22到8.70秒、6.00倍,额外0.01GiB;与参考图感知距离LPIPS为0.267,越低越好,绝非无损。Wan2.1-14B约14次配置由370到105.2秒、3.52倍,视频质量分80.86对参考81.11。NFE按论文表记有效去噪求值预算,是跨样本平均,单样本可变;使用双分支引导的模型每次实际还需条件/无条件两次Transformer前向。 原文表3|FLUX.1-dev约14次有效求值下的SpecKCast组件消融。频率分解、按频带扭曲时间和不确定性自适应调度共同带来最佳参考保真,完整模型PSNR24.28、LPIPS0.146、耗时3.45秒。 批判点评:PSNR、SSIM与LPIPS主要衡量贴近50步参考,不自动代表用户更喜欢;6倍是图像特定设置,不能套给全部视频。Wan额外内存表中约0.05GiB,摘要“低于0.05”不宜当所有模型严格上界。已计算步仍处理全部空间token;离线校准和自适应耗时需纳入部署预算,尚无核实方法代码入口。 10. MuLaCover:给旋律和弦换速度与唱法 MuLaCover: Flexible Cover Song Generation via Symbolic Tonal Control | 穆罕默德·本·扎耶德人工智能大学;北京大学;MuLa Labs Vera Praxis Lab;香港中文大学;南京艺术学院 | arXiv:2610.26684 关键词:歌曲生成, 符号乐谱, 翻唱控制, 部分参考 前序问题:想保留一首歌的旋律和和弦,却换成另一种风格、速度,逐帧音频条件容易把新版本也锁在原节拍上;只给一段副歌时更加受限。 方法直觉:保留“唱什么旋律、配什么和弦”的简谱骨架,把原录音时间先归一化;让文字指定新歌词与风格,生成器自己决定新版本如何铺开。 本文贡献:从参考录音抽取旋律与和弦,统一到每分钟120拍、十六分音符网格。旋律用128个音高各自的起音/延音状态共256维,和弦用12音级;投影后通过门控自适应跨注意力接入HeartMuLa-3B的28层中最后8层。先30秒片段预热,再全曲训练,最后用同一歌不同版本的“内容/歌词风格音频”交叉配对微调。掩蔽乐谱区间支持续写、向前后扩展和补副歌;前两阶段仅训新模块,最后加低秩适配。 原文图1|MuLaCover。(a)N层歌曲主干输入歌词l、风格s和音频token a,最后L层以GACA门控自适应跨注意力注入乐谱内容c;(b)c先经各层自注意力细化,再以tanh限制的可学门控合入隐藏状态;(c)前两阶段四信号取同版本,第三阶段c取同曲另一版本;颜色区分版本。(d)内容序列掩码支持部分参考:rho=0保留alpha T到beta T区间以向外生成,rho=1保留其补集以填内部,T为乐谱长度;默认alpha=0、beta=1、rho=0为全曲。 实验效果:约20万合成歌曲用于数据构造,16张A100 80GB训练,新增可训参数约3亿至4亿而非整个模型规模。完整翻唱任务在32首源歌检索库中,本法/Suno-v5.5的CSI首位找回率为0.97/0.98,越高越好;音素错误率0.13/0.11,越低越好,后者更佳。22名有效参与者对8首抽样歌给出95个完整人歌组合、1520次五分评分,本法整体音乐性3.75±0.22,对照3.88±0.21,区间为95%置信区间。 原文表1|全曲翻唱任务的客观评测,箭头标指标优劣方向,粗体为最好、下划线为次好。比较音频审美、歌词、风格和原曲检索;本法与商业对照各有优劣,不能用单列概括全部音乐性。 批判点评:可控性不等于逐音符精确复制,自动旋律和和弦转录错误会传递;小检索库与听评也不足证明所有风格等价商业系统。部分参考任务的SongEcho掩蔽与ACE-Step串联是作者适配,不能当原生能力公平等同。未报告完整推理时延显存,训练新模块也有成本。项目与代码 可访问,项目副标题写Lead Sheet Control,原文保留Tonal Control;仓库标权重与输出限非商业用途。 趋势观察 编辑应先想哪些信息不能丢 DeOverlay固定源引导,ColorModern只传播颜色,UniAVC固定满意分支;三者都把保留目标放进具体操作。 监督对象要对准失败阶段 MT Forcing练学生自己生成的历史,LayerEditor检查图层重新合成,Wan-Alpha++把可见参考搬到有效条件位置。 计算预算必须有分母 Halcyon的275倍算总预训练,SpecKCast的6倍是特定采样设置,ColorModern的816帧/秒仅末段传播。 多维指标共同决定是否可用 MuLaCover旋律检索与歌词精度不同步,MeV表面一致性不能取代分镜控制,UniAVC分布距离好也不保证所有同步指标领先。 今日讨论 DeOverlay同一检查点的四步/六步消融,遮挡区PSNR仅从32.461到32.467,相对时延却从1.00到1.25;速度表四步为2.0712帧/秒,主榜六步尚无对应端到端行。若你要做批量视频字幕移除,会收集哪些指标,结合遮挡区感知距离、运动边界残影、天然文字保留率与实际耗时,判断这两步是否值得,而不直接拿六步质量和一步3.0847帧/秒拼成一个配置? 人工智能炼丹君 整理 | 2026-10-21
-
AIGC 每日速读|2026-10-20|Adobe多参考视频编辑OmniXRef 今日 AIGC 论文速览 今日共 10 篇 · 多参考视频编辑 1 篇 · 多轮图像编辑 1 篇 · 视频几何纠错与视频配音 2 篇 · 像素生成与推理效率 2 篇 · 语音与个性化生成 2 篇 · 可控3D头像与世界模型 2 篇 重点论文标题列表 OmniXRef(Adobe):多段参考各取所需再改视频 MTEdit(商汤):先拼好编辑轨迹再拆训练对 VGC(加州默塞德):生成完再修镜头下的几何 MFlow(Adobe):按数据方向学该预测什么 Sink-Sparse(西安交大):保留重要注意力再补全局 选读入口:要用多段参考改视频,先读 OmniXRef;连续修图越改越脏读 MTEdit,生成视频已有几何变形读 VGC。训练像素生成器读 MFlow,长序列注意力慢读 Sink-Sparse;动作细节配错音读 SCR-V2A,语音首响预算紧读 DriftTTS。两图合成准备慢读 Kingfisher;表情带偏镜头读 VDAs,镜头回访忘场景读 PPMem。 今日论文速览 1. OmniXRef:多段参考各取所需再改视频 OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing | Adobe Research;布朗大学 | arXiv:2610.22744 关键词:视频编辑, 多模态参考, 属性迁移, 位置编码 前序问题:想让原视频沿参考片的镜头运动,再套另一段的灯光,模型却把参考人物也搬了进来。多个参考不仅要“都看到”,还要分清每段只允许借什么。 方法直觉:把每个参考做成一个带任务和编辑说明的小包,再给这些包预留固定位置。网络可同时比较全部输入,而不把参考数量改变误当成位置含义改变。 本文贡献:冻结 Qwen3-VL-8B 多模态语言模型提取交错文本/视觉上下文,视觉位置换成视频编码潜变量,单流扩散 Transformer 联合去噪。Mix-Patchify按任务压缩参考的空间 token,源/目标保持细粒度、参考时间轴不压缩。R²-RoPE 是预留参考槽的旋转位置编码:为参考预留8槽,训练随机分配不重复位置,避免增加参考时越出训练坐标范围。约1000万训练样本经272P单参考、272P双参考、480P精调逐级学习;主要文字编辑数据约700万为内部数据。 图2|OmniXRef-Model整体结构。参考包统一承载文本、图像和视频参考。多模态语言模型从交错输入提取语义上下文;单流扩散Transformer通过完整自注意力联合处理上下文文本、视觉token及噪声,使多个参考包同时约束编辑结果。下方Mix-Patchify将视频潜变量按所需粒度切块,再映射为扩散token。 实验效果:OmniXRef-Bench 共125例,覆盖镜头、动作、内容、风格、视觉特效五类,用 Gemini 3.8 Flash 裁判。RA参考遵循、VQ画质、SP源内容保留各按0至5分评估;综合分另惩罚参考泄漏,非简单均值。总体综合分OmniXRef/Seedance 2.5为3.78/2.73,SP为4.68/3.71;但VQ为3.68/3.70,画质并未胜过该商用对照。支持三参考的展示来自双参考训练后的组合泛化,不能据8槽宣称8参考质量已充分评测。 表2|OmniXRef-Bench视频参考属性迁移的逐类别语言模型裁判评估,含内容、风格、特效、镜头、动作及五类总体均值。RA为参考遵循,VQ为视觉质量,SP为源内容保留,三者均为0至5分且越高越好;Score按原协议综合并惩罚参考泄漏,不能按三分算术平均解释。商用模型为参考,粗体只标其余方法最优;横线表示缺少结果。 批判点评:训练与推理要付多参考 token 及全注意力开销;局部压缩并不消除随参考数增加的计算。有限125例及语言模型裁判适合看属性迁移趋势,非普遍产品排名。主表和消融表的完整模型数值略异,正文统一用主表;项目页 仍标Code Soon,没有已开源证据。 2. MTEdit:先拼好编辑轨迹再拆训练对 MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing | 商汤研究院;香港科技大学;斯坦福大学;清华大学AIR | arXiv:2610.23751 关键词:多轮编辑, 轨迹数据, 上下文学习, 质量漂移 前序问题:连续改八次图,第八次可能已经脏了;若训练数据本身也靠逐轮改图获得,模型会学到这种累积退化。怎样得到既遵循连续指令、又不越改越坏的训练链? 方法直觉:先在同一画布里共同生成多个编辑状态,再把画布拆成轨迹。共享视觉上下文让各状态互相约束,比每轮只承接上一次的误差更稳。 本文贡献:PTC(packed trajectory canvas,打包轨迹画布)流程先筛高分辨率美学种子图,再用视觉语言模型规划画布提示,让闭源图像模型一次生成多个状态。随后做坏例过滤、拆格、局部特征匹配与几何对齐,并补逐轮指令,得到50万条轨迹、269万次编辑,最多8轮、平均5.38轮。既包含只执行当前指令,也包含需记住历史的约束、指代和简短指令。用块因果注意力及交错位置编码联合训练多轮,微调 Qwen-Image-Edit-Causal。 图2|MTEdit数据构造。(a)筛选高分辨率与高美学质量种子图。(b)视觉语言模型依据种子图规划PTC画布提示,指导闭源图像模型在共享视觉上下文中共同生成多个编辑状态。(c)过滤坏例、生成逐轮提示,拆分画布并做局部特征匹配和几何对齐,将状态转换为含指令与目标图的多轮编辑轨迹。 实验效果:MTEdit-Bench 含100条8轮逐步编辑链,另有三类各50条4轮上下文任务。受控消融用相同图像/提示、相同教师,各造1万条8轮链,再让同一主干训练5000步:第8轮 PTC/逐轮生成的 IF 指令遵循分为5.06/4.26,CC 内容一致性分为4.44/3.84,DRS 抗画质漂移分为4.22/3.96。IF/CC 是视觉语言裁判0至10分,低于6的首次失败后后续轮置零;DRS是两种画质评分平均、0至5分,不随失败清零。 表3|逐步编辑子基准上的受控消融。Method表示训练数据用PTC共同生成还是逐轮生成;每种构造各1万条八轮轨迹、同主干同超参数训练5000步。逐轮报告IF指令遵循、CC内容一致性与DRS抗画质漂移,均越高越好,粗体标最优。IF/CC为0至10分且首个失败之后后续归零;DRS为0至5分并保留实际分数。 批判点评:结果支持数据构造方式,不代表闭源教师可被低成本替代;画布生成、筛选与对齐成本仍须支付。完整模型第8轮DRS为4.33,但指令遵循仍落后最强闭源模型,不能把画质稳定等同编辑正确。低分置零会放大早期失败影响,比较时应沿用同协议;未核实MTEdit专属代码或数据下载入口,也无会议接收证据。 3. VGC:生成完再修镜头下的几何 Learning to Correct Geometry in Generated Videos | 加州大学默塞德分校;南洋理工大学;北京大学;卡内基梅隆大学 | arXiv:2610.23856 关键词:视频修正, 几何一致性, 配对监督, 光流 前序问题:镜头移动时,灯杆变成两根、门框扭曲;换一个视频生成器又要重新解决。能否在成片后统一修正,而不修改原生成模型? 方法直觉:拿真实视频当正确答案,让现有补帧生成器制造“同场景但几何出错”的版本,再训练一个专门纠错的视频模型。难点是错片仍要走原镜头路线。 本文贡献:VG-Pairs按相机旋转和平移量决定分段数,在运动方向转折处选关键帧,分段用 Wan 2.1-Fun-InP 补中间帧并拼接,避免只给首尾时走捷径。VGC以 Wan 2.1-1.3B 做视频到视频去噪,输入错片、文本和从错片计算的光流;光流是相邻帧运动场,用于区分全局相机移动与局部物体运动,推理时同样可得。训练使用约8000条DL3DV及6.3万条SpatialVID视频,81帧、832×480,32张H100训练1万步。 图3|VGC流程。从真实视频中按相机运动选自适应关键帧,图生视频补全器合成有几何扭曲的片段作训练输入;纠错器学习还原几何一致的目标视频。光流由错片计算并作辅助条件,帮助区分镜头移动与场景动态。中央三维重建仅用于示意,实际流程不使用该重建。 实验效果:在200条保留DL3DV提示、CogVideoX-5B文生视频上,用独立三维重建再投影衡量一致性:PSNR由15.6668到16.6940,像素均方误差MSE由0.0333到0.0264,均改善;LPIPS感知距离却由0.5285升至0.5733,反而变差。图生视频的3DCS三维一致性误差亦由0.7944到0.8121,越低越好,不能宣称所有几何指标均提高。大模型14B扩展到动态场景和720P,属于另一配置。 表2|DL3DV中三种CogVideoX来源生成器的文生/图生视频几何修正。通过独立三维重建与再投影计算PSNR、结构相似度SSIM、感知距离LPIPS、均方误差MSE和三维一致性误差3DCS;前两者越高越好,后三者越低越好。括号是加VGC后的变化,亦展示与VideoGPA叠加。PSNR和MSE多改善,但LPIPS均变差,图生视频的部分SSIM、3DCS也退化,不能据原表概括所有指标改善。 批判点评:改进主要来自配对监督;加光流的增益有限,额外纠错生成、视频编码及光流计算均增加延迟,论文未给完整部署耗时。重投影自洽也不保证忠于真实场景。已核实NeurIPS 2026接收;代码 现释放14B无光流版,不能直接等同上述1.3B含光流实验。项目页作者与arXiv有一名作者差异,本稿保留arXiv原始名单与机构。 4. MFlow:按数据方向学该预测什么 Rethinking the design space of Vanilla Pixel Diffusion Transformers | Adobe Research;马里兰大学帕克分校 | arXiv:2610.23854 关键词:像素生成, 流匹配, 参数化, 高频细节 前序问题:直接在像素上生成时,预测干净图像有时比预测变化速度容易,但换大模型、换视频就未必。固定一种目标,还可能让整套训练都在迁就不合适的表示。 方法直觉:不同数据方向的难度不同:轮廓和细纹不必用同一种预测目标。让模型为每个方向学习“更像图像还是更像速度”,再统一还原成采样需要的速度。 本文贡献:先用 PCA 主成分分析计算固定的图像块或视频块正交方向,再学习各方向的系数 m_i,范围0至1。目标为 x₀−Mε:x₀是干净信号,ε是噪声,M按这些系数重加权噪声;m_i=0对应干净预测,1对应速度预测。将输出解析恢复为速度后计算流匹配损失,避免系数靠缩小目标投机。另加 ConvRefiner:冻结主干,用轻量卷积残差和对抗损失补细节,专门处理 JiT 类大图像块模型的高频缺失。 图3|MFlow预测参数化。按PCA数据主方向比较固定干净预测、固定速度预测、低秩二值分配的AsymFlow,以及连续可学习的MFlow。左侧曲线展示各方向的系数m_i,0偏向干净图像、1偏向速度;右侧用干净图像减去重加权噪声展示不同目标。黑色表示干净预测,白色表示速度预测。 实验效果:UCF-101 类别条件视频为16帧、128×128;各模型独立调采样参数,B级 MFlow/JiT/AsymFlow 的 FVD(视频特征分布距离,越低越好)为122/152/126。ImageNet 256×256、H级加相同感知损失时,FID(图像分布距离,越低越好)为1.81/1.82/1.79,并非全面最优。卷积细化器在冻结训练600轮的主干上另练30轮,恢复每像素0.5至0.7周期的径向高频能量,FID基本保持;文生图另有5000步细化训练。 表4|UCF-101类别条件视频生成B级模型比较。作者分别训练并独立调优每个模型的采样超参数,视频为16帧、128×128;FVD以1万生成视频估计分布距离,越低越好。潜空间基线为Wan视频编码器加latent-DiT;像素JiT、AsymFlow、MFlow分别为152、126、122。表内编码器名中的1.3B不是所比较生成器的参数规模。 批判点评:价值是减少人工选择预测子空间,不是推理必然更快。小模型、是否加入感知损失会改变排名;高频统计改善也不等同细节真实。大规模文生图用了内部预训练与微调数据,复现门槛需单算;额外卷积、训练和显存没有完整端到端量化。作者项目页 未提供方法代码入口,不能把网页模板仓库当代码;论文仍在审稿。 5. Sink-Sparse:保留重要注意力再补全局 Sink-Sparse Hybrid Attention for Efficient Inference in T2I/T2V Diffusion Transformers | 西安交通大学;厦门大学;上海交通大学 | arXiv:2610.22975 关键词:生成加速, 稀疏注意力, 离线校准, 全局补偿 前序问题:视频token越多,反复计算全连接注意力越慢;每一步再搜索该留哪些关联,也可能吃掉稀疏化收益。能否一次找好,以后重复利用? 方法直觉:同一层同一注意力头常反复关注相似位置。保留这个稳定骨架,再用低分辨率全局摘要补上弱关联,兼顾省算与上下文。 本文贡献:离线在每个主干分别跑4提示×2噪声种子的完整轨迹,汇总精确块级注意力概率质量;每行选能覆盖阈值τ的最少块,固定掩码跨步复用。在线稀疏分支保留重要块,补偿分支只将key/value(供查询读取的键和值)按30个token均值池化,query仍保持原长;依据两支归一化常数自适应融合。模型权重、采样步数不变,免训练不等于免校准。 图4|Sink-Sparse Hybrid Attention两阶段流程。离线对少量提示、种子及去噪步采集稠密注意力,精确汇总块级概率质量并按行覆盖阈值τ选出每层每头固定掩码。在线各步复用掩码,稀疏分支保留稳定高质量关联;全长query读取均值池化的key/value以补全局信息,最后按归一化常数融合两分支。 实验效果:单A800 80GB,Wan2.1-1.3B、832×480、81帧、50步:τ=0.85时由164.80降到106.73秒、1.54倍;VBench八维均分0.656到0.659,越高越好,非官方完整总分。τ=0.70可到94.57秒、1.74倍,但均分降为0.647。Z-Image-Turbo 2048×2048、8步由23.39到14.88秒、1.57倍;GenEval2中各属性问答软分的几何均值Soft-TIFA GM由16.38降至15.21,越高越好。计时排除初始化和写文件;默认离线校准约22分钟为按稠密耗时估算。 表1|Wan2.1-1.3B文生视频主比较,832×480、81帧、50步、单A800 80GB。Dense为同一优化算子栈的稠密基准164.80秒,加速倍数以它为分母;计时不含模型初始化和视频写入。τ=0.70/0.85为速度/质量档。八列分别评主体、运动平滑、动态幅度、背景、场景、美学、成像及总体一致性,均越高越好;八维均分由未四舍五入值计算,非完整VBench总分。 批判点评:这是已测两主干上的质量与速度取舍,图像设置并非无损。固定掩码可能遗漏罕见或分布变化下的关系,不应跨主干直接复用;稀疏率只统计主分支,不包含补偿分支。尚未核实作者代码入口,也未报告完整峰值显存,不把免训练写成零部署成本。 6. SCR-V2A:盯住真正发声的局部来配音 Semantic-Critical Regions for Video-to-Audio Generation | 悉尼大学 | arXiv:2610.23021 关键词:视频配音, 局部语义, 适配控制, 音画对齐 前序问题:画面里人和乐器都很大,真正发声的却是手与琴弦接触处。只用整帧语义,配音可能听着像那个场景,却错过细小动作和节奏。 方法直觉:先找“哪里最能解释声音”,把局部热图与原视频同时送入生成器:局部提示事件,全局保住场景,标签补声音类别。 本文贡献:SCR指语义关键区域。用MotionFormer视频编码器预测声音标签,只微调最后块与分类头;保留概率高于0.65、最多5个标签,通过类别梯度加权的激活图定位区域,跨标签取最大,再与原帧各占50%叠加。热图适配器弥合热图和自然视频的差别,二者由共享视觉编码器编码后拼接,经控制适配器注入预训练音频扩散U-Net(带跨层跳接的去噪网络),标签作辅助语义条件,最后解码频谱与波形。 图2|SCR-V2A整体结构。声音相关视觉定位预测标签并提取语义关键区域热图;原始视频与经热图适配器处理的热图由共享编码器编码,融合后经控制适配器注入冻结音频扩散U-Net,并联合声音标签的文本特征生成频谱与波形。彩色箭头区分视频、定位、融合、音频及文本路径,火焰/锁表示可训练/冻结组件。 实验效果:在VGGSound约20万条10秒片、310类上训练,并用CountixAV测跨域。域内SCR-V2A/MMAudio 的FAD(VGGish特征上的音频分布距离,越低越好)为1.07/1.84,DeSync音画时间不同步分为0.680/0.440、越低越好,后者更强。跨域FAD为2.16/2.22。30人对20视频的5秒音频作五分评价,本法总体音质3.93±0.94、语义对齐4.10±0.88、时间对齐3.50±0.97;MMAudio时间对齐3.87±0.94。195M指可训练参数,非整模型参数或推理内存。 表1|VGGSound域内和CountixAV域外客观比较。FD、FAD为不同音频特征空间的分布距离,KLD为类别概率分布差异,DeSync为时间不同步分,均越低越好;IS为音频质量/多样性分,IB为ImageBind音画语义相似度%,均越高越好。Seeing&Hearing直接在测试时优化IB,比较需注意该条件。#Params按文中说明计可训练参数,非总推理参数;粗体/下划线标最优/次优。 批判点评:局部区域有助分布质量和语义,不保证时序最佳。梯度热图、双路视觉编码和扩散本身均需计算,缺端到端时延与峰值显存证据,不能只凭可训练参数宣称部署轻。标签误判也会把注意力引向错处;这些差异不由小规模听评自动证明显著。arXiv明确写ACM Multimedia Asia 2026已接收,未核实专属代码入口。 7. DriftTTS:把迭代搬到训练来一步发声 DriftTTS: One-stage Single Step Text-to-Speech via Generative Drifting | 首尔市立大学人工智能系 | arXiv:2610.22960 关键词:语音生成, 生成漂移, 单步采样, 片段监督 前序问题:语音生成器要反复调用解码器,交互响应变慢;蒸馏虽能减步,却通常先付一遍多步教师训练。能否从头训练一个只调用一次的模型? 方法直觉:让生成结果在训练中靠近真实语音片段、远离当前错误分布,推理时就直接落到目标附近;片段一起比较还能避免单帧“对了、拼起来却不顺”。 本文贡献:沿用Matcha-TTS文本编码器和时长预测器,用MAS单调对齐搜索把每个文字token的表示按持续时间展开,形成接近目标梅尔频谱(声学能量随时间与频带变化)的先验。解码器接先验与随机噪声,一次预测频谱,无时间步嵌入。训练随机裁80帧约0.93秒片段,以掩码自编码器MAE提取特征;真实批次作吸引样本、生成批次作排斥样本且排除自身,三个温度共同计算漂移损失。 图1|DriftTTS训练流程。文本编码器与MAS单调对齐搜索依据每个token持续时间重复其表示,构造先验ε=μ;解码器单次把先验映为生成片段。片段漂移在MAE掩码自编码器的特征空间中比较生成与真实目标片段,将训练中的生成分布推向目标;推理无需重复该漂移优化。 实验效果:LJSpeech单说话人训练2000轮、4张A10,每GPU批量64;另训练MAE,波形仍由HiFi-GAN声码器合成。500条评测、单A10、批量1:NFE即解码器调用次数,DriftTTS为1;WER单词错误率1.80%,MOS五分听感均分4.43±0.08,对照Matcha-TTS十次调用为1.93%、4.38±0.08。RTF为模型推理秒数/音频秒数,排除声码器:0.00441对0.0187,约4.2倍;单步RapFlow为0.00419,仍略快。MOS来自153人290份响应。 表1|LJSpeech评测。NFE为推理解码器调用次数;WER为单词错误率%、越低越好;MOS为五分主观听感均值及所报区间、越高越好,来自153名听者的290份响应。单A10测RTF即推理秒数除音频秒数,表中单位10⁻³且不含声码器,越低越好。Ground truth为真实语音,Vocoded GT为声码器重建。 批判点评:“从头单阶段”限定TTS模型,不代表没有预训练声码器或额外特征网络。去MAE后WER升至20.03%,片段与特征空间是必要条件;训练大批量和2000轮的成本不能隐去。多说话人、零样本与长语音尚待验证,MOS区间重叠也不能声称听感显著胜过多步。作者音频页 可访问,尚无代码入口;机构是首尔市立大学,非首尔大学。 8. Kingfisher:重组前四级图码来换风格 Kingfisher: Fast Personalized Visual Autoregressive Generation via Scale-Aware Prompt-Conditioned Scale Decomposition | 越南胡志明市科学大学;越南国家大学胡志明市分校;日本国立情报学研究所 | arXiv:2610.23238 关键词:个性化生成, 视觉自回归, 风格迁移, 尺度分解 前序问题:想保留一张实拍的主体、借另一张的画风,逐对训练LoRA适配器太慢;直接混合图像表示又容易把主体和风格一起换掉。 方法直觉:视觉自回归生成先画粗结构再补细节。抓住最早几级里决定主体与外观的部分,拆开后重新组合,再让冻结的生成器补完后续。 本文贡献:在冻结的 Infinity 多尺度生成器上,只处理前四级残差码。用中性外观提示和物体提示查询生成器,SVD奇异值分解提取“中性外观仿射空间”与“物体内容子空间”,据此投影并联合优化内容、风格及残差。重组时前两级换外观、第三级保留内容语义锚、第四级补内容方向;其余级由原生成器按位自校正生成。无需更新模型权重,但每对图片仍有图码优化。 图3|Kingfisher整体流程。将内容图A和风格图B用冻结编码器变为多尺度残差码,通过中性与物体提示分别构造外观仿射空间、物体内容子空间;在选定早期尺度将图码拆为内容、风格和残差并优化约束,再重组成语义前缀。冻结Infinity生成器按位自校正补剩余尺度,保留A结构并引入B外观。 实验效果:CSD-100的100张图各配5张不同类别风格图,共500个有序组合,每法一图,固定种子2026。Kingfisher/UnZipLoRA 的内容相似度CSD-C为0.5519/0.5782,后者更好;风格相似度CSD-S为0.5222/0.3673,本法更好,二者均为特征余弦相似度。单A100每对准备23.54±1.86秒,对照CSD-VAR为171.65±11.82秒;准备后每图1.61±0.15秒,对照1.39±0.12秒。20人600次强制选择中获254票、42.3%,是相对偏好。 表2|单A100效率与人工偏好。Prep./pair是每对内容/风格图的准备优化秒数;Infer./image是准备完成后单张生成秒数,两者不可混用。数值为均值与所报告离散度。人工偏好来自20参与者共600次强制选择:Votes为票数、Pref.为占比;这不是开放用户群的绝对满意率。 批判点评:加速集中在准备阶段,并非每图推理最快。171.65除23.54约7.29倍,与摘要7.5倍和正文“超过10倍”不一致,本稿保留原秒数;也不沿用未明确分母的54倍宣传。仅单张内容/风格、固定种子协议,不足证明开放场景通用解耦;项目页 标代码即将开放。 9. VDAs:表情与镜头分开驱动头像 Video Diffusion Avatars: Taming Video Diffusion Models into Controllable 3D Avatars | 慕尼黑工业大学;Woven by Toyota;Toyota Motor Europe | arXiv:2610.23772 关键词:可控头像, 视频扩散, 表情解耦, 多视角 前序问题:拿一段正脸表情去驱动侧面头像,表情编码里夹带的原镜头会把新视角拉回去;仅靠传统三维脸模又难表达舌头与嘴内细节。 方法直觉:把“做什么表情”和“从哪儿看”分开,再用不同相机的参考、驱动和目标三元组训练,迫使模型不能偷用驱动镜头。 本文贡献:在 WAN-Animate-14B 上使用 X-NeMo 学习式表情码,经解耦器分成表情与相机部分,再翻译回原模型可接受的条件格式,相机部分取中性值。代理网格将头部/躯干局部坐标方向与明暗编码成图像,联合控制镜头、颈部及上身,三维骨架补姿态。冻结去噪主干,只微调条件相关组件;公开多视角数据上的相机三元组进一步去掉视角捷径。 图2|Video Diffusion Avatar结构。镜头、上身姿态与表情作为独立控制信号进入WAN-Animate-14B。解耦的X-NeMo表情码翻译成原生条件格式,并配视角中性相机码;代理网格渲染编码镜头和姿态。多视角数据的参考、驱动、目标相机三元组训练多视角一致性,主扩散块冻结而条件相关组件微调。 实验效果:单张A100训练34小时,推理20步。BecomingLit 的25条同人驱动测试中,VDAs/MVP4D 的脸部LPIPS感知距离为0.202/0.282,越低越好;JOD感知质量预测分为3.99,对照中最高CAP4D为2.40,越高越好。另测22条Multiface同人和13条BecomingLit跨人驱动。完整模型在单A100生成77帧、576×1024约12分钟;四步蒸馏原型改为288×512可达论文所报4.8帧/秒,但降低画质。 表2|定量结果:每格左/右依次为BecomingLit和Multiface;同人驱动各25和22例,跨人驱动仅BecomingLit的13例。MMDM为CAP4D的扩散组件。PSNR、JOD感知质量、ID身份相似度、Expr表情一致性越高越好;LPIPS和AKD平均关键点距离越低越好。跨人无逐像素真值,故仅评身份、表情及关键点;颜色在各数据集内部排序。 批判点评:完整模型适合离线制作,不能把34小时训练或低分辨率原型速度当作高清实时渲染能力。作者当前仓库对快速版写约3.5帧/秒,与论文4.8的原型口径分开;长序列仍可能漂移,光照烘在参考中。静态三维高斯重建只是多视角一致性探针,视频输出不等于直接交付可实时渲染的三维资产。代码 已有推理脚本与权重说明。 10. PPMem:把场景记成平面再转镜头 Persistent Planar Memory for Video World Models | 清华大学;蚂蚁集团;香港科技大学 | arXiv:2610.23795 关键词:视频生成, 世界模型, 平面记忆, 相机控制 前序问题:镜头绕回刚才的房间,墙和门却换了位置;只看最近几帧不够,逐像素累积三维点又让场景记忆膨胀。怎样在连续生成中保存可再投影的空间结构? 方法直觉:墙、地板和立面大多接近平面。把这些面记住,再从下一段的目标相机渲染深度,相当于让生成器沿着同一份场景草图继续画。 本文贡献:在 Wan 2.2 TI2V 5B 扩散 Transformer(用注意力网络逐步去噪的视频生成器)上,每段生成约25帧,并预测平面。每面用7个参数表示:中心深度、两个矩形尺度、四元数(四维旋转表示)。旧面通过遮挡投票删除,近邻按观测质量去重,再与新面合并。深度既作为输入通道,也经 DTF(把深度切成网络处理的特征单元token再融合)补入几何特征;先训练视频主干,再冻结主干训练几何头及 LoRA 低秩适配器。推理去噪后另做一次启用几何适配器的前向来提取平面。 图2|PPMem整体结构。带噪视频潜变量与源视图投影RGB、可见掩码、平面池渲染的部分深度按通道拼接,前序上下文帧在时间上前置。Wan扩散主干的两路token分别由视频解码器恢复RGB,或经几何LoRA及ViT深度token融合后解码成逐帧平面。平面合并进持久池,再按下一段目标相机渲染并回馈条件。 实验效果:主实验训练使用 DL3DV 与 RealEstate10K 超过8万片段,576×1024;两测试集各100场景。DL3DV 的121帧完整系统对照中,PPMem/Gen3C 的 PSNR(像素保真信噪比,越高越好)为13.98/13.59,LPIPS(感知距离,越低越好)为0.464/0.565。各模型按自身原生分辨率评测,不能把差异全部归给记忆。同主干、低分辨率消融中,预测深度/真值及其倒数均小于1.25的比例由无持久记忆64.0%升至70.3%。约400帧后10万个平面约5MB,仅为几何记忆;额外深度编码器约8700万参数,非零推理成本。 表2|DL3DV和RealEstate10K上的短程完整系统比较。两种帧预算N=49与N=121;N指输出帧数,VMem短档用48帧。49帧时多数基线只生成一段,121帧时Voyager、VMem、SPMem需自回归衔接。PSNR、CLIP语义及DINOv2结构相似度越高越好,LPIPS感知距离越低越好。每种方法按自身原生分辨率与画幅评测,输入及真值相应裁剪缩放。 批判点评:适合静态、平面丰富且相机路径已知的环境;作者亦承认动态内容与非平面细节受限。5MB不能当整机显存,作者仓库默认设置约需19GiB GPU内存。主榜是跨系统比较,消融才控制主干;深度 token 融合的阈值准确率也未优于仅通道拼接。已核实 NeurIPS 2026 接收;项目与代码 可访问,未运行模型。 趋势观察 控制先分清信息该进哪里 MTEdit共享画布防止训练轨迹漂移,OmniXRef按参考包限定属性,VDAs把表情与镜头分开;保持内容不能靠泛泛加大条件强度。 记忆与纠错处理不同时间点 PPMem把几何记忆带入下一段生成,VGC在视频生成后修正;前者不能代替后者的成片检查,后者也没有持久世界状态。 省算需要保留成本账 Sink-Sparse要离线校准并付全局补偿,Kingfisher要逐对优化图码,DriftTTS把多步推理的工作搬到训练;同叫免训练或一步,账本并不相同。 主指标无法代替全部验收 MFlow补高频而FID变化小,VGC重投影改善却有感知退化,SCR-V2A音频分布质量与时间对齐也有取舍。 今日讨论 OmniXRef 在125例多参考编辑测试中的综合分为3.78,Seedance 2.5为2.73;源内容保留分为4.68/3.71,但画质分为3.68/3.70,并未领先。如果要给真实剪辑流程选模型,你会用哪些指标同时检查参考属性迁移、源内容保留、参考泄漏、画质和参考数增加后的计算成本,而不只看综合分? 人工智能炼丹君 整理 | 2026-10-20
-
AIGC 每日速读|2026-10-19|Meta让图像token先学特征FeaTok 今日 AIGC 论文速览 今日共 10 篇 · 图像表征与统一生成 2 篇 · 图像编辑与蒸馏 2 篇 · 视频计算与采样加速 2 篇 · 视频时序控制 1 篇 · 三维材质生成 1 篇 · 音乐与长语音生成 2 篇 重点论文标题列表 FeaTok(Meta):图像token先学特征再画图 Intern Lumina U2(上海AI Lab):一个视觉位置装八本码表 ACEdit(特拉维夫大学):连续改十次也守住原图细节 FocusOPD(中科大):只在早期深层补蒸馏监督 Speculative Forcing(KAIST):画好的视频token提前交卷 选读入口:想重新训练图像表示,先读 FeaTok,关心统一图像理解与生成再接 Intern Lumina U2;连续改图会漂移,直接看 ACEdit,要合并多个教师看 FocusOPD。视频算得慢,按位置早停读 Speculative Forcing,按时间缓存读 SoftCache;事件先后不对读 TSG。商品三维小字丢失看 SUPRA-Tex,低预算文生音乐看 MIDI-REPA,语音超过50秒开始跳读或变声看 VoXtend。 今日论文速览 1. FeaTok:图像token先学特征再画图 FeaTok: Feature-Loss Tokenization for Image Generation | Meta FAIR;Mila;蒙特利尔大学;哥伦比亚大学;牛津大学;麦吉尔大学 | arXiv:2610.22060 关键词:图像生成, 特征重建, 离散编码, 全局条件 前序问题:把图片压成离散token后,重建得像,不代表后面的生成器容易学。逐像素还原会迫使编码器保留许多局部细节,却未必组织好物体与场景的关系;token就是供模型预测的离散视觉单元。 方法直觉:先教编码器抓住视觉特征中的结构,再单独教解码器把这些单元画回像素。生成器先决定全局内容,再补局部,减少每一步从零猜整幅画的负担。 本文贡献:FeaTok用冻结视觉编码器四个等间隔层的归一化特征均值作目标,通过特征重建训练编码器、量化器与特征解码器;像素解码器仍训练,但在输入处截断梯度,像素损失不能反过来塑造token。全局特征和局部图块各用一个量化器,生成时先预测全局token,再以其为条件预测图块。SigLIP、SigLIP2、DINOv2、DINOv3均做受控实验;只换特征目标时SigLIP2并不获益,加入全局token才超过像素版。 图2|FeaTok的编码及生成流程。蓝色为传统离散编码器,橙色为本方法:特征损失L_feat只训练特征解码器D_feat,从全局及局部图块token重建冻结编码器的多层目标y;像素损失L_pix仅训练像素解码器D_pix,输入的图块token已截断梯度。图中未画出的生成器联合建模全局量化器Q_global与图块量化器Q_patch的token。 实验效果:ImageNet-1k、256×256、五万张生成样本,无引导FeaTok-L-DINOv3的gFDr6为3.13,离散基线VFMTok2为4.38;它平均六种特征空间中以固定参考距离归一化的Fréchet距离比,越低越好。对连续RAEv2为3.13对3.95,采样运算量1.27对47.72 TFLOPs,TFLOPs指每图万亿次浮点运算,约38倍是算量比。单L40S、批量256、含像素解码的实测吞吐14.36对1.09图/秒,峰值22.0对13.4 GiB。 表2|ImageNet-1k 256×256上的连续特征基线对比。无引导时FeaTok以更低采样运算量取得所列模型最低gFDr6;Size为生成器参数量,TFLOPs为无引导每图采样浮点运算量。各指标列以粗体和下划线表示最优、次优。有引导连续基线转录自Singh等人2026论文;有引导RAEv2仍优于FeaTok,不能把无引导结论扩到整表。gFDr6为六特征空间归一化Fréchet距离比均值,越低越好。 批判点评:有引导RAEv2仍以2.17优于FeaTok的3.08,不能称全面超越连续模型。DINOv3特征监督使重建PSNR从20.61降至17.45,PSNR是逐像素重建信噪比、越高越好,说明细节存在代价。文生图还需预训练75000次后微调500次,不是从零500次。项目页明确代码与权重待开源审批。 2. Intern Lumina U2:一个视觉位置装八本码表 Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation | 上海AI Lab;华为;上海交大;大连理工;清华;上海创智学院;悉尼大学;港科大(广州);中科院深圳先进院;中科大;港中文 | arXiv:2610.20818 关键词:统一生成理解, 多码本, 掩码扩散, 稳定性感知采样 前序问题:统一模型既要读懂图片,又要生成纹理。一处画面只用一个离散编号,容量受限;直接把连续图像特征接入文本模型,又要协调不同表示和训练目标。 方法直觉:每个视觉位置用八个互补编号描述,主干同时推理所有位置,小预测头在每个位置内依次补齐八个编号,把空间并行与局部依赖分工。 本文贡献:冻结AToken编码器将图像、视频、三维输入转成统一离散表示,每处有8个码本、每码本4096项。各码本独立嵌入后在同一位置拼接、投影成一个主干token;掩码扩散主干预测缺失位置,多码本自回归头依次预测该位置的8个码。文本按块扩散生成,图像全画布迭代;MoE即混合专家,只激活部分参数。整机约16.9B参数、每token激活约1.4B,B为十亿。 图3|Intern Lumina U2整体结构:视觉输入由AToken编码成视觉token,文本编码为文本token;MoE混合专家扩散语言主干通过文本头恢复掩码文本、以块扩散生成回答,通过多码本自回归头恢复掩码视觉位置。每个视觉token的K个码按顺序预测;本模型K=8,不同位置由主干并行处理。 实验效果:主模型在1024张昇腾910B上训练,另有训练token预算不同的NVIDIA参考线。同一检查点、1024×1024、553条GenEval提示、每提示1图、引导强度4.0的加速实验,默认96个外层扩散步需159.9秒;PHV即Plateau-Halton sampling with V-verify,以置信度平台决定解掩码、Halton顺序选位置,再由验证器按隐状态漂移刷新缓存,合用后平均60.4步、35.9秒,4.45倍。主干前向次数由192降至121,含有条件和无条件两支;相应GenEval物体属性组合分86.6至89.3;原文该计时表未清楚注明卡型,不把35.9秒视作指定910B的单卡性能。 表4|同一检查点1024×1024文生图推理加速:553条GenEval提示,每条一图,引导4.0、温度0.9、随机种子42。Steps为实际外层扩散步数,平台自适应行随提示变化;BB fwd同时计有条件及无条件主干前向,括号为缓存命中率。时间为去掉首次内核预热后的每图墙钟时间,含缓存预热。选定PHV使用δ_p=0.18、f_p=0.005,其余缓存和验证参数固定。单图GenEval不能与表7四种子协议直接对比,所列配置均未低于production path。 批判点评:该加速表是单种子协议,不能与四种子主榜的89分混算;60.4步也不是60.4次主干前向。多码本头本身仍有解码开销。当前生成能力限图像生成和编辑,视频与三维是理解输入,尚未验证视频或三维生成。代码可访问,本次未运行模型。 3. ACEdit:连续改十次也守住原图细节 ACEdit: Stable Multi-Turn Image Editing via Asymmetric Conditioning | 特拉维夫大学 | arXiv:2610.22328 关键词:多轮图像编辑, 自生成轨迹, 非对称条件, 分数蒸馏 前序问题:先换衣服,再加道具,改到后面人脸和背景一起漂移。训练时看干净原图,使用时却不断编辑自己的输出;误差逐轮累积,用固定配对目标硬教也会错位。 方法直觉:学生照常在自己的上一轮结果上编辑,老师始终看干净原图与累计指令。学生走一条可能出错的长路,老师从源头判断现在该变成什么,避免把旧错误当成要保留的细节。 本文贡献:学生为四步FLUX.2-klein-9B,冻结教师与可训练辅助编辑器为同系列base版。教师和辅助器都看原图及合并指令,二者预测差形成分数蒸馏梯度,辅助器拟合学生当前输出分布。训练以10轮自生成编辑轨迹暴露真实输入,仅对抽中的当前轮当前去噪步回传梯度,轮间直接传潜变量,省去反复像素编解码。学生只训练rank16的LoRA低秩适配权重,共27.8M参数,M为百万。 图2|ACEdit方法。左:学生沿自身生成轨迹逐轮编辑,上一轮图像I_(e-1)和当前指令产生当前去噪步的干净估计。右:估计加噪至τ,同时送入冻结教师及可训练辅助编辑器;两者都以干净原图I_0和截至第e轮的累计指令为条件。教师表示期望的干净条件分布,辅助器拟合学生实际生成分布,二者预测差给出蒸馏梯度,把多轮输出推向不退化的目标分布。 实验效果:96张合成图、每图10条局部指令,共960条;单B200约4.4 GPU小时,505次迭代中只有100次学生更新,推理仍为4步。EdiVal-10测试252条真实照片编辑链,十轮末KRIS视觉语言裁判质量分2.73至3.19、一致性3.03至3.85,均为1至5分;指令遵循3.31至3.38未标显著差异。未编辑背景LPIPS感知距离由0.351降至0.254,越低越好;未编辑锚点DINOv2距离只在148条有效链统计。 表1|EdiVal-10定量对比。除锚点距离外,均在252条编辑链累计十轮后计算;锚点距离只统计148条锚对象大部分位于编辑区外的链。质量为KRIS视觉语言裁判的1至5分和第1至10轮HPSv3变化;保留性为同裁判一致性、未编辑锚点DINOv2距离及背景LPIPS距离;编辑性用第10轮指令遵循分检查是否偷懒不编辑。模型按主干分组,粗体及下划线为列最优和次优,星号表示与本方法配对差异超过两个标准误。 批判点评:稳定性改善不等于永不忘记旧编辑,论文仍出现“让登山者微笑”时抹掉先前墨镜的失败。Emu Edit的HPSv3质量变化-0.15还略优于本方法-0.17,不应每列都称第一。与30步MT-OPSD的主干和分辨率不同。作者项目代码仍标Coming soon。 4. FocusOPD:只在早期深层补蒸馏监督 FocusOPD: Structure-Guided On-Policy Distillation for Diffusion Models | 中科大;港科大(广州);华为诺亚方舟实验室 | arXiv:2610.21250 关键词:图像生成, 多教师蒸馏, 方向对齐, 监督预算 前序问题:把构图、画字和审美三个教师合进一个生成器,只匹配最后输出,学生内部特征仍可能接不住教师能力。全层全时刻强行对齐,又增加训练开销。 方法直觉:先定位差距集中在哪些层、哪些去噪阶段,再把额外监督花在那里。高噪声早期负责搭结构,深层负责落实语义,方向一致可能比把所有特征数值抄齐更有用。 本文贡献:在学生自己的10步轨迹上抽取并截断梯度的状态,让学生和同架构教师读取同一输入。保留原OPD即在策略分布上的输出蒸馏,再对选定深层和早期步骤的逐token特征归一化,最小化余弦方向差;只更新学生的LoRA适配权重。SD3.5-M受控配置选最后12层、前40%去噪段,推理只保留学生,不增加教师。 图4|FocusOPD流程:教师与学生读取来自学生轨迹的相同状态,输出监督遵循原有OPD协议,额外特征方向监督集中在早期去噪与深层。推理只使用训练后的学生,没有额外教师调用。 实验效果:512×512、训练至检查点1000,SD3.5-M加在DiffusionOPD上,GenEval组合正确率0.953至0.967,PickScore偏好奖励23.797至23.944,LAION审美分6.052至6.199,均越高越好。独立监督预算消融中,选择12层及早期40%的更新耗时18.99秒,全24层全轨迹21.77秒,纯输出监督16.54秒;每个并行进程的CPU教师缓存分别432、2160和0 MiB,不能说是GPU显存。 表3|SD3.5-M和DiffusionOPD上的特征监督消融。单次更新耗时统计第11至1000步;教师缓存是每个并行进程存于CPU的张量负载,不是GPU显存。特征变量都用余弦距离、权重λ=0.3;所有方法训练完整24层Transformer,Last-12只限制监督位置而非只训练12层。Time列标监督覆盖范围,Time/up为秒,缓存为MiB。 批判点评:主表与开发集消融数字不同,不能把消融的0.960当主榜0.967的同一运行。各指标并非单调:DanceOPD加监督后的文字识别准确率0.952降至0.945,STEP-OPD的PickScore也稍降。论文对两个主干选窗是否完全一致有文字出入;本期12层/40%只指明示的SD3.5-M配置。额外监督比纯输出训练更贵,未确认独立公开实现。 5. Speculative Forcing:画好的视频token提前交卷 Speculative Forcing for Efficient Autoregressive Video Generation | 韩国科学技术院(KAIST AI);NAVER AI Lab | arXiv:2610.22347 关键词:视频生成加速, token早停, 收敛验证, 上下文缓存 前序问题:少步视频模型仍让每个视觉token完整跑四步,即使静态背景早已接近最终结果,也要陪着运动区域继续算。把整块一起早停又会把未修好的细节带入后续视频。 方法直觉:逐个检查中途的干净估计,足够接近四步结果的token先定稿;后续只更新还没完成的部分。已交卷的内容仍能作为上下文被其他位置读取。 本文贡献:提供两种验证器:免训练版使用与干净历史内容的相似性及跨步稳定性;学习版读取冻结生成器的中间特征,用三层三维卷积预测每token相对完整结果的剩余误差,再做局部时空平滑。接受后冻结该token,只保留key/value供注意力匹配和取回内容。学习头分别用1000条提示或1000个初始场景的完整轨迹训练,阈值控制提前接受程度。 图3|Speculative Forcing:基线让每个token走完整去噪表;本方法把中间干净估计当草稿,验证器预测其相对完整结果的剩余差距rel_k(i)。预测已收敛者接受定稿,后续只作为注意力的key和value参与上下文,因此下一次去噪仅更新尚未接受的token。 实验效果:单H100、LongLive 1.3B、5秒VBench视频,学习版平均每token去噪1.68次,吞吐26.40至41.74帧/秒,总分83.08至83.21;这不是整机只调用1.68次。30秒VBench-Long为1.72次、24.5至37.8帧/秒。Lingbot-World 2.0相机运动测试200场景、每段253帧,平均2.55次、18.1至24.5帧/秒;质量随时间波动的Drift由3.094降至2.839,越低越好。 表1|LongLive生成5秒视频。Mean Steps是每个token平均实际去噪次数,不是完整网络调用次数;标准VBench的16个维度汇总为总分、质量与语义分,均越高越好,吞吐在单张H100上测量。TF为免训练验证器,H为学习头验证器;与1至4步统一采样分别对照。 批判点评:阈值放松并非免费:世界生成阈值从0.24提至0.32,虽到28.3帧/秒,Drift却升至3.398。定稿是不可撤回的,错误接受会影响后续上下文;训练版还要先采完整轨迹。它研究token去噪早停,与上期交付缓存的Speculative Sampling是不同机制。代码仓库当前仅说明内部审查后发布,尚未确认实现可用。 6. SoftCache:缓存还够用就往前多走一步 SoftCache: Adaptive Step Size Caching for Diffusion Transformers | 特拉维夫大学;莱赫曼大学 | arXiv:2610.22369 关键词:扩散加速, 自适应步长, 特征缓存, 网格重排 前序问题:缓存加速通常只决定“重算还是复用”,但一次刚刷新的缓存与即将过期的缓存,仍按相同步长前进,没把剩余精度余量用于减少采样节点。 方法直觉:缓存越新、估计误差越小,就允许走得远些;快到刷新阈值时收回原步长。跳到原网格之间后,还要同步调整后面的节点,否则会浪费一次计算走极短的路。 本文贡献:用输入廉价探针累计的陈旧信号与阈值之间的归一化余量设置复用步长;轨迹开始及探针突变时禁跳。为支持离网格时刻,用最近两次新算残差沿时间线性外推,并在大加速时阻尼;跳后将剩余节点重新均匀分布到终点。无需训练,但多保存一个历史残差张量,刷新阈值仍需按速度目标选择。 图2|刷新信号包含的不只是二值决定。(a)无缓存FLUX轨迹上,复用残差相对误差E_i的分箱中位数与四分位带随累计刷新信号A_i上升。(b)硬缓存只将A_i与阈值τ比较,并在缓存节点使用原步长Δ_i;SoftCache还读取距阈值的余量,A_i越低步长越长,上限JΔ_i。星号表示两面板同一A_i:低误差允许长跳,高误差只短跳,越过τ则重算刷新。 实验效果:FLUX.1-dev、1024×1024、DrawBench 200提示、原50步Euler、单H100 NVL,与同提示同随机种子的无缓存结果比较。最快档去噪环节15.49至2.24秒、6.91倍,PSNR18.58对SeaCache17.46,LPIPS0.327对0.409;PSNR信噪比越高、LPIPS感知距离越低表示更接近原采样。峰值分配内存均33.8 GB。混元视频65帧640×480、946提示最快档6.05倍;Wan2.1另在RTX A5000,不能跨设备比较绝对耗时。 表1|FLUX、DrawBench 200提示,每个分块对应一个速度档,逐行报告实际加速比。DrmSim为DreamSim感知距离;PSNR信噪比、SSIM结构相似度越高越好,LPIPS和DreamSim距离越低越好,四者均衡量与同提示同种子无缓存采样的保真度,不能读成绝对生成质量或人类偏好。 批判点评:6.91倍计同步后的去噪循环,不是含全部编解码的端到端服务时间。四个保真指标衡量接近无缓存结果,不能等同人类更喜欢;随预算收紧它自身也会变差,FLUX慢档PSNR23.20、快档18.58。需验证新主干的刷新信号是否仍可靠。代码入口可访问。 7. TSG:把视频先后顺序写成可执行约束 Temporal Specification Guidance for Text-to-Video Generation | 宾夕法尼亚大学;丰田北美研发 | arXiv:2610.20822 关键词:可控视频生成, 时序逻辑, 注意力引导, 生成验收 前序问题:要求红灯变绿,模型可能两种颜色都画到了,却顺序错了;要求一个物体先进入、另一个持续存在,文字出现不代表时序要求真的满足。 方法直觉:把“先发生、持续到、在某段时间出现”写成机器可检查的时间规则,再沿着增加规则满足度的方向调整生成过程。 本文贡献:TSG即Temporal Specification Guidance,用带时间区间的时序逻辑表达事件约束,从视频对文本的注意力提取每个概念随时间的证据。LogSTOP在对数空间计算可微满足分,将其对注意力的梯度改写为注意力偏置,额外条件前向得到引导方向,叠加CFG无分类器引导;CFG通过有条件和无条件预测差加强提示。无需外部概念分类器,也不对视频Transformer权重反向传播;默认前15采样步启用。 图2|时序规格引导TSG。额外条件前向中,逐注意力头对时序证据按规格评分,并应用由梯度得到的logit偏置,再以得到的预测扩充无分类器引导CFG。Transformer权重不接收梯度。示例视频由Wan2.2 5B生成。 实验效果:220提示、11类约束、5至6秒视频、五种主干,规则满足准确率提高9.5至20个百分点。单B200、Wan2.1-1.3B为15.9%至31.4%,时间1.39至2.35分钟,峰值30.48至30.52 GiB;画质分69.25降至67.39。A14B另用H200,满足率35.9%至46.8%,耗时24.28至35.18分钟。评测均匀抽21帧,Qwen2.5-VL-7B判概念是否存在后才按规则计分。 表1|220提示基准上的时序约束满足率、画质、时间和峰值内存。除Wan2.2 A14B在H200测量外,其余时间与内存均在B200测量;时间单位分钟,内存GiB。Base为仅CFG,TSG为加入规格引导;满足率变化应读为百分点,附带倍数为各自基线时间比,跨设备绝对时间不能直接排序。 批判点评:免训练也付出额外前向时延,低显存增量不能写成低计算代价。最强配置仍只有46.8%满足率,注意力只是概念代理,视觉语言裁判和21帧抽样也可能漏掉短事件。其优势是可检查的约束接口,还不能宣称视频已严格满足形式化保证;原文未确认可用独立代码入口。 8. SUPRA-Tex:三维表面也能保住小字纹理 SUPRA-TEX: 3D Generation with Super-Aligned Texture | 华为;上海交大;华中科大 | arXiv:2610.22352 关键词:三维纹理生成, 物理材质, 可见锚定, 不可见面补全 前序问题:给商品照片生成三维资产,正面标签变糊、背面纹理接不上;光照烘进颜色后,换个灯源就显得不真实。可见面细节与不可见面补全需要分开处理。 方法直觉:先把照片中可信的颜色和材质投到三维表面,当作固定参考;生成器集中补看不到的区域,再协调全表面,减少反复改写已经观察到的小字和图案。 本文贡献:二维编辑模型估计去光照的反照率、金属度、粗糙度,即物理渲染PBR材质;有效观测投到可见表面体素,未观察处不以虚构填充值冒充证据。冻结材质编码器将观测编码到目标生成潜空间,另附覆盖范围与边界距离;交错流Transformer把观测作为只读key/value,交替更新未观察单元与全表面。60层生成器在64张GPU训练,推理25步Euler、不用CFG。 图1|SUPRA-Tex。左:二维转换器从单参考图估计去光照的反照率、金属度、粗糙度。中:利用网格M与相机投影π将有效估计投到可见体素,部分PBR输入省略不可见体素;冻结材质编码器E_mat将其映到目标潜空间,连同覆盖与边界元数据组成观测C_o。右:以几何潜变量G为条件,交错流Transformer从噪声Z_1生成完整材质Z_0。插图中固定只读流O提供key/value,生成流X交替更新未观察单元U与全表面S;冻结解码器D_mat输出表面PBR材质,分别从左右打光展示。 实验效果:给定真实网格与单张参考图,在DTC-Tex的100个商品及Complex-Tex的110个网格,以同光照同相机渲染参考视角和15个新视角。新视角前景PSNR为22.134对Pixal3D的20.377、20.488对19.402,PSNR越高越接近真实像素。另在两者共享预测几何的端到端实验,DTC-Tex四视角PSNR28.65对26.88;几何生成与贴纹理协议必须分开看。 表2|在表1各方法各指标的有效对象上,分开报告一个参考视角及15个新视角的保真度;PSNR_fg使用真实前景掩码,PSNR越高、LPIPS感知距离越低越好。Shaded为带光照渲染,Albedo为反照率。新视角先对每个对象平均、再跨对象平均,包含已观察和未观察表面;缺少PBR输出的方法对应反照率为横线。 批判点评:新视角同时包含已见和未见表面,不能把它称为纯背面准确率。几何是固定条件,形状或相机错位无法靠纹理修复;二维金属度估错也会被保留下来。商业系统对比另用两视图,不能与此处单图实验混算。代码与权重入口已读,未实跑。 9. MIDI-REPA:用音符结构教小模型作曲 MIDI-REPA: Improving Text-to-Music Generation with Symbolic Representation Alignment | 台湾大学;加州大学圣迭戈分校 | arXiv:2610.20967 关键词:文生音乐, 符号监督, 表征对齐, 低成本训练 前序问题:音乐生成器直接从密集波形学旋律与节奏,有限预算下容易学到音色却抓不住音符结构。扩大参数并非唯一办法,训练目标本身也可以更明确。 方法直觉:先让现成转谱器把训练音频写成简化音符表,训练时要求生成器的中间特征也能读出这张表;推理时撤掉老师,仍按文本生成声音。 本文贡献:在122M参数FluxAudio-S上,用自动音乐转录AMT提取与音频潜变量时间对齐的MIDI音符目标,轻量时间卷积头以余弦相似度辅助流匹配训练。MuScriptor音符卷帘表是108时间帧×88音高的二值矩阵;与分7乐器族的立方目标、Basic Pitch目标对比。最稳配置对齐第L2层、覆盖完整去噪轨迹,冻结SAME-L音频编码器处理10秒44.1kHz立体声。 图1|MIDI-REPA框架:自动音乐转录AMT提取的符号目标通过轻量投影头与余弦相似度对齐损失监督中间音频表征,同时保留去噪目标。设计研究分别检查(a)对齐哪一种符号目标、(b)在主干哪一层对齐、(c)在流匹配轨迹的哪一段启用对齐。 实验效果:筛选后的JamendoMIDI有51077曲,排除验证及重叠参考后训练49034曲、约3161小时,30万次更新,单RTX3090约31.3 GPU小时;该时间未单独覆盖全量离线转谱成本。Song Describer Dataset(SDD)受控实验,Fréchet音频距离FAD从0.5275降至0.4947,越低越好;CLAP音频与文本嵌入相似度从0.2220至0.2686,越高越好。ATTM另80条提示为FAD0.497、CLAP0.315;推理25步Euler和4.5引导,不增加转谱器或对齐头。 表4|80条域内提示上的ATTM客观比较。Borda排名在17个官方系统加本方法的集合上重算,表中仅展示六个官方决赛系统和FluxAudio-S基线。训练成本按ATTM峰值FP16吞吐换算,A100-eq为等效GPU小时,不是实际设备时间;FAD音频分布距离越低、CLAP音频文本相似度和CCS字幕一致性分越高越好。重算Rank并非新增官方比赛名次。 批判点评:14.2 A100等效GPU小时是按峰值半精度吞吐换算,不是实际在A100训练;ATTM重算综合排名也不是比赛官方新名次。MIDI监督取决于转谱质量,Basic Pitch在同一测试FAD0.5363还差于基线。这里只验证短片段,未证明完整歌曲结构。arXiv明确Submitted to ICASSP 2027,不能写已接收。代码入口已核验。 10. VoXtend:短语音模型连续读到四分钟 Speaking Longer Than Learned: Training-Free Long-Form Generation for Full-Stream Text-to-Speech | 首尔市立大学 | arXiv:2610.19553 关键词:长语音合成, 窗口限制, 说话人保持, 免训练外推 前序问题:只见过50秒语音的流式模型,读长文时会跳音、越读越不像同一个人。持续保留开头的参考声音并清理旧缓存,也没有消除这种退化。 方法直觉:先让模型反复工作在熟悉的位置区间,再持续提醒它“声音像开头这个人”。缩短窗口解决发音位置偏差,给参考声音加注意力偏置解决身份漂移。 本文贡献:在VoXtream2上定位:把缓存重置推迟到900帧,发音加速仍在训练边界625帧附近出现,说明不是简单丢历史。于是把时间Transformer的缓存窗口W从625缩为375帧,帧率12.5Hz,相当50秒与30秒窗口;重置仍保留声学提示和近期帧并重算key/value。再向参考音频对应的注意力logit即归一化前分数加常量b=1.5,强化声纹条件,无需追加训练。 图2|音频生成的局部位置与每帧预期推进音素数,分别取窗口W=400、625、900帧。阴影为随机8段语句的标准误。把缓存重置推迟到900帧仍在625附近异常推进,用来区分位置范围问题与重置丢失历史;这是方法诊断图,非生成系统结构图。 实验效果:LibriSpeech-Long dev-clean的281段、15.89小时、最长约4分钟,平均7.88秒开头作声学提示。整体单词错误率WER8.63%至3.58%,越低越好;说话人嵌入余弦相似度SPK-SIM0.659至0.759,越高越好。158名听众评自然度,每模型325次评分,五分制MOS均4.03。仅缩窗口至375的RTX3090实时因子RTF由0.415至0.433,RTF是计算时长除音频播放时长、小于1表示快于播放;不是完整双改动的计时。 表1|长语音整体及分段表现。WER为单词错误率(%)、越低越好,SPK-SIM为说话人特征余弦相似度、MOS为五分主观评分,均越高越好。MOS按均值与95%置信区间报告;GT为真实语音,GT+Mimi为编解码重建。按0至210秒分段与整体分别比较,不能把单段变化当整段平均。 批判点评:Qwen3-TTS与MOSS-TTS错误率仍更低,不能称长语音整体最强。窗口太小至250帧,WER反升6.51%;声学提示占用和重置重算也构成成本。证据来自特定主干与英语朗读,未验证多人对话或跨语言;VoXtend是本期沿用作者项目域名的短标签。作者音频样例可访问,尚未确认公开代码。 趋势观察 先决定表示要服务谁 FeaTok限制像素梯度,Intern Lumina U2给每处八个码;重建、生成和理解的表示目标需要明确分工。 把监督花在实际输入上 ACEdit让学生面对自己的编辑输出,FocusOPD沿学生轨迹补早期深层监督,MIDI-REPA则在音乐中间特征补音符结构。 加速要区分计算粒度 Speculative Forcing按token早停,SoftCache按缓存余量跳时间节点;前者平均token次数、后者去噪循环加速都不能替代服务端到端计时。 保持与改变要有具体条件 TSG约束事件时间,SUPRA-Tex固定可信观测,VoXtend调整位置窗口并保留声纹条件;它们各有额外计算与失效场景。 今日讨论 FeaTok无引导采样为1.27 TFLOPs,对照RAEv2为47.72,但批量256的端到端吞吐是14.36对1.09图/秒,显存则22.0对13.4 GiB。若你要选择线上图像表示,哪种证据能够支持你在同显存预算、同质量目标且含像素解码的条件下采用FeaTok,并验证算量优势能兑现多少请求吞吐? 人工智能炼丹君 整理 | 2026-10-19
-
AIGC 每日速读|2026-10-16|首尔大学先修图再一步生成Priming 今日 AIGC 论文速览 今日共 10 篇 · 一步生成与表征训练 2 篇 · 视频蒸馏与交互服务 2 篇 · 视频缓存压缩 1 篇 · 原生高分辨率编辑 1 篇 · 三维场景生成 1 篇 · 语音驱动与语音合成 2 篇 · 生成视频物理评测 1 篇 重点论文标题列表 Priming(首尔大学):先学修复再学一步作画 RECON(澳国立):把语义送进生成器后半段 Glance Forcing(武汉大学):一条轨迹只负责初始化 Speculative Sampling(中科大):先画未来但别急着提交 TempoKV(上交):缓存只存难预测的残差 选读入口:训练一步图像模型先读 Priming,再读 RECON 理解语义如何传到后层;做少步视频看 Glance Forcing,搭交互产品再看 Speculative Sampling 的到显示时延,长视频显存紧张看 TempoKV。需要4K改图看 BluePixel 的背景保留,换相机重访同一场景看 SceneAE。语音驱动人像看 Kandinsky S2V,要研究解码能否改错看 Revise-TTS;最后用 PhyMetric 检查视频到底违反了什么物理现象。 今日论文速览 1. Priming:先学修复再学一步作画 Are We Overthinking One-Step Generation? | 首尔大学;哈佛大学 | arXiv:2610.20331 关键词:一步生成, 重建预训练, 分布后训练, 最优传输 前序问题:想把噪声一次变成图像,直接从零匹配整批生成图与真实图的分布,训练常很昂贵。模型还没学会物体结构,就要同时解决像什么、覆盖哪些样本的问题。 方法直觉:先练修复被噪声破坏的图像,再练从纯噪声作画。修复阶段有一一对应的正确答案,先教会网络图像长什么样;后训练再要求一批作品的整体分布接近真实数据。 本文贡献:Priming Models 两阶段使用同一生成网络。第一阶段在固定噪声水平 s=0.8 做像素重建,并加感知特征损失;s 表示混入噪声的水平,不是采样步数。第二阶段从高斯噪声一步生成,利用冻结图像编码器的特征做熵正则最优传输:在两批特征间分配匹配关系,并加入停止梯度的生成样本项,即该分支只作数值参照、不反向更新,以优化分布而非逐图照抄。默认不用额外可学习风格向量,也不需要多步扩散教师蒸馏。 图1|Priming 的训练投入与生成质量:左侧在ImageNet比较训练浮点运算量与FID,展示质量和训练成本的权衡;右侧说明简单重建预训练提供有效初始化,使后续分布后训练更高效。FID是生成与真实特征分布的距离,越低越好。 实验效果:ImageNet 的256×256类别条件生成中,约4.051亿参数的 Priming-L 先训练160遍数据,再后训练25000次更新,FID为1.19,总训练量238.95 EFLOPs;1 EFLOP代表10的18次方浮点运算。FID衡量生成与真实图像特征分布差异,越低越好。原表 W-Flow 为1.33、3744.43 EFLOPs,属于不同方法的训练账本比较。文生图的一步版本 GenEval 从一步 MeanFlow 的0.548提高到0.818;GenEval测物体、属性与空间组合正确率,但仍低于100步流模型的0.873。 表2|文生图对比:Priming优于一步MeanFlow,使用logit-normal噪声分布预训练的变体以较少训练运算接近四步MeanFlow;扩展到两步也具有竞争力。†标记的对照数值来自Wang等人2026a论文。GenEval衡量物体属性组合正确率,DPG-Bench衡量密集文本指令遵循,均越高越好;EFLOPs是训练浮点运算总量,不是秒数。 批判点评:摘要“约十分之一训练量”不能解释为同硬件快十倍;预训练、特征编码与批间传输计算仍要支付。训练特征选择也会改变排名:更换编码器可改善另一分布指标却恶化FID,说明单分数不足以验收。RT-1视频预测中,其FVD(视频特征分布距离,越低越好)为30.96,仍差于32步流模型的27.24,不能照搬表注称所有质量指标均胜。本文代码提供训练入口,本次未实跑模型。作者代码。 2. RECON:把语义送进生成器后半段 Representation Conditioning for Generation | 澳大利亚国立大学 | arXiv:2610.20608 关键词:表征条件, 语义注入, 训练加速, 扩散Transformer 前序问题:用视觉编码器监督生成器的前几层,前半段学到了物体语义,后半段却未必能用好。以往 REPA 表征对齐训练结束后,还会丢掉连接两种特征的投影头。 方法直觉:把已经学会的语义做成一张便签,直接交给后面的绘图层。训练时用真实图像提取的可靠便签;生成时没有真实图,就让保留下来的投影头估计这张便签。 本文贡献:Representation Conditioning(RECON,表征条件)将视觉编码器特征池化成默认1个语义 token,即供网络注意力读取的特征单元,与图像块特征拼接送入后续层。推理复用 REPA 的多层感知机投影头,因此不再调用真实图像编码器。为缓解训练用真特征、推理用预测特征的落差,只在归一化噪声时间 t<0.5 时注入;高噪声阶段不提供便签。默认大模型用零填充对齐维度,无新增参数;小模型若特征维度不足,仍可能增加线性映射。 图1|RECON把原先丢弃的表征用于后层条件:(a)REPA以冻结视觉编码器监督投影头gϕ,推理时丢弃该头;(b)RECON训练时将视觉编码器的token送往后层;(c)推理保留gϕ作为编码器代理,执行同样条件注入;(d)ImageNet 256×256、无引导的五万样本生成FID随训练步数变化,RECON更早达到SiT-XL/2与REPA最终质量。 实验效果:ImageNet 256×256、SiT-XL/2、批量256、无引导设置下,训练40万次更新后,RECON的生成FID为3.25,REPA为7.90;延长到240万次为2.21。该指标用5万生成样本估计,越低越好。摘要63倍对SiT、25倍对REPA指达到相近质量所需的训练收敛进度,不是推理速度。MS-COCO文生图在MMDiT、15万次训练、50次网络评估、引导强度1下,FID从9.85降到8.26,图文特征相似度CLIP从0.2273升到0.2313。 表3|MS-COCO文生图:MMDiT主干,常微分方程采样,50 NFE(网络函数评估次数),训练150000次;w是引导强度。FID越低越好,CLIP图文相似度越高越好;在展示的两种引导强度下RECON优于REPA。 批判点评:保留投影头、拼接语义token都需要运行,参数不增不代表零推理开销。ImageNet主协议仍用250步随机微分方程采样,文生图用50步常微分方程采样,不能称一步生成。不同引导方式会改变最终排名;有引导的系统对比还包含Autoguidance(以较弱生成模型作参照的引导),必须与无引导收敛图分开读。作者代码。 3. Glance Forcing:一条轨迹只负责初始化 Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance | 武汉大学;电子科技大学;中山大学;华盛顿大学;新加坡国立大学;中南大学 | arXiv:2610.20220 关键词:视频蒸馏, 慢快专家, 轨迹初始化, 分布匹配 前序问题:把能同时看前后帧的视频模型变成实时逐块生成器,通常先收集大量教师去噪轨迹。若只留一条轨迹,单个学生同时拟合布局和纹理,质量会明显崩塌。 方法直觉:先搭骨架和最后描细节,本来就不该由同一种步伐完成。把高噪声阶段的语义布局与低噪声阶段的细节交给不同适配器,减少它们争用同一表示的冲突。 本文贡献:Glance Forcing 使用慢、快两组 LoRA,即少量低秩可训练权重;预训练教师保持冻结。慢专家处理早期结构,快专家处理后期纹理,各自接受阶段目标。概率流常微分方程轨迹用于把少步路径拉直,之后的分布匹配蒸馏仍负责生成质量。单样本设置压缩的是轨迹监督,不是从零只看一个视频就学会所有内容;后续分布匹配仍使用25000规模的数据。 图3|慢快专家流程:逐块自回归扩散模型使用分阶段LoRA适配器完成去噪,Slow-LoRA在早期产生粗结构,Fast-LoRA在后期细化细节;专家各自的目标进一步改善时间连贯性与空间保真度。LoRA是以少量低秩权重适配原网络。 实验效果:Wan2.1-1.3B(13亿参数)、480×832、81帧,使用8张A100训练。逐块四步设置的完整模型 VBench 综合分84.33,Causal Forcing为84.04;VBench汇总视频质量与语义等维度,越高越好。单轨迹版本后训练后为84.22,但语义分79.11低于对照81.84。轨迹采集约1个A100 GPU小时,是初始化数据准备成本;不能把图示11600倍扩展成完整训练或推理收益。完整模型相对Causal Forcing人评胜率63.3%,来自50条提示、3名标注者、150票,不能套给所有单样本变体。 表1|与既有模型对比,生成质量与此前方法相当或更好。Data为训练数据规模,Dyn.为动态程度,Vision.为VisionReward视觉奖励分,Instruct.为指令遵循;*表示跨阶段沿用同组模型。吞吐与首段时延在H100上分别用每秒帧数与秒报告,不含VAE解码时间;轨迹初始化行与分布匹配后训练行应分开比较,单轨迹版语义分并非最优。 批判点评:单条轨迹的内容很敏感:低运动样本后训练总分79.81,而默认男孩样本84.22,差异远大于对照间的零点几分。两个专家也要按阶段切换,单轨迹并未消除冻结大教师、后训练和适配器成本。应先检查自己的运动分布和语义需求。作者项目页。 4. Speculative Sampling:先画未来但别急着提交 Speculative Sampling in Interactive Video Generation | 中国科学技术大学;香港中文大学;独立研究者 | arXiv:2610.20556 关键词:交互视频, 预测缓存, 可撤换未来, 端到端时延 前序问题:用户改变动作指令后,即使模型采样很快,也可能要等到整段视频播完才生效。缩小生成块能减少等待,却损失联合建模质量和GPU并行效率。 方法直觉:可以一次画出较长的未来,但每次只交付一小段;没交付的部分先放缓存。指令不变就继续用,指令变了就替换尚未承诺的未来,已经交付的前缀保持不动。 本文贡献:每次将接下来要交付的1个潜帧与额外噪声潜帧拼成较大的双向窗口,共同采样并缓存预测。潜帧是视频压缩空间中的时间单元,通常对应多个像素帧。有限状态机协调生成和缓存消费;新条件触发可行位置重规划,不强行打断正在执行的生成。作者把到显示的时延拆成生成前等待、首个可交付输出计算(含视频解码)、播放排队,避免只报Transformer单次前向时间。 图3|投机采样服务控制:(a)联合生成填充预测缓存,供细粒度交付及播放,按播放进度补充;(b)有限状态机在Produce生成与Consume复用之间协调,此例每次交付q=1个潜帧。新条件在可行位置重规划,不中断正在执行的生成,两种状态下播放均继续。 实验效果:每组服务臂使用30条配对的60秒交互轨迹。Wan1.3B的480p长块在低频更新下,响应时延中位数从3.23秒降到1.32秒,95百分位从4.64秒降到1.91秒;高频更新中位数从3.11秒降到1.35秒。长块设置用8张B300运行扩散主干,另有视频解码GPU;短块用4张,两种资源配置不能直接当同成本比较。LTX长块低频中位数4.82→2.39秒,但播放欠载比例0.069%→0.204%。 表3|Wan1.3B、LTX-2.3及Sol-H3的480p级在线服务实验。Baseline为整块承诺,投机采样为本方法;LTX括号内配置对扩散Transformer应用CUDA Graph录制与重放。普通执行下长短块隔离块大小,括号内外的短块隔离执行方式。L50、L95分别是响应时延中位数与95百分位,单位秒;GPU内核活跃度与播放欠载为百分比,GPU活跃度是所监测设备按时间加权的平均值,设备覆盖范围按各模型正文定义。 批判点评:缓存的未来可能被新指令废弃,因此要额外支付生成、存储及重规划成本。它移除了固定块边界的部分等待,却不保证所有模型和执行模式更好:LTX短块采用CUDA Graph时,低频中位时延反而从1.81升到2.01秒,欠载也增加。CUDA Graph是预录制并重放GPU工作以减少调度开销,不能与普通执行混成一个对照。作者项目页。 5. TempoKV:缓存只存难预测的残差 TempoKV: Predictive KV Cache Quantization for Autoregressive Video Generation | 上海交通大学;华南理工大学;阿里巴巴 | arXiv:2610.15324 关键词:视频缓存量化, 时序预测, 非对称KV, 低比特残差 前序问题:长视频逐段生成时,注意力要保存以往帧的key/value缓存,显存不断增长。直接套语言模型的量化方案,会忽略视频相邻帧的冗余,也可能使误差随时间放大。 方法直觉:能从历史猜到的部分不用完整抄一遍,只存猜错多少。key负责注意力匹配,value是按匹配结果取回的内容;先猜key,再用重建key帮助猜value,比两者各猜各的更准确。 本文贡献:TempoKV 用8条BF16校准提示离线收集缓存,线性回归拟合固定预测器。BF16是16位脑浮点格式。推理先从同位置历史key预测当前key,再从已重建当前key和短value历史预测value,只对预测残差做低位量化。默认key看前2帧、value看前1帧,并可让key获得更多比特;不更新生成模型权重,但并非无需校准或额外算子。 图2|TempoKV:(a)离线从8条校准提示采集干净BF16缓存轨迹,以线性回归拟合预测器;(b)在线由重建key历史预测当前key,再由对齐的重建key与value历史预测value,只存低位残差R。key用于注意力匹配,value用于内容聚合,BF16是16位脑浮点格式。 实验效果:MovieGen前128条提示、832×480、717帧的Causal Forcing实验中,key/value各2比特的k2v2达到6.71倍缓存压缩,六项VBench视觉分均值77.04,BF16为76.95;改用k4v2,压缩4.73倍、均值77.11。k4v2表示key4比特、value2比特。Self-Forcing同协议k2v2为73.32,仍低于BF16的74.23,说明高压缩在不同主干上代价不同。 表1|MovieGen上的Causal Forcing,832×480、717帧。每个精度组内最优与次优分别用粗体与下划线标记。压缩比仅针对缓存;k4v2表示key4比特、value2比特。PSNR/SSIM越高越接近BF16,LPIPS/FID越低越接近;Visual Quality是六种视频视觉维度均值,不能当作整机加速。 批判点评:6.71倍是缓存体积的压缩比,包含量化元数据等开销,不能换算整机显存减少6.71倍或推理快6.71倍。预测器、反量化和保留历史都有成本;必须与自己的注意力实现一起计时。论文称代码将发布,未给可核实的作者仓库,本期不补造代码链接。 6. BluePixel:原生4K编辑还要守住背景 BluePixel: Toward Native 4K Agentic Image Editing | vivo;南京大学;上海交通大学 | arXiv:2610.19882 关键词:原生4K编辑, 渐进VAE适配, 背景保持, 专家协作 前序问题:把图片中的字或衣服改对,背景也可能悄悄变化;到4K分辨率,微小漂移尤其明显。只提高分辨率,也不能让通用编辑器自动具备调色、虚拟试穿等专长。 方法直觉:先让模型承载大画布,再按任务学专长,最后提速。编辑处跟教师走,不编辑处锚定原图;精确调色等操作交给专用工具,系统再逐次检查。 本文贡献:BluePixel 把1K预训练编辑器通过渐进式VAE适配升到原生4K;VAE是将像素压缩到潜空间并重建的自编码器。后续以监督微调、持续学习和奖励优化兼顾能力与细节。少步蒸馏的SATP(源图锚定目标投影)按教师预测相对源图的编辑强度区分保留区域与变化区域,构造教师结果和原图潜变量的混合目标,补偿非编辑区漂移。配套系统分解指令、路由专家,以同一奖励模型验收并有限重试。 图2|第一阶段与最终模型对比:第一阶段检查点能够编辑但能力有限;经历第二阶段的渐进监督微调、按基准定向微调、持续学习与强化学习后,最终模型的编辑质量及细节保真度明显提高。此图是阶段结果对照,不是SATP模块架构。 实验效果:50步教师压到4步后,单张昆仑芯P800 XPU、BF16精度、无其他优化下完成一次4K编辑为8.7秒,正文称约4倍加速;这是编辑器,未包含任意多轮工具调用。VINS-4KEval++共3305例,七模型共同覆盖2513例的表8中,BluePixel综合8.62/10、成功率63.2%,GPT Image 2为9.15、74.8%;非编辑区一致性9.06,对照9.34。 表8|VINS-4KEval++七模型共同覆盖2513例,BluePixel综合排名第二,仅次GPT Image 2,非编辑区一致性也第二。采用BluePixReward裁判,BluePixel做提示改写并报告8个种子的均值,外部模型每例一个输出;每种子明细在原论文表4。分数0至10、越高越好,Success为同一裁判认定成功的比例;IF为指令遵循,NC为非编辑区一致性,VQ为视觉质量。 批判点评:本模型报8个随机种子的平均值并做提示改写,外部模型每例1个输出;同一自家奖励模型又用于训练与评测,排名应配合独立人评。完整系统会增加规划、验收和重试时延;8.7秒不能代表整套系统。SATP完整推导与训练配方另待配套论文,当前论文并非所有环节都可独立复现。作者代码。 7. SceneAE:存一个场景再换相机看 SceneAE: Scene Generation and Reconstruction in Queryable 3D-Anchored Latent Space | 北京邮电大学;加州大学伯克利分校;鉴智机器人;SynapX | arXiv:2610.19708 关键词:三维锚点潜空间, 场景生成, 几何内容解耦, 相机控制 前序问题:按视频帧存场景,同一个房间换一条相机路线就可能又生成一遍,还会把物体外观与观察角度绑在一起。记住了之前的画面,不等于有可重复查询的场景。 方法直觉:把场景记成稀疏的空间笔记:每条笔记有三维坐标和局部内容。相机移动时只查询这些笔记并渲染;生成时先安排几何,再给几何填外观。 本文贡献:SceneAE 以3000个显式三维锚点及其隐式内容特征表示场景。编码器借冻结的Depth Anything 3估深度并提特征,反投影成点云后选择锚点,聚合可见视角信息;解码器按目标相机输出RGB和深度。生成Transformer先按相机控制未来几何布局,再以几何为条件生成内容,避免每换轨迹都重新合成整段视频。 图3|几何与内容解耦的扩散Transformer:先以相机条件控制未来几何布局,再用几何布局控制纹理内容,因而更准确跟随相机。场景潜空间直接锚定三维位置,解码时可重复查询。 实验效果:DL3DV、RealEstate10K和ScanNet训练样本用9视角,分辨率518×376,8张A800训练10万次。RealEstate10K双视角条件下,像素重建信噪比PSNR为19.8、结构相似度SSIM为0.68,对照GLD为19.4、0.67,均越高越好;DL3DV同设置PSNR17.9却低于GLD的18.1。表1每步145毫秒,对照285毫秒,不能称完整视频仅145毫秒。往返轨迹记忆实验PSNR30.7,对照GEN3C29.8。 表1|外观生成定量对照:报告像素重建信噪比PSNR、结构相似度SSIM,以及VBench的主体、背景和多视角一致性,均越高越好;另报GFLOPs(十亿次浮点运算)与每步毫秒数衡量效率。单视角、双视角及两个数据集应分别看,不能把每步时间当整段端到端时间。 批判点评:重复查看同一表示很有吸引力,但几何质量依赖深度基础模型、相机位姿和可见性估计。几何对比中Gen3R采用VGGT生成评估参考,本方法与GLD采用DA3,参考源不同,不能简单当同一真实三维标尺。它主要展示相机驱动场景生成与重建,尚不能据此声称任意动态世界均稳定;未确认作者代码入口。 8. Kandinsky S2V:语音驱动人物且记住前情 Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation | Kandinsky 实验室(Kandinsky Lab) | arXiv:2610.19290 关键词:语音驱动视频, 多尺度记忆, 口型同步, 策略蒸馏 前序问题:单张照片配音生成长人物视频,既要嘴型跟得上声音,又要跨段保持身份、姿态和动作;只盯嘴部,容易丢掉整个人物的连贯表演。 方法直觉:声音与文字负责当下怎么说,参考图负责是谁,压缩记忆负责刚才怎么动。旧帧记粗略轮廓,最近帧保留细节,把记忆预算花在时间上更近的地方。 本文贡献:Kandinsky S2V 1.0 用冻结Qwen2.5-Omni的文本和音频特征,参考图经视频VAE编码,三尺度FramePack将过去30个潜帧按远到近分为24、4、2帧并逐级减小压缩;当前视频帧只注意对应时间段的音频。训练117万单说话人片段,结合参考记忆混合和按脸面积调整的损失。π-Flow蒸馏把每段策略的5个干净潜变量估计一次预测出来,再通过无需额外网络调用的子步积分,最终16个策略段、不用有无条件双分支引导。 图2|Kandinsky S2V架构:冻结Qwen2.5-Omni的Thinker文本特征及音频塔特征,分别进入扩散Transformer内Nt个文本块与Na个音频块。参考图经冻结Hunyuan三维VAE编码,其潜变量与带噪目标zt及多尺度FramePack历史记忆拼接,C表示拼接。每个块执行视觉自注意力V2V、文本交叉注意力V2T、按周期插入的音频交叉注意力V2A及前馈层;最后由冻结VAE解码回像素。交叉注意力使当前视觉特征读取相应条件。 实验效果:Lite与Pro是系列简称,实际参数约23亿和214亿。每段生成125帧、25 FPS,对应5秒播放时长。H100、512×768、单GPU上,Pro基础版每段914秒,蒸馏版173秒;8GPU时162秒与57秒。1280×768单GPU为3854秒与675秒,体现设备、分辨率不同不能只报一个速度。作者摘要给5.4倍端到端收益;80条俄语HD人评中,多数项目74%至100%打平,牙齿嘴部蒸馏版获38%偏好、基础版3%。 表5|发布推理代码在H100上对Lite与Pro逐块计时。每行GPU数量与耗时按位置一一对应;SD为512×768,HD为1280×768,时间单位秒。每块125帧、25 FPS,故播放时长5秒;单卡Pro蒸馏版SD为173秒、基础914秒,不能将输出帧率当生成速度。 批判点评:25 FPS是输出帧率,不是实时生成吞吐。Pro蒸馏后EMTD口型相关分8.03略低于基础8.05,Lite也出现同步下降,不能写蒸馏后所有指标都升。自回归长链还会累积误差,数据以单说话人为主,多人互动并非已验证能力。作者项目页。论文所列代码仓库及权重集合本次回读均为404,暂未确认可下载状态。 9. Revise-TTS:说错的声音token还能再改 Revise-TTS: A Non-Masking Refinement Framework for Masked Diffusion Models in Text-to-Speech | 谢菲尔德大学;HojoAI | arXiv:2610.19499 关键词:语音合成, 非掩码修正, 层级二值量化, 迭代自纠错 前序问题:掩码扩散语音模型像填空,一旦高置信度预测被提交,后续步骤通常不再改它。早期发错的声音单元会留在上下文里,继续影响后面。 方法直觉:允许已经写上的答案被擦掉重做。声音先编码成可从粗到细细化的二进制单元,模型既练补全缺失内容,也练从掺杂错误的整段内容里恢复正确声音。 本文贡献:HBQ是层级二值量化,每次把当前量化区间对半分,形成有粗细次序的位串,可打包成整数或逐位预测。GRN是生成式修正网络,训练输入混合真实和随机token;token是离散声音单元。模型预测完整序列,推理按余弦进度保留部分预测、把剩余位置换成随机token再修正,而非用专门掩码符号永久填空。一次重建训练目标不等于一次推理,主实验仍迭代32步。 图1|层级二值量化HBQ:每轮将选定量化区间对半分。连续值z=-0.113经过三轮产生位序列011,对应离散索引3;按正文重建值为-0.125。二值位可按整数或逐位提供给语音模型。 实验效果:主模型使用Emilia英语46800小时、中文49900小时,16张A100训练25万次;小规模消融另用4卡,不能混成主训练成本。LS-PC英语测试中,Revise-TTS单词错误率2.00%,OmniVoice为1.57%,说话人相似度0.519对0.697;Seed中文测试错误率1.19%对0.89%,中文这里按字符计错。32步修正保留了可用自然度,但没有全面超越基线。Higgs编码器的受控实验中,修正模式同样弱于掩码模式的说话人相似度。 表4|固定Higgs声音编码器,用8张GPU在Emilia英语/中文微调后,比较掩码与生成修正解码。Steps列100k指100000次训练更新,不是100000次推理;主推理协议是32次修正。SIM是说话人相似度、越高越好,英语WER为单词错误率、中文同列按字符计错,越低越好。修正并未在所有数据集和指标占优。 批判点评:这篇的价值是展示可撤回的解码机制及量化接口的限制。词错率越低越好,说话人相似度越高越好;二者要一起验收。换到HBQ的编码器重建本身就较差,不能把主系统的差距全归因于修正策略。作者明确Under review,不写会议接收;没有核实到作者代码和真实端到端计时,32步也不等于实时。 10. PhyMetric:别只问视频看起来合理吗 PhyMetric: Diagnosing Physical Plausibility in Text-to-Video Generation via Scene-Level QA | 内华达大学里诺分校 | arXiv:2610.19823 关键词:视频生成评测, 物理合理性, 场景诊断, 问答裁判 前序问题:生成的玻璃杯碰撞后没有正确反应,画面却很逼真;泛泛问“符合物理吗”,视觉语言模型可能高置信度说是。整体分数无法告诉开发者究竟哪一步坏了。 方法直觉:把验收改成观察清单:针对这个场景本应出现的现象逐项问是非题,再挑能回答问题的时间帧。问的是可见后果,而非让裁判凭印象打一个总分。 本文贡献:PhyMetric覆盖6类物理领域、50个细分类别、1115个场景,每场景8个平衡是非问题,共8920题,带12种诊断维度。为每个场景提供物理规律、预期时序、可见征象与常见失败的结构化先验,再按问题选择视频帧交给视觉语言模型作答,逐场景、维度与类别聚合;它评估生成结果,不是给生成器装物理仿真引擎。 图3|PhyMetric评估:给定物理场景s,文生视频模型按描述cs生成视频Vs。对每个场景是非问题,按问题抽取帧,并提供描述规律、预期后果和常见失败的结构化物理先验Ks;视觉语言模型结合帧与先验回答。问题正确率先聚成场景分S(s,Vs),再对全部场景平均成模型分,使整体印象转成可诊断的物理检查。 实验效果:完整1115场景、两种开源裁判的平均总体分,Wan2.2-14B为72.78,Cosmos-7B为72.59;数值接近,且会随裁判变化。受控消融中,Qwen3.5-9B裁判使用场景问题及先验为74.91,无先验72.75;换成泛化的整体问题时48.88,接近均衡是非题的50%机会水平。该受控结果不是完整榜单分数,也不是人类标注准确率。 表2|完整1115场景的开源视觉语言裁判结果。Average是两种裁判的平均分;Overall为总体聚合,Weighted按题目难度和诊断维度权重聚合,分数越高越好,不能与100场景受控实验混用。Wan2.2-14B平均Overall为72.78,Cosmos-7B为72.59,两个裁判下细微顺序会变化。 批判点评:先验并非越多越好:GPT-5.4裁判加入默认先验后受控分数从73.94降到72.25,尽管与人的相关性可能改善。问题构造、抽帧和裁判偏差仍影响结论;每场景8次问题判断还增加评估调用成本。接近0.2分的模型差距不应写成已证明的绝对物理优势。作者项目页。 趋势观察 先学什么影响后训练成本 Priming先做重建,RECON把语义送给后层,Glance按噪声区间分工;同样少步,不同初始化承担的责任不同。 交付与计算要分开计账 投机采样延后未来帧的承诺,TempoKV只压缓存,Kandinsky输出25 FPS但仍慢生成;吞吐、响应、存储和播放时长是四件事。 保留接口比追求单分数更难 BluePixel锚定未编辑背景,SceneAE解耦几何与内容,Revise-TTS暴露声音编码器质量瓶颈;模块相接处决定最终效果。 诊断问题需要足够具体 PhyMetric把整体合理性拆成场景问题;其不同裁判并非一致受益,BluePixel也用自家奖励判定成功,验收来源应明确。 今日讨论 Priming-L在ImageNet 256×256达到FID 1.19,但RT-1视频的FVD为30.96,仍高于32步流模型的27.24。若要判断“先重建再一步生成”能否替代你的少步模型,哪种实验能固定总训练算量,并同时检查图像分布、长时序一致性和特征编码器带来的评价偏差? 人工智能炼丹君 整理 | 2026-10-16
-
AIGC 每日速读|2026-10-15|微软把生成压到4次评估SMD 今日 AIGC 论文速览 今日共 10 篇 · 少步生成与高分辨率 2 篇 · 理解与编辑控制 2 篇 · 视频超分与运镜 2 篇 · 原生三维生成 1 篇 · 语音与歌声编辑 2 篇 · 音画同步评测与奖励 1 篇 重点论文标题列表 SMD(微软):把局部弯路留给训练 AReA(多伦多大学):大画布先看全局再看细节 DuplexBridge(中科大):先分清没听懂还是没画对 QK-Edit(字节):只换查询与键保住原结构 FlashVSR+(上海AI Lab):单张4090做完整4K超分 选读入口:如果你要缩短生成等待,先读 SMD,接着用 AReA 看大分辨率下如何省注意力;做视频修复再读 FlashVSR+ 的4090卸载条件。复杂编辑失败先读 DuplexBridge 的责任划分,需要保留原视频结构再读 QK-Edit,运镜控制看 GTL。三维贴图异常看 Channel Match;有现场噪声的改词看 AnyEdit,改变语气看 Prime-EVC,音画验收最后读 SyncReward。 今日论文速览 1. SMD:把局部弯路留给训练 Simplifying and Improving On-Policy Distillation for Few-Step Diffusion | 微软研究院;纽约大学;香港科技大学 | arXiv:2610.18472 关键词:少步蒸馏, 同策略回归, 代理路径, 教师排斥 前序问题:把几十次去噪直接缩成几次,常会遇到同一大步内教师方向不断变化:学生只预测一个方向,局部监督互相打架,视频训练还可能先变好再退化。 方法直觉:像用一条直线代替弯路:学生学习这一大段的平均方向,训练时另找一个能弯曲、但不改变起终点的辅助路径,接住局部变化。部署时只走学生的大步。 本文贡献:Simplified Matching Distillation(SMD,简化匹配蒸馏)沿学生当前生成路径查询冻结教师,回归速度。Pivot 辅助网络输出积分为零的残差,使区间内方向可变而终点不变;再用同一教师的弱引导或跳层预测作负参照,拉开与较差方向的距离。只在训练使用 Pivot 和教师,不依赖在线分数估计或对抗训练,也不改部署模型结构。 图10|对同策略回归的两项改进:(a)代理路径允许一个粗步长内的局部速度变化,但固定学生速度时保持起终点不变;(b)排斥同一教师较弱的预测,与模仿目标教师预测互补。两项改进为便于解释分别展示,均只用于训练。 实验效果:原论文 Qwen-Image 实验统一为 4 NFE;NFE 是生成网络前向调用次数,教师 50 步含有条件与无条件两分支,共 100 次。SMD 的 GenEval(物体及属性组合正确率)0.873,高于 Lightning 的 0.852,略低于教师 0.874;密集指令遵循分 DPG 为 88.7,教师 88.3。OneIG 综合分同为 0.540,但多样性 0.144 低于教师 0.195。 表2|Qwen-Image 文生图:NFE 计算网络前向评估次数,教师的 50×2 包括有条件与无条件两个 CFG 引导分支;粗体和下划线为少步方法中的第一、第二,不含教师。†是 PDD 原文表3及6–8的欧拉版本,未有公开 checkpoint。各项越高越好;综合分不等于每项都领先。 批判点评:少调用网络不能直接换算墙钟加速;训练仍要教师查询和 Pivot。Wan2.1-14B 视频的语义分 80.52 低于 AnyFlow 的 82.10,330亿参数(33B)的音画联合模型分别测 4/8 次调用,不能统称全任务四次且全面领先。作者代码含推理与训练入口,本次未执行模型复现。 2. AReA:大画布先看全局再看细节 AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers | 多伦多大学;Vector研究所 | arXiv:2610.17227 关键词:高分辨率生成, 自适应感受野, 跨尺度注意力, 局部窗口 前序问题:把原生约千像素的图像模型直接拉到四千像素,注意力计算猛增,还容易复制主体、扭曲布局。只改位置编码,不能同时处理关注对象数量暴涨的问题。 方法直觉:构图时看整幅画的缩略版,修细节时只看邻近区域。缩的是被查询的上下文,输出画布始终保持目标分辨率,因此不需要先生成小图再放大。 本文贡献:AReA 即自适应感受野注意力,无需训练。早期保留全分辨率 query(查询),对 key/value(供匹配与聚合的信息)按块取中心代表,统一到较粗坐标;后期改用逐渐收缩的窗口。稀疏全局信息桥维持远处联系,重叠边界缓解接缝,离散小波变换识别平滑区并进一步拆窗。切换按噪声水平设定,FLUX.1 前 8 步、Qwen-Image 前 20 步采用全局粗阶段。 图4|AReA 流程:在噪声水平阈值 σ⋆处从阶段一切换到阶段二。阶段一全分辨率查询访问每个 f×f 块选出的一个 key/value,f 随步数调整,坐标映射到接近训练分辨率的网格;阶段二逐渐缩小局部窗口,并进一步拆分离散小波变换图中平滑区域的窗口以降低计算。 实验效果:H100 上的 Aesthetic-4K 含 195 条提示。在 4096×4096 的 FLUX.1 设置,单图时间从全注意力 314 秒降至 151 秒;另用 1000 条复杂提示组成 HRGen-1K,图文对齐 CLIP 分从 23.36 到 29.89,偏好预测 PickScore 从 19.04 到 21.44,均越高越好。6144×6144 的最高加速 3.2 倍属于另一分辨率设置。 表1|Aesthetic-4K 上 FLUX.1 与 Qwen-Image 在不同分辨率和宽高比的对照,粗体为最佳、下划线为第二;时延单位秒、越低越好,奖励、美学、图文匹配和偏好分越高越好,整体与局部裁剪的 Fréchet 距离越低越好。收益随主干与分辨率变化。 批判点评:不增参数仍需实现窗口、信息桥与拆窗调度;切换阈值按主干经验选择。固定窗口消融虽有不错的美学或 CLIP 分,却出现布局破碎,因此这些分数不能替代主体数量和接缝检查。作者项目页提供演示及代码入口,未实跑其模型。 3. DuplexBridge:先分清没听懂还是没画对 DuplexBridge: Coordinating Understanding and Generation for Unified Image Editing | 中国科学技术大学;阿里巴巴Wan团队 | arXiv:2610.18819 关键词:统一图像编辑, 角色分工, 双向信任门控, 完整遵循评测 前序问题:让统一模型先理解指令再编辑,最终改错时却不知道该罚谁:可能理解阶段认错对象,也可能条件没错、生成阶段执行失误。共享一个奖励会把责任混在一起。 方法直觉:先把任务写成可验收的交接单:改哪个对象、最终变成什么、哪些内容必须保留。理解者对交接单是否忠实负责,绘图者对是否照交接单完成负责。 本文贡献:同一模型分别承担理解与生成角色,不另接外部理解模块。源图约束的结构化 bridge 传递目标、变化和不变量;理解的局部监督不看生成图,生成的局部监督检查实际收到的条件。只有伙伴可信时才接收相应全局任务反馈,同时保留有效局部反馈,交替训练两角色。 图3|伙伴互信门控:执行可信度控制理解者能否接收全局反馈,提示可信度控制生成者能否接收全局反馈;局部反馈仍各有独立有效性掩码。图将两角色的全局资格及局部奖励符号简写;路由矩阵假定判断可用,Yr 是基准编辑结果,与任务提供的参考图不同。 实验效果:CE-Bench 有 1200 个任务;CCR 指所有变化与保留要求同时通过的任务比例,区别于平均要求通过率。Wan-Image-7B 直接编辑的 CCR 为 53.83%,完整系统 77.08%,包括提示增强、监督微调及强化学习。共同监督初始化后,仅比较门控:无门控 70.92%,双门控 77.08%,不能把全系统增益都归给门控。 表10|Wan-Image 全局奖励门控消融:前四行只变化两项语义信任决策,保留局部监督与奖励有效性条件。oracle 使用额外标注;等数量随机门控与保留分组结构的随机门控是不同对照。CCR 为全部变化与保留要求同时通过的任务百分比,双门控为77.08,无门控为70.92。 批判点评:推理增加了原生理解及条件生成环节,训练还需奖励判断;文中奖励模型的相对时延不等于整套编辑端到端时延。自动裁判与人评仍有误差,公开任务类别构成也随要求数量变化,不能把要求越多分越低解读为单变量因果。未确认作者完整训练实现的公开入口。 4. QK-Edit:只换查询与键保住原结构 QK-Edit: Revisiting Attention-based Injection in MM-DiT for Image and Video Editing | 加州大学默塞德分校;字节跳动Seed;字节跳动智能创作;香港中文大学 | arXiv:2610.17829 关键词:图像视频编辑, 查询键替换, 多模态注意力, 无需训练 前序问题:给真实视频换主体时,直接套用旧图像编辑的注意力注入,可能保住原结构却不听新指令,或跟上指令却把动作与背景弄坏。 方法直觉:注意力里,query 像每个位置提出的问题,key 用于匹配位置,value 才是取回的内容。借用原视频的查询与键来固定布局,同时让新文本和当前内容负责改变外观。 本文贡献:在把文本与视觉合并处理的多模态扩散 Transformer 中,只替换视觉 query/key,保留目标文本特征与目标 value。生成素材可在原采样时缓存,真实素材先反演回噪声并记录特征;图像仅在前 30% 去噪步注入,视频为前 20%。不训练参数,但需要源特征缓存及真实素材的反演计算。 图6|查询与键操纵策略:替换注意力 Q 与 K 的视觉部分,在目标提示遵循和源结构保持之间取得平衡;Q 是查询特征,K 是用于匹配的键,文本部分及用于聚合内容的 value 保留目标分支。 实验效果:A100 上以 FLUX.1-dev 编辑图像、HunyuanVideo 编辑视频。真实 TGVE+ 视频中,帧间 CLIP 余弦一致性 0.921、偏好预测 PickScore 20.52,Flatten 为 0.887、19.91;但描述修改方向的 ViCLIP 分为 0.196,低于 Flatten 0.204。论文覆盖 65 至 129 帧、320×320 至 1280×720 的视频设置。 表3|TGVE+ 真实视频编辑:比较修改方向及输出整体的 ViCLIP 语义对齐、帧间 CLIP 一致性和 PickScore 偏好预测,箭头均向上。QK-Edit 的方向分0.196低于 Flatten 的0.204,其他展示列较高,不能解读为所有指标第一。 批判点评:结构保持不等于所有语义指标最佳,且不是每条基准样本都使用最大分辨率和帧数。缓存与反演使“免训练”仍有时间和显存成本,原文未给统一端到端开销数字。真实反演在复杂运动中易有误差,未改区域仍可能被轻微改动;文字渲染与体操等复杂运动也受主干限制。未确认作者方法仓库可用。 5. FlashVSR+:单张4090做完整4K超分 FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching | 上海人工智能实验室;香港中文大学;清华大学;CPII(InnoHK) | arXiv:2610.17552 关键词:生成式视频超分, 混合注意力, 奖励蒸馏, 缓存卸载 前序问题:视频超分即从低分辨率恢复高分辨率;即使把扩散压成一步,4K 时空注意力仍可能撑爆显存,切成小块又容易产生边缘瑕疵,普通蒸馏也未必保住文字。 方法直觉:大部分层只管附近像素和前面的帧,少数层负责远处联系;训练时多学习奖励高的教师轨迹,奖励模型只负责打分,无需把梯度穿过它。 本文贡献:每五个扩散 Transformer 块保留一个全局块,其余采用局部时空注意力,适配训练后再蒸馏。Ry-DMD(奖励收益分布匹配蒸馏)用奖励加权的教师轨迹修改目标分布估计,支持不可微的黑盒奖励。4090 上另用适配注意力算子,并把保留全局层的 key/value 缓存卸到 CPU 固定内存,异步预取回显卡。 图2|FlashVSR+ 三阶段训练:第一阶段用图像视频数据训练140亿参数的全注意力多步教师;第二阶段适配混合注意力学生获得强初始化;第三阶段用 Ry-DMD 蒸馏成一步生成器,奖励反馈修改教师项估计,无需奖励梯度。 实验效果:效率测 89 帧视频,含 1080p、2K、4K。最高约 2 倍是去噪主干加速,峰值显存约降 45%;单张 24GB RTX 4090 的 4K 运行还包含上述卸载优化。文字识别奖励实验中,识别准确指标从基线 0.624 到 0.776;像素保真 PSNR 从 23.94 到 24.86,感知差异 LPIPS 从 0.246 到 0.240,后者越低越好。 图6|89帧视频的效率对照:(a)H200同级 GPU 上的 GPU 计算时间与峰值显存;(b)RTX4090 的端到端墙钟推理时间,包含 CPU key/value 缓存卸载与异步预取开销。SeedVR2整帧运行显存不足,改用切块;H200同级设备上的Ours-Base与旧FlashVSR结构及流程相同,旧算子不支持4090。两个面板口径不同,主干加速不能直接当完整路径加速。 批判点评:一步不等于实时;CPU 传输、预取、编码解码仍占时间。真实 VideoLQ 上无参考质量 MUSIQ 为 47.64,低于旧 FlashVSR 的 49.70,不能宣称所有质量分都更好。项目与代码入口已核验,训练适配和高分辨率设备条件需要一起复现。 6. GTL:把运镜主体和焦点分开控 Gen Through the Lens: Camera-Controllable Video Generation via Cross-Coordinate Conditioning Fusion | 腾讯视频太阳系 | arXiv:2610.15900 关键词:可控视频生成, 三坐标条件, 三维框控制, 景深与变焦 前序问题:输入一张照片再让相机环绕人物,常分不清是相机动、人物动还是焦距变;只给相机轨迹,人物位置与景深也未必按要求走。 方法直觉:分别给摄影机设置、世界里的运动轨迹、主体的三维占位框,再让它们在同一几何空间中对齐,避免把所有摄影要求挤进一句模糊提示。 本文贡献:Gen Through the Lens(GTL)融合相机、世界、物体三个坐标空间:恢复有统一实际尺度的相机参数,以彩色世界网格编码运镜,以带深度的三维框编码主体位姿,并加入分层景深与变焦条件。Wan2.1-14B(140亿参数)的编码器、解码器与生成主干冻结,只训练上下文适配器,分运镜、主体及变焦、景深三阶段加入控制。 图3|GTL 总体架构:在相机、世界与物体坐标空间联合输入相机运动、物体运动及景深控制信号,引导视频生成,源图像和几何条件共同约束生成主干。 实验效果:训练基础集约 11 万段,另构建 8000 段变焦与 15000 段景深数据,统一 81 帧、480p;原文报告约 288 GPU 小时。1000 段独立测试中,GTL 的视频分布距离 FVD 为 86.54,RealCam-I2V 为 98.76,越低越好;相机平移误差 8.59 对 9.86,但旋转误差 4.89°高于对照 4.63°。 表2|与现有方法的定量比较:误差及分布距离越低越好,重叠及语义指标越高越好;屏幕空间误差按图像对角线的百分比报告。*列需谨慎,RealCam-I2V 与 GEN3C 不支持显式物体运动或目标定位,可能使它们的物体指标较差。GTL旋转误差并非最优。 批判点评:主体框训练以人为主,非人物泛化主要来自定性展示;部分对照不支持显式物体控制,物体指标并非同等功能比较。几何来自自动估计,误差会传到条件和评测,训练成本也不是单次生成时延;未提供可直接对照的推理显存或时间,未确认完整开源实现。 7. Channel Match:形状没坏也要校准纹理接口 Channel Match: Calibrating Shape Latents for Few-Step 3D Generation | 威廉玛丽学院;SparcAI公司 | arXiv:2610.15321 关键词:原生三维生成, 少步蒸馏, 通道统计校准, 几何纹理接口 前序问题:三维模型两步就生成了正确形状,贴上材质却出现黑斑,问题可能不是网格坏了,而是几何隐变量的统计分布偏离纹理模型训练时的输入。 方法直觉:几何与纹理像两道串联工序:前一道加速后输出格式没变,数值分布却变了。先把接口上每个通道的均值与波动尺度校准,再交给原来的纹理生成器。 本文贡献:在 TRELLIS.2 的 1024³ 分辨率设置,用连续自一致性与解析速度回归联合蒸馏几何模型,自适应平衡两种损失。自定义 JVP 注意力核计算沿教师方向的速度变化;JVP 是雅可比矩阵与向量之积,无需显式存整张雅可比矩阵。Channel Match 无需再训练,按通道标准差亏损检测分布塌缩,触发尺度或均值加尺度校准,保持生成器不变。 图1|少步分布偏移及 Channel Match 校准:从左到右是输入、未校准两步学生的无纹理网格与物理材质渲染,以及校准后网格与渲染。偏移的形状潜变量会让冻结纹理模型产生黑斑;校准后几何保持不变。示例选择几何简单、两步教师和学生都接近多步参考的样本,以隔离潜变量统计偏移而非几何重建错误,并非全部复杂物体的保证。 实验效果:单张 A800-80GB 上,几何采样从 5.29 秒到 1.18 秒,约 4.5 倍;图像到形状完整路径 11.51 秒到 7.55 秒,约 1.5 倍。72 个容易出材质伪影的演示资产,统一四视角、对照十二步教师渲染,完整校准将感知差异 LPIPS 从 0.0802 降到 0.0747;这是更接近教师,不是接近真实照片的直接测量。 表3|TRELLIS.2 的72个演示资产与十二步教师渲染作四视角比较。仅标准差和均值加标准差两种校准都使学生更接近教师,完整校准在这批材质伪影较多的资产上收益更大。下半部分为各指标改善的资产比例;它不代表完整 Toys4K 或真实纹理误差。 批判点评:3216 个较简单 Toys4K 资产中,单独校准标准差更稳,完整均值校准反而可能稍差。JVP 增加的是训练开销,纹理阶段保持不变限制总加速。原文的结构相似度 SSIM、像素保真 PSNR 在正文与表格有个别数值不一致,因此本文只采用一致的 LPIPS 与计时数据;尚未确认作者完整公开实现。 8. AnyEdit:改人声时留下现场的声音 AnyEdit: A Unified Framework for Speech and Singing Voice Editing with Real-World Environmental Consistency | 香港中文大学(深圳);华为媒体技术与体验设计研究所;澳门城市大学;Amphion公司 | arXiv:2610.15665 关键词:语音歌声编辑, 环境一致性, 抗噪韵律, 分阶段声学渲染 前序问题:在有伴奏、回声或街噪的录音里换一句话,常把环境声一并擦掉,或让没修改的词也变了音调。先做人声分离还会引入分离伪影。 方法直觉:先在干净的语义空间里决定说什么、怎么唱,再借周围原始声音还原现场感。这样编辑能力和噪声混响的处理不必在同一个步骤里互相干扰。 本文贡献:不显式分离人声:自回归模型生成韵律与内容风格 token(离散片段编码);教师学生训练从受损录音恢复干净韵律,50Hz 特征压成 6.25Hz token。流匹配声学模型再依据原音色及上下文渲染频谱。未修改区域加权监督稳定原有语气,并用歌曲重复段对齐挖出的真实配对做直接偏好优化;这仍依赖合适的重复结构。 图1|AnyEdit 总体架构:先在干净语义空间预测韵律与内容风格,再结合原声学上下文生成频谱并还原波形;NFE 为流匹配推理时的函数评估次数,图中按常微分方程积分步骤计,不包含全部前后处理。 实验效果:AnyEditBench 同时覆盖中英语音和歌声、干净/模拟/真实环境。真实英语语音中,单词错误率 WER 为 0.0616,Vevo2 为 0.0778;真实英语歌声 WER 为 0.1749,对照 0.2809,背景嵌入相似度为 0.7384,对照 0.5671,后者越高越好。但英语语音背景相似度 0.7705 低于 SSR-Speech 的 0.8729。 表2|AnyEditBench 真实环境子集,分语音与歌声两域。英语用单词错误率 WER、中文用字符错误率 CER,基频相关仅测歌声;粗体为各域最优,下划线指优于统一基线 Vevo2。另列说话人及背景相似度、混响时间误差与信噪比误差,不能仅以识别率概括环境保持。 批判点评:极端语音信噪比 0dB,即信号与噪声功率相当时,WER 为 0.386,差于 Vevo2 的 0.196,不能把平均收益当全条件保证。两阶段处理与多步声学解码仍有成本,未给统一时延。arXiv 备注明确称 NeurIPS 2026 接收;作者演示与公开评测集可访问,未确认完整训练代码。 9. Prime-EVC:情绪先配好再一步变声 Prime-EVC: One-Step Expressive Emotional Voice Conversion via Emotion-Primed Flow Matching | 九州大学;东华大学;腾讯混元;日本国立情报学研究所;东京大学;独立研究者 | arXiv:2610.16036 关键词:情绪语音转换, 一步流匹配, 韵律条件, 说话人保持 前序问题:想把同一句话由平静改成兴奋,直接把多步情绪转换模型砍成一步,往往只剩平滑的平均音色,目标情绪没真正进入音高和能量。 方法直觉:与其让一步采样临时猜出情绪,不如先预测“这个人表达这种情绪时”的逐帧音高与强弱,把难题移到条件端,再让解码器完成剩下的声学细节。 本文贡献:Prime-EVC 是情绪语音转换而非从文本直接生成。冻结 HuBERT 提取内容,通过 FiLM(按特征缩放和偏移)融合说话人与五类情绪;情绪方差适配器预测逐帧音高与能量,再施加情绪分类及频谱时间变化监督。扩散 Transformer 的条件流匹配解码器一步欧拉更新生成梅尔频谱,BigVGAN 将其转成波形。 图1|Prime-EVC 的编码、条件、渲染流程:从原语音取得内容,以说话人与情绪融合风格及逐帧韵律构造条件,再由一步条件流匹配解码器和声码器生成转换语音。一步指流解码更新,不是整条路径只有一次计算。 实验效果:ESD 英语十位说话人、五类情绪、16kHz,6000 次转换;16 位听者评每系统 100 条样本。自然度主观均分 3.77±0.03、情绪均分 3.90±0.04(±表示95%置信区间半宽),高于四步 DurFlex 的 3.63、3.79。A6000、批量 1,含声学模型及声码器的 RTF 为 0.038(耗时/音频时长),对照四步 0.132、百步 1.917。 表1|ESD 上整体比较,粗体仅在转换系统中排名;GT 为真实语音,vocoded 为声码器重建。自然度与情绪主观评分给均值及95%置信区间,自动质量、情绪与说话人相似度越高越好,字符及单词错误率、RTF越低越好;RTF包含声学模型及共享声码器,主干参数量并不相同。 批判点评:一步只计流解码器的网络评估,内容编码与声码器仍执行;模型约 9800 万参数,对照约 1.59 亿,也影响速度。说话人是训练过的十个嵌入,不是任意新音色克隆;去掉部分监督时 WER 还略好,情绪与可懂度需一起看。arXiv 标注在研预印本;作者样例可听,未确认训练代码。 10. SyncReward:声音对得上也得让人认同 SyncReward: Human-Aligned Synchronization Reward for Audio-Visual Generation | 中国人民大学;腾讯微信 | arXiv:2610.16338 关键词:音画同步奖励, 人类评分对齐, 时间对比学习, 生成后训练 前序问题:视频里的声音语义相关,却未在可见动作发生时响起;只奖励某个同步指标,模型可能把指标刷高,观众仍觉得嘴型或撞击声对不上。 方法直觉:先学习同一片段中哪个声音对应哪个时刻,再学人类如何判定“完全不同步、部分同步、同步”。内容匹配与时间对齐分别训练,避免只靠主题相似过关。 本文贡献:基于音画感知编码器,先用同片段错时负样本及跨片段语义负样本做对比学习,再冻结编码器,以人类 0/1/2 级评分训练交互 Transformer 与打分头,结合回归和成对排序。输出 0–2 的同步分。SyncReward-Data-80K 是约 8 万条评分;作者仓库说明为 80001 条评分覆盖 57099 个片段,不能把评分数直接写成独立片段数。 图3|SyncReward 两阶段训练:第一阶段以匹配音画片段、同视频错时负样本和同批跨视频语义负样本做对比学习;第二阶段冻结两种编码器,只训练跨模态 Transformer 与评分头,结合人类同步评分的回归和成对排序损失,输出0–2分。火焰与雪花分别表示训练和冻结。 实验效果:整体人评排序相关 Spearman ρ×100 为 78.2、成对排序准确率 83.6%,只做第一阶段为 60.5、74.6%。LTX-2.3 每提示生成 16 条再择优,人类偏好分为 63.67%,基模为 32.31%;用 DiffusionNFT 后训练为 65.78%。这些偏好分是基于基模比较的暂定估计,原文说明尚待完整两两评估,不能当全对全胜率。 表2|以同步分作奖励,分别比较十六选一与 DiffusionNFT 后训练;人类和 Gemini 偏好使用相同留出提示,自动指标也在同一批生成视频计算。当前偏好分为相对基模比较的暂定估计,作者说明将以完整两两评估替换;不同自动指标不构成统一胜率。 批判点评:十六选一要支付 16 次生成与打分成本;后训练有额外训练预算,未提供完整部署时延。模型可能提高嘴型同步却遗漏提示要求的乐器,同步奖励不能单独保证内容遵循。作者仓库提供打分、训练及基准入口,本次未复现;四类声音覆盖也不等于所有长视频场景。 趋势观察 把额外工作放到合适阶段 SMD的Pivot只留训练,AReA随去噪进度改感受野,Prime-EVC先把情绪放进条件。一步或少步的含义,要结合其余模块和前后处理判断。 编辑失败需要明确责任 DuplexBridge区分理解与执行,QK-Edit区分结构与内容。局部机制有效不保证所有语义指标都赢,验收要同时覆盖改变与保留。 接口分布同样影响最终质量 Channel Match的形状没坏但材质变差,AnyEdit把干净编辑与现场渲染分开。模块单独达标仍可能在连接处出错。 奖励与设备条件决定兑现方式 FlashVSR+依赖混合训练及4090缓存卸载,SyncReward十六选一需要额外生成。偏好分、去噪速度和完整产品耗时是不同账本。 今日讨论 SMD把Qwen-Image从教师100次网络评估压到4次,GenEval为0.873对0.874,但多样性从0.195降到0.144。训练仍要教师查询与Pivot,部署也有前后处理;你会用哪些指标和固定预算实验,验证减少网络调用后是否仍保住服务需要的变体覆盖? 人工智能炼丹君 整理 | 2026-10-15
-
AIGC 每日速读|2026-10-14|斯坦福让图像少误导文本SFG 今日 AIGC 论文速览 今日共 10 篇 · 图像生成机制 2 篇 · 视频缓存、压缩与纠错 3 篇 · 原生三维编辑 1 篇 · 流式动作与长动作评测 2 篇 · 情绪语音生成 1 篇 · 视频文字评测 1 篇 重点论文标题列表 SFG(斯坦福):减少图像对文本的错误反馈 T2I Sinks(复旦):高注意力位置不能随手删 CORAL-KV(AMD):跨层预测压小视频缓存 UniGVC(中科大):同一码流选直播或高清回看 PreCoG(港大):先看预览再修缓存轨迹 今日论文速览 1. SFG:减少图像对文本的错误反馈 Images Talk Back: Guiding MMDiTs by Suppressing Image-to-Text Feedback | 斯坦福大学;清华大学;纽约大学 | arXiv:2610.13941 关键词:多模态扩散, 语义反馈引导, 双向注意力, 推理期控制 前序问题:MMDiT 用联合注意力让当前图像更新内部文本表征;图像少画一个物体时,这条反馈可能把错误写回文本,并继续影响后续图像。 本文贡献:Semantic Feedback Guidance(SFG,语义反馈引导)在冻结模型中增加辅助分支:加强图像到文本反馈、减弱文本到图像条件,再让采样方向远离该分支。iSFG 则在正常条件前向内直接抑制前者、加强后者。修改位置在 softmax 与 value 聚合后,保留注意力归一化和模态内项;图像 SFG 只在前 20% 采样步启用额外分支。 图2|图像对文本反馈路径:输入prompt保持不变,当前图像通过图像到文本消息写入内部文本状态,随后文本再指导图像更新。缺失橙子的中间图像可能被纠正,也可能把缺失状态延续;文本标签和AI生成水果仅示意可能状态。 实验效果:表 2:1024×1024 图像、相同 prompt 与 seed,FLUX 的 CFG→CFG+SFG,GenEval 0.6661→0.7479,HPSv2.1 30.96→31.66;SD3.5M 的 GenEval 0.6890→0.7110。表 3:SD3.5M 的 iSFG 为 0.7047、HPS 32.98,比 CFG 高 1.33,增益与 SFG 不相同。 表2|有CFG的文生图比较:SD3.5M与FLUX上,各额外引导均叠加CFG。Count、Pos、C.-Attr分别为计数、位置、颜色属性,Overall为六类平均;HPSv2.1为四风格平均,ImageReward用同图像。各方法prompt与seed相同,FLUX的GenEval从0.6661至0.7479。 批判点评:SFG 无 CFG 时约用 1.2K 次模型评估,有 CFG 时约 2.2K;iSFG 零额外评估不等于零时延,也不能套用 SFG 的较大 GenEval 收益。干预支持反馈方向解释,尚不证明所有模型、场景都有效。官方仓库可见图像与视频推理源代码及配置,未运行复现。 2. T2I Sinks:高注意力位置不能随手删 Exploring Attention Sinks in Text-to-Image Transformers from Diffusion and Autoregressive Models | 复旦大学;上海创智学院;上海科学智能研究院 | arXiv:2610.13337 关键词:生成注意力分析, attention sink, 结构性位置, register探针 前序问题:某些 token 获得异常多的注意力,并不说明它们可有可无;把语言模型中对 attention sink 的直觉直接套给图像生成,可能损坏结构。 本文贡献:本文以 T2I Sinks 作阅读简称。对 FLUX.1、Z-Image 和 Infinity-2B 逐层逐头分析注意力,再以 logit 惩罚、value 清零、头剪枝及阶段性 token 移除作干预。扩散模型的 sink 常在模态边界、文本区和空间角落;自回归模型集中于首个全局 token。额外 register token 只作小范围探针。 图1|图像生成attention sink研究总览:(a)双向扩散与因果自回归架构;(b)FLUX.1与Infinity-2B的代表性sink;(c)logit惩罚、value替换和头剪枝;(d)干预及分阶段全局token移除结果。扩散sink聚集在模态边界和空间角落,Infinity首个全局token明显集中。 实验效果:表 5:Infinity-2B 从首尺度起移除全局 token,GenEval 64.56→11.37;从第 4 尺度开始为 62.90。FLUX 全程移除结构位置则为 67.14→64.81。表 7:FLUX 加 register,GenEval 67.14→68.85、DPG 83.67→84.01,register 的 top-1 sink 比例仅 0.53%。 表7|FLUX的register token探针:加入register后GenEval和DPG改善,原生sink位置的top-1比例略降;register自身比例0.53%,说明部分重新分配,不能称完全取代结构性sink。 批判点评:结构角色依赖生成范式和阶段,不能把 sink 都称为坏注意力。register 的结果是单主干探针;部分位置干预影响小,但剪掉高 sink 头更伤,关注位置不能替代关注头。本文未提供可确认的作者方法代码入口,也未证明通用推理加速。 3. CORAL-KV:跨层预测压小视频缓存 CORAL-KV: Compact Cross-Layer Prediction and Residual Coding for Autoregressive Video KV Caches | AMD;威斯康星大学麦迪逊分校 | arXiv:2610.12514 关键词:视频KV压缩, 跨层预测, 低秩加分块, 残差量化 前序问题:长视频的历史 key/value 缓存不断增长;只在单层内聚类量化,残差误差会随生成累积,边界处还可能突然失真。 本文贡献:CORAL-KV 先用上一层重建缓存预测当前 key,再用当前重建 key 和上一层 value 预测当前 value,只量化预测残差。block-DPLR 用块对角项建模头内通道、低秩项建模跨头联系;可跨视频复用离线预测器,也可固定低秩项、为当前视频重拟合块对角项,以更大缓存换保真。 图3|CORAL-KV重建:第ℓ层由前一层重建缓存预测key,加量化key残差;再用当前重建key与上一层value预测value,加量化value残差。两预测器都由块对角与rank-r低秩部分组成,解码不取原始key/value。 实验效果:表 1:单视频 HY-WorldPlay 285 帧,QVG-4→复用 CORAL-KV,缓存 13.36→6.90 GB、相对 BF16 输出的 PSNR 16.66→16.98 dB;MAGI-1 192 帧为 1.58→0.99 GB、26.14→31.09 dB。视频适配版本 MAGI-1 为 1.15 GB、32.47 dB,相对 BF16 的生成时延增加 10.0%。 表1|匹配比较中的保真与总缓存:HY-WorldPlay含285帧的已完成缓存块,保真评估保留最近48个latent帧;16视频列把共享预测器只计一次。PSNR/SSIM/LPIPS相对BF16生成,时延列为相对BF16开销,协议见附录F.3,不是全进程峰值显存或并发吞吐。 批判点评:内存数字只涵盖存储缓存,不是整个进程峰值显存;16 视频数是共享参数核算,不是16路并发实测。时延在 MI355X 测量,HY-WorldPlay 适配版本开销达29.1%。保真对照是同 seed 的 BF16 输出,不能当真实视频准确率。只验证两个主干,本文未确认作者代码入口。 4. UniGVC:同一码流选直播或高清回看 Unified Generative Video Compression with Autoregressive and Bidirectional Video Diffusion | 中国科学技术大学;快手 | arXiv:2610.13023 关键词:生成式视频压缩, 共享码流, 双模式解码, 单步蒸馏 前序问题:双向扩散解码画质更好却需要整段视频;自回归解码适合流式播放,但上下文受限。同一视频直播和回看不应被迫存两份码流。 本文贡献:层次潜变量 codec 生成同一压缩码流和递归条件,分别驱动双向 BI-DiT 与窗口自回归 AR-DiT。先联合适配 codec 和两套 LoRA,再用双向模型作教师把 AR 蒸馏到一步,最后在像素空间微调并训练条件 tiny decoder。共享的是传输表示,解码端仍保留两套参数。 图1|UniGVC训练与推理:(a)共同适配共享latent codec和双向/窗口因果DiT的LoRA;(b)合并LoRA,在相同codec条件下用双向DiT的真实score、伪score及对抗监督将AR蒸馏为一步;(c)像素空间改进AR及条件tiny decoder;(d)同一codec条件选择回看或流式解码。 实验效果:表 2:HEVC-B 1080p、0.0005–0.004 bpp,50步双向+原VAE为0.14 FPS,一步AR+tiny decoder为36.85 FPS。每帧 codec、DiT、解码器分别7.42、16.10、3.62 ms;最终训练组合相对双向基线的 BD-LPIPS +0.001、BD-DISTS +0.017,仍有感知差距。 表2|解码加速和增强消融:BI-50为50步双向,AR-1为一步自回归,Orig为原Wan VAE,Tiny为轻量解码器;Adv.DMD、Pixel FT、Cond.VAE-D为不同训练组件。在HEVC-B 1080p与0.0005–0.004 bpp四码率测试,最终AR为36.85 FPS,BD-LPIPS和BD-DISTS仍高于双向基线。 批判点评:250倍左右是对该50步双向方案的解码速度比较,不能称比通用视频编码器快250倍。极低码率可能补出合理但非原视频的细节;高FPS依赖一步AR与tiny decoder,不能套给双向质量档。原文声明代码和模型以后发布,未确认已开放。 5. PreCoG:先看预览再修缓存轨迹 PreCoG: Preview-Edit for Efficient Video Correction in Generation-Time | 香港大学NICE Lab;北京邮电大学 | arXiv:2610.13174 关键词:视频生成纠错, 低成本预览, 缓存轨迹编辑, 反事实软投影 前序问题:每次查出漏物体、动作绑定或时序错误就重新完整生成,既重复计算,又可能把已正确的内容改坏。 本文贡献:PreQA 用规划、评估、修正三个步骤,将原 prompt 拆成固定要求并从低步数预览诊断失败;PreEdit 以目标与反事实条件的预测差编辑缓存轨迹,用分块软投影减弱无关方向变化。每次选要求覆盖率最高的预览继续改,只对最终选中候选完整渲染;无需额外训练视频主干。 图1|共用轨迹的预览与完整渲染:成对视频具有相同prompt与seed,预览用少步完成。图中百分比是采样步数比例,不是实测耗时比例;主体与阶段大体对应,细节和姿态仍可能不同。 实验效果:表 1:Wan2.2-T2V-A14B、81帧、832×480、原40步,预览14+2+2步、最多4轮。直接生成→PreCoG,VBench 82.06→83.49、T2V-Comp 55.27→62.28、VS2 3.708→3.854;耗时895.0→2022.9秒,为2.26倍。相对VSR的3620.3秒更快,但VSR的VS2为3.973。 表1|视频纠错比较:列出VBench、T2V-CompBench、VS2及推理耗时,Δ为相对直接生成。PreCoG提高质量和对齐,耗时2022.9秒仍是直接生成的2.26倍;VS2 3.854低于VSR的3.973,不代表各项最高。 批判点评:这里的VBench是六维均值,不与其他论文全维总分直接比。98.24%预览一致性来自固定seed的初始候选诊断,不能保证任意纠错后续。规划和反馈依赖Qwen3.8-27B,多轮纠错仍有额外成本;人工评估仅4人。未确认作者完整框架代码入口。 6. 3DRAG:在原生三维潜空间拖动物体 3DRAG: 3D-Native Object Drag Editing with Generative Models | 上海科技大学 | arXiv:2610.13216 关键词:原生3D拖拽, 稀疏体素, 占用感知位移, logits级融合 前序问题:用2D扩散监督拖3D常有视角不一致,纯几何变形又容易破坏拓扑、纹理或未编辑区域。 本文贡献:在TRELLIS的稀疏3D潜空间构建弹性位移场,用占用感知winner-takes-all避免映射冲突;对结构和SLAT两阶段反演,缓存潜变量及Q/K/V。生成时搬移潜状态,在logits层融合目标与缓存源token,未编辑区域用缓存保留。无需训练或每次编辑优化,仍需反演与去噪。 图2|3DRAG流程:输入物体编码到稀疏体素潜空间,同时由拖拽指令建立位移场。TRELLIS结构ST与SLAT阶段反演获取缓存潜变量和Q/K/V;采样时用缓存与位移场保持细节、产生自然变形并保留未编辑区域。 实验效果:表 1:100个3D物体、单H20、64³体素,反演及去噪各25步。3DRAG未编辑区域PSNR 31.50、拖拽MD 15.89、FID 21.99、耗时227.74秒;APAP为22.52、18.01、63.31、275.13秒。纯几何ARAP仅3.32秒,不能称全表最快或交互实时。 表1|3D拖拽比较:评估未编辑区域保留、拖拽准确、整体3D质量和运行时间,向上/下箭头标明优劣。3DRAG的PSNR为31.50、MD为15.89、耗时227.74秒;ARAP仅3.32秒,生成方法的质量收益不能当全表最快。 批判点评:64³限制细薄结构精度,TRELLIS的VAE仍带色偏;GPTEval3D由模型裁判给分,不能当独立人工真值。原文列MM ’26会议信息与DOI,未把其他稿件模板当接收。官方仓库可见编辑UI、推理及依赖配置,需另备TRELLIS权重,未运行复现。 7. Sonic-AMG:声音边来角色边做反应 Sonic-AMG: Streaming Human Motion Generation from Spatial Audio | 布朗大学;麻省理工学院;耶鲁大学;香港大学 | arXiv:2610.13300 关键词:空间音频动作生成, 因果flow, 自身rollout训练, 空间反馈 前序问题:离线模型先知道整段声音及真实身体位置,在线角色却要边听边动;生成姿态的误差又会改变声源相对位置,形成训练推理差异。 本文贡献:将声学内容与身体相对声源位置分成token,用因果Transformer和flow head生成动作潜变量,再以因果解码器还原四帧片段。rehearsal训练结合整段teacher forcing与短自身rollout;空间反馈根据生成root姿态重新计算声源相对位置,使训练和在线条件一致。 图2|Sonic-AMG架构:交错声学what、空间where与动作token,经因果Transformer与flow head生成动作latent;空间反馈从解码root姿态更新身体相对声源位置SSL。Xk、zk、mk分别为四帧动作块、latent及投影token。 实验效果:表 2:SAM,在真实身体位置GT条件下,MOSPA→Sonic-AMG,FID 8.242→6.505、R@1 0.942→0.957;实际Online条件下Sonic为FID 8.066、R@1 0.943。作者项目报告RTX A6000首帧184 ms,对照MOSPA为10846 ms;首帧时延不是长期稳定吞吐。 表2|SAM定量比较:Causal表示支持因果生成,†表示引用Xu等2025报告;GT使用真实身体的声源相对位置,Online由生成root姿态更新。Sonic-AMG GT的FID为6.505,Online为8.066;R-precision与Diversity含95%置信区间,不应混用协议。 批判点评:主实验仍假设已知世界声源位置,且给4帧真实初始动作;不能把GT最优数字当完全自主在线表现。长时连贯与多事件切换主要是定性证据,机器人演示是离线物理仿真。作者项目页已核验;原文称代码与模型将在接收后发布,未确认接收。 8. Emo-BPO:同时学目标情绪和反向情绪 Emo-BPO: Emotion Bidirectional Preference Optimization for Diffusion-based Emotional TTS | 威廉玛丽学院;埃默里大学;乔治梅森大学 | arXiv:2610.12958 关键词:情绪语音生成, 双向偏好优化, 对比扩散引导, 后期引导调度 前序问题:只奖励目标情绪,没有学习如何远离竞争情绪,CFG的正反预测容易缺少区分,细粒度语气控制不稳。 本文贡献:把同文本、不同情绪的音频对调换次序,训练情绪对齐与情绪对比两条score分支;推理用对比CFG强化目标、压低其他情绪,并把引导强度留给后期去噪。基于Grad-TTS,只微调扩散解码器,冻结文本编码器及时长预测器,波形用HiFi-GAN生成;仍依赖已有情绪标注。 图1|Emo-BPO总览:训练调换同文本情绪对,部分微调预训练主干,同时学习情绪对齐EA与情绪对比EC扩散分支。推理在CFG内组合两路预测,强化目标情绪并抑制竞争情绪;训练仍利用已有情绪标注。 实验效果:表 1:英语ESD与EmoVoiceDB、三次运行均值,Emo-BPO的Emo SIM 99.23、UTMOS 4.52、平均情绪识别0.87;CosyVoice2为98.47、4.43、0.82。WER为3.84,略高于CosyVoice2的3.77,不能说可懂度也最佳。表 2的30人主观MOS为3.93、情绪MOS 4.25。 表1|客观情绪TTS评估:比较Emo SIM、韵律相似、可懂度、UTMOS及五类情绪识别,三次独立运行取平均。Emo-BPO的UTMOS为4.52、情绪识别均值0.87;可懂度列实为WER、越低越好,3.84不优于CosyVoice2的3.77。 批判点评:只有英语五类情绪,同文本配对与情绪标签是数据条件,免新增标注不等于无监督。自动MOS和情绪分类器可能有域偏差,没有给出完整部署时延。arXiv备注明确称Interspeech 2026接收;作者项目页可听样例,未确认完整训练代码开放。 9. ELMA:长动作要记住上一段约束 ELMA: Benchmarking Anaphoric Compositions for Long-Term Text-to-Motion Generation | 庆应义塾大学;庆应AI中心;索尼集团 | arXiv:2610.13549 关键词:长动作生成, 跨段指代, 连续数据集, 状态保持评测 前序问题:“继续敬礼并走路”要求保留上一段手势,只给各段独立字幕会让生成角色换动作时忘记约束。 本文贡献:从真实连续视频筛出30秒全身动作,以自动跟踪、姿态恢复和两阶段质量过滤构建ELMA,再生成带前文的六段字幕并标注指代依赖。数据含13.2k片段、110小时;ELMABench取测试集1k片段,每段5秒,只在指代目标段计分。A2M训练把当前与此前CLIP文本嵌入加权融合。 图3|ELMA数据构建:上部为动作收集,下部为字幕标注。SAM2人物跟踪与两阶段后处理筛出高质量动作,先生成连贯episode的分段字幕,再识别指代目标和跨段依赖;全部自动生成,仍有恢复和标注误差。 实验效果:表 2:FlowMDM在T2M训练→A2M推理时FID 1.9363、R-P@3 0.4211;A2M训练→A2M推理为1.5287、0.4662。但Matching Score 7.6015→8.1161变差;UniMotion的FID 18.3490→19.0050也未改善。不能把数据微调收益称跨模型普遍有效。 表2|不同训练推理设置:T2M为独立指令,A2M为带前文依赖指令;FID、Matching Score越低越好,R-P@3越高越好,Diversity应接近GT。FlowMDM的A2M训练改善FID与检索,但Matching Score变差,UniMotion也非统一改善。 批判点评:由视频恢复的动作和自动字幕有噪声,30秒及六段不能代表任意长流。依赖保持仍用分布与文本动作嵌入度量,需检查具体状态。arXiv备注与项目页称NeurIPS 2026 Evaluations & Datasets接收;作者项目页仍为Coming Soon,数据和代码未确认可下载。 10. TextVBench:分开测视频文字正确和稳定 TextVBench: Evaluating Text Rendering and Preservation in Video Generation | 中国科学技术大学 | arXiv:2610.13412 关键词:视频文字生成评测, OCR目标匹配, 时间一致性, 多参考文字保留 前序问题:视频里的字可能一直错但十分稳定,也可能每帧变;只看清晰度或OCR识别率,会混淆字符正确、跨帧保持与额外乱码。 本文贡献:分别构建300个中英T2V prompt和200个Ref2V参考,先把OCR候选关联到指定文字目标,再算空间字符保真S、同目标相邻观测的时间保真T,以长度加权聚合成TextVScore。多参考只在活跃视角匹配并处理重现;额外可读文字单列Extra,不混进主分。 图2|TextVBench统一评估:目标来自T2V指定文本或Ref2V参考区,编号框为OCR观测;同目标可跨框拼接而不改写。空间保真对目标,时间保真对同目标前后观测;漏掉EVERY DAY是24个归一字符中的8个。多参考跳过不活跃视角并在重现时比较;长度加权得到S/T,额外文字独立报告。场景和数值是示意。 实验效果:表 1:八个T2V模型、六个Ref2V模型,共2400+1200视频,3FPS抽样、最多30帧、OCR置信阈值0.80。T2V中MiniMax-H3的TextVScore 68.320,Wan2.2-A14B为43.853;Ref2V头三名仅56.506、56.465、56.388,相差0.119分,不足以宣称可靠总排名。 表1|总体结果:T2V测指定文字生成,Ref2V测参考文字保留;Spatial和Temporal范围0–1,TextVScore为0–100,Extra越低越好,粗体仅为各轨道列内最优。Ref2V前三名只差0.119分,不能将小差距看作可靠总排序。 批判点评:模型按各自推荐设置测试,不是算力对齐。未决OCR候选路由依赖Qwen3.8-27B;难度同时改变文字量、布局等属性,切片下降不证明单一原因。3FPS也会漏短暂闪烁,中文字形等OCR误差仍影响得分。本文未确认作者评测实现或数据下载入口。 趋势观察 信息流要看因果作用 SFG抑制错误回写,T2I Sinks显示高注意力token可能有结构作用。注意力数值、语义直觉和干预结果应分开看。 共享表示不消除部署成本 CORAL-KV共享预测器,UniGVC共享码流,PreCoG共享缓存轨迹;分别节省缓存、传输或重复渲染,仍有拟合、解码模型和反馈计算。 在线与长时条件各有门槛 Sonic-AMG在线重算空间位置,但主实验仍需声源坐标;ELMA测跨段依赖,部分指标和模型未改善。真实状态保持还要逐段验收。 可控性需要具体失败指标 3DRAG分别测未编辑区域与拖拽,Emo-BPO同时看情绪和WER,TextVBench分开正确文字与稳定文字。单一总分不能代替产品目标。 今日讨论 SFG把FLUX的GenEval从0.6661提高到0.7479,iSFG零额外模型评估但增益较小;如果你的图像任务更在意物体计数、偏好分或时延,会用哪些实测证据选择这两种控制? 人工智能炼丹君 整理 | 2026-10-14
-
AIGC 每日速读|2026-10-13|上海AI Lab接力画图InstantFusion 今日 AIGC 论文速览 今日共 10 篇 · 图像生成接口与表征 3 篇 · 流式视频与效率 4 篇 · 语义图像编辑 1 篇 · 语音量化 1 篇 · 音乐生成评测 1 篇 重点论文标题列表 InstantFusion(上海AI Lab):让不同图像模型接力去噪 RG(阿里):让内部表征真正带动画图 CoVA(南开):把VAE特征分阶段用好 Memory Forcing(快手):固定缓存也保留中程历史 ForcingBooster(港科大):简单区域提前停复杂区域多算 今日论文速览 1. InstantFusion:让不同图像模型接力去噪 InstantFusion: A Shared Latent Interface for Heterogeneous Image Generators | 上海人工智能实验室;复旦大学;上海交通大学;香港中文大学 | arXiv:2610.13944 关键词:跨模型图像生成, 共享潜空间, 动态对齐, 接力去噪 前序问题:不同生成器各有所长,但中间状态直接交给另一模型会出现伪影;为每对模型训练桥接器,又难随着模型数量扩展。 本文贡献:为每个冻结生成器训练轻量 Latent AutoEncoder,把中间状态编码到共享空间,再由目标模型解码。训练同时约束重建、同噪声状态对齐与局部去噪速度对齐;推理根据预测干净潜变量的变化选择交接点。同一接口支持模型组合、接力加速及跨架构蒸馏,不必为每对模型单独建映射。 论文 Figure 1:InstantFusion 概览。训练时,每个冻结生成器的专用 LAE 把中间状态映射到共享表示空间,同时对齐潜状态与去噪动态。推理时,发送模型的状态经共享空间翻译到接收模型的潜空间,自适应准则决定接收模型何时接管去噪。图中接口、接力加速、偏好组合与蒸馏是不同用途。 实验效果:表 2:接入 Qwen-Image 后,SD3 的 GenEval-v2 从 22.14→35.06,FLUX.1 从 22.86→36.54,分别增加 12.92、13.68 分;OneIG-Bench 平均分为 0.4776、0.5007。SD3 组合的 CLIP 分 28.65→26.98、推理分 0.2770→0.2730,不能说所有指标同时提升。 论文 Table 2:基础生成器与跨模型组合比较,展示少量高质量生成器如何帮助较弱模型。列含 GenEval-v2、CVTG-2K、CLIP 及 OneIG-Bench 的对齐、文字、多样性、风格、推理与平均分。Qwen-Image+SD3 的 GenEval-v2 为 35.06,+FLUX.1 为 36.54;各自增量为 12.92、13.68 分。部分 CLIP 与推理数值下降,原表增量箭头不能替代实际数值判断。 批判点评:当前方法要求共享 VAE 和兼容时间参数,不能任意拼接不同编解码器;同时装载多个主干增加显存与存储。冻结主干仍需训练接口,重复往返也会损伤保真度。表 3 不同接力对象有速度与质量取舍,不能把摘要加速范围外推所有组合。官方仓库可见 LAE/OPD 训练及 SD3/Qwen 推理实现,HuggingFace 可见接口权重;其他演示组合未逐一确认实现,未运行复现。 2. RG:让内部表征真正带动画图 Learning Representations to Guide Pixel Diffusion Transformers | 中山大学;阿里巴巴;香港大学;上海交通大学 | arXiv:2610.12978 关键词:像素空间生成, 表征引导, 低维瓶颈, 训练目标修正 前序问题:中间层对齐视觉教师后,语义可能被后续像素合成覆盖;更强表征或更复杂像素解码器,不一定换来更好的生成。 本文贡献:Representation Guidance 用低维瓶颈连接普通 Transformer 编码器与解码器;比较解码器有无内部表征时的预测速度差,把停止梯度后的差值加进 flow matching 训练目标,迫使生成使用表征。默认由 EMA 网络形成引导,训练仍叠加 DINOv2 的 REPA 对齐;内部引导不能说成完全不用外部表征监督。 论文 Figure 6:Representation Guidance 训练。编码器把带噪输入 z_t 经瓶颈映射为 r;共享解码器在有 r 和无 r 两种条件下预测干净图像,再转成 v_with_rep 和 v_without_rep,其差为 Δv_rep。无表征分支由原 flow matching 目标 v=x−ε 监督,有表征分支由沿停止梯度偏移外推的 v_RG 监督。 实验效果:表 2:ImageNet 256×256,RG-XL/16 为 725M 参数、600 epochs,FID 1.55;RG-L/16 为 459M、同训练轮数,FID 1.79。表中的 PixelDiT-XL 为 797M、320 epochs、FID 1.61,JiT-G/16 为 2B、600 epochs、FID 1.82;训练预算与外部模型并不完全相同。 论文 Table 2:ImageNet 256×256 类别条件结果,比较潜空间与像素空间模型。预训练列列出额外使用的外部模型,粗体标示列内最佳。RG-XL/16 在 600 epochs 达 FID 1.55,725M 参数,外部表征列为 DINOv2;同时列出 IS、Precision、Recall。不同模型训练轮数及预训练组件不同,FID 排名不等于同成本比较。 批判点评:RG 增加两次无梯度 EMA 前向,推理无需这两次教师调用,但训练成本仍存在;低噪声区间、warm-up 和引导强度均属方法条件。现有实验聚焦图像,视频、3D、音频迁移尚未证实。官方仓库目前仅有 README 与展示素材,作者把代码和权重列为待发布,不能称已开源实现。 3. CoVA:把VAE特征分阶段用好 CoVA: Composing VAE Representations for Generative Learning | 极豪科技;南开大学 | arXiv:2610.13322 关键词:生成表征学习, VAE特征组合, 分阶段监督, 软标签幅值 前序问题:VAE 特征擅长重建,却不一定带来生成需要的语义结构;直接平均类别嵌入又会改变幅值,让 FID 改善与语义作用混在一起。 本文贡献:在线训练小型 latent composer,通过类别监督、掩码重建和水平翻转一致性整理 VAE 特征。前期用其密集特征对齐 SiT,中后期停止对齐,最后阶段使用停止梯度的类别后验软条件,并恢复硬标签嵌入的幅值,隔离方向语义与条件强度效应。辅助模块只在训练使用。 论文 Figure 3:SRA2 与 CoVA 比较。(a)SRA2 通过轻量投影与辅助对齐损失,把 SiT 中间特征对齐到 VAE 特征。(b)CoVA 在线组合干净 VAE 潜变量,语义及空间目标训练 composer,早期用密集特征作对齐,后期用停止梯度的类别后验作软条件。(c)分阶段从对齐转为软条件,使训练收敛更快、生成质量更好。 实验效果:表 1:ImageNet 256×256、batch 256、不开 CFG,同为 400K 次训练,SiT-XL/2 的 FID 从 17.2→7.4,REPA 为 7.9。表 3:增加 8.5M 辅助参数,训练吞吐从 8.1→7.0 iter/s,计算量 114.46→122.69 GFLOPs;改善收敛不等于单次训练更快。 论文 Table 1:不同训练迭代数的 FID。全部在 ImageNet 256×256、batch 256、不开 CFG;列出 SiT-B/2、L/2、XL/2 的参数数目及 REPA、SRA2、CoVA。XL/2 同为 400K 时原 SiT 17.2、REPA 7.9、CoVA 7.4;CoVA 1M 为 4.4、2M 为 3.6,不能把不同迭代数当同预算结果。 批判点评:主实验是类别条件 ImageNet,不能外推开放域文生图。表 5 显示只缩小条件幅值就能降 FID,却损失 Recall,评估应一起看覆盖度。原文未给出可确认的 CoVA 官方方法代码入口。 4. Memory Forcing:固定缓存也保留中程历史 Memory Forcing: Attendable Mid-Horizon History for Streaming Video Generation | 南京大学;清华大学;快手可灵团队;上海人工智能实验室 | arXiv:2610.11756 关键词:流式视频生成, 固定KV缓存, 中程记忆, 分库RoPE 前序问题:只保留开头与最近帧的 KV 缓存,会忘掉已离开窗口的事件;人物离场再回来,身份和场景容易漂移。 本文贡献:把原有固定大小缓存分成 sink、archive、working 三区。近期区满时,将与新片段最不相似的旧片段移入档案区,档案满后按 FIFO 淘汰;所有 key 保持原始形式,在注意力时用 Bank-aware RoPE 重赋时间位置,使旧事件可被检索。继续沿用 Rolling Forcing 的滚动去噪和 DMD 训练。 论文 Figure 2:Archive & Working Banks,每行缓存大小相同。(a)只有当前窗口被填满。(b)首个 chunk 进入 sink 并固定保留。(c)有空位时后续 chunk 写入 working。(d)working 满后,根据与新片段的相似度选历史写入 archive。(e)archive 满时由 FIFO 丢弃最旧 chunk。原 caption 分五步叙述,原图(d)合并相似写入与 FIFO 淘汰;颜色区分三类记忆,未增加独立历史存储。 实验效果:表 1:1.3B 模型,官方 VBench 总分 5 秒 83.88、60 秒 83.20,下降 0.68 分;LongLive 为 83.23→82.21,下降 1.02 分。表 2 的 30 秒消融中,working-only 总分 82.41,archive+working 为 83.58;60 秒 similarity 写入为 83.20,FIFO 为 82.96。 论文 Table 2:Wan2.1-T2V-1.3B 在官方 VBench 的 30秒及60秒消融,全部为16 FPS、832×480,报告总分、质量、语义。(a)记忆库;(b)Bank-aware RoPE 的连续、阶梯、折叠、插值分配;(c)相似度写入与 FIFO。30秒 archive+working 为83.58,working-only为82.41;60秒相似度写入为83.20、FIFO为82.96。 批判点评:缓存不增大不等于保存全部过去,档案仍会淘汰,最不相似也不必然等于最重要;分库和 RoPE 需要适配训练。论文对 Gen-Complex、MovieGen 等集合的结果不同,不能只用一个总分替代记忆验收。原文明确代码与权重拟在接收后发布,未确认会议接收或现已开源。 5. ForcingBooster:简单区域提前停复杂区域多算 ForcingBooster: Adaptive Patch-wise Denoising for Fast Autoregressive Video Diffusion | 香港科技大学;VAST;澳门科技大学 | arXiv:2610.12625 关键词:自回归视频加速, patch动态路由, 提前退出, on-policy训练 前序问题:每个 patch 都执行相同去噪步数,静态背景浪费计算;统一减步又让新区域与复杂细节得不到足够修正。 本文贡献:轻量 router 在每步预测各 patch 的停止概率,提前停止的干净预测及其 KV 作为仍在去噪区域的上下文。通过无梯度自身 rollout 记录退出并回放,以重建损失和计算成本训练路由概率;主干和时间表固定,首个 chunk 仍用四步。这里需要路由器训练,并非免训练加速。 论文 Figure 2:自适应 patch 推理与 on-policy router 训练。(a)router 选择继续去噪的 patch,已停止 patch 的预测提供可复用 KV 上下文。(b)无梯度 rollout 记录退出位置用于回放,重建和计算成本通过停止概率训练 router。主干固定,路由模块仍需训练。 实验效果:表 1:Causal Forcing 1.3B、81 帧、480×832、16 FPS,单 A800、BF16、batch 1。含文本编码、router、KV 与 VAE 的平均端到端时间 11.15→8.56 秒,1.30 倍;patch-NFE 减少 50.19%,VBench 总分 82.08→81.55。减少一半 patch 更新不能叫两倍端到端加速。 论文 Table 1:Causal Forcing checkpoint 上的比较,时间包括生成直至 VAE 解码。加速和 denoising patch-NFE 减少均相对该模型四步基线;列含质量、语义、总分、时间、加速及 NFE 减少。ForcingBooster 时间8.56秒、1.30倍、减少50.19%,总分81.55;四步11.15秒、总分82.08。首段统一四步,不能将 NFE 减少等同整体加速。 批判点评:保留质量是接近基线而非完全相同;路由误判会让尚未完成的细节早退,不同主干加速幅度也不同。文中路由器训练 500 steps,动态稀疏执行有开销。作者项目页及官方仓库可见 Wan 方法实现和权重入口,未运行复现。 6. CacheScope:把完整计算留给高风险步骤 CacheScope: Exact-Compute Allocation for Training-Free Diffusion Acceleration | 中山大学 | arXiv:2610.12530 关键词:扩散缓存加速, 轨迹归一化, 浅层探针, 完整计算调度 前序问题:浅层特征变化同时受到输入轨迹位移和网络响应影响;直接用变化量决定缓存更新,可能把计算花在错误步骤。 本文贡献:每步运行第一个 Transformer block,分别量出输入位移 Δx 与输出变化 Δy,用 s=Δy/(Δx+ε) 衡量沿当前轨迹的灵敏度。累计达到阈值才运行余下 blocks 并更新缓存,否则沿用同一有界一阶重建器;CFG 两分支分别累计。无需训练、梯度或辅助网络,改变的是完整计算落点。 论文 Figure 2:CacheScope 概览。每步先运行第一个 Transformer block 为浅层探针,量出输入轨迹相对位移 Δx_t 和探针响应 Δy_t,累计 s_t=Δy_t/(Δx_t+ε)。超过阈值 τ 才精确计算其余 blocks 并刷新缓存,否则沿用不变的有界一阶重建器。这是相对原探针调度的唯一改动;CFG 的两分支维护独立累计量与缓存。 实验效果:表 2:32 个留出 prompt、各指标取中位数。Wan2.1 Moderate 的原始探针调度 D 与 CacheScope S 约为 2.492、2.493 倍加速,LPIPS 0.0772→0.0414;但 SSIM 0.8961→0.9220。FLUX Fast 下 S 为 3.566 倍、LPIPS 0.1246;数值需按同主干、速度区间和同一重建器解释。 论文 Table 2:32个留出 prompt 的受控调度比较,指标为 prompt 中位数。D、M、S 信号共享同一个 DiCache 有界一阶 Γ 重建器、探针深度和 warm-up,只改变累积信号;统计检验使用附录F.2严格匹配跳步的子集。列含加速、LPIPS、PSNR、SSIM,粗体/下划线为主干和速度档内最佳/次佳。Wan Moderate 的D/S LPIPS为0.0772/0.0414,FLUX Fast 的S为3.566倍、0.1246。 批判点评:LPIPS、PSNR、SSIM 是相对密集生成输出的保真,不是真实图像真值。浅层探针不是完整误差证明,阈值与 warm-up 仍需选;快档可能出现细节偏差,不能称无损。原文未给出可确认的作者方法代码入口,部署价值需在自己的 prompt 与采样器上验证。 7. HD-VSR:消费卡靠关键帧与插帧做超分 High-Throughput Generative Video Super-Resolution on a Single Consumer GPU | Ethical AI Novelties;塞浦路斯理工大学 | arXiv:2610.13179 关键词:生成式视频超分, 稀疏关键帧, RIFE插帧, 邻域注意力 前序问题:逐帧运行扩散超分成本高;全局时空耦合虽能稳视频,却难在单张消费卡上兼顾吞吐和显存。 本文贡献:本文以 HD-VSR 作阅读简称。用预训练一步 AdcSR 增强稀疏关键帧,用 RIFE 从相邻高分辨率关键帧插出中间帧,再以运动门控决定是否回退生成;把部分高分辨率全局注意力替换为邻域注意力,语义关键低分辨率层保留全局。zero-shot 指推理时组合,不是组件从未训练。 论文 Figure 2:所提流程。复用两个预训练组件:AdcSR 对稀疏关键帧做超分,RIFE 作时间插帧。新贡献在组合方式:运动感知交错关键帧策略决定何时调用生成主干,免微调的混合注意力加速空间生成器高分辨率层,时间装配把超分关键帧和插帧合并为完整序列。 实验效果:表 1:RTX 4090、1280×720、关键帧间隔 K=3、batch B=8,吞吐 32.66 FPS、峰值显存 8.99 GB;同 K、B=1 为 8.28 FPS、2.33 GB。表 4 的 4K、B=1,邻域注意力相对原实现 0.76→1.10 FPS,44.7% 提升,基线和口径不同。 论文 Table 1:1280×720下不同关键帧间隔K和batch B的吞吐与显存。K=1、B=1为3.04 FPS、2.03 GB,K=3、B=1为8.28 FPS、2.33 GB;K=3、B=8为32.66 FPS、8.99 GB。K增大时更多帧来自插帧,B增大是吞吐批量,表格不能证明单流32.66 FPS的低延迟。 批判点评:32.66 FPS 是批量交错吞吐,不能当单段低延迟实时生成;插帧需要后一关键帧,高运动和遮挡会受影响。表 3 有感知分下降,作者明确以重建保真换效率,不能称超分质量全面领先。本文未提供可确认的整套框架官方代码入口,AdcSR 与 RIFE 本身也不是本文新模型。 8. ThinkDrag:先理解拖拽意图再改变图像 ThinkDrag: Semantic Drag-Based Image Editing with Visual Reasoning | 南洋理工大学S-Lab | arXiv:2610.13316 关键词:拖拽图像编辑, 视觉推理, 端点标记, 语义编辑评测 前序问题:把拖拽当几何位移,容易移动了像素却没有形成合理的姿态或物体变化;大结构改动也让特征点跟踪失准。 本文贡献:基于 BAGEL 训练统一理解与生成模型,用合成语义编辑对、拖拽点和推理轨迹监督 LoRA。Drag Endpoint Markers 为起终点建立图像空间对应,可直接生成,也可先输出显式推理。构建 145 例 DragBench++,以参考编辑与语义点跟踪补充原有几何距离评测。 论文 Figure 4:ThinkDrag 统一多模态模型流程。源图像、文本化拖拽约束及 Drag Endpoint Markers 为图像生成提供空间对应;模型可直接编辑,或先产生解释拖拽意图的推理轨迹再编辑。图中两种模式共享理解与生成模型,端点标记区别于仅用于展示的箭头。 实验效果:表 1:DragBench++,ThinkDrag 参考图保真 IF* 为 0.905、MD_MLLM 为 34.24;LightningDrag 为 0.836、57.28。原 DragBench 上 ThinkDrag FID 30.05、MD 28.84,GeoDrag MD 22.77 更低。附录推理模式相对直接模式只赢 75/145,即 51.7%,不是稳定全面胜出。 论文 Table 1:DragBench++与DragBench结果,TTO/OS/FT分别为测试时优化、一步方法、微调。IF对输入图像,IF*对参考编辑,MD为DIFT跟踪距离,MD_MLLM为语义跟踪距离,FID衡量分布差异;↑/↓标指标方向,缺测为横线。ThinkDrag主表为直接模式:++上IF*0.905、MD_MLLM34.24;原DragBench的MD28.84,GeoDrag22.77更低。 批判点评:数据和新评测含合成图像及模型裁判,参考编辑也不是唯一正确解。主表采用直接模式,不能把全部提升归给显式推理;推理增加串行生成时间,点跟随精度未处处最好。作者项目页与仓库已核验;当前仅 README/LICENSE/assets,数据、权重和推理代码均列 TODO,尚不能据此复现。 9. TTS-Q:把量化精度留给后期音色 TTS-Q: Perception-Guided Post-Training Quantization of Text-to-Speech Diffusion Transformers | Wyze;纽约市立大学城市学院;中科院计算所;台湾大学;清华大学 | arXiv:2610.12474 关键词:语音扩散量化, 音色保真, 任务匹配校准, 后期FFN精度 前序问题:低字词错误率不代表声音仍像目标说话人;四位语音扩散量化的音色损失集中在特定层与去噪阶段。 本文贡献:在任务匹配候选中选初始重建误差高的语音,取特定采样状态校准 FlatQuant;权重保持 W4,把末期 FFN 激活升为 A9,其余用 A3,匹配约四位的名义激活预算。该预算按参数加权,并不保证同样的实测时延;没有重新训练 TTS 主干,仍有离线校准优化。 论文 Figure 1:TTS-Q。上方文本和说话人参考条件化TTS DiT,采样状态用于离线校准,阴影FFN为推理精度分配;CER/SIM为字符错误率/说话人相似度。左下按初始损失排序任务匹配候选,取语音-步数快照拟合均匀W4A4。右下权重W4,晚期FFN激活升精度、其他位置降精度;早晚示意在相同名义预算比较,名义预算不等于实测时延。 实验效果:表 1:Seed-TTS-eval 留出集,3.5B 英文,均匀 W4A4 参考 SIM 0.7796→TTS-Q 0.7829,全精度为 0.7834;WER 1.813%→1.918%,全精度 1.919%。各方案 32 条校准、steps {13,14}。附录 S11 的 15.83→4.44 GB 来自均匀 W4A4 部署,未测试混合 TTS-Q 路径。 论文 Table 1:Seed-TTS-eval留出集,zh/hard/en为1720/300/888项;中文CER和英文WER均为百分数,另报SIM。校准均为32项、steps{13,14}、64快照;三个均匀W4A4行仅选择数据不同,lossmax为均匀参考。TTS-Q权重W4,A9/A3均衡预算在1B/3.5B为4.000/3.947位;粗体只在量化结果中按列比较,全精度不参与。3.5B英文SIM为0.7829、WER为1.918%。 批判点评:名义四位不等于全程 W4A4,更不能把均匀量化的显存和速度归给混合方案;1B 部署量化路径还可能更慢。原摘要与 PDF 均记首发 8月11日,本期是首次纳入,不能称10月新发。原文未给出可确认的方法官方仓库或权重入口。 10. MusicEval Probes:音乐裁判是否真的听了音频 What Do Audio-Language Judges of Generated Music Listen For? Four Probes with Controls from Expert Ratings | 华沙理工大学计算机科学研究所 | arXiv:2610.13247 关键词:音乐生成评测, 音频语言裁判, 位置偏差, 专家对照 前序问题:裁判评分与专家相关,不等于它真正听懂音乐质量;文本提示、候选位置和问法都可能改变生成模型排名。 本文贡献:以 MusicEval Probes 作阅读简称,审计五个开放音频语言裁判:去掉音频、同 prompt 换另一模型音乐、交换成对顺序、重写指令,并用专家评分计算相应对照。MusicEval 覆盖 2748 段音乐,后两项也测 SongEval,直接检验生成音乐评价是否可靠,而非提出音乐生成器。 论文 Figure 1:五个裁判的四种探针中两种,附95% bootstrap区间。左侧同prompt换音乐,实心/空心为裁判分对实际播放片段/被替换片段专家分的标准化系数,分别看质量与对齐;真正听音频应追随播放片段。右侧在相同300段音乐上换三种指令问法,比较与专家质量分的相关。 实验效果:表 1:Qwen3-Omni 音乐质量 Spearman 相关为 0.31;去掉音频后为 0.04,专家构造的 prompt-only 对照为 0.08。表 2:600 对样本交换顺序,Music Flamingo 99% 仍选同一位置,Qwen3-Omni 为 25%;随机参照是 50%,同位置意味着优选音乐随交换改变。 论文 Table 2:同prompt交换的列报告裁判分对实际播放与被替换片段专家分的标准化回归系数,共2327次交换。顺序交换列报告600对样本两种顺序下选同位置的比例、其中选第二位置的比例、顺序平均偏好与专家一致的比例;随机参照为0.50/0.25/0.50,区间见表13和12。Music Flamingo同位置0.99,Qwen3-Omni为0.25,不能把同位置率当音质准确率。 批判点评:相关系数不是准确率,位置偏差也不是总体音质差。问法实验使用固定 300 段片段,结论受裁判版本、prompt 和数据集约束。模型级相关与片段级相关不能混用,选音乐生成器时应同时做专家验证。原论文未提供可确认的本研究官方实现入口。 趋势观察 表征既要对齐也要服务生成 InstantFusion对齐中间状态与速度,RG直接改变内部表征对预测的影响,CoVA分阶段使用VAE特征。表征图看着更有语义,不等于最终生成收益。 预算应该落在最需要的位置 Memory Forcing决定缓存留下谁,ForcingBooster决定哪些patch继续去噪,CacheScope决定哪些步骤完整计算,TTS-Q把名义精度留给晚期FFN。预算口径不同,收益须配条件。 吞吐与训练收敛各有代价 HD-VSR高FPS依靠批量和插帧;CoVA单步训练更慢但同迭代FID更低。不能把batch吞吐叫单流低延迟,也不能把少训练轮数直接等同省时比例。 评测要拆开目标和对照 ThinkDrag的几何点距与语义合理性未必一致,MusicEval Probes检验音频、位置和问法的干扰。生成部署需要原始任务与人工验收共同决定。 今日讨论 InstantFusion把SD3的GenEval-v2从22.14提高到35.06,但仍要求共享VAE、兼容时间参数并装载多个主干;你需要哪些指标和显存证据,如何判断接力生成是否值得用在自己的图像工作流中? 人工智能炼丹君 整理 | 2026-10-13
-
AIGC 每日速读|2026-10-12|Google把token留给细节BudgetPix 今日 AIGC 论文速览 今日共 10 篇 · 图像计算与自训练 3 篇 · 视频编辑与加速 3 篇 · 局部三维生成 1 篇 · 音视频与语音控制 2 篇 · 生成编辑评测 1 篇 重点论文标题列表 BudgetPix(Google):按细节分配可变token预算 Data-space DMD(字节):不用时间表直接反复修图 Rubric-CEPR(MBZUAI):只把核验通过的编辑教回模型 VINCIE-NExT(字节):先编辑关键帧再把变化传给视频 PTD(NVIDIA):让四步学生沿自己的曲线学 今日论文速览 1. BudgetPix:按细节分配可变token预算 BudgetPix: Compute-Adaptive Tokenization for Pixel-Space Image Diffusion | 伊利诺伊大学厄巴纳-香槟分校;Google | arXiv:2610.12307 关键词:像素空间扩散, 四叉树, 可变token预算, 多尺度解码 前序问题:固定网格给平滑背景和复杂纹理相同的计算预算;直接减少 token 又容易破坏细节,难用一个模型适配不同推理预算。 本文贡献:BudgetPix 按图像强度直方图熵构造四叉树,复杂区域保留细 patch,平滑区域合并为粗 token;多尺度 Patch Aggregator 编码粗格,Refiner 恢复固定分辨率。训练时扰动布局与预算,推理按当前去噪预测重估布局。新增编解码路径需要训练,Transformer 从已有像素空间扩散模型初始化。 论文 Figure 3:BudgetPix 总览。编码器把固定大小图像变成不同尺度、可变数量的 token,解码器恢复固定分辨率,训练和推理都支持不同 token 数。紫色编码器与解码器从头训练,蓝色 Transformer 从已有主干初始化;图中三部分共同构成预算自适应像素空间扩散。 实验效果:表 1:1024² PixelDiT-T2I,BudgetPix 在 25% token 预算下 GenEval 为 0.725、DPG-Bench 为 83.7;原模型全预算分别为 0.721、84.8。原模型同为 25% 预算时降至 0.323、55.1。不同指标说明保留指令遵循的程度,不能把 25% token 预算直接当四倍端到端加速。 论文 Table 1:1024² PixelDiT 文生图在 100%、90%、80%、70%、60%、50%、25% token 预算下的 GenEval 与 DPG-Bench。BudgetPix 各预算指标高于对应原模型;25% 时 GenEval 0.725、DPG 83.7,原模型全预算为 0.721、84.8。这里是预算与指标比较,未给出四倍端到端时延。 批判点评:布局依据中间预测,尚未出现的小细节可能分不到 token;PixelDiT 的全分辨率像素阶段还形成计算下限。需先微调,不能视为免训练插件,也不能把一个指标接近说成画质无损。作者项目页目前未提供可确认的方法代码或权重入口。 2. Data-space DMD:不用时间表直接反复修图 Few-Step Generation via Data-Space Iteration | 字节 Seed | arXiv:2610.12102 关键词:少步图像生成, 数据空间迭代, DMD蒸馏, 自rollout 前序问题:少步采样通常仍沿概率流选定几个时间点;难例和不同空间区域需要的修正次数不同,手工时间表未必适合。 本文贡献:共享生成器从噪声开始,直接把上一轮数据预测、原始噪声和迭代编号作为条件,反复修正干净样本,不再在每轮输出后按指定时间点重新加噪。通过分布匹配蒸馏 DMD 训练每一轮输出,并用自身 rollout 形成训练输入。它取消流时间离散化,仍需选择迭代次数与训练噪声采样。 论文 Figure 1:(a)现有少步生成沿概率流空间迭代,需要预定时间离散化,可能并不最优;图中从初始噪声经多个带噪状态到数据端点。(b)数据空间迭代直接修正每轮数据预测,以原始噪声和轮次作条件,取消流时间离散化瓶颈。两排小图用于示意各自迭代过程。 实验效果:表 3:类别条件 ImageNet 256×256,四次网络评估、启用 CFG 时,Data-space DMD 的 FID 为 2.29,均匀时间表 DMD 为 2.61,搜索三种时间表后的 Phased DMD 为 2.37。250 次评估的流模型 FID 为 2.06,少步方案尚未达到该教师水平。 论文 Table 3:ImageNet 256×256 的主结果,FID 越低越好。上半不开 CFG,下半启用 CFG;比较 250 NFE 流模型、1–4 NFE DMD、4 NFE Phased DMD 与数据空间 DMD。oracle 仅取三种搜索时间表中的最佳结果;数据空间方法无需时间表,启用 CFG 的四步 FID 为 2.29,教师 250 NFE 为 2.06。 批判点评:主结果是类别条件小图,文生图与其他模态仍属未来工作;自 rollout 有训练成本,不是把任何现有采样器换个循环就有效。不同训练权重与 CFG 需同时核对。作者在附录给出实现细节,未从论文入口确认独立代码仓库或权重。 3. Rubric-CEPR:只把核验通过的编辑教回模型 Rubric-CEPR: Self-Evolving Image Editing via Reward-Verified Self-Distillation | 穆罕默德·本·扎耶德人工智能大学;阿尔托大学 | arXiv:2610.12469 关键词:图像编辑, 内部奖励, 可行性门控, 自蒸馏 前序问题:模型自己生成的编辑样本可能真实却没按指令改;单一奖励还可能让“保留得好”补偿“根本没编辑”,把失败教回模型。 本文贡献:Planner 从未标注图像提出结构化编辑要求,Editor 采样多个候选,冻结 Critic 利用原编辑器的视觉语言特征和 VAE 潜变量检查新状态、旧状态消除及局部保留。任何适用检查不通过就拒绝,再把最佳可行样本用于 LoRA 加权去噪训练;主要循环不查询外部奖励模型。 论文 Figure 2:Rubric-CEPR 的提出、编辑、核验与蒸馏循环。冻结 Qwen-Image-Edit 提供 Qwen2.5-VL 理解分支、MMDiT 与 VAE;Planner 的 LoRA 给出指令 c 和结构化要求 s,Editor 的 LoRA 采样 K 个编辑。冻结 Critic 以语义支持与增益、VAE 保留检查构成 R=Gate·√(Edit×Preserve),新状态、旧状态消除、正确操作、无关内容保留与局部性任一适用项失败即拒绝;最佳通过样本训练 Editor,难度带内提案轨迹训练 Planner,进入下一轮。主要循环不查询外部奖励模型。 实验效果:表 1:Qwen-Image-Edit-2509 在 ImgEdit 的 0–5 分制总分 4.36→4.60,相对提升 5.5%;物体分离 3.41→4.26,相对提升 24.9%。总分差为 0.24±0.02,报告的是三次训练种子的标准差。表 2 的 GEdit-Bench 总分 7.39→8.31。 论文 Table 1:ImgEdit 各编辑类别及总分,0–5 分制。内部奖励自蒸馏使 Qwen-Image-Edit-2509 总分 4.36→4.60,相对提升 5.5%,差值 0.24±0.02 为三种子标准差;物体分离 3.41→4.26,相对提升 24.9%。Δ 按 100×(适配分−原分)/原分计算;† UniWorld 使用外部奖励,其原模型与裁判协议不同,不能直接横向归因。 批判点评:内部可检查的编辑更受益:若原模型完全采不到正确样本,多采样也找不到训练目标;调整类内部信号最多追回 30% 的 oracle 空间。主要结果是一次适配,不能称为持续多轮自进化。跨论文裁判协议不同。作者仓库可访问,未运行复现。 4. VINCIE-NExT:先编辑关键帧再把变化传给视频 VINCIE-NExT: Unlocking Video Editing from Images via In-Context Modeling | 新加坡国立大学;字节 Seed;中国科学技术大学 | arXiv:2610.12104 关键词:视频编辑, 图像示范, 共享空间位置, 编辑链 前序问题:视频编辑三元组昂贵;成熟图像编辑数据很多,但改对一帧不代表变化能稳定传到所有视频帧。 本文贡献:把任务拆成视频→图像→编辑图像→视频,以源与目标图像对作为上下文示范;TDF3D-RoPE 将示范和视频帧放在共享空间坐标中,统一扩散主干联合学习各子链。Chain-of-Editing 在推理时先得到编辑图像,再生成编辑视频,也允许更强图像编辑器提供示范。 论文 Figure 2:VINCIE-NExT 总体架构。把视频编辑分成视频→图像→图像→视频子任务链,源图 Iˢ 与编辑图 Iᵗ 作为上下文视觉示范。统一扩散主干据此把成熟图像编辑先验迁移到视频帧;图中各段代表可组合子链,而非完全无需视频编辑训练数据。 实验效果:表 1:431 段 OpenVE-Bench,Gemini 2.5 Pro 按 1–5 分评分,VINCIE-NExT 总分 3.08,高于 OpenVE-Edit 的 2.49,但低于 Runway Aleph 的 3.65;输出分辨率分别为 640×480、1280×704、1280×720。表 2 的第一阶段 256×256 模型,全数据加 CoE 为 2.65,不是同条件的 3.08。 论文 Table 1:OpenVE-Bench 八类编辑比较,Gemini 2.5 Pro 按 1–5 分自动评分。#Reso. 为输出分辨率,灰行是闭源商业模型。VINCIE-NExT 在 640×480 总分 3.08,OpenVE-Edit 在 1280×704 为 2.49,Runway Aleph 在 1280×720 为 3.65;各类包括全局风格、背景、局部改删增、字幕、创意与相机编辑。 批判点评:训练仍用了 OpenVE 视频编辑配对,不能叫完全不用配对视频;关键帧编辑错误会被传播,长视频与大相机运动仍待验证。CoE 增加串行扩散阶段。arXiv 注释明确已接收 NeurIPS 2026。作者项目页有仓库入口,但当前仓库只有 LICENSE 和 README,方法实现与权重尚未公开。 5. PTD:让四步学生沿自己的曲线学 Parametric Trajectory Distillation for Few-Step Video Generation | 洛桑联邦理工学院;NVIDIA;斯坦福大学 | arXiv:2610.11498 关键词:视频少步蒸馏, 参数化轨迹, 教师速度监督, 多样性 前序问题:把高度弯曲的教师轨迹压成几次学生评估,学生容量可能学不动,导致细节变软或不同种子生成近似视频。 本文贡献:Parametric Trajectory Distillation 让学生预测片段的平均速度与多项式曲率,在学生当前曲线上查询教师速度,以最小二乘损失同时学位移和形状;部署时去掉曲率头,只用平均速度更新端点。MiniMax-H3 的最后一个较平滑片段采用教师积分目标,并非所有片段都同一种监督。 论文 Figure 2:参数化轨迹蒸馏。一次学生评估输出平均速度 h 与曲率系数 c,参数化潜变量去噪片段;在学生曲线上查询教师速度,以同一个最小二乘损失监督两者。推理只使用 h 更新片段端点,移除曲率头。小视频图示意片段终止于数据端点,同样构造适用于中间噪声层;箭头为步长缩放速度,默认每片段查询两次教师。 实验效果:表 1:Wan2.1-14B 四次网络评估,匹配训练设置的 PDD 复现 VBench 总分 83.67→PTD 84.57,语义分 77.40→81.10。盲测人类偏好份额相对 PDD 为 55.1%,相对 MiniMax-H3 上的 LightX2V Turbo 为 63.4%。这是两项独立比较,不是所有基线的平均胜率。 论文 Table 1:Wan2.1-14B 的 VBench 与多样性。粗体只对比相同训练设置下 PDD 第96次更新与 PTD 第64次更新;灰色行是已发表参考,训练预算及协议不同。NFE 含引导评估,教师为 50×2;多样性是 V-JEPA 2 与 VideoMAE V2 特征余弦距离。PTD 总分和语义分提升,但这两项多样性不高于该 PDD 复现;rCM 用专有 prompt 且未报告多样性。 批判点评:表 1 的 VideoMAE 多样性 0.0254→0.0180,改善并非所有指标同时成立;发表的参考行训练预算和协议不同。去掉训练曲率头不等于不用蒸馏,四次评估也不等于视频生成时延。作者项目页有演示,未确认 PTD 方法权重公开。 6. iCATS:按交互与噪声动态稀疏注意力 iCATS: Fast Video Generation via Interaction-Aware Sparse Attention and Timestep-Adaptive Sparsity | 杭州师范大学;平头哥半导体;阿里巴巴 | arXiv:2610.11302 关键词:视频DiT加速, 交互聚类, SNR稀疏调度, 尾部合并 前序问题:独立按特征距离聚类 query 与 key,未必保留实际注意力交互;固定稀疏度和不规则簇填充又会损伤画质与 GPU 利用率。 本文贡献:iCATS 用 query-key 点积交互定义聚类目标,并改写成低成本二次型;以信噪比 SNR 调整各去噪时间步的 top-p 稀疏掩码。执行时将不满计算块的尾部 token 重新分配,减少 padding。无需微调生成主干,但聚类、调度与稀疏 kernel 都有实际开销。 论文 Figure 3:iCATS 的稀疏注意力流程。①按 query-key 交互聚类,用簇中心估计簇级 softmax;②以 SNR 引导每个去噪步的 top-p 值并选注意力计算区域;③在稀疏 kernel 前重分配未对齐计算块的 query 簇尾部 token,减少不规则簇的 padding。图中 interaction clustering 为交互聚类,Euclidean clustering 仅用于首个稀疏步初始化 query 簇。 实验效果:表 1:5 秒 720p、八张 H100,HunyuanVideo-T2V-13B 的 iCATS-Base 从 1730 秒降至 854 秒,2.03 倍,PSNR 31.017 dB;Wan2.1-T2V-14B 从 1889→1222 秒,1.55 倍,PSNR 29.301 dB。相应 VBench 为 0.844 与 0.838。 论文 Table 1:三种视频主干的密集、SVG、SVG2、iCATS-Base 与 Turbo 比较。PSNR、SSIM、LPIPS 衡量相对原模型输出的保真度,VBench 衡量视频质量,Time 是实测秒数,Sparsity 是理论注意力计算削减比例。5秒720p、八H100下,Hunyuan Base 为854秒、2.03倍、31.017dB,Wan文生视频 Base 为1222秒、1.55倍、29.301dB;不可把稀疏率当整体加速率。 批判点评:PSNR 比的是相同配置的原密集模型输出,不是真实视频真值;理论稀疏率不能当实际整体加速率。八卡结果不能外推单卡,且聚类多卡并行和 token 级 kernel 仍待优化。未从论文作者入口确认代码或权重公开。 7. SpaceFlow:不同3D部位分配不同控制强度 SpaceFlow: Locally Controllable 3D Generation | 苏黎世联邦理工学院;斯坦福大学;Microsoft | arXiv:2610.12399 关键词:3D生成, 局部几何控制, 部件条件路由, 自相似引导 前序问题:对整个物体统一控制强度,难同时保住指定结构并让其他部位自由生成;局部材质 prompt 还可能串到别的部件。 本文贡献:SpaceFlow 在 TRELLIS 推理中给每个几何 primitive 指定强弱控制,在受控时间段注入高控制区域;生成结构后用 PartField 划分部件,将局部文本或图像外观条件路由到对应区域,再用自相似引导细化外观。几何约束与外观条件分别作用,支持同一物体各部位不同自由度。 论文 Figure 2:SpaceFlow 流程。输入可编辑几何及局部控制强度 τᵢ,在受控时间段把高控制区域注入稀疏结构 flow;PartField 分割生成结构后,将每个部件的文字或图像条件只路由到该部件,再经外观 flow 与自相似引导得到局部几何和外观可控的3D资产。 实验效果:表 1:83 个资产,局部 τ=3/10 对比统一 τ=3,prompt 与几何保真胜率 78.3%、总体胜率 75.9%,但真实感胜率仅 43.4%;对比统一 τ=10,总体胜率为 68.7%。表 4 的外观总体评分 6.78,但纹理细节 6.49 低于 TRELLIS 的 6.87。 论文 Table 1:83个资产上局部几何控制胜率。SpaceFlow 低/高 τ 为3/10,与统一全局 τ=3及τ=10的 SpaceControl 比较 prompt与几何保真、真实感和总体偏好;括号为95% Wilson区间。对τ=3,总体75.9%但真实感43.4%;对τ=10,总体68.7%,说明保真与真实感存在条件相关取舍。 批判点评:胜率来自指定视觉语言裁判与资产集,表中附 95% Wilson 区间,不能当任意3D对象的成功率。语义与强几何约束冲突时会变形;更多局部控制也未必提升纹理细节。原文给出推理设置,未确认作者已发布 SpaceFlow 实现。 8. SepGen:同次生成视频混音和两路分轨 SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model | 特拉维夫大学;Google | arXiv:2610.11361 关键词:音视频生成, 分轨生成, 文本寻址, 混音噪声调度 前序问题:音视频模型通常只给一条混音;想换视角做空间音频,或单独编辑某个声源,就缺少可寻址的独立波形。 本文贡献:SepGen 在预训练音视频双流模型中增加分轨 adapter,每路由独立描述指定声源,在同次采样中生成视频、混音与分轨。分离模式保持输入混音干净;生成模式在高噪声读取带噪混音,低于阈值 σ_g 后读取其干净预测,减少分轨与混音错位。原混音主干保持不变。 论文 Figure 2:σ空间中的三种推理调度,从左到右:(a)分离模式保持混音 m 干净;(b)朴素共享噪声生成让分轨和混音处于同一噪声层;(c)SepGen 的分轨在 σ_g 以上读带噪混音,以下读其干净估计 ẑ₀,m,以改善生成时各声源与混音的对应。 实验效果:表 1:134 个声音案例和 60 个语音案例,联合生成的声音裁判分为 3.82,FlowSep 串行分离为 3.35;语音 WER 为 0.07,即 7%,FlowSep 为 1.03,即 103%。额外自分离声音分为 4.21,却使 WER 变为 0.10;这需要再运行一次,不能算同次采样。 论文 Table 1:生成评测,134个声音与60个语音案例;所有串行基线对同一生成混音和相同描述做分离,两行 SepGen 都使用生成 checkpoint。Judge/J-swap 为声音裁判及描述交换分,CLAP/C-swap为声音文本对齐及交换分,越高越好;语音WER与跨轨Cosine越低越好。联合采样WER0.07是7%,额外自分离WER0.10是10%;粗体与下划线是最好与次好,不代表额外自分离也是一次采样。 批判点评:当前训练和评估固定两个声源,不能声称任意数量分轨;声源仍带原场景混响与距离线索,完整新视角空间渲染属于后续工作。codec 重合成相位还影响 SI-SDR 的解释。作者项目页列出代码、模型和数据入口,未运行复现。 9. EDICT:全局改音色局部切换说话方式 Edit Who Speaks, Control How They Speak: Global Timbre Editing and Local Instruction Control for TTS | 新加坡国立大学;LIGHTSPEED;南洋理工大学;独立研究者 | arXiv:2610.11437 关键词:语音生成, 音色编辑, 局部指令, KV缓存重建 前序问题:参考语音克隆保留旧音色,文字设计又难在同一参考上微改;整句表达指令无法准确控制每个文本片段的语气。 本文贡献:EDICT 先把参考语音和结构化属性编辑送入可训练音色编辑器,生成 codec token 参考,作为各段共享的身份锚。冻结 TTS 主干按分段指令连续生成,在每个边界重建 KV 缓存:换入新指令和文本,同时保留首段与最近一段选定声学上下文,让表达变化但声音身份连续。 论文 Figure 1:EDICT 联合全局音色编辑与局部表达控制。可训练编辑器读取源参考和全局编辑指令,输出共享codec参考;每段冻结TTS均使用它。在指令边界重建KV缓存,以选定历史声学上下文保持衔接,多个片段组成一条连续话语。 实验效果:表 4:Qwen3-TTS-VD 联合控制,EDICT 的片段指令准确率 81.62%、过渡质量 83.45%;原 Joint 为 60.19%、70.07%。段间说话人相似度为 0.917、与原 0.918 接近;英文 WER 3.6%→5.1%,中文 CER 1.2%→1.9%,内容正确性付出代价。 论文 Table 4:Qwen3-TTS-VD上的联合音色及表达控制,请求结合TimbreEdit-Bench的音色编辑与IntraTTS-Bench的分段指令。SIM-T是整条语音与目标声线相似度,SIM-I是段间相似度;WER/CER分别为英文/中文百分数,粗体/下划线为最好/次好且分语种排名。EDICT的SegAcc81.62%、Trans83.45%、SIM-I0.917;错误率5.1%/1.9%,须与控制分共同看。 批判点评:音色编辑器仍要训练,冻结 TTS 主干不等于全系统免训练;训练、指令构造和评测含合成数据与模型裁判。指令遵循更高不能代替低错误率,推广到更多声线还待验证。作者演示页,未确认官方方法代码与权重入口。 10. RISEBench++:检查图像编辑是否真的推理对 Reasoning-Informed Visual Editing | 上海交通大学;东南大学;华南理工大学;微软亚洲研究院;复旦大学;华东师范大学 | arXiv:2610.12343 关键词:生成编辑评测, 隐式规则, 多轮一致性, 多图条件 前序问题:画得自然或保住外观,不代表模型从图中推断了正确状态;因果、空间规则和多轮条件经常在编辑图像中失效。 本文贡献:RISEBench++ 用六类推理、12 个子类和 65 种任务组织 1000 个英中文人工标注案例,覆盖单图、多图与多轮编辑。裁判分别评指令推理、外观一致性和视觉合理性,以任务条件检查生成图像;论文另研究带规划与核验的编辑执行流程,本期关注生成能力评测。 论文 Figure 3:RISEBench++的三维评测与流程。指令推理与外观一致性由Gemini-3-Flash按类别专用prompt评判,视觉合理性由Gemini-3.1-Flash-Lite评判;分别检查是否推理并执行正确、保留应保内容及画面是否合理,不能以自然外观替代推理正确性。 实验效果:表 1、2:共评估 58 个视觉编辑方案。英文集 GPT-Image-2.5 Sunburst 总任务准确率 56.6%,逻辑类 27.0%、混合类 39.0%;Nano Banana Pro 总分 54.6%,逻辑类 36.0%。领先总分也可能有明显类别短板,不能从一个榜单分推断所有编辑能力。 论文 Figure 6:英文RISEBench++细粒度任务准确率雷达图,展示七个模型在12个子类的65种任务上的表现。各轴对应不同任务,局部短板与总分排名并不一致;数值是此评测协议的任务判定,不是所有真实编辑的通用成功率。 批判点评:准确率是本数据集、指定模型版本和裁判协议下的任务判定;混合多轮错误会累积,英中文结果须分别看。不是纯视觉理解测验,产出要求确实编辑图像。官方仓库提供评测说明与样例,完整千例数据链接已单独核查。 趋势观察 先定义计算预算再谈加速 BudgetPix分配token,Data-space DMD调整迭代位置,PTD匹配学生能学的曲线,iCATS兼顾注意力保真和kernel开销。token比例、网络评估次数和端到端时延是不同口径。 内部监督也要验证失败条件 Rubric-CEPR用不可互相补偿的门控筛目标;RISEBench++把推理执行与外观合理性分开。画面真实或自评高分都不够,仍要检查未编辑内容和真实任务约束。 把控制绑定到正确对象与时间 VINCIE-NExT绑定关键帧示范,SpaceFlow路由到局部部件,SepGen分配声源描述,EDICT在分段边界重建上下文。局部控制有效,还要验证全局一致性与连续性。 更高总分仍可能付出代价 EDICT内容错误率、SpaceFlow纹理细节、PTD部分多样性都揭示不同目标间的取舍。部署时应使用自己的分辨率、声源数、视频长度与硬件复核。 今日讨论 BudgetPix用四叉树按熵分配token,在25%预算下GenEval为0.725,但全分辨率像素阶段形成计算下限;你会用哪些细节证据与端到端时延测量,判断这种预算在自己的图像生成场景中是否值得采用? 人工智能炼丹君 整理 | 2026-10-12