
搜索到
43
篇与
图像生成
的结果
-
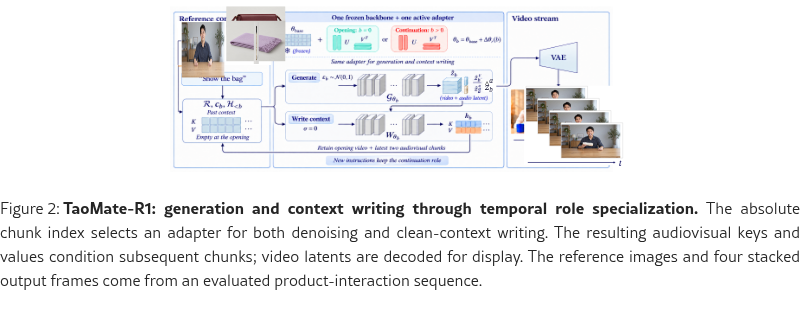
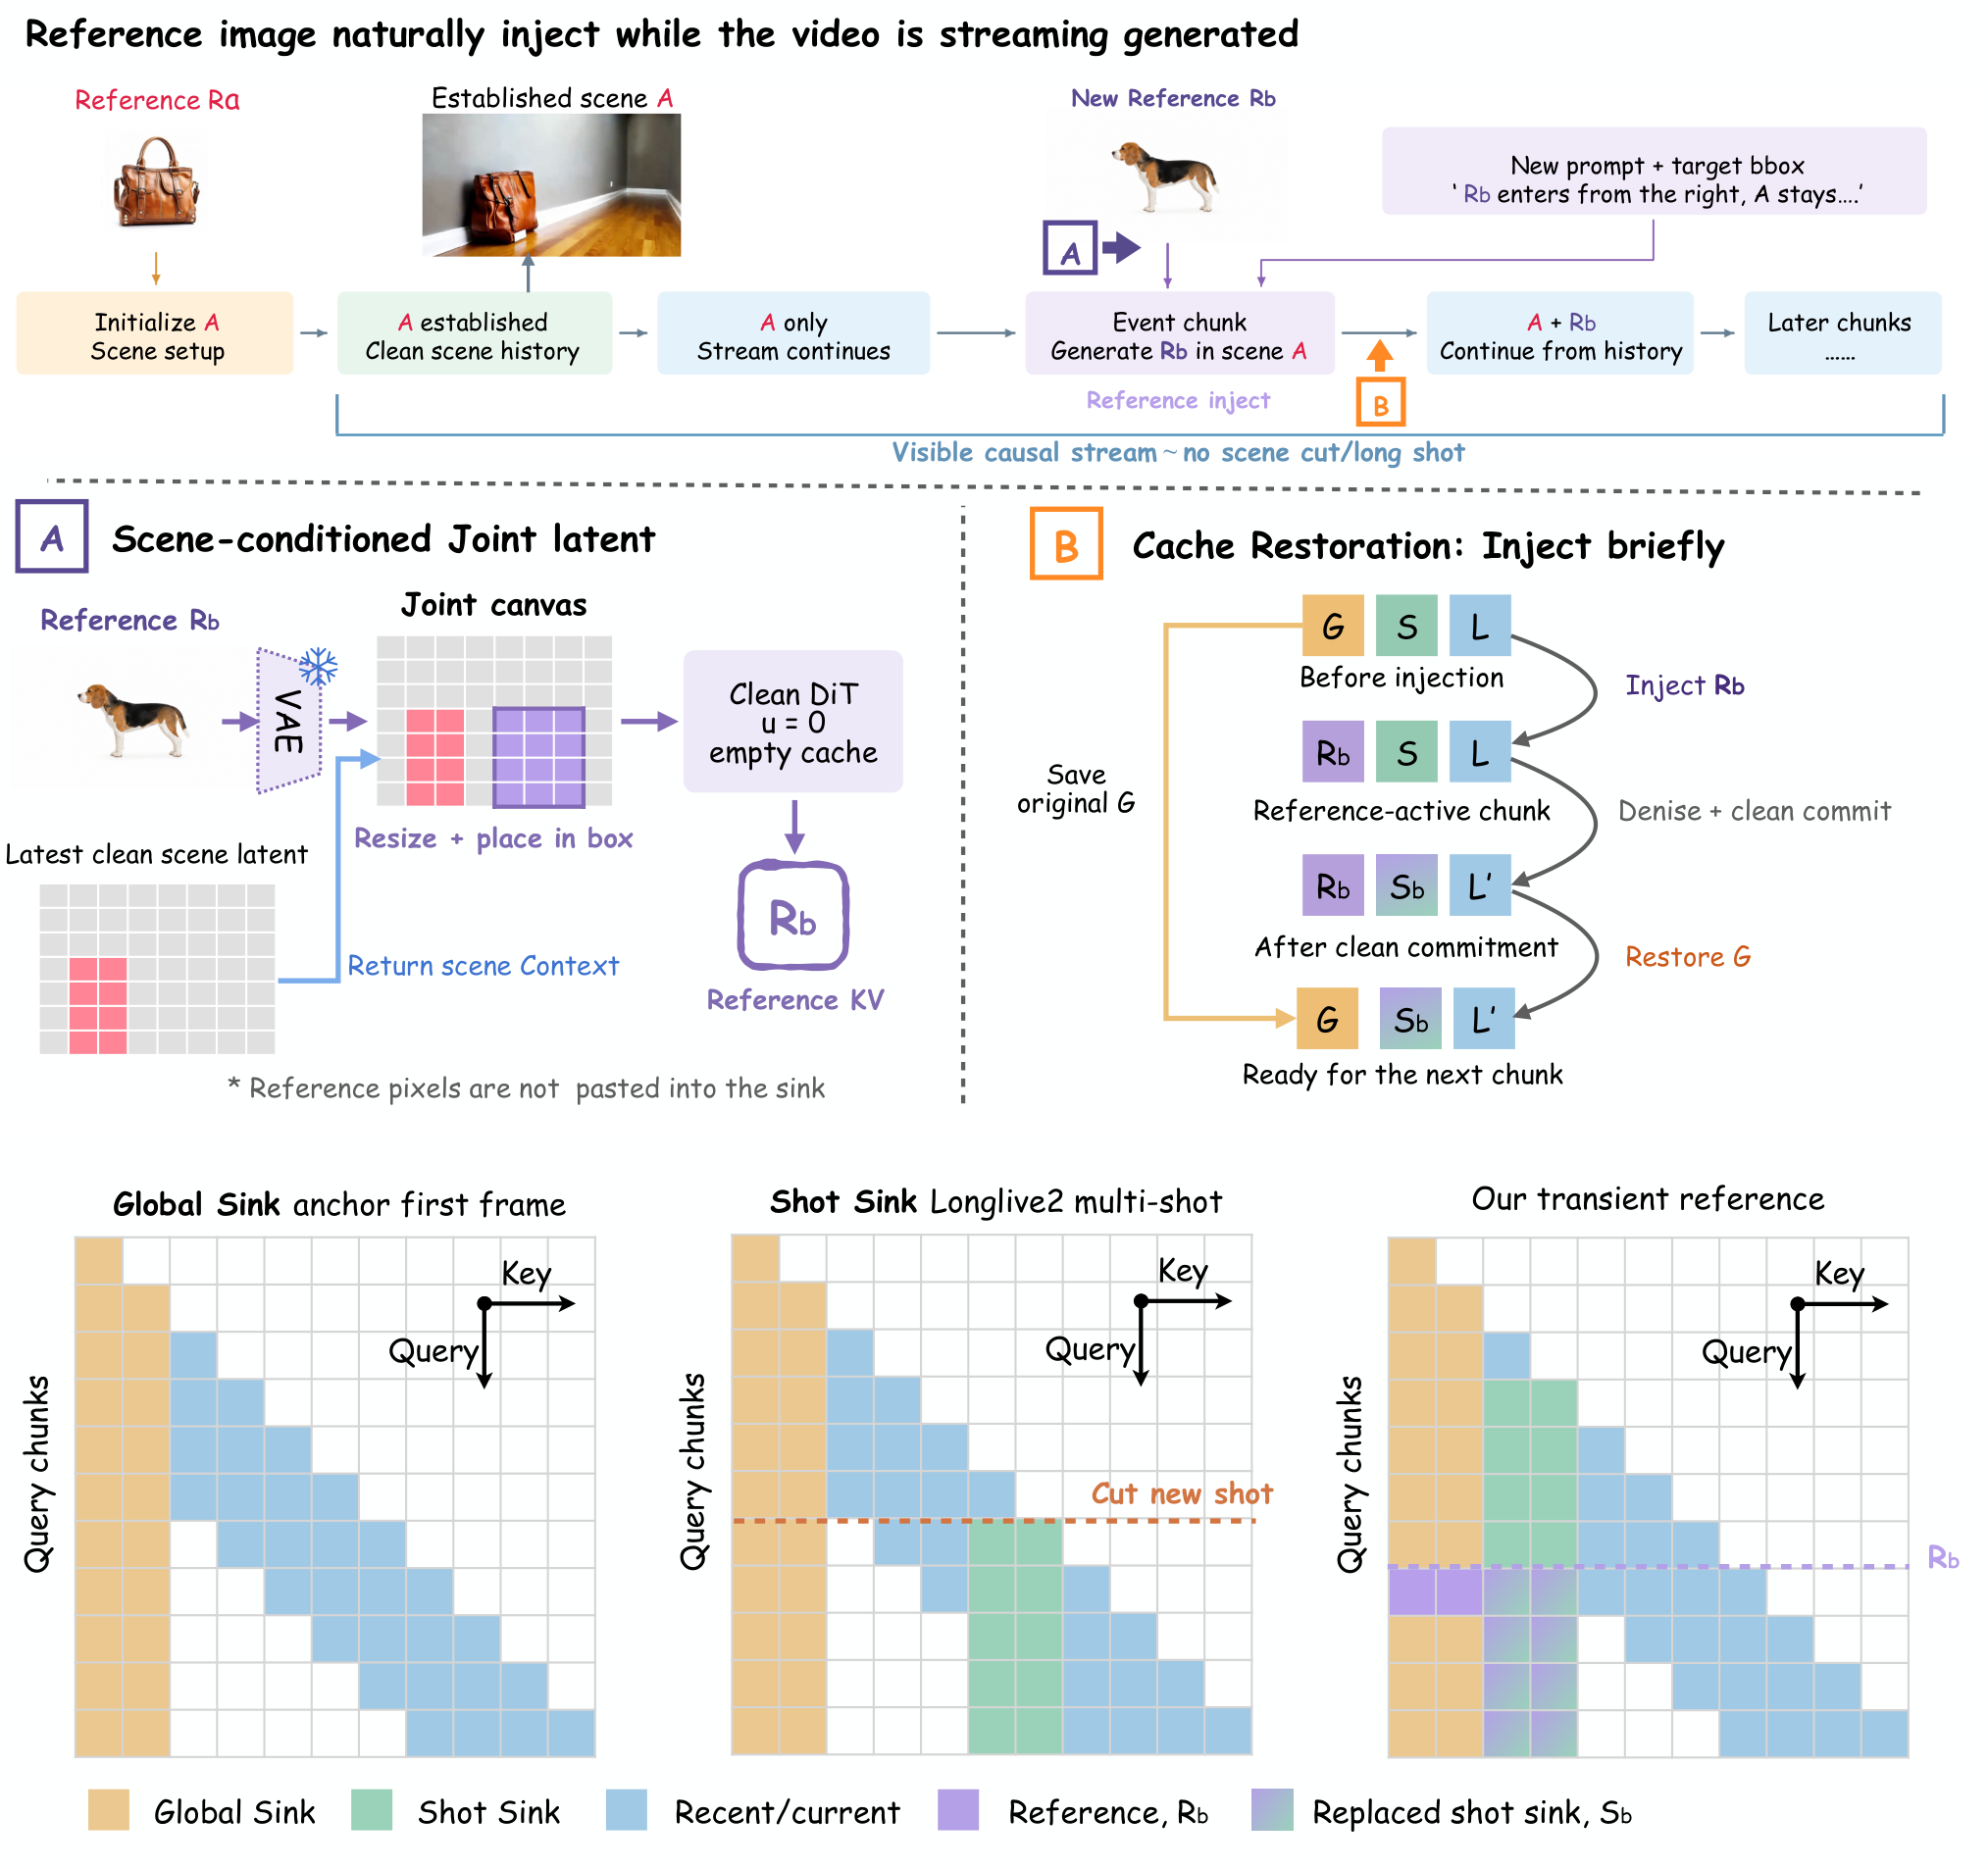
 AIGC 每日速读|2026-11-12|阿里多参考长视频换指令不断档-TaoMate-R1 今日 AIGC 论文速览 今日共 10 篇 · 多参考与广告视频审修 2 篇 · 多场景视频与生成加速 3 篇 · 几何控制与图文生成 2 篇 · 三维动作生成 1 篇 · 生成结果评测 2 篇 重点论文标题列表 TaoMate-R1(阿里):多参考长视频换指令不断档 Review-and-Edit(Anoki):广告视频问题一键找到修复入口 OneReel(伊利诺伊大学香槟分校):多场景视频只共享少量关键帧 MG-Cache(北京邮电大学):视频去噪按时间层级双重缓存 FADE(四川大学):预测弯曲去噪轨迹少算视频 选读入口:要用多张参考图连续拍人和商品,先读 TaoMate-R1;要从广告成片定位错误并派给修复工具,读 Review-and-Edit。想控制跨场景一致性读 OneReel;要在既有 DiT 上提速,对照 MG-Cache 的缓存内存和 FADE 的离线校准。要画准钟表与披萨比例读 Angular Control;要让图文长文配图对位读 UniWeaver;做长序列 3D 动作看 FlashMotion。评估改图判官和视频物理常识,分别读 EditJudge-Bench 与 PhyRubric。 今日论文速览 1. TaoMate-R1:多参考长视频换指令不断档 TaoMate-R1: Temporal Role Specialization for Streaming Multi-Reference Video Generation | 阿里巴巴集团 | arXiv:2611.14307 关键词:视频生成, 多参考生成, 流式生成, LoRA, 场景连续性 前序问题:指定人物和商品后连续拍两分钟,提示词中途换动作或物品;按片段生成常在接缝处换掉人物、房间或亮度。 方法直觉:把“开场建景”和“后续延续”当成两种时间职责,各自用一套低秩适配器;同一职责既生成当前片段,也写入下一段要看的历史。 本文贡献:TaoMate-R1 在冻结的 MiniMax H3 主干上配两组 LoRA,而非按去噪与写历史两种操作分组。Self Gradient Forcing 让开场和延续适配器沿自己生成的历史联合训练。32 个多参考案例采用相同两适配器预算比较。 Figure 2: TaoMate-R1: generation and context writing through temporal role specialization. The absolute chunk index selects an adapter for both denoising and clean-context writing. The resulting audiovisual keys and values condition subsequent chunks; video latents are decoded for display. The reference images and four stacked output frames come from an evaluated product-interaction sequence. 实验效果:在 10 条约两分钟、指令会变化且共用教师音频条件的长流上,相对按操作分组,接缝平均亮度跳变从 1.96 降至 0.613;接缝 DINO 特征相似度从 0.973 到 0.990。DINO 是图像特征相似度,数值越高通常表示相邻帧外观更接近。该比较没有统一报告端到端推理延迟。 Figure 6: Scene continuity over a two-minute interaction. Each row combines the first frame’s left half, centre columns sampled every 0.5 s, and the last frame’s right half (case 006, 119 s). Grey ticks mark instruction changes; endpoints retain native aspect ratios. The bands contrast composition changes in clip-wise generation with stable presenter and table geometry in the TaoMate-R1 stream. 批判点评:这是按参考生成新音视频,不是对现成视频直接编辑。接缝更平稳不等于所有指令都执行成功:长流的问答遵循分为 0.980,按操作分组为 1.00;结论依赖这套主干、两适配器预算和共享音频条件。 2. Review-and-Edit:广告视频问题一键找到修复入口 Multimodal Judges Flag, Humans Decide: A Review-and-Edit Framework for AI-Generated Product Video Ads | Anoki 公司 | arXiv:2611.13178 关键词:生成视频审阅, 视频编辑, 商品一致性, 多模态评测, 人工复核 前序问题:电商商品页自动变成短广告后,镜头里商品形状、文案、旁白或字幕可能错;只给整条广告打一个好坏分,编辑者不知道该修哪一幕。 方法直觉:把广告按场景和六类问题拆开,让多模态 judge 先指出时间点与依据,再由人确认;每条确认的问题直达对应编辑工具。 本文贡献:系统检查商品、场景质量、发音、脚本、声音和字幕。门户把模型发现与商品照片、事实资料并列给审阅者;确认后可借别条广告的镜头、重生镜头、做视频到视频编辑或局部高分辨率修复。这里的核心是审修流程,视频生成与修复工具作为可替换后端。 Figure 3 : The production portal. Panels (a) to (c) show the review and panel (d) the edit page. (a) The review page for one ad: 1 the ad and its scenes, 2 the six questions, collapsed, each tagged when a judge flagged it, and 3 the evidence: the catalog photos, product facts, brand kit and script. (b) 4 A judge’s finding sits inside the question with its scene, kind and evidence; the reviewer accepts or rejects each with a thumbs up or down and 5 answers below, where “Product wrong” then asks which scenes are at fault. (c) 6 The scene judges’ finding above 7 the per-scene grid, with keep, swap out or no opinion for each scene, and 8 the secondary options for the kind of problem. (d) On the edit page: 9 the scenes with confirmed issues; 10 a confirmed issue opens the scene tool on its scene, with 11 the scene’s versions and 12 ways to change it: another ad’s scene of the same product, a new scene, or Repair, which fixes the scene in place, today by regenerating its clip at higher resolution. 实验效果:在自家流水线的 120 条广告、562 个场景中,辅助审阅标记约 60% 的场景有商品问题。对其中 60 条广告,辅助审阅的多数标记率为 58%,隐藏 judge 后两名审阅者为 26%;两组不能直接视作随机对照。另在盲标的 120 个场景上,商品 judge 的 AUC 为 0.84;它召回 29 个缺陷中的 26 个,但 56 个告警中仅 26 个是真缺陷。 Figure 2 : One generated 15 s ad ( video in our release) as judges and reviewers reviewed it, one row per question. Reviewers accepted the judges’ product findings and rejected nearly all of their pronunciation findings. They also marked the S3 and S4 captions and added two problems the judges missed in S2: an impossible motion in the scene and an unsupported claim in its line. 批判点评:高召回带来较多误报,必须保留人工决定;实验证据来自单一市场、英语旁白和一条内部生成流水线。研究没有证明全自动编辑或审核耗时一定缩短。 3. OneReel:多场景视频只共享少量关键帧 OneReel: Efficient Multi-Scene Video Generation with Scene-Structured Attention | 伊利诺伊大学香槟分校;得州大学奥斯汀分校;斯坦福大学 | arXiv:2611.10594 关键词:多场景视频生成, 稀疏注意力, 共享记忆, 多GPU 前序问题:多场景视频若所有帧彼此全连接,注意力成本随场景数迅速膨胀;分场景单独生成又容易让人物和物体跨场景变样。 方法直觉:场景内部保持完整注意力,跨场景只交换被挑出的代表帧;提示词和时长先划定每个场景的作用范围。 本文贡献:OneReel 无需再训练生成主干:对每个场景保留本地注意力,把聚类选出的潜变量代表帧放进有界共享记忆;再把本地及共享 K/V 打包为连续的可变长注意力输入,并按通信成本选择多 GPU 分工。理论上的跨场景注意力随场景数由平方变线性。 Figure 5: Scene-structured attention across model architectures. Rows denote queries and columns denote keys. Purple denotes scene-local interactions; orange denotes selected foreign video K/V from a shared memory. The example shows one head; text queries remain local. 实验效果:四种生成模型的实验相对稠密注意力报告端到端 1.7–4.9 倍加速。40 个多场景请求中,HunyuanVideo-1.5 480p 的文本遵循分从稠密的 27.7 提至 61.9;同表的动作分从 34.5 到 64.1。分数只在论文这套多场景提示与评测协议下可比,性能还依赖共享记忆和多 GPU 打包实现。 Figure 10: Minute-long generation with HunyuanVideo-1.5. OneReel captures the requested scene changes, while dense generation remains visually repetitive. 批判点评:需事先给出场景提示及持续时间;代表帧太少会漏掉跨场景细节,太多则削弱加速。作者对一分钟长视频另加场景局部 RoPE,说明注意力作用域之外的时间位置编码同样影响效果。 4. MG-Cache:视频去噪按时间层级双重缓存 MG-Cache: Multi-Granularity Caching for Accelerating Diffusion Transformer Inference | 北京邮电大学 | arXiv:2611.11365 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 多粒度缓存 前序问题:扩散 Transformer 要重复计算几十次;各时间步和各层变化程度不同,统一跳过容易积累误差,高清长视频尤其耗时。 方法直觉:先用小批校准样本找出可跳过的去噪时间步,在线再按各层输入变化和重要性决定是否复用注意力或 MLP 的中间特征。 本文贡献:MG-Cache 的第一阶段离线分析时间步冗余,第二阶段对层内模块按稳定度与敏感度动态缓存;无需重新训练生成模型。论文在 HunyuanVideo 与 FLUX.1-dev 上同时测速度、画质和相对未缓存输出的保真度。 Figure 2 : Overview of the Multi-Granularity Cache (MG-Cache). We design a two-stage strategy to exploit computational redundancy during inference. Stage 1 performs a static offline analysis to identify and preserve critical timesteps based on a timestep feature table [ M ^ t ] [\hat{M}_{t}] constructed from a small batch of calibration dataset. Stage 2 introduces a dynamic layer-wise caching mechanism that computes layer importance scores and input stability to adaptively determine whether to reuse cached features. 实验效果:HunyuanVideo 文生视频、544×960、129 帧、原始 50 步条件下,慢档由 982.03 秒降至 358.86 秒,即 2.74 倍;VBench 从 75.45% 到 75.14%,PSNR 27.44 dB 是相对原始输出的像素保真度。bf16 层缓存对该分辨率需 49.8 GB,论文使用内存卸载;因此速度收益不能脱离缓存容量与数据搬运谈。 Figure 1 : Visual quality comparison. While achieving a higher speedup than baselines, our method also maintains superior fidelity to the original output. For instance, in the first row (Prompt 1), other methods exhibit blurring on the text "stop," whereas our method preserves text sharpness. 批判点评:离线校准和高分辨率层缓存是额外成本。快档可进一步提速,但同表 VBench 降到 74.13%;部署需按显存、内存和质量目标调阈值。 5. FADE:预测弯曲去噪轨迹少算视频 FADE: Fractional Anomalous Dynamics Extrapolation for Training-Free Diffusion Transformers Acceleration | 四川大学 | arXiv:2611.10514 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 特征预测 前序问题:缓存法在跳过多个去噪步时通常按直线或整数阶变化外推特征;遇到弯曲且随时间变化的轨迹,误差会累积。 方法直觉:用分数阶动力学描述特征轨迹的弯曲程度;先离线测好各阶段和层的参数,在线按查表结果在完整计算和预测步之间交替。 本文贡献:FADE 用 Mittag–Leffler 分数阶算子外推 DiT 中间特征,离线校准最合适的阶数并存入多维查找表;推理时按时空位置取参数,减少被跳过步骤的计算且不微调主干。 Figure 2 : Overall framework of FADE. FADE consists of an offline profiling stage and an online inference stage. The offline stage calibrates and stores the optimal fractional orders in a static LUT, while the online stage alternates between full-compute and prediction steps using LUT-retrieved orders for feature forecasting. The upper-right panel illustrates the geometric contrast between the FADE trajectory and the integer-order trajectory in the latent space. 实验效果:HunyuanVideo 文生视频的同表条件下,原始 50 步耗时 190.2 秒、VBench 80.68%;FADE 在 N=6、m=1 设置下耗时 37.9 秒、VBench 80.12%。按列出的延迟相除,墙钟加速约 5.02 倍;表中 Spd. 列的 5.56 倍与 FLOPs 比 29,773/5,359 一致,两个口径不应混写。同预算 HiCache 为 37.8 秒和 79.93%,FADE 主要改善该表的质量而非进一步缩短时延。 Figure 5 : Qualitative comparison on text-to-video generation. 批判点评:收益依赖离线校准的查找表及具体主干;换架构或采样预算需重新标定。VBench 相对原始生成仍下降 0.56 个百分点,不能把“保真”写成无损。 6. Angular Control:让画出来的时钟真指向指定时刻 Continuous Angular Control in Text-to-Image Generation via Geometric Token Encoding | 毕尔肯特大学;CISPA 亥姆霍兹信息安全中心;弗赖堡大学 | arXiv:2611.13172 关键词:图像生成, 几何控制, 扩散模型, 角度编码 前序问题:让文生图模型画 10:10 很容易,要求 1:45 时两根针常常还是落回惯见姿势;要求披萨只剩指定圆弧比例也有类似问题。 方法直觉:把时针、分针或扇区边界的角度编码成周期性的正弦和余弦 token,直接放进提示词;训练时由局部约束逐步放松到整物体约束,让数字位置落到正确部件。 本文贡献:该法在冻结文本编码器前插入角色专属几何 token,并用 LoRA 调整 SD 2.1 去噪器。Stochastic Localization Relaxation(SLR)混合部件框、物体框和无定位三种训练监督;推理无需输入框。另用指针互换偏好损失防止时针和分针角度对调。 Figure 2 : Left: Overview of our geometric token encoding framework, illustrated for clock-time control. The target clock time ( h , m ) (h,m) or fraction-sector boundaries are encoded as sinusoidal pairs and mapped through the projection network P P to produce role-specific geometric tokens h , m \mathbf{e}_{h},\mathbf{e}_{m} (or s , e \mathbf{e}_{s},\mathbf{e}_{e} ) injected into the prompt before the frozen text encoder. Both tasks share the same MLP architecture and condition a LoRA-adapted SD 2.1 denoising U-Net. Right: Stochastic Localization Relaxation (SLR). Training samples one of three localization regimes (55/30/15%): component-level CALL using component boxes, object-level CALL using a shared object box, and unconstrained standard cross-attention. No localization input is required at inference. 实验效果:时钟 Acc@6° 指两针都在目标角度 6° 内;四种未微调基线均低于 1%,本法在不同读图器下约 63–78%。圆形物体比例误差不超过 0.10 的 Acc@0.10,训练类为 89.5%,未见过的物体类为 88.8%,未见过的比例为 84.9%;基线约 20%。这些数字来自带精确角度标注的任务数据。 Figure 8 : Qualitative comparison of the original periodic encoding and the augmented encoding with the scalar fraction f f near the angular boundaries. The periodic encoding produces small sectors near 0 ∘ 0^{\circ} but may generate narrow slices even for complete-sector targets ( 360 ∘ 360^{\circ} ), reflecting its endpoint ambiguity. Adding f f distinguishes the endpoints and enables complete-object generation, but can produce oversized sectors for small target angles ( 1 ∘ 1^{\circ} – 5 ∘ 5^{\circ} ). Results are shown for pizza, pie, and cake. 批判点评:必须有任务专用的几何标注与训练;复杂场景或部件不清时精度会下降。0° 与 360° 的周期编码端点相同,附录增加比例标量虽能区分整圆,却可能放大小角度扇区。 7. UniWeaver:把文字和配图按任务一起编排 UniWeaver: Harnessing Unified Multimodal Models for Interleaved Text-Image Generation | 俄亥俄州立大学;伦敦大学学院;香港中文大学;香港科技大学(广州);香港大学 | arXiv:2611.13530 关键词:图文交错生成, 多模态生成, 规划, 视觉反馈 前序问题:用户只说“做一份操作指南”,统一多模态模型常先写完一段再补图,图与步骤错位,关键步骤也可能没有画面。 方法直觉:先确定每一段要讲什么、配什么图和共享风格,生成后再按可观察清单检查图片是否支持文字;失败时修正局部。 本文贡献:UniWeaver 是模型无关的图文交错生成工作流,包含任务范围、文字与图片规划、参考图分配和视觉复核。作者用该流程构造覆盖 20 类任务的 1 万条训练轨迹,并建立 120 条留出任务的 UniWeaver-Bench,从文字覆盖、写作质量、视觉覆盖与图文对齐评估终稿。 Figure 3: Overview of UniWeaver. ① UniWeaver introduces a structured workflow for interleaved text-image generation, with execution trajectories providing supervision for fine-tuning (Section 3.1 ). ② UniWeaver-10K Dataset provides 10,000 goal-only tasks paired with structured planning trajectories across 20 task families (Section 3.2 ). ③ UniWeaver-Bench systematically evaluates final interleaved outputs on 120 held-out tasks (Section 3.3 ). 实验效果:在同一 120 任务消融协议中,基于 BAGEL 的完整方法综合分 58.89;去掉共享视觉风格为 48.21,去掉任务目标为 53.01。分数按任务门禁通过率加权,只对过门任务计算;不能直接解读为每张图片质量提高 10.68 分。论文未给统一的额外模型调用成本与端到端耗时。 Figure 5: Qualitative comparison on two representative tasks. UniWeaver produces more coherent, actionable instructions with task-relevant visuals, while baselines exhibit repetitive content, missing details, or ineffective visual support. Zoom in for better view. 批判点评:这一流程依赖规划与视觉 judge,长文可能增加调用与返工成本;评测本身也依赖模型判分。图文能力提升并不自动代表单张图的生成模型更强。 8. FlashMotion:一万帧动作也能快生成 FlashMotion: Ultra-Fast Long-Term 3D Motion Generation | 腾讯 IEG Motus Group;中国人民大学;清华大学;得州大学达拉斯分校;武汉大学;南开大学;香港大学 | arXiv:2611.13626 关键词:3D动作生成, 文生动作, 音乐舞蹈, 语音手势, 少步采样 前序问题:游戏和虚拟人的长动作既要跟文本、音乐或语音走,又要少采样、少显存;长序列常出现脚滑、抖动或推理跟不上交互。 方法直觉:同时缩短“要采几步”和“每步有多贵”:用少步平均速度预测完整动作,再用轻量双向时序模块看前后动作与条件。 本文贡献:FlashMotion 将带运动学和动力学约束的 3D motion-space MeanFlow 与约 6000 万参数的 BiMamba/CoBiMamba 组合,支持文生动作、音乐生舞蹈和语音生手势;Adaptive Soft mask 用于动作中间段编辑。这里生成的是 3D 运动表示,后续骨骼绑定与渲染另算。 Fig. 2: Overview of FlashMotion . (a) Inference flow with clean-motion prediction and MeanFlow updates. (b) Training model inputs and output: noisy motion, conditions, and timesteps are mapped to the clean-motion target. (c) Shared BiMamba/CoBiMamba block. Dashed purple paths denote optional conditioning, omitted in BiMamba and used in CoBiMamba for condition-guided state selection. 实验效果:BABEL 长序列文生动作实验中,四步版 R@1 为 29.134%,对 DART 的 26.105%;R@1 是文本查询时正确动作排在第一的比例。RTX 3090、batch=1 的一万帧动作输出,论文报 46,303 FPS,对 DART 的 75 FPS;这是运动序列吞吐,不是最终视频渲染帧率。一阶段更快但 FID 更差,反映速度与分布质量取舍。 Fig. 3: Text-to-motion comparison under a shared sequence of 3 prompts. 批判点评:仿真中的动作可用于角色动画,但机器人执行和真实人体安全性不能由这些分数推导。速度比较受动作长度、硬件和只计模型生成的口径影响。 9. EditJudge-Bench:先测判官会不会看错改图 EditJudge-Bench: Auditing VLM Image-Edit Judges with Synthetic Ground Truth | 丹麦技术大学;Pioneer Centre for AI | arXiv:2611.12524 关键词:图像编辑评测, VLM判官, 合成真值, 反事实 前序问题:图像编辑榜常请视觉语言模型判断“改对了吗”,但真实改图既有意外副作用又没有精确真值,判官判错时很难归因。 方法直觉:用 Blender 场景参数生成编辑前后对,哪一物体、位置、材质或形状被改过都有确定答案;再让 VLM 判断编辑指令是否真的执行。 本文贡献:EditJudge-Bench 有 1,382 对合成图,覆盖九类编辑并配错误方向、错对象、无编辑等反事实指令;以 25 种判官配置检验指令核验可靠性,并比较不同提示模板和图文顺序。它评测的是编辑判官,不是推出新的图像编辑模型。 Figure 2: Overview of the nine edit types in EditJudge-Bench . The central inset shows the underlying Blender scene parameter modified by each edit: object position \mathbf{x} , rotation \mathbf{r} , scale \mathbf{s} , shape parameter θ \mathbf{\theta} , articulation joint ψ \mathbf{\psi} , material \mathbf{m} , visibility \mathbf{v} , lighting state \mathbf{l} , and camera state \mathbf{c} . Surrounding images show one rendered edit from the source image per category. Because each edit is a deterministic parameter change, magnitude and direction are known exactly. 实验效果:论文报告 GPT-4o 使用常见 VIEScore 模板的整体 AUROC 为 69.0%;AUROC 是随机抽一正一负时把正确编辑排得更高的概率。若干微调判官为 51.7–66.3%,图文顺序等提示格式可改变结果最多 14.1 个百分点。尽管测试图是合成的,判官排名与两项真人偏好榜的 Spearman 相关分别为 0.95 和 0.71。 Figure 3: Example image pairs in EditJudge-Bench . For each edit type, we show three original/edited image pairs from our benchmark. 批判点评:Blender 场景与真实照片仍有域差;排名相关高不表示任何单一判官在真实编辑上都可靠。旋转、形状等空间编辑尤其难判,应逐类审计。 10. PhyRubric:逐条指出生成视频违反哪条物理 PhyRubric: Rubric-Grounded Diagnostic Evaluation of Physical Commonsense in Text-to-Video Generation | 伊利诺伊大学芝加哥分校 | arXiv:2611.13576 关键词:视频生成评测, 物理常识, 细项量表, 时间戳诊断 前序问题:文生视频若小勺瞬间跳位、按钮还没按灯就亮,单个“物理分”说不清问题发生在哪一秒,也不利于修提示词。 方法直觉:在看到生成视频前,先把每条提示词拆成语义与物理预期;播放后逐项给出是否达成及对应时间戳。 本文贡献:PhyRubric 包含五个物理领域、34 类情境;PhyRubric-Bench 对十种文生视频模型做细项诊断,另用 3,788 条视频训练开源 PhyRubric-Judge。判官分别报语义遵循 SA、物理是否可评、物理分 PC,并给违反预期的证据。 Figure 2 : Overview of PhyRubric. (1) Rubric formulation : each caption is paired with a rubric covering semantic adherence (SA) and physical commonsense (PC), constructed before any video is seen and reused to score videos from all models. (2) PhyRubric-Bench : captions spanning five physical domains and their rubrics are drafted by LLMs and reviewed by humans. Videos from 10 T2V models are pre-annotated by an agent and verified by humans. (3) Train & Judge : an agentic annotator labels training videos to build PhyRubric-Train, on which we train PhyRubric-Judge. Given a video and its caption, the judge outputs an SA score, whether PC is assessable, a PC score, and a diagnosis of the violated expectation with timestamped evidence. 实验效果:在该榜单,JP 是全部视频中 SA 与 PC 都至少 4/5 的比例;Seedance 2.5 平均 JP 44.20%,Veo 3.1 为 36.20%,但并非跨数据集总排名。判官相对真人物理分的 Pearson r 为 0.32,Gemini 4 Argon 为 0.31;两者物理通过判别 AUC 均 0.68,说明自动诊断仍有明显误差。 Figure 7 : Two failure cases from PhyRubric-Bench. (a) A small squirt of ketchup becomes a full bowl and the spoon jumps between 1.50 s and 1.62 s. (b) The roof light is lit from the first frame, before the finger reaches the button at 2.30 s. 批判点评:PC 只对“物理可评”的视频平均,单看它会漏掉根本没生成目标事件的失败;JP 更适合合看。细项量表和时间戳需人审,诊断改写提示词的示例不能直接当作普遍修复率。 趋势观察 把长视频的共同信息压到必要位置 TaoMate-R1 按时间职责训练适配器,OneReel 只交换场景代表帧;一个处理生成历史角色,一个处理跨场景注意力。 加速仍要算额外状态成本 MG-Cache 在高分辨率视频需要大型层缓存;FADE 需要离线校准分数阶。两者速度数字均不可脱离各自硬件和采样设置。 可控生成与评测都转向可定位证据 Angular Control 把角度直接编码进 prompt,Review-and-Edit 按场景定位问题,EditJudge-Bench 与 PhyRubric 追问判官和物理诊断的可靠性。 今日讨论 TaoMate-R1 在十条两分钟长流上把接缝亮度跳变从 1.96 降到 0.613,但长流问答遵循分略低于按操作分组。若按开场与延续分组拍一条中途连续换五次商品指令的广告,哪些指标能同时验证接缝、人物身份和指令执行,何时该放弃这套分组? 人工智能炼丹君 整理 | 2026-11-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
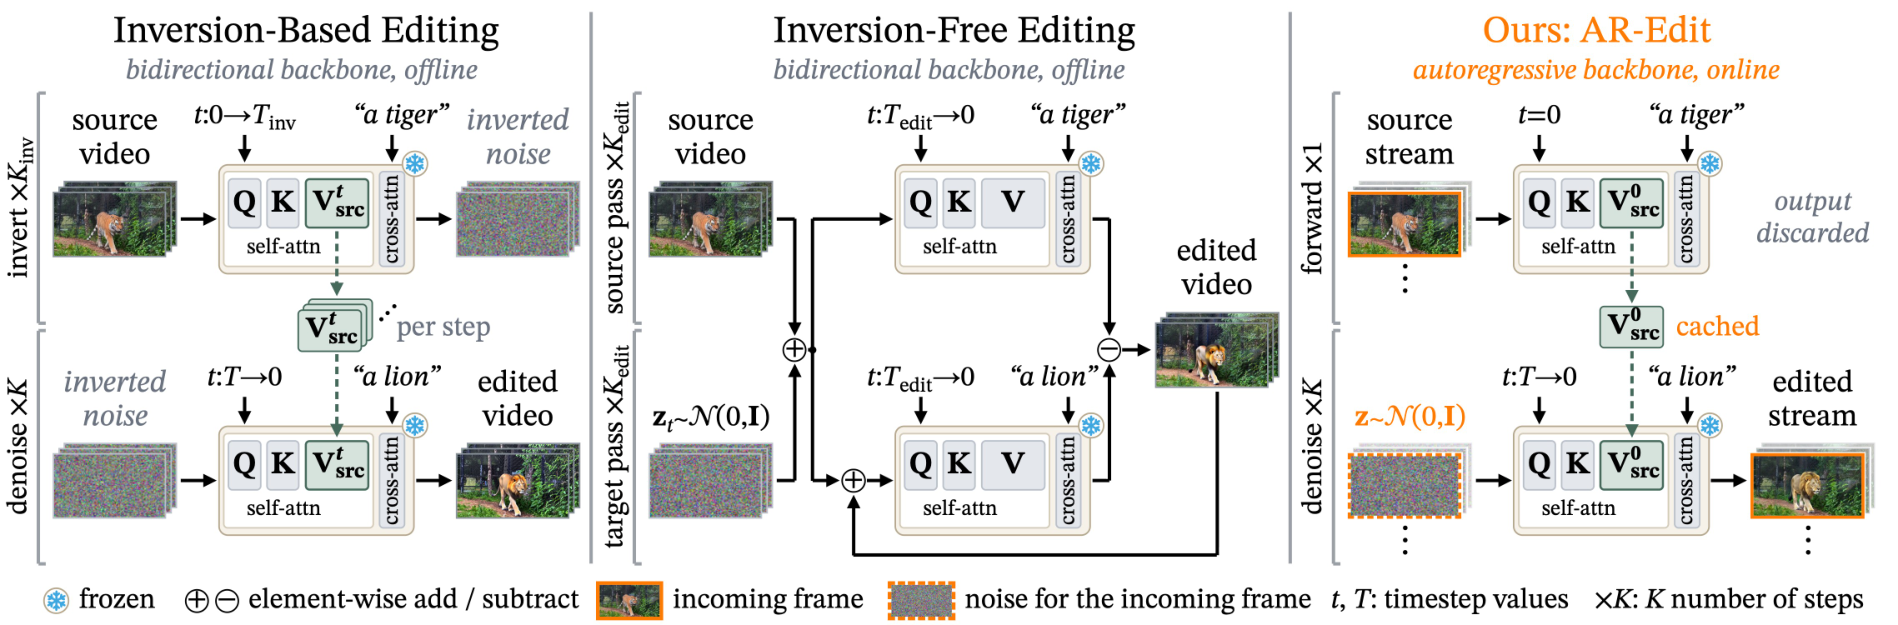
AIGC 每日速读|2026-11-10|巴黎萨克雷免反演流式改片AR-Edit 今日 AIGC 论文速览 今日共 10 篇 · 流式视频编辑与视频生成 4 篇 · 图像编辑、生成与评测 3 篇 · 音效与音乐编辑 2 篇 · 视频生成加速 1 篇 重点论文标题列表 AR-Edit(巴黎萨克雷):边播边改且保住原片 StitchEdit(港科大):换视角也留住空间关系 UniRGBA(字节):烟雾泡泡直接带透明通道 TraF(华为):续长视频时记住去噪过程 Video-Coder(中佛罗里达大学):让三维草稿指导成片 选读入口:直播输入还在到来,先看 AR-Edit 怎样保住未改部分,核对首帧延迟和稳态帧率。手里只有静态图又要改遮挡或视角,转到 StitchEdit。做烟雾叠层看 UniRGBA,做 30 秒续写看 TraF。要在成片前约束碰撞和轨迹,读 Video-Coder。改一段音效选 FoleyForge,改多轨音乐选 ProCraft。关心图文细节、视频注意力预算和否定词失效,分别读 UniMore、InstaGen 和 T2I-NSI。 今日论文速览 1. AR-Edit:边播边改且保住原片 AR-Edit: Training-Free Autoregressive Video Editing without Inversion | 巴黎萨克雷大学、巴黎综合理工、Télécom Paris、法国国家科学研究中心 | arXiv:2611.09795 关键词:视频编辑, 流式推理, 注意力注入, 少步扩散 前序问题:直播画面里想把外套换色,下一段视频还没到,背景和人脸却得尽可能保持原样。离线反演会先用模型把原视频还原成可重新生成的噪声,再改着生成。它需要看完整片段,也增加每段开销。 方法直觉:把注意力想成两步:查询 Q 和键 K 决定往哪里找,值 V 是读出来的内容。作者在少步视频模型里发现,高噪声阶段的 Q、K 跨时间步较稳定,V 随内容改变。于是每段原片只抽一次 V,改后的文字仍然掌握信息流向。 本文贡献:AR-Edit 在干净端对当前源视频块前向计算一次,缓存深层自注意力的 V。输出从高斯噪声起步,用目标提示去噪。默认在 Reward Forcing 的前两步替换指定深层的全部 V,随后从源、目标提示的差异词提取交叉注意力软掩码,只在编辑区外继续借用源 V。每段结束刷新历史缓存,下段只读已经到来的帧。这条路线依赖 DMD(分布匹配蒸馏,把教师输出分布迁给少步学生)训练好的因果主干。 视频编辑路线对比|左侧先将源视频反演为噪声,再按目标提示去噪。中间直接把源视频传输成编辑结果。两条离线路径都需多次运行双向主干。右侧 AR-Edit 在自回归主干中按到达顺序处理,单次提取源 V,在目标提示引导的纯噪声去噪过程中注入。 实验效果:作者用 120 条 Pexels 片段,覆盖 10 类编辑。单张 H100 上,同用 Self Forcing 的四步设置,AR-Edit 相对 StreamEdit 由 6.12 升至 10.25 帧/秒,首帧延迟由 1.38 降到 0.85 秒,已分配显存峰值由 41.3 降至 31.8 GB。每块前向次数 NFE 从 10 到 6,6 次包括四次去噪、一次源 V 提取和一次刷新。Reward Forcing 上相对 DynaEdit 的保留分 7.17→7.28、文本分 5.96→6.11。保留与文本由 Qwen2.5-VL 按 1–10 评分。高光强度直方图相似度 TF 从 0.39 到 0.47。 编辑质量与成本|按主干分块,粗体最佳、下划线次佳。TF 衡量源强度分布的保持程度,越高越少过曝类瑕疵。峰值显存同时列出实际分配量与框架预留量。 批判点评:四步 Self Forcing 对照的文本遵循分仍从 5.87 略降至 5.77,较强的源信号会压住编辑。论文测的是显卡侧首帧和吞吐,10.25 帧/秒不能直接折算为 25 或 30 帧/秒直播能力。差异词掩码适合局部变化,改整场光线或要求重排空间关系时要另验。 来源补充:项目或实现、代码或模型、基准或数据。 2. StitchEdit:换视角也留住空间关系 StitchEdit: Stitching Depth Priors into Image Editors via Per-Layer Gradient Probing | 香港科技大学 | arXiv:2611.07922 关键词:图像编辑, 深度先验, 梯度探测, LoRA 前序问题:把杯子移到书后面时,模型可能把杯子画在书面上,或把原本挡住的东西也重画。位置、遮挡和换视角要求编辑器先弄清近远关系。 方法直觉:同一图像主干已学过一些几何规律。先让模型学会预测深度,再用少量样本检查每层的深度训练方向与编辑训练方向是否冲突,就能决定哪些层值得继续调。 本文贡献:冻结多模态扩散 Transformer,在注意力的查询、键、值投影插入 LoRA(低秩参数更新),用源图条件学习去噪出深度图。再用两个任务的梯度余弦相似度衡量更新方向:接近 1 同向,负值说明一阶近似下会互相损害。保留浅层的适配器并用较高学习率,中层按余弦逐步减弱,深层冲突区移除适配器。实际编辑只输入原图与指令,部署无需额外深度网络。 两阶段训练|第一阶段冻结主干并用 LoRA 激活深度能力。逐层探测衡量深度和编辑目标是否兼容。第二阶段按探测曲线决定适配器裁剪边界及每层编辑学习率。 实验效果:150 个 StitchEditBench 样例覆盖空间变换、遮挡和视角。相对同一深度初始化后各层统一微调,感知距离 LPIPS 由 0.14 降到 0.10,深度一致分 DCS 从 0.80 升至 0.92,基于 CLIP 图文表征的编辑方向相似度由 0.76 到 0.81。四个方案中获 58% 偏好票,Nano-Banana 为 16%。作者报告校准探测约需单张 H100 30 分钟,编辑推理不增加新分支。 StitchEditBench 主结果|统一微调从同一个深度适配器起步,但统一更新各层会丢失几何知识。StitchEdit 依据探测结果选择性训练,比较感知距离、深度一致性、编辑方向和用户偏好。 批判点评:文字难以表达精确的位移和旋转角。浅层到深层的冲突曲线来自这套主干与校准样本,换模型应重做探测。论文写明代码和基准拟待接收后放出,项目页可读。 来源补充:项目或实现。 3. UniRGBA:烟雾泡泡直接带透明通道 UniRGBA: Unifying RGB and Alpha in Pretrained Video Diffusion Models | 字节跳动 | arXiv:2611.09069 关键词:视频生成, 透明通道, 视频编码, DoRA 前序问题:想把烟雾、玻璃泡泡叠进已有画面,仅生成彩色视频还得再抠图。半透明区域会透出背景,简单的前景轮廓很难表达这些细节。 方法直觉:给原视频编码器加一条透明度输入,尽量保留原模型已经学会的颜色和动作。RGB 是红绿蓝三通道,alpha 是每个像素的覆盖程度,合起来是 RGBA。 本文贡献:作者扩展 Wan2.1 的视频 VAE(把像素压缩为可去噪的潜变量并解码回来),在首尾卷积把新输入和输出通道以零初始化,保留原 RGB 权重,选择性解冻约 5% 参数。训练用颜色、透明度、合成后的外观、硬透明区域、感知与分布约束。KL 散度惩罚潜变量分布偏离冻结的 RGB 编码器。后期加轻量对抗训练,再用 DoRA(把权重大小和方向分开适配)微调原扩散 Transformer,让同一套潜变量走原有生成主干。 RGBA 视频编码器|在 Wan2.1 VAE 的输入和输出卷积加零初始化通道。橙色参与训练,蓝色冻结。目标包括 RGB、alpha、合成效果及硬透明区域的像素损失,以及感知、KL 和参考 KL 约束。 实验效果:作者的特效数据上,第二阶段重建相对 Wan-Alpha 的整体峰值信噪比 PSNR 由 25.00 升至 29.16 dB,alpha 由 30.50 到 34.45 dB。透明视频文本匹配分为 4.2600 对 3.9794,美学分则为 0.4694 对 0.5232。RGB WebVid 重建对原 Wan2.1 从 36.73 降至 33.41 dB。最终重建训练用 1.7 万条高质量数据,VAE 实验用 32 张 GPU;正文未给出生成端的统一时延对照。 生成评估|透明文生视频比较 DoRA 变体、Wan-Alpha 和 TransPixeler。普通 RGB 文生视频与原 Wan2.1 比较,检验替换编码器的影响。各行粗体为最佳。 批判点评:局部半透明区域尤其值得单验。其 alpha 掩码内 PSNR 为 22.02 dB,Wan-Alpha 为 22.54 dB,与整体透明度指标走向不同。用在实拍抠像或要适配不同合成背景时,应测最终合成边缘和颜色。原文未给出本方法公开代码。 4. TraF:续长视频时记住去噪过程 Trajectory Forcing: Exploiting Diffusion Trajectories for Autoregressive Long Video Generation | 华为诺亚方舟实验室 | arXiv:2611.09096 关键词:长视频生成, 自回归扩散, 去噪轨迹, 分布匹配蒸馏 前序问题:长视频按块生成时,上一块的最终帧看起来正常,后面却可能突然静止、变糊或换了主体。只给下一块看最后成片,会丢掉此前生成过程中的线索。 方法直觉:把去噪比作反复从草稿改到成片。上一块的不同版本分别留下粗结构和细节,下一块的不同去噪阶段可以借用合适的草稿。 本文贡献:Trajectory Forcing 训练分两段。先把真实视频和高斯噪声插值,用模型重预测造出近似去噪轨迹,做监督学习。再让学生模型逐块生成,把自己真正走过的去噪轨迹作为上下文,用 DMD(分布匹配蒸馏)对齐教师的输出分布。轨迹位置由 γ 控制,极大值退回只取终点,默认四步设置取 γ=2。推理保留滑窗以及首块注意力缓存锚点。 自回归与自回归扩散|(a) 普通自回归的 token 是单个已完成单元,下一 token 直接看此前 token。(b) 扩散视频块经过 T 次去噪形成轨迹,理想因子分解中每次去噪都可看前序块的完整轨迹。 实验效果:以 Wan2.1 13 亿参数学生评测,5 秒 VBench 946 条提示,总分 85.15,对 Self Forcing 84.31,吞吐从 17 降至 15 帧/秒、首段延迟从 0.69 到 0.78 秒。128 条提示的 30 秒评估把时序、单帧、文本三个分数等权平均,TraF 73.98 对 Self Forcing 71.06。默认第二阶段维护轨迹缓存,作者估计训练时间多约 6%,没有增加去噪器求值次数。 30 秒视频评估|128 条提示。时序质量、单帧质量和文本对齐按 CausVid 协议聚合,三轴等权得到总分。VideoScore2 一列是文本对齐子分。灰色标出经过长视频专项训练的方法。 批判点评:30 秒综合分最高与首尾最稳是两件事。首尾各 5 秒的成像分绝对差为 1.38,Rolling Forcing 是 0.56,后者另做了长视频训练。30 秒是论文验证窗口,超出该长度的漂移还需单独测。NeurIPS 2026 接收见 arXiv 评论。 来源补充:项目或实现。 5. Video-Coder:让三维草稿指导成片 Video-Coder: Reinforcing Agentic Coding for Video Generation | 中佛罗里达大学、维尔茨堡大学、Microsoft Research、清华大学、北卡罗来纳大学教堂山分校、威斯康星大学麦迪逊分校 | arXiv:2611.09894 关键词:视频生成, 三维预演, 强化学习, 物理一致性 前序问题:拍一个球碰倒杯子,直接文生视频可能让球穿杯而过。给生成器一段结构正确的预演,能把构图、碰撞时机和物体轨迹明确下来。 方法直觉:先用可运行代码搭出粗略三维舞台,让镜头和物体按规则走,再由视频生成器完成外观。代码是中间工件,实验检验的是最终视频的表现。 本文贡献:在能执行代码、渲染并返还错误或视觉反馈的环境中训练 Qwen3.5-9B。先用约 6000 个监督示范教它生成三维草稿,再用约 2000 条强化学习样例联合优化执行结果和下游生成视频。训练后期逐渐降低执行奖励,让代理更重视最终成片。渲染出的草稿作为结构与运动条件传给下游模型。 从代码到视频|Video-Coder 编写并执行代码搭建三维场景,渲染草稿视频,为下游视频生成器提供显式结构和运动信号。 实验效果:PhyGenBench 的力学、光学、热学、材料四项聚合分,MiniMax-H3 加 90 亿参数 Video-Coder 从 0.61 到 0.67,光学由 0.73 到 0.79。VBench-2.0 对应物理均分 54.58%→78.19%,其中材料项 75.02% 低于 CogVideoX-1.5 的 83.19%。训练代理用 8 张 H100,强化学习阶段另用 16 张 H100 部署下游模型生成训练反馈。 PhyGenBench 物理评估|比较各模型在力学、光学、热学和材料四项及平均分上的表现。粗体表示最佳。 批判点评:推理多了写代码、执行和渲染,论文没给统一端到端延迟。简单刚体碰撞适合显式预演,难描述的材质和复杂流体不能凭有草稿就保证准确。作者仓库提供训练和推理入口,结果仍依赖下游生成器。 来源补充:项目或实现、代码或模型。 6. FoleyForge:一句话修改现成音效 FoleyForge: Free-form, Controllable, Rectified-flow Editing of Sound Effects | Adobe、纽约大学 | arXiv:2611.08695 关键词:音效编辑, 整流流, 声音保真, 响度控制 前序问题:有一段雨声音效,想让它像打在铁皮屋顶上,同时保留原来的节奏。纯文字重新生成容易换掉声音身份,传统音效工具则要求操作者知道要动哪种参数。 方法直觉:让模型同时听原声和读改法,再给响度、改动强度和能量轮廓各自的旋钮。能量轮廓指声音能量随时间的起伏,保住它通常更像原音,但也会限制有意改动。 本文贡献:以 Sketch2Sound 为基础微调整流流 Transformer。整流流学习把噪声沿速度场搬运到音频表征。用音频语言模型生成编辑指令,配对数字信号处理或保持相似的生成式改动,共 46.4 万组三元样本(源音、指令、目标音)。冻结文字与音频编码器,仅训生成主干。无分类器引导比较保留和省略条件时的模型预测,分别控制响度、改动强度与能量轮廓。 控制项消融|左上扫目标响度,右上扫编辑强度,左下比较从无改动到剧烈改动的 SILA 语言等级,右下比较能量轮廓开关。各属性响应单调。主实验默认启用能量轮廓,以较窄的控制范围换取更高源音保真,轮廓相关系数由 0.11 到 0.37。 实验效果:有标准答案的轻改集 100 条,无唯一答案的创意集 90 条。创意集上相对 SAO-Instruct,Qwen 指令分 2.69→3.44,音频语义保真余弦 0.831→0.602。打开默认能量轮廓后,作者在控制消融里测得轮廓相关系数 0.11→0.37。训练为 8 张 GPU、8 万步,论文未给统一的编辑端到端延迟。 指令遵循与源音保真|对轻改集和创意集取平均。两个方向的分数都高才接近理想编辑,采样初始化和能量轮廓会移动这个取舍点。 批判点评:默认与保真版适用于不同交付目的。试听研究仅 25 人、10 条创意集源片,且筛掉 10 秒及以上音频。付费音效库来源限制了训练数据复现。作者提供试听,公开的 SAO-Instruct 权重属于对照系统。 来源补充:项目或实现。 7. ProCraft:半分钟音乐一次改多轨 ProCraft: Instruction-Driven Music Production from Free-Form Text | 佐治亚理工、台湾大学、Sony Computer Science Laboratories | arXiv:2611.07423 关键词:音乐编辑, 复合指令, 音频编码, 自回归 前序问题:想对一段音乐同时去掉鼓声、给吉他加效果并保留人声,拆成三次编辑会让前一次输出的误差传给后一次。 方法直觉:把源音编码为离散音频 token,用一组可学习查询提取本次改法,生成每个目标 token 时都能回看这份编辑计划。 本文贡献:ProCraft 是 5 亿参数的自回归音频编解码语言模型,处理 30 秒片段,覆盖贝斯、鼓、吉他、钢琴、风琴、铜管、簧管和弦乐组,支持去除音轨、提取、伴奏、单乐器翻奏、换乐器、降噪和音效修改。输入按文字、源音代码和可学习查询排列,最后的查询状态形成编辑头,经带门控的交叉注意力送入每个解码层。训练时另用四个多层感知机把第 4 层对齐到预训练音乐表征 MERT、音高、乐器和音效目标。训练样本按需组合音轨操作和效果修改,再合成文字与音频配对。 ProCraft 架构|指令、源代码和 K 个可学习查询先于目标代码。查询的最终隐藏状态组成编辑头,逐层经门控交叉注意力注入。训练用四个多层感知机把第 4 层对齐到 MERT、音高、乐器和 StemFX 目标。 实验效果:在合成多轨 Slakh 的复合指令上,去除、提取、降噪的尺度不变信号失真比 SI-SDR 为 −7.39、−15.73、−4.74 dB,Audio-Omni 对应 −24.88、−23.98、−26.02 dB,越高表示更接近目标音轨。另有真实录音与 16 人试听。单张 RTX 5090 预热后,30 秒片段、2250 个目标 token、单条处理约 38 秒,加超分辨率约 40 秒。批大小 8 时摊销约 5 秒和 7 秒每条,单条交互延迟不能用批处理摊销代替。 复合指令评估|在 Slakh 上比较去除、提取、降噪的 SI-SDR,以分贝报告,越高越接近参考音轨。 批判点评:复合提示下跑赢自由文本编辑器,和单操作专用工具的优劣要分开。真实音频的单项去除,HTDemucs-6s 为 12.854 dB,ProCraft 为 −5.114 dB。30 秒片段测试也无法回答整首曲子的段落衔接。项目页公开试听。原文称代码和权重计划发布。 来源补充:项目或实现。 8. UniMore:读图和生图都盯住细节 UniMore: Fine-Grained Supervision for Unified Understanding and Generation | 威廉与玛丽学院、卡内基梅隆大学、伊利诺伊大学厄巴纳香槟分校、松鼠 Ai、威斯康星大学麦迪逊分校 | arXiv:2611.08996 关键词:图像生成, 多模态理解, 细粒度监督, LoRA 前序问题:模型能画出花,却把黄花画成粉花。给它同一张图做描述,又容易只说画面里有花。两项任务都漏了人真正关心的细节。 方法直觉:让生图分支学习从短语画对应的小区域,让看图分支判断哪句话漏了细节或说错颜色。把两个小改动合回原模型,部署时照常调用。 本文贡献:生成分支用开放词汇检测器的定位置信度和 CLIP 图文语义一致性给短语、裁剪区域配对打分,按主干原有的图像生成目标学习。理解分支学习完整正确描述,同时排序压低删除细节、篡改细节及不相关的描述。两支各自在相同主干上做 LoRA(低秩适配),最后按固定权重把两份参数更新并入,无需推理路由。 UniMore 双支训练|(a) 图文对提供带定位评分的短语与局部裁剪,训练图像预测。(b) 整图分支拟合完整描述,并和删去、改错细节或完全无关的描述比较排序。两支从相同主干独立适配,再把更新合入单一模型。候选卡片为示意,文案是节选。 实验效果:在 70 亿参数 BAGEL、512×512 图像、50 步采样设置下,测知识相关生图的 WISE 总分由 39.89 升至 43.48,UEval(综合统一模型生成表现)由 30.90 到 31.60,仍低于同主干 LatentUMM 的 31.80。多模态理解平均由 67.05 到 69.46。原文的 Janus-Pro 和 Show-o2 两支训练总计约 0.595 与 0.356 GPU 小时,各分支用单张 H100;不等同于 BAGEL 成本。 生成评测|比较统一多模态模型和 BAGEL 后训练变体。表内报告 UEval 与 WISE 的类别和总分,粗体、下划线分别为 BAGEL 后训练组第一、第二。 批判点评:短语和裁剪适合颜色与局部属性,两个对象的全图关系可能超出裁剪视野。合并保持原推理接口,论文未另报加速。已核作者训练包、合并权重与训练数据页面。 来源补充:项目或实现、代码或模型、基准或数据。 9. InstaGen:稀疏注意力给尾部留预算 InstaGen: Group-Shared Importance Sampling for Fast Video Generation | 印度理工学院孟买分校、加州大学伯克利分校 | arXiv:2611.08610 关键词:视频生成加速, 稀疏注意力, 重要性采样, 推理内核 前序问题:长视频去噪中,每个位置都和大量时空位置做注意力,慢得明显。只保留分数最高的块虽然快,却会在权重分散时丢掉一批各自不强、合起来重要的线索。 方法直觉:先精算最重要的一批,再从剩余里抽样估计。少被抽到的样本中选后获得更高权重,同一组查询共用样本,让 GPU 还能按规则的密集块算。 本文贡献:对查询与键做聚类,用质心分数估计每组键的注意力质量。预留精算预算后,对其余键做按分数、无放回的概率抽样,按纳入概率的倒数给样本加权,在注意力归一化前以分数偏置实现。共享采样保证一个查询组拥有相同的键块,修改 FlashAttention-3 内核计算;文字交叉注意力保持稠密。 共享重要性采样|(a) 对查询和键分组。(b) 用质心打分估计每个查询组选择键组的概率 π。(c) 顶部键组必算,尾部按 π 抽样并乘以 1/π。(d) 同组查询共享选中的键,注意力可在一个内核按密集块执行。 实验效果:单 H100 80 GB、22 条 VBench 提示、720p 81 帧 50 步。Wan2.1 140 亿参数版本上,带预热的 8% 精算加 8% 抽样相对 SVG2,整体注意力密度 53.34%→42.67%,同种子相对稠密参考的 PSNR 22.38→24.61 dB,端到端加速 1.53→1.65 倍。整体密度按所有调用中的查询键对计算,预热全算,因此高于单次稀疏的 16%。 Wan2.1 主结果|PSNR、结构相似度 SSIM 和感知距离 LPIPS 均与同种子稠密视频对照,质量分取 22 条提示平均。E+S 是每次稀疏调用的精算和抽样比例。InstaGen 沿用 SVG2 的预热(最初 30% 步和 3% 层),整体密度含全量预热。加速为单 H100 上的端到端时间比,粗体是各列稀疏方法最佳。 批判点评:同种子更像稠密结果不代表所有审美维度都提高。14B 无预热的抽样配置 PSNR 只有 21.84 dB,选择预热和预算仍有质量、速度取舍。当前证据来自两种 Wan2.1 尺寸及 Hopper GPU,未核到作者代码链接。 10. T2I-NSI:测模型能不能画出没有 T2I Models Rarely Invert Negation but Often Fail to Suppress Negated Concepts: Benchmarking Negation Suppression in Text-to-Image Generation | 印度理工学院焦特布尔分校、科罗拉多州立大学 | arXiv:2611.09304 关键词:文生图, 否定提示, 成对评测, 开放词汇检测 前序问题:提示写一张没有台灯的桌子,生图仍把灯画了进去。要区分模型忽略否定,还是把肯定和否定条件理解反了,得把同一概念的两种提示放在一起测。 方法直觉:先检查正向提示有没有真的画出目标。它从一开始就没画出台灯,负向提示也没出现台灯,就很难用这一对图证明模型懂否定。 本文贡献:将肯定与否定提示配成原子,一个原子是一组针对同一概念和语境的文本条件。按词汇语义、词形和句法分层。T2I-NSI(文生图否定敏感指数)衡量从正向到否定时目标出现度是否下降,范围 −1 至 1。稳健评分融合 CLIP 图文相似度、视觉问答及开放词汇检测,按各探针分歧降权。基础版本只用 CLIP。 三种否定提示示例|上为句法否定的金合欢树,中为词形否定的未张开猪笼草,下为词汇语义否定的不可见金字塔。FLUX.2、Qwen-Image-2512 和 SD 3.5 对否定提示生成相近画面,被否定概念仍存在。 实验效果:全量提示库有 759,869 个原子、目录含 5082 个对象,实际生成 916,272 张图。三个开放权重模型各约 15.2 万原子,稳健分依次为 FLUX.2 0.0378、Qwen-Image-2512 0.0306、SD 3.5 0.0198。三模型倒置计数分别为 0、3、2,按该表的 151,970 原子口径各自四舍五入到 0.00%。持续出现分别为 15.50%、13.03%、16.92%。评测需要每原子成对生成,再跑多路探针;论文给出图量,未给跨供应商统一成本。 开放权重模型失败分类|稳健评分按原文 4.2 节分类,行合计约为 100%。三模型的倒置分别有 0、3、2 个,分母为各 151,970 个原子,取两位小数均显示 0.00%。 批判点评:开放权重模型有逾七成原子归于弱呈现,持续出现率不能当成所有否定指令的失败率。闭源 GPT-Image-1.5 的 0.0934 基于 1200 个原子,比较总体分要看匹配子集。WACV 2027 接收见 arXiv 评论,仓库提供评测代码和提示。 来源补充:项目或实现。 趋势观察 编辑信号需要明确作用区域 AR-Edit 用差异词软掩码把注入限制到编辑区外。StitchEdit 在训练前找出深度与编辑冲突的层,两篇分别在推理和训练阶段控制干预。 生成过程可以保留中间表达 TraF 让下一块使用历史块的去噪轨迹,Video-Coder 把三维预演交给下游视频模型,UniRGBA 则从编码阶段就保留透明度。 保住原音和改到位分别打分 FoleyForge 的创意集上,指令评审分提升而源音保真下降。ProCraft 的复合提示结果不能替代真实录音上与单任务工具的对比。 先读分母,再读分数 InstaGen 把稀疏调用预算与包含预热的整体密度分开。T2I-NSI 用成对提示区分目标持续出现、倒置和弱呈现。 今日讨论 AR-Edit 在四步 Self Forcing 上将首帧延迟从 1.38 秒降至 0.85 秒,但文本遵循分从 5.87 变为 5.77。如果要在直播里只换主持人的外套,怎样在同一路源视频上测量首帧、稳态吞吐、换色完成度和背景保真,再决定何时加强源特征注入? 人工智能炼丹君 整理 | 2026-11-10
-
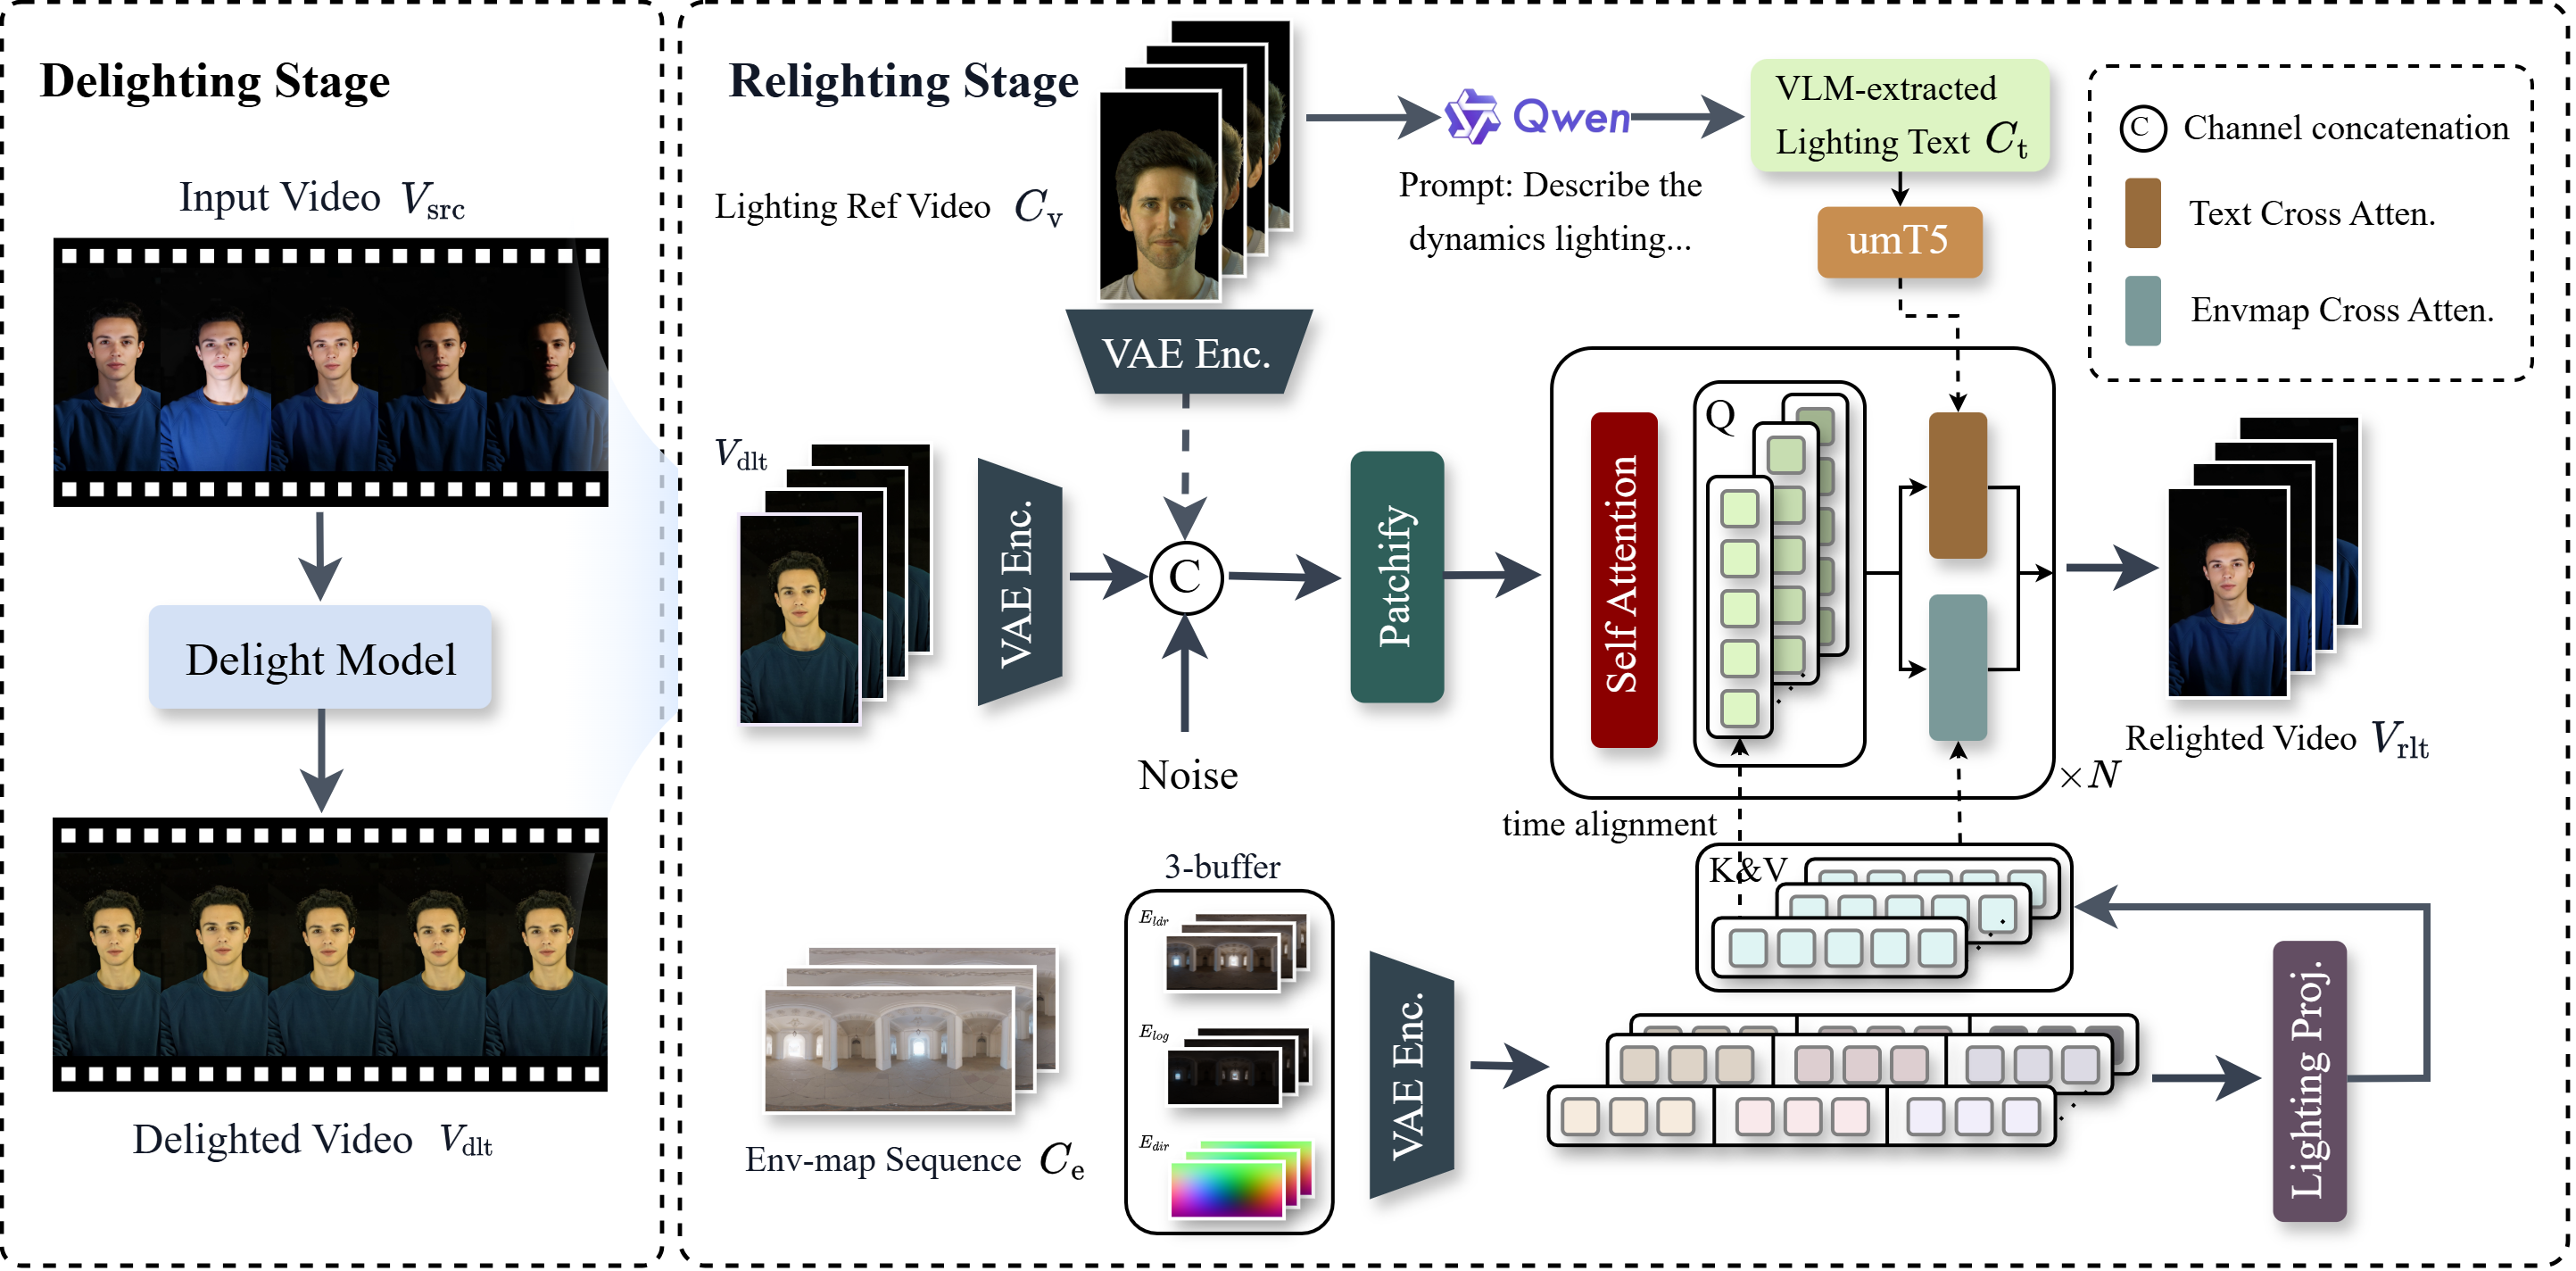
AIGC 每日速读|2026-11-09|NeurIPS 借视频换光FlashRelight 今日 AIGC 论文速览 今日共 10 篇 · 视频重照明与运动控制 4 篇 · 图像编辑与少步生成 2 篇 · 视频质量与联合生成评测 2 篇 · 语音编辑与蒸馏 2 篇 重点论文标题列表 FlashRelight(浙江大学):借一段视频给人像换光 WeLM-Image(腾讯):一套模型读图也能改图 Chronos(中科大):先排动作再锁人物身份 HME(澳国立):让扩散噪声记住参考动作 Disen-Forcing(澳国立):把记场景和管动作分开 选读入口:给拍好的肖像视频换灯光,先读 FlashRelight 的去光和迁光。要处理多张静态参考图,读 WeLM-Image。要从参考图造新视频,按身份与动作顺序选 Chronos,按运动轨迹选 HME。续写 30 秒后总跑偏,读 Disen-Forcing 怎样给注意力头分工。生成片返工读 ArtiVidRM 的缺陷清单,做语音改词、加笑声读 VoxCanvas-41M,关心语音推理成本读 Route-DMD。少步生图看 FisherDistill 的教师统计,跨镜头音画验收读 CAST-Bench 的声源与说话人指标。 今日论文速览 1. FlashRelight:借一段视频给人像换光 FlashRelight: Portrait Video Relighting with Dynamic Lighting | 浙江大学;vivo 影像实验室 | arXiv:2611.06355 关键词:视频参考编辑, 肖像重照明, 动态光照, 两阶段扩散 前序问题:一段自拍已经拍完,脸上还是原来的顶光。你想借另一段视频里的彩灯变化,却要保住原来的人、动作和衣服。直接加一层滤镜会把旧阴影和新高光叠在一起,转头时尤其明显。 方法直觉:先把旧光压成接近中性的底片,再按目标打新光。给第二阶段一段参考视频时,尽量只拿光的颜色、方向和变化节奏,让第一段视频继续决定人物长相与动作。 本文贡献:两个阶段都从 Wan2.1-1.3B 视频扩散模型初始化。去光模型压制源光和阴影,输出携带原外观的近中性视频。重照明模型每次启用一种条件:环境光贴图序列通过时序对齐的交叉注意力逐帧控制,文字经 umT5 编码控制语义,参考视频的潜变量与去光视频、噪声按通道拼接,并辅助提取灯光描述。训练时把参考视频强模糊、平移和缩放亮度,降低人物特征泄漏。数据混合 OLAT(逐次只开一盏灯的采集)合成序列和动态合成视频,兼顾可控照明与肖像运动。两阶段分别训练 3 万和 4 万次更新,使用 LoRA 低秩权重更新。 Figure 3|FlashRelight 分两步。左侧去光模型压制输入视频原有照明与阴影,输出近中性的肖像视频。右侧将它与一种有效的动态光照条件送入重照明模型,生成最终视频。参考视频提供潜变量和光照描述,环境贴图通过时序对齐的交叉注意力进入去噪。 实验效果:未参与训练的 10 位受试者、16 条环境光序列上,对 DiffusionRenderer,前景 LPIPS(感知距离,低更好)由 0.3781 到 0.1635,PSNR(像素保真度,单位 dB)由 17.3683 到 23.1099,身份特征相似度由 0.6143 到 0.8097。文字条件下 FID(生成与目标图像的特征分布距离)31.16,对 Light-A-Video 的 51.78,但相邻帧感知变化 tLPIPS 为 0.1417,对方 0.1395。单张 H20 上,832×480、49 帧、两阶段各 50 步合计 185.9 秒,PyTorch 峰值预留显存 15.23 GiB,对照为 503.3 秒和 44.22 GiB。计时不含外部预处理与保存。 Figure 7|参考视频引导的动态换光。每列上方给出参考视频的灯光变化,每行左侧是源肖像。对应输出把参考的明暗、高光、颜色变化带到源肖像,同时尽量保留源人物身份与动作。这里展示定性样例。 批判点评:参考视频迁光没有配对真值,论文用定性样例验证,环境光与文字实验的分数不能代替这一任务的定量结果。去光视频也只是实用中间态,强遮挡和残余阴影可能影响第二阶段。官方仓库已建,核验时 README 仍预告发布。 2. WeLM-Image:一套模型读图也能改图 WeLM-Image: A Unified Image Generation Model towards Visual Intelligence | 腾讯微信视觉团队 | arXiv:2611.07392 关键词:多参考图像编辑, 共享注意力, 稀疏专家, 少步蒸馏 前序问题:把两张商品图和一张布景图交给模型做海报,模型得分清哪张负责什么,还要保住商品字样。多张参考一多,理解、合成和推理成本会一起上升。 方法直觉:让读图和画图走两条分工明确的路径,仍能在同一序列互相看见。画图时按当前图块调用少数专家,给编辑保留足够容量。 本文贡献:文本、参考图语义、图像潜变量和加噪目标交错打包。MoT(Mixture-of-Transformers)让理解与生成分用投影和前馈权重,共用带遮罩的自注意力。MoE(混合专家)为每个 token(特征单元)挑选部分前馈网络,主干含视觉编码器、排除图像压缩模型,存 317 亿参数,每个目标潜空间 token 激活约 54 亿生成参数。统一三轴旋转位置编码同时保留文本顺序和图块行列。先分别按规则表优化文生图、编辑策略,再让学生在自己到达的不同噪声状态学习对应老师。Turbo 用 MeanFlow 学噪声区间的平均变化,压缩到 8 步。 Figure 2|从左到右为多模态输入与分词、27 层主干,以及单层展开。理解路径和生成路径各保留专用投影与稀疏专家。打包后共享带遮罩的自注意力,归一化、位置编码、输出投影与残差连接维持各自的数据流。 实验效果:论文 1536 分辨率模型在单图编辑 UnicBench 总分 8.992,Turbo 为 8.664,GPT-Image-2 为 9.079。GEdit 中英总分均值为 8.381,同组 HunyuanImage-3.0-Instruct-Distil-CoT 为 8.385。单张 H20 输出 1024×1024,一次预热后的 3 次平均墙钟(不计加载):纯文字生图 50 步基版 56.99 秒,8 步 Turbo 4.98 秒。Turbo 输入 1 至 4 张图的编辑为 6.78 至 13.17 秒。 Table 14|单图编辑四套基准。GEdit 取英语与中文总分平均,ImgEdit 和 UnicBench 用各自总分,WeGenEditBench 取文字编辑和单图编辑子集平均。闭源模型作为参照,排除在前三着色之外。 批判点评:参数激活数按目标 token 计,设备仍得容纳全套权重与运行缓存。质量分数和测速分别对应论文的评测配置,不能用 4.98 秒替代多参考编辑耗时。技术报告公开,原文未给可确认的本模型权重或代码入口。 3. Chronos:先排动作再锁人物身份 Chronos: Sequential Identity-Preserving Video Generation by Temporal Anchoring | 中国科学技术大学;华南理工大学;华为;独立研究者 | arXiv:2611.05893 关键词:参考视频生成, 人物身份保留, 关键帧锚定, 候选路由 前序问题:给人物照片,让他在视频里先拿起蛋糕再咬一口。脸抓得太紧,模型可能只会轻微转头,反过来做大动作时又容易换脸或打乱次序。 方法直觉:把长指令拆成有先后的镜头关键帧,让生成器有具体画面可追。不同模型各生成候选,再同时看动作、脸和画面选片。 本文贡献:语义提示锚定用 GPT 模型提取参考图的身份线索,按遮挡与视角风险补足描述。视觉帧锚定把描述变成按时间排列的参考关键帧,单段用首锚,多段可加分段锚。Wan2.2 I2V-14B(140 亿参数的图生视频模型)两轨共用,单段还用 Seedance,多段还用 Wan FLF2V(首尾帧条件生成)。生成后按文本、身份、视频质量和语言模型复核加权排序,对异常片段额外复审。 Figure 2|输入参考图、原提示和可选时间段说明。语义锚定先提身份线索,按低、中、高风险调整提示。视觉帧锚定给第一轨一个锚帧,第二轨可再加分段锚帧。各轨生成器分别出片,经文字、主体、质量与语言模型评分,再复审异常候选并选出最终视频。 实验效果:ACM MM 2026 身份保持视频生成挑战官方榜单按名次汇总,低分更好:人脸轨 2.5 并列第一,顺序动作轨 1.25 独列第一。论文的对照评测是另一套高分更好的总分,单段 0.6769 对 RefAlign 的 0.6214,多段 0.6102 对 Phantom 的 0.5725。单段主体分 0.6840 低于 RefAlign 的 0.7996,多段动作幅度分 0.1479 也低于对照组。 Table 2|两轨分别报告身份、文本对齐、画面和运动相关分数,以及高者更好的总分。Chronos 在两轨总分均领先,单项仍有取舍。表内粗体为该项最优。 批判点评:这是参考图生新视频,输入并不要求保留某段源视频。多模型采样与额外裁判是成本,论文未给统一的每条延迟和显存。成绩属于本次挑战及给定参评系统。赛事榜单核实两个名次,原文未列 Chronos 独立实现。 4. HME:让扩散噪声记住参考动作 Householder Motion Embedding: Noise Modulation for Motion-Controllable Video Generation | 澳大利亚国立大学;Vertex Lab;亚马逊 | arXiv:2611.07294 关键词:参考运动迁移, 光流控制, Householder 反射, 噪声调制 前序问题:想让新画面里的车走参考视频中的路线。把噪声像素跟着光流搬动,插值可能把原本独立的噪声混在一起,还得补一遍分布修正。 方法直觉:固定空间位置,只旋转该位置的一组噪声通道。旋转不改变标准高斯云团的形状,却能用上帧的噪声和当前光流在帧间留下一致的运动线索。 本文贡献:HME(Householder Motion Embedding)先估计光流,也就是相邻帧的像素位移,并重采样到模型压缩后的图块网格。每个位置用流的横向、纵向分量生成反射方向,将前一帧的通道向量经 K 次 Householder 反射(沿超平面镜像)映射到下一帧。复合变换保持正交,因此在固定运动条件下保留帧内标准高斯结构。γ 是混入独立噪声的退化程度,调低能让生成更贴参考运动。以 CogVideoX-5B-I2V 为底座微调,输出由首帧、文本和运动条件共同决定。 Figure 2|三阶段依次估计与重采样光流、用 Householder 反射构造跨帧相关的噪声,以及微调扩散模型并推理。右上用首帧和运动条件生成新视频,底部展开了光流到反射方向、通道正交变换、逐帧递推的过程。 实验效果:DAVIS 运动迁移上,γ=0.3、K=2 相较 GWTF 的 γ=0.5,光流端点误差 EPE 从 5.644 降到 4.433,CoTracker 轨迹重叠 mIoU 从 0.464 到 0.546。默认两次反射在 RTX PRO 6000 Blackwell 上构造一份 1024×1024、16 通道噪声潜变量用 2.80 毫秒,是 GWTF 约 2.7 倍速度。论文另外在 480×720、49 帧条件下,用 10 万段视频微调 3 万次,4 张 A100 共 40 GPU·天。 Table 1|DAVIS 的运动控制图生视频对比。分别衡量主体和背景一致性、闪烁和平滑性、特征分布距离、光流误差、轨迹重叠与图像相似度。粗体为最优,下划线为最强对照。 批判点评:2.7 倍是噪声构造的对照,完整生成仍要先估光流再做扩散采样。低 γ 容易把光流里的错误一并传给生成。论文试的是图生新视频的运动控制,无法据此保证保留任意源视频的像素。原文未列独立实现入口。 5. Disen-Forcing:把记场景和管动作分开 Disen-Forcing: Disentangling Semantic Anchoring from Motion for Autoregressive Video Diffusion | 澳大利亚国立大学;Sony AI;CSIRO;索尼集团 | arXiv:2611.02822 关键词:长视频扩散, 首帧锚定, 注意力头分工, 分布匹配蒸馏 前序问题:逐段续写时,首帧从缓存滚出去,场景和人物容易漂移。强行让每个注意力头都看首帧又可能把动作冻住,变成一段稳定却不怎么动的视频。 方法直觉:有些注意力头擅长认开场,有些负责看最近的动作。前者保留全局参照,后者专注局部,用同样的缓存预算做两种工作。 本文贡献:从蒸馏前的初始模型测各头分给首帧的平均注意力,按百分位固定少数 Anchor Heads。分布匹配蒸馏时,锚定头只读开场和当前帧,工作头只读滑窗与当前帧。额外做一次反事实前向,把锚定头的开场缓存替换为经图像解码再编码的局部上下文,用其相邻帧注意力作为固定目标,以 KL 散度(概率分布差异)约束常规前向。额外前向只发生在训练。以 Self-Forcing 和 Causal-Forcing 两个底座验证。 Figure 5|三种上下文路由。左图滑窗前进后丢弃早期帧。中图在滑窗外保留首帧上下文,但所有头看到同样内容。右图在蒸馏时仅让少量锚定头访问开场,工作头只看局部滑窗,保留原有分工。 实验效果:30 秒约 500 帧的 VBench-Long,Self-Forcing 加全头首帧缓存时动态分 35.66、首尾成像质量差 3.40,改用分工后为 73.12 和 4.03,原底座为 40.44 和 7.23。动态分高者更活跃,首尾差低者漂移更小。60 秒约 1000 帧的 VBench-Long 六项均分由原底座 74.75 到 82.34。训练 600 次有效更新用 8 张 H100 约 14 小时,附录所测摊销单步耗时 10.2 到 10.8 秒,论文记约 5%。 Table 1|30 秒约 500 帧与 1 分钟约 1000 帧的长视频对照。分工可用于 Self-Forcing 和 Causal-Forcing 蒸馏。首尾成像质量差越低越好,VBench-Long 六项均分越高越好,粗体标出各时长最高总分。 批判点评:全头首帧缓存仍有更小的首尾成像差和更高的个别一致性分。分头方案改善的是动作与外观的平衡,也会继承教师的错误。不同大小模型能观察到头的分工,迁移后的生成收益仍待验证。项目页有长视频演示,代码标注即将发布。 6. ArtiVidRM:先列视频瑕疵再打分 ArtiVidRM: Verifiable Artifact-as-Rubric Reward Modeling for Explicit Quality Articulation in Video Generation | 东南大学;Opus AI Research;中国科学院自动化研究所;伊利诺伊大学厄巴纳-香槟分校;加州大学洛杉矶分校 | arXiv:2611.07301 关键词:视频纠错, 缺陷清单, 奖励模型, 偏好预测 前序问题:生成片里的手穿过抽屉,奖励模型给了低分,却没说哪里坏、怎么改。一句听起来像解释的评语,也可能和最终评分无关。 方法直觉:先指出能在画面中核对的瑕疵,再用清单打分。生成器需要第二次出片时,可以把瑕疵转成更具体的提示。 本文贡献:多个检查器先给候选瑕疵,合并后按视频证据核验,过滤后保留 22640 对视频。用 Qwen3-VL-8B-Instruct 多模态模型先监督学习结构化清单,再用强化学习同时奖励格式、语义覆盖和偏好排序。覆盖奖励鼓励找到人类关心的瑕疵,不对列得越长给越多分。长度惩罚对多报全罚、少报半罚,因为漏报还会扣召回分。配对奖励用两条视频的分差学习人类排序。 Figure 3|两阶段训练。左侧用有瑕疵清单的视频监督微调多模态模型,右侧对同一提示的 A、B 视频分别列瑕疵和给分,再联合格式、语义覆盖、配对偏好和长度惩罚训练。 实验效果:GenAI-Bench 去掉人工平局后,成对偏好准确率 0.753,VisionReward 为 0.744。保留平局时两者同为 0.518。VBench-2.0 保留平局 0.572,对 UnifiedReward 的 0.541,MonetBench 两种口径都落后 VisionReward。用清单改写提示让 Veo 3.1 再生成,VBench 美学、成像两维分别提高 1.85 和 1.30 分,主体与场景一致性几乎不变。 Table 1|域外基准上的成对偏好准确率。w/T 保留真实平局,w/oT 剔除真实平局。各模型使用默认的平局阈值(适用时)。粗体是最好结果,下划线是第二,星号为原论文报告值,短横线为无可用数据。 批判点评:闭源实验是改提示重生成,不能在原片上只修一处。额外的视频模型评估和二次生成消耗算力,论文未报告统一额外时延。自动清单偏向显眼的渲染、光照和纹理问题,罕见错误仍值得人工查验。原文未给独立代码入口。 7. VoxCanvas-41M:一句话指挥录音改词加笑声 VoxCanvas-41M: A Large-Scale Bilingual Dataset for Instruction-Based Speech Editing and Its Learning Dynamics | 上海交通大学;上海创智学院;北京通用人工智能研究院;天津大学 | arXiv:2611.08251 关键词:指令语音编辑, 双语训练数据, 非语言声音, 学习动力学 前序问题:录好的一句“周一早上见”改成周五,最好只替换那两个字,声音和前后停顿都保住。让模型在指定位置加笑声又需要另一类样本,而真实成对录音难以大规模收集。 方法直觉:先定位字词与声音发生的时间,再只让合成器补上编辑区段。能自动制造一对前后录音,就能系统比较插入、删除和替换是怎么学会的。 本文贡献:从公开语音收集音频,Qwen3-ASR 重转写,再用强制对齐把词或字映射到时间。语言模型生成操作说明和编辑后文本,F5-TTS 文本转语音在原音频上下文里补段。规则、多模型和人工抽查筛选,英语筛零词错误,中文筛零拼音错误,避免同音字误罚。约 4100 万对是编辑样本对数,覆盖单段、多段、按位置定位,以及 39 类笑声、叹气等非词语声音的增删。用低秩适配微调 AuK,仅约 1.3% 的原模型参数量参与训练。 Figure 1|语音编辑数据生产。A 建任务分类,B 从开源语音集取原录音,C 自动转写和强制对齐,D 大语言模型写编辑指令与目标文本,E 用文本转语音结合原上下文重合成局部,F 规则和多模型筛选后做人类抽查。 实验效果:SpeechEditBench 上中英内容编辑准确率平均由 AuK 的 91.05 到 95.22,非词语编辑由 53.25 到 54.50。英语内容准确率 96.78,对同设置用 GigaEdit-L 微调的 94.22。另一套 Ming 自由编辑测试的英语完整项,词错误率 4.11 到 3.77,音色相似度 0.88 到 0.89,GigaEdit-L 同项音色相似为 0.94。学习曲线显示把插入与删除混训会拖慢插入,删除本身变化较小。 Table 2|在不同数据上微调 AuK 的语音编辑结果。SpeechEditBench 的 Avg. 是中英内容编辑准确率平均。GigaEdit-L 只含英语,故略去中文与双语平均。另一组分中英文的基础与完整项,分别报词错率、准确率、音色相似和未编辑内容的词错率。粗体是最好成绩。 批判点评:数据主要由合成编辑与识别筛选得到,零拼音错可能放过同音词。任务覆盖中英内容和非词语声音,尚无情绪、风格或依赖历史的多轮编辑。1.3% 是微调参数口径,不能换算为推理速度。数据管线、数据页与演示均可访问,数据页有具体发布范围。 8. Route-DMD:四步语音蒸馏分任务走 Route-DMD: Distribution Matching Distillation with Task-Routed Mechanism for Speech Foundation Models | 上海交通大学;北京通用人工智能研究院;上海创智学院;南洋理工大学;腾讯混元 | arXiv:2611.08011 关键词:语音基础模型, 少步蒸馏, 任务路由, 说话人分离 前序问题:同一个语音模型既要念文本、改录音,也要从混合音轨里分离说话人。把生成任务的少步蒸馏直接搬到分离,学生失误后,老师可能在没见过的混合状态上给错方向。 方法直觉:先让学生学会从不同噪声水平走向同一个答案,再按任务选监督。分离有对应的干净音轨可直接比,生成或开放式编辑则更适合学输出分布。 本文贡献:第一阶段从 AuK 教师初始化,做 500 次一致性蒸馏更新。第二阶段按任务路由,目标说话人或人声分离直接对干净目标做均方误差回归。其他任务用解耦 DMD(分布匹配蒸馏),将分布差和条件引导分开计算,保留学习学生分布的辅助评分网络。教师生成回放用 APG(自适应投影引导)减轻语音削波,四步学生推理省掉 CFG(分别计算有条件与无条件预测再组合的无分类器引导)。 Figure 1|先做一致性蒸馏,让学生从相邻噪声状态预测同一干净端点。随后按任务分流,分离任务用干净音轨的均方误差,其他任务用解耦 DMD。右侧分别从真实与生成分布评分差、真实条件与无条件评分差取训练信号。 实验效果:单张 H20 上,端到端 RTF(耗时除以生成音频时长)从 32 步 AuK 的 0.4333 降到 4 步的 0.0958,约快 4.5 倍。主观自然度均值 4.23 到 4.34、指令跟随均值 4.50 到 4.57,两者各自的 95% 置信区间都重叠。SeedTTS-Eval 平均词错误率 2.65 到 2.85,Libri2Mix 由 9.12 到 10.07,后者虽有主观质量代理指标提升,字词识别仍回退。 Table 2|主观自然度和指令跟随报告全体评分均值及 95% 置信区间。端到端实时因子在单张 NVIDIA H20 上测量,越低越快,比较 32 步 AuK 与四步 Route-DMD。 批判点评:分离退回有配对真值的监督,迁移到缺干净目标的任务要重新选路。四步加速是单卡与测试协议下的端到端结果,未展示相同倍数的显存下降。AuK 仓库提供四步 AuK-Flash 权重指引、推理与蒸馏训练入口,项目页可听任务样例。 9. FisherDistill:少步生图用统计信号补课 FisherDistill: Diffusion Distribution Distillation via Closed-Form Fisher Critics | 纽约州立大学布法罗分校;加州大学伯克利分校;Meta 署名作者以个人身份参与 | arXiv:2611.07604 关键词:少步图像生成, Fisher 线性判别, 分布匹配, 冻结教师特征 前序问题:学生模型只用一步生图,即使学了老师的去噪能力,生成图的整体分布仍可能偏。再加一个需交替训练的对抗判别器,会引入一套新的优化。 方法直觉:把真假图像投到同一个老师的特征空间,找出均值分得最开、组内波动相对最小的方向。学生朝真实的一侧修正。 本文贡献:冻结教师的中间层先离线统计真实图的均值与协方差(特征之间共同变化的程度),在线用滑动平均追踪生成图。将两类均值差用带正则的组内协方差重新加权,线性方程直接给 Fisher 方向。用上一更新留下的统计量固定本步方向,避免同一批既拟合又打分,梯度仍通过当前教师特征回学生。Fisher 修正叠在原蒸馏目标上,保留原方法需要的生成分布评分网络。 Figure 3|Fisher 修正叠加于原蒸馏。真实图经冻结教师离线提特征,生成图在线估计统计,两者各有均值和协方差。所选层用正则化协方差求从生成均值指向真实均值的 Fisher 方向,并将它转成学生的梯度信号。原蒸馏与生成分布评分器仍在。 实验效果:ImageNet 64×64 类别条件生图,一次 NFE(网络前向次数)的 DMD 设置下 FID 从 2.64 降到 1.40,同预算对抗精修 DMD2 为 1.42。换用 SiD 起点,1.54 到 1.34,对抗 SiD²A 仍为 1.31。SD v1.5 的消融中,初始 FID 9.28,仅用均值差变 9.85,完整协方差降到 8.46。几组 FID 都是特征分布距离,低更好,不能等同单张观感。 Table 1|预训练 EDM 教师下的 ImageNet 64×64 类条件生成。比较求解器、蒸馏、对抗精修和 Fisher 精修,有数据时报告前向次数、FID、精确率和召回率。每个分布匹配组内最优加粗,带匕首号者用官方代码按匹配预算复现,其他组结果来自原文或引用工作。 批判点评:真实图统计、挑选能区分真假的教师层和求解协方差都发生在训练端,论文未给统一的端到端训练节时量。推理前向数没增加。低分辨率类条件结果也不能替代高分辨率文字渲染验证。项目页与论文所链仓库可访问,本次仅确认说明与演示,未确认可跑的训练入口。 10. CAST-Bench:听清每个镜头是谁在发声 CAST-Bench: Tracing Every Sound to Its Source in Multi-Shot Audio-Video Generation | 西北工业大学;复旦大学;浙江大学;北京大学 | arXiv:2611.05422 关键词:音视频联合生成, 多镜头评测, 声源绑定, 说话人一致性 前序问题:两个人跨镜头对话,画面和声音各自都像真的,但第二镜头的人可能说了第一人的台词,背景敲门声也可能消失。只看一个总分,发现不了是串音还是漏事件。 方法直觉:先给每条要求填一张卡,写清谁发声、什么时候响、声画各要满足什么。生成后按同一份结构化清单逐项核对。 本文贡献:CAST-Bench 先从网络视频统计声源,再由专家与语言模型划分九类声源,每类 100 条。为每条指定主体、声源、事件和镜头,再用 GPT-5.5 渲染成自然语言,经专家校验。900 条中 439 条单镜头、461 条多镜头,合计 2499 个镜头,覆盖九种语言。18 个指标按画面表现、内容一致性、音频与语义对齐分组,组合专用模型与多模态裁判,检查声源匹配、嘴型、说话人身份和台词。 Figure 2|左上从网络视频统计到专家和语言模型分类、结构化元数据、GPT-5.5 渲染提示,再由专家核验补齐覆盖。左下是 900 提示、2499 镜头、九种语言和九类声源。右侧展示画面、内容及声音语义共 18 项指标,单、多镜头分别报告。 实验效果:单镜头评 12 个系统,九个共同系统另评多镜头。只看其中音频与语义对齐的 0–100 分,Veo 3.1 单镜头单人 76.23、多人 70.55,多镜头单人 54.61、多人 50.39。Kling 3.0-Omni 对应 71.10、68.00、58.88、55.94,单人单镜头两者顺序与多人多镜头相反。论文按子集分别评分,并报告每模型抽 50 条、每条三名标注者的对照。 Table 3|音频与语义对齐分为 0–100。先区分单镜头与多镜头,每组再区分恰好一位说话人与多于一位说话人,比较九种系统。 批判点评:多镜头协议增加跨镜头任务,分数差反映不同难度和打分规则,不能当作完全同条件的因果降幅。常见接口生成约 10 秒,Veo 为 8 秒,模型条件也影响排名。多路裁判与生成都有成本,原文未给统一单条延迟。官方仓库提供提示与评测入口。 趋势观察 参考信号要分清职责 FlashRelight 用源视频定身份动作、用参考片定灯光。Chronos 用参考照和时序锚帧造新片,HME 让参考片只提供光流。测试需要分别验收内容保留和实际控制。 稳定还要留出动作空间 Disen-Forcing 在 30 秒 Self-Forcing 对照中,把全头缓存的动态分 35.66 提到 73.12,同时首尾成像差由 3.40 变为 4.03。两项都报,才看得清取舍。 少步蒸馏按任务和分布选信号 Route-DMD 给分离单独走干净目标回归。FisherDistill 在 DMD 生图上把 FID 从 2.64 降到 1.40,靠冻结教师特征的协方差描述生成分布偏差。 返工清单与验收分母各有用处 ArtiVidRM 用瑕疵清单给 Veo 3.1 重写提示,成像分改善而主体一致性几乎不变。CAST-Bench 按镜头数和说话人数拆分,揭示跨镜头说话人归属的薄弱环节。 今日讨论 FlashRelight 在 10 位未见受试者、16 条环境光序列上把身份相似度从 DiffusionRenderer 的 0.6143 提到 0.8097,借参考视频换光却只有定性样例。如果手里有同一个人打两种动态光的成对视频,如何验证迁光后的灯光变化和身份保留各自达标,并让只复制原视频的对照无法通过? 人工智能炼丹君 整理 | 2026-11-09
-
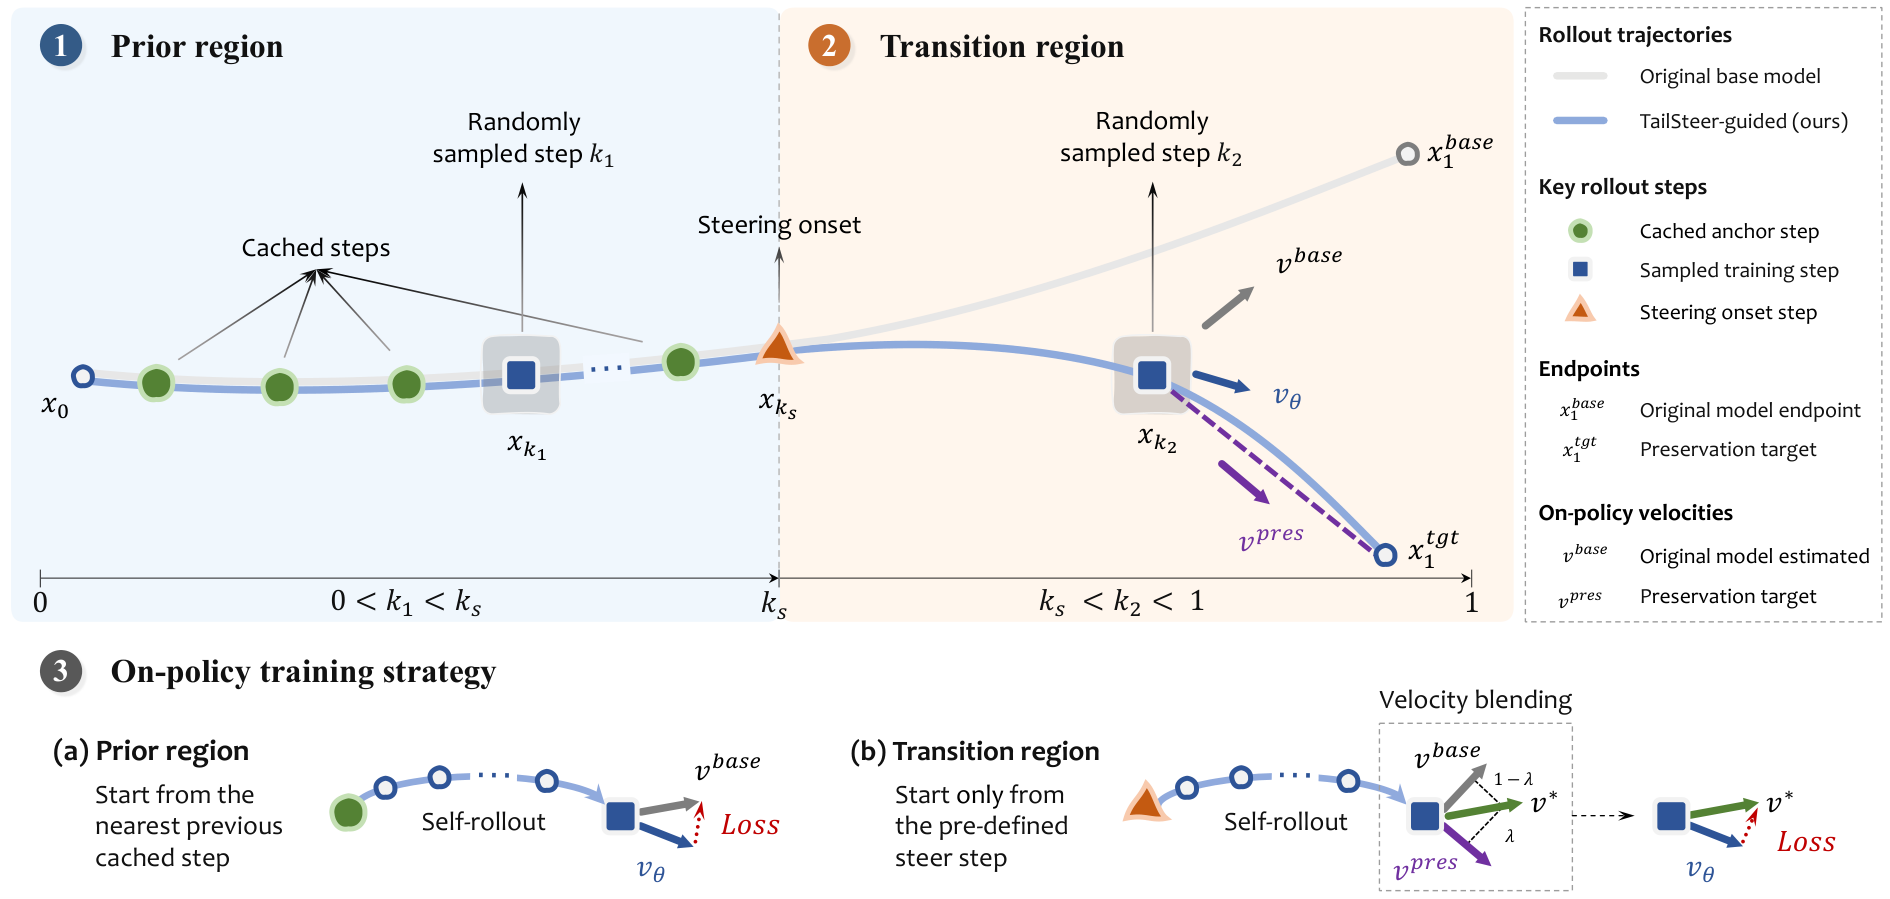
AIGC 每日速读|2026-11-06|港中文连续改图少跑偏TailSteer 今日 AIGC 论文速览 今日共 10 篇 · 多轮图像编辑与参考视频生成 2 篇 · 实时视频音效 1 篇 · 长视频缓存压缩 2 篇 · 少步图像与视频训练 3 篇 · 情绪视频对齐 1 篇 · 复杂多参考生成评测 1 篇 重点论文标题列表 TailSteer(港中文):连续改图别把旧细节磨掉 DualCast(浙江大学):商品和主播两张参考各司其职 LiveFoley(莫纳什大学):看着视频现场补音效 NanoKV(浙江大学):视频历史压小但不承诺同比提速 NextGAN(西湖大学):先教判别器指对生成方向 选读入口:反复改图总磨掉背景,先读 TailSteer 的保留与成功率取舍;想用商品图加主播图新生成视频看 DualCast,不要把它当原视频动作编辑。游戏或交互配音读 LiveFoley 的 156 毫秒口径;显存不够读 NanoKV 与 VAR-Q,前者需拟合、后者免校准。做少步生成训练,按梯度信号 NextGAN、文字监督 NitroFusion2、轨迹分布 VA-TDM 依次选;需要情绪表演对齐看 EmoReward,复杂多参考验收看 LongBanana 的逐项清单与通过率。 今日论文速览 1. TailSteer:连续改图别把旧细节磨掉 TailSteer: Trajectory-Tail Steering for Drift-Resistant Multi-turn Image Editing | 香港中文大学;商汤;上海人工智能实验室 | arXiv:2611.06741 关键词:多轮图像编辑, 轨迹尾部训练, 在策略监督, 内容保留 前序问题:给人物连续换衣服、改发型,十几轮后连没有要求改变的脸和背景也变了。单次编辑分高,不能保证把输出反复作为输入时仍保住旧细节。 方法直觉:去噪早期负责大结构,末尾仍能修正细小漂移。让早期像原模型一样走,只在轨迹尾部逐渐拉回本应不变的区域,避免为保真牺牲整段生成能力。 本文贡献:冻结原编辑器,用无改动和局部编辑指令生成轨迹,经检查得到保留掩码。目标端点在保留区复制源图,其余区域沿用模型自己选定的编辑结果,不需要人工配对目标图。训练副本在前段拟合原模型速度,后段混合原速度与指向保留端点的速度;监督点来自副本自己实际到达的状态,即在策略训练。缓存早期锚点缩短回放,尾部从固定起点连续走;只反传采样点,不穿过整段回放。推理只用一个训练后的模型,不切模型或附加保真模块。 Figure 5|TailSteer 在策略训练:分别随机取早期状态和尾部状态;早期监督原模型速度,转向区逐渐混合原速度与指向保留端点的速度。早期从最近的前置缓存锚点回放,尾部固定从转向起点回放;在训练副本实际到达的状态重算目标,仅对所取一步的预测反传。 实验效果:四个底座覆盖 FLUX、SenseNova 和 Qwen,训练各 2000 次更新、有效批 16、8 张 H100。FLUX.2 Klein 9B 每次编辑 50 步、训练从第 46 步开始转向保留目标:Add & Preserve 十轮非编辑区 PSNR 峰值信噪比 13.85→19.96dB,SSIM 结构相似 0.289→0.621,感知距离 LPIPS0.524→0.290。累计对象准确率 31.02%→31.84%,但 MSE-Bench 第五轮成功率 40%→33%;单轮 GEdit 英文 7.47→7.52,中文 7.42→7.39。15–20 轮示例只是可视化,不是平均成功率。 Figure 8|Add & Preserve 十轮编辑的框外漂移指标。TailSteer 在全部底座降低漂移,保留能力接近或超过 GPT-Image-2.5-Sunburst;虚线表示 TailSteer-Klein 绕开轮间 VAE 重新编码后的进一步收益。该图评价保留,不代表所有编辑成功指标都提升。 批判点评:保留背景与执行新指令是两个目标,起始步越早未必越好,不能称所有指标全面提升。“无需配对数据”仍需 11947 张候选源图、轨迹生成和筛选;并非零数据训练。推理沿用原步数,但未给统一新增墙钟或显存测量。原文给出的项目页本次返回 404,未确认可用代码或权重;本次未运行训练。 2. DualCast:商品和主播两张参考各司其职 DualCast: Dual-Image Conditioned Diffusion Transformers for Digital Human E-Commerce Video Generation | 浙江大学;蚂蚁集团 | arXiv:2611.05825 关键词:参考视频生成, 双图角色分离, 区域加权, 电商数字人 前序问题:拿商品图和主播照片生成展示视频,模型可能只认商品,把人物挤出画面;也可能人物很像,包装文字却变了。两张参考承担的职责不同,直接混在一起会互相争抢条件。 方法直觉:给“卖什么”和“谁来卖”固定入口:商品放序列前端,人物放后端,中间才生成视频;训练时对商品和脸部错误多扣分。 本文贡献:以 Wan2.2-I2V-14B 扩散 Transformer 为底座。VAE 变分自编码器分别把两张图压为潜变量,固定在时间序列两端;只去噪、监督、解码中间视频,不输出参考帧。CLIP 图像语义编码各 257 个 token(特征单元),与文字一起做交叉注意力。背景、商品、脸和交叠区损失权重 0.5/2/2/3;按 2:1:1 概率训练双参考、仅商品、仅人物。保留底座高低噪声双专家分工,在各自噪声区间微调。训练集 1 万段含合成视频,非 1 万段真实拍摄。 Figure 2|DualCast 总览。商品和人物分别 VAE 编码,固定于扩展潜序列前后边界;仅中间视频潜变量去噪、监督及解码。两参考的 CLIP 嵌入与文字一起作交叉注意力上下文。商品与脸掩码决定区域加权,条件丢弃让同一模型支持双图、仅商品、仅人物三种输入。 实验效果:独立 150 组留出商品/人物,生成 720×560、81 帧;不兼容方法用最接近比例。五维感知分由多模态模型按 0–5 打分再除 5,平均 0.9848,对 VACE0.9224;脸身份指标 ID-Adj0.8517,对底座 0.8206、Wan2.7 的 0.8498。11 个单指标平均名次 1.73,非 11 项全胜。两阶段各在 128 张 A100 训练 8 小时。附录推理统计混合六个方法,不能把双参考均值 867 秒直接归给 DualCast。 Table 1|语义一致、五维感知质量和视频质量的定量比较。感知原分除 5 归一到 0–1,5D Avg 是其算术平均;平均名次计算 11 个独立指标并排除 5D 平均,并列用平均名次。只有平均名次越低越好,其他越高越好;†为本方法底座,粗体为最优、高亮为本方法名列第一的指标。 批判点评:这是双图条件下新生成展示视频,并非保持任意原视频动作的参考编辑。自动时序诊断仍标出 14/150 商品变形、13/150 重影,属于模型疑似标记而非人工确诊;零身份漂移标记不等于绝不换脸。主表高分依赖固定模型裁判,跨域广告和真实直播仍需核验;原文未给可确认独立代码地址。 3. LiveFoley:看着视频现场补音效 LiveFoley: Dynamic Real-Time Video-to-Audio Generation for Immersive Interactive Worlds | 莫纳什大学;南京大学;生数科技;坦佩雷大学;阿里巴巴;清华大学 | arXiv:2611.05988 关键词:流式视频生音频, 滑动窗口, 因果扩散, 延迟预算 前序问题:画面里敲了一下门,声音迟半拍就出戏。等整段视频再配音能看全动作,但无法边玩边听;把视觉窗口缩短又容易看不清动作。 方法直觉:保留一整窗历史,让窗口尾端贴住最新帧,只输出新到帧的特征。音频去噪再看看已经生成的声音,既不断上下文,也不用等未来。 本文贡献:冻结 Synchformer 视觉编码器,每个窗口 16 帧,25 帧每秒下覆盖 0.64 秒;步幅 1/2/4 个 token 分别只需等待 0.08/0.16/0.32 秒。两层 Synchronizer 把不同步幅特征对齐,音频后端统一每秒 12.5 次生成、每段 80 毫秒。History LocDiT 局部流匹配头读前两段干净声音;可选 Future-Warmup 同时预热下一段,用当前隐状态加未来视觉近似条件,下一段丢弃并在下一轮重生,额外等 80 毫秒。因果声学 VAE 支持 16kHz 单声道和 48kHz 立体声。 Figure 2|流式视觉前端。每点表示一个位置的 token。(a)缩小分块窗口会减延迟也缩感受野。(b)窗口尾贴最新帧,保持完整历史感受野,只等一次步幅;黑点为新输出,灰点为历史、虚点为首帧填充,只供编码上下文、不输出。(c)Synchronizer 把不同步幅的 token 映射到共享空间,一个后端切换步幅。 实验效果:约 2000 小时、74.5 万段训练;VGGSound 完整测试中,48k 版 DeSync 声画错位代理 0.48,离线 MMAudio-L0.47,低更好。16k 版 PANNs 特征分布距离 9.56,对离线 8.48,仍有质量差距。人听平均意见分:音质 MOS-Q3.23、同步 MOS-A3.58,离线同步 3.79。单 A800、步幅 1 默认 History 首段可播放音频 156 毫秒,包含 80 毫秒前端等待;236 毫秒为在该测量上加 80 毫秒未来等待的估算。步幅 4 让前端调用频率减为四分之一,不等于全系统快四倍。 Table 1|VGGSound 系统比较。前端等待为编码新分块或步幅前必须缓冲的视频时间;离线模型先看完整段。在线 MMAudio 是作者免训练改造。粗体/下划线为各在线或离线组最好/次好;灰色为无官方权重的引用结果、不排名。WorldSonus 的 0.10 秒是 30 帧每秒下 3 帧;LiveFoley 的 16/48kHz 均默认 History LocDiT、步幅 1。 批判点评:模型必须对已听见的声音立即承诺,突发事件与长程声学延续仍受因果约束;不能把在线领先写成整体胜过离线。感知延迟阈值来自特定用户实验,不保证节奏游戏所有人都无感。官方项目页提供演示,官方代码仓库目前只写 Code coming soon;本次未运行模型测时。 4. NanoKV:视频历史压小但不承诺同比提速 NanoKV: High-Ratio KV Cache Compression for Autoregressive Video Generation | 浙江大学;英伟达 | arXiv:2611.06377 关键词:视频缓存压缩, 键值分工, 低比特残差, 混合维度注意力 前序问题:长视频越续写,历史键值缓存越占显存;一刀切压缩会忘掉场景。即使存小了,注意力前再解回全尺寸,也可能更慢。 方法直觉:把相似历史共有的内容存一次,剩余差异才压缩;负责“查哪段”的键要保住注意力输出,负责“取什么”的值要保住低比特内容,两者分开训练。 本文贡献:冻结视频主干,在线聚类中心共享内容,把多头与通道合并后的残差投影为 INT4 四比特系数,同时存中心索引和尺度。键解码器按连续网络块输出对齐;值编码/解码器在实际量化路径上拟合。基础版还原全维键值后计算注意力,Fast 版另拟合低维读取器,敏感层、头或历史保留全维,按统一 softmax 归一合并。48 条轨迹拟合,每种设置用 100 张图×4 相机动作即 400 段视频评估;拟合不包含测试图。 Figure 4|NanoKV 总览。(a)多头通道联合编码,把历史存为系数和共享中心,基础版全维读取,Fast 版混合维度读取。(b)残差编码为 INT4,解码后加回中心。(c)键解码器用块输出对齐,值编码解码器用量化感知拟合。(d)固定策略把历史分到全维/低维注意力;低维分支先降低查询维度,恢复输出维度后用 LSE 即对数求和指数统计合并。 实验效果:单 A100 的 HY-WorldPlay:计入附加存储的 KV 由 20.96GiB 到 0.80GiB,有效 26.09 倍,名义系数 32 倍。对同输入未压缩输出的 PSNR19.56dB,比 KVTC18.56 高 1dB;它不是对真实视频的保真。端到端加速比基础版 0.96、Fast1.06,1 以下更慢;Fast 的 PSNR 降为 19.04。进程峰值 NVML 显存 58.70→38.56GiB,并未压成原来的 1/26。另一 LingBot 主干 Fast 加速比仍仅 0.98。 Table 1|质量、压缩与效率比较。括号内是名义系数压缩率,有效 KV 压缩含附加存储;总 KV 单位 GiB。PSNR/SSIM/LPIPS 对同输入未压缩生成比较,非真实视频;VBench 评整体质量。原模型列绝对端到端秒数,其余列原耗时除方法耗时的加速比,低于 1 表示更慢。 批判点评:场景一致性、缓存大小、总显存与墙钟必须分别看。Fast 省的是历史注意力计算,后期近似误差还会累积;编码拟合也不是免训练量化。官方代码可见三底座集成、拟合和推理说明,未在本机复现其 GPU 结果。 5. NextGAN:先教判别器指对生成方向 NextGAN: Towards Simple and Scalable GAN Training for Image and Video Generation | 西湖大学;剑桥大学;浙江大学;独立研究者 | arXiv:2611.06270 关键词:少步生成, 梯度回归, 冻结表征, 对抗训练 前序问题:判别器只告诉生成器“像不像”,没有明确教它往哪改。一步生图没有后续纠错机会,训练给出的梯度方向尤其关键。 方法直觉:在真实与生成特征之间选中间点,直接教判别器的输入梯度指向真实特征。生成器仍沿这个标量势函数上升,不把整套采样流程换成新的求解器。 本文贡献:同条件下独立配对参考/生成特征,在线段插值点回归两端位移。标量 critic 是可训练打分势函数,输入梯度才是被监督的方向;固定生成器时,这等价于带梯度能量惩罚的对抗目标。图像用冻结视觉编码器,视频用关掉 LoRA 低秩适配器的原 Wan 主干作表征,再加势函数头;训练时交替更新判别器与生成器。视频随机回放长度,只反传最后一次去噪,不需要在线教师速度或预存教师轨迹。 Figure 2|NextGAN 如何教生成器。生成和真实特征的插值点上,先把标量 critic 的输入梯度训练为两端位移,端点停止梯度;再固定 critic,让生成特征沿势函数上升。曲面画的是负势函数,所以上升看起来向下。两次更新在训练中交替。 实验效果:ImageNet256×256 潜空间 DiT-XL/1 一次网络计算 FID 分布距离 1.54,对抗形式 1.36;像素 JiT-B 为 2.87,低更好且设置不同。832×480×81 帧,Wan2.1-1.3B 一次/两次/四次网络前向的 VBench 总分 80.80/83.13/82.72;两次比 rCM 高 1.25 分、AnyFlow 高 0.47 分。14B 两次为 82.73,同规模 AnyFlow 仍领先。步数/前向不是实测墙钟,未据此宣称同比倍速。 Table 2|832×480×81 帧的文字生成视频 VBench 结果,按参数规模和 NFE 网络计算次数分组。是否需要在线教师评分单独标注;同一步数和规模下比较,不把 1.3B 排名外推到 14B。NextGAN1.3B 两次总分 83.13,14B 两次 82.73,14B 仍有更强对照。 批判点评:更多步数没有保证更高总分;不依赖在线教师也仍需预训练主干、冻结特征反传与交替对抗优化。理想粒子动力学收敛条件不能当有限神经网络必然收敛。原文所列 LINs-lab/NextGAN 仓库,本次 GitHub 读取返回 404,代码可获取性未确认,不宣传能立刻复现。 6. NitroFusion2:一步生图也得把字写对 NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers | 萨里大学;Turing Elite Research Labs | arXiv:2611.05648 关键词:对抗蒸馏, 文字流监督, 按属性判别, 少步图像生成 前序问题:一步画海报容易让字母糊成纹理。只用图像特征区分真假,会奖励画面锐利,却不一定检查文字是否真的拼对。 方法直觉:联合注意力里的文字 token 已经读过图像,让它来当判别器的观察口;每次只问字体、物体或布局等一个方面,监督就能对准对应错误。 本文贡献:学生和冻结判别主干都从 Z-Image-Turbo 初始化。TSAD 即 Text-Stream Adversarial Distillation,在文字流中间注意力输出接轻量判别头,保留图像流头;独立文字编码器没有读图,不能直接提供这种图像梯度。ACD 即 Aspect-Cued Discrimination,按图像标注文字、物体、风格、背景、动作、布局六方面,加完整描述共七类提示,每步均匀抽有效项。学生仍读原提示,裁判读抽到的提示并路由专门头,共用一次主干计算。参考训练图 10 万张,由 12 步底座生成,中英各半。 Figure 2|TSAD 与 ACD 架构。TSAD 在文字 token 中间状态接判别头,并保留常规图像流头。ACD 从图像构造有证据支持的属性字段,每训练步抽一项作为裁判条件并选择对应文字头,让判别聚焦该属性。 实验效果:6B 即 60 亿参数,一个模型支持不同步数。一次前向 NFE=1 时,LongText 英文 43.34、中文 47.78,对 TwinFlow29.18/36.85;GenEval 组合正确 75.86、DPG 复杂指令 86.48。两次文字分 76.03/81.95,但 GenEval74.46 低于底座两次 76.53。八次底座文字分 91.74/92.56 仍明显更高;不能把一个指标超过八步理解成整体等质八倍快。 Table 1 和 Table 2|Z-Image 少步学生与 GenEval 细分,原 HTML 把两表放在同一复合图。参数、NFE、中英文文字渲染、组合、复杂提示和整体质量分别比较;两步 Turbo++为 6B+6B 两套权重。GenEval 保留单物体、双物体、计数、颜色、位置和颜色属性六类,不能把总分替代所有任务都胜出。 批判点评:它把训练信号从局部纹理扩展到提示描述的属性,但极复杂布局仍难;所有消融共 1000 训练步,不等于最终模型总训练预算。两步 Turbo++用两套 6B 权重,不能当成同一 6B 模型对比。尚缺同硬件完整墙钟与峰值显存测量。官方项目页列出官方推理代码、权重和 ComfyUI 流程;推荐两步流程第一步额外用 0.5 强度去蒸馏 LoRA,第二步关掉,复现须区分与主表的采样配置。本次未跑模型。 7. VA-TDM:四步学生要学自己真会走的路 VA-TDM: A Unified View for Improving Few-Step Diffusion Models by Velocity Adversarial Distillation | 香港科技大学;香港中文大学深圳 | arXiv:2611.06796 关键词:速度对抗蒸馏, 轨迹分布匹配, 双形式监督, 四步生成 前序问题:把 50 步教师压成 4 步,学生的中间图仍带噪,直接拿最终干净图再加噪训练裁判,可能学的是另一种分布,给学生错误方向。 方法直觉:沿学生自己走过的每段轨迹监督速度,既用稳定但只约束平均内容的信号,也用更完整但方差高的分布信号,让两者共同教同一个学生。 本文贡献:VAD 即 Velocity Adversarial Distillation,用可学习 critic 估计教师与学生速度差。A 形式从学生干净预测构造低方差速度,匹配条件均值;B 形式跟随中间状态再加噪,连接真实学生分布的 score(对数密度梯度)。两套在线场共用骨干、分输出头,显式输入当前转移终点;混合两种生成器更新并对 critic 输出停止梯度,避免不稳定。教师速度正则需相应修正 critic 比例。先沿学生轨迹做教师常微分方程回归预热,再做各段分布匹配,不只是对最终图训。 Figure 2|critic 输出是否停止梯度的比较。让梯度穿过未停止的 critic 输出会导致不稳定并崩溃;实际 VA-TDM 采用停止 critic 输出的更新。此图是训练机制证据,不是模型架构图。 实验效果:每次学生生成 4 次网络前向,记 4 NFE。SD3.5-Medium 的 GenEval0.67,对四步 TDM0.61;文字识别 OCR0.59 对 0.57。FLUX.2 Klein4B 的组合 0.80 对官方四步 0.78,同提示图像间 LPIPS 多样距离 0.56 对 0.47,但 PickScore 偏好代理 0.8694 低于 0.8746。教师 50 步的无分类器引导每步有条件/无条件两分支,计 50×2=100 次前向。还扩到 33B 音视频 H3,不能把 100/4 当实测 25 倍端到端加速。 Table 1|分底座的四步系统评估。每底座少步配置最好/次好用粗体/下划线标注;保留可核验组合与 OCR、画质、美学及偏好、多样性各列。教师 50 步有条件与无条件两分支计 100 次 NFE,学生四步计 4 次。FLUX 的 PickScore 并非最优,不称全指标领先。 批判点评:共享辅助骨干节省的是两套在线场训练成本,蒸馏本身仍要教师与预热;正文未给统一部署墙钟和峰值显存。A/B 理论匹配依赖精确场等假设,实践停止梯度也有意改变梯度,不能直接套完美收敛结论。官方代码给出 SD3.5 四步学生参考训练;不等于 33B 模型全套训练资产已公开。 8. EmoReward:别让假笑骗过视频奖励 EmoReward: Self-Evolving Reward Calibration for Emotional Video Generation RL | 香港科技大学;腾讯混元;复旦大学;滑铁卢大学 | arXiv:2611.06518 关键词:情绪视频生成, 奖励校准, 证据有效性, 跨训练记忆 前序问题:“克制的悲伤”不一定需要夸张表情。固定奖励若总偏爱大幅动作,生成器可能挤出假笑和过量肢体运动,把评分抬高却演错情绪。 方法直觉:先把情绪拆成可观察线索,再问每条线索在当前画面是否可信;从一次已完成训练中归纳哪个裁判可靠,用固定权重表指导下一次训练。 本文贡献:Plan 生成情绪脚本,含愉悦度、唤醒度、面部动作单元 AU、身体线索和表达时间窗;Act 只评分已经生成的视频。七个奖励提供器参与融合,色彩和运动强度另作辅助观测,共九通道,不能说九个全进记忆校准。Reflect 按训练阶段、脸置信度、冲突和微妙表达门控,剔除无效证据后归一权重;RewardMemory 从完成的参考轮次估相关性,导出有界乘数,下一轮固定不变。只有生成器接受强化学习梯度,裁判和记忆不在线更新。 Figure 2|EmoReward 在当前视频和跨训练轮次校准情绪证据。Plan 把意图变为评价准则,Act 返回分数和证据有效性;Reflect 把当前门与记忆乘数结合,对活跃提供器归一。Evolve 从已完成参考训练估计情境可靠性,构造下一轮固定乘数。情绪奖励补充原视频奖励;GRPO 更新生成器,提供器与记忆表保持冻结。 实验效果:HunyuanVideo1.5、批 2、每提示 4 个候选,独立 302 个情绪提示;在 SAGE-GRPO 上 VideoAlign 总体加 0.5645。VideoAlign 也参与优化,因此该增益不是独立情绪真实性证明。18 人对 30 提示三档评价,每方法每维 540 个判断:情绪“好”60.0%对 SAGE53.0%,时序 54.3%对 51.5%,画质 57.2%对 45.0%。它们是好评比例,不是配对胜率;自动偏好与文本对齐变化不全为正。 Table 3|18 位参与者对 30 个提示进行情绪保真、时序连贯和画质三档评价;每方法每维 540 次判断。粗体表示每维最高 Good 比例,百分比保留一位小数。保留 Bad/Normal/Good 完整分布,好评比例不当成配对偏好胜率或独立样本人数。 批判点评:记忆可靠性与原评价器有信息重叠,仍缺匹配全局记忆对照来单独证明按情境校准的收益。人评需按参与者和提示处理重复判断,不能把 540 次当 540 个独立人;跨图像底座部分预算也不等。七路评分增加后训练成本,未报告统一开销。官方仓库已可读,未运行其中训练流程;名称“自演化”不代表运行中自己重训奖励模型。 9. VAR-Q:按视频生成块保护缓存大数 VAR-Q: Tuning-free KV Cache Quantization for Visual Autoregressive Image and Video Generation | 加州大学圣巴巴拉分校;明尼苏达大学 | arXiv:2611.05380 关键词:视觉自回归, 免校准量化, 块通道分组, 比特打包 前序问题:把语言模型的缓存量化搬到视频上,一样的四比特可能忽然让画面崩掉。视觉模型一次生成一帧或一尺度,数值结构不等于逐字生成的连续 token 流。 方法直觉:少数大数承载关键功能,量化一组时不能把大数与小数混在同一标尺里。沿特征通道和生成块同时切分,直接借用采样循环已有边界。 本文贡献:分析发现键的大数受投影权重、归一化通道增益和 RoPE 旋转位置编码共同影响,值更依赖输入。对每个“通道×生成块”单独设对称量化尺度,默认子块比例 r=1;减小 r 在块内再细分,增加尺度存储但不需检测或校准。键和值共用分组规则。Triton 内核把低于 8 比特的整数实际打包到字节、读取时解包,避免只把数值量化却仍按 16 比特存。覆盖逐尺度图像/视频和逐帧视频九模型,无需微调主干。 Figure 8|VAR-Q 流程。缓存按通道与生成块两个轴分组,各组量化并由位打包内核压缩存储;生成块边界来自模型的逐尺度或逐帧循环,不另检测大数。 实验效果:A10080GB 上,Self-Forcing1.3B 的 5 秒视频、批 12,INT4 缓存 67.49→16.95GB,省 74.88%;VBench 总分 82.94→80.99,低 1.95 分。LongLive1.3B 的 30 秒、批 20,INT4 总分 80.92→79.60;INT6 为 80.94,但缓存省 59.25%。Infinity-8B 在 INT3 的组合准确 83.28,距 BF16 的 83.54 低 0.26 分。GB 是十进制容量,别与 NanoKV 的 GiB 混算;各主干位宽和序列不同。 Table 4|逐帧 Self-Forcing5 秒与 LongLive30 秒生成,列键值缓存 GB 及相对 BF16 降幅。质量粗体/下划线为最好/次好;分别保留 VBench 主体、背景、平滑、动态、美学和总质量,以及视觉模型的画质、动态与文字评分。Self-Forcing 批 12、LongLive 批 20,不能横跨两个模型直接比容量;INT4 质量存在退步。 批判点评:不能把“最高 78.5%省缓存”与“几乎不掉质量”当所有四比特配置都成立;视频低位宽仍有明显取舍。最大 6 倍批量是容量受限下的批大小,不是每条视频六倍提速;此处不据摘要上限外推吞吐。原文只说早期版本曾在 ICCV2025 工作坊展示,不标主会接收,尚未核到可用官方实现链接。 10. LongBanana:三十多张参考能否真正用对 LongBanana: An Expert-Verified Benchmark for Long-Context Multi-Reference Image Synthesis | 华南师范大学;不列颠哥伦比亚大学;Vector Institute;加拿大 CIFAR AI 讲席;卡内基梅隆大学;滑铁卢大学;可灵研究;马里兰大学;清华大学;香港科技大学;香港大学 | arXiv:2611.06856 关键词:多参考图像生成, 关系约束, 原子清单, 生成评测 前序问题:把 32 张人物和物品参考交给生图系统,画面好看却可能漏人、串身份或站错位置。一个整体美学分数看不出究竟漏了哪项要求。 方法直觉:把“谁、什么属性、和谁有什么关系”拆成图结构,再变成可核查清单。评估器逐条找证据;生成工作流则能检查中间图,决定补查参考或修图。 本文贡献:90 任务按 3×3 分类,每例约 32 张参考、20 条约束,总计 4670 个原子检查。检查按内容、关系绑定和全局约束分工,评分 0/1/2 表示未满足/部分或不确定/满足;负项要求“不出现”时,正确缺席给 2。RPR 工作流依次取证推理、计划执行、反思修图;图像仍由生成模型输出,非纯语言推理榜。人评覆盖 90 任务×10 配置=900 图、46700 次检查,其中 15%即 7005 项双标,一致率 89.4%、加权κ0.83。 Figure 4|LongBanana-Eval 流程。解析器为每项拼装相关参考证据,路由给内容保真、关系绑定、全局约束三类裁判;裁判检查证据、按需调用核验工具,返回标签及支持轨迹。逐项平均得到各维及整体分。 实验效果:固定 Nano Banana2,OpenClaw 加 RPR 使非加权清单均分 76.1→78.4;P@70%即难度加权得分至少 70 的任务比例 40.0%→47.8%,与 OpenCode 最简配置并列,非唯一最好。OpenCode 加 RPR 均分 77.3→77.8 但通过率 47.8%→43.3%。自动清单裁判与人类三档精确一致率 66.81%,普通单次视觉模型 50.99%,仍有 24.81%完全相反的 0/2 错误。 Table 2|留出 90 任务,固定图像底座 Nano Banana2,只比较生成外壳与工作流。九子类和 Overall Avg 是 0–100 非加权清单平均,P@70%是难度加权得分至少 70 的任务比例;均越高越好,粗体/下划线最优/次优。比较直接、分解、最简代理和加 RPR,不把均分与通过率混同。 批判点评:这是复杂条件图像合成评测,不能因有智能体就外推通用代理能力。直接分解基线能看到构造关系图,代理看不到,比较需保留该不对称。RPR 多次生成、检查和调用工具,未给同成本结论;均分涨也可能通过率跌。官方项目页及仓库明确声明已被 NeurIPS2026 接收,arXiv 评论标评测数据轨道。公开仓库另有新接口,与论文固定实验配置并非逐项相同,不能直接当原表复现。 趋势观察 保留与编辑要同时验收 TailSteer把十轮背景PSNR推至19.96dB,却在所选起点让第五轮成功率40%降至33%;不动的地方更像,不等于该改的都改对。 压缩比不是整机倍速 NanoKV有效KV压26.09倍,基础版墙钟反而稍慢;VAR-Q省的是低比特缓存。容量、峰值显存、吞吐与每段延迟分别计量。 少步学习的监督口在移动 NextGAN教判别梯度方向,NitroFusion2读取看过图像的文字状态,VA-TDM监督学生真实中间分布;少步不是只删采样循环。 评分要回答具体问题 EmoReward的人评好评与优化器分数不同;LongBanana均分78.4也只有47.8%任务跨过加权70分门槛。报告分布、协议与成本,才知道能否用。 今日讨论 TailSteer 在 FLUX.2 Klein 从第 46 步加强保留,十轮非编辑区 PSNR 由 13.85 升到 19.96dB,但 MSE-Bench 第五轮成功率 40%降到 33%。若用于连续换装,应如何验证保留背景与执行新指令同时成立,避免把没改对但更像原图的结果误当成功? 人工智能炼丹君 整理 | 2026-11-06
-
AIGC 每日速读|2026-11-05|吉大换主角也留下原表情ReXMo 今日 AIGC 论文速览 今日共 10 篇 · 参考视频编辑 1 篇 · 高分辨率与图内文字编辑 2 篇 · 视频续写与像素生成 2 篇 · 图像蒸馏与推理搜索 2 篇 · 可控语音与空间音频 2 篇 · 数值属性控制 1 篇 重点论文标题列表 ReXMo(吉林大学):换了主角也要留下原表情 FLASH(复旦大学):小图定编辑大图接着补细节 FlowTranslator(复旦大学):把招牌换成译文还留下街景 ReCR(斯坦福大学):长视频该记住哪些旧画面 U-JiT(Meta):不先压视频也能补回高频 选读入口:需要参考照片换视频演员,先读 ReXMo,特别区分真实换角和往返重建;要改 4K 海报接着读 FLASH 的 309.69/215.31 秒取舍,改街景招牌读 FlowTranslator 的固定译文协议。续写越长越跑偏看 ReCR 的历史选择与显存增长,研究基础架构看 U-JiT 的 128/256 分辨率条件。做四步生图训练读 StepX-OPD;语音服务读 TTSonic 的内容/音色拆分,空间音频编辑读 Spatial Transfusion。愿多花推理算力再看 PATTS;需要明确属性刻度最后看 ScoreDial 的独立审计,避免把代理分数当物理事实。 今日论文速览 1. ReXMo:换了主角也要留下原表情 ReXMo: End-to-End Video Character Replacement with Expression and Motion Preservation | 吉林大学 | arXiv:2611.04633 关键词:参考视频编辑, 角色替换, 成对三元组, 表情适配器 前序问题:把双人表演的一位演员换成参考照片中的人,动作骨架相同,嘴角和眼神却可能变了;两人靠近时,表情还会串给另一人。只给姿态或挖空人物区域,难以保住这些细节。 方法直觉:先造出“动作与场景一样、身份不同”的视频对,再倒过来训练:让模型从换过人的视频恢复原演员。全身替换学好后冻结它,另给每位演员接一条表情信息通道。 本文贡献:底座为 Wan2.2-TI2V-5B。训练三元组是合成驱动视频、原视频和原身份参考帧;驱动潜变量与带噪目标按通道拼接,参考图另编码为上下文 token(特征单元)。冻结预训练主干、自编码器和文字编码器,只更新秩 80 的 Motion LoRA 低秩适配器及扩展输入层。第二阶段用约 3 万段 512×512 对齐脸部片段,冻结运动提取器,每 5 个扩散 Transformer 块插入一次表情交叉注意力;仅训 Face Encoder 和 Face Adapter,按演员对应关系注入。两阶段均用 97 帧、24 帧每秒片段,各训 1 万步;Wan2.2-Animate 只用于造训练数据,不参与最终推理。 Figure 2|ReXMo 两阶段:第一阶段用合成跨身份配对三元组学习参考引导角色替换;第二阶段冻结替换模型,用对齐脸部序列训练表情增强适配器,保留细微表情。 实验效果:合成跨身份基准先由原演员 A 生成新身份 B,再恢复 A,与原 A 比较,属于往返重建协议。单人 Pose-DTW(姿态动态时间对齐距离,低更好)由 SCAIL-2 的 0.0263 降到 0.0258,PCK@0.2(容差内关键点比例)0.9879→0.9890;多人距离 0.0314→0.0312。表情适配消融的 Expr-LMD(表情关键点误差)0.3415→0.2905、LVD(关键点速度差)0.0389→0.0288。人物替换感知评分中画质 4.32、时序 4.12、外观 4.39,但运动平滑 3.90 低于 SCAIL 的 3.92。 Table 1|合成跨身份替换基准的定量比较,分单人和多人。原视频 A 先改为 B,再恢复 A,用姿态动态时间距离、关键点正确率、关节速度及加速度误差衡量动作,用 PSNR、LPIPS、SSIM、均方误差衡量重建。各列箭头给出方向;这是往返重建而非任意换角的成功率。 批判点评:提升包含很小的重建差值,往返协议也不能等同任意真实视频换角的成功率。多人对应路由不是无条件解决遮挡;论文没有交代足够清楚的测试规模、统一推理墙钟与峰值显存,不能称实时或零额外成本。50 人偏好实验是配对选择,不当成 50 条视频。原文承诺后续公开数据与代码,未给可核验实现地址;标题机构来自作者地址脚注。 2. FLASH:小图定编辑大图接着补细节 Efficient and Faithful High-Resolution Image Editing with Sparse Cross-Resolution Denoising | 上海创智学院;复旦大学;阶跃星辰;香港中文大学 | arXiv:2611.04416 关键词:高清图像编辑, 跨分辨率去噪, 局部注意力, 渐进推理 前序问题:把海报改到 4K,直接放大模型网格会让注意力计算暴涨;先在 1K 修改再交给超分模型,又可能修清了纹理却偏离原来的编辑目标。 方法直觉:保留一条看完整张小图的编辑轨迹,高分辨率分支沿着它补细节。大图只读附近的源图和目标区域,先保证修改方向一致,再花计算恢复局部纹理。 本文贡献:以 FLUX.2 Klein Base 4B 为底座,在 VINS-120K 实际 131010 个样本上训练。冻结 1K 分支,只给高分支加秩 32 的 LoRA。信息单向从小图流向大图;大图查询读取对齐的小图带噪目标邻域,以及本尺度源图/目标的 Halo 扩展窗口。主配置小图半径 R=3,线性放大 n=2/4 对应 Halo 宽 h=Rn=6/12 个潜空间 token。按分辨率调整噪声时间,YaRN 扩展旋转位置编码。渐进版前 12 步只走 1K,再将干净估计解码、缩放、重新编码和加噪,余下 16 步由同一编辑器完成,非外接超分。 Figure 3|FLASH 总览:冻结 1K 分支锚定全局编辑,局部高分辨率注意力恢复细节,渐进推理以 1K 去噪前缀替代早期高分辨率步骤。 实验效果:1K/2K/4K 在此分别为 1024×1024、2048×2048、4096×4096 像素。509 条、12 类指令的 VINS-4KEval,质量按编辑类型宏平均。4K 主配置 28 步、单图,直接/渐进耗时 309.69/215.31 秒,含分辨率过渡但不含模型加载,减少 30.5%;HaarPSI 全图感知相似 0.4067→0.3775,保留区结构相似 mSSIM 为 0.7621→0.7369。独立 R=1 前向诊断 17.33→4.13 秒,注意力 15.2→0.60 秒,分别 4.2 倍和 25.3 倍;这不是主配置 R=3 的端到端加速。 Table 1|2K/4K 主比较,粗体/下划线为最好/次好,时间不排名。HaarPSI 用全图,mPSNR/mSSIM/mMSE 用保留区,mLPIPS 用编辑区,整体编辑时用全图。阴影行不接外部超分;时间是含完整生成、不含加载的秒数。直接/渐进 4K 为 309.69/215.31 秒,质量存在取舍。 批判点评:源图相似不等于编辑完成:这些指标主要衡量未改区域和源输出差异,不能证明每条指令都执行正确。扩大邻域并非各指标单调变好,渐进也有可见质量代价;未报告可统一比较的峰值显存。原文指向的 FLASH 仓库在本次 GitHub 读取返回 404,按暂不可获取报告,不宣称代码已开放。 3. FlowTranslator:把招牌换成译文还留下街景 FlowTranslator: Training-Free In-Image Machine Translation with Flow-Based Editing | 复旦大学;上海市多模态具身智能重点实验室 | arXiv:2611.04303 关键词:图内翻译, 免训练编辑, 噪声解耦, 位移反馈 前序问题:翻译照片里的招牌,文字翻对还不够:字要写进原位置,街景不能重画。源图与目标只差几个小字时,两条去噪路径太像,模型又容易原样输出。 方法直觉:先在文字区域稍微松开两条路径共用的噪声,让修改启动;等译文字形开始出现,再把已经形成的修改位移放大一点,末段停止放大以修稳笔画。 本文贡献:冻结 60 亿参数 Z-Image-Turbo。PP-OCRv5 识别文字和框,每图调用一次 Doubao-Seed-2.0-lite,生成原文/译文描述。每步用同一扩散 Transformer(DiT)分别预测源与目标速度,只在扩展 15%的文字掩码内累积速度差。RCR 即 Region Coupling Release,早期部分解除噪声相关,强度 0.5,从噪声时间 0.6 到 0.3 关闭;CE 即 Coupling Expansion,中段按 sin²时间门放大已有位移,强度 0.4。共 50 个求解步、前 45 步编辑,速度差增益 1.3;每步需源/目标分支,免训练不等于一次前向。 Figure 2|FlowTranslator:OCR 抽源文字,冻结语言模型生成目标译文描述;冻结 VAE 把源图编码成潜变量。每步同一冻结 DiT 预测源/目标条件速度,速度差更新编辑状态;RCR 在文字区扰动目标噪声,CE 将已累积位移放大再反馈。最终编辑潜变量解码为译文图片。 实验效果:PRIM 每方向 340 条真实文字条、5 种英译语言,EasyOCR 回读,BLEU 衡量译文词组匹配、COMET 估计翻译质量,均越高越好。对相同设置的 Masked FlowEdit,平均 BLEU16.9→20.6、COMET53.3→57.2;CE 单独 BLEU20.21,完整 20.57,主要收益来自位移反馈。1280 张 ScenePair 英译中,固定各方法文字框与目标译文,准确率 33.44%→40.08%,结构相似 SSIM0.9533→0.9509;这隔离的是指定译文渲染阶段,不是整条识别翻译链路。 Table 2|PRIM 的 EasyOCR 回读评测。BLEU 使用两套官方参考译文,COMET 使用 Google 参考译文,平均值由未四舍五入的各方向数值计算。五种英译方向每种 340 条,完整方法平均 BLEU20.6、COMET57.2;英译俄仍是明显弱项。 批判点评:俄文字形仍弱,英译俄 BLEU 仅 4.6;TTV 合成文字图基准的大字上的增益很小,且源图 SSIM 低于专门训练方法。掩码外潜变量不变也不保证解码后每像素不变。实验用单 RTX4090,但未给完整时延或峰值显存;外部 OCR 与商业语言模型同样有成本。未核到本方法官方实现,不将其引用的 FLUX 仓库当成源码。 4. ReCR:长视频该记住哪些旧画面 What Remains in Sight? Autoregressive Video Decoding as Representation-Guided Context Rewriting | 斯坦福大学 | arXiv:2611.04164 关键词:自回归视频生成, 历史选择, 位置重编号, 全历史缓存 前序问题:视频不断往后续,最近几帧看得清,开头的人和场景却忘了。盲目拉长注意力窗口很贵,而同一长度的窗口里,也可能塞满重复的近景。 方法直觉:每次续写前从过去挑一小组画面:既像整段故事、又能补充近期没出现的信息,还要保住早期与末端线索。挑完按时间顺序重新排成紧凑序列供模型读取。 本文贡献:不训练主干,每块生成 3 个潜帧。取第 20 层(从 0 计)的干净历史前向特征,逐帧平均并归一化,只计算一次。全局与近期摘要分别作早期/近期加权;贪心选择同时考虑全局相似、近期冗余、首尾覆盖和已选帧之间的重复。再最多交换一帧以扩展空间布局范围。全部层保存未加位置编码的键/值,每块选好历史后,在紧凑时间位置重新施加 RoPE 旋转编码。可见历史预算不超过原生窗口,不增加解码器前向,但保留所有过去键/值以便重选。 Figure 2|ReCR 不暴露全部历史或固定近期窗口,而用单元表示给历史打分,选择紧凑可见上下文。选择偏好表示效用、首尾覆盖,并减少重复;图中未画出的空间范围交换每步最多一次。之后按紧凑因果轴重编时间位置,再送给因果视频解码器。 实验效果:128 条 MovieGen 提示、四步因果主干,在 30/60 秒 VBench-Long 上报告。Self-Forcing 的综合质量 60 秒 78.19→81.60,Causal-Forcing77.41→82.08;该分数由七个质量维度汇总,不是完整 VBench 总分。并非单项全胜:Self-Forcing 主体一致 96.67→96.43。单 H200、批 1 的 60 秒续写,Self-Forcing 每块 728→712 毫秒,Infinity-RoPE 却 667→710 毫秒。300 秒是超长展示,主要系统量化是 60 秒。 Table 1|VBench-Long 的 30 秒/60 秒评测,每格按两时长列出,分数越高越好;粗体和下划线为最好与次好。综合质量来自所列七个质量维度;动态程度、主体/背景一致、闪烁、运动平滑、美学与成像质量分别保留,不将总体增益说成每项全胜。 批判点评:固定可见 token 不等于固定显存:全历史 GPU 缓存随时长线性增长;官方例子 240 潜帧、30 层、每帧 1560 个 token、12 头、头宽 128、16 位数需约 69GB,仅是缓存估算。取特征、选择与重排也有计算。官方代码仓库含选择器、缓存与合成解码器示例,实际接入视频主干仍需自己改注意力接口,不冒称已提供完整基准一键复现。 5. U-JiT:不先压视频也能补回高频 Pixel-space video generation with U-JiT | Meta FAIR;索邦大学;Valeo.ai | arXiv:2611.04764 关键词:像素视频生成, 多尺度Transformer, 高频细节, 采样配方 前序问题:视频先压到潜空间,会损失细节;直接在像素上生成,又常把大块时空 patch(图像分块)投影成太窄的特征,细纹理像被切掉了一截。 方法直觉:沿模型深度先细后粗再细:外层的小 patch 看清局部,内层的大 patch 和宽通道处理语义,再通过跳连还原。让同一个生成模型承担原先自编码器负责的细节工作。 本文贡献:U 形 Transformer 在不同层改变时空 patch 大小,用线性投影和时空重排下采样/上采样,每尺度一条残差连接。外层注意力按 8×8×4 窗口分块,像素层再将 token 压缩后计算注意力以控制浮点运算。预测干净视频、用速度误差训练,另加 LPIPS 学习型图像特征距离作为感知损失。采样调整时间分配,把更多步骤留给低频结构;使用 CFG(组合有条件/无条件预测的引导),仅在 0.1–1 时间区间启用。潜空间基线也调引导和时间偏移,避免把配方收益全算成架构收益。 Figure 3|U-JiT 架构总览。编码与解码块按计算量匹配主干中的标准 JiT 块;外层小 patch、内层大 patch,通过下/上采样与跳连同时保留细节和语义。 实验效果:Kinetics-600、128×128,5 帧条件、生成 12 帧但评估接续 11 帧。XL 版 5.87 亿参数,单前向约 1.3 万亿次浮点运算,FVD(视频分布距离,低更好)0.61,JiT 为 0.71、此前 WaiT 为 0.84;相对后者降低约 27%,最强同训潜空间对照 0.62。逐帧 FID 图像分布距离 3.15,Wan2.1 潜空间版 11.05。256×256 类别生视频生成 65 帧,FVD3.00 对最佳潜空间 3.31;每条切 4 段 16 帧,5 万视频合计 20 万段用于评分。 Table 2|5 条件帧续 12 帧,128×128、空间 8×8 时间 4 的内部压缩,比较 B 与 XL 规模。FLOPs 为单前向且不含潜模型解码器,Pixel 勾叉区分像素/潜空间;实际续写评估 11 帧,生成多一帧用于 patch 对齐。U-JiT-XL 的 FVD0.61、FID3.15,对照口径不能外推为高清文字生成。 批判点评:这里的 f32t8 表示内层 patch 空间 32×32、时间 8 帧,不是另训视频自编码器;也不是已经验证 4K 开放文字视频。FLOPs 只计单次前向,潜模型解码开销没计入,不能据此推断完整墙钟或显存更省。高分辨率主实验需 400/600 轮训练,成本不能忽略;未核到本方法公开实现,原文引用的 JiT 代码属于基线。 6. StepX-OPD:四步学生直接向多个老师学 StepX-OPD: Rethinking Multi-Teacher On-Policy Distillation in Diffusion Models | 阶跃星辰;西湖大学 | arXiv:2611.04386 关键词:多教师蒸馏, 四步生图, 在策略状态, 低噪声回归 前序问题:先把画图、写字、听指令几位老师合成全步模型,再压成四步,第二阶段可能把第一阶段刚学到的能力丢回去,训练也得排队等。 方法直觉:让学生从一开始就按四步走,每次在自己真正会经过的状态上请相应老师纠错;靠近干净图像时,再直接对齐速度方向,少绕一段长轨迹。 本文贡献:在策略 OPD 指用学生自己产生的状态教学。每个训练批只来自一种能力数据,静态路由到对应冻结教师,不混平均教师输出。四段轨迹每轮随机内部时间点,在相邻状态间插值,再按精确前向加噪分布构造监督点;用轨迹分布匹配 TDM 和低噪声速度回归共同训练,回归权重 0.5。前 200 步由初始学生自蒸馏预热,之后接 3 位教师。SD3.5-Medium 与 FLUX.1-dev 分别实验,秩 32 低秩学生,8 张 H800、全局批 256。 Algorithm 1|StepX-OPD 主配置训练流程:按数据源选批,预热后路由冻结专长教师,学生四步轨迹随机内部时间点;在相邻状态间插值并重新加噪,同一教师提供分布匹配和低噪声速度回归目标;学生与分布评分器分别更新。保留原算法的输入、循环和回归开关。 实验效果:512×512 下,四步模型的四指标标准化 Average 在 SD3.5 为 0.8901,顺序 DiffusionOPD+TDM 为 0.8403;FLUX 为 0.8902 对 0.8761。SD3.5 的 GenEval 组合准确 0.944、OCR 文字识别准确 0.899,40 步 Flow-OPD 为 0.905/0.885;PickScore 人类偏好代理 22.98 低于顺序蒸馏 23.41。SD3.5 报告优化阶段 GPU 小时少约 37%,不包含从零训练全部教师。四步是学生 4 次前向;SD3.5 全步 CFG 要两分支,40 步对应 80 次前向,不能混为相同计数。 Table 1|两个基础架构的 40 步与 4 步图像生成,后半块为压缩后模型。NFE 为前向次数:SD3.5 的 40 步有引导为 80 次,四步学生为 4 次;FLUX 分别 40 与 4。Average 只用组合、文字、画质和偏好四指标的固定归一化,非九项原分平均。 批判点评:Average 只汇总 GenEval、OCR、DeQA 画质代理、PickScore,经固定区间归一化,不是四项原分直接平均,也不是全部九项雷达图。未要求文字时仍会把提示词写进图:计数从底座 21 升到 DiffusionOPD218,StepX 降到 94,却未回到 21。官方代码仓库有训练推理,但 README 描述按 KL 分布差异加权的回归变体,主文主配置为无该权重的代理损失,复现需核配置,不能笼统称完全一致。 7. TTSonic:内容语气和音色分开控制 TTSonic: A Unified Framework for Composable and Controllable Speech Generation | 字节跳动抖音内容团队 | arXiv:2611.04282 关键词:可控语音生成, 语义声学分离, 音色设计, 噪声参考克隆 前序问题:换个说话人不该改台词,照着“压低声音、稍显迟疑”读又不能把身份一起换掉。把语义、语气和音色全塞进同一表示,往往顾此失彼。 方法直觉:先规划说什么、怎么说,再用另一条音色条件把它唱成声音。换声时直接复用源语音的内容 token,设计新嗓音时只替换音色向量。 本文贡献:16kHz 输入经 19 层 E-Branchformer 和有限标量量化 FSQ,每秒 25 个离散语音 token、码本 16384 项;先用自动语音识别监督语义,再冻结编码器,只调量化映射,兼顾重建与理解。Qwen3.5 初始化的语言模型自回归生成语义/韵律序列,可先输出简短风格规划。因果流匹配声学模型将每 token 重复到 2 个梅尔频谱帧,接参考音色或 Text2Timbre 文字生成的 192 维说话人向量,声码器输出 24kHz 波形。换声与增强绕过语言模型,使用源语音 token;声学训练仅见同一句语音的 token 与音色,不用成对换声目标。 Figure 2|TTSonic 由语音 tokenizer、文字到语义语言模型、声学流匹配模型组成。语言模型支持标准克隆和带风格规划的指令控制;流匹配既可接参考语音提取的说话人特征,也可接 Text2Timbre 生成的音色嵌入。 实验效果:20 亿参数,Seed-TTS 中文 CER 字符错误率 0.78%、SIM 说话人余弦相似 0.784,CosyVoice3 为 1.12%/0.781;英文 WER 词错误率 1.66%却落后 Auk 的 1.02%。中文指令 APS(声学参数控制准确率)88.8%,英文 77.6%,FireRedTTS3 英文 80.7%。VoiceBank 含噪参考克隆,WER1.90%→1.45%、WavLM 相似 0.299→0.369。受控编码器对照中,第二阶段使换声自然度 NMOS3.64→3.91,但英文客观 WER2.67%→3.13%。 Table 2|Seed-TTS-Eval 零样本合成,按 TTS 专用与统一多任务模型分组;统一模型列内粗体/下划线为最好/次好,相同最优同时加粗。星号参数不包含该方法冻结的 Qwen2.5-Omni,横杠表示未公开。中文及困难中文看 CER 字符错误率,英文看 WER 词错误率,SIM 为说话人相似;低错误和高相似分别更好。 批判点评:自然度收益伴随内容准确与换声相似的取舍,不能写成第二阶段各指标全升。SIM、APS 和自然度回答不同问题;同评测表含引用公开结果与本方复测,非全部统一重训。因果模块也不自动保证低延迟,论文未给完整首包、实时因子或峰值显存。官方演示页可听样例,本次未核到公开权重与训练代码。 8. Spatial Transfusion:只移动钟声别把整个房间重录 Spatial Transfusion: From Structured Spatial Scene Understanding to Generation and Editing | 微软;卡内基梅隆大学 | arXiv:2611.02330 关键词:空间音频生成, 原子编辑, 模态路由, 一阶全景声 前序问题:让钟声从左移到右,背景风声和房间混响应该延续;按新描述重生整段,钟声动了,其他声源也可能全换掉。 方法直觉:让理解和生成共用骨干,但给声音和文字各自的适配器。编辑时把原音频直接交给去噪分支,教它每次只改一个场景因素,而不把旧场景仅压成文字。 本文贡献:采用四通道一阶全景声 FOA,保留全方位方向线索;16kHz 音频由 FOA-VAE 压到每秒 7.8 个、512 维潜变量。冻结 Sci-Phi 的 Phi-4 多模态骨干,新增文字秩 16、音频秩 640 低秩路径及输入/时间/输出模块,共 9.43 亿可训参数,对比全量 38.5 亿。文字因果预测,音频双向流匹配;编辑源潜变量还与带噪目标按通道拼接。12 种原子操作涵盖增删换源、移动、音量、音高与时间;四阶段从单源到至多 5 源,再接自然语言,共 460 万理解/生成场景、240 万编辑场景。 Figure 1|共享 Transformer 骨干:(a)理解用文字交叉熵,(b)生成和(c)编辑用目标 FOA-VAE 潜变量的流匹配。编辑额外把干净源潜变量与带噪目标按通道拼接。FOA 是一阶四通道全景声,非普通单声道。 实验效果:主表是第三阶段结构化 JSON 条件、FOA-MEIR 留出集,生成/编辑 50 步,引导系数 3.5/4.0。生成 FAD-PSELD(兼顾声学事件与方向的分布距离)3.82→0.964,编辑 0.596→0.323,均相对同骨干全量微调且低更好。编辑 CLAP-AA 源输出语义相似 0.795→0.841,EditFLAM 语义修改响应 15.5→17.8;仅语义操作算后者。完全复制输入的距离 0.005 却修改分 0,说明保真不能代替改对。 Table 5|FOA-MEIR 留出集编辑结果。复制输入可保留声音但 EditFLAM 为 0;仅真值目标 JSON 重新生成的修改分 19.7 高于 17.8,却更损源音频相似与空间分布。完整方法比全量微调的修改响应、源输出相似、文本相似和空间分布距离更好;主表对应阶段 3 的结构化输入。 批判点评:阶段 4 自然语言接口的编辑距离 0.772,不能拿阶段 3 的 0.323 宣传自由文字编辑。理解方向误差 13.6°→14.3°、声源数准确 0.674→0.635,整体保留能力不代表每项不退步。模型仍依赖模拟场景与固定操作体系,未报告统一墙钟/峰值显存,9.43 亿可训也不等于总模型只有这么大。细节可读原论文 PDF;所列项目页本次重定向到 GitHub 登录页,未核实公开音频样例或完整实现。 9. PATTS:等想法和画面可靠了再打分 PATTS: Parallel-Aware Test-Time Scaling for Thought-Image Generation in Multimodal Discrete Diffusion LLMs | 澳大利亚国立大学;CSIRO Data61;亚马逊 | arXiv:2611.04948 关键词:并行思考生图, 轨迹搜索, 可靠性门控, 测试时计算 前序问题:同时“想”和“画”的扩散模型,不一定越想越对。中间草图还没稳定就请视觉裁判评分,会淘汰本来能画对的轨迹;只挑最终图又浪费了前面的纠错机会。 方法直觉:同时养几条思考与画图轨迹,先看模型自己的不确定性和前后稳定度;等文字与画面足够一致,再增加外部裁判权重,提前淘汰较差路线。 本文贡献:MMaDA-Parallel 在同一离散去噪轨迹并行生成推理和图像 token。截点用最高概率填补未解码位置得到预览,取熵、前两名概率差、剩余遮挡比例、相邻预览重合、跨模态相似与排名稳定等 6 类特征。逻辑门混合标准化内部可靠性分与 Qwen2.5-VL-7B 的外部是/否概率;低可靠性时复用缓存裁判分,并按递减存活预算搜索。门参数在独立开发集固定,所谓信任是代理权重,不是已校准的正确概率。 Figure 1|PATTS 方法。左侧每个截点读模型 token 概率、熵、注意力与干净思考/图像预览,生成内部可靠性特征。右侧信任门在内部轨迹可靠性与外部视觉语言验证间分配奖励权重,据分数剪枝并传播,最后从存活轨迹选结果。 实验效果:GenEval 含 553 提示、6 类任务,整体是类别准确率等权平均。512×512、32 次图像/128 次文字去噪、引导 4.0,N=32 指初始搜索轨迹数。4 次重复下,GenEval 无搜索 0.628、最终 32 选 1 为 0.787、FKD0.810、PATTS0.844±0.014。按论文生成模型前向计数 NFE,PATTS1796 次、平均验证 38.2 个预览、端到端 55.1 秒;FKD5280 次/160 个/154.9 秒,无搜索 161 次/9.9 秒。次数不是采样步数,也不包含独立裁判的全部计算。 Table 1|MMaDA-Parallel 上的 GenEval。NFE 计生成器前向,Ver 计每提示验证的候选预览,时延为生成一张选中图片的端到端墙钟;只整体分数报告误差条,粗体/下划线为最好/次好,†为在同主干重实现基线。N=32 是搜索轨迹,非 32 步采样;PATTS 平均 38.2 次验证是重复运行平均数。 批判点评:相对搜索方法更省,但比一次直出仍贵约 5.6 倍墙钟。全部完整方法实验只用一个主干,跨三基准不等于跨模型已验证;信任特征在 N=16 计数子集的排名一致仅 0.19 对时间门 0.17。arXiv 评论确认 WACV2027 接收,但所给 PATTS 仓库本次 GitHub 读取 404,按代码暂不可获取报告,未宣称可立即复现。 10. ScoreDial:把喜欢的程度变成可调刻度 ScoreDial: Precise Control of Visual Attributes in Image Generation via Regressor Guidance from Limited Human Ratings | 庆应义塾大学;普利司通 | arXiv:2611.05004 关键词:数值可控生图, 人评回归, 误差自适应, 独立审计 前序问题:“让房间更复杂”只指定方向,“复杂度 0.7”还要求落到指定刻度。若拿同一个评分器既指导生成又验收,模型可能只学会讨好分数。 方法直觉:先用少量人评学一把尺,数值条件把图推到大致位置,再按当前误差逐步修正;最后另请没参与生成的评分器和人看,确认画面属性真的变了。 本文贡献:每属性 100–479 张人评图训练冻结视觉特征上的岭回归 R;轮胎实际 118 张、室内 100、食物 479、肥皂 150。SD3.5-Medium 分别做域 LoRA,并把目标 c 的嵌入注入全部 Transformer 块。30 步采样前 20%不开梯度引导,其后对解码的干净估计计算(R(x)−c)²梯度,归一化方向,用当前误差与噪声确定幅度,每活动步共两次引导/重新加噪;不反传穿过整个去噪器。域训练池 984/100/479/800 张,不把有人评数与全部训练图数混说。 Figure 2|ScoreDial 分开目标定位与剩余误差修正。(A)冻结预训练视觉骨干和岭回归头组成可微属性评分器 R。(B)目标 c 的可学习嵌入进入每个 Transformer 块,并与域 LoRA 共同训练;活动引导步在干净解码图上计算误差,归一化平方误差梯度,再按误差和噪声调步长修正潜变量。 实验效果:1024×1024,目标 0.1/0.3/0.5/0.7/0.9 各 10 个种子,每属性 50 图。四属性 R 平均绝对误差 0.0069–0.0129;排序相关ρ=0.980 是五档并列目标下可达到的上限,非完美预测人类。独立 SigLIP 审计器仍用同批人评,但未参与训练生成器或引导;其轮胎端点位移 0.285,MPGD-flow 为−0.021。单 RTX5090、批 1,平均 29.5 秒/11.9GB,对纯数值提示 5.5 秒/7.7GB、MPGD-flow16.6 秒/11.9GB。 Table 1|同种子匹配比较:每方法每属性 5 档目标×10 种子=50 图,MPGD-flow+把强度提高一档。上半部分是部署 R 的误差及目标/输出 Spearman 相关,±为每种子均值的标准差;下半是独立审计器的同种子 0.9/0.1 端点位移均值与标准差。审计器按属性训练,只同行比较;R 精确不自动等于真实属性变化。 批判点评:轮胎与肥皂各 15 人盲评,平均人评分随目标变化的线性 R²为 0.665/0.786;不推广为四属性都做了同样人评。轮胎“防滑”是视觉印象,不是实测摩擦性能。独立骨干共用标签仍非完全独立人群,四窄域结果也不是万能语义旋钮。WACV2027 接收由 arXiv 评论确认;官方代码仓库含拟合、训练和生成脚本,说明插值梯度非确定性,不能保证同种子逐位复现;本次未运行模型。 趋势观察 要保留的是有用证据 ReXMo让身份与表情分路,FLASH让小图管布局,ReCR挑选历史。条件并非越多越好,关键是它是否仍支持目标修改。 速度必须带上计时口径 FLASH的25.3倍只指独立注意力诊断,主配置渐进端到端省30.5%;PATTS比搜索基线更快,却比一次直出更慢。 高相似与高分都需要反例 复制空间音频有极低分布距离却没做修改;ScoreDial的评分误差小,还要看独立审计与人评。源保真、执行完成和实际偏好分别核验。 参数不等于全部部署成本 ReCR不增加解码前向却保留全历史缓存;StepX少算训练阶段不含预训教师;TTSonic分离模块也仍缺端到端延迟证据。 今日讨论 ReXMo 的表情误差从 0.3415 降到 0.2905,但单人往返姿态距离只从 0.0263 到 0.0258,感知运动平滑 3.90 还低于 SCAIL 的 3.92。若双人表演中有人转头遮住半张脸,应如何验证新增表情通道保住了原来的情绪,而不是只在容易跟踪的合成脸上提高了关键点分数? 人工智能炼丹君 整理 | 2026-11-05
-
AIGC 每日速读|2026-11-04|Adobe跨镜头改片先打草稿MoviEdit 今日 AIGC 论文速览 今日共 10 篇 · 跨镜头与复杂视频编辑 2 篇 · 口型修复与换音编辑 2 篇 · 人物个性化动画 1 篇 · 联合音视频生成 2 篇 · 图像生成与扩散效率 2 篇 · 关系可控空间音频 1 篇 重点论文标题列表 MoviEdit(Adobe):先打全片草稿再跨镜头修改 VideoEditor-MoE(腾讯):一条指令让多个修改一起发生 TaoMate-FVSR(阿里):修清嘴唇也要听对声音 VidDub(港科大):换了台词别再逼嘴形照旧 One Image(Mila):一张照片先自造姿态样本 选读入口:要把已改好的一帧传遍多镜头,先读 MoviEdit,注意首帧/任意帧参考分数和 8 张 H100 计时;一条指令改多处读 VideoEditor-MoE,先看有利案例筛选限制。修生成视频小脸读 TaoMate-FVSR,换台词配音读 VidDub,两者的真值首帧与嘴区监督不同。单图驱动跳舞读 One Image Is Enough 的 9.3 分钟每人物准备;连续数字人读 TaoMate-HD 的文本窗口,联合训练读 OmniOPD 的分组教师成本。部署前对照 Z-Cache 的 FLOPs 和墙钟,训练一步图像模型读 EASD,做空间声音最后读 Rel2Traj 的真值结构与听测边界。 今日论文速览 1. MoviEdit:先打全片草稿再跨镜头修改 MoviEdit: Long-form Multi-Shot Video Editing Made Easy | Adobe;韩国科学技术院 | arXiv:2611.02737 关键词:跨镜头视频编辑, 任意帧参考, 全局草稿, 自回归传播 前序问题:把一段短片里同一人的外套换掉,镜头一切,衣服可能换色,甚至改到另一个人。只在每个镜头单独改,难以保证全片认的是同一个主体、沿用的是同一个改法。 方法直觉:先看完整段视频,在稀疏小画面上定下全片修改草稿,再逐块补清楚。草稿管跨镜头一致,最近片段管动作连续,源视频管未编辑区域;参考可以是任意镜头中已改好的一帧。 本文贡献:三条自动制数路线分别做像素对齐修改、跨镜头主体定位、半像素对齐生成,从 205228 对筛到 86619 对,约 8.7 万对,另混入私有短单镜头编辑数据。扩散 Transformer 的 Draft/Render 两阶段共享权重:前者在时空压缩、时间帧数减半的全序列上双向注意;后者读取草稿、原片及最近块,因果自回归细化。用速度矩匹配蒸馏为草稿 12 步、渲染 4 步,并缓存文字、草稿、源片和生成历史的键/值特征。64 张 H200 上先训文字编辑 17000 步,再训参考帧传播 8000 步。 Figure 5|长视频编辑的级联建模。MoviEdit 共享同一去噪器 fθ,先在下采样全序列上用 Draft Editor 生成全局一致的轻量修改草稿,再由 Render Editor 逐块传播到全分辨率视频,同时抑制长时间外观漂移。 实验效果:MoviEdit-Bench 含 64 条生成源视频、128 个编辑场景,15 秒多镜头且不提供物体掩码。文字编辑的 overall edit success 为 0.790,Aleph 2.0 为 0.764;它是抽样帧同时满足所有适用视觉语言裁判条件的比例,非完整视频零错误率。任意帧参考传播为 0.786 对 0.781,首帧子集为 0.803 对 0.806。540p、361 帧、8 张 H100 上,去噪耗时 364.1→11.8 秒,30.9 倍;包含 3.6 秒草稿与 8.2 秒渲染,不冒充含读写与编解码的端到端响应。 Table 1 与 Table 2|MoviEdit-Bench 的长多镜头定量评测,分别对应文字指导 V2V 及已编辑参考帧指导 IV2V 传播;X-shot 表示跨镜头。参考评测又分首帧与任意帧。文字总分 0.790 对 Aleph 的 0.764,首帧参考 0.803 对 0.806、任意帧 0.786 对 0.781,各指标与子集不能混成全面领先。 批判点评:任意帧已编辑参考确有证据,但全片草稿需要先看到未来源帧,不能据此称实时在线编辑。相似人物和局部遮挡仍会选错目标;25 秒 17 镜头是训练 15 秒以外的展示,非无限长验证。首帧参考并非全面超过 Aleph;训练数据与模型也未完整公开。项目页目前提供展示和独立基准仓库,不等于编辑器权重已开源。 2. VideoEditor-MoE:一条指令让多个修改一起发生 VideoEditor-MoE: Scaling Complex Video Editing with Mixture of Experts | 腾讯;新加坡国立大学;厦门大学 | arXiv:2611.03043 关键词:复杂视频编辑, 混合专家, 键值路由, 稀疏激活 前序问题:让车变蓝、天空变日落,视频可能只改对一件事。把模型整体做大很贵,按“加物体、换背景”手工分专家,又可能忽略同一对象的多项修改彼此相关。 方法直觉:让每个视觉 token(模型处理的特征单元)自行选专家,还让注意力读取不同专家提供的键/值。专家不必对应人起的任务类别,而可随内容和噪声状态分工。 本文贡献:从 Kiwi-Edit 的 50 亿参数、30 层视频底座扩展。在前 28 层交替插入混合专家 MoE 模块,最后两层保持稠密;注意力与前馈网络各自路由。查询和输出投影共享,全部 token 经选中的成对键/值专家形成候选,路由权重的对数加进注意力分数,仍保留全局跨帧交互。140 亿版用 7 专家选 3,560 亿版扩为 35 专家而仍选 3,每 token 约激活 80 亿;140/560 亿仅计 DiT,含其他模块约 185/605 亿。训练有流匹配、相邻帧速度差和负载均衡;扩大模型时用 AdamW 解耦权重衰减,避免专家输出被压小。 Figure 2|VideoEditor-MoE。(a)前 28 层交替稠密与 MoE 扩散 Transformer 块,之后保留两个稠密块。(b)共享查询读取所有视频 token 经路由得到的键/值对。(c)每个 MoE 块由专家自注意力、稠密指令交叉注意力和专家前馈网络组成。 实验效果:49 帧、832×480、16 帧每秒输出,50 步 Euler 采样。主表中 140 亿/560 亿版的编辑执行分 90.15/94.70,前馈 MoE 对照 88.45;执行指每条原子修改在首、中、末三帧至少两帧可见,再按案例平均乘 100。但附录 C 明确案例是依赖结果筛选、偏向 560 亿版的有利样例,因此这些数字只说明该样例集,不能当总体基准成功率。140 亿版用 24 张 80GB H100 训练 18630 步,视觉编码器和视频自编码器冻结。 Table 1|定量比较:560 亿总参数、每 token 激活 80 亿的版本在三个指标第一,140 亿版第二,粗体与下划线分别标最佳/次佳。按附录 C 范围,这些是依赖结果筛选的有利案例而非总体基准;执行、完成度与画质也不是同一量。 批判点评:同样激活 80 亿不代表同显存、同延迟:560 亿权重仍须保存,注意力还读取多份键/值,主文未给同硬件完整推理成本。三帧裁判也漏掉中间动态;路由内容敏感来自 20 训练样本的探测,不能证明专家就是稳定语义类别。代码仓库有训练推理实现,权重页需申请访问;不能把有利样例上的领先扩大成无条件结论。 3. TaoMate-FVSR:修清嘴唇也要听对声音 TaoMate-FVSR:Audio-Guided Facial Video Restoration | 阿里巴巴集团 | arXiv:2611.03393 关键词:音频引导人脸修复, 参考注入, 源噪声混合, 口型纠正 前序问题:生成视频里的脸太小,普通超分辨率可能把牙齿补清楚,却补出与声音不符的嘴形。若替换了音轨,继续复制原嘴唇运动反而会把错误保留下来。 方法直觉:把低清源脸当结构线索,允许嘴部重新生成;把清晰参考只当外观锚,把最近几帧只当运动线索,再让目标声音约束发音动作。 本文贡献:冻结因果视频 VAE(把像素压缩到潜空间的自编码器)、HuBERT 语音编码器及 SyncNet 音画同步判别器,训练 Wan 视频 Transformer 和条件投影。源潜变量混入 0.80–0.95 强度噪声,再做流匹配,混合强度与流时间是不同量。稀疏参考独立编码、连续 4 帧历史序列编码,放入互不重叠的时间位置后投影相加,不替换去噪状态。第一阶段用退化图像/视频学习还原;第二阶段用口型被改变的退化视频配目标声音纠正发音,加入同步监督。窗口 5 条件帧加 72 有效帧,步幅 56,复用 16 帧重叠潜轨迹及有状态解码。 Figure 2|音频引导人脸视频修复。第一阶段用退化图像/视频与对应目标联合训练;静态图只使用流匹配均方误差ℒMSE 及 RGB 损失,视频另加时序监督。第二阶段用退化配音源与目标音轨修口型。稀疏外观参考和连续历史放在不同条件位置。视频自编码器 VAE、HuBERT 及 SyncNet 冻结,视频 Transformer 与条件投影可训练;生成视频小图用于示意输入和目标角色。 实验效果:150 条 MEAD/HDTF/TalkVid 及内部说话人视频,4 倍降采样后回到 512×512,同一有效视频等权平均;可接参考的对照与 Ours 都用未退化真值首帧。Ours 的 LPIPS 感知误差 0.0793、DISTS 结构纹理感知距离 0.0858,低于 InstantRestore 的 0.1380/0.1421;同步置信 Sync-C 为 7.413、距离 Sync-D 为 7.561,前者高后者低更好。SparkVSR 的 PSNR 像素还原 30.62dB 仍高于本方法 28.67dB。30 视频去掉音频后 Sync-C 为 4.283,完整为 7.621。 Table 1|原音轨人脸修复:150 条视频基准,对共同有效片段等权平均,深绿/浅绿标最佳/次佳。支持参考的方法与 Ours 同用真值首帧,Ours+额外用 GPT-Image 增强该帧;完整 512×512 帧评分。Ours 感知误差与同步更好,SparkVSR 像素还原更好,增强参考又改变忠实度与锐利度的取舍。 批判点评:把参考交给 GPT-Image 增强的 Ours+,无参考画质 MUSIQ 达 77.62,但 PSNR 降到 23.52dB、LPIPS 升至 0.2402,说明更锐利不等于忠实。原生生成视频没有真值,首帧参考来自输入,与 150 条定量协议不能混说。修复与换音 30 条评测分开;未给统一墙钟与峰值显存,不能称实时。官方项目已指向实现仓库,但本次只核资源,不运行模型。 4. VidDub:换了台词别再逼嘴形照旧 VidDub: Replacement-Aware Distillation for Two-Step Video Dubbing | 香港科技大学;腾讯;浙江大学;独立研究者;清华大学;阿卜杜拉国王科技大学 | arXiv:2611.03404 关键词:视频配音编辑, 换音监督, 两步蒸馏, 全上下文 前序问题:给同一段表演换台词时,脸和背景应该保留,嘴形却必须改变。若训练仍要求重建原视频嘴部,音频在催它变,像素损失又在逼它不变。 方法直觉:按声音是否被替换决定哪些源像素可信:原音轨可重建全脸,换音轨只保留嘴外区域,嘴内交给音画同步信号。先解决监督冲突,再把采样压到两步。 本文贡献:Wan-1.3B 配 VACE 视频条件与 2.87 亿参数音频适配器,冻结 Whisper-small 语音特征。每窗 81 帧对应 21 个视频潜帧,窗口内双向注意。教师训练混 70%原音、30%替换音:替换音时屏蔽嘴区的流速度、像素与感知重建,只保嘴外和同步损失;同步训练器冻结但梯度穿过它和解码器。随后把 48 步带 CFG(有条件与无条件预测组合的引导)教师轨迹回归到两步学生,再用分布匹配蒸馏补画质;推理每步仅一条音频条件分支。长片每次推进 64 帧,融合 17 帧重叠。 Figure 3|三阶段训练蒸馏。顶部是教师的音频预热、联合编辑适配和换音感知精修。(a)不成对替换语音时屏蔽源嘴部重建。(b)用带引导轨迹回归,把 48 步 CFG 教师蒸馏成两步学生。(c)分布匹配蒸馏恢复最终两步模型的视觉真实感;CFG 即组合条件与无条件预测的引导。 实验效果:HDTF-30 换音:两步 VidDub 的 Sync-C 同步置信 10.102、Sync-D 距离 5.856,Lip Forcing 为 6.884/8.284;FVD 视频分布距离 27.66,教师 27.49,低更好,两步并非画质无损。单 H20 预处理输入上的吞吐 11.3 帧每秒,不包括完整数据准备。独立三种训练种子的嘴区屏蔽消融,换音 Sync-C 平均增 0.833。TalkVid 请求 500 条,跨方法排名另用共同有效 308 条;VidDub-Bench 共同有效 245 条,不能把各方法有效分母混成统一 500/256 条。 Table 1|HDTF 比较。Params 包含推理时加载的所有神经网络模块,FPS 在单 H20 上测量;†表示本文扩散模型只报告预处理完成输入上的吞吐。分同音重建与换音配音,两步 VidDub 换音 Sync-C/D 为 10.102/5.856、FVD27.66,教师 FVD27.49,不将预处理吞吐当全流程速度。 批判点评:它是离线整窗编辑,不是两步就能实时直播。身份并非全胜:HDTF 换音身份余弦 0.902,LatentSync 为 0.970;同音像素还原也有退步。补充材料的持久缓存流式尝试在 60 秒出现下脸塌陷,不能当最终稳定实现。最终长片用源片重新锚定的重叠窗口。代码仓库已有训练推理与发布校验,未在本机复现,媒体数据权限与依赖仍要逐项核查。 5. One Image:一张照片先自造姿态样本 One Image Is Enough: Self-Generated Supervision for Personalizing Human Video Diffusion at Test Time | 康考迪亚大学;魁北克人工智能研究所 Mila | arXiv:2611.02964 关键词:单图人物动画, 自生成监督, 静态片段适配, 测试时个性化 前序问题:拿一张人物照驱动跳舞,转身后容易脸不像、衣服变样。微调能记住人,却通常要这人的多姿态视频,还可能把原视频里的运动方式一起学进去。 方法直觉:先用图像模型把同一人“摆”成几个关键姿态,再把每张图重复成静止短片来微调。训练信号只带外观,不带错误运动,让视频模型原有动作能力继续工作。 本文贡献:基于 FLUX.1 Kontext 加姿态 ControlNet,用域内视频二帧配对先训练生成器 LoRA(低秩参数适配器);这部分并非完全无需训练。测试时从驱动姿态做最远点采样,默认取 5 个关键姿态,各用 8 个相互作用候选。去噪后半段按 DINOv2 身体外观相似与清晰度重采样并加噪保持多样,末尾用 ArcFace 人脸身份相似选一帧。把选出的每张图和固定姿态重复成静态片段,对冻结的 UniAnimate-DiT/Wan2.1-I2V-14B 仅更新每人物低秩适配器。推理合并适配权重,不新增模型参数。 Figure 2|单图人物个性化流程。输入单一参考 xref 与驱动姿态序列 P,用姿态条件图像生成器 G 合成目标姿态的伪真值帧。(a)每姿态多个候选组成相互作用粒子系统,按相对参考的 DINO 身体外观奖励在去噪中重采样,最后用 ArcFace 人脸身份选一帧;所有奖励只读参考。(b)每人物低秩更新Δθ在所选帧的静态重复片段上适配冻结动画模型 Fθ,再由适配模型生成视频。没有用该人物视频、目标真值或人类反馈;仍需要驱动姿态及预先域内训练。 实验效果:在 TikTok 同配方、只换监督来源的对照中,FVD 视频分布距离从底座 206.0 降到 133.5,5 张真实帧适配为 157.3;FaceID 全视频人脸身份相似从 0.597 到 0.617,真实帧为 0.615。与主比较表的另一底座 402.14 分开,不跨表混算。跨人动作驱动在 Unseen100-Val 上身份 0.431→0.571,姿态准确率 0.817→0.822。单 H100、81 帧,每人物造伪帧 9.2 分钟、适配 5 步 5.8 秒,总约 9.3 分钟,峰值 62.1GiB;每视频推理另 1.8 分钟、21.6GiB。 Table 5|监督来源对照。所有行使用同一适配配方,仅改变监督来源;FaceID 人脸身份、BodySIM 身体外观相似在 TikTok 完整视频上计算,生成器 G 单独图像质量另在原表 4 报告。伪帧 FVD133.5 低于真实 5 帧 157.3,但身体相似 0.887 略低于 0.888,不宣称全指标最好。 批判点评:无目标人物视频,不等于无驱动姿态、无域内训练或无需每人物成本。真实 5 帧的身体相似 0.888 略高于伪帧 0.887;选帧奖励消融中另一组合 FVD429 低于默认 496,不能照图注称默认所有指标最好。摘要称代码权重可用,但官方仓库目前只有说明、许可证和展示,标注 2026 年 12 月计划开放;依仓库实况写待开放。arXiv 明确 WACV2027 已接收。 6. TaoMate-HD:边续说话边把视频补高清 TaoMate-HD: Progressive-Resolution Autoregressive Audio-Video Generation | 阿里巴巴集团;南京大学 | arXiv:2611.03394 关键词:流式音视频生成, 渐进分辨率, 分阶段缓存, 文本续读 前序问题:数字人边收新文字边说话,高清每步都算太慢;文字窗口前移,又可能重复说重叠句子或把句尾接错。视觉变清楚和台词接得上要同时解决。 方法直觉:每块先在小画面想清结构,最后一步才补高清;每一阶段把自己的音画预测交给下一块同一阶段。保留已经说出的音频历史,新文字中的重叠内容就能充当上下文。 本文贡献:从 MiniMax-H3 训练秩 128 低秩适配,10000 对自构造蒸馏数据。每块 3 次去噪:前 2 次 480×864,末次 768×1376,声音潜空间尺寸不变;升分辨率时用耦合高低网格噪声修正,避免直接插值改变噪声分布。各阶段独立缓存键/值,留初始视频锚与最近 2 块音画;换文字只刷新文字投影,不重编码旧历史。学生读重叠的新窗口,学生分布评分器保留初始窗口,教师读原始转录前缀,形成非对称分布匹配蒸馏;每块还需 3 次干净历史编码。 Figure 2|每块的细化成为下一块历史。N=3 指两次粗视频网格评估后一次高清细化;各阶段估计干净音画终点,在自身原网格编码,交给下一块同阶段,支持右下的阶段并行。声音潜变量几何全程保持。左下训练部分从所选阶段的干净预测组成高清序列,供真假两个蒸馏评分器使用;生成器与评分器共享场景、说话人条件,但各角色文字窗口不同。 实验效果:100 个 1–10 分钟序列,768×1376、24 帧每秒、32kHz 立体声。8 张 H20 同设置比较,直接高清平均 491 秒、渐进串行 307 秒,1.60 倍;加入阶段重叠、量化、注意力和编解码调度后 160 秒,额外 1.92 倍,最终 8.99 帧每秒,尚低于 24 帧播放率。时间包含预编码文字后的生成与音画解码。续读配置的 CER(转录字符错误率)30.751%→19.570%,降 11.181 个百分点;首尾声学特征余弦 0.97064→0.97905。 Table 2|分辨率、质量与推理吞吐,全部用相同批次输入和 GPU。直接 480p 是独立低分辨率参照,TaoMate-HD 指阶段并行部署。直接 768p、渐进串行、并行分别 2.93、4.68、8.99 帧每秒;最后一项还合并量化与编解码调度,不能只归为分辨率或并行的单项收益。 批判点评:1.92 倍是整套部署优化收益,不能只归因阶段并行;跨其他论文 22.4 倍比较有计时区间和分辨率差异,不拿来当同条件加速。续读两配置还改变历史、增广和辅助监督,11.181 点不是单因素因果效果;插入错误反增 2.74 点,同步距离也略退步。小时级有展示,主量化是 1–10 分钟;长程色亮度分低于旧 TaoMate。项目已开放推理与预览权重,未验证完整训练重现。 7. OmniOPD:教会画面也别把声音教坏 OmniOPD: Stable On-Policy Distillation for Joint Audio-Video Generation | 中国科学技术大学 | arXiv:2611.02803 关键词:音视频联合生成, 在策略蒸馏, 特权视觉, 可靠性加权 前序问题:同一模型同时优化画面和声音,声音 token 远少于视频 token,训练信号容易不稳;只把声音奖励乘大,画面和声音可能一起退步。 方法直觉:请专长不同的音频、视频教师分别教学生。音频教师额外看到更干净的画面,更容易判断该发什么声音;多采几条轨迹,再降低不可靠步骤的影响。 本文贡献:用 LTX-2 的 220 亿参数双流模型初始化,分别按视觉或音频及同步奖励做低秩强化学习教师,蒸馏时冻结。学生自己生成去噪轨迹,即在策略 OPD,不只看教师分布样本。音频教师与学生共用同一音频状态,但教师视频时间 q=t/[t+exp(s)(1−t)]小于学生 t,t 越小噪声越低,s 为正移位量;由学生干净预测重新加噪构造条件。每提示采 G 条联合音画轨迹增加声音监督,按教师学生的转移 KL 差异(概率分布偏离度)给越界步骤指数降权;视频蒸馏同时保留。G 增加也会增加轨迹生成和教师调用。 Figure 3|OmniOPD。(A)学生按自身轨迹采样,冻结视频教师与音频教师分别蒸馏各模态。(B)音频教师与学生看同一音频状态,却额外看更干净视频上下文,产生更有信息的音频目标。(C)多噪声采样覆盖不同噪声与去噪步骤,状态可靠性加权减轻不可靠信号。 实验效果:JavisBench 相同设置对比普通 OPD:VQ 视觉质量 3.174→3.347、AQ 音频质量 5.342→5.449,DeSync 音画失同步 0.583→0.457,低更好。对 LTX-2.3 基线为 2.714/5.252/0.584。它没有同时追平每个教师:音频教师 AQ5.576,顺序训练 Cascade 的 DeSync0.432 都更好。组数从 1 到 2 时 AQ 反降 5.342→5.223,3 组才到 5.393,不能宣称更多分支必然提升。主文没有统一训练墙钟或峰值显存。 Table 2|JavisBench 不同训练设置的定量比较,覆盖音画质量、文本一致、音画语义一致及同步。普通 OPD 的视觉/音频质量 3.174/5.342,OmniOPD 为 3.347/5.449;失同步 DeSync 从 0.583 降到 0.457,但 Cascade 的 0.432 更低,不能称每项领先。 批判点评:不对称教师输入更干净,其“KL”依赖共同转移参数和协方差的假设,宜看作训练可靠性准则,不当成自动可证的真实音频误差。正文写 LTX-2,表写 LTX-2.3,复现须核具体 checkpoint。公开代码仓库有推理、合并与评测脚本,评分还依赖多个模型服务;可核到这些接口,不代表完整教师强化训练都已重现。 8. Z-Cache:缓存猜错后回头修一段 Z-Cache: Accelerating Diffusion Transformers via Self-Reflection | 上海交通大学;南方科技大学;阿里云;华中科技大学 | arXiv:2611.01846 关键词:扩散缓存, 双锚点回溯, 质量恢复, 墙钟开销 前序问题:扩散模型跳过中间完整计算、直接复用特征,能省计算,但猜错的特征会把后面图像一路带偏。等下次完整计算得到更准特征时,错误已经传播了。 方法直觉:先把一段缓存采样当临时草稿;拿到下一次本来就要算的完整特征后,用前后两个锚点重估中间特征,再重跑这段潜变量更新,确认后才继续。 本文贡献:这是免训练包装器,可接 TaylorSeer、SpeCa、MagCache 等预测器。采样顺序 a 到 b 之间先按旧锚预测,b 处做原计划的完整前向;再用两端预测的凸组合修正,权重(i−a)/(b−a)随窗口位置前移。丢掉临时窗口潜状态,重采样同一段,并用保留的 b 处特征提交修正后的末端。这里不新增完整前向,但有缓存读取、预测、潜更新及特征存储,绝非零额外工作;局部误差界依赖更新的 Lipschitz 连续及双锚确能降低特征误差。 Figure 3|Z-Cache 流程。图按反向扩散 t、t−1 等标注,正文则按随采样推进递增的序号。传统缓存只从旧完整计算锚点预测当前窗口,随后前进;Z-Cache 把窗口视为临时状态,拿到下一次原定完整计算锚点后,构建前后双锚特征,重新采样该窗口并提交修正末端,在循环内纠正轨迹而不增加完整前向次数。 实验效果:FLUX.1-dev/DrawBench 等效缓存间隔 8,TaylorSeer 加 Z-Cache 后,相对原 50 步的 FLOPs(浮点运算数)缩减 6.22 倍,墙钟加速却是 2.93 倍;相对 TaylorSeer 本身延迟 2.83→3.17 秒,LPIPS 感知差异 0.5190→0.4692、PSNR 像素一致 28.46→28.71,峰值同 39.96GiB。MagCache 同间隔加包装后延迟 1.86→2.78 秒、峰值 33.85→37.98GiB。HunyuanVideo/VBench 间隔 7,得分 79.09→79.60,耗时 21.01→23.08 秒;原 50 步为 80.66、145 秒。 Table 2|FLUX.1-dev 在 DrawBench 的完整成对结果,按等效缓存间隔 N 分组;每组基础/加 Z-Cache 成对中较好质量加粗,灰行是 Z-Cache。括号参数:TeaCache 的 L 是 rel_l1_thresh,SpeCa 的 B/D/m/M 分别 base/decay/min/max,MagCache 的 T/K/R 分别 th/K/retention。L-Speed 是墙钟加速、F-Speed 是计算量缩减,均相对原采样。间隔 8 的 TaylorSeer 包装后 F-Speed6.22 倍而 L-Speed2.93 倍;延迟和显存有额外代价。 批判点评:它恢复激进缓存质量,不是让已有缓存再更快;比较无加速模型可快,比较同预测器通常更慢。摘要“6.22 倍”须按主表区分计算量与墙钟。以原采样输出作参考的 PSNR 或 LPIPS 衡量轨迹接近,不等于人类偏好无损;TeaCache 某设置 ImageReward 还退步。arXiv 评论明确 NeurIPS2026 poster,未找到可核实的本方法官方仓库地址,不把引用的 FLUX 仓库当其源码。 9. EASD:给不同蒸馏目标分配噪声区 Efficient Hybrid Distillation: Synergizing Score and Adversarial Objectives for One-Step Diffusion | 清华大学;鹏城实验室;美团 | arXiv:2611.03017 关键词:一步图像生成, 混合蒸馏, 噪声区间, 冻结教师判别器 前序问题:把扩散模型蒸馏成一步,分数蒸馏和对抗蒸馏简单相加,并不保证互补:前者低噪声时信号弱,后者高噪声时又分不清真假,白花训练算力。 方法直觉:让擅长全局分布的分数目标多看高噪声,让判别细节的对抗目标多看较低噪声;仍留两者少量重叠,避免极低噪声判别器过拟合和模式坍塌。 本文贡献:Efficient Adversarial Score Distillation 用 Logit-Normal 采样:先从均值μ、标准差 s 的正态取值,再经 sigmoid 映射到 0–1 噪声时间。分数目标μ=0.8、对抗目标μ=−0.8,二者 s=1.6,软偏置而非硬切半区。流匹配直接在速度预测空间蒸馏;冻结教师中间层接轻量前馈判别头,只训练头以保持特征稳定。学生分布评分网络用指数滑动平均 EMA 或周期预热稳定;ImageNet 默认不叠加 CFG,并用潜空间模式分离损失保持类内多样性。 Figure 4|用于扩散 Transformer 的判别器。为保证训练稳定与效率,在冻结的教师 Transformer 中间块连接轻量可训练前馈网络头;教师特征保持不变,判别头学习真假分布区别。 实验效果:ImageNet256×256、1000 类,以 50000 生成图计算 FID 分布距离,越低越好。6.75 亿参数 SiT-XL/2+REPA 教师 FID1.42;一步 EASD 训 20 轮为 1.49、60 轮加评分 EMA 为 1.41,周期预热版本 1.39;60 轮与 20 轮须分开。ImageNet64 严格同混合范式对照,5:1 更新比、批 280 下,DMD2 到 10 万/20 万步 FID1.72/1.52,加噪声自适应为 1.50/1.35,完整 EASD 为 1.46/1.26;相应报告时间 28 小时与 23 小时,不能把训练步数比当墙钟倍数。 Table 3|类条件 ImageNet256×256 上与快速流模型比较,列出轮数、参数、NFE 模型函数调用数及 FID。教师 SiT-XL/2+REPA 为 6.75 亿参数、FID1.42;EASD 一步 20 轮 1.49,60 轮评分 EMA 版 1.41、迭代预热版 1.39。训练轮数和引导调用口径不同,不能当成相同训练成本或开放文本任务排名。 批判点评:1.39 是类条件 ImageNet,不是开放文本生图或高清视频指标;不同模型训练轮数、教师预训练成本也不相同。所谓两目标统一依赖理想判别器等近似,实际对抗仍可能坍塌,不能写为不会冲突。原文明确 NeurIPS2026 接收;摘要称代码模型可用,但官方 EASD 仓库目前只有 Coming soon 说明,按待开放报告。推理一步不包含教师、评分器与判别器的训练代价。 10. Rel2Traj:让狗的声音一直跟着汽车 Rel2Traj: Inter-Source Relation-Aware Trajectory Generation for Text-To-Spatial-Audio | 早稻田大学;休斯敦大学 | arXiv:2611.01147 关键词:空间音频生成, 多声源轨迹, 关系条件扩散, 双耳渲染 前序问题:“汽车从左到右开,狗跟在后面”,两个声音各自移动合理,也可能中途交叉、不再跟随。只逐声源生成,难让整段的相对关系一直成立。 方法直觉:先把描述拆成谁跟谁、每个声源大概在哪里,再一起生成所有轨迹;把已有声效沿轨迹做双耳渲染,让几何可核对,也让人用耳机检验听觉关系。 本文贡献:用 Qwen3-4B 的量化低秩 QLoRA 适配解析运动、关系和每源 10 项锚点;两轮关系图消息传递后,宽 192、4 层 8 头的镜像等变 Transformer 联合去噪每源 16 个三维关键帧,以 20 步 DDIM 采样、插值到 30 帧每秒。轨迹生成器共 152 万参数,其中去噪 92 万。固定渲染器处理多普勒、头相关传递函数 HRTF 及房间反射,声音来自 ESC-50 和预训练文生音频模型离线材料。5091 训练、242 验证、1020 组合测试场景,时长 8–14 秒;冻结 5 组运动—关系组合只在测试出现。 Figure 1|Rel2Traj 三阶段:(1)文本解析成声源关系图与每源锚点;(2)关系条件关键帧扩散联合生成全部轨迹;(3)双耳渲染与评测。底部逐帧关系边界同时定义 RSR 满足率、辅助训练损失及可选采样引导;所有报告结果关闭该引导。 实验效果:RSR 关系满足率是规定时间内、超过死区阈值的合格帧占比,每场景 10 次生成、不择优,再按场景平均。组合测试 0.983,独立逐源 0.869、规则求解 0.919;几何主表除 LLM 直接输出外都使用真值解析结构,因此不是完整文本端到端成功率。24 名有效听者、28 道覆盖 6 类关系的二选一,识别率 86.0%,与真值差−3.3 个百分点;等效检验只支持预设±10 点范围。 Table 1|验证 val 与组合留出 comp 的 RSR,每场景 10 次采样平均、不择优,再按场景平均;位置三阶导 jerk 及轨迹多样性在组合集报告。规则求解器与 LLM 直接输出是确定性的,每场景只有一组轨迹。Rel2Traj 组合 RSR0.983、独立逐源 0.869,但 jerk9.8 高于 9.2;除 LLM 直接输出外主表使用真值结构条件,非完整文本端到端成绩。 批判点评:联合模型的 jerk(位置三阶导数幅度、越低越平顺)9.8 高于独立模型 9.2,关系更准不代表轨迹更平滑;去掉显式关系损失 RSR 反为 0.987,不能把收益全归辅助几何损失。受控语言、每场最多 1 条声源间关系、不含纯竖直运动限制开放描述。没有报告完整解析、音频生成和渲染总时延;仅投稿 ICASSP2027,尚非接收。项目页有音频与轨迹浏览器,未核到官方实现仓库。 趋势观察 参考要分清外观与目标动作 MoviEdit用已改帧指导跨镜头,TaoMate-FVSR把外观参考与运动历史分槽,VidDub在换音时停用原嘴部重建。共同方向是只保留参考中仍可信的部分,而不是照抄全部像素。 算力数字先拆清计数范围 MoviEdit的11.8秒来自8张H100去噪,Z-Cache的6.22倍是FLOPs缩减,TaoMate-HD的8.99帧每秒来自整套部署。采样步数、单token激活参数和完整响应时间各自回答不同问题。 自动评分要先看选择和分母 VideoEditor-MoE明确筛出自身有利案例;VidDub另报共同有效集合;Rel2Traj几何表使用真值解析。先看样本怎么来,再决定数值能推到多广。 论文与代码开放各查一次 One Image Is Enough和EASD摘要称资源可用,仓库却仍待开放;VideoEditor-MoE有实现但权重需申请。能读论文、能看展示和能复现实验是三个阶段。 今日讨论 MoviEdit 把 540p、361 帧在 8 张 H100 上的去噪从 364.1 秒降到 11.8 秒,任意帧参考总分 0.786 略高于 Aleph 的 0.781,首帧子集 0.803 却低于 0.806。若目标人物在切镜后被遮挡,应按参考帧位置、相似人物和遮挡程度分组,如何验证全局草稿到底是在保身份,还是把首个错误传播到整片? 人工智能炼丹君 整理 | 2026-11-04
-
AIGC 每日速读|2026-11-03|普渡拿相册修视频保住本人AlbumVSR 今日 AIGC 论文速览 今日共 10 篇 · 参考引导修复与图像编辑 4 篇 · 视频生成与物理诊断 2 篇 · 图像训练加速 1 篇 · 声音与动作生成 2 篇 · 三维记忆世界生成 1 篇 重点论文标题列表 AlbumVSR(普渡):拿相册修视频别修成另一人 RADI3N(布法罗):挪动部件让纹理跟着走 PicturePerfect(高通):同一个人换表情保住背景 WeGenEditBench(腾讯):高分改图也要逐项查漏 Any Forcing(西电):先把首帧做好再一步续拍 选读入口:修模糊人脸视频先读 AlbumVSR,重点看 0.586→0.670 的身份收益和未计入 0.07 秒的预处理;需要摆物体部件读 RADI3N,同一人照片换表情读 PicturePerfect,评测编辑是否漏要求读 WeGenEditBench。部署长视频再读 Any Forcing 的首帧 4 步与后续 1 步;训练扩散模型看 RadialObj,不把 FID 收益当墙钟倍数。交互音频读 MFlowAudio 的首块和解码代价;数字人读 TalkFlow 的单说话人协议。做世界模型前先用 GeoFlip 拆开事件与结构,最后对照 L3G-World 完整/快版及空间记忆增长。 今日论文速览 1. AlbumVSR:拿相册修视频别修成另一人 AlbumVSR: Identity-Preserving Face Video Super-Resolution from a Personal Photo Album | 普渡大学 | arXiv:2610.39001 关键词:参考引导视频修复, 身份保持, 流式扩散, 相册纹理 前序问题:模糊视频里,鼻眼细节已经丢失。单靠模型补清晰,可能补出一张好看却不像本人的脸;同一个人的其他照片能提供线索,但拍摄角度不同,不能直接贴上去。 方法直觉:把相册分成两份证据:一份回答是谁,另一份把皮肤等纹理转到当前脸朝向。前者整个人共用,后者逐视频窗口更新,让生成器参考身份与姿态对齐的细节。 本文贡献:以冻结的 FlashVSR-tiny 单步视频扩散 Transformer 为底座。MagFace 身份编码器与 CLIP 外观编码器将相册聚合成 4 个 token(模型读入的特征单元);先按质量加权中心筛除余弦相似度低于 0.5 的参考,若全被筛掉则保留最高质量一张。FLAME 人脸网格的 UV 纹理坐标融合出 512×512 图集,再按低清视频的 DECA 人脸拟合结果渲染 256×256 五通道视图,分 8×8 块得到 64 个纹理 token。每层交叉注意力追加这 68 个 token 的键/值,原文字缓存不变;仅训练相册头与秩 16 的 LoRA 低秩适配,共约 2300 万参数,约占 17.5 亿冻结参数的 1.3%。首窗 21 帧、此后每次推进 8 帧。 Figure 1|每个身份的相册只编码一次。4 个集合 token 承载身份;融合纹理、可见性、位移图逐流式窗口渲染并编码为 64 个 token。冻结 DiT 每层把相册键/值追加到文字缓存,训练只更新相册头与 LoRA。 实验效果:VoxCeleb2 的 488 个身份分 355 训练、42 验证、91 测试,测试相册来自不同拍摄会话,含 3–21 张、中位数 9 张。重退化含两轮模糊噪声、4 倍降采样和视频压缩;各视频只评分前 85 帧,输入另补 4 帧末帧副本,先身份内平均再等权平均。相对冻结底座,ArcFace 身份余弦 ID-GT 为 0.586→0.670,脸部峰值信噪比 PSNR-F 为 24.98→26.71 dB;按未舍入配对差计算的身份增益为 0.083,95%区间[0.072,0.095]。RTX4070Ti 修复调用 0.07 秒/帧,A100 为 0.04 秒/帧,含窗口 UV 渲染但不含离线相册编码与低清视频拟合。 Table 1|91 个测试身份的重退化结果;剑号方法统一用裁脸后贴回协议。SSIM-F 为脸部结构相似,时延设备 A 为 80GB A100 PCIe、W 为 RTX4070Ti。VIDD 仅描述、不排名,其余指标粗体/下划线为最佳/次佳。ID-GT、ID-alb、PSNR-F、SSIM-F、MUSIQ 越高越好;LPIPS-F、Warp 和秒/帧越低越好,时延排除预处理。 批判点评:更像本人不等于所有画质指标都更好:无参考画质 MUSIQ 从 72.34 降到 52.32,轻退化下身份分也低于 SeedVR2。第 2 路纹理在最终 2 万步消融中身份只增 0.001、区间跨零,主要收益是 MUSIQ 增加 0.69。相邻帧身份变化 VIDD 低于真值不自动代表更自然。只测单数据集的合成退化与整理过的相册,尚未证明真实监控或受污染相册有效;0.07 秒不是完整直播时延。原文未给本方法官方代码链接。 2. RADI3N:挪动部件让纹理跟着走 RADI3N: GeometRic ImAge EDiting via ParametrIc 3D CoNtrol | 纽约州立大学布法罗分校;萨里大学;西蒙菲莎大学 | arXiv:2610.40973 关键词:几何图像编辑, 部件控制, 协方差平滑, 跨图注意力 前序问题:想只转动照片中鹦鹉的头,拖二维点可能把脖子拉断;即使三维形状摆对,生成器又可能把旧位置的纹理抄回来。形状控制和外观跟随要一起解决。 方法直觉:先在三维里摆好部件,再借原图恢复外观。部件边界的转动要平滑;借纹理时,弱化注意力对旧坐标的执着,让它找语义上对应的部位。 本文贡献:视觉语言模型定位物体与部件,SAM3D 把单图升为网格;多视角分割投到 UV 纹理坐标后投票,抽取稀疏控制点,接受三平移加三旋转的 6 自由度命令。CS-ARAP 在尽量保持局部刚性的变形求解中,先平滑邻域协方差再做奇异值分解求旋转,并加入双拉普拉斯项抑制边界曲率突变。随后用 IP-Adapter 图像条件与 SDS(借扩散模型给渲染图的梯度)细调网格。最终跨图注意力只调源图键的旋转位置编码 RoPE:去高频、放大低频,让纹理随新几何移动,无需把原图反演回噪声。 Figure 2|几何编辑流程。阶段 1:输入图升成 3D 网格,CS-ARAP 通过协方差平滑和双拉普拉斯求解得到平滑形变;中间渲染和源视图经 IP-Adapter 保持身份。阶段 2:将阶段 1 的雅可比场用控制点约束与扩散模型 SDS 梯度联合细调,生成语义合理的最终网格再渲染。 实验效果:GeoBench 含 811 源图、5988 条移动/旋转/缩放指令。相对 Nano Banana2,三轴平均绝对角误差 MAAE 从 12.04°降至 7.07°,误差不超过 5°的比例从 37.4%升到 78.9%;换独立 Hunyuan3D 重建器测角度后,本方法为 8.41°与 74.6%,说明收益不只来自复用 SAM3D 评分。端到端每编辑 95–100 秒,FlowDrag 为 120–135 秒,FreeFine 为 40–45 秒;CS-ARAP 单独求解 1.79 秒、69 次迭代,不等于完整编辑时间。 Table 2|GeoBench 几何与外观比较。WE 是变形误差、D-RMSE 是深度均方根差、MAAE 是三轴平均绝对角误差,均越低越好;Acc@5°为角误差 5°内比例。外观用 CLIP-I、FID、主体一致 SUBC、DINOv2 距离、背景一致 BC 评价;RADI3N 几何更准,CLIP-I、FID 与 BC 并非全部第一。 批判点评:几何更准有外观取舍:CLIP 图像相似度 0.924、图像分布距离 FID148.47,均不及 Nano Banana2 的 0.933 与 144.08。角度仍依赖自动重建,极端遮挡或初始网格错误可能传给后续优化;视频只是下游应用展示,不能写成已有视频参考编辑基准全面胜出。代码地址当前为空仓,尚无可核实实现;95–100 秒的硬件口径未在主文同处给出。 3. PicturePerfect:同一个人换表情保住背景 PicturePerfect: Diffusion-based Same-identity Facial Replacement | 高通 AI Research | arXiv:2610.39344 关键词:同身份面部替换, 表情编辑, SDXL, 光照增强 前序问题:合影中某人闭眼,另一张同一个人的照片表情正好。只传关键点会丢脸部细节,直接把参考脸贴过来又会带入错误光照、角度和背景。 方法直觉:训练时给模型看同一个人的参考脸,但故意打乱颜色、位置和照明,迫使它借表情与身份,再适应原合影,而非原样复制参考照片。 本文贡献:从目标图分割内脸,施加仿射、颜色、翻转及 NeuralGaffer 重打光增强,得到驱动脸。SDXL 的变分自编码器 VAE 先压缩图像,再把原图、增强驱动脸、带噪目标潜变量沿宽度拼接,训练扩散模型恢复目标。内部数据抽 25000 张中性脸,每张用 LivePortrait 生成 20 种表情,约 50 万图、6724 身份;每组 21 图可抽 420 个有序异图配对,总计可采样超过 1000 万对,并非 1000 万独立实拍。8 张 A100、有效批 64,微调 25000 步,图像训练尺寸 576×576。 Figure 2|PicturePerfect 网络:从同身份源图 s 与目标 tg 中,将目标内脸分割为驱动 d;缩放、旋转、平移和重打光模拟现实变化。三图通过 SDXL 的 VAE 编码,源图、增强驱动和带噪目标沿空间宽度拼接,由文字条件扩散模型学习去噪。 实验效果:同分布测试从 FFHQ 与 VoxCeleb2 各合成 5000 样本:身份余弦 CSIM 为 0.818,LivePortrait 为 0.558;FID 图像分布距离 7.81,DAM 为 24.86,越低越好。跨拍摄条件测试中,真实 PicturePerfect 的 CSIM0.631、FID28.08,但表情距离 2.50 差于 HyperReenact 的 2.25,姿态距离也未领先。10 人对每人 252 个同分布、175 个跨分布输出作真假判断,本方法被判真的比例 59%和 44%,这是感知比例而非任务成功率。 Table 1|与已有方法比较 ArcFace 身份余弦 CSIM、图像分布 FID、姿态 APD、表情 AED、视线 AGD、感知 LPIPS 和像素 PSNR。蓝色/下划线为最佳/次佳。FFHQ 与 VoxCeleb2 样本由 LivePortrait 合成,PicturePerfect 采用筛选的真实跨会话配对。不可靠 FID 记横线;上半同分布与下半跨分布分开评价,不能因身份胜出宣称姿态表情全胜。 批判点评:它专为同身份照片替换设计,不是跨身份换脸或视频时序模型。训练主要依赖 LivePortrait 合成,眼部、头发及极端脸尺寸仍会出错;PSNR 像素还原和 LPIPS 感知距离也并未全胜。没有增强时部分数字反而更高,作者将其解释为复制捷径,补充表中保留了这些反向结果。原文是 ECCV2026 生物识别生成模型 Workshop 终稿,不写成 ECCV 主会;数据是将来开放声明,未核到本方法代码,主文也未报告每图推理时间。 4. WeGenEditBench:高分改图也要逐项查漏 From Evaluation to Evolution: Benchmarking Image Editing and Evolving Image Models | 中山大学;腾讯 WeChat Vision;西安电子科技大学;复旦大学;清华大学深圳国际研究生院 | arXiv:2610.41210 关键词:图像编辑评测, 原子检查单, 定向数据, 低秩适配 前序问题:让模型把鞋子和摆件都变成银色,鞋子改得漂亮就可能拿高分,漏改的摆件被总分盖住。这样的反馈很难告诉下一轮训练到底缺什么。 方法直觉:评分前把需求拆成小检查单,先留下哪一项没做到的证据,再汇总;训练时只把失败类别与抽象条件传给新数据构造,避免照着测试图重新造题。 本文贡献:基准有 2740 实例、19 任务族、148 任务类型,覆盖单图、文字密集及多参考编辑。统一视觉语言裁判逐项记录扣分与理由,再给执行、保留、画质、专门要求四维 0–5 分;每子集 10%实例由 3 位专家抽审,修订后所有模型重评相关样本。WeGenEvoStudio 用失败诊断、检索新素材、合成监督、秩 16 的 LoRA 适配再重评。每个底座—基准单独训练 25000 例,分给 5 个弱类别各 5000 例;32 张 MLU590、每设备批 1,额外还有检索、生成与裁判调用成本。 Figure 4|WeGenEvoStudio 把评价证据转为定向训练数据。诊断 Agent 挑弱项、形成数据处方,构造 Agent 检索概念或新的源图,合成生成与编辑任务;监督更新后重新评价闭环。图中的曝光编辑和分数条只用于示意流程,不代表独立量化实验。 实验效果:15 种模型配置中,GPT-Image-2 单图总分 4.076,Seedream5.0Pro 文字编辑 4.291;不同场景总分公式不同,不能横向直接当同一能力。GPT 单图中总分≥4 的 644 输出仍有 315 个含严重失败项,即 48.9%,不是全部输出的失败率。在报告选定的 Top-5 单图弱类别上,FLUX.2 总分 1.083→3.517;Qwen 编辑器 2.834→3.208,按未舍入值增 0.373、13.2%。目标类别因底座而异,前后只比较共同有效实例。 Table 4|四基准中报告选择的 Top-5 类别比较。FLUX.2 在 WeGenBench 使用 326 个共同有效配对;不同底座目标集不同,绿/红为正/负变化。T2I 列是文生图,其他为编辑;EG/PR/VQ/DS 分别执行、保留、画质、专门要求,F/O 为相应总分。数值展示专化收益及负向维度,不等于全基准或多轮进化成绩。 批判点评:Top-5 定向收益不能冒充全基准进步,更不能证明已完成多轮自主进化。Qwen 在 GEdit 完整基准总分反降 0.190,单图目标上专门要求分降 0.128;更会执行显眼操作仍可能破坏其他规则。裁判版本与少量无效响应影响有效样本,微小名次差未必稳健;检索消融也有动物类别退步。未核到本框架官方实现地址,不能把各底座开放当作系统已开源。 5. Any Forcing:先把首帧做好再一步续拍 Any Forcing: Any-Step Generality and One-Step Stability for Autoregressive Video Generation | 西安电子科技大学;华为计算技术研究所;华为诺亚方舟实验室 | arXiv:2610.42031 关键词:自回归视频, 一步采样, 对抗蒸馏, 长期记忆选择 前序问题:把扩散视频压成一步后,第一张潜在帧一旦模糊,后续就一路带偏;只留下最近画面,又容易忘记最初的主体。换采样预算时也常要重训模型。 方法直觉:训练时同时检查整段是否真实、少一步能否接近多一步、首帧是否够好。推理时保留开头和最近画面,再从旧画面里挑真正还有用的少量记忆。 本文贡献:以 Causal Forcing 的 ODE 蒸馏因果模型初始化 Wan2.1-1.3B 学生。共享判别器做真实分布对齐、相同步噪声的相邻步一致性及首帧增强,前 200 训练步另对齐教师常微分方程 ODE 采样终点;16 张 A100 训练 1000 次迭代,每次生成器更新配 5 次假分布评分模型更新。长视频保留 3 个全局锚点、2 个长期记忆及 1 个近期上下文;候选须同时比最弱记忆更贴近全局锚点和近期内容才替换。将历史位置按顺序映回训练 RoPE 位置编码范围,选择只用干净历史查询,不用当前纯噪声查询。 Figure 3|Any Forcing 整体。左:共享判别器联合真实分布对齐、跨步一致性和首帧增强,早期加教师 ODE 终点监督。右:全局锚点、动态记忆池、近期上下文组成记忆;按全局语义相关及局部价值判断新候选,随后将位置映入训练 RoPE 范围。图中 Fj 仅以视频帧示意第 j 帧。 实验效果:480p、946 提示各采 5 次,VBench 的 5 秒总分:4 步 85.09;首个潜在帧 4 步、以后 1 步为 85.06;首帧 2 步、以后 1 步为 84.79。这里 NFE 是每潜在帧的模型函数调用数,“一步”不代表全视频只调一次,也不代表首帧一步。30/60 秒在前一种计划下为 84.56/84.46。单 H100 短/长视频吞吐 20.9/24.7 帧每秒;长视频无训练选择机制,与生成器的蒸馏训练分开计。 Table 1|480p 的 5 秒 VBench 比较,少步左右组分别 4 步、2 步;一步组 1*和 1†首个潜在帧分别 4 步、2 步,此后均 1 步。各采样组内最佳/次佳粗体/下划线;Sem 为语义,IQ 成像质量、AQ 美学、OC 物体类别,越高越好。完整维度另在补充材料,一步不能解释成全片一次调用。 批判点评:长视频对照把 Infinity RoPE 等记忆策略接到同一本文生成器上,主要隔离记忆策略差别,不能当成各原始系统直接排名。128 提示的消融不能说覆盖全部 946 提示;综合分接近也不证明每一维都不退步。固定容量会丢历史,60 秒稳定不等于无限记忆。官方项目有展示与评测,目前未提供可核实的代码仓链接;FPS 未给完整交互首帧响应时间。 6. RadialObj:让扩散更新别只挤少数通道 No Channels Left Behind: Understanding Diffusion Acceleration through Residual Gates | 延世大学;NAVER AI Lab | arXiv:2610.40914 关键词:扩散训练加速, 残差门, 通道参与度, 无教师正则 前序问题:给扩散模型加特征对齐,训练变快了,究竟是教师传来空间结构,还是模型内部更新方式也变了?只盯最终图像,很难分清原因。 方法直觉:Transformer 每个残差分支前有逐通道旋钮,控制该通道更新放进去多少。作者观察到,加速训练往往让更多通道共同承担更新,于是尝试只约束特征长度来改变这种分配。 本文贡献:AdaLN-Zero 用门向量α逐通道缩放残差输出,且同一门跨图像 token 位置共用。归一化参与比 nPR 为各门幅度平方之和的平方,除以四次方和再除通道数 D;若只有 m 个等幅非零通道,它为 m/D,衡量分配是否集中,不衡量更新总大小。Radial 目标在速度预测损失外,惩罚每张图全部 token 与通道拼平后的特征范数偏离目标 c,无教师、无样本两两距离。扫描 5 个目标后选 c=10√(ND),N 是 token 数,D 是通道数;前 5 次迭代校准辅助梯度约为主损失的 10%。 Figure 1|从残差门观察到训练改进。左:AdaLN-Zero 逐通道缩放残差输出,同门跨 token 位置共享。中:nPR 衡量门幅度平方在通道上分配的均匀程度,跨 REPA 教师更高的平均参与度与更低 FID 相关。右:Radial 只惩罚每样本特征范数,不需预训练教师或样本两两比较。 实验效果:ImageNet256×256、SiT-B/2 训练 40 万步:FID 图像分布距离从普通训练 16.24、Dispersive13.19 降到 11.83,越低越好;末层门平均 nPR 从 0.434、0.525 升到 0.642。这里在 101 个扩散时间点×1000 类别上计算后平均。带教师的 REPA 仍更好,FID7.71;Radial 的空间 FID 为 5.27,略差于 Dispersive5.25。它是在同训练步数改善质量,不能直接换算同等质量墙钟加速倍数。 Table 3|ImageNet256×256、SiT-B/2 训练 40 万步,比较普通训练、Dispersive 和 Radial,REPA 是带教师参考;最佳无教师结果加粗。FID 和空间 FID 越低越好,IS、精确率和召回率越高越好;Radial 的 FID11.83 优于 13.19,但空间 FID5.27 略差于 5.25,REPA 的 FID7.71 仍更优。 批判点评:相关性不是完整因果证明:训练后把门强行拉均匀并不总能改善质量。理论只在忽略跳连交叉项、通道对称等条件下讨论局部门空间小步,不能保证实际优化器每步都提高参与度。目标范数经 FID 选优,这份搜索也有成本;研究以 ImageNet 类别条件模型为主,尚未验证任意文生视频。论文给的代码链接当前 404,不宣称可复现。 7. MFlowAudio:边出声音边接新的提示 MFlowAudio: Efficient Text-to-Audio Synthesis via Mamba-based Stateful Flow Matching | 伦敦大学学院;伦敦国王学院 | arXiv:2610.41852 关键词:文生音频, 有状态流匹配, 双轴Mamba, 动态提示 前序问题:想先听人群再听马鸣,整段生成必须等完,分段生成又可能在提示切换处咔哒一下。普通注意力还会随时长积攒越来越多历史缓存。 方法直觉:像逐行读谱一样沿时间保留固定状态,再横着看潜在通道间的联系;每块接上上一块状态,换提示时削弱与旧状态重复的驱动力,让新声音接进来。 本文贡献:TCMamba 把时间扫描与通道扫描结合,用流匹配学习从高斯噪声到声音潜变量的连续速度场;VAE 负责波形压缩/解码,文字用 T5 编码。有状态流匹配 SFM 按块缓存每次前向的终态,在固定块长、通道数和文字长度下,状态缓存不随总时长增大。SDCG 即状态解耦条件引导,在切换边界额外做一次带历史但无文字的前向,区分新文字与旧声音贡献;不是完全免费控制。44.1kHz 数据训练,581M 约 5.81 亿参数,8 张 H100、每卡批 64 训练 100 轮。 Figure 1|MFlowAudio 关键组件。左:VAE 及声码器在声音和潜变量间编码/解码,噪声经 TCMamba 变成声音。中:TCMamba 块含文字与时间调制、时间 Mamba、通道 Mamba、交叉注意力及前馈层。右:沿时间和潜通道的双扫描机制分别捕获时间依赖与跨通道关系。 实验效果:单 RTX5080/16GB、20 次平均,10 秒音频耗 1.93 秒,TangoFlux3.51 秒;30 秒耗 3.10 对 3.55 秒,后者延迟降低约 12.7%,不是 14.5%少耗时(14.5%对应速度比提升)。64 个潜在位置约 3 秒一块,首块约 1.8 秒。AudioCaps4352 测试样本的 10 秒结果:FD 音频特征分布距离 11.8569 优于 15.8429,但 VGGish 特征 FAD 距离 2.5248 差于 2.1963;文字声音对齐 CLAP0.4957 也略低于 0.4990。动态提示边界谱变化比 BBR 为 4.3287,TangoFlux 为 11.6443,越低表示切换点相对背景变化更平滑。 Table 1|AudioCaps 测试集的 10 秒/30 秒结果,参数列 B 为十亿、M 为百万。FD、KL 及 VGGish/OpenL3 特征 FAD 越低越好,IS 及 CLAP 对齐越高越好;base 与后续微调配置分列,不应跨列混搭。MFlowAudio10 秒 FD 占优,但微调后 VGGish-FAD 与 CLAP 仍不及 TangoFlux。 批判点评:不能把固定 18MB 的状态缓存当成整个系统显存恒定:它按一次前向计,采样步数及解码器仍有开销。非因果 VAE 要重叠和前瞻,边界控制还额外前向;完整播放时延需连解码一起算。消融中引导的 BBR4.3287 反差于未经调整的 4.2633,控制服从与平滑有取舍;BBR 也不等于听感无瑕。arXiv 评论标注 NeurIPS2026,但正文不扩写奖项;演示页存在,未核到本方法完整训练代码。 8. TalkFlow:嘴脸和身体分开生成再协调 TalkFlow: Structured Latent Flow Matching for Speech Driven Holistic Motion Generation | 纽约州立大学石溪分校;Futurewei Technologies | arXiv:2610.40972 关键词:语音驱动动作, 三流潜空间, 流匹配, 面身协调 前序问题:数字人嘴型跟上了,手势却慢半拍;把脸与全身都压进同一表示,又可能丢表情细节。它们节奏不同,但必须演同一段话。 方法直觉:先让整套骨架记住身体连接关系,再把上身、下身、表情分三路压缩与生成,用少量可控的信息交换协调,而非各自生成后硬拼。 本文贡献:SMPL-X 参数化人体含 55 关节旋转与 100 表情系数。先用整身图卷积保留拓扑,再形成上身/下身/表情三路连续潜变量;自编码器与生成器都用 FiLM 按特征缩放偏移并加门,连接上身—下身及上身—表情,无直接下身—表情边。HuBERT 语音、Librosa 声学、FastText 词向量和 SBERT 句向量组成分路条件,不能省略转录文字。冻结解码器后以流匹配从随机噪声生成动作,并加积分后解码的重建损失。训练窗 240 帧即 8 秒,时间压缩 4 倍;长序列推理只重叠 8 原始帧、线性混合与平滑,区别于训练分段重叠 60 帧。 Figure 2|TalkFlow 整体架构。阶段 1 先按整身姿态和表情两条空间支路编码,再经时间编码形成上身、下身、表情三路潜变量。阶段 2 把语音特征分路条件化并用结构化流生成。FiLM 门交互协调上身—下身与上身—表情,无直接下身—表情交互;冻结阶段 1 解码器还原 SMPL-X 人体动作。 实验效果:BEAT2 沿用 Speaker-2 单说话人、85%/7.5%/7.5%划分。50 次 Euler 函数求值(逐步积分速度场),预提取语音条件后单 RTX4070TiSUPER 为 0.006 秒/帧,不含特征准备。表中面部顶点均方误差 MSE5.77,单位 10⁻⁸;顶点 L1 差 LVD6.65,单位 10⁻⁵,均优于 MambaTalk6.29/6.90。动作特征分布距离 FGD5.24,单位 10⁻¹,差于 EchoMask4.62;节拍一致 BCS7.84、单位 10⁻¹,也低于 ProbTalk8.10。37 人排名中,真实感、语义和整体同步获最低平均名次,越低越好。 Table 1|BEAT2 比较,按表情、身体手势和全身动作生成分组。FGD 与 BCS 以 10⁻¹显示,MSE 以 10⁻⁸、LVD 以 10⁻⁵显示,DIV 是坐标变化量;粗体/下划线为最佳/次佳。FGD、MSE、LVD 低更好,BCS、DIV 高不自动等于更自然;TalkFlow 面部误差较好但动作分布及多样性非全面领先。 批判点评:节拍分接近最佳不代表更自然:真值 BCS6.86 还低于多种生成器,强行追节拍不能代表自然。DIV 是坐标差异量,不是高层风格多样性,TalkFlow 为 11.48 而 EchoMask13.37。单说话人不能证明跨人泛化,也无显式风格或全局位移,偶有滑脚。项目与代码已有训练/推理源码;完整基准评分仍依赖外部 EMAGE 工具,本次未运行模型。 9. GeoFlip:挪一点支撑结果会翻转吗 GeoFlip: Benchmarking Geometry-Sensitive Physics in Video Generation | 纽约市立大学;墨尔本大学;中山大学;香港中文大学;卡内基梅隆大学 | arXiv:2610.42002 关键词:视频生成评测, 几何干预, 物理结果翻转, 结构完整性 前序问题:同一块木板,伸出桌边少一点能稳住,多一点就会掉下去。两个视频都很清晰、动作也流畅,却可能无视这点几何差别而给出同样结果。 方法直觉:固定文字、质量和摩擦等物理条件,只改支撑范围或物体位置,先用仿真验证结果应该翻转,再分别看生成器有没有改对事件,以及有没有顺手把硬物掰弯。 本文贡献:基准含 482 对、964 段参考,覆盖支撑、力矩、重力、接触、弹性、滑轮六类;程序建场、物理模拟与数值误差检查后用 Blender 渲染。模型只看各自首帧和共享提示,独立生成。事件正确率先在每任务内按事件类别平衡召回,再对任务等权宏平均;不确定算错。结构完整性只把明确无变形/增件等的条件算清楚,不与事件正确合并成一个成功标签。像素 PSNR 和结构 SSIM 另评参考相似度。 Figure 2|几何诱发物理结果翻转的构造与配对评测。先程序建场、数值验证再渲染,482 对共 964 条件;保持提示和其他物理设置不变,只改几何。示例增加桌边悬出范围使稳住变跌落,但模型可能两种初始条件都跌落;整对两项都正确才算配对成功,不能用单条件正确率替代。 实验效果:16 模型主比较用共同 442 个条件、34 任务,不是全部 964 段;GPT-6-Astra 每视频看 8 抽帧。Wan2.2 事件正确率最高 27.98%,结构完整仅 34.38%;LingBot 分别 26.69%与 60.81%。LTX 的 PSNR29.87dB 最高,事件率却 18.41%,可见像不像参考与物理事件不同。跨裁判另用 346 条件,事件/结构排名 Spearman 相关 0.906/0.929;结构分绝对差平均 15.14 个百分点,即便排序一致,宽严仍差很大。 Figure 4|同 442 条件下 16 种视频模型的事件正确率与结构完整性散点,每点一个模型;两轴均为 GPT 裁判按任务宏平均的百分比,编号对应原论文表 2 前三总体名次。事件高不代表结构完整,Wan2.2 事件 27.98%而结构 34.38%,LingBot 结构 60.81%但事件 26.69%。 批判点评:27.98%是任务宏平均事件率,不是几何配对同时成功率,也不是现实物理能力上限。参考相似度只用 40 段,与 442 条件的事件/结构分分母不同;模型采用各自分辨率、帧数与采样计划,不能当同算力竞赛。八抽帧可能漏过程错误,结构标签裁判分歧明显。研究提供受控诊断而非视频纠错算法,执行完整 16 模型及双裁判需另付生成/评测成本;原文未给官方基准代码链接。 10. L3G-World:把三维记忆直接喂给视频模型 L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory | KAIST AI;梨花女子大学;KAIST Urban AI Institute | arXiv:2610.40614 关键词:世界生成, 潜在三维记忆, 高斯更新, 少步蒸馏 前序问题:相机绕房间一圈回来,家具位置变了。保存每帧历史会越来越占内存;保存三维场景后每次渲染彩色图再编码,又拖慢新画面生成。 方法直觉:记忆按场景的地盘分配,不按走了多久重复堆;把视频模型本来读的压缩特征也放进三维点里,换视点时直接渲染给它。 本文贡献:L3G-Mem 用彩色重建误差和不透明度找记忆缺口,只在那里聚类创建高斯元(带位置、尺度及特征的可渲染单元),并取当前可见旧高斯做残差修正。新旧 token 共同注意力交互;每高斯另存变分自编码器 VAE 潜特征。L3G-Gen 以 Cosmos-Predict2.5 为底座,拼接目标视点渲染的潜特征、不透明度和噪声生成下一块,再回写记忆。LoRA 低秩微调、AnyFlow 少步蒸馏得到 Fast 版;各模块用 4 张 A100 训练。内存随已探索空间增大,重复走相同区域才趋稳,不是无限地图零增长。 Figure 2|L3G-Mem。a:将当前窗口与前一记忆输入,先按当前相机渲染旧记忆,确定哪些几何特征要聚类成新建查询,哪些可见高斯的 token 应取出精修;两组共同经 Transformer,分别解码为新高斯与残差更新。b:旧记忆的 RGB 和不透明度用新建掩码找待补区域,更新后记忆能重建当前已观测场景。 实验效果:481 帧往返同相机路径测试中,完整模型 DL3DV 返回视点的 PSNR16.00dB、LPIPS 感知差异 0.366,NeoVerse 为 13.53/0.652;这是前后同位姿自洽,不是未知世界真值。原文表 1 另用单 H100、400 帧成本测试:480×832、峰值 7.4GiB、总吞吐 9.02 帧/秒;实时流程采用少步版,不能把完整模型画质与 Fast 速度当同一配置。表 2 的 VAE 渲染 1086.58 帧/秒只计记忆条件形成,也不是整段视频速度。 Table 1|记忆计算效率。T 为生成帧数,R 为分辨率大小,S 为场景空间覆盖;OOM 表示显存不足。所有成本按单 H100 生成 400 帧测量,各方法原生分辨率不同。比较记忆类型、构建、精修、空间增长、峰值显存、全流程 FPS 与是否实时;L3G-World 行 480×832、7.4GiB、9.02FPS,不能混同独立记忆渲染吞吐。 批判点评:快版在 DL3DV 的 FID43.05 差于完整版 40.57,RealEstate10K 的自洽与位姿也非全项领先;未知区域仍是生成,不证明物理正确。主文实验设置写单 A100 效率,而表 1 明确 H100,应按表分开引用。摘要的原语减少 38.6 倍与正文对 NeoVerse 的 266–417 倍基线不同,不能混作同一加速倍数。项目与仓库当前发布计划仍未勾选模型/推理代码,仅有说明和展示;尚不能声称可直接复现。 趋势观察 先确定参考究竟提供什么 AlbumVSR 把身份与朝向对齐纹理拆开,RADI3N 分开几何与纹理,PicturePerfect 破坏驱动光照以免复制。参考不是越完整越好,需阻断会随条件变化的错误线索。 单一总分会藏住真实取舍 WeGenEditBench 高分输出仍可能漏项,GeoFlip 把事件与结构分开,TalkFlow 的节拍分甚至高过真值也不保证自然。按任务失败逐项复核,比只看榜首更有用。 缓存越小越要写清计数口径 Any Forcing 只保少量历史,MFlowAudio 每前向状态缓存不随时长增长,L3G 记忆按空间覆盖增长。三者都不是无限上下文无成本;首帧、额外前向和解码仍要单算。 诊断有价值但别跨越因果边界 RadialObj 给出门参与度相关性及局部条件分析,WeGenEvoStudio 做一轮定向适配。前者不是完整因果定理,后者不是已验证无限自我进化。 今日讨论 AlbumVSR 的 ID-GT 从 0.586 到 0.670,MUSIQ 却从 72.34 降到 52.32;第 2 路纹理只把身份增 0.001。若相册里混入错人,应怎样用“相似度低于 0.5”的筛选与错人相册对照,确定何时拒绝参考、退回普通视频修复? 人工智能炼丹君 整理 | 2026-11-03
-
AIGC 每日速读|2026-11-02|首尔大只锁末帧该改处Partial 今日 AIGC 论文速览 今日共 10 篇 · 编辑目标与多轮修复 2 篇 · 长视频生成与推理加速 2 篇 · 图像生成接口与多样性 2 篇 · 像素生成架构 1 篇 · 语音与音乐生成 2 篇 · 4D视听场景 1 篇 重点论文标题列表 Partial(首尔大):末帧只锁该改的区域 EditAgent(Adobe):多轮改图带着证据选结果 WanAR+FixAR(CMU):隔几段回看长视频修漂移 AB-Attention(InfRec):少算注意力还补回漏算份额 AnyOrder-AR(石溪大学):旧自回归模型补出任意区域 选读入口:做图生视频转变,先看 Partial 的背景反向运动 0.599 降至 0.387,并检查编辑区域未来是否仍有效;多轮改图读 EditAgent,同时核算约十余倍基准总 GPU 小时。做长镜头相机控制读 WanAR+FixAR 的静态场景边界,部署视频主干再看 AB-Attention 的 H20 内核与代码待开放。复用旧图像模型补图读 AnyOrder-AR;需要同提示多方案看 TokenRepel 的多样性/指令正确率取舍;训练像素模型读 SpecSlot 的调用计数。克隆声音先挑参考读 AudioSelector,手头有鼓谱再读 MiDiff,最后用 SonoWorld4D 核对新听音位置与完整全景的实验条件。 今日论文速览 1. Partial:末帧只锁该改的区域 Edited Endpoints as Partial Goals for Image-to-Video Generation | 首尔大学;OGQ | arXiv:2610.39179 关键词:图生视频, 编辑终点, 局部约束, 时序伪影 前序问题:想把视频中的公交车逐渐变紫,先改出一张终点图能说清目标。但编辑器同时保留了起点的路牌和道路布局;把整张图强压成末帧,移动过的背景可能突然倒回原位。 方法直觉:终点图只负责告诉模型车该变成什么样,没被要求改动的背景交给视频模型继续预测。编辑相关区域与未来仍然有效的区域是两件事,前者只能提供一个可用的近似。 本文贡献:从 FLUX.2-klein-base-9B 编辑器中提取预选物体/编辑短语的文字—图像注意力,平均归一化后,用双分量高斯混合与 Ising 空间相邻先验估计二值掩码 M0。在每轮去噪中,末帧潜变量只在 M0 内投向编辑终点,外部保留模型预测;掩码固定在终点坐标,不跟随运动。适配 Wan2.2-Turbo、SANA-Video 和 HunyuanVideo-1.5,不微调视频模型;这研究图生视频转变,不是对已有整段视频逐帧编辑。 Figure 1|编辑终点保留下来的背景未必适合未来:整帧约束把新外观和旧布局一起锁住;Partial 只锁编辑器注意力估计的 M0 蓝框内,淡化位置保留视频预测。源帧来自 DAVIS 公交车,经 FiVE-Bench 提供。 实验效果:TC-Bench-I2V 的 120 条提示中 103 条源视频仍可用,每条件配对 5 种子,共 515 段。Wan2.2 上 Full→Partial:转变完成率 TCR 41.94%→42.91%,差异不显著;背景晚期反向运动占比 BMR 0.599→0.387,显著下降。Hunyuan 的硬切诊断 HC 从 12.96→5.69,HC 是相邻帧 CLIP 特征相似度相对中位数的最大跌幅、表中乘 100,越低越好。供体背景对照额外生成一段 Partial 视频,在仍约束整帧时也减伪影,说明不只是约束面积起作用。 Figure 2|Partial 相对 Full 的时序诊断配对差。103 提示、5 种子,误差条为 95%置信区间;空心标记表示不显著,原文表 1 与 C1 另列绝对水平和区间。改善伪影与 TCR 差异不显著需分别解读。 批判点评:无显著差异不等于已证明完成率等价;相关区域里仍可能有不该在未来重现的路牌。动态程度 DD 只检测运动,不能断言运动正确。选择掩码还需图像编辑与注意力提取,供体实验多一次生成,不能把视频阶段 FPS 当完整系统延迟。原文给出项目与代码预告;指定代码仓当前 404,未核到可用实现或数据。 2. EditAgent:多轮改图带着证据选结果 EditAgent: Rethinking Agentic Image Editing | Adobe Research;加州大学圣迭戈分校 | arXiv:2610.39664 关键词:多轮图像编辑, 专用工具路由, 候选对比, 历史修复 前序问题:先磨砂玻璃,再让房间更亮,第二轮可能把第一轮磨砂擦掉。一直让同一个编辑器反复改自己的结果,会累积错误;只给裁判看缩略图,也容易漏掉局部瑕疵。 方法直觉:同一原图交给通用编辑器和适用的专用工具并行尝试,再给裁判局部放大、改动图和可计算的量,而不是只问哪张好看。每轮结束再检查旧要求是否仍成立。 本文贡献:规划器拆依赖步骤,分析器与路由器选方法;SAM 2.1 分割模型把定位框转成掩码。能力池含局部编辑、去物体、移动、缩放合成、光度算子、旋转和扩图。每次最多 3 候选,裁判一次横向比较及读取核验记录;每步最多 2 次重试,每轮最多 2 次重规划。后续轮次若破坏历史要求,做一次修复并仅在通过检查时采纳。这里核心输出是编辑图像,不把通用工具调用本身当 AIGC 贡献。 Figure 3|下方请求拆成有依赖的步骤,每次接受结果成为下一步源图;上方放大第一步:A 规划器排序,分析器/路由器选择适用方法;B 各方法从同源并行生成并附核验记录;C 现成视觉语言裁判比较候选和记录,接受或反馈重试。 实验效果:诊断集 600 组、30 类编辑,5 名专业修图师共同标注。144 例、4 次生成预算的并行/串行盲比中,并行赢 102、串行赢 28、平 14;78.5%以 130 个非平局为分母,裁判调用最多 2 次对 4 次。EdiVal 含 572 个三轮会话,512 像素下 Qwen 编辑器第 3 轮综合分 47.64→55.46,FLUX 为 53.20→59.45;同基准 H100 总推理 GPU 小时却从 1.1→12.9、0.5→6.3,不是每图延迟。 Table 3|EdiVal 各模型比较,每格为第 1/2/3 轮的 0 至 100 分,分别衡量指令遵循、内容一致和综合质量;闭源数字取自 EdiVal。带剑号方法按 1024 像素生成,所有输出下采样到 512×512 评价。不能把分辨率不同的行视作完全同算力对照。 批判点评:能力池收益依赖定位、专用模型与裁判;同一 Qwen 兼任内部和部分外部评分器,作者另换 Gemma 复核。诊断集专业人士协商标注,不是 5 份独立投票;方法提到 515 组可用候选,但前述 600 减 81 为 519,原文口径存在 4 组差异,不能擅自补齐。未核到本方法官方实现,论文列出的底座和工具开源不等于整套 EditAgent 已开源。 3. WanAR+FixAR:隔几段回看长视频修漂移 Hierarchical Diffusion for Camera-controlled Autoregressive Video Generation | 卡内基梅隆大学;牛津大学 | arXiv:2610.37983 关键词:相机控制, 长视频生成, 层级纠错, 静态场景 前序问题:拿一张室内照片让相机绕着走,越走越远容易歪墙、丢家具。只把相机姿态编码交给模型,坐标尺度也可能对不上;每段都看上一段最后一帧又会把错误传下去。 方法直觉:先按深度把旧画面搬到新机位,模型补看不见的空洞;积累几段后抽稀关键帧,一次回看更长历史来修正,再把中间帧补齐。 本文贡献:WanAR 用 MoGe-2 估深度,按目标相机姿态变换上一帧,作为视频补全条件。FixAR 跨多次生成抽取稀疏关键帧去噪纠错,InterpolatAR 插回相邻关键帧之间的画面。三阶段共享 Wan2.1-I2V-14B 底座,各加载秩 32 的 LoRA 低秩微调参数;每个模型、每个数据集用 8 张 H100 训练 1 万步,约一天。训练分辨率 256×256;评价统一裁剪缩放和时间采样,不把原生分辨率直接混比。 Figure 2|WanAR、FixAR、InterpolatAR 共用 Wan2.1 主干、各装阶段专用 LoRA。上:MoGe-2 估输入或上一段末帧深度,变换到未来机位作为 WanAR 条件;中:跨段抽稀关键帧由 FixAR 回看较长历史纠漂移;下:InterpolatAR 补相邻修正帧之间的画面。三阶段整体仍可自回归延长。 实验效果:RealEstate10K 中,相比 TrajCrafter,峰值信噪比 PSNR 14.35→16.69 dB、感知差异 LPIPS 0.410→0.341、视频分布距离 FVD 347.75→282.59;前者高、后两者低更好。DL3DV 的 FVD 703.82→640.64,但 FID 图像分布距离 47.75 差于 Lingbot 的 40.26。单张 80GB H100 生成 280 帧,本文 336×592 耗 12 分钟/峰值 41GB;480×832 耗 17 分钟/48GB,两档都要 10 次扩散模型调用。 Table 1|RealEstate10K 静态场景长视频与新视图合成比较。WanAR+FixAR 结合精确机位控制和层级纠错,主要指标优于表列基线;TrajCrafter 这类短新视图方法也强于多种长视频方法。mPSNR 只计与首帧共同可见区域,用于观察机位一致性,不代表所有未知区域有唯一真值。 批判点评:只适合静态场景,不能据此宣称人物动态或通用世界模型。尺度分布差很多时跨数据集失效;没有内置长久记忆,绕回原处仍可能不一致。FixAR 本身有限历史,仍不消除漂移。原文的项目明确代码待开放;不同基线主干、原生分辨率与调用数不同,17 分钟不是纯架构同算力胜出。 4. AB-Attention:少算注意力还补回漏算份额 AB-Attention: Accurate Block Attention for Accelerating Video Diffusion Transformers | InfRec;香港中文大学(深圳);山东大学;东京大学;复旦大学;加州大学伯克利分校;香港科技大学;新加坡国立大学 | arXiv:2610.39663 关键词:视频扩散加速, 块内聚类, 概率加权采样, GPU内核 前序问题:长视频的所有视觉 token 相互看一遍很贵。只保留重要块虽省算力,丢掉的块也从注意力归一化里消失,容易让结果偏离完整注意力。 方法直觉:把算力多分给可能重要的小块,但不让任何块的入选概率变成零;抽到后按入选概率倒数补权重,像抽样调查校正抽样偏差。 本文贡献:块内查询聚类选择器 IBCS 在每个 128 查询块里聚 8 个中心,估计各键值块重要性,不全局重排 token。SIP 即按入选概率加权采样,无放回抽取 4-token 键值块,在注意力 logit 上减去入选概率的对数;内核再把小块拼入完整 tensor-core 计算瓦片。分子和归一化因子的估计分别无偏,其比值并非因此严格无偏。无需训练,只支持前向推理。 Figure 3|A:IBCS 在每查询块内聚类,中心加权注意力为键值块评分;B:SIP 按评分设入选概率π,不排除任何块,抽中后按 1/π补权重;C:内核收集小块装入 tensor-core 瓦片,并在 logit 上减 logπ。概率校正不意味着归一化后的比值严格无偏。 实验效果:600 条 Penguin 提示、720p,Wan2.1 为 81 帧、HunyuanVideo 为 129 帧;同提示和种子对照完整注意力。H20、BF16、50 步中前 10 步及首个 Transformer 块仍密集计算,稀疏计划每 4 步更新。Wan14B 跳过稀疏阶段 89.16%注意力、PSNR 相对密集输出 30.788 dB、总耗时 4743.52→2571.52 秒,1.84 倍;Hunyuan 为 92.35%、34.347 dB、4399.03→1974.61 秒,2.23 倍。 Table 1|Wan2.1 文生视频 1.3B/14B 与 HunyuanVideo13B 的画质和效率。阴影行为完整注意力参考;PSNR/SSIM/LPIPS 比较同种子密集输出,VBench 列衡量美观、背景一致、成像、运动平滑、主体一致。稀疏度是稀疏阶段跳过的注意力比例,时延和加速是整段生成测量;H20 设置下最高 2.23 倍。 批判点评:89%至 92%不是整个生成流程节省同等比例;PSNR 高表示更像密集参考,不代表人类画质绝对更好。VBench 部分维度仍略低于密集版。内核针对 H20、只测 3 个文生视频主干,其他硬件与训练反向尚无验证。官方仓库当前只有说明与演示,明确写代码待放出,不能称已可复现。 5. AnyOrder-AR:旧自回归模型补出任意区域 Unlocking Any-Order Generation in Pretrained Autoregressive Image Models | 纽约州立大学石溪分校;ILLS;蒙特利尔高等技术学院 | arXiv:2610.39293 关键词:任意顺序生成, 自回归适配, 位置条件, 区域补全 前序问题:模型按从左上到右下的固定次序画图,补中间一块时却需要同时看它四周;会画整张图,不代表预训练接口能表达这种条件。 方法直觉:保留已经学会的图像知识,明确告诉模型下一个要预测哪个空间位置,再从熟悉的逐行顺序逐步过渡到随机顺序,避免直接打乱训练把旧知识冲掉。 本文贡献:未来感知位置嵌入在输入层加入下一个目标位置的向量;LlamaGen 旋转位置编码、RAR 绝对位置编码都按真实空间位置而非解码步索引。顺序课程从逐行到均匀随机排列,继续训练 LlamaGen-L/XL 和 RAR-L/XL 四个底座,不改离散视觉 tokenizer 或加补图专用网络。保留键值缓存 KV cache 与并行解码;vLLM 服务仍需仓库自定义模型适配。AnyOrder-AR 是本期便于阅读的短名。 Figure 1|同一逐行自回归 LlamaGen-L 适配后,通过改变已知 token 位置完成左侧补图、中间区域条件重画、右侧扩图,不需任务专用训练、采样器改造或辅助网络。原逐行列失败源于不能消费非连续上下文,不是同任务共享接口下的弱基线;这是能力概览而非架构图。 实验效果:ImageNet 256×256、5 万样本,中心补图 FID 6.21,对 MaskGIT 余弦日程 10.44、Halton 日程 7.82、MAR-L 6.63;FID 越低越好。扩图从 128×128 中心裁剪补到全图,FID 5.84 对 MAR-L 6.86,但精确率/召回率 0.720/0.637 低于 MAR-L 的 0.736/0.649。代价是四底座类别条件生成 FID 增加 1.17 至 1.93;适配约多 13%至 33%训练计算,LlamaGen-XL 总预算约原预训练 1.25 倍。 Table 3|ImageNet256×256 补图/扩图,以 TF-Inception 评价 5 万样本。补图用中心掩码;扩图把 128×128 中心裁剪补到全图。FID 越低越好,IS、精确率、召回率越高越好;MaskGIT 包含余弦和 Halton 两日程,MAR-L 在扩图精确/召回仍较高。 批判点评:这里只验证 ImageNet 类别条件和区域补全,不能当文字指令编辑、身份保留或高分辨率已解决。比从头训练的对照匹配总计算,但训练日程不相同;对 MAR-L 也没有运行级不确定性估计。代码含训练、补图、扩图与 vLLM 入口;arXiv 评论明确 NeurIPS 2026 poster,不从论文排版猜接收。 6. TokenRepel:同一句提示别总画得一样 TokenRepel: Generating Diverse Image Sets Without Compromising Quality | 澳大利亚国立大学;Homenet Research;CarryAI | arXiv:2610.39913 关键词:图像集多样性, token排斥, 密度保护, 推理引导 前序问题:同一句提示生成四张图,换了随机种子却常常只有同一构图的细微变体。强行拉开样本又可能把人物结构和文字要求一起拉坏。 方法直觉:先让不同图的内部视觉特征拉开夹角,再把会偏离模型高密度方向的更新削掉。目标是整组图有更多变化,同时尽量留在模型熟悉的图像范围内。 本文贡献:把隐藏 token 归一化到单位球面,用 von Mises-Fisher 混合分布的负黎曼梯度推动跨图 token 分散;密度保护把排斥引起的预测变化投到与模型 score 方向相容的半空间,并扩到中间层。score 是引导样本向更高概率区域移动的方向估计。测试 FLUX.1-dev、4 步 FLUX.2-Klein-9B、SDXL;分别只在前 3/1/5 步施加排斥,早层做密度保护,不需训练。 Figure 2|TokenRepel 方法示意。a 左:图 1 的 token 受其他图 token 构成分布的负梯度排斥;a 右:按余弦相似度加权的其他图 token 均值决定梯度方向。b 左:等高线为学得分布,绿虚箭头为原 score,黑实箭头为排斥后 score;b 右:密度保护把排斥更新投到高密度半空间,灰色实箭头表示投影结果。c:排斥放在注意力输出后、密度保护放在层输出后,说明两种操作在 Transformer 层内的位置。 实验效果:GenEval 每提示 4 图、512 分辨率、各法同初始噪声。FLUX.2 单设置下,成对 DreamSim 视觉距离 0.1964→0.2643、Vendi 特征谱熵对应的有效样本数 1.6791→1.8280;两者越高越多样。HPSv3 偏好分 9.0595→8.9825,GenEval 指令组合正确率 0.8813→0.8525,时延为底座 1.32 倍。FLUX.1 为 1.15 倍、SDXL 为 1.05 倍,不能把三主干的成本合成一个数字。 Table 1|GenEval 固定设置比较,FLUX.1、FLUX.2 与 SDXL 分别采用 HPSv3 阈值 7.4、8.8、5.5。多样性列为成对 DreamSim、Vendi 与 LPIPS;质量列含偏好、图文和组合指令分,时延为各自底座倍数。提高多样性仍可能降低部分质量指标,阈值设置不等于质量完全无损。 批判点评:“不损质量”是受阈值约束的取舍,表里 GenEval、PickScore 与部分偏好分仍下降;批大小变大使 Vendi 升高,也受计数口径影响,不直接证明总体分布更丰富。保护机制不直接适用于输出概率的自回归模型。arXiv 评论为 NeurIPS 2026,正文另有 camera-ready 差异说明;未在原文直接核到本方法代码仓,不以引用的 FLUX 链接冒充。 7. SpecSlot:细节多一份全局通信不翻倍 Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers | 北京大学;南洋理工大学;商汤 | arXiv:2610.40647 关键词:像素空间生成, 频带分工, 全局局部注意力, 计算口径 前序问题:直接在像素上生成图像,切更小图块能保细节,但 token 数和全局注意力一起膨胀。局部纹理也被迫参与所有区域的通信,算力未必花得合算。 方法直觉:同一空间锚点分给多个 slot,各管一段频率;只有最低频 slot 跨区域沟通,细节先在锚点内部交流。slot 是具有指定输出职责的特征单元,不是额外图像。 本文贡献:W 为空间锚点数,K 为每锚点频带 slot 数,总图像状态数 N=W×K;DCT 离散余弦变换把平滑结构与细节分到互不重叠系数带。全球注意力只处理 W 个低频载体及上下文状态,局部注意力混合各锚点的 K 个 slot。重叠窗口频谱解码与空间修正相加,生成状态、速度目标和损失仍在像素空间,不是外训压缩器。整流流模型以连续速度把噪声搬到图像。 Figure 2|每个空间锚点展开 K 个 slot;G 块只让最低径向频率 slot0 载体跨锚点并与上下文交换,L 块在单锚点内部混合全部 slot。最终解码重叠 DCT 频谱基底与锚点对齐空间修正,在像素空间相加。 实验效果:同配方重训 120 轮,ImageNet-512 的 W256/K4:FID 9.14 对计算匹配 JiT-CM 的 11.98,单次条件前向 135.64 对 141.21 十亿浮点运算。相对 JiT-B/16 的 219.56 少 38.2%计算,但 FID 仍差 0.69。256 像素文生图、400 轮,DPG-Bench 复杂指令分 62.21 对 61.15,GenEval 却 26.99 对 29.78。单 H800、批 128 的 512 训练峰值 17.39GB/卡;Heun-50 是区间数,另表固定批量实测含无分类器引导的网络调用为 187 次/图,不能理解成只调用 50 次。 Table 1|ImageNet 画质与计算。各 SpecSlot 分配报告扫参后最佳证据宽度 B 与引导 CFG,SF-B/32 在 512 分辨率 CFG9.50;十亿浮点运算为单次条件前向,图/秒为 Heun-50 峰值吞吐,横线是 B 不适用。JiT 均按统一配方重训 120 轮;512 分辨率计算匹配差距更大,但高计算 JiT-B/16 的 FID 仍更低。 批判点评:减少前向浮点运算不等于按同比例降低端到端时间;引导强度 CFG 在模型间不同,两个文生图指标也不一致,不能概括为全面胜出。更密锚点或更多 slot 仍增加局部计算。arXiv 标注 ICLR 2027 在审,绝非已接收。代码含模型与训练入口,权重仓链接已核验但本次未运行模型。 8. AudioSelector:克隆声音先挑好参考片段 What Makes a Good Audio Prompt for Zero-Shot TTS? Learning Prompt Selection from Synthesis Outcomes | 耶路撒冷希伯来大学 | arXiv:2610.40372 关键词:零样本语音合成, 参考选择, 输出监督, 词错误率 前序问题:从一段播客里剪几秒来克隆声音,最干净的一段不一定让合成器少念错字。挑参考的音质与用它生成后的可懂度,是两种目标。 方法直觉:先离线观察同一合成器使用不同片段后会念错多少,再让小网络直接从参考音频预测哪段更适合。部署时只挑片段,不必为每个候选预合成许多句。 本文贡献:冻结 2100 万参数 Whisper-base 编码器,训练两层 Transformer 及注意力池化的 140 万参数网络;按每条录音内部候选的词错误率排序监督,5 个随机初始化模型分数取均值。每条主说话人的 30 秒区间剪出 3/5/10 秒候选 10/6/3 个,共 19 个;每候选用 5 句×3 种子生成 15 个输出。训练/开发/测试隔离录音,并移除训练中与测试声音匹配者。AudioSelector 为本期对论文 audio selector 的短称,不是新模型品牌。 Figure 1|由合成结果训练的小音频选择网络,选出的参考带来比预测音质更大的词错误率收益,选择时无需合成。400 条独立测试录音、随机参考为基准,WER 收益按百分点且越高越好;探测法每候选合成 12 次,Qwen1.7B 复用 0.6B 的选择器/描述器,误差条为 95%区间。这是方法效果概览,原文没有独立网络结构图。 实验效果:400 条英语测试录音,Qwen3-TTS 0.6B 相对随机参考的 WER 词错误率降 1.36 个百分点、约相对 32%;UTMOS 预测自然度选取降 0.83 个百分点。1.36 与 0.83 来自四舍五入表值,配对原始差报告 0.54 个百分点。效果接近每候选试合成 12 句、每录音 228 次合成的方案。选择时不合成不等于无计算,仍需编码 19 段、5 网络打分;离线标注每底座约 100 至 270 个 L40S GPU 小时。 Table 1|Qwen3-TTS0.6B 的 400 条测试录音,每条 19 候选共同选取。Δ为相对同录音随机候选的改进,WER 与失败为下降百分点,其余为指标单位;Audiobox 为未参与选择的保留裁判。剑号/双剑号表示与 UTMOS 规则配对差区间显著更好/更差,不能按表中舍入值替代原始配对差。 批判点评:只测 4 个模型、3 家族及英语录音/加噪语音,最好选择器依赖本底座的生成标签。7 人、72 条录音听测未发现自然度代价,却不足以验证可懂度优势;也未覆盖重音和表现力。WER 主要用自动识别器,不能代表所有人类听感。未核到作者在原文给出的独立实现链接,公开底座不能代替选择器代码。 9. MiDiff:用鼓谱指导坏鼓声再生成 MiDiff: MIDI-Conditioned Diffusion Models for Drum Audio Enhancement | 巴伊兰大学 | arXiv:2610.38619 关键词:鼓声音频修复, MIDI条件, 在线转谱, 测试集选参 前序问题:现场鼓声被混响、削波和噪声弄糊,仅靠音频不易知道某一下究竟是什么鼓、打了多重。即使敲击时刻找对,音色仍可能恢复错。 方法直觉:MIDI 钢琴卷帘像一份时间对齐的鼓谱:每行一种鼓、格子亮度是击打力度。把鼓种和力度直接交给去噪网络,比只在输出端催它敲准时间更有效。 本文贡献:在 SGMSE 语音增强扩散的复数短时傅里叶变换 STFT 域里建模;STFT 把波形变成带幅相的时间—频率表示。冻结预训练 9 鼓类、128 维 MIDI 编码器,各 U-Net 层用可学习时间对齐,再结合入口注入、FiLM 特征缩放/平移和交叉注意力。没有真值 MIDI 时,先用音频网络去噪,噪声降低后让带扩散时间条件的自动鼓转谱器在线估计,再切 MiDiff。两张 A100 训练 60 轮;采样 30 个预测步,每步另 1 个 Langevin 校正,不是 30 次网络计算。 Figure 2|左:入口注入把原始 MIDI 卷帘编码,经零初始化 1×1 卷积投影,加到 NCSN++处理带噪音频与退化观测的首层输出。右:层级音频特征依次经过残差块、可选 FiLM 特征调制、自注意力和可选交叉注意力,各层读入时间尺度对齐的 MIDI 嵌入。 实验效果:StemGMD 同一鼓手不同会话,训练 16.08 小时、测试 1.16 小时 100 段,16kHz 单声道。真值鼓谱下 FAD 音频特征分布距离 1.268→0.233,越低越好;参数 65.6→71.2 百万,多 5.6 百万。时序误差却 0.028→0.029 毫秒/秒,说明主收益不在敲击定时。无外部鼓谱时 FAD 0.676、较音频基线约降 47%,但切换时间 0.75 从测试集 9 点扫描选出,属于事后最佳值。 Table II|StemGMD 结果全部指标越低越好。FAD 衡量音频特征分布距离,MSD 为 dB 谱距离,TTER 为每秒瞬态时序误差。带剑号 Cold Diffusion 测试与其他模型用相同退化输入;验证输入却来自单独 44.1kHz 退化再下采样 16kHz,只能近似比较验证列。MiDiff 较 SGMSE 主要改善 FAD,而测试 MSD 及 TTER 略差。 批判点评:合成鼓库与模拟退化,训练/测试共享鼓手和音色库,未验证真实录音、独立鼓手或独立鼓组。16kHz 最高可恢复 8kHz 以下频段;无正式听测,单次随机采样也分不清小差异。真值 MIDI 是强条件,无谱结果不能等同独立验证泛化;时延和峰值显存未给统一测量。项目保留旧版 0.29/0.56 数字与编码压缩描述,和当前原文不同;代码按钮无有效实现链接,本稿以原文为准。投稿 IEEE/ACM TASLP 不等于接收。 10. SonoWorld4D:换个听音位置声源也跟着走 SonoWorld4D: From One Video to a 4D Audio-Visual Scene via Diffusion Synchronization | 马里兰大学帕克分校 | arXiv:2610.40640 关键词:4D视听生成, 动态声源, 双空间扩散, 新视点声场 前序问题:看一辆车从镜头前经过,换到街对面的虚拟听众,声音峰值和频率变化应随新距离改变。把原机位合成的单声道录音直接搬过去,常把旧机位的响度与多普勒变化也搬过去。 方法直觉:先给每个会动的物体一条轨迹和一份贴身声音,再让物体坐标与相机坐标的生成结果互相校正。这样换听众时可以重新计算传播,而不是只平移一段录音。 本文贡献:深度、相机和前景分割分解场景,动态物体与 360 度背景用可快速渲染的 3D 高斯表示,做尺度和局部位移对齐。静态声源用文字生成;动态声源在每步扩散中从物体空间渲染到相机混音,又经声源分离与逆渲染映回各物体,双空间同步。新听众的距离衰减、遮挡、传播时延和多普勒效应参与声学渲染,再编码 ambisonics 球谐方向声场、解码为双耳声音。 Figure 2|单目视频先估深度、机位、前景掩码及视觉语言模型的音频提示。视觉分支重建动态物体高斯,将扩出的 360 度全景变为背景高斯,以尺度和局部位移对齐世界坐标。音频分支静态源用文字生成;动态源每步由前向渲染 Ri 把物体预测映到相机混音,再由分离和逆渲染 Qi 映回各源。最后支持新视点视觉/空间声音渲染。 实验效果:SonoScene4D 共 54 段、每段 8 秒,30 帧/秒 360 度视频配 48kHz 一阶 ambisonics 麦克风,麦克风与相机不在同位置。相对最接近的 Sonic4D,方向角误差 55.5→40.7 度、声场相关系数 0.446→0.647;越低/越高分别更好。50 人、9 场景听测中音频偏好 66.4%,是成对选择率。重要条件:该定量实验用采集的完整背景全景和跟踪裁出的前景视频,不能把分数都归于任意单目视频输入。 Table 1|SonoScene4D 视频转 4D 视听场景比较,含完整方法与动态声音分别用文字生成 T2A、视频生成 V2A 的消融。方位/俯仰与整体角误差以度计、越低越好;相关系数 CC、方向检出 AUC、音频及文字 CLAP 语义相似度越高越好。基线任务输入不同,完整方法优势需连同完整背景全景的评测条件理解。 批判点评:基线有单声源、全景输入或不支持新视点等差异,作者为它们适配输入/渲染,需按任务解释。实时的是已构建场景的视听渲染,不是整个场景生成;未报告统一端到端耗时/峰值显存。真实场景的几何、分割和源分离错误会沿流程传递。项目明确实现待开放;54 段与 9 场景听测也不足证明复杂场景全覆盖。 趋势观察 编辑条件要区分现在与未来 Partial把旧布局从终点要求中释放,EditAgent又在多轮中主动保住历史要求。该放开的背景与该保留的编辑依赖不同任务,不能统一用越像源图越好打分。 省计算与省时间分别核算 AB-Attention只在部分步稀疏化,SpecSlot将全局与局部角色拆开,AudioSelector把反复试合成搬到离线训练。三者省的计算阶段不同,完整时间账单必须单独看。 生成灵活性要报告代价和反向指标 AnyOrder-AR补图更灵活但类别生成FID变差,TokenRepel更分散但组合指令分下滑,SpecSlot的DPG与GenEval方向不同。一个亮点数字不应遮住任务间取舍。 强条件实验要和真实部署分开 MiDiff真值鼓谱与测试集选切换点,SonoWorld4D的完整全景背景,都给模型更有利条件。收益可以读,但下一步应固定参数、限制输入并做独立测试。 今日讨论 Partial 把 Wan2.2 的 BMR 从 0.599 降至 0.387,TCR 差异却不显著。如果公交车要变紫并驶出画面,应在什么条件下启用“掩码固定在终点坐标,不跟随运动”的约束?如何固定提示和种子,测量完成率、背景反转和物体离场,决定何时撤掉终点约束? 人工智能炼丹君 整理 | 2026-11-02
-
AIGC 每日速读|2026-10-30|小米只给局部视频换画风LociArt 今日 AIGC 论文速览 今日共 10 篇 · 视频局部编辑与图像编辑防护 2 篇 · 物理外观编辑与视频记忆 2 篇 · 生成训练与表征 2 篇 · 少步生成安全 1 篇 · 图像与音乐编辑评测 2 篇 · 交互视频世界 1 篇 重点论文标题列表 LociArt(小米):只给选中区域换画风 CaD(普林斯顿):让编辑器照抄原图来防改 SREdit(西南大学):先看投影照得动哪里再改 VMem-Bench(可灵):旧参考能记住也能带错人 NTI(港大):训练别只认唯一下一块 选读入口:要给视频局部换画风,先读 LociArt 并确认风格已学、区域互不重叠;想保护照片免遭改动,读方向相反的 CaD。要把改图投回实体,读 SREdit 的额外 0.60 至 0.73 秒与完整系统成本;长故事换装或角色退场,读 VMem-Bench 的召回/错带实体取舍。训练视觉自回归看 NTI,选择压缩器先看 WithinVAE 的生成负结果。部署少步模型再读 DICE;手机预算读 MoI-Bench,编辑音乐读 SMEBench。最后用 BoxWorld 思考哪些互动规则应交给显式引擎。 今日论文速览 1. LociArt:只给选中区域换画风 LociArt: A Unified Paradigm for Free-Style Local Video Stylization | 小米 MiLM Plus;西安电子科技大学 | arXiv:2610.36456 关键词:局部视频风格化, 极坐标风格掩码, 区域几何约束, 风格扩展 前序问题:想让视频里的熊变成铅笔画,周围石头仍保留原色;整段换风格容易,局部换风格却会越界、闪烁。二值掩码只说改哪里,还没有把每个区域与它的风格绑在一起。 方法直觉:把风格当成单位圆上不同方向,直接写进要编辑的区域;再同时保留压缩后的上下文和原掩码的几何边界。模型既知道这里该换什么画风,也知道影响应停在哪里。 本文贡献:GRNStyle 基于 GRN 生成细化网络,以二进制视觉 token(压缩视觉单元)并行迭代生成。三通道风格掩码前两维存缩放后的极坐标,第三维存占用,不额外增加通道或 token。编码掩码减去空掩码编码,消除空条件偏置;池化的原掩码提供几何支撑,再与源视频特征经逐块视觉/文字门控注入。自动全局风格化、去物体、抠图与合成构造 10 万对视频;从预训练 GRNEdit 初始化 20 亿参数主干,8 张 H200 全量微调,训练 61 帧、20 帧/秒、18 种风格。 原文图 2|GRNStyle 总览。(a)极坐标风格掩码把风格绑定到区域,并支持多区域组合;(b)减去空掩码的锚定证据与原掩码几何支撑同源视频特征融合,经逐块门控引导局部视频风格化。 实验效果:80 条视频、84 个视频-物体掩码单元,前景/背景两协议共 168 例。对同数据微调的 VACE-1.3B,区域风格原型相似度 SPS 前景 0.386→0.407、背景 0.676→0.705;未编辑区域 PSNR 峰值信噪比 25.43→25.92、25.49→26.15 dB。相邻帧 CLIP 视觉特征余弦一致性 0.980→0.983,均越高越好,但不是像素级无闪烁保证。10 扩 15 风格且不回放旧数据,旧类 SPS 下降 0.022,对二值版 0.102。 原文表 1|LociArt 基准比较。fg/bg 为编辑目标掩码及其补集;FT 为局部风格微调,星号为免训练,剑号为直接合成掩码且非编辑区复制源像素,因此省略不可比 PSNR,双剑号为图像方法。SPS、区域文字相似、非目标保真和相邻帧一致性及风格/保留裁判分均越高越好,粗体和下划线分别标最优与次优。 批判点评:多区域组合只展示不相交区域及已学风格的定性案例,不能称任意参考图零样本编辑;旧风格仍遗忘。20 人、160 例的用户研究每例仅一人评分,不是每人评完全部。未给统一推理时延/峰值显存,新增条件不加 token 不等于零开销。项目有演示,本次未核到 GRNStyle 实现或权重。 2. CaD:让编辑器照抄原图来防改 Copying As Defense: Protecting Images from Editing By Eliciting Model Copying | 普林斯顿大学;Adobe Research | arXiv:2610.35566 关键词:图像编辑防护, 早层参考注意力, 逐token目标, 优化成本 前序问题:分享照片前加一层微小扰动,希望别人难以篡改。把编辑器对原照片的注意力压低,可能只让它凭文字重画另一个人,仍然完成了不希望发生的编辑。 方法直觉:反过来,让待生成区域过度关注原图。注意力总量归一化,原图占得越多,文字指令和新画布分到的越少,模型就更容易复制输入而不是执行改动。 本文贡献:CaD 是 Copying-as-Defense。对白盒可访问的扩散 Transformer 编辑器,优化输入像素扰动,逐目标 token、逐注意力头最大化早期双流块分给参考图的注意力质量。只对选定早层计算损失,前向与反向都在最后目标块截断。50 张受保护图来自 20 张筛选人像与 30 张合成人体图,每张 15 条指令,共 750 个编辑输出/配置;比较 FLUX Kontext 与 FIBO Edit。 原文图 2|在 Flux Kontext 早期双流块不断加深的前缀中累积干预。Target→Ref=0 移除参考注意力,=1 把所有目标查询注意力分给参考键。(a)压低参考仍能按指令生成,拉满则越来越复制自然图或黑参考;(b)10 张 BodyBench 图的 PickScore 文字图像匹配分,无干预和=0 保持高且近乎平坦,=1 随干预块增加而下降。这是机制诊断,不是 CaD 算法流程图。 实验效果:每像素最大扰动 12/255 时,FLUX Kontext 的 BodyBench 编辑成功率 81.6%→5.1%,DeContext 为 24.9%;成功由视觉语言模型同时判断改动、身份保留及伪影。FIBO 的人像为 80.0%→18.3%,但全身图 CaD56.4%反而高于 Diff-PGD47.6%。FLUX 每优化步 0.647 秒,对 DeContext1.232 秒;CaD1000 步共 10.78 分钟,对方 800 步 16.43 分钟,不能把每步约 1.9 倍当总耗时倍率。 原文表 1|最大扰动 12/255 下两个编辑器和两个数据集的保护。蓝色粗体/浅蓝标最好/次好;编辑成功、文字匹配和身份分越低代表防护越强,保护图 LPIPS 越低、PSNR 越高越不易察觉。运行时间分别是每步秒数与每图分钟数;基线 800 步、CaD1000 步,不能混为同预算。 批判点评:输出可能是有损复制或带伪影的失败图,防编辑不等于恢复干净原照;LPIPS 感知距离与 PSNR 还要核保护图是否可见改变。实验只 50 张且针对已知白盒编辑器,JPEG 压缩、缩放和去扰动会削弱保护,不能许诺跨平台永久有效。原文未给可核实的作者方法代码入口。 3. SREdit:先看投影照得动哪里再改 SREdit: Scene Response Guided Appearance Editing for Projection Mapping | 西南大学 | arXiv:2610.32792 关键词:投影外观编辑, 场景响应图, 早期源图锚定, 物理重现 前序问题:把雕像照片改成翡翠,再投回实体,屏幕上很亮的绿未必能照出来;编辑器还可能改了轮廓。后面的投影补偿只能调光,救不了已经偏离实物的目标图。 方法直觉:先估计各处表面对投影光的响应。照不动的地方多保留原色与明暗,能照动的区域再大胆修改;只在生成前段拉住结构,把后段留给纹理。 本文贡献:冻结已重建、已标定的高斯可微场景渲染器,从表面反射、法线及投影/观察方向求逐通道响应,再取均值并在物体支撑域归一化。采样前 20%用同噪声级的源图潜变量锚定,按响应和时间权重修正 Euler 更新,后段恢复原编辑器;不用训练或反传编辑器。Qwen 与 LongCat 分别 40/50 步,控制强度 2.5/3.0 由另一个场景选择。最后独立优化投影补偿图。 原文图 1|固定物理场景的外观编辑流程。前 r 比例采样用源外观保住配准,场景响应图让低响应区域保留更多源信息、高响应区域允许更大变化;剩余步骤由原编辑器完成,再迭代优化补偿图并进行实体投影。 实验效果:6 套固定实物-投影-相机装置、18 个文字任务,论文报告 64GB A100。LongCat 生成目标与实拍结果的 PSNR14.7231→20.6623 dB、LPIPS 感知距离 0.3369→0.2316,后者越低越好;耗时 58.50→59.10 秒,峰值 29.73GiB 不变。Qwen88.37→89.10 秒、57.94→57.95GiB。参考图编辑仅测 Qwen、4 场景 12 例,PSNR18.5257→21.7335;20 人 720 次判断整体偏好 72.4%。 原文表 1|6 套装置 18 个提示的实体投影质量与效率均值。PSNR、SSIM、LPIPS 及色差比较各自目标与相机实拍;CLIP、BLIP-ITM 评文字请求一致性。时间是单张目标生成墙钟秒数,VRAM 是生成期峰值分配显存,粗体/下划线标最好/次好,剑号为二维表面方法。 批判点评:PSNR 比较各方法自己的目标与实拍,目标难度不同,不能直接当编辑优劣;需结合文字一致性与人工评价。响应是软约束,过强会抹掉纹理;场景重建、标定和补偿成本不包含在新增不到 1 秒的编辑开销里。固定机位物体实验尚不覆盖动态表面;原文未给方法代码。 4. VMem-Bench:旧参考能记住也能带错人 More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation | 中国科学技术大学;可灵研究;清华大学;香港科技大学;香港城市大学 | arXiv:2610.35001 关键词:长视频视觉记忆, 参考检索, 当前状态正确性, 双轨诊断 前序问题:长故事里人物换了围巾,检索旧帧却把旧围巾带回来;已经离场的人也可能因同框参考再次出现。“长得像过去”与“符合现在剧情”并不是同一个目标。 方法直觉:把检查分成生成前与生成后:先问检索的证据是否合适,再问新视频真正保住了谁、错带了谁。这样能区分检索覆盖、历史相似和当前状态正确性。 本文贡献:Track-A 在 92 部真实影片的 16548 片段上,只从过去检索、随后揭示当前片段,不运行生成器。Track-B 为 30 条人工构思故事、2824 个 5 秒片段;共享 FLUX.2 关键帧合成与 Wan2.2-TI2V-5B,对四种检索策略各取 3 帧,再与无记忆及获得真值实体 ID 的最近出现参考对照。各策略从自己的输出继续写记忆,因此比较完整闭环策略;这里 causal 仅指不看未来,不是固定历史上的单参考因果干预。 原文图 2|(a)两轨按时间读当前指令与历史:A 轨在揭示真实下一片段前检索评分,随后用真实片段更新;B 轨先生成评分,再用自身输出更新。(b)B 轨故事与压力族覆盖统计,同一片段可以有多个压力标签。 实验效果:共享生成器下,必需人物/道具召回率 0.559→0.628 至 0.693,生成实体中真正需要的比例即精确率 0.977→0.915 至 0.938;禁止实体保持不出现的比例 0.968→0.845 至 0.898。检测到的回归实体与历史 DINOv3 视觉特征相似度 0.35→0.49 至 0.57,却可能奖励过时外观。62 次长间隔人物回归中 61 次已在提示写新外观,去掉外观描述后无记忆召回 0.984→0.565,揭示提示泄漏的混淆。 原文图 3|相对无记忆策略的整体取舍。点为策略差,横须为每故事一次生成条件下配对故事重采样 95%置信区间;标题给无记忆绝对分。(a,b)人物/道具召回及精确率,(c)禁止实体不出现,(d,e)人物短间隔/长间隔回归召回,前五项用百分点;长间隔 62 次中 61 次提示已写新外观。(f)历史 DINOv3 相似度使用独立余弦刻度,只取两次均检出的策略相关子集,越像过去不代表当前越正确。最近出现真值 ID 对照预算可变,检索策略固定 3 帧。 批判点评:每故事/策略只一次生成,置信区间反映故事间波动;第二裁判的无记忆召回变为 0.361,绝对分依赖裁判。与独立原生生成器的方法不能只归因记忆好坏;论文不是加速方案。代码有评测和共享生成工具,完整数据另取,原始生成视频及逐段评分包未包含。 5. NTI:训练别只认唯一下一块 Visual Autoregressive Generation with Next Token Imagination | 香港大学;萨里大学 | arXiv:2610.36793 关键词:视觉自回归训练, 上下文自适应软目标, 快照上下文, 训练预算 前序问题:自回归模型前面采出一块略不同的花纹,训练仍逼它接回唯一真值下一块,可能把合理的新组合也罚掉。但允许任意“想象”,又会越走越偏。 方法直觉:把相近视觉 token 当候选,再看当前上下文是否仍与真值上下文给出相似预测。接近时允许多种续写,分歧大或模型不自信时,把监督收回到真值附近。 本文贡献:NTI 即 Next Token Imagination。SCA 快照上下文近似定期用冻结模型在真值前缀下采样替换 token;CRI 上下文调节想象结合码本余弦相似度、真值/替换上下文预测的总变差距离及熵置信度,分配真值与非真值的软目标概率。真值序列与替换序列混入同批单次训练前向,保留原自回归损失。1024 项码本将 256×256 图压为 256 个 token,快照每 16 轮刷新,替换概率上限先升至 0.3,320 轮后归零,最后 80 轮只用真值。 原文图 2|NTI 训练总览:快照近似构造模型预测上下文;结合码本相似、真值与生成上下文预测进行上下文调节想象,给出不同合理 token 的软监督,再由自回归生成器与视觉解码器输出图像。 实验效果:ImageNet-1K 类条件、400 轮、5 万生成图:同 461M 即 4.61 亿参数 AR-L 主干,FID 图像分布距离 3.02→1.67,越低越好;IS 类别可辨性/覆盖代理 256.20→312.72,越高越好。8 张 A100 估算每轮含摊销快照成本 11.62→12.80 分钟,在线双前向 22.90 分钟;约 10%额外训练成本,不是免费监督。NTI-L 用 CFG 无分类器引导强度 14,推理流程不变。 原文表 1|ImageNet-1K 的 256×256 类条件生成比较。N/A 为无离散码本,N/R 为原文未报,横线为对应检查点未公开,剑号为作者自行训练实现;吞吐为每秒图数,FID 越低、IS 与吞吐越高越好。各家架构、训练轮数和引导设置不同,同 AR-L 的 3.02 到 NTI-L1.67 才是直接训练策略对照。 批判点评:主要证据限 ImageNet 类条件,不等于开放域文字生成或语义组合已解决;码本相近也不是有效图像的数学保证。较低 FID 不能证明更大分布覆盖。代码与权重已给训练/采样和 S/B/L 推理权重,权重不含优化器或回放状态,不能用于原位续训;本次未运行模型。 6. WithinVAE:压缩器自己教自己学语义 WithinVAE: Compact Visual Autoencoding with Self-Distilled Semantics | 上海交通大学;中国电信人工智能研究院 | arXiv:2610.36593 关键词:视觉自编码器, 自蒸馏语义, 有序压缩token, 生成负结果 前序问题:图像压缩器能还原纹理,却未必把“同一类物体”放在容易学习的位置。借识别模型的语义又可能丢掉外观细节:能否在重建任务内部组织语义? 方法直觉:让自编码器的滑动平均副本做老师,比较同图不同裁剪的表示;同时越靠后的压缩 token 越容易被丢掉,迫使主要信息先写在前面。能重建与有语义各自用独立实验检验。 本文贡献:主模型用 ViT-L 编码/解码、256 个查询,经逐 token VAE 变分自编码瓶颈变为 256×32 连续数值。后位 token 的独立屏蔽概率线性升至 0.5,解码器可只读前缀。全局 DINO 式自蒸馏对齐平均压缩 token,局部 iBOT 式遮挡预测约束图块编码;EMA 即参数指数滑动平均老师,观察干净视图且不反传。仍用 One-D-Piece 生成预训练初始化和 ConvNeXt 感知损失,“不用外部识别语义目标”不是整个系统从零。 原文图 2|WithinVAE 训练:ViT-L 图块与 256 查询经逐 token 变分瓶颈成为 256×32 有序序列,位置相关屏蔽后由像素解码器重建;全局 DINO 式分支匹配压缩 token 均值,局部 iBOT 式分支匹配学生遮挡图块,目标来自看干净视图的编码器/VAE 滑动平均副本。 实验效果:ImageNet256、5 万验证图,对 RPiAE 连续标量数 16384→8192,PSNR21.30→22.66 dB,重建 FID0.50→0.46;冻结线性分类准确率 65.404%→71.886%,同架构仅重建版 66.814%。8192 是 token 数乘通道数,不是压缩比特数。8 张 H100,自编码器训练 10 轮,下游 6.75 亿参数 LightningDiT 训练 80 轮;有引导生成 FID 却是 3.67,对 RPiAE1.51,越低越好。 原文表 3|6.75 亿参数 LightningDiT 训练 80 轮的 ImageNet 类条件生成。RPiAE 为其论文报告值,WithinVAE 为 5 万样本评测;引导按各自实现,只对开/关不声明数值完全相同。生成 FID 越低越好,IS 及生成精确率/召回率越高越好;WithinVAE 有引导 FID3.67 仍落后 RPiAE1.51,重建收益不能代替生成收益。 批判点评:重建和分类提升没有带来更好生成,是本文关键负结果;两种实现的引导细节并未声明完全相同,不把差值全归因表示。前缀 128token 重建 22.33dB 是主模型,另一个 512×96 潜变量模型的 25.63dB 不能混用。全局分类不证明每 token 具备对象分割语义;未给统一编解码时延、显存及作者代码入口。 7. DICE:少步出图也要重做概念擦除 Haste Makes Waste? Towards Safe Few-Step Text-to-Image Models | 特拉维夫大学 | arXiv:2610.36665 关键词:少步生成安全, 概念擦除, 直线路径重加噪, 自蒸馏保留 前序问题:把文生图蒸馏成一到四步后,原模型有效的概念擦除可能失灵;猛改权重又会毁掉正常图像。安全能力不能直接随老师的画质与速度一起继承。 方法直觉:不要只在少步采样恰好访问的高噪声点上训练。沿干净样本到高斯噪声的整条直线均匀取点,同时要求擦除后的速度场尽量贴近擦除前的少步模型。 本文贡献:DICE 即 Distillation-Integrated Concept Erasure,在已蒸馏的 FLUX Schnell、FLUX SCFM 和 SD3.5 Turbo 联合注意力层训练 LoRA 低秩适配。三项损失分别反向压低目标概念速度、抑制指向概念文字 token 的注意力、匹配冻结擦除前模型的速度。干净概念潜变量由原少步模型生成,再按均匀噪声级线性重加噪;保留项初始化为零,不需访问原全步老师或重跑蒸馏。 原文图 4|FLUX Dev 与 FLUX Schnell 速度场对潜变量扰动的经验局部敏感度,横轴为噪声级 sigma,误差棒为跨图样本标准差;Schnell 在高噪声区更敏感。这是设计直线路径重加噪的诊断证据,不是完整因果证明。 实验效果:NSFW-1k 提示集,FLUX Schnell 的 NudeNet 裸露检测阳性率 0.2348→0.0456,最好既有擦除对照 0.1608;四步 HPSv2 人类偏好代理 0.2909→0.2887,略降。@5 表示同提示五次采样至少一次被检出,DICE 仍 0.1700;不能把 0.0456 当所有违规内容的失败率。作者代码默认 100 步微调、秩 256;FLUX 配置需单张 80GB 卡,SD3.5 配置需两张,未据此推算训练耗时。 原文表 VI|NSFW-1k 少步模型的安全检测与正常生成偏好。NudeNet 和 SD-Checker 阳性率越低越好,@5 为五次采样至少一次阳性;一/四步 HPSv2 越高越好,各模型内粗体为该列最优。DICE 降低阳性但未清零,偏好分仍有下降,不能把检测器阳性等同所有有害概念。 批判点评:白盒对抗提示下 Schnell 阳性率仍 0.455,防线有明显剩余漏洞;实验限裸露/暴力及自动裁判,机制敏感度是诊断而非完整因果证明。IEEE S&P 2027 接收由 arXiv 评论明确支持。代码与LoRA 权重已给,本次只核文件/配置,不运行。 8. MoI-Bench:手机跑得快还得改得对 MoI-Bench: A Benchmark for Image Generation and Editing on Mobile Devices | 伦敦大学学院;南京大学;香港理工大学;华东师范大学 | arXiv:2610.37599 关键词:端侧生成编辑评测, 操作目标解耦, 任务覆盖率, 端到端实测 前序问题:手机能 3 秒出一张图,不代表能删对合照里的人,还保住其余人的脸。把文字替换与文字删除混成“文字编辑”,总分会掩盖真正缺失的能力。 方法直觉:把用户要求拆成“做什么操作×针对什么目标”,再分别问指令执行、画质与未改细节保留。另测手机上的时间、存储和峰值内存,让能力和部署成本各有坐标。 本文贡献:16 类操作、8 类目标形成 64 种适用子任务,共 1150 例,并非完整 128 格笛卡尔积。MoI-Eval 逐样本设问题,以 0/0.6/1 评未满足/部分/完全满足;组内均值、组间加权几何平均,避免好画质完全抵消没改对。总体质量按样本等权,覆盖率按 64 子任务等权,阈值为任务均分至少 0.6;不支持任务保留零分,确认执行错误剔除。19 模型的质量以 A100 参考实现或云 API 出图测,手机另测少于 40 亿总参数模型。 原文图 1|(a)从移动用户需求建立任务;(b)沿操作、目标与评价准则三轴结构化评估;(c)用质量-可部署二维坐标指导模型改进,区分速度够用与任务覆盖仍不足。 实验效果:手机共同任务是文生图,只有 DreamLite 成功部署编辑。各配置预热 1 次再测 3 次,DreamLite1024×1024、4 步在 iPhone17 Pro 为 3.22 秒/1305.7MiB 峰值,在小米 15 Pro 为 18.19 秒/2390.5MiB。Mobile-O512×512、20 步在 iOS2.81 秒,但任务覆盖 0.11,对 DreamLite0.64;分辨率、每步成本不同,不能按步数判快慢。内存分别是 iOS 物理占用和 Android 进程 PSS 比例分摊内存。 原文表 8|iPhone17 Pro 与小米 15 Pro 部署。参数含编码器/图像编解码等全部参数化部件,分辨率与步数不同;Size 为模型存储 MiB,E2E 为端到端秒数,Mem 为峰值应用内存 MiB,iOS 用物理占用、Android 用 PSS。Janus-Pro 的 Android 时延用预计算提示嵌入而排除准备时间;Ovis 的 D2 旁剑号指出可见伪影。 批判点评:质量来自参考配置,时延来自手机配置,二维图不证明量化后的每张手机图都保持同一质量;3 次平均也不覆盖热降频。iOS 与 Android 使用不同推理栈,差值不能简化成芯片优劣。数据与评测代码已给,模型推理适配器尚未提供;任务覆盖低也可能因为模型定位只生成。 9. SMEBench:换乐器别只听文字分数 SMEBENCH: Benchmarking Neural Music Editing with Synthetized MIDI Edits | Mila;拉瓦尔大学;梅努斯大学;康考迪亚大学;土伦大学;艾克斯马赛大学;CNRS LIS;CNRS ILLS | arXiv:2610.36715 关键词:成对音乐编辑评测, MIDI可控干预, 音源保留, 指标排名反转 前序问题:把弦乐换成铜管,音乐和文字很匹配,旋律却全换了。没有成对目标音频,很难区分“确实完成编辑”与“重新生成了一首像要求的曲子”。 方法直觉:先在 MIDI 音符事件里只改一个可记录的属性,再用同一音色库渲染原版与目标版。原音频衡量保留,目标衡量已知有效改法,文字衡量描述匹配,三条线分开比较。 本文贡献:从 MIDI 乐谱裁 10 秒,按实际存在的乐器筛可用编辑,覆盖换/删/提取/加倍乐器、连断奏、渐强渐弱与校音等 12 种操作;同一 SoundFont 采样音色库生成单声道 22050Hz 音频,再筛可听性与质量并核文字。共 11160 对,平衡测试 3600 例、每操作 300 例;另以真实分轨构造 416 例 SME-Real、来自 107 轨。比较 5 种共用 AudioLDM2 音乐底座的扩散编辑方法与不保源的 MusicGen 文字生成。 原文图 1|成对音乐编辑构造:分析 10 秒 MIDI 片段决定可用操作与目标,执行符号干预,用同一 SoundFont 渲染源/目标并筛听感和质量;从 MIDI、音频和编辑元数据提取事实形成四种文字描述,音频与文字检查通过后保存已知干预及成对目标。 实验效果:测试集用编辑后描述作条件:MusicGen 的 CLAP-T 文字-音频特征相似度 0.350 最高,但对成对目标的 CLAP-A 音频相似度仅 0.492,SteerMusic0.691;目标 LPAPS 感知距离 5.926 对 4.482,越低越好。换成命令式条件,文字分偏好 VCI、目标音频指标偏好 ZETA。17 人听 20 个抽样对、共 236 次评分,指令对齐 3.99/5;连奏、删乐器、换鼓三项未可靠超过量表中点,剔除后主感知汇总只含 9 操作。 原文表 3|SMEBench 测试集模型排名。编辑后描述和命令式输入分开,数值是均值及 95%重采样置信区间;CLAP 文字/音频相似度越高、LPAPS 目标感知距离越低越好,粗体为各条件/指标最好均值。文字排名与两种成对目标音频排名不同;目标仅是一种受控合法实现,非全部有效输出集合。 批判点评:目标仅代表一种合法实现,接近它不等于穷尽编辑正确性;MIDI 不覆盖人声、混音和母带处理,真实补集也不覆盖全部 12 类。论文没有给统一时延/显存排名,不能从音频指标推出部署速度。数据与构造代码已给,含 MIDI/真实分轨构造及指标工具;源 MIDI 与音色库须另取,本次未复现六个编辑系统。 10. BoxWorld:规则引擎决定视频里会发生什么 BoxWorld: Let World Engines Control and Video Generators Render | 不列颠哥伦比亚大学;Vector 人工智能研究所;华为加拿大 | arXiv:2610.36371 关键词:交互视频生成, 对象状态接口, 区域注意力, 自生成轨迹蒸馏 前序问题:没拿钥匙,生成世界却自己把门打开:视频模型擅长画常见后续,不一定严格执行条件规则。每改玩法就重训生成器,也不适合快速做交互世界。 方法直觉:把“事情该不该发生”交给显式规则引擎,把“看起来怎样”交给视频生成器。引擎持续发每个对象的位置、身份与当前状态,生成器照状态画下一段。 本文贡献:编码代理先按规则生成 Box World Engine,交互时不逐步调用代理。对象接口含二维框、固定外观属性、动态状态;逐帧掩码交叉注意力只允许视觉 token 读覆盖自己的框,零初始化门控注入每块。以 LongLive 为底座,先冻主干学布局,再用 4000 段游戏视频和秩 16 LoRA 学状态变化,最后秩 64 LoRA 在自身生成历史上做分布匹配蒸馏,恢复四步生成;三阶段 20000/10000/400 次更新。 原文图 3|(a)状态绑定模块把每物体二维框、外观属性和动态状态编码为 token,掩码交叉注意力让每个视觉 token 只读覆盖自己的对象;(b)模块插在渲染器每块自注意力和原交叉注意力之间。 实验效果:832×480、4 步,布局模块仅噪声级大于 0.8 启用;论文报告生成吞吐 20.7 帧/秒,与 LongLive 相同。PairedStateBench 含 16 场景族 87 例、37 对分支;两分支都满足目标的比例 13.5%→97.3%,完整多阶段任务 8.0%→83.9%。要求事件出现/禁止事件不出现分别 92.2%/90.5%,不是同一分母。对照模型输入接口不同;20.7 是生成吞吐,不等于用户动作到显示响应的延迟。 原文表 1|PairedStateBench 按整体及简单/中等/困难报告。剑号为仅公开相机控制的 LingBot-v2,Oracle 额外得到互动后果文字;FPS 为生成吞吐。Trigger、Suppress、成对分支成功、状态吻合、发生时机与完整任务成功各有分母,均越高越好,简单例不适用 Suppress。BoxWorld 获得对象状态,其他方法使用各自接口,不能当等条件纯生成器比较。 批判点评:规则正确性来自显式引擎,不能称生成器自己学会通用物理推理;二维框与状态文字也不能约束所有细粒度接触和遮挡。原文没有足以统一复核的 FPS 硬件与峰值显存账单,单机部署仍待实测。项目展示结果,本次未核到作者渲染器代码或权重。 趋势观察 保留与改动需要同一接口里的两条约束 LociArt把风格写进掩码又补原几何,SREdit按物理响应限制改动;CaD则用过强参考注意力阻断编辑。控制强弱不是越大越好,先明确任务要变化还是防变化。 评测要检查执行变化和保留什么 VMem-Bench的历史相似度能奖励旧围巾,SMEBench的文字匹配会偏好重写整首音乐;应把当前状态、目标改动和源内容保留分别计分。 表征更好与生成更好仍有距离 NTI在同AR主干降低FID,WithinVAE却出现重建和线性分类更好、生成更差。训练目标的收益必须落在真正的生成实验,不能只看中间表示。 速度账单包含模型外的条件 MoI-Bench分开参考画质与手机成本,DICE为少步模型额外做擦除微调,BoxWorld把规则交给引擎;推理步数、生成吞吐与端到端响应各自报告。 今日讨论 LociArt 从 10 扩到 15 种风格、不回放旧数据,旧类 SPS 仍下降 0.022,对二值掩码 0.102;多区域仅有已学风格的定性展示。如果剪辑任务要给熊和背景分别换画风,应在什么条件下启用这种组合?如何固定掩码并用多种子实验收集区域风格、边界外变化和旧风格遗忘的证据,确定可以接受的保留阈值? 人工智能炼丹君 整理 | 2026-10-30
-
AIGC 每日速读|2026-10-29|新国大新角色入场保住原镜头ReferStream 今日 AIGC 论文速览 今日共 10 篇 · 流式视频参考注入与视频修复 2 篇 · 图像身份与统一编辑 2 篇 · 参考加速与多样性修复 2 篇 · 图像生成训练 2 篇 · 可控音乐合成 1 篇 · 原生三维生成 1 篇 重点论文标题列表 ReferStream(新国大):新角色入场保住原场景 TINDER(南洋理工):从坏帧反推噪声再去退化 ALADDIN(Sumsub):一步换身份保留表情姿态 FrameForge(中科大):用虚拟时间学不同图像改法 ToDoPro(港大):先小图探路再省参考计算 选读入口:视频正在生成、希望临时加入参考角色,先读 ReferStream;已有视频模糊或低清,接着读 TINDER 并比较 4 倍超分的保真与感知冲突。改人脸身份选 ALADDIN,兼顾主体/边缘/指令三类改图读 FrameForge。多参考服务卡显存读 ToDoPro,四步模型总重复构图读 ReSeed。训练预算分配读 KnowThenDraw,联合训练损失低却出图崩读 SpeeDiff。想编辑弯音和力度读 GuitarLFM;最后再用 GenSfM 理解四张未标机位照片如何联合生成三维。 今日论文速览 1. ReferStream:新角色入场保住原场景 ReferStream: Interactive Subject Injection for Streaming Video Generation | 伯恩茅斯大学;新加坡国立大学;浙江大学;香港科技大学;之江实验室 | arXiv:2610.37566 关键词:流式参考注入, 场景上下文, 临时缓存, 主体保留 前序问题:视频已经生成到雨伞镜头,这时才给一张黑猫照片,希望猫接着入场,伞还在。把照片长期塞进生成记忆,可能连伞和背景也改掉;已输出画面又不能重来。 方法直觉:先把参考放进当前场景的压缩画布,让模型在原场景里理解新角色;只在入场这一小段借用参考记忆,随后恢复原记忆。新角色继续依靠刚生成的视频历史留下来。 本文贡献:冻结 LongLive2-5B,无需额外训练。Joint Latent 将参考的 VAE(变分自编码器,将图像压缩并重建)的特征缩放到最新干净场景帧的指定矩形,再做一次干净前向,抽取注意力键/值 K/V。Cache Restoration 先备份全局缓存条目,注入参考,生成并提交当前 chunk(连续潜变量片段)后,仅恢复备份条目,保留新生成历史及推进的位置。默认每 chunk 8 个潜帧、4 个采样步;参考矩形不是前景分割,重叠处后写覆盖,位置只作软引导。 原文图 2|连续镜头入场示意。上:主体 A 已建立,参考 B 到达并约束下一片段。中 A:将参考与最新场景潜变量合成,干净 DiT 前向提取参考键值 R_j;中 B:备份全局 K/V、注入 R_j、去噪并提交后恢复备份,保留新局部历史 L′。S′为更新后的镜头锚点,无刷新时等于 S。下部是缓存访问示意,不是实测注意力;照片来自基准,后续生成是示意。 实验效果:自建基准 68 条脚本,48 条连续镜头、20 条可切镜头;有不一致参考的条目统一排除,按有效案例等权。整体对无视觉参考的 LongLive2,新主体相似度 39.99→52.86、旧主体相似度 42.29→73.18,目标类别计数准确率 73.90%→82.33%。相似度是原值乘 100,不是身份识别准确率。共同单种子消融中,去掉场景合成/完整方法的新主体相似度 63.10/51.31、旧主体相似度 70.56/72.17,保留与引入有取舍。 原文表 3|共同连续镜头集合、种子 0 的组件消融。粗体为各列最好点估计,完整方法为蓝行。新/旧主体相似度越高越好,新/旧重复率越低越好;场景合成和缓存恢复都改善原主体保留与重复指标,但代价是新主体相似度下降。 批判点评:这是生成中的参考注入,不能回改已输出帧。离线基线提前得到全部参考,输出分辨率和帧率也不同,不能据分数声称更快;额外干净前向和 K/V 备份尚无统一时延/显存账单。基准是开发型精选集合,检测漏检、自动时间对齐和单种子影响结论。项目 的仓库目前为网页与演示素材,未核到生成实现。 2. TINDER:从坏帧反推噪声再去退化 Taming Noise Initialization for Zero-shot Video Restoration with Image Diffusion Priors | 南洋理工大学;河北工业大学;瑞典皇家理工学院;深圳北理莫斯科大学 | arXiv:2610.37290 关键词:零样本视频修复, 噪声初始化, 自适应频域混合, 轨迹注意力 前序问题:用图像扩散器逐帧修模糊视频,单帧好看却会闪。独立噪声丢掉帧间关联,同一噪声又不反映物体运动;从坏帧反推噪声,还可能把模糊纹理一起带回去。 方法直觉:让初始化先记住原视频怎样连续变化,再保留较可靠的低频结构、用随机噪声替换受污染频率。恢复时让相邻帧中对应区域互相参照,同时约束结果符合已知退化测量。 本文贡献:原文称 TINDER:先做 20 步 DDIM 确定性扩散反演,将退化帧映射回相关初始噪声;按各帧频域能量选择高斯低通截止频率,以 η 表示保留能量比例,再混入高频高斯噪声。MGTA(测量引导轨迹注意力)从坏帧的邻帧 patch(局部图块)匹配建立对应,只在采样的 UNet(U 形多尺度去噪网络)解码层沿轨迹聚合特征;在反演时加入该注意力反而强化退化。DDS 或 DiffPIR 负责每步的数据一致性,无需再训练视频底座。 原文图 2|TINDER 总览:从退化视频做 DDIM 反演生成具有原时序关联的噪声,再用自适应噪声混合抑制反演中保留的退化、使噪声趋向高斯;采样过程中再以测量引导轨迹注意力利用帧间关联。 实验效果:DAVIS、REDS4、Set8 各取 100 段、每段 16 帧;测 13×13、标准差 2.0 高斯模糊、2/4 倍超分及随机 70%像素缺失。同 DDS 下 DAVIS 去模糊对同噪声基线,PSNR 峰值信噪比保真分 27.90→29.43 dB,LPIPS 感知距离 0.1873→0.1763,FVD 视频分布距离 72.26→63.42,后两者越低越好。RTX A5000 上整流程 9.67→20.18 秒/视频;MGTA 约多 1.94 秒和 500MB,采样另需 20 或 50 步。 原文表 I|DAVIS、REDS4、Set8 的视频去模糊、2 倍/4 倍超分与 70%随机缺失修补定量比较;PSNR 和 SSIM 越高越保真,LPIPS 感知距离和 FVD 视频分布距离越低越好,粗体为最优。4 倍超分保真略升而感知/视频距离变差;修补也非所有指标领先。 批判点评:4 倍超分的 DAVIS PSNR 26.89→27.09,却伴随 LPIPS 0.2538→0.2701、FVD 155.58→258.18 变差,不能写成全面修复领先。任务依赖已知退化和可靠对应,未证明真实未知混合退化同样有效。正文说 70%缺失,超参数表却标 10%,本稿沿主设置并披露冲突;arXiv 评论只列期刊名,不据此宣称已接收。原文未给可核实代码入口。 3. ALADDIN:一步换身份保留表情姿态 ALADDIN: Adversarial Latent Diffusion Distillation for One-Step Identity Swapping | Constructor 大学;Sumsub | arXiv:2610.37503 关键词:一步身份编辑, 对抗训练, 伪标签三元组, 独立身份评测 前序问题:换上参考人物的身份,还要保留目标照片的表情、头发和眼镜。多步扩散耗调用次数,纯对抗生成又容易损失真实感;如果训练与打分用同一个人脸编码器,指标还会偏向熟悉它的方法。 方法直觉:借预训练流模型的生成能力直接做一步修改,再借同一冻结模型的中间特征判断真假。先换成别人,再让学生换回本人,用原照片监督,获得真实感与身份强度之间可调的折中。 本文贡献:以 FLUX.1-Krea-dev 初始化,冻结 VAE 和底座,训练秩 64 LoRA 低秩适配及 PuLID 身份交叉注意力;目标潜变量按固定噪声级 0.2 做一次速度更新。判别器读取冻结扩散器四层特征,身份、姿态、50 维几何表情及脸外掩码损失约束输出。老师混合跨身份/同身份对训练,学生用老师在线生成的三元组伪目标与感知重建训练;这不是每步模仿老师轨迹的常规蒸馏。 原文图 2|ALADDIN 训练。左:老师接目标和冻结 PuLID 源身份,单步生成,由身份、姿态、表情和背景损失约束;生成/真实图的潜变量加相同噪声级后经冻结扩散器,中间特征供判别器判断真假。右:冻结老师将身份 B 移到 A 的目标图;学生从老师初始化,把 A 换回伪目标,用真实 A 目标图作重建监督。 实验效果:512×512、固定 1000 组 FFHQ,独立 WebFace-R50 评身份。学生重建权重 7 对 APPLE,身份相似度同为 0.40,CLIP 特征分布距离(文中称 FID)3.34/3.22,姿态误差 1.56/1.86、表情误差 0.60/0.63,误差越低越好。生成器 1 次网络评估对 28 次,不等于整流程快 28 倍。4 张 H100 上,老师 10 万图对约 4.5 小时,学生 1.5 万图对约 50 分钟;训练集本身有 410 万图像,不能写成只需 10 万张原始数据。 原文表 2|FFHQ 固定 1000 图对比较,FID 使用 CLIP ViT-B/32 特征;身份相似度与 Top-1/Top-5 检索率由 WebFace-R50 计算,检索率以百分数报告。组内按 FID 从差到好排列;粗体/下划线标领先值。InSwapper 用同一评分身份模型作条件;换独立 MS1M 编码器,学生权重 1 为 0.55,对 InSwapper0.56。姿态和表情误差越低越好。 批判点评:增大重建权重会削弱身份迁移:权重 1/7 相似度 0.50/0.40。大年龄差、少见身份和纹身保留仍失败;分布距离采用 CLIP 而非标准 Inception 特征,不能横比通用 FID。InSwapper 用评分编码器作条件,仍有例外。arXiv 明确写 Accepted to WACV 2027;未找到作者方法代码,不把引用的 FLUX 仓库当实现。 4. FrameForge:用虚拟时间学不同图像改法 FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation | 中国科学技术大学;FrameX.AI | arXiv:2610.36545 关键词:视频先验迁移, 虚拟时间路由, 中间潜变量, 统一图像编辑 前序问题:保留人物换背景、把边缘图画成照片、让猫换姿势,对输入的保留程度不同。把所有任务都当相同间隔的“前帧→后帧”,会让一个共享编辑器互相拖累。 方法直觉:借视频模型对不同幅度变化的经验,按输入与去噪阶段选择虚拟时间距离;再加一个中间特征状态,帮助传递“怎么变”。它输出的是图片,虚拟时间不是实际生成长视频。 本文贡献:冻结 HunyuanVideo1.5-T2V-720P 与 VAE,统一秩 32 LoRA。MoTE(时间专家混合)每步路由选择一套 RoPE 旋转位置编码,等效视频跨度 17/69/121 帧,实际只保留条件、目标与一个中间位置。CoTR(时间推理链)加无像素监督的噪声中间潜变量;训练中期以 0.5 概率屏蔽目标与文字/条件的直接注意力,迫使信息经中间状态,末期和推理恢复全注意力。三任务各 17 万样本,合计 51 万,512×512。 原文图 2|FrameForge 将不同条件图像任务建模成视频底座的目标帧预测。多模态扩散 Transformer 共同处理文字、条件、中间推理和带噪目标 token 并预测速度;MoTE 每步选虚拟间隔的 RoPE;CoTR 加入从噪声开始、经注意力更新的中间隐层状态。训练中期随机屏蔽条件/文字到目标的直接注意力,鼓励中间路径。 实验效果:GEdit 英文 606 例、11 类,GPT-4.1 评语义/画质/综合:动作修改综合 ChronoEdit 5.76→6.84,全类 5.08→6.12;但画质 6.88→6.52。DreamBench 30 主体×25 提示综合 0.739,对 ChronoEdit 0.729,主体一致性 0.739 低于 0.757。2 张 A800 训练 1.2 万更新约 6 天,1.82 亿可训练参数;推理 50 步及额外中间状态,未给统一单图延迟/显存。 原文表 3|GEdit 指令图像编辑,分别列动作修改及全类总体的语义一致、感知质量和综合分,均越高越好。闭源与开源分组,主干列不同。FrameForge 动作综合 6.84、全类 6.12 优于 ChronoEdit,但全类画质 6.52 低于 6.88,闭源总体仍更强。 批判点评:“推理链”是隐层通信设计,没有可读的逐步推理或中间图真值;全类综合仍低于闭源对照。主干、数据和任务接口与其他方法不同,不能把跨系统差距全归因路由。作者项目、推理代码及LoRA 权重均已核到;仓库含三专家/一个中间潜变量配置与三任务入口,权重未下载验证。会议接收未确认。 5. ToDoPro:先小图探路再省参考计算 ToDoPro: Faster and Better Reference-Based Generation: Early Token Reduction via Downsampled Self-Probing | 香港大学;南洋理工大学 | arXiv:2610.34782 关键词:参考生成加速, 低分辨率探测, 分层token裁剪, 激活显存 前序问题:同时给多张参考,模型把背景、无关小物和主体一起反复读,越加参考越慢、显存越高。直接缩小所有图又会丢主体纹理;外接重要性模型还会增加部署负担。 方法直觉:先让原模型在小图上走一趟便宜的探路,判断文字和待生成画面真正会读取哪里。重要区域保留细节,中等区域保留缩略全局,低价值区域再丢掉。 本文贡献:参考图长宽各缩 2 倍;FLUX.2-Klein-4B 先探 2 步再做原 4 步主采样,Qwen-Image-Edit/HiDream 分别探 10 步、主 40/50 步。用生成及文字查询对参考的注意力,在全部层平均为利用分数;Triton 内核兼容不显式保存注意力矩阵的 FlashAttention。每个原 2×2 token 块(模型特征单元)按高/中/低重要度做 4→4、4→1、4→0,中档坐标放在原块中心,无需训练或新参数。 原文图 5|空间与时间下采样的自探测裁剪。先用长宽各 2 倍下采样图及稀疏时间表做去噪,抽取参考利用分数;主采样前据此保留高重要度、丢弃低重要度、用低分辨率 token 替换中等重要度。例图用 4 步 FLUX.2-Klein-4B;探测和主采样是两个阶段。 实验效果:单 80GB H800、种子 42,FLUX.2-Klein-4B 在 MultiBanana 快速档,端到端 5.74→2.50 秒,2.30 倍;峰值激活显存 15.3→7.3GB,五维质量均值 4.70→4.72。MACRO 7.93→3.20 秒、24.7→11.5GB,四任务均分 6.18→6.20。慢档 MultiBanana 3.43 秒、9.8GB、均分 4.88。质量改善与速度是不同档位,不能拼成同一最优点。 原文表 1|FLUX.2-Klein-4B 在 MultiBanana 和 MACRO 的质量/效率。MultiBanana 五维为指令、参考、背景主体匹配、物理真实、视觉质量,MACRO 四任务为定制、插图、空间、时间;平均分越高越好。时延为端到端秒数,Speed 为对原模型倍率,Act.VRAM 为激活显存 GB,时延/显存越低越好。快慢档分开,不能拼成同一工作点。 批判点评:激活显存不含全部模型常驻权重,不能承诺 7.3GB 卡可运行。极高裁剪率会失去必要细节,小字/稀疏部件可能在探测时漏掉;新目标 token 占多数时收益缩小。参考一致性快速档 4.85 略低于原 4.86。作者仓库目前为空,“将开源”不等于代码已可用。 6. ReSeed:只补首步找回不同种子差异 A First-Step Bias Restores Lost Diversity in Diffusion Model Distillation | 格拉茨技术大学;奥地利复杂性科学中心;瑞士数据科学中心 | arXiv:2610.37110 关键词:少步蒸馏修复, 种子响应, 首步偏置, 多样性取舍 前序问题:四步模型出图很快,同一句提示换随机种子却总画出相似构图。究竟要重训整模型,还是某一个去噪区间把随机差异压掉了? 方法直觉:先替换老师的第一段轨迹定位瓶颈,再只给学生首步加小偏置,学老师在这段时间走了多远。偏置本身不携带种子,差异来自它改变了冻结网络对不同输入的响应。 本文贡献:冻结蒸馏学生,在每个 Transformer 块输出增加零初始化逐通道残差偏置,仅首步启用。监督目标是老师从相同噪声/提示出发、跨首个学生区间的平均速度,非终点瞬时速度;后 3 步仍用原学生。FLUX 学生增加 233472 参数,占去噪器 0.00196%,约 8000 提示-噪声对训练,不需目标图、解码或对抗网络。理论界只约束首步端点响应误差,不保证最终图像多样性。 原文图 3|ReSeed 概览。(a)首步收缩可能合并不同种子轨迹,老师和 ReSeed 保留替代路径;(b)冻结底座,把首步块输出偏置拟合到老师区间平均速度;(c)偏置在第 2 至 4 步关闭。示意说明干预位置,不是最终多样性的理论保证。 实验效果:FLUX 四步 SenseFlow,100 提示各 10 种子,DINOv3 视觉特征两两余弦距离 0.1575→0.2336,提升 48.3%;另 5000 张 COCO 图的 FID 为 40.22→34.65。Wan 四步 DMD2 在 320 条 VBench 提示每条 8 视频,DINOv2 视频多样性 0.3374→0.4290,但动态程度 0.531→0.329、文字匹配 0.2419→0.2365。采样网络评估次数不增;各模型实测时延多 0.14%至 0.41%,激活峰值至多多 1MiB。 原文表 2|FLUX 质量与多样性比较。NFE 为去噪器网络评估次数,DINO/CLIP 特征距离和 LPIPS 跨种子距离越高越多样;CLIP 文字匹配、PickScore/HPS 偏好代理、美学越高越好,FID 分布距离越低越好。ReSeed 保留 4 次评估并提高多样性、降低 FID,但偏好及美学略降;误差为跨适配训练种子波动。 批判点评:更分散的特征不等于更丰富且符合提示的内容;FLUX 人类偏好代理分与美学也略降。视频只一次适配训练,跨提示 bootstrap 不能代表跨训练波动;仅验证流匹配 Transformer。作者代码包含训练、生成和评测入口,但权重及完整提示库不在仓库,老师/学生另备。 7. KnowThenDraw:先学语义再让扩散画细节 Know, then Draw: A New Learning Paradigm for Visual Generation | 加州大学圣迭戈分校;Adobe Research | arXiv:2610.37626 关键词:自回归预训练, 语义token, 像素扩散渲染, 计算分配 前序问题:画得像不代表理解“两个物体、颜色和位置”。如果自回归阶段花大量精力还原像素纹理,能否反而挤占学习场景语义的预算? 方法直觉:把“知道该画什么”与“画得细腻”交给不同学习目标。先预测语义编码,随后冻结该骨干,让扩散模块把其表示渲染成像素;前一阶段的编码不必单独解码成好图。 本文贡献:AR 自回归按位置指令、随机顺序预测离散视觉 token。比较重建型、语义加重建型及 Semantic-LM 纯语言监督码本;后者量化冻结 Qwen2.5-VL 视觉特征,无图像解码器或重建损失。后训练复用冻结 AR 注意力投影,仅训练输入、时间和扩散专用前馈/归一化及像素输出模块。训练渲染用真图 token,推理改用 AR 生成 token,存在条件分布差异;分别拟合两阶段规模规律,主口径预算约 3:2。 原文图 2|学习分工:自回归预训练用离散 token 预测获取视觉知识;随后冻结预训练骨干,增加复用其注意力与表示的扩散模块,将知识渲染为高保真图片。自回归专注知识,扩散专注渲染。 实验效果:约 400M 最终参数、同累计图像曝光的控制实验:AR→像素扩散 GenEval 组合指令分 65.51、DPG 细粒度提示分 71.11;纯像素扩散 61.16/62.56。约 3B 最终版训练 6600 H100 GPU 小时,GenEval0.86、DPG87.78;前者 553 提示每条 1 图,后者 1065 提示每条 4 图。推理 AR 采样后再 50 步 Euler 像素渲染,带语义/文字双引导,未给统一整图延迟。 原文表 3|GenEval 与 DPG 文生图评测。模型大小以十亿参数计,各系统组件计数可能不同,横线为缺失结果。作者用大语言模型改写提示匹配训练分布。GenEval 分单物体、双物体、计数、颜色、位置与颜色属性,综合为六类均值;本方法约 3B,综合 0.86,DPG87.78。 批判点评:评测用大语言模型改写提示,并按固定种子评分选提示变体,不能当完全未触碰的测试协议。6600 小时没有计入所有外部预训练资产;3960/2640 是阶段预算分配,非各阶段独立计时。拟合损失下限是外推且混合真图条件影响,不能证明 AR 普遍胜扩散。原文未给作者方法代码入口。 8. SpeeDiff:像素回路拦住潜空间坍缩 SpeeDiff: Scalable Pixel-Anchored End-to-End Latent Diffusion Model | 字节跳动 Seed;加州理工学院;Meta | arXiv:2610.36419 关键词:端到端潜空间训练, 像素重建锚定, 双表示对齐, 训练成本 前序问题:同时训练图像压缩器和扩散器,损失下降却画不出东西:编码器可能把不同图压到几个狭窄峰,扩散预测常数就能拿低损失,像素语义却丢了。 方法直觉:不能只在压缩空间里自我打分,还要把去噪估计解码成图片,核对真的保留原图。让像素误差沿完整路径反传,堵住“把表示做简单就过关”的捷径。 本文贡献:TPR(Tweedie 像素重建)从中间噪声状态估计干净潜变量,送 VAE 解码器并与真图计算均方/感知误差,同时保留 VAE 重建和流匹配损失,不切断到编码器的梯度。全 Transformer VAE 与改进 DiT 联合缩放,REPA++同时将干净潜变量和早层扩散特征对齐到冻结 DINOv3 视觉表示。每训练步 1 次编码、1 次扩散和 2 次解码;256 图用空间 16 倍压缩、32 通道,512 图改 32 倍压缩。 原文图 2|SpeeDiff 四条训练分支:VAE 编码/解码重建;标准随机插值和速度预测的扩散损失;Tweedie 干净潜变量估计解码后与真图比较的 TPR 分支;潜变量和中间扩散特征同时对齐视觉底座的 REPA++分支。VAE 与扩散从零联合训练,梯度不截断;视觉特征底座冻结。 实验效果:ImageNet 类条件、无引导、5 万生成图评 gFID 生成图与真图视觉特征的分布距离。80 轮原始联合训练 33.95,加 TPR 为 5.79,加架构为 3.66,再加 REPA++为 1.69;XL200 轮在 256/512 分别 1.50/1.53。更实用的同 7.93FID 对照,16 张 H100、批 256,训练步 23.52 倍减少,计每步 0.16→0.31 秒后耗时加速 12.14 倍;峰值 57.34GB 对 26.97GB。默认采样 250 次网络评估。 原文表 1|80 轮 ImageNet256 生成、无引导 FID。上半部分扩散到 VAE 梯度截断,下半为真正端到端;原联合训练 33.95,加入 TPR 降 5.79,再加架构 3.66 和 REPA++1.69。两个组依次加组件,FID 越低越好,表示像素锚定使联合梯度有效。 批判点评:摘要 140/61 倍是特定收敛比较口径,不是逐步训练或出图速度;完整联合训练更费显存。最佳版依赖预训练 DINOv3,不能称整个系统从零;尚未证明开放域文字生成同样有效。arXiv 明确接收 CVPR 2026,本月上传不等于本月才完成研究;未给可核实方法代码。 9. GuitarLFM:先改每根弦的演奏再合成 Expressive Guitar Synthesis via Controllable Latent Flow Matching | 台湾大学 | arXiv:2610.36786 关键词:可控吉他合成, 逐弦音高包络, 跨弦注意力, 潜空间流匹配 前序问题:MIDI 乐谱写了哪个音、何时弹,却没写弯音和余音怎样变化。直接把乐谱变音频,即使音符正确,演奏细节也难以单独修改。 方法直觉:先预测每根弦的连续音高和响度曲线,把“怎么演奏”变成能编辑的中间控制;再让声音生成器负责音色和波形,不必同时猜演奏与合成。 本文贡献:六弦输入含音高、发声状态、音内相对位置、起音及力度。轴向 Transformer 分开沿时间/弦建模,跨弦门从零初始化;先出 f0 基频和 RMS 均方根振幅包络,再由条件编码器经 AdaLN 自适应归一化调制扩散 Transformer,流匹配生成 Stable Audio Open 压缩音频。逐弦解码,经各弦学习的脉冲响应滤波后混合;可再用仅 MIDI 的力度预测器替代音频提取力度。 原文图 2|逐弦声音合成器架构:音高 f0 及 RMS 振幅包络经条件编码,发声状态 s 和起音 o 提供额外提示;紫色圆是学习的弦身份嵌入。轴向 Transformer 特征经自适应归一化调制轴向扩散 Transformer,由常微分方程求解器生成压缩音频,Stable Audio Open 解码;每弦输出再用学习的各弦脉冲响应混合。 实验效果:GuitarSet 按录音 306/18/36 划训练/验证/测试,44.1kHz,训练裁 5.9 至 11.9 秒。真实音频力度条件下,对同结构单阶段,f0 平均绝对误差 33.53→26.52 音分(100 音分为半音),包络相关 0.63→0.88。32 人听 18 段 8 秒,1 至 5 分总体偏好 2.54→3.04;但多尺度频谱损失 8.79 高于 DDSP-Guitar8.27,越低越好。推理 50 个 Euler 步、引导强度 2,条件/无条件预测额外耗计算,未报统一实时率。 原文表 1|客观与主观结果。Ref 为各方法从音频提取的力度,Pred 为仅 MIDI 预测力度;MOS 听感仅比较真音频和三个 Ref 系统。Oracle synth 用真实控制作合成上界,横线表示不适用/未评。音高误差用音分、包络误差和 MSSL 越低越好,包络相关及内容正确/表现力/音质/偏好评分越高越好。 批判点评:听感分只评音频提取力度版本,不能移植给纯 MIDI 版;后者包络误差 0.61 对 0.30,听感未评。单数据集和逐弦专门录音限制泛化,项目长音频样例无对照。代码与模型页由项目给出,本次不运行音频模型。ICASSP 2027 只是投稿,非接收。 10. GenSfM:四张照片一起猜形状和机位 Generative Structure from Motion with Native 3D Diffusion | 香港大学;Transengram;腾讯 | arXiv:2610.35522 关键词:原生三维生成, 联合形状位姿, 紧凑机位编码, 逐体素图像条件 前序问题:四张没标相机的物体照片,既要补出没看到的背面,也要找准各照片从哪里拍。先估机位再生成,第一步错了,细节就会贴到错误表面。 方法直觉:把形状和每个机位一起放进同一去噪过程,相互校正;粗形状与机位对齐后,再按真实投影位置读取图像纹理,而不只靠整图语义猜细节。 本文贡献:基于 TRELLIS,粗阶段联合处理 4096 形状 token、四视图共 256 机位 token 及 128 共享 register 全局信息 token。UV 体积把每体素投到图像的二维坐标编码成 4×4×4 机位潜网格,较 16 立方网格少 64 倍 token,非全模型快 64 倍。DINOv2 语义加多尺度卷积特征作条件;细阶段按估计机位逐体素采样并跨视图平均。约 43 万资产、每资产 24 渲染视图,训练每次取 4 张。 原文图 2|GenSfM 粗到细总览:把未知位姿的多视图三维恢复化为联合生成;粗阶段用多模态形状-位姿扩散 Transformer 同时去噪稀疏结构与逐视图三维机位 token,恢复形状与相机;细阶段按恢复的机位为每体素采样图像条件,细化几何与外观并输出结构化潜变量。 实验效果:Toys4k/GSO 各前 400 物体、每物体两组互斥四视图,共各 800 物体-视图组。相似变换 ICP(迭代匹配点云)对齐后,对 TRELLIS-M,未见视图 PSNR24.01→28.54、22.28→25.50 dB;双向平方 Chamfer 点云距离的跨物体中位数 0.4329→0.1133、0.5200→0.1882,表中单位×0.001。原始相对旋转误差低于 5 度比例 97.23%/98.21%。粗/细各 25 步,机位/粗阶段各 8 张 H200、细阶段 4 张,均训练 100 万更新。 原文表 3|与三维生成方法比较:对无输入机位的标准化三维输出,两侧输出网格各采 10 万表面点,以相似变换 ICP 迭代对齐到真值坐标,再评价未见视图光度和几何。PSNR/SSIM/F 分越高越好,LPIPS 及双向平方 Chamfer 跨物体中位数越低越好;Toys4k 和 GSO 分开,不能混同另一表的点图最小二乘对齐。 批判点评:各能力族用不同对齐协议,不能跨表混用数字;未知侧仍是生成推断,非测量真值。只验证物体中心、四视图,场景和更多视图待证;细阶段训练用真值机位,推理误差会错贴特征。NeurIPS 2026 接收有 arXiv 评论证据;项目可查,尚未核到方法代码和统一推理时延/显存。 趋势观察 控制介入的位置决定保留边界 ReferStream临时替换全局缓存,TINDER改初始噪声与采样注意力;两者都处理视频连续性,但一个引入新主体,一个恢复已知退化。 借视频先验仍须先看实际输出 FrameForge借虚拟时间生成单张图,ReferStream才是流式视频。不能因为底座叫视频模型,就把任务和收益写成视频编辑。 首步与表征是两类不同修复 ReSeed在冻结学生首步补种子响应,SpeeDiff在训练期让像素误差约束潜空间;前者维持四步采样,后者默认250次网络评估。 可编辑中间表示需要协议兜底 GuitarLFM把每弦演奏曲线暴露出来,GenSfM把形状和机位一起生成;前者听感只评音频力度版,后者限四视图物体,控制接口不能代替泛化证据。 今日讨论 ReferStream 加入场景合成后,旧主体相似度 70.56→72.17,新主体 63.10→51.31。已输出画面不能重来时,如何固定参考到达时刻与目标框,用多种子实验分别收集主体还原、旧场景保留和重复率证据,决定何时启用场景合成或减弱注入? 人工智能炼丹君 整理 | 2026-10-29
-
AIGC 每日速读|2026-10-28|浙大首帧改动带着整段走EditDistill 今日 AIGC 论文速览 今日共 10 篇 · 参考视频编辑 1 篇 · 参考图效果与变换迁移 2 篇 · 多视角视频生成 2 篇 · 视频蒸馏与推理加速 2 篇 · 语音与空间音频生成编辑 2 篇 · 三维场景编辑 1 篇 重点论文标题列表 EditDistill(浙大):首帧怎么改整段跟着走 KINESYS(工业光魔):借参考特效但少动原镜头 CrossPair(蚂蚁):示范一对图迁移同一种改法 WorldCast(小米):大幅绕拍时记住人物背面 OmniShowcase(KAIST):四面参考加法线转台稳绕拍 选读入口:已有视频想改衣服、照明或局部物体,先读 EditDistill,重点看首帧代表性和 CLIP-E 没有领先的边界。图像上借烟火等参考特效选 KINESYS,已有改前改后示范想迁移同一操作选 CrossPair。需要数字相机轨迹及人物多面锚点看 WorldCast;以四面照片做主体展示看 OmniShowcase。训练四步视频模型读 SF2,已有 Blackwell 推理服务读 Triage。研究图像先验能否跨到声音读 ImageTTS;要移动某个声音且保住其他音轨读 AMBIT。最后,需要把单视图修改落回可渲染三维资产时看 VidEdit3D,并核对逐场景拟合成本。 今日论文速览 1. EditDistill:首帧怎么改整段跟着走 EditDistill: Is It Possible to Guide Video Editing with Image Editing? | 浙江大学;浙江理工大学;清华大学;北京航空航天大学 | arXiv:2610.34303 关键词:首帧示范编辑, 编辑描述, 时序保留, 轻量条件注入 前序问题:把首帧里的人换上红围巾不难,难的是走动、转身后围巾还在,背景和动作也没被重画。逐帧调用图像编辑器会闪烁,单给修改后的首帧又可能把整个场景带偏。 方法直觉:从修改前后两张图里提炼“改了什么”,把它与图里原本的内容分开;让视频底座负责把这个变化安放到各帧。描述的是变化规则,而不是把某一帧像素贴满整段。 本文贡献:第一阶段在冻结 VAE(图像与压缩潜变量间的编解码器)空间,读取原图、改图及差分,以残差重建和 KL 相对熵分布约束学出 1024 维编辑描述;推理取分布均值。第二阶段冻结 Wan2.1-I2V-14B,隔三块插入融合器:交叉注意力定位局部,FiLM 特征缩放/平移调全局外观,加法分支补编辑偏置,零初始化门控制注入。训练除流匹配外,约束输出变化描述与示范一致,并用冻结 DINO 视觉特征保留源帧结构。两阶段用约 200 万图对、10 万筛选合成视频对及 OpenVid 重建样本;分别 20 万与 3 万次更新,16 张 80GB H800。 原文图 3|EditDistill 总览:第一阶段将修改前后图像对编码为编辑描述 d;第二阶段冻结 Wan2.1-I2V-14B,仅训练轻量融合注入模块,在选定 Transformer 块注入 d,引导源视频去噪成时间连贯的编辑视频。 实验效果:VACE-benchmark 统一 480×832、81 帧,推理 50 步;与 VACE 比,未编辑区域 DINO 相似度 0.701→0.738,光流对齐误差 Warp(越低越稳)3.42→2.97,FVD 视频特征分布距离 914.6→852.1。CLIP-E 编辑方向相似度 0.245,略低于 VACE 的 0.247;CLIP-T 文字匹配 0.282 也低于 0.302。注入模块约 480MB,原文称不足底座参数 4%;这是模块大小,不能当实际峰值显存或整片时延。 原文表 1|统一 480×832、81 帧比较。CLIP-E 和 CLIP-T 分别测编辑方向和文字匹配,DINO-sim 测非编辑区域保留,Temp.与 Warp 测时序相似和光流对齐误差,FVD 测视频分布距离;前四项越高越好,Warp/FVD 越低越好,粗体和下划线分别为最优和次优。EditDistill 在保留、时序和 FVD 领先,编辑匹配并非全部最优。 批判点评:主体一致性 0.942 低于 Omni-Video 的 0.964,首帧无法代表的大动作、遮挡和转场仍是弱点;局部注意力也可能溢到邻区。编辑描述可重复使用不等于已验证任意视频底座迁移。代码 已有推理入口及模块,权重可用性本次未下载验证。 2. KINESYS:借参考特效但少动原镜头 KINESYS: Test-Time Adaptation for Reference-Based Effect Editing in Images | 北卡罗来纳大学教堂山分校;工业光魔;费耶特维尔州立大学 | arXiv:2610.33292 关键词:参考特效编辑, 测试时适配, 双路反馈, 多候选搜索 前序问题:想给赛车加上参考照片里那种烟雾,编辑器却连车身和机位都改了。只问“烟像不像”会漏掉源图被破坏,只追求相似又可能什么都没改;作者研究的是图像特效编辑。 方法直觉:请两位分工不同的检查员指导调参:一位对照特效参考问形态和位置,另一位看原图、指令与结果,检查是否乱改。对几个随机起点分别优化,挑能在新噪声上也稳定工作的版本。 本文贡献:FLUX.2 Klein 4B 冻结底座,逐请求调秩 16 的 LoRA 低秩适配。Gemma 4 E4B-it 做参考问答,EditReward 给指令与质量反馈;每轮 3 个固定噪声候选共用一套适配权重,奖励加权抑制坏样本,早期排斥项维持多样性。五次独立搜索在第 16/31 次更新后保留 3/2 路,每路最多 100 次更新;用同一留出噪声评估中间权重,选择后再采样新变体。底座每次出图 4 步,参考长边上限 384 像素;用户还需指令、三条类别问题和可选掩码。 原文图 2|KINESYS 总览:参考问答 VQA 与看源图的 EditReward 提供互补反馈。K 次独立搜索各有自己的 LoRA 参数φ_k 和 N 个固定噪声候选;α_i 为候选目标权重,随时间衰减的λ_div(t)D 防止早期模式坍缩。横轴 0 到 T 为优化更新,弱搜索在剪枝点停止,留下的继续到后续权重检查点。 实验效果:81 请求、两随机种子中,各方法共同完成 156 例;八类包括烟雾、火焰、积雪、船尾浪。相对 Nano Banana 2,LPIPS 源图感知距离 0.429→0.377(越低越接近),TPIPS 文本条件感知相似度 0.696→0.731(越高越接近)。16 编辑的人评中,保留原图偏好 45%对 25%,特效转移 48%对 42%,其余为平局;前者 41 份答卷,多数非特效专家。多路反复出图并反传是每请求额外成本,论文未给统一耗时和峰值显存。 原文表 1|81 个请求、两种子中各方法共同完成的 156 例比较;开源权重方法按 Gemini 分排列,粗体/下划线为一/二名。匕首表示 EditReward 用于本方法优化和选择,并非独立裁判;双匕首表示 Nano Banana 2 与 Gemini 裁判同属一模型家族。LPIPS 距离越低、TPIPS 相似度越高越保留源图,其余为编辑质量模型评分。 批判点评:源图相似不等于特效成功;EditReward 既参与优化又选最终权重,不能把该分数当独立验证。人评样本小,156 例还排除了各服务未共同完成的 6 例;与闭源特效转移接近不能写成全面超越。项目 可查,本次未找到作者可确认的方法代码链接。 3. CrossPair:示范一对图迁移同一种改法 CrossPair: Unlocking Generalist Visual Transformation Learning in Image Editors | 浙江大学;蚂蚁集团 | arXiv:2610.34333 关键词:示例驱动编辑, 双路径条件, 关系方向对齐, 跨内容迁移 前序问题:给“这张改前→这张改后”的示范,再让模型处理另一张图,它可能复制示范人物而没学会改法。修复、换装、风格化看似不同,都需要把变换从示范内容中剥出来。 方法直觉:让一条路径理解操作含义,另一条保留颜色与纹理,再要求两组不同场景的“变化方向”一致。比较的是各场景内部怎样变,不是假设两张不相关照片的同位置就是同一个物体。 本文贡献:以 Qwen-Image-Edit-2511 为底座,把示范前、示范后、待改图按固定角色顺序送入 VLM 视觉语言编码和 VAE 外观编码。冻结 DINOv3 在训练时找每组图的变化区域,聚合特征差分并对齐方向;目标图只提供停止梯度的变化权重,预测分支保留梯度,低噪声时才加强该约束。只训练秩 128 LoRA,DINO 分支推理移除。Transform-360K 实际有 91010 条四图记录,360K 指记录级图像出现次数,非 36 万独立样本;含 8000 多细粒度关系。 原文图 2|CrossPair 总览:示范图对和待改图一起进入底座原有 VLM 语义及 VAE 外观路径,引导流预测。仅在训练时,正确目标提供停止梯度的变化定位权重,冻结 DINOv3 比较示范及预测查询的变化方向;VAE/VLM 编码器冻结,只训练生成器 LoRA。 实验效果:1095 个已见操作留出查询上,Relation252K 衍生训练版的 CLIP 目标图相似度 0.871、方向相似度 0.438,对照 RelationAdapter 为 0.777/0.355。450 个未见操作查询上,扩展数据版目标相似度 0.783、LPIPS 距离 0.402;原数据版为 0.744/0.440。GPT-5.5 一次匿名排序的未见操作首选率 43.5%,但保留源内容首选率仅 11.2%。训练图面积上限 262144 像素;额外 DINO 只增训练成本,论文未给统一部署时延/显存对照。 原文表 2|已见操作和未见操作的确定性指标及 GPT-5.5 单次排序首选率。R252K/T360K 表示不同训练混合。CLIP-I 对目标/源图相似度、CLIP-Dir 方向相似度越高越好,LPIPS 对目标距离越低越好;首选率分整体、操作与源内容保留三类,不能把整体首选率当编辑成功率。 批判点评:推理只给一对示范不等于训练只靠一对:训练另有待改图的正确结果,也有可指明操作的文字。新数据版同时改变数量和组成,不能把全部收益归因单一损失;系统对照保留各自原生采样器。源图保留弱于 LoRWeB,任务需权衡迁移力度;原文未提供可核实的项目或代码入口。 4. WorldCast:大幅绕拍时记住人物背面 WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control | 武汉大学;小米 | arXiv:2610.33135 关键词:相机轨迹控制, 多视角人物记忆, 几何对齐, 大角度视频 前序问题:镜头绕人物转半圈,正脸像本人,背面却换了发型和衣服。第一帧里根本没有这些信息;镜头走对路径,与人物每一面保持同一身份,是两个耦合问题。 方法直觉:把源图投影成沿相机轨迹的粗参考,明确哪里看不到;再把人物正背侧参考放进共同三维坐标,目标机位从对得上的参考里取细节,而不从所有照片无差别拼信息。 本文贡献:Wan2.1-I2V-14B 接收初始图、文字、目标内外参及补充人物视图。深度反投影后沿轨迹渲染 RGB 和覆盖掩码,Plücker 射线编码相机位置与方向;GAMA(几何对齐记忆注意力)先用前景掩码和多视图几何估计对齐参考,再在 20 处插入记忆块。第一阶段用 76698 条 SpatialVID 和 5 万 UE5 序列训练相机控制,第二阶段用 3 万 Blender 多视角样本训练记忆分支;81 帧、832×480,两个阶段分别 5/8 轮。 原文图 2|WorldCast 总览:把沿目标轨迹对齐的几何指导,与先在共同坐标系对齐的多视角人物记忆结合,使相机路径和人物补充外观共同指导视频生成。 实验效果:CLACT 评测含 42 场景(17 合成、25 真实)各六条轨迹。相对 Uni3C,ATE 绝对轨迹误差 0.098→0.065,相对旋转误差 1.069→0.896,跨视角几何差异 MEt3R(越低越一致)0.324→0.228,ArcFace 身份相似度 0.374→0.555。画质分 0.719,低于 Lyra 2.0 的 0.725;不是所有指标领先。增加多参考和 20 个记忆块需要计算与存储,原文没有统一实测时延账单。 原文表 1|CLACT 主比较,箭头表示越小/越大越好,Anchors 表示是否增加人物视图。ATE/RTE/RRE 为绝对轨迹、相对平移/旋转误差;MEt3R 为跨视角几何差异;Arcf./CLIP/DINO 为身份或视觉特征相似度,Subj./IQ 为主体稳定和画质。WorldCast 使用额外人物视图,画质和主体稳定未在所有对照中领先。 批判点评:方法用了额外人物参考,而大多数相机基线只给初始图;不能把信息增量全当架构收益。遮挡、前景分割和相机对齐失准仍会污染记忆。代码 有推理入口,README 明确专用权重仍待发布,不能据演示命令声称现在能完整复现;其推荐显存也不是论文峰值测量。 5. OmniShowcase:四面参考加法线转台稳绕拍 OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images | KAIST;仁荷大学;FLIPTION | arXiv:2610.35684 关键词:多视角主体生成, 法线转台, 三维一致性, 合成视频数据 前序问题:给了茶壶四面照片,视频绕拍时仍可能长出第二个壶嘴。照片分别告诉模型各面像什么,却没明确告诉它这些面属于怎样的同一件立体物体。 方法直觉:先由同样四张参考重建粗几何,转一圈记录表面朝向,作为独立的结构说明书;照片提供外观,法线提供形状。说明书不必逐帧对齐最终视频,镜头动作仍由文字指定。 本文贡献:构建 4000 条 Showcase-4K 视频,12 种相机运动、88 种轨迹配置。主体由真实三维资产渲染,视频修补只生成背景;条件也从四张参考重建,避免训练偷用真值网格。25 帧法线转台编码为 7 帧潜变量,80 帧目标编码为 20 帧,再加四张独立参考,共 31 个时间位置;token 即模型处理的特征单元。条件保持干净,仅目标加噪。Wan2.1-I2V-14B 只调秩 128 LoRA,四张 B200 训练 33000 次更新约 50 小时。 原文图 4|OmniShowcase 总览:从 N=4 张参考图重建几何并渲染法线转台。参考图及法线条件送入经 LoRA 调优的图生视频扩散 Transformer 参考路径;模型用照片外观与法线结构生成视频,无需针对每个新主体再优化。 实验效果:ShowcaseBench 的 50 主体、四条 360 度轨迹与训练资产隔离,另测 NAVI 的 35 主体,各方法均给同样四张图。相对 3DreamBooth,留出集 DINO 主体相似度 0.707→0.799,归一化并刚性对齐后的 GT-CD 双向点云距离 0.1717→0.0824;NAVI 相对 MV-S2V 为 0.1816→0.0975。留出集美学分 0.574 低于 MAGREF-MV 的 0.614。推理虽无需逐主体调优,仍要先重建与渲染转台,不能当作零预处理。 原文表 2|ShowcaseBench 的 50 主体与 NAVI 的 35 主体主比较,共九指标。DINO/CLIP 测身份,MEt3R、GT-CD 及 RotCov 测跨视图结构、对齐后点云距离及视点覆盖,ViCLIP 测文字匹配,Imaging/Aesthetic/Dynamic 测画质、美学与运动。相似度和画质类越高越好,三个结构/覆盖距离越低越好;粗体/下划线为最优/次优。美学指标未领先。 批判点评:它是多视图主体生成,不是对原视频逐帧重拍,也不是数字相机路径的严格控制。不同参考间主体非刚性变化处理不了,背景有合成感,几何分还依赖重建和对齐器。仓库 当前只有说明及素材,数据、推理、权重和训练代码均列为待发布。 6. SF2:少步视频还要学中间表征 Beyond Distribution Matching: Self-Supervised Representation Forcing for Few-Step Video Generation | 上海交通大学;腾讯混元;南洋理工大学 | arXiv:2610.35594 关键词:少步视频蒸馏, 表征自监督, 非对称噪声, 时空一致性 前序问题:把几十步视频压成四步,最终画面分布看着接近,人物关节仍会跳,倒掉的墙还会长回来。只约束出图结果,没有直接要求学生学会稳定的内部时空表示。 方法直觉:让学生看更破碎的噪声拼图,老师看同一生成轨迹上较干净的一刻;学生既要出好视频,也要预测老师中间层怎样理解它。老师来自学生参数的慢速平均,无需另请视觉大模型。 本文贡献:Self Flow Forcing(SF2)保留 DMD 分布匹配蒸馏目标,复用已有四步生成轨迹,取高/低噪声状态。学生混合两者,EMA 指数移动平均老师只看较干净状态;用投影器把学生 30%深度特征对齐老师 70%深度,余弦损失只更新学生。默认同一空间掩码跨帧复用,避免从相邻帧照抄;双向/因果最大比例设 0.4/0.2。EMA 动量 0.99,先 100 次仅训练投影器,再加入权重 0.5 的表征目标。 原文图 1|SF2 总览:学生去噪轨迹最干净预测继续承担标准 DMD 输出损失;两个中间状态 x_t/x_s(t>s)用空间掩码混成学生的高污染输入,EMA 老师只看较干净 x_s。通过可学习投影器和停止梯度的余弦损失对齐不同深度隐层,老师以指数平均更新,不引入外部预训练特征。 实验效果:Wan2.1-T2V-1.3B、四步、848×480,单 H100 同组比较:双向版 VBench 视频质量及语义评测总分 83.19→84.15,报告速度 16.2 FPS(帧/秒)、时延 4.22 秒不变;因果版相对 Causal-Forcing 总分 84.04→84.15,VisionReward 偏好模型均分 6.326→7.523,报告 17 FPS。一个训练周期定义为 1 次生成器和 5 次判别 score 模型更新,新增分支占周期 6.2%,不是训练总成本免费;推理不保留 EMA 或投影器。吞吐按表注为帧/秒,正文另写样本/秒有冲突,不能据此换算完整视频时延。 原文表 2|VBench 及 VisionReward 比较,分双向多步、蒸馏双向、自回归多步、蒸馏自回归四组,粗体只标各可比组最优;蒸馏组共享 Wan2.1-T2V-1.3B。吞吐量按表注为 FPS,时延为秒,单 H100;正文另一处写 samples/s,存在单位表述不一致,本稿沿表注且不跨组解释整片时延。Total/Quality/Semantic 和 VisionReward 均越高越好。 批判点评:不把内部特征对齐等同物理正确证明;三维重渲染探针也用了外部重建器,因果/双向速度及延迟口径不能混作整片首帧体验。arXiv 评论明确已接收 NeurIPS 2026。仓库 当前只有 README 并写代码将发布,不能称已可复现。 7. Triage:注意力每块分三档算 Triage: Skip, Skim, or Refine Attention Tiles in Video Diffusion Transformers | 首尔大学 | arXiv:2610.35706 关键词:视频推理加速, 注意力分块, 四位计算, 误差路由 前序问题:视频几万个 token 彼此做注意力,计算量随长度平方增长。统一砍掉一部分块会漏掉重要细节,保留块全用同一种低精度,又把算力花在了误差本就很小的地方。 方法直觉:像读长文:无关段落看摘要,普通段落略读,关键段落精读。根据每块近似造成的输出误差,把多花一次计算能换来多少精度算清楚,再按同一个预算价格选择。 本文贡献:先用聚类树把相似查询和键组成 tile 注意力块,统计均值、方差和键值协方差,预测三档误差。skip 以块均值贡献替代,非直接清零;skim 用 NVFP4 四位乘法;refine 再加量化残差乘法。价格π越大越节省,路由按误差下降与新增成本决定升级。单个融合内核在同一次 softmax 归一化中合并三档,利用 RTX Blackwell 的 FP4 计算单元,无需再训练生成器。 原文图 5|Triage 总览:规划阶段①聚类树将相似查询与键分块,②路由按预测误差分值 Ẽ_t=m̃_t(J_t+R_t)√w_h 选择略过、低精度或残差精修;m̃_t 为估计注意力质量,J/R 为近似误差项,w_h 为头输出权重。执行阶段③同一遍计算中,略过块用均值,普通块用一次 NVFP4 乘法,精修块用三次乘法计入残差。块图案仅作示意。 实验效果:五设置各 50 提示/图文对,只换视觉自注意力,首 20%步和第一块仍密集计算。RTX 5090、HunyuanVideo 540p/129 帧在π=0.3 时整段加速 2.32 倍、对密集视频 PSNR 像素信噪比 34.46 分贝;π=0.15 是 2.21 倍、36.37 分贝。同卡 Wan2.2 720p 只加速 1.38 倍;96GB RTX PRO 6000 的 LTX-2.5 为 1.84 倍。含预处理的单次注意力 4.1–8.6 倍,与不含预处理的内核最高 13.5 倍不同。 原文表 1|五设置各 50 提示的端到端结果:PSNR/SSIM 相对密集输出越高越好、LPIPS 距离越低越好;VBench 为五维平均质量,E2E 为整片相对密集版速度比。Density 是计算块占比,括号是全部块中的精修占比;Tokens 是每序列视觉 token,LTX 仅指阶段 2。π为误差与计算的价格。S/L/S+L 分别稀疏、四位及八位组合;粗体标最好方法,硬件分 32GB RTX 5090 和 96GB RTX PRO 6000。 批判点评:PSNR 衡量贴近密集输出,不是现实世界真值;VBench 画质也并非每组都超过密集版。收益依赖 Blackwell 硬件、序列长度与密集暖启,不能泛化为所有 GPU 或整套服务提速。原文没有作者方法仓库;其 CUTLASS 引用只是底层库,ICML 模板也不当接收证据。 8. ImageTTS:画图底座读频谱学说话 ImageTTS: Repurposing Pretrained Image Diffusion Transformers for Speech Synthesis | 武汉大学;微软;香港中文大学 | arXiv:2610.34807 关键词:跨模态生成迁移, 图像潜空间, 零样本语音, 风格指令 前序问题:图像生成器学到的东西能否帮助语音,而不只是借用同款网络?语音还要求字念对、短参考里是谁在说话,两类能力必须分开检验。 方法直觉:把频率随时间变化的声谱图当灰度图片复制成三通道,让图像编码器压缩;再比较同一结构从画图权重和随机权重起步,分清“表示能装下声音”和“生成先验真有帮助”。 本文贡献:100 频带的 log-mel 声谱插值到 512 高,时间补齐 16 倍数并归一化成伪 RGB;冻结 FLUX.2 VAE 和 Qwen3 文字编码器,微调 4B 图像 DiT 扩散 Transformer,做条件流匹配。零样本用参考语音前缀,指令版把文本内容与说话风格一起编码;生成声谱再经 BigVGAN-v2 声码器还原波形。规模版用 10 万小时 Emilia、64 张 40GB A100 训练 18 万次更新,指令版再用 9000 小时和零样本等量混合训 5 万次。 原文图 2|ImageTTS-base 架构:以流匹配 DiT 为主干,由双流块和单流块组成,并接受时间步σ条件。用 Euler 积分求解潜变量,经冻结 FLUX.2 VAE 解码器与 BigVGAN-v2 声码器合成语音。 实验效果:585 小时 LibriTTS 初始化实验,同为 10 万次更新,图像预训练/随机的 WER 词错误率 2.7%/4.2%;随机训 15 万次仍 3.8%。冻结 VAE 在 LibriTTS 重建 STOI 可懂度 0.99、说话人相似度 0.95,这是重建而非生成分。规模版 Seed-TTS 英文 WER1.12%、中文 CER 字错误率 1.68%,中文说话人相似度 0.72 低于 F5-TTS 的 0.76;CapSpeech 风格属性平均准确率 0.66。推理 50 个 Euler 求解步,文字/语音双引导需额外前向,非只调用网络 50 次。 原文表 2|同为 10 万次训练更新,交叉比较图像预训练/随机初始化及图像 VAE 潜空间/直接 mel 建模,粗体为各指标最优。WER 词错误率按百分数越低越好,SIM 说话人相似度、DNSMOS 预测感知质量越高越好;潜空间预训练 WER2.7%,随机 4.2%,直接 mel 保留说话人略强,表示选择存在取舍。 批判点评:正确发音与身份保持有取舍,不能把重建分数套给生成。更大私有数据系统不是同数据公平对照;只在约 10 万小时 Emilia 组比较优势。未给统一实时率或峰值显存,演示 自称 ICLR 2027 匿名投稿,不构成接收;本次未发现可确认的代码。 9. AMBIT:挪一个声源其他声音少受扰 Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion | 香港科技大学;Noiz AI;华盛顿大学 | arXiv:2610.34415 关键词:空间音频编辑, 可执行场景计划, 四通道表示, 在策略自蒸馏 前序问题:把狗叫从左边移到右边,背景音乐却变声或偏了方向。空间音频编辑既要执行哪条声源怎么动,也要保留其余声音的音色、响度与位置,只写一段目标描述不够。 方法直觉:先列完整目标场景:改谁、保留谁、何时响、沿哪里移动,再渲染声音。计划负责可说清的控制,原音频负责计划写不全的细节;两者共同约束,减少保留部分被重新想象。 本文贡献:FOA 一阶 Ambisonics 以 W 全向及三方向分量表达声场,非四个独立扬声器。共享 Transfusion Transformer 在自回归模式逐 token 产 ScenePlan,在流匹配模式生成音频潜变量;可执行计划含声源类型、文字、时间和三维直线路径。编辑同时用原始潜变量及 CLAP 对比音文特征;VAE 以共享解码器全向重建、分组 KL 和空间协方差保留通道关系。OPSD 在策略自蒸馏让老师纠正学生自己产生的计划前缀与采样状态,联合更新两模式。主干及接口 3.326 亿可训练参数,训练 160 万 FOA 例及 100 万编辑对。 原文图 2|AMBIT 总览:(a)共享 Transformer 预测可执行 ScenePlan 并以编译计划指导原生 FOA 潜空间流渲染;编辑在两模式使用源潜变量,在规划时加入 Ambit CLAP 特征。(b)OPSD 在学生前缀和实际访问状态上蒸馏 token 及干净潜变量预测,联合更新共享块及自回归/DiT 模块。(c)VAE 结合共享解码器的全向 W 辅助恢复、分组 KL 和空间协方差监督。 实验效果:8000 生成请求、5000 编辑对;相对 SwanWeave,基础版编辑配对 CLAP 音文相似度 0.68→0.84,FAD 音频特征分布距离 0.57→0.24;未编辑声源方向平均绝对误差 0.90→0.17 弧度,绝对响度变化 8.40→1.65 分贝。单声源指标只在带标注的孤立活动区间计算,不能覆盖所有重叠混音。联合 OPSD 的 FAD0.211,对继续监督训练为 0.232。计划最长约 15 秒,规划与连续渲染均耗计算,未提供统一端到端时延。 原文表 5|空间音频编辑:上部为混合声场指标,下部为孤立区间上的非编辑声源保留与目标声源方向。角度误差单位为弧度,响度变化为分贝;Direction MAE 为方向平均绝对误差,W NMSE 为全向通道归一化均方误差,Angular traj.RMSE 为角轨迹均方根误差,越低越好,wCS 方向加权余弦相似度越高越好。粗体为各列最好。保留原声需单独检查,不能用目标方向正确替代。 批判点评:长声景和连续多轮编辑的一致性仍待验证;语音自然度 UTMOS3.52 低于 Qwen3-TTS 的 4.18,不是音质全胜。方向误差弧度不能误写成角度。代码 有生成和编辑实现,但 README 明确预训练模型尚待发布,现有命令需要本地模型包。 10. VidEdit3D:先沿镜头改视频再改三维 VidEdit3D: Flexible 3D Gaussian Editing with Video Diffusion | 西湖大学;利兹大学;南洋理工大学;加州大学默塞德分校 | arXiv:2610.35756 关键词:三维高斯编辑, 轨迹组织, 视频先验, 区域选择优化 前序问题:给三维场景里的人戴上耳机,一张视图改好了,换角度耳机却不见了;逐视图编辑还可能动到邻近家具。目标既是跨角度一致,又允许局部形状真的改变。 方法直觉:把静态三维场景的绕拍渲染排成平滑视频,借视频模型的时序能力传播首视图编辑,再只把该改的区域拟合回三维。镜头移动造成的画面变化不应变成人物自己乱动。 本文贡献:输入已重建 3DGS(三维高斯点及颜色、透明度组成的可渲染场景)、标定视图、改过的锚点图及前后提示。TGR 选 4 或 7 关键视图,最远点覆盖后排成短闭环,样条插值成 61 帧片段,双向从同一锚点传播。FAVE 共享源/改状态噪声,用源结构校正限制漂移;ECG 在同一改后状态对比源/目标图条件,早期放大源条件拉开编辑信号。注意力差分给区域掩码;RS-GS 用跨视图掩码和深度剔除遮挡后背景,只更新选中高斯。 原文图 2|VidEdit3D 总览:将三维编辑转成沿轨迹的视频编辑。第一步 TGR 组织选中视图为平滑片段;第二步 FAVE 从用户修改锚点传播,借 ECG 增强语义对齐、注意力掩码保留背景;第三步 RS-GS 以逆渲染将二维结果抬升回三维,仅允许目标高斯更新。 实验效果:50 编辑案例、同场景同提示,参考条件方法还给同一锚点。相对 EditSplat,CLIP-D 图像变化与文字变化方向相似度 0.0813→0.1275;相对 GaussCtrl,跨视图几何差异 MEt3R0.1137→0.1126,改进幅度较小。底座 Wan2.1-I2V-14B-480P,50 步日程强度 0.9,即 45 个有效去噪步;每个接受片段都需传播,再做 3000 次高斯优化。免网络微调并不免三维拟合,论文未给统一整流程时延/显存。 原文表 1|编辑忠实度与多视图一致性比较:CLIP-D 为编辑方向对齐,CLIP-S 为目标语义匹配,DINO 为跨视图特征相似,前三项越高越好;MEt3R 为重叠相邻视角几何差异,越低越好。VidEdit3D 四项领先,粗体标最优,但 MEt3R 相对 GaussCtrl 的优势只有 0.0011,不夸大为几何完全正确。 批判点评:视图相似度过滤在首个不合格片段就停止该分支,覆盖不足或重遮挡仍可能留下未改区域;新对象还受选中高斯及增密范围限制。跨角度一致不能证明几何真值正确。仓库 当前仅说明和素材,方法代码标为即将发布。 趋势观察 示范变化比完整目标更适合传递编辑意图 EditDistill把图对提炼为变化描述,CrossPair把跨场景特征变化对齐;两者都在区分内容和操作,但前者用于视频时序,后者用于不同图像。 几何条件的对齐方式决定控制边界 WorldCast按相机几何读取人物锚点,OmniShowcase用独立法线转台给形状而不逐帧锁相机;不能将两种多视图方法当成同一种控制。 速度优化要标明省的是哪一步 SF2以额外训练换四步质量,Triage改注意力精度,KINESYS反而按请求多路调优;收益需要回到训练、推理和服务成本分别看。 保留能力需要单独测 KINESYS的源图保留、AMBIT的未编辑声源方向与响度、VidEdit3D的非目标高斯冻结,各自给出更具体的保持对象。 今日讨论 EditDistill 对比 VACE,未编辑区域 DINO 相似度 0.701→0.738、Warp 误差 3.42→2.97,但编辑方向 CLIP-E 为 0.245,仍低于 0.247。面对首帧无法代表的大动作,固定修改与生成预算后,如何用转身、遮挡的分级实验,收集证据区分“更稳地传播改动”和“编辑力度更弱”,分别衡量目标变化与非目标保留? 人工智能炼丹君 整理 | 2026-10-28
-
AIGC 每日速读|2026-10-27|高通换机位也让动作对齐SyncVid 今日 AIGC 论文速览 今日共 10 篇 · 参考视频重拍与相机控制 2 篇 · 图像编辑与透明素材 3 篇 · 图像生成模型 1 篇 · 旋律音频生成 1 篇 · 音频驱动三维头像 1 篇 · 多参考图生成评测 1 篇 · 城市三维生成 1 篇 重点论文标题列表 SyncVid(高通):换机位也让同一动作对齐 WorldForge V2(西湖大学):换镜头时少带进重建破绽 LOCI(Meta):同图每个人都有独立编辑旋钮 AlphaAnything(字节):透明素材不用另造一套潜空间 EditJev(北京大学):先挑合适的改图模型再开工 选读入口:要把已有视频换机位并对齐人物动作,先读 SyncVid,再读 WorldForge V2 比较噪声同步与轨迹参考两条路。合照里不同人改不同程度,读 LOCI;做玻璃、发丝等透明素材读 AlphaAnything。部署多个编辑器先看 EditJev 的路由与估算时延;想研究扩散之外的图像生成,读 TEM 并留意持续采样链。已有音频模型想跟旋律走,读 Melody Guidance;照片做可转头数字人,接 AudioLift。多张参考总串细节,借 MDMR-Bench 拆验收项;做可逐栋编辑的城市三维资产,再读 CityLift 及掩码和数据域边界。 今日论文速览 1. SyncVid:换机位也让同一动作对齐 SyncVid: World-Equivariant Diffusion for Synchronized Video Generation | 高通 AI Research | arXiv:2610.31765 关键词:参考视频重拍, 跨视角同步, 结构化噪声, 近似白化 前序问题:给同一段舞蹈换两个机位,人物可能在左视角抬手、右视角却已经转身。每个视角各自生成得通顺,不代表它们描绘的是同一时刻、同一个动作。怎样让遮挡后露出的部分也尽量一致? 方法直觉:别让各机位从互不相干的随机噪声开始:先给场景里的三维小颗粒各分配一份固定噪声,再按新机位投影。不同机位看见同一个颗粒,就拿到相关的随机起点;生成器负责把不完整的投影补成画面。 本文贡献:NoPo4D 将单目视频重建成随时间变化的高斯点,噪声绑定不随时间变化的规范坐标锚点;未观察背景用包围场景的立方体补足。投影会使邻像素过度相关,于是用规范三维位置的随机傅里叶特征及 QR 正交分解(构造正交方向的局部变换)做近似白化:降低局部相关,同时保留跨视角对应。源视频和渲染视频作为条件,以秩 256 的 LoRA 低秩适配微调 Wan2.2-14B;36000 组合成视频对,加 2000 条真实静态视频折叠出的约 13500 对,八张 H100 训练 10000 次更新。 原文 PDF 图 2|跨视角一致的近似白化:噪声向量绑定三维高斯点与背景立方体,栅格化使不同机位共享对应关系,但重叠足迹带来局部相关。虚线框用规范锚点 X 的位置经随机傅里叶特征及约化 QR 分解得到逐像素正交变换 Q;它依赖三维位置而非屏幕坐标,同一表面跨视角、跨时间共享变换。右侧噪声在帧内近似独立高斯,视角间仍同步;这种白化不是严格独立性保证。 实验效果:Multi-ViewBench 含 200 片段,统一 5 秒、15 帧/秒、480p,方法输出 75 帧。相对 Reshoot-Anything,动态区域可信匹配点 1268→1332,跨视角 FVD(视频特征分布距离,越低越好)202.22→146.99;跨视角 CLIP 相似度按百分制 89.96→91.66。相机旋转/平移误差 0.151/0.121,逊于 ArtiFixer 的 0.0780/0.0529。单 H100、480×832、50 步生成耗时 1203.1 秒,另有 4D 重建 4.18 秒、噪声渲染 6.44 秒、白化 0.53 秒;未报峰值显存。 原文表 1|Multi-ViewBench 上的视角同步、时间一致性及相机精度比较。Generation Length 为实际生成帧数,49 至 75 帧不等;Mat. Pix.为动态/静态区域的高置信匹配点数,越高越好;FVD-V 为跨视角视频分布距离,越低越好;CLIP-V、CLIP-F 分别为跨视角和时间相似度,越高越好;RotErr、TransErr 为相机旋转和平移误差,越低越好。SyncVid 输出 75 帧、动态匹配 1332、FVD-V146.99,但相机误差 0.151/0.121 未领先。 批判点评:三维跟踪或遮挡出错仍会破坏同步;白化仅近似,不能保证像素独立或真实世界几何正确。200 片段由视觉语言模型筛选,且不同对照输出长度不同,不能把匹配点当严格同帧数胜率。原文所列项目主页本次返回 404,未确认代码或权重已公开;机构由四位作者的高通公司邮箱及原 PDF 核验。 2. WorldForge V2:换镜头时少带进重建破绽 WorldForge V2: Eliciting Camera-Trajectory Alignment in Video Diffusion Models | 西湖大学;北京航空航天大学;新加坡管理大学 | arXiv:2610.31640 关键词:相机轨迹控制, 视频重渲染, 速度缓存, 轨迹低秩适配 前序问题:把一段实拍改成绕物体转动,深度重建的孔洞和错位很容易一起变成视频里的浮空结构。直接强塞参考帧会伤画质,完全交给模型又可能不按指定机位走。 方法直觉:先把画面按目标相机路径粗略投影,再挑适合承载运动信息的潜变量通道施加约束;保留原生成器的预测作校正。重拍指导可以带路,但不应把错误参考当成必须照抄的真值。 本文贡献:IRR(步内递归精修)在预测的干净潜变量中融合参考,再统一加噪;FLF(光流门控潜变量融合)比较位移、方向和异常流,筛选运动相关通道;DSG(双路径自校正引导)比较有无轨迹引导的预测,以角度自适应投影校正。v-cache 复用上一步速度预测,少算额外前向。进一步按 Shapley 贡献筛选网络块训练 Trajectory LoRA:LongCat 用 48 块中的 36 块、8 场景 50 视频、1200 次更新;H3 用 50 块中的 38 块、1 场景 50 视频、1500 次更新,均含 200 次锚点预热,再混合引导状态训练。 原文图 2|WorldForge V2 总览:单张图或视频帧与目标相机路径先经几何重建,渲染对齐轨迹的参考帧。无训练路径在预测干净潜空间依次执行 IRR 步内精修、FLF 运动通道筛选和 DSG 双路径校正;高效路径用 V-Cache 在带噪潜空间融合轨迹,结合对轨迹敏感块的轻量 LoRA,仅少量训练数据学习相机控制。目标是在沿指定路径变化时保留底座生成能力。 实验效果:无训练动态重渲染覆盖超过 30 源视频:相对 TrajectoryCrafter,FVD 视频分布距离 97.31→93.17,但 ATE(全局相机位置误差)0.431→0.527,反而更差。学习版在 40 个留出场景、200 条轨迹比较,统一 640×360 评分;H3 的 PSNR 像素信噪比 20.21 分贝、LPIPS 感知距离 0.2698,对照 UniWorld-View 为 17.15/0.3370。单 A100 估算均时 H3 为 707.3 秒,叠加公开加速 LoRA 后 139.0 秒;各方法使用原生配置,非严格等结构提速。 原文表 III|Trajectory LoRA 与相机控制方法对比。PSNR、SSIM 衡量目标视角像素和结构重建,越高越好;LPIPS 衡量感知距离,Vis/Disocc 分别限于可见与新露出区域,越低越好;ATE 为全局轨迹误差,RPE-T/R 为局部平移/旋转误差。两底座改善重建与新区域补全;H3 局部相机误差最低,但 ATE0.00685 仍高于 UniWorld-View0.00625。粗体和下划线分别标示最优与次优。 批判点评:无训练引导与学习版是两条路径,不能把单场景训练说成整个系统免训练;更新数不含底座预训练。单场景有泛化价值,但大幅度深度错误、人群遮挡仍会留下破绽;全局轨迹指标也非全胜。代码 含 Wan、LongCat 和 H3 相关实现,未实际运行模型。 3. LOCI:同图每个人都有独立编辑旋钮 LOCI: Localized Continuous Control for Multi-Subject Image Editing | Meta AI 研究团队 | arXiv:2610.31950 关键词:多主体图像编辑, 区域低秩适配, 注意力绑定, 连续强度控制 前序问题:合照里想让左边的人渐渐变老、右边的人只添胡须,调大某个编辑旋钮却可能把所有人一起改。只框定区域解决不了改多少,只调全局强度也解决不了改谁。 方法直觉:让每条指令只和自己的主体绑定,再把低秩适配器原来统一的强度拆成逐个图文片段(token)的强度。训练时先学会把指定编辑完全压回原图,推理时缩放这条抑制方向,得到连续的编辑幅度。 本文贡献:冻结 FLUX.1-Kontext,将文字、待编辑图及源图 token(模型处理的文字或图像片段)按主体分组;区域框或掩码决定写入范围,重叠区域取更强抑制值。IDAttn(主体解耦注意力)在中间块隔离主体,首尾块允许视觉信息互通以协调光照;训练和推理使用同样路由。α为抑制量:1 不改、0 为名义编辑、负数进一步外推。秩 16 适配器仅用 22482 个单区域例,八张 H200 训练 10000 次;不用针对多人数量再训练。 原文图 2|LOCI 架构。阶段 1 由用户提供源图、逐区域框 B、指令及独立控制α;阶段 2 把文字、目标与源图 token 分成主体分组 T/L/C,低秩残差按α逐 token 门控,背景 L_u/C_u 无适配残差。阶段 3 冻结 Flux.1-Kontext 的 19 个双流与 38 个单流块:0–9 及 47–56 块协调视觉信息,10–46 块隔离主体。插图为两种查询—键注意力矩阵;协调阶段主体图像 token 可读取所有视觉 token,补足背景连续性证据。 实验效果:128 个合成多主体场景、427 主体编辑对,每图 2–7 主体;统一 1024×1024、28 去噪步。双旋钮 7×7 网格中,相对事后拼接 SliderEdit 与 IDAttn,语义串扰 0.2776→0.2211,感知串扰 0.1909→0.1860;串扰是非目标变化相对目标变化的比值,越低越好。多区域同时编辑成功率 0.9099,略低于无连续控制的 IDAttn 单独版 0.9153。未报告额外墙钟时延和显存,单次联合编辑仍需要 28 步,不是一次网络调用。 原文表 2|协议 C 让各主体同时名义编辑,区域成功率及最差区域 CLIP 增益越高越好;协议 D 在双旋钮网格分别测目标响应和串扰,仅适用于有连续控制的方法。语义与 LPIPS 感知串扰越低越好。LOCI 区域成功率 0.9099,IDAttn 单独版 0.9153;LOCI 串扰 0.2211/0.1860,事后拼接 0.2776/0.1909。粗体、下划线为最优与次优,不能将无滑块方法当作协议 D 的零串扰。 批判点评:合成场景的框/掩码已提供,不能外推自动定位和任意拥挤合照。背景虽不写入适配器残差,注意力仍可能传播变化,不能保证背景完全不变。感知串扰相对事后拼接只小幅改善;若框重叠,最强抑制优先也会影响旋钮独立性。原文没有本方法代码入口,不把引用的 FLUX 仓库当 LOCI 代码。 4. AlphaAnything:透明素材不用另造一套潜空间 AlphaAnything: Extending Pretrained RGB Generators to RGBA | 清华大学;字节跳动;北京大学 | arXiv:2610.32413 关键词:透明图像生成, 共享潜空间, 单向特征传递, 透明度端点损失 前序问题:生成玻璃、烟雾或发丝后再抠图,边界容易灰一圈;重新训练透明图像编码器,又可能损失原模型的小字和颜色。能不能让原彩色生成器直接产生透明素材? 方法直觉:在原有 RGB 三色解码器旁加一条预测透明度的支路,支路只能读取彩色特征,不能改回彩色解码过程。同时把透明度误差传回生成器,让它生成的潜变量本身更适合解码透明边界。 本文贡献:RGBA 比 RGB 多一个 alpha 不透明度通道:0 全透明、1 全不透明,中间值半透明。冻结原 VAE(变分自编码器)的编码与 RGB 解码,训练生成 Transformer 的秩 64 LoRA 及 alpha 支路,固定同一潜变量时 RGB 解码严格不变。EA(端点感知)损失按前景/背景混合权重的 Fisher–Rao 弧长衡量误差,可精确表示 0 和 1,错误饱和时仍有梯度;再对前景与背景误差分别开方聚合,增强小片错误的影响。各变体 20000 次更新、全局批量 16,文字生成训练有 8963 份 RGBA 样本。 原文图 2|AlphaAnything 总览:Transformer 的 LoRA 与嵌在 VAE 中的 alpha 分支,仅经生成式训练学习 RGBA。RGB 到 alpha 的单向特征共享,使给定同一潜变量时 RGB 解码保持原样;透明度监督仍可通过冻结但可微的解码器回传生成器,因此最终生成的潜变量允许改变。 实验效果:图像转 RGBA 测试为 295 源图中的 735 目标层;Qwen-Image-Edit 底座相对 OmniAlpha,Soft IoU(软透明度交并比)0.6881→0.9223,LPIPS 感知距离 0.0911→0.0136。文字生成在白底/黑底合成图上平均评分;AlphaTest 的 FID 分布距离却不领先,例如 FLUX.2 版 75.1796,对照 Qwen-Image-2.1 为 72.2720。FLUX.2 隔离解码 0.148→0.249 秒,端到端附加 0.244%;2.299→2.386GiB 是 VAE 单独峰值,非完整模型显存。 原文表 3|RGBA-Image 的图像转 RGBA 比较。RGB L1 为颜色绝对误差;Soft IoU 为软透明度交并比,越高越好;SAD 为透明度绝对差总量;LPIPS 为合成图感知距离;Alpha Grad 与 Alpha Conn 分别评透明度边缘梯度与连通误差,后五类距离/误差越低越好。AlphaAnything 比较 FLUX.2 与 Qwen-Image-Edit 底座,不能把后者更高成绩完全归因于统一方法。 批判点评:固定潜变量的 RGB 解码不变,不保证适配后的生成结果与原模型逐像素相同,潜变量已经被训练改变。透明数据和指标仍有限,文字生成的分布质量未全面胜出。仓库 本次只有 README、素材和忽略文件,不能称实现或权重已开源。 5. EditJev:先挑合适的改图模型再开工 EditJev: System One Routing for Image Editing Models | 北京大学;清华大学 | arXiv:2610.32635 关键词:图像编辑路由, 偏好排序, 质量时延权衡, 单次评分 前序问题:换背景、提衣服、擦汽车,各家编辑器的强弱不同。所有请求都交给平均成绩最高的模型,既可能改错对象,也可能为简单操作等太久;每次先把所有模型都跑一遍又更贵。 方法直觉:先让一个小裁判只看源图和指令,预测五个编辑器谁更合适;把它的质量偏好与事先测好的速度分合起来,只执行被选中的一个。裁判直接输出五维分数,省去逐字生成模型名。 本文贡献:Qwen3-VL-4B 多模态底座冻结主参数,只训练 LoRA 与线性偏好头,读取最后一个非填充 token。候选为 FLUX.2 Klein 4B/9B、FLUX.1-Kontext、OmniGen2 及 Qwen-Image-Edit。离线对每条训练请求运行全部候选,分别评编辑、保留、自然度、伪影;前两项与后两项各取较差值,再取几何平均,仅用差至少 0.5 的模型对训练排序。推理用β权衡质量与归一化速度,ImgEdit 取 0.7、GEdit-En 取 0.02,测试无需看到生成结果。 原文图 2|EditJev 总览:原图注把离线候选出图、自动评估及路由器训练写作上半部,把质量时延推理写作下半部;实际图面顺序相反,上部为在线选择,下部为离线偏好训练,本稿按图面解读。离线阶段运行所有候选用于偏好监督,在线并非先把所有输出生成后再筛选。 实验效果:737 个 ImgEdit 与 606 个 GEdit-En 请求,按各自官方协议和 GPT-5.1 裁判评分;相对固定 Qwen-Image-Edit,总分 4.540→4.592、8.194→8.255。RTX PRO 6000 上候选各测 20 请求均时,按选中模型频率加路由开销,估算总时延 56.90→22.33 秒、56.90→38.88 秒;不是每条请求端到端重测。路由单独平均 0.094 秒,依据 5 次本地请求。20 案例、20 人共 400 次判断,人类选择一致 327 次,即 81.75%。 原文表 3|固定 Qwen-Image-Edit、GPT-5.5 路由和 EditJev 的时延比较,含路由推理与选中编辑器生成,越低越好。ImgEdit 分别 56.90/51.15/22.33 秒,GEdit-En 分别 56.90/53.55/38.88 秒;按各模型实测均时与选择频率估算平均总时延,不表示每条请求都做同样端到端重测。 批判点评:质量提升较小,依赖固定候选池和自动评判偏好;新增编辑器不等于现有评分头自动适配。离线全部候选出图及标注成本未消失,论文也未给完整多模型驻留显存账单。两数据集β不同,不能把省 60.8%时延直接套到任意负载;人评只覆盖 20 案例。原文未提供本方法代码地址。 6. TEM:让图像沿低能量方向慢慢成形 Scaling Transformer Energy-based Models For High Quality Image Synthesis | 麻省理工学院;伊利诺伊大学厄巴纳香槟分校;哈佛大学 | arXiv:2610.31889 关键词:能量图像生成, 多层能量头, 正样本表征对齐, 持续采样链 前序问题:能量模型给每张候选图打一个越低越合理的分数,再沿梯度修图,理论上很灵活;现实中高维采样费算力、训练不稳定,常只能做小图。怎样把这条路线带到现代图像生成规模? 方法直觉:在压缩后的潜空间里打分,让不同深度的评分头分别看纹理、结构和语义,最后加总。只给真实图像补上视觉教师的密集特征监督,避免把错误生成样本也强行拉向同一特征目标。 本文贡献:TEM(Transformer 能量模型)用视觉 Transformer 输出标量能量,多个中间层能量头求和。训练压低真实图能量、抬高自身 MCMC(马尔可夫链蒙特卡洛)负样本能量;采样匹配损失兼顾低能量和多样性,PRA(正样本表征对齐)只对真实图对齐冻结 DINOv2 特征。图像经 Stable Diffusion 自编码器压成 32×32×4 潜变量;训练每次 40 次 Langevin 梯度更新,批量 256,共 50000 次优化,训练缓冲区容量 16000、复用概率 0.99。 原文图 2|架构与训练:左边 TEM 用 Transformer 块处理 VAE 编码的潜变量 token,多层标量能量头相加成总能量;右边对比训练降低真实样本 x+能量、提高 MCMC 生成负样本 x−能量,PRA 只将真实样本内部表征对齐冻结视觉基础模型 VFM。不同深度能量头共同约束纹理、布局和语义。 实验效果:ImageNet 类别条件生成,6.09 亿参数 TEM-XL、60 次采样更新、50000 张图计算 FID(特征分布距离,越低越好):256×256 为 3.82,512×512 为 8.24。同尺寸 DiT-XL 无分类器自由引导为 9.62,有引导为 2.27,不能称全面超过扩散。评估前 5000 条链从高斯噪声起步,后续复用 40 步缓冲状态,再各追加 60 步。附录 256 图采样 14.48 万亿浮点操作/份,DiT 为 29.66 万亿;这是计算量,非墙钟或显存实测。 原文表 1|ImageNet 256×256 与 512×512 类别条件生成,FID 由 50000 样本计算、越低越好;Params 主要按 256 配置,NFE 是论文列出的采样网络评估口径,能量梯度更新成本需另参附录。CFG 列表示分类器自由引导,空线是未报告。TEM-XL 6.09 亿参数、60 步、FID3.82/8.24,主结果无 CFG;各 baseline 数字取原论文,不是全部同机重跑。 批判点评:步数包含能量梯度,不能与普通去噪前向调用一一等价。持续链复用是成绩协议的重要部分,不代表每图独立 60 步从纯噪声开始。多算未必让分布更好:60→80 步,FID3.82→4.72、召回 0.57→0.51,清晰度换来模式覆盖下降。项目 与代码 有训练、采样实现,未执行模型。 7. Melody Guidance:不用重训也能照旋律生成声音 Melody Guidance for Audio Diffusion Models Without Retraining | 德国埃尔朗根纽伦堡大学;International Audio Laboratories Erlangen | arXiv:2610.32211 关键词:旋律音频生成, 推理期引导, 可微音高估计, 三角波初始化 前序问题:手里有无条件音频扩散模型,想让它按一条旋律唱或弹,通常得重新准备旋律配对数据。只在推理时用音高误差硬拽,又容易得到音准对了、音色却变假的声音。 方法直觉:先用目标音高合成有泛音的三角波作草稿,再让生成器把草稿修成真实音色;每步用可求梯度的音高检测器纠偏。草稿减轻纠偏负担,扩散先验负责声音自然,两者要一起调。 本文贡献:F0 是基频、决定主音高;dSWIPE 是可微音高估计器,用候选音高相关性的 softmax 代替硬选最大值,使音高误差可反传。在每步预测的干净波形上计算误差,经解码器传回潜变量,并按噪声量和梯度范数归一化;波形模型可直接引导。λ为纠偏强度,t_init 为开始去噪的噪声位置;目标音高用标准差 50 音分平滑,100 音分为一个半音,保留颤音空间。唱声 LOUDAR 取λ=2.5、t_init=0.8;吉他为 2/0.7,两钢琴模型为 0.3/0.65。 原文图 1|旋律引导采样:目标 F0 基频曲线 y 先合成三角波热启动信号 x_init,按需编码成 z_init;反向扩散逐步细化,同时经 dSWIPE 可微音高检测器的似然梯度拉向目标旋律。热启动与梯度引导共同减少音准与真实音色的冲突。 实验效果:100 条 POP909 旋律、四个底座。唱声用 CREPE 独立提音高,RPA(发声帧原始音高准确率)0.91、OA(含清浊音判断的总体准确率)0.86,DiffSinger 为 0.76/0.85。吉他 OA0.79 低于 DDSP-Guitar0.84;钢琴 MR-CQT 的 OA0.78 优于 PianoKontext0.63,但同为 MAESTRO 训练的 FAD(音频特征分布距离)0.39 较 0.25 差。无需旋律专属重训仍要逐步反传,论文没给墙钟、采样步数总账和峰值显存。 原文表 1|唱声、吉他和钢琴分组结果。RPA 为发声帧原始音高准确率,OA 还计入清浊音识别;下标 C/S 分别指 CREPE/SWIPE 音高提取,准确率越高越好。KAD 与 FAD 分别为核音频距离、Fréchet 音频距离,越低越好;唱声和吉他对照训练数据不同,只能指示相对质量,钢琴同为 MAESTRO 才较可比。不同提音高器下准确率不应混写。 批判点评:唱声和吉他对照训练数据不同,不能按 FAD 或 KAD 音频分布距离直接排统一音质榜;钢琴对照同数据才较可比。音素、拨弦动作、音头和衰减仍由无条件先验决定,不能据旋律控制推断歌词或演奏法可控。试听项目 可访问,未确认本方法代码已公开。 8. AudioLift:一张照片先补五机位再成头像 AudioLift: Audio-Driven Single Image to Full-Head Gaussian Avatar via Multi-view Video Generation | 耶鲁大学;加州大学默塞德分校;卡内基梅隆大学 | arXiv:2610.31747 关键词:音频驱动头像, 多视角视频生成, 高斯重建, 后脑补全 前序问题:单张照片驱动数字人说话,正面看着不错,一转到侧后方就可能头颈断开、帽子消失。参数化人脸的运动空间也难覆盖夸张张嘴,能否借视频生成能力补全完整头部? 方法直觉:先让同一声音驱动五个同步机位,再把每个时刻的五张图拼成三维高斯头像。生成的机位不完全一致,所以重建器训练时就故意看些错位侧视图,学会以清晰正面作锚点。 本文贡献:第一阶段基于 13 亿参数 StableAvatar,四斜机位排成 2×2 画布,另加正面流;同一时刻的视觉 token 读取相同音频窗口,全局注意力共享五视角信息。第二阶段微调 FaceLift 逐帧前馈重建,侧视输入加网格畸变与相机扰动,正面保持干净;活动体积正则压低头部范围外高斯的不透明度,后方三个角度区间用冻结教师低权重蒸馏。训练 2641 条语音序列、328 身份,第二阶段 648 片段各 16 帧,共 10368 多视角场景;两阶段分别 6800 和 7328 次更新,八张 48GB RTX 6000 Ada。 原文图 2|AudioLift 两阶段:(a)音频驱动多视角生成,四个斜视角拼成 2×2 画布,另加正面流,同一时刻的五视角共享音频上下文及跨视角注意力;(b)三维高斯序列重建,微调的前馈重建器逐帧把生成的五机位提升为三维高斯头像,得到可从任意机位、任意时刻渲染的高斯序列。干净参考视图为去噪器提供条件,侧面与正面按时间交错成同一 token 序列,以共享自注意力连接各视角。 实验效果:RenderMe-360 测试 42 片段、21 身份,HDTF 另 21 对照片语音;81 帧、25 帧/秒,统一 512×512 白底计分。前者相对 SDTalk,正面 FID 分布距离 77.05→44.53,但 SSIM 结构相似度 0.710→0.678;新机位 PSNR 像素信噪比 10.99→12.27 分贝。新视角只评第 0 帧五个未见相机,正面评 1–80 帧,不能混成全动态新视角定量。第一阶段五视角各 416×608、30 步;未报端到端耗时与实际峰值显存。 原文表 1|RenderMe-360 端到端比较,(a)正面、(b)新视角。PSNR 像素信噪比、SSIM 结构相似度及 CSIM-ref 参考身份余弦相似度越高越好,LPIPS 感知距离与 FID 特征分布距离越低越好。正面评 1–80 帧,新视角仅第 0 帧五个未见相机;AudioLift 正面 FID44.53,但 SSIM0.678 低于 SDTalk0.710,不是所有指标都更优。 批判点评:后脑来自教师的合理补全,不能声称恢复照片未拍到的真实发型;逐帧前馈重建也不是对整段做显式时间优化。无逐人优化不等于无训练或实时。演示超过 20 秒,但主定量仅 3.24 秒窗口。项目 和所链接仓库 已列出,仓库含两阶段推理、配置与说明,未执行模型。 9. MDMR-Bench:多张参考图要逐项查有没有串 MDMR-Bench: A Multi-Dimensional Benchmark for Multi-Reference Image Generation | 南京大学;华为研究;香港大学 | arXiv:2610.32459 关键词:多参考生成评测, 检查清单, 非目标保留, 裁判一致性 前序问题:给三张人物、服装和场景参考,结果看着漂亮却把衣服纹理抄错,或者换衣时连脸也变。一个笼统美学分不容易指出是哪条约束没满足,多参考生成需要更细的验收。 方法直觉:把每个要求拆成可回答“是/否”的检查项,既问整体有没有完成,也问某个人、某个属性是否保留。任务家族等权汇总,避免数量最多的容易题把分数撑高。 本文贡献:2390 案例覆盖实体融合、属性转移、单图多元素提取、信息图操作与视觉推理;前两类各 936 和 982 例,常有 2–4 参考图。约 50 万图图库经模型打标签、任务分桶、自动验证及人工筛查;48.2%案例至少含一张合成参考。五维按指令/一致/组合/最小改动/质量分别权重 0.20/0.25/0.25/0.20/0.10,维内整体与原子问题等权;先按子任务平均,最后五任务家族等权。默认 Gemini-3-Pro 裁判,非把各样本简单平均。 原文图 1|MDMR-Bench 概览:多参考图生成覆盖实体融合、属性转移、多元素提取、信息图操作及视觉推理等挑战。五个评估方面均使用整体问题与原子细节问题组成的检查清单,分开诊断指令满足、参考保留、组合、额外修改及画质,而不是只给笼统总分。 实验效果:主榜百分制:GPT-Image-2 总分 88.8,Nano Banana Pro85.1,开源组 FLUX.2 为 51.3;这是本基准指定裁判和原生支持分辨率下的分数。GPT-Image-1.5 指令分 90.3,但最小改动仅 56.8,揭示过度编辑。200 案例 800 输出的人评形成 5924 项判断,默认裁判与人类一致率 0.853,Cohen κ(扣除随机一致后的指标)0.642。逐项裁判增加 API 调用成本,未报告统一评测时延或峰值显存。 原文表 2|默认 Gemini-3-Pro 裁判的主榜,百分制;GPT-5.4 裁判另列附录。Following/Consistency/Composition/Minimality/Quality 分别为遵循指令、参考一致、合理组合、最小额外改动和画质,Overall 按既定权重与任务家族等权汇总。闭源与开源模型分组,GPT-Image-2 为 88.8,FLUX.2 为 51.3;这些是指定协议下评分,不是普适成功率。 批判点评:合成参考、人工维度权重与裁判偏好会影响榜单;属性任务中参考数多的子集更难,不是同一案例只改参考数的因果实验。主榜与任务表对 GPT-Image-2 总分分别 88.8 和 88.7,本稿按主榜口径保留差异。arXiv 评论明确接收 NeurIPS 2026 评测与数据集轨道;代码 本次 404,数据 尚无法确认公开下载,不沿用摘要“已公开”的断言。 10. CityLift:一张城市图补成可拆分楼群 CityLift: Compositional 3D Urban Generation from a Single Image | 西安交通大学;中关村学院 | arXiv:2610.32728 关键词:城市三维生成, 场景骨架, 空间特征继承, 独立楼宇网格 前序问题:从城市斜拍图做三维资产,逐栋生成容易楼高不对、楼群互撞;整城一次生成又难单独编辑一栋。遮挡让完整几何与相对布局都难猜,怎样同时照顾? 方法直觉:先在同一坐标系搭一份楼群粗骨架,再给每栋楼分自己的细化空间。楼在哪里、有多大,以及从整体读到的三维特征,都随同一坐标变换送进局部生成器,最后按原变换放回。 本文贡献:输入除了单张图,还需要每栋楼实例掩码。共享参数的场景/单楼双流稀疏结构 Transformer 交互,生成 64³占用骨架和隐藏特征;确定性局部坐标映射同时用于占用、特征、训练目标与最终组装。TRELLIS 流模型从噪声重生成局部结构,再由预训练 SAM 3D 生成纹理网格;低噪声阶段另约束占用重叠、质心和轴向分布。CityLift-5K 有 4997 合成场景、36338 栋,训练 4497/验证 250/测试 250;训练用两张 80GB A100,局部模块 18000 次更新。 原文图 2|CityLift 总览:输入单张城市图与逐栋楼掩码,在共同坐标系生成可独立编辑网格。(a)共享的场景/单楼生成器联合预测粗占用,隐式包含位置、尺度和几何;(b)骨架坐标映射 T 把占用及上下文特征 F 重采样进单楼局部空间,得到对齐条件 A;(c)局部流模型依据 A 及楼图特征 e 从噪声重建细稀疏结构,指导网格生成,再沿继承变换放回场景。 实验效果:250 个留出场景平均 7.8 栋,楼与场景均隔离。CD(双向表面最近点平均距离,以网格单元计)单楼相对 Pixal3D 由 2.547→1.011;场景相对 SAM 3D 由 2.595→1.079,F@2(两格阈值内精确率召回率的调和平均)0.597→0.855。每场景 115 秒,比 Pixal3D1482.4 秒快,但慢于 SAM 3D83.7 秒和整场景 TRELLIS.2 的 39.2 秒;未报实际峰值显存。真实 InstanceBuilding 来源渲染测试场景 CD2.012→1.531,收益较合成集小。 原文表 1|CityLift-5K 的单楼与场景几何比较,距离以网格单元计。CD 为双向倒角距离,Acc 为生成到参考的单向距离,Comp 为参考到生成的完整性误差,均越低越好;F@1/F@2 为一格/两格阈值 F 分数,越高越好。横线表示没有独立楼输出;末列为秒/场景。CityLift 场景 CD1.079、F@2 为 0.855、115 秒,并非表中最快。 批判点评:外部真实来源也是从已重建网格再渲染 RGB 与掩码,不能说直接验证任意无人机实拍。外部数据单楼阈值 F 分数和单向精度仍落后 Pixal3D,改善主要来自覆盖与组装。不可见立面是生成性补全,不等于测量真值。项目 可查,本次未发现可确认的方法代码入口。 趋势观察 先定义哪些东西必须保持 SyncVid保持动作的跨机位对应,LOCI限制区域串扰,AlphaAnything只保证固定潜变量的RGB解码;三种保持各有不同对象。 控制常从表示入口开始 场景级噪声、逐token适配强度、原潜空间的透明度监督,比再加一段笼统指令更明确地约束干预位置。 省下的计算要按实际协议计 EditJev报告频率加权估算,TEM复用持续采样链,WorldForge叠加加速LoRA;它们的数字不是同一种时间账单。 完成感不能替代验收清单 MDMR-Bench分开指令与非目标保持,AudioLift区分正面动态与首帧新视角,CityLift分开单楼与整场景质量。 今日讨论 SyncVid 的跨视角 FVD 从 202.22 降到 146.99,相机旋转误差却比 ArtiFixer 更大。若同步收益主要来自把噪声绑定三维锚点,你会怎样用等帧数、同底座实验,分别改变遮挡程度和几何误差,收集哪些独立证据,区分动作同步、轨迹准确与新露出内容的真实一致性? 人工智能炼丹君 整理 | 2026-10-27