
搜索到
43
篇与
图像生成
的结果
-
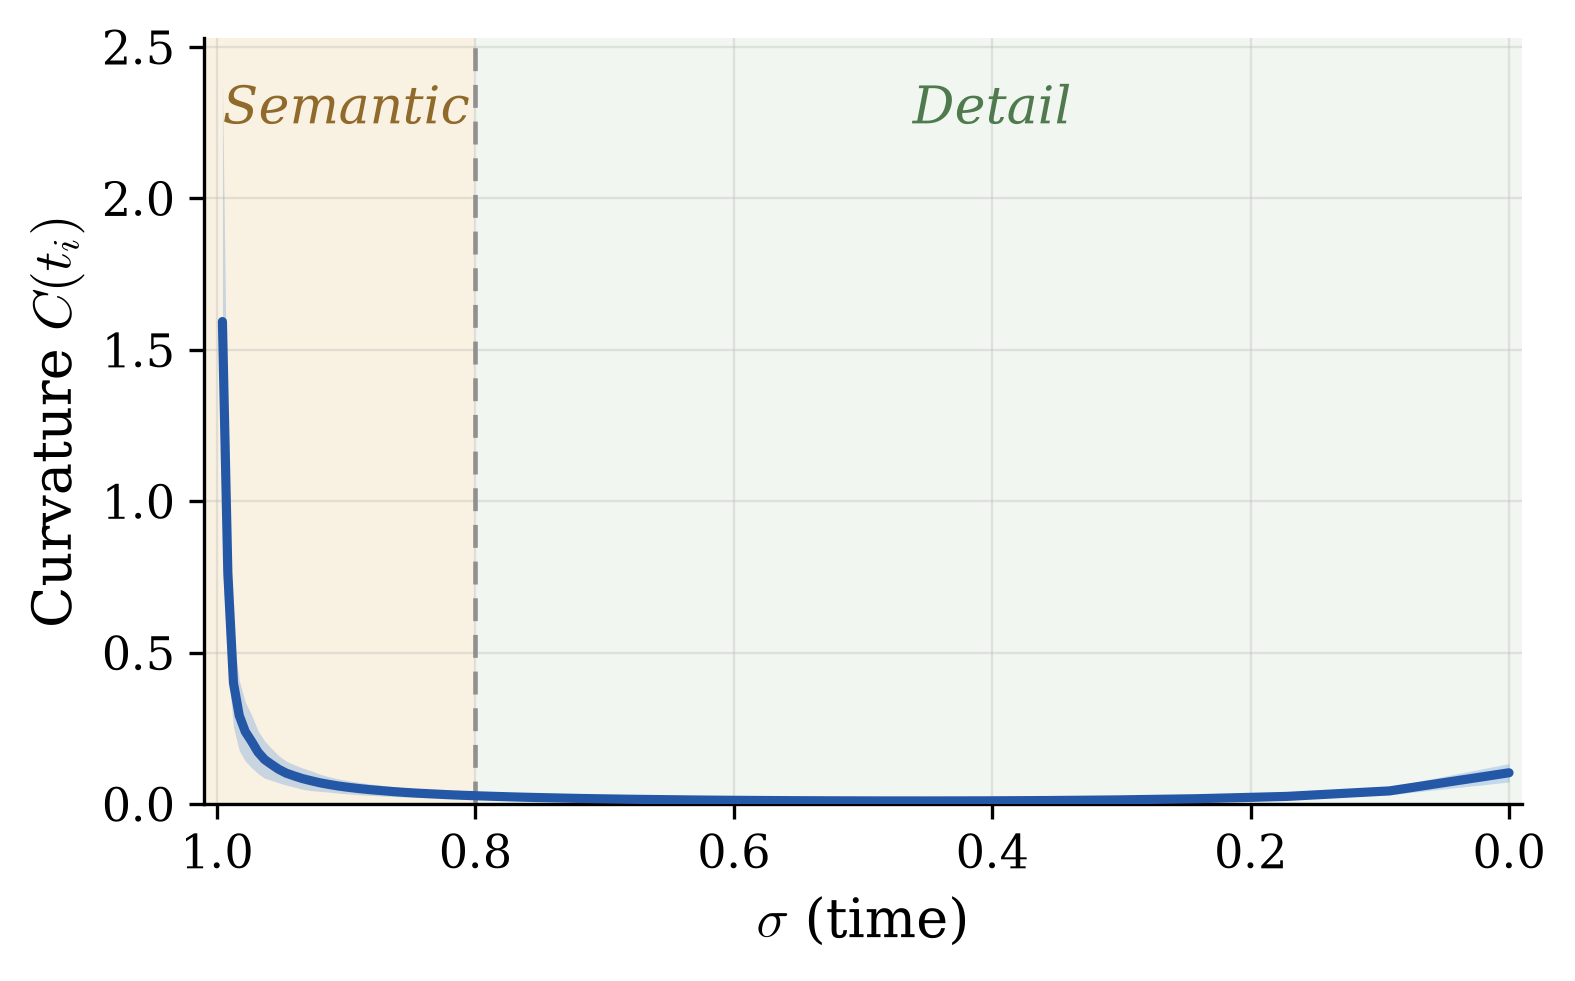
 AIGC 每日速读|2026-08-12|阿里DUET两步视频质量多样性双赢 今日 AIGC 论文速览 今日共 10 篇 · 视频生成加速与少步蒸馏 3 篇 · 统一多模态表征与理解生成一体化 1 篇 · 音频与音乐生成 3 篇 · 扩散架构机理与图像编辑 2 篇 · RGBA 视频与资产生成 1 篇 重点论文标题列表 DUET(阿里巴巴·北京大学·清华大学深圳国际研究生院):两步视频生成质量多样性双赢 UniSpace(美团):8B统一模型扔掉VAE通路 SonicWeave(快手可灵团队·香港中文大学·清华大学深圳国际研究生院):一套权重生成全类音频场景 FullDiT(复旦大学·阿里巴巴 Token Foundry):音乐生成胜过五家商业系统 adaLN-Gaussian(北京大学·百度·UC Berkeley):零初始化才是DiT的真功臣 今日论文速览 1. DUET:两步视频生成质量多样性双赢 DUET: A Diversity-Quality Duet of Distillation Experts for Two-Step Video Generation | 阿里巴巴·北京大学·清华大学深圳国际研究生院 | arXiv:2608.09637 关键词:两步视频生成,少步蒸馏,质量多样性权衡,专家分工,流匹配 前序问题:扩散模型能生成高质量视频,但迭代采样的开销让实际部署很难受。少步蒸馏是主流解法,却暴露出一个绕不开的质量-多样性权衡:轨迹级蒸馏(如 sCM)倾向保住多样性但质量偏弱,分布级蒸馏(如 DMD)质量强但生成结果的结构多样性大幅塌缩。此前的工作大多试图在 loss 层面把两类目标混合调和,结果总是按下一头翘起另一头,且混合目标本身的优化难度还额外增加了训练成本。 本文贡献:面向极端的两步视频生成,提出 DUET,把权衡改造成噪声层面的专家分工:sCM 专家接管高噪声那一步,负责铺开多样的结构布局;DMD 专家接管低噪声那一步,负责精修外观细节。两个专家各自按原生目标独立训练,因此完全绕开了 loss 级组合的优化困难,质量与多样性是联合获得而非互相交换。作者进一步指出剩下的瓶颈在于「接力界面」和高噪声阶段本身,用 RL 引导的专家自适应加以解决,得到 DUET+。 实验效果:在 Wan2.1-T2V-1.3B 骨干上,DUET 把 sCM 的两步质量拉到接近 DMD 的水平,同时几乎完整保留其结构多样性——约为 DMD 的两倍;DUET+ 在保住这一多样性优势的同时进一步提升整体质量。 批判点评:这篇的洞察很值钱:把「质量 vs 多样性」从一个需要折中的标量权衡,重新表述成「不同噪声区间需要不同归纳偏置」的分工问题,从而让两个专家都能按最适合自己的目标训练。这比在 loss 里加权重系数干净得多,也解释了为什么此前的混合方案总在原地打转。局限也很清楚:两步生成需要同时维护两个专家权重,显存与部署复杂度是单模型方案的两倍,论文对这部分成本交代不足;「接力界面」被承认是瓶颈,说明高噪声专家交给低噪声专家的中间状态存在分布不匹配,DUET+ 用 RL 打补丁而非从原理上解决;此外骨干只验证了 1.3B 的 Wan2.1,在 14B 级别模型上噪声分工的最优切分点是否仍在同一位置,完全未知。 2. UniSpace:8B统一模型扔掉VAE通路 UniSpace: Unified Visual Representation and Scalable Multimodal Modeling | 美团 | arXiv:2608.08676 关键词:统一多模态,视觉表征,Patch重参数化,理解生成一体化,MoE 前序问题:语义视觉编码器已成为多模态理解和图像生成语义条件化的核心接口,但它的最终 token 会丢弃细粒度视觉细节,导致像素重建能力很差,因此无法直接用在图像生成、编辑这类对重建敏感的任务上。业界的通行做法是另外挂一条 VAE 通路专门负责重建,代价是架构分裂、两套表征空间难以对齐。 本文贡献:作者先做了一个反直觉的诊断:语义 ViT 的冻结 Transformer 块并非本质上无法保留视觉细节,真正把表征推向语义抽象、让细粒度信息难以从最终 token 恢复的,是原始的 patch 参数化方式。基于此提出 Patch Reparameterization——保留原有语义通路不动,另加一条重建感知的 patch embedding,把细粒度视觉信息送进同一批冻结 ViT 块。由此得到的统一表征既保住多模态理解能力,又能做高保真图像重建,重建-生成权衡曲线更优。作者进一步把这套表征放大成 UniSpace,一个 8B 的 Mixture-of-Transformer-Experts 模型,在同一个视觉空间里完成理解、生成和编辑,完全不需要独立的 VAE 通路。 实验效果:系统级评测显示模型具备可用的文生图能力与指令式图像编辑能力,验证了「重参数化后的预训练 ViT 可以充当可扩展多模态建模的统一视觉接口」这一主张。 批判点评:把矛头指向 patch 参数化而非 Transformer 块本身,这个归因方向是这篇最有价值的部分——它意味着大量「语义编码器保不住细节」的结论可能都是参数化方式的问题,而不是架构的固有缺陷,从而打开了「保留冻结语义骨干、只改输入侧」的低成本改造空间。去掉 VAE 通路对统一模型的架构简化意义很实在。但也要冷静看:论文用「practical text-to-image generation」这类措辞而非硬指标对比,说明生成质量距离专用 T2I 模型仍有明显差距,8B MoTE 的规模也不小;「重建-生成的有利权衡」是相对自身消融而言,缺少与 VAE 方案在同等算力下的正面对照;另外冻结 ViT 的容量上限是否会在更大规模上成为瓶颈,文中没有给出 scaling 证据。 3. SonicWeave:一套权重生成全类音频场景 SonicWeave: Chunk-Routed Mixture-of-Experts for Unified Audio Scene Generation | 快手可灵团队·香港中文大学·清华大学深圳国际研究生院 | arXiv:2608.09571 关键词:统一音频生成,Chunk路由MoE,流匹配,音频场景合成,专家专业化 前序问题:文本条件的通用音频生成正从孤立的语音、音乐、音效合成,走向用单个模型把它们组合成可控、连贯的音频场景。这个统一设定格外棘手:异质成分对共享骨干提出互相冲突的结构要求,而一个复杂混合场景内部还可能包含局部不同甚至相互重叠的内容,需要在同一段音频里做细粒度自适应。现有音频 MoE 大多在领域级别做路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。 本文贡献:提出 SonicWeave,一个面向统一音频场景生成的流匹配模型,核心是带冲突门先验-证据路由机制的 chunk 级 MoE(CPE-MoE)。它按连续的声学 chunk 做路由,把编码结构化文本条件与扩散阶段的全局先验,和来自演化中声学状态的局部证据结合起来;一个学出来的冲突门在局部状态不可靠时倾向采信全局先验,只在某区域明显偏离全局场景语境时才让局部证据主导路由。单套权重即支持语音、音乐、音效、歌声及其细粒度混合。 实验效果:在 TTS、TTA、TTM 三类基准上一致优于受控的 Dense 与 Base-MoE 基线;复杂场景评测进一步显示组合质量提升,路由分析揭示出跨扩散阶段的内容相关专家专业化现象。 批判点评:「按 chunk 路由」这个粒度选择切中了要害:语音的音素、音乐的节拍、音效的事件都是有时间跨度的结构,逐 token 决定专家等于在同一个声学事件内部反复换脑,chunk 级正好对上声学连续性。冲突门的设计也挺聪明——扩散早期局部状态本来就是噪声,此时强行采信局部证据只会引入路由抖动,用全局先验兜住是对的。不足在于对比强度:论文的对照是自己控制的 Dense 与 Base-MoE 基线,而非各领域的 SOTA 专用模型,所以「统一模型是否已经不输专精模型」这个最关键的问题没有回答;chunk 长度作为一个关键超参,其敏感性分析在摘要层面没有体现;此外 MoE 的实际激活参数量与推理开销未交代,工业落地时的性价比无法评估。 4. FullDiT:音乐生成胜过五家商业系统 Beyond Reconstruction: Full-Context Generative DiT for Music Generation | 复旦大学·阿里巴巴 Token Foundry | arXiv:2608.08787 关键词:音乐生成,暴露偏差,条件DiT,RVQ编解码,分类器无关引导 前序问题:混合式音乐生成器把自回归语言模型的长程规划能力,和扩散/流模型渲染器的高保真结合起来。但存在一个被忽视的部署错配:渲染器是用干净的、从目标推导出的 codec token 训练的,上线时却要接收语言模型的不完美预测,这就形成了 codec 接口层面的暴露偏差——训练时没见过的错误 token 分布,在推理时成了常态。 本文贡献:作者不再把渲染当成简单的重建任务,而是把它重新表述为「从一个不完美离散计划出发的全上下文生成」。为此提出 FullDiT:一个条件 DiT,融合八路帧对齐的 RVQ 流与独立编码的歌词、caption,并在完整声学隐序列上做非因果自注意力。训练阶段引入 Error-Matched Distractor Conditioning(EMDC),把每个 codebook 的替换率匹配到教师强制下的 top-1 错误率,并从余弦 KNN 邻域中采样「近似错答」token,同时不改变声学目标。推理阶段用四路 classifier-free guidance(4-CFG)独立缩放 codec、歌词、caption 三类引导增量。 实验效果:匹配消融显示 EMDC 在合成扰动下把 ViSQOL 提升 0.77,且在非并列比较中明显更受偏好;进一步消融验证了全曲上下文与渲染器侧文本条件各自的增益。完整系统在 18 项自动指标中的 15 项上超过五个商业系统,并在 Artificial Analysis 带唱音乐榜单上进入前三。 批判点评:EMDC 是这篇最扎实的一笔:不是随机加噪,而是把干扰率精确对齐到教师强制的真实 top-1 错误率,并从 KNN 邻域取「像是对的错答」,这让训练分布真正逼近推理时会遇到的错误结构,比通用数据增广讲得通得多。渲染器侧也吃歌词和 caption 这一点也很合理——语言模型的 plan 一旦出错,渲染器至少还有文本可以校正。质疑点在于评测:「18 项中的 15 项超过五家商业系统」这类表述缺少商业系统的具体版本与调用时间,商业模型迭代极快,可复现性存疑;ViSQOL 提升 0.77 是在「合成扰动」这一人造条件下测得的,真实语言模型错误分布是否同构未验证;八路 RVQ 加全序列非因果注意力意味着相当高的显存与延迟开销,论文未给出与主流方案的推理成本对照。 5. adaLN-Gaussian:零初始化才是DiT的真功臣 Unveiling the Secret of AdaLN-Zero in Diffusion Transformer | 北京大学·百度·UC Berkeley | arXiv:2608.09438 关键词:扩散Transformer,adaLN-Zero,零初始化,条件化机制,TPAMI 前序问题:扩散 Transformer(DiT)已成为图像生成的主流架构,围绕它的性能改进层出不穷,但社区对它的理解仍然停留在表面。一个典型例子是 adaLN-Zero:所有人都知道它比 adaLN 效果好,也都在用,但到底是哪一部分设计在起作用,一直没人系统回答过。 本文贡献:本文深入拆解 DiT 中的关键条件化机制 adaLN-Zero,把它的性能来源分解为三个候选要素——类似 SE 的结构、零初始化、以及「渐进式」更新顺序,并逐一做受控验证,最终证明零初始化是其中最具决定性的因素。基于这一理解,提出分析导向的初始化策略 adaLN-Gaussian:它既是对上述分析的经验验证,也是一个能稳定改善优化效率的实用初始化方法。另一方面,受 SE 式结构启发,提出改进的条件化机制 SE-adaLN-Zero。 实验效果:遵循 DiT 设置在四个数据集上做了充分实验,尤其在 ImageNet1K 上验证了 adaLN-Gaussian 与 SE-adaLN-Zero 的有效性和泛化性;除类别到图像生成之外,还在文生图任务上评估了两种改进方法的泛化能力。论文已被 IEEE TPAMI 2026 接收。 批判点评:这是今天最「不性感但最有长期价值」的一篇。当整个领域都在往上堆模块时,回头把一个被默认使用了数年的组件拆开做归因,得到的是可迁移的设计原则而不是又一个刷分技巧——「零初始化主导」这个结论对任何做残差式条件注入的架构都有参考意义,adaLN-Gaussian 作为一行初始化改动,落地成本几乎为零。局限在于实验尺度:遵循原始 DiT 设置意味着规模偏小,ImageNet1K 类别到图像生成与今天动辄十亿参数的 T2I/T2V 训练环境差距不小,零初始化的主导地位在大规模、长训练下是否依然成立需要更强证据;文生图上的泛化验证在摘要中只是一笔带过,没有给出具体量级;此外 SE-adaLN-Zero 作为结构改动会带来额外参数与算力,论文未讨论其与收益的性价比。 6. REST:把RL副产物直接当蒸馏监督 RL-Native Distillation: Exploiting Scored Trajectories for Few-Step Image Generation | 上海交通大学·阿里巴巴淘天集团 | arXiv:2608.09226 关键词:少步图像生成,RL蒸馏协同,优势调制,奖励对齐,无CFG推理 前序问题:高效文生图既需要基于强化学习的奖励对齐,也需要少步蒸馏,但这两个流程通常被串行执行:先 RL 对齐、再压缩步数。这不仅推高训练成本,还有一个隐患——压缩过程可能把前一阶段辛苦对齐来的奖励收益又丢掉。 本文贡献:作者提出一个 RL 原生视角:扩散 RL 本身就在生成带奖励分数的有限步轨迹,这些中间状态是天然的蒸馏监督来源,而不是采样过程的一次性副产物。基于此提出 REST(Reward-Enhanced Scored-Trajectory Distillation),一个单阶段的 RL-蒸馏协同训练框架,把一个解耦的学生挂到任意 RL 教师上:学生从教师不断演化的 rollout 轨迹中分段学习,而教师原本的优化过程完全不受干扰。为避免无差别模仿把教师的低奖励行为也一并保留,进一步提出 Advantage-Modulated Distillation(AMD),把 rollout 的优势值转换为基础蒸馏损失上的带符号权重——强化来自优选轨迹的监督,并轻度排斥低奖励轨迹。整个框架轻量且即插即用,不需要额外的图像 rollout、独立蒸馏数据集或对抗训练。 实验效果:在组合式生成、视觉文字渲染、人类偏好对齐三类任务上,REST 使无 CFG 的少步推理能够追平甚至超越其 40 步的 RL 教师,而额外训练成本低于纯 RL 的 25%。在 DrawBench 上 PickScore 比 RTDMD 高 0.82,且只需其五分之一的训练迭代数。 批判点评:这篇的核心洞察属于「看见了别人扔掉的东西」:RL 阶段每一步 rollout 都自带奖励分数和完整中间状态,串行流水线却把它们当垃圾清掉,然后再花一遍算力重新造蒸馏数据——指出这点之后,单阶段协同几乎是自然结论。AMD 用带符号权重区分优劣轨迹也很关键,否则蒸馏会连教师的坏习惯一起继承。落地友好度高:不改教师、不加 rollout、不用对抗训练,额外成本 25% 以内。需要打问号的地方:学生学的是教师「演化中」的轨迹,教师早期还没对齐好时的轨迹质量偏低,论文没说清如何避免学生被早期噪声带偏(是否需要 warmup 或权重退火);「追平甚至超过 40 步教师」中的「超过」很可能来自 AMD 对低奖励轨迹的排斥效应,本质上是奖励模型上的进一步过拟合,是否真正提升人类感知质量存疑;此外三类任务均偏重可自动打分的能力,对开放域美学的影响未评估。 7. EditMod:1K图编辑仅需1.57秒 Model the Edit, Not the Image: Visual Autoregressive Editing from a Source-Centric Perspective | 北京理工大学·浙江大学·腾讯·深圳大学 | arXiv:2608.09057 关键词:视觉自回归,图像编辑,源为中心,多尺度残差,免反演 前序问题:下一尺度视觉自回归模型(VAR)通过由粗到细的高效预测生成高质量图像,已是一条强有力的生成范式,但它在文本引导图像编辑上的潜力基本没被开发。现有的免训练 VAR 编辑方法大多把编辑表述为「以源图为引导或约束的目标条件重新生成」,还往往依赖反演、测试时优化、注意力控制或用户提供的掩码。这种生成为中心的表述没有充分利用 VAR 天然提供的多尺度源表征,还引入了额外计算或人工干预。 本文贡献:作者转向源为中心的 VAR 编辑视角:把编码后的源图像 token 当作主要视觉状态,编辑过程只聚焦于条件诱发的变化量。基于这一视角提出 EditMod——在共享的自回归上下文下,对比源条件预测与目标条件预测,把两者之差视为逐尺度的编辑方向,再把它作为残差更新施加到选定尺度的源 token 上。整条链路不需要反演、不需要测试时优化、也不需要用户掩码。 实验效果:实验显示 EditMod 在源图保真度上处于领先水平,同时保持很强的文本对齐能力;在单张 A100 上完成 1K 分辨率图像的端到端编辑仅需 1.57 秒,且无需任何逐图预处理准备。 批判点评:「建模编辑量而不是重建整张图」这个转向非常对症:编辑任务本来就只有小部分内容需要变,让模型从零重新生成整图,既浪费算力又让未编辑区域无谓漂移。用源条件与目标条件预测之差作为逐尺度编辑方向,思路上和 classifier-free guidance 的差分同源,但落在 VAR 的多尺度 token 上更自然,也顺带解释了为什么能免反演、免掩码。1.57 秒完成 1K 编辑的数字对交互式应用相当有吸引力。局限在于:残差更新施加在「选定尺度」上,哪些尺度该动、动多少,摘要没交代选择准则,很可能是需要调的超参数,直接影响可用性;差分方向对提示词写法的敏感度未讨论——目标提示与源提示措辞差异过大时,差分可能失控;此外 VAR 生态目前的基座模型数量与质量都远不如扩散系,方法再好也受限于骨干天花板。 8. BAG:缓存复用改由门控网络决策 BAG: Budget-Aware Gating for Diffusion Caching | 浙江大学·西湖大学 AGI Lab | arXiv:2608.09231 关键词:扩散缓存,预算感知,门控网络,调度蒸馏,DiT加速 前序问题:扩散缓存是加速 DiT 的轻量手段——在去噪步之间复用中间特征,但现有范式面临一个根本权衡:在线启发式规则缺乏全局预算意识,不知道整体算力还剩多少;静态调度表则缺乏实例自适应能力,也无法灵活适配运行时变化的预算约束。 本文贡献:提出 BAG(Budget-Aware Gating),一种把全局预算节奏控制与动态、实例自适应的特征复用统一起来的缓存策略。它不再依赖手工规则,而是用一个轻量门控网络,在每一步同时以预算状态和局部轨迹反馈为条件,动态决定「执行完整计算」还是「复用缓存特征」。该策略通过离线到在线的调度蒸馏训练得到——把离线搜索出的调度表所包含的决策能力,迁移进一个紧凑的在线门控。 实验效果:在 FLUX.1-dev 与 Wan2.1 上的大量实验表明,BAG 在各个加速档位上一致优于当前最好的缓存方法,并且在不同分辨率、随机种子和引导强度下都保持稳健。代码将开源。 批判点评:把「算还是复用」这个决策交给一个同时看全局预算和局部轨迹的小门控,方向是对的:静态表不知道当前这张图难不难,在线启发式不知道预算还剩多少,两者的盲区正好互补。离线搜索调度表再蒸馏成在线门控,也是一种务实的工程折中——离线搜索能看到全局最优,在线门控只需继承其决策模式。可疑之处在于泛化边界:门控网络是学出来的,训练时的预算区间、分辨率和模型骨干一旦超出,决策是否还成立没有交代;论文强调在不同分辨率、种子、引导强度下稳健,但这些都属于同骨干内的扰动,换到未见过的 DiT 上是否需要重新蒸馏是关键问题。另外门控本身的推理开销虽称轻量,但在高加速档位下相对总算力的占比会被放大,摘要未给出具体数字。 9. CuteTTS:首音延迟直降23.3% CuteTTS: Efficient and High-Quality Speech Synthesis via Autoregressive Modeling of Continuous Latents | 复旦大学·上海创智学院 | arXiv:2608.08638 关键词:零样本TTS,连续自回归,流匹配,引导步蒸馏,低延迟 前序问题:零样本文本转语音已经在支撑交互式助手、个性化媒体和无障碍工具,所有 TTS 系统都要同时满足三件事:忠实的语言渲染、一致的说话人身份、以及低延迟响应。但紧凑的流式系统必须在一个可预测的低码率隐序列里保住足够的声学细节,而迭代式扩散采样与 classifier-free guidance 又会在每个自回归步上把推理成本乘上一遍。 本文贡献:提出 CuteTTS,一个紧凑的连续自回归 TTS 系统:把语义对齐的因果 VAE 隐变量、patch 级自回归、显式说话人条件化与双向流匹配头结合起来。进一步提出 guidance-step distillation,把 classifier-free guidance 与多步求解器一起吸收进单个区间条件化的学生模型,从而在推理时不必再为引导和多步求解重复付费。 实验效果:在 LibriSpeech 与 Seed-TTS-Eval 上,零样本音色克隆的可懂度与说话人相似度具备竞争力;蒸馏使首音延迟相对基础模型降低 23.3%、实时率降低 40.8%,而客观与主观质量保持相当。 批判点评:把 CFG 和多步求解一起蒸进「区间条件化」的单个学生,这一手比单纯做步数蒸馏更实用:交互式 TTS 的痛点是首音延迟,而 CFG 意味着每步都要跑两遍前向,属于纯粹的常数倍开销,能一并吸收掉收益很直接。走连续隐变量而非离散 token,也规避了码本容量对声学细节的硬约束。不足在于对比强度不够:「competitive」这种措辞通常意味着没有在可懂度或相似度上取得优势,仅是持平,而真正的卖点全在效率数字上;23.3% 和 40.8% 都是相对自身基础模型的相对提升,没有给出与主流流式 TTS 的绝对延迟对照,工业选型时价值有限;双向流匹配头与因果 VAE 的组合在流式场景下的前瞻依赖长度也没交代,这直接决定能否真正做到低延迟流式。 10. GameAlpha:透明区域跳算省35%token Alpha as an Efficiency Signal: Visibility-Routed RGBA Image-to-Video Generation | 北京大学·字节跳动·清华大学 | arXiv:2608.09355 关键词:RGBA视频生成,游戏素材,可见性路由,流匹配,DiT加速 前序问题:RGBA 视频把 RGB 外观与 alpha 通道结合,让动画素材能贴到任意背景上,游戏行业用量极大。但高质量游戏 RGBA 动画生成有两个卡点:一是现有 RGBA 视频数据集以写实内容为主,游戏素材覆盖很少;二是传统的先生成再抠像流水线在 RGB 合成之后才估计 alpha,半透明区域常被背景糊掉,导致抠像输出不稳定。近期开始有工作联合建模 RGB 与 alpha,但大多是文本条件的,效率与质量上仍有未解问题。 本文贡献:构建 GameAlpha-2.4K,一个 2.4K 片段的游戏风格 RGBA 视频数据集,用抠像友好的合成、多假设 alpha 恢复和基于合成的质量门筛选制成。在此之上训练一个参考图条件的 RGBA 视频生成器,单次前向同时产出 RGB 帧与 alpha 遮罩。为提升效率,提出 visibility router:在早期阶段就识别出透明 token,跳过它们后续的 DiT 更新;同时用 x_0-lock 让这些 token 沿原始流匹配调度朝自预测终点前进,避免被跳过后偏离轨迹。 实验效果:模型的 FVD 低于传统两阶段流水线;visibility router 在最后两个 DiT 去噪步中跳过 35% 的 token 评估,带来 1.2 倍骨干加速,质量退化可忽略。 批判点评:「把 alpha 当效率信号」这个提法很巧:alpha 通道本身就明确标出了哪些区域是透明的、几乎不含内容,这等于免费拿到一张算力分配图,不需要额外训预测器去猜哪里重要——这是本文最讨巧也最合理的一点。x_0-lock 的补充也必要,否则被跳过的 token 会脱离流匹配轨迹造成边缘伪影。但工业价值需要打折看:1.2 倍加速且仅作用于最后两个去噪步,这个收益相当有限,与今天另外两篇(BAG、DUET)动辄数倍的加速不在一个量级;GameAlpha-2.4K 只有 2.4K 片段,对视频生成而言规模偏小,是否足以支撑通用游戏素材生成存疑;FVD 低于两阶段流水线是个较弱的基线选择,未与近期联合建模 RGBA 的方法正面比较;此外游戏风格数据训出的模型跨美术风格泛化能力完全未讨论。 趋势观察 少步蒸馏从「二选一」走向「按噪声分工」 — 阿里与北大的 DUET 把长期困扰少步蒸馏的质量-多样性权衡拆成了一个分工问题:轨迹级蒸馏(sCM)保多样性、分布级蒸馏(DMD)保质量,此前所有工作都在试图用一个 loss 把两者调和,结果总是牺牲一方。DUET 干脆让 sCM 专家接管高噪声那一步负责铺开结构,DMD 专家接管低噪声那一步负责精修细节,两个专家各按自己的原生目标独立训练,绕开了 loss 组合的优化困难。两步视频生成上质量逼近 DMD、结构多样性保住 sCM 水平(约为 DMD 的两倍)。这是今天最干净的一个「把权衡改造成分工」的范式样本。 推理加速的重心从「压缩步数」转向「花掉的算力值不值」 — 今天有三篇从不同角度攻同一件事。上交与淘天的 REST 指出 RL 对齐与少步蒸馏被串行执行是纯粹的浪费——扩散 RL 本身就在生成带奖励分数的有限步轨迹,那些中间状态是天然的蒸馏监督,不该当采样副产品扔掉;单阶段协同训练后,无 CFG 的少步推理能追平甚至超过 40 步的 RL 教师,额外训练成本不到纯 RL 的 25%。浙大与西湖的 BAG 则戳破缓存策略的两难:在线启发式没有全局预算意识、静态调度又缺乏实例自适应,改用一个轻量门控网络同时看预算状态和局部轨迹反馈来决定「这一步算还是复用」。字节与北大的 GameAlpha 走的是第三条路——不去改调度,而是让 alpha 通道直接充当算力分配图,透明 token 早早识别出来后跳过后续 DiT 更新。三条路线的共同指向是:加速的下一程不在「少走几步」,而在算力分配的精细化——按训练流程、按实例难度、按空间区域,各有各的省法。 统一模型开始拆掉 VAE 这根拐杖 — 美团的 UniSpace 提出一个反直觉的观察:语义 ViT 的冻结 Transformer 块并非天生保不住视觉细节,真正把表征推向语义抽象的是原始的 patch 参数化方式。于是它做 Patch Reparameterization——保留原语义通路,另加一条重建感知的 patch embedding,把细粒度信息喂给同一批冻结 ViT 块,最终把理解、生成、编辑装进同一个视觉空间,8B 的 Mixture-of-Transformer-Experts 全程不需要独立的 VAE 通路。这条路子如果站得住,意味着统一多模态模型的架构可以显著简化:一个预训练 ViT 即可充当通用视觉接口。 音频生成开始追求「一套权重装下所有声音」 — 快手可灵团队与港中文的 SonicWeave 把语音、音乐、音效、歌声以及它们的细粒度混合塞进单个流匹配模型。它的技术判断很具体:现有音频 MoE 大多在领域级别路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。SonicWeave 改按连续声学 chunk 路由,并用一个冲突门在局部状态不可靠时倾向全局先验、在区域偏离全局场景时才让局部证据说话。复旦与阿里 Token Foundry 的 FullDiT 则捅破混合式音乐生成的一个部署真相:渲染器用干净的目标 codec token 训练,上线却要吃语言模型的不完美预测,这是典型的暴露偏差;把渲染重新定义为「从不完美离散计划出发的全上下文生成」,并按教师强制下的 top-1 错误率匹配干扰替换率,最终在 18 个自动指标中的 15 项上超过五家商业系统。 扩散架构的「知其所以然」终于开始补课 — 北大与百度的 adaLN-Zero 研究(TPAMI 2026)值得单独一提:DiT 已被用了几年,但 adaLN-Zero 为什么比 adaLN 好,社区一直只有直觉。这篇把候选解释拆成三条——SE 式结构、零初始化、渐进式更新顺序,逐一做消融,最终证明零初始化才是主导因素,并顺势给出 adaLN-Gaussian 初始化与 SE-adaLN-Zero 改进结构。在基座模型迭代如飞的当下,这类回头做机理归因的工作反而更稀缺:它给出的是可迁移的设计原则,而不是又一个刷分技巧。 人工智能炼丹君 整理 | 2026-08-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
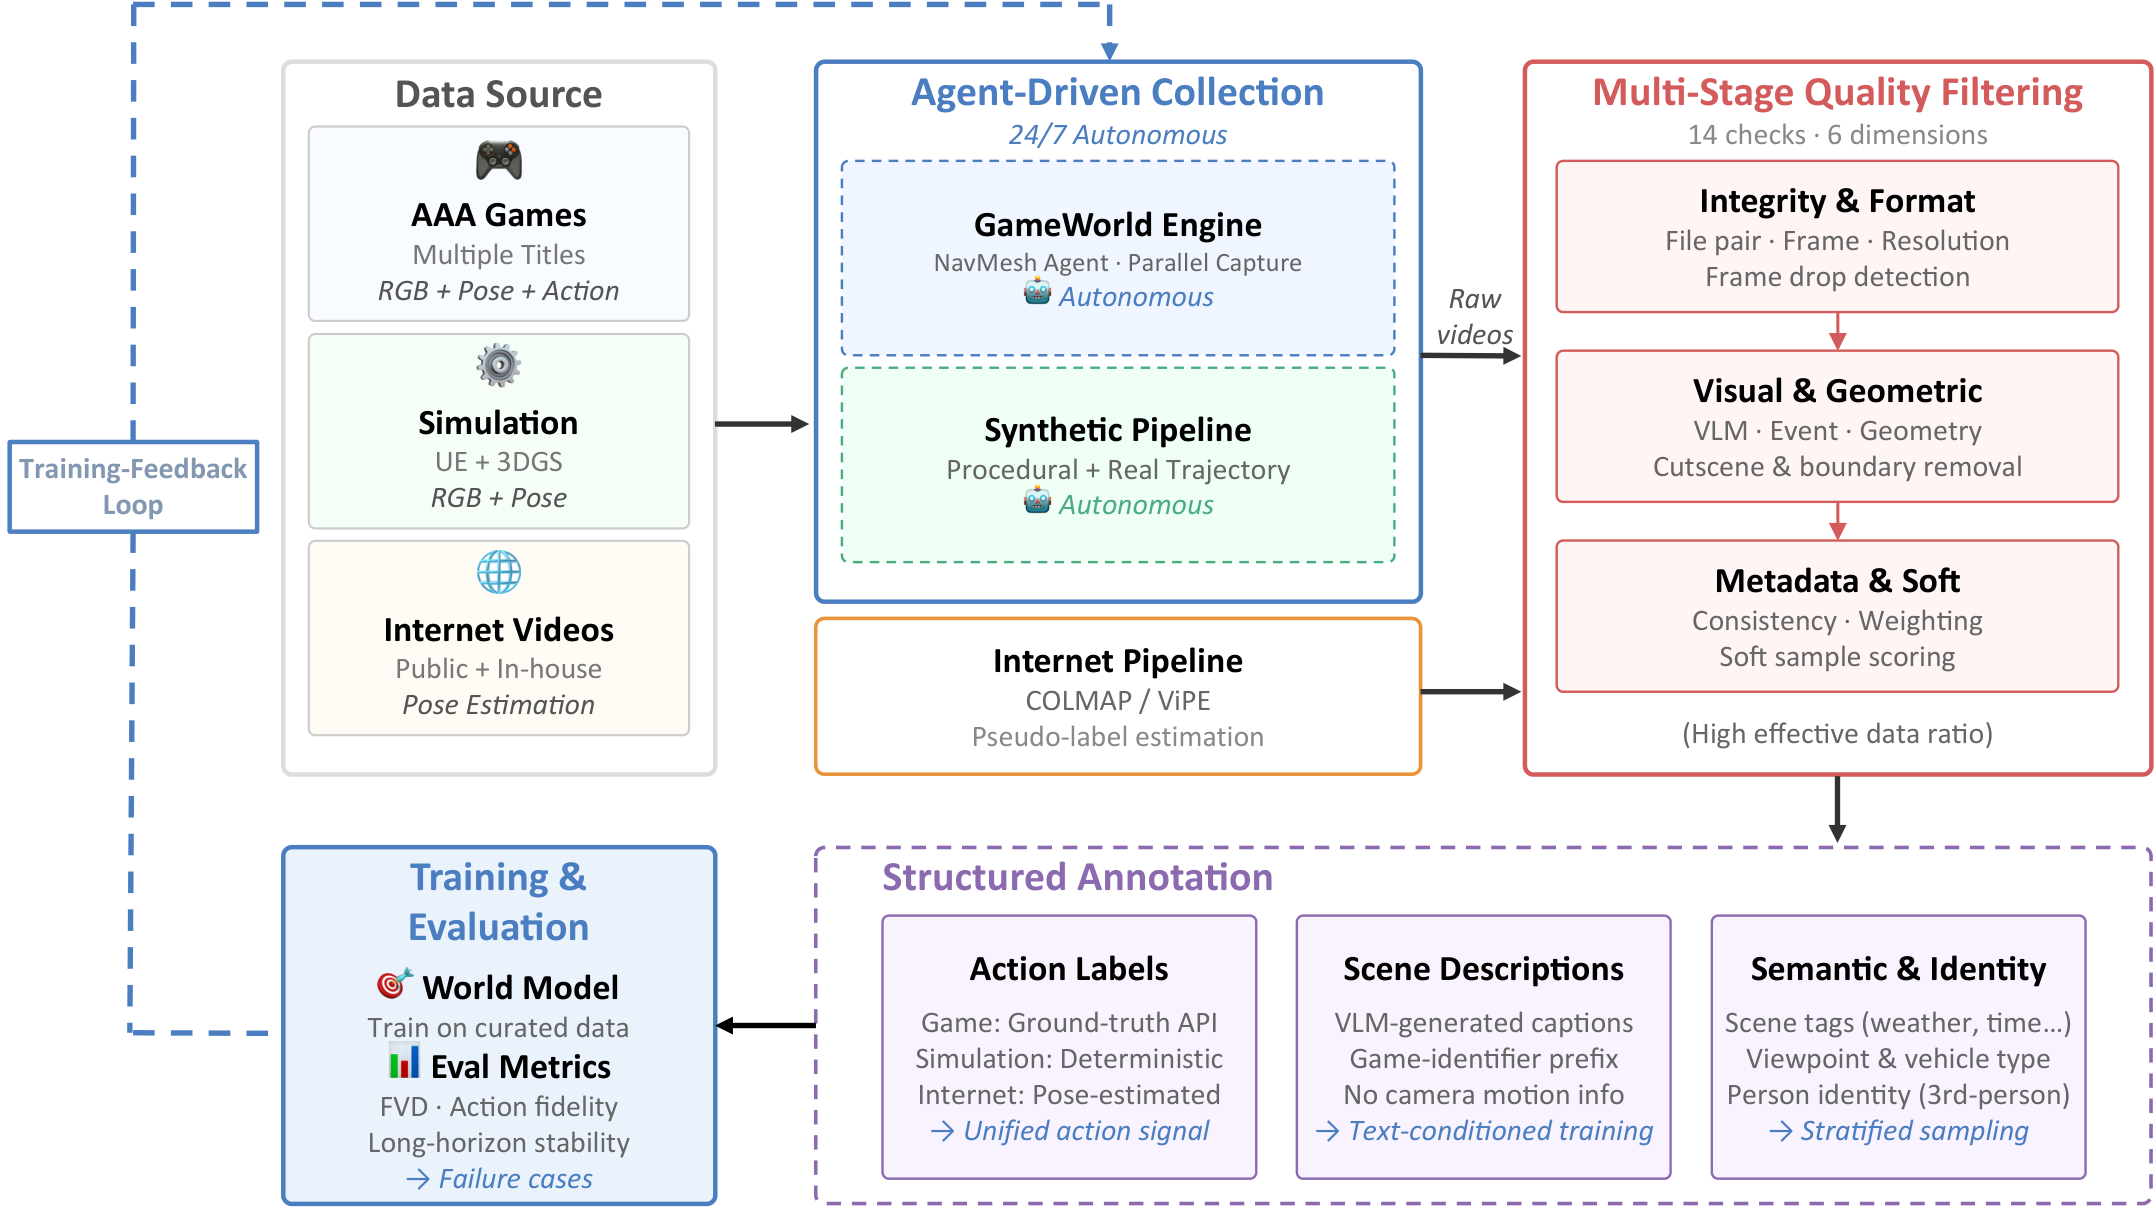
AIGC 每日速读|2026-07-23|阿里高德5090单卡实时世界模型ABot-World-0 今日 AIGC 论文速览 今日共 10 篇 · 交互式世界模型 2 篇 · 高效图像/视频生成与编辑 3 篇 · 可控与电影级视频生成 2 篇 · 生成新用途与安全 2 篇 · 音乐生成 1 篇 重点论文标题列表 ABot-World-0(阿里·高德AMAP):单卡5090实时交互世界模型 AlayaWorld(Alaya Lab):15B交互式长时程世界模型开源 Mage-Flow(Microsoft):微软4B高效图像生成与编辑 OSVE(高丽大学):首个单步视频编辑快155倍 HeadCast(快手可灵):免训练按注意力头加速AR视频 今日论文速览 1. ABot-World-0:单卡5090实时交互世界模型 ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU | 阿里·高德AMAP | arXiv:2607.19191 关键词:世界模型,实时交互,自回归视频,蒸馏,单卡部署 前序问题:交互式视频世界模型要同时具备交互、持久时空一致、稳定长时程生成与高效响应,且此前多依赖重型算力,难在消费级单卡上实时长时程运行。 本文贡献:提出动作条件视频世界模型 ABot-World-0,配套横跨 AAA 游戏/仿真引擎/互联网视频的多源数据基建(WorldExplorer 训练反馈驱动采集 + 14 项确定性质检 + VLM 评估 + 动作/文本同步标注);训练上把双向动作条件教师经 teacher forcing 与 ODE 蒸馏渐进蒸成因果学生,并提 LongForcing 对齐长自 rollout 与扩展时程教师、抑制分布与自回归漂移;原始键盘动作作统一控制接口,参考角色记忆保第三人称身份一致;部署上协同设计流式推理栈(轻量 VAE 解码、高效注意力、内存感知调度、低比特 DiT)。 实验效果:在优化的低比特配置下,单张 NVIDIA RTX 5090 桌面 GPU 上以最高 16FPS 流式生成 720P 视频,动作到首帧延迟 1.2s、峰值显存约 19GiB;在 WorldRoamBench 与长交互 rollout 上展现有竞争力的可控性与连贯的长时程世界演化。 批判点评:把交互式世界模型压进消费级单卡(5090/16FPS/19GiB)是极硬的工程落地,多源数据基建+LongForcing 抑漂移思路完整、阿里高德背景也贴近实景重建。但 16FPS/720P 距真正丝滑仍有距离、低比特下的画质代价、超长时程一致与物理合理性、以及对开放动作的泛化仍需检验。 2. AlayaWorld:15B交互式长时程世界模型开源 AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report | Alaya Lab | arXiv:2607.18367 关键词:世界模型,交互生成,自回归蒸馏,长时程,开源 前序问题:视频世界模型能即时从文本/图像/视频生成可交互环境,但要落地需同时具备交互、持久时空一致、稳定长时程生成与高效响应四大耦合能力。 本文贡献:提出交互式长时程视频世界模型 AlayaWorld:基于 15B 视频扩散 Transformer,在相机轨迹与可切换文本提示下自回归生成短潜块;有界视觉上下文融合持久 sink 帧、压缩时序历史、几何对齐空间记忆与近帧条件;用自 rollout 收集的损坏历史与预测残差训练以降长期漂移;提出离散自回归蒸馏(结合分布匹配蒸馏、self-forcing++、一致性蒸馏)把推理从约 30 步降到每块 4 步。 实验效果:生成 540p/720p、24fps 视频,在 iWorld-Bench 上长时程生成最佳;定位为全栈、开源、长期项目,为交互式视频世界模型研究提供可扩展基座。 批判点评:15B 世界模型+四步蒸馏+全栈开源,对社区推进交互式世界模型很有价值,几何对齐空间记忆+损坏历史训练也对症长程漂移。但 24fps/720p 的实时性、复杂交互下的一致与可控、以及开源基座的训练成本与数据获取门槛,仍是从 demo 到产品要迈的坎。 3. Mage-Flow:微软4B高效图像生成与编辑 Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing | Microsoft | arXiv:2607.19064 关键词:图像生成,图像编辑,原生分辨率,VAE,少步蒸馏 前序问题:大规模视觉生成器越来越强,但训练、微调与部署成本高昂,难以兼顾高分辨率质量与交互级效率。 本文贡献:推出紧凑 4B 生成栈 Mage-Flow:由轻量高保真潜表征分词器 Mage-VAE 与原生分辨率多模态扩散 Transformer(整流流匹配)协同设计。Mage-VAE 用单步扩散式编解码+锚定潜表征正则,在保持强公开 VAE 重建质量的同时把分词成本降一个数量级以上;配合原生分辨率打包与栈级 CUDA 核融合,端到端训练吞吐提升约 2.5 倍。基于此构建 Base/RL 对齐/Turbo 三档、覆盖生成与编辑:Diffusion-NFT 提升指令遵循/文字渲染/美学/编辑保真,配对抗感知引导的少步蒸馏产出 4 步 Turbo。 实验效果:尽管规模紧凑,Mage-Flow 与 Mage-Flow-Edit 在标准生成/编辑基准上具竞争力;Turbo 变体让高分辨率交互实用——单张 A100、1024² 下生成仅 0.59s、编辑仅 1.02s,显存占用小。 批判点评:微软用「分词器-骨干-系统」协同把 4B 小模型的高分辨率生成/编辑做到 0.59s/1.02s,工业化落地感很强、成本友好。但 4B 规模在极致画质/复杂语义/长文本渲染上的天花板、与十亿级大模型的差距,以及 RL 对齐/蒸馏带来的多样性与保真权衡,仍需在更广场景验证。 4. OSVE:首个单步视频编辑快155倍 OSVE: One Step Video Editing with One Step Diffusion Models | 高丽大学 | arXiv:2607.19895 关键词:视频编辑,单步扩散,噪声预测,时序一致,实时 前序问题:扩散模型的文本引导视频编辑因多步采样与反演而慢得不实用。 本文贡献:提出 OSVE,首个成功把单步文生图(T2I)模型适配到高质量视频编辑的框架,攻克反演、可编辑性与时序一致三大难题:训练一个可学习编码器单次前向预测每帧初始噪声以绕开慢速迭代反演,并用结构感知编辑(SAE)损失在结构对齐图对上训练以在编辑中保留源视频几何;提出统一帧编辑(UFE)拼接帧潜表征在单步生成中促成跨帧注意力保时序连贯;对长视频用带锚帧的滑窗保全局一致。 实验效果:编辑质量匹配或超过 SOTA 多步方法,同时快约 155~171 倍,为实用实时视频编辑铺路;代码开源。 批判点评:把单步 T2I 迁到视频编辑、直接预测初始噪声避开反演,155~171 倍提速+结构保持的设计很漂亮,实时编辑价值大。但依赖结构对齐图对训练编码器、单步生成对大幅/复杂编辑的上限、以及长视频滑窗拼接处的一致,仍需更强样例检验。 5. HeadCast:免训练按注意力头加速AR视频 HeadCast: Casting Attention Heads for Efficient Autoregressive Video Generation | 快手可灵 | arXiv:2607.20125 关键词:自回归视频,推理加速,KV缓存,注意力头,免训练 前序问题:自回归(AR)视频扩散是长视频/流式合成的有力范式,但持续增长的 KV cache 让注意力成为主导推理成本(高分辨率下每帧 token 众多);现有缓存淘汰用粗糙启发式致帧间闪烁,或需重训。 本文贡献:提出免训练、即插即用的加速框架 HeadCast:基于「预训练 AR 模型注意力头呈稳定异质行为」的观察,短暖机后在最大噪声步一次性把每个注意力头分为 Sink/Dummy/Spatial/Global 四类,并把单体 KV cache 重构为按头分路径;关键是保留维持长程时序一致的 Global 头。因 Spatial 路径在固定网格上运算,其节省随分辨率增长。 实验效果:在多个 SOTA AR 模型上,720P 加速至多 1.62 倍、1080P 至多 1.95 倍,VBench 质量与全注意力持平且基本无闪烁;代码开源。 批判点评:「按注意力头功能分类+分路径缓存」免训练即插即用、且分辨率越高越省,对长视频/流式生成的推理成本是很实用的解法(可灵背景更贴落地)。但一次性分类的稳健性、四类原型对不同模型的普适、以及在极长序列/更高分辨率下保真与加速的平衡,仍需更多模型验证。 6. ShotPlan:可学习规划token做电影级多镜头 ShotPlan: Cinematic Video Generation with Learnable Planning Token | 中国电信TeleAI·哈工大 | arXiv:2607.17675 关键词:电影级生成,多镜头,规划token,转场,视频扩散 前序问题:现有视频生成在单镜头上效果惊艳,但电影级生成需要连贯叙事与有效多镜头组合、需显式镜头规划,仍受限。 本文贡献:提出 ShotPlan,在视频扩散基座上做显式多镜头电影级生成:引入可学习规划 token 捕捉镜头级转场线索、可与原视频生成 token 无缝融合以控制转场时间戳;规划 token 配分数时间旋转位置编码(FRoPE),使镜头转场可在帧级建模。 实验效果:显著超过现有电影级视频生成方法,提供更灵活的镜头管理与更强的镜头间一致性。 批判点评:用「可学习规划 token+帧级 FRoPE」把多镜头转场显式化,是对电影级叙事生成痛点的对症设计,中国电信 TeleAI 出品。但多镜头的叙事连贯不止转场时机,人物/场景跨镜头一致、复杂运镜与更长叙事的可控性,以及与专业剪辑的差距仍需更多验证。 7. The generator is the tracker:视频生成器即多目标跟踪器 The generator is the tracker: Multi-object tracking by painting persistent identity colours | 康奈尔大学 | arXiv:2607.17120 关键词:多目标跟踪,视频生成,身份一致,重识别,LoRA 前序问题:多目标跟踪(MOT)传统被拆成检测+关联,身份靠轨迹缓存、运动模型、外观嵌入等外部状态维护;能否让视频生成器直接用像素维护这种状态? 本文贡献:微调 22B 文生视频扩散模型(LTX-2.3)配轻量上下文 LoRA,把 RGB 片段翻译成 ID-map 片段——每个人被涂成随时间持久的独特纯色(同色=同身份);长视频以链式窗口生成、每窗以上一窗清理后的尾部为条件,短续训教模型延展给定着色,身份便无需跟踪器/运动模型/重识别模块地沿链流动。 实验效果:DanceTrack 测试榜上达 40.3 HOTA(据称首个上榜且无检测器/无跟踪栈的生成式跟踪器),虽低于专用 SOTA(≥70),但误差画像独特——关联分 AssA 44.1 超原基准全部跟踪器,短板仅在检测;同样生成窗改用经典事后关联得分差一倍(18.2 HOTA);383 个遮挡事件中以 42% 条件率在间隙后重获身份(外观嵌入基线为 0),表明其着色是涌现的重识别信号。 批判点评:「让生成器用像素维护身份」把 MOT 重构为着色生成,关联能力与遮挡重识别的涌现很惊艳、思路极具启发。但 40.3 HOTA 距实用尚远(检测是硬短板)、依赖 22B 大模型链式生成成本高、极密集/快速场景下的可扩展性仍是问题,更像范式验证而非即用方案。 8. Keyframe-Anchored:序列动作视频的身份保持 Keyframe-Anchored Identity Preservation for Sequential-Action Video Generation | 中科大 | arXiv:2607.17985 关键词:身份保持,文生视频,关键帧,序列动作,免训练 前序问题:保身份的文生视频要在整段视频中维持指定主体可识别性;IPVG26 挑战把它从单一整体提示扩展到带时间戳的动作序列——主体须按序完成一串不同动作且身份一致,而端到端生成器随运动累积易外观漂移。 本文贡献:提出免训练三阶段流水线:动作感知提示润色阶段先把输入改写为指定每个动作终态的图像生成提示;保身份生成阶段以参考身份与前一帧联合条件产出关键帧序列,从而解耦时不变外观与时变姿态;身份感知推理增强阶段用多参考引导与身份驱动噪声搜索合成中间片段,双重强化采样期身份保真。 实验效果:在 IPVG26 官方 Track 2 榜排名第三,展现有竞争力的性能与较强通用性。 批判点评:用「关键帧锚定+解耦外观与姿态」免训练做序列动作身份保持,工程组合清晰、竞赛第三也证明有效。但依赖关键帧质量与多阶段拼接,中间片段合成的动作流畅、长序列多动作下的累积漂移,以及免训练相对专门训练方法的天花板仍待观察。 9. BSB:时序一致性越狱商用T2V Between Safe Boundaries: Exploiting Temporal Consistency for Jailbreaking Text-To-Video Generation Models | 中科大 | arXiv:2607.17279 关键词:文生视频,越狱攻击,时序一致性,MCTS,AI安全 前序问题:文生视频(T2V)模型广泛部署,其对越狱攻击的鲁棒性引发担忧;现有方法多从文生图迁移,未利用视频固有的时序一致性、需大量视频查询优化(黑盒不可行)、且对抗提示搜索靠启发式局部信号缺结构化探索。 本文贡献:提出结构化、查询高效的 T2V 越狱框架 BSB:利用时序一致性,把有害意图编码为两个各自无害的「边界状态」之间的转变,攻击那些插值时易在中间帧产生不安全内容的边界状态对;为避免在视频空间直接评估所有候选的高昂开销,BSB 在更廉价的文本代理空间做蒙特卡洛树搜索(MCTS),并用稀疏视频级评估定期校准。 实验效果:在 Veo 3.1、Sora 2、Seedance、Kling v1 等主流商用 T2V 上,BSB 超越所有现有越狱基线,攻击成功率较最强对手平均相对提升 18.6%;揭示时序一致性是被忽视却关键的攻击面。 批判点评:把「时序一致性」从能力变成攻击面、用文本代理空间 MCTS 做查询高效黑盒越狱,视角新颖且对主流商用模型有效,安全警示意义大。但作为攻击方法需警惕滥用、防御侧的对应缓解未深入,攻击在持续迭代的商用安全策略下的长期有效性也存疑。 10. Full-Song:分层自回归+流匹配全曲生成 Pushing the Frontier of Full-Song Generation: Hierarchical Autoregressive Planning Meets Flow-Matching Rendering | 阿里(Token Foundry) | arXiv:2607.20253 关键词:歌曲生成,自回归,流匹配,RVQ,翻唱 前序问题:从歌词、文本描述与音乐属性生成高质量全长歌曲仍具挑战,且需统一支持词到歌、纯器乐、翻唱等多任务。 本文贡献:提出统一歌曲生成框架,支持歌词到歌、器乐生成、翻唱三任务:语义感知分词器把音频编码为 8 码本 RVQ token;hybird-LM 在其上做分层自回归音频 token 建模生成全曲;FullDiT 在连续 VAE 潜空间以码本 token/歌词/文本为条件做全曲流匹配以提升保真;翻唱用旋律模块从参考音频抽取并离散化旋律线索、在保留原旋律的同时引导生成;并探索 DPO/GRPO/OPD 做 hybird-LM 后训练、对 FullDiT 用基于流的 GRPO 提升音乐性与渲染质量。 实验效果:在多语种自动基准与 Artificial Analysis 带人声音乐榜上,框架在所评设置下取得有竞争力的表现。 批判点评:「分层自回归规划+流匹配渲染」的双阶段设计兼顾结构与音质、还统一了词到歌/器乐/翻唱三任务(阿里出品),工程完整。但全曲生成对长程结构、人声吐字与音乐性要求极高,多任务统一下各子任务的上限、翻唱的版权与旋律保真边界,以及主观音乐性的稳定性仍需更多盲测检验。 趋势观察 世界模型冲进消费级实时 — ABot-World-0 单张 RTX5090 跑 720P/16FPS 实时交互世界、AlayaWorld 15B 开源长时程世界模型,交互式世界模型正从云端走向桌面单卡。 高效小模型吃下生成与编辑 — 微软 Mage-Flow 用 4B 栈把 1024² 生成压到 0.59s、编辑 1.02s,'紧凑协同设计'让高分辨率生成编辑走向交互实用。 少步/免训练把视频推向实时 — OSVE 首次让单步 T2I 做视频编辑快 155~171 倍、HeadCast 免训练按注意力头分类加速 AR 视频,效率优化在编辑与长视频两端并进。 视频生成能力外溢到感知与叙事 — '生成器即跟踪器'用视频生成做多目标跟踪、ShotPlan 用规划 token 做多镜头电影级叙事,生成模型的能力正外溢到跟踪、导演等新任务。 生成的可信与安全被正面拷问 — BSB 用时序一致性越狱主流商用 T2V(攻击成功率相对+18.6%),揭示视频生成安全的新攻击面,安全治理需跟上能力跃迁。 人工智能炼丹君 整理 | 2026-07-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
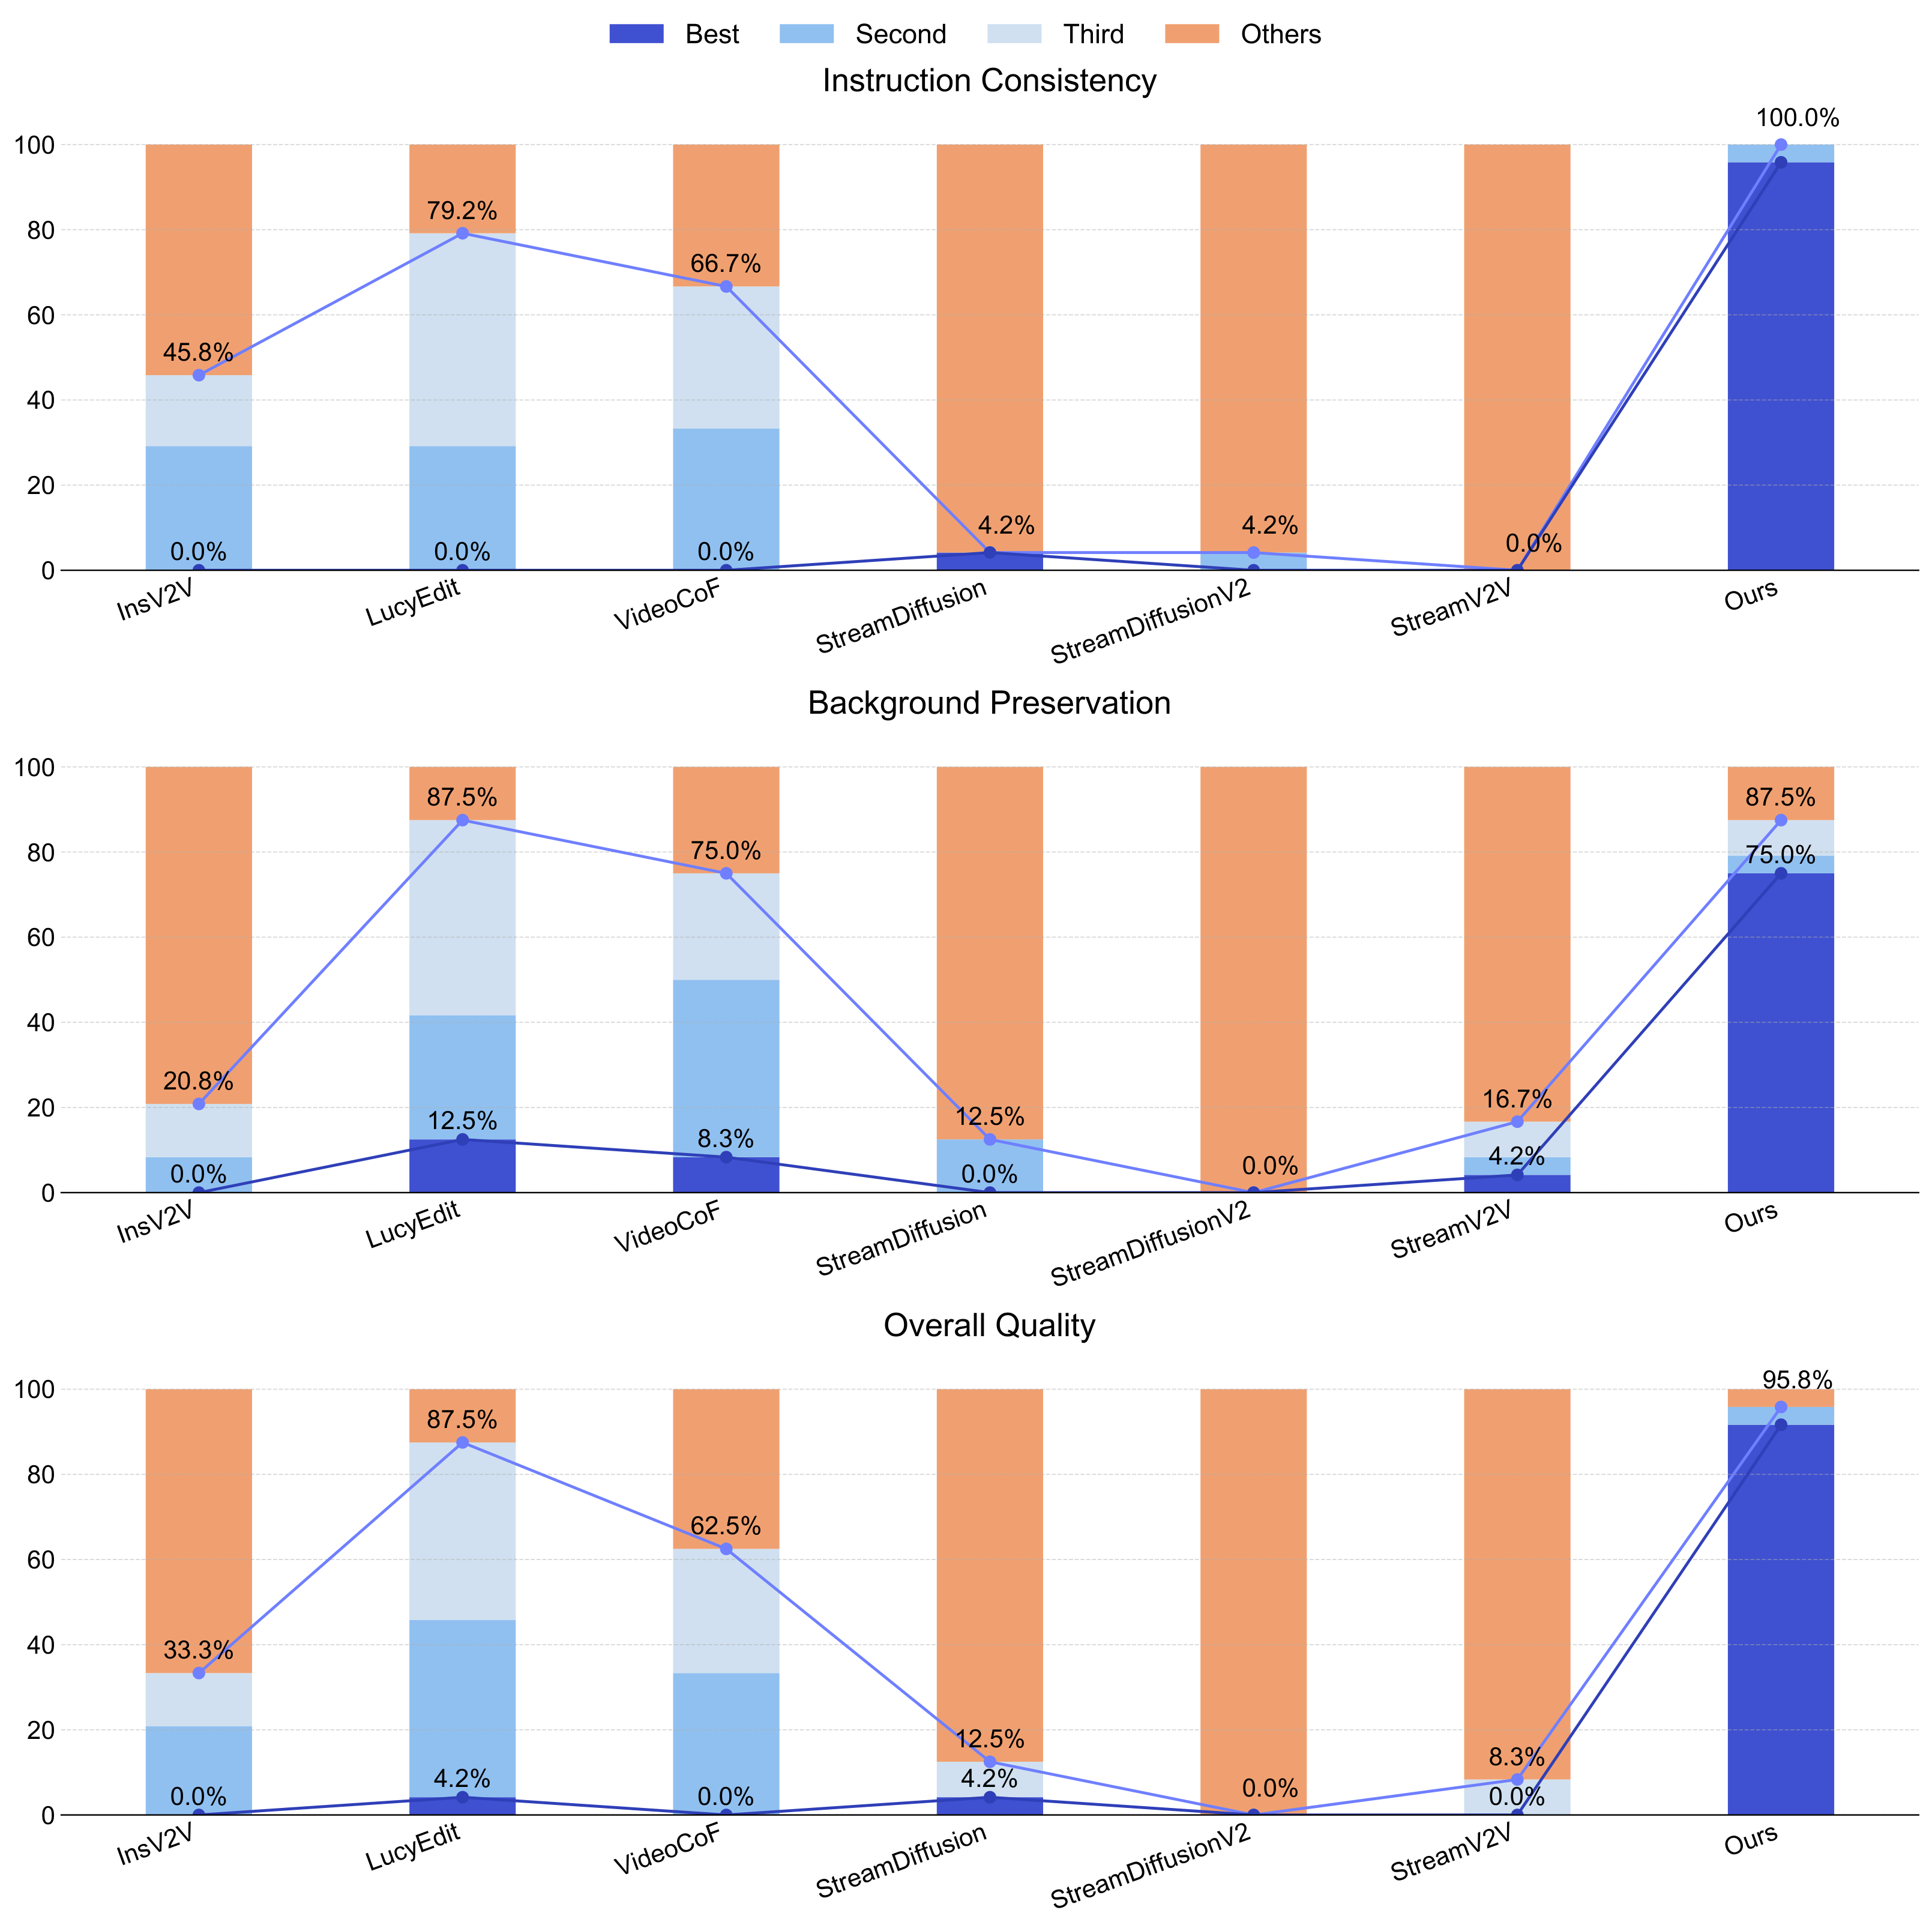
AIGC 每日速读|2026-06-29|清华LiveEdit实时流式视频编辑12.66FPS 今日 AIGC 论文速览 今日共 9 篇 · 视频编辑与生成 3 篇 · 自回归图像生成 2 篇 · 推理加速与压缩 2 篇 · 生成质量与评测 2 篇 重点论文标题列表 LiveEdit(清华·港科大):实时流式视频编辑12.66FPS Causal-rCM(清华·UT Austin·NVIDIA):统一TF+SF自回归扩散蒸馏 PRA(北京大学·深势科技):像素自回归生成新SOTA TMP(腾讯混元):剪枝把80B图像模型塞进4090 LearniBridge(清华(深圳)):可学习特征缓存加速扩散 今日论文速览 1. LiveEdit:实时流式视频编辑12.66FPS LiveEdit: Towards Real-Time Diffusion-Based Streaming Video Editing | 清华·港科大 | arXiv:2606.26740 关键词:视频编辑,流式生成,实时,蒸馏,缓存 前序问题:流式视频编辑落地受两大瓶颈制约:跨时间维持背景与非编辑区稳定,以及实时交互所需的低延迟;而现有流式视频生成方法多为合成设计,因严格保真与区域控制要求无法直接用于编辑。 本文贡献:提出新型流式视频编辑框架,做因果、逐帧编辑且强内容保持、实时响应。核心是三阶段蒸馏管线,把强双向基础模型的编辑能力渐进迁移到高效单向流式编辑器,实现稳定长程编辑而不牺牲画质;并引入面向自回归的 mask cache 跨帧复用区域相关计算,减少冗余、加速推理;还建立了专门的流式视频编辑基准。 实验效果:在流式基线中达到 SOTA 画质,同时把推理速度大幅提升到 12.66 FPS,适配交互与 AR 场景。 批判点评:用「双向→单向」三阶段蒸馏+mask cache 把视频编辑推到实时(12.66FPS),方向价值高、还补齐了流式视频编辑基准空白。但 12.66FPS 距真正流畅交互仍有差距,逐帧因果编辑对快速运动/大幅编辑的长程一致性、以及对复杂编辑指令的上限仍需更多验证。 2. Causal-rCM:统一TF+SF自回归扩散蒸馏 Causal-rCM: A Unified Teacher-Forcing and Self-Forcing Open Recipe for Autoregressive Diffusion Distillation in Streaming Video Generation and Interactive World Models | 清华·UT Austin·NVIDIA | arXiv:2606.25473 关键词:视频生成,自回归扩散,蒸馏,世界模型,一致性模型 前序问题:因果扩散 Transformer 的自回归视频扩散已成实时流式生成与动作可控交互世界模型的主流,但其蒸馏配方缺乏统一、可扩展的开源方案。 本文贡献:把先进蒸馏框架 rCM 扩展到自回归视频扩散,利用前向/反向散度互补——teacher-forcing(TF)对应离线前向散度因果训练、self-forcing(SF)对应在线反向散度精修。贡献含:(1)证明 TF 一致性模型是 SF-DMD 的最佳初始化补充;(2)首次为自回归视频扩散实现连续时间 TF 一致性模型(sCM/MeanFlow),靠自定义 mask FlashAttention-2 JVP kernel 实现,收敛比离散时间快 10×;(3)推出统一可扩展的算法-基建开源配方 Causal-rCM;(4)仅用合成数据训练即在逐帧/分块流式生成上达 SOTA。 实验效果:蒸馏后的 2 步因果 Wan2.1-1.3B 仅 1-2 采样步即得 VBench-T2V 84.63;并应用于全模态世界基础模型 Cosmos 3,实现动作可控的交互世界模型。 批判点评:把 rCM 的「前向×反向散度互补」干净地迁到自回归设定,10× 收敛+全开源配方含金量高,世界模型落地也实在。但收益依赖既有 rCM/DMD 体系与定制 kernel 工程,仅用合成数据训练在真实分布上的泛化、以及 1.3B 规模外的可扩展性仍待看。 3. PRA:像素自回归生成新SOTA Parallel Rollout Approximation for Pixel-Space Autoregressive Image Generation | 北京大学·深势科技 | arXiv:2606.27978 关键词:自回归生成,像素空间,ImageNet,FID,生成理解统一 前序问题:像素空间连续 token 自回归(AR)直接把图像建模为原始像素块序列、免离散分词,但面临耦合难题:高维像素块单步误差大,teacher-forcing 训练又造成训练-推理鸿沟使误差跨步累积;现有 x-prediction、噪声注入只部分缓解,精确 rollout 又因顺序采样太慢不实用。 本文贡献:提出 Parallel Rollout Approximation(PRA):生成低维中间态而非高维像素块,再用像素解码器映回像素 token,保持「像素进-像素出」AR 接口;并通过同一「中间态→像素」路径按位置独立地构造类推理输入,逼近推理时 rollout 的像素反馈接口,同时保留并行 teacher-forcing 训练。 实验效果:ImageNet-1K 256² 类条件生成上,135M 的 PRA-S 取得 FID 2.58,超过此前十亿级像素 AR 的 3.60;511M 的 PRA-L 进一步到 FID 1.94,刷新像素空间 AR 新 SOTA;ImageNet 分类探针准确率也高于其他 AR/扩散基线。 批判点评:用「低维中间态+并行近似 rollout」一招同时治高维误差与训练-推理鸿沟,135M 超十亿参数、FID 1.94 的数字很硬,且指向生成-理解统一。但仍限 ImageNet 类条件、256² 规模,能否迁到大规模文生图与更高分辨率、像素解码器的额外开销如何仍待验证。 4. TMP:剪枝把80B图像模型塞进4090 TMP: Tree-structured Mixed-policy Pruning for Large-scale Image Generation and Editing | 腾讯混元 | arXiv:2606.27089 关键词:模型剪枝,图像生成,MoE,混元,推理降本 前序问题:现代图像生成模型为高保真不断膨胀,参数与算力开销巨大;HunyuanImage-3.0 等开源 SOTA 达 80B、推荐 3×80GB GPU 才能推理,社区难用;而现有结构化剪枝多为 DiT 定制,HunyuanImage-3.0 却是 MoE 解码器 LLM(Hunyuan-A13B),并不适配。 本文贡献:提出首个树形混合策略剪枝框架 TMP,泛化 T2I 与 TI2I 任务、MoE 与 DiT 架构,并可作为步数蒸馏模型的最后一级压缩。 实验效果:把 HunyuanImage-3.0 从 80B 压到 20B(75% 压缩)、生成质量损失有限,并经工程优化让 20B 版在单张 24GB 4090 上可推理(脚本与权重已并入官方开源仓库);还把 Z-Image turbo 从 6B 压到 4B(33%)几乎无损。 批判点评:把 80B 模型塞进单卡 4090 是实打实的工业级降本,覆盖 MoE/DiT 与 T2I/TI2I 也通用,开源落地诚意足。但 75% 剪枝下'有限损失'的主观质量边界、对极端 prompt/细节的退化,以及剪枝叠加步蒸馏后的稳定性仍需更全面评测。 5. LearniBridge:可学习特征缓存加速扩散 LearniBridge: Learnable Calibration of Feature Caching for Diffusion Models Acceleration | 清华(深圳) | arXiv:2606.26778 关键词:特征缓存,扩散加速,DiT,LoRA,低秩 前序问题:DiT 在图像/视频生成上算力开销高,特征缓存靠复用中间表征加速,但现有方法依赖历史特征、在高加速比下误差累积严重。 本文贡献:研究所需特征校正的本质,发现最优校正更新在不同 prompt 间共享一个低秩子空间;据此提出 LearniBridge——可学习的特征缓存校正机制,用轻量 LoRA 更新跨多个时间步桥接,仅需 3-5 个训练样本即可有效校正。 实验效果:图像/视频生成上对 FLUX、HunyuanVideo、WAN2.1 分别达 5.87×、5.75×、4.10× 加速;WAN2.1 在 4.10× 加速下 VBench 较此前 SOTA 提升 1.28%,代码已开源。 批判点评:「校正更新共享低秩子空间」是漂亮的结构性洞察,3-5 样本+LoRA 的轻量校正很实用,加速比与质量提升兼得。但低秩假设在更激进加速比或差异极大的 prompt 分布下是否仍成立、跨架构迁移的稳健性,仍需更广验证(实验用昇腾 910B)。 6. DomainShuttle:开放域主体驱动文生视频 DomainShuttle: Freeform Open Domain Subject-driven Text-to-video Generation | 港科大 | arXiv:2606.26058 关键词:文生视频,主体驱动,跨域生成,RoPE,个性化 前序问题:开放域主体驱动文生视频(S2V)含 in-domain(尽量保主体特征)与 cross-domain(保内在特征但允许无关属性随文本灵活变化)两类;现有方法偏重 in-domain 的主体保真,限制了跨域(新风格/语义组合/域属性)的可编辑与适应性。 本文贡献:提出理想 S2V 应能在不同域间自由「穿梭」,并提出 DomainShuttle:用 Domain-MoT 解耦视频与参考特征、以域感知 AdaLN 做参考图域专属建模;用 Video-Reference DualRoPE 把参考图 token 与视频 token 置于独立 RoPE 空间实现精细主体级空间建模;用 Cross-Pair Consistent Loss 提取不受无关特征影响的内在主体特征。 实验效果:在 in-domain 与 cross-domain 上均显著超过现有方法,跨多样开放域场景兼具高主体保真与生成灵活性。 批判点评:把 S2V 从「死磕保真」重构为「按需在域间穿梭」,DualRoPE 与解耦设计对症跨域编辑痛点。但 in/cross-domain 的平衡靠多模块拼接、复杂度上升,「自由穿梭」的可控边界与对极端跨域(强风格化)的保真衰减仍需看更多样例。 7. Don't Settle:免训练破解流模型多样性坍缩 Don't Settle at the Mode! Mitigating Diversity Collapse in Pretrained Flow Models via Feature Self-Guidance | 印度科学理工·斯坦福 | arXiv:2606.27371 关键词:流模型,多样性坍缩,自引导,免训练,文生图 前序问题:SOTA 流模型按文本/图像生成惊艳图像,但同一条件下多次采样会「多样性坍缩」;现有方法要么靠潜空间引导(效果有限),要么靠样本选择(依赖外部奖励模型、推理开销大)。 本文贡献:提出高效、免训练的自引导机制缓解多样性坍缩、无需额外奖励模型:在批量生成时用「特征自引导」分散流模型内部特征;再用流形正则步把分散特征投影回数据流形,确保多样的同时不偏离输入条件。即插即用,仅增边际推理开销。 实验效果:在多步/少步文生图、深度图到图、参考图生成等多个条件流模型上,多样性显著提升且保真不降,计算开销与 I.I.D. 基线几乎持平(单张 H200 评测)。 批判点评:「特征自引导+流形正则」免训练、免奖励模型地破解多样性坍缩,开销几乎为零、即插即用,很实用。但'分散特征'的强度需与流形约束精细权衡,过度分散可能伤条件对齐;多样性指标(DINO)与人类感知多样性的一致性也值得进一步检验。 8. Safe-AR:自改进码本做AR图像安全 Safe Autoregressive Image Generation with Iterative Self-Improving Codebooks | 牛津大学 | arXiv:2606.27147 关键词:自回归生成,内容安全,码本,统一多模态,自改进 前序问题:自回归统一多模态模型靠顺序预测离散视觉 token(来自码本)生成图像,这种类语言架构擅长文本条件生成,但「以自回归方式生成的图像有多安全」少被研究。 本文贡献:提出迭代自改进码本做安全自回归生成:利用统一多模态模型自身的理解与判断能力、无需人工标注就识别不安全生成图像,并固定码本中的内在表征以消除有害映射。两步法——先用模型识别不安全生成、构造有害/安全图文对建「有害空间」并据此更新码本消除有害输出;再在无害空间内用安全图文对做自适应微调保证质量;两步反复直到无进一步改进。 实验效果:无需任何外部反馈,模型安全性被迭代式提升,同时维持生成质量。 批判点评:「让模型自己判别+修码本」把安全做成无需人工标注的闭环自改进,思路自洽、对统一多模态模型尤其契合。但'用模型判自身不安全'存在盲区(模型识别不到的有害类型无法修复),码本级干预对生成多样性/罕见概念的潜在副作用也需评估。 9. PhyEditBench:物理感知图像编辑基准 PhyEditBench: A Real-World Multi-Stage Benchmark for Physics-Aware Image Editing | 南京大学 | arXiv:2606.26551 关键词:图像编辑,物理推理,评测基准,视频生成,测试时扩展 前序问题:指令式图像编辑虽进步显著,但现有基准缺乏对「基于物理的推理」这一处理真实场景关键能力的全面评估。 本文贡献:提出 PhyEditBench 评估编辑模型的物理理解:按层级分类法设 4 大类 12 子类,含 238 个从真实视频提取以捕捉真实物理动态的高质量高清实例,外加 35 个合成「反物理」实例。并提出免训练基线 PhyWorld,用测试时扩展+潜空间缩减策略。 实验效果:对当前 SOTA 编辑方法的实证分析暴露其物理推理的明显短板;PhyWorld 超过同类模型,表明视频生成过程可有效充当图像编辑的推理机制。 批判点评:把「物理推理」单列为编辑能力维度并配反物理样例,戳中当前编辑模型的真实痛点,PhyWorld「借视频生成做推理」也很有启发。但 238+35 实例规模偏小、层级分类的覆盖与主观性,以及物理正确性评判本身的标准化,都是基准可信度的关键变量。 趋势观察 视频生成/编辑全面冲向实时流式 — LiveEdit 把流式视频编辑推到 12.66FPS,Causal-rCM 用 2 步因果蒸馏达 VBench 84.63,实时交互成为视频 AIGC 的主战场。 蒸馏与缓存成为降本双引擎 — Causal-rCM 统一 TF+SF 蒸馏、LearniBridge 可学习特征缓存(FLUX 5.87×),'更少步+复用计算'是效率竞赛的两条主线。 像素空间自回归逼近扩散画质 — PRA 用并行近似 rollout 把像素 AR 刷到 FID 1.94、135M 超十亿参数,自回归路线在图像生成上持续逼近扩散。 大模型剪枝走向单卡可用 — TMP 把 80B HunyuanImage 压到 20B 并塞进 4090,开源大图像模型的'平民化部署'成为工业重点。 生成的可信度被系统拷问 — PhyEditBench 测物理推理短板、Safe-AR 做码本级安全、Don't Settle 救多样性坍缩,质量/安全/多样性等'软指标'正被正面攻坚。 人工智能炼丹君 整理 | 2026-06-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-29|生数科技minWM开源实时交互视频世界模型 今日 AIGC 论文速览 今日共 8 篇 · 视频世界模型 3 篇 · 流式视频生成 1 篇 · 音视频联合生成 1 篇 · 可控图像生成与数据 2 篇 · 大模型记忆与微调 1 篇 重点论文标题列表 minWM:实时交互视频世界模型全栈开源 NAVA:原生音视频对齐联合生成6.3B Gamma-World:多智能体生成式世界模型 AdaState:流式视频生成自演化锚点 YoCausal:视频生成因果性认知基准 今日论文速览 1. minWM:实时交互视频世界模型全栈开源 minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models | 生数科技, 清华大学 | arXiv:2605.30263 关键词:视频世界模型·实时交互·自回归蒸馏·开源·生数科技 前序问题:视频扩散基础模型已能高质量出片,但把它变成实时交互视频世界模型仍然难:交互世界模型需要可控、因果、低延迟的 rollout,实践上要打通数据构造、可控微调、自回归训练、少步蒸馏、流式推理整条链路,而开源社区一直缺一套能跑通的端到端 recipe 本文贡献:minWM:全栈开源框架,把现成的双向 T2V/TI2V 视频基础模型转成「相机可控 + 少步自回归」的世界模型。先对双向扩散做相机控制微调,再用 Causal Forcing / Causal Forcing++ 流程(AR diffusion 训练 + causal ODE/consistency 蒸馏 + 非对称 DMD)蒸成少步自回归生成器做低延迟 rollout。框架模块化、架构可扩展:在 Wan2.1-T2V-1.3B(cross-attention 条件注入)和 HY1.5-TI2V-8B(MMDiT)上分别实例化,还能把 HY-WorldPlay 等已有世界模型适配到新数据分布、训练配方与延迟目标 实验效果:不止放出可运行脚本、checkpoint、文档和推理代码,还给出相机轨迹质量、可控性训练步数、最小 batch size 等实战 ablation——是这个方向少见的「能跑起来、可复现、可扩展」的实时交互视频世界模型配方 (github.com/shengshu-ai/minWM) 批判点评:「全栈开源 + 跨两种主流架构(Wan2.1 cross-attn / HY1.5 MMDiT)实例化 + 可适配已有世界模型」三点让它成为这个方向稀缺的工程基建,对想做实时交互视频的团队意义重大。但框架 / recipe 类工作的核心价值在工程完整度而非单点创新;Causal Forcing++ 与非对称 DMD 联训的稳定性、长 rollout 的累积漂移控制还可以披露更多 2. NAVA:原生音视频对齐联合生成6.3B Native Audio-Visual Alignment for Generation | 百度 ERNIE | arXiv:2605.30073 关键词:音视频联合生成·原生对齐·MMDiT·音色可控·百度 前序问题:联合音视频生成要做到时序同步 + 语义连贯,但现有开源方案要么走「双塔 + 后验对齐」(弱化细粒度音视频协同演化),要么走「三模态全统一」(把语义条件和底层同步耦死在一起)——两条路线都有结构性缺陷 本文贡献:NAVA:context-conditioned 的原生音视频对齐框架。先在专用交互空间建立音视频对应关系,再用外部 context 条件化联合去噪。用 Align-then-Fuse MMDiT 架构实例化,从「模态感知的音视频对齐」平滑过渡到「模态共享的联合去噪」;并提出 Timbre-in-Context Conditioning,把参考音色线索关联到对应语音片段,实现可控语音音色 实验效果:在 Verse-Bench 和 Seed-TTS 上配合用户研究表明:仅用 6.3B 参数即取得更优视频质量、精确的音视频同步、有竞争力的音频质量,以及更强的参考音色可控性 批判点评:「先对齐后融合」而非「一上来全统一」的设计直击双塔 / 三模态两条路线的痛点,6.3B 拿下多项指标性价比很高;Timbre-in-Context 把音色可控做进 context 是干净的设计。但「专用交互空间 + 联合去噪」的两阶段是否引入额外训练复杂度、对更长音视频的扩展性仍需观察 3. Gamma-World:多智能体生成式世界模型 Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players | NVIDIA, 清华大学 | arXiv:2605.28816 关键词:多智能体·世界模型·RoPE·稀疏注意力·NVIDIA 前序问题:交互式视频世界模型大多聚焦单 agent(从单一控制信号生成未来观测),但很多生成环境需要多 agent 同时在共享空间行动(多玩家 / 机器人 / 具身体)。扩到多 agent 需要原则性设计:各 agent 独立可控、排列对称、推理高效,同时跨时间和视角保持一致 本文贡献:生成式多智能体世界模型。提出 Simplex Rotary Agent Encoding:3D RoPE 的无参扩展,把 agent 表示成旋转角空间里正单纯形的顶点,给每个 agent 不同相位又保持排列等价——无需学习 per-slot 身份或固定排序即可扩展 agent 身份;提出 Sparse Hub Attention:用可学习 hub token 中介跨 agent 交互,把跨 agent 注意力从二次降到线性。再把全上下文扩散 teacher 蒸成因果 student,带 KV cache 顺序生成时间块,实现 24FPS 的动作响应生成 实验效果:多人虚拟环境实验中,在视频保真度、动作可控性、agent 间一致性上超越 slot-based 和 dense-attention 基线,且无需额外训练即可从 2 玩家泛化到 4 玩家 批判点评:「用正单纯形顶点的旋转相位编码 agent 身份」是极优雅的无参设计——天然排列对称又可扩展;Sparse Hub Attention 把多 agent 注意力线性化是务实工程;从 2 人零样本泛化到 4 人很有说服力。但 hub token 数量与 agent 数的可扩展上限、长时序多 agent 一致性的退化曲线需要更大规模验证 4. AdaState:流式视频生成自演化锚点 AdaState: Self-Evolving Anchors for Streaming Video Generation | 弗吉尼亚理工 Virginia Tech | arXiv:2605.30349 关键词:流式视频生成·自回归扩散·自演化锚点·KV cache·时间相对 前序问题:自回归视频扩散逐块生成、每块条件于已生成内容,但模型结构性地「锚定在第一帧」:首帧 KV 占据注意力 cache 的特权位置、作为整段主场景参考。作为最干净无误差的位置,这个锚点吸走过多注意力,压制视频动态、把场景构图锁死在初始视角,结果是「时间上很浅」的视频——运动、镜头、场景推进都被静态一致性压制 本文贡献:用「自适应 state」替换静态锚点——一个隐 latent,模型每块和内容一起去噪但从不渲染。模型不再参考冻结的首帧,而是每步通过同时关注「前一 state + 当前内容」自己生成场景锚点,产出随生成内容演化的参考。不同于编码绝对时间的标准视频生成,本方法把时间当相对量:每个生成步看到相同的位置结构、state transition 每块都相同。这给生成过程引入了递归——去噪即 transition 函数,KV cache 即载体,无需任何外部模块 实验效果:实验表明自适应 state 大幅改善视频动态,让生成视频内出现更丰富的运动和更自然的场景推进 批判点评:「首帧 KV 锚点偷走注意力 → 视频时间上变浅」的诊断非常精准,用「可去噪但不渲染的隐 state」做自演化锚点是优雅的零外部模块方案,把时间从绝对改成相对的视角很有启发。但「丰富运动」与「时序一致性」本就是 trade-off,自演化锚点会不会牺牲长程一致性需要定量;缺与显式 memory / anchor 方法的正面对比 5. YoCausal:视频生成因果性认知基准 YoCausal: How Far is Video Generation from World Model? A Causality Perspective | 上海 AI Lab, 阳明交大 NYCU | arXiv:2605.30346 关键词:视频生成·世界模型·因果性·评测基准·上海AILab 前序问题:视频扩散模型(VDM)正走向世界模型,关键问题是:它们真懂因果,还是只过拟合统计时序模式?现有基准大多依赖合成数据,受 sim-to-real gap 限制真实世界泛化 本文贡献:YoCausal:受认知科学「违反预期(VoE)」范式启发的两级基准。零成本地把真实世界视频时序反转,作为天然反事实样本,建立可任意扩展的评测协议。Level 1 提出 Reverse Surprise Index (RSI),用去噪 loss 量化「时间箭头」感知;Level 2 提出 Causality Cognition Index (CCI),用 VLM 把数据分层成因果 / 非因果子集,把真正的因果推理从时序偏置中解耦 实验效果:评测 13 个 SOTA VDM 发现:感知到时间箭头并不意味着理解因果,且相对人类级因果认知仍存在显著差距 批判点评:「时序反转真实视频做零成本反事实」是极聪明的基准构造,RSI / CCI 两级指标把「时间感知」与「因果认知」分层解耦的思路很清晰,给「视频生成→世界模型」泼了必要的冷水。但用去噪 loss 衡量「惊讶度」是否完全等价于因果理解仍可争议;VLM 分层本身的可靠性会传导到 CCI 的结论 6. GenClaw:代码驱动的智能体图像生成 GenClaw: Code-Driven Agentic Image Generation | 中山大学 | arXiv:2605.30248 关键词:图像生成·智能体·代码驱动·可控生成·中山大学 前序问题:图像生成已从「文本条件像素合成」走向「具备视觉理解 + 工具调用的多模态 agent」,但现有 agent 仍受制于底层黑盒图像模型——工作流困在「为优化生成反复改 prompt」的循环里,没有直接操控画布的机制。LLM 作为精确视觉构建「画笔」的潜力基本未被开发 本文贡献:GenClaw:代码驱动的智能体图像生成范式,让 agent 像人类艺术家一样创作——先构思、再起草、最后上色。agent 先通过搜索和推理构建概念知识与上下文;再用代码(SVG / HTML / Three.js)渲染可执行的视觉草图;最后用图像生成模型补充纹理、材质、真实感。代码在此作为可控的中间画布,桥接语言推理与像素合成,把程序逻辑与生成模型的视觉表现力无缝整合 实验效果:把图像生成从黑盒范式转成类似真实人类创作的分阶段过程,朝着高度可控、可解释的视觉生成系统迈出一步 批判点评:「代码作中间画布」是把可控性问题转译成「可执行草图」的聪明思路——SVG / HTML / Three.js 草图天然结构化、可精确编辑,比反复改 prompt 强太多;构思-起草-上色的拟人流程也很有叙事性。但代码草图能表达的视觉复杂度有上限(精细写实场景难用 SVG 起草),最终仍依赖底层生成模型的「上色」能力;端到端延迟和失败率需要量化 7. GPIC:28万亿像素许可级图像语料 GPIC: A Giant Permissive Image Corpus for Visual Generation | 斯坦福 李飞飞团队 | arXiv:2605.30341 关键词:图像语料·视觉生成·许可数据集·flow matching·斯坦福 前序问题:研究可扩展的视觉生成方法需要大、可获取、稳定的数据集,但开放且许可清晰的大规模图像语料长期稀缺 本文贡献:GPIC:约 28 万亿像素的巨型许可图像语料。由 SOTA 视觉语言模型为多样互联网图像生成 caption,含 1 亿训练 + 20 万验证 + 100 万测试样本。所有图像均「研究 + 商用」许可宽松,经安全过滤、去重,集中托管于 Hugging Face。提供生成建模的 benchmark 协议,并给出像素空间 flow matching 的参考 baseline 实验效果:数据集、benchmark、模型全部开放(stanford-vision-lab/gpic);为视觉生成提供「大规模 + 许可清晰 + 稳定可复现」的公共底座 批判点评:「许可宽松 + 商用可用 + 安全去重 + 集中托管」直击当前生成数据集的版权 / 可复现痛点——这种基础设施工作对整个社区的长尾价值很高,28 万亿像素 + 完整 benchmark + baseline 让它即插即用。但「VLM 自动 caption」的质量上限会限制可训出的文本对齐能力;与 LAION 类已有大语料的去重重叠和质量差异需要更透明 8. Parametric Memory Law:LoRA参数记忆的幂律定律 How LoRA Remembers? A Parametric Memory Law for LLM Finetuning | 浙江大学, 阿里 | arXiv:2605.30260 关键词:LoRA·参数记忆·幂律·LLM微调·浙大 前序问题:LLM 需持续学习更新知识,LoRA 被广泛用于记忆更新,但现有研究多靠定性下游评测,对「精确参数记忆」的定量容量极限和底层动力学几乎没探索 本文贡献:用 LoRA 作为受控的记忆容量探针,在 latent 空间系统量化精确参数记忆。提出 Parametric Memory Law:把 loss 下降 ΔL 与有效参数量、序列长度联系起来的稳健幂律。token 级细粒度分析揭示确定性相变——证明预测概率 p>0.5 是 greedy decoding 下逐字召回的充分条件。据此提出 MemFT:阈值引导的优化策略,把训练预算动态重分配到次阈值 token 实验效果:实证表明 MemFT 能提升记忆保真度和效率;为「LoRA 到底记住多少、怎么记」给出可量化的定律而非定性结论 (github.com/zjunlp/ParametricMemoryLaw) 批判点评:「用 LoRA 当记忆容量探针 + 找出幂律 + p>0.5 相变的充分条件」是把模糊的「记忆能力」做成可量化科学定律的扎实工作,MemFT 把定律反哺成实际训练策略形成漂亮闭环。但幂律的普适性需要跨更多模型规模 / 任务验证;「逐字召回」的记忆与「泛化知识」的记忆是两回事,定律对后者的适用边界要谨慎 趋势观察 视频生成正在「世界模型化」:从出片段走向实时交互、多智能体、可因果 — minWM 把双向 T2V/TI2V 蒸成相机可控的少步自回归世界模型并全栈开源;Gamma-World 用单纯形旋转编码 + 稀疏 hub 注意力把世界模型从单 agent 扩到多 agent(2→4 人零样本泛化、24FPS);YoCausal 用时序反转真实视频做反事实基准,量出 13 个 SOTA VDM 距离「真懂因果」仍有显著差距——视频生成的下一站从「画面好」转向「能交互、有因果、多主体」 自回归流式视频生成开始解决「时间太浅」的结构病 — AdaState 诊断出首帧 KV 锚点偷走注意力、把场景锁死在初始视角,改用「可去噪但不渲染的自演化隐 state」做相对时间锚点,显著改善运动和场景推进——流式视频生成从「保一致」转向「敢动起来」 音视频联合生成走向「先对齐后融合」的原生范式 — NAVA 指出双塔后验对齐弱化协同、三模态全统一耦合语义与同步两条路都有缺陷,提出 Align-then-Fuse MMDiT 先在交互空间建音视频对应、再 context 条件化联合去噪,6.3B 拿下多项 SOTA + 可控音色——音视频生成的架构共识正在形成 图像生成的可控性升级:代码做中间画布、许可数据做底座 — GenClaw 用 SVG/HTML/Three.js 可执行草图作中间画布,把「反复改 prompt」换成「构思-起草-上色」的拟人可控流程;GPIC 放出 28 万亿像素、研究+商用许可宽松、安全去重的图像语料 + benchmark + flow matching baseline——可控生成的「方法」和「数据底座」被同时推进 大模型记忆与微调走向「可量化定律」 — How LoRA Remembers 用 LoRA 当记忆探针,给出 loss 下降 ΔL 与有效参数 / 序列长度的 Parametric Memory Law,发现 p>0.5 是逐字召回的充分条件,并据此提出阈值引导的 MemFT——把「LoRA 记多少」从定性评测推到可解析的幂律 人工智能炼丹君 整理 | 2026-05-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-27|美团LongCat-Avatar 1.5开源逼近闭源数… 今日 AIGC 论文速览 今日共 7 篇 · 工业级数字人开源对标闭源 1 篇 · 音视频联合生成评测体系 1 篇 · 视觉生成新范式:层级与通道级 2 篇 · DiT 推理加速与可控编辑 2 篇 · 原生多模态架构路线图 1 篇 重点论文标题列表 LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongAV-Compass:首个分钟级音视频生成评测基准 MRT:20B多层透明图像生成超Qwen CVQ:通道级VQ取代patch挑战传统 RT-Lynx:激活稀疏化让DiT GEMM加速1.55x 今日论文速览 1. LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongCat-Video-Avatar 1.5 Technical Report | 美团 LongCat Team | arXiv:2605.26486 关键词:数字人·美团 LongCat·8 NFE 蒸馏·RLHF·开源对标闭源 前序问题:音频驱动视频生成虽然进展飞快,但要做到「商业级稳定性」仍然难——商用场景下需要的不仅是「唇形对得上」,还要全身时序稳定、长视频身份不漂、多人交互/物体交互不崩,并且部署侧推理 budget 严苛 本文贡献:美团 LongCat-Video-Avatar 1.5:以「系统工程 + 生产就绪」而非架构创新为优先项的开源数字人框架。把 audio encoder 升级到 Whisper Large 并精修训练 recipe,做到准确唇形同步 + 全身时序稳定 + 长视频严格身份一致;通过严格数据清洗 + RLHF 训练,泛化到动漫/动物等风格化域,并原生处理多人交互和物体处理这类真实复杂场景;为工业部署引入 advanced step distillation 把推理压到 8 NFE 实验效果:在 500+ 多样测例 benchmark 上的定量指标 + 严格人评显示 v1.5 在 human-likeness 和专家级质量评估上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越;开源发布拉近了「学术原型」与「商业级部署」的差距 批判点评:美团摆明用「工程优先」的姿态——Whisper Large + 严苛数据 + RLHF + 8 NFE 蒸馏这套组合拳是教科书级的工业打法,公开报告稀缺。但「commercial-grade」更多靠数据规模和清洗,单一架构 trick 不构成壁垒;对标 HeyGen / OmniHuman 1.5 的具体维度需要更详细的 ablation 才能说服业界,且 8 NFE 与 Kling Avatar 2.0 之间的真实人评差距值得追踪 2. LongAV-Compass:首个分钟级音视频生成评测基准 LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV | 北京大学, Kling, 南大, 上交, 港科广州, 上海 AI Lab | arXiv:2605.26244 关键词:音视频生成·minute-scale·评测基准·T2AV/I2AV/V2AV·北大 前序问题:音视频联合生成正在从「短片段」走向「分钟级长内容」,但现有评测协议几乎都还停留在 5-10 秒文本条件生成;很少支持文本/图像/视频三种条件统一评测,更没说清楚长时间下身份一致性、叙事连贯、音画对齐到底怎么退化 本文贡献:LongAV-Compass:首个面向 minute-long 音视频生成的系统化评测基准。284 个精选测例覆盖 T2AV / I2AV / V2AV 三种输入,按应用场景和生成复杂度组织;统一评测框架结合 MLLM 辅助评估和 DINO-v2 / ArcFace / CLIP / ImageBind 等感知指标,覆盖 20+ 细粒度维度——段内质量、跨段一致性、全局叙事连贯、语义对齐、音画同步全都评 实验效果:在 11 个代表性模型上跑 + 人对齐验证,把当前系统在「保持连贯、保持语义对齐、保持时序一致」上的瓶颈量化呈现;为分钟级音视频生成提供了首个诊断式 testbed——音视频联合生成的「评测短板」正式被补上 批判点评:把音视频联合生成的评测从 5-10s 短片推到分钟级是必要补位——评测落后一直是这个赛道的隐形天花板。20+ 细粒度维度 + MLLM 辅助 + 4 大经典感知模型组合非常综合。但 MLLM 评测本身的偏置是隐忧,DINO-v2/ArcFace/CLIP/ImageBind 的权重融合策略需要更多 ablation;分钟级测例 284 个对开源社区评测可行但工业级评测仍偏小 3. MRT:20B多层透明图像生成超Qwen MRT: Masked Region Transformer for Layered Image Generation and Editing at Scale | 微软亚研 MSRA | arXiv:2605.27235 关键词:多层图像生成·20B·masked region·8 步实时·MSRA 前序问题:层级图像生成与编辑是图像生成走向「可复用 / 可重编辑 / 可组合」的关键能力——类比自然语言里的「逐词编辑」——但在大规模上一直是 underexplored 的空白。多层透明生成 + 多任务统一框架既缺数据也缺方法 本文贡献:MRT:20B 参数 masked region diffusion 模型,专为多层透明图像生成与编辑打造,在 10M+ 多语言设计样本上训练,支持多 aspect ratio 与多语言 prompt。两项核心贡献:(i) 把 text-to-layers / image-to-layers / layers-to-layers 三任务统一到「共享 masked region diffusion」框架,靠 selective token masking 灵活切换层级生成与编辑;(ii) overflow-aware canvas layer 处理边界 inconsistency 并支持半透明背景合成,做出可编辑且延伸至画布外的完整图层。配套 diffusion 蒸馏实现 8 步实时多层生成 实验效果:在三项任务上全面超越此前 SOTA 包括商业系统;user-study 显著优于同期 Qwen-Image-Layered 的 image-to-layers 质量,且推理快 10-100×,activation GPU 显存降低 50-90%——为多层透明图像生成立下新基准 批判点评:把多层图像生成做到 20B + 三任务统一 + 8 步实时是非常工业化的工作量;超越 Qwen-Image-Layered 的人评结果是强信号。但 10M+ 设计样本的语义/版权分布未明,多语言/多 ratio 的真实可控性需要更细 ablation;overflow-aware canvas layer 在极端 aspect ratio 下的稳定性也需要追踪 4. CVQ:通道级VQ取代patch挑战传统 Channel-wise Vector Quantization | 上海创新研究院, 西湖大学, 浙大, 复旦 | arXiv:2605.26089 关键词:视觉 tokenization·channel-wise VQ·CAR·next-channel·DPG 86.7 前序问题:传统视觉自回归(VAR)和 VQ-based 文生图都把图像分成 patch、给每个 patch 分配一个离散 token——但这种 patch 视角本质是「把图像当空间网格」,不太符合人类绘画「先勾结构再补细节」的层次过程。codebook 利用率上不去、增大 codebook 后 collapse 也是顽疾 本文贡献:Channel-wise Vector Quantization (CVQ):新视觉 tokenization 范式,离散化对象从 patch 换到 feature map 的每一个 channel——一张图被表示为「不同层级视觉细节的离散等级」而不是「空间 patch 网格」。基于 CVQ 提出 Channel-wise Autoregressive (CAR):next-channel prediction 替代 next-patch prediction,先勾全局结构再渐进精修细粒度属性 实验效果:CVQ 在 16K+ codebook 规模下实现 100% codebook 利用率(无任何 trick),重建质量显著超过传统 VQ;CAR 在文生图上拿到 DPG 86.7 / GenEval 0.79——证明「按 channel 分层渲染」是 patch-based 视觉自回归的现实替代品 批判点评:把 tokenization 从空间 patch 切换到 channel 维度是真正的范式 rethink——「先结构后细节」也与人类作画过程契合。100% codebook 利用率是很硬的数字。但 channel 抽象层次的物理含义不够清晰(哪个 channel 对应「结构」哪个对应「细节」依赖训练涌现),跨分辨率/跨模态时的稳定性需要进一步验证;与 latest DiT 路线的端到端比较略浅 5. RT-Lynx:激活稀疏化让DiT GEMM加速1.55x RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models | 国内系统研究团队 | arXiv:2605.26632 关键词:DiT 加速·激活稀疏化·N:M sparsity·CUDA kernel·1.55x 前序问题:DiT 推理太贵——量化和蒸馏已经被深挖,但能砍掉将近一半 FLOPs 的「半结构化稀疏(N:M sparsity)」一直 underexplored。原因是大家都在做 weight 稀疏化,但对 weight 做 50% 剪枝会拿掉关键模型容量,让生成质量崩坏 本文贡献:RT-Lynx:核心 insight 是「DiT 的激活本身天然稀疏,比 weight 更适合 N:M 半结构化稀疏化」。提出 paradigm shift——从 weight sparsification 转到 activation sparsification;配 error-compensation 缓解精度损失;并实现针对该场景高度优化的 CUDA kernel 实验效果:线性层平均 1.55× speedup,多个扩散模型上保留原生生成质量同时显著加速;为 DiT 部署提供「除量化和蒸馏外的第三条加速路线」 批判点评:把「稀疏化目标」从 weight 切到 activation 是非常对的洞察——activation 在 inference 时本来就动态出现 zero,强制 N:M 模式损失更小。1.55× 加速 + 不掉质量在 DiT 推理优化里属于实打实的硬增量。但 N:M 模式需要硬件配合(Ampere/Hopper 的 sparse tensor core),消费级 GPU 上的实际收益要打折;激活稀疏化对极长 token 序列(高分辨率视频)下的可扩展性需评测 6. ControlLight:Flow Matching做连续强度可控低光增强 ControlLight: Towards Controllable, Consistent, and Generalizable Low-Light Enhancement | 中科院深圳, StepFun | arXiv:2605.25569 关键词:低光增强·flow matching·连续可控·一致性·中科院深圳 前序问题:现有深度学习低光增强方法都在「有限数据集 + 单一增强目标」上训练——既泛化差又不可控。真实场景里同一张暗图,不同用户/不同场景需要不同的增强强度,但现有方法把它当作一个固定函数 fit 本文贡献:ControlLight:「可控 + 一致 + 可泛化」的低光增强框架。先建大规模真实退化图像数据集,对每张图给出「连续光照强度」标签作为监督;引入 misalignment-aware weighted flow matching loss,让模型在不同控制强度下输出仍然保持图像结构一致——用户可以连续滑动「增强强度」拿到不同结果而不撕裂 实验效果:在多个 benchmark 上超过现有低光增强 SOTA,同时具备「连续强度可控」+ 「真实场景泛化」能力,把低光增强从「一锤子函数」改造成「可调节工具」 批判点评:把 flow matching 用到低光增强 + 连续条件标签 + misalignment-aware loss 三件套是非常 clean 的设计——其中「misalignment-aware」直接 attack 不同强度下结构一致的根因。但「连续光照强度标签」如何从真实退化数据获取本身是个隐藏难题;与最近基于 diffusion 的图像 restoration 在极端低光场景的比较需要更全面 7. Native MM Roadmap:原生多模态架构路线图三分类 Toward Native Multimodal Modeling: A Roadmap | 华威大学, Monash, 港理工, 腾讯优图 | arXiv:2605.25343 关键词:原生多模态·NMM·路线图·three-class taxonomy·腾讯优图 前序问题:多模态建模正在从 modality-agnostic 推理走向 world modeling。早期 late-fusion(拼 encoder + frozen LLM + 输出头)已显疲态,最近转向 Native Multimodal Modeling (NMM)——把各模态从根上集成进同一个 transformer 拿到更强性能。但 NMM 的设计空间目前仍未系统化 本文贡献:为社区提供形式化的 NMM 路线图:(1) 形式化定义「架构原生性」,区分 mid-fusion / early-fusion 与非原生范式;(2) 从「输入-输出对偶」角度把现有 native 模型组织成三类——Multi-to-Text(跨模态理解,纯文本输出)/ Multi-to-Target(场景化生成,如图像/音频/视频生成)/ Multi-to-Multi(对称输入输出的统一建模);(3) 全栈式工业视角剖析从架构协调、海量数据 curation、训练 recipe 到推理部署和评测的端到端 pipeline 实验效果:把当前散乱的「统一多模态架构」研究归结成一份可被工程师和研究员同时参考的路线图——理解和生成在「统一 transformer 范式」下无缝共存是 NMM 的目标终态。对走向 GPT-4o / Gemini 1.5 级原生多模态的开源工作给出系统化方法学 批判点评:「形式化 architectural nativity + 输入输出对偶三分类 + 全栈工业视角」三个层次组织得很清晰——是社区急需的概念清理。但综述类天然有「分类强、实证少」的局限,三类边界(特别是 Multi-to-Target 和 Multi-to-Multi)在最新模型上可能交叉;对未来 1-2 年具体技术抉择的指导力度需要在落地 case 中验证 趋势观察 工业级开源数字人 / 视觉基础模型加速对标闭源 — 美团 LongCat-Video-Avatar 1.5 用 Whisper Large + RLHF + 8 NFE 蒸馏的工业打法,在 500+ 测例上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越——昨天百度 ERNIE-Image 是文生图,今天美团 LongCat-Avatar 是数字人——国内大厂正在多个垂类同时按下「开源对标闭源」按钮 音视频联合生成评测从「短片」推到「分钟级」 — LongAV-Compass 提供首个 minute-scale 音视频生成评测基准——284 个测例覆盖 T2AV / I2AV / V2AV、20+ 细粒度维度(段内质量 + 跨段一致 + 全局叙事 + 语义对齐 + 音画同步)。和最近 Baton / SpongeBob / StreamChar 等音视频联合生成模型一起,把「短片评测」时代正式翻篇 视觉生成 tokenization / 架构范式正在被 rethink — MRT 把「图像生成」从单层 RGB 推到「多层透明 + 三任务统一 + 8 步实时」;CVQ 把视觉 tokenization 从 patch-wise 切换到 channel-wise,重提「先结构后细节」的人类作画过程并拿到 100% codebook 利用率与 GenEval 0.79——patch + 单层这两个长期假设都在被挑战 DiT 推理加速的第三条路:从「weight 稀疏」转向「activation 稀疏」 — RT-Lynx 指出 DiT 激活本身就稀疏,对 N:M 半结构化稀疏化远比 weight 鲁棒,配合错误补偿和定制 CUDA kernel 拿到 1.55× 线性层加速且不掉质量——量化、蒸馏之外,「激活稀疏化」正式成为 DiT 部署的第三条加速路线 Native 多模态架构走向系统化,可控生成成为最后一公里 — Toward Native Multimodal Modeling 把原生多模态架构形式化为「Multi-to-Text / Multi-to-Target / Multi-to-Multi」三分类,给出从架构到训练到部署的全栈 roadmap;ControlLight 用 misalignment-aware flow matching 把低光增强做成「连续强度可控」工具——「统一架构 + 可控生成」正在收敛成下一代生成模型的双轨 人工智能炼丹君 整理 | 2026-05-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
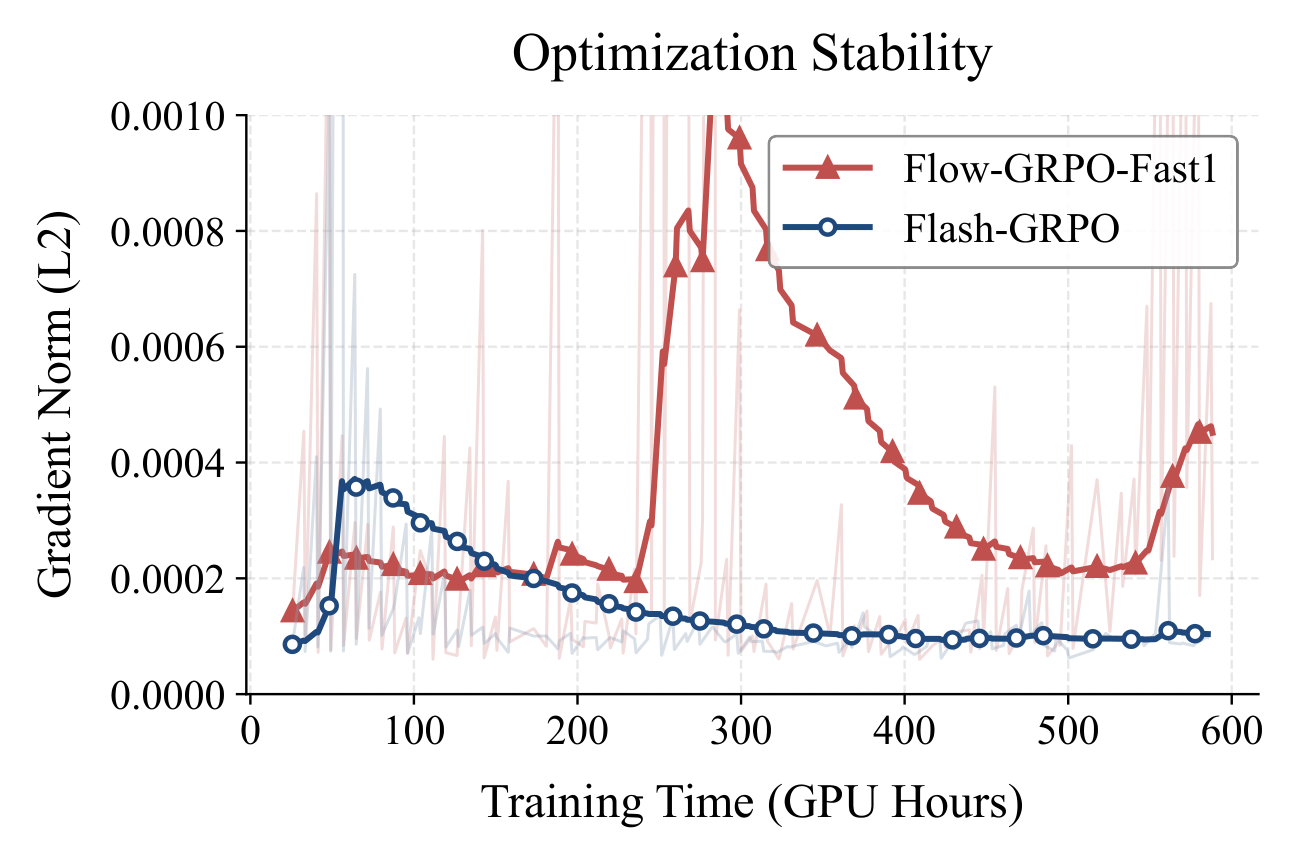
AIGC 每日速读|2026-05-18|14B视频对齐单步训练Flash-GRPO 今日 AIGC 论文速览 今日共 7 篇 · 视频扩散对齐与定制 2 篇 · 图像生成几何与少步推理 2 篇 · 多镜头视频与实体一致性 1 篇 · 3D 重建与世界模型 2 篇 重点论文标题列表 Flash-GRPO:14B 视频对齐单步训练即超全轨迹 Spherical-FM:球面插值贴合潜空间路径 ⚡ Sphere-Latent-Enc:解耦图像编码器与球面去噪 EntityBench:多镜头视频实体一致性基准 FashionChameleon:单卡 23.8 FPS 实时换装 今日论文速览 1. Flash-GRPO:14B 视频对齐单步训练即超全轨迹 Flash-GRPO: Efficient Alignment for Video Diffusion via One-Step Policy Optimization | 浙江大学, 京东 | arXiv:2605.15980 关键词:视频扩散·GRPO 对齐·单步训练·时间步分组·14B 大模型 ⚠️ 前序问题:GRPO 已成为对齐视频扩散模型与人类偏好的关键工具,但训练 14B 视频扩散模型动辄需要数百 GPU 天;现有效率方法靠在时间步上做滑动窗口子采样,根本上破坏了优化稳定性,且无法逼近全轨迹训练的对齐质量 本文贡献:提出 Flash-GRPO 单步训练框架:(1) Iso-Temporal Grouping 通过 prompt 内部的时间一致性消除时间步混淆方差,把策略表现与时间步难度解耦;(2) Temporal Gradient Rectification 中和不同时间步的尺度因子,防止梯度幅值跨时间步剧烈漂移;最终单步 GRPO 即可超越全轨迹训练的对齐质量 实验效果:在 1.3B 到 14B 视频扩散模型上验证:训练显著加速、稳定性优于全轨迹基线,对齐质量达到 SOTA,让 14B 视频对齐从「数百 GPU 天」级实验变得可负担 批判点评:把视频 GRPO 的瓶颈精准定位到「时间步混淆 + 梯度尺度漂移」并各个击破,工程上极具实用性;但单步训练对教师 reward 噪声的鲁棒性、与 Causal Forcing 类少步 AR 视频的兼容性还需进一步验证 2. Spherical-FM:球面插值贴合潜空间路径 Aligning Latent Geometry for Spherical Flow Matching in Image Generation | Virginia Tech, fal | arXiv:2605.15193 关键词:Flow Matching·球面几何·潜空间·slerp·图像生成 ⚠️ 前序问题:潜空间 flow matching 通常在高斯噪声与 VAE 潜在变量之间走线性路径,但两端点都集中在薄薄的球壳上,欧式弦线在每一步都「离开了壳」——即使预处理对齐了半径,路径仍然不在真实的数据流形上 本文贡献:把每个潜在 token 分解为「径向 + 角度」两个分量,用 swap 探针证明感知和语义内容主要由方向承载、径向贡献远小于此;据此把数据潜变量投影到固定 token 半径,用高斯噪声的径向投影作为球面先验,冻结 encoder 微调 decoder,并把线性插值替换为球面插值(slerp)——测速目标因此在构造上变成纯角度,路径全程贴在球面上 实验效果:在多种图像 tokenizer 下一致改善 ImageNet-256 的类条件 FID;扩散网络结构无需改动、不引入辅助 encoder 或表征对齐目标,是一条极简但有效的几何修复路径 批判点评:回到流形几何本身解决「半径漂移」问题,理论清晰、实现极简——这是少有的「几乎零代码改动就涨点」的范式工作;但球面假设是否对所有 VAE 潜空间都成立、对 video latent 这种时空联合分布是否仍适用,还需更广验证 3. Sphere-Latent-Enc:解耦图像编码器与球面去噪 Efficient Image Synthesis with Sphere Latent Encoder | MBZUAI | arXiv:2605.15592 关键词:少步图像生成·球面潜空间·解耦训练·Sphere Encoder·推理加速 ⚠️ 前序问题:consistency 与 meanflow 类少步生成虽然推理便宜,但训练不稳定、可扩展性差;近期 Sphere Encoder 能少步出图,却需要在像素空间和潜空间间反复切换,重建与生成挤在同一架构里互相打架 本文贡献:把框架解耦为「固定预训练图像编码器 + 独立的球面潜在去噪模型」,完全在球面潜空间里训练去噪模型——训练和推理都不再需要反复跨像素/潜空间切换,重建和生成各自专精,互不掣肘 实验效果:在 Animal-Faces、Oxford-Flowers、ImageNet-1K 上同时显著超越 Sphere Encoder 的画质和推理速度,对比强力少步与多步基线也能取得有竞争力的结果,是一个高效少步图像合成的新基线 批判点评:「解耦」这个看似平凡的工程决策,反映出一个被忽略的事实:把重建和生成耦合在同一目标里很容易互相妥协;但跨数据集泛化、与扩散 Transformer 的兼容、以及球面潜空间的尺度上限仍需进一步研究 4. EntityBench:多镜头视频实体一致性基准 EntityBench: Towards Entity-Consistent Long-Range Multi-Shot Video Generation | ByteDance, Rice University | arXiv:2605.15199 关键词:多镜头视频·实体一致性·评测基准·记忆增强·叙事生成 ⚠️ 前序问题:多镜头视频生成把单镜头延伸到连贯叙事,但跨镜头维持角色、物体、地点的一致性长期是难题;现有评测用独立生成的 prompt 集,实体覆盖有限、一致性指标过于简单,难以做标准化比较 本文贡献:提出 EntityBench:从真实叙事媒体里抽取的 140 个 episode、2,491 个镜头,按易/中/难三档同时跟踪角色、物体、地点的实体调度(最长 50 镜头、13 跨镜头角色、22 跨镜头物体、回归间隔最长 48 镜头);配套三支柱评测套件解耦 intra-shot 质量、prompt 跟随、跨镜头一致性,并用保真度门控只让正确出现的实体进入跨镜头打分;另发布 EntityMem 基线:先把每实体的可信视觉参考存入持久记忆库,再生成 实验效果:实验显示现有方法的跨镜头实体一致性随回归距离急剧下降,显式 per-entity 记忆带来最高角色保真度(Cohen's d = +2.33)和实体出现率,为多镜头视频提供了能区分 SOTA 的标准评测 批判点评:把多镜头视频的「角色/物体/地点」标准化为可量化的 entity schedule 是社区一直缺的基础设施;但 140 个 episode 主要来自既有叙事媒体,对完全开放生成场景的覆盖度、评测自动化中视觉感知模型的偏差,仍是后续要补的环节 5. FashionChameleon:单卡 23.8 FPS 实时换装 FashionChameleon: Towards Real-Time and Interactive Human-Garment Video Customization | 厦门大学, 阿里巴巴 | arXiv:2605.15824 关键词:视频定制·实时交互·KV Cache·In-Context Learning·电商生成 ⚠️ 前序问题:服装级人物视频定制有巨大商业价值(电商、内容创作),但现有方法不支持低延迟交互式服装控制——用户无法在生成过程中实时切换服装,且多服装训练数据稀缺 本文贡献:提出 FashionChameleon 实时交互式自回归视频定制框架:(1) 不训多服装数据,用单参考-服装对配合 in-context learning 训练 Teacher Model,强制 reference/garment 失配迫使模型隐式保持单服装切换的连贯;(2) Streaming Distillation with In-Context Learning 用 in-context teacher forcing 微调,并用梯度重加权 distribution matching distillation 改善外推一致性;(3) Training-Free KV Cache Rescheduling 通过 garment KV refresh / historical KV withdraw / reference KV disentangle 实现切换时保留运动连贯 实验效果:支持长视频外推一致性 + 实时交互式服装切换,单 GPU 23.8 FPS 实时生成,比已有基线快 30-180 倍 批判点评:用「单服装数据 + KV 调度」绕过了多服装数据采集的瓶颈,是非常聪明的工程方案;但 KV 调度对极端切换(颜色/版型差异巨大)的视觉伪影、长时间交互后的累积漂移,仍是产品化的关键考验 6. VGGT-Ω:前馈 3D 重建首现 Scaling Law VGGT-Ω: Scaling Feed-Forward 3D Reconstruction | Meta FAIR, Oxford VGG | arXiv:2605.15195 关键词:前馈 3D 重建·register attention·scaling·动态场景·VLA ⚠️ 前序问题:VGGT 这类前馈式 3D 重建模型已经能与传统优化基线掰手腕,并提供几何感知特征服务下游任务;但要把这种模型 scale up 训练到更大的数据规模,原架构的显存占用与计算冗余成为最大障碍 本文贡献:提出 VGGT-Ω:(1) 用单一密集预测头 + 多任务监督简化原架构,去掉昂贵的高分辨率卷积层;(2) 用 register 把场景信息聚合为紧凑表示,并引入 register attention 把跨帧信息交换限定在 register 之间,部分替代全局 attention;(3) 配套高质量动态场景标注流水线 + 自监督协议;训练显存只需前代 30%,得以使用 15× 监督数据 + 大量无标注视频 实验效果:在静态与动态场景多个 benchmark 上一致刷 SOTA,例如 Sintel 上相机估计精度比之前最好结果提升 77%;学到的 register 还能改善 VLA 模型并支持语言对齐,证明重建可以作为空间理解的可扩展代理任务 批判点评:「重建模型也存在 scaling law」并通过架构精简一次性把训练规模拉满,是 VGGT 系列工作的关键里程碑;但 register 数量与表达能力的取舍、动态场景对真实开放视频的泛化,仍需在更复杂自由场景下追加验证 7. ReactiveGWM:解耦玩家与 NPC 跨游戏零样本 ReactiveGWM: Steering NPC in Reactive Game World Models | 腾讯, 新加坡国立大学, 港理工, 港科大广州 | arXiv:2605.15256 关键词:游戏世界模型·NPC 交互·零样本迁移·扩散主干·可控生成 ⚠️ 前序问题:现有游戏世界模型只从玩家主观视角模拟环境,把 NPC 当作背景像素,无法捕捉玩家与 NPC 的交互;本质上更像被动视频渲染器而非真正的仿真引擎,缺少建模动作引发的 NPC 反应所需的物理理解 本文贡献:提出 ReactiveGWM:显式解耦玩家控制与 NPC 行为——玩家动作通过轻量加性偏置注入扩散主干,NPC 高层响应(进攻/控制/防御)通过 cross-attention 模块 grounding;这些模块学到与游戏无关的交互逻辑表示,可零样本插入其他无标注游戏的世界模型,无需领域微调即可解锁可操控 NPC 交互 实验效果:在两款街头霸王上验证:保持精细玩家可控性的同时实现稳健、prompt 对齐的 NPC 策略遵循,为「策略丰富、可控的 NPC 交互」打开了零样本扩展的可能 批判点评:把「玩家 vs NPC」拆成两条解耦支路是非常优雅的设计,零样本迁移到其他游戏的能力让世界模型走出单一题材;但目前只验证了对战类游戏,开放世界 RPG 的多 NPC 协作、长时序情节一致性仍是开放问题 趋势观察 视频扩散对齐进入「单步训练」时代 — Flash-GRPO 把全轨迹 GRPO 压缩到单步训练,靠 iso-temporal grouping 与 temporal gradient rectification 修复时间步混淆与梯度漂移——14B 视频对齐从「数百 GPU 天」级实验降为可负担成本,视频扩散偏好对齐正在跨过工程化门槛 流匹配开始「修几何」而不是堆模型 — Spherical-FM 用径向/角度分解证明感知信息主要由方向承载,把线性插值改为球面插值即在多个 tokenizer 上一致涨点;Sphere Latent Encoder 进一步把生成完全搬到球面潜空间——少步图像生成的下一波收益来自「让路径贴上流形」 多镜头视频从「能拍」走向「记得住」 — EntityBench 把跨镜头角色/物体/地点一致性升级为可量化基础设施,配套 EntityMem 显式记忆库验证「记忆」是关键变量——多镜头视频生成的下一战场不是单镜头质量,而是叙事意义上的实体连续性 人物-服装视频生成走向实时交互 — FashionChameleon 用 in-context learning + KV cache 调度实现 23.8 FPS 单 GPU 实时换装,比基线快 30-180 倍——电商和内容创作的「实时交互式视频定制」从 demo 走向产品级 重建模型也存在 scaling law — VGGT-Ω 用 register attention 等架构精简把训练显存压到 30%,在 15× 数据上推到 77% Sintel 提升;ReactiveGWM 让世界模型零样本迁移到不同游戏——「重建+世界模型」开始从感知任务走向通用空间智能 人工智能炼丹君 整理 | 2026-05-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-13|INSET图像即词汇开启统一视觉生成新范式 今日 AIGC 论文速览 今日共 10 篇 · 统一视觉生成与编辑 3 篇 · 视频生成与叙事 2 篇 · 视觉分词与表征 2 篇 · 视频理解与推理 1 篇 · Agent 与训练方法论 2 篇 重点论文标题列表 INSET:将图像作为原生词汇无缝嵌入文本指令— Qwen-Image-2.0:全能图像生成基础模型 ⚡ DRoRAE:轻量级融合模块通过能量约束路由和增量 CausalCine:交互式自回归框架 ELF:在连续嵌入空间中基于连续时间 今日论文速览 1. INSET:将图像作为原生词汇无缝嵌入文本指令— INSET (Images iN SEnTences): Interleaved Instruction for Unified Visual Generation | MIT, ETH | arXiv:2605.12305 关键词:交错指令·统一视觉生成·图像词汇化·多图一致性·数据引擎 ⚠️ 前序问题:现有多模态语言模型已支持从多图指令生成图像,但在处理复杂交错指令时性能急剧下降——根本原因在于当前范式中图像和文本结构性分离,模型必须跨越困难的长距离依赖才能将描述与视觉目标正确匹配,导致多图一致性和精确绑定失败 本文贡献:提出 INSET(Images iN SEnTences),将图像作为原生词汇无缝嵌入文本指令——直接把视觉特征放在对应语义槽位,利用 Transformer 的上下文局部性替代长距离依赖实现精确对象绑定;同时设计可扩展数据引擎,借助 VLM 和 LLM 从标准图像/视频数据集合成 1500 万高质量交错样本 实验效果:在 InterleaveBench 上显著超越 SOTA,多图一致性和文本对齐方面领先,且随输入复杂度增加性能差距进一步扩大;架构天然扩展支持多模态图像编辑,把视觉内容作为指令一部分实现高度表达性的视觉操控 批判点评:图像词汇化的核心直觉新颖——把多图绑定从长距离依赖问题转化为局部上下文问题是范式级改变;但 1500 万合成数据的复现成本极高,模型与数据是否开源将直接决定其影响力,且论文未给出 FLOPS/推理延迟的对比 2. Qwen-Image-2.0:全能图像生成基础模型 Qwen-Image-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.10730 关键词:图像生成·文本渲染·多语言排版·扩散Transformer·统一编辑 ⚠️ 前序问题:现有图像生成模型在超长文本渲染、多语言排版、高分辨率写实、鲁棒指令遵循和高效部署方面仍面临挑战,尤其在文字密集和组合复杂场景中表现不足 本文贡献:提出 Qwen-Image-2.0 全能图像生成基础模型:将 Qwen3-VL 作为条件编码器与多模态扩散 Transformer 结合,支持联合条件-目标建模;支持 1K token 长度指令生成文字密集内容(幻灯片、海报、信息图、漫画),显著提升多语言文字保真度和排版质量 实验效果:在生成和编辑任务上大幅超越之前的 Qwen-Image 模型,在写实感、细节丰富度、纹理真实性和光照一致性方面均有显著提升 批判点评:统一生成和编辑的全能架构令人印象深刻,但技术报告形式缺乏与开放社区模型的公平对比;1K token 长指令的实际推理成本和延迟未详述 3. DRoRAE:轻量级融合模块通过能量约束路由和增量 Beyond the Last Layer: Multi-Layer Representation Fusion for Visual Tokenization | Peking University, Meituan, Tsinghua University | arXiv:2605.10780 关键词:视觉分词器·多层融合·表征自编码·缩放律·图像生成 ⚠️ 前序问题:表征自编码器(Representation AE)复用冻结预训练视觉编码器作为视觉分词器,但现有方法仅提取最后一层特征,丢弃了中间层分布的丰富层次化信息——低层视觉细节在最后一层仅以衰减残差形式存活 本文贡献:提出 DRoRAE(深度路由表征自编码器):轻量级融合模块通过能量约束路由和增量校正自适应聚合所有编码器层;三阶段解耦训练策略先在冻结解码器的隐式分布约束下学习融合,再微调解码器充分利用丰富表征 实验效果:在 ImageNet-256 上将 rFID 从 0.57 降至 0.29,生成 FID 从 1.74 降至 1.65;发现融合容量与重建质量间的对数线性缩放律(R²=0.86) 批判点评:多层融合的思路简洁有效,对数线性缩放律的发现为视觉分词器提供了新的可预测扩展维度;但融合模块的额外计算开销和对不同编码器架构的泛化性需更多验证 4. CausalCine:交互式自回归框架 CausalCine: Real-Time Autoregressive Generation for Multi-Shot Video Narratives | HKUST, Ant Group, SJTU | arXiv:2605.12496 关键词:多镜头视频·自回归生成·实时推理·记忆路由·镜头转换 ⚠️ 前序问题:自回归视频生成以实时开放式合成为目标,但电影叙事不是无限延伸单一场景——它需要事件演进、视角切换和镜头边界。现有 AR 模型将长序列视为延伸单镜头,导致长推演中运动停滞和语义漂移 本文贡献:提出 CausalCine 交互式自回归框架:将多镜头视频生成转化为在线导演过程;先在原生多镜头序列上训练因果基础模型学习复杂镜头转换先验,再提出 Content-Aware Memory Routing (CAMR) 按注意力相关性动态检索历史 KV 条目,最后蒸馏为少步实时生成器 实验效果:显著超越自回归基线,接近双向模型能力,同时解锁因果生成的流式交互特性,支持动态 prompt 实时切换 批判点评:多镜头叙事的问题设定高度实用,CAMR 的内容感知路由设计优雅;但蒸馏后的少步生成器是否保持镜头转换的多样性存疑;训练数据中多镜头标注的获取成本未讨论 5. ELF:在连续嵌入空间中基于连续时间 ELF: Embedded Language Flows | MIT (Kaiming He 团队) | arXiv:2605.10938 关键词:连续扩散语言模型·Flow Matching·嵌入空间·CFG·文本生成 ⚠️ 前序问题:扩散/流模型在连续数据(图像、视频)生成中占主导地位,但应用于语言建模时,当前领先的扩散语言模型(DLM)仍主要操作离散 token,连续 DLM 尚未证明有效性 本文贡献:提出 ELF(Embedded Language Flows):在连续嵌入空间中基于连续时间 Flow Matching 的扩散模型,在最终时间步通过共享权重网络映射到离散 token;这一公式化使得从图像扩散模型迁移成熟技术(如 CFG)变得直接 实验效果:大幅超越领先的离散和连续 DLM,以更少的采样步骤实现更好的生成质量,证明连续 DLM 可以通过最小适配有效工作 批判点评:Kaiming He 团队的工作一贯简洁有力——将连续流匹配应用于语言的思路开创性地打通了图像和语言扩散的技术栈;但语言的离散本质是否在连续空间中引入不必要的量化误差值得深入分析 6. PhyGround:标准化物理推理基准 PhyGround: Benchmarking Physical Reasoning in Generative World Models | Northeastern University, ETH | arXiv:2605.10806 关键词:物理推理基准·世界模型·视频生成评估·VLM评判器·人类评估 ⚠️ 前序问题:生成式世界模型被期望捕获真实世界物理规则,但评估生成视频是否真正遵循物理定律仍极具挑战——现有基准存在粗粒度评估掩盖逐律失败、标注偏见和自动评估器物理感知不足等问题 本文贡献:提出 PhyGround 标准化物理推理基准:250 个精选 prompt 配有预期物理结果,覆盖固体力学、流体动力学、光学等 13 条物理定律的分类学;通过社会科学实验设计执行 459 名标注者大规模人类评估;发布 PhyJudge-9B 物理专用 VLM 评判器 实验效果:PhyJudge-9B 相对偏差仅 3.3%(vs Gemini-3.1-Pro 的 16.6%);人类标注达到高分半相关性(Spearman's ρ > 0.90),揭示当前视频生成器在视觉逼真和物理推理间的持续鸿沟 批判点评:评估框架设计严谨(借鉴社会科学实验方法论),PhyJudge-9B 的开源贡献显著;但 250 个 prompt 的规模可能不足以覆盖开放世界物理场景的长尾分布 7. GridProbe:无训练后验探测推理范式 GridProbe: Posterior-Probing for Adaptive Test-Time Compute in Long-Video VLMs | MIT | arXiv:2605.10762 关键词:长视频理解·自适应计算·帧选择·后验探测·VLM推理 ⚠️ 前序问题:长视频 VLM 理解被单次整体前向传播瓶颈化——数千帧的二次注意力成本高昂;现有帧选择方法依赖编码器空间相似度,在推理密集型查询(否定、跨帧计数、全局总结)上失败 本文贡献:提出 GridProbe 无训练后验探测推理范式:将帧排列为 K×K 网格,执行轻量行列探测,用冻结 VLM 自身推理能力在答案空间中评分证据,外积生成可解释重要性图;提出 Shape-Adaptive Selection 闭式规则以每问题自适应帧预算替代固定预算 实验效果:在 Video-MME-v2 上匹配整体基线精度(差 1.6pp)的同时减少 3.36x TFLOPs;在 LongVideoBench 上 Pareto 主导基线(+0.9pp at 0.35x compute);2B 选择器 + 8B QA 组合在 0.52x 计算量下提升 +4.0pp 批判点评:后验探测的思路巧妙——用模型自身推理能力选帧替代外部相似度;Shape-Adaptive Selection 的闭式解优雅实用;但网格排列假设可能在超长视频中引入信息损失 8. AlphaGRPO:将 GRPO 应用于 AlphaGRPO: Unlocking Self-Reflective Multimodal Generation in UMMs via Decompositional Verifiable Reward | HKU | arXiv:2605.12495 关键词:多模态生成·GRPO·可验证奖励·自反思·统一模型 ⚠️ 前序问题:统一多模态模型(UMM)缺乏有效的强化学习对齐方案——多模态生成场景中提供稳定监督信号极具挑战,现有整体标量奖励无法捕捉多维语义和质量要求 本文贡献:提出 AlphaGRPO:将 GRPO 应用于 AR-Diffusion UMM,无需额外冷启动阶段;引入分解可验证奖励(DVReward)——LLM 将复杂请求分解为原子可验证语义/质量问题,由通用 MLLM 评估提供可靠可解释反馈;解锁推理型文生图和自反思精炼能力 实验效果:在 GenEval、TIIF-Bench、DPG-Bench、WISE 等多模态生成基准上取得稳健提升,同时在未训练的编辑任务(GEdit)上也获得显著增益 批判点评:分解可验证奖励的设计思路与 Auto-Rubric as Reward 异曲同工,自反思精炼是引人注目的涌现能力;但 DVReward 的可靠性仍受限于评估用 MLLM 的能力上限 9. Shepherd:函数式编程模型 Shepherd: A Runtime Substrate Empowering Meta-Agents with a Formalized Execution Trace | Stanford, META | arXiv:2605.10913 关键词:Meta-Agent·执行追踪·分叉重放·函数式编程·Agent基础设施 ⚠️ 前序问题:Meta-Agent 对目标 Agent 的操作缺乏形式化框架——无法有效记录、分叉和重放 Agent 执行状态,限制了运行时干预、反事实优化和训练等高级能力 本文贡献:提出 Shepherd 函数式编程模型:将 meta-agent 操作形式化为函数(核心操作在 Lean 中机械化),以 Git-like 执行追踪记录每次交互为类型化事件,支持任意状态分叉和重放;进程+文件系统 fork 速度比 Docker 快 5 倍,重放时 prompt-cache 复用率 >95% 实验效果:运行时干预将结对编程通过率从 28.8% 提升至 54.7%;反事实优化在四个基准上领先最多 11 分且墙钟时间减少 58%;Tree-RL 训练在 TerminalBench-2 上从 34.2% 提升至 39.4% 批判点评:将 Agent 执行形式化为可分叉追踪的系统设计前沿且实用,Git-like 语义直观易理解;但 Lean 形式化的学习曲线和实际部署复杂度可能限制采用 10. On-Policy Distillation:系统实证研究 OPD/OPSD The Many Faces of On-Policy Distillation: Pitfalls, Mechanisms, and Fixes | MIT, ETH | arXiv:2605.11182 关键词:在策略蒸馏·自蒸馏·LLM后训练·失败分析·知识蒸馏 ⚠️ 前序问题:在策略蒸馏(OPD)和在策略自蒸馏(OPSD)作为 LLM 后训练方法前景广阔,但现有结果不一致——有时有效有时退化,何时有效、何时失败及其原因不清楚 本文贡献:系统实证研究 OPD/OPSD 的成功与失败条件,识别三种失败机制:1)teacher 条件化在 student 前缀上的分布错配;2)有偏 TopK reverse-KL 梯度的优化不稳定;3)OPSD 特有的实例特定特权信息缺失问题;提出 stop-gradient TopK、RLVR-adapted teacher 和 SFT-stabilized student 等修复方案 实验效果:为 OPD/OPSD 建立系统性指导:数学推理中对 teacher 选择和 loss 形式高度敏感,系统提示内化场景中 OPSD 有效 批判点评:实证分析全面深入,三种失败机制的识别为该领域提供了重要的实践指导;修复方案虽有效但增加了训练复杂度 趋势观察 统一生成范式成熟化 — INSET 和 Qwen-Image-2.0 分别从交错指令和全能框架角度推进统一视觉生成——前者将图像提升为文本词汇实现精确绑定,后者通过 VLM+MDT 实现生成/编辑一体化,标志着统一生成从概念验证走向工程化 自回归视频走向电影叙事 — CausalCine 首次将多镜头叙事引入自回归视频生成,通过内容感知记忆路由和少步蒸馏实现实时交互导演——AR 视频不再局限于单镜头延伸,开始具备电影级叙事能力 连续扩散模型跨域迁移 — ELF 证明连续 Flow Matching 可以有效用于语言建模,DRoRAE 发现视觉分词器的对数线性缩放律——扩散/流模型的核心技术正在跨越模态边界寻找新的应用空间 物理推理成为生成质量新维度 — PhyGround 构建了首个标准化物理推理基准并开源 PhyJudge-9B,揭示当前视频生成器「看起来真实但物理错误」的系统性问题——物理一致性正从加分项变为硬性要求 RL 对齐驱动生成自反思 — AlphaGRPO 通过分解可验证奖励在 UMM 上解锁了自反思精炼能力——模型不仅能生成,还能自主诊断和修正对齐失败,预示着生成模型将具备更强的自我改进能力 人工智能炼丹君 整理 | 2026-05-13