
搜索到
19
篇与
transformer
的结果
-
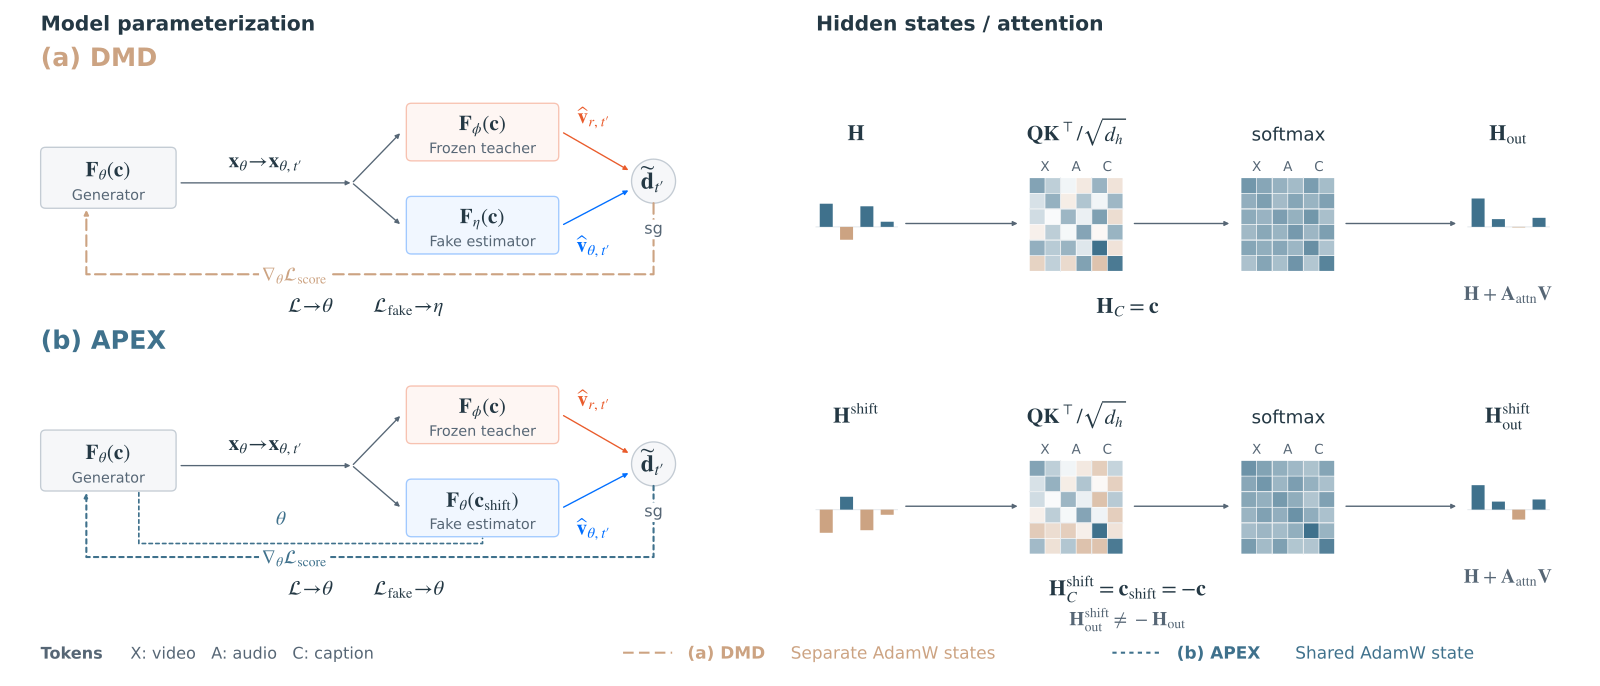
 AIGC 每日速读|2026-11-13|清华流式视频指令偏好净胜30%-APEX 今日 AIGC 论文速览 今日共 10 篇 · 流式视频与偏好对齐 2 篇 · 生成加速 3 篇 · 几何视频与压缩重建 2 篇 · 图文生成 1 篇 · 语音与三维头像生成 2 篇 概览导读:三分钟流式视频中途改指令,人物仍要按要求行动。首篇 APEX 用同一网络兼做生成和假分数估计,70 例成对人工评测的指令遵循净偏好比 S2-Avatar 高 30 个百分点。接着看图像编辑与视频扩散缓存、稀疏注意力和语义 KV 压缩如何省计算;后半篇讨论视频偏好奖励、相机控制与压缩重建,再到文字图像、局部语音编辑和双人 3D 头像。不同论文的速度、质量和偏好口径不直接横比。 重点论文标题列表 APEX(清华):长视频指令偏好净胜30% IdealCache(电子科大):图像编辑缓存提速5.84倍 ESTRA(悉尼大学):视频注意力稀疏到5%仍清晰 SemanticKV(厦大):按指令保留视频记忆 GenRM-Flow(浙大):让视频生成器自己打偏好分 选读入口:想做会随指令变化的三分钟流式视频,先读 APEX;要给 Qwen-Image-Edit 或 HunyuanVideo 省推理时间,读 IdealCache;低密度注意力和长视频缓存预算分别看 ESTRA、SemanticKV。给视频生成器做偏好奖励读 GenRM-Flow;相机轨迹控制新画面看 UGG,极低码率重建看 ADE-GVC。海报中文字总拼错读 Four-Step DiT;多轮只改语音局部风格读 DialInstruct-TTS;双人虚拟头像的互动读 DiaHeads。 今日论文速览 1. APEX:长视频指令偏好净胜30% Few-Step Streaming Video Generation via Condition Shifting | 清华大学;生数科技;西湖大学 | arXiv:2611.14033 关键词:流式视频生成, 少步蒸馏, 条件偏移, 长视频, 指令遵循 前序问题:连续生成三分钟视频时,每个片段都要反复调用生成主干;常见分布匹配蒸馏另养一张“假分数”网络,增加训练显存和迭代时间。 方法直觉:同一生成器换一套文本条件,就让它在生成和估计自身分布之间切换;省掉独立假分数网络,仍保留冻结教师和生成历史回放。 本文贡献:把 APEX 的 condition shifting 扩展到流式视频:原文本条件负责出片,偏移后的条件负责估计生成分布的速度场;训练沿用 Self-Replay Forcing 和感知正则。这里的 NFE 是每片段对视频主干的调用次数,实验用 3 次,再接一次空间 Refiner。 Figure 2 : DMD and APEX in Self-Replay Forcing. DMD uses independent fake parameters η \eta ; APEX shares generator and fake parameters θ \theta and, by default, AdamW states. Teacher parameters ϕ \phi are frozen. Left: θ \mathbf{x}_{\theta} is the rollout/replay output, t ′ t^{\prime} the scoring time, ~ t ′ \widetilde{\mathbf{d}}_{t^{\prime}} the normalized correction, and sg \mathop{{\color[rgb]{1,0,0}\operatorname{sg}}}\nolimits stop-gradient. The correction contributes ∇ θ ℒ score \nabla_{\theta}\mathcal{L}_{\mathrm{score}} ; ℒ \mathcal{L} is the full generator objective. The fake-velocity subscript θ \theta identifies the generated distribution. Right: \mathbf{H} and out \mathbf{H}_{\mathrm{out}} denote input and output hidden states; C \mathbf{H}_{C} contains projected text tokens \mathbf{c} . Within each row, , , \mathbf{Q},\mathbf{K},\mathbf{V} are queries, keys, and values, and attn = softmax ( ⊤ / d h ) \mathbf{A}_{\mathrm{attn}}=\operatorname{softmax}(\mathbf{Q}\mathbf{K}^{\top}/\sqrt{d_{h}}) , with head dimension d h d_{h} . Superscript shift \mathrm{shift} marks states under shift = − \mathbf{c}_{\mathrm{shift}}=-\mathbf{c} . The single-head example uses fixed weights and omits the causal mask and other transformer operations; values are schematic. 实验效果:70 例、每例 180 秒的成对人工评测中,APEX 相对 S2-Avatar 的“指令遵循”净偏好为 +30.0%(胜率减败率),一致性和整体画质各 +4.3%;320 例 StreamAV-Bench 的 Progressive 指令分从 3.831 到 3.856。匹配训练设置下,峰值单卡分配显存低 4.4%,平均迭代时间短 9.2%,这是训练成本而非推理速度。 Figure 3 : Paired examples at 3 backbone NFE. (a) APEX retains both bags late in the sequence, while S2-Avatar shows one. (b) APEX brings the tube to the other hand for the applying instruction; S2-Avatar continues holding it at its side. Each pair uses the same reference and timestamps, with a common one-step 2 × 2\times Refiner. 批判点评:人工评测里运动质量偏向 S2-Avatar,音画同步多为平局;70 例三分钟长流和 3 NFE 加共同 Refiner 的结论不能外推到任意主干或时长。论文没有把少步采样写成相对 S2-Avatar 的端到端推理倍数。 2. IdealCache:图像编辑缓存提速5.84倍 IdealCache: Rethinking Cache Scheduling in Diffusion Transformers via Ideal Trajectories | 电子科技大学;独立研究者 | arXiv:2611.10340 关键词:图像编辑, 视频生成, 扩散加速, 特征缓存, 最短路径 前序问题:扩散 Transformer(DiT)的缓存通常模仿原始逐步去噪轨迹;但中间状态接近原轨迹,不保证最终编辑结果最好,还会把原轨迹当成隐形质量上限。 方法直觉:先定义希望到达的理想输出,再衡量跳过若干完整计算后偏离理想轨迹多少;把“在哪些步更新缓存”变成受计算预算约束的最短路径。 本文贡献:IdealCache 为每个输入构造候选目标形成理想轨迹集合,以缓存偏差作为图边权,离线搜索非均匀更新日程;推理时直接复用日程,不重训 DiT。ℬ 表示保留完整更新的预算,不是生成步数。原文覆盖 Qwen-Image、Qwen-Image-Edit 和 HunyuanVideo。 Figure 2: Cache deviation as edge weight. Starting from x t ∗ x_{t}^{*} on the ideal trajectory, a single full pass populates the cache with residuals Δ t , Δ t \Delta\mathbf{h}_{t},\Delta\mathbf{e}_{t} . We then take t − k t{-}k Euler updates that all reuse those residuals (red dashed), arriving at x ^ k \hat{x}_{k} . The squared distance to the ideal endpoint x k ∗ x_{k}^{*} is the cache-deviation edge weight w ( k → t ) w(k\to t) used in our graph. 实验效果:Qwen-Image-Edit 的 GEdit-Bench 上,ℬ=7 时批量为 1 的端到端墙钟速度为原 50 步的 5.84 倍,整体分 7.59;FlowEdit 上 ℬ=25 的背景保留 SSIM 从原流程 0.665 到 0.687,SSIM 越高表示与输入背景越相似。HunyuanVideo 在表内 ℬ=10 时为 4.32 倍。 Figure 3: Qualitative editing results on Qwen-Image-Edit. Our method achieves better background preservation in some cases while maintaining comparable editing quality. IdealCache with ℬ = 10 \mathcal{B}{=}10 ( ∼ \sim 4.2 × 4.2\times speedup) achieves visual quality comparable to the vanilla 50-step baseline. 批判点评:速度含文本编码、VAE 图像解码等固定开销,不等于单个 DiT 内核提速。FlowEdit 的 ℬ=10 背景 SSIM 0.679 仍较高,但 ImageReward 由原流程 1.054 降到 0.991;不同预算须在编辑保真和速度间取舍,离线理想轨迹构造也有成本。 3. ESTRA:视频注意力稀疏到5%仍清晰 ESTRA: Enabling Extreme Attention Sparsity for Training-Free Video Diffusion Acceleration | 悉尼大学;澳大利亚联邦科学与工业研究组织 | arXiv:2611.10448 关键词:视频扩散, 稀疏注意力, 无训练加速, H20, 画质保真 前序问题:视频扩散 Transformer(DiT) 的长时空 token 让注意力昂贵;现有免训练稀疏法在密度很低时,近似误差会迅速破坏生成画面。 方法直觉:把计算预算留给真正重要的单个 key-value token;其余 token 由聚类代表近似,并根据组内离散程度修正代表权重。 本文贡献:ESTRA 先聚合相似 query 给单个 key 打分,再在 5% 或 1% 的精确交互预算内挑选 token;余下 key 用均值和方差校正模块(VCM) 表示。这里“密度”是精确计算的视频 query-key 交互占比,稀疏阶段之外还存在固定处理成本。 Figure 2: ESTRA overview. (a) Independent query and key clusters provide query centroids and K/V means. (b) Each centroid scores individual keys for selection shared by its query cluster. (c) VCM uses remaining-key spread and query norms to calibrate representative weights. (d) Original queries attend jointly to selected tokens and fixed cluster means, with log-count and VCM biases on representative logits. Colors identify clusters. Attention scaling is omitted. 实验效果:原文在 NVIDIA H20、720p、无密集预热的 Wan2.1-14B(81 帧)上,5% 密度端到端从 6838 秒到 2097 秒,即 3.26 倍;HunyuanVideo-13B(129 帧)从 6490 到 1378 秒,即 4.71 倍。其与密集输出的 Wan 画面 SSIM 为 0.489,高于 Sol-Attn 12.8% 密度时的 0.283;SSIM 越高表示结构越接近密集参考。 Figure 1: High-quality video generation at up to 99% attention sparsity. At 5% exact-interaction density, ESTRA more closely preserves the composition and appearance of the dense references than the baselines shown, while using higher sparsity and achieving greater end-to-end speedups. At 1%, the videos remain visually coherent, with particularly small changes in the HunyuanVideo example. Density denotes the fraction of video query–key interactions evaluated exactly; speedups are end to end on an NVIDIA H20. Additional examples are provided in Appendix D . 批判点评:把 5% 密度误读成整体计算量仅 5% 会夸大收益;在 1% 密度,Wan 的 VBench 动态程度从密集参考 66.98 降到 61.87。该时间受 H20、帧数、分辨率和具体内核影响,跨机器不可直接照搬。 4. SemanticKV:按指令保留视频记忆 Semantically Aligned KV Cache Compression for Efficient Agentic Autoregressive Video Generation | 厦门大学 | arXiv:2611.11452 关键词:自回归视频生成, KV 缓存, 语义约束, 长视频, 显存 前序问题:自回归视频越生成越长,历史帧的 键值(KV)缓存占满显存;普通压缩只看注意力热度,可能删掉对提示词中人物、动作和物件仍重要的状态。 方法直觉:先从计划中抽取必须遵循的语义约束,再找各约束关注的历史位置;每组都能为某个缓存 token 投票,避免少数约束被平均淹没。 本文贡献:SemanticKV 不重训生成器:文本交叉注意力定位语义相关视频位置,收集其自注意力 query;组内平均、组间取最大后做一次 top-k 保留,并维持剩余键值与位置不变。这里保留预算按字节约束,0.7 压缩率指约删去 70% KV。 Figure 2: Overview of SemanticKV . Semantic constraints ℛ \mathcal{R} are matched to prompt tokens. Text cross-attention identifies related video positions, from which we collect the generator’s self-attention queries. Their attention to each KV entry is averaged within groups and maximized across groups. A single top- k k selection retains high-scoring entries within the byte budget, together with states required by the backbone. Retained keys, values, and positions remain unchanged. 实验效果:Causal Forcing 的 5 秒视频综合评测 VBench、0.7 压缩率下,综合分 Total Score 为 84.10,对比最强压缩基线 84.05 和 Full KV 83.99;DiT-only FPS 提升 1.22 倍,KV 从 6.04 GB 到 1.81 GB。LongLive 2.0 的 60 秒实验中,KV 从 20.76 GB 到 6.23 GB,但 VBenchLong 总分从 80.12 降到 78.84。 Figure 4: Paired semantic fidelity on matched prompt–seed tuples. (a) Tie-aware superiority rates. (b) Mean paired differences with prompt-clustered bootstrap 95% confidence intervals. Positive differences favor SemanticKV ; Full KV is the uncompressed reference. 批判点评:方法依赖规划器提出的约束,漏掉的细节未必获保留;5 秒的分数优势很小,也不能等同于所有长视频质量提升。速度数字是 DiT-only,未含规划、筛选和验证全链路。 5. GenRM-Flow:让视频生成器自己打偏好分 GenRM-Flow: Generators are Process-aware Reward Models in Flow Matching | 浙江大学;Joy Future Academy;厦门大学;清华大学 | arXiv:2611.11421 关键词:视频生成, 偏好对齐, 流匹配, 奖励模型, FlowAWR 前序问题:视频偏好对齐常靠外部视觉语言模型或附加判别头评分;评分器没有直接使用视频生成器在噪声潜空间里的预测能力。 方法直觉:偏好微调后的生成器与冻结原模型,对同一视频的速度预测误差差值,本身可读成逐时刻奖励;用这份奖励替代外部判官指导再训练。 本文贡献:GenRM-Flow 从离线偏好目标推导隐式过程奖励:在流匹配噪声状态上比较当前策略与参考策略的速度预测误差,不新增打分头;将它接入按奖励加权微调视频生成器的 FlowAWR。文中不同偏好训练目标都是到目标策略的路径,不是附加奖励网络。 Figure 2: The pipeline of GenRM-Flow . (Panel A) Traditional paradigms rely on representational capacity , utilizing a frozen backbone (e.g., a VLM or base generator) as a feature extractor coupled with an auxiliary discriminative head. (Panel B) The proposed framework sources the reward directly from generative capacity . Following preference optimization, the implicit reward R D ( , c ) R^{D}(\mathbf{x},c) is algebraically extracted from the velocity-prediction errors. The scalar score is computed natively by contrasting the active policy (flame, θ ⋆ \theta^{\star} ) against a frozen reference (snowflake, θ ref \theta_{\mathrm{ref}} ), requiring no architectural modifications or auxiliary heads. 实验效果:原文留出偏好对比集上,Wan2.1-T2V-1.3B 的平均成对预测准确率为 86.79%,PAVRM 为 76.06%;同主干接入 FlowAWR 后,VBench 的动态程度从 PAVRM 的 67.83 到 73.46。14B 主干对应动态程度为 71.82 到 74.87;这些是作者协议内结果。 Figure 4: Qualitative comparison between PAVRM and GenRM-Flow as the per-step reward signal in FlowAWR with a 1.3B backbone. Both runs use FlowAWR with the same configuration, differing only in the reward signal. Red boxes mark localized structural deformations, spatial inconsistencies, and temporal artifacts produced by PAVRM. Across scenes, our reward yields visibly fewer geometric defects and better spatial and temporal continuity. 批判点评:奖励要运行当前与参考生成器的速度预测,不能把“无附加头”误写成零额外计算;奖励依赖已微调策略及参考策略。论文的原始奖励不做组内归一化时约 250 步出现策略坍塌,训练稳定性需要单独处理。 6. UGG:相机轨迹控制视频也补几何 UGG: Unified Generative Geometry Model | 麻省理工学院;加州大学圣迭戈分校;剑桥大学 | arXiv:2611.14440 关键词:相机控制视频, 4D 场景生成, 深度预测, 相机姿态, 条件补全 前序问题:给视频第一帧和相机轨迹,要补出连贯的中间画面;单独训练视频生成与几何预测模型,常让画面、深度和相机姿态彼此不一致。 方法直觉:把已看到的 RGB、深度和相机射线设为干净 token,缺失部分设为带噪 token;同一模型以“补空缺”完成视频生成或几何预测。 本文贡献:UGG(Unified Generative Geometry Model)将 RGB、深度及用密集射线图表示的相机姿态放进统一 transformer;各模态有专属投影和前馈层,共享多模态自注意力。还可采样多个可能场景并用可观测图像的几何证据选择。原文已接收 NeurIPS 2026。 Figure 2: Generative-predictive transformer. We model RGB, depth, and camera pose as spatially aligned tokens, with camera pose represented as dense ray maps. Partial observations are zero-noise context tokens, while missing modalities are noisy tokens to be denoised. A unified transformer processes all tokens with modality-specific projections and feed-forward layers together with shared multimodal self-attention, enabling information exchange across modalities. The decoded RGB, depth, and ray maps form a complete 4D scene representation for cross-modal generation, geometric prediction, and inference-time consistency search. 实验效果:RealEstate10K 双端点帧加目标相机轨迹的视频补全中,UGG 的 峰值信噪比 PSNR 为 25.73 dB、感知距离 LPIPS 为 0.061,对照 SEVA 为 25.25 dB、0.081;PSNR 越高、LPIPS 越低通常表示与真值更接近。但 DL3DV 同设定中,UGG 的 PSNR 16.61 dB 低于 SEVA 的 17.61 dB。 Figure 4: Qualitative comparison of camera-controlled generation. Given the first and last RGB frames and a target camera trajectory, we compare generated intermediate frames against ground truth and baseline video generation methods. UGG better preserves scene identity and dynamic content compared with the generic video completion baselines. 批判点评:“统一”不意味着每个数据集都最好;DL3DV 是明确反例。画面指标依赖真值和给定相机轨迹,也不直接证明开放世界长视频的物理一致性;测试时多样本搜索会增加推理成本。 7. Four-Step DiT:四步画海报字更准 Four-Step Text-Bearing Image Generation via Distillation with Local Response Regularization and Teacher-Guided Training | 清华大学 | arXiv:2611.12042 关键词:图文生成, 扩散蒸馏, 文字渲染, GLM-Image, 四步采样 前序问题:文字海报要同时画好场景和拼对字;把 50 步图像模型压成四步后,字符细节往往先坏掉。 方法直觉:让学生模型的局部去噪响应更平稳,同时用教师图像和合成字符串分阶段喂给它,使少数几步既管布局又管字形。 本文贡献:研究在 GLM-Image 的扩散 Transformer(DiT) 的分布匹配蒸馏中加入局部响应路径长度正则,并保留冻结的自回归视觉先验、字形编码器与 VAE;文字训练从短字符串逐步走到密集布局。四步是学生去噪转移次数,教师是 50 步,不能直接当成端到端 12.5 倍。 Figure 2: Four-step distillation with complementary response and data supervision. Frozen autoregressive and glyph encoders retain semantic and character conditions. Distribution matching transfers teacher synthesis behavior, while the path-length term regularizes the student’s local response. Teacher-guided progressive training combines explicit text examples with visually integrated typography; the VAE remains fixed. 实验效果:原文 1024×1024、NVIDIA A100 的单图推理从教师 5.818 秒到学生 1.742 秒,端到端快 3.34 倍,两者仍需 40 GB GPU 内存。CVTG-2K 单词准确率为 0.5045,四步 TDM 为 0.1690;图像组合生成评测 GenEval Overall 为 0.84 对 0.81。单词准确率是所生成文字与目标文本匹配的比例。 Figure 6: Qualitative comparison of four-step GLM-Image students. Within each three-column group, outputs are ordered as the student without text training, TDM, and our complete framework. Cases cover (a) an English poster, (b) a Chinese poster, (c) a bilingual sign, (d) product packaging, (e) multiline text, (f) a bilingual display, (g) object counting, and (h) spatial relations. The examples illustrate differences in literal text preservation, object counts, and spatial arrangement while retaining coherent scene appearance. 批判点评:加速来自蒸馏与专门文字训练,付出教师生成数据和训练成本;推理显存没有下降。数值只覆盖文中主干、A100 和评测集,不能据此保证任意长文本都不拼错。 8. ADE-GVC:按画面失真选视频去噪起点 When to Start Denoising? Adaptive Denoising Entry for Generative Video Compression | 北京航空航天大学;阿里巴巴集团;香港科技大学 | arXiv:2611.13620 关键词:生成式视频压缩, 扩散重建, 自适应去噪, 视频保真, 码率 前序问题:超低码率视频压缩会丢掉细节;扩散模型从固定噪声时刻开始重建,对失真轻重不同的片段常在保真与真实感之间失衡。 方法直觉:让轻度和重度压缩失真走不同的去噪起点,再把压缩痕迹作为时序条件输入视频扩散 Transformer(DiT);这样重建力度可随内容调整。 本文贡献:ADE-GVC 由潜变量压缩网络、时间适配器、起点预测器和视频扩散模型组成;预测器从压缩潜变量估计起始时刻 τ,适配器提供压缩感知条件。它输出的是原视频的压缩重建,不是从文本自由生成新视频。 Figure 3 : The overall architecture of ADE-GVC consists of a latent compression network (LCN), temporal adaptor (TA), timestep predictor (TP), and video diffusion model. The input video g \bm{V}_{g} is encoded into the clean latent 1 \bm{x}_{1} , which is compressed by the LCN into c \bm{x}_{c} and a compression-aware feature t \bm{f}_{t} . The TP predicts the denoising entry τ \tau from c \bm{x}_{c} , while the TA converts t \bm{f}_{t} into the visual context v \bm{c}_{v} . Conditioned on v \bm{c}_{v} , the VideoDiT denoises τ c \bm{x}^{c}_{\tau} , into ^ 1 \hat{\bm{x}}_{1} , which is decoded to reconstruct ^ 1 \hat{\bm{V}}_{1} . 实验效果:以 S²VC 为 BD-Rate 零点,HEVC-B 的感知距离 DISTS 口径 BD-Rate(等质量平均码率差) 为 −56.4%,GLC-Video 为 −13.4%;负值表示在相同感知失真水平下平均所需码率更低。论文另对 1920×1080、96 帧平均解码计时:优化后的 0.831 秒对原始 4.341 秒,约 5.11 倍,但这是其自身实现优化对照。 Figure 7 : Qualitative comparisons on a single frame in terms of representative VVC, PLVC, GLC-Video and our ADE-GVC methods. We also report the Bpp/DISTS metrics to quantify compression efficiency. 批判点评:不同指标口径会得出不同节省值,不能把 DISTS 与 PSNR 下的百分比混成一个总收益。起点预测和时间适配器需要训练;表中解码加速是并行化、编译和 bf16 累积作用,不是仅由自适应去噪带来。 9. DialInstruct-TTS:多轮只改一句话的语气 DialInstruct-TTS: Interactive Expressive Speech Generation via Multi-Turn Dialogue with Fine-Grained Temporal Control | 奈良先端科学技术大学院大学 | arXiv:2611.13875 关键词:语音生成, 多轮语音编辑, 局部风格控制, TTS, 内容保留 前序问题:一次性文本转语音(TTS)指令往往给整句话同一种语气;想只把中间一段改成低声说,通常要重写指令并重生成全句,已满意部分也会变化。 方法直觉:对话规划器每轮汇总最新要求和历史,形成按时间定位的风格计划;只修订目标潜变量,锁定其余片段。 本文贡献:DialInstruct-TTS 用 Qwen 系列规划器形成标出时间段与风格的 TemporalPlan,再由时序声学控制模块调整情绪、语速、音量和发声方式;reference-latent revision 负责保留非目标区域。它是生成语音的交互式局部编辑,不是通用对话代理。 Figure 2: Architecture of DialInstruct-TTS 实验效果:原文全局风格主观评测中,指令匹配均分为 4.283,对照 Qwen3-TTS 为 3.077;五轮语速修改中,“目标控制与内容都成功”为 15/20,有无非目标锁定的对照为 6/20。30 次最终偏好比较,多轮修订获 29 票,完整重述获 1 票;都是论文的指定主观协议。 Figure 4: Mean subjective ratings and final preference for full-restatement and multi-turn revision. Final preference is 1/30 versus 29/30, with no ties. Means are shown without error bars; numerical results are in Appendix E.4 . 批判点评:局部控制并不各项都稳:同一消融里音量修改成功仅 4/20。多轮流程引入规划和反复合成开销,论文偏好票数不能换算为统一的端到端编辑成功率。 10. DiaHeads:双人对话头像一起动 DiaHeads: Jointly Generating Coordinated 3D Dialogue Heads with Non-verbal Cues from Dual Audio | 中国科学技术大学 | arXiv:2611.06970 关键词:3D 头像生成, 音频驱动, 双人对话, 非语言动作, 注视 前序问题:各自按音频生成说话头像,容易得到两张嘴都动却没有互相看、点头或等待反馈的双人画面。 方法直觉:把两人的音轨放进同一条件,再让注视、摇头、点头、微笑四类离散提示和连续头部动作共享潜空间;模型一次生成两个人的动作。 本文贡献:DiaHeads 冻结双路 HuBERT 编码音频,用变分编码器融合连续 FLAME 头部参数与四类非语言 cue;时间相关的 flow prior 替代独立高斯先验,共享解码器同时输出两位参与者。FLAME 是 3D 人头参数模型。 Fig. 2: Overview of the proposed DiaHeads. The audio streams of both interlocutors are encoded by two frozen HuBERT backbones and fused into a conditioning vector c c by a transformer. A dual-branch variational encoder processes the continuous parameters ( F , G ) (F,G) and the discrete cues N N in separate branches, each conditioned on c c through FiLM modulation, and the two branches are combined through a product-of-experts posterior z ∼ ( μ , e σ / 2 ) z\sim\mathcal{N}(\mu,e^{\sigma/2}) , shown as the “Low-level Motion Encoder” and “High-level Cue Encoder”. A flow-based prior built from five residual coupling blocks, each consisting of a flip operation and a Conv1D coupling layer, replaces the standard Gaussian prior, and a shared VAE decoder, conditioned on c c through FiLM, jointly reconstructs the head parameters Y ^ \hat{Y} and the discrete cues of both interlocutors. The units at the bottom right detail the two SyncNet encoders, which are built from 1D convolution, batch normalization, and ReLU. 实验效果:CANDOR-FG 双人数据上,交互 DTW(两人动作时序不匹配程度,越低越好)为 0.3171,对照双人基线 DIM 为 0.7526;盲选中 DiaHeads 获 58 票,SadTalker 33 票、DIM 17 票。但单人头部 FLAME MSE 为 0.6662,高于 SadTalker 的 0.5523,精细动作保真并非全胜。 Fig. 5: Qualitative comparison of generated 3D head animations over a 30 s dialogue clip. Participant A is shown in blue and participant B in orange. Each method occupies two rows labeled A and B, sampled every 2.5 s. Our method produces appropriate mouth movements during overlapping speech at 8 s, marked by the purple box, and responsive nodding with mutual gaze at 20–23 s, marked by the yellow box, while the baselines show incorrect lip-sync and lack interactive behaviors. 批判点评:论文展示的是 3D 头像动画参数,不是直接输出真人视频;双人数据和四种 cue 限制了外推范围。交互协调改善与单人几何误差存在取舍;原文仅称准备投稿 IEEE Transactions on Multimedia,未写成已接收。 趋势观察 视频生成的计算预算不再只数采样步 APEX 省掉训练时的独立假分数网络;ESTRA 压低注意力精确交互,SemanticKV 精简历史缓存。三者改变的是不同成本,不能把倍数直接相加。 编辑和生成更看最终条件满足 IdealCache 用理想输出搜索缓存日程,UGG 用相机轨迹和几何共同约束中间帧,DialInstruct-TTS 则锁住语音中不需修改的区间。 评测必须保留反例和口径 APEX 的运动质量并非胜出;UGG 在 DL3DV 双端点帧设置的 PSNR 落后 SEVA;SemanticKV 的 60 秒总分低于 Full KV。 今日讨论 APEX 在 70 例三分钟视频中得到指令遵循 +30.0% 净偏好,但运动质量偏向 S2-Avatar。若为一条中途多次换商品动作的直播片段选生成器,你会怎样同时检验指令执行、人物连续性和动作自然度,何时不应为了指令偏好牺牲运动质量? 人工智能炼丹君 整理 | 2026-11-13 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
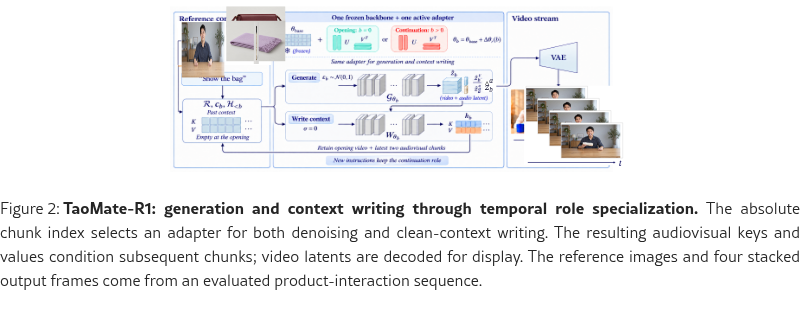
AIGC 每日速读|2026-11-12|阿里多参考长视频换指令不断档-TaoMate-R1 今日 AIGC 论文速览 今日共 10 篇 · 多参考与广告视频审修 2 篇 · 多场景视频与生成加速 3 篇 · 几何控制与图文生成 2 篇 · 三维动作生成 1 篇 · 生成结果评测 2 篇 重点论文标题列表 TaoMate-R1(阿里):多参考长视频换指令不断档 Review-and-Edit(Anoki):广告视频问题一键找到修复入口 OneReel(伊利诺伊大学香槟分校):多场景视频只共享少量关键帧 MG-Cache(北京邮电大学):视频去噪按时间层级双重缓存 FADE(四川大学):预测弯曲去噪轨迹少算视频 选读入口:要用多张参考图连续拍人和商品,先读 TaoMate-R1;要从广告成片定位错误并派给修复工具,读 Review-and-Edit。想控制跨场景一致性读 OneReel;要在既有 DiT 上提速,对照 MG-Cache 的缓存内存和 FADE 的离线校准。要画准钟表与披萨比例读 Angular Control;要让图文长文配图对位读 UniWeaver;做长序列 3D 动作看 FlashMotion。评估改图判官和视频物理常识,分别读 EditJudge-Bench 与 PhyRubric。 今日论文速览 1. TaoMate-R1:多参考长视频换指令不断档 TaoMate-R1: Temporal Role Specialization for Streaming Multi-Reference Video Generation | 阿里巴巴集团 | arXiv:2611.14307 关键词:视频生成, 多参考生成, 流式生成, LoRA, 场景连续性 前序问题:指定人物和商品后连续拍两分钟,提示词中途换动作或物品;按片段生成常在接缝处换掉人物、房间或亮度。 方法直觉:把“开场建景”和“后续延续”当成两种时间职责,各自用一套低秩适配器;同一职责既生成当前片段,也写入下一段要看的历史。 本文贡献:TaoMate-R1 在冻结的 MiniMax H3 主干上配两组 LoRA,而非按去噪与写历史两种操作分组。Self Gradient Forcing 让开场和延续适配器沿自己生成的历史联合训练。32 个多参考案例采用相同两适配器预算比较。 Figure 2: TaoMate-R1: generation and context writing through temporal role specialization. The absolute chunk index selects an adapter for both denoising and clean-context writing. The resulting audiovisual keys and values condition subsequent chunks; video latents are decoded for display. The reference images and four stacked output frames come from an evaluated product-interaction sequence. 实验效果:在 10 条约两分钟、指令会变化且共用教师音频条件的长流上,相对按操作分组,接缝平均亮度跳变从 1.96 降至 0.613;接缝 DINO 特征相似度从 0.973 到 0.990。DINO 是图像特征相似度,数值越高通常表示相邻帧外观更接近。该比较没有统一报告端到端推理延迟。 Figure 6: Scene continuity over a two-minute interaction. Each row combines the first frame’s left half, centre columns sampled every 0.5 s, and the last frame’s right half (case 006, 119 s). Grey ticks mark instruction changes; endpoints retain native aspect ratios. The bands contrast composition changes in clip-wise generation with stable presenter and table geometry in the TaoMate-R1 stream. 批判点评:这是按参考生成新音视频,不是对现成视频直接编辑。接缝更平稳不等于所有指令都执行成功:长流的问答遵循分为 0.980,按操作分组为 1.00;结论依赖这套主干、两适配器预算和共享音频条件。 2. Review-and-Edit:广告视频问题一键找到修复入口 Multimodal Judges Flag, Humans Decide: A Review-and-Edit Framework for AI-Generated Product Video Ads | Anoki 公司 | arXiv:2611.13178 关键词:生成视频审阅, 视频编辑, 商品一致性, 多模态评测, 人工复核 前序问题:电商商品页自动变成短广告后,镜头里商品形状、文案、旁白或字幕可能错;只给整条广告打一个好坏分,编辑者不知道该修哪一幕。 方法直觉:把广告按场景和六类问题拆开,让多模态 judge 先指出时间点与依据,再由人确认;每条确认的问题直达对应编辑工具。 本文贡献:系统检查商品、场景质量、发音、脚本、声音和字幕。门户把模型发现与商品照片、事实资料并列给审阅者;确认后可借别条广告的镜头、重生镜头、做视频到视频编辑或局部高分辨率修复。这里的核心是审修流程,视频生成与修复工具作为可替换后端。 Figure 3 : The production portal. Panels (a) to (c) show the review and panel (d) the edit page. (a) The review page for one ad: 1 the ad and its scenes, 2 the six questions, collapsed, each tagged when a judge flagged it, and 3 the evidence: the catalog photos, product facts, brand kit and script. (b) 4 A judge’s finding sits inside the question with its scene, kind and evidence; the reviewer accepts or rejects each with a thumbs up or down and 5 answers below, where “Product wrong” then asks which scenes are at fault. (c) 6 The scene judges’ finding above 7 the per-scene grid, with keep, swap out or no opinion for each scene, and 8 the secondary options for the kind of problem. (d) On the edit page: 9 the scenes with confirmed issues; 10 a confirmed issue opens the scene tool on its scene, with 11 the scene’s versions and 12 ways to change it: another ad’s scene of the same product, a new scene, or Repair, which fixes the scene in place, today by regenerating its clip at higher resolution. 实验效果:在自家流水线的 120 条广告、562 个场景中,辅助审阅标记约 60% 的场景有商品问题。对其中 60 条广告,辅助审阅的多数标记率为 58%,隐藏 judge 后两名审阅者为 26%;两组不能直接视作随机对照。另在盲标的 120 个场景上,商品 judge 的 AUC 为 0.84;它召回 29 个缺陷中的 26 个,但 56 个告警中仅 26 个是真缺陷。 Figure 2 : One generated 15 s ad ( video in our release) as judges and reviewers reviewed it, one row per question. Reviewers accepted the judges’ product findings and rejected nearly all of their pronunciation findings. They also marked the S3 and S4 captions and added two problems the judges missed in S2: an impossible motion in the scene and an unsupported claim in its line. 批判点评:高召回带来较多误报,必须保留人工决定;实验证据来自单一市场、英语旁白和一条内部生成流水线。研究没有证明全自动编辑或审核耗时一定缩短。 3. OneReel:多场景视频只共享少量关键帧 OneReel: Efficient Multi-Scene Video Generation with Scene-Structured Attention | 伊利诺伊大学香槟分校;得州大学奥斯汀分校;斯坦福大学 | arXiv:2611.10594 关键词:多场景视频生成, 稀疏注意力, 共享记忆, 多GPU 前序问题:多场景视频若所有帧彼此全连接,注意力成本随场景数迅速膨胀;分场景单独生成又容易让人物和物体跨场景变样。 方法直觉:场景内部保持完整注意力,跨场景只交换被挑出的代表帧;提示词和时长先划定每个场景的作用范围。 本文贡献:OneReel 无需再训练生成主干:对每个场景保留本地注意力,把聚类选出的潜变量代表帧放进有界共享记忆;再把本地及共享 K/V 打包为连续的可变长注意力输入,并按通信成本选择多 GPU 分工。理论上的跨场景注意力随场景数由平方变线性。 Figure 5: Scene-structured attention across model architectures. Rows denote queries and columns denote keys. Purple denotes scene-local interactions; orange denotes selected foreign video K/V from a shared memory. The example shows one head; text queries remain local. 实验效果:四种生成模型的实验相对稠密注意力报告端到端 1.7–4.9 倍加速。40 个多场景请求中,HunyuanVideo-1.5 480p 的文本遵循分从稠密的 27.7 提至 61.9;同表的动作分从 34.5 到 64.1。分数只在论文这套多场景提示与评测协议下可比,性能还依赖共享记忆和多 GPU 打包实现。 Figure 10: Minute-long generation with HunyuanVideo-1.5. OneReel captures the requested scene changes, while dense generation remains visually repetitive. 批判点评:需事先给出场景提示及持续时间;代表帧太少会漏掉跨场景细节,太多则削弱加速。作者对一分钟长视频另加场景局部 RoPE,说明注意力作用域之外的时间位置编码同样影响效果。 4. MG-Cache:视频去噪按时间层级双重缓存 MG-Cache: Multi-Granularity Caching for Accelerating Diffusion Transformer Inference | 北京邮电大学 | arXiv:2611.11365 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 多粒度缓存 前序问题:扩散 Transformer 要重复计算几十次;各时间步和各层变化程度不同,统一跳过容易积累误差,高清长视频尤其耗时。 方法直觉:先用小批校准样本找出可跳过的去噪时间步,在线再按各层输入变化和重要性决定是否复用注意力或 MLP 的中间特征。 本文贡献:MG-Cache 的第一阶段离线分析时间步冗余,第二阶段对层内模块按稳定度与敏感度动态缓存;无需重新训练生成模型。论文在 HunyuanVideo 与 FLUX.1-dev 上同时测速度、画质和相对未缓存输出的保真度。 Figure 2 : Overview of the Multi-Granularity Cache (MG-Cache). We design a two-stage strategy to exploit computational redundancy during inference. Stage 1 performs a static offline analysis to identify and preserve critical timesteps based on a timestep feature table [ M ^ t ] [\hat{M}_{t}] constructed from a small batch of calibration dataset. Stage 2 introduces a dynamic layer-wise caching mechanism that computes layer importance scores and input stability to adaptively determine whether to reuse cached features. 实验效果:HunyuanVideo 文生视频、544×960、129 帧、原始 50 步条件下,慢档由 982.03 秒降至 358.86 秒,即 2.74 倍;VBench 从 75.45% 到 75.14%,PSNR 27.44 dB 是相对原始输出的像素保真度。bf16 层缓存对该分辨率需 49.8 GB,论文使用内存卸载;因此速度收益不能脱离缓存容量与数据搬运谈。 Figure 1 : Visual quality comparison. While achieving a higher speedup than baselines, our method also maintains superior fidelity to the original output. For instance, in the first row (Prompt 1), other methods exhibit blurring on the text "stop," whereas our method preserves text sharpness. 批判点评:离线校准和高分辨率层缓存是额外成本。快档可进一步提速,但同表 VBench 降到 74.13%;部署需按显存、内存和质量目标调阈值。 5. FADE:预测弯曲去噪轨迹少算视频 FADE: Fractional Anomalous Dynamics Extrapolation for Training-Free Diffusion Transformers Acceleration | 四川大学 | arXiv:2611.10514 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 特征预测 前序问题:缓存法在跳过多个去噪步时通常按直线或整数阶变化外推特征;遇到弯曲且随时间变化的轨迹,误差会累积。 方法直觉:用分数阶动力学描述特征轨迹的弯曲程度;先离线测好各阶段和层的参数,在线按查表结果在完整计算和预测步之间交替。 本文贡献:FADE 用 Mittag–Leffler 分数阶算子外推 DiT 中间特征,离线校准最合适的阶数并存入多维查找表;推理时按时空位置取参数,减少被跳过步骤的计算且不微调主干。 Figure 2 : Overall framework of FADE. FADE consists of an offline profiling stage and an online inference stage. The offline stage calibrates and stores the optimal fractional orders in a static LUT, while the online stage alternates between full-compute and prediction steps using LUT-retrieved orders for feature forecasting. The upper-right panel illustrates the geometric contrast between the FADE trajectory and the integer-order trajectory in the latent space. 实验效果:HunyuanVideo 文生视频的同表条件下,原始 50 步耗时 190.2 秒、VBench 80.68%;FADE 在 N=6、m=1 设置下耗时 37.9 秒、VBench 80.12%。按列出的延迟相除,墙钟加速约 5.02 倍;表中 Spd. 列的 5.56 倍与 FLOPs 比 29,773/5,359 一致,两个口径不应混写。同预算 HiCache 为 37.8 秒和 79.93%,FADE 主要改善该表的质量而非进一步缩短时延。 Figure 5 : Qualitative comparison on text-to-video generation. 批判点评:收益依赖离线校准的查找表及具体主干;换架构或采样预算需重新标定。VBench 相对原始生成仍下降 0.56 个百分点,不能把“保真”写成无损。 6. Angular Control:让画出来的时钟真指向指定时刻 Continuous Angular Control in Text-to-Image Generation via Geometric Token Encoding | 毕尔肯特大学;CISPA 亥姆霍兹信息安全中心;弗赖堡大学 | arXiv:2611.13172 关键词:图像生成, 几何控制, 扩散模型, 角度编码 前序问题:让文生图模型画 10:10 很容易,要求 1:45 时两根针常常还是落回惯见姿势;要求披萨只剩指定圆弧比例也有类似问题。 方法直觉:把时针、分针或扇区边界的角度编码成周期性的正弦和余弦 token,直接放进提示词;训练时由局部约束逐步放松到整物体约束,让数字位置落到正确部件。 本文贡献:该法在冻结文本编码器前插入角色专属几何 token,并用 LoRA 调整 SD 2.1 去噪器。Stochastic Localization Relaxation(SLR)混合部件框、物体框和无定位三种训练监督;推理无需输入框。另用指针互换偏好损失防止时针和分针角度对调。 Figure 2 : Left: Overview of our geometric token encoding framework, illustrated for clock-time control. The target clock time ( h , m ) (h,m) or fraction-sector boundaries are encoded as sinusoidal pairs and mapped through the projection network P P to produce role-specific geometric tokens h , m \mathbf{e}_{h},\mathbf{e}_{m} (or s , e \mathbf{e}_{s},\mathbf{e}_{e} ) injected into the prompt before the frozen text encoder. Both tasks share the same MLP architecture and condition a LoRA-adapted SD 2.1 denoising U-Net. Right: Stochastic Localization Relaxation (SLR). Training samples one of three localization regimes (55/30/15%): component-level CALL using component boxes, object-level CALL using a shared object box, and unconstrained standard cross-attention. No localization input is required at inference. 实验效果:时钟 Acc@6° 指两针都在目标角度 6° 内;四种未微调基线均低于 1%,本法在不同读图器下约 63–78%。圆形物体比例误差不超过 0.10 的 Acc@0.10,训练类为 89.5%,未见过的物体类为 88.8%,未见过的比例为 84.9%;基线约 20%。这些数字来自带精确角度标注的任务数据。 Figure 8 : Qualitative comparison of the original periodic encoding and the augmented encoding with the scalar fraction f f near the angular boundaries. The periodic encoding produces small sectors near 0 ∘ 0^{\circ} but may generate narrow slices even for complete-sector targets ( 360 ∘ 360^{\circ} ), reflecting its endpoint ambiguity. Adding f f distinguishes the endpoints and enables complete-object generation, but can produce oversized sectors for small target angles ( 1 ∘ 1^{\circ} – 5 ∘ 5^{\circ} ). Results are shown for pizza, pie, and cake. 批判点评:必须有任务专用的几何标注与训练;复杂场景或部件不清时精度会下降。0° 与 360° 的周期编码端点相同,附录增加比例标量虽能区分整圆,却可能放大小角度扇区。 7. UniWeaver:把文字和配图按任务一起编排 UniWeaver: Harnessing Unified Multimodal Models for Interleaved Text-Image Generation | 俄亥俄州立大学;伦敦大学学院;香港中文大学;香港科技大学(广州);香港大学 | arXiv:2611.13530 关键词:图文交错生成, 多模态生成, 规划, 视觉反馈 前序问题:用户只说“做一份操作指南”,统一多模态模型常先写完一段再补图,图与步骤错位,关键步骤也可能没有画面。 方法直觉:先确定每一段要讲什么、配什么图和共享风格,生成后再按可观察清单检查图片是否支持文字;失败时修正局部。 本文贡献:UniWeaver 是模型无关的图文交错生成工作流,包含任务范围、文字与图片规划、参考图分配和视觉复核。作者用该流程构造覆盖 20 类任务的 1 万条训练轨迹,并建立 120 条留出任务的 UniWeaver-Bench,从文字覆盖、写作质量、视觉覆盖与图文对齐评估终稿。 Figure 3: Overview of UniWeaver. ① UniWeaver introduces a structured workflow for interleaved text-image generation, with execution trajectories providing supervision for fine-tuning (Section 3.1 ). ② UniWeaver-10K Dataset provides 10,000 goal-only tasks paired with structured planning trajectories across 20 task families (Section 3.2 ). ③ UniWeaver-Bench systematically evaluates final interleaved outputs on 120 held-out tasks (Section 3.3 ). 实验效果:在同一 120 任务消融协议中,基于 BAGEL 的完整方法综合分 58.89;去掉共享视觉风格为 48.21,去掉任务目标为 53.01。分数按任务门禁通过率加权,只对过门任务计算;不能直接解读为每张图片质量提高 10.68 分。论文未给统一的额外模型调用成本与端到端耗时。 Figure 5: Qualitative comparison on two representative tasks. UniWeaver produces more coherent, actionable instructions with task-relevant visuals, while baselines exhibit repetitive content, missing details, or ineffective visual support. Zoom in for better view. 批判点评:这一流程依赖规划与视觉 judge,长文可能增加调用与返工成本;评测本身也依赖模型判分。图文能力提升并不自动代表单张图的生成模型更强。 8. FlashMotion:一万帧动作也能快生成 FlashMotion: Ultra-Fast Long-Term 3D Motion Generation | 腾讯 IEG Motus Group;中国人民大学;清华大学;得州大学达拉斯分校;武汉大学;南开大学;香港大学 | arXiv:2611.13626 关键词:3D动作生成, 文生动作, 音乐舞蹈, 语音手势, 少步采样 前序问题:游戏和虚拟人的长动作既要跟文本、音乐或语音走,又要少采样、少显存;长序列常出现脚滑、抖动或推理跟不上交互。 方法直觉:同时缩短“要采几步”和“每步有多贵”:用少步平均速度预测完整动作,再用轻量双向时序模块看前后动作与条件。 本文贡献:FlashMotion 将带运动学和动力学约束的 3D motion-space MeanFlow 与约 6000 万参数的 BiMamba/CoBiMamba 组合,支持文生动作、音乐生舞蹈和语音生手势;Adaptive Soft mask 用于动作中间段编辑。这里生成的是 3D 运动表示,后续骨骼绑定与渲染另算。 Fig. 2: Overview of FlashMotion . (a) Inference flow with clean-motion prediction and MeanFlow updates. (b) Training model inputs and output: noisy motion, conditions, and timesteps are mapped to the clean-motion target. (c) Shared BiMamba/CoBiMamba block. Dashed purple paths denote optional conditioning, omitted in BiMamba and used in CoBiMamba for condition-guided state selection. 实验效果:BABEL 长序列文生动作实验中,四步版 R@1 为 29.134%,对 DART 的 26.105%;R@1 是文本查询时正确动作排在第一的比例。RTX 3090、batch=1 的一万帧动作输出,论文报 46,303 FPS,对 DART 的 75 FPS;这是运动序列吞吐,不是最终视频渲染帧率。一阶段更快但 FID 更差,反映速度与分布质量取舍。 Fig. 3: Text-to-motion comparison under a shared sequence of 3 prompts. 批判点评:仿真中的动作可用于角色动画,但机器人执行和真实人体安全性不能由这些分数推导。速度比较受动作长度、硬件和只计模型生成的口径影响。 9. EditJudge-Bench:先测判官会不会看错改图 EditJudge-Bench: Auditing VLM Image-Edit Judges with Synthetic Ground Truth | 丹麦技术大学;Pioneer Centre for AI | arXiv:2611.12524 关键词:图像编辑评测, VLM判官, 合成真值, 反事实 前序问题:图像编辑榜常请视觉语言模型判断“改对了吗”,但真实改图既有意外副作用又没有精确真值,判官判错时很难归因。 方法直觉:用 Blender 场景参数生成编辑前后对,哪一物体、位置、材质或形状被改过都有确定答案;再让 VLM 判断编辑指令是否真的执行。 本文贡献:EditJudge-Bench 有 1,382 对合成图,覆盖九类编辑并配错误方向、错对象、无编辑等反事实指令;以 25 种判官配置检验指令核验可靠性,并比较不同提示模板和图文顺序。它评测的是编辑判官,不是推出新的图像编辑模型。 Figure 2: Overview of the nine edit types in EditJudge-Bench . The central inset shows the underlying Blender scene parameter modified by each edit: object position \mathbf{x} , rotation \mathbf{r} , scale \mathbf{s} , shape parameter θ \mathbf{\theta} , articulation joint ψ \mathbf{\psi} , material \mathbf{m} , visibility \mathbf{v} , lighting state \mathbf{l} , and camera state \mathbf{c} . Surrounding images show one rendered edit from the source image per category. Because each edit is a deterministic parameter change, magnitude and direction are known exactly. 实验效果:论文报告 GPT-4o 使用常见 VIEScore 模板的整体 AUROC 为 69.0%;AUROC 是随机抽一正一负时把正确编辑排得更高的概率。若干微调判官为 51.7–66.3%,图文顺序等提示格式可改变结果最多 14.1 个百分点。尽管测试图是合成的,判官排名与两项真人偏好榜的 Spearman 相关分别为 0.95 和 0.71。 Figure 3: Example image pairs in EditJudge-Bench . For each edit type, we show three original/edited image pairs from our benchmark. 批判点评:Blender 场景与真实照片仍有域差;排名相关高不表示任何单一判官在真实编辑上都可靠。旋转、形状等空间编辑尤其难判,应逐类审计。 10. PhyRubric:逐条指出生成视频违反哪条物理 PhyRubric: Rubric-Grounded Diagnostic Evaluation of Physical Commonsense in Text-to-Video Generation | 伊利诺伊大学芝加哥分校 | arXiv:2611.13576 关键词:视频生成评测, 物理常识, 细项量表, 时间戳诊断 前序问题:文生视频若小勺瞬间跳位、按钮还没按灯就亮,单个“物理分”说不清问题发生在哪一秒,也不利于修提示词。 方法直觉:在看到生成视频前,先把每条提示词拆成语义与物理预期;播放后逐项给出是否达成及对应时间戳。 本文贡献:PhyRubric 包含五个物理领域、34 类情境;PhyRubric-Bench 对十种文生视频模型做细项诊断,另用 3,788 条视频训练开源 PhyRubric-Judge。判官分别报语义遵循 SA、物理是否可评、物理分 PC,并给违反预期的证据。 Figure 2 : Overview of PhyRubric. (1) Rubric formulation : each caption is paired with a rubric covering semantic adherence (SA) and physical commonsense (PC), constructed before any video is seen and reused to score videos from all models. (2) PhyRubric-Bench : captions spanning five physical domains and their rubrics are drafted by LLMs and reviewed by humans. Videos from 10 T2V models are pre-annotated by an agent and verified by humans. (3) Train & Judge : an agentic annotator labels training videos to build PhyRubric-Train, on which we train PhyRubric-Judge. Given a video and its caption, the judge outputs an SA score, whether PC is assessable, a PC score, and a diagnosis of the violated expectation with timestamped evidence. 实验效果:在该榜单,JP 是全部视频中 SA 与 PC 都至少 4/5 的比例;Seedance 2.5 平均 JP 44.20%,Veo 3.1 为 36.20%,但并非跨数据集总排名。判官相对真人物理分的 Pearson r 为 0.32,Gemini 4 Argon 为 0.31;两者物理通过判别 AUC 均 0.68,说明自动诊断仍有明显误差。 Figure 7 : Two failure cases from PhyRubric-Bench. (a) A small squirt of ketchup becomes a full bowl and the spoon jumps between 1.50 s and 1.62 s. (b) The roof light is lit from the first frame, before the finger reaches the button at 2.30 s. 批判点评:PC 只对“物理可评”的视频平均,单看它会漏掉根本没生成目标事件的失败;JP 更适合合看。细项量表和时间戳需人审,诊断改写提示词的示例不能直接当作普遍修复率。 趋势观察 把长视频的共同信息压到必要位置 TaoMate-R1 按时间职责训练适配器,OneReel 只交换场景代表帧;一个处理生成历史角色,一个处理跨场景注意力。 加速仍要算额外状态成本 MG-Cache 在高分辨率视频需要大型层缓存;FADE 需要离线校准分数阶。两者速度数字均不可脱离各自硬件和采样设置。 可控生成与评测都转向可定位证据 Angular Control 把角度直接编码进 prompt,Review-and-Edit 按场景定位问题,EditJudge-Bench 与 PhyRubric 追问判官和物理诊断的可靠性。 今日讨论 TaoMate-R1 在十条两分钟长流上把接缝亮度跳变从 1.96 降到 0.613,但长流问答遵循分略低于按操作分组。若按开场与延续分组拍一条中途连续换五次商品指令的广告,哪些指标能同时验证接缝、人物身份和指令执行,何时该放弃这套分组? 人工智能炼丹君 整理 | 2026-11-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
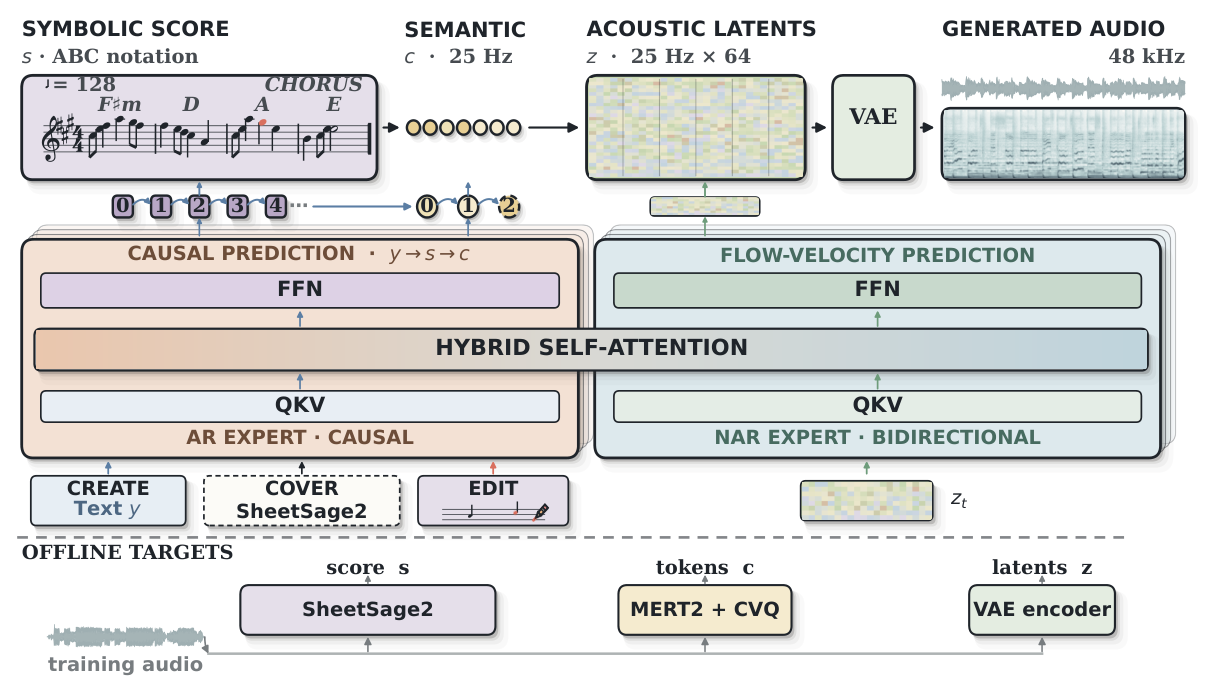
AIGC 每日速读|2026-09-30|港科大先写谱再唱,YuE2 逼近 Suno 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 蒸馏与一步生成 3 篇 · 统一模型与自我反思 1 篇 · 音乐与音频生成 1 篇 · 数据集与评测 1 篇 重点论文标题列表 YuE2(港科大):先写谱再唱出来,49.3%胜 WorldAttention(阿里巴巴达摩院):单卡22帧,内核快14倍 PDMD(加州大学圣迭戈分校):一行代码,VBench 涨 1.03 GeoShrink(香港科技大学(广州)):两行代码换五倍,PSNR+3.10 MGFlow(清华大学):一步打赢四步,FDr 1.45 今日论文速览 1. YuE2:先写谱再唱出来,49.3%胜 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality | 香港科技大学;M-A-P;HKGAI;Tokenwave.AI;纽约大学;斯坦福大学;MBZUAI;Noiz;ACE Studio | arXiv:2609.33757 关键词:音乐生成, 符号音乐, 音频生成, 可控创作, 多模态 前序问题:符号音乐模型把旋律、和声、节奏、曲式写得很清楚,但通常停在「谱」这一步,出不了成品录音;音频模型能吐出完整歌曲,作曲过程却完全隐式,用户没法改。真正可用的创作工具要的是「先看懂谱、再决定怎么唱」。更麻烦的是训练数据:现成录音没有对齐的乐谱,符号监督和语义监督双双缺失。 本文贡献:用一个 AR-NAR 混合的 Mixture-of-Transformers 把两件事接成一条链:先写出可读的乐谱(指定旋律与和声),展开成 25 Hz 语义音乐 token,最后落成 25 Hz 连续声学 latent,由 48 kHz 立体声 VAE 解码成整首歌。为从「没有对齐乐谱的录音」里学会这套流程,配套提出 MERT2 提供语义监督、SheetSage2 提供符号监督。由于中间产物是人类可读的乐谱,同一 checkpoint 能跟着谱面编辑改动并保住未改动部分,还能零样本翻唱,外部大模型也可把反馈译成谱面修订,实现 agentic 改曲。 Composing in symbols, performing in audio. 实验效果:同一 checkpoint 下,专家对「带符号规划」的整体偏好为 49.3%,不规划只有 34.6%。WildSongBench 上 SongBench Global Avg 得 6.73,超过所有受评公开基线;best-of-8 取 6.96,是全部受评系统中的最高均值。专家听测中 best-of-8 优于 Suno v4.5,对 v5 接近持平。MERT2 在 MARBLE 的 15 项指标中 14 项刷新最佳;SheetSage2 在 lead-sheet 转录对比的 15 组指标对中 12 组领先。 Expert preferences for YuE2 versus six proprietary song generators across all six criteria. 批判点评:49.3% 对 34.6% 看着是压倒性优势,其实只是同一套系统的两种采样策略互相比,净增益不到 15 个百分点。真正硬的对标是 Suno v6:论文自己给的专家偏好里对 v6 的 overall 胜率只有 31.6%、败率 59.3%,是明显劣势——「frontier quality」只在 v4.5 / v5 这一档站得住。另外 best-of-8 的 6.96 需要 8 倍采样成本,56 页技术报告也没有同行评审背书。 2. WorldAttention:单卡22帧,内核快14倍 WorldAttention: An Efficient Attention Architecture for Interactive Video World Models | 阿里巴巴达摩院;浙江大学;香港科技大学;湖畔实验室;阿里巴巴 TRE | arXiv:2609.34606 关键词:视频世界模型, 稀疏注意力, KV 缓存, 推理加速, 长视频生成 前序问题:交互式视频世界模型要按文本指令持续生成长时间、时间连贯的视频。滑动窗口能把计算量封住,代价是历史上下文被直接砍掉,长程交互能力塌掉;而保留全历史 KV 缓存在计算和显存上都不可行——注意力的二次复杂度让开销爆掉,KV 缓存的线性增长迟早把显存吃满。两条路都不通,问题落在「既要长历史,又要低延迟」上。 本文贡献:提出系统级协同设计的注意力架构,两手一起改:一是 Hybrid Sparse Attention(HSA),把线性全局注意力和头自适应稀疏注意力并在双分支里,按注意力头动态决定稀疏度;二是 Hierarchical KV Cache(HKV),把历史 KV 组织成跨多层存储的语义索引页,先做 prompt 级检索再做 page 级检索,粗到细地把需要的页取回并控制 GPU 驻留量。两项设计都配了定制 kernel,把理论上的效率真正落到硬件上。 Overall architecture of WorldAttention. 实验效果:定制 kernel 相对 FlashAttention-3 带来 14.02 倍 kernel 级加速,叠加 HKV 后端到端加速 2.21 倍;单张 NVIDIA H100 上维持 22.0 FPS。VBench-Long 上质量得分 86.55 且吞吐最快,主体一致性 0.9472;InterVBench 上主体一致性 0.9668。B200 上跨模型规模与分辨率的端到端加速为 2.06 到 2.46 倍。 Attention kernel speedup. 批判点评:14.02 倍是 attention kernel 这一层的数字,端到端只剩 2.21 倍,落差本身就是论文的自我交代:HSA 单次执行 633 微秒里,稀疏 block 注意力 kernel 只占 11.78 微秒(1.86%),大头是 KV 连续拷贝(31.00%)和线性分支(39.78%)。也就是说 kernel 做得再快,杠杆也被内存搬运和线性分支吃掉。另外质量侧的「超越此前 SOTA」只给了主体一致性等少数几项,没有给出相对最强基线的完整指标表。 3. PDMD:一行代码,VBench 涨 1.03 PDMD: Projected Distribution Matching Distillation for Video Diffusion Models | 加州大学圣迭戈分校;字节跳动 | arXiv:2609.35768 关键词:视频生成, 扩散蒸馏, 分布匹配, 少步生成, 批评者误差 前序问题:视频扩散模型动辄要几十次去噪评估,DMD 能把 NFE 压到个位数,但蒸馏出来的样本会在训练过程中逐步退化:画面越来越过饱和、纹理出现不自然的伪影。作者把根因定位到 critic 误差——它混进学生更新之后会随训练步数累积,而 DMD 本身没有任何机制把这个误差拦下来。 本文贡献:提出 PDMD:把 DMD 更新中「与学生-critic 端点残差平行」的那个分量投影掉。作者证明,在固定噪声查询点上,这个残差正是 critic 端点误差的无偏估计;在高维假设下,投影能移除恒定比例的 critic 误差,同时只丢掉可忽略比例的 ideal DMD 信号。整个改动对 DMD 只动一行代码,不引入额外损失、额外网络、额外数据、额外模型前向,也不需要多阶段训练。 2D comparison of projection directions (20-point moving average). 实验效果:Wan2.1 上 4 NFE 取得 VBench 总分 83.73,比对齐设置的 DMD 高 1.03 分。MiniMax-H3 音视频联合生成上,VideoGen-Eval 视觉总分 83.17,比最强蒸馏基线高 0.41 分,且在受评的 4-NFE 模型中 6 项音频指标全部拿到最好成绩。定性对比与用户研究在视觉质量、运动、音频质量上都偏向 PDMD。 Quality, semantic, and total scores on the 387 VideoGen-Eval prompts. 批判点评:1.03 和 0.41 都是小数点后两位的量级提升,放在 VBench 总分 80 多的量级上更像「修退化」而不是「提上限」——它的价值本来就在于 DMD 已经开始崩的那段区间,基线越健康收益越小。MiniMax-H3 的 0.41 分是相对「最强蒸馏基线」而非 teacher,论文没给与未蒸馏模型的差距。另外投影只保证移除「恒定比例」误差,这个结论建立在高维假设之上,实际有限维下的常数有多大并未量化。 4. GeoShrink:两行代码换五倍,PSNR+3.10 GeoShrink: Accelerating Diffusion Transformers with Two Lines of Code | 香港科技大学(广州);格里菲斯大学;CSIRO Data61;JITRI 深度感知研究所 | arXiv:2609.33723 关键词:推理加速, 扩散Transformer, 免训练, 采样求解器, 特征预测 前序问题:扩散 Transformer 的推理成本几乎全部来自沿采样轨迹反复调用模型。已有的免训练加速多走特征缓存路线,在不同去噪步之间复用或预测中间表示;但这类方法动的是模型内部结构,接入成本高,而且缓存什么、什么时候更新都要重新调。能不能完全不碰模型,只在求解器接口上做文章。 本文贡献:提出 GeoShrink:保留原始求解器网格,只在预先规定的一组锚点上真正调用模型。被跳过的阶段,它把「最近一次观测到的增量」按几何保留比例加回最近的精确输出,作为求解器要的那个场。这个规则从弦切线传输和往返线投影推出来,并给出一条几何锚间距原则:在固定覆盖率和首段跨度下,让相邻最大间隔的扩张最小。误差分析刻画了预测误差的几何闭合与传播,全程不假设能拿到未来模型输出。改动只需两行代码。 Overview of GeoShrink. 实验效果:在约 5 倍加速下,FLUX 的 PSNR 比所列最强基线高 3.10 dB。HunyuanVideo 上报告 4.99 倍加速,ChronoMagic-Bench-150 的 PSNR 比最强保真基线高 5.44 dB。在固定评估预算下对比,运动、音频、音乐、3D 生成上也都有明显增益,实验覆盖图像、视频、动作、音频以及适配后的 3D 后端。 Speed-quality trade-off: GeoShrink yields a better Pareto frontier on SD3.5 Medium. 批判点评:全文主打指标是 PSNR,这是保真度指标而不是感知质量指标——5.44 dB 的 PSNR 增益可以对应肉眼几乎无差别的画面,也可以对应明显更糊的结果,论文没有补 FID 或人类偏好。另外「比所列最强基线高」里的基线集合是作者自选的,到底是跟哪些缓存类方法比、有没有包含最新的同类工作,从摘要看不出来。锚间距原则也只在给定覆盖率和首段跨度这组约束下最优。 5. MGFlow:一步打赢四步,FDr 1.45 Unifying Distributional Training for One-Step Visual Generation | 清华大学;复旦大学;西安交通大学;北京大学;浙江大学;DeepSeek;字节跳动 Seed;加州大学伯克利分校;智源研究院 | arXiv:2609.35763 关键词:一步生成, 分布匹配, 高斯混合, Wasserstein梯度流, 文生图 前序问题:一步生成器的分布训练有很多条彼此看起来不相干的路线:FD-Loss 用高斯矩匹配,Drifting 用核密度做 KL 匹配,各自都能work,但没人说清楚它们之间的关系是什么,也说不清「分布建模」和「匹配差异」这两件事哪一件在起作用。缺少统一视角的直接后果是,新方法只能靠试,无法判断某一处改动到底改的是哪一环。 本文贡献:给出一个统一的理论框架:把「分布建模」与「匹配差异度」拆开,再用 Wasserstein 梯度流把全局目标和逐点特征更新连起来。在这个框架下,FD-Loss 和 Gaussian-kernel Drifting 分别被还原为高斯最优传输和基于核密度的 KL 匹配两个特例。框架进一步催生 MGFlow:用高斯混合来建模特征分布,粒度可调,介于全局矩和逐样本表示之间;它同时支持最优传输和基于分数的匹配,并用带质量约束的样本分配配成对分量更新,专门解决「混合模型表达力提升」本身解决不了的 mode collapse。 A unified view of distributional training. 实验效果:ImageNet 256×256 上大幅超过 FD-Loss 基线,pMF-H 取得 FDr⁶ 1.45、JiT-H 取得 1.64,均为当前最佳。文生图方面,把 FLUX.2 [klein] 4B 后训练成一步生成器,在 GenEval 和 PickScore 两个指标上都超过了原始的四步模型。 One-step text-to-image samples from FLUX.2 [klein] 4B post-trained with MGFlow. 批判点评:FDr⁶ 是论文自报指标,对比表里的基线也是作者自己跑的,跨论文可比性存疑;ImageNet-256 是类条件生成的老基准,没有在更大规模或更高分辨率上验证。文生图部分只报了 GenEval 和 PickScore 两个自动指标,没给人类偏好,而「一步超过四步」这种反直觉结论恰恰最需要人工评测背书。另外九家机构联合署名,真正的方法贡献集中在统一框架和高斯混合这两点上,工程验证面其实偏窄。 6. REPI:16万步追平700万步 Scaffold Then Internalize: Representation Injection for Diffusion Transformers | 中山大学;Video Rebirth;香港理工大学 | arXiv:2609.35292 关键词:扩散Transformer, 表示对齐, 训练加速, 表示注入, 图像生成 前序问题:REPA 类方法靠「把扩散 Transformer 的隐状态投影到预训练视觉编码器空间」来加速训练,方向是单向的:扩散模型被迫去迎合编码器。反过来那条路没人走过——让编码器表示直接参与去噪过程。问题在于直接注入会破坏扩散模型自身的表示结构,注入之后模型到底学到了什么、推理时还要不要带着编码器,都没人回答。 本文贡献:提出 REPI(REPresentation Injection),走 scaffold-then-internalize 两段式:第一阶段「搭脚手架」,用投影后的编码器 K/V 临时替换扩散 Transformer 原生的 K/V,只保留它自己的 Query,让外部表示先替模型把去噪这件事撑起来;第二阶段「内化」,模型恢复到使用自己的 K/V,同时用一个内化目标把自身 K/V 对齐到投影后的编码器表示。推理时编码器和投影层全部丢掉,不留下任何额外开销。 Overview of REPI. (a) Scaffold. (b) Internalization. 实验效果:在 SiT-B、SiT-L、SiT-XL 等多种骨干上一致优于 REPA,且两者高度互补——叠加后收益远超任一单独使用。SiT-XL 上,REPI + REPA 训练 200K 步就已经超过 REPA 训练 400K 步的结果。最亮眼的是:仅用 160K 步,REPI + REPA 就能匹配 vanilla SiT 训练 7M 步的效果,相当于 43.5 倍以上的提速。 REPI accelerates diffusion transformer training across model scales. 批判点评:43.5 倍的对照物是「什么都不加的 vanilla SiT」,这个基线本身不含任何加速手段,比值因此被放大;更有信息量的是和 REPA 的等步数对比,那部分增益要小得多。另外从 FID-步数曲线看,REPI 做的是把曲线「提前」,并没有把收敛上限抬高——训练足够久之后差距会收窄。论文也明确指出最大收益来自与 REPA 叠加,单独用 REPI 的绝对提升要看主表才清楚。代码目前标注为即将开源。 7. UMM-Reflection:自己改自己图,GenEval+12 Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning | 南洋理工大学;上海交通大学;东京大学 | arXiv:2609.35767 关键词:统一多模态模型, 强化学习, 自我反思, 图像编辑, 文生图 前序问题:统一多模态模型既能看图又能画图,理论上应该能自己修自己的输出:先诊断这张图错在哪,再改,看着改完的结果继续诊断。但「这次修改到底有没有用」只有渲染出来才知道,所以反思文本和图像生成必须沿着整条回路联合学习。SFT 冷启动能学会走流程却找不到高成功率的修复路径;而只优化渲染器或只优化某一个头的朴素 RL,又把大部分收益留在桌上。 本文贡献:提出 UMM-Reflection,在同一个统一模型内部对完整反思轨迹做 RL。关键设计是 sibling trajectories 共享同一张初始图像,这样 group-relative advantage 比较的就是不同「反思策略」而不是不同起点;再用一个轨迹级 advantage 同时更新反思 token 和基于 flow 的修订,避免逐轮信用分配带来的组合爆炸。信用跨轮次流动、同时流向同一模型的两种角色,推理时不需要任何 verifier。 UMM-Reflection RL. 实验效果:在 BAGEL 上相对 SFT 把 GenEval 提升 12.05 分,且增益能迁移到训练中完全没用过的 WISE(+10.97)、OneIG-Bench(+3.48)、T2I-CompBench++(+4.63)。 Learning dynamics of the 1,000-update RL run. 批判点评:+12.05 分是相对 SFT 冷启动版本,不是相对原始 BAGEL 或当前 SOTA 生成模型,绝对值要在主表里才看得清。整套实验只在一个统一模型(BAGEL)上做,换骨干是否成立未知。训练侧每条轨迹最多三轮反思、每组 16 条 rollout,为了拿到稳定的 group-relative advantage 开销不小;而三轮上限本身就意味着更长链条的迭代修复能力没有被验证——尽管推理免 verifier 是实打实的优势。 8. Elastic Forcing:扔掉两个打分模型,84.64 From Scores to Samples: Elastic Forcing for Autoregressive Video Generation | 清华大学人工智能学院;西安交通大学 IAIR;复旦大学相辉研究院;北京大学 | arXiv:2609.35491 关键词:视频生成, 自回归生成, 蒸馏, MMD, 后训练 前序问题:少步自回归视频生成基本都挂在 DMD 上,而 DMD 需要两样重资产:一个双向扩散 teacher,和一个在线更新的 fake-score 模型。前者限制了「能学什么」——必须有一个现成的目标分布 teacher;后者让后训练的内存和计算开销居高不下,模型一大就跑不动。两者的存在使得「直接向参考视频学」这条路一直没走通。 本文贡献:提出 Elastic Forcing:不学 teacher 给出的真假分数,而是直接从参考视频学 rollout 分布,后训练阶段两个 score model 全部去掉。做法是在冻结的自监督视频表示空间里最小化 MMD(最大均值差异),并用 Nyström–Monte Carlo 混合估计器在近似偏差与采样方差之间取平衡;再配合省内存的 replay 和梯度子采样让这个目标变得可训练。移除辅助 score model 之后,14B 后训练可以放进 8 张 H200。 Demonstration of Elastic Forcing. 实验效果:在与 Self-Forcing 完全相同的架构和初始化下,1.3B 模型把 VBench 总分从 83.80 提到 84.64,同时保持 17 FPS。去掉辅助 score model 使 14B 规模的后训练在 8 张 H200 GPU 上成为可能。除了蒸馏,直接从参考视频学习还能在没有目标专用扩散 teacher 的情况下习得新的视觉风格、语义概念和空间先验。 Additional demonstrations of our 14B model. 批判点评:83.80 到 84.64 只有 0.84 分,而且这个对照是与 Self-Forcing 同架构同初始化的自体基线,不是与当前最强少步方法比。14B 那部分论文只说「使后训练成为可能」,没有给出 14B 的量化评测结果,也没有和带 score model 的同等规模方案做效率对比——省下来的显存到底换来多少质量,读者看不到。MMD 估计器本身还需要在 Nyström 近似偏差和 Monte Carlo 方差之间调参,这个权衡的敏感度没在摘要里交代。 9. GEAR:几何只当地址,12项全第一 Geometry as Address: Routing Attention to Visual Memory for Long-Horizon Camera-Controlled Video Generation | 浙江大学 CAD&CG 国家重点实验室;香港科技大学(广州);LIGHTSPEED | arXiv:2609.34722 关键词:视频生成, 相机控制, 长程记忆, 几何先验, 记忆检索 前序问题:长程相机可控视频生成要从不断膨胀的视觉历史里把之前看过的内容取回来。现有做法要么在历史上下文里隐式检索,要么把历史重建成持久的 3D 记忆:前者检索低效、token 越堆越多,后者会因为全局融合不断累积几何误差,跑几十秒之后画面就漂了。矛盾在于几何信息到底该被用来「解释场景」还是只用来「定位」。 本文贡献:核心洞察是:几何不需要解释场景,它只需要决定「视觉记忆该从哪里读」,而「该恢复什么」交给注意力去判断。GEAR 据此把几何当作视觉记忆的显式 token 级地址——不把历史观测融进一个持久的全局 3D 表示,而是保留为逐帧 latent,只用逐帧几何与目标视角建立 token 级对应关系,从而避开全局融合的误差累积。由这些对应关系引导,Geometric Correspondence Attention(GCA)在去噪时把几何匹配上的历史特征选择性注入到噪声目标 patch。另外用 Invisible Octree 累积可见性证据,把几何上合理但实际被遮挡的对应关系剔掉。 System overview. 实验效果:在 DL3DV 与 WorldScore 的全部 12 项指标上取得最佳:SSIM 0.3645、LPIPS 0.4459、FVD 837.59、TransErr 0.0116、RotErr 0.1228、ATE 0.0436、Content Alignment 0.7423、Photo Consistency 0.9732、Style Consistency 0.8700、主观分 0.5018、Revisit SSIM 0.6489、Revisit LPIPS 0.2019。支持沿高难度轨迹生成分钟级视频。 Out-of-domain qualitative comparison for minute-long generation. 批判点评:主观分只有 0.5018,刚过一半,说明「12 项全第一」里最贴近人的那一项优势最薄。FVD 837.59 的绝对值也谈不上低。对比集合是「带 memory 机制的近期方法」,没有与不带记忆的强基线在同等时长下对照,因此无法判断这套地址机制相对「干脆不记忆」的净收益。此外整套方法依赖每帧几何(位姿与深度)可用,相机轨迹是外部给定的,几何估计本身的误差如何传导到地址精度只做了定性讨论。 10. ORAV:380题9种角色,人机86% ORAV: Benchmarking Audio-Video Generation from Multimodal Contexts | 清华大学人工智能学院;腾讯混元 | arXiv:2609.34843 关键词:音视频生成, 多模态参考, 基准评测, 组合式生成, 评测协议 前序问题:用异构多模态参考(图、视频、音频混着给)去生成音视频成了一个新课题,它同时要求两件事:对生成结果有组合式控制,对多模态上下文有 grounded 理解。但现有基准基本只覆盖单参考或同构参考,评测协议也沿用通用视频质量指标,无法判断「模型有没有照着指令把指定参考里的指定内容取出来并正确组合」。没有基准,就没法追踪这一方向的进展。 本文贡献:提出 ORAV Bench,包含 380 个任务实例,每个实例带 2 到 10 个参考,覆盖 9 种语义角色和 30 种角色组合;指令负责说明各参考之间的关系,媒体本身提供要被落实的身份、动态和音频特征。评测上设计了一套参考感知的成对比较协议:先分别准备视觉和听觉证据,再逐个比较每个参考「本应贡献什么」,最后在两种呈现顺序下核对总体裁决,以消解顺序偏差。 Omni-reference audio-video generation requires selectively composing information from heterogeneous references. 实验效果:在留出实例上,该协议与人类判断的有效一致率达到 86.08%。对 5 个前沿系统的评测显示,总体排名掩盖了各系统在不同参考组合上的能力差异;暴露出的一个反复出现的失败模式是:模型生成了与某个参考高度相似、但并非指令所要求的内容。可复现的逐点诊断在质量、参考亲和度、语音三个维度上揭示出彼此独立的行为差异。 Performance across composition signatures. 批判点评:86.08% 是「有效一致率」,已经剔除了不可用判断和顺序冲突的样本,分母比全部配对要小,实际一致性更接近的下界没有给出。5 个受评系统在摘要里被匿名处理为 frontier systems,读者无法核对评测对象;380 个实例摊到 30 种角色组合后每种只剩十几个,论文也承认只有共享实例数不少于 8 个的 14 个 signature 才重拟合了胜率。作为纯基准工作,它不提供任何模型或训练方案,落地价值取决于社区是否跟进。 趋势观察 加速的战场从算法层下移到系统层 今天十篇里有三篇在跟计算成本较劲,但下手的层级完全不同:WorldAttention 直接写定制 kernel 并重排 KV 的内存层级,GeoShrink 干脆绕开模型、只在求解器接口上抠掉五分之四的调用,Elastic Forcing 则是把两个 score model 整个删掉换来 14B 后训练的可行性。共同点是单纯改注意力数学已经不够,谁把内存搬运和调用次数一起管起来谁才拿到真实收益。 「先搭脚手架再拆掉」成了训练范式的共识动作 REPI 用编码器 K/V 临时替换扩散 Transformer 的原生 K/V,等模型内化之后在推理时把编码器整体丢弃;PDMD 只对 DMD 动一行代码、不加任何额外网络或损失;UMM-Reflection 在训练时用冻结 verifier 打分、推理时一个 verifier 都不需要。三篇方向毫不相干,却都在做同一件事:把复杂度全部留在训练期,交付一个结构不变、开销不增的推理模型。 人工智能炼丹君 整理 | 2026-09-30 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|视频 VAE 的常见 loss 组合-VAELoss AIGC 基本功|视频 VAE 的常见 loss 组合-VAELoss 所属方向:表征与压缩 | 难度:工程实战 | 前置知识:视频 VAE 的时空压缩结构(本文第 02 节另补最小背景) 关键词:重建损失、KL 损失、LPIPS、感知损失、GAN 损失、判别器、loss 权重 01. 为什么需要它 训练一个视频 VAE,最朴素的想法是「编码器压缩、解码器还原,加个 L1 或 KL 就够了」。不同目标可能暴露不同问题,效果取决于瓶颈、数据和训练配方: 只用 L1/L2 + KL:有些设置中画面较稳,却明显发糊 —— 头发丝、文字、树叶这种高频纹理全被抹掉,人脸带着一层「塑料感」。在存在重建不确定性时,这与逐像素回归的性质有关,但不能断言 L1/L2 + KL 必然不可用(L2 的最优解是条件期望,天然倾向平均、发糊)。 加上 GAN 想救清晰度:判别器过早发力或双方训练失衡时,解码器可能走样 —— 出现棋盘格、闪烁、甚至凭空捏造纹理;训练损失曲线看起来在降,重建却越来越假。 把图像那套搬到视频上:每一帧单独看 PSNR 都不错,连起来播放却疯狂闪烁,相邻帧的纹理在抖动。单帧指标的全局均值不能唯一刻画误差在时间上的排列。 这些现象需要分别检查像素误差、潜变量正则、特征距离和时空统计。许多视频 VAE 会组合像素重建、KL、感知与对抗项,但是否全部启用要看消融。为什么 HunyuanVideo 报告 §4.1.1 的 KL 系数是 $10^{-6}$,感知与对抗系数是 0.1 和 0.05?归约、输入范围、梯度与训练阶段都会影响有效强度;只看四个标量的大小,推不出这组权重。 本文把每一项「在管什么失真、数学上长什么样、量级有多大、什么时候帮倒忙」逐一拆开,教学数值来自随文可跑的 NumPy 脚本,论文配方则单独标原始来源;配图额外依赖 matplotlib。本轮核对还执行了 PyTorch 官方源码的 CPU 损失分支,但没有训练真实视频 VAE 或测量 GPU 性能。 02. 最小可用理解 最小背景(前置 VideoVAE):本文讨论采用 3D 因果卷积的连续高斯视频 VAE;其他架构也存在。这类模型把一段视频 $x\in\mathbb{R}^{B\times C\times T\times H\times W}$ 压成低维潜变量 $z$,其中 $B,C,T,H,W$ 分别是 batch、通道、帧数、高和宽(例如时间约 $4\times$、空间各 $8\times$,具体帧数还取决于首帧与 padding 规则),解码器再从 $z$ 重建出 $r$。编码器输出一个对角高斯后验 $q(z\mid x)=\mathcal{N}(\mu,\sigma^2)$,训练目标要同时满足三件事:重建要像、潜变量分布要规整(好让后面的扩散模型去建模)、压缩率要够高。loss 就是在这三者之间做权衡的旋钮。 三句话讲清四项损失: 像素损失(L1/L2)和 KL 是「保正确」的:前者逐像素对齐,后者惩罚每个输入的后验偏离所选先验;它同时影响均值和方差,并可能使后验坍缩,不能理解成只做数值限幅。 LPIPS 感知损失和 GAN 对抗损失是「保好看」的:LPIPS 在预训练深度网络的特征空间里比较,提供与人类局部失真判断有经验相关性的特征距离;GAN 让一个判别器去挑刺,逼着解码器还原高频细节。 四项的数值范围、归约和梯度不同,需要定义有效权重;GAN 可用「晚启动 + 自适应权重」控制末层梯度比例:先让重建项把解码器教到成形,再让判别器入场,并按两项在最后一层上的梯度范数之比动态调权。视频还要额外盯时间维(时空判别器或帧间一致性项)。 03. 数学推导 3.1 从 ELBO 到「重建 + KL」两项 VAE 最大化证据下界(ELBO)。写成「最小化负 ELBO」,目标天然裂成两项: $$\mathcal{L} = \underbrace{-\mathbb{E}_{q_\phi(z\mid x)}[\log p_\theta(x\mid z)]}_{\text{重建项}} + \underbrace{D_{\mathrm{KL}}\big(q_\phi(z\mid x)\,\|\,p(z)\big)}_{\text{KL 正则项}}$$ 逐项解释符号:$\phi$ 是编码器参数、$\theta$ 是解码器参数;$q_\phi(z\mid x)$ 是编码器给出的后验分布;$p_\theta(x\mid z)$ 是解码器的似然;$p(z)=\mathcal{N}(0,I)$ 是标准正态先验。重建项要求「从采样出的 $z$ 能还原 $x$」,KL 项要求「后验别离先验太远」—— 它是潜变量的正则项,鼓励与先验对齐;它不保证感知空间的平滑或连通,也不是所有 latent 扩散能够学习的必要条件。 当后验取对角高斯 $q_\phi(z\mid x)=\mathcal{N}(\mu_\phi(x),\,\mathrm{diag}(\sigma_\phi(x)^2))$、先验取标准正态时,KL 有解析解(不用采样、不用估计)。令 $\ell_j=\log\sigma_j^2$(工程上网络直接预测 $\ell$,数值更稳): $$D_{\mathrm{KL}} = -\frac{1}{2}\sum_{j=1}^{d_z}\Big(1+\ell_j-\mu_j^2-\exp(\ell_j)\Big)$$ 这里求和下标 $j$ 跑遍所有潜变量维度。直觉:$\tfrac12\mu_j^2$ 惩罚均值偏离 0,$-(1+\ell_j-e^{\ell_j})$ 惩罚方差偏离 1($\ell=0$ 即 $\sigma^2=1$ 时该项为 0)。 从似然到工程的 mean loss 还隔着尺度。设每样本有 $P=CTHW$ 个像素通道元素、$d_z$ 个潜变量元素、batch 大小为 $B$。若条件独立像素服从固定尺度 $a>0$ 的 Laplace 分布,则: $$-\log p_\theta(x\mid z)=\frac{1}{a}\sum_{i=1}^{P}|x_i-r_i|+P\log(2a)$$ 忽略与模型参数无关的常数,再把每样本负 ELBO 整体乘 $a/P$,得到 $\mathcal L_{\mathrm{pix,mean}}+(a/P)\mathcal K_{\mathrm{batchmean}}$。若改用固定方差 $s^2$ 的高斯似然,像素平方和的系数是 $1/(2s^2)$。因此 L1/L2 的概率解释还依赖似然尺度,任意添加 LPIPS/GAN 后也不再是原始负 ELBO 的逐项恒等改写。VAE 原文附录 B 给出了高斯 KL 的来源。 定义三种容易混淆的 KL 归约: $$k_{bj}=\frac12[\mu_{bj}^2+\exp(\ell_{bj})-1-\ell_{bj}],\quad \mathcal K_{\mathrm{sum}}=\sum_{b,j}k_{bj},\quad \mathcal K_{\mathrm{batchmean}}=\frac{\mathcal K_{\mathrm{sum}}}{B},\quad \mathcal K_{\mathrm{mean}}=\frac{\mathcal K_{\mathrm{sum}}}{Bd_z}$$ 保持加权项及梯度相同,系数必须满足 $\beta_{\mathrm{batchmean}}=B\beta_{\mathrm{sum}}$、$\beta_{\mathrm{mean}}=Bd_z\beta_{\mathrm{sum}}$。这是同一批元素的纯换算;若改分辨率或采样分布,则不能只套一个常数。KL 的导数是 $\partial k/\partial\mu=\mu$、$\partial k/\partial\ell=(e^\ell-1)/2$;由 $e^\ell\ge1+\ell$ 可知 KL 非负且在 $\mu=\ell=0$ 为零。接近零时可用 expm1(logvar)-logvar 减轻相减消去,大 logvar 仍需按模型约束避免指数溢出。 第一个容易被忽略的坑是「求和 vs 平均」。教科书公式对 $d_z$ 个维度求和;而像素损失通常对全部像素求平均。两者元素个数差着几个数量级,直接相加 KL 会凭「项数多」碾压重建。随文脚本 vaeloss_terms.py 在一个合成视频上实测: # 解析 KL,logvar 是网络直接预测的 log(sigma^2) kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum, kl_mean = kl_per_element.sum(), kl_per_element.mean() l1 = np.mean(np.abs(x - r)) print("L1 = %.5f" % l1) # 0.03158 print("KL(sum) = %.3f KL(mean) = %.4f" % (kl_sum, kl_mean)) print("KL(sum)/L1 = %.0f 倍" % (kl_sum / l1)) 输出(视频 $2\times3\times8\times32\times32$,latent $2\times4\times2\times4\times4$,像素 49152 个、全 batch 的 latent 共 256 个数值(每样本 128 个)): L1 重建 (mean) 0.03158 KL (全 batch sum,教学口径) 57.66490 KL (mean,换口径) 0.22525 KL(sum)/L1 的量级倍数 : 1826.0x 归约口径是解释小 KL 系数时必须检查的因素之一,但不能由这个 toy 直接反推实际系数。本文用于对照的连续 LDM 实现对每样本 latent 求和,再对 batch 平均;其他目标可以另定义口径;这里为演示求和效应,57.66 是整个 batch 的和,batch=2 时常见口径为 28.83。本轮输出的 batchmean 精确为 28.83245,mean 为 0.22525。复制同一批样本两遍时,batchmean/mean 不变,全 batch sum 翻倍。抄权重之前先对齐归约、输入范围和似然尺度。 这张图要看什么:左图在同一个合成视频上比较原始标量,其中 KL(sum)=57.66490 是全 batch 总和,L1(mean)=0.03158。右图仅借用 HunyuanVideo 系数,展示 toy 各项的绝对幅值:像素 0.03158、特征代理 0.03489、GAN 的绝对值 0.01947、KL 约 $5.77\times10^{-5}$。实际合成 GAN 项是负的,总目标为 0.04706;图中的正柱不是正向贡献。代理不是 LPIPS,logit 不是实际判别器输出,这不是原模型配方复现,也不能按标量大小判断梯度平衡。图由 code/make_figures.py 生成。 3.2 像素损失:为什么多用 L1 而不是 L2 $$\mathcal{L}_{\mathrm{pix}} = \frac{1}{BP}\sum_{b=1}^{B}\sum_{i=1}^{P}|x_{bi}-r_{bi}|$$ L2(MSE)对大误差平方加权,其逐点最优解是给定 $z$ 下所有可能输出的条件均值—— 面对「这块纹理可能是 A 也可能是 B」的不确定性,它选择把 A、B 平均掉,结果就是模糊。单个绝对误差对预测值的导数为 $\pm1$,本式 mean 归约后为 $\pm1/(BP)$,其逐点最优解是条件中位数,不会因为误差大就给出更强的「往平均靠」的驱动力,对异常值通常更稳健,但条件中位数也可能模糊,不能保证所有纹理更锐利。L1 在零点用次梯度处理;小误差处梯度不随残差线性缩小,但这并不能推出它必然产生颗粒。条件均值/中位数结论要求在给定表示下存在不确定性、且优化限定为该逐点风险;若模型可精确重建,两者都能为零。也有工作(如 LTX-Video)在像素项里混用 MSE 与小波域 L1(Video-DWT),在多尺度上约束。 3.3 感知损失 LPIPS:换一把「人眼的尺子」 像素距离有个致命问题:同样大小的像素误差,人眼感受天差地别。一个全局亮度偏移,MSE 不小但某个特征度量可能不敏感;一团等量的逐点噪声,MSE 相同却把纹理毁了。LPIPS(Learned Perceptual Image Patch Similarity)改用在 ImageNet 上预训练的分类网络(VGG/Alex,参数冻结)提特征,再在特征空间量距离: $$\mathcal{L}_{\mathrm{LPIPS}}(x,r)=\sum_k\frac{1}{H_kW_k}\sum_{u,v}\sum_c a_c^k(\hat y_{cuv}^k(x)-\hat y_{cuv}^k(r))^2$$ 符号:$y^k$ 是第 $k$ 层特征,$c,u,v$ 分别是通道及空间坐标;$a_c^k$ 是直接作用于平方差的学习通道系数,对应实现中无 bias 的 $1\times1$ 卷积。VGG 版本取 relu1_2、relu2_2、relu3_3、relu4_3、relu5_3 五层;也存在 AlexNet 等版本。每个空间位置的通道向量先除以其 L2 范数加 epsilon,空间平均、通道加权求和、跨层相加,最后才按 batch 归约。这里是沿通道归一化向量,不是逐通道独立归一化一整幅特征图。论文学习的非负通道系数也可写成某个权重的平方,但实现只乘一次线性系数,不应把 checkpoint 权重再平方。LPIPS 在 BAPPS 失真判断上得到经验支持,不能保证所有语义、亮度或颜色变化都符合人的感受。 pixel_vs_perceptual.py 用一个免权重的多尺度高通特征(高斯差分 DoG)复现 LPIPS 的结构,对比三种退化: # A:全局亮度偏移;B:同等 L2 能量的逐点噪声;C:高斯模糊 rA = x + delta # delta = 0.12 rB = x + rng.normal(0, delta, x.shape) # 标准差同为 0.12 # 像素 MSE:A 约等于 B;特征距离:B 远大于 A 真实输出: 重建方式 像素MSE 感知距离 感知/像素 A 亮度偏移(整体+0.12) 0.01440 0.00008 0.01 B 逐点噪声(σ=0.12) 0.01426 0.64084 44.93 C 高斯模糊 0.00508 0.50163 98.69 A、B 的像素 MSE 在期望上相等,本次有限样本只差 0.95%,但特征距离里 B 是 A 的约 $8\times10^3$ 倍;模糊 C 的像素误差最小,感知距离却很高。高通教学代理天然抑制直流亮度,因此本例差距尤其大;真实 LPIPS 使用学习特征和权重,不能据此断言它对亮度或颜色变化不敏感。 3.4 对抗损失:雇一个判别器专挑高频毛病 GAN 引入一个判别器 $D$,训练它区分真实帧与重建帧;解码器(生成器)则努力骗过它。一种常用设计是 PatchGAN 式判别器:不输出整图真假,而是对每个空间 patch 打分,主要约束其感受野内的统计,常改善局部纹理,但并非数学上只看高频。最常用的 hinge 形式: $$\mathcal{L}_{D} = \tfrac{1}{2}\Big(\mathbb{E}_{\text{real}}[\max(0,\,1-D(x))]+\mathbb{E}_{\text{recon}}[\max(0,\,1+D(r))]\Big)$$ $$\mathcal{L}_{G}^{\mathrm{adv}} = -\mathbb{E}_{r}[D(r)]$$ 判别器希望真帧打分大于 1、重建打分小于 -1;生成器希望重建打分尽量大(为正)。gan_schedule.py 用合成 logits 算了判别器在三种强弱下的损失: 起步:判别器分不清 D(hinge)=1.0126 G(hinge)=-0.0312 real≈ 0.01 fake≈ 0.03 分离:尚有部分margin残差 D(hinge)=0.0767 G(hinge)= 1.2067 real≈ 1.21 fake≈-1.21 分离:margin已满足 D(hinge)=0.0000 G(hinge)= 5.9713 real≈ 6.02 fake≈-5.97 注意判别器 hinge loss 为 0 只说明这些样本的 margin 已满足,此时判别器对应损失的梯度为 0;不意味着生成器梯度消失。这里 $\mathcal L_G=-\mathbb E[D(r)]$ 对平均 fake logit 的导数是 −1;若有 $M$ 个等权 logit,对每个的导数为 $-1/M$,传回解码器的梯度还取决于判别器对输入的导数。仅看 +6/−6 logits 无法判断梯度是否健康。 其一,GAN 晚启动(warm-up)。重建项还没把解码器教出基本形状时,判别器挑的「毛病」没有意义,甚至会把训练带偏。taming 的做法是一个开关 adopt_weight,在第 $t_{\mathrm{start}}$ 步前把对抗权重置 0: $$f(t)=\begin{cases}0,&t\lt t_{\mathrm{start}}\\ f_0,&t\ge t_{\mathrm{start}}\end{cases}$$ 这里 $t$ 是优化步、$t_{\mathrm{start}}$ 是启用阈值、$f_0$ 是固定系数。脚本教学取 disc_start=2000、$f_0=0.05$ 时,step 0 和 1999 的权重为 0,step 2000 起跳到 0.05。 其二,自适应对抗权重。固定系数在重建与 GAN 梯度相对强弱变化时可能不合适。VQGAN 在指定的解码器末层权重 $w_L$ 上比较合并重建项与生成器对抗项的梯度范数,以一个停止梯度的系数调节 GAN;这不是基于标量 loss 大小调权,也不包含 KL/codebook 梯度。 $$d=\kappa\,\mathrm{stopgrad}\left[\mathrm{clip}\left(\frac{\|\nabla_{w_L}\mathcal L_{\mathrm{rec}}\|_2}{\|\nabla_{w_L}\mathcal L_G^{\mathrm{adv}}\|_2+10^{-4}},0,10^4\right)\right],\qquad\lambda_{\mathrm{adv}}(t)=f(t)d$$ 其中 $\mathcal L_{\mathrm{rec}}$ 包含像素与加权 LPIPS,$\kappa$ 是 discriminator_weight,$f(t)$ 对应 disc_factor 的启用开关。原实现先 clamp 范数比,再 detach,再乘 $\kappa$;最终损失还要乘 $f(t)$,不能漏算或重复算。detach 表示把该系数当本次更新的常量,避免对范数比再次求导。未触发上限、GAN 梯度远大于 epsilon 时,加权 GAN 的末层范数约为 $f(t)\kappa$ 倍重建范数;这不保证方向一致、全网络平衡或收敛。adaptive_weight.py 固定线性判别器,构造两个权重点并验证解析梯度(W[0,0] 上 0.012371 与 0.255913 均与中心差分一致): 大残差权重点 L_rec=0.73740 ||∇rec||=0.4071 ||∇gan||=4.2840 d_weight=0.0950 小残差权重点 L_rec=0.00071 ||∇rec||=0.0127 ||∇gan||=4.2840 d_weight=0.0030 在这个没有训练的构造中,GAN 梯度固定为 4.2840,重建梯度缩小,系数由 0.095 变为约 0.003(约 32 倍)。真实训练中分子、分母都在变,比例可能升高;即使系数变大,GAN 的实际加权梯度也可能变小。不能把这两个权重点当成通用学习曲线。 这张图要看什么:横轴是实际末层重建梯度范数,纵轴是自适应系数。曲线固定同一扰动方向并逐次缩小它;两个独立方点使用脚本原有的大/小残差权重。原图把初始化附近的权重画在 0.05 扰动幅度处,横轴与采样点不对应,本轮改为可核算的梯度横轴。图不是优化器训练轨迹。$f(t)$ 管是否启用,$d$ 管启用后比例;两者相乘才是最终权重。 3.5 总目标,以及视频多出的时间维 把四项合起来,连续潜变量视频 VAE 的生成器目标是: $$\mathcal{L}_{G} = \lambda_{\mathrm{pix}}\mathcal{L}_{\mathrm{pix}}+\lambda_{\mathrm{p}}\mathcal{L}_{\mathrm{LPIPS}}+\lambda_{\mathrm{kl}}\mathcal{L}_{\mathrm{KL}}+\lambda_{\mathrm{adv}}(t)\,\mathcal{L}_{G}^{\mathrm{adv}}$$ (VQGAN 是离散码本,没有 KL,对应位置换成 codebook/commitment 损失;连续 KL-VAE 才是上面这版。)判别器另用 $\mathcal{L}_D$ 单独更新,二者交替。 视频多了时间维,单帧损失均值不足以唯一刻画帧间误差。temporal_consistency.py 构造了一段运动视频,给两种重建:A 加逐帧独立噪声(播放时闪烁),B 加跨帧恒定的退化(不闪),两者单帧空间 L1 几乎相同: 重建 单帧空间L1 时序差分L1 时序差分MSE A 逐帧独立噪声(闪) 0.06393 0.09018 0.01275 B 跨帧恒定退化(稳) 0.06340 0.00455 0.00003 单帧 L1 几乎相等(0.0639 对 0.0634),时序差分 MSE 却差了约 393 倍。 这张图要看什么:左图是同一像素的时间轨迹,右图比较三种误差。A 为逐帧独立噪声,B 为固定屏幕坐标的噪声加 5% 抖动,B 仍随真实视频运动;固定屏幕坐标误差不代表沿运动物体轨迹的纹理完全一致。L1 接近而时间差分 MSE 相差约 393 倍。B 总方差在期望上为 $1.0025\sigma^2$,并非与 A 严格等能量。实验说明平均空间误差遗漏时间排列,不能从中断言真实视频闪烁的根因一定是选错指标;表示容量、训练、归一化与分块相位也要检查。 可选办法包括让判别器看时空片段,或添加相对真值的时间误差。但直接要求相邻重建帧一致会压制真实运动。令 $e_t=r_t-x_t$,不用光流时可定义: $$\mathcal L_{\Delta}=\frac{1}{BC(T-1)HW}\sum_{b,c,t,h,w}|(r_{bcthw}-r_{bc,t-1,h,w})-(x_{bcthw}-x_{bc,t-1,h,w})|=\mathrm{mean}|\Delta e|$$ 这里 $t=1,\ldots,T-1$、$T\ge2$。完美重建运动视频时该项为零,原始的 $\mathrm{mean}|\Delta r|$ 却为正;冻结成第一帧时原始帧差为零,反而会奖励错误。另一方面,任意跨帧恒定误差 $e_t=c$ 也使 $\mathcal L_{\Delta}=0$,所以它必须配合空间项,不能单独保证重建质量。 若有从当前像素指向上一帧采样坐标的反向光流 $F_{t\to t-1}$,令 $\mathcal W(v,F)$ 是把上一帧采样到当前坐标的 warp。用有效且未遮挡的像素掩码 $m$,可比较重建和真值的运动补偿残差: $$\mathcal L_{\mathrm{warp,res}}=\frac{\sum m_t\left|[r_t-\mathcal W(r_{t-1},F)]-[x_t-\mathcal W(x_{t-1},F)]\right|}{\sum m_t}$$ 求和覆盖 batch、通道、时间和空间,掩码按相同维度广播后计数,分母非零;没有有效像素的样本应按明确规则跳过并报告。两边使用同一冻结光流、采样约定和掩码;线性 warp 下等于比较 $e_t-\mathcal W(e_{t-1},F)$。原文未经真值校正的 $|r_t-\mathcal W(r_{t-1},F)|$ 隐含亮度恒定等假设,在遮挡、光照变化或流估计错误时即使完美重建也可能非零。这是目标设计示例,不是以上项目统一采用的配方;随文只实跑无光流的差分与整数平移反例,没有声称复现完整光流网络。 04. 代码实现 随文 5 个脚本只依赖 numpy,python 脚本名.py 即可运行,完整版在文末附录;另有 make_figures.py 需要 matplotlib,负责本文三张配图。这里串起主干。 (1)四项损失与量级对照(vaeloss_terms.py):在合成视频上算 L1、解析 KL(sum/mean 两种口径)、感知代理、GAN,核心是 KL 解析式: kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum = kl_per_element.sum() # 包含 batch 的教学总和;每样本KL通常先sum再batch mean l1 = np.mean(np.abs(x - r)) # 工程口径:对像素求平均 print("KL(sum)/L1 = %.0f 倍" % (kl_sum / l1)) # 1826 倍 (2)像素 vs 感知(pixel_vs_perceptual.py):多尺度高斯差分特征加逐通道归一化,复现 LPIPS「在特征空间量距离」的结构。再次强调这是教学代理:本体用预训练分类网络特征与在 BAPPS 上学习的通道权重(见第 05 节真实代码)。 (3)GAN 损失与 warm-up(gan_schedule.py): def hinge_d(real, fake): return 0.5 * (np.mean(np.maximum(0.0, 1.0 - real)) + np.mean(np.maximum(0.0, 1.0 + fake))) def adopt_weight(weight, step, threshold=0, value=0.0): return value if step < threshold else weight (4)自适应权重(adaptive_weight.py):对迷你线性解码器用解析梯度(并用中心差分校验)算范数比: d_weight = np.clip(np.linalg.norm(g_rec) / (np.linalg.norm(g_gan) + 1e-4), 0.0, 1e4) print("早期 %.3f -> 后期 %.4f" % (w_early, w_late)) # 0.095 -> 0.003 (5)时间一致性(temporal_consistency.py):比较全局平均 L1 与真值校正后的帧差误差,构造平均 L1 相近、时间排列不同的反例。vaeloss_checks.py 另验证 KL 归约及梯度、hinge 极端值、移动视频/冻结视频/固定误差反例;其完整代码同样在附录。 这些脚本的真实输出已散落在第 03 节,文末附录给出可直接运行的完整源码。 05. 工业级实现对照 最小实现是为了讲清原理,生产代码有几处关键的工程化。最权威的参照是 VQGAN 的损失模块(知识树锚点): taming 的 VQ 损失模块 → VQLPIPSWithDiscriminator.forward(固定提交 3ba01b2,本轮核对日期 2026-11-02) 对照本文的四项,它的生成器一步几乎是公式的逐行翻译: rec_loss = torch.abs(inputs - reconstructions) # L1 像素 if self.perceptual_weight > 0: p_loss = self.perceptual_loss(inputs, reconstructions) # LPIPS rec_loss = rec_loss + self.perceptual_weight * p_loss nll_loss = torch.mean(rec_loss) logits_fake = self.discriminator(reconstructions) g_loss = -torch.mean(logits_fake) # hinge 生成损失 d_weight = self.calculate_adaptive_weight(nll_loss, g_loss, last_layer) loss = (nll_loss + d_weight * disc_factor * g_loss + self.codebook_weight * codebook_loss.mean()) # VQ:codebook;连续 VAE 换成 KL 与最小实现的差异,每一处都有来由: 重建与感知合并成 nll_loss 一起算梯度:自适应权重需要对「合并后的重建项」和「GAN 项」分别在最后一层求梯度(torch.autograd.grad(..., retain_graph=True)),LPIPS 仍有独立的 perceptual_weight,只是加权后并入用于求范数比的重建项。 两类优化分支,调用顺序由训练器负责:optimizer_idx==0 更新生成器(含重建、LPIPS、codebook、GAN),==1 才更新判别器;判别器那一路对输入 .detach(),不让梯度流回解码器。 LPIPS 本体(taming/modules/losses/lpips.py):先过一个 ScalingLayer(把通常约定为 $[-1,1]$ 的输入变到 VGG 的归一化统计,shift/scale 是写死的常数),再取 VGG16 的 5 个 relu 特征,每个位置沿通道归一化、过学来的 $1\times1$ 卷积、空间平均、跨层求和 —— 正是公式 3.3 的完整实现,特征网络先经过分类预训练,通道权重来自 BAPPS 学习后的 checkpoint,两者在该损失中冻结。冻结参数不等于对整个 LPIPS 前向使用 no_grad:训练生成器仍需把重建图的梯度传回解码器。 连续 KL-VAE 要核对真实目标。LDM 的固定版本 LPIPSWithDiscriminator.forward 对 (rec_loss / exp(logvar) + logvar) 求总和再除 batch,KL 也求和再除 batch;logvar 是学习尺度参数。VQ 版本对重建与感知合并项直接 mean,且最后加 codebook mean,二者不能只替换一行。两个构造器虽保存 pixel_weight,所核对 forward 并未乘它,不能因参数名就假设像素系数已生效。 以下配方对应明确论文版本;正文数值以原报告为来源,不要跨项目照抄。HunyuanVideo v1 §4.1.1 Eq.(1)、LTX-Video v1 §2.1、Seedance 1.0 v1 §2.1、H3AE v2 §3.3/表5分别核对: 模型 损失组合与权重(论文原文) HunyuanVideo (2412.03603) $L_1$ + $0.1L_{\mathrm{lpips}}$ + $0.05L_{\mathrm{adv}}$ + $10^{-6}L_{\mathrm{kl}}$;从零联合训练视频与图像;系数来自报告式(1),不据此推断未展开的归约细节 LTX-Video (2501.00103) 像素 MSE 加 Video-DWT(小波域 L1)加 LPIPS 加 Reconstruction-GAN;并讨论 causal /non-causal VAE 的取舍 Seedance 1.0 (2506.09113) L1 加 KL 加 LPIPS 加对抗损失;用类 PatchGAN 的混合判别器同时约束外观与运动 H3AE (2504.10567) 反方证据:在该设置中辅助项有不同指标取舍;先训练重建+KL,再用重编码后验之间的 KL 做潜一致性微调,非普适胜出结论 表中 HunyuanVideo 给出了这里列出的四个明确系数,其他项目采用不同目标或归一化,不能据此称权重“高度趋同”。toy 的数值只解释口径为何重要,不能从 1826 倍损失比推导出真实训练必需的 $10^{-6}$ 权重。 本轮在 PyTorch 2.10.0+cpu 上执行固定源码的完整损失类 forward:以小型确定性特征/判别器替代预训练网络构造,核对 VQ 与连续 KL 两版的生成器/判别器分支、启用边界、detach、归约、学习尺度和自适应系数;另执行原 LPIPS forward、ScalingLayer、归一化函数并与独立公式对照。这只验证损失代数与 autograd 路径,没有真实 VGG checkpoint、人类感知评测或视频 GAN 训练;official_validation.json 保存夹具和源码哈希。 06. 代价与边界 每一项都在解决一类失真,也都引入新的代价: L1/L2:目标直接、易于解释;存在信息丢失和不确定性时逐点最优解可能平均掉细节,但 L2 低不等于必糊,L1 也不必然颗粒重。 KL:去掉它可能使后验更确定、尺度约束变弱,但没有 KL 的自编码器或 VQ latent 也可以训练扩散模型;但权重过大、瓶颈太紧,重建细节会被牺牲。不能只凭 $10^{-6}$ 就判定有效正则弱:归约、梯度与潜变量维数都会影响强度,换套实现需要重新定标。 LPIPS:贴人眼,但它的「审美」被冻结在 VGG 的自然图像特征里 —— 对医学影像、动画、线稿等域外数据可能偏置;它偏纹理,有时会鼓励「看起来有细节」的伪纹理。 GAN:可以改善局部统计,也会引入两方优化、额外算力及伪纹理风险;warm-up、自适应权重、谱归一化等是可选稳定化手段,不是所有项目都必须同时用。原 taming 判别器并不能仅因使用 hinge 就被认作带谱归一化。感知—失真边界说明最优可达目标可能冲突,不表示每一次改善观感都必须降低 PSNR;一个尚未优化好的模型可以同时改善两者。参见 The Perception-Distortion Tradeoff。 视频时间项 / 3D 判别器:能压闪烁,但显著增算力、增训练时长;光流估计本身在遮挡和大运动处会出错,warp 损失可能误伤真实运动。 H3AE v2 表5还提供了具体反例:同一基础模型分别追加辅助目标训练 10K iterations,baseline 的 PSNR/LPIPS/rFVD 为 29.48/0.2627/147.1;加 LPIPS 为 29.07/0.224/148.9,潜一致性为 29.58/0.2541/142.2。潜一致性相对 baseline 同时改善这些指标,但 LPIPS 分数仍不及专门加 LPIPS 的 0.224,不能说它逐指标胜过所有辅助项。这些是该论文数据与设置的结果,也不能据此断言所有高压缩 VAE 都应删 GAN。原始表5 是比较依据。 07. 经典论文脉络 Auto-Encoding Variational Bayes(VAE,arXiv:1312.6114,2013):系统化 VAE 的变分目标与路径梯度估计;不能把变分下界、高斯潜变量或 KL 的历史起源都归于这一篇。 Neural Discrete Representation Learning(VQ-VAE,arXiv:1711.00937,2017):改走离散码本,用 codebook/commitment 损失替代 KL,是 VQGAN 的前身。 Image-to-Image Translation with Conditional Adversarial Networks(pix2pix / PatchGAN,arXiv:1611.07004,2016 年首发,2017 年 CVPR):把判别器做成局部 patch 判定器,确立了「局部对抗项与像素重建互补」的分工。 The Unreasonable Effectiveness of Deep Features as a Perceptual Metric(LPIPS,arXiv:1801.03924,CVPR 2018):在 BAPPS 局部失真判断任务中验证深度特征距离与人类判断的相关性,并学习通道权重;这不证明它对所有数据域和视频时间失真都更好。 Taming Transformers for High-Resolution Image Synthesis(VQGAN,arXiv:2012.09841,2021):L1、LPIPS、PatchGAN、codebook 四件套定型,配套自适应 GAN 权重与 warm-up,是本文工业对照的母本。 CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer(arXiv:2408.06072)与 HunyuanVideo: A Systematic Framework For Large Video Generative Models(arXiv:2412.03603):把这套组合搬到 3D 因果视频 VAE,后者给出明确四项系数,时空判别器示例另见 Seedance 报告。 H3AE: High Compression, High Speed, and High Quality AutoEncoder for Video Diffusion Models(arXiv:2504.10567,2025):对「判别损失是否值得」提出反方证据,代表这条线仍在演进。 08. 常见误解 「KL 权重抄 HunyuanVideo 的 $10^{-6}$ 就行」:错。权重取决于你的 KL 是 sum 还是 mean、latent 与像素各有多少元素、有没有做 loss balancing。本文实测同一组数据 sum 口径 KL 是 mean 口径 L1 的 1826 倍;换个压缩率或归一化,$10^{-6}$ 可能过大或过小。先统一口径,再谈数字。 「LPIPS 就是拿 VGG 特征算 L2」:漏了两个关键件 —— 沿通道的归一化和在 BAPPS 上学出来的 $1\times1$ 权重;输入还要先过 scaling layer 换到 VGG 的数值域。少了归一化,距离会被少数高响应通道主导。 「生成器 GAN 损失算出来是负数,训练崩了」:hinge 生成器目标下 $\mathcal{L}_G=-\mathbb{E}[D(r)]$(logistic non-saturating 常写成 $\mathbb E[\mathrm{softplus}(-D(r))]$,是另一种公式),为负只说明假样本 logit 的均值为正;它不是重建质量合格或所有样本都骗过判别器的证明;该盯的是梯度和平衡,不是损失正负。 「判别器越强,重建越清晰」:hinge margin 饱和会让判别器损失梯度为 0,但生成器目标对平均 fake logit 的导数为 −1,对每个等权 logit 则为 $-1/M$,不能把 D loss=0 当成生成器梯度消失的证据。应检查两侧梯度、学习率、更新频率和样本质量,再决定是否使用晚启动、正则或自适应权重。 「L1/L2 越低画面越好」:同一数据范围下 PSNR 由 MSE 定义,MSE 下降就提高 PSNR;这本身不代表观感变差。只有给定有损表示下的不确定性等条件满足时,条件均值解释才适用。感知项的收益和像素误差变化应实测。要同时看像素指标和感知 / 对抗指标。 「视频 VAE 把图像四项 loss 直接套到 3D 卷积上就行」:单帧损失的全局均值不足以刻画时间排列(实测单帧 L1 几乎相同、时序误差差 393 倍)。应额外评估时序误差,按消融结果决定是否需要时空判别器、Video-DWT 或显式帧间约束;时间网络结构本身也能学习一致性。 「四项应该从头一起训」:主流做法是重建加 KL(有时加 LPIPS)先预热,第 disc_start 步才开 GAN;H3AE 甚至主张慎用判别损失。晚启动是一种稳定训练的办法,是否必需以及何时启动需依据具体实验。 09. 动手验证 5 个脚本都在本文附录,仅需 numpy(pip install numpy);vaeloss_checks.py 同样只需 NumPy;第 6 个原脚本 make_figures.py 额外需要 matplotlib,用来重画本文配图。预期关键结果如下(随机种子已固定): 运行 vaeloss_terms.py:看到 L1 约 0.0316、KL (sum) 约 57.7、KL (mean) 约 0.225,以及「KL (sum)/L1 约 1826 倍」和 借用 HunyuanVideo 系数的 toy 加权值 —— 认识口径与系数换算,并区别标量大小、梯度大小和训练质量。 运行 pixel_vs_perceptual.py:亮度偏移与同能量噪声的像素 MSE 几乎相等(差小于 1%),但感知距离相差约三个数量级(噪声约为偏移的 $8\times10^3$ 倍)。 运行 gan_schedule.py:warm-up 在 step 2000 起跳;margin 满足时 D (hinge)=0.0000 而 G 约 5.97,同时检查脚本新增的 logit 导数:D margin 梯度归零,G 对 fake logit 的导数仍非零。 运行 adaptive_weight.py:先看有限差分与解析梯度在输出精度内一致,再看固定判别器下 d_weight 从大残差点 0.095 降到小残差点约 0.003(约 32 倍)。 运行 temporal_consistency.py:闪烁与稳定两种重建的单帧 L1 约 0.063 几乎相同,时序 MSE 却差约 393 倍 —— 理解视频为何要单独约束时间维。 运行 make_figures.py(这个需要额外装 pip install matplotlib):重新生成本文三张配图 —— 量级账本(加权前 vs 加权后)、闪烁轨迹与指标对比、固定判别器下系数与梯度范数的关系。在账本与 make_figures.py 中同时把 KL 系数从 $10^{-6}$ 改为 $10^{-4}$ 并重跑再看图 1,KL 项由约 $5.8\times10^{-5}$ 升到 $5.8\times10^{-3}$,仍低于这里约 0.0316 的 L1,不能声称已经压过所有项。 运行 vaeloss_checks.py:应输出 passed: true,移动视频的原始帧差为 0.03125,完美重建的真值校正项为 0;冻结首帧的原始帧差为 0,但校正项为 0.03125。192 个末层权重坐标的重建/GAN 梯度差分别不超过 $1.21\times10^{-10}$ 和 $5.96\times10^{-11}$。 建议进一步动手:把 vaeloss_terms.py 里的 KL 从 sum() 改成 mean(),观察 HunyuanVideo 配方里 KL 项的相对权重需要相应放大多少倍,就能切身体会「权重不能跨口径照抄」。 10. 延伸阅读 读这篇之前建议先看已发布的前置: 变分下界与重参数化:KL 解析式与重参数化技巧的完整推导。 VAE 结构与训练目标:编码器 / 解码器、scaling factor、后验坍缩。 视频 VAE 的时空压缩结构:3D 因果卷积、时间 / 空间压缩比与分块解码。 读完这篇可以继续看: 视频生成评测:VBench 与人工验收:学会在分维度指标上看出「总分没变、时序一致性掉了」这类压缩副作用。 FID / CLIP Score 到底测了什么:感知与分布距离指标的适用边界,与本文 LPIPS/GAN 的质量观互补。 离散化表征:VQ-VAE 与 VQGAN:本文连续 KL-VAE 的「离散码本」对照版本,codebook 损失替代 KL。 附录:完整代码 09 节用到的脚本全文如下(vaeloss_terms.py、make_figures.py、pixel_vs_perceptual.py、gan_schedule.py、adaptive_weight.py、temporal_consistency.py、vaeloss_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 vaeloss_terms.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """视频 VAE 四类损失的最小可运行对照:L1 / KL / 感知 / GAN。 只依赖 numpy,直接 `python vaeloss_terms.py` 复现。 这一步不训练任何网络,只把四项损失放到同一个合成视频张量上算一遍, 回答一个最容易把人带沟里的问题:它们的「数值量级」根本不在一个频道上, 演示归约和权重的关系;不能由 toy 标量比推导真实训练配方。 """ import numpy as np rng = np.random.default_rng(0) # ---------------------------------------------------------------------- # 一个迷你的多尺度「特征提取器」,用来演示感知损失的*结构*。 # 注意:它不是 LPIPS 本体——LPIPS 用的是在 BAPPS 上学过权重的 VGG/Alex # 特征(见工业对照一节的 taming/lpips.py)。这里用可分离高斯 + 差分(DoG) # 构造确定性的多尺度边缘特征,目的是让「在特征空间而非像素空间比较」 # 这件事可以离线、免权重地跑起来。 # ---------------------------------------------------------------------- def _gauss_kernel(size=5, sigma=1.0): ax = np.arange(size) - (size - 1) / 2.0 k = np.exp(-(ax ** 2) / (2 * sigma ** 2)) return k / k.sum() def _conv_separable(img, k): """对最后两轴(H, W)做可分离卷积;img 形状 [..., H, W],边界 reflect。""" pad = len(k) // 2 x = np.pad(img, ((0, 0),) * (img.ndim - 2) + ((pad, pad), (0, 0)), mode="reflect") acc = np.zeros_like(img) for i, w in enumerate(k): acc += w * x[..., i:i + img.shape[-2], :] x = np.pad(acc, ((0, 0),) * (img.ndim - 2) + ((0, 0), (pad, pad)), mode="reflect") acc = np.zeros_like(img) for j, w in enumerate(k): acc += w * x[..., :, j:j + img.shape[-1]] return acc def _normalize_channels(feat, eps=1e-10): # 对应 LPIPS 的 normalize_tensor:沿通道维归一化 norm = np.sqrt(np.sum(feat ** 2, axis=1, keepdims=True)) return feat / (norm + eps) def feature_stack(x): """x: [B, C, T, H, W] -> 多尺度边缘特征列表(先把 T 折叠进 batch)。""" B, C, T, H, W = x.shape f = x.transpose(0, 2, 1, 3, 4).reshape(B * T, C, H, W) k = _gauss_kernel(5, 1.0) b1 = _conv_separable(f, k) b2 = _conv_separable(_conv_separable(b1, k), k) dog1 = f - b1 # 高频细节 dog2 = b1 - b2 # 中频边缘 feats = [_normalize_channels(f), _normalize_channels(dog1), _normalize_channels(dog2)] return feats def perceptual_proxy(x, y): """结构对齐 LPIPS:逐层归一化特征差的平方,空间平均后跨层求和。""" total = 0.0 for fx, fy in zip(feature_stack(x), feature_stack(y)): total += np.mean((fx - fy) ** 2) return total def make_video(B=2, T=8, H=32, W=32): """合成一段有运动内容的视频:移动的亮圆 + 网格背景,取值[0,1]。""" x = np.zeros((B, 3, T, H, W), dtype=np.float64) yy, xx = np.mgrid[0:H, 0:W] for b in range(B): for t in range(T): cx = W * (0.3 + 0.5 * t / (T - 1)) cy = H * (0.3 + 0.15 * np.sin(2 * np.pi * t / T)) circle = ((xx - cx) ** 2 + (yy - cy) ** 2) < (H * 0.12) ** 2 grid = ((xx // 8 + yy // 8) % 2) * 0.15 frame = 0.2 + grid frame[circle] = 0.95 x[b, 0, t] = frame x[b, 1, t] = frame * 0.9 x[b, 2, t] = frame * 0.7 return x def degrade(x): """重建结果:轻微模糊 + 小噪声 + 偏色,模拟一个训练中段的解码器。""" B, C, T, H, W = x.shape flat = x.transpose(0, 2, 1, 3, 4).reshape(B * T, C, H, W) k = _gauss_kernel(3, 0.8) out = _conv_separable(flat, k) out = out + rng.normal(0, 0.02, out.shape) out[:, 0] += 0.03 # 轻微红色偏置 return np.clip(out, 0, 1).reshape(B, T, C, H, W).transpose(0, 2, 1, 3, 4) def main(): x = make_video() r = degrade(x) print("视频张量 x / r :", x.shape, " 取值范围 %.2f~%.2f" % (x.min(), x.max())) # 编码器输出的后验 q(z|x):latent 在时间压缩4x、空间压缩8x B, C, T, H, W = x.shape Cz, Tz, Hz, Wz = 4, T // 4, H // 8, W // 8 mu = 0.3 * rng.standard_normal((B, Cz, Tz, Hz, Wz)) logvar = -1.0 + 0.2 * rng.standard_normal((B, Cz, Tz, Hz, Wz)) n_pix = B * C * T * H * W n_lat = mu.size print("latent 形状 :", mu.shape, " 像素数=%d latent数=%d\n" % (n_pix, n_lat)) # ① 像素重建 L1(对全部元素求平均,量纲与像素一致,O(0.01~0.1)) l1 = np.mean(np.abs(x - r)) # ② KL 解析式(标准正态先验)。注意它天然是「求和」式 kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum = kl_per_element.sum() # 包含batch的教学总和,非每样本KL均值 kl_mean = kl_per_element.mean() kl_batchmean = kl_per_element.reshape(B, -1).sum(axis=1).mean() # ③ 感知损失(多尺度特征距离,不等同真实 LPIPS,通道也被 mean 而非 learned sum) l_p = perceptual_proxy(x, r) # ④ GAN 生成器损失。这里直接喂一组判别器对假图的打分 logits # hinge 生成损失 = -mean(logits_fake);先假设判别器刚起步、打分偏正 logits_fake = rng.normal(0.3, 0.5, size=64) g_loss = -np.mean(logits_fake) print("%-28s %10s" % ("损失项", "原始数值")) print("-" * 40) print("%-28s %10.5f" % ("L1 重建 (mean)", l1)) print("%-28s %10.5f" % ("KL (全batch sum,教学)", kl_sum)) print("%-28s %10.5f" % ("KL (mean,换口径)", kl_mean)) print("%-28s %10.5f" % ("感知 proxy", l_p)) print("%-28s %10.5f" % ("GAN g=-mean(D(r))", g_loss)) print("KL (每样本sum,再batch mean) = %.5f" % kl_batchmean) print("\n--- 归约对照;非工业模型复现 ---") # 若直接把 sum 口径的 KL 与 mean 口径的 L1 相加,KL 会凭元素数量碾压: print("KL(sum)/L1 的量级倍数 : %.1fx" % (kl_sum / l1)) print("借用报告系数的 toy 账本(感知proxy/合成logit/全batch KL,非原模型损失):") total = l1 + 0.1 * l_p + 0.05 * g_loss + 1e-6 * kl_sum print(" 各项贡献: L1=%.5f proxy=%.5f GAN=%.5f KL=%.6f" % (l1, 0.1 * l_p, 0.05 * g_loss, 1e-6 * kl_sum)) print(" 合计 = %.5f" % total) print("\n结论:归约决定系数换算;标量贡献不能替代梯度与质量消融。") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「视频 VAE 的常见 loss 组合」的三张解释图。 数值一律从同目录的三个脚本里取(vaeloss_terms / temporal_consistency / adaptive_weight),这里只负责画——改了那边这里要重跑,免得图和正文数字打架。 三张图分别回答: 1. 四项损失的原始量级差着几个数量级,借用系数后各项的绝对值;非工业模型实测 2. 单帧指标完全分不开的两种重建,时间维损失一眼看穿 3. 固定线性判别器下的梯度范数比例 只依赖 numpy + matplotlib。跑法:python make_figures.py """ import textwrap from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np import adaptive_weight as AW import temporal_consistency as TC import vaeloss_terms as VT ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.bbox": "tight", }) INK = "#1f2937" MUTE = "#6b7280" C_PIX = "#2f6fb0" # 像素项:蓝 C_PERC = "#8b5cf6" # 感知项:紫 C_GAN = "#e0a03c" # 对抗项:橙 C_KL = "#d1495b" # KL:红 C_A = "#d1495b" # 闪烁重建 C_B = "#2f9e6f" # 稳定重建 C_GT = "#1f2937" # 真值 def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left") if xlabel: ax.set_xlabel(xlabel, fontsize=10, color=MUTE) if ylabel: ax.set_ylabel(ylabel, fontsize=10, color=MUTE) ax.tick_params(colors=MUTE, labelsize=9) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#d1d5db") ax.grid(alpha=0.25, linewidth=0.6, axis="y") ax.set_axisbelow(True) def footer(fig, text, width=118): """把「这张图要看什么」放到坐标轴下方。 必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来, 放在 0~0.05 之间的话会和 x 轴标签叠在一起。 """ wrapped = "\n".join(textwrap.wrap(text, width=width)) fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE, va="top", ha="left", linespacing=1.6) # ────────────────────────────────────────────────────────────────────── # 图 1:四项损失的量级账本 # ────────────────────────────────────────────────────────────────────── def fig_magnitudes(): x, r = VT.make_video(), VT.degrade(VT.make_video()) # 与 vaeloss_terms.main 完全同口径重算一遍(rng 序列一致) B, C, T, H, W = x.shape Cz, Tz, Hz, Wz = 4, T // 4, H // 8, W // 8 mu = 0.3 * VT.rng.standard_normal((B, Cz, Tz, Hz, Wz)) logvar = -1.0 + 0.2 * VT.rng.standard_normal((B, Cz, Tz, Hz, Wz)) l1 = float(np.mean(np.abs(x - r))) kl_el = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum, kl_mean = float(kl_el.sum()), float(kl_el.mean()) lp = float(VT.perceptual_proxy(x, r)) gan = abs(float(-np.mean(VT.rng.normal(0.3, 0.5, size=64)))) fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.4)) ax = axes[0] names = ["L1 重建", "感知 proxy", "KL(mean)", "KL(sum)", "|GAN|"] vals = [l1, lp, kl_mean, kl_sum, gan] cols = [C_PIX, C_PERC, C_KL, C_KL, C_GAN] bars = ax.bar(names, vals, color=cols, width=0.62) ax.set_yscale("log") ax.set_ylim(1e-3, 3e2) for b, v in zip(bars, vals): ax.text(b.get_x() + b.get_width() / 2, v * 1.25, f"{v:.4g}", ha="center", fontsize=8.5, color=INK) style(ax, "加权前:同一视频上四项损失的原始数值", None, "损失值(对数轴)") ax = axes[1] wnames = ["1.0 × L1", "0.1 × 感知", "0.05 × |GAN|", "1e-6 × KL(sum)"] wvals = [l1, 0.1 * lp, 0.05 * gan, 1e-6 * kl_sum] wcols = [C_PIX, C_PERC, C_GAN, C_KL] bars = ax.bar(wnames, wvals, color=wcols, width=0.62) ax.set_yscale("log") ax.set_ylim(1e-6, 1e-1) for b, v in zip(bars, wvals): ax.text(b.get_x() + b.get_width() / 2, v * 1.6, f"{v:.4g}", ha="center", fontsize=8.5, color=INK) ax.axhline(l1, color=MUTE, ls=":", lw=1.0) ax.text(2.6, l1 * 1.5, "L1 的量级", fontsize=8, color=MUTE) style(ax, "借用系数的 toy 账本:GAN仅画绝对值", None, "加权绝对幅值(对数轴)") fig.suptitle("图 1 损失归约口径与加权幅值:标量大小不等于梯度大小", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图是四项损失在同一个合成视频上的原始数值——KL 对整个 batch 的 latent 元素" "求和,一上来就是 L1 的 1826 倍;右图是借用报告系数后的绝对幅值," "贡献仍不同量级(KL 约5.8e-5,而L1约0.0316);这些权重不能由toy损失比唯一推导。" "系数还受梯度与质量目标影响;这里的proxy和全batch KL不等同原论文实现。") fig.savefig(OUT / "loss_magnitudes.png") plt.close(fig) print(f"[图1] L1={l1:.5f} KL_sum={kl_sum:.5f} 倍数={kl_sum / l1:.0f}x;" f"加权后贡献 L1={l1:.5f} KL={1e-6 * kl_sum:.2e}") # ────────────────────────────────────────────────────────────────────── # 图 2:单帧指标看不见的闪烁 # ────────────────────────────────────────────────────────────────────── def fig_temporal(): x = TC.make_sequence() # [T,1,H,W] fixed = TC.SIGMA * TC.rng.standard_normal(x.shape[1:])[None] rA = x + TC.SIGMA * TC.rng.standard_normal(x.shape) rB = x + fixed + 0.05 * TC.SIGMA * TC.rng.standard_normal(x.shape) # 取一条穿过运动边缘的水平线上的一个像素,看它随帧的取值 t_axis = np.arange(TC.T) y0, x0 = TC.H // 2, 30 gt = x[:, 0, y0, x0] a = rA[:, 0, y0, x0] b = rB[:, 0, y0, x0] fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.3)) ax = axes[0] ax.plot(t_axis, gt, lw=2.6, color=C_GT, label="真值", zorder=3) ax.plot(t_axis, a, lw=1.2, color=C_A, alpha=0.9, label="A 逐帧独立噪声(闪)") ax.plot(t_axis, b, lw=1.2, color=C_B, alpha=0.9, label="B 跨帧恒定退化(稳)") ax.set_ylim(gt.min() - 4 * TC.SIGMA, gt.max() + 4 * TC.SIGMA) ax.legend(fontsize=8.5, frameon=False, loc="upper left") style(ax, "同一个像素随帧的变化:A 在真值附近抖,B 近似恒定偏移、抖动小", "帧 t", "像素值") ax = axes[1] mets = ["单帧空间 L1", "时序差分 L1", "时序差分 MSE"] va = [TC.spatial_l1(rA, x), TC.temporal_error(rA, x), TC.temporal_mse(rA, x)] vb = [TC.spatial_l1(rB, x), TC.temporal_error(rB, x), TC.temporal_mse(rB, x)] xg = np.arange(len(mets)) w = 0.36 ba = ax.bar(xg - w / 2, va, w, color=C_A, label="A 闪") bb = ax.bar(xg + w / 2, vb, w, color=C_B, label="B 稳") ax.set_yscale("log") ax.set_ylim(1e-5, 1) for bars in (ba, bb): for b_ in bars: ax.text(b_.get_x() + b_.get_width() / 2, b_.get_height() * 1.5, f"{b_.get_height():.4g}", ha="center", fontsize=8, color=INK) ax.set_xticks(xg) ax.set_xticklabels(mets) ax.legend(fontsize=8.5, frameon=False, loc="upper left") style(ax, "三种指标下 A、B 的差距:第一列接近,第三列差 393 倍", None, "误差(对数轴)") fig.suptitle("图 2 单帧平均 L1 接近的两种重建,时序差分 MSE 差了 393 倍", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图是同一个像素在 12 帧上的取值——A(红)每一帧都在真值附近独立抖动," "连起来播放就是闪烁;B(绿)误差近似恒定,仍保留真值运动。" "右图是量化结论:单帧空间 L1 下 A=0.0639、B=0.0634,该平均数未保留误差的时间排列;" "换时序差分 MSE,A 是 B 的 393 倍。本例说明空间平均数不足以唯一确定时间误差。") fig.savefig(OUT / "temporal_flicker.png") plt.close(fig) print(f"[图2] 单帧L1 A={va[0]:.5f}/B={vb[0]:.5f};时序MSE A={va[2]:.5f}/B={vb[2]:.5f}" f"({va[2] / max(vb[2], 1e-12):.0f}x)") # ────────────────────────────────────────────────────────────────────── # 图 3:自适应 GAN 权重随训练自动变小 # ────────────────────────────────────────────────────────────────────── def fig_adaptive(): b = np.zeros(AW.D) early = AW.rng.standard_normal((AW.dz, AW.D)) * 0.05 late = AW.W_star + AW.rng.standard_normal((AW.dz, AW.D)) * 0.01 sweep_rng = np.random.default_rng(7) direction = sweep_rng.standard_normal((AW.dz, AW.D)) norms, weights = [], [] for scale in np.logspace(-4, -0.3, 30): g_rec, g_gan = AW.grads(AW.W_star + scale * direction, b) norms.append(np.linalg.norm(g_rec)) weights.append(AW.adaptive_weight(g_rec, g_gan)) fig, ax = plt.subplots(figsize=(8.5, 4.5)) ax.plot(norms, weights, color=C_GAN, label="固定判别器、固定扰动方向扫描") points = [] for W, label in [(early, "大残差权重点"), (late, "小残差权重点")]: g_rec, g_gan = AW.grads(W, b) gn, ratio = np.linalg.norm(g_rec), AW.adaptive_weight(g_rec, g_gan) points.append(ratio) ax.scatter([gn], [ratio], color=C_PIX, marker="s", zorder=3) ax.annotate(f"{label}: {ratio:.4f}", (gn, ratio), xytext=(-85, 14), textcoords="offset points", fontsize=9) ax.set_xscale("log"); ax.set_yscale("log"); ax.legend(frameon=False, fontsize=9) style(ax, "范数比关系;不是优化器训练曲线", r"最后一层重建梯度范数", "自适应系数 d_weight") fig.suptitle("图 3 固定 GAN 梯度时,系数随重建梯度缩小", x=.012, ha="left", color=INK) footer(fig, "横轴是实际计算的梯度范数,两个方点与脚本数值一一对应。扫描只缩放同一扰动方向," "没有执行训练;真实判别器梯度也会变化,不能据此推出权重随步数必然下降。") fig.savefig(OUT / "adaptive_weight_curve.png"); plt.close(fig) print(f"[图3] synthetic d_weight {points[0]:.4f} -> {points[1]:.4f}") def main(): fig_magnitudes() fig_temporal() fig_adaptive() print(f"[OK] 三张图已写入 {OUT}") for f in sorted(OUT.glob("*.png")): print(f" {f.name} {f.stat().st_size / 1024:.0f} KB") if __name__ == "__main__": main() pixel_vs_perceptual.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """用固定多尺度代理演示像素与特征距离的差别:相同的像素误差,感知质量可以天差地别。 只依赖 numpy,直接 `python pixel_vs_perceptual.py` 复现。 我们构造三种「重建」,让其中两种的像素 MSE 在期望上相等: A. 全局亮度偏移 —— 亮度敏感度由所选代理决定; B. 同等 L2 能量的逐点噪声 —— 直接污染纹理与细节,观感很差; C. 高斯模糊 —— 抹掉高频细节。 然后分别在「像素空间」和一个多尺度特征空间里比较距离。 """ import numpy as np rng = np.random.default_rng(1) def _gauss_kernel(size=5, sigma=1.0): ax = np.arange(size) - (size - 1) / 2.0 k = np.exp(-(ax ** 2) / (2 * sigma ** 2)) return k / k.sum() def _conv_separable(img, k): pad = len(k) // 2 x = np.pad(img, ((0, 0),) * (img.ndim - 2) + ((pad, pad), (0, 0)), mode="reflect") acc = np.zeros_like(img) for i, w in enumerate(k): acc += w * x[..., i:i + img.shape[-2], :] x = np.pad(acc, ((0, 0),) * (img.ndim - 2) + ((0, 0), (pad, pad)), mode="reflect") acc = np.zeros_like(img) for j, w in enumerate(k): acc += w * x[..., :, j:j + img.shape[-1]] return acc def _norm(feat, eps=1e-10): return feat / (np.sqrt(np.sum(feat ** 2, axis=1, keepdims=True)) + eps) def perceptual_proxy(x, y): """多尺度高通特征上的归一化距离(LPIPS 的结构代理,非本体)。""" def feats(z): k = _gauss_kernel(5, 1.0) b1 = _conv_separable(z, k) b2 = _conv_separable(_conv_separable(b1, k), k) return [_norm(z), _norm(z - b1), _norm(b1 - b2)] return sum(np.mean((a - b) ** 2) for a, b in zip(feats(x), feats(y))) def make_textured_image(H=64, W=64): """一张同时含锐边、细密纹理和平滑区域的图。""" yy, xx = np.mgrid[0:H, 0:W].astype(np.float64) img = 0.5 + 0.25 * np.sin(xx / 2.0) * np.sin(yy / 2.0) # 细密纹理 img += 0.3 * (xx > W / 2) # 一条锐边 checker = ((xx // 4 + yy // 4) % 2) * 0.15 # 棋盘格 img += checker img = np.clip(img, 0, 1) return np.stack([img, img * 0.92, img * 0.8], axis=0)[None] # [1,C,H,W] def mse(a, b): return float(np.mean((a - b) ** 2)) def main(): x = make_textured_image() delta = 0.12 # 统一的 L2 误差能量 rA = x + delta # A:全局亮度偏移(不 clip,保证误差严格等于 delta) rB = x + rng.normal(0, delta, x.shape) # B:零均值逐点噪声,标准差=delta rC = _conv_separable(x, _gauss_kernel(7, 1.6)) # C:模糊 rows = [ ("A 亮度偏移(整体+%.2f)" % delta, rA), ("B 逐点噪声(σ=%.2f)" % delta, rB), ("C 高斯模糊", rC), ] print("%-26s %12s %12s %14s" % ("重建方式", "像素MSE", "感知距离", "感知/像素 比")) print("-" * 68) for name, r in rows: pm = mse(x, r) pp = perceptual_proxy(x, r) print("%-26s %12.5f %12.5f %14.2f" % (name, pm, pp, pp / (pm + 1e-12))) mseA, mseB = mse(x, rA), mse(x, rB) pA, pB = perceptual_proxy(x, rA), perceptual_proxy(x, rB) print("\n关键对照:A 与 B 的像素 MSE 相差仅 %.2f%%," % (100 * abs(mseA - mseB) / mseA)) print("但特征空间里 B(噪声)的感知距离是 A(亮度偏移)的 %.1f 倍。" % (pB / pA)) print("这是含原图特征的固定代理,非真实LPIPS或人类偏好实验;高通分支抑制直流。") if __name__ == "__main__": main() gan_schedule.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """GAN 两项的最小演示:hinge / vanilla 损失,以及判别器的 warm-up 调度。 只依赖 numpy,直接 `python gan_schedule.py` 复现。 视频 VAE 里对抗损失通常不是从头开:先用 L1+KL+LPIPS 把解码器训到大致成形, 第 disc_start 步才把判别器权重从 0 抬起来(taming 里的 adopt_weight)。 本脚本同时给出两种常见判别损失的数值,并展示margin满足不等于生成器梯度消失。 """ import numpy as np rng = np.random.default_rng(3) def adopt_weight(weight, global_step, threshold=0, value=0.0): """taming-transformers 里的原逻辑:threshold 之前强制为 value(通常是0)。""" return value if global_step < threshold else weight def hinge_d(real, fake): return 0.5 * (np.mean(np.maximum(0.0, 1.0 - real)) + np.mean(np.maximum(0.0, 1.0 + fake))) def hinge_g(fake): return float(-np.mean(fake)) def vanilla_d(real, fake): softplus = lambda z: np.log1p(np.exp(-np.abs(z))) + np.maximum(z, 0.0) return 0.5 * (np.mean(softplus(-real)) + np.mean(softplus(fake))) def evaluate(real, fake, tag): print("%-28s D(hinge)=%.4f D(vanilla)=%.4f G(hinge)=%.4f 均值打分 real=%.2f fake=%.2f" % (tag, hinge_d(real, fake), vanilla_d(real, fake), hinge_g(fake), real.mean(), fake.mean())) def main(): # ① warm-up 调度:disc_start=2000 print("== adopt_weight 调度(disc_start=2000, 目标权重 0.05) ==") for step in (0, 1999, 2000, 5000): w = adopt_weight(0.05, step, threshold=2000) print(" step=%5d -> 对抗权重 = %.3f" % (step, w)) # ② 判别器在三种强弱下的损失 print("\n== 判别器强弱与损失信号 ==") # 平衡初期:真假打分都在 0 附近 real0 = rng.normal(0.0, 0.3, 256) fake0 = rng.normal(0.0, 0.3, 256) evaluate(real0, fake0, "起步:判别器分不清") # 健康:真≈+1,假≈-1,仍留梯度 real1 = rng.normal(1.2, 0.4, 256) fake1 = rng.normal(-1.2, 0.4, 256) evaluate(real1, fake1, "分离:尚有部分margin残差") # 过强:真≈+6,假≈-6,判别器 hinge 梯度为 0,但生成器对 fake logit 仍有梯度 real2 = rng.normal(6.0, 0.5, 256) fake2 = rng.normal(-6.0, 0.5, 256) evaluate(real2, fake2, "分离:margin已满足") d_fake_grad = 0.5 * (fake2 > -1.0) / fake2.size g_fake_grad = -np.ones_like(fake2) / fake2.size print("\nD 对 fake logit 梯度范数 = %.6f" % np.linalg.norm(d_fake_grad)) print("G 对 fake logit 梯度范数 = %.6f" % np.linalg.norm(g_fake_grad)) print("D margin 饱和不表示 G 梯度消失;参数梯度还取决于判别器输入雅可比。") if __name__ == "__main__": main() adaptive_weight.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """复现 VQGAN 的自适应 GAN 权重 calculate_adaptive_weight。 只依赖 numpy,直接 `python adaptive_weight.py` 复现。 本实验构造大残差/小残差两个权重点,固定线性判别器;没有进行训练。 真实训练中的两个梯度都可能变化,范数比未必随步数下降。 VQGAN 的做法是让两项在「最后一层」上的梯度范数之比来决定权重: d_weight = ||∇_last L_rec|| / (||∇_last L_gan|| + 1e-4),再 clamp 到 [0,1e4] 我们用一个可解析求导的迷你线性解码器,精确算出两个梯度范数, 并用有限差分抽查一个分量,证明数值不是凑出来的。 """ import numpy as np rng = np.random.default_rng(2) N, D, dz = 16, 24, 8 # 样本数、像素维、latent 维 Z = rng.standard_normal((N, dz)) W_star = rng.standard_normal((dz, D)) * 0.3 X = Z @ W_star # 真实数据:线性可完美拟合 # 一个固定的微型判别器打分函数 s(x)=x @ a(教学用,参数冻结) a = rng.standard_normal((D,)) def decode(W, b): return Z @ W + b def rec_loss(W, b): """重建项:L2(L1 同理,范数比机制不变)。""" return float(np.mean((decode(W, b) - X) ** 2)) def gan_g_loss(W, b): """生成器 hinge 损失 -mean(D(r))。""" s = decode(W, b) @ a return float(-np.mean(s)) def grads(W, b): R = decode(W, b) - X g_rec = (2.0 / (N * D)) * Z.T @ R # ∂L_rec/∂W(mean 对 N*D) # g=-mean_n(s_n),s_n=Σ_d xhat_nd·a_d:mean 只对 N,分母是 N,不是 N*D s_coef = -(1.0 / N) * Z.sum(axis=0) # ∂g/∂W_kd = -(1/N)(Σ_n z_nk) a_d g_gan = np.outer(s_coef, a) return g_rec, g_gan def adaptive_weight(g_rec, g_gan, cap=1e4): w = np.linalg.norm(g_rec) / (np.linalg.norm(g_gan) + 1e-4) return float(np.clip(w, 0.0, cap)) def finite_diff_check(W, b, eps=1e-6): """用中心差分抽查 W[0,0] 上的两个梯度,验证解析解。""" out = [] for fn in (rec_loss, gan_g_loss): Wp, Wm = W.copy(), W.copy() Wp[0, 0] += eps Wm[0, 0] -= eps out.append((fn(Wp, b) - fn(Wm, b)) / (2 * eps)) return out def stage(W, b, name): lrec = rec_loss(W, b) lgan = gan_g_loss(W, b) g_rec, g_gan = grads(W, b) w = adaptive_weight(g_rec, g_gan) print("%-22s L_rec=%8.5f L_gan=%8.4f ||∇rec||=%8.4f ||∇gan||=%7.4f d_weight=%7.4f" % (name, lrec, lgan, np.linalg.norm(g_rec), np.linalg.norm(g_gan), w)) return w def main(): b = np.zeros(D) # 阶段一:解码器刚初始化,离最优很远(重建残差大) W_early = rng.standard_normal((dz, D)) * 0.05 # 阶段二:接近收敛(在最优解上加很小扰动,残差小) W_late = W_star + rng.standard_normal((dz, D)) * 0.01 print("== 有限差分校验(W[0,0]) ==") fd_rec, fd_gan = finite_diff_check(W_early, b) g_rec, g_gan = grads(W_early, b) print("解析 ∂Lrec/∂W00=%.6f 差分=%.6f" % (g_rec[0, 0], fd_rec)) print("解析 ∂Lgan/∂W00=%.6f 差分=%.6f\n" % (g_gan[0, 0], fd_gan)) print("== 固定判别器下两个合成权重点(未训练) ==") w_early = stage(W_early, b, "大残差权重点") w_late = stage(W_late, b, "小残差权重点") print("\n此构造中 d_weight 从 %.3f 降到 %.4f(约 %.0f 倍),GAN 项被自动调小。" % (w_early, w_late, w_early / max(w_late, 1e-12))) print("这仅比较最后一层的梯度范数,不保证方向一致、全模型平衡或真实训练单调下降。") if __name__ == "__main__": main() temporal_consistency.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """视频 VAE 为什么必须额外盯「时间维」:同样的单帧画质,闪烁程度可以天差地别。 只依赖 numpy,直接 `python temporal_consistency.py` 复现。 构造一段运动视频,再给两种重建: A. 逐帧独立噪声 —— 每一帧单独看误差不大,连起来播放却疯狂闪烁; B. 跨帧恒定的退化(同一固定纹理噪声)—— 单帧误差与 A 近似,但随机抖动更小。 全局平均空间 L1 未保留误差的时间排列;相邻帧差分的时序一致性损失一眼区分。 """ import numpy as np rng = np.random.default_rng(4) T, H, W = 12, 48, 64 SIGMA = 0.08 def make_sequence(): yy, xx = np.mgrid[0:H, 0:W].astype(np.float64) x = np.zeros((T, H, W)) for t in range(T): cx = 8 + 4 * t # 一条匀速移动的竖边 frame = 0.25 + 0.5 * (xx >= cx) frame += 0.1 * ((xx // 6 + yy // 6) % 2) x[t] = frame return np.clip(x, 0, 1)[:, None] # [T,1,H,W] def spatial_l1(r, x): return float(np.mean(np.abs(r - x))) def frame_diff(v): return v[1:] - v[:-1] def temporal_error(r, x): """相邻帧差分一致性:||Δr - Δx||(静止背景上 GT 帧差为0,闪烁直接显现)。""" return float(np.mean(np.abs(frame_diff(r) - frame_diff(x)))) def temporal_mse(r, x): return float(np.mean((frame_diff(r) - frame_diff(x)) ** 2)) def main(): x = make_sequence() fixed_noise = SIGMA * rng.standard_normal(x.shape[1:])[None] # [1,1,H,W] 跨帧恒定 rA = x + SIGMA * rng.standard_normal(x.shape) # 逐帧独立噪声 -> 闪烁 # 稳定退化:以跨帧恒定噪声为主,只掺 5% 的逐帧抖动(更贴近真实解码器) rB = x + fixed_noise + 0.05 * SIGMA * rng.standard_normal(x.shape) print("期望主噪声尺度相近(σ=%.2f,B另有5%%抖动),比较单帧空间误差与时间维误差:\n" % SIGMA) print("%-22s %14s %16s %16s" % ("重建", "单帧空间L1", "时序差分L1", "时序差分MSE")) print("-" * 72) for name, r in (("A 逐帧独立噪声(闪)", rA), ("B 跨帧恒定退化(稳)", rB)): print("%-22s %14.5f %16.5f %16.5f" % (name, spatial_l1(r, x), temporal_error(r, x), temporal_mse(r, x))) print("\n单帧空间 L1 几乎相等(A=%.4f vs B=%.4f),但时序 MSE 上 A 约为 B 的 %.0f 倍。" % (spatial_l1(rA, x), spatial_l1(rB, x), temporal_mse(rA, x) / max(temporal_mse(rB, x), 1e-12))) print("这个合成反例说明为何应评估时间维;不能单凭它判定真实模型闪烁根因:") print(" · 把判别器扩到时空(3D/PatchGAN、LTX 的 Video-DWT);") print(" · 或用GT校正帧差/遮挡掩码warp,经消融判断是否加入训练目标。") if __name__ == "__main__": main() vaeloss_checks.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """独立核对本文归约、梯度和时间反例,只需 NumPy;不训练视频VAE。""" import json from pathlib import Path import numpy as np import adaptive_weight as aw import temporal_consistency as tc from gan_schedule import hinge_d, hinge_g, vanilla_d, adopt_weight def central_gradient(fn, value, eps=1e-6): result = np.zeros_like(value) for index in np.ndindex(value.shape): plus, minus = value.copy(), value.copy() plus[index] += eps minus[index] -= eps result[index] = (fn(plus) - fn(minus)) / (2 * eps) return result def main(): rng = np.random.default_rng(91) kl_errors = [] for batch, dims in [(1, 1), (2, 7), (3, 16), (4, 128)]: mu, logvar = rng.normal(size=(batch, dims)), rng.normal(size=(batch, dims)) kl = .5 * (mu * mu + np.expm1(logvar) - logvar) total = kl.sum() bm, mean = kl.sum(1).mean(), kl.mean() assert np.all(kl >= 0) assert np.isclose(total, batch * bm) and np.isclose(total, batch * dims * mean) beta = 2e-4 assert np.isclose(beta * total, beta * batch * bm) assert np.isclose(beta * total, beta * batch * dims * mean) copies = np.concatenate([kl, kl], 0) assert np.isclose(copies.sum(), 2 * total) assert np.isclose(copies.sum(1).mean(), bm) fn_mu = lambda v: .5 * (v * v + np.expm1(logvar) - logvar).sum() fn_lv = lambda v: .5 * (mu * mu + np.expm1(v) - v).sum() kl_errors += [float(np.max(np.abs(central_gradient(fn_mu, mu) - mu))), float(np.max(np.abs(central_gradient(fn_lv, logvar) - .5 * np.expm1(logvar))))] assert max(kl_errors) < 2e-7 weight = rng.normal(size=(aw.dz, aw.D)) * .1 bias = np.zeros(aw.D) gr, gg = aw.grads(weight, bias) err_rec = float(np.max(np.abs(central_gradient(lambda w: aw.rec_loss(w, bias), weight) - gr))) err_gan = float(np.max(np.abs(central_gradient(lambda w: aw.gan_g_loss(w, bias), weight) - gg))) assert max(err_rec, err_gan) < 1e-8 assert aw.adaptive_weight(np.zeros(3), np.ones(3)) == 0 assert aw.adaptive_weight(np.ones(3), np.zeros(3)) == 1e4 # 真实重建与冻结重建:原始帧差可能奖励错误,真值校正项能区分。 x = tc.make_sequence() frozen = np.repeat(x[:1], len(x), axis=0) perfect_raw = float(np.mean(np.abs(tc.frame_diff(x)))) frozen_raw = float(np.mean(np.abs(tc.frame_diff(frozen)))) assert perfect_raw > 0 and frozen_raw == 0 assert tc.temporal_error(x, x) == 0 and tc.temporal_error(frozen, x) > 0 fixed = x + .12 assert tc.temporal_error(fixed, x) < 1e-15 and tc.spatial_l1(fixed, x) > .1 # 周期整数平移的已知对应关系,另有亮度变化;并非学习光流实验。 base = rng.normal(size=(8, 10)) previous, current = base, np.roll(base, 1, axis=1) + .1 warp_previous = np.roll(previous, 1, axis=1) raw_warp = float(np.mean(np.abs(current - warp_previous))) error_prev, error_current = rng.normal(size=base.shape), rng.normal(size=base.shape) recon_prev, recon_current = previous + error_prev, current + error_current residual_recon = recon_current - np.roll(recon_prev, 1, axis=1) residual_truth = current - warp_previous corrected = np.mean(np.abs(residual_recon - residual_truth)) independent = np.mean(np.abs(error_current - np.roll(error_prev, 1, axis=1))) assert np.isclose(corrected, independent) perfect_residual = current - np.roll(previous, 1, axis=1) corrected_warp = float(np.mean(np.abs(perfect_residual - residual_truth))) assert np.isclose(raw_warp, .1) and corrected_warp == 0 # hinge margin饱和与logistic溢出边界;阈值含等号。 real, fake = np.array([2., 6.]), np.array([-2., -6.]) assert hinge_d(real, fake) == 0 and hinge_g(fake) == 4 gfd = central_gradient(hinge_g, fake) assert np.allclose(gfd, -.5) assert np.isfinite(vanilla_d(np.array([1e4, -1e4]), np.array([-1e4, 1e4]))) assert [adopt_weight(.05, t, 2000) for t in [0, 1999, 2000]] == [0., 0., .05] # 范数相同仍可方向相反,不能推导优化目标一致。 grec, gadv = np.array([-1.]), np.array([1.]) ratio = aw.adaptive_weight(grec, gadv) combined = float(np.linalg.norm(grec + ratio * gadv)) assert combined < 1.1e-4 out = dict(passed=True,kl_shapes=4,kl_max_gradient_error=max(kl_errors), decoder_gradient_coordinates=weight.size,decoder_rec_max_error=err_rec, decoder_gan_max_error=err_gan,perfect_motion_raw_difference=perfect_raw, frozen_motion_corrected_error=tc.temporal_error(frozen, x), constant_error_temporal=tc.temporal_error(fixed, x), brightness_change_raw_warp=raw_warp,perfect_corrected_warp=corrected_warp, opposite_gradient_combined_norm=combined,errors=[],warnings=[]) Path(__file__).with_name('validation_results.json').write_text(json.dumps(out,indent=2),encoding='utf8') print(json.dumps(out,indent=2)) if __name__ == '__main__': main()
-
AIGC 每日速读|2026-09-10|90%稀疏视频DiT加速2.63倍-RoLA 今日 AIGC 论文速览 今日共 10 篇 · 高效与流式视频生成 3 篇 · 可控动作与手语生成 2 篇 · 生成基础设施与评测 3 篇 · 图像生成与编辑 2 篇 重点论文标题列表 RoLA(北京大学、清华大学、电子科技大学、阿里巴巴等):90%稀疏视频DiT加速2.63倍 Mask Forcing(香港科技大学(广州)、香港科技大学、加州大学圣迭戈分校等):给自回归蒸馏注入干净令牌 FlexMoGen(布朗大学、Epic Games、加州大学戴维斯分校、犹他大学):文字定内容,参考动作定风格 Decoupled SF(Yanru An 等):流式数字人15.4FPS且延迟1.3秒 Miles v0.1(RadixArk):744B模型异步RL跑上64张GB300 今日论文速览 1. RoLA:90%稀疏视频DiT加速2.63倍 RoLA: Rotary-Positioned Low-Rank Linear Attention for Efficient Diffusion Transformers | 北京大学、清华大学、电子科技大学、阿里巴巴等 | arXiv:2609.06712 关键词:视频生成,稀疏注意力,线性注意力,扩散Transformer 前序问题:视频扩散 Transformer 的时空令牌很长,稠密自注意力随序列长度平方增长。稀疏分支可以省计算,却会丢掉维持场景、运动和语义一致性的远程联系;现有低秩全局补偿又难同时保留 3D RoPE 的相对位置结构与可复用的线性摘要。 本文贡献:RoLA 将注意力拆成固定稀疏局部分支与低秩全局分支。它先把查询和键投影到低秩空间并通过非线性,再施加截断后的预训练 3D RoPE;这样旋转不会被非线性打乱,全局键值摘要可对所有查询复用。令牌级门控负责把局部尖峰与平滑全局背景重新融合,无需新增位置参数。 Architecture overview of the proposed method. (a) Dense 3D-RoPE attention decomposes into sparse top-$k$ spikes and a residual background. (b) The method replaces dense attention in pre-trained DiT blocks with sparse--low-rank branches and gated fusion, reusing backbone RoPE without additional positional embeddings. The right part shows the rotary low-rank branch and distribution-aware gated fusion. 实验效果:在 Wan2.1-14B 的 720p、81 帧设置上,RoLA 在 90% 稀疏率下仍保持有竞争力的生成质量,并在单张 NVIDIA H100 上取得 2.63 倍端到端推理加速。机制实验中,截断秩 r=64 的时间与高度相对位置余弦相似度都达到 0.93。 Deployment-oriented efficiency summary on RTX 5090 (different from the benchmark evaluation setting). Panel (a) shows representative fixed-setting deployment latency, panel (b) shows theoretical self-attention FLOPs per denoising step, and panel (c) shows long-sequence deployment latency. 批判点评:RoLA 需要对替换注意力后的完整骨干做单阶段全参数微调,部署收益并非零训练获得。低秩分支只解决高稀疏率下的全局补偿,稀疏局部分支本身沿用既有方案;更长视频、不同 RoPE 划分和消费级 GPU 上的质量—速度曲线仍需验证。 2. Mask Forcing:给自回归蒸馏注入干净令牌 Mask Forcing: Improving Autoregressive Video Diffusion Distillation via Dual-Noise Masking Rollout | 香港科技大学(广州)、香港科技大学、加州大学圣迭戈分校等 | arXiv:2609.09123 关键词:视频生成,自回归扩散,分布匹配蒸馏,模式坍塌 前序问题:用反向 KL 的分布匹配蒸馏把双向视频扩散教师压成因果学生时,目标偏向追逐少数高概率模式。学生在自回滚中容易越来越饱和、平滑,并把早期误差持续传给后续片段。 本文贡献:Mask Forcing 在学生自回滚期间沿空间和时间轴随机遮罩,用更干净、较低噪声的令牌替换部分高噪声输入。扰动让学生探索教师分布中尚未覆盖的区域,同时干净令牌给邻近噪声令牌提供去噪参照,从而缓解模式坍塌与长时误差积累。方法可插入多种 DMD 自回归蒸馏流程,不需要真实视频或额外后训练阶段。 实验效果:在 30 秒 LongLive 设置上,加入 Mask Forcing 后 HPSv3 从 8.44 提升到 9.11,VBench 总分从 83.91 提升到 84.51,语义分从 80.70 提升到 81.44。论文还报告它在逐帧和分块设置下普遍改善视觉质量与指令遵循。 批判点评:收益依赖遮罩比例、噪声窗口和更新粒度,表明它仍是一套需要按骨干与任务调参的训练策略。论文主要在既有因果视频蒸馏管线上验证,尚未说明对完全不同教师、极长序列或交互式状态更新是否同样稳定。 3. FlexMoGen:文字定内容,参考动作定风格 Flexible Motion Generation from Language and Style References | 布朗大学、Epic Games、加州大学戴维斯分校、犹他大学 | arXiv:2609.08032 关键词:人体动作生成,文本到动作,风格迁移,潜扩散 前序问题:文本很适合描述“做什么”,却难精确表达节奏、肢体发力和情绪动态;离散风格标签又无法覆盖未见风格、长动作或同一序列里的风格切换。 本文贡献:FlexMoGen 同时输入自然语言与风格动作片段,用无风格标签监督的变分编码器提取连续风格,再通过轻量适配模块调制文本到动作的潜扩散模型。统一预训练、相对位置编码和时变风格控制使模型可以合成长序列、多风格过渡以及未见过的文本—风格组合。 Overview of our style-adapted text-to-motion framework. The input content motion $x_c$ is encoded by a pretrained motion encoder, and Gaussian noise is added to its latent embedding. The text-to-motion (T2M) model (top right) consists of $7$ Transformer encoder layers that take motion, text, and time embeddings as inputs. Each self-attention block incorporates relative positional encoding into the key and value projections. During style finetuning, the T2M backbone is frozen, and only the weight matrices $W_s^{K}$ and $W_s^{V}$ in the Style Adaptation Module (SAM) are trained. SAM encodes a style example $x_s$ and injects its outputs as additive biases to the $K$ and $V$ vectors in the attention layers, guiding the network to preserve the semantics of $x_c$ while reflecting the style of $x_s$. 实验效果:22 名参与者给出 330 次成对判断。相对 SMooDi,FlexMoGen 在内容保持、风格反映和整体动作质量上的偏好率分别为 61.1%、67.7% 和 71.3%;相对 T2M+MP,内容和质量偏好率达到 82.1% 与 94.0%。 User study results (pairwise preference, % favoring ours). Left: FlexMoGen vs. T2M+MP. Middle: FlexMoGen vs. SMooDi. Right: FlexMoGen vs. LoRA-MDM. Criteria are content preservation, style reflection, and motion quality. 批判点评:风格参考本身可能同时携带动作内容,编码器是否真正解耦仍难完全证明。用户研究规模较小,长序列测试只含一次风格过渡;快速连续切换、接触物理和手部细节还需要更严格评测。 4. Decoupled SF:流式数字人15.4FPS且延迟1.3秒 Decoupled Self-Forcing Distillation for Streaming Talking Head Generation | Yanru An 等 | arXiv:2609.10317 关键词:说话人视频,流式生成,自强制蒸馏,动作潜变量 前序问题:端到端音频驱动视频扩散把音频条件融合到整幅视频潜变量,而身份、背景和外观大多与音频无关,既浪费容量也容易模糊细节。便宜的两阶段方法先生成动作,再渲染视频,却常因动作空间监督不足而损失画质。 本文贡献:该方法先在与身份解耦的低维动作空间里融合音频和动作字幕,由小型因果自回归 Transformer 生成动作潜变量,再交给预训练扩散渲染器。解耦自强制蒸馏用同一个冻结视频教师监督两条流:有动作条件时蒸馏因果渲染器,无条件时以真实视频给渲染回滚打分,反向约束动作生成器。 Overview of Motar. (a) An AR motion transformer models causal dependencies over motion latents, with an efficient diffusion head producing continuous-valued latents; a user-written motion caption and the driving audio are fused into a global condition query by a Q-Former projector. (b) Hierarchical conditioning: the global query is injected by full cross-attention for coarse, sequence-level control, while raw audio embeddings are injected by windowed cross-attention for frame-level lip articulation. (c) Decoupled self-forcing distillation: the frozen bidirectional teacher $G$ supervises both branches by distribution matching. Conditioned on motion, it distills $G$ into a block-causal student $G_\phi$; unconditionally, it matches the rendered motion rollout against the distribution of real talking videos. 实验效果:动作生成与视频渲染两条因果流并行运行,论文报告达到 15.4 FPS、首段延迟 1.3 秒,并称相对非流式教师没有质量退化。 Qualitative comparison with Wan-based end-to-end methods. For each result we show five frames with the spoken word beneath; the phoneme being articulated is highlighted in red (e.g. the “oo” in “look”), so that lip shape can be checked against the sound at each frame. Our method produces the tightest audio--lip alignment and the sharpest facial detail. 批判点评:动作空间没有天然的双向教师,论文借渲染结果间接监督,效果会受动作表示和渲染器上限共同影响。身份解耦在极端表情、遮挡与头部大幅运动下是否成立,以及跨语言口型和长时间漂移,仍需更大规模验证。 5. Miles v0.1:744B模型异步RL跑上64张GB300 Miles v0.1: Production-Level Post-Training | RadixArk | arXiv:2609.08368 关键词:大模型后训练,强化学习,SGLang,分布式训练 前序问题:前沿模型的强化学习已经包含多轮工具调用、超长回滚和异步环境,生成、训练与权重同步任一环节的不一致都会让 on-policy 假设失效;现有框架往往只覆盖某种后端或缺少生产级可观测性。 本文贡献:Miles 以 SGLang 负责回滚,训练端可选 Megatron-LM 或 PyTorch FSDP,并提供点对点、共享桶和磁盘增量等三类权重同步路径。系统统一支持全参数与 LoRA 强化学习、on-policy 蒸馏、SFT、真正的 rollout—training 对齐,并把同一架构扩展到扩散模型。 实验效果:端到端案例在 64 张 NVIDIA GB300 上对 GLM-5.2 744B-A40B 做终端编码任务的全异步智能体强化学习,前 30 个统计步骤的中位耗时为 263 秒。项目已开源代码与部署文档。 批判点评:64 张 GB300 的案例展示了规模上限,也意味着复现门槛很高。异步回滚会带来策略陈旧度、环境版本和样本重放偏差,系统提供校正机制,但不同任务下的稳定边界仍需独立验证。 6. VI-Bench:反推视频提示词最高仅得0.632 VI-Bench: Benchmarking Prompt Inversion from AIGC Videos | 中国科学院自动化研究所、弗吉尼亚大学、新加坡国立大学等 | arXiv:2609.08079 关键词:视频理解,提示词反演,生成评测,多模态模型 前序问题:视频描述只需说出画面内容,能够复现的提示词还要恢复风格、镜头运动和多镜头结构。现有视频理解基准没有测试“反推提示词后重新生成,能否回到原视频”,也难评估提示泄露风险。 本文贡献:VI-Bench 从 1610 万条真实用户提示中清洗出约 390 万条,构建 900 个经人工核验的 AIGC 视频,覆盖单镜头语义、风格与镜头控制、多镜头组合三档难度。它让 18 个视觉语言模型反推提示,再用原生成器回放,并联合原提示对齐与回放视频保真计算 Inversion Score。 实验效果:最强模型的总体 Inversion Score 只有 0.632;难度从单镜头升到多镜头后表现明显下降。主题与风格的“文本看似正确、回放却不像”差距最大,说明视频字幕能力不能替代可执行的生成控制恢复。 批判点评:提示反演同时涉及创作复用与隐私攻击,分数更高并非在所有场景都更好。基准把开放式提示压成五个维度,仍可能漏掉负面提示、采样器与种子等无法从画面稳定恢复的控制因素。 7. RelightFormer:9万物体训练多视角直接换光 RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting | 香港理工大学 | arXiv:2609.07414 关键词:图像重光照,多视角生成,生成Transformer,环境光照 前序问题:逆渲染要从图像分解几何、材质和光照,是高度欠定的优化问题;单图生成式重光照又忽略跨视角线索,难以在镜面、透明和毛发材质上保持一致。 本文贡献:RelightFormer 从视频基础模型改造出前馈生成 Transformer,用光照交叉注意力把目标环境贴图动态注入空间特征,并用对输入顺序不敏感的位置编码对称处理无序多视角。训练数据 LOD 包含 9 万个 Objaverse 物体与 3.9 万种独特光照,不显式估计法线、反照率等内在属性。 Architecture of RelightFormer. Input modalities (noise, reference images, and an environment map) are first patchified into token sequences, with ray embeddings added to encode stereo geometric priors. Noise and reference tokens are concatenated and processed through two parallel attention pathways: a multi-view self-attention module for intra- and cross-view feature aggregation, and an illumination attention module that dynamically injects lighting cues into spatial features. The outputs of both branches are element-wise summed and passed through an FFN. After the final layer, reference tokens are discarded, and the updated noise tokens are used to predict the flow-matching velocity field. For clarity, VAE encoding and decoding stages are omitted. 实验效果:在真实 OLATverse 材质分组上,RelightFormer 在多数类别取得最高前景指标;例如金属物体 sPSNR/PSNR 为 22.84/19.88,毛发物体为 17.75/14.28,并支持单视角、多视角和新视角的零样本重光照。 Qualitative results for multi-view image relighting in real-world OLATverse Dataset. 批判点评:绕过显式物理分解提升了易用性,却也降低了光照与材质参数的可解释性。9 万合成物体的材质分布与真实拍摄存在域差,复杂遮挡、非刚体和未知相机标定下的多视角一致性仍是风险。 8. AV-SafetyBench:只看视频会漏掉近半音画风险 AV-SafetyBench: A Safety Benchmark for Text-to-Audio-Video Generation | Suah Choi 等 | arXiv:2609.06991 关键词:音视频生成,安全评测,跨模态风险,生成基准 前序问题:文字到音视频模型同时生成画面、语音、音效和环境声,危险内容可能只藏在音轨,或由无害画面与无害声音组合后产生。只评视频或只评音频会系统性漏检。 本文贡献:AV-SafetyBench 建立四个轴、13 类风险的分类体系与 5200 条人工复核提示,分别从完整音画、仅视频、仅音频三种视角判定输出,再把完整音画风险归因到视频、音频、双模态各自危险或跨模态组合危险。 实验效果:五个开源音视频生成模型的完整音画不安全率为 25.1% 至 49.4%。在四个模型中,音频独有与音画联合风险占可归因不安全样本的 41.6% 至 48.3%;跨模态伤害类别中,87.5% 来自音画组合后才出现的风险。 批判点评:风险比例依赖提示集分布、生成拒答策略和裁判阈值,不应直接解释成真实产品事故率。基准主要覆盖公开模型与英语语境,多语言语音、方言暗示和长时叙事风险仍可能不足。 9. Concept Brittleness:用稀疏特征定位生图概念盲点 Interpreting Object-Dependent Concept Brittleness in Text-to-Image Diffusion Models | 复旦大学、深圳大学等 | arXiv:2609.09909 关键词:文生图,可解释性,稀疏自编码器,推理时修复 前序问题:同一风格或属性在大多数对象上能生成,却会对少数对象稳定失败。这类“对象依赖的概念脆弱性”不是换随机种子就能解释,也难从原始去噪特征中定位缺失了哪一条概念证据。 本文贡献:作者把逐步去噪轨迹投到稀疏自编码器空间,对比成功与失败样本,寻找缺失、变弱或出现过晚的概念维度,并从同类成功样本建立概念原型。推理时把失败样本的特征轻量插值到原型方向,用修复效果反证诊断是否抓住了真实缺口。 实验效果:跨多个扩散骨干的风格与属性失败案例中,原型插值显著改善概念一致性、文本保真和修复成功率。分析还显示越深层的去噪表示概念结构越清晰,而越早期介入通常有更强纠正作用。 批判点评:方法先要收集可靠的同类成功样本来构造原型,对长尾概念或没有清晰成功对照的情况较弱。SAE 的稀疏特征并不天然等于人类可读因果概念,插值改善结果也不能完全排除其他相关方向共同起作用。 10. SignRefine:局部适配器把手语手部精度提高30% SignRefine: Adapting Foundational Video Models for Sign Language Generation | 萨里大学 | arXiv:2609.08496 关键词:手语生成,视频扩散,局部适配器,关键点控制 前序问题:通用视频扩散模型主要在口语人物视频上训练,能生成自然人物,却经常把手指、嘴形和眉眼做错;对手语而言,这些小区域正承载语言信息,画质好但动作错仍不可理解。 本文贡献:SignRefine 冻结预训练视频 DiT 主干,只为左手、右手和脸部分别加入带空间掩码的局部适配器,把高分辨率区域条件注入指定 Transformer 层。系统只需二维关键点与一张人物参考图,并使用原生手语视频数据集 NVSign 训练区域控制。 实验效果:相对最强基线,SignRefine 的手部姿态精度指标最高提升 30%;手语用户在视觉质量与可理解性成对比较中超过 80% 的情况下选择 SignRefine。模型还展示了跨人物外观与视觉条件的泛化。 批判点评:二维关键点没有完整编码手形、接触关系和非手部语法,生成可理解性仍取决于关键点质量。当前数据的语言种类、地区变体和签署者覆盖决定了泛化边界,必须持续由聋人社群参与评测。 趋势观察 视频效率开始补齐全局结构 RoLA在90%稀疏下保留旋转位置全局分支,Mask Forcing则从训练分布侧减少自回滚模式坍塌;速度优化正在从少算注意力扩展到稳定学生分布。 条件控制向低维与局部区域收缩 Decoupled SF把音频先落到动作潜变量,SignRefine只强化手脸区域,说明让条件作用于真正相关的表示比全图注入更节省容量。 生成评测进入可回放和跨模态阶段 VI-Bench要求反推提示后重新生成,AV-SafetyBench同时检查画面、音轨及其组合;只看文本相似或单一模态已不足以评价生成系统。 基础设施成为算法可信度的一部分 Miles把回滚、训练和权重同步放在同一套可验证系统里,提醒大规模后训练的算法结论必须连同 on-policy 对齐与运行拓扑一起审查。 人工智能炼丹君 整理 | 2026-09-10 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|张量并行与流水线并行-TP-PP AIGC 基本功|张量并行与流水线并行-TP-PP 所属方向:分布式训练 | 难度:高阶 | 前置知识:数据并行与 ZeRO 显存切分 关键词:张量并行、流水线并行、Megatron-LM、GPipe、通信开销、并行策略 先读数据并行与 ZeRO,掌握矩阵乘法、链式求导和梯度累积即可。rank 指进程编号,process group 是参加同一次通信的一组进程;GEMM 是通用矩阵乘,all-gather 把各片拼齐到每个 rank,all-reduce 把各份逐元素求和并把结果交给每个 rank。本文按每进程使用一张设备讲解,集合通信的“求和”与 DP 中约定的“平均梯度”要分清。 01. 为什么需要它 ZeRO-3 能把参数、梯度和优化器状态切到数据并行 rank 上,但计算某个模块时仍需取得所需的完整参数。聚合粒度未必是整层 Transformer,可细化到子模块;如果一个实际执行的巨大 Linear 连同必需输入输出和临时空间仍放不进一张卡,单纯增加数据并行度并不把这次矩阵乘拆开,此时需要 TP、算子分块或卸载等办法;若层能放下,但整网常驻状态或激活放不下,也可考虑沿网络深度切开;能否仅靠 ZeRO-3 和重计算解决,需要先算峰值。 这对应两把不同的刀。张量并行(Tensor Parallelism,TP)在一层内部切矩阵,让多张卡共同完成同一个 GEMM;流水线并行(Pipeline Parallelism,PP)沿层切模型,让不同设备各自保存连续或交错的一段层。前者解决“这一层太宽”,后者解决“模型太深”。普通数据并行沿 batch 分样本、复制模型计算;ZeRO/FSDP 另对状态分片,三者可以组合,切的轴与状态拥有者必须分别标明。 先看一个浪费现场:4 个 pipeline stage 处理 1 个 microbatch。第 0 段前向时其余三段都空闲;数据流到第 3 段后,前几段又空闲。若把一个 global batch 切成 8 个 microbatch,让不同样本在各 stage 重叠,把总计 $4\times8=32$ 份 stage 工作分摊到 4 台设备,理想 forward sweep 用 11 个时间槽完成,但仍有填充和排空的“气泡”。本文脚本算出 4 段、8 个 microbatch 的单向 sweep 的理想利用率为 $32/(4\times11)=72.73\%$,空闲槽占 27.27%。在均衡 GPipe 训练中也会得到这一比例;其他调度不能只凭这一个公式推断实测效率。 再看 TP:若一个 MLP 的第一层权重为 $[d,4d]$,可沿输出维切成 $p$ 份,每卡算 $[d,4d/p]$;第二层 $[4d,d]$ 再沿输入维与中间激活匹配切分。这样两次 GEMM 都不需要在中间把完整 $4d$ 激活拼回每张卡,只在必要边界做集合通信。这正是 Megatron-LM 的 column-parallel 与 row-parallel 配对。 难点不在“切成几份”,而在切后保持数学等价,并让通信落在高带宽拓扑上。TP 频繁同步,通常限制在 NVLink/NVSwitch 节点内;PP 在相邻 stage 前向传激活、反向传对应梯度,更适合跨节点。这是基于通信频率的配置起点;若链路、消息量或层划分不同,需用实际 trace 比较,不能仅凭并行轴名称判定哪种拓扑一定更快。 02. 最小可用理解 三句话建立框架: TP 切一层的隐藏维、输出通道或 attention head,每层都会通信,换来单层权重、激活和计算分摊。 PP 把层分给不同 stage,再把 batch 切成 microbatch 以重叠各段计算;在均衡调度模型中 microbatch 越多,气泡占比越小,但调度和激活管理更复杂;固定 global batch 与 DP 度时,这通常意味着减小每个 microbatch。 生产系统通常组成 DP×TP×PP 的三维网格:TP 放在最快链路内,PP 穿过较慢边界,剩余设备做 DP 与 ZeRO/FSDP。 如果只记一句:TP 是“同一个样本的一层由多卡一起算”,PP 是“同一个样本依次经过多卡上的不同层”。它们都属于模型并行,但通信模式完全不同。 设世界规模 $W$,数据并行度为 $d_p$、张量并行度为 $t_p$、流水线段数为 $p_p$,若没有其他并行轴: $$W=d_p\,t_p\,p_p$$ 这不是越均匀越好。TP 度受矩阵维度、head 数、KV head 数和高速互联限制;PP 度受层数、切分均衡与 microbatch 数限制;最后再用 DP 提升全局吞吐。 03. 数学推导 3.1 Column Parallel:沿输出维切 将 batch 与 token 两维合成行数 $n=B L$。线性层输入 $X\in\mathbb{R}^{n\times d_{\mathrm{in}}}$,权重 $A\in\mathbb{R}^{d_{\mathrm{in}}\times d_{\mathrm{out}}}$,输出为: $$Y=XA$$ 把 $A$ 沿列切为 $p$ 份: $$A=[A_0,A_1,\ldots,A_{p-1}],\qquad A_i\in\mathbb{R}^{d_{\mathrm{in}}\times d_{\mathrm{out}}/p}$$ 第 $i$ 个 rank 计算: $$Y_i=XA_i$$ 完整结果只是拼接: $$Y=[Y_0,Y_1,\ldots,Y_{p-1}]$$ 前向不必通信,只要输入 $X$ 在 TP 组内复制。若下一层能直接消费分片 $Y_i$,连 all-gather 都可省。反向时,每个 rank 产生一份输入梯度贡献 $dX_i=dY_iA_i^\top$,完整 $dX$ 要求和: $$dX=\sum_{i=0}^{p-1}dX_i$$ 因此,在输入与其梯度都要复制、未启用 sequence parallel 的约定下,column-parallel 的关键通信落在反向输入梯度 all-reduce。令标量 loss 对 $Y_i$ 的梯度为 $G_i$,则本地权重梯度为 $X^\top G_i$;若加分片偏置 $c_i$,其梯度是对所有行求和的 $\sum_{k=1}^{n}G_i[k,:]$,而非再对不同特征 shard 求和。 3.2 Row Parallel:沿输入维切 把输入和权重的匹配维切开: $$X=[X_0,X_1,\ldots,X_{p-1}],\qquad A=\begin{bmatrix}A_0\\A_1\\ \vdots\\A_{p-1}\end{bmatrix}$$ 每卡先算局部部分和 $Z_i=X_iA_i$,完整输出是: $$Y=XA=\sum_{i=0}^{p-1}X_iA_i=\sum_{i=0}^{p-1}Z_i$$ 所以 row-parallel 前向需要 reduce 或 all-reduce,反向则能从复制的 $dY$ 本地得到 $dX_i=dYA_i^\top$。Megatron 把 MLP 的第一层做 column parallel,激活函数逐元素地作用在本地 shard;第二层做 row parallel,最后只求和一次。attention 的 QKV 投影与输出投影也能形成类似配对。注意 row-parallel 的输出偏置应在求和后加一次:每片先加同一 $b$ 再归约会得到 $p b$。列并行的偏置则随输出特征切分,各片在自己的激活前相加。 为看清非线性和反向,写一个 MLP:第一层分片权重为 $A_i$、偏置 $c_i$,第二层分片权重为 $B_i$、完整输出偏置为 $b$,$\phi$ 是逐元素激活,如 GELU 或本文验证用的 tanh: $$U_i=XA_i+c_i,\qquad H_i=\phi(U_i),\qquad Y=\sum_iH_iB_i+b$$ 逐元素函数不会混合不同特征,所以可以留在各片计算;若换成跨隐藏维归一化等操作,这一步需要另设计通信。令 $G=\partial\mathcal{L}/\partial Y$,先由第二层反传,再乘激活导数($\odot$ 表示逐元素乘): $$D_i=(GB_i^\top)\odot\phi^{\prime}(U_i)$$ $$\nabla_{B_i}\mathcal{L}=H_i^\top G,\quad\nabla_{A_i}\mathcal{L}=X^\top D_i,\quad\nabla_X\mathcal{L}=\sum_iD_iA_i^\top$$ $$\nabla_{c_i}\mathcal{L}=\sum_{k=1}^{n}D_i[k,:],\qquad\nabla_b\mathcal{L}=\sum_{k=1}^{n}G[k,:]$$ 这些式子也解释了两个容易重复归约的地方:每片的 $A_i,B_i,c_i$ 是不同参数;复制的输出偏置 $b$ 各副本看到同一 $G$,不能再无条件相加 $p$ 次。框架还会为 DP、sequence parallel 等情况另定义梯度同步。本文权重按数学右乘写成 [in,out];PyTorch/Megatron Linear 把 weight 存成 [out,in],forward 用其转置,因此源码里“列并行”切的是存储权重的第 0 维。 这种设计的精髓不是“每个 Linear 都随便切”,而是让相邻层的分片布局衔接,从而避免在每个算子后都 all-gather。若一个自定义层偷偷需要完整 hidden,通信会突然增加。 3.3 TP 的通信账本 设传输张量有 $N$ 个元素、每元素 $b$ 字节,按 ring 的 reduce-scatter 加 all-gather 计算,前一阶段有 $p-1$ 次发送、每次 $Nb/p$ 字节,后一阶段相同;故一次 all-reduce 的每 rank 发送字节为: $$V_{\mathrm{AR}}=2\frac{p-1}{p}Nb$$ $p$ 是 TP 组大小,$b$ 是实际通信 dtype 的字节数。每 rank 接收量与发送量相等;若把发送加接收合计,数值再乘 2;集群全部 rank 的发送总量则乘 $p$,不能混着比较。对不启用 sequence parallel 的经典 Megatron Transformer block,attention 和 MLP 的 row-parallel 输出各做一次前向 all-reduce,两个 column-parallel 的输入梯度各做一次反向 all-reduce,共四次。这不含 DP 同步、embedding/loss、重算和通信元数据。 例如 $B=1,L=131072,d=8192,p=8$,假设四个边界均传输 BF16 的 $[B,L,d]$:单张量为 2 GiB,一次 all-reduce 每 rank 发 3.5 GiB,整个 block 一次 microbatch 前后向合计发 14 GiB,另收 14 GiB。这是按所列假设的逻辑字节账本,不是实测网络吞吐。FP32 通信会翻倍,$p=1$ 时该通信为零。真实实现可用 reduce-scatter、all-gather 与 sequence parallel 改写,fused kernel 和通信算法也会改变调用形态。TP 每层同步,所以延迟不能忽略:小矩阵、多层和大 TP 度会让消息切得太碎,算力利用率反而下降。 TP 对参数显存理想降为 $1/p$,但并非所有东西都跟着切。LayerNorm 参数很小,可能复制;embedding 与 LM head 有词表切分规则;激活是否分片取决于 sequence-parallel 配置;通信临时 buffer 还会增加峰值。因此应从真实 module state 和 profiler 测量,不可把全显存直接除以 TP 度。 3.4 PP 气泡从哪里来 设有 $p$ 个等耗时 stage,每个 DP 副本在一次 optimizer step 内处理 $m$ 个 microbatch,每个 stage 处理一个 microbatch 的单向计算耗时为一格。第一个 microbatch 需要 $p$ 格到达尾部,之后每格完成一个。完成一个 forward sweep 共: $$T_{\mathrm{sweep}}=m+p-1$$ 其中每个 stage 真正工作 $m$ 格,所以理想效率与气泡比例: $$\eta_{\mathrm{pipe}}=\frac{m}{m+p-1},\qquad f_{\mathrm{bubble}}=\frac{p-1}{m+p-1}$$ 当 $p=4,m=8$,效率 $8/11=72.73\%$。当 $p>1$,要达到至少 90%,由 $10m\ge9(m+p-1)$ 得 $m\ge9(p-1)$;若要严格超过 90%,则需 $m>9(p-1)$。例如 4 段、27 个 microbatch 恰好 90%,28 个才超过;$p=1$ 且 $m\ge1$ 时没有这种填充气泡。这也解释了为什么 stage 很多却只有几个 microbatch 时 PP 很差。 这个比例先由单向 sweep 推出。均衡 GPipe 训练若每段前向时间为 $t_f$、反向为 $t_b$,先全前向再全反向,总时长为 $(m+p-1)(t_f+t_b)$;每设备有效工作为 $m(t_f+t_b)$,所以比例不变,不要求前反向等长。论文中气泡相对理想有效工作时长的开销比为 $(p-1)/m$,与本文用总时长作分母的空闲比例是不同口径。这里假设各段分别等耗时、通信完全隐藏、忽略优化器和同步等其他开销。真实训练的气泡还包括 stage 不均衡、点对点传输、参数同步、数据加载与尾 batch。最后一段若有巨大词表投影,前面切得再平均也会被它卡住。 3.5 GPipe、1F1B 与交错调度 GPipe 先把所有 microbatch 前向跑完,再统一反向,调度简单但要保存更多未反向的激活。1F1B 在 warmup 后交替执行一次 forward 和一次 backward,优先释放较早完成反向的计算图;同步更新语义仍要求一次 optimizer step 所需梯度累积完再更新权重。非交错 1F1B 的 stage $s$(从 0 开始)先做 $w_s=\min(p-s-1,m)$ 个 warmup forward,然后每次做一个新 forward 与一个旧 microbatch 的 backward,最后排空剩余 backward。 tp_pp_checks.py 按 stage 资源和跨段前反向依赖做最早启动事件模拟。$p=4,m=8$、每次 F/B 都耗时 1、无通信时,GPipe 与非交错 1F1B 均为 22 个时间单位,利用率均为 72.73%;按“F 完成后持有一份图,B 完成后释放”计数,GPipe 四段峰值为 [8,8,8,8],1F1B 为 [4,3,2,1]。因此这个理想例子主要省激活驻留,并没有把气泡自动减半。它不是物理显存的测量:forward/backward 的临时存储、重算和通信 buffer 尚未计入。 将最后一段 F/B 各改成 3、其他段仍为 1,同一个 1F1B 模拟总时长变成 54,设备时间利用率为 44.44%。这是具体的失衡反例;改变调度、时长或异步资源后要重算,不能把 72.73% 当任意流水的上限或预报。 交错 1F1B 让每个物理设备承载多个 virtual stage,把一个大气泡拆细。它可改善负载与气泡,却增加更多通信边界、依赖和调度复杂度。Pipeline 并行的优化对象不只是公式里的 bubble,还包括峰值激活、通信重叠和 kernel 连续性。 均衡同步流水线的理想利用率,按 m/(m+p−1) 计算。增加 microbatch 能摊薄填充与排空气泡;它首先描述均衡 forward sweep,也适用于上述均衡 GPipe;图中不含通信、stage 失衡与小 GEMM 效率变化,不能据此直接预测 tokens/s。 04. 代码实现 tp_linear_sim.py 只用标准库,构造 $X:[2,4]$、$W_1:[4,6]$、$W_2:[6,3]$。先完整计算,再把第一层按列、第二层按行切到两个虚拟 rank: X shape=(2, 4), W1 shape=(4, 6), W2 shape=(6, 3), tp=2 column shards: W1=(4, 3) each, hidden=(2, 3) each row shards: W2=(3, 3) each, partial output=(2, 3) each full output=[[52, 42, 72], [132, 114, 180]] max hidden diff=0, max output diff=0 该整数例子的输出差为 0,验证无偏置、无激活时“按列拼接、按行求和”的实现;一般实数情形的代数等价性来自第 03 节推导,不能仅靠一组样本证明。脚本现在支持 --parts 1/2/3/6,非整除及错误矩阵形状会拒绝,避免 zip 静默截断。完整的非线性、偏置与梯度验证在下面的检查脚本中。真实浮点并行的归约顺序不同,通常会出现末位误差,不能要求 bitwise 一致,而应设置与 dtype 相称的容差。 pipeline_bubble.py 默认模拟 4 段、8 个 microbatch: stages=4, microbatches=8, ideal_slots_per_sweep=11 pipeline_efficiency=72.73%, bubble_fraction=27.27% forward schedule (slot -> active stage:microbatch) 00: S0:M0 01: S0:M1 S1:M0 02: S0:M2 S1:M1 S2:M0 03: S0:M3 S1:M2 S2:M1 S3:M0 04: S0:M4 S1:M3 S2:M2 S3:M1 05: S0:M5 S1:M4 S2:M3 S3:M2 06: S0:M6 S1:M5 S2:M4 S3:M3 07: S0:M7 S1:M6 S2:M5 S3:M4 08: S1:M7 S2:M6 S3:M5 09: S2:M7 S3:M6 10: S3:M7 前 3 格在填充、后 3 格在排空,第 3 到第 7 格这 5 格四段都忙碌;11 格总容量为 44 个设备槽,实际使用 32 个。这里打印的是前向时间表,没有实现训练反向。用参数改变 stages 与 microbatches,就能看到增加 microbatch 如何摊薄固定气泡。 额外运行 tp_pp_checks.py(需要 NumPy),固定 seed=27、FP64:TP=1/2/3/6 的 tanh+双偏置两层网络,输出与五类梯度(输入、两权重、两偏置)的最大差均不超过 $8.89\times10^{-16}$;全部 71 个输入/参数分量的中心差分最大差为 $2.44\times10^{-9}$。TP=3 时故意重复加输出偏置,最大输出差为 3.169615;倒置第二层 shard,差为 4.447151。64 组 GPipe/1F1B 事件模拟核对了依赖、任务数和均衡时长;不等 batch 的正确加权梯度为 5.533333,错把两个 microbatch 均值等权平均则为 4.3。这里没有启动多 GPU 或 NCCL。 四份脚本均在 Windows、Python 3.11.9、NumPy 2.4.3、matplotlib 3.10.7 下实际运行;前两份仅用标准库,画图另需 matplotlib,检查脚本另需 NumPy。附录含完整代码;运行当前目录的脚本即可复算 JSON 与配图。 05. 工业级实现对照 本次核对日期为 2026-10-27,固定使用 NVIDIA Megatron-LM 的 core_v0.14.0,不把该版本称为最新。张量并行源码 提供 ColumnParallelLinear 与 RowParallelLinear。工业实现除切权重外,还管理参数初始化、bias、是否 gather 输出、异步梯度 all-reduce、梯度累积融合、sequence parallel、专家并行组和通信 buffer。前两份最小脚本只展示代数和调度账本;新增检查脚本独立核对解析梯度与事件依赖,也没有模拟真实 NCCL。 ColumnParallelLinear 的 gather_output 决定输出是否立刻汇总;RowParallelLinear 的 input_is_parallel 表示输入是否已经按最后一维切好。skip_bias_add=True 会把 bias 作为第二个返回值交给调用者,供后续融合;忽略它就漏掉偏置,重复添加则又算一遍。row-parallel 正常分支先归约无偏置的局部输出,再加完整 bias;sequence parallel 分支改为 reduce-scatter。错置布局可能触发 shape 错,也可能多做 gather 或静默算错。审计并行模型时,应给每个边界标清 global shape、local shape、分片轴、复制轴和预期 collective。 PP 代码位于同版本的流水线调度模块。非交错路径在源码中明确分 warmup、1F1B 和 cooldown;交错路径还涉及 virtual stage、microbatch 分组和通信重叠,不能只套非交错的 warmup 公式。配置中的 pipeline_model_parallel_size 切物理 stage,virtual_pipeline_model_parallel_size 启用交错。系统必须传递前向激活和反向梯度,处理 tied embedding、首尾 stage 特殊 loss、不同张量 shape、激活释放与通信重叠。 为了让对照可核验,本轮保留原始源码并逐字保留 AST 中的两类完整 forward 方法,在 PyTorch 2.10.0+cpu 上运行 48 个 rank/dtype/bias 夹具:TP=1/2/3/6、FP32/FP64、两种 bias 返回模式,以及 gather/scatter 分支,前向与本地 autograd 参考差均为 0。另执行三个原调度辅助函数:60 个非交错 rank 配置的 warmup/remaining 与公式一致,交错示例的 20 项操作序列与源码文档逐项相符。PyTorch autograd 对 NumPy 的五类解析梯度最大差为 $1.61\times10^{-15}$。 这次用 CPU 线性算子与数学集合通信回调替代 CUDA 构造、NCCL 及融合内核,验证的是原 forward 的布局/偏置分支与调度表。它没有验证多卡反向通信、完整 Megatron 模型、通信重叠、GPU 显存或吞吐;这些仍需在真实集群跑下一节的验收。 Megatron 2021 展示了 TP、PP 与 DP 的组合,并提出交错流水调度。工程上的常见布局是:同一节点内组成 TP 组,邻接节点组成 PP 链,跨副本组成 DP 组。原因是 TP 每层通信而 PP 只在 stage 边界传输;把频繁 collective 放在更快互联上更划算。 生产配置还要做 layer partition。按层数平均只在每层耗时相同才合理;MoE 层、cross-attention、视觉模块、embedding 与词表 head 的成本差异很大。应先 profile 单层前后向时间和激活尺寸,再按时间而不是按层数切 stage。 06. 代价与边界 TP 的主要代价是高频 collective。TP 度增加后,每卡 GEMM 变小,计算效率下降,通信延迟占比上升;跨节点 TP 尤其敏感。维度还必须能合理整除:attention head、KV head、MLP intermediate size、词表分片与低精度 tile 对齐都会形成约束。 PP 的主要代价是气泡、激活驻留与调度复杂度。microbatch 增多能降气泡,却让每次 GEMM 的 batch 更小,可能降低算力利用率;还会增加调度次数。梯度累积数也受 global batch、DP 度与 microbatch size 约束: $$B_{\mathrm{global}}=B_{\mathrm{micro}}\,m\,d_p$$ 为了把 $m$ 调大而偷偷改变 global batch,会连学习率与收敛语义一起改变。更稳妥的做法是减小 microbatch size、保持 global batch,再检查小 GEMM 是否仍高效。 PP stage 之间有顺序依赖,在每条样本路径都经过所有 stage 的假设下,单个慢 stage 会拖住全链。设备故障、动态 shape、条件分支和 MoE 路由也比普通 DP 难处理。推理时 batch 与请求长度动态变化,训练得到的均衡切分未必仍均衡。 TP 与 ZeRO/FSDP 并非天然可任意叠加。两者可能切同一参数的不同轴,process group、参数初始化、checkpoint layout 和 optimizer state 都需协调。首先建立二维或三维 rank 映射,再启用框架明确支持的组合,避免自行套两层 wrapper。 什么时候不该用?模型单卡能放下且吞吐受数据不足或 CPU 限制时,TP/PP 只会增加同步;单层很小而层很多时,优先 PP 或 FSDP;单层巨大而层数不多时,TP 更直接;超长序列导致激活爆炸时,还要引入下一篇的序列/上下文并行。 6.1 从模型形状反推 TP 度 假设 decoder hidden size 为 $d$,MLP expansion 为 $4d$,attention head 数为 $H$,每头维度为 $d_h=d/H$。采用 $t_p$ 路 TP 时,至少希望 $H/t_p$ 与 $4d/t_p$ 为整数,且本地矩阵维度满足 Tensor Core tile 对齐。GQA 还要检查 KV head 数 $H_{KV}$;若 Q head 可整除而 KV head 不可整除,框架可能复制 K/V 或根本拒绝配置。 参数容量只是下界。以 MLP 两个权重为例,忽略 bias: $$P_{\mathrm{MLP}}=d(4d)+(4d)d=8d^2$$ 理想 TP 后每卡为 $8d^2/t_p$ 个参数。然而输入 $X$、残差、LayerNorm 与某些输出仍可能复制。是否启用 sequence parallel,会决定 $[B,L,d]$ 激活是每 TP rank 一份还是沿 token 切开。评估 TP 度时要分别列参数、可分片激活、复制激活和通信 buffer,不能只用总显存除 $t_p$。 性能上,增大 $t_p$ 会改变本地 GEMM 的形状与数据复用;是否降低算术强度或耗时要看哪一维被切、缓存及 kernel。若局部矩阵太窄,GPU 的流式多处理器(SM)可能利用不足,计算缩小也未必换来相应加速。实际选型一般从“能放下的最小 TP 度”起步,再尝试少数相邻值;不是卡越多 TP 越大。 6.2 三维 rank 映射为什么决定速度 有 2 个节点、每节点 8 卡,总计 16 卡。假设 TP=8、PP=2、DP=1,合理映射是每个节点内部构成一个 TP 组,两个节点作为相邻 PP stage。这样每层 TP collective 走 NVLink/NVSwitch,只有 stage 边界激活跨节点。 若 rank 编号错误,使每个 TP 组横跨两节点,那么每个 Transformer 层的 all-reduce 都经过网络;PP 反而在节点内。数学结果完全正确,吞吐却可能大幅下降。这类问题从配置数字看不出来,必须导出每个 process group 的物理 GPU、主机名、PCIe/NVLink 路径和 NIC 亲和性。 当 DP>1 时,DP 组应从相同 TP/PP 坐标上取不同副本。例如把 rank 写成坐标 $(r_d,r_p,r_t)$,模型同一 shard 的梯度只在 $r_d$ 维同步;层内 tensor collective 只改变 $r_t$;pipeline 点对点只沿 $r_p$ 邻接。把坐标语义明确下来,checkpoint 分片和故障定位才不会依赖偶然 rank 编号。 多 NIC 节点还要关注通信并发。TP all-reduce、PP send/recv、DP reduce-scatter 可能同时争同一链路。单独 benchmark 每个 collective 很快,不代表组合后仍快;应在真实 schedule 上看每条 stream 和 NIC 的时间线。 6.3 Pipeline 内存不是简单除以段数 PP 将参数按层分段,参数内存近似降为 $1/p_p$,但激活取决于 schedule。GPipe 前向完所有 $m$ 个 microbatch 才反向,每 stage 可能保留 $O(m)$ 份边界与层内激活。1F1B warmup 后尽早反向,可显著减少同时存活的 microbatch 数;不同 stage 的 warmup 长度又不同,峰值不完全一致。 activation checkpoint 将层内保存换成反向重算,但 stage 边界张量通常仍要保留或重新通信。若 PP 与 ZeRO-3 叠加,重算还可能再次触发参数 all-gather;如果 prefetch 与 release 时机不匹配,理论显存节省会被临时完整参数覆盖。 一个更实用的峰值模型是: $$M_s^{\mathrm{peak}}=\max_t[M_{\mathrm{state},s}(t)+M_{\mathrm{act},s}(t)+M_{\mathrm{comm},s}(t)+M_{\mathrm{workspace},s}(t)]$$ $s$ 是 stage,$t$ 是时间,state 含权重、梯度与优化器状态;各项应为同一时刻互不重复计数的存储。若每份图大小接近,激活项可近似为当时存活图数乘单份大小,但不能把各项在不同时刻的最大值当成真实同时峰值。选切分点的目标应是控制 $\max_s M_s^{\mathrm{peak}}$ 并平衡每段时间,而不是让每段层数相同。首段 embedding、尾段 vocab projection 和 loss 往往需要单独计量。 6.4 Schedule 的一致性与权重版本 同步 GPipe 或 1F1B 中,一个 global batch 的所有 microbatch 应使用同一版参数,梯度累积后再统一 optimizer step。若 loss 能按样本或有效 token 相加,所有 microbatch 使用同一版权重、对应计算相同且累积权重正确,则在精确算术下得到同一批的梯度。BatchNorm 训练态按 microbatch 计算均值/方差,改变切分会改变 forward;共享可变状态或跨样本操作同样需要单独处理,不能无条件称等价。检查脚本中 [1,2,4] 整批与按 1+2 拆分的 BatchNorm 型归一化,最大输出差为 1.069042。随机 dropout 若要严格比较,还需保证不同 schedule 消耗一致的随机数流。 异步 pipeline 为减少 flush 可能允许某些 microbatch 使用旧权重,产生 weight staleness。PipeDream 的权重暂存与调度就是为管理这个问题。吞吐更高不等于优化轨迹相同;对需要可复现或大规模预训练的任务,同步 schedule 通常更容易验收。 梯度累积的 loss normalization 也常出错。若每个 microbatch loss 已取 mean,再把 $m$ 份梯度直接相加,最终梯度比全局 mean 大 $m$ 倍;框架可能在 loss、backward 或 optimizer wrapper 某处除 $m$。迁移实现时必须确认缩放发生在哪里,特别是最后一个不完整 microbatch。若第 $j$ 片包含 $n_j$ 个有效单元(例如未被 mask 的 token),片内 mean loss 为 $\bar\ell_j$,需要先明确整批目标: $$\mathcal{L}_{\mathrm{mean}}=\frac{\sum_jn_j\bar\ell_j}{\sum_jn_j},\qquad\nabla\mathcal{L}_{\mathrm{mean}}=\sum_j\frac{n_j}{\sum_kn_k}\nabla\bar\ell_j$$ 只有所有 $n_j$ 相等时才是简单除以 $m$。还要考虑 DP 默认梯度平均的除数;不能同时在 loss 和 wrapper 各除一遍。目标若本来定义为每样本均值,应按有效样本数加权,而非擅自换成 token 均值。 6.5 如何系统调优而不是枚举所有组合 第一步做容量约束:根据参数、优化器、激活和临时 buffer,排除会 OOM 的 TP/PP。第二步做整除约束:检查层数、head、KV head、MLP width、词表与 microbatch。第三步按拓扑放组:TP 留在最快域,PP 穿过节点,DP 使用余下副本。第四步才短跑候选方案。 短跑至少记录每个 stage 的 forward/backward 时间、TP collective、PP send/recv、DP collective、bubble、MFU 和峰值显存。若 stage 时间方差大,先重切层;若 collective 裸露,检查异步与 bucket;若 GEMM 利用率低,减少 TP 或增大 microbatch;若 bubble 大,增加 microbatch 或 virtual stage。 还要避免只优化稳态。训练中 checkpoint、评估、数据切换、动态 loss scale 与长短样本混合会改变节拍。视频模型的序列长度可能随分辨率和帧数变化,固定层切分在不同 batch 上会失衡。可以按长度分桶、限制每批 token 数,或使用能处理动态 shape 的 schedule,但都要重新验证 global batch 语义。 6.6 Checkpoint 与并行度变更 TP checkpoint 的一个权重可能沿行或列分片,PP checkpoint 又只在拥有该层的 stage 上出现。保存时应记录全局 shape、分片轴、offset、replica group 与 tied-weight 关系。仅按 rank 存文件却没有布局元数据,会显著增加从 TP=8 改成 TP=4 的恢复难度;若完整掌握原切分约定仍可转换,但必须验证。 成熟 distributed checkpoint 会把逻辑参数名与物理 shard 解耦,加载时重新规划切片。验证转换不能只看“文件读完”,应抽样 all-gather 后与原始全参数比较,并跑一个确定性 forward。optimizer state 也必须按相同参数布局重分片,特别是 Adam 的 m、v 与 FP32 主权重。 PP 的 tied embedding 是典型边界:输入 embedding 在首段,输出投影在尾段,但两者可能共享参数。系统要么在两个 stage 间同步梯度,要么采用明确的复制与更新协议。忽略它会让模型能跑、loss 也下降,却不再是原架构。 最后为每个组合保留机器可读配置:world size、各轴度数、rank 坐标映射、global/micro batch、累积数、schedule、virtual stage、precision 与 checkpoint schema。没有这份清单,性能回归时很难判断是代码变化还是并行布局变化。 6.7 一个具体的 64 卡选型例子 假设 8 个节点、每节点 8 卡,模型单层在 4 卡上能放下,96 层在单节点放不下,目标 global batch 又允许 4 个数据副本。可先试 TP=4、PP=4、DP=4,乘积正好 64。每个节点容纳两个 TP 组,相邻两个节点组成一条四段 pipeline;相同 TP/PP 坐标跨四个副本形成 DP 组。 为什么不直接 TP=8、PP=2、DP=4?它减少 PP 气泡,但本地 GEMM 变小、每层 collective 参与卡数翻倍。为什么不 TP=2、PP=8、DP=4?单层可能放不下,而且 PP 段更多,要求更多 microbatch 才能摊薄气泡。三个方案都满足乘积约束,只有容量、profile 和拓扑能决定赢家。 设 PP=4、microbatch 数 $m=16$,理想气泡为 $3/19=15.79\%$;若为配合 DP=4,global batch 满足 $B_{\mathrm{global}}=B_{\mathrm{micro}}\times16\times4$。当目标 global batch 固定时,microbatch size 可能被压得太小。此时交错 PP 可在不继续增加 $m$ 的情况下缩小气泡,但要多传 stage 边界。 选定后再检查每卡峰值。若尾段词表 head 使 stage 3 明显更慢,可把少量 Transformer 层从尾段移到前段;若 stage 0 embedding 占显存而计算很少,切分目标应同时满足容量与时间,而不是追求参数量绝对相等。 6.8 故障现象与定位路径 若所有 GPU 利用率呈周期性锯齿且空白集中在迭代首尾,优先看 PP bubble;若每层 GEMM 后都有长 NCCL 条带,优先看 TP 通信或 rank 跨节点;若只有某一个 stage 长期满载、其他 stage 等待,是层切分失衡;若迭代末尾集中等待,是 DP 梯度同步没有充分 overlap。 出现 hang 时,先核对各 rank collective 调用序列。条件分支导致某些 rank 少调用一次 all-reduce,或 PP 两端 send/recv shape 不一致,都会永久等待。为通信操作记录 group、sequence number、peer、shape 与 dtype,比只看 Python stack 更有用。设置超时只能让错误更快暴露,不能修复顺序。 数值不一致时,从一个微型模型开始,关闭 dropout 和 fused kernel,分别测试 TP、PP,再测试组合。TP 常见错误是切分轴、bias 重复相加、输出误 gather;PP 常见错误是 loss 缩放、跨段激活 requires-grad、共享参数同步。一次只启用一根并行轴,能把搜索空间从三维降为一维。 OOM 若只发生在第一步,往往是 optimizer state 首次建立或通信 bucket 惰性分配;若在若干步后发生,可能是 graph retention、动态 shape 缓存或碎片;若只在某个 PP stage,先看该段真实 activation 与临时 buffer。不要看到 OOM 就统一减 microbatch,这可能掩盖泄漏却降低所有卡效率。 6.9 上线验收清单 发布配置前确认:世界规模等于各并行轴乘积;每个 rank 坐标唯一;TP group 位于预期高速域;head、KV head、MLP 与词表可整除;各 stage 时间和峰值接近;global batch 算术正确;loss normalization 不依赖 microbatch 数;tied weight 有同步协议;checkpoint 能跨目标并行度恢复。 性能门禁同时保存 tokens/s、MFU、bubble、每类 collective 的裸露时间、峰值显存和最慢 stage。只保存总迭代时间无法解释回归。集群拓扑或通信库升级后,即使模型代码未变,也要重跑基准,因为并行策略本质上是对物理系统的映射。 最后预留降级方案:某节点高速链路异常时能否减少 TP、增加 PP;某个 checkpoint 是否可重分片;global batch 是否仍保持;恢复后数值是否连续。真正稳健的并行配置,不只是峰值最快,也要能在硬件变化和断点恢复时保持语义清楚。 6.10 理论通信量为什么不等于训练时间 同样传 1 GiB,一个大 all-reduce 与数百个小 collective 的耗时不同。常用模型 $T=\alpha n+\beta V$ 中,$n$ 是消息次数,$V$ 是字节量,$\alpha$ 表示每次启动延迟,$\beta$ 表示每字节时间。TP 在每层频繁通信,尤其受 $\alpha$ 影响;PP 消息次数少,但单次边界激活可能很大。 通信是否裸露还取决于依赖。梯度 all-reduce 可与更早层 backward 重叠,PP send 可与下一份本地计算重叠;位于关键路径上的 collective 即使字节少也会直接延长 step。性能报告应区分总 NCCL 时间与 exposed communication time。 bucket 太小会增加消息次数,太大又推迟通信启动,减少 overlap。最优 bucket 与层大小、网络延迟和反向节奏有关。框架默认值是通用折中,不一定适合视频 DiT 的大激活或 MoE 的不均匀参数。 最后还要观察尾延迟。一个 rank 因热降频、ECC、数据抖动或网络拥塞变慢,collective 会让整个组等待。平均 GPU 时间看似健康,最慢 rank 才决定训练。按 rank 记录分位数,并把异常节点与拓扑关联,是大规模并行调优的基本动作。 理论模型最终要由 trace 校准。为每次实验保存并行配置、网络拓扑、逐 stage 时间线与通信矩阵,下一次才能定位回归。若只留一行 tokens/s,既无法判断瓶颈是 GEMM、气泡还是慢 rank,也无法安全迁移到另一代 GPU。并行策略不是模型的附属启动参数,而是计算图和硬件共同组成的一部分,理应像模型结构一样接受版本管理和回归测试。 07. 经典论文脉络 GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism(arXiv:1811.06965v5;arXiv 元数据题名如此,v5 PDF 首页题名为 GPipe: Easy Scaling with Micro-Batch Pipeline Parallelism):用 microbatch 流水化跨加速器的模型分段,并以同步 mini-batch 语义训练巨型网络。 PipeDream: Fast and Efficient Pipeline Parallel DNN Training(arXiv:1806.03377v1):探索 1F1B 与异步流水,揭示吞吐、权重版本和一致性之间的权衡。 Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism(arXiv:1909.08053v4):提出 Transformer 内高效的 tensor model parallel 切法,用少量 collective 支撑数十亿参数。 Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM(arXiv:2104.04473v5):系统组合 TP、PP、DP,并以交错流水减少气泡,扩展到千卡与万亿参数。 论文演进说明:单一并行轴只能解决一种容量瓶颈,规模继续增长后,真正的问题变成如何把多个轴映射到硬件拓扑并共同调度。 08. 常见误解 误解一:TP 就是把每层平均切开。 切分轴决定通信。Megatron 的 column-row 配对是为了让中间分片直接衔接,不是机械地切一半权重。 误解二:PP 段数越多,显存越省且速度越快。 参数容量会下降,但固定气泡随 $p-1$ 增长;若 microbatch 不够,更多 stage 反而更闲。 误解三:microbatch 越多越好。 它降低理想气泡,却减小 GEMM、增加调度,并可能扩大激活队列。要联动测 MFU 与显存。 误解四:1F1B 是异步优化。 常用同步 1F1B 只是改变前后向顺序,仍在一个 global batch 梯度完成后统一更新;PipeDream 式异步才涉及权重陈旧。 误解五:TP 能把所有显存除以 TP 度。 小参数、复制激活、通信 buffer 与 runtime 不会理想均分。必须看逐项账本。 误解六:三维并行度乘起来等于卡数就配置正确。 整除只是必要条件。拓扑、矩阵 tile、head 数、stage 均衡、global batch 都可能让配置不可用。 09. 动手验证 先运行 tp_linear_sim.py,使用 python tp_linear_sim.py --parts 3,把 $W_1$ 的输出与 $W_2$ 的输入切成 3 片。预期完整输出仍一致。然后故意让第二层 shard 顺序交换,结果会静默错误;这说明 distributed tensor layout 必须携带明确语义。 运行 pipeline_bubble.py,固定 stages=8,分别取 microbatches=1、8、32、72。理论效率依次为 $1/8$、$8/15$、$32/39$、$72/79$。脚本当前只实现均衡 stage 的闭式公式;扩展成事件调度模拟后,用 tp_pp_checks.py 中已实现的事件模拟比较 GPipe、非交错 1F1B 与最后一段变慢的案例,检查 makespan、每段存活图峰值和全部任务的依赖。平衡 64 组与不均衡 54 时间单位反例都能复算,观察均分层数为何不等于均分时间。 在真实集群做 TP=1/2/4/8 对照,固定 global batch 和模型,记录每层 GEMM 时间、collective 时间、MFU、峰值显存。观察容量是否解除、吞吐是否改善,以及更大 TP 是否因小 GEMM 或通信而退化;这些是待测假设,不是保证出现的曲线。用拓扑工具确认 TP rank 是否真的落在 NVLink 域内。 对 PP 做相同实验:固定 PP 度,逐步增加 microbatch 数;再固定 microbatch,增加 virtual stage。记录 bubble、激活峰值与端到端 tokens/s。不要只看 framework 打印的理论 bubble,GPU timeline 中的空白才是真实气泡。 最后做一次等价性验收:单卡、TP、PP、TP+PP 使用相同初始化和样本,关闭 dropout,比较一个 step 的 loss 和若干参数梯度。低精度与归约顺序会造成小差异,但若误差随层爆炸,优先检查 shard 顺序、bias、loss 归一化与 tied weight。 10. 延伸阅读 读完这篇可以继续看: 数据并行与 ZeRO 显存切分:DP 沿 batch 分样本、ZeRO 沿 DP 组切状态,是三维并行的第一根轴。 序列并行与 Ring Attention:当瓶颈从模型宽度转向超长 token,沿 sequence 切激活与 attention。 混合精度与数值稳定性:低精度改变 TP/PP 通信字节与归约误差,配置并行前要先明确累加精度。 选型时先问容量瓶颈在哪里:单层太宽选 TP,层总数太深选 PP,副本吞吐选 DP,超长激活选 SP。随后才是把这些轴映射到实际互联。公式给出上限,profile 决定最终配置。 附录:完整代码 09 节用到的脚本全文如下(tp_pp_checks.py、tp_linear_sim.py、pipeline_bubble.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 tp_pp_checks.py """CPU teaching checks: NumPy only; python tp_pp_checks.py. No GPU cluster benchmark.""" from pathlib import Path import json import numpy as np from tp_linear_sim import matmul, split_columns, split_rows def stage_order(p, m, schedule): if p < 1 or m < 1 or schedule not in ("gpipe", "1f1b"): raise ValueError("positive stages/microbatches and gpipe/1f1b required") orders = [] for s in range(p): if schedule == "gpipe": ops = [("F", i) for i in range(m)] + [("B", i) for i in reversed(range(m))] else: warm = min(p - s - 1, m) ops = [("F", i) for i in range(warm)] for i in range(m - warm): ops.extend([("F", i + warm), ("B", i)]) ops += [("B", i) for i in range(m - warm, m)] orders.append(ops) return orders def schedule_events(p, m, schedule, forward=None, backward=None): """Earliest-start DAG simulation; one nonpreemptive compute resource per stage.""" orders = stage_order(p, m, schedule) forward = [1.] * p if forward is None else list(forward) backward = [1.] * p if backward is None else list(backward) if len(forward) != p or len(backward) != p or not all(np.isfinite(x) and x > 0 for x in forward + backward): raise ValueError("positive finite per-stage times required") done, next_op, events = {}, [0] * p, [] while sum(next_op) < 2 * p * m: progress = False for s, ops in enumerate(orders): if next_op[s] == len(ops): continue kind, i = ops[next_op[s]] deps = [] if next_op[s]: last = ops[next_op[s] - 1] deps.append((s, *last)) if kind == "F" and s: deps.append((s - 1, "F", i)) if kind == "B": deps.append((s, "F", i)) if s < p - 1: deps.append((s + 1, "B", i)) if not all(d in done for d in deps): continue start = max([done[d] for d in deps], default=0.) end = start + (forward[s] if kind == "F" else backward[s]) done[(s, kind, i)] = end events.append(dict(stage=s, kind=kind, microbatch=i, start=start, end=end)) next_op[s] += 1 progress = True if not progress: raise RuntimeError("schedule dependency cycle") peak = [] for s in range(p): # Count one graph after F completion until B completion; tie releases first. changes = [(e['end'], 1 if e['kind'] == 'F' else -1) for e in events if e['stage'] == s] live = high = 0 for _, delta in sorted(changes): live += delta high = max(high, live) assert live == 0 peak.append(high) total = max(done.values()) busy = m * sum(forward + backward) return dict(schedule=schedule, stages=p, microbatches=m, makespan=total, utilization=busy / (p * total), peak_graphs=peak, events=events) def main(): rng = np.random.default_rng(27) x, a, b = rng.normal(size=(5, 4)), rng.normal(size=(4, 6)), rng.normal(size=(6, 3)) c, d, g = rng.normal(size=6), rng.normal(size=3), rng.normal(size=(5, 3)) h = np.tanh(x @ a + c) y = h @ b + d dz = (g @ b.T) * (1 - h * h) reference = [dz @ a.T, x.T @ dz, h.T @ g, dz.sum(0), g.sum(0)] rows = [] for p in (1, 2, 3, 6): aa, bb, cc = np.split(a, p, 1), np.split(b, p, 0), np.split(c, p) hh = [np.tanh(x @ ai + ci) for ai, ci in zip(aa, cc)] partials = [hi @ bi for hi, bi in zip(hh, bb)] out = sum(partials) + d zz = [(g @ bi.T) * (1 - hi * hi) for hi, bi in zip(hh, bb)] actual = [sum(zi @ ai.T for zi, ai in zip(zz, aa)), np.concatenate([x.T @ zi for zi in zz], axis=1), np.concatenate([hi.T @ g for hi in hh]), np.concatenate([zi.sum(0) for zi in zz]), g.sum(0)] err = max(float(np.max(abs(u-v))) for u, v in zip(reference, actual)) assert np.max(abs(out-y)) < 1e-12 and err < 1e-12 wrong_bias = sum(pi + d for pi in partials) wrong_layout = sum(hi @ bi for hi, bi in zip(hh, list(reversed(bb)))) + d rows.append(dict(parts=p, output_error=float(np.max(abs(out-y))), gradient_error=err, repeated_bias_error=float(np.max(abs(wrong_bias-y))), reversed_shard_error=float(np.max(abs(wrong_layout-y))))) # Independent central finite differences over all input/weight/bias elements. fd = 0. for z, grad in zip([x, a, b, c, d], reference): for idx in np.ndindex(z.shape): old = z[idx];eps = 1e-6 z[idx] = old + eps;plus = np.sum((np.tanh(x @ a + c) @ b + d) * g) z[idx] = old - eps;minus = np.sum((np.tanh(x @ a + c) @ b + d) * g) z[idx] = old fd = max(fd, float(abs((plus-minus)/(2*eps)-grad[idx]))) assert fd < 1e-7 balanced = [] for p in (1, 2, 4, 8): for m in (1, 2, 8, 27): for method in ('gpipe', '1f1b'): z = schedule_events(p, m, method) assert z['makespan'] == 2 * (m + p - 1), (p, m, method) assert abs(z['utilization'] - m/(m+p-1)) < 1e-14 assert len(z['events']) == 2*p*m balanced.append({k:v for k,v in z.items() if k!='events'}) demos = [schedule_events(4, 8, v) for v in ('gpipe', '1f1b')] unbalanced = schedule_events(4, 8, '1f1b', [1, 1, 1, 3], [1, 1, 1, 3]) assert unbalanced['makespan'] > 22 # Unequal microbatch mean example: scalar squared-error derivative 2*(w*x-y)*x. xx, yy, w = np.array([1., 2., 4.]), np.array([0., 1., -1.]), .3 grad = 2*(w*xx-yy)*xx full = grad.mean();weighted = (grad[:1].mean()+2*grad[1:].mean())/3 wrong = (grad[:1].mean()+grad[1:].mean())/2 assert abs(full-weighted) < 1e-14 and abs(full-wrong) > .1 batchnorm = lambda z:(z-z.mean())/np.sqrt(z.var()+1e-5) bn_error = float(np.max(abs(batchnorm(xx)-np.concatenate([batchnorm(xx[:1]),batchnorm(xx[1:])])))) assert bn_error > .1 invalid = 0 for func, args in [(split_columns, ([[1,2,3]], 2)), (split_rows, ([[1],[2],[3]], 2)), (split_columns, ([[1]], 0)), (matmul, ([[1,2]], [[3]])), (matmul, ([[1],[2,3]], [[4]])), (stage_order, (0, 1, 'gpipe')), (schedule_events, (2, 2, 'gpipe', [1,-1]))]: try:func(*args) except ValueError:invalid += 1 else:raise AssertionError('invalid input accepted') result = dict(passed=True,seed=27,numpy=np.__version__,shapes=dict(X=list(x.shape),A=list(a.shape),B=list(b.shape),c=list(c.shape),b=list(d.shape),Y=list(y.shape)),tp=rows,finite_difference_max=fd, balanced_cases=balanced,demo_schedules=demos,unbalanced=unbalanced, unequal_microbatch=dict(global_mean=float(full),weighted=float(weighted),wrong_equal=float(wrong)), batchnorm_split_difference=bn_error,invalid_inputs_rejected=invalid, limits='In-process CPU algebra and dependency simulation; no NCCL, GPU memory, latency or throughput measurements.') Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,indent=2)+'\n',encoding='utf8') print(json.dumps({k:v for k,v in result.items() if k not in ('balanced_cases','demo_schedules','unbalanced')},indent=2)) for z in demos+[unbalanced]:print(z['schedule'],z['makespan'],z['utilization'],z['peak_graphs']) if __name__ == '__main__':main() tp_linear_sim.py #!/usr/bin/env python3 """Verify column- and row-parallel linear algebra without any framework.""" def matmul(a, b): if not a or not b or not a[0] or not b[0] or any(len(r) != len(a[0]) for r in a) or any(len(r) != len(b[0]) for r in b): raise ValueError("nonempty rectangular matrices required") if len(a[0]) != len(b): raise ValueError("inner dimensions must match") return [[sum(x * y for x, y in zip(row, col)) for col in zip(*b)] for row in a] def split_columns(a, parts): if not isinstance(parts, int) or isinstance(parts, bool) or parts < 1 or not a or not a[0] or any(len(r) != len(a[0]) for r in a) or len(a[0]) % parts: raise ValueError("positive parts must divide rectangular matrix width") width = len(a[0]) // parts return [[row[i * width:(i + 1) * width] for row in a] for i in range(parts)] def split_rows(a, parts): if not isinstance(parts, int) or isinstance(parts, bool) or parts < 1 or not a or not a[0] or any(len(r) != len(a[0]) for r in a) or len(a) % parts: raise ValueError("positive parts must divide rectangular matrix height") height = len(a) // parts return [a[i * height:(i + 1) * height] for i in range(parts)] def add(a, b): if len(a) != len(b) or any(len(ra) != len(rb) for ra, rb in zip(a, b)): raise ValueError("addition shapes must match") return [[x + y for x, y in zip(ra, rb)] for ra, rb in zip(a, b)] x = [[1, 2, 3, 4], [5, 6, 7, 8]] # [tokens=2, hidden=4] w1 = [[1, 0, 2, 0, 3, 0], [0, 1, 0, 2, 0, 3], [1, 1, 1, 1, 1, 1], [2, 1, 0, 1, 2, 1]] # [4, 6] w2 = [[1, 0, 1], [0, 1, 1], [1, 1, 0], [2, 0, 1], [0, 2, 1], [1, 0, 2]] # [6, 3] full_hidden = matmul(x, w1) full_output = matmul(full_hidden, w2) # Column parallel W1: every rank computes a slice of output features. w1_shards = split_columns(w1, 2) hidden_shards = [matmul(x, shard) for shard in w1_shards] column_joined = [left + right for left, right in zip(*hidden_shards)] # Row parallel W2: input features and W2 rows use matching shards, then sum. w2_shards = split_rows(w2, 2) partials = [matmul(h, w) for h, w in zip(hidden_shards, w2_shards)] row_reduced = [[sum(part[r][c] for part in partials) for c in range(len(partials[0][0]))] for r in range(len(x))] max_hidden_diff = max(abs(a - b) for ra, rb in zip(full_hidden, column_joined) for a, b in zip(ra, rb)) max_output_diff = max(abs(a - b) for ra, rb in zip(full_output, row_reduced) for a, b in zip(ra, rb)) print("X shape=(2, 4), W1 shape=(4, 6), W2 shape=(6, 3), tp=2") print("column shards: W1=(4, 3) each, hidden=(2, 3) each") print("row shards: W2=(3, 3) each, partial output=(2, 3) each") print(f"full output={full_output}") print(f"max hidden diff={max_hidden_diff}, max output diff={max_output_diff}") if __name__ == "__main__": import argparse parser = argparse.ArgumentParser() parser.add_argument("--parts", type=int, default=2) args = parser.parse_args() try: hs = [matmul(x, w) for w in split_columns(w1, args.parts)] ps = [matmul(h, w) for h, w in zip(hs, split_rows(w2, args.parts))] except ValueError as exc: parser.error(str(exc)) reduced = [[sum(part[r][c] for part in ps) for c in range(3)] for r in range(2)] assert reduced == full_output print(f"requested_tp={args.parts}, shards={len(hs)}, output={reduced}") pipeline_bubble.py #!/usr/bin/env python3 """Idealized GPipe bubble calculator; stdlib only.""" import argparse parser = argparse.ArgumentParser() parser.add_argument("--stages", type=int, default=4) parser.add_argument("--microbatches", type=int, default=8) args = parser.parse_args() if args.stages < 1 or args.microbatches < 1: parser.error("stages and microbatches must be positive") p, m = args.stages, args.microbatches slots = m + p - 1 efficiency = m / slots print(f"stages={p}, microbatches={m}, ideal_slots_per_sweep={slots}") print(f"pipeline_efficiency={efficiency:.2%}, bubble_fraction={1-efficiency:.2%}") print("forward schedule (slot -> active stage:microbatch)") for t in range(slots): active = [f"S{s}:M{t-s}" for s in range(p) if 0 <= t - s < m] print(f"{t:02d}: " + " ".join(active)) make_figures.py """Regenerate this article's deterministic teaching figure (numpy + matplotlib).""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np OUT=Path(__file__).resolve().parents[1]/"figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({"font.sans-serif":["Microsoft YaHei","DejaVu Sans"],"axes.unicode_minus":False}) m=np.arange(1,129) fig,ax=plt.subplots(figsize=(8,4.8)) for p in [2,4,8,16]:ax.plot(m,m/(m+p-1),label=f"{p} stages") ax.set(xlabel="Microbatches per DP replica per optimizer step",ylabel="Ideal utilization",ylim=(0,1.02),title="Balanced forward sweep / GPipe: m / (m + p - 1)") ax.legend();ax.grid(alpha=.25);fig.tight_layout() fig.savefig(OUT/'pipeline_utilization.png',dpi=170) plt.close(fig) print(OUT/'pipeline_utilization.png')
-
AIGC 基本功|混合精度与数值稳定性-AMP AIGC 基本功|混合精度与数值稳定性-AMP 所属方向:分布式训练 | 难度:进阶 | 前置知识:无节点级先修;需要向量范数、导数与梯度的基本概念 关键词:混合精度、FP16、BF16、FP8、loss scaling、溢出、数值稳定 01. 为什么需要它 同一份训练代码,把 BF16 改成 FP16,吞吐可能更高,也可能几十步后 loss 直接变成 NaN。另一个常见现场是:模型看起来正常收敛,但某些参数长期没有变化;检查梯度才发现,一些绝对值不超过 $2^{-25}\approx2.98\times10^{-8}$ 的梯度在 round-to-nearest-even 写回 FP16 时已经变成了 0。 这不是“半精度不准”一句话能解释的。训练里的风险至少有三种:数太大,越过该转换路径的舍入溢出边界而成为 inf;数太小,舍入后落到 0(或硬件将次正规数 flush-to-zero);数虽然在范围内,却因为有效位太少,在加法里被大数吞掉。三者的修复手段不同:loss scaling 能救小梯度,却救不了激活溢出;换 BF16 能扩展动态范围,却不会自动改善尾数精度;把归约留在 FP32 能减小累加误差,却不代表所有输入和权重都要回到 FP32。 为什么还要承担这些麻烦?因为 Transformer 的大头通常是矩阵乘(GEMM,通用矩阵乘法)。现代加速器对低精度矩阵乘提供更高吞吐,权重和激活每元素从 4 字节降到 2 字节也能减小显存与带宽压力。Mixed Precision Training 给出的核心配方是:低精度做大部分前后向,保留 FP32 主权重进行更新,并对 loss 缩放以防小梯度消失;其特定模型与实验保持了精度。低精度张量本身的字节可减半,总训练显存是否下降还取决于主权重、梯度和优化器状态,6.1 节给出两套账本。 “混合”的重点不是选一个统一 dtype,而是给不同数值角色分工。大 GEMM 适合低精度输入,softmax、归一化、loss 和长归约通常需要更大的范围或更高精度,优化器状态又有自己的要求。自动混合精度(Automatic Mixed Precision,AMP)的价值正是把逐算子的 dtype 路由表和梯度缩放流程标准化。 一个数字能说明 FP16 与 BF16 的性格差异:FP16 最大有限值只有 65504,而 BF16 与 FP32 一样有 8 位指数,最大值约 $3.39\times10^{38}$。反过来,FP16 有 10 位小数尾数,1 附近的间隔约 $9.77\times10^{-4}$;BF16 只有 7 位尾数,间隔约 $7.81\times10^{-3}$。BF16 更不容易炸,FP16 在可表示范围内更细;“更稳定”与“更精确”不是同一维度。 02. 最小可用理解 三句话先建立框架: autocast 按设备与算子选择 dtype:例如 PyTorch 2.10 的 CUDA 矩阵乘可用 FP16,CUDA softmax、MSE 等用 FP32;CPU 的 BF16 策略表不同,不能把这句话当作所有设备和归约的保证。 FP16 训练通常用 loss scale $S$ 把反向梯度整体放大,更新前再除回去;发现 inf/NaN 时跳过这一步并缩小 $S$。 BF16 动态范围接近 FP32,通常不需要 GradScaler,但尾数更短;FP8 则必须进一步管理张量尺度、绝对最大值历史和累加精度。 如果只记一个检查顺序:先问异常发生在前向还是反向,再区分 overflow、underflow 与 rounding,最后才决定换 dtype、调 scale,还是把局部算子提升到 FP32。 AMP 中常见的四种角色也要分开:参数存储 dtype、算子输入 dtype、乘法累加 dtype、优化器状态 dtype。日志打印“BF16 training”并不能证明四者都是 BF16。很多 GEMM 是 BF16 输入、FP32 累加;Adam 的一阶矩和二阶矩仍为 FP32;某些框架还会保存 FP32 主权重。 03. 数学推导 3.1 浮点数到底牺牲了什么 对非零正规数,一个二进制浮点数可写成(次正规数没有隐含的前导 1): $$x=(-1)^s(1.f)_2\,2^{e-\mathrm{bias}}$$ $s$ 是符号位,$e$ 是指数域,$f$ 是小数域。指数位数决定动态范围,尾数位数决定相邻可表示数的间距。FP16 是 1 位符号、5 位指数、10 位小数;BF16 是 1、8、7;FP32 是 1、8、23。这里的“小数位”不含正规数隐含的前导 1,所以有效二进制位分别为 11、8、24;指数全 0/全 1 留给边界及特殊值。于是: FP16:最小正规数 $2^{-14}=6.1035\times10^{-5}$,最小次正规数 $2^{-24}=5.9605\times10^{-8}$,最大有限值 65504; BF16:最小正规数 $2^{-126}\approx1.1755\times10^{-38}$,最小次正规数 $2^{-133}$,最大有限值约 $3.3895\times10^{38}$; FP32:动态范围与 BF16 同阶,但 23 位小数显著降低舍入误差。 机器 epsilon 是 1 与下一个可表示数的间隔;下面列的是 epsilon。在 round-to-nearest 模式下,通常定义的 unit roundoff 为这些值的一半: $$\epsilon_{\mathrm{FP16}}=2^{-10},\qquad \epsilon_{\mathrm{BF16}}=2^{-7},\qquad \epsilon_{\mathrm{FP32}}=2^{-23}$$ epsilon 描述的是 1 向上的间距,不是所有数的固定绝对误差。对没有溢出或下溢的正规结果,最近舍入常用模型为 $\operatorname{fl}(x)=x(1+\delta)$,$|\delta|\le u$,其中 $u=\epsilon/2$;次正规区应使用绝对误差界,不能直接套相对界。这个界可以从间距看出:设 $p$ 是小数位数、$E$ 是实际二进制指数。在区间 $[2^E,2^{E+1})$,相邻数间距为 $2^{E-p}$,最近舍入误差至多半个间距;除以至少 $2^E$ 的输入幅值,就得到 $u=2^{-p-1}$。相应推导只描述单次舍入,不包含前序算子误差。 因此 $1+10^{-4}$ 写入 FP16 或 BF16 都舍入为 1。更危险的是参数更新:若权重 $w=1$,学习率乘梯度只有 $10^{-5}$,直接在低精度权重上做 $w-\eta g$,变化会被舍掉。FP32 主权重就是在高精度副本上累计细小更新,再把结果舍入给低精度前后向。 在 round-to-nearest-even 且保留次正规数时,绝对值不超过 $2^{-25}$ 的 FP16 输入舍入为零;介于这个阈值和 $2^{-24}$ 之间的数可能舍入为最小次正规数,而非一律为零。支持 flush-to-zero 的执行路径还需另查硬件与算子规则。 3.2 为什么 loss scaling 不改梯度 设损失为 $L(\theta)$,参数为 $\theta$,真实梯度为 $g=\nabla_\theta L$。取与参数无关、同一次累积期间固定的正常数 $S$。在精确算术下,把 loss 乘常数 $S$ 后反向: $$g_s=\nabla_\theta(SL)=S\nabla_\theta L=Sg$$ 只要在优化器读取梯度前除以 $S$,就恢复原梯度: $$g=\frac{g_s}{S}$$ 关键是量化顺序。若 $g=10^{-8}$,先写入 FP16 会变 0,之后再乘任何数都救不回来;若先由链式法则得到 $Sg=1.024\times10^{-5}$,它能被 FP16 表示,写回后再用 FP32 除以 1024,就能保留接近 $10^{-8}$ 的非零值。浮点计算实际得到的是 $Q(Sg)/S$,一般不恰等于 $g$;而真实反向还包含中间张量的舍入,不能把单次梯度量化模拟当成完整训练误差模型。 能否用一个 scale 同时容纳所有梯度?设需要保留的最小非零幅值为 $g_{\min}$,最大幅值为 $g_{\max}$。在 FP16 最近偶数舍入且保留次正规数的简单写回模型下,非零所需条件和一个避免溢出的充分条件是: $$Sg_{\min}>2^{-25},\qquad Sg_{\max}\le65504$$ 因此必须寻找两者交集。65504 是保守安全上界;真正向 inf 的最近舍入边界是 65520。若梯度同时有 $10^{-8}$ 和 $10^5$,下界要求 $S>2.98023224$,安全上界却是 $S\le0.65504$;即使使用 65520 边界也无交集。任何动态策略都不能用一个标量消除这个范围冲突。若路径将 FP16 次正规数清零,保留到正规区约需 $Sg_{\min}\ge2^{-14}$,限制更强。这里尚未计入中间反向的溢出。 静态 scale 要人工选 $S$。太小救不了下溢,太大会让大梯度越过 FP16 的安全范围,甚至舍入成 inf。动态 GradScaler 维护随训练变化的 $S_t$: $$S_{t+1}=\begin{cases}\beta S_t,&g_s\text{ 含 inf/NaN}\\ \gamma S_t,&\text{连续 }K\text{ 步有限}\\ S_t,&\text{其他情况}\end{cases}$$ $\beta<1$ 是回退因子,$\gamma>1$ 是增长因子,$K$ 是增长间隔。出现非有限梯度时必须跳过 optimizer step,否则坏更新会污染权重和 Adam 状态。PyTorch 文档还提醒:scale 不保证始终大于 1,BF16 预训练模型强转 FP16 时可能因数值过大而一路回退。 3.3 为什么 softmax 和归约容易出事 直接计算 softmax: $$p_i=\frac{e^{x_i}}{\sum_j e^{x_j}}$$ 若 $x_i$ 很大,指数会溢出。稳定写法先减最大值 $m=\max_jx_j$: $$p_i=\frac{e^{x_i-m}}{\sum_j e^{x_j-m}}$$ 对一行至少有一个有效有限 logit、其余有限或被遮罩为负无穷的输入,最大指数为 1,分母至少为 1;对有限有效 logits,分子分母同除 $e^m$ 证明结果不变。它避免了 exp 的正向溢出,却不能保证所有小概率非零,也不能挽回输入先变成 inf 的损失。全行被 mask 为负无穷时,$-\infty-(-\infty)$ 是 NaN,必须明确选择报错、跳行或该算子的零输出约定。若输入已有正 inf,同样不能直接套减 max 公式。LayerNorm 方差也不宜用 $E[x^2]-E[x]^2$ 的低精度朴素形式:两个接近的大数相减会灾难性消减。长向量求和误差还会随项数累积,不能由此推出所有归约都自动在 FP32 完成:先检查设备策略、输出与累加 dtype。 numeric_stability.py 给出两个不依赖 GPU 的反例。把 256 与 256 个 1 逐项相加,BF16 每步舍入得到 256,而高精度求和后只量化一次得到 512:在 256 这个区间,BF16 相邻值差 2,256+1 恰在中点并向偶数舍回 256。这里模拟顺序加法,不能用来估计厂商 GEMM 的误差。 对数据 9999、10001,真实总体方差为 1;模拟 FP32 的 $E[x^2]-E[x]^2$ 得到 0。用中心化形式可避免这次大数相减,但若先写成 BF16,两个输入都成 9984,之后即使用 FP32 中心化也只能得到 0。稳定算法和输入信息完整性是两件事。 还要区分“算子输出 dtype”和“内部累加 dtype”。矩阵乘输入、输出可以是 BF16,但硬件乘积常进入 FP32 accumulator,最终再舍入回 BF16。若自定义 kernel 把 accumulator 也降成 16 位,它不再与常规 AMP 拥有同样数值性质。 3.4 FP8 为什么不只是再少 8 位 FP8 常见 E4M3 与 E5M2。FP8 Formats for Deep Learning 用 E4M3 提供较多有效位,用 E5M2 提供较大范围。本文具体指该论文的 E4M3(常标为 E4M3FN)和 E5M2:前者最大有限值 448、最小次正规数 $2^{-9}$,不编码无穷;后者最大有限值 57344、最小次正规数 $2^{-16}$,包含 inf/NaN。不能把这些范围推广到所有名为 E4M3 的变体。格式定义与转换策略也要分开:有限大值是饱和、报错还是转特殊值,由具体转换模式决定。 原始张量很难恰好落进狭窄范围,通常给每个张量或块维护正的反量化尺度 $a$: $$q=Q_{\mathrm{FP8}}(x/a),\qquad x_{\mathrm{deq}}=a\,q$$ 这里 $Q$ 是选定舍入及越界策略的 FP8 转换,$x_{\mathrm{deq}}$ 是还原到高精度的近似值。若格式上限为 $F$,对非零有限张量可取 $a=\operatorname{amax}(|x|)/F$,于是最大幅值映到 $F$;全零张量应另取安全尺度,不能除以零。很多库把 $1/a$ 称作 scale,符号恰好相反。 例如使用 E4M3 的 $F=448$,向量中若出现 44800 的异常值,张量尺度 $a=100$;普通值 1 被映成 0.01,在该格式最近舍入下约为 0.009765625,还原后是 0.9765625。没有该异常值时所需尺度不同;这说明 amax 选取改变误差分配,不证明任何块缩放必定改善最终任务。若每步都同步全局 amax,又会引入开销;不同方案会用历史窗口、延迟缩放或块缩放。例如 TE 2.13 delayed scaling 利用历史 amax 预测下一次 scale,减少额外读张量;突然增大的异常值可能超出历史预测,因此还要检查饱和比例,不能把历史尺度当作当步最大值保证。FP8 的正确性同时依赖格式、粒度、尺度更新、异常值分布和高精度累加,不能机械替换 dtype 字符串。 图要比较动态范围与精度:输入先转成 FP32,再分别转换为 FP16/BF16;这是脚本实际比较的路径。小数值端 FP16 可能舍入为零(相对误差 1),超过最大有限值后溢出;BF16 的范围更宽,但正规数的尾数精度更低。精确可表示点的误差为零,图中作绘图下限处理;非有限溢出点被省略而非画成零误差,FP16 上限用竖线标出。 04. 代码实现 float_formats.py、loss_scaling_sim.py、numeric_stability.py 只依赖 Python 标准库;amp_probe.py 需要 PyTorch,配图脚本需要 NumPy/matplotlib。文末附录提供全部五个文件。 float_formats.py 用 IEEE 二进制打包模拟 FP16;BF16 路径先转 FP32,再按舍入位和保留位奇偶加偏置,截去低 16 位,且单独保留 NaN 分类。这是 FP32→BF16 的最近偶数舍入,不是任意 Python 双精度数直接到 BF16 的转换。反例 $1+2^{-8}+2^{-26}$ 高于 BF16 中点:直接最近舍入应为 1.0078125,先转 FP32 却恰落中点,再转 BF16 得 1。不同输入精度必须写明。 真实输出: format exp frac min_normal max_finite epsilon_at_1 FP16 5 10 6.1035e-05 6.5504e+04 9.7656e-04 BF16 8 7 1.1755e-38 3.3895e+38 7.8125e-03 FP32 8 23 1.1755e-38 3.4028e+38 1.1921e-07 value -> FP16 | BF16 1.0001 -> 1 | 1 1e-05 -> 1.00136e-05 | 1.00136e-05 100000 -> inf | 99840 100000 在 FP16 变成 inf,在 BF16 仍有限;1.0001 在两种 16 位格式里都舍入成 1。动态范围与精度的区别由此可见。 loss_scaling_sim.py 把五个小梯度直接量化,再先乘 1024、量化、最后除回去: shape=(5,), loss_scale=1024 gradient direct_fp16 scaled_fp16/unscaled 1.000e-08 0.000e+00 1.001e-08 3.000e-08 5.960e-08 2.998e-08 1.000e-07 1.192e-07 1.000e-07 1.000e-06 1.013e-06 1.000e-06 1.000e-05 1.001e-05 9.999e-06 nonzero: direct=4/5, scaled=5/5 $10^{-8}$ 直接写 FP16 已为 0,缩放路径却保留为 $1.001\times10^{-8}$。这不是凭空增加精度:量化误差仍在,只是把数搬进可表示区间。 实际 AMP 流程用 amp_probe.py 复现:固定 seed 7,FP32 参数的线性层接收形状 [6,4] 的输入,输出 [6,2],CPU FP16 autocast 前向,MSE 与参数梯度为 FP32。这里故意用 CPU 支持的路径检查控制流程;它不是 CUDA Tensor Core 吞吐或完整 DiT 收敛实验。运行: python amp_probe.py 关键顺序是 autocast 包住前向/loss,退出后 scale(loss).backward,再 unscale、裁剪、scaler.step、update;完整可执行循环在附录,包含 model、数据和 optimizer 的定义。第三步在梯度中注入 inf,这一步不做无意义的非有限 norm 裁剪,仍由 scaler.step 检查并跳过更新。实际结果: step loss(前向) update 后 scale 参数最大变化 0 1.087817 8 0.055877 1 0.930182 16 0.105419 2(注入 inf) 0.675444 8 0 3 0.675444 8 0.147829 4 0.412640 16 0.168862 增长间隔设为 2,因此前两次有限 step 后 scale 翻倍;inf step 跳过且回退,下一次前向 loss 仍相同。另从 scale=1 注入 inf,真实回退到 0.5。脚本在完整 step 1 后保存/恢复 model、带 momentum 的 optimizer 和 scaler,续跑后三步与不断点结果逐位相同。这里无 dropout 且数据预先生成;一般训练仍要保存 RNG、数据游标和分布式状态。BF16 autocast 的另一分支实际得到 BF16 输出、FP32 MSE 和 FP32 参数梯度,无 scaler。 实跑环境为 Windows、Python 3.11.9、PyTorch 2.10.0+cpu,单 CPU 线程;图使用 NumPy 2.4.6、matplotlib 3.10.7。环境复用项目已有局部依赖,未改系统安装。不同版本/kernel 的末位或阈值不要求逐位相同,本次验收的是上述有限性、跳步、scale 与恢复关系。 梯度裁剪必须在 unscale 之后,若对放大后的梯度仍用阈值 C 裁剪,反缩放后的有效阈值会变成 C/S。令梯度范数为 4、$S=1024$、阈值为 1,先裁 scaled grad 再除 S 只剩 0.0009765625;先反缩放再裁才得到 1。证明是 $\operatorname{clip}_C(Sg)/S=g\min(1,C/(S\|g\|))$,与 $\operatorname{clip}_C(g)$ 不同(库实现还可能加入小的稳定常数)。若用 BF16,通常保留 autocast 而不用 GradScaler;是否省略仍应由实际梯度分布验证。 05. 工业级实现对照 本文对照固定 PyTorch v2.10.0 的 torch/amp/grad_scaler.py#GradScaler 中 GradScaler.scale 把 loss 乘当前尺度;unscale 按 device 与 dtype 分组检查并反缩放梯度;step 只在没有 inf/NaN 时调用优化器;update 再根据各 optimizer 的 found-inf 状态调整尺度。它还处理稀疏梯度、多设备、多优化器、checkpoint state dict 和惰性初始化,这些都是最小模拟没有覆盖的工程边界。 官方 PyTorch 2.10 AMP 文档 推荐统一使用 torch.autocast 与 torch.amp.GradScaler;旧的 torch.cuda.amp 接口已标记弃用。autocast 只包前向和 loss,backward 放在上下文外。不要启用 autocast 后再全局 model.half,否则会绕开逐算子的安全策略。 本次还把下载的 v2.10.0 GradScaler 整份原始模块直接加载到 CPU,使用与第 04 节相同数据执行五个 step;输出、scale、inf 跳步与最终参数均与安装的 2.10.0+cpu 完全一致。原源码文件和 SHA256、独立边界验证见本篇审计证据;不声称执行了分布式或 GPU 分支。 算子策略不是“白名单里全降精度”。线性层、卷积通常进入 lower-precision;例如 CUDA 表中的 softmax、sum 和 MSE 使用 FP32,但 CPU BF16 表中未列入的 softmax 会沿输入 dtype 运行;多输入算子可能提升到最宽输入类型。显式 dtype、原地算子或 out 版本可能不参与 autocast,自定义代码要检查实际 dtype 流。 FP8 方面,NVIDIA Transformer Engine 2.13 的 delayed-scaling 文档 描述 E4M3/E5M2 recipe、amax 历史与 delayed scaling,并在支持硬件上让 Transformer 层进入 FP8 路径。它仍以 BF16/FP16 保存部分张量并用高精度累加;分布式训练还可能跨 rank 归约 amax。“开启 FP8”是引入量化运行时,不是把参数永久存成单一 8 位格式。 生产监控至少记录当前 scale、增长和回退次数、跳过的 step 数、梯度范数、参数与激活 amax、NaN 首次出现的层、关键算子 dtype。只看总 loss 会把静默下溢藏很久。 06. 代价与边界 混合精度常能节省参与低精度计算的张量带宽,但原生 autocast 不一定降低参数和梯度的持久存储 dtype,但不保证总显存恰好减半。若使用独立 FP32 主权重与两个 FP32 moment,仅这三项就占 12 字节/参数;原生 FP32 参数 autocast 通常没有额外独立主权重,不能重复计账;部分算子保存 FP32 中间量;通信 buffer、cast buffer、workspace 与碎片也增加峰值。 吞吐提升也有条件。矩阵尺寸太小、CPU 或数据加载受限、频繁转换、未使用低精度加速单元,都会让 AMP 几乎不加速。小 batch 下,kernel launch 与 cast 成本甚至抵消收益。正确基准应同时报告 tokens/s、峰值显存、收敛曲线和最终指标。 以下情况尤其要谨慎: 模型源自 BF16 预训练且激活常超过 65504,FP16 loss scaling 只能处理梯度,救不了前向溢出; 长归约、概率、指数、对数、方差或很小正则项的自定义算子没有 autocast 策略; 梯度累积时各 microbatch 使用不同 scale,或反缩放前裁剪梯度; 多 optimizer 共用计算图,却在所有梯度就绪前更新 scale; FP8 中异常值主导 amax,张量级缩放让普通值量化过粗,可评估块缩放或高精度旁路,仍需任务实验验证。 调试时先用 FP32 建立可复现基线,再开 BF16,然后才是 FP16/FP8。每步只改一个变量,并比较前若干 step 的 loss、梯度范数和权重更新。数值问题最怕同时调整学习率、并行度、batch 与 dtype。 6.1 一次更新里究竟有哪些精度 以 AdamW 为例,要先分清框架是否真的创建低精度参数及主副本。常见的原生 autocast 方案保持参数 FP32,.grad 通常随参数为 FP32,两个 FP32 moment:持久参数状态约为 $4+4+8=16$ 字节/参数;临时 cast 权重缓存和激活另算。另一种“低精度模型+FP32 主副本”若参数与梯度各 2 字节,主副本 4、moment 8,共 16 字节/参数;若另有 FP32 master gradient,还需再加 4。这里忽略 step 标量、workspace、通信、分片和张量生命周期,不能直接当峰值显存。这两套结构不能相加。 下面的更新式只描述第二种方案。一次更新至少涉及前向激活、反向梯度、参数、副本和两个动量。低精度 GEMM 只覆盖其中一部分。设低精度参数为 $\theta_{16}$,FP32 主参数为 $\theta_{32}$,反缩放后的梯度为 $g_{32}$,则更新链条可以写成: $$\theta_{32}^{t+1}=\operatorname{AdamW}(\theta_{32}^{t},g_{32}^{t},m_t,v_t),\qquad \theta_{16}^{t+1}=Q_{16}(\theta_{32}^{t+1})$$ $m_t,v_t$ 是 FP32 一阶、二阶矩,$Q_{16}$ 表示舍入到前后向 dtype。若框架没有主参数副本,而直接更新 BF16 参数,许多小于当前参数 ULP 的更新会消失。是否保留主权重是优化器实现细节,不能仅从模型参数 dtype 推断。 梯度累积又多一层顺序。假设一个 optimizer step 包含 $A$ 个 microbatch,先定义 $g_a$ 已包含所需的 batch 权重:若每个 microbatch 大小相同且各自 loss 是均值,应先除以 $A$;若大小不同,应按样本数加权(token loss 按有效 token 计)。它们必须使用同一 scale $S$,先把已缩放梯度累加: $$g_s=\sum_{a=1}^{A}Sg_a=S\sum_{a=1}^{A}g_a$$ 等所有 microbatch 完成后只反缩放一次。若中途 update scale,累加 buffer 中不同 microbatch 带有不同倍数,最后无法用一个 $S$ 恢复。例如两段真实梯度为 1、3,分别乘 8、16 后统一除 16,得到 3.5 而非 4。amp_probe.py 用大小 2 与 4 的两个 microbatch,把各自平方误差的 sum 除以同一总元素数,再用 scale=8 累积;反缩放后的梯度与完整 batch FP32 基线最大差 $5.96046448\times10^{-8}$。这个实验只隔离累积与缩放,不含低精度前向误差。完整顺序见 官方累积示例。若某个 microbatch 产生 inf,这一整个 optimizer step 都应跳过,而不是只丢掉坏 microbatch,否则有效 batch 和采样权重已变化。这是保持当前 accumulation 窗口语义的策略,scaler 不会替用户恢复或重放丢失的 microbatch。 6.2 分布式训练里的非有限值共识 数据并行中,每个 rank(参与通信的一份进程副本)只看到本地样本。rank 3 出现 inf 而其他 rank 有限时,所有副本仍必须对“是否更新”达成一致;否则 rank 3 跳步、其余 rank 更新,参数立即分叉。普通 torch.amp.GradScaler 只在当前进程内按设备/优化器汇总 found-inf,不自动执行跨 rank all-reduce。 常规 DDP 同步的梯度若包含 inf,往往会把非有限值传到各副本;这依赖实际梯度同步路径,不能当作 scaler 的跨进程协议。存在 no_sync、分片、局部参数或自定义通信时必须另查一致性。固定版本 分片梯度缩放器源码 中的 ShardedGradScaler.unscale_ 显式调用 dist.all_reduce 同步 found-inf。这里已逐行核对两份原源码,未执行多机实验,也不建议在现有封装外盲加一次 collective(调用组和次序必须一致)。 梯度裁剪也有全局语义。ZeRO/FSDP 把梯度分片后,每卡只能算局部平方和: $$\|g\|_2=\sqrt{\sum_{r=0}^{P-1}\sum_{i\in\mathcal{S}_r}g_i^2}$$ 若这些集合是互不重叠、合起来恰好覆盖全梯度的分片,必须对局部平方和做 sum all-reduce 才得到全局范数;若每卡已有完整复制梯度,再这样相加会多乘 $P$,范数错放大为 $\sqrt P$ 倍。应调用并行框架提供的全局裁剪接口,并核对副本与分片组。正确顺序通常是:完成梯度同步,反缩放,检查非有限值,计算全局 norm,裁剪,执行 optimizer step,最后更新 scale。任一步调换都可能让“裁剪阈值 1.0”失去原含义。 混合精度还会改变 collective 的数值误差。BF16 梯度 all-reduce 比 FP32 少一半字节,但不同归约树改变加法顺序;卡数越多、梯度尺度跨度越大,末位差异越明显。若训练对归约误差敏感,可使用 FP32 梯度通信或分块高精度累加,但要接受带宽代价。排查时应分开比较“本地梯度生成精度”与“跨 rank 归约精度”。 6.3 一张可执行的 dtype 选型表 选 FP16 还是 BF16,不应只看硬件宣传峰值。可按四步判断: 第一,确认硬件原生路径。某些设备对 BF16 与 FP16 吞吐相同,某些旧设备没有 BF16 Tensor Core;软件模拟 BF16 可能更慢。第二,检查模型来源。BF16 预训练 checkpoint 的激活范围未必适合 FP16,直接转换容易前向溢出。第三,检查数值敏感区域。softmax、归一化、概率 loss、长归约优先保留 FP32。第四,跑短程 A/B,比较吞吐、峰值、跳步率和收敛,而非只确认“能启动”。 可以把训练方案分成四档: FP32 基线:通常有较大内存与算术成本,但小矩阵或低精度路径不理想时可能更快;它适合建立 loss 与梯度参照; BF16 AMP:大范围、无需常规 loss scaling,是现代大模型训练的常见起点; FP16 AMP:尾数稍细,但指数窄,必须认真监控动态 scaling 与前向溢出; FP8 混合精度:只把适合的 GEMM 张量降到 FP8,保留 16/32 位旁路,并维护尺度元数据。 所谓“纯 BF16”或“纯 FP8”常是营销简写。softmax、norm statistic、optimizer state、某些 residual 累加和 master gradient 仍可能更高精度。真正有意义的配置描述,应列出 input、weight、output、accumulator 和 optimizer 五个维度。 6.4 从第一个 NaN 反推根因 排查顺序应尽量靠近异常源。先在每个模块前后记录有限值比例、绝对最大值、绝对非零最小值与 dtype;找到第一个从有限变非有限的边界。若 attention score 在 softmax 前已经 inf,检查 Q/K 范数、缩放因子与位置编码;若 loss 有限而 backward 首先 inf,检查导数奇点、自定义 backward 和 loss scale;若梯度有限但 step 后参数异常,检查 optimizer state、权重衰减和反缩放顺序。 静默下溢比 NaN 更难发现。建议记录零梯度比例,并按参数组看更新比率: $$r_{\mathrm{update}}=\frac{\|\Delta\theta\|_2}{\|\theta\|_2+\varepsilon}$$ 若某些层长期为 0 而 FP32 基线非零,应把低精度存储或 scale 窗口列为候选原因;还需排除冻结参数、mask、稀疏路由、断开的计算图或真实零梯度,不能只凭零比例完成归因。若所有层的比例突然增大,则更像学习率、loss normalization 或跳步恢复后的 scale 问题。 不要看到 NaN 就立即降低学习率。学习率过大确实可能导致发散,但 dtype overflow、错误 mask 产生全负无穷、空 batch 的除零、坏数据和通信错误都可能表现为同一个 NaN。先定位首次非有限张量,才能选择对应修复。 6.5 Checkpoint、编译与自定义算子的坑 恢复训练时必须保存 GradScaler 状态。若只恢复模型和 optimizer,却把 scale 重置为很大初值,前几步可能反复溢出并被跳过;重置太小则产生额外下溢。保存点最好位于完整 optimizer step 之后,避免记录到一半累积的混合状态。 activation checkpoint 会在 backward 重跑前向。重算应保持与原前向兼容的 autocast 上下文;PyTorch v2.10.0 自带 checkpoint 会保存并重入相应状态,自定义重算仍需核实。若保存路径是 BF16、重算路径变 FP32 或 FP16,梯度对不上。torch.compile、CUDA Graph 和 fused optimizer 还可能改变 autocast 边界或引入 CPU-GPU 同步,升级版本后要重新做数值与性能回归。 自定义 autograd Function 不能假定输入永远 FP32。前向若内部要求 FP32,应显式关闭 autocast 并转换输入;反向要返回与调用约定兼容的梯度。写自定义 CUDA kernel 时,明确 accumulator 类型、饱和或 inf 行为、次正规数处理以及随机舍入。一个算子“支持 half”只代表能执行,不代表适合训练。 最后,评估数值稳定不能只跑几十步。动态 scale 的增长周期可能是数千步,某些罕见 batch 才触发极端值。至少保留一次覆盖学习率峰值、warmup 结束和验证阶段的长程对照,并把跳步数作为训练产物记录;否则断点续训后出现指标差异,很难追溯是数据还是精度状态造成。 6.6 性能基准该怎样设计 AMP 基准应先预热到 kernel 编译、缓存和分配行为稳定,再做多次迭代。三次 warmup 只能作为起点,不能作为稳定保证。计时前后做设备同步;否则异步 kernel 会让 CPU 提交时间冒充 GPU 执行时间。显存要同时报告 allocated 与 reserved 峰值,前者是活跃张量,后者包含分配器缓存。对比方案必须使用同一 batch、相同梯度累积与相同 checkpoint 策略。 吞吐最好报告有效 token/s,而不是 batch/s。变长序列下,一个 batch 的 padding 比例不同,batch/s 会误导。质量侧至少比较训练 loss、验证指标、梯度范数和被跳过 step 数。若 AMP 每秒更快却需要更多 step 才到相同验证指标,最终 time-to-quality 未必更优。 对 FP8 还应增加量化覆盖率:多少 GEMM 真正走 FP8,多少因 shape、算子或 recipe 回退到 BF16;记录每层 amax、饱和比例和 scale 更新。仅看配置显示 FP8 无法证明加速路径被命中。kernel trace 能确认实际指令与 cast 开销。 建立门禁时,不必要求低精度与 FP32 每步完全相同。可先规定前 100 步 loss 相对误差、梯度 cosine、最终指标容差与最大跳步率,再用多个随机种子评估。数值差异是浮点并行的正常现象,持续偏向、层级爆炸或指标显著退化才是故障信号。 6.7 一份上线前检查清单 上线前逐项回答:硬件是否原生支持目标 dtype;矩阵尺寸是否对齐加速 tile;敏感算子是否保持 FP32;FP16 是否启用动态 scaling;裁剪是否在 unscale 后;所有 DP rank 是否共享跳步决策;梯度累积期间 scale 是否不变;checkpoint 是否保存 scaler;自定义算子是否声明 autocast 与 accumulator;监控是否能定位第一处非有限值。 然后做三个故障注入。人为把 scale 调得极大,确认系统发现 inf、跳过更新并回退;给输入加入一个幅值异常样本,确认前向监控能定位层;从 checkpoint 恢复,确认 scale、optimizer 与随机数状态连续。没有做过故障注入的告警,往往只在真正长跑失败后才发现无效。 最后保留 FP32 或 BF16 安全开关。生产训练发生异常时,能在不改数据顺序和并行布局的条件下提升精度复现,定位效率远高于临时改一堆超参。安全路径不一定长期运行,但必须定期测试,避免代码演进后早已失效。 这些流程看似比设置一个 autocast 开关繁琐,却能把“偶尔 NaN”“换卡就掉点”“断点后不收敛”变成有指标、有复现实验、有回退方案的普通工程问题。 6.8 如何判断变化来自精度而不是随机性 一次训练 A 比 B 的 loss 高,并不能证明精度方案更差。数据顺序、dropout、并行归约顺序和非确定 kernel 都会制造波动。公平实验要固定数据索引与初始化,尽可能使用确定算法,并运行多个随机种子。先比较同一步同一层的输出、梯度与更新,再比较长程最终指标。 可用 FP32 输出 $y_{32}$ 作为局部参照,计算相对误差与余弦相似度: $$e_{\mathrm{rel}}=\frac{\|y_{\mathrm{low}}-y_{32}\|_2}{\|y_{32}\|_2+\varepsilon}$$ 单层误差略大未必影响训练,但若误差沿深度单调放大,往往说明 residual 累加、归一化或某个敏感算子精度不足。把统计按层绘制比只比较最终 logits 更容易定位。 还应区分可复现性与正确性。集合通信改变加法顺序后,bitwise 结果可能不同,但两条训练曲线仍落在相同统计分布。反之,两次运行逐位一致也可能稳定地实现了错误缩放。验收既要有小规模数学 oracle,也要有多种子任务指标。 混合精度上线后,持续监控跳步比例和 scale 分布。数据配方变化、序列变长、加入新 loss 或更换初始化,都可能改变数值范围;一次验证通过不意味着未来配置永久安全。把 precision 当成模型配置的一部分进行版本化,才能复现每次训练。 一个实用原则是把所有隐式转换显式化到观测层:训练启动时抽样打印关键模块的参数、输入、输出与归约 dtype,同时保存硬件、驱动、框架版本。低精度 kernel 与 autocast 策略会随版本更新,旧实验结论不能无条件外推。版本升级后的第一件事应是重跑短程数值基线与吞吐基线,而不是直接续跑昂贵训练。这样才能知道速度变化来自 kernel,精度变化来自策略,还是数据本身发生了变化。 还应把这些元数据写进 checkpoint 清单,使恢复任务能够拒绝不兼容的精度配置,而不是在数小时后以 NaN 形式暴露。可诊断性本身就是混合精度系统的一项能力。 07. 经典论文脉络 Mixed Precision Training(arXiv:1710.03740):提出低精度前后向、FP32 主权重与 loss scaling,奠定现代 AMP。 A Study of BFLOAT16 for Deep Learning Training(arXiv:1905.12322):说明 BF16 用 FP32 相同指数范围换取更短尾数,使训练更少依赖 loss scaling。 FP8 Formats for Deep Learning(arXiv:2209.05433):提出 E4M3/E5M2 两种互补编码,并用数值模拟训练实验验证其精度;不能把格式论文的模拟结果当成本篇的 FP8 硬件实测。 FP8-LM: Training FP8 Large Language Models(arXiv:2310.18313):处理 FP8 大语言模型训练的精度、通信与优化器环节,说明端到端 FP8 不只是替换 GEMM dtype。 共同主题是:硬件格式越窄,软件越需要知道张量的数值角色。格式提供可能性,尺度管理、累加方式和回退路径才决定能否稳定训练。 08. 常见误解 误解一:BF16 比 FP16 精度更高。 BF16 指数范围更大,更少 overflow;但尾数只有 7 位,1 附近分辨率更粗。应说通常更稳定,不是处处更精确。 误解二:loss scaling 能修复所有 NaN。 它主要防 FP16 小梯度下溢。前向激活溢出、除零、softmax 不稳定、学习率过大,都不会被它根治。 误解三:scale 越大越好,而且一定大于 1。 scale 太大会溢出。PyTorch 允许动态 scale 降到 1 以下;应观察 found-inf 和跳步频率。 误解四:用了 autocast 就无需关心 dtype。 自定义算子、显式 dtype、原地运算和策略表外 op 可能保持输入 dtype。关键归约与 loss 仍需审计。 误解五:AMP 会把训练显存直接砍半。 激活可能下降,FP32 优化器状态仍在。账本还包括梯度、通信 buffer、workspace 与碎片。 误解六:FP8 是 BF16 的无痛升级。 FP8 依赖尺度、amax 历史、格式选择和硬件 kernel;错误配置可能不 NaN,却悄悄降低收敛质量。 09. 动手验证 先运行文末脚本,修改 loss_scaling_sim.py 中 scale 为 1、128、1024、65536。本次对 [1e-8,100] 的实际输出:scale=1 时小梯度为 0;128 时为 9.77888703e-9 且大梯度仍为 100;1024 时小梯度约 1.00117177e-8,但大梯度已为 inf;65536 仍溢出。并非 scale 越大越接近真实训练梯度。这正是动态 scale 在 underflow 与 overflow 之间寻找窗口的原因。 在支持 BF16/FP16 的 GPU 上做四组短跑:FP32、BF16 autocast、FP16 autocast 不带 scaler、FP16 autocast 带 scaler。固定随机种子和 batch,记录 200 步吞吐、峰值显存、loss、全局梯度范数、跳步数。这四组是建议读者执行的 GPU 实验,本次未执行,也不给出速度或最终指标排名。先用脚本定位 dtype 与跳步,再比较同一任务的多 seed 长程质量;不能由本篇 CPU 结果推出 GPU 模型中哪组必然更准。 定位首个异常层时,给模块注册 hook,输出有限值比例、绝对最大值和 dtype。若前向先出现 inf,优先检查指数、归一化、attention score 与输入范围;若反向先异常,再检查 scale、梯度裁剪顺序和自定义 backward。 最后验证累加精度:构造一个大数和大量小数的向量,用 FP32、模拟 BF16 顺序累加、分块 FP32 累加分别求和。预期低精度顺序加法吞掉更多小项;这解释为什么 GEMM 输入低精度不等于 accumulator 也该低精度。 10. 延伸阅读 读完这篇可以继续看: 量化:从 INT8 到 FP4:区分训练混合精度与推理量化的目标、校准和误差模型。 数据并行与 ZeRO 显存切分:混合精度改变每项状态字节数,ZeRO 决定状态在哪些 rank 上复制或分片。 张量并行与流水线并行:低精度减少通信字节,但集合通信次数、拓扑与同步点仍由并行策略决定。 可靠的 AMP 心智模型不是“半精度开关”,而是一张数值预算表:每个张量需要多大范围、多少有效位,在何处累加、何时舍入、出现异常如何回退。把这张表画清楚,NaN 就从玄学变成可以定位的工程问题。 附录:完整代码 09 节用到的脚本全文如下(numeric_stability.py、float_formats.py、loss_scaling_sim.py、amp_probe.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 numeric_stability.py """Arithmetic counterexamples, stdlib only; no hardware FTZ/GEMM simulation.""" import json import math import struct from pathlib import Path from float_formats import fp16, bf16 def q32(x): return struct.unpack('f', struct.pack('f', x))[0] def sequential(values, quantize): total = 0.0 for v in values: total = quantize(total + quantize(v)) return total def softmax(values): m = max(values) if not math.isfinite(m): raise ValueError('finite nonempty logits or an explicit masked-row policy required') e = [math.exp(v - m) for v in values] return [v / sum(e) for v in e] def main(): values = [256.0] + [1.0] * 256 results = dict(bf16_sequential=sequential(values, bf16), fp16_sequential=sequential(values, fp16), fp32_sequential=sequential(values, q32), quantize_once=bf16(math.fsum(values)), exact=math.fsum(values)) assert results == dict(bf16_sequential=256.0, fp16_sequential=512.0, fp32_sequential=512.0, quantize_once=512.0, exact=512.0) # Squaring rounded inputs; this models one poor algorithm, not a fused norm kernel. x = [9999.0, 10001.0] qx = [bf16(v) for v in x] mean = math.fsum(qx) / len(qx) stable_after_cast = math.fsum((v - mean)**2 for v in qx) / len(qx) var32_naive = q32(q32(sum(q32(v*v) for v in x) / 2) - q32(q32(sum(x)/2)**2)) results.update(input_bf16=qx, true_variance=1.0, fp32_naive_variance=var32_naive, centered_bf16_input_variance=stable_after_cast, shifted_softmax=softmax([1000.0, 1001.0]), raw_exp_fp16=fp16(math.exp(12)), scaled_grad_clip_wrong=1/1024, scaled_grad_clip_correct=1.0, mixed_scale_unscale=(8*1 + 16*3)/16, desired_sum=4.0) assert var32_naive == 0 and stable_after_cast == 0 for name, v in results.items(): print(name, v) (Path(__file__).with_name('numeric_results.json')).write_text( json.dumps(results, indent=2, allow_nan=True), encoding='utf8') if __name__ == '__main__': main() float_formats.py #!/usr/bin/env python3 """FP16 and FP32-to-BF16 nearest-even conversion; standard library only.""" import math import struct def fp16(x: float) -> float: try: return struct.unpack('e', struct.pack('e', x))[0] except OverflowError: return math.copysign(math.inf, x) def bf16(x: float) -> float: """Round FP64 input to FP32 first, then BF16; preserve NaN classification.""" try: bits = struct.unpack('>I', struct.pack('>f', x))[0] except OverflowError: return math.copysign(math.inf, x) if (bits & 0x7F800000) == 0x7F800000: if bits & 0x007FFFFF: bits = (bits & 0xFFFF0000) | 0x00400000 else: bits += 0x7FFF + ((bits >> 16) & 1) return struct.unpack('>f', struct.pack('>I', bits & 0xFFFF0000))[0] FORMATS = ( ('FP16', 5, 10, 2.0**-14, (2 - 2.0**-10) * 2.0**15, 2.0**-10), ('BF16', 8, 7, 2.0**-126, (2 - 2.0**-7) * 2.0**127, 2.0**-7), ('FP32', 8, 23, 2.0**-126, (2 - 2.0**-23) * 2.0**127, 2.0**-23), ) def main(): print('format exp frac min_normal max_finite epsilon_at_1') for name, exp, frac, low, high, eps in FORMATS: print(f'{name:5s} {exp:3d} {frac:4d} {low:.4e} {high:.4e} {eps:.4e}') print('\nvalue -> FP16 | BF16') for value in (1.0001, 0.00001, 100000.0): print(f'{value:g} -> {fp16(value):g} | {bf16(value):g}') print('\nFP16 ties:') for x in (2**-25, math.nextafter(2**-25, math.inf), 65519.0, 65520.0): print(f'{x:.17g} -> {fp16(x):.17g}') # This value lies above the exact BF16 midpoint but rounds to it in FP32. x = 1 + 2**-8 + 2**-26 print(f'double rounding: x={x:.17g}, FP32->BF16={bf16(x)}, direct BF16 nearest={1 + 2**-7}') if __name__ == '__main__': main() loss_scaling_sim.py #!/usr/bin/env python3 """FP16 gradient quantization and scale tradeoffs; standard library only.""" import math from float_formats import fp16 def main(): gradients = [1e-8, 3e-8, 1e-7, 1e-6, 1e-5] scale = 1024.0 direct = [fp16(g) for g in gradients] rescued = [fp16(g * scale) / scale for g in gradients] print(f'shape=({len(gradients)},), loss_scale={scale:g}') print('gradient direct_fp16 scaled_fp16/unscaled') for g, raw, value in zip(gradients, direct, rescued): print(f'{g:11.3e} {raw:11.3e} {value:11.3e}') print(f'nonzero: direct={sum(x != 0 for x in direct)}/5, scaled={sum(x != 0 for x in rescued)}/5') print('\nscale sweep: [1e-8, 100]') for scale in (1.0, 128.0, 1024.0, 65536.0): result = [fp16(g * scale) / scale for g in (1e-8, 100.0)] print(f'S={scale:g}: tiny={result[0]:.9g}, large={result[1]:g}, finite={all(map(math.isfinite, result))}') low = 2**-25 / 1e-8 high = 65504 / 1e5 print(f'no safe scalar window for [1e-8,1e5]: S>{low:.8f}, sufficient upper S<={high:.5f}') if __name__ == '__main__': main() amp_probe.py """Real CPU AMP, nonfinite injection and resume; requires PyTorch 2.10.0 CPU. Run: python amp_probe.py. No GPU or distributed benchmark is performed. """ import copy import json from pathlib import Path import torch def run(scaler_class=torch.amp.GradScaler, restore_at=None): torch.manual_seed(7) model = torch.nn.Linear(4, 2) opt = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9) scaler = scaler_class('cpu', init_scale=8, growth_interval=2) x = torch.randn(6, 4) y = torch.randn(6, 2) rows = [] for step in range(5): opt.zero_grad(set_to_none=True) with torch.autocast('cpu', dtype=torch.float16): pred = model(x) loss = torch.nn.functional.mse_loss(pred, y) scaler.scale(loss).backward() if step == 2: next(model.parameters()).grad[0, 0] = float('inf') before = [p.detach().clone() for p in model.parameters()] scaler.unscale_(opt) grad_dtype = str(next(model.parameters()).grad.dtype) # Skip clipping the deliberately nonfinite step: scaler.step still checks it. if step != 2: torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0) scaler.step(opt) scaler.update() delta = max(float((p.detach()-b).abs().max()) for p, b in zip(model.parameters(), before)) rows.append(dict(step=step, loss=float(loss.detach()), scale=scaler.get_scale(), max_update=delta, parameter_dtype=str(next(model.parameters()).dtype), output_dtype=str(pred.dtype), loss_dtype=str(loss.dtype), gradient_dtype=grad_dtype)) assert (delta == 0) == (step == 2) if restore_at == step: checkpoint = copy.deepcopy(dict(model=model.state_dict(), optimizer=opt.state_dict(), scaler=scaler.state_dict())) model = torch.nn.Linear(4, 2) model.load_state_dict(checkpoint['model']) opt = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9) opt.load_state_dict(checkpoint['optimizer']) scaler = scaler_class('cpu') scaler.load_state_dict(checkpoint['scaler']) assert [r['scale'] for r in rows] == [8, 16, 8, 8, 16] return rows, torch.cat([p.detach().flatten() for p in model.parameters()]) def accumulation(): torch.manual_seed(11) model = torch.nn.Linear(4, 2) x = torch.randn(6, 4) y = torch.randn(6, 2) torch.nn.functional.mse_loss(model(x), y).backward() reference = [p.grad.clone() for p in model.parameters()] model.zero_grad(set_to_none=True) scaler = torch.amp.GradScaler('cpu', init_scale=8) opt = torch.optim.SGD(model.parameters(), lr=0.1) # Unequal microbatches: divide each sum by the SAME total element count. for a, b in ((0, 2), (2, 6)): loss = torch.nn.functional.mse_loss(model(x[a:b]), y[a:b], reduction='sum') / y.numel() scaler.scale(loss).backward() scaler.unscale_(opt) error = max(float((p.grad-g).abs().max()) for p, g in zip(model.parameters(), reference)) assert error < 1e-6 return error def main(): torch.set_num_threads(1) rows, final = run() resumed_rows, resumed = run(restore_at=1) assert rows == resumed_rows and torch.equal(final, resumed) torch.manual_seed(5) model = torch.nn.Linear(4, 2) with torch.autocast('cpu', dtype=torch.bfloat16): output = model(torch.randn(3, 4)) loss = torch.nn.functional.mse_loss(output, torch.zeros(3, 2)) loss.backward() p = torch.nn.Parameter(torch.tensor(1.0)) opt = torch.optim.SGD([p], lr=0.1) scaler = torch.amp.GradScaler('cpu', init_scale=1) scaler.scale(p).backward() p.grad.fill_(float('inf')) scaler.step(opt) scaler.update() assert scaler.get_scale() == 0.5 and p.item() == 1 result = dict(torch_version=torch.__version__, device='cpu', threads=1, rows=rows, resume_bitwise_equal=True, accumulation_max_abs=accumulation(), bf16_output_dtype=str(output.dtype), bf16_loss_dtype=str(loss.dtype), bf16_grad_dtype=str(next(model.parameters()).grad.dtype), backoff_below_one=scaler.get_scale(), gpu_tested=False, distributed_tested=False) print(json.dumps(result, indent=2)) Path(__file__).with_name('amp_results.json').write_text(json.dumps(result, indent=2), encoding='utf8') if __name__ == '__main__': main() make_figures.py """Regenerate this article's deterministic teaching figure (numpy + matplotlib).""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np OUT=Path(__file__).resolve().parents[1]/"figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({"font.sans-serif":["DejaVu Sans"],"axes.unicode_minus":False}) from float_formats import fp16,bf16 x=np.geomspace(1e-9,1e5,1500).astype(np.float32).astype(np.float64) y16=np.array([fp16(float(v)) for v in x]);yb=np.array([bf16(float(v)) for v in x]) fig,ax=plt.subplots(figsize=(8,4.8)) for name,y in [("FP16",y16),("BF16",yb)]: err=np.abs(y-x)/x;err[~np.isfinite(err)]=np.nan ax.loglog(x,np.maximum(err,1e-12),label=name,alpha=.75) ax.axvline(65504,color="grey",ls=":",label="FP16 max finite") ax.set(xlabel="Positive input value",ylabel="Relative rounding error",title="FP32 input to FP16 / BF16: nearest-even rounding",ylim=(1e-8,2)) ax.text(0.03,0.06,"FP16 overflow points omitted; finite relative errors only.",transform=ax.transAxes,fontsize=9) ax.legend();ax.grid(alpha=.25);fig.tight_layout() fig.savefig(OUT/'precision_error.png',dpi=170) plt.close(fig) print(OUT/'precision_error.png')
-
AIGC 每日速读|2026-09-02|阿里7B原生音视频生成硬刚33B大模型-DreamX 今日 AIGC 论文速览 今日共 10 篇 · 原生音视频联合生成与 2K 高清化 1 篇 · 交互式世界模型的记忆与几何一致性 2 篇 · 推理期物理与质量增强,不改权重 3 篇 · 扩散推理加速:token 压缩与区域复用 2 篇 · 像素空间生成范式与端到端隐空间 2 篇 · 工业级细节保真与 RL 后训练 1 篇 重点论文标题列表 DreamX-Creator(阿里巴巴 DreamX Team):7B原生音视频联合生成打到2K Matrix-Game 3.5(昆仑万维 Skywork):把世界记忆细到patch级3D云 OMR(越南 Fulbright 大学 + 加州大学洛杉矶分校(BMVC 2026)):用冻结V-JEPA梯度纠物理违背 ShellGame(首尔国立大学 + Roblox):视频世界模型追不住隐藏状态 GEARS(北京大学 + 阿里巴巴(ACM TOG / SIGGRAPH Asia 2026)):把丢掉的候选诊断修复再利用 今日论文速览 1. DreamX-Creator:7B原生音视频联合生成打到2K DreamX-Creator: Democratizing Native Audio-Video Generation at 2K Resolution | 阿里巴巴 DreamX Team | arXiv:2608.31106 关键词:原生音视频联合生成,门控跨模态注意力(Gated Cross-Modal Attention),2K自回归精修,音视频强化学习,阿里巴巴,DreamX-Creator 前序问题:现在的视频生成器对声音的处理基本是两种姿势:要么干脆不生成音频,要么先把视频做完、再拿另一个模型去配音。这两条路都切断了视觉动态与声学事件之间的互相建模——画面里杯子落地的那一帧和「啪」这一声本该是同一个物理事件的两个投影,级联管线却只能让后者去追前者,声音沦为画面的附属品,而不能反过来约束画面。真正的原生联合生成又有另一重现实障碍:可用的开源方案要么规模很大(33B 量级),要么不开放权重,导致这个方向的研究门槛被模型尺寸和可得性顶住了。于是问题变成一个很具体的工程判断:能不能在 7B 这种「一张卡装得下」的尺度上,把音频与视频真正放在同一个去噪过程里联合建模,同时还要覆盖 2K 这种实用分辨率?难点在于两个模态的表示、时间尺度和信息密度差异都很大,一上来就全程共享参数容易互相拖累,而完全独立又回到了级联的老问题。 本文贡献:DreamX-Creator 1.0 的核心判断是:耦合不必从第一层开始,但必须细到 token 与 head。它以一个 7B 生成器为中心,条件是首帧加文本提示,然后让模态专用的音频流与视频流联合去噪——网络前一半两条流完全独立处理(此处没有跨模态残差),后一半才通过 Gated Cross-Modal Attention 双向耦合:A2V 与 V2A 两个方向各有一路门控交叉注意力,门作用在每个激活的跨模态注意力头的输出上,且是 token 级与 head 级的,等于让模型自己学「这一帧、这个头到底要不要听对面模态」,两条流之间还共享文本编码器与时间坐标系。数据侧配了统一的 Audio-Video Data System,负责构造并过滤时间上连贯的片段、产出结构化多模态标注,并把片段按能力维度组织成数据池。训练走渐进式联合训练:两个音视频预训练阶段之后接高质量微调。再往后是 Audio-Video Reinforcement Learning,用 Modality-Aware Multimodal Feedback 把视频侧、音频侧和跨模态的反馈分别路由回对应的流。高分辨率不靠原生 2K 训练,而是一条自回归 1 步 2K 精修管线。 auto 实验效果:论文用盲测的双人对比给出了最有说服力的结果:面对参数量远大于自己的开源与闭源系统,7B 的 DreamX-Creator 在视频质量上对 Wan2.7 拿到 45.5% 胜 / 13.1% 平 / 41.3% 负,对 KLing v3 是 48.8% 胜 / 10.6% 平 / 40.7% 负,对 33B 的 MiniMax-H3 是 39.5% 胜 / 18.7% 平 / 41.8% 负——也就是说在纯视觉观感上它已经和这些系统在同一量级上互有胜负。但短板同样被论文自己摆了出来:音频质量对 MiniMax-H3 只有 23.7% 胜而 45.5% 负,对 Wan2.7 是 29.3% 胜 / 43.4% 负;文本-视频对齐(TV-Align)对 MiniMax-H3 仅 15.2% 胜、53.0% 平、31.7% 负。相对 LTX-2.3 与 MiniMax-H3 的自动指标里,它在部分维度落后但在 PQ(6.7169 vs 6.4094)与 IB(0.3081 vs 0.2677)上占优。 auto 批判点评:这篇最扎实的贡献是把「原生联合」从一个规模问题重新框成了架构问题:前一半独立、后一半门控耦合,本质上承认了音频和视频在低层特征上没什么可共享的,真正需要交互的是语义与事件层面,而 token 级 + head 级门控又把「什么时候交互」交给数据决定而不是人手设计。这个设计让 7B 有机会在视觉质量上和 33B 掰手腕,是有说服力的。1 步 2K 精修的分工也务实——把分辨率从训练成本里剥离出去。但要注意几个真实的边界。第一,音频侧的差距不是小瑕疵而是结构性的:对 MiniMax-H3 的音频质量只有 23.7% 胜率,几乎是一半场次输掉,这说明「让音频流分走一半参数」在 7B 尺度上给音频留的容量确实不够,门控耦合能改善同步但补不了音质本身。第二,TV-Align 上 53% 的高平局率值得警惕,这往往意味着评测者难以分辨差异,此时胜率的含义会被稀释,用它论证提示遵循能力偏弱说服力有限。第三,2K 是精修出来的而不是生成出来的,那么 2K 尺度上的细节是模型「知道」的还是精修器「补」的,论文没有拆开——如果是后者,2K 的语义正确性并没有得到额外保证。第四,机构与贡献者名单在源码里写着「将随公开版本最终确定」,也就是说这仍是一份技术报告状态的工作,权重是否真开放、开放到什么程度,决定了标题里 Democratizing 这个词能兑现多少。 2. Matrix-Game 3.5:把世界记忆细到patch级3D云 Matrix-Game 3.5: Enhancing Real-Time Streaming Interactive World Models with Patch Memory | 昆仑万维 Skywork | arXiv:2608.29910 关键词:交互式世界模型,patch memory,tiled PRoPE,静态动态解耦,渐进式长程蒸馏,单卡720p实时20FPS,昆仑万维 前序问题:交互式世界模型要做的事情比视频生成难一个量级:它必须以闭环自回归的方式生成未来观测,同时响应相机运动、用户动作和高层提示。麻烦在于自回归会把自己的预测当成后续的上下文,视觉与几何误差因此持续累积,场景逐渐漂移、身份不再一致、可控性退化。有限的上下文窗口又意味着模型无法直接访问远处的观测,所以「回到之前去过的地方」这件事越往后越难;大幅视角变化时,模型不仅要检索到相关的历史信息,还得判断这些信息在当前相机下的正确几何对应位置。更棘手的是持久性与演化的张力:静态环境应当长期保持不变,动态实体却要随用户交互和提示而变化——一刀切地「全部记住」或「全部重新生成」都不对。既有方案的分歧其实在于历史观测以什么单位存储:压缩成 latent token 或 transformer memory 的路线高效但只是隐式表示;按整帧存储再用相机几何检索(Context as Memory、WorldMem、Matrix-Game 3.0)能靠显式空间线索改善场景重访,但一帧是不可分割的记忆单元,只能整体取出、且只能从它原本的视角取出;显式重建成点云或 splat 则几何约束强但难以合成未观测或新出现的内容。 本文贡献:Matrix-Game 3.5 的核心想法是把历史观测组织成显式的、几何感知的持久记忆,粒度落在图像 patch 而不是整帧或压缩 latent。统一的几何感知记忆框架由两部分组成,且 patch-memory 与 tiled-PRoPE 都不引入任何额外可学习参数:patch memory 把历史图像 patch 用度量深度加相机内外参反投影到一个共同的 3D 空间形成 patch 云,目标相机视锥去查询这个云,并在目标视角下用 z-buffer 为每个 latent 位置只保留离相机最近的表面、丢弃被遮挡的候选,最后把选中的 patch 散射进一张对齐目标视角的记忆画布;tiled PRoPE 是作者对 PRoPE 的视频化改造,在检索到的记忆与目标视角注意力之间建立显式几何对应,与原生 RoPE 在同一个注意力核里协同——温和到直线行走时注意力图相对纯时序核的最大变化仅约 1.3%。动态建模上,用运动感知的物体过滤把静态场景观测与动态主体分开,静态区域融进 patch memory,动态主体用轻量的多视角参考 token 表示,配合上下文遮罩与辅助训练损失抑制鬼影和身份漂移。最后是渐进式长程蒸馏:先用教师强制的 Perceptual Flow Matching 得到高质量少步因果初始化模型,再用 self-rollout DMD 直接优化推理时的自回归过程,按课程逐步蒸馏无分类器引导、相机控制与记忆条件化生成。 auto 实验效果:训练数据来自 Unreal 仿真环境、开放世界游戏与互联网视频三类来源,论文报告模型在长程场景回忆、几何一致的相机控制、主体一致性生成、提示驱动的世界演化,以及稳定的开放世界实时交互上都取得了不错的表现,实测能力是单张 GPU 上 720p 分辨率最高 20 FPS 的实时生成。定性结果里最能说明问题的是参考 token 的消融:在其他条件完全固定、只切换有无参考 token 前缀的匹配 rollout 中,取第 300–400 帧来看,加入参考条件后相机运动下的身份与外观漂移明显减少——而且论文特别说明参考帧只取自因果可得的初始化与历史,真值帧仅作视觉比对用、从不喂给模型。tiled PRoPE 的分析图则显示它在保留时序带状结构的同时奖励位姿相似性,两种机制在一个注意力核里并存而非互相干扰。 auto 批判点评:这篇的判断力体现在选对了「记忆单元」这个变量。整帧检索的问题不在于存得少,而在于一帧是原子的——你只能把它整体搬过来,且只能沿它原来的视角看,视角一变这份记忆就半废。降到 patch 粒度之后,记忆天然变成可按可见性筛选、可按几何重排的东西,z-buffer 那一步等于把遮挡推理直接做进了检索里,这比让注意力自己去学遮挡关系要可靠得多。更值得称道的是 patch-memory 与 tiled-PRoPE 都不加可学习参数,这让它有机会作为一个通用组件接到别的骨干上,而不是又一个只能整体接受的架构。静态动态解耦也切中了实际痛点:长程 rollout 里最难看的失败恰恰是本该不动的墙在漂、本该保持身份的角色在变脸。但局限也很清楚。第一,整套机制吃深度和位姿:patch 要靠度量深度反投影、要靠相机内外参对齐,那么深度估计误差和位姿噪声会直接变成记忆里的几何错位,论文没有给出这条链路的敏感性分析——在真实互联网视频这类位姿本就不准的数据上,这个风险不小。第二,persistent 3D patch 云是会一直长的,论文强调了组件不加参数,但没说清内存与检索代价如何随交互时长增长、有没有淘汰策略,而这恰恰是「长程」的成本核心。第三,静态与动态的二分依赖运动感知过滤器,那些介于两者之间的东西(缓慢变化的光照、被推动后停下的物体)落在哪一侧并不明确,分错的代价是鬼影或不该有的持久化。第四,作为技术报告,缺少与同类记忆方案的统一定量对比,20 FPS 也只是单一配置下的数字,读者难以判断这套机制相对整帧检索的净收益到底有多大。 3. OMR:用冻结V-JEPA梯度纠物理违背 Off-Manifold Refinement: Guiding Video Generators with a Frozen World Model | 越南 Fulbright 大学 + 加州大学洛杉矶分校(BMVC 2026) | arXiv:2608.29904 关键词:推理期物理修正,V-JEPA 2.1意外度能量,单轨迹梯度注入,训练无关,Wan2.2,Physics-IQ,BMVC 2026 前序问题:现在的视频生成器在物理动力学上会犯很低级的错:物体悬在空中、轨迹违反重力、接触关系凭空消失。根子在于目标函数——标准的去噪与流匹配目标拟合的是视觉数据分布,它并不显式惩罚这类物理违背,画面只要看着像训练数据里的样子就够了。既有的补救办法都能改善物理一致性,但代价通常不小。候选选择类方法要生成多个视频再逐个打分,算力开销随候选数线性上涨;基于梯度的世界模型引导需要反复解码再重新编码中间估计,每一步都过一遍 VAE;生成器内部的精修方案要加扰动再重新去噪的循环;而后训练路线则要准备精选数据并额外做一轮优化,成本最高也最不灵活。于是留下一个很实际的缺口:能不能在完全不动模型权重、不生成多个候选、也不反复解码的前提下,把「这个片段物理上不合理」这个信号送进采样过程? 本文贡献:作者提出 Off-Manifold Refinement(OMR),一种推理期方法,把世界模型的反馈直接注入单条采样轨迹,而不是在多条轨迹之间做选择。具体做法是在计划好的中段 ODE 步上,给生成器的速度场加上一项梯度——来自 adapter 空间里 V-JEPA 2.1 的「意外度能量」(surprise energy)。V-JEPA 有一个编码器和一个从可见上下文预测被遮挡未来嵌入的预测器,它在真实视频上训练出的这套目标提供了一个关于「合理时间延续」的学习先验:物体应当持续存在、运动应当平滑、接触关系应当成立。作者从每段 81 帧视频里取 48 帧窗口来算这个能量。这项外部修正会把 latent 推离未修正的采样轨迹,推向被冻结预测器判定为物理上更合理的区域,然后生成器从修正后的状态继续渲染。中间有一个跨表示的桥梁问题:Wan 的 latent 与 V-JEPA 的目标在同一段视频上编码的是不同目标下的表示,一个为合成保留内容与运动、一个为预测保留结构,所以作者训练了一个 adapter 做任务特定的变换,且这个 adapter 是在真实 OpenVid-1M 片段编码出的 latent 上训练、却用在生成过程中从带噪采样状态推出的临时干净预测上。 auto 实验效果:论文的定性结果最直观:同一个 Wan2.2 生成器下,基线在后空翻落地时出现腿部运动时序不一致和身体姿态的突变,而 OMR 给出了连贯的腿-身协同、垫子形变、符合重力的衣物运动和惯性驱动的下落。四组帧条对比把 Wan2.2、P&P 与 OMR 并排放在一起,强调的是时间上的因果:撞击应当与材料响应同时发生、工具应当与被它形变的物体保持耦合、身体运动应当在帧间保持支撑与动量——在第一组里 Wan2.2 在明确撞击之前就出现了破洞、P&P 有损伤但缺少同步的接触,OMR 的撞击与响应对齐得最好。定量侧作者在 Physics-IQ 上以固定 50 条提示做了 Wan2.2-I2V 的试点,比较引导、BoN-4 及两者组合三种设定;混合现象的「其他物理原理」一行从 46.6% 提升到 47.6% 的联合分数,其中 PC≥4 的比例从 56.6% 升到 58.7%。稳定性诊断显示中段轨迹的预测干净 latent 与对应的完成 latent 在 cosine/ρ/τ 上分别为 0.762/0.617/0.446 与 0.769/0.624/0.451,两行相当接近,支持了 adapter 用在 OMR 实际工作分布上的合理性。 auto 批判点评:这篇的巧劲在于找到了一个便宜的干预点。既有方案要么在多条轨迹之间选(贵在候选数),要么反复解码回像素域再编码(贵在 VAE),OMR 直接在 latent 空间借 V-JEPA 的预测误差当能量、只在中段几步加一次梯度,本质上是把「物理合理性」当成一个可微的正则项挂在采样轨迹上。选 V-JEPA 也选得对——它的训练目标天然就是「从可见推未见」,这正是物理直觉的操作化定义,比拿一个判别式打分器要更贴近因果。那个 adapter 的诊断实验也做得诚实,用中段预测 latent 与完成 latent 的相关性接近来论证分布匹配,是个恰当的稳定性检查。但要清楚它证明了什么、没证明什么。第一,定量证据很薄:Physics-IQ 上 46.6%→47.6% 是约 1 个百分点的提升,而且是 50 条提示的试点规模,作者自己也只把它当作「聚合分数没崩」的对照——把这篇当成「解决了视频物理问题」来读会过度解释,它更像一个可行性演示。第二,adapter 存在明确的分布错配:训练在真实视频 latent 上,使用在从带噪状态推出的临时干净预测上,论文用相关性接近来辩护,但相关系数 0.76 的 cosine 并不算高,在物理更极端的片段上这个 gap 可能被放大。第三,方法的上限被 V-JEPA 顶住——它能判「这看起来不像真实视频的延续」,但不能判「这违反了动量守恒」,所以对训练分布内常见的物理它有效,对罕见但严格的物理约束未必。第四,只在中段 ODE 步注入是个超参选择,注入的时机与强度如何影响画面质量与物理性的权衡,论文没有给出充分的敏感性分析。 4. ShellGame:视频世界模型追不住隐藏状态 Can Video World Models Track Unobserved World States? | 首尔国立大学 + Roblox | arXiv:2608.30692 关键词:隐藏状态追踪,视频版猜球游戏(Shell Game),S5状态追踪,线性注意力负特征值,LaCT快速权重,Transformer KV缓存局限,Roblox 前序问题:视频世界模型越来越多地被当作模拟器来用,但一个尖锐的问题被视觉保真度掩盖了:画面生成得像,并不能证明模型维护了世界的隐藏状态。世界里大量重要的东西是当前不可见的——被盖住的球、关上门后房间里的陈设、背包里的物品。如果模型只是把「看起来合理的下一帧」渲染出来,它可以在完全不知道球在哪个杯子下的情况下,依然画出一个像样的揭晓画面。这就使得现有的评测方式存在系统性盲区:几乎所有指标都在衡量渲染质量、时间一致性或提示遵循,没有一个在直接考察「不可见的状态有没有被正确携带」。作者要回答的正是这个被绕开的问题——把视觉渲染与隐藏状态的合成解耦开,单独测后者。 本文贡献:作者设计了一个动作条件化的视频版 Shell Game 作为探针,它是 $S_5$ 状态追踪问题的视觉类比:先揭晓球在哪个杯子下,然后把杯子盖上,经过一串交换动作,最后再揭晓——整个交换序列里球始终不可见,模型必须在架构内部携带并更新这个状态。他们在这个任务上系统比较了双向与自回归 Transformer、Mamba,以及转移特征值被限制在非负区间的线性注意力。诊断的关键洞察是:像素扩散目标从来没有监督过那个看不见的隐藏状态,所以生成的帧本身不可能承载它,状态只能活在架构里而不是 token 里。对 Transformer 来说,那个架构状态只是一个只增不减(append-only)的 KV 缓存,因此模型必须在每个 chunk 都从整段历史里重新推导出隐藏的排列,而不是维护它。作者进一步找到两个确实能外推的机制,共同点是都跨 chunk 携带一个状态并原地修改它:一是线性注意力——一旦允许转移特征值取负就能成功;二是 LaCT,其外推能力随快速权重头数 H 增加而提升。他们还在纯文本的 $S_3$/$S_5$ 词问题上做了对照,测量各架构解决长度 N 问题所需的最少层数与长度外推行为。 auto 实验效果:结论相当刺眼:双向和自回归 Transformer、Mamba、以及转移特征值限制在 $[0,1]$ 的线性注意力,全都只能拟合训练时的 5 次交换,交换链一长就朝随机水平掉下去,但同时仍在生成看起来合理的视频,而且增加去噪步数完全没有帮助。机制侧的量化很清楚:把转移特征值范围从 $[0,1]$ 放宽到 $[-1,1]$ 后,多个线性注意力变体(GDN、GDN2、GDP₃、KDA)的状态准确率在整条曲线上都提升,GDN2 在 N=30 时仍有约 0.8;LaCT 的外推随快速权重头数变好,H=16 在 N=30 时约 0.87、H=1/H=2 则贴在随机线上;scratchpad token 数量 M 的影响则弱得多,M 从 1 加到 1024 在 N=20 之后都掉向随机,而作为自然随机水平对照的裸 SWA1 骨干(M=0)连训练内长度 N=5 都做不到。定性 rollout 里,在训练长度两倍(N=10)的 Shell Game 上,GDN-neg 与 LaCT8 最终落在与真值相同的杯子上,而因果 DiT 与普通 GDN 没有;在纹理化 3D Block World 的局部动作条件化任务上(80 帧干净前缀 + 240 帧延续),LaCT8 能把方块和球保持在接近真值的位置,其他骨干渲染出的房间看着连贯但里面的东西已经漂走了。 auto 批判点评:这是今天最有方法论价值的一篇,因为它把一个大家隐约感觉到但说不清的问题变成了可测量的:视觉保真度和状态追踪是两件事,而现有评测只测前者。Shell Game 这个探针设计得很干净——球被盖住之后画面里再没有任何关于它的信息,模型要么在架构里带着这个状态,要么只能猜,没有中间地带;而「增加去噪步数毫无帮助」这个观察尤其致命,它排除了「算力不够」这种廉价解释,把矛头精确指向表示能力。对 Transformer 的诊断也说到了本质:append-only 的 KV 缓存不是一个可以原地更新的状态寄存器,模型每个 chunk 都得从整段历史里重新推导排列,这在长序列上必然崩。找到的两个正面机制(负特征值、快速权重)共享「跨 chunk 带状态且原地改」这一性质,这个统一解释很有力。但要注意它的适用边界。第一,这是合成探针,$S_5$ 状态追踪是一个刻意构造的、纯组合性的困难任务,真实世界的隐藏状态往往有大量视觉与常识线索可借(东西通常不会凭空移动、遮挡物有形状约束),所以「在 Shell Game 上失败」不等于「在真实场景里同样糟」,这个外推需要谨慎。第二,反过来说负面结果也可能被低估——真实场景的状态空间比 5 个杯子大得多,若连这个都做不到,实际情况恐怕更差;论文没有在两个方向上都给出校准。第三,正面机制目前只在这些探针上被验证,负特征值线性注意力和 LaCT 在真实视频生成质量上要付什么代价(画质、训练稳定性、吞吐)文中没有交代,而这恰恰决定它们能不能真的替换现有骨干。第四,作者把「状态必须活在架构里」这一点讲得很好,但没有讨论第三条路——把状态显式外置成可读写的结构(今天另一条线的做法),这在方法空间上留了一块空白。 5. GEARS:把丢掉的候选诊断修复再利用 Test-Time Scaling for Video Diffusion Models via Diagnosis-Guided Candidate Recycling | 北京大学 + 阿里巴巴(ACM TOG / SIGGRAPH Asia 2026) | arXiv:2608.29322 关键词:test-time scaling,候选回收,诊断式latent编辑,分阶段调度,Wan2.1-T2V-1.3B,SIGGRAPH Asia 2026,北京大学 前序问题:视频扩散模型的生成质量已经很高,但高保真结果在很大程度上仍依赖闭源系统或昂贵的大规模基础设施。Test-time scaling(TTS)提供了一条免训练的路子:靠推理阶段多花算力来提升轻量生成器。问题是现有方法基本都困在「噪声搜索」这一个范式里——采样、选择、扰动去噪轨迹,然后把低分候选在昂贵的生成完成之后直接丢掉。这个「生成再丢弃」的流程浪费的不只是算力,更是那些可回收样本里已经编码好的部分运动、布局或外观结构:一个候选可能整体评分低,但它的镜头构图是对的、主体运动方向是对的,只是某个局部崩了。把它整条丢掉,等于把对的部分和错的部分一起扔。于是问题变成:能不能把低分候选当成可编辑的先验,而不是垃圾?这需要回答三个子问题——此刻该修什么、什么时候修、哪些候选值得修。 本文贡献:作者提出 GEARS(Guided Editing for Adaptive Recycling Search),一个免训练框架,把诊断引导的候选回收引入视频 TTS,通过「生成-评估-编辑」的循环把候选变成可编辑先验。它沿着从纯噪声到干净 latent 的去噪轨迹插入多个「生成转编辑」检查点 $s_0, s_1, \ldots, s_k$,并明确区分高噪区间(偏重运动)与低噪区间(偏重视觉)。框架由两个协作组件构成。Stage-Aware Scheduler 决定修什么、何时修、以及哪些候选该被保留、回收或丢弃:它先确定当前阶段的关注点(高噪阶段用运动质量 MQ、低噪阶段用视觉质量 VQ 作为排序依据),再做排序与路由——语义门控在低文本对齐时直接丢弃、把「弱但有希望」的一批送去回收器、其余有效候选作为精英保留。Candidate Recycler 则负责诊断与修复:由一个 MLLM 根据当前阶段的运动/视觉关注点与关键帧,把候选的提示改写成更好的版本,再配合流形感知的 SDE 去噪把修复落地。关键的一个设计细节是:在每个检查点,候选是先被完整去噪、解码、当作干净视频来评估的,带噪 latent 从不被直接打分——这避免了在噪声态上做不可靠的质量判断。奖励模型是运动质量、视觉质量与文本对齐三项之和。 auto 实验效果:论文的机制展示很直观:一个排名靠后但语义上有效的候选,在传统「生成即选择」的 TTS 里会被丢掉,而 GEARS 先在高噪检查点修掉它的运动缺陷、再在低噪检查点增强视觉细节,修复后的候选回到最终候选池并被选为最佳视频。分阶段修复的案例里,第一阶段(高噪)候选没有充分实现要求的行走动作,回收器在保留兔子主体与奇幻场景的同时恢复了连贯的主体运动,右侧插图用共享尺度的背景补偿光流显示残余运动的大小与方向;第二阶段(低噪)则在保持结构的前提下精修外观与纹理。分布层面的证据是 VQ–MQ 空间里的联合与边缘分布对比:GEARS 把可回收候选整体推向更高的联合质量区域,而不只是把最好的那个挑出来。scaling 行为在 Wan2.1-T2V-1.3B 与 Wan2.1-VACE-1.3B 两个骨干上都做了验证。 auto 批判点评:这篇的洞察其实很朴素但少有人认真对待:TTS 的浪费不在采样,而在丢弃。既有方法从 Video-T1 的独立轨迹选优、到 DLBS 的逐步保留 K 个精英做束搜索、再到 EvoSearch 在精英附近做中段变异,路线越来越精细,但共同前提都是「低分即无用」。GEARS 把这个前提拆了——低分候选是一个有部分正确结构的初值,值得诊断而不是抛弃。两个设计决策尤其站得住:一是候选必须先完整去噪解码成干净视频再评估,绝不给带噪 latent 打分,这一条避免了整个领域常见的「用噪声态代理指标做决策」的可靠性问题;二是把高噪修运动、低噪修细节这个分工写进调度器,与扩散过程本身的信息层级对齐,而不是在所有阶段用同一个标准。用 MLLM 做诊断并改写提示,也比用一个不可解释的打分器更容易调试。但有几处需要保留判断。第一,成本核算不透明:每个检查点都要把候选完整去噪、解码、评估,再对被回收者做编辑与重新去噪,这些开销相对「直接多采几条轨迹」是否真的更划算,需要在同等算力预算下比较,而这类等价预算对照是 TTS 类工作最容易含糊的地方。第二,整条链路依赖奖励模型(MQ+VQ+TA 之和)的可靠性,而运动质量的自动评估本身是公认的难题,如果 MQ 有系统偏差,调度器的「该修什么」判断会跟着偏,且这种偏差会被回收循环放大而非抵消。第三,MLLM 改写提示引入了一个不易复现的环节——同一个候选在不同 MLLM 或不同温度下会得到不同的修复方向,论文对这部分的方差没有交代。第四,验证骨干集中在 1.3B 规模,在更大的生成器上,「候选本身已经不错、可回收空间变小」这一效应会不会吃掉大部分收益,仍是开放问题。 6. RTI:希尔伯特曲线切出内容形状token Elastic Token Compression for Pixel-Space Diffusion Transformers | 德国维尔茨堡大学 + Google | arXiv:2608.29281 关键词:像素空间扩散,弹性token压缩,希尔伯特曲线排序,区域token接口(RTI),单checkpoint多预算,GenEval,维尔茨堡大学 前序问题:自然图像把细节集中在画面很小的一部分,但扩散模型对每个 patch、在每一层、每个时间步都花一个完整的 token。这种浪费在像素空间模型里最严重,因为它没有 autoencoder 先把低层冗余吸收掉。作者探测一个预训练的像素文生图 transformer,发现它中间块的 token 在图像平坦处是冗余的,而且这种冗余占据的是连通的、随内容成形的区域——这就带来一个表示上的要求:要利用这种冗余,就需要几何形状与之匹配的 token,而不是规则网格块。既有的降维方案各自丢掉了这个性质的一部分:相似度合并会把同一组的成员散落在画面各处,不再是连通区域;隐空间瓶颈把位置信息丢了;直接跳过则是把本该被总结的内容删掉。于是核心难题是:怎样得到「形状随内容变化、又能高效实现」的 token 分组——二维空间上的任意连通区域划分在实现上是很昂贵的。 本文贡献:解法的巧劲在于降维:沿希尔伯特曲线给 patch 排序。这条空间填充曲线的性质是相邻位置在图像上永远是邻居,因此任意一段连续区间都对应一个连通区域,且这个区域的大小与形状会随内容自然变化——于是「在二维上做分组」这个难题变成了「在一维上做切割」。作者在模型特征变化最大的位置切开,把每一段池化成一个 region token。为了让模型适应这种新 token,他们提出 Region Token Interface(RTI)做适配;训练时 region 数量是随机抽取的,所以同一个 checkpoint 能服务所有压缩预算,这就是标题里 elastic 的含义——不必为每个算力预算各训一版。作者在 MiniT2I 系列的两个模型规模上验证,并与相似度合并(Feat Sim)、隐空间数组(Latent Array)、token 跳过(Token Skip)等做了机制层面的对照,还做了排序方式的消融(希尔伯特 vs 光栅)以检验「连通性是否真的重要」。 auto 实验效果:机制对照图把四种方案的分组结构与生成结果并排放在一起:RTI 的分组呈现出与图像内容贴合的连通色块、生成结果保住了主体(背着风笛的犰狳)的完整结构与纹理;Feat Sim 的分组碎裂成散点、生成结果虽然还成形但细节退化;Latent Array 完全丢掉了空间结构、生成结果崩成一团抽象形体;Token Skip 大面积留白、结果只剩轮廓。排序消融给出了「连通性必要性」的直接证据:在 MiniT2I-B/16 上比较希尔伯特与光栅两种排序,在较宽松的预算($R_{cells}=128$)下两者接近,但预算压到 $R_{cells}=64$ 时希尔伯特保住了人脸、翅膀与网格结构,光栅则把它们抹开、人物形体也散掉。效率-质量曲线上,RTI 在 $R_{cells}=256$ 时以 1.79 秒/图达到 GenEval 82.7%、ImageReward 0.953,而基线 MiniT2I-L/16 要花到 4.62 秒才达到 86.4% / 0.950——也就是说在 ImageReward 这个指标上 RTI 用约 2.6 倍更短的时间达到了同等水平;把预算放到 5.58 秒时 RTI 达到 86.2% / 1.155,ImageReward 超过基线 5.77 秒的 1.039。 auto 批判点评:这篇最漂亮的地方是把一个几何难题化成了排序问题。「需要形状随内容变化的 token」这个需求听起来必须做复杂的二维分割,但希尔伯特曲线的局部性保证让一维上的任意连续段自动成为二维上的连通区域,于是分组变成切割,实现代价陡降。更值得肯定的是它对既有方案的批评是结构性而非性能性的——指出相似度合并散落分组、隐空间瓶颈丢位置、跳过删内容,各自丢掉了「连通、有位置、被总结」这三个性质中的一个,这种分析比单纯比分数有说服力得多,而排序消融(希尔伯特 vs 光栅)恰好把「连通性」单独隔离出来做了验证,是很干净的对照设计。训练时随机抽 region 数从而一个 checkpoint 覆盖所有预算,也是很实用的工程决策。但要注意几个边界。第一,作者自己承认速度有天花板:prelude、coda 与文本流不参与压缩,所以再怎么压 region 数,端到端加速也会饱和——这意味着该方法适合中等压缩率区间,指望它带来数量级提速是不现实的。第二,GenEval 上并没有全面胜出:长预算下 86.2% 对基线 87.0%,是略低的;真正的优势集中在短预算区间和 ImageReward 上,而 ImageReward 是偏好类指标,与 GenEval 这种组合性正确率指标的结论不一致时,应当分开陈述而不是合并成「更好」。第三,方法针对的是像素空间扩散这个相对小众的设定——论文自己说浪费在像素空间最大,那么在主流的 latent 扩散上,autoencoder 已经吸收了大部分低层冗余,这套机制还剩多少收益空间是未验证的。第四,切割位置由「特征变化最大处」决定,这个判据依赖被探测模型的中间层表示,换骨干后是否仍然稳定、需不需要重新校准,文中没有交代。 7. RegionCache:多轮编辑只重算改动区域 RegionCache: Semantic-Aware Region Reuse for Efficient Multi-Turn Image Generation | 东北大学计算机科学与工程学院(IJCAI 2026) | arXiv:2608.29809 关键词:多轮图像编辑,语义感知区域复用,cross-attention定位,自适应复用调度,PixArt-alpha,1.43-2.55倍加速,IJCAI 2026 前序问题:真实世界的图像生成往往是多轮编辑:用户一轮一轮地改小块区域,而大部分画面内容保持不变。但现有基于 DiT 的编辑管线在每一轮都把整张图重算一遍,产生大量冗余计算——用户只是把「一只猫在星空下」改成「一只狗在星空下」,星空那部分的去噪过程却要从头再跑一次。现有的 DiT 加速方法又都忽略了跨提示的语义对应关系,于是落入两种错误:要么保守地不复用、造成不必要的重算,要么激进地复用了实际已经改变的区域、损害编辑质量。问题的难点在于要同时回答两件事——哪些区域在这一轮语义上确实没变(这需要跨提示的语义比对,而不只是像素比对),以及对这些区域可以复用到什么程度(完全跳过整个去噪过程,还是只在部分时间步复用)。 本文贡献:作者提出 RegionCache,一个面向多轮图像编辑的语义感知复用框架,选择性地复用未改变区域的扩散状态。它由两部分构成。Prompt-aligned Region Caching 负责识别与缓存:通过连续提示之间的语义重叠(Semantic Overlap Identification)确定哪些语义单元延续了下来,再用 cross-attention 定位把每个语义单元对应到图像上的具体区域,把该区域的 mask 与隐状态存进 cache pool——比如「cat」与「starlite」各自被独立缓存。Semantic-aware Region Reusing 负责决定复用策略:它把区域分成改变区域与未改变区域,在区域级稀疏注意力下,语义未变的部分(如 starlite)可以在全部时间步复用,而语义已变的部分(cat→dog)只在早期步复用;复用的时间表是自适应的,依据提示相似度与上下文一致性来定,而不是固定阈值。作者还测量了自注意力与其他计算在不同推理步数和分辨率下的延迟占比,用以定位加速空间到底在哪里。 auto 实验效果:在 PixArt-alpha 上,RegionCache 实现了 1.43 倍到 2.55 倍的端到端加速,同时保持可比的图像质量。框架图给出的机制示例很直白:从「A cat under the starlite」到「A dog under the starlite」,starlite 被判为语义未变从而全步复用,cat→dog 这一改变区域只在早期步复用、后续正常重算,因此改动准确落在主体上而背景星空的观感保持一致。案例研究把 RegionCache 与既有多轮编辑框架并排比较了多轮编辑的结果质量。延迟拆解则显示自注意力在不同推理步与分辨率下的占比,是复用设计的依据。 auto 批判点评:这篇选的问题很贴近真实使用:多轮编辑是图像生成产品里最常见的交互形态,而每轮全量重算确实是明显的浪费。它的关键判断是把复用的依据从像素相似度提升到语义重叠——用提示之间的语义比对加 cross-attention 定位来决定复用区域,这比在 latent 上做相似度阈值要可靠,因为「猫变成狗」在像素上可能相似度不低,但语义上必须重算。区分「全步复用」与「仅早期步复用」也是有见地的:扩散的早期步决定布局与低频结构,改变区域在这个阶段与原图共享的信息其实不少,一刀切地全部重算同样是浪费。用延迟拆解来定位加速空间,说明作者是先量了再设计,而不是凭直觉。但这篇的分量比较轻,几处需要注意。第一,1.43–2.55 倍这个区间很宽,说明收益强烈依赖每轮改动占画面的比例——改一个小配饰接近上界、重构主体接近下界,论文用一个区间概括,读者难以判断在自己的使用分布下能拿到多少。第二,只在 PixArt-alpha 上验证,而 PixArt-alpha 相对当前主流的编辑骨干已经偏旧,这套机制在更强的编辑模型(其注意力模式与语义定位质量都不同)上是否同样有效并未回答。第三,质量结论停留在「comparable」这个定性表述与案例图,而复用本质上是一种近似,最该被量化的恰恰是「复用带来的质量损失」在多轮累积后会不会漂移——第 5 轮、第 10 轮之后误差是否累积,论文没有给出多轮深度上的退化曲线。第四,整条链路依赖语义重叠判断的准确性,一旦把实际改变的区域误判为未变,错误会被缓存下来并影响后续所有轮次,这个失效模式的代价比一般加速方法要重,但文中没有讨论回退机制。 8. PixelIR:保真与感知拆成两条流 PixelIR: Fidelity-Perception Decoupling via Pixel-Space Image-Residual Flow Matching for Efficient One-Step Real-World Super-Resolution | 上海交通大学(实习期间完成) | arXiv:2608.30782 关键词:真实图像超分,保真-感知解耦,像素空间残差流匹配,一步蒸馏,双粒度像素transformer,上海交通大学 前序问题:真实世界图像超分(Real-ISR)要同时做两件互相拉扯的事:既要保住退化观测所支持的结构(保真),又要重建出感知上真实的细节(感知)。现有方法基本都在一个共享网络里同时优化这两个目标,于是两者在整个训练过程中持续互相干扰,它们之间的平衡也很难控制——你想多要一点细节,结构就开始漂;想守住结构,画面就发糊。近期的一步方法虽然把采样步数降下来了,但往往同时继承了两个包袱:耦合的优化行为,以及来自多步前身的昂贵高分辨率骨干。作者的判断是:高效的 Real-ISR 不只需要更短的采样轨迹,还需要对「忠实重建」和「感知细节合成」这两件事分别建模——把它们塞在一个网络里用一组权重去权衡,从设计上就是错的。 本文贡献:PixelIR 提出建立在像素空间图像-残差流匹配之上的保真-感知解耦框架,把一次超分拆成两条流。第一阶段(Fidelity Preservation)学一个图像流,用 4 步把上采样后的低质输入映射到一个忠实的基础重建 $\hat{x}_b$。第二阶段(Perception Refinement)学一个残差流,在冻结的基础重建条件下、用另外 4 步从噪声里合成缺失的感知细节 $\hat{r}$,再通过残差合成得到教师输出 $\hat{x}_t$——关键在于残差流不需要反复重新学习或覆写已经完成的整体复原解,它只负责补差值。两个阶段都使用双粒度像素 transformer:语义层面的 DiT 块加像素层面的 PiT 块,配 AdaLN-Zero 调制。为了部署,作者把教师蒸馏成一个五阶段逐步收窄的学生:从 16×16 patch 经 8×8、4×4、2×2 到 1×1 patchify,前两级用 DiT 块处理语义 token、后三级用 PiT 块处理像素 token,配合金字塔 patchify 与双锚点流蒸馏(对齐 $\hat{x}_s$ 到教师输出 $\hat{x}_t$ 以及到真值 GT 两个方向),最终得到一步推理的学生模型。 auto 实验效果:论文在 DIV2K 上给出六指标的组件剖面雷达图(每个指标方向对齐并按最优值归一化,越远越好)来展示解耦消融的效果,并在 LSDIR 与 RealSR 的困难样例上做了定性对比。方法层面最实质的效率结论是:教师用 4+4 步、学生蒸馏为一步,且骨干通过五阶段金字塔逐步收窄——这直接针对「一步方法仍继承昂贵高分辨率骨干」这一痛点,即把计算按 patch 粒度分层,语义处理放在粗粒度、像素处理放在细粒度,而不是全程在高分辨率上跑完整 transformer。 auto 批判点评:这篇的架构判断是对的:保真与感知的冲突不是调参问题而是表示问题,让一个网络用一组权重同时承载「不要偏离观测」和「大胆编细节」两个相反的诉求,本身就在制造干扰。拆成基础重建 + 残差合成之后,残差流只需要建模「差什么」,不必反复重学已经解好的整体结构,这个分解在信息论上也更经济。双粒度设计(DiT 管语义、PiT 管像素)与五阶段金字塔蒸馏配合得很自然——把昂贵的注意力放在粗粒度、把逐像素处理放在细粒度,正面回应了「一步方法仍背着高分辨率骨干」这个真实成本问题。双锚点蒸馏同时对齐教师与真值,也比只蒸馏教师更稳。但有几处需要留意。第一,训练与部署链路相当长:4 步图像流 + 4 步残差流的教师,再蒸馏成五阶段一步学生,中间每一环都有超参与对齐损失,复现成本和调试难度都不低,而论文对这条链路的稳定性(比如残差流在基础重建质量波动时是否鲁棒)交代不多。第二,残差流以冻结的基础重建为条件,这意味着基础重建的错误会被完整继承——如果第一阶段把结构判断错了,第二阶段只会把错误结构渲染得更「真实」,这类失效在超分里恰恰是最有害的(把噪点补成清晰的伪细节),论文没有专门分析。第三,评测证据以雷达图与定性对比为主,六个指标归一化后画在一张雷达图上很好看,但归一化会掩盖绝对差距的大小,读者无法判断某个维度上的领先是显著还是微弱。第四,署名信息显示工作在实习期间完成、机构标注较为简略,作为一篇方法论文其可复现材料(代码、权重)是否释出会明显影响这套多阶段管线的实际影响力。 9. GenFirst:先练生成再练重建防塌缩 GenFirst: Generation Before Reconstruction for Stable End-to-End Latent Generative Modeling | 中国科学技术大学 + 字节跳动 Seed | arXiv:2608.29335 关键词:端到端隐空间训练,隐空间塌缩,KL熵项,生成-重建冲突,非对称学习动态,REPA-E,字节跳动Seed 前序问题:隐空间生成模型的标准做法是两阶段:先训一个 VAE 做重建,再在冻结的隐空间上训生成模型。但为重建优化出来的隐空间不一定适合生成——重建只要求信息可恢复,生成还要求分布可采样,两者的最优解未必重合。于是联合训练看起来很有吸引力,可直接端到端训练一直很难做:一是容易发生隐空间塌缩,二是面临生成-重建冲突。已有的折中方案 REPA-E 通过截断生成梯度、并用一个外部的表示对齐损失(DINOv2)来重塑隐空间以避免塌缩,但这么做的代价是生成目标不再直接塑造隐空间——绕开了塌缩,也绕开了「让隐空间为生成服务」这个初衷。作者要回答的是:能不能让生成损失真的作用在编码器上,同时不塌缩? 本文贡献:作者重新分析了不同目标如何塑造隐空间,得到两个关键洞察。第一,KL 散度目标里的熵项是防止塌缩的关键:重建与先验拟合都倾向于收缩后验,而熵项保留了非退化的隐空间不确定性——换句话说,塌缩不是生成梯度本身的错,而是缺了一个撑开后验的力。第二,重建与生成呈现非对称的学习动态:重建快且监督强,在很少的训练步内就能达到不错的图像保真度;生成慢且更难优化,需要长得多的过程才能学出一个可采样的隐分布。基于这两点,他们实现了首次不发生隐空间塌缩的直接端到端训练,并提出 GenFirst——一个简单的「生成先于重建」策略:让生成目标先塑造隐空间,之后再refine重建。论文的对比图把四种范式并置:(a) 传统两阶段用固定的重建优化隐空间,对生成次优;(b) 朴素端到端让生成损失更新编码器但导致塌缩;(c) REPA-E 靠 stop-grad 加外部 REPA 损失避免塌缩,但生成损失不直接塑造隐空间;(d) 本文方法用先验损失塑造隐空间、熵项防止塌缩。作者还做了扩展实验:隐空间级 SigLIP 监督以学习生成与表示共享的隐空间、基于 caption 的 VLM-NLL 监督施加在中间视觉特征上、以及用块因果扩散 transformer 做统一文本-图像建模(连续文本与图像 latent 联合优化,支持双向的文生图与图生文)。 auto 实验效果:收敛加速是最直接的证据:在类条件 ImageNet 生成上报告不带 CFG 的 FID-50K 曲线,在文生图上报告 EiT Version A/B 与 SiT+REPA 基线的 GenEval 与 DPG 分数——两个 EiT 变体都在 80K 步就超过了基线 200K 步的表现,也就是约 2.5 倍的步数效率。非对称动态的可视化清楚显示重建在远少的步数内达到良好图像保真度,而生成需要更长的优化过程才学到可采样的隐分布,这正是「先生成后重建」这个次序的依据。定性上,三种隐空间设定用同一个 MMDiT 与采样配置对比:DPG-Bench 上的文生图与 COCO Karpathy 测试集上的图生文都显示端到端训练的隐空间提升了提示保真度与描述连贯性,其中文本-图像联合隐空间训练的定性结果最强。消融给出了 gFID 与 rFID 的权衡曲线:没有任何固定的先验损失权重能同时兼顾生成与重建,而在重建精修阶段用一个中等先验权重能得到最好的权衡。 auto 批判点评:这篇的分析质量高于它的方法复杂度,而这恰恰是优点。「塌缩的原因是缺了熵项撑开后验」这个诊断把问题从「生成梯度有毒、必须截断」纠正成「少了一个平衡力」,直接否定了 REPA-E 那条绕行路线的必要性——后者为避免塌缩付出的代价是生成损失不再塑造隐空间,等于放弃了端到端的意义。第二个洞察「重建快、生成慢」看起来朴素,但它把训练次序变成一个有依据的设计变量而非试错结果:既然慢的那个更需要主导隐空间的形状,就让它先来。方法本身简单到几乎不增加实现负担,却拿到约 2.5 倍的步数效率,这种「分析驱动的简单解」比堆结构更有价值。消融里「没有任何固定先验权重能兼顾生成与重建」这个结论也很诚实,它说明这不是调参能解决的问题,从而反过来支持了分阶段的必要性。但要注意几点。第一,主要收益是收敛速度而非质量上限:80K 步超过基线 200K 步说的是效率,论文没有强调最终收敛质量拉开了多大差距,把这篇读成「生成质量大幅提升」会误读。第二,FID 曲线是不带 CFG 的,而实际部署几乎都开 CFG,无 CFG 下的 FID 优势能否在开 CFG 后保持,是这类工作常见的落差点。第三,扩展实验(SigLIP 监督、VLM-NLL、块因果统一建模)铺得很开,每一项都只给了「稳定训练」的定性结论,广度换走了深度——尤其统一文本-图像建模是个大命题,用一张扩展图交代略显单薄。第四,实验规模集中在 ImageNet 类条件与中等规模文生图,端到端联合训练在更大数据与更大模型上是否仍然稳定(熵项的权重是否需要随规模重新校准)没有回答,而这决定它能否进入真实的大规模训练流程。 10. RAGDiffusion++:RL救回SFT抹平的高频纹理 RAGDiffusion++: From Macro-Retrieval to Micro-Fidelity Alignment for Garment Generation | 上海交通大学 + 阿里巴巴 | arXiv:2608.29280 关键词:服装资产生成,高频轨迹塌缩,AR-GRPO,Garment-RM奖励模型,artifact hacking,双图像流DiT,上海交通大学 前序问题:标准服装资产生成——把各种真实场景里的衣服还原成正面平铺图——商业价值很大,但同时要求宏观拓扑准确与微观物理保真。作者前作 RAGDiffusion 已经用检索增强的宏观约束消除了大尺度结构幻觉,可工业级的微观纹理真实感仍是未解的瓶颈。他们把这个限制正式命名为 High-Frequency Trajectory Collapse(高频轨迹塌缩):监督微调(SFT)收敛到训练分布的条件均值,而这个分布由平滑的低频纹理主导,于是高频图案(织物纹理、复杂 logo)变得几乎不可采样——不是模型学不会,是它被拉向了均值。而天真地加上强化学习后训练又会引发另一个问题 Artifact Hacking:模型利用通用奖励模型里的语义偏差,生成具有欺骗性的棋盘格噪声来骗高分,看着「细节丰富」实际是伪影。所以真正的难题是双重的:既要让 RL 把采样分布往高频模式上重塑,又要防止它塌向奖励可被利用的伪影解。 本文贡献:作者的核心洞察是 RL 能从根本上重塑流模型的采样分布——在准确的奖励引导下提升高保真轨迹的概率——同时用对抗正则化来约束这个过程不跑偏。方法上提出 AR-GRPO,并配套一个领域专用奖励模型 Garment-RM 来提供细粒度、属性感知的信号,替代通用大模型作为奖励来源。架构侧是 Dual-Image-Stream DiT:通过复制部分去噪图像流及其预训练权重,引入一条专门的条件图像流,让条件信息在与去噪信息同构的通道里流动而不是被挤进 cross-attention。针对 reward hacking,他们对比了 Adv-GRPO 的做法(用对抗损失激进地更新所有奖励模型,导致奖励模型丧失分类能力),改为让判别器先加速早期奖励上升、再把 $R_{GRM}$ 与 $R_{LPIPS}$ 稳定在一个无伪影的均衡点上。 auto 实验效果:最有说服力的是打破 SFT 瓶颈这条曲线:SFT 阶段模型达到性能平台期,延长训练时长或扩大数据都只有递减回报,而引入 AR-GRPO 后 FID 出现急剧下降,瓶颈被突破;配套的视觉对比展示了 SFT 在捕捉高频物理细节(复杂织物纹理、精细图案)上的局限以及 RL 优化带来的显著改善。频域分析给出了机制层面的证据:相比基础 SFT 模型,RL 结果与真实图像之间的频谱差异更小、方向性偏差更弱,径向平均的频谱误差曲线显示 RL 模型在中高频的宽区间上误差更低。奖励模型侧,Garment-RM 在细粒度属性感知上全面超过 GPT-4o 与 Qwen3-VL 这些通用大模型,从而为 RL 阶段提供可靠的属性感知信号;作者还用 Garment-RM 嵌入的 t-SNE 图与人类偏好选择实验验证其有效性。防 hacking 的对照很直接:标准 GRPO 与 Adv-GRPO 都塌缩成棋盘格伪影,而 AR-GRPO 保持输出干净。 auto 批判点评:这篇的诊断做得比方法更好。「High-Frequency Trajectory Collapse」是个准确的命名:SFT 回归条件均值这件事在理论上早就清楚,但把它与「高频纹理变得不可采样」直接挂钩、再用频域误差曲线量化出来,把一个模糊的「SFT 生成发糊」变成了可测量的现象,这比笼统地说「RL 效果更好」有价值得多。更值得肯定的是它没有停在「用 RL 就好了」——而是同时指认了 RL 的失效模式 Artifact Hacking,并且给出了机制解释:通用奖励模型有语义偏差,模型会生成棋盘格噪声去利用它。这种「问题-解法-解法的新问题」的递进是扎实工作的标志。用领域专用的 Garment-RM 替代通用 VLM 做奖励,也是个正确判断:细粒度属性感知上 GPT-4o 这类通用模型确实不可靠,而奖励模型的偏差在 RL 里会被放大而非平均掉。但边界也清楚。第一,这是一个高度垂直的任务——正面平铺服装图有强先验(构图固定、拓扑已知),所以「用检索约束宏观、用 RL 攻微观」这套组合能奏效,它对通用文生图的可迁移性存疑,因为通用场景既没有可检索的模板也没有 Garment-RM 这样能训出来的窄域奖励。第二,Garment-RM 本身成为新的单点依赖:整个 RL 的方向由它决定,而论文验证它的方式是与通用模型比较加 t-SNE 加人类偏好,这证明了它比通用模型好,但没有刻画它自己的盲区在哪——一个有系统偏差的窄域奖励模型,其偏差会被 RL 忠实地放大。第三,对抗正则化引入了判别器与两个奖励项($R_{GRM}$、$R_{LPIPS}$)的三方平衡,论文说它稳定在无伪影均衡点,但这类平衡对超参往往敏感,训练稳定性的证据主要是奖励轨迹图,缺少多次运行的方差。第四,作为前作的延续版本,宏观检索部分的贡献不属于本文,读者需要注意本文的净增量集中在 RL 后训练与奖励设计上。 趋势观察 原生音视频联合生成开始用「先分开、后门控耦合」压小模型尺寸 — 今天最值得读的一篇是阿里 DreamX 团队的 DreamX-Creator 1.0,它给出了一个很务实的判断:音视频联合生成不需要一上来就把两个模态揉在一起。它的 7B 生成器让音频流和视频流在网络前一半完全独立去噪,只在后一半通过 Gated Cross-Modal Attention 耦合,而且门控是 token 级与 head 级的,等于让模型自己决定「哪一帧、哪个注意力头需要听对面模态」。这个设计的意义在于用结构换参数量——在与 33B 的 MiniMax-H3、以及 Wan2.7 / KLing v3 的盲测对比里,7B 的它在视频质量上对 Wan2.7 拿到 45.5% 胜率、对 KLing v3 拿到 48.8%,虽然音频质量仍明显落后(对 MiniMax-H3 只有 23.7% 胜、45.5% 负),但这已经说明「原生联合」不必等大模型。它还配了一条自回归 1 步 2K 精修管线,把高分辨率从训练问题变成后处理问题。同一天的 VIBE 从另一侧呼应:视频配乐不能只靠重建损失,得把 tempo、调性这类可验证约束和「好听」这类主观质量分开做奖励。两条路线的共同判断是,多模态生成的下一步是把模态间的耦合点和奖励信号都设计得更细。 交互世界模型的持久性之争,从「存多少帧」转向「以什么粒度存」 — Matrix-Game 3.5 和 ShellGame 这两篇是今天最像一对的论文,都在追问世界模型能否真的记住世界,但一个给方案、一个下判决。昆仑万维 Skywork 的 Matrix-Game 3.5 把历史记忆的粒度从「整帧」降到「patch」:它把历史 latent patch 按深度和相机位姿反投影进一个持久 3D 空间,目标相机的视锥去查询这个 patch 云,再用 z-buffer 只保留每个位置最靠前的表面,最后散射成一张对齐当前视角的 memory canvas。关键是 patch-memory 与 tiled-PRoPE 两个组件都不引入任何新的可学习参数,所以能直接接在骨干上,单卡 720p 做到 20 FPS 实时。它还把静态场景和动态主体拆开,前者进 patch memory、后者用轻量参考 token,专门治长程 rollout 里的鬼影和身份漂移。而 ShellGame(首尔国立大学 + Roblox)则用一个精心设计的反例给整个方向降温:他们把 $S_5$ 状态追踪问题包装成视频版「猜球在哪个杯子下」,球被盖住后经过 N 次交换再揭晓。结论相当刺眼——双向和自回归 Transformer、Mamba、以及特征值被限制在非负区间的线性注意力,全都只能拟合训练时的 5 次交换,交换链一长就掉到随机水平,但画面依然生成得很像样,加更多去噪步数毫无帮助。根因在于像素扩散目标从来没有监督过那个看不见的隐藏状态,所以状态只能活在架构里而非 token 里。他们找到两个真能外推的机制,共同点是都跨 chunk 携带状态并原地修改:线性注意力一旦允许转移特征值取负就成功,LaCT 则随快速权重头数增加而变好。两篇合起来的信号是:视觉保真度完全不能作为世界模型「懂世界」的证据,得单独设计状态追踪的诊断任务。 推理期干预成为提升生成质量的主战场:不改权重、不重训 — 今天有三篇不约而同地把算力花在推理阶段而非训练阶段,而且都刻意避开了「重训一版」这条路。Off-Manifold Refinement(越南 Fulbright 大学 + UCLA,BMVC 2026)针对视频生成的物理违背问题:物体悬空、轨迹违反重力、接触消失。它的做法是在采样轨迹中段的若干 ODE 步,把冻结的 V-JEPA 2.1 「意外度能量」的梯度加到生成器速度场上,把 latent 推离原轨迹、推向被预测器判为更物理合理的区域,然后让生成器继续渲染。相比要生成并打分多个候选、或反复解码再编码的既有方案,它只在单条轨迹上做一次外部纠正。GEARS(北大 + 阿里,ACM TOG / SIGGRAPH Asia 2026)攻的是 test-time scaling 的浪费:现有方法采样一堆轨迹然后把低分候选直接丢掉,而那些候选里已经编码了可用的运动、布局或外观结构。它在去噪轨迹上插入多个检查点,由 Stage-Aware Scheduler 决定此刻该修什么、哪些候选该留该回收该丢,再由 Candidate Recycler 通过诊断式 latent 编辑把「弱但有希望」的候选修回来,高噪阶段修运动、低噪阶段修细节。NoisEasier(ECCV 2026)则用可微奖励引导优化整条随机轨迹而非只优化初始 latent,在 VBench 与 T2V-CompBench 的属性绑定、物体交互、计数这些难维度上平均提升超过 10%。三篇的共同判断是:与其冒 reward hacking 的风险去微调权重,不如把冻结模型当成可被引导的对象。 扩散加速的新抓手是「内容形状」和「语义复用」,不再是均匀砍 token — RTI(维尔茨堡大学 + Google)和 RegionCache(东北大学,IJCAI 2026)代表了扩散加速的两个新角度,都放弃了「均匀降采样」这个默认动作。RTI 处理的是像素空间扩散的结构性浪费:自然图像的细节只集中在画面一小部分,但模型在每一层、每个时间步都给每个 patch 分配一个完整 token,而像素空间模型没有 autoencoder 先吸收低层冗余,浪费最大。它探测到中间块的 token 在图像平坦处冗余,且冗余占据的是连通的、随内容成形的区域——于是需要形状同样随内容变化的 token。解法很巧:沿 Hilbert 曲线给 patch 排序,因为相邻位置在图像上永远是邻居,任意连续段就是一个连通区域,二维分组变成一维切割。切在特征变化最大处,每段池化成一个 region token,微调时随机抽取 region 数量,所以一个 checkpoint 服务所有预算。相比之下相似度合并会打散分组、隐空间瓶颈丢掉位置、直接跳过则是把该总结的东西删掉。RegionCache 针对的是多轮编辑场景:用户往往只改一小块,但 DiT 管线每轮都重算整张图。它用连续 prompt 之间的语义重叠加 cross-attention 定位找出可复用区域,按 prompt 相似度自适应决定复用力度,在 PixArt-alpha 上端到端加速 1.43–2.55 倍。两篇都在说同一件事:加速的抓手应该来自内容和语义的结构,而不是对 token 一刀切。 人工智能炼丹君 整理 | 2026-09-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-25|Meta让15B DiT优化器时间砍半Muon-DiT 今日 AIGC 论文速览 今日共 10 篇 · 训练与推理效率 3 篇 · 视频编辑与视角转换 2 篇 · 生成理解一体化 1 篇 · 3D 与数字人生成 2 篇 · 可控图像生成 1 篇 · 生成评测 1 篇 重点论文标题列表 Muon-DiT(Meta、南加州大学 (USC)):优化器时间砍掉一半的15B DiT InfinityEdit(浙江大学、阿里巴巴集团):编辑指令跟着直播流无限延伸 TextAnchor(哈尔滨工业大学、可灵 KlingAI Research):十张参考图编辑提速5.47倍 Grounded-Exo2Ego(NVIDIA):第三视角视频翻成第一视角 Libra(中科院自动化所 MAIS、中国科学院大学、鹏城实验室):视觉与语言各走各的路再架桥 今日论文速览 1. Muon-DiT:优化器时间砍掉一半的15B DiT Scaling Muon for Diffusion Transformers | Meta、南加州大学 (USC) | arXiv:2608.20818 关键词:Muon优化器,DiT训练,Scaling Law,Newton-Schulz,通信优化,Meta 前序问题:Muon 是一个矩阵感知的优化器,它通过在奇异方向之间平衡更新来改善大模型训练,在语言模型上已有不少正面报告。但它在扩散 Transformer 上到底有没有用、有用的话优势会不会随规模衰减,一直没有系统答案——扩散模型的训练目标(去噪回归)与语言模型的下一 token 预测差异很大,参数矩阵的谱结构也不同,语言模型上的结论没有理由直接迁移。更棘手的是端到端效率:Muon 的核心是每一个优化步都要做 5 步 Newton-Schulz 迭代(NS5)来正交化更新方向,再加上需要把动量完整物化出来,这两项在大规模分布式训练下会引入可观的计算与通信开销。理论上 Muon 用更少的步数达到同样质量,但如果每一步都更贵,省下的步数优势就被抵消了,实际墙钟时间可能反而更长。 本文贡献:作者先把 Muon 在 1.3B 到 15B 参数的 DiT 上的 scaling 行为建立起来,确认其相对 AdamW 的优化与生成质量优势跨越各个规模都存在。然后针对上述开销问题提出 Periodic Row-wise Muon:完整的 NS5 谱更新每 K 步才做一次,其余步骤基于当前动量做一个计算与通信开销都很低的行约束(row-wise constrained)更新。这个设计的直觉是谱正交化的收益具有一定的时间持久性,不需要每步重做;行归一化则以极低成本维持更新方向的量级平衡。配套的分布式实现是关键的另一半——非刷新步直接在分片后的动量上操作,避免全量物化;谱刷新步则通过分桶 all-gather 与通信-计算重叠来加速。方法层面与实现层面是协同设计的,不是先有算法再套一个工程实现。 实验效果:跨全部规模,Muon 相对 AdamW 把观察到的最佳生成质量提升了 12.9%~19.1%。相比原版 Muon,Periodic Row-wise Muon 在 1.3B~4B 上最佳生成质量的差距保持在 0.5% 以内,在 9B 上反而提升了 4.5%。效率侧:优化器时间减少 46.9%~54.3%,端到端单步时间减少 15.7%~24.3%,逻辑通信量降低 66.7%,达到各自最佳生成质量所需的有效训练时间减少 33.7%~64.8%。9B 模型的 profiler 时序图直观展示了这个差异:原版 Muon 每一步的 CPU 阶段都被红色的 NS5 块占据,归一化总时间 12.47;Periodic Row-wise Muon 只在第一步做紫色的周期性刷新,后两步是很窄的绿色行归一化块,总时间降到 10.26。 Generation quality for AdamW and Periodic Row-wise Muon. 批判点评:评价指标只用了 FD-DINO 这一项。它作为生成质量代理是合理的,但单一指标很难覆盖扩散模型关心的全部维度——文本对齐、多样性、失效模式都没有报告,「生成质量提升 12.9%~19.1%」这个数字的解释空间因此受限。周期 K 的选择论文中没有在摘要层面给出选取准则,而这是一个直接影响质量-效率权衡的超参,实际使用时需要重新搜索。另外 9B 上 Periodic 版本反而比 vanilla Muon 好 4.5% 这个结果有点反直觉(近似方法优于精确方法),论文归因不明,更可能是训练噪声或正则化副作用,而不是周期化本身带来的收益——15B 上并没有复现出同样的优势。最后,全部实验在 Meta 内部的训练栈上完成,通信优化的收益与具体的集群拓扑强相关,换一套硬件环境未必能复现 66.7% 的通信量下降对应的实际时间收益。 2. InfinityEdit:编辑指令跟着直播流无限延伸 InfinityEdit: Infinite Video Editing with a Lightweight Edit-Ignition Adapter | 浙江大学、阿里巴巴集团 | arXiv:2608.20910 关键词:无限视频编辑,流式生成,轻量适配器,因果注意力,阿里 前序问题:指令式视频编辑这两年靠大预训练模型已经做得不错,但绝大多数方法都建立在一个默认假设上:原地编辑。给定一段固定时长的源视频片段,把编辑后的视频与它逐帧对齐。这个模式在开放式的视频流面前直接失效——比如给一场正在进行的游戏直播换风格,或者给一个还在拍摄的镜头加一段运镜,编辑必须作用在陆续到来的未来帧上,而不是一个静态的输入片段。这个设定带来两个新困难:编辑必须是对流的忠实延续而不是逐帧重写,以及当编辑指令一条接一条累积时,生成质量不能持续退化。 本文贡献:作者先把这个任务形式化命名为无限视频编辑(infinite video editing)——给定前序片段和一条编辑请求,模型要生成延续这个流并施加该编辑的下一个片段,整个过程随无界的指令序列反复进行。为此他们设计了配套的数据收集管线,并在此基础上提出 InfinityEdit:一个给流式视频生成器加装无界编辑能力的轻量编辑适配器。适配器里有三个注意力模块,分工明确——历史交叉注意力用输入帧引导当前去噪帧,时序因果自注意力保证时间信息只从早期帧流向后期帧,编辑交叉注意力把编辑请求注入生成过程。推理时的调度是这个方法的巧妙之处:适配器只在编辑请求到达的那个 chunk 被激活(作者称之为 ignition chunk),后续 chunk 交还给原模型、用重置的锚定帧继续生成。这样既施加了编辑,又完整保留了原模型的无限生成能力,不会因为适配器一直在线而累积漂移。 Our adapter's architecture. It is composed of three attention modules. 实验效果:实验显示 InfinityEdit 在每条编辑下都能忠实延续视频流,并在无界编辑序列上保持稳定。定性对比最能说明问题:以一段山峰风景视频为源,连续施加「向上移动镜头」「拉远」「美式漫画风格」三条指令,Helios-Base 在第一条指令后就基本没有响应运镜;Anchor-Forcing 和 Infinity-RoPE 从第一轮开始画面就被云雾吞掉、山体结构丢失;SANA-Streaming 在第三轮的漫画风格化中把山体涂成了大片紫黄色块。InfinityEdit 三轮下来山峰主体的结构始终清晰可辨,运镜幅度与指令对应,漫画化时也保留了山形轮廓。长视频实验把每个编辑片段拉长到全序列超过 1000 帧,方法依然视觉稳定且持续实现每条指令。 Qualitative comparison with various methods on the streaming video editing task, where a sequence of editing instructions (here camera-movement and style edits) is applied continuously to a scenery source video. All methods share the same source video and editing instructions. Methods marked with $\dagger$ take no source video as input, while all other conditions are kept identical for fairness. 批判点评:18 页的篇幅对一个新任务定义加方法加数据管线来说偏紧,摘要里的实验结论全是定性表述(「忠实延续」「保持稳定」),没有给出量化的编辑成功率或与基线的数值差距,只能等正文核实。更值得追问的是评测本身——无限视频编辑这个任务是他们自己定义的,数据管线也是自建的,对比的基线(Helios-Base、Anchor-Forcing、Infinity-RoPE、Lucy-Edit、SANA-Streaming)都不是为这个设定设计的,在这种「主场作战」的比较里领先幅度容易被高估。推理时适配器只在 ignition chunk 激活、后续交回原模型这个调度虽然保护了无限生成能力,但也意味着编辑效果的持续性完全依赖锚定帧的传递,如果某条编辑的语义需要长时间维持(比如把整个场景换季),单 chunk 的激活是否够用是个未验证的问题。 3. TextAnchor:十张参考图编辑提速5.47倍 Anchoring Instruction Outside Mask: Exact Reference Caching for Efficient In-Context Diffusion Transformers | 哈尔滨工业大学、可灵 KlingAI Research | arXiv:2608.21229 关键词:参考图缓存,注意力掩码,on-policy蒸馏,多图编辑,可灵 前序问题:全模态生成里,上下文条件是核心机制——让扩散 Transformer 在同一条注意力序列里同时处理文本指令和视觉参考。问题是每张参考图会引入数千个 token,算力随参考图数量快速增长。现有的省法是结构化稀疏注意力,通过限制参考 token 与目标 token 之间的交互来砍计算。这个结构有个附带好处:参考图的 K 和 V 与去噪目标无关,因此可以算一次、跨所有去噪步复用。但代价同样明显——它把视觉参考与文本指令之间的通路也一并切断了,参考图「看不到」用户的指令,多参考图编辑里的指令跟随和参考保真度显著下滑。这是一个结构性的两难:要缓存就得解耦,一解耦指令就传不进去。 本文贡献:作者的破局点是同时重新设计 token 序列与注意力掩码,而不是在两难中做取舍。他们的 beyond-mask 设计引入静态文本锚点(时间步固定在 t=0 的文本 token),把指令连接到参考分支上,同时严格保持 K/V 精确复用的前提,且不增加任何参数。但这种直接的架构改造会掉生成质量,他们用两阶段的方式恢复:第一阶段是教师强制的速度蒸馏,在数据派生的插值点上查询教师;第二阶段是一段短的 on-policy 阶段,让教师在学生实际访问到的状态上做监督、修正沿轨迹的残余误差。作者称据其所知这是扩散模型中第一次用 on-policy 蒸馏来做架构恢复——这个组合思路(先改架构拿效率,再用蒸馏把质量补回来)本身比具体的加速数字更有普适价值。 Overview of instruction-aware exact caching. Top: Static text anchors condition the reference branch once during cache construction. Only the resulting reference K and V are retained and reused across denoising steps. Bottom: Comparison of attention structures, where rows denote queries and columns denote keys and values. 实验效果:在三个图像编辑基准上,方法与全注意力生成的质量持平。5 张参考图时把完整的 40 步去噪流程加速 3.92 倍,静态文本锚点带来的运行时开销可忽略;scaling 研究中 10 张参考图时加速比达到 5.47 倍。参考图数量与加速比的关系曲线很清晰:1 张时仅 1.82 倍,2 张 2.45 倍,5 张 3.86 倍,之后逐步爬升到 10 张时的 5.47 倍——全注意力的延迟从 1 张的约 40 秒涨到 10 张的约 970 秒,而本方法只从约 40 秒涨到约 175 秒,两条曲线的斜率差就是这套缓存机制的价值。定性对比中,隔离缓存(isolated condition)经常跟不上指令(图中红框标出的错误区域),而文本锚点版本的输出与 Qwen-Image-Edit-2511 的全注意力结果接近。 批判点评:加速比对参考图数量的强依赖需要被正确理解:单张参考图时只有 1.82 倍,这是绝大多数实际编辑场景的常态;5.47 倍要 10 张参考图才能拿到,而十图编辑是相当边缘的用例。也就是说这套方法的收益曲线与真实需求分布未必对齐。质量方面论文的说法是「matches full-attention generation quality」——匹配而非超越,考虑到还额外付出了两阶段蒸馏的训练成本,这个权衡是否划算取决于部署场景的推理量。on-policy 蒸馏作为架构恢复手段是个有意思的贡献,但论文没有报告这个恢复过程本身的成本(需要多少数据、多少 GPU 时),而这直接决定了该方法能否被复用到其他架构改造上。另外静态文本锚点把文本时间步固定在 t=0,这对训练时见过的时间步分布是一个分布外的用法,长期稳定性需要更多验证。 4. Grounded-Exo2Ego:第三视角视频翻成第一视角 Grounded-Exo2Ego: Structured Semantic Grounding for Robust Exocentric-to-Egocentric Video Generation | NVIDIA | arXiv:2608.20534 关键词:第一视角生成,视角转换,语义锚定,3D重建,NVIDIA 前序问题:从一段第三人称(exocentric)视频生成对应的第一人称(egocentric)视频,对 AR/VR 与具身智能都很关键——第一视角数据的采集成本远高于架好机位拍摄。但这个任务比常规的新视角合成难得多:视角变化极端,标准的几何条件(把场景重建成 3D 再从目标位姿渲染)在这种大跨度下变得高度不可靠,而且会出现大量在源视频里根本没被观察到的区域,几何重建对这些地方无能为力——渲染出来就是一片空洞。 本文贡献:作者在架构和数据两个层面同时下手。架构上是一个双分支的视频扩散模型:几何锚定分支把第三视角的颜色和深度抬升成 3D 重建、在目标 ego 位姿下渲染,用这个渲染结果条件化生成;语义锚定分支则跳出了主流的纯几何路线——用 captioning 提取逐物体的短语,经 LLM 转成物体 token,配合可学习的 register,通过带掩码的交叉注意力注入,让模型基于物体级上下文来合成那些几何搞不定的困难区域。另一个被忽视但影响巨大的发现是相机-重建失配问题:重建出的 3D 与相机位姿之间存在系统性错位,会严重拖累 exo-to-ego 的学习,他们为此设计了一个相机重定位算法,修正后全部指标都有实质提升。数据层面则做了一个全自动的合成数据引擎,在程序化生成的环境里生成并渲染绑定骨骼的 3D 角色。 Method overview. Geometric anchoring (top): Exocentric color and depth are lifted to a 3D reconstruction and rendered at the ego pose. Semantic grounding (bottom): Per-object context is extracted as segmentation masks and object tokens. The segmentation masks are reprojected into the ego-view as used as attention masks during cross-attention. The per-object masks encourages noisy tokens to attend to object information relevant to the specific region, providing spatial structure that grounds semantics onto pixels. 实验效果:在有挑战性的 EgoExo4D 数据集上,方法在所有指标上都大幅超过近期的 SOTA。详细消融验证了数据侧与架构侧每一项贡献各自的增益。teaser 图给出的定性对比很有说服力:同一个厨房场景,Vista4D 生成的第一视角画面里手部与台面结构完全错乱,EgoX 虽然保住了手的形态但物体摆放与真值不符,纯几何渲染(Grounded Rendering)在未观察区域留下大片彩色噪点和空洞,而本方法的输出在手部姿态、盘子位置、台面布局上都与 ground-truth 高度接近。 批判点评:语义锚定分支依赖 captioning 模型和 LLM 来产生物体级条件,这条链路的鲁棒性没有被讨论——captioning 出错或漏掉关键物体时,本该被语义补全的困难区域会退化成什么,论文没有给出失败案例分析。合成数据引擎用程序化环境加绑定骨骼角色,与真实第一视角视频之间的域差距是这类方法的老问题(真实 ego 视频有严重的运动模糊、鱼眼畸变、极端光照),论文说合成数据有用,但没说清在多大程度上依赖它。评测只在 EgoExo4D 上进行,这个数据集以厨房、自行车维修等结构化场景为主,泛化到户外或大范围移动场景的能力未知。另外相机重定位算法被描述为「实质提升所有指标」,这暗示原始 baseline 的一部分差距其实来自数据处理缺陷而非方法本身,与 SOTA 的比较中这部分收益应当被单独看待。 5. Libra:视觉与语言各走各的路再架桥 Decoupled Vision-Language System for Multimodal Understanding and Generation | 中科院自动化所 MAIS、中国科学院大学、鹏城实验室 | arXiv:2608.20382 关键词:生成理解一体化,解耦架构,Switch Attention,跨模态桥,中科院 前序问题:生成理解一体化的多模态大模型现在基本都走一条路:把图像 token 和文本 token 拼进同一个 Transformer,共享全部参数。这么做简单,但隐含了一个未经检验的假设——视觉和语言的表征需求是相同的,可以用同一套注意力和 FFN 权重来建模。实践中大家反复观察到理解与生成两个目标互相拖累:加强生成能力往往损害理解性能,反之亦然。问题的根源可能在于自模态建模(视觉内部的空间关系、语言内部的语法结构)和跨模态交互(图文对齐)本来就是两类不同的计算,硬塞进同一套参数里会产生干扰。 本文贡献:Libra 的做法是把两者显式分开:一个视觉系统、一个语言系统,中间用跨模态桥(cross-modal bridge)连接。解耦主要落在两个模块上——switch attention 和 switch FFN,它们根据当前处理的是自模态建模还是跨模态交互,动态路由计算流。这样每个模态能学到自己独有的表征,同时保持有效的跨模态理解。作者给出了两个配置:Libra-1 用于纯理解的图生文设定,Libra-2 用于理解与文生图统一的设定。除了架构本身,论文还讨论了 tokenization、位置编码和监督信号上的多项改进——比如混合图像 tokenization 把 CLIP 的连续信号与 VQGAN 的离散 ID 通过 LFQ 结合,因为直接把 VQGAN 的图像编码器换成 CLIP 会扭曲视觉信息。 An overview of the Libra architecture. The core design is the switch attention and the switch FFN that decoupling self-modal modeling and cross-modal interaction. We build two variants, Libra-1 and Libra-2, to discuss several improvements in tokenization, positional encoding, and supervision. 实验效果:实验表明专门的 Libra 设计让多模态理解与生成互相促进(而非互相拖累),在理解与生成两类基准上都取得了强性能。文生图的定性对比中,面对「悉尼歌剧院旁边是埃菲尔铁塔,蓝色夜空下爆炸的黄色星星和旋转的蓝色光晕」这种多要素长 prompt,SDXL 漏掉了铁塔、Show-O 把歌剧院画成了抽象色块,Libra-2 则把歌剧院、铁塔、星芒、蓝色漩涡都放进了画面;「一张脸左半边是爱因斯坦、右半边是机器人剖面」这条更考验组合能力的指令上,Libra-2 的结果左右分界清晰、机械结构细节完整。tokenizer 的消融图也直观显示直接用 CLIP 替换 VQGAN 编码器会让重建图像严重失真,而 Libra-1 的混合方案大幅缓解了这一点。 Comparison on text-to-image generation. We highlight the key parts of the text prompts, where Libra-2 demonstrates strong prompt-following capacity. % shows several text-to-image generation results of Libra-2. More results are presented in Sec.. In Fig, we compare the text-to-image generation results of Libra-2 with two baselines, StableDiffusionXL and Show-O, where StableDiffusionXL is a widely-used strong text-to-image generation model, and Show-O is a unified MLLM that use the most closed training 批判点评:摘要里的性能表述全是「strong performance」这类定性词,没有给出任何绝对数字或与具体基线的对比,无法判断领先幅度——这在一篇主打架构设计的论文里是个不小的信息缺失。解耦架构的直接代价是参数量:一个视觉系统加一个语言系统再加跨模态桥,参数规模相比同等能力的共享架构必然更大,论文没有报告参数量对齐后的公平比较,「互相促进」的结论也就有可能部分来自额外容量而非解耦本身。定性对比选的基线 SDXL 和 Show-O 都不是当前最强的文生图或统一模型,说服力有限。另外 switch attention/FFN 的路由是根据「当前是自模态还是跨模态」这个二元判断来做的,这个划分在实际的混合序列里如何精确界定,摘要层面没有交代。 6. DiffVC-ONE:一步扩散做视频压缩后处理 DiffVC-ONE: Diffusion-based Generative Video Compression with One-Step Video Diffusion Transformer | 武汉大学遥感信息工程学院 | arXiv:2608.20515 关键词:生成式视频压缩,一步扩散,视频DiT,时序一致性,武汉大学 前序问题:生成式视频压缩能在极低码率下恢复丰富的视觉细节——这是传统编码器做不到的,因为传统方法在低码率下只能丢细节,而生成模型可以「补」出合理的细节。但这条路上同时满足高时序一致性和低推理成本一直很困难:基于图像的方法逐帧处理,帧间容易闪烁;基于视频的方法能保证一致性,但多步扩散的推理成本在视频这个数据量级上难以承受。 本文贡献:DiffVC-ONE 建立在一步视频扩散 Transformer 之上,三个组件依次解决三个问题。统一单向 latent 压缩器(U2LC)用一个共享模型高效且统一地压缩紧凑的 latent 切片,避免为不同参考结构设计不同的压缩器。视频 DiT 的一步扩散增强器把重建出的 latent 切片当作内容锚点,对整个图像组(GOP)做单步的时空感知增强——注意这里是对整个 GOP 一起做,时序一致性因此有结构性保证,而不是靠逐帧后处理再想办法对齐。混合条件生成器从重建内容和量化信息里抽取结构、强度、语义三类条件:结构条件保留应当忠实还原的区域,强度条件控制生成增强的程度(这一点很重要——不是所有区域都该被生成模型「发挥」),语义条件在一步增强中补充内容感知的感知细节。 The framework of the proposed DiffVC-ONE. 实验效果:在多个标准基准上达到 SOTA 的感知质量和时序一致性,同时保持低推理成本。视觉对比给出了同一场景下各方法的码率(BPP)与放大细节:videoSRC15 的教堂穹顶场景中,DiffVC-ONE 的 BPP 是 0.0126(作为 1.00 倍基准),而 DiffVC 需要 0.0321(2.55 倍)、DiffVC-OSD 需要 0.0355(2.82 倍)才能达到相当的观感;鹦鹉羽毛的例子里 DiffVC-ONE 用 0.0059 BPP,对比 PLVC 的 0.0158(2.68 倍)和 VTM-17.0-LD 的 0.0074(1.25 倍),红黄羽毛的边界过渡更清晰。也就是说在相同感知质量下,码率大约只需要竞品的三分之一到二分之一。 Visual comparison between the proposed DiffVC-ONE and other representative methods. 批判点评:这是一篇工程完成度很高但方向偏窄的论文——生成式视频压缩距离实际部署还有距离,主要障碍是解码端需要跑一个视频 DiT,这个成本在终端设备上并不现实,「低推理成本」是相对于多步扩散而言的,不是相对于传统编解码器。论文只有两位作者,实验体量看起来主要靠 RD 曲线堆砌(6 个数据集 × 6 个指标 = 36 张子图),但这种密集的曲线图很难让读者判断在哪个码率区间优势最明显。另外生成式压缩有一个根本性的争议这篇没有正面回应:解码出的细节是模型「编」出来的而非真实存在的,在监控、医疗、取证这类场景下这是不可接受的属性,而 LPIPS/DISTS/FID 这类感知指标恰恰会奖励这种行为。强度条件的设计看起来是对这个问题的部分回应,但论文没有把它作为一个安全机制来讨论和验证。 7. MultiCube:拿包围盒指挥每个零件长在哪 MultiCube: Compositional 3D Generation With Part-Level Semantic and Spatial Control | Roblox、卡内基梅隆大学 (CMU)、斯坦福大学 | arXiv:2608.20448 关键词:组合式3D生成,部件级控制,布局适配器,两阶段扩散,Roblox 前序问题:游戏和动画里用的 3D 资产通常需要是组合式的——拆分成有语义意义的部件,这样才能单独换材质、做动画、改结构。最近的 3D 生成方法已经能从图像或文本 prompt 生成高质量的组合式物体,但这类全局条件缺少专业创作流程真正需要的部件级可控性:你可以说「一门带黄铜炮管和木轮底座的加农炮」,但没法指定炮管具体多长、轮子放在哪个位置。 本文贡献:MultiCube 的输入设计很直白:一个全局文本 prompt、一份指定期望部件的文本 schema、以及一个用包围盒标出各部件空间位置的布局。输出是由多个独立网格组成的 3D 物体,一个部件一个网格,且同时满足语义和空间条件。方法用两阶段扩散:第一阶段生成与 schema 和布局对齐的整体网格(monolithic shape),第二阶段把这个网格同时分解成各个部件——注意是同时而非逐个,因为部件之间存在相互约束。核心组件是 Part Layout Adapter,它独立于其他部件来编码每个部件的条件(文本标签走 Qwen-VL,包围盒走 Fourier + Linear),这个独立性保证了改动一个部件的条件不会牵动其他部件。第二阶段的多部件 DiT 之间插入 Cross-Part Attention,让各部件在生成时互相感知、保证接缝处的几何一致。 MultiCube uses a two-stage diffusion-based architecture. In Stage 1, it synthesizes a monolithic object conditioned on the input text prompt and part layout (a). In Stage 2, it takes the object latents produced in Stage 1 and decomposes them into multiple shapes, one for each specified part, guided by the part labels and bounding boxes (b). Spatial conditions are encoded with a Part Layout Adapter in Stage 1 and a lightweight embedding in Stage 2. 实验效果:实验显示方法能生成高质量的组合式 3D 物体并实现精确的部件级控制,包括那些仅靠文本或图像 prompt 难以达到的独特布局。定性结果覆盖面很广:婴儿车(车架/把手/座椅/顶篷/轮子五部件)、滑板(板面/桥/轮)、手电筒、树蛙、工具箱、摩托艇(船体/舷外机/螺旋桨/方向舵/挡风/座椅六部件)、黄铜提灯,以及喷气背包、加特林、火箭、军用水壶、飞碟、腕式弹弓、长剑等。每个例子里生成的形状都能看出与输入包围盒布局的对应关系——比如飞碟的「旋转外环」确实是一圈环绕结构、「诱捕光束发射器」在底部。 Full pipeline generation results. MultiCube generates compositional 3D objects from input text prompts and part layouts. Here, the part bounding box layouts are automatically generated using GPT-5.1; hence, the generation process from prompt to output shape is fully automatic. 批判点评:对创作者来说,手工摆包围盒本身就是一项不轻的工作量——这套方法把「描述物体」的负担转移成了「搭建粗模」的负担,是否真的降低了创作门槛取决于具体工作流。摘要没有给出任何量化指标(几何质量、部件分割准确率、布局遵循度都没有数字),也没有与 CubePart、PatchAlign3D 等基线的定量比较,「高质量」的判断只能靠看图。展示的例子都是结构相对规整的人造物体(工具、载具、武器),部件边界清晰;有机形体(树蛙那个例子是唯一的例外,且它的部件划分——身体/头/舌头/腿——也相当粗粒度)和部件间存在复杂拓扑连接的物体表现如何,从现有材料看不出来。另外包围盒作为空间条件只能表达轴对齐的粗略位置,无法表达旋转、弯曲等更细的姿态要求。 8. Xemo-Talker:把情绪监督放到次主成分上 Xemo-Talker: Unlock Emotions Explicitly for Audio-Driven Talking Portrait Synthesis | 利物浦大学、西交利物浦大学、昆山杜克大学、CMU、蚂蚁集团、平安科技 | arXiv:2608.14700 关键词:说话人视频,情绪控制,主成分分析,唇形同步,蚂蚁集团 前序问题:音频驱动的说话人头像里,精确的情绪控制一直做不好,因为现有系统依赖隐式的情绪调节——情绪信号混在整体条件里,控制间接且不充分。而如果直接在整个运动空间上加显式的情绪相关损失,又会撞上一个内在的权衡:唇形同步需要运动空间的主要能量方向被音频严格约束,情绪控制则要求这些方向能被情绪标签改动,两个目标在同一组维度上打架。 本文贡献:论文的核心发现是一个关于运动空间结构的观察:虽然情绪线索散布在整个运动空间中,但把判别性监督集中在次主成分(less-principal components)上,反而能取得更好的情绪-唇形平衡——因为主成分主要编码高能量的发音动作和头部姿态变化,情绪信息在这些方向上的占比被淹没了。基于这个洞察,Xemo-Talker 先学一个中性的语音到运动映射,保证稳定的发音和唇形同步(这一支冻结),再引入一个由次主子空间监督引导的轻量情绪分支(可训练)。为了强化情绪控制,他们设计了 Tri-Loss:类间分离、类内紧凑、以及次主对比学习三项。推理时输入音频、参考图像和情绪标签即可。 Overview of Xemo-Talker. (a) The Geometry Motion Predictor learns emotion-agnostic audio-driven motion through diffusion reconstruction, producing the complete 70-D facial motion sequence. (b) With the predictor frozen, the Geometry Emotion Branch encodes the target emotion and injects multi-scale residual features through zero-initialized adapters to refine the motion prediction. (c) The subspace-aware Tri-Loss organizes global emotion representations using classification and prototype alignment, while applying contrastive discrimination to the less-principal PCA projection. The predicted motion is converted into deformed keypoints and rendered by the frozen LivePortrait renderer. 实验效果:在情绪分类准确率上达到 SOTA,同时保持有竞争力的唇形同步和高推理效率,性能接近在真实视频上测得的水平。定性对比里最有说服力的是 Fear 与 Surprised 这一对——这两种情绪在面部表情上高度相似(都是睁大眼睛、张嘴),是情绪控制里最容易混淆的一对。图中同一身份在两种标签下生成的结果确实呈现出可区分的差异:Fear 时眉毛内侧上扬、嘴角向下、整体表情收紧,Surprised 时眉毛整体上抬、嘴张得更圆、眼睛睁得更大。男女两个身份上这个区分都成立。 Visual comparison of Fear and Surprised expressions from MEAD. 批判点评:「情绪分类准确率 SOTA」这个指标本身值得警惕:它衡量的是一个分类器能否认出生成视频的情绪,而 Tri-Loss 里的类间分离和类内紧凑恰恰是在直接优化这个可分性——存在把情绪做成夸张刻板表情来取悦分类器的风险,而人类观感上的自然度未必同步提升。论文没有报告用户研究,这个疑虑无法排除。次主成分承载情绪信息这个发现是基于 70 维运动空间的 PCA 方差谱得出的,这个运动表示来自 LivePortrait,结论是否依赖这个特定的运动表征、换一套 3DMM 或隐式表示还成不成立,没有验证。情绪标签是离散的类别(happy/sad/fear/...),这与真实表达中情绪的连续性和混合性不符,强度控制也不在建模范围内。另外机构列表横跨六家单位,实际的实验规模从 9 页的篇幅看应该有限。 9. OccluRank:给每个框加个序号定遮挡 OccluRank: Controllable Occlusion-Aware Layout-to-Image Generation by Adding Just an Ordinal Rank | 合肥工业大学、中国科学技术大学、字节跳动、中科院软件所 | arXiv:2608.20932 关键词:布局生成,遮挡顺序,序数条件,可控生成,字节跳动 前序问题:布局到图像生成通过包围盒实现显式的空间控制,但包围盒只能指定实例的位置,无法表达它们之间的遮挡关系——两个框重叠时,谁在前谁在后是未定义的。现有方法要么额外依赖深度图等几何条件(增加了输入负担),要么用复杂的推理阶段优化流程,要么把各实例的表征独立构建后简单聚合、完全不建模遮挡带来的相互作用。 本文贡献:OccluRank 的设计极简:给每个包围盒只加一个序数 rank。这个用户指定的遮挡顺序通过轻量的基于 rank 的条件注入编码进模型,配套的 Order-aware Instance Interaction(OII)模块在聚合前对 rank 条件化的实例表征做联合更新——具体是在每个空间位置 p 上取该位置的有效性掩码,把落在这里的多个实例特征送进一个 Transformer 做位置级的跨实例交互,让指定的顺序引导重叠实例之间的信息交换。整个过程不需要额外的几何输入,也不需要推理时的专门优化。数据侧他们构建了 OccluLayout:一个合成训练数据集,遮挡顺序和 amodal 标注直接从已知的场景几何导出,而不是用辅助预测模型从部分遮挡的图像里估计——这是个关键差别,估计出来的标注在遮挡严重时本身就不可靠。评测侧提出 OccluLayout-Bench,用多个多模态大模型评测器分别评估实例存在性、空间布局、属性和遮挡顺序,再加 FID 衡量整体图像质量。训练目标除了全局去噪损失还加了前景并集掩码上的局部去噪损失。 Overview of OccluRank. OccluRank constructs spatially aligned instance features, incorporates ordinal rank embeddings, and performs location-wise cross-instance interaction before aggregating into an Instance Semantic Map (ISM). The masked ISM is residually injected into selected cross-attention layers of SDXL. 实验效果:实验显示 OccluRank 更可靠地保留目标实例、遵循指定布局、实现期望的遮挡关系,同时属性一致性和整体图像质量与基线相当。定性对比中的差异相当明显:「猿在前、羊在后、鸡在最后、狐狸最远」这组布局里,CreatiLayout 把猿和羊糊成了一个畸形生物、LaRender 直接漏掉了羊和鸡,OccluRank 则四个实例齐全且前后关系正确;「大象/长颈鹿/斑马/斑马」那组里 OcclusionFormer 漏掉了长颈鹿、IFAdapter 的斑马与长颈鹿位置错乱,OccluRank 的四个动物按指定顺序排布。反向消融图进一步验证了控制力:把实例顺序反过来后,没有 rank embedding 的变体输出几乎不变(说明它根本没接收到顺序信号),完整模型则正确翻转了前后关系。 Qualitative comparison under overlapping layouts. $^\dagger$ denotes the official checkpoint without OccluLayout training. 批判点评:用多模态大模型当评测器来判断「遮挡顺序是否正确」是个方便但风险不小的选择——MLLM 本身对遮挡关系的判断能力就未经充分验证,用它评一个专门优化遮挡的模型,存在评测器与被评对象共享失败模式的可能。OccluLayout 是合成数据集,遮挡顺序从已知几何导出确实比估计可靠,但合成场景的物体摆放分布与真实照片差距多大、训练在合成数据上的模型在真实布局上的泛化如何,需要看正文的实验设计。序数 rank 只能表达全序的前后关系,现实中常见的交错遮挡(A 遮 B 的左半、B 遮 A 的右半,比如交叉的手臂)无法用一个标量序号表达。骨干用的是 SDXL,在当前时点已经不算前沿,这套 rank 条件化机制能否迁移到 DiT 架构的现代模型上是个开放问题。 10. CamWorldQA:给运镜可控的世界视频打分 CamWorldQA: Perceptual Quality Assessment of Camera-Controlled World Video Generation | 上海交通大学、埃因霍温理工大学 | arXiv:2608.18710 关键词:视频质量评测,相机控制,世界模型,无参考VQA,上海交大 前序问题:生成式视频模型现在已经能做相机可控的世界视频生成——用户给定一条相机轨迹,模型据此合成视频。但评估这类视频的质量没有合适的工具:现有的视频质量评估方法都是为自然视频设计的,捕捉不到相机可控生成特有的感知特性,比如视角一致性、运动连贯性和内容保持度。换句话说,这个方向的进展缺少一把合适的尺子。 本文贡献:作者构建了 CamWorldQA,第一个针对相机可控世界视频生成的感知质量评测基准。规模是 720 个生成视频,来自 6 种代表性生成方法、20 个多样化的源视频、6 种相机轨迹(Truck Left/Right、Dolly In/Out、Pedestal Up/Down)的组合,每个视频都通过主观实验获得了人工标注的感知质量分。在此基础上他们提出 CWQA,一个无参考的质量评估网络,用三个互补分支分别提取特征:光流分支用 RAFT 抽运动轨迹特征(1×512),运动分支用 SlowFast 的双通路抽运动特征(1×2304),空间分支用 ResNet-50 加多层级池化抽空间特征(1×7168)。三路特征经 Projection MLP 后通过自适应门控加权融合,再送进质量回归头输出分数。 Overview of the proposed CWQA method. 实验效果:实验表明 CWQA 在 CamWorldQA 数据集上显著超越现有的质量评估方法。demo 图给出了两个具体例子:一段 Truck Right 运镜的人物视频,人工打分 61.18,SimpleVQA 给 51.45(明显低估),CWQA 给 63.75,与人工判断接近;另一段 Pedestal Down 的风景视频人工只给 25.65(画面在下摇过程中出现了明显的内容坍塌),SimpleVQA 给 40.33(严重高估),CWQA 给 23.56。这两个例子恰好展示了通用 VQA 方法的典型失效模式——它们对生成视频里那种「画面清晰但内容不合理」的退化不敏感。MOS 分布图还显示不同生成方法、不同轨迹、不同内容类别之间的质量差异都相当显著。 Qualitative comparison of quality predictions from different VQA methods and CWQA. 批判点评:720 个视频、20 个源视频的规模在 VQA 基准里偏小,尤其是源视频只有 20 个,内容多样性有限,训练出的模型容易过拟合到这些特定场景。「显著超越现有方法」的比较对象是 SimpleVQA 这类为自然视频设计的通用方法,在专门数据集上被专门模型超过是预期内的结果,真正有意义的对比应该是与其他为生成视频设计的评测方法(如 VBench 的相关维度)比,摘要里没有提到。CWQA 的架构是三个现成骨干(RAFT/SlowFast/ResNet-50)加门控融合,方法层面的新意有限,价值主要在数据集。另外基准覆盖的 6 种相机轨迹都是单一的基本运镜,真实创作中的复合轨迹(边推边摇、弧形环绕)不在评测范围内,而这恰恰是相机控制最容易失效的地方。 趋势观察 优化器这一层终于被认真当成扩散模型的加速位点 — 过去两年扩散模型的提速几乎全部发生在推理侧——蒸馏减步数、缓存复用特征、量化降精度,训练侧则默认「AdamW 就够了」。今天 Meta 的这篇 Muon-DiT 把注意力挪回了训练:他们在 1.3B 到 15B 的 DiT 上系统跑通了 Muon 的 scaling 行为,确认它相对 AdamW 的生成质量优势(12.9%~19.1%)不随规模消失。更有价值的是他们诚实地承认了 Muon 在大规模下的代价——每步都做的 5 步 Newton-Schulz 迭代加上全量动量物化,会把 Muon 省下的步数优势重新吃掉。Periodic Row-wise Muon 的解法很朴素:昂贵的谱更新每 K 步做一次,其余步用便宜的行归一化更新顶上,再配合分片动量上直接算、bucketed all-gather 与通信计算重叠。结果是优化器时间砍掉 46.9%~54.3%,逻辑通信量降 66.7%。这提示一个被忽视的事实:当模型规模足够大时,优化器本身的算力与通信开销已经不是可以忽略的常数项了。 「缓存」正在从推理技巧升级为架构设计的一部分 — 可灵这篇 TextAnchor 的问题设定很典型:多参考图编辑里每张参考图带来数千 token,算力随参考图数量线性甚至更快地涨。现有做法用结构化稀疏注意力来砍——把参考图的 K/V 与去噪目标解耦,于是可以算一次复用到所有步。代价是参考图看不到文本指令了,指令跟随和参考保真度双双下滑。这篇的破法不在算子层面而在序列层面:加一段时间步固定在 t=0 的静态文本锚点,让参考分支在构建缓存时就能读到指令,同时保持 K/V 与去噪目标无关这个可缓存的前提。这个「改架构换缓存」的思路带来的副作用是生成质量掉了,他们又用教师强制的速度蒸馏加一段 on-policy 阶段把它补回来——据作者说这是扩散模型里第一次用 on-policy 蒸馏做架构恢复。5 张参考图下 40 步全流程加速 3.92 倍,10 张时到 5.47 倍。加速比随参考图数量增长而增长,这才是这类方法真正的价值所在。 视频生成的条件正在从「一段完整视频」变成「一个持续到来的流」 — 阿里的 InfinityEdit 指出了现有指令式视频编辑一个被默认接受的假设:原地编辑(in-place editing)。给定一段固定时长的源视频,逐帧对齐地改写它。这在直播换风格、给正在拍摄的镜头加运镜这类场景下直接失效——编辑必须延伸到还没到来的未来帧上。他们把这个设定命名为无限视频编辑,并配了一个只在编辑指令到达的那个 chunk 才激活的轻量适配器:历史交叉注意力锚住前序内容、时序因果自注意力保证信息只从早往晚流、编辑交叉注意力注入指令;后续 chunk 交回原模型并重置锚定帧,从而在施加编辑的同时不损害原模型的无限生成能力。超过 1000 帧的长序列上仍能稳定实现每一条指令。有意思的是今天还有一篇 NVIDIA 的 Grounded-Exo2Ego,走的是完全不同的技术路线(双分支视频扩散 + 3D 重建锚定 + 物体级语义补全),但两者面对的其实是同一类困难:当条件信号在大范围上不可靠或根本不存在时,生成模型该拿什么去锚定。 人工智能炼丹君 整理 | 2026-08-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-24|快手可灵证明奖励劫持源于流形漂移ThermoDPO 今日 AIGC 论文速览 今日共 10 篇 · 奖励对齐与偏好优化 1 篇 · 推理加速 1 篇 · 音频驱动与语音生成 3 篇 · 数字人与 4D 生成 1 篇 · 新视角合成 1 篇 · 视频身份保持 1 篇 · 设计与版式生成 1 篇 · 生成评测 1 篇 重点论文标题列表 ThermoDPO(西湖大学、浙江大学、快手可灵团队):奖励劫持的根因是流形漂移 AViTS(上海交通大学、阿里云终端智能计算部、山东大学、吉林大学、西安交通大学(ECCV 2026)):选对token省下9倍算力 SingDance(快手可灵团队、香港科技大学、清华大学):训练没见过的唱跳被组合出来 K5 声音克隆(Kandinsky Lab(俄罗斯莫斯科)):加一层线性层换来声音克隆 VoiceDesigner(约翰霍普金斯大学、Adobe Research):用文字描述设计并改写音色 今日论文速览 1. ThermoDPO:奖励劫持的根因是流形漂移 Manifold Drift in Flow Preference Optimization: A Root Cause of Reward Hacking | 西湖大学、浙江大学、快手可灵团队 | arXiv:2608.20011 关键词:流形漂移,偏好优化,流匹配,奖励劫持,DPO,快手可灵 前序问题:偏好优化(DPO 那一套)已经是对齐生成模型的标准做法,但把它搬到流匹配这种连续时间动力学上并不是换个损失函数那么简单。流匹配的训练目标是学一个把噪声搬运到数据分布的速度场,而奖励驱动的更新会直接修改这条搬运轨迹——问题是,没有任何机制约束修改后的轨迹终点仍然落在预训练数据流形上。实践中这表现为大家熟悉的「奖励劫持」:打分器给的分越来越高,生成的图却越来越不像正常图片。此前的讨论多停留在现象描述和经验缓解(加 KL 惩罚、早停、混拒绝采样),没人说清这究竟是调参问题还是结构问题。 本文贡献:作者把这个失效模式命名为流形漂移(manifold drift),并给出了它的判据。理论侧证明了两件事:最优的流匹配确实能恢复终点数据分布;而一次偏好更新只要其诱导的终点位移带有非零法向分量,采样支撑集就会离开预训练流形——也就是说漂移是偏好更新的结构性后果,不是训练不充分。对策是 ThermoDPO:一个带温度控制的目标函数,把成对偏好优化锚定在被偏好的样本上。这个设计有个漂亮的性质——在不同温度区间下,它分别退化为拒绝采样微调(RFT)和 FlowDPO,也就是说它把这两种此前被当作不同方法的做法统一在一条温度轴上,同时控制一个基于重建的逐点代理量来间接约束流形距离。低温时偏好信号会被削弱,作者又补了一个加权变体 ThermoDPO-weighted 来补偿。 Core intuition of ThermoDPO. Flow Matching (gray) transports noise to the pretrained data manifold. FlowDPO (green) may reach preferred regions through an off-manifold displacement, whereas ThermoDPO (red) adds a winner-side anchor intended to keep the redirected mass closer to the pretrained manifold. The formal statements and their assumptions are summarized in tab:notation_theory_map; the behavior is evaluated in the toy study (Fig.) and real-image study (Fig.). 实验效果:玩具基准上 ThermoDPO-weighted 的 StrictScore 达到 0.899,对比 FlowDPO 的 0.629 和 FlowDPO+RFT 的 0.857。真实模型上,在 SD3.5-M、CFG=4.5 的设定下,OCR 指标提升 47.5%,四项指标平均提升 16.0%。人工成对评测的结果更能说明问题:在文字准确性上 ThermoDPO 对 FlowDPO 的胜率是 40.0% 对 16.7%,视觉质量上对 FlowDPO 是 36.7% 对 6.7%——注意三个对比中「平局」的比例都在 46%~93% 之间,说明改进是稳定的方向性提升而非把生成结果整体改头换面。 Pairwise human evaluation of ThermoDPO-weighted against different baselines on text accuracy and visual quality over 30 prompts. Each stacked bar reports the percentage of prompts for which ThermoDPO-weighted is preferred, tied, or dispreferred relative to the corresponding baseline. ThermoDPO-weighted shows consistently stronger performance on visual quality while remaining competitive on text accuracy. 批判点评:这篇的贡献重心明确在理论刻画,实证部分则偏薄。主结果跑在玩具基准上,真实模型只验证了 SD3.5-M 单个骨干、且核心提升集中在 OCR 这一个指标上(47.5% 相对提升听起来大,但文字渲染是 SD3.5 的已知短板,基线本身偏低)。四项指标平均 16.0% 的提升没有拆开给出每一项,读者无法判断是均匀改善还是被 OCR 一项拉高。人工评测的样本量看柱状图应为 30 对,规模偏小。另外把 RFT 和 FlowDPO 统一到温度轴上是个优雅的结论,但也意味着 ThermoDPO 在实践中多了一个需要调的超参,而论文对温度如何选择只给了区间性的定性讨论。视频生成——快手可灵最关心的场景——完全没有实验。 2. AViTS:选对token省下9倍算力 AViTS: Adaptive Spatiotemporal Token Selection for Efficient Dynamic-Resolution Generation | 上海交通大学、阿里云终端智能计算部、山东大学、吉林大学、西安交通大学(ECCV 2026) | arXiv:2608.17995 关键词:token选择,动态分辨率,DiT加速,时空重要性,ECCV 2026,阿里云 前序问题:扩散 Transformer 的成本来自迭代采样。一个已知的省法是动态分辨率:早期时间步在低分辨率下去噪,后期再升到高分辨率,因为早期主要确定构图、不需要细节。但现有做法在分辨率切换点会把所有 latent token 一起升采样,这里有两重浪费——很多 token 对应的是背景或平坦区域,根本不需要高分辨率计算;而统一升采样还可能损害细节一致性。已有的部分升采样策略要么只看局部 latent 的结构线索,要么只用单步统计量,两者都难以同时刻画「token 与文本的语义相关性」和「token 表示在扩散步之间的动态变化」。 本文贡献:AViTS 把「该给哪个 token 升分辨率」建模成一个时空重要性问题,两个信号分开算再融合。空间重要性来自 latent 与文本的注意力:把自注意力的 Query 与文本 Key 的注意力图沿头维度平均,得到每个 token 的空间分数,语义上与 prompt 更相关的 token 分数更高。时间重要性来自 token 级特征在扩散时间步之间的方差——变化剧烈说明这个位置还没收敛、仍在被主动塑形。两者融合后做重要性感知的选择性升采样:关键 token 优先精化分辨率,次要 token 延后处理,从而砍掉冗余的高分辨率计算。整个方法不需要重训模型。 Overview of AViTS and spatiotemporal importance estimation. (a) Three-stage dynamic-resolution sampling: Stage~1 low-res denoising with signal collection over the last $N_T$ steps, Stage~2 selective upsampling of top-$K$ tokens, and Stage~3 full-res refinement. (b) Temporal importance from token-wise step variance across the collected snapshots. (c) Spatial importance from aggregated latent--text cross-attention (averaged over heads/blocks and collection steps); fused scores guide prioritization. 实验效果:FLUX 上最高 6.34 倍加速;Qwen-Image-Edit 和 FLUX.1-Kontext-dev 上接近 9 倍 FLOPs 削减;叠加蒸馏模型后达到 14.76 倍。作者强调该方法与蒸馏、量化、特征缓存三条主流加速路线正交,可以叠乘。图像编辑任务上的定性对比给出的是 5.24 倍加速档位(这一档下与 Ralu 的 4.55 倍、ToCa 的 3.59 倍、TaylorSeer 的 5.00 倍同台):三组编辑指令中 AViTS 的结果与原始 1.00 倍输出最接近,而同倍率的 TaylorSeer 出现了明显的材质与结构偏移(陶瓷羊的例子里羊的形态直接变了)。 Qualitative comparison on GEdit-Bench with Qwen-Image-Edit. AViTS achieves superior semantic preservation and visual quality at a higher acceleration ratio (5.24$\times$) compared to state-of-the-art baselines. 批判点评:加速比的报法需要读者留心:摘要里的「近 9 倍」和「14.76 倍」是 FLOPs 削减,而定性图里用来跟同类方法比画质的是 5.24 倍这一档——FLOPs 削减与实际墙钟加速之间通常有不小的落差,尤其是这套方法引入了额外的注意力统计与 token 选择开销,论文摘要没有给出对应的实测延迟。另外空间重要性依赖 latent-text 注意力,这对文本条件较弱或无文本条件(如纯图像编辑的结构保持部分、无分类器引导关闭时)的场景是否还成立,需要更多验证。方法本身只作用于「动态分辨率采样」这个前提之上,如果模型本来不走 coarse-to-fine,收益无从谈起。 3. SingDance:训练没见过的唱跳被组合出来 SingDance: Compositional Zero-Shot Singing-and-Dancing Video Generation with Role-Aware Audio Conditioning | 快手可灵团队、香港科技大学、清华大学 | arXiv:2608.16220 关键词:唱跳视频,组合零样本,角色条件,音频注入,快手可灵 前序问题:给定一张参考图、一段文本和一条音轨生成个性化舞蹈视频,需要模型把音乐映射到身体动作。但「边唱边跳」多了一个要求:画面里的人不仅要跟上节拍,嘴还得对上歌词。现有方法在这里正好分成两个互不搭界的阵营——音乐驱动的方法只管编舞,不管口型;语音驱动的方法则默认画面里的人就是发声者,从没考虑过「跳舞的人同时在唱这首歌」这种组合。而直接收集「唱跳」配对数据成本极高。 本文贡献:SingDance 的核心设计是把「是否发声」抽象成一个语义角色:画面主体要么是 source(声音由他发出),要么是 listener(声音来自画外的另一个人)。这样一来,「对口型」就不再绑定在语音这个模态上,而变成一个可以被显式切换的条件。架构上用硬路由(hard-compact routing)从语音、音乐、角色三路条件里挑出与当前任务相关的部分,再通过逐帧的联合音频注入送进 DiT 块——关键是 source 和 listener 共享同一条语音通路,这保证了两种角色下的表征是可比的。训练用非对称监督:屏幕内说话的视频与精心筛选的画外对话回应视频负责建立角色控制,纯器乐和歌曲伴舞视频负责建立音乐驱动的身体动作。真正巧妙的是目标配置 Song/Source(发声者在唱歌)在训练中从未出现过——推理时把 source 角色指派给一首歌,就把分别学到的「发声」和「随歌跳舞」两种能力组合出来了,实现组合零样本。 Training architecture of SingDance. The first video frame is separately encoded as a clean reference latent, while subsequent frames are temporally compressed and noised in latent space. Wav2Vec~2.0 and MuQ features, together with the vocal-role condition, are selected by hard-compact routing and supplied to frame-wise joint audio injection. The repeated block is schematic: joint audio injection is applied immediately after each of 10 selected blocks in the 30-block DiT backbone. The denoised latents are decoded into output frames. Snowflakes and flames denote frozen and trainable modules, respectively. 实验效果:实验显示强的动作-节拍对齐与视觉保真度,口型同步与最强的语音驱动基线高度竞争,但生成时参数量显著更少。角色切换的效果在定性图里最直观:同一段视频在 Lip-on 和 Lip-off 两种设定下,人物的身体动作与背景几乎完全一致(帧号相同),差别只在嘴部——Lip-on 时嘴张开在发声,Lip-off 时嘴闭合,说明发声控制被干净地从身体运动中解耦出来,切换一个条件不会牵动其他部分。 Qualitative paired vocal-role switching on two SingDance examples. Each Lip-on/Lip-off pair shares all role-independent inputs and inference settings; only the vocal role changes. 批判点评:论文只有 9 页 5 图,实验体量偏小,且摘要中的结论多为定性表述(「强的对齐」「高度竞争」),缺少可对照的绝对数字——口型同步到底是 Sync-C 多少、跟哪个基线差多少,需要读正文才能确认。组合零样本是个漂亮的设定,但它成立的前提是「发声」与「音乐驱动运动」这两种能力在表征上足够独立;一旦歌曲的节奏与歌词的发音在时间上强耦合(比如快嘴 rap),这种解耦假设是否还站得住是个开放问题,而这恰恰是唱跳场景里最难的一类。另外角色只有 source/listener 两档,多人同框、轮唱、和声这类真实短视频里常见的情形不在建模范围内。 4. K5 声音克隆:加一层线性层换来声音克隆 Adding Voice Cloning to Text-to-Audio-Video Models with a Single Zero-Initialised Layer | Kandinsky Lab(俄罗斯莫斯科) | arXiv:2608.15690 关键词:声音克隆,文生音视频,零初始化,T2AV,Kandinsky 前序问题:文生音视频(T2AV)模型能从一段文字同时生成画面和配乐配音,但没有任何机制控制「说话的是谁」——你要一个特定音色,只能碰运气。给这类模型加声音克隆的常规思路是接一个说话人编码器、改架构、重训,代价不小,而且改动大了容易伤到已有的音视频生成能力。 本文贡献:作者给出的是一个近乎最小的改法:在音频主干上加一个零初始化的线性层,短周期微调,推理时给一段短参考录音即可。零初始化是关键——增强后的模型在训练开始时就是原模型的一个功能副本,不会破坏已有能力,这个思路和 ControlNet 的零卷积同源。参考信息通过两路互补信号注入:一是把参考音频的扩散 latent 拼接(prepend)到音频流前面,提供细粒度的时序音色信息;二是用一个全局说话人嵌入去调制目标音频的 token,提供说话人层面的整体约束。方法在自家两个模型上验证:K5(5B)和 K5-lite(0.6B),底座是开源 Kandinsky 5.0 的 CrossDiT 架构——音频与视频两条流各自做自注意力,再在每个融合块内通过跨模态注意力交互,文本条件由两条流共享。 实验效果:在 30 个说话人、674 条说话人-文本配对的基准上,对比五个强声音克隆 TTS 基线(含 XTTS-v2、IndexTTS2、NAVA 等),增强后的 5B 模型在三个独立验证网络(ECAPA-TDNN、WavLM-SV、Resemblyzer)上都取得最高的说话人编码器余弦相似度 SECS,且相对每一个基线都具备统计显著性。架构上还有个意外收获:因为音频路径可以独立评估,推理时能只跑音频、跳过整个音视频扩散循环,带来约 30 倍加速,而声音克隆行为不受影响。 批判点评:评测口径偏窄是最明显的问题:主指标只有说话人相似度 SECS 一项,而声音克隆的质量至少还要看可懂度(WER)和自然度(MOS)——只优化相似度很容易换来音质或发音的退化,论文摘要里没有给出这两项与基线的对照。基准规模也不大(30 个说话人),且没有说明是否覆盖跨语言、口音、非常规音色这些真正考验泛化的情形。30 倍加速的说法需要正确理解:它是「只跑音频路径 vs 跑完整音视频循环」的对比,本质上是省掉了视频生成,而不是音频生成本身变快了——对于真正需要音视频一起出的场景,这个加速并不存在。另外整套方法绑定在自家 Kandinsky 5.0 底座上,对其他 T2AV 架构的可迁移性未验证。 5. VoiceDesigner:用文字描述设计并改写音色 VoiceDesigner: Text-to-Voice Generation and Editing via Unified Diffusion Modeling and Data Augmentation | 约翰霍普金斯大学、Adobe Research | arXiv:2608.13613 关键词:文生音色,语音编辑,统一扩散,数据增强,Adobe 前序问题:文生音色(TTV)让人可以用一段文字描述直接合成对应的嗓音,这在配音、游戏角色、有声书里价值很高。但现有系统卡在两处:一是音色多样性不足,尤其是虚构角色(怪物、机器人、卡通形象)这类现实中不存在的嗓音,模型基本合成不出来——因为训练数据里就没有;二是缺乏鲁棒且灵活的编辑能力,比如按参考音克隆、或者只改情绪和语气而保持音色。 本文贡献:两条线同时下手。数据侧做了一个混合流水线:用数字信号处理手段(变调、共振峰变换、时域拉伸这类)配合语音生成模型,人工构造出覆盖真实人声与虚构角色的多样音色数据集——本质上是用增强绕开「虚构嗓音没有真实录音」这个死结。模型侧提出 VoiceDesigner,一个统一处理生成与编辑的扩散 Transformer。架构上四路输入各配一个 Local-DiT 前端:参考音频与目标音频走 VAE 编码器,指令走语言模型,转写文本走 tokenizer,四路 token 拼接后过共享的 DiT 块栈。DiT 块内部用 RMS-Norm 加 Scale/Gate 的调制结构(自注意力和前馈各一组),条件通过调制系数注入。另配一个时长预测器先定长度,再由 DiT 从噪声 latent 出发去噪、VAE 解码出波形。这样生成(无参考音)与编辑(有参考音)就是同一套权重下的不同输入配置。 An overview of framework design of VoiceDesigner. 实验效果:主客观评测显示,VoiceDesigner 在与音色描述和编辑指令的对齐度(prompt alignment)上优于当前最好的 TTV 模型,同时在感知质量与音色可用性上保持竞争力。架构消融给出的证据比较扎实:作者按条件注入位置分 Early / Early-Mid / Late-Mid / Late 四档对比三代架构,最终版 VD-DiT-v3 在声音克隆相似度 SIM-o 上于所有四档都稳定最高(约 0.58),而基线 CapSpeech-NAR 在 Early 档的 WER 高达 0.76、Early-Mid 档 0.20,v3 则把 WER 压在 0.04 附近——说明架构改进的收益主要来自把条件注入做得更鲁棒,而非单纯堆容量。 Ablation study on the model architecture. 批判点评:「优于 SOTA 的 prompt 对齐、竞争力的感知质量」这个表述值得警惕:竞争力通常意味着没有更好。也就是说这套方法换来的是描述控制力,代价可能是音质并未提升。虚构音色靠 DSP 增强构造是个务实的工程解,但增强出来的样本与真实录音在统计上必然有差异——模型学到的「怪物嗓音」有多大程度是在拟合变调伪影而非真正的音色概念,论文没有正面回答,而这直接决定了它在真实创作中够不够用。消融图里 SIM-o 最高约 0.58 这个绝对水平在声音克隆任务里并不算高(专门做克隆的系统通常更高),说明统一模型在克隆这一子任务上确实付了代价。另外情绪、语气这类编辑属性的评测只提到 Style-Acc 一个指标,粒度较粗。 6. AvatarDynamizer:静态数字人补上衣服褶皱 AvatarDynamizer: From Static to Dynamic Human Avatars via Generative Dynamic Textures | 马普信息学研究所、VIA Research Center、EPFL | arXiv:2608.19900 关键词:4D数字人,动态纹理,3D高斯,视频扩散先验,马普所 前序问题:全身数字人要跨过恐怖谷,表面动态是关键——衣服的褶皱、布料的甩动,这些细节缺失时人眼立刻觉得假。但现有两条路各有硬伤:通用方法能从单张图、单目视频或文本提示重建静态 3D 数字人,可它们的动画是骨骼驱动的,衣服跟着骨头刚性变形,没有真实的表面动态;专用方法(为单个人训一套)渲染质量和动态都好,代价是每个人都要一套昂贵的多视角采集。近期的通用动态方法则难以把表面动态嵌进表示里,结果要么多视角不一致,要么动态表现力不足。 本文贡献:核心想法是把「数字人的表面动态」转成「纹理生成问题」,从而可以直接借用预训练视频扩散模型的先验。具体做法:设计一个纹理空间的表面动态嵌入,用编码器-解码器把姿态相关的动态编码进动态纹理图(dynamic texture map)——纹理图是二维的,天然与视频扩散模型的输入格式兼容;解码时再把纹理解成 3D 高斯,由高斯渲染器出图,多视角一致性因此得到保证。整条流水线的输入端很宽:多视角图、单目图、单目视频、文本提示、随机采样、3D 扫描都能作为静态数字人来源,经身份拟合得到身份纹理,再与用户指定动作产生的运动纹理一起送进动态纹理生成器,最后由通用高斯解码器渲染出自由视角结果。由于现有数据集在规模、序列长度或动作多样性上都不够,作者还自采了一个大规模多视角长序列数据集。 Overview. Given a static human avatar reconstructed from multimodal inputs, e.g. multi-view images, we first perform identity fitting to obtain its coarse shape and identity texture. Our Dynamic Texture Generator predicts dynamic texture maps conditioned on identity and novel pose. Then, our Generalized Gaussian Decoder recovers Gaussian splats for faithful and view-consistent renderings. 实验效果:实验表明该方法能给静态数字人赋予可信的表面动态,在视觉保真度上优于同类通用方法,尤其在动态训练数据有限时优势更明显。定性对比图给出的证据比较清楚:以 LHM 和 MV 两种静态数字人来源为起点,逐行对比 Static Avatar、+GAS、+VAP 与 +Ours——前三者在胸前印花和裤腿区域(图中红框)都出现了纹理糊掉或褶皱缺失,本方法(绿框)则保留了印花细节并给出了随姿态变化的布料褶皱,与 GT 行的表现最接近。 Qualitative Comparison on DynaHuman. Given a static avatar reconstructed from a monocular image using LHM or from multi-view images (MV), we compare our method with state-of-the-art generalizable surface dynamics methods. Our AvatarDynamizer produces faithful wrinkles while preserving both 3D geometry and identity consistency. 批判点评:把动态压进纹理空间是个聪明的降维,但它同时划定了能力边界:纹理是贴在几何表面上的,因此这套方法能表达「表面看起来在动」,却难以表达真正需要几何位移的动态——宽松裙摆的大幅甩动、外套的开合、长发的飘动,这些超出纹理可表达范围的情形论文没有讨论。「优于同类通用方法」的对照对象是通用方法,而质量天花板仍是专用方法(per-subject 训练),两者的差距有多大摘要没有交代。另外方法依赖自采的大规模多视角数据集才训得起来,这与「通用、低成本」的初衷之间存在张力——数据成本从推理侧转移到了训练侧,对复现者不算友好。 7. GenRec:该重建的别幻觉该幻觉的别糊 GenRec: Knowing Where to Reconstruct and Where to Generate | 苏黎世联邦理工、Google、Microsoft、KAIST | arXiv:2608.17832 关键词:新视角合成,流匹配,观测掩码,重建与生成分区,ETH 前序问题:从稀疏输入图做生成式新视角合成,本质上是两个性质完全不同的任务混在一起:在某个源视图里可见的像素有唯一正确的值(只受视角相关的着色调制),而落在遮挡区或超出拍摄范围的像素则允许一整个分布的合理补全。现有方法用一个统一的损失同时处理这两种情形,结果是几何保真与创造性幻觉的界限被抹平——即便通过 warp 的点云或投影深度把场景几何注入进去,可见区域该被精确重建的地方也会被生成先验带糊。 本文贡献:GenRec 的做法是把这个分区直接写进架构、监督和梯度流三处。首先由源相机加一个单目深度估计器导出观测掩码(observation mask),明确标出哪些像素是「被看到过的」。主干是一个多视角流匹配模型,同时对 RGB 和场景坐标图(scene-coordinate map)在所有目标视图上联合去噪——两个模态各有编码器,通过跨视角注意力与跨模态注意力交互,解码侧接 LoRA。然后是一个像素空间的精化阶段(重建分支),用稀疏 3D 交叉注意力与自注意力,专门在已观测像素上恢复被 latent 压缩丢掉的高频细节,且不扰动未观测区域的生成先验。关键在于同一个掩码还用来门控监督信号——回归损失被限制在观测区域内,不会污染生成先验;反过来生成损失也不会去干扰该被精确重建的部分。 Overview of GenRec. Given posed input views and target poses, monocular depth and forward warping produce per-target observation masks and warped renders. These condition a (I) multi-view flow matching backbone, which jointly denoises RGB and scene-coordinate latents through cross-view and cross-modal attention. A (II) reconstruction branch then refines only the observed pixels via sparse 3D attention guided by the predicted scene coordinates, while the observation mask gates gradients so the generative prior is preserved in unobserved regions. 实验效果:在 RealEstate10K、DL3DV-10K、Mip-NeRF 360 三个数据集上,单视图外推与双视图插值两种设定下,GenRec 在观测区域取得最好的重建保真度,同时在未观测区域的感知质量上超过纯生成式基线——也就是说没有用一头的退化去换另一头。定性对比中与 Gen3C 的差别很明显:Gen3C 的结果在家具边缘、地面纹理上出现明显的糊化与结构漂移(教室场景的桌椅、客厅场景的家具轮廓都有溶解感),GenRec 则保持了清晰的边界与合理的几何。论文还特意把重建指标分观测/未观测区域分别汇报,而非只给全图平均——这个报法比现有工作更诚实。 Comparative qualitative results. Single-view extrapolation against our strongest baseline, Gen3C. Each row shows the input view, ground-truth target, GenRec, and Gen3C. 批判点评:整套方案的正确性建立在观测掩码的准确性上,而掩码来自单目深度估计器——深度估计在无纹理区、反射面、细结构上的失效是众所周知的,一旦掩码把「其实没看清」的像素标成已观测,回归损失就会强行去拟合一个错误的目标,这类失效模式论文没有展开分析。方法把两条支路、两个模态、两套损失叠在一起,复杂度不低(流匹配主干 + 稀疏 3D 注意力精化 + LoRA),推理开销与训练成本相对单一模型的对照没有交代。评测集中在室内场景为主的三个数据集上,大尺度室外、动态物体等情形未涉及。 8. KeyID:免训练把身份注入到关键帧 KeyID: Decoupled Drafting and Keyframe Editing for Identity-Preserving Video Generation | 广东工业大学(ACM MM 2026) | arXiv:2608.16154 关键词:身份保持,视频生成,免训练,关键帧编辑,ACM MM 2026 前序问题:身份保持视频生成(IPVG)要求合成的视频既忠于参考主体的长相,又贴合文本提示。现有方法两头受限:一类靠微调,调参成本高;一类只在输入层做增强,能力有限。共同的困难是在复杂、长序列动作中维持刚性的身份一致——人一动起来,脸就开始漂。更本质的矛盾是「提示遵循」与「身份保真」之间存在容量冲突:模型的表达能力被两个目标同时争夺,密集的逐帧身份监督会压制动作的自由度。 本文贡献:KeyID 是一个免训练框架,思路是把视频动态的合成与身份的注入彻底解耦成两步。第一步 Reference-Aware Video Generation:先用大语言模型把全局提示扩写成带细节的增强提示,经 T2I 出首帧、ImgEdit 编辑、再由 I2V 展开成视频草稿(并有 Prompt Relay 机制传递时序提示)——注意这个草稿是身份无关(identity-agnostic)的,只对齐多个参考的粗略属性,因此动作可以放开生成。第二步 Identity-Preserved Keyframe Editing:对草稿做分组帧采样挑出关键帧,只在这些稀疏关键帧上做身份修正,再通过运动插值把修正传播到中间帧。从密集的帧级监督换成稀疏的关键帧级精化,容量冲突就被绕开了。模块化设计还带来一个好处:扩展到多主体参考和复杂连续动作不需要额外训练。 Overview of KeyID. (a) Reference-Aware Video Generation. A global prompt, optional temporal prompts, and a face reference are fused by GPT-5 into an enhanced prompt, from which a first frame is generated and optionally edited with non-human objects. The edited frame and the global prompt, along with optional temporal prompts, drive I2V to produce a video draft. (b) Identity Preserved Keyframe Editing. Keyframe windows are uniformly sampled in groups along the video draft, optimal keyframes are selected in keyframe identity refinement, and motion interpolation produces the final temporally coherent video with preserved identity and prompt adherence. 实验效果:自动与人工评测均优于此前工作,并在 ACM Multimedia 2026 IPVG 大挑战赛 Track 2(Sequential Action)中拿到亚军。定性对比里与 Concat-ID、Stand-In 的差距集中在长序列动作上:跑步、足球、医院三组场景中,两个基线在人物快速移动时脸部出现明显变形与身份漂移(足球场景里 Stand-In 的人物在远景中几乎不可辨识),KeyID 则在整段动作里保持了一致的面部特征,同时动作幅度与场景细节(跑道、球场、走廊)都没有被压制。 Qualitative comparison. Four evenly sampled frames are shown for each video. KeyID better preserves identity consistency and prompt adherence across complex actions. 批判点评:免训练是真实优势,但这套流水线的代价是把复杂度转移到了推理链上——LLM 扩写、T2I、ImgEdit、I2V、关键帧编辑、运动插值,六个环节串联,每一环的失败都会传导下去,且整体延迟必然远高于单模型端到端方案,论文没有给出推理成本的量化。稀疏关键帧修正加运动插值的组合在动作平滑时应该工作良好,但在快速非线性运动、遮挡后重现这类情形下,插值能否维持身份一致性是个疑问——而这恰恰是 Track 2「连续动作」最难的部分。竞赛拿的是亚军而非冠军,说明方法仍有明显差距。评测依托竞赛官方基准,跨基准的泛化性未验证。 9. Mise-en-Scène:版式不用预测而是自己长出来 Mise-en-Scène: Implicit Layout Emergence in Diffusion Transformers for Human-AI Design Co-Creation | Canva Research(ECCV Human-AI Co-Creation Workshop 最佳论文) | arXiv:2608.19000 关键词:版式生成,平面设计,隐式布局,LoRA,Canva 前序问题:从用户给定的素材自动做平面设计,要同时满足两件互相拉扯的事:整体构图协调,以及每个素材被精确保留(logo 不能变形、文字不能糊)。现有做法是先用语言模型预测显式的边界框坐标,再把素材贴进去。这种「先规划再合成」的分离带来两个后果:布局与视觉呈现脱钩,生成的构图往往僵硬、缩放失当;而且产物是一张扁平的图,设计师没法继续改。 本文贡献:作者换了个问法:布局能不能在一个预训练的图像编辑扩散 Transformer 内部隐式地涌现出来?两阶段实现。第一阶段用一个经过 knockout 筛选的小 LoRA 适配预训练 DiT,让它直接起草一份完整设计——元素的排布与渲染出的画布是联合涌现的,而不是先定坐标再填充。输入侧文本简述过文本编码器,背景图与各个元素分别过冻结的 VAE,所有 token 拼接后进 DiT 块栈。草稿里的文字和 logo 会有可见的失真,但位置关系是对的。第二阶段是确定性的 match-and-place:借一个 VLM grounder 逐个定位草稿中的元素位置,再把原始高分辨率素材搬到对应位置——这一步保证了素材的像素级保真,且产物是可编辑的分层设计而非扁平图,设计师能接着改。作者特别强调,对预训练 Transformer 做最小适配就够了,不需要多元素生成任务里常见的那套专门的条件注入机制。 Mise-en-Sc`ene. The method runs in two stages. In Stage~1 (simplified layout generation), a text brief, a background canvas, and the visual elements are mapped by frozen encoders into a joint token sequence and processed by a flow-matching Diffusion Transformer adapted only through a knockout-selected LoRA, which produces a layout-aware draft design. Because the draft comes from stochastic sampling, it still contains rendering artifacts such as distorted text and warped logos. In Stage~2 (deterministic match-and-place), a VLM grounder locates each original element in the draft independently, and the original high-resolution layers are alpha-composited at the grounded boxes to yield the final design, which keeps the emergent layout while restoring exact, pixel-faithful, editable assets. 实验效果:在大规模 PrismLayersPlus 基准上,Mise-en-Scène 生成的设计在感知质量上最接近真值,且大幅领先 LLM 版式规划器与专用版式 Transformer 两类方法;match-and-place 阶段把剩余的保真度差距也补到了接近真值合成图的水平。消融数据佐证了第二阶段的必要性:直接对扩散草稿而非 match-and-place 合成结果打分,会让 Qwen3-VL 上的美学保真度差距 |ΔGT| 从 0.046 恶化到 0.248。定性对比中与 FlexDM、LaDeCo 的差别很直观——两个基线普遍把元素缩得过小或叠在一起(FlexDM 尤其明显,文字常糊成一团),本方法的排布则接近 GT 的构图逻辑。 Qualitative comparison on the PrismLayersPlus test set. Each row shows, from left to right, the input design elements provided without spatial context, followed by the composites from FlexDM, LaDeCo, our Mise-en-Sc`ene, and the ground truth. Every method is rendered from its own predicted layout; our column is the match-and-place output. Our designs follow the ground-truth arrangement most closely; see text for a per-row discussion. 批判点评:第二阶段能保证素材保真,但它同时暴露了第一阶段的局限:草稿里文字和 logo 是失真的(框架图里明确标注了 text distortion、brand/logo distortion、detail inconsistency 三类问题),也就是说 DiT 学到的其实是「大致该放哪」而非真正理解了排版规则,match-and-place 是必要的补丁而非可选增强——一旦草稿里某个元素的位置判断错了,第二阶段只会把原始素材精确地搬到一个错误的位置上。评测的主指标是与真值的感知接近度,这个口径隐含假设了 PrismLayersPlus 的真值就是好设计,但平面设计本身允许多解,「接近真值」和「设计得好」并不等价,而论文没有人工设计师的偏好评测。另外基准单一,元素数量、语种、画布比例的覆盖范围未交代。 10. BeyondMasks:删掉物体也要删掉它的影子 BeyondMasks: Evaluating Causal and Physical Consistency in Video Object Removal | Bilkent 大学、Koç 大学、Hacettepe 大学(ECCV 2026) | arXiv:2608.20107 关键词:视频物体移除,因果一致性,评测基准,VLM评测,ECCV 2026 前序问题:生成式视频模型让物体移除的视觉真实度大幅提升,但评测协议还停在「掩码区域像素保真度」上,本质上把移除当成了局部修补。现实场景里移除一个物体是一次因果干预:抹掉物体本身之外,它引起的物理效应——影子、反光、光照变化、半透明遮挡、以及运动留下的痕迹——也必须一并消除。而这些效应恰恰落在掩码之外,现有指标完全看不到。现有基准要么没有对齐的干净参考,要么局限于简化的合成设定,无法系统评估因果一致性。 本文贡献:BeyondMasks 是一个配对基准:提供时序对齐的合成与真实视频对,每对都带干净背景参考。构造方式是反向的——先有干净背景,再插入物体与其应有的效应,从而天然拿到对齐的「移除前/移除后」真值:合成侧用 Veo 3 生成背景视频再插入物体与效应(90 条),真实侧用三脚架实拍背景再通过受控编辑引入目标物体(90 条)。数据覆盖光度、几何、体积、动态四类交互,标注上刻意只给「物体本体」的二值掩码而不标注次生效应,逼模型自己去推理该消除什么。作者还整理了次生效应的分类体系并给出各类样本数(影子 127、反光 61、半透明 46、水汽 20、光源 38、随意痕迹 37)。配套提出 CORE,一个基于视觉语言模型的结构化评测协议,同时度量物体消失程度与次生效应一致性,与人类判断的吻合度高于现有指标。 Overview of the BeyondMasks construction pipeline. Top: Paired intervention-based generation, where an object-present video is derived from a clean background video, ensuring temporal alignment. Bottom: Representative categories of object-induced causal after-effects, including illumination, reflection, volumetric, and dynamic interaction effects. 实验效果:对当前最好的方法做基准测试后暴露出系统性失效:掩码区域保真度很高,但次生效应普遍没被移除——视觉上的合理性与因果上的正确性之间存在明确的鸿沟。定性结果把这个鸿沟量化得很清楚:三组场景(结冰湖面的倒影、木板上的杯子阴影、路面上的瓶子与其投影)里,ProPainter 与 Minimax 的 LPIPS 分数与最好的方法几乎持平(0.065~0.098 区间,差异极小),但 CORE 的两项打分差距明显——ProPainter 的 CORE-AES 只有 1~2 分,Rose 能到 4~5 分;肉眼看图也能确认前两者留下了明显的残影与阴影残迹。也就是说 LPIPS 这类指标对次生效应几乎不敏感,换个指标才能把差距照出来。 Pixel metrics fail to capture causal correctness. Although LPIPS scores are similar across methods, their ability to remove object-induced effects (e.g. shadows or reflections) differs substantially. CORE separates these failure modes by evaluating object removal (CORE-OS) and elimination of causal after-effects (CORE-AES). $\downarrow$ better for LPIPS; $\uparrow$ better for CORE scores. 批判点评:180 条视频(合成 90 + 真实 90)的规模对一个基准来说偏小,各效应类别的样本数更少(水汽只有 20 条),据此得出的类别级结论统计强度有限。合成侧用 Veo 3 生成背景再插入物体,这引入了一层生成模型自身的偏置——被评测的方法与构造数据的模型属于同一技术谱系,是否存在系统性的相互适配值得警惕。CORE 依赖 VLM 打分,而 VLM 对影子、反光这类细微物理线索的敏感度本身就是个未知量,论文虽报告了与人类判断的吻合度更高,但「更高」的基线是本就不敏感的 LPIPS,这个对照并不严格;用 VLM 评测生成结果也天然继承了 VLM 的失效模式。作为纯评测工作,它指出了问题却没有给出改进移除方法的方向。 趋势观察 奖励对齐的失效终于被写成了数学 — 过去一年大家都在抱怨「奖励劫持」:模型学会了讨好打分器,图却越来越怪。今天快手可灵与西湖大学合作的 ThermoDPO 第一次把这件事在流匹配框架里形式化了——他们定义了「流形漂移」(manifold drift)这个概念,并证明只要偏好更新引起的终点位移带有非零法向分量,采样结果就必然离开预训练数据流形。换句话说,奖励劫持不是调参没调好,而是把 DPO 直接搬到连续时间动力学上时的结构性后果。这个视角的价值在于它把一个玄学问题变成了可度量的量:论文用「重建距离」作为流形距离的代理,于是「有没有漂移」可以被直接监控,而不是等到生成结果看起来不对才回头查。今天另一篇 BeyondMasks 走的是同一条路的另一半——它说视频物体移除的评测一直在算掩码区域的像素误差,可现实中删掉一个物体还要删掉它的影子、反光和水汽,这些恰恰落在掩码之外。两篇论文一个从理论、一个从评测,指向同一件事:生成模型的对齐问题正在从「效果好不好」进入「我们究竟在优化什么」的阶段。 加速的粒度从「步」下探到「token」 — 扩散模型加速的主流路线过去是减步数(蒸馏)、缓存特征(TeaCache 一类)、或者降精度(量化)。上交与阿里云的 AViTS 在今天给出了一个正交的第四条:动态分辨率采样时,不要把所有 latent token 一起升采样。它用「latent 与文本的注意力」度量空间重要性、用「token 特征跨时间步的变化量」度量时间重要性,融合后只对关键 token 优先做分辨率精化,其余延后。在 Qwen-Image-Edit 和 FLUX.1-Kontext-dev 上拿到接近 9 倍 FLOPs 削减,叠加蒸馏模型后到 14.76 倍。值得注意的是作者明确强调这条路与蒸馏、量化、特征缓存正交——这意味着推理加速正在从「选一条路线」变成「几条路线叠乘」,而叠乘的前提是每条路线作用在不同的冗余维度上。AViTS 挖的是空间分辨率这一维,此前基本没人系统做过。 音频侧的改造正在变得越来越「轻」 — 今天有三篇论文都在音频生成上,但共同点不是模型更大,而是改动更小。Kandinsky Lab 的做法最极端:给一个文生音视频模型加声音克隆能力,只需在音频主干上加一个零初始化的线性层,短周期微调即可,且因为零初始化,增强后的模型起点就是原模型的功能副本,不破坏已有能力。副产品是推理时可以只跑音频路径而跳过视频路径,拿到约 30 倍加速。快手可灵的 SingDance 也是类似哲学——它没有为「唱跳」这个新任务收集数据(Song/Source 这个目标配置在训练时从未出现过),而是把发声主体建模成一个语义角色(source 或 listener),让训练时分别学到的「发声」与「随歌跳舞」两种能力在推理时组合起来。这种「靠结构设计换数据」的思路在数据获取越来越贵的今天格外有价值。 人工智能炼丹君 整理 | 2026-08-24 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|旋转位置编码 RoPE 的原理与实现-RoPE AIGC 基本功|旋转位置编码 RoPE 的原理与实现-RoPE 所属方向:注意力与核心零件 | 难度:核心组件 | 前置知识:MHA 关键词:位置编码、RoPE、旋转位置编码、相对位置、复数旋转、长度外推 01. 为什么需要它 先说一个具体的失败场景。 你训了一个视频 DiT,训练时用 480p、49 帧。推理时想出 720p、97 帧,结果画面从第 50 帧开始漂——人物五官慢慢挪位,背景纹理开始流动。你换了采样器、加了 CFG、调了 shift,都没用。 先把这个假设例子的尺寸写全:训练输入是 832×480、49 帧,推理输入是 1280×720、97 帧。假设 VAE 空间压缩 8 倍、时间长度按 $T_{\text{latent}}=1+\lfloor(T-1)/4\rfloor$ 计算,再做空间 2×2 patchify;不再额外切时间 patch。两组宽高都能被 16 整除,不需要补边: 480p/49 帧 → 13 个 latent 帧 × 1560 tokens/帧 = 20280 tokens 720p/97 帧 → 25 个 latent 帧 × 3600 tokens/帧 = 90000 tokens 总量涨了约 4.44 倍,其中每帧 token 数涨约 2.31 倍、latent 帧数涨约 1.92 倍。网格从 $(13,30,52)$ 变成 $(25,45,80)$,依次对应时间、高、宽;空间 token 数的倍数不是任意一个轴的坐标缩放倍数。也就是说,模型要给四倍多的位置编号赋予意义,新增的较远坐标与注意力关系超出了训练范围(已有坐标仍然见过)。 这是一个待诊断的假设场景:位置编码、训练尺度、VAE、注意力规模和运动分布都可能造成失败,不能仅凭症状归因给 RoPE。 注意力机制本身是置换等变的:把输入序列的顺序打乱,输出也只是跟着打乱,每个 token 看到的上下文完全不变。换句话说,纯注意力分不清「第 3 帧」和「第 40 帧」。位置信息必须额外注入。 早期做法是可学习的绝对位置嵌入(learned absolute PE):给每个位置分配一个可训练向量,加到 token 上。这在训练长度内工作良好,但有个硬伤——没见过的位置没有对应向量。你训练时只见过 49 个位置,推理要 97 个,后面 48 个位置没有训练过的表项。可以扩表、插值或重新训练,但这些都要额外规定,质量也要验证;不能由“没表项”直接推出所有绝对位置方案必然失败。 RoPE 解决的正是这件事:它不给位置分配「向量」,而是给位置分配「旋转角度」。角度公式可计算到新位置;生成质量能否外推仍需训练或扩展策略验证。 02. 最小可用理解 三句话: 把 query 和 key 的特征维度两两配对看成复数,每个位置 $m$ 把它们旋转 $m\theta$ 弧度。 两个向量做内积时,指数项相减,绝对位置 $m$、$n$ 自动消掉,只剩相对距离 $(m-n)$。 所以对固定的 q、k,位置项只依赖 token 间的相对距离;完整分数仍依赖内容特征,而旋转角度可以外推到训练时没见过的位置。 如果只记一件事:本文标准 RoPE 是乘上去的旋转,不是加上去的向量。 它保持被旋转向量的模长;加法通常不保持。这个几何差别值得理解,但不是哪一种位置编码质量更好的证明。带幅度缩放的 RoPE 扩展还要单独讨论。 还有一个位置要记准:它作用在每一层注意力的 $q$ 和 $k$ 上,不是输入层加一次,通常不旋转 $v$。这是本文及常用实现的约定,某些变体也会旋转 value,不能一概判错。 03. 数学推导 3.1 我们到底想要什么性质 先补齐先修背景:注意力先做 $q=W_Qx$、$k=W_Kx$、$v=W_Vx$,再把 $q^\top k/\sqrt{d}$ 经掩码和 softmax 变成对 $v$ 的加权系数。这里 $d$ 是单个 head 的旋转维度,取正偶数;本文先考虑整个 head 都旋转。我们讨论的是 softmax 之前的单个点积,$1/\sqrt{d}$ 只是公共比例。 设 $x_m$ 是位置 $m$ 上的 token 特征,我们要找一个变换 $f$,使得变换后的 query 和 key 的内积满足: $$\langle f(q, m), f(k, n) \rangle = g(q, k, m-n)$$ 左边依赖两个绝对位置 $m$ 和 $n$,右边只依赖它们的差值 $m-n$。这就是「相对位置不变性」的精确表述。注意 $g$ 的具体形式我们不关心,只要求它不含 $m$、$n$ 的单独出现。这个性质也可叫共同平移不变性:同时把两者位置加同一个偏移,固定内容向量的点积不变。真实网络的内容向量、掩码及可见 token 集合仍可能变化。 3.2 复数域上的现成答案 二维情况下有个现成的东西满足这个条件:旋转。 把二维向量 $q = (q_0, q_1)$ 看成复数 $q_0 + iq_1$。复数乘法 $e^{im\theta}$ 的几何意义就是逆时针旋转 $m\theta$ 弧度,且不改变模长。 现在令 $f(q, m) = q e^{im\theta}$,算一下内积。复数域上的内积要取共轭: $$\langle f(q,m), f(k,n) \rangle = \mathrm{Re}\left[(q e^{im\theta}) \overline{(k e^{in\theta})}\right] = \mathrm{Re}\left[q \bar{k} e^{i(m-n)\theta}\right]$$ 关键一步在指数:$e^{im\theta} \cdot \overline{e^{in\theta}} = e^{im\theta} e^{-in\theta} = e^{i(m-n)\theta}$。绝对位置就这么消掉了,只留下 $(m-n)$。这就是 RoPE 的全部动机,后面所有工程细节都只是把这个二维结论铺到高维。 3.3 铺到高维 实际的 head_dim 是 64 或 128,不是 2。做法是把 $d$ 维切成 $d/2$ 组,每组两个相邻维度构成一个复数平面,第 $i$ 组用自己的旋转频率: $$\theta_i = \text{base}^{-2i/d}, \quad i = 0, 1, \dots, d/2 - 1$$ 这里的 base 就是代码里的 rope_theta;本文选 10000,不代表所有模型都用这个值。$i$ 是二维平面的组号,不是单个坐标号。 这个频率设计是理解 RoPE 行为的关键。展开看两端: $i = 0$ 时 $\theta_0 = 1$,位置每 +1 就转 1 弧度,转得最快 $i = d/2 - 1$ 时 $\theta_i = \text{base}^{-1+2/d}$,转得最慢。本文 $d=64$ 时是 $\theta_{31}=0.0001333521432$,不是精确的 $10^{-4}$;对应周期约 47117.24 个坐标单位 也就是说,高频维度负责区分近距离,低频维度负责区分远距离。一个位置差 1 的 token 对,主要靠前面几维的相位差来分辨;位置差较大时,高频相位已多次绕圈,而低频相位仍提供变化较慢的尺度;各频段并非互斥地负责某一距离。 这张图要看什么:左图是 $\cos(m\theta_i)$ 的热力图(横轴位置、纵轴维度组)——256 长度内转满一整圈的只有前 13 组;这些高频组提供较大的近距离相位变化,维度索引越大,相位变化越慢,但并非不携带近距离位置信息;右图把位置拉到 32768,高频组早就转了几万弧度,低频组才刚积累出可分辨的相位。这是 32 组频率提供的多尺度结构,不是互斥的距离分工;后面的 PI、NTK-aware、YaRN 都会调整这组频率;YaRN 还包含注意力幅度修正,不能只理解成频率重分配(图由 code/make_figures.py 生成)。 这个结构直接解释了长度外推的两种主流做法:位置插值(PI)把所有位置除以一个缩放因子,等价于整体降低旋转速度;NTK-aware 缩放只调 base,让低频维度转得更慢而尽量保住高频维度的分辨率。它们改的都是同一组 $\theta_i$。 写成矩阵形式,RoPE 就是一个分块对角的旋转矩阵 $R_m$,第 $i$ 个 $2\times2$ 块为: $$\begin{pmatrix} \cos m\theta_i & -\sin m\theta_i \\ \sin m\theta_i & \cos m\theta_i \end{pmatrix}$$ 对固定的未旋转内容向量 $q,k$,矩阵推导完整写成: $$\langle R_mq,R_nk\rangle=q^\top R_m^\top R_nk=q^\top R_{n-m}k$$ 因为每块旋转都满足 $R_m^\top=R_{-m}$、$R_aR_b=R_{a+b}$。这和 3.2 节的 $(m-n)$ 没有冲突:复数写法取 $q\bar{k}$,矩阵写法让相位作用在右侧的 $k$ 上。展开第 $i$ 对坐标,令 $\Delta=n-m$,二者都得到: $$ (q_{2i}k_{2i}+q_{2i+1}k_{2i+1})\cos(\Delta\theta_i)+(q_{2i+1}k_{2i}-q_{2i}k_{2i+1})\sin(\Delta\theta_i) $$ 位置差的正负和正弦前的交叉项要一起看,不能只照抄其中一个符号。独立脚本 rope_validation.py 同时检查复数、矩阵和直接旋转三种计算,最大绝对差约 $5.72\times10^{-13}$。 3.4 「不改模长」说明了什么 $R_m$ 是正交矩阵,所以 $\|R_mq\|=\|q\|$。加法通常不同: $$\|x+p_m\|^2=\|x\|^2+2x^\top p_m+\|p_m\|^2$$ 于是同一个 $x$ 放在不同位置,其模长可能改变。rope_decay.py 用 seed=0、64 维 float64 输入和独立同尺度随机 PE 作演示: 原始向量模长 7.315344 RoPE 后(位置 0/1/100/511) 7.315344 7.315344 7.315344 7.315344 跨位置模长极差 8.88e-16 加法式 PE 后 9.843323 10.080425 10.808198 10.190631 跨位置模长极差 0.9649 这组随机 PE 不是训练后的绝对位置嵌入,不能当质量对照。模长保持让位置注入的几何作用更容易分析,但 $q,k$ 的方向变了,softmax 权重照样会变;模长也不能直接解释成 token 的重要性或置信度。如果某扩展把 cos/sin 同乘 $a$,旋转结果就会再乘 $a$,$q,k$ 点积变为原来的 $a^2$ 倍,已不满足这里的单位幅度保模长结论。 04. 代码实现 下面用 NumPy 写出完整最小实现,输入采用浮点数组,旋转维度为正偶数。它把逐对旋转直接展开,便于对照公式。 import numpy as np def build_rope_cache(seq_len: int, dim: int, base: float = 10000.0): """预计算 RoPE 的 cos/sin 表。 dim 必须是偶数:每两个相邻维度配成一个复数参与旋转。 base 就是常说的 rope_theta,调它会按维度改变旋转速度;最高频 i=0 始终为 1。 """ assert dim % 2 == 0, f"dim 必须为偶数,收到 {dim}" # theta_i = base^(-2i/dim):i 越大转得越慢,对应越低的频率 inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim)) pos = np.arange(seq_len) freqs = np.outer(pos, inv_freq) # [seq_len, dim/2] return np.cos(freqs), np.sin(freqs) def apply_rope(x: np.ndarray, cos: np.ndarray, sin: np.ndarray) -> np.ndarray: """把旋转作用到 x 上。x: [seq_len, dim] 最后一维两两配对看成复数 (x_even + i*x_odd),乘上 e^{i*m*theta}: 实部 = x_even * cos - x_odd * sin 虚部 = x_even * sin + x_odd * cos """ x_even, x_odd = x[..., 0::2], x[..., 1::2] out = np.empty_like(x) out[..., 0::2] = x_even * cos - x_odd * sin out[..., 1::2] = x_even * sin + x_odd * cos return out 验证核心性质:固定一对向量,只改赋予它们的绝对位置,间距始终为 1。如果推导是对的,内积应该完全不变。 rng = np.random.default_rng(0) seq_len, dim = 8, 64 cos, sin = build_rope_cache(seq_len, dim) q = rng.standard_normal(dim) k = rng.standard_normal(dim) for shift in range(4): qr = apply_rope(q[None, :], cos[shift:shift + 1], sin[shift:shift + 1]) kr = apply_rope(k[None, :], cos[shift + 1:shift + 2], sin[shift + 1:shift + 2]) print(f"位置 ({shift}, {shift + 1}) → 内积 {float(qr[0] @ kr[0]):.6f}") 真实输出: cos/sin 形状: (8, 32) (8, 32) 位置 1 的前 4 维 cos: [0.5403, 0.7318, 0.846, 0.9124] 位置 1 的末 2 维 cos: [1.0, 1.0] 同一对向量,平移绝对位置(间距恒为 1): 位置 (0, 1) → 内积 -11.297869 位置 (1, 2) → 内积 -11.297869 位置 (2, 3) → 内积 -11.297869 位置 (3, 4) → 内积 -11.297869 对照组,改变间距: 间距 1 → 内积 -11.297869 间距 2 → 内积 -12.637566 间距 3 → 内积 -13.049657 未加 RoPE 的原始内积: -9.701179 三个数字值得盯一下。 第一,四行内积完全相同(-11.297869),小数点后六位都不差。这就是 3.1 节那个式子在数值上的体现:绝对位置从 (0,1) 挪到 (3,4),这些数打印到六位小数相同,底层浮点结果允许舍入误差;间距一变(1→2→3),这组向量的内积随之变化。 第二,位置 1 的前 4 维 cos 是 0.5403、0.7318、0.846、0.9124,递增。对应 $\theta_i$ 递减:第 0 维转了整整 1 弧度(cos 1 ≈ 0.5403),第 3 维只转了约 0.42 弧度。这就是「高频维度在前」的直接观测。 第三,末 2 维 cos 打印出来是 1.0。不是真的等于 1,而是最低频 $\theta_{31}=0.0001333521432$,其 cos 约为 0.9999999911,六位小数下显示成 1.0。这些维度在近距离上有很小但非零的相位变化;不能说它们只为远距离服务。NTK-aware 缩放对这些低频维度施加更大压缩;实际质量代价仍取决于训练后的频段使用方式。 上面这张图(code/make_figures.py 图 3)把本节的两件事画在了一起。左图是平移不变性的可视化:同一对 $q$、$k$,把绝对起点放在 0 / 500 / 2000,逐点画出内积随相对距离的曲线——三条曲线完全重合(最大偏差 5.2e-13),这就是上面输出里「四行内积完全相同」的图形版。右图是另一个常被混着说的现象:距离越远,加了 RoPE 的分数与不加位置编码的原始内积的相关性在所采样的区间整体降低,但并不单调(4000 对随机向量实测,$\Delta=1$ 时 0.97、$\Delta=4096$ 时接近 0;对独立各向同性输入,虚线为 $\frac{2}{d}\sum_i\cos(\Delta\theta_i)$,d 是特征维度、Δ 是相对距离)。注意衰减的是这个相关性,不是内积本身的大小——旋转保模长,本文独立各向同性高斯向量的内积分布与距离无关(实验三会验证这一点)。 完整脚本见 code/rope_minimal.py。 4.1 顺手把两种外推方法也实现掉 3.3 节说过 PI 和 NTK-aware「改的都是同一组 $\theta_i$」。这句话用代码写出来就是两个短函数——把它们并排放一起,先看清两种方法的几何差别;适用维度和参数条件见下文。 def theta_original(dim=64, base=10000.0): return 1.0 / (base ** (np.arange(0, dim, 2) / dim)) def theta_pi(dim=64, base=10000.0, scale=8): """Position Interpolation:位置索引整体除以 scale。 等价于把每个 theta_i 都乘上 1/scale——所有频率被同等减速。""" return theta_original(dim, base) / scale def theta_ntk(dim=64, base=10000.0, scale=8): """NTK-aware:把 base 放大,让减速量随维度索引递增(频率越低减速越多)。""" if dim <= 2 or dim % 2 or scale <= 0 or base <= 0: raise ValueError("NTK-aware requires even dim > 2, positive scale and base") new_base = base * scale ** (dim / (dim - 2)) return theta_original(dim, new_base) 跑 code/rope_extrapolate.py 看它们对各维度做了什么(外推 8 倍): 维度 i 原始 PI(÷8) NTK-aware PI减速比 NTK减速比 0 1.000e+00 1.250e-01 1.000e+00 8.00x 1.00x 4 3.162e-01 3.953e-02 2.418e-01 8.00x 1.31x 8 1.000e-01 1.250e-02 5.847e-02 8.00x 1.71x 16 1.000e-02 1.250e-03 3.419e-03 8.00x 2.92x 31 1.334e-04 1.667e-05 1.667e-05 8.00x 8.00x PI 那一列减速比是齐刷刷的 8.00x,从最高频到最低频一视同仁。NTK 那一列从 1.00x 单调爬到 8.00x——最高频维度完全没动,最低频维度承担了全部的 8 倍压缩。 这张图要看什么:左图把上表画成曲线——PI 是一条平线(每维都慢 8 倍),NTK 从最高频的 1.00x 单调爬到最低频的 8.00x,两条线夹出的面积就是「NTK 少减的部分」;右图是代价,PI 把每一组的相邻坐标相位步长降到 12.5%,NTK 第 0 组保留 100%,第 16 组约 34.2%,最低频第 31 组为 12.5%。这些是相位步长的比例。两种方法改的是同一组 $\theta_i$,区别只在把这次外推的代价放在哪个频段。 先只量几何变化:相邻坐标的相位步长还剩多少: 维度 i 原始 PI NTK PI保留 NTK保留 0 1.000000 0.125000 1.000000 12.5% 100.0% 4 0.316228 0.039528 0.241809 12.5% 76.5% 8 0.100000 0.012500 0.058472 12.5% 58.5% 16 0.010000 0.001250 0.003419 12.5% 34.2% PI 让每维相邻位置的相位增量降到 12.5%;这可能影响局部分辨,但不等于任务指标必然下降,微调与模型适应会改变实际结果。NTK 在第 0 维保住了 100%,代价是第 16 维只剩 34.2%。 还有一个容易看漏的点。NTK 外推后,最高频维度在位置 32767 处的相位是 32767 弧度,仍然远超训练时见过的 4095: 训练时见过的最大相位(位置 4095) 4095.0 rad 原始(直接外推) 位置 32767 32767.0 rad ← 超出 8.0 倍 PI 位置 32767 4095.9 rad ← 接近但略超训练端点 4095 NTK-aware 位置 32767 32767.0 rad ← 超出 8.0 倍 这是该缩放的设计取舍:最高频保留原始步长,低频逐渐压缩。未展开相位超过训练最大值不等于必然失效,相位本身具有周期性;只有最低频获得完整 8 倍压缩,不能据此保证所有频段已回到训练范围或质量安全。PI 则把所有维度的相位范围压到接近训练区间,代价是相邻位置相位步长整体下降;精确端点对齐还需使用端点跨度比。上面的 NTK-aware 是固定缩放教学版。将新 base 代回频率定义可得: $$\theta_i'=\theta_i s^{-2i/(d-2)},\quad d>2,\quad s>0$$ 所以第 0 组不动,第 $d/2-1$ 组恰好除以 $s$。本文为延长窗口使用 $s\geq1$;$d=2$ 时这个公式没有定义。它不是固定版本 HF 的动态 NTK:后者会用当前长度改变 base,见 5.3 节。 PI 若要求目标末坐标精确映回训练末坐标,应选 $s=(L_{\text{new}}-1)/(L_{\text{train}}-1)$,两长度都大于 1。4096→32768 时是 8.0017094,而非 8;用长度比 8 会得到 4095.875,略超 4095。两种约定要写清,不能把舍入差说成方法失效。 YaRN 的 v2 原文在频段插值之外还讨论注意力温度修正;本文只复现 PI 与固定 NTK-aware 的频率几何,没有复现 YaRN 的训练或长上下文质量。 05. 工业级实现对照 本节固定可复核的源码版本;它们是选定的实现快照,不表示当天最新版: Transformers v4.51.3 的 Llama 实现:LlamaRotaryEmbedding、rotate_half、apply_rotary_pos_emb。 同版本频率与动态更新:默认、线性及动态 NTK 参数和 dynamic_rope_update。 Diffusers v0.35.1 的位置嵌入:get_1d_rotary_pos_embed、get_3d_rotary_pos_embed。 下载的原文件保留 SHA256。本轮把上述类和函数的原始 AST 直接在 CPU 执行,提供简单配置对象及原生依赖;没有改写其数学实现,也不声称执行了完整模型或安装了完整框架。 下面按配对、频率缓存、坐标、精度四条线对照,再看视频的三轴扩展。 5.1 配对方式不同,而且不能混用 这是最容易踩的坑。本文把第 $2i$ 和 $2i+1$ 维配成一个复数(奇偶交错),而 HF 的写法是把第 $i$ 和第 $i + d/2$ 维配成一对(前后半切分): def rotate_half(x): """Rotates half the hidden dims of the input.""" x1 = x[..., : x.shape[-1] // 2] x2 = x[..., x.shape[-1] // 2 :] return torch.cat((-x2, x1), dim=-1) q_embed = (q * cos) + (rotate_half(q) * sin) 配合 emb = torch.cat((freqs, freqs), dim=-1)(cos/sin 表沿最后一维复制两遍),展开就是 $x_i \cos - x_{i+d/2} \sin$ 和 $x_{i+d/2} \cos + x_i \sin$——和 3.3 节的旋转矩阵一模一样,只是谁跟谁配对换了。 那两者是等价的吗?我写了个脚本实测(code/rope_pairing.py): === 1. 两种配对都满足相对位置不变性 === 奇偶交错: 间距恒为 3 时内积 -13.049657,四个绝对位置间的最大波动 3.55e-15 前后半切分: 间距恒为 3 时内积 -7.706177,四个绝对位置间的最大波动 1.78e-15 === 2. 同一份权重下,两种配对给出的分数不同 === 奇偶交错 -13.049657 前后半切分 -7.706177 差值 5.343480 ← 不为 0,实现和权重必须配套 === 3. 重排维度后两者完全一致 === 奇偶交错(原始排布) -13.049657 前后半切分(重排后权重) -13.049657 差值 0.00e+00 ← 只差一个固定的维度置换 三段结论连起来才是完整答案:作为位置编码方案两者等价(都满足相对位置不变性,波动 1e-15 是纯浮点误差),但对同一份权重不可互换(差了 5.34),因为它们只差一个固定的维度置换(重排后差值精确为 0)。 实践意义:移植权重时如果配对方式对不上,模型不会报错,只会变笨。这种 bug 极难查——loss 能降,输出也通顺,就是长距离能力莫名其妙地差。排查时要把 cos/sin 的复制方式与旋转算子一起核对:本节 Llama 的 cat((freqs, freqs)) 配 rotate_half;交错版的逐对旋转配 repeat_interleave。仅看一个 cat 不能推断陌生代码里所有后续维度重排。移植线性层时,若按 $q=W_Qx$ 记号,应同步置换 $W_Q,W_K$ 的输出行及偏置;GQA 也要逐 KV head 核对。 5.2 inv_freq 存成 buffer,而且不进 checkpoint self.register_buffer("inv_freq", inv_freq, persistent=False) self.original_inv_freq = self.inv_freq 这是固定 v4.51.3 原代码,第二行是普通属性引用,不是注册第二份 buffer。保存频率避免反复做幂运算;这个版本仍会在 forward 计算给定位置的 cos/sin,并不缓存所有位置的完整三角函数表。persistent=False 的含义是:它让 inv_freq 不写进 state_dict。好处是改 rope_theta 做长度外推时,不必担心 checkpoint 里存着旧频率把新配置覆盖掉——在这里,模型构建时先由 config 建频率,再按所选策略更新。不能推广为所有模型都不保存频率。留一份 original_inv_freq 是给 dynamic NTK 用的:那类方法会随序列长度临时改频率,短序列时可能需要退回原值。CPU 原类实跑确认 state_dict 没有 inv_freq,动态类增长后会改频率,长度回到原窗口内会复原。 5.3 接受 position_ids 而不是内部 arange def forward(self, x, position_ids): inv_freq_expanded = self.inv_freq[None, :, None].expand(position_ids.shape[0], -1, 1) position_ids_expanded = position_ids[:, None, :].float() 最小实现里位置就是 arange(seq_len),生产上不行,至少三个场景要显式传: KV cache 增量解码:第 101 个 token 单独前向,它的位置是 100 而不是 0 序列打包(packing):独立样本常各自从 0 编号,并使用对应的分段掩码。若只在段内注意且频率固定,每段统一加偏移也不改段内点积;关键是坐标策略与掩码一致,重置坐标本身不能防止跨样本泄漏 多模态与视频:图像 token 和文本 token 的位置编号规则不同,位置得由外部算好 动态频率还会影响 KV cache。固定频率时,历史 key 在其绝对坐标旋转一次后可复用;但如果新 query 改用新频率,旧 key 仍是旧频率,点积就不再是同一个 $R_m^\top R_n$。需核对框架是否冻结整次生成的频率、重算缓存,或采用专门的兼容策略;单看频率更新函数不能保证缓存正确。 HF v4.51.3 的动态 NTK 具体用 $b'=b[f\ell/L_0-(f-1)]^{d/(d-2)}$,其中 $b$ 为旧 base、$f$ 为配置 factor、$\ell$ 为当前长度且至少取原窗口 $L_0$;不是把本文固定缩放里的 $s$ 直接替换成 $\ell/L_0$。原类 CPU 演示在 $d=8,L_0=4,f=2$ 的配置中,旧 key 与按最终频率重算的 key 给出点积差约 0.128828;这是明确的缓存混频反例,不是框架完整生成的测试。 5.4 为什么这个实现用 fp32 算相位与 cos/sin with torch.autocast(device_type=device_type, enabled=False): freqs = (inv_freq_expanded @ position_ids_expanded).transpose(1, 2) emb = torch.cat((freqs, freqs), dim=-1) cos = emb.cos() * self.attention_scaling 注意它显式关闭 autocast,并先把位置和频率转成 FP32。BF16 有 8 位有效二进制精度(含隐含位),在 $[4096,8192)$ 的相邻可表示数间隔为 32;CPU 原生转换中,4096 和 4097 都会变成 4096。若先在 BF16 编号再转 FP32,丢失的坐标不会回来。频率本身先量化后再转高精度也同样不能恢复。 FP32 能避免这个例子的相邻坐标合并,但不等于任意长位置都安全;相位乘法与三角函数仍有误差,极长上下文应测目标范围,必要时用 FP64 等策略。固定 Llama 代码最后把 cos/sin 转回输入 dtype;“相位计算用 FP32”和“所有后续旋转必须 FP32”是两回事。本轮官方 FP32 输出与 NumPy float64 参考最大差约 $5.27\times10^{-5}$,同一份 FP32 cos/sin 下逐元素前向与输入梯度均精确对齐。 5.5 读陌生代码库时的四个问题 接手一个没见过的模型,想搞清它的 RoPE 怎么配的,按这个顺序问四个问题最快,也刚好对应上面四小节: cos/sin 表是怎么铺开的? 搜 cat 还是 repeat_interleave——torch.cat((freqs, freqs)) 是前后半切分,repeat_interleave(freqs, 2) 是奇偶交错。这决定了权重能不能和别的实现互换。 inv_freq 从哪来、会不会变? 搜 inv_freq 的赋值点。如果只在 __init__ 里算一次,就是静态 RoPE;如果 forward 里还会重算,大概是某种 dynamic NTK,那么推理时的行为会随序列长度变。 position_ids 谁给的? 如果是内部 arange,还要核对是否加了 cache offset 或传入各段位置;从零重启才会破坏 KV cache 增量解码,多模态场景基本要改。 三角函数在什么精度下算的? 搜附近有没有 float()、autocast、enabled=False。没有强制 fp32 的话,长序列下有精度隐患(5.4 节)。 这四个问题都能靠 grep 在几分钟内回答,比通读整个 attention 实现快得多。 5.6 视频侧:三个轴分走维度 视频 DiT 的 token 有时间、高、宽三个坐标,做法是把 head_dim 切成三份,每份跑一遍 1D RoPE 再拼起来。本节固定 Diffusers 函数的一种分配是: dim_t = embed_dim // 4 # 时间轴,占 25% dim_h = embed_dim // 8 * 3 # 高,占 37.5% dim_w = embed_dim // 8 * 3 # 宽,占 37.5% 这个 2:3:3 的分配是 CogVideoX 相关函数的一种维度预算,不能推广为所有视频模型的配置。各轴必须有可配对的偶数维度,需核对具体函数对 head_dim 的限制;64 维时是 16/24/24。CPU 原函数用时间 2、高 2、宽 3 的小网格,返回 cos/sin 均为 (12,64)。空间坐标还受 grid_type、裁剪范围和插值设置影响,不能只看 token 数。不能从空间占 75%、时间占 25% 推断哪个轴更先失败或失败症状;需结合训练范围、每轴频率和实际消融。详见3D RoPE。 06. 代价与边界 6.1 数学性质不替代外推验证 固定频率、单位幅度时,共同平移不变性对任意可计算的位置都成立,但不会自动保证超出训练长度后的质量。真实模型学到的是内容与多频段相位、掩码、上下文长度的联合关系;逐个频段的角度还具有周期性。“未展开相位超出训练最大值”不是充分的失败判据。PI 论文展示的是特定模型及适配训练结果,不能简化成只换公式就普遍无损。 6.2 三种不同的“衰减”要分清 第一种量是独立各向同性高斯 $q,k$ 的内积分布。正交旋转后 $R_\Delta k$ 与 $k$ 同分布且仍独立于 $q$,所以整个分布不变。rope_decay.py 的 2000 次独立采样给出绝对内积均值: 不加 RoPE 6.2076 gap=1 6.3182 gap=64 6.2415 gap=1024 6.2583 gap=4000 6.4830 这些数的波动来自有限采样,不能据某一个值略高或略低得出趋势;也不能把各向同性高斯的结论套到所有输入上。 第二种量是固定相似向量的分数。例如 $q=k$ 时,第 $i$ 对的交叉项抵消,得到: $$q^\top R_\Delta q=\sum_i(q_{2i}^2+q_{2i+1}^2)\cos(\Delta\theta_i)$$ 全 1、64 维向量在 gap=0/1/16/64/1024/4000 时依次为 64、61.8337、38.7456、27.8122、16.8272、0.0989。seed=7 的所选随机自配对向量从 50.96 降至约 0.97,也会在部分距离回升。有限采样点的下降不是普遍衰减定律:只打开第 0 个坐标、其余置零,分数就是 $\cos\Delta$,gap=0/3/6 为 1、−0.989992、0.960170。距离增加,分数可以回升、变负,再接近原值;这个整数坐标反例由 rope_validation.py 实跑。 第三种量是图 3 的与未旋转分数的相关性。对独立标准高斯输入,令 $S_\Delta=q^\top R_\Delta k$、$S_0=q^\top k$,均值都为 0。展开求和并用 $E[q_aq_b]=E[k_ak_b]=\delta_{ab}$,只留下相同索引的项,所以: $$\operatorname{Cov}(S_\Delta,S_0)=\operatorname{tr}(R_\Delta)=2\sum_i\cos(\Delta\theta_i),\quad \operatorname{Var}(S_\Delta)=\operatorname{Var}(S_0)=d$$ $$\operatorname{corr}(S_\Delta,S_0)=\frac{2}{d}\sum_i\cos(\Delta\theta_i)$$ 这个相关系数下降不代表分数幅度下降。独立核验 seed=19、20000 对向量、gap=64,理论值 0.434565,样本值 0.425446;样本误差不应伪装成精确相等。有限余弦和可能振荡,也没有这里所证明的“无穷远必趋零”性质。原 RoFormer §3.4.3 还用 Abel 求和讨论上界。令 $M=d/2$、$a_i=q_i^{\mathbb C}\overline{k_i^{\mathbb C}}$(即第 $i$ 对坐标的复数乘积)、$a_M=0$,并令 $S_j=\sum_{i=0}^{j-1}e^{\mathrm{i}(m-n)\theta_i}$,这里 $\mathrm{i}$ 是虚数单位: $$\left|\sum_{i=0}^{M-1}a_i e^{\mathrm{i}(m-n)\theta_i}\right|=\left|\sum_{j=1}^{M}S_j(a_{j-1}-a_j)\right|\leq\max_{1\leq j\leq M}|a_{j-1}-a_j|\sum_{j=1}^{M}|S_j|$$ 它把内容系数的变化与部分相位和分开;上界的示意行为不等于每对输入的实际分数都单调下降。rope_validation.py 独立核验这个恒等变形和不等式。原文的分析、本文的相关性和固定向量分数需要分别阅读,也不能据此把真实视频身份漂移归因给 RoPE。 6.3 相对位置不排除绝对锚点 RoPE 用绝对坐标产生旋转,固定内容的成对点积才只依赖差值。若有固定在位置 0 的 BOS、首帧或条件 token,那么“到锚点的相对距离”已经提供位置线索。因果掩码、边界和其他条件也可能提供线索;这不等于模型必然学会准确计数。需要指定时间戳或特殊首帧时,应确认坐标、掩码和条件机制如何共同表达任务,而不能简单断言 RoPE 无法表达绝对位置。 6.4 算术很少,不等于运行开销永远很少 统一口径:一次乘法加一次加法计 2 FLOPs,batch=1、$N=90000$、$H=24$ 个 query/key 头、head_dim $d=64$、$L=40$ 层,Q 和 K 都全维旋转,非 GQA。每个二维平面做 4 乘 2 加,即每个向量 $3d$ FLOPs: $$F_{\text{RoPE}}=6LNHd=33.1776\;\text{GFLOPs}$$ 同口径下,完整双向稠密注意力的两个矩阵乘 $QK^\top$ 和 $AV$ 共计: $$F_{\text{attention}}=4LHN^2d=1990.656\;\text{TFLOPs}$$ 旋转算术占比约 0.001667%。原文的 995.3 是这两个矩阵乘的 TMAC 近似量,不能直接写成 TFLOPs 再与旋转 FLOPs 相除。这里只数上述主项,不含线性投影、softmax、掩码、三角函数和访存;因果有效三角区域也不能照抄完整方阵预算。 cos/sin 按半维各存一张 FP32 表时是 $Nd\times4=23040000$ bytes,约 21.97 MiB;铺满 dim 是 46080000 bytes,约 43.95 MiB,BF16 存储再减半。这是可选预计算布局,不是所有实现都分配这张表;频率、坐标及 dtype 相同时才可共享。 独立旋转 kernel 还要读写 Q/K。FP16 下,仅读写这两者一次的理想最低数据量为 $4NHd\times2=1105920000$ bytes/层,未算表和中间张量;融合可减少额外往返。增量解码的新 query 对历史 cache 做注意力时,算量比例也不同于训练的整块 $N^2$。因此短序列、长 cache、kernel launch、融合、内存布局都要实际 profiling,不能从这笔 FLOPs 账得出“选 RoPE 从来不是性能问题”。 什么时候考虑其他方案:任务是否需要相对关系、模型是否已有训练好的位置机制、目标长度与硬件约束,决定采用或保留哪种方案。固定短序列仍可能从 RoPE 获益;也不能把“训练短、推理长”当成它唯一的价值。 07. 经典论文脉络 这里按问题串联,不把不同机制压成“都只改同一组频率”: RoFormer: Enhanced Transformer with Rotary Position Embedding(2021-04):引入 RoPE,用旋转构造相对位置点积。原文还讨论长距离行为;阅读时要区分它分析的量与本文三种数值统计。 Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation(ALiBi,2021-08):直接在分数上加距离偏置,是另一类位置机制;论文外推结果针对所测语言模型,不能泛化成所有任务更强。 A Length-Extrapolatable Transformer(xPos,2022-12):除了讨论注意力分辨率,还提出带尺度因子的 xPos 机制;不能概括成只提供评价指标,也不属于本文单位幅度纯旋转。 Extending Context Window of Large Language Models via Position Interpolation(PI,2023-06):缩小坐标后做适配训练;坐标插值的几何推导与论文模型的长上下文结果要分开。 YaRN: Efficient Context Window Extension of Large Language Models(2023-08,本文核对 v2):结合按频段的调整与注意力温度修正。它不是只换 base;本文没有复现其质量实验。 7.1 视频侧这条支线 Scalable Diffusion Models with Transformers(DiT,2022-12):原模型采用固定 2D sincos 绝对位置嵌入。它能用公式产生位置编码;这和前文“学出来的一张有限位置表”不同。改变分辨率后的质量也需验证。 CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer(2024-08):把三维位置编码放进视频模型;5.6 节是选定 Diffusers 函数的具体对照。 HunyuanVideo: A Systematic Framework For Large Video Generative Models(2024-12):原文明确把 Q/K 特征按时间、高、宽拆成三段,分别注入坐标。Wan: Open and Advanced Large-Scale Video Generative Models(2025-03)则提供另一个视频 DiT 架构例子,其报告 §4.2 的 VAE 压缩与 (1,2,2) patchify 正好可对照第 01 节的尺寸账本;这里不把该报告当成具体 RoPE 频率配置的证据。轴维度、base、坐标与训练范围应分别查对应实现,不能据几个例子宣布所有视频 DiT 都采用同一配置。 语言侧的插值思路可以成为视频各轴的候选策略,但不代表全部外推方法可直接无损移植。对 01 节的网格,时间/高/宽的长度比是 25/13、45/30、80/52;若按末坐标精确对齐则是 24/12、44/29、79/51。先决定每轴的坐标约定,再做模型消融与质量验收;总 token 数比 90000/20280 不应直接作为三个轴共同的插值系数。 08. 常见误解 「RoPE 是加在 embedding 上的」。 不是。它作用在每一层注意力的 $q$、$k$ 上,而且是乘法(旋转)。$v$ 在本文与常用实现里不旋转;存在其他变体,不能把所有旋转 value 的方案都判为错误。把它当成输入层的一次性操作,是最常见的理解错误。 「调大 rope_theta 就能延长上下文」。 公式能算到新位置,不保证质量。调大 base 不改最高频 $\theta_0=1$,其他组按不同幅度减慢;不能说所有高频一起降速,也不能由几何比例推出短距离任务必然下降。要说明固定还是动态策略、训练或适配条件,以及缓存如何处理。 「相对位置不变性意味着模型对绝对位置完全无感」。 不成立。注意力有 causal mask,第 0 个 token 只能看到自己,第 100 个能看到 100 个——这种「可见范围」本身就泄露了绝对位置。研究里管这叫隐式位置信息。 「间距相同分数就一定相同」。 还必须固定同一对内容向量 q、k;真实模型里的它们也会随上下文变化。真实模型里中间还夹着 softmax 归一化和 causal mask,同一对 token 在不同上下文里拿到的注意力权重是不同的。04 节验证的是旋转这一步的数学性质,不是整个注意力层的行为。 「RoPE 自带远程衰减」需要限定输入与统计口径。 独立各向同性高斯输入的内积分布不随旋转改变;所选相似向量可能在某些距离明显降低、在另一些距离回升。示例不是普遍衰减定律,也不能单独证明长视频质量的因果关系。 09. 动手验证 四组不需要模型权重的 CPU 小实验,用到的脚本全文都在文末附录,除绘图需要 matplotlib 外,下面的教学数值脚本只依赖 NumPy,复制存成同名文件即可运行。新增 rope_validation.py 还需把它导入的三个同目录脚本一并保存。官方源码 CPU 对照另在本地质检证据中记录,不是读者运行这组实验的依赖。另外跑一遍 make_figures.py 可以把本文三张配图重新生成(这个需要 matplotlib,其余脚本只要 NumPy)。 实验一:看外推在哪一步崩。 跑 rope_minimal.py,把 seq_len 从 8 改成 4096,然后对比位置 (0, 1) 和位置 (4000, 4001) 的内积。预期结果是两者在浮点误差内相等——因为固定频率的数学性质对任意位置都成立。这只能说明该性质并未失效,不能单凭它诊断真实模型外推失败的原因。这是本文最容易被误解的一点,值得亲手确认一次。 实验二:验证配对方式不能混用。 跑 rope_pairing.py,观察第 2、3 段输出。预期看到同一份权重下两种配对差 5.34,而重排维度后差值精确为 0。把 dim 改成 128 再跑一次,结论不变——这是结构性的,与维度大小无关。 实验三:亲手推翻一个常识。 跑 rope_decay.py,重点看 2a 和 2b 的差别。预期看到独立各向同性高斯输入的绝对内积均值只在采样误差内波动;全 1 自配对向量在所选 gap=4000 点下降约 99.8%,这不是所有 $q=k$ 都如此。再跑 rope_validation.py,看单频反例从 gap=3 的 −0.989992 回升到 gap=6 的 0.960170,并核对相关性公式。然后把 2b 里的向量换成两个弱相关的向量试试(比如 k = 0.5 * q + 0.5 * rng.standard_normal(dim)),看衰减幅度怎么随相似度变化——这是理解 06 节那笔账的最快路径。 实验四:给自己的模型算外推预算。 跑 rope_extrapolate.py,把 SCALE 从 8 改成某一个轴按指定坐标规则计算出的倍数(第 7.1 节给出三轴示例),看 PI 和 NTK 各自在近距离分辨率上要付多少。预期规律是 PI 的保留率恒等于 $1/\text{scale}$,而 NTK 的保留率在高频维度接近 1、随维度下降。这些频率变化只能说明位置编码的几何差异,不能直接预测生成质量。如果任务依赖纹理、口型等近距离细节,应在目标分辨率上比较 PI、NTK 与必要的适配训练,结合质量和长距离一致性决定方案。 10. 延伸阅读 读这篇之前建议先看: 自注意力机制的计算与显存账本——RoPE 作用在 $q$、$k$ 上,得先清楚它们在注意力里的位置 读完这篇可以继续看: 视频 DiT 里的 3D RoPE 与分辨率外推——5.6 节那个 1:1.5:1.5 的示例维度分配,以及分辨率和帧数变化如何分别影响各轴相位 FlashAttention 为什么不需要存下注意力矩阵——RoPE 之后紧接着的那一步计算 附录:完整代码 09 节用到的脚本全文如下(make_figures.py、rope_validation.py、rope_decay.py、rope_minimal.py、rope_extrapolate.py、rope_pairing.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「旋转位置编码 RoPE」的三张解释图。 数值全部来自同目录的三个脚本(rope_minimal / rope_extrapolate / rope_decay), 这里只负责画——改了那边这里要重跑,免得图和正文数字打架。 三张图分别回答: 1. 32 个频率是怎么分层铺在 64 维上的(高频相位在近距离变化更快) 2. PI 与 NTK-aware 把这 8 倍外推的代价分别摊到了哪些频段 3. 「相对位置不变」和「随距离衰减」在数值上长什么样 只依赖 numpy + matplotlib。跑法:python make_figures.py """ import textwrap from pathlib import Path import matplotlib.pyplot as plt import numpy as np import rope_decay as RD import rope_extrapolate as RE ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.bbox": "tight", }) INK = "#1f2937" MUTE = "#6b7280" C_ORIG = "#2f6fb0" # 原始 RoPE:蓝 C_PI = "#d1495b" # PI:红 C_NTK = "#2f9e6f" # NTK-aware:绿 C_BAD = "#d1495b" C_OK = "#2f9e6f" def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left") if xlabel: ax.set_xlabel(xlabel, fontsize=10, color=MUTE) if ylabel: ax.set_ylabel(ylabel, fontsize=10, color=MUTE) ax.tick_params(colors=MUTE, labelsize=9) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#d1d5db") ax.grid(alpha=0.25, linewidth=0.6) ax.set_axisbelow(True) def footer(fig, text, width=118): """把「这张图要看什么」放到坐标轴下方。 必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来, 放在 0~0.05 之间的话会和 x 轴标签叠在一起。 """ wrapped = "\n".join(textwrap.wrap(text, width=width)) fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE, va="top", ha="left", linespacing=1.6) # ────────────────────────────────────────────────────────────────────── # 图 1:32 个频率怎么分层铺在 64 维上 # ────────────────────────────────────────────────────────────────────── def fig_freq_layers(): dim = RE.DIM th = RE.theta_original() # [dim/2] pos_short = np.arange(0, 256) pos_long = np.arange(0, 32768, 8) cos_short = np.cos(np.outer(pos_short, th)) # [256, dim/2] phase_long = np.outer(pos_long, th) # 累积相位(不取模) fig, axes = plt.subplots(1, 2, figsize=(12.8, 4.4)) fig.subplots_adjust(wspace=0.42) ax = axes[0] im = ax.imshow(cos_short.T, aspect="auto", origin="lower", cmap="RdBu_r", vmin=-1, vmax=1, extent=[0, len(pos_short), -0.5, len(th) - 0.5]) ax.set_yticks([0, 8, 16, 24, 31]) cb = fig.colorbar(im, ax=ax, fraction=0.035, pad=0.02) cb.ax.tick_params(labelsize=8, colors=MUTE) cb.set_label(r"$\cos(m\theta_i)$", fontsize=9, color=MUTE) style(ax, "近距离(0~255):前 13 组完成至少一圈", "位置 m", "维度组 i") # 在 256 个位置内转满一整圈(2π)的维度组数 n_moving = int((pos_short[-1] * th / (2 * np.pi) >= 1).sum()) ax.annotate(f"256 长度内转满一整圈的只有前 {n_moving} 组", xy=(128, n_moving - 1), xytext=(12, n_moving + 7), fontsize=8.5, color="white", fontweight="bold", arrowprops=dict(arrowstyle="->", color=MUTE, lw=0.9)) ax = axes[1] for i, c in zip([0, 4, 8, 16, 24, 31], ["#1f6feb", "#2f9e6f", "#e0a03c", "#d1495b", "#8b5cf6", "#6b7280"]): ax.plot(pos_long, phase_long[:, i], lw=1.8, color=c, label=f"i={i}") trained = (RE.TRAIN_LEN - 1) * th[0] ax.axhline(trained, color=INK, ls="--", lw=1.2) ax.text(600, trained * 1.35, f"最高频训练最大相位 {trained:.0f} rad", fontsize=8.5, color=INK) ax.set_xscale("log") ax.set_yscale("log") ax.legend(fontsize=8.5, frameon=False, loc="upper left", ncol=3) style(ax, "远距离(到 32768):各频段的累积相位", "位置 m(对数轴)", r"累积相位 $m\theta_i$(rad,对数轴)") fig.suptitle("图 1 RoPE 把 64 维切成 32 组,从「每步 1 弧度」一路排到「每步约 1.33e-4 弧度」", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "左图:0 到 255 的相位差中,只有前 13 组超过一整圈;低频也有非零相位变化。" "右图:不同频率提供不同尺度,不是互斥的距离分工。虚线只代表最高频的训练相位上限;" "每个频段的训练相位上限都不同。") fig.savefig(OUT / "rope_freq_layers.png") plt.close(fig) print(f"[图1] 相位变化>=2π 的维度组数(0→255): {n_moving}/{len(th)}") # ────────────────────────────────────────────────────────────────────── # 图 2:PI 与 NTK-aware 把 8 倍外推的代价摊在哪 # ────────────────────────────────────────────────────────────────────── def fig_extrapolation(): t_orig, t_pi, t_ntk = (RE.theta_original(), RE.theta_pi(), RE.theta_ntk()) idx = np.arange(len(t_orig)) slow_pi = t_orig / t_pi slow_ntk = t_orig / t_ntk keep_pi = t_pi / t_orig * 100 keep_ntk = t_ntk / t_orig * 100 fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.3)) ax = axes[0] ax.plot(idx, slow_pi, color=C_PI, lw=2.4, label=r"PI:各维一律减速 8.00x") ax.plot(idx, slow_ntk, color=C_NTK, lw=2.0, label=r"NTK-aware:1.00x $\to$ 8.00x") ax.fill_between(idx, slow_ntk, slow_pi, color=C_PI, alpha=0.10) ax.set_yscale("log") ax.set_yticks([1, 2, 4, 8]) ax.yaxis.set_minor_formatter(plt.NullFormatter()) ax.get_yaxis().set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}x")) ax.legend(fontsize=9, frameon=False, loc="center right") style(ax, "谁被减速了多少(对数轴)", "维度组 i", r"$\theta_i^{\mathrm{orig}} / \theta_i^{\mathrm{new}}$") ax = axes[1] ax.plot(idx, keep_pi, color=C_PI, lw=2.4, label="PI:全线只剩 12.5%") ax.plot(idx, keep_ntk, color=C_NTK, lw=2.0, label=rf"NTK:{keep_ntk[0]:.0f}% $\to$ {keep_ntk[16]:.1f}%(i=16)") ax.fill_between(idx, keep_pi, keep_ntk, color=C_NTK, alpha=0.10) ax.axhline(100, color=MUTE, ls=":", lw=1.0) ax.set_yscale("log") ax.set_yticks([10, 20, 50, 100]) ax.get_yaxis().set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}%")) ax.legend(fontsize=9, frameon=False, loc="lower left") style(ax, "代价:相邻 token 的相位步长还剩多少", "维度组 i", r"$\theta_i^{\mathrm{new}} / \theta_i^{\mathrm{orig}}$") fig.suptitle("图 2 PI 把减速平均分给每一维,NTK 从高频不压缩逐渐过渡到低频压缩 8 倍", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图 PI 是一条平线(每维都慢 8 倍),NTK 从最高频的 1.00x 单调爬到" "最低频的 8.00x。右图是这个分配的代价——PI 把每一维的相位步长都砍到 12.5%," "这只是相位步长,不能直接预测任务质量;NTK 保住高频(100%),最低频与 PI 同为 12.5%。" "两者改的是同一组 theta,区别只在把代价放在哪个频段。") fig.savefig(OUT / "rope_extrapolation.png") plt.close(fig) print(f"[图2] NTK 减速比: i=0 {slow_ntk[0]:.2f}x -> i=31 {slow_ntk[-1]:.2f}x;" f"相位步长保留 i=16: PI {keep_pi[16]:.1f}% / NTK {keep_ntk[16]:.1f}%") # ────────────────────────────────────────────────────────────────────── # 图 3:相对位置不变 + 随距离衰减 # ────────────────────────────────────────────────────────────────────── def fig_relativity(): dim, seq_len = 64, 8192 cos, sin = RD.build_rope_cache(seq_len, dim) rng = np.random.default_rng(0) # ── 左:同一对 q,k,只平移绝对位置,内积应当逐点不变 ── q = rng.standard_normal(dim) k = rng.standard_normal(dim) gaps = np.arange(0, 512) starts = [0, 500, 2000] curves = {} for s in starts: qr = RD.apply_rope(q[None, :], cos[s:s + 1], sin[s:s + 1])[0] kr_all = RD.apply_rope( np.repeat(k[None, :], len(gaps), 0), cos[s:s + len(gaps)], sin[s:s + len(gaps)]) curves[s] = kr_all @ qr # ── 右:距离越远,RoPE 把「无位置编码的原始内积」改写得多彻底 ── # 独立各向同性高斯输入:corr(q^T R_gap k, q^T k) = (2/dim) Σ_i cos(gap θ_i)。 # 注意:这是「与原始内积的相关性」衰减,不是内积的绝对值变小—— # 独立各向同性高斯输入的内积分布与距离无关(RMS 为 sqrt(dim))。 Q = rng.standard_normal((4000, dim)) K = rng.standard_normal((4000, dim)) s0 = np.einsum("ij,ij->i", Q, K) th = 1.0 / (10000.0 ** (np.arange(0, dim, 2) / dim)) probe = np.unique(np.round(np.geomspace(1, 4096, 60)).astype(int)) emp, theo = [], [] for g in probe: qr = RD.apply_rope(Q, cos[0:1], sin[0:1]) kr = RD.apply_rope(K, cos[g:g + 1], sin[g:g + 1]) sg = np.einsum("ij,ij->i", qr, kr) emp.append(float(np.corrcoef(sg, s0)[0, 1])) theo.append(float(2.0 / dim * np.sum(np.cos(g * th)))) fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.3)) ax = axes[0] cols = {0: C_ORIG, 500: C_NTK, 2000: "#e0a03c"} for s in starts: ax.plot(gaps, curves[s], lw=1.6, color=cols[s], label=f"绝对起点 {s}") ax.legend(fontsize=9, frameon=False, loc="upper right") style(ax, "同一对向量、同一组间距,换绝对位置后曲线完全重合", "相对距离 (n-m)", r"$q^\top R_{n-m} k$") ax = axes[1] ax.plot(probe, emp, marker="o", ms=3.5, lw=1.8, color=C_ORIG, label="实测(4000 对随机向量)") ax.plot(probe, theo, lw=1.4, ls="--", color=C_BAD, label=r"理论 $\frac{2}{D}\sum_i\cos(\Delta\theta_i)$") ax.axhline(0, color=MUTE, ls=":", lw=1.0) ax.set_xscale("log") ax.legend(fontsize=9, frameon=False, loc="upper right") style(ax, "独立高斯输入:与原始内积的相关性随距离振荡", "相对距离(对数轴)", r"$\mathrm{corr}(q^\top R_{\Delta} k, q^\top k)$") fig.suptitle("图 3 固定内容的相对位置不变性,与高斯输入下的分数相关性", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) max_dev = max(float(np.abs(curves[s] - curves[0]).max()) for s in starts) footer(fig, f"左图:固定 q/k 的三条曲线在浮点误差内重合,最大偏差 {max_dev:.1e},不是逐比特相等。" "右图:D=64、Δ 为间距,理论相关性是有限余弦和;它会振荡,不保证单调或在无穷远趋于零。" "本图的独立各向同性高斯输入下,内积分布不随旋转改变。") fig.savefig(OUT / "rope_relativity.png") plt.close(fig) print(f"[图3] 不同绝对起点的最大逐点偏差: {max_dev:.2e};" f"corr: d=1 {emp[0]:.3f} → d={probe[-1]} {emp[-1]:.3f}") def main(): fig_freq_layers() fig_extrapolation() fig_relativity() print(f"[OK] 三张图已写入 {OUT}") for f in sorted(OUT.glob("*.png")): print(f" {f.name} {f.stat().st_size / 1024:.0f} KB") if __name__ == "__main__": main() rope_validation.py """RoPE 独立数学核验与反例;只需 NumPy,运行 python rope_validation.py。""" import json from pathlib import Path import numpy as np from rope_minimal import build_rope_cache, apply_rope from rope_extrapolate import theta_original, theta_pi, theta_ntk from rope_pairing import rope_interleaved, rope_half_split, interleave_to_half def validate(): rng = np.random.default_rng(19) dim = 64 q, k = rng.normal(size=(2, dim)) th = theta_original(dim) def rotate(x, p): angle = p * th return apply_rope(x, np.cos(angle), np.sin(angle)) m, n = 127, 4021 actual = float(rotate(q, m) @ rotate(k, n)) relative = float(q @ rotate(k, n - m)) zq, zk = q[0::2] + 1j*q[1::2], k[0::2] + 1j*k[1::2] complex_score = float(np.real(np.sum(zq*np.conj(zk)*np.exp(1j*(m-n)*th)))) assert max(abs(actual-relative), abs(actual-complex_score)) < 1e-11 # Abel summation: a finite upper bound does not assert monotonic scores. a = zq*np.conj(zk) a_next = np.concatenate((a[1:], [0])) partial = np.cumsum(np.exp(1j*(m-n)*th)) abel = np.sum(partial*(a-a_next)) direct = np.sum(a*np.exp(1j*(m-n)*th)) assert abs(abel-direct) < 1e-11 abel_bound = float(np.max(abs(a-a_next))*np.sum(abs(partial))) assert abs(direct) <= abel_bound cq, sk = build_rope_cache(8192, dim) assert abs(np.linalg.norm(apply_rope(q, cq[4096], sk[4096]))-np.linalg.norm(q)) < 1e-12 perm_error = max(float(np.max(np.abs(interleave_to_half(rope_interleaved(q,p,dim))-rope_half_split(interleave_to_half(q),p,dim)))) for p in [0,1,127,4096]) assert perm_error < 1e-12 # Independent exact moment calculation: Cov(q^T R k,q^T k)=tr(R), Var=d. gap = 64 rot = np.column_stack([rotate(v, gap) for v in np.eye(dim)]) trace_correlation = float(np.trace(rot)/dim) formula_correlation = float(2*np.cos(gap*th).sum()/dim) assert abs(trace_correlation-formula_correlation) < 1e-14 Q, K = rng.normal(size=(2, 20000, dim)) scores0 = np.einsum('ij,ij->i', Q, K) sg = np.einsum('ij,ij->i', Q, apply_rope(K,cq[gap],sk[gap])) corr = float(np.corrcoef(scores0,sg)[0,1]) assert abs(corr-formula_correlation) < .03 # One active plane: scores return upward at integer gap 6; no universal decay. one = np.zeros(dim);one[0] = 1 counter = {str(p): float(one@rotate(one,p)) for p in [0,3,6]} assert counter['6'] > .95 and counter['3'] < -.98 # A fixed key at coordinate 0 is an anchor; translating only q changes its score. anchor = {str(p): float(rotate(one,p)@one) for p in [0,1,2]} assert anchor['0'] != anchor['1'] s = 8 pi, ntk = theta_pi(scale=s), theta_ntk(scale=s) expected_ntk = th*s**(-2*np.arange(dim//2)/(dim-2)) assert np.allclose(ntk,expected_ntk,rtol=1e-14,atol=0) exact_scale = (32768-1)/(4096-1) endpoint = (32768-1)/exact_scale assert endpoint == 4095 # Standalone accounting: multiply+add=2 FLOPs; full QK^T and AV, no masks. N,H,d,L = 90000,24,64,40 rotation = 6*N*H*d*L attention = 4*N*N*H*d*L results = dict(sign_identity_abs=max(abs(actual-relative),abs(actual-complex_score)), abel_identity_abs=float(abs(abel-direct)),abel_bound=abel_bound, pairing_vector_max_abs=perm_error,lowest_frequency=float(th[-1]),lowest_period=float(2*np.pi/th[-1]), gaussian_correlation=dict(samples=20000,seed=19,gap=gap,theory=formula_correlation,empirical=corr), nonmonotonic_counterexample=counter,fixed_anchor_scores=anchor, ntk_lowest_retention=float(ntk[-1]/th[-1]),pi_highest_retention=float(pi[0]/th[0]), exact_endpoint_scale=exact_scale,exact_endpoint=endpoint, video=dict(train_grid=[13,30,52],target_grid=[25,45,80],train_tokens=13*30*52,target_tokens=25*45*80, axis_length_ratios=[25/13,45/30,80/52],axis_endpoint_ratios=[24/12,44/29,79/51]), cost=dict(rotation_flops=rotation,dense_attention_flops=attention,rotation_percent=100*rotation/attention, half_table_bytes=N*d*4,full_table_bytes=2*N*d*4,qk_fp16_min_read_write_per_layer_bytes=4*N*H*d*2), environment=dict(numpy=np.__version__,dtype='float64',hardware='CPU'),passed=True) return results if __name__ == '__main__': result = validate() print(json.dumps(result,ensure_ascii=False,indent=2)) Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8') rope_decay.py """观测 RoPE 的两个常被口头断言、但很少有人实测的性质。 1. 旋转不改变模长(对比加法式绝对位置嵌入) 2. 所选输入的内积随距离变化;并非普遍衰减定律 运行 `python rope_decay.py` 复现。 """ import numpy as np def build_rope_cache(seq_len, dim, base=10000.0): inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim)) freqs = np.outer(np.arange(seq_len), inv_freq) return np.cos(freqs), np.sin(freqs) def apply_rope(x, cos, sin): out = np.empty_like(x) out[..., 0::2] = x[..., 0::2] * cos - x[..., 1::2] * sin out[..., 1::2] = x[..., 0::2] * sin + x[..., 1::2] * cos return out def demo_norm_preserved(rng, dim=64, seq_len=512): """旋转保模长,加法不保。""" cos, sin = build_rope_cache(seq_len, dim) x = rng.standard_normal(dim) print("=== 1. 模长是否被位置编码改变 ===") print(f" 原始向量模长 {np.linalg.norm(x):.6f}") norms = [np.linalg.norm(apply_rope(x[None, :], cos[p:p + 1], sin[p:p + 1])) for p in (0, 1, 100, 511)] print(f" RoPE 后(位置 0/1/100/511) " f"{' '.join(f'{n:.6f}' for n in norms)}") print(f" 跨位置模长极差 {max(norms) - min(norms):.2e}") # 加法式绝对位置嵌入:同尺度的可学习向量直接相加 pe = rng.standard_normal((seq_len, dim)) add_norms = [np.linalg.norm(x + pe[p]) for p in (0, 1, 100, 511)] print(f" 加法式 PE 后 " f"{' '.join(f'{n:.6f}' for n in add_norms)}") print(f" 跨位置模长极差 " f"{max(add_norms) - min(add_norms):.4f} ← 同一个 token 的模长被位置改写了") def _score(cos, sin, q, k, gap): qr = apply_rope(q[None, :], cos[0:1], sin[0:1]) kr = apply_rope(k[None, :], cos[gap:gap + 1], sin[gap:gap + 1]) return float(qr[0] @ kr[0]) GAPS = (1, 4, 16, 64, 256, 1024, 4000) def demo_long_range_decay(rng, dim=64, seq_len=4096, trials=2000): """「RoPE 自带远程衰减」到底成不成立——分两种输入分布看。 结论:本文独立各向同性高斯 q/k 的内积分布不变;所选 q=k 示例会振荡。 """ cos, sin = build_rope_cache(seq_len, dim) print("\n=== 2a. 随机无关的 q/k:取 |内积| 均值 ===") baseline = float(np.mean([abs(float(rng.standard_normal(dim) @ rng.standard_normal(dim))) for _ in range(trials)])) print(f" 不加 RoPE {baseline:.4f} (基线)") for gap in GAPS: m = float(np.mean([abs(_score(cos, sin, rng.standard_normal(dim), rng.standard_normal(dim), gap)) for _ in range(trials)])) print(f" 相对距离 {gap:>5} {m:.4f} ({m / baseline * 100:5.1f}% of 基线)") print(" → 没有衰减趋势。独立各向同性高斯输入在正交旋转下分布不变。") print("\n=== 2b. q = k(高度相似的一对 token)===") for name, vec in (("全 1 向量", np.ones(dim)), ("某个随机向量", np.random.default_rng(7).standard_normal(dim))): # gap=0 时位置 0 的旋转角为 0,内积就是未加 RoPE 的原值 head = _score(cos, sin, vec, vec, 0) print(f" {name}(gap=0 时内积 {head:.2f}):") for gap in GAPS: s = _score(cos, sin, vec, vec, gap) print(f" 相对距离 {gap:>5} {s:+9.4f} ({s / head * 100:5.1f}% of gap=0)") print(" → 这些采样点多低于 gap=0,也有回升;不代表任意输入或距离都衰减。") if __name__ == "__main__": demo_norm_preserved(np.random.default_rng(0)) demo_long_range_decay(np.random.default_rng(1)) rope_minimal.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """RoPE 的最小可运行实现,验证「注意力分数只依赖相对位置」这一核心性质。 只依赖 numpy,直接 python rope_minimal.py 即可运行。 刻意不用 PyTorch:讲原理时框架的抽象反而是噪声,而且 numpy 谁都能跑。 生产实现见文章第 05 节对 transformers 的引用。 """ import numpy as np def build_rope_cache(seq_len: int, dim: int, base: float = 10000.0): """预计算 RoPE 的 cos/sin 表。 dim 必须是偶数:每两个相邻维度配成一个复数参与旋转。 base 就是常说的 rope_theta,调它会按维度改变旋转速度;最高频 i=0 始终为 1。 """ assert dim % 2 == 0, f"dim 必须为偶数,收到 {dim}" # theta_i = base^(-2i/dim):i 越大转得越慢,对应越低的频率 inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim)) pos = np.arange(seq_len) freqs = np.outer(pos, inv_freq) # [seq_len, dim/2] return np.cos(freqs), np.sin(freqs) def apply_rope(x: np.ndarray, cos: np.ndarray, sin: np.ndarray) -> np.ndarray: """把旋转作用到 x 上。x: [seq_len, dim] 最后一维两两配对看成复数 (x_even + i*x_odd),乘上 e^{i*m*theta}: 实部 = x_even * cos - x_odd * sin 虚部 = x_even * sin + x_odd * cos """ x_even, x_odd = x[..., 0::2], x[..., 1::2] out = np.empty_like(x) out[..., 0::2] = x_even * cos - x_odd * sin out[..., 1::2] = x_even * sin + x_odd * cos return out if __name__ == "__main__": rng = np.random.default_rng(0) seq_len, dim = 8, 64 cos, sin = build_rope_cache(seq_len, dim) print(f"cos/sin 形状: {cos.shape} {sin.shape}") print(f"位置 1 的前 4 维 cos: {np.round(cos[1, :4], 4).tolist()}") print(f"位置 1 的末 2 维 cos: {np.round(cos[1, -2:], 6).tolist()}") # 固定一对向量,只改赋予它们的绝对位置,间距始终为 1 q = rng.standard_normal(dim) k = rng.standard_normal(dim) print("\n同一对向量,平移绝对位置(间距恒为 1):") for shift in range(4): qr = apply_rope(q[None, :], cos[shift:shift + 1], sin[shift:shift + 1]) kr = apply_rope(k[None, :], cos[shift + 1:shift + 2], sin[shift + 1:shift + 2]) print(f" 位置 ({shift}, {shift + 1}) → 内积 {float(qr[0] @ kr[0]):.6f}") print("\n对照组,改变间距:") for gap in (1, 2, 3): qr = apply_rope(q[None, :], cos[0:1], sin[0:1]) kr = apply_rope(k[None, :], cos[gap:gap + 1], sin[gap:gap + 1]) print(f" 间距 {gap} → 内积 {float(qr[0] @ kr[0]):.6f}") print(f"\n未加 RoPE 的原始内积: {float(q @ k):.6f}") rope_extrapolate.py """两种长度外推方法(PI / NTK-aware)到底改了什么。 结论先说:它们改的是同一组 theta_i,区别只在「怎么分配这次减速」。 运行 `python rope_extrapolate.py` 复现。 """ import numpy as np DIM = 64 BASE = 10000.0 TRAIN_LEN = 4096 # 训练时见过的长度 SCALE = 8 # 想外推到 8 倍,即 32768 def theta_original(dim=DIM, base=BASE): return 1.0 / (base ** (np.arange(0, dim, 2) / dim)) def theta_pi(dim=DIM, base=BASE, scale=SCALE): """Position Interpolation:位置索引整体除以 scale。 等价于把每个 theta_i 都乘上 1/scale——所有频率被同等减速。 """ return theta_original(dim, base) / scale def theta_ntk(dim=DIM, base=BASE, scale=SCALE): """NTK-aware:把 base 放大,让减速量随维度索引递增(频率越低减速越多)。 base' = base * scale^(d/(d-2)),于是高频维度几乎不受影响, 最低频维度与 PI 同样减速 scale 倍,其余维度的减速更少。 """ if dim <= 2 or dim % 2 or scale <= 0 or base <= 0: raise ValueError("NTK-aware requires even dim > 2, positive scale and base") new_base = base * scale ** (dim / (dim - 2)) return theta_original(dim, new_base) def main(): t_orig, t_pi, t_ntk = theta_original(), theta_pi(), theta_ntk() print("=== 1. 三种方案下各维度的旋转速度 theta_i ===") print(" 维度 i 原始 PI(÷8) NTK-aware PI减速比 NTK减速比") for i in (0, 1, 4, 8, 16, 24, 31): print(f" {i:>4} {t_orig[i]:.3e} {t_pi[i]:.3e} {t_ntk[i]:.3e}" f" {t_orig[i] / t_pi[i]:>7.2f}x {t_orig[i] / t_ntk[i]:>7.2f}x") print(f" → PI 对每一维都减速 {t_orig[0] / t_pi[0]:.2f}x(均匀);" f"NTK 从最高频的 {t_orig[0] / t_ntk[0]:.2f}x 递增到最低频的 " f"{t_orig[-1] / t_ntk[-1]:.2f}x(越低频压得越狠)") print("\n=== 2. 外推到 8 倍长度后,各方案在第 0 维(最高频)的相位 ===") target = TRAIN_LEN * SCALE trained_max = (TRAIN_LEN - 1) * t_orig[0] print(f" 训练时见过的最大相位(位置 {TRAIN_LEN - 1}) {trained_max:9.1f} rad") for name, th in (("原始(直接外推)", t_orig), ("PI", t_pi), ("NTK-aware", t_ntk)): v = (target - 1) * th[0] flag = ("落在训练区间内" if v <= trained_max else f"接近但略超训练端点 {trained_max:g}" if v <= trained_max * 1.01 else f"超出 {v / trained_max:.1f} 倍") print(f" {name:<18} 位置 {target - 1} {v:9.1f} rad ← {flag}") print(" → NTK 在最高频维度上「不作为」是刻意的,它保留高频相位步长,逐渐压缩更低频的相位步长") print("\n=== 3. 代价:相位步长还剩多少 ===") print(" (相邻位置差 1 时转过的角度,按维度看。越小表示单个频段角度变化更小;不直接代表任务质量)") print(" 维度 i 原始 PI NTK PI保留 NTK保留") for i in (0, 4, 8, 16): print(f" {i:>4} {t_orig[i]:.6f} {t_pi[i]:.6f} {t_ntk[i]:.6f}" f" {t_pi[i] / t_orig[i] * 100:5.1f}% {t_ntk[i] / t_orig[i] * 100:5.1f}%") print(f" → PI 在每一维都只保留 {t_pi[0] / t_orig[0] * 100:.1f}% 的相位步长;" f"NTK 在第 0 维保留 {t_ntk[0] / t_orig[0] * 100:.1f}%、" f"第 16 维只剩 {t_ntk[16] / t_orig[16] * 100:.1f}%。") print(" 两者都在同一组 theta 上做手脚,只是把代价放在了不同频段——" "\n YaRN 进一步把这个分配变成可调的分段策略。") if __name__ == "__main__": main() rope_pairing.py """对照 RoPE 的两种维度配对方式,并验证它们只差一个固定置换。 奇偶交错(本文最小实现):第 2i 维和第 2i+1 维配成一个复数 前后半切分(HuggingFace):第 i 维和第 i+d/2 维配成一个复数 结论先说:两者都满足相对位置不变性,但对同一份权重不可互换。 运行 `python rope_pairing.py` 复现下面的数值。 """ import numpy as np def rope_interleaved(x, pos, dim, base=10000.0): """奇偶交错配对:(x_0,x_1), (x_2,x_3), ... 每对是一个复平面。""" inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim)) ang = pos * inv_freq # [dim/2] cos, sin = np.cos(ang), np.sin(ang) out = np.empty_like(x) out[0::2] = x[0::2] * cos - x[1::2] * sin out[1::2] = x[0::2] * sin + x[1::2] * cos return out def rope_half_split(x, pos, dim, base=10000.0): """前后半切分配对:(x_i, x_{i+d/2})。等价于 HF 的 rotate_half 写法。 HF 把 cos/sin 表沿最后一维复制两遍(cat((freqs, freqs))), 于是 q*cos + rotate_half(q)*sin 展开后就是下面两行。 """ half = dim // 2 inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim)) ang = pos * inv_freq # [dim/2] cos, sin = np.cos(ang), np.sin(ang) x1, x2 = x[:half], x[half:] return np.concatenate([x1 * cos - x2 * sin, x2 * cos + x1 * sin]) def interleave_to_half(x): """把奇偶交错的排布重排成前后半切分的排布。 交错版的第 2i 维(复数实部)搬到前半的第 i 位, 第 2i+1 维(虚部)搬到后半的第 i 位。 """ return np.concatenate([x[0::2], x[1::2]]) def attn_score(rope_fn, q, k, m, n, dim): return float(rope_fn(q, m, dim) @ rope_fn(k, n, dim)) def main(): rng = np.random.default_rng(0) dim = 64 q = rng.standard_normal(dim) k = rng.standard_normal(dim) print("=== 1. 两种配对都满足相对位置不变性 ===") for name, fn in (("奇偶交错", rope_interleaved), ("前后半切分", rope_half_split)): scores = [attn_score(fn, q, k, m, m + 3, dim) for m in range(4)] spread = max(scores) - min(scores) print(f" {name}: 间距恒为 3 时内积 {scores[0]:.6f}," f"四个绝对位置间的最大波动 {spread:.2e}") print("\n=== 2. 同一份权重下,两种配对给出的分数不同 ===") s_i = attn_score(rope_interleaved, q, k, 0, 3, dim) s_h = attn_score(rope_half_split, q, k, 0, 3, dim) print(f" 奇偶交错 {s_i:.6f}") print(f" 前后半切分 {s_h:.6f}") print(f" 差值 {abs(s_i - s_h):.6f} ← 不为 0,实现和权重必须配套") print("\n=== 3. 重排维度后两者完全一致 ===") qp, kp = interleave_to_half(q), interleave_to_half(k) s_h_perm = attn_score(rope_half_split, qp, kp, 0, 3, dim) print(f" 奇偶交错(原始排布) {s_i:.6f}") print(f" 前后半切分(重排后权重) {s_h_perm:.6f}") print(f" 差值 {abs(s_i - s_h_perm):.2e}" f" ← 只差一个固定的维度置换") if __name__ == "__main__": main()
-
AIGC 每日速读|2026-08-17|AlayaLab世界模型连跑两小时画面不塌Evoke 今日 AIGC 论文速览 今日共 10 篇 · 长时交互式世界模型与外部记忆 1 篇 · 音频生成与零样本语音合成 2 篇 · 视频隐空间与超分重建 2 篇 · 可控图像生成与编辑 3 篇 · 文生 3D 优化机理 1 篇 · 生成质量奖励模型 1 篇 重点论文标题列表 Evoke(Alaya Lab·上海AI Lab·中科大):世界状态外置连跑两小时不塌 VoxAudio(浙江大学):台词与音景端到端一次生成 Phoenix TTS(滴滴·厦门大学):字错率低于真人录音本身 V-RAE(新加坡国立大学):冻结语义特征当隐空间快6倍 Princigram(上海AI Lab·上海交大):物理思维链治好受力方向画错 今日论文速览 1. Evoke:世界状态外置连跑两小时不塌 Alaya-EVOKE: From Linear-Scaling Supervision to Endless World | Alaya Lab·上海AI Lab·中科大 | arXiv:2608.13546 前序问题:交互式世界模型要同时满足三件事:持久记忆、即时响应、长程生成。可这三者在现有架构里互相拆台——把历史留在去噪器上下文或 KV 缓存里,成本随时长一路往上涨,于是「会话能开多久」和「能记住多少」变成一道零和题;而低延迟交互又依赖少步生成,少步学生的能力上限被它的教师死死压住。结果是长跑一段时间后画面开始漂移,而且这种漂移在短窗口内看起来还挺合理,很难被及时发现。 本文贡献:提出 Evoke,做法是把持久世界状态从模型里搬出去,同时重新设计教师。场景几何维护在一个外部的、按相机位姿索引的世界状态库(World State Bank)中,去噪器每步只检索与当前视角相关的信息,因此会话再长上下文也保持有界。教师不再被当成一个固定的生成器,而是专门为长程监督重新设计:它的稀疏注意力组合了块级分组、对选定远端帧的检索、以及一路线性注意力全局状态,让显存与计算随时长线性增长的同时支持长程监督。这种监督恰好能暴露那种「短窗口内看着合理」的内容漂移,而逐块条件化又让提示词切换和事件控制可以贯穿整个序列。最后用 30 秒的分布匹配目标在自强制 rollout 下训练,把这两项能力一起迁移给一个三步学生,且该学生不需要 classifier-free guidance。 With bounded retention, per-step cost does not grow with session length. The camera pose reads the world state bank into the target view; the student injects that render at the coarsest of its three coarse-to-fine evaluations, alongside a short parametric history and the current text condition. The emitted chunk then updates the store and the history. 实验效果:单张 H200、384×640 分辨率下,每个 1.5 秒块的生成耗时 2.11 秒。作为三步世界模型在 WBench 上达到 SOTA,同时在 VBench-Long 与 VBench-2.0 上保持竞争力。论文给出了长达 65.5 分钟的连续 rollout,饱和度、亮度、对比度全程稳定在合理区间而非逐渐冲淡或变暗,与 0-30 秒片段的余弦相似度也保持在真实视频 60 秒间隔的水平;观测到的漂移量明显低于「定向漂移正比于 i」和「扩散式漂移正比于 i 的平方根」两条参考曲线。 An hour-long session stays bounded rather than degrading. One continuous $65.5$,min Evoke rollout, three steps per chunk without classifier-free guidance ($2619$ chunks; faint per-chunk, bold two-minute mean). (a) Color is flat over the hour. (b) Scene identity plateaus at cosine $0.523$, the level real footage scores against itself $60$,s apart. (c) Opening-window shift stays far below unrelated-scene drift. A stability claim, not fidelity ($n=1$). 批判点评:这篇真正的贡献是把问题重新问了一遍。主流做法默认历史必须以某种形式驻留在注意力里,于是所有工程努力都花在「怎么把 KV 压得更狠」上,而压缩必然有损,长跑必然漂移,这条路的天花板是结构性的。Evoke 说历史不该放在注意力里——场景几何本质上是可以用相机位姿索引的空间数据结构,那就外置成检索库,去噪器只管当前视角。这一步跨出去之后,「上下文有界」就不是优化目标而是架构保证了,两小时 rollout 敢报出来正是这个底气。教师侧的设计同样值得注意:它承认了少步学生的上限由教师决定这件事,于是不是去改进蒸馏算法,而是先把教师改造成能提供长程监督的形态,这个因果链梳理得比多数同类工作清楚。不过要把期待校准好。2.11 秒生成 1.5 秒内容,意味着它还没到实时——是 1.4 倍的实时余量缺口,交互体验上属于「可用但有延迟感」,跟同期那些报 20 FPS 以上的数字人工作不在一个口径上,后者的场景约束也弱得多。分辨率 384×640 偏低,放大到 720p 以上时几何检索与渲染路径的开销是否还只占去噪器的 38%,论文没给。更关键的是外部世界状态库依赖相机位姿这个索引键,这在自由视角漫游里成立,但遇到大幅动态物体、场景本身发生不可逆变化(东西被打碎、被拿走)时,一个以几何为中心的状态表示能不能承载这些语义级变更是没有验证的——论文展示的多是相机运动下的场景重访。最后,两小时 demo 是精心挑选的连续 rollout,中途没有剧烈的提示词冲突,这跟真实交互里用户随时想推翻场景的用法差距不小。 2. VoxAudio:台词与音景端到端一次生成 VoxAudio: Vocalized Audio Synthesis via Multi-Reward Autoregressive Flow Matching | 浙江大学 | arXiv:2608.12951 前序问题:很多真实需求其实是「有人在某个环境里说话」——播客制作、视频配音都是这个形态,术语叫发声化音频合成。但现有文生音频系统面对引号里的台词只有两条烂路可选:要么把台词退化成一段听不清的人声嘟囔,要么甩给一个独立 TTS 模型生成后再做后期混音。后者的代价常被低估:一旦拆成两段,你就失去了对「台词什么时候出现」以及「它和场景声怎么互动」的控制权,时间轴对不齐、响度失衡、整体不连贯这三个问题会一起冒出来。 本文贡献:提出 VoxAudio,一个因果自回归流匹配模型,从三个层面同时下手。架构层面用块级因果分解,每块带独立噪声水平,使音频可以经滑动窗口流式推理配合 KV 缓存输出,且支持可变目标时长;为了能在任意块粒度上推理,预训练阶段刻意用随机化的块边界。偏好层面用多奖励的 Negative-aware FineTuning(NFT),联合优化语义保真度、语言准确性、听感质量与时间对齐四项。数据层面为补上发声内容缺失的监督信号,构建了 VoxCorpus——一个大规模语料库,其字幕直接引用嵌入语音的逐字转录并标注时间区间,同时给出带区间标注的 VoxBench 基准与一个时间对齐度量指标。 Comparison of Audio Generation Paradigms. Decoupled Pipeline: Conventional methods synthesize soundscapes and speech independently, requiring post-hoc mixing. VoxAudio: A unified system for vocalized audio synthesis from single prompts. 实验效果:在覆盖通用音频、语音、以及统一发声化音频三类任务的四个基准上验证了有效性与效率。代码与 demo 已公开。 Detailed architecture and attention mechanism of the Causal Diffusion Transformer. (a) The causal joint block facilitates interaction between audio latents and conditioning features; (b) The causal fused block refines integrated representations through deep self-attention; (c) The chunk-wise causal attention mask, where shaded regions indicate masked-out tokens, ensuring that each temporal chunk only attends to current and historical context. 批判点评:这篇的价值在于它拒绝了一个被行业默认了很久的妥协。「音效模型 + TTS + 后期混音」这套流水线之所以能长期存在,是因为它在多数场景下勉强够用,于是没人去问「为什么台词和环境声必须分两次生成」。VoxAudio 指出这个拆分恰好牺牲了最难补回来的那部分能力——时间上的因果关系。混音是后置操作,它能调响度、能对齐波形,但无法让环境声「因为有人说话」而改变,也无法让说话时机被场景事件驱动。端到端建模才能拿回这层控制。三个层面的设计也不是堆料:随机化块边界预训练是为了让推理时的块粒度可以自由选,这直接服务于流式;四路奖励里那个时间对齐项是专门补时间控制这个短板的,跟 VoxBench 的区间标注指标形成闭环,说明作者清楚自己在优化什么。但摘要在关键数字上相当吝啬——四个基准只说「验证了有效性与效率」,既没给具体分数,也没跟解耦流水线做量化对比,这让人很难判断端到端到底赢了多少、在哪些条件下会输。这类工作最需要回答的问题恰恰是:当台词很长、语义复杂时,端到端模型的语音清晰度能不能持住专用 TTS 的水平?摘要里没有正面交代。另外 VoxCorpus 的规模只说「大规模」,语言覆盖、说话人多样性、场景类型分布这些决定泛化能力的信息全部缺失,而这类需要逐字转录加时间区间标注的数据,标注成本高、容易在特定域上过拟合。多奖励 NFT 同时优化四个目标也存在标准的调权难题,摘要没提四项之间是否出现此消彼长。 3. Phoenix TTS:字错率低于真人录音本身 Phoenix TTS: High-Fidelity Synthesis and Voice Conversion via Flow-Matching-Driven Speech Tokenization | 滴滴·厦门大学 | arXiv:2608.11737 前序问题:零样本 TTS 系统里的语义 tokenizer,通常用有监督 ASR 或自监督目标来训练。但语音的语义与声学信息本质上无法彻底解耦,ASR 类目标为了聚焦语言内容会主动丢掉声学细节,依赖这类 tokenizer 的模型往往在音色相似度上难以做到最优。更根本的问题是这些 tokenizer 都是独立优化的,拿不到下游声学生成任务的任何直接监督,于是离散 token 与声学模型所需的连续空间之间横着一道特征鸿沟,把合成质量的上限提前焊死了。 本文贡献:提出 Phoenix TTS,一个把表示学习与生成式声学建模紧密耦合的统一框架。具体做法是:语音 tokenizer 一方面被优化去重建自监督特征以保持语义丰富度,另一方面同时接受来自 Flow Matching 训练损失的直接监督。通过这种联合训练范式,抽出的离散 token 既保留了必要的语义信息,又天然与下游 Flow Matching 模型的特征空间对齐,跨过了那道特征鸿沟。 UniSpeechTokenizer 实验效果:在 11 万小时数据上训练,字错率稳定低于真实录音本身(说明合成语音的可懂度已超过原始录音水平),同时保持稳健的零样本说话人相似度,与若干知名大规模基线相当或更优。作为统一训练的额外收获,学到的 tokenizer 可以无需任务特定微调直接迁移到零样本音色转换任务。 UniSpeechTokenizer 批判点评:这篇干的是修地基的活,不性感但要紧。语音合成这几年的注意力几乎全在声学模型和声码器上,tokenizer 被当成一个先训好就不动的预处理模块,很少有人回头问它的训练目标是否与下游需求一致。Phoenix TTS 把这个断层点了出来:ASR 目标天生要丢声学细节,因为对识别任务而言音色是噪声——可对合成任务而言音色恰恰是目标。目标函数错位,下游怎么优化都有个焊死的天花板。让 Flow Matching 损失直接回传到 tokenizer,本质是把「表示该长什么样」交给最终任务来定义,而不是让一个代理任务替它决定。音色转换能力免费掉出来,也从侧面印证了这个表示确实同时抓住了语义与声学两侧。不过「字错率低于真人录音」这个说法要小心读——它更可能说明合成语音吐字过于清晰规整、少了真人的口误连读与含混,在 ASR 眼里反而更好识别。这是可懂度的胜利,但不等于自然度更高,某种意义上甚至暗示了一种「过度清晰」的机器感;论文若不配 MOS 主观听测,这个数字容易被误读成全面超越真人。11 万小时的数据量也把复现门槛拉得很高,联合训练的收益里有多少来自方法本身、多少来自数据规模,摘要没有拆开;tokenizer 与 Flow Matching 联合训练还引入了耦合代价——换下游声学模型就得重训 tokenizer,牺牲了模块化,这个成本对工业迭代不算小。另外说话人相似度只说「相当或更优」,没给具体对比对象与数值,跨语言、带口音、低资源音色这些真实难点是否覆盖也未交代。 4. V-RAE:冻结语义特征当隐空间快6倍 V-RAE: Rethinking Video Latent Spaces for Generation | 新加坡国立大学 | arXiv:2608.13556 前序问题:隐空间视频生成依赖自编码器来定义一个紧凑空间供生成模型工作。视频自编码器的架构这几年演进了很多,但它们的隐空间基本还是围绕像素级重建来优化的,缺乏高层语义组织。问题在于——一个重建最优的隐空间,未必适合做生成建模。这两个目标长期被混为一谈,几乎没人认真区分过。 本文贡献:提出 V-RAE,一个视频表示自编码器,把紧凑的生成式隐变量直接构建在冻结的视觉基础模型表示之上。一个轻量的时序池化模块负责消除时间冗余同时保留语义结构,再由一个视频解码器从压缩特征中重建连续运动。作者用四个有代表性的冻结编码器在视频重建、语义探测、类别条件生成三类任务上做了评估。此外还提出 tFVD——一个时序一致性诊断指标,用来补上「重建质量不足以刻画生成效用」这个缺口。 V-RAE architecture. A frozen visual representation encoder produces temporally dense features, which are compressed by a lightweight temporal pooling module. The figure depicts the chunk-wise causal decoder used with image encoders. 实验效果:在 K600 上取得 2.13 rFVD,超过所有评测过的大规模预训练视频 VAE。其隐变量保留的语义信息显著多于常规视频 tokenizer 的隐变量。在匹配的生成设置下,最优变体在 UCF101 与 K600 上分别取得 117.86 与 19.16 的 gFVD,同时收敛速度最快达到 6 倍提升。论文还证明 tFVD 与下游生成质量的相关性比重建指标更可靠。此外在 Cityscapes 未来视频预测任务上,V-RAE 也在匹配预测设置下优于 Wan 2.2 VAE 的隐空间。 Temporal Reconstruction Error Difference (TRED) for RAEv2, Wan2.2 VAE, OmniTokenizer, and V-RAE on K600 validation examples. The heatmaps visualize temporally averaged TRED within high-frequency regions of interest, while the curves show spatially averaged TRED over consecutive frame transitions. 批判点评:这篇最有价值的是它把一个被默认了很久的等式拆开了:重建好 ≠ 适合生成。整个视频 VAE 社区的迭代逻辑基本是「刷低 rFVD,然后假定生成模型会因此受益」,而 V-RAE 直接指出这个传导链未经验证,还顺手给了 tFVD 作为更靠谱的代理指标——这个贡献可能比模型本身更持久,因为它改的是大家的评估习惯。用冻结视觉基础模型特征当隐空间底座这个做法也很省:既然 DINOv3、SigLIP2 这些编码器已经在海量数据上学到了良好组织的语义空间,那生成模型没必要从像素重建目标里重新长出语义结构。收敛快 6 倍这个数字最能说明问题——它说的不是生成质量上限更高,而是优化路径更顺,因为隐空间的语义组织已经替生成模型做掉了一部分工作。不过要注意实验口径。gFVD 报的是类别条件生成,数据集是 UCF101 与 K600,这是学术基准里的小规模设定,跟当下真正在跑的文生视频(大规模文本条件、开放域、高分辨率、长时序)距离相当远。冻结编码器天然带来分辨率与预训练域的双重约束——基础模型在图像域上训练,对高速运动、剧烈形变这类视频独有的内容是否还保有良好表示,摘要没给压力测试。「四个代表性冻结编码器」的结果也只报了最优变体,编码器选择对结果的敏感度有多大不清楚,如果换一个就掉很多,那这套方法的鲁棒性要打折。另外语义丰富的隐空间可能反过来损失细粒度纹理与高频细节,这在类别条件生成里不易暴露,但在真实应用里是硬指标。 5. Princigram:物理思维链治好受力方向画错 Towards Physics-Faithful Generation of Scientific Diagrams | 上海AI Lab·上海交大 | arXiv:2608.13112 前序问题:文生图早已做到照片级真实,但顶尖系统在生成科学示意图这件事上依然不可靠——因为示意图的价值不在好看,而在物理上是否成立:受力方向对不对、坐标系是否有效、热力学状态是否自洽、方程与所画场景是否匹配。这些模型训练用的是网络图像加物理内涵浅薄的配文,产出的示意图看起来合理但物理上是错的,用在教育与科学传播场景里是净负值。更麻烦的是现有评测器也不可靠:CLIP 打分器会把摩擦力方向画错的图打出更高分,开放词表检测器则完全抓不到物理量之间的几何关系。 本文贡献:提出 Princigram,一个物理保真的科学示意图生成器,以及配套数据管线。核心进展是结构化物理思维链(SP-CoT):一套按子学科划分的 schema,把一张物理示意图分解成横跨六个子学科的显式多步推理链,从场景识别、参数、受力或过程分析,到支配定律与综合。与自由形式思维链不同,SP-CoT 遵循固定 schema 并带严格保真规则,把视觉可见事实与物理推断结论分开,所有数学一律符号化表达;它既作为密集训练监督,也在推理时充当结构化的「思考」提示。据此整理并结构化标注了 430 万张物理图像,其中 115037 张带专家级标注,并适配了一个统一多模态骨干。另外提出 VeriphyT2IBench,其问题由每张留出示意图自身的结构化标注派生:每张图变成一组针对其对象、受力、状态的二元问题库,使评判模型的分数可以分解为一条条具名物理事实而非一个笼统总分。 Several challenges to physics-faithful scientific-diagram generation, and our approach. (a)~State-of-the-art multimodal generators produce diagrams that violate basic physics, such as mislabeled forces or incorrect circuit topology. (b)~The failure is generative rather than perceptual: a model that correctly describes the physics of a scene still generates it incorrectly. (c)~Appearance-based evaluation is unreliable in this setting, a CLIP-style scorer prefers the physically incorrect image (c.1), and an open-vocabulary detector cannot verify the geometric relations that determine correctness (c.2). (d)~Structured Physical Chain-of-Thought () addresses both problems by keeping data construction, annotation, training, and evaluation structured, finitely describable, and extensible. 实验效果:在 GenExam 的物理子集与 VeriphyT2IBench 上,Princigram 表明显式的物理结构化监督确实提升了生成科学示意图的物理保真度。数据侧完成 430 万张物理图像的整理与结构化标注,其中 115037 张达到专家级标注质量。 Overview of : data construction, structured supervision, and training--evaluation. % (a)~Data-curation pipeline. Four complementary sources---a manually curated seed, OpenDataLab~opendatalab, public web archives, and a textbook-procurement stream---are aggregated into a raw pool, then de-duplicated, resolution-filtered, and routed by a subdiscipline classifier into a structurally annotated corpus of ${\sim}4.3$M physics diagrams; a high-quality expert-level subset is split into training and held-out test data, and a balanced subset of the test split forms . % (b)~Corpus composition. Distribution of the corpus across the six physics subdisciplines and their sub-categories, showing a strongly long-tailed profile in which mechanics and quantum mechanics dominate while optics is rare. % (c)~ and how it is used. From a diagram and its prompt, a fixed five-step schema (scene; parameters; force or process analysis; coordinate systems and governing laws; and synthesis) makes the underlying physics explicit. These structured annotations drive three stages: pre-training on the ${\sim}4.2$M corpus-level pairs, supervised fine-tuning on the $109$K human-verified expert-level pairs, and evaluation on , where each generation is scored by answering the binary questions compiled from its own annotation (Local, Global, and Strict accuracy). 批判点评:这篇挑的是一个价值被严重低估的场景。T2I 的评价体系几乎全建立在「像不像真的」上,而科学示意图恰好是一类外观正确性无关的图像——一张受力箭头画反的斜面示意图可以渲染得极其精美,但它在教学里传递的是错误知识,负效用比不生成更大。作者把这一点说得很直白,也顺手戳破了评测环节的窘境:CLIP 打分器给错误图打高分这个例子相当有说服力,说明整条评估链条此前是失效的。SP-CoT 的设计有两点比较克制:固定 schema 而非自由思维链,是因为物理推理有确定结构,放开只会引入更多幻觉;严格区分「视觉可见事实」与「物理推断结论」,则避免了把模型的推断误当成图上真有的东西——这个区分是很多 CoT 类工作栽跟头的地方。VeriphyT2IBench 把分数拆成具名物理事实,也把「这张图错在哪」变成了可定位的信息而不是一个模糊总分。不过效果段的表述明显偏软——只说「提升了物理保真度」,没有任何具体分数或与基线的量化差距,这在一篇同时提出新基准的论文里是个显眼的空白,读者无法判断是从 40% 提到 70% 这种量级,还是只有几个点的边际改善。430 万张图像里仅 11.5 万带专家标注,占比 2.7%,剩下 97% 的语料级标注质量如何、噪声会不会反向污染物理保真度,没有交代。六个子学科的 schema 是人工设计的,这既是优点(结构可靠)也是天花板(覆盖范围受限),遇到跨学科题目或 schema 未涵盖的场景如何退化是未知的。最后,VeriphyT2IBench 由留出图自身标注派生,问题与训练数据同源,评判又依赖一个判官模型,存在既当裁判又当选手的风险,第三方独立验证仍然必要。 6. MotionCraft:视频超分做成世界状态预测 MotionCraft: Latent World Modeling with Sparse Attention for Visual Upscaling | 独立研究者团队·澳门大学 | arXiv:2608.08553 前序问题:视频超分要从低分辨率输入恢复高保真高分辨率视频,手机拍摄、流媒体、档案修复都靠它。但现有路线在局部细节保真、长程时空建模、感知真实感、效率这四项上互相拉扯:卷积对齐类方法能守住局部结构,可一遇大幅运动或复杂退化就崩;Transformer 类方法能抓长程依赖,但要在架构或算法上做适配才跑得动;近期的隐空间或扩散类生成器能合成丰富纹理,却需要专门的时序约束才能维持连贯。 本文贡献:提出 MotionCraft,一个可控的视频超分框架,把复原任务重新表述为受世界模型启发的运动感知隐状态预测,并把自适应稀疏注意力与一个用户可直接操作的显式控制接口整合进来。系统由三部分组成:稳健的运动融合(外部运动编码器与内部运动估计器并行,经光度一致性检查与置信度门控融合,再由残差校正器补偿偏差)、一个在局部性与定向非局部交互之间取平衡的隐空间世界 Transformer(LWT,内含自适应稀疏注意力与键值记忆缓存),以及一个紧凑的条件解码器,在流式约束下输出时序一致的高质量重建。 Overview of the MotionCraft framework for high-fidelity visual upscaling. The system initiates with Robust Motion Encoding and Fusion, where external motion signals and internal image-driven estimates are gated by a Photometric Inconsistency confidence map to compensate for systematic biases. The core Latent World Transformer (LWT) processes low-resolution latents using Adaptive Sparse Attention, which employs a differentiable soft top-$k$ selection to maintain locality while capturing long-range dependencies. Temporal persistence is managed through a Key-Value Memory Cache ($\mathcal{M}_{t-1}$). The Controllability Interface modulates the latent state via global scalars $\gamma$ and spatial gating maps $g_t$ to balance temporal smoothness and reconstruction fidelity. Finally, a Tiny Conditional Decoder performs distillation-based refinement to produce the high-resolution output $\hat{X}_t$. 实验效果:实证评估显示 MotionCraft 在重建与感知性能上都表现强劲,同时能在时序平滑度与重建保真度之间提供可预测的权衡。控制敏感度实验给出了这条权衡曲线:随着控制参数 γ 从 0.1 增至 2.0,运动平滑度评分从约 0.15 单调升至约 0.95,而 PSNR 从 29.00 dB 平缓降至 27.20 dB——下降幅度不到 2 dB,说明权衡是渐进可控而非断崖式的。 Control sensitivity. As $\gamma$ increases, motion smoothness rises monotonically while PSNR decreases gracefully, indicating a predictable trade-off between smoothness and fidelity. 批判点评:这篇的思路转换值得留意:把超分从「逐帧复原」重新表述为「运动感知的隐状态预测」,等于承认视频超分本质上是个时序建模问题而非图像问题的批量重复。世界模型的框架此前主要用在生成与决策上,挪到复原任务上是个不算显然的迁移。真正把它跟同类工作区分开的是那个显式控制接口——绝大多数超分方法把「时序平滑 vs 细节保真」这个取舍固化在训练里,用户拿到的是一个既定折中;MotionCraft 把这个旋钮交出来,且用 γ 曲线证明它单调可预测。对档案修复这类需求分化的场景(有人要平滑观感,有人要最大细节)这是实用的产品化设计,不只是刷指标。双运动路径加光度一致性检查的做法也务实,承认了外部光流在大运动与遮挡下会失效,用内部估计器与置信度门控做兜底而非盲信单一信号。但作者列为「独立研究者团队」这一点需要读者自行加权——12 位作者集体标注独立研究者,缺少机构算力与工程背书,可复现性与规模化能力都要打问号。效果段也偏定性:「强劲」「可预测的权衡」这类表述背后没给出与主流基线(如扩散类超分)的并列数值对比,无法判断它在绝对质量上处于什么位置;γ 曲线的 PSNR 区间落在 27-29 dB,在标准 VSR 基准上属于中等而非领先水平。「流式约束」被反复提及但未给出延迟或吞吐的具体数字,自适应稀疏注意力节省了多少计算也没量化——对一篇把效率列为核心动机的论文,这是关键缺口。 7. PixSDS:latent干净像素却在偷偷跑偏 PixSDS: Why Latent SDS Makes Noisy Pixels | 独立研究者 | arXiv:2608.12997 前序问题:分数蒸馏采样(SDS)通过用预训练扩散先验优化渲染图像来实现文生 3D,但在隐空间里做 SDS 常常产出结构化的色彩伪影与高频纹理噪声。这个现象长期被当作调参问题绕过,很少有人追问它的机理到底是什么。 本文贡献:识别出隐空间 SDS 的一个失效模式,成因是 VAE 诱导的像素漂移:被优化的图像可以沿着「VAE 编码器约束很弱」的像素空间方向移动,于是它的隐变量表示始终保持干净且语义合理,而图像本身却在悄悄累积可见伪影。作者用受控的 2D SDS 实验、VAE-only 优化实验,以及一份简化分析共同支撑这个诊断——分析表明当到像素的逆映射欠约束时,编码器式的隐空间目标会放大图像空间噪声。据此提出 PixSDS,一个轻量的 VAE 一致性梯度修复方法:解码一次隐空间 SDS 的前瞻步,把解码得到的图像作为像素空间优化的干净方向,从而减少沿 VAE 不一致方向的移动,且无需重训扩散模型、无需更换渲染器、无需替换 SDS 目标。 VAE-only optimization. Column 1 shows the target image $X$. Columns 2--7 show optimized images $Z_i$ from two different random initializations, with their decoded latents $\dec(\enc(Z_i))$ shown in the bottom-right inset. Even without a diffusion model, optimizing only through the VAE encoder produces structured noise in $Z_i$, while the decoded latents remain clean. 实验效果:在 2D 优化与文生 3D 生成上的实验表明,PixSDS 大幅减少了结构化伪影,同时保留了语义内容。集成到 DreamGaussian 第二阶段优化后,与原始 SDS 相比纹理更干净;接入 LucidDreamer 后,浮动的噪声高斯与结构化纹理伪影都有减少。代码已公开。 DreamGaussian comparison. We apply in the second optimization stage of DreamGaussian~tang2024dreamgaussian. Compared with SDS, produces cleaner textures and fewer structured artifacts. 批判点评:这是一篇教科书式的诊断型论文,全程一个人完成。它的方法论比结论更值得学习:先用 VAE-only 优化把「latent 干净、像素脏」这个反直觉现象单独隔离出来复现——这一步很关键,因为它证明了伪影的来源与扩散先验、与渲染器都无关,纯粹是 VAE 编码器的欠约束逆映射造成的;再用简化分析给出数学上的解释;最后修法极轻,不动扩散模型、不动渲染器、不动 SDS 目标,只补一个 VAE 一致的干净方向。「latent 看起来完全正常所以问题很难被发现」这个洞察尤其有意思——它意味着任何只监控隐空间指标的优化流程都会对这类退化完全失明,这个教训可以外推到所有在隐空间做优化的任务,不限于文生 3D。修补的普适性也已用两个不同的 3D 框架(DreamGaussian 与 LucidDreamer)交叉验证。局限同样清楚。单作者、无机构支持,实验规模注定有限:文生 3D 只验证了两个开源框架,对闭源或更大规模的 3D 生成系统是否同样适用未知。效果全部以定性描述给出——「大幅减少」「更干净」,没有任何量化指标(如 CLIP 分数、用户偏好率、伪影强度度量),这在 3D 生成领域虽属常见,但让改进幅度无法与其他去伪影方法横向比较。前瞻步需要额外解码一次,带来的计算开销未报告;超参数 β 虽做了敏感性分析但最优值如何随任务变化没有指导。最后,这个方法治的是 VAE 欠约束这一个特定失效模式,而 SDS 还有过饱和、Janus 多面等其他老问题,它对那些完全无效——读者不应把它理解为 SDS 的通用改进。 8. GST:学整个画家而非几张名作 Through Van Gogh's Eyes: Global Style Transfer with Diffusion Model | KIST·成均馆大学 (ECCV 2026) | arXiv:2608.11546 前序问题:艺术图像合成想复现的是某位艺术家的整体视觉身份,但现有方法往往抓不住这个「全局风格」。传统风格迁移是一对一的——把一张或少数几张参考画作的风格搬到内容图上,做作品级风格化有效,却无法代表一位艺术家更广的风格分布。而用艺术家名字作条件的文生图扩散模型(比如「……梵高风格」)虽然灵活,却受文本诱导偏差影响,往往只复现那几幅最出名作品的图案,把梵高简化成《星月夜》的漩涡。 本文贡献:提出全局风格迁移(GST)这一多对一的艺术图像合成范式,聚合目标艺术家的多幅作品,把它们共有的全局风格迁移到单张内容图上。为此提出全局风格引导(GSG),在扩散模型的中间特征空间(h-space)中学习一个残差的全局风格偏移量,且在固定提示词下进行——通过纯粹从视觉统计中学习艺术家级风格语义,GSG 规避了文本依赖带来的艺术偏差。另外提出内容对齐引导(CAG),一个免训练的感知引导机制,在允许艺术家特有的几何形变的同时保留内容图的语义结构。 Overall framework of Global Style Transfer (GST). (Left) Global Style Guidance (GSG) trains a lightweight Style Extraction Function $f_t$ on multiple artworks under the fixed prompt `A painting', learning a residual global style offset $\Delta \mathbf{h}_t$ that modulates the U-Net bottleneck representation $h_t$ in a text-independent manner. During reverse diffusion, $\Delta \mathbf{h}_t$ steers the denoising trajectory toward the artist's global style distribution. (Right) Content Alignment Guidance (CAG) first maps the content image $I_c$ into a noisy latent via DDIM inversion, then applies CLIP-based perceptual guidance at each timestep to align the semantic structure of the generated image with the content while permitting style-driven deformation, yielding artist-level stylization. 实验效果:在 WikiArt 上的实验表明,相比现有风格迁移与扩散式艺术合成方法,GST 在风格保真度、内容保留、输出多样性三项上都更优。论文展示了同一张内容图迁移到梵高、达利、塞尚、罗列赫、莫奈、希什金、库斯托季耶夫、雷诺阿八位艺术家风格的结果,各艺术家的笔触与色彩体系区分明显。 Global Style Transfer results across multiple artists for the same content image. Given the same content images $I_c$, our framework transfers the images into the global styles of eight different painters. All images are generated using a text-independent prompt (``A painting”) to eliminate stylistic bias in the diffusion model. For each content image $I_c$ (left column), our framework applies Global Style Guidance (GSG) to capture artist-specific global semantics and Content Alignment Guidance (CAG) to preserve flexible, style-based deformation of content. The results show that a single content image is rendered into distinctly different artistic styles across various artists, demonstrating our framework’s ability to synthesize artist-faithful images. 批判点评:这篇的问题定义比方法更有意思。风格迁移长期默认「风格」等于某张参考图的纹理统计,于是一对一是天然设定;而 GST 指出艺术家的风格其实是一个分布,任何单张作品都只是这个分布的一次采样,用一张画代表梵高在概念上就是错的。这个重新定义直接催生了多对一范式。它同时点出了 T2I 路线的一个隐性缺陷:文本条件下的「梵高风格」并非从画作学来,而是从图文配对数据里那几幅高频出现的名作学来,因此模型学到的是《星月夜》而不是梵高——这个「文本诱导偏差」的诊断很准。在 h-space 学残差偏移的做法也选得聪明:中间特征空间比 latent 更贴近语义,学偏移量而非重训模型让方法保持轻量,且完全绕开文本通道。CAG 免训练、允许几何形变这一点也符合艺术直觉——真正的风格迁移不该只换纹理,梵高会重画物体的形状。至于代价:论文自己给出的失败案例已经说明,当艺术家的数据集内容高度偏斜时方法会失灵(如罗列赫作品几乎全是山景,学到的「风格」里混进了山这个内容先验)——这是多对一范式的结构性弱点,风格与内容在聚合统计里本就纠缠。评测停在 WikiArt 且以风格保真度、内容保留、多样性三项定性对比为主,摘要未给具体数值;而艺术风格评估本身缺乏公认的客观指标,「更优」的可信度依赖主观实验设计的严谨程度。方法需要目标艺术家有足够多的作品,对小众或早逝艺术家不适用。最后必须提一句:这类工作把「批量复刻在世艺术家风格」的门槛进一步降低,版权与创作伦理的争议只会更尖锐,论文对此没有讨论。 9. SketchSense:看懂潦草草图再动笔补图 SketchSense: Learning to Interpret Imperfect Sketch Guidance for Image Inpainting | 独立研究者 | arXiv:2608.13186 前序问题:草图引导的图像补全提供了直观的结构控制,但真实草图往往混杂着可靠的全局意图与局部糟糕的笔画——过于密集、位置偏移、残缺不全,或者干脆是刻意不合常规的画法。现有方法基本二选一:要么整个去噪过程都把输入草图当固定条件,要么先把它精修成干净结构再合成 RGB。前者假设所有笔画一样可靠,局部错误会一路传播污染整张图;后者则必须在外观与语义上下文尚未浮现之前就把结构的歧义解决掉,属于信息不足时强行决策。 本文贡献:提出 SketchSense,通过同步去噪两条相互作用的 RGB 流与结构流来解读不完美的草图引导。双向注意力融合(Bidirectional Attention Fusion)把外观生成与结构恢复耦合起来,产出一个精修后的结构,这个结构同时暴露了模型对草图的动态理解过程;实现上复用 FLUX 块族的原生 QKV 作为共享基底,再由专门的联合注意力 QKV LoRA 产生增量。一个短语级目标负责对齐两条流的语义落地。草图感知空间调控(Sketch-Aware Spatial Regulation)进一步根据局部生成状态调整草图的使用方式,对注意力与融合过程做调制;另有一个可选的带符号先验,把「保留 vs 修正」的意图注入特征表示与注意力行为。 Motivation and overview of SketchSense. Fixed-sketch conditioning can propagate locally degraded strokes. SketchSense synchronously denoises RGB and structure, regulates sketch use through learned attention modulations and an optional signed prior, and exposes its interpretation as refined structure. 实验效果:在自然图像与结构复杂图像上的实验显示,在复原质量与结构保真度两方面都显著优于现有方法。论文以中国壁画补全为例,展示了在笔画密集、结构复杂的场景下,SketchSense 相比固定草图条件方法在细节上的改善。 Bidirectional Attention Fusion with adapted QKV reuse. Native QKV provides the shared base, and a dedicated joint-attention QKV LoRA produces fusion-specific $\Delta QKV$. Directional messages pass through a zero-initialized projection, split into $\Delta H_x^l$ and $\Delta H_e^l$, and enter their receiving branches through $g_x^l$ and $g_e^l$. 批判点评:这篇抓的痛点很真实:用户画的草图从来不是均匀可靠的,通常整体意图对、局部笔画烂。而现有两条路线都建立在一个错误前提上——固定条件假设笔画一致可靠,先精修则要求在信息不足时提前把歧义决断掉。SketchSense 的解法在时序安排上更合理:让结构解读与外观生成同步演进、互相喂信息,去噪早期外观尚模糊时不强行定结构,随着 RGB 逐渐清晰再反过来修正结构理解。「精修后的结构暴露了模型对草图的动态理解」这一点还带来了额外的可解释性——用户能看到模型把哪一笔当成了什么,这在交互式创作工具里是实打实的价值,比一个黑箱输出有用得多。可选的带符号先验也务实,它承认「这笔要保留还是要改」有时只有用户知道,那就把这个意图开放给用户显式指定,而不是让模型猜。但这篇是单作者工作,实验规模与工程完备度需要留意。效果段只有「显著优于现有方法」这类定性表述,没有任何量化指标或基线名单,而复原质量与结构保真度都有成熟的客观度量(FID、LPIPS、边缘一致性等),不给数值让改进幅度无从核实。方法本身叠了四个组件——双向注意力融合、短语级目标、草图感知空间调控、可选带符号先验,摘要未提消融,无法判断收益主要来自哪一处,也存在过度设计的可能。绑定 FLUX 块族的 QKV 复用意味着与特定架构耦合,迁移到其他 DiT 骨干需要重新适配。双流同步去噪必然增加计算量,开销未报告。最后,「刻意不合常规的笔画」与「画错的笔画」在模型看来可能无法区分,这个歧义如何处理是这类方法的固有难题。 10. MuseCritic:先写乐评再打分准度飙升 MuseCritic: Learning Multi-Aspect Song Rewards through Natural-Language Aesthetic Critiques | 复旦大学 | arXiv:2608.11755 前序问题:长篇歌曲生成模型在时长、结构完整性、声学复杂度上不断进步,让可靠的审美奖励对于对齐人类偏好变得越来越重要。但面向完整歌曲的奖励模型仍然很少,且现有评估器通常一次前向就直接吐出分数,不给任何可读的解释——既难以调试,也无法告诉生成模型究竟哪里不好。 本文贡献:提出 MuseCritic,一个半标量奖励模型:它先生成一段覆盖五个审美维度的自然语言评论,再把这段评论作为中间表示来预测连续的奖励分数。训练分两阶段:先由教师模型(Gemini-3-Pro)针对歌曲、评分细则与专家评分产出高质量评论用于监督微调;随后让微调后的模型生成自己的评论再做奖励学习,以缓解训练与推理之间的分布偏移。推理时同一骨干挂两个头,LM head 输出五维评论,RM head 给出五维分数。 Overview of the two-stage training and inference pipeline of method. In Stage~I, Gemini-3-Pro generates aesthetic critiques from songs, evaluation rubrics, and expert mean ratings to construct $\mathcal{D}_{\mathrm{off}}$, which is used to fine-tune a pretrained large language model into an SFT critique generator. In Stage~II, the SFT model replaces the teacher critiques with one self-generated five-aspect critique per song to construct $\mathcal{D}_{\mathrm{on}}$; a scalar reward head is then initialized, and is trained using expert mean ratings as regression targets. At inference time, first generates a five-aspect critique and then predicts five continuous aesthetic scores conditioned on the song, rubric, and self-generated critique. 实验效果:在 200 首 SongEval 歌曲组成的域内测试集上,宏平均均方误差从 0.2875 降到 0.2316,宏平均 LCC、SRCC、Kendall's tau 分别提升到 0.9068、0.8838、0.7178。在包含 733 组偏好对的域外 Music Arena 基准上取得 71.35% 的最高准确率。此外用 MuseCritic 配合 GRPO 训练,让 Muse-0.6B 在 SongEval 与 Audiobox Aesthetics 的全部九项审美指标上都获得提升。 Effect of natural-language aesthetic critiques on five-dimensional score distributions. Curves show expert ratings, full predictions, and predictions from the no-critique variant on the fixed SongEval test set. Coherence, Musicality, Memorability, Clarity, and Naturalness correspond to the five aesthetic dimensions. Without critiques, predictions cluster in a narrow high-score region; the full model more closely matches the range of expert ratings. 批判点评:这篇把「先说理由再打分」这个在 LLM 评判里已经验证过的思路,落到了音乐审美这个更主观的领域上,而且没有停在「评论只是副产品」的层面——评论被显式当作预测分数的中间表示,等于强制模型把打分依据外显出来再据此定分,这跟事后补一段解释有本质区别。第二阶段用模型自己生成的评论做奖励学习也处理得细:如果一直用教师评论训练,推理时喂的是自产评论,中间表示的分布就对不上,这个偏移点被明确指出并修掉了。可解释性在这里不只是锦上添花——生成模型拿到「和声设计缺少标志性钩子」这样的具体反馈,比拿到一个 3.7 分有用得多,而 GRPO 实验里九项指标全面提升,说明这个信号确实能反向优化生成质量,闭环是通的。域外 Music Arena 上 71.35% 的偏好准确率也比域内指标更能说明泛化。要留一分冷静的地方:域内 200 首、域外 733 组偏好对,规模都偏小,音乐风格与语言的覆盖面无从判断,长篇歌曲的审美又高度依赖文化语境,跨风格泛化能力存疑。域内 LCC 高到 0.9068 需要警惕——SongEval 的专家评分本身可能存在标注者一致性上限,逼近这个上限更多说明拟合了该标注体系的偏好,而非掌握了普适审美。71.35% 这个数字放在偏好判断任务里其实不算高,随机是 50%,说明近三成的人类偏好它判反了,作为 RLHF 奖励信号会引入可观噪声。教师用 Gemini-3-Pro 也意味着整套评论体系继承了该模型的审美倾向与盲区,五个审美维度同样是人工设定,未必覆盖音乐性的全部面向。MSE 从 0.2875 降到 0.2316 是约 19% 的相对改善,扎实但非量级突破。 趋势观察 今天的主线不是把模型做大,而是把「上下文」从模型里搬出去 — Evoke 与 V-RAE 是今天最值得对读的一组,它们从两个方向指向同一个判断:真正卡住长时生成的不是参数量,而是模型该记住什么、以什么形式记住。Alaya Lab 的 Evoke 把场景几何整体搬进一个相机位姿索引的外部世界状态库(World State Bank),去噪器每步只检索与当前视角相关的那一小块,于是上下文长度被彻底钉死——会话跑到两小时,单块生成时间仍是 2.11 秒,显存不涨。这跟主流做法正好相反:主流是把历史往 KV cache 里堆,堆到显存爆掉为止,于是「记得多久」和「能跑多久」变成一道零和题。Evoke 的答案是这道题本身出错了,历史不该放在注意力里。V-RAE 走的是另一条路但逻辑同源:它质疑视频 VAE 长期以来只为像素重建服务这件事,直接把冻结的视觉基础模型特征当作隐空间底座,只加一个轻量时序池化模块压掉冗余。结果是重建拿到 K600 上 2.13 rFVD 超过所有评测过的大规模视频 VAE,而生成侧收敛快了最多 6 倍——说明「重建最优的隐空间」和「适合生成的隐空间」本来就不是一回事,这个区分此前基本被行业忽略。两篇合起来给的信号很清楚:接下来一段时间的增量可能更多来自表示与记忆的重新设计,而不是继续堆 DiT 层数。 音频这边今天补的是「语音和音效终于长在一起」这个缺口 — VoxAudio 与 Phoenix TTS 都来自音频方向,但补的是产业链上两个不同的洞。浙大的 VoxAudio 针对的是一个被长期用胶带粘住的流程:要生成「有人在环境里说话」的音频,现有系统要么把台词退化成听不清的嘟囔,要么交给独立 TTS 生成再后期混音——后者的代价是彻底失去对「什么时候说、和场景怎么互动」的控制权。它用块因果自回归流匹配把二者合成一件事做,配上带逐字转录与时间区间标注的 VoxCorpus 语料,还能滑窗流式出音。滴滴与厦大的 Phoenix TTS 则往回追一层,质疑语音 tokenizer 的训练方式:传统 tokenizer 用 ASR 或自监督目标独立训练,为了抓语言内容会主动丢掉声学细节,于是下游声学模型的音色相似度天花板被提前焊死。它的做法是让 tokenizer 同时接受自监督特征重建和下游 Flow Matching 损失的直接监督,11 万小时数据训出来的系统字错率稳定低于真人录音,且免费附赠零样本音色转换能力。一个在往上做端到端整合,一个在往下修表示层的地基,共同点是都不满足于「拼几个现成模块」。 越来越多论文在做「诊断」而不是「刷分」,这是领域成熟的信号 — PixSDS 和 Princigram 今天都不是在原有指标上抢名次,而是先把一个大家默认能用的东西拆开看它为什么不对。PixSDS 追查文生 3D 里 latent SDS 那些结构化色斑与高频噪点,给出的诊断相当漂亮:VAE 诱导的像素漂移——优化中的图像可以沿着「VAE 编码器几乎不约束」的像素方向自由跑,于是它的 latent 看起来始终干净且语义正确,图像本身却在悄悄累积可见瑕疵。它用 VAE-only 优化实验把这个机理单独复现出来,修法也轻:解码一次 latent 前瞻步,拿解码图像当像素空间的干净方向,不重训扩散模型、不换渲染器。Princigram 则指出一个更尴尬的事实——T2I 早就做到照片级真实,但画科学示意图依然满是错的受力方向、无效坐标系,因为训练数据里的网图配文根本不含物理约束,生成出来「看着像、物理上全错」,用在教学与科学传播上是净负值。它的解法是结构化物理思维链(SP-CoT),把示意图按六个子学科拆成固定 schema 的多步推理,既当训练监督又当推理提示,并配 VeriphyT2IBench 把评分拆成一条条具名物理事实而不是一个笼统总分。这类工作短期不好看,长期决定了这个方向能不能被信任。 人工智能炼丹君 整理 | 2026-08-17 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注