
搜索到
19
篇与
transformer
的结果
-
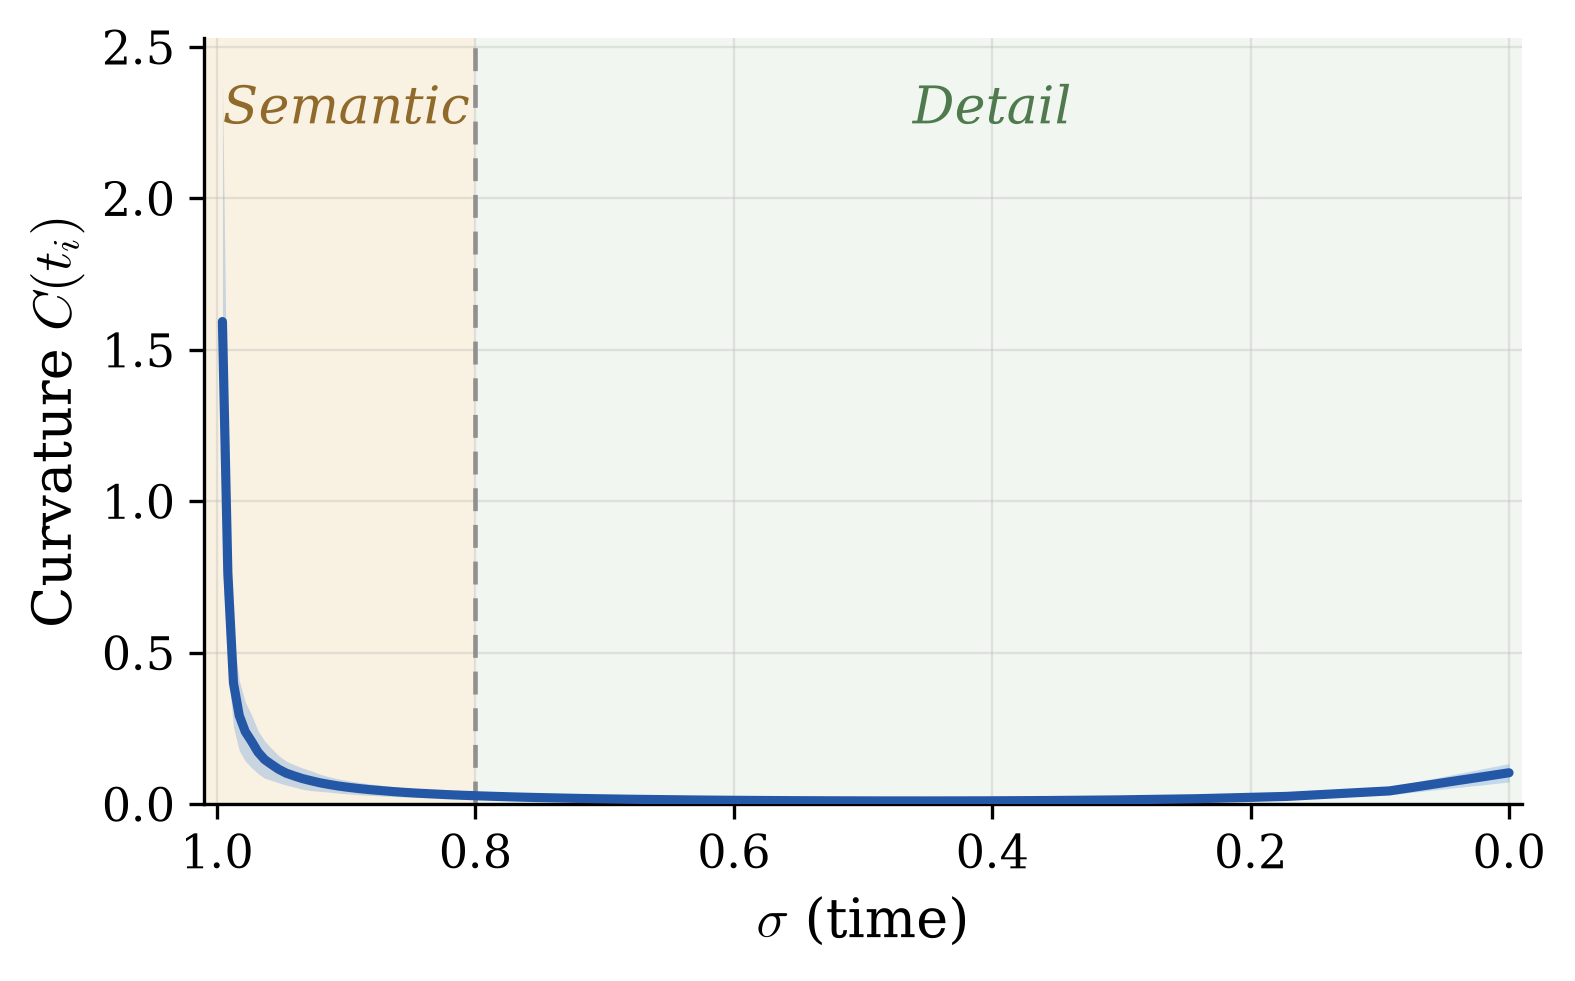
 AIGC 每日速读|2026-08-14|阿里14B数字人实时跑三分钟LiveAnimate 今日 AIGC 论文速览 今日共 10 篇 · 实时流式数字人与人体动画 3 篇 · 统一音频场景生成与语音合成 2 篇 · 视频扩散推理加速 2 篇 · 可编辑 3D 世界状态与预演 1 篇 · 生成模型安全与概念擦除 1 篇 · 统一多模态模型评测 1 篇 重点论文标题列表 LiveAnimate(港中文·阿里Qwen·Liblib AI):14B 数字人首次实时流式跑三分钟 Avatar-Forever(港理工·字节跳动·AMD):22B 数字人单卡 27.2 FPS 无限时长 ⚡ MiDashengLM-Gen(小米 MiLM Plus·上海交大 X-LANCE):统一音频生成把语音错词率砍到 2.79% LoSA(悉尼大学·CSIRO):锁死 99% 注意力质量换 3.2 倍加速 UniSwap(港中文·阿里Qwen):单模型同时换脸换声还能流式 今日论文速览 1. LiveAnimate:14B 数字人首次实时流式跑三分钟 LiveAnimate: Stable Long-Form Streaming Human Animation in Real-Time | 港中文·阿里Qwen·Liblib AI | arXiv:2608.11745 ⚠️ 前序问题:姿态驱动的人体动画要从一张参考图加一路驱动姿态流合成目标人物视频,直播、远程呈现、虚拟主播这类交互场景天然要求实时出画。但扩散类系统生成一个片段动辄几分钟到几小时,响应式交互根本无从谈起。更麻烦的是长时段:即便勉强加速,流式生成一路推下去,外观和身份会随时间漂移,KV 缓存也会随时长无限膨胀,导致延迟越跑越高。 本文贡献:提出 LiveAnimate,作者称是首个在十亿参数量级上同时做到实时流式与稳定长时生成的动画系统,底座是 14B 参数的视频扩散 Transformer。两阶段训练先用 Reference-Anchored Teacher-Forcing Adaptation 把预训练的双向 DiT 改造成块因果自回归生成器,再用 Block-wise Self-Forcing Distillation 把采样预算压到 3 步。关键设计是 Pose-Retrieval Sink Attention(PR-Sink)——一个有界 KV 缓存机制:Static Sink 永久锚定首个生成块,Dynamic Sink 保留一个按姿态检索出的历史块,外加三槽滚动窗口。姿态复现时 PR-Sink 直接取回相关外观上下文,无需保留整条序列,因此显存与单块延迟不随流长增长。工程侧再叠 Ulysses 序列并行与算子融合。 Overview of ours. Given a reference image and streaming pose signals, our system generates video blocks autoregressively. Each block undergoes 3-step denoising followed by a clean KV update. PR-Sink augments a three-block rolling window with the first generated block and a pose-matched historical block selected from a compact memory bank. Ulysses sequence parallelism distributes attention computation across GPUs. 实验效果:在两张 NVIDIA H100 上达到 19.63 FPS 流式推理。在三分钟基准上,从最初 30 秒到最后一分钟,感知质量与身份一致性几乎保持恒定,而此前系统在同样的 rollout 长度上要么显著退化,要么需要数小时离线计算。 Quality and identity over a three-minute rollout. Metrics are computed on a 0--10,s prefix, the 0--30,s initial window, and three subsequent temporal segments. The full model is highlighted in red. Flat trajectories indicate resistance to accumulated degradation. Higher is better for ASE, IQA, and DINO-S; lower is better for FID and V-MAE. 批判点评:这篇的价值不在某个单点数字,而在它把「实时」「长时」「大模型」这三个此前互相拆台的约束第一次同时满足了。以往路线要么把模型缩到 1B 级换实时、要么牺牲长时稳定性,LiveAnimate 直接在 14B 上硬啃,靠的是把长时漂移问题重新定义为缓存管理问题——PR-Sink 的姿态检索思路很聪明:人体动画的驱动信号本身是周期性、可索引的,姿态复现时把对应的历史外观取回来,比无脑保留全序列或粗暴丢弃都更划算,而且天然给出了「显存恒定」这个硬保证。这也是它敢报三分钟基准的底气。但必须把期待校准:19.63 FPS 是两张 H100 的成绩,单卡折半后离消费级部署仍隔着代际,成本上更接近云服务而非端侧;3 步蒸馏在人体动画这种强条件任务上损失可控,不代表能平移到弱条件的开放域生成。三分钟也还不是「长时」的终点,直播场景动辄数小时,Static Sink 永久锚首块的设计在超长 rollout 下是否会因首帧与当下姿态相关性衰减而变成噪声源,论文没给出压力测试。另外姿态检索依赖驱动信号的可复现性,遇到几乎不重复的自由舞蹈或大幅视角变化,Dynamic Sink 可能长期取不到有用的历史块,退化为纯滚动窗口。它是一个扎实的工程胜利,但把它读成「数字人已经解决」会误判。 2. Avatar-Forever:22B 数字人单卡 27.2 FPS 无限时长 Avatar-Forever: Decoupled Parallel Training for High-Quality Real-Time Infinite Avatars | 港理工·字节跳动·AMD | arXiv:2608.12107 ⚠️ 前序问题:现有流式视频系统普遍依赖以蒸馏为核心的串行训练管线来实现少步长视频生成,这个范式有两处硬伤。第一,前面阶段引入的失败或分布偏移会污染后续优化,让整个训练很难收敛;第二,蒸馏式目标天生偏向短程生成,一旦自回归误差在长 rollout 上累积,质量会明显退化。换句话说,「生成效率」和「长时鲁棒性」被强行塞进同一条串行流水线里,两个目标互相打架。 本文贡献:提出 Avatar-Forever,把上述两种能力当成两个独立能力并行训练,而不是串行耦合。一个分支做全参数蒸馏,训出一个视觉质量高的高效生成器;另一个分支通过 Recovery-oriented Rollout Training(RRT)训练一个轻量长程适配器,专门提升长时推理条件下的生成鲁棒性。解耦并行的设计简化了整体训练流程,也避免了少步生成与长程适配之间不必要的目标冲突。推理侧再引入 ForeverCache——一种分块特征缓存机制,大幅削减流式推理中对历史的冗余重算。整套方案构建在 22B 视频基础模型之上。 Overview of Avatar-Forever. Top: Existing streaming avatar systems employ sequential distillation pipelines, leading to stage-wise dependence and objective interference. Bottom: Avatar-Forever learns few-step efficiency and long-horizon robustness in parallel. A lightweight adapter is trained under accumulated rollout errors, and it is merged with the distilled generator in inference. In addition, ForeverCache is proposed to reuse historical features for efficient streaming inference. 实验效果:支持无界的音频驱动数字人生成,同时保持身份一致性、动作连贯性与视觉保真度;在单张 H100 上实现 768×512 高分辨率视频端到端 27.2 FPS 吞吐。 Visual results of extended-duration generation. We uniformly sample frames from a continuous video generated for more than 11 minutes. Avatar-Forever maintains stable identity, facial structure, and scene content while producing natural expressions, coherent head and body motion, and accurate audio--visual synchronization throughout the extended autoregressive rollout. The bottom row shows the corresponding driving-audio waveform. 批判点评:和 LiveAnimate 同天出现、目标高度重叠,但方法论切入点完全不同,两篇并读信息量最大。LiveAnimate 是在推理侧动手术(PR-Sink 管缓存),Avatar-Forever 是在训练侧动手术——它指出的「串行蒸馏管线中前序阶段污染后序优化」是个被长期容忍的隐性成本,把少步高效与长程鲁棒拆成两条并行分支各自优化、最后组合,是很清晰的解耦思路,也顺带解决了「蒸馏目标偏爱短程」这个结构性偏见。RRT 显式面向恢复能力训练,比单纯加长训练序列更对症。数字上它比 LiveAnimate 更漂亮:22B 更大的底座、单卡 27.2 FPS、且声称无界时长。但正因为漂亮,几处要打问号:分辨率是 768×512,低于 LiveAnimate 的对照设定,FPS 之间不能直接横比;「无限时长(infinite)」是个很强的措辞,摘要只给了机制性论证(ForeverCache 削冗余 + 长程适配器)而没有报出具体跑了多久的实测曲线,而长 rollout 的退化通常是缓慢累积而非突然崩溃,缺时长轴上的量化曲线就难以证伪。解耦并行还带来一个未被讨论的问题:两个分支各自最优,组合后是否仍最优?论文把「避免目标冲突」当成优点,但也意味着两者之间的协同信号被切断了,轻量适配器能否完全兜住全参数蒸馏生成器在长程上的所有失效模式,缺少消融就只能存疑。它是很有说服力的工程范式提案,但「无限」二字值得读者自己打个折。 3. MiDashengLM-Gen:统一音频生成把语音错词率砍到 2.79% MiDashengLM-Gen: Unified Audio Scene Generation via LLM-Driven Autoregressive Flow Matching | 小米 MiLM Plus·上海交大 X-LANCE | arXiv:2608.11804 ⚠️ 前序问题:要生成同时混合语音、音乐与音效的连贯音频场景一直很难。现有做法普遍是拼装式管线:一个冻结、解耦的文本编码器喂给一个独立的音频解码器。这种结构限制了跨模态联合优化,最直接的代价是语音清晰度很差——统一模型能生成「听起来像有人说话」的音频,但说的词经常是糊的,这让它们在需要真正传达内容的场景里没法用。 本文贡献:提出 MiDashengLM-Gen,一个端到端框架,把预训练大语言模型与逐 token 的条件流匹配(per-token conditional flow matching)耦合起来,做自回归、变长的混合音频场景生成。作者称这是首个用单一端到端训练模型完成通用文本到音频生成的方案——不再是「冻结编码器 + 独立解码器」的拼装,而是让 LLM 的语义能力与流匹配的声学生成能力在同一次训练中联合优化。框架也自然扩展到多语言设定。代码与检查点均已开源。 实验效果:在 Seed-TTS 基准上,英文词错误率(WER)从 12.15% 降到 2.79%,逼近专用 TTS 系统的 1.24%;多语言 WER 相比现有基线也很有竞争力;同时在 MECAT 基准上保持了有竞争力的混合音频生成质量。 Training loss and STFT L2 distance curves for different DiT width/depth configurations. Topline denotes DashengTokenizer encode-to-decode reconstruction. 批判点评:这篇最值得看的是它把「统一模型的语音清晰度」这个长期被含糊掉的短板量化成了一个能被追打的数字。此前统一音频生成的评测常聚焦整体音频质量或文本一致性,语音是否真的能听清则被稀释在综合分里——12.15% 的 WER 意味着每八个词就错一个,这个水平在演示视频里听起来可能还行,实际上完全无法承载信息。降到 2.79% 是 4.4 倍的收敛,把统一模型从「不可用」拉进「可用」的门槛内,而且没有牺牲混合音频质量,说明端到端联合训练确实解决了拼装管线里跨模态优化被切断的根因。开源也让结论可验证。但离终点仍有距离:2.79% 对 1.24% 是 2.25 倍的差距,专用 TTS 依然明显更清晰,「逼近」的措辞略微乐观;在有背景音乐和音效叠加的真实混合场景下,WER 是否还能守住 2.79%,摘要没有拆分报告——而这恰恰是统一模型相对专用 TTS 唯一的存在理由,也是最该给出的数字。MECAT 上「有竞争力」是个偏保守的表述,暗示混合音频质量可能并未超越专门的音频生成模型,那么这套统一方案的定位就更像「一个模型够用」而非「一个模型更好」。逐 token 流匹配的推理开销也未见报告,自回归叠流匹配在长音频上的延迟表现是落地的关键变量。方向正确、增益扎实,但别把它当成统一音频生成已经追平专用系统。 4. LoSA:锁死 99% 注意力质量换 3.2 倍加速 LoSA: Near-Lossless Sparse Attention for Training-Free Video Diffusion Acceleration | 悉尼大学·CSIRO | arXiv:2608.12032 ⚠️ 前序问题:视频扩散 Transformer 采样成本极高:每个去噪步都要在很长的 3D token 序列上做自注意力,这是二次复杂度,分辨率和时长一涨就成为绝对瓶颈。稀疏注意力能在不重训的前提下削减这笔开销,但现有方法普遍追求激进稀疏度——越往后每多榨一点加速,付出的注意力保真度代价越不成比例,质量塌得比速度涨得快。 本文贡献:LoSA 反向切入这条权衡曲线:先用构造方式把保真度锁死在近无损,再在这个约束允许的范围内尽可能多地砍计算。两个观察让这个区间变得可行——大约 40% 的块交互可以被移除而仍保留 99% 的注意力质量(attention mass),且高质量支撑集在各去噪步之间是稳定的。于是 LoSA 固定的是「保留质量阈值 99%」而不是稀疏率:在某个早期稠密步测出精确的块注意力质量,为每个 head 和 query 块保留满足该阈值的最小 key/value 块集合,然后把冻结的块索引复用到其余所有步。整套方法无需训练。 Overview of . Left: video diffusion attention contains a low-mass tail, allowing approximately $40\%$ of the block area to be removed while retaining approximately $99\%$ of the attention mass. Right: after a dense warm-up, measures exact block masses at $t_0$ and constructs the mask $\Omega$ by retaining, for each layer, head, and query block, the smallest prefix whose cumulative mass reaches $\theta$. The same frozen mask is reused at all remaining steps, while Q/K/V and attention weights are recomputed from the current hidden states. Bottom: with optional feature caching, the cache selects which steps are computed, while accelerates self-attention within every computed step. 实验效果:在 Wan2.1-1.3B 上,仅 LoSA 单独使用即带来 1.36 倍加速,VBench Overall 仅降 0.06 分。组合收益最大:与特征缓存叠加后,在 HunyuanVideo 上达到 3.2 倍加速、质量仅降 0.02 分,而同等速度下最强稀疏基线要降 0.32 分(差距 16 倍)。在三个视频扩散 Transformer 与最高 3.2 倍加速的范围内,LoSA 始终给出最好的无训练速度-质量权衡。 Speed--quality trade-off on Wan2.1-1.3B. Each point reports VBench Overall versus end-to-end speedup. and its cached variants form the entire Pareto frontier: every baseline configuration is matched or dominated by a configuration, showing that near-lossless sparse attention preserves quality better than aggressive sparsity or cache-only acceleration. 批判点评:这篇的贡献是把加速方法的接口从「设一个稀疏率」换成「设一个质量阈值」,这个换位比它的加速倍数更有价值。稀疏率是手段侧参数,用户真正关心的是质量损失上界;以往调稀疏率本质是盲调——不同模型、不同分辨率下同一个稀疏率对应的质量损失完全不同,只能试。LoSA 直接把用户可控量改成「保留 99% 注意力质量」,让加速变成有保证的操作,这是工程可用性上的实质进步。两个观察也很干净:40% 块交互可删且高质量支撑跨步稳定,后者尤其重要——正因为稳定,才能只在一个早期步测量、后续全部复用,把测量开销摊薄到近乎为零。3.2 倍下 0.02 对 0.32 分的差距(16 倍)比任何单点加速数字都更能说明方法优越。但要看清它的适用边界:注意力质量守恒并不等于生成质量守恒,99% 的 mass 保留是个代理指标,VBench 分数掉得少也只说明主流评测捕捉不到差异,细粒度的运动连贯与细节纹理是否有肉眼可辨的损失需要看实际样本。「索引冻结」这个核心简化建立在支撑集跨步稳定的经验观察上,一旦遇到运动剧烈、场景切换的内容,早期步测出的支撑集对后期步的代表性会下降,论文没报按内容类型拆分的结果。另外 1.36 倍的单独加速其实不算高,3.2 倍是叠加特征缓存后的复合结果,意味着大部分加速红利来自另一个正交方法,LoSA 更准确的定位是「一个不拖后腿、可安全叠加的稀疏化组件」,而非独立的加速引擎。 5. UniSwap:单模型同时换脸换声还能流式 UniSwap: Streaming Audio-Visual Identity Swapping for Talking Videos | 港中文·阿里Qwen | arXiv:2608.11752 ⚠️ 前序问题:说话视频的角色替换要求同时迁移外观与声音,还得保住源视频的动作、场景、语言内容和音视频时序对齐。现有方法用两个分别优化的模型处理视觉和音频,音视频一致性很难强制约束——脸换了、声音换了,但两者的匹配关系和口型同步会松掉。更现实的障碍是数据:跨身份的对齐训练对本身极其稀缺,没有成对样本就没法直接监督。 本文贡献:提出 UniSwap,作者称是首个做流式联合音视频身份替换的框架。给定源视频、参考图像和一段参考语音,UniSwap 在单个音视频扩散 Transformer 内同时迁移参考外观与音色,同时保住源内容与动态。为解决对齐数据稀缺,设计 swap-and-reconstruct 管线:从真实片段中剥离视觉与声音身份,再用原片段作为重建目标。从双向骨干出发逐步适配——In-context Pretraining 学联合替换,Conditional Streaming Adaptation 转为块因果 KV 缓存生成,Efficient Self-forcing DMD 缓解暴露偏差并把每块采样从 30 步压到 3 步。Efficient Multi-LoRA Switching 让 DMD 的三个角色共享同一个冻结骨干;Feature-RoPE Decomposition 把缓存位置保持在训练范围内,支撑稳定长时推理。 Overview of UniSwap. The three-stage pipeline comprises (a) In-Context Pretraining for joint audio-video replacement, (b) Conditional Streaming Adaptation with block-causal masking and KV-cached inference, and (c) Efficient Self-Forcing DMD, which reduces denoising to 3 steps per block. Feature-RoPE Decomposition bounds cached positions while preserving cross-modal physical-time alignment. 实验效果:实验显示强音视频同步性、有竞争力的身份保持、高效流式与稳定长时生成;单张 H100 上块式自回归 3 步采样达到 13.6 FPS,支持小时级长时生成。 Qualitative comparison on the long-video benchmark. Frames are sampled every 10 seconds from 1-minute generations. The baselines exhibit identity drift and visual artifacts as generation progresses (highlighted in red), while UniSwap preserves the reference identity throughout the full duration. Zoom in for details. 批判点评:把换脸和换声塞进同一个扩散 Transformer,最直接的收益是音视频一致性从「事后对齐」变成「联合建模的内生属性」,这在口型同步上是结构性优势——两个独立模型无论怎么后处理,都难保证音色变化和面部动态的耦合关系正确。swap-and-reconstruct 的自监督构造也很实用,把「没有跨身份成对数据」这个死结转化为可重建的代理任务。Multi-LoRA 共享冻结骨干让三个 DMD 角色不必各存一份权重,是很务实的显存优化。但这篇要额外提一句风险:联合音视频身份替换在能力上等价于「更难被察觉的深度伪造」——单独换脸或单独换声都留有模态间不一致的破绪,而联合替换恰恰把这个最有效的检测线索抹掉了。摘要通篇未提任何水印、溯源或滥用防护机制,这在同一天还有 PEAK(概念擦除)和 SafeCA(T2V 越狱防御)在做安全侧工作的语境下,对比格外刺眼。技术层面也有保留:身份保持只说「有竞争力」,是个偏弱的措辞,暗示相比专用换脸模型可能并不占优,联合建模换来的一致性可能以单模态精度为代价;13.6 FPS 低于同天 LiveAnimate 的 19.63(两卡)和 Avatar-Forever 的 27.2(单卡),联合音视频的算力代价是实打实的;「小时级」的稳定性同样缺少时长轴上的量化曲线。方法扎实,但这是一篇技术评价和伦理评价必须分开打分的论文。 6. Luna-TTS:扩散语言模型 TTS 首块延迟 41.6 毫秒 Luna-TTS Family Technical Report | VUI Labs·上海交大 | arXiv:2608.11593 ⚠️ 前序问题:现代 TTS 被自回归编解码语言模型主导,但左到右解码带来三重结构性代价:延迟随语句长度增长、错误沿已提交前缀累积、以及在残差矢量量化(RVQ)的 token 网格上强加了一个人为的生成顺序——RVQ 网格本身并不存在这样的顺序。这三点在需要低延迟、长语句、高稳定性的场景里都是硬伤。 本文贡献:提出 Luna-TTS Family,基于扩散语言模型的 TTS 系统,在中英日韩四语种、100 万小时语音上预训练。整个家族由一个预训练自回归文本 LLM 渐进适配而来:从因果注意力到双向、最终到块因果,两个变体共享同一套 tokenizer、数据管线与 0.6B 骨干血统。Luna-TTS 完全非自回归,用固定步数的并行细化生成整个 RVQ token 网格,零样本音色克隆与语音编辑天然表现为 infilling 任务;Luna-TTS Realtime 由继续训练得到,在 32 个编解码帧(1.28 秒)的块上自回归、块内并行去噪,支持 KV 缓存的块式生成与增量音频交付。退火微调阶段加入对情绪与非言语声(NVV)的显式控制,强化学习阶段用 GRPO、策略比在实际去噪轨迹上计算。 实验效果:Realtime 变体端到端 RTF 0.0240、本地首块延迟 41.6 毫秒(预热服务协议下)。Seed-TTS-Eval 上在对比的开源与商业系统中四项指标全部最优:test-zh 达 0.73 CER / 79.7 SIM,test-en 达 1.49 WER / 76.8 SIM;更难的野外 CV3-Eval 上中英错误率均为对比中最低。对比领先商业系统,在 NVV 与情绪控制的多数客观、模型评分与人工评分指标上取得最好结果。 批判点评:这篇的路线选择值得单独拎出来看。当前 TTS 的主流叙事是「自回归 LLM + 编解码 token」,Luna 反过来论证这条路存在结构性错配:RVQ 的 token 网格是二维的(时间 × 码本层),左到右强加一维顺序纯属人为,而扩散语言模型的并行细化天然匹配这种结构。这个论点不只是效率优化,而是对生成顺序这一建模假设的直接质疑——首块延迟 41.6 毫秒、RTF 0.0240 的数字则是对该论点的支撑证据。更聪明的是它不从零训练,而是把预训练的自回归文本 LLM 渐进适配(因果→双向→块因果),复用了文本 LLM 的语义能力,这也解释了 0.6B 这么小的骨干能打赢商业系统。NAR 与 Realtime 两个变体共享血统、覆盖离线高质量与流式低延迟两种场景,产品化考量很完整。需要保留的地方:41.6 毫秒明确标注在「预热服务协议」下测得,真实服务的冷启动、并发排队与网络往返都不在这个数字里,别直接当端到端体验延迟读;Seed-TTS-Eval 上四项全优的对照集是「我们对比的系统」,商业系统版本迭代很快,这类横评的时效性通常只有几个月;机构标注为 VUI Labs Research,是相对新的团队,1 万小时级以上的数据来源与许可情况未在摘要说明,这在 100 万小时规模下是个不可忽略的合规问题。技术报告体裁也意味着消融相对薄——渐进适配的三个阶段各自贡献多少、GRPO 那一步的实际增益有多大,都需要正文细读才能判断。 7. GeoFlow:别再从纯高斯噪声重画已知场景 GeoFlow: Efficient Driving Video Generation via Geometry-Aligned Priors | 北航 (ECCV 2026) | arXiv:2608.12203 ⚠️ 前序问题:扩散模型与流匹配能合成高保真驾驶视频,但受制于大量采样步带来的高推理延迟。作者把低效归因到一个被普遍默认的选择:标准高斯源分布——连续帧各自初始化为独立的高斯噪声。这忽略了驾驶视频里极强的时空相关性,逼着模型把上一帧里已经确定的场景结构从噪声里重新生成一遍,既算得冗余,又容易产生几何不一致。 本文贡献:提出 GeoFlow,用显式几何先验实现高效驾驶视频生成。不再从标准高斯噪声采样,而是利用多视图几何与空间自适应的噪声注入,构造一个 Geometry-Aligned Prior(GAP)分布作为起点。这个初始化拉近了源分布与数据分布的距离,从而得到明显更直、更短的采样轨迹——流匹配的核心成本正来自轨迹的曲折程度,把起点挪近就等于直接砍掉了大部分传输代价。 Schematic of the proposed GeoFlow framework. % Instead of initializing from an uninformative noise, % Our method leverages multi-view geometry to bridge the gap between the source and target manifolds. % The pipeline projects visual features into a latent point cloud, which is rendered to the target view to form a geometric prior. To bridge the gap between the source and target manifolds, we leverage multi-view geometry to construct a Geometry-Aligned Prior Distribution, where an Spatially-Adaptive Noise Injection strategy is introduced to reduce error accumulation due to depth and rendering artifacts. Bottom Panel: As visualized in the sampling trajectory comparison, our initialization significantly shortens and straighten the flow, % yielding a nearly straight generation path (green) compared to the highly curved trajectory of the standard Gaussian baseline (red), thereby enabling high-fidelity synthesis within several inference steps. 实验效果:训练与推理效率均显著提升:在基线模型上仅需数小时微调即可明显提升少步生成质量;完全收敛训练后,大幅削减了达到当前最优视频生成质量所需的推理步数。ECCV 2026 接收。 Ablation of Noise Injection. 批判点评:这篇的洞察很干净,也很容易被低估:整个扩散/流匹配社区把「从标准高斯出发」当成了公理,但对结构高度冗余的视频而言,这个起点其实是在浪费——上一帧已经确定的道路、建筑、车道线,凭什么要从纯噪声里重新长一遍?GeoFlow 把加速的着力点从「怎么走得快」(蒸馏、缓存、稀疏化)挪到了「从哪儿出发」,这是与主流加速路线正交的维度,理论上可以叠加。用多视图几何构造先验也很合理:驾驶场景的相机内外参和多视图关系是已知的,这些确定性信息本该被直接利用而不是让网络去猜。「仅需数小时微调」意味着它可以作为补丁挂到现有基线上,落地摩擦很小。但适用面要看清楚:这套方法吃的是驾驶场景「几何强先验 + 时空强冗余」的红利,多视图标定、连续帧结构高度重叠都是自动驾驶数据的特殊性质,换到开放域视频(镜头切换、剧烈运动、无标定)里,GAP 能否构造得出来是个大问号,所以别把它读成通用视频加速方案。效果描述也偏定性——「大幅削减推理步数」「显著提升」都没给出具体倍数或 FVD 数字,摘要层面无法判断它相比同类少步方法的量化位置。另有一个方法内在张力值得注意:先验越强,采样轨迹越短越直,但生成多样性也越受约束;驾驶视频生成常被用于仿真罕见场景(corner case),如果先验把输出往「几何上像前一帧」的方向拽得太紧,恰恰会削弱它在最有价值场景上的表达能力,这个权衡摘要没有讨论。 8. StateFlow:给视频创作补一个持久 3D 状态层 StateFlow: Building, Evolving, and Accessing 3D World States for Previsualization | 北京交大·北大·BAAI·Mootion AI | arXiv:2608.12314 ⚠️ 前序问题:预演(previsualization)是影视、游戏、建筑与城市设计中连接想法与制作的中间层,创作者要在这一层反复打磨场景、动作、镜头与时空动态。但现有生成方法靠简单提示词、用一次性图像或视频合成去联合控制所有这些因素,可控性很弱,也几乎不支持迭代编辑——改一处就得整体重生成,上一版的结果全丢。作者点出问题的根子:一个世界由多个带几何、外观和其他属性的元素加上相机组成,不同帧其实是这份共享状态的局部修改或重组,绝大部分内容是被复用的。缺失的组件是一个显式且持久的工作状态。 本文贡献:提出 StateFlow,以状态为中心的生成式预演框架。不做一次性视频生成,而是用一个可编辑的 3D 世界来组织场景结构、演化与相机,需要更高保真时再让现成视频模型来增强画质。这个世界被维护为场景元素与相机配置的持久结构化 3D 状态,作为预演的核心工作表示。三个阶段:State construction 通过先验引导、冲突感知的双视图初始化,把生成的 2D 内容抬升为连贯 3D 世界;State evolution 把用户意图翻译成结构化的状态转移并保留世界记忆,避免每次编辑都全场景重生成;State access 用渲染反馈反思机制把相机方案细化为视觉上可行的轨迹,而不是只依赖 VLM 的语义判断。 Qualitative comparison on Scene Generation 实验效果:实验显示 StateFlow 能为视频创作与类游戏原型制作产出高质量 3D 世界。 Qualitative comparison on previsualization applications. Case~1 and Case~3 showcase video creation, while Case~2 shows 3D game prototyping. Video-generation baselines consistently suffer from spatial--temporal inconsistency, identity drifting, and restricted camera motion, whereas StateFlow operates on a persistent and interactive 3D world, yielding precise, highly controllable, and geometry--appearance-consistent results. 批判点评:这篇提的问题比它给的方案更重要。当前视频生成的交互范式基本是「抽奖」——改一个词,整段重出,上一版的所有满意之处一并丢失,这在需要迭代收敛的专业创作流程里是致命的。StateFlow 把矛头指向缺少持久状态,这个诊断很准:把「视频」当作输出、把「3D 世界状态」当作可编辑的真源,编辑就从重新生成变成状态转移,世界记忆得以保留,这才是专业工具该有的形态。三阶段拆分也各有对症之处,尤其 State access 用渲染反馈来验证相机轨迹的物理可行性、不轻信 VLM 的语义判断,是个务实的清醒设计——VLM 说「镜头从这里推过去很好」和这条轨迹真的不穿墙是两件事。但这篇的实验部分是明显短板:摘要只给了「能产出高质量 3D 世界」这种定性结论,没有任何量化指标、没有与一次性视频生成基线的可控性对比、也没有用户研究,而「可控性」和「迭代效率」恰恰是它的核心主张,最该被量化。方案本身也把难题转移而非消除了:把 2D 内容抬升为连贯 3D 世界(单视图/双视图 3D 重建)本身就是未解问题,「冲突感知的双视图初始化」听起来是在缓解不一致而非解决它,一旦初始状态几何有误,后续所有编辑都建在歪地基上。它还依赖现成视频模型做画质增强,那么最终输出的一致性又部分回到了那个不可控的黑箱里。作为范式提案很有启发,作为可用工具还需要更硬的证据。 9. PEAK:擦概念把攻击成功率从96.5%压到5.6% PEAK: Precise and Persistent Concept Erasure via k-Sparse Autoencoders | 合肥工大·中科大·澳门大学 | arXiv:2608.10985 ⚠️ 前序问题:从大规模文生图扩散模型中擦除概念因版权侵权、隐私侵犯与不良内容的顾虑而愈发关键,但现有方法很难同时做到精确与持久:概念相关表征定位不准会造成意外的语义干扰(擦掉一个概念顺带损伤无关生成能力),而底层概念知识删除不彻底又让对抗性恢复成为可能——攻击者用精心构造的提示词就能把「已擦除」的概念重新召回。 本文贡献:提出 PEAK,通过 k-稀疏自编码器(kSAE)实现精确且持久的概念擦除。先在扩散去噪网络的内部激活上训练一个 kSAE,把稠密表征分解为可解释的稀疏特征;再对比目标提示与非目标提示诱发的稀疏激活,按激活强度与激活频率两个维度识别出一小组目标特有特征。随后用这些定位到的特征做参数优化,选择性抑制目标相关激活,同时相对原模型保留互补的非目标激活。这种特征引导的优化把概念擦除直接嵌入扩散参数,因而不需要任何推理时干预,也让擦除对对抗攻击具备有效的持久性。代码与模型已开源。 The main pipeline of the proposed PEAK. (a) A frozen kSAE encodes diffusion-model activations induced by matched target and non-target prompts, and target-specific features are selected by contrasting their activation scores. (b) The selected target features are suppressed during fine-tuning, and the other features are aligned with those of the original model. 实验效果:在 I2P 基准上,PEAK 把 NudeNet 检测数从 582 降到 6,平均攻击成功率(ASR)从 96.52% 降到 5.63%,同时在 MS-COCO 上以近零的 KID 保持了通用生成质量。 Qualitative evaluation of PEAK across different diffusion architectures. PEAK consistently erases target concepts while preserving non-target semantics in both SDXL and FLUX models. 批判点评:这篇把可解释性研究的工具真正用出了实效,路径值得注意:kSAE 本是机制可解释性领域用来把稠密激活拆成人类可读稀疏特征的手段,PEAK 把它当作「定位手术刀」——先分解再靠激活强度和频率双重筛选出目标特有特征,比在稠密表征上直接调参精确得多,这也直接对应上了「精确」与「持久」两个诉求:定位准则不伤及无辜(COCO 近零 KID 佐证),删得彻底则抗对抗恢复(ASR 96.52%→5.63%)。把擦除烧进参数、不需推理时干预,工程上也更可靠——任何依赖推理时过滤的方案都能被绕过或直接关掉。开源让结论可复现。但要清楚它的边界:5.63% 的 ASR 不是零,意味着约二十次尝试里仍有一次能召回目标概念,对真正的滥用防护而言这个残余风险并不小,而攻击方法是持续演进的,今天的 5.63% 在更强的新攻击下会退化多少不可知。NudeNet 582→6 的评测面也偏窄——I2P 加 NudeNet 主要覆盖裸露类内容,版权风格、特定人物身份这些擦除需求的难度分布完全不同(风格是弥散的,很难在稀疏特征里被干净地切出来),摘要未给出跨概念类型的分解结果。同时擦除多个概念时特征之间是否干扰、KID 是否会累积恶化,也没有报告。另外这类方法有个绕不开的现实前提:它要求模型权重可改,对已经分发到用户手上的开源权重毫无追溯力——真正的擦除必须发生在发布之前。技术质量很高,但别把它当成安全问题的终点。 10. SGU:让统一模型对自己画的图做推理 Do You See What You Draw? A Semantic Closed-Loop Framework for Holistic Evaluation of Unified Multimodal Models | 浙江大学 | arXiv:2608.11907 ⚠️ 前序问题:大视觉语言模型越来越追求把视觉生成与理解统一进同一套参数空间,但如何连贯地评估这种结构性统一仍是关键难题。当前评测协议基本把生成能力和判别能力当成两个独立任务分别打分,缺的是面向统一多模态模型(UMM)的系统级评估——两项单独都很高,不代表它们在同一套参数里真的打通了。 本文贡献:提出 Self-Generative-Understanding(SGU),一个无需标注的评测框架,用语义闭环挑战来探测统一模型的整合能力。它不需要任何新标注,而是利用 UMM 自身兼具理解与生成的双重能力:先让模型感知一张图并产出文本描述,接着基于该描述重建视觉上下文,最后对自己生成的输出做推理。这条闭环管线提供了一个零成本测试床,产出专门用于把 UMM 当作统一系统来评估的整合性能分数。 Illustration of traditional UMM evaluation and our Self-Generative-Understanding (SGU) framework. (a) Existing evaluations often assess generation ($\mathcal{M}_G$) and understanding ($\mathcal{M}_U$) separately, producing capability-specific scores such as $s_g$ and $s_u$. These metrics remain valuable for component-wise diagnosis but do not directly provide a system-level view of how a UMM behaves when understanding and generation are jointly involved. (b) SGU provides a complementary closed-loop evaluation framework tailored to UMMs. It requires the model to understand an input image, generate a textual representation, reconstruct a visual context from that representation, and reason over the reconstructed image, yielding an outcome-based system-level score $s_{\text{umm}}$. 实验效果:大量实验显示,即便是表现很好的 UMM 也常常无法对自己生成的上下文进行推理,暴露出理解或生成各自单独评测都捕捉不到的局限。 批判点评:「让模型对自己画的图做推理」这个设计的巧妙之处在于零标注:闭环把模型自己的输出当成下一步的输入,评测信号完全内生,不需要人工标注也就不需要为每个新模型准备新数据。它探测的东西也确实是现有评测的盲区——理解分和生成分各自很高,只说明两个模块都能干活,不说明它们共享的表征是自洽的;如果模型看图能说出 A、按 A 画图、却对画出来的图推理不出 A,那所谓「统一」就只是参数共享而非语义打通。「高性能 UMM 常常无法对自己生成的上下文推理」这个发现本身就值得整个统一模型社区认真对待。但这个框架有个结构性弱点:闭环里的误差会复合传播,最终分数低到底是理解错了、生成偏了,还是推理跳了,很难归因,而缺乏归因能力的指标对改进模型的指导价值有限。零标注同时也意味着没有绝对基准——闭环失败可能只是因为文本描述天然不可能完整承载一张图的全部信息(描述必然有损,重建必然有偏),这部分损失是任务内在的,不该全算成模型缺陷,摘要没有说明如何区分内在信息损失与真实的能力缺口。另外闭环分数在不同模型间是否可比也需要论证:一个描述更啰嗦的模型可能因为传递了更多信息而闭环得分更高,但这未必意味着它更「统一」。它作为诊断性探针很有价值,作为排行榜指标则要谨慎。 趋势观察 实时数字人今天出现了两条互不知情的技术路线,答案不唯一 — 今天最值得对读的是 LiveAnimate 与 Avatar-Forever——同一天投出、目标几乎完全重叠(大模型底座上的实时流式长时数字人),但动手的位置完全相反。港中文与阿里 Qwen 的 LiveAnimate 在推理侧做手术:它把「长时外观漂移」重新定义为一个缓存管理问题,PR-Sink 用 Static Sink 永久锚定首块、Dynamic Sink 按姿态指纹检索历史块、外加三槽滚动窗口,使显存与单块延迟不随流长增长,14B DiT 在两张 H100 上跑到 19.63 FPS,三分钟基准上从前 30 秒到最后一分钟质量近乎水平。港理工与字节的 Avatar-Forever 则在训练侧动刀:它指出以蒸馏为核心的串行管线有个被长期容忍的隐性成本——前序阶段的失败与分布偏移会污染后续优化,且蒸馏目标天生偏爱短程,于是把「少步高效」和「长程鲁棒」拆成两条并行分支各自训练(后者用 Recovery-oriented Rollout Training),推理再叠 ForeverCache,22B 底座上单卡 27.2 FPS、实测跑到 11 分 44 秒身份不崩。两条路线都成立,且正交——一个管缓存怎么用,一个管模型怎么练,理论上可以叠加。这也说明实时数字人已经从「能不能做到」进入「怎么做更划算」的工程竞速阶段,港中文那一组更进一步,同天还投了 UniSwap 把同一套流式技术栈迁移到音视频联合身份替换上,13.6 FPS 单卡、小时级长时。要留一分清醒:三篇的分辨率、卡数、时长口径各不相同,FPS 数字之间不能直接横比;「无限」「小时级」这类措辞普遍缺少时长轴上的量化退化曲线,而长 rollout 的失效通常是缓慢累积而非突然崩溃。 加速研究开始把「用户该拧哪个旋钮」当成一等问题 — LoSA 和 GeoFlow 都在做视频扩散加速,但两篇最有价值的东西都不是加速倍数。悉尼大学与 CSIRO 的 LoSA 把稀疏注意力的可控参数从「稀疏率」换成了「保留 99% 注意力质量」——这是接口层面的改动,却直接解决了一个长期的盲调问题:同一个稀疏率在不同模型、不同分辨率下对应的质量损失完全不同,用户只能试,而用户真正关心的从来是质量损失的上界。锁死阈值再反推能砍多少计算,加速就从赌博变成了有保证的操作;配合「高质量支撑集跨去噪步稳定」这个观察,只在一个早期步测量、后续全部复用冻结索引,测量开销被摊薄到近乎为零,最终在 HunyuanVideo 上 3.2 倍加速仅降 0.02 分,同等速度下最强稀疏基线要降 0.32 分。北航的 GeoFlow(ECCV 2026)换了另一个维度:整个社区把「从标准高斯噪声出发」当成公理,但对结构高度冗余的驾驶视频而言,上一帧已经确定的道路和建筑凭什么要从纯噪声里重新长一遍?它用多视图几何与空间自适应噪声注入构造 Geometry-Aligned Prior,把起点直接挪到数据分布附近,采样轨迹变得更直更短。这是与蒸馏、缓存、稀疏化都正交的加速维度,且只需数小时微调就能挂到现有基线上。两篇的边界也要看清:LoSA 的 1.36 倍单独加速并不高,3.2 倍是叠加特征缓存后的复合结果,它更准确的定位是「一个不拖后腿、可安全叠加的组件」;GeoFlow 吃的是驾驶场景「几何强先验 + 时空强冗余」的特殊红利,换到无标定、镜头切换剧烈的开放域视频未必构造得出这个先验,而且先验越强、多样性越受约束,用于仿真罕见场景时这个权衡值得警惕。 统一模型的评价标准正在从「各项都高」转向「内部是否自洽」 — 今天有三篇论文从不同角度指向同一件事:把能力拼在一起不等于打通了。浙大的 SGU 提出一个零标注的语义闭环评测——让统一多模态模型先描述一张图、再按自己的描述重建图像、最后对自己生成的图做推理。发现是扎实的:即便理解分和生成分都很高的模型,也常常无法对自己生成的上下文正确推理,图中模型对原图答「猫朝左」、对自生成图答「猫朝前」,这类失效在分离式评测里完全看不到;六个模型的闭环排名与孤立排名折线明显交叉,说明分开打分预测不了统一系统的整合表现。小米 MiLM Plus 与上交的 MiDashengLM-Gen 则给出了「不自洽」的具体代价:以往统一音频生成靠冻结文本编码器加独立音频解码器的拼装管线,跨模态优化被切断,最直接的后果是语音清晰度崩坏——Seed-TTS 上英文 WER 高达 12.15%,每八个词错一个,演示视频里听着还行,实际完全无法承载信息;改成 LLM 与逐 token 条件流匹配端到端联合训练后降到 2.79%,4.4 倍收敛,且混合音频质量没掉。北京交大与北大的 StateFlow 从交互侧提出另一种自洽:当前视频生成的编辑范式基本是抽奖,改一个词整段重出、上一版的满意之处全丢,它主张缺的是一个显式且持久的 3D 世界状态,把编辑从重新生成变成状态转移。三篇合起来看,「统一」这个词正在被要求兑现更硬的东西:不只是参数共享,而是表征自洽、跨模态联合优化、以及状态可持久。当然也别过度乐观——SGU 的闭环误差难以归因,文本描述天然有损这部分内在损失不该全算成模型缺陷;MiDashengLM-Gen 的 2.79% 对专用 TTS 的 1.24% 仍有 2.25 倍差距,且未拆分报告有背景音乐音效叠加时的 WER,而那恰恰是统一模型唯一的存在理由;StateFlow 的实验只给了定性结论,可控性与迭代效率这两个核心主张最该被量化却没有量化。 人工智能炼丹君 整理 | 2026-08-14 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
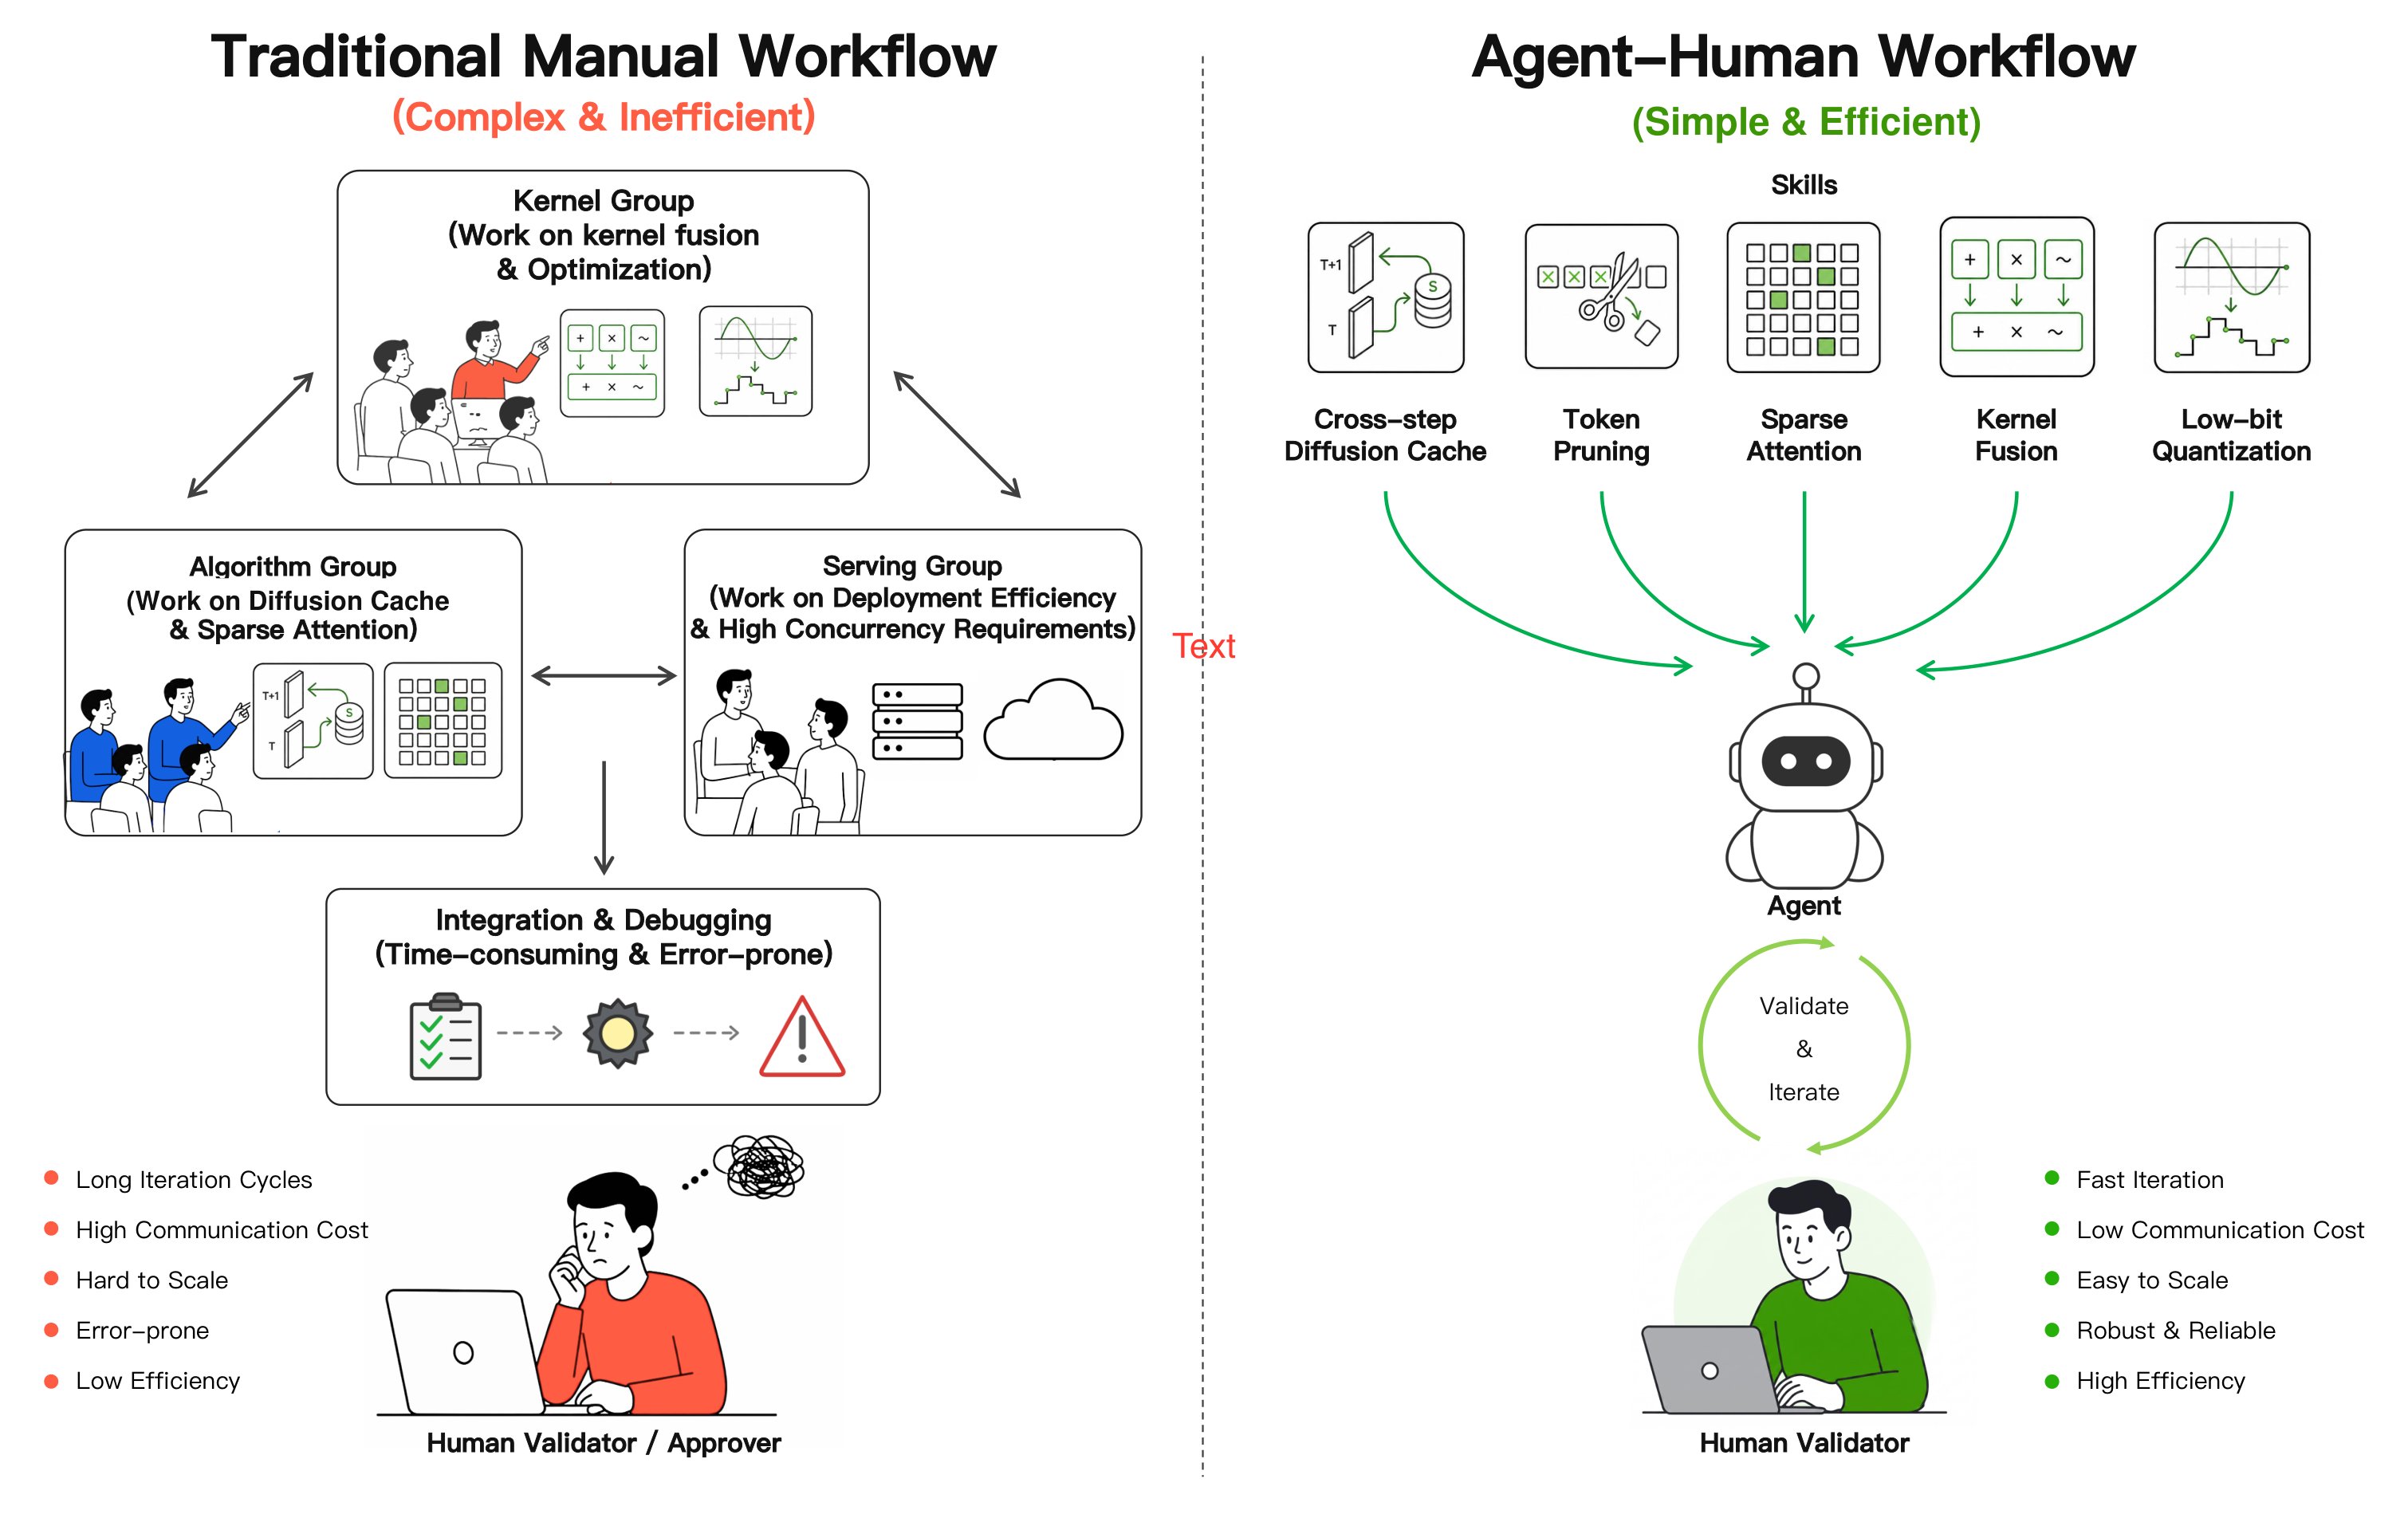
深度解读|NVIDIA Sol-Engine|Agent自动调栈视频推理快2.77倍 Sol-Engine 深度解读:NVIDIA 让 Agent 自己调出视频推理加速栈,端到端 2.27~2.77 倍 论文:Sol Video Inference Engine: Agent-Native Full-Stack Acceleration Framework for Efficient Video Generation 机构:NVIDIA Research(Efficient AI Team & Singapore Lab)· 港大 · MIT 人类作者:Yitong Li、Junsong Chen、Haopeng Li、Haozhe Liu、Jincheng Yu、Ligeng Zhu、Ping Luo、Song Han、Enze Xie 论文首页署名:NVIDIA SANA Team*、Codex*、GPT-Image2(* 同等贡献) 日期:2026-06(arXiv 2606.23743) 代码:论文给出 GitHub Code 与 Project Page 链接入口,截至发稿未见公开可跑的完整仓库 论文类型:技术报告 / 系统工程论文(非新算法论文) 01 先说说这东西是干嘛用的 先说一个容易被忽略的细节:这篇论文的署名里,Codex 和 GPT-Image2 是和 NVIDIA SANA Team 并列的"同等贡献作者"。arXiv 页面还专门单独列了一栏 "Human authors",把 9 位人类作者和 AI 分开标注。 这不是行为艺术。论文的主张就是"让 agent 来干加速工程这件活",所以把干活的 agent 署名进去,逻辑上是自洽的。 回到技术本身。Sol Video Inference Engine(下面简称 Sol-Engine)解决的问题很具体: 视频扩散模型的推理加速,没有通用配方。 现在业界已经攒了一大堆免训练加速手段——跨步缓存、稀疏注意力、token 剪枝、低比特量化、算子融合。每一个单独看都有效。但真到部署时会发现一件很烦的事: 在 Cosmos3-Super 上调好的缓存策略,搬到 LTX-2.3 上就崩,因为后者用的是 res_2s 二阶采样器,不是 Euler; 在 544×960 分辨率下管用的稀疏模式,换到 1088×1920 就掉质量; 在 B200 上收益明显的 NVFP4 量化,换张不支持 FP4 的卡就基本白干。 于是每换一个「模型 × 硬件 × 推理配置」组合,就得重新调一遍。而这三个维度一乘起来是个组合爆炸。NVIDIA 的做法是:别让人一个个调了,把这五类技术做成"技能"暴露给 agent,让 agent 自己搜。 具体产出是三个真实部署的加速栈: 模型 参数量 SGLang 基线 Sol-Engine 加速 Cosmos3-Super 64B(4 卡 SP) 99.6 s 43.9 s 2.27× LTX-2.3 22B 97.8 s 41.0 s 2.38× SANA-Video 2B 29.4 s 10.6 s 2.77× VBench 平均分变化在 ±0.54% 以内。全程免训练,不动模型权重。 (图片来源:论文 Figure 1。左侧是传统模式:kernel 组、算法组、推理服务组各管一段,最后人工集成调试,迭代周期长、沟通成本高、易出错;右侧是 Sol-Engine 模式:五类加速技能暴露给 agent,agent 做局部搜索和栈集成,人只负责验收和迭代) 02 主要亮点,以及需要冷静看的地方 值得关注的地方: 把"加速"这件事重新定义为逐实例调优问题,而不是"发明一个更好的方法"。这个问题重构本身比具体数字更有价值; 三个模型跨越 2B 到 64B,架构差异极大(MoT 混合专家、两阶段推理、线性注意力),同一套流程都拿到了 2× 以上,说明不是过拟合到单一 backbone; 用并行技能 agent + 集成 agent两层结构规避了单 agent 搜全局空间的成本问题,工程上是合理设计; 明确指出 PSNR 这类相似度指标和人类感知不对齐,并给出了反例图(详见第 07 段)——这个观察对整个视频加速评测圈都有价值; 附录 A 的超参配置写得非常细,细到 TeaCache 阈值 1.15、起始第 10 步、LTX 跳过的具体 call 索引 [13,14,16,...,27]。这部分是全文最能直接抄走用的资产; 量化不是一刀切,而是按去噪步选择性施加:Cosmos3-Super 的前 3 步和后 3 步保持高精度,只在中间步走 NVFP4。这个经验规则很实用。 需要冷静看的地方: "agent 比人快"这个核心主张没有对照实验。论文说"with little human effort",但没给 agent 用的是什么模型、搜了多少轮、花了多少 GPU 小时或 token 成本,也没有"人工调优需要 N 人周 vs agent 需要 M 小时"的量化对比; 没有消融证明 agent 搜索优于随机搜索或网格搜索。这是最大的方法论空白——如果把同样的搜索预算给随机搜索也能找到差不多的配置,那"agentic"就更多是包装而不是贡献; 人工验收仍在环里,所以这不是全自动流程。而"人觉得可以接受"本身是主观且不可复现的判断标准; 只在 B200 / B300 上做了实测,而这两张卡正好是 NVFP4 的主场。论文 Figure 3 把 H200 和 RTX 5090 画进了"硬件空间",但没有给这两张卡的任何实测数字; VBench 平均分几乎不变,但单维度有明显退化被平均分抹平了:成像质量在 Cosmos3-Super 上掉 1.35%、在 SANA-Video 上掉 1.64%,LTX-2.3 的美学质量掉 2.09%; 只报单请求延迟,没有吞吐量和显存峰值数据。生产部署更关心并发下的 QPS; Cosmos3-Super 是 NVIDIA 自家模型,有"自家模型自家调"的信息优势; 没有和 TeaCache、Sparse VideoGen2 等单点方法做同环境端到端对比——这些方法在论文里是"技能库的候选项",不是"被击败的基线"。 03 视频加速这条赛道现在什么样 在看 Sol-Engine 怎么组合之前,先把它调用的这些"技能"各自的来路说清楚。视频扩散加速大致分三层打: 算法层:缓存。 相邻去噪步算出来的东西很像,那就别重复算。代表工作是 TeaCache(用 timestep 嵌入预测输出变化量,变化小就复用缓存残差)、TaylorSeer(ICCV 2025,用泰勒展开预测未来特征,而不只是复用旧特征)、EasyCache(运行时自适应调整复用策略)。 模型层:稀疏注意力 + token 剪枝。 视频的时空 token 序列很长,注意力矩阵里大量连接贡献很小。稀疏注意力方向有 PISA(分块稀疏 + 一阶泰勒补偿)、Sparse VideoGen 1/2、SpargeAttention、Radial Attention、VSA。token 剪枝方向有 ToMe-SD、Astraea、TAPE、CoReDiT。 Kernel 层:量化 + 算子融合。 量化有 PTQ4DiT、Q-DiT、SVDQuant、SageAttention 1/2/3。融合有 CUTLASS epilogue、ByteTransformer、CODA(把 transformer block 重写成 GEMM + epilogue 程序)。 另一条相关线索是"agent 做系统优化":CUDA-LLM 和 CudaForge 已经证明 agent 配上编译检查、正确性验证、profiling 反馈,可以自动生成或优化 CUDA kernel。The AI Scientist 则证明 agent 能跑完整的科研闭环。 Sol-Engine 站的位置很清楚:它不发明上面任何一层的新方法,它做的是"怎么把这些方法组合起来并调对参数"的自动化。 这个定位决定了它的价值和局限——价值在于把学术界攒的一堆单点技术真正落到部署;局限在于它本身没有新的算法贡献。 04 为什么"通用加速配方"这件事不成立 这是全文论证最扎实的一段,也是理解 Sol-Engine 为什么要用 agent 的关键。 论文先把冗余拆成三层,然后给了一个很有说服力的数据。 (图片来源:论文 Figure 2。左:未加速推理路径中算法级、模型级、kernel 级三层冗余的分布,30 步去噪中 GEMM 约占 40%、Softmax 约 20%,剩下是 RoPE、norm 等碎片算子;右:同一个 LTX-2.3、同一张卡,仅改变分辨率后的时间分布对比) 看右边那两条: LTX-2.3 在 544×960、token 长度 15,810 时:GEMM 38.8% / Softmax 19.9% / 逐元素+norm 41.3% 同一个模型在 1088×1920、token 长度 63,240 时:GEMM 24.8% / Softmax 47.6% / 逐元素+norm 27.6% 分辨率翻一倍,Softmax 占比从 19.9% 直接涨到 47.6%,GEMM 从 38.8% 掉到 24.8%。 瓶颈换了个位置。 低分辨率下你该去优化碎片算子和 GEMM,高分辨率下你该去优化注意力。同一个模型、同一张卡,只改了分辨率,最优的优化方向就完全不同了。 这就是"instance-specific"的实证。再把模型架构和硬件两个维度乘进来: (图片来源:论文 Figure 3。模型维度:Cosmos3-Super 64B 混合 Transformer、LTX-2.3 22B 两阶段推理、SANA-Video 2B 线性注意力;硬件维度:B200 192GB/FP4·8·16/约 9000 TFLOPS、H200 141GB/FP8·16·BF16/约 1979 TFLOPS、RTX 5090 32GB/FP4·8·16/约 3352 TOPS;配置维度:480p~1080p 分辨率、5~30 秒时长、16~48 fps 帧率) 论文的具体论证是: 模型决定数值敏感性:不同 backbone 对量化的鲁棒性、注意力冗余度、缓存跨步稳定性、token 剪枝容忍度都不一样; 硬件决定瓶颈暴露在哪:在 B200 这种高算力卡上,大 GEMM 快到一定程度后,小算子的启动开销和访存受限的 epilogue 就占了更大比例;换到算力弱的卡上,密集计算仍然主导,那些启动开销反而看不见; 配置决定 token 数和运行时平衡:注意力随 token 数平方增长,FFN 大致线性增长,所以分辨率一变,注意力和 FFN 的时间占比就会大幅移动。 结论是两句话:部署实例太多,穷举人工调优不可扩展;但每个实例内部的优化问题结构是清晰的——目标(延迟)和约束(质量不掉)都明确,这恰好适合交给 agent 自动化。 05 五个加速技能,每一个在干什么 (这段偏技术,只想看结果的可以直接跳到 08。) Sol-Engine 的技能库里有五样东西。每一样都不是新发明,但 agent 需要为每一样决定"用哪个方案 + 怎么调参"。 1. 跨步缓存(Cross-Step Cache) 高质量生成通常要 30~50 步去噪。相邻步之间模型反复执行结构相似的计算,隐状态变化缓慢。缓存就是跳过一些步的计算,用之前的结果补上。 Agent 要决定的事:选哪个缓存策略(TeaCache / EasyCache / TaylorSeer)、跳步时间表、缓存什么(特征还是残差)、补偿规则、warmup 多少步、最多允许连续跳几步。 2. 稀疏注意力(Sparse Attention) 视频 token 在时间上跨帧冗余、空间上帧内冗余,很多注意力边对最终输出贡献极小。稀疏注意力砍掉这些边,把平方复杂度压下来。 Agent 要决定的事:用哪个稀疏后端(PISA / SpargeAttention / SVG2)、哪些层可以安全稀疏化、哪些层必须保持 dense、稀疏模式、补偿策略。 3. Token 剪枝(Token Pruning) 不是砍注意力边,而是直接砍序列本身——跳过、合并或重建冗余的 latent token。序列短了,后面的注意力和 FFN 都跟着省。 Agent 要决定的事:剪枝准则、剪枝比例、层调度、时间步调度、重建规则。论文特别强调这里的验证重点是时序连贯性和后期步的细节保真——剪枝最容易破坏的就是运动的稳定性。 4. 量化(Quantization) 论文对量化的判断很清醒:量化能带来多少实际加速,取决于隐藏层维度、token 数和硬件特性;而模型对量化噪声的敏感度,取决于它自己的训练参数分布。所以加速潜力和质量代价都会随部署实例剧烈变化。 Agent 要决定的事:profiling 各层敏感度和张量形状,然后调逐层精度分配、权重/激活位宽、随时间步变化的缩放。 5. 算子融合(Kernel Fusion) Transformer 推理会在 GEMM 周围反复启动一堆算术强度很低的算子:bias 加法、残差更新、归一化、激活函数、缩放、layout 转换。融合就是趁中间结果还在寄存器或共享内存里就把后续算子做完,而不是写回 HBM 再启一个 kernel。 Agent 要决定的事:融合哪些算子序列、用手写 kernel 还是编译器生成、怎么匹配当前的张量形状和精度格式。典型候选是 GEMM + GELU、GEMM + residual、RoPE + norm。 论文把融合定位成后期任务——要等前面几层加速做完、瓶颈重新暴露之后再来做,因为融合的收益完全取决于"此刻什么在拖后腿"。 06 Agent 工作流怎么转起来 (图片来源:论文 Figure 5。① 加速技能库:缓存/token 剪枝/稀疏注意力/算子融合/量化;② 并行适用性执行器:每个技能一个 agent 独立判断是否适用并给出最优实现,图中示例显示 token 剪枝被判定为"不适用,会造成不可忽略的损失";③ 集成 agent:组合已选技能、全局参数调优、端到端质量检查、生成栈补丁;④ 人工验收:效率面板看延迟/吞吐/显存,质量面板看一致性/视觉保真/对齐,最后决定接受还是修订策略。论文脚注注明各方法的适用性在不同模型上会变,图中实现仅作示意) 整个流程分三段: 第一段:并行技能 agent 做局部搜索。 不让单个 agent 去搜整个全局空间——技能太多,联合搜索空间太大,成本和耗时都不划算。改成每个技能族一个独立 agent,各自在自己的小空间里并行搜。 比如缓存 agent 去搜跳步时间表和补偿规则,算子融合 agent 去 profile 每个 kernel 的耗时然后试 GEMM + GELU、RoPE + norm 这些组合。 有意思的是图里显示 agent 会主动报告"不适用"——token 剪枝在那个模型上被判定为损失不可忽略,直接出局。这比强行把五个技能都堆上去要合理。 第二段:集成 agent 做全局组合。 这一段是真正的难点。论文说得很直白: 这些方法不是独立的,最终端到端加速不等于各自局部收益的直接乘积。而且很多技术是有损的,直接把局部最优选择堆起来会累积近似误差,产出不可接受的结果。 所以集成器不是简单汇总第一阶段的结果,而是要重新做全局优化。它要解决的具体问题包括:缓存和稀疏注意力这两个有损方法叠加之后还能不能接受?量化和算子融合在同一个部署目标下有没有兼容的实现? 第三段:人工验收给质量反馈。 用固定的验证集看每个集成候选,判断视觉质量是否可接受。这个反馈决定下一轮 agent 是可以往更激进的加速推,还是要收敛回保守一点。 07 为什么人还必须留在环里 这一段是我认为全文最有洞察的部分,而且它的价值超出这篇论文本身。 问题是:既然要自动化,为什么不把质量判断也自动化?用 PSNR 做约束不就闭环了吗? 论文给了反例。 (图片来源:论文 Figure 6。上排为经过人工验收的结果——PSNR 更差但视觉质量更好;下排为未经人工验收的结果——PSNR 更好但视觉质量更差。左侧瀑布场景中,下排的水流细节糊成一片;右侧机器人场景中,下排的面部和城市结构出现明显退化) 看左边那组瀑布:上排(人工验收通过的)PSNR 分数更差,但水流的岩石细节清晰;下排(PSNR 分数更好的)水流糊成一团。右边机器人那组同理,下排的脸部和背景建筑明显退化。 原因是 PSNR 这类逐像素相似度指标有个结构性缺陷: 当加速后的输出只是改变了一些无害的视觉细节(比如水花的具体形状变了,但一样清晰合理),PSNR 会判定距离很大——虽然人看着完全能接受; 反过来,当输出出现模糊、时序抖动、运动不连贯这类真正致命的退化时,它在数值上反而可能离基线更近——因为模糊本身就是向均值收敛。 所以如果拿 PSNR 当优化目标,agent 会被引导向"生成模糊但数值安全"的方向。这正好是最不该要的结果。 论文的处理是老实承认这一点,把人留在环里做最终把关,并把"建立更强的端到端视觉质量评估器"列为未来工作——具体设想包括学习式视频偏好模型、伪影检测器、物理一致性检查、VLM 端到端质量判断。 这个观察对做视频生成评测的人来说值得单独拿出来看:只要自动指标和人类感知的错位没有解决,任何"全自动加速搜索"都会朝着指标漏洞的方向优化。 08 加速数字逐级拆解 这是全文最硬的一张图,把每一层技术各自贡献了多少秒都标出来了。 (图片来源:论文 Figure 4。绿色为去噪/DiT 阶段,灰色为 VAE 解码阶段,每一行代表叠加一层加速技术后的耗时构成,红色箭头标注累积加速倍率) 先看总表(NVIDIA B200,三种部署延迟与两套加速倍率): 模型 官方 pipeline SGLang 基线 Sol-Engine vs SGLang vs 官方 Cosmos3-Super 64B(4 卡 SP) 108.3 s 99.6 s 43.9 s 2.27× 2.47× LTX-2.3 22B 118.1 s 97.8 s 41.0 s 2.38× 2.88× SANA-Video 2B 34.2 s 29.4 s 10.6 s 2.77× 3.23× 论文主表用 SGLang 归一化,同时也给出了官方 pipeline 的延迟供参考,这点算诚实——毕竟 SGLang 本身已经比官方实现快了一截(比如 LTX 从 118.1 s 降到 97.8 s),拿官方版当基线会让倍率凭空好看一截。 Cosmos3-Super(64B,4 卡序列并行) 拆解路径:99.6 s(去噪 94.5 + VAE 4.8)→ 缓存后 52.4 s(去噪 47.3,1.90×)→ 加 kernel 融合与量化后 43.9 s(去噪 39.1,2.27×) 这个模型的加速几乎全靠缓存吃下来了——单缓存一项就 1.90×。原因是 64B 的 MoT 架构里 transformer block 极大,跳过一次去噪步省下的绝对时间非常可观。 缓存 agent 选的是 TeaCache 风格策略。量化则是按去噪步选择性施加,这是很值得抄的经验: 前 3 步和后 3 步保持高精度——早期步决定全局结构,晚期步细化高频细节,这两头用低精度分别会导致结构偏移和高频伪影; 中间那些"比较规整"的步走 NVFP4,作用在算术密度高的 GEMM 层:FFN 的 gate-up 和 down 投影、注意力的 QKV 和输出投影。 LTX-2.3(22B,两阶段) 拆解路径:97.8 s → 缓存后 70.3 s(1.39×)→ 加 token 剪枝和稀疏注意力后 58.5 s(增量 1.20×,累积 1.67×)→ 加算子融合和量化后 41.0 s(2.38×) 分阶段看更清楚(第一阶段 / 第二阶段 / VAE): 配置 一阶段 二阶段 VAE 总计 SGLang 基线 60.8 s 28.2 s 8.8 s 97.8 s + 缓存 33.3 s 28.2 s 8.8 s 70.3 s + token 剪枝 & 稀疏注意力 33.3 s 16.4 s 8.8 s 58.5 s + 算子融合 & 量化 24.6 s 11.0 s 5.4 s 41.0 s 这张表把"分工"说得很明白:缓存只砍了一阶段,稀疏注意力和 token 剪枝只砍了二阶段。 原因是 LTX-2.3 的流水线本身是两段式的——一阶段用 res_2s 二阶采样器跑 15 步生成 544×960 的 latent,二阶段上采样到 1088×1920 再精修 3 步,最后 VAE 解码 241 帧。二阶段的 token 数是一阶段的 4 倍,注意力成本占大头,所以稀疏化和剪枝的收益都在这里。 值得注意的是缓存在这个模型上只拿到 1.39×,明显低于 Cosmos3-Super 的 1.90×。论文解释了原因:res_2s 是二阶采样器,而市面上大部分缓存启发式规则是按 Euler 类调度假设设计的,直接套不上。Agent 最后是靠固定步跳过策略而不是在线阈值判断绕过了这个问题。 SANA-Video(2B,线性注意力) 拆解路径:29.4 s(去噪 28.2 + VAE 1.2)→ 缓存后 19.8 s(去噪 18.6,1.48×)→ 加 kernel 优化后 10.6 s(去噪 9.4,2.77×) 这个模型的情况反过来了:因为 SANA-Video 本身就是效率导向设计的(用线性注意力替掉平方复杂度的标准注意力),模型层已经没什么可榨的了,所以完全不用稀疏注意力和 token 剪枝,收益全来自算法层缓存和 kernel 层优化。 缓存 agent 选的是 EasyCache,50 步里跳掉约 16 步。kernel 层的三个改动都很朴素但有效(详见第 10 段)。 一个需要提醒的点:2.77× 是三个模型里最高的倍率,但它的绝对基数最小(29.4 s → 10.6 s)。小模型的 kernel 启动开销占比高,torch.compile 这类图优化的相对收益天然更大。别把 2.77× 直接理解成"这套栈在大模型上也能到 2.77×"。 09 质量到底掉没掉 论文用 VBench 做质量把关。先看结论表: 配置 平均分 主体一致性 背景一致性 时序闪烁 运动平滑 美学质量 成像质量 整体一致性 Cosmos3-Super 64B 基线 0.7759 0.9687 0.9301 0.9859 0.9923 0.6134 0.7276 0.2133 Sol-Engine 0.7775 0.9723 0.9382 0.9877 0.9935 0.6197 0.7178 0.2133 Δ +0.21% +0.37% +0.87% +0.18% +0.12% +1.03% -1.35% +0.00% LTX-2.3 22B 基线 0.7646 0.9010 0.9245 0.9675 0.9871 0.6234 0.7012 0.2474 Sol-Engine 0.7605 0.9006 0.9137 0.9704 0.9840 0.6104 0.7013 0.2429 Δ -0.54% -0.04% -1.17% +0.30% -0.31% -2.09% +0.01% -1.82% SANA-Video 2B 基线 0.7864 0.9730 0.9648 0.9626 0.9843 0.6650 0.6892 0.2660 Sol-Engine 0.7847 0.9750 0.9654 0.9646 0.9842 0.6624 0.6779 0.2637 Δ -0.21% +0.21% +0.06% +0.21% -0.01% -0.39% -1.64% -0.86% 平均分变化确实很小:+0.21% / -0.54% / -0.21%。论文的说法是"加速来自消除冗余和低效操作,而不是牺牲感知上关键的计算",从平均分看站得住。 但平均分掩盖了两个细节: 第一,成像质量(imaging quality)这一维在 Cosmos3-Super 上掉了 1.35%,在 SANA-Video 上掉了 1.64%,是这两个模型各自跌幅最大的维度(LTX-2.3 是唯一例外,这一维基本没动,+0.01%)。成像质量衡量的正是单帧的清晰度和伪影水平,也就是有损加速最容易伤到的地方。平均分之所以没动,是因为主体一致性、背景一致性、时序闪烁这些维度绝对值都在 0.9 以上且波动极小,把跌幅稀释掉了。 第二,LTX-2.3 的美学质量掉了 2.09%,是全表最大的单项跌幅,同时整体一致性掉 1.82%。这个模型是三个里唯一叠满了缓存+稀疏注意力+token 剪枝+量化四层的,有损方法堆得最多,代价也最明显。 还有一点值得说:VBench 的"整体一致性"(overall consistency,衡量文本-视频对齐)绝对值只有 0.21~0.27,本身分辨力就有限,在这个区间讨论 ±1.8% 的变化意义不大。 定性对比图看着确实还行: (图片来源:论文 Figure 7。每组上排为未加速的 SGLang 结果,下排为 Sol-Engine 加速结果,标注了各自的加速倍率。Cosmos3-Super 是机械臂刷盘子,LTX-2.3 是老人织渔网,SANA-Video 是热气球飞越麦田。场景布局、主体排布和运动结构基本保持) 论文自己的表述是"加速后的输出在精细视觉细节上可能有轻微差异,但整体视觉质量、运动质量和物理保真度仍然很强"。这个说法和数据是一致的——要的是"部署可接受",不是"逐像素一致"。 10 三个模型的具体配置(最能直接抄的部分) (这段是纯工程细节,不打算自己动手的可以跳到 13。) 附录 A 的信息密度非常高。如果你手上正好有这几个模型要部署,这些参数可以直接当起点用。 共性原则(论文明确说三个模型只在实现范围和超参上不同,方法层面原则一致): 缓存始终作为免训练的去噪步复用策略,但具体时间表按模型走; 稀疏注意力只在注意力图有足够结构性时才引入,否则不动; token 剪枝只在中间 token 冗余到"丢一部分不会有可见伪影"时才用; 量化选择性施加,数值脆弱的阶段留高精度,稳定的 GEMM 密集区域降精度; kernel 优化包括 epilogue 融合、QKV 路径融合、归一化路径融合、编译器图融合,只在对目标工作负载稳定时才启用。 Cosmos3-Super 缓存:TeaCache 风格残差重放,阈值 1.15,起始第 10 步,最多 3 次连续命中。判据是测量生成隐状态跨去噪步的相对 L1 变化并累积,累积值低于阈值就跳过生成路径的 transformer block,否则重算并刷新缓存残差; 量化:前 3 步 + 后 3 步走 dense/高精度路径,中间步用 NVFP4,作用于 FFN gate-up / down 投影和注意力 QKV / 输出投影。 LTX-2.3 两阶段结构:一阶段 res_2s 采样器 15 步 @544×960,二阶段上采样精修 3 步 @1088×1920,VAE 解码 241 帧; 缓存:用固定步跳过而非在线 TeaCache 阈值。预设名 8of15_last_29calls——一阶段共 29 次 denoiser 调用,在调用索引 [13, 14, 16, 17, 18, 19, 20, 21, 22, 24, 25, 26, 27] 复用上次计算结果(reuse_mode=last、max_skip_steps=30)。也就是 29 次里跳掉 13 次,约 45%; 稀疏注意力:PISA 只用于二阶段的高分辨率精修 transformer。稀疏度 0.9(密度 0.1),block size 64,只替换 video self-attention,一阶段稀疏调度关闭;二阶段 layer 0~1 保持 dense,之后的层用分块稀疏 + 近似余项 + 打分路由 + FlashAttention dense 兜底; token 剪枝:也只在二阶段。精修调用中按 feat_norm 显著性保留 50% video token,只在 refinement call 1 和 2 上做; 量化:NVFP4 只用于 video FFN 的输入/输出投影,NVFP4 融合的 proj_in+GELU 与 proj_out+bias+gate 路径关闭; 无损融合开关(这一串很长,照抄):block-0 self-attention 共享、guidance-prefix 共享、QK+RoPE 融合、RMS-AdaLN 融合、AdaLN 融合、QKNorm+RoPE 融合、双调制融合、cross-attention 双调制融合、Ada values 融合、残差门融合、FFN proj_in+GELU 融合、gate-to-output 编译、audio QKVG 融合、全局 QKNorm+RoPE 融合、tiled VAE 解码编译; 蒸馏 LoRA 强度:一阶段 0.25、二阶段 0.5;二阶段 sigmas 为 [0.909375, 0.725, 0.421875, 0.0]。 SANA-Video 测试配置:81 帧、50 步、480p(832×480); 不用稀疏注意力、token 剪枝、NVFP4 FFN 量化; 缓存:EasyCache,阈值 0.1,warmup 3 步,空间下采样步长 8。判据是从下采样隐状态估计在线的输入-输出变换率,累积估计的相对输出变化,低于阈值就跳过整个 transformer block 栈。缓存残差在未 batch 的 CFG 分支间共享,避免注入过期的 guidance;50 步里约跳 16 步; 三个 kernel 级改动:① 线性注意力的 K/V 聚合保持 BF16 tensor-core 执行,不提升到 FP32;② Q/K/V 投影权重加载后拼接,合并成一个 GEMM;③ DiT block 栈用 torch.compile 编译,max-autotune 模式用 max-autotune-no-cudagraphs + 子进程 autotuning + 持久化 TorchInductor 缓存; 低比特线性注意力 kernel 额外贡献约 1.2× kernel 级加速,重建损失很小(PSNR 高于 30 dB)。 从这三份配置里能提炼出的通用直觉: 模型越大,缓存的相对收益越高(64B 拿到 1.90×,2B 只有 1.48×); 本身已经做过效率优化的架构(线性注意力),模型层加速基本没戏,要往算法层和 kernel 层找; 多阶段流水线要分阶段施策,高分辨率阶段才值得上稀疏注意力和剪枝; 量化不要一刀切,首尾去噪步和数值脆弱模块留高精度; 非标准采样器(二阶、多阶)会让主流缓存启发式失效,退化成固定步跳过反而更稳。 11 换硬件会怎样 论文额外做了单卡 Cosmos3-Super 在 B200 和 B300 上的对比: 配置 延迟 加速 B200 × SGLang 353.5 s 1.00× B200 × Sol-Engine 143.8 s 2.46× B300 × SGLang 351.9 s 1.00× B300 × Sol-Engine 137.6 s 2.56× B300 相对 B200 的 BF16 算力差不多,但 NVFP4 算力更高。结果符合预期: Cosmos3-Super 依赖 NVFP4 执行较多,所以在 B300 上拿到更明显的端到端收益(2.46× → 2.56×); LTX-2.3 和 SANA-Video 对 NVFP4 依赖较轻,单卡场景下换到 B300 端到端几乎没变化。 这个实验本意是展示框架的硬件适应性,但反过来读出的信息更重要:这套栈的收益里有相当一部分绑定在 FP4 硬件支持上。 如果部署环境是 H100/H200 这类只有 FP8 的卡,或者更老的 A100,量化这一层的贡献会大幅缩水,2× 这个数字就不能直接搬。 论文 Figure 3 把 H200 和 RTX 5090 都画进了硬件空间图,但正文和附录都没有给这两张卡的任何实测数据。这是一个明显的缺口——一个号称"解决硬件异构性"的框架,只在同代同架构的两张卡上验证了硬件维度。 顺便注意单卡 Cosmos3-Super 的绝对延迟:353.5 s 基线,加速后 143.8 s。而 4 卡序列并行版本是 99.6 s → 43.9 s。64B 模型单卡出一段视频要两分半,这个量级离交互式使用还很远。 12 想自己复现要注意什么 能不能直接跑起来? 论文在摘要末尾给了 "Github Code" 和 "Project Page" 的链接入口,但截至发稿我没有找到公开可跑的完整仓库。所以现实的用法是:把附录 A 当配置说明书,在自己的推理栈上手动复刻。 好消息是所有依赖的技术都有公开实现: 缓存:TeaCache、EasyCache、TaylorSeer 都有开源仓库; 稀疏注意力:PISA、SpargeAttention、Sparse VideoGen 2 都开源; 量化:SVDQuant、SageAttention 系列开源; 融合:CUTLASS epilogue 是官方文档,torch.compile 是现成的。 运行时基座是 SGLang。 论文明确说部署接口组织成"dense 基线路径"和"组合后的 fullopt 路径"两条,所以测出来的对比是端到端服务栈,不是孤立的 kernel 微基准。这个做法值得学——很多加速论文只报 kernel 级数字,端到端一测就缩水。 硬件门槛不低:主实验在 B200 上,Cosmos3-Super 用了 4 卡序列并行。如果只有单卡,参考第 11 段的单卡数字。 如果要复刻 agent 部分:论文没有公开 agent 的实现细节——用什么模型、prompt 怎么写、搜索循环怎么组织、每个技能 agent 的工具接口长什么样,全都没有。想复现这一层,参考 CudaForge 和 CUDA-LLM 这两篇会更实际。 一个务实的建议:如果你的目标只是把某个视频模型的推理跑快一倍,没必要先搭 agent 框架。直接照抄第 10 段的经验规则(缓存优先、首尾步留高精度、高分辨率阶段才上稀疏、torch.compile 兜底),手工调两三轮大概就能吃到大部分收益。Agent 的价值在于你要同时维护很多个部署实例,而不在于单个实例能调得更好。 13 需要留意的限制 前面零散提过一些,这里集中说。 1. 核心主张缺对照实验。 论文反复强调"with little human effort"、"in a fraction of the usual human effort",但通篇没有任何量化:agent 用的什么模型?搜了多少轮?消耗多少 GPU 小时和 token?人工调优同样的目标要多久?没有这组对比,"agent 省人力"就只是一个断言。 2. 没有搜索策略的消融。 这是我认为最要紧的空白。Agent 相比随机搜索、网格搜索、贝叶斯优化的优势在哪?论文没做这个对比。考虑到每个技能的搜索空间其实不大(缓存阈值、稀疏度、剪枝比例这些都是低维连续或离散参数),传统超参搜索方法完全可能达到同样效果。如果是这样,"agentic" 的贡献就主要在"自动化编排和写补丁代码",而不在"搜得更好"。 3. 不是全自动。 人工验收在环,且论文自己承认这是当前的主要限制。而"人觉得可接受"是主观标准——换一批验收人,加速激进程度的上限就会变。这也意味着结果不完全可复现。 4. 硬件验证面太窄。 只有 B200 和 B300,同代同架构。Figure 3 承诺的 H200、RTX 5090 都没有实测。而 NVFP4 量化的收益强烈依赖 FP4 硬件,这一层在非 Blackwell 卡上会显著缩水。 5. 质量评测的选择性。 VBench 平均分变化在 ±0.54% 内,但成像质量维度三个模型有两个跌超过 1.3%,LTX-2.3 的美学质量跌 2.09%。论文正文只讨论平均分"基本持平",没有专门解释这些单维退化。另外定性对比图是作者挑的,Figure 7 加附录 B 的 18 组对比里没有失败案例。 6. 没有吞吐和显存数据。 全文只有单请求端到端延迟。生产部署要看的是并发下的吞吐、显存峰值、以及加速后能否提高 batch size。稀疏注意力和 token 剪枝理论上能省显存,但论文没量化。 7. 缺少与单点方法的端到端对比。 TeaCache、SVG2、SVDQuant 这些在论文里是"技能库候选",没有"单独用某一个方法能到多少倍"的完整对照。Figure 4 的分层拆解某种程度上补上了这个信息(比如 Cosmos3 单缓存 1.90×),但那是在 Sol-Engine 自己调参下的结果,不是各方法原始实现的公平对比。 8. 自家模型的信息优势。 Cosmos3-Super 是 NVIDIA 自己的模型,团队对它的架构、数值特性、训练分布都有外部研究者拿不到的信息。这不影响结果的真实性,但会影响"这套流程对任意第三方模型都同样有效"这个推论的强度。 9. 论文类型的定位。 署名(把 Codex 和 GPT-Image2 列为作者)、结构(大量篇幅在描述工程配置)、缺少方法论消融——这些都指向它更像一份高质量工程实践报告,而不是一篇方法论文。按技术报告的标准看,它的信息密度很高;按方法论文的标准看,它的验证是不完整的。 14 横向对比表格 下面这张表是我按公开信息整理的,不是论文原表。需要特别说明:Sol-Engine 没有和这些方法做同环境的端到端对比,所以加速倍率跨行不可直接比较(模型、硬件、分辨率、基线都不同)。 方案 覆盖层级 自动化程度 免训练 论文报告的加速 质量代价 硬件绑定 Sol-Engine 算法 + 模型 + kernel 全栈 Agent 并行搜索 + 集成 + 人工验收 是 端到端 2.27~2.77×(B200) VBench 平均 ±0.54% 较强(NVFP4 依赖 Blackwell) TeaCache 算法(缓存) 手工调阈值 是 本文实测单项 1.39~1.90× 中等,跳步越多越明显 无 EasyCache 算法(运行时自适应缓存) 在线自适应 是 本文实测单项 1.48× 中等 无 PISA 模型(分块稀疏注意力) 手工选层与稀疏度 是 本文中作为二阶段组件 小(有泰勒补偿) 无 Sparse VideoGen 2 模型(语义感知稀疏) 在线 profiling 是 注意力级为主 小 需定制 kernel SVDQuant kernel(4bit 量化) 手工 是(PTQ) 显存与访存收益为主 小 需低比特支持 SLA2 模型(稀疏 + 线性混合) 可学习 Router 否,需 QAT 微调 端到端 2.30~4.35×(RTX 5090) 需微调,作者称可超 full attention 无 CudaForge kernel(CUDA kernel 生成) Agent + 硬件反馈 是 单 kernel 级 无(要求数值正确) 无 几点解读: Sol-Engine 的差异化不在"加速比更高",而在"覆盖层级最全 + 调参过程自动化"。单看倍率,SLA2 在 Wan2.1-14B-720P 上报出 4.35×,比 Sol-Engine 的任何一个数字都高——但那需要 QAT 微调,不是免训练,且模型和硬件都不同; 免训练这一栏很关键。Sol-Engine 全程不动权重,这让它可以直接套到任何已发布的模型上,工程摩擦远小于需要微调的方案; 硬件绑定这一栏是 Sol-Engine 相对吃亏的地方。它的 kernel 层收益有相当部分来自 NVFP4,换卡就要重新评估。 15 总结感受 我觉得这篇论文真正的价值不在那几个 2× 的数字,而在它把问题重新框了一遍。 过去两年视频加速方向的论文,主流叙事是"我提出了一个新的缓存/稀疏/量化方法,比前人快 X 倍"。这类工作攒到今天已经足够多了,多到出现了一个新的瓶颈:没人知道该怎么把它们组合起来用在自己的部署上。 Sol-Engine 承认了这个现实,并给出一个务实的回答:这是个组合优化和调参问题,人工做不划算,交给 agent。Figure 2 那组数据(同一个模型同一张卡,分辨率翻倍后 Softmax 占比从 19.9% 涨到 47.6%)是全文最有说服力的论证——它证明"通用最优配方"这个东西压根不存在。 但作为一篇方法论文,它的验证是不完整的。 缺 agent vs 传统超参搜索的对照,缺人力成本的量化,硬件维度只验证了同代两张卡。这些不是小瑕疵,而是直接关系到"agentic 到底贡献了什么"这个核心问题。以现在的证据,我倾向于认为 agent 在这里的主要价值是自动化了编排和代码补丁生成,而不是搜到了人搜不到的解。 所以我给不同人的建议不一样: 如果你是工程师,正要部署这几个模型——直接去看附录 A,第 10 段我已经整理好了。那些经验规则(缓存优先、首尾步留高精度、多阶段流水线分阶段施策、非标准采样器退化成固定步跳过)比 agent 框架有用得多,手工调两三轮就能吃到大部分收益。 如果你是研究者——最值得跟进的不是 agent 框架本身,而是它暴露的那个空洞:缺一个和人类感知对齐的自动视频质量评估器。 论文的人工验收环节之所以拆不掉,根子就在这。谁把这个问题解决了,"全自动加速搜索"才真的能闭环,而且这个能力的价值远超加速这一个场景。 如果你在做技术决策——记住 2× 是在 B200 上、免训练、单请求延迟的数字。换硬件要重新评估(尤其没有 FP4 支持的卡),关心吞吐的话论文没给数据,而且你自己的模型需要重新跑一遍搜索流程。 最后说回开头那个细节。把 Codex 和 GPT-Image2 署名成作者,arXiv 用 "Human authors" 单独一栏来区分——这件事本身可能比论文的技术内容更值得记一笔。 它标记了一个开始:AI 参与科研产出的程度已经到了需要在署名规范上做制度性区分的地步。至于这算进步还是隐忧,各人判断不同,但趋势看起来是不可逆的。 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-12|阿里DUET两步视频质量多样性双赢 今日 AIGC 论文速览 今日共 10 篇 · 视频生成加速与少步蒸馏 3 篇 · 统一多模态表征与理解生成一体化 1 篇 · 音频与音乐生成 3 篇 · 扩散架构机理与图像编辑 2 篇 · RGBA 视频与资产生成 1 篇 重点论文标题列表 DUET(阿里巴巴·北京大学·清华大学深圳国际研究生院):两步视频生成质量多样性双赢 UniSpace(美团):8B统一模型扔掉VAE通路 SonicWeave(快手可灵团队·香港中文大学·清华大学深圳国际研究生院):一套权重生成全类音频场景 FullDiT(复旦大学·阿里巴巴 Token Foundry):音乐生成胜过五家商业系统 adaLN-Gaussian(北京大学·百度·UC Berkeley):零初始化才是DiT的真功臣 今日论文速览 1. DUET:两步视频生成质量多样性双赢 DUET: A Diversity-Quality Duet of Distillation Experts for Two-Step Video Generation | 阿里巴巴·北京大学·清华大学深圳国际研究生院 | arXiv:2608.09637 关键词:两步视频生成,少步蒸馏,质量多样性权衡,专家分工,流匹配 前序问题:扩散模型能生成高质量视频,但迭代采样的开销让实际部署很难受。少步蒸馏是主流解法,却暴露出一个绕不开的质量-多样性权衡:轨迹级蒸馏(如 sCM)倾向保住多样性但质量偏弱,分布级蒸馏(如 DMD)质量强但生成结果的结构多样性大幅塌缩。此前的工作大多试图在 loss 层面把两类目标混合调和,结果总是按下一头翘起另一头,且混合目标本身的优化难度还额外增加了训练成本。 本文贡献:面向极端的两步视频生成,提出 DUET,把权衡改造成噪声层面的专家分工:sCM 专家接管高噪声那一步,负责铺开多样的结构布局;DMD 专家接管低噪声那一步,负责精修外观细节。两个专家各自按原生目标独立训练,因此完全绕开了 loss 级组合的优化困难,质量与多样性是联合获得而非互相交换。作者进一步指出剩下的瓶颈在于「接力界面」和高噪声阶段本身,用 RL 引导的专家自适应加以解决,得到 DUET+。 实验效果:在 Wan2.1-T2V-1.3B 骨干上,DUET 把 sCM 的两步质量拉到接近 DMD 的水平,同时几乎完整保留其结构多样性——约为 DMD 的两倍;DUET+ 在保住这一多样性优势的同时进一步提升整体质量。 批判点评:这篇的洞察很值钱:把「质量 vs 多样性」从一个需要折中的标量权衡,重新表述成「不同噪声区间需要不同归纳偏置」的分工问题,从而让两个专家都能按最适合自己的目标训练。这比在 loss 里加权重系数干净得多,也解释了为什么此前的混合方案总在原地打转。局限也很清楚:两步生成需要同时维护两个专家权重,显存与部署复杂度是单模型方案的两倍,论文对这部分成本交代不足;「接力界面」被承认是瓶颈,说明高噪声专家交给低噪声专家的中间状态存在分布不匹配,DUET+ 用 RL 打补丁而非从原理上解决;此外骨干只验证了 1.3B 的 Wan2.1,在 14B 级别模型上噪声分工的最优切分点是否仍在同一位置,完全未知。 2. UniSpace:8B统一模型扔掉VAE通路 UniSpace: Unified Visual Representation and Scalable Multimodal Modeling | 美团 | arXiv:2608.08676 关键词:统一多模态,视觉表征,Patch重参数化,理解生成一体化,MoE 前序问题:语义视觉编码器已成为多模态理解和图像生成语义条件化的核心接口,但它的最终 token 会丢弃细粒度视觉细节,导致像素重建能力很差,因此无法直接用在图像生成、编辑这类对重建敏感的任务上。业界的通行做法是另外挂一条 VAE 通路专门负责重建,代价是架构分裂、两套表征空间难以对齐。 本文贡献:作者先做了一个反直觉的诊断:语义 ViT 的冻结 Transformer 块并非本质上无法保留视觉细节,真正把表征推向语义抽象、让细粒度信息难以从最终 token 恢复的,是原始的 patch 参数化方式。基于此提出 Patch Reparameterization——保留原有语义通路不动,另加一条重建感知的 patch embedding,把细粒度视觉信息送进同一批冻结 ViT 块。由此得到的统一表征既保住多模态理解能力,又能做高保真图像重建,重建-生成权衡曲线更优。作者进一步把这套表征放大成 UniSpace,一个 8B 的 Mixture-of-Transformer-Experts 模型,在同一个视觉空间里完成理解、生成和编辑,完全不需要独立的 VAE 通路。 实验效果:系统级评测显示模型具备可用的文生图能力与指令式图像编辑能力,验证了「重参数化后的预训练 ViT 可以充当可扩展多模态建模的统一视觉接口」这一主张。 批判点评:把矛头指向 patch 参数化而非 Transformer 块本身,这个归因方向是这篇最有价值的部分——它意味着大量「语义编码器保不住细节」的结论可能都是参数化方式的问题,而不是架构的固有缺陷,从而打开了「保留冻结语义骨干、只改输入侧」的低成本改造空间。去掉 VAE 通路对统一模型的架构简化意义很实在。但也要冷静看:论文用「practical text-to-image generation」这类措辞而非硬指标对比,说明生成质量距离专用 T2I 模型仍有明显差距,8B MoTE 的规模也不小;「重建-生成的有利权衡」是相对自身消融而言,缺少与 VAE 方案在同等算力下的正面对照;另外冻结 ViT 的容量上限是否会在更大规模上成为瓶颈,文中没有给出 scaling 证据。 3. SonicWeave:一套权重生成全类音频场景 SonicWeave: Chunk-Routed Mixture-of-Experts for Unified Audio Scene Generation | 快手可灵团队·香港中文大学·清华大学深圳国际研究生院 | arXiv:2608.09571 关键词:统一音频生成,Chunk路由MoE,流匹配,音频场景合成,专家专业化 前序问题:文本条件的通用音频生成正从孤立的语音、音乐、音效合成,走向用单个模型把它们组合成可控、连贯的音频场景。这个统一设定格外棘手:异质成分对共享骨干提出互相冲突的结构要求,而一个复杂混合场景内部还可能包含局部不同甚至相互重叠的内容,需要在同一段音频里做细粒度自适应。现有音频 MoE 大多在领域级别做路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。 本文贡献:提出 SonicWeave,一个面向统一音频场景生成的流匹配模型,核心是带冲突门先验-证据路由机制的 chunk 级 MoE(CPE-MoE)。它按连续的声学 chunk 做路由,把编码结构化文本条件与扩散阶段的全局先验,和来自演化中声学状态的局部证据结合起来;一个学出来的冲突门在局部状态不可靠时倾向采信全局先验,只在某区域明显偏离全局场景语境时才让局部证据主导路由。单套权重即支持语音、音乐、音效、歌声及其细粒度混合。 实验效果:在 TTS、TTA、TTM 三类基准上一致优于受控的 Dense 与 Base-MoE 基线;复杂场景评测进一步显示组合质量提升,路由分析揭示出跨扩散阶段的内容相关专家专业化现象。 批判点评:「按 chunk 路由」这个粒度选择切中了要害:语音的音素、音乐的节拍、音效的事件都是有时间跨度的结构,逐 token 决定专家等于在同一个声学事件内部反复换脑,chunk 级正好对上声学连续性。冲突门的设计也挺聪明——扩散早期局部状态本来就是噪声,此时强行采信局部证据只会引入路由抖动,用全局先验兜住是对的。不足在于对比强度:论文的对照是自己控制的 Dense 与 Base-MoE 基线,而非各领域的 SOTA 专用模型,所以「统一模型是否已经不输专精模型」这个最关键的问题没有回答;chunk 长度作为一个关键超参,其敏感性分析在摘要层面没有体现;此外 MoE 的实际激活参数量与推理开销未交代,工业落地时的性价比无法评估。 4. FullDiT:音乐生成胜过五家商业系统 Beyond Reconstruction: Full-Context Generative DiT for Music Generation | 复旦大学·阿里巴巴 Token Foundry | arXiv:2608.08787 关键词:音乐生成,暴露偏差,条件DiT,RVQ编解码,分类器无关引导 前序问题:混合式音乐生成器把自回归语言模型的长程规划能力,和扩散/流模型渲染器的高保真结合起来。但存在一个被忽视的部署错配:渲染器是用干净的、从目标推导出的 codec token 训练的,上线时却要接收语言模型的不完美预测,这就形成了 codec 接口层面的暴露偏差——训练时没见过的错误 token 分布,在推理时成了常态。 本文贡献:作者不再把渲染当成简单的重建任务,而是把它重新表述为「从一个不完美离散计划出发的全上下文生成」。为此提出 FullDiT:一个条件 DiT,融合八路帧对齐的 RVQ 流与独立编码的歌词、caption,并在完整声学隐序列上做非因果自注意力。训练阶段引入 Error-Matched Distractor Conditioning(EMDC),把每个 codebook 的替换率匹配到教师强制下的 top-1 错误率,并从余弦 KNN 邻域中采样「近似错答」token,同时不改变声学目标。推理阶段用四路 classifier-free guidance(4-CFG)独立缩放 codec、歌词、caption 三类引导增量。 实验效果:匹配消融显示 EMDC 在合成扰动下把 ViSQOL 提升 0.77,且在非并列比较中明显更受偏好;进一步消融验证了全曲上下文与渲染器侧文本条件各自的增益。完整系统在 18 项自动指标中的 15 项上超过五个商业系统,并在 Artificial Analysis 带唱音乐榜单上进入前三。 批判点评:EMDC 是这篇最扎实的一笔:不是随机加噪,而是把干扰率精确对齐到教师强制的真实 top-1 错误率,并从 KNN 邻域取「像是对的错答」,这让训练分布真正逼近推理时会遇到的错误结构,比通用数据增广讲得通得多。渲染器侧也吃歌词和 caption 这一点也很合理——语言模型的 plan 一旦出错,渲染器至少还有文本可以校正。质疑点在于评测:「18 项中的 15 项超过五家商业系统」这类表述缺少商业系统的具体版本与调用时间,商业模型迭代极快,可复现性存疑;ViSQOL 提升 0.77 是在「合成扰动」这一人造条件下测得的,真实语言模型错误分布是否同构未验证;八路 RVQ 加全序列非因果注意力意味着相当高的显存与延迟开销,论文未给出与主流方案的推理成本对照。 5. adaLN-Gaussian:零初始化才是DiT的真功臣 Unveiling the Secret of AdaLN-Zero in Diffusion Transformer | 北京大学·百度·UC Berkeley | arXiv:2608.09438 关键词:扩散Transformer,adaLN-Zero,零初始化,条件化机制,TPAMI 前序问题:扩散 Transformer(DiT)已成为图像生成的主流架构,围绕它的性能改进层出不穷,但社区对它的理解仍然停留在表面。一个典型例子是 adaLN-Zero:所有人都知道它比 adaLN 效果好,也都在用,但到底是哪一部分设计在起作用,一直没人系统回答过。 本文贡献:本文深入拆解 DiT 中的关键条件化机制 adaLN-Zero,把它的性能来源分解为三个候选要素——类似 SE 的结构、零初始化、以及「渐进式」更新顺序,并逐一做受控验证,最终证明零初始化是其中最具决定性的因素。基于这一理解,提出分析导向的初始化策略 adaLN-Gaussian:它既是对上述分析的经验验证,也是一个能稳定改善优化效率的实用初始化方法。另一方面,受 SE 式结构启发,提出改进的条件化机制 SE-adaLN-Zero。 实验效果:遵循 DiT 设置在四个数据集上做了充分实验,尤其在 ImageNet1K 上验证了 adaLN-Gaussian 与 SE-adaLN-Zero 的有效性和泛化性;除类别到图像生成之外,还在文生图任务上评估了两种改进方法的泛化能力。论文已被 IEEE TPAMI 2026 接收。 批判点评:这是今天最「不性感但最有长期价值」的一篇。当整个领域都在往上堆模块时,回头把一个被默认使用了数年的组件拆开做归因,得到的是可迁移的设计原则而不是又一个刷分技巧——「零初始化主导」这个结论对任何做残差式条件注入的架构都有参考意义,adaLN-Gaussian 作为一行初始化改动,落地成本几乎为零。局限在于实验尺度:遵循原始 DiT 设置意味着规模偏小,ImageNet1K 类别到图像生成与今天动辄十亿参数的 T2I/T2V 训练环境差距不小,零初始化的主导地位在大规模、长训练下是否依然成立需要更强证据;文生图上的泛化验证在摘要中只是一笔带过,没有给出具体量级;此外 SE-adaLN-Zero 作为结构改动会带来额外参数与算力,论文未讨论其与收益的性价比。 6. REST:把RL副产物直接当蒸馏监督 RL-Native Distillation: Exploiting Scored Trajectories for Few-Step Image Generation | 上海交通大学·阿里巴巴淘天集团 | arXiv:2608.09226 关键词:少步图像生成,RL蒸馏协同,优势调制,奖励对齐,无CFG推理 前序问题:高效文生图既需要基于强化学习的奖励对齐,也需要少步蒸馏,但这两个流程通常被串行执行:先 RL 对齐、再压缩步数。这不仅推高训练成本,还有一个隐患——压缩过程可能把前一阶段辛苦对齐来的奖励收益又丢掉。 本文贡献:作者提出一个 RL 原生视角:扩散 RL 本身就在生成带奖励分数的有限步轨迹,这些中间状态是天然的蒸馏监督来源,而不是采样过程的一次性副产物。基于此提出 REST(Reward-Enhanced Scored-Trajectory Distillation),一个单阶段的 RL-蒸馏协同训练框架,把一个解耦的学生挂到任意 RL 教师上:学生从教师不断演化的 rollout 轨迹中分段学习,而教师原本的优化过程完全不受干扰。为避免无差别模仿把教师的低奖励行为也一并保留,进一步提出 Advantage-Modulated Distillation(AMD),把 rollout 的优势值转换为基础蒸馏损失上的带符号权重——强化来自优选轨迹的监督,并轻度排斥低奖励轨迹。整个框架轻量且即插即用,不需要额外的图像 rollout、独立蒸馏数据集或对抗训练。 实验效果:在组合式生成、视觉文字渲染、人类偏好对齐三类任务上,REST 使无 CFG 的少步推理能够追平甚至超越其 40 步的 RL 教师,而额外训练成本低于纯 RL 的 25%。在 DrawBench 上 PickScore 比 RTDMD 高 0.82,且只需其五分之一的训练迭代数。 批判点评:这篇的核心洞察属于「看见了别人扔掉的东西」:RL 阶段每一步 rollout 都自带奖励分数和完整中间状态,串行流水线却把它们当垃圾清掉,然后再花一遍算力重新造蒸馏数据——指出这点之后,单阶段协同几乎是自然结论。AMD 用带符号权重区分优劣轨迹也很关键,否则蒸馏会连教师的坏习惯一起继承。落地友好度高:不改教师、不加 rollout、不用对抗训练,额外成本 25% 以内。需要打问号的地方:学生学的是教师「演化中」的轨迹,教师早期还没对齐好时的轨迹质量偏低,论文没说清如何避免学生被早期噪声带偏(是否需要 warmup 或权重退火);「追平甚至超过 40 步教师」中的「超过」很可能来自 AMD 对低奖励轨迹的排斥效应,本质上是奖励模型上的进一步过拟合,是否真正提升人类感知质量存疑;此外三类任务均偏重可自动打分的能力,对开放域美学的影响未评估。 7. EditMod:1K图编辑仅需1.57秒 Model the Edit, Not the Image: Visual Autoregressive Editing from a Source-Centric Perspective | 北京理工大学·浙江大学·腾讯·深圳大学 | arXiv:2608.09057 关键词:视觉自回归,图像编辑,源为中心,多尺度残差,免反演 前序问题:下一尺度视觉自回归模型(VAR)通过由粗到细的高效预测生成高质量图像,已是一条强有力的生成范式,但它在文本引导图像编辑上的潜力基本没被开发。现有的免训练 VAR 编辑方法大多把编辑表述为「以源图为引导或约束的目标条件重新生成」,还往往依赖反演、测试时优化、注意力控制或用户提供的掩码。这种生成为中心的表述没有充分利用 VAR 天然提供的多尺度源表征,还引入了额外计算或人工干预。 本文贡献:作者转向源为中心的 VAR 编辑视角:把编码后的源图像 token 当作主要视觉状态,编辑过程只聚焦于条件诱发的变化量。基于这一视角提出 EditMod——在共享的自回归上下文下,对比源条件预测与目标条件预测,把两者之差视为逐尺度的编辑方向,再把它作为残差更新施加到选定尺度的源 token 上。整条链路不需要反演、不需要测试时优化、也不需要用户掩码。 实验效果:实验显示 EditMod 在源图保真度上处于领先水平,同时保持很强的文本对齐能力;在单张 A100 上完成 1K 分辨率图像的端到端编辑仅需 1.57 秒,且无需任何逐图预处理准备。 批判点评:「建模编辑量而不是重建整张图」这个转向非常对症:编辑任务本来就只有小部分内容需要变,让模型从零重新生成整图,既浪费算力又让未编辑区域无谓漂移。用源条件与目标条件预测之差作为逐尺度编辑方向,思路上和 classifier-free guidance 的差分同源,但落在 VAR 的多尺度 token 上更自然,也顺带解释了为什么能免反演、免掩码。1.57 秒完成 1K 编辑的数字对交互式应用相当有吸引力。局限在于:残差更新施加在「选定尺度」上,哪些尺度该动、动多少,摘要没交代选择准则,很可能是需要调的超参数,直接影响可用性;差分方向对提示词写法的敏感度未讨论——目标提示与源提示措辞差异过大时,差分可能失控;此外 VAR 生态目前的基座模型数量与质量都远不如扩散系,方法再好也受限于骨干天花板。 8. BAG:缓存复用改由门控网络决策 BAG: Budget-Aware Gating for Diffusion Caching | 浙江大学·西湖大学 AGI Lab | arXiv:2608.09231 关键词:扩散缓存,预算感知,门控网络,调度蒸馏,DiT加速 前序问题:扩散缓存是加速 DiT 的轻量手段——在去噪步之间复用中间特征,但现有范式面临一个根本权衡:在线启发式规则缺乏全局预算意识,不知道整体算力还剩多少;静态调度表则缺乏实例自适应能力,也无法灵活适配运行时变化的预算约束。 本文贡献:提出 BAG(Budget-Aware Gating),一种把全局预算节奏控制与动态、实例自适应的特征复用统一起来的缓存策略。它不再依赖手工规则,而是用一个轻量门控网络,在每一步同时以预算状态和局部轨迹反馈为条件,动态决定「执行完整计算」还是「复用缓存特征」。该策略通过离线到在线的调度蒸馏训练得到——把离线搜索出的调度表所包含的决策能力,迁移进一个紧凑的在线门控。 实验效果:在 FLUX.1-dev 与 Wan2.1 上的大量实验表明,BAG 在各个加速档位上一致优于当前最好的缓存方法,并且在不同分辨率、随机种子和引导强度下都保持稳健。代码将开源。 批判点评:把「算还是复用」这个决策交给一个同时看全局预算和局部轨迹的小门控,方向是对的:静态表不知道当前这张图难不难,在线启发式不知道预算还剩多少,两者的盲区正好互补。离线搜索调度表再蒸馏成在线门控,也是一种务实的工程折中——离线搜索能看到全局最优,在线门控只需继承其决策模式。可疑之处在于泛化边界:门控网络是学出来的,训练时的预算区间、分辨率和模型骨干一旦超出,决策是否还成立没有交代;论文强调在不同分辨率、种子、引导强度下稳健,但这些都属于同骨干内的扰动,换到未见过的 DiT 上是否需要重新蒸馏是关键问题。另外门控本身的推理开销虽称轻量,但在高加速档位下相对总算力的占比会被放大,摘要未给出具体数字。 9. CuteTTS:首音延迟直降23.3% CuteTTS: Efficient and High-Quality Speech Synthesis via Autoregressive Modeling of Continuous Latents | 复旦大学·上海创智学院 | arXiv:2608.08638 关键词:零样本TTS,连续自回归,流匹配,引导步蒸馏,低延迟 前序问题:零样本文本转语音已经在支撑交互式助手、个性化媒体和无障碍工具,所有 TTS 系统都要同时满足三件事:忠实的语言渲染、一致的说话人身份、以及低延迟响应。但紧凑的流式系统必须在一个可预测的低码率隐序列里保住足够的声学细节,而迭代式扩散采样与 classifier-free guidance 又会在每个自回归步上把推理成本乘上一遍。 本文贡献:提出 CuteTTS,一个紧凑的连续自回归 TTS 系统:把语义对齐的因果 VAE 隐变量、patch 级自回归、显式说话人条件化与双向流匹配头结合起来。进一步提出 guidance-step distillation,把 classifier-free guidance 与多步求解器一起吸收进单个区间条件化的学生模型,从而在推理时不必再为引导和多步求解重复付费。 实验效果:在 LibriSpeech 与 Seed-TTS-Eval 上,零样本音色克隆的可懂度与说话人相似度具备竞争力;蒸馏使首音延迟相对基础模型降低 23.3%、实时率降低 40.8%,而客观与主观质量保持相当。 批判点评:把 CFG 和多步求解一起蒸进「区间条件化」的单个学生,这一手比单纯做步数蒸馏更实用:交互式 TTS 的痛点是首音延迟,而 CFG 意味着每步都要跑两遍前向,属于纯粹的常数倍开销,能一并吸收掉收益很直接。走连续隐变量而非离散 token,也规避了码本容量对声学细节的硬约束。不足在于对比强度不够:「competitive」这种措辞通常意味着没有在可懂度或相似度上取得优势,仅是持平,而真正的卖点全在效率数字上;23.3% 和 40.8% 都是相对自身基础模型的相对提升,没有给出与主流流式 TTS 的绝对延迟对照,工业选型时价值有限;双向流匹配头与因果 VAE 的组合在流式场景下的前瞻依赖长度也没交代,这直接决定能否真正做到低延迟流式。 10. GameAlpha:透明区域跳算省35%token Alpha as an Efficiency Signal: Visibility-Routed RGBA Image-to-Video Generation | 北京大学·字节跳动·清华大学 | arXiv:2608.09355 关键词:RGBA视频生成,游戏素材,可见性路由,流匹配,DiT加速 前序问题:RGBA 视频把 RGB 外观与 alpha 通道结合,让动画素材能贴到任意背景上,游戏行业用量极大。但高质量游戏 RGBA 动画生成有两个卡点:一是现有 RGBA 视频数据集以写实内容为主,游戏素材覆盖很少;二是传统的先生成再抠像流水线在 RGB 合成之后才估计 alpha,半透明区域常被背景糊掉,导致抠像输出不稳定。近期开始有工作联合建模 RGB 与 alpha,但大多是文本条件的,效率与质量上仍有未解问题。 本文贡献:构建 GameAlpha-2.4K,一个 2.4K 片段的游戏风格 RGBA 视频数据集,用抠像友好的合成、多假设 alpha 恢复和基于合成的质量门筛选制成。在此之上训练一个参考图条件的 RGBA 视频生成器,单次前向同时产出 RGB 帧与 alpha 遮罩。为提升效率,提出 visibility router:在早期阶段就识别出透明 token,跳过它们后续的 DiT 更新;同时用 x_0-lock 让这些 token 沿原始流匹配调度朝自预测终点前进,避免被跳过后偏离轨迹。 实验效果:模型的 FVD 低于传统两阶段流水线;visibility router 在最后两个 DiT 去噪步中跳过 35% 的 token 评估,带来 1.2 倍骨干加速,质量退化可忽略。 批判点评:「把 alpha 当效率信号」这个提法很巧:alpha 通道本身就明确标出了哪些区域是透明的、几乎不含内容,这等于免费拿到一张算力分配图,不需要额外训预测器去猜哪里重要——这是本文最讨巧也最合理的一点。x_0-lock 的补充也必要,否则被跳过的 token 会脱离流匹配轨迹造成边缘伪影。但工业价值需要打折看:1.2 倍加速且仅作用于最后两个去噪步,这个收益相当有限,与今天另外两篇(BAG、DUET)动辄数倍的加速不在一个量级;GameAlpha-2.4K 只有 2.4K 片段,对视频生成而言规模偏小,是否足以支撑通用游戏素材生成存疑;FVD 低于两阶段流水线是个较弱的基线选择,未与近期联合建模 RGBA 的方法正面比较;此外游戏风格数据训出的模型跨美术风格泛化能力完全未讨论。 趋势观察 少步蒸馏从「二选一」走向「按噪声分工」 — 阿里与北大的 DUET 把长期困扰少步蒸馏的质量-多样性权衡拆成了一个分工问题:轨迹级蒸馏(sCM)保多样性、分布级蒸馏(DMD)保质量,此前所有工作都在试图用一个 loss 把两者调和,结果总是牺牲一方。DUET 干脆让 sCM 专家接管高噪声那一步负责铺开结构,DMD 专家接管低噪声那一步负责精修细节,两个专家各按自己的原生目标独立训练,绕开了 loss 组合的优化困难。两步视频生成上质量逼近 DMD、结构多样性保住 sCM 水平(约为 DMD 的两倍)。这是今天最干净的一个「把权衡改造成分工」的范式样本。 推理加速的重心从「压缩步数」转向「花掉的算力值不值」 — 今天有三篇从不同角度攻同一件事。上交与淘天的 REST 指出 RL 对齐与少步蒸馏被串行执行是纯粹的浪费——扩散 RL 本身就在生成带奖励分数的有限步轨迹,那些中间状态是天然的蒸馏监督,不该当采样副产品扔掉;单阶段协同训练后,无 CFG 的少步推理能追平甚至超过 40 步的 RL 教师,额外训练成本不到纯 RL 的 25%。浙大与西湖的 BAG 则戳破缓存策略的两难:在线启发式没有全局预算意识、静态调度又缺乏实例自适应,改用一个轻量门控网络同时看预算状态和局部轨迹反馈来决定「这一步算还是复用」。字节与北大的 GameAlpha 走的是第三条路——不去改调度,而是让 alpha 通道直接充当算力分配图,透明 token 早早识别出来后跳过后续 DiT 更新。三条路线的共同指向是:加速的下一程不在「少走几步」,而在算力分配的精细化——按训练流程、按实例难度、按空间区域,各有各的省法。 统一模型开始拆掉 VAE 这根拐杖 — 美团的 UniSpace 提出一个反直觉的观察:语义 ViT 的冻结 Transformer 块并非天生保不住视觉细节,真正把表征推向语义抽象的是原始的 patch 参数化方式。于是它做 Patch Reparameterization——保留原语义通路,另加一条重建感知的 patch embedding,把细粒度信息喂给同一批冻结 ViT 块,最终把理解、生成、编辑装进同一个视觉空间,8B 的 Mixture-of-Transformer-Experts 全程不需要独立的 VAE 通路。这条路子如果站得住,意味着统一多模态模型的架构可以显著简化:一个预训练 ViT 即可充当通用视觉接口。 音频生成开始追求「一套权重装下所有声音」 — 快手可灵团队与港中文的 SonicWeave 把语音、音乐、音效、歌声以及它们的细粒度混合塞进单个流匹配模型。它的技术判断很具体:现有音频 MoE 大多在领域级别路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。SonicWeave 改按连续声学 chunk 路由,并用一个冲突门在局部状态不可靠时倾向全局先验、在区域偏离全局场景时才让局部证据说话。复旦与阿里 Token Foundry 的 FullDiT 则捅破混合式音乐生成的一个部署真相:渲染器用干净的目标 codec token 训练,上线却要吃语言模型的不完美预测,这是典型的暴露偏差;把渲染重新定义为「从不完美离散计划出发的全上下文生成」,并按教师强制下的 top-1 错误率匹配干扰替换率,最终在 18 个自动指标中的 15 项上超过五家商业系统。 扩散架构的「知其所以然」终于开始补课 — 北大与百度的 adaLN-Zero 研究(TPAMI 2026)值得单独一提:DiT 已被用了几年,但 adaLN-Zero 为什么比 adaLN 好,社区一直只有直觉。这篇把候选解释拆成三条——SE 式结构、零初始化、渐进式更新顺序,逐一做消融,最终证明零初始化才是主导因素,并顺势给出 adaLN-Gaussian 初始化与 SE-adaLN-Zero 改进结构。在基座模型迭代如飞的当下,这类回头做机理归因的工作反而更稀缺:它给出的是可迁移的设计原则,而不是又一个刷分技巧。 人工智能炼丹君 整理 | 2026-08-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
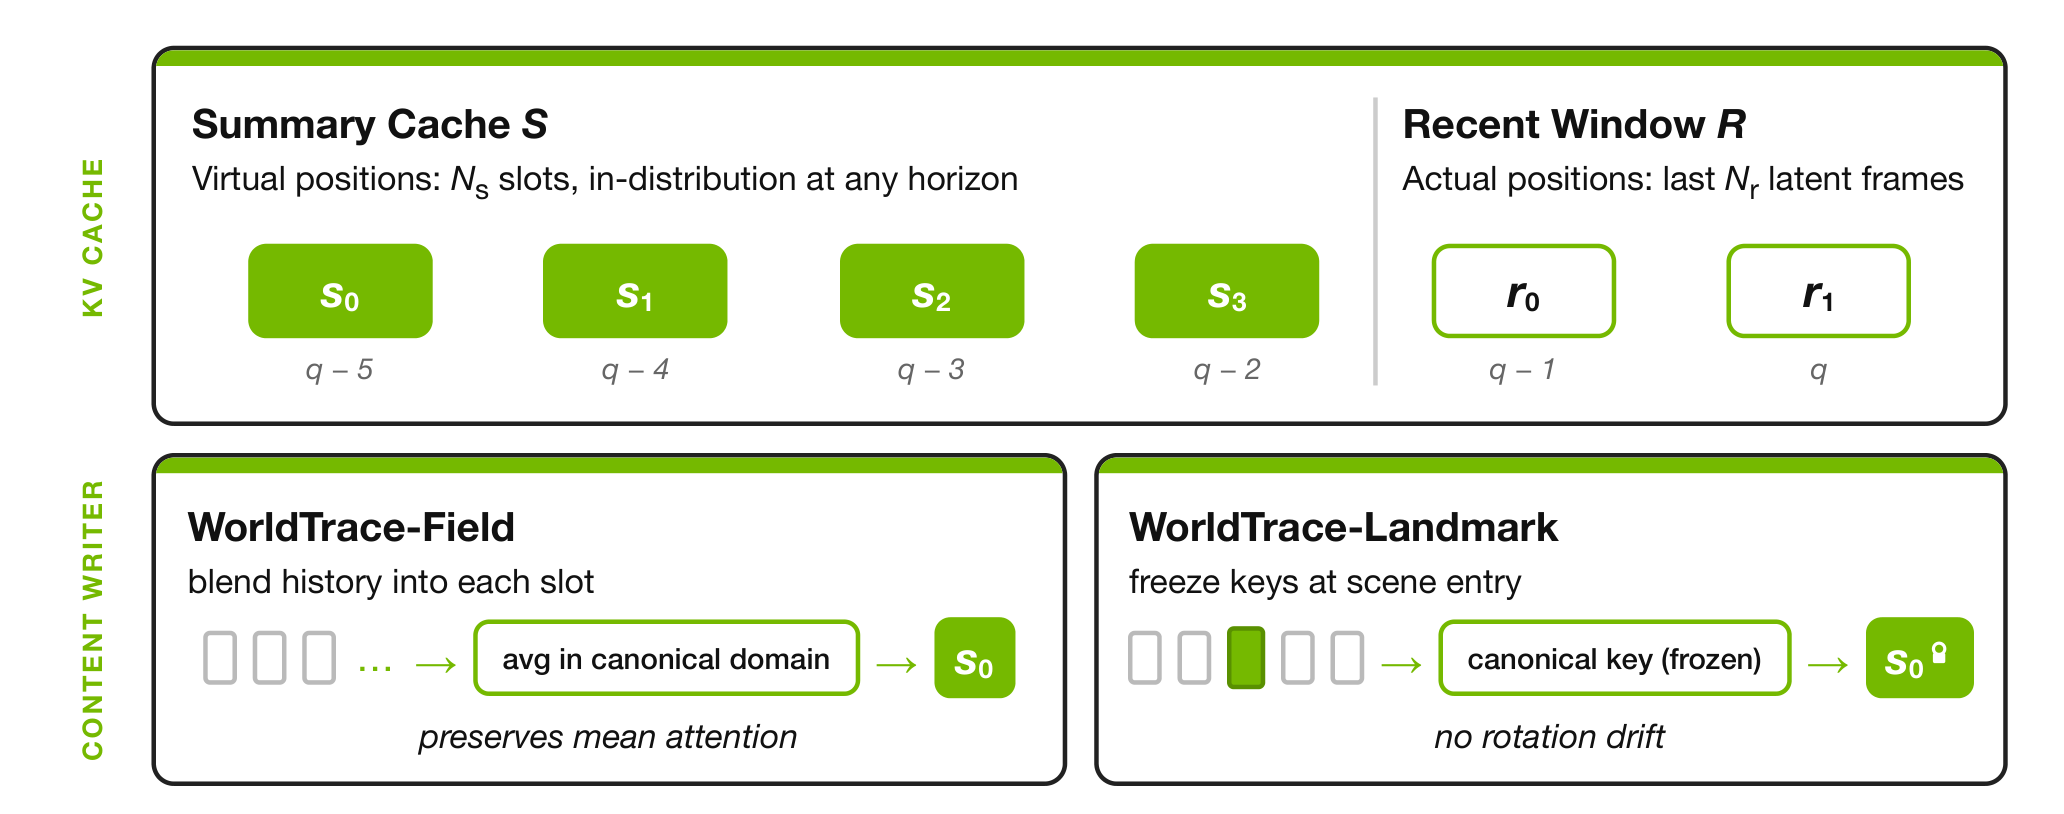
AIGC 每日速读|2026-08-11|NVIDIA免训练治好世界模型失忆WorldTrace 今日 AIGC 论文速览 今日共 10 篇 · 世界模型长时一致性与物理保真 2 篇 · 可控图像生成与区域编辑 4 篇 · 生成效率与免训练适配 2 篇 · 语音与数字人生成 2 篇 重点论文标题列表 WorldTrace(NVIDIA·普林斯顿大学·多伦多大学):免训练治好世界模型失忆 InsertFuse(上海交通大学·上海创智学院·西安交通大学·武汉大学):先训专家再蒸馏成一个 MOSAIK(华为加拿大):砍70%算力质量不掉 ControlRef(中山大学·清华大学·北京理工大学):稀疏布局延迟砍掉八成 HRDiT(兰卡斯特大学·华南理工·NVIDIA AI Tech Centre):现成DiT免训练出高清 今日论文速览 1. WorldTrace:免训练治好世界模型失忆 Addressable Memory for Video World Models | NVIDIA·普林斯顿大学·多伦多大学 | arXiv:2608.07408 关键词:视频世界模型,长时记忆,RoPE外推,KV cache压缩,免训练 前序问题:交互式视频世界模型依赖不断增长的 KV cache 当视觉记忆,来承接已生成的帧。但作者发现,一旦 rollout 超出训练时长,模型就无法可靠地寻址已存内容——因为时间维度的 RoPE 偏移跑到了训练时从未见过的范围之外,注意力检索不到相关视觉信息。更麻烦的是,天真地在 RoPE 旋转后的空间里压缩 cache 会直接破坏记忆,相当于把互不兼容的位置相位平均在一起。 本文贡献:提出免训练的记忆框架 WorldTrace:给每个摘要槽位分配一个互不相同、且落在训练分布内的虚拟位置,让压缩后的记忆保持「可寻址」。在这个可寻址 cache 之上研究两条压缩路线——WorldTrace-Field 压缩历史以维持时序连贯,WorldTrace-Landmark 在检测到的场景转换处保存原样场景轨迹以支持情节式回忆。同时提出 LoopBench,专门评测「绕一大圈之后能否重建先前访问过的场景」。 实验效果:WorldTrace-Field 把时序一致性提升 15.5%;WorldTrace-Landmark 在 LoopBench 上把情节式回忆提升 19.5%。全程无需重新训练,即扩展了视觉持久生成的长度。 批判点评:这篇的价值主要在诊断而非方法:把「世界模型跑长了会失忆」从模糊的「容量不够」精确归因到 RoPE 外推越界加旋转空间压缩相位冲突,并指出必须让虚拟位置落回训练分布内,这个洞察干净且可迁移——长上下文语言模型里的同类问题同样适用。免训练、可直接挂到现成模型上,落地成本几乎为零。局限是它本质在给外推能力打补丁而非根治:虚拟位置复用意味着不同时刻的记忆共享位置编码,冲突在更长 rollout 上迟早重现;Field 与 Landmark 两条路线各优化一个指标(时序连贯 vs 情节回忆),说明还没找到统一解;LoopBench 是作者自建的,绝对难度和外部可比性有待其他团队验证。 2. InsertFuse:先训专家再蒸馏成一个 InsertFuse: A Unified Framework for Multi-Category Reference-Guided Image Insertion | 上海交通大学·上海创智学院·西安交通大学·武汉大学 | arXiv:2608.06490 关键词:图像插入,On-Policy蒸馏,流匹配,区域平衡,参考引导 前序问题:参考引导的图像插入(把一个参考物体自然地放进目标场景)要同时处理人物、服饰、家具、logo 等多种类别,而不同类别的插入行为差异很大。直接联合训练一个通用模型会产生跨类别干扰——学插家具的能力会把插人物的能力带偏;而分别训练多个专用模型又无法统一部署。此外插入区域通常远小于背景,直接做流匹配会让监督信号被背景主导,且对物体尺度敏感。 本文贡献:提出 InsertFuse,核心思路是把「类别专属能力的学习」与「跨类别能力的整合」解耦:先为不同插入类别各训一个专家,再用 Insertion On-Policy Distillation(IOPD)把它们的能力合并进单个学生模型——在学生实际访问到的状态上去查询匹配的那个专家,从而保住类别专属的插入行为,又避免了直接联合训练的跨类别干扰。为改善空间控制,提出 Token 对齐的几何条件(TAGC),把掩码导出的几何线索映射到视觉 token 网格;以及区域平衡流匹配,对插入区域内外的预测误差分别归一化,防止背景主导和尺度依赖的监督失衡。另引入 Reference CFG,在固定场景与几何条件下隔离并强化视觉参考带来的引导,再由 IOPD 把这份增强监督迁移进统一学生。 实验效果:在公开的 AnyInsertion benchmark 和作者自建的多类别测试集上,多数指标达到最优,在多样插入类别上都表现出很强的参考保真度与生成质量。 批判点评:「先训专家、再 on-policy 蒸馏成一个」这条路子在大语言模型里已被验证,搬到图像插入上很对症——插入任务的类别差异确实大到会互相拖累,而 IOPD 在学生自己走到的状态上查专家(而非离线蒸馏固定数据),能避免分布错位,这是关键细节。区域平衡流匹配也点出一个容易被忽视的工程真相:插入区域只占画面一小块,不做归一化,损失基本被背景吃掉。不足在于成本:要先训 N 个专家再蒸馏,整体训练开销远高于单模型方案,论文没交代专家数量和总算力,实用性判断打折;「多数指标最优」的措辞意味着有指标不占优,具体哪些没说;此外自建测试集与公开 benchmark 混合汇报,容易掩盖在标准集上的真实位次。 3. MOSAIK:砍70%算力质量不掉 MOSAIK: Multi-Patch Content-Aware Spatial Allocation of Image Tokens for Efficient Generation | 华为加拿大 | arXiv:2608.05450 关键词:像素空间扩散,异构patch,推理加速,token预算,华为 前序问题:像素空间扩散模型避开了潜空间扩散的重建天花板,但 token 数量高得多,在自注意力的二次复杂度下生成成本高昂。已有的效率方法通过在选定的去噪步使用更大 patch 来减少 token,但每一步都在整张图上用同一个 patch 尺寸,忽略了不同区域被粗化时的保真损失其实差别很大。 本文贡献:提出 MOSAIK,一个「损伤引导」的框架,让 patch 尺寸同时随区域和去噪步变化。改造 PixelDiT 骨干使其能生成任意异构的 patch 布局,并用一个轻量预测器基于中间去噪特征估计每个区域被粗化会造成多大保真损失。在给定 token 预算下,损伤引导的布局预测器把细 patch 分给敏感区域、粗 patch 分给其余区域。 实验效果:在 FLOPs 减少 70%、token 数减少 83% 的同时,GenEval 与全算力 PixelDiT 持平,DPG-Bench 仅下降 1.0 分。与包括时序 patch 调度、特征缓存在内的多种效率范式相比,在中等预算下极具竞争力,在算力极度受限的场景下持续超越这些基线。 批判点评:「不同区域被粗化的代价不一样」这个观察太朴素了,以至于之前的 patch 调度工作集体忽略——把逐步的时间维调度扩展到空间维,并且用一个学出来的损伤预测器而非手工启发式来分配预算,思路正确且数字漂亮:砍 70% FLOPs 而 GenEval 持平,这个性价比在效率方向里属于第一梯队,尤其在算力受限区间超越特征缓存类方法,说明它不是靠预算宽松堆出来的。风险在于:异构 patch 布局需要改造骨干(PixelDiT),无法像特征缓存那样零成本挂到现成模型;损伤预测器本身要跑,在极小预算下它的开销占比会上升;此外评测集中在 GenEval/DPG 这类文图对齐指标,异构 patch 边界在高频纹理和小字上是否留下可见接缝,摘要没有交代。 4. ControlRef:稀疏布局延迟砍掉八成 ControlRef: Efficient Layout-Guided Multi-Instance Generation via Anchored 4D-RoPE | 中山大学·清华大学·北京理工大学 | arXiv:2608.06878 关键词:布局引导生成,多实例合成,4D-RoPE,MM-DiT,推理加速 前序问题:布局引导的多实例生成对多模态扩散 Transformer(MM-DiT)的可控合成很关键,但要把这个能力整合进统一架构一直很难。此前框架依赖冗余的全分辨率画布填充加 Shifted-RoPE 来管理多张参考图:这套机制在稀疏布局下把计算开销急剧放大,又破坏了关键的低频 RoPE 特征,形成严重的空间-频率折损,把绝对空间对应关系搞模糊。 本文贡献:提出 ControlRef。用统一实例-布局控制(UILC)注意力掩码严格解耦实例间的语义交互,强制精确的区域绑定。为进一步促进区域级空间对齐,提出 Anchored 4D-RoPE:把 token 直接锚定到它们的绝对几何中心——先把参考图预对齐到对应边界框的分辨率,再把布局 token 和参考 token 都物理锚定到绝对几何中心,并让参考沿 z 轴堆叠,从而原生保留空间先验,无需有损位移就缓解了空间-频率折损。 实验效果:在视觉保真度和定位准确率上达到最优,同时把稀疏布局下的推理延迟削减 80% 以上,稠密场景下的显存开销降低 50%。 批判点评:这篇把「Shifted-RoPE 用位移换对齐」这个隐性代价揭示得很清楚——位移破坏低频分量,而低频恰恰承载绝对空间信息,于是控制精度和算力两头同时受损。改成把 token 物理锚定到绝对几何中心、参考沿 z 轴堆叠(这也是 4D 的来源),是从坐标系层面而非加约束层面解决问题,延迟降 80%、显存降 50% 属于工程上很实在的收益。需要留意的是:稀疏布局的 80% 提速本质来自不再做全分辨率填充,收益高度依赖布局稀疏程度,稠密场景下只剩 50% 显存收益,宣传口径要打折;把参考预对齐到边界框分辨率意味着参考图会被重采样,小物体的细节保真如何没有交代;此外方法与 MM-DiT 的位置编码强耦合,迁移到其他架构的成本未知。 5. HRDiT:现成DiT免训练出高清 HRDiT: Training-Free High-Resolution Image Generation with Off-the-Shelf Diffusion Transformer Models (ECCV 2026) | 兰卡斯特大学·华南理工·NVIDIA AI Tech Centre | arXiv:2608.07003 关键词:免训练,高分辨率生成,Diffusion Transformer,空间错乱,ECCV2026 前序问题:免训练的文本到高分辨率图像生成正获得越来越多关注,但已有研究主要集中在把现成的 U-Net 扩散模型适配到高分辨率;对现成 Diffusion Transformer(DiT)的适配进展有限——尽管 DiT 在有限分辨率下的文生图能力本来更强。 本文贡献:指出两个特别阻碍现成 DiT 免训练做高分辨率合成的关键挑战——空间错乱(spatial disorder)与生成时间过长,并针对性提出一套专门适配现成 DiT 的方法。代码已公开。 实验效果:大量实验验证了方法的有效性。论文已被 ECCV 2026 接收。 批判点评:问题定位很到位:社区做免训练超高分辨率的技巧大多是 U-Net 时代的遗产,而主力基座早已换成 DiT,这个空档确实值得补;免训练、直接用现成权重、代码开源,落地门槛几乎为零,ECCV 2026 接收也算一层同行背书。但这条摘要是今天十篇里写得最含糊的:只说「有两个挑战」和「提出一种新方法」,具体机制、能撑到多高分辨率、加速比多少、与 ScaleCrafter/DemoFusion 这类前作差多少,一个数字都没给。即使实验部分扎实,这种写法也会让读者在信息筛选阶段先流失一批——对一篇主打「免训练即插即用」的工作来说,是很可惜的自我设限。 6. MaskFlow:掩码写进流匹配目标 MaskFlow: Precise, Consistent and Seamless Regional Image Editing | 商汤研究院·北京航空航天大学·南洋理工大学 | arXiv:2608.06929 关键词:区域图像编辑,流匹配,掩码条件,边界融合,商汤 前序问题:区域图像编辑因为空间可控性受到关注。但即便基于指令和基于掩码参考的方法都能做到不错的语义对齐,可靠的区域控制仍然困难——编辑必须被准确定位,并且与被保留的上下文自然融合,而现有方法常在边界留下痕迹或污染背景。 本文贡献:提出训练框架 MaskFlow,同时追求精确定位、一致的背景保持和无缝的边界过渡。关键做法是把掩码直接纳入概率路径和流匹配目标,让可编辑区域内的生成与区域外的源保持协同优化,而不是事后拼接。另提出 Soft-Poisson 去缝合模块,在训练和采样两个阶段都对预测的向量场做精修,改善编辑前景与保留背景的平滑融合。同时设计数据合成管线构建 MEData——面向区域图像编辑训练的掩码数据集。 实验效果:在自然场景和信息图(infographic)图像上的实验显示,定量与定性评测均相对竞争方法取得一致提升。 批判点评:把掩码写进概率路径和流匹配目标、而不是当成后处理的贴回操作,这是方法论上的正解——边界不自然的根源就是训练目标里从来没有「区域内外要协同」这一条。Soft-Poisson 在训练和采样两侧都介入也考虑得比较周全;选信息图当评测场景很实用,因为文字和线条对缝合痕迹最不宽容。不足在于它是训练框架而非免训练插件,接入成本比同类高;效果描述停留在「一致提升」,缺具体数字和基线对比,而区域编辑的差异往往只体现在边界几十个像素上,这类主观性强的改进尤其需要量化和用户研究支撑;MEData 由合成管线构造,与真实用户涂抹掩码的分布是否一致也需要验证。 7. EmoWorld:情感拆成三路分别调 EmoWorld: A Decoupled Affective Field for Controllable Emotional Video Generation | 香港科技大学(广州)等 | arXiv:2608.06231 关键词:情感视频生成,可控生成,冻结DiT,残差操控,Wan2.2 前序问题:情感决定观众如何解读一个场景,但现有视频生成器把全局氛围、承载情感的语义线索、以及情绪的时间推进这三件事全都揉在同一条文本条件里,导致无法分别控制——想调暗氛围就连带改了画面内容,想加一个悲伤的道具又连带改了整体色调。 本文贡献:提出 EmoWorld,在冻结的流匹配视频扩散 Transformer(Video DiT)内部解耦这三个因素。一次性准备阶段从「几何保持的中性全景图」与「情感编辑后的全景图」中提取逐层的情感方向和一个可复用的线索库。推理时:视觉氛围操控(VAS)把氛围方向注入隐藏状态;语义情感操控(SAS)为语义线索单独隔离出一个可独立缩放的 prompt 残差;时间情感操控(TAS)在去噪时间与视频时间两个维度上插值端点残差场。全程不更新生成器参数。 实验效果:在 Wan2.2 上,VAS 把目标情绪对齐度提升 19%、同时把时序波动代理指标降低 48%;SAS 把目标情绪对齐度提升 37%、检测到的承载情感线索增加 36%;TAS 相对最强基线把过渡单调性提升 15%。覆盖 27 个情绪类别的文生视频与图生视频设定,可跨多个 Video-DiT 骨干移植,并支持相机条件下的构图。 批判点评:把「情感」这个含混的条件拆成氛围、语义线索、时间推进三路分别注入,是这篇最漂亮的地方——它把一个说不清的美学需求变成了三个可分别缩放的旋钮,而且完全不动生成器权重、能跨骨干移植,工程友好度很高;用几何保持的中性/情感全景图对来抽取情感方向,也是个巧妙的构造。要谨慎的是评测指标的自定义程度偏高:「时序波动代理」「过渡单调性」都是作者自拟的量,19%/37%/48% 这些百分比缺少公认基线的对照,跨论文可比性差;情绪这类主观维度最终仍需人类评测,摘要未提及用户研究;此外方法依赖一次性准备阶段产出的线索库,换主题域或换骨干后是否需要重建,成本没有交代。 8. GAUGE:方程对了加速度还是错 GAUGE: A Measurement-Grounded Benchmark for Physical Fidelity in Simulation Engines and Video World Models | 上海人工智能实验室·香港大学·上海交通大学·浙江大学 | arXiv:2608.05948 关键词:物理保真度,视频世界模型,物理引擎,诊断基准,上海AI Lab 前序问题:物理引擎支撑着具身智能的大规模训练与评估,而生成式视频世界模型正在成为未来状态与交互的隐式模拟器。但现有的物理保真度评估往往各自孤立进行,且严重依赖感知相似度或人工判断,几乎无法告诉你到底是哪条物理原理、哪个参数被违反了。 本文贡献:提出 GAUGE,一个以真实世界为基准的诊断性 benchmark,联合评估数值模拟器与生成式视频世界模型对真实物理的复现与偏离。包含 22 个受控任务族,覆盖刚体、柔性线缆、织物和体积可变形物体;以真实世界轨迹为基准,配套标定过的物理元数据、不确定性标注和任务专属可观测量,涵盖碰撞、摩擦、动量传递、振荡、自接触、形变等基本物理过程。 实验效果:用广义轨迹误差在 14 个任务族上评测 Isaac Sim、Genesis 与 Newton,并在 5 个刚体任务上评测 6 个图生视频模型的物理定律一致性与推断参数的时序稳定性。结果显示没有任何一个物理引擎在全部任务上保真,最大偏差出现在冲击性接触、织物快速运动和体积形变;更值得警惕的是,视频世界模型能产出「方程形式符合预期」的轨迹,但恢复出的加速度、动量传递和振荡时序全是错的。 批判点评:把物理引擎和生成式视频模型放进同一套以真实轨迹标定的尺子下衡量,这个设计本身就是贡献——此前两个社区各说各话,一边比轨迹误差一边比感知相似度,根本无法对话。最有价值的结论是「方程形式对但加速度错」:这精确刻画了视频模型的物理是表层拟合而非机制正确,对所有把视频世界模型当具身智能模拟器用的团队都是一记警钟,而这种可归因到具体物理量的诊断,是感知相似度指标永远给不出的。局限在于覆盖不平衡:物理引擎评了 14 个任务族,视频模型只评了 5 个刚体任务,柔性和形变这些最难的场景恰恰没测到生成模型;真实轨迹的标定精度与不确定性标注本身也会引入误差上限;22 个任务族的构造和评分细节能否被外部团队稳定复现,要等数据与代码放出后才能判断。 9. SemBridge:语义token只在训练时用 SemBridge: Semantic Token Anchoring for Continuous-Latent Autoregressive Speech Generation | 西北工业大学·Soul AI Lab | arXiv:2608.07462 关键词:自回归语音生成,连续潜表示,语义token监督,零样本TTS,歌声合成 前序问题:连续潜表示的自回归语音生成通过避免量化损失、保留更丰富的声学信息,成为离散 token 建模之外一条有前景的路线。但连续声学目标并不把语言结构暴露成显式的 token 级预测目标,结果自回归语言模型只能通过预测声学来间接获得语言结构,这会损害生成语音的内容保真度——说白了就是音色和韵律很好,但字容易念错。 本文贡献:提出 SemBridge,一个仅在训练阶段生效的语义 token 锚定框架。用离散语义 token 直接监督自回归 LM 的状态,并采用语义对齐的声学 VAE,把连续目标空间组织在同一个语义参照系之下。语义监督只在训练时使用,推理阶段完全保持连续,因此不引入量化损失。在零样本文本转语音(TTS)和乐谱条件的歌声合成(SVS)两个任务上评估。 实验效果:在多个基准上,SemBridge 改善了以词错误率和字错误率(WER/CER)衡量的内容准确率,同时保持有竞争力的说话人相似度和感知质量。结果表明,对自回归状态施加显式语义 token 监督,是连续语音生成的一个有效且通用的方向。模型代码与 checkpoint 将开源。 批判点评:「训练时用离散语义 token 当拐杖、推理时完全撤掉」这个设计非常讨巧——它精准命中连续潜表示路线的软肋(音质好但内容易错),又不把量化损失带回推理阶段,属于两头好处都要的正确姿势,而且同时在 TTS 和歌声合成上验证,说明不是针对单一任务的技巧。不足是收益描述偏保守:内容准确率提升、说话人相似度和感知质量「保持有竞争力」,这个措辞通常意味着后两项略有折损,具体折多少要看正文;语义 token 的质量高度依赖所用的语义编码器,换一个编码器结论是否稳定没有交代;此外 16 位作者的大团队工作却只给出相对提升而无绝对 WER 数字,可比性打了折扣。 10. SubtleTalk:眉毛眨眼终于不再呆滞 SubtleTalk: Generating Controllable Weakly-correlated Facial Dynamics for 3D Talking Heads via Residual Flow Matching | 上海交通大学·腾讯 | arXiv:2608.06408 关键词:3D说话人,弱相关动态,残差流匹配,Valence-Arousal,腾讯 前序问题:音频驱动的 3D 面部动画要从语音合成真实且时序连贯的运动。尽管唇形同步已有显著进展,但眉毛运动、眨眼、头部动作这些「弱相关动态」——对照片级真实感恰恰至关重要——仍然难以忠实建模,常常表现得僵死或不自然地重复。作者归因于三点:一是弱相关动态的条件信息不足;二是确定性回归难以捕捉多样的运动模式;三是上半脸伪标签不可靠、数据集多样性有限造成的数据瓶颈。 本文贡献:提出 SubtleTalk,通过多条件建模与残差流匹配生成自然可控的弱相关面部动态。第一,针对单靠语音引导不足,引入可解释的控制信号——韵律、区域强度、Valence-Arousal(效价-唤醒度),显式刻画弱相关动态的时机、幅度和情感变化。第二,针对确定性回归表达力有限,在稳定的语音驱动运动先验之上构建残差流匹配,让模型捕捉超出确定性预测的随机偏差。第三,为缓解数据瓶颈,构建 SubtleTalk-Face 数据集,约 3900 个身份、74 小时数据,通过简单可扩展的伪标注管线构建,改进了上半脸追踪并带有帧级 VA 标注。 实验效果:大量实验表明,该方法在显著提升弱相关面部动态的真实感和多样性的同时,保持了准确的唇形同步。 批判点评:问题诊断分层很清楚:条件不足、回归表达力不足、数据不足,三条各配一个对策,而不是笼统地上一个更大的模型。「弱相关动态」这个提法本身就抓住了数字人恐怖谷的真正来源——唇形对了但眉眼呆滞,观众立刻觉得假;用残差流匹配在确定性先验之上叠随机偏差,是承认这类动作本质多模态、不该被回归到均值,方向正确;3900 身份、74 小时并带帧级 VA 标注的数据集也是实打实的贡献。局限是上半脸标注仍来自伪标注管线,而上半脸恰恰是原问题里「伪标签不可靠」的部分,这在方法论上有一点自我循环的味道;效果只给了「显著提升真实感和多样性」的定性说法,而多样性和真实感之间通常是权衡(动得多容易动得怪),缺少量化取舍曲线;此外三路控制信号的调参空间不小,实际使用的易用性有待验证。 趋势观察 长时一致性的病根被重新定位到「位置编码的可寻址性」 — NVIDIA 与普林斯顿的 WorldTrace 指出,视频世界模型跑超训练时长后失忆,真正原因不是 KV cache 装不下,而是 RoPE 的时间偏移跑出了训练分布,模型根本「找不到」存进去的内容;更糟的是在 RoPE 旋转后的空间里直接压缩,等于把相位不兼容的记忆平均成糊状。给每个摘要槽位分配一个落在分布内的虚拟位置,免训练就把时序一致性提了 15.5%、情节回忆提了 19.5%。这是今天最典型的「诊断比方法更值钱」。 生成效率的战场从「少走几步」转到「每一块像素值不值得花算力」 — 华为加拿大的 MOSAIK 指出,此前的 patch 调度都是在时间维上做手脚——某几个去噪步换大 patch,但整张图仍用同一个尺寸,完全忽略了不同区域被粗化时保真损失差别巨大。它训了一个轻量预测器估计每个区域的「损伤程度」,把细 patch 分给敏感区、粗 patch 分给其余,FLOPs 砍 70%、token 砍 83% 而 GenEval 与全算力持平、DPG 只掉 1.0 分,并且在算力极度受限时持续超越特征缓存类方法。空间维的自适应预算分配,是这条路上被漏掉的一整个维度。 免训练与训练后处理,仍然是投入产出比最高的一档工作 — HRDiT(ECCV 2026)把免训练高分辨率生成从 U-Net 时代搬到现成 DiT 上,只需解决空间错乱和生成耗时两个卡点;WorldTrace 完全不动权重就修好长时记忆;EmoWorld 在冻结的 Video DiT 上做三路情感操控,27 类情绪、跨多个骨干可移植,全程不更新生成器参数。当基座模型迭代速度远快于论文周期时,「不碰权重」正在成为一种务实的方法论选择。 可控生成的瓶颈从「像不像」转向「位置对不对、别处别动」 — 中山大学与清华的 ControlRef 发现前作用全分辨率画布填充加 Shifted-RoPE 管多张参考图,既在稀疏布局下浪费大量算力,又破坏低频 RoPE 特征、模糊了绝对空间对应;改成把 token 锚定到绝对几何中心的 Anchored 4D-RoPE,稀疏布局延迟砍掉 80% 以上、稠密场景显存省一半。商汤的 MaskFlow 把掩码直接写进概率路径和流匹配目标,从训练目标层面保证「区域内生成、区域外保源」;上交的 InsertFuse 则用区域平衡流匹配,对插入区域内外分别归一化误差,防止小目标的监督被背景吃掉。三篇都在说同一件事:控制不是往外加约束,而是改坐标系和目标函数。 评测正在从「打分」走向「诊断违反了哪条物理定律」 — 上海 AI Lab 联合港大、上交、浙大的 GAUGE 用真实世界轨迹做基准,22 个受控任务族覆盖刚体、柔性线缆、织物和体积可变形物,同时评物理引擎(Isaac Sim、Genesis、Newton)和 6 个图生视频模型,结论相当刺眼:没有一个引擎在全部任务上物理保真;而视频世界模型能生成「方程形式看起来对」的轨迹,但加速度、动量传递和振荡时序全是错的。这种可归因到具体物理量的评测,比再多一个感知相似度分数有用得多。 人工智能炼丹君 整理 | 2026-08-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-27|NVIDIA单卡视频生成提速120倍SANA2.0 今日 AIGC 论文速览 今日共 5 篇 · 高效视频生成 1 篇 · 交互式世界模型与生成渲染 2 篇 · 可控视频生成 1 篇 · 人像图像编辑 1 篇 重点论文标题列表 SANA-Video 2.0(NVIDIA):混合线性注意力高效视频生成 WorldWeaver(UCLA·Adobe):多智能体流式世界模型 Closing the Loop(Roblox·宾州州立):免训练解决生成渲染回访不一致 GraphVid(UIUC):交互图可控的图生视频 MagicMakeup(浙大·vivo):区域可控的高保真妆容迁移 今日论文速览 1. SANA-Video 2.0:混合线性注意力高效视频生成 SANA-Video 2.0: Hybrid Linear Attention with Attention Residuals for Efficient Video Generation | NVIDIA | arXiv:2607.21553 关键词:视频生成,线性注意力,扩散Transformer,高效推理,视频DiT 前序问题:视频扩散 Transformer 用全 softmax 注意力质量高但随序列二次增长、长高清视频代价大;纯线性注意力可 O(N) 扩展却缺全秩 token 交互、质量受损。 本文贡献:提出统一架构下 5B/14B 的混合视频扩散 Transformer SANA-Video 2.0:混合线性-softmax 注意力以 3:1 比例把门控线性注意力(O(N) 为主的混合)与周期性门控 softmax 锚点结合,恢复纯线性注意力缺失的全秩交互;块注意力残差(AttnRes)把完成的块摘要路由进后续线性层、复用锚点特征并把深层有效秩提升约 12%;从零训练直接学完整混合(而非线性化预训练模型),降分辨率代理实验确定 25% softmax 为质量-效率最优点。 实验效果:40 步采样下单张 H100、480p 生成 13.2s 达 VBench 84.30,与远大的 softmax 视频 DiT 具竞争力却延迟极低;编译后 DiT 前向在 720p/60s 比匹配全 softmax 基线快 3.2 倍(时长越长差距越大);再加 Sol-Engine 全栈优化(核融合/缓存/稀疏注意力)提速 3.58 倍,5B 管线 720p/5s 达 13.06s,比 Wan2.2-A14B 快 120 倍。 批判点评:用「混合线性-softmax+块注意力残差」在大幅降本下恢复 softmax 级表达力、且从零训得完整混合,单卡 720p 与 120× 提速对长高清视频落地意义大(NVIDIA 出品)。但混合比例/锚点设计的通用性、从零训练的成本、以及极长时长与更高分辨率下质量与效率的平衡仍需更多验证。 2. WorldWeaver:多智能体流式世界模型 Streaming Multi-Agent Autoregressive Diffusion Model with World State Registers | UCLA·Adobe | arXiv:2607.21594 关键词:世界模型,多智能体,自回归扩散,状态寄存器,流式生成 前序问题:多智能体交互世界模型不仅要生成一致观测,还要维持跨智能体持久、随视角演化的世界状态;现有自回归视频扩散把观测历史作条件上下文,难在多智能体/多视角下维持共享状态。 本文贡献:提出流式多智能体视频扩散模型 WorldWeaver(W²),用跨智能体世界状态寄存器增强 rollout:可学习 token 存储共享世界信息、跟踪各智能体状态、并在每生成一块后动态更新;用跨越个体智能体状态、含鸟瞰的全局状态视图与场景文本的监督信号为寄存器提供 grounding;架构上用 Mixture-of-Transformers 让世界状态建模与视觉帧建模各用独立权重。 实验效果:在双智能体 Minecraft 视频生成上,显式世界状态建模提升了逻辑一致性与生成质量。 批判点评:用「世界状态寄存器+MoT 分权」把多智能体共享状态显式化,直指现有 AR 世界模型只靠观测历史的短板,UCLA·Adobe 出品思路扎实。但目前主要在 Minecraft 双智能体上验证,真实复杂场景、更多智能体与更长时程下的状态一致与可扩展性仍待检验。 3. Closing the Loop:免训练解决生成渲染回访不一致 Closing the Loop: Training-Free Revisit Consistency for Autoregressive Generative Rendering | Roblox·宾州州立 | arXiv:2607.21848 关键词:生成渲染,自回归视频,回环一致,免训练,3D世界 前序问题:条件视频生成可把 3D 引擎渲染(深度/无纹理几何)转成写实视频用于游戏与沉浸内容,需长时程自回归持续合成新帧并保持持久 3D 世界;但 AR 生成器用有界 KV cache 分块合成,当相机在上下文被淘汰后回访某地,即使条件渲染仍与几何对齐,模型也常重新生成不一致外观。 本文贡献:提出无需任何后训练的方案,利用 3D 引擎已提供的对应关系解决回访不一致:时间对应把位姿匹配的历史潜块检索回 KV cache 作回环记忆;空间对应用相机位姿与深度重投影,把 token 级注意力偏向检索块中几何对应区域。 实验效果:在从 TartanAir/TartanGround 挖掘的回环轨迹上(贴近复杂真实场景),在回访一致性上超过现有免训练基线,且不损整体视频质量。 批判点评:把 3D 引擎自带的时空对应变成免训练的回环记忆,精准命中 AR 生成渲染的回访漂移,Roblox 背景贴近游戏落地、零后训练很实用。但依赖 3D 引擎提供精确对应(纯生成场景不适用)、检索与重投影的额外开销,以及大幅动态/光照变化下的一致仍需更多验证。 4. GraphVid:交互图可控的图生视频 GraphVid: Interactive Graph-Controllable Video Generation | UIUC | arXiv:2607.21580 关键词:图生视频,可控生成,交互图,多主体,数据集 前序问题:可控视频生成难在用文本或主要约束像素移动的运动控制精确指定多物体交互;基于轨迹的控制常需为多物体画准确轨迹,随场景复杂度扩展差、遮挡/重叠下含糊。 本文贡献:提出图条件的图生视频模型 GraphVid,通过结构化交互图实现灵活而精确的多主体交互控制;并构建大规模、以交互为中心、带结构化关系标注的视频数据集 GraphVid-Bench 以训练交互感知的视频生成模型。 实验效果:尽管训练数据与可训练参数远少于此前运动控制方法,GraphVid 仍具强可控性与画质:相比 Motion-I2V,FID 最多降 39.9%、FVD 降 37.6%,PSNR 从 9.87 升至 15.98、SSIM 从 0.38 升至 0.61。 批判点评:用「交互图」作结构化语义接口控制多主体视频,比画轨迹更省数据、更抗遮挡歧义,指标提升明显、范式有启发。但交互图的构建与交互标注成本、复杂/开放场景下图到视频的忠实度,以及相比像素级控制的精细度边界仍需更多检验。 5. MagicMakeup:区域可控的高保真妆容迁移 MagicMakeup: A Region-Controllable Diffusion Transformer for High-Fidelity Makeup-Transfer | 浙大·vivo | arXiv:2607.20924 关键词:妆容迁移,图像编辑,扩散Transformer,区域控制,身份保持 前序问题:妆容迁移要把参考妆容迁到源脸同时保源身份;扩散方法虽推进整脸编辑,但强区域可控、妆容保真与身份保持仍难——像素-注意力错位致溢出到非目标区、双图条件下迁移/保持概念不清致妆容属性与身份耦合、且缺身份一致且区域标注的高分辨率数据集。 本文贡献:提出基于扩散 Transformer 的区域可控高保真妆容迁移框架 MagicMakeup,建立在空间约束与概念解耦上:Token 对齐区域门控把像素 mask 与注意力对齐并施加区域特定 logit 门控以实现精确区域编辑并保身份;跨模态感知引导对齐文本与图像特征以厘清迁移与保持概念;并设计经区域特定卸妆生成 1024×1024 数据对的流程、建立合成与真实统一基准。 实验效果:大量定量定性实验表明,MagicMakeup 提升区域可控性、妆容保真与身份保持,且跨风格、种族、姿态具强鲁棒。 批判点评:用「区域门控+概念解耦」对症妆容迁移的溢出与身份耦合,配区域标注高分辨率数据与统一基准,工程扎实、vivo 背景贴近手机影像落地。但依赖卸妆合成的数据对质量、极端妆容/复杂光照下的保真,以及区域门控在细小部位的精度仍有提升空间。 趋势观察 线性注意力把视频生成推向高效 — NVIDIA SANA-Video 2.0 用混合线性-softmax 注意力,单卡 H100 生成 720p、比 Wan2.2-A14B 快 120 倍,效率成为长/高清视频生成的主战场。 世界模型走向多智能体与持久状态 — WorldWeaver 用跨智能体世界状态寄存器维持多智能体/多视角共享世界,交互式世界模型开始正视'共享状态一致'难题。 自回归生成渲染死磕长程一致 — Closing the Loop 免训练用 3D 引擎对应关系做回环记忆,解决相机回访时的外观不一致,生成式渲染向可用的持久 3D 世界靠拢。 可控生成走向结构化语义接口 — GraphVid 用交互图控制多主体视频生成、比轨迹控制更省数据更精确,'结构化语义'成为可控生成的新范式。 扩散编辑深入区域级精细控制 — MagicMakeup 用 token 对齐区域门控+概念解耦做高保真区域可控妆容迁移,图像编辑正从整脸走向部位级精修。 人工智能炼丹君 整理 | 2026-07-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-22|华为40万美元逼近闭源Boogu-Image 今日 AIGC 论文速览 今日共 10 篇 · 统一图像生成与编辑 2 篇 · 视频编辑与长视频一致性 5 篇 · 视频插帧与生成效率 1 篇 · 情绪语音生成 1 篇 · 像素扩散技术综述 1 篇 重点论文标题列表 Boogu-Image-0.1(华为香港AI Lab·港大·港科大):40万美元逼近闭源图像模型 D2DF(西交·国家电网AI Lab·浙工大·百度):视频消物一秒只需一步 SlotMem(港大·清华):按角色寻址记住长片人物 ReBind(快手可灵·港科大·南大·北大):显式绑定多参考视频编辑 FlowMimic(字节):图片编辑数据实时变视频 今日论文速览 1. Boogu-Image-0.1:40万美元逼近闭源图像模型 Boogu-Image-0.1: Boosting Open Agentic Multimodal Generation via Understanding under a Minimal Budget | 华为香港AI Lab·港大·港科大 | arXiv:2607.13125 关键词:统一多模态,文生图,图像编辑,Agent推理,开源模型 前序问题:Nano-Banana-Pro、GPT-Image-2 等闭源系统靠模型理解、提示改写与推理时编排形成系统级优势,但内部配方不公开;开源社区如何在有限数据和算力下同时做好文生图、快速推理、指令编辑和中英文字渲染,缺少可复现路线。 本文贡献:发布 Boogu-Image-0.1 开源统一理解生成模型族,含 Base、Turbo、Edit、Edit-Turbo。核心不是只堆生成骨干,而是强化多模态编码器、Agent 式提示重写、数据质量和训练管线,并用 Agentic inference-time scaling 把理解能力转成生成与编辑质量;权重、代码和训练配方均以 Apache 2.0 开源。 实验效果:仅使用 2.0862 亿张去重图像,Base 理论训练成本约 40 万美元;标准基准上持续匹敌或超过其他开源模型,结果逼近领先闭源系统,并覆盖高质量文生图、快速推理、指令编辑和中英文字渲染。 批判点评:「华为团队用 40 万美元把开源模型推近闭源系统」兼具机构信号与成本冲击力,且把系统级配方完整开放,比单点榜单更有价值。但“理论训练成本”未必包含数据、失败实验与基础设施总成本;逼近闭源的结论也依赖所选基准,真实复杂编辑和生产稳定性仍需社区复验。 2. D2DF:视频消物一秒只需一步 From Draft to Draft-Free: One-Step Video Object Removal via Privileged Distillation and Fast Planting | 西交·国家电网AI Lab·浙工大·百度 | arXiv:2607.14976 关键词:视频编辑,物体移除,一步生成,一致性蒸馏,视频修复 前序问题:视频物体移除中,光流/注意力传统方法容易留伪影、结果不自然;扩散方法更真实却需要多步去噪,速度难以实用,而且常依赖外部粗糙移除稿作为输入。 本文贡献:提出 D2DF 三阶段框架:先训练教师把低质移除草稿多步精修成高保真视频;再用先验特权一致性蒸馏(PPCD)将能力压到一步学生;最后以基于时序掩码 Transformer 的自引导快速植入(SGFP),在潜空间自动生成场景一致伪草稿,得到完全不依赖外部草稿的一步模型。 实验效果:有草稿和无草稿两版在多项指标上均达 SOTA,质量与效率超过传统及多步生成方法;单个视频的去噪过程约 1 秒。 批判点评:从“多步精修草稿”蒸馏到“无草稿一步消物”,既解决速度又去掉外部依赖,1 秒数字极具产品价值。但 SGFP 伪草稿的场景推断仍可能在大面积遮挡、复杂动态背景中失真,一步模型的失败可修复性也弱于多步迭代。 3. SlotMem:按角色寻址记住长片人物 SlotMem: Character-Addressable Internal Memory for Narrative Long Video Generation | 港大·清华 | arXiv:2607.15772 关键词:长视频生成,角色一致性,内部记忆,DiT,叙事视频 前序问题:叙事长视频中角色跨场景、隔很久再出现时容易换脸。全局记忆的检索线索并不针对身份,现有角色方法又把身份和姿态、背景等偶然因素混在粗粒度帧级 KV 中,有限容量下还缺少持续更新。 本文贡献:提出可按角色寻址的内部记忆 SlotMem:Character-Semantic Probe 从交叉注意力中定位角色相关 token;Memory Encoder 把 DiT token 压成紧凑的逐角色 slot;Memory Writer 随生成保守更新每个角色的新观察;Character-Wise Cross-Attention 只把对应角色记忆注入同一人物的局部 token。 实验效果:在多个叙事长视频基准上,相比现有方法显著改善跨长时间间隔的角色一致性,同时维持相当的视频总体质量;代码已开源。 批判点评:把“记住整帧”改成“按角色地址读写”,对多角色长片身份漂移非常对症,内存也更省。但角色探针一旦漏检或多人遮挡、换装,错误可能写回并长期污染;如何处理新角色、身份合并与开放世界角色数量仍是难点。 4. ReBind:显式绑定多参考视频编辑 ReBind: Multi-Reference Video Editing via Structured Instructions with Explicit Reference Relationships | 快手可灵·港科大·南大·北大 | arXiv:2607.14681 关键词:视频编辑,多参考,结构化指令,可灵,视觉绑定 前序问题:多参考图条件视频编辑需要明确“哪个参考提供哪个属性”,但自然语言指令通常不写清参考关系,通用 MLLM 也难稳定生成,导致人物、材质、灯光等来源互相串线。 本文贡献:提出 ReBind,以在语义位置嵌入 reference token 的结构化指令作为中间表示,显式绑定视觉属性与来源。ReBind-Instruct 通过两阶段渐进训练学习生成精确参考关系;ReBind-Edit 则轻量适配文生视频模型,按绑定关系协调多个参考源。 实验效果:ReBind-Instruct 的指令质量显著超过通用 MLLM;ReBind-Edit 在参考图条件视频编辑中达到开源方法 SOTA,能更准确组合多视觉来源。 批判点评:把多参考歧义从“模型自己猜”变成结构化显式绑定,是复杂编辑走向可控生产的关键一步,可灵团队也有真实产品场景。但需要专用 MLLM 先生成中间指令,链路更长;参考关系正确不代表遮挡、几何和时间一致性一定正确。 5. FlowMimic:图片编辑数据实时变视频 FlowMimic: Mask-free Visual Editing and Generation with Pixel-pair Warped Flow Field for Online Video Editing Data Generation and Modality Mimicry | 字节 | arXiv:2607.18227 关键词:视频编辑,数据生成,光流,图像视频统一,免Mask 前序问题:视频编辑数据采集依赖人工 mask、I2V/ControlNet 合成和 VLM 过滤,不仅耗时、易引错,任务多样性也远落后图像编辑;推理时还常需外部 MLLM 或显式 mask 才能定位编辑区域。 本文贡献:提出像素对时序扭曲流场,可从图像编辑样本实时生成对应视频编辑样本,并证明仅用这类数据即可学习多层级视频编辑。将图像视作视频特例,以生成/编辑两种 modality mimic loss 让图像与视频能力互相模仿;再加入指代表达分割等感知任务和区域感知潜空间、注意力损失,让模型内化“理解指令—定位区域—只改该处”的能力。 实验效果:无需人工视频 mask 与传统重型合成管线,即可在线扩展多种视频编辑任务;同一模型统一图像/视频生成与编辑,并实现推理期免 mask 的区域感知编辑。 批判点评:把海量图像编辑数据通过流场实时“升格”为视频数据,直击视频编辑数据荒,字节背景也说明工程价值。但扭曲流场能模拟的运动与遮挡仍有限,由图像任务迁移出的时序规律未必覆盖真实长视频和复杂镜头运动。 6. STBridge:让模型说的和画的一致 STBridge: Shared-Target Alignment for Bridging Understanding and Generation in UMMs | 腾讯优图·吉林大学 | arXiv:2607.17140 关键词:统一多模态,理解生成对齐,图像编辑,强化学习,腾讯优图 前序问题:统一多模态模型虽然共用架构,却可能正确描述目标、实际编辑出另一回事;语言输出与视觉输出分居不同空间,在细粒度实体、属性、空间关系和局部细节上尤其缺乏同一目标约束。 本文贡献:提出共享目标对齐 STBridge:在图像编辑中,让目标 caption 表达期望视觉结果、编辑图像实现同一结果,以共同目标状态串起理解和生成。训练采用 align-then-optimize:先监督微调建立共享目标通道,再以序列强化学习优化围绕目标的跨任务协同。 实验效果:在视觉理解、图像生成和图像编辑基准上均持续优于初始化模型;对齐分析确认“模型描述的目标”和“模型生成的结果”之间差距明显缩小。 批判点评:指出“共架构不等于共语义”,并用共享目标把说与画绑在一起,是统一模型后训练的重要方向。但依赖高质量目标 caption 和顺序 RL,目标文本可能成为新的信息瓶颈;复杂视觉变化也未必能被一句 caption 完整表达。 7. TANGO:测试时绕开长视频死路 Test-Time Noise Guided Adaptation for Realistic Autoregressive Video Generation | CERTH·阿姆斯特丹大学 | arXiv:2607.15849 关键词:自回归视频,测试时适配,长视频,噪声引导,FVD 前序问题:自回归视频扩散可生成任意长视频,却会累积误差并逐渐偏离训练条件分布;即使每帧看起来都在真实流形上,某些轨迹也可能走到模型无法继续的“终点”,后续必然崩坏。 本文贡献:提出测试时终点规避 TANGO:假设可良好延续的未来轨迹,其预测噪声应匹配前向加噪的各向同性高斯分布。模型先向前预测一步,用自身充当输出批评器;一旦预测噪声偏离期望分布,就搜索替代轨迹,避免驶入终点,无需重新训练骨干。 实验效果:相对 SOTA,VBench 绝对提升 3.1%,15 秒视频上的平均 FVD 降低 28.3%;代码已开放。 批判点评:让扩散模型用噪声分布自检未来能不能走通,比只把当前帧拉回真实流形更深入,测试时即可插入。但前瞻搜索增加推理开销,各向同性噪声假设未必适合所有内容,且只能绕路、不能补足模型缺失的动态知识。 8. SPEED:一步像素扩散插帧快63% SPEED: One-Step Pixel Diffusion for High-quality Video Frame Interpolation | ACM MM 2026·复旦·B站 | arXiv:2607.15585 关键词:视频插帧,像素扩散,一步生成,4K,ACM MM 前序问题:扩散视频插帧有两大瓶颈:潜空间经 VAE 解码不可避免丢失细节,多步采样又带来高显存与高延迟;尤其 4K 插帧中,精细纹理与效率难兼得。 本文贡献:提出一步像素扩散 SPEED:渐进多阶段架构配动态 patch 缩放,学习多尺度运动、结构和外观;Noise-Update-Only Attention 只更新噪声、保护干净条件帧语义并把计算降近 50%;漂移感知时间步采样与定制目标直接在像素空间预测图像,实现不降质的一步推理。 实验效果:SNU-FILM 上 LPIPS 降低 8.8%,推理加快 63.3%、显存降低 10.6%;在高难 4K 基准上 LPIPS 最多优于先前方法 51.5%,达到 SOTA。 批判点评:一步、像素空间、4K 三个难点同时拿下,复旦+B站且获 ACM MM 2026,数字很硬。但像素扩散训练成本可能转移到离线阶段,动态 patch 与多阶段结构更复杂;插帧 SOTA 不等同于通用视频生成可直接受益。 9. AuEmoChat:离散情绪token让对话更真 AuEmoChat: Authentic Emotion Understanding and Rendering for Conversational Speech Synthesis | ACM MM 2026·内蒙古大学·港中文深圳 | arXiv:2607.15755 关键词:对话语音合成,情绪生成,Flow Matching,Token合并,TTS 前序问题:对话语音合成要理解多轮上下文并表现像人的细腻情绪,但现有方法常把情绪压成七类等有限标签;同时历史中的冗余多模态 token 干扰上下文理解,导致声音情感僵硬或前后不一致。 本文贡献:提出 AuEmoChat:AuEmoCodec 用有限标量量化从大规模情绪语音学习离散真实情绪 token 空间;AuEmoToMe 在保留情绪相关上下文的同时合并冗余多轮 token;自回归文本-语音模型预测目标情绪与语音 token,最后用 Authentic Emotion Flow Matching 联合对话上下文、情绪和声学先验渲染语音。 实验效果:在 NCSSD-EmCap 上超过 SOTA 对话语音合成基线,生成语音的情绪表达更丰富、更真实;代码与语音演示计划开放。 批判点评:从少数人工情绪标签转向数据驱动的离散情绪空间,并同时处理多轮冗余,贴近真实对话产品。但“真实情绪”评价主观且受数据文化偏差影响,离散 token 也可能把连续情绪重新切碎;跨语言、跨说话人泛化仍是关键。 10. Pixel-Space DiT:像素DiT绕开VAE细节瓶颈 Pixel-Space Diffusion Transformers | 北大·Stanford·Cornell·南大 | arXiv:2607.17585 关键词:像素扩散,DiT,VAE,生成综述,统一多模态 前序问题:潜扩散靠 VAE 压缩实现高效高分辨率生成,但固定视觉 tokenizer 会丢纹理和结构细节,重建目标与生成目标分离也限制端到端优化;直接像素扩散则面临高维建模、噪声调度、损失加权和 token 效率难题。 本文贡献:系统综述 Pixel-Space Diffusion Transformer,从模型架构、连续生成机制和统一多模态建模三条线梳理直接在原始像素上扩散的方法,讨论如何去掉 VAE 瓶颈,并让像素、文本与任务条件进入共享 token 空间由同一 Transformer 处理。 实验效果:归纳当前像素 DiT 的代表方法、核心挑战与技术路线,指出其在高保真单阶段生成及理解生成一体化视觉基座上的潜力,并给出未来研究方向。 批判点评:像素空间正在重新成为生成主线,这篇综述适合建立全景认知;但它不是新算法、没有单一实验突破,且像素 DiT 的巨大训练成本与 token 数仍是现实约束,应放在今日列表末尾而非主推。 趋势观察 开源图像模型开始公开系统级配方 — Boogu-Image 不只开权重,还公开强编码器、Agent 提示改写、数据与训练管线,以约 40 万美元理论成本逼近闭源系统,竞争从单模型走向完整生成系统。 视频编辑同时冲刺一步化与免标注数据 — D2DF 把视频消物压到一步约 1 秒,FlowMimic 则把图像编辑样本实时变成视频数据;一个砍推理成本,一个砍数据成本。 长视频从全局缓存转向结构化记忆与自检 — SlotMem 按角色地址读写身份记忆,TANGO 在测试时用预测噪声自检轨迹死路,长视频一致性开始从粗粒度历史帧走向可解释内部状态。 复杂编辑把视觉来源和目标语义显式绑定 — ReBind 用 reference token 绑定多参考来源,STBridge 用共享目标绑定模型说的与画的,可控编辑正在减少让模型自行猜测的隐式接口。 生成底座向像素空间与真实情绪扩展 — SPEED 以一步像素扩散实现 4K 插帧,Pixel-Space DiT 总结绕开 VAE 的技术路线;AuEmoChat 则把生成边界扩到多轮对话中的细腻情绪语音。 人工智能炼丹君 整理 | 2026-07-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-13|INSET图像即词汇开启统一视觉生成新范式 今日 AIGC 论文速览 今日共 10 篇 · 统一视觉生成与编辑 3 篇 · 视频生成与叙事 2 篇 · 视觉分词与表征 2 篇 · 视频理解与推理 1 篇 · Agent 与训练方法论 2 篇 重点论文标题列表 INSET:将图像作为原生词汇无缝嵌入文本指令— Qwen-Image-2.0:全能图像生成基础模型 ⚡ DRoRAE:轻量级融合模块通过能量约束路由和增量 CausalCine:交互式自回归框架 ELF:在连续嵌入空间中基于连续时间 今日论文速览 1. INSET:将图像作为原生词汇无缝嵌入文本指令— INSET (Images iN SEnTences): Interleaved Instruction for Unified Visual Generation | MIT, ETH | arXiv:2605.12305 关键词:交错指令·统一视觉生成·图像词汇化·多图一致性·数据引擎 ⚠️ 前序问题:现有多模态语言模型已支持从多图指令生成图像,但在处理复杂交错指令时性能急剧下降——根本原因在于当前范式中图像和文本结构性分离,模型必须跨越困难的长距离依赖才能将描述与视觉目标正确匹配,导致多图一致性和精确绑定失败 本文贡献:提出 INSET(Images iN SEnTences),将图像作为原生词汇无缝嵌入文本指令——直接把视觉特征放在对应语义槽位,利用 Transformer 的上下文局部性替代长距离依赖实现精确对象绑定;同时设计可扩展数据引擎,借助 VLM 和 LLM 从标准图像/视频数据集合成 1500 万高质量交错样本 实验效果:在 InterleaveBench 上显著超越 SOTA,多图一致性和文本对齐方面领先,且随输入复杂度增加性能差距进一步扩大;架构天然扩展支持多模态图像编辑,把视觉内容作为指令一部分实现高度表达性的视觉操控 批判点评:图像词汇化的核心直觉新颖——把多图绑定从长距离依赖问题转化为局部上下文问题是范式级改变;但 1500 万合成数据的复现成本极高,模型与数据是否开源将直接决定其影响力,且论文未给出 FLOPS/推理延迟的对比 2. Qwen-Image-2.0:全能图像生成基础模型 Qwen-Image-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.10730 关键词:图像生成·文本渲染·多语言排版·扩散Transformer·统一编辑 ⚠️ 前序问题:现有图像生成模型在超长文本渲染、多语言排版、高分辨率写实、鲁棒指令遵循和高效部署方面仍面临挑战,尤其在文字密集和组合复杂场景中表现不足 本文贡献:提出 Qwen-Image-2.0 全能图像生成基础模型:将 Qwen3-VL 作为条件编码器与多模态扩散 Transformer 结合,支持联合条件-目标建模;支持 1K token 长度指令生成文字密集内容(幻灯片、海报、信息图、漫画),显著提升多语言文字保真度和排版质量 实验效果:在生成和编辑任务上大幅超越之前的 Qwen-Image 模型,在写实感、细节丰富度、纹理真实性和光照一致性方面均有显著提升 批判点评:统一生成和编辑的全能架构令人印象深刻,但技术报告形式缺乏与开放社区模型的公平对比;1K token 长指令的实际推理成本和延迟未详述 3. DRoRAE:轻量级融合模块通过能量约束路由和增量 Beyond the Last Layer: Multi-Layer Representation Fusion for Visual Tokenization | Peking University, Meituan, Tsinghua University | arXiv:2605.10780 关键词:视觉分词器·多层融合·表征自编码·缩放律·图像生成 ⚠️ 前序问题:表征自编码器(Representation AE)复用冻结预训练视觉编码器作为视觉分词器,但现有方法仅提取最后一层特征,丢弃了中间层分布的丰富层次化信息——低层视觉细节在最后一层仅以衰减残差形式存活 本文贡献:提出 DRoRAE(深度路由表征自编码器):轻量级融合模块通过能量约束路由和增量校正自适应聚合所有编码器层;三阶段解耦训练策略先在冻结解码器的隐式分布约束下学习融合,再微调解码器充分利用丰富表征 实验效果:在 ImageNet-256 上将 rFID 从 0.57 降至 0.29,生成 FID 从 1.74 降至 1.65;发现融合容量与重建质量间的对数线性缩放律(R²=0.86) 批判点评:多层融合的思路简洁有效,对数线性缩放律的发现为视觉分词器提供了新的可预测扩展维度;但融合模块的额外计算开销和对不同编码器架构的泛化性需更多验证 4. CausalCine:交互式自回归框架 CausalCine: Real-Time Autoregressive Generation for Multi-Shot Video Narratives | HKUST, Ant Group, SJTU | arXiv:2605.12496 关键词:多镜头视频·自回归生成·实时推理·记忆路由·镜头转换 ⚠️ 前序问题:自回归视频生成以实时开放式合成为目标,但电影叙事不是无限延伸单一场景——它需要事件演进、视角切换和镜头边界。现有 AR 模型将长序列视为延伸单镜头,导致长推演中运动停滞和语义漂移 本文贡献:提出 CausalCine 交互式自回归框架:将多镜头视频生成转化为在线导演过程;先在原生多镜头序列上训练因果基础模型学习复杂镜头转换先验,再提出 Content-Aware Memory Routing (CAMR) 按注意力相关性动态检索历史 KV 条目,最后蒸馏为少步实时生成器 实验效果:显著超越自回归基线,接近双向模型能力,同时解锁因果生成的流式交互特性,支持动态 prompt 实时切换 批判点评:多镜头叙事的问题设定高度实用,CAMR 的内容感知路由设计优雅;但蒸馏后的少步生成器是否保持镜头转换的多样性存疑;训练数据中多镜头标注的获取成本未讨论 5. ELF:在连续嵌入空间中基于连续时间 ELF: Embedded Language Flows | MIT (Kaiming He 团队) | arXiv:2605.10938 关键词:连续扩散语言模型·Flow Matching·嵌入空间·CFG·文本生成 ⚠️ 前序问题:扩散/流模型在连续数据(图像、视频)生成中占主导地位,但应用于语言建模时,当前领先的扩散语言模型(DLM)仍主要操作离散 token,连续 DLM 尚未证明有效性 本文贡献:提出 ELF(Embedded Language Flows):在连续嵌入空间中基于连续时间 Flow Matching 的扩散模型,在最终时间步通过共享权重网络映射到离散 token;这一公式化使得从图像扩散模型迁移成熟技术(如 CFG)变得直接 实验效果:大幅超越领先的离散和连续 DLM,以更少的采样步骤实现更好的生成质量,证明连续 DLM 可以通过最小适配有效工作 批判点评:Kaiming He 团队的工作一贯简洁有力——将连续流匹配应用于语言的思路开创性地打通了图像和语言扩散的技术栈;但语言的离散本质是否在连续空间中引入不必要的量化误差值得深入分析 6. PhyGround:标准化物理推理基准 PhyGround: Benchmarking Physical Reasoning in Generative World Models | Northeastern University, ETH | arXiv:2605.10806 关键词:物理推理基准·世界模型·视频生成评估·VLM评判器·人类评估 ⚠️ 前序问题:生成式世界模型被期望捕获真实世界物理规则,但评估生成视频是否真正遵循物理定律仍极具挑战——现有基准存在粗粒度评估掩盖逐律失败、标注偏见和自动评估器物理感知不足等问题 本文贡献:提出 PhyGround 标准化物理推理基准:250 个精选 prompt 配有预期物理结果,覆盖固体力学、流体动力学、光学等 13 条物理定律的分类学;通过社会科学实验设计执行 459 名标注者大规模人类评估;发布 PhyJudge-9B 物理专用 VLM 评判器 实验效果:PhyJudge-9B 相对偏差仅 3.3%(vs Gemini-3.1-Pro 的 16.6%);人类标注达到高分半相关性(Spearman's ρ > 0.90),揭示当前视频生成器在视觉逼真和物理推理间的持续鸿沟 批判点评:评估框架设计严谨(借鉴社会科学实验方法论),PhyJudge-9B 的开源贡献显著;但 250 个 prompt 的规模可能不足以覆盖开放世界物理场景的长尾分布 7. GridProbe:无训练后验探测推理范式 GridProbe: Posterior-Probing for Adaptive Test-Time Compute in Long-Video VLMs | MIT | arXiv:2605.10762 关键词:长视频理解·自适应计算·帧选择·后验探测·VLM推理 ⚠️ 前序问题:长视频 VLM 理解被单次整体前向传播瓶颈化——数千帧的二次注意力成本高昂;现有帧选择方法依赖编码器空间相似度,在推理密集型查询(否定、跨帧计数、全局总结)上失败 本文贡献:提出 GridProbe 无训练后验探测推理范式:将帧排列为 K×K 网格,执行轻量行列探测,用冻结 VLM 自身推理能力在答案空间中评分证据,外积生成可解释重要性图;提出 Shape-Adaptive Selection 闭式规则以每问题自适应帧预算替代固定预算 实验效果:在 Video-MME-v2 上匹配整体基线精度(差 1.6pp)的同时减少 3.36x TFLOPs;在 LongVideoBench 上 Pareto 主导基线(+0.9pp at 0.35x compute);2B 选择器 + 8B QA 组合在 0.52x 计算量下提升 +4.0pp 批判点评:后验探测的思路巧妙——用模型自身推理能力选帧替代外部相似度;Shape-Adaptive Selection 的闭式解优雅实用;但网格排列假设可能在超长视频中引入信息损失 8. AlphaGRPO:将 GRPO 应用于 AlphaGRPO: Unlocking Self-Reflective Multimodal Generation in UMMs via Decompositional Verifiable Reward | HKU | arXiv:2605.12495 关键词:多模态生成·GRPO·可验证奖励·自反思·统一模型 ⚠️ 前序问题:统一多模态模型(UMM)缺乏有效的强化学习对齐方案——多模态生成场景中提供稳定监督信号极具挑战,现有整体标量奖励无法捕捉多维语义和质量要求 本文贡献:提出 AlphaGRPO:将 GRPO 应用于 AR-Diffusion UMM,无需额外冷启动阶段;引入分解可验证奖励(DVReward)——LLM 将复杂请求分解为原子可验证语义/质量问题,由通用 MLLM 评估提供可靠可解释反馈;解锁推理型文生图和自反思精炼能力 实验效果:在 GenEval、TIIF-Bench、DPG-Bench、WISE 等多模态生成基准上取得稳健提升,同时在未训练的编辑任务(GEdit)上也获得显著增益 批判点评:分解可验证奖励的设计思路与 Auto-Rubric as Reward 异曲同工,自反思精炼是引人注目的涌现能力;但 DVReward 的可靠性仍受限于评估用 MLLM 的能力上限 9. Shepherd:函数式编程模型 Shepherd: A Runtime Substrate Empowering Meta-Agents with a Formalized Execution Trace | Stanford, META | arXiv:2605.10913 关键词:Meta-Agent·执行追踪·分叉重放·函数式编程·Agent基础设施 ⚠️ 前序问题:Meta-Agent 对目标 Agent 的操作缺乏形式化框架——无法有效记录、分叉和重放 Agent 执行状态,限制了运行时干预、反事实优化和训练等高级能力 本文贡献:提出 Shepherd 函数式编程模型:将 meta-agent 操作形式化为函数(核心操作在 Lean 中机械化),以 Git-like 执行追踪记录每次交互为类型化事件,支持任意状态分叉和重放;进程+文件系统 fork 速度比 Docker 快 5 倍,重放时 prompt-cache 复用率 >95% 实验效果:运行时干预将结对编程通过率从 28.8% 提升至 54.7%;反事实优化在四个基准上领先最多 11 分且墙钟时间减少 58%;Tree-RL 训练在 TerminalBench-2 上从 34.2% 提升至 39.4% 批判点评:将 Agent 执行形式化为可分叉追踪的系统设计前沿且实用,Git-like 语义直观易理解;但 Lean 形式化的学习曲线和实际部署复杂度可能限制采用 10. On-Policy Distillation:系统实证研究 OPD/OPSD The Many Faces of On-Policy Distillation: Pitfalls, Mechanisms, and Fixes | MIT, ETH | arXiv:2605.11182 关键词:在策略蒸馏·自蒸馏·LLM后训练·失败分析·知识蒸馏 ⚠️ 前序问题:在策略蒸馏(OPD)和在策略自蒸馏(OPSD)作为 LLM 后训练方法前景广阔,但现有结果不一致——有时有效有时退化,何时有效、何时失败及其原因不清楚 本文贡献:系统实证研究 OPD/OPSD 的成功与失败条件,识别三种失败机制:1)teacher 条件化在 student 前缀上的分布错配;2)有偏 TopK reverse-KL 梯度的优化不稳定;3)OPSD 特有的实例特定特权信息缺失问题;提出 stop-gradient TopK、RLVR-adapted teacher 和 SFT-stabilized student 等修复方案 实验效果:为 OPD/OPSD 建立系统性指导:数学推理中对 teacher 选择和 loss 形式高度敏感,系统提示内化场景中 OPSD 有效 批判点评:实证分析全面深入,三种失败机制的识别为该领域提供了重要的实践指导;修复方案虽有效但增加了训练复杂度 趋势观察 统一生成范式成熟化 — INSET 和 Qwen-Image-2.0 分别从交错指令和全能框架角度推进统一视觉生成——前者将图像提升为文本词汇实现精确绑定,后者通过 VLM+MDT 实现生成/编辑一体化,标志着统一生成从概念验证走向工程化 自回归视频走向电影叙事 — CausalCine 首次将多镜头叙事引入自回归视频生成,通过内容感知记忆路由和少步蒸馏实现实时交互导演——AR 视频不再局限于单镜头延伸,开始具备电影级叙事能力 连续扩散模型跨域迁移 — ELF 证明连续 Flow Matching 可以有效用于语言建模,DRoRAE 发现视觉分词器的对数线性缩放律——扩散/流模型的核心技术正在跨越模态边界寻找新的应用空间 物理推理成为生成质量新维度 — PhyGround 构建了首个标准化物理推理基准并开源 PhyJudge-9B,揭示当前视频生成器「看起来真实但物理错误」的系统性问题——物理一致性正从加分项变为硬性要求 RL 对齐驱动生成自反思 — AlphaGRPO 通过分解可验证奖励在 UMM 上解锁了自反思精炼能力——模型不仅能生成,还能自主诊断和修正对齐失败,预示着生成模型将具备更强的自我改进能力 人工智能炼丹君 整理 | 2026-05-13