


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

论文:Sol Video Inference Engine: Agent-Native Full-Stack Acceleration Framework for Efficient Video Generation
机构:NVIDIA Research(Efficient AI Team & Singapore Lab)· 港大 · MIT
人类作者:Yitong Li、Junsong Chen、Haopeng Li、Haozhe Liu、Jincheng Yu、Ligeng Zhu、Ping Luo、Song Han、Enze Xie
论文首页署名:NVIDIA SANA Team*、Codex*、GPT-Image2(* 同等贡献)
日期:2026-06(arXiv 2606.23743)
代码:论文给出 GitHub Code 与 Project Page 链接入口,截至发稿未见公开可跑的完整仓库
论文类型:技术报告 / 系统工程论文(非新算法论文)
先说一个容易被忽略的细节:这篇论文的署名里,Codex 和 GPT-Image2 是和 NVIDIA SANA Team 并列的"同等贡献作者"。arXiv 页面还专门单独列了一栏 "Human authors",把 9 位人类作者和 AI 分开标注。
这不是行为艺术。论文的主张就是"让 agent 来干加速工程这件活",所以把干活的 agent 署名进去,逻辑上是自洽的。
回到技术本身。Sol Video Inference Engine(下面简称 Sol-Engine)解决的问题很具体:
视频扩散模型的推理加速,没有通用配方。
现在业界已经攒了一大堆免训练加速手段——跨步缓存、稀疏注意力、token 剪枝、低比特量化、算子融合。每一个单独看都有效。但真到部署时会发现一件很烦的事:
于是每换一个「模型 × 硬件 × 推理配置」组合,就得重新调一遍。而这三个维度一乘起来是个组合爆炸。NVIDIA 的做法是:别让人一个个调了,把这五类技术做成"技能"暴露给 agent,让 agent 自己搜。
具体产出是三个真实部署的加速栈:
| 模型 | 参数量 | SGLang 基线 | Sol-Engine | 加速 |
|---|---|---|---|---|
| Cosmos3-Super | 64B(4 卡 SP) | 99.6 s | 43.9 s | 2.27× |
| LTX-2.3 | 22B | 97.8 s | 41.0 s | 2.38× |
| SANA-Video | 2B | 29.4 s | 10.6 s | 2.77× |
VBench 平均分变化在 ±0.54% 以内。全程免训练,不动模型权重。
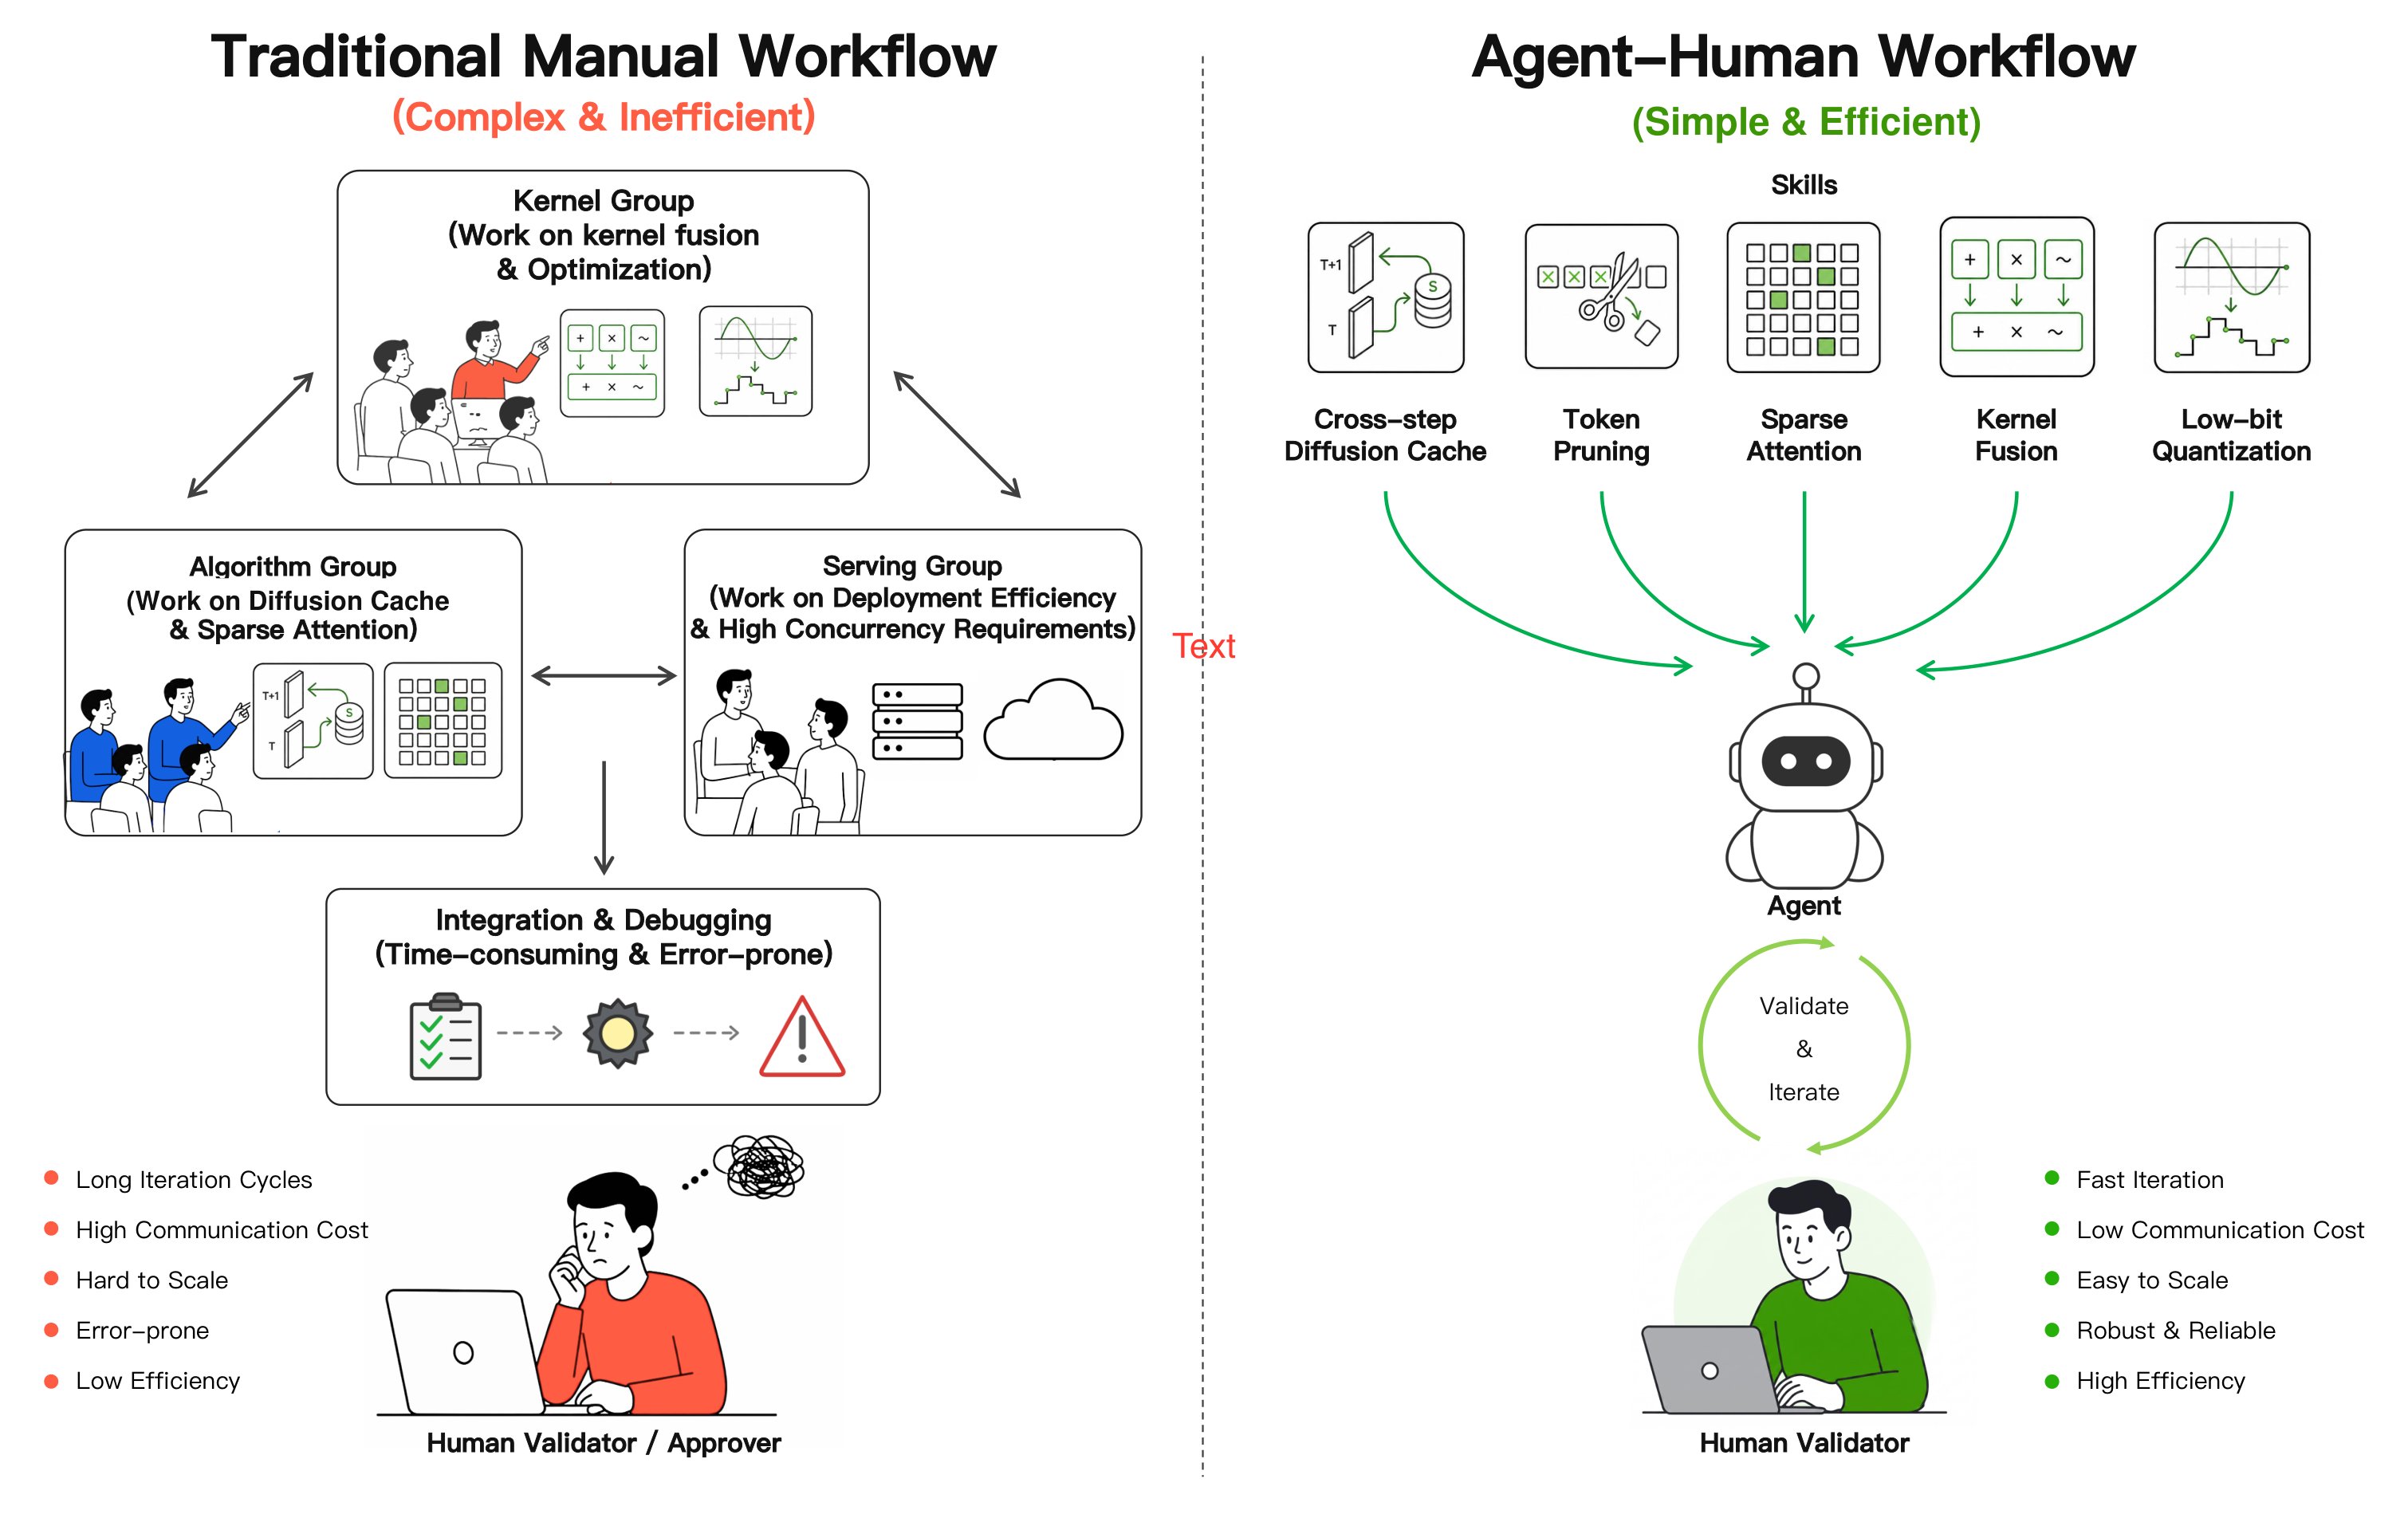
(图片来源:论文 Figure 1。左侧是传统模式:kernel 组、算法组、推理服务组各管一段,最后人工集成调试,迭代周期长、沟通成本高、易出错;右侧是 Sol-Engine 模式:五类加速技能暴露给 agent,agent 做局部搜索和栈集成,人只负责验收和迭代)
值得关注的地方:
需要冷静看的地方:
在看 Sol-Engine 怎么组合之前,先把它调用的这些"技能"各自的来路说清楚。视频扩散加速大致分三层打:
算法层:缓存。 相邻去噪步算出来的东西很像,那就别重复算。代表工作是 TeaCache(用 timestep 嵌入预测输出变化量,变化小就复用缓存残差)、TaylorSeer(ICCV 2025,用泰勒展开预测未来特征,而不只是复用旧特征)、EasyCache(运行时自适应调整复用策略)。
模型层:稀疏注意力 + token 剪枝。 视频的时空 token 序列很长,注意力矩阵里大量连接贡献很小。稀疏注意力方向有 PISA(分块稀疏 + 一阶泰勒补偿)、Sparse VideoGen 1/2、SpargeAttention、Radial Attention、VSA。token 剪枝方向有 ToMe-SD、Astraea、TAPE、CoReDiT。
Kernel 层:量化 + 算子融合。 量化有 PTQ4DiT、Q-DiT、SVDQuant、SageAttention 1/2/3。融合有 CUTLASS epilogue、ByteTransformer、CODA(把 transformer block 重写成 GEMM + epilogue 程序)。
另一条相关线索是"agent 做系统优化":CUDA-LLM 和 CudaForge 已经证明 agent 配上编译检查、正确性验证、profiling 反馈,可以自动生成或优化 CUDA kernel。The AI Scientist 则证明 agent 能跑完整的科研闭环。
Sol-Engine 站的位置很清楚:它不发明上面任何一层的新方法,它做的是"怎么把这些方法组合起来并调对参数"的自动化。
这个定位决定了它的价值和局限——价值在于把学术界攒的一堆单点技术真正落到部署;局限在于它本身没有新的算法贡献。
这是全文论证最扎实的一段,也是理解 Sol-Engine 为什么要用 agent 的关键。
论文先把冗余拆成三层,然后给了一个很有说服力的数据。
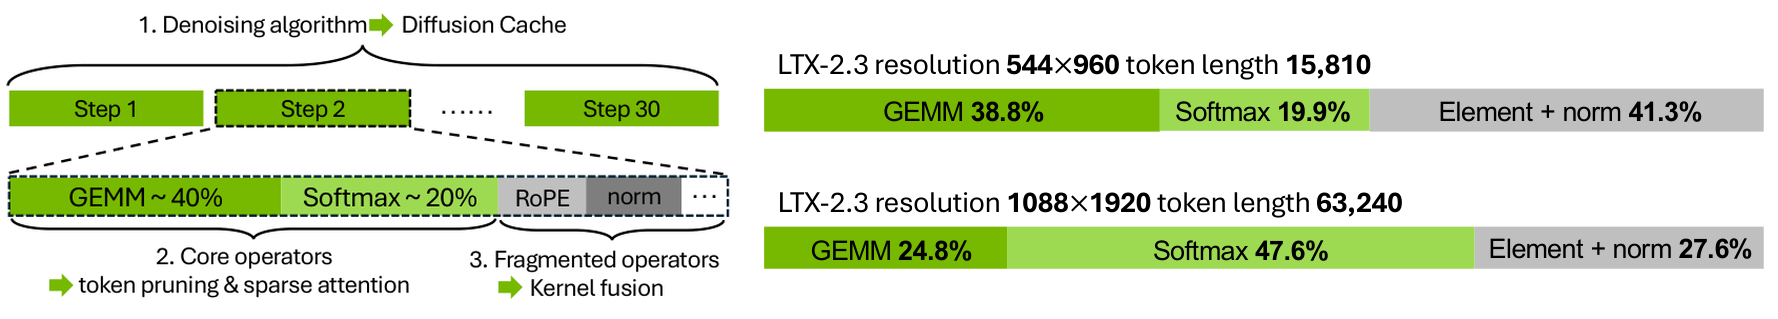
(图片来源:论文 Figure 2。左:未加速推理路径中算法级、模型级、kernel 级三层冗余的分布,30 步去噪中 GEMM 约占 40%、Softmax 约 20%,剩下是 RoPE、norm 等碎片算子;右:同一个 LTX-2.3、同一张卡,仅改变分辨率后的时间分布对比)
看右边那两条:
分辨率翻一倍,Softmax 占比从 19.9% 直接涨到 47.6%,GEMM 从 38.8% 掉到 24.8%。
瓶颈换了个位置。 低分辨率下你该去优化碎片算子和 GEMM,高分辨率下你该去优化注意力。同一个模型、同一张卡,只改了分辨率,最优的优化方向就完全不同了。
这就是"instance-specific"的实证。再把模型架构和硬件两个维度乘进来:
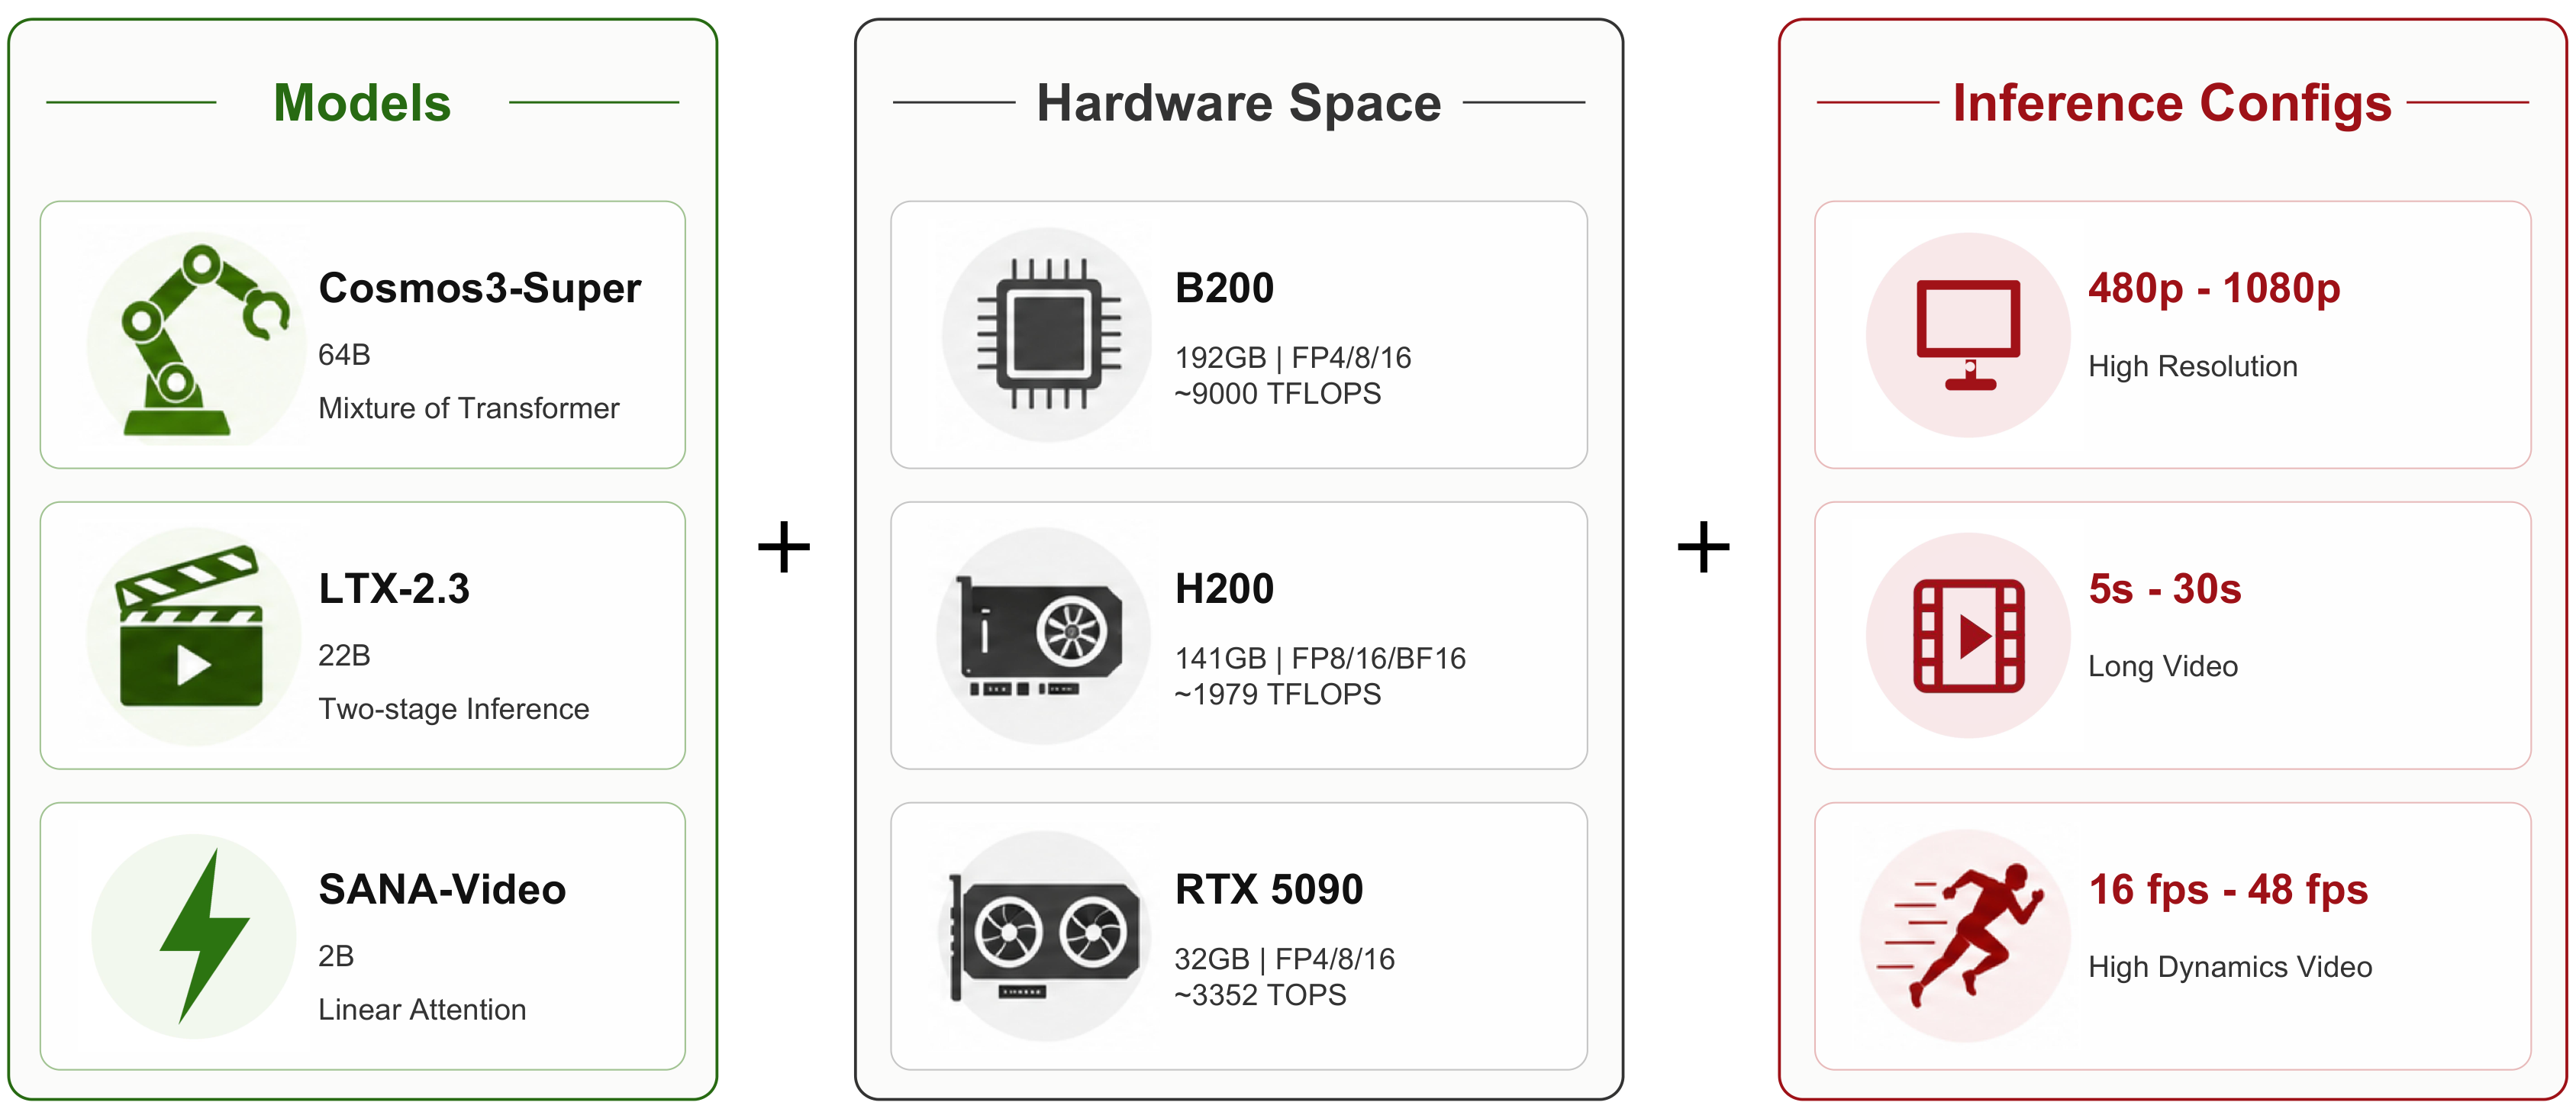
(图片来源:论文 Figure 3。模型维度:Cosmos3-Super 64B 混合 Transformer、LTX-2.3 22B 两阶段推理、SANA-Video 2B 线性注意力;硬件维度:B200 192GB/FP4·8·16/约 9000 TFLOPS、H200 141GB/FP8·16·BF16/约 1979 TFLOPS、RTX 5090 32GB/FP4·8·16/约 3352 TOPS;配置维度:480p~1080p 分辨率、5~30 秒时长、16~48 fps 帧率)
论文的具体论证是:
结论是两句话:部署实例太多,穷举人工调优不可扩展;但每个实例内部的优化问题结构是清晰的——目标(延迟)和约束(质量不掉)都明确,这恰好适合交给 agent 自动化。
(这段偏技术,只想看结果的可以直接跳到 08。)
Sol-Engine 的技能库里有五样东西。每一样都不是新发明,但 agent 需要为每一样决定"用哪个方案 + 怎么调参"。
1. 跨步缓存(Cross-Step Cache)
高质量生成通常要 30~50 步去噪。相邻步之间模型反复执行结构相似的计算,隐状态变化缓慢。缓存就是跳过一些步的计算,用之前的结果补上。
Agent 要决定的事:选哪个缓存策略(TeaCache / EasyCache / TaylorSeer)、跳步时间表、缓存什么(特征还是残差)、补偿规则、warmup 多少步、最多允许连续跳几步。
2. 稀疏注意力(Sparse Attention)
视频 token 在时间上跨帧冗余、空间上帧内冗余,很多注意力边对最终输出贡献极小。稀疏注意力砍掉这些边,把平方复杂度压下来。
Agent 要决定的事:用哪个稀疏后端(PISA / SpargeAttention / SVG2)、哪些层可以安全稀疏化、哪些层必须保持 dense、稀疏模式、补偿策略。
3. Token 剪枝(Token Pruning)
不是砍注意力边,而是直接砍序列本身——跳过、合并或重建冗余的 latent token。序列短了,后面的注意力和 FFN 都跟着省。
Agent 要决定的事:剪枝准则、剪枝比例、层调度、时间步调度、重建规则。论文特别强调这里的验证重点是时序连贯性和后期步的细节保真——剪枝最容易破坏的就是运动的稳定性。
4. 量化(Quantization)
论文对量化的判断很清醒:量化能带来多少实际加速,取决于隐藏层维度、token 数和硬件特性;而模型对量化噪声的敏感度,取决于它自己的训练参数分布。所以加速潜力和质量代价都会随部署实例剧烈变化。
Agent 要决定的事:profiling 各层敏感度和张量形状,然后调逐层精度分配、权重/激活位宽、随时间步变化的缩放。
5. 算子融合(Kernel Fusion)
Transformer 推理会在 GEMM 周围反复启动一堆算术强度很低的算子:bias 加法、残差更新、归一化、激活函数、缩放、layout 转换。融合就是趁中间结果还在寄存器或共享内存里就把后续算子做完,而不是写回 HBM 再启一个 kernel。
Agent 要决定的事:融合哪些算子序列、用手写 kernel 还是编译器生成、怎么匹配当前的张量形状和精度格式。典型候选是 GEMM + GELU、GEMM + residual、RoPE + norm。
论文把融合定位成后期任务——要等前面几层加速做完、瓶颈重新暴露之后再来做,因为融合的收益完全取决于"此刻什么在拖后腿"。
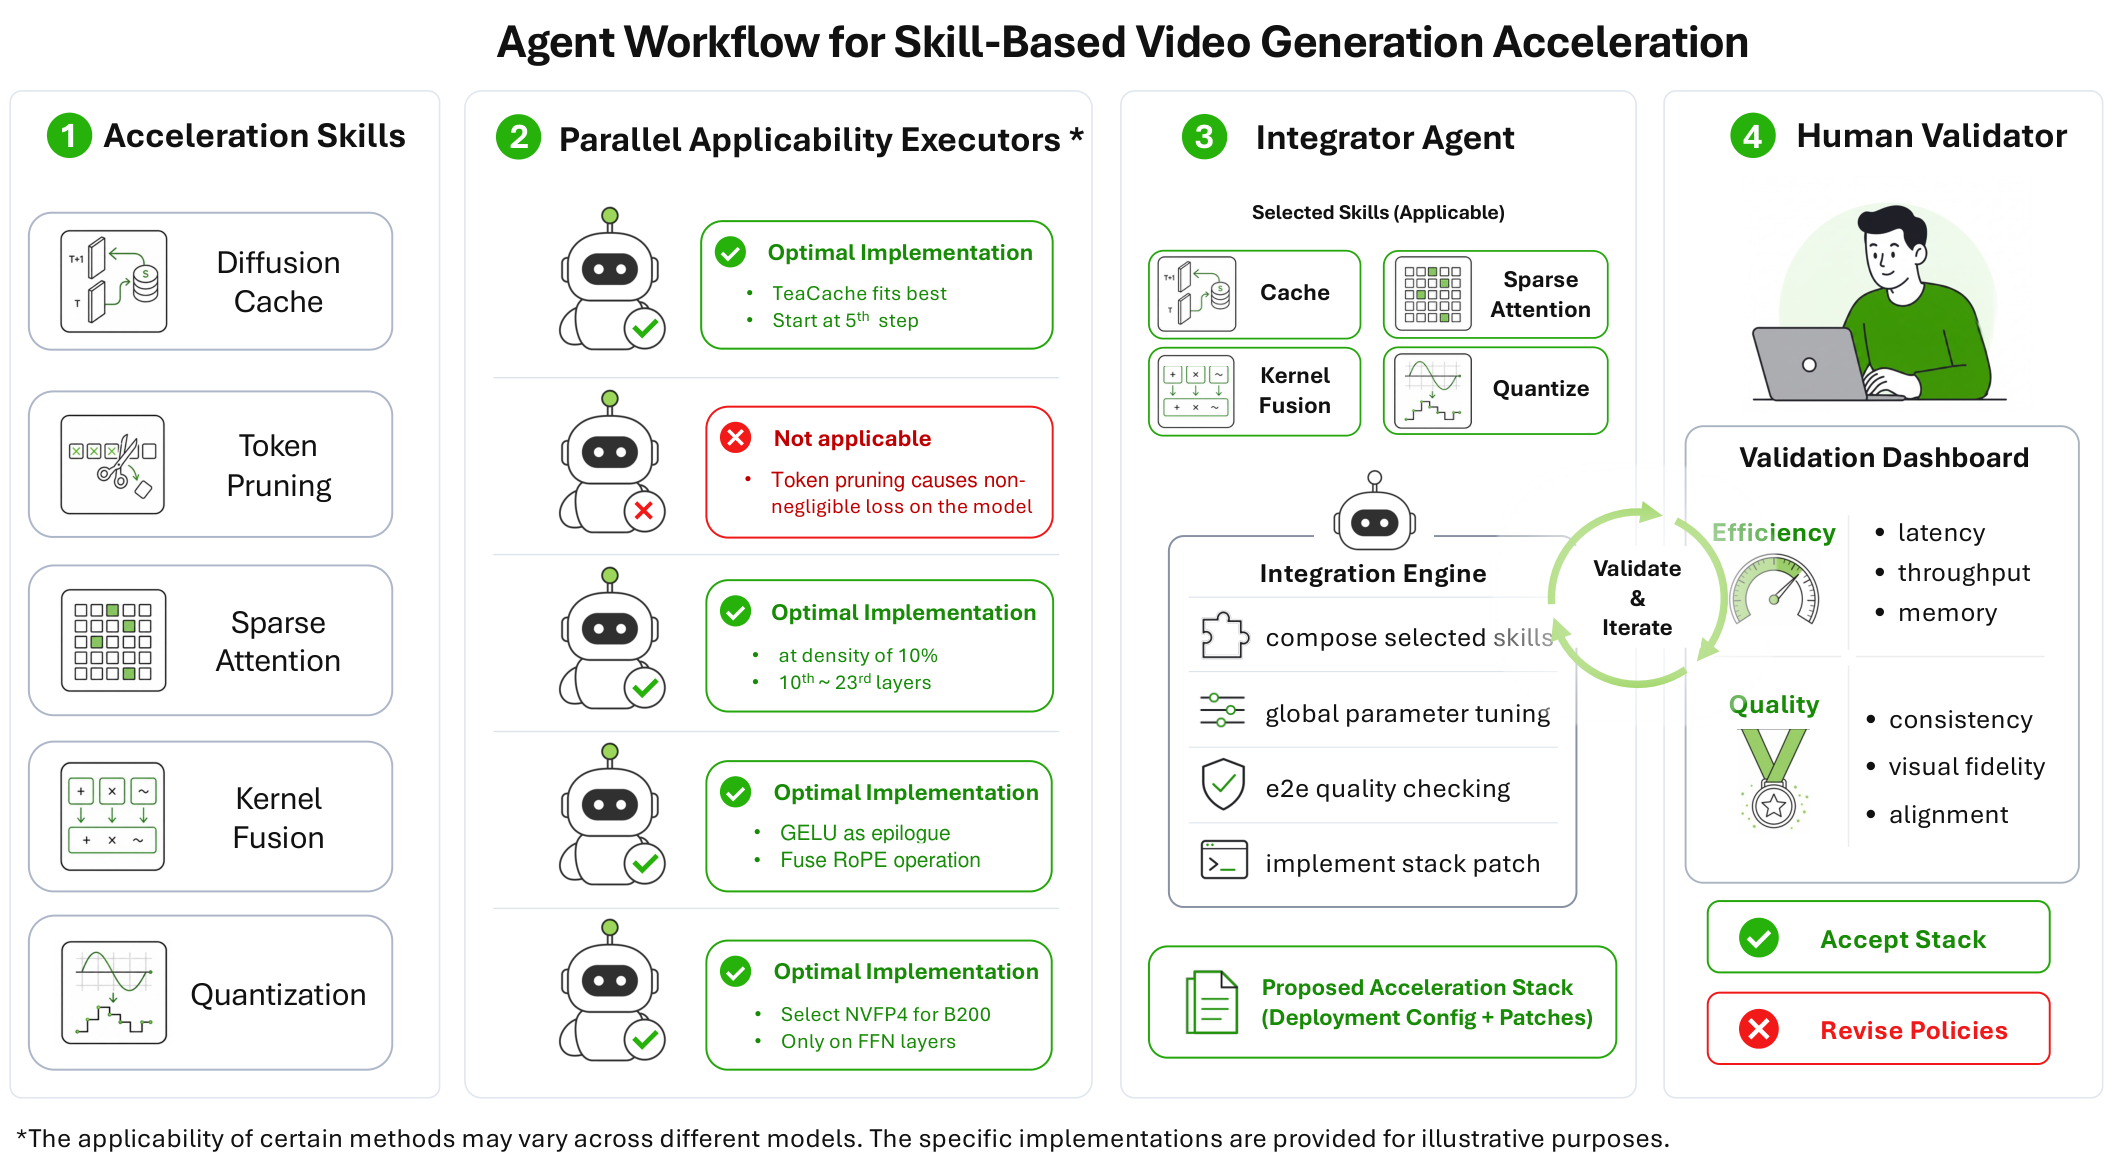
(图片来源:论文 Figure 5。① 加速技能库:缓存/token 剪枝/稀疏注意力/算子融合/量化;② 并行适用性执行器:每个技能一个 agent 独立判断是否适用并给出最优实现,图中示例显示 token 剪枝被判定为"不适用,会造成不可忽略的损失";③ 集成 agent:组合已选技能、全局参数调优、端到端质量检查、生成栈补丁;④ 人工验收:效率面板看延迟/吞吐/显存,质量面板看一致性/视觉保真/对齐,最后决定接受还是修订策略。论文脚注注明各方法的适用性在不同模型上会变,图中实现仅作示意)
整个流程分三段:
第一段:并行技能 agent 做局部搜索。
不让单个 agent 去搜整个全局空间——技能太多,联合搜索空间太大,成本和耗时都不划算。改成每个技能族一个独立 agent,各自在自己的小空间里并行搜。
比如缓存 agent 去搜跳步时间表和补偿规则,算子融合 agent 去 profile 每个 kernel 的耗时然后试 GEMM + GELU、RoPE + norm 这些组合。
有意思的是图里显示 agent 会主动报告"不适用"——token 剪枝在那个模型上被判定为损失不可忽略,直接出局。这比强行把五个技能都堆上去要合理。
第二段:集成 agent 做全局组合。
这一段是真正的难点。论文说得很直白:
这些方法不是独立的,最终端到端加速不等于各自局部收益的直接乘积。而且很多技术是有损的,直接把局部最优选择堆起来会累积近似误差,产出不可接受的结果。
所以集成器不是简单汇总第一阶段的结果,而是要重新做全局优化。它要解决的具体问题包括:缓存和稀疏注意力这两个有损方法叠加之后还能不能接受?量化和算子融合在同一个部署目标下有没有兼容的实现?
第三段:人工验收给质量反馈。
用固定的验证集看每个集成候选,判断视觉质量是否可接受。这个反馈决定下一轮 agent 是可以往更激进的加速推,还是要收敛回保守一点。
这一段是我认为全文最有洞察的部分,而且它的价值超出这篇论文本身。
问题是:既然要自动化,为什么不把质量判断也自动化?用 PSNR 做约束不就闭环了吗?
论文给了反例。

(图片来源:论文 Figure 6。上排为经过人工验收的结果——PSNR 更差但视觉质量更好;下排为未经人工验收的结果——PSNR 更好但视觉质量更差。左侧瀑布场景中,下排的水流细节糊成一片;右侧机器人场景中,下排的面部和城市结构出现明显退化)
看左边那组瀑布:上排(人工验收通过的)PSNR 分数更差,但水流的岩石细节清晰;下排(PSNR 分数更好的)水流糊成一团。右边机器人那组同理,下排的脸部和背景建筑明显退化。
原因是 PSNR 这类逐像素相似度指标有个结构性缺陷:
所以如果拿 PSNR 当优化目标,agent 会被引导向"生成模糊但数值安全"的方向。这正好是最不该要的结果。
论文的处理是老实承认这一点,把人留在环里做最终把关,并把"建立更强的端到端视觉质量评估器"列为未来工作——具体设想包括学习式视频偏好模型、伪影检测器、物理一致性检查、VLM 端到端质量判断。
这个观察对做视频生成评测的人来说值得单独拿出来看:只要自动指标和人类感知的错位没有解决,任何"全自动加速搜索"都会朝着指标漏洞的方向优化。
这是全文最硬的一张图,把每一层技术各自贡献了多少秒都标出来了。
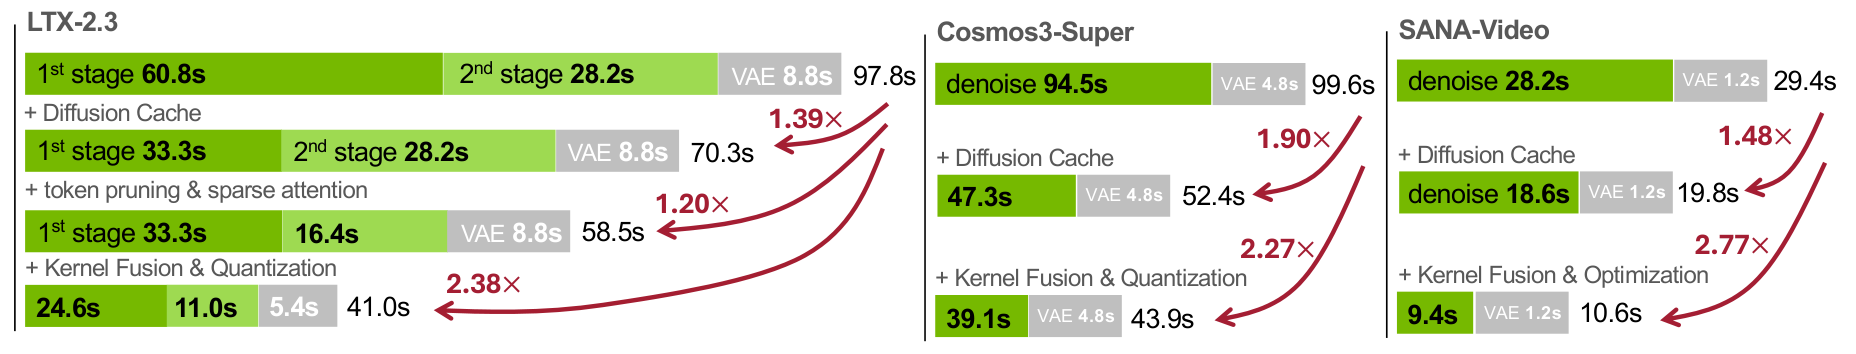
(图片来源:论文 Figure 4。绿色为去噪/DiT 阶段,灰色为 VAE 解码阶段,每一行代表叠加一层加速技术后的耗时构成,红色箭头标注累积加速倍率)
先看总表(NVIDIA B200,三种部署延迟与两套加速倍率):
| 模型 | 官方 pipeline | SGLang 基线 | Sol-Engine | vs SGLang | vs 官方 |
|---|---|---|---|---|---|
| Cosmos3-Super 64B(4 卡 SP) | 108.3 s | 99.6 s | 43.9 s | 2.27× | 2.47× |
| LTX-2.3 22B | 118.1 s | 97.8 s | 41.0 s | 2.38× | 2.88× |
| SANA-Video 2B | 34.2 s | 29.4 s | 10.6 s | 2.77× | 3.23× |
论文主表用 SGLang 归一化,同时也给出了官方 pipeline 的延迟供参考,这点算诚实——毕竟 SGLang 本身已经比官方实现快了一截(比如 LTX 从 118.1 s 降到 97.8 s),拿官方版当基线会让倍率凭空好看一截。
拆解路径:99.6 s(去噪 94.5 + VAE 4.8)→ 缓存后 52.4 s(去噪 47.3,1.90×)→ 加 kernel 融合与量化后 43.9 s(去噪 39.1,2.27×)
这个模型的加速几乎全靠缓存吃下来了——单缓存一项就 1.90×。原因是 64B 的 MoT 架构里 transformer block 极大,跳过一次去噪步省下的绝对时间非常可观。
缓存 agent 选的是 TeaCache 风格策略。量化则是按去噪步选择性施加,这是很值得抄的经验:
拆解路径:97.8 s → 缓存后 70.3 s(1.39×)→ 加 token 剪枝和稀疏注意力后 58.5 s(增量 1.20×,累积 1.67×)→ 加算子融合和量化后 41.0 s(2.38×)
分阶段看更清楚(第一阶段 / 第二阶段 / VAE):
| 配置 | 一阶段 | 二阶段 | VAE | 总计 |
|---|---|---|---|---|
| SGLang 基线 | 60.8 s | 28.2 s | 8.8 s | 97.8 s |
| + 缓存 | 33.3 s | 28.2 s | 8.8 s | 70.3 s |
| + token 剪枝 & 稀疏注意力 | 33.3 s | 16.4 s | 8.8 s | 58.5 s |
| + 算子融合 & 量化 | 24.6 s | 11.0 s | 5.4 s | 41.0 s |
这张表把"分工"说得很明白:缓存只砍了一阶段,稀疏注意力和 token 剪枝只砍了二阶段。
原因是 LTX-2.3 的流水线本身是两段式的——一阶段用 res_2s 二阶采样器跑 15 步生成 544×960 的 latent,二阶段上采样到 1088×1920 再精修 3 步,最后 VAE 解码 241 帧。二阶段的 token 数是一阶段的 4 倍,注意力成本占大头,所以稀疏化和剪枝的收益都在这里。
值得注意的是缓存在这个模型上只拿到 1.39×,明显低于 Cosmos3-Super 的 1.90×。论文解释了原因:res_2s 是二阶采样器,而市面上大部分缓存启发式规则是按 Euler 类调度假设设计的,直接套不上。Agent 最后是靠固定步跳过策略而不是在线阈值判断绕过了这个问题。
拆解路径:29.4 s(去噪 28.2 + VAE 1.2)→ 缓存后 19.8 s(去噪 18.6,1.48×)→ 加 kernel 优化后 10.6 s(去噪 9.4,2.77×)
这个模型的情况反过来了:因为 SANA-Video 本身就是效率导向设计的(用线性注意力替掉平方复杂度的标准注意力),模型层已经没什么可榨的了,所以完全不用稀疏注意力和 token 剪枝,收益全来自算法层缓存和 kernel 层优化。
缓存 agent 选的是 EasyCache,50 步里跳掉约 16 步。kernel 层的三个改动都很朴素但有效(详见第 10 段)。
一个需要提醒的点:2.77× 是三个模型里最高的倍率,但它的绝对基数最小(29.4 s → 10.6 s)。小模型的 kernel 启动开销占比高,torch.compile 这类图优化的相对收益天然更大。别把 2.77× 直接理解成"这套栈在大模型上也能到 2.77×"。
论文用 VBench 做质量把关。先看结论表:
| 配置 | 平均分 | 主体一致性 | 背景一致性 | 时序闪烁 | 运动平滑 | 美学质量 | 成像质量 | 整体一致性 |
|---|---|---|---|---|---|---|---|---|
| Cosmos3-Super 64B | ||||||||
| 基线 | 0.7759 | 0.9687 | 0.9301 | 0.9859 | 0.9923 | 0.6134 | 0.7276 | 0.2133 |
| Sol-Engine | 0.7775 | 0.9723 | 0.9382 | 0.9877 | 0.9935 | 0.6197 | 0.7178 | 0.2133 |
| Δ | +0.21% | +0.37% | +0.87% | +0.18% | +0.12% | +1.03% | -1.35% | +0.00% |
| LTX-2.3 22B | ||||||||
| 基线 | 0.7646 | 0.9010 | 0.9245 | 0.9675 | 0.9871 | 0.6234 | 0.7012 | 0.2474 |
| Sol-Engine | 0.7605 | 0.9006 | 0.9137 | 0.9704 | 0.9840 | 0.6104 | 0.7013 | 0.2429 |
| Δ | -0.54% | -0.04% | -1.17% | +0.30% | -0.31% | -2.09% | +0.01% | -1.82% |
| SANA-Video 2B | ||||||||
| 基线 | 0.7864 | 0.9730 | 0.9648 | 0.9626 | 0.9843 | 0.6650 | 0.6892 | 0.2660 |
| Sol-Engine | 0.7847 | 0.9750 | 0.9654 | 0.9646 | 0.9842 | 0.6624 | 0.6779 | 0.2637 |
| Δ | -0.21% | +0.21% | +0.06% | +0.21% | -0.01% | -0.39% | -1.64% | -0.86% |
平均分变化确实很小:+0.21% / -0.54% / -0.21%。论文的说法是"加速来自消除冗余和低效操作,而不是牺牲感知上关键的计算",从平均分看站得住。
但平均分掩盖了两个细节:
第一,成像质量(imaging quality)这一维在 Cosmos3-Super 上掉了 1.35%,在 SANA-Video 上掉了 1.64%,是这两个模型各自跌幅最大的维度(LTX-2.3 是唯一例外,这一维基本没动,+0.01%)。成像质量衡量的正是单帧的清晰度和伪影水平,也就是有损加速最容易伤到的地方。平均分之所以没动,是因为主体一致性、背景一致性、时序闪烁这些维度绝对值都在 0.9 以上且波动极小,把跌幅稀释掉了。
第二,LTX-2.3 的美学质量掉了 2.09%,是全表最大的单项跌幅,同时整体一致性掉 1.82%。这个模型是三个里唯一叠满了缓存+稀疏注意力+token 剪枝+量化四层的,有损方法堆得最多,代价也最明显。
还有一点值得说:VBench 的"整体一致性"(overall consistency,衡量文本-视频对齐)绝对值只有 0.21~0.27,本身分辨力就有限,在这个区间讨论 ±1.8% 的变化意义不大。
定性对比图看着确实还行:

(图片来源:论文 Figure 7。每组上排为未加速的 SGLang 结果,下排为 Sol-Engine 加速结果,标注了各自的加速倍率。Cosmos3-Super 是机械臂刷盘子,LTX-2.3 是老人织渔网,SANA-Video 是热气球飞越麦田。场景布局、主体排布和运动结构基本保持)
论文自己的表述是"加速后的输出在精细视觉细节上可能有轻微差异,但整体视觉质量、运动质量和物理保真度仍然很强"。这个说法和数据是一致的——要的是"部署可接受",不是"逐像素一致"。
(这段是纯工程细节,不打算自己动手的可以跳到 13。)
附录 A 的信息密度非常高。如果你手上正好有这几个模型要部署,这些参数可以直接当起点用。
共性原则(论文明确说三个模型只在实现范围和超参上不同,方法层面原则一致):
8of15_last_29calls——一阶段共 29 次 denoiser 调用,在调用索引 [13, 14, 16, 17, 18, 19, 20, 21, 22, 24, 25, 26, 27] 复用上次计算结果(reuse_mode=last、max_skip_steps=30)。也就是 29 次里跳掉 13 次,约 45%;feat_norm 显著性保留 50% video token,只在 refinement call 1 和 2 上做;max-autotune-no-cudagraphs + 子进程 autotuning + 持久化 TorchInductor 缓存;从这三份配置里能提炼出的通用直觉:
论文额外做了单卡 Cosmos3-Super 在 B200 和 B300 上的对比:
| 配置 | 延迟 | 加速 |
|---|---|---|
| B200 × SGLang | 353.5 s | 1.00× |
| B200 × Sol-Engine | 143.8 s | 2.46× |
| B300 × SGLang | 351.9 s | 1.00× |
| B300 × Sol-Engine | 137.6 s | 2.56× |
B300 相对 B200 的 BF16 算力差不多,但 NVFP4 算力更高。结果符合预期:
这个实验本意是展示框架的硬件适应性,但反过来读出的信息更重要:这套栈的收益里有相当一部分绑定在 FP4 硬件支持上。 如果部署环境是 H100/H200 这类只有 FP8 的卡,或者更老的 A100,量化这一层的贡献会大幅缩水,2× 这个数字就不能直接搬。
论文 Figure 3 把 H200 和 RTX 5090 都画进了硬件空间图,但正文和附录都没有给这两张卡的任何实测数据。这是一个明显的缺口——一个号称"解决硬件异构性"的框架,只在同代同架构的两张卡上验证了硬件维度。
顺便注意单卡 Cosmos3-Super 的绝对延迟:353.5 s 基线,加速后 143.8 s。而 4 卡序列并行版本是 99.6 s → 43.9 s。64B 模型单卡出一段视频要两分半,这个量级离交互式使用还很远。
能不能直接跑起来? 论文在摘要末尾给了 "Github Code" 和 "Project Page" 的链接入口,但截至发稿我没有找到公开可跑的完整仓库。所以现实的用法是:把附录 A 当配置说明书,在自己的推理栈上手动复刻。
好消息是所有依赖的技术都有公开实现:
运行时基座是 SGLang。 论文明确说部署接口组织成"dense 基线路径"和"组合后的 fullopt 路径"两条,所以测出来的对比是端到端服务栈,不是孤立的 kernel 微基准。这个做法值得学——很多加速论文只报 kernel 级数字,端到端一测就缩水。
硬件门槛不低:主实验在 B200 上,Cosmos3-Super 用了 4 卡序列并行。如果只有单卡,参考第 11 段的单卡数字。
如果要复刻 agent 部分:论文没有公开 agent 的实现细节——用什么模型、prompt 怎么写、搜索循环怎么组织、每个技能 agent 的工具接口长什么样,全都没有。想复现这一层,参考 CudaForge 和 CUDA-LLM 这两篇会更实际。
一个务实的建议:如果你的目标只是把某个视频模型的推理跑快一倍,没必要先搭 agent 框架。直接照抄第 10 段的经验规则(缓存优先、首尾步留高精度、高分辨率阶段才上稀疏、torch.compile 兜底),手工调两三轮大概就能吃到大部分收益。Agent 的价值在于你要同时维护很多个部署实例,而不在于单个实例能调得更好。
前面零散提过一些,这里集中说。
1. 核心主张缺对照实验。 论文反复强调"with little human effort"、"in a fraction of the usual human effort",但通篇没有任何量化:agent 用的什么模型?搜了多少轮?消耗多少 GPU 小时和 token?人工调优同样的目标要多久?没有这组对比,"agent 省人力"就只是一个断言。
2. 没有搜索策略的消融。 这是我认为最要紧的空白。Agent 相比随机搜索、网格搜索、贝叶斯优化的优势在哪?论文没做这个对比。考虑到每个技能的搜索空间其实不大(缓存阈值、稀疏度、剪枝比例这些都是低维连续或离散参数),传统超参搜索方法完全可能达到同样效果。如果是这样,"agentic" 的贡献就主要在"自动化编排和写补丁代码",而不在"搜得更好"。
3. 不是全自动。 人工验收在环,且论文自己承认这是当前的主要限制。而"人觉得可接受"是主观标准——换一批验收人,加速激进程度的上限就会变。这也意味着结果不完全可复现。
4. 硬件验证面太窄。 只有 B200 和 B300,同代同架构。Figure 3 承诺的 H200、RTX 5090 都没有实测。而 NVFP4 量化的收益强烈依赖 FP4 硬件,这一层在非 Blackwell 卡上会显著缩水。
5. 质量评测的选择性。 VBench 平均分变化在 ±0.54% 内,但成像质量维度三个模型有两个跌超过 1.3%,LTX-2.3 的美学质量跌 2.09%。论文正文只讨论平均分"基本持平",没有专门解释这些单维退化。另外定性对比图是作者挑的,Figure 7 加附录 B 的 18 组对比里没有失败案例。
6. 没有吞吐和显存数据。 全文只有单请求端到端延迟。生产部署要看的是并发下的吞吐、显存峰值、以及加速后能否提高 batch size。稀疏注意力和 token 剪枝理论上能省显存,但论文没量化。
7. 缺少与单点方法的端到端对比。 TeaCache、SVG2、SVDQuant 这些在论文里是"技能库候选",没有"单独用某一个方法能到多少倍"的完整对照。Figure 4 的分层拆解某种程度上补上了这个信息(比如 Cosmos3 单缓存 1.90×),但那是在 Sol-Engine 自己调参下的结果,不是各方法原始实现的公平对比。
8. 自家模型的信息优势。 Cosmos3-Super 是 NVIDIA 自己的模型,团队对它的架构、数值特性、训练分布都有外部研究者拿不到的信息。这不影响结果的真实性,但会影响"这套流程对任意第三方模型都同样有效"这个推论的强度。
9. 论文类型的定位。 署名(把 Codex 和 GPT-Image2 列为作者)、结构(大量篇幅在描述工程配置)、缺少方法论消融——这些都指向它更像一份高质量工程实践报告,而不是一篇方法论文。按技术报告的标准看,它的信息密度很高;按方法论文的标准看,它的验证是不完整的。
下面这张表是我按公开信息整理的,不是论文原表。需要特别说明:Sol-Engine 没有和这些方法做同环境的端到端对比,所以加速倍率跨行不可直接比较(模型、硬件、分辨率、基线都不同)。
| 方案 | 覆盖层级 | 自动化程度 | 免训练 | 论文报告的加速 | 质量代价 | 硬件绑定 |
|---|---|---|---|---|---|---|
| Sol-Engine | 算法 + 模型 + kernel 全栈 | Agent 并行搜索 + 集成 + 人工验收 | 是 | 端到端 2.27~2.77×(B200) | VBench 平均 ±0.54% | 较强(NVFP4 依赖 Blackwell) |
| TeaCache | 算法(缓存) | 手工调阈值 | 是 | 本文实测单项 1.39~1.90× | 中等,跳步越多越明显 | 无 |
| EasyCache | 算法(运行时自适应缓存) | 在线自适应 | 是 | 本文实测单项 1.48× | 中等 | 无 |
| PISA | 模型(分块稀疏注意力) | 手工选层与稀疏度 | 是 | 本文中作为二阶段组件 | 小(有泰勒补偿) | 无 |
| Sparse VideoGen 2 | 模型(语义感知稀疏) | 在线 profiling | 是 | 注意力级为主 | 小 | 需定制 kernel |
| SVDQuant | kernel(4bit 量化) | 手工 | 是(PTQ) | 显存与访存收益为主 | 小 | 需低比特支持 |
| SLA2 | 模型(稀疏 + 线性混合) | 可学习 Router | 否,需 QAT 微调 | 端到端 2.30~4.35×(RTX 5090) | 需微调,作者称可超 full attention | 无 |
| CudaForge | kernel(CUDA kernel 生成) | Agent + 硬件反馈 | 是 | 单 kernel 级 | 无(要求数值正确) | 无 |
几点解读:
我觉得这篇论文真正的价值不在那几个 2× 的数字,而在它把问题重新框了一遍。
过去两年视频加速方向的论文,主流叙事是"我提出了一个新的缓存/稀疏/量化方法,比前人快 X 倍"。这类工作攒到今天已经足够多了,多到出现了一个新的瓶颈:没人知道该怎么把它们组合起来用在自己的部署上。
Sol-Engine 承认了这个现实,并给出一个务实的回答:这是个组合优化和调参问题,人工做不划算,交给 agent。Figure 2 那组数据(同一个模型同一张卡,分辨率翻倍后 Softmax 占比从 19.9% 涨到 47.6%)是全文最有说服力的论证——它证明"通用最优配方"这个东西压根不存在。
但作为一篇方法论文,它的验证是不完整的。 缺 agent vs 传统超参搜索的对照,缺人力成本的量化,硬件维度只验证了同代两张卡。这些不是小瑕疵,而是直接关系到"agentic 到底贡献了什么"这个核心问题。以现在的证据,我倾向于认为 agent 在这里的主要价值是自动化了编排和代码补丁生成,而不是搜到了人搜不到的解。
所以我给不同人的建议不一样:
如果你是工程师,正要部署这几个模型——直接去看附录 A,第 10 段我已经整理好了。那些经验规则(缓存优先、首尾步留高精度、多阶段流水线分阶段施策、非标准采样器退化成固定步跳过)比 agent 框架有用得多,手工调两三轮就能吃到大部分收益。
如果你是研究者——最值得跟进的不是 agent 框架本身,而是它暴露的那个空洞:缺一个和人类感知对齐的自动视频质量评估器。 论文的人工验收环节之所以拆不掉,根子就在这。谁把这个问题解决了,"全自动加速搜索"才真的能闭环,而且这个能力的价值远超加速这一个场景。
如果你在做技术决策——记住 2× 是在 B200 上、免训练、单请求延迟的数字。换硬件要重新评估(尤其没有 FP4 支持的卡),关心吞吐的话论文没给数据,而且你自己的模型需要重新跑一遍搜索流程。
最后说回开头那个细节。把 Codex 和 GPT-Image2 署名成作者,arXiv 用 "Human authors" 单独一栏来区分——这件事本身可能比论文的技术内容更值得记一笔。 它标记了一个开始:AI 参与科研产出的程度已经到了需要在署名规范上做制度性区分的地步。至于这算进步还是隐忧,各人判断不同,但趋势看起来是不可逆的。
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)