搜索到
92
篇与
视频生成
的结果
-
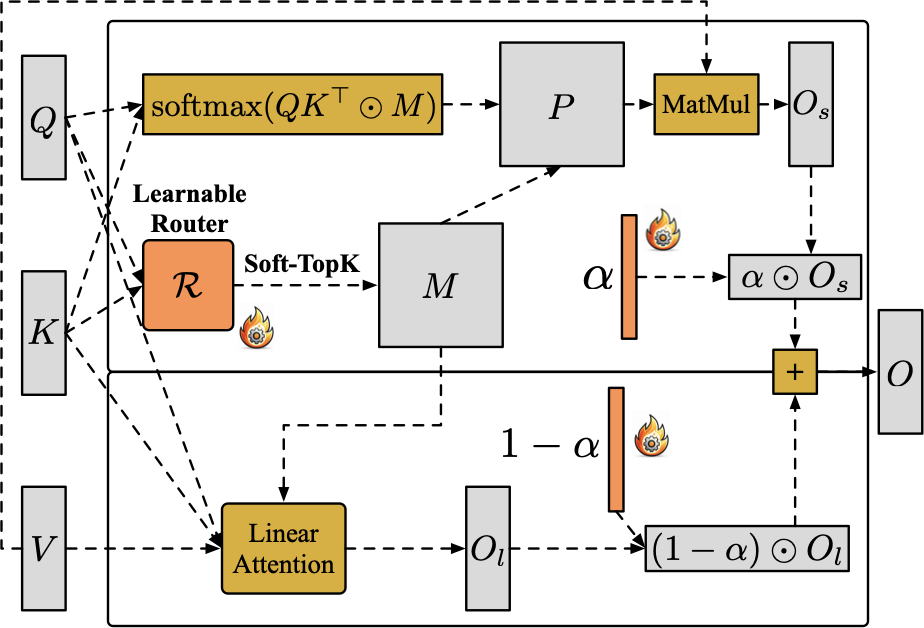
 深度解读|清华SLA2|97%稀疏对比DeepSeek DSA SLA2 深度解读:97% 稀疏、18.7 倍注意力加速,它和 DeepSeek DSA 的可学习 Indexer 到底差在哪 论文:SLA2: Sparse-Linear Attention with Learnable Routing and QAT 机构:清华大学 · UC Berkeley 作者:Jintao Zhang、Haoxu Wang、Kai Jiang、Kaiwen Zheng、Youhe Jiang、Ion Stoica、Jianfei Chen、Jun Zhu、Joseph E. Gonzalez 日期:2026-02-13(arXiv v1) 相关代码:thu-ml/SLA(仓库已引用 SLA2,但当前公开用法主要对应前代 SLA) 重点对比:DeepSeek-V3.2 技术报告 · DeepSeek-V3.2-Exp 官方实现 论文状态:arXiv 预印本;源码使用 ICML 2026 preprint 模板,不等于已被 ICML 接收 01 先说说这东西是干嘛用的 简单讲:SLA2 是给视频扩散模型做的“注意力分流器”。 生成视频时,Transformer 里的每个视觉 token 原本要和大量其他 token 做完整注意力,序列一长,计算量就按平方增长。SLA2 不想把 97% 的连接粗暴删掉,而是把连接分成两路: 少数重要连接走稀疏 Softmax Attention,保留精确计算; 大量剩余连接走线性注意力,用低秩聚合保留背景信息; 一个可学习 Router决定哪些块进入哪一路; 一个可学习的 $\alpha$ 决定两路输出各占多少; 稀疏分支再叠加低比特计算和 QAT,继续压低耗时。 在 Wan2.1-1.3B-480P 和 Wan2.1-14B-720P 上,论文把稀疏率推到 97%。此时考虑线性分支后,作者给出的实际计算节省约为 96.7%;RTX 5090 上前向 Attention Kernel 从 FlashAttention2 的 219 TOPS 提高到 4079 TOPS,按图中数字约为 18.6~18.7 倍。 但先别把这个结果理解成“整个视频生成快 18.7 倍”。端到端加速是: Wan2.1-1.3B-480P:159 秒降到 69 秒,约 2.30 倍; Wan2.1-14B-720P:3043 秒降到 700 秒,约 4.35 倍。 原因很直接:Attention 之外还有 FFN、VAE、调度与数据搬运。Kernel 快 18.7 倍,不代表整条流水线同倍率加速。 02 主要亮点,以及别被数字带偏的地方 主要亮点: 找到了前代 SLA 的一个明确数学错位:稀疏 Softmax 会重新归一化,输出并不等于原注意力矩阵被 mask 后的那部分; 用可学习的 $\alpha$ 显式修正稀疏分支的行缩放,并用 $1-\alpha$ 约束线性分支,避免总输出幅度漂移; Router 不再直接对池化后的 $QK^\top$ 做启发式 Top-k,而是在 $Q$、$K$ 上增加可学习投影; 训练时用 SoftTop-k 让 Router 可反传,推理时切回硬 Top-k; QAT 只在前向模拟低比特,反向仍使用 FP16,兼顾部署速度与训练稳定性; 97% 稀疏下,1.3B 模型 Attention FLOPs 从 52.75T 降到 1.82T,约为原来的 3.45%; 14B 模型 Attention FLOPs 从 292.6T 降到 9.26T,约为原来的 3.16%。 需要冷静看的地方: 训练与评测使用同一批私有 3000 段、每段约 5 秒的视频,文本由 Qwen3-VL-Flash 生成,外部可复现性有限; Full Attention 没有经过同样的 500 步高质量数据微调,SLA2 超过 Full Attention 不能全部归因于稀疏结构; “29 倍”对应的是 52.75T / 1.82T 的理论 FLOPs 比,不是 Kernel 实测,也不是端到端速度; 论文写“INT8 或 FP8”等低比特形式,并说明方案沿用 SageAttention2++,但没有把最终实验所用精确数据格式、逐张量尺度配置交代完整; 14B 延迟实验在单张 RTX 5090 上启用了顺序 CPU Offload,论文排除了 Offload 开销,因此不等同于普通单卡真实墙钟时间; 当前 thu-ml/SLA 仓库能明确跑的是前代 SLA,README 虽已加入 SLA2 引用,但未给出完整 SLA2 训练和 QAT 复现命令。 03 前代 SLA 的思路:删掉之前,先给“长尾”找个去处 传统稀疏注意力的做法比较像裁员:只保留 Top-k 连接,其余直接置零。问题是,视频注意力里被删掉的大量小权重可能单个不重要,但合起来仍承载全局色调、背景一致性和长程运动信息。 SLA 的思路更柔和: 大权重连接交给稀疏 Softmax Attention; 剩余连接交给线性注意力; 两路结果相加,线性分支前再放一个可学习投影。 它依赖一个观察:扩散模型的完整注意力矩阵 $P$ 往往可以拆成“高稀疏部分 $P_1$ + 低秩部分 $P_2$”。稀疏分支精确处理尖峰,线性分支近似处理长尾,理论上比纯 Top-k 更适合高稀疏率。 前代 SLA 的 Router 却比较朴素:先对相邻 token 的 $Q$、$K$ 做平均池化,再按池化注意力分数大小选 Top-k。分数最大的一批进稀疏分支,其余进线性分支。这个规则能用,但“权重大”不等于“必须由精确 Softmax 计算”;有些权重搬到线性分支后仍容易被低秩结构表达。 SLA2 的目标不是简单找“大权重”,而是找出“哪一组连接留给线性分支后,整体近似误差最小”。 04 SLA2 修了前代什么:关键不是 Router,而是先补上缩放错位 (这段稍微技术一点,不感兴趣可以跳到 05。) 设完整注意力概率矩阵为: $$P=\mathrm{softmax}(QK^\top/\sqrt d)$$ 给定二值 mask $M$,理想分解是: $$P_1=P\odot M,\qquad P_2=P\odot(1-M),\qquad P=P_1+P_2$$ 直觉上,稀疏分支应该计算 $P_1V$。但实际的 Masked Softmax 会在保留位置上重新归一化。设每一行被 mask 选中的概率质量为: $$\alpha=P_1\mathbf 1$$ 真正由稀疏 Softmax 得到的是: $$P_s=P_1/\alpha$$ 所以目标并不是 $P_sV$,而是: $$P_1V=\alpha\odot(P_sV)$$ 这就是前代 SLA 的尺度错位:稀疏分支每行都被强行归一化到和为 1,把本来只占 $\alpha$ 的概率质量放大了。前代让线性分支后面的投影同时做两件事——近似 $P_2V$,再抵消稀疏分支多出来的缩放误差。一个分支承担两个目标,学习难度自然更高。 SLA2 改成: $$O=\alpha\odot O_s+(1-\alpha)\odot O_l$$ 这里 $O_s$、$O_l$ 都先做行归一化。$\alpha$ 恢复稀疏分支本来应占的概率质量,$1-\alpha$ 给线性分支分配剩余质量,两路相加后仍保持归一化。这个改动看起来只多了一对系数,实际上把“谁负责什么”重新理顺了。 需要留意:理论推导里的 $\alpha$ 是完整注意力在 mask 内的真实概率和;工程实现中的 $\alpha$ 是训练得到的参数。它是对真实比例的学习近似,不是推理时先算完整注意力再精确求和——否则加速就没有意义了。论文也没有说明具体如何把学习参数约束到 $[0,1]$,例如是否经过 Sigmoid。 (图片来源:论文 Figure 1。Router 从 Q/K 产生块级 mask;被选块走稀疏低比特 Softmax,未选块进入线性分支,最后由 α 和 1-α 混合。) 05 Learnable Router 到底学什么 (技术细节,可选阅读。) 视频 token 数量很大,如果 Router 自己也计算完整 $N\times N$ 分数,加速收益会被它吃掉。SLA2 先对相邻 token 做块级平均池化: $$\bar Q=\mathrm{pool}(Q),\qquad \bar K=\mathrm{pool}(K)$$ 实验使用的块大小是: Query Block:$b_q=128$; Key/Value Block:$b_{kv}=64$。 然后加两组可学习投影: $$P_c=\mathrm{proj}_q(\bar Q)\mathrm{proj}_k(\bar K)^\top$$ 每一行选最高的 $k\%$: $$M_c=\mathrm{Top\mbox{-}k}(k\%,P_c)$$ 其中 $k\%=5\%、4\%、3\%$,分别对应大约 95%、96%、97% 的稀疏率。得到的是块级 mask,不是逐 token mask。GPU Kernel 直接按块跳过乘法,不必把 $M_c$ 展开成巨大的 $N\times N$ 矩阵。 可学习的部分不是 Top-k 本身,而是 $\mathrm{proj}_q$ 和 $\mathrm{proj}_k$。它们把 Q/K 映射到一个“更适合做分流”的空间。如果两个投影都设为单位矩阵,就退化成前代 SLA 的启发式 Router。 这也解释了它和 DeepSeek DSA 的第一个共同点:两者都不是直接相信主注意力的原始点积,而是训练一个便宜的旁路打分器,提前预测哪些连接值得进入昂贵注意力。 这里要区分“前向输入”和“训练监督”:SLA2 Router 前向只读取 Q/K,但 Stage 1 用 Full Attention 与 SLA2 最终输出的 MSE 训练,目标经过了 $PV$,所以监督信号间接依赖 V。DeepSeek DSA 的 Indexer 前向和注意力分布 KL 目标都不直接依赖 V。 06 两阶段训练:为什么 Router 只在第一阶段真正学习 SLA2 的训练分成两个阶段。 Stage 1:先把 Router 和 $\alpha$ 初始化好 从扩散模型每层、每个扩散时间步采样 Q/K/V; Full Attention 输出作为目标; SLA2 输出作为学生; 优化目标是两者输出的 MSE; 分别针对 5%、4%、3% 保留率训练 Router 与 $\alpha$。 硬 Top-k 不可导,所以训练时换成 SoftTop-k: $$\mathrm{SoftTop\mbox{-}k}(P_c)_{ij}=\sigma((P_c)_{ij}/\tau+\lambda_i)$$ $\tau=0.1$。$\lambda_i$ 通过二分搜索求解,使每行的软选择总和严格接近目标预算。这个设计不是随便用个 sigmoid,而是让软 mask 仍然保持固定的稀疏预算。 Stage 2:换回硬 Top-k,微调整个视频扩散模型 用 SLA2 替换原 Attention; Router 使用与推理一致的硬 Top-k; Router 不再更新; 微调整个扩散模型参数 $\Theta$ 和 $\alpha$; 优化标准扩散损失。 这个安排很务实:第一阶段解决“Top-k 不可导”,第二阶段解决“软选择和真实部署不一致”。代价是 Router 学到的是第一阶段 Full Attention 输出近似,后续端到端训练不会继续按最终生成损失调整路由边界。 07 QAT 怎么接进稀疏注意力 SLA2 只量化稀疏分支的核心矩阵乘法。 前向过程可以拆成两段: 量化 Q/K,低比特计算 $\hat Q\hat K^\top$,再反量化后做 Softmax; 量化概率 P 和 V,低比特计算 $\hat P\hat V$,再反量化得到 $O_s$。 此外,Kernel 先对 K 做列均值平滑,量化/反量化方案沿用 SageAttention2++。整个计算基于 FlashAttention 风格的在线 Softmax,只对 mask 命中的块做 QK 和 PV,不会先生成完整分数矩阵再遮掉 97%。 反向传播则全部使用原始 FP16 Q/K/V 和前向输出计算梯度。也就是说: 前向看到真实量化误差,让模型学会适应低比特噪声; 反向不强行做低比特梯度,避免训练不稳定; 论文称低比特部分额外带来约 1.3 倍 Kernel 加速。 Table 2 的消融也支持 QAT 有用:同样做量化推理,去掉 QAT 后,1.3B 模型的 AQ 从 64.62 降到 61.85,Vision Reward 从 0.1039 降到 0.0850。 不过论文没有把最终实验精确采用 INT8 还是 FP8、各张量尺度粒度和完整 Kernel 配置写透。工程复现时,这不是小细节,而是决定误差和速度的关键参数。 08 推理时 GPU 到底少算了什么 SLA2 的高效不只来自“mask 很稀”,还来自两条分支都避免了完整 $N^2$ 物化。 命中 mask 的块: 做量化 QK; 在线计算局部 Softmax; 做量化 PV; 累积到稀疏输出 $O_s$。 未命中 mask 的块: 不做逐 Query-Key 的 QK; 先按块累积 $(K^\phi)^\top V$; 再由 $Q^\phi$ 与聚合结果相乘; 得到线性输出 $O_l$。 最后按块对应的 $\alpha$ 混合两路。论文算法给出的 $\alpha$ 输入形状是 $N/b_q\times1$,说明工程实现实际上是 Query Block 级混合,而不是每个 Query token 各自一套完全独立比例。 这点很重要:论文正文常把 $\alpha$ 写成 $N\times1$,算法实现则使用 $N/b_q\times1$。两者表达的是同一思路,但粒度不同;复现时应以 Kernel/算法描述为准。 09 实验结果:哪些数字真的有说服力 实验底模是 Wan2.1-T2V-1.3B-480P 和 Wan2.1-T2V-14B-720P。训练集是私有的 3000 段公开视频,每段约 5 秒;每种方法微调 500 步,1.3B batch size 64,14B batch size 15。 在 1.3B 模型、97% 稀疏率下: IQ:66.64,Full Attention 为 63.67; OC:21.42,Full Attention 为 20.27; AQ:64.62,Full Attention 为 64.41; MS:98.04,Full Attention 为 98.95; SC:94.83,Full Attention 为 95.40; Vision Reward:0.1039,Full Attention 为 0.1084; FLOPs:1.82T,Full Attention 为 52.75T。 所以更准确的说法是:SLA2 在图像质量、整体一致性和审美分上高于未微调 Full Attention,但运动平滑、主体一致性与偏好奖励仍略低。不能概括成“所有指标超过 Full Attention”。 14B、97% 稀疏时,SLA2 的 IQ/OC/AQ 为 66.93/21.12/65.14;Full Attention 为 68.01/22.44/64.66。它在审美分更高,但 IQ 和 OC 没超过 Full Attention。相较于 90% 稀疏的 VMoBA、VSA、SLA,SLA2 整体更稳。 (图片来源:论文 Figure 2。第一人称化妆视频案例;这是作者选择的单个定性样例,不代表平均质量。) (图片来源:论文 Figure 3。草地奔跑猫咪案例;SLA2 97% 稀疏与 Full Attention 的关键帧接近。) 10 SLA2 Router 和 DeepSeek DSA Indexer:相同点 先说结论:两者共享的是“Learned Retrieval before Attention”范式,不是同一种稀疏注意力实现。 共同点主要有六个: 前向路由都由 Q/K 相关信号驱动,不读取 V。 但训练目标不同:SLA2 的输出 MSE 经过 $PV$,监督间接依赖 V;DSA 的注意力分布 KL 目标不直接依赖 V。 都有独立于主注意力的轻量打分空间。 SLA2 用 $\mathrm{proj}_q(\bar Q)\mathrm{proj}_k(\bar K)^\top$;DSA 用多头 Indexer 的投影 q/k 和门控权重。 最终都执行硬 Top-k。 Router/Indexer 只负责候选检索,真正的主注意力只在选中位置计算。 都先学习近似 Full Attention,再让主模型适应稀疏模式。 SLA2 Stage 1 拟合 Full Attention 输出;DSA Dense Warm-up 对齐主注意力分布,随后稀疏继续训练。 Router/Indexer 自己仍有全局扫描成本。 它们不是让选点免费,而是用便宜打分替代昂贵主注意力。DSA Indexer 的 Prefill 仍是 $O(L^2)$,只是常数远小于主 MLA;收益取决于旁路足够轻、主 Attention 足够重。 都要求 Kernel 真正按索引跳过计算。 只生成 mask、仍调用 Dense Attention 并不会获得论文速度。SLA2 依赖块稀疏 FlashAttention 风格 Kernel;DSA 依赖 Indexer Logit Kernel 与 FlashMLA 稀疏 Kernel。 这个共同范式可以概括成:先花小钱做检索,再花大钱做精算。 11 根本差异一:DSA 是“保留或丢弃”,SLA2 是“精算或近似” 这是最重要的区别。 DeepSeek DSA 对每个 Query token 从历史 KV 中选 Top-2048。选中的 token 进入主 MLA Attention,未选中的 token 不参与该 Query 的主注意力计算。 SLA2 则没有把未选连接直接丢掉: 选中的块走精确稀疏 Softmax; 未选中的块走线性注意力聚合; 两路由 $\alpha$ 加权组合。 所以两者的 Router 优化目标不同: DSA 要找“哪些历史 token 最值得保留”; SLA2 要找“哪些连接必须精确算,哪些可以交给低秩近似”。 这也是为什么 SLA2 不能照搬 DSA 的 KL Attention Map Distillation。它不仅要排序重要性,还要考虑剩余矩阵是否容易被线性分支表达。 12 根本差异二:两个可学习打分器具体怎么学 (技术细节,可选阅读。) DeepSeek DSA 的 Lightning Indexer 对 Query token $h_t$ 和历史 token $h_s$,DSA 的分数是: $$I_{t,s}=\sum_{j=1}^{H_I}w^I_{t,j}\cdot\mathrm{ReLU}\left((q^I_{t,j})^\top k^I_s\right)$$ 官方配置为: Indexer Heads:64; Index Head Dim:128; 每个 Query 选择 Top-2048; 历史长度不足 2048 时全部保留,因此“约 98.4% 稀疏”只适用于 128K 序列末端,不能当成整条因果注意力矩阵的平均稀疏率; Key 是单份共享表示,符合 MQA 模式; Query 来自 MLA 的低秩 Query Latent; 每层各自运行 Indexer,不跨层共享 Top-k; 官方实现对 Indexer Q/K 使用部分 RoPE,并以 FP8 + Hadamard Transform 加速。 Dense Warm-up 时,DSA 把主注意力各 Head 的分数汇总、L1 归一化为目标分布,用 KL 散度训练 Indexer: 1000 步; 每步 16 条 128K 序列; 总计约 2.1B token; 只训练 Indexer,主模型冻结。 稀疏训练阶段: 每个 Query 选 2048 个 KV; 主模型用语言建模损失训练; Indexer 继续用选中集合上的 KL 对齐; Indexer 输入从主模型计算图 Detach; 15000 步、每步 480 条 128K 序列; 总计约 943.7B token。 SLA2 的 Router SLA2 只有两组投影后的块级点积,没有 DSA 的 64 个 Indexer Head、ReLU 聚合和 Query 自适应 Head 权重。它在 Stage 1 通过 SoftTop-k 可微选择,以最终 Attention 输出 MSE 训练 Router 和 $\alpha$。 这个差别可以理解为: DSA 学的是“注意力分布排序器”; SLA2 学的是“两种近似算子之间的分区器”。 13 效率数字不能直接横比 (图片来源:论文 Figure 4。SLA2 97% 稀疏达到 4079 TOPS;FlashAttention2 为 219 TOPS。) (图片来源:论文 Figure 5。上:1.3B-480P;下:14B-720P,14B 数据排除了 CPU Offload 开销。) SLA2 报的是 RTX 5090 上视频扩散 Attention Kernel 和视频生成延迟。DeepSeek DSA 报的是 H800 集群上 128K 文本模型的 Prefill/Decode 成本,并用每 GPU 小时 2 美元估算服务成本。 两者至少有五个不可控变量: 模型域:视频扩散 vs 自回归语言模型; 硬件:RTX 5090 vs H800 集群; 主注意力:普通视频 DiT Attention vs MLA; 稀疏粒度:块级百分比 vs token 级固定 Top-2048; 输出指标:TOPS/秒数 vs 服务成本曲线。 因此不能说“SLA2 18.7 倍,比 DSA 更快”,也不能反过来说 DSA 更适合所有场景。能比较的是机制和复杂度,不能把两篇论文的速度数字放在同一排行榜。 14 横向对比:SLA2 与 DeepSeek DSA 的 14 个维度 维度 SLA2 Learnable Router DeepSeek DSA Lightning Indexer 目标模型 视频扩散 Transformer 自回归大语言模型 主注意力 稀疏 Softmax + 线性 Attention MLA 的稀疏主注意力 路由对象 Query Block × KV Block Query token × 历史 KV token 未选连接 进入线性分支近似 不进入该 Query 的主 Attention Router 输入 池化后的 Q/K Hidden/Query Latent 投影出的 q/k V 的角色 前向路由不读 V;Stage 1 输出 MSE 经 $PV$ 间接依赖 V 前向与注意力分布 KL 目标均不直接依赖 V 打分函数 两个可学习投影后的点积 64 Head、ReLU、Query 门控加权求和 选择预算 每行 3%/4%/5% 块 每个 Query 固定 Top-2048 token 训练监督 Full/SLA2 输出 MSE + 扩散损失 主注意力分布 KL + 语言建模损失 Top-k 可微性 Stage 1 用 SoftTop-k 反传 用独立 KL 训练 Indexer,不穿过硬 Top-k 第二阶段 Router 冻结 继续由 KL 单独优化 分支混合 学习 $\alpha$ 与 $1-\alpha$ 无线性补偿分支,无 $\alpha$ 量化角色 QAT 直接训练低比特稀疏 Attention Indexer 可用 FP8;模型本身为 FP8 部署体系 官方复现状态 SLA 仓库公开,SLA2 完整训练链尚不明确 权重、推理代码与高性能 Kernel 已公开 再补一个容易混淆的点:DeepSeek 还有 MoE Expert Router。DSA Lightning Indexer 不是专家路由器,它路由的是“当前 Query 应该看哪些历史 KV”;SLA2 Router 路由的是“某个注意力块应走稀疏 Softmax 还是线性近似”。三者名字相似,但对象不同。 15 总结感受:两条路线会合流,但不会互相替代 我对 SLA2 的评价是:数学修补比 97% 稀疏这个标题数字更有价值。 它首先把前代 SLA 的缩放错位讲清楚,再用 $\alpha/(1-\alpha)$ 让两条分支各归其位。Learnable Router 和 QAT 是建立在这个正确分解上的工程增强,不是孤立的技巧堆叠。 与 DeepSeek DSA 对比后,技术路线也更清晰: 如果未选连接可以安全丢弃,DSA 的 token 级 Top-k 更直接; 如果未选连接数量巨大但合起来仍重要,SLA2 的线性补偿更稳; DSA 的多头 Indexer 更像高容量检索器; SLA2 的块级 Router 更便宜,也更容易映射到视频 GPU Kernel; DSA 用 KL 拟合注意力分布,SLA2 用输出误差学习“精算/近似”分区; 两者未来最可能的合流点,是用更强 Indexer 做块或 token 检索,再为未选部分保留低秩残差通道。 研究者建议:值得跟进的方向不是单纯继续把稀疏率从 97% 推到 98%,而是验证 Router 是否跨 Prompt、分辨率、时长和模型层稳定;也可以尝试 DSA 式多头 Indexer + SLA2 线性残差,比较 KL 分布蒸馏与输出 MSE 哪个更适合扩散模型。 工程师建议:目前先把 SLA2 当成有潜力的 Kernel/训练方案,不要当作即插即用库。你需要定制块稀疏 Kernel、线性分支、QAT 和两阶段微调;没有官方完整脚本时,复现成本明显高于普通 FlashAttention 替换。 产品侧建议:这项工作真正能带来的不是“同一张卡快 18.7 倍出视频”,而是在 Attention 成为主要瓶颈的高分辨率、长视频场景中,把端到端耗时压到原来的约 43% 或 23%。是否值得接入,要看你的 FFN、VAE 和数据搬运占比。 最后给一句最短判断: DSA 是学会“该看谁”,SLA2 是学会“谁要精看、谁可以略读”;共同方向是把 Attention 从固定算子变成可学习的计算资源分配器。 作者:人工智能炼丹君 日期:2026-07-25 声明:个人观点,仅供参考。数据来源于 SLA2、DeepSeek-V3.2 原始论文及官方实现,如有偏差以原文为准。
-
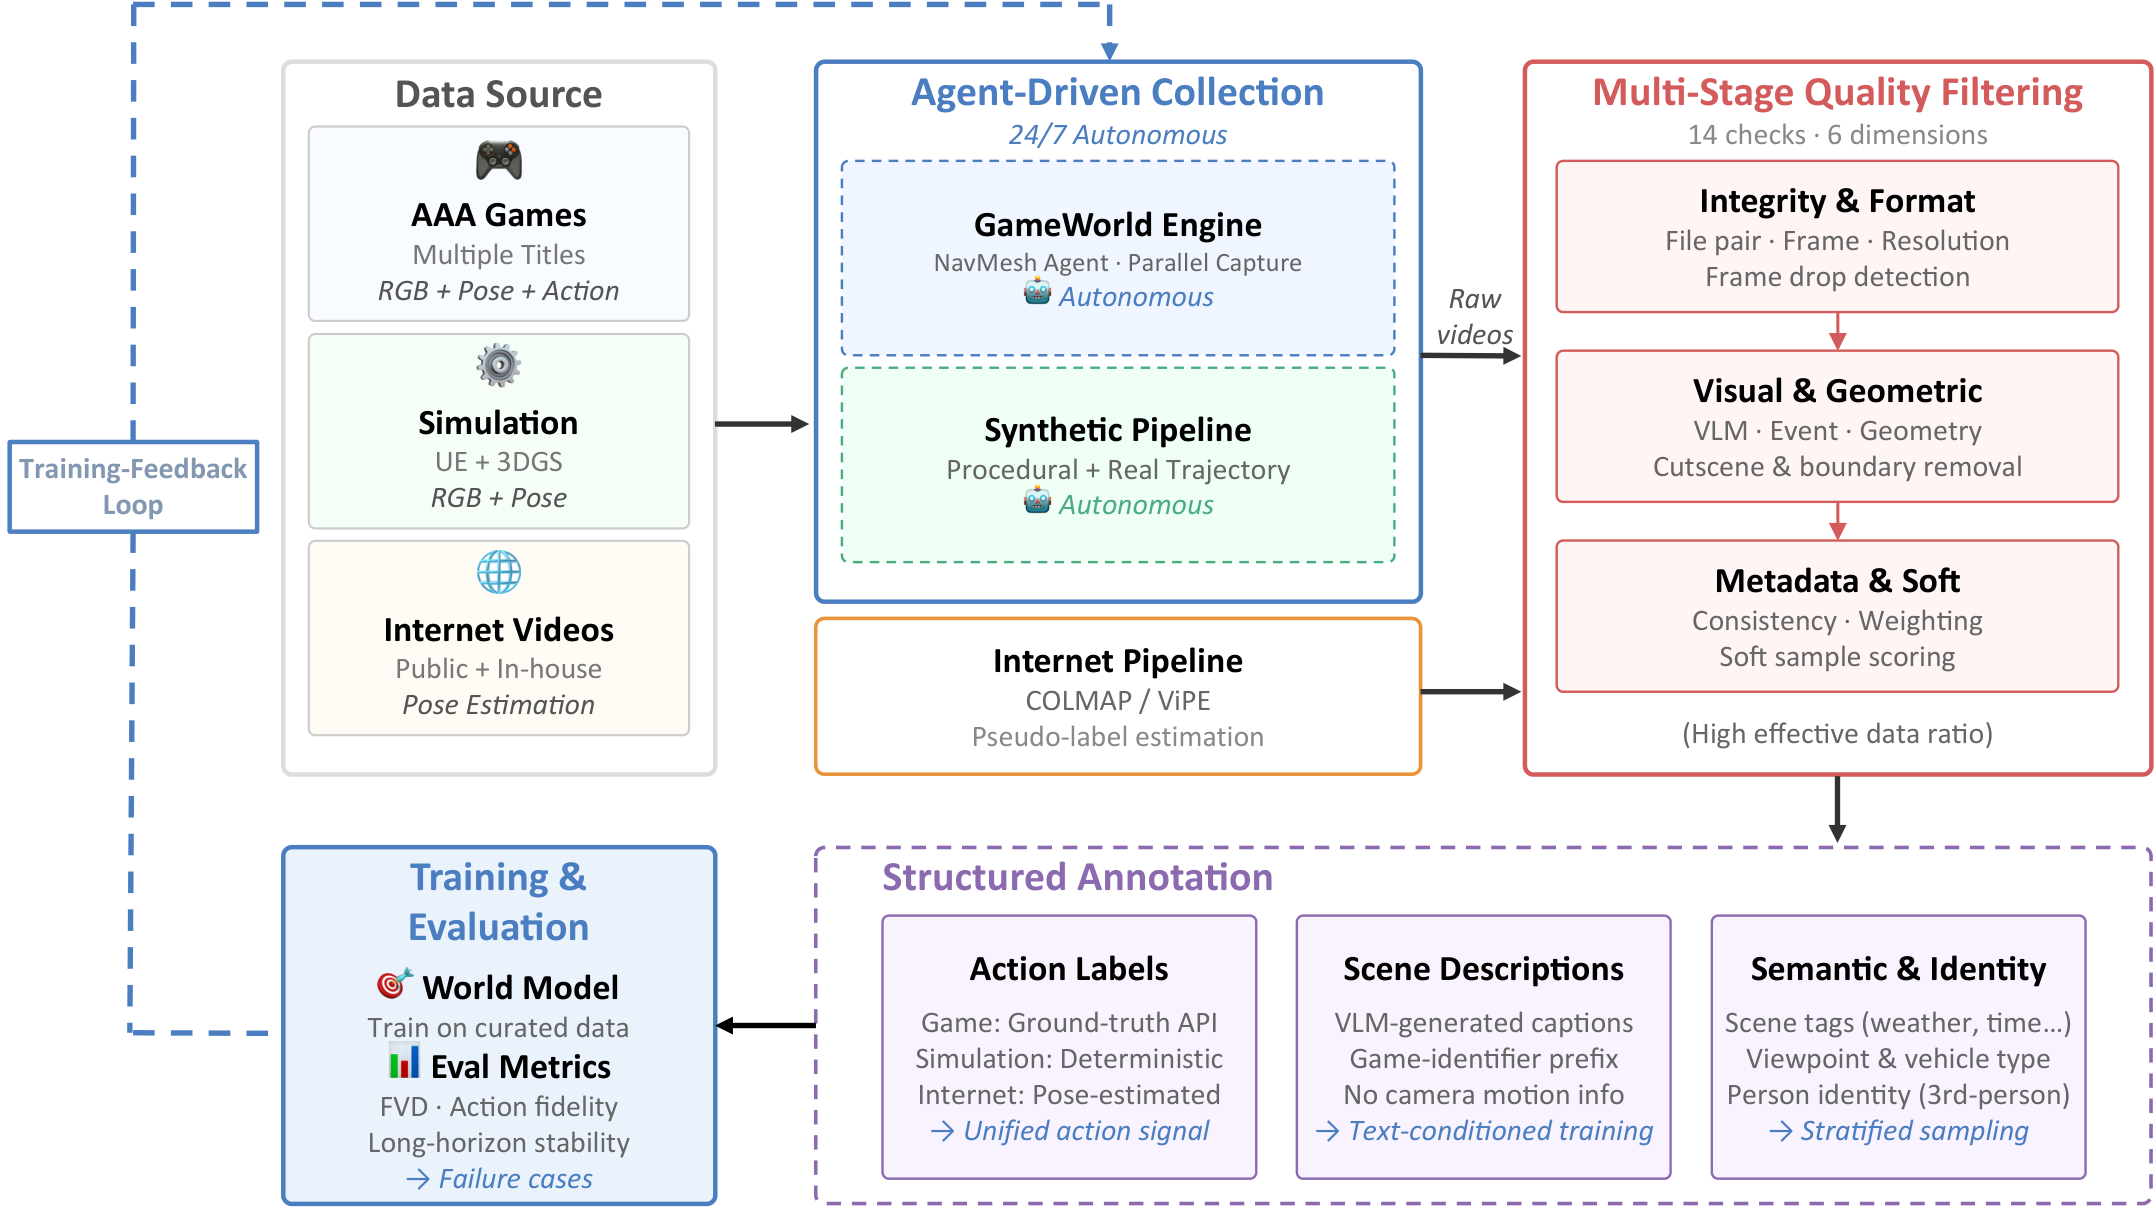
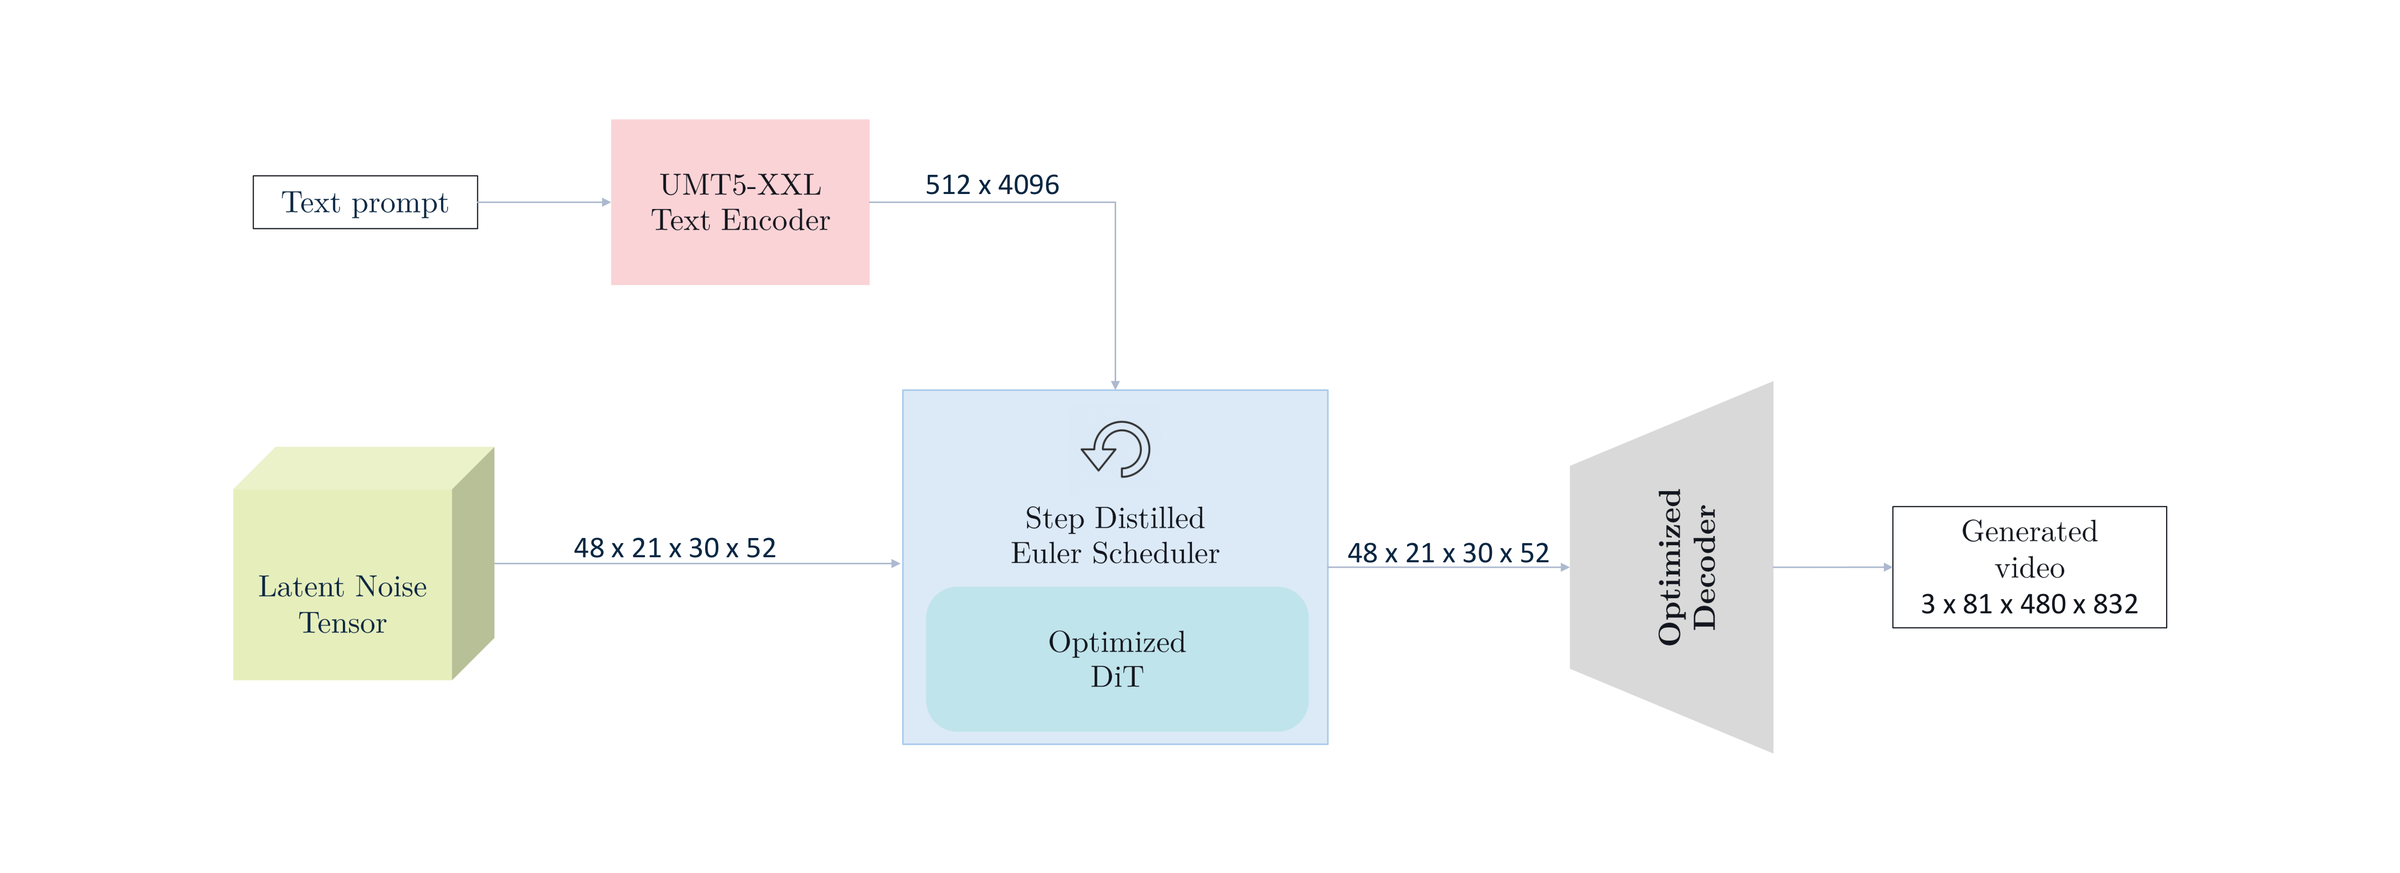
AIGC 每日速读|2026-07-23|阿里高德5090单卡实时世界模型ABot-World-0 今日 AIGC 论文速览 今日共 10 篇 · 交互式世界模型 2 篇 · 高效图像/视频生成与编辑 3 篇 · 可控与电影级视频生成 2 篇 · 生成新用途与安全 2 篇 · 音乐生成 1 篇 重点论文标题列表 ABot-World-0(阿里·高德AMAP):单卡5090实时交互世界模型 AlayaWorld(Alaya Lab):15B交互式长时程世界模型开源 Mage-Flow(Microsoft):微软4B高效图像生成与编辑 OSVE(高丽大学):首个单步视频编辑快155倍 HeadCast(快手可灵):免训练按注意力头加速AR视频 今日论文速览 1. ABot-World-0:单卡5090实时交互世界模型 ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU | 阿里·高德AMAP | arXiv:2607.19191 关键词:世界模型,实时交互,自回归视频,蒸馏,单卡部署 前序问题:交互式视频世界模型要同时具备交互、持久时空一致、稳定长时程生成与高效响应,且此前多依赖重型算力,难在消费级单卡上实时长时程运行。 本文贡献:提出动作条件视频世界模型 ABot-World-0,配套横跨 AAA 游戏/仿真引擎/互联网视频的多源数据基建(WorldExplorer 训练反馈驱动采集 + 14 项确定性质检 + VLM 评估 + 动作/文本同步标注);训练上把双向动作条件教师经 teacher forcing 与 ODE 蒸馏渐进蒸成因果学生,并提 LongForcing 对齐长自 rollout 与扩展时程教师、抑制分布与自回归漂移;原始键盘动作作统一控制接口,参考角色记忆保第三人称身份一致;部署上协同设计流式推理栈(轻量 VAE 解码、高效注意力、内存感知调度、低比特 DiT)。 实验效果:在优化的低比特配置下,单张 NVIDIA RTX 5090 桌面 GPU 上以最高 16FPS 流式生成 720P 视频,动作到首帧延迟 1.2s、峰值显存约 19GiB;在 WorldRoamBench 与长交互 rollout 上展现有竞争力的可控性与连贯的长时程世界演化。 批判点评:把交互式世界模型压进消费级单卡(5090/16FPS/19GiB)是极硬的工程落地,多源数据基建+LongForcing 抑漂移思路完整、阿里高德背景也贴近实景重建。但 16FPS/720P 距真正丝滑仍有距离、低比特下的画质代价、超长时程一致与物理合理性、以及对开放动作的泛化仍需检验。 2. AlayaWorld:15B交互式长时程世界模型开源 AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report | Alaya Lab | arXiv:2607.18367 关键词:世界模型,交互生成,自回归蒸馏,长时程,开源 前序问题:视频世界模型能即时从文本/图像/视频生成可交互环境,但要落地需同时具备交互、持久时空一致、稳定长时程生成与高效响应四大耦合能力。 本文贡献:提出交互式长时程视频世界模型 AlayaWorld:基于 15B 视频扩散 Transformer,在相机轨迹与可切换文本提示下自回归生成短潜块;有界视觉上下文融合持久 sink 帧、压缩时序历史、几何对齐空间记忆与近帧条件;用自 rollout 收集的损坏历史与预测残差训练以降长期漂移;提出离散自回归蒸馏(结合分布匹配蒸馏、self-forcing++、一致性蒸馏)把推理从约 30 步降到每块 4 步。 实验效果:生成 540p/720p、24fps 视频,在 iWorld-Bench 上长时程生成最佳;定位为全栈、开源、长期项目,为交互式视频世界模型研究提供可扩展基座。 批判点评:15B 世界模型+四步蒸馏+全栈开源,对社区推进交互式世界模型很有价值,几何对齐空间记忆+损坏历史训练也对症长程漂移。但 24fps/720p 的实时性、复杂交互下的一致与可控、以及开源基座的训练成本与数据获取门槛,仍是从 demo 到产品要迈的坎。 3. Mage-Flow:微软4B高效图像生成与编辑 Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing | Microsoft | arXiv:2607.19064 关键词:图像生成,图像编辑,原生分辨率,VAE,少步蒸馏 前序问题:大规模视觉生成器越来越强,但训练、微调与部署成本高昂,难以兼顾高分辨率质量与交互级效率。 本文贡献:推出紧凑 4B 生成栈 Mage-Flow:由轻量高保真潜表征分词器 Mage-VAE 与原生分辨率多模态扩散 Transformer(整流流匹配)协同设计。Mage-VAE 用单步扩散式编解码+锚定潜表征正则,在保持强公开 VAE 重建质量的同时把分词成本降一个数量级以上;配合原生分辨率打包与栈级 CUDA 核融合,端到端训练吞吐提升约 2.5 倍。基于此构建 Base/RL 对齐/Turbo 三档、覆盖生成与编辑:Diffusion-NFT 提升指令遵循/文字渲染/美学/编辑保真,配对抗感知引导的少步蒸馏产出 4 步 Turbo。 实验效果:尽管规模紧凑,Mage-Flow 与 Mage-Flow-Edit 在标准生成/编辑基准上具竞争力;Turbo 变体让高分辨率交互实用——单张 A100、1024² 下生成仅 0.59s、编辑仅 1.02s,显存占用小。 批判点评:微软用「分词器-骨干-系统」协同把 4B 小模型的高分辨率生成/编辑做到 0.59s/1.02s,工业化落地感很强、成本友好。但 4B 规模在极致画质/复杂语义/长文本渲染上的天花板、与十亿级大模型的差距,以及 RL 对齐/蒸馏带来的多样性与保真权衡,仍需在更广场景验证。 4. OSVE:首个单步视频编辑快155倍 OSVE: One Step Video Editing with One Step Diffusion Models | 高丽大学 | arXiv:2607.19895 关键词:视频编辑,单步扩散,噪声预测,时序一致,实时 前序问题:扩散模型的文本引导视频编辑因多步采样与反演而慢得不实用。 本文贡献:提出 OSVE,首个成功把单步文生图(T2I)模型适配到高质量视频编辑的框架,攻克反演、可编辑性与时序一致三大难题:训练一个可学习编码器单次前向预测每帧初始噪声以绕开慢速迭代反演,并用结构感知编辑(SAE)损失在结构对齐图对上训练以在编辑中保留源视频几何;提出统一帧编辑(UFE)拼接帧潜表征在单步生成中促成跨帧注意力保时序连贯;对长视频用带锚帧的滑窗保全局一致。 实验效果:编辑质量匹配或超过 SOTA 多步方法,同时快约 155~171 倍,为实用实时视频编辑铺路;代码开源。 批判点评:把单步 T2I 迁到视频编辑、直接预测初始噪声避开反演,155~171 倍提速+结构保持的设计很漂亮,实时编辑价值大。但依赖结构对齐图对训练编码器、单步生成对大幅/复杂编辑的上限、以及长视频滑窗拼接处的一致,仍需更强样例检验。 5. HeadCast:免训练按注意力头加速AR视频 HeadCast: Casting Attention Heads for Efficient Autoregressive Video Generation | 快手可灵 | arXiv:2607.20125 关键词:自回归视频,推理加速,KV缓存,注意力头,免训练 前序问题:自回归(AR)视频扩散是长视频/流式合成的有力范式,但持续增长的 KV cache 让注意力成为主导推理成本(高分辨率下每帧 token 众多);现有缓存淘汰用粗糙启发式致帧间闪烁,或需重训。 本文贡献:提出免训练、即插即用的加速框架 HeadCast:基于「预训练 AR 模型注意力头呈稳定异质行为」的观察,短暖机后在最大噪声步一次性把每个注意力头分为 Sink/Dummy/Spatial/Global 四类,并把单体 KV cache 重构为按头分路径;关键是保留维持长程时序一致的 Global 头。因 Spatial 路径在固定网格上运算,其节省随分辨率增长。 实验效果:在多个 SOTA AR 模型上,720P 加速至多 1.62 倍、1080P 至多 1.95 倍,VBench 质量与全注意力持平且基本无闪烁;代码开源。 批判点评:「按注意力头功能分类+分路径缓存」免训练即插即用、且分辨率越高越省,对长视频/流式生成的推理成本是很实用的解法(可灵背景更贴落地)。但一次性分类的稳健性、四类原型对不同模型的普适、以及在极长序列/更高分辨率下保真与加速的平衡,仍需更多模型验证。 6. ShotPlan:可学习规划token做电影级多镜头 ShotPlan: Cinematic Video Generation with Learnable Planning Token | 中国电信TeleAI·哈工大 | arXiv:2607.17675 关键词:电影级生成,多镜头,规划token,转场,视频扩散 前序问题:现有视频生成在单镜头上效果惊艳,但电影级生成需要连贯叙事与有效多镜头组合、需显式镜头规划,仍受限。 本文贡献:提出 ShotPlan,在视频扩散基座上做显式多镜头电影级生成:引入可学习规划 token 捕捉镜头级转场线索、可与原视频生成 token 无缝融合以控制转场时间戳;规划 token 配分数时间旋转位置编码(FRoPE),使镜头转场可在帧级建模。 实验效果:显著超过现有电影级视频生成方法,提供更灵活的镜头管理与更强的镜头间一致性。 批判点评:用「可学习规划 token+帧级 FRoPE」把多镜头转场显式化,是对电影级叙事生成痛点的对症设计,中国电信 TeleAI 出品。但多镜头的叙事连贯不止转场时机,人物/场景跨镜头一致、复杂运镜与更长叙事的可控性,以及与专业剪辑的差距仍需更多验证。 7. The generator is the tracker:视频生成器即多目标跟踪器 The generator is the tracker: Multi-object tracking by painting persistent identity colours | 康奈尔大学 | arXiv:2607.17120 关键词:多目标跟踪,视频生成,身份一致,重识别,LoRA 前序问题:多目标跟踪(MOT)传统被拆成检测+关联,身份靠轨迹缓存、运动模型、外观嵌入等外部状态维护;能否让视频生成器直接用像素维护这种状态? 本文贡献:微调 22B 文生视频扩散模型(LTX-2.3)配轻量上下文 LoRA,把 RGB 片段翻译成 ID-map 片段——每个人被涂成随时间持久的独特纯色(同色=同身份);长视频以链式窗口生成、每窗以上一窗清理后的尾部为条件,短续训教模型延展给定着色,身份便无需跟踪器/运动模型/重识别模块地沿链流动。 实验效果:DanceTrack 测试榜上达 40.3 HOTA(据称首个上榜且无检测器/无跟踪栈的生成式跟踪器),虽低于专用 SOTA(≥70),但误差画像独特——关联分 AssA 44.1 超原基准全部跟踪器,短板仅在检测;同样生成窗改用经典事后关联得分差一倍(18.2 HOTA);383 个遮挡事件中以 42% 条件率在间隙后重获身份(外观嵌入基线为 0),表明其着色是涌现的重识别信号。 批判点评:「让生成器用像素维护身份」把 MOT 重构为着色生成,关联能力与遮挡重识别的涌现很惊艳、思路极具启发。但 40.3 HOTA 距实用尚远(检测是硬短板)、依赖 22B 大模型链式生成成本高、极密集/快速场景下的可扩展性仍是问题,更像范式验证而非即用方案。 8. Keyframe-Anchored:序列动作视频的身份保持 Keyframe-Anchored Identity Preservation for Sequential-Action Video Generation | 中科大 | arXiv:2607.17985 关键词:身份保持,文生视频,关键帧,序列动作,免训练 前序问题:保身份的文生视频要在整段视频中维持指定主体可识别性;IPVG26 挑战把它从单一整体提示扩展到带时间戳的动作序列——主体须按序完成一串不同动作且身份一致,而端到端生成器随运动累积易外观漂移。 本文贡献:提出免训练三阶段流水线:动作感知提示润色阶段先把输入改写为指定每个动作终态的图像生成提示;保身份生成阶段以参考身份与前一帧联合条件产出关键帧序列,从而解耦时不变外观与时变姿态;身份感知推理增强阶段用多参考引导与身份驱动噪声搜索合成中间片段,双重强化采样期身份保真。 实验效果:在 IPVG26 官方 Track 2 榜排名第三,展现有竞争力的性能与较强通用性。 批判点评:用「关键帧锚定+解耦外观与姿态」免训练做序列动作身份保持,工程组合清晰、竞赛第三也证明有效。但依赖关键帧质量与多阶段拼接,中间片段合成的动作流畅、长序列多动作下的累积漂移,以及免训练相对专门训练方法的天花板仍待观察。 9. BSB:时序一致性越狱商用T2V Between Safe Boundaries: Exploiting Temporal Consistency for Jailbreaking Text-To-Video Generation Models | 中科大 | arXiv:2607.17279 关键词:文生视频,越狱攻击,时序一致性,MCTS,AI安全 前序问题:文生视频(T2V)模型广泛部署,其对越狱攻击的鲁棒性引发担忧;现有方法多从文生图迁移,未利用视频固有的时序一致性、需大量视频查询优化(黑盒不可行)、且对抗提示搜索靠启发式局部信号缺结构化探索。 本文贡献:提出结构化、查询高效的 T2V 越狱框架 BSB:利用时序一致性,把有害意图编码为两个各自无害的「边界状态」之间的转变,攻击那些插值时易在中间帧产生不安全内容的边界状态对;为避免在视频空间直接评估所有候选的高昂开销,BSB 在更廉价的文本代理空间做蒙特卡洛树搜索(MCTS),并用稀疏视频级评估定期校准。 实验效果:在 Veo 3.1、Sora 2、Seedance、Kling v1 等主流商用 T2V 上,BSB 超越所有现有越狱基线,攻击成功率较最强对手平均相对提升 18.6%;揭示时序一致性是被忽视却关键的攻击面。 批判点评:把「时序一致性」从能力变成攻击面、用文本代理空间 MCTS 做查询高效黑盒越狱,视角新颖且对主流商用模型有效,安全警示意义大。但作为攻击方法需警惕滥用、防御侧的对应缓解未深入,攻击在持续迭代的商用安全策略下的长期有效性也存疑。 10. Full-Song:分层自回归+流匹配全曲生成 Pushing the Frontier of Full-Song Generation: Hierarchical Autoregressive Planning Meets Flow-Matching Rendering | 阿里(Token Foundry) | arXiv:2607.20253 关键词:歌曲生成,自回归,流匹配,RVQ,翻唱 前序问题:从歌词、文本描述与音乐属性生成高质量全长歌曲仍具挑战,且需统一支持词到歌、纯器乐、翻唱等多任务。 本文贡献:提出统一歌曲生成框架,支持歌词到歌、器乐生成、翻唱三任务:语义感知分词器把音频编码为 8 码本 RVQ token;hybird-LM 在其上做分层自回归音频 token 建模生成全曲;FullDiT 在连续 VAE 潜空间以码本 token/歌词/文本为条件做全曲流匹配以提升保真;翻唱用旋律模块从参考音频抽取并离散化旋律线索、在保留原旋律的同时引导生成;并探索 DPO/GRPO/OPD 做 hybird-LM 后训练、对 FullDiT 用基于流的 GRPO 提升音乐性与渲染质量。 实验效果:在多语种自动基准与 Artificial Analysis 带人声音乐榜上,框架在所评设置下取得有竞争力的表现。 批判点评:「分层自回归规划+流匹配渲染」的双阶段设计兼顾结构与音质、还统一了词到歌/器乐/翻唱三任务(阿里出品),工程完整。但全曲生成对长程结构、人声吐字与音乐性要求极高,多任务统一下各子任务的上限、翻唱的版权与旋律保真边界,以及主观音乐性的稳定性仍需更多盲测检验。 趋势观察 世界模型冲进消费级实时 — ABot-World-0 单张 RTX5090 跑 720P/16FPS 实时交互世界、AlayaWorld 15B 开源长时程世界模型,交互式世界模型正从云端走向桌面单卡。 高效小模型吃下生成与编辑 — 微软 Mage-Flow 用 4B 栈把 1024² 生成压到 0.59s、编辑 1.02s,'紧凑协同设计'让高分辨率生成编辑走向交互实用。 少步/免训练把视频推向实时 — OSVE 首次让单步 T2I 做视频编辑快 155~171 倍、HeadCast 免训练按注意力头分类加速 AR 视频,效率优化在编辑与长视频两端并进。 视频生成能力外溢到感知与叙事 — '生成器即跟踪器'用视频生成做多目标跟踪、ShotPlan 用规划 token 做多镜头电影级叙事,生成模型的能力正外溢到跟踪、导演等新任务。 生成的可信与安全被正面拷问 — BSB 用时序一致性越狱主流商用 T2V(攻击成功率相对+18.6%),揭示视频生成安全的新攻击面,安全治理需跟上能力跃迁。 人工智能炼丹君 整理 | 2026-07-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-16|字节Seed读回提示当奖励SpectraReward 今日 AIGC 论文速览 今日共 5 篇 · 文生图强化学习与奖励 1 篇 · 视频生成潜空间与物理评测 2 篇 · 文生图个性化 1 篇 · 统一视觉表示与编辑 1 篇 重点论文标题列表 SpectraReward(港大·字节Seed·北大):MLLM读回提示当零样本奖励 VideoRAE(港中文深圳·华科·中科大):冻结视频基座炼成生成潜空间 Seriality Gap(UC Berkeley):视频扩散缺可扩展串行算力 IdentityTuning(特拉维夫大学·Cornell):免训练调身份token改五官 RINO(约翰霍普金斯·CMU·UCSC·Rice):万物皆RGB统一视觉接口 今日论文速览 1. SpectraReward:MLLM读回提示当零样本奖励 Read It Back: Pretrained MLLMs Are Zero-Shot Reward Models for Text-to-Image Generation | 港大·字节Seed·北大 | arXiv:2607.11886 关键词:文生图,强化学习,奖励模型,MLLM,零样本 前序问题:文生图强化学习的上限取决于奖励模型,但偏好标注贵、迭代慢;现有零样本 MLLM 奖励要么靠打分/logit(校准噪声大),要么做问题分解验证(工程复杂),缺一个免标注、免微调、开箱即用的奖励方案。 本文贡献:提出 SpectraReward:冻结预训练 MLLM,对生成图像做一次图像条件、teacher-forced 前向,用「原提示在图像条件下的平均 token 对数似然」当奖励,直接复用图文对齐能力,无需偏好标签与奖励微调。另对统一多模态模型提出 Self-SpectraReward——用策略自身理解分支当生成分支奖励,形成无外部奖励/知识的闭环自改进。 实验效果:覆盖 2 个扩散模型、3 种 RL 算法、4 大家族 9 个 MLLM 骨干(4B–235B)、5 个 OOD 文生图基准;BAGEL 上 TIIF-Bench +10.0、GenEval +4.3/5.5,并超过 AlphaGRPO。Self-SpectraReward 可匹敌甚至超过大得多的外部奖励模型,说明奖励-策略分布对齐比单纯放大奖励模型更关键。 批判点评:把「提示能否从图像读回来」做成训练免费奖励,绕开偏好数据与裁判噪声,字节 Seed+港大背景、实验覆盖面也扎实。但似然奖励对短/模板化提示可能不够敏感,Self-SpectraReward 依赖统一多模态架构,且「更大 MLLM 未必更好」意味着落地仍需仔细选骨干而非盲目缩放。 2. VideoRAE:冻结视频基座炼成生成潜空间 VideoRAE: Taming Video Foundation Models for Generative Modeling via Representation Autoencoders | 港中文深圳·华科·中科大 | arXiv:2607.14088 关键词:视频生成,表征自编码器,视频基座模型,潜空间,DiT 前序问题:视频生成多依赖 3D-VAE 潜空间,但传统 3D-VAE 主要优化像素重建,语义与时空结构偏弱;V-JEPA 2、VideoMAEv2 等视频基座理解强,却少有人验证其冻结表征能否压成紧凑、可重建、利于生成的视频潜。 本文贡献:提出 VideoRAE:用冻结视频基座编码器的多尺度层级特征,经轻量 1D 自注意力投影器压缩;同时支持扩散 Transformer 的连续潜与自回归的离散 token(多码本高维量化)。解码时用与冻结 VFM 教师的局部-全局表征对齐目标保语义,无需 KL 正则。 实验效果:连续/离散两套设定下重建均强;UCF-101 上 AR/DiT 的 class-to-video gFVD 分别达 40 与 93(SOTA),收敛约比竞品自编码器快 5×;在受控 2B 文生视频实验中替换 LTX-VAE 亦更快收敛。 批判点评:把「理解向视频基座」改造成「生成友好潜空间」,连续+离散双轨、对齐目标替代 KL,方向很对、收敛数字漂亮。但依赖外部冻结 VFM 教师、投影器与量化设定仍有设计敏感度,开放域长视频/文生视频上相对专用 VAE 的画质上限仍需更大规模验证。 3. Seriality Gap:视频扩散缺可扩展串行算力 The Seriality Gap in Video Diffusion Models | UC Berkeley | arXiv:2607.13031 关键词:视频扩散,物理推理,世界模型,串行性,评测 前序问题:多球碰撞要求逐步推演因果链,但标准双向视频扩散在因果链变长时性能塌陷,即使加更多去噪步也救不回来;此前缺少把「依赖事件结构」与「视频长度」拆开的受控诊断。 本文贡献:在多球硬球动力学上定义串行性缺口(Seriality Gap):双向去噪循环无法提供可扩展的串行算力。用等长单球对照隔离「依赖事件」而非长度;干预实验比较自回归/分块生成与加深骨干等能增加有效串行计算的手段,并理论证明对确定性视频预测去噪步并不增加串行深度。 实验效果:双向扩散随碰撞链变长显著变差,单球对照下缺口基本消失;加去噪步无法弥合缺口,而自回归/更小时间块与加深网络更有效。常见失败含穿透、球数错乱、颜色身份互换。 批判点评:用极简硬球探针+理论证明把「看起来会动」和「真有串行因果算力」拆开,Berkeley 诊断很犀利,对「视频扩散当世界模型」泼了冷水。但设定高度合成、与开放域文生视频差距大,迁移边界需谨慎;主要是诊断而非即插即用修补方案。 4. IdentityTuning:免训练调身份token改五官 Latent-Identity Tuning in Text-to-Image Personalization Models | 特拉维夫大学·Cornell | arXiv:2607.11885 关键词:文生图,个性化,身份调谐,人脸,潜空间 前序问题:人脸生成与编辑精度要求极高,轻微改动就会改变身份感;现有个性化方法忠实复现身份,却几乎无法「改身份本身」(如加胡子、改鼻子、加雀斑)并让改后身份在后续所有生成中保持一致。 本文贡献:定义身份调谐(identity tuning):直接改个性化编码器里编码身份的潜表示,而非改单张图。无需额外训练,利用冻结编码器架构挖掘潜语义方向;身份潜由一组扮演不同角色、常对应特定面部区域的 token 组成,可在选定 token 子空间内做局部、细粒度、语义连贯的编辑。 实验效果:定性和定量实验显示可做多样局部人脸编辑(改鼻子、加雀斑/胡子、控眼睛开合、迁移眉毛等),且改后身份能跨多样提示一致生成到新场景。 批判点评:把「改一张脸」升级成「改可复用的身份 latent」,免训练挖方向、token-区域对应清晰,产品叙事很强。但依赖特定个性化编码器结构,跨模型迁移与全身/多主体场景、以及极端 stylization 下身份连贯性仍待用户侧验证。 5. RINO:万物皆RGB统一视觉接口 Let RGB Be the Language of Vision | 约翰霍普金斯·CMU·UCSC·Rice | arXiv:2607.12450 关键词:统一视觉,图像编辑,零样本,RGB表示,条件生成 前序问题:视觉任务表示碎片化——RGB、one-hot mask、连续深度图各用各的编解码与适配器,难像 LLM 用文本那样用统一接口自由交互;多数视觉基座仍像任务专家而非通用视觉学习者。 本文贡献:提出 RINO(RGB In and RGB Out):掩码、深度等结构化视觉信号一律表示为 RGB,通用视觉任务统一成 RGB→RGB 图像编辑问题;在通用图像编辑骨干(如 Qwen-Image-Edit)上仅用无参数数据转换模块,不做任务专用微调,共享与自然图像相同的编解码架构与参数。 实验效果:零样本覆盖 20+ 理解/生成任务:深度估计 δ₁ 达 0.938,接近 Depth Anything 专家模型;条件生成在既有协议下刷新零样本 SOTA;人评亦认可其理解与生成结果。 批判点评:「让 RGB 当视觉的语言」把理解与条件生成压进同一编辑接口,零样本广度与深度数字都有冲击力。但 RGB 编码连续几何/离散标签必有信息损失,复杂开放词汇分割与精细控制仍可能输给专用头,且强依赖强编辑骨干的先验——换弱骨干时统一范式收益会否缩水仍待看。 趋势观察 文生图 RL 奖励转向「免训即用」 — SpectraReward 用 MLLM 图像条件提示似然当奖励,Self-SpectraReward 更让理解分支自赏生成分支,奖励设计从偏好标注/裁判打分转向复用预训练对齐与策略自身理解。 视频基座表征开始反哺生成潜空间 — VideoRAE 把冻结 V-JEPA/VideoMAE 表征压成连续/离散生成潜,收敛快于传统 3D-VAE,理解向视频基座正成为新一代视频 tokenizer 的候选。 视频生成的「世界模型」能力被探针拆穿 — Seriality Gap 证明双向视频扩散缺可扩展串行算力,碰撞链一长就塌、加去噪步也救不回来,评测正从画质指标转向可控物理探针。 人像个性化从复现身份走向调谐身份 — IdentityTuning 免训练挖掘身份 token 方向,一次改鼻子/胡子/雀斑后跨提示一致生成,产品叙事从「像我」升级到「按我想要的样子像我」。 统一视觉接口押宝「万物皆 RGB」 — RINO 把 mask/深度/姿态条件统一成 RGB 编辑,零样本逼近专家深度模型,统一多模态正从「文本接口」扩到「共享视觉语言」。 人工智能炼丹君 整理 | 2026-07-16 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-14|DeepMind断言视频生成即通用视觉底座 今日 AIGC 论文速览 今日共 7 篇 · 视频生成基础模型与推理 2 篇 · 高效视频生成与重建 2 篇 · 音乐舞蹈与全景生成 2 篇 · 高效语音合成 1 篇 重点论文标题列表 GenCeption(Google DeepMind):视频生成模型是通用视觉学习器 OPSD-V(美团·港科大·港城大):在线自蒸馏救少步AR视频 OpenCoF(字节Seed·港中文):让视频生成学会逐帧推理 LongE2V(阳明交大(台湾)):扩散先验统一事件视频重建 Wan-Dancer(阿里通义):分钟级音乐到舞蹈生成 今日论文速览 1. GenCeption:视频生成模型是通用视觉学习器 Video Generation Models are General-Purpose Vision Learners | Google DeepMind | arXiv:2607.09024 关键词:视频生成,视觉基础模型,预训练,深度估计,涌现泛化 前序问题:NLP 靠下一 token 预测从任务专用模型走向强大的通用基础模型;那么计算机视觉要达到通用模型,需要什么等价的催化剂? 本文贡献:主张大规模文生视频是计算机视觉的强预训练范式,能提供通用视觉智能所需的时空先验、视觉-语言对齐与可扩展性。提出 GenCeption:以预训练视频生成扩散骨干定义一个前馈感知模型,可由文本指令引导执行多种视觉任务。 实验效果:在深度、表面法线、相机位姿估计、指代表达分割、3D 关键点预测等多样任务上达 SOTA,常匹配或超过 DepthAnything3、SAM3、VGGT-Omega、Sapiens 等专用模型;视频生成预训练优于 V-JEPA、Video MAE,数据效率极高(用少 7~500 倍数据即可比肩 D4RT/VGGT-Omega);且现涌现行为——仅用合成人像视频训练即可泛化到真实影像与动物/机器人等分布外类别。 批判点评:用 DeepMind 的分量把「视频生成=通用视觉基础」这一论断做实,跨任务 SOTA+惊人数据效率+涌现泛化,说服力强、方向指引意义大。但依赖大规模视频扩散骨干、算力门槛高,各下游任务仍需文本指令引导与适配,'通用'在更开放任务/真实部署下的稳健性仍需检验。 2. OPSD-V:在线自蒸馏救少步AR视频 OPSD-V: On-Policy Self-Distillation for Post-Training Few-Step Autoregressive Video Generators | 美团·港科大·港城大 | arXiv:2607.08766 关键词:视频生成,自回归,自蒸馏,少步采样,长视频 前序问题:少步自回归(AR)视频生成器能低延迟产长视频,但长程 AR 展开时存在误差累积与运动动态减弱。 本文贡献:提出在线(on-policy)自蒸馏范式 OPSD-V 做少步 AR 视频后训练:减少长程退化的同时保持原有少步推理路径。核心是训练时引入真实长视频作时序上下文、提供稠密的轨迹级监督——学生严格按推理时 rollout、以自己此前生成的 KV cache 为条件逐块生成;教师在学生所到的相同去噪状态评估,但用更干净、AR 一致的时序缓存(旧历史可替换为真实视频上下文),从而在在线 AR 缓存动态下给出稠密的去噪级纠正目标,不改采样器/去噪步数/推理时缓存机制。 实验效果:应用于 Self-Forcing、LongLive 等代表性少步 AR 视频模型,视觉质量、运动动态与 VBenchLong 一致提升;10 人用户研究中 66.0% 场景更偏好 OPSD-V(排除平局达 82.5%)。 批判点评:「学生走真实推理路径、教师用真实视频上下文给稠密纠正」是对少步 AR 长视频退化的精准手术,且不动推理链、即插即改。但需真实长视频作上下文、训练成本上升,纠正上限受教师与真实上下文质量制约,超长时程的漂移是否彻底解决仍待观察。 3. OpenCoF:让视频生成学会逐帧推理 OpenCoF: Learning to Reason Through Video Generation | 字节Seed·港中文 | arXiv:2607.08763 关键词:视频生成,视频推理,Chain-of-Frame,数据集,注意力 前序问题:推理已成大模型核心能力;视频生成提供了不同于 Chain-of-Thought 的路径——推理可经时序相连的帧展开(Chain-of-Frame, CoF)。但现有视频生成器多在通用语料上训练,缺乏针对 CoF 推理的多样监督与专门设计。 本文贡献:提出 OpenCoF 框架:含横跨 11 类任务的推理视频数据集 OpenCoF-17K,以及微调视频模型 Wan-CoF 研究多样时序监督能否改善 CoF;并进一步给模型配「视觉+文本推理 token」分别捕捉低层视觉线索与高层语义先验以做空间/时序推理,通过性能对比与注意力分析考察这些 token 在模型深度、去噪步、空间与时间上的贡献。 实验效果:在四个视频推理基准上,Wan-CoF 较 Wan2.2-I2V-A14B 基线取得可观提升;数据、模型与代码全开源。 批判点评:把「用连贯帧展开推理」正式化为 CoF 并配数据集+推理 token,为「会推理的视频生成」提供了抓手,开源也利于生态。但视频推理评测仍不成熟、'画面推理'与真实逻辑正确性的关系待厘清,推理 token 带来的额外结构与开销在更复杂任务上的收益仍需验证。 4. LongE2V:扩散先验统一事件视频重建 LongE2V: Long-Horizon Event-based Video Reconstruction, Prediction, and Frame Interpolation with Video Diffusion Models | 阳明交大(台湾) | arXiv:2607.08770 关键词:事件相机,视频重建,视频扩散,插帧,时序一致 前序问题:从稀疏事件流恢复高质量视频很难:回归方法常糊化纹理,现有生成模型又难保长期稳定。 本文贡献:提出 LongE2V,用预训练视频扩散先验联合处理事件相机的视频重建、预测与插帧:微调基础视频模型获高数据效率与更优感知质量;用自回归展开(Autoregressive Unrolling)与自适应上下文切换缓解超长序列时序漂移;用重编码对齐+交叉残差校正保证插帧的精确双向一致;用事件体素密度增强确保跨传感器分辨率鲁棒。 实验效果:真实基准上在重建/预测/插帧三任务全面超过 SOTA,时序连贯性突出且具零样本泛化。 批判点评:把视频扩散先验迁到事件相机这一低层重建任务、一套框架吃三任务,数据效率与感知质量兼得,思路新颖。但依赖预训练视频先验与微调、事件-视频域差处理,极端稀疏/高速场景下的重建保真与长程漂移仍是挑战。 5. Wan-Dancer:分钟级音乐到舞蹈生成 Wan-Dancer: A Hierarchical Framework for Minute-scale Coherent Music-to-Dance Generation | 阿里通义 | arXiv:2607.09581 关键词:音乐到舞蹈,长视频,分层生成,RoPE,阿里通义 前序问题:直接从音乐生成长时长、高清、节奏同步的舞蹈视频仍很难——现有扩散模型多在 20 秒后失效,无论走中间 3D 骨架还是端到端合成,长时都有时序漂移、身份不一致与动作重复。 本文贡献:提出分钟级连贯音乐到舞蹈生成的分层框架:把过程解耦为全局关键帧规划与局部时序精修,利用整轨音乐上下文保长程连贯;关键创新含经时间映射 RoPE 的动态帧率自适应(精确对齐)、基于光流的损失(增强动作连续性)、动作速度控制(快速运动保细节)。 实验效果:突破常规时长壁垒,生成稳定、超过一分钟的 720p/30fps 舞蹈视频;跨五种舞种、可由音频与文本共同条件,刷新长时长连贯舞蹈合成 SOTA。 批判点评:「全局规划+局部精修」的分层设计对症长视频漂移,分钟级 720p/30fps 与多舞种适配很有产品感(通义出品)。但舞蹈生成对身份一致与物理合理要求高,分层拼接处的连贯、复杂高速编舞的保真,以及音乐-动作语义对齐的细腻度仍需更多样例检验。 6. Canvas360:几何感知的上下文全景生成 Enhancing In-context Panoramic Generation via Geometric-aware Pretraining | Insta360·清华 | arXiv:2607.08765 关键词:全景生成,上下文生成,几何感知,深度,图像编辑 前序问题:全景文生图快速进步,上下文(in-context)编辑成自然延伸,但缺乏大规模高质量的上下文全景训练数据,且全景几何一致性难保。 本文贡献:提出两阶段框架 Canvas360:几何感知预训练+下游任务微调。构建含 1M 高质量配对全景样本的 Canvas360Dataset(覆盖风格迁移/修补/外扩/编辑);建模上用并行深度生成、速度环形填充与相似度损失正则,学习几何感知表征、捕捉物体畸变细节、提升几何一致与全局连贯;借强全景先验,用 token 级拼接统一支持多种下游上下文全景任务。 实验效果:显著提升全景图像保真,在全景专用 FAED 指标上尤强,其余量化指标具竞争力或领先,任务覆盖与建模灵活性超过此前方法。 批判点评:补齐上下文全景的大规模数据+几何感知预训练,环形填充等针对全景畸变的设计对症,Insta360 背景也贴近实拍应用。但 1M 数据靠深度预测配对、质量受预测器限制,全景特有的极区畸变与跨接缝一致在复杂编辑下仍是难点。 7. FreyaTTS:免tokenizer的高效边端TTS FreyaTTS Technical Report | Freya Team | arXiv:2607.09530 关键词:语音合成,流匹配,免tokenizer,边端部署,土耳其语 前序问题:高可靠、高效的对话式语音合成需要在小模型上同时兼顾质量与部署效率。 本文贡献:推出 FreyaTTS:183.2M 参数、免 tokenizer、土耳其语优先的非自回归条件流匹配 DiT,工作在冻结的 AudioVAE2 连续潜空间(16kHz 编码/48kHz 解码),把容量全用于文本到潜表征映射。三大改进:(1)从 92 个土耳其字符词表端到端建模,无音素器/G2P 前端/离散语音分词器;(2)非自回归并行去噪,一次性预测整段潜序列;(3)面向生产的两阶段后训练(单说话人音色锁定+短句覆盖)提升一致性与短输入鲁棒。 实验效果:在 Freya-TR-Eval 上 WER 8.0%、CER 3.0%,以极小参数超过更大开源系统;消费级 GPU RTF 0.11、笔记本 CPU 也快于实时,适配边端部署;权重/代码/基准以 Apache-2.0 开源。 批判点评:免 tokenizer+非自回归+边端友好,把小模型 TTS 的质量与效率平衡做得很实用,开源也友好。但为土耳其语优先,跨语言/多语种泛化未知,183.2M 小模型在情感/多说话人/长文本上的表现天花板仍有限。 趋势观察 视频生成被当作通用视觉基础 — GenCeption 证明文生视频预训练能催生通用视觉智能(深度/法线/位姿/分割全 SOTA),视频生成不只是合成工具、更是感知底座。 少步自回归视频死磕长程质量 — OPSD-V 用在线自蒸馏修复少步 AR 视频的误差累积与动态衰减,'长视频不崩'成为实时生成的关键命题。 视频生成学会'用画面推理' — OpenCoF 提出 Chain-of-Frame 让模型在时序帧上展开推理,视频生成正从'画得像'走向'想得对'。 扩散先验反哺低层视觉重建 — LongE2V 借视频扩散先验统一事件相机的重建/预测/插帧,生成式先验持续反哺低层视觉与重建任务。 长时长与垂直场景生成加速落地 — Wan-Dancer 把音乐到舞蹈推到分钟级 720p、Canvas360 做上下文全景、FreyaTTS 把 TTS 塞进边端,生成向长时长与专用场景延伸。 人工智能炼丹君 整理 | 2026-07-14 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-10|高通MobileWan让5B视频扩散上手机16FPS 今日 AIGC 论文速览 今日共 10 篇 · 生成加速与高效训练 3 篇 · 生成理解一体化 1 篇 · 视频修复与重打光 3 篇 · 音频与语音生成 2 篇 · 生成安全与对齐 1 篇 重点论文标题列表 MobileWan(高通(Qualcomm)):5B视频扩散首上手机16FPS Dynamic-in-Few-Step(西湖大学·vivo·浙大):少步蒸馏配动态稀疏30倍 FourTune(MIT·Stanford·CMU):全4bit后训练提速2.27倍 Gen4U(Google DeepMind):冻结视频扩散当通用编码器 LightCrafter(CMU·多伦多大学·博世):PBR代理视频重打光更可控 今日论文速览 1. MobileWan:5B视频扩散首上手机16FPS MobileWan: Closing the Quality Gap for Mobile Video Diffusion | 高通(Qualcomm) | arXiv:2607.06173 关键词:视频扩散,移动端部署,循环蒸馏,注意力剪枝,VBench 前序问题:视频扩散靠把 Transformer 扩到数十亿参数换质量,但手机端模型受限于 0.4-1.8B 小参数预算、生成质量上不去;难点是如何在内存受限的移动硬件上跑服务器级大模型。 本文贡献:证明高质量移动端视频生成不必用小模型——把服务器级 5B 视频扩散 Transformer 高效部署到手机。以 Wan2.2-5B 为起点,用循环蒸馏把视频生成改造成分块自回归、常数内存注意力;配合因果线性注意力让模型推理时像 RNN 运行且跨块保持时序一致;再提出可学习注意力头剪枝(二值化逐头门控+噪声偏置稀疏目标端到端优化+蒸馏微调),叠加采样步蒸馏与内存优化 VAE 解码。 实验效果:成为首个可部署到商用手机的 5B 级视频扩散模型;在 Qualcomm Snapdragon 8 Gen 5 NPU 上以 20 秒端到端延迟生成 5 秒 480×832、16 FPS 视频,VBench 得分 83.79,刷新移动端视频生成 SOTA。 批判点评:用「循环重构+因果线性注意力+逐头剪枝+步蒸馏」组合拳把 5B 大模型压进手机 NPU,是移动端视频生成的一次实打实突破,高通自家 NPU 落地也很硬核。但 480×832/5 秒/16 FPS 仍是受限规格、20 秒延迟离交互式实时尚有距离,多重压缩(剪枝+线性注意力+步蒸馏)对复杂运动/长视频的质量损失、以及对非骁龙硬件的可迁移性仍待观察。 2. Dynamic-in-Few-Step:少步蒸馏配动态稀疏30倍 Dynamic-in-Few-Step: Unifying Dynamic Computation and Few-Step Distillation for Efficient Video Generation | 西湖大学·vivo·浙大 | arXiv:2607.06631 关键词:视频扩散,少步蒸馏,动态稀疏,模型混合,后训练加速 前序问题:视频扩散质量高但算力昂贵;少步蒸馏虽提速,却对所有去噪阶段强制统一的静态结构,忽视了不同噪声水平天然不同的算力需求。 本文贡献:提出后训练加速框架,把动态结构稀疏化直接融进蒸馏过程:不同于对固定管线做事后压缩,它联合优化去噪步数与结构稀疏度,把预训练视频扩散变成紧凑的、逐步专用的模型混合(Mixture-of-Models, MoM);并用渐进训练策略+输出回滚机制解决联合优化的训练不稳定,配套专用推理引擎高效部署。 实验效果:与现有加速技术正交且高效:在 Wan-14B 上,在 4 步蒸馏基础上再去掉 24% 的每步 FLOPs、额外带来 1.2× 墙钟加速,相对 50 步教师达到 30× 提速,同时保持有竞争力的生成质量。 批判点评:抓住「不同噪声步算力需求不同」这一被少步蒸馏忽视的冗余,用逐步专用 MoM 把动态稀疏与蒸馏联合优化、且与其它加速正交,思路精准、30× 提速实在。但 MoM 带来路由与部署复杂度、需专用推理引擎,「4 步基础上再省 24% FLOPs」的绝对增益有限,训练稳定性靠渐进策略+回滚机制维持、调参成本与更大规模泛化仍待看。 3. FourTune:全4bit后训练提速2.27倍 FourTune: Towards Fully 4-Bit Efficient Post-Training for Diffusion Models | MIT·Stanford·CMU | arXiv:2607.05711 关键词:扩散模型,4-bit量化,后训练,LoRA,FLUX 前序问题:大扩散模型后训练受显存占用大、训练慢制约,现有参数高效微调(PEFT)只能部分缓解,始终困在「省显存却不省算力」的内存-速度权衡里(如 LoRA 全精度骨干仍占大量显存、QLoRA 频繁在线反量化反增开销)。 本文贡献:提出 FourTune,基于端到端 W4A4G4(权重/激活/梯度全 4-bit)的高效后训练框架:三分支混合管线在标准 LoRA 上增设冻结的数值稳定器,隔离对量化敏感的离群值,从而在原生 4-bit 计算下稳定训练;并用硬件友好的分块量化与定制融合算子支持高效量化反向传播、降低显存带宽开销。 实验效果:在定制化、强化学习、蒸馏三类任务上均可匹配全精度微调质量;在 FLUX.1-dev(12B)上,相比 BF16 LoRA 显存开销降低 2.25×、端到端训练吞吐提升 2.27×。 批判点评:把量化从推理推进到「后训练全 4-bit(含梯度)」,用冻结数值稳定器隔离离群值破解 4-bit 训练不稳定,配定制融合算子拿到 2.25× 显存/2.27× 吞吐,MIT/Stanford/CMU 这套量化天团工程含金量高。但 W4A4G4 依赖特定硬件与定制 kernel、通用性受限,数值稳定器额外分支的开销、以及更大模型/更长训练下 4-bit 梯度的精度累积误差仍需更多验证。 4. Gen4U:冻结视频扩散当通用编码器 Gen4U: Unifying Video Generation and Understanding via Diffusion | Google DeepMind | arXiv:2607.06856 关键词:视频扩散,生成理解一体化,表征探测,视频编码器,零样本 前序问题:以往认为扩散表征只擅长低层几何、拙于高层语义,生成与理解被割裂看待;能否让同一个视频扩散模型既生成又理解,缺乏系统证据。 本文贡献:用互近邻(mutual-kNN)对齐度量系统探测 SOTA 视频扩散(Veo3、Wan2.2)的中间激活,揭示其潜空间沿网络深度与噪声水平高度结构化:中等噪声给出线性可分的全局语义,低噪声保留细粒度细节但空间分散、需注意力解码。据此提出 Gen4U,用单次前向复用这些生成表征,把冻结的大规模视频扩散直接当作强视频编码器。 实验效果:冻结、免微调的视频扩散在视频分类、深度估计、相机位姿估计、图像/视频描述等一系列语义与非语义任务上都极具竞争力,在保留原模型高质量生成能力的同时统一了生成与理解两大范式。 批判点评:用对齐度量把「视频扩散潜空间怎样编码语义」讲清楚,并证明冻结模型免微调即是强编码器,是对「生成即理解」的漂亮实证,DeepMind 用 Veo3 背书说服力强。但探针依赖对 mutual-kNN 等度量与噪声/层位的精心选点,下游任务用简单读出头、与专用微调 SOTA 仍有差距,且强依赖顶级视频扩散(Veo3 闭源),可复现与在更弱模型上的普适性存疑。 5. LightCrafter:PBR代理视频重打光更可控 LightCrafter: PBR-Conditioned Video Diffusion Refinement for Controllable and Consistent Relighting | CMU·多伦多大学·博世 | arXiv:2607.08016 关键词:视频重打光,PBR渲染,视频翻译,时序一致,CogVideoX 前序问题:视频重打光要同时兼顾长时时序一致与基于物理的光传输,依赖对材质/几何/光照等本征属性的准确估计。已有两条路都不理想:逆渲染+正渲染重建噪声大、难处理全局光照;生成式视频到视频翻译则可控性差、时序不稳、且受配对训练数据限制。 本文贡献:提出 LightCrafter 混合管线,把视频重打光重构为「对一段代理视频做视频翻译」:不直接翻译输入视频,而是把「输入在目标光照下的 PBR 渲染」翻译为最终结果——将光照目标烘焙进 PBR 代理,免去教扩散模型理解环境贴图等光照概念,既能实现更精细的光照控制、又天然带来长时时序一致。为补足 PBR 难建模的全局光照,在合成配对视频+真实无配对视频上后训练 CogVideoX 以调用视频生成模型的光度先验。 实验效果:在真实世界重打光基准上超越此前 SOTA,并贡献了一个用于深入分析的合成基准;将开源数据集、基准、指标与代码。 批判点评:用「PBR 代理+视频翻译」把光照控制从难教的生成条件变成可烘焙的物理渲染,兼得可控性与时序一致,思路巧妙、实测超 SOTA。但方案质量受前置 PBR 渲染(依赖本征估计)的上限约束,全局光照仍要靠后训练 CogVideoX 兜底,两阶段管线的复杂度、以及对复杂材质/强动态场景的泛化仍待检验。 6. FADRA:频率感知扩散修复视频人脸 FADRA: Frequency-Aware Diffusion with Residual Adaptation for Video Face Restoration | UAE大学·中国海洋大学·MBZUAI | arXiv:2607.06389 关键词:视频人脸修复,频率感知,扩散模型,残差自适应,时序一致 前序问题:视频人脸修复(VFR)要从严重退化的视频里恢复高质量且时序一致的面部细节,现有方法难以在空间保真与时序连贯间取得平衡。 本文贡献:提出 FADRA,频率感知+迭代残差自适应的扩散框架:借预训练文生视频扩散的强时序一致性,用轻量 LoRA 适配器+低质(LQ)像素对齐特征融合高效迁移冻结生成先验;再引入重复残差自适应头(RRAH)在骨干后做逐步残差精修——RRAH 把 LQ 潜变量与当前速度预测一起作输入,在每个流匹配步反复回看 LQ 线索、预测残差更新;另设频率感知损失在多个频段显式监督、强调对感知质量关键且易时序抖动的频率分量。 实验效果:恢复出更好的面部结构、产出比 SOTA 更时序一致的视频,在定量指标与主观感知上均有明显提升。 批判点评:用「LoRA 迁移生成先验+RRAH 逐步残差回看 LQ+频率感知损失」三招治 VFR 的空间-时序权衡,把频域监督用在易抖动分量上很对症。但方法叠了多个模块、对预训练文生视频先验依赖强,RRAH 重复精修的推理开销、以及在极端退化或大姿态/遮挡人脸上的鲁棒性仍需更多验证。 7. DiffCVE:编码先验引导压缩视频增强 DiffCVE: Diffusion-based Compressed Video Enhancement | 武汉大学 | arXiv:2607.07195 关键词:压缩视频增强,编码先验,扩散模型,QP条件,VAE解码 前序问题:严重压缩视频的感知质量增强很难:伪影模式复杂、信息损失大;直接套用扩散模型往往忽视压缩退化特性,还可能引入与结构不一致的幻觉。 本文贡献:提出 DiffCVE:用编码先验增强的双条件(CPDC)分支联合建模压缩视频与编码先验,让残差、运动矢量等编码先验在去噪过程中提供互补的结构与运动引导;用压缩退化语义提示(CDSP)以 QP 条件文本提示+LoRA 微调让扩散过程感知压缩严重程度;再在 VAE 解码器里加入编码先验引导的加权融合(CPWF),用 QP 预测的权重融合 VAE 编码器与编码先验编码器特征。 实验效果:在提升感知质量上效果显著,尤其在严重压缩设置下优势明显;项目页提供了增强视频演示。 批判点评:把「编码先验(残差/运动矢量/QP)」这一压缩视频独有信息喂进扩散去噪与解码,对症「忽视退化特性+幻觉」两大痛点,充分利用视频编码域知识很务实。但强依赖可拿到的编码先验(需解码端配合)、QP 条件与三模块叠加的复杂度,以及在跨编码标准/未知码率下的泛化仍待验证。 8. Flowley:端到端单阶段视频配音 Precise Video-to-Audio Generation with Cross-Modal Alignment in Latent Space | FPT Software·NVIDIA | arXiv:2607.06405 关键词:视频到音频,端到端,交叉注意力,音视频同步,VGGSound 前序问题:视频到音频(V2A)要为无声视频合成语义一致且时序同步的声音,但许多方法靠多阶段训练(算力高、耗时长),或把视觉转成文本以借用文生音频模型(牺牲细粒度时序线索)。 本文贡献:提出 Flowley,端到端单阶段训练架构,融合视觉特征与文本提示生成配音;核心是渐进软掩码交叉注意力,把音视频同步直接嵌进注意力机制、相较标准注意力零额外算力;并提出即插即用的 SoundCap 管线,为视频生成细粒度、声音导向的描述来引导模型(弥补现有 V2A 基准缺乏声音描述的问题)。 实验效果:不集成任何预训练音视频对齐模块,Flowley 在 VGGSound 多项指标上达到 SOTA;引入 SoundCap 后,零样本设置下音频质量进一步超过最强的闭源方法。 批判点评:用「软掩码交叉注意力零成本内建同步+SoundCap 补声音描述」把 V2A 做成单阶段端到端,免掉专用对齐模块还拿 SOTA,简洁高效。但收益部分来自 SoundCap 描述质量(引入额外描述管线),VGGSound 之外更开放场景的时序精准同步、以及对无明显声源/复杂多声源视频的泛化仍待验证。 9. SR-FD:分布正则降少步TTS错字36% Fréchet Distance Loss on Speech Representations for Text-to-Speech Synthesis | 台湾大学·华盛顿大学 | arXiv:2607.06027 关键词:语音合成,流匹配,Fréchet距离,分布正则,少步采样 前序问题:少步扩散/流匹配 TTS 通常用条件流匹配、重建、停止预测等局部目标训练,优化稳定却从不追问「采样出的语音是否服从高质量语音的分布」。 本文贡献:提出语音表征 Fréchet 距离损失(SR-FD),一种面向免 tokenizer 流匹配自回归 TTS 的训练期分布正则:微调时模型用与部署一致的少步采样器合成语音,SR-FD 把该语音的冻结 Whisper 与 CTC 特征的均值和协方差,对齐到离线从三种互补内容目标算好的参考统计;无需判别器、也不增加推理期计算。 实验效果:在 Seed-TTS 英文上,四步 SR-FD 微调把 WER 从四步 VoxCPM2 基线的 2.2279% 降到 1.4147%(相对降 36.5%),还超过原十步基线的 1.7366%;说话人相似度与客观质量代理保持在十步水平。 批判点评:把「生成分布是否像真语音」用 Fréchet 距离显式约束、且无判别器/零推理开销,让四步 TTS 可懂度反超十步基线、WER 降 36.5% 很漂亮。但增益主要体现在可懂度(WER)、对音色/韵律等主观维度提升有限,依赖 Whisper/CTC 特征与离线参考统计的选取,跨语言/多说话人与更大模型上的迁移仍待验证。 10. AEGIS:定位注意力头防视觉同义越狱 AEGIS: A Mechanism-Guided Defense against Visual Synonym Jailbreaks in Text-to-Image Models | 复旦·阿里 | arXiv:2607.06120 关键词:文生图,安全对齐,越狱防御,注意力头,推理期干预 前序问题:文生图扩散虽保真度高、应用广,却易被「视觉同义词攻击(VSA)」越狱——看似良性的提示通过隐式视觉联想诱导出违禁图像;现有防御大多围绕过滤/编辑时显式暴露的不安全概念,对 VSA 留有盲区,陷入「防不住 VSA 或误伤相似良性概念」的安全-效用两难。 本文贡献:从「静态压制预设不安全概念」转向「动态追踪不安全语义如何在生成中涌现」。机理分析发现:VSA 与显式不安全提示都通过稀疏的「语义注入注意力头」收敛,这些头是违禁视觉语义的推理期瓶颈。据此提出 AEGIS(经识别与引导的自适应规避防护),一种推理期防御,仅在被识别出的脆弱注意力头上施加相似度感知的排斥。 实验效果:对比 16 个基线,AEGIS 同时提升安全与效用:在 SD 1.4 上把域内暴力/裸露 VSA 的攻击成功率(ASR)降到 0.00/0.03、域外显式与对抗攻击 ASR≤0.09;保持良性图像保真、不误伤难负概念,并可在重识别关键头后迁移到 SD 2.1 与 FLUX.1。 批判点评:用机理分析锁定「语义注入注意力头」这一 VSA 瓶颈、只在少数脆弱头做定向排斥,既躲开全局压制的误伤又不需重训,把安全-效用两难做出正收益、还能跨模型迁移,思路犀利。但依赖对脆弱头的准确识别(每个骨干需重识别),面对自适应攻击者绕开这些头、或更强开源模型上的稳健性仍是开放问题,推理期干预对生成多样性的潜在影响也需观察。 趋势观察 视频生成加速冲向端侧与实时 — MobileWan 把 5B 视频扩散塞进手机 NPU、Dynamic-in-Few-Step 在 Wan-14B 上做到 30× 提速,视频扩散加速正从「云端少步」推进到「端侧部署+动态稀疏」,落地门槛快速下探。 量化从推理走进后训练全链路 — FourTune 把权重/激活/梯度全压到 4-bit 做后训练,在 FLUX 12B 上省 2.25× 显存,低比特正从推理阶段延伸到微调/强化学习/蒸馏的完整后训练闭环。 视频扩散正成为通用视觉基座 — Gen4U 证明冻结的视频扩散免微调即是强编码器,可同时做生成与分类/深度/位姿/描述,「生成即理解」让一个大模型统一多任务成为新范式。 视频修复复用生成先验+物理/编码先验 — LightCrafter 用 PBR 代理烘焙光照、FADRA 用频率感知残差修脸、DiffCVE 用编码先验补压缩视频,视频修复类工作普遍「借预训练生成先验+注入领域先验」提质。 多模态生成扩到音频且更重安全 — Flowley 单阶段视频配音、SR-FD 用分布正则提 TTS 可懂度,音频生成同步演进;AEGIS 则用机理定位注意力头防 T2I 越狱,安全从静态过滤转向生成期动态干预。 人工智能炼丹君 整理 | 2026-07-10 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
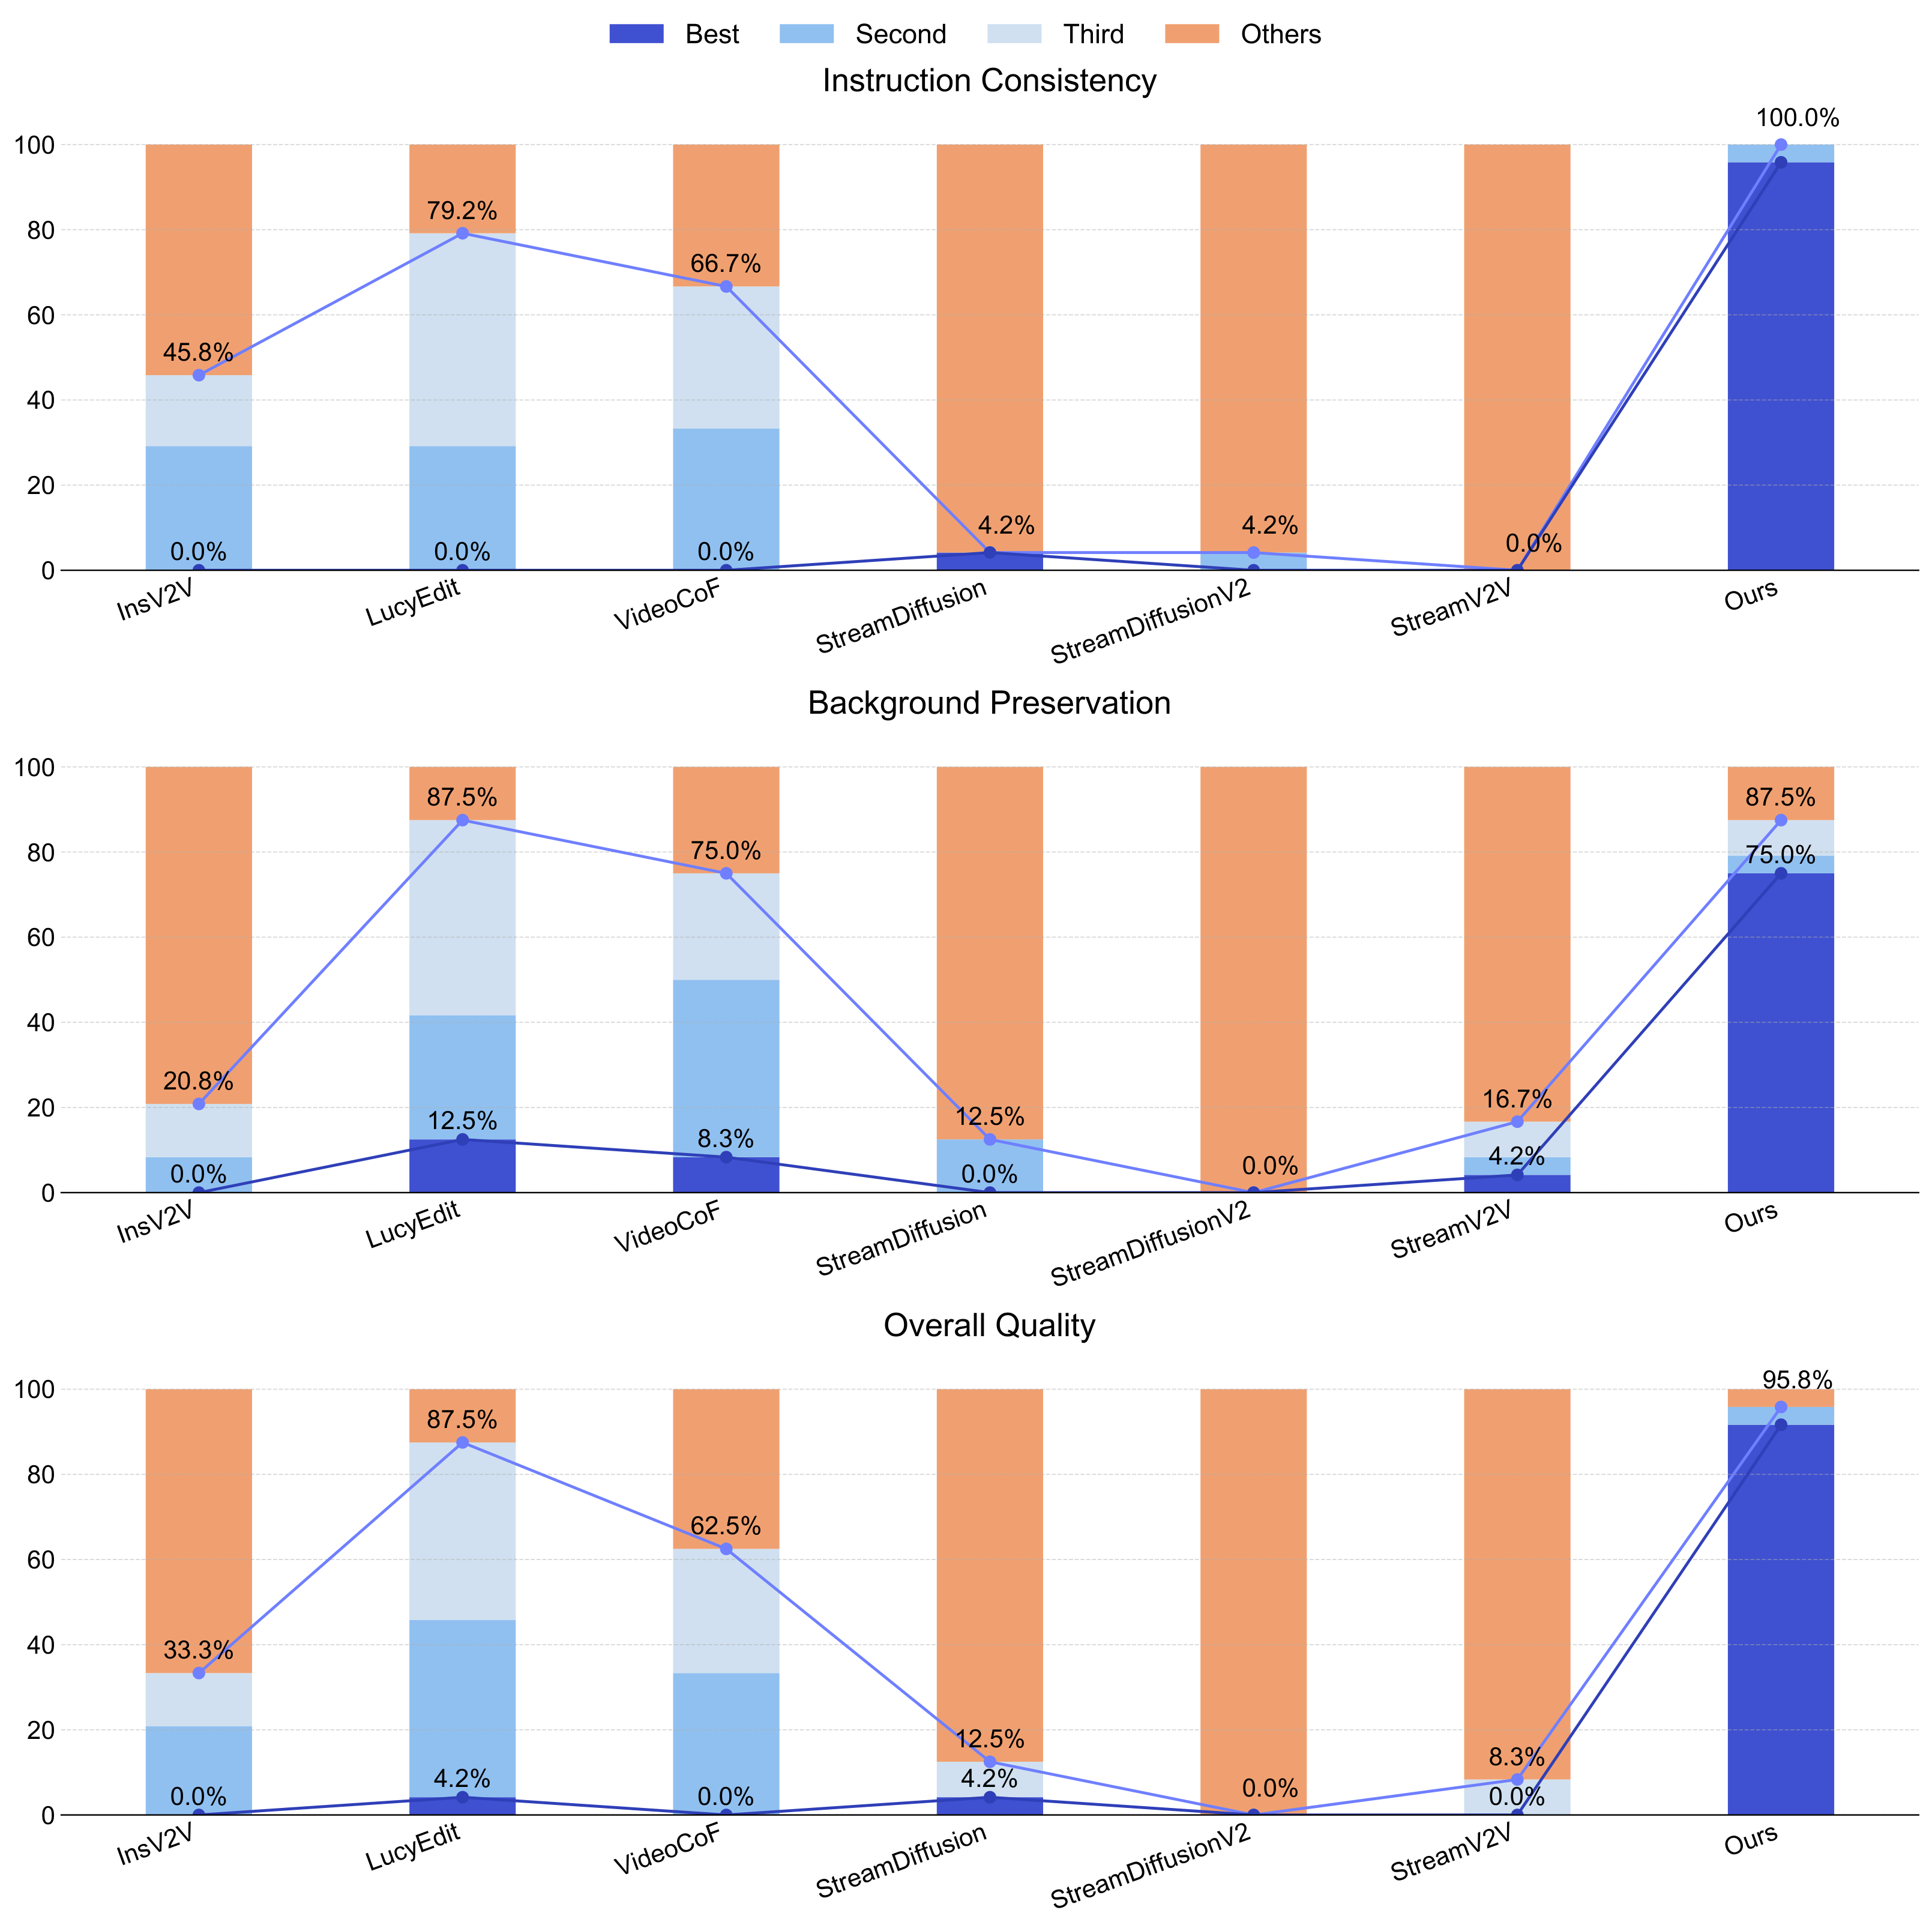
AIGC 每日速读|2026-06-29|清华LiveEdit实时流式视频编辑12.66FPS 今日 AIGC 论文速览 今日共 9 篇 · 视频编辑与生成 3 篇 · 自回归图像生成 2 篇 · 推理加速与压缩 2 篇 · 生成质量与评测 2 篇 重点论文标题列表 LiveEdit(清华·港科大):实时流式视频编辑12.66FPS Causal-rCM(清华·UT Austin·NVIDIA):统一TF+SF自回归扩散蒸馏 PRA(北京大学·深势科技):像素自回归生成新SOTA TMP(腾讯混元):剪枝把80B图像模型塞进4090 LearniBridge(清华(深圳)):可学习特征缓存加速扩散 今日论文速览 1. LiveEdit:实时流式视频编辑12.66FPS LiveEdit: Towards Real-Time Diffusion-Based Streaming Video Editing | 清华·港科大 | arXiv:2606.26740 关键词:视频编辑,流式生成,实时,蒸馏,缓存 前序问题:流式视频编辑落地受两大瓶颈制约:跨时间维持背景与非编辑区稳定,以及实时交互所需的低延迟;而现有流式视频生成方法多为合成设计,因严格保真与区域控制要求无法直接用于编辑。 本文贡献:提出新型流式视频编辑框架,做因果、逐帧编辑且强内容保持、实时响应。核心是三阶段蒸馏管线,把强双向基础模型的编辑能力渐进迁移到高效单向流式编辑器,实现稳定长程编辑而不牺牲画质;并引入面向自回归的 mask cache 跨帧复用区域相关计算,减少冗余、加速推理;还建立了专门的流式视频编辑基准。 实验效果:在流式基线中达到 SOTA 画质,同时把推理速度大幅提升到 12.66 FPS,适配交互与 AR 场景。 批判点评:用「双向→单向」三阶段蒸馏+mask cache 把视频编辑推到实时(12.66FPS),方向价值高、还补齐了流式视频编辑基准空白。但 12.66FPS 距真正流畅交互仍有差距,逐帧因果编辑对快速运动/大幅编辑的长程一致性、以及对复杂编辑指令的上限仍需更多验证。 2. Causal-rCM:统一TF+SF自回归扩散蒸馏 Causal-rCM: A Unified Teacher-Forcing and Self-Forcing Open Recipe for Autoregressive Diffusion Distillation in Streaming Video Generation and Interactive World Models | 清华·UT Austin·NVIDIA | arXiv:2606.25473 关键词:视频生成,自回归扩散,蒸馏,世界模型,一致性模型 前序问题:因果扩散 Transformer 的自回归视频扩散已成实时流式生成与动作可控交互世界模型的主流,但其蒸馏配方缺乏统一、可扩展的开源方案。 本文贡献:把先进蒸馏框架 rCM 扩展到自回归视频扩散,利用前向/反向散度互补——teacher-forcing(TF)对应离线前向散度因果训练、self-forcing(SF)对应在线反向散度精修。贡献含:(1)证明 TF 一致性模型是 SF-DMD 的最佳初始化补充;(2)首次为自回归视频扩散实现连续时间 TF 一致性模型(sCM/MeanFlow),靠自定义 mask FlashAttention-2 JVP kernel 实现,收敛比离散时间快 10×;(3)推出统一可扩展的算法-基建开源配方 Causal-rCM;(4)仅用合成数据训练即在逐帧/分块流式生成上达 SOTA。 实验效果:蒸馏后的 2 步因果 Wan2.1-1.3B 仅 1-2 采样步即得 VBench-T2V 84.63;并应用于全模态世界基础模型 Cosmos 3,实现动作可控的交互世界模型。 批判点评:把 rCM 的「前向×反向散度互补」干净地迁到自回归设定,10× 收敛+全开源配方含金量高,世界模型落地也实在。但收益依赖既有 rCM/DMD 体系与定制 kernel 工程,仅用合成数据训练在真实分布上的泛化、以及 1.3B 规模外的可扩展性仍待看。 3. PRA:像素自回归生成新SOTA Parallel Rollout Approximation for Pixel-Space Autoregressive Image Generation | 北京大学·深势科技 | arXiv:2606.27978 关键词:自回归生成,像素空间,ImageNet,FID,生成理解统一 前序问题:像素空间连续 token 自回归(AR)直接把图像建模为原始像素块序列、免离散分词,但面临耦合难题:高维像素块单步误差大,teacher-forcing 训练又造成训练-推理鸿沟使误差跨步累积;现有 x-prediction、噪声注入只部分缓解,精确 rollout 又因顺序采样太慢不实用。 本文贡献:提出 Parallel Rollout Approximation(PRA):生成低维中间态而非高维像素块,再用像素解码器映回像素 token,保持「像素进-像素出」AR 接口;并通过同一「中间态→像素」路径按位置独立地构造类推理输入,逼近推理时 rollout 的像素反馈接口,同时保留并行 teacher-forcing 训练。 实验效果:ImageNet-1K 256² 类条件生成上,135M 的 PRA-S 取得 FID 2.58,超过此前十亿级像素 AR 的 3.60;511M 的 PRA-L 进一步到 FID 1.94,刷新像素空间 AR 新 SOTA;ImageNet 分类探针准确率也高于其他 AR/扩散基线。 批判点评:用「低维中间态+并行近似 rollout」一招同时治高维误差与训练-推理鸿沟,135M 超十亿参数、FID 1.94 的数字很硬,且指向生成-理解统一。但仍限 ImageNet 类条件、256² 规模,能否迁到大规模文生图与更高分辨率、像素解码器的额外开销如何仍待验证。 4. TMP:剪枝把80B图像模型塞进4090 TMP: Tree-structured Mixed-policy Pruning for Large-scale Image Generation and Editing | 腾讯混元 | arXiv:2606.27089 关键词:模型剪枝,图像生成,MoE,混元,推理降本 前序问题:现代图像生成模型为高保真不断膨胀,参数与算力开销巨大;HunyuanImage-3.0 等开源 SOTA 达 80B、推荐 3×80GB GPU 才能推理,社区难用;而现有结构化剪枝多为 DiT 定制,HunyuanImage-3.0 却是 MoE 解码器 LLM(Hunyuan-A13B),并不适配。 本文贡献:提出首个树形混合策略剪枝框架 TMP,泛化 T2I 与 TI2I 任务、MoE 与 DiT 架构,并可作为步数蒸馏模型的最后一级压缩。 实验效果:把 HunyuanImage-3.0 从 80B 压到 20B(75% 压缩)、生成质量损失有限,并经工程优化让 20B 版在单张 24GB 4090 上可推理(脚本与权重已并入官方开源仓库);还把 Z-Image turbo 从 6B 压到 4B(33%)几乎无损。 批判点评:把 80B 模型塞进单卡 4090 是实打实的工业级降本,覆盖 MoE/DiT 与 T2I/TI2I 也通用,开源落地诚意足。但 75% 剪枝下'有限损失'的主观质量边界、对极端 prompt/细节的退化,以及剪枝叠加步蒸馏后的稳定性仍需更全面评测。 5. LearniBridge:可学习特征缓存加速扩散 LearniBridge: Learnable Calibration of Feature Caching for Diffusion Models Acceleration | 清华(深圳) | arXiv:2606.26778 关键词:特征缓存,扩散加速,DiT,LoRA,低秩 前序问题:DiT 在图像/视频生成上算力开销高,特征缓存靠复用中间表征加速,但现有方法依赖历史特征、在高加速比下误差累积严重。 本文贡献:研究所需特征校正的本质,发现最优校正更新在不同 prompt 间共享一个低秩子空间;据此提出 LearniBridge——可学习的特征缓存校正机制,用轻量 LoRA 更新跨多个时间步桥接,仅需 3-5 个训练样本即可有效校正。 实验效果:图像/视频生成上对 FLUX、HunyuanVideo、WAN2.1 分别达 5.87×、5.75×、4.10× 加速;WAN2.1 在 4.10× 加速下 VBench 较此前 SOTA 提升 1.28%,代码已开源。 批判点评:「校正更新共享低秩子空间」是漂亮的结构性洞察,3-5 样本+LoRA 的轻量校正很实用,加速比与质量提升兼得。但低秩假设在更激进加速比或差异极大的 prompt 分布下是否仍成立、跨架构迁移的稳健性,仍需更广验证(实验用昇腾 910B)。 6. DomainShuttle:开放域主体驱动文生视频 DomainShuttle: Freeform Open Domain Subject-driven Text-to-video Generation | 港科大 | arXiv:2606.26058 关键词:文生视频,主体驱动,跨域生成,RoPE,个性化 前序问题:开放域主体驱动文生视频(S2V)含 in-domain(尽量保主体特征)与 cross-domain(保内在特征但允许无关属性随文本灵活变化)两类;现有方法偏重 in-domain 的主体保真,限制了跨域(新风格/语义组合/域属性)的可编辑与适应性。 本文贡献:提出理想 S2V 应能在不同域间自由「穿梭」,并提出 DomainShuttle:用 Domain-MoT 解耦视频与参考特征、以域感知 AdaLN 做参考图域专属建模;用 Video-Reference DualRoPE 把参考图 token 与视频 token 置于独立 RoPE 空间实现精细主体级空间建模;用 Cross-Pair Consistent Loss 提取不受无关特征影响的内在主体特征。 实验效果:在 in-domain 与 cross-domain 上均显著超过现有方法,跨多样开放域场景兼具高主体保真与生成灵活性。 批判点评:把 S2V 从「死磕保真」重构为「按需在域间穿梭」,DualRoPE 与解耦设计对症跨域编辑痛点。但 in/cross-domain 的平衡靠多模块拼接、复杂度上升,「自由穿梭」的可控边界与对极端跨域(强风格化)的保真衰减仍需看更多样例。 7. Don't Settle:免训练破解流模型多样性坍缩 Don't Settle at the Mode! Mitigating Diversity Collapse in Pretrained Flow Models via Feature Self-Guidance | 印度科学理工·斯坦福 | arXiv:2606.27371 关键词:流模型,多样性坍缩,自引导,免训练,文生图 前序问题:SOTA 流模型按文本/图像生成惊艳图像,但同一条件下多次采样会「多样性坍缩」;现有方法要么靠潜空间引导(效果有限),要么靠样本选择(依赖外部奖励模型、推理开销大)。 本文贡献:提出高效、免训练的自引导机制缓解多样性坍缩、无需额外奖励模型:在批量生成时用「特征自引导」分散流模型内部特征;再用流形正则步把分散特征投影回数据流形,确保多样的同时不偏离输入条件。即插即用,仅增边际推理开销。 实验效果:在多步/少步文生图、深度图到图、参考图生成等多个条件流模型上,多样性显著提升且保真不降,计算开销与 I.I.D. 基线几乎持平(单张 H200 评测)。 批判点评:「特征自引导+流形正则」免训练、免奖励模型地破解多样性坍缩,开销几乎为零、即插即用,很实用。但'分散特征'的强度需与流形约束精细权衡,过度分散可能伤条件对齐;多样性指标(DINO)与人类感知多样性的一致性也值得进一步检验。 8. Safe-AR:自改进码本做AR图像安全 Safe Autoregressive Image Generation with Iterative Self-Improving Codebooks | 牛津大学 | arXiv:2606.27147 关键词:自回归生成,内容安全,码本,统一多模态,自改进 前序问题:自回归统一多模态模型靠顺序预测离散视觉 token(来自码本)生成图像,这种类语言架构擅长文本条件生成,但「以自回归方式生成的图像有多安全」少被研究。 本文贡献:提出迭代自改进码本做安全自回归生成:利用统一多模态模型自身的理解与判断能力、无需人工标注就识别不安全生成图像,并固定码本中的内在表征以消除有害映射。两步法——先用模型识别不安全生成、构造有害/安全图文对建「有害空间」并据此更新码本消除有害输出;再在无害空间内用安全图文对做自适应微调保证质量;两步反复直到无进一步改进。 实验效果:无需任何外部反馈,模型安全性被迭代式提升,同时维持生成质量。 批判点评:「让模型自己判别+修码本」把安全做成无需人工标注的闭环自改进,思路自洽、对统一多模态模型尤其契合。但'用模型判自身不安全'存在盲区(模型识别不到的有害类型无法修复),码本级干预对生成多样性/罕见概念的潜在副作用也需评估。 9. PhyEditBench:物理感知图像编辑基准 PhyEditBench: A Real-World Multi-Stage Benchmark for Physics-Aware Image Editing | 南京大学 | arXiv:2606.26551 关键词:图像编辑,物理推理,评测基准,视频生成,测试时扩展 前序问题:指令式图像编辑虽进步显著,但现有基准缺乏对「基于物理的推理」这一处理真实场景关键能力的全面评估。 本文贡献:提出 PhyEditBench 评估编辑模型的物理理解:按层级分类法设 4 大类 12 子类,含 238 个从真实视频提取以捕捉真实物理动态的高质量高清实例,外加 35 个合成「反物理」实例。并提出免训练基线 PhyWorld,用测试时扩展+潜空间缩减策略。 实验效果:对当前 SOTA 编辑方法的实证分析暴露其物理推理的明显短板;PhyWorld 超过同类模型,表明视频生成过程可有效充当图像编辑的推理机制。 批判点评:把「物理推理」单列为编辑能力维度并配反物理样例,戳中当前编辑模型的真实痛点,PhyWorld「借视频生成做推理」也很有启发。但 238+35 实例规模偏小、层级分类的覆盖与主观性,以及物理正确性评判本身的标准化,都是基准可信度的关键变量。 趋势观察 视频生成/编辑全面冲向实时流式 — LiveEdit 把流式视频编辑推到 12.66FPS,Causal-rCM 用 2 步因果蒸馏达 VBench 84.63,实时交互成为视频 AIGC 的主战场。 蒸馏与缓存成为降本双引擎 — Causal-rCM 统一 TF+SF 蒸馏、LearniBridge 可学习特征缓存(FLUX 5.87×),'更少步+复用计算'是效率竞赛的两条主线。 像素空间自回归逼近扩散画质 — PRA 用并行近似 rollout 把像素 AR 刷到 FID 1.94、135M 超十亿参数,自回归路线在图像生成上持续逼近扩散。 大模型剪枝走向单卡可用 — TMP 把 80B HunyuanImage 压到 20B 并塞进 4090,开源大图像模型的'平民化部署'成为工业重点。 生成的可信度被系统拷问 — PhyEditBench 测物理推理短板、Safe-AR 做码本级安全、Don't Settle 救多样性坍缩,质量/安全/多样性等'软指标'正被正面攻坚。 人工智能炼丹君 整理 | 2026-06-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-22|近两周精选-MaineCoon实时音视频世界模型 今日 AIGC 论文速览 今日共 10 篇 · 音视频与世界模型 2 篇 · 视频生成与编辑 3 篇 · 图像超分与编辑 2 篇 · 人脸修复与动画生成 2 篇 · 生成安全治理 1 篇 重点论文标题列表 MaineCoon(Catnip AI):22B实时音视频社交世界模型 DFD(密歇根·NVIDIA·UIUC):一行代码救回少步视频多样性 UniTemp(威斯康星·Adobe·UCLA):任意时序方向自回归视频生成 teasr(上海交大):免teacher任意步实景超分 AudioWeave(电信TeleAI·中科大):统一音频生成与编辑 今日论文速览 1. MaineCoon:22B实时音视频社交世界模型 MaineCoon: Pursuing A Real-Time Audio-Visual Social World Model | Catnip AI | arXiv:2606.17800 关键词:世界模型,音视频生成,实时自回归,流式生成,社交互动 前序问题:全球视频内容日益在社交平台上被互动式消费,但面向「社交世界」的视频生成模型长期被忽视;既有世界模型擅长模拟物理环境或游戏世界,却与人本社交动态脱节。 本文贡献:首次提出「社交世界模型」定位并造出原型 MaineCoon——首个面向社交互动优化的实时音视频自回归模型,22B 参数,单 GPU 流式生成、亚秒级交互、最高 47.5 FPS。引入自重采样、跨模态表征对齐、域感知偏好优化与强化在线策略蒸馏(ROPD)稳定并加速训练;并设计首个 agentic 流式推理框架,用 agentic 缓存管理与提示规划支持千秒级超长生成、抑制漂移。 实验效果:在高质量、低延迟、长时音视频自回归上刷新 SOTA,单 H100 上每秒生成成本压到 <$0.001 且持续下降,指向 AI-native 社交平台的范式转移。 批判点评:把「世界模型」从物理/游戏拓展到「人本社交动态」,22B 实时音视频+亚秒交互的工程指标极硬,方向极具想象力。但目前仍是原型与 position 论文,长程社交一致性、真实交互可控性与安全治理都待检验,47.5FPS 也依赖 H100 级硬件。 2. DFD:一行代码救回少步视频多样性 Data-Forcing Distillation: Restoring Diversity and Fidelity in Few-Step Video Generation | 密歇根·NVIDIA·UIUC | arXiv:2606.18478 关键词:视频生成,扩散蒸馏,DMD,少步采样,多样性 前序问题:把多步视频扩散蒸馏成少步学生时,DMD/DMD2 因反向 KL 目标出现两大顽疾:样本多样性骤降、输出过饱和而偏离真实视频外观。 本文贡献:提出 Data-Forcing Distillation(DFD):仅需改动一行代码的后训练框架,核心用「教师分数差异」引导学生贴向真实数据分布、把它拉回缺失的模态(mode),从而缓解模式坍缩。 实验效果:在少步视频生成上同时恢复多样性与保真度,去除过饱和、更贴近真实视频外观,且改动极小、收敛快。 批判点评:把少步蒸馏的多样性坍缩精确归因到反向 KL,并用「教师分数差异」一行代码修复,诊断锋利、落地极简。但收益建立在 DMD2 框架之上,'一行代码'表述偏营销,跨更大模型与更极端少步(1-2 步)的稳健性仍需验证。 3. UniTemp:任意时序方向自回归视频生成 UniTemp: Unlocking Video Generation in Any Temporal Order via Bidirectional Distillation | 威斯康星·Adobe·UCLA | arXiv:2606.18702 关键词:视频生成,自回归,双向蒸馏,任意时序,长视频 前序问题:自回归视频扩散在流式长视频上表现强,却被限制为前向时序生成;而真实创作常需灵活方向,如基于未来上下文反向延展、或基于过去+未来做中间插帧。 本文贡献:训练出支持任意时序方向生成的自回归模型 UniTemp,统一前向、后向与中间(inbetween)生成;用双向蒸馏化解被广泛使用的因果 3D VAE 所带来的关键技术障碍。 实验效果:在流式长视频场景把生成从单向扩展为任意时序方向的灵活创作,兼顾前向/后向/插帧三类需求。 批判点评:把「时序方向」从固定前向解放为任意方向,契合真实创作需求,双向蒸馏对付因果 VAE 也有巧思。但任意方向带来的误差累积与跨方向一致性更难控,反向/插帧下的长视频漂移是否同样可控仍待观察。 4. teasr:免teacher任意步实景超分 TEASR: Training-Efficient Any-Step Diffusion Transformer for Real-World Image Super-Resolution | 上海交大 | arXiv:2606.16188 关键词:超分辨率,扩散模型,任意步,训练高效,实景图像 前序问题:扩散模型在真实世界图像超分(Real-ISR)上质量高但采样慢;现有一步蒸馏虽快,却需辅助 teacher 模型、推高训练显存、难扩展到大架构,且固定步数缺乏速度-质量权衡的灵活性。 本文贡献:提出训练高效的「任意步」扩散框架 TEASR:在单一模型内同时支持一步与多步修复、可按需在速度与质量间权衡,且无需 teacher 模型,从而显著降低训练成本并可扩展到大型架构。 实验效果:在真实图像超分上兼顾训练高效、可扩展与「一步/多步」灵活推理,去掉了对 teacher 的依赖。 批判点评:去掉 teacher 依赖+任意步可调,直击一步蒸馏的训练成本与僵化痛点,工程价值高。但 Real-ISR 评测口径多样,'训练高效'相对谁、在多大骨干上仍占优需看完整数字,极端退化下的细节幻觉也是超分通病。 5. AudioWeave:统一音频生成与编辑 Unified Audio Generation and Editing via Joint Condition Modeling and Progressive Training | 电信TeleAI·中科大 | arXiv:2606.16435 关键词:音频生成,音频编辑,文生音,统一建模,渐进训练 前序问题:现有工作把文生音(TTA)与指令式音频编辑等任务当作独立挑战、各用专属架构或模块,缺乏统一建模范式,导致系统搭建开销与复杂度大、可扩展性受限。 本文贡献:提出统一模型 AudioWeave:用联合条件建模+渐进式训练把音频生成与编辑收进单一模型,既覆盖文生音也覆盖基于指令的音频编辑,降低系统复杂度、提升可扩展性。 实验效果:一个模型同时胜任文生音与基于指令的音频编辑,减少维护多套任务专属架构的工程负担。 批判点评:把生成与编辑收进统一条件建模,顺应「大一统」趋势、工程上省事。但统一模型常面临生成与编辑能力的相互妥协,渐进式训练的配比、编辑精度与背景保真能否双赢需看消融与主观评测。 6. PermaVid:编辑后保持一致的视频生成 PermaVid: Consistent Video Generation Across Edits via Disentangled Context Memory | 上海交大·斯坦福·南洋理工·港中文 | arXiv:2606.16449 关键词:视频生成,视频编辑,上下文记忆,一致性,Wan2.1 前序问题:视频生成在编辑(改外观/布局)后需要「持久一致」:后续生成应跨时间、跨视角保持连贯;但现有记忆设计在修改后易过时失效,存储上下文可能失准。 本文贡献:提出 PermaVid(基于 Wan2.1-14B):构建多模态上下文记忆,把空间上下文解耦为「语义外观+几何结构」,并设计编辑感知的记忆更新与检索策略,确保编辑后跨时间、跨视角仍连贯。 实验效果:在编辑操作后维持长程时间与视角一致性,缓解记忆过时导致的崩坏。 批判点评:把记忆解耦成外观/结构并做「编辑感知更新」,对症视频编辑后的一致性塌缩,且基于强骨干 Wan2.1-14B。但解耦记忆+检索更新增加系统复杂度与显存(32×H200 训练),编辑链路变长时的累积误差与检索误命中仍是隐患。 7. TV-Edit:文字+视觉联合指令图像编辑 Text-Vision Co-Instructed Image Editing | 香港理工·OPPO | arXiv:2606.16767 关键词:图像编辑,文本指令,视觉提示,联合建模,FLUX 前序问题:文字指令语义表达强但空间控制粒度粗,拖拽/点选等视觉提示空间精准但语义意图模糊,二者各有短板难以兼得。 本文贡献:提出 Text-Vision Co-Instructed Image Editing(TV-Edit):把文字指令建模为语义意图、把稀疏视觉指令建模为空间引导,二者联合驱动编辑;在 Qwen-Image-Edit 与 FLUX.1 Kontext 双骨干上用少量控制器块实现,验证跨骨干通用性。 实验效果:统一文字与视觉提示之长,实现语义清晰且空间精准的图像编辑,并能在不同编辑骨干上通用。 批判点评:「文+视觉联合指令」补齐了纯文字/纯视觉各自的短板,且证明跨 Qwen/FLUX 骨干通用。但需稀疏视觉标注、用户交互成本上升,联合指令冲突(语义与空间矛盾)时如何取舍、复杂多目标编辑的可扩展性仍待考。 8. RGFVR:参考引导的人脸视频修复 RGFVR: Reference-Guided Face Video Restoration with Flow Matching | 慕尼黑工业大学 | arXiv:2606.16401 关键词:人脸修复,视频修复,身份保持,流匹配,参考引导 前序问题:从退化观测做人脸视频修复需同时恢复视觉保真、时间一致与主体身份;现有方法要么无参考(易丢身份)、要么 subject-specific(难泛化到未见身份)。 本文贡献:提出主体无关、参考引导的身份保持框架 RGFVR:把「感知+描述」双模态身份条件注入预训练 flow-based 文生视频模型(Wan2.1-T2V-1.3B + ArcFace 人脸编码器),两阶段训练、第一阶段仅训身份条件参数。 实验效果:在严重退化下既保身份又保时间一致,并能泛化到未见身份,无需逐人微调。 批判点评:双模态身份条件+参考引导兼顾保真与泛化,避开 subject-specific 的逐人训练。但依赖参考图质量与 ArcFace 身份编码,当参考与目标姿态/表情差异大时身份注入可能反成约束,1.3B 小骨干也限制极端修复上限。 9. SketchKeyAnime:稀疏关键草图生成动画 SketchKeyAnime: Reference-anchored Sparse Key-Sketch Animation Synthesis | 北京邮电大学 | arXiv:2606.19958 关键词:动画生成,视频扩散,关键草图,中间帧,可控生成 前序问题:传统动画依赖手绘关键帧、中间帧与上色;现有动画/视频生成方法多需 RGB 边界帧、密集逐帧条件或完整草图序列,难以适配低成本输入。 本文贡献:提出视频扩散框架 SketchKeyAnime:仅凭「稀疏关键草图」即可生成结构可控、外观一致、时间连贯的动画;含 Sketch Relation Transformer 与 Sketch Resampler 处理稀疏关系,并用 Sketch Cross Attention 与自适应加权损失强化线稿区域。 实验效果:在低成本输入(稀疏关键草图+参考)下产出结构可控、外观一致的动画,贴合真实动画生产流程。 批判点评:把输入门槛降到「稀疏关键草图」很贴合动画产线降本诉求,线稿增强损失也对症。但稀疏输入意味着中间帧靠模型想象,复杂动作/大幅形变的可控性与一致性更难,4×V100 训练规模也限制了分辨率与时长。 10. REINS:训练free做视频扩散安全对齐 Pulling The REINS: Training-Free Safety Alignment of Video Diffusion Models via Representation Steering | UC Riverside·YouTube | arXiv:2606.17257 关键词:视频扩散,安全对齐,表征引导,训练无关,内容安全 前序问题:开源权重视频扩散可生成暴力、虚假等逼真不安全内容;现有防护要么靠昂贵安全微调(损伤通用能力),要么靠外部过滤(易被对抗提示绕过)。 本文贡献:提出训练无关的推理时安全引导 REINS(Representation-space Inference-time Safety steering):发现安全相关结构在隐藏态激活中线性编码,用 SPCA 求出安全方向,并在推理时把模型内部表征朝安全方向引导;1.3B T2V 模型全流程 <24 GPU 小时即可完成。 实验效果:不微调、不损通用能力地把视频扩散在推理时对齐到安全生成,且较难被提示对抗轻易绕过,成本极低。 批判点评:「安全方向线性可引导」既给出可解释结论又落地为零训练方法,成本极低(<24 GPU 时)、不损通用能力,治理价值高。但线性引导对复杂/组合型不安全语义的覆盖有限,强对抗下方向是否仍稳健、引导强度与画质的权衡都需更大规模红队验证。 趋势观察 实时音视频自回归走向社交世界模型 — MaineCoon 22B 单 GPU 47.5FPS、每秒成本<$0.001,把世界模型从物理/游戏推向人本社交互动,瞄准 AI-native 社交平台。 少步/任意步成为视频与超分主线 — DFD 一行代码救回少步视频多样性,teasr 免 teacher 任意步超分,'又快又好且可调'是效率竞赛的新解法。 视频生成解放时序与编辑一致性 — UniTemp 支持任意时序方向生成,PermaVid 用解耦记忆保编辑后一致,视频创作正变得更灵活、更可控。 统一建模继续吞并子任务 — AudioWeave 把音频生成与编辑统进一个模型,TV-Edit 把文字与视觉指令联合,'一个模型多种活'趋势延续。 安全治理走向训练无关与可解释 — REINS 发现安全方向在激活里线性可引导,<24 GPU 时不伤通用能力地对齐,生成安全从'微调/过滤'转向推理时引导。 人工智能炼丹君 整理 | 2026-06-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-01|英伟达SANA单卡24FPS实时流式视频编辑 今日 AIGC 论文速览 今日共 8 篇 · 实时/高效视频生成 2 篇 · 视频世界模型 2 篇 · 统一多模态生成 2 篇 · 音频生成 2 篇 重点论文标题列表 SANA-Streaming(NVIDIA, MIT):单卡RTX5090实时流式视频编辑 LVSA(开源·JiusiServe):免训练长视频稀疏注意力3x提速 Lumos-Nexus(NUS, 阿里达摩院):高效统一视频生成推理驱动 DecMem(快手可灵, 港大 HKU):解耦记忆做分钟级一致世界生成 Light Interaction(浙江大学, NVIDIA):免训练交互视频世界模型加速 今日论文速览 1. SANA-Streaming:单卡RTX5090实时流式视频编辑 SANA-Streaming: Real-time Streaming Video Editing with Hybrid Diffusion Transformer | NVIDIA, MIT | arXiv:2605.30409 关键词:实时视频编辑·混合DiT·GDN线性注意力·RTX5090·英伟达 前序问题:实时流式视频到视频编辑(V2V)对直播、游戏等交互应用至关重要,但它对时序一致性和推理吞吐都有极苛刻的要求——既要逐帧流式出片、又要保住跨帧一致,还得在消费级 GPU 上跑得动,前人一直没能同时满足 本文贡献:SANA-Streaming:系统-算法协同设计的高分辨率实时流式视频编辑框架,三件套。(1) Hybrid DiT:在 SANA-Video 全线性骨干里均匀插入 5 个 softmax 注意力块 + 15 个高效 Gated DeltaNet(GDN) 块,用线性块保效率、softmax 块补局部建模与首块一致性,恒定显存 + 任意长度;(2) Cycle-Reverse 正则:用 flow matching 从生成内容反向预测源帧来强制语义一致,无需成对长编辑视频;(3) 面向 NVIDIA Blackwell(RTX 5090) 的系统协同:融合 GDN kernel + 混合精度量化(MPQ) 拉满 Tensor Core 实验效果:单张 RTX 5090 上做到 1280×704 分辨率、24 端到端 FPS 的实时编辑,DiT 核心跑到 58 FPS;混合设计相比纯 softmax 变体长视频生成只需 5.56GB 显存、提速 3.7×;在时序连贯性和系统吞吐上都显著超越现有 SOTA 批判点评:「混合线性/softmax DiT + 反向一致性正则 + 面向 5090 的量化协同」把实时视频编辑从「论文 demo」真正推到「消费级单卡可跑」,24FPS 端到端是非常硬的工程里程碑;恒定显存是流式落地的关键。但 2B 模型的编辑能力上限、复杂语义编辑的保真度、以及对 5090 之外硬件的可移植性还需观察;Cycle-Reverse 正则在大幅度编辑下的稳定性值得追踪 2. LVSA:免训练长视频稀疏注意力3x提速 LVSA: Training-Free Sparse Attention for Long Video Diffusion | 开源·JiusiServe | arXiv:2605.31057 关键词:长视频扩散·免训练稀疏注意力·旋转全局锚点·Wan/Hunyuan·昇腾NPU 前序问题:稠密自注意力是长视频扩散推理的算力和质量双瓶颈:开销随序列长度二次增长,且超过训练长度后模型收敛到「近静态」——画面冻结、重复循环。现有方案要么太贵(要重训),要么在「提速 + 保质」上无法同时可扩展地满足 本文贡献:LVSA(Long Video Sparse Attention):免训练、模型无关的 block-sparse 注意力,把结构化窗口模式 + 旋转全局锚点(rotating global anchors) 结合,去掉「固定网格偏置」这一长程时序伪影的根因;配 FlashInfer kernel 落地,且天生支持多 GPU(context-parallel + sparse ring KV 交换)。还提出 VQeval 评测工具,专门给「循环/冻结」失败正确扣分(这类失败在 VBench-Long 等评测里反而被奖励) 实验效果:在 6× 训练长度下 Wan2.1-1.3B 提速 3.17×、Wan2.1-14B 提速 2.98×,HunyuanVideo 1.5 在 1.5× 长度提速 3.33×,还能让 HY1.5 跑到单卡原本 OOM 的 2× 长度;相比 RIFLEx/UltraViCo 分别快 2.41×/3.27×;在昇腾 NPU 上 Wan2.2-A14B/Wan2.1-1.3B 也提速 2.71×/3.24×。训练长度内质量中性、超长时质量为正 批判点评:「旋转全局锚点 + 结构化窗口」去掉固定网格偏置,是把「超训练长度变冻结」这一长视频顽疾从根上治理的漂亮思路;免训练 + 多 GPU + 跨 GPU/NPU 的工程完整度很高,VQeval 还顺手补了「循环失败被错误奖励」的评测漏洞。但 block-sparse 的固定模式对极复杂运动场景是否丢细节需要看;锚点数量与长度的 scaling 关系、与可训练稀疏(VSA 类)的质量上限对比可更深入 3. Lumos-Nexus:高效统一视频生成推理驱动 Lumos-Nexus: Efficient Frequency Bridging with Homogeneous Latent Space for Video Unified Models | NUS, 阿里达摩院 | arXiv:2605.31603 关键词:统一视频生成·频率桥接·推理驱动·VR-Bench·阿里达摩院 前序问题:基于 connector 的统一视频模型在「指令理解驱动生成」上能力很强,但把一个大的高保真生成器塞进统一训练循环计算上不可行,从而限制了可达到的画质上限——理解强但画质受限 本文贡献:Lumos-Nexus:训练高效的统一视频生成框架,两阶段设计。训练阶段只把一个轻量生成器与理解模块对齐,学会接收推理驱动的语义控制;推理阶段引入 Unified Progressive Frequency Bridging(UPFB),在共享 latent 空间把生成逐步交棒给高容量预训练生成器,做粗到细精修,从而在不牺牲推理质量的前提下产出高保真视频。还提出 VR-Bench 专门评测「把推断意图翻译成连贯且语义对齐视频」的能力 实验效果:在 VBench 上视觉真实度与时序连贯性大幅提升,同时在 VR-Bench 上展现强推理驱动生成性能;用「轻量训练 + 推理时频率桥接交棒」绕开了「把大生成器塞进训练循环」的算力死结 批判点评:「训练只对齐轻量生成器、推理时再用频率桥接交棒给大模型」是把统一模型「理解-生成」解耦的聪明工程,既省训练又保画质;VR-Bench 把「推理对齐」立成新评测维度很有意义。但 UPFB 的交棒边界(何时交、交多少)对画质/语义一致的影响、两个生成器在共享 latent 的兼容性细节需要更多 ablation 4. DecMem:解耦记忆做分钟级一致世界生成 DecMem: Towards Minute-Long Consistent World Generation with Decoupled Memory | 快手可灵, 港大 HKU | arXiv:2605.31336 关键词:世界模型·解耦记忆·长视频一致性·分钟级生成·快手可灵 前序问题:视频生成模型推动了可控世界模型快速进展,但在长程推理下维持细粒度时空一致性仍是核心难题——朴素的可学习记忆架构有两大根本缺陷:计算低效 + 注意力发散(attention dispersion) 本文贡献:DecMem:超越显式 3D 记忆和粗粒度帧级隐式建模,提出细粒度、可学习、可扩展的记忆。先系统分析注意力发散问题,再用解耦记忆架构:Sparse Global Memory 负责对全局历史的高效细粒度访问,Anchored Local Memory 负责稳定高质量的外推。两者解耦,分别解决「效率」和「外推稳定」 实验效果:大量实验显著超越当前 SOTA;通过精确高效的长期记忆 + 更强外推能力,DecMem 实现分钟级、高保真、高一致的可控长视频生成 批判点评:把「记忆」拆成 Sparse Global(管全局访问效率)+ Anchored Local(管外推稳定)两条解耦通路,直击长视频记忆「又要全又要稳还要快」的三难,分钟级一致是世界模型很硬的指标。但解耦记忆的额外参数/显存开销、Sparse Global 的检索精度上限、以及与显式 3D 记忆在强几何一致场景的对比可更充分 5. Light Interaction:免训练交互视频世界模型加速 Light Interaction: Training-Free Inference Acceleration for Interactive Video World Models | 浙江大学, NVIDIA | arXiv:2605.31158 关键词:交互世界模型·免训练加速·自适应计算·3D稀疏注意力·浙大 前序问题:交互式视频世界模型逐块生成、响应用户控制的相机运动(实时游戏模拟、虚拟场景漫游、具身 AI 训练),但扩到长交互轨迹代价极高:上下文记忆增长、注意力二次复杂度、反复去噪步骤 本文贡献:Light Interaction:免训练的交互式视频世界模型推理加速框架。核心洞察是「交互天然带来轨迹相关的自适应计算」——新探索时检索到的空间记忆可丢弃、时序上下文可按局部 latent 动态调整、相机重访熟悉区域时早期步输出可复用。据此组合自适应上下文管理 + 去噪缓存加速 + 软硬协同的 3D block-sparse 注意力(融合 Triton kernel) 实验效果:在 HY-WorldPlay 和 Matrix-Game-3.0 上无需重训即取得最高 2.59× 提速,同时保持有竞争力的视觉质量 批判点评:「交互轨迹本身就提供了该算多少的信号」是很锐利的洞察——重访可复用、新探索可丢记忆,把自适应计算和交互语义绑定,免训练即插即用对落地友好。但收益高度依赖轨迹的「重访比例」,在持续探索新场景的轨迹上加速会打折;3D block-sparse 的质量损失边界、与 minWM 类自回归蒸馏路线的组合潜力值得探索 6. Representation Forcing:去VAE瓶颈的统一多模态 Representation Forcing for Bottleneck-Free Unified Multimodal Models | 港大 HKU, 字节 Seed | arXiv:2605.31604 关键词:统一多模态·去VAE·表征强制·像素空间生成·字节Seed 前序问题:统一多模态模型(UMM)想用单一模型同时做感知和生成,但现有 UMM 仍依赖一个冻结、单独预训练的 VAE 做图像生成,构成结构性瓶颈;而直接去掉 VAE 又会带来质量缺口——模型得从原始像素同时学高层结构和底层细节 本文贡献:Representation Forcing(RF):让「表征预测」成为模型的原生能力来弥合这一缺口。具体是强制 decoder 在出像素前先自回归预测视觉表征作为中间 token,这些 token 留在 context 里、在同一 backbone 内引导像素扩散。把表征从「感知的输出」变成「生成的目标」,从而彻底不需要任何外部生成式 latent 空间 实验效果:RF 对理解和生成双双有益:图像生成上,像素空间 + RF 的模型匹配 SOTA 的 VAE 版统一模型;图像理解上,像素空间 RF 普遍优于其 VAE 版变体——朝着端到端、无瓶颈的 UMM 迈出有效一步 批判点评:「先自回归预测视觉表征 token 再扩散出像素」把外挂 VAE 的结构瓶颈内化成模型原生能力,是统一模型「去外部 latent」方向很干净的解法,且理解/生成同时受益说明表征-生成共享是对的。但自回归预测表征 token 引入的推理开销、表征 token 的设计对不同分辨率/模态的可扩展性、以及相比强 VAE 版在超高保真上的差距需要更多验证 7. SwanSphere:全景视频流式生成空间音频 Towards Streaming Synchronized Spatial Audio Generation via Autoregressive Diffusion Transformer | 浙江大学 | arXiv:2605.30940 关键词:空间音频·流式生成·自回归扩散·全景视频·浙大 前序问题:实时准确的空间音频生成对沉浸式体验至关重要,但现有空间音频合成技术常受困于「生成质量 vs 高推理延迟」的取舍,且难以从多模态输入中捕获精确的空间信息 本文贡献:SwanSphere:从全景视频 + 文本提示生成高保真空间音频的统一流式框架。三大贡献:(1) 因果自回归扩散 transformer 架构,支持流式高质量空间音频生成;(2) Spatial Video-Audio Contrastive(SVAC) 对比学习把视频编码器对齐到声学域,再用多目标在线直接偏好优化(ODPO) 增强空间感知与多模态空间音频合成的鲁棒性;(3) 针对当前空间音频数据稀缺,开发自动标注 pipeline 生成详细空间 caption 实验效果:在 video-to-spatial 和 text-to-spatial 两类空间音频生成任务上均取得更优性能 (demo swanaigc.github.io) 批判点评:「因果 AR 扩散做流式 + SVAC 跨模态对齐 + ODPO 偏好优化 + 自动空间标注」一套组合直击空间音频「质量/延迟/数据」三重痛点,从全景视频生成空间音频是 VR/沉浸式应用很实在的能力,与同组 SwanVoice 一道补齐音频生成的空间维度。但空间音频评测主观性强、客观指标尚不统一;ODPO 的奖励设计与全景视频的空间精度上限还需更多披露 8. SwanVoice:长篇零样本对话语音合成 SwanVoice: Expressive Long-Form Zero-Shot Speech Synthesis for Both Monologue and Dialogue | 浙江大学, 字节 | arXiv:2605.30993 关键词:零样本TTS·长篇对话·flow-matching·DiffusionNFT·浙大 前序问题:零样本 TTS 在单说话人合成上已大幅进步,但富有表现力的长篇多说话人对话仍很难。常见做法是用独白 TTS 逐句合成再拼接——增加推理成本,且常破坏跨轮次的声学一致性、对话连贯性和情感连续性。近期对话 TTS 仍难同时兼顾表现力一致、可控说话人切换和独白质量 本文贡献:SwanData-Speech + SwanVoice。数据侧用 Swan Forced Aligner 做停顿感知的词级对齐、RobustMegaTTS3 处理发音困难样本,从野外音频构建独白与对话语料。SwanVoice 是 1–4 人零样本 TTS:25Hz VAE + 带停顿符号与拼音替换的原始文本条件 + 带说话人轮次条件的 flow-matching DiT;训练从独白起步,经混合与真实对话数据,再用 DiffusionNFT 后训练 + 音素级和说话人相似度奖励 实验效果:在 SwanBench-Speech 上,独白与对话设置下的丰富度与层次分都高于所有评测的开源基线,内容准确率仍是主要限制 (demo swanaigc.github.io) 批判点评:把长篇对话 TTS 从「逐句独白拼接」升级成端到端建模,flow-matching DiT + 说话人轮次条件 + DiffusionNFT 后训练这套组合很完整,停顿感知对齐的数据工程是务实加分项。但作者自承内容准确率(WER/CER) 仍是短板,说明表现力和保真度的 trade-off 还在;25Hz 低帧率 VAE 在高保真音质上的天花板、4 人以上对话的可扩展性需要继续看 趋势观察 实时/高效视频生成进入「系统-算法协同」深水区 — SANA-Streaming 用混合 DiT(softmax + GDN 线性)+ Cycle-Reverse 正则 + 面向 RTX5090 的混合精度量化,在单张消费级 GPU 做到 1280×704、24 端到端 FPS 的实时流式视频编辑;LVSA 免训练 block-sparse + 旋转全局锚点,把 Wan2.1/HunyuanVideo 长视频推理提速最高 3.3×、还跨 GPU/NPU——视频生成的「实时化」正从算法和系统两端被同时撬动 视频世界模型的两大瓶颈——长程一致性与交互推理成本——被正面攻坚 — DecMem 用 Sparse Global + Anchored Local 解耦记忆,把可控世界生成推到分钟级一致;Light Interaction 抓住「交互天然带来轨迹相关的自适应计算」,免训练把 HY-WorldPlay/Matrix-Game-3.0 推理加速 2.59×——世界模型从「能生成」转向「长得住、跑得起」 统一多模态正在拆掉「外挂 VAE」这块结构性瓶颈 — Representation Forcing 让 decoder 先自回归预测视觉表征作为中间 token、再在同一 backbone 内引导像素扩散,像素空间模型即可匹配 VAE 版统一模型且理解更强;Lumos-Nexus 用渐进频率桥接把生成交棒给高容量预训练生成器、在共享 latent 做粗到细——统一模型在「去外部 latent」和「高保真」两条线同时推进 推理驱动 / 可控成为视频生成的新评测维度 — Lumos-Nexus 提出 VR-Bench 专测「把推理意图翻译成连贯视频」的能力;视频生成的评测从「画质 + 时序」扩展到「推理对齐」——可控性的内涵正在变深,生成模型被要求「不仅画得好,还要想得对」 音频生成从「单声道说话」走向「长篇对话 + 空间声场」 — SwanVoice 用 25Hz VAE + flow-matching DiT + DiffusionNFT 后训练做 1–4 人长篇零样本对话 TTS,富有表现力且说话人切换可控;SwanSphere 用因果自回归扩散 + SVAC 跨模态对齐 + ODPO,从全景视频/文本流式生成高保真空间音频——音频生成正在「对话连贯性」和「空间沉浸感」两个维度同时进化,补齐视觉生成之外的听觉一环 人工智能炼丹君 整理 | 2026-06-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-29|生数科技minWM开源实时交互视频世界模型 今日 AIGC 论文速览 今日共 8 篇 · 视频世界模型 3 篇 · 流式视频生成 1 篇 · 音视频联合生成 1 篇 · 可控图像生成与数据 2 篇 · 大模型记忆与微调 1 篇 重点论文标题列表 minWM:实时交互视频世界模型全栈开源 NAVA:原生音视频对齐联合生成6.3B Gamma-World:多智能体生成式世界模型 AdaState:流式视频生成自演化锚点 YoCausal:视频生成因果性认知基准 今日论文速览 1. minWM:实时交互视频世界模型全栈开源 minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models | 生数科技, 清华大学 | arXiv:2605.30263 关键词:视频世界模型·实时交互·自回归蒸馏·开源·生数科技 前序问题:视频扩散基础模型已能高质量出片,但把它变成实时交互视频世界模型仍然难:交互世界模型需要可控、因果、低延迟的 rollout,实践上要打通数据构造、可控微调、自回归训练、少步蒸馏、流式推理整条链路,而开源社区一直缺一套能跑通的端到端 recipe 本文贡献:minWM:全栈开源框架,把现成的双向 T2V/TI2V 视频基础模型转成「相机可控 + 少步自回归」的世界模型。先对双向扩散做相机控制微调,再用 Causal Forcing / Causal Forcing++ 流程(AR diffusion 训练 + causal ODE/consistency 蒸馏 + 非对称 DMD)蒸成少步自回归生成器做低延迟 rollout。框架模块化、架构可扩展:在 Wan2.1-T2V-1.3B(cross-attention 条件注入)和 HY1.5-TI2V-8B(MMDiT)上分别实例化,还能把 HY-WorldPlay 等已有世界模型适配到新数据分布、训练配方与延迟目标 实验效果:不止放出可运行脚本、checkpoint、文档和推理代码,还给出相机轨迹质量、可控性训练步数、最小 batch size 等实战 ablation——是这个方向少见的「能跑起来、可复现、可扩展」的实时交互视频世界模型配方 (github.com/shengshu-ai/minWM) 批判点评:「全栈开源 + 跨两种主流架构(Wan2.1 cross-attn / HY1.5 MMDiT)实例化 + 可适配已有世界模型」三点让它成为这个方向稀缺的工程基建,对想做实时交互视频的团队意义重大。但框架 / recipe 类工作的核心价值在工程完整度而非单点创新;Causal Forcing++ 与非对称 DMD 联训的稳定性、长 rollout 的累积漂移控制还可以披露更多 2. NAVA:原生音视频对齐联合生成6.3B Native Audio-Visual Alignment for Generation | 百度 ERNIE | arXiv:2605.30073 关键词:音视频联合生成·原生对齐·MMDiT·音色可控·百度 前序问题:联合音视频生成要做到时序同步 + 语义连贯,但现有开源方案要么走「双塔 + 后验对齐」(弱化细粒度音视频协同演化),要么走「三模态全统一」(把语义条件和底层同步耦死在一起)——两条路线都有结构性缺陷 本文贡献:NAVA:context-conditioned 的原生音视频对齐框架。先在专用交互空间建立音视频对应关系,再用外部 context 条件化联合去噪。用 Align-then-Fuse MMDiT 架构实例化,从「模态感知的音视频对齐」平滑过渡到「模态共享的联合去噪」;并提出 Timbre-in-Context Conditioning,把参考音色线索关联到对应语音片段,实现可控语音音色 实验效果:在 Verse-Bench 和 Seed-TTS 上配合用户研究表明:仅用 6.3B 参数即取得更优视频质量、精确的音视频同步、有竞争力的音频质量,以及更强的参考音色可控性 批判点评:「先对齐后融合」而非「一上来全统一」的设计直击双塔 / 三模态两条路线的痛点,6.3B 拿下多项指标性价比很高;Timbre-in-Context 把音色可控做进 context 是干净的设计。但「专用交互空间 + 联合去噪」的两阶段是否引入额外训练复杂度、对更长音视频的扩展性仍需观察 3. Gamma-World:多智能体生成式世界模型 Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players | NVIDIA, 清华大学 | arXiv:2605.28816 关键词:多智能体·世界模型·RoPE·稀疏注意力·NVIDIA 前序问题:交互式视频世界模型大多聚焦单 agent(从单一控制信号生成未来观测),但很多生成环境需要多 agent 同时在共享空间行动(多玩家 / 机器人 / 具身体)。扩到多 agent 需要原则性设计:各 agent 独立可控、排列对称、推理高效,同时跨时间和视角保持一致 本文贡献:生成式多智能体世界模型。提出 Simplex Rotary Agent Encoding:3D RoPE 的无参扩展,把 agent 表示成旋转角空间里正单纯形的顶点,给每个 agent 不同相位又保持排列等价——无需学习 per-slot 身份或固定排序即可扩展 agent 身份;提出 Sparse Hub Attention:用可学习 hub token 中介跨 agent 交互,把跨 agent 注意力从二次降到线性。再把全上下文扩散 teacher 蒸成因果 student,带 KV cache 顺序生成时间块,实现 24FPS 的动作响应生成 实验效果:多人虚拟环境实验中,在视频保真度、动作可控性、agent 间一致性上超越 slot-based 和 dense-attention 基线,且无需额外训练即可从 2 玩家泛化到 4 玩家 批判点评:「用正单纯形顶点的旋转相位编码 agent 身份」是极优雅的无参设计——天然排列对称又可扩展;Sparse Hub Attention 把多 agent 注意力线性化是务实工程;从 2 人零样本泛化到 4 人很有说服力。但 hub token 数量与 agent 数的可扩展上限、长时序多 agent 一致性的退化曲线需要更大规模验证 4. AdaState:流式视频生成自演化锚点 AdaState: Self-Evolving Anchors for Streaming Video Generation | 弗吉尼亚理工 Virginia Tech | arXiv:2605.30349 关键词:流式视频生成·自回归扩散·自演化锚点·KV cache·时间相对 前序问题:自回归视频扩散逐块生成、每块条件于已生成内容,但模型结构性地「锚定在第一帧」:首帧 KV 占据注意力 cache 的特权位置、作为整段主场景参考。作为最干净无误差的位置,这个锚点吸走过多注意力,压制视频动态、把场景构图锁死在初始视角,结果是「时间上很浅」的视频——运动、镜头、场景推进都被静态一致性压制 本文贡献:用「自适应 state」替换静态锚点——一个隐 latent,模型每块和内容一起去噪但从不渲染。模型不再参考冻结的首帧,而是每步通过同时关注「前一 state + 当前内容」自己生成场景锚点,产出随生成内容演化的参考。不同于编码绝对时间的标准视频生成,本方法把时间当相对量:每个生成步看到相同的位置结构、state transition 每块都相同。这给生成过程引入了递归——去噪即 transition 函数,KV cache 即载体,无需任何外部模块 实验效果:实验表明自适应 state 大幅改善视频动态,让生成视频内出现更丰富的运动和更自然的场景推进 批判点评:「首帧 KV 锚点偷走注意力 → 视频时间上变浅」的诊断非常精准,用「可去噪但不渲染的隐 state」做自演化锚点是优雅的零外部模块方案,把时间从绝对改成相对的视角很有启发。但「丰富运动」与「时序一致性」本就是 trade-off,自演化锚点会不会牺牲长程一致性需要定量;缺与显式 memory / anchor 方法的正面对比 5. YoCausal:视频生成因果性认知基准 YoCausal: How Far is Video Generation from World Model? A Causality Perspective | 上海 AI Lab, 阳明交大 NYCU | arXiv:2605.30346 关键词:视频生成·世界模型·因果性·评测基准·上海AILab 前序问题:视频扩散模型(VDM)正走向世界模型,关键问题是:它们真懂因果,还是只过拟合统计时序模式?现有基准大多依赖合成数据,受 sim-to-real gap 限制真实世界泛化 本文贡献:YoCausal:受认知科学「违反预期(VoE)」范式启发的两级基准。零成本地把真实世界视频时序反转,作为天然反事实样本,建立可任意扩展的评测协议。Level 1 提出 Reverse Surprise Index (RSI),用去噪 loss 量化「时间箭头」感知;Level 2 提出 Causality Cognition Index (CCI),用 VLM 把数据分层成因果 / 非因果子集,把真正的因果推理从时序偏置中解耦 实验效果:评测 13 个 SOTA VDM 发现:感知到时间箭头并不意味着理解因果,且相对人类级因果认知仍存在显著差距 批判点评:「时序反转真实视频做零成本反事实」是极聪明的基准构造,RSI / CCI 两级指标把「时间感知」与「因果认知」分层解耦的思路很清晰,给「视频生成→世界模型」泼了必要的冷水。但用去噪 loss 衡量「惊讶度」是否完全等价于因果理解仍可争议;VLM 分层本身的可靠性会传导到 CCI 的结论 6. GenClaw:代码驱动的智能体图像生成 GenClaw: Code-Driven Agentic Image Generation | 中山大学 | arXiv:2605.30248 关键词:图像生成·智能体·代码驱动·可控生成·中山大学 前序问题:图像生成已从「文本条件像素合成」走向「具备视觉理解 + 工具调用的多模态 agent」,但现有 agent 仍受制于底层黑盒图像模型——工作流困在「为优化生成反复改 prompt」的循环里,没有直接操控画布的机制。LLM 作为精确视觉构建「画笔」的潜力基本未被开发 本文贡献:GenClaw:代码驱动的智能体图像生成范式,让 agent 像人类艺术家一样创作——先构思、再起草、最后上色。agent 先通过搜索和推理构建概念知识与上下文;再用代码(SVG / HTML / Three.js)渲染可执行的视觉草图;最后用图像生成模型补充纹理、材质、真实感。代码在此作为可控的中间画布,桥接语言推理与像素合成,把程序逻辑与生成模型的视觉表现力无缝整合 实验效果:把图像生成从黑盒范式转成类似真实人类创作的分阶段过程,朝着高度可控、可解释的视觉生成系统迈出一步 批判点评:「代码作中间画布」是把可控性问题转译成「可执行草图」的聪明思路——SVG / HTML / Three.js 草图天然结构化、可精确编辑,比反复改 prompt 强太多;构思-起草-上色的拟人流程也很有叙事性。但代码草图能表达的视觉复杂度有上限(精细写实场景难用 SVG 起草),最终仍依赖底层生成模型的「上色」能力;端到端延迟和失败率需要量化 7. GPIC:28万亿像素许可级图像语料 GPIC: A Giant Permissive Image Corpus for Visual Generation | 斯坦福 李飞飞团队 | arXiv:2605.30341 关键词:图像语料·视觉生成·许可数据集·flow matching·斯坦福 前序问题:研究可扩展的视觉生成方法需要大、可获取、稳定的数据集,但开放且许可清晰的大规模图像语料长期稀缺 本文贡献:GPIC:约 28 万亿像素的巨型许可图像语料。由 SOTA 视觉语言模型为多样互联网图像生成 caption,含 1 亿训练 + 20 万验证 + 100 万测试样本。所有图像均「研究 + 商用」许可宽松,经安全过滤、去重,集中托管于 Hugging Face。提供生成建模的 benchmark 协议,并给出像素空间 flow matching 的参考 baseline 实验效果:数据集、benchmark、模型全部开放(stanford-vision-lab/gpic);为视觉生成提供「大规模 + 许可清晰 + 稳定可复现」的公共底座 批判点评:「许可宽松 + 商用可用 + 安全去重 + 集中托管」直击当前生成数据集的版权 / 可复现痛点——这种基础设施工作对整个社区的长尾价值很高,28 万亿像素 + 完整 benchmark + baseline 让它即插即用。但「VLM 自动 caption」的质量上限会限制可训出的文本对齐能力;与 LAION 类已有大语料的去重重叠和质量差异需要更透明 8. Parametric Memory Law:LoRA参数记忆的幂律定律 How LoRA Remembers? A Parametric Memory Law for LLM Finetuning | 浙江大学, 阿里 | arXiv:2605.30260 关键词:LoRA·参数记忆·幂律·LLM微调·浙大 前序问题:LLM 需持续学习更新知识,LoRA 被广泛用于记忆更新,但现有研究多靠定性下游评测,对「精确参数记忆」的定量容量极限和底层动力学几乎没探索 本文贡献:用 LoRA 作为受控的记忆容量探针,在 latent 空间系统量化精确参数记忆。提出 Parametric Memory Law:把 loss 下降 ΔL 与有效参数量、序列长度联系起来的稳健幂律。token 级细粒度分析揭示确定性相变——证明预测概率 p>0.5 是 greedy decoding 下逐字召回的充分条件。据此提出 MemFT:阈值引导的优化策略,把训练预算动态重分配到次阈值 token 实验效果:实证表明 MemFT 能提升记忆保真度和效率;为「LoRA 到底记住多少、怎么记」给出可量化的定律而非定性结论 (github.com/zjunlp/ParametricMemoryLaw) 批判点评:「用 LoRA 当记忆容量探针 + 找出幂律 + p>0.5 相变的充分条件」是把模糊的「记忆能力」做成可量化科学定律的扎实工作,MemFT 把定律反哺成实际训练策略形成漂亮闭环。但幂律的普适性需要跨更多模型规模 / 任务验证;「逐字召回」的记忆与「泛化知识」的记忆是两回事,定律对后者的适用边界要谨慎 趋势观察 视频生成正在「世界模型化」:从出片段走向实时交互、多智能体、可因果 — minWM 把双向 T2V/TI2V 蒸成相机可控的少步自回归世界模型并全栈开源;Gamma-World 用单纯形旋转编码 + 稀疏 hub 注意力把世界模型从单 agent 扩到多 agent(2→4 人零样本泛化、24FPS);YoCausal 用时序反转真实视频做反事实基准,量出 13 个 SOTA VDM 距离「真懂因果」仍有显著差距——视频生成的下一站从「画面好」转向「能交互、有因果、多主体」 自回归流式视频生成开始解决「时间太浅」的结构病 — AdaState 诊断出首帧 KV 锚点偷走注意力、把场景锁死在初始视角,改用「可去噪但不渲染的自演化隐 state」做相对时间锚点,显著改善运动和场景推进——流式视频生成从「保一致」转向「敢动起来」 音视频联合生成走向「先对齐后融合」的原生范式 — NAVA 指出双塔后验对齐弱化协同、三模态全统一耦合语义与同步两条路都有缺陷,提出 Align-then-Fuse MMDiT 先在交互空间建音视频对应、再 context 条件化联合去噪,6.3B 拿下多项 SOTA + 可控音色——音视频生成的架构共识正在形成 图像生成的可控性升级:代码做中间画布、许可数据做底座 — GenClaw 用 SVG/HTML/Three.js 可执行草图作中间画布,把「反复改 prompt」换成「构思-起草-上色」的拟人可控流程;GPIC 放出 28 万亿像素、研究+商用许可宽松、安全去重的图像语料 + benchmark + flow matching baseline——可控生成的「方法」和「数据底座」被同时推进 大模型记忆与微调走向「可量化定律」 — How LoRA Remembers 用 LoRA 当记忆探针,给出 loss 下降 ΔL 与有效参数 / 序列长度的 Parametric Memory Law,发现 p>0.5 是逐字召回的充分条件,并据此提出阈值引导的 MemFT——把「LoRA 记多少」从定性评测推到可解析的幂律 人工智能炼丹君 整理 | 2026-05-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-28|北大OSP-Next视频生成跨硬件加速 今日 AIGC 论文速览 今日共 11 篇 · 视频生成全栈加速 4 篇 · 视频生成新能力 2 篇 · 音频统一生成 2 篇 · 语音合成与编辑 2 篇 · 扩散模型对齐 1 篇 重点论文标题列表 OSP-Next:稀疏+量化+RL全栈视频生成1.64x PARE:视频DiT结构剪枝+动态路由 ⚡ Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Dasheng AudioGen:首个文生混合音频场景统一模型 今日论文速览 1. OSP-Next:稀疏+量化+RL全栈视频生成1.64x OSP-Next: Efficient High-Quality Video Generation with Sparse Sequence Parallelism, HiF8 Quantization, and Reinforcement Learning | 北大袁粒组, 华为 | arXiv:2605.28691 关键词:视频生成·稀疏注意力·序列并行·HiF8·北大袁粒组 ⚠️ 前序问题:Diffusion Transformer 在视频生成上已经能出好东西,但 full attention 二次开销死死压住效率。前人方案各做一段(稀疏 / 量化 / 蒸馏),缺一套能同时打通通信、计算、精度的端到端方案——尤其在「多卡序列并行」上和「跨国产硬件」上 本文贡献:OSP-Next:把稀疏注意力 + 序列并行 + 量化 + RL 后训练全栈打通的高效 T2V 框架。Skiparse-2D Attention 在空间维做 token-wise + group-wise 稀疏并保留 FlashAttention 兼容;提出 Sparse Sequence Parallelism (SSP) 用一次 All-to-All 切换稀疏模式,相比 Ulysses SP 通信量降低 75%;HiF8 量化支持 8-bit 联合训练 + 稀疏 fine-tune;Mix-GRPO 后训练弥补稀疏模型的质量回退 实验效果:VBench 总分 83.73% 超越 Wan2.1 基线;5 秒 720P/768P 设置下,H200 单 GPU 加速 1.64×,8 GPU 加速 1.52×;OSP-Next-HiF8 仅掉 0.4% 分数即可在国产昇腾 Ascend 950PR 上拿到 1.69× 和 2.27× 加速——是少见的同时验证国际/国产硬件的视频生成加速方案 批判点评:「稀疏注意力 + 序列并行 + 量化 + RL」四件套全栈打通,每一件单独不算新,但 SSP 把通信量直接打掉 75% 是非常硬的工程数字;跨 H200 + 昇腾的双硬件验证为国产硬件视频生成提供了稀缺的实证。但 Skiparse-2D 是 fixed pattern,对极复杂运动场景的可适配性需要看;Mix-GRPO 与 SSP 联训的稳定性细节披露还可以更多 2. PARE:视频DiT结构剪枝+动态路由 PARE: Pruning and Adaptive Routing for Efficient Video Generation | 港中文 CUHK, 上海 AI Lab, 悉尼大学 | arXiv:2605.27336 关键词:视频 DiT·结构剪枝·动态路由·Wan2.1-14B·上海 AI Lab ⚠️ 前序问题:Video DiT 又宽(block 宽)又深(架构深)又要多步采样,部署成本极高。前人通过压宽/压深/压步数减成本,但都 commit 到固定架构——不能针对单个输入或不同去噪阶段动态调整 本文贡献:PARE:把宽度剪枝和深度自适应路由联合做。宽度上观察到 attention head 自然分化为空间 vs 时序角色,设计区分两类的 importance scoring 避免「运动关键的 temporal head」被过早剪掉;深度上训轻量 router 以 denoising timestep + 视觉内容为条件,动态选择每步执行哪些 block——实现「按输入动态计算」而非静态删除。两阶段 progressive pipeline 先用蒸馏修复宽度剪枝的质量损失,再联合优化 student + router 解耦学习目标 实验效果:在 Wan2.1-14B 上对 I2V 和 T2V 都大幅降低每步算力且保住 VBench 各维度质量;与 step 蒸馏天然可组合进一步加速——把「静态剪枝」时代翻篇成「动态路由按需算」 批判点评:「区分空间/时序 head 重要性 + denoising-step 条件的 block router」两个洞察都直击 Video DiT 的结构性冗余。动态路由实现「按输入按 timestep 算」是 efficient video gen 的下一阶段方向。但 router 本身的训练稳定性、推理时的额外 overhead、以及与 OSP-Next 类静态稀疏组合后的边际收益需要更细 ablation 3. Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 Quantized Keys Steal Attention: Bias Correction for KV-Cache Compression in Video Diffusion | 慕尼黑工大 TUM, Tensordyne | arXiv:2605.26266 关键词:视频扩散·KV cache·INT2 量化·Jensen 偏差·长视频 ⚠️ 前序问题:chunk-wise 自回归视频扩散依赖前序 chunk 的 KV cache 避免重复计算,但视频越长 cache 越大,量化 KV 到低 bit 又会显著掉画质。掉画质的根因是什么?以前没人说清楚 本文贡献:首次明确指出根因:softmax 注意力中 exp 的凸性让量化噪声系统性放大「被 cache 的 keys」对注意力的贡献——作者命名为 Jensen bias(量化的 keys 会偷走当前 chunk 的注意力质量)。给出 per-attention-score 的解析修正项,在 expectation 上消除该 bias,只用量化 step size 和 query norm 即可在线算;用二阶 Taylor 近似让额外计算开销可忽略、无需额外显存 实验效果:在 MAGI-1 / SkyReels-V2 / HY-WorldPlay 三个长视频模型上 INT2 量化即可恢复大部分掉的质量、接近 BF16;用 50% 更少显存的 INT2 反而能超过 INT4——长视频 KV cache 压缩拿到新的帕累托前沿 批判点评:把「量化掉画质」从经验问题改写成「Jensen 偏差」这一可解析的统计现象是真正的科学贡献——一行公式校正、零额外显存就拿到 INT2 ≈ BF16 的质量。这种「找根因 + 闭式解」的工作含金量高。但局限在 chunk-wise AR 视频扩散,对非 AR 的全局扩散 KV 压缩不直接适用;与 SmoothQuant 等激活/权重路线的组合策略还可探索 4. SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Timestep-Aware SVDQuant-GPTQ for W4A4 Quantization of Wan2.2-I2V | 华中科技大学 HUST | arXiv:2605.27003 关键词:W4A4 量化·Wan2.2·MoE DiT·SVDQuant·华中科大 ⚠️ 前序问题:把大型视频 DiT 推到 W4A4 量化可以省一大块显存,但两道坎卡死:(1) 稀疏的「大幅激活 outlier」;(2) 不同去噪 timestep 的激活分布漂移很大。这两个问题在 Wan2.2-I2V 双专家 MoE DiT(高噪/低噪两个 expert 量化敏感度完全不同)下被进一步放大——单一全局校准策略根本拿不下 本文贡献:Timestep-Aware SVDQuant-GPTQ:(1) SVDQuant-based 低秩 outlier 补偿处理激活大幅 outlier;(2) GPTQ 重建感知残差权重量化;(3) timestep-bin-wise 逐层激活 clipping-ratio 搜索,对每个 MoE expert 独立完成。三件套合起来就是「按 expert + 按 timestep」精细化校准的 PTQ 框架 实验效果:在 OpenS2V-Eval 上相对 BF16 把峰值 GPU 内存降 59.3%,VBench 平均分仅掉 0.9%,Imaging Quality 仅掉 2.3%——证明「expert + timestep 双感知校准」是 MoE 视频 DiT 量化高保真的必要条件 批判点评:把 MoE DiT 量化从「全局校准」拉到「按 expert + 按 timestep」是正确的颗粒度切分——双专家的量化敏感度本来就不同,强行全局必然掉点。59.3% 内存降 + <1% 质量损是漂亮的工业数字。但 PTQ 路线天然依赖 calibration set 质量,长视频/复杂运动的覆盖度需要追踪;与昨天 RT-Lynx 类激活稀疏的组合潜力值得探索 5. Dasheng AudioGen:首个文生混合音频场景统一模型 Dasheng AudioGen: A Unified Model for Generating Coherent Audio Scenes from Text | 小米, 上海交大 | arXiv:2605.27838 关键词:音频场景生成·multi-view caption·flow matching·小米·DiT ⚠️ 前序问题:音频生成长期被「按域切分」——语音、音乐、音效各有独立模型——做不到从一句描述生成「同时包含人声 + 背景音乐 + 环境音效」的连贯混合音频场景。两大障碍:缺真实混合音频的细粒度监督;声学表示难以同时承载多个并发音频组件 本文贡献:Dasheng AudioGen:首个统一生成混合音频场景的端到端框架。两个核心:(i) structured multi-view captions——把复杂声学场景显式解耦成互补的描述视图,让每个音频层都有细粒度控制;(ii) 高维统一「语义-声学」表示作为共享 latent,注入语义先验加速跨模态训练收敛,同时高维特征空间提供解耦并发声音组件的容量。在此基础上一个简单的 flow-matching DiT 就能跑出端到端高质量音频场景生成 实验效果:在混合音频类别接近真实录音质量,单类型生成(speech/music/SFX)也与专用模型打平——首次把「视觉生成里图文统一」的思路真正落到音频场景上;配套建立音频场景生成的综合评测 pipeline 批判点评:「structured multi-view captions + 高维语义-声学统一 latent」是非常对症的两个设计——把音频域的「描述粒度」和「表示容量」都拉到能容纳混合场景的层次。flow-matching DiT 的工程极简性也很好。但 multi-view caption 的自动构造成本/质量、高维 latent 增加的 DiT 训练开销,以及与商用 ElevenLabs Sound Effect / Stable Audio 2 的端到端对比都需要更细评测 6. HarmoVid:视频肖像重打光和谐化稳定不闪烁 HarmoVid: Relightful Video Portrait Harmonization | Adobe Research, UNC | arXiv:2605.28811 关键词:视频肖像·relight 和谐化·deflicker·alpha mask·Adobe ⚠️ 前序问题:把人物前景视频和谐到目标背景场景(同步阴影、色调、光照强度——relightful harmonization)的硬伤是:视频域没法采集「同一动作不同光照」的成对标注数据。最直接的方案——「按帧调用图像和谐模型」——会带来严重时序抖动(flicker) 本文贡献:HarmoVid 给出整套视频和谐化方案:(i) 全新的 lighting deflickering 模型稳定全局和局部光照 flicker,把「逐帧 image-harmonization」的输出升级成可监督的 paired 视频数据;(ii) 视频扩散模型在 deflickered 真实 + 合成视频上学习;(iii) asymmetric alpha mask conditioning 让模型从真实视频里学到干净的边界 实验效果:在时序连贯、自然度、边界干净度、物理合理光照行为多个维度超越此前所有 image-based 和 video-based 和谐化方法;relighting 表现力也保住——人物视频合成 / 后期合成的标准工业链路被显著升级 批判点评:用「先 deflicker 再训练」绕开「无成对数据」的死结是非常聪明的——deflicker 把单帧图像和谐输出转化成可用监督,是真正的杠杆点。asymmetric alpha mask 也很实用。但 deflicker 模型本身的失败模式(强光/复杂阴影)会传导到下游;与 Adobe 自家的商业级合成工具的真实对比需要更细评测 7. SmartDirector:多关键帧条件电影级视频叙事控制 SmartDirector: Keyframe-Conditioned Cinematic Video Generation with Narrative Pacing Control | 国内视频生成团队 | arXiv:2605.27891 关键词:电影级视频·多关键帧·叙事节奏·两阶段·Director-Gen/SR ⚠️ 前序问题:视频的「叙事质量」决定感知价值,但现有视频生成方法主要靠 text prompt 或首尾帧这类稀疏 condition——对叙事结构和时序节奏的精确控制非常有限,导出不了真正「有 pacing 的电影感视频」 本文贡献:SmartDirector:以多关键帧增强视频生成的叙事能力。支持单镜头、多镜头叙事合成、视频延展三类场景。两阶段:(i) Director-Gen 在低分辨率上以关键帧为条件生成;(ii) Director-SR 利用高分辨率关键帧作为语义锚点把细粒度细节补回来。配套数据管线从电影中精选单镜头/多镜头序列以支撑多关键帧训练 实验效果:在多个评测上大幅超越 SOTA,把视频生成从「按 prompt 出 5 秒片段」升级到「按多关键帧出有节奏的多镜头序列」——电影级视频生成的可控性接近真实创作工作流 批判点评:「多关键帧 + 两阶段先粗后细」直击「电影级叙事控制」的实际痛点——单 prompt / 首尾帧确实远远不够。两阶段把分辨率 vs 叙事控制解耦是合理设计。但「关键帧」的获取成本(人工/AI辅助)和叙事节奏的可量化评测仍是模糊地带;多镜头切换的时空一致性细节需要更深 ablation 8. LoSATok:1280维语义压缩到128维统一audio LoSATok: Low-dimensional Semantic-Acoustic Tokenizer for Cross-Domain Audio Understanding and Generation | 清华深圳, 面壁智能 | arXiv:2605.27840 关键词:audio tokenizer·128 维·语义瓶颈·清华深圳·面壁 ⚠️ 前序问题:音频 tokenizer 是统一「音频理解」和「音频生成」的根基。理解需要高层语义;生成需要语义 + 声学细节。现有统一 tokenizer 在高维连续 latent 里同时编码——这增加了 DiT 生成端的建模负担 本文贡献:LoSATok:观察到 1280 维语义 encoder 特征是可压缩的,引入 Semantic Bottleneck 压到 128 维,并用 time-relation loss 保时序特征一致性;再用「双层级语义监督」同时利用高维/低维语义信号——让 tokenizer 在紧凑 latent 空间里同时承载语义和声学细节 实验效果:在 speech / music / 通用 audio 上 SemBo 保住强低维语义容量,LoSATok 与多个语义表示比较 understanding 性能仍有竞争力;在 DiT 端的 speech / music / audio 生成上一致改进——证明「低维 audio 表示也能同时支撑理解与生成」 批判点评:把「audio 统一 tokenizer」的维度从 1280 砍到 128 是非常硬的容量压缩——若真的不掉理解还能提升生成,那就解掉了「audio 统一表示卡 DiT」的关键梗。time-relation loss + 双层级语义监督是合理工程。但 128 维下声学细节的极限(音乐复杂混音、长 reverb)需要更细测试;与 Dasheng AudioGen 高维路线的端到端比较是行业级议题 9. CosyEdit2:GRPO语音编辑反哺零样本TTS CosyEdit2: Speech-Editing-Oriented Reinforcement Learning Unlocks Better Zero-Shot TTS | 南开大学 | arXiv:2605.25930 关键词:语音编辑·GRPO·zero-shot TTS·南开大学·post-training ⚠️ 前序问题:语音编辑和 zero-shot TTS 同源于「prompt 驱动的语音生成」,但语音编辑对「与周围未编辑内容的局部声学一致性」要求严苛得多。SFT 让 TTS 模型获得编辑能力的路线被卡在「成对编辑数据不完美 + 优化信号粗粒度」 本文贡献:CosyEdit2:建立「先 SFT 初始化 → 再 editing-oriented GRPO 后训练」的两阶段框架。GRPO 阶段在「无目标语音」的数据上做,把语音编辑当作 RL 任务优化,让模型从粗粒度匹配走向精细局部声学一致 实验效果:不仅在语音编辑上显著提升,还反哺 zero-shot TTS 能力——揭示「编辑任务 ↔ 合成任务」之间隐藏的相互增益;GRPO 在 audio 域被验证是有效的 post-training 范式 批判点评:把 GRPO 引入 audio 域、并用「编辑反哺合成」这个新角度证明两个任务的深层互助,是非常聪明的科学故事。无目标语音的 RL 设计也比依赖成对数据更可扩展。但 GRPO 的 reward 设计细节、跨语种/多说话人鲁棒性、以及对 prosody 细节的影响需要更系统评测 10. PilotTTS:高德200K小时开源TTS竞品级 PilotTTS: A Disciplined Modular Recipe for Competitive Speech Synthesis | 高德 AMAP | arXiv:2605.27258 关键词:TTS·200K 小时·开源·Q-Former·高德 AMAP ⚠️ 前序问题:SOTA TTS 系统通常需要数百万小时专有数据 + 多阶段复杂架构——这对资源受限的研究团队是几乎跨不过去的门槛。开源社区想自己训出竞品级 TTS 一直缺成熟 recipe 本文贡献:PilotTTS:高德 AMAP 用「最小化架构 + 严格数据工程」做出竞品级轻量自回归 TTS。仅用 200K 小时数据 + 全开源工具处理。两大贡献:(i) 可复现的多阶段数据处理 pipeline(质量评估 + 标签标注 + 过滤);(ii) Q-Former conditioning 紧凑模型架构,通过 cross-sample paired training 解耦说话人身份与说话风格。统一框架支持 zero-shot voice cloning / 11 类情感合成 / 4 类副语言合成 / 14 种中文方言 实验效果:在 Seed-TTS Eval 上 test-en WER 1.50%(最低)、test-zh CER 0.87%;两个测试集说话人相似度都最高(0.862 / 0.815)——超越使用大得多数据集训出来的系统。完整 data pipeline + 预训练权重 + 代码全开源 (AMAPVOICE/PilotTTS) 批判点评:「200K 小时 + 开源工具 + 极简架构」做出超越百万小时专有数据系统的 TTS——是非常有信号量的开源胜利,对中小团队意义重大。Q-Former 解耦说话人/风格的设计也是 clean。但 PilotTTS 主打数据工程而非架构创新,复现门槛仍在「数据处理 pipeline 的工程细节」;与昨天 LongCat-Avatar 类「audio + 视频联合」的下一步集成是开放问题 11. LAIR:扩散模型从成对偏好升级到列表对齐 Beyond Pairwise Preferences: Listwise Reward-Aware Alignment for Diffusion Models | 斯坦福, 加州理工 Caltech | arXiv:2605.26491 关键词:diffusion 对齐·listwise preference·advantage-weighted·Stanford·Ermon ⚠️ 前序问题:preference optimization 已成 RLHF 之外对齐 T2I 扩散的高效替代,但现有方法基本都把监督降到 binary pairwise——这在「同 prompt 有多张候选 + 有连续 reward 分数」时严重浪费信息(一个 winner-loser 标签远远没用上 reward 分布) 本文贡献:Diffusion LAIR:reward-aware listwise preference optimization。每个 prompt 把候选组的 reward 分数转成中心化 advantage 权重,再优化「advantage-weighted regression」目标——目标定义在 implicit reward(当前模型 vs 固定参考模型的 denoising-loss 改进量)上,配二次惩罚正则隐式 reward 幅度。结果是同时用所有候选而非选 pair,并保持保守。LAIR 目标在 implicit-reward 空间有 bounded closed-form 最优解,把正则强度 → 偏好更新幅度的关系写清楚 实验效果:在 SD1.5 / SDXL 上对 T2I 生成 / 组合生成 / 图像编辑 benchmark 都超越 strong pairwise preference optimization baseline;为 diffusion 对齐提供「更接近 RLHF reward 信息密度但不需在线 RL」的中间路线 批判点评:把 DPO 类 pairwise 升级到 listwise + 给出 closed-form 最优解的清晰表述是教科书级的方法工作——既保留 offline 偏好优化的稳定性,又用上了 reward score 的全部信息。但 listwise 数据采集成本高于 pairwise(要 N 张同 prompt 候选 + reward 分),实际落地的数据可得性是隐藏成本;与 in-context 在线 RL(GRPO 类)的端到端比较略浅 趋势观察 视频生成进入「全栈加速」时代:稀疏 + 量化 + 并行 + 路由 + RL 多管齐下 — OSP-Next 把稀疏注意力 + Sparse Sequence Parallelism(通信 -75%)+ HiF8 量化 + Mix-GRPO 一锅端,跨 H200 / 昇腾双硬件分别 1.64× / 2.27× 加速;PARE 联合宽度剪枝 + 动态深度路由,在 Wan2.1-14B 上按输入按 timestep 动态算;SVDQuant-GPTQ 把 Wan2.2 双专家 MoE DiT 推到 W4A4 显存降 59.3%——视频生成的工业部署正在被「全栈加速」改写 长视频 KV cache 压缩出现「找根因 + 闭式解」类突破 — Quantized Keys Steal Attention 首次把「量化 KV 掉画质」从经验现象写成 Jensen bias(exp 凸性放大 cache key 贡献)的可解析统计现象,一行公式校正零额外显存,让 MAGI-1 / SkyReels-V2 / HY-WorldPlay 在 INT2 上接近 BF16——把 chunk-wise AR 长视频的 KV 压缩从「玄学调参」推到「有理论的工程」 音频生成统一化:从「按域切分」走向「一句描述出混合场景」 — Dasheng AudioGen 是首个能从一句描述同时生成 speech + music + SFX 混合连贯场景的统一模型,关键是 structured multi-view captions + 高维语义-声学统一 latent;LoSATok 反过来把 1280 维语义压到 128 维统一 tokenizer 反哺 DiT 生成;CosyEdit2 在 audio 域用 GRPO 把「编辑」反哺「TTS」——audio 正在重走视觉「统一模型」的同一条路 视频生成的「叙事控制」与「视频后期」继续拓宽到工业链路 — SmartDirector 把视频生成从「按 prompt 出 5 秒片段」升级到「多关键帧 + 两阶段先粗后细」做电影级叙事节奏控制;HarmoVid 用 deflicker 模型破解「视频和谐化无成对数据」的死结,把视频肖像 relight 和谐化做到工业级稳定——视频生成的可控性从「内容」深入到「节奏」和「后期合成」 开源 TTS / 对齐方法补齐 audio + diffusion 的「最后一公里」 — 高德 PilotTTS 用 200K 小时 + 开源工具 + Q-Former 极简架构做出超越百万小时专有系统的开源 TTS(Seed-TTS Eval 第一);Diffusion LAIR 把 T2I 对齐从 pairwise 升级到 listwise,给出 implicit-reward 的 closed-form 最优解——开源社区在 audio 合成 + diffusion 对齐这两个长期被闭源霸占的方向同时迈出了「竞品级 + 理论级」的双台阶 人工智能炼丹君 整理 | 2026-05-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-27|美团LongCat-Avatar 1.5开源逼近闭源数… 今日 AIGC 论文速览 今日共 7 篇 · 工业级数字人开源对标闭源 1 篇 · 音视频联合生成评测体系 1 篇 · 视觉生成新范式:层级与通道级 2 篇 · DiT 推理加速与可控编辑 2 篇 · 原生多模态架构路线图 1 篇 重点论文标题列表 LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongAV-Compass:首个分钟级音视频生成评测基准 MRT:20B多层透明图像生成超Qwen CVQ:通道级VQ取代patch挑战传统 RT-Lynx:激活稀疏化让DiT GEMM加速1.55x 今日论文速览 1. LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongCat-Video-Avatar 1.5 Technical Report | 美团 LongCat Team | arXiv:2605.26486 关键词:数字人·美团 LongCat·8 NFE 蒸馏·RLHF·开源对标闭源 前序问题:音频驱动视频生成虽然进展飞快,但要做到「商业级稳定性」仍然难——商用场景下需要的不仅是「唇形对得上」,还要全身时序稳定、长视频身份不漂、多人交互/物体交互不崩,并且部署侧推理 budget 严苛 本文贡献:美团 LongCat-Video-Avatar 1.5:以「系统工程 + 生产就绪」而非架构创新为优先项的开源数字人框架。把 audio encoder 升级到 Whisper Large 并精修训练 recipe,做到准确唇形同步 + 全身时序稳定 + 长视频严格身份一致;通过严格数据清洗 + RLHF 训练,泛化到动漫/动物等风格化域,并原生处理多人交互和物体处理这类真实复杂场景;为工业部署引入 advanced step distillation 把推理压到 8 NFE 实验效果:在 500+ 多样测例 benchmark 上的定量指标 + 严格人评显示 v1.5 在 human-likeness 和专家级质量评估上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越;开源发布拉近了「学术原型」与「商业级部署」的差距 批判点评:美团摆明用「工程优先」的姿态——Whisper Large + 严苛数据 + RLHF + 8 NFE 蒸馏这套组合拳是教科书级的工业打法,公开报告稀缺。但「commercial-grade」更多靠数据规模和清洗,单一架构 trick 不构成壁垒;对标 HeyGen / OmniHuman 1.5 的具体维度需要更详细的 ablation 才能说服业界,且 8 NFE 与 Kling Avatar 2.0 之间的真实人评差距值得追踪 2. LongAV-Compass:首个分钟级音视频生成评测基准 LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV | 北京大学, Kling, 南大, 上交, 港科广州, 上海 AI Lab | arXiv:2605.26244 关键词:音视频生成·minute-scale·评测基准·T2AV/I2AV/V2AV·北大 前序问题:音视频联合生成正在从「短片段」走向「分钟级长内容」,但现有评测协议几乎都还停留在 5-10 秒文本条件生成;很少支持文本/图像/视频三种条件统一评测,更没说清楚长时间下身份一致性、叙事连贯、音画对齐到底怎么退化 本文贡献:LongAV-Compass:首个面向 minute-long 音视频生成的系统化评测基准。284 个精选测例覆盖 T2AV / I2AV / V2AV 三种输入,按应用场景和生成复杂度组织;统一评测框架结合 MLLM 辅助评估和 DINO-v2 / ArcFace / CLIP / ImageBind 等感知指标,覆盖 20+ 细粒度维度——段内质量、跨段一致性、全局叙事连贯、语义对齐、音画同步全都评 实验效果:在 11 个代表性模型上跑 + 人对齐验证,把当前系统在「保持连贯、保持语义对齐、保持时序一致」上的瓶颈量化呈现;为分钟级音视频生成提供了首个诊断式 testbed——音视频联合生成的「评测短板」正式被补上 批判点评:把音视频联合生成的评测从 5-10s 短片推到分钟级是必要补位——评测落后一直是这个赛道的隐形天花板。20+ 细粒度维度 + MLLM 辅助 + 4 大经典感知模型组合非常综合。但 MLLM 评测本身的偏置是隐忧,DINO-v2/ArcFace/CLIP/ImageBind 的权重融合策略需要更多 ablation;分钟级测例 284 个对开源社区评测可行但工业级评测仍偏小 3. MRT:20B多层透明图像生成超Qwen MRT: Masked Region Transformer for Layered Image Generation and Editing at Scale | 微软亚研 MSRA | arXiv:2605.27235 关键词:多层图像生成·20B·masked region·8 步实时·MSRA 前序问题:层级图像生成与编辑是图像生成走向「可复用 / 可重编辑 / 可组合」的关键能力——类比自然语言里的「逐词编辑」——但在大规模上一直是 underexplored 的空白。多层透明生成 + 多任务统一框架既缺数据也缺方法 本文贡献:MRT:20B 参数 masked region diffusion 模型,专为多层透明图像生成与编辑打造,在 10M+ 多语言设计样本上训练,支持多 aspect ratio 与多语言 prompt。两项核心贡献:(i) 把 text-to-layers / image-to-layers / layers-to-layers 三任务统一到「共享 masked region diffusion」框架,靠 selective token masking 灵活切换层级生成与编辑;(ii) overflow-aware canvas layer 处理边界 inconsistency 并支持半透明背景合成,做出可编辑且延伸至画布外的完整图层。配套 diffusion 蒸馏实现 8 步实时多层生成 实验效果:在三项任务上全面超越此前 SOTA 包括商业系统;user-study 显著优于同期 Qwen-Image-Layered 的 image-to-layers 质量,且推理快 10-100×,activation GPU 显存降低 50-90%——为多层透明图像生成立下新基准 批判点评:把多层图像生成做到 20B + 三任务统一 + 8 步实时是非常工业化的工作量;超越 Qwen-Image-Layered 的人评结果是强信号。但 10M+ 设计样本的语义/版权分布未明,多语言/多 ratio 的真实可控性需要更细 ablation;overflow-aware canvas layer 在极端 aspect ratio 下的稳定性也需要追踪 4. CVQ:通道级VQ取代patch挑战传统 Channel-wise Vector Quantization | 上海创新研究院, 西湖大学, 浙大, 复旦 | arXiv:2605.26089 关键词:视觉 tokenization·channel-wise VQ·CAR·next-channel·DPG 86.7 前序问题:传统视觉自回归(VAR)和 VQ-based 文生图都把图像分成 patch、给每个 patch 分配一个离散 token——但这种 patch 视角本质是「把图像当空间网格」,不太符合人类绘画「先勾结构再补细节」的层次过程。codebook 利用率上不去、增大 codebook 后 collapse 也是顽疾 本文贡献:Channel-wise Vector Quantization (CVQ):新视觉 tokenization 范式,离散化对象从 patch 换到 feature map 的每一个 channel——一张图被表示为「不同层级视觉细节的离散等级」而不是「空间 patch 网格」。基于 CVQ 提出 Channel-wise Autoregressive (CAR):next-channel prediction 替代 next-patch prediction,先勾全局结构再渐进精修细粒度属性 实验效果:CVQ 在 16K+ codebook 规模下实现 100% codebook 利用率(无任何 trick),重建质量显著超过传统 VQ;CAR 在文生图上拿到 DPG 86.7 / GenEval 0.79——证明「按 channel 分层渲染」是 patch-based 视觉自回归的现实替代品 批判点评:把 tokenization 从空间 patch 切换到 channel 维度是真正的范式 rethink——「先结构后细节」也与人类作画过程契合。100% codebook 利用率是很硬的数字。但 channel 抽象层次的物理含义不够清晰(哪个 channel 对应「结构」哪个对应「细节」依赖训练涌现),跨分辨率/跨模态时的稳定性需要进一步验证;与 latest DiT 路线的端到端比较略浅 5. RT-Lynx:激活稀疏化让DiT GEMM加速1.55x RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models | 国内系统研究团队 | arXiv:2605.26632 关键词:DiT 加速·激活稀疏化·N:M sparsity·CUDA kernel·1.55x 前序问题:DiT 推理太贵——量化和蒸馏已经被深挖,但能砍掉将近一半 FLOPs 的「半结构化稀疏(N:M sparsity)」一直 underexplored。原因是大家都在做 weight 稀疏化,但对 weight 做 50% 剪枝会拿掉关键模型容量,让生成质量崩坏 本文贡献:RT-Lynx:核心 insight 是「DiT 的激活本身天然稀疏,比 weight 更适合 N:M 半结构化稀疏化」。提出 paradigm shift——从 weight sparsification 转到 activation sparsification;配 error-compensation 缓解精度损失;并实现针对该场景高度优化的 CUDA kernel 实验效果:线性层平均 1.55× speedup,多个扩散模型上保留原生生成质量同时显著加速;为 DiT 部署提供「除量化和蒸馏外的第三条加速路线」 批判点评:把「稀疏化目标」从 weight 切到 activation 是非常对的洞察——activation 在 inference 时本来就动态出现 zero,强制 N:M 模式损失更小。1.55× 加速 + 不掉质量在 DiT 推理优化里属于实打实的硬增量。但 N:M 模式需要硬件配合(Ampere/Hopper 的 sparse tensor core),消费级 GPU 上的实际收益要打折;激活稀疏化对极长 token 序列(高分辨率视频)下的可扩展性需评测 6. ControlLight:Flow Matching做连续强度可控低光增强 ControlLight: Towards Controllable, Consistent, and Generalizable Low-Light Enhancement | 中科院深圳, StepFun | arXiv:2605.25569 关键词:低光增强·flow matching·连续可控·一致性·中科院深圳 前序问题:现有深度学习低光增强方法都在「有限数据集 + 单一增强目标」上训练——既泛化差又不可控。真实场景里同一张暗图,不同用户/不同场景需要不同的增强强度,但现有方法把它当作一个固定函数 fit 本文贡献:ControlLight:「可控 + 一致 + 可泛化」的低光增强框架。先建大规模真实退化图像数据集,对每张图给出「连续光照强度」标签作为监督;引入 misalignment-aware weighted flow matching loss,让模型在不同控制强度下输出仍然保持图像结构一致——用户可以连续滑动「增强强度」拿到不同结果而不撕裂 实验效果:在多个 benchmark 上超过现有低光增强 SOTA,同时具备「连续强度可控」+ 「真实场景泛化」能力,把低光增强从「一锤子函数」改造成「可调节工具」 批判点评:把 flow matching 用到低光增强 + 连续条件标签 + misalignment-aware loss 三件套是非常 clean 的设计——其中「misalignment-aware」直接 attack 不同强度下结构一致的根因。但「连续光照强度标签」如何从真实退化数据获取本身是个隐藏难题;与最近基于 diffusion 的图像 restoration 在极端低光场景的比较需要更全面 7. Native MM Roadmap:原生多模态架构路线图三分类 Toward Native Multimodal Modeling: A Roadmap | 华威大学, Monash, 港理工, 腾讯优图 | arXiv:2605.25343 关键词:原生多模态·NMM·路线图·three-class taxonomy·腾讯优图 前序问题:多模态建模正在从 modality-agnostic 推理走向 world modeling。早期 late-fusion(拼 encoder + frozen LLM + 输出头)已显疲态,最近转向 Native Multimodal Modeling (NMM)——把各模态从根上集成进同一个 transformer 拿到更强性能。但 NMM 的设计空间目前仍未系统化 本文贡献:为社区提供形式化的 NMM 路线图:(1) 形式化定义「架构原生性」,区分 mid-fusion / early-fusion 与非原生范式;(2) 从「输入-输出对偶」角度把现有 native 模型组织成三类——Multi-to-Text(跨模态理解,纯文本输出)/ Multi-to-Target(场景化生成,如图像/音频/视频生成)/ Multi-to-Multi(对称输入输出的统一建模);(3) 全栈式工业视角剖析从架构协调、海量数据 curation、训练 recipe 到推理部署和评测的端到端 pipeline 实验效果:把当前散乱的「统一多模态架构」研究归结成一份可被工程师和研究员同时参考的路线图——理解和生成在「统一 transformer 范式」下无缝共存是 NMM 的目标终态。对走向 GPT-4o / Gemini 1.5 级原生多模态的开源工作给出系统化方法学 批判点评:「形式化 architectural nativity + 输入输出对偶三分类 + 全栈工业视角」三个层次组织得很清晰——是社区急需的概念清理。但综述类天然有「分类强、实证少」的局限,三类边界(特别是 Multi-to-Target 和 Multi-to-Multi)在最新模型上可能交叉;对未来 1-2 年具体技术抉择的指导力度需要在落地 case 中验证 趋势观察 工业级开源数字人 / 视觉基础模型加速对标闭源 — 美团 LongCat-Video-Avatar 1.5 用 Whisper Large + RLHF + 8 NFE 蒸馏的工业打法,在 500+ 测例上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越——昨天百度 ERNIE-Image 是文生图,今天美团 LongCat-Avatar 是数字人——国内大厂正在多个垂类同时按下「开源对标闭源」按钮 音视频联合生成评测从「短片」推到「分钟级」 — LongAV-Compass 提供首个 minute-scale 音视频生成评测基准——284 个测例覆盖 T2AV / I2AV / V2AV、20+ 细粒度维度(段内质量 + 跨段一致 + 全局叙事 + 语义对齐 + 音画同步)。和最近 Baton / SpongeBob / StreamChar 等音视频联合生成模型一起,把「短片评测」时代正式翻篇 视觉生成 tokenization / 架构范式正在被 rethink — MRT 把「图像生成」从单层 RGB 推到「多层透明 + 三任务统一 + 8 步实时」;CVQ 把视觉 tokenization 从 patch-wise 切换到 channel-wise,重提「先结构后细节」的人类作画过程并拿到 100% codebook 利用率与 GenEval 0.79——patch + 单层这两个长期假设都在被挑战 DiT 推理加速的第三条路:从「weight 稀疏」转向「activation 稀疏」 — RT-Lynx 指出 DiT 激活本身就稀疏,对 N:M 半结构化稀疏化远比 weight 鲁棒,配合错误补偿和定制 CUDA kernel 拿到 1.55× 线性层加速且不掉质量——量化、蒸馏之外,「激活稀疏化」正式成为 DiT 部署的第三条加速路线 Native 多模态架构走向系统化,可控生成成为最后一公里 — Toward Native Multimodal Modeling 把原生多模态架构形式化为「Multi-to-Text / Multi-to-Target / Multi-to-Multi」三分类,给出从架构到训练到部署的全栈 roadmap;ControlLight 用 misalignment-aware flow matching 把低光增强做成「连续强度可控」工具——「统一架构 + 可控生成」正在收敛成下一代生成模型的双轨 人工智能炼丹君 整理 | 2026-05-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-26|百度ERNIE-Image开源8B DiT追平闭源 今日 AIGC 论文速览 今日共 11 篇 · 国产开源文生图基础模型 1 篇 · 音视频联合生成与编辑 3 篇 · 视频生成训练范式革新 2 篇 · few-step 蒸馏与自回归视频蒸馏 2 篇 · 推理时自适应与视频编辑 3 篇 重点论文标题列表 ERNIE-Image:百度8B DiT开源逼近闭源SOTA Baton:首引语义蓝图驱动音视频联合生成 ⚡ SpongeBob:首个端到端音视频联合编辑Sync+30% StreamChar:长时流式角色音视频实时生成 PixelWizard:原生2K/4K视频生成10倍加速 今日论文速览 1. ERNIE-Image:百度8B DiT开源逼近闭源SOTA ERNIE-Image Technical Report | 百度 Baidu ERNIE Team | arXiv:2605.25347 关键词:ERNIE-Image·百度·8B DiT·MT-DMD 蒸馏·industrial-grade ⚠️ 前序问题:开源文生图模型与闭源顶级系统在指令跟随、文字渲染、美学质量上仍有明显差距。差距主要来自两件事:预训练数据噪声大且长尾概念覆盖差;后训练人类偏好对齐的稳定性不足,蒸馏期间还会出现 capability drift(蒸馏前能做的事,蒸馏后做不到了) 本文贡献:ERNIE-Image:8B 单流 DiT 架构开源文生图基础模型。预训练用 bottom-up 数据管线(细粒度分类 + 富 caption + 美学评估 + 分层采样)压噪同时保长尾;后训练 top-down 高需求场景 + 多样化 prompt + 稳定化 DPO;ERNIE-Image-Turbo 实现 8-NFE 高效生成,配套 MT-DMD 蒸馏算法缓解 capability drift。配套发布 industrial-grade ERNIE-Image-Aes 美学模型和 ERNIE-Image-Aes-1K benchmark(首个针对真实场景的美学评测基准) 实验效果:开源模型中达到 leading 表现,在指令跟随/文字渲染/美学三项接近顶级闭源商业模型;模型权重和美学评测资源全部开源,覆盖完整工业流水线(包括 Prompt Enhancer 把简短意图扩展为结构化视觉描述) 批判点评:「8B DiT + bottom-up 预训练 + top-down 后训练 + 稳定 DPO + Turbo 蒸馏」是教科书级的工业开源大模型训法,单独哪一项都不算新颖,但全部端到端打通、配套基础设施 + 评测开源是最大贡献。但闭源 SOTA(GPT-Image / Imagen 4 / Midjourney v7)的差距具体几何缺乏精确量化对比,且 industrial-grade aesthetic model 的偏好可能强烈反映中文用户审美,国际场景适用性需观察 2. Baton:首引语义蓝图驱动音视频联合生成 Baton: Explicit Semantic Blueprints for Joint Video-Audio Generation | 复旦大学, 腾讯混元 | arXiv:2605.25195 关键词:音视频联合生成·explicit planning·VA-Planner·腾讯混元·Relative RoPE ⚠️ 前序问题:开源扩散模型做音视频联合生成时,两个模态的去噪轨迹各自为政,导致音画不同步、长时一致性差。根因:现有方法用现成 encoder 的粗粒度 text embedding 引导音/视频去噪——这丢掉了细粒度语义,更关键的是缺少一个跨模态的「长 horizon 共享规划」 本文贡献:提出 Baton:首个引入 explicit semantic planning 的音视频联合生成框架。VA-Planner(带双语义对齐塔的多模态 LLM)让可学习 query 同时 cross-attend 视频和音频特征,吐出一对语义对齐的音/视频 planned token(关键帧级蓝图);这些 plan token 通过 cross-attention 注入扩散 backbone,与粗 text embedding 互补;进一步提出 Relative Semantic RoPE 把 planned token 和 latent 映射到共享时空坐标系,让 latent 准确 attend 到对应语义线索 实验效果:在标准音视频联合生成 benchmark 上定性定量都显著超过基线;首次把「先规划后渲染」的范式从单模态扩散扩展到跨模态联合扩散——和昨天 Bernini「MLLM 规划 + DiT 渲染」是同向延续 批判点评:「explicit semantic planning」做跨模态联合生成是非常对的方向——粗 text embedding 当指挥棒本来就太宽松。VA-Planner + Relative Semantic RoPE 解决了「plan 怎么对齐 latent」的工程关键。但 VA-Planner 多了一次 MLLM 推理,端到端时延和显存对比单 DiT 联合扩散需要进一步说明;planned token 颗粒度是 keyframe-level 而非 frame-level,复杂动作对齐上限仍受限 3. SpongeBob:首个端到端音视频联合编辑Sync+30% SpongeBob: Sync-Aware Harmonious Audio-Visual Generative Editing | 中科大 USTC | arXiv:2605.25193 关键词:音视频联合编辑·端到端·Sync-Aware·Context-Aware·USTC ⚠️ 前序问题:物理世界的视觉和声音本就耦合,但现有视频编辑全部是「视觉编完,再单独配音/换音」的解耦 pipeline,没有双向模态交互。结果是:(i) 音画不同步;(ii) 改动后的画面和保留下来的原音之间出现语义冲突(看到打字键盘却继续是说话声) 本文贡献:SpongeBob:首个端到端音视频联合编辑框架,带双向 cross-modal 交互。Sync-Aware Mechanism 通过双向注意力 + 时序对齐 + 空间约束让视觉编辑跟声音事件对齐;Context-Aware Module 用声/像 context attention 防止编辑后语义冲突;Sync-Preserving Training and Guidance(SPTG)在保持画质的同时强化对齐。配套构建可扩展数据管线 + subject-level 大规模数据集 + SpongeBob-Bench 评测 实验效果:Sync-C(音画同步指标)+30%、Ctx-F1(上下文一致性)+12.5%,显著超越现有 baseline;首次把「音视频编辑」推到 explicit joint 范式,让「改了画也改对应音」成为可能 批判点评:把音视频编辑从「解耦串行」改成「联合并行」是必要的下一步,Sync-Aware + Context-Aware 双模块设计简洁;但训练数据规模和评测集都依赖作者自建,第三方复现成本高;编辑场景的覆盖(替换/插入/删除)和真实创作工作流的对接深度还需后续验证 4. StreamChar:长时流式角色音视频实时生成 StreamChar: Long-Horizon Streaming Character Audio-Video Generation with Decoupled Orchestration | 阿里通义实验室 | arXiv:2605.25659 关键词:流式生成·角色动画·decoupled orchestration·阿里通义·sink-chunk memory ⚠️ 前序问题:实时流式的角色音视频联合生成要同时满足:(1) 说出指定 transcript;(2) 跨 chunk 保持视觉身份;(3) 严格的播放预算(低延迟)。三个目标相互掣肘——逐 chunk 的自回归生成会累积 transcript-audio 错位和视觉漂移;为低延迟而做的 few-step 蒸馏又会牺牲空间多样性和时序质量 本文贡献:StreamChar:把「长 horizon 规划」与「短窗音视频去噪」解耦的流式框架。LLM 编排器(orchestrator)用 transcript 和历史上下文产出帧对齐的音频条件;joint audio-video DiT 做局部双向去噪并带 reference + motion-frame conditioning;两阶段蒸馏先压缩 sampler 再用 online chunk rollout 微调 student;progress-aware pointer 在 rollout 训练时把部分 transcript 与生成音频对齐;sink-chunk memory 提供持久视觉 anchor 缓解长 horizon 漂移 实验效果:把流式 character animation 这个被低延迟严重压制的方向推到「长 horizon + 严格时延 + 身份稳定」可同时满足;解耦式架构让 LLM 做规划、扩散 backbone 做细节生成成为长视频流式生成的可行新范式 批判点评:把「orchestrator vs denoiser」解耦解决了流式 + 长时生成两难,sink-chunk memory + progress pointer 是非常针对性的工程设计。但 LLM orchestrator 引入额外推理路径,对端到端时延的真实贡献需要更细评测;joint audio-video DiT 蒸馏后的 student 与教师模型 audio-visual coherence 的差距上限值得跟踪 5. PixelWizard:原生2K/4K视频生成10倍加速 PixelWizard: Towards Efficient High-Fidelity Video Generation at Ultra-Large Spatial Resolution | 港科大广州, 小米 | arXiv:2605.25801 关键词:高分辨率视频·原生 2K/4K·10× 加速·分层 anchor·小米 ⚠️ 前序问题:高分辨率视频生成有两个相互耦合的瓶颈:(1) token 序列爆炸让优化偏向局部纹理而牺牲全局连贯(结构坍塌);(2) 训练成本巨大、推理延迟严重。简单堆分辨率根本不可持续 本文贡献:PixelWizard 把全局结构建模和细粒度细节合成分层解耦:先建立一个紧凑的时空 anchor 浓缩稠密结构先验,再以此引导高分辨率细节生成,缓解局部优化偏置;引入 Noise-Span Aligned Shortcut Training 让模型可以「大步」遍历生成轨迹(突破推理瓶颈);Exponential Index-Biased Sampling + Adaptive Noise-Span Calibration 把优化与高分辨率网格的偏移噪声 schedule 对齐,实现 robust few-step 推理且无需蒸馏的开销 实验效果:原生 2K/4K 视频生成加速 >10×,同时保证视觉质量;不依赖蒸馏(避免 capability drift),是高分辨率视频生成的「全栈式」效率优化方案 批判点评:分层 anchor + shortcut training 思路很正——直接面对「token 爆炸」根因。10× 加速 + 不蒸馏的组合非常吸引人;但与最新蒸馏路线(如 DMD2/Causal Distill)的端到端对比缺失,结构 anchor 是否能跨场景(人物运动/复杂相机)稳定泛化需要更细评测 6. Paris 2.0:首个去中心化预训练视频生成FVD减半 Paris 2.0: A Decentralized Diffusion Model for Video Generation | Bagel Network | arXiv:2605.26064 关键词:去中心化训练·DDM·视频生成预训练·FVD 2×·Bagel ⚠️ 前序问题:训视频生成模型几乎都要 monolithic GPU 大集群,开源社区无法独立完成时序连贯的视频生成预训练。前作 Paris 1.0 证明了图像生成可以分布式训练(去中心化扩散 DDM),但「时序连贯的视频生成」在 decentralized 训练范式下仍是 open problem 本文贡献:Paris 2.0:首个通过去中心化(decentralized)计算完成预训练的视频生成模型。训练 recipe 基于 Paris 1.0 的开源 DDM 扩展到视频领域,关闭了「分布式训视频」最后一块短板。同 compute budget 下与 monolithic 模型在相同数据上对照评估 实验效果:在 low-resolution 文生视频训练上,相同总算力预算下相比 monolithic baseline,FVD 从 561.04 降到 279.01(~2.0× 提升),CLIP 文本-视频相似度与美学分数双双提升。证明 decentralized 训练不仅可行而且能反超 monolithic——开源社区独立训视频基础模型门槛被显著拉低 批判点评:「分布式 GPU 也能训视频生成」是范式级的工程突破——把视频生成预训练的算力门槛从「必须有大集群」拉到「能聚起多组消费级 GPU」。同算力预算下反超 monolithic 是惊喜数字。但还停留在 low-resolution 段位,高分辨率长视频下分布式通信开销是否仍能 hold 住,是后续最大悬念 7. RTDMD:4步生成同时蒸馏对齐刷新SOTA Reinforcing Few-step Generators via Reward-Tilted Distribution Matching | Sea AI Lab, 港科大 | arXiv:2605.26108 关键词:few-step 扩散·蒸馏·RLHF·GRPO·FLUX.2 ⚠️ 前序问题:few-step 扩散蒸馏已能让图像生成又快又好,但和人类偏好对齐还是难——直接套 RLHF 会破坏蒸馏后的分布稳定性,难以兼得「步数少 + 画质高 + 对齐人类偏好」 本文贡献:RTDMD(Reward-Tilted Distribution Matching Distillation):两阶段统一蒸馏与 RL 对齐。理论上证明 minimizing KL 到「reward-tilted teacher」自然分解为分布匹配 + reward maximization 两项。Stage1:AC-DMD(Ambient-Consistent DMD)做子区间分布匹配 + consistency 正则化,让 fake score 模型追上漂移的 generator;Stage2:混合 policy gradient——GRPO-style estimator 处理随机中间步 + direct reward backprop 处理确定性 final step;进一步用 step-subset GRPO(SubGRPO)降方差 实验效果:在 SD3 / SD3.5 / FLUX.2 上仅 4 步推理就刷新 preference / aesthetic / compositional 三类指标 SOTA,超越此前所有 few-step 文生图方法,代码模型开源 批判点评:把蒸馏和 RL 对齐写成同一个 KL 优化问题在理论上很优雅,工程实现 AC-DMD + 混合 policy gradient + SubGRPO 三件套也都是合理设计;但 GRPO 在 4 步采样下的方差估计仍可能高,跨更多底模(SD3.5 / FLUX 之外)的稳定性需要更多验证 8. AFD:on-policy黑盒蒸馏自回归视频 On-Policy Adversarial Flow Distillation for Autoregressive Video Generation | 新加坡国立大学 NUS | arXiv:2605.26105 关键词:自回归视频·黑盒蒸馏·on-policy·flow-matching·Bradley-Terry ⚠️ 前序问题:自回归视频生成器对流式、长 horizon、交互应用非常有吸引力,但把强黑盒 teacher 蒸馏成 causal student 极其困难:student 必须在自己 rollout 分布下学习,而实际 teacher 通常只暴露 prompt-conditioned 完成的视频,结构/容量/时序设计/采样 schedule 都不同。这让 SFT 是 off-policy 的、score-based 蒸馏不适用、直接对抗模仿对去噪步级 credit assignment 又太稀疏 本文贡献:AFD(Adversarial Flow Distillation):异构黑盒视频蒸馏的 on-policy 框架。同 prompt 同时 query teacher 和 rollout 当前 student;训 prompt-paired Bradley-Terry discriminator 估计 clean-sample 教师-学生差异;把 on-policy advantage 转成 forward-process flow-matching 更新到 student 自己的 noised state 上。这套设计让 student 拿到稠密 velocity-field 监督,且无需 teacher score / latent / 去噪轨迹 / step alignment / reverse-chain RL 实验效果:把「自回归视频生成 + 黑盒强 teacher」蒸馏从死局拉到可行——这恰是流式视频 + 大闭源 teacher 时代的最关键工程问题。on-policy 学习避免分布漂移,flow-matching 转换提供稠密信号,是 RTDMD 在「自回归视频」侧的对偶贡献 批判点评:把「黑盒、异构、自回归视频」三个最难维度同时解决,思路非常对——on-policy + 对抗 + flow-matching 转换是当前最合理的组合。但 Bradley-Terry discriminator 在视频域的样本效率与训练稳定性、以及面对真正巨大闭源 teacher(如商用 Sora / Veo 级别)的 query 成本,是工程落地的真实门槛 9. TT-SAC:talking-head推理时自适应免训练 Test-Time Self-Adaptive Conditioning for Stable Audio-Driven Talking-Head Generation | 格里菲斯大学 Griffith | arXiv:2605.25488 关键词:talking-head·推理时自适应·免训练·feedback loop·身份保持 ⚠️ 前序问题:音频驱动 talking-head(AniTalker / FLOAT / Sonic 等)当前主流是:一张静态参考图条件整段视频生成。但静态身份条件 vs 动态面部运动天然错配,导致 identity drift、时序不一致、感知质量下降 本文贡献:TT-SAC(Test-Time Self-Adaptive Conditioning):完全 parameter-free 的推理时框架,让预训练 talking-head 模型在生成过程中自适应调整 conditioning,不需要重训、不需要梯度、不需要任何额外监督。把 generator 与 encoder 组成 feedback loop:generator 输出再被 encoder 编码,构造与时序动力学对齐的精修 conditioning;单步自适应即近似 self-consistent equilibrium,稳定跨时长的身份与运动 实验效果:把 talking-head 的「静态参考图」假设彻底打破——同一组预训练权重,仅靠推理时 feedback loop 即可显著缓解 identity drift 和时序退化;零训练成本即可升级现有 talking-head 模型,是非常实用的 plug-in 改造 批判点评:把 generator-encoder feedback 当作 implicit fixed-point 迭代是聪明的——既廉价又对预训练模型友好。但 single adaptation step 是否真能稳定逼近 self-consistent equilibrium 取决于具体模型,对发生面部大幅度运动或镜头切换时的鲁棒性需要更细评测;feedback 单步 vs 多步的边际收益曲线也值得展开 10. RVEDiT:MLLM注入Token让DiT分粒度推理编辑 Reasoning to Align: Implicit Reasoning in Diffusion Transformers for Video Editing | 华为 | arXiv:2605.24674 关键词:视频编辑·DiT·MLLM Token·分粒度路由·华为 ⚠️ 前序问题:指令视频编辑需要按自然语言改源视频,同时保留无关内容、保持时序一致。但现有 DiT 编辑器有两个结构性缺陷:(1) 条件信号不分粒度灌入所有 transformer block,单一 token 流既要编码全局意图又要编码细粒度证据;(2) cross-attention 模式只受 pixel-level 重建间接监督,内部推理过程完全不受约束 本文贡献:RVEDiT:implicit Reasoning Video Editing DiT。两个互补组件:(i) Granularity-Routed Token Conditioning——从 MLLM 蒸馏出 learnable editing token 路由到浅层 block,深层 block 留给原生视觉/文本 token,自然形成 coarse-to-fine 编辑过程;(ii) Reference-Anchored Attention Alignment——训练时用参数共享 reference 分支,最大化编辑/参考分支注意力特征的互信息,正则化内部推理但推理时零额外开销 实验效果:在标准指令视频编辑 benchmark 上一致超过 SOTA,对 localized 和 compositional 编辑提升最大;引入 MLLM 推理但部署时单分支,性价比高 批判点评:「分粒度路由 conditioning + reference 互信息对齐」两个手段都直击 DiT 编辑器的结构性病灶,思路非常清晰。但 MLLM 提供的 editing token 是离线蒸馏,可能不能捕捉新颖指令;reference 分支在训练时翻倍显存,长视频上的可扩展性需评测 11. Squeeze-MLLM:MLLM+VAE双条件根治主体生成贴图 Squeezing Capacity from Multimodal Large Language Models for Subject-driven Generation | 多伦多大学 U of T | arXiv:2605.26111 关键词:Subject-driven·MLLM·VAE 身份·DLA·copy-paste ⚠️ 前序问题:subject-driven 生成(保留参考主体身份 + 跟随文字指令)此前主流是 text 和 reference 各编各的——这天然削弱跨模态推理,并导致典型的 copy-paste artifact(参考图被原样贴上去)。最近 MLLM + diffusion 框架改善了指令跟随,但忽略了身份保持 本文贡献:把 diffusion model condition 在 MLLM 上(让 text 和 reference 联合编码),同时用 VAE 做 identity conditioning;新设 Dual Layer Aggregation (DLA) 模块聚合 MLLM 多层级特征做最优 conditioning;用多阶段去噪策略在推理时渐进式平衡 MLLM 提供的语义和 VAE 提供的细节身份 实验效果:把多模态理解和身份保持调和得很好,缓解了 copy-paste 问题,人类偏好评测上 subject-driven 生成超越现有方法;项目页面开放 批判点评:「MLLM 编联合语义 + VAE 守身份细节」的双通道是非常合理的分工——比纯 MLLM/纯 reference encoder 都更接近问题本质。DLA + 多阶段去噪是工程上的细致打磨;但 VAE 通道也可能引入贴图倾向(VAE 重建本身就有 identity 偏置),与最新 IP-Adapter / OmniGen 等的端到端对比是否在所有场景占优需要更细评测 趋势观察 国产开源文生图基础模型加速对标闭源 SOTA — 百度 ERNIE-Image 8B 单流 DiT 系统化打通预训练 bottom-up 数据 + 后训练 top-down + 稳定 DPO + Turbo 蒸馏 + 工业 aesthetic 评测全栈,且模型/数据全部开源——开源阵营在指令跟随/文字渲染/美学三项已逼近 GPT-Image/Imagen/Midjourney 等闭源顶级系统 音视频联合生成进入「规划 + 流式 + 编辑」三角范式 — Baton 用 VA-Planner(多模态 LLM)吐出音/视频共享语义蓝图驱动联合扩散;SpongeBob 通过双向 cross-modal 交互做端到端音视频联合编辑;StreamChar 用 LLM orchestrator 解耦长 horizon 规划与短窗去噪做流式角色音视频——音视频从「各编各的」彻底走向「联合规划 + 联合渲染」 视频生成同时突破两个壁垒:分辨率天花板与训练算力门槛 — PixelWizard 把全局 anchor 与细节合成分层解耦,加上 Noise-Span Aligned Shortcut Training,原生 2K/4K 视频生成提速 10× 且不蒸馏;Paris 2.0 首次完成 decentralized 视频生成预训练,同算力下 FVD 从 561→279(2×)反超 monolithic baseline——视频生成的「分辨率天花板」被工程化突破,「训练必须大集群」被打破 few-step 蒸馏从图像扩散扩展到自回归视频生成 — RTDMD 把蒸馏和 RL 对齐写成同一 KL 优化(4 步刷 SD3/FLUX.2 SOTA);AFD 把 on-policy 对抗 + flow-matching 转换组合用于黑盒异构 teacher 蒸馏 causal 视频 student——证明「步数少 + 画质高 + 对齐人类偏好 + 流式自回归」可以同时拿到,且不依赖白盒 teacher score / 轨迹访问 推理时自适应/编辑成为零训练能力升级标配 — TT-SAC 让 talking-head 模型在推理时通过 generator-encoder feedback loop 自适应 conditioning(免训练、免梯度);RVEDiT 把 MLLM 推理 token 路由到 DiT 浅层 block 形成 coarse-to-fine 编辑;Squeeze-MLLM 用 MLLM+VAE 双通道在推理时渐进平衡语义与身份——「不重训也能拿到新能力」正在成为生成模型的标准升级路径 人工智能炼丹君 整理 | 2026-05-26 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注