搜索到
127
篇与
人工智能
的结果
-
 AIGC 每日速读|2026-05-21|智能编辑成统一模型通用任务Uni-Edit 今日 AIGC 论文速览 今日共 13 篇 · 统一多模态与图像编辑 2 篇 · 视频生成与编辑 5 篇 · 高效推理与稀疏注意力 3 篇 · 安全与可控生成 2 篇 · 图像复原与评测 2 篇 重点论文标题列表 Uni-Edit:智能编辑成为统一模型唯一训练任务 FullFlow:只训LoRA把T2I升级成双向多模态 ⚡ DVG:时空联合自适应HunyuanVideo提速7倍 BA-Att:块预降采样稀疏注意力提速7倍 FlowLong:滑窗加流形约束推理期出长视频 今日论文速览 1. Uni-Edit:智能编辑成为统一模型唯一训练任务 Uni-Edit: Intelligent Editing Is A General Task For Unified Model Tuning | CUHK MMLab | arXiv:2605.21487 关键词:UMM 统一多模态·智能图像编辑·通用任务·BAGEL·Janus-Pro ⚠️ 前序问题:统一多模态模型(UMM,理解+生成+编辑三件事一起做)当前主要靠混合多任务训练。但任务之间天生冲突,逼出了复杂的多阶段 pipeline、海量数据混合和各种平衡 trick——结果只是性能折中而非真正互相增强 本文贡献:提出 Uni-Edit:智能图像编辑作为 UMM tuning 的「第一个通用任务」。一个任务、一个训练阶段、一个数据集就能同时提升理解/生成/编辑三种能力。为此构建首个自动化可扩展智能编辑数据合成 pipeline:把多样 VQA 数据转化为带嵌入问题和嵌套逻辑的复杂编辑指令,得到 Uni-Edit-148k 数据集(reasoning-intensive 指令 + 高质量编辑图像) 实验效果:BAGEL 与 Janus-Pro 上仅用 Uni-Edit 单任务训练即获得三种能力的全面增强,无需任何辅助操作;模型/数据/代码已开源在 HuggingFace 和 GitHub 批判点评:「编辑作为通用任务」的洞察是范式级——编辑天生需要「理解 + 生成」两件事,这是其作为通用任务的根本理由;但 Uni-Edit-148k 是 VQA 数据合成的,复杂场景下指令质量上限仍受 VQA 数据集决定;BAGEL/Janus-Pro 之外能否泛化到更多 UMM(OmniGen/UniGen)需要后续验证 2. FullFlow:只训LoRA把T2I升级成双向多模态 FullFlow: Upgrading Text-to-Image Flow Matching Models for Bidirectional Vision-Language Generation | ETH Zürich, Google Zurich | arXiv:2605.20316 关键词:统一多模态·LoRA 升级·Rectified Flow·双向生成·参数高效 ⚠️ 前序问题:现代 T2I 扩散模型有强视觉先验,但只暴露在单向 text→image 生成。从 T2I 衍生的统一视觉语言模型要么靠大规模联合预训练,要么大幅重训文本通路——两者都浪费了 T2I backbone 已经学到的强图像先验 本文贡献:提出 FullFlow 参数高效配方:只训 LoRA 适配器和轻量 text head 就把预训练的 rectified-flow T2I 模型升级成双向 vision-language 生成器。图像保持原生连续 flow,文本走离散 insertion 过程;图像/文本独立 timestep 让推理变成「二维生成空间」中的轨迹选择,单 backbone 同时支持 text→image / image→text / 联合采样 / partial-text 预测 实验效果:在 SD3 上同等可训参数和 LoRA rank 下,T2I FID 62.7 → 31.6,I2T CIDEr 2.0 → 99.4(远超之前 SOTA Dual Diffusion);峰值 VRAM 从 ~84GB 降到 ~38GB,吞吐 8×(双 RTX A5000 训 24h,仅训 ~5% backbone 参数);同样配方迁移到 FLUX.1-dev 并支持 partial-text 做下游 VQA 批判点评:5% 参数开销实现双向多模态是非常高 ROI 的工程贡献——把扩散视觉先验「升级 vs 重建」拉到了正确选择;但 image→text CIDEr 99.4 vs Dual Diffusion 2.0 的对比量级悬殊,可能反映 baseline 设置问题;与原生统一模型(BAGEL/Janus)的端到端能力对比缺失 3. DVG:时空联合自适应HunyuanVideo提速7倍 Dynamic Video Generation: Shaping Video Generation Across Time and Space | 上海交大, 华南理工, 清华大学 | arXiv:2605.21042 关键词:视频扩散加速·时空联合·渐进分辨率·HunyuanVideo·近无损 ⚠️ 前序问题:视频扩散每步要处理大量 token,迭代去噪极昂贵。最近渐进分辨率采样在早期阶段降 latent 分辨率取得加速,但 scale 到视频上仍困难——时序维度引入跨视频差异巨大的时空需求,只压一个维度要么加速有限要么质量退化 本文贡献:提出 DVG(Dynamic Video Generation)框架:跨时间和空间联合分配计算,自动选择内容感知(content-aware)的加速策略,无需手工调参或重训。通过学习每个视频的最佳时空降采样模式,实现近无损加速 实验效果:HunyuanVideo / HunyuanVideo-1.5 上达到 7× 加速;与蒸馏组合可达 18× 加速;近无损跨模型跨任务,可作为大规模高效视频生成系统的关键组件——代码开源 批判点评:把渐进分辨率从空间扩到时空联合是合理的下一步,自动 content-aware 策略避免了手工 schedule;但加速倍数高度依赖底模容量与内容多样性,对极端运动场景的 robustness 论文未充分披露;7×→18× 的复合是否保留各自的画质底线需更细粒度评测 4. BA-Att:块预降采样稀疏注意力提速7倍 Efficient Long-Context Modeling in Diffusion Language Models via Block Approximate Sparse Attention | 香港科大, 港大, 浙大, 港中文 | arXiv:2605.19726 关键词:扩散语言模型·稀疏注意力·块降采样·FlashAttention·长上下文 ⚠️ 前序问题:扩散语言模型(DLM)能做全局连贯、双向、可控文本生成,但 scale 到超长序列仍昂贵。现有 block-sparse attention 用固定采样模式(尾部、反斜对角条带)选块——这种 prior-driven 采样会漏关键 token、分布偏移下不稳定 本文贡献:提出 BA-Att 框架:block-wise 预降采样操作在压缩空间识别 informative 区域,避免依赖脆弱的位置先验。理论上定义 oracle post-downsample attention map,形式化前 vs 后降采样方案的近似误差;引入轻量 norm-sorting 模块和协方差补偿修正(用对角 QK 方差近似完整协方差),降复杂度 实验效果:比 FlashAttention 加速最高 6.95×;50% 稀疏度下保持接近 full-attention 性能,跨语言模型/多模态语言模型/视频生成模型一致——证明高效率和强泛化 批判点评:把 sparse attention 的「选块」从 prior-based 升级到 learned downsampled space 是非常正确的方向,6.95× 加速比 FlashAttention 还快是亮眼的工程数字;但 50% 稀疏率下「接近 full」的具体差距需更精细评测;对极长上下文(1M+)的渐近行为仅理论保证而无实测 5. FlowLong:滑窗加流形约束推理期出长视频 FlowLong: Inference-time Long Video Generation via Manifold-constrained Tweedie Matching | KAIST, Amazon | arXiv:2605.20910 关键词:长视频生成·推理期方法·Tweedie matching·滑窗·流形约束 ⚠️ 前序问题:把视频扩散模型生成时长扩到长序列一直没解决:双向模型扩展紧绑架构且长距退化严重,自回归模型有 exposure bias 累积漂移并产生重复运动。现有 training-free 方案没有同时跨这两条路线 本文贡献:提出 architecture-agnostic 推理期长视频生成方法:滑动重叠窗口生成长视频,相邻窗口预测的 clean sample 通过 Tweedie matching 在重叠区强制流形约束 + 时序一致;high-noise 阶段用 stochastic early-phase sampling,每次 Tweedie matching 校正后注入新噪声同步窗口轨迹,再切到 deterministic ODE sampling 保留细节 实验效果:可生成数倍于原生窗口长度的视频,时序一致性和视觉质量超越 training-free 与自回归两类基线;同一思路无微调即可扩展到音视频联合生成、文生 3DGS——证明这套方法是通用的 批判点评:Tweedie matching 在窗口边界做修正是 elegant 的解法,几乎是「无需训练」的最简扩展;但滑窗推理时延比单 pass 显著增加,长视频对内存的累积压力不算小;与原生因果模型(如 Causal Forcing++/Mutual Forcing)相比,缺少同等长度下的直接对比 6. StreamGVE:少步流式生成做训练免视频编辑 StreamGVE: Training-Free Video Editing via Few-Step Streaming Video Generation | UBC ECE | arXiv:2605.21466 关键词:视频编辑·训练免微调·少步流式生成·noise-to-data·双分支 ⚠️ 前序问题:视频编辑方法可行但要花很多昂贵迭代且编辑结果质量勉强。作者把症结归因到「data-to-data」范式——它和现代生成模型(noise-to-data)天生不兼容,绕远路反而拉低了编辑质量 本文贡献:从 noise-to-data 视角重做视频编辑:基于预训练的流式生成模型构建 StreamGVE,保留 few-step 采样并无缝注入源视频条件;引入双分支快速采样(self-attention bridge + cross-attention grounding/boosting)兼顾采样和条件;提出 source-oriented guidance 提目标质量,再加 visual prompting 增强编辑灵活性 实验效果:在多种视频编辑任务上一致超越现有方法,即使在 few-step 设置下也能以最少时间代价完成;方法对不同底模具有鲁棒性和泛化能力 批判点评:把视频编辑「从 data-to-data 转向 noise-to-data」是个范式级洞察,能直接复用流式生成模型的少步能力——很省工;但在风格迁移、物体替换等具体编辑任务上的优势是否一致需要更细分对比;source-oriented guidance 的强度调参成本未明 7. FlowErase-RL:首个GRPO范式的概念擦除框架 FlowErase-RL: Rethinking Concept Erasure as Reward Optimization in Flow Matching Models | 哈工大深圳, 清华深圳, 吉林大学, 鹏城实验室, 清华大学 | arXiv:2605.19739 关键词:Flow Matching·概念擦除·GRPO·安全生成·双路径奖励 ⚠️ 前序问题:Flow Matching 文生图模型质量飞涨同时安全风险也在加剧,要擦除有害/不想要的概念。现有方案要么是推理期干预(效果有限),要么靠 SFT(依赖精对齐数据 + 多概念扩展性差)——擦除问题一直缺少更优范式 本文贡献:首次把概念擦除重新表述为 reward optimization 问题,提出基于 GRPO 的 FlowErase-RL:(1) 双路径动态奖励——CE(Concept Erasure)奖励抑制目标概念,NS(Non-target Space)奖励保住生成质量;(2) 性能驱动的自适应切换策略,无需显式监督就能稳定训练;通用支持裸露/物体/艺术风格三类擦除 实验效果:裸露/物体/艺术风格三类擦除均达 SOTA,图像质量与语义对齐保持很好;对抗攻击鲁棒性强,多概念场景扩展性好——开辟了 Flow Matching 安全可控生成的新范式 批判点评:把擦除从 SFT 转向 RL 是聪明的——擦除本质是分布偏移而非分类,RL 的奖励更贴合;但 GRPO 训练成本不低,CE/NS 双奖励的权重边界对效果影响多大未深入消融;擦除概念之间的相互干扰(擦了概念 A 影响概念 B 的生成)这一长尾问题未充分讨论 8. CPC-VAR:首次给VAR模型做持续多概念个性化 CPC-VAR: Continual Personalized and Compositional Generation in Visual Autoregressive Models | 哈工大深圳, 清华深圳国际研究生院, 鹏城实验室, 华南理工 | arXiv:2605.19750 关键词:持续学习·VAR 个性化·概念神经元·多概念合成·解纠缠 ⚠️ 前序问题:Visual Autoregressive(VAR)做文生图效率高,但现有 VAR 个性化只能静态训单概念——序列学新概念时旧概念会被灾难性遗忘,多概念合成又会出现特征纠缠和属性不一致。这是 VAR 个性化生成的两个老大难 本文贡献:首次系统研究 VAR 持续个性化生成,提出统一框架。两个核心组件:(1) GCNS(Gradient-based Concept Neuron Selection),找到每个概念相关的神经元,只约束跨任务冲突参数,不扩展模型也能抗遗忘;(2) 上下文感知组合策略:多分支特征建模 + 空间条件引导的局部 cross-attention 融合,做精确解纠缠的多概念合成 实验效果:长序列持续个性化场景下显著领先现有 baseline,多概念图像合成上也优于现有方法,证明 VAR 完全有能力做可扩展可控的个性化生成 批判点评:VAR 个性化第一次被系统化研究是好事,神经元级别的 GCNS 设计也比经典扩散模型路线(DreamBooth/LoRA)更经济;但实验是否覆盖到 10+ 概念的真实长尾、跨概念组合的失败模式分析略浅,VAR 底模本身的天花板(vs 扩散模型)没有正面比较 9. DyMoS:一个标量旋钮控 I2V 运动幅度 Rebalancing Reference Frame Dominance to Improve Motion in Image-to-Video Models | 延世大学 Yonsei, GIST, Adobe Research | arXiv:2605.19398 关键词:I2V·运动控制·注意力 rebalance·训练免微调·DyMoS ⚠️ 前序问题:I2V(image-to-video)相比 T2V 生成的视频普遍过于静态。前人方案靠削弱或修改图像条件来增加运动,但要么需要额外训练,要么牺牲了对参考图像的保真度——「动起来 vs 像参考图」是个长期 tradeoff 本文贡献:识别出「reference-frame dominance」是动作抑制的核心机制:非参考帧对参考帧 key token 分配过多 self-attention,导致参考信息被过度跨时传播、压制了帧间动态。提出 DyMoS(Dynamic Motion Slider):训练免微调、模型无关,初始去噪步 rebalance 生成帧到参考帧的注意力路径,输入图和模型权重都不动,只引入一个标量参数连续控制运动强度 实验效果:多个 SOTA I2V backbone 上一致提升运动动态,同时保持视觉质量和对参考图的保真度;提供 user 一个可调的运动旋钮 批判点评:把「动起来 vs 像参考图」从冲突变成可调旋钮是非常实用的工程贡献;但 attention rebalance 的具体公式对不同架构可能需重新调,论文给出的 generality 主要在 SD 系列底模;标量旋钮是否能控制不同方向的运动(横向 vs 纵向)需要更细粒度评测 10. MSAVBench:首个多镜头音视频生成评测基准 MSAVBench: Towards Comprehensive and Reliable Evaluation of Multi-Shot Audio-Video Generation | 复旦大学, 港大, 阿里通义实验室, 浙大, 北大 | arXiv:2605.20183 关键词:多镜头音视频·评测基准·导演级控制·自适应分镜·MSAVBench ⚠️ 前序问题:视频生成正从单镜头扩展到复杂多镜头音视频(MSAV)叙事,但评测仍是基础性挑战——现有 benchmark 范围有限、数据多样性不足、评测流水线僵化,无法系统可靠地评估现代 MSAV 模型 本文贡献:推出 MSAVBench 首个面向多镜头音视频生成的综合评测基准 + 自适应混合评测框架。覆盖视频/音频/镜头/参考四个维度,多种任务设置,最多 15 个镜头,挑战性的非真实场景。评测框架的鲁棒性来自三件事:分镜分割的自适应 self-correction、主观指标的实例级 rubric、复杂判断的工具溯源证据抽取 实验效果:与人类判断的 Spearman 秩相关达 91.5%,对齐度极高;系统评测 19 个 SOTA 闭源/开源模型显示:当前系统在导演级控制和细粒度音视频同步上仍有困难,模块化/agentic 生成 pipeline 是缩小开源-闭源差距的有前途路径;benchmark 数据和评测代码将开源 批判点评:把音视频生成评测从「单镜头质量」推进到「多镜头叙事 + 导演级控制」是必要的下一步;91.5% Spearman 与人类对齐很高,自适应分镜 self-correction 是工程亮点;但 15 个镜头作为基准上限对真正的长视频(>5 分钟、几十个镜头)覆盖度有限;非真实场景的标注成本与一致性如何控制仍是开放问题 11. CogOmniControl:专用CogVLM认知创意意图引导生成 CogOmniControl: Reasoning-Driven Controllable Video Generation via Creative Intent Cognition | 澳门大学 SKL-IOTSC, 腾讯 Online-Video BU | arXiv:2605.19995 关键词:可控视频生成·专业 VLM·创意意图认知·闭环 harness·in-context ⚠️ 前序问题:视频扩散模型对 abstract / 稀疏 / 复杂条件依然脆弱——专业制作工作流(分镜草图、黏土渲染等)下表现差。现有方案要么用 adapter 注入条件,要么把通用 VLM 耦合到扩散 backbone——能力鸿沟仍在,难以输出对齐用户创意意图的视频 本文贡献:提出 CogOmniControl 推理驱动框架:把可控视频生成因式分解为「创意意图认知」+「生成」。专门用真实动漫制作数据训了一个专业版 CogVLM,比通用 VLM 更准确地从稀疏抽象条件中识别用户创意意图,转译成密集 reasoning 输出;CogOmniDiT 通过 in-context generation 统一多种条件,并用 RL 对齐到 CogVLM reasoning 输出。进一步利用 CogVLM 做评测与 Best-of-N 选择,整个框架是闭环 harness 架构。同时发布 CogReasonBench / CogControlBench 来自专业工作流的真实创意意图数据 实验效果:两个 benchmark 上一致超越现有开源模型,在分镜草图、黏土渲染等专业条件下尤其明显——证明专业 VLM 介入的认知能力对可控生成是有效的 批判点评:专业 VLM 当「创意意图认知器」是个新颖思路,引入 reasoning 缓解条件稀疏问题——但训练专业版 VLM 的数据规模有限,跨垂直域(动漫→真人/工业)泛化未验证;闭环 harness 架构推理时延偏高,落地工业流水线存在挑战 12. DiSI:单模型连续滑动失真感知权衡 Disentangling Generation and Regression in Stochastic Interpolants for Controllable Image Restoration | 同济大学, 复旦大学 | arXiv:2605.21381 关键词:图像复原·Stochastic Interpolant·生成-回归解耦·失真感知权衡·像素空间 ⚠️ 前序问题:图像复原(IR)领域生成式(Diffusion/Flow Matching)擅长合成真实纹理但慢且像素保真度差;经典回归式方法单步高效像素准确——两条路线长期不能兼得 本文贡献:提出 DiSI 统一框架:把底层 Stochastic Interpolant 过程显式解耦为独立的生成分量和回归分量。这种解耦让模型在「纯回归 → 全生成」之间连续可控过渡。技术上提供两条具体采样轨迹和统一 sampler 支持任意轨迹的少步推理;网络是像素空间的双分支 U-Net 风格 transformer(专用分支增强条件引导同时保高吞吐) 实验效果:在多种 IR 任务上以高效率取得有竞争力的结果;独有特性:单一模型推理期就能控制失真-感知 tradeoff(distortion-perception trade-off),不再需要训多个模型 批判点评:把 SI 过程拆成生成+回归两个可独立调用的分量,在理论上很优雅,给「失真-感知」连续控制提供了第一种统一手段;但实际 IR 任务中如何选择最佳轨迹(用户需指定 tradeoff?)的 UI/控制接口论文未深入讨论;与最新 OSEDiff/PASD 等方法的端到端对比有所欠缺 13. ABSS:初始几步注意力筛 seed 提画质 Boosting Text-to-Image Diffusion Models via Core Token Attention-Based Seed Selection | Brandeis University | arXiv:2605.19532 关键词:文生图·Seed Selection·Cross-Attention·训练免微调·SD ⚠️ 前序问题:文生图扩散模型的输出对随机 seed 极度敏感——不同 seed 同 prompt 画质和文图对齐差异巨大。但「该用哪个 seed」一直靠盲选,缺乏系统的预选机制 本文贡献:观察到一个关键现象:在前几步去噪过程中,对 prompt 中 core token(content-bearing words)的 cross-attention dynamic 强烈预测最终生成质量。基于此提出 ABSS(Attention-Based Seed Selection),训练免微调即插即用:候选 seed 跑前几步,用对 core token 的 cross-attention 打分排序,只保留 top-k 完成完整生成,不需要固定阈值 实验效果:三个 benchmark 上 Stable Diffusion 各变体的文图对齐和视觉质量一致提升,人工偏好与对齐指标都有改善;可作为现有 seed 优化 pipeline 的轻量预选附加组件叠加额外收益 批判点评:很经济的工程发现:把 seed 筛选问题转换为前几步 attention 信号读取,几乎没有计算开销;但这种基于 attention 的代理指标在跨架构(DiT/MMDiT)的可迁移性需要进一步验证;core token 的提取依赖 prompt parsing 的鲁棒性 趋势观察 「编辑」开始成为统一多模态模型的核心训练任务 — Uni-Edit 把智能编辑提为 UMM 单一通用训练任务,BAGEL/Janus-Pro 上一个数据集就能同时提理解/生成/编辑——「编辑作为通用任务」的认知正在替代「混合多任务训练」的范式。FullFlow 用同样的精简思路(只训 5% 参数)把 T2I 升级成双向多模态,从「重训」走向「升级」 视频生成加速进入「时空联合 + 稀疏注意力」阶段 — DVG 把渐进分辨率从单空间扩到时空联合,HunyuanVideo 上 7× 加速 + 蒸馏达 18×;BA-Att 用块预降采样稀疏注意力比 FlashAttention 还快 6.95×。视频扩散下一阶段的加速重心从单维度优化转向「时空 + 稀疏」组合拳 长视频生成从训练扩展走向「推理期方法」 — FlowLong 用 Tweedie matching 滑窗 training-free 把视频时长扩到数倍——这条 inference-time 路线和 Mutual Forcing/Causal Forcing++ 的训练侧路线形成互补,意味着长视频不一定要重新训模型 I2V 运动控制和文生图 seed 选择都被「单一标量旋钮 + Attention 信号」攻破 — DyMoS 用一个标量参数控 I2V 运动幅度(attention rebalance);ABSS 用初始几步 cross-attention 信号筛 seed——共同点是把「需要训练才能解决」的问题,转化为「读取已有 attention 信号」的免训练方案 概念擦除从 SFT 范式跨入 RL 范式 — FlowErase-RL 首次用 GRPO 做 Flow Matching 概念擦除,CE+NS 双路径动态奖励替代精对齐 SFT 数据——证明在 Flow Matching 时代,「擦除」本质上更适合用 RL 的分布偏移视角而非分类监督视角 人工智能炼丹君 整理 | 2026-05-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-20|视频生成补物理常识NEWTON 今日 AIGC 论文速览 今日共 4 篇 · 物理常识与可控视频生成 2 篇 · 世界模型与实时交互 1 篇 · 高效音频生成 1 篇 重点论文标题列表 NEWTON:Agent 编排物理工具链补条件提物理常识 IAMFlow:免训练身份记忆解决长叙事视频漂移 Stable Audio 3:H200 上 2 秒生成数分钟变长音频 Incantation:自然语言每0.25秒控多实体19.7FPS 今日论文速览 1. NEWTON:Agent 编排物理工具链补条件提物理常识 NEWTON: Agentic Planning for Physically Grounded Video Generation | 浙江大学, 香港理工大学, IROOTECH/三一集团 | arXiv:2605.18396 关键词:视频生成·物理常识·Agentic Planning·VideoPhy-2·Flow-GRPO 前序问题:视频生成模型画面好看但系统性违反物理常识——VideoPhy-2 上最强模型 joint accuracy 仅 32.6%。论文把根源诊断为「条件规约瓶颈」:文本 prompt 是物理世界的有损压缩,遗漏了真正决定动力学的参数(速度/质量/碰撞角度),单纯堆模型容量补不回来从未被指定的信息 本文贡献:提出 NEWTON 框架:把视频生成「降级」为 agent 工具箱中的一个动作,由可学习的 planner 编排关键帧生成、科学计算、prompt 改写等物理感知工具构造丰富条件,再用 verifier 闭环迭代;planner 是唯一可训练组件,在多轮真实交互中用 Flow-GRPO 在线优化。提出物理条件需满足的三条性质:sufficiency / dynamism / verifiability 实验效果:VideoPhy-2 上 joint accuracy 显著提升:LTX-Video 21.4% → 29.7%(+8.3pp),Veo-3.1 30.7% → 37.4%(+6.7pp),关键是不修改任何视频生成器底模,只改 planner 批判点评:把视频生成嵌入 agent loop 是个聪明的 reframe——既然底模拿不到完整物理参数就别强求底模,把信息构造交给可推理的 planner;但 Flow-GRPO 的训练成本不低,物理工具链对生成时延的影响论文未充分披露,verifier 能否在更多元物理现象上稳定收敛仍待验证 2. IAMFlow:免训练身份记忆解决长叙事视频漂移 Advancing Narrative Long Video Generation via Training-Free Identity-Aware Memory | 浙江大学, 腾讯优图, 华中科大, 上海交大 | arXiv:2605.18733 关键词:长视频生成·身份记忆·训练免微调·叙事生成·NarraStream-Bench 前序问题:自回归长视频生成在视觉保真度和交互上进步快,但长序列里身份漂移、角色重复、属性丢失的问题严重;现有方案要么用预定义策略压缩历史帧,要么靠粗糙的隐式注意力检索关键帧,对「带角色切换的演化型 prompt」都处理不好 本文贡献:提出 IAMFlow 训练免微调身份感知记忆框架:用 LLM 从每个 prompt 抽实体并赋予全局唯一 ID,建立身份记忆;用 VLM 异步从渲染帧验证并修正属性,把隐式相似度匹配换成显式实体追踪。配套异步视觉验证 + 自适应 prompt 切换 + 模型量化的推理加速流水线,并发布 NarraStream-Bench 长叙事流式视频评测基准(324 个多 prompt 脚本) 实验效果:NarraStream-Bench 上整体最佳,比最强 baseline 高 2.56 分;60 秒多 prompt 生成相比最高效 baseline 还有 1.39× 加速,做到「质量更好且更快」 批判点评:把身份当作显式可寻址符号、用 VLM 异步验证属性,是把 agentic memory 思想正式带进长视频生成的工作;但训练免微调依赖 LLM/VLM 的稳定性和延迟,多角色密集交互场景下全局 ID 解析是否还稳健仍是开放问题;NarraStream-Bench 的 324 个脚本规模偏小,对极端长视频(>3 分钟)的覆盖度有限 3. Stable Audio 3:H200 上 2 秒生成数分钟变长音频 Stable Audio 3: Fast Latent Diffusion for Variable-Length Audio Generation | Stability AI | arXiv:2605.17991 关键词:音频生成·latent diffusion·变长生成·对抗后训练·消费级开源 前序问题:音频生成模型在「变长生成 + 编辑修补 + 推理速度 + 消费级硬件可跑」四件事之间往往要做妥协;以前的 SA1/SA2 在长度灵活性和速度上还有进一步压榨空间,且开源生态需要一个能在 MacBook 上几秒出结果的版本 本文贡献:推出 small/medium/large 三档变长音频 latent diffusion 模型;核心创新:(1) 新的 semantic-acoustic VAE 同时压缩音频且保留语义结构;(2) 支持 inpainting 做精细化音频编辑与短录音续写;(3) 对抗后训练(adversarial post-training)减少推理步数同时提升保真度与 prompt 贴合度;(4) 训练数据全部来自 licensed + Creative Commons 数据,规避版权风险 实验效果:H200 GPU 上不到 2 秒生成数分钟音乐/音效;MacBook Pro M4 上不到几秒生成;small/medium 权重 + 训练推理 pipeline 全开源,能在消费级硬件上跑 批判点评:Stability AI 用同一份开源策略持续做了 SA1/SA2/SA3 三代——这种「商用规避版权 + 真开源 + 真在消费硬件能跑」的工作工业价值最高;但 large 档不开源、对中文/中性别人声的覆盖度论文未深入披露、是否包含 vocal/mixing 级编辑也需后续测试 4. Incantation:自然语言每0.25秒控多实体19.7FPS Incantation: Natural Language as the Action Interface for Multi-Entity Video World Models | 上海交大, NVIDIA Research, USTC, UCAS, NUS, UWaterloo, HKUST, HKU, 紫光研究院 | arXiv:2605.18601 关键词:视频世界模型·自然语言动作接口·实时流式·Self-Forcing·跨游戏泛化 前序问题:当前交互式视频世界模型画质好但缺多实体细粒度控制和跨实体/跨世界泛化——根因在「动作接口」:标准控制协议(动画 ID、设备输入、场景级 caption)在设计期就把动作语义绑死到具体实体或引擎上,无法跨游戏迁移 本文贡献:首次把自然语言作为视频世界模型的动作接口:每 0.25 秒(1 个 latent frame)一条自然语言条件,原生支持同时多实体控制和跨实体概念迁移;架构是预训练双向视频底模 + frame-local text cross-attention;通过 ODE-initialized Self-Forcing 蒸馏 + RoPE-decoupled 滑窗 KV-cache 实现实时长 horizon 流式生成;同款架构和训练配方迁移到《拳皇》只需换 per-entity 动作词表 实验效果:跨实体迁移成功率 89% vs Action-Index baseline 43%;out-of-vocabulary prompts 90% vs 0%;2 步学生模型在 480p 上稳定 19.7 FPS,2 小时长 rollout 不发散,FVD 维持稳定;同时发布 Elden Ring 玩家-Boss 战斗剪辑数据集预览 批判点评:把世界模型的动作接口从「枚举 ID」升级到「自由语言」是非常正确的方向,跨实体 89% vs 43% 的提升清晰证明了价值;但训练数据是手工标注的游戏片段(Elden Ring/KOF),真实世界视频里语言 → 物理动作的映射可能远比游戏复杂;Self-Forcing 蒸馏依赖双向教师的瓶颈仍未解(参考 Mutual Forcing 路线的下一步演化方向) 趋势观察 视频生成把「物理 / 身份 / 多实体」推到 agent 接口层 — 今天的三篇视频文章都在做同一件事:把视频生成从「单 prompt → 一段画面」升级为「Agent 编排条件 + 显式记忆/接口」。NEWTON 用 planner+verifier 给视频生成补物理参数;IAMFlow 用 LLM/VLM 异步给长叙事维护身份记忆;Incantation 用自然语言每 0.25 秒控制多实体。共同点:底模不动,靠外层 agentic 结构补语义 物理常识成为视频生成评测的下一个高地 — NEWTON 在 VideoPhy-2 上把 LTX-Video 从 21.4% 推到 29.7%、Veo-3.1 从 30.7% 推到 37.4%——但绝对值仍不到 40%。视频生成的下一阶段评测从「画质」转向「物理可解释性」 长视频靠「显式身份记忆」而不是「KV 容量」 — IAMFlow 的关键观察:与其压缩历史帧,不如显式给每个实体一个全局 ID 并用 VLM 异步验证属性。这是把 LLM 时代成熟的 Memory/Retrieval 思想正式搬进视频生成的标志性工作 世界模型的动作接口正在自然语言化 — Incantation 把世界模型动作从「枚举 ID」升级为「自然语言每帧条件」,跨实体迁移 89% vs 43% 的提升说明这条路线确实可行——下一阶段的世界模型可能会全面采用语言作为控制信号 音频生成的开源生态在收敛 — Stable Audio 3 用 licensed + CC 数据 + small/medium 开源 + 消费级硬件,把 SA 系列做到了「研究者本地可玩」的硬件包络——这套打法可能会被音视频联合生成(如昨日的 Mutual Forcing)下一代复制 人工智能炼丹君 整理 | 2026-05-20 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
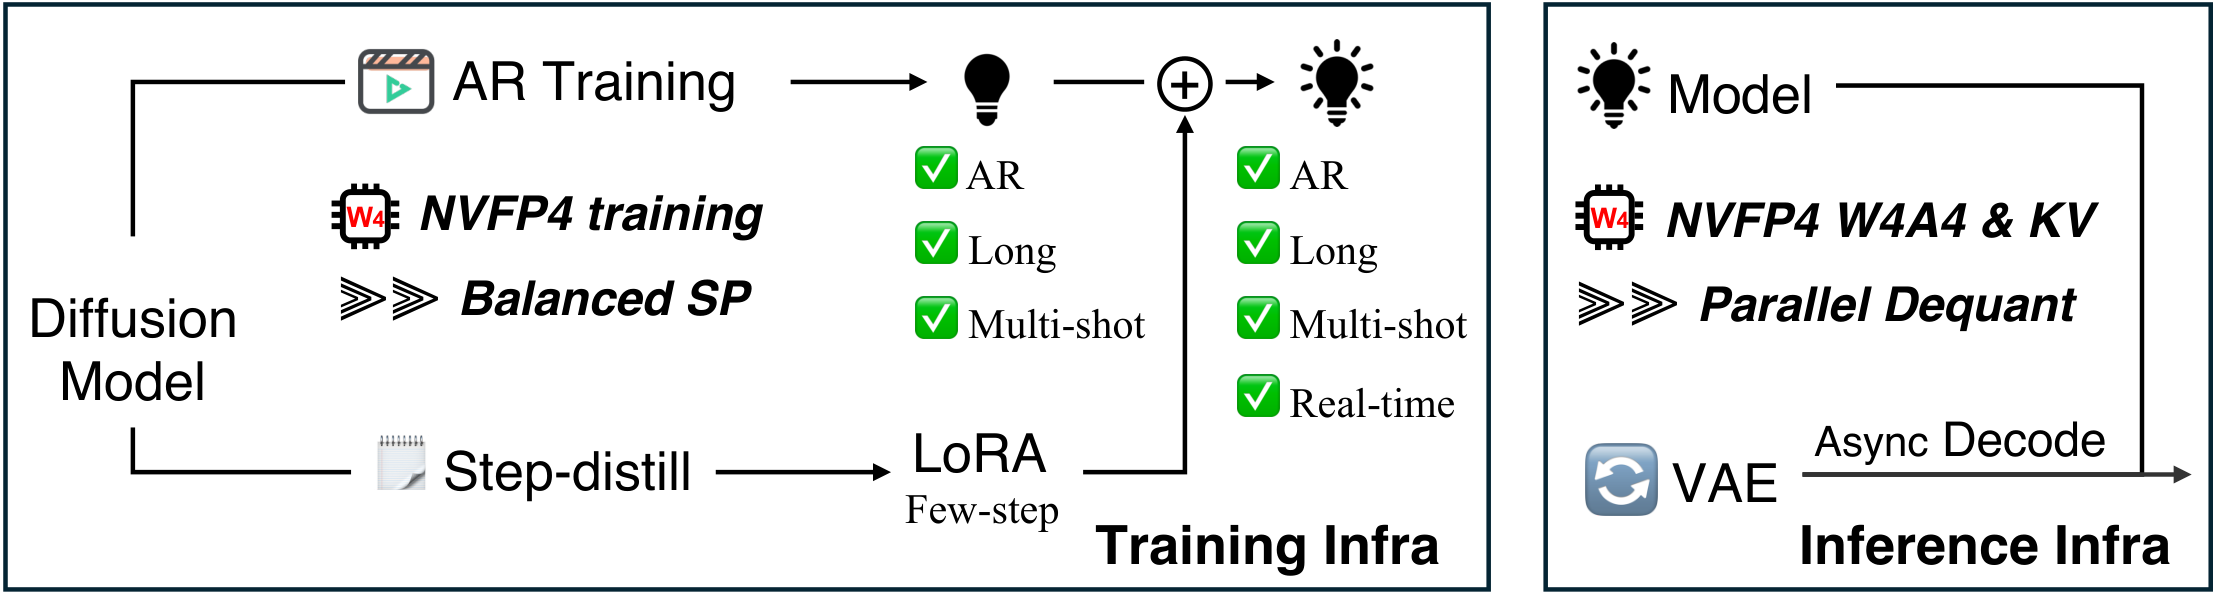
AIGC 每日速读|2026-05-19|长视频生成FP4训推全栈LongLive-2.0 今日 AIGC 论文速览 今日共 13 篇 · 长视频生成与训推优化 2 篇 · 扩散推理加速与量化 4 篇 · 视频编辑与实时特效 2 篇 · 统一多模态生成 1 篇 · 音频生成与综述 2 篇 · 扩散 RL 后训练 2 篇 重点论文标题列表 LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× TACache:Rectified Flow 训练免训练加速 4.14× Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Lance:原生统一图像视频理解生成 MoE 模型 StreamingEffect:单 H200 实时 720p 人像视频特效 今日论文速览 1. LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× LongLive-2.0: An NVFP4 Parallel Infrastructure for Long Video Generation | NVIDIA | arXiv:2605.18739 关键词:长视频生成·NVFP4·序列并行·AR 视频扩散·Song Han 前序问题:长视频生成的训练和推理同时卡在显存和速度上:现有 Self-Forcing 系列依赖 ODE 初始化 + DMD 蒸馏,流程冗长;推理端把 KV cache 与计算精度压不下去,使得分钟级、多镜头、可交互的 AR 视频生成在大模型规模下难以落地 本文贡献:提出 LongLive-2.0:首个 NVFP4 端到端长视频生成训练 + 推理基础设施。(1) 训练侧的 Balanced SP——把 teacher-forcing 布局与序列并行(SP)协同设计,在每个 rank 上配对干净历史 + 噪声目标的时间块,并搭配 SP-aware 分块 VAE 编码;(2) 直接把扩散模型微调成长时多镜头交互式 AR 模型,跳过 ODE 初始化 + DMD 蒸馏;(3) 推理侧 Blackwell 上跑 W4A4 NVFP4,KV cache 也量化到 NVFP4,配合异步流式 VAE 解码 实验效果:训练加速 2.15×、推理加速 1.84×;LongLive-2.0-5B 在保持 benchmark 强表现的同时达到 45.7 FPS 推理;可独立 LoRA 切换为 4 步 / 2 步实时生成模式,是首个面向长视频生成的 NVFP4 训推一体系统 批判点评:把 NVFP4 这种 Blackwell 新精度从推理推到训练全链路是工程级里程碑,5B 跑出 45.7 FPS 把长视频 AR 推到了实时门槛;但 NVFP4 对硬件的强绑定限制了非 Blackwell 集群的复现路径,量化 KV cache 在多镜头切换时的累积误差也值得长期追踪 2. TACache:Rectified Flow 训练免训练加速 4.14× Accelerating Rectified Flow Models via Trajectory-Aware Caching | 上海交大, 军事科学院, 华为 | arXiv:2605.16789 关键词:Rectified Flow·训练-free 加速·缓存·正交分解·扩散推理 前序问题:扩散与 Rectified Flow 模型靠迭代评估速度场出图/出视频,计算昂贵;现有 cache 方法靠跳步加速,但粗略的近似在长跳步区间累积误差大,激进加速下质量明显劣化 本文贡献:提出 TACache(Trajectory-Aware Cache)训练-free 加速框架,遵循「先跳步后补偿」范式:对 RF 轨迹上离散速度加速度做正交分解(平行 + 正交残差),分离每步近似误差的幅值与方向来源;离线阶段用幅值 / 方向累积阈值生成跳步表,在线阶段结合样本历史正交方向重构被跳过的速度,无需额外模型评估 实验效果:在 BAGEL、FLUX.1-dev、Wan2.1-1.3B 上分别实现文生图 4.14×、文生视频 2.11× 加速;在所有 reference-based fidelity 指标上一致优于已有 cache 类方法 批判点评:「先跳步后补偿」+ 速度加速度正交分解,把 cache 类方法从经验调参推到了误差可控的工程范式;但分解效果对模型与数据集分布敏感,离线统计在 prompt 分布漂移时是否仍稳定,还需要更长尾的验证 3. Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Aurora: Unified Video Editing with a Tool-Using Agent | 罗切斯特大学, Adobe | arXiv:2605.18748 关键词:视频编辑·VLM Agent·工具调用·统一扩散·欠规范请求 前序问题:现有统一视频编辑模型把文本、源视频、参考图喂进同一个 DiT 一把搞定替换 / 删除 / 风格 / 参考插入;设计很灵活,但默认用户已提供了 model-ready 的文本、参考图与空间锚定——真实请求里这些往往缺失 本文贡献:提出 Aurora:把工具增强 VLM agent 与统一视频扩散 transformer 配对——agent 把原始用户请求映射成对齐 transformer 条件通道的结构化编辑计划,先解决「文本和视觉欠规范」再生成;用监督数据训练完整编辑规划 + 参考图选取,再用偏好对训练鲁棒工具调用与指令润色;并发布 AgentEdit-Bench 评估「欠规范用户请求」下的 agentic 视频编辑能力 实验效果:在 AgentEdit-Bench 与两个现有视频编辑 benchmark 上,Aurora 显著超越纯指令 baseline;VLM agent 还能迁移到其他冻结的视频编辑模型,作为通用前置规划层 批判点评:把视频编辑里「用户输入欠规范」这一真实痛点显式拆解给 VLM agent 处理,是务实且可迁移的范式;但 agent 错误规划带来的级联编辑错误尚未充分量化,agent + DiT 的端到端延迟也是落地前要解决的关键 4. Lance:原生统一图像视频理解生成 MoE 模型 Lance: Unified Multimodal Modeling by Multi-Task Synergy | 字节跳动 Intelligent Creation Lab | arXiv:2605.18678 关键词:统一多模态·MoE·双流架构·原生训练·图像视频生成 前序问题:统一多模态模型要么靠模型尺寸堆量、要么沿用图文为主的设计,在「图像 + 视频 × 理解 + 生成 + 编辑」的全格子上很难一并打通;理解和生成两条能力路径互相干扰,多模态 token 异质性也让位置编码难以兼顾 本文贡献:提出 Lance:原生轻量级统一多模态模型,从零训练,采用「双流 MoE + 共享交错多模态序列」架构——联合上下文学习同时把理解与生成的能力路径解耦;引入 modality-aware RoPE 缓解异质视觉 token 的相互干扰;训练采用分阶段多任务范式,配合自适应数据调度同时强化语义理解与视觉生成 实验效果:图像和视频生成上大幅超越现有开源统一模型,同时保持强多模态理解能力,证明统一不必靠堆参数,「能力路径解耦」是更可持续的统一范式 批判点评:「统一上下文 + 解耦能力路径」的设计直击当前统一模型最大痛点:什么都做但什么都不极致;不过双流 MoE 的训练稳定性、与闭源旗舰模型的差距,以及在更长视频上的可扩展性仍待时间检验 5. StreamingEffect:单 H200 实时 720p 人像视频特效 StreamingEffect: Real-Time Human-Centric Video Effect Generation | 新加坡国立 Show Lab | arXiv:2605.17019 关键词:视频编辑·实时流式·人像特效·因果蒸馏·VideoEffect-130K 前序问题:电商直播、娱乐、Vlog 等场景需要实时人像视频特效,但缺数据、缺可部署的编辑模型;视频编辑的高效蒸馏几乎没人做,现有加速大多围绕文生视频,无法保住身份、背景与时序一致性 本文贡献:提出 StreamingEffect:上下文式视频编辑架构 + 因果 AR 学生蒸馏,把采样从 50 步压到 4 步;支持关键帧控制——可以在线注入参考特效帧并沿流传播,实现交互式编辑;同时构建 VideoEffect-130K 数据集——70K 特效视频 + 60K 编辑视频、600 类特效,是已知最大的人像视频特效数据集 实验效果:在单张 H200 GPU 上实现实时高质量 720p 视频编辑,数据集和方法共同填补了「人像视频特效实时编辑」的开源生态空白 批判点评:把视频编辑显式当作「实时流式 + 关键帧可控」问题来解,配套 130K 高质量数据是最大的工程贡献;但 600 类特效的覆盖度、4 步学生在长流式生成下身份漂移、以及 H200 之外的部署门槛,是产品化关键考验 6. MeanFlow-LSE:MeanFlow 蒸馏推到 80B 工业级模型 Stabilizing, Scaling & Enhancing MeanFlow for Large-scale Diffusion Distillation | 西电, 腾讯混元 | arXiv:2605.17834 关键词:MeanFlow·扩散蒸馏·大规模训练·HunyuanImage·少步生成 前序问题:MeanFlow 因公式简洁、表现强劲在少步蒸馏受关注,但优化目标不稳定 + 「mean-seeking bias」限制了它在大规模工业模型上的应用,蒸馏到 12B / 80B 级别经常训练崩溃或质量塌陷 本文贡献:(1) 引入 warm-up 技术,用离散解替代原 MeanFlow 微分解,避免 stop-gradient 项含未训好模型导致的训练崩溃;等模型对平均速度场有初步拟合后再切回微分解继续精炼;(2) 引入轨迹分布对齐作为辅助目标,缓解极少步推理下复杂目标分布上的 mean-seeking bias,让学生模型轨迹分布贴近教师 实验效果:在 FLUX.1-dev(12B)上超越现有蒸馏方法;推到 80B 的 SOTA 工业模型 HunyuanImage 3.0,依然展现出鲁棒泛化与强表现,是首次把 MeanFlow 蒸馏验证到 80B 量级 批判点评:warm-up + 轨迹分布对齐两步组合直击 MeanFlow 在大模型上的两大顽疾,工程上意义重大;但 warm-up 阶段 / 切换时机依赖经验设定,对不同 backbone 的迁移性还需更系统消融 7. I2V-Survey:图生视频扩散首份系统综述 Image-to-Video Diffusion: From Foundations to Open Frontiers | 港城大, 格里菲斯大学等 | arXiv:2605.17248 关键词:图生视频·扩散综述·I2V·taxonomy·开放挑战 前序问题:图生视频(I2V)已成为生成模型的核心方向,对内容一致性、身份保留与运动连贯性的要求都比通用视频生成更严;但现有论文大多把 I2V 当作通用视频生成的子话题,缺乏专门的 taxonomy 与系统分析 本文贡献:把扩散 I2V 单独立题,系统梳理任务定义、模型架构、数据集、评测指标,并按架构和训练范式给出 taxonomy;进一步抽取 4 个核心设计——条件编码 / 时序建模 / 噪声先验 / 时空上采样,配合典型应用与开放挑战 实验效果:为 I2V 这一独立子方向提供首份结构化综述,给出可复用的 4 大设计轴和应用-挑战双视角,便于研究者和工程团队系统理解技术路径 批判点评:把 I2V 从「视频生成的角落」抬到独立子方向,「4 个核心设计 + taxonomy」是清晰可用的索引框架;但综述截止时间内未能覆盖最新一波因果 / 实时 I2V,未来需要持续更新追踪 8. WavFlow:原始波形空间直生高保真音频 WavFlow: Audio Generation in Waveform Space | Meta AI, 东北大学 | arXiv:2605.18749 关键词:音频生成·波形空间·Flow Matching·V2A·T2A 前序问题:现代音频生成几乎都依赖潜空间压缩,引入额外复杂度并潜在丢失信息;但波形空间维度极高、能量分布稀疏,让扩散模型直接在波形上建模长期失败 本文贡献:提出 WavFlow:直接在原始波形空间生成高保真音频,无中间表示。通过 waveform patchify 把音频重塑为 2D token grid,引入 amplitude lifting 对齐信号尺度,使 flow matching 中的 x-prediction 优化稳定;并构建自动化数据流水线,整理 500 万视频-文本-音频三元组,从零学习细粒度声学模式 实验效果:在视频转音频 VGGSound 上取得 FD_PaSST 59.98 / IS_PANNs 17.40 / DeSync 0.44;在文生音频 AudioCaps 上 FD_PANNs 10.63 / IS_PANNs 12.62,与已有潜空间方法持平或超越,证明中间压缩并非高质量音频合成的必要条件 批判点评:「不要 latent,直接干波形」是颇有勇气的反潮流路线,patchify + amplitude lifting 是让 flow 在波形上稳的关键工程;但波形 flow matching 的训练成本与采样开销比 latent 方案高得多,工业级落地需要更激进的加速 9. TAPE:时序感知 token 剪枝免训加速视频扩散 Temporal Aware Pruning for Efficient Diffusion-based Video Generation | 匹兹堡大学, IIT, Rutgers, Microsoft AI | arXiv:2605.17837 关键词:视频扩散·token 剪枝·训练-free 加速·时序一致性·ViT 前序问题:视频扩散 ViT 架构出视频质量高,但长时空序列上的注意力计算极贵;已有 token 剪枝多基于 attention、按帧独立操作,难以保住跨帧时序连贯,naive 应用会产生背景不稳、闪烁、画质下降 本文贡献:提出 TAPE 训练-free 时序感知剪枝:(i) 时序平滑对齐相邻帧的 token 重要性,抑制选择抖动;(ii) 在选定层做 token 重选,使剪枝匹配各层的不同语义关注,避免误差在特定区域累积;(iii) 时间步级预算调度——早期噪声重的步骤激进剪、后期保真关键步骤放宽 实验效果:显著提速的同时保持高视觉保真度,超越前期 token reduction 方法;作为 plug-in 训练-free 加速,能直接套到现有视频扩散模型上 批判点评:把 token 剪枝从「每帧独立」拉回「时序感知」是补足视频域专属约束的正确方向,三项设计互相协同;但激进时间步预算调度对极长视频的累积误差、以及 ViT 之外架构的迁移性仍是开放问题 10. SafeDiffusion-R1:在线 GRPO + CLIP 引导奖励安全对齐 SafeDiffusion-R1: Online Reward Steering for Safe Diffusion Post-Training | MBZUAI | arXiv:2605.18719 关键词:扩散安全·在线 RL·GRPO·CLIP 引导·内容审核 前序问题:扩散模型移除预训练中学到的不安全内容,现有方法要么需要昂贵的 unsafe-text 配 safe-image 监督数据,要么走离线 RL / SFT 在合成数据上训,灾难性遗忘严重,生成质量明显劣化,扩展性差 本文贡献:提出在线 RL 框架:在正负 prompt 上跑 GRPO;引入 steering reward 机制利用 CLIP 嵌入空间的固有性质——把文本表示推向正向安全方向、远离负向,无需为每个安全维度单独训 reward 模型;在线策略让模型从包括显式不安全 prompt 在内的多样请求中学习而不灾难性遗忘 实验效果:不当内容下降到 18.07%(vs SD v1.4 的 48.9%),裸露检测 15 vs baseline 646;GenEval 组合生成质量从 42.08% 提升到 47.83%;安全增益泛化到 7 类未见有害 prompt 类别 批判点评:把「安全对齐」从离线 SFT 推到在线 GRPO,叠加 CLIP 嵌入引导避开 reward 模型训练,工程友好且可扩展;但 CLIP 嵌入方向偏向、对抗性提示下 steering 的鲁棒性,仍需对抗压力测试持续追踪 11. CGPO:按 reward 方差自适应难度的文生图 RL Curriculum Group Policy Optimization: Adaptive Sampling for Unleashing the Potential of Text-to-Image Generation | 北邮, 中国电信 TeleAI | arXiv:2605.17807 关键词:文生图·GRPO·课程学习·自适应采样·RL 对齐 前序问题:文生图 RL(特别是 GRPO 系)训练时统一采样策略忽视了样本难度与模型当前能力的匹配,训练效率低,模型常在已掌握或还远不能掌握的 prompt 上空转 本文贡献:提出 CGPO 自适应课程训练框架:每条 prompt 生成一组图像由 reward 模型打分,用组内 reward 方差作为「prompt 不一致性」的在线 proxy——方差高说明模型部分掌握但未稳定,正是最该多采的可学习 prompt,从而提高其采样概率;再用比例公平优化做类别校准,平衡多类别数据集的训练难度 实验效果:在 GenEval、T2I-CompBench++、DPG Bench 上一致提升生成性能,为 GRPO 类文生图 RL 提供可即插即用的课程化增强 批判点评:用 reward 方差当「可学习 prompt」proxy 是优雅且无需额外标注的设计;但 reward 模型本身的偏差会被该 proxy 放大,长期训练下需要监控 reward hacking 12. DiRotQ:PCA 旋转感知 W4A4 DiT 量化 DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers | d-Matrix | arXiv:2605.16732 关键词:DiT·4-bit 量化·PCA 旋转·W4A4·FLUX 前序问题:DiT 出图质量 SOTA 但推理代价高;激进 PTQ 到 4-bit 能省算力却经常严重掉点;已有 smoothing / mixed precision / rotation / low-rank residual 等方法都只能部分缓解,与 FP16/BF16 仍有可见差距 本文贡献:提出 DiRotQ W4A4 PTQ 框架——通过 PCA 找到激活方差主成分所在的低秩子空间,对该子空间用更高精度保留,其余分量量化到 4-bit;推理时用校准得到的正交变换把激活旋转到 PCA 基,逆旋转离线融入权重;再叠加 GPTQ 的权重量化形成完整 W4A4 系统,并给出 Triton kernel 端到端加速 实验效果:在 PixArt-Σ MJHQ-30K 上取得 FID 15.9 / PSNR 19.1 dB,超越 SVDQuant(FID 18.9 / 17.6);12B FLUX.1-dev 在单卡 RTX 4090 上显存降 2.1×,推理比 BF16 加速 2.3×;并首次提出 VLM-as-a-Judge 评测协议 批判点评:把 PCA 子空间高精度保留 + 离线融入权重的设计,把旋转量化做到了 W4A4 的较好均衡,落地友好;但 PCA 校准对长尾 prompt 的覆盖度、VLM-as-a-Judge 与人类偏好的对齐度,是后续要追踪的关键 13. SpectralProgressive:频谱先粗后细动态扩展分辨率 Spectral Progressive Diffusion for Efficient Image and Video Generation | Stanford | arXiv:2605.18736 关键词:频谱扩散·渐进分辨率·训练-free 加速·视频生成·去噪调度 前序问题:扩散模型在频域里隐式自回归生成——低频先出、高频后出;在噪声主导的早期对全分辨率做计算大量冗余,但目前没人把这一观察系统化用于推理加速 本文贡献:提出 Spectral Progressive Diffusion 通用框架——沿去噪轨迹渐进扩展分辨率;设计频谱噪声扩展机制,并从模型自身的功率谱推出最优分辨率调度;支持 training-free 加速和一种新的微调配方,进一步同时改善效率与质量 实验效果:在多个 SOTA 预训练图像和视频生成模型上获得显著加速,且画质保持;为预训练扩散模型提供一条「无需重训」的频谱渐进推理路线 批判点评:把扩散「频谱自回归」的隐式行为显式化为分辨率调度,思路清晰且与 cache 等加速正交;但频谱调度对噪声分布的假设强依赖训练分布,跨数据集与跨模态迁移性需更广验证 趋势观察 NVFP4 把长视频生成训推一体化推到实用门槛 — LongLive-2.0 把 NVFP4 从纯推理量化推到训练 + KV cache + 异步流式 VAE 解码全链路,5B 模型跑出 45.7 FPS——下一代视频生成基础设施开始与 Blackwell 硬件深度协同,长视频 AR 真正走向「可部署的实时」 扩散加速从 cache 推到「频谱 + 时序 + 量化」三路同时压榨 — TACache 从轨迹正交分解给跳步补偿、TAPE 从时序感知做 token 剪枝、SpectralProgressive 从频谱调度动态扩展分辨率、DiRotQ 从 PCA 旋转把 DiT 推到 W4A4——扩散推理优化第一次在「时间步 / 空间 token / 数值精度 / 频谱通道」四个轴上系统并进 视频编辑进入 agent 时代 — Aurora 把模糊用户请求交给 VLM agent 拆解成结构化编辑计划再喂给 DiT;StreamingEffect 配套 130K 数据 + 4 步因果蒸馏直接做实时人像特效——视频编辑从「模型一把吃下所有输入」转向「agent 解码意图 + 模型专注生成」 统一多模态从堆参数走向「能力路径解耦」 — Lance 用「双流 MoE + 共享交错序列」把理解与生成的能力路径显式解耦,配合 modality-aware RoPE 处理 token 异质性;证明轻量原生设计也能在「图像 + 视频 × 理解 + 生成 + 编辑」全格子上同时领先 扩散 RL 对齐从 reward 工程走向 reward 机制 — SafeDiffusion-R1 用 CLIP 嵌入做 steering reward 替代专门 reward 模型;CGPO 把 reward 方差当 prompt 难度 proxy 实现自适应采样——扩散 RL 后训练正在从「堆 reward 模型」转向「挖 reward 信号本身的几何」 人工智能炼丹君 整理 | 2026-05-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
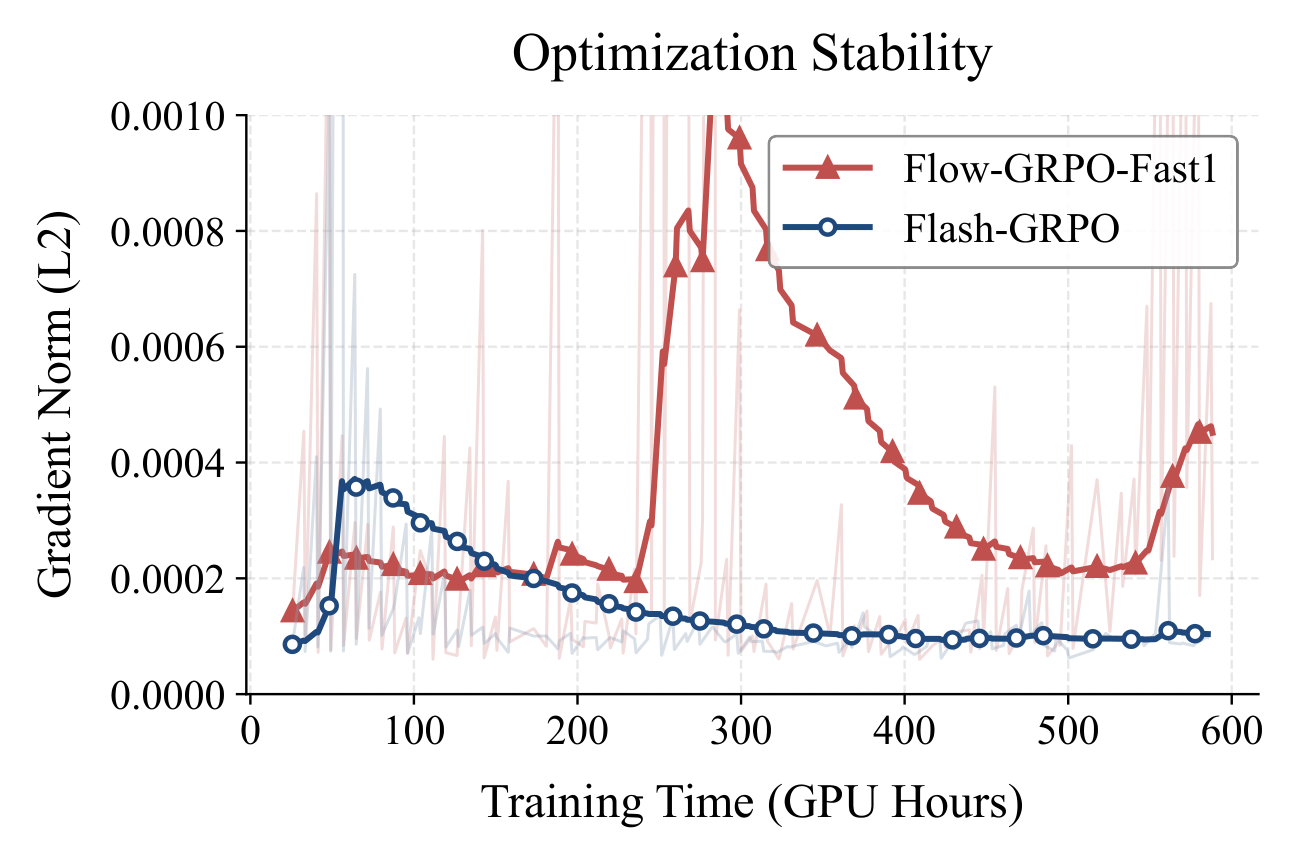
AIGC 每日速读|2026-05-18|14B视频对齐单步训练Flash-GRPO 今日 AIGC 论文速览 今日共 7 篇 · 视频扩散对齐与定制 2 篇 · 图像生成几何与少步推理 2 篇 · 多镜头视频与实体一致性 1 篇 · 3D 重建与世界模型 2 篇 重点论文标题列表 Flash-GRPO:14B 视频对齐单步训练即超全轨迹 Spherical-FM:球面插值贴合潜空间路径 ⚡ Sphere-Latent-Enc:解耦图像编码器与球面去噪 EntityBench:多镜头视频实体一致性基准 FashionChameleon:单卡 23.8 FPS 实时换装 今日论文速览 1. Flash-GRPO:14B 视频对齐单步训练即超全轨迹 Flash-GRPO: Efficient Alignment for Video Diffusion via One-Step Policy Optimization | 浙江大学, 京东 | arXiv:2605.15980 关键词:视频扩散·GRPO 对齐·单步训练·时间步分组·14B 大模型 ⚠️ 前序问题:GRPO 已成为对齐视频扩散模型与人类偏好的关键工具,但训练 14B 视频扩散模型动辄需要数百 GPU 天;现有效率方法靠在时间步上做滑动窗口子采样,根本上破坏了优化稳定性,且无法逼近全轨迹训练的对齐质量 本文贡献:提出 Flash-GRPO 单步训练框架:(1) Iso-Temporal Grouping 通过 prompt 内部的时间一致性消除时间步混淆方差,把策略表现与时间步难度解耦;(2) Temporal Gradient Rectification 中和不同时间步的尺度因子,防止梯度幅值跨时间步剧烈漂移;最终单步 GRPO 即可超越全轨迹训练的对齐质量 实验效果:在 1.3B 到 14B 视频扩散模型上验证:训练显著加速、稳定性优于全轨迹基线,对齐质量达到 SOTA,让 14B 视频对齐从「数百 GPU 天」级实验变得可负担 批判点评:把视频 GRPO 的瓶颈精准定位到「时间步混淆 + 梯度尺度漂移」并各个击破,工程上极具实用性;但单步训练对教师 reward 噪声的鲁棒性、与 Causal Forcing 类少步 AR 视频的兼容性还需进一步验证 2. Spherical-FM:球面插值贴合潜空间路径 Aligning Latent Geometry for Spherical Flow Matching in Image Generation | Virginia Tech, fal | arXiv:2605.15193 关键词:Flow Matching·球面几何·潜空间·slerp·图像生成 ⚠️ 前序问题:潜空间 flow matching 通常在高斯噪声与 VAE 潜在变量之间走线性路径,但两端点都集中在薄薄的球壳上,欧式弦线在每一步都「离开了壳」——即使预处理对齐了半径,路径仍然不在真实的数据流形上 本文贡献:把每个潜在 token 分解为「径向 + 角度」两个分量,用 swap 探针证明感知和语义内容主要由方向承载、径向贡献远小于此;据此把数据潜变量投影到固定 token 半径,用高斯噪声的径向投影作为球面先验,冻结 encoder 微调 decoder,并把线性插值替换为球面插值(slerp)——测速目标因此在构造上变成纯角度,路径全程贴在球面上 实验效果:在多种图像 tokenizer 下一致改善 ImageNet-256 的类条件 FID;扩散网络结构无需改动、不引入辅助 encoder 或表征对齐目标,是一条极简但有效的几何修复路径 批判点评:回到流形几何本身解决「半径漂移」问题,理论清晰、实现极简——这是少有的「几乎零代码改动就涨点」的范式工作;但球面假设是否对所有 VAE 潜空间都成立、对 video latent 这种时空联合分布是否仍适用,还需更广验证 3. Sphere-Latent-Enc:解耦图像编码器与球面去噪 Efficient Image Synthesis with Sphere Latent Encoder | MBZUAI | arXiv:2605.15592 关键词:少步图像生成·球面潜空间·解耦训练·Sphere Encoder·推理加速 ⚠️ 前序问题:consistency 与 meanflow 类少步生成虽然推理便宜,但训练不稳定、可扩展性差;近期 Sphere Encoder 能少步出图,却需要在像素空间和潜空间间反复切换,重建与生成挤在同一架构里互相打架 本文贡献:把框架解耦为「固定预训练图像编码器 + 独立的球面潜在去噪模型」,完全在球面潜空间里训练去噪模型——训练和推理都不再需要反复跨像素/潜空间切换,重建和生成各自专精,互不掣肘 实验效果:在 Animal-Faces、Oxford-Flowers、ImageNet-1K 上同时显著超越 Sphere Encoder 的画质和推理速度,对比强力少步与多步基线也能取得有竞争力的结果,是一个高效少步图像合成的新基线 批判点评:「解耦」这个看似平凡的工程决策,反映出一个被忽略的事实:把重建和生成耦合在同一目标里很容易互相妥协;但跨数据集泛化、与扩散 Transformer 的兼容、以及球面潜空间的尺度上限仍需进一步研究 4. EntityBench:多镜头视频实体一致性基准 EntityBench: Towards Entity-Consistent Long-Range Multi-Shot Video Generation | ByteDance, Rice University | arXiv:2605.15199 关键词:多镜头视频·实体一致性·评测基准·记忆增强·叙事生成 ⚠️ 前序问题:多镜头视频生成把单镜头延伸到连贯叙事,但跨镜头维持角色、物体、地点的一致性长期是难题;现有评测用独立生成的 prompt 集,实体覆盖有限、一致性指标过于简单,难以做标准化比较 本文贡献:提出 EntityBench:从真实叙事媒体里抽取的 140 个 episode、2,491 个镜头,按易/中/难三档同时跟踪角色、物体、地点的实体调度(最长 50 镜头、13 跨镜头角色、22 跨镜头物体、回归间隔最长 48 镜头);配套三支柱评测套件解耦 intra-shot 质量、prompt 跟随、跨镜头一致性,并用保真度门控只让正确出现的实体进入跨镜头打分;另发布 EntityMem 基线:先把每实体的可信视觉参考存入持久记忆库,再生成 实验效果:实验显示现有方法的跨镜头实体一致性随回归距离急剧下降,显式 per-entity 记忆带来最高角色保真度(Cohen's d = +2.33)和实体出现率,为多镜头视频提供了能区分 SOTA 的标准评测 批判点评:把多镜头视频的「角色/物体/地点」标准化为可量化的 entity schedule 是社区一直缺的基础设施;但 140 个 episode 主要来自既有叙事媒体,对完全开放生成场景的覆盖度、评测自动化中视觉感知模型的偏差,仍是后续要补的环节 5. FashionChameleon:单卡 23.8 FPS 实时换装 FashionChameleon: Towards Real-Time and Interactive Human-Garment Video Customization | 厦门大学, 阿里巴巴 | arXiv:2605.15824 关键词:视频定制·实时交互·KV Cache·In-Context Learning·电商生成 ⚠️ 前序问题:服装级人物视频定制有巨大商业价值(电商、内容创作),但现有方法不支持低延迟交互式服装控制——用户无法在生成过程中实时切换服装,且多服装训练数据稀缺 本文贡献:提出 FashionChameleon 实时交互式自回归视频定制框架:(1) 不训多服装数据,用单参考-服装对配合 in-context learning 训练 Teacher Model,强制 reference/garment 失配迫使模型隐式保持单服装切换的连贯;(2) Streaming Distillation with In-Context Learning 用 in-context teacher forcing 微调,并用梯度重加权 distribution matching distillation 改善外推一致性;(3) Training-Free KV Cache Rescheduling 通过 garment KV refresh / historical KV withdraw / reference KV disentangle 实现切换时保留运动连贯 实验效果:支持长视频外推一致性 + 实时交互式服装切换,单 GPU 23.8 FPS 实时生成,比已有基线快 30-180 倍 批判点评:用「单服装数据 + KV 调度」绕过了多服装数据采集的瓶颈,是非常聪明的工程方案;但 KV 调度对极端切换(颜色/版型差异巨大)的视觉伪影、长时间交互后的累积漂移,仍是产品化的关键考验 6. VGGT-Ω:前馈 3D 重建首现 Scaling Law VGGT-Ω: Scaling Feed-Forward 3D Reconstruction | Meta FAIR, Oxford VGG | arXiv:2605.15195 关键词:前馈 3D 重建·register attention·scaling·动态场景·VLA ⚠️ 前序问题:VGGT 这类前馈式 3D 重建模型已经能与传统优化基线掰手腕,并提供几何感知特征服务下游任务;但要把这种模型 scale up 训练到更大的数据规模,原架构的显存占用与计算冗余成为最大障碍 本文贡献:提出 VGGT-Ω:(1) 用单一密集预测头 + 多任务监督简化原架构,去掉昂贵的高分辨率卷积层;(2) 用 register 把场景信息聚合为紧凑表示,并引入 register attention 把跨帧信息交换限定在 register 之间,部分替代全局 attention;(3) 配套高质量动态场景标注流水线 + 自监督协议;训练显存只需前代 30%,得以使用 15× 监督数据 + 大量无标注视频 实验效果:在静态与动态场景多个 benchmark 上一致刷 SOTA,例如 Sintel 上相机估计精度比之前最好结果提升 77%;学到的 register 还能改善 VLA 模型并支持语言对齐,证明重建可以作为空间理解的可扩展代理任务 批判点评:「重建模型也存在 scaling law」并通过架构精简一次性把训练规模拉满,是 VGGT 系列工作的关键里程碑;但 register 数量与表达能力的取舍、动态场景对真实开放视频的泛化,仍需在更复杂自由场景下追加验证 7. ReactiveGWM:解耦玩家与 NPC 跨游戏零样本 ReactiveGWM: Steering NPC in Reactive Game World Models | 腾讯, 新加坡国立大学, 港理工, 港科大广州 | arXiv:2605.15256 关键词:游戏世界模型·NPC 交互·零样本迁移·扩散主干·可控生成 ⚠️ 前序问题:现有游戏世界模型只从玩家主观视角模拟环境,把 NPC 当作背景像素,无法捕捉玩家与 NPC 的交互;本质上更像被动视频渲染器而非真正的仿真引擎,缺少建模动作引发的 NPC 反应所需的物理理解 本文贡献:提出 ReactiveGWM:显式解耦玩家控制与 NPC 行为——玩家动作通过轻量加性偏置注入扩散主干,NPC 高层响应(进攻/控制/防御)通过 cross-attention 模块 grounding;这些模块学到与游戏无关的交互逻辑表示,可零样本插入其他无标注游戏的世界模型,无需领域微调即可解锁可操控 NPC 交互 实验效果:在两款街头霸王上验证:保持精细玩家可控性的同时实现稳健、prompt 对齐的 NPC 策略遵循,为「策略丰富、可控的 NPC 交互」打开了零样本扩展的可能 批判点评:把「玩家 vs NPC」拆成两条解耦支路是非常优雅的设计,零样本迁移到其他游戏的能力让世界模型走出单一题材;但目前只验证了对战类游戏,开放世界 RPG 的多 NPC 协作、长时序情节一致性仍是开放问题 趋势观察 视频扩散对齐进入「单步训练」时代 — Flash-GRPO 把全轨迹 GRPO 压缩到单步训练,靠 iso-temporal grouping 与 temporal gradient rectification 修复时间步混淆与梯度漂移——14B 视频对齐从「数百 GPU 天」级实验降为可负担成本,视频扩散偏好对齐正在跨过工程化门槛 流匹配开始「修几何」而不是堆模型 — Spherical-FM 用径向/角度分解证明感知信息主要由方向承载,把线性插值改为球面插值即在多个 tokenizer 上一致涨点;Sphere Latent Encoder 进一步把生成完全搬到球面潜空间——少步图像生成的下一波收益来自「让路径贴上流形」 多镜头视频从「能拍」走向「记得住」 — EntityBench 把跨镜头角色/物体/地点一致性升级为可量化基础设施,配套 EntityMem 显式记忆库验证「记忆」是关键变量——多镜头视频生成的下一战场不是单镜头质量,而是叙事意义上的实体连续性 人物-服装视频生成走向实时交互 — FashionChameleon 用 in-context learning + KV cache 调度实现 23.8 FPS 单 GPU 实时换装,比基线快 30-180 倍——电商和内容创作的「实时交互式视频定制」从 demo 走向产品级 重建模型也存在 scaling law — VGGT-Ω 用 register attention 等架构精简把训练显存压到 30%,在 15× 数据上推到 77% Sintel 提升;ReactiveGWM 让世界模型零样本迁移到不同游戏——「重建+世界模型」开始从感知任务走向通用空间智能 人工智能炼丹君 整理 | 2026-05-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
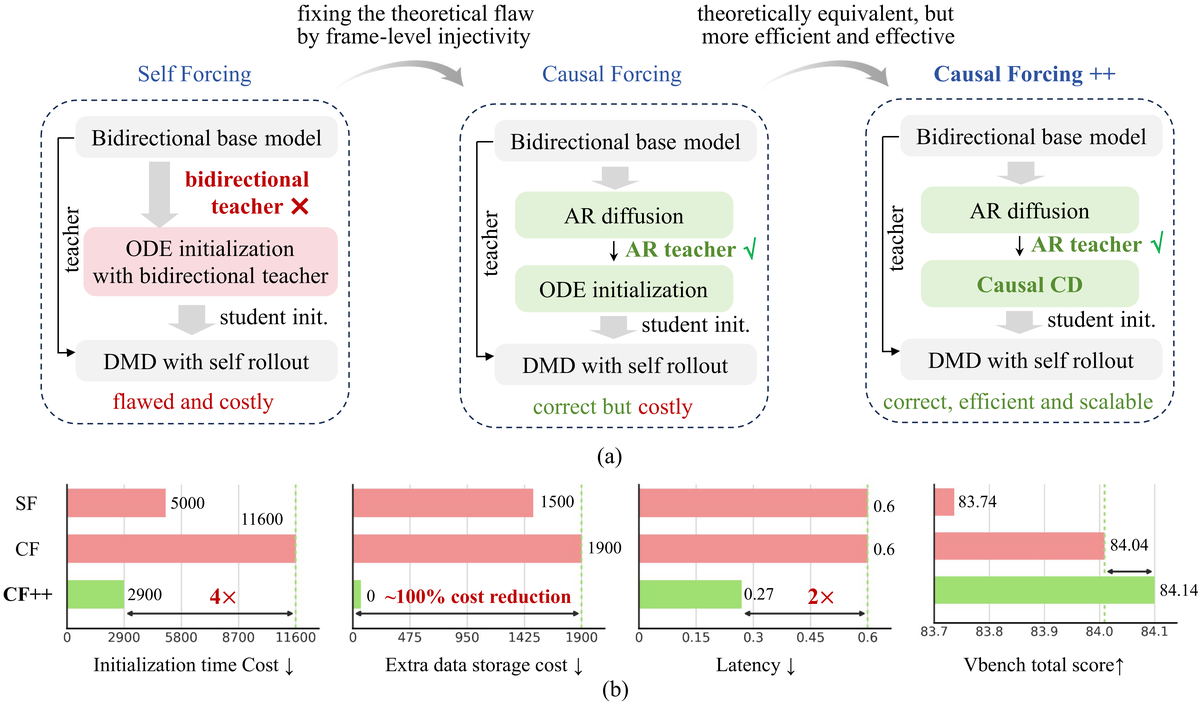
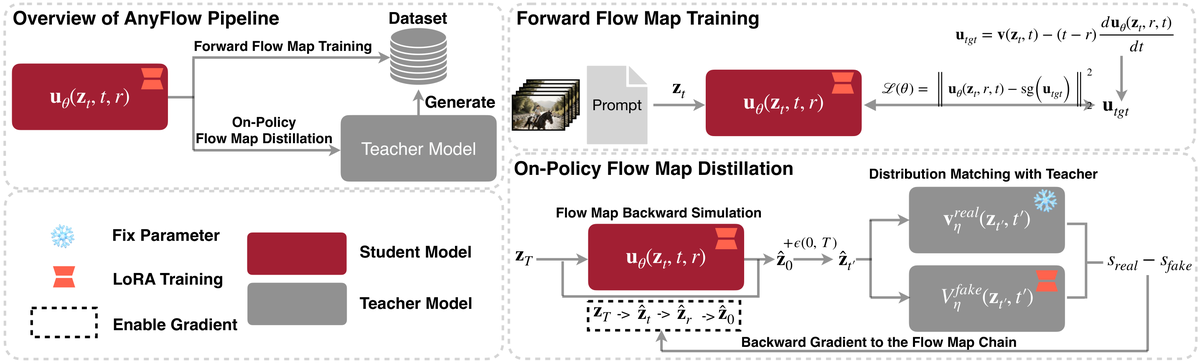
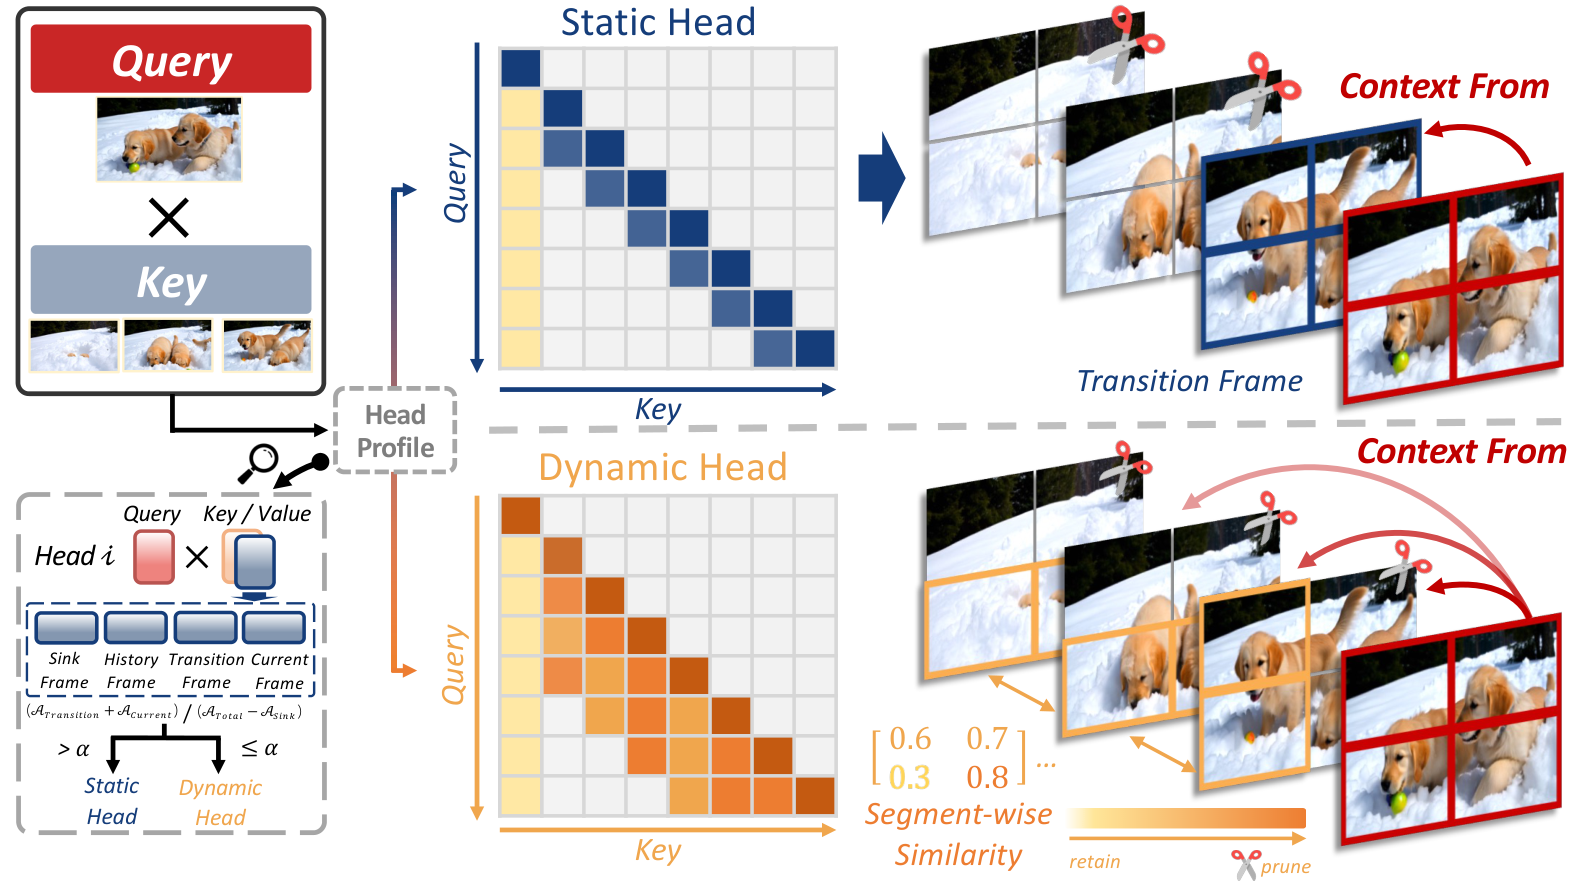
AIGC 周末专题|2026-05-17|实时自回归视频生成加速 AIGC 周末专题深度解读:实时自回归视频生成:从蒸馏加速到流式交互的范式突破 人工智能炼丹君 整理 | 2026年5月17日(周日) 覆盖时间:2026-05-11 ~ 2026-05-16 本期概述 本期 AIGC 周末专题聚焦实时自回归视频生成:从蒸馏加速到流式交互的范式突破方向,精选 8 篇代表性论文进行深度解读。 方向分布: 自回归蒸馏加速 4 篇 (Causal Forcing++, AnyFlow, RAVEN, CDM) 流式推理与 KV Cache 优化 3 篇 (Forcing-KV, SWIFT, HSA) 世界模型与多镜头叙事 2 篇 (SANA-WM, CausalCine) 含 NVIDIA/MIT 联合 × 2 技术路线与时间线 基础蒸馏时代(2022.06 — 2024.06) 描述:Progressive Distillation 开创渐进蒸馏路线,Consistency Models 提出端点一致性映射,少步生成从理论走向实践。 关键节点: 2022.06:Progressive Distillation:渐进蒸馏开山作 2023.03:Consistency Models:一步生成理论突破 2023.12:DMD/DMD2:分布匹配蒸馏 2024.06:SD-Turbo/SDXL-Turbo:1-4 步商用 因果 AR 蒸馏兴起(2024.06 — 2025.12) 描述:Self Forcing 开创 AR 视频蒸馏范式,Causal Forcing 将 chunk-wise 4 步推向可用,流式视频生成原型出现。 关键节点: 2024.09:Self Forcing:AR 视频蒸馏开创 2025.02:Causal Forcing:chunk-wise 4 步实用 2025.06:Genie3:action-conditioned 世界模型 2025.12:LongLive:长视频流式生成 实时化爆发期(2026.01 — 2026.05) 描述:Frame-wise 蒸馏、KV Cache 压缩、无训练加速三线并进,实时交互式视频生成从实验室走向产品。 关键节点: 2026.03:CDM:连续时间分布匹配突破离散瓶颈 2026.05:Causal Forcing++:frame-wise 2 步实时 2026.05:AnyFlow:Flow Map 恢复步数可扩展性 2026.05:Forcing-KV/SWIFT:单卡 20-29 FPS 世界模型与叙事融合(2026.03 — 未来) 描述:实时 AR 视频生成与世界模型、多镜头叙事融合,从'生成画面'走向'仿真世界'。 关键节点: 2026.05:SANA-WM:消费级 GPU 分钟级世界模型 2026.05:CausalCine:多镜头叙事 AR 生成 未来:实时世界仿真 + 用户交互式导演 1. Causal Forcing++:因果一致性蒸馏实现 Frame-wise 2 步实时视频生成:清华 TSAIL 将因果 AR 蒸馏从 chunk-wise 4 步推进到 frame-wise 2 步,首帧延迟降低 50% 论文: Causal Forcing++:因果一致性蒸馏实现 Frame-wise 2 步实时视频生成 arXiv: 2605.15141 机构: Tsinghua TSAIL, 生数科技 (Shengshu) 1.1 研究动机 核心问题: Frame-wise AR 蒸馏的初始化策略与少步目标错位 实时交互式视频生成需要低延迟、流式、可控的 rollout。Causal Forcing 等先驱已经证明 chunk-wise 4 步蒸馏的可行性,但 chunk 粒度过粗——每生成 16 帧需 4 步 DiT forward pass,首帧延迟仍以秒计。如果能做到 frame-wise 1-2 步,每帧只需 1-2 次 forward pass,延迟可再降一个量级。问题是:现有蒸馏初始化策略要么目标错位、要么不能少步生成、要么算力大到无法 scale。 前序工作及局限: Causal Forcing:Chunk-wise 4 步成功但延迟仍高 Consistency Models:提供一致性蒸馏理论基础 与前序工作的本质区别: Causal CD 只需一次教师 ODE 步在线监督,三阶段初始化解决冷启动 1.2 方法原理 Causal Forcing++ 解决的核心问题是:如何在 frame-wise 粒度做高效的因果 AR 蒸馏?关键观察:Causal Consistency Distillation 学的流图与 Causal ODE 蒸馏完全等价,但训练信号更简洁——只需教师模型做一步 ODE 更新,学生学习匹配该更新结果。这避免了传统蒸馏需要预计算完整 PF-ODE 轨迹的巨大开销。 三阶段初始化解决冷启动:(1) 双向扩散预训练让模型学习高质量生成能力;(2) 因果适配将双向注意力切换为因果 mask,保持生成质量同时获得 AR 属性;(3) 少步蒸馏在上述基础上训练 frame-wise 1-2 步推理。 进一步将流水线扩展到 Genie3 风格 action-conditioned 世界模型,用相同 Causal CD 范式蒸馏交互式世界模型,支持动态 action 实时驱动。 1.3 核心创新 提出 Causal CD(因果一致性蒸馏)流水线:核心观察是 Causal CD 学习与 Causal ODE 蒸馏相同的 AR 条件流图,但只需在相邻时间步之间用一次教师 ODE 步在线提供监督,无需预计算完整 PF-ODE 轨迹——既高效又易优化。三阶段初始化策略彻底解决 frame-wise 蒸馏的冷启动问题。 1.4 实验结果 在 frame-wise 2 步设定下,全面超越 SOTA 4 步 chunk-wise Causal Forcing:VBench Total +0.1、VBench Quality +0.3、VisionReward +0.335。首帧延迟降低 50%。Stage 2 训练成本降至约 1/4。扩展到世界模型同样有效。 1.5 关键洞察 [{'point': '教师 ODE 误差放大', 'detail': '1-2 步生成使教师单步 ODE 的离散化误差直接影响学生最终输出,误差没有后续步骤修正的机会'}, {'point': '世界模型场景的 action 复杂度', 'detail': '在简单 action 下表现优秀,但面对复杂多步交互指令时的稳定性需要更多压力测试'}, {'point': '未开源', 'detail': '论文来自产业实验室,复现需等待官方代码公开'}] 技术演进定位: Frame-wise 因果 AR 蒸馏的实时交互级方案 可能的后续方向: Frame-wise 1 步 端到端无分阶段初始化 2. AnyFlow:任意步数视频蒸馏的 Flow Map 统一框架:NUS Show Lab + MIT + NVIDIA 首次基于 Flow Map 实现 4→32 步性能单调提升 论文: AnyFlow:任意步数视频蒸馏的 Flow Map 统一框架 arXiv: 2605.13724 机构: National University of Singapore Show Lab, MIT, NVIDIA 2.1 研究动机 核心问题: Consistency Distillation 步数增加时性能退化 过去一年的少步视频生成被一致性蒸馏(Consistency Distillation)统治——4-8 步即可出图。但一个致命问题:把步数从 4 加到 16/32,画质反而崩溃。为什么?CD 用一致性轨迹替换了原始 PF-ODE 轨迹,破坏了 ODE 采样在测试时的可扩展行为。用户需要'任意步数'推理的灵活性——算力充裕时多步出精品,紧急场景少步求速度——但 CD 做不到。 前序工作及局限: Consistency Models:端点映射 z_t→z_0 破坏 ODE 语义 Shortcut Models:任意区间跳跃但未系统化 与前序工作的本质区别: Flow Map z_t→z_r 目标 + FMBS on-policy 训练恢复步数可扩展性 2.2 方法原理 AnyFlow 的核心洞察:一致性蒸馏学的是 z_t→z_0 的端点映射,这迫使模型'一步到位'——当允许多步时,中间状态没有明确的 ODE 语义,因此步数越多反而越混乱。 Flow Map 解决方案:不学端点映射,而是学任意时间区间 [t, r] 的流图过渡 z_t→z_r。当 r=0 退化为一步生成,当 r>0 退化为多步 ODE 采样的某一段——自然统一了少步和多步。 FMBS 训练方法:传统蒸馏是 off-policy 的——用教师 ODE 生成配对 (z_t, z_r)。AnyFlow 提出 on-policy 方法:让学生自身做 Euler rollout,在 rollout 路径上反向模拟真实的流图过渡,用于训练。这解决了视频域因果生成的 exposure bias 问题。 在双向 DiT(Open-Sora Plan)和因果 AR(CausalVAR)两类骨干、1.3B 到 14B 全规模区间验证。 2.3 核心创新 提出 AnyFlow——首个基于 flow map 的任意步数视频扩散蒸馏框架。核心突破:(1) 将蒸馏目标从端点一致性 z_t→z_0 升级为流图过渡 z_t→z_r(任意时间区间),让学生学会任意区间跳跃;(2) Flow Map Backward Simulation (FMBS) 把完整 Euler rollout 拆为多段 shortcut,用 on-policy rollout 替代 off-policy 配对蒸馏。 2.4 实验结果 在双向和因果两类视频扩散骨干上一致达到或超越 consistency baseline。关键突破:步数从 4 提升到 16/32 时性能不再退化、反而单调上升,重新恢复了 ODE 采样的 test-time scaling 优势。在 14B 模型上同样有效。 2.5 关键洞察 [{'point': '复现门槛高', 'detail': '需要 1B-14B 级别教师模型 + 大规模 on-policy rollout,数据与算力两端门槛都不低'}, {'point': '具体数值缺失', 'detail': '论文未公开 VBench/UCF-FVD 等标准 benchmark 的绝对数值,难以与其他方法直接对比'}, {'point': '训练效率', 'detail': 'On-policy rollout 的训练时间和显存开销与 off-policy CD 的对比数据不够充分'}] 技术演进定位: 首次理论解释 CD 多步退化并给出 flow map 解决方案 可能的后续方向: 自适应步数调度 Flow Map + RL 结合 3. RAVEN:训练-测试对齐的实时自回归视频外推:帝国理工 AGI Lab 提出 CM-GRPO 在一致性核上直接做 RL 论文: RAVEN:训练-测试对齐的实时自回归视频外推 arXiv: 2605.15190 机构: Imperial College London AGI Lab 3.1 研究动机 核心问题: 因果视频蒸馏训练用真实 history、推理用自身 rollout 的分布 gap 因果自回归视频扩散模型通过蒸馏高保真双向教师已能实现少步推理。但一个根本性问题一直被忽视:训练时用真实 history(来自数据集)作为条件,推理时却用模型自身 rollout 的结果作为 history——两者分布不同。随着 rollout 长度增加,这个训练-测试分布 gap 会累积放大,导致长序列生成质量严重退化。 前序工作及局限: Self Forcing:self-rollout 训练但未系统性解决对齐 GRPO:RL 对齐但在扩散模型上公式复杂 与前序工作的本质区别: RAVEN rollout 重打包 + CM-GRPO 在一致性核上做 RL 3.2 方法原理 RAVEN 解决的核心问题是训练-测试分布不对齐。具体做法:训练时不再只用真实数据作为 history 条件,而是让模型先做一段 rollout 生成'假 history',然后把这个 rollout 的干净端点重新打包为条件输入,让模型在自身 rollout 分布上继续学习。这样训练时看到的 history 分布就与推理时一致。 CM-GRPO 的创新在于简化了 RL 在生成模型上的应用。传统 flow-model RL 需要构造 Euler-Maruyama 辅助过程来定义 policy gradient,复杂且不稳定。CM-GRPO 的观察:consistency model 的每步采样本质上是条件高斯转移 p(z_{t-1}|z_t) = N(μ(z_t), σ²I),可以直接在这个高斯核上定义 log-probability 并做 GRPO——公式简洁、梯度稳定。 两者组合:RAVEN 让模型在正确分布上训练,CM-GRPO 让模型朝奖励方向优化。 3.3 核心创新 提出 RAVEN training-time test 框架:把每次自身 rollout 重打包为(干净历史端点 + 噪声去噪状态)交错序列,让训练注意力对齐推理时的外推方式。进一步提出 CM-GRPO:把 consistency 采样步重新表达为条件高斯转移,直接在该核上做在线 RL,避免了 flow-model RL 中 Euler-Maruyama 辅助过程的复杂性。 3.4 实验结果 RAVEN 在质量、语义、动态度多维评测上超越近期因果视频蒸馏 baseline。CM-GRPO 与 RAVEN 组合后进一步提升性能。训练-测试对齐效果在长序列(>100 帧)上尤为显著。 3.5 关键洞察 [{'point': '内存开销', 'detail': 'RAVEN 重打包需要额外存储 rollout 结果,对长序列的内存占用影响未充分量化'}, {'point': '奖励设计敏感性', 'detail': 'CM-GRPO 的效果强依赖于奖励函数设计,在更复杂/多维奖励场景下的稳定性有待验证'}, {'point': '模型规模验证', 'detail': '在更大模型尺度(>5B)上是否同样有效需要进一步实验'}] 技术演进定位: 系统性解决因果视频蒸馏训练-测试对齐的首个完整方案 可能的后续方向: 多奖励 CM-GRPO 自适应 rollout 长度 4. Forcing-KV:注意力头特化驱动的 KV Cache 混合压缩:NVIDIA/MIT/ETH 联合发现注意力头功能特化规律,单卡 H200 达 29+ FPS 论文: Forcing-KV:注意力头特化驱动的 KV Cache 混合压缩 arXiv: 2605.09681 机构: NVIDIA, MIT, ETH Zurich, ZJU 4.1 研究动机 核心问题: AR 视频扩散历史帧 KV Cache 线性膨胀导致显存爆炸 自回归视频扩散模型(如 Self Forcing)通过流式生成实现了开放式长视频合成。但致命瓶颈来了:随着生成帧数增加,历史帧的 KV Cache 线性膨胀——注意力复杂度爆炸 + 显存不够用。一段 30 秒的 1080P 视频,KV Cache 就能吃掉整张 H100 的 80GB 显存。如果不压缩 KV Cache,流式视频生成就永远停留在几秒级别。 前序工作及局限: Flash Attention:算法层面加速但不压缩缓存 Token Merging:图像域 token 压缩 与前序工作的本质区别: 发现注意力头功能特化并据此设计静态/动态混合压缩 4.2 方法原理 Forcing-KV 的核心发现:在自回归视频扩散模型中,不同注意力头承担完全不同的功能角色,这种分工是稳定且可预测的。 静态头特征:注意力分布集中在远程 token(历史帧的关键区域),负责跨 chunk 的语义连续性和帧内的结构保真。这些头对'哪些远程 token 重要'的判断高度一致,因此可以做结构化剪枝——只保留少数高注意力权重的远程 token。 动态头特征:注意力集中在近邻 token(前几帧),负责帧间运动预测和局部一致性。近邻帧之间往往高度相似,因此可以做相似度驱动的动态剪枝——当相邻片段的 KV 向量相似度超过阈值时合并。 工程实现:KV-cache 同步机制确保压缩后的 cache 在多 head 之间保持一致的时间索引;缓存 Euler 更新将已压缩 token 的 denoising 中间状态缓存起来避免重复计算。 4.3 核心创新 首次发现视频扩散模型中注意力头具有稳定的功能特化:静态头(Static Heads)负责跨 chunk 过渡和帧内保真,关注远程 token;动态头(Dynamic Heads)负责帧间运动与一致性,关注近邻 token。基于此设计混合压缩:对静态头执行结构化剪枝(保留远程关键 token),对动态头执行基于片段相似度的动态剪枝(移除冗余近邻)。 4.4 实验结果 在 LongLive 和 Self Forcing 两个 AR 视频扩散模型上验证。480P 场景:1.35x/1.50x 加速。1080P 场景:加速比达 2.82x。单卡 H200 达到 29+ FPS 并减少 30% cache 显存。无需离线 profiling,运行时自动判断头类型。 4.5 关键洞察 [{'point': '架构通用性', 'detail': '仅在两个 AR 视频扩散模型上验证,是否推广到非 AR 架构(如 CogVideoX)有待检验'}, {'point': '头分类稳定性', 'detail': '静态/动态头的划分是否在新架构或不同训练阶段仍然成立存疑'}, {'point': '质量退化分析', 'detail': '在极端压缩比下(如 80%+ 裁剪)的视觉质量退化模式需要更多系统性分析'}] 技术演进定位: 首次揭示视频扩散注意力头分工并实现实时 29 FPS 可能的后续方向: 自适应头分类 hierarchical cache 5. SWIFT:无训练语义自适应记忆实现高效流式长视频:中科大/复旦/Georgia Tech 提出逐头语义注入,单卡 H100 达 22.6 FPS 论文: SWIFT:无训练语义自适应记忆实现高效流式长视频 arXiv: 2605.09442 机构: University of Science and Technology of China, Fudan University, Georgia Institute of Technology 5.1 研究动机 核心问题: 流式长视频 prompt 切换时 KV Cache 管理困难 流式长视频生成的核心挑战之一是语义切换——当 prompt 变化时(例如从'人走路'切换到'人跑步'),模型需要在保持视觉连贯性的同时响应新语义。现有方法在 prompt 边界处要么重建整个 KV Cache(慢),要么固定缓存大小无法适配语义变化(质量差)。 前序工作及局限: StreamingT2V:滑动窗口但无语义感知 ControlNet/P2P:注入控制但非流式 与前序工作的本质区别: 无训练语义注入代替缓存重建,逐头梯度化更新 5.2 方法原理 SWIFT 解决的问题:流式视频生成中 prompt 切换时如何高效更新记忆? 传统做法是在 prompt 边界处清空并重建 KV Cache,这造成两个问题:(1) 重建开销大,打断流式生成的实时性;(2) 清空历史信息可能导致前后帧视觉不连贯。 SWIFT 的做法完全不同:不清空缓存,而是把新 prompt 的语义'注入'到已有 cache 中。具体实现:计算每个注意力头当前 KV 状态与新 prompt 特征的对齐度(余弦相似度),对齐度高的头已经自然适配新语义(少注入),对齐度低的头需要更多新信息(多注入)。 自适应动态窗口:不同 prompt 阶段的记忆需求不同——刚切换时需要大窗口保持过渡平滑,稳定后可缩小窗口节省显存。SWIFT 根据生成帧数和语义稳定度自动调整窗口大小。 关键优势:完全无训练,可直接插入任何因果视频扩散模型。 5.3 核心创新 提出 SWIFT(Semantic Windowing and Injection for Flexible Transitions)无训练框架:(1) 语义注入缓存增强——不重建缓存,而是将新 prompt 语义注入已有缓存中;(2) 逐头语义注入——每个注意力头按自身与当前视频状态的对齐度决定接收多少新语义更新;(3) 自适应动态窗口——按 prompt 阶段分配时间记忆容量。 5.4 实验结果 在保持生成质量的同时,单卡 H100 上达到 22.6 FPS。多 prompt 长视频(>200 帧)的语义切换平滑度显著优于重建方案。与 Self Forcing 等 AR 模型即插即用兼容。 5.5 关键洞察 [{'point': '语义对齐度计算延迟', 'detail': '逐头计算语义对齐度本身引入额外延迟,在极端实时场景下可能成为瓶颈'}, {'point': '双向注意力适用性', 'detail': '仅在因果视频扩散模型上验证,对双向注意力架构是否同样有效存疑'}, {'point': '复杂语义切换', 'detail': '在多重、快速的语义切换场景下(如 5 秒内切换 3 次 prompt)的稳定性未充分验证'}] 技术演进定位: 首个无训练的流式语义切换方案 可能的后续方向: 与 KV 压缩组合 多模态条件注入 6. CDM:连续时间分布匹配蒸馏:阿里/南开提出动态连续调度,从离散锚定进化到连续流形优化 论文: CDM:连续时间分布匹配蒸馏 arXiv: 2605.06376 机构: Alibaba, Nankai University 6.1 研究动机 核心问题: DMD 离散锚定导致少步生成伪影 DMD(Distribution Matching Distillation)是少步扩散蒸馏的主流范式之一,但有个根本缺陷:它在离散时间步上做分布匹配——只在 {0, 0.25, 0.5, 0.75, 1.0} 等稀疏锚点对齐分布。这种离散锚定加上反向 KL 散度的模式寻求特性,容易产生视觉伪影和过度平滑。通常需要额外的 GAN 判别器或奖励模型来修补,系统复杂度极高。 前序工作及局限: DMD/DMD2:离散时间步分布匹配 Progressive Distillation:渐进蒸馏但步数固定 与前序工作的本质区别: 连续时间采样 + 轨迹偏离匹配,移除 GAN/奖励辅助 6.2 方法原理 ![Overview of Continuous-Time Distribution Matching (CDM). Top: Our approach employs a dynamic continuous time schedule during backward simulation, sampling intermediate anchors uniformly from $(0, 1]$. Bottom Left: CFG augmentation (CA) and distribution matching (DM) operate on this dynamic schedule to align text-image conditions and data distributions at on-trajectory anchors. Bottom Right: To address inter-anchor inconsistency, the proposed CDM objective explicitly extrapolates off-trajectory latents ($x_t_i'$) using the predicted velocity.](https://jefxiong.cn/assets/images/AIGC/20260516/2605.06376_1.png) CDM 的核心洞察:DMD 之所以需要 GAN 和奖励模型修补,是因为离散锚定注定了'覆盖不全'——轨迹上 99% 的点没有监督信号,模型在这些无监督区域自由飘移。 解决方案:把分布匹配从离散点扩展到连续流形。具体实现:(1) 训练过程中不再用固定时间步集合 {t₁, t₂, ...},而是在 [0,1] 上连续采样匹配点,采样概率密度随训练动态调整——模型薄弱的区域被更频繁地采样;(2) 对齐目标不再局限于 ODE 轨迹上的点,还主动采样轨迹附近的'偏离点'——这迫使模型学习在轨迹邻域内也保持良好的分布匹配。 效果:连续调度消除了离散锚定的覆盖空洞,偏离匹配增强了模型在采样扰动下的鲁棒性。两者组合后,即使不用 GAN 和奖励模型,视觉质量也能匹配甚至超越带这些辅助模块的方案。 6.3 核心创新 将 DMD 框架从离散锚定首次迁移到连续优化:(1) 动态连续调度——允许在任意轨迹点(而非预设锚点)做分布匹配,采样点随训练自适应调整;(2) 连续时间对齐目标——主动在偏离 ODE 轨迹的位置做匹配,增强鲁棒性。无需 GAN、无需奖励模型等复杂辅助模块。 6.4 实验结果 ![Empirical evidence of schedule decoupling. (a) Conventional distillation strictly anchors backward simulation to predefined discrete inference timesteps. In contrast, our dynamic scheduling optimizes over uniformly sampled continuous timesteps $t (0, 1]$ at each iteration. (b) Visually, the dynamically scheduled model produces finer details and fewer artifacts than the strictly aligned baseline. (c) Quantitatively, it also attains a higher HPSv3 score, indicating that exact discrete alignment is not only unnecessary but in fact restrictive---motivating our continuous-time formulation.](https://jefxiong.cn/assets/images/AIGC/20260516/2605.06376_2.png) 在 SD3-Medium 和 Longcat-Image 上展示了高度竞争力的少步生成视觉保真度。4 步 FID 达到接近 50 步教师的水平。代码已开源(GitHub)。无需 GAN 或奖励模型的极简架构降低了工程复杂度。 6.5 关键洞察 [{'point': '训练开销', 'detail': '连续调度增加了每步的采样复杂度,实际训练时间和显存开销的对比数据不够充分'}, {'point': '视频域验证缺失', 'detail': '仅在图像模型上验证,视频域的时序一致性是否同样受益未知'}, {'point': '与 CD 方法对比', 'detail': '与 Consistency Distillation 的直接对比较少,两者互补性未探讨'}] 技术演进定位: 分布匹配蒸馏从离散走向连续的进化 可能的后续方向: 视频域连续调度 自适应精度匹配 7. SANA-WM:2.6B 参数分钟级世界模型的算力民主化:NVIDIA/MIT/港科大提出 Hybrid Linear DiT,单卡 RTX 5090 生成 60s 720p 论文: SANA-WM:2.6B 参数分钟级世界模型的算力民主化 arXiv: 2605.15178 机构: NVIDIA, MIT, HKUST 7.1 研究动机 核心问题: 分钟级世界模型训练和推理都需要海量资源 分钟级世界模型是通往具身智能和虚拟环境仿真的必经之路。但现有方案面临三重困境:(1) 画质要求媲美产业级大模型(LingBot-World、HY-WorldPlay),(2) 训练需要海量闭源数据和数百张 GPU,(3) 推理需要多卡集群。结果是:开源社区几乎没有可用的分钟级世界模型。 前序工作及局限: Genie2/3:分钟级但闭源/昂贵 SANA:高效图像生成架构 与前序工作的本质区别: Hybrid Linear Attention + 公开数据 + 量化蒸馏 → 消费级 GPU 7.2 方法原理 SANA-WM 的核心挑战:如何用有限资源做出质量不差的分钟级世界模型? Hybrid Linear Attention:纯 softmax attention 的 O(n²) 复杂度在分钟级视频(数千帧)上不可承受。SANA-WM 将 frame-wise 的 Gated DeltaNet(线性复杂度,处理帧内 token)与跨帧的 softmax attention(处理时序依赖)混合——帧内用线性、帧间用 softmax,总复杂度接近 O(n)。 Dual-Branch Camera Control:世界模型需要精确的 6-DoF 相机控制。SANA-WM 设计双分支:一个分支处理相机轨迹的全局运动趋势,另一个处理局部帧间旋转/平移细节,两者融合后注入 DiT。 数据方案:不依赖闭源数据,而是从公开视频(WebVid 等)自动提取 metric-scale 6-DoF 相机姿态作为 action 标签。标注流水线基于 DUSt3R + SLAM,全自动无人工。 推理优化:蒸馏 + NVFP4 量化,在单张 RTX 5090 上 34 秒生成 60s 720p clip。 7.3 核心创新 提出 SANA-WM:首个面向分钟级视频生成的开源高效世界模型。三大技术突破:(1) Hybrid Linear Attention——frame-wise Gated DeltaNet 与 softmax attention 混合,长上下文内存 O(n) 可控;(2) Dual-Branch Camera Control——保证 6-DoF 轨迹精确跟随;(3) 鲁棒标注流水线——从公开视频自动提取 metric-scale 6-DoF 相机姿态。 7.4 实验结果 仅用约 213K 公开视频片段、64 张 H100 训练 15 天。单 GPU 即可生成 60s 720p clip。蒸馏量化版在单卡 RTX 5090 上 NVFP4 下 34 秒完成。在 1 分钟世界模型 benchmark 上动作跟随精度强于现有开源 baseline,画质相当但吞吐高 36 倍。 7.5 关键洞察 [{'point': 'Refiner 依赖', 'detail': '1 分钟生成仍依赖 stage-2 refiner 外置模块,端到端质量与商业闭源仍有差距'}, {'point': '场景多样性', 'detail': '213K 公开视频的场景覆盖度有限,复杂室内/多物体交互场景可能生成质量不稳定'}, {'point': '6-DoF 精度', 'detail': '自动标注的 6-DoF 姿态精度受限于 DUSt3R/SLAM 的能力,在快速运动或低纹理场景可能有偏差'}] 技术演进定位: 首个面向消费级硬件的开源分钟级世界模型 可能的后续方向: 多模态 action 物理引擎耦合 8. CausalCine:多镜头叙事的实时自回归视频生成:港科大/蚂蚁/上交提出内容感知记忆路由 CAMR 支持动态镜头切换 论文: CausalCine:多镜头叙事的实时自回归视频生成 arXiv: 2605.12496 机构: HKUST, Ant Group, SJTU 8.1 研究动机 核心问题: AR 视频模型无法处理多镜头叙事中的镜头转换 现有自回归视频模型解决了'开放式生成'——可以无限延伸画面。但电影叙事不是无限延伸单一场景——它需要事件演进、视角切换、镜头边界。当用户说'先拍远景,然后切到近景,再来个俯拍'时,现有 AR 模型将其视为单一长序列延伸,结果:运动停滞、语义漂移、无法处理镜头转换。 前序工作及局限: Self Forcing:单镜头流式生成 MovieGen:多镜头但非 AR/非实时 与前序工作的本质区别: CAMR 内容感知路由 + 多镜头训练数据构建 8.2 方法原理 CausalCine 解决的核心问题:如何让 AR 视频模型理解'镜头'概念? 传统 AR 视频模型把所有帧当作同质序列——前一帧和后一帧的关系是'延续'。CausalCine 引入镜头边界的概念:同一镜头内的帧关系是'延续',跨镜头帧关系是'切换'——两者需要完全不同的记忆策略。 CAMR (Content-Aware Memory Routing) 的具体做法:不使用固定的滑动窗口来管理历史 KV Cache,而是让每个新 token 通过注意力得分动态选择'回忆什么'。镜头切换时,与新镜头语义相关的历史(如同一人物的远景)被高权重检索,无关历史(如前一场景的背景细节)被低权重淡化。 这本质上是一种学习到的'选择性遗忘'——让模型在保持叙事连贯性(人物/故事线)的同时,允许视觉内容的突变(场景切换)。 最后蒸馏为少步实时生成器,保持交互式特性。 8.3 核心创新 将多镜头视频生成转化为在线导演过程:(1) 在原生多镜头序列上训练因果基础模型,学习复杂的镜头转换先验(淡入淡出/硬切/运镜等);(2) 提出 Content-Aware Memory Routing (CAMR)——按注意力相关性动态检索历史 KV 条目而非固定窗口,让镜头切换时记忆'该忘的忘、该记的记'。 8.4 实验结果 显著超越自回归基线,接近双向模型能力。多镜头叙事的连贯性(人物一致性、情节连续性)在主观评测中远超现有 AR 方案。支持动态 prompt 实时切换——生成中途改变指令,模型自动执行镜头切换。 8.5 关键洞察 [{'point': '训练数据获取', 'detail': '原生多镜头视频的镜头边界标注获取成本未讨论,是否需要大量人工标注'}, {'point': '蒸馏后多样性', 'detail': '蒸馏为少步生成器后,镜头转换的多样性(淡入/硬切/运镜等)是否被压缩到少数模式'}, {'point': '长叙事稳定性', 'detail': '超过 10 个镜头的长叙事中,人物一致性是否能稳定维持'}] 技术演进定位: 首个面向多镜头叙事的实时 AR 视频框架 可能的后续方向: 分镜自动规划 多角色追踪 横向对比与技术脉络总结 横向对比:本周实时视频生成技术路线对比 论文 核心方法 推理步数 单卡速度 是否需要训练 视频长度 是否开源 Causal Forcing++ 因果一致性蒸馏 Frame-wise 2 步 未公布 FPS 需蒸馏训练 开放式流式 未开源 AnyFlow Flow Map 任意步数蒸馏 4-32 步灵活 未公布 FPS 需蒸馏训练 标准长度 待开源 RAVEN 训练-测试对齐 + CM-GRPO 少步(具体步数未公布) 未公布 FPS 需 RL 训练 开放式流式 待开源 Forcing-KV KV Cache 混合压缩 与基模型一致 29+ FPS (H200) 无训练推理优化 开放式长视频 待开源 SWIFT 语义注入缓存 与基模型一致 22.6 FPS (H100) 完全无训练 多 prompt 长视频 待开源 CDM 连续时间分布匹配 4 步 标准推理 需蒸馏训练 图像(待扩展视频) 已开源 SANA-WM Hybrid Linear DiT 多步(+量化加速) 34s/60s clip (5090) 需完整训练 60s 分钟级 已开源 CausalCine 内容感知记忆路由 少步(蒸馏后) 实时级 需多镜头训练 多镜头叙事 待开源 核心技术趋势 因果自回归蒸馏从 chunk-wise 4 步推向 frame-wise 1-2 步,实时交互成为现实 Causal Forcing++ 证明因果一致性蒸馏可以在 frame 粒度实现高质量 2 步生成,首帧延迟降低 50%,解锁了真正的流式交互式视频生成 训练-推理分布对齐成为自回归视频蒸馏的核心议题 RAVEN 通过 rollout 重打包直接弥合训练时 teacher history 与推理时 student rollout 的分布 gap,配合 CM-GRPO 实现端到端对齐 KV Cache 压缩与自适应记忆方案使流式视频生成在单卡上实现 20-30 FPS Forcing-KV 发现注意力头的功能特化规律(静态/动态),SWIFT 提出无训练语义注入方案,两者分别在 H200 和 H100 单卡上实现实时吞吐 世界模型正在从封闭系统走向开源、从秒级走向分钟级 SANA-WM 以 2.6B 参数 + 213K 公开视频在单卡 RTX 5090 上生成 60s 720p 视频,吞吐比闭源方案高 36 倍,标志着世界模型的算力民主化 核心技术难点与开放问题 四大核心难点 1. 少步生成的质量天花板 当采样步数降到 1-2 步,模型本质上在做'条件预测'而非'迭代去噪'。Causal Forcing++ 在 2 步下已接近 4 步水平,但与 50 步教师仍有可见差距。AnyFlow 通过 flow map 让多步时性能恢复,但 1-2 步仍是瓶颈。核心问题:少步生成的理论质量上界在哪里? 2. 长序列的累积误差与遗忘 所有 AR 模型都面临长序列退化:RAVEN 通过训练-测试对齐缓解,Forcing-KV/SWIFT 通过 cache 管理控制,CausalCine 通过 CAMR 选择性遗忘。但 1000+ 帧的真正长视频中,这些方案能否持续有效?'选择性遗忘'与'不该遗忘'之间的精确边界难以界定。 3. 蒸馏与 RL 对齐的统一 本周出现三条竞争路线:Causal CD(蒸馏为主)、AnyFlow(flow map 蒸馏)、CM-GRPO(RL 对齐)。它们解决不同层面问题但目前各自为战——是否存在一个统一框架,先 flow map 蒸馏获得任意步数能力,再 CM-GRPO 对齐到人类偏好? 4. 实时生成的硬件民主化 Forcing-KV 在 H200、SWIFT 在 H100、SANA-WM 在 RTX 5090 上实现实时/近实时。但消费级 GPU(如 RTX 4090 甚至 RTX 4060)上呢?真正的用户端实时体验需要把算力需求再降一个量级,这可能需要蒸馏+量化+剪枝+cache 压缩的全栈优化。 今日讨论 自回归视频生成已经进入'实时'门槛——Forcing-KV 29 FPS、SWIFT 22.6 FPS、Causal Forcing++ frame-wise 2 步。下一步的核心问题是:实时生成的质量天花板在哪里?当采样步数降到 1-2 步,模型本质上在做'条件预测'而非'迭代去噪',这对视觉保真度的根本影响是什么?AnyFlow 通过 flow map 让步数可伸缩、RAVEN 通过 RL 对齐推理分布——这两条路线谁更有可能统一少步和多步的质量-速度曲线? 人工智能炼丹君 整理 | 数据来源:arXiv 2026-05-11 ~ 2026-05-16 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-15|实时视频2步出帧Causal Forcing++ 今日 AIGC 论文速览 今日共 8 篇 · 实时 AR 视频与世界模型 3 篇 · 相机控制与视频生成 2 篇 · 图像编辑持续学习 1 篇 · 扩散模型 RL 后训练 1 篇 · 视频世界模型评测 1 篇 重点论文标题列表 Causal Forcing++:因果一致性蒸馏 Warp-as-History:把相机引起的形变直接转化为「相机扭曲 ACE-LoRA:动态正则化框架 RefDecoder:参考条件视频 VAE decoder DiffusionOPD:多任务训练范式 今日论文速览 1. Causal Forcing++:因果一致性蒸馏 Causal Forcing++: Scalable Few-Step Autoregressive Diffusion Distillation for Real-Time Interactive Video Generation | 清华 TSAIL, 生数科技 | arXiv:2605.15141 关键词:少步AR视频·因果一致性蒸馏·实时交互生成·世界模型·Genie3 前序问题:实时交互式视频生成需要低延迟、流式、可控的 rollout。现有自回归扩散蒸馏在 chunk-wise 4 步取得了不错效果,但 chunk 粒度过粗、采样延迟仍然不可忽略;当尝试更激进的 frame-wise 1-2 步时,少步 AR 学生的初始化策略要么目标错位、要么不能少步生成、要么算力代价大到无法 scale 本文贡献:提出 Causal Forcing++ 因果一致性蒸馏(Causal CD)流水线:核心观察是 Causal CD 学习与 Causal ODE 蒸馏相同的 AR-条件流图,但只需在相邻时间步之间用一次教师 ODE 步在线提供监督,无需预先计算并存储完整 PF-ODE 轨迹——既高效又易优化;进一步把流水线扩展到 Genie3 风格的 action-conditioned 世界模型 实验效果:在 frame-wise 2 步设定下,全面超越 SOTA 4 步 chunk-wise Causal Forcing:VBench Total +0.1、VBench Quality +0.3、VisionReward +0.335,同时首帧延迟降低 50%、Stage 2 训练成本降至约 1/4 批判点评:把蒸馏从 chunk-wise 4 步推进到 frame-wise 2 步,是实时交互式视频生成可用性上的关键一步——把瓶颈识别为「初始化」是非常贴切的诊断;但 1-2 步生成对教师 ODE 误差的放大效应、以及在更复杂 action 条件下的稳定性还需更多压力测试 2. Warp-as-History:把相机引起的形变直接转化为「相机扭曲 Warp-as-History: Generalizable Camera-Controlled Video Generation from One Training Video | 上海交大, 上海 AI Lab | arXiv:2605.15182 关键词:相机控制·视频生成·零样本·伪历史·LoRA 微调 前序问题:相机可控视频生成已经很成熟,但现有方法普遍需要在大规模带相机标注的视频上做后训练(额外的 camera encoder、控制分支、注意力/位置编码改造);training-free 方案则把代价转嫁到测试时优化或 denoising 时的额外 guidance,依然不便宜 本文贡献:提出 Warp-as-History:把相机引起的形变直接转化为「相机扭曲后的伪历史」,在 frozen 视频生成模型自带的「视觉历史」通路中喂进去——目标帧位置编码对齐、剔除没有有效观测来源的 token,无需训练或架构改动即可零样本服从相机轨迹;可选用一段相机标注视频做轻量 LoRA 微调进一步提升泛化能力 实验效果:在多个数据集上的实验显示:完全 training-free 即可让冻结视频生成模型获得不平凡的相机轨迹跟随能力;只用「一段」相机标注视频做 LoRA 微调,即可在未见视频上同时改善相机贴合度、画质与运动动态 批判点评:把相机可控问题视作「历史 warp」是一个非常优雅的视角,几乎不增加任何训练成本;但 zero-shot 能力依赖底模的「视觉历史」通路是否足够强,没有该通路的扩散视频模型迁移性可能受限;另外极端轨迹下的孔洞填充质量值得关注 3. ACE-LoRA:动态正则化框架 ACE-LoRA: Adaptive Orthogonal Decoupling for Continual Image Editing | 上海交大, vivo AI Lab | arXiv:2605.14948 关键词:持续学习·图像编辑·LoRA·正交解耦·CIE-Bench 前序问题:现有 SOTA 扩散模型靠参数高效微调(LoRA 等)适配各类图像编辑任务,但真实业务需要在不断到来的新任务上持续学习同时保留旧任务能力;图像编辑的持续学习问题至今几乎没人系统研究,灾难性遗忘问题严重 本文贡献:提出 ACE-LoRA 动态正则化框架:通过 Adaptive Orthogonal Decoupling 自动识别并正交化任务间干扰,再用 Rank-Invariant Historical Information Compression 解决持续更新中的可扩展性瓶颈;同时发布 CIE-Bench——业内首个面向图像编辑的持续学习评测基准 实验效果:在指令保真度、视觉真实感、抗遗忘鲁棒性上一致优于现有 baseline,建立了「图像编辑持续学习」这一子方向的标准方法+标准评测 批判点评:把「持续学习」首次正式带到图像编辑领域,问题设定和 benchmark 都非常务实;但 14 维基因式正交化的超参对任务序列分布的鲁棒性、以及面对几十个长尾编辑任务时压缩策略的极限,需要更长任务流的实测 4. RefDecoder:参考条件视频 VAE decoder RefDecoder: Enhancing Visual Generation with Conditional Video Decoding | University of Washington, UNC | arXiv:2605.15196 关键词:视频 VAE·参考条件 decoder·视频生成·即插即用·VBench 前序问题:主流 latent 视频扩散模型的 denoising 网络条件丰富,但 VAE decoder 几乎都是无条件的——这种结构性不对称导致细节流失、与输入参考图不一致,是当前视频生成「看起来糊糊的」的隐藏元凶 本文贡献:提出 RefDecoder 参考条件视频 VAE decoder:用一个轻量图像编码器把参考帧映射成细节丰富的高维 token,在 decoder 每个 upsampling stage 与去噪后的视频 latent token 共同处理(reference attention),让 decoder 也获得与 denoising 网络对等的条件信息 实验效果:在 Wan 2.1、VideoVAE+ 等多个 decoder backbone 上一致提升 PSNR 最多 +2.1dB(Inter4K / WebVid / Large Motion);可直接热插拔进现有视频生成系统,无需额外微调,VBench I2V 上主体一致性、背景一致性、综合质量全面提升;天然泛化到风格迁移、视频编辑精修等任务 批判点评:这是一项「补条件」的低风险高收益工作,可即插即用是工程师最爱的属性;但 decoder 端注入参考可能在大幅运动场景下与 latent 表示冲突,长视频累积误差与 reference token 选择策略仍有优化空间 5. DiffusionOPD:多任务训练范式 DiffusionOPD: A Unified Perspective of On-Policy Distillation in Diffusion Models | 阿里 Wan Team, 复旦 | arXiv:2605.15055 关键词:扩散模型 RL·On-Policy 蒸馏·多任务·Wan Team·文生图 前序问题:强化学习是改进文生图扩散模型的强力工具,但现有方法大多局限于单任务优化——多任务联合 RL 受困于跨任务干扰和不平衡,级联 RL 又笨重且易遗忘 本文贡献:提出 DiffusionOPD 多任务训练范式:先独立训练任务专属 teacher,再沿学生自己的 rollout 轨迹做 Online Policy Distillation 把多 teacher 能力蒸馏到统一学生;理论上首次把 OPD 框架从离散 token 提升到连续状态 Markov 过程,给出闭式 per-step KL 目标,统一 SDE 与 ODE refinement,方差更低、泛化更好 实验效果:一致超越多奖励 RL 与级联 RL 基线,训练效率与最终性能两端均占优,在所有评测基准上达到 SOTA 批判点评:把 OPD 严格地搬上连续扩散是漂亮的理论延伸,多任务版本对落地非常有价值;但 teacher 数量增加后蒸馏的 token-level KL 是否仍稳定、teacher 与学生 capacity 失配时的下界,仍需更大规模实验 6. RAVEN:框架 RAVEN: Real-time Autoregressive Video Extrapolation with Consistency-model GRPO | 帝国理工 AGI Lab | arXiv:2605.15190 关键词:实时 AR 视频·一致性模型·CM-GRPO·训练-测试对齐·流式生成 前序问题:因果自回归视频扩散模型靠把过去内容外推未来 chunk 实现实时流式生成,蒸馏自高保真双向教师后已能少步推理;但训练时 history 分布与推理时实际 rollout 分布之间的 gap 一直限制长序列的生成质量 本文贡献:提出 RAVEN training-time test 框架:把每次自身 rollout 重打包为「干净历史端点 + 噪声去噪状态」交错序列,让训练注意力对齐推理时的外推方式,同时让下游 chunk loss 监督未来预测所依赖的历史表示;进一步提出 CM-GRPO,把 consistency 采样步重新表达为条件高斯转移,直接在该核上做在线 RL,避免了之前 flow-model RL 公式中的 Euler-Maruyama 辅助过程 实验效果:RAVEN 在质量、语义、动态度多维评测上超越近期因果视频蒸馏 baseline;CM-GRPO 与 RAVEN 组合后进一步提升性能 批判点评:把 training-test 不一致问题正面解决并配套 CM-GRPO 是组合拳;但 RAVEN 重打包对长序列内存占用的影响、CM-GRPO 在更复杂奖励上的稳定性,还需要在更大模型尺度上验证 7. SANA-WM:2.6B 参数原生面向 1 SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer | NVIDIA, MIT, 港科大 | arXiv:2605.15178 关键词:世界模型·分钟级视频·Hybrid Linear Attention·6-DoF 相机·开源 前序问题:一分钟级别的世界模型既要画质媲美 LingBot-World、HY-WorldPlay 这些产业级大模型,又要在算力、数据、推理硬件三方面都「能用得起」——目前几乎没有开源方案能同时做到 本文贡献:提出 SANA-WM:2.6B 参数原生面向 1 分钟视频生成的开源世界模型——(1) Hybrid Linear Attention 把 frame-wise Gated DeltaNet 与 softmax attention 混合,长上下文内存可控;(2) Dual-Branch Camera Control 保证 6-DoF 轨迹精确跟随;(3) 两阶段生成 + long-video refiner;(4) 鲁棒标注流水线从公开视频中提取 metric-scale 6-DoF 相机姿态作为动作标签 实验效果:仅用约 213K 公开视频片段、64 张 H100 训练 15 天,每个 60s 720p clip 单 GPU 即可生成;蒸馏量化版可在单卡 RTX 5090 上 NVFP4 量化下 34 秒生成 60s 720p;在 1 分钟世界模型 benchmark 上动作跟随精度强于现有开源 baseline,画质相当但吞吐高 36 倍 批判点评:把「分钟级世界模型」做到能在单张消费卡上跑动,是世界模型走向开发者手里的关键一步;但 1 分钟仍然依赖「stage-2 refiner」这一外置模块,端到端 1 分钟生成质量与商业闭源仍有差距 8. PDI-Bench:几何一致性量化框架 Quantitative Video World Model Evaluation for Geometric-Consistency | UCSD, 港科大等 | arXiv:2605.15185 关键词:视频世界模型·几何一致性·评测基准·3D 重建·物理推理 前序问题:生成视频模型越来越被当作隐式世界模型来研究,但「生成视频是否产生了物理合理的 3D 结构与运动」一直缺乏客观度量——现有评测要么靠人工打分要么靠学习式 grader,对几何失败的诊断力都很弱 本文贡献:提出 PDI-Bench(Perspective Distortion Index)几何一致性量化框架:先用 SAM 2、MegaSaM、CoTracker3 抽取物体级观测,单目重建到 3D 世界坐标,再算三类射影几何残差——尺度-深度对齐、3D 运动一致性、3D 结构刚性;配套 PDI-Dataset 覆盖多种压力测试场景 实验效果:在多个 SOTA 视频生成器上揭示了通用感知指标完全捕获不到的「几何特定失败模式」,为「物理基础视频生成 / 物理世界模型」的进展提供了可诊断信号 批判点评:把视频世界模型评测从「看起来对不对」推进到「几何上对不对」是必要的下一步,依托成熟 3D 工具链让指标可复现;但单目重建本身的误差对 PDI 指标的噪声有多大、对真实开放世界长尾场景的覆盖度,是后续要补的关键证据 趋势观察 实时交互视频生成进入 frame-wise 时代 — Causal Forcing++ 把少步 AR 视频从 chunk-wise 4 步压缩到 frame-wise 2 步,首帧延迟降一半;RAVEN 用 training-time test + CM-GRPO 直击 history 分布漂移——实时交互视频已经从「能动」进入「秒级响应」 相机控制从「重训」走向「零样本 + 一段视频微调」 — Warp-as-History 把相机条件转译为 frozen 模型自带的视觉历史通路,零样本即跟随;只用一段视频做 LoRA 即可泛化到未见素材——相机可控视频生成从「依赖大规模标注」滑向「轻数据即用」 VAE decoder 不再是哑终端 — RefDecoder 指出主流视频扩散模型 decoder 长期处于「无条件」状态,导致细节流失;用 reference attention 给 decoder 也加上条件,PSNR 直接 +2.1dB——decoder 端的条件化正成为视频生成的下一个低悬果实 世界模型走向消费级硬件 — SANA-WM 用 Hybrid Linear Attention + 量化在单卡 RTX 5090 上跑出 34 秒生成 60 秒 720p——分钟级世界模型第一次具备了「开发者本地可玩」的硬件包络 评测从感知质量转向几何/物理一致性 — PDI-Bench 把视频世界模型的考评从「看起来真不真」转到「几何上对不对」,借助成熟 3D 工具链给出射影几何残差——这预示着视频生成下一阶段的评测竞赛是「物理可解释性」 人工智能炼丹君 整理 | 2026-05-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-14|视频扩散从少步到任意步AnyFlow 今日 AIGC 论文速览 今日共 6 篇 · 视频扩散与推理加速 2 篇 · 图像生成与表征 2 篇 · 图像编辑与对齐评测 1 篇 · RL 后训练方法论 1 篇 重点论文标题列表 AnyFlow:——首个基于 flow map AsymFlow:rank-asymmetric ⚡ Qwen-Image-VAE-2.0:高压缩 VAE 套件 Edit-Compass:EditReward-Compass Orthrus:双视图框架 今日论文速览 1. AnyFlow:——首个基于 flow map AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation | 新加坡国立大学 Show Lab, MIT, NVIDIA | arXiv:2605.13724 关键词:视频扩散·Flow Map·On-Policy 蒸馏·Any-Step·推理加速 ⚠️ 前序问题:近一年的少步视频生成几乎被一致性蒸馏(Consistency Distillation)统治,4-8 步即可出图,但只要把采样步数从 4 加到 16/32 画质反而塌——CD 用一致性轨迹替换了原始 PF-ODE 轨迹,破坏了 ODE 采样在测试时的可扩展行为,无法服务「任意步数」推理需求 本文贡献:提出 AnyFlow——首个基于 flow map 的任意步数视频扩散蒸馏框架:(1) 把蒸馏目标从端点一致性映射 z_t→z_0 升级为流图过渡 z_t→z_r,让学生学会任意时间区间的跳跃;(2) Flow Map Backward Simulation 把完整 Euler rollout 拆为多段 shortcut,用 on-policy rollout 替代 off-policy 配对蒸馏,缓解少步采样的离散化误差和因果生成的 exposure bias 实验效果:在双向 DiT 与因果两类视频扩散骨干、1.3B 到 14B 全规模区间一致达到或超越 consistency baseline;当步数从 4 提升到 16/32 时性能不再退化、反而单调上升,重新恢复了 ODE 采样的 test-time scaling 优势 批判点评:把蒸馏目标从端点一致性升级到任意区间流图是范式级创新,FMBS 的 on-policy 反向模拟在视频域是首次系统化提出;但论文未公开 VBench/UCF-FVD 等具体数值,复现门槛在 1B-14B 教师 + 大规模 on-policy rollout,数据与算力两端都不低 2. AsymFlow:rank-asymmetric Asymmetric Flow Models | Stanford, ETH | arXiv:2605.12964 关键词:Flow Matching·像素扩散·非对称参数化·FLUX.2·文生图 ⚠️ 前序问题:高维像素空间下做 flow matching 速度预测时,模型必须建模与图像同维的高维噪声,即使数据本身有强低秩结构也只能用满秩参数化硬扛,导致像素扩散与潜空间模型间长期存在显著质量差距 本文贡献:提出 AsymFlow:rank-asymmetric 速度参数化——噪声预测限制在低秩子空间、数据预测保持满维,不改网络结构与训练/采样流程即可解析恢复完整速度;首次给出潜空间预训练→像素空间微调的可行路径,让 FLUX.2 klein 9B 的潜空间先验直接初始化像素生成 实验效果:ImageNet 256×256 取得 1.57 FID,大幅超越同类 DiT/JiT 像素扩散;从 FLUX.2 klein 9B 微调出的像素文生图模型在 HPSv3、DPG-Bench、GenEval 上全面超越其潜空间基模,主观真实感显著提升 批判点评:rank-asymmetric 视角直击像素扩散的本质瓶颈,无侵入式参数化是工程甜点;但低秩子空间的秩选择、与 FLUX.2 这种顶级模型的耦合是否过强、跨数据集泛化能力都还需更大规模验证 3. Qwen-Image-VAE-2.0:高压缩 VAE 套件 Qwen-Image-VAE-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.13565 关键词:图像 VAE·高压缩·文本渲染·扩散兼容·视觉分词器 ⚠️ 前序问题:高压缩比 VAE 在重建保真度和 diffusability 之间长期难以兼得——压得越狠下游 DiT 越难训,文本密集场景(文档、海报)的字符更是首当其冲糊掉 本文贡献:提出 Qwen-Image-VAE-2.0 高压缩 VAE 套件:架构上引入 Global Skip Connections + 扩展潜空间通道;训练上用十亿级图像 + 合成渲染引擎专项强化文本场景;潜空间用增强语义对齐策略让其更适合扩散建模;编解码器采用非对称 + attention-free 主干降低编码开销 实验效果:在公开重建基准上达到 SOTA;提出 OmniDoc-TokenBench 文档专项评测,在高压缩比下兼顾通用与文本场景;下游 DiT 实验显示其 diffusability 显著优于现有高压缩基线,收敛速度明显加快 批判点评:把 VAE 当成独立产品打磨——文档专项 benchmark + 文本渲染合成数据是务实的工程亮点;但相对其他高压缩 VAE 的提升幅度需等论文公开数值后比较,「diffusability」的量化定义仍偏经验 4. Edit-Compass:EditReward-Compass Edit-Compass & EditReward-Compass: A Unified Benchmark for Image Editing and Reward Modeling | 字节跳动 Doubao Team 等 | arXiv:2605.13062 关键词:图像编辑·Reward Model·多维评测·RL 对齐·Benchmark ⚠️ 前序问题:现有图像编辑 benchmark 难度不足、评测维度粗放,已无法区分前沿模型;与此同时图像编辑 RL 越来越依赖 reward model,但 reward model 评测仍停留在脱离实际 RL 场景的设定上,导致编辑模型与 reward model 都缺少可靠裁判 本文贡献:提出 Edit-Compass + EditReward-Compass 统一评测套件:前者含 2,388 条精标实例,覆盖世界知识推理、视觉推理、多图编辑等六级递进任务,采用结构化推理 + 细粒度 rubric 多维评分;后者含 2,251 对偏好对,模拟真实 RL 优化中的 reward 场景 实验效果:为前沿编辑模型提供了能拉开差距的多维难度梯度,配套的 reward model 评测能反映 RL 训练中 reward model 的真实表现,为后续编辑模型与 reward model 的迭代提供统一坐标系 批判点评:把「编辑能力」和「reward model 能力」两条评测线收编进同一套 benchmark 是踏实的基础工作;2,251 对偏好对的标注一致性、reward 评测对真实 RL 收益的预测力,是这类工作走向社区共识的关键门槛 5. Orthrus:双视图框架 Orthrus: Memory-Efficient Parallel Token Generation via Dual-View Diffusion | Adobe Research, University of Oregon | arXiv:2605.12825 关键词:并行解码·扩散语言模型·KV Cache·推理加速·双视图 ⚠️ 前序问题:自回归 LLM 生成保真度高但串行解码慢,扩散语言模型可并行却质量退化、训练贵、收敛缺乏严格保证——视觉/多模态 token 生成场景同样面临「快」与「准」难以兼得 本文贡献:提出 Orthrus 双视图框架:在冻结的 AR LLM 上挂载一个轻量可训练扩散并行视图,两视图共用同一份高保真 KV Cache——AR 头负责 prefill 构建准确表征、扩散头负责并行解码;通过两视图共识机制保证无损推理,把扩散并行解码移植到 Transformer 几乎零侵入 实验效果:在保证完全等价生成(lossless)的前提下,相比纯自回归提供最高 7.8x 加速,KV Cache 内存仅增加 O(1),参数增量极小;为视觉/多模态自回归 token 生成提供直接可用的并行加速路线 批判点评:把扩散当成 AR 的「并行外设」而不是替代品,借共识机制保留 AR 保真度,工程上很优雅;但 7.8x 加速属上限值,真实任务下并行步内的拒绝率与吞吐曲线值得进一步给出,扩散头训练成本也未充分披露 6. Beyond-GRPO:奖励分配原则 Beyond GRPO and On-Policy Distillation: An Empirical Sparse-to-Dense Reward Principle for Language-Model Post-Training | Meta | arXiv:2605.12483 关键词:LLM 后训练·GRPO·On-Policy 蒸馏·奖励密度·稀疏到稠密 ⚠️ 前序问题:在「可验证标注极其稀缺」的后训练场景下,主流做法(在部署模型本身上跑 GRPO)忽视了一个奖励密度原则:稀疏的序列级奖励应该用在能产生有效探索的强模型上、稠密的 token 级奖励才适合把行为压缩进小模型,这一直觉对生成模型的 RL 对齐同样关键 本文贡献:提出 Sparse-to-Dense 奖励分配原则:把宝贵的可验证数据先「上游」给强 teacher 跑 GRPO 做探索,再以稠密蒸馏的形式「下游」灌给小学生,最后在学生侧再补一段稀疏 RL;具体配方为 forward-KL warmup → OPD on-policy → 学生侧 GRPO 的三段桥 实验效果:在 Qwen3-1.7B 学生固定的前提下,先在 8B teacher 上 RL 再蒸馏全面优于直接在学生上 GRPO;学生侧后续 GRPO 把 MATH 从 75.4% 提升到 78.5%、比 replay baseline 高 2.8 分,AIME 端点也最强 批判点评:「奖励密度」的视角让 GRPO 与 OPD 不再对立而成同一光谱的两端,对资源紧张团队的实践指导价值很高;但结论建立在数学这一可验证任务上,对图像/多模态生成等弱验证任务能否平移仍待验证 趋势观察 视频扩散从「少步」走向「任意步」 — AnyFlow 把蒸馏目标从端点一致性升级到任意区间的 flow map,叠加 on-policy 反向模拟,让一个学生模型在 1/4/16/32 步上都呈现良性 scaling——少步视频生成第一次有了真正的「test-time 预算自由度」 像素扩散借势潜空间预训练 — AsymFlow 用 rank-asymmetric 速度参数化把高维噪声预测限制在低秩子空间,并首次跑通了「FLUX.2 klein 9B 潜空间→像素空间」的微调路径——像素扩散与潜空间扩散开始走向「初始化共享、后期分化」的新协作方式 VAE 不再是配角,而是产品 — Qwen-Image-VAE-2.0 把高压缩 VAE 当作独立产品打磨:Global Skip Connections + 扩展通道 + 文档专项 benchmark,承认了「VAE 决定 DiT 上限」的事实,VAE 进入「文本可读、扩散友好、推理便宜」的三维竞赛 编辑模型与 reward model 同台同尺 — Edit-Compass 把「图像编辑能力」和「reward model 能力」并入同一评测套件,并把 reward model 评测从脱节场景改造成贴合 RL 实战的偏好对——前沿编辑模型的 RL 对齐第一次有了配套的统一坐标系 稀疏-稠密奖励分配成为后训练新共识 — Beyond-GRPO 给出一条简单规则:稀缺可验证数据先在强 teacher 上做稀疏 RL,再以稠密蒸馏下沉到小学生,最后学生侧补稀疏 RL;这一原则同样适用于多模态生成模型的 reward 分配,正在成为下一代 alignment pipeline 的骨架 人工智能炼丹君 整理 | 2026-05-14
-
AIGC 每日速读|2026-05-13|INSET图像即词汇开启统一视觉生成新范式 今日 AIGC 论文速览 今日共 10 篇 · 统一视觉生成与编辑 3 篇 · 视频生成与叙事 2 篇 · 视觉分词与表征 2 篇 · 视频理解与推理 1 篇 · Agent 与训练方法论 2 篇 重点论文标题列表 INSET:将图像作为原生词汇无缝嵌入文本指令— Qwen-Image-2.0:全能图像生成基础模型 ⚡ DRoRAE:轻量级融合模块通过能量约束路由和增量 CausalCine:交互式自回归框架 ELF:在连续嵌入空间中基于连续时间 今日论文速览 1. INSET:将图像作为原生词汇无缝嵌入文本指令— INSET (Images iN SEnTences): Interleaved Instruction for Unified Visual Generation | MIT, ETH | arXiv:2605.12305 关键词:交错指令·统一视觉生成·图像词汇化·多图一致性·数据引擎 ⚠️ 前序问题:现有多模态语言模型已支持从多图指令生成图像,但在处理复杂交错指令时性能急剧下降——根本原因在于当前范式中图像和文本结构性分离,模型必须跨越困难的长距离依赖才能将描述与视觉目标正确匹配,导致多图一致性和精确绑定失败 本文贡献:提出 INSET(Images iN SEnTences),将图像作为原生词汇无缝嵌入文本指令——直接把视觉特征放在对应语义槽位,利用 Transformer 的上下文局部性替代长距离依赖实现精确对象绑定;同时设计可扩展数据引擎,借助 VLM 和 LLM 从标准图像/视频数据集合成 1500 万高质量交错样本 实验效果:在 InterleaveBench 上显著超越 SOTA,多图一致性和文本对齐方面领先,且随输入复杂度增加性能差距进一步扩大;架构天然扩展支持多模态图像编辑,把视觉内容作为指令一部分实现高度表达性的视觉操控 批判点评:图像词汇化的核心直觉新颖——把多图绑定从长距离依赖问题转化为局部上下文问题是范式级改变;但 1500 万合成数据的复现成本极高,模型与数据是否开源将直接决定其影响力,且论文未给出 FLOPS/推理延迟的对比 2. Qwen-Image-2.0:全能图像生成基础模型 Qwen-Image-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.10730 关键词:图像生成·文本渲染·多语言排版·扩散Transformer·统一编辑 ⚠️ 前序问题:现有图像生成模型在超长文本渲染、多语言排版、高分辨率写实、鲁棒指令遵循和高效部署方面仍面临挑战,尤其在文字密集和组合复杂场景中表现不足 本文贡献:提出 Qwen-Image-2.0 全能图像生成基础模型:将 Qwen3-VL 作为条件编码器与多模态扩散 Transformer 结合,支持联合条件-目标建模;支持 1K token 长度指令生成文字密集内容(幻灯片、海报、信息图、漫画),显著提升多语言文字保真度和排版质量 实验效果:在生成和编辑任务上大幅超越之前的 Qwen-Image 模型,在写实感、细节丰富度、纹理真实性和光照一致性方面均有显著提升 批判点评:统一生成和编辑的全能架构令人印象深刻,但技术报告形式缺乏与开放社区模型的公平对比;1K token 长指令的实际推理成本和延迟未详述 3. DRoRAE:轻量级融合模块通过能量约束路由和增量 Beyond the Last Layer: Multi-Layer Representation Fusion for Visual Tokenization | Peking University, Meituan, Tsinghua University | arXiv:2605.10780 关键词:视觉分词器·多层融合·表征自编码·缩放律·图像生成 ⚠️ 前序问题:表征自编码器(Representation AE)复用冻结预训练视觉编码器作为视觉分词器,但现有方法仅提取最后一层特征,丢弃了中间层分布的丰富层次化信息——低层视觉细节在最后一层仅以衰减残差形式存活 本文贡献:提出 DRoRAE(深度路由表征自编码器):轻量级融合模块通过能量约束路由和增量校正自适应聚合所有编码器层;三阶段解耦训练策略先在冻结解码器的隐式分布约束下学习融合,再微调解码器充分利用丰富表征 实验效果:在 ImageNet-256 上将 rFID 从 0.57 降至 0.29,生成 FID 从 1.74 降至 1.65;发现融合容量与重建质量间的对数线性缩放律(R²=0.86) 批判点评:多层融合的思路简洁有效,对数线性缩放律的发现为视觉分词器提供了新的可预测扩展维度;但融合模块的额外计算开销和对不同编码器架构的泛化性需更多验证 4. CausalCine:交互式自回归框架 CausalCine: Real-Time Autoregressive Generation for Multi-Shot Video Narratives | HKUST, Ant Group, SJTU | arXiv:2605.12496 关键词:多镜头视频·自回归生成·实时推理·记忆路由·镜头转换 ⚠️ 前序问题:自回归视频生成以实时开放式合成为目标,但电影叙事不是无限延伸单一场景——它需要事件演进、视角切换和镜头边界。现有 AR 模型将长序列视为延伸单镜头,导致长推演中运动停滞和语义漂移 本文贡献:提出 CausalCine 交互式自回归框架:将多镜头视频生成转化为在线导演过程;先在原生多镜头序列上训练因果基础模型学习复杂镜头转换先验,再提出 Content-Aware Memory Routing (CAMR) 按注意力相关性动态检索历史 KV 条目,最后蒸馏为少步实时生成器 实验效果:显著超越自回归基线,接近双向模型能力,同时解锁因果生成的流式交互特性,支持动态 prompt 实时切换 批判点评:多镜头叙事的问题设定高度实用,CAMR 的内容感知路由设计优雅;但蒸馏后的少步生成器是否保持镜头转换的多样性存疑;训练数据中多镜头标注的获取成本未讨论 5. ELF:在连续嵌入空间中基于连续时间 ELF: Embedded Language Flows | MIT (Kaiming He 团队) | arXiv:2605.10938 关键词:连续扩散语言模型·Flow Matching·嵌入空间·CFG·文本生成 ⚠️ 前序问题:扩散/流模型在连续数据(图像、视频)生成中占主导地位,但应用于语言建模时,当前领先的扩散语言模型(DLM)仍主要操作离散 token,连续 DLM 尚未证明有效性 本文贡献:提出 ELF(Embedded Language Flows):在连续嵌入空间中基于连续时间 Flow Matching 的扩散模型,在最终时间步通过共享权重网络映射到离散 token;这一公式化使得从图像扩散模型迁移成熟技术(如 CFG)变得直接 实验效果:大幅超越领先的离散和连续 DLM,以更少的采样步骤实现更好的生成质量,证明连续 DLM 可以通过最小适配有效工作 批判点评:Kaiming He 团队的工作一贯简洁有力——将连续流匹配应用于语言的思路开创性地打通了图像和语言扩散的技术栈;但语言的离散本质是否在连续空间中引入不必要的量化误差值得深入分析 6. PhyGround:标准化物理推理基准 PhyGround: Benchmarking Physical Reasoning in Generative World Models | Northeastern University, ETH | arXiv:2605.10806 关键词:物理推理基准·世界模型·视频生成评估·VLM评判器·人类评估 ⚠️ 前序问题:生成式世界模型被期望捕获真实世界物理规则,但评估生成视频是否真正遵循物理定律仍极具挑战——现有基准存在粗粒度评估掩盖逐律失败、标注偏见和自动评估器物理感知不足等问题 本文贡献:提出 PhyGround 标准化物理推理基准:250 个精选 prompt 配有预期物理结果,覆盖固体力学、流体动力学、光学等 13 条物理定律的分类学;通过社会科学实验设计执行 459 名标注者大规模人类评估;发布 PhyJudge-9B 物理专用 VLM 评判器 实验效果:PhyJudge-9B 相对偏差仅 3.3%(vs Gemini-3.1-Pro 的 16.6%);人类标注达到高分半相关性(Spearman's ρ > 0.90),揭示当前视频生成器在视觉逼真和物理推理间的持续鸿沟 批判点评:评估框架设计严谨(借鉴社会科学实验方法论),PhyJudge-9B 的开源贡献显著;但 250 个 prompt 的规模可能不足以覆盖开放世界物理场景的长尾分布 7. GridProbe:无训练后验探测推理范式 GridProbe: Posterior-Probing for Adaptive Test-Time Compute in Long-Video VLMs | MIT | arXiv:2605.10762 关键词:长视频理解·自适应计算·帧选择·后验探测·VLM推理 ⚠️ 前序问题:长视频 VLM 理解被单次整体前向传播瓶颈化——数千帧的二次注意力成本高昂;现有帧选择方法依赖编码器空间相似度,在推理密集型查询(否定、跨帧计数、全局总结)上失败 本文贡献:提出 GridProbe 无训练后验探测推理范式:将帧排列为 K×K 网格,执行轻量行列探测,用冻结 VLM 自身推理能力在答案空间中评分证据,外积生成可解释重要性图;提出 Shape-Adaptive Selection 闭式规则以每问题自适应帧预算替代固定预算 实验效果:在 Video-MME-v2 上匹配整体基线精度(差 1.6pp)的同时减少 3.36x TFLOPs;在 LongVideoBench 上 Pareto 主导基线(+0.9pp at 0.35x compute);2B 选择器 + 8B QA 组合在 0.52x 计算量下提升 +4.0pp 批判点评:后验探测的思路巧妙——用模型自身推理能力选帧替代外部相似度;Shape-Adaptive Selection 的闭式解优雅实用;但网格排列假设可能在超长视频中引入信息损失 8. AlphaGRPO:将 GRPO 应用于 AlphaGRPO: Unlocking Self-Reflective Multimodal Generation in UMMs via Decompositional Verifiable Reward | HKU | arXiv:2605.12495 关键词:多模态生成·GRPO·可验证奖励·自反思·统一模型 ⚠️ 前序问题:统一多模态模型(UMM)缺乏有效的强化学习对齐方案——多模态生成场景中提供稳定监督信号极具挑战,现有整体标量奖励无法捕捉多维语义和质量要求 本文贡献:提出 AlphaGRPO:将 GRPO 应用于 AR-Diffusion UMM,无需额外冷启动阶段;引入分解可验证奖励(DVReward)——LLM 将复杂请求分解为原子可验证语义/质量问题,由通用 MLLM 评估提供可靠可解释反馈;解锁推理型文生图和自反思精炼能力 实验效果:在 GenEval、TIIF-Bench、DPG-Bench、WISE 等多模态生成基准上取得稳健提升,同时在未训练的编辑任务(GEdit)上也获得显著增益 批判点评:分解可验证奖励的设计思路与 Auto-Rubric as Reward 异曲同工,自反思精炼是引人注目的涌现能力;但 DVReward 的可靠性仍受限于评估用 MLLM 的能力上限 9. Shepherd:函数式编程模型 Shepherd: A Runtime Substrate Empowering Meta-Agents with a Formalized Execution Trace | Stanford, META | arXiv:2605.10913 关键词:Meta-Agent·执行追踪·分叉重放·函数式编程·Agent基础设施 ⚠️ 前序问题:Meta-Agent 对目标 Agent 的操作缺乏形式化框架——无法有效记录、分叉和重放 Agent 执行状态,限制了运行时干预、反事实优化和训练等高级能力 本文贡献:提出 Shepherd 函数式编程模型:将 meta-agent 操作形式化为函数(核心操作在 Lean 中机械化),以 Git-like 执行追踪记录每次交互为类型化事件,支持任意状态分叉和重放;进程+文件系统 fork 速度比 Docker 快 5 倍,重放时 prompt-cache 复用率 >95% 实验效果:运行时干预将结对编程通过率从 28.8% 提升至 54.7%;反事实优化在四个基准上领先最多 11 分且墙钟时间减少 58%;Tree-RL 训练在 TerminalBench-2 上从 34.2% 提升至 39.4% 批判点评:将 Agent 执行形式化为可分叉追踪的系统设计前沿且实用,Git-like 语义直观易理解;但 Lean 形式化的学习曲线和实际部署复杂度可能限制采用 10. On-Policy Distillation:系统实证研究 OPD/OPSD The Many Faces of On-Policy Distillation: Pitfalls, Mechanisms, and Fixes | MIT, ETH | arXiv:2605.11182 关键词:在策略蒸馏·自蒸馏·LLM后训练·失败分析·知识蒸馏 ⚠️ 前序问题:在策略蒸馏(OPD)和在策略自蒸馏(OPSD)作为 LLM 后训练方法前景广阔,但现有结果不一致——有时有效有时退化,何时有效、何时失败及其原因不清楚 本文贡献:系统实证研究 OPD/OPSD 的成功与失败条件,识别三种失败机制:1)teacher 条件化在 student 前缀上的分布错配;2)有偏 TopK reverse-KL 梯度的优化不稳定;3)OPSD 特有的实例特定特权信息缺失问题;提出 stop-gradient TopK、RLVR-adapted teacher 和 SFT-stabilized student 等修复方案 实验效果:为 OPD/OPSD 建立系统性指导:数学推理中对 teacher 选择和 loss 形式高度敏感,系统提示内化场景中 OPSD 有效 批判点评:实证分析全面深入,三种失败机制的识别为该领域提供了重要的实践指导;修复方案虽有效但增加了训练复杂度 趋势观察 统一生成范式成熟化 — INSET 和 Qwen-Image-2.0 分别从交错指令和全能框架角度推进统一视觉生成——前者将图像提升为文本词汇实现精确绑定,后者通过 VLM+MDT 实现生成/编辑一体化,标志着统一生成从概念验证走向工程化 自回归视频走向电影叙事 — CausalCine 首次将多镜头叙事引入自回归视频生成,通过内容感知记忆路由和少步蒸馏实现实时交互导演——AR 视频不再局限于单镜头延伸,开始具备电影级叙事能力 连续扩散模型跨域迁移 — ELF 证明连续 Flow Matching 可以有效用于语言建模,DRoRAE 发现视觉分词器的对数线性缩放律——扩散/流模型的核心技术正在跨越模态边界寻找新的应用空间 物理推理成为生成质量新维度 — PhyGround 构建了首个标准化物理推理基准并开源 PhyJudge-9B,揭示当前视频生成器「看起来真实但物理错误」的系统性问题——物理一致性正从加分项变为硬性要求 RL 对齐驱动生成自反思 — AlphaGRPO 通过分解可验证奖励在 UMM 上解锁了自反思精炼能力——模型不仅能生成,还能自主诊断和修正对齐失败,预示着生成模型将具备更强的自我改进能力 人工智能炼丹君 整理 | 2026-05-13
-
AIGC 每日速读|2026-05-12|Forcing-KV 视频扩散2.82倍加速突破实时 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与加速 4 篇 · 图像生成与超分 2 篇 · 生成对齐与评估 2 篇 · 视频理解 1 篇 · 语音合成 1 篇 重点论文标题列表 Forcing-KV:混合 KV cache 压缩策略 TIE:一种即插即用的区间感知 RoPE SWIFT:无训练框架 Unison:统一框架 Auto-Rubric as Reward:将 VLM 内隐偏好知识外化为 今日论文速览 1. Forcing-KV:混合 KV cache 压缩策略 Forcing-KV: Hybrid KV Cache Compression for Efficient Autoregressive Video Diffusion Models | Nvidia, MIT, ETH Zurich, ZJU | arXiv:2605.09681 关键词:KV Cache压缩·自回归视频扩散·注意力头特化·流式视频生成·推理加速 前序问题:自回归视频扩散模型(如 Self Forcing)实现了流式长视频生成,但历史帧的 KV cache 冗余导致注意力复杂度爆炸和显存瓶颈,严重限制可扩展性 本文贡献:提出 Forcing-KV 混合 KV cache 压缩策略:发现注意力头具有稳定的功能特化(静态头负责跨 chunk 过渡和帧内保真,动态头负责帧间运动与一致性),对静态头执行结构化剪枝,对动态头执行基于片段相似度的动态剪枝 实验效果:单卡 H200 达到 29+ FPS 并减少 30% cache 显存;在 LongLive 和 Self Forcing 上分别获得 1.35x 和 1.50x 加速(480P),1080P 场景加速比达 2.82x 批判点评:注意力头功能特化的发现颇具洞察,但实验仅在两个 AR 视频扩散模型上验证,是否推广到 CogVideoX 等非 AR 架构有待检验;静态/动态头的划分策略对新架构是否仍然成立存疑 2. TIE:一种即插即用的区间感知 RoPE TIE: Time Interval Encoding for Video Generation over Events | University of Science and Technology of China, Fudan University | arXiv:2605.10543 关键词:时间区间编码·多事件视频生成·RoPE·DiT·时间控制 前序问题:现有视频生成器将时间表征为离散点(点式位置编码),无法表示时间区间和重叠事件——68% 的通用视频片段和 99% 的机器人/游戏片段包含事件重叠,但多事件生成器仍假设单一活跃 prompt 本文贡献:提出 Time Interval Encoding (TIE),一种即插即用的区间感知 RoPE 泛化方案,将时间区间提升为 DiT 交叉注意力的一等原语;基于时间可积性和持续时间不变性两个原则推导出高效闭式 sinc 解 实验效果:在 OmniEvents 数据集上将人工验证的时间约束满足率从 77.34% 提升至 96.03%,时间边界误差从 0.261s 降至 0.073s,同时保持视觉质量不损 批判点评:理论推导优雅(sinc 解的闭式形式),但区间编码的假设依赖均匀核,非均匀时间分布场景的鲁棒性需进一步验证;数据集规模和事件复杂度有限 3. SWIFT:无训练框架 SWIFT: Prompt-Adaptive Memory for Efficient Interactive Long Video Generation | University of Science and Technology of China, Fudan University, Georgia Institute of Technology | arXiv:2605.09442 关键词:长视频生成·语义切换·无训练·自适应记忆·流式推理 前序问题:流式长视频生成中的连续语义切换需要自适应记忆保持视觉连贯性,但现有方法在 prompt 边界重建缓存导致冗余计算,固定显存预算无法灵活适配语义变化 本文贡献:提出 SWIFT(Semantic Windowing and Injection for Flexible Transitions)无训练框架:引入语义注入缓存增强而非重建记忆,逐头语义注入使每个注意力头按视频状态对齐度接收更新,自适应动态窗口按 prompt 阶段分配时间记忆 实验效果:在保持生成质量的同时,单卡 H100 上达到 22.6 FPS,为多 prompt 长视频生成建立了显著更高效的方案 批判点评:无训练方案的通用性令人印象深刻,但逐头注入的语义对齐度计算本身可能引入延迟;仅在因果视频扩散模型上验证,对双向注意力架构的适用性存疑 4. Unison:统一框架 Unison: Harmonizing Motion, Speech, and Sound for Human-Centric Audio-Video Generation | Wuhan University, Westlake University | arXiv:2605.08729 关键词:音视频生成·多模态协调·语音合成·音效生成·人物视频 前序问题:人物视频中的动作、语音和音效具有异质时序特征,联合生成时各模态难以保持一致对齐,导致运动-语音-环境音之间出现明显不匹配 本文贡献:提出 Unison 统一框架:音频流内通过语义引导的协调策略解耦语音与音效生成(双向音频交叉注意力+语义条件门控),跨模态通过双向交叉模态 forcing 策略让更干净的模态引导更噪声的模态,配合渐进稳定策略 实验效果:在音频感知质量和跨模态同步性两方面均达到 SOTA,有效缓解了语音主导问题并增强了声学清晰度 批判点评:多模态协调机制设计精巧,但「更干净模态引导更噪声模态」的假设在实际复杂场景中不一定成立;人物视频数据集的多样性可能限制泛化能力 5. Auto-Rubric as Reward:将 VLM 内隐偏好知识外化为 Auto-Rubric as Reward: From Implicit Preferences to Explicit Multimodal Generative Criteria | Nanyang Technological University, Ant Group, MMLab, CUHK | arXiv:2605.08354 关键词:奖励建模·RLHF·评分准则·文生图对齐·可解释AI 前序问题:多模态生成模型的 RLHF 对齐将人类多维判断压缩为标量/成对标签,丢失了组合结构化偏好,导致奖励 hacking 和不可解释性 本文贡献:提出 Auto-Rubric as Reward (ARR):将 VLM 内隐偏好知识外化为 prompt 特定的评分准则(rubric),将整体意图分解为独立可验证的质量维度;进一步提出 Rubric Policy Optimization (RPO) 将多维评估蒸馏为稳健的二元奖励 实验效果:在文生图和图片编辑基准上超越成对奖励模型和 VLM 裁判,证明瓶颈不在知识缺失而在缺乏分解接口 批判点评:将隐式偏好显式化为 rubric 的思路新颖且可解释性强,但 rubric 生成依赖 VLM 质量——若 VLM 本身存在偏见则 rubric 会继承;RPO 的二元奖励简化是否在高维偏好空间中信息损失过大值得探讨 6. SMFSR:保持噪声起始点 Noise-Started One-Step Real-World Super-Resolution via LR-Conditioned SplitMeanFlow and GAN Refinement | Nanjing University of Science and Technology, ETH Zurich | arXiv:2605.09328 关键词:真实超分·单步推理·流匹配蒸馏·GAN精炼·噪声起始 前序问题:扩散模型真实超分面临效率-质量权衡:多步方法质量好但慢,单步方法用直接 LR→HR 映射替代噪声起始过程从而削弱随机性,限制了真实纹理合成能力 本文贡献:提出 SMFSR:保持噪声起始点+学习以 LR 为条件的直接噪声到 HR 映射;Interval Splitting Consistency 将多步轨迹蒸馏为单步平均速度预测;GAN 精炼阶段(DINOv3 判别器+变分分数蒸馏)补偿渐进精炼的缺失 实验效果:在单步扩散超分方法中达到 SOTA 感知质量,保持快速单步推理的同时实现逼真的纹理细节合成 批判点评:噪声起始+单步映射的设计巧妙地兼顾了多样性和效率,但 GAN 精炼阶段引入的额外训练成本和模式坍塌风险未充分讨论;DINOv3 判别器的选择缺乏消融对比 7. ExtraVAR:无训练策略 ExtraVAR: Stage-Aware RoPE Remapping for Resolution Extrapolation in Visual Autoregressive Models | Tsinghua University | arXiv:2605.10045 关键词:视觉自回归·分辨率外推·RoPE重映射·无训练·注意力校准 前序问题:Visual Autoregressive(VAR)模型训练分辨率固定,直接外推到更高分辨率会出现三种失败模式:全局重复、局部重复和细节退化——根因是频段-阶段错配 本文贡献:提出 Stage-Aware RoPE Remapping 无训练策略:为每个频段分配阶段特定的重映射规则,联合抑制三种失败模式;进一步提出 Entropy-Driven Adaptive Attention Calibration,通过分辨率无关的归一化熵量化注意力分散度并生成逐头缩放因子 实验效果:在结构连贯性和细节保真度上一致优于现有分辨率外推方法,无需额外训练即可在 VAR 模型上实现高分辨率图像生成 批判点评:对 VAR 生成过程中频段-阶段关系的分析深入且自洽,但无训练方法的质量上限受限于原始模型的表征能力;熵驱动校准的闭式解依赖于注意力分布的特定假设 8. OZ-TAL:在线零样本时序动作定位 OZ-TAL: Online Zero-Shot Temporal Action Localization | Harbin Institute of Technology | arXiv:2605.09976 关键词:零样本·在线动作定位·视觉语言模型·无训练·时序定位 前序问题:在线时序动作定位方法通常在特定领域训练,面对未见动作时泛化能力有限,无法适应开放世界中任意视频流的实时动作检测 本文贡献:提出在线零样本时序动作定位(OZ-TAL)新任务和无训练框架:利用现成视觉语言模型(VLM),引入额外机制增强视觉表征并缓解 VLM 固有偏差,在流式视频中检测从未见过的动作 实验效果:在 THUMOS14 和 ActivityNet-1.3 上建立 OZ-TAL 基准,在离线和在线零样本设置下均大幅超越现有 SOTA 批判点评:零样本+在线检测的问题设定有实际价值,但无训练框架对 VLM 能力高度依赖——VLM 的时序理解弱点可能成为瓶颈;基准设置仍较为受限 9. WorldReasonBench:将视频生成评估重构为世界状态预测任务 WorldReasonBench: Human-Aligned Stress Testing of Video Generators as Future World-State Predictors | University of Waterloo, MBZUAI | arXiv:2605.10434 关键词:视频生成评估·世界模型·推理基准·状态预测·奖励模型 前序问题:视频生成器被视为「世界模拟器」,但缺乏直接测试模型能否推理世界状态演化的基准——视频可以视觉逼真但物理/因果/信息一致性完全错误 本文贡献:提出 WorldReasonBench:将视频生成评估重构为世界状态预测任务(初始状态+动作→未来视频),包含 436 个结构化测试用例覆盖 4 个推理维度和 22 个子类别;提出双重评估方法论(过程感知推理验证+多维质量评估)和 WorldRewardBench(~6K 专家标注偏好对) 实验效果:揭示当前视频生成器在视觉逼真与世界推理之间存在持续鸿沟:视频可以看起来令人信服但在动力学、因果性或信息保存方面失败 批判点评:评估框架设计系统全面,但 436 个测试用例的规模可能不足以覆盖开放世界的复杂性;「世界推理」的定义边界模糊——部分子类别更接近常识推理而非物理模拟 10. GibbsTTS:动力学最优调度器 Kinetic-Optimal Scheduling with Moment Correction for Metric-Induced Discrete Flow Matching in Zero-Shot Text-to-Speech | The University of Tokyo | arXiv:2605.09386 关键词:零样本TTS·离散流匹配·动力学最优调度·CTMC·语音合成 前序问题:度量诱导离散流匹配(MI-DFM)利用 token-latent 几何进行离散生成,但受限于启发式调度器需要超参搜索和一阶 CTMC 求解器的有限步路径跟踪误差 本文贡献:推导出动力学最优调度器(训练无关,以恒定 Fisher-Rao 速度遍历概率路径),并引入有限步矩校正调整跳转概率同时保持跳转目标分布不变;构建 GibbsTTS 零样本语音合成系统 实验效果:在统一架构和大规模数据集的控制对比中,GibbsTTS 达到最佳客观自然度且在主观评估中优于掩码离散生成基线;说话人相似度在四个测试集中三个排第一 批判点评:动力学最优调度的理论推导严谨(Fisher-Rao 恒速)且无需额外训练,但 codec-based TTS 的 token 离散化本身引入的信息损失是否被该方法放大未讨论 趋势观察 KV Cache 压缩从 LLM 迁移到视频扩散 — Forcing-KV 证明了注意力头功能特化在视频扩散中同样成立,混合剪枝策略为 AR 视频模型开辟了 1080P 实时生成的路径。LLM 加速技巧向视觉生成的系统性迁移正成为趋势。 时间控制从离散点走向连续区间 — TIE 将 RoPE 从时间点泛化到时间区间,使多事件重叠可被直接表示。这标志着视频生成对时间维度的建模精度正从帧级跃迁到事件级。 无训练方法的崛起与边界 — SWIFT、ExtraVAR 和 OZ-TAL 均采用无训练范式,通过精巧的注意力操作或外部 VLM 实现新能力。无训练方法的共同局限在于受限于基础模型的表征天花板。 奖励建模从隐式走向可解释分解 — ARR 将 RLHF 的黑盒偏好分解为可验证的 rubric 维度,WorldReasonBench 将视频评估分解为 22 个推理子类别——结构化、可解释的评估正在替代标量评分。 单步生成的效率-质量帕累托前沿推进 — SMFSR 通过保持噪声起始+流匹配蒸馏+GAN 精炼,在单步推理中逼近多步质量。单步生成方法正在系统性地补全其相对于多步方法的各项短板。 人工智能炼丹君 整理 | 2026-05-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
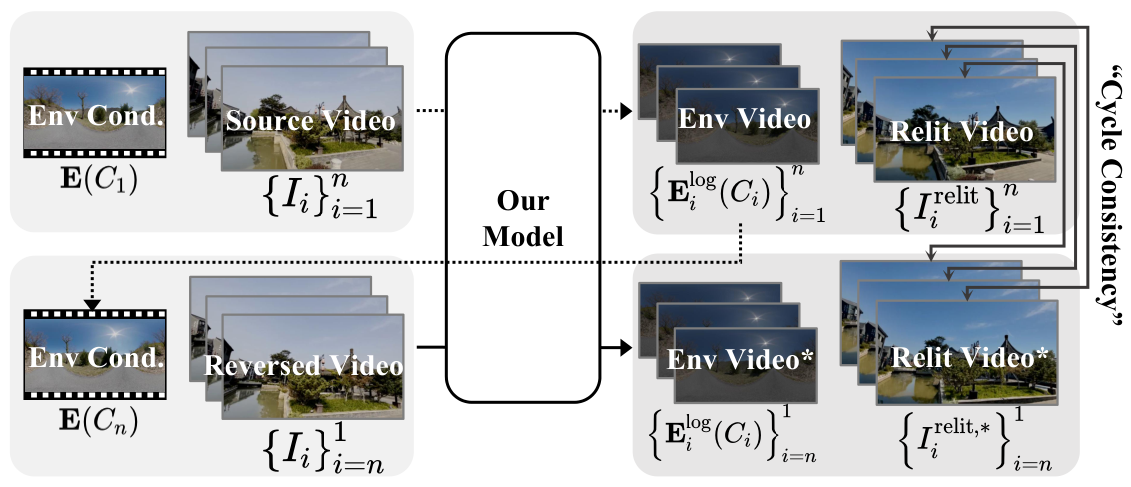
AIGC 每日速读|2026-05-11|Cola DLM 扩散语言模型挑战自回归范式 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与渲染 3 篇 · 扩散模型对齐与RL 2 篇 · 推理加速与蒸馏 2 篇 · 评测基准与奖励模型 2 篇 · 医学视频编辑 1 篇 重点论文标题列表 Relit-LiVE:无需相机位姿的物理一致视频重光照 MARBLE:多维奖励平衡的扩散模型强化学习 HSA:异构步数分配加速DiT视频生成 VURB:视频理解奖励模型的鲁棒基准 ReasonEdit:可解释图像编辑评估 今日论文速览 1. Relit-LiVE:无需相机位姿的物理一致视频重光照 Relit-LiVE: Relight Video by Jointly Learning Environment Video | ETH | arXiv:2605.06658 关键词:视频重光照 · 视频扩散 · 环境贴图预测 · 内在分解 · 神经渲染 前序问题:现有视频重光照范式依赖精确的内在分解(albedo/normal/shading),但真实视频的内在分解高度不可靠,导致重光照结果出现外观失真、材质破损和时序伪影累积 本文贡献:提出 Relit-LiVE,通过引入原始参考图像恢复内在分解中丢失的关键场景线索,并首创环境视频预测公式,在单次扩散过程中同时生成重光照视频和逐帧环境贴图 实验效果:在合成和真实场景基准上均一致优于SOTA视频重光照和神经渲染方法,支持场景级渲染、材质编辑、物体插入和流式视频重光照等下游应用 批判点评:联合预测环境贴图的方式优雅地避开了内在分解的瓶颈,但环境视频预测本身的精度上限取决于扩散模型的几何理解能力;流式重光照的实时性指标未详细报告 2. MARBLE:多维奖励平衡的扩散模型强化学习 MARBLE: Multi-Aspect Reward Balance for Diffusion RL | ETH | arXiv:2605.06507 关键词:扩散模型RL · 多奖励对齐 · 梯度平衡 · 二次规划 · RLHF 前序问题:扩散模型多奖励对齐中,加权求和方案因样本级别不匹配导致梯度互相稀释——大多数 rollout 仅对特定奖励维度有信息量,对其他维度无关,加权聚合丢失了这种差异性 本文贡献:提出 MARBLE 梯度空间优化框架,为每个奖励维度维护独立优势估计器并计算逐奖励策略梯度,通过求解二次规划问题将多维梯度协调为单一更新方向,无需人工调权重 实验效果:在 SD3.5 Medium + 5 个奖励维度上同时提升全部指标,将加权求和方案中最差维度的梯度余弦从80%批次为负扭转为持续正值,训练速度保持基线的 0.97 倍 批判点评:QP 求解将多奖励冲突显式化处理是优雅的,但 5 维奖励的结论能否推广到更多维度(如10+)需验证;EMA 平滑引入的额外超参数可能增加调优成本 3. HSA:异构步数分配加速DiT视频生成 Not All Tokens Need 40 Steps: Heterogeneous Step Allocation in Diffusion Transformers for Efficient Video Generation | Johns Hopkins University | arXiv:2605.06892 关键词:DiT加速 · 异构步数分配 · KV-cache · 视频生成 · 无训练推理 前序问题:DiT 视频生成标准推理对每个 token 均匀施加相同去噪步数,但人类视觉忽略大量冗余运动,均匀分配造成巨大计算浪费 本文贡献:提出 HSA(Heterogeneous Step Allocation),基于 token 速度动态为不同时空 token 分配不同去噪步数,通过 KV-cache 同步机制和缓存 Euler 更新实现无训练推理加速 实验效果:在 Wan-2 和 LTX-2 模型的 T2V/I2V 任务上显著优于现有缓存方法,在 50% 和 25% 计算预算下仍保持结构完整性和生成质量,无需离线 profiling 批判点评:基于速度动态的 token 重要性判断简单高效,但速度指标能否准确捕获所有视觉显著性值得商榷;在极端加速(如 25% 预算)下的长视频质量退化模式需要更多分析 4. VURB:视频理解奖励模型的鲁棒基准 Video Understanding Reward Modeling: A Robust Benchmark and Performant Reward Models | PKU / ByteDance | arXiv:2605.07872 关键词:视频奖励模型 · 偏好学习 · CoT推理 · 视频理解 · 基准测试 前序问题:多模态奖励模型在文本和图像领域进展迅速,但视频理解方向的奖励建模严重受限于缺乏鲁棒的评测基准和高质量偏好数据 本文贡献:提出 VURB 基准(2,100 偏好对 + 长链推理痕迹)和 VUP-35K 全自动偏好数据集,训练出 VideoDRM(判别式)和 VideoGRM(生成式)两种视频奖励模型 实验效果:两种奖励模型在 VURB 和 VideoRewardBench 上均达到 SOTA,VUP-35K 数据同时提升奖励性能和模型推理能力,best-of-N 测试时缩放显著增益 批判点评:统一框架覆盖了基准设计、数据构建和模型训练,但 VURB 偏好对数量(2,100)相对有限;VUP-35K 全自动构建的偏好质量上限取决于标注模型的视频理解能力 5. ReasonEdit:可解释图像编辑评估 ReasonEdit: Towards Interpretable Image Editing Evaluation via Reinforcement Learning | SJTU / UESTC | arXiv:2605.07477 关键词:图像编辑评估 · CoT推理 · 奖励模型 · GRPO · 可解释AI 前序问题:现有文本引导图像编辑(TIE)评估方法大多依赖标量分数缺乏可解释性,主要原因是缺少高质量的 TIE 解释数据集和有效的奖励模型来训练可解释评估器 本文贡献:构建 ReasonEdit-22K 数据集(22K 编辑图 + 113K CoT 样本 + 1.3M 人类判断),提出 RE-Reward 奖励模型和基于 GRPO 训练的可解释评估模型 ReasonEdit 实验效果:在多个公开基准上与人类偏好对齐度优于现有方法,能生成高质量可解释评估文本,实现更透明可信的图像编辑评估 批判点评:首个将 CoT 推理与奖励模型结合到图像编辑评估的工作,数据规模可观(1.3M 人类判断);但可解释性的评估本身就是主观的,"逻辑性/准确性/有用性"三维度的标注一致性需关注 6. CDM:连续时间分布匹配蒸馏 Continuous-Time Distribution Matching for Few-Step Diffusion Distillation | Alibaba / Nankai | arXiv:2605.06376 关键词:蒸馏加速 · 分布匹配 · 连续时间 · Flow Matching · 少步生成 前序问题:DMD 蒸馏在稀疏离散时间步上做分布匹配,加上反向 KL 散度的模式寻求特性,容易产生视觉伪影和过度平滑输出,通常需要 GAN 或奖励模型等复杂辅助模块来恢复保真度 本文贡献:将 DMD 框架从离散锚定首次迁移到连续优化,提出动态连续调度(任意轨迹点分布匹配)和连续时间对齐目标(主动偏离轨迹匹配),无需 GAN 或奖励模型等复杂辅助模块 实验效果:在 SD3-Medium 和 Longcat-Image 上展示了高度竞争力的少步生成视觉保真度,代码已开源 批判点评:连续时间优化思路自然且优雅,有效弥补了 DMD 离散锚定的根本缺陷;但连续调度增加了采样复杂度,实际训练时间和显存开销的对比数据不够充分 7. CASCADE:上下文感知的推测解码加速图像生成 CASCADE: Context-Aware Relaxation for Speculative Image Decoding | UIUC / Qualcomm | arXiv:2605.07230 关键词:自回归图像生成 · 推测解码 · 树搜索 · 接受放松 · 推理加速 前序问题:自回归图像生成计算密集且缓慢,现有推测解码在图像域无法实现文本域那样的效率提升,核心瓶颈是目标模型在图像生成时不确定性高导致草稿 token 拒绝率高 本文贡献:发现目标模型在树状推测解码中的语义可互换性和收敛性两个冗余模式,利用隐状态冗余实现有原则的接受放松策略,并将冗余信号注入草稿模型训练提升独立性能 实验效果:在多个文生图模型和草稿架构上实现最高 3.6 倍加速,保持图像质量和文本-提示忠实度,达到基于草稿的推测解码 SOTA 批判点评:从冗余模式出发设计接受放松策略的思路新颖,3.6x 加速在实用中很有价值;但放松策略的质量保证依赖于冗余模式假设的普适性,在风格差异大的生成任务中可能失效 8. Flow-OPD:在策略蒸馏统一Flow Matching对齐 Flow-OPD: On-Policy Distillation for Flow Matching Models | USTC / UCLA / CUHK / Xiaohongshu | arXiv:2605.08063 关键词:Flow Matching · 在策略蒸馏 · GRPO · 多任务对齐 · 文生图 前序问题:现有 Flow Matching 文生图模型在多任务对齐时面临两大瓶颈:标量奖励导致的奖励稀疏性和异构目标联合优化的梯度干扰,引发"跷跷板效应"和奖励黑客 本文贡献:提出 Flow-OPD,首个将在策略蒸馏集成到 Flow Matching 的统一后训练框架:先通过单奖励 GRPO 培养领域专家教师,再通过冷启动+三步编排将异质专长蒸馏到单一学生模型 实验效果:基于 SD3.5 Medium,GenEval 从 63 提升至 92,OCR 准确率从 59 提升至 94,比 vanilla GRPO 总体提升约 10 分,并展现出"超越教师"效应 批判点评:OPD 从 LLM 社区引入扩散模型是很好的跨界迁移,GenEval +29 的提升显著;但两阶段训练(先训专家再蒸馏)的总计算成本较高,MAR 正则化引入的额外教师也增加了复杂度 9. Diffusion-APO:轨迹感知视频扩散偏好对齐 Diffusion-APO: Trajectory-Aware Direct Preference Alignment for Video Diffusion Transformers | Kuaishou | arXiv:2605.07503 关键词:视频扩散 · 偏好对齐 · 轨迹感知 · RLHF · DPO 前序问题:大规模视频扩散模型与人类意图对齐需要弥合训练噪声分布与推理轨迹之间的固有差异,现有 DPO 和 GRPO 方案受限于有偏奖励模型或次优时间步采样 本文贡献:提出 Diffusion-APO 轨迹感知算法,通过同步训练噪声与推理去噪路径最大化梯度信号效能,配合在线排名/半在线锚定/离线精细化/蒸馏漂移校正的统一模块化 RLHF 框架 实验效果:在视觉质量和指令跟随上一致优于标准基线,同时在模型加速过程中有效保持生成保真度,提供了可扩展的端到端视频扩散对齐方案 批判点评:轨迹感知的梯度信号同步是一个被忽视但重要的问题,模块化 RLHF 框架提供了灵活的多阶段对齐能力;但没有依赖标量奖励模型这一点需要更多消融验证其优势来源 10. OphEdit:无训练的眼科手术视频文本引导编辑 OphEdit: Training-Free Text-Guided Editing of Ophthalmic Surgical Videos | IIST India | arXiv:2605.07695 关键词:手术视频编辑 · 无训练 · ODE反演 · CFG注入 · 眼科AI 前序问题:高保真手术视频生成对医学训练和AI开发至关重要,但将生成模型适配为精确视频编辑面临严峻挑战——手术属性修改(器械-组织交互、手术阶段变换)需满足严格的解剖和时序约束 本文贡献:提出 OphEdit,利用二阶 ODE 反演捕获注意力值张量,在去噪阶段选择性注入 CFG 条件分支,在保持眼部解剖几何的同时实现文本驱动的手术语义修改 实验效果:临床评估显示在器械替换、手术阶段变换等复杂转换中,结构保真度和时序一致性优于自然域视频编辑器,为首个眼科手术域的无训练视频编辑应用 批判点评:首次将无训练视频编辑应用于眼科手术域是一个有价值的交叉创新;但眼科手术的解剖结构相对规整,是否能推广到更复杂的手术场景(如腹腔镜/心脏外科)需验证 趋势观察 视频重光照告别内在分解 — Relit-LiVE 跳过不可靠的内在分解,直接引入参考图像+环境视频联合预测,重新定义了视频重光照的范式 多奖励对齐进入梯度空间 — MARBLE 和 Flow-OPD 不约而同地在梯度层面解决多奖励冲突,标志着扩散模型 RLHF 从标量聚合向精细化梯度调控演进 推理加速的「不均匀」哲学 — HSA 和 CASCADE 都挑战了「均匀对待所有 token/步数」的默认假设,用异构分配和冗余利用实现更聪明的计算资源调度 蒸馏从离散走向连续 — CDM 将 DMD 从固定离散锚点迁移到连续轨迹优化,消除了离散化带来的视觉伪影,是蒸馏范式的重要理论推进 AI评测走向可解释 — ReasonEdit 和 VURB 推动评测从不透明的标量分数走向 CoT 推理和长链偏好标注,让评估本身变得可审计 人工智能炼丹君 整理 | 2026-05-11
-
AIGC每日速读|2026-05-08|JoyAI统一模型唤醒空间智能,通义D-OPSD破解少步… 今日核心看点 JoyAI-Image D-OPSD Stream-T1 LIVEditor PhysForge 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 统一多模态生成与理解 2 篇 (JoyAI-Image, Open-Source Editors) 扩散模型微调与蒸馏 1 篇 (D-OPSD) 视频生成与编辑加速 2 篇 (Stream-T1, LIVEditor) 3D生成与风格迁移 2 篇 (PhysForge, DiLAST) 生成内容检测与评测 3 篇 (HAAD, StableI2I, RLFSeg) 今日论文速览 1. JoyAI-Image:唤醒空间智能的统一多模态理解与生成模型 Awaking Spatial Intelligence in Unified Multimodal Understanding and Generation | JoyAI | 2605.04128 关键词: 统一多模态模型·MLLM+MMDiT·空间智能·文生图·指令编辑·新视角推理 前序工作问题: 现有统一多模态模型仅追求功能整合(理解+生成),但在空间感知、几何推理和可控编辑方面能力不足,理解与生成之间缺乏双向增强的闭环 贡献: 提出 JoyAI-Image,将空间增强 MLLM 与 MMDiT 通过共享多模态接口耦合,结合统一指令微调、长文本渲染监督、空间编辑信号和新视角辅助推理,实现理解↔生成双向增强 效果: 在理解、生成、长文本渲染和编辑四大基准上均达 SOTA 或高度竞争,展示了统一模型通向空间智能和世界模型的可行路径 批判点评: 论文未公开模型权重和训练数据细节,且作者机构信息模糊;空间智能的评估维度仍有限,缺少与 GPT-4o 等商业模型在编辑任务上的系统对比 2. D-OPSD:让少步蒸馏扩散模型持续微调不掉速 D-OPSD: On-Policy Self-Distillation for Continuously Tuning Step-Distilled Diffusion Models | Tongyi-MAI (Alibaba) | 2605.05204 关键词: 少步蒸馏·on-policy自蒸馏·LLM/VLM编码器·持续微调·概念学习 前序工作问题: Z-Image-Turbo、FLUX.2-klein 等少步蒸馏模型在传统 SFT 微调后会丧失少步推理能力,导致质量严重退化 贡献: 发现 LLM/VLM 编码器的 in-context 能力可被扩散模型继承,据此设计 on-policy 自蒸馏:同一模型分别以纯文本和多模态条件扮演学生/教师,在模型自身轨迹上最小化分布差异,实现概念/风格学习且保持少步能力 效果: 在 Z-Image-Turbo 和 FLUX.2-klein 上验证,微调后保持原始少步推理速度的同时成功学习新概念和风格 批判点评: 仅验证了图像生成,能否扩展到视频蒸馏模型未知;自蒸馏的教师信号质量依赖参考图像质量,在困难概念上的鲁棒性有待验证 3. Stream-T1:流式视频生成的测试时缩放框架 Stream-T1: Test-Time Scaling for Streaming Video Generation | USTC / FrameX-AI | 2605.04461 关键词: 测试时缩放·流式视频生成·噪声传播·奖励剪枝·记忆沉降 前序工作问题: 基于扩散模型的测试时缩放(TTS)方法候选探索成本巨大且缺乏时序引导,在视频生成中难以规模化应用 贡献: 提出 Stream-T1,首个面向流式视频生成的综合 TTS 框架,包含三个模块:噪声传播(利用历史高质量噪声引导当前生成)、奖励剪枝(短期美学+滑动窗口长期一致性)、记忆沉降(奖励驱动的 KV-cache 动态路由) 效果: 在 5 秒和 30 秒视频基准上显著提升时序一致性、运动平滑度和帧级视觉质量,配合 Stream-R1 构成完整流式生成体系 批判点评: TTS 天然增加推理时间,三个模块叠加后的实际延迟开销未量化;奖励模型本身的偏差可能导致错误剪枝 4. LIVEditor:稀疏注意力加速统一视频编辑 Lightning Unified Video Editing via In-Context Sparse Attention | ICML 2026 | 2605.04569 关键词: 视频编辑·稀疏注意力·ICL·170万数据集·注意力延迟60%削减 前序工作问题: 基于上下文学习(ICL)的视频编辑方法因二次注意力成本产生严重计算瓶颈,限制了实际部署 贡献: 提出 ISA(In-context Sparse Attention),首个面向 ICL 视频编辑的近无损稀疏框架:上下文 token 裁剪 + Query 锐度驱动的动态分组(高误差走全注意力、低误差走零阶泰勒近似),并构建 170 万高质量编辑数据集训练 LIVEditor 效果: 注意力模块延迟削减约 60%,同时在 EditVerseBench、IVE-Bench、VIE-Bench 三个基准上超越 SOTA,ICML 2026 接收 批判点评: 稀疏注意力的误差阈值需手动调节,不同编辑类型的最优配置可能不同;170 万数据集的构建细节和质量保证流程未充分披露 5. PhysForge:物理驱动的交互式3D资产生成 PhysForge: Generating Physics-Grounded 3D Assets for Interactive Virtual World | HKU MMLab | 2605.05163 关键词: 3D资产生成·物理蓝图·运动学注入·15万资产数据集·ICML 2026 前序工作问题: 现有3D生成方法聚焦静态几何,忽略了交互虚拟世界所需的材质、功能、运动学等物理属性,生成的资产无法直接用于仿真 贡献: 提出 PhysForge 两阶段解耦框架:(1) VLM 物理架构师规划分层物理蓝图(材质→功能→运动学);(2) 物理驱动扩散模型通过 KineVoxel Injection 同时合成高保真几何与精确运动学参数。配套 PhysDB 15万资产四级物理标注数据集 效果: 生成的资产可直接用于物理仿真,功能合理性和几何质量均优于现有方法,ICML 2026 接收 批判点评: 15 万数据集的标注质量和覆盖范围未详述;VLM 物理蓝图的错误传播到下游生成的容错机制不明确 6. DiLAST:2D扩散引导唤醒3D潜空间风格迁移 Structured 3D Latents Are Surprisingly Powerful: Unleashing Generalizable Style with 2D Diffusion | N/A | 2605.04412 关键词: 3D风格迁移·结构化3D潜空间·2D扩散引导·OOD风格·即插即用 前序工作问题: 现有3D风格化方法依赖训练分布内的风格图像,面对分布外(OOD)风格时性能严重退化甚至失败 贡献: 提出 DiLAST,利用预训练2D扩散模型作为风格先验教师,通过扩散引导对齐渲染视图与目标风格,优化结构化3D潜空间表示,发现潜空间本身表达力极强但被低估 效果: 在多种数据和多个3D生成骨干上验证有效,即插即用地实现多样OOD风格迁移 批判点评: 需要逐样本优化,速度较慢;风格一致性在复杂拓扑结构上是否稳定未充分验证 7. StableI2I:I2I任务的内容保真与一致性统一评估框架 StableI2I: Spotting Unintended Changes in Image-to-Image Transition | N/A | 2605.04453 关键词: I2I评估·内容保真·前后一致性·无参考评测·MLLM基准 前序工作问题: 现有 I2I 评估主要关注指令遵循和感知质量,忽略了输出是否保持输入的语义对应和空间结构,导致"改了不该改的地方"难以被检测 贡献: 提出 StableI2I 统一动态评估框架,无需参考图像即可评估内容保真和前后一致性;构建 StableI2I-Bench 系统评估 MLLM 在保真与一致性判断上的准确度 效果: 与人类主观判断高度相关,可作为 I2I 系统的标准化诊断工具 批判点评: 评测指标的鲁棒性仅在有限模型集上验证;"不该改的地方"的定义本身带有主观性,边界案例处理不够充分 8. Open-Source Editors:开源图像编辑模型是零样本视觉学习器 Open-Source Image Editing Models Are Zero-Shot Vision Learners | N/A | 2605.04566 关键词: 图像编辑模型·零样本·深度估计·法线估计·语义分割·涌现能力 前序工作问题: 生成模型具有零样本视觉理解能力的证据集中在闭源模型,开源图像编辑模型是否也具备这种涌现能力尚未系统验证 贡献: 系统评估 Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit 三个开源编辑模型在深度估计、法线估计和语义分割上的零样本表现,验证编辑预训练本身催生视觉理解能力 效果: FireRed 法线估计 17.69° 超越微调的 Marigold(20.86°)并匹配 Vision Banana(17.78°);Qwen 在 DIODE 深度达 δ₁=0.868 批判点评: 仅测试三个模型,样本量有限;编辑预训练数据的分布偏差可能导致某些任务表现虚高而非真正涌现 9. HAAD:用哈密顿动力学检测AI生成图像 Detecting Deepfakes via Hamiltonian Dynamics | NUS | 2605.04405 关键词: Deepfake检测·哈密顿动力学·势能面·稳定性分析·跨数据集迁移 前序工作问题: Deepfake 检测器需要针对每种新生成技术反复校准,难以泛化,根本原因是依赖静态模式匹配而非捕获真实/伪造图像的本质差异 贡献: 提出 HAAD,从物理动力学角度出发:将图像潜空间建模为势能面,真实图像对应低能稳定盆地、生成图像对应高能不稳定状态,通过哈密顿轨迹的 action 和能量耗散两个统计量区分真伪 效果: 在跨数据集迁移基准上超越 SOTA 基线,无需针对新生成器重训练 批判点评: 物理类比的假设过强——高质量生成模型可能也会逼近稳定均衡;计算轨迹的额外开销可能限制实时部署 10. RLFSeg:整流流替代扩散实现零样本文本分割 From Diffusion to Rectified Flow: Rethinking Text-Based Segmentation | ICMR 2026 | 2605.04590 关键词: 文本分割·整流流·零样本·单步推理·无架构修改 前序工作问题: 将扩散模型用作文本分割的特征提取器会继承其生成噪声-去噪的固有性质,这对判别性分割任务有害,且需要优化时间步 贡献: 提出 RLFSeg,用 Rectified Flow 替代扩散过程,在潜空间中学习从图像到分割掩码的直接映射,引入标签细化和自适应单步采样策略,零修改模型结构 效果: 在零样本场景下显著优于之前的扩散方法,单步推理即可达到高精度,ICMR 2026 接收 批判点评: 仅在文本分割任务验证,能否推广到其他像素级任务未知;Rectified Flow 的训练稳定性在大规模数据上的表现有待验证 趋势观察 统一生成-理解模型走向空间智能 — JoyAI-Image 将空间理解、文生图、编辑融为一体并加入新视角推理,标志着统一模型从'能做'走向'做好'的拐点 少步蒸馏模型的微调困境被破解 — D-OPSD 利用 LLM/VLM encoder 的 in-context 能力实现 on-policy 自蒸馏,让 Z-Image-Turbo 等模型微调不掉速,打开了个性化少步模型的大门 视频编辑从'能改'走向'秒改' — LIVEditor 通过 ISA 稀疏注意力将上下文冗余裁剪 60%,同时刷新三个编辑基准,ICML'26 认可说明效率与质量可以兼得 人工智能炼丹君 整理 | 2026-05-08
-
AIGC每日速读|2026-05-06|DiT-MoE统一多模态模型25B仅激活3B,运动感知缓… 今日核心看点 DiT-MoE统一多模态25B(Mamoda2.5) 运动感知缓存加速6.28x(MotionCache) 线性化SD3.5仅1h微调(T5) 64层RVQ音乐生成(Khala) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 统一多模态生成 1 篇 (Mamoda2.5) 视频/图像生成加速 3 篇 (MotionCache, SD3.5-T5, TOC-SR) 音乐生成 1 篇 (Khala) 评测基准 2 篇 (BRITE, Pixel Perfect) 图像编辑与数据集 1 篇 (ScribbleEdit) 3D/人体生成 2 篇 (BlenderRAG, HumanSplatHMR) 今日论文速览 1. Mamoda2.5: Enhancing Unified Multimodal Model with DiT-MoE Mamoda2.5:DiT-MoE统一多模态模型,25B参数仅激活3B,视频编辑加速95.9x | Unknown (Industry) | arXiv:2605.02641 关键词: 统一多模态·DiT-MoE·AR-Diffusion·视频生成·蒸馏加速 前序工作问题: 多模态理解与生成模型通常分离训练,缺乏统一框架;视频编辑推理速度慢难以部署 贡献: 提出统一AR-Diffusion框架,为Diffusion Transformer配备细粒度MoE(128专家Top-8路由),25B参数仅激活3B;联合少步蒸馏与强化学习将30步压缩为4步 效果: VBench 2.0视频生成顶尖,视频编辑创新高;匹敌Kling O1等闭源模型;编辑推理加速95.9x,广告场景成功率98% 批判点评: 128专家路由的负载均衡和专家坍缩问题未详细分析;仅激活3B参数是否在复杂多模态推理任务上存在能力天花板待验证 2. MotionCache: Motion-Aware Caching for Efficient Autoregressive Video Generation MotionCache:运动感知缓存加速自回归视频生成6.28x | Xiamen University | arXiv:2605.01725 关键词: 视频生成加速·运动感知·缓存复用·SkyReels-V2·MAGI-1 前序工作问题: 自回归视频生成因逐步去噪计算量巨大难以部署;现有缓存策略采用粗粒度块级跳步,忽略像素级运动动态 贡献: 形式化证明缓存误差与残差不稳定性的关联,提出利用帧间差分作为像素级运动代理的粗到细策略:预热阶段建立语义连贯,随后按运动权重动态调整每Token更新频率 效果: SkyReels-V2加速6.28x(VBench仅降1%),MAGI-1加速1.64x(VBench仅降0.01%),代码已开源 批判点评: 帧间差分作为运动代理过于简单,无法区分相机运动与物体运动;预热阶段长度为超参数,对不同内容敏感 3. SD3.5-T5: Linearizing Vision Transformer with Test-Time Training 用TTT线性化SD3.5:1小时微调实现1.47x推理加速 | Tsinghua University / ICML 2026 | arXiv:2605.02772 关键词: 线性注意力·TTT·SD3.5·推理加速·权重迁移 前序工作问题: Softmax注意力二次复杂度限制高分辨率生成效率;从头训练线性注意力模型成本过高 贡献: 发现TTT的两层动态公式与Softmax注意力结构对齐,可直接继承预训练权重;引入Key实例归一化和轻量局部性增强模块保持表征一致性 效果: 4xH20 GPU仅1小时微调,文生图质量与原模型可比;1K分辨率1.32x加速,2K分辨率1.47x加速(ICML 2026) 批判点评: 1.47x加速幅度相比FlashAttention等工程优化的叠加优势有限;TTT的额外在线学习开销在批处理场景的表现未报告 4. Khala: Scaling Acoustic Token Language Models Toward High-Fidelity Music Generation Khala:64层RVQ统一声学Token语言建模,无需语义Token阶段 | Tsinghua University | arXiv:2605.01790 关键词: 音乐生成·声学Token·RVQ·语言建模·粗到细 前序工作问题: 现有音乐生成将语义Token与声学Token分离为异构表示空间,系统复杂且信息传递断裂 贡献: 证明文本-声学对齐可在纯声学Token语言建模中涌现无需语义Token阶段;设计64层RVQ统一表示,两阶段粗到细框架固定62步推理,混合注意力训练 效果: 高保真音乐生成,文本-人声对齐自然涌现;超分辨率模型从骨干迁移学习显著提升收敛和质量 批判点评: 64层RVQ的编码复杂度和码本利用率未详细分析;固定62步推理对不同长度音乐的效率适配性待验证 5. BRITE: A Benchmark for Reliable and Interpretable T2V Evaluation on Implausible Scenarios BRITE:首个含音视频对齐的T2V评测基准,实测Sora 2/Veo 3.1/Gen4.5 | Unknown | arXiv:2605.00873 关键词: T2V评测·不合理场景·音视频对齐·人工循环·QA可解释 前序工作问题: 现有T2V评测忽视不合理场景和音视频对齐维度;全自动MLLM评测易受幻觉和歧义影响 贡献: 统一不合理场景提示、细粒度音视频一致性评估和QA式可解释评测三大组件;人工循环协议保障可靠性 效果: 实测Sora 2/Veo 3.1/Runway Gen4.5/Pixverse V5.5/Qwen3Max五大模型,发现物体-动作绑定和音视频同步存在显著性能缺口 批判点评: 仅评测5个模型样本量有限,结论的统计显著性和可推广性存疑;人工循环协议扩展成本高 6. TOC-SR: Task-Optimal Compact Diffusion for Image Super Resolution TOC-SR:贝叶斯优化发现紧凑扩散架构,6.6x参数压缩单步超分 | Unknown (Industry) | arXiv:2605.02767 关键词: 图像超分·紧凑扩散·贝叶斯优化·蒸馏·单步推理 前序工作问题: 扩散超分模型因大参数量和多步采样难以在边缘设备部署 贡献: 从16通道隐扩散模型出发,通过特征级生成蒸馏构建高效替代块,用epsilon约束贝叶斯优化搜索最优紧凑架构,再将多步过程蒸馏为单步生成器 效果: 参数量压缩6.6x,计算量减少2.8x,单步推理保持强重建质量 批判点评: NAS搜索成本本身较高,一次性投入是否划算取决于部署规模;蒸馏后模型在困难退化场景的鲁棒性未评估 7. ScribbleEdit: Synthetic Data for Image Editing with Scribbles and Text ScribbleEdit:涂鸦+文本联合编辑大规模合成数据集 | UC Berkeley | arXiv:2605.01135 关键词: 图像编辑·涂鸦输入·合成数据·空间对齐·多模态控制 前序工作问题: 用户难以同时传达精确空间布局和语义细节;缺乏涂鸦-文本联合编辑的专用训练数据 贡献: 设计自动生成管线:通过修复生成源-目标图像对,配对人工涂鸦和VLM生成的文本指令,构建大规模合成数据集 效果: 微调后模型在空间对齐和语义一致性上显著提升,扩散和自回归两类模型均受益 批判点评: 合成涂鸦与真实用户涂鸦分布差异可能导致域迁移问题;VLM生成的文本指令质量依赖VLM能力上限 8. BlenderRAG: High-Fidelity 3D Object Generation via Retrieval-Augmented Code Synthesis BlenderRAG:检索增强代码合成生成高保真3D对象 | University of Bologna | arXiv:2605.00632 关键词: 3D生成·RAG·Blender代码·LLM·检索增强 前序工作问题: LLM直接生成3D建模代码编译成功率低且几何一致性差,无需微调的3D生成方案匮乏 贡献: 构建500例专家验证的多模态数据集(50类别),RAG检索语义相似示例辅助LLM生成可执行Blender代码,无需微调或特殊硬件 效果: 编译成功率从40.8%提升至70%(+29.2%),CLIP语义对齐从0.41提升至0.77,跨4个LLM一致有效 批判点评: 500例数据集规模有限,复杂场景和组合对象的覆盖度不足;代码生成方式难以表达光滑曲面等连续几何 9. HumanSplatHMR: Closing the Loop Between Human Mesh Recovery and Gaussian Splatting Avatar HumanSplatHMR:闭环联合优化人体Mesh恢复与高斯泼溅化身 | University of Michigan | arXiv:2605.02784 关键词: 人体重建·高斯泼溅·Mesh恢复·闭环优化·新视角合成 前序工作问题: 现有方法将姿态估计与外观重建解耦,姿态误差累积到渲染中无法修正 贡献: 通过可微渲染闭环,将光度/分割/深度损失反向传播到姿态参数和全局位置,实现姿态-外观联合优化 效果: 全局3D姿态恢复精度和新视角渲染质量均超越解耦基线,无需动捕设备即可从视频重建高质量化身 批判点评: 闭环优化增加训练时间;对遮挡严重或极端姿态的鲁棒性未充分验证 10. Pixel Perfect: Relational Image Quality Assessment with Spatially-Aware Distortions Pixel Perfect:自监督关系型IQA,无需人工标注的空间感知质量评估 | Unknown | arXiv:2605.02863 关键词: 图像质量评估·自监督·关系型·空间感知·对比学习 前序工作问题: 传统IQA依赖MOS人工标注,成本高且无法提供可解释的局部反馈 贡献: 从绝对质量预测转向关系型方向性评估;自监督合成失真引擎生成训练数据;反对称目标训练失真预测网络输出空间感知解耦图;对比学习训练评分网络 效果: 完全无需人工标注,提供失真类型/强度/方向的空间感知映射,可针对性优化图像处理算法 批判点评: 合成失真与真实世界失真分布差距可能影响泛化;关系型评估难以与传统MOS指标直接对比 趋势观察 MoE+蒸馏成为统一多模态模型标配 — Mamoda2.5 用128专家Top-8路由实现25B参数仅激活3B,再通过蒸馏+RL将30步压缩为4步,95.9x加速;统一模型正在从'大而全'走向'大而高效' 推理加速从粗粒度跳步走向精细化自适应 — MotionCache 按像素运动强度分配去噪资源实现6.28x加速,SD3.5-T5 用线性注意力替代Softmax实现1.47x加速,加速策略日趋精细和理论化 人工智能炼丹君 整理 | 2026-05-06