


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 音视频与世界模型 2 篇 · 视频生成与编辑 3 篇 · 图像超分与编辑 2 篇 · 人脸修复与动画生成 2 篇 · 生成安全治理 1 篇
MaineCoon: Pursuing A Real-Time Audio-Visual Social World Model | Catnip AI | arXiv:2606.17800
关键词:世界模型,音视频生成,实时自回归,流式生成,社交互动
前序问题:全球视频内容日益在社交平台上被互动式消费,但面向「社交世界」的视频生成模型长期被忽视;既有世界模型擅长模拟物理环境或游戏世界,却与人本社交动态脱节。
本文贡献:首次提出「社交世界模型」定位并造出原型 MaineCoon——首个面向社交互动优化的实时音视频自回归模型,22B 参数,单 GPU 流式生成、亚秒级交互、最高 47.5 FPS。引入自重采样、跨模态表征对齐、域感知偏好优化与强化在线策略蒸馏(ROPD)稳定并加速训练;并设计首个 agentic 流式推理框架,用 agentic 缓存管理与提示规划支持千秒级超长生成、抑制漂移。
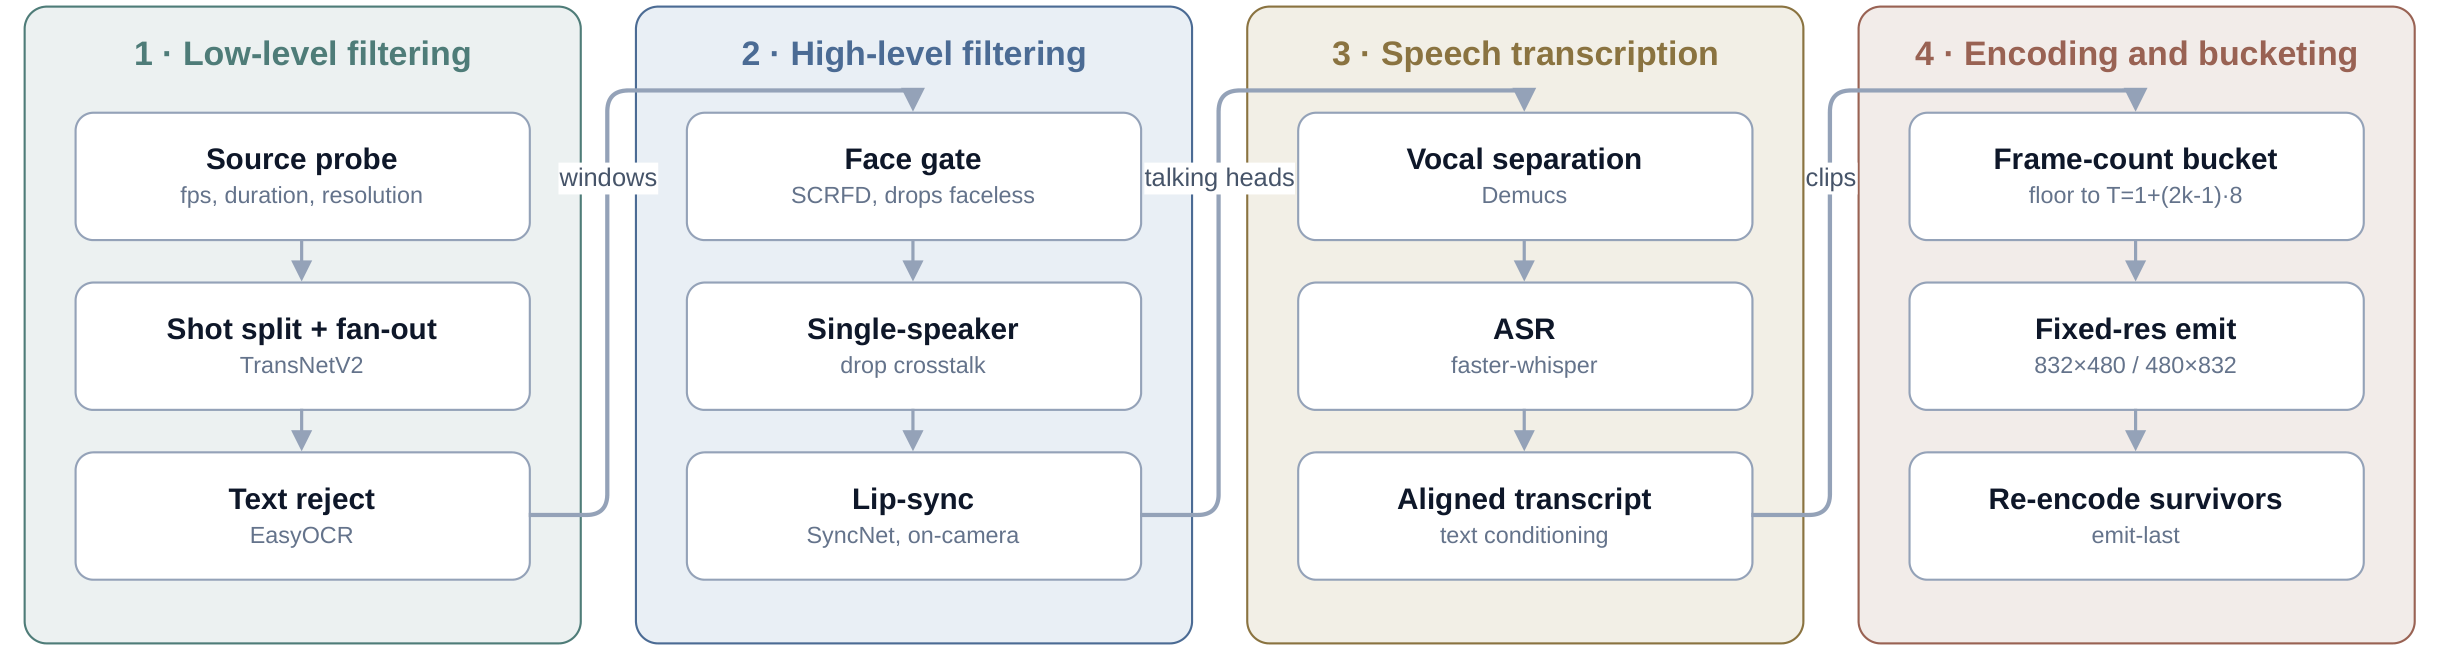
实验效果:在高质量、低延迟、长时音视频自回归上刷新 SOTA,单 H100 上每秒生成成本压到 <$0.001 且持续下降,指向 AI-native 社交平台的范式转移。
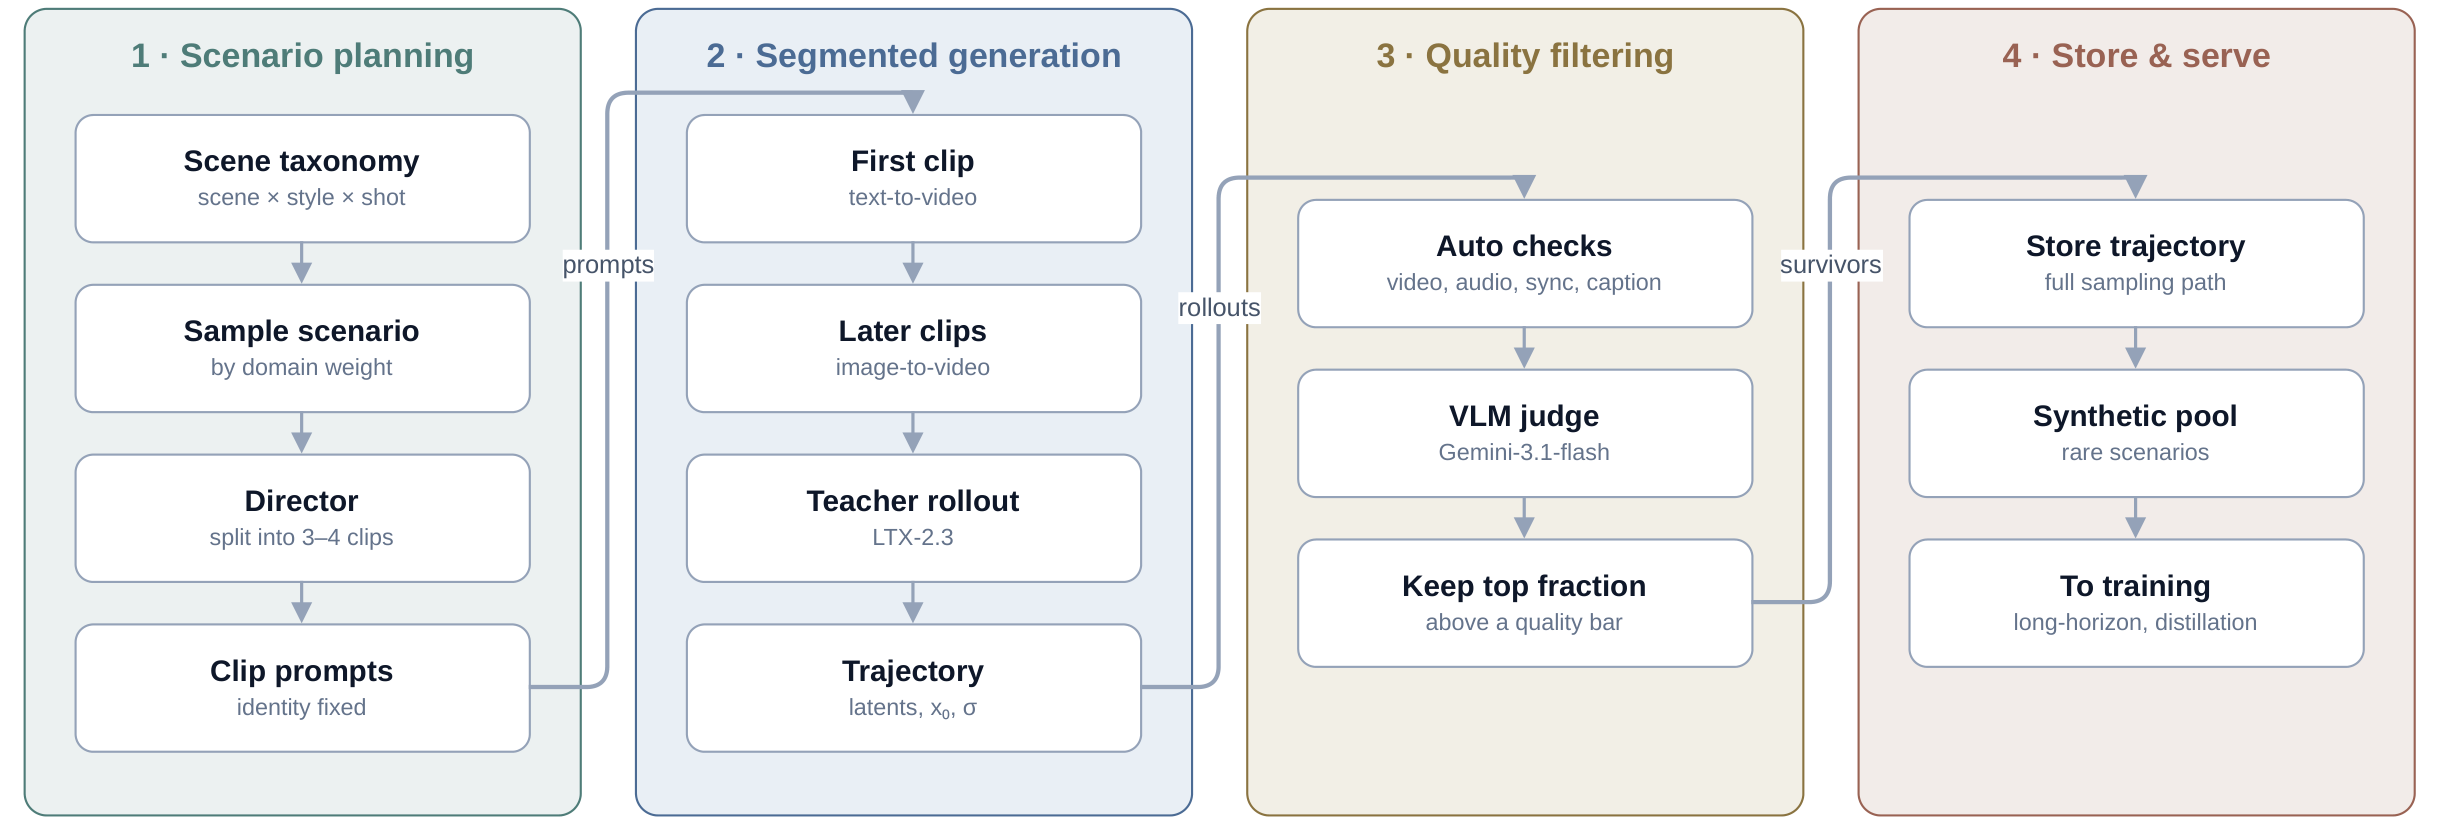
批判点评:把「世界模型」从物理/游戏拓展到「人本社交动态」,22B 实时音视频+亚秒交互的工程指标极硬,方向极具想象力。但目前仍是原型与 position 论文,长程社交一致性、真实交互可控性与安全治理都待检验,47.5FPS 也依赖 H100 级硬件。
Data-Forcing Distillation: Restoring Diversity and Fidelity in Few-Step Video Generation | 密歇根·NVIDIA·UIUC | arXiv:2606.18478
关键词:视频生成,扩散蒸馏,DMD,少步采样,多样性
前序问题:把多步视频扩散蒸馏成少步学生时,DMD/DMD2 因反向 KL 目标出现两大顽疾:样本多样性骤降、输出过饱和而偏离真实视频外观。
本文贡献:提出 Data-Forcing Distillation(DFD):仅需改动一行代码的后训练框架,核心用「教师分数差异」引导学生贴向真实数据分布、把它拉回缺失的模态(mode),从而缓解模式坍缩。
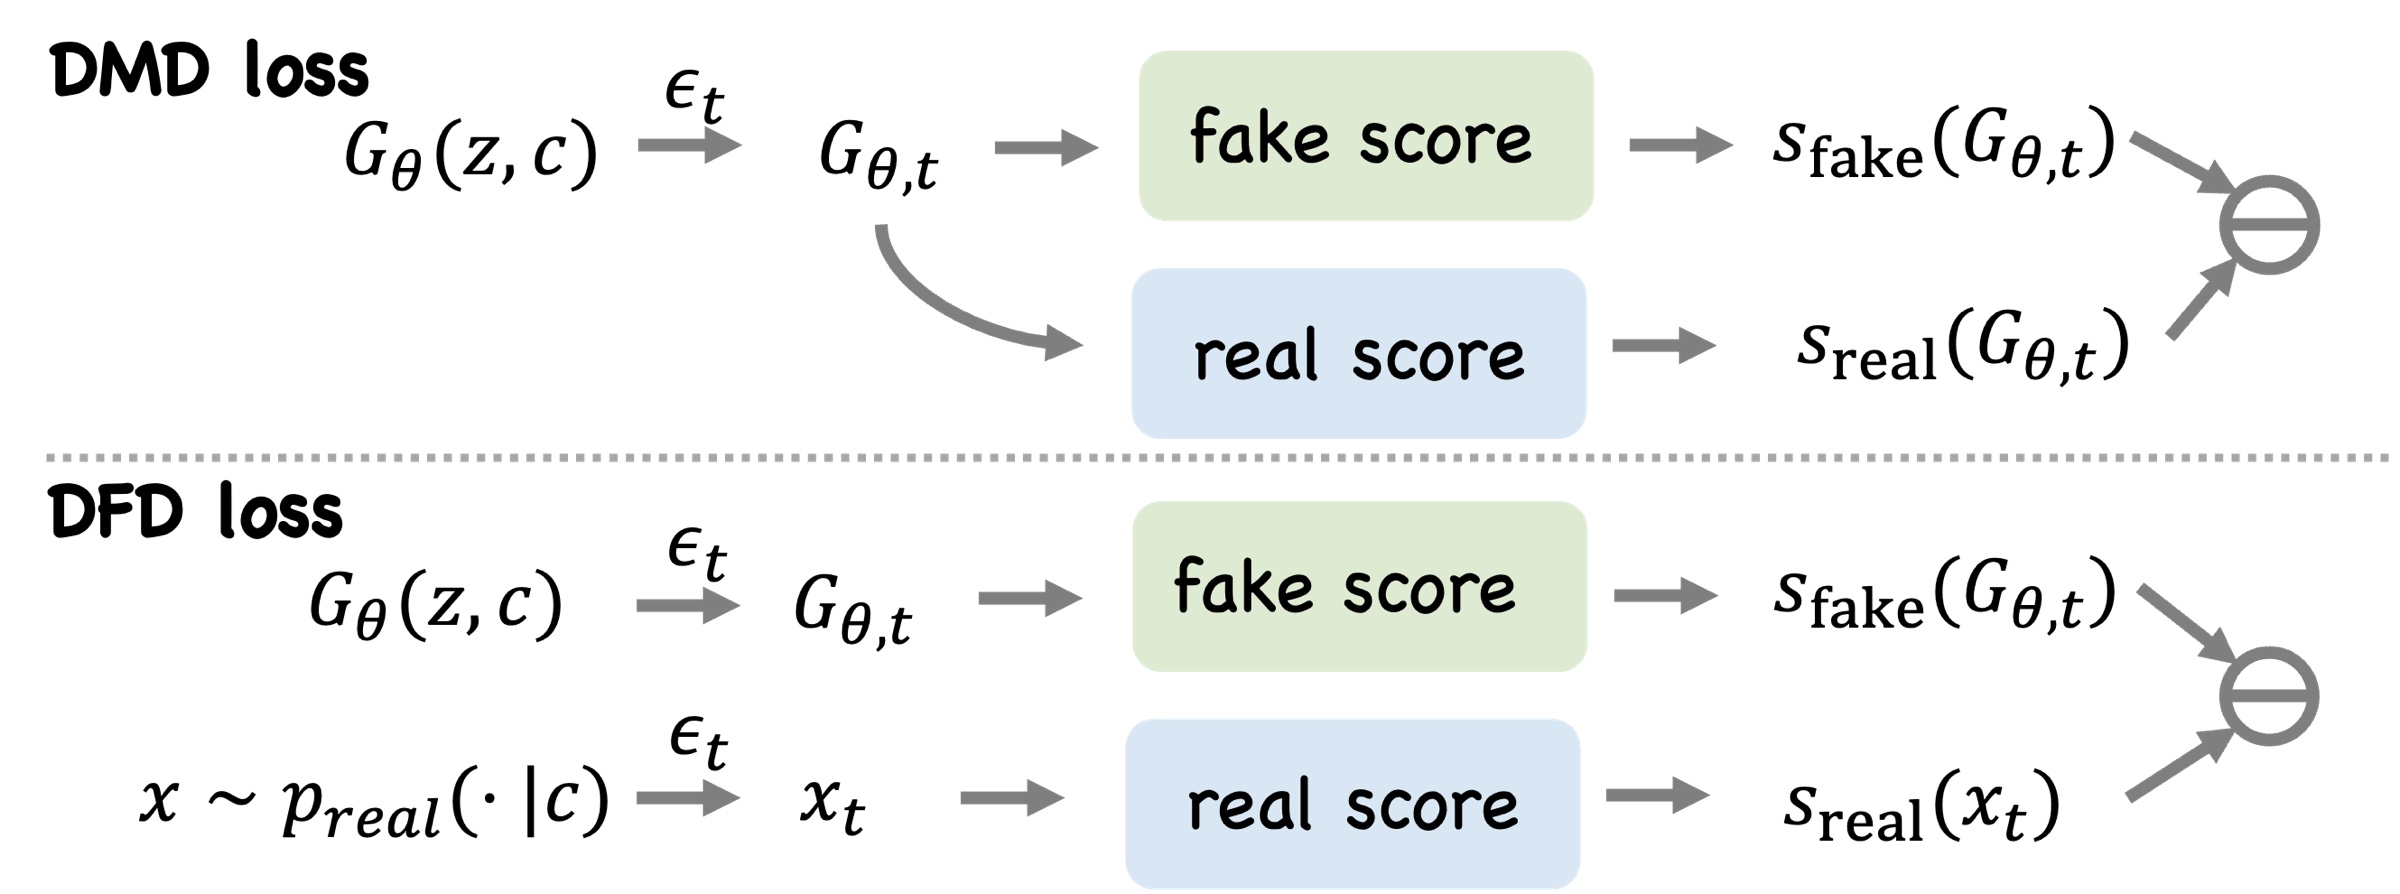
实验效果:在少步视频生成上同时恢复多样性与保真度,去除过饱和、更贴近真实视频外观,且改动极小、收敛快。
批判点评:把少步蒸馏的多样性坍缩精确归因到反向 KL,并用「教师分数差异」一行代码修复,诊断锋利、落地极简。但收益建立在 DMD2 框架之上,'一行代码'表述偏营销,跨更大模型与更极端少步(1-2 步)的稳健性仍需验证。
UniTemp: Unlocking Video Generation in Any Temporal Order via Bidirectional Distillation | 威斯康星·Adobe·UCLA | arXiv:2606.18702
关键词:视频生成,自回归,双向蒸馏,任意时序,长视频
前序问题:自回归视频扩散在流式长视频上表现强,却被限制为前向时序生成;而真实创作常需灵活方向,如基于未来上下文反向延展、或基于过去+未来做中间插帧。
本文贡献:训练出支持任意时序方向生成的自回归模型 UniTemp,统一前向、后向与中间(inbetween)生成;用双向蒸馏化解被广泛使用的因果 3D VAE 所带来的关键技术障碍。

实验效果:在流式长视频场景把生成从单向扩展为任意时序方向的灵活创作,兼顾前向/后向/插帧三类需求。
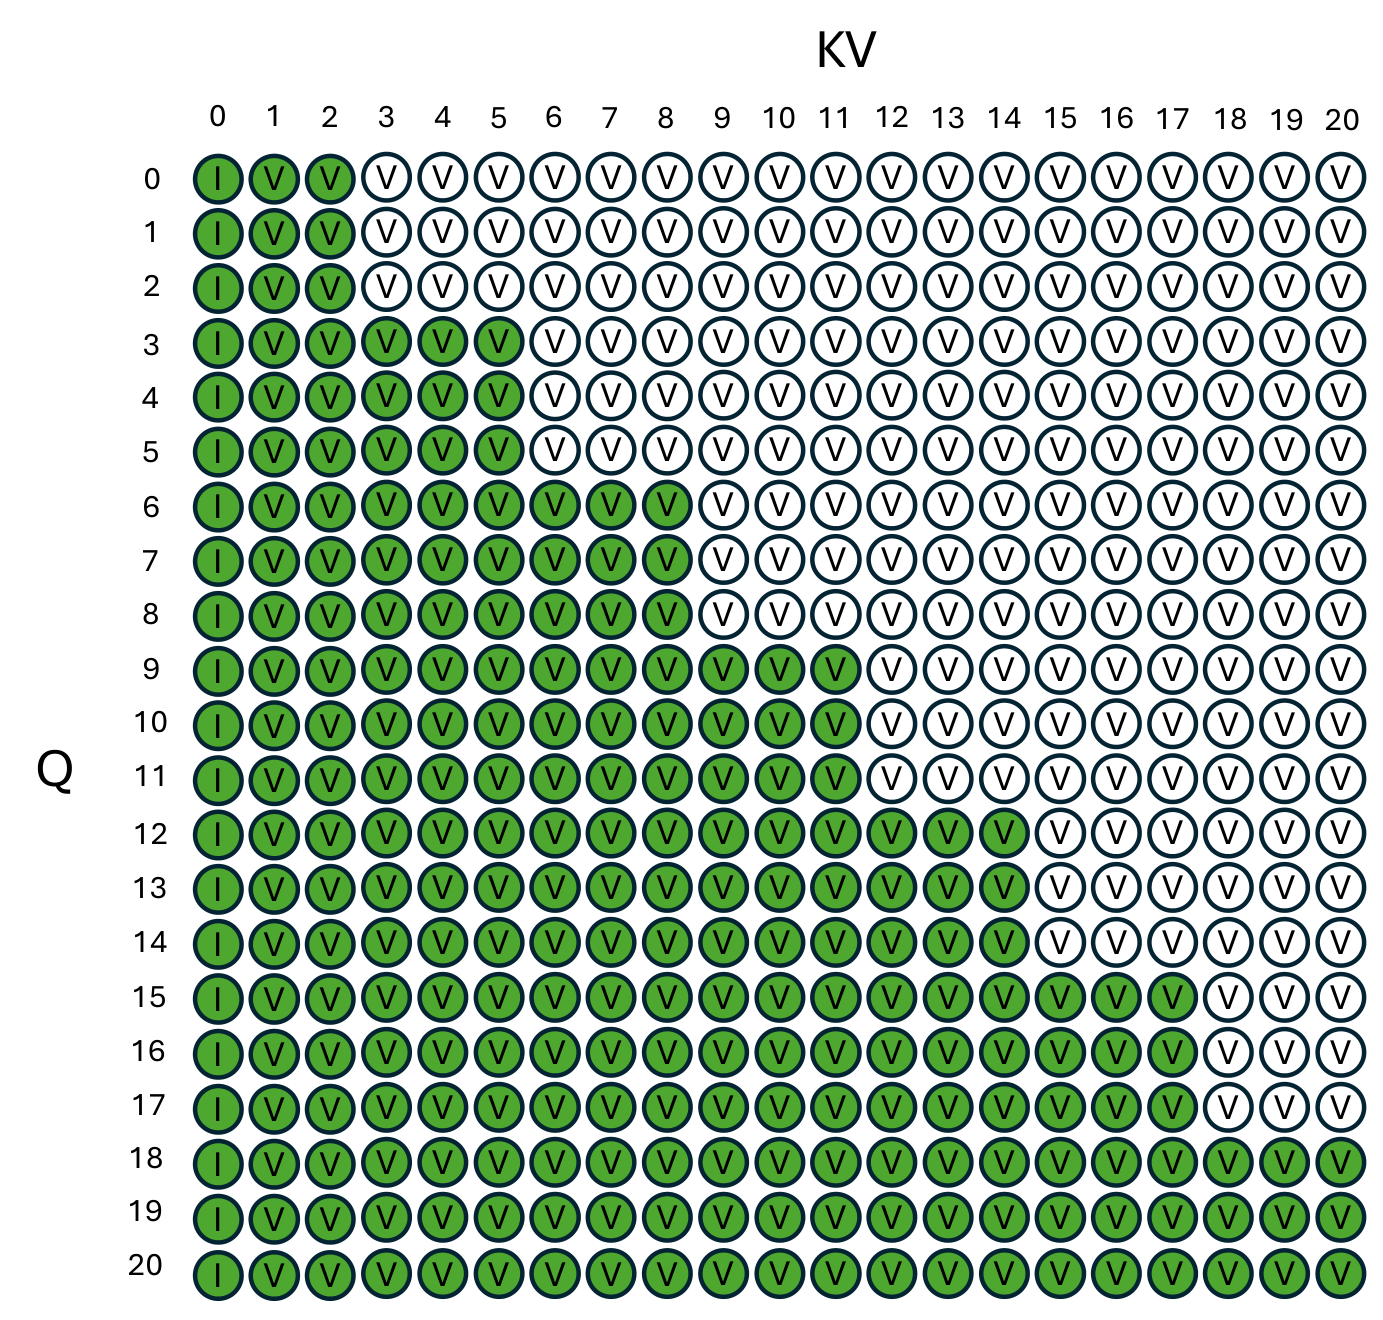
批判点评:把「时序方向」从固定前向解放为任意方向,契合真实创作需求,双向蒸馏对付因果 VAE 也有巧思。但任意方向带来的误差累积与跨方向一致性更难控,反向/插帧下的长视频漂移是否同样可控仍待观察。
TEASR: Training-Efficient Any-Step Diffusion Transformer for Real-World Image Super-Resolution | 上海交大 | arXiv:2606.16188
关键词:超分辨率,扩散模型,任意步,训练高效,实景图像
前序问题:扩散模型在真实世界图像超分(Real-ISR)上质量高但采样慢;现有一步蒸馏虽快,却需辅助 teacher 模型、推高训练显存、难扩展到大架构,且固定步数缺乏速度-质量权衡的灵活性。
本文贡献:提出训练高效的「任意步」扩散框架 TEASR:在单一模型内同时支持一步与多步修复、可按需在速度与质量间权衡,且无需 teacher 模型,从而显著降低训练成本并可扩展到大型架构。
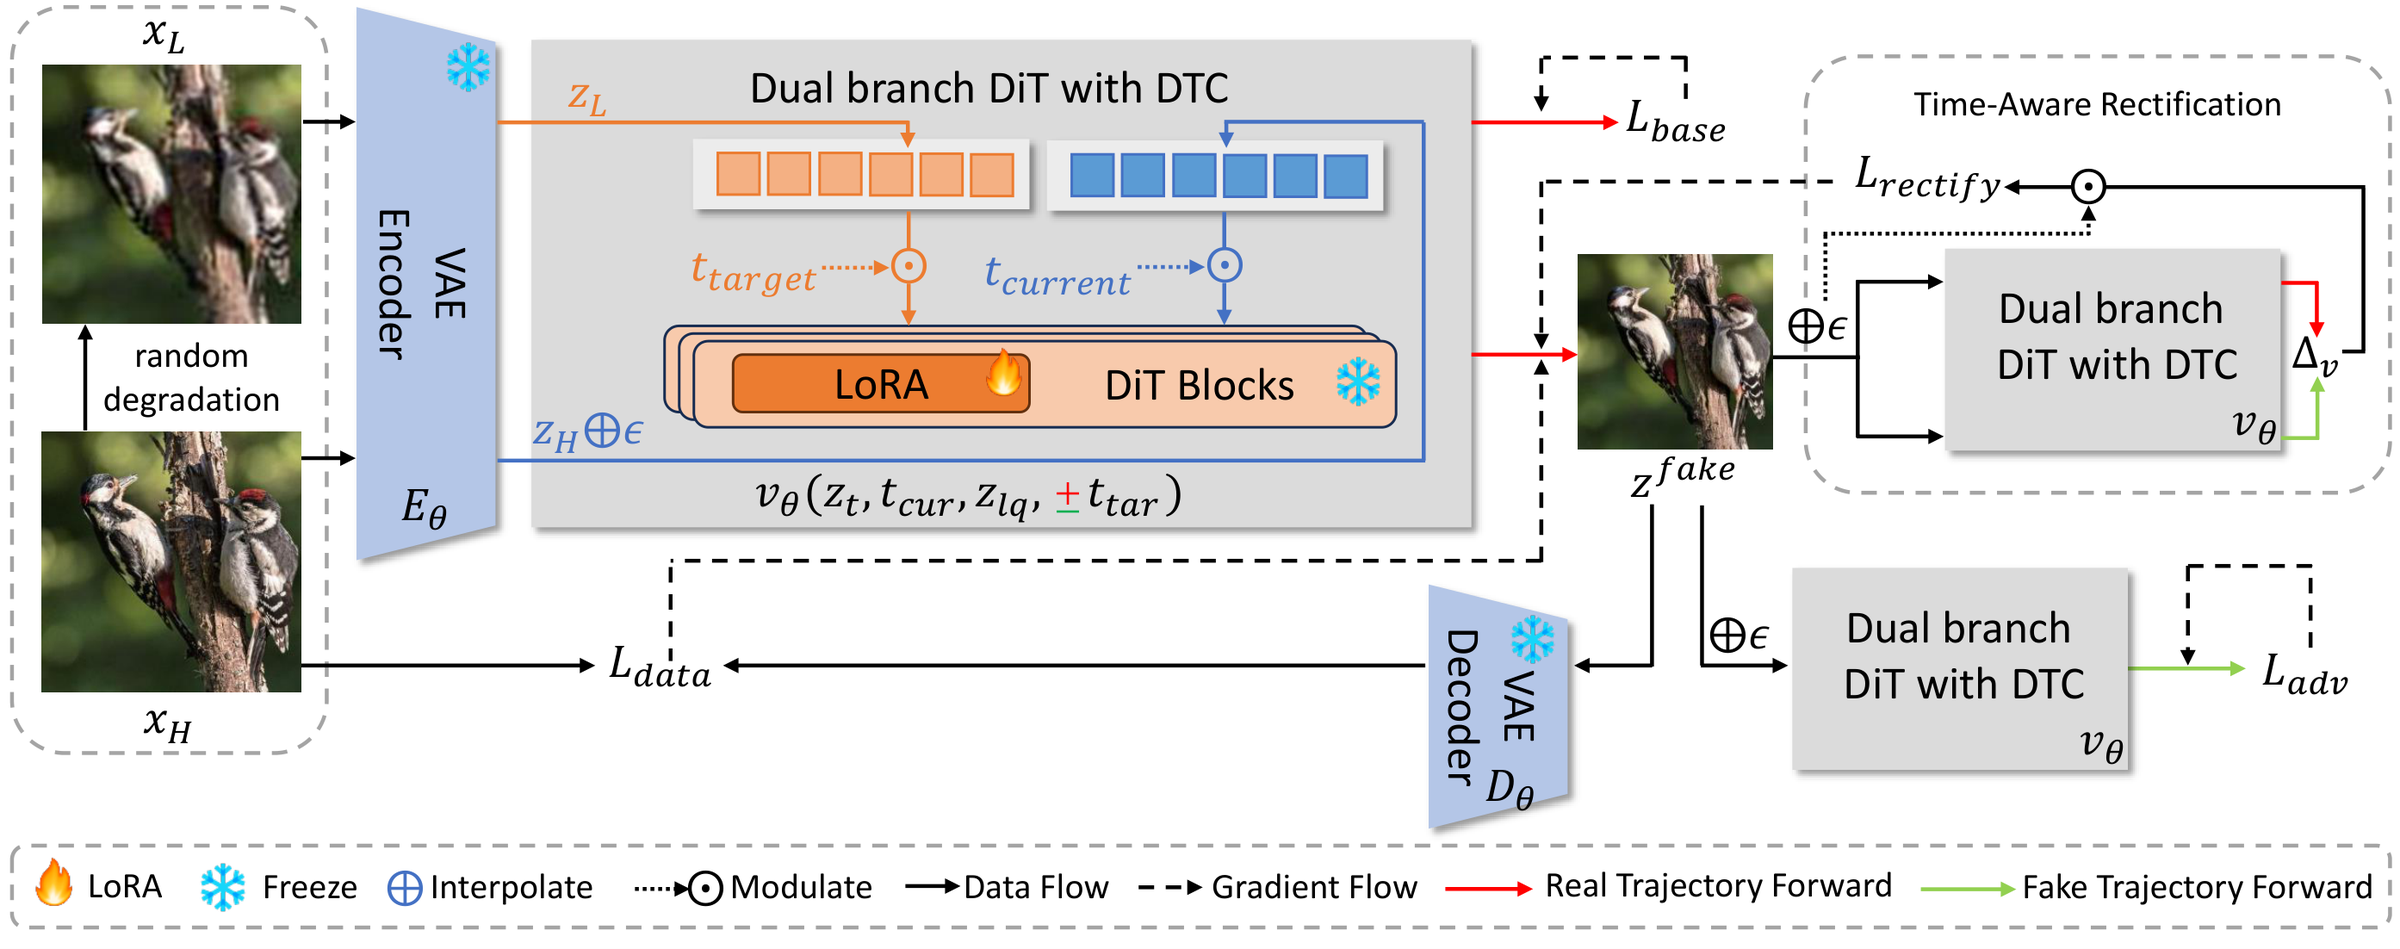
实验效果:在真实图像超分上兼顾训练高效、可扩展与「一步/多步」灵活推理,去掉了对 teacher 的依赖。

批判点评:去掉 teacher 依赖+任意步可调,直击一步蒸馏的训练成本与僵化痛点,工程价值高。但 Real-ISR 评测口径多样,'训练高效'相对谁、在多大骨干上仍占优需看完整数字,极端退化下的细节幻觉也是超分通病。
Unified Audio Generation and Editing via Joint Condition Modeling and Progressive Training | 电信TeleAI·中科大 | arXiv:2606.16435
关键词:音频生成,音频编辑,文生音,统一建模,渐进训练
前序问题:现有工作把文生音(TTA)与指令式音频编辑等任务当作独立挑战、各用专属架构或模块,缺乏统一建模范式,导致系统搭建开销与复杂度大、可扩展性受限。
本文贡献:提出统一模型 AudioWeave:用联合条件建模+渐进式训练把音频生成与编辑收进单一模型,既覆盖文生音也覆盖基于指令的音频编辑,降低系统复杂度、提升可扩展性。
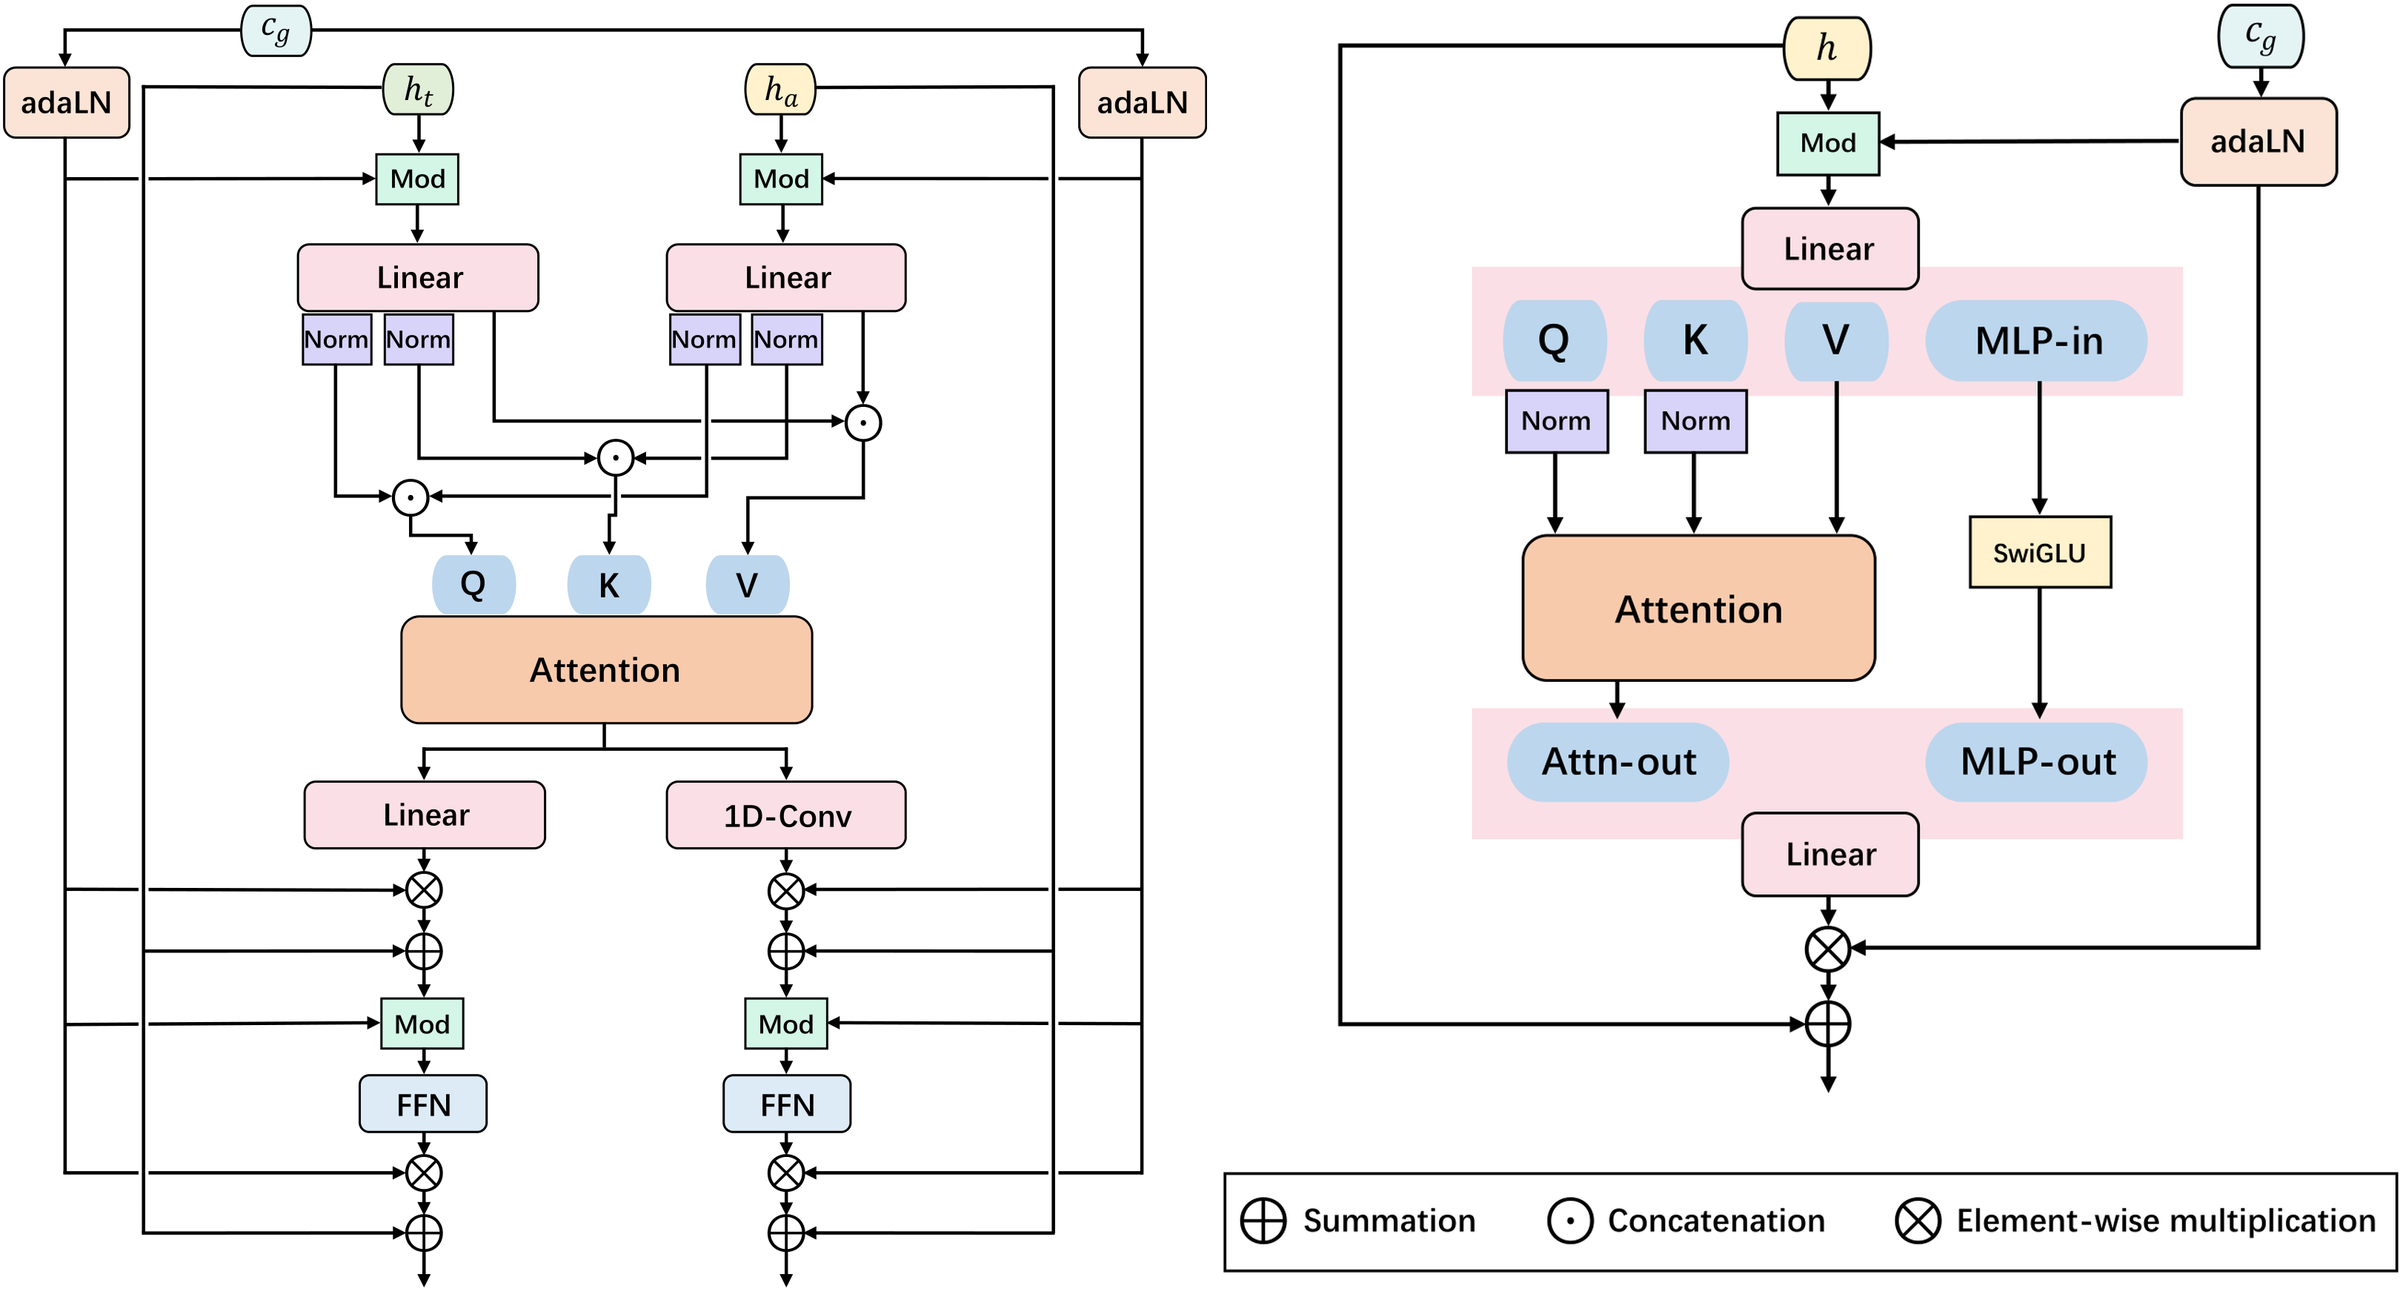
实验效果:一个模型同时胜任文生音与基于指令的音频编辑,减少维护多套任务专属架构的工程负担。
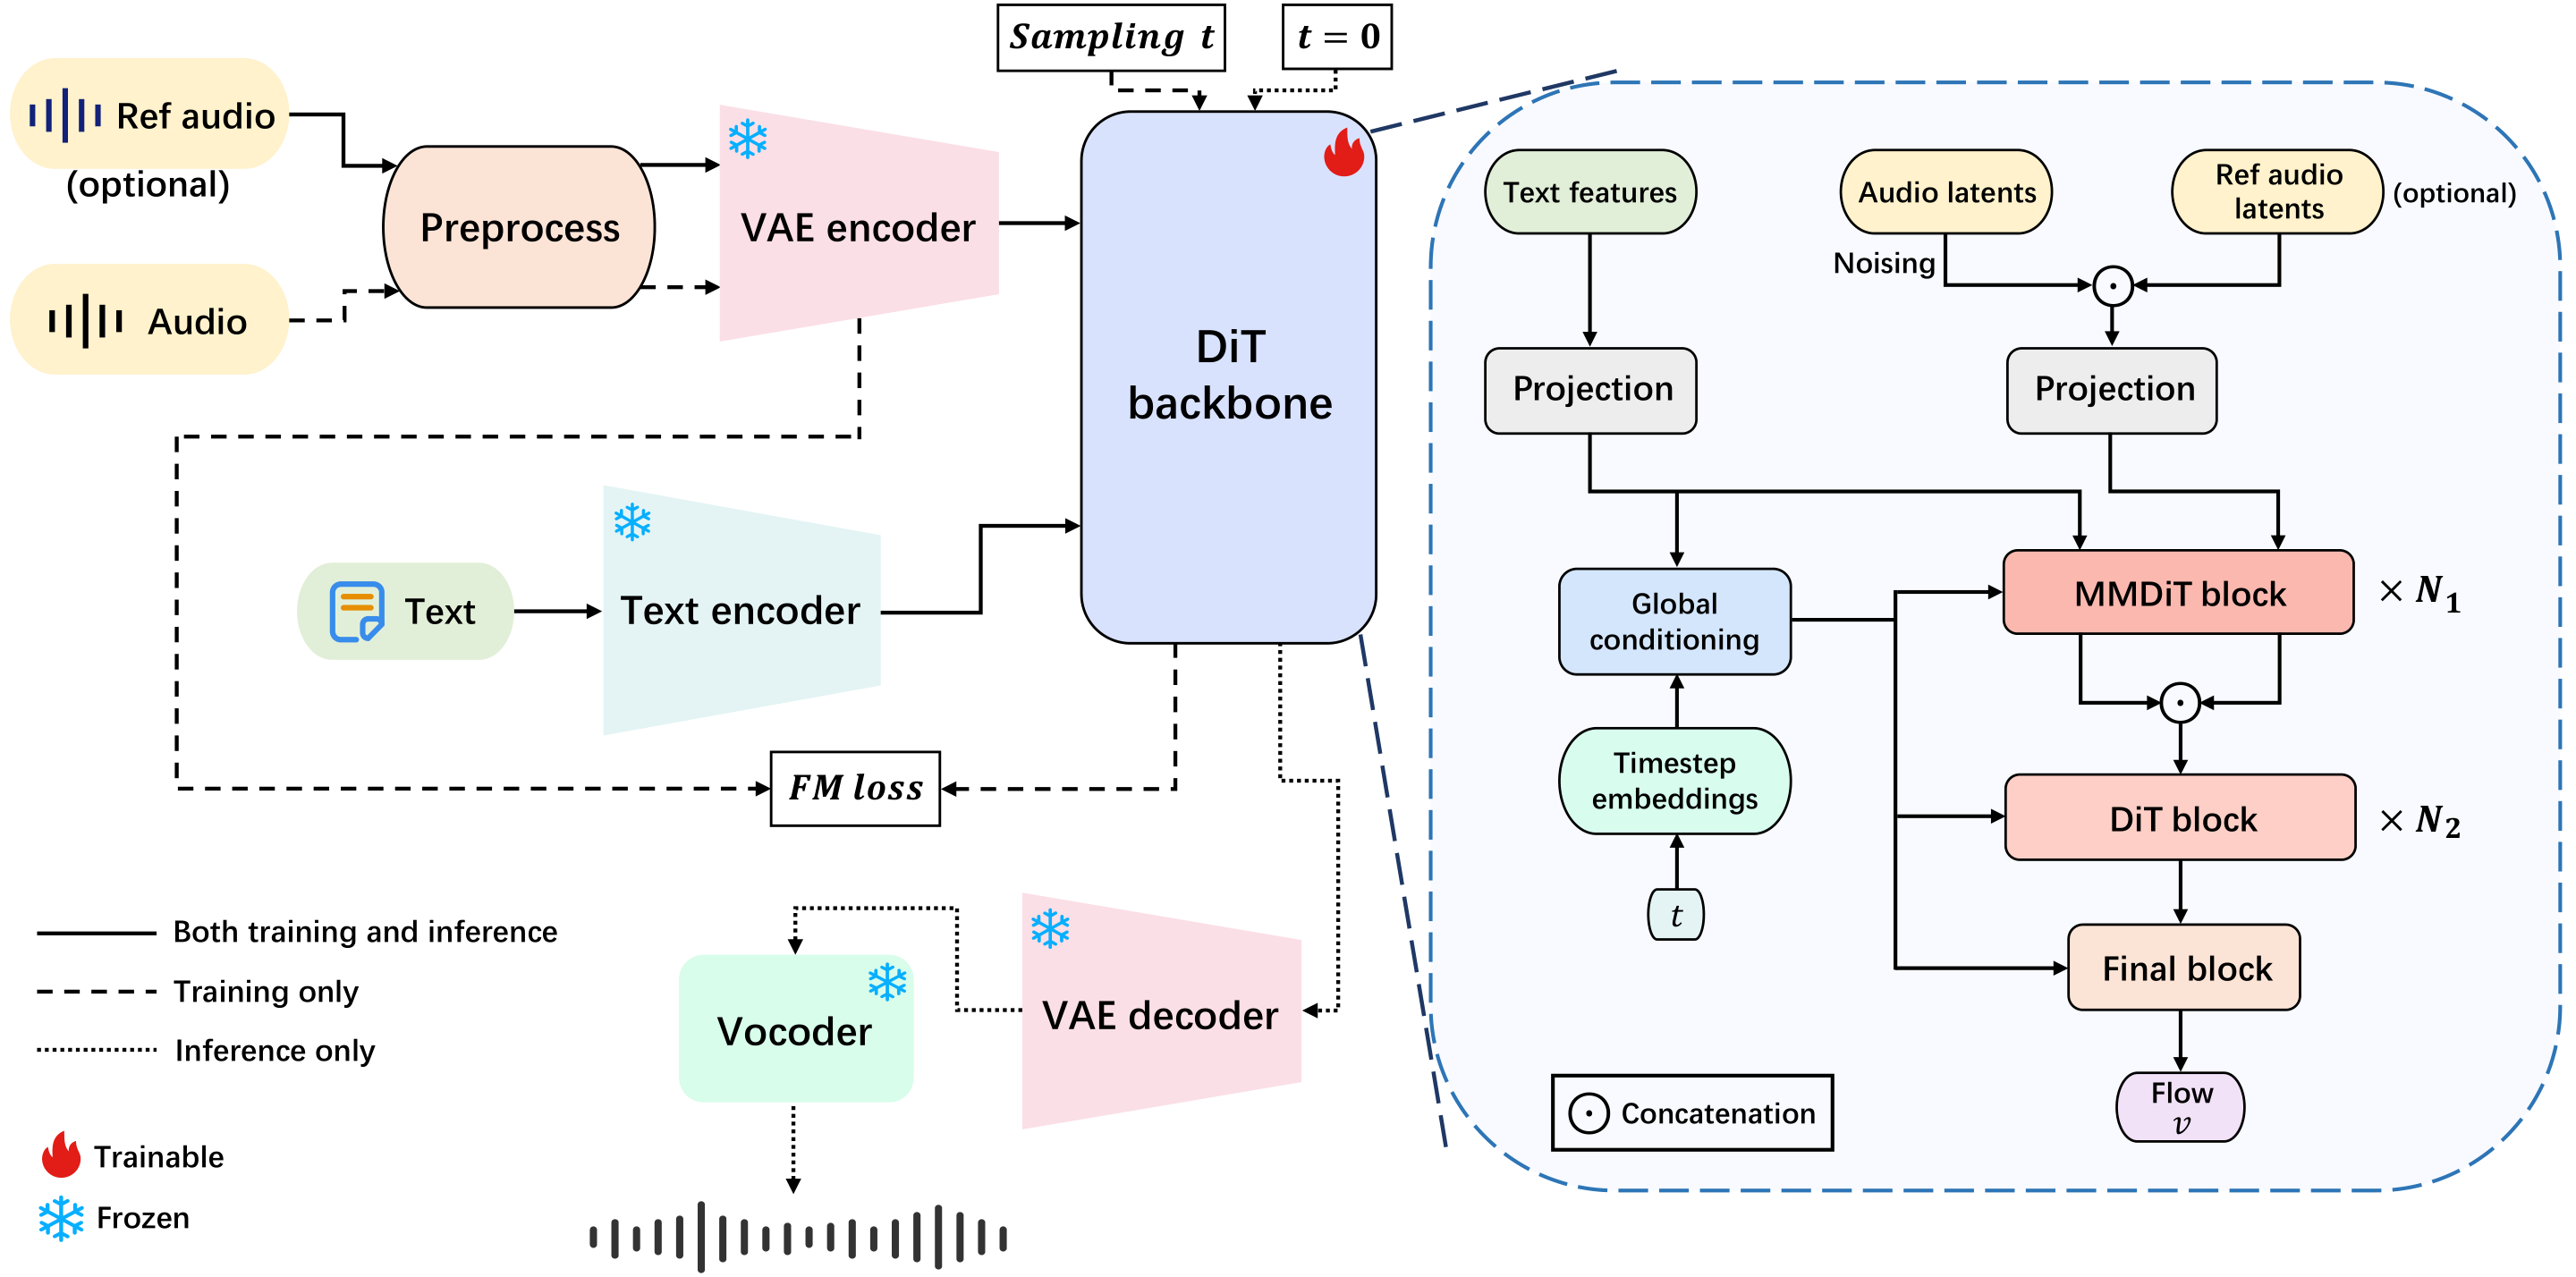
批判点评:把生成与编辑收进统一条件建模,顺应「大一统」趋势、工程上省事。但统一模型常面临生成与编辑能力的相互妥协,渐进式训练的配比、编辑精度与背景保真能否双赢需看消融与主观评测。
PermaVid: Consistent Video Generation Across Edits via Disentangled Context Memory | 上海交大·斯坦福·南洋理工·港中文 | arXiv:2606.16449
关键词:视频生成,视频编辑,上下文记忆,一致性,Wan2.1
前序问题:视频生成在编辑(改外观/布局)后需要「持久一致」:后续生成应跨时间、跨视角保持连贯;但现有记忆设计在修改后易过时失效,存储上下文可能失准。
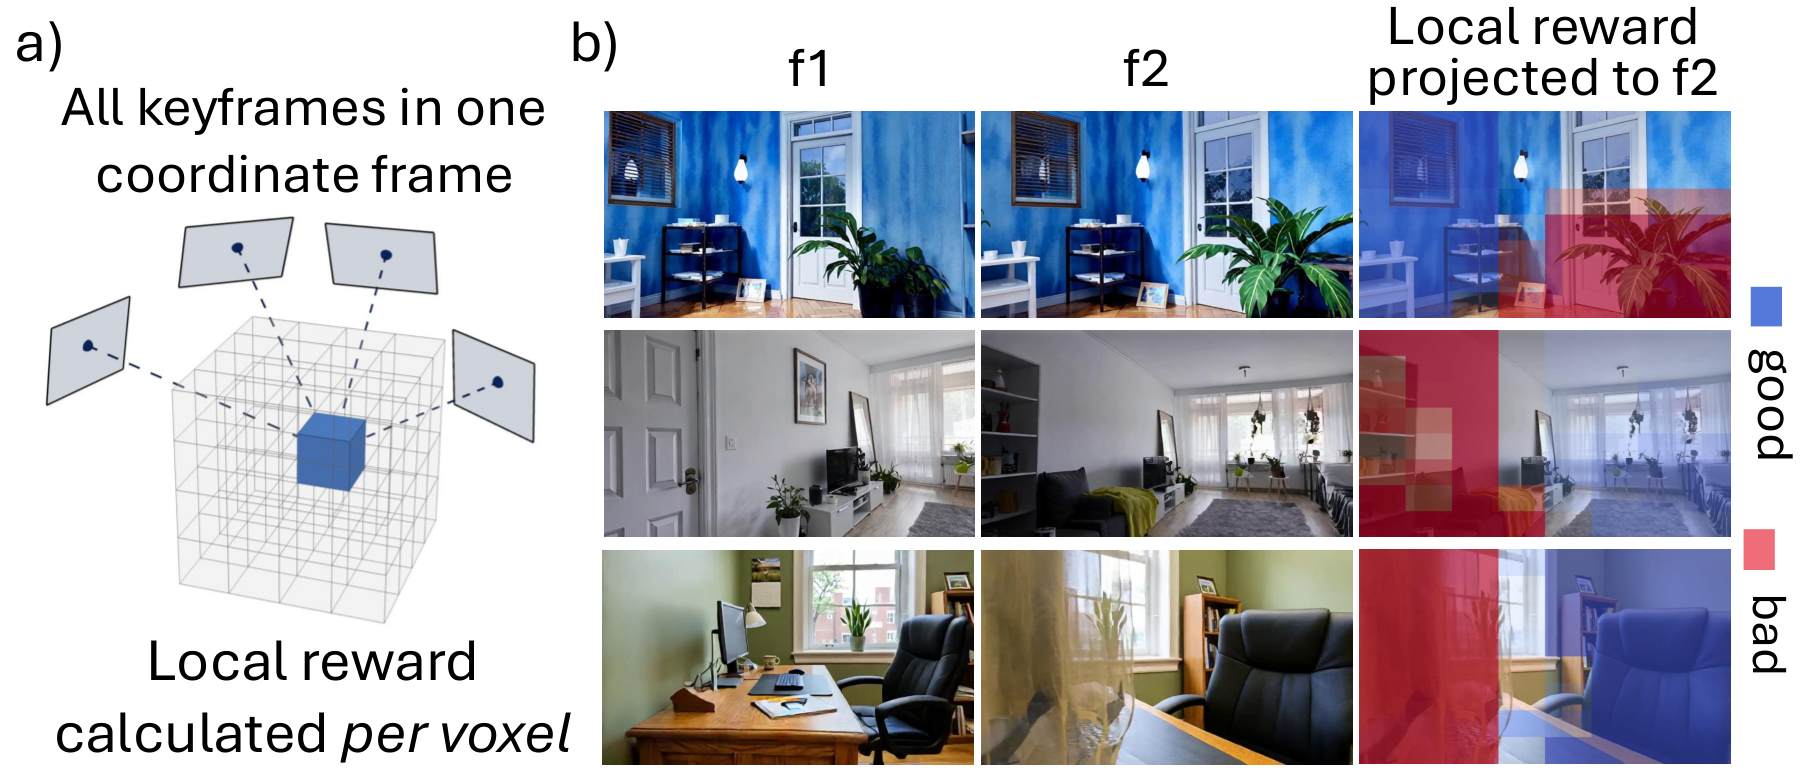
本文贡献:提出 PermaVid(基于 Wan2.1-14B):构建多模态上下文记忆,把空间上下文解耦为「语义外观+几何结构」,并设计编辑感知的记忆更新与检索策略,确保编辑后跨时间、跨视角仍连贯。

实验效果:在编辑操作后维持长程时间与视角一致性,缓解记忆过时导致的崩坏。
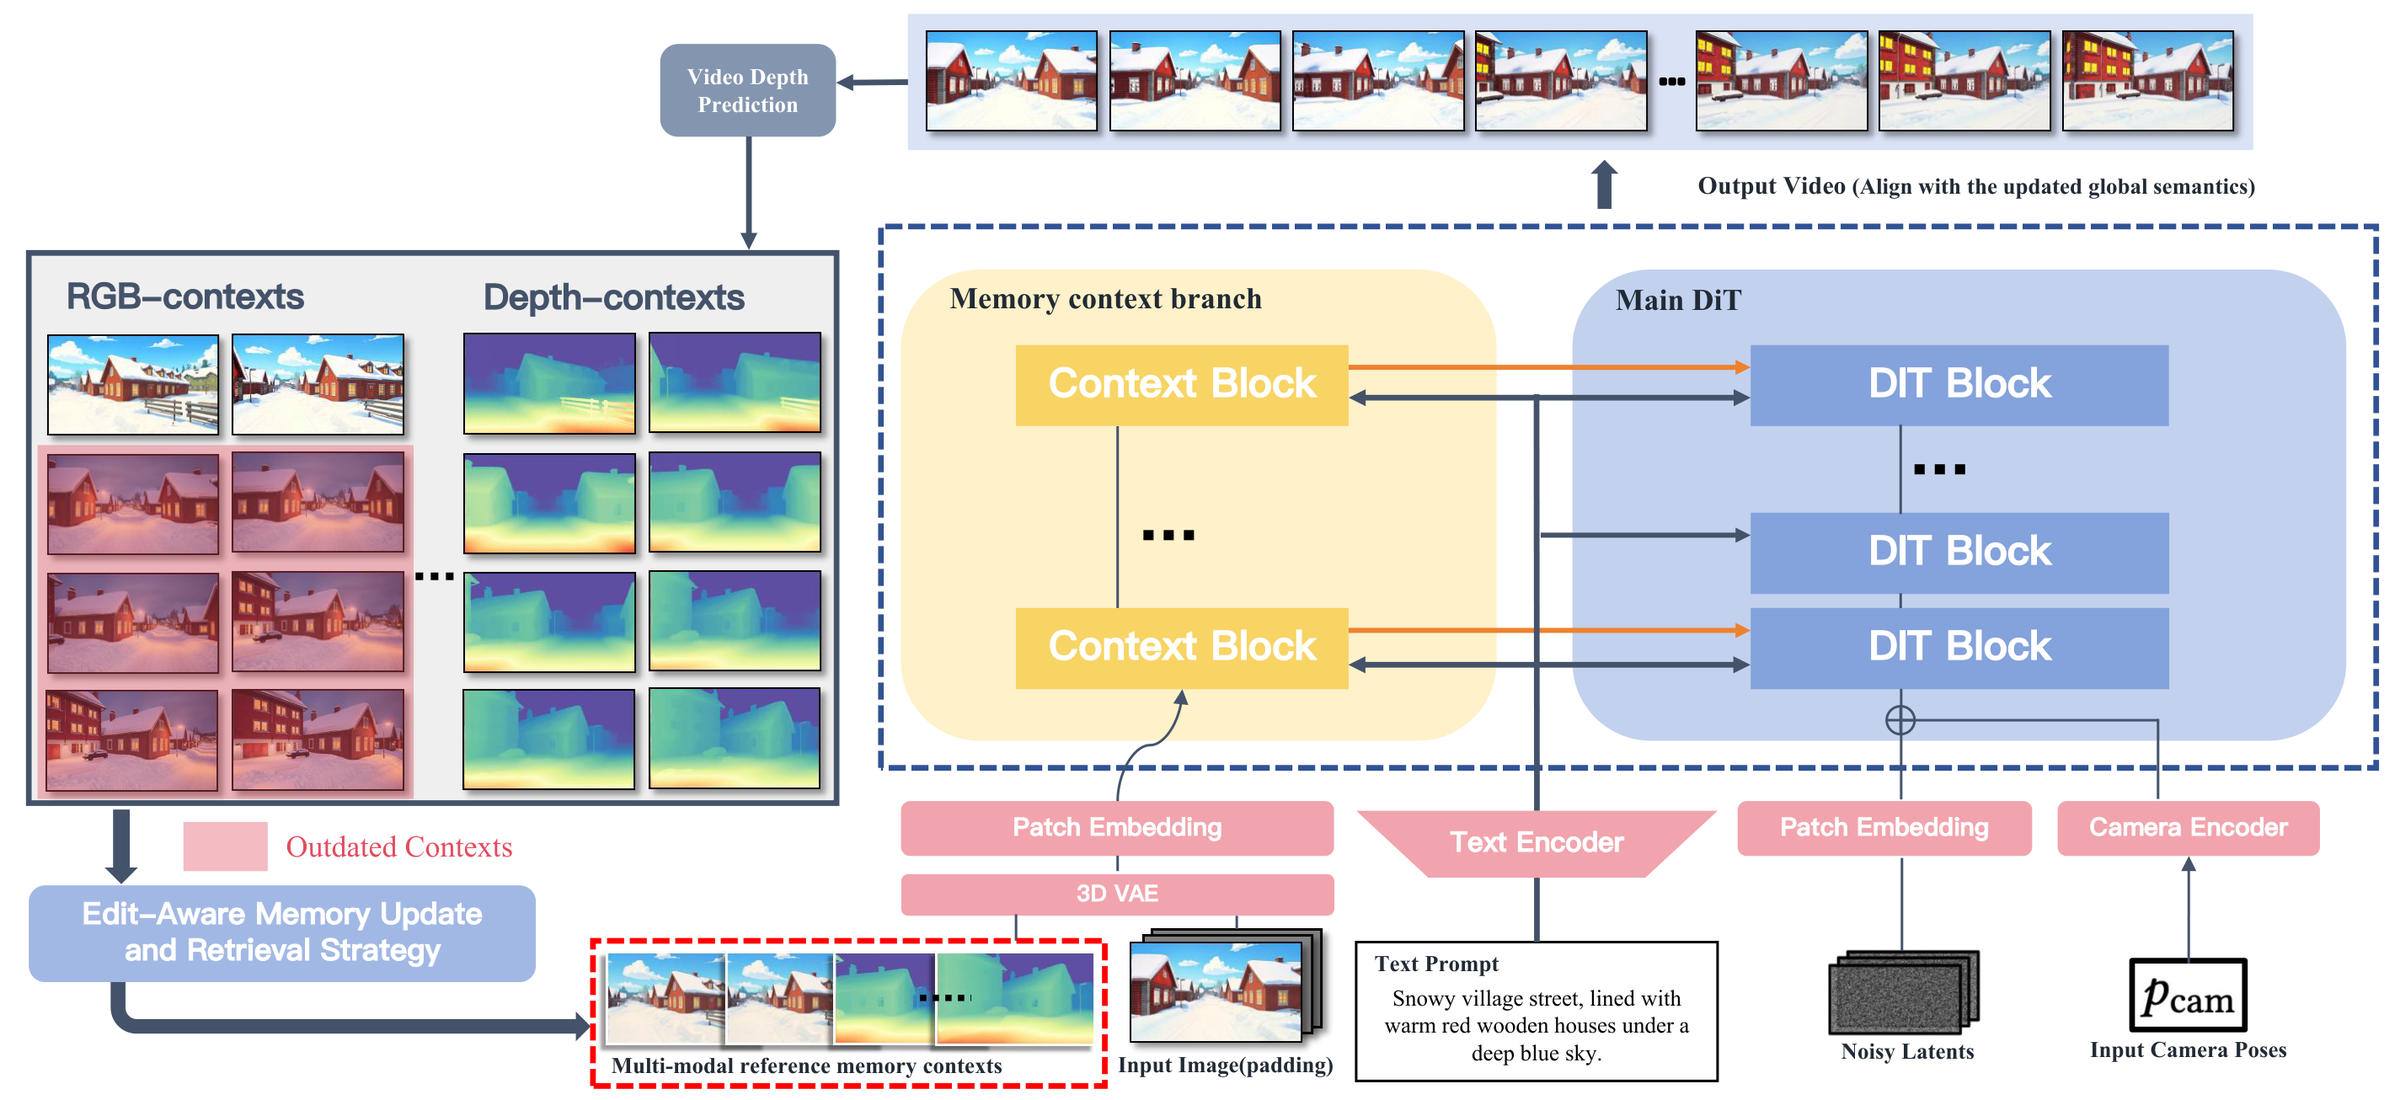
批判点评:把记忆解耦成外观/结构并做「编辑感知更新」,对症视频编辑后的一致性塌缩,且基于强骨干 Wan2.1-14B。但解耦记忆+检索更新增加系统复杂度与显存(32×H200 训练),编辑链路变长时的累积误差与检索误命中仍是隐患。
Text-Vision Co-Instructed Image Editing | 香港理工·OPPO | arXiv:2606.16767
关键词:图像编辑,文本指令,视觉提示,联合建模,FLUX
前序问题:文字指令语义表达强但空间控制粒度粗,拖拽/点选等视觉提示空间精准但语义意图模糊,二者各有短板难以兼得。
本文贡献:提出 Text-Vision Co-Instructed Image Editing(TV-Edit):把文字指令建模为语义意图、把稀疏视觉指令建模为空间引导,二者联合驱动编辑;在 Qwen-Image-Edit 与 FLUX.1 Kontext 双骨干上用少量控制器块实现,验证跨骨干通用性。
实验效果:统一文字与视觉提示之长,实现语义清晰且空间精准的图像编辑,并能在不同编辑骨干上通用。
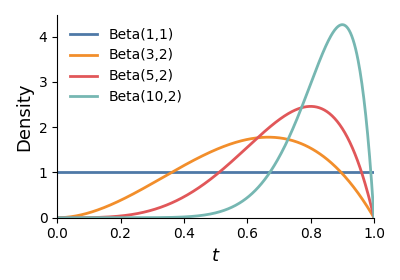
批判点评:「文+视觉联合指令」补齐了纯文字/纯视觉各自的短板,且证明跨 Qwen/FLUX 骨干通用。但需稀疏视觉标注、用户交互成本上升,联合指令冲突(语义与空间矛盾)时如何取舍、复杂多目标编辑的可扩展性仍待考。
RGFVR: Reference-Guided Face Video Restoration with Flow Matching | 慕尼黑工业大学 | arXiv:2606.16401
关键词:人脸修复,视频修复,身份保持,流匹配,参考引导
前序问题:从退化观测做人脸视频修复需同时恢复视觉保真、时间一致与主体身份;现有方法要么无参考(易丢身份)、要么 subject-specific(难泛化到未见身份)。
本文贡献:提出主体无关、参考引导的身份保持框架 RGFVR:把「感知+描述」双模态身份条件注入预训练 flow-based 文生视频模型(Wan2.1-T2V-1.3B + ArcFace 人脸编码器),两阶段训练、第一阶段仅训身份条件参数。
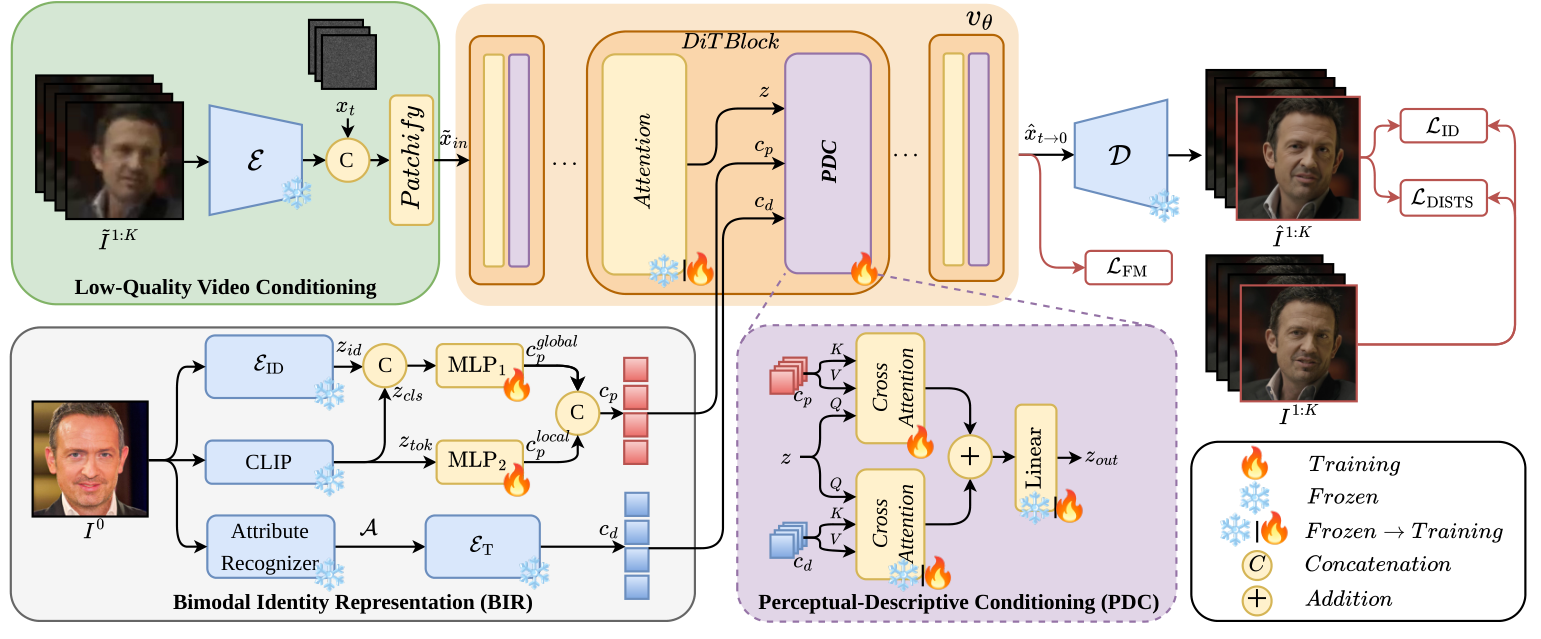
实验效果:在严重退化下既保身份又保时间一致,并能泛化到未见身份,无需逐人微调。
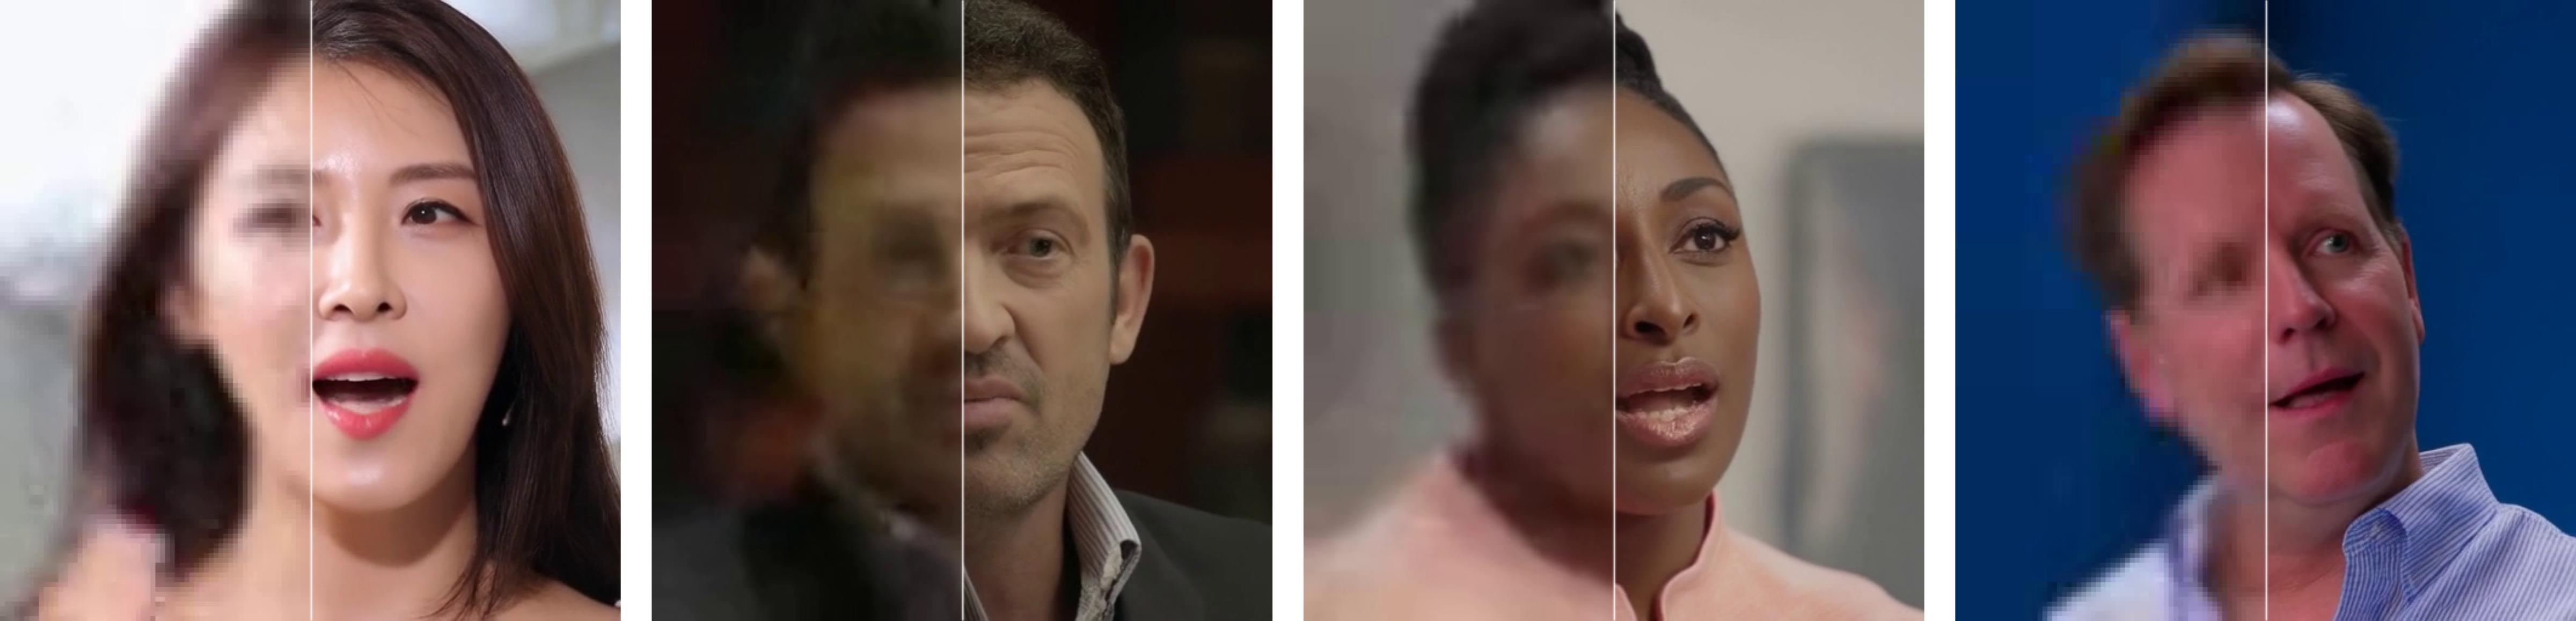
批判点评:双模态身份条件+参考引导兼顾保真与泛化,避开 subject-specific 的逐人训练。但依赖参考图质量与 ArcFace 身份编码,当参考与目标姿态/表情差异大时身份注入可能反成约束,1.3B 小骨干也限制极端修复上限。
SketchKeyAnime: Reference-anchored Sparse Key-Sketch Animation Synthesis | 北京邮电大学 | arXiv:2606.19958
关键词:动画生成,视频扩散,关键草图,中间帧,可控生成
前序问题:传统动画依赖手绘关键帧、中间帧与上色;现有动画/视频生成方法多需 RGB 边界帧、密集逐帧条件或完整草图序列,难以适配低成本输入。
本文贡献:提出视频扩散框架 SketchKeyAnime:仅凭「稀疏关键草图」即可生成结构可控、外观一致、时间连贯的动画;含 Sketch Relation Transformer 与 Sketch Resampler 处理稀疏关系,并用 Sketch Cross Attention 与自适应加权损失强化线稿区域。

实验效果:在低成本输入(稀疏关键草图+参考)下产出结构可控、外观一致的动画,贴合真实动画生产流程。
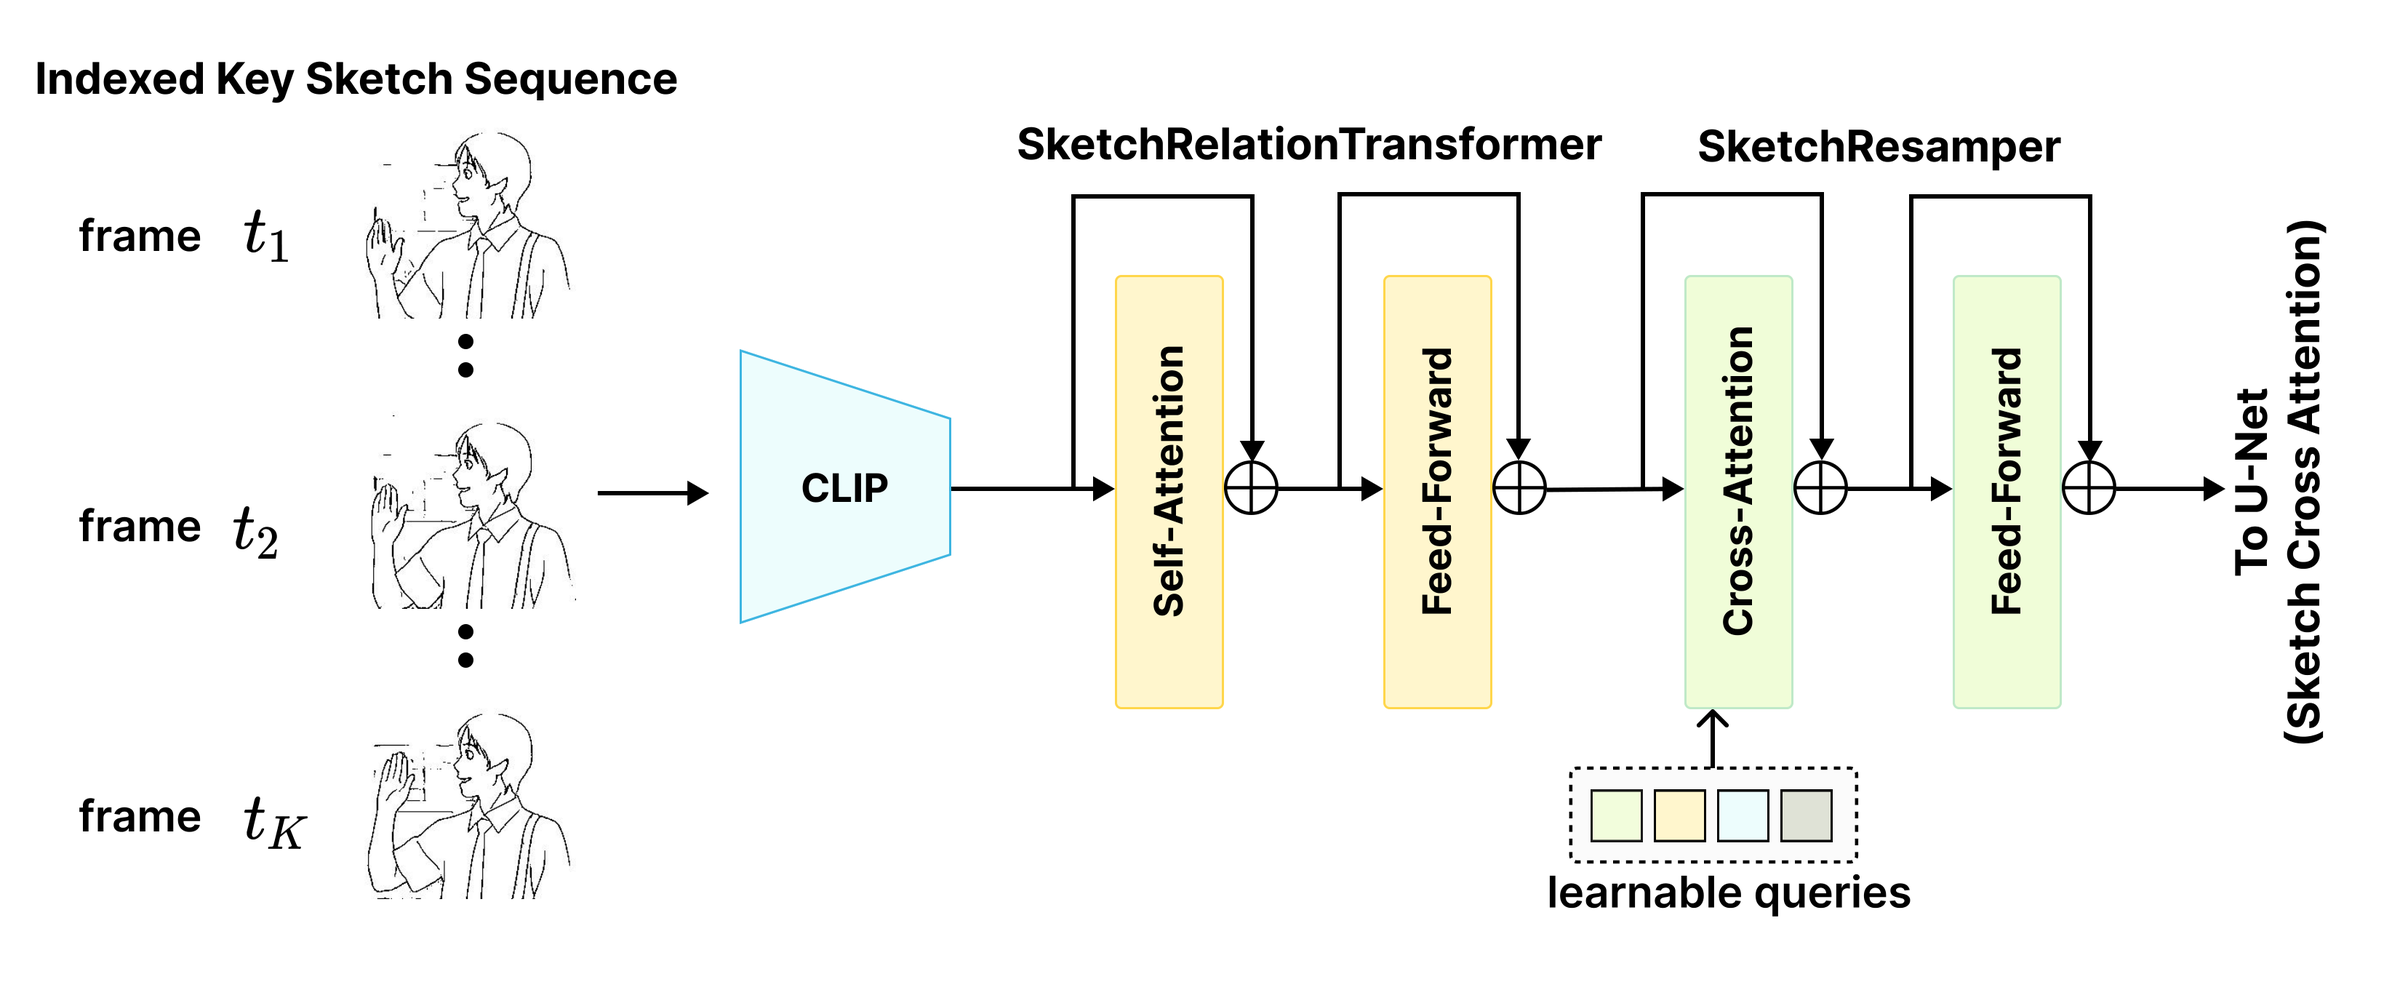
批判点评:把输入门槛降到「稀疏关键草图」很贴合动画产线降本诉求,线稿增强损失也对症。但稀疏输入意味着中间帧靠模型想象,复杂动作/大幅形变的可控性与一致性更难,4×V100 训练规模也限制了分辨率与时长。
Pulling The REINS: Training-Free Safety Alignment of Video Diffusion Models via Representation Steering | UC Riverside·YouTube | arXiv:2606.17257
关键词:视频扩散,安全对齐,表征引导,训练无关,内容安全
前序问题:开源权重视频扩散可生成暴力、虚假等逼真不安全内容;现有防护要么靠昂贵安全微调(损伤通用能力),要么靠外部过滤(易被对抗提示绕过)。
本文贡献:提出训练无关的推理时安全引导 REINS(Representation-space Inference-time Safety steering):发现安全相关结构在隐藏态激活中线性编码,用 SPCA 求出安全方向,并在推理时把模型内部表征朝安全方向引导;1.3B T2V 模型全流程 <24 GPU 小时即可完成。

实验效果:不微调、不损通用能力地把视频扩散在推理时对齐到安全生成,且较难被提示对抗轻易绕过,成本极低。
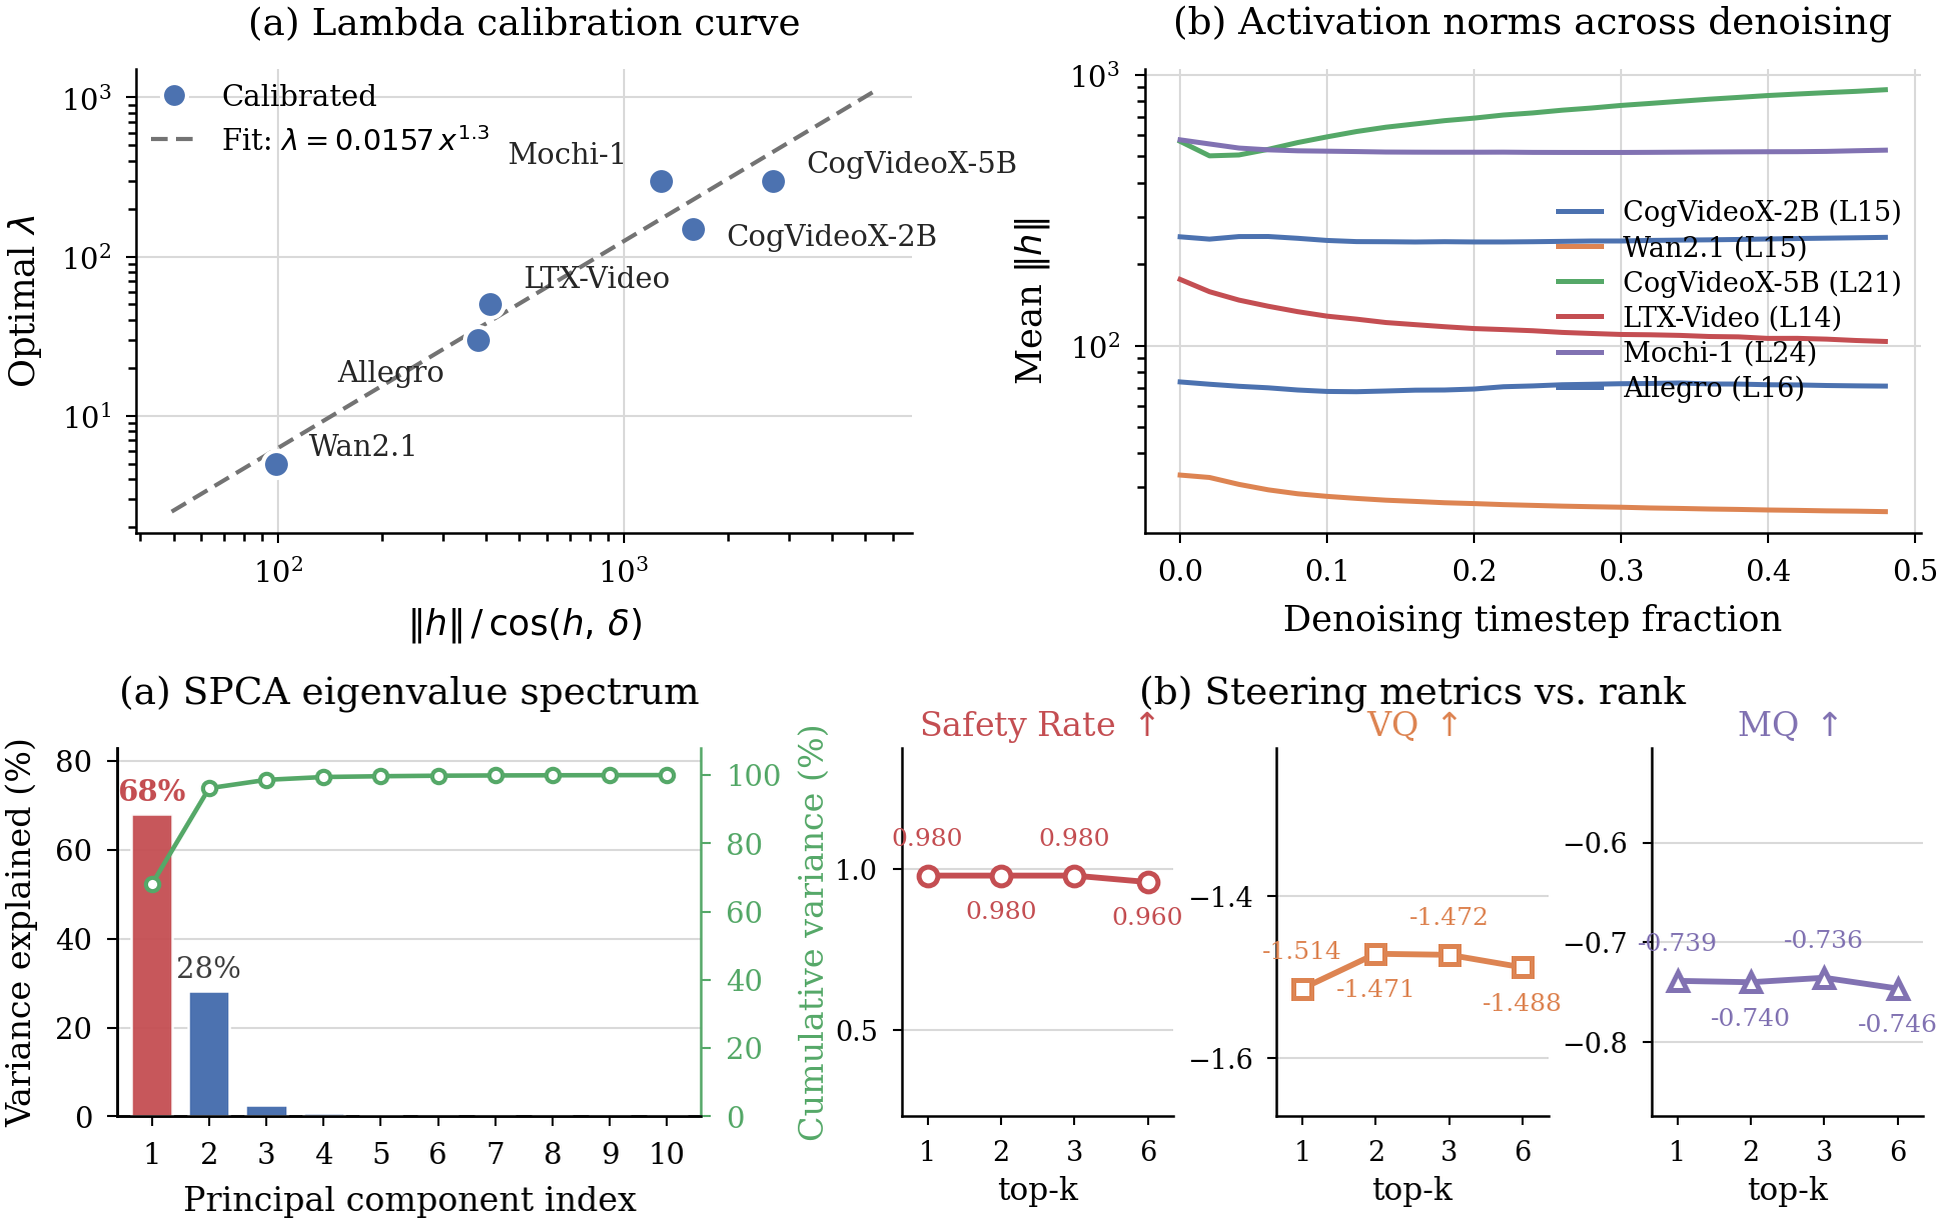
批判点评:「安全方向线性可引导」既给出可解释结论又落地为零训练方法,成本极低(<24 GPU 时)、不损通用能力,治理价值高。但线性引导对复杂/组合型不安全语义的覆盖有限,强对抗下方向是否仍稳健、引导强度与画质的权衡都需更大规模红队验证。
人工智能炼丹君 整理 | 2026-06-22
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注




评论 (0)