搜索到
127
篇与
人工智能
的结果
-
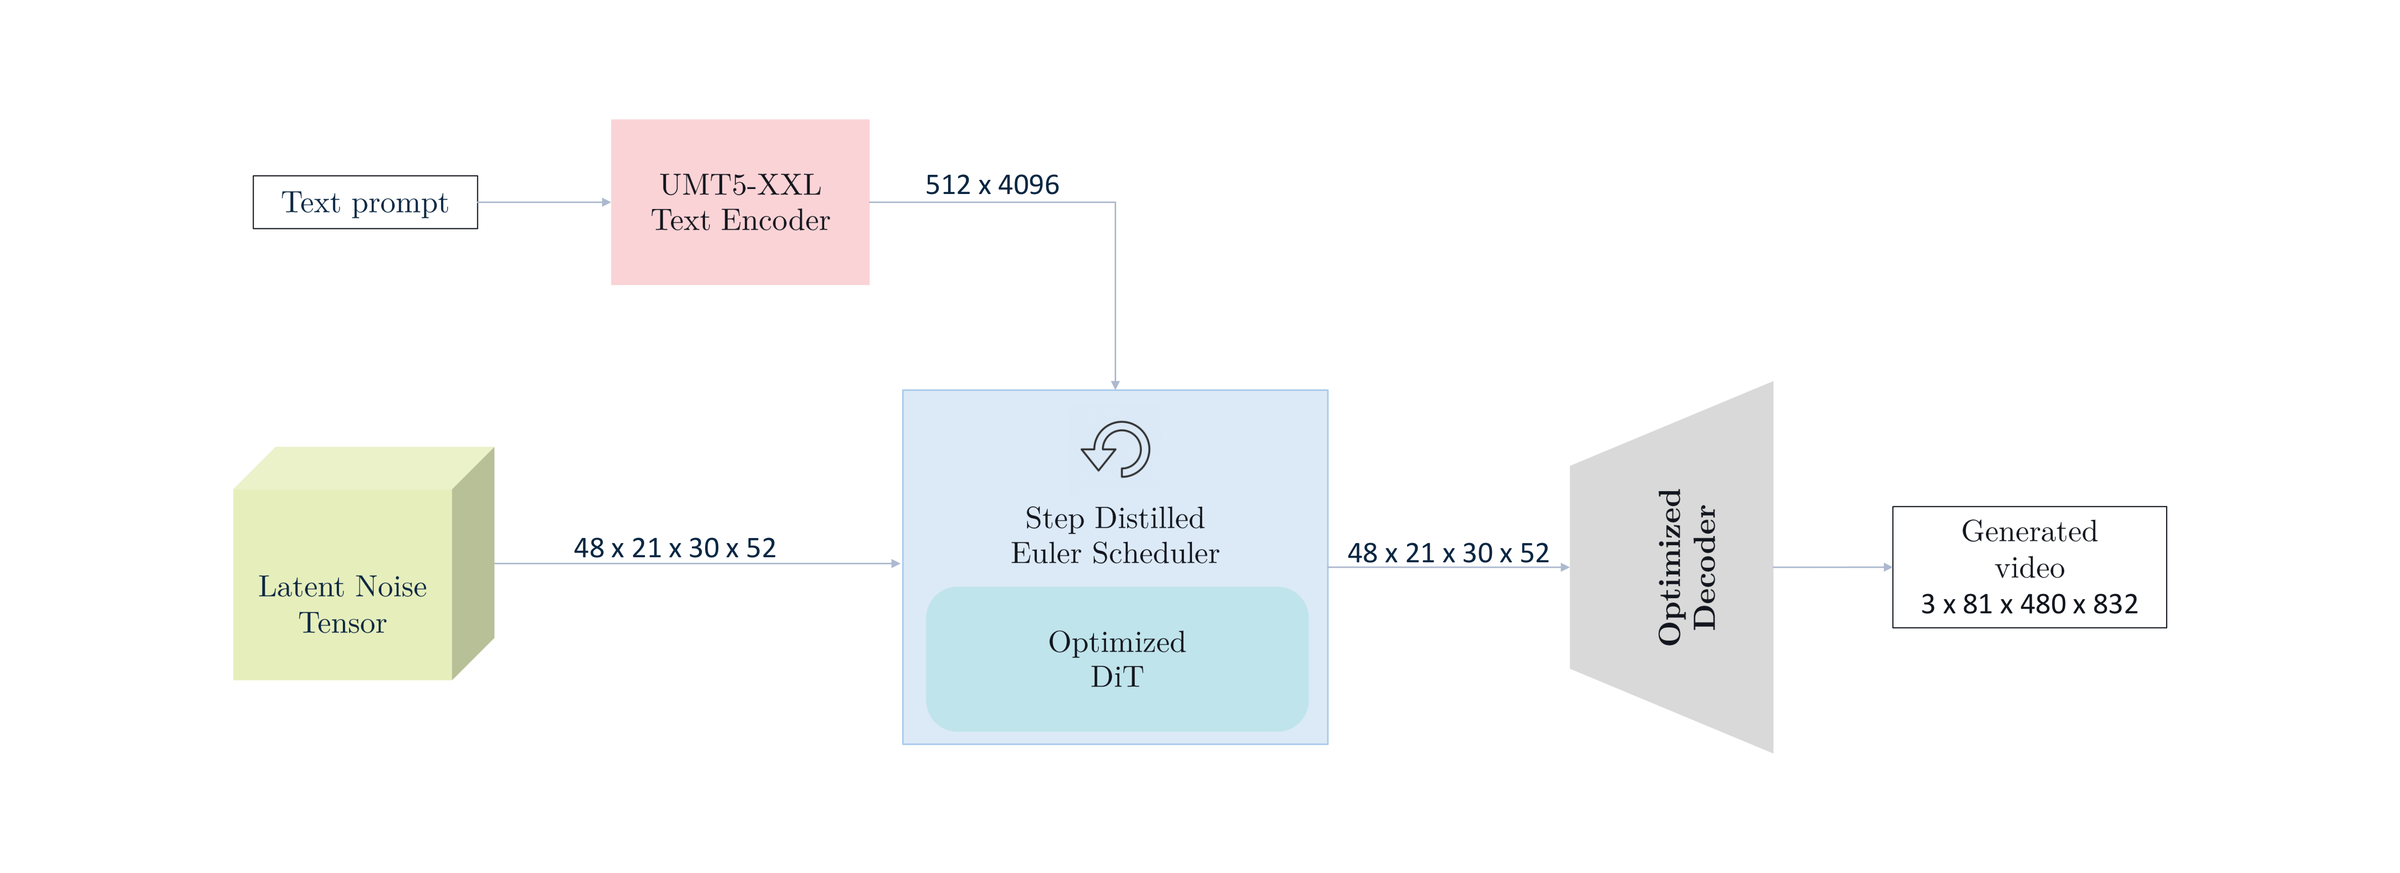
 AIGC 每日速读|2026-07-10|高通MobileWan让5B视频扩散上手机16FPS 今日 AIGC 论文速览 今日共 10 篇 · 生成加速与高效训练 3 篇 · 生成理解一体化 1 篇 · 视频修复与重打光 3 篇 · 音频与语音生成 2 篇 · 生成安全与对齐 1 篇 重点论文标题列表 MobileWan(高通(Qualcomm)):5B视频扩散首上手机16FPS Dynamic-in-Few-Step(西湖大学·vivo·浙大):少步蒸馏配动态稀疏30倍 FourTune(MIT·Stanford·CMU):全4bit后训练提速2.27倍 Gen4U(Google DeepMind):冻结视频扩散当通用编码器 LightCrafter(CMU·多伦多大学·博世):PBR代理视频重打光更可控 今日论文速览 1. MobileWan:5B视频扩散首上手机16FPS MobileWan: Closing the Quality Gap for Mobile Video Diffusion | 高通(Qualcomm) | arXiv:2607.06173 关键词:视频扩散,移动端部署,循环蒸馏,注意力剪枝,VBench 前序问题:视频扩散靠把 Transformer 扩到数十亿参数换质量,但手机端模型受限于 0.4-1.8B 小参数预算、生成质量上不去;难点是如何在内存受限的移动硬件上跑服务器级大模型。 本文贡献:证明高质量移动端视频生成不必用小模型——把服务器级 5B 视频扩散 Transformer 高效部署到手机。以 Wan2.2-5B 为起点,用循环蒸馏把视频生成改造成分块自回归、常数内存注意力;配合因果线性注意力让模型推理时像 RNN 运行且跨块保持时序一致;再提出可学习注意力头剪枝(二值化逐头门控+噪声偏置稀疏目标端到端优化+蒸馏微调),叠加采样步蒸馏与内存优化 VAE 解码。 实验效果:成为首个可部署到商用手机的 5B 级视频扩散模型;在 Qualcomm Snapdragon 8 Gen 5 NPU 上以 20 秒端到端延迟生成 5 秒 480×832、16 FPS 视频,VBench 得分 83.79,刷新移动端视频生成 SOTA。 批判点评:用「循环重构+因果线性注意力+逐头剪枝+步蒸馏」组合拳把 5B 大模型压进手机 NPU,是移动端视频生成的一次实打实突破,高通自家 NPU 落地也很硬核。但 480×832/5 秒/16 FPS 仍是受限规格、20 秒延迟离交互式实时尚有距离,多重压缩(剪枝+线性注意力+步蒸馏)对复杂运动/长视频的质量损失、以及对非骁龙硬件的可迁移性仍待观察。 2. Dynamic-in-Few-Step:少步蒸馏配动态稀疏30倍 Dynamic-in-Few-Step: Unifying Dynamic Computation and Few-Step Distillation for Efficient Video Generation | 西湖大学·vivo·浙大 | arXiv:2607.06631 关键词:视频扩散,少步蒸馏,动态稀疏,模型混合,后训练加速 前序问题:视频扩散质量高但算力昂贵;少步蒸馏虽提速,却对所有去噪阶段强制统一的静态结构,忽视了不同噪声水平天然不同的算力需求。 本文贡献:提出后训练加速框架,把动态结构稀疏化直接融进蒸馏过程:不同于对固定管线做事后压缩,它联合优化去噪步数与结构稀疏度,把预训练视频扩散变成紧凑的、逐步专用的模型混合(Mixture-of-Models, MoM);并用渐进训练策略+输出回滚机制解决联合优化的训练不稳定,配套专用推理引擎高效部署。 实验效果:与现有加速技术正交且高效:在 Wan-14B 上,在 4 步蒸馏基础上再去掉 24% 的每步 FLOPs、额外带来 1.2× 墙钟加速,相对 50 步教师达到 30× 提速,同时保持有竞争力的生成质量。 批判点评:抓住「不同噪声步算力需求不同」这一被少步蒸馏忽视的冗余,用逐步专用 MoM 把动态稀疏与蒸馏联合优化、且与其它加速正交,思路精准、30× 提速实在。但 MoM 带来路由与部署复杂度、需专用推理引擎,「4 步基础上再省 24% FLOPs」的绝对增益有限,训练稳定性靠渐进策略+回滚机制维持、调参成本与更大规模泛化仍待看。 3. FourTune:全4bit后训练提速2.27倍 FourTune: Towards Fully 4-Bit Efficient Post-Training for Diffusion Models | MIT·Stanford·CMU | arXiv:2607.05711 关键词:扩散模型,4-bit量化,后训练,LoRA,FLUX 前序问题:大扩散模型后训练受显存占用大、训练慢制约,现有参数高效微调(PEFT)只能部分缓解,始终困在「省显存却不省算力」的内存-速度权衡里(如 LoRA 全精度骨干仍占大量显存、QLoRA 频繁在线反量化反增开销)。 本文贡献:提出 FourTune,基于端到端 W4A4G4(权重/激活/梯度全 4-bit)的高效后训练框架:三分支混合管线在标准 LoRA 上增设冻结的数值稳定器,隔离对量化敏感的离群值,从而在原生 4-bit 计算下稳定训练;并用硬件友好的分块量化与定制融合算子支持高效量化反向传播、降低显存带宽开销。 实验效果:在定制化、强化学习、蒸馏三类任务上均可匹配全精度微调质量;在 FLUX.1-dev(12B)上,相比 BF16 LoRA 显存开销降低 2.25×、端到端训练吞吐提升 2.27×。 批判点评:把量化从推理推进到「后训练全 4-bit(含梯度)」,用冻结数值稳定器隔离离群值破解 4-bit 训练不稳定,配定制融合算子拿到 2.25× 显存/2.27× 吞吐,MIT/Stanford/CMU 这套量化天团工程含金量高。但 W4A4G4 依赖特定硬件与定制 kernel、通用性受限,数值稳定器额外分支的开销、以及更大模型/更长训练下 4-bit 梯度的精度累积误差仍需更多验证。 4. Gen4U:冻结视频扩散当通用编码器 Gen4U: Unifying Video Generation and Understanding via Diffusion | Google DeepMind | arXiv:2607.06856 关键词:视频扩散,生成理解一体化,表征探测,视频编码器,零样本 前序问题:以往认为扩散表征只擅长低层几何、拙于高层语义,生成与理解被割裂看待;能否让同一个视频扩散模型既生成又理解,缺乏系统证据。 本文贡献:用互近邻(mutual-kNN)对齐度量系统探测 SOTA 视频扩散(Veo3、Wan2.2)的中间激活,揭示其潜空间沿网络深度与噪声水平高度结构化:中等噪声给出线性可分的全局语义,低噪声保留细粒度细节但空间分散、需注意力解码。据此提出 Gen4U,用单次前向复用这些生成表征,把冻结的大规模视频扩散直接当作强视频编码器。 实验效果:冻结、免微调的视频扩散在视频分类、深度估计、相机位姿估计、图像/视频描述等一系列语义与非语义任务上都极具竞争力,在保留原模型高质量生成能力的同时统一了生成与理解两大范式。 批判点评:用对齐度量把「视频扩散潜空间怎样编码语义」讲清楚,并证明冻结模型免微调即是强编码器,是对「生成即理解」的漂亮实证,DeepMind 用 Veo3 背书说服力强。但探针依赖对 mutual-kNN 等度量与噪声/层位的精心选点,下游任务用简单读出头、与专用微调 SOTA 仍有差距,且强依赖顶级视频扩散(Veo3 闭源),可复现与在更弱模型上的普适性存疑。 5. LightCrafter:PBR代理视频重打光更可控 LightCrafter: PBR-Conditioned Video Diffusion Refinement for Controllable and Consistent Relighting | CMU·多伦多大学·博世 | arXiv:2607.08016 关键词:视频重打光,PBR渲染,视频翻译,时序一致,CogVideoX 前序问题:视频重打光要同时兼顾长时时序一致与基于物理的光传输,依赖对材质/几何/光照等本征属性的准确估计。已有两条路都不理想:逆渲染+正渲染重建噪声大、难处理全局光照;生成式视频到视频翻译则可控性差、时序不稳、且受配对训练数据限制。 本文贡献:提出 LightCrafter 混合管线,把视频重打光重构为「对一段代理视频做视频翻译」:不直接翻译输入视频,而是把「输入在目标光照下的 PBR 渲染」翻译为最终结果——将光照目标烘焙进 PBR 代理,免去教扩散模型理解环境贴图等光照概念,既能实现更精细的光照控制、又天然带来长时时序一致。为补足 PBR 难建模的全局光照,在合成配对视频+真实无配对视频上后训练 CogVideoX 以调用视频生成模型的光度先验。 实验效果:在真实世界重打光基准上超越此前 SOTA,并贡献了一个用于深入分析的合成基准;将开源数据集、基准、指标与代码。 批判点评:用「PBR 代理+视频翻译」把光照控制从难教的生成条件变成可烘焙的物理渲染,兼得可控性与时序一致,思路巧妙、实测超 SOTA。但方案质量受前置 PBR 渲染(依赖本征估计)的上限约束,全局光照仍要靠后训练 CogVideoX 兜底,两阶段管线的复杂度、以及对复杂材质/强动态场景的泛化仍待检验。 6. FADRA:频率感知扩散修复视频人脸 FADRA: Frequency-Aware Diffusion with Residual Adaptation for Video Face Restoration | UAE大学·中国海洋大学·MBZUAI | arXiv:2607.06389 关键词:视频人脸修复,频率感知,扩散模型,残差自适应,时序一致 前序问题:视频人脸修复(VFR)要从严重退化的视频里恢复高质量且时序一致的面部细节,现有方法难以在空间保真与时序连贯间取得平衡。 本文贡献:提出 FADRA,频率感知+迭代残差自适应的扩散框架:借预训练文生视频扩散的强时序一致性,用轻量 LoRA 适配器+低质(LQ)像素对齐特征融合高效迁移冻结生成先验;再引入重复残差自适应头(RRAH)在骨干后做逐步残差精修——RRAH 把 LQ 潜变量与当前速度预测一起作输入,在每个流匹配步反复回看 LQ 线索、预测残差更新;另设频率感知损失在多个频段显式监督、强调对感知质量关键且易时序抖动的频率分量。 实验效果:恢复出更好的面部结构、产出比 SOTA 更时序一致的视频,在定量指标与主观感知上均有明显提升。 批判点评:用「LoRA 迁移生成先验+RRAH 逐步残差回看 LQ+频率感知损失」三招治 VFR 的空间-时序权衡,把频域监督用在易抖动分量上很对症。但方法叠了多个模块、对预训练文生视频先验依赖强,RRAH 重复精修的推理开销、以及在极端退化或大姿态/遮挡人脸上的鲁棒性仍需更多验证。 7. DiffCVE:编码先验引导压缩视频增强 DiffCVE: Diffusion-based Compressed Video Enhancement | 武汉大学 | arXiv:2607.07195 关键词:压缩视频增强,编码先验,扩散模型,QP条件,VAE解码 前序问题:严重压缩视频的感知质量增强很难:伪影模式复杂、信息损失大;直接套用扩散模型往往忽视压缩退化特性,还可能引入与结构不一致的幻觉。 本文贡献:提出 DiffCVE:用编码先验增强的双条件(CPDC)分支联合建模压缩视频与编码先验,让残差、运动矢量等编码先验在去噪过程中提供互补的结构与运动引导;用压缩退化语义提示(CDSP)以 QP 条件文本提示+LoRA 微调让扩散过程感知压缩严重程度;再在 VAE 解码器里加入编码先验引导的加权融合(CPWF),用 QP 预测的权重融合 VAE 编码器与编码先验编码器特征。 实验效果:在提升感知质量上效果显著,尤其在严重压缩设置下优势明显;项目页提供了增强视频演示。 批判点评:把「编码先验(残差/运动矢量/QP)」这一压缩视频独有信息喂进扩散去噪与解码,对症「忽视退化特性+幻觉」两大痛点,充分利用视频编码域知识很务实。但强依赖可拿到的编码先验(需解码端配合)、QP 条件与三模块叠加的复杂度,以及在跨编码标准/未知码率下的泛化仍待验证。 8. Flowley:端到端单阶段视频配音 Precise Video-to-Audio Generation with Cross-Modal Alignment in Latent Space | FPT Software·NVIDIA | arXiv:2607.06405 关键词:视频到音频,端到端,交叉注意力,音视频同步,VGGSound 前序问题:视频到音频(V2A)要为无声视频合成语义一致且时序同步的声音,但许多方法靠多阶段训练(算力高、耗时长),或把视觉转成文本以借用文生音频模型(牺牲细粒度时序线索)。 本文贡献:提出 Flowley,端到端单阶段训练架构,融合视觉特征与文本提示生成配音;核心是渐进软掩码交叉注意力,把音视频同步直接嵌进注意力机制、相较标准注意力零额外算力;并提出即插即用的 SoundCap 管线,为视频生成细粒度、声音导向的描述来引导模型(弥补现有 V2A 基准缺乏声音描述的问题)。 实验效果:不集成任何预训练音视频对齐模块,Flowley 在 VGGSound 多项指标上达到 SOTA;引入 SoundCap 后,零样本设置下音频质量进一步超过最强的闭源方法。 批判点评:用「软掩码交叉注意力零成本内建同步+SoundCap 补声音描述」把 V2A 做成单阶段端到端,免掉专用对齐模块还拿 SOTA,简洁高效。但收益部分来自 SoundCap 描述质量(引入额外描述管线),VGGSound 之外更开放场景的时序精准同步、以及对无明显声源/复杂多声源视频的泛化仍待验证。 9. SR-FD:分布正则降少步TTS错字36% Fréchet Distance Loss on Speech Representations for Text-to-Speech Synthesis | 台湾大学·华盛顿大学 | arXiv:2607.06027 关键词:语音合成,流匹配,Fréchet距离,分布正则,少步采样 前序问题:少步扩散/流匹配 TTS 通常用条件流匹配、重建、停止预测等局部目标训练,优化稳定却从不追问「采样出的语音是否服从高质量语音的分布」。 本文贡献:提出语音表征 Fréchet 距离损失(SR-FD),一种面向免 tokenizer 流匹配自回归 TTS 的训练期分布正则:微调时模型用与部署一致的少步采样器合成语音,SR-FD 把该语音的冻结 Whisper 与 CTC 特征的均值和协方差,对齐到离线从三种互补内容目标算好的参考统计;无需判别器、也不增加推理期计算。 实验效果:在 Seed-TTS 英文上,四步 SR-FD 微调把 WER 从四步 VoxCPM2 基线的 2.2279% 降到 1.4147%(相对降 36.5%),还超过原十步基线的 1.7366%;说话人相似度与客观质量代理保持在十步水平。 批判点评:把「生成分布是否像真语音」用 Fréchet 距离显式约束、且无判别器/零推理开销,让四步 TTS 可懂度反超十步基线、WER 降 36.5% 很漂亮。但增益主要体现在可懂度(WER)、对音色/韵律等主观维度提升有限,依赖 Whisper/CTC 特征与离线参考统计的选取,跨语言/多说话人与更大模型上的迁移仍待验证。 10. AEGIS:定位注意力头防视觉同义越狱 AEGIS: A Mechanism-Guided Defense against Visual Synonym Jailbreaks in Text-to-Image Models | 复旦·阿里 | arXiv:2607.06120 关键词:文生图,安全对齐,越狱防御,注意力头,推理期干预 前序问题:文生图扩散虽保真度高、应用广,却易被「视觉同义词攻击(VSA)」越狱——看似良性的提示通过隐式视觉联想诱导出违禁图像;现有防御大多围绕过滤/编辑时显式暴露的不安全概念,对 VSA 留有盲区,陷入「防不住 VSA 或误伤相似良性概念」的安全-效用两难。 本文贡献:从「静态压制预设不安全概念」转向「动态追踪不安全语义如何在生成中涌现」。机理分析发现:VSA 与显式不安全提示都通过稀疏的「语义注入注意力头」收敛,这些头是违禁视觉语义的推理期瓶颈。据此提出 AEGIS(经识别与引导的自适应规避防护),一种推理期防御,仅在被识别出的脆弱注意力头上施加相似度感知的排斥。 实验效果:对比 16 个基线,AEGIS 同时提升安全与效用:在 SD 1.4 上把域内暴力/裸露 VSA 的攻击成功率(ASR)降到 0.00/0.03、域外显式与对抗攻击 ASR≤0.09;保持良性图像保真、不误伤难负概念,并可在重识别关键头后迁移到 SD 2.1 与 FLUX.1。 批判点评:用机理分析锁定「语义注入注意力头」这一 VSA 瓶颈、只在少数脆弱头做定向排斥,既躲开全局压制的误伤又不需重训,把安全-效用两难做出正收益、还能跨模型迁移,思路犀利。但依赖对脆弱头的准确识别(每个骨干需重识别),面对自适应攻击者绕开这些头、或更强开源模型上的稳健性仍是开放问题,推理期干预对生成多样性的潜在影响也需观察。 趋势观察 视频生成加速冲向端侧与实时 — MobileWan 把 5B 视频扩散塞进手机 NPU、Dynamic-in-Few-Step 在 Wan-14B 上做到 30× 提速,视频扩散加速正从「云端少步」推进到「端侧部署+动态稀疏」,落地门槛快速下探。 量化从推理走进后训练全链路 — FourTune 把权重/激活/梯度全压到 4-bit 做后训练,在 FLUX 12B 上省 2.25× 显存,低比特正从推理阶段延伸到微调/强化学习/蒸馏的完整后训练闭环。 视频扩散正成为通用视觉基座 — Gen4U 证明冻结的视频扩散免微调即是强编码器,可同时做生成与分类/深度/位姿/描述,「生成即理解」让一个大模型统一多任务成为新范式。 视频修复复用生成先验+物理/编码先验 — LightCrafter 用 PBR 代理烘焙光照、FADRA 用频率感知残差修脸、DiffCVE 用编码先验补压缩视频,视频修复类工作普遍「借预训练生成先验+注入领域先验」提质。 多模态生成扩到音频且更重安全 — Flowley 单阶段视频配音、SR-FD 用分布正则提 TTS 可懂度,音频生成同步演进;AEGIS 则用机理定位注意力头防 T2I 越狱,安全从静态过滤转向生成期动态干预。 人工智能炼丹君 整理 | 2026-07-10 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-03|北航ETH免训练让FLUX画图提速25倍MrFlow 今日 AIGC 论文速览 今日共 5 篇 · 文生图生成加速与效率 2 篇 · 可控图生视频 1 篇 · 生成安全与对齐 1 篇 · 多模态视觉推理与评测 1 篇 重点论文标题列表 MrFlow(北航·ETH苏黎世):免训练多分辨率提速25倍 GEAR(北大·腾讯混元):端到端联训VQ与自回归 TrajLoc(Amazon·特拉维夫大学):注意力高斯热图控多物体 SAGE(中佛罗里达大学):揭穿安全对齐高效用假象 PixelEyes(武汉大学·UC Merced):解耦推理与感知精准定位 今日论文速览 1. MrFlow:免训练多分辨率提速25倍 Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling | 北航·ETH苏黎世 | arXiv:2607.01642 关键词:文生图,流匹配,免训练加速,多分辨率,超分辨率 前序问题:文生图扩散/流匹配质量随规模提升而算力暴涨(Qwen-Image-20B 单张 1024² 在 A100 上采样达 47 秒);已有免训练多分辨率加速在潜空间做上采样并选择性修改局部,常带来明显模糊或伪影。 本文贡献:提出 MrFlow——面向预训练流匹配模型的免训练多分辨率加速:分阶段「低分辨率快速生成主结构 → 像素空间用轻量预训练 GAN 超分 → 注入低强度噪声做高频重采样 → 高分辨率精修细节」,利用图像在不同分辨率下的结构一致与细节差异实现由粗到细的高效生成,无需任何训练或运行时动态识别,且可与时间步蒸馏正交叠加。 实验效果:在 FLUX.1-dev 与 Qwen-Image 上端到端加速达 10×,OneIG 指标较加速前差距控制在 1% 以内,显著超越其他免训练加速策略;叠加预训练蒸馏权重后进一步冲到 25× 加速。 批判点评:把「先低分辨率出结构、再像素超分、最后高分辨率精修」串成免训练流水线,几乎零训练成本换来 10-25× 提速、还能与蒸馏正交叠加,对 FLUX/Qwen-Image 这类主流模型即插即用,工程性价比极高。但收益依赖轻量 GAN 超分网络质量(论文也承认 Real-ESRGAN 最平衡),像素超分对强纹理/文字细节可能引入偏差、需高分辨率步纠正,极端 25× 场景仍要借蒸馏权重、并非纯免训练。 2. GEAR:端到端联训VQ与自回归 GEAR: Guided End-to-End AutoRegression for Image Synthesis | 北大·腾讯混元 | arXiv:2606.32039 关键词:自回归生成,VQ tokenizer,表征对齐,端到端训练,ImageNet 前序问题:视觉生成通常两阶段训练——先训 tokenizer 做重建再冻结,再在其离散索引/连续潜上训生成器;这种解耦让 tokenizer 完全不知道生成器「什么好建模」,且 VQ 索引不可微、直通估计(STE)会崩,梯度无法回传到 tokenizer。 本文贡献:提出 GEAR,端到端联合训练 VQ tokenizer 与自回归(AR)生成器,用表征对齐引导。关键是对码本分配做「双读出」:硬 one-hot 分支用下一 token 预测训练 AR,可微软分支携带表征对齐损失、只回传去引导 tokenizer——让 AR 主动把 tokenizer 推向自己更易预测的索引分布,把对齐负担从 tokenizer 转移到 AR(与扩散侧「让潜变量本身更语义」的做法正相反)。 实验效果:相比强基线 LlamaGen-REPA,ImageNet gFID 收敛最高提速 10×,学到明显更好的 patch 级、空间连贯特征,并可泛化到多种量化器(VQVAE/LFQ/IBQ)与文生图任务。 批判点评:用「双读出」优雅绕开 VQ 不可微、把表征对齐负担从 tokenizer 挪到 AR,是对两阶段范式的一次范式级反思,收敛提速 10× 且跨量化器/文生图泛化,北大+腾讯混元背景也更接近落地。但端到端联训的稳定性与显存开销、软分支对齐目标的设计敏感度,以及在更大分辨率/更大码本下能否延续优势仍待验证。 3. TrajLoc:注意力高斯热图控多物体 TrajLoc: Trajectory-Attention Localization for Multi-Object Motion Control | Amazon·特拉维夫大学 | arXiv:2607.00861 关键词:图生视频,多物体控制,轨迹控制,交叉注意力,身份保持 前序问题:图生视频(I2V)里控制多物体运动,既要保各自身份、又要遵循不同目标轨迹;已有方法把多条轨迹揉进共享的稠密条件信号,物体越多、路径交叉遮挡时对象级对应越难保持。 本文贡献:提出 TrajLoc,为每个物体施加严格的逐对象空间约束、彼此隔离:直接在注意力层里把每个物体 token 的交叉注意力权重替换为「以其每帧目标位置为中心的高斯热图」;同一套逐对象 token 接口通过可学习嵌入携带轨迹与深度,并以编码首帧外观替代物体 token 来保持身份一致。 实验效果:在含最多 20 个同时受控物体及分布外真实场景的六个数据集上,视觉保真与轨迹遵循度一致提升;应用于 CogVideoX-5B 与 Wan2.1-14B 两种异构骨干,较最强基线平均 +4.3 dB PSNR、轨迹终点误差降低 51%。 批判点评:用「把交叉注意力权重直接换成高斯热图」实现逐物体硬空间约束,简洁、可跨 CogVideoX/Wan2.1 骨干迁移,20 物体拥挤场景下轨迹终点误差降 51% 很实在。但高斯热图是相对刚性的先验,对形变大/尺度剧变或非刚体运动可能过约束,深度与轨迹共用一套 token 的表达上限、以及热图中心定位对细粒度交互(接触/穿插)的处理仍待观察。 4. SAGE:揭穿安全对齐高效用假象 The Illusion of High Utility in Safety Alignment of Text-to-Image Diffusion Models | 中佛罗里达大学 | arXiv:2607.00402 关键词:文生图,安全对齐,语义坍缩,几何正则,TIFA 前序问题:文生图安全对齐要压制有害生成同时保住良性提示的效用,但现有「高安全+高效用」的结论多建立在 FID/CLIPScore 等粗粒度全局指标上,对细粒度语义正确性不敏感,制造了「高效用假象」。 本文贡献:用结构化评测(TIFA 问答式忠实度)戳穿假象——安全对齐模型在物体数量、属性、关系上语义保真明显下滑;进而定位根因为文本编码器嵌入空间的「语义坍缩」(嵌入分布收缩+提示间相似结构扭曲),且与结构化效用损失强相关。据此提出结构感知几何正则(SAGE),在对齐时显式保住嵌入分布展度与提示间关系结构。 实验效果:SAGE 恢复了结构化效用(TIFA 较此前 SOTA +5.0%),同时保持强安全性能与有竞争力的粗粒度效用分数(已被 ECCV 2026 接收)。 批判点评:从「粗指标掩盖语义退化」这一反直觉观察出发、用嵌入几何正则对症「语义坍缩」,视角犀利、从诊断到方案闭环完整,TIFA +5.0% 也证明可恢复细粒度效用。但方案聚焦文本编码器嵌入几何、对更深层去噪网络诱发的语义损失覆盖有限,安全与效用的权衡在更强攻击/更广有害概念下能否稳住、以及 TIFA 之外评测的一致性仍需扩验。 5. PixelEyes:解耦推理与感知精准定位 PixelEyes: Decoupling Perception and Reasoning for Pinpoint Visual Evidence Seeking | 武汉大学·UC Merced | arXiv:2607.00115 关键词:多轮视觉推理,MLLM,指代分割,视觉搜索,评测基准 前序问题:多轮视觉推理里,MLLM 反复定位失败导致轨迹又长又冗余;根因是推理与感知纠缠在同一模型内——边推理边定位,定位不准又触发更多推理轮次、把轨迹撑大。 本文贡献:提出 PixelEyes,把推理与感知显式解耦:推理器只决定「找什么」,专用感知工具回答「在哪」。含两招——(1) 掩码引导视觉搜索:调用指代分割模型给出掩码级精确定位,免去推理器补偿粗糙 grounding;(2) 语义区域广度优先搜索(BFS):把探索组织为对语义区域的 BFS,消除反复裁剪错误子区域造成的冗余回路。并通过重合成专家轨迹构建 PixelEyes-6K 数据集,另建零提示视觉搜索基准 Pinpoint-Bench(含实例级掩码/框,区分定位失败与推理失败)。 实验效果:近期 SOTA 的 MLLM 与视觉推理智能体在 Pinpoint-Bench 上仍留有很大提升空间,印证其质量与难度;代码与模型已开源。 批判点评:把「推理定位纠缠」拆成「推理器+分割感知工具」两件事、再用语义区域 BFS 剪掉冗余回路,思路清晰且直击多轮视觉搜索的实际痛点,配套 Pinpoint-Bench 也补齐了「定位 vs 推理」失败区分的评测缺口。但方案依赖外部指代分割模型精度、分割错误会直接卡住定位,BFS 在超大图/极多语义区域下的开销,以及它属视觉理解/grounding 而非生成、与生成一体化的结合仍需后续工作。 趋势观察 免训练加速把文生图推向实时 — MrFlow 用分阶段多分辨率+像素超分免训练冲到 10-25×,加速正从「靠蒸馏训练」转向「零训练即插即用」,让 FLUX/Qwen-Image 这类大模型的推理成本快速下探。 端到端联训打破生成的两阶段范式 — GEAR 用双读出让 AR 反过来引导 tokenizer,把「先训 tokenizer 再训生成器」的解耦范式改成端到端联合优化,ImageNet 收敛提速 10×,范式级重构正在自回归生成里发生。 可控生成从单目标走向多物体精细约束 — TrajLoc 在注意力层用逐物体高斯热图硬约束最多 20 个物体的轨迹与身份,可控视频生成的粒度从「整体运动」细化到「每个实例的路径」。 生成安全开始正视效用的真实代价 — SAGE 揭穿安全对齐「高效用假象」,用结构化评测与嵌入几何正则守住细粒度语义,安全研究从「粗指标达标」转向「细粒度效用可验证」。 视觉智能体靠解耦感知与评测基准补短板 — PixelEyes 把推理与感知解耦、配套 Pinpoint-Bench,多轮视觉搜索开始用专用感知工具+可区分失败类型的基准来定位瓶颈。 人工智能炼丹君 整理 | 2026-07-03 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-02|快手可灵MemLearner可学习记忆视频世界模型 今日 AIGC 论文速览 今日共 9 篇 · 视频世界模型与人像动画 2 篇 · 图像生成与编辑 3 篇 · 蒸馏加速与模型压缩 2 篇 · 语音合成与生成媒体 2 篇 重点论文标题列表 MemLearner(港大·快手可灵):可学习记忆查询的视频世界模型 WarpI2I(卡内基梅隆):显著区warp保结构做图像翻译 MEPA(西电·华为):VAR配MoE解耦多尺度表征 Cross-Space Distillation(VinAI·罗格斯):跨潜空间蒸馏一步学生 SyncCache(北大·上海AILab·vivo):音频驱动人像动画缓存加速 今日论文速览 1. MemLearner:可学习记忆查询的视频世界模型 MemLearner: Learning to Query Context Memory for Video World Models | 港大·快手可灵 | arXiv:2606.31734 关键词:视频世界模型,记忆,上下文查询,一致性,交互生成 前序问题:视频世界模型据用户动作与历史帧预测未来世界状态,但缺乏记忆导致长时生成场景不一致;此前基于规则的上下文帧检索在遮挡与动态物体场景下泛化差。 本文贡献:提出基于学习的自适应上下文查询 MemLearner:用 query token 桥接上下文与预测 token,直接借视频生成模型自身做上下文查询,复用预训练视觉先验、无需从零训额外模块,并含高效训练/推理策略。收集含遮挡与动态物体的长视频数据集(带相机位姿标注),提出兼用带标注渲染与无标注真实视频的多数据集训练策略。 实验效果:在场景一致性与记忆上显著超过此前视频世界模型,尤其在遮挡与动态挑战场景下优势明显。 批判点评:把「记忆检索」从规则升级为可学习查询、且复用生成模型自身先验,是对世界模型长程一致性痛点的对症之解,有快手可灵背景更接近落地。但仍依赖带位姿标注数据构建、查询机制在超长时程下的累积漂移,以及对开放世界更复杂交互的泛化仍待检验。 2. WarpI2I:显著区warp保结构做图像翻译 WarpI2I: Image Warping for Image-to-Image Translation | 卡内基梅隆 | arXiv:2606.31018 关键词:图像翻译,重打光,显著性,图像warp,扩散模型 前序问题:图像到图像(I2I)翻译在人像重打光、驾驶场景翻译等任务上已见成效,但紧凑型潜在扩散模型(LDM)的编码器把高分辨率输入压到空间下采样的潜空间,常难保细粒度结构。 本文贡献:提出简单的显著性引导 warp-unwarp 框架:编码前把空间表征向显著区域重分配(warp),在不提高潜空间分辨率的前提下更好保留结构细节;warp 后的图像交给原扩散模型处理,再经逆 warp 映回。另配一个基于 outpainting 的高效合成数据生成管线,为图像重打光产出高质量配对数据。方法与模型无关、无需改架构、几乎零额外算力。 实验效果:在人像重打光、驾驶场景重打光与翻译上,结构保持、光照忠实度与画质均提升;逐帧应用即可自然扩展到视频且时序稳定性好。 批判点评:「warp 到显著区再 unwarp」用几乎零成本换取结构保真,即插即用、跨模型通用,工程性价比高。但显著性估计的质量直接决定收益,非均匀形变对非显著区/大范围全局变化可能引入损失,视频靠逐帧应用而非原生时序建模也限制了强运动场景。 3. MEPA:VAR配MoE解耦多尺度表征 MEPA: Multi-Scale Representation Alignment for Visual Autoregressive Modeling with Mixture of Experts | 西电·华为 | arXiv:2607.00371 关键词:视觉自回归,MoE,多尺度,ImageNet,自监督 前序问题:视觉自回归(VAR)开创由粗到细的多尺度自回归生成,但多尺度表征学习存在固有缺陷:低尺度主要捕全局语义、高尺度关注细节,跨尺度共享架构引发优化冲突;且因果自回归下早期尺度的错误语义会传播并显著劣化最终输出。 本文贡献:提出尺度感知 token 路由的 MoE 架构,允许按尺度自适应选专家、解耦各尺度表征学习;并用外部自监督特征增强早期尺度语义建模——非朴素对齐,而是为 VAR 范式设计残差特征聚合方案。 实验效果:ImageNet 256² 上,仅用默认一半训练轮次、更小参数预算即取得优于稠密基线的 FID,训练成本仅微增;随训练轮次增大差距进一步拉开。 批判点评:用 MoE 按尺度分工+自监督特征补早期语义,精准对症 VAR 的跨尺度冲突与误差传播,训练效率提升实在。但 MoE 带来路由与部署复杂度,「一半轮次超稠密」的优势在更大规模/更高分辨率与文生图场景能否延续仍待验证。 4. Cross-Space Distillation:跨潜空间蒸馏一步学生 Cross-Space Distillation: Teaching One-Step Students with Modern Diffusion Teachers | VinAI·罗格斯 | arXiv:2606.32020 关键词:扩散蒸馏,一步生成,跨潜空间,SD1.5,部署 前序问题:现代一步扩散靠基于分布的时间步蒸馏获高质量,却依赖「师生须同一潜空间」这一关键假设,阻止把 SD3.5/Flux 等高容量老师的知识迁到潜分辨率与 VAE 参数化都不同的紧凑学生(如 SD1.5)。 本文贡献:形式化提出 Cross-Space Distillation(师生在潜分辨率与 VAE 空间双双不同),并引入 Bridge——轻量潜空间接口,把学生潜变量映到老师空间而不改学生骨干:以冻结的学生 VAE 解码器作空间先验+紧凑可学习投影器,用潜重建与注意力保真目标训练以稳定对齐老师空间(ECCV 2026)。 实验效果:跨多种现代老师,Bridge 为紧凑一步学生带来显著增益——如把 SD1.5 从 5.4 提升到 9.4 HPSv3,同时保持一步推理、低延迟与广泛生态兼容。 批判点评:打破「师生同空间」限制、用轻量桥接把大老师蒸进小学生,兼顾部署友好与生态兼容,思路清晰、增益明显。但 Bridge 仍需针对师生对训练,跨差异极大的 VAE/分辨率时对齐质量、以及一步学生画质上限能否逼近老师仍是问题。 5. SyncCache:音频驱动人像动画缓存加速 SyncCache: Exploiting Asymmetric Dynamics for Fast Audio-Driven Portrait Animation | 北大·上海AILab·vivo | arXiv:2606.30849 关键词:人像动画,音频驱动,特征缓存,推理加速,唇同步 前序问题:DiT 大幅推进音频驱动人像动画,但算力高、推理延迟大;现有免训练扩散缓存多为文本条件生成设计,忽视人像动画固有的空间与模态不均衡。 本文贡献:提出免训练、面向 DiT 人像动画的缓存加速 SyncCache,显式利用「非对称动态」:音频驱动、集中在人物区域的高频动态比低频视觉背景更难也更关键。用空间非对称探测优先关注动态人区的误差敏感度;用模态解耦缓存跳过重 DiT 块(复用稳定的块间残差)、同时持续重算轻量音频块以保精确唇同步;并把内存自适应缓存选择建模为离线动态规划、无在线开销。 实验效果:在 HunyuanVideo-Avatar 上达 4.12×、Wan-S2V 上 3.75× 加速,视觉近无损且音频对齐精确。 批判点评:抓住「音频高频动态集中在人脸」这一非对称结构做差异化缓存,唇同步与背景分而治之很聪明,加速比可观。但方法针对人像动画定制、跨其他音驱视频任务的通用性有限,缓存比与画质/唇同步的权衡在极端表情/快速语音下仍需验证。 6. AnyBokeh:物理引导任意到任意虚化编辑 AnyBokeh: Physics-Guided Any-to-Any Bokeh Editing with Optical Fingerprint Transfer | 南洋理工 | arXiv:2606.31959 关键词:虚化编辑,景深,物理引导,弥散圆,图像编辑 前序问题:景深控制是摄影基本工具,但单图拍后虚化(bokeh)编辑仍难;现有方法多假设全对焦输入、或先复原全对焦再渲染,会丢弃源图模糊线索并把复原伪影传到最终结果。 本文贡献:提出物理引导的任意到任意虚化编辑 AnyBokeh:不把源模糊当退化去除,而用带符号弥散圆(CoC)图与视差图估计源模糊状态;通过建模「带符号 CoC 与视差差」的线性关系估计源专属「光学指纹」,把源光学特性迁到目标对焦与光圈设置;生成式编辑器以源/目标 CoC 图为条件做相对模糊合成,实现空间自适应的去模糊、保持与散焦渲染。还构建了带精确深度/对焦距离/完整 EXIF 的高保真合成数据集。 实验效果:真实基准上在任意到任意虚化、全对焦到虚化、散焦去模糊上均忠实可控,且免去现有方法常需的全对焦复原与测试时虚化级标定。 批判点评:用「光学指纹+带符号 CoC」把虚化编辑建在物理量上,避开全对焦复原的伪影链,泛化性与可控性都更好。但依赖对 CoC/视差的准确估计,真实复杂场景(多层景深、透明/高光)下物理假设是否成立、合成到真实的域差仍需关注。 7. VitalityCompress:图像到3D扩散模型压缩 Vitality-Aware Compression for Efficient Image-to-Shape Diffusion Transformers | KRAFTON | arXiv:2607.00382 关键词:3D生成,图像到形状,模型压缩,剪枝量化,DiT 前序问题:3D 形状生成进展显著,但大型 DiT 模型在资源受限场景算力过高;其他域的扩散压缩策略难直接迁到 3D,此前 3D 效率工作又多聚焦推理速度而非骨干压缩。 本文贡献:提出首个面向图像到形状(image-to-shape)DiT 的压缩框架:基于「3D DiT 各层对几何合成重要性非均匀」的观察,构建几何感知、以「活力(vitality)」为引导的框架,融合结构化剪枝、自适应量化与定向微调。 实验效果:在多个 SOTA 图像到 3D 模型上实现最高 66% 模型体积缩减,同时保持与全尺寸相当的合成保真度,可作即插即用的高效 3D 生成方案。 批判点评:把「层重要性非均匀」用于几何感知压缩、剪枝+量化+微调三管齐下,填补 3D 骨干压缩空白,通用性不错。但 66% 缩减下几何细节(薄结构/高频表面)的保真边界、量化实际加速高度依赖硬件/kernel,跨更多 3D 表示的迁移仍待看。 8. UniGuidance-FM:统一引导框架加速语音合成 Enhancing Flow Matching with A Unified Guidance Framework for Efficient and Robust Speech Synthesis | 作业帮 | arXiv:2607.00363 关键词:语音合成,流匹配,推理加速,音色泄漏,TTS 前序问题:流匹配(FM)已成语音生成的强范式,但受高推理延迟与音色泄漏制约。 本文贡献:提出统一引导框架,用两条互补策略提升效率与鲁棒:数据侧用异构增强的 Data-guidance 促使模型解耦语言内容与声学残留;模型侧提出增强的 Model-guidance,协同轨迹校正与新颖的内在引导目标,把条件知识蒸进网络权重、拉直推理轨迹,从而免去 Classifier-Free Guidance(CFG)开销。 实验效果:推理提速近 3 倍,同时较 SOTA 基线有效提升说话人相似度(VC 与 TTS 均评)。 批判点评:把「数据解耦+模型内在引导」统一起来同时治延迟与音色泄漏、还省掉 CFG,思路简洁有效、提速实在。但内在引导蒸掉 CFG 后对强可控性/多样性的影响、音色泄漏在跨语言或极端音色下是否彻底解决仍需更多主观评测。 9. Vertigo Vertigo:AI逐场景重构希区柯克名片 Vertigo Vertigo: Reconstructing a Cinematic Ideal through its Predictive AI Double | 伦敦艺术大学 | arXiv:2607.00047 关键词:视频生成,关键帧插值,电影重构,潜先验,生成媒体 前序问题:生成式媒体与经典电影的关系是「范式转变」还是「同一逻辑的加速」?缺乏可量化的探针。 本文贡献:Vertigo Vertigo 用仅 2.78% 原片帧作稀疏关键帧锚点,经大型视频扩散模型做首末帧插值,逐场景重构希区柯克《迷魂记》(1958);把这部「关于强迫性重构人造理想」的电影本身当探针,检验生成系统里编码的经典电影规范(入选 Ars Electronica EXPANDED 2026)。 实验效果:经计算分析与媒体理论学者(Manovich 等)评述,73.1% 的帧可辨认为《迷魂记》的合理再现、仅 3.6% 灾难性失败,表明电影规范被深度压缩进模型潜先验;成片以原片与其「预测影子」的不稳定叠影呈现。 批判点评:把「用 2.78% 帧重构整部经典」做成对生成模型潜先验的文化探针,视角新颖、跨艺术与技术,量化保真数字也有说服力。但本质是艺术/媒体理论作品而非方法创新,'可辨认率'的主观评判、以及结论对不同影片/模型的普适性都有限。 趋势观察 视频世界模型死磕长程一致性 — MemLearner 用可学习记忆查询解决遮挡/动态下的场景漂移,记忆机制成为交互式视频世界模型的核心命题,快手可灵已在推动落地。 用低成本改造换生成保真 — WarpI2I 用显著区 warp 几乎零成本保结构、AnyBokeh 以光学指纹免全对焦复原,'不改架构/不加算力'的即插即用增强成潮流。 加速从缓存到跨空间蒸馏多线并进 — SyncCache 差异化缓存(4.12×)、Cross-Space 把大老师蒸进 SD1.5、UniGuidance-FM 省掉 CFG 提速 3×,效率优化在训练/推理/蒸馏全线展开。 自回归与MoE联手提升生成效率 — MEPA 给 VAR 配尺度感知 MoE,半数训练轮次即超稠密基线,稀疏化正成为提升生成模型训练效率的抓手。 生成扩到3D与文化再创作 — VitalityCompress 压缩图像到 3D 扩散模型(-66%),Vertigo Vertigo 用视频扩散重构经典电影,生成的边界向 3D 与媒体艺术延伸。 人工智能炼丹君 整理 | 2026-07-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
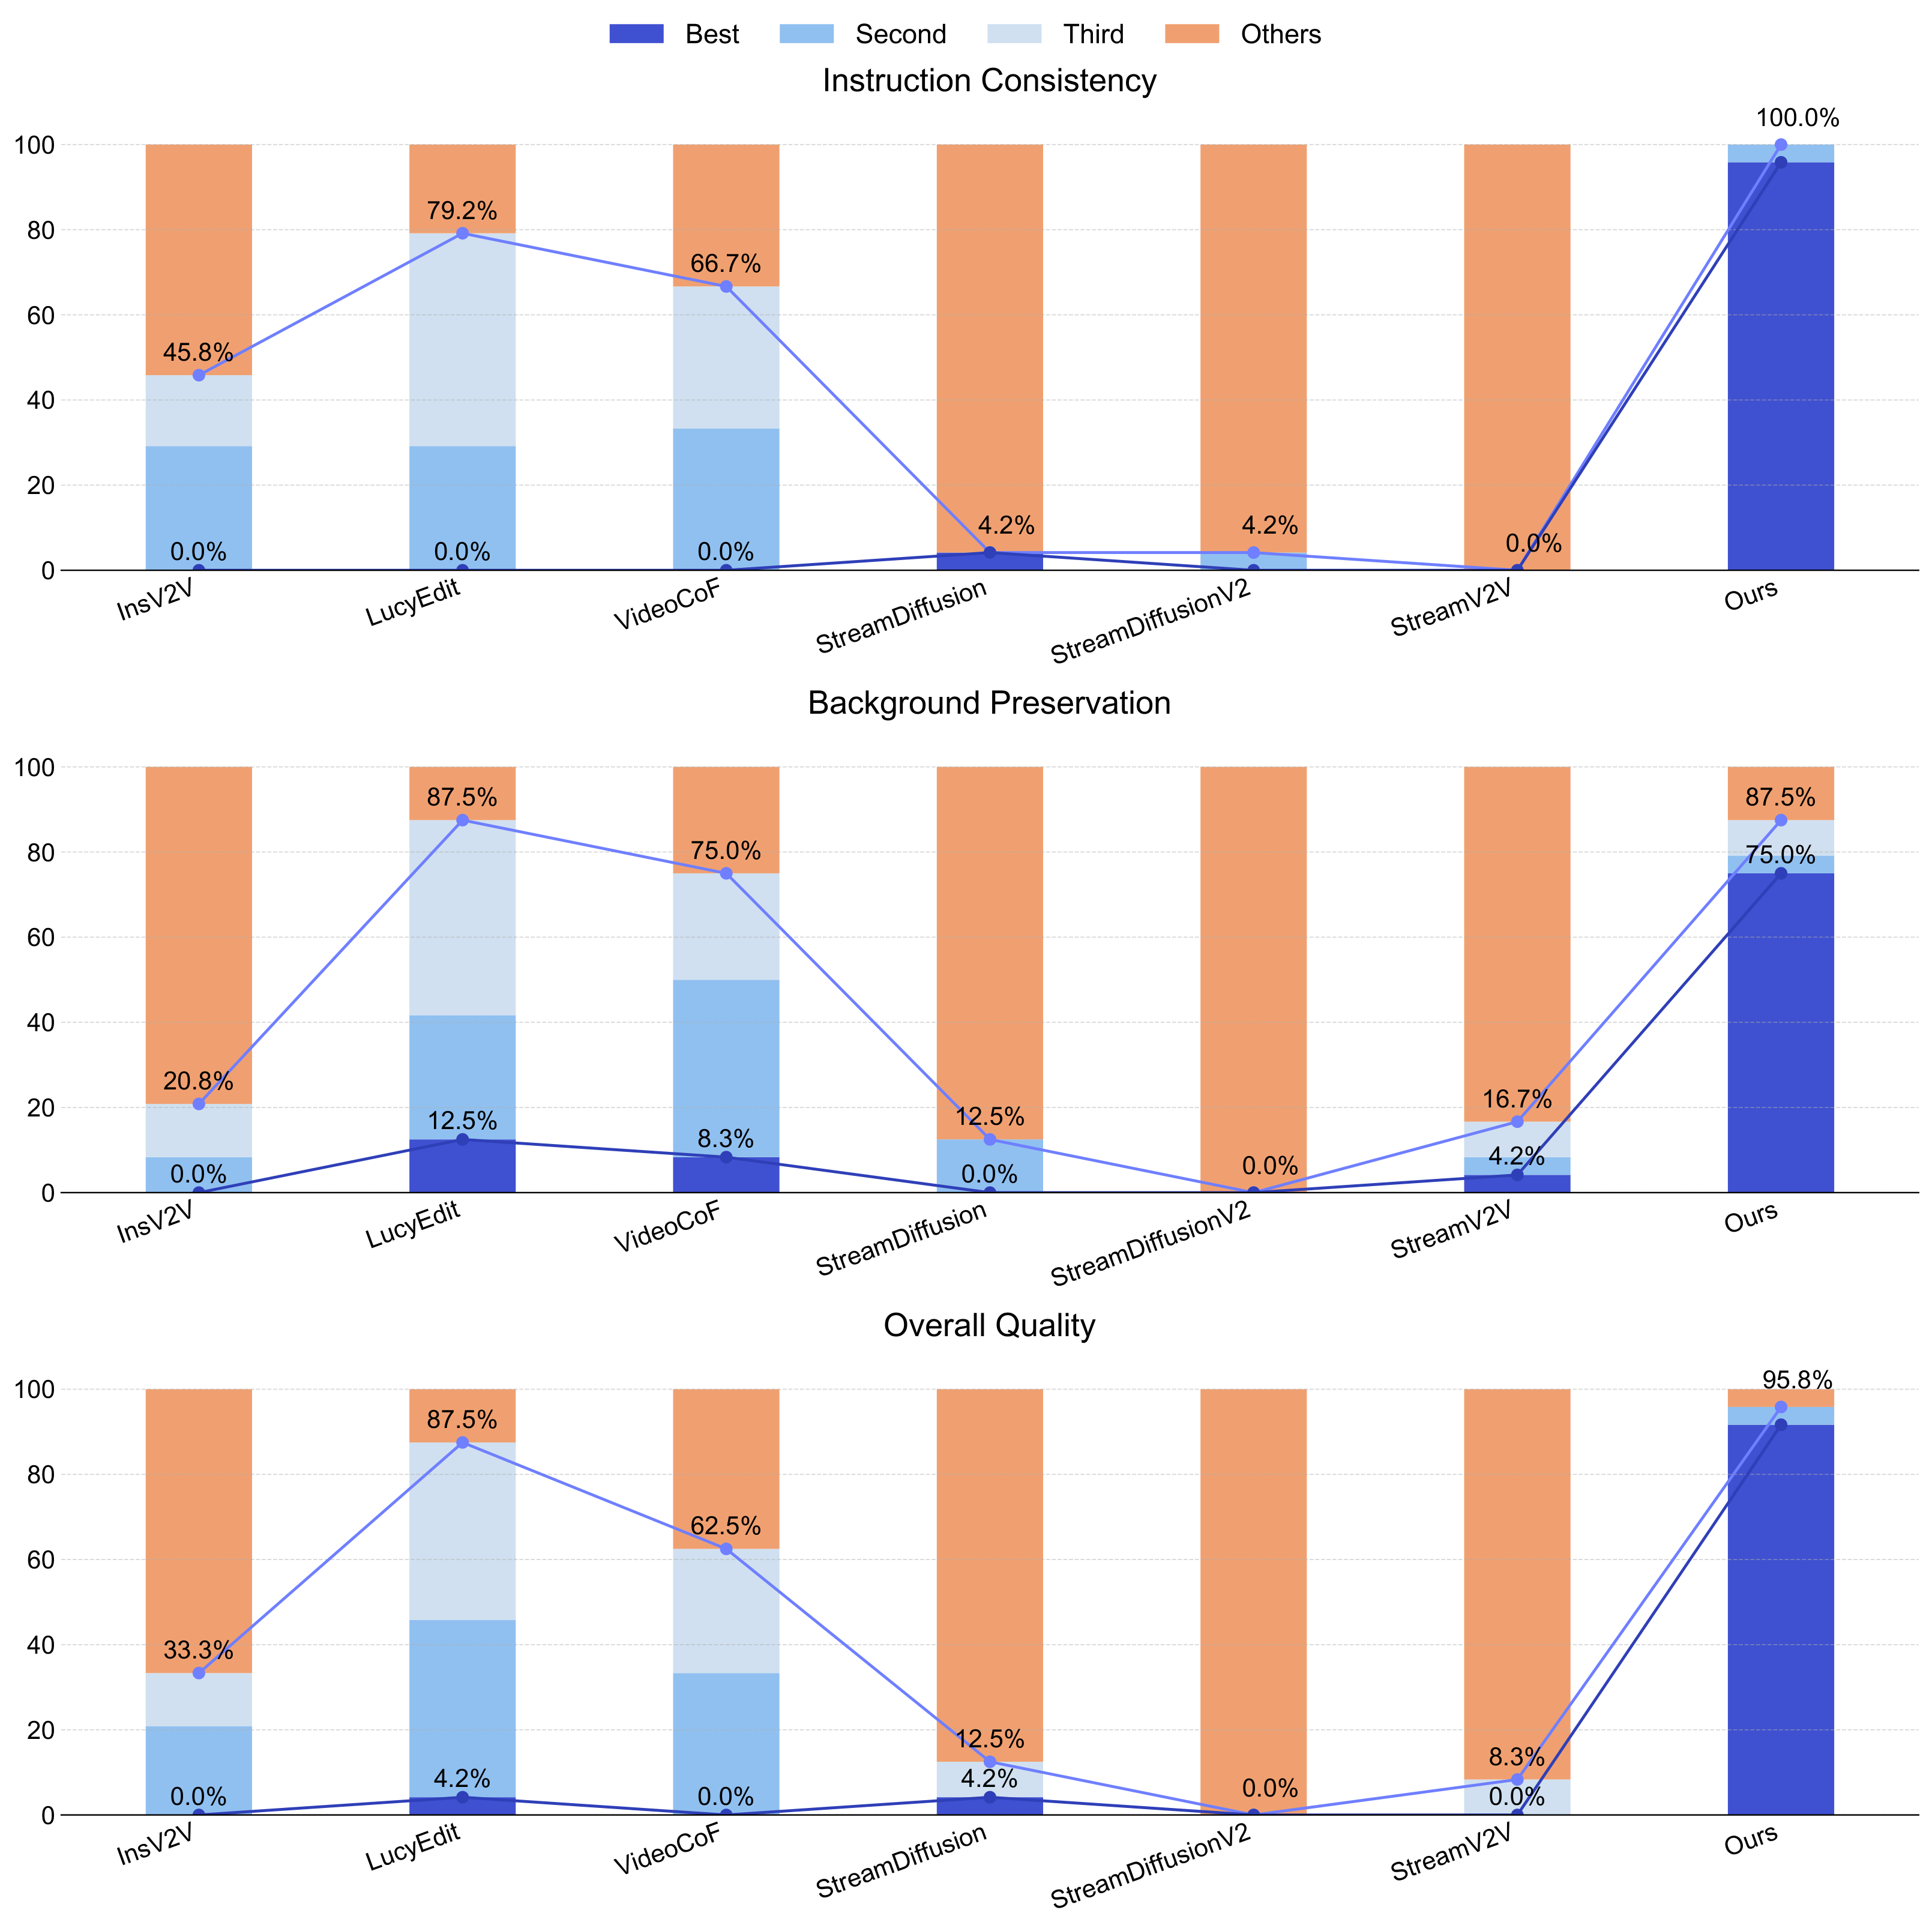
AIGC 每日速读|2026-06-29|清华LiveEdit实时流式视频编辑12.66FPS 今日 AIGC 论文速览 今日共 9 篇 · 视频编辑与生成 3 篇 · 自回归图像生成 2 篇 · 推理加速与压缩 2 篇 · 生成质量与评测 2 篇 重点论文标题列表 LiveEdit(清华·港科大):实时流式视频编辑12.66FPS Causal-rCM(清华·UT Austin·NVIDIA):统一TF+SF自回归扩散蒸馏 PRA(北京大学·深势科技):像素自回归生成新SOTA TMP(腾讯混元):剪枝把80B图像模型塞进4090 LearniBridge(清华(深圳)):可学习特征缓存加速扩散 今日论文速览 1. LiveEdit:实时流式视频编辑12.66FPS LiveEdit: Towards Real-Time Diffusion-Based Streaming Video Editing | 清华·港科大 | arXiv:2606.26740 关键词:视频编辑,流式生成,实时,蒸馏,缓存 前序问题:流式视频编辑落地受两大瓶颈制约:跨时间维持背景与非编辑区稳定,以及实时交互所需的低延迟;而现有流式视频生成方法多为合成设计,因严格保真与区域控制要求无法直接用于编辑。 本文贡献:提出新型流式视频编辑框架,做因果、逐帧编辑且强内容保持、实时响应。核心是三阶段蒸馏管线,把强双向基础模型的编辑能力渐进迁移到高效单向流式编辑器,实现稳定长程编辑而不牺牲画质;并引入面向自回归的 mask cache 跨帧复用区域相关计算,减少冗余、加速推理;还建立了专门的流式视频编辑基准。 实验效果:在流式基线中达到 SOTA 画质,同时把推理速度大幅提升到 12.66 FPS,适配交互与 AR 场景。 批判点评:用「双向→单向」三阶段蒸馏+mask cache 把视频编辑推到实时(12.66FPS),方向价值高、还补齐了流式视频编辑基准空白。但 12.66FPS 距真正流畅交互仍有差距,逐帧因果编辑对快速运动/大幅编辑的长程一致性、以及对复杂编辑指令的上限仍需更多验证。 2. Causal-rCM:统一TF+SF自回归扩散蒸馏 Causal-rCM: A Unified Teacher-Forcing and Self-Forcing Open Recipe for Autoregressive Diffusion Distillation in Streaming Video Generation and Interactive World Models | 清华·UT Austin·NVIDIA | arXiv:2606.25473 关键词:视频生成,自回归扩散,蒸馏,世界模型,一致性模型 前序问题:因果扩散 Transformer 的自回归视频扩散已成实时流式生成与动作可控交互世界模型的主流,但其蒸馏配方缺乏统一、可扩展的开源方案。 本文贡献:把先进蒸馏框架 rCM 扩展到自回归视频扩散,利用前向/反向散度互补——teacher-forcing(TF)对应离线前向散度因果训练、self-forcing(SF)对应在线反向散度精修。贡献含:(1)证明 TF 一致性模型是 SF-DMD 的最佳初始化补充;(2)首次为自回归视频扩散实现连续时间 TF 一致性模型(sCM/MeanFlow),靠自定义 mask FlashAttention-2 JVP kernel 实现,收敛比离散时间快 10×;(3)推出统一可扩展的算法-基建开源配方 Causal-rCM;(4)仅用合成数据训练即在逐帧/分块流式生成上达 SOTA。 实验效果:蒸馏后的 2 步因果 Wan2.1-1.3B 仅 1-2 采样步即得 VBench-T2V 84.63;并应用于全模态世界基础模型 Cosmos 3,实现动作可控的交互世界模型。 批判点评:把 rCM 的「前向×反向散度互补」干净地迁到自回归设定,10× 收敛+全开源配方含金量高,世界模型落地也实在。但收益依赖既有 rCM/DMD 体系与定制 kernel 工程,仅用合成数据训练在真实分布上的泛化、以及 1.3B 规模外的可扩展性仍待看。 3. PRA:像素自回归生成新SOTA Parallel Rollout Approximation for Pixel-Space Autoregressive Image Generation | 北京大学·深势科技 | arXiv:2606.27978 关键词:自回归生成,像素空间,ImageNet,FID,生成理解统一 前序问题:像素空间连续 token 自回归(AR)直接把图像建模为原始像素块序列、免离散分词,但面临耦合难题:高维像素块单步误差大,teacher-forcing 训练又造成训练-推理鸿沟使误差跨步累积;现有 x-prediction、噪声注入只部分缓解,精确 rollout 又因顺序采样太慢不实用。 本文贡献:提出 Parallel Rollout Approximation(PRA):生成低维中间态而非高维像素块,再用像素解码器映回像素 token,保持「像素进-像素出」AR 接口;并通过同一「中间态→像素」路径按位置独立地构造类推理输入,逼近推理时 rollout 的像素反馈接口,同时保留并行 teacher-forcing 训练。 实验效果:ImageNet-1K 256² 类条件生成上,135M 的 PRA-S 取得 FID 2.58,超过此前十亿级像素 AR 的 3.60;511M 的 PRA-L 进一步到 FID 1.94,刷新像素空间 AR 新 SOTA;ImageNet 分类探针准确率也高于其他 AR/扩散基线。 批判点评:用「低维中间态+并行近似 rollout」一招同时治高维误差与训练-推理鸿沟,135M 超十亿参数、FID 1.94 的数字很硬,且指向生成-理解统一。但仍限 ImageNet 类条件、256² 规模,能否迁到大规模文生图与更高分辨率、像素解码器的额外开销如何仍待验证。 4. TMP:剪枝把80B图像模型塞进4090 TMP: Tree-structured Mixed-policy Pruning for Large-scale Image Generation and Editing | 腾讯混元 | arXiv:2606.27089 关键词:模型剪枝,图像生成,MoE,混元,推理降本 前序问题:现代图像生成模型为高保真不断膨胀,参数与算力开销巨大;HunyuanImage-3.0 等开源 SOTA 达 80B、推荐 3×80GB GPU 才能推理,社区难用;而现有结构化剪枝多为 DiT 定制,HunyuanImage-3.0 却是 MoE 解码器 LLM(Hunyuan-A13B),并不适配。 本文贡献:提出首个树形混合策略剪枝框架 TMP,泛化 T2I 与 TI2I 任务、MoE 与 DiT 架构,并可作为步数蒸馏模型的最后一级压缩。 实验效果:把 HunyuanImage-3.0 从 80B 压到 20B(75% 压缩)、生成质量损失有限,并经工程优化让 20B 版在单张 24GB 4090 上可推理(脚本与权重已并入官方开源仓库);还把 Z-Image turbo 从 6B 压到 4B(33%)几乎无损。 批判点评:把 80B 模型塞进单卡 4090 是实打实的工业级降本,覆盖 MoE/DiT 与 T2I/TI2I 也通用,开源落地诚意足。但 75% 剪枝下'有限损失'的主观质量边界、对极端 prompt/细节的退化,以及剪枝叠加步蒸馏后的稳定性仍需更全面评测。 5. LearniBridge:可学习特征缓存加速扩散 LearniBridge: Learnable Calibration of Feature Caching for Diffusion Models Acceleration | 清华(深圳) | arXiv:2606.26778 关键词:特征缓存,扩散加速,DiT,LoRA,低秩 前序问题:DiT 在图像/视频生成上算力开销高,特征缓存靠复用中间表征加速,但现有方法依赖历史特征、在高加速比下误差累积严重。 本文贡献:研究所需特征校正的本质,发现最优校正更新在不同 prompt 间共享一个低秩子空间;据此提出 LearniBridge——可学习的特征缓存校正机制,用轻量 LoRA 更新跨多个时间步桥接,仅需 3-5 个训练样本即可有效校正。 实验效果:图像/视频生成上对 FLUX、HunyuanVideo、WAN2.1 分别达 5.87×、5.75×、4.10× 加速;WAN2.1 在 4.10× 加速下 VBench 较此前 SOTA 提升 1.28%,代码已开源。 批判点评:「校正更新共享低秩子空间」是漂亮的结构性洞察,3-5 样本+LoRA 的轻量校正很实用,加速比与质量提升兼得。但低秩假设在更激进加速比或差异极大的 prompt 分布下是否仍成立、跨架构迁移的稳健性,仍需更广验证(实验用昇腾 910B)。 6. DomainShuttle:开放域主体驱动文生视频 DomainShuttle: Freeform Open Domain Subject-driven Text-to-video Generation | 港科大 | arXiv:2606.26058 关键词:文生视频,主体驱动,跨域生成,RoPE,个性化 前序问题:开放域主体驱动文生视频(S2V)含 in-domain(尽量保主体特征)与 cross-domain(保内在特征但允许无关属性随文本灵活变化)两类;现有方法偏重 in-domain 的主体保真,限制了跨域(新风格/语义组合/域属性)的可编辑与适应性。 本文贡献:提出理想 S2V 应能在不同域间自由「穿梭」,并提出 DomainShuttle:用 Domain-MoT 解耦视频与参考特征、以域感知 AdaLN 做参考图域专属建模;用 Video-Reference DualRoPE 把参考图 token 与视频 token 置于独立 RoPE 空间实现精细主体级空间建模;用 Cross-Pair Consistent Loss 提取不受无关特征影响的内在主体特征。 实验效果:在 in-domain 与 cross-domain 上均显著超过现有方法,跨多样开放域场景兼具高主体保真与生成灵活性。 批判点评:把 S2V 从「死磕保真」重构为「按需在域间穿梭」,DualRoPE 与解耦设计对症跨域编辑痛点。但 in/cross-domain 的平衡靠多模块拼接、复杂度上升,「自由穿梭」的可控边界与对极端跨域(强风格化)的保真衰减仍需看更多样例。 7. Don't Settle:免训练破解流模型多样性坍缩 Don't Settle at the Mode! Mitigating Diversity Collapse in Pretrained Flow Models via Feature Self-Guidance | 印度科学理工·斯坦福 | arXiv:2606.27371 关键词:流模型,多样性坍缩,自引导,免训练,文生图 前序问题:SOTA 流模型按文本/图像生成惊艳图像,但同一条件下多次采样会「多样性坍缩」;现有方法要么靠潜空间引导(效果有限),要么靠样本选择(依赖外部奖励模型、推理开销大)。 本文贡献:提出高效、免训练的自引导机制缓解多样性坍缩、无需额外奖励模型:在批量生成时用「特征自引导」分散流模型内部特征;再用流形正则步把分散特征投影回数据流形,确保多样的同时不偏离输入条件。即插即用,仅增边际推理开销。 实验效果:在多步/少步文生图、深度图到图、参考图生成等多个条件流模型上,多样性显著提升且保真不降,计算开销与 I.I.D. 基线几乎持平(单张 H200 评测)。 批判点评:「特征自引导+流形正则」免训练、免奖励模型地破解多样性坍缩,开销几乎为零、即插即用,很实用。但'分散特征'的强度需与流形约束精细权衡,过度分散可能伤条件对齐;多样性指标(DINO)与人类感知多样性的一致性也值得进一步检验。 8. Safe-AR:自改进码本做AR图像安全 Safe Autoregressive Image Generation with Iterative Self-Improving Codebooks | 牛津大学 | arXiv:2606.27147 关键词:自回归生成,内容安全,码本,统一多模态,自改进 前序问题:自回归统一多模态模型靠顺序预测离散视觉 token(来自码本)生成图像,这种类语言架构擅长文本条件生成,但「以自回归方式生成的图像有多安全」少被研究。 本文贡献:提出迭代自改进码本做安全自回归生成:利用统一多模态模型自身的理解与判断能力、无需人工标注就识别不安全生成图像,并固定码本中的内在表征以消除有害映射。两步法——先用模型识别不安全生成、构造有害/安全图文对建「有害空间」并据此更新码本消除有害输出;再在无害空间内用安全图文对做自适应微调保证质量;两步反复直到无进一步改进。 实验效果:无需任何外部反馈,模型安全性被迭代式提升,同时维持生成质量。 批判点评:「让模型自己判别+修码本」把安全做成无需人工标注的闭环自改进,思路自洽、对统一多模态模型尤其契合。但'用模型判自身不安全'存在盲区(模型识别不到的有害类型无法修复),码本级干预对生成多样性/罕见概念的潜在副作用也需评估。 9. PhyEditBench:物理感知图像编辑基准 PhyEditBench: A Real-World Multi-Stage Benchmark for Physics-Aware Image Editing | 南京大学 | arXiv:2606.26551 关键词:图像编辑,物理推理,评测基准,视频生成,测试时扩展 前序问题:指令式图像编辑虽进步显著,但现有基准缺乏对「基于物理的推理」这一处理真实场景关键能力的全面评估。 本文贡献:提出 PhyEditBench 评估编辑模型的物理理解:按层级分类法设 4 大类 12 子类,含 238 个从真实视频提取以捕捉真实物理动态的高质量高清实例,外加 35 个合成「反物理」实例。并提出免训练基线 PhyWorld,用测试时扩展+潜空间缩减策略。 实验效果:对当前 SOTA 编辑方法的实证分析暴露其物理推理的明显短板;PhyWorld 超过同类模型,表明视频生成过程可有效充当图像编辑的推理机制。 批判点评:把「物理推理」单列为编辑能力维度并配反物理样例,戳中当前编辑模型的真实痛点,PhyWorld「借视频生成做推理」也很有启发。但 238+35 实例规模偏小、层级分类的覆盖与主观性,以及物理正确性评判本身的标准化,都是基准可信度的关键变量。 趋势观察 视频生成/编辑全面冲向实时流式 — LiveEdit 把流式视频编辑推到 12.66FPS,Causal-rCM 用 2 步因果蒸馏达 VBench 84.63,实时交互成为视频 AIGC 的主战场。 蒸馏与缓存成为降本双引擎 — Causal-rCM 统一 TF+SF 蒸馏、LearniBridge 可学习特征缓存(FLUX 5.87×),'更少步+复用计算'是效率竞赛的两条主线。 像素空间自回归逼近扩散画质 — PRA 用并行近似 rollout 把像素 AR 刷到 FID 1.94、135M 超十亿参数,自回归路线在图像生成上持续逼近扩散。 大模型剪枝走向单卡可用 — TMP 把 80B HunyuanImage 压到 20B 并塞进 4090,开源大图像模型的'平民化部署'成为工业重点。 生成的可信度被系统拷问 — PhyEditBench 测物理推理短板、Safe-AR 做码本级安全、Don't Settle 救多样性坍缩,质量/安全/多样性等'软指标'正被正面攻坚。 人工智能炼丹君 整理 | 2026-06-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-22|近两周精选-MaineCoon实时音视频世界模型 今日 AIGC 论文速览 今日共 10 篇 · 音视频与世界模型 2 篇 · 视频生成与编辑 3 篇 · 图像超分与编辑 2 篇 · 人脸修复与动画生成 2 篇 · 生成安全治理 1 篇 重点论文标题列表 MaineCoon(Catnip AI):22B实时音视频社交世界模型 DFD(密歇根·NVIDIA·UIUC):一行代码救回少步视频多样性 UniTemp(威斯康星·Adobe·UCLA):任意时序方向自回归视频生成 teasr(上海交大):免teacher任意步实景超分 AudioWeave(电信TeleAI·中科大):统一音频生成与编辑 今日论文速览 1. MaineCoon:22B实时音视频社交世界模型 MaineCoon: Pursuing A Real-Time Audio-Visual Social World Model | Catnip AI | arXiv:2606.17800 关键词:世界模型,音视频生成,实时自回归,流式生成,社交互动 前序问题:全球视频内容日益在社交平台上被互动式消费,但面向「社交世界」的视频生成模型长期被忽视;既有世界模型擅长模拟物理环境或游戏世界,却与人本社交动态脱节。 本文贡献:首次提出「社交世界模型」定位并造出原型 MaineCoon——首个面向社交互动优化的实时音视频自回归模型,22B 参数,单 GPU 流式生成、亚秒级交互、最高 47.5 FPS。引入自重采样、跨模态表征对齐、域感知偏好优化与强化在线策略蒸馏(ROPD)稳定并加速训练;并设计首个 agentic 流式推理框架,用 agentic 缓存管理与提示规划支持千秒级超长生成、抑制漂移。 实验效果:在高质量、低延迟、长时音视频自回归上刷新 SOTA,单 H100 上每秒生成成本压到 <$0.001 且持续下降,指向 AI-native 社交平台的范式转移。 批判点评:把「世界模型」从物理/游戏拓展到「人本社交动态」,22B 实时音视频+亚秒交互的工程指标极硬,方向极具想象力。但目前仍是原型与 position 论文,长程社交一致性、真实交互可控性与安全治理都待检验,47.5FPS 也依赖 H100 级硬件。 2. DFD:一行代码救回少步视频多样性 Data-Forcing Distillation: Restoring Diversity and Fidelity in Few-Step Video Generation | 密歇根·NVIDIA·UIUC | arXiv:2606.18478 关键词:视频生成,扩散蒸馏,DMD,少步采样,多样性 前序问题:把多步视频扩散蒸馏成少步学生时,DMD/DMD2 因反向 KL 目标出现两大顽疾:样本多样性骤降、输出过饱和而偏离真实视频外观。 本文贡献:提出 Data-Forcing Distillation(DFD):仅需改动一行代码的后训练框架,核心用「教师分数差异」引导学生贴向真实数据分布、把它拉回缺失的模态(mode),从而缓解模式坍缩。 实验效果:在少步视频生成上同时恢复多样性与保真度,去除过饱和、更贴近真实视频外观,且改动极小、收敛快。 批判点评:把少步蒸馏的多样性坍缩精确归因到反向 KL,并用「教师分数差异」一行代码修复,诊断锋利、落地极简。但收益建立在 DMD2 框架之上,'一行代码'表述偏营销,跨更大模型与更极端少步(1-2 步)的稳健性仍需验证。 3. UniTemp:任意时序方向自回归视频生成 UniTemp: Unlocking Video Generation in Any Temporal Order via Bidirectional Distillation | 威斯康星·Adobe·UCLA | arXiv:2606.18702 关键词:视频生成,自回归,双向蒸馏,任意时序,长视频 前序问题:自回归视频扩散在流式长视频上表现强,却被限制为前向时序生成;而真实创作常需灵活方向,如基于未来上下文反向延展、或基于过去+未来做中间插帧。 本文贡献:训练出支持任意时序方向生成的自回归模型 UniTemp,统一前向、后向与中间(inbetween)生成;用双向蒸馏化解被广泛使用的因果 3D VAE 所带来的关键技术障碍。 实验效果:在流式长视频场景把生成从单向扩展为任意时序方向的灵活创作,兼顾前向/后向/插帧三类需求。 批判点评:把「时序方向」从固定前向解放为任意方向,契合真实创作需求,双向蒸馏对付因果 VAE 也有巧思。但任意方向带来的误差累积与跨方向一致性更难控,反向/插帧下的长视频漂移是否同样可控仍待观察。 4. teasr:免teacher任意步实景超分 TEASR: Training-Efficient Any-Step Diffusion Transformer for Real-World Image Super-Resolution | 上海交大 | arXiv:2606.16188 关键词:超分辨率,扩散模型,任意步,训练高效,实景图像 前序问题:扩散模型在真实世界图像超分(Real-ISR)上质量高但采样慢;现有一步蒸馏虽快,却需辅助 teacher 模型、推高训练显存、难扩展到大架构,且固定步数缺乏速度-质量权衡的灵活性。 本文贡献:提出训练高效的「任意步」扩散框架 TEASR:在单一模型内同时支持一步与多步修复、可按需在速度与质量间权衡,且无需 teacher 模型,从而显著降低训练成本并可扩展到大型架构。 实验效果:在真实图像超分上兼顾训练高效、可扩展与「一步/多步」灵活推理,去掉了对 teacher 的依赖。 批判点评:去掉 teacher 依赖+任意步可调,直击一步蒸馏的训练成本与僵化痛点,工程价值高。但 Real-ISR 评测口径多样,'训练高效'相对谁、在多大骨干上仍占优需看完整数字,极端退化下的细节幻觉也是超分通病。 5. AudioWeave:统一音频生成与编辑 Unified Audio Generation and Editing via Joint Condition Modeling and Progressive Training | 电信TeleAI·中科大 | arXiv:2606.16435 关键词:音频生成,音频编辑,文生音,统一建模,渐进训练 前序问题:现有工作把文生音(TTA)与指令式音频编辑等任务当作独立挑战、各用专属架构或模块,缺乏统一建模范式,导致系统搭建开销与复杂度大、可扩展性受限。 本文贡献:提出统一模型 AudioWeave:用联合条件建模+渐进式训练把音频生成与编辑收进单一模型,既覆盖文生音也覆盖基于指令的音频编辑,降低系统复杂度、提升可扩展性。 实验效果:一个模型同时胜任文生音与基于指令的音频编辑,减少维护多套任务专属架构的工程负担。 批判点评:把生成与编辑收进统一条件建模,顺应「大一统」趋势、工程上省事。但统一模型常面临生成与编辑能力的相互妥协,渐进式训练的配比、编辑精度与背景保真能否双赢需看消融与主观评测。 6. PermaVid:编辑后保持一致的视频生成 PermaVid: Consistent Video Generation Across Edits via Disentangled Context Memory | 上海交大·斯坦福·南洋理工·港中文 | arXiv:2606.16449 关键词:视频生成,视频编辑,上下文记忆,一致性,Wan2.1 前序问题:视频生成在编辑(改外观/布局)后需要「持久一致」:后续生成应跨时间、跨视角保持连贯;但现有记忆设计在修改后易过时失效,存储上下文可能失准。 本文贡献:提出 PermaVid(基于 Wan2.1-14B):构建多模态上下文记忆,把空间上下文解耦为「语义外观+几何结构」,并设计编辑感知的记忆更新与检索策略,确保编辑后跨时间、跨视角仍连贯。 实验效果:在编辑操作后维持长程时间与视角一致性,缓解记忆过时导致的崩坏。 批判点评:把记忆解耦成外观/结构并做「编辑感知更新」,对症视频编辑后的一致性塌缩,且基于强骨干 Wan2.1-14B。但解耦记忆+检索更新增加系统复杂度与显存(32×H200 训练),编辑链路变长时的累积误差与检索误命中仍是隐患。 7. TV-Edit:文字+视觉联合指令图像编辑 Text-Vision Co-Instructed Image Editing | 香港理工·OPPO | arXiv:2606.16767 关键词:图像编辑,文本指令,视觉提示,联合建模,FLUX 前序问题:文字指令语义表达强但空间控制粒度粗,拖拽/点选等视觉提示空间精准但语义意图模糊,二者各有短板难以兼得。 本文贡献:提出 Text-Vision Co-Instructed Image Editing(TV-Edit):把文字指令建模为语义意图、把稀疏视觉指令建模为空间引导,二者联合驱动编辑;在 Qwen-Image-Edit 与 FLUX.1 Kontext 双骨干上用少量控制器块实现,验证跨骨干通用性。 实验效果:统一文字与视觉提示之长,实现语义清晰且空间精准的图像编辑,并能在不同编辑骨干上通用。 批判点评:「文+视觉联合指令」补齐了纯文字/纯视觉各自的短板,且证明跨 Qwen/FLUX 骨干通用。但需稀疏视觉标注、用户交互成本上升,联合指令冲突(语义与空间矛盾)时如何取舍、复杂多目标编辑的可扩展性仍待考。 8. RGFVR:参考引导的人脸视频修复 RGFVR: Reference-Guided Face Video Restoration with Flow Matching | 慕尼黑工业大学 | arXiv:2606.16401 关键词:人脸修复,视频修复,身份保持,流匹配,参考引导 前序问题:从退化观测做人脸视频修复需同时恢复视觉保真、时间一致与主体身份;现有方法要么无参考(易丢身份)、要么 subject-specific(难泛化到未见身份)。 本文贡献:提出主体无关、参考引导的身份保持框架 RGFVR:把「感知+描述」双模态身份条件注入预训练 flow-based 文生视频模型(Wan2.1-T2V-1.3B + ArcFace 人脸编码器),两阶段训练、第一阶段仅训身份条件参数。 实验效果:在严重退化下既保身份又保时间一致,并能泛化到未见身份,无需逐人微调。 批判点评:双模态身份条件+参考引导兼顾保真与泛化,避开 subject-specific 的逐人训练。但依赖参考图质量与 ArcFace 身份编码,当参考与目标姿态/表情差异大时身份注入可能反成约束,1.3B 小骨干也限制极端修复上限。 9. SketchKeyAnime:稀疏关键草图生成动画 SketchKeyAnime: Reference-anchored Sparse Key-Sketch Animation Synthesis | 北京邮电大学 | arXiv:2606.19958 关键词:动画生成,视频扩散,关键草图,中间帧,可控生成 前序问题:传统动画依赖手绘关键帧、中间帧与上色;现有动画/视频生成方法多需 RGB 边界帧、密集逐帧条件或完整草图序列,难以适配低成本输入。 本文贡献:提出视频扩散框架 SketchKeyAnime:仅凭「稀疏关键草图」即可生成结构可控、外观一致、时间连贯的动画;含 Sketch Relation Transformer 与 Sketch Resampler 处理稀疏关系,并用 Sketch Cross Attention 与自适应加权损失强化线稿区域。 实验效果:在低成本输入(稀疏关键草图+参考)下产出结构可控、外观一致的动画,贴合真实动画生产流程。 批判点评:把输入门槛降到「稀疏关键草图」很贴合动画产线降本诉求,线稿增强损失也对症。但稀疏输入意味着中间帧靠模型想象,复杂动作/大幅形变的可控性与一致性更难,4×V100 训练规模也限制了分辨率与时长。 10. REINS:训练free做视频扩散安全对齐 Pulling The REINS: Training-Free Safety Alignment of Video Diffusion Models via Representation Steering | UC Riverside·YouTube | arXiv:2606.17257 关键词:视频扩散,安全对齐,表征引导,训练无关,内容安全 前序问题:开源权重视频扩散可生成暴力、虚假等逼真不安全内容;现有防护要么靠昂贵安全微调(损伤通用能力),要么靠外部过滤(易被对抗提示绕过)。 本文贡献:提出训练无关的推理时安全引导 REINS(Representation-space Inference-time Safety steering):发现安全相关结构在隐藏态激活中线性编码,用 SPCA 求出安全方向,并在推理时把模型内部表征朝安全方向引导;1.3B T2V 模型全流程 <24 GPU 小时即可完成。 实验效果:不微调、不损通用能力地把视频扩散在推理时对齐到安全生成,且较难被提示对抗轻易绕过,成本极低。 批判点评:「安全方向线性可引导」既给出可解释结论又落地为零训练方法,成本极低(<24 GPU 时)、不损通用能力,治理价值高。但线性引导对复杂/组合型不安全语义的覆盖有限,强对抗下方向是否仍稳健、引导强度与画质的权衡都需更大规模红队验证。 趋势观察 实时音视频自回归走向社交世界模型 — MaineCoon 22B 单 GPU 47.5FPS、每秒成本<$0.001,把世界模型从物理/游戏推向人本社交互动,瞄准 AI-native 社交平台。 少步/任意步成为视频与超分主线 — DFD 一行代码救回少步视频多样性,teasr 免 teacher 任意步超分,'又快又好且可调'是效率竞赛的新解法。 视频生成解放时序与编辑一致性 — UniTemp 支持任意时序方向生成,PermaVid 用解耦记忆保编辑后一致,视频创作正变得更灵活、更可控。 统一建模继续吞并子任务 — AudioWeave 把音频生成与编辑统进一个模型,TV-Edit 把文字与视觉指令联合,'一个模型多种活'趋势延续。 安全治理走向训练无关与可解释 — REINS 发现安全方向在激活里线性可引导,<24 GPU 时不伤通用能力地对齐,生成安全从'微调/过滤'转向推理时引导。 人工智能炼丹君 整理 | 2026-06-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
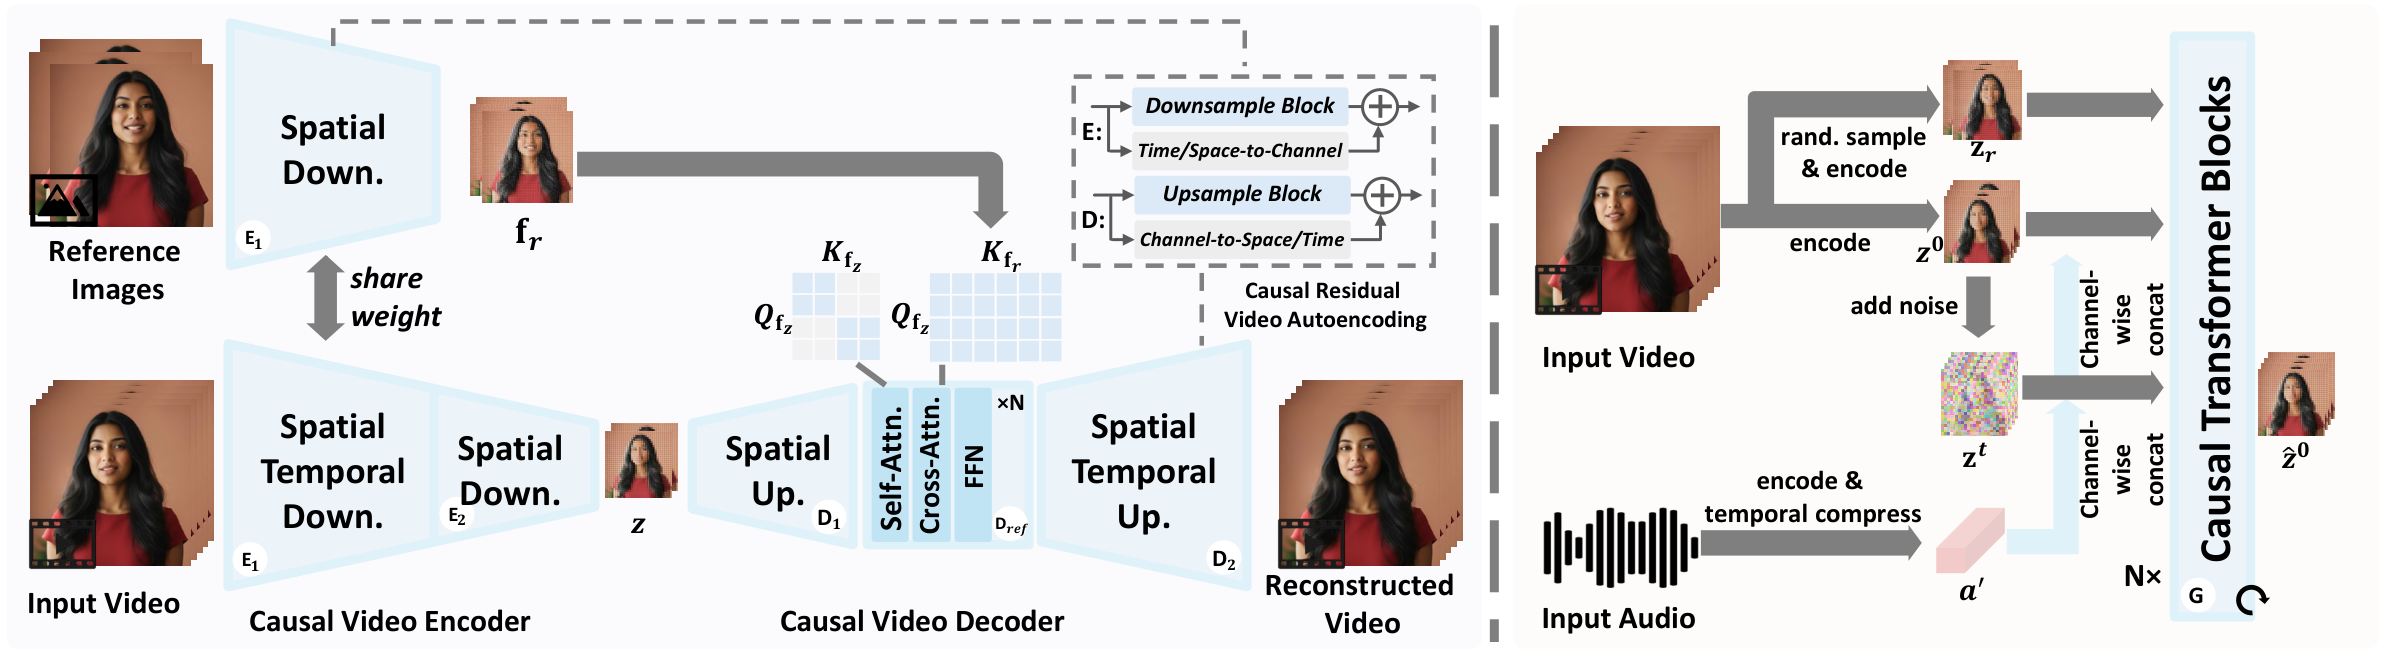
AIGC 每日速读|2026-06-02|微软实时流式数字人视频比肩大模型 今日 AIGC 论文速览 今日共 9 篇 · 实时与高效视频生成 2 篇 · 视频与图像编辑 3 篇 · 自回归与多模态生成 2 篇 · 可信与安全生成 2 篇 重点论文标题列表 实时流式数字人(微软研究院):语音驱动实时流式肖像视频 AlbedoEdit(马普所·NVIDIA·UCSB):反照率引导统一视频编辑 MT-EditFlow(Apple·UCLA·UT Austin):RL优化多轮图像编辑 边界保护量化(中科院大学·华为昇腾):Wan2.1视频DiT零损W8A8 RDA(中南大学·牛津·微软):免重训提升AR文字渲染 今日论文速览 1. 实时流式数字人:语音驱动实时流式肖像视频 Real-Time Generation of Streamable Talking Portrait Video with Reference-Guided Deep Compression VAEs | 微软研究院 | arXiv:2606.01620 关键词:数字人,流式生成,因果VAE,Rectified Flow,实时 前序问题:视频扩散模型画质虽好但算力高,难以用于实时交互式数字人场景。 本文贡献:提出面向流式场景的「语音+参考图」驱动数字人视频生成框架:用因果视频 VAE 做深度潜空间压缩,配自回归潜空间去噪生成器。VAE 可接入可变数量参考图作为引导,让网络聚焦动态信息而非静态外观,从而同时提升压缩率与重建质量;并把残差自编码范式扩展到时空因果建模,生成器基于 Rectified Flow Transformer 分块自回归产出视频潜变量。 实验效果:实现高质量数字人视频的实时生成,速度显著快于基线大模型;在真实感、生动性与视频质量上与大模型持平甚至更优。 批判点评:「因果 VAE + 参考图引导 + 分块自回归 RFT」把流式实时数字人做到与大模型同档画质,工程价值很高。但验证集中在语音驱动的正面肖像窄域,缺乏对长时序漂移、侧脸大幅运动、多说话人等极端场景的系统评测,实时性也强依赖特定硬件。 2. AlbedoEdit:反照率引导统一视频编辑 AlbedoEdit: Unified Instance-Level Video Editing with Albedo Guidance | 马普所·NVIDIA·UCSB | arXiv:2606.01362 关键词:视频编辑,反照率,实例级,物体插入,纹理编辑 前序问题:细粒度实例级视频编辑(插入/删除/纹理)要么只有粗语义控制,要么任务专用、难通用。 本文贡献:提出统一视频编辑框架 AlbedoEdit,同时支持物体插入、删除与纹理编辑。核心洞察是本征反照率图不含光照、镜面、阴影与互反射,是指定外观编辑的理想用户接口。基于视频基座模型微调,把源 RGB 视频按用户编辑的首帧反照率翻译为编辑后 RGB 视频;在覆盖三类编辑的配对合成数据集上训练,隐式学会协调编辑内容并模拟高光、软阴影、镜面反射等真实视觉效果。 实验效果:在物体插入、删除、纹理编辑上定性定量均超越 SOTA 视频编辑方法,且单一框架统一支持三类任务。 批判点评:用「反照率」作编辑接口巧妙绕开了光照纠缠,统一三类编辑很优雅。但训练依赖配对合成数据集,真实视频与合成域之间的差距、以及用户能否方便地编辑反照率图(而非直接画 RGB)是落地的现实门槛。 3. MT-EditFlow:RL优化多轮图像编辑 MT-EditFlow: Reinforcement Learning for Multi-Turn Image Editing with Flow Matching | Apple·UCLA·UT Austin | arXiv:2606.01985 关键词:多轮编辑,强化学习,流匹配,GRPO,奖励建模 前序问题:单轮训练的编辑模型在多轮交互编辑中会因「一轮失败毁全程」和误差累积而崩溃。 本文贡献:提出流匹配强化学习框架 MT-EditFlow,把多轮视角与多奖励统一进 GRPO 与 NFT 两类 RL 方法。系统分析轮级聚合打分策略、VLM 推理模式(权衡奖励偏差与方差)、优势融合层级(防奖励黑客),并发现把聚合优势广播到整条编辑轨迹,能弥合局部规划与全局多轮成功之间的鸿沟。 实验效果:在多个基座上显著提升;把 FLUX.1-Kontext-dev 的第 3 轮整体表现提升 6.85 分,超过 Qwen-Image-Edit 等开源 SOTA,并保持高边际成功率、降低暴露偏差。 批判点评:把多轮编辑当作序列决策、用 RL 显式优化轨迹级奖励,方向对路。但奖励信号高度依赖 VLM 打分,VLM 自身偏差会被放大;6.85 分的提升也主要在 turn-3 这一特定设置,更长交互的稳健性仍待验证。 4. 边界保护量化:Wan2.1视频DiT零损W8A8 Boundary-Protection W8A8 HiFloat8 Quantization for Large-Scale Text-to-Video Diffusion Transformers | 中科院大学·华为昇腾 | arXiv:2606.00957 关键词:量化,W8A8,HiFloat8,视频DiT,昇腾NPU 前序问题:视频 DiT 逐块激活分布异质,首尾块统计特性与中间块根本不同,均匀量化失效。 本文贡献:面向 Wan2.1-T2V-14B 在昇腾 910B 上的 W8A8 HiFloat8 量化,对全部 40 个注意力块做逐块激活分析(max-abs、标准差、峰度、99 分位),提出边界保护策略:首 2 块、尾 3 块保留 BF16,其余 35 块用 W8A8 HiF8 量化,兼顾误差遏制与输出保真。 实验效果:PTQ 在 VBench 全部 5 个维度上持平甚至略超 BF16 基线,5-prompt 内无可测精度损失;消融证明须同时保护首尾才有效;量化 35 块省约 12GB 显存,单卡可推理。 批判点评:把「边界块敏感」这一经验观察落到具体保护配置,工程实用且有消融支撑。但评测仅 5 条 prompt、样本量太小,统计说服力有限;QAT 在单卡下反而不如 PTQ,且当前工具链软件量化更慢,硬件原生 HiF8 收益尚未真正兑现。 5. RDA:免重训提升AR文字渲染 Residual Decoder Adapter: ID-Preserving Tokenizer Adaption for Autoregressive Text Rendering | 中南大学·牛津·微软 | arXiv:2606.01911 关键词:自回归生成,文字渲染,Tokenizer,残差适配器,OCR 前序问题:视觉自回归模型文字渲染笔画模糊、字形错乱,根源在 tokenizer 重建细节不足,但重训代价高。 本文贡献:提出 Residual Decoder Adapter(RDA):不改 token 空间、事后升级 tokenizer——引入与原码本共享分布的配对码本,以及在像素空间学习重建图与真值微小残差的并行分支,从而非侵入式增强 tokenizer 且兼容已有 AR 模型,无需重训 tokenizer 与生成模型。 实验效果:大幅提升文字渲染:微调 Janus-Pro 的 OCR 准确率在 TextVisionBlend 从 24.52% 升至 58.26%、StyledTextSynth 从 12.75% 升至 36.81%。 批判点评:「残差适配器」思路精巧,免重训就能补齐文字短板,迁移成本低。但本质是给解码器打补丁、治标性质,token 空间本身的信息瓶颈未动;提升集中在 OCR 类指标,对复杂版式、多语言长文本的泛化仍需更多验证。 6. TFinv:免训练一步扩散反演编辑 Training-free image inversion for one-step diffusion models | 巴塞罗那CVC·MBZUAI·吉大 | arXiv:2606.01380 关键词:图像反演,一步扩散,免训练,图像编辑,PIE-Bench 前序问题:一步扩散模型的真实图像反演与编辑受限于初始潜变量可编辑性与图文 Caption Gap 两大障碍。 本文贡献:提出免训练框架 TFinv:迭代噪声对齐 (iterNA) 缩小初噪与高斯分布的差距、后缀学习 (suffL) 用可学习后缀 token 增强图文对齐,实现精确反演到初噪并便于编辑;并提出基于 mask 的局部编辑以保护背景完整性。 实验效果:在 PIE-Bench 上达到一步扩散编辑 SOTA,效率显著优于多步反演方法。 批判点评:免训练把一步扩散的反演难题拆成「初噪可编辑性 + 图文对齐」两个可操作因子,干净利落。但推理时仍需迭代对齐与后缀学习,并非真正零开销;评测主要在 PIE-Bench,对复杂多物体场景的编辑保真度还需更广验证。 7. ProductWebGen:商品网页生成评测基准 ProductWebGen: Benchmarking Multimodal Product Webpage Generation | 上海交大·快手 | arXiv:2606.01022 关键词:商品网页,多模态生成,统一模型,图像编辑,基准 前序问题:从商品图+指令生成可渲染 HTML 网页需要严格视觉一致与高保真指令遵循,缺乏系统基准。 本文贡献:推出 ProductWebGen 基准:500 个测试样本、13 个品类,每样本含源图、视觉内容指令与网页指令;系统对比两类工作流——编辑式(LLM+图像编辑模型分别生成 HTML 与图)与统一模型式(单 UM 同时生成)。并构建 SFT 数据集 ProductWebGen-1k(1000 组真实商品图+LLM 生成 HTML),在开源 UM BAGEL 上验证有效。 实验效果:编辑式在网页指令遵循与内容吸引力上领先,统一模型式在满足视觉内容指令上更有优势;SFT 数据显著提升 BAGEL 表现。 批判点评:把多模态生成能力落到电商网页这一真实落地场景,任务设计与双工作流对比都很务实。但 500 样本规模偏小、评测多依赖模型/人工主观打分,且「可渲染 HTML」的工程正确性与跨浏览器一致性等硬指标尚未充分覆盖。 8. SafeGen-Bench:图生视频安全性评测基准 SafeGen-Bench: Benchmarking Safety in Image-Conditioned Text-to-Video Generation | 威斯康星·清华·JHU | arXiv:2606.01481 关键词:视频安全,图生视频,红队评测,内容护栏,基准 前序问题:现有视频安全基准只测恶意文本,忽视「安全文本+安全图像」组合仍可能生成有害内容。 本文贡献:推出 SafeGen-Bench 评测条件式 T2V(图生视频)安全性:定义 10 类恶意类别,聚焦时序与行为相关风险,精选多源起始帧配对文本 prompt 模拟真实输入;评测多个条件 T2V 模型,并测试文本/图像护栏的有效性。 实验效果:当前模型难以稳定规避恶意内容,不安全分数最高达 44.5(尤其在追求高质量时);单模态护栏不足以防御,7 类恶意类别下失败率达 80%。 批判点评:点出「安全输入也能合成有害视频」这一被忽视的真实风险并量化护栏失效,警示意义强。但 10 类恶意类别与起始帧选择带主观性,'unsafety score' 的判定依赖评估模型,跨文化/跨场景的有害定义边界也较模糊。 9. KG-FairDiff:知识图谱引导T2I去偏 KG-FairDiff: Knowledge Graph-Guided Prompt Refinement for Demographically Fair Text-to-Image Generation | Sharif·KTH·Vanderbilt | arXiv:2606.01282 关键词:文生图,公平性,去偏,知识图谱,prompt改写 前序问题:文生图系统继承训练数据的人口与文化刻板印象,重训不可行、固定模板又忽视文化语境。 本文贡献:提出模型无关的推理时框架 KG-FairDiff,把公平感知的 prompt 改写形式化为约束优化并做成闭环:约 1200 条文化/偏见三元组的知识图谱检索结构化上下文、LLM 改写器提出修订、验证器只接受能降低基于散度的公平损失且保持语义保真的 prompt;证明改写循环有限步终止,并审计 8 个广泛部署的生成器。 实验效果:在保持 prompt 语义的同时,显著降低性别、种族、年龄及交叉维度的差异,提供无需重训、可直接部署的公平化方案。 批判点评:不碰闭源权重、用推理时 prompt 改写+知识图谱做去偏,部署友好且有终止性证明,务实。但公平损失与目标分布的设定本身带价值判断,1200 条三元组的覆盖与文化偏向也会引入新偏差;强行改写 prompt 可能损害用户原意,'去偏'与'忠实'的取舍仍是开放问题。 趋势观察 实时化成为视频生成主线 — 微软用因果 VAE+分块自回归 RFT 把数字人做到实时流式,边界保护量化让 14B 视频 DiT 单卡零损部署,'又快又省'是今天最强信号。 编辑从单轮走向多轮/实例级 — MT-EditFlow 用 RL 优化多轮编辑轨迹,AlbedoEdit 用反照率统一实例级视频编辑,编辑的可控性与交互性同步进化。 免训练/事后增强降低改造成本 — TFinv 免训练做一步扩散反演,RDA 免重训给 tokenizer 打残差补丁,KG-FairDiff 推理时改写 prompt 去偏——都在追求'不动主模型'。 评测与安全补齐落地短板 — ProductWebGen 补电商网页生成基准,SafeGen-Bench 揭示图生视频的安全盲区,工具与红队评测正追上生成能力。 多极化算力与机构同台 — 微软、马普所、NVIDIA、Apple 与上海交大、中科院大学+华为昇腾、中南大学同日发声,研究力量与算力底座多极化。 人工智能炼丹君 整理 | 2026-06-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-01|英伟达SANA单卡24FPS实时流式视频编辑 今日 AIGC 论文速览 今日共 8 篇 · 实时/高效视频生成 2 篇 · 视频世界模型 2 篇 · 统一多模态生成 2 篇 · 音频生成 2 篇 重点论文标题列表 SANA-Streaming(NVIDIA, MIT):单卡RTX5090实时流式视频编辑 LVSA(开源·JiusiServe):免训练长视频稀疏注意力3x提速 Lumos-Nexus(NUS, 阿里达摩院):高效统一视频生成推理驱动 DecMem(快手可灵, 港大 HKU):解耦记忆做分钟级一致世界生成 Light Interaction(浙江大学, NVIDIA):免训练交互视频世界模型加速 今日论文速览 1. SANA-Streaming:单卡RTX5090实时流式视频编辑 SANA-Streaming: Real-time Streaming Video Editing with Hybrid Diffusion Transformer | NVIDIA, MIT | arXiv:2605.30409 关键词:实时视频编辑·混合DiT·GDN线性注意力·RTX5090·英伟达 前序问题:实时流式视频到视频编辑(V2V)对直播、游戏等交互应用至关重要,但它对时序一致性和推理吞吐都有极苛刻的要求——既要逐帧流式出片、又要保住跨帧一致,还得在消费级 GPU 上跑得动,前人一直没能同时满足 本文贡献:SANA-Streaming:系统-算法协同设计的高分辨率实时流式视频编辑框架,三件套。(1) Hybrid DiT:在 SANA-Video 全线性骨干里均匀插入 5 个 softmax 注意力块 + 15 个高效 Gated DeltaNet(GDN) 块,用线性块保效率、softmax 块补局部建模与首块一致性,恒定显存 + 任意长度;(2) Cycle-Reverse 正则:用 flow matching 从生成内容反向预测源帧来强制语义一致,无需成对长编辑视频;(3) 面向 NVIDIA Blackwell(RTX 5090) 的系统协同:融合 GDN kernel + 混合精度量化(MPQ) 拉满 Tensor Core 实验效果:单张 RTX 5090 上做到 1280×704 分辨率、24 端到端 FPS 的实时编辑,DiT 核心跑到 58 FPS;混合设计相比纯 softmax 变体长视频生成只需 5.56GB 显存、提速 3.7×;在时序连贯性和系统吞吐上都显著超越现有 SOTA 批判点评:「混合线性/softmax DiT + 反向一致性正则 + 面向 5090 的量化协同」把实时视频编辑从「论文 demo」真正推到「消费级单卡可跑」,24FPS 端到端是非常硬的工程里程碑;恒定显存是流式落地的关键。但 2B 模型的编辑能力上限、复杂语义编辑的保真度、以及对 5090 之外硬件的可移植性还需观察;Cycle-Reverse 正则在大幅度编辑下的稳定性值得追踪 2. LVSA:免训练长视频稀疏注意力3x提速 LVSA: Training-Free Sparse Attention for Long Video Diffusion | 开源·JiusiServe | arXiv:2605.31057 关键词:长视频扩散·免训练稀疏注意力·旋转全局锚点·Wan/Hunyuan·昇腾NPU 前序问题:稠密自注意力是长视频扩散推理的算力和质量双瓶颈:开销随序列长度二次增长,且超过训练长度后模型收敛到「近静态」——画面冻结、重复循环。现有方案要么太贵(要重训),要么在「提速 + 保质」上无法同时可扩展地满足 本文贡献:LVSA(Long Video Sparse Attention):免训练、模型无关的 block-sparse 注意力,把结构化窗口模式 + 旋转全局锚点(rotating global anchors) 结合,去掉「固定网格偏置」这一长程时序伪影的根因;配 FlashInfer kernel 落地,且天生支持多 GPU(context-parallel + sparse ring KV 交换)。还提出 VQeval 评测工具,专门给「循环/冻结」失败正确扣分(这类失败在 VBench-Long 等评测里反而被奖励) 实验效果:在 6× 训练长度下 Wan2.1-1.3B 提速 3.17×、Wan2.1-14B 提速 2.98×,HunyuanVideo 1.5 在 1.5× 长度提速 3.33×,还能让 HY1.5 跑到单卡原本 OOM 的 2× 长度;相比 RIFLEx/UltraViCo 分别快 2.41×/3.27×;在昇腾 NPU 上 Wan2.2-A14B/Wan2.1-1.3B 也提速 2.71×/3.24×。训练长度内质量中性、超长时质量为正 批判点评:「旋转全局锚点 + 结构化窗口」去掉固定网格偏置,是把「超训练长度变冻结」这一长视频顽疾从根上治理的漂亮思路;免训练 + 多 GPU + 跨 GPU/NPU 的工程完整度很高,VQeval 还顺手补了「循环失败被错误奖励」的评测漏洞。但 block-sparse 的固定模式对极复杂运动场景是否丢细节需要看;锚点数量与长度的 scaling 关系、与可训练稀疏(VSA 类)的质量上限对比可更深入 3. Lumos-Nexus:高效统一视频生成推理驱动 Lumos-Nexus: Efficient Frequency Bridging with Homogeneous Latent Space for Video Unified Models | NUS, 阿里达摩院 | arXiv:2605.31603 关键词:统一视频生成·频率桥接·推理驱动·VR-Bench·阿里达摩院 前序问题:基于 connector 的统一视频模型在「指令理解驱动生成」上能力很强,但把一个大的高保真生成器塞进统一训练循环计算上不可行,从而限制了可达到的画质上限——理解强但画质受限 本文贡献:Lumos-Nexus:训练高效的统一视频生成框架,两阶段设计。训练阶段只把一个轻量生成器与理解模块对齐,学会接收推理驱动的语义控制;推理阶段引入 Unified Progressive Frequency Bridging(UPFB),在共享 latent 空间把生成逐步交棒给高容量预训练生成器,做粗到细精修,从而在不牺牲推理质量的前提下产出高保真视频。还提出 VR-Bench 专门评测「把推断意图翻译成连贯且语义对齐视频」的能力 实验效果:在 VBench 上视觉真实度与时序连贯性大幅提升,同时在 VR-Bench 上展现强推理驱动生成性能;用「轻量训练 + 推理时频率桥接交棒」绕开了「把大生成器塞进训练循环」的算力死结 批判点评:「训练只对齐轻量生成器、推理时再用频率桥接交棒给大模型」是把统一模型「理解-生成」解耦的聪明工程,既省训练又保画质;VR-Bench 把「推理对齐」立成新评测维度很有意义。但 UPFB 的交棒边界(何时交、交多少)对画质/语义一致的影响、两个生成器在共享 latent 的兼容性细节需要更多 ablation 4. DecMem:解耦记忆做分钟级一致世界生成 DecMem: Towards Minute-Long Consistent World Generation with Decoupled Memory | 快手可灵, 港大 HKU | arXiv:2605.31336 关键词:世界模型·解耦记忆·长视频一致性·分钟级生成·快手可灵 前序问题:视频生成模型推动了可控世界模型快速进展,但在长程推理下维持细粒度时空一致性仍是核心难题——朴素的可学习记忆架构有两大根本缺陷:计算低效 + 注意力发散(attention dispersion) 本文贡献:DecMem:超越显式 3D 记忆和粗粒度帧级隐式建模,提出细粒度、可学习、可扩展的记忆。先系统分析注意力发散问题,再用解耦记忆架构:Sparse Global Memory 负责对全局历史的高效细粒度访问,Anchored Local Memory 负责稳定高质量的外推。两者解耦,分别解决「效率」和「外推稳定」 实验效果:大量实验显著超越当前 SOTA;通过精确高效的长期记忆 + 更强外推能力,DecMem 实现分钟级、高保真、高一致的可控长视频生成 批判点评:把「记忆」拆成 Sparse Global(管全局访问效率)+ Anchored Local(管外推稳定)两条解耦通路,直击长视频记忆「又要全又要稳还要快」的三难,分钟级一致是世界模型很硬的指标。但解耦记忆的额外参数/显存开销、Sparse Global 的检索精度上限、以及与显式 3D 记忆在强几何一致场景的对比可更充分 5. Light Interaction:免训练交互视频世界模型加速 Light Interaction: Training-Free Inference Acceleration for Interactive Video World Models | 浙江大学, NVIDIA | arXiv:2605.31158 关键词:交互世界模型·免训练加速·自适应计算·3D稀疏注意力·浙大 前序问题:交互式视频世界模型逐块生成、响应用户控制的相机运动(实时游戏模拟、虚拟场景漫游、具身 AI 训练),但扩到长交互轨迹代价极高:上下文记忆增长、注意力二次复杂度、反复去噪步骤 本文贡献:Light Interaction:免训练的交互式视频世界模型推理加速框架。核心洞察是「交互天然带来轨迹相关的自适应计算」——新探索时检索到的空间记忆可丢弃、时序上下文可按局部 latent 动态调整、相机重访熟悉区域时早期步输出可复用。据此组合自适应上下文管理 + 去噪缓存加速 + 软硬协同的 3D block-sparse 注意力(融合 Triton kernel) 实验效果:在 HY-WorldPlay 和 Matrix-Game-3.0 上无需重训即取得最高 2.59× 提速,同时保持有竞争力的视觉质量 批判点评:「交互轨迹本身就提供了该算多少的信号」是很锐利的洞察——重访可复用、新探索可丢记忆,把自适应计算和交互语义绑定,免训练即插即用对落地友好。但收益高度依赖轨迹的「重访比例」,在持续探索新场景的轨迹上加速会打折;3D block-sparse 的质量损失边界、与 minWM 类自回归蒸馏路线的组合潜力值得探索 6. Representation Forcing:去VAE瓶颈的统一多模态 Representation Forcing for Bottleneck-Free Unified Multimodal Models | 港大 HKU, 字节 Seed | arXiv:2605.31604 关键词:统一多模态·去VAE·表征强制·像素空间生成·字节Seed 前序问题:统一多模态模型(UMM)想用单一模型同时做感知和生成,但现有 UMM 仍依赖一个冻结、单独预训练的 VAE 做图像生成,构成结构性瓶颈;而直接去掉 VAE 又会带来质量缺口——模型得从原始像素同时学高层结构和底层细节 本文贡献:Representation Forcing(RF):让「表征预测」成为模型的原生能力来弥合这一缺口。具体是强制 decoder 在出像素前先自回归预测视觉表征作为中间 token,这些 token 留在 context 里、在同一 backbone 内引导像素扩散。把表征从「感知的输出」变成「生成的目标」,从而彻底不需要任何外部生成式 latent 空间 实验效果:RF 对理解和生成双双有益:图像生成上,像素空间 + RF 的模型匹配 SOTA 的 VAE 版统一模型;图像理解上,像素空间 RF 普遍优于其 VAE 版变体——朝着端到端、无瓶颈的 UMM 迈出有效一步 批判点评:「先自回归预测视觉表征 token 再扩散出像素」把外挂 VAE 的结构瓶颈内化成模型原生能力,是统一模型「去外部 latent」方向很干净的解法,且理解/生成同时受益说明表征-生成共享是对的。但自回归预测表征 token 引入的推理开销、表征 token 的设计对不同分辨率/模态的可扩展性、以及相比强 VAE 版在超高保真上的差距需要更多验证 7. SwanSphere:全景视频流式生成空间音频 Towards Streaming Synchronized Spatial Audio Generation via Autoregressive Diffusion Transformer | 浙江大学 | arXiv:2605.30940 关键词:空间音频·流式生成·自回归扩散·全景视频·浙大 前序问题:实时准确的空间音频生成对沉浸式体验至关重要,但现有空间音频合成技术常受困于「生成质量 vs 高推理延迟」的取舍,且难以从多模态输入中捕获精确的空间信息 本文贡献:SwanSphere:从全景视频 + 文本提示生成高保真空间音频的统一流式框架。三大贡献:(1) 因果自回归扩散 transformer 架构,支持流式高质量空间音频生成;(2) Spatial Video-Audio Contrastive(SVAC) 对比学习把视频编码器对齐到声学域,再用多目标在线直接偏好优化(ODPO) 增强空间感知与多模态空间音频合成的鲁棒性;(3) 针对当前空间音频数据稀缺,开发自动标注 pipeline 生成详细空间 caption 实验效果:在 video-to-spatial 和 text-to-spatial 两类空间音频生成任务上均取得更优性能 (demo swanaigc.github.io) 批判点评:「因果 AR 扩散做流式 + SVAC 跨模态对齐 + ODPO 偏好优化 + 自动空间标注」一套组合直击空间音频「质量/延迟/数据」三重痛点,从全景视频生成空间音频是 VR/沉浸式应用很实在的能力,与同组 SwanVoice 一道补齐音频生成的空间维度。但空间音频评测主观性强、客观指标尚不统一;ODPO 的奖励设计与全景视频的空间精度上限还需更多披露 8. SwanVoice:长篇零样本对话语音合成 SwanVoice: Expressive Long-Form Zero-Shot Speech Synthesis for Both Monologue and Dialogue | 浙江大学, 字节 | arXiv:2605.30993 关键词:零样本TTS·长篇对话·flow-matching·DiffusionNFT·浙大 前序问题:零样本 TTS 在单说话人合成上已大幅进步,但富有表现力的长篇多说话人对话仍很难。常见做法是用独白 TTS 逐句合成再拼接——增加推理成本,且常破坏跨轮次的声学一致性、对话连贯性和情感连续性。近期对话 TTS 仍难同时兼顾表现力一致、可控说话人切换和独白质量 本文贡献:SwanData-Speech + SwanVoice。数据侧用 Swan Forced Aligner 做停顿感知的词级对齐、RobustMegaTTS3 处理发音困难样本,从野外音频构建独白与对话语料。SwanVoice 是 1–4 人零样本 TTS:25Hz VAE + 带停顿符号与拼音替换的原始文本条件 + 带说话人轮次条件的 flow-matching DiT;训练从独白起步,经混合与真实对话数据,再用 DiffusionNFT 后训练 + 音素级和说话人相似度奖励 实验效果:在 SwanBench-Speech 上,独白与对话设置下的丰富度与层次分都高于所有评测的开源基线,内容准确率仍是主要限制 (demo swanaigc.github.io) 批判点评:把长篇对话 TTS 从「逐句独白拼接」升级成端到端建模,flow-matching DiT + 说话人轮次条件 + DiffusionNFT 后训练这套组合很完整,停顿感知对齐的数据工程是务实加分项。但作者自承内容准确率(WER/CER) 仍是短板,说明表现力和保真度的 trade-off 还在;25Hz 低帧率 VAE 在高保真音质上的天花板、4 人以上对话的可扩展性需要继续看 趋势观察 实时/高效视频生成进入「系统-算法协同」深水区 — SANA-Streaming 用混合 DiT(softmax + GDN 线性)+ Cycle-Reverse 正则 + 面向 RTX5090 的混合精度量化,在单张消费级 GPU 做到 1280×704、24 端到端 FPS 的实时流式视频编辑;LVSA 免训练 block-sparse + 旋转全局锚点,把 Wan2.1/HunyuanVideo 长视频推理提速最高 3.3×、还跨 GPU/NPU——视频生成的「实时化」正从算法和系统两端被同时撬动 视频世界模型的两大瓶颈——长程一致性与交互推理成本——被正面攻坚 — DecMem 用 Sparse Global + Anchored Local 解耦记忆,把可控世界生成推到分钟级一致;Light Interaction 抓住「交互天然带来轨迹相关的自适应计算」,免训练把 HY-WorldPlay/Matrix-Game-3.0 推理加速 2.59×——世界模型从「能生成」转向「长得住、跑得起」 统一多模态正在拆掉「外挂 VAE」这块结构性瓶颈 — Representation Forcing 让 decoder 先自回归预测视觉表征作为中间 token、再在同一 backbone 内引导像素扩散,像素空间模型即可匹配 VAE 版统一模型且理解更强;Lumos-Nexus 用渐进频率桥接把生成交棒给高容量预训练生成器、在共享 latent 做粗到细——统一模型在「去外部 latent」和「高保真」两条线同时推进 推理驱动 / 可控成为视频生成的新评测维度 — Lumos-Nexus 提出 VR-Bench 专测「把推理意图翻译成连贯视频」的能力;视频生成的评测从「画质 + 时序」扩展到「推理对齐」——可控性的内涵正在变深,生成模型被要求「不仅画得好,还要想得对」 音频生成从「单声道说话」走向「长篇对话 + 空间声场」 — SwanVoice 用 25Hz VAE + flow-matching DiT + DiffusionNFT 后训练做 1–4 人长篇零样本对话 TTS,富有表现力且说话人切换可控;SwanSphere 用因果自回归扩散 + SVAC 跨模态对齐 + ODPO,从全景视频/文本流式生成高保真空间音频——音频生成正在「对话连贯性」和「空间沉浸感」两个维度同时进化,补齐视觉生成之外的听觉一环 人工智能炼丹君 整理 | 2026-06-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-29|生数科技minWM开源实时交互视频世界模型 今日 AIGC 论文速览 今日共 8 篇 · 视频世界模型 3 篇 · 流式视频生成 1 篇 · 音视频联合生成 1 篇 · 可控图像生成与数据 2 篇 · 大模型记忆与微调 1 篇 重点论文标题列表 minWM:实时交互视频世界模型全栈开源 NAVA:原生音视频对齐联合生成6.3B Gamma-World:多智能体生成式世界模型 AdaState:流式视频生成自演化锚点 YoCausal:视频生成因果性认知基准 今日论文速览 1. minWM:实时交互视频世界模型全栈开源 minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models | 生数科技, 清华大学 | arXiv:2605.30263 关键词:视频世界模型·实时交互·自回归蒸馏·开源·生数科技 前序问题:视频扩散基础模型已能高质量出片,但把它变成实时交互视频世界模型仍然难:交互世界模型需要可控、因果、低延迟的 rollout,实践上要打通数据构造、可控微调、自回归训练、少步蒸馏、流式推理整条链路,而开源社区一直缺一套能跑通的端到端 recipe 本文贡献:minWM:全栈开源框架,把现成的双向 T2V/TI2V 视频基础模型转成「相机可控 + 少步自回归」的世界模型。先对双向扩散做相机控制微调,再用 Causal Forcing / Causal Forcing++ 流程(AR diffusion 训练 + causal ODE/consistency 蒸馏 + 非对称 DMD)蒸成少步自回归生成器做低延迟 rollout。框架模块化、架构可扩展:在 Wan2.1-T2V-1.3B(cross-attention 条件注入)和 HY1.5-TI2V-8B(MMDiT)上分别实例化,还能把 HY-WorldPlay 等已有世界模型适配到新数据分布、训练配方与延迟目标 实验效果:不止放出可运行脚本、checkpoint、文档和推理代码,还给出相机轨迹质量、可控性训练步数、最小 batch size 等实战 ablation——是这个方向少见的「能跑起来、可复现、可扩展」的实时交互视频世界模型配方 (github.com/shengshu-ai/minWM) 批判点评:「全栈开源 + 跨两种主流架构(Wan2.1 cross-attn / HY1.5 MMDiT)实例化 + 可适配已有世界模型」三点让它成为这个方向稀缺的工程基建,对想做实时交互视频的团队意义重大。但框架 / recipe 类工作的核心价值在工程完整度而非单点创新;Causal Forcing++ 与非对称 DMD 联训的稳定性、长 rollout 的累积漂移控制还可以披露更多 2. NAVA:原生音视频对齐联合生成6.3B Native Audio-Visual Alignment for Generation | 百度 ERNIE | arXiv:2605.30073 关键词:音视频联合生成·原生对齐·MMDiT·音色可控·百度 前序问题:联合音视频生成要做到时序同步 + 语义连贯,但现有开源方案要么走「双塔 + 后验对齐」(弱化细粒度音视频协同演化),要么走「三模态全统一」(把语义条件和底层同步耦死在一起)——两条路线都有结构性缺陷 本文贡献:NAVA:context-conditioned 的原生音视频对齐框架。先在专用交互空间建立音视频对应关系,再用外部 context 条件化联合去噪。用 Align-then-Fuse MMDiT 架构实例化,从「模态感知的音视频对齐」平滑过渡到「模态共享的联合去噪」;并提出 Timbre-in-Context Conditioning,把参考音色线索关联到对应语音片段,实现可控语音音色 实验效果:在 Verse-Bench 和 Seed-TTS 上配合用户研究表明:仅用 6.3B 参数即取得更优视频质量、精确的音视频同步、有竞争力的音频质量,以及更强的参考音色可控性 批判点评:「先对齐后融合」而非「一上来全统一」的设计直击双塔 / 三模态两条路线的痛点,6.3B 拿下多项指标性价比很高;Timbre-in-Context 把音色可控做进 context 是干净的设计。但「专用交互空间 + 联合去噪」的两阶段是否引入额外训练复杂度、对更长音视频的扩展性仍需观察 3. Gamma-World:多智能体生成式世界模型 Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players | NVIDIA, 清华大学 | arXiv:2605.28816 关键词:多智能体·世界模型·RoPE·稀疏注意力·NVIDIA 前序问题:交互式视频世界模型大多聚焦单 agent(从单一控制信号生成未来观测),但很多生成环境需要多 agent 同时在共享空间行动(多玩家 / 机器人 / 具身体)。扩到多 agent 需要原则性设计:各 agent 独立可控、排列对称、推理高效,同时跨时间和视角保持一致 本文贡献:生成式多智能体世界模型。提出 Simplex Rotary Agent Encoding:3D RoPE 的无参扩展,把 agent 表示成旋转角空间里正单纯形的顶点,给每个 agent 不同相位又保持排列等价——无需学习 per-slot 身份或固定排序即可扩展 agent 身份;提出 Sparse Hub Attention:用可学习 hub token 中介跨 agent 交互,把跨 agent 注意力从二次降到线性。再把全上下文扩散 teacher 蒸成因果 student,带 KV cache 顺序生成时间块,实现 24FPS 的动作响应生成 实验效果:多人虚拟环境实验中,在视频保真度、动作可控性、agent 间一致性上超越 slot-based 和 dense-attention 基线,且无需额外训练即可从 2 玩家泛化到 4 玩家 批判点评:「用正单纯形顶点的旋转相位编码 agent 身份」是极优雅的无参设计——天然排列对称又可扩展;Sparse Hub Attention 把多 agent 注意力线性化是务实工程;从 2 人零样本泛化到 4 人很有说服力。但 hub token 数量与 agent 数的可扩展上限、长时序多 agent 一致性的退化曲线需要更大规模验证 4. AdaState:流式视频生成自演化锚点 AdaState: Self-Evolving Anchors for Streaming Video Generation | 弗吉尼亚理工 Virginia Tech | arXiv:2605.30349 关键词:流式视频生成·自回归扩散·自演化锚点·KV cache·时间相对 前序问题:自回归视频扩散逐块生成、每块条件于已生成内容,但模型结构性地「锚定在第一帧」:首帧 KV 占据注意力 cache 的特权位置、作为整段主场景参考。作为最干净无误差的位置,这个锚点吸走过多注意力,压制视频动态、把场景构图锁死在初始视角,结果是「时间上很浅」的视频——运动、镜头、场景推进都被静态一致性压制 本文贡献:用「自适应 state」替换静态锚点——一个隐 latent,模型每块和内容一起去噪但从不渲染。模型不再参考冻结的首帧,而是每步通过同时关注「前一 state + 当前内容」自己生成场景锚点,产出随生成内容演化的参考。不同于编码绝对时间的标准视频生成,本方法把时间当相对量:每个生成步看到相同的位置结构、state transition 每块都相同。这给生成过程引入了递归——去噪即 transition 函数,KV cache 即载体,无需任何外部模块 实验效果:实验表明自适应 state 大幅改善视频动态,让生成视频内出现更丰富的运动和更自然的场景推进 批判点评:「首帧 KV 锚点偷走注意力 → 视频时间上变浅」的诊断非常精准,用「可去噪但不渲染的隐 state」做自演化锚点是优雅的零外部模块方案,把时间从绝对改成相对的视角很有启发。但「丰富运动」与「时序一致性」本就是 trade-off,自演化锚点会不会牺牲长程一致性需要定量;缺与显式 memory / anchor 方法的正面对比 5. YoCausal:视频生成因果性认知基准 YoCausal: How Far is Video Generation from World Model? A Causality Perspective | 上海 AI Lab, 阳明交大 NYCU | arXiv:2605.30346 关键词:视频生成·世界模型·因果性·评测基准·上海AILab 前序问题:视频扩散模型(VDM)正走向世界模型,关键问题是:它们真懂因果,还是只过拟合统计时序模式?现有基准大多依赖合成数据,受 sim-to-real gap 限制真实世界泛化 本文贡献:YoCausal:受认知科学「违反预期(VoE)」范式启发的两级基准。零成本地把真实世界视频时序反转,作为天然反事实样本,建立可任意扩展的评测协议。Level 1 提出 Reverse Surprise Index (RSI),用去噪 loss 量化「时间箭头」感知;Level 2 提出 Causality Cognition Index (CCI),用 VLM 把数据分层成因果 / 非因果子集,把真正的因果推理从时序偏置中解耦 实验效果:评测 13 个 SOTA VDM 发现:感知到时间箭头并不意味着理解因果,且相对人类级因果认知仍存在显著差距 批判点评:「时序反转真实视频做零成本反事实」是极聪明的基准构造,RSI / CCI 两级指标把「时间感知」与「因果认知」分层解耦的思路很清晰,给「视频生成→世界模型」泼了必要的冷水。但用去噪 loss 衡量「惊讶度」是否完全等价于因果理解仍可争议;VLM 分层本身的可靠性会传导到 CCI 的结论 6. GenClaw:代码驱动的智能体图像生成 GenClaw: Code-Driven Agentic Image Generation | 中山大学 | arXiv:2605.30248 关键词:图像生成·智能体·代码驱动·可控生成·中山大学 前序问题:图像生成已从「文本条件像素合成」走向「具备视觉理解 + 工具调用的多模态 agent」,但现有 agent 仍受制于底层黑盒图像模型——工作流困在「为优化生成反复改 prompt」的循环里,没有直接操控画布的机制。LLM 作为精确视觉构建「画笔」的潜力基本未被开发 本文贡献:GenClaw:代码驱动的智能体图像生成范式,让 agent 像人类艺术家一样创作——先构思、再起草、最后上色。agent 先通过搜索和推理构建概念知识与上下文;再用代码(SVG / HTML / Three.js)渲染可执行的视觉草图;最后用图像生成模型补充纹理、材质、真实感。代码在此作为可控的中间画布,桥接语言推理与像素合成,把程序逻辑与生成模型的视觉表现力无缝整合 实验效果:把图像生成从黑盒范式转成类似真实人类创作的分阶段过程,朝着高度可控、可解释的视觉生成系统迈出一步 批判点评:「代码作中间画布」是把可控性问题转译成「可执行草图」的聪明思路——SVG / HTML / Three.js 草图天然结构化、可精确编辑,比反复改 prompt 强太多;构思-起草-上色的拟人流程也很有叙事性。但代码草图能表达的视觉复杂度有上限(精细写实场景难用 SVG 起草),最终仍依赖底层生成模型的「上色」能力;端到端延迟和失败率需要量化 7. GPIC:28万亿像素许可级图像语料 GPIC: A Giant Permissive Image Corpus for Visual Generation | 斯坦福 李飞飞团队 | arXiv:2605.30341 关键词:图像语料·视觉生成·许可数据集·flow matching·斯坦福 前序问题:研究可扩展的视觉生成方法需要大、可获取、稳定的数据集,但开放且许可清晰的大规模图像语料长期稀缺 本文贡献:GPIC:约 28 万亿像素的巨型许可图像语料。由 SOTA 视觉语言模型为多样互联网图像生成 caption,含 1 亿训练 + 20 万验证 + 100 万测试样本。所有图像均「研究 + 商用」许可宽松,经安全过滤、去重,集中托管于 Hugging Face。提供生成建模的 benchmark 协议,并给出像素空间 flow matching 的参考 baseline 实验效果:数据集、benchmark、模型全部开放(stanford-vision-lab/gpic);为视觉生成提供「大规模 + 许可清晰 + 稳定可复现」的公共底座 批判点评:「许可宽松 + 商用可用 + 安全去重 + 集中托管」直击当前生成数据集的版权 / 可复现痛点——这种基础设施工作对整个社区的长尾价值很高,28 万亿像素 + 完整 benchmark + baseline 让它即插即用。但「VLM 自动 caption」的质量上限会限制可训出的文本对齐能力;与 LAION 类已有大语料的去重重叠和质量差异需要更透明 8. Parametric Memory Law:LoRA参数记忆的幂律定律 How LoRA Remembers? A Parametric Memory Law for LLM Finetuning | 浙江大学, 阿里 | arXiv:2605.30260 关键词:LoRA·参数记忆·幂律·LLM微调·浙大 前序问题:LLM 需持续学习更新知识,LoRA 被广泛用于记忆更新,但现有研究多靠定性下游评测,对「精确参数记忆」的定量容量极限和底层动力学几乎没探索 本文贡献:用 LoRA 作为受控的记忆容量探针,在 latent 空间系统量化精确参数记忆。提出 Parametric Memory Law:把 loss 下降 ΔL 与有效参数量、序列长度联系起来的稳健幂律。token 级细粒度分析揭示确定性相变——证明预测概率 p>0.5 是 greedy decoding 下逐字召回的充分条件。据此提出 MemFT:阈值引导的优化策略,把训练预算动态重分配到次阈值 token 实验效果:实证表明 MemFT 能提升记忆保真度和效率;为「LoRA 到底记住多少、怎么记」给出可量化的定律而非定性结论 (github.com/zjunlp/ParametricMemoryLaw) 批判点评:「用 LoRA 当记忆容量探针 + 找出幂律 + p>0.5 相变的充分条件」是把模糊的「记忆能力」做成可量化科学定律的扎实工作,MemFT 把定律反哺成实际训练策略形成漂亮闭环。但幂律的普适性需要跨更多模型规模 / 任务验证;「逐字召回」的记忆与「泛化知识」的记忆是两回事,定律对后者的适用边界要谨慎 趋势观察 视频生成正在「世界模型化」:从出片段走向实时交互、多智能体、可因果 — minWM 把双向 T2V/TI2V 蒸成相机可控的少步自回归世界模型并全栈开源;Gamma-World 用单纯形旋转编码 + 稀疏 hub 注意力把世界模型从单 agent 扩到多 agent(2→4 人零样本泛化、24FPS);YoCausal 用时序反转真实视频做反事实基准,量出 13 个 SOTA VDM 距离「真懂因果」仍有显著差距——视频生成的下一站从「画面好」转向「能交互、有因果、多主体」 自回归流式视频生成开始解决「时间太浅」的结构病 — AdaState 诊断出首帧 KV 锚点偷走注意力、把场景锁死在初始视角,改用「可去噪但不渲染的自演化隐 state」做相对时间锚点,显著改善运动和场景推进——流式视频生成从「保一致」转向「敢动起来」 音视频联合生成走向「先对齐后融合」的原生范式 — NAVA 指出双塔后验对齐弱化协同、三模态全统一耦合语义与同步两条路都有缺陷,提出 Align-then-Fuse MMDiT 先在交互空间建音视频对应、再 context 条件化联合去噪,6.3B 拿下多项 SOTA + 可控音色——音视频生成的架构共识正在形成 图像生成的可控性升级:代码做中间画布、许可数据做底座 — GenClaw 用 SVG/HTML/Three.js 可执行草图作中间画布,把「反复改 prompt」换成「构思-起草-上色」的拟人可控流程;GPIC 放出 28 万亿像素、研究+商用许可宽松、安全去重的图像语料 + benchmark + flow matching baseline——可控生成的「方法」和「数据底座」被同时推进 大模型记忆与微调走向「可量化定律」 — How LoRA Remembers 用 LoRA 当记忆探针,给出 loss 下降 ΔL 与有效参数 / 序列长度的 Parametric Memory Law,发现 p>0.5 是逐字召回的充分条件,并据此提出阈值引导的 MemFT——把「LoRA 记多少」从定性评测推到可解析的幂律 人工智能炼丹君 整理 | 2026-05-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-28|北大OSP-Next视频生成跨硬件加速 今日 AIGC 论文速览 今日共 11 篇 · 视频生成全栈加速 4 篇 · 视频生成新能力 2 篇 · 音频统一生成 2 篇 · 语音合成与编辑 2 篇 · 扩散模型对齐 1 篇 重点论文标题列表 OSP-Next:稀疏+量化+RL全栈视频生成1.64x PARE:视频DiT结构剪枝+动态路由 ⚡ Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Dasheng AudioGen:首个文生混合音频场景统一模型 今日论文速览 1. OSP-Next:稀疏+量化+RL全栈视频生成1.64x OSP-Next: Efficient High-Quality Video Generation with Sparse Sequence Parallelism, HiF8 Quantization, and Reinforcement Learning | 北大袁粒组, 华为 | arXiv:2605.28691 关键词:视频生成·稀疏注意力·序列并行·HiF8·北大袁粒组 ⚠️ 前序问题:Diffusion Transformer 在视频生成上已经能出好东西,但 full attention 二次开销死死压住效率。前人方案各做一段(稀疏 / 量化 / 蒸馏),缺一套能同时打通通信、计算、精度的端到端方案——尤其在「多卡序列并行」上和「跨国产硬件」上 本文贡献:OSP-Next:把稀疏注意力 + 序列并行 + 量化 + RL 后训练全栈打通的高效 T2V 框架。Skiparse-2D Attention 在空间维做 token-wise + group-wise 稀疏并保留 FlashAttention 兼容;提出 Sparse Sequence Parallelism (SSP) 用一次 All-to-All 切换稀疏模式,相比 Ulysses SP 通信量降低 75%;HiF8 量化支持 8-bit 联合训练 + 稀疏 fine-tune;Mix-GRPO 后训练弥补稀疏模型的质量回退 实验效果:VBench 总分 83.73% 超越 Wan2.1 基线;5 秒 720P/768P 设置下,H200 单 GPU 加速 1.64×,8 GPU 加速 1.52×;OSP-Next-HiF8 仅掉 0.4% 分数即可在国产昇腾 Ascend 950PR 上拿到 1.69× 和 2.27× 加速——是少见的同时验证国际/国产硬件的视频生成加速方案 批判点评:「稀疏注意力 + 序列并行 + 量化 + RL」四件套全栈打通,每一件单独不算新,但 SSP 把通信量直接打掉 75% 是非常硬的工程数字;跨 H200 + 昇腾的双硬件验证为国产硬件视频生成提供了稀缺的实证。但 Skiparse-2D 是 fixed pattern,对极复杂运动场景的可适配性需要看;Mix-GRPO 与 SSP 联训的稳定性细节披露还可以更多 2. PARE:视频DiT结构剪枝+动态路由 PARE: Pruning and Adaptive Routing for Efficient Video Generation | 港中文 CUHK, 上海 AI Lab, 悉尼大学 | arXiv:2605.27336 关键词:视频 DiT·结构剪枝·动态路由·Wan2.1-14B·上海 AI Lab ⚠️ 前序问题:Video DiT 又宽(block 宽)又深(架构深)又要多步采样,部署成本极高。前人通过压宽/压深/压步数减成本,但都 commit 到固定架构——不能针对单个输入或不同去噪阶段动态调整 本文贡献:PARE:把宽度剪枝和深度自适应路由联合做。宽度上观察到 attention head 自然分化为空间 vs 时序角色,设计区分两类的 importance scoring 避免「运动关键的 temporal head」被过早剪掉;深度上训轻量 router 以 denoising timestep + 视觉内容为条件,动态选择每步执行哪些 block——实现「按输入动态计算」而非静态删除。两阶段 progressive pipeline 先用蒸馏修复宽度剪枝的质量损失,再联合优化 student + router 解耦学习目标 实验效果:在 Wan2.1-14B 上对 I2V 和 T2V 都大幅降低每步算力且保住 VBench 各维度质量;与 step 蒸馏天然可组合进一步加速——把「静态剪枝」时代翻篇成「动态路由按需算」 批判点评:「区分空间/时序 head 重要性 + denoising-step 条件的 block router」两个洞察都直击 Video DiT 的结构性冗余。动态路由实现「按输入按 timestep 算」是 efficient video gen 的下一阶段方向。但 router 本身的训练稳定性、推理时的额外 overhead、以及与 OSP-Next 类静态稀疏组合后的边际收益需要更细 ablation 3. Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 Quantized Keys Steal Attention: Bias Correction for KV-Cache Compression in Video Diffusion | 慕尼黑工大 TUM, Tensordyne | arXiv:2605.26266 关键词:视频扩散·KV cache·INT2 量化·Jensen 偏差·长视频 ⚠️ 前序问题:chunk-wise 自回归视频扩散依赖前序 chunk 的 KV cache 避免重复计算,但视频越长 cache 越大,量化 KV 到低 bit 又会显著掉画质。掉画质的根因是什么?以前没人说清楚 本文贡献:首次明确指出根因:softmax 注意力中 exp 的凸性让量化噪声系统性放大「被 cache 的 keys」对注意力的贡献——作者命名为 Jensen bias(量化的 keys 会偷走当前 chunk 的注意力质量)。给出 per-attention-score 的解析修正项,在 expectation 上消除该 bias,只用量化 step size 和 query norm 即可在线算;用二阶 Taylor 近似让额外计算开销可忽略、无需额外显存 实验效果:在 MAGI-1 / SkyReels-V2 / HY-WorldPlay 三个长视频模型上 INT2 量化即可恢复大部分掉的质量、接近 BF16;用 50% 更少显存的 INT2 反而能超过 INT4——长视频 KV cache 压缩拿到新的帕累托前沿 批判点评:把「量化掉画质」从经验问题改写成「Jensen 偏差」这一可解析的统计现象是真正的科学贡献——一行公式校正、零额外显存就拿到 INT2 ≈ BF16 的质量。这种「找根因 + 闭式解」的工作含金量高。但局限在 chunk-wise AR 视频扩散,对非 AR 的全局扩散 KV 压缩不直接适用;与 SmoothQuant 等激活/权重路线的组合策略还可探索 4. SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Timestep-Aware SVDQuant-GPTQ for W4A4 Quantization of Wan2.2-I2V | 华中科技大学 HUST | arXiv:2605.27003 关键词:W4A4 量化·Wan2.2·MoE DiT·SVDQuant·华中科大 ⚠️ 前序问题:把大型视频 DiT 推到 W4A4 量化可以省一大块显存,但两道坎卡死:(1) 稀疏的「大幅激活 outlier」;(2) 不同去噪 timestep 的激活分布漂移很大。这两个问题在 Wan2.2-I2V 双专家 MoE DiT(高噪/低噪两个 expert 量化敏感度完全不同)下被进一步放大——单一全局校准策略根本拿不下 本文贡献:Timestep-Aware SVDQuant-GPTQ:(1) SVDQuant-based 低秩 outlier 补偿处理激活大幅 outlier;(2) GPTQ 重建感知残差权重量化;(3) timestep-bin-wise 逐层激活 clipping-ratio 搜索,对每个 MoE expert 独立完成。三件套合起来就是「按 expert + 按 timestep」精细化校准的 PTQ 框架 实验效果:在 OpenS2V-Eval 上相对 BF16 把峰值 GPU 内存降 59.3%,VBench 平均分仅掉 0.9%,Imaging Quality 仅掉 2.3%——证明「expert + timestep 双感知校准」是 MoE 视频 DiT 量化高保真的必要条件 批判点评:把 MoE DiT 量化从「全局校准」拉到「按 expert + 按 timestep」是正确的颗粒度切分——双专家的量化敏感度本来就不同,强行全局必然掉点。59.3% 内存降 + <1% 质量损是漂亮的工业数字。但 PTQ 路线天然依赖 calibration set 质量,长视频/复杂运动的覆盖度需要追踪;与昨天 RT-Lynx 类激活稀疏的组合潜力值得探索 5. Dasheng AudioGen:首个文生混合音频场景统一模型 Dasheng AudioGen: A Unified Model for Generating Coherent Audio Scenes from Text | 小米, 上海交大 | arXiv:2605.27838 关键词:音频场景生成·multi-view caption·flow matching·小米·DiT ⚠️ 前序问题:音频生成长期被「按域切分」——语音、音乐、音效各有独立模型——做不到从一句描述生成「同时包含人声 + 背景音乐 + 环境音效」的连贯混合音频场景。两大障碍:缺真实混合音频的细粒度监督;声学表示难以同时承载多个并发音频组件 本文贡献:Dasheng AudioGen:首个统一生成混合音频场景的端到端框架。两个核心:(i) structured multi-view captions——把复杂声学场景显式解耦成互补的描述视图,让每个音频层都有细粒度控制;(ii) 高维统一「语义-声学」表示作为共享 latent,注入语义先验加速跨模态训练收敛,同时高维特征空间提供解耦并发声音组件的容量。在此基础上一个简单的 flow-matching DiT 就能跑出端到端高质量音频场景生成 实验效果:在混合音频类别接近真实录音质量,单类型生成(speech/music/SFX)也与专用模型打平——首次把「视觉生成里图文统一」的思路真正落到音频场景上;配套建立音频场景生成的综合评测 pipeline 批判点评:「structured multi-view captions + 高维语义-声学统一 latent」是非常对症的两个设计——把音频域的「描述粒度」和「表示容量」都拉到能容纳混合场景的层次。flow-matching DiT 的工程极简性也很好。但 multi-view caption 的自动构造成本/质量、高维 latent 增加的 DiT 训练开销,以及与商用 ElevenLabs Sound Effect / Stable Audio 2 的端到端对比都需要更细评测 6. HarmoVid:视频肖像重打光和谐化稳定不闪烁 HarmoVid: Relightful Video Portrait Harmonization | Adobe Research, UNC | arXiv:2605.28811 关键词:视频肖像·relight 和谐化·deflicker·alpha mask·Adobe ⚠️ 前序问题:把人物前景视频和谐到目标背景场景(同步阴影、色调、光照强度——relightful harmonization)的硬伤是:视频域没法采集「同一动作不同光照」的成对标注数据。最直接的方案——「按帧调用图像和谐模型」——会带来严重时序抖动(flicker) 本文贡献:HarmoVid 给出整套视频和谐化方案:(i) 全新的 lighting deflickering 模型稳定全局和局部光照 flicker,把「逐帧 image-harmonization」的输出升级成可监督的 paired 视频数据;(ii) 视频扩散模型在 deflickered 真实 + 合成视频上学习;(iii) asymmetric alpha mask conditioning 让模型从真实视频里学到干净的边界 实验效果:在时序连贯、自然度、边界干净度、物理合理光照行为多个维度超越此前所有 image-based 和 video-based 和谐化方法;relighting 表现力也保住——人物视频合成 / 后期合成的标准工业链路被显著升级 批判点评:用「先 deflicker 再训练」绕开「无成对数据」的死结是非常聪明的——deflicker 把单帧图像和谐输出转化成可用监督,是真正的杠杆点。asymmetric alpha mask 也很实用。但 deflicker 模型本身的失败模式(强光/复杂阴影)会传导到下游;与 Adobe 自家的商业级合成工具的真实对比需要更细评测 7. SmartDirector:多关键帧条件电影级视频叙事控制 SmartDirector: Keyframe-Conditioned Cinematic Video Generation with Narrative Pacing Control | 国内视频生成团队 | arXiv:2605.27891 关键词:电影级视频·多关键帧·叙事节奏·两阶段·Director-Gen/SR ⚠️ 前序问题:视频的「叙事质量」决定感知价值,但现有视频生成方法主要靠 text prompt 或首尾帧这类稀疏 condition——对叙事结构和时序节奏的精确控制非常有限,导出不了真正「有 pacing 的电影感视频」 本文贡献:SmartDirector:以多关键帧增强视频生成的叙事能力。支持单镜头、多镜头叙事合成、视频延展三类场景。两阶段:(i) Director-Gen 在低分辨率上以关键帧为条件生成;(ii) Director-SR 利用高分辨率关键帧作为语义锚点把细粒度细节补回来。配套数据管线从电影中精选单镜头/多镜头序列以支撑多关键帧训练 实验效果:在多个评测上大幅超越 SOTA,把视频生成从「按 prompt 出 5 秒片段」升级到「按多关键帧出有节奏的多镜头序列」——电影级视频生成的可控性接近真实创作工作流 批判点评:「多关键帧 + 两阶段先粗后细」直击「电影级叙事控制」的实际痛点——单 prompt / 首尾帧确实远远不够。两阶段把分辨率 vs 叙事控制解耦是合理设计。但「关键帧」的获取成本(人工/AI辅助)和叙事节奏的可量化评测仍是模糊地带;多镜头切换的时空一致性细节需要更深 ablation 8. LoSATok:1280维语义压缩到128维统一audio LoSATok: Low-dimensional Semantic-Acoustic Tokenizer for Cross-Domain Audio Understanding and Generation | 清华深圳, 面壁智能 | arXiv:2605.27840 关键词:audio tokenizer·128 维·语义瓶颈·清华深圳·面壁 ⚠️ 前序问题:音频 tokenizer 是统一「音频理解」和「音频生成」的根基。理解需要高层语义;生成需要语义 + 声学细节。现有统一 tokenizer 在高维连续 latent 里同时编码——这增加了 DiT 生成端的建模负担 本文贡献:LoSATok:观察到 1280 维语义 encoder 特征是可压缩的,引入 Semantic Bottleneck 压到 128 维,并用 time-relation loss 保时序特征一致性;再用「双层级语义监督」同时利用高维/低维语义信号——让 tokenizer 在紧凑 latent 空间里同时承载语义和声学细节 实验效果:在 speech / music / 通用 audio 上 SemBo 保住强低维语义容量,LoSATok 与多个语义表示比较 understanding 性能仍有竞争力;在 DiT 端的 speech / music / audio 生成上一致改进——证明「低维 audio 表示也能同时支撑理解与生成」 批判点评:把「audio 统一 tokenizer」的维度从 1280 砍到 128 是非常硬的容量压缩——若真的不掉理解还能提升生成,那就解掉了「audio 统一表示卡 DiT」的关键梗。time-relation loss + 双层级语义监督是合理工程。但 128 维下声学细节的极限(音乐复杂混音、长 reverb)需要更细测试;与 Dasheng AudioGen 高维路线的端到端比较是行业级议题 9. CosyEdit2:GRPO语音编辑反哺零样本TTS CosyEdit2: Speech-Editing-Oriented Reinforcement Learning Unlocks Better Zero-Shot TTS | 南开大学 | arXiv:2605.25930 关键词:语音编辑·GRPO·zero-shot TTS·南开大学·post-training ⚠️ 前序问题:语音编辑和 zero-shot TTS 同源于「prompt 驱动的语音生成」,但语音编辑对「与周围未编辑内容的局部声学一致性」要求严苛得多。SFT 让 TTS 模型获得编辑能力的路线被卡在「成对编辑数据不完美 + 优化信号粗粒度」 本文贡献:CosyEdit2:建立「先 SFT 初始化 → 再 editing-oriented GRPO 后训练」的两阶段框架。GRPO 阶段在「无目标语音」的数据上做,把语音编辑当作 RL 任务优化,让模型从粗粒度匹配走向精细局部声学一致 实验效果:不仅在语音编辑上显著提升,还反哺 zero-shot TTS 能力——揭示「编辑任务 ↔ 合成任务」之间隐藏的相互增益;GRPO 在 audio 域被验证是有效的 post-training 范式 批判点评:把 GRPO 引入 audio 域、并用「编辑反哺合成」这个新角度证明两个任务的深层互助,是非常聪明的科学故事。无目标语音的 RL 设计也比依赖成对数据更可扩展。但 GRPO 的 reward 设计细节、跨语种/多说话人鲁棒性、以及对 prosody 细节的影响需要更系统评测 10. PilotTTS:高德200K小时开源TTS竞品级 PilotTTS: A Disciplined Modular Recipe for Competitive Speech Synthesis | 高德 AMAP | arXiv:2605.27258 关键词:TTS·200K 小时·开源·Q-Former·高德 AMAP ⚠️ 前序问题:SOTA TTS 系统通常需要数百万小时专有数据 + 多阶段复杂架构——这对资源受限的研究团队是几乎跨不过去的门槛。开源社区想自己训出竞品级 TTS 一直缺成熟 recipe 本文贡献:PilotTTS:高德 AMAP 用「最小化架构 + 严格数据工程」做出竞品级轻量自回归 TTS。仅用 200K 小时数据 + 全开源工具处理。两大贡献:(i) 可复现的多阶段数据处理 pipeline(质量评估 + 标签标注 + 过滤);(ii) Q-Former conditioning 紧凑模型架构,通过 cross-sample paired training 解耦说话人身份与说话风格。统一框架支持 zero-shot voice cloning / 11 类情感合成 / 4 类副语言合成 / 14 种中文方言 实验效果:在 Seed-TTS Eval 上 test-en WER 1.50%(最低)、test-zh CER 0.87%;两个测试集说话人相似度都最高(0.862 / 0.815)——超越使用大得多数据集训出来的系统。完整 data pipeline + 预训练权重 + 代码全开源 (AMAPVOICE/PilotTTS) 批判点评:「200K 小时 + 开源工具 + 极简架构」做出超越百万小时专有数据系统的 TTS——是非常有信号量的开源胜利,对中小团队意义重大。Q-Former 解耦说话人/风格的设计也是 clean。但 PilotTTS 主打数据工程而非架构创新,复现门槛仍在「数据处理 pipeline 的工程细节」;与昨天 LongCat-Avatar 类「audio + 视频联合」的下一步集成是开放问题 11. LAIR:扩散模型从成对偏好升级到列表对齐 Beyond Pairwise Preferences: Listwise Reward-Aware Alignment for Diffusion Models | 斯坦福, 加州理工 Caltech | arXiv:2605.26491 关键词:diffusion 对齐·listwise preference·advantage-weighted·Stanford·Ermon ⚠️ 前序问题:preference optimization 已成 RLHF 之外对齐 T2I 扩散的高效替代,但现有方法基本都把监督降到 binary pairwise——这在「同 prompt 有多张候选 + 有连续 reward 分数」时严重浪费信息(一个 winner-loser 标签远远没用上 reward 分布) 本文贡献:Diffusion LAIR:reward-aware listwise preference optimization。每个 prompt 把候选组的 reward 分数转成中心化 advantage 权重,再优化「advantage-weighted regression」目标——目标定义在 implicit reward(当前模型 vs 固定参考模型的 denoising-loss 改进量)上,配二次惩罚正则隐式 reward 幅度。结果是同时用所有候选而非选 pair,并保持保守。LAIR 目标在 implicit-reward 空间有 bounded closed-form 最优解,把正则强度 → 偏好更新幅度的关系写清楚 实验效果:在 SD1.5 / SDXL 上对 T2I 生成 / 组合生成 / 图像编辑 benchmark 都超越 strong pairwise preference optimization baseline;为 diffusion 对齐提供「更接近 RLHF reward 信息密度但不需在线 RL」的中间路线 批判点评:把 DPO 类 pairwise 升级到 listwise + 给出 closed-form 最优解的清晰表述是教科书级的方法工作——既保留 offline 偏好优化的稳定性,又用上了 reward score 的全部信息。但 listwise 数据采集成本高于 pairwise(要 N 张同 prompt 候选 + reward 分),实际落地的数据可得性是隐藏成本;与 in-context 在线 RL(GRPO 类)的端到端比较略浅 趋势观察 视频生成进入「全栈加速」时代:稀疏 + 量化 + 并行 + 路由 + RL 多管齐下 — OSP-Next 把稀疏注意力 + Sparse Sequence Parallelism(通信 -75%)+ HiF8 量化 + Mix-GRPO 一锅端,跨 H200 / 昇腾双硬件分别 1.64× / 2.27× 加速;PARE 联合宽度剪枝 + 动态深度路由,在 Wan2.1-14B 上按输入按 timestep 动态算;SVDQuant-GPTQ 把 Wan2.2 双专家 MoE DiT 推到 W4A4 显存降 59.3%——视频生成的工业部署正在被「全栈加速」改写 长视频 KV cache 压缩出现「找根因 + 闭式解」类突破 — Quantized Keys Steal Attention 首次把「量化 KV 掉画质」从经验现象写成 Jensen bias(exp 凸性放大 cache key 贡献)的可解析统计现象,一行公式校正零额外显存,让 MAGI-1 / SkyReels-V2 / HY-WorldPlay 在 INT2 上接近 BF16——把 chunk-wise AR 长视频的 KV 压缩从「玄学调参」推到「有理论的工程」 音频生成统一化:从「按域切分」走向「一句描述出混合场景」 — Dasheng AudioGen 是首个能从一句描述同时生成 speech + music + SFX 混合连贯场景的统一模型,关键是 structured multi-view captions + 高维语义-声学统一 latent;LoSATok 反过来把 1280 维语义压到 128 维统一 tokenizer 反哺 DiT 生成;CosyEdit2 在 audio 域用 GRPO 把「编辑」反哺「TTS」——audio 正在重走视觉「统一模型」的同一条路 视频生成的「叙事控制」与「视频后期」继续拓宽到工业链路 — SmartDirector 把视频生成从「按 prompt 出 5 秒片段」升级到「多关键帧 + 两阶段先粗后细」做电影级叙事节奏控制;HarmoVid 用 deflicker 模型破解「视频和谐化无成对数据」的死结,把视频肖像 relight 和谐化做到工业级稳定——视频生成的可控性从「内容」深入到「节奏」和「后期合成」 开源 TTS / 对齐方法补齐 audio + diffusion 的「最后一公里」 — 高德 PilotTTS 用 200K 小时 + 开源工具 + Q-Former 极简架构做出超越百万小时专有系统的开源 TTS(Seed-TTS Eval 第一);Diffusion LAIR 把 T2I 对齐从 pairwise 升级到 listwise,给出 implicit-reward 的 closed-form 最优解——开源社区在 audio 合成 + diffusion 对齐这两个长期被闭源霸占的方向同时迈出了「竞品级 + 理论级」的双台阶 人工智能炼丹君 整理 | 2026-05-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-27|美团LongCat-Avatar 1.5开源逼近闭源数… 今日 AIGC 论文速览 今日共 7 篇 · 工业级数字人开源对标闭源 1 篇 · 音视频联合生成评测体系 1 篇 · 视觉生成新范式:层级与通道级 2 篇 · DiT 推理加速与可控编辑 2 篇 · 原生多模态架构路线图 1 篇 重点论文标题列表 LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongAV-Compass:首个分钟级音视频生成评测基准 MRT:20B多层透明图像生成超Qwen CVQ:通道级VQ取代patch挑战传统 RT-Lynx:激活稀疏化让DiT GEMM加速1.55x 今日论文速览 1. LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongCat-Video-Avatar 1.5 Technical Report | 美团 LongCat Team | arXiv:2605.26486 关键词:数字人·美团 LongCat·8 NFE 蒸馏·RLHF·开源对标闭源 前序问题:音频驱动视频生成虽然进展飞快,但要做到「商业级稳定性」仍然难——商用场景下需要的不仅是「唇形对得上」,还要全身时序稳定、长视频身份不漂、多人交互/物体交互不崩,并且部署侧推理 budget 严苛 本文贡献:美团 LongCat-Video-Avatar 1.5:以「系统工程 + 生产就绪」而非架构创新为优先项的开源数字人框架。把 audio encoder 升级到 Whisper Large 并精修训练 recipe,做到准确唇形同步 + 全身时序稳定 + 长视频严格身份一致;通过严格数据清洗 + RLHF 训练,泛化到动漫/动物等风格化域,并原生处理多人交互和物体处理这类真实复杂场景;为工业部署引入 advanced step distillation 把推理压到 8 NFE 实验效果:在 500+ 多样测例 benchmark 上的定量指标 + 严格人评显示 v1.5 在 human-likeness 和专家级质量评估上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越;开源发布拉近了「学术原型」与「商业级部署」的差距 批判点评:美团摆明用「工程优先」的姿态——Whisper Large + 严苛数据 + RLHF + 8 NFE 蒸馏这套组合拳是教科书级的工业打法,公开报告稀缺。但「commercial-grade」更多靠数据规模和清洗,单一架构 trick 不构成壁垒;对标 HeyGen / OmniHuman 1.5 的具体维度需要更详细的 ablation 才能说服业界,且 8 NFE 与 Kling Avatar 2.0 之间的真实人评差距值得追踪 2. LongAV-Compass:首个分钟级音视频生成评测基准 LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV | 北京大学, Kling, 南大, 上交, 港科广州, 上海 AI Lab | arXiv:2605.26244 关键词:音视频生成·minute-scale·评测基准·T2AV/I2AV/V2AV·北大 前序问题:音视频联合生成正在从「短片段」走向「分钟级长内容」,但现有评测协议几乎都还停留在 5-10 秒文本条件生成;很少支持文本/图像/视频三种条件统一评测,更没说清楚长时间下身份一致性、叙事连贯、音画对齐到底怎么退化 本文贡献:LongAV-Compass:首个面向 minute-long 音视频生成的系统化评测基准。284 个精选测例覆盖 T2AV / I2AV / V2AV 三种输入,按应用场景和生成复杂度组织;统一评测框架结合 MLLM 辅助评估和 DINO-v2 / ArcFace / CLIP / ImageBind 等感知指标,覆盖 20+ 细粒度维度——段内质量、跨段一致性、全局叙事连贯、语义对齐、音画同步全都评 实验效果:在 11 个代表性模型上跑 + 人对齐验证,把当前系统在「保持连贯、保持语义对齐、保持时序一致」上的瓶颈量化呈现;为分钟级音视频生成提供了首个诊断式 testbed——音视频联合生成的「评测短板」正式被补上 批判点评:把音视频联合生成的评测从 5-10s 短片推到分钟级是必要补位——评测落后一直是这个赛道的隐形天花板。20+ 细粒度维度 + MLLM 辅助 + 4 大经典感知模型组合非常综合。但 MLLM 评测本身的偏置是隐忧,DINO-v2/ArcFace/CLIP/ImageBind 的权重融合策略需要更多 ablation;分钟级测例 284 个对开源社区评测可行但工业级评测仍偏小 3. MRT:20B多层透明图像生成超Qwen MRT: Masked Region Transformer for Layered Image Generation and Editing at Scale | 微软亚研 MSRA | arXiv:2605.27235 关键词:多层图像生成·20B·masked region·8 步实时·MSRA 前序问题:层级图像生成与编辑是图像生成走向「可复用 / 可重编辑 / 可组合」的关键能力——类比自然语言里的「逐词编辑」——但在大规模上一直是 underexplored 的空白。多层透明生成 + 多任务统一框架既缺数据也缺方法 本文贡献:MRT:20B 参数 masked region diffusion 模型,专为多层透明图像生成与编辑打造,在 10M+ 多语言设计样本上训练,支持多 aspect ratio 与多语言 prompt。两项核心贡献:(i) 把 text-to-layers / image-to-layers / layers-to-layers 三任务统一到「共享 masked region diffusion」框架,靠 selective token masking 灵活切换层级生成与编辑;(ii) overflow-aware canvas layer 处理边界 inconsistency 并支持半透明背景合成,做出可编辑且延伸至画布外的完整图层。配套 diffusion 蒸馏实现 8 步实时多层生成 实验效果:在三项任务上全面超越此前 SOTA 包括商业系统;user-study 显著优于同期 Qwen-Image-Layered 的 image-to-layers 质量,且推理快 10-100×,activation GPU 显存降低 50-90%——为多层透明图像生成立下新基准 批判点评:把多层图像生成做到 20B + 三任务统一 + 8 步实时是非常工业化的工作量;超越 Qwen-Image-Layered 的人评结果是强信号。但 10M+ 设计样本的语义/版权分布未明,多语言/多 ratio 的真实可控性需要更细 ablation;overflow-aware canvas layer 在极端 aspect ratio 下的稳定性也需要追踪 4. CVQ:通道级VQ取代patch挑战传统 Channel-wise Vector Quantization | 上海创新研究院, 西湖大学, 浙大, 复旦 | arXiv:2605.26089 关键词:视觉 tokenization·channel-wise VQ·CAR·next-channel·DPG 86.7 前序问题:传统视觉自回归(VAR)和 VQ-based 文生图都把图像分成 patch、给每个 patch 分配一个离散 token——但这种 patch 视角本质是「把图像当空间网格」,不太符合人类绘画「先勾结构再补细节」的层次过程。codebook 利用率上不去、增大 codebook 后 collapse 也是顽疾 本文贡献:Channel-wise Vector Quantization (CVQ):新视觉 tokenization 范式,离散化对象从 patch 换到 feature map 的每一个 channel——一张图被表示为「不同层级视觉细节的离散等级」而不是「空间 patch 网格」。基于 CVQ 提出 Channel-wise Autoregressive (CAR):next-channel prediction 替代 next-patch prediction,先勾全局结构再渐进精修细粒度属性 实验效果:CVQ 在 16K+ codebook 规模下实现 100% codebook 利用率(无任何 trick),重建质量显著超过传统 VQ;CAR 在文生图上拿到 DPG 86.7 / GenEval 0.79——证明「按 channel 分层渲染」是 patch-based 视觉自回归的现实替代品 批判点评:把 tokenization 从空间 patch 切换到 channel 维度是真正的范式 rethink——「先结构后细节」也与人类作画过程契合。100% codebook 利用率是很硬的数字。但 channel 抽象层次的物理含义不够清晰(哪个 channel 对应「结构」哪个对应「细节」依赖训练涌现),跨分辨率/跨模态时的稳定性需要进一步验证;与 latest DiT 路线的端到端比较略浅 5. RT-Lynx:激活稀疏化让DiT GEMM加速1.55x RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models | 国内系统研究团队 | arXiv:2605.26632 关键词:DiT 加速·激活稀疏化·N:M sparsity·CUDA kernel·1.55x 前序问题:DiT 推理太贵——量化和蒸馏已经被深挖,但能砍掉将近一半 FLOPs 的「半结构化稀疏(N:M sparsity)」一直 underexplored。原因是大家都在做 weight 稀疏化,但对 weight 做 50% 剪枝会拿掉关键模型容量,让生成质量崩坏 本文贡献:RT-Lynx:核心 insight 是「DiT 的激活本身天然稀疏,比 weight 更适合 N:M 半结构化稀疏化」。提出 paradigm shift——从 weight sparsification 转到 activation sparsification;配 error-compensation 缓解精度损失;并实现针对该场景高度优化的 CUDA kernel 实验效果:线性层平均 1.55× speedup,多个扩散模型上保留原生生成质量同时显著加速;为 DiT 部署提供「除量化和蒸馏外的第三条加速路线」 批判点评:把「稀疏化目标」从 weight 切到 activation 是非常对的洞察——activation 在 inference 时本来就动态出现 zero,强制 N:M 模式损失更小。1.55× 加速 + 不掉质量在 DiT 推理优化里属于实打实的硬增量。但 N:M 模式需要硬件配合(Ampere/Hopper 的 sparse tensor core),消费级 GPU 上的实际收益要打折;激活稀疏化对极长 token 序列(高分辨率视频)下的可扩展性需评测 6. ControlLight:Flow Matching做连续强度可控低光增强 ControlLight: Towards Controllable, Consistent, and Generalizable Low-Light Enhancement | 中科院深圳, StepFun | arXiv:2605.25569 关键词:低光增强·flow matching·连续可控·一致性·中科院深圳 前序问题:现有深度学习低光增强方法都在「有限数据集 + 单一增强目标」上训练——既泛化差又不可控。真实场景里同一张暗图,不同用户/不同场景需要不同的增强强度,但现有方法把它当作一个固定函数 fit 本文贡献:ControlLight:「可控 + 一致 + 可泛化」的低光增强框架。先建大规模真实退化图像数据集,对每张图给出「连续光照强度」标签作为监督;引入 misalignment-aware weighted flow matching loss,让模型在不同控制强度下输出仍然保持图像结构一致——用户可以连续滑动「增强强度」拿到不同结果而不撕裂 实验效果:在多个 benchmark 上超过现有低光增强 SOTA,同时具备「连续强度可控」+ 「真实场景泛化」能力,把低光增强从「一锤子函数」改造成「可调节工具」 批判点评:把 flow matching 用到低光增强 + 连续条件标签 + misalignment-aware loss 三件套是非常 clean 的设计——其中「misalignment-aware」直接 attack 不同强度下结构一致的根因。但「连续光照强度标签」如何从真实退化数据获取本身是个隐藏难题;与最近基于 diffusion 的图像 restoration 在极端低光场景的比较需要更全面 7. Native MM Roadmap:原生多模态架构路线图三分类 Toward Native Multimodal Modeling: A Roadmap | 华威大学, Monash, 港理工, 腾讯优图 | arXiv:2605.25343 关键词:原生多模态·NMM·路线图·three-class taxonomy·腾讯优图 前序问题:多模态建模正在从 modality-agnostic 推理走向 world modeling。早期 late-fusion(拼 encoder + frozen LLM + 输出头)已显疲态,最近转向 Native Multimodal Modeling (NMM)——把各模态从根上集成进同一个 transformer 拿到更强性能。但 NMM 的设计空间目前仍未系统化 本文贡献:为社区提供形式化的 NMM 路线图:(1) 形式化定义「架构原生性」,区分 mid-fusion / early-fusion 与非原生范式;(2) 从「输入-输出对偶」角度把现有 native 模型组织成三类——Multi-to-Text(跨模态理解,纯文本输出)/ Multi-to-Target(场景化生成,如图像/音频/视频生成)/ Multi-to-Multi(对称输入输出的统一建模);(3) 全栈式工业视角剖析从架构协调、海量数据 curation、训练 recipe 到推理部署和评测的端到端 pipeline 实验效果:把当前散乱的「统一多模态架构」研究归结成一份可被工程师和研究员同时参考的路线图——理解和生成在「统一 transformer 范式」下无缝共存是 NMM 的目标终态。对走向 GPT-4o / Gemini 1.5 级原生多模态的开源工作给出系统化方法学 批判点评:「形式化 architectural nativity + 输入输出对偶三分类 + 全栈工业视角」三个层次组织得很清晰——是社区急需的概念清理。但综述类天然有「分类强、实证少」的局限,三类边界(特别是 Multi-to-Target 和 Multi-to-Multi)在最新模型上可能交叉;对未来 1-2 年具体技术抉择的指导力度需要在落地 case 中验证 趋势观察 工业级开源数字人 / 视觉基础模型加速对标闭源 — 美团 LongCat-Video-Avatar 1.5 用 Whisper Large + RLHF + 8 NFE 蒸馏的工业打法,在 500+ 测例上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越——昨天百度 ERNIE-Image 是文生图,今天美团 LongCat-Avatar 是数字人——国内大厂正在多个垂类同时按下「开源对标闭源」按钮 音视频联合生成评测从「短片」推到「分钟级」 — LongAV-Compass 提供首个 minute-scale 音视频生成评测基准——284 个测例覆盖 T2AV / I2AV / V2AV、20+ 细粒度维度(段内质量 + 跨段一致 + 全局叙事 + 语义对齐 + 音画同步)。和最近 Baton / SpongeBob / StreamChar 等音视频联合生成模型一起,把「短片评测」时代正式翻篇 视觉生成 tokenization / 架构范式正在被 rethink — MRT 把「图像生成」从单层 RGB 推到「多层透明 + 三任务统一 + 8 步实时」;CVQ 把视觉 tokenization 从 patch-wise 切换到 channel-wise,重提「先结构后细节」的人类作画过程并拿到 100% codebook 利用率与 GenEval 0.79——patch + 单层这两个长期假设都在被挑战 DiT 推理加速的第三条路:从「weight 稀疏」转向「activation 稀疏」 — RT-Lynx 指出 DiT 激活本身就稀疏,对 N:M 半结构化稀疏化远比 weight 鲁棒,配合错误补偿和定制 CUDA kernel 拿到 1.55× 线性层加速且不掉质量——量化、蒸馏之外,「激活稀疏化」正式成为 DiT 部署的第三条加速路线 Native 多模态架构走向系统化,可控生成成为最后一公里 — Toward Native Multimodal Modeling 把原生多模态架构形式化为「Multi-to-Text / Multi-to-Target / Multi-to-Multi」三分类,给出从架构到训练到部署的全栈 roadmap;ControlLight 用 misalignment-aware flow matching 把低光增强做成「连续强度可控」工具——「统一架构 + 可控生成」正在收敛成下一代生成模型的双轨 人工智能炼丹君 整理 | 2026-05-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-26|百度ERNIE-Image开源8B DiT追平闭源 今日 AIGC 论文速览 今日共 11 篇 · 国产开源文生图基础模型 1 篇 · 音视频联合生成与编辑 3 篇 · 视频生成训练范式革新 2 篇 · few-step 蒸馏与自回归视频蒸馏 2 篇 · 推理时自适应与视频编辑 3 篇 重点论文标题列表 ERNIE-Image:百度8B DiT开源逼近闭源SOTA Baton:首引语义蓝图驱动音视频联合生成 ⚡ SpongeBob:首个端到端音视频联合编辑Sync+30% StreamChar:长时流式角色音视频实时生成 PixelWizard:原生2K/4K视频生成10倍加速 今日论文速览 1. ERNIE-Image:百度8B DiT开源逼近闭源SOTA ERNIE-Image Technical Report | 百度 Baidu ERNIE Team | arXiv:2605.25347 关键词:ERNIE-Image·百度·8B DiT·MT-DMD 蒸馏·industrial-grade ⚠️ 前序问题:开源文生图模型与闭源顶级系统在指令跟随、文字渲染、美学质量上仍有明显差距。差距主要来自两件事:预训练数据噪声大且长尾概念覆盖差;后训练人类偏好对齐的稳定性不足,蒸馏期间还会出现 capability drift(蒸馏前能做的事,蒸馏后做不到了) 本文贡献:ERNIE-Image:8B 单流 DiT 架构开源文生图基础模型。预训练用 bottom-up 数据管线(细粒度分类 + 富 caption + 美学评估 + 分层采样)压噪同时保长尾;后训练 top-down 高需求场景 + 多样化 prompt + 稳定化 DPO;ERNIE-Image-Turbo 实现 8-NFE 高效生成,配套 MT-DMD 蒸馏算法缓解 capability drift。配套发布 industrial-grade ERNIE-Image-Aes 美学模型和 ERNIE-Image-Aes-1K benchmark(首个针对真实场景的美学评测基准) 实验效果:开源模型中达到 leading 表现,在指令跟随/文字渲染/美学三项接近顶级闭源商业模型;模型权重和美学评测资源全部开源,覆盖完整工业流水线(包括 Prompt Enhancer 把简短意图扩展为结构化视觉描述) 批判点评:「8B DiT + bottom-up 预训练 + top-down 后训练 + 稳定 DPO + Turbo 蒸馏」是教科书级的工业开源大模型训法,单独哪一项都不算新颖,但全部端到端打通、配套基础设施 + 评测开源是最大贡献。但闭源 SOTA(GPT-Image / Imagen 4 / Midjourney v7)的差距具体几何缺乏精确量化对比,且 industrial-grade aesthetic model 的偏好可能强烈反映中文用户审美,国际场景适用性需观察 2. Baton:首引语义蓝图驱动音视频联合生成 Baton: Explicit Semantic Blueprints for Joint Video-Audio Generation | 复旦大学, 腾讯混元 | arXiv:2605.25195 关键词:音视频联合生成·explicit planning·VA-Planner·腾讯混元·Relative RoPE ⚠️ 前序问题:开源扩散模型做音视频联合生成时,两个模态的去噪轨迹各自为政,导致音画不同步、长时一致性差。根因:现有方法用现成 encoder 的粗粒度 text embedding 引导音/视频去噪——这丢掉了细粒度语义,更关键的是缺少一个跨模态的「长 horizon 共享规划」 本文贡献:提出 Baton:首个引入 explicit semantic planning 的音视频联合生成框架。VA-Planner(带双语义对齐塔的多模态 LLM)让可学习 query 同时 cross-attend 视频和音频特征,吐出一对语义对齐的音/视频 planned token(关键帧级蓝图);这些 plan token 通过 cross-attention 注入扩散 backbone,与粗 text embedding 互补;进一步提出 Relative Semantic RoPE 把 planned token 和 latent 映射到共享时空坐标系,让 latent 准确 attend 到对应语义线索 实验效果:在标准音视频联合生成 benchmark 上定性定量都显著超过基线;首次把「先规划后渲染」的范式从单模态扩散扩展到跨模态联合扩散——和昨天 Bernini「MLLM 规划 + DiT 渲染」是同向延续 批判点评:「explicit semantic planning」做跨模态联合生成是非常对的方向——粗 text embedding 当指挥棒本来就太宽松。VA-Planner + Relative Semantic RoPE 解决了「plan 怎么对齐 latent」的工程关键。但 VA-Planner 多了一次 MLLM 推理,端到端时延和显存对比单 DiT 联合扩散需要进一步说明;planned token 颗粒度是 keyframe-level 而非 frame-level,复杂动作对齐上限仍受限 3. SpongeBob:首个端到端音视频联合编辑Sync+30% SpongeBob: Sync-Aware Harmonious Audio-Visual Generative Editing | 中科大 USTC | arXiv:2605.25193 关键词:音视频联合编辑·端到端·Sync-Aware·Context-Aware·USTC ⚠️ 前序问题:物理世界的视觉和声音本就耦合,但现有视频编辑全部是「视觉编完,再单独配音/换音」的解耦 pipeline,没有双向模态交互。结果是:(i) 音画不同步;(ii) 改动后的画面和保留下来的原音之间出现语义冲突(看到打字键盘却继续是说话声) 本文贡献:SpongeBob:首个端到端音视频联合编辑框架,带双向 cross-modal 交互。Sync-Aware Mechanism 通过双向注意力 + 时序对齐 + 空间约束让视觉编辑跟声音事件对齐;Context-Aware Module 用声/像 context attention 防止编辑后语义冲突;Sync-Preserving Training and Guidance(SPTG)在保持画质的同时强化对齐。配套构建可扩展数据管线 + subject-level 大规模数据集 + SpongeBob-Bench 评测 实验效果:Sync-C(音画同步指标)+30%、Ctx-F1(上下文一致性)+12.5%,显著超越现有 baseline;首次把「音视频编辑」推到 explicit joint 范式,让「改了画也改对应音」成为可能 批判点评:把音视频编辑从「解耦串行」改成「联合并行」是必要的下一步,Sync-Aware + Context-Aware 双模块设计简洁;但训练数据规模和评测集都依赖作者自建,第三方复现成本高;编辑场景的覆盖(替换/插入/删除)和真实创作工作流的对接深度还需后续验证 4. StreamChar:长时流式角色音视频实时生成 StreamChar: Long-Horizon Streaming Character Audio-Video Generation with Decoupled Orchestration | 阿里通义实验室 | arXiv:2605.25659 关键词:流式生成·角色动画·decoupled orchestration·阿里通义·sink-chunk memory ⚠️ 前序问题:实时流式的角色音视频联合生成要同时满足:(1) 说出指定 transcript;(2) 跨 chunk 保持视觉身份;(3) 严格的播放预算(低延迟)。三个目标相互掣肘——逐 chunk 的自回归生成会累积 transcript-audio 错位和视觉漂移;为低延迟而做的 few-step 蒸馏又会牺牲空间多样性和时序质量 本文贡献:StreamChar:把「长 horizon 规划」与「短窗音视频去噪」解耦的流式框架。LLM 编排器(orchestrator)用 transcript 和历史上下文产出帧对齐的音频条件;joint audio-video DiT 做局部双向去噪并带 reference + motion-frame conditioning;两阶段蒸馏先压缩 sampler 再用 online chunk rollout 微调 student;progress-aware pointer 在 rollout 训练时把部分 transcript 与生成音频对齐;sink-chunk memory 提供持久视觉 anchor 缓解长 horizon 漂移 实验效果:把流式 character animation 这个被低延迟严重压制的方向推到「长 horizon + 严格时延 + 身份稳定」可同时满足;解耦式架构让 LLM 做规划、扩散 backbone 做细节生成成为长视频流式生成的可行新范式 批判点评:把「orchestrator vs denoiser」解耦解决了流式 + 长时生成两难,sink-chunk memory + progress pointer 是非常针对性的工程设计。但 LLM orchestrator 引入额外推理路径,对端到端时延的真实贡献需要更细评测;joint audio-video DiT 蒸馏后的 student 与教师模型 audio-visual coherence 的差距上限值得跟踪 5. PixelWizard:原生2K/4K视频生成10倍加速 PixelWizard: Towards Efficient High-Fidelity Video Generation at Ultra-Large Spatial Resolution | 港科大广州, 小米 | arXiv:2605.25801 关键词:高分辨率视频·原生 2K/4K·10× 加速·分层 anchor·小米 ⚠️ 前序问题:高分辨率视频生成有两个相互耦合的瓶颈:(1) token 序列爆炸让优化偏向局部纹理而牺牲全局连贯(结构坍塌);(2) 训练成本巨大、推理延迟严重。简单堆分辨率根本不可持续 本文贡献:PixelWizard 把全局结构建模和细粒度细节合成分层解耦:先建立一个紧凑的时空 anchor 浓缩稠密结构先验,再以此引导高分辨率细节生成,缓解局部优化偏置;引入 Noise-Span Aligned Shortcut Training 让模型可以「大步」遍历生成轨迹(突破推理瓶颈);Exponential Index-Biased Sampling + Adaptive Noise-Span Calibration 把优化与高分辨率网格的偏移噪声 schedule 对齐,实现 robust few-step 推理且无需蒸馏的开销 实验效果:原生 2K/4K 视频生成加速 >10×,同时保证视觉质量;不依赖蒸馏(避免 capability drift),是高分辨率视频生成的「全栈式」效率优化方案 批判点评:分层 anchor + shortcut training 思路很正——直接面对「token 爆炸」根因。10× 加速 + 不蒸馏的组合非常吸引人;但与最新蒸馏路线(如 DMD2/Causal Distill)的端到端对比缺失,结构 anchor 是否能跨场景(人物运动/复杂相机)稳定泛化需要更细评测 6. Paris 2.0:首个去中心化预训练视频生成FVD减半 Paris 2.0: A Decentralized Diffusion Model for Video Generation | Bagel Network | arXiv:2605.26064 关键词:去中心化训练·DDM·视频生成预训练·FVD 2×·Bagel ⚠️ 前序问题:训视频生成模型几乎都要 monolithic GPU 大集群,开源社区无法独立完成时序连贯的视频生成预训练。前作 Paris 1.0 证明了图像生成可以分布式训练(去中心化扩散 DDM),但「时序连贯的视频生成」在 decentralized 训练范式下仍是 open problem 本文贡献:Paris 2.0:首个通过去中心化(decentralized)计算完成预训练的视频生成模型。训练 recipe 基于 Paris 1.0 的开源 DDM 扩展到视频领域,关闭了「分布式训视频」最后一块短板。同 compute budget 下与 monolithic 模型在相同数据上对照评估 实验效果:在 low-resolution 文生视频训练上,相同总算力预算下相比 monolithic baseline,FVD 从 561.04 降到 279.01(~2.0× 提升),CLIP 文本-视频相似度与美学分数双双提升。证明 decentralized 训练不仅可行而且能反超 monolithic——开源社区独立训视频基础模型门槛被显著拉低 批判点评:「分布式 GPU 也能训视频生成」是范式级的工程突破——把视频生成预训练的算力门槛从「必须有大集群」拉到「能聚起多组消费级 GPU」。同算力预算下反超 monolithic 是惊喜数字。但还停留在 low-resolution 段位,高分辨率长视频下分布式通信开销是否仍能 hold 住,是后续最大悬念 7. RTDMD:4步生成同时蒸馏对齐刷新SOTA Reinforcing Few-step Generators via Reward-Tilted Distribution Matching | Sea AI Lab, 港科大 | arXiv:2605.26108 关键词:few-step 扩散·蒸馏·RLHF·GRPO·FLUX.2 ⚠️ 前序问题:few-step 扩散蒸馏已能让图像生成又快又好,但和人类偏好对齐还是难——直接套 RLHF 会破坏蒸馏后的分布稳定性,难以兼得「步数少 + 画质高 + 对齐人类偏好」 本文贡献:RTDMD(Reward-Tilted Distribution Matching Distillation):两阶段统一蒸馏与 RL 对齐。理论上证明 minimizing KL 到「reward-tilted teacher」自然分解为分布匹配 + reward maximization 两项。Stage1:AC-DMD(Ambient-Consistent DMD)做子区间分布匹配 + consistency 正则化,让 fake score 模型追上漂移的 generator;Stage2:混合 policy gradient——GRPO-style estimator 处理随机中间步 + direct reward backprop 处理确定性 final step;进一步用 step-subset GRPO(SubGRPO)降方差 实验效果:在 SD3 / SD3.5 / FLUX.2 上仅 4 步推理就刷新 preference / aesthetic / compositional 三类指标 SOTA,超越此前所有 few-step 文生图方法,代码模型开源 批判点评:把蒸馏和 RL 对齐写成同一个 KL 优化问题在理论上很优雅,工程实现 AC-DMD + 混合 policy gradient + SubGRPO 三件套也都是合理设计;但 GRPO 在 4 步采样下的方差估计仍可能高,跨更多底模(SD3.5 / FLUX 之外)的稳定性需要更多验证 8. AFD:on-policy黑盒蒸馏自回归视频 On-Policy Adversarial Flow Distillation for Autoregressive Video Generation | 新加坡国立大学 NUS | arXiv:2605.26105 关键词:自回归视频·黑盒蒸馏·on-policy·flow-matching·Bradley-Terry ⚠️ 前序问题:自回归视频生成器对流式、长 horizon、交互应用非常有吸引力,但把强黑盒 teacher 蒸馏成 causal student 极其困难:student 必须在自己 rollout 分布下学习,而实际 teacher 通常只暴露 prompt-conditioned 完成的视频,结构/容量/时序设计/采样 schedule 都不同。这让 SFT 是 off-policy 的、score-based 蒸馏不适用、直接对抗模仿对去噪步级 credit assignment 又太稀疏 本文贡献:AFD(Adversarial Flow Distillation):异构黑盒视频蒸馏的 on-policy 框架。同 prompt 同时 query teacher 和 rollout 当前 student;训 prompt-paired Bradley-Terry discriminator 估计 clean-sample 教师-学生差异;把 on-policy advantage 转成 forward-process flow-matching 更新到 student 自己的 noised state 上。这套设计让 student 拿到稠密 velocity-field 监督,且无需 teacher score / latent / 去噪轨迹 / step alignment / reverse-chain RL 实验效果:把「自回归视频生成 + 黑盒强 teacher」蒸馏从死局拉到可行——这恰是流式视频 + 大闭源 teacher 时代的最关键工程问题。on-policy 学习避免分布漂移,flow-matching 转换提供稠密信号,是 RTDMD 在「自回归视频」侧的对偶贡献 批判点评:把「黑盒、异构、自回归视频」三个最难维度同时解决,思路非常对——on-policy + 对抗 + flow-matching 转换是当前最合理的组合。但 Bradley-Terry discriminator 在视频域的样本效率与训练稳定性、以及面对真正巨大闭源 teacher(如商用 Sora / Veo 级别)的 query 成本,是工程落地的真实门槛 9. TT-SAC:talking-head推理时自适应免训练 Test-Time Self-Adaptive Conditioning for Stable Audio-Driven Talking-Head Generation | 格里菲斯大学 Griffith | arXiv:2605.25488 关键词:talking-head·推理时自适应·免训练·feedback loop·身份保持 ⚠️ 前序问题:音频驱动 talking-head(AniTalker / FLOAT / Sonic 等)当前主流是:一张静态参考图条件整段视频生成。但静态身份条件 vs 动态面部运动天然错配,导致 identity drift、时序不一致、感知质量下降 本文贡献:TT-SAC(Test-Time Self-Adaptive Conditioning):完全 parameter-free 的推理时框架,让预训练 talking-head 模型在生成过程中自适应调整 conditioning,不需要重训、不需要梯度、不需要任何额外监督。把 generator 与 encoder 组成 feedback loop:generator 输出再被 encoder 编码,构造与时序动力学对齐的精修 conditioning;单步自适应即近似 self-consistent equilibrium,稳定跨时长的身份与运动 实验效果:把 talking-head 的「静态参考图」假设彻底打破——同一组预训练权重,仅靠推理时 feedback loop 即可显著缓解 identity drift 和时序退化;零训练成本即可升级现有 talking-head 模型,是非常实用的 plug-in 改造 批判点评:把 generator-encoder feedback 当作 implicit fixed-point 迭代是聪明的——既廉价又对预训练模型友好。但 single adaptation step 是否真能稳定逼近 self-consistent equilibrium 取决于具体模型,对发生面部大幅度运动或镜头切换时的鲁棒性需要更细评测;feedback 单步 vs 多步的边际收益曲线也值得展开 10. RVEDiT:MLLM注入Token让DiT分粒度推理编辑 Reasoning to Align: Implicit Reasoning in Diffusion Transformers for Video Editing | 华为 | arXiv:2605.24674 关键词:视频编辑·DiT·MLLM Token·分粒度路由·华为 ⚠️ 前序问题:指令视频编辑需要按自然语言改源视频,同时保留无关内容、保持时序一致。但现有 DiT 编辑器有两个结构性缺陷:(1) 条件信号不分粒度灌入所有 transformer block,单一 token 流既要编码全局意图又要编码细粒度证据;(2) cross-attention 模式只受 pixel-level 重建间接监督,内部推理过程完全不受约束 本文贡献:RVEDiT:implicit Reasoning Video Editing DiT。两个互补组件:(i) Granularity-Routed Token Conditioning——从 MLLM 蒸馏出 learnable editing token 路由到浅层 block,深层 block 留给原生视觉/文本 token,自然形成 coarse-to-fine 编辑过程;(ii) Reference-Anchored Attention Alignment——训练时用参数共享 reference 分支,最大化编辑/参考分支注意力特征的互信息,正则化内部推理但推理时零额外开销 实验效果:在标准指令视频编辑 benchmark 上一致超过 SOTA,对 localized 和 compositional 编辑提升最大;引入 MLLM 推理但部署时单分支,性价比高 批判点评:「分粒度路由 conditioning + reference 互信息对齐」两个手段都直击 DiT 编辑器的结构性病灶,思路非常清晰。但 MLLM 提供的 editing token 是离线蒸馏,可能不能捕捉新颖指令;reference 分支在训练时翻倍显存,长视频上的可扩展性需评测 11. Squeeze-MLLM:MLLM+VAE双条件根治主体生成贴图 Squeezing Capacity from Multimodal Large Language Models for Subject-driven Generation | 多伦多大学 U of T | arXiv:2605.26111 关键词:Subject-driven·MLLM·VAE 身份·DLA·copy-paste ⚠️ 前序问题:subject-driven 生成(保留参考主体身份 + 跟随文字指令)此前主流是 text 和 reference 各编各的——这天然削弱跨模态推理,并导致典型的 copy-paste artifact(参考图被原样贴上去)。最近 MLLM + diffusion 框架改善了指令跟随,但忽略了身份保持 本文贡献:把 diffusion model condition 在 MLLM 上(让 text 和 reference 联合编码),同时用 VAE 做 identity conditioning;新设 Dual Layer Aggregation (DLA) 模块聚合 MLLM 多层级特征做最优 conditioning;用多阶段去噪策略在推理时渐进式平衡 MLLM 提供的语义和 VAE 提供的细节身份 实验效果:把多模态理解和身份保持调和得很好,缓解了 copy-paste 问题,人类偏好评测上 subject-driven 生成超越现有方法;项目页面开放 批判点评:「MLLM 编联合语义 + VAE 守身份细节」的双通道是非常合理的分工——比纯 MLLM/纯 reference encoder 都更接近问题本质。DLA + 多阶段去噪是工程上的细致打磨;但 VAE 通道也可能引入贴图倾向(VAE 重建本身就有 identity 偏置),与最新 IP-Adapter / OmniGen 等的端到端对比是否在所有场景占优需要更细评测 趋势观察 国产开源文生图基础模型加速对标闭源 SOTA — 百度 ERNIE-Image 8B 单流 DiT 系统化打通预训练 bottom-up 数据 + 后训练 top-down + 稳定 DPO + Turbo 蒸馏 + 工业 aesthetic 评测全栈,且模型/数据全部开源——开源阵营在指令跟随/文字渲染/美学三项已逼近 GPT-Image/Imagen/Midjourney 等闭源顶级系统 音视频联合生成进入「规划 + 流式 + 编辑」三角范式 — Baton 用 VA-Planner(多模态 LLM)吐出音/视频共享语义蓝图驱动联合扩散;SpongeBob 通过双向 cross-modal 交互做端到端音视频联合编辑;StreamChar 用 LLM orchestrator 解耦长 horizon 规划与短窗去噪做流式角色音视频——音视频从「各编各的」彻底走向「联合规划 + 联合渲染」 视频生成同时突破两个壁垒:分辨率天花板与训练算力门槛 — PixelWizard 把全局 anchor 与细节合成分层解耦,加上 Noise-Span Aligned Shortcut Training,原生 2K/4K 视频生成提速 10× 且不蒸馏;Paris 2.0 首次完成 decentralized 视频生成预训练,同算力下 FVD 从 561→279(2×)反超 monolithic baseline——视频生成的「分辨率天花板」被工程化突破,「训练必须大集群」被打破 few-step 蒸馏从图像扩散扩展到自回归视频生成 — RTDMD 把蒸馏和 RL 对齐写成同一 KL 优化(4 步刷 SD3/FLUX.2 SOTA);AFD 把 on-policy 对抗 + flow-matching 转换组合用于黑盒异构 teacher 蒸馏 causal 视频 student——证明「步数少 + 画质高 + 对齐人类偏好 + 流式自回归」可以同时拿到,且不依赖白盒 teacher score / 轨迹访问 推理时自适应/编辑成为零训练能力升级标配 — TT-SAC 让 talking-head 模型在推理时通过 generator-encoder feedback loop 自适应 conditioning(免训练、免梯度);RVEDiT 把 MLLM 推理 token 路由到 DiT 浅层 block 形成 coarse-to-fine 编辑;Squeeze-MLLM 用 MLLM+VAE 双通道在推理时渐进平衡语义与身份——「不重训也能拿到新能力」正在成为生成模型的标准升级路径 人工智能炼丹君 整理 | 2026-05-26 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-25|字节Bernini让MLLM规划DiT渲染视频 今日 AIGC 论文速览 今日共 11 篇 · 统一视频生成与编辑 2 篇 · Unified Audio 与音乐生成 2 篇 · 文生图基础架构与高清解码 3 篇 · 视频世界模型与可控生成 2 篇 · 高效推理与长上下文 2 篇 重点论文标题列表 Bernini:MLLM做语义规划DiT做像素渲染 StepAudio 2.5:单一音频基础模型三任务全SOTA ⚡ PiD:512潜变量→2048图像 <1秒解码 SCOPE:首个跨游戏FPS世界模型zero-shot迁移 DecQ:8个查询+3.9%算力把RAE重建拉满 今日论文速览 1. Bernini:MLLM做语义规划DiT做像素渲染 Bernini: Latent Semantic Planning for Video Diffusion | 字节跳动 Bernini Team | arXiv:2605.22344 关键词:统一视频生成·MLLM 规划·DiT 渲染·SA-3D RoPE·CoT ⚠️ 前序问题:MLLM 擅长跨模态推理与语义对齐,扩散模型擅长高保真像素合成——但目前两条路线要么混入一个端到端 unified model(损失各自强项),要么靠 adapter 松耦合(语义传递不充分)。视频生成与编辑亟需一种新分工,能把 MLLM 的语义规划能力和 DiT 的像素渲染能力同时榨干 本文贡献:提出 Bernini 统一视频生成与编辑框架:MLLM 规划器直接在 ViT embedding 空间预测目标语义表征(不是文本),DiT 渲染器以这个语义 plan 为主条件,文本特征 + 编辑场景下的源视频 VAE 特征做辅助引导。规划器和渲染器分开训练 + 轻量协同微调,保住各自预训练能力。引入 SA-3D RoPE(Segment-Aware 3D RoPE)处理多视觉输入,并在规划器中引入 CoT reasoning 把「理解」翻译成「生成指令」 实验效果:在多项视频生成与视频编辑 benchmark 上达到 SOTA;编辑任务上 MLLM 的预训练理解力可直接迁移为强泛化能力——挑战性编辑场景下尤其明显 批判点评:「MLLM 当规划器、扩散模型当渲染器」是非常合理的下一代统一架构分工——既避免了端到端 unified model 的能力打架,也比 adapter 路线传递了更丰富的语义。但论文用 ViT embedding 而非文本作为接口让组件互换性变差,规划器换到其他 MLLM 需要重新对齐;SA-3D RoPE 在多视觉输入场景的扩展上限(如 5+ 参考图)未充分测试 2. StepAudio 2.5:单一音频基础模型三任务全SOTA StepAudio 2.5 Technical Report | 阶跃星辰 StepFun | arXiv:2605.23463 关键词:Unified Audio·ASR·TTS·实时对话·RLHF ⚠️ 前序问题:Unified audio-language model 是大趋势,可现实是它们在 ASR/TTS/实时对话三件事上常常打不过专用系统——语义理解、生成合成、低延迟对话天生有结构与目标差异。如何让一个 backbone 同时压过三个专用 SOTA 是开放挑战 本文贡献:StepAudio 2.5 把「模态接口统一」与「目标分化」分两层处理:文本与音频共享多模态表征空间作为底座,任务特化由「数据构造 + 优化目标 + 解码策略」三件事决定。重头戏是把 post-training 从标准 SFT 升级为「任务定制 RLHF」——ASR 用可验证 multi-token decoding 提速、TTS 用 preference-based RLHF + context-rich supervision 保表现力、Realtime 用 generative reward modeling 框架优化人格一致与低延迟 实验效果:在 ASR / TTS / Realtime 三个方向的标准 benchmark 上同时达到 SOTA,证明「单一音频语言基础模型在三个目标上压过专用系统」是可行的——RLHF 是统一 backbone「分化部署」的关键钥匙 批判点评:把「目标分化交给 RLHF」是非常聪明的分工——既保住统一架构的训练效率,又给三个任务留出独立优化空间。但论文的 RLHF 训练成本巨大且对各任务的奖励信号设计依赖深,落地复现门槛高;与 GPT-4o / Gemini 这种闭源多模态对话模型的实时对话直接对比缺失 3. PiD:512潜变量→2048图像 <1秒解码 PiD: Fast and High-Resolution Latent Decoding with Pixel Diffusion | NVIDIA, 多伦多大学, Vector Institute | arXiv:2605.23902 关键词:Pixel Diffusion·高清解码·DMD2 蒸馏·6× 加速·RAE ⚠️ 前序问题:T2I 主流采用「潜空间扩散 + decoder 还原像素」两段式,但 decoder 是重建优化的——只学逆向 encoder,并不主动合成细节。当目标分辨率拉到百万级(megapixel),decoder 的计算变得非常昂贵,画质上限也被牢牢锁死 本文贡献:提出 PiD(Pixel Diffusion Decoder):把「latent → pixel」decoding 改写成「条件像素扩散」,统一了解码与超分两步。直接在高分辨率像素空间去噪,原生支持 4× / 8× 上采样;通过轻量 sigma-aware adapter 把含噪 latent 注入像素扩散 backbone,使 PiD 能在 latent 还没去噪完时提前接手,让上游 latent diffusion 提前停步。再用 DMD2 蒸馏把推理压到 4 步。同时支持普通 VAE latent 和语义 latent(SigLIP/DINOv2,给 RAE 模型用) 实验效果:512×512 latent 解码为 2048×2048 像素在消费级 RTX 5090 上 <1 秒(峰值 13GB),在 GB200 上最快 210ms——比 cascaded diffusion-based super-resolution 快约 6×,视觉保真度也更好。直接把「高清文生图」的推理成本拉到接近实用区间 批判点评:把 decoder 从「重建优化」改为「条件生成优化」是非常正确的方向——这是 RAE 路线之外又一条反思 latent decoding 的工作。<1 秒 2K 解码 + 6× 加速是少有的同时省时又提质的硬数字;但 PiD 与原生 pixel-space 扩散(如 PixArt-Σ pixel)之间的对比仍未完全展开,DMD2 4-step 蒸馏的稳定性如何随分辨率扩展仍需观察 4. SCOPE:首个跨游戏FPS世界模型zero-shot迁移 SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models | 国科大 UCAS-Terminus AI Lab, 新加坡国立 NUS, 浙江大学, 港科大广州 | arXiv:2605.23345 关键词:FPS 世界模型·视频扩散·跨游戏迁移·CrossFPS·per-pixel 条件 ⚠️ 前序问题:FPS(第一人称射击)游戏的可玩世界模型,每一帧都要响应高频重叠的多种操作信号,同时还不能扰动屏幕中无关区域。已有方案要么全图注入动作信号(粒度太粗),要么只在单款游戏上训(无法跨游戏迁移) 本文贡献:观察到 FPS 操作具有「空间选择性」:开火/换弹只影响武器周围的局部 scope,而镜头/移动指令影响全局背景。SCOPE 在预训练视频扩散 transformer 的每个 block 插入条件模块,把特征重塑成 per-pixel 时序序列,每个位置根据本地视觉内容计算自己的动作响应——不依赖任何分割标注就把 in-scope 效果与 out-of-scope 生成分开。同时构建 CrossFPS:首个多游戏 FPS 数据集(7 款游戏、69K 帧对齐 10-DoF 控制信号片段),让模型学到游戏无关的视觉-动作映射 实验效果:训得的世界模型在多个未见场景上 zero-shot 迁移成功,动作响应度强、scope 分离精确,跨游戏泛化效果优——首次让 FPS 世界模型走出「单游戏专门训」的范式 批判点评:「scope 局部 vs 全局」的解构是非常贴近 FPS 物理直觉的观察,per-pixel 时序条件注入比全图条件优雅得多。CrossFPS 数据集让 FPS 世界模型有了 ImageNet 时刻的基础;但 10-DoF 控制信号离真实玩家的复杂连招仍有距离,对长 horizon 一致性(数百帧战斗)效果论文未充分披露 5. DecQ:8个查询+3.9%算力把RAE重建拉满 DecQ: Detail-Condensing Queries for Enhanced Reconstruction and Generation in Representation Autoencoders | 复旦大学, 上海 AI Lab | arXiv:2605.22777 关键词:RAE·DINOv2·细节 Query·重建生成解耦·3.9% 算力 ⚠️ 前序问题:Representation Autoencoder(RAE,把视觉基础模型当 tokenizer encoder)能让 latent diffusion 收敛更快、生成更好——但 VFM 必须冻住,限制了细粒度重建能力。如果反过来微调 VFM 解锁重建,又会破坏预训练语义空间、拖累生成。重建 vs 生成长期是 trade-off 本文贡献:DecQ 思路简单优雅:用一组轻量「detail-condensing queries」通过 condenser 模块从中间层 VFM 特征里抽取细粒度信息,再把这些 query 拼到 decoder 端辅助重建,同时在生成建模阶段与 patch token 一起被预测。深浅两层信息都被聚合,无需碰 VFM 主权重,重建-生成 trade-off 被巧妙绕开 实验效果:DINOv2-based RAE 上仅加 8 个 query 和 3.9% 额外算力,PSNR 从 19.13 dB 提到 22.76 dB(重建端 +3.6dB);生成端比 RAE 收敛快 3.3×,无 guidance FID 1.41、有 guidance FID 1.05——重建与生成同时提升且开销可忽略 批判点评:「不碰冻结 VFM、只加一组 query 当辅助通道」是非常 ROI 高的设计,是「冻结 vs 微调」之外的第三条路。从 PSNR / FID 数字看是确凿的正向贡献;但 8 个 query 是否够撑起更大分辨率(512+)下的细节量级仍待验证,与最新 token-merging / FlexQuery 等类似工作的对比略浅 6. SEGA:DiT训练免微调按频段动态缩放注意力 SEGA: Spectral-Energy Guided Attention for Resolution Extrapolation in Diffusion Transformers | 多伦多大学, Vector Institute | arXiv:2605.22668 关键词:DiT·分辨率外推·RoPE·训练免微调·频段自适应 ⚠️ 前序问题:DiT 在训练分辨率之外生成时画质显著掉,目前 training-free 方案常用 RoPE 外推 + 注意力 scaling 修正,但 scaling 都是一刀切——对 RoPE 各分量(含不同频段)施加同样的缩放,导致「全局结构 vs 细节恢复」此消彼长 本文贡献:提出 SEGA:完全 training-free,根据每个去噪步 latent 的空间-频段结构,动态地对 RoPE 不同分量分别 scaling。低频分量保结构、高频分量恢细节,按内容自适应分配——而不是固定常数 实验效果:多个目标分辨率上一致提升 DiT 高分辨率合成质量,超过现有 training-free 基线;不需要重训,可即插即用 批判点评:「不同频段差别 scaling 而不是常数」是经过谱分析后的小而正确的改进,对 DiT 高清生成是廉价收益。但论文主要在 SD3/FLUX 系列上验证,更激进外推倍率(如 4×)下是否仍稳健没充分展开;与 ScaleCrafter / FreeU 等同类训练免微调方案的端到端定量对比较少 7. Gated DeltaNet-2:线性注意力擦写解耦1.3B全面胜出 Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention | NVIDIA | arXiv:2605.22791 关键词:线性注意力·Gated DeltaNet·擦写解耦·长上下文·NVIDIA ⚠️ 前序问题:线性注意力把无界 softmax cache 压缩成固定 recurrent state,难点不在于「忘掉什么」而在于「怎么编辑这个压缩记忆而不打乱已有联系」。已有 Delta-rule 模型用 scalar gate 同时控制 key 端的擦除和 value 端的写入——一个标量做两件事,能力被绑死 本文贡献:Gated DeltaNet-2(GDN-2)泛化了 Gated DeltaNet 与 KDA:把 erase 与 write 解耦成两个 channel-wise gate(擦除门 b_t / 写入门 w_t);两者塌缩到同一 scalar 时退化为 KDA,再叠加 decay 塌缩则退化为 Gated DeltaNet。配套给出 fast-weight 更新视角、chunkwise WY 算法(channel-wise decay 吸收到非对称 erase 因子)、gate-aware backward——保住了高效并行训练 实验效果:1.3B 参数在 100B FineWeb-Edu tokens 上训完,在语言建模/常识推理/检索上综合超过 Mamba-2 / GDN / KDA / Mamba-3 变体;在 RULER 长上下文 needle-in-a-haystack 多 key retrieval 上优势最大,纯循环与混合架构都强。代码开源 批判点评:「擦除/写入解耦」是 linear attention 设计上一个本应早被做的细节修正——一个 gate 控两件事本来就是工程妥协。GDN-2 是少有「同时改写规则又保住并行训练」的设计;但论文聚焦语言建模,对视觉生成场景(视频扩散 / 多模态 backbone)线性注意力替换的实际收益尚需后续验证,1.3B 规模在 7B+ 是否仍领先 Mamba-3 也是开放问题 8. Geo-Align:首个相机控制视频生成RL几何奖励 Geo-Align: Video Generation Alignment via Metric Geometry Reward | 中科大, 上海 AI Lab, 浙大 | arXiv:2605.23903 关键词:相机控制视频·RL 对齐·metric 3D 奖励·video re-rendering ⚠️ 前序问题:相机控制视频生成(video-to-video re-rendering)此前几乎全靠合成数据上的 SFT,真实多视角同步视频极度稀缺,模型在真实 OOD 视频上对物理尺度与相机轨迹的遵循非常差——「能拍但不像」一直没解决 本文贡献:Geo-Align 首次为相机控制视频再渲染提出 RL 框架:基于预训练模型,用「尺度感知感知奖励」对齐。具体而言引入 metric 3D estimator 从生成视频中抽取精确相机轨迹,对 rotation / translation 偏差显式惩罚;数据 pipeline 精心设计——以真实条件视频 + 合成数据派生的目标相机轨迹训练,消除对 paired data 的依赖 实验效果:相机可控性与视觉保真度同时优于现有 SFT 基线,验证 metric geometry 奖励是补救「合成 → 真实」迁移损耗的有效手段——是 video re-rendering 的下一步 批判点评:把 video re-rendering 从 SFT 推进到 RL + 几何奖励是必然的下一步,metric 3D estimator 当 reward model 思路漂亮;但 metric 3D estimator 本身的精度上限直接决定奖励质量,对动态场景(人物快速运动、遮挡)的估计误差如何不被奖励放大需要后续验证 9. LMDM:消费级笔记本跑实时音乐扩散 Live Music Diffusion Models: Efficient Fine-Tuning and Post-Training of Interactive Diffusion Music Generators | UC San Diego, CMU, Mila, Northeastern | arXiv:2605.22717 关键词:音乐扩散·实时生成·KV Cache·ARC-Forcing·consumer GPU ⚠️ 前序问题:现在最强的「实时流式音乐生成」走的是 discrete-AR(离散自回归)路线,训练和推理都要工业级算力。开源社区强势的音频扩散是双向、非流式的——理论上不能做实时演奏 本文贡献:LMDM 重新审视 block-wise outpainting 扩散管线:识别出诸多推理瓶颈是它比 discrete-AR 慢的根因,提出 block-wise KV Caching 补回;进一步引入 ARC-Forcing post-training,无需 RL 或 reward model 就能稳健做对齐,缓解 error accumulation 实验效果:扩散模型首次在推理复杂度上反超离散 AR 路线,能在消费级游戏本上本地实时跑——支持文条件生成、草图条件音乐合成、jamming;论文还展示了 LMDM 作为「generative delay」在真人音乐家即兴演奏中的真实艺术家-AI 合作 批判点评:把扩散从「非流式」拉到「实时演奏」是开源社区音频生成的关键一步——把 KV Cache 思路从语言模型迁过来很合理。但和 Suno/Udio 这类闭源系统直接对比缺失,对极长(>10 分钟)持续演奏的稳定性论文未深入讨论;ARC-Forcing 替代 RLHF 的 robustness 在不同流派/复杂编曲下的表现仍需更多实验 10. ETCHR:图像编辑器即多模态推理助手 ETCHR: Editing To Clarify and Harness Reasoning | 上海 AI Lab, 港中文 | arXiv:2605.23897 关键词:Think with Images·图像编辑·推理增强·VLM 奖励·MLLM 解耦 ⚠️ 前序问题:MLLM「think with images」范式越来越火,但 toolkit 路线被固定动作束缚,unified 路线产生的中间图常常很噪。如果想用「专用图像编辑器」当 MLLM 的视觉推理助手,会遇到两个 gap:(1) language-side,被动指令跟随的编辑器无法把抽象问题映射成合适的视觉变换;(2) generation-side,推理深度增加时编辑正确性快速退化 本文贡献:ETCHR 提出一个「question-conditioned, reasoning-aware」图像编辑器,与下游 understanding model 完全解耦。两阶段训练:第一阶段 Reasoning Imitation(在编辑轨迹上 SFT),第二阶段 Reasoning Enhancement(用 VLM-derived 奖励同时优化编辑正确性 + 下游推理准确率)。解耦让 ETCHR 可以 plug into 任意开闭源 MLLM 而无需重训 实验效果:覆盖细粒度感知/图表理解/逻辑推理/拼图复原/3D 理解 5 类任务,Pass@1 平均提升:Qwen3-VL-8B +4.82(55.95→60.77)、Gemini-3.1-Flash-Lite +5.47(65.08→70.55)、1T MoE Kimi K2.5 +4.61(76.55→81.16)——证明 reasoning-aware editor 通用有效 批判点评:「编辑器作为 MLLM 的可插拔视觉推理助手」是非常正确的下一步分工,比 toolkit / unified 两条路线都更模块化。但 ETCHR 训练强依赖 VLM-derived rewards,奖励信号的偏差可能复制到编辑器;与最新 unified MLLM(如 GPT-4o Image / Bagel)端到端的 think-with-image 能力对比还需要更全面 11. Swift Sampling:泰勒展开找时序惊奇帧0.02倍开销 Swift Sampling: Selecting Temporal Surprises via Taylor Series | Microsoft Research India | arXiv:2605.22678 关键词:长视频·帧选择·预测编码·Taylor 展开·训练免微调 ⚠️ 前序问题:长视频里大部分帧冗余,关键信息藏在「时序惊奇」——视觉特征偏离了预测轨迹的瞬间。已有 training-free 帧选择要么靠辅助网络(额外算力),要么靠视频特化的超参(不通用) 本文贡献:受脑科学预测编码启发,Swift Sampling 把视频建模成视觉 latent 空间里可微的轨迹,计算 velocity 和 acceleration,用 Taylor 展开预测后续帧的「预期路径」。偏离预期最猛的帧 = 时序惊奇帧 = 应被采样的关键帧。训练免微调、几乎零额外开销 实验效果:比基线只多 0.02× 算力开销(比领先方法的 overhead 还低 30×)。3 个长视频 QA benchmark + 10 个下游任务上一致优于 uniform sampling 与其他 query-agnostic 基线;长视频小预算场景下提升最大(+12.5 分准确率) 批判点评:「预测编码 → Taylor 外推 → 惊奇帧」的链条简洁且物理直觉强,几乎零成本是工程上极少见的免费收益。但 Swift Sampling 是 query-agnostic 的——任务相关的关键帧(需要 query-conditional)仍是它的盲区,未来与 query-aware 方法的组合空间巨大 趋势观察 统一架构出现新分工:MLLM 当语义规划器,扩散/像素模型当渲染器 — Bernini 用 MLLM 在 ViT embedding 空间预测目标语义,DiT 拿这个 plan 当主条件渲染像素;ETCHR 把编辑器训成 MLLM 可插拔的视觉推理助手——「端到端 unified」之外,「语义规划 + 像素渲染」的分工路线正在成型。这条路线把各组件的预训练能力都榨干,比 adapter 更深、比端到端更模块化 像素空间扩散解码器替代传统 VAE:高清/高效解码的新范式 — PiD 把 latent→pixel 改成条件像素扩散,512 latent <1 秒解到 2048 像素(消费级 RTX 5090),比 cascaded SR 快 6× 且画质更好;DecQ 不动 RAE 冻结 VFM 只加 8 个 query + 3.9% 算力就让重建 PSNR +3.6dB、生成收敛快 3.3×——「decoder 该重建还是该生成」的争论开始让位给「decoder 应同时承担解码与上采样」的新范式 Unified Audio 模型靠任务定制 RLHF 同时压过专用系统 — StepAudio 2.5 把 ASR/TTS/Realtime 三件事架在共享 backbone 上,让任务分化交给「数据 + RLHF reward + 解码策略」三件套——ASR 用可验证 multi-token decoding、TTS 用 preference RLHF、Realtime 用 generative reward modeling,最终三项 benchmark 同时 SOTA。证明「unified 不必妥协」的关键钥匙是 RLHF 视频生成对齐从 SFT 走向几何/物理约束的强化学习 — Geo-Align 首次给相机可控视频再渲染加 RL:用 metric 3D estimator 抽取相机轨迹,对 rotation/translation 偏差显式给奖励,不再依赖稀缺的 paired 真实多视角数据。SCOPE 的 per-pixel 时序条件设计也隐含「空间选择性」的物理直觉——视频生成的对齐方式开始引入几何/物理约束 推理期免训练优化在文生图/长视频/长上下文遍地开花 — SEGA 给 DiT 做按频段自适应注意力 scaling 解决高分辨率外推;Swift Sampling 用 Taylor 展开找时序惊奇帧选关键帧(0.02× 开销 +12.5 分);GDN-2 把线性注意力的 erase/write 解耦改善长上下文检索——「免训练 + 信号利用」的范式从图像扩散扩到视频/语言全场景,给落地侧带来快速收益 人工智能炼丹君 整理 | 2026-05-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注