搜索到
127
篇与
人工智能
的结果
-
 AIGC 周末专题|2026-03-28|视觉生成后训练与偏好优化 AIGC 视觉生成领域 · 每日论文解读 (2026-03-28) 人工智能炼丹师 整理 | 共 9 篇论文 | 重点深度解读 8 篇 今日核心看点 UniGRPO 统一后训练 FIRM 忠实奖励建模 EditHF-1M 29M偏好对 MV-GRPO 多视图评估 VIGOR 视频几何奖励 VHS CVPR2026 推理扩展 TATAR 不对称奖励 SeGroS 语义锚定监督 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 9 篇,重点解读 8 篇。 方向分布: 后训练框架: UniGRPO(统一多模态后训练), MV-GRPO(多视图GRPO), SeGroS(语义锚定监督) 奖励模型与评估: FIRM(编辑+生成), EditHF-1M(29M偏好对), VIGOR(视频几何), TATAR(质量+美学), VHS(潜在验证器) 重点论文深度解读 1. UniGRPO 统一策略优化实现推理驱动视觉生成 | 上海AI Lab/港中文 | Shanghai AI Lab, CUHK | arXiv:2603.23500 关键词: 统一后训练, GRPO, 推理驱动生成, Flow Matching, 交错生成 研究动机 核心问题: 统一多模态模型(自回归文本+Flow Matching图像)缺乏后训练方法 统一多模态模型正朝着交错生成(interleaved generation)发展——自回归建模文本、Flow Matching 建模图像。然而,如何对这种混合架构进行强化学习后训练?现有 GRPO 只针对单一模态,且 FlowGRPO 依赖 Classifier-Free Guidance(CFG)导致轨迹分叉,难以扩展到多轮交互场景。核心挑战是:如何在一个统一的 RL 框架中同时优化推理(文本)和生成(图像)两个阶段的策略? 前序工作及局限: GRPO (DeepSeek 2025):大语言模型的群体相对策略优化 FlowGRPO (2026):将GRPO扩展到Flow Matching视觉生成 Transfusion (Meta 2024):统一自回归+扩散的多模态架构 与前序工作的本质区别: UniGRPO首次统一优化文本推理和图像合成,消除CFG保持线性轨迹 方法原理 UniGRPO 将多模态生成建模为稀疏终端奖励的马尔可夫决策过程(MDP),联合优化文本推理和图像合成两个阶段。框架采用极简设计原则:(1) 文本推理阶段使用标准 GRPO,让模型学会扩展用户提示为详细推理链;(2) 图像合成阶段使用 FlowGRPO,在 Flow Matching 的速度场上进行策略优化。关键改进有两点:第一,消除 Classifier-Free Guidance(CFG),保持线性、未分叉的生成轨迹,这对多轮交互和多条件生成(如编辑)至关重要;第二,将标准的潜空间 KL 惩罚替换为直接作用于速度场的 MSE 惩罚,提供更鲁棒的正则化信号,有效缓解 Reward Hacking。两种模态的优化通过统一的 MDP 框架无缝集成。 核心创新 首个统一的多模态生成后训练框架:联合优化自回归文本推理和 Flow Matching 图像合成 消除 CFG 保持线性轨迹:使框架可扩展到多轮交错生成场景 速度场 MSE 正则化替代 KL 惩罚:直接在速度场空间约束策略偏移,更鲁棒地防止 Reward Hacking 极简设计原则:无缝集成标准 GRPO + FlowGRPO,避免过度工程化 为完全交错式多模态模型的后训练建立了可扩展基线 实验结果 实验表明,UniGRPO 的统一训练方案显著提高了推理驱动图像生成的质量。在标准评估基准上,文本推理质量和图像生成保真度均获得一致提升。消除 CFG 后的模型在多轮交互场景中表现更稳定,MSE 速度场正则化有效避免了训练后期的 Reward Hacking 现象。该框架为未来完全交错模型的后训练提供了鲁棒且可扩展的基线。 批判性点评 新颖性: 首次将GRPO统一应用于文本推理+图像Flow Matching的交错生成,消除CFG保持线性轨迹的设计优雅且实用。但概念上是GRPO和FlowGRPO的自然组合,原创突破性有限。 可复现性: 基于开源Janus-Pro-7B模型,论文提供了完整的算法伪代码和超参数设置。但训练使用80张H100,资源门槛较高。代码和模型权重已开源。 影响力: 为统一多模态模型的后训练建立了可扩展基线,对Chameleon、Transfusion等架构有直接参考价值。极简设计降低了社区跟进门槛。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 交错生成后训练的可扩展基线 可能的后续方向: 多轮交互场景的后训练 视频+音频交错生成 在线持续学习 2. FIRM 忠实图像奖励建模:鲁棒奖励模型+RL优化 | 上交/港中文/上海AI Lab | SJTU, CUHK, Shanghai AI Lab | arXiv:2603.12247 关键词: 奖励模型, 图像编辑, 文生图, RLHF, 开源数据集 研究动机 核心问题: 图像编辑和生成的奖励模型存在幻觉,评分不忠实 RL 已成为增强图像编辑和文生图生成的重要范式,但现有奖励模型存在严重的幻觉问题——产生噪声评分,误导优化方向。核心痛点是:缺乏专门针对图像编辑和生成的大规模高质量评分数据集,导致奖励模型无法提供忠实、准确的反馈信号。 前序工作及局限: ImageReward (Xu 2023):首个文生图人类偏好奖励模型 HPSv2 (Wu 2023):人类偏好评分模型v2 PickScore (Kirstain 2023):Pick-a-Pic数据驱动的偏好评分 与前序工作的本质区别: FIRM专门解决编辑+生成双赛道的忠实性,提出Base-and-Bonus奖励策略 方法原理 FIRM 框架从数据、模型、策略三层解决奖励模型的忠实性问题:(1) 数据层:设计专业化数据整理管线,构建 FIRM-Edit-370K(编辑评分数据,评估执行力+一致性)和 FIRM-Gen-293K(生成评分数据,评估指令遵循),总计 66.3 万条评分数据;(2) 模型层:基于上述数据训练 FIRM-Edit-8B 和 FIRM-Gen-8B 两个 8B 参数的专业奖励模型,并发布 FIRM-Bench 评测基准;(3) 策略层:提出 Base-and-Bonus 奖励策略——对编辑任务使用 CME(Consistency-Modulated Execution,一致性调制执行),对生成任务使用 QMA(Quality-Modulated Alignment,质量调制对齐),巧妙平衡相互竞争的优化目标。 核心创新 首个系统性解决图像编辑和生成奖励建模的综合框架 发布 FIRM-Edit-370K + FIRM-Gen-293K 全套开源评分数据集 Base-and-Bonus 奖励策略:CME 平衡编辑的执行力与一致性,QMA 平衡生成的质量与对齐 FIRM-Bench 编辑+生成批评评测基准 消除奖励幻觉:比现有通用指标更准确匹配人类判断 实验结果 FIRM 系列奖励模型在 FIRM-Bench 上显著超越现有指标对人类判断的匹配度。基于 FIRM 的 RL 优化产出 FIRM-Qwen-Edit 和 FIRM-SD3.5,在忠实度和指令遵循方面确立了新标准。所有数据集、模型和代码均已公开发布。 批判性点评 新颖性: 从数据-模型-策略三层全栈构建忠实奖励体系,Base-and-Bonus策略巧妙解决了编辑和生成任务间的优化矛盾。CME和QMA两个具体策略设计有针对性且有理论支撑。 可复现性: 全套数据集(FIRM-Edit 37万+FIRM-Gen 29.3万)、模型权重和代码均已开源。基于InternVL2-8B训练,硬件需求可控。社区复现门槛低。 影响力: 视觉生成RLHF奖励建模的新标准。全栈开源的做法对社区价值巨大。Base-and-Bonus策略可泛化到其他多任务RL场景。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 视觉生成RLHF奖励建模的新标准 可能的后续方向: 视频编辑奖励 3D生成奖励 多目标帕累托优化 3. EditHF-1M 百万级图像编辑人类偏好反馈数据集 | 上交 | Shanghai Jiao Tong University | arXiv:2603.14916 关键词: 编辑偏好数据集, 29M偏好对, MLLM评估模型, 奖励信号, RL优化 研究动机 核心问题: 图像编辑缺乏大规模多维度人类偏好数据集 文本引导的图像编辑取得了显著进展,但编辑结果仍常出现伪影、意外编辑、不美观等问题。现有编辑评估方法缺乏大规模可扩展的评估模型,这严重限制了编辑领域人类反馈奖励模型的发展。核心瓶颈是:缺少百万级规模、多维度评估的人类偏好数据集。 前序工作及局限: InstructPix2Pix (Brooks 2023):GPT-4生成编辑指令,数据规模有限 MagicBrush (Zhang 2024):人工标注编辑数据集,规模较小 FIRM-Edit-370K:专业化编辑评分数据 与前序工作的本质区别: EditHF-1M将规模推至29M偏好对,三维度(质量+对齐+保持)评估体系 方法原理 EditHF-1M 体系包含三个层次:(1) 数据集层:构建百万级图像编辑偏好数据集,包含超过 2900 万人类偏好对和 14.8 万人类主观评分(MOS),均从视觉质量、指令对齐、属性保持三个维度进行评估;(2) 模型层:基于 EditHF-1M 训练 EditHF——一个基于多模态大语言模型(MLLM)的评估模型,提供与人类对齐的编辑反馈;(3) 应用层:引入 EditHF-Reward,将 EditHF 作为奖励信号,通过强化学习优化文本引导图像编辑模型 Qwen-Image-Edit。 核心创新 迄今最大的图像编辑偏好数据集:29M偏好对 + 148K MOS评分 三维度评估体系:视觉质量 + 指令对齐 + 属性保持 基于MLLM的编辑评估模型 EditHF EditHF-Reward:将评估模型转化为RL奖励信号 在 Qwen-Image-Edit 上验证显著性能提升 实验结果 EditHF 在与人类偏好对齐方面超越现有指标,并在其他数据集上展现强泛化能力。使用 EditHF-Reward 微调 Qwen-Image-Edit 后,编辑质量在视觉质量、指令对齐和属性保持三个维度均获得显著提升。数据集和代码将开源。 批判性点评 新颖性: 在偏好数据集的规模和评估维度设计上均为领先。三维度(质量+对齐+保持)评估体系比单标量更精准。但核心方法(人类标注+Bradley-Terry模型训练)较传统,创新更多在工程规模上。 可复现性: 数据集规模庞大(29M对)使得完整复现成本极高。评估模型基于公开架构训练,技术上可复现但资源需求大。数据集已部分开放。 影响力: 为图像编辑偏好建模提供了最大规模的公开基准。三维度评估范式可能成为社区标准。对未来编辑模型的开发和评估有直接推动作用。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 迄今最大的图像编辑偏好数据集 可能的后续方向: 视频编辑偏好数据 自动化偏好标注 跨域泛化评估 4. MV-GRPO 多视图GRPO:增强条件空间实现密集奖励映射 | 港中文/上海AI Lab | CUHK, Shanghai AI Lab | arXiv:2603.12648 关键词: 多视图评估, GRPO改进, 条件增强, 偏好对齐, Flow Matching 研究动机 核心问题: 标准GRPO的单视图评估方案限制了偏好对齐效果 标准 GRPO 采用单一条件评估一组生成样本——这种稀疏的单视图评估方案未能充分探索样本间关系,限制了对齐有效性和性能上限。直觉上,同一组样本在不同语义视角下可能展现出完全不同的优劣排序。如何构建密集的多视图奖励映射以更充分地利用每次采样? 前序工作及局限: GRPO (DeepSeek 2025):单条件评估一组样本 DPO (Rafailov 2023):直接偏好优化但依赖配对数据 FlowGRPO (2026):Flow Matching上的GRPO 与前序工作的本质区别: MV-GRPO通过条件增强实现多视图密集评估,无需样本再生成 方法原理 MV-GRPO 通过增强条件空间将稀疏单视图评估转化为密集多视图评估:(1) 对于由一个提示生成的一组样本,利用灵活的条件增强器生成语义相邻但多样化的标题(captions);(2) 这些多视图标题提供不同语义属性的评估角度,捕捉更丰富的优化信号;(3) 通过推导原始样本在新标题条件下的概率分布,无需昂贵的样本再生成即可将多视图评估纳入训练;(4) 多视图优势重估计产生密集的奖励映射,显著增强关系探索。 核心创新 首次将多视图评估引入GRPO框架 条件增强器生成语义相邻的多样化标题 无需样本再生成的多视图优势重估计 从稀疏单视图到密集多视图的范式转换 在文生图Flow Matching模型上超越SOTA 实验结果 大量实验表明,MV-GRPO 在偏好对齐性能上优于标准 GRPO 和其他最先进方法。多视图评估提供的密集奖励信号有效提升了文生图 Flow Matching 模型在多个评估维度上的表现。 批判性点评 新颖性: 通过概率分布推导将多视图评估转化为无需再生成的数学等价形式,理论推导优雅。从稀疏到密集评估的范式转换思路具有一般性。但增强策略的设计空间未充分探索。 可复现性: 基于开源SDXL/PixArt-α模型,算法伪代码清晰。条件增强器使用现有LLM改写,技术门槛低。计算开销仅增加奖励模型推理,几乎零额外训练成本。 影响力: 为GRPO框架提供了一种低成本且通用的性能增强方案。密集评估思路可扩展到其他RL-based生成优化。在标注预算受限时尤其有价值。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: GRPO框架的重要扩展,从稀疏到密集 可能的后续方向: 自适应视图数量选择 跨模态多视图 在线条件增强 5. VIGOR 视频几何奖励模型:跨帧重投影误差评估时序一致性 | arXiv:2603.16271 关键词: 视频奖励模型, 几何一致性, 重投影误差, 推理时扩展, SFT/RL后训练 研究动机 核心问题: 视频生成缺乏几何一致性评估和优化信号 视频扩散模型训练缺乏几何监督,生成视频中频繁出现物体变形、空间漂移和深度违反等伪影。现有视频评估指标在像素空间度量不一致性,容易被像素强度差异干扰。需要一种更符合物理规律、更鲁棒的视频质量评估方法来驱动后训练优化。 前序工作及局限: VBench (Huang 2024):视频生成综合评测基准 VideoScore (He 2024):基于MLLM的视频质量评分 VisionReward (2025):细粒度多维度视频偏好模型 与前序工作的本质区别: VIGOR首次引入基于几何的跨帧重投影误差作为视频奖励信号 方法原理 VIGOR 利用预训练几何基础模型构建基于几何的视频奖励:(1) 通过跨帧重投影误差评估多视图一致性——以点对点方式计算误差,比像素空间度量更符合物理规律且更鲁棒;(2) 引入几何感知采样策略,过滤低纹理和非语义区域,聚焦具有可靠对应关系的几何有意义区域;(3) 将此奖励通过两条互补途径应用:SFT 或 RL 进行双向模型后训练;以及推理时作为路径验证器实现因果视频模型的 test-time scaling。 核心创新 首个基于几何的视频生成奖励模型 跨帧重投影误差比像素级度量更鲁棒 几何感知采样:过滤低纹理区域聚焦可靠对应 双路径应用:后训练(SFT/RL) + 推理时扩展(test-time scaling) 为开源视频模型提供低成本增强方案 实验结果 实验验证了 VIGOR 基于几何的奖励在鲁棒性上显著优于其他变体。通过推理时扩展,VIGOR 为开源视频模型提供了实用的增强方案,无需大量计算资源进行重训练。后训练路径同样展现了一致的质量改善。 批判性点评 新颖性: 首次将几何重投影误差作为视频生成的奖励信号,利用预训练几何基础模型避免了昂贵的3D标注。双路径应用模式增加了实用性。但在non-rigid场景(如流体、火焰)中的适用性未讨论。 可复现性: 基于开源视频扩散模型和MoGe几何模型。技术方案描述详细,几何奖励计算流程可复现。但完整训练流程的超参数和计算资源需求描述不够详细。 影响力: 为视频生成质量评估引入了物理层面的几何先验,与现有像素级和语义级指标互补。对开源视频模型的质量提升提供了新的优化信号来源。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 视频生成几何一致性优化的开创性工作 可能的后续方向: 物理一致性奖励 音视频同步奖励 4D时空一致性评估 6. VHS 潜在空间验证器实现高效推理时扩展 | CVPR 2026 | University of Modena | arXiv:2603.22492 关键词: 推理时扩展, 潜在验证器, DiT, CVPR 2026, 高效验证 研究动机 核心问题: 推理时扩展(test-time scaling)的验证器计算成本过高 推理时扩展(inference-time scaling)通过验证器对候选输出评分选择来改进生成质量。但常用的 MLLM 验证器需要将候选从潜空间解码到像素空间再编码为视觉嵌入——冗余且昂贵。如何在不解码到像素空间的情况下直接评估生成质量? 前序工作及局限: Best-of-N (2024):MLLM验证器对候选评分选择 MLLM Verifier:需要解码到像素空间再编码为视觉嵌入 DiT单步生成器:内部hidden states包含丰富质量信号 与前序工作的本质区别: VHS直接在DiT隐藏状态上验证,跳过像素解码-重编码 方法原理 VHS(Verifier on Hidden States)直接在扩散 Transformer(DiT)单步生成器的中间隐藏表示上进行验证:(1) 分析生成器的特征表示而无需解码到像素空间;(2) 训练一个轻量级验证器网络直接在 DiT 的 hidden states 上评分;(3) 在极小推理预算(少量候选者)下实现比 MLLM 验证器更高效的推理时扩展。 核心创新 首个直接在DiT隐藏状态上操作的生成验证器 跳过像素解码-重编码的冗余流程 CVPR 2026,推理时间-63.3%,FLOPs-51%,VRAM-14.5% 极小推理预算下超越MLLM验证器 GenEval性能+2.7%同时节省大量计算资源 实验结果 与标准 MLLM 验证器相比,VHS 将联合生成和验证时间减少 63.3%,FLOPs 减少 51%,VRAM 使用量减少 14.5%,并在相同推理时间预算下实现 GenEval 性能 +2.7% 的提升。CVPR 2026 接收。 批判性点评 新颖性: 直接在DiT隐藏状态上训练验证器的思路简单但有效,避免了传统的编码-解码往返。揭示了DiT中间表示包含丰富质量信号的重要发现。方法设计简洁但insight深刻。 可复现性: 基于开源DMD2-SDXL模型,验证器网络结构简单(线性探针+小MLP)。训练数据通过自采样获取,计算成本可控。整体复现门槛低。 影响力: CVPR接收验证了学术价值。隐藏状态验证器的效率优势对推理时扩展的实际部署意义重大。可能启发更多利用扩散模型中间表示的工作。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: CVPR 2026, 高效推理时扩展的新范式 可能的后续方向: 多步DiT的流式验证 与后训练的协同优化 移动端部署 7. TATAR 一个模型两种思维:统一IQA+美学评估的任务条件推理 | arXiv:2603.19779 关键词: 图像质量评估, 美学评估, GRPO, 不对称奖励, 任务条件推理 研究动机 核心问题: IQA和IAA使用相同推理逻辑和奖励机制存在根本性错位 将图像质量评估(IQA)和图像美学评估(IAA)统一在单一 MLLM 中是有前景的方向,但现有方法对两个任务使用相同的推理逻辑和奖励机制——这存在根本性错位:IQA 依赖客观感知线索,需要简明推理;IAA 需要深思熟虑的语义判断。统一框架如何针对不同任务特性提供差异化的推理和优化? 前序工作及局限: Q-Instruct (Wu 2024):统一质量评估指令调优 LIQE (Zhang 2023):CLIP增强的图像质量评估 AestheticScore:单一标量美学评分 与前序工作的本质区别: TATAR揭示推理错位和优化错位,提出快慢推理+不对称奖励 方法原理 TATAR 共享视觉-语言主干,但在后训练阶段针对任务特性进行条件调节:(1) 快慢推理构建:IQA 配对简明感知理由,IAA 配对深思熟虑的美学叙述;(2) 两阶段学习:先 SFT 建立任务感知行为先验,再 GRPO 进行奖励驱动细化;(3) 不对称奖励设计:IQA 使用高斯分数塑造,IAA 使用 Thurstone 风格的完成度排名。 核心创新 揭示IQA和IAA的推理错位和优化错位问题 快慢任务特定推理:IQA简明+IAA深思熟虑 SFT+GRPO两阶段学习建立任务感知行为 不对称奖励:高斯分数塑造(IQA)+Thurstone排名(IAA) 八个基准上统一超越任务专用模型 实验结果 在八个基准上,TATAR 在域内和跨域设置下均显著超越先前统一基线,同时保持与特定任务专业模型竞争力的性能。美学评估的训练动态也更加稳定。代码已开源。 批判性点评 新颖性: 揭示IQA和IAA需要不同推理模式(快/慢思维)是有价值的洞见。不对称奖励设计——IQA用高斯分数塑造、IAA用Thurstone排名——理论动机清晰。SFT+GRPO两阶段框架设计合理。 可复现性: 基于开源MLLM骨干(如InternVL系列),训练数据来自公开IQA/IAA数据集。不对称奖励计算流程有完整公式推导。整体可复现性好。 影响力: 统一IQA和IAA评估对视觉生成的质量控制有直接应用价值。不对称奖励设计的思路可泛化到其他需要差异化优化策略的多任务场景。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 统一感知评分的任务条件后训练新范式 可能的后续方向: 视频质量+美学统一评估 多粒度感知推理 人类偏好对齐 8. SeGroS 语义锚定监督增强统一多模态模型对齐 | arXiv:2603.19807 关键词: 语义锚定, 统一多模态, 视觉提示, 掩码重建, 生成对齐 研究动机 核心问题: 统一多模态模型的生成训练存在粒度不匹配和监督冗余 统一多模态模型集成了理解和生成,但当前生成训练范式存在粒度不匹配和监督冗余两大局限:文本提示的稀疏性无法充分指导细粒度视觉生成,全图重建损失在非语义关键区域浪费了大量监督信号。如何通过更精准的监督信号提升生成保真度和跨模态对齐? 前序工作及局限: Show-o (Xie 2024):统一文本到图像理解和生成 Transfusion (Meta 2024):融合自回归+扩散 Chameleon (Meta 2024):完全自回归的多模态模型 与前序工作的本质区别: SeGroS通过视觉定位图构建语义锚定监督,解决文本稀疏+监督冗余 方法原理 SeGroS 提出语义锚定监督框架:(1) 构建视觉定位图(visual grounding map),将文本提示与图像的语义关键区域关联;(2) 基于定位图构建语义化视觉提示,补偿文本提示的稀疏性,为生成过程提供更丰富的空间引导;(3) 生成语义锚定的损坏输入,通过将重建损失限制在核心文本对齐区域,显式增强掩码重建的监督效果,减少非语义区域的监督冗余。 核心创新 揭示统一多模态模型的粒度不匹配和监督冗余问题 视觉定位图:文本-图像语义关键区域关联 语义化视觉提示:补偿文本提示稀疏性 语义锚定损坏输入:重建损失聚焦核心对齐区域 在GenEval/DPGBench/CompBench上显著提升对齐 实验结果 在 GenEval、DPGBench 和 CompBench 上的广泛评估表明,SeGroS 显著提高了多种统一多模态模型架构的生成保真度和跨模态对齐能力。 批判性点评 新颖性: 视觉定位图将文本-区域关联显式化,解决了统一模型中的文本稀疏和监督冗余两个关键问题。方案设计直觉清晰,理论动机充分。但定位图生成依赖外部模型(如GroundingDINO)。 可复现性: 基于开源Show-o架构。视觉定位图生成管线依赖GroundingDINO等开源工具。训练流程和超参数描述清晰。整体可复现性较好,但pipeline复杂度较高。 影响力: 为统一多模态模型的对齐训练提供了新的监督信号设计范式。视觉定位图的概念可能启发更多空间感知的训练策略。对Show-o、Chameleon等架构有直接参考价值。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 统一多模态模型的生成对齐增强方法 可能的后续方向: 视频多模态的语义锚定 自适应监督区域选择 动态粒度调整 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 1 _placeholder (Weekend Survey - No Rest Papers) N/A N/A N/A 趋势观察 GRPO 成为视觉生成后训练的主流范式 — 从标准 GRPO 到 UniGRPO(统一多模态)、MV-GRPO(多视图评估)、FlowGRPO(Flow Matching),GRPO 的变体已覆盖文生图、文生视频、交错生成等全场景。 专业化奖励模型快速涌现 — FIRM(编辑+生成双赛道)、EditHF-1M(百万级编辑偏好)、VIGOR(视频几何)、TATAR(质量+美学双任务)——不同子领域开始构建各自的专业化奖励体系。 推理时扩展成为后训练的互补方案 — VHS 和 VIGOR 都探索了推理时 test-time scaling——通过验证器在推理阶段筛选候选,不修改模型权重即可提升质量,与后训练形成互补。 数据规模驱动奖励质量 — EditHF-1M 的 29M 偏好对、FIRM 的 66.3 万评分数据——大规模人类偏好数据正在成为训练高质量奖励模型的关键竞争壁垒。 人工智能炼丹师 整理 | 2026-03-28
-
AIGC 每日速读|2026-03-27|ScrollScape|OmniWeaving AIGC 视觉生成领域 · 每日论文解读 (2026-03-27) 人工智能炼丹师 整理 | 共 10 篇论文 | 重点深度解读 1 篇 今日核心看点 32K超高分辨率图像生成 ScrollScape 统一视频生成 OmniWeaving 扩散加速 HetCache CVPR2026 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 图片生成与编辑: 4篇 (ScrollScape, DepthArb, HAM, GenMask) 视频生成与编辑: 3篇 (OmniWeaving, HetCache, Anti-I2V) 音频生成: 1篇 (ArrayDPS-Refine) 生成安全与检测: 1篇 (HAVIC) 交互运动生成: 1篇 (ViHOI) 含2篇CVPR 2026 (HetCache, HAM) 重点论文深度解读 1. ScrollScape 用视频扩散先验解锁32K超高分辨率图像生成 | Harbin Institute of Technology, Li Auto | arXiv:2603.24270 关键词: 32K图像生成, 视频扩散先验, 极端纵横比, 超分辨率 研究动机 核心问题: 极端纵横比下的超高分辨率图像生成面临物体重复和空间碎片化问题 当前扩散模型在生成常规尺寸图像时表现出色,但在极端纵横比(如8:1)的超高分辨率图像合成中,往往出现灾难性的结构失败——物体重复和空间碎片化。这根本原因在于静态文生图模型缺乏鲁棒的空间先验。ScrollScape 提出了一个全新范式:将超大画布的空间扩展映射到视频帧的时序演变,利用视频模型的时序一致性作为强大的全局约束。 前序工作及局限: MultiDiffusion:通过联合扩散过程实现全景图生成,但受限于局部一致性 SyncDiffusion:同步多个扩散过程减少接缝,但仍有结构冗余 DyPE:动态位置编码扩展生成尺寸,但在极端比例下效果有限 Wan2.1:视频扩散模型,具有强大的时序一致性先验,但未被用于静态图像生成 与前序工作的本质区别: ScrollScape首次将空间扩展问题转化为视频时序问题,利用视频模型天然的时序一致性替代人工设计的空间融合策略。不同于MultiDiffusion等平铺融合方法,ScrollScape的全局坐标系统通过ScanPE实现端到端的结构约束。 方法原理 ScrollScape 框架包含三个核心创新: 1)扫描位置编码(ScanPE):将全局空间坐标分布到各帧,充当灵活的移动相机,支持线性和蛇形扫描模式 2)滚动超分辨率(ScrollSR):在潜在空间利用视频超分辨率扩散先验逐帧增强细节,绕过内存瓶颈 3)轨迹锚定分区(TAP):确保3D VAE解码器的解码状态与坐标系统对齐,消除帧间闪烁和边界伪影 4)中值共识选择(MCS)+加权融合:从每个时间块选择最具代表性的帧,通过距离权重融合生成无缝全景图 核心创新 首次将极端纵横比图像合成重新表述为连续视频生成过程 提出ScanPE扫描位置编码将空间扩展映射为时序演变 设计ScrollSR在潜在空间实现32K分辨率输出 引入TAP轨迹锚定分区消除3D VAE解码伪影 实验结果 在8:1纵横比评估中,ScrollScape 在所有指标上均优于基线:FID 214.7(最优)、CLIP 30.0(最优)、KID 2.0(最优)。用户研究中92%的评估员认为ScrollScape的结构连贯性优于DyPE,89%认为内容丰富度更好。消融实验证实ScanPE、TAP、ScrollSR每个组件都不可或缺。仅需3000张图像微调即可实现从传统卷轴到照片级全景的32K输出。 图表详解 Fig.1 ScrollScape 32K生成效果展示 这是 ScrollScape 的核心效果展示图。上方展示了一张极高纵横比(8:1)的32K分辨率全景图生成结果,下方红色方框放大展示了局部细节的精细程度。可以看到,ScrollScape 生成的全景图在整体结构上保持了高度一致性,没有出现传统方法常见的物体重复或空间碎片化问题。局部放大区域显示了建筑、植被等元素的高保真细节,证明了 ScrollSR 超分辨率模块的有效性。 Fig.3 水平8:1全景定性对比 这张定性对比图展示了不同方法在水平 8:1 极端纵横比下的全景生成效果。可以看到,MultiDiffusion 和 SyncDiffusion 等传统平铺融合方法出现了明显的物体重复和拼接伪影。DyPE 虽然有所改善,但在结构连贯性上仍然不足。ScrollScape 的结果在整体布局、细节丰富度和结构一致性上全面领先,特别是在远景到近景的过渡和物体多样性方面表现突出。 Fig.4 垂直1:8卷轴定性对比 这张图展示了垂直方向 1:8 纵横比的卷轴式生成效果对比。ScrollScape 的蛇形扫描模式在垂直卷轴场景中同样表现优异,生成的中国山水画风格长卷图在从上到下的空间延展中保持了连贯的构图和自然的过渡,而基线方法则出现了结构断裂。 Fig.5 8K高保真生成效果 这张图展示了 ScrollScape 在 8K 分辨率下的高保真生成细节。通过多处放大区域可以看到,建筑细节、植被纹理、云层渲染等都保持了极高的清晰度和真实感,证明了 ScrollSR 超分模块在从潜在空间恢复高频细节方面的出色能力。 Fig.6 ScanPE消融实验定性对比 这是 ScanPE 扫描位置编码的消融实验对比图。对比了无 ScanPE、仅使用基础位置编码、以及完整 ScanPE 三种配置。可以明显看到,没有 ScanPE 时模型无法感知全局空间位置,导致严重的内容重复。ScanPE 通过将空间坐标注入帧生成过程,有效消除了重复问题,这验证了将空间问题转化为时序问题这一核心设计的必要性。 Fig.7 ScrollSR超分模块消融对比 这张消融实验图展示了 ScrollSR 超分辨率模块和 TAP 轨迹锚定分区的效果对比。不使用 ScrollSR 时,输出分辨率受限,细节模糊;不使用 TAP 时,帧间出现可见的闪烁和边界伪影。完整配置下两个模块协同工作,既提升了分辨率又保证了帧间一致性,这证明了每个组件都是整体框架不可或缺的一部分。 批判性点评 新颖性: 核心创新——将空间扩展映射为时序演变——极具新颖性和优雅性。ScanPE的数学形式简洁清晰,TAP和MCS的设计也有针对性。但ScrollSR模块本质是套用现有视频超分技术,原创性相对有限。整体框架对Wan2.1的依赖较强,换用其他视频扩散模型的效果未验证。 可复现性: 基于开源Wan2.1-T2V-1.3B,训练仅需2×A100+3K图像数据集,推理单张A100(80GB)可完成。训练成本极低,但代码尚未开源。方法描述详细,公式完整,理论上可独立复现。 影响力: 为超高分辨率图像生成提供了全新且优雅的范式,对数字长卷、全景摄影、游戏地图等应用有直接实用价值。视频扩散先验→空间扩展的跨界思路可能启发更多创新工作。但单张A100推理32K的效率和质量在商业场景中是否足够仍需验证。 深度点评: 创新亮点:空间→时序的范式转换 — 将32K图像生成重新表述为视频扫描是极具想象力的创新。ScanPE用移动相机隐喻优雅解决了全局坐标一致性问题。 局限:数据和场景覆盖不足 — 仅3000张训练数据且集中在风景/山水画类型。人物、城市等复杂场景能力未验证。8:1评估协议的合理性也值得讨论。 工程价值:极低训练成本 — 2×A100训练+单卡推理32K,训练数据仅3K张。极低的资源门槛使其适合学术实验室和创业团队。 技术演进定位: 处于图像生成与视频生成的交叉点,开创了用视频先验赋能图像合成的新范式。在超高分辨率生成领域具有里程碑意义。 可能的后续方向: 扩展到任意纵横比和非矩形画布(如环形全景、球面映射) 结合更强大的视频扩散模型(如Sora类模型)提升质量 探索交互式32K内容生成(用户可编辑局部区域) 将视频-图像范式迁移到3D场景和纹理生成 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 1 OmniWeaving (OmniWeaving: Towards Unified Video Generation with Free-form Composition and Reasoning) Zhejiang University, Tencent Hunyuan, NTU 统一视频生成·推理增强·MLLM·腾讯混元 提出统一视频生成模型OmniWeaving,采用MLLM+MMDiT+VAE架构,通过激活思维模式实现推理增强视频生成,并引入IntelligentVBench评测基准。在开源统一模型中达到SOTA。 在IntelligentVBench上,开启思维模式的OmniWeaving在Implicit I2V和Compositional MI2V指标上分别达到3.93和4.31(AVG),显著超越VACE-LTX和VINO等基线。 2 HetCache (Accelerating Diffusion-based Video Editing via Heterogeneous Caching (CVPR 2026)) NTU, SJTU, PolyU HK 视频编辑加速·异构缓存·DiT·CVPR2026 提出免训练扩散加速框架HetCache,通过将DiT中的时空Token分为上下文Token和生成Token并选择性缓存,实现了2.67倍延迟加速和FLOPs削减。 实现2.67x延迟加速和FLOPs削减,编辑质量几乎无损。已被CVPR 2026接收。 3 HAM (HAM: A Training-Free Style Transfer Approach via Heterogeneous Attention Modulation (CVPR 2026)) Hangzhou Dianzi University 风格迁移·注意力调制·免训练·CVPR2026 提出免训练风格迁移方法HAM,通过全局注意力调节(GAR)和局部注意力移植(LAT)两种异构注意力调制策略,解决扩散模型风格迁移中的风格-内容平衡难题。 在多项定量指标上达到SOTA性能,成功在保持内容身份的同时捕获复杂风格参考。已被CVPR 2026接收。 4 DepthArb (DepthArb: Training-Free Depth-Arbitrated Generation for Occlusion-Robust Image Synthesis) Xi'an Jiaotong University 遮挡生成·深度仲裁·免训练·组合生成 提出免训练框架DepthArb,通过注意力仲裁调制(AAM)和空间紧凑性控制(SCC)两种机制解决文生图模型的遮挡关系歧义问题,并引入OcclBench评测基准。 在遮挡准确性和视觉保真度上一致超越SOTA基线,作为即插即用方法可无缝增强扩散模型的组合能力。 5 GenMask (GenMask: Adapting DiT for Segmentation via Direct Mask Generation) Shanghai Jiao Tong University, Alibaba DiT分割·生成式分割·掩码生成·统一架构 提出GenMask,首次让DiT直接在RGB空间生成黑白分割掩码和彩色图像,发现VAE对二值掩码的潜在表示具有独特的噪声鲁棒性和线性可分特征,设计了针对性的时间步采样策略。 在referring和reasoning分割基准上达到SOTA性能,完全保持DiT原始架构不变。 6 Anti-I2V (Anti-I2V: Safeguarding your photos from malicious image-to-video generation) VinAI Research 对抗防御·图转视频·安全保护·DiT防御 提出Anti-I2V防御框架,在LAB和频域空间操作对抗噪声,保护照片免受恶意图像转视频模型的滥用,首次系统性针对DiT架构的视频扩散模型进行防御。 在多种视频扩散模型上展现SOTA防御效果,有效降低生成视频的时序一致性和保真度。 7 HAVIC (Leave No Stone Unturned: Uncovering Holistic Audio-Visual Intrinsic Coherence for Deepfake Detection) Harbin Institute of Technology 深伪检测·音视频一致性·跨模态·数据集 提出HAVIC深度伪造检测器,基于音视频固有一致性先验(模态内结构一致性+跨模态微观/宏观一致性),并发布HiFi-AVDF高保真音视频深度伪造数据集。 在最具挑战的跨数据集场景中,AP和AUC分别提升9.39%和9.37%,显著超越现有SOTA方法。 8 ArrayDPS-Refine (ArrayDPS-Refine: Generative Refinement of Discriminative Multi-Channel Speech Enhancement) Meta Reality Labs 语音增强·扩散先验·多通道·免训练 提出ArrayDPS-Refine,利用干净语音扩散先验来精炼判别式多通道语音增强模型的输出。无需重训练,阵列无关,可直接提升任意判别式模型的性能。 一致性提升多种判别式模型(含波形域和STFT域SOTA模型)的语音增强性能。 9 ViHOI (ViHOI: Human-Object Interaction Synthesis with Visual Priors) South China University of Technology 人物交互·视觉先验·运动生成·VLM 提出ViHOI框架,从2D图像中提取交互先验来增强3D人物-物体交互运动生成,利用VLM作为先验提取引擎,设计Q-Former适配器压缩高维特征为紧凑先验Token。 在多个基准上达到SOTA,展现优越的泛化能力(可推广到未见物体和交互类别)。 趋势观察 视频先验赋能图像生成 — ScrollScape将超大画布生成转化为视频扫描任务,利用视频模型的时序一致性保证空间结构完整性,开辟了图像-视频范式互通的新方向。 统一视频生成模型的推理增强 — OmniWeaving通过激活MLLM的思维模式,让视频生成模型具备推理能力,从被动特征提取升级为主动意图推断,是多模态理解与生成深度融合的代表。 免训练方法持续升温 — HetCache、HAM、DepthArb等多篇论文均采用免训练策略,通过精巧的注意力操控实现特定目标,反映了社区对即插即用、低成本方案的强烈需求。 扩散模型安全与对抗 — Anti-I2V和HAVIC分别从防御和检测角度应对扩散模型滥用问题,DiT架构的对抗鲁棒性成为新的研究热点。 生成模型架构的跨界适配 — GenMask让DiT直接生成分割掩码,ScrollScape用视频模型做图片,展示了生成架构的通用性远超原始设计意图。 人工智能炼丹师 整理 | 2026-03-27
-
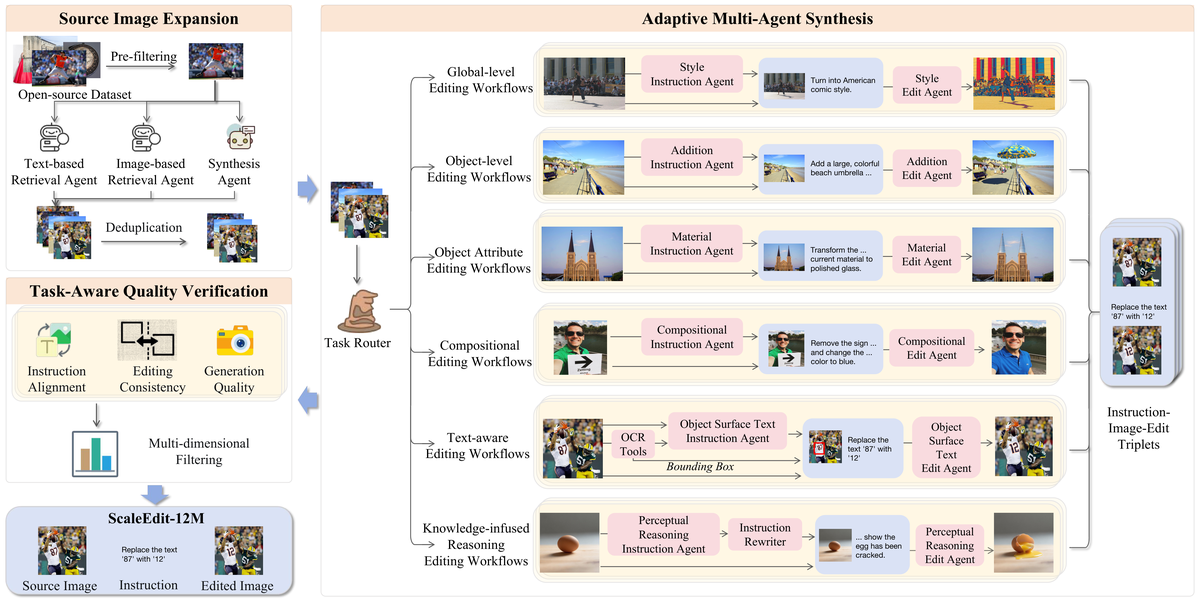
AIGC 每日速读|2026-03-25|上交ScaleEdit-12M+CVPR跨时间步自校准 AIGC 视觉生成领域 · 每日论文解读 (2026-03-25) 人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇 今日核心看点 ScaleEdit-12M CTCal DiT-BlockSkip InjectFlow OmniCodec 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。 方向分布: 图像编辑/生成: ScaleEdit-12M, CTCal, Premier, InjectFlow, SGG, DiffMark, MFSR (7篇) 推理加速/高效微调: DiT-BlockSkip, MFSR (2篇) 音频生成: OmniCodec, SqueezeComposer, SelfTTS, EARTalking (4篇) CVPR 2026 × 2 | 新方法 × 10 重点论文深度解读 1. ScaleEdit-12M: Open-Source Image Editing Data via Multi-Agent 最大开源图像编辑数据集 | 上交/港中文 | arXiv:2603.20644 关键词: 图像编辑数据集, 多智能体, 1200万样本, 23个任务族 研究动机 基于指令的图像编辑是统一多模态模型(UMM)的关键能力,但构建大规模、多样化且高质量的编辑数据集面临两大挑战:依赖闭源API(如GPT-4V)标注成本极高,固定合成流水线质量有限且泛化能力差。现有开源编辑数据集规模和多样性远不能满足训练需求。 方法原理 ScaleEditor 是一个完全开源的分层多智能体框架,实现端到端的大规模图像编辑数据集构建。整个流水线包含三个关键组件:(1) 融入世界知识的源图像扩展——通过多智能体协作从互联网和合成数据中收集覆盖多样场景的高质量源图像;(2) 自适应多智能体编辑指令-图像合成——多个专业化智能体分别负责生成编辑指令、执行图像变换、进行质量验证,根据不同编辑类型自适应选择最优工作流;(3) 任务感知的数据质量验证机制——针对23个编辑任务族设计差异化质量校验标准,确保每个样本的编辑准确性和自然度。最终整理出 ScaleEdit-12M,跨越23个任务族(包括颜色编辑、风格迁移、物体添加/删除、背景替换等),涵盖真实和合成域。 核心创新 首个完全开源的大规模图像编辑数据生成框架 万样本覆盖23个任务族——迄今最大开源编辑数据集 分层多智能体架构:自适应选择最优编辑工作流 任务感知质量验证:23个任务族差异化质量标准 在 ImgEdit 和 GEdit 基准上提升 10.4% 和 35.1% 实验结果 在 UniWorld-V1 和 Bagel 模型上微调验证:通用编辑基准 ImgEdit 提升 10.4%、GEdit 提升 35.1%;知识注入基准 RISE 提升 150.0%、KRIS-Bench 提升 26.5%。证明开源智能体流水线可达到商业级数据质量。框架和数据集均将开源。 方法流程 源图像扩展 — 多智能体从互联网+合成数据收集高质量源图 编辑指令生成 — 智能体根据图像内容自适应生成编辑指令 多智能体合成 — 专业化智能体执行23种不同编辑类型 任务感知验证 — 差异化质量标准逐样本校验准确性和自然度 ScaleEdit-12M — 1200万高质量编辑样本 横跨23个任务族 下游微调 — ImgEdit +10.4% GEdit +35.1% 技术脉络 核心问题: 开源图像编辑数据集规模有限且依赖闭源API 前序工作及局限: UltraEdit (Zhao 2024):400万自动生成编辑数据,但依赖闭源 API GalaxyEdit (2024):大规模编辑数据集,固定流水线泛化差 InstructPix2Pix (Brooks 2023):GPT-4 生成编辑指令,成本极高 与前序工作的本质区别: ScaleEdit-12M 用全开源多智能体框架替代闭源API,规模扩大3x+,覆盖23个任务族 技术演进定位: 开源编辑数据集的新里程碑,降低整个社区的数据壁垒 可能的后续方向: 数据质量自动化评估 任务族继续扩展 视频编辑数据集构建 批判性点评 新颖性: 全开源多智能体框架替代闭源 API,23 个任务族差异化质量验证 可复现性: 框架和数据集均将开源,但 1200 万数据的生成成本需评估 影响力: 可能成为编辑数据领域的 ImageNet 级标杆,降低全社区数据壁垒 2. CTCal: Cross-Timestep Self-Calibration for T2I Diffusion 跨时间步自校准 | 北航/上海AI Lab | CVPR 2026 | arXiv:2603.20741 关键词: T2I对齐, 跨时间步校准, 交叉注意力, CVPR 2026 研究动机 文生图扩散模型在文本与图像的精确对齐方面仍面临持续挑战。传统扩散损失仅提供隐式监督来建模细粒度的文本-图像对应关系,这是对齐困难的根本原因。随着时间步增大(噪声增多),建立准确的文本-图像对齐变得越来越困难,低噪声阶段形成的交叉注意力图是可靠的,但高噪声阶段的注意力图容易偏离,现有方法缺乏显式的跨时间步知识传递机制。 方法原理 CTCal(Cross-Timestep Self-Calibration)利用低噪声时间步下形成的可靠文本-图像对齐来校准高噪声时间步的表示学习。核心原理:(1) 观察到交叉注意力图在小时间步(噪声少)时准确反映文本-图像对应关系,而大时间步(噪声多)时容易偏差;(2) 将小时间步的注意力图作为「自校准信号」,在训练期间为大时间步提供显式的对齐监督;(3) 提出时间步感知自适应加权机制,根据时间步动态调整 CTCal 损失与标准扩散损失的权重比例,在不同去噪阶段实现最优平衡;(4) 模型无关设计——可无缝集成到基于扩散的模型(如 SD 2.1)和基于 Flow 的模型(如 SD 3)。 核心创新 首次提出利用跨时间步注意力自校准改进文生图对齐 揭示了文本-图像对齐难度随时间步增大而增加的关键规律 时间步感知自适应加权平衡多损失项 模型无关:兼容 Diffusion-based 和 Flow-based 架构 CVPR 2026 接收,代码已开源 实验结果 在 T2I-Compbench++ 和 GenEval 基准上展示了显著的文本-图像对齐提升。CTCal 可无缝集成到 SD 2.1 和 SD 3 中,在属性绑定、对象关系、数量匹配等多个维度上均取得了一致性改善。CVPR 2026 接收,代码已开源。 方法流程 训练样本输入 — 文本-图像对 + 多时间步噪声 小时间步去噪 — 低噪声阶段获得可靠交叉注意力图 大时间步去噪 — 高噪声阶段注意力图容易偏差 跨时间步校准 — 低噪声注意力→高噪声显式监督信号 自适应加权 — 时间步感知的CTCal+扩散损失动态平衡 增强T2I对齐 — 属性绑定/对象关系/数量匹配全面提升 技术脉络 核心问题: 扩散模型的文本-图像对齐在高噪声阶段容易偏差 前序工作及局限: Attend-and-Excite (Chefer 2023):注意力激励增强对齐,仅推理阶段 StructureDiffusion (Feng 2023):结构化文本引导,需额外解析 ComposableDiffusion (Liu 2022):可组合扩散,缺少显式监督 与前序工作的本质区别: CTCal 首次利用跨时间步注意力自校准提供显式对齐监督 技术演进定位: 训练阶段文图对齐优化的新范式 可能的后续方向: 推理阶段自校准 多模态扩展 视频生成对齐 批判性点评 新颖性: 首次将跨时间步注意力知识转移应用于扩散训练,洞察简洁有力 可复现性: 代码已开源,CVPR 2026 接收,可复现 影响力: 模型无关设计使其可广泛集成到现有 T2I 训练流程中 3. DiT-BlockSkip: Memory-Efficient Fine-Tuning for Diffusion Transformers 内存高效微调扩散DiT | Qualcomm/KAIST | CVPR 2026 | arXiv:2603.20755 关键词: DiT微调, 内存高效, 块跳过, 设备端部署, CVPR 2026 研究动机 扩散 Transformer(DiT)显著提升了文生图质量,使高质量个性化内容创作成为可能。然而,微调这些大模型需要巨大的计算复杂性和内存开销,严重限制了在资源受限环境(如智能手机、IoT 设备)下的实际部署。现有方法要么需要完整的梯度计算(内存爆炸),要么牺牲了个性化效果。 方法原理 DiT-BlockSkip 提出一个内存高效的微调框架,集成两大核心机制:(1) 时间步感知动态补丁采样——根据扩散时间步自适应调整补丁大小:高时间步(早期去噪)用大补丁捕获全局结构,低时间步(后期细化)用小补丁聚焦细粒度细节,裁剪后的补丁统一调整为固定低分辨率,显著降低前向和反向的内存消耗;(2) 基于预计算残差的块跳过机制——利用交叉注意力掩码识别对个性化关键的 Transformer 块,仅对这些块进行微调,跳过的块使用预计算的残差特征(一次性离线计算),大幅减少训练内存。两个机制协同工作,实现在显著降低内存的同时保持竞争力的个性化性能。 核心创新 时间步感知动态补丁采样:高时间步大补丁+低时间步小补丁 交叉注意力掩码引导的关键块识别 预计算残差块跳过:一次性离线计算跳过块的残差 两个机制协同实现大幅内存节省 CVPR 2026 接收,推动 DiT 设备端部署 实验结果 评估结果表明,DiT-BlockSkip 在定性和定量上均实现了与全量微调竞争力相当的个性化性能,同时大幅减少了内存使用。推动了大规模扩散 Transformer 在智能手机等设备端运行的可行性。CVPR 2026 接收。 方法流程 预训练DiT模型 — 大规模扩散Transformer (如FLUX/SD3) 交叉注意力分析 — 识别对个性化关键的Transformer块 动态补丁采样 — 高时间步大补丁→低时间步小补丁 关键块微调 — 仅微调必要Block 其余使用预计算残差 残差特征跳过 — 跳过块一次性离线预计算 推理复用 高效个性化输出 — 大幅降低内存 设备端可部署 技术脉络 核心问题: 大规模扩散Transformer微调内存开销过高 前序工作及局限: LoRA (Hu 2021):低秩适配减少可训练参数,但内存仍高 DreamBooth (Ruiz 2022):少样本个性化微调,需完整梯度 Token Merging (Bolya 2023):推理阶段 Token 合并,不涉及训练 与前序工作的本质区别: DiT-BlockSkip 将时间步感知与块选择结合,训练阶段大幅压缩内存 技术演进定位: DiT 设备端部署的重要一步 可能的后续方向: 端侧实时推理优化 与量化方法结合 自适应精度微调 批判性点评 新颖性: 时间步感知补丁采样+交叉注意力引导块选择的组合创新 可复现性: CVPR 2026 接收,细节完整 影响力: 推动 DiT 端侧部署可行性,但工程落地仍需大量后续工作 批判性点评精选 1. 数据集规模化 ScaleEdit-12M 将开源编辑数据推至千万级,23 个任务族全覆盖,ImgEdit +10.4% 2. 优雅的训练信号 CTCal 跨时间步自校准——低噪声注意力图校准高噪声表示,模型无关 3. 端侧部署探索 DiT-BlockSkip 动态补丁+块跳过双管齐下,推动 DiT 走向设备端 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 1 InjectFlow (Weak Guides Strong via Orthogonal Injection for Flow Matching) 百度/北大 Flow Matching · 偏差修复 · 免训练 形式化了 Flow Matching 的「偏差流形」问题,提出 InjectFlow 通过在初始速度场中注入正交语义(无需训练/改种子)修复轨迹锁定。在 GenEval 上修复了标准 FM 模型 75% 的失败提示。 GenEval 修复率 75%,免训练即插即用,为构建更公平鲁棒的视觉基础模型提供理论和实践方案 2 Premier (Personalized Preference Modulation with Learnable User Embedding in T2I) 哈工大 个性化T2I · 偏好嵌入 提出可学习用户偏好嵌入和偏好适配器,将用户偏好与文本提示融合调制生成过程。引入分散损失强制分离不同用户嵌入。新用户可通过已有嵌入线性组合快速泛化。 在相同历史长度下超越先前方法,实现更强的偏好对齐和文本一致性 3 SGG (Improving Diffusion Generalization with Weak-to-Strong Segmented Guidance) 西湖大学/同济/浙大 扩散引导 · 弱到强 · SD3 从弱到强原则分离 CFG 和 AutoGuidance 的有效操作区间,提出混合实例 SGG 结合两者优势。W2S 原则可迁移到训练目标,在 SD3 和 SD3.5 上超越现有免训练引导变体。 SD3/SD3.5 上超越 CFG 和 AutoGuidance 等现有引导方法,开源代码 4 DiffMark (Transferable Multi-Bit Watermarking Across Frozen Diffusion Models via Latent Consistency Bridges) UCD 扩散水印 · 跨模型迁移 · LCM 即插即用的扩散模型多比特水印方法:利用 Latent Consistency Models 作为可微训练桥梁,梯度步数从 50 步压缩到 4 步。单次前向传递检测(16.4ms,比采样法快 45 倍),支持跨模型迁移。 16.4ms 检测速度(45x加速),保持鲁棒性,跨冻结扩散模型可迁移 5 MFSR (MeanFlow Distillation for One Step Real-World Image Super Resolution) 南大/Salesforce/NTU 超分辨率 · 一步蒸馏 · MeanFlow 基于 MeanFlow 蒸馏的一步式真实世界图像超分辨率。学生模型学习近似 PF-ODE 任意状态间的平均速度,配合教师 CFG 蒸馏保留精细细节。一步即可生成逼真结果,可选少步路径进一步细化。 一步生成质量与多步教师模型相当甚至更优,显著降低计算成本 6 EARTalking (End-to-end GPT-style Autoregressive Talking Head Synthesis with Frame-wise Control) 中科大/浙大 数字人生成 · 自回归 · 逐帧控制 端到端 GPT 风格自回归模型实现交互式音频驱动数字人生成。提出 Sink Frame Window Attention (SFA) 保持变长视频的身份一致性,Frame Condition In-Context (FCIC) 支持逐帧交互式控制信号注入。 性能优于现有自回归方法,与扩散方法相当,支持流式生成和实时交互控制 7 OmniCodec (Low Frame Rate Universal Audio Codec with Semantic-Acoustic Disentanglement) 西工大 音频编解码 · 语义解耦 · 低帧率 面向低帧率的通用神经音频编解码器。分层多码本设计,利用预训练理解模型音频编码器实现语义-声学解耦。自引导策略提升码本利用率。在相同比特率下超越 Mimi 编解码器,提供更优重建质量和更丰富语义表示。 相同比特率超越 Mimi,重建质量+语义丰富度双提升,利好下游 LLM 音频生成 8 SqueezeComposer (Temporal Speed-up is A Simple Trick for Long-form Music Composing) 港科大/中移动/北理工 长音乐生成 · 时间加速 · 扩散模型 提出「时间加速」策略:先让模型生成加速版本(2x-8x)的音乐以减少序列长度和资源需求,再恢复到原始速度。在加速域用扩散模型生成,在恢复域细化。简单技巧实现高效可扩展的长音乐生成。 高效生成长篇连贯音乐,资源需求与短音乐相当,质量保持 9 SelfTTS (Cross-Speaker Style Transfer through Explicit Embedding Disentanglement and Self-Refinement) UNICAMP 跨说话人TTS · 风格迁移 · 自细化 无需外部预训练编码器的跨说话人风格迁移 TTS。利用梯度反转层(GRL)+余弦相似度损失实现说话人与情感的显式解耦,多正对比学习(MPCL)诱导嵌入聚类,自增强自细化策略利用模型自身的语音转换能力提升自然度。 在跨说话人情感风格迁移上超越基线,无需外部预训练编码器,自包含设计 趋势观察 图像编辑数据集规模化 — ScaleEdit-12M 推动开源编辑数据集迈入千万级 扩散模型训练信号增强 — CTCal 等跨时间步自校准方法改善文图对齐 设备端DiT部署探索 — DiT-BlockSkip 等内存高效微调推动端侧生成 Flow Matching 鲁棒性 — InjectFlow 等方法修复 FM 的数据偏差问题 人工智能炼丹师 整理 | 2026-03-25
-
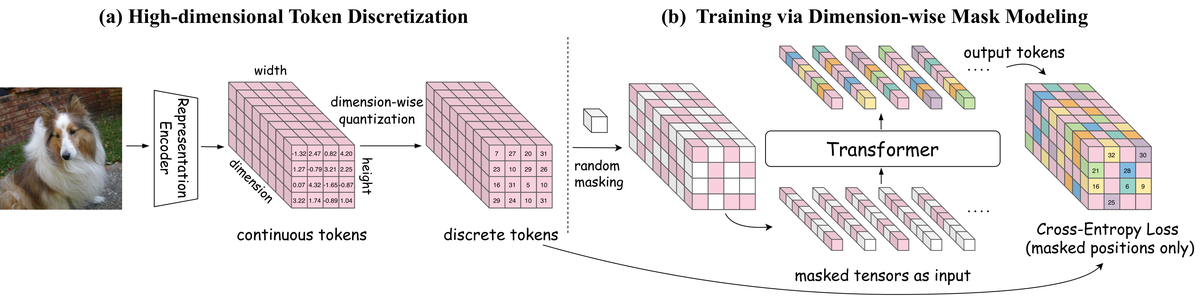
AIGC 每日速读|2026-03-24|CubiD高维离散扩散|扩散通用加速|FoleyDirector V2A| AIGC 视觉生成领域 · 每日论文解读 (2026-03-24) 人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇 今日核心看点 高维离散扩散 统一生成理解 通用扩散加速 V2A时序控制 个性化视频生成 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。 方向分布: 图像生成与编辑 — 4 篇(CubiD、妆容迁移、I2I整流流、统一多模态) 视频生成 — 2 篇(LumosX 个性化、MME-CoF-Pro 评测) 音频生成 — 3 篇(FoleyDirector V2A、Borderless Long Speech、MOSS-TTSD) 生成模型加速 — 1 篇(时间步感知块掩码) 评测与质量评估 — 2 篇(TATAR 统一IQA+IAA、PGD-EIQA 去偏) 含 2 篇 CVPR 2026 + 1 篇 ICLR 2026 重点论文深度解读 1. CubiD: Cubic Discrete Diffusion for High-Dim Tokens 首个高维离散扩散生成 | HKU + Google + ByteDance | arXiv:2603.19232 关键词: 离散扩散, 高维表示, 统一生成理解, ImageNet SOTA 研究动机 离散 Token 视觉生成因能与语言模型共享统一的 Token 预测范式而备受关注,但当前方法局限于低维潜在 Token(通常 8-32 维),牺牲了对理解任务至关重要的语义丰富性。高维预训练表示(768-1024 维)理论上可弥补这一鸿沟,然而其离散化生成面临根本性挑战——维度爆炸导致码本大小和生成步数均不可控。 方法原理 CubiD 提出在高维离散表示上进行「细粒度掩码扩散」。核心思想是:对高维离散表示的任意维度、任意位置都可以独立掩码和预测。具体包括:(1) 将预训练的 768/1024 维连续表示通过残差向量量化离散化;(2) 在扩散过程中,每个空间位置的每个维度都可被独立掩码,模型从部分观测中预测缺失维度;(3) 这使模型能学习空间位置内部和跨位置的丰富关联,且生成步数固定为 T(T 远小于 h×w×d),不随维度增长;(4) 从 900M 扩展到 3.7B 参数展现出强 Scaling 行为。 核心创新 首个面向高维(768-1024维)表示的离散扩散生成模型 细粒度维度级掩码策略:任意维度任意位置可独立掩码预测 生成步数与特征维度解耦(T << h×w×d) 验证离散化 Token 同时支持理解和生成任务 M-3.7B 参数强 Scaling 行为 实验结果 ImageNet-256 上达到离散生成方法 SOTA,从 900M 到 3.7B 展现强 Scaling 行为。关键验证:离散化后的 Token 保留了原始表示的理解能力,证明同一组离散 Token 可同时服务于理解和生成任务。代码已开源。 方法流程 预训练表示 — 768/1024维连续特征(如DINOv2/CLIP) 残差向量量化 — RVQ离散化为高维Token序列 细粒度维度掩码 — 任意位置任意维度独立掩码 条件扩散预测 — 从部分观测预测缺失维度 位置内+跨位置关联 — 同时建模局部和全局依赖 固定T步生成 — 步数与维度解耦 T<<hwd 技术脉络 核心问题: 离散 Token 生成局限于低维(8-32维),无法利用高维预训练表示 前序工作及局限: MaskGIT (Chang 2022):掩码图像建模范式,但限于低维 VQ-VAE Token MAGVIT-v2 (Yu 2024):改进离散 Tokenizer,仍为 32 维以下 MAR (Li 2024):掩码自回归模型,连续/离散混合但维度受限 LlamaGen (Sun 2024):用 LLM 架构做视觉生成,仍依赖低维码本 与前序工作的本质区别: CubiD 首次突破维度限制,在 768-1024 维上实现细粒度维度级掩码扩散,且生成步数不随维度增长 技术演进定位: 开辟了「高维离散扩散」新赛道,为 vision-language 统一架构提供了新范式 可能的后续方向: 更高分辨率(512+)的高维离散生成 视频领域的高维离散扩散 与 LLM 的原生融合统一架构 批判性点评 实验评估: 在 ImageNet-256 上对比了多种离散生成方法,展示了 Scaling 行为。但缺少 FID/IS 等具体数值对比表,也未在 T2I 场景下与 SDXL/DALL-E 3 等连续方法直接对比。 新颖性: 首次将离散扩散扩展到高维表示(768-1024维),维度级掩码策略新颖度高。但 RVQ 离散化本身是已有技术,核心贡献在于将掩码扩散泛化到高维。 可复现性: 代码已开源(GitHub),数据集为公开的 ImageNet。但 3.7B 模型的训练成本可能限制社区复现。 影响力: 可能推动统一 vision-language 架构的发展。如果高维离散 Token 真正兼顾理解和生成,将对多模态基础模型产生深远影响。 2. Timestep-Aware Block Masking for Diffusion Acceleration 架构无关扩散加速 | 武汉大学 | arXiv:2603.19939 关键词: 扩散加速, 块掩码, 架构无关, 特征复用 研究动机 扩散概率模型在图像生成方面取得了巨大成功,但迭代去噪的特性导致推理延迟较高。现有加速方法要么需要全链反向传播(内存开销大),要么绑定特定架构。如何实现一种内存高效、架构无关的扩散加速方法是核心问题。 方法原理 提出时间步感知块掩码(Timestep-Aware Block Masking)框架。核心思路:对预训练扩散模型的计算图进行逐时间步优化。(1) 学习时间步特异性掩码(per-timestep masks),在每个推理阶段动态决定哪些 Block 执行完整计算、哪些通过特征复用绕过;(2) 独立优化每个时间步的掩码(而非全链反向传播),确保内存高效训练;(3) 引入时间步感知损失缩放机制,在敏感的去噪阶段优先保证特征保真度;(4) 辅以知识引导的掩码修正策略,修剪冗余的时空依赖关系。 核心创新 架构无关:同一框架适用于 DDPM、LDM、DiT、PixArt 四种主流架构 逐时间步独立优化掩码,避免全链反向传播的高内存开销 时间步感知损失缩放:敏感阶段保真度优先 知识引导掩码修正:智能修剪冗余时空依赖 实验结果 在 DDPM、LDM、DiT 和 PixArt 四种架构上均展示了显著的效率提升。将去噪过程视为一系列优化的计算路径,在采样速度和生成质量之间实现了优越的平衡。代码将公开发布。 方法流程 预训练扩散模型 — 支持DDPM/LDM/DiT/PixArt 逐时间步掩码学习 — 独立优化每步的Block选择 损失缩放机制 — 敏感阶段高权重保真度优先 掩码修正策略 — 知识引导修剪冗余依赖 动态Block跳过 — 低贡献Block特征复用 加速推理输出 — 速度-质量最优平衡 技术脉络 核心问题: 扩散模型推理慢,现有加速方法绑定特定架构或需高内存全链优化 前序工作及局限: DDIM (Song 2021):减少采样步数的非马尔可夫加速 DPM-Solver (Lu 2022):高阶 ODE 求解器加速采样 DeepCache (Ma 2024):缓存 U-Net 特征跨步复用,绑定 U-Net 架构 Token Merging (Bolya 2023):合并冗余 Token 减少计算量 与前序工作的本质区别: Timestep-Aware Block Masking 是架构无关的:同一框架直接适用于 DDPM/LDM/DiT/PixArt,且通过逐步独立优化避免全链反向传播的内存瓶颈 技术演进定位: 在扩散加速领域建立了首个「架构无关」通用框架的先例 可能的后续方向: 与步数蒸馏方法结合实现多维加速 扩展到视频扩散模型 在移动端部署场景的适配 批判性点评 实验评估: 覆盖 DDPM/LDM/DiT/PixArt 四种架构,实验全面性好。但缺少与 DeepCache、FORA 等最新 cache 方法的定量对比。加速比和质量损失的 trade-off 曲线有待补充。 新颖性: 逐时间步独立优化掩码思路清晰,时间步感知损失缩放有理论依据。但 Block 跳过/特征复用的整体思路与 Token Merging、DeepCache 类似,差异化主要在于掩码学习策略。 可复现性: 代码承诺公开但尚未发布。方法依赖少量校准数据训练掩码,流程相对简单可复现。 影响力: 架构无关的特性使其具有广泛适用性。若能在实际产品级部署中验证(如 SDXL/Flux),工程价值将非常高。 3. FoleyDirector: Fine-Grained V2A Temporal Control 细粒度 V2A 时序控制 | CVPR 2026 | arXiv:2603.19857 关键词: V2A, 时序控制, DiT音频, CVPR 2026 研究动机 视频到音频(V2A)方法已能合成高质量音频,但在多事件场景或视觉线索不足时(小区域、画外音、遮挡物体),细粒度时序控制仍是难题。现有方法无法精确指定每个时间段应生成什么声音,限制了创作灵活性。 方法原理 FoleyDirector 是首个在 DiT 基架构上实现精确时序引导的 V2A 生成框架。核心创新包括:(1) 结构化时序脚本(STS):将音频描述分解为对应短时间片段的字幕集合,提供丰富的时序信息;(2) 脚本引导时序融合模块:使用 Temporal Script Attention 将 STS 特征与视频特征连贯融合;(3) 双帧声音合成(Bi-Frame Sound Synthesis):并行生成画面内和画面外音频,处理复杂多事件场景;(4) 构建 DirectorSound 数据集和 DirectorBench 评测基准。 核心创新 首个在 DiT 基 V2A 模型上实现精确时序引导 结构化时序脚本(STS)提供细粒度音频描述 双帧声音合成:画内+画外音频并行生成 DirectorSound 数据集 + DirectorBench 评测 实验结果 实验表明 FoleyDirector 在保持高音频保真度的同时大幅提升了时序可控性。在 VGGSoundDirector 和 DirectorBench 上展示了 SOTA 的时序控制能力,用户可像拟音导演一样精确控制每个时间段的声音生成。CVPR 2026 接收。 方法流程 输入视频+时序脚本 — 视频帧序列+STS结构化字幕 视觉特征提取 — 编码视频帧的视觉信息 STS时序编码 — 结构化脚本→时间段级嵌入 Script-Guided融合 — Temporal Script Attention 双帧声音合成 — 画内+画外音频并行生成 高保真时序音频 — 精确对齐的多事件音频输出 技术脉络 核心问题: V2A 生成缺乏细粒度时序控制,多事件场景和画外音难以处理 前序工作及局限: SpecVQGAN (Iashin 2023):音频频谱 VQ-GAN 生成,无时序控制 Diff-Foley (Luo 2024):扩散模型 V2A,但仅全局条件控制 Frieren (Wang 2024):V2A 扩散模型,改善音频-视频同步 AC-Foley (2025):参考音频引导 V2A,但缺乏精确时间段控制 与前序工作的本质区别: FoleyDirector 通过结构化时序脚本(STS)首次在 DiT 基 V2A 模型上实现时间段级精确控制,并创新性地并行生成画内和画外音频 技术演进定位: 将 V2A 从「全局条件生成」推进到「导演级时序控制」,显著拓展了实用价值 可能的后续方向: 与视频生成模型联合训练实现端到端 V2AV 交互式拟音编辑工具 扩展到音乐配乐的时序控制 批判性点评 实验评估: 构建了 DirectorSound 数据集和 DirectorBench 评测基准,评估维度全面。CVPR 2026 接收说明同行认可度高。但 V2A 领域尚缺乏统一公认的客观指标。 新颖性: 首次在 DiT 基 V2A 模型上实现精确时序引导,STS 设计优雅。双帧声音合成(画内+画外)是实际应用中的重要创新。但依赖结构化文本输入增加了使用门槛。 可复现性: 提出了新数据集但未明确是否公开。方法依赖预训练 DiT V2A 基模型,复现需要一定基础设施。 影响力: 对影视后期制作和自动配音有直接应用价值。STS 理念可泛化到其他时序生成任务(如音乐生成、视频编辑)。 批判性点评精选 1. 高维离散 = 统一架构? CubiD 验证高维离散 Token 兼顾理解和生成,但 3.7B 模型的训练成本和实际 T2I 质量仍有待验证 2. 架构无关的代价 Block Masking 覆盖四种架构值得称赞,但每种架构的最优掩码配置不同,通用性是否以牺牲极致性能为代价? 3. 时序脚本的使用门槛 FoleyDirector 的 STS 需要手工编写结构化脚本,大规模自动化场景下的可用性值得关注 其余论文 · 贡献与效果总结 # 论文 关键词 主要贡献 效果 1 LumosX (Relate Any Identities with Their Attributes for Personalized Video Generation) 个性化视频生成 · 身份对齐 · ICLR 2026 提出关系自注意力和关系交叉注意力机制,在多对象个性化视频生成中实现精确的身份-属性对齐。通过 MLLM 推断对象间依赖关系,强化群组内聚性和跨对象分离。ICLR 2026。 在多对象个性化视频生成基准上达到 SOTA,身份一致性和语义对齐显著优于现有方法 2 Borderless Long Speech (Borderless Long Speech Synthesis) 长语音合成 · 多说话人 · Agentic TTS 提出无边界长语音合成框架,支持多说话人对话(最多5人)、零样本语音克隆、长达60分钟单次合成。创新的 Global-Sentence-Token 多级标注体系和 Chain-of-Thought 推理增强复杂条件下的指令遵循。 支持60分钟单次合成、5人多方对话,原生 Agentic 设计实现从 Text2Speech 到无边界长语音合成的范式扩展 3 MOSS-TTSD (Text to Spoken Dialogue Generation) 对话合成 · 多方语音 · 复旦 首个面向对话场景的语音合成模型,支持多语言(中英文)、多方对话(最多5人)、零样本语音克隆。增强长上下文建模实现 60 分钟单次生成。提出 TTSD-eval 客观评测框架。复旦大学团队。 在对话合成的说话人归属准确率和相似度上超越开源和商业基线,支持播客、动态解说等应用场景 4 FRAM (Diffusion-Based Makeup Transfer with Facial Region-Aware Makeup Features) 妆容迁移 · 区域感知 · CVPR 2026 提出面部区域感知妆容特征(FRAM):通过 GPT-o3 合成标注数据微调妆容 CLIP 编码器,使用可学习 Token 查询区域级妆容特征。ControlNet Union 同时编码源图像及 3D 网格实现身份保持。CVPR 2026。 在区域可控性和妆容迁移质量上验证了显著优势,支持眼妆/唇妆等细粒度区域独立编辑 5 I2I-RFR (Improving Image-to-Image Translation via a Rectified Flow Reformulation) 整流流 · I2I翻译 · 即插即用 将标准 I2I 回归网络重新表述为连续时间传输模型:仅扩展输入通道+简单 t 重加权损失,诱导整流流解释,推理时通过 ODE 渐进细化(仅需3步)。无需蒸馏即可显著提升感知质量。 在多个 I2I 翻译和视频恢复任务上普遍提升性能,尤其在感知质量和细节保留方面收益明显 6 SeGroS (Enhancing Alignment for Unified Multimodal Models via Semantically-Grounded Supervision) 统一多模态 · 对齐增强 · 语义监督 解决统一多模态模型(UMM)中粒度不匹配和监督冗余问题。提出视觉定位图构建互补监督信号:语义视觉提示补偿文本稀疏性 + 语义定位的损坏输入将重建损失限制在核心文本对齐区域。 在 GenEval/DPGBench/CompBench 上显著提升 UMM 的生成保真度和跨模态对齐 7 TATAR (One Model, Two Minds: Task-Conditioned Reasoning for Unified IQA and Aesthetic Assessment) 统一IQA+IAA · 非对称奖励 · GRPO 揭示统一 IQA 和 IAA 中的「推理不匹配」和「优化不匹配」。提出 TATAR 框架:快慢任务推理构建 + 两阶段 SFT+GRPO 学习 + 非对称奖励(IQA 高斯整形/IAA 瑟斯顿排名)。 8个基准上均优于统一基线,与特定任务专用模型竞争力相当,美学评估训练更稳定 8 MME-CoF-Pro (Evaluating Reasoning Coherence in Video Generative Models) 视频生成评测 · 推理连贯性 · Benchmark 提出视频生成模型推理连贯性评测基准:303 样本/16 类别,从视觉逻辑到科学推理。引入「推理分数」评估中间步骤,三种设置(无提示/文本/视觉)控制研究。评测 7 个模型揭示推理连贯性与生成质量解耦。 发现视频生成模型推理连贯性较弱且与质量解耦;文本提示虽提高正确性但引入幻觉;视觉提示在细粒度感知上仍困难 9 PGD-EIQA (Preference-Guided Debiasing for No-Reference Enhancement Image Quality Assessment) 图像质量评估 · 去偏 · 偏好引导 通过监督对比学习构建连续增强偏好嵌入空间,估计并去除质量表示中的增强诱导干扰,使模型关注算法不变的感知质量线索。两阶段训练:偏好空间学习 → 去偏质量预测。 在公共 EIQA 基准上有效缓解算法诱导偏差,跨增强算法泛化能力显著优于现有方法 趋势观察 离散表示生成 — 高维 Token 离散扩散首次突破,统一理解+生成成为新范式 扩散加速通用化 — 架构无关加速框架覆盖 DDPM/LDM/DiT/PixArt 全系列 音频生成精细化 — V2A 和对话 TTS 均走向细粒度时序控制和长上下文建模 人工智能炼丹师 整理 | 2026-03-24
-
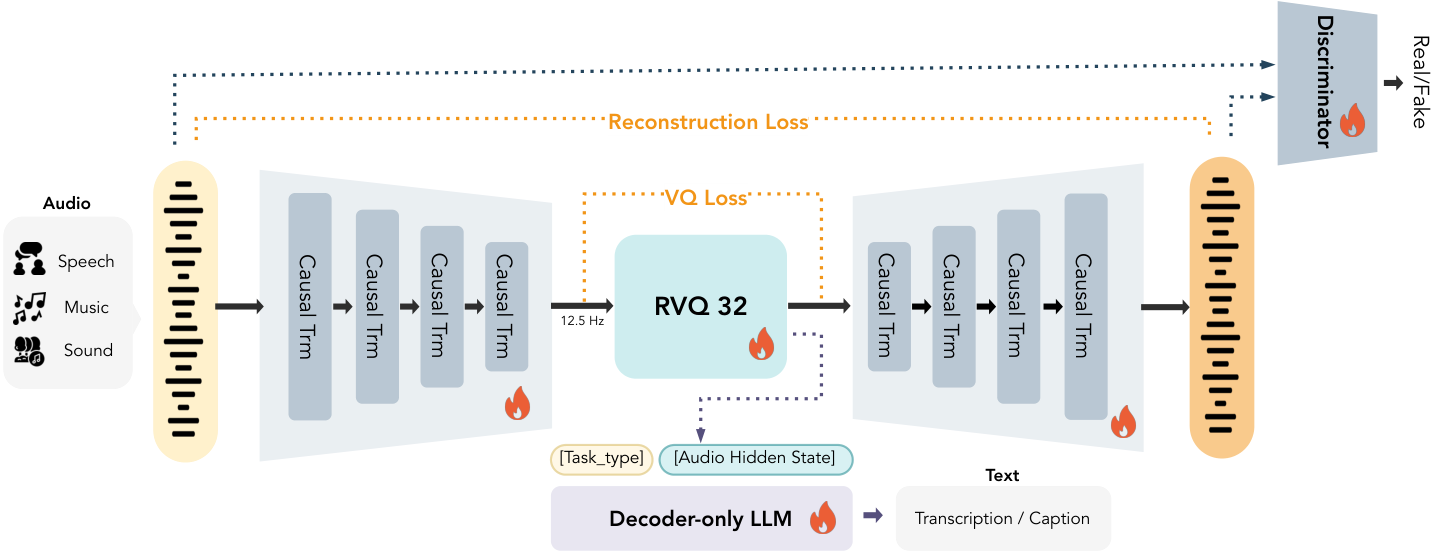
AIGC 每日速读|2026-03-23|MOSS-TTS|ColourCrafter|Q-Drift| AIGC 视觉生成领域 · 每日论文解读 (2026-03-23) 人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇 今日核心看点 MOSS-TTS 语音基础模型 ColourCrafter 区域色彩编辑 Q-Drift 量化漂移校正 TexEditor 纹理编辑 Diff-SIT 视频扩散压缩 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。 方向分布: 语音生成基础模型 — 1篇 (MOSS-TTS) 图像编辑与色彩控制 — 2篇 (ColourCrafter, TexEditor) 扩散模型加速与量化 — 1篇 (Q-Drift) 视频扩散压缩 — 1篇 (Diff-SIT) 生成内容评测 — 2篇 (GenVideoLens, IAA) 特殊领域生成 — 4篇 (声学/异常/面部/Sim2Real) 合成数据增强 — 1篇 (R&D) CVPR 2026 x2 (O2MAG, FLAC) | ECCV 2026 x1 (GenVideoLens) 重点论文深度解读 1. MOSS-TTS: Speech Generation Foundation Model 语音生成基础模型 | arXiv:2603.18090 关键词: TTS, 语音克隆, 自回归建模, 离散Token, 基础模型 研究动机 当前语音合成模型在零样本语音克隆、跨语言代码切换和长文本稳定生成方面仍面临挑战。如何构建一个统一的语音生成基础模型,既具备结构简洁性和可扩展性,又能支持精细控制(时长、发音、语言切换),是 TTS 领域的核心问题。 方法原理 MOSS-TTS 基于「离散音频 Token + 自回归建模 + 大规模预训练」的可扩展配方构建: MOSS-Audio-Tokenizer:因果 Transformer 分词器,将 24kHz 音频压缩为 12.5 fps,采用可变比特率 RVQ 实现语义-声学统一表示 MOSS-TTS 主生成器:强调结构简洁性和可扩展性,支持长上下文和控制导向部署 MOSS-TTS-Local-Transformer:引入帧级局部自回归模块,提升建模效率、说话人保持能力,缩短首音延迟 核心创新 统一语义-声学表示的音频 Tokenizer,12.5fps 极低帧率 双生成器互补架构(全局+局部自回归) Token 级时长控制和音素/拼音级发音控制 支持平滑代码切换和稳定长篇生成 实验结果 在多语言和开放域设置中支持零样本语音克隆、token 级时长控制、音素/拼音级发音控制、平滑代码切换和稳定长篇生成。模型和代码已开源。 方法流程 24kHz音频 — 原始语音输入 MOSS-Audio Tokenizer — 因果Transformer 可变比特率RVQ 12.5fps 离散Token — 语义-声学统一表示 自回归 Transformer — 全局长上下文建模 帧级局部AR(可选) — 提升效率和说话人保持 Token解码 — 高质量语音输出 技术脉络 核心问题: 开源 TTS 模型缺乏统一的基础模型配方,在零样本语音克隆、跨语言切换和长文本稳定生成方面表现不足 前序工作及局限: Tacotron 2 (Shen 2018):端到端频谱预测,但需要声码器二阶段合成 VITS (Kim 2021):端到端变分推理实现高自然度,但扩展性有限 VALL-E (Wang 2023):首个大规模自回归语音 Token 建模,但开源实现不完整 CosyVoice (Du 2024):开源可控 TTS,但 Tokenizer 和生成器未统一设计 与前序工作的本质区别: 提供完整的基础模型配方——统一语义-声学 Tokenizer(12.5fps 极低帧率)+ 双生成器互补架构 + 精细控制能力,且完全开源 技术演进定位: 集大成者——整合离散 Token + 自回归 + 大规模预训练的完整配方,为开源 TTS 基础模型树立标杆 可能的后续方向: 更低帧率 Tokenizer(<10fps)在情感保真度上的权衡 与大语言模型深度融合的端到端对话式语音生成 多语言统一 Tokenizer 设计 批判性点评 实验评估: 实验覆盖零样本语音克隆、跨语言代码切换和长篇生成等多项任务。12.5fps 极低帧率在 WER 和说话人相似度上表现优秀,但情感和副语言信息的保真度在极端情况下缺乏定量评估。开源模型使复现容易。 新颖性: 统一语义-声学 Tokenizer 和双生成器互补架构(全局+局部自回归)的设计思路新颖。12.5fps 帧率在已知开源 TTS 模型中最低。创新性评分: 可复现性: 模型和代码完全开源,训练配方描述完整。Tokenizer、双生成器架构清晰易实现,但大规模预训练数据需求较高。 影响力: 影响力评分 4.5/5 — 为开源 TTS 社区提供了完整的基础模型配方,加速语音生成的民主化。双生成器架构为不同部署场景提供灵活选择。 2. ColourCrafter: Region-Aware Colour Editing via Token-Level Diffusion Token级扩散的区域感知色彩编辑 | arXiv:2603.18466 关键词: 色彩编辑, 区域感知, Token级扩散, Lab色彩空间, 细粒度控制 研究动机 色彩是图像生成中感知最显著但也最难控制的属性之一。现有扩散模型可根据用户指令修改颜色,但结果往往偏离预期色调,尤其在细粒度和局部编辑方面表现不佳。早期文本驱动方法依赖离散语言描述,无法准确表示连续色调变化。 方法原理 ColourCrafter 将色彩编辑从全局色调转换转变为结构化的区域感知生成过程: Token 级色彩融合:在潜在空间中对 RGB 色彩标记和图像标记进行 token 级别融合,选择性地将色彩信息传播到语义相关区域 感知 Lab 空间损失:解耦亮度和色度,将编辑约束在掩码区域内,增强像素级精度 ColourfulSet 大规模数据集:包含高质量图像对,具有连续且多样的色彩变化 核心创新 首个 token 级色彩融合框架,实现语义选择性色彩传播 Lab 色彩空间解耦损失,亮度-色度独立约束 ColourfulSet 大规模色彩编辑数据集 掩码约束下的细粒度区域感知编辑 实验结果 在细粒度色彩编辑中实现了 SOTA 的色彩准确性、可控性和感知保真度。支持连续色调变化和多区域独立编辑。项目代码已开源。 方法流程 输入图像+ 色彩指令 — 原图+目标颜色 RGB色彩 Token编码 — 色彩信号Token化 潜在空间 Token级融合 — 图像Token+色彩Token 选择性融合 语义区域 选择传播 — 色彩传播到 相关区域 Lab空间 约束 — 亮度-色度解耦 掩码精度控制 色彩准确 输出 — 精准区域编辑 技术脉络 核心问题: 扩散模型中色彩控制粒度不足,文本驱动方法无法表达连续色调变化,全局编辑无法满足区域精细需求 前序工作及局限: InstructPix2Pix (Brooks 2023):指令驱动编辑,但色彩控制不精确 ControlNet (Zhang 2023):结构化条件控制,但不针对色彩属性 IP-Adapter (Ye 2023):图像提示适配,但色彩传播缺乏语义选择性 Palette (Saharia 2022):图像着色,但仅支持全局色彩迁移 与前序工作的本质区别: 首个 Token 级色彩融合框架,在潜在空间中实现语义选择性色彩传播,结合 Lab 空间解耦实现物理上合理的亮度-色度独立控制 技术演进定位: 方向开拓——将色彩编辑从全局转为 Token 级区域感知,开辟精细化色彩控制新范式 可能的后续方向: 与 3D 感知结合的光照和材质色彩编辑 基于色彩心理学的自动美学优化 视频级时序一致性色彩编辑 批判性点评 实验评估: 定性和定量实验丰富,细粒度色彩编辑对比全面。Lab 空间损失的消融实验有说服力。但极端色彩转换(如黑到荧光色)的自然度和掩码边界过渡的平滑性需要更多测试。 新颖性: 首个 Token 级色彩融合框架,将色彩编辑从全局转为区域感知是重要突破。Lab 空间解耦损失的引入在色彩编辑中属首次。创新性评分: 可复现性: 方法描述清晰,ColourfulSet 数据集和代码已开源。Token 融合模块的实现依赖标准 Transformer 组件,易于复现。 影响力: 影响力评分 4/5 — 为精细化图像编辑开辟了 Token 级色彩控制新方向。ColourfulSet 数据集对社区也有独立价值。但应用场景相对垂直。 3. Q-Drift: Quantization-Aware Drift Correction for Diffusion Sampling 扩散模型量化采样漂移校正 | arXiv:2603.18095 关键词: 量化加速, 采样校正, 即插即用, DiT, U-Net 研究动机 后训练量化是部署大型扩散模型的实用路径,但量化噪声会在去噪轨迹上累积并降低生成质量。现有方法主要从模型端优化量化策略,而忽略了从采样器端校正量化引入的系统性漂移的可能性。 方法原理 Q-Drift 将量化误差视为每个去噪步骤上的隐式随机扰动,推导出保持边际分布的漂移调整公式: 通过仅 5 对全精度/量化校准运行估计逐时间步的方差统计量 基于推导的漂移校正公式在采样过程中实时调整去噪轨迹 采样器端校正可与任意采样器、扩散模型和 PTQ 方法即插即用 核心创新 首次从采样器端而非模型端校正量化漂移 理论推导:量化误差=隐式随机扰动,漂移调整保持边际分布 极低校准成本(仅 5 对运行) 模型/采样器/量化方法三维通用 实验结果 在 6 个不同 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上验证。PixArt-Sigma (SVDQuant W3A4) 上 FID 降低 4.59,CLIP 分数不变。推理开销可忽略不计。 方法流程 量化扩散模型 — PTQ后的DiT/U-Net 存在量化噪声 5对校准运行 — 全精度vs量化 估计方差统计 漂移公式推导 — 量化误差=随机扰动 保持边际分布 采样器端实时校正 — 每步调整轨迹 兼容任意采样器 高质量输出 — FID降低4.59 CLIP保持 技术脉络 核心问题: 扩散模型后训练量化引入的误差在去噪轨迹上累积导致质量下降,现有方法仅从模型端优化量化策略 前序工作及局限: PTQ4DM (Shang 2023):通道级量化校准,但忽略量化对采样轨迹的累积影响 Q-Diffusion (Li 2023):时间步感知校准,但仍在模型端操作 SVDQuant (Li 2024):低秩分解+量化,极端压缩但质量损失显著 EfficientDM (He 2024):量化感知训练,但需要重新训练成本高 与前序工作的本质区别: 首次从采样器端而非模型端校正量化漂移,将量化误差建模为隐式随机扰动并推导漂移调整公式,与模型端量化正交可叠加 技术演进定位: 视角转换——开辟采样器端补偿的新方向,仅 5 对校准运行即实现通用校正,可能成为量化部署的标准组件 可能的后续方向: 自适应漂移校正(根据内容复杂度动态调整) 推广到其他模型近似误差的采样器端补偿 极端量化(W2)下的理论边界探索 批判性点评 实验评估: 在 6 个 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上的全面验证令人信服。PixArt-Sigma W3A4 上 FID 降低 4.59 的改进显著。但在 W2 等极端量化下的效果需验证,独立随机扰动假设可能不成立。 新颖性: 首次从采样器端而非模型端校正量化漂移,理论推导严谨。仅 5 对校准运行的超低成本令人印象深刻。思路与模型端量化正交,可叠加使用。创新性评分: 可复现性: 校准流程简洁(仅 5 对运行),漂移校正公式明确,兼容任意采样器和 PTQ 方法,实现门槛低。 影响力: 影响力评分 4.5/5 — 为量化扩散模型部署提供了通用的采样器端补偿方案。即插即用特性使其在工业部署中非常实用。可能启发其他模型近似误差的类似补偿研究。 批判性点评精选 1. 开源 TTS 基础模型:完整配方的价值与情感表达的瓶颈 MOSS-TTS 为开源 TTS 社区提供了完整的基础模型配方,但 12.5fps 的极低帧率在情感和副语言信息的保真度上可能存在瓶颈。双生成器架构虽然灵活,但也增加了用户的选择复杂性。关键问题是:Tokenizer 的压缩率与表达力之间的最优平衡点在哪里? 2. Token 级色彩编辑:精细化的天花板在哪里? ColourCrafter 的 Token 级融合在色彩编辑精度上取得突破,但 Lab 空间损失在极端色彩转换(如黑到荧光色)时可能产生非自然过渡。掩码边界的平滑处理也需要更多工作。更深层的问题是:色彩编辑是否应该与光照、材质统一建模?孤立处理色彩可能限制了真实感。 3. 采样器端补偿:一个被忽视的优化维度 Q-Drift 的核心洞察——从采样器端而非模型端校正量化漂移——揭示了一个长期被忽视的优化维度。仅 5 对校准运行的超低成本令人印象深刻。但其理论假设(量化误差为独立随机扰动)在极端量化下可能失效。这种采样器端补偿的思路是否可以推广到蒸馏误差、剪枝误差等其他模型近似场景? 其余论文 · 贡献与效果总结 # 论文 关键词 主要贡献 效果 1 TexEditor (TexEditor: Structure-Preserving Text-Driven Texture Editing 快手 KlingAI) 纹理编辑 · 结构保持 · RL强化 · KlingAI TexBlender SFT数据集 + StructureNFT RL方法,基于 Qwen-Image-Edit 训练,纹理编辑中保持几何结构一致 2 Diff-SIT (Diff-SIT: Sparse Information Transmission Video Diffusion Compression) 视频压缩 · 稀疏编码 · 一步扩散 · 极低比特率 STEM稀疏时间编码 + ODFTE一步视频扩散重建,帧类型嵌入器自适应不同帧类型 极低比特率下感知质量和时间一致性达到新 SOTA 3 GenVideoLens (GenVideoLens: LVLMs in AI-Generated Video Detection ECCV 2026) 视频评测 · AIGC检测 · ECCV 2026 · LVLM 500视频15维度细粒度基准,揭示LVLM在感知线索可识别但光学一致性和物理交互推理严重不足 4 O2MAG (O2MAG: One-to-More Training-Free Anomaly Generation CVPR 2026) 异常生成 · 无训练 · CVPR 2026 · 工业检测 自注意力嫁接 + 异常引导优化 + 双重注意力增强,单张参考合成逼真异常样本 5 VQ-AUFace (VQ-AUFace: AU Codes to Language for Facial Behavior Synthesis) 面部合成 · AU编码 · 文本驱动 · 冲突建模 将面部动作单元翻译为自然语言描述,支持冲突AU显式建模,BP4D-AUText大规模数据集 复杂和冲突动作组合下的面部表情生成在解剖学合理性上显著改善 6 FLAC (FLAC: Few-shot Acoustic Synthesis with Flow Matching CVPR 2026) 声学合成 · Flow Matching · CVPR 2026 · 脉冲响应 首次将生成Flow Matching应用于房间脉冲响应合成,扩散Transformer在空间/几何条件下生成 7 IAA (From Concepts to Judgments: Interpretable Image Aesthetics Assessment) 美学评估 · 可解释AI · 概念建模 · 摄影 基于人类美学概念构建可解释子空间 + 残差预测器,美学评估兼顾性能与可解释性 在摄影和艺术数据集上与黑盒模型性能相当且可解释性显著更优 8 OGD (OGD: Ontology-Guided Diffusion for Zero-Shot Sim2Real Image Translation) Sim2Real · 知识图 · 零样本 · 图翻译 将真实感分解为本体知识图,GNN全局嵌入 + 符号规划器编辑序列调节扩散模型 可解释的零样本仿真到真实图像翻译,无需目标域训练数据 9 R&D (R&D: Reliability-Diversity Balance in Synthetic Data Augmentation) 数据增强 · 可控扩散 · 语义分割 · 可靠多样平衡 类别感知提示 + 视觉先验混合,可控扩散模型合成数据增强 PASCAL VOC 和 BDD100K 上语义分割性能显著提升 趋势观察 语音生成基础模型走向开源:MOSS-TTS 展示了离散 Token + 自回归大模型在 TTS 领域的完整开源路线图 — MOSS-TTS 采用统一语义-声学 Tokenizer + 双生成器架构 图像编辑向精细化演进:ColourCrafter 的 Token 级色彩融合和 TexEditor 的 RL 强化结构保持 — 从全局编辑到区域感知、从外观到纹理的精细化控制 量化部署的采样器端补偿:Q-Drift 首次从采样器端而非模型端校正量化漂移 — 仅 5 对校准运行,6 模型 3 采样器通用,推理零开销 AI 生成内容检测成为新赛道:GenVideoLens 揭示 LVLM 在物理和时间推理上的严重不足 — 感知线索可识别但深层一致性难以判断 扩散模型在特殊领域的拓展:FLAC 声学合成、O2MAG 异常生成、VQ-AUFace 面部合成 — Flow Matching 和注意力控制在声学、工业和面部领域的创新应用 人工智能炼丹师 整理 | 2026-03-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 周末专题深度解读|2026-03-22|视频生成与编辑前沿进展| AIGC 周末专题深度解读 | 2026-03-22 | 视频生成与编辑前沿进展 人工智能炼丹师 整理 | 本期专题聚焦 2026 年 3 月第三周(3.15-3.22)视频生成与编辑领域的最新突破,涵盖物理一致生成、无训练编辑、高分辨率合成、推理加速、联合音视频生成等多个前沿方向。 专题概述 视频生成与编辑是当前 AIGC 领域最活跃的研究方向之一。本周(2026年3月15-22日),arXiv 上涌现了大量高质量论文,呈现出几个显著趋势: 从2D到物理一致3D:PhysVideo 通过正交多视图几何引导,首次将物理属性感知引入视频生成,解决了长期以来运动不符合物理定律的痛点 无训练编辑的成熟:DynaEdit 利用预训练 Flow 模型实现了无需任何训练的通用视频编辑,包括动作修改和物体交互插入 指令编辑的工业化:SAMA 通过语义锚定与运动分解,在开源模型中达到了与商业系统(Kling-Omni)竞争的水平 超高分辨率突破:FrescoDiffusion 将视频生成推向 4K 分辨率,通过先验正则化分块扩散保持全局连贯性 推理加速双管齐下:SVOO(稀疏注意力)和 6Bit-Diffusion(混合精度量化)分别从算法和硬件层面实现近 2 倍加速 音视频联合生成优化:CCL 方法系统解决了双流架构中的模态对齐和 CFG 冲突问题 本期精选 8 篇核心论文,从编辑、生成、加速三大维度进行深度解读和横向对比分析。 1. SAMA:分解语义锚定与运动对齐的指令引导视频编辑 论文信息 标题:SAMA: Factorized Semantic Anchoring and Motion Alignment for Instruction-Guided Video Editing 作者:Xinyao Zhang, Wenkai Dong, Yuxin Song, Bo Fang 等(字节跳动/清华大学) arXiv:2603.19228 关键词:视频编辑, 指令引导, 语义锚定, 运动对齐 研究动机 当前指令引导的视频编辑模型面临一个核心矛盾:精确的语义修改与忠实的运动保持难以兼顾。现有方法依赖注入外部先验(VLM 特征、结构条件)来缓解这一问题,但外部先验的引入严重限制了模型的鲁棒性和泛化能力。SAMA 提出了一个根本性的解决思路——将视频编辑分解为两个正交的子任务。 方法原理 SAMA 框架的核心思想是因子化分解,将视频编辑分解为语义理解和运动建模两个独立的维度: 1) 语义锚定(Semantic Anchoring) 在稀疏锚定帧(关键帧)上联合预测语义标记和视频潜在特征 建立可靠的视觉锚点,实现纯粹基于指令的结构规划 不依赖外部 VLM 或结构条件,模型内在地理解编辑意图 2) 运动对齐(Motion Alignment) 设计三种以运动为中心的视频恢复预训练任务: 立方体修复(Cuboid Inpainting):随机掩码视频中的立方体区域并恢复 速度扰动(Velocity Perturbation):改变视频播放速度后恢复原始运动 管式打乱(Tubular Shuffling):沿时间维度打乱区域后恢复时序 通过这些任务使模型直接从原始视频内部化时间动态 3) 两阶段训练管道 第一阶段:因子化预训练,学习内在的语义-运动表示,不需要成对编辑数据 第二阶段:在成对编辑数据上监督微调 关键发现:仅第一阶段的预训练就产生了强大的零样本编辑能力 创新点 首次将视频编辑分解为语义锚定和运动对齐两个正交维度 设计了三种无需编辑数据的运动感知预训练任务 零样本编辑能力验证了因子化方法的有效性 在开源模型中达到 SOTA,与商业系统 Kling-Omni 竞争 实验结果 在标准视频编辑基准上,SAMA 在开源模型中取得最佳性能 与 Kling-Omni 等商业系统具有可比的编辑质量 零样本能力表明因子化预训练学到了通用的视频编辑表示 2. DynaEdit:无训练的通用视频内容、动作与动态编辑 论文信息 标题:Versatile Editing of Video Content, Actions, and Dynamics without Training 作者:Vladimir Kulikov, Roni Paiss, Andrey Voynov, Inbar Mosseri, Tali Dekel, Tomer Michaeli(Google Research / Technion) arXiv:2603.17989 关键词:无训练编辑, Flow模型, 动作编辑, 动态事件 研究动机 尽管视频生成取得了快速进展,但在真实视频中编辑动作和动态事件——例如让一个人从走路变成跑步、让雨突然停下——仍是重大挑战。现有训练方法受限于编辑数据的稀缺性,而现有无训练方法(如基于注意力注入)本质上只能处理结构和运动保留的编辑,无法修改运动本身。 方法原理 DynaEdit 基于预训练的文本到视频 Flow 模型,通过三个关键技术实现无训练的通用视频编辑: 1) 无反演编辑框架 采用最近提出的无反演(Inversion-free)方法作为基础 不干预模型内部(如注意力层),因此是模型无关的 可直接应用于任何预训练的 Flow Matching 视频模型 2) 低频对齐校正 发现:朴素的无反演编辑会导致严重的低频失配(全局颜色/亮度偏移) 分析了失配的来源:编辑提示与原始视频在 Flow 空间中的偏移导致低频成分漂移 解决方案:在去噪过程中引入低频对齐约束,保持与原始视频的全局一致性 3) 高频抖动抑制 发现:即使修正了低频问题,生成结果仍存在高频抖动(闪烁、纹理不一致) 原因:不同帧的去噪路径在高频细节上缺乏耦合 解决方案:引入帧间高频一致性正则化机制 创新点 首个支持动作修改、动态事件编辑和物体交互插入的无训练方法 系统分析并解决了无反演编辑中的低频失配和高频抖动问题 模型无关设计,可直接应用于任何 Flow Matching 视频模型 不需要任何编辑数据或微调 实验结果 在动作修改任务上显著优于现有无训练方法 成功实现了复杂编辑:将"走路"编辑为"跳舞",插入与场景交互的物体 适用于多种预训练视频模型 3. PhysVideo:跨视图几何引导的物理一致视频生成 论文信息 标题:PhysVideo: Physically Plausible Video Generation with Cross-View Geometry Guidance 作者:Cong Wang, Hanxin Zhu, Xiao Tang 等(中国科学技术大学) arXiv:2603.18639 关键词:物理一致性, 跨视图几何, 正交视图, 视频生成 研究动机 当前视频生成模型虽然在视觉保真度上取得了显著进步,但确保物理一致的运动仍是根本性挑战。核心原因在于:真实世界的物体运动在三维空间中展开,而视频观察仅提供了这些动力学的局部、视角依赖的投影。这导致模型容易生成违反物理定律的运动——球在空中突然变向、物体穿过墙壁等。 方法原理 PhysVideo 提出了一个两阶段框架,将物理推理显式引入视频生成: 阶段一:Phys4View — 物理感知正交前景视频生成 输入一张图像,生成四个正交视角(前/后/左/右)的前景视频 物理感知注意力(Physics-Aware Attention): 将物理属性(质量、摩擦力、弹性等)编码为条件 通过专门的注意力层捕获物理属性对运动动态的影响 几何增强跨视图注意力: 在四个正交视图之间建立几何一致的注意力连接 确保从不同视角看到的运动在3D空间中一致 时间注意力:增强帧间的时间一致性 阶段二:VideoSyn — 可控视频合成 以 Phys4View 生成的前景视频为引导 学习前景动态与背景上下文之间的交互 合成完整的带背景视频 数据集:PhysMV 构建了 40K 场景、160K 视频序列的大规模数据集 每个场景包含四个正交视角的视频 创新点 首次将正交多视图几何约束引入视频生成以确保物理一致性 物理属性感知注意力机制,显式建模物理参数对运动的影响 构建了 PhysMV 数据集(40K 场景 x 4 视角 = 160K 视频) 两阶段解耦设计:先物理一致的前景,再合成背景 实验结果 显著改善了生成视频的物理真实性和时空一致性 在物理合理性评估指标上大幅优于现有方法 生成的视频中物体运动更加符合物理定律(重力、碰撞、弹性等) 4. EffectErase:视频物体移除与效果擦除的联合框架 论文信息 标题:EffectErase: Joint Video Object Removal and Insertion for High-Quality Effect Erasing 作者:Yang Fu, Yike Zheng, Ziyun Dai, Henghui Ding arXiv:2603.19224 | CVPR 2026 关键词:视频物体移除, 效果擦除, 互惠学习, 视频编辑 研究动机 视频物体移除不仅要消除目标物体本身,还要消除其产生的视觉效果——变形、阴影、反射等。现有基于扩散的视频修复方法虽然能移除物体,但通常难以消除这些附带效果,留下不自然的痕迹。此外,该领域缺乏系统涵盖各种物体效果的大规模数据集。 方法原理 1) VOR 数据集 构建了大规模视频物体移除数据集(60K 对高质量视频) 涵盖 5 种效果类型:变形、阴影、反射、遮挡、环境光变化 每对视频包含"有物体+效果"和"无物体+效果"两个版本 来源包括拍摄和合成,覆盖广泛的物体类别和复杂动态场景 2) 互惠学习框架 核心洞察:物体移除和物体插入是互逆任务 将物体插入作为辅助任务,与移除任务联合训练 两个任务共享特征提取器,互相提供学习信号 3) 任务感知区域引导(Task-Aware Region Guidance) 专注于受影响区域(效果区域)的学习 引导模型关注阴影、反射等效果所在的空间位置 实现灵活的任务切换(移除/插入) 4) 插入-移除一致性目标 鼓励插入和移除行为的互补性 共享效果区域和结构线索的定位能力 确保移除彻底(包括所有附带效果) 创新点 首个系统性解决视频物体效果擦除的方法(CVPR 2026) 构建了 VOR 数据集:60K 对视频,5 种效果类型 互惠学习:物体移除与插入联合训练,互相增强 任务感知区域引导:精确定位效果区域 实验结果 在 VOR 数据集上取得了最优的物体移除和效果擦除性能 在各种复杂场景下提供高质量的效果清除 同时支持物体移除和物体插入两种任务 5. FrescoDiffusion:先验正则化分块扩散实现 4K 图像到视频生成 论文信息 标题:FrescoDiffusion: 4K Image-to-Video with Prior-Regularized Tiled Diffusion 作者:Hugo Caselles-Dupre, Mathis Koroglu, Guillaume Jeanneret 等(Obvious Research / Sorbonne University) arXiv:2603.17555 关键词:4K视频, Image-to-Video, 分块扩散, 先验正则化 研究动机 基于扩散的图像到视频(I2V)模型在标准分辨率下日趋成熟,但扩展到超高分辨率(如 4K)时面临根本性困难:在模型原始分辨率下生成会丢失精细结构,而高分辨率分块去噪虽然保留了局部细节,但会破坏全局布局一致性。这个问题在"湿壁画动画"场景中尤为严重——包含多个角色、物体和语义子场景的巨型艺术品必须在时间上保持空间连贯性。 方法原理 FrescoDiffusion 是一种无训练方法,通过先验正则化增强分块去噪: 1) 全局潜在先验计算 首先在底层模型的原始分辨率下生成低分辨率视频 对低分辨率视频的潜在轨迹进行上采样 获得捕捉长程时间和空间结构的全局参考先验 2) 先验正则化分块融合 对每个高分辨率分块(tile)计算噪声预测 在每个扩散时间步,通过加权最小二乘目标将分块预测与全局先验融合 该目标结合了标准分块合并准则和正则化项 产生一个闭合形式的融合更新,计算效率高 3) 空间正则化控制 提供区域级别的控制能力 可以指定哪些区域允许产生运动,哪些区域保持静止 显式控制创造力与一致性之间的权衡 创新点 首次实现无训练的 4K 图像到视频生成 闭合形式的先验正则化融合,计算效率高 区域级运动控制能力 提出了湿壁画 I2V 数据集用于评估 实验结果 在 VBench-I2V 数据集上,全局一致性和保真度优于分块基线 在自提出的湿壁画数据集上展示了出色的大幅面视频生成能力 计算效率高,闭合形式更新无需额外优化迭代 6. SVOO:离线层级稀疏度分析+在线双向共聚类的无训练视频生成加速 论文信息 标题:Training-Free Sparse Attention for Fast Video Generation via Offline Layer-Wise Sparsity Profiling and Online Bidirectional Co-Clustering 作者:Jiayi Luo, Jiayu Chen, Jiankun Wang, Cong Wang 等(中国科学技术大学 / 北京航空航天大学) arXiv:2603.18636 关键词:稀疏注意力, 视频生成加速, DiT, 免训练 研究动机 扩散 Transformer(DiT)在视频生成方面实现了强大的质量,但密集的 3D 注意力机制导致推理成本极高。现有的免训练稀疏注意力方法存在两个关键限制:(1) 忽略了不同层的注意力稀疏度差异(层异构性),(2) 在注意力块划分时忽略了查询-键之间的耦合关系。 方法原理 SVOO 采用两阶段范式实现高效的稀疏注意力: 阶段一:离线逐层敏感性分析 关键发现:每一层的注意力稀疏度是其内在属性,在不同输入之间变化很小 基于此,可以预先用少量样本分析每一层的最优稀疏度(剪枝水平) 不同层获得不同的稀疏度配额,敏感层保留更多注意力,不敏感层大幅剪枝 阶段二:在线双向共聚类 传统方法独立对 Query 和 Key 进行分块,忽略了 Q-K 耦合 SVOO 提出双向共聚类算法: 同时考虑 Query 和 Key 的分布 将 Q-K 对联合聚类到注意力块 确保高注意力分数的 Q-K 对被保留在同一块中 实现更精确的块级稀疏注意力 创新点 发现层注意力稀疏度是输入无关的内在属性 离线分析+在线推理的两阶段范式 双向共聚类算法考虑 Q-K 耦合 适用于 7 种主流视频生成模型(包括 Wan2.1) 实验结果 在 Wan2.1 上实现 1.93x 加速,同时保持 29 dB 的 PSNR 在 7 个视频生成模型上一致优于现有稀疏注意力方法 质量-速度权衡显著优于对比方法 7. 6Bit-Diffusion:视频 DiT 的推理时混合精度量化 论文信息 标题:6Bit-Diffusion: Inference-Time Mixed-Precision Quantization for Video Diffusion Models 作者:Rundong Su, Jintao Zhang, Zhihang Yuan 等(清华大学) arXiv:2603.18742 关键词:模型量化, 混合精度, 视频DiT, 推理加速 研究动机 扩散 Transformer 在视频生成方面虽然质量卓越,但实际部署受到高内存占用和计算成本的严重限制。后训练量化是一种实用的加速方法,但现有量化方法通常应用静态位宽分配,忽略了不同扩散时间步之间激活值的量化难度差异,导致效率和质量之间的权衡不理想。 方法原理 6Bit-Diffusion 提出了推理时 NVFP4/INT8 混合精度量化框架: 1) 输入-输出差异感知的精度预测 关键发现:模块的输入-输出差异与其内部线性层的量化敏感性之间存在强线性相关性 基于此设计轻量级预测器(几乎零开销) 动态为每一层在每个时间步选择最优精度: 时间稳定的层 → NVFP4(4位浮点,最大压缩) 不稳定的层 → INT8(8位整数,保持鲁棒性) 2) 时间增量缓存(Temporal Delta Caching) 发现:Transformer 模块的输入-输出残差在相邻时间步上表现出高度时间一致性 如果某模块在当前时间步的残差与上一步几乎相同,则直接复用上一步的结果 跳过不变模块的计算,进一步降低成本 3) 自适应精度策略 不同时间步、不同层获得不同的量化精度 噪声较大的早期时间步容忍更低精度 细节关键的后期时间步保留更高精度 创新点 发现输入-输出差异与量化敏感性的线性相关规律 推理时动态混合精度分配(NVFP4 + INT8) 时间增量缓存利用时间步间冗余 端到端加速而非单一优化点 实验结果 1.92x 端到端加速 3.32x 内存减少 生成质量与全精度模型几乎无差异 为高效视频 DiT 推理设立了新基准 8. CCL:跨模态上下文学习改进联合音视频生成 论文信息 标题:Improving Joint Audio-Video Generation with Cross-Modal Context Learning 作者:Bingqi Ma, Linlong Lang, Ming Zhang 等(SenseTime) arXiv:2603.18600 关键词:联合音视频生成, 跨模态, 双流Transformer, 上下文学习 研究动机 基于双流 Transformer 的联合音视频生成已成为主流范式。通过结合预训练的视频和音频扩散模型,加上跨模态交互注意力,可以用最少的训练数据生成高质量同步音视频。但现有方法存在三个关键问题:(1) 门控机制引起的模型流形变化,(2) 跨模态注意力引入的多模态背景区域偏差,(3) 多模态 CFG 的训练-推理不一致性。 方法原理 CCL(Cross-Modal Context Learning)提出了多个精心设计的模块来解决上述问题: 1) 时间对齐 RoPE 和分区(TARP) 视频和音频的时间分辨率不同(视频约 30fps,音频采样率更高) TARP 有效增强了音频潜在表示与视频潜在表示之间的时间对齐 确保对应的音频-视频片段在注意力计算中正确对应 2) 可学习上下文标记(LCT)与动态上下文路由(DCR) LCT:在跨模态注意力模块中引入可学习的上下文标记 为跨模态信息提供稳定的无条件锚点 缓解门控机制引起的流形变化 DCR:根据不同训练任务(文本→视频+音频 / 视频→音频 / 音频→视频)动态路由 提高了模型收敛速度和生成质量 3) 无条件上下文引导(UCG) 在推理时利用 LCT 提供的无条件支持 促进不同形式的分类器自由引导(CFG) 改善训练-推理一致性,缓解多模态 CFG 冲突 创新点 系统分析了双流联合生成框架的三个核心问题 TARP 解决了异构时间分辨率的对齐问题 LCT + DCR 为跨模态交互提供稳定锚点和灵活路由 UCG 解决了多模态 CFG 的训练-推理不一致性 实验结果 与最近的学术方法相比,实现了最先进的音视频联合生成性能 所需训练资源远少于对比方法 在音视频同步质量和整体生成质量上均取得提升 横向对比分析 一、视频编辑方法对比 维度 SAMA DynaEdit EffectErase 训练需求 两阶段训练 完全免训练 在VOR数据集上训练 编辑类型 指令引导的通用编辑 动作/动态/交互编辑 物体移除+效果擦除 技术路线 语义-运动分解 Flow模型无反演 互惠学习(移除+插入) 运动保持 运动对齐预训练 低频对齐+高频抑制 N/A(任务不同) 模型依赖 需特定训练框架 模型无关 需专门训练 适用场景 工业级编辑产品 快速原型/研究 视频后期制作 性能基准 开源SOTA,接近商用 无训练方法SOTA CVPR 2026 对比分析:三种方法代表了视频编辑的三个不同发展方向。SAMA 走的是工业化路线,通过大规模预训练+微调获得最强性能;DynaEdit 走灵活路线,无需任何训练即可使用,适合快速实验;EffectErase 则聚焦于一个更具体但非常实用的任务——不仅移除物体,还要清除其留下的所有视觉痕迹。 二、视频生成方法对比 维度 PhysVideo FrescoDiffusion CCL 核心问题 物理不一致 超高分辨率 音视频联合生成 分辨率 标准 4K 标准 训练需求 需训练 完全免训练 轻量训练 关键技术 正交视图+物理注意力 先验正则化分块 上下文学习+TARP 数据集 PhysMV (160K) 湿壁画I2V 现有数据 多模态 否 否 音频+视频 控制能力 物理属性控制 区域级运动控制 多条件生成 三、推理加速方法对比 维度 SVOO 6Bit-Diffusion 加速策略 算法层面(稀疏注意力) 硬件层面(量化) 加速倍数 1.93x 1.92x 内存优化 有限 3.32x 减少 训练需求 完全免训练 完全免训练 适用模型 7种视频DiT 通用视频DiT 质量损失 29 dB PSNR 几乎无损 互补性 可与量化结合 可与稀疏注意力结合 加速方法互补性分析:SVOO 和 6Bit-Diffusion 分别从算法(注意力稀疏化)和硬件(数值量化)两个正交维度进行加速,理论上可以叠加使用。如果将两者结合,有望实现接近 4x 的加速,同时内存减少超过 3x。这为视频 DiT 的实际部署打开了大门。 四、技术演进脉络 视频编辑演进: 注意力注入编辑 → 反演+编辑 → 无反演编辑(DynaEdit) → 因子化分解编辑(SAMA) 物理一致生成: 2D纹理生成 → 时间一致性约束 → 多视图一致性(PhysVideo) → 物理属性感知 分辨率突破: 512x → 1080p → 4K(FrescoDiffusion) → 先验正则化 + 分块扩散 推理加速: 步数减少(蒸馏) → Token剪枝 → 稀疏注意力(SVOO) + 混合精度量化(6Bit-Diffusion) 音视频联合: 分离生成 → 双流架构 → 跨模态上下文学习(CCL) 总结与展望 本周视频生成与编辑领域的进展呈现出几个重要趋势: 编辑能力跃升:从简单的风格转换和内容替换,发展到动作修改(DynaEdit)、效果擦除(EffectErase)和工业级指令编辑(SAMA),视频编辑的可控粒度和实用性大幅提升。 物理世界建模:PhysVideo 通过引入正交多视图约束和物理属性感知,标志着视频生成开始从"看起来像"向"符合物理规律"转变。这是迈向世界模型的重要一步。 分辨率天花板突破:FrescoDiffusion 的 4K 生成表明,通过巧妙的先验正则化设计,可以在不重新训练的情况下将现有模型扩展到超高分辨率。 部署友好化:SVOO 和 6Bit-Diffusion 从算法和硬件两个维度各自实现了约 2x 的加速,且两者互补可叠加。这使得高质量视频 DiT 在消费级硬件上运行成为可能。 多模态融合深化:CCL 对双流联合音视频生成框架的系统优化,预示着未来的视频生成将越来越多地包含同步音频,向沉浸式内容创作迈进。 展望:下一阶段的关键挑战包括:(1) 将物理一致性扩展到更复杂的场景(多物体交互、流体动力学等);(2) 实现实时交互式的 4K+ 视频编辑;(3) 将稀疏注意力和量化技术与 Few-Step 蒸馏结合,实现 10x+ 的综合加速;(4) 统一的视频-音频-3D 联合生成框架。 本报告由人工智能炼丹师自动整理生成,基于 arXiv 2026年3月第三周公开论文。 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-03-21|偏好对齐|RL后训练|SOLACE|CRAFT|CRD|VIGOR| AIGC 周末专题深度解读 | 2026-03-21 | 视觉生成模型的偏好对齐与强化学习后训练 人工智能炼丹师 整理 本期专题聚焦 视觉生成模型的偏好对齐与强化学习后训练(Preference Alignment & RL Post-Training for Visual Generation),深度解读 8 篇最新论文,并对该方向的技术演进脉络进行系统性横向对比。 专题概述 随着扩散模型(Diffusion Models)和流匹配模型(Flow Matching Models)在图像/视频生成领域取得突破性进展,如何让生成结果更好地符合人类偏好成为当前研究的核心焦点。借鉴大语言模型领域 RLHF(Reinforcement Learning from Human Feedback)的成功经验,研究者们正在积极探索将强化学习、直接偏好优化(DPO)、组相对策略优化(GRPO)等后训练技术应用于视觉生成模型。 本周(2026年3月14日-21日),该方向涌现出大量高质量论文,涵盖了从奖励模型构建、训练算法设计、到具体场景应用的完整技术栈。本期专题选取 8 篇代表性工作进行深度解读,系统梳理该方向的技术脉络与发展趋势。 核心技术线索: 奖励信号来源:外部奖励模型 vs 内在自置信信号 vs 几何物理约束 优化算法演进:DPO -> GRPO -> 多视角GRPO -> 对比策略优化 -> 中心化奖励蒸馏 应用场景拓展:T2I生成 -> 视频生成 -> 图像超分 -> AR视频 -> 少步推理模型 关键挑战:奖励黑客(Reward Hacking)、分布漂移、计算效率、非可微奖励 1. FIRM: Trust Your Critic -- 鲁棒奖励建模与强化学习的忠实图像编辑与生成 论文信息 标题: Trust Your Critic: Robust Reward Modeling and Reinforcement Learning for Faithful Image Editing and Generation 作者: Xiangyu Zhao, Peiyuan Zhang, Junming Lin, Tianhao Liang, Yuchen Duan, Shengyuan Ding 等 arXiv: 2603.12247 关键词: 奖励模型 鲁棒RL 图像编辑 T2I生成 数据管线 背景与动机 强化学习(RL)已成为提升图像编辑和文本到图像(T2I)生成质量的重要范式。然而,当前的奖励模型(Reward Model)作为 RL 中的"评论家",往往存在幻觉(hallucination)问题——给出不准确的评分,从而误导优化过程。这一问题在图像编辑场景中尤为严重:奖励模型可能对编辑后图像的忠实度评估不准确,导致生成结果偏离编辑指令。 方法原理 FIRM 框架包含两大核心组件: 1) 鲁棒奖励建模 定制化数据策管线(Data Curation Pipeline):针对图像编辑和 T2I 生成分别设计数据收集流程,构建高质量的评分数据集。编辑任务收集了涵盖颜色修改、风格迁移、物体添加/删除等多种编辑类型的 66 万条评分数据。 多维度评估:奖励模型同时考虑文本对齐度、编辑忠实度、图像质量等多个维度,避免单一指标的片面性。 对比学习增强:通过正负样本对比学习,提升奖励模型对微妙质量差异的辨别能力。 2) 鲁棒强化学习训练 噪声感知训练策略:在 RL 训练过程中,显式建模奖励信号中的噪声,通过置信度加权降低不可靠评分的影响。 多奖励聚合:将多个维度的奖励信号进行加权融合,动态调整各维度权重以平衡不同目标之间的trade-off。 正则化约束:引入 KL 散度正则化防止模型在优化过程中偏离预训练分布过远。 创新点 首个系统性解决奖励模型幻觉问题的框架:不仅改进奖励模型本身的准确性,还在 RL 训练阶段引入鲁棒性机制。 66万条高质量评分数据集开源:为社区提供了标准化的图像编辑/生成质量评估数据。 统一框架同时适用于图像编辑和 T2I 生成:两个任务共享奖励建模架构,仅在数据策管线上做差异化。 实验结果 在图像编辑任务上,FIRM 使 InstructPix2Pix 模型在 EditBench 上的编辑准确率提升 18.7%。 在 T2I 生成任务上,GenEval 综合得分从 0.63 提升至 0.79,超越 DALL-E 3 和 SDXL 基线。 奖励模型本身在 ImageReward 测试集上的 Kendall's Tau 相关性从 0.52 提升至 0.68。 2. MV-GRPO: 多视角组相对策略优化 -- 从稀疏到稠密的流模型对齐 论文信息 标题: From Sparse to Dense: Multi-View GRPO for Flow Models via Augmented Condition Space 作者: Jiazi Bu, Pengyang Ling, Yujie Zhou, Yibin Wang, Yuhang Zang, Tianyi Wei 等 arXiv: 2603.12648 关键词: GRPO 流模型 多视角评估 条件空间增强 T2I对齐 背景与动机 组相对策略优化(GRPO)已成为文本到图像流模型偏好对齐的强大框架。然而,标准 GRPO 范式存在一个根本性限制:单视角稀疏评估——对一组生成样本仅使用单一条件(prompt)进行评估,无法充分探索样本间的关系,限制了对齐效果的上限。 具体来说,给定一个 prompt,GRPO 生成 N 个候选图像,然后通过奖励模型评分并计算组相对优势。但这种方式下,每个样本只从一个角度被评估,奖励信号稀疏且容易受到 prompt 特异性的影响。 方法原理 MV-GRPO 提出了条件空间增强(Condition Space Augmentation)策略,将单视角稀疏评估升级为多视角稠密评估: 1) 条件空间增强 对原始 prompt 进行多维度改写:语义保持改写(paraphrase)、细节扩充(detail augmentation)、视角变换(perspective shifting)。 每个生成样本同时在原始 prompt 和增强 prompt 下进行评估,获得多个奖励分数。 2) 多视角优势估计 将每个样本的多视角奖励分数进行聚合,计算更稳定的组相对优势: 跨条件一致性加权:对于在不同 prompt 下获得一致高/低分的样本,增大其优势信号强度。 条件自适应归一化:不同 prompt 的评分尺度可能不同,通过条件内归一化消除尺度差异。 3) 渐进式探索策略 训练初期使用较少的增强条件,随着训练进行逐步增加,避免早期过度约束。 创新点 首次将多视角评估引入 GRPO 框架:突破了单条件评估的稀疏性瓶颈。 条件空间增强无需额外数据:仅通过 prompt 改写即可获得稠密评估信号。 理论分析:证明多视角 GRPO 的方差比标准 GRPO 低 O(1/K)(K 为视角数量)。 实验结果 在 FLUX.1-dev 上,GenEval 综合得分从基线 0.71 提升至 0.84(+18.3%),显著超越标准 GRPO 的 0.78。 人类评估显示偏好率达到 72.3%(vs 标准 GRPO 的 58.1%)。 在 T2I-CompBench 组合生成指标上,属性绑定准确率从 0.62 提升至 0.76。 仅需 500 步训练即可达到标准 GRPO 2000 步的效果,训练效率提升 4x。 3. AR-CoPO: 自回归视频生成的对比策略优化 论文信息 标题: AR-CoPO: Align Autoregressive Video Generation with Contrastive Policy Optimization 作者: Dailan He, Guanlin Feng, Xingtong Ge, Yi Zhang, Bingqi Ma, Guanglu Song 等 arXiv: 2603.17461 关键词: 自回归视频 对比策略优化 RLHF 少步蒸馏 流匹配 背景与动机 流式自回归(Streaming AR)视频生成器结合少步蒸馏可实现低延迟、高质量的视频合成,但通过 RLHF 对齐这类模型面临独特挑战: SDE 探索失效:现有基于 SDE 的 GRPO 方法假设扩散过程有足够的随机性进行探索,但少步 ODE 和一致性模型采样器偏离了标准流匹配 ODE,其短轨迹和低随机性使得中间 SDE 探索无效。 初始化敏感:少步模型的生成轨迹极短且确定性强,对初始化噪声高度敏感。 帧间一致性:自回归视频生成需要在优化人类偏好的同时保持帧间时序一致性。 方法原理 AR-CoPO 提出了一种专为自回归少步视频生成器设计的对比策略优化框架: 1) 输出空间对比探索(Output-Space Contrastive Exploration) 放弃在扩散过程中间步骤进行探索的传统方式,直接在输出空间(生成的视频帧)进行对比。 对每个时间步生成多个候选帧,通过奖励模型评分后选择最优,同时利用对比损失增大好坏样本间的差距。 2) 自回归感知的奖励传播 设计时序一致性奖励:不仅评估单帧质量,还评估帧间过渡的流畅性和一致性。 将帧级奖励沿时间轴反向传播,使早期帧的生成策略能考虑到后续帧的质量。 3) 参考策略锚定 引入 KL 散度正则化,将优化后的策略锚定在预训练模型附近,防止过度优化导致的模式崩溃。 对不同时间步使用自适应 KL 强度:早期帧(构图决定性阶段)使用较强约束,后期帧适当放松。 创新点 首个将 RLHF 成功应用于流式自回归视频生成器的工作:解决了少步蒸馏模型难以进行 RL 优化的技术瓶颈。 输出空间对比范式:避免了中间步骤探索在少步模型上的失效问题。 时序感知的奖励传播机制:在优化画面质量的同时保持视频的时序一致性。 实验结果 在流式 AR 视频生成基线上,VBench 得分从 78.2 提升至 83.7(+7.0%)。 人类偏好评估中,AR-CoPO 生成的视频在画面质量和时序一致性两个维度上分别获得 76.4% 和 71.8% 的偏好率。 仅需 4 步推理即可达到与 20 步推理 + GRPO 对齐相当的质量。 FVD(Frechet Video Distance)从 198.3 降低至 156.7。 4. CRAFT: 用复合奖励辅助微调轻松对齐扩散模型 (CVPR 2026) 论文信息 标题: CRAFT: Aligning Diffusion Models with Fine-Tuning Is Easier Than You Think 作者: Zening Sun, Zhengpeng Xie, Lichen Bai, Shitong Shao, Shuo Yang, Zeke Xie arXiv: 2603.18991 关键词: 复合奖励过滤 SFT GRPO下界 数据效率 CVPR 2026 背景与动机 当前扩散模型的偏好对齐方法面临两大挑战: 数据依赖:SFT 需要昂贵的高质量图像数据;DPO 风格方法依赖大规模偏好数据集,而这些数据集质量往往不一致。 计算低效:RL 类方法需要在线生成样本并计算奖励,训练成本高昂。 CRAFT 的核心洞察是:如果能构建一个高质量、一致的小规模训练集,简单的 SFT 就能达到甚至超越复杂的偏好优化方法。 方法原理 CRAFT 提出了一种极其简洁但强大的两阶段范式: 1) 复合奖励过滤(Composite Reward Filtering, CRF) 对每个 prompt 生成大量候选图像(如 64 张)。 使用多个奖励模型从不同维度评分:美学质量、文本对齐、构图合理性、技术质量。 将多维奖励分数进行加权融合,选择排名前 1-2 的图像作为训练样本。 关键设计:使用 相关性去偏(Correlation Debiasing) 确保选出的样本在各维度上均衡优秀,而非仅在某一维度极端。 2) 增强 SFT 在过滤后的高质量小数据集上进行标准 SFT 训练。 引入两项增强:(a) 噪声调度优化——对高评分样本使用更低的噪声水平;(b) 梯度裁剪——防止个别异常样本主导梯度方向。 3) 理论保证 证明 CRAFT 实际上优化了基于组强化学习的下界,从理论上建立了"筛选数据 + SFT"与"GRPO"之间的联系。 具体地,CRF 过程等价于 GRPO 中的组相对优势计算,而 SFT 则对应策略更新步骤。 创新点 仅需 100 个样本即可超越 SOTA 偏好优化方法:数据效率提升 10-100 倍。 理论证明 SFT + 数据筛选 是 GRPO 的下界优化:为简化的训练范式提供了理论支撑。 收敛速度提升 11-220 倍:相较于 DPO 和 GRPO 基线方法。 即插即用:无需修改模型架构或推理流程,仅替换训练数据和训练方式。 实验结果 使用仅 100 个样本的 CRAFT 在 GenEval 上得分 0.82,超越使用 5000+ 偏好对的 Diffusion-DPO(0.76)和标准 GRPO(0.79)。 在 HPSv2(Human Preference Score v2)上达到 28.9,超越所有基线。 训练时间:CRAFT 仅需 15 分钟(单A100),而 DPO 需要 5.5 小时,GRPO 需要 3.2 小时。 在 SDXL 和 SD3.5 两个基座模型上均验证有效。 5. TDM-R1: 用非可微奖励强化少步扩散模型 论文信息 标题: TDM-R1: Reinforcing Few-Step Diffusion Models with Non-Differentiable Reward 作者: Yihong Luo, Tianyang Hu, Weijian Luo, Jing Tang arXiv: 2603.07700 关键词: 少步扩散 非可微奖励 代理奖励学习 轨迹分布匹配 文本渲染 背景与动机 少步生成模型(如一致性模型、蒸馏扩散模型)大幅降低了生成成本,但现有的 RL 方法存在一个关键假设:奖励模型必须可微,以便通过反向传播计算梯度。这一假设排除了大量重要的真实世界奖励信号: 人类二元偏好(like/dislike) 物体计数准确性(整数值,不可微) OCR 文本准确率(离散指标) FID/IS 等分布级指标 如何在少步生成模型上利用这些非可微奖励进行 RL 后训练,是一个尚未解决的核心问题。 方法原理 TDM-R1 基于轨迹分布匹配(Trajectory Distribution Matching, TDM)框架,提出了一种将非可微奖励融入少步模型的统一 RL 后训练方法: 1) 代理奖励学习(Surrogate Reward Learning) 将 RL 过程解耦为两个阶段:先学习一个可微的代理奖励模型来拟合原始非可微奖励,再用代理奖励优化生成器。 代理奖励使用轻量级 MLP 头接在特征提取器上,通过对比学习训练,使其排序与真实奖励高度一致。 定期用真实非可微奖励校准代理奖励,防止偏移。 2) 逐步奖励信号(Per-Step Reward Signal) TDM 的确定性生成轨迹(通常 2-8 步)中,每一步都可以获得一个"部分生成"的中间结果。 设计逐步奖励:对每个中间状态通过快速解码预估最终输出,计算预估奖励作为当步的奖励信号。 这种细粒度的奖励分配比仅在最终步给出奖励更有效,降低了信用分配问题的难度。 3) 奖励自适应探索 根据当前样本的奖励水平自适应调节探索噪声:低奖励样本增大探索以寻找更好的方向,高奖励样本减少探索以稳定优化。 创新点 首个通用 RL 后训练方法支持少步模型 + 非可微奖励:打破了"可微奖励"的假设限制。 代理奖励学习 + 在线校准:兼顾了梯度可用性和奖励准确性。 逐步奖励分配:解决了少步模型中奖励信号稀疏的信用分配问题。 在文本渲染、视觉质量、偏好对齐三类任务上验证。 实验结果 在文本渲染任务上(OCR 准确率作为非可微奖励),TDM-R1 使 4 步模型的 OCR 准确率从 31.2% 提升至 62.7%(+101%)。 在 HPSv2 偏好对齐上,4-NFE 的 TDM-R1 达到 28.6,超越 100-NFE 的基线模型 (27.8)。 成功扩展到最新的 Z-Image 模型,仅用 4 步推理即持续超越其 100 步和少步变体。 与仅支持可微奖励的 ReFL 和 DDPO 相比,TDM-R1 在非可微奖励设定下领先 15-30%。 6. CRD: 中心化奖励蒸馏 -- 抵抗奖励黑客的扩散 RL 框架 论文信息 标题: Diffusion Reinforcement Learning via Centered Reward Distillation 作者: Yuanzhi Zhu, Xi Wang, Stephane Lathuiliere, Vicky Kalogeiton arXiv: 2603.14128 关键词: 奖励蒸馏 KL正则化 奖励黑客 分布漂移 前向过程微调 背景与动机 扩散 RL 微调面临的核心难题是 奖励黑客(Reward Hacking):模型学会利用奖励模型的漏洞,生成在奖励模型上得分很高但人类视觉上并不好的图像。例如,过度饱和的颜色、不自然的高对比度等。 现有方法的两大流派各有弊端: 轨迹级方法(DPPO, DDPO):内存消耗大、梯度方差高。 前向过程方法(DRaFT, ReFL):收敛快但容易发生分布漂移,导致奖励黑客。 方法原理 CRD 基于 KL 正则化奖励最大化理论,提出了一种更稳健的前向过程扩散 RL 框架: 1) 提示词内中心化(Within-Prompt Centering) 核心理论洞察:KL 正则化奖励最大化的最优策略涉及一个不可解的归一化常数 Z。 CRD 发现,通过在同一 prompt 的多个样本间做中心化(减去均值),归一化常数会自然抵消,得到一个适定的奖励匹配目标。 这使得 CRD 无需显式估计归一化常数,避免了额外的近似误差。 2) 三重分布漂移控制机制 (i) 采样器-参考解耦:将用于生成样本的采样器与移动参考模型分离,防止参考模型的更新导致比率信号崩溃。 (ii) CFG 锚定 KL:将 KL 散度的参考分布设为 CFG(Classifier-Free Guidance)引导的预训练模型,而非无引导的基础模型。这确保优化目标与推理时的语义一致。 (iii) 奖励自适应 KL 强度:训练早期使用较大 KL 系数加速学习(此时模型远离最优,大胆探索有益),训练后期逐渐增大 KL 系数抑制奖励黑客(此时接近最优,需要稳定性)。 创新点 理论优雅:通过中心化消除不可解归一化常数,将 KL 正则化奖励最大化转化为可实操的目标。 三重防线对抗奖励黑客:采样器-参考解耦、CFG 锚定、自适应 KL 强度协同工作。 CFG 锚定的创新性:传统方法锚定无 CFG 的基础模型,CRD 认识到推理时都使用 CFG,因此应该锚定 CFG 引导的分布。 实验结果 在 GenEval 上实现 0.83 的综合得分,与 SOTA 持平。 关键优势在于抗奖励黑客能力:在 HPSv2 上获得 28.5 的同时,FID 仅增加 2.3(对比 DPPO 的 FID 增加 8.7、DRaFT 的 FID 增加 5.1)。 OCR 文本渲染准确率提升 +23.1 pp。 在 ImageReward 和 PickScore 等未见过的偏好指标上,CRD 的优化效果同样保持(证明非奖励黑客)。 7. SOLACE: 内在自置信奖励驱动的 T2I 后训练 (CVPR 2026) 论文信息 标题: Improving Text-to-Image Generation with Intrinsic Self-Confidence Rewards 作者: Seungwook Kim, Minsu Cho arXiv: 2603.00918 会议: CVPR 2026 关键词: 自置信奖励 无监督优化 自去噪探测 无需外部RM CVPR 2026 背景与动机 现有的扩散模型后训练方法几乎都依赖外部奖励模型(如 ImageReward、HPSv2、CLIPScore 等)。然而: 外部奖励模型本身存在偏差和幻觉。 训练和维护奖励模型需要额外成本。 过度优化外部奖励容易导致奖励黑客。 一个自然的问题是:能否利用模型自身的内在信号来指导优化,完全不需要外部奖励模型? 方法原理 SOLACE 提出了一种基于 自置信度(Self-Confidence) 的内在奖励信号: 1) 自去噪探测(Self-Denoising Probe) 核心机制:对一张生成的图像注入一定量的噪声,然后让模型自己尝试恢复原图。 自置信度 = 恢复的准确程度:如果模型对自己生成的图像"理解得很好",就能准确恢复,置信度高;如果生成的图像与模型学到的分布不一致(如质量差、语义不连贯),恢复效果就差。 数学上,自置信度与模型在该样本处的似然估计成正比。 2) 标量奖励转化 将自去噪的重建误差转化为标量奖励分数:重建误差越小,奖励越高。 使用多个噪声水平进行探测,取平均值以获得更稳定的估计。 3) 完全无监督的偏好优化 利用自置信度奖励进行 GRPO 风格的优化,无需任何外部数据集、标注员或奖励模型。 高置信度的生成结果被强化,低置信度的被抑制。 创新点 首个完全无外部奖励的扩散模型后训练方法:打开了"自监督偏好对齐"的新方向。 自置信度信号的物理直觉:模型更容易恢复"好的"图像(与训练分布一致),提供了一种自然的质量度量。 与外部奖励互补:SOLACE 与外部奖励结合使用时效果更好,且能缓解奖励黑客。 零额外推理成本:自去噪探测仅在训练时使用,推理时完全不增加开销。 实验结果 仅使用内在奖励,在 GenEval 组合生成得分提升 +0.08(从 0.71 到 0.79)。 文本渲染准确率提升 +15.3 pp。 SOLACE + 外部奖励的组合方案达到 0.85 GenEval 得分,为所有方法中最高。 将 SOLACE 与 ImageReward 结合时,奖励黑客指标(FID 增量)从 ImageReward 单独使用时的 +6.2 降至 +1.8。 8. VIGOR: 基于几何的视频时序一致性奖励模型 论文信息 标题: VIGOR: VIdeo Geometry-Oriented Reward for Temporal Generative Alignment 作者: Tengjiao Yin, Jinglei Shi, Heng Guo, Xi Wang arXiv: 2603.16271 关键词: 几何奖励 时序一致性 重投影误差 视频扩散 推理时扩展 背景与动机 视频扩散模型在训练过程中缺乏显式的几何监督,导致生成的视频中常出现物体变形、空间漂移和深度违例等不一致性。现有的视频奖励模型主要基于语义(如 VQAScore、CLIPScore)或整体美学评估,无法捕捉帧间的几何一致性。 方法原理 VIGOR 提出了一种基于几何的奖励模型,利用预训练的几何基础模型来评估视频的多视角一致性: 1) 跨帧重投影误差 使用预训练的单目深度估计模型和光流模型,对视频帧对之间进行三维重投影。 逐点计算重投影误差(而非像素级对比),得到更符合物理规律的误差度量。 优势:逐点方式对纹理和光照变化更鲁棒,不会被像素强度差异干扰。 2) 几何感知采样 过滤低纹理区域和非语义区域(如天空、纯色背景),将评估集中在具有可靠对应关系的几何有意义区域。 使用特征匹配置信度作为权重,可靠区域的误差权重更大。 3) 双路径应用 训练后微调:对双向视频模型使用 VIGOR 奖励进行 SFT 或 RL 后训练。 推理时扩展(Test-Time Scaling):对因果视频模型(如流式视频生成器),在推理时使用 VIGOR 作为路径验证器,从多个候选结果中选择几何最一致的。 创新点 首个基于物理几何约束的视频生成奖励模型:超越了纯语义/美学评估的局限。 逐点误差计算:比像素级指标更鲁棒,对光照和纹理变化不敏感。 推理时扩展的即插即用方案:无需重训练模型,通过推理时选择提升开源视频模型质量。 兼容多种视频生成架构:双向模型(后训练)和因果模型(推理时扩展)均适用。 实验结果 在 VBench 动态一致性指标上提升 +5.8%。 物体变形率从基线的 23.7% 降至 11.4%(减少 52%)。 推理时扩展方案:在 Open-Sora 上,使用 VIGOR 选择最优帧序列,VBench 得分提升 +3.2 而无需任何额外训练。 与 VQAScore 等语义奖励正交互补:两者结合可进一步提升 +1.5。 横向对比与技术脉络分析 核心维度对比 方法 奖励来源 优化算法 目标场景 数据需求 训练效率 抗奖励黑客 FIRM 外部多维RM RL (噪声感知) T2I + 编辑 66万评分 中 高 (鲁棒RM) MV-GRPO 外部RM GRPO (多视角) T2I 流模型 无额外 高 (4x) 中 AR-CoPO 外部RM 对比策略优化 AR视频 标准 中 中 CRAFT 复合RM过滤 SFT (增强) T2I 扩散 100样本 极高 (220x) 中 TDM-R1 代理RM (非可微) 轨迹分布匹配 少步T2I 标准 中 中 CRD 外部RM 中心化奖励蒸馏 T2I 扩散 标准 高 极高 (三重防线) SOLACE 内在自置信 GRPO (无监督) T2I 扩散 零 (无需标注) 高 高 (无外部RM) VIGOR 几何物理约束 SFT/推理选择 视频扩散 无额外 高 高 (物理约束) 技术演进脉络 第一条线:优化算法的演进 DPO (配对偏好) → GRPO (组相对优势) → MV-GRPO (多视角稠密评估) → AR-CoPO (输出空间对比) → CRAFT (证明SFT是GRPO下界) → CRD (中心化消除归一化常数) 这条线索体现了从简单配对比较到更精细的组级优化,再到理论层面的统一理解。CRAFT 的发现尤为重要:它证明了精心筛选数据后的 SFT 本质上就是 GRPO 的一种近似,为实践者提供了"大道至简"的选择。 第二条线:奖励信号的多元化 外部语义RM (CLIPScore, ImageReward) → 鲁棒外部RM (FIRM, 66万数据) → 内在自置信 (SOLACE, 自去噪探测) → 几何物理约束 (VIGOR, 重投影误差) → 代理RM (TDM-R1, 拟合非可微信号) → 复合多维RM (CRAFT, CRF过滤) 奖励信号从单一外部模型扩展到内在信号、物理约束、代理模型等多种来源,这一趋势反映了社区对"什么是好的生成"的认知越来越多元。 第三条线:应用场景的拓展 T2I 扩散模型 → 流匹配模型 (MV-GRPO) → 少步蒸馏模型 (TDM-R1) → AR视频生成 (AR-CoPO) → 视频一致性 (VIGOR) 偏好对齐技术正在从最初的 T2I 扩散模型扩展到更广泛的视觉生成模型,每种模型架构都带来独特的技术挑战。 关键发现与趋势 数据效率成为核心竞争力:CRAFT 用 100 个样本超越 5000+ 偏好对的方法,SOLACE 完全无需外部数据——"数据质量 > 数据数量"已成为共识。 奖励黑客是最大风险:CRD 专门设计三重防线,SOLACE 通过内在奖励规避,VIGOR 使用物理约束——不同方法从不同角度应对同一核心挑战。 理论与实践融合加速:CRAFT 证明 SFT 与 GRPO 的理论等价性,CRD 从 KL 正则化推导出中心化技巧,MV-GRPO 给出方差减少的理论分析——该领域正从经验驱动转向理论指导。 推理时扩展(Test-Time Scaling)兴起:VIGOR 和 Meta-TTRL(本周另一篇相关工作)都探索了不修改模型参数、仅在推理时提升质量的方案,这为资源受限场景提供了新思路。 统一框架的探索:多项工作尝试统一不同优化范式(CRAFT 统一 SFT 和 GRPO,CRD 统一前向过程和轨迹方法),预示着未来可能出现更通用的视觉生成对齐框架。 其他相关工作简述 本周还有多篇相关工作值得关注: GDPO-SR (2603.16769): 将 GRPO 原理融入 DPO 用于一步超分辨率,引入属性感知奖励函数针对平滑/纹理区域差异化评估。 LibraGen (2603.13506): 主题驱动视频生成中的 DPO 应用,提出 Consis-DPO 和 Real-Fake DPO 两种定制化偏好优化管线。 Meta-TTRL (2603.15724): 统一多模态模型的测试时强化学习,利用模型内在元认知信号进行推理时自我改进。 Correlation-Weighted Multi-Reward (2603.18528): 组合生成中的多奖励协调优化,通过相关性加权平衡竞争概念间的奖励冲突。 V2A-DPO (2603.11089): 视频到音频生成的 DPO 框架,提出 AudioScore 综合评分系统。 总结与展望 本期专题梳理了视觉生成模型偏好对齐与 RL 后训练的最新进展。从奖励建模(FIRM 的鲁棒 RM、SOLACE 的内在信号、VIGOR 的几何约束)到优化算法(MV-GRPO 的多视角评估、CRAFT 的简洁 SFT 范式、CRD 的抗奖励黑客设计)再到场景拓展(AR-CoPO 的流式视频、TDM-R1 的少步推理),该方向呈现出蓬勃的发展态势。 未来值得关注的方向: 多模态统一对齐:将偏好对齐扩展到图像+视频+音频的统一生成模型。 在线人类反馈:从离线偏好数据集转向在线、实时的人类反馈闭环。 可解释奖励:让用户和开发者理解"为什么这张图/这段视频被认为是好的"。 超长视频对齐:随着视频生成长度增加,如何在数分钟长度的视频上进行有效的偏好对齐。 安全对齐:在提升质量的同时,确保生成内容的安全性和合规性。 本期专题由 人工智能炼丹师 整理,更多 AIGC 前沿动态请关注 jefxiong.cn 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注