AIGC 视觉生成领域 · 每日论文解读 (2026-03-23)
人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇
今日核心看点
- MOSS-TTS 语音基础模型
- ColourCrafter 区域色彩编辑
- Q-Drift 量化漂移校正
- TexEditor 纹理编辑
- Diff-SIT 视频扩散压缩
今日概览
今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。
方向分布:
- 语音生成基础模型 — 1篇 (MOSS-TTS)
- 图像编辑与色彩控制 — 2篇 (ColourCrafter, TexEditor)
- 扩散模型加速与量化 — 1篇 (Q-Drift)
- 视频扩散压缩 — 1篇 (Diff-SIT)
- 生成内容评测 — 2篇 (GenVideoLens, IAA)
- 特殊领域生成 — 4篇 (声学/异常/面部/Sim2Real)
- 合成数据增强 — 1篇 (R&D)
CVPR 2026 x2 (O2MAG, FLAC) | ECCV 2026 x1 (GenVideoLens)
重点论文深度解读
1. MOSS-TTS: Speech Generation Foundation Model
语音生成基础模型 | arXiv:2603.18090
关键词: TTS, 语音克隆, 自回归建模, 离散Token, 基础模型
研究动机
当前语音合成模型在零样本语音克隆、跨语言代码切换和长文本稳定生成方面仍面临挑战。如何构建一个统一的语音生成基础模型,既具备结构简洁性和可扩展性,又能支持精细控制(时长、发音、语言切换),是 TTS 领域的核心问题。
方法原理
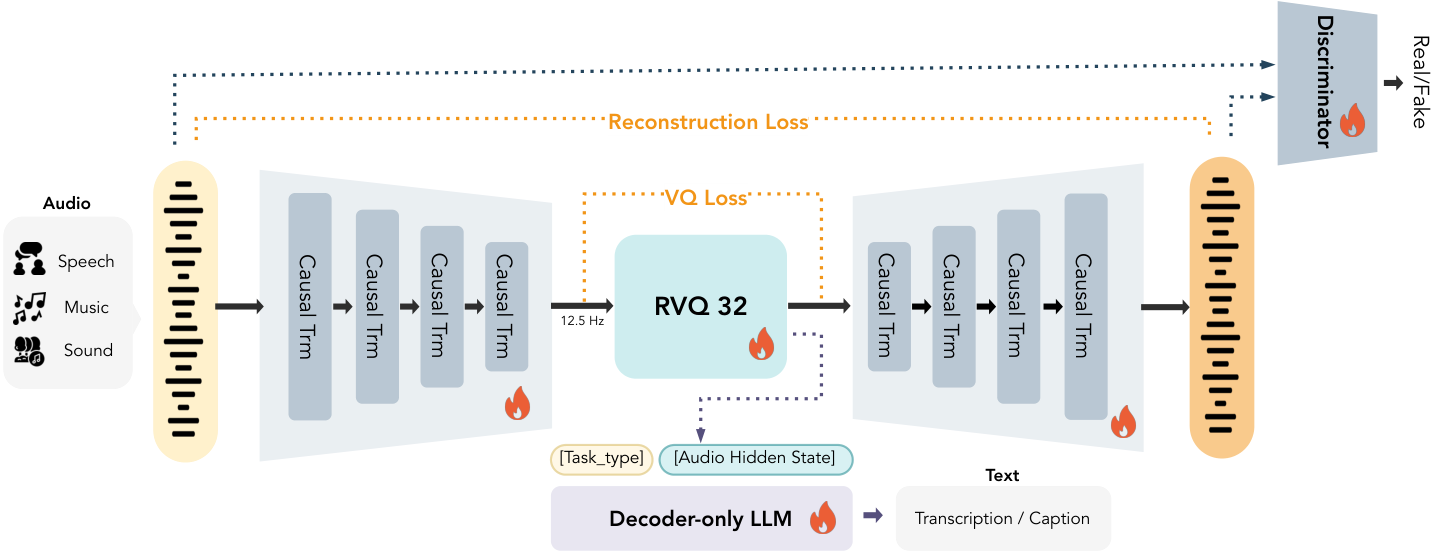
MOSS-TTS 基于「离散音频 Token + 自回归建模 + 大规模预训练」的可扩展配方构建:
- MOSS-Audio-Tokenizer:因果 Transformer 分词器,将 24kHz 音频压缩为 12.5 fps,采用可变比特率 RVQ 实现语义-声学统一表示
- MOSS-TTS 主生成器:强调结构简洁性和可扩展性,支持长上下文和控制导向部署
- MOSS-TTS-Local-Transformer:引入帧级局部自回归模块,提升建模效率、说话人保持能力,缩短首音延迟
核心创新
- 统一语义-声学表示的音频 Tokenizer,12.5fps 极低帧率
- 双生成器互补架构(全局+局部自回归)
- Token 级时长控制和音素/拼音级发音控制
- 支持平滑代码切换和稳定长篇生成
实验结果
- 在多语言和开放域设置中支持零样本语音克隆、token 级时长控制、音素/拼音级发音控制、平滑代码切换和稳定长篇生成。模型和代码已开源。
方法流程
- 24kHz音频 — 原始语音输入
- MOSS-Audio Tokenizer — 因果Transformer 可变比特率RVQ
- 12.5fps 离散Token — 语义-声学统一表示
- 自回归 Transformer — 全局长上下文建模
- 帧级局部AR(可选) — 提升效率和说话人保持
- Token解码 — 高质量语音输出
技术脉络
核心问题: 开源 TTS 模型缺乏统一的基础模型配方,在零样本语音克隆、跨语言切换和长文本稳定生成方面表现不足
前序工作及局限:
- Tacotron 2 (Shen 2018):端到端频谱预测,但需要声码器二阶段合成
- VITS (Kim 2021):端到端变分推理实现高自然度,但扩展性有限
- VALL-E (Wang 2023):首个大规模自回归语音 Token 建模,但开源实现不完整
- CosyVoice (Du 2024):开源可控 TTS,但 Tokenizer 和生成器未统一设计
与前序工作的本质区别: 提供完整的基础模型配方——统一语义-声学 Tokenizer(12.5fps 极低帧率)+ 双生成器互补架构 + 精细控制能力,且完全开源
技术演进定位: 集大成者——整合离散 Token + 自回归 + 大规模预训练的完整配方,为开源 TTS 基础模型树立标杆
可能的后续方向:
- 更低帧率 Tokenizer(<10fps)在情感保真度上的权衡
- 与大语言模型深度融合的端到端对话式语音生成
- 多语言统一 Tokenizer 设计
批判性点评
- 实验评估: 实验覆盖零样本语音克隆、跨语言代码切换和长篇生成等多项任务。12.5fps 极低帧率在 WER 和说话人相似度上表现优秀,但情感和副语言信息的保真度在极端情况下缺乏定量评估。开源模型使复现容易。
- 新颖性: 统一语义-声学 Tokenizer 和双生成器互补架构(全局+局部自回归)的设计思路新颖。12.5fps 帧率在已知开源 TTS 模型中最低。创新性评分:
- 可复现性: 模型和代码完全开源,训练配方描述完整。Tokenizer、双生成器架构清晰易实现,但大规模预训练数据需求较高。
- 影响力: 影响力评分 4.5/5 — 为开源 TTS 社区提供了完整的基础模型配方,加速语音生成的民主化。双生成器架构为不同部署场景提供灵活选择。
2. ColourCrafter: Region-Aware Colour Editing via Token-Level Diffusion
Token级扩散的区域感知色彩编辑 | arXiv:2603.18466
关键词: 色彩编辑, 区域感知, Token级扩散, Lab色彩空间, 细粒度控制
研究动机
色彩是图像生成中感知最显著但也最难控制的属性之一。现有扩散模型可根据用户指令修改颜色,但结果往往偏离预期色调,尤其在细粒度和局部编辑方面表现不佳。早期文本驱动方法依赖离散语言描述,无法准确表示连续色调变化。
方法原理

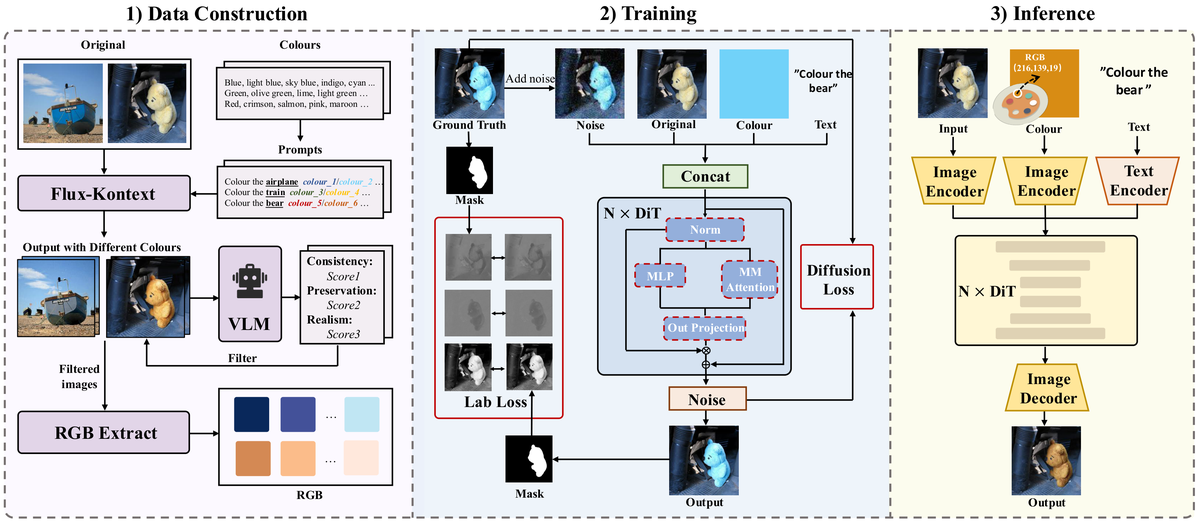
ColourCrafter 将色彩编辑从全局色调转换转变为结构化的区域感知生成过程:
- Token 级色彩融合:在潜在空间中对 RGB 色彩标记和图像标记进行 token 级别融合,选择性地将色彩信息传播到语义相关区域
- 感知 Lab 空间损失:解耦亮度和色度,将编辑约束在掩码区域内,增强像素级精度
- ColourfulSet 大规模数据集:包含高质量图像对,具有连续且多样的色彩变化
核心创新
- 首个 token 级色彩融合框架,实现语义选择性色彩传播
- Lab 色彩空间解耦损失,亮度-色度独立约束
- ColourfulSet 大规模色彩编辑数据集
- 掩码约束下的细粒度区域感知编辑
实验结果
- 在细粒度色彩编辑中实现了 SOTA 的色彩准确性、可控性和感知保真度。支持连续色调变化和多区域独立编辑。项目代码已开源。
方法流程
- 输入图像+ 色彩指令 — 原图+目标颜色
- RGB色彩 Token编码 — 色彩信号Token化
- 潜在空间 Token级融合 — 图像Token+色彩Token 选择性融合
- 语义区域 选择传播 — 色彩传播到 相关区域
- Lab空间 约束 — 亮度-色度解耦 掩码精度控制
- 色彩准确 输出 — 精准区域编辑
技术脉络
核心问题: 扩散模型中色彩控制粒度不足,文本驱动方法无法表达连续色调变化,全局编辑无法满足区域精细需求
前序工作及局限:
- InstructPix2Pix (Brooks 2023):指令驱动编辑,但色彩控制不精确
- ControlNet (Zhang 2023):结构化条件控制,但不针对色彩属性
- IP-Adapter (Ye 2023):图像提示适配,但色彩传播缺乏语义选择性
- Palette (Saharia 2022):图像着色,但仅支持全局色彩迁移
与前序工作的本质区别: 首个 Token 级色彩融合框架,在潜在空间中实现语义选择性色彩传播,结合 Lab 空间解耦实现物理上合理的亮度-色度独立控制
技术演进定位: 方向开拓——将色彩编辑从全局转为 Token 级区域感知,开辟精细化色彩控制新范式
可能的后续方向:
- 与 3D 感知结合的光照和材质色彩编辑
- 基于色彩心理学的自动美学优化
- 视频级时序一致性色彩编辑
批判性点评
- 实验评估: 定性和定量实验丰富,细粒度色彩编辑对比全面。Lab 空间损失的消融实验有说服力。但极端色彩转换(如黑到荧光色)的自然度和掩码边界过渡的平滑性需要更多测试。
- 新颖性: 首个 Token 级色彩融合框架,将色彩编辑从全局转为区域感知是重要突破。Lab 空间解耦损失的引入在色彩编辑中属首次。创新性评分:
- 可复现性: 方法描述清晰,ColourfulSet 数据集和代码已开源。Token 融合模块的实现依赖标准 Transformer 组件,易于复现。
- 影响力: 影响力评分 4/5 — 为精细化图像编辑开辟了 Token 级色彩控制新方向。ColourfulSet 数据集对社区也有独立价值。但应用场景相对垂直。

3. Q-Drift: Quantization-Aware Drift Correction for Diffusion Sampling
扩散模型量化采样漂移校正 | arXiv:2603.18095
关键词: 量化加速, 采样校正, 即插即用, DiT, U-Net
研究动机
后训练量化是部署大型扩散模型的实用路径,但量化噪声会在去噪轨迹上累积并降低生成质量。现有方法主要从模型端优化量化策略,而忽略了从采样器端校正量化引入的系统性漂移的可能性。
方法原理
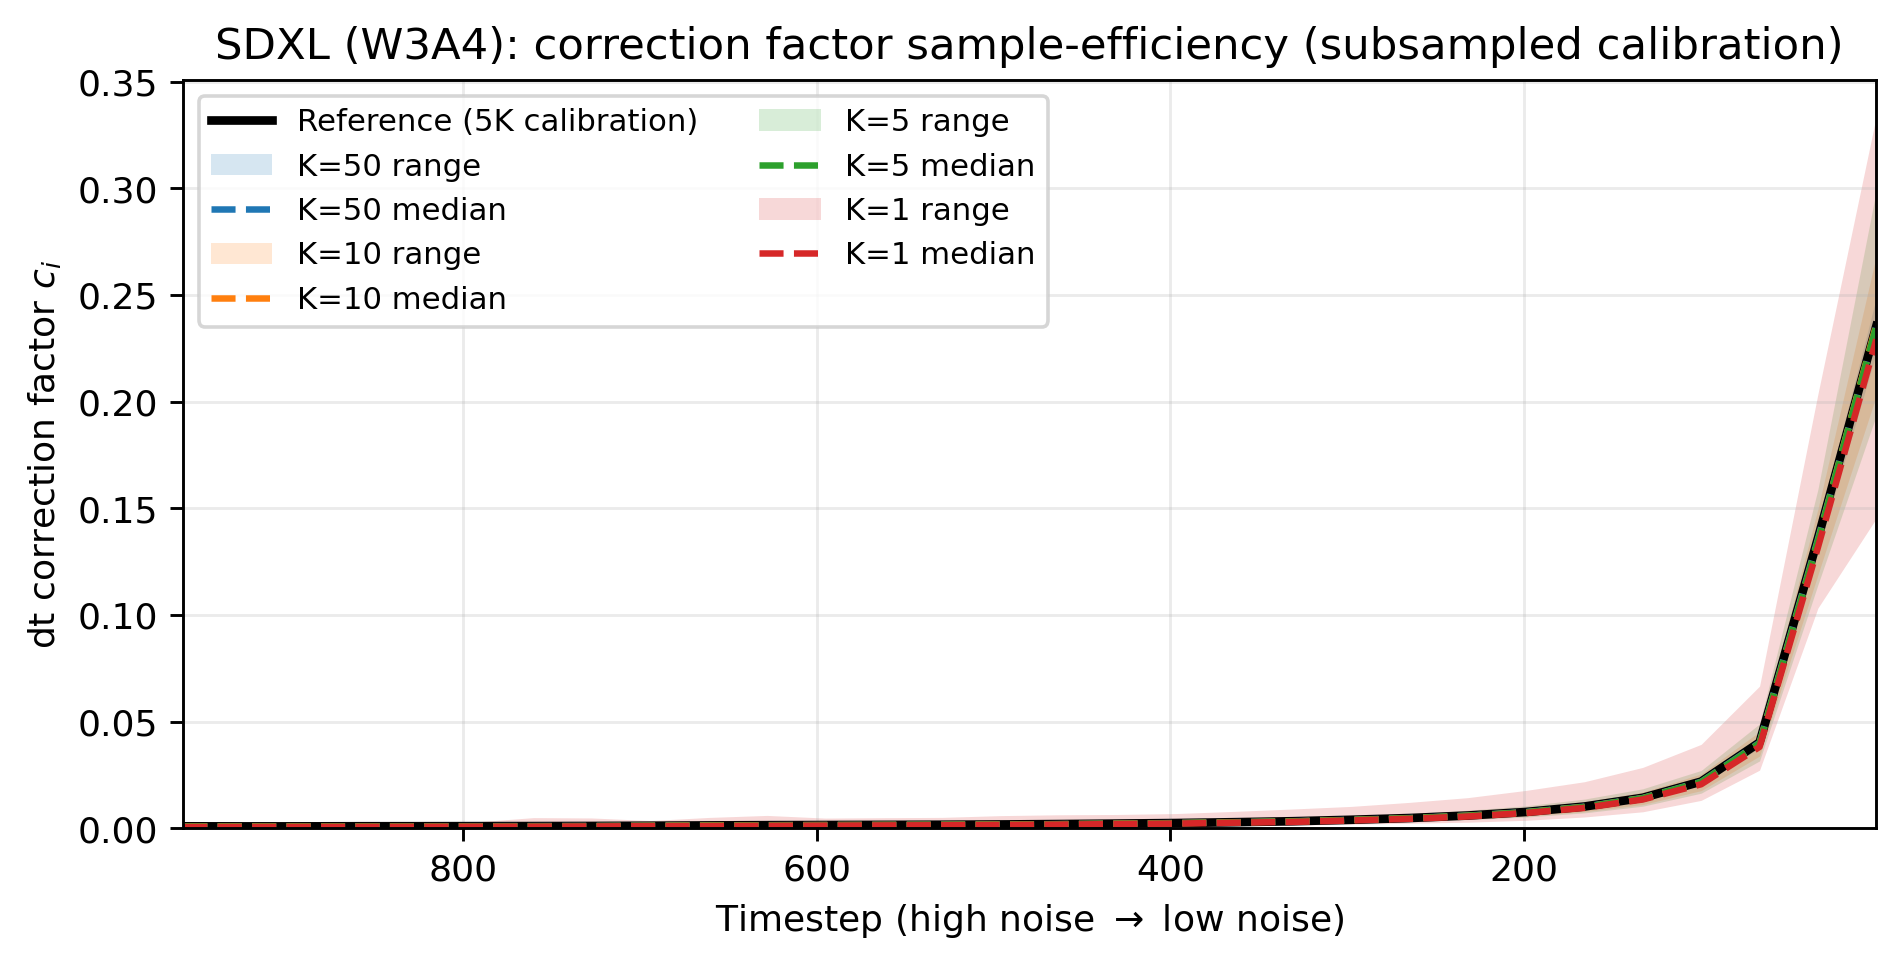
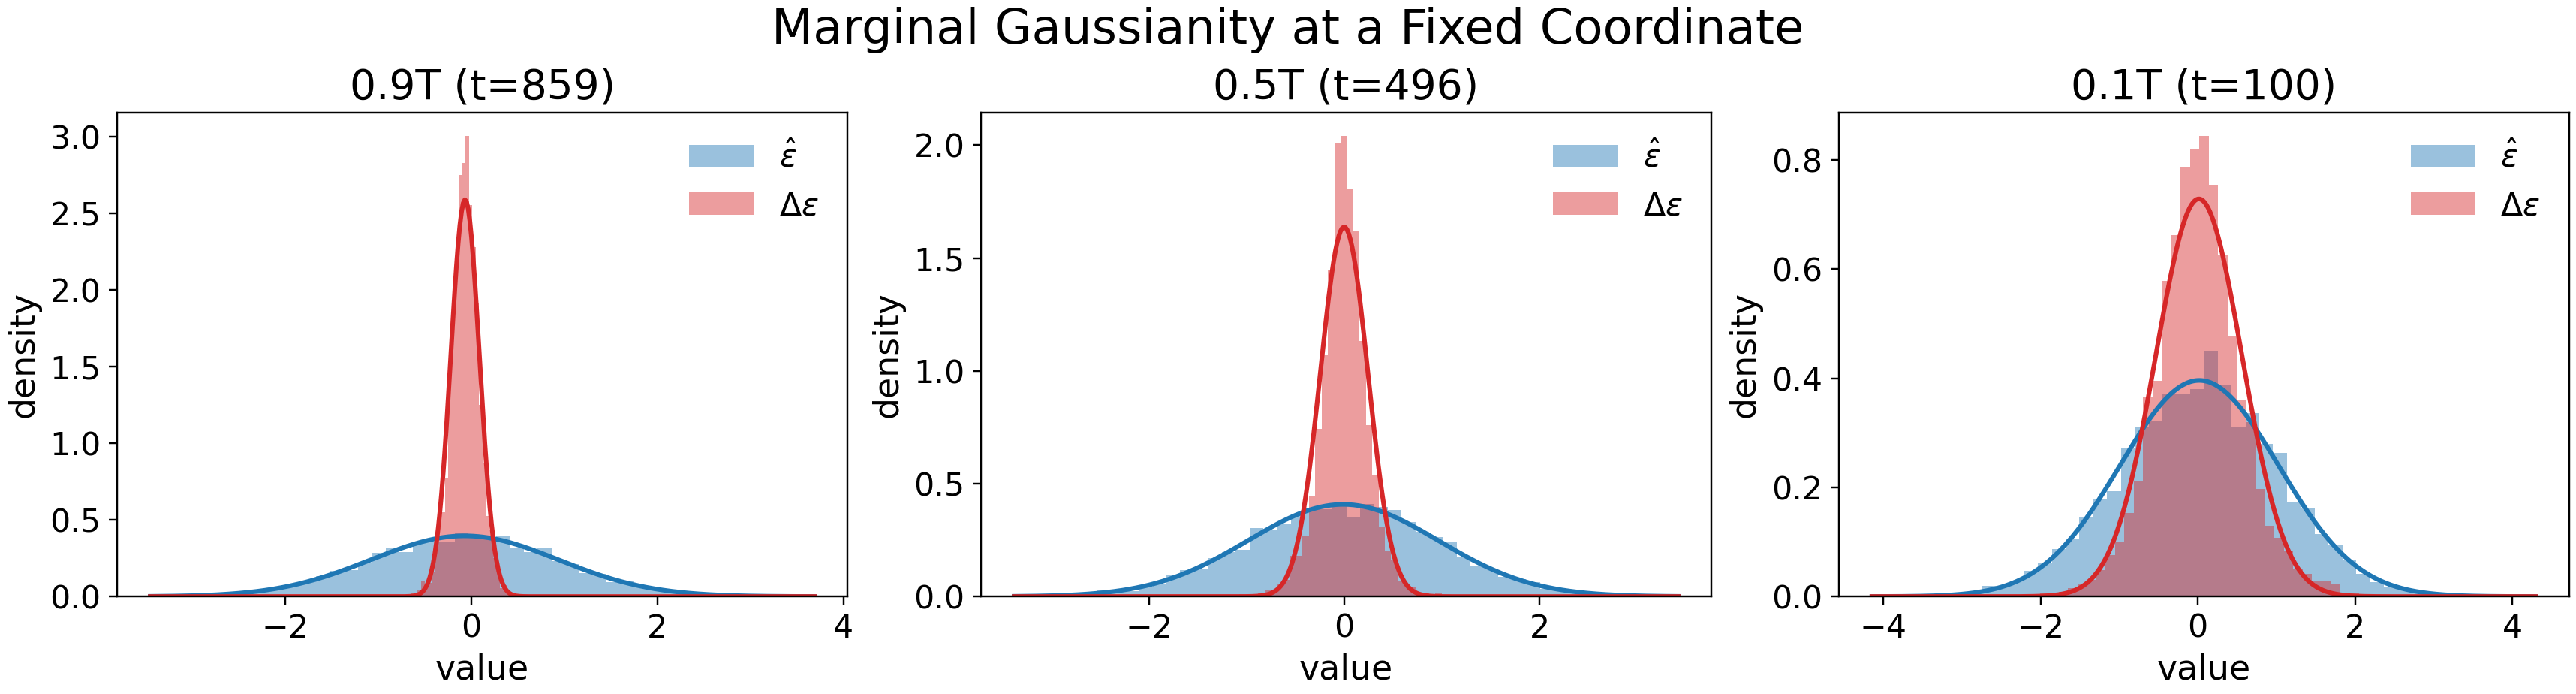
Q-Drift 将量化误差视为每个去噪步骤上的隐式随机扰动,推导出保持边际分布的漂移调整公式:
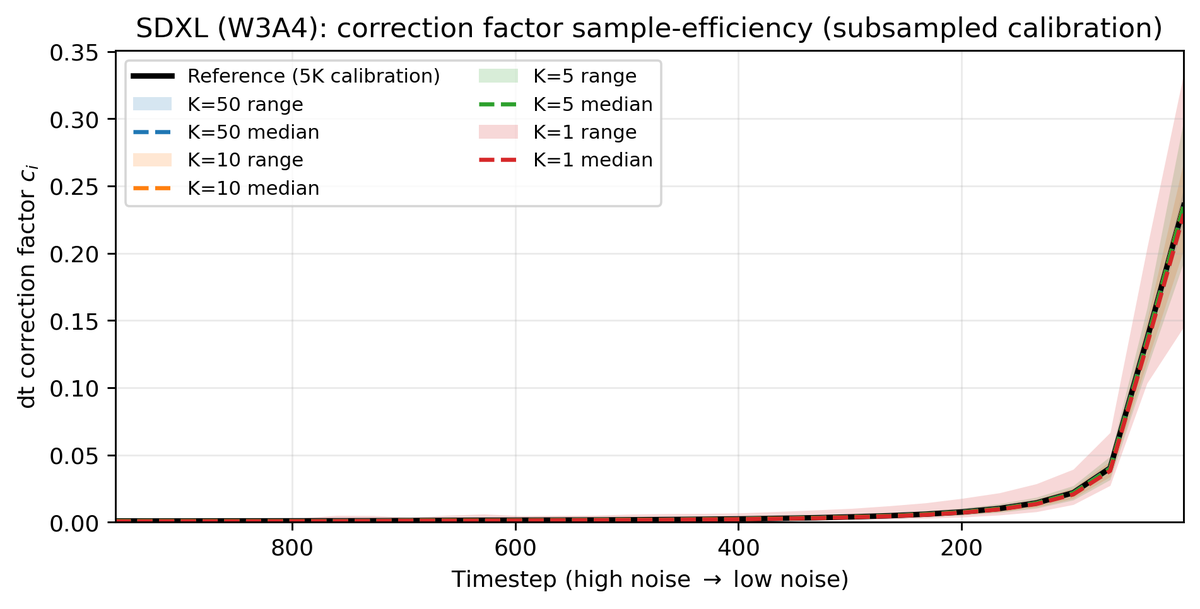
- 通过仅 5 对全精度/量化校准运行估计逐时间步的方差统计量
- 基于推导的漂移校正公式在采样过程中实时调整去噪轨迹
- 采样器端校正可与任意采样器、扩散模型和 PTQ 方法即插即用
核心创新
- 首次从采样器端而非模型端校正量化漂移
- 理论推导:量化误差=隐式随机扰动,漂移调整保持边际分布
- 极低校准成本(仅 5 对运行)
- 模型/采样器/量化方法三维通用
实验结果
- 在 6 个不同 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上验证。PixArt-Sigma (SVDQuant W3A4) 上 FID 降低 4.59,CLIP 分数不变。推理开销可忽略不计。
方法流程
- 量化扩散模型 — PTQ后的DiT/U-Net 存在量化噪声
- 5对校准运行 — 全精度vs量化 估计方差统计
- 漂移公式推导 — 量化误差=随机扰动 保持边际分布
- 采样器端实时校正 — 每步调整轨迹 兼容任意采样器
- 高质量输出 — FID降低4.59 CLIP保持
技术脉络
核心问题: 扩散模型后训练量化引入的误差在去噪轨迹上累积导致质量下降,现有方法仅从模型端优化量化策略
前序工作及局限:
- PTQ4DM (Shang 2023):通道级量化校准,但忽略量化对采样轨迹的累积影响
- Q-Diffusion (Li 2023):时间步感知校准,但仍在模型端操作
- SVDQuant (Li 2024):低秩分解+量化,极端压缩但质量损失显著
- EfficientDM (He 2024):量化感知训练,但需要重新训练成本高
与前序工作的本质区别: 首次从采样器端而非模型端校正量化漂移,将量化误差建模为隐式随机扰动并推导漂移调整公式,与模型端量化正交可叠加
技术演进定位: 视角转换——开辟采样器端补偿的新方向,仅 5 对校准运行即实现通用校正,可能成为量化部署的标准组件
可能的后续方向:
- 自适应漂移校正(根据内容复杂度动态调整)
- 推广到其他模型近似误差的采样器端补偿
- 极端量化(W2)下的理论边界探索
批判性点评
- 实验评估: 在 6 个 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上的全面验证令人信服。PixArt-Sigma W3A4 上 FID 降低 4.59 的改进显著。但在 W2 等极端量化下的效果需验证,独立随机扰动假设可能不成立。
- 新颖性: 首次从采样器端而非模型端校正量化漂移,理论推导严谨。仅 5 对校准运行的超低成本令人印象深刻。思路与模型端量化正交,可叠加使用。创新性评分:
- 可复现性: 校准流程简洁(仅 5 对运行),漂移校正公式明确,兼容任意采样器和 PTQ 方法,实现门槛低。
- 影响力: 影响力评分 4.5/5 — 为量化扩散模型部署提供了通用的采样器端补偿方案。即插即用特性使其在工业部署中非常实用。可能启发其他模型近似误差的类似补偿研究。
批判性点评精选
1. 开源 TTS 基础模型:完整配方的价值与情感表达的瓶颈
MOSS-TTS 为开源 TTS 社区提供了完整的基础模型配方,但 12.5fps 的极低帧率在情感和副语言信息的保真度上可能存在瓶颈。双生成器架构虽然灵活,但也增加了用户的选择复杂性。关键问题是:Tokenizer 的压缩率与表达力之间的最优平衡点在哪里?
2. Token 级色彩编辑:精细化的天花板在哪里?
ColourCrafter 的 Token 级融合在色彩编辑精度上取得突破,但 Lab 空间损失在极端色彩转换(如黑到荧光色)时可能产生非自然过渡。掩码边界的平滑处理也需要更多工作。更深层的问题是:色彩编辑是否应该与光照、材质统一建模?孤立处理色彩可能限制了真实感。
3. 采样器端补偿:一个被忽视的优化维度
Q-Drift 的核心洞察——从采样器端而非模型端校正量化漂移——揭示了一个长期被忽视的优化维度。仅 5 对校准运行的超低成本令人印象深刻。但其理论假设(量化误差为独立随机扰动)在极端量化下可能失效。这种采样器端补偿的思路是否可以推广到蒸馏误差、剪枝误差等其他模型近似场景?
其余论文 · 贡献与效果总结
| # |
论文 |
关键词 |
主要贡献 |
效果 |
| 1 |
TexEditor (TexEditor: Structure-Preserving Text-Driven Texture Editing |
快手 KlingAI) |
纹理编辑 · 结构保持 · RL强化 · KlingAI |
TexBlender SFT数据集 + StructureNFT RL方法,基于 Qwen-Image-Edit 训练,纹理编辑中保持几何结构一致 |
| 2 |
Diff-SIT (Diff-SIT: Sparse Information Transmission Video Diffusion Compression) |
视频压缩 · 稀疏编码 · 一步扩散 · 极低比特率 |
STEM稀疏时间编码 + ODFTE一步视频扩散重建,帧类型嵌入器自适应不同帧类型 |
极低比特率下感知质量和时间一致性达到新 SOTA |
| 3 |
GenVideoLens (GenVideoLens: LVLMs in AI-Generated Video Detection |
ECCV 2026) |
视频评测 · AIGC检测 · ECCV 2026 · LVLM |
500视频15维度细粒度基准,揭示LVLM在感知线索可识别但光学一致性和物理交互推理严重不足 |
| 4 |
O2MAG (O2MAG: One-to-More Training-Free Anomaly Generation |
CVPR 2026) |
异常生成 · 无训练 · CVPR 2026 · 工业检测 |
自注意力嫁接 + 异常引导优化 + 双重注意力增强,单张参考合成逼真异常样本 |
| 5 |
VQ-AUFace (VQ-AUFace: AU Codes to Language for Facial Behavior Synthesis) |
面部合成 · AU编码 · 文本驱动 · 冲突建模 |
将面部动作单元翻译为自然语言描述,支持冲突AU显式建模,BP4D-AUText大规模数据集 |
复杂和冲突动作组合下的面部表情生成在解剖学合理性上显著改善 |
| 6 |
FLAC (FLAC: Few-shot Acoustic Synthesis with Flow Matching |
CVPR 2026) |
声学合成 · Flow Matching · CVPR 2026 · 脉冲响应 |
首次将生成Flow Matching应用于房间脉冲响应合成,扩散Transformer在空间/几何条件下生成 |
| 7 |
IAA (From Concepts to Judgments: Interpretable Image Aesthetics Assessment) |
美学评估 · 可解释AI · 概念建模 · 摄影 |
基于人类美学概念构建可解释子空间 + 残差预测器,美学评估兼顾性能与可解释性 |
在摄影和艺术数据集上与黑盒模型性能相当且可解释性显著更优 |
| 8 |
OGD (OGD: Ontology-Guided Diffusion for Zero-Shot Sim2Real Image Translation) |
Sim2Real · 知识图 · 零样本 · 图翻译 |
将真实感分解为本体知识图,GNN全局嵌入 + 符号规划器编辑序列调节扩散模型 |
可解释的零样本仿真到真实图像翻译,无需目标域训练数据 |
| 9 |
R&D (R&D: Reliability-Diversity Balance in Synthetic Data Augmentation) |
数据增强 · 可控扩散 · 语义分割 · 可靠多样平衡 |
类别感知提示 + 视觉先验混合,可控扩散模型合成数据增强 |
PASCAL VOC 和 BDD100K 上语义分割性能显著提升 |
趋势观察
- 语音生成基础模型走向开源:MOSS-TTS 展示了离散 Token + 自回归大模型在 TTS 领域的完整开源路线图 — MOSS-TTS 采用统一语义-声学 Tokenizer + 双生成器架构
- 图像编辑向精细化演进:ColourCrafter 的 Token 级色彩融合和 TexEditor 的 RL 强化结构保持 — 从全局编辑到区域感知、从外观到纹理的精细化控制
- 量化部署的采样器端补偿:Q-Drift 首次从采样器端而非模型端校正量化漂移 — 仅 5 对校准运行,6 模型 3 采样器通用,推理零开销
- AI 生成内容检测成为新赛道:GenVideoLens 揭示 LVLM 在物理和时间推理上的严重不足 — 感知线索可识别但深层一致性难以判断
- 扩散模型在特殊领域的拓展:FLAC 声学合成、O2MAG 异常生成、VQ-AUFace 面部合成 — Flow Matching 和注意力控制在声学、工业和面部领域的创新应用
人工智能炼丹师 整理 | 2026-03-23
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注









评论 (0)