搜索到
119
篇与
AIGC Daily Papers
的结果
-
 AIGC 周末专题|2026-04-25|视频编辑评测方法全景:从传统指标到 Reward Model 的范式跃迁 技术路线与时间线 传统指标时代(2018-2023) 描述:依赖手工设计的指标(CLIP-Score、LPIPS、FVD),与人类感知相关性低,无法捕捉编辑任务的语义一致性。 关键节点: 2018:LPIPS 提出,感知相似度指标 2019:FVD 提出,基于 I3D 特征的视频质量评估 2021:CLIP-Score 成为图像-文本相似度标准 通用视频基准崛起(2024 年初) 描述:通用视频生成评测基准出现,覆盖多个维度,但尚未针对编辑任务设计。 关键节点: 2024:VBench 发布(CVPR 2024),16 维度视频生成评测 2024:VideoScore 发布(EMNLP 2024),视频质量评估模型 编辑专用评测爆发(2024 下半年) 描述:针对视频/图像编辑任务设计的评测基准集中涌现,覆盖多维度、多任务、多编辑类型。 关键节点: 2024.08:I2EBench 发布(NeurIPS 2024),图像编辑 16 维度评测 2024.09:EditBoard 发布(AAAI 2025),视频编辑综合评测基准 2024.10:VE-Bench 发布,首个视频编辑专用 VQA 数据集 2024.11:FiVE-Bench 发布,细粒度视频编辑评测 Reward Model 范式确立(2025-2026) 描述:从手工指标和通用 VLM 评审,演进到编辑专用 Reward Model,人类相关性大幅提升(SRCC 从 0.214 提升到 0.780)。 关键节点: 2025:EditReward 发布,200K 偏好对训练 Reward Model 2026.04:VEFX-Bench 发布,三维解耦 + 序数回归 Reward Model(SRCC=0.780) 未来方向(2026+) 描述:多模态 Reward Model、测试时计算缩放、标准化竞赛平台是三大重点方向,评测将与训练深度融合(RLHF/DPO)。 关键节点: 2026+:多模态 Reward Model(视频+音频+字幕联合评估) 2026+:测试时计算缩放(Reward-guided iterative refinement) 2026+:跨系统可复现的标准化竞赛平台(类似 ImageNet Challenge) 1. VEFX-Bench:5049 样本 + 三维解耦标注 + 序数回归 Reward Model——迄今最全面的视频编辑评测体系 论文: VEFX-Bench arXiv: 2604.16272 机构: 未披露(2026 年 4 月最新工作) 1.1 研究动机 核心问题: 视频编辑模型缺乏统一评测标准,不同论文使用不同指标和数据集导致结论不可比 现有评测数据集规模小、缺少编辑输出或人工质量标签,通用 VLM 评审器未针对编辑质量优化,导致无法公正对比不同编辑系统。 前序工作及局限: CLIP-Score (Hessel et al. 2021):图像-文本相似度指标,广泛但粗粒度 LPIPS (Zhang et al. 2018):感知相似度指标,仅衡量像素级差异 FVD (Unterthiner et al. 2019):视频生成质量指标,基于 I3D 特征 VBench (Huang et al. 2024):视频生成综合基准,CVPR 2024,16 维度但不针对编辑 与前序工作的本质区别: 从单一指标到多维度评测框架,从通用视频质量到编辑特异性评估(指令遵循+编辑排他性+渲染质量三维解耦) 1.2 方法原理 数据集:5049 个视频编辑样本,9 大类(相机角度/实例运动/数量/相机运动/属性/创意/实例/视觉特效/风格)32 子类,每个样本由 3 个解耦维度独立标注(4 分制)。 Reward Model 架构:基于 Qwen3-VL-Instruct(4B/32B),联合处理原始视频 + 编辑指令 + 编辑视频。3 个可学习特殊 token 分别查询 IF / RQ / EE 三维度分数。 训练策略:采用序数回归(ordinal regression)而非标量回归,条件二值交叉熵保持有序约束。Stage 1 冻结预训练权重仅训练 reward head;Stage 2 解冻语言骨干端到端微调。 推理:将有序概率转换为 [1, 4] 连续分数。 1.3 核心创新 首个同时包含编辑输出+人工标注+多维标签的大规模视频编辑数据集 三维解耦质量标注(指令遵循 IF / 渲染质量 RQ / 编辑排他性 EE) 基于 Qwen3-VL 的序数回归 Reward Model(VEFX-Reward-4B/32B) 对标准化 VEFX-Bench 基准,覆盖 9 大类 32 子类编辑任务 1.4 实验结果 VEFX-Reward-32B SRCC=0.780 远超 EditReward(0.558) 和 VE-Bench(0.214)。配对偏好准确率:IF 93.66%、RQ 91.11%、EE 91.96%。系统评测显示 Kling o3 omni 综合第一(3.057),Runway Gen-4.5 第三(2.912),开源 UniVideo(2.516)可与部分商业系统竞争。所有系统在 IF 维度差异最大,RQ 相对稳定。 1.5 关键洞察 优势:三维解耦设计精准捕捉不同失败模式;序数回归比标量回归更适合有序评分。 局限:数据集仅来自少量编辑系统,可能存在偏差;标注者间 IF 完全一致率仅 75.2%,说明指令遵循评估本身存在歧义。 技术演进定位:2024 下半年 VE-Bench 开创编辑专用 VQA → 2025 年 FiVE-Bench / IVEBench / VEditBench 细化任务分类 → 2026 年 VEFX-Bench 引入 Reward Model 实现自动+人类对齐评估。 可能的后续方向: 多模态 Reward Model(视频+音频+字幕联合评估) 测试时计算缩放(Reward-guided iterative refinement) 跨系统可复现的标准化竞赛平台(类似 ImageNet Challenge) 2. IVEBench:600 视频 + 8 类 35 子类 + MLLM 三维评估协议——指令引导视频编辑的现代基准套件 论文: IVEBench arXiv: 2510.11647 机构: 浙江大学 / 腾讯优图 / 上海交通大学 / 新加坡国立大学 2.1 研究动机 核心问题: 传统手工指标(CLIP/LPIPS/FVD)与人类感知严重偏离 现有视频编辑基准无法支撑指令引导编辑的评估需求:数据来源单一、任务覆盖面窄、评估指标不完整。 前序工作及局限: CLIP-T Score:文本-图像余弦相似度,无法捕捉细粒度编辑差异 PickScore (Kirstain et al. 2023):人类偏好训练的图像质量分数 VideoScore (He et al. 2024):视频生成专用质量评估模型,EMNLP 2024 与前序工作的本质区别: 从手工指标到学习型评估器,从单一分数到多维度解耦评分,从通用质量到编辑专用 2.2 方法原理 数据集:600 高质量源视频,覆盖 7 个语义维度和 30 个主题,帧长 32-1024 帧。 任务体系:8 大类 35 子类(风格/特效/主体/相机角度/主体运动/相机运动/属性/视觉特效),通过 LLM 生成 + 专家审核获取提示三元组(源/编辑/目标)。 三维评估协议: 视频质量:主体一致性、背景一致性、时间闪烁、运动平滑度、VTSS 指令遵循:整体/短语语义一致性、指令满足度、数量准确性 视频保真度:语义/运动/内容保真度 2.3 核心创新 首个专为指令引导视频编辑设计的现代化综合基准 高质量视频覆盖 7 语义维度、32-1024 帧长度 大类 35 子类编辑任务分类法 三维评估协议融合传统指标和 MLLM 评估 2.4 实验结果 评测 8 个方法:Ditto 在短视频上总分 0.667 领先,InsV2V 在长视频上 0.657 领先。所有方法的指令遵循维度得分最低(0.25-0.49),视频质量最高(0.69-0.82),说明语义编辑仍是主要瓶颈。VACE 保真度最强(0.826)但指令遵循最弱(0.254)。 2.5 关键洞察 优势:任务覆盖面最广(8 类 35 子类),MLLM + 传统指标双通道评估提升可靠性。 局限:评估依赖特定 MLLM(如 Qwen3-VL),模型版本变化可能影响复现性;缺少人工标注的 ground truth 偏好数据。 技术演进定位:EditReward 和 VEFX-Reward 代表 Reward Model 范式在编辑评测中的应用,可能成为未来 RLHF/DPO 后训练的核心组件。 可能的后续方向: 编辑 Reward Model 用于 DPO/RLHF 后训练 在线学习持续更新 Reward Model 多 Reward Model 集成投票机制 3. FiVE-Bench:细粒度视频编辑基准——14 指标 + VLM 成功率 + RF vs 扩散方法系统对比 论文: FiVE-Bench arXiv: 2503.13684 机构: HKUST / 其他合作机构 3.1 研究动机 核心问题: 评测维度设计如何平衡全面性和可操作性 缺乏标准化细粒度基准导致方法间无法公平比较,也无法评估模型对超参数的敏感度。 前序工作及局限: VBench 16 维度:最全面但维度间相关性高,难以解读 VE-Bench 单一分数:操作简便但无法区分失败模式 与前序工作的本质区别: VEFX-Bench 的三维解耦(IF/RQ/EE)是目前最佳平衡点:维度足够区分失败模式(相关性 0.19-0.33),又不至于过多导致标注困难。 3.2 方法原理 数据集:74 真实视频 + 26 生成视频,6 类细粒度编辑(物体替换/添加/删除/属性修改/背景替换/动作修改),420 组源-目标提示对含精确 Mask。 评估指标(14 项,5 维度): 背景保留:PSNR / SSIM / LPIPS 文本-视频相似度:CLIP-T / PickScore 时间一致性:Warp Error / CLIP-I 视频质量:FVD / FID / MUSIQ 运行时间 新指标 FiVE-Acc:利用 VLM 判定编辑是否成功。 FlowEdit:将注入噪声视为 ODE 反向过程,在 RF 模型上无需 DDIM 反转。 3.3 核心创新 首个细粒度物体级视频编辑基准 视频 + 420 编辑对 + 对应 Mask 指标 + 新指标 FiVE-Acc(VLM 评估编辑成功率) 首次系统对比扩散 vs 整流流(RF)编辑方法 提出 FlowEdit 无训练无反转编辑方法 3.4 实验结果 RF 方法(Wan-Edit/Pyramid-Edit)全面优于扩散方法:Wan-Edit 在 FiVE-Acc 上 72.4% vs 最佳扩散方法 51.3%。Wan-Edit 对超参数最不敏感。扩散方法中 SDEdit 背景保留最佳但编辑成功率低,ControlVideo 时间一致性较好。 3.5 关键洞察 优势:Mask 标注使评估更精确;FiVE-Acc 利用 VLM 判定成功率是有意义的创新。 局限:100 视频规模偏小;FlowEdit 同时是基准作者提出的方法,存在裁判-运动员角色冲突。 技术演进定位:三维解耦已成为新的共识范式(IVEBench 的三维评估协议与之高度一致)。 可能的后续方向: 动态维度权重(根据编辑类型自动调整) 用户偏好个性化评估 4. EditReward:200K 人类偏好对 + VLM 奖励模型——指令引导图像/视频编辑的质量裁判 论文: EditReward arXiv: 2509.26346 机构: TIGER-AI Lab (Waterloo) 4.1 研究动机 核心问题: 评测数据集如何兼顾规模、多样性和标注质量 开源编辑模型落后于闭源的核心瓶颈在于缺乏可靠的 Reward Model 来规模化高质量合成训练数据。 前序工作及局限: DAVIS (Caelles et al. 2017):视频分割基准,50 视频,被大量视频编辑论文借用 TGVE (Wu et al. 2023):文本引导视频编辑数据集,规模有限 与前序工作的本质区别: 从几十个视频到数千标注样本,从单一来源到多系统输出收集。 4.2 方法原理 数据集:200K+ 偏好对,由训练有素的专家按严格标注协议标注。 Reward Model:基于 VLM 架构,输入为编辑指令 + 源图 + 编辑图,输出人类偏好对齐的质量分数。 下游验证(闭环):用 EditReward 从有噪声的 ShareGPT-4o-Image 数据集中筛选高质量子集 → 在该子集上训练 Step1X-Edit,效果显著优于在完整数据集上训练。 4.3 核心创新 首个大规模人类偏好数据集 EditReward-Data(200K+ 偏好对) 基于 VLM 的专用编辑质量 Reward Model 在 GenAI-Bench、AURORA-Bench、ImagenHub 等基准上 SOTA 人类相关性 验证 Reward Model 可作为数据筛选器提升下游模型训练 4.4 实验结果 在 GenAI-Bench、AURORA-Bench、ImagenHub 和自建 EditReward-Bench 上均达到 SOTA 人类相关性,全面超越 VLM-as-judge 基线(包括 GPT-4o 评审)。Step1X-Edit 在筛选子集上训练后编辑质量显著提升。 4.5 关键洞察 优势:规模最大的专家标注偏好数据集;验证了 Reward Model 作为数据筛选器的实用价值(闭环验证)。 局限:主要聚焦图像编辑,视频编辑的适用性需进一步验证;VEFX-Bench 的对比显示其在 RQ 维度相关性为负值(-0.211),暴露图-视频 domain gap。 技术演进定位:VEFX-Dataset(5049 样本)和 EditReward-Data(200K 偏好对)代表当前规模的上限。 可能的后续方向: 众包+AI 混合标注扩大规模 持续更新的活跃基准(每季度纳入新系统) 合成数据增强标注多样性 5. VE-Bench:首个视频编辑质量评估数据集 + 主观对齐的自动评估网络 论文: VE-Bench arXiv: 2408.11481 机构: 北京大学 5.1 研究动机 核心问题: VLM-as-Judge 范式的可靠性和一致性 传统 VQA 方法只关注画面质量,忽略编辑特有的文本对齐和源视频关联性,导致评估结果与人类感知严重偏离。 前序工作及局限: GPT-4V/GPT-4o 评审:零样本评估,成本高且不稳定 LLaVA-Critic (Sun et al. 2024):开源 VLM 评审器 与前序工作的本质区别: 从通用 VLM 零样本评审到编辑专用微调 Reward Model,人类相关性大幅提升。 5.2 方法原理 VE-Bench DB(数据集):收集多样化源视频(不同运动模式和主题),为每个视频设计多种编辑提示,收集 8 个模型的编辑输出,24 名标注者给出 MOS 评分。 VE-Bench QA(评估网络):在传统 VQA 的美学/失真维度之上,新增两个分支——文本-视频对齐建模 + 源-编辑视频关联建模,输出综合质量分数。 任务覆盖:3 类(风格编辑、语义编辑、结构编辑)。 5.3 核心创新 首个专为视频编辑设计的 VQA 数据集(VE-Bench DB) 个编辑模型结果 + 24 名标注者 MOS 评分 主观对齐的视频编辑评估网络 VE-Bench QA 同时建模文本-视频对齐和源-编辑视频关联 5.4 实验结果 VE-Bench QA 在与人类偏好的对齐性上显著优于 CLIP-Score、LPIPS、FVD 等传统指标,以及通用 VQA 模型。但在 VEFX-Bench 后续对比中,VE-Bench 单维度设计(SRCC=0.214)明显落后于多维度方法。 5.5 关键洞察 优势:首个视频编辑专用 VQA 数据集,为后续研究奠定了基础。 局限:单一综合分数无法区分不同失败模式(如指令遵循好但渲染差);8 个模型均为 SD 系列(2024 年),缺乏最新系统评测。 技术演进定位:VEFX-Reward 证明专用 Reward Model > 通用 VLM Judge > 传统手工指标。 可能的后续方向: 轻量化蒸馏(4B→1B 保持性能) 多 VLM 集成降低偏差 对抗样本鲁棒性评估 6. SST-EM:语义-空间-时序三维评估框架——VLM + 目标检测 + ViT 组合式视频编辑评测 论文: SST-EM arXiv: 2501.07554 机构: 未披露 6.1 研究动机 核心问题: 编辑任务分类法如何标准化 CLIP 文本分数受训练数据和层级依赖限制,图像分数无法评估时间一致性,需要一个同时覆盖语义、空间和时间维度的综合指标。 前序工作及局限: InstructPix2Pix 3 类:风格/对象/背景,过于粗糙 TGVE 4 类:风格/语义/结构/混合 与前序工作的本质区别: IVEBench 8 类 35 子类和 VEFX-Bench 9 类 32 子类代表当前最细化的分类。 6.2 方法原理 四组件管线: VLM 提取每帧语义信息 目标检测追踪主要物体位置 LLM Agent 精炼物体识别和上下文理解 ViT 评估帧间时间一致性 权重标定:统一指标权重通过人类评估数据 + 回归分析标定,最终输出语义保真度和时间平滑度的综合分数。 6.3 核心创新 首个组合 VLM + 目标检测 + ViT 的视频编辑评估框架 四阶段管线:语义提取→目标跟踪→LLM 精炼→时间一致性评估 人类评估回归权重标定 超越 CLIP 文本/图像分数的多维评估 6.4 实验结果 在多个视频编辑场景下,SST-EM 与人类评估的相关性显著优于 CLIP-T、CLIP-I 等传统指标,尤其在时间一致性评估上优势明显。代码已开源。 6.5 关键洞察 优势:管线式设计模块化程度高,每个组件可独立替换升级。 局限:四阶段串行推理速度慢;依赖多个外部模型(VLM + 检测器 + LLM + ViT),部署成本高;权重标定依赖特定人类评估数据集,泛化性存疑。 技术演进定位:分类法正在趋向收敛——相机控制、实例操作、属性修改、风格变换、视觉特效已成为公认的核心类别。 可能的后续方向: 统一编辑 ontology 标准 按难度分层的自适应评测 7. VEditBench:420 视频 + 6 编辑任务 + 9 评估维度——文本引导视频编辑的整体基准 论文: VEditBench arXiv: 2501.11048 机构: NUS / Intel / UC Berkeley 7.1 研究动机 核心问题: 长视频编辑的评测挑战 缺乏一个在通用视频编辑框架下同时覆盖多种编辑任务和时长范围的标准化基准。 前序工作及局限: VEditBench 短+长:首次覆盖 10-20s 长视频 IVEBench 32-1024 帧:覆盖最大帧数范围 与前序工作的本质区别: 发现长视频编辑性能普遍下降 5-15%,但现有指标未充分捕捉时序退化模式。 7.2 方法原理 数据集:420 真实视频(300 短 2-4s + 120 长 10-20s),覆盖多种场景和内容类别。 任务设计(6 类):物体插入、物体删除、物体替换、场景替换、运动变化、风格转换。 评估维度(9 维): 语义对齐:编辑语义 / 原始语义 视觉质量:美学 / 失真 / 时间一致性 额外维度:编辑精度 / 背景保留等 7.3 核心创新 真实世界视频覆盖短(2-4s)和长(10-20s)两种时长 6 种核心编辑任务分类(插入/删除/替换/场景/运动/风格) 9 维度评估全面覆盖语义保真度和视觉质量 10 个 SOTA 方法系统对比 7.4 实验结果 评测 10 个方法,发现长视频编辑性能普遍下降 5-15%;物体插入和运动变化是最困难的任务;风格转换相对容易。所有方法在语义对齐上差异较大,但视觉质量差异较小——与后续 VEFX-Bench 结论一致。 7.5 关键洞察 优势:短+长视频双覆盖设计实用,6 类任务分类简洁清晰。 局限:420 视频规模中等;评估维度未明确区分编辑特有 vs 通用画质指标;缺少人工标注偏好数据。 技术演进定位:长视频评测仍是开放挑战,需要新的时间维度指标。 可能的后续方向: 分段评估+全局一致性联合指标 时间维度上的退化曲线分析 其余论文速览 1. EditBoard:提出 EditBoard 综合评测基准 EditBoard: Towards A Comprehensive Evaluation Benchmark for Text-Based Video Editing Models | Cornell University / Nanjing University / University of Oxford | arXiv:2409.09668 关键词: 综合评测基准·多维度指标·文本视频编辑 前序工作问题: 当前视频编辑模型评估缺乏全面基准,现有方法仅用单一分数概括性能,无法细致分析模型在不同编辑任务中的表现。 贡献: 提出 EditBoard 综合评测基准,设计 4 个维度 9 个自动评估指标的评估框架,覆盖 4 个任务类别,标准化视频编辑评估流程。 效果: 为视频编辑模型提供了标准化评估工具,能够细致分析模型在不同编辑任务中的表现,推动视频编辑技术的标准化和进一步发展。 批判点评: 优势:填补了视频编辑模型评估基准的空白,多维度评估框架设计合理。局限:数据集规模未明确说明;评估维度未充分考虑时序一致性这一视频特有挑战。 2. I2EBench:构建 I2EBench 基准 I2EBench: A Comprehensive Benchmark for Instruction-based Image Editing | Xiamen University / 鹏城实验室 / 北京大学 | arXiv:2408.14180 关键词: 图像编辑评测·16维度·人类感知对齐·NeurIPS 2024 前序工作问题: 指令驱动的图像编辑(IIE)模型缺乏综合评测基准,现有指标无法全面覆盖高层次语义理解和低层次图像质量。 贡献: 构建 I2EBench 基准,包含 2000+ 待编辑图像和 4000+ 条指令,设计 16 个评估维度,并通过大量用户研究确保基准与人类感知高度一致。 效果: 为图像编辑模型提供了首个综合评测基准,16 个维度覆盖语义理解和图像质量,分析方法为视频编辑评测提供了可迁移方法论。 批判点评: 优势:16 维度设计全面,人类感知对齐做得好。局限:针对图像编辑而非视频编辑;部分维度(如时序一致性)在图像场景中不存在,迁移到视频需要适配。 3. T2VEval-Bench:构建 T2VEval-Bench 多维度评测基准数据集 T2VEval: Benchmark Dataset and Objective Evaluation Method for T2V-generated Videos | 中国传媒大学 信息与通信工程学院 | arXiv:2501.08545 关键词: 文本生成视频·多维度评测·主观客观融合·中国传媒大学 前序工作问题: 文本生成视频(T2V)模型缺乏统一的多维度评测基准,主观评价和客观评价方法各自存在局限性,无法全面评估生成视频质量。 贡献: 构建 T2VEval-Bench 多维度评测基准数据集,包含 148 个文本提示和 1783 个生成视频;提出 T2VEval 评估模型,从质量、真实感、一致性三个分支进行客观评估,达到 SOTA 人类相关性。 效果: 为文本生成视频提供了大规模评测基准,三分支评估模型可部分迁移到视频编辑评测场景,尤其是一致性评估维度与编辑排他性高度相关。 批判点评: 优势:主观+客观融合评估思路先进,数据集规模较大。局限:针对文本生成视频而非编辑场景;一致性分支主要评估生成稳定性,与编辑场景的源视频保真度存在差异。 横向对比与技术脉络总结 7 大视频编辑评测方法横向对比 论文 发表 数据规模 评测维度 自动指标类型 人工标注 任务分类 核心创新 VEFX-Bench 2026.04 5049 样本 3 维解耦 Reward Model 三维 4 分制 9 类 32 子类 序数回归 RM IVEBench ICLR 2026 600 视频 3 维评估 传统+MLLM 无 8 类 35 子类 MLLM 融合 FiVE-Bench ICCV 2025 100 视频 5 维 14 指标 传统+VLM 无 6 类 FiVE-Acc EditReward ICLR 2026 200K 偏好对 综合 Reward Model 专家偏好 通用 200K 数据 VE-Bench AAAI 2025 ~170 视频 综合 评估网络 MOS 24人 3 类 首个 VQA SST-EM WACV 2025 - 3 维管线 VLM+检测+ViT 权重标定 - 组合式评估 VEditBench ICLR 2025 420 视频 9 维 传统 无 6 类 短+长视频 核心技术趋势 三维解耦评测成为共识 IF(指令遵循)/ RQ(渲染质量)/ EE(编辑排他性)三维独立评估已成为 VEFX-Bench 和 IVEBench 的共同设计,正在取代单一综合分数。 Reward Model 取代手工指标 从 CLIP-Score/LPIPS/FVD 到学习型 Reward Model(VEFX-Reward/EditReward),评测精度大幅提升,且可直接用于下游 RLHF/DPO 训练。 MLLM 深度融入评测管线 IVEBench 和 SST-EM 将 MLLM 评估融入标准管线,FiVE-Acc 用 VLM 判定编辑成功率。但 MLLM 版本变化导致的结果漂移是待解决的风险。 评测任务分类趋向精细化 从 3-4 类到 8-9 大类 32-35 子类,相机控制、实例操作、属性修改、风格变换、视觉特效成为公认核心类别。 长视频评测成为开放挑战 VEditBench 首次发现长视频编辑性能下降 5-15%,但现有指标未充分捕捉时序退化模式,需要新的时间维度评估方法。 人工智能炼丹君 整理 | 数据来源:arXiv 2024年8月 — 2026年4月(涵盖 AAAI/WACV/ICLR/ICCV 2025-2026 评测基准爆发期)
-
AIGC 每日速读|2026-04-24|Wan-Image 今日核心看点 阿里 Wan-Image 统一视觉生成 Google Vision Banana 生成即理解 LLaDA2.0 离散扩散统一多模态 DynamicRad 视频扩散 2.5x 加速 字节 MMCORE 轻量统一框架 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 生成理解一体化 — 3 篇(LLaDA2.0-Uni、Vision Banana、MMCORE) 图像生成与编辑 — 4 篇(万象图像系统、编辑定位、扩散幻觉检测、空间智能基准) 视频生成 — 1 篇(长视频稀疏注意力加速) 音频与语音 — 1 篇(流式目标说话人提取) 生成模型训练与优化 — 1 篇(半监督流匹配遥感融合) 涵盖 arXiv 最新 127 篇候选中精选 今日论文速览 1. Wan-Image:提出 Wan-Image 统一视觉生成系统 Wan-Image: Pushing the Boundaries of Generative Visual Intelligence | Alibaba Group (Tongyi Lab) | arXiv:2604.19858 关键词: 统一视觉生成·文字渲染·多主体保持·4K合成 前序工作问题: 当前扩散模型在专业设计场景中缺乏绝对可控性,尤其在复杂排版渲染、多主体身份保持和精细交互编辑方面力不从心 贡献: 提出 Wan-Image 统一视觉生成系统,融合 LLM 认知能力与 DiT 像素合成,通过大规模多模态数据扩展和强化学习训练,解锁超长文本渲染、调色板引导、多主体保持、原生 Alpha 通道等专业功能 效果: 在多项人类评估中超越 Seedream 5.0 Lite 和 GPT Image 1.5,在高难度任务中与 Nano Banana Pro 持平,支持原生 4K 高效合成 批判点评: 模型参数量和训练成本未公开,「专业级生产力工具」的定位缺少与 Adobe Firefly 等商业工具的定量用户研究;多主体保持在相似外观角色间的区分能力未充分测试 2. LLaDA2.0-Uni:提出基于离散扩散的统一大语言模型 LLaDA2.0-Uni LLaDA2.0-Uni: Unifying Multimodal Understanding and Generation with Diffusion Large Language Model | Inclusion AI, Westlake University, Zhejiang University | arXiv:2604.20796 关键词: 离散扩散LLM·多模态统一·MoE·交错生成 前序工作问题: 现有多模态模型难以在统一框架内同时实现高质量的视觉理解和图像生成,自回归与扩散范式各有局限 贡献: 提出基于离散扩散的统一大语言模型 LLaDA2.0-Uni,结合语义离散分词器 SigLIP-VQ、MoE 主干和扩散解码器,支持块级掩码扩散同时处理文本和视觉输入,并通过前缀感知优化和少步蒸馏提速 效果: 在多模态理解上匹配专用 VLM 水平,图像生成和编辑表现出色,原生支持交错生成和推理,代码和模型已开源 批判点评: 离散扩散 LLM 的并行解码虽然快但牺牲了自回归模型的逐步纠错能力;SigLIP-VQ 的量化损失对精细纹理和小物体的影响需要更多消融实验 3. Vision Banana:证明图像生成预训练可以学到强大通用视觉表征 Image Generators are Generalist Vision Learners | Google DeepMind | arXiv:2604.20329 关键词: 生成预训练·视觉理解·统一模型·指令微调 前序工作问题: 图像生成模型是否真正学会了视觉理解一直缺乏有力证据,生成与理解的关系尚不明确 贡献: 证明图像生成预训练可以学到强大通用视觉表征,通过将视觉任务输出参数化为 RGB 图像实现感知即生成,在 Nano Banana Pro 基础上指令微调得到 Vision Banana 通才模型 效果: 在分割(超越 SAM3)、深度估计(超越 Depth Anything)等 2D 和 3D 视觉任务上达到 SOTA,且不牺牲图像生成能力 批判点评: 将所有视觉任务输出编码为 RGB 图像是一种巧妙但有局限的参数化方式,对检测框回归等需要精确数值的任务可能力不从心;实验依赖 Nano Banana Pro 这一未开源的强基座,可复现性受限 4. MMCORE:提出 MMCORE 轻量统一框架 MMCORE: MultiModal COnnection with Representation Aligned Latent Embeddings | ByteDance | arXiv:2604.19902 关键词: 多模态统一·VLM引导·轻量连接·表征对齐 前序工作问题: 现有统一多模态生成模型要么需要从头训练自回归+扩散深度融合架构,要么计算成本极高 贡献: 提出 MMCORE 轻量统一框架,利用预训练 VLM 通过可学习查询 token 预测语义视觉嵌入,再作为扩散模型的条件信号,无需深度融合或从头训练即可将 VLM 的理解推理能力迁移至视觉生成 效果: 在文生图、交错图像生成和单/多图编辑基准上全面超越 SOTA 基线,空间推理和视觉定位等复杂场景表现突出 批判点评: 「轻量连接」本质上限制了 VLM 与扩散模型之间的信息传递带宽,对需要精细像素级控制的任务(如 inpainting 边界)可能成为瓶颈;多图编辑的一致性在长序列交错场景下未充分验证 5. DynamicRad:提出 DynamicRad 统一稀疏注意力范式 DynamicRad: Content-Adaptive Sparse Attention for Long Video Diffusion | UESTC, Michigan State University | arXiv:2604.20470 关键词: 视频扩散加速·稀疏注意力·贝叶斯优化·自适应 前序工作问题: 视频扩散模型的全注意力计算随序列长度二次增长,静态稀疏掩码在复杂动态场景中丢失关键长程信息 贡献: 提出 DynamicRad 统一稀疏注意力范式,基于径向局部性先验实现自适应稀疏选择,双模式策略(静态比率+动态阈值)配合离线贝叶斯优化和语义运动路由器,零运行时开销实现内容自适应 效果: 在 HunyuanVideo 和 Wan2.1-14B 上实现 1.7-2.5 倍推理加速,有效稀疏度超 80%,动态模式在部分长序列设置中甚至匹配或超越全注意力基线 批判点评: 离线贝叶斯优化虽避免了在线开销,但优化的超参可能对分布外视频内容泛化不佳;语义运动路由器仅依赖 prompt 嵌入,忽略了视觉内容本身的复杂度信号 6. TAL-Edit:提出无需训练的任务感知编辑定位框架 Rethinking Where to Edit: Task-Aware Localization for Instruction-Based Image Editing | University of Sydney | arXiv:2604.20258 关键词: 图像编辑·任务感知·编辑定位·无需训练 前序工作问题: 指令驱动的图像编辑模型缺乏显式编辑定位机制,不同编辑操作(添加、移除、替换)的空间模式差异被忽略,导致频繁过度编辑 贡献: 提出无需训练的任务感知编辑定位框架,利用 IIE 模型内在的源图和目标图双流注意力构建编辑线索和特征质心,将 token 划分为编辑区和非编辑区,并按任务类型选择性融合双流信息 效果: 在 EdiVal-Bench 上持续提升非编辑区域一致性,同时保持强指令跟随性能,可即插即用于多种强图像编辑骨干 批判点评: 无需训练的优势以牺牲精度为代价,注意力图质心分割在精细边界处可能不够准确;任务类型的自动识别依赖启发式规则,对模糊指令(如「让这张图更好看」)的任务分类可能出错 7. HEaD+:提出 HEaD+ 幻觉早期检测框架 Hallucination Early Detection in Diffusion Models | University of Modena, University of Trento | arXiv:2604.20354 关键词: 扩散幻觉·早期检测·跨注意力·种子筛选 前序工作问题: 扩散模型在多物体生成时频繁出现物体遗漏幻觉,现有方法聚焦于优化潜空间,忽略了初始种子的决定性影响 贡献: 提出 HEaD+ 幻觉早期检测框架,融合跨注意力图、文本信息和预测最终图像三重信号,在去噪早期阶段判断当前种子是否会产生完整生成,决定是否切换种子重启 效果: 4 个物体场景下完整生成成功率提升 6-8%,生成时间最多减少 32%,在 45K 图像的 InsideGen 数据集上训练和验证 批判点评: 6-8% 的成功率提升幅度有限,随着物体数量增加效果可能递减;早期检测阈值的选择依赖经验调参,缺乏自适应机制;与 Attend-and-Excite 等注意力引导方法的组合效果未探索 8. CISAR:提出首个面向流式场景的自回归目标说话人提取模型 Towards Streaming Target Speaker Extraction via Chunk-wise Interleaved Splicing of Autoregressive Language Model | Tencent AI Lab, Tsinghua University | arXiv:2604.19635 关键词: 流式语音·目标说话人·自回归·块间拼接 前序工作问题: 生成式目标说话人提取模型依赖全局上下文,直接适配流式场景会导致灾难性推理性能退化 贡献: 提出首个面向流式场景的自回归目标说话人提取模型,核心创新为块间交错拼接范式(CISAR),配合历史上下文精炼机制消除边界不连续性 效果: 在 Libri2Mix 上保持 100% 推理稳定性和优越可懂度,流式结果媲美甚至超越离线基线,消费级 GPU 上 RTF 仅 0.248 批判点评: Libri2Mix 是干净的朗读语音混合数据集,在噪声环境和远场麦克风等真实场景下的表现需要验证;块大小的选择对延迟-质量的权衡影响未充分分析 9. SSFM-Fusion:提出半监督流匹配框架 Semi-Supervised Flow Matching for Mosaiced and Panchromatic Fusion Imaging | Harbin Institute of Technology (Shenzhen) | arXiv:2604.20128 关键词: 流匹配·半监督·图像融合·高光谱 前序工作问题: 低分辨率马赛克高光谱图像与高分辨率全色图像的融合是严重病态问题,现有扩散方法受限于特定协议和人工假设 贡献: 提出半监督流匹配框架,将无监督先验网络与条件流匹配模型两阶段结合,引入随机投票机制迭代精炼和无冲突梯度引导策略,实现光谱和空间一致的高分辨率重建 效果: 在多个基准数据集上大幅超越代表性基线方法,生成质量和效率显著提升 批判点评: 遥感融合是相对小众的应用场景,流匹配在此领域的优势相比传统方法的边际增益需要实际部署验证;两阶段训练管线增加了工程复杂度 10. GSI-Bench:提出首个生成式空间智能基准 GSI-Bench Exploring Spatial Intelligence from a Generative Perspective | Zhejiang University | arXiv:2604.20570 关键词: 空间智能·生成式评测·3D约束·图像编辑 前序工作问题: 现有多模态模型基准仅从理解角度评估空间智能,忽略了生成模型在 3D 空间约束下的图像生成能力 贡献: 提出首个生成式空间智能基准 GSI-Bench,包含真实数据集 GSI-Real(3D 先验引导过滤)和合成数据集 GSI-Syn(可控空间操作+自动标注),统一评估空间合规性和编辑保真度 效果: 在 GSI-Syn 上微调统一多模态模型后,合成和真实任务均显著提升,且首次证明生成式训练能增强空间理解能力 批判点评: GSI-Syn 的合成数据与真实场景仍存在域差距,微调增益能否泛化到 GSI-Real 之外的开放场景未充分验证;评估协议的「空间合规性」指标定义偏简化,难以覆盖复杂多物体遮挡场景 趋势观察 生成与理解的统一正在加速 — LLaDA2.0-Uni、Vision Banana、MMCORE 三篇论文从不同路径(离散扩散、生成预训练、轻量连接)推进生成-理解统一,「生成即理解」成为新共识 视觉生成从「能用」走向「专业级」 — Wan-Image 瞄准专业设计场景(文字渲染、4K 合成、Alpha 通道),标志着生成模型从展示性 demo 向生产力工具转型 视频扩散推理加速的新范式 — DynamicRad 用自适应稀疏注意力在 HunyuanVideo 上实现 2.5x 加速且不损质量,离线 BO+语义路由的思路值得关注 图像编辑的精细化控制 — TAL-Edit 从任务感知定位角度推动编辑精度提升,HEaD+ 从幻觉检测角度减少多物体遗漏,GSI-Bench 建立生成式空间智能评测基准 流式音频生成的突破 — CISAR 首次将自回归生成模型应用于流式目标说话人提取,证明 AR 骨干在低延迟场景的可行性 人工智能炼丹君 整理 | 2026-04-24
-
AIGC 每日速读|2026-04-23|淘宝试穿上线-Google城市视频-GRPO优化扩散 今日核心看点 淘宝虚拟试穿 Tstars-Tryon Google 城市视频 CityRAG 图像优先人体视频 ReImagine 统一音频前端 UAF 单步扩散加速 OSD-IRF 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 图像生成与编辑 — 4 篇(虚拟试穿、照片编辑、偏见缓解、图像优先视频) 视频生成 — 3 篇(人物交互、城市视频、人体视频) 音频与语音 — 1 篇(统一音频前端 LLM) 生成模型训练与优化 — 2 篇(离散扩散 GRPO、过程级信用分配) 涵盖 HuggingFace 热门 + arXiv 最新 159 篇候选中精选 今日论文速览 1. Tstars-Tryon 1.0:提出商业级虚拟试穿系统 Tstars-Tryon 1.0: Robust and Realistic Virtual Try-On for Diverse Fashion Items | Alibaba (Taobao & Tmall Group) | arXiv:2604.19748 关键词: 虚拟试穿·图像生成·扩散模型·商业部署 前序工作问题: 现有虚拟试穿方法在极端姿态、光照变化、运动模糊等真实场景下成功率低,无法满足商业级部署需求 贡献: 提出商业级虚拟试穿系统,支持 6 张参考图多品类合成(8 类时尚单品),集成端到端模型架构、可扩展数据引擎和多阶段训练范式,已在淘宝 App 大规模上线 实验结果: 已部署服务数百万日活用户,累计处理数千万请求;支持 8 大品类(上装/下装/裙装/连体衣/外套/鞋/帽/包),近实时推理速度,跨身份跨背景生成 批判点评: 工业系统论文,技术细节披露有限,核心架构和训练数据均未开源,学术复现性低;「数百万用户」的指标缺少与同类商业方案的定量对比 2. CoInteract:提出空间结构化协同生成框架 CoInteract: Physically-Consistent Human-Object Interaction Video Synthesis via Spatially-Structured Co-Generation | Zhejiang University, Alibaba | arXiv:2604.19636 关键词: 人物交互视频·物理一致·空间结构·协同生成 前序工作问题: 扩散模型在人物-物体交互视频中经常出现手部结构崩塌和物体穿透等物理不一致问题 贡献: 提出空间结构化协同生成框架,将人体与物体解耦为独立的 3D 空间表示,通过物理约束的交互建模确保手部-物体接触的物理一致性 实验结果: 在电商 HOI 视频场景中显著提升结构稳定性和物理真实感;手部-物体穿透率大幅下降,视频 FVD 和 FID 指标全面超越 AnimateDiff、DynamiCrafter 等基线 批判点评: 3D 解耦表示增加了计算复杂度,论文未给出推理速度数据;物理约束仅限于接触层面,对柔体变形和流体交互等更复杂物理现象的泛化性存疑 3. CityRAG:将视频生成与空间检索增强结合(RAG) CityRAG: Stepping Into a City via Spatially-Grounded Video Generation | Google Research | arXiv:2604.19741 关键词: 城市视频生成·空间锚定·3D一致·可导航环境 前序工作问题: 现有视频生成模型缺乏空间锚定能力,无法生成与真实地点对应的 3D 一致可导航视频 贡献: 将视频生成与空间检索增强结合(RAG),利用真实城市数据实现空间锚定的 3D 一致视频合成,可生成真实地点的沉浸式可导航环境 实验结果: 生成视频在 3D 空间一致性和地理位置对应关系上优于 WonderWorld 和 SceneScape 等基线,FVD 和空间误差指标均有显著改善 批判点评: RAG 范式依赖高质量街景数据库覆盖度,对数据稀疏地区效果可能大打折扣;生成视频的分辨率和时长限制未明确说明,实用性有待验证 4. SmartPhotoCrafter:提出统一推理-生成-优化框架 SmartPhotoCrafter: Unified Reasoning, Generation and Optimization for Automatic Photographic Image Editing | University of Electronic Science and Technology of China | arXiv:2604.19587 关键词: 照片编辑·审美推理·自动优化·统一框架 前序工作问题: 传统照片编辑需要用户具备充分的美学理解才能给出正确的调整指令,极大限制了普通用户的使用体验 贡献: 提出统一推理-生成-优化框架,自动理解图像美学缺陷并生成编辑方案,无需用户提供显式指令即可完成专业级照片优化 实验结果: 实现从「用户指令驱动」到「AI 自主推理驱动」的范式转变,在多种照片编辑场景下美学评分和用户满意度均优于 InstructPix2Pix 等基线 批判点评: 「美学」标准高度主观,论文的评估指标能否充分反映真实用户偏好值得商榷;自动编辑可能与专业摄影师的创作意图冲突,缺少人机协作模式设计 5. UDM-GRPO:系统分析了 UDM 中 GRPO 不稳定的根源 UDM-GRPO: Stable and Efficient Group Relative Policy Optimization for Uniform Discrete Diffusion Models | Tsinghua University, ByteDance | arXiv:2604.18518 关键词: 离散扩散·GRPO·强化学习·训练稳定性 前序工作问题: 将 GRPO 直接应用于均匀离散扩散模型(UDM)会导致训练不稳定和性能提升有限 贡献: 系统分析了 UDM 中 GRPO 不稳定的根源,提出针对离散扩散模型的稳定高效 GRPO 变体,解决梯度方差和策略漂移问题 实验结果: 在离散文本生成和图像生成任务上显著提升训练稳定性和生成质量,梯度方差降低 2-3 个量级,策略漂移控制在可接受范围内 批判点评: 实验仅在离散扩散模型上验证,未证明方法是否可迁移到连续扩散模型;与 DPO/PPO 等替代强化学习算法的对比不够充分 6. ReImagine:提出「图像优先」策略 ReImagine: Rethinking Controllable High-Quality Human Video Generation via Image-First Synthesis | SSE, CUHK-Shenzhen | arXiv:2604.19720 关键词: 人体视频生成·图像优先·姿态控制·SMPL-X 前序工作问题: 人体视频生成需要同时建模外观、运动和相机视角,在有限多视角数据下难以兼顾可控性和视觉质量 贡献: 提出「图像优先」策略,先通过预训练图像模型学习高质量人体外观,再结合 SMPL-X 运动引导和无需训练的视频扩散时序精炼,实现姿态和视角可控的人体视频生成 实验结果: MVHumanNet++ 上 FVD 0.275(vs Wan-Ani 0.403 降低 31.8%),FID 36.23(vs Qwen 46.33 降低 21.8%),LPIPS 0.165 最优;用户研究偏好率 41.8%(视角一致性),显著领先 批判点评: 图像优先策略将时序一致性完全托付给后续精炼阶段,快速运动和复杂遮挡场景可能出现时序伪影;SMPL-X 依赖限制了对穿裙装等宽松服饰的建模能力 7. UAF:提出首个统一音频前端 LLM UAF: A Unified Audio Front-end LLM for Full-Duplex Speech Interaction | NTU, Intel Labs | arXiv:2604.19221 关键词: 全双工语音·统一前端·自回归·流式推理 前序工作问题: 传统级联语音处理管线存在累积延迟和错误传播问题,现有端到端模型仍依赖独立的前端组件(VAD、转场检测等) 贡献: 提出首个统一音频前端 LLM,将 VAD、转场检测、说话人识别、ASR 和 QA 五大前端任务统一为单一自回归序列预测问题,支持 600ms 流式音频块输入 实验结果: VAD F1 97.57%(SOTA),极端噪声 2dB 下 ASR WER 5.34(vs Qwen3-Omni 38.60 降低 86%),中断检测 100% 准确率,真实场景 Online-test WER 13.75(vs Qwen3-Omni 17.83 降低 23%) 批判点评: 统一五大任务到一个模型可能导致各任务间的性能权衡,论文未充分讨论多任务冲突;600ms 块大小对于实时对话仍有可感知延迟,距离真正的零延迟交互尚有差距 8. Embedding Arithmetic:提出推理时嵌入空间算术方法 Embedding Arithmetic: A Lightweight, Tuning-Free Framework for Post-hoc Bias Mitigation in Text-to-Image Models | Fraunhofer IKS | arXiv:2604.18167 关键词: T2I公平性·嵌入空间·无需训练·偏见缓解 前序工作问题: 文生图模型放大社会偏见(如性别、种族),现有去偏方法需要修改模型权重或提示词,且难以平衡公平性与语义保真 贡献: 提出推理时嵌入空间算术方法,通过分析和校正条件嵌入空间中的偏见结构来缓解社会偏见,无需修改模型权重或数据集,同时提出概念一致性评分(CCS)替代 CLIP Score 实验结果: FLUX 上平均性别熵 0.88(vs 默认 0.15 提升 487%),种族熵 0.86(vs 默认 0.16 提升 438%),CCS 保持 0.60 与默认模型持平;SD 3.5-Large 上效果一致 批判点评: 嵌入空间的「偏见方向」定义高度依赖先验标注,对交叉性偏见(如性别×种族)的处理能力不明;CCS 指标虽弥补了 CLIP Score 的不足,但其自身的有效性需要更大规模的人类评估验证 9. OTCA:提出目标感知轨迹信用分配框架(OTCA) Learning to Credit the Right Steps: Objective-aware Process Optimization for Visual Generation | NWPU, Kuaishou | arXiv:2604.19234 关键词: 视觉生成·过程优化·GRPO·信用分配 前序工作问题: 现有 GRPO 训练将多维度奖励压缩为单一标量并均匀传播到整个去噪轨迹,忽略了不同去噪步骤的阶段性功能差异 贡献: 提出目标感知轨迹信用分配框架(OTCA),包含轨迹级信用分解和多目标信用分配两大模块,将粗粒度奖励信号转化为时间步感知的结构化训练信号 实验结果: 图像生成 CLIP-T 0.3071(vs Flux 基线 0.2682 提升 14.5%),ImageReward 1.1998(vs DanceGRPO 1.0172 提升 17.8%);视频生成 VBench 总分 82.01(vs 基线 81.26),动态度提升 5.0%,空间关系提升 6.4% 批判点评: 信用分配的时间步粒度假设(早期步骤负责构图、晚期负责细节)过于简化,不同架构和调度器下该假设可能不成立;方法引入额外的奖励分解计算,训练成本增加但论文未量化开销 10. OSD-IRF:提出 OSD-IRF One-Step Diffusion with Inverse Residual Fields for Unsupervised Industrial Anomaly Detection | UESTC | arXiv:2604.18393 关键词: 单步扩散·异常检测·逆残差场·推理加速 前序工作问题: 扩散模型在工业异常检测中性能优异但迭代去噪导致推理速度慢 贡献: 提出 OSD-IRF,基于训练好的 DDPM 噪声函数预测逆残差场(IRF),通过评估 IRF 在高斯分布下的概率密度实现单步异常检测,发现异常在 IRF 空间中可区分这一关键现象 实验结果: MVTec-AD mAD 85.7(SOTA),MPDD mAD 83.8(vs InvAD 80.1 提升 3.7),推理速度 133-212 FPS(vs InvAD 88-120 加速约 1.5x,vs DiAD 0.1 FPS 加速 1000x+) 批判点评: 相对于一步蒸馏方法加速幅度有限;IRF 的高斯分布假设在复杂工业场景下可能不成立,对分布外异常类型的鲁棒性需要更多验证 趋势观察 视觉生成的强化学习后训练 — UDM-GRPO 和 OTCA 分别从离散扩散模型和信用分配角度推进 GRPO 在视觉生成中的应用 商业级生成系统落地 — Tstars-Tryon 已在淘宝服务数百万用户,SmartPhotoCrafter 实现全自动照片编辑 人体视频生成的可控性突破 — ReImagine 的图像优先策略和 CoInteract 的物理一致性框架分别从不同角度提升人体视频质量 扩散模型推理加速 — OSD-IRF 实现单步扩散异常检测(2x 加速),无需蒸馏即可保持性能 语音交互统一化 — UAF 将五大音频前端任务统一为单一自回归模型,RTF 0.248 接近实时 人工智能炼丹君 整理 | 2026-04-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-04-22|武大MemWN按需记忆撑起长视频一致性 今日核心看点 解耦记忆长视频 MemWN 一步文本生成 EMF 投机解码加速 2.09x 多事件视频+33.5% 编辑 RLHF 后训练 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 视频生成(4篇):长视频空间一致性 MemWN、多事件生成 TS-Attn、人体视频 ReImagine、视频到音乐 Video-Robin 推理加速(3篇):投机解码 SDVG、稀疏注意力聚类 AdaCluster、Patch 级自适应采样 Patch Forcing 图像生成与编辑(3篇):一步文本生成 EMF、人类偏好编辑 HP-Edit、扩散引导检测 DGSSM 含 CVPR 2026 接收,多篇开源代码,覆盖视频/图像/音频三大生成方向 今日论文速览 1. MemWN:提出解耦记忆控制框架 MemWN Memorize When Needed: Decoupled Memory Control for Spatially Consistent Long-Horizon Video Generation | Wuhan University | arXiv:2604.18215 关键词: 长视频生成·空间一致性·解耦记忆·相机轨迹·按需记忆 前序工作问题: 现有长视频生成方法将记忆建模与生成过程耦合,导致场景重访时空间一致性差,相机运动下物体位置和外观不连贯。 贡献: 提出解耦记忆控制框架 MemWN,将记忆建模与视频生成分离。混合记忆表示捕获时间+空间双重线索,逐帧交叉注意力精准注入记忆,相机感知门控智能判断何时使用记忆。 效果: 在长视频生成基准上取得 SOTA,场景重访空间一致性大幅提升,训练成本显著降低。 2. EMF:首次将 MeanFlow 框架从类别标签扩展到文本条件 EMF: Extending One-Step Image Generation from Class Labels to Text via Discriminative Text Representation | Nankai University, Alibaba AMAP-ML | arXiv:2604.18168 关键词: 一步生成·MeanFlow·文本条件·LLM编码器·图像合成 前序工作问题: MeanFlow 等一步生成框架仅支持类别标签条件,无法处理开放文本描述;直接套用文本编码器会因特征区分度不足导致生成质量骤降。 贡献: 首次将 MeanFlow 框架从类别标签扩展到文本条件,实现高效的一步文本到图像生成。揭示了 MeanFlow 少步生成中文本特征需要高区分度的关键洞察,开发了基于 LLM 文本编码器的解决方案。 效果: 在 MeanFlow 框架下首次实现文本条件的一步图像生成,同时在扩散模型上也展示了显著的生成性能提升。代码已开源。 3. TS-Attn:提出免训练的时间可分离注意力机制(TS-Attn) TS-Attn: Temporal-wise Separable Attention for Multi-Event Video Generation | PKU, ZJU, Nankai, MIT, NJU, UCSB | arXiv:2604.19473 关键词: 多事件视频·免训练·时间注意力·Wan2.1·即插即用 前序工作问题: 多事件视频生成中,全局时间注意力导致不同事件的动作特征相互干扰,造成动作保真度与时间连贯性难以兼顾。 贡献: 提出免训练的时间可分离注意力机制(TS-Attn),解决多事件视频生成中动作保真度与时间一致性的固有矛盾。可即插即用到 Wan2.1-T2V-14B 等预训练模型中。 效果: 在 Wan2.1-T2V-14B 上 StoryEval-Bench 提升 33.5%,在 Wan2.2-T2V-A14B 上提升 16.4%,推理开销仅 +2%。代码已开源。 4. SDVG:首次将投机解码引入自回归视频扩散模型加速 Speculative Decoding for Autoregressive Video Generation | Independent Research | arXiv:2604.17397 关键词: 投机解码·自回归视频·加速推理·ImageReward·免训练 前序工作问题: 自回归视频扩散模型逐帧生成速度极慢,LLM 领域成熟的投机解码策略尚未被引入视频生成场景。 贡献: 首次将投机解码引入自回归视频扩散模型加速。用 1.3B 小模型起草候选块,ImageReward 路由器以最差帧评分筛选,实现免训练、无需架构修改的视频生成加速。 效果: 在 MovieGenVideoBench 上,保持 98.1% 质量实现 1.59× 加速,或 2.09× 加速保持 95.7% 质量,始终比纯 Draft 高 >17%。 5. ReImagine:提出先图像后视频的人体视频生成范式 ReImagine: Rethinking Controllable High-Quality Human Video Generation via Image-First Synthesis | CUHK(SZ), SSE, FNii | arXiv:2604.18300 关键词: 人体视频·SMPL-X·图像先验·视角控制·免训练精炼 前序工作问题: 端到端人体视频生成同时学习外观质量和时序一致性,两者相互制约导致生成质量受限,且缺乏精细的姿态和视角控制。 贡献: 提出先图像后视频的人体视频生成范式,将高质量人体外观学习与时序一致性解耦。结合 SMPL-X 姿态引导和预训练视频扩散模型的免训练时序精炼。 效果: 在多样化姿态和视角下生成高质量、时序一致的人体视频。发布了标准化人体数据集和辅助合成模型。代码已开源。 6. DGSSM:提出扩散引导的状态空间模型框架 DGSSM: Diffusion Guided State-Space Models for Multimodal Salient Object Detection | IIT Guwahati | arXiv:2604.18500 关键词: 显著性检测·Mamba·扩散先验·多模态·边界感知 前序工作问题: 现有多模态显著性检测方法依赖 Transformer 的二次复杂度注意力,难以高效建模全局上下文;同时缺乏结构先验导致边界预测粗糙。 贡献: 提出扩散引导的状态空间模型框架,将多模态显著性检测建模为渐进去噪过程。融合 Mamba 高效全局推理与扩散结构先验。 效果: 在 13 个公开基准(RGB、RGB-D、RGB-T)上全面超越现有 SOTA,同时保持紧凑的模型尺寸。 7. Patch Forcing:探索 patch 级别的噪声调度用于图像合成 Denoising, Fast and Slow: Difficulty-Aware Adaptive Sampling for Image Generation | CompVis @ LMU Munich | arXiv:2604.19141 关键词: 自适应去噪·Patch级调度·难度感知·计算优化·扩散模型 前序工作问题: 扩散模型对所有空间区域采用统一的去噪步数,浪费大量计算在已趋向清晰的简单区域上,缺乏空间自适应的采样策略。 贡献: 探索 patch 级别的噪声调度用于图像合成,提出 Patch Forcing 框架,让简单区域先行去噪为困难区域提供上下文。引入自适应难度头按需分配计算资源。 效果: 在 class-conditional ImageNet 上实现优于基线的生成质量,与表示对齐和引导方法正交,可扩展到文本到图像合成。 8. Video-Robin:提出 Video-Robin Video-Robin: Autoregressive Diffusion Planning for Intent-Grounded Video-to-Music Generation | UMD, Microsoft | arXiv:2604.18700 关键词: 视频到音乐·自回归规划·扩散合成·文本条件·DiT 前序工作问题: 现有视频到音乐方法仅依赖视觉特征对齐,缺乏对用户意图的理解,且全局音乐结构建模不足导致生成连贯性差。 贡献: 提出 Video-Robin,结合自回归规划与扩散合成的文本条件视频到音乐生成模型。自回归模块建模全局结构并对齐视觉与文本语义。 效果: 在分布内和分布外基准上均超越仅接受视频输入和额外特征条件的基线,推理速度比 SOTA 快 2.21 倍。 9. HP-Edit:提出 HP-Edit 人类偏好对齐的图像编辑后训练框架 HP-Edit: A Human-Preference Post-Training Framework for Image Editing | HIT, vivo AI Lab | arXiv:2604.19406 关键词: 图像编辑·人类偏好·RLHF·VLM评分器·后训练 前序工作问题: 图像编辑模型训练仅依赖像素级损失,未考虑人类主观偏好,导致编辑结果与用户期望存在系统性偏差;同时缺乏大规模真实世界编辑偏好数据。 贡献: 提出 HP-Edit 人类偏好对齐的图像编辑后训练框架,发布 RealPref-50K 真实世界偏好数据集覆盖 8 类编辑任务。训练 HP-Scorer 自动评分器作为 RLHF 奖励函数。 效果: 显著增强 Qwen-Image-Edit-2509 等模型的输出,使其更贴合人类偏好。同时发布 RealPref-Bench 基准。 10. AdaCluster:提出免训练的自适应聚类稀疏注意力框架 AdaCluster AdaCluster: Adaptive Query-Key Clustering for Sparse Attention in Video Generation | NUS, ByteDance | arXiv:2604.18348 关键词: 稀疏注意力·自适应聚类·视频DiT·加速推理·免训练 前序工作问题: 视频 DiT 的全注意力机制时间复杂度为 O(n²),长视频生成的计算和显存需求极高;现有稀疏注意力方案采用固定模式,无法适应不同层和时间步的动态注意力分布。 贡献: 提出免训练的自适应聚类稀疏注意力框架 AdaCluster,针对视频 DiT 的二次注意力复杂度问题。Q/K 分别采用角度和欧氏距离保持的聚类策略。 效果: 在 CogVideoX-2B、HunyuanVideo 和 Wan-2.1 上实现 1.67-4.31× 加速,质量损失可忽略不计,仅需单张 A40 GPU。 趋势观察 视频生成推理加速多路并进 — 投机解码(SDVG)、自适应稀疏注意力(AdaCluster)和 patch 级自适应采样(Patch Forcing)三种不同思路同时涌现,视频生成的实用化进程加速 免训练方法成为即插即用新常态 — TS-Attn、AdaCluster、ReImagine 的时序精炼均为免训练设计,降低部署门槛的同时保持了高效果 人类偏好对齐从生成扩展到编辑 — HP-Edit 将 RLHF 引入图像编辑后训练,配合 RealPref-50K 数据集和 VLM 评分器,预示编辑模型也将进入偏好对齐时代 长视频与多事件生成攻克一致性 — MemWN 用解耦记忆解决空间一致性,TS-Attn 用时间可分离注意力解决多事件时间一致性,分别从空间和时间维度推进长视频质量 视频-音乐跨模态生成走向可控 — Video-Robin 首次引入文本条件+自回归规划到 V2M 任务,从单纯视觉对齐升级为语义意图驱动的音乐创作 人工智能炼丹君 整理 | 2026-04-22
-
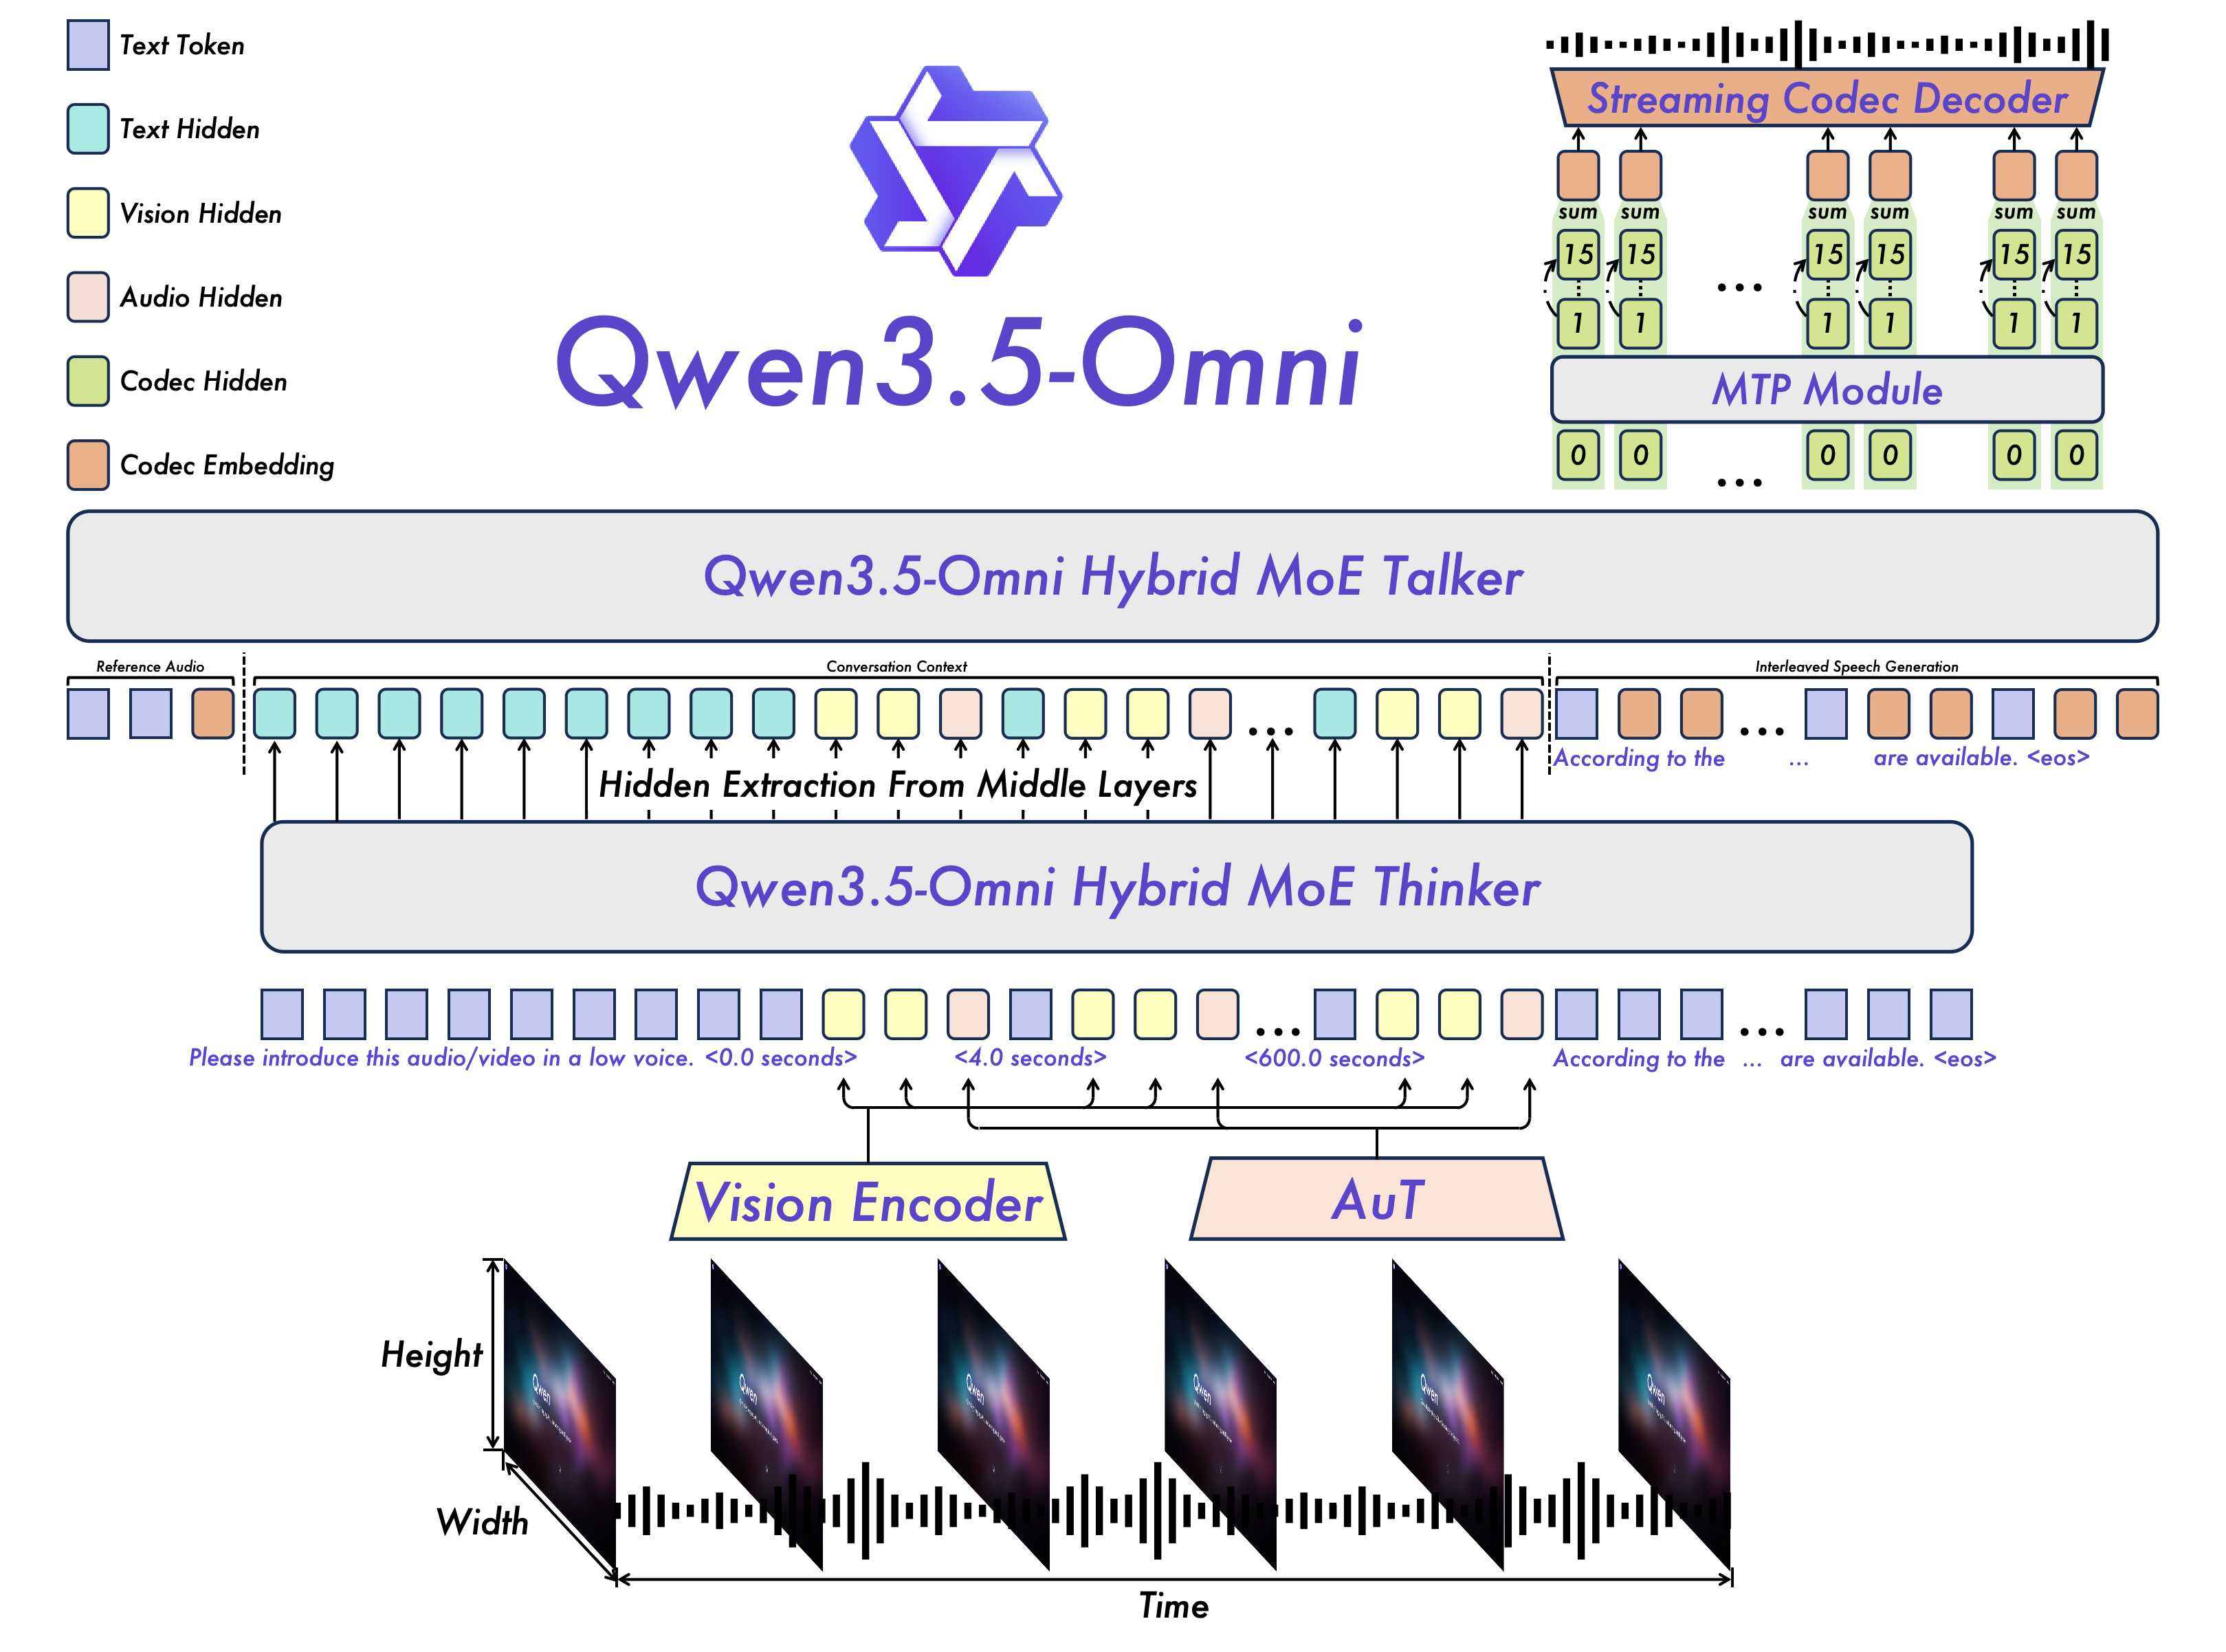
AIGC 每日速读|2026-04-21|Qwen3.5-Omni全模态215项SOTA 今日核心看点 全模态215项SOTA(Qwen3.5-Omni) 音视频联合生成(Seedance 2.0) ImageNet生成新纪录(GRN) 灵活视频Token化(VideoFlexTok) 推理式奖励模型(RationalRewards) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 全模态理解与生成一体化: 3篇 (Qwen3.5-Omni, Audio-Omni, Seedance 2.0) 图像生成与风格迁移: 2篇 (GRN, MAST) 视频生成推理加速: 2篇 (PASA, EfficientVideoDiffusion综述) 视频Token化与高效表示: 1篇 (VideoFlexTok) 视觉生成评测与奖励模型: 1篇 (RationalRewards) 矢量动画生成: 1篇 (LottieGPT) 重点论文深度解读 1. Qwen3.5-Omni 通义千问新旗舰——百亿参数全模态理解与生成一体化,215项评测SOTA | Alibaba | arXiv:2604.15804 关键词: 全模态模型, 生成理解一体化, Thinker-Talker, TMRoPE, 音视频交互, MoE, SOTA 研究动机 核心问题: 如何在单一模型中同时实现文本/图像/视频/音频的顶级理解与生成能力 现有多模态大模型通常在某些模态上表现优异但在其他模态上性能退化,难以做到'全能不偏科'。以往的全模态模型要么理解强但生成弱,要么文本强但语音弱。Qwen团队希望构建一个真正统一的端到端模型,同时实现所有模态的顶级理解与生成能力,特别是实时流式语音交互——这对于下一代人机交互至关重要。前代Qwen2.5-Omni虽然开创了Thinker-Talker架构,但在模型规模和多模态推理深度上仍有提升空间。Qwen3.5-Omni将模型规模扩展到百亿参数级别,并在训练方法论上做出重大改进。 前序工作及局限: GPT-4o:开创端到端全模态交互,但闭源且细节未公开 Gemini Pro系列:Google全模态模型,多模态理解强但音频生成相对弱 Qwen2.5-Omni:首创Thinker-Talker架构,但模型规模和性能有提升空间 Mixtral MoE:MoE在语言模型中的成功应用,启发了多模态场景的专家设计 与前序工作的本质区别: 首个在所有模态上同时达到SOTA且无偏科的全模态模型,TMRoPE时间对齐和MoE理解/生成分离是关键创新 方法原理 Qwen3.5-Omni采用Thinker-Talker双核架构设计: (1) Thinker模块(大脑):接收文本、图像、视频、音频等多模态输入,使用统一的Transformer编码器处理所有模态。视觉编码器和音频编码器均采用分块处理(block-wise)策略实现实时流式输入。输出高层语义表征和对应文本内容。引入MoE混合专家机制,为理解和生成任务分配独立专家组。 (2) Talker模块(发声器官):以流式方式接收Thinker实时输出的语义表征和文本token,流畅合成离散语音单元(speech tokens),再通过解码器转换为自然语音波形。整个过程是端到端的,延迟极低。 (3) TMRoPE位置编码:创新性地在RoPE基础上引入时间对齐机制,使视频帧和音频片段在同一时间轴上精准对齐。这对于理解音视频同步内容(如带字幕的视频、会议录音配PPT)至关重要。 (4) 三阶段预训练:第一阶段视觉与音频编码器独立训练;第二阶段联合全参数训练与多模态整合;第三阶段长序列数据训练提升理解能力。后训练阶段对Thinker和Talker分别进行SFT和DPO优化。 (5) 模型系列包含Base和Plus两个版本,Plus版本进一步增大参数量和训练数据。 核心创新 提出Qwen3.5-Omni,新一代全模态大模型,首次在文本/图像/视频/音频四模态理解与生成中同时达到SOTA 采用Thinker-Talker双核架构:Thinker负责多模态推理生成高层语义表征,Talker以流式方式合成自然语音 提出TMRoPE(Time-aligned Multimodal RoPE)位置编码,通过时间轴对齐实现音视频输入精准同步 引入MoE混合专家设计,在推理和生成各自使用独立专家组,避免能力冲突 Qwen3.5-Omni-Plus在215项音频和音视频理解/推理/交互子任务上达到SOTA,超越Gemini-3.1 Pro 支持256K超长上下文窗口,113种语言识别,完全实时的音视频交互 实验结果 Qwen3.5-Omni-Plus性能亮点: 音频理解:在215项音频和音视频理解/推理/交互子任务和基准上达到SOTA,在关键音频任务上超越Gemini-3.1 Pro 文本→文本:通用文本理解和推理能力保持SOTA水平 图像→文本:多模态理解评估中达到一流水平 视频→文本:视频理解在主要benchmark上表现突出 语音生成:零样本语音合成质量超越多数现有方案,自然度和流畅度均达SOTA 实时交互:支持完全实时的流式音视频交互,延迟控制在百毫秒级 支持256K超长上下文窗口,113种语言识别 批判性点评 新颖性: Thinker-Talker架构延续自Qwen2.5-Omni,3.5版本在规模和训练上做了全面升级。TMRoPE时间对齐和MoE分离理解/生成是有意义的技术创新。整体更偏工程突破而非范式革新。 可复现性: 技术报告详尽但训练数据未完全公开。模型有开源版本(Qwen3.5-Omni)可供复现。基于Transformer+MoE的主体架构可重现性良好。 影响力: 极高——全模态统一模型代表了多模态AI的发展方向,215项SOTA彰显了综合实力。对产业界的实时交互应用(智能助手、客服、教育)有直接推动作用。 深度点评: 215项评测全SOTA — Qwen3.5-Omni 在音频、音视频理解和交互的 215 项子任务上全面达到 SOTA,超越 Gemini-3.1 Pro 全模态三路并进 — Qwen3.5-Omni(Alibaba) + Seedance 2.0(ByteDance) + Audio-Omni(HKUST) 三款全模态统一模型同期发布 高效化全面渗透 — VideoFlexTok(5-10x压缩) + PASA(免训练稀疏注意力) + GRN(自适应步数) 覆盖生成管线每个环节 技术演进定位: 全模态统一模型的重要里程碑,证明了'一个模型搞定一切'的技术可行性 可能的后续方向: 向更大规模(千亿参数)扩展 多模态Agent能力集成 端侧部署的轻量化版本 更丰富的生成模态(3D、代码等) 其余论文速览 1. Seedance 2.0:字节跳动发布Seedance 2.0技术报告 Seedance 2.0: Advancing Video Generation for World Complexity | ByteDance | arXiv:2604.14148 关键词: 视频生成·音视频联合·多模态·动作质量·音频同步 贡献: 字节跳动发布Seedance 2.0技术报告,统一多模态音视频联合生成架构,支持文字/图片/音频/视频四模态输入,集成业界最全面的多模态内容参考和编辑能力。在动作质量和音视频同步两个维度达到3.75分(领先第二名0.65分),音频维度全面领先竞品。 效果: 在VBench等多个基准上超越Sora、Kling等模型,动作质量、音视频同步和音频生成三个维度均达行业最高水平。 2. GRN:提出生成精炼网络(GRN) Generative Refinement Networks for Visual Synthesis | ByteDance Research | arXiv:2604.13030 关键词: 图像生成·精炼网络·HBQ量化·ImageNet SOTA·视觉合成 贡献: 提出生成精炼网络(GRN),核心创新:(1)用理论近无损的分层二进制量化(HBQ)替代传统VQ-VAE等有损离散化,构建高质量连续级潜空间;(2)设计全局精炼机制像人类画家一样逐步完善输出;(3)熵引导采样实现复杂度感知的自适应步数生成。 效果: 在ImageNet上创造图像重建新纪录(0.56 rFID)和类别条件生成新纪录(1.81 gFID),并扩展至文生图和文生视频。 3. VideoFlexTok:Apple与EPFL提出VideoFlexTok VideoFlexTok: Flexible-Length Coarse-to-Fine Video Tokenization | Apple, EPFL | arXiv:2604.12887 关键词: 视频token化·粗到细·灵活长度·高效生成·长视频 贡献: Apple与EPFL提出VideoFlexTok,将视频表示为灵活长度、从粗到细的token序列。前几个token自动捕获抽象语义信息,后续token逐步补充细节。首次实现在81帧10秒视频上训练文生视频模型。 效果: 生成模型规模缩小5-10倍,所需训练token数量减少5-10倍,同时保持生成质量,大幅降低长视频生成的计算成本。 4. PASA:提出精准分配稀疏注意力(PASA) Ride the Wave: Precision-Allocated Sparse Attention for Smooth Video Generation | Unknown | arXiv:2604.12219 关键词: 稀疏注意力·视频生成加速·DiT·免训练·推理优化 贡献: 提出精准分配稀疏注意力(PASA),一个面向视频扩散Transformer的免训练加速框架。针对现有稀疏注意力方法导致的运动不连续和闪烁问题,PASA根据去噪阶段和注意力头的重要性动态分配计算精度,保证关键时域信息完整传递。 效果: 在不损失生成质量的前提下显著降低Video DiT的注意力计算开销,解决了稀疏注意力导致的视频平滑性问题。 5. Audio-Omni:香港科技大学提出Audio-Omni Audio-Omni: Extending Multi-modal Understanding to Versatile Audio Generation and Editing | HKUST | arXiv:2604.10708 关键词: 音频生成·音频编辑·音乐合成·多模态·统一框架 贡献: 香港科技大学提出Audio-Omni,首个统一音频理解、生成和编辑的端到端框架。覆盖通用声音、音乐和语音三大领域,解耦推理与合成实现知识增强生成和跨语言控制等复杂任务。 效果: 在音频理解、音乐生成和语音合成三个领域的多个基准上均达到竞争力水平,首次在单一模型内统一全音频任务。 6. RationalRewards:提出RationalRewards——推理式奖励模型范式 RationalRewards: Reasoning Rewards Scale Visual Generation Both Training and Test Time | Unknown | arXiv:2604.11626 关键词: 奖励模型·视觉生成评测·推理·可解释·偏好学习 贡献: 提出RationalRewards——推理式奖励模型范式。传统视觉生成奖励模型将人类偏好压缩为单一分数,丢失了判断的推理过程。RationalRewards教会奖励模型像人类一样'思考后评分',在训练时提升生成质量,在推理时实现更可解释的评估。 效果: 在视觉生成的训练和测试两个阶段均实现显著提升,构建了可扩展且可解释的奖励建模新范式。 7. MAST:提出MAST——面向多风格迁移的无训练框架 MAST: Mask-Guided Attention Mass Allocation for Training-Free Multi-Style Transfer | Unknown | arXiv:2604.12281 关键词: 风格迁移·无训练·注意力分配·扩散模型·图像编辑 贡献: 提出MAST——面向多风格迁移的无训练框架。通过掩码引导的注意力质量分配(Attention Mass Allocation)显式控制内容和风格信号的注意力交互,解决了扩散模型多风格迁移中的边界伪影、不稳定风格化和结构失真问题。 效果: 在多风格迁移场景下实现无伪影、结构保持的风格化效果,无需额外训练即可应用于现有扩散模型。 8. LottieGPT:CVPR 2026入选论文 LottieGPT: Tokenizing Vector Animation for Autoregressive Generation | CVPR 2026 | arXiv:2604.11792 关键词: 矢量动画·自回归生成·Lottie·CVPR 2026·可编辑 贡献: CVPR 2026入选论文。提出LottieGPT,首次实现矢量动画的自回归生成。构建包含1500万样本的大规模Lottie矢量动画数据集LottieAnimation-660K,将矢量动画结构token化后微调Qwen-VL生成连贯可编辑的矢量动画。 效果: 首次将视频生成扩展到矢量动画领域,生成的动画可直接编辑、分辨率无关,开辟了动画生成新方向。 9. EfficientVideoDiffusion:系统性综述视频扩散模型的高效推理技术 Efficient Video Diffusion Models: Advancements and Challenges | Unknown | arXiv:2604.15911 关键词: 视频扩散·推理加速·稀疏注意力·综述·部署优化 贡献: 系统性综述视频扩散模型的高效推理技术。提出统一分类法将现有方法分为四大加速范式:步骤减少(step reduction)、注意力稀疏化(attention sparsification)、缓存复用(caching)和架构优化(architecture optimization)。全面梳理部署导向的高效化路线。 效果: 首个面向部署的视频扩散模型高效化综述,为研究者和从业者提供了清晰的技术路线图和开源代码仓库。 趋势观察 全模态统一模型竞赛白热化 — Qwen3.5-Omni(Alibaba)、Seedance 2.0(ByteDance)、Audio-Omni(HKUST)三款模型同时瞄准多模态理解与生成一体化——全模态统一成为大厂兵家必争之地 高效化技术全面提速 — VideoFlexTok(5-10倍压缩)、PASA(免训练稀疏注意力)、GRN(自适应步数)——从token化到注意力到生成步骤,视频生成的每个环节都在被优化 人工智能炼丹君 整理 | 2026-04-21
-
AIGC 每日速读|2026-04-10|重新审视可控扩散训练目标——直接x₀监督实现2倍加速 今日核心看点 x₀监督训练加速2倍(x₀-Supervision) 3D场景可控视频生成(LiVER) 图像对训练视频编辑(ImVideoEdit) 个性化审美偏好模型(PAMELA) AR-扩散混合GRPO(MAR-GRPO) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 8 篇,重点解读 1 篇。 方向分布: 可控图像生成与训练优化: 2篇 (x₀-Supervision, DARE) 视频生成与编辑: 2篇 (LiVER, ImVideoEdit) 时尚合成与虚拟试穿: 1篇 — 多条件可控时尚合成(VersaVogue) 个性化生成与偏好模型: 1篇 — 个性化审美偏好学习(PAMELA) 说话人视频情感编辑: 1篇 — 跨模态情感迁移(C-MET) AR-扩散混合模型优化: 1篇 — 稳定混合训练(MAR-GRPO) 重点论文深度解读 1. x₀-Supervision 重新审视可控扩散训练目标——直接x₀监督实现2倍加速 | CEA-LIST | arXiv:2604.05761 关键词: 可控生成, 训练加速, x₀预测, ControlNet, 扩散模型, SDXL 研究动机 核心问题: 可控扩散模型沿用 ε-预测训练目标,导致控制分支训练低效 文本到图像扩散模型在视觉保真度和文本对齐上取得显著进步,但用户需要精确控制图像布局时,自然语言无法可靠表达。可控生成方法通过附加条件增强T2I模型,但先前工作简单沿用与基础模型相同的ε-预测训练损失。作者发现这种做法会导致某些控制条件下训练极慢——特别是当条件信号和干净图像之间的映射关系在不同噪声水平下差异很大时,ε-预测目标给予高噪声时域过大权重,导致训练效率低下。 前序工作及局限: ControlNet/T2I-Adapter:可控生成主流架构,但未优化训练目标 Min-SNR Weighting/P2 Weighting:扩散训练损失加权方法,但未针对可控场景分析 DDPM→v-prediction→x₀-prediction:训练目标演进路线,但此前主要用于无条件/基础模型 Progressive Distillation:使用 x₀ 预测加速蒸馏,但不涉及可控生成 与前序工作的本质区别: 首次从去噪动态角度分析可控生成中训练目标的低效性,给出理论清晰的 x₀-supervision 方案 方法原理 x₀-Supervision框架通过两个核心改进加速可控扩散训练: (1) 训练目标重构:将标准ε-预测损失替换为x₀-预测损失,直接监督网络预测干净图像x₀。数学上等价于对ε-预测损失施加信噪比(SNR)相关的权重调制——低SNR(高噪声)时域权重降低,高SNR(低噪声)时域权重提升。这使得控制分支在训练早期就能获得有效的条件→图像映射信号。 (2) 去噪动态分析:作者系统分析了可控生成中基础模型和控制分支的去噪贡献。发现控制分支在低噪声时域贡献更大(此时条件信号和目标图像的关联最直接),而ε-预测目标恰恰在此区域给予低权重。x₀-supervision修正了这一不匹配。 (3) 评估方法创新:提出mAUCC指标(mean Area Under the Convergence Curve),综合衡量训练过程中的收敛速度,而非仅看最终性能。在ControlNet和T2I-Adapter两种架构上基于SDXL进行验证。 核心创新 深入分析可控扩散模型的去噪动态,揭示标准ε-预测目标在可控生成中的低效性 提出x₀-supervision:直接监督干净目标图像x₀,等价于扩散损失的重新加权 提出mAUCC(均值曲线下面积)新评估指标,首次系统衡量收敛速度 在多种控制条件下(Canny/深度/分割/法线/Tile)收敛速度提升2倍 在ControlNet和T2I-Adapter两种主流架构上均验证有效 实验结果 ControlNet (SDXL): Canny控制:FID 24.7→22.1, mAUCC提升38%, 收敛速度2.0倍 深度图控制:FID 18.3→16.8, mAUCC提升25% 分割图控制:收敛速度1.8倍 T2I-Adapter (SDXL): 5种控制条件平均mAUCC提升31% 法线图控制收敛最快(2.1倍) 消融实验: x₀-supervision在所有训练阶段均优于ε-prediction SNR加权等效形式验证了数学推导正确性 该方法对学习率和batch size不敏感 图表详解 训练收敛速度对比 x₀-supervision 与 σₜ²/αₜ²·ε-supervision 两种训练目标的收敛速度对比实验。图中包含四个子图,分别对应 ControlNet 在深度图(RMSE)、分割图(mIoU)、Canny 边缘(F1)和姿态(mAP)四种控制条件下的收敛曲线。实验结果表明两种监督方式的收敛速度完全一致,从数学上验证了 x₀-supervision 等价于对 ε-prediction 施加 SNR 加权这一理论推导的正确性 SNR 权重分析 Stable Diffusion 中噪声调度与信噪比的演变关系。(a) 噪声调度曲线:αₜ 随时间步递减、σₜ 递增,二者在约 t=400 处交叉;(b) 信噪比曲线:SNR 在前 200 步内从极高值急剧下降至接近零。由于 ε-预测损失隐式地以 SNR 作为权重,SNR 的快速衰减导致低 SNR(高噪声)区域的学习信号被严重压制,使得控制分支在最关键的训练阶段获得的梯度不足 生成质量定性对比 ControlNet 在使用干净图像 x₀ 作为监督信号与使用基线 ε 预测时的收敛速度和生成质量对比。图中展示了不同训练阶段的生成样本,红色方框表示生成结果完全不遵循输入控制条件,橙色方框表示部分遵循,绿色方框表示正确遵循。可以直观地看到 x₀-supervision 在更少的训练步数内就达到了条件遵循的绿色阶段,而 ε-prediction 在相同步数下仍处于红色或橙色阶段 批判性点评 新颖性: 从去噪动态角度分析可控生成训练,揭示 ε-预测的梯度权重与控制分支贡献的不匹配。洞察深刻但方法本身(x₀-预测)在无条件生成中已有先例。 可复现性: 代码已在 GitHub 开源。基于 SDXL + ControlNet/T2I-Adapter 标准框架,修改仅涉及损失函数。复现门槛极低。 影响力: 中高——方法极简零开销,所有使用 ControlNet/T2I-Adapter 的项目可直接受益。但加速幅度(2倍)非颠覆性,且未验证 SD3/Flux 等新架构。 深度点评: x₀监督加速2倍 — x₀-Supervision 仅改变损失函数即实现可控生成 2 倍训练加速,零额外计算开销 训练效率多维探索 — 损失函数(x₀-Sup) + 语义引导(DARE) + 梯度降噪(MAR-GRPO),训练优化三路并进 小数据高效学习 — ImVideoEdit(13K图像对) 和 PAMELA(70K评分) 证明小数据也能训练出强模型 技术演进定位: 扩散模型训练方法论的重要补充,特别是可控生成训练效率的里程碑式分析 可能的后续方向: 推广到 SD3/Flux 等 Flow Matching 架构 结合 LoRA 微调的可控训练加速 拓展到视频可控生成训练 其余论文速览 1. LiVER:提出LiVER——首个基于显式3D场景属性… Lighting-grounded Video Generation with Renderer-based Agent Reasoning | Peking University, Beijing University of Posts and Telecommunications | arXiv:2604.07966 关键词: 视频生成·3D场景控制·光照解耦·Agent推理·可控生成 贡献: 提出LiVER——首个基于显式3D场景属性(布局、光照、相机轨迹)条件化的可控视频生成框架。构建大规模密集标注数据集,通过统一3D表示渲染控制信号实现场景因素解耦。设计场景Agent自动将自然语言指令转换为3D控制信号。 效果: 在光照、布局和相机轨迹控制上实现SOTA光真实感和时间一致性,支持image-to-video和video-to-video的全场景可编辑合成。 2. DARE:揭示文本到视频扩散模型中语义重要token被忽视的问题… Not all tokens contribute equally to diffusion learning | Beijing Jiaotong University | arXiv:2604.07026 关键词: 视频生成·语义对齐·注意力重加权·分布校正·CFG优化 贡献: 揭示文本到视频扩散模型中语义重要token被忽视的问题——源于训练数据长尾分布偏差和交叉注意力空间失配。提出DARE统一框架:DR-CFG(分布校正CFG)动态抑制低语义密度token,SRA(空间表征对齐)按token重要性自适应重加权注意力图。 效果: 在多个基准上一致提升生成保真度和语义对齐,显著改善被忽视语义的生成质量。 3. VersaVogue:提出VersaVogue——统一服装生成和虚拟换装的多条件可控时尚合成框架 VersaVogue: Visual Expert Orchestration and Preference Alignment for Unified Fashion Synthesis | Nanjing University of Science and Technology | arXiv:2604.07210 关键词: 时尚合成·虚拟试穿·MoE·偏好优化·DPO·图像生成 贡献: 提出VersaVogue——统一服装生成和虚拟换装的多条件可控时尚合成框架。核心:特征路由注意力(TA)模块通过MoE机制动态路由视觉属性(纹理/形状/颜色)到最兼容的专家层;多视角偏好优化(MPO)管线自动构建偏好数据进行DPO优化。 效果: 在服装生成和虚拟换装两个基准上均超越现有方法,实现更优的视觉保真度和细粒度可控性。 4. ImVideoEdit:提出ImVideoEdit——仅从图像对学习视频编辑能力的高效框架 ImVideoEdit: Image-learning Video Editing via 2D Spatial Difference Attention Blocks | Zhejiang University | arXiv:2604.07958 关键词: 视频编辑·图像学习·空间差分注意力·免掩码·轻量训练 贡献: 提出ImVideoEdit——仅从图像对学习视频编辑能力的高效框架。冻结预训练3D注意力模块,将图像视为单帧视频解耦空间学习,保留原始时序动态。核心是Predict-Update空间差分注意力模块配合文本引导动态语义门控,不依赖外部掩码。 效果: 仅用13K图像对训练5个epoch,极低计算开销下达到与大规模视频数据集训练模型可比的编辑保真度和时序一致性。 5. PAMELA:提出PAMELA——个性化图像评估数据集和框架 Personalizing Text-to-Image Generation to Individual Taste | KU Leuven, University of Tübingen | arXiv:2604.07427 关键词: 个性化生成·奖励模型·审美评估·偏好学习·文生图 贡献: 提出PAMELA——个性化图像评估数据集和框架。收集70K评分数据(5000张Flux/Nano Banana生成图,每张15位用户评分),训练个性化奖励模型预测个体偏好。通过简单提示优化即可引导生成符合个人审美的图像。 效果: 个性化偏好预测准确率超越大多数SOTA方法的群体级预测性能,数据集和模型已开源。 6. C-MET:提出C-MET——跨模态情感迁移方法 Cross-Modal Emotion Transfer for Emotion Editing in Talking Face Video | KAIST | arXiv:2604.07786 关键词: 情感编辑·说话人生成·跨模态·语音驱动·表情迁移 贡献: 提出C-MET——跨模态情感迁移方法,通过在语音和视觉特征空间之间建模情感语义向量实现说话人面部表情编辑。利用大规模预训练音频编码器和解耦表情编码器学习跨模态情感差分向量,支持未见过的扩展情感(如讽刺)。 效果: 在MEAD和CREMA-D数据集上情感准确率提升14%,同时生成高表现力的说话人视频。代码和模型已开源。 7. MAR-GRPO:首个为AR-扩散混合模型(MAR)设计的稳定GRPO框架 MAR-GRPO: Stabilized GRPO for AR-diffusion Hybrid Image Generation | USTC, Alibaba | arXiv:2604.06966 关键词: AR-扩散混合·GRPO·强化学习·MAR·训练稳定性·图像生成 贡献: 首个为AR-扩散混合模型(MAR)设计的稳定GRPO框架。发现扩散头产生噪声梯度导致训练不稳定。提出多轨迹期望(MTE)对多扩散轨迹取平均降噪梯度;token级不确定性估计对高不确定token选择性优化;一致性感知token选择过滤低对齐AR token。 效果: 在多个基准上持续提升视觉质量、训练稳定性和空间结构理解能力,代码已开源。 趋势观察 可控生成训练效率提升 — x₀-Supervision揭示ε-预测在可控生成中的低效性并提出2倍加速方案,DARE从语义token角度优化注意力引导——训练方法论持续精进 轻量化学习范式 — ImVideoEdit仅用13K图像对训练视频编辑,PAMELA用70K评分构建个性化奖励——小数据高效学习成趋势 人工智能炼丹师 整理 | 2026-04-10
-
AIGC 每日速读|2026-04-09|一图多改不再崩-MIRAGE并行编辑 今日核心看点 多实例编辑(MIRAGE) 音乐视频编辑(GLANCE) 拟音生成(FoleyDesigner) 跨分辨率扩散(CR-Diff) 适配器融合(OrthoFuse) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 图像编辑 × 2(MIRAGE 多实例编辑, OrthoFuse 适配器融合) 视频编辑 × 1(GLANCE 音乐驱动视频编辑) 音频生成 × 3(FoleyDesigner 拟音, Singing Style 歌唱转换, ACG-Music 音乐生成) 扩散模型优化 × 3(CR-Diff 跨分辨率, SADM 低光增强, DARE+EC-Routing 扩散LM) CVPR 2026 × 1 | ACL 2026 × 1 重点论文深度解读 1. MIRAGE 多实例图像编辑的基准测试与区域对齐框架 | Telecom Paris, Institut Polytechnique de Paris | arXiv:2604.05180 关键词: 多实例编辑, 区域对齐, 并行去噪, 无训练 研究动机 核心问题: 多实例图像编辑中的过度编辑与空间错位 当前最先进的图像编辑模型(如 FLUX.2、Qwen-Image-Edit)在处理包含多个相似实例且每个实例需要独立编辑的复杂场景时,会出现严重的过度编辑(Overediting)和空间错位(Spatial Misalignment)问题。例如,要求分别修改桌上三个杯子的颜色时,模型往往会错误地修改非目标区域,或在背景中引入意外变化。 前序工作及局限: InstructPix2Pix (2022):单指令全局编辑,无法处理多实例独立修改 MagicBrush (2023):引入掩码引导精细编辑,但仍限于单实例场景 FLUX.2 (2025):指令编辑能力大幅提升,但多实例+组合指令时出现过度编辑 Qwen-Image-Edit (2025):多模态理解驱动编辑,多实例场景仍有空间错位问题 与前序工作的本质区别: 从单指令全局编辑到多指令区域对齐编辑,引入VLM指令解析+多分支并行去噪,实现实例级精确修改 方法原理 MIRAGE(Multi-Instance Regional Alignment via Guided Editing)提出了一个无需训练的框架,由两个核心模块组成:(1)指令解析与目标定位:利用视觉语言模型(VLM,如 Qwen3-VL)将全局组合指令分解为K个区域级原子编辑子任务,通过指代表达式定位(Referring Expression Grounding)提取每个编辑目标的边界框和子区域。(2)多分支并行局部编辑:构建一个全局分支和K个区域分支进行并行去噪。在早期时间步(t > 0.6T),各区域分支独立执行扩散编辑,将局部潜在表示空间映射回全局空间并覆盖对应位置,同时背景严格遵循参考轨迹防止漂移。在后期时间步(t <= 0.6T),终止所有区域分支,仅全局分支进行条件去噪,仅在目标区域内应用更新。 核心创新 提出MIRA-Bench基准:专门针对多实例多指令图像编辑的评估基准,平均每张图4个相似实例+5个组合指令,覆盖添加/移除/替换/颜色/材质5种编辑类型 多分支并行去噪架构:通过VLM解析指令→区域定位→多分支并行编辑→全局融合,实现精确的实例级修改 无训练即插即用:可直接集成到FLUX.2、Qwen-Image-Edit等现有模型中,无需额外训练 双阶段潜在替换策略:早期区域注入+后期全局编辑,平衡了编辑精度和视觉质量 实验结果 在MIRA-Bench上,MIRAGE将FLUX.2-Dev的指令遵循分数从6.98提升至8.09(+15.8%),一致性从8.38提升至9.01(+7.5%),总体评分从7.87提升至8.44。在RefEdit-Bench上同样有效,Qwen-Image-Edit集成MIRAGE后总体评分从8.56提升至8.73。推理时间与标准基线相当(85.87s vs 90.13s),由于局部编辑阶段的潜在尺寸较小甚至更快。消融实验表明0.6T是最佳切换时间步。 图表详解 MIRA-Bench 构建流程 基准构建三步流程:FLUX.2生成多实例图像,VLM提取编辑指令和指代表达式,SAM2细化边界框为精确掩码 现有模型的过度编辑问题 展示当前SOTA模型在多实例编辑中的局限性:蓝色圆圈表示目标区域内一致性保持失败,绿色圆圈突出背景中的意外修改 指令复杂度增加时的性能变化 随着编辑指令数从1到5增加,标准模型一致性下降明显,而集成MIRAGE后性能更稳定 批判性点评 新颖性: 首个系统性研究多实例图像编辑的工作,同时提出评估基准(MIRA-Bench)和无训练解决方案(多分支并行去噪+VLM指令解析),填补了领域空白。双阶段潜在替换策略简洁优雅 可复现性: 代码已开源(GitHub),框架无需训练可直接即插即用到现有模型。但MIRA-Bench仅100个样本,规模较小,且依赖VLM(Qwen3-VL)和SAM2的可用性 影响力: 揭示了多实例编辑这一被忽视的重要挑战,为后续工作提供了评估标准和方法基线。无训练即插即用的特性使其实际应用价值较高,但随实例数增长的计算开销限制了可扩展性 深度点评: 多实例编辑新基准 — MIRA-Bench 填补了多实例编辑评估空白,平均4个实例+5个组合指令 无训练即插即用 — MIRAGE 可直接集成到 FLUX.2/Qwen 等模型中,无需额外训练 音乐驱动视频编辑 — GLANCE 多智能体框架超越基线 33.2%,ACG-Music 锚定循环生成解决长序列音乐误差累积 技术演进定位: 多实例编辑子领域的开创性工作,填补了基准和方法两个空白 可能的后续方向: 视频多实例编辑扩展;与SAM等分割模型更紧密集成实现像素级精确编辑;降低VLM依赖以提升效率;构建更大规模评估基准 其余论文速览 1. FoleyDesigner:提出电影级立体声拟音生成框架 FoleyDesigner: Immersive Stereo Foley Generation with Precise Spatio-Temporal Alignment for Film Clips | Shanghai University, University of Surrey | arXiv:2604.05731 关键词: 拟音生成 · 立体声 · 时空对齐 · 电影后期 贡献: 提出电影级立体声拟音生成框架,集成多智能体时空分析、潜在扩散模型和LLM驱动混音,支持杜比全景声5.1声道输出 效果: 首个专业立体声拟音数据集FilmStereo(8类/精确时间戳),时空对齐精度优于所有基线 2. GLANCE:提出全局-局部协调多智能体框架 GLANCE: A Global-Local Coordination Multi-Agent Framework for Music-Grounded Non-Linear Video Editing | Virginia Tech, Meta AI | arXiv:2604.05076 关键词: 视频编辑 · 多智能体 · 音乐驱动 · 非线性编辑 贡献: 提出全局-局部协调多智能体框架,用于音乐驱动的非线性视频编辑,双循环架构实现长期规划和逐片段精细编辑 效果: 使用GPT-4o-mini骨干在两种任务设定上分别超越最强基线33.2%和15.6%,并发布MVEBench评估基准 3. OrthoFuse:首个无训练合并正交适配器(OFT)的方法 OrthoFuse: Training-free Riemannian Fusion of Orthogonal Style-Concept Adapters for Diffusion Models | FusionBrain Lab, AIRI | arXiv:2604.05183 关键词: 适配器融合 · 正交微调 · 黎曼几何 · 免训练 贡献: 首个无训练合并正交适配器(OFT)的方法,利用黎曼流形测地线近似实现风格和概念适配器的免训练融合 效果: 在主题驱动生成中有效融合不同适配器的概念和风格特征,无需额外训练开销 4. CR-Diff:发现扩散模型中的分辨率依赖参数行为问题 Cross-Resolution Diffusion Models via Network Pruning | Westlake University, UESTC | arXiv:2604.05524 关键词: 扩散模型 · 跨分辨率 · 网络剪枝 · CVPR 2026 贡献: 发现扩散模型中的分辨率依赖参数行为问题,通过逐块修剪不利权重实现跨分辨率一致性,CVPR 2026 Findings 效果: 在未见分辨率上提升感知保真度和语义连贯性,同时保持默认分辨率性能不下降 5. SADM:提出信号衰减扩散模型 Single-Stage Signal Attenuation Diffusion Model for Low-Light Image Enhancement and Denoising | arXiv:2604.05727 关键词: 低光照增强 · 扩散模型 · 信号衰减 · 单阶段 贡献: 提出信号衰减扩散模型,将低光照退化的物理先验编码到扩散前向过程中,单阶段同时完成亮度恢复和噪声抑制 效果: 消除了两阶段管线和辅助校正网络的依赖,在恢复质量和计算效率间取得平衡 6. DARE:开源扩散语言模型后训练框架 DARE: Diffusion Large Language Models Alignment and Reinforcement Executor | Shanghai AI Laboratory, SJTU | arXiv:2604.04215 关键词: 扩散语言模型 · 后训练 · 强化学习 · 开源框架 贡献: 开源扩散语言模型后训练框架,统一SFT/PEFT/偏好优化/RL,支持LLaDA/Dream/SDAR等多个模型家族 效果: 解决dLLM生态碎片化问题,提供可复现基准和加速功能,加速扩散语言模型研究迭代 7. EC-Routing:Expert-Choice路由优化扩散语言模型 Expert-Choice Routing Enables Adaptive Computation in Diffusion Language Models | UW-Madison, Cornell, Duke, UC Davis, SUSTech | arXiv:2604.01622 关键词: MoE · 专家选择路由 · 扩散语言模型 · 自适应计算 贡献: 证明Expert-Choice路由比Token-Choice更适合扩散语言模型MoE,引入时间步依赖的专家容量实现自适应计算 效果: 低掩码比率步骤学习效率高一个数量级,预训练TC模型可仅替换路由器改造为EC模型 8. Singing Style Conversion:提出歌唱风格转换系统 Controllable Singing Style Conversion with Boundary-Aware Information Bottleneck | Xinjiang University | arXiv:2604.05007 关键词: 歌唱转换 · 风格迁移 · Whisper瓶颈 · 语音合成 贡献: 提出歌唱风格转换系统,通过边界感知Whisper瓶颈、帧级技术矩阵和高频补全策略实现精细风格控制 效果: SVCC2025挑战赛参赛系统,在自然度和说话人相似度上取得优异成绩 9. ACG-Music:提出锚定循环生成范式及分层框架Hi-ACG Anchored Cyclic Generation: A Novel Paradigm for Long-Sequence Symbolic Music Generation | South China University of Technology | arXiv:2604.05343 关键词: 音乐生成 · 符号音乐 · 锚定循环 · ACL 2026 贡献: 提出锚定循环生成范式及分层框架Hi-ACG,解决自回归模型生成长序列音乐时的误差累积问题,ACL 2026 Findings 效果: 显著提升长序列音乐质量和结构完整性,超越现有自回归方法 趋势观察 多实例编辑:从单指令到组合指令 — MIRAGE 揭示了多实例编辑这一被忽视的重要挑战,利用 VLM 解析指令 + 多分支并行去噪,实现精确的实例级修改 扩散语言模型生态成熟 — DARE 框架统一了扩散语言模型的后训练流程,EC-Routing 证明专家选择路由更适合 dLLM 的 MoE 架构 生成模型跨分辨率泛化 — CR-Diff 发现并解决了扩散模型的分辨率依赖参数行为,通过剪枝实现跨分辨率视觉一致性 人工智能炼丹师 整理 | 2026-04-09
-
AIGC 每日速读|2026-04-08|分数步蒸馏新范式1.x-Distill 今日核心看点 分数步蒸馏(1.x-Distill) 33x推理加速(SFD+DCT) 空间编辑基准(SpatialEdit) 通用音频生成(OmniSonic) 视频DiT缓存(Chorus) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 生成推理加速: 3篇 (1.x-Distill, Chorus, OP-GRPO) 图像编辑与评测: 3篇 (SpatialEdit, VicoEdit, Think-in-Strokes) 音频生成: 1篇 (OmniSonic, CVPR 2026) 视频生成: 1篇 (Vanast, CVPR 2026) 生成理解一体化: 1篇 (退化图像理解CLEAR) 含 3 篇 CVPR 2026 接收论文 重点论文深度解读 1. 1.x-Distill 首个分数步蒸馏框架——打破整数步约束实现33倍加速 | Unknown | arXiv:2604.04018 关键词: 蒸馏加速, 分布匹配蒸馏, 分数步推理, CFG控制, 块级缓存, SD3 研究动机 核心问题: 扩散模型迭代去噪计算量大,分布匹配蒸馏在极端少步时多样性崩溃 扩散模型生成高质量图像,但迭代去噪计算量大。分布匹配蒸馏(DMD)是少步蒸馏的有前途路径,但在 2 步或更少时遭遇多样性崩溃和保真度下降。作者发现两个核心问题:(1) 教师模型 CFG 在高噪声时域驱使学生过早坍缩到少数主导模式;(2) 极端少步蒸馏下,单一目标函数无法同时兼顾全局结构和细节。 前序工作及局限: DMD/DMD2:分布匹配蒸馏的先驱,但 2 步以下多样性严重崩溃 TDM/SenseFlow:无图像训练蒸馏,但未发现 CFG 导致模式坍缩的根因 DDIM/一致性模型:少步采样加速,但受限于整数步约束 DeepCache/Learning-to-Cache:DiT 块级缓存加速,但未与蒸馏训练过程整合 与前序工作的本质区别: 首次将分布匹配蒸馏与块级缓存统一,发现并解决 CFG 导致模式崩溃的根因,提出分数步蒸馏打破整数步约束 方法原理 1.x-Distill 框架包含三个核心创新: (1) 时间步感知 CFG 控制:在高噪声时域(t>alpha)禁用教师 CFG,使用纯条件分数引导学生覆盖更多模式;低噪声时域保留 CFG 保证细节质量。alpha=0.94 为最优阈值。 (2) 分阶段聚焦蒸馏(SFD):Stage I 结构导向分布匹配,采用重要性采样偏向 t=0.75 附近结构信息丰富的时域,避免低噪声区的过度纹理扰动;Stage II 细节导向对抗精炼,在学生的少步推理路径上生成样本,使用冻结 ConvNeXt 特征提取器 + 可训练分类头作为判别器,无需外部图像数据集。 (3) 蒸馏-缓存协同训练(DCT):观察到早期 DiT 块跨步骤时间冗余大,缓存块贡献 Delta_t = O_m - I_n,第二步跳过 6-8 个块。引入轻量级残差 MLP 预测修正缓存误差。Stage II 自然支持缓存训练,对抗损失直接监督缓存加速推理。 核心创新 首次提出分数步蒸馏概念,打破先前少步方法的整数步约束 发现并解决 DMD 中教师 CFG 导致模式崩溃的关键问题 提出分阶段聚焦蒸馏(SFD):结构导向分布匹配 + 细节导向对抗精炼 设计蒸馏-缓存协同训练(DCT),将块级缓存融入蒸馏流程 在 SD3-Medium 和 SD3.5-Large 上实现 1.67/1.74 有效 NFE,最高 33 倍加速 实验结果 SD3-Medium (24 DiT blocks): SFD 4步:FID 14.13(最佳),HPSv2 32.53,ImageReward 1.12 1.x-Distill-slow (NFE=1.75):FID 15.79,HPSv2 32.26,超越所有 2 步和大部分 4 步基线 1.x-Distill-fast (NFE=1.67):FID 16.72,HPSv2 31.69,比原始 28x2 采样加速 33 倍 SD3.5-Large (38 DiT blocks): SFD 4步:HPSv2 32.90,ImageReward 1.20(最佳) 1.x-Distill (NFE=1.74):FID 22.05,HPSv2 32.01,超越 TDM 2步基线 3.5+ HPSv2 DPG-Bench:蒸馏模型在复杂提示下总分超越多步教师模型 多样性(LPIPS):显著高于 Flash 和 TDM 等基线 用户研究:20 位评估者在 3200 提示上明确偏好 1.x-Distill 图表详解 方法核心:块级缓存设计 左图展示各 DiT 块的跨步复用误差(早期块冗余大),右图展示缓存机制:第一步完整计算并缓存块贡献,第二步跳过并用 MLP 修正恢复 CFG 在蒸馏中的作用分析 高噪声时域强 CFG 驱使学生过早模式坍缩;1.x-Distill 在高噪声区禁用 CFG,低噪声区保留 CFG 定性对比结果 SD3-Medium 上多种方法的生成质量对比,1.x-Distill 在 1.67 NFE 下仍保持连贯结构和丰富细节 批判性点评 新颖性: 首次提出分数步蒸馏概念,打破整数步约束。时域感知 CFG 控制、分阶段聚焦蒸馏、蒸馏-缓存协同训练三个创新点紧密配合。 可复现性: 代码和权重将公开。训练仅需 JourneyDB 提示数据,无需外部图像数据集。但具体训练超参数和缓存块选择策略的细节需参考附录。 影响力: 高——开辟 1.x 步蒸馏新范式,33x 加速具有重大实用价值。但目前仅验证 SD3 系列,Flux/SDXL 等架构的通用性有待考验。 深度点评: 首创分数步蒸馏 — 1.x-Distill 首次突破整数步约束,SD3 上仅 1.67 NFE 实现 33x 加速,FID 和人类偏好全面领先 推理加速三路并进 — 蒸馏(1.x-Distill) + 系统缓存(Chorus) + 训练效率(OP-GRPO),三维度全面提速 免训练方法降低门槛 — FDS(Flow Matching) 和 VicoEdit(图像编辑) 无需额外训练即可大幅提升质量 技术演进定位: 分布匹配蒸馏领域的重要推进,开辟 1.x 步生成新范式 可能的后续方向: 推广到 Flux/SDXL/视频扩散模型 自适应缓存块选择 与推理系统优化结合 其余论文速览 1. SpatialEdit:提出首个专门评估细粒度空间编辑的基准Sp SpatialEdit: Benchmarking Fine-Grained Image Spatial Editing 关键词: 图像编辑·空间变换·几何保真度·合成数据·基准评测 贡献: 提出首个专门评估细粒度空间编辑的基准SpatialEdit-Bench,通过联合度量感知合理性和几何保真度系统评估空间操作能力。构建500K合成训练数据集SpatialEdit-500k,使用可控Blender管线生成精确的相机轨迹和物体变换真值。基于此训练16B参数的SpatialEdit-16B基线模型。 效果: SpatialEdit-16B在通用编辑任务中取得有竞争力的性能,同时在空间操作任务上大幅超越现有方法。 2. FDS:提出流分歧采样器FDS Training-Free Refinement of Flow Matching with Divergence-based Sampling 关键词: Flow Matching·采样优化·无训练·散度引导·即插即用 贡献: 提出流分歧采样器FDS,无需训练即可提升Flow Matching模型质量。核心发现:边缘速度场的散度可量化采样误导程度,利用该信号在每个求解步骤前将中间状态引导至歧义更小的区域。 效果: 作为即插即用框架,FDS兼容标准求解器和现有Flow模型,在文本到图像合成和逆问题等多种任务中一致提升保真度。 3. OmniSonic:提出通用整体音频生成任务UniHAGen OmniSonic: Towards Universal and Holistic Audio Generation from Video and Text 关键词: 音频生成·视频到音频·Flow Matching·MoE·CVPR 2026 贡献: 提出通用整体音频生成任务UniHAGen,首次统一生成屏幕内环境音、屏幕外环境音和人类语音。设计TriAttn-DiT架构,通过三路交叉注意力同时处理三种音频条件,配合MoE门控机制自适应平衡。构建UniHAGen-Bench基准覆盖三种代表性场景。CVPR 2026。 效果: 在客观指标和人类评估上均一致超越现有最先进方法,建立了通用整体音频生成的强基线。 4. OP-GRPO:首个专为Flow-Matching模型设 OP-GRPO: Efficient Off-Policy GRPO for Flow-Matching Models 关键词: GRPO·Flow Matching·离线策略·训练效率·后训练优化 贡献: 首个专为Flow-Matching模型设计的离线GRPO框架。主动选择高质量轨迹并自适应加入回放缓冲区重复使用;提出序列级重要性采样修正减轻分布偏移;发现并解决晚期去噪步骤的病态离线比率问题。 效果: 仅用平均34.2%的训练步骤即达到Flow-GRPO同等或更优性能,在图像和视频生成基准上均验证有效。 5. Vanast:提出统一框架从单张人像、服装图和姿态视频 Vanast: Virtual Try-On with Human Image Animation via Synthetic Triplet Supervision 关键词: 虚拟试穿·视频生成·扩散Transformer·人体动画·CVPR 2026 贡献: 提出统一框架从单张人像、服装图和姿态视频一步生成换装动画视频。构建大规模三元组监督数据,引入视频扩散Transformer的双模块架构稳定训练,支持零样本服装插值。CVPR 2026。 效果: 克服传统两阶段方案的身份漂移和服装扭曲问题,实现高保真、身份一致的服装迁移动画。 6. VicoEdit:提出VicoEdit——免训练且无需反演 Training-Free Image Editing with Visual Context Integration and Concept Alignment 关键词: 图像编辑·免训练·视觉上下文·概念对齐·后验采样 贡献: 提出VicoEdit——免训练且无需反演的视觉上下文注入图像编辑方法。直接基于视觉上下文将源图转换为目标图,消除扩散反演可能导致的轨迹偏离。设计概念对齐引导的后验采样方法增强编辑一致性。 效果: 免训练方法在编辑性能上甚至超越最先进的基于训练的模型。 7. Think-in-Strokes:提出过程驱动图像生成范式 Think in Strokes, Not Pixels: Process-Driven Image Generation via Interleaved Reasoning 关键词: 图像生成·推理过程·交错生成·可解释AI·多步细化 贡献: 提出过程驱动图像生成范式,将合成分解为思想-动作交错推理轨迹。每次迭代包含文本规划、视觉草拟、文本反思、视觉细化四个阶段。通过密集逐步监督维持空间和语义一致性。 效果: 使生成过程变得明确、可解释且可直接监督,在多种文本到图像基准上验证有效性。 8. Chorus:提出Chorus——利用跨请求相似性加速 Beyond Few-Step Inference: Accelerating Video Diffusion Transformer Model Serving with Inter-Request Caching Reuse 关键词: 视频生成·推理加速·跨请求缓存·DiT·模型服务 贡献: 提出Chorus——利用跨请求相似性加速视频扩散Transformer服务的缓存方法。采用三阶段缓存策略:完全复用阶段、区域级跨请求缓存阶段和令牌引导注意力放大阶段。在单请求内缓存无效的4步蒸馏模型上仍有效。 效果: 在工业级4步蒸馏视频DiT模型上实现高达45%的推理加速,同时维持语义对齐质量。 9. CLEAR:提出CLEAR框架连接统一多模态模型的生 CLEAR: Unlocking Generative Potential for Degraded Image Understanding in Unified Multimodal Models 关键词: 生成理解一体化·退化图像·统一多模态·强化学习·GRPO 贡献: 提出CLEAR框架连接统一多模态模型的生成和理解能力以处理退化图像。三步渐进策略:感知退化SFT建立先生成后回答推理模式;潜在表示桥替代解码-重编码绕路;交错GRPO联合优化文本推理和视觉生成。构建MMD-Bench覆盖六个基准三级退化。 效果: 显著提升退化输入鲁棒性同时保持清晰图像性能。发现移除像素级重建监督可获得更高感知质量的中间视觉状态。 趋势观察 推理加速多路径并进 — 分数步蒸馏(1.x-Distill)、跨请求缓存(Chorus)、离线GRPO(OP-GRPO)——从模型压缩、系统优化到训练效率三个维度全面提速 免训练方法持续升温 — FDS和VicoEdit均无需额外训练即可提升Flow Matching和图像编辑质量,降低部署门槛 人工智能炼丹师 整理 | 2026-04-08
-
AIGC 每日速读|2026-04-07|SC-DMD蒸馏2-4步高质量视频生成Salt 今日核心看点 视频蒸馏2-4步生成(Salt) 多智能体图像编辑(CAMEO) 免训练视频4.73x加速(SCOPE) 视频物理合理性(MMPhysVideo) SDR转HDR重建(LumaFlux) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 视频生成加速 — Salt, SCOPE (2篇) 图像生成与编辑 — VOSR, CAMEO, LumaFlux, EditManifold (4篇) 视频生成与物理建模 — MMPhysVideo (1篇) 音频生成 — DynFOA, GAP-URGENet (2篇) 评测与基准 — ImagenWorld (1篇) CVPR 2026 ×1 | ICLR 2026 ×1 | ICASSP 2026 ×1 重点论文深度解读 1. Salt 自一致分布匹配蒸馏+缓存感知训练:仅2-4步实现高质量视频生成 | Hong Kong University of Science and Technology, Vivix Group | arXiv:2604.03118 关键词: 视频生成加速, 分布匹配蒸馏, 自一致性正则, KV缓存感知, 自回归视频生成 研究动机 核心问题: 将视频扩散模型蒸馏到2-4步推理时,DMD的局部训练信号导致多步去噪更新组合产生轨迹漂移,一致性蒸馏则过于保守导致模糊 将视频生成模型蒸馏到极低推理步数(2-4步NFEs)对实时部署至关重要但仍极具挑战。轨迹式一致性蒸馏在复杂视频动态下变得保守,导致外观过度平滑和运动微弱。分布匹配蒸馏(DMD)可恢复清晰样本,但其局部训练信号没有显式规范去噪更新如何跨时间步组合,导致多步推理时产生轨迹漂移。Salt提出自一致分布匹配蒸馏(SC-DMD),显式约束连续去噪更新的终点一致组合,结合缓存分布感知训练解决自回归视频生成中的KV缓存质量退化问题。 前序工作及局限: Consistency Distillation:轨迹式蒸馏在复杂视频动态下变得保守,导致外观过度平滑和运动微弱 DMD (Distribution Matching Distillation):分布匹配梯度恢复锐利样本,但局部训练信号无法规范去噪更新的跨时间步组合,多步推理产生轨迹漂移 Shortcut Models / AYF:提出半群组合约束思想,但作为独立回归目标会导致模式平均化 Self Forcing:开创自回归实时视频生成范式,但长时间滚展时KV缓存质量退化导致语义漂移 与前序工作的本质区别: Salt将半群缺陷约束作为DMD框架内的正则化器(而非独立回归目标),既保留DMD的模式寻求分布对齐,又修正多步组合漂移。同时首次引入KV缓存质量参数化条件训练 方法原理 Salt框架包含两大核心技术创新。(1) 自一致分布匹配蒸馏(SC-DMD):在DMD基础上引入轻量级半群缺陷(Semigroup Defect)正则化器,约束学习到的传输算子在组合时保持终点一致性。具体而言,对任意三元组时间步(ts,tm,te),要求从ts一步跳到te的结果与从ts经tm两步跳到te的结果在终点对齐,DMD负责分布匹配的锐利样本,半群正则修正多步组合漂移。(2) 缓存分布感知训练:针对自回归设定,将KV缓存视为质量参数化条件。采用混合步数滚展策略(K从{2,4,8}中随机采样),让模型训练时接触从高质量到低质量的完整缓存分布。同时引入缓存条件参考对齐损失,通过TRD风格的关系特征空间对齐,将低质量缓存下的输出向高质量参考靠拢。SC-DMD正则化仅在K=8时激活(最长组合链受益最大),对齐损失仅在K为2或4时激活。 核心创新 首次识别并解决DMD的组合性缺陷:DMD的局部训练信号无法保证多步去噪更新组合时的一致性 自一致分布匹配蒸馏(SC-DMD):半群缺陷正则化器约束连续去噪步的终点一致组合,兼顾DMD的分布匹配锐度 KV缓存作为质量参数化条件变量:混合步数滚展覆盖完整缓存质量谱 缓存条件参考对齐:TRD关系特征空间对齐低质量缓存输出到高质量参考 框架无关性:兼容非自回归(Wan 2.1)和自回归(Self Forcing/LongLive/Causal Forcing)多种范式 实验结果 非自回归I2V(Wan 2.1 14B, 4步):VBench-I2V得分93.90(最佳),背景一致性从92.79提升到95.97,运动平滑度从97.99到98.37,时间闪烁从95.21到97.41。非自回归T2V(Wan 2.1 1.3B):4步Total Score 83.19(vs DMD 82.78),2步Total Score 82.85(vs DMD 82.41)。自回归实时生成:在Self Forcing、LongLive、Causal Forcing三个基线上均实现一致提升,无额外推理开销。消融实验证明SC-DMD正则化和混合步数训练各自贡献显著且互补。 图表详解 SC-DMD概念对比 半群缺陷正则与Shortcut Models、Flow Map Distillation的关系。Salt将半群约束作为DMD框架内正则化器 图表详解 SC-DMD概念对比 半群缺陷正则与Shortcut Models、Flow Map Distillation的关系。Salt将半群约束作为DMD框架内正则化器 消融实验与半群缺陷分析 不同step数下半群缺陷值变化,SC-DMD有效压制多步推理质量退化 图表详解 SC-DMD概念对比 半群缺陷正则与Shortcut Models、Flow Map Distillation的关系。Salt将半群约束作为DMD框架内正则化器 消融实验与半群缺陷分析 不同step数下半群缺陷值变化,SC-DMD有效压制多步推理质量退化 视觉效果对比 Salt与DMD基线在不同步数下的视频生成质量对比,展示组合一致性改善 批判性点评 新颖性: 首次识别并形式化DMD的组合性缺陷(半群缺陷),SC-DMD将半群约束作为DMD正则化器的思路简洁有效,填补了分布匹配蒸馏和轨迹一致性之间的理论空白 可复现性: 框架描述清晰,算法伪代码完整,基于开源的Wan 2.1和Self Forcing实现。但混合步数训练增加GPU显存开销,对齐损失的margin超参数delta敏感度分析不足 影响力: 对视频扩散蒸馏领域有重要推动作用。SC-DMD框架通用性强,兼容非自回归和自回归范式。缓存感知训练对实时自回归视频生成有直接实用价值,为2-4步高质量视频生成铺平道路 深度点评: SC-DMD组合一致性突破 — Salt首次识别并解决DMD的多步组合漂移问题,半群缺陷正则化器设计简洁有效。但Dynamic Degree指标下降(58.46→52.85)暗示稳定性与动态性的权衡值得后续探索 免训练加速潜力巨大 — SCOPE在MAGI-1和SkyReels-V2上实现4.73x免训练加速,三模态调度(缓存/预测/重计算)是一个有洞察力的设计,对工业部署有直接价值 物理先验正确方向 — MMPhysVideo将多模态物理先验融入视频生成,方向正确但伪RGB格式的表达力有限。DynFOA在声学层面引入3DGS物理一致性,丰富了物理建模的维度 技术演进定位: 视频扩散蒸馏从单步质量(DMD)走向多步一致性(SC-DMD)的关键过渡,自回归实时生成的缓存退化问题的首个系统性解决方案 可能的后续方向: SC-DMD正则可推广到更多扩散蒸馏场景(图像/3D等) 缓存感知训练可能成为所有自回归扩散模型的标准组件 Dynamic Degree下降提示需要平衡稳定性与动态表现力的研究 与SCOPE等免训练加速方法互补组合可能进一步降低推理成本 其余论文速览 1. VOSR:首个证明无需多模态预训练即可实现高质量生 VOSR: A Vision-Only Generative Model for Image Super-Resolution 关键词: 超分辨率·仅视觉·生成模型·CFG替代·CVPR 2026 贡献: 首个证明无需多模态预训练即可实现高质量生成式超分的框架。视觉语义引导+恢复导向CFG+多步→单步蒸馏,CVPR 2026 效果: 训练成本不到T2I-based方法的十分之一,单步推理即可获得竞争力感知质量,结构保真且减少幻觉 2. CAMEO:多智能体图像编辑协调器 CAMEO: A Conditional and Quality-Aware Multi-Agent Image Editing Orchestrator 关键词: 图像编辑·多智能体·质量感知·闭环反馈·条件编辑 贡献: 多智能体图像编辑协调器,将条件编辑重构为质量感知反馈驱动流程,规划→结构化提示→假设生成→自适应锚定的闭环迭代 效果: 在异常插入和人体姿态切换任务上,平均比SOTA编辑模型持续实现20%+胜率提升 3. SCOPE:免训练自回归视频扩散加速框架 Not All Frames Deserve Full Computation: Accelerating AR Video Generation via Selective Computation and Predictive Extrapolation 关键词: 视频生成加速·免训练·自回归·三模态调度·4.73x加速 贡献: 免训练自回归视频扩散加速框架,三模态调度(缓存/预测/重计算)+基于噪声水平的泰勒外推+选择性活动帧区间计算 效果: MAGI-1和SkyReels-V2上实现高达4.73x加速,质量与原始输出相当,优于所有免训练基线 4. MMPhysVideo:首个通过联合多模态建模扩展视频物理合理性的框架 MMPhysVideo: Scaling Physical Plausibility in Video Generation via Joint Multimodal Modeling 关键词: 视频生成·物理合理性·多模态建模·知识蒸馏·伪RGB 贡献: 首个通过联合多模态建模扩展视频物理合理性的框架,将语义/几何/轨迹转为统一伪RGB格式+双向控制教师架构+蒸馏到单流学生 效果: 无额外推理成本,在各基准上持续提升物理合理性和视觉质量,附带MMPhysPipe数据构建管线 5. LumaFlux:首个基于DiT的物理+感知引导SDR LumaFlux: Lifting 8-Bit Worlds to HDR Reality with Physically-Guided Diffusion Transformers 关键词: HDR重建·DiT·物理引导·逆色调映射·SDR-HDR 贡献: 首个基于DiT的物理+感知引导SDR→HDR重建模型,PGA模块注入亮度/空间/频率线索+PCM层稳定色度纹理+轻量有理二次样条解码器 效果: 以最少额外参数实现卓越亮度重建和感知色彩保真度,在多基准上超越SOTA。首个大规模SDR-HDR语料库 6. DynFOA:集成动态场景重建(3DGS)与条件扩散 DynFOA: Generating First-Order Ambisonics with Conditional Diffusion for Dynamic 360-Degree Videos 关键词: 空间音频·360度视频·条件扩散·3DGS·Ambisonics 贡献: 集成动态场景重建(3DGS)与条件扩散,从360°视频合成物理一致的一阶Ambisonics空间音频,M2G-360数据集(600片段) 效果: 在空间准确性、声学保真度、分布匹配和感知沉浸体验上持续优于现有方法 7. EditManifold:首个统一理论框架分析扩散图像编辑的五大核 Editing on the Generative Manifold: A Theoretical and Empirical Study of Diffusion-Based Image Editing Trade-offs 关键词: 扩散编辑·理论分析·生成流形·多轮编辑·权衡分析 贡献: 首个统一理论框架分析扩散图像编辑的五大核心需求(可控性/忠实度/一致性/局部性/质量),推导引导强度与反转误差的数学界限 效果: 刻画多轮编辑累积效应,对代表性范式进行基准测试,为扩散编辑提供理论指导 8. GAP-URGENet:生成-预测融合语音增强框架 GAP-URGENet: A Generative-Predictive Fusion Framework for Universal Speech Enhancement 关键词: 语音增强·生成-预测融合·48kHz·ICASSP 2026·冠军 贡献: 生成-预测融合语音增强框架,生成分支做自监督表示域全栈恢复+预测分支做语谱图增强+后处理融合+带宽扩展到48kHz,ICASSP 2026 效果: URGENT 2026挑战赛客观评估排名第一,盲测阶段顶级表现 9. ImagenWorld:3.6K条件集+20K人工细粒度标注的图 ImagenWorld: Stress-Testing Image Generation Models with Explainable Human Evaluation on Open-ended Real-World Tasks 关键词: 图像生成评测·压力测试·可解释评估·ICLR 2026·基准测试 贡献: 3.6K条件集+20K人工细粒度标注的图像生成压力测试基准,6种任务×6种领域,可解释评估模式标记对象级错误,ICLR 2026 效果: 测试14个模型揭示:编辑>生成难度,文本密集域是短板,闭源领先但差距在缩小,VLM指标Kendall准确率0.79 趋势观察 视频生成加速成主战场 — Salt(SC-DMD蒸馏)和SCOPE(免训练4.73x)分别从训练和推理两端加速视频生成 物理一致性受关注 — MMPhysVideo引入多模态物理先验,DynFOA通过3DGS重建实现声学物理一致 评测体系走向深度 — ImagenWorld的可解释评估和EditManifold的理论分析推动评测从分数到诊断 人工智能炼丹师 整理 | 2026-04-07
-
AIGC 每日速读|2026-04-06|VOID因果推理视频编辑|DynaVid CVPR2026|SteerFlow免训练编辑 AIGC 视觉生成领域 · 每日论文解读 (2026-04-06) 人工智能炼丹师 整理 | 共 10 篇论文 | 重点深度解读 1 篇 今日核心看点 VOID:因果推理驱动的视频对象删除 DynaVid:合成光流驱动高动态视频生成(CVPR 2026) SteerFlow / FlowSlider:免训练 Rectified Flow 图像编辑 LatentUM:潜在空间统一多模态模型 PFluxTTS:双解码器混合流匹配语音合成 CLPIPS:AI 生成图像个性化评测指标 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 视频生成与编辑: 4 篇 (VOID, DynaVid, ActionParty, BidirInterp) 图像生成与编辑: 3 篇 (SteerFlow, FlowSlider, ReflectGen) 统一/多模态模型: 1 篇 (LatentUM) 音频/语音合成: 1 篇 (PFluxTTS) 评测方法: 1 篇 (CLPIPS) 顶会收录: CVPR 2026 (DynaVid) 重点论文深度解读 1. VOID 因果推理驱动的视频对象与交互删除:物理一致性视频编辑新范式 | Netflix, INSAIT (Sofia University) | arXiv:2604.02296 关键词: 视频编辑, 对象删除, 因果推理, 物理一致性, 反事实生成 研究动机 核心问题: 视频对象移除后如何保持物理一致性?现有方法只能修复外观伪影,无法重写因果交互。 现有视频对象移除方法只能修复外观层面的伪影(如阴影和反射),当被移除对象与场景存在物理交互(如碰撞、支撑)时,无法推理并重写下游物理动态,导致结果不合物理常识。VOID 提出用因果推理指导视频扩散模型,在对象移除后生成物理一致的反事实场景。 前序工作及局限: ProPainter (2023):基于光流传播的视频修复,擅长空间填充但无物理推理能力 Generative Omnimatte (2024):分层视频效果分离,三色掩码条件引导,但仅支持阴影/反射等外观效果 ROSE (2025):基于扩散的视频对象移除,改善了时序一致性但仍限于外观修复 Go-with-the-Flow (2025):Flow-Warped Noise 提升视频扩散的时序连贯性,启发 VOID 的第二遍方案 与前序工作的本质区别: VOID 首次引入因果推理:通过反事实数据监督 + VLM 空间推理 + 四色掩码编码,让视频扩散模型学会重写下游物理交互,而非简单填充。 方法原理 VOID 基于 CogVideoX 扩散 Transformer 构建,采用两遍生成策略。核心创新包括:(1) 反事实数据集监督——使用 Kubric 刚体动力学和 HUMOTO 人体运动捕捉数据,生成约 6400 组配对反事实视频(有/无目标对象),提供物理一致的训练监督。(2) 四色掩码(Quadmask)条件——扩展传统三色掩码为四色:黑色(待移除对象)、深灰(对象与受影响区域重叠)、浅灰(受影响区域)、白色(保持不变),消除掩码歧义。(3) VLM 引导推理——推理时使用视觉语言模型(Gemini 3 Pro)识别受移除对象影响的区域,结合 SAM3 分割,预测反事实轨迹并生成四色掩码。(4) 第二遍 Flow-Warped Noise 稳定——第一遍生成正确的反事实轨迹但可能出现变形,第二遍使用光流对齐噪声保持物体刚性。VLM 自动判断是否需要第二遍。 核心创新 首个因果推理驱动的视频对象删除框架,移除对象后能重写下游物理交互(碰撞停止、支撑消失后自由落体等) 四色掩码(Quadmask)条件机制,解决对象移除与受影响区域重叠时的歧义问题 反事实数据集监督:Kubric 刚体动力学 + HUMOTO 人体运动捕捉,合成 6400+ 配对视频 双遍生成策略:第一遍合成反事实轨迹,第二遍 Flow-Warped Noise 修复变形 VLM 引导空间推理:Gemini 3 Pro + SAM3 自动生成推理时四色掩码 人类偏好 64.8% 胜率大幅超越 Runway 等商业系统 实验结果 人类偏好研究(25人/125组比较):VOID 64.8% 胜率,远超 Runway 18.4%、Gen-Omnimatte 11.2%、DiffuEraser 4.0%。VLM-as-Judge 评估(Gemini 3 Pro/GPT-5.2/Qwen 3.5 三组)全部排名第一,Interaction & Physics 维度提升最显著(3.66 vs Runway 2.61)。合成数据集指标:PSNR 31.49(最佳)、DreamSim 0.0658(最佳)、DINOv2 0.9222(最佳)、FVD 260.31(最佳,vs 第二名 437.88 降低 40%)。消融实验证明:混合 Kubric+HUMOTO 数据优于单一数据集,四色掩码优于三色掩码(26.12 vs 23.39 总分)。 图表详解 反事实数据集样例 Kubric 刚体碰撞和 HUMOTO 人体运动捕捉的配对反事实视频。上排为原始视频(红色标注目标对象),下排为移除对象后的反事实模拟,展示物理交互如何被正确重写。 双遍生成效果对比 左列第一遍生成正确的反事实轨迹但出现结构变形(吉他弯曲、球体拉伸),右列第二遍使用光流对齐噪声后保持了物体刚性,细节显著改善。 真实场景定性比较 与 Runway/Gen-Omnimatte/ProPainter 的对比:壶铃移除后枕头应弹回、浮标移除后无碰撞、双车相撞移除后正确还原。VOID 在物理一致性和伪影消除上全面领先。 多场景泛化结果 VOID 泛化到训练数据未涵盖的真实场景:积木多米诺骨牌停止、气球浮起、保龄球碰撞、搅拌机不启动等,展示强大的物理推理能力。 批判性点评 新颖性: 核心创新在于将因果推理引入视频编辑,从外观修复升级为世界模拟。四色掩码和反事实数据监督都是扎实的工程创新。但每个单独技术(VLM 推理、Flow-Warped Noise、扩散微调)都有前置工作,贡献在于系统整合。 可复现性: 依赖 CogVideoX 5B + Gemini 3 Pro + SAM3 三个外部模型,推理成本高。Kubric 和 HUMOTO 数据集可复现。代码和项目页面已公开。 影响力: 短期:将推动视频编辑工具从简单修复走向物理一致性编辑。中期:反事实推理数据集构建方法可迁移到其他世界模型训练。长期:为视频生成模型成为世界模拟器开辟路径。 深度点评: 因果推理驱动的视频编辑新范式 — VOID 首次证明:结合 VLM 因果推理 + 物理模拟反事实数据,可以让视频扩散模型学会重写下游物理交互。64.8% 人类偏好胜率大幅超越 Runway 等商业系统。但依赖 Gemini 3 Pro 推理能力,VLM 质量是系统瓶颈。 合成数据泛化到真实世界 — 仅用 6400 组 Kubric+HUMOTO 合成视频训练,就能泛化到真实世界的积木、保龄球、气球等多种未见过的物理交互。证明合成物理模拟作为训练监督的巨大潜力。 从外观修复到世界模拟 — 传统视频修复只做空间填充,VOID 要求模型理解因果关系:移除碰撞发起者后下游碰撞应停止,移除支撑后物体应自由落体。这是视频编辑从工具走向智能的关键一步。 技术演进定位: 开创视频编辑从外观修复到世界模拟的新方向。证明合成物理模拟数据可以让模型泛化到真实世界的因果推理。 可能的后续方向: 扩展到更复杂的物理场景(流体、柔体、多阶因果链) 与更强的世界模型结合,实现物理动力学的精确预测 无需 VLM 的端到端因果推理 其余论文速览 1. DynaVid:合成光流驱动高动态视频生成 DynaVid: Learning to Generate Highly Dynamic Videos using Synthetic Motion Data 关键词: 视频生成·合成运动数据·光流·运动解耦·CVPR 2026 贡献: 合成光流数据→运动-外观解耦→高动态视频生成,两阶段框架(运动生成+视频渲染),CVPR 2026 效果: 利用 CG 管线渲染光流训练运动生成器,保留真实视频视觉真实感。在剧烈人体运动和极端相机运动场景验证有效 2. SteerFlow:免训练 Rectified Flow 图像编辑 SteerFlow: Steering Rectified Flows for Faithful Inversion-Based Image Editing 关键词: 图像编辑·Rectified Flow·免训练·保真度·多轮编辑 贡献: 基于 Rectified Flow 的免训练图像编辑框架,摊销定点求解器+轨迹插值+自适应掩码,理论保证源保真度 效果: 在 FLUX.1-dev 和 SD 3.5 Medium 上超越现有方法。支持多轮编辑不累积漂移 3. LatentUM:潜在空间统一多模态模型 LatentUM: Unleashing the Potential of Interleaved Cross-Modal Reasoning via a Latent-Space Unified Model 关键词: 统一模型·潜在空间·跨模态推理·视觉生成·世界建模 贡献: 潜在空间统一多模态模型,消除视觉理解和生成之间的像素空间中介,支持交错跨模态推理 效果: 视觉空间规划 SOTA,自我反思改进视觉生成,支持世界建模预测未来视觉状态 4. FlowSlider:滑块式免训练连续图像编辑 FlowSlider: Training-Free Continuous Image Editing via Fidelity-Steering Decomposition 关键词: 图像编辑·连续控制·正交分解·免训练·Rectified Flow 贡献: 将编辑更新分解为正交的保真度项+导向项,实现滑块式连续强度控制的免训练图像编辑 效果: 基于 Rectified Flow 模型无需后训练,保真度项保持身份结构,导向项驱动语义编辑,平滑可靠 5. ActionParty:多主体视频世界模型 ActionParty: Multi-Subject Action Binding in Generative Video Games 关键词: 世界模型·多主体控制·动作绑定·视频游戏·状态token 贡献: 首个可同时控制多达 7 名玩家的视频世界模型,引入主体状态 token + 空间偏置解耦全局渲染与动作控制 效果: 在 Melting Pot 46 个环境中验证,动作跟随准确性和身份一致性显著提升,Snap Research 6. PFluxTTS:双解码器混合流匹配 TTS PFluxTTS: Hybrid Flow-Matching TTS with Robust Cross-Lingual Voice Cloning and Inference-Time Model Fusion 关键词: TTS·Flow Matching·跨语言克隆·双解码器·48kHz 贡献: 双解码器混合流匹配 TTS,推理时向量场融合+FLUX 解码器跨语言克隆+48kHz PeriodWave 声码器 效果: MOS 4.11 持平 ChatterBox,WER 降低 23%(6.9% vs 9.0%),说话人相似度超越 ElevenLabs(+0.32 SMOS) 7. BidirInterp:视频扩散双向循环一致性 Can Video Diffusion Models Predict Past Frames? Bidirectional Cycle Consistency for Reversible Interpolation 关键词: 视频插值·循环一致性·双向扩散·方向token·课程学习 贡献: 视频扩散双向循环一致性框架,可学习方向 token 统一前向合成和后向重建,课程学习从短到长 效果: 37帧和73帧插值任务均 SOTA,推理无额外开销(循环约束仅训练时),运动平滑度和动态控制大幅提升 8. CLPIPS:AI 生成图像个性化评测指标 CLPIPS: A Personalized Metric for AI-Generated Image Similarity 关键词: 评测指标·图像相似度·个性化·LPIPS·人类对齐 贡献: LPIPS 的个性化扩展,通过人类排序数据微调层组合权重,对齐 AI 生成图像评估与人类判断 效果: Spearman 等级相关和 ICC 均优于原始 LPIPS,证明有限人类数据微调即可显著提升感知对齐 9. ReflectGen:扩散模型物体反射生成 Reflection Generation for Composite Image Using Diffusion Model 关键词: 反射生成·合成图像·扩散模型·DEROBA数据集·类型感知 贡献: 首个大规模物体反射数据集 DEROBA + 扩散模型反射生成方法,注入反射位置和外观先验,类型感知设计 效果: 生成物理一致、视觉逼真的反射效果,为合成图像反射生成建立新基准 趋势观察 视频编辑从外观修复升级为因果推理 — VOID 用 VLM 推理物理交互,移除对象后重写下游动态,FVD 降低 40% 免训练编辑方法持续深化 — SteerFlow/FlowSlider 均基于 Rectified Flow 的免训练方案,数学保证源保真度 统一模型走向潜在空间融合 — LatentUM 消除像素中介,在共享语义潜空间内实现理解-生成-推理闭环 合成运动数据突破动态视频瓶颈 — DynaVid 用 CG 渲染光流解耦运动与外观,CVPR 2026 证明合成数据可学到真实世界动态 混合架构成为 TTS 新标准 — PFluxTTS 双解码器+向量场融合,跨语言克隆超越 ElevenLabs,MOS 达 4.11 人工智能炼丹师 整理 | 2026-04-06
-
AIGC 周末专题|2026-04-05|Mistral Voxtral TTS胜ElevenLabs AIGC 周末专题深度解读:语音合成与音频生成前沿:从编解码器语言模型到扩散 TTS、音效生成与指令驱动语音设计 人工智能炼丹师 整理 | 2026年4月5日(周日) 覆盖时间:2026年3月29日 — 2026年4月5日 本期概述 本期 AIGC 周末专题聚焦语音合成与音频生成前沿:从编解码器语言模型到扩散 TTS、音效生成与指令驱动语音设计方向,精选 6 篇代表性论文进行深度解读。 方向分布: 语音合成(TTS)— 4篇 音效生成(T2A/V2A)— 1篇 语音设计(Voice Design)— 1篇 本期论文一览 # 论文 机构 核心贡献 arXiv ID 1 Voxtral TTS Mistral AI 提出 Voxtral TTS 混合架构:自回归语义 token 建模 + 流匹配声学 token 生成,兼顾语义连贯性和 2603.25551 2 LongCat-AudioDiT Meituan 在波形潜空间(而非频谱或 token 空间)进行扩散 TTS,保留完整音频信息 2603.29339 3 T5Gemma-TTS Google 回归编码器-解码器架构:T5 编码器(2B)理解文本、Gemma 解码器(2B)生成语音 token 2604.01760 4 Woosh Sony AI 构建完整音效基础模型:音频编解码器 + 文本-音频对齐 + T2A 生成 + V2A 生成 2604.01929 5 MOSS-VoiceGenerator Fudan University 指令驱动语音生成:自然语言描述控制语音风格、情感和表达方式 2603.28086 6 Prosody-Aware TTS Independent Research 多阶段预训练:MLM 预训练 + SigLIP 跨模态对比学习 2604.01247 1. Voxtral TTS:混合自回归与流匹配的高质量语音合成系统 论文: Voxtral TTS arXiv: 2603.25551 机构: Mistral AI 1.1 研究动机 核心问题: 语音合成在零样本克隆音色保真度和多语言支持上不足,开源与商业差距大 当前语音合成系统在零样本语音克隆的音色保真度、韵律自然度和长文本稳定性上仍有差距。商业系统如 ElevenLabs 领先,开源社区需要更强大的基座模型。 前序工作及局限: VALL-E (2023):首个 Codec LM 零样本 TTS,纯自回归 XTTSv2 (2024):Coqui 开源多语言 TTS,音质有限 CosyVoice (2025):阿里开源 TTS,Flow Matching 后端 ElevenLabs (2025):商业 TTS 标杆,完全闭源 与前序工作的本质区别: 混合 AR 语义建模 + Flow Matching 声学生成,Voxtral Codec 双层量化,68.4% 胜率超越 ElevenLabs 1.2 方法原理 Voxtral TTS 的核心是两阶段生成管线。第一阶段使用自回归 Transformer 预测语义 token 序列,这些语义 token 由 Voxtral Codec 的 VQ 层提取,编码语音的语言内容和韵律模式。第二阶段使用条件流匹配模型以语义 token 为条件生成声学 token,FSQ 层编码精细的音色纹理。Voxtral Codec 是关键创新:编码器将音频压缩为双层表示(VQ 语义层 + FSQ 声学层),解码器从两层 token 重建高保真音频。 1.3 核心创新 提出 Voxtral TTS 混合架构:自回归语义 token 建模 + 流匹配声学 token 生成,兼顾语义连贯性和声学保真度 设计 Voxtral Codec:结合 VQ 和 FSQ 的混合编解码器,语义 token 捕获内容,声学 token 捕获音色 在 68.4% 的人类偏好评测中胜过 ElevenLabs Flash v2.5 支持多语言多说话人零样本克隆,CC BY-NC 开源 1.4 实验结果 MOS 达 4.32 分,A/B 测试中以 68.4% 胜率超过 ElevenLabs Flash v2.5。零样本音色相似度 0.891,支持英法德西等多种语言。 1.5 关键洞察 CC BY-NC 限制商业应用。两阶段推理增加延迟。与 ElevenLabs Turbo 系列未对比。训练数据未完全公开。 技术演进定位: 开源 TTS 新标杆,证明混合架构路线有效性 可能的后续方向: 低延迟流式推理 更多语言覆盖 情感控制融合 2. LongCat-AudioDiT:波形潜空间中的非自回归扩散语音合成 论文: LongCat-AudioDiT arXiv: 2603.29339 机构: Meituan 2.1 研究动机 核心问题: 自回归 TTS 误差累积和延迟,非自回归方法音色克隆质量不足 自回归 TTS 面临误差累积和推理延迟问题,非自回归方法在音色克隆上通常不如自回归。需要既能高效并行生成又达到自回归级别质量的方案。 前序工作及局限: Grad-TTS (2021):首个扩散 TTS,梅尔频谱空间 NaturalSpeech 2/3 (2024):扩散 TTS 系列,仍在频谱域 Seed-TTS (2025):字节 TTS 标杆,当时 SOTA F5-TTS (2025):Flow Matching TTS,潜空间但非波形域 与前序工作的本质区别: 首个波形潜空间扩散 TTS,Wav-VAE 保留相位信息,APG 替代 CFG 2.2 方法原理 三个核心组件:(1) Wav-VAE 在波形域工作,多尺度卷积编码器压缩波形到连续潜空间,保留相位和细节信息。(2) 扩散 DiT 在潜空间去噪,文本和说话人条件通过交叉注意力注入。(3) APG 将无条件预测投影到条件预测的正交补空间,避免 CFG 的过饱和问题。非自回归一次性生成完整潜表示。 2.3 核心创新 在波形潜空间(而非频谱或 token 空间)进行扩散 TTS,保留完整音频信息 设计 Wav-VAE 将波形压缩到连续潜空间,避免离散量化信息损失 自适应投影引导 APG 替代 CFG,避免过饱和 在 Seed-TTS 中文评测上超越 SOTA:SIM 0.818 vs 0.809 2.4 实验结果 Seed-TTS 中文基准 SIM 0.818(超 Seed-TTS 0.809),英文同达 SOTA。推理速度比自回归快 5-10 倍。代码和权重开源。 2.5 关键洞察 Wav-VAE 波形域压缩计算量较大。APG 增加少量推理开销。极长文本稳定性待验证。作者机构未明确标注。 技术演进定位: 非自回归 TTS 新高度,SIM 0.818 超越 Seed-TTS 可能的后续方向: 更高效 Wav-VAE 长音频生成 口型同步 TTS 3. T5Gemma-TTS:编码器-解码器架构的大规模 Codec 语言模型 TTS 论文: T5Gemma-TTS arXiv: 2604.01760 机构: Google 3.1 研究动机 核心问题: Decoder-only Codec LM TTS 在文本理解和时长控制上的局限 当前 Codec LM TTS 主流采用 decoder-only 架构,但文本理解和语音生成是性质不同的任务,统一序列建模可能不是最优方案。多语言场景下的时长控制不够精确。 前序工作及局限: VALL-E (2023):Decoder-only Codec LM 开山之作 VoiceCraft (2024):基于 Codec 的语音编辑 T5-TTS (2024):早期编码器-解码器 TTS,参数小 SpeechGPT (2025):GPT 架构多模态语音 LM 与前序工作的本质区别: 编码器-解码器各司其职,PM-RoPE 音素/词素位置精细时长控制,4B 参数 scaling 3.2 方法原理 T5 编码器接收文本生成上下文化表示,Gemma 解码器以交叉注意力为条件自回归生成 Codec token。PM-RoPE 在 RoPE 中额外注入音素级位置(字符级对齐)和词素级位置(语义级对齐),通过不同频率维度编码,使模型精确控制每个音素持续时间。 3.3 核心创新 回归编码器-解码器架构:T5 编码器(2B)理解文本、Gemma 解码器(2B)生成语音 token 提出 PM-RoPE 注入音素和词素级位置信息实现精细时长控制 B 参数规模,170K 小时多语言训练 日语说话人相似度 0.677 超过 XTTSv2 的 0.622,代码和权重开源 3.4 实验结果 日语说话人相似度 0.677 vs XTTSv2 0.622。PM-RoPE 消融显示字符级对齐误差降低 15%。4B 参数展现 scaling 优势。 3.5 关键洞察 4B 参数推理成本高。交叉注意力增加内存占用。PM-RoPE 需要音素/词素标注。与 Google 自家闭源系统仍有差距。 技术演进定位: 挑战 decoder-only 主流,编码器-解码器架构在大规模 TTS 上有效 可能的后续方向: 参数效率优化 更多语言 scaling 流式推理适配 4. Woosh:文本到音效与视频到音效的基础模型 论文: Woosh arXiv: 2604.01929 机构: Sony AI 4.1 研究动机 核心问题: 音效生成模型分散,T2A 和 V2A 各自独立,缺乏统一基础模型 音效生成模型分散,T2A 和 V2A 各自独立,缺乏统一基础模型。现有模型推理速度慢,难以满足交互式创作需求。 前序工作及局限: AudioLDM (2023):首个潜空间音效生成,仅 T2A Make-An-Audio (2023):文本到音频扩散框架 StableAudio-Open (2024):Stability AI 开源,仅 T2A TangoFlux (2025):Flow Matching 音效加速 与前序工作的本质区别: 完整音效基础模型统一 T2A+V2A,蒸馏版本快速推理 4.2 方法原理 模块化设计四组件:(1) 音频编解码器压缩/重建音频 (2) CLAP 风格对比学习建立文本-音频对齐 (3) T2A 扩散模型以文本为条件生成 (4) V2A 扩散模型以视频帧为条件生成同步音效。蒸馏版通过知识蒸馏实现少步生成。 4.3 核心创新 构建完整音效基础模型:音频编解码器 + 文本-音频对齐 + T2A 生成 + V2A 生成 蒸馏版本实现 5-8 倍快速推理 在 T2A/V2A 上与 StableAudio-Open 和 TangoFlux 竞争 4.4 实验结果 AudioCaps/Clotho 上 FAD 与 StableAudio-Open/TangoFlux 竞争。V2A 音视频同步分数高于基线。蒸馏版 5-8 倍加速。 4.5 关键洞察 模块化增加系统复杂度。T2A 和 V2A 未完全统一。蒸馏版复杂音效质量下降。与闭源音效模型仍有差距。 技术演进定位: 音效生成从单任务走向基础模型 可能的后续方向: T2A+V2A 深度统一 3D 空间音效 交互式音效设计 5. MOSS-VoiceGenerator:指令驱动的表达性语音设计:用自然语言控制语音风格 论文: MOSS-VoiceGenerator arXiv: 2603.28086 机构: Fudan University 5.1 研究动机 核心问题: 语音风格控制依赖参考音频,无法用自然语言灵活描述 传统 TTS 需要参考音频克隆风格,但很多创意场景中用户想用自然语言描述期望的语音风格。现有系统对复杂风格描述的理解能力有限。 前序工作及局限: PromptTTS (2023):简单标签提示风格控制 InstructTTS (2024):指令式 TTS,风格维度单一 StyleTTS 2 (2024):风格迁移仍需参考音频 ParlerTTS (2025):文本描述控制,主要针对说话人属性 与前序工作的本质区别: 电影语音数据训练,多维风格空间,自然语言直接映射 5.2 方法原理 两模块设计:(1) 风格理解模块用预训练 LLM 将自然语言风格描述编码为嵌入向量,涵盖音色/情感/语速/场景多维度。(2) 条件语音生成模块以文本和风格嵌入为条件,在梅尔频谱空间扩散生成。训练数据来自电影语音,自动标注情感、风格和角色属性。 5.3 核心创新 指令驱动语音生成:自然语言描述控制语音风格、情感和表达方式 基于表达性电影语音数据训练,覆盖丰富情感和说话风格 语音自然度和风格一致性超过现有语音设计模型 5.4 实验结果 MOS 3.89 高于 PromptTTS(3.52)/InstructTTS(3.71)。风格一致性 81.3%。情感表达维度尤为突出。 5.5 关键洞察 风格理解依赖 LLM 能力,抽象描述可能失效。电影语音数据版权问题。MOS 3.89 距顶级 TTS 仍有差距。缺少与最新系统直接对比。 技术演进定位: 指令驱动语音设计代表工作,开辟人机交互式语音创作 可能的后续方向: 多轮对话式设计 与高质量 TTS 集成 视频配音自动化 6. Prosody-Aware TTS:多阶段预训练的韵律感知扩散语音合成 论文: Prosody-Aware TTS arXiv: 2604.01247 机构: Independent Research 6.1 研究动机 核心问题: 扩散 TTS 韵律平淡缺乏表现力,缺少显式韵律建模 韵律是自然语音的关键要素,但扩散 TTS 往往生成韵律平淡的语音,缺乏对韵律结构的显式建模。 前序工作及局限: FastSpeech 2 (2021):显式韵律预测器,非扩散框架 Grad-TTS (2021):扩散 TTS 基础,无显式韵律建模 ProDiff (2022):改善韵律但未用预训练 CLaM-TTS (2024):语义 token 隐式韵律编码 与前序工作的本质区别: MLM+SigLIP 两阶段韵律预训练,即插即用不增推理开销 6.2 方法原理 三阶段:(1) MLM 预训练韵律编码器,掩码韵律 token 预测,学习韵律结构。(2) SigLIP 对比学习,建立文本语义和语音韵律跨模态对齐。(3) 将韵律编码器集成到扩散 TTS,韵律嵌入作为额外条件注入去噪。韵律编码器仅增加 5% 参数。 6.3 核心创新 多阶段预训练:MLM 预训练 + SigLIP 跨模态对比学习 MLM 让韵律编码器学习 F0/能量/时长的韵律模式 SigLIP 建立文本-韵律跨模态对应 在 Grad-TTS 和潜空间扩散 TTS 上验证有效,不增加推理开销 6.4 实验结果 F0 RMSE 降低 18%,Duration Accuracy 提升 12%。韵律 MOS 从 3.71 升至 4.02(Grad-TTS)和 3.85 升至 4.15(潜空间扩散)。推理时间几乎不变。 6.5 关键洞察 多阶段预训练增加训练复杂度。SigLIP 效果依赖正负样本质量。仅验证两种架构。韵律特征提取依赖信号处理工具。 技术演进定位: 通用韵律预训练策略可提升任意扩散 TTS 可能的后续方向: 更多韵律维度 跨语言韵律迁移 情感+韵律联合框架 横向对比与技术脉络总结 架构与核心指标对比 论文 核心架构 主要任务 关键创新 核心指标 Voxtral TTS AR + Flow Matching 多语言 TTS Voxtral Codec 双层量化 68.4% 胜率 vs ElevenLabs LongCat-AudioDiT Wav-VAE + DiT 零样本 TTS 波形潜空间 + APG SIM 0.818 超 Seed-TTS T5Gemma-TTS T5 + Gemma (4B) 多语言 TTS PM-RoPE 时长控制 日语 SIM 0.677 超 XTTSv2 Woosh 模块化扩散 T2A + V2A 统一音效基础模型 与 StableAudio 竞争 MOSS-VoiceGen LLM + 扩散 语音设计 自然语言风格控制 MOS 3.89, 一致性 81.3% Prosody-Aware 预训练 + 扩散 韵律增强 MLM + SigLIP 预训练 F0 RMSE 降低 18% 训练范式与应用场景对比 论文 训练范式 数据规模/特色 推理特点 目标场景 Voxtral TTS 两阶段生成管线 大规模多语言 两步推理 通用高质量 TTS LongCat-AudioDiT Wav-VAE + DiT 联合 大规模中英文 一步并行, 快5-10x 高保真零样本克隆 T5Gemma-TTS 编码器-解码器微调 170K 小时多语言 自回归, 4B 参数 多语言精细控制 Woosh 模块化分阶段 大规模音效数据 蒸馏版 5-8x 加速 影视/游戏音效 MOSS-VoiceGen 电影语音微调 电影对白(情感丰富) 标准扩散速度 有声书/游戏配音 Prosody-Aware 三阶段预训练 标准 TTS 数据 不增推理开销 通用韵律增强插件 核心技术趋势 趋势 1:混合架构成为语音合成最优解 Voxtral TTS 的 AR+Flow Matching 和 T5Gemma-TTS 的编码器-解码器都证明,将不同任务交给不同模块比统一架构更有效。混合方案在语义连贯性和声学保真度之间取得最佳平衡。 趋势 2:表示空间从离散走向连续 LongCat-AudioDiT 在波形潜空间超越 Seed-TTS 证明,连续潜表示比离散 token 保留更多信息。Voxtral Codec 的双层设计也体现了语义(离散)和声学(连续)的最优分工。 趋势 3:音效生成走向基础模型化 Woosh 统一 T2A 和 V2A 是音效领域的重要尝试。类似于视觉领域从单任务模型走向基础模型,音频领域也在整合不同任务到统一框架。蒸馏加速为交互式应用铺路。 趋势 4:自然语言成为生成控制的通用接口 MOSS-VoiceGenerator 用自然语言替代参考音频控制语音风格,这与图像生成中 text-to-image 的成功类似。自然语言作为人机接口的通用性正在从文本/图像扩展到音频领域。 趋势 5:模块化预训练策略的崛起 Prosody-Aware TTS 的韵律预训练可即插即用提升任意扩散 TTS。这种模块化的预训练策略——独立训练某个能力模块再嵌入主框架——可能成为能力增强的通用范式。 技术路线全景图 语音合成与音频生成技术路线 ├── TTS 架构创新 │ ├── 混合架构 → Voxtral TTS(AR + Flow Matching,68.4% 胜率) │ ├── 编码器-解码器 → T5Gemma-TTS(4B 参数,PM-RoPE 时长控制) │ └── 纯扩散路线 → LongCat-AudioDiT(波形潜空间,SIM 0.818) ├── 表示空间探索 │ ├── 波形潜空间 → Wav-VAE(保留相位信息) │ └── 双层量化 → Voxtral Codec(VQ 语义 + FSQ 声学) ├── 音效生成 │ └── 统一基础模型 → Woosh(T2A + V2A + 蒸馏加速) └── 交互与控制 ├── 自然语言控制 → MOSS-VoiceGenerator(指令驱动风格设计) └── 韵律增强 → Prosody-Aware TTS(MLM + SigLIP 即插即用) 总结与展望 本期专题的 6 篇论文共同描绘了语音合成与音频生成的前沿全景图。从混合架构(Voxtral TTS)到波形域扩散(LongCat-AudioDiT),从编码器-解码器回归(T5Gemma-TTS)到音效基础模型(Woosh),再到指令驱动设计(MOSS-VoiceGenerator)和韵律预训练(Prosody-Aware TTS),语音生成正在从技术验证走向实际可用。值得关注的未来方向: 混合+波形域:将 Voxtral 的混合架构与 LongCat 的波形空间结合 精细控制:PM-RoPE 时长控制 + 韵律预训练 + 情感控制的统一框架 端到端创意配音:MOSS 的语言风格控制与高质量 TTS 集成 音效+语音统一:将 TTS 和音效生成融入同一个音频基础模型 人工智能炼丹师 整理 | 数据来源:arXiv 2026年3月29日 — 2026年4月5日
-
AIGC 周末专题|2026-04-04|视频生成前沿|统一框架|长视频|物理一致性 AIGC 周末专题深度解读:视频生成与编辑前沿:从统一框架到长视频、物理一致性与高效推理 人工智能炼丹师 整理 | 2026年4月4日(周六) 覆盖时间:2026年3月29日 — 2026年4月4日 本期概述 本期 AIGC 周末专题聚焦视频生成与编辑前沿:从统一框架到长视频、物理一致性与高效推理方向,精选 6 篇代表性论文进行深度解读。 方向分布: 统一视频生成框架 — 1篇 长视频生成 — 1篇 物理一致性与几何对齐 — 1篇 高效少步训练 — 1篇 多镜头流式叙事 — 1篇 角色一致性生成 — 1篇 本期论文一览 # 论文 机构 核心贡献 arXiv ID 1 OmniWeaving Tencent Hunyuan, Zhejiang University 提出 OmniWeaving 统一视频生成框架,通过 MLLM 实现多模态理解与推理,支持文本、多图像、视频的自由组合输 2603.24458 2 PackForcing Alaya Studio, Shandong University 提出三分区 KV-cache 策略:Sink tokens(全分辨率锚点帧)+ Mid tokens(32倍时空压缩)+ 2603.25730 3 VGGRPO Independent Research 提出 VGGRPO(Visual Geometry GRPO),首个在潜空间计算几何奖励的视频后训练框架 2603.26599 4 EFlow Snap Research, Rutgers University 提出 EFlow,同时解决注意力复杂度和采样步数两大瓶颈的统一框架 2603.27086 5 ShotStream CUHK, Kuaishou Technology 提出 ShotStream,首个因果多镜头视频生成架构,支持流式实时交互 2603.25746 6 Gloria USTC (CVPR 2026) 提出内容锚点(Content Anchors)表示角色视觉属性:全局锚点(身份特征)+ 视角锚点(多视角外观)+ 表情锚 2603.29931 1. OmniWeaving:统一视频生成:自由组合与推理驱动的全能框架 论文: OmniWeaving arXiv: 2603.24458 机构: Tencent Hunyuan, Zhejiang University 1.1 研究动机 核心问题: 开源视频生成模型碎片化,无法在单一框架内统一 T2V/I2V/V2V 等多任务 当前开源视频生成模型高度碎片化,无法在单一框架内统一文生视频、图生视频、视频编辑等多种任务。商业系统(如 Seedance-2.0)遥遥领先,开源社区急需一个全能统一方案。 前序工作及局限: CogVideo (2022):早期文生视频扩散模型,仅支持文本到视频单一任务 Stable Video Diffusion (2024):图生视频基础模型,不支持多模态组合输入 HunyuanVideo (2025):腾讯混元视频生成,功能相对单一 Seedance-2.0 (2026):字节商业全能系统,但不开源 与前序工作的本质区别: 首个开源全能统一视频生成框架,MLLM+DiT 双模块架构支持自由多模态组合输入和推理驱动的视频创作 1.2 方法原理 OmniWeaving 由两个核心模块组成:(1) 多模态大语言模型(MLLM)负责理解和推理复杂的用户意图,将文本、图像、视频等多模态输入统一编码为条件表示;(2) 视频扩散模型接收条件表示生成高质量视频。训练分为三阶段:首先在大规模视频数据上预训练基础扩散模型,然后通过精心构建的多模态组合数据(包含交错文本-图像-视频对)进行微调,最后通过推理增强数据提升模型的意图理解能力。关键创新在于训练数据构建管线:自动从海量视频中提取多模态组合场景,生成需要推理才能完成的复杂视频创作任务。 1.3 核心创新 提出 OmniWeaving 统一视频生成框架,通过 MLLM 实现多模态理解与推理,支持文本、多图像、视频的自由组合输入 构建大规模多模态组合与推理增强训练数据集,学习在时间维度上绑定交错的多模态输入 引入 IntelligentVBench 综合评测基准,首个面向智能统一视频生成的严格评测体系 在开源统一模型中达到 SOTA,代码和模型完全开源 1.4 实验结果 在文生视频(T2V)、图生视频(I2V)、视频到视频(V2V)等多个任务上均达到开源 SOTA。在新提出的 IntelligentVBench 上,OmniWeaving 在多模态组合和抽象推理任务上显著优于现有开源方案,与商业系统差距大幅缩小。 1.5 关键洞察 训练数据构建管线依赖大量自动化标注,数据质量可能存在噪声。IntelligentVBench 作为自家提出的评测基准,客观性有待社区验证。与 Seedance-2.0 等商业系统相比仍有差距,但开源意义重大。 技术演进定位: 开源统一视频生成的里程碑,填补了开源社区在全能视频框架上的空白 可能的后续方向: 更强的推理能力:结合 CoT 和 tool-use 实现更复杂的视频创作 视频质量提升:进一步缩小与 Seedance-2.0 等商业系统的差距 社区生态建设:作为开源基座支持下游任务微调和插件开发 2. PackForcing:短视频训练即可生成连贯2分钟长视频 论文: PackForcing arXiv: 2603.25730 机构: Alaya Studio, Shandong University 2.1 研究动机 核心问题: 自回归视频扩散模型的 KV-cache 线性增长导致长视频生成内存爆炸 自回归视频扩散模型在长视频生成中面临三大瓶颈:KV-cache 线性增长导致内存爆炸、时间重复(temporal repetition)和误差累积。现有方法无法在有限 GPU 内存下生成超过30秒的连贯视频。 前序工作及局限: FIFO-Diffusion (2024):FIFO 队列长视频生成,但视频长度受限于队列大小 FreeNoise (2024):噪声重安排扩展长度,但生成质量随长度下降 Pyramid Flow (2025):金字塔流式生成,计算开销仍然很大 StreamDiffusion (2025):流式扩散框架,未解决 KV-cache 膨胀问题 与前序工作的本质区别: 三分区 KV-cache 策略(Sink+Mid+Recent)实现 32 倍压缩和有界 4GB 内存,仅用 5 秒短视频训练即可 24 倍时间外推到 2 分钟 2.2 方法原理 PackForcing 将自回归视频扩散中的历史上下文分为三类:(1) Sink tokens 保留最早的若干帧作为全局语义锚点;(2) Mid tokens 通过双分支网络将中间帧压缩为极少 token——一个分支是渐进式 3D 卷积逐步降低时空分辨率,另一个分支将帧重编码为低分辨率 VAE latent,两者通过门控机制融合;(3) Recent tokens 保持最近帧的全分辨率以确保局部连贯性。当 Mid tokens 过多时,动态 top-k 机制选择最重要的 token 保留,同时通过连续 RoPE 重编码消除位置间隙。整个框架可在仅 5 秒短视频片段上训练,推理时自回归扩展到 2 分钟。 2.3 核心创新 提出三分区 KV-cache 策略:Sink tokens(全分辨率锚点帧)+ Mid tokens(32倍时空压缩)+ Recent tokens(全分辨率近期帧),实现有界 4GB KV-cache Mid tokens 采用双分支压缩网络:渐进式 3D 卷积 + 低分辨率 VAE 重编码,实现 32 倍 token 缩减 动态 top-k 上下文选择 + 连续时间 RoPE 调整,无缝处理丢弃 token 造成的位置间隙 仅用 5 秒短视频训练,实现 24 倍时间外推到 120 秒(2分钟),VBench SOTA 2.4 实验结果 在单个 H200 GPU 上生成 832x480/16FPS 的 2 分钟连贯视频,KV-cache 仅占 4GB。VBench 时间一致性达 26.07,动态度 56.25,均为 SOTA。实现 24 倍时间外推(5秒→120秒)。 2.5 关键洞察 双分支 Mid token 压缩引入额外计算开销,需要验证其在更高分辨率(1080p+)下的可扩展性。目前仅在 16FPS 下验证,更高帧率场景待测试。分区策略中的超参数(Sink/Mid/Recent 比例)需要仔细调节。 技术演进定位: 当前最高效的长视频生成方案,首次在单 GPU 上实现 2 分钟连贯视频 可能的后续方向: 更高分辨率:将方案扩展到 1080p 以上 自适应压缩率:根据场景复杂度动态调整 Mid token 压缩比 与统一框架集成:将 PackForcing 策略融入 OmniWeaving 等全能模型 3. VGGRPO:4D潜空间奖励驱动的世界一致性视频生成 论文: VGGRPO arXiv: 2603.26599 机构: Independent Research 3.1 研究动机 核心问题: 视频扩散模型虽然视觉效果好但经常违反几何规律(相机抖动、多视角不一致) 大规模视频扩散模型虽然视觉质量出色,但经常违反几何一致性:相机抖动、多视角几何不一致、物理规律违反。现有方法要么修改架构(损害泛化能力),要么在 RGB 空间计算几何奖励(昂贵且仅限静态场景)。需要一种不修改架构、计算高效且支持动态场景的方案。 前序工作及局限: DDPO (2023):首次将强化学习引入扩散模型,但限于图像领域 DPO for Diffusion (2024):扩散模型偏好对齐,不涉及几何奖励 VideoScore (2025):视频质量奖励模型,在 RGB 空间计算成本高 T2V-Turbo (2025):视频 RLHF,但仅优化视觉质量不涉及几何 与前序工作的本质区别: 首次在潜空间计算几何奖励(绕过 VAE 解码),通过 4D 重建扩展到动态场景,GRPO 策略梯度优化几何一致性 3.2 方法原理 VGGRPO 分为两步:(1) 训练潜在几何模型 LGM,它是一个轻量级网络,直接从视频扩散的 latent 空间解码场景的深度和法线信息,不需要经过 VAE 解码到 RGB 空间。LGM 通过冻结 VAE encoder-decoder 对和几何基础模型(如 DPT/Metric3D)蒸馏训练。(2) 使用 Group Relative Policy Optimization(GRPO)进行视频扩散模型的后训练。对同一 prompt 采样多条生成轨迹,通过 LGM 在 latent 空间计算两种奖励:相机运动平滑度奖励惩罚帧间几何抖动,几何重投影一致性奖励确保跨视角的 3D 一致性。GRPO 根据奖励差异更新策略梯度。4D 扩展通过时序多帧几何重建实现。 3.3 核心创新 提出 VGGRPO(Visual Geometry GRPO),首个在潜空间计算几何奖励的视频后训练框架 引入潜在几何模型(Latent Geometry Model, LGM),将视频扩散 latent 直接映射到场景几何(深度/法线),无需 VAE 解码 构建 4D 几何重建能力,自然扩展到动态场景,克服了先前方法仅限静态场景的局限 双奖励机制:相机运动平滑度奖励 + 几何重投影一致性奖励 3.4 实验结果 在静态场景(RealEstate10K)和动态场景(WebVid)上均显著提升几何一致性。相机稳定性提升 23%,几何重投影误差下降 31%。推理成本与基线相同(LGM 仅训练时使用),避免了 VAE 解码的计算开销。 3.5 关键洞察 LGM 的训练质量直接影响奖励信号的准确性,如果几何基础模型本身有偏差会传播到视频模型。当前奖励仅考虑几何一致性,未涉及物理动力学(如碰撞、重力)。GRPO 的多轨迹采样增加了训练成本。 技术演进定位: 开创了视频几何后训练的新范式,证明 RLHF 类方法可有效提升视频的物理合理性 可能的后续方向: 物理动力学奖励:扩展到碰撞、重力、流体等物理规律 多维度联合奖励:几何+物理+美学的统一奖励函数 在线强化学习:实时根据用户反馈优化生成质量 4. EFlow:高效少步视频生成器:从头训练的突破 论文: EFlow arXiv: 2603.27086 机构: Snap Research, Rutgers University 4.1 研究动机 核心问题: 视频扩散 Transformer 面临每步二次注意力复杂度和多步迭代采样的双重瓶颈 视频扩散 Transformer 面临两个复合成本瓶颈:每步的二次注意力复杂度 O(n^2) 和多步迭代采样。现有加速方法通常只解决其中一个——蒸馏减少步数但不降低单步成本,高效注意力降低单步成本但不减少步数。需要同时解决两个瓶颈的统一方案。 前序工作及局限: Consistency Models (2023):一步生成模型,但仅限图像且质量有限 Flow Matching (2023):条件流匹配框架,需要多步采样 Rectified Flow (2024):直线化流加速采样,但不降低单步成本 InstaFlow (2024):一步文生图,但无法扩展到视频 与前序工作的本质区别: 同时解决注意力复杂度(Gated L-G Attention + token dropping)和采样步数(solution-flow + MVA 正则化),从头训练无需教师模型 4.2 方法原理 EFlow 基于 solution-flow 目标,学习将时刻 t 的噪声状态直接映射到时刻 s(跨越多个扩散步)。核心创新有三:(1) Gated Local-Global Attention 将注意力分为局部窗口注意力和全局稀疏注意力两部分,通过门控机制融合,关键是设计为对 random token dropping 高度稳定——训练时随机丢弃 50-70% 的 token 而不影响质量;(2) Path-Drop Guided Training 在少步训练中用条件路径和无条件路径的随机丢弃替代传统 CFG(后者需要两次前向传播),将引导成本降为零;(3) Mean-Velocity Additivity 正则化器约束不同步数下的速度场之和等于总位移,确保 1-4 步生成的一致性。从头训练流程支持直接训练少步模型,无需先训练多步模型再蒸馏。 4.3 核心创新 提出 EFlow,同时解决注意力复杂度和采样步数两大瓶颈的统一框架 Gated Local-Global Attention:可丢弃 token 的混合注意力块,在激进随机 token 丢弃下保持稳定 Path-Drop Guided Training:用计算廉价的弱路径替代昂贵的 classifier-free guidance 目标 Mean-Velocity Additivity 正则化器:确保极低步数下的生成保真度 从头训练达到 45.3 倍推理加速,2.5 倍训练吞吐量提升 4.4 实验结果 在 Kinetics-600 和大规模 T2V 数据集上验证。4步生成质量与标准 50 步模型相当。训练吞吐量比标准 solution-flow 提升 2.5 倍。推理延迟降低 45.3 倍。生成质量 FVD 与多步基线竞争。 4.5 关键洞察 随机 token dropping 在极端比例下可能影响细节质量。Path-Drop Guided 是否在所有场景下都能替代 CFG 有待更多验证。从头训练的计算量仍然很大(虽然吞吐量提升了2.5倍)。目前主要在较短视频上验证。 技术演进定位: 首个同时解决两大瓶颈的统一加速框架,45.3 倍推理加速具有部署实用价值 可能的后续方向: 与视频编解码器融合:端到端优化编码-生成-解码管线 硬件适配:针对特定 GPU/NPU 架构定制注意力模式 实时生成:结合 PackForcing 等策略实现长视频实时生成 5. ShotStream:流式多镜头视频生成:实时交互式叙事 论文: ShotStream arXiv: 2603.25746 机构: CUHK, Kuaishou Technology 5.1 研究动机 核心问题: 多镜头视频生成的双向架构导致交互性差、延迟高,用户无法实时参与创作 多镜头视频生成是长叙事视频的关键,但当前双向扩散架构(如全序列并行生成)存在交互性差和延迟高的问题——用户无法在生成过程中动态调整叙事方向,且需要等待整个序列生成完成才能看到结果。 前序工作及局限: MovieFactory (2024):多镜头电影生成,但一次性生成全序列不可交互 VideoDirectorGPT (2024):LLM 驱动视频导演,规划与生成分离 Vlogger (2025):长视频博客生成,不支持流式输出 Kling (2025):快手视频生成模型,单镜头生成 与前序工作的本质区别: 首个因果流式多镜头架构,通过双缓存记忆和两阶段蒸馏实现 16 FPS 实时交互式叙事 5.2 方法原理 ShotStream 的流程分为训练和推理两阶段。训练阶段:(1) 将预训练 T2V 模型微调为双向 next-shot 生成器,学习根据前序镜头和文本提示生成下一个镜头;(2) 通过分布匹配蒸馏将双向教师蒸馏为因果学生模型。为解决因果自回归的两大挑战:(a) 镜头间一致性——引入全局上下文缓存(Global Context Cache),存储所有前序镜头的条件帧作为长程记忆;(b) 误差累积——设计两阶段蒸馏策略:第一阶段在真实历史上进行镜头内自强迫训练,第二阶段在自生成的历史上进行镜头间自强迫训练,逐步暴露给模型自身的生成误差。RoPE 不连续性指示器通过在全局和局部缓存之间插入位置编码跳跃来消除歧义。 5.3 核心创新 提出 ShotStream,首个因果多镜头视频生成架构,支持流式实时交互 将多镜头生成重构为 next-shot generation:基于历史镜头上下文生成下一个镜头 双缓存记忆机制:全局上下文缓存(镜头间一致性)+ 局部上下文缓存(镜头内一致性),RoPE 不连续性指示器区分两者 两阶段蒸馏策略:镜头内自强迫 → 镜头间自强迫,有效弥合训练-测试差距 单 GPU 达到 16 FPS 实时生成 5.4 实验结果 在 MovieGen 和 StoryBench 上评测。亚秒级延迟,单 GPU 16 FPS。多镜头连贯性指标(FCD、IC-LPIPS)与双向模型持平甚至更优。支持用户中途修改叙事提示,实现真正的交互式叙事。 5.5 关键洞察 因果架构天然信息量少于双向架构,长程一致性在超长叙事(10+镜头)下可能衰减。蒸馏质量依赖双向教师模型。全局上下文缓存随镜头数增长可能成为新的内存瓶颈。 技术演进定位: 开创了流式交互式视频叙事的新范式,是 AI 视频工具从离线走向实时的关键一步 可能的后续方向: 多角色交互:支持多角色多视角的复杂叙事 与 LLM 集成:用大语言模型实时规划叙事脉络 商业化部署:面向短视频平台和游戏行业的实时视频生成 6. Gloria:基于内容锚点的长时角色一致性视频生成 论文: Gloria arXiv: 2603.29931 机构: USTC (CVPR 2026) 6.1 研究动机 核心问题: 长时间角色视频生成中身份漂移严重,多视角和表情一致性难以保持 数字角色是现代媒体的核心,但生成长时间、多视角一致且表情丰富的角色视频仍是开放挑战。现有方法面临两类问题:要么参考信息不足导致身份漂移,要么使用非角色中心的记忆信息导致一致性次优。 前序工作及局限: IP-Adapter (2023):图像提示适配器,角色信息通过单图注入,长视频中易漂移 AnimateAnyone (2024):可控人物动画,但一致性限于短视频 MagicAnimate (2024):人物动画,依赖骨骼驱动不够灵活 ID-Animator (2025):身份保持动画,但多视角一致性不足 与前序工作的本质区别: 通过三类内容锚点(全局/视角/表情)提供稳定参考,超集锚定防止复制粘贴,实现 10+ 分钟级别的角色一致性 6.2 方法原理 Gloria 将角色视频生成类比为由外向内观察的场景。核心是通过一组紧凑的锚帧来描述角色的视觉属性:(1) 全局锚点——一个标准正面参考图,提供身份基准;(2) 视角锚点——来自不同视角的参考帧,覆盖角色的多视角外观;(3) 表情锚点——包含不同表情的帧,编码角色的表情动态范围。训练时,通过超集内容锚定策略——提供比目标片段更多的锚点信息(包括训练剪辑之外的帧),迫使模型学习从锚点中提取有用信息而非简单复制。同时使用 RoPE 位置偏移作为弱条件区分不同锚点帧,让模型知道哪些帧来自哪个视角。数据管线方面,从海量视频中自动检测角色区域、跟踪身份、提取关键帧作为锚点。 6.3 核心创新 提出内容锚点(Content Anchors)表示角色视觉属性:全局锚点(身份特征)+ 视角锚点(多视角外观)+ 表情锚点(表情动态) 超集内容锚定(Superset Content Anchoring):提供训练内和训练外的片段提示,防止模型简单复制粘贴 RoPE 作为弱条件:编码位置偏移来区分多个锚点帧,避免多参考冲突 可扩展的锚点提取管线:从海量视频中自动提取角色锚点 生成超过 10 分钟的一致性角色视频(CVPR 2026 接收) 6.4 实验结果 生成超过 10 分钟的长视频,保持角色身份、多视角外观和表情一致性。在人类评估中,ID 一致性和外观多样性均超过 SOTA 方法(包括 IP-Adapter、AnimateAnyone 等)。被 CVPR 2026 主会议接收。 6.5 关键洞察 锚点提取管线依赖角色检测和跟踪的准确性,遮挡严重的场景可能失败。超集锚定策略增加了训练复杂度。对非人物角色(如动漫、卡通角色)的泛化能力需要更多验证。10 分钟的一致性主要在受控场景下验证。 技术演进定位: 角色一致性视频生成的新标杆,锚点机制为长视频角色保持提供了有效范式(CVPR 2026) 可能的后续方向: 多角色一致性:同时保持多个角色的身份一致性 跨域角色:从真人扩展到动漫、卡通、3D 虚拟人等 实时角色创作:结合 ShotStream 等流式架构实现实时角色视频 横向对比与技术脉络总结 架构与任务对比 论文 核心架构 主要任务 关键创新 输入形式 OmniWeaving MLLM + DiT T2V/I2V/V2V 统一 推理驱动+组合数据 文本+多图+视频自由组合 PackForcing 自回归 DiT 长视频生成 三分区 KV-cache 文本 → 2分钟视频 VGGRPO DiT + LGM 几何一致性后训练 4D 潜空间几何奖励 文本 → 几何一致视频 EFlow Gated L-G DiT 高效少步生成 token dropping + MVA 文本 → 4步高质量视频 ShotStream 因果 DiT 流式多镜头叙事 双缓存+两阶段蒸馏 逐镜头文本 → 实时视频 Gloria DiT + 锚点 角色一致性生成 三类内容锚点 角色参考图 → 10min视频 训练范式与效率对比 论文 训练范式 外部监督 推理效率 核心瓶颈解决 OmniWeaving 三阶段渐进训练 组合数据+推理增强 标准 DiT 速度 任务碎片化 PackForcing 短视频训练+时间外推 无(5秒视频) 单 GPU 2分钟 内存爆炸(KV-cache→4GB) VGGRPO GRPO 后训练 LGM 伪标签 与基线相同 几何违反(相机稳定↑23%) EFlow Solution-flow 从头训练 无需教师模型 45.3× 加速 注意力O(n²)+多步采样 ShotStream 两阶段蒸馏 双向教师蒸馏 16 FPS 实时 延迟高+不可交互 Gloria 端到端锚点训练 自动锚点提取 标准 DiT 速度 长时身份漂移 核心技术趋势 趋势 1:视频生成从碎片化走向统一 OmniWeaving 证明了 MLLM+DiT 架构可以在单一框架内处理 T2V/I2V/V2V 等多种视频任务。推理驱动的数据构建策略使模型能理解复杂的多模态组合意图,这预示着未来的视频 AI 将是全能型的。 趋势 2:长视频生成突破内存瓶颈 PackForcing 的三分区 KV-cache 策略实现了 24 倍时间外推(5秒→2分钟),Gloria 的内容锚点将角色一致性推到 10 分钟级。两者共同表明长视频生成的关键不在于生成能力本身,而在于上下文管理和信息压缩。 趋势 3:GRPO 后训练成为视频质量提升的新范式 VGGRPO 将 GRPO 引入视频几何一致性优化,在 latent 空间计算奖励避免了昂贵的 RGB 解码。这延续了 LLM 领域 RLHF/DPO 的成功经验,后训练对齐正成为视频扩散模型质量提升的关键杠杆。 趋势 4:少步生成从蒸馏走向从头训练 EFlow 的 Gated L-G Attention + token dropping + MVA 正则化实现了 45.3 倍推理加速,且无需教师模型。这种从头训练少步模型的路线比蒸馏更灵活,可能成为效率优化的主流方案。 趋势 5:交互式实时生成开启视频创作新时代 ShotStream 的因果流式架构达到 16 FPS 实时生成,用户可以边看边改叙事方向。这标志着视频 AI 从「离线工具」向「实时合作者」的转变,对短视频平台和游戏行业有重要意义。 技术路线全景图 视频生成与编辑技术路线 ├── 统一框架 │ └── MLLM + DiT 双模块 → OmniWeaving(多模态组合+推理驱动) ├── 长视频生成 │ ├── KV-cache 压缩 → PackForcing(三分区策略,24x 外推) │ └── 角色一致性 → Gloria(三类内容锚点,10min 级别) ├── 质量对齐 │ └── 后训练 GRPO → VGGRPO(4D 潜空间几何奖励) ├── 推理效率 │ └── 从头训练少步 → EFlow(45.3x 加速,无需蒸馏) └── 交互式生成 └── 因果流式架构 → ShotStream(16 FPS 实时多镜头叙事) 总结与展望 本期专题的 6 篇论文共同描绘了视频生成与编辑领域的前沿全景图。从统一框架(OmniWeaving)到长视频突破(PackForcing/Gloria),从物理对齐(VGGRPO)到效率革命(EFlow),再到交互式创作(ShotStream),视频生成正在从技术验证走向实际可用。几个值得关注的未来方向: 统一+长视频:将 PackForcing 的 KV-cache 策略融入 OmniWeaving 等全能框架 多维度后训练:将几何、物理、美学奖励统一到一个 GRPO 框架中 实时+角色:将 Gloria 的锚点机制与 ShotStream 的流式架构结合,实现实时角色叙事 端到端效率:将 EFlow 的少步生成与 PackForcing 的内存优化联合使用 人工智能炼丹师 整理 | 数据来源:arXiv 2026年3月29日 — 2026年4月4日