


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。
方向分布:
CVPR 2026 ×1 | ICLR 2026 ×1 | ICASSP 2026 ×1
自一致分布匹配蒸馏+缓存感知训练:仅2-4步实现高质量视频生成 | Hong Kong University of Science and Technology, Vivix Group | arXiv:2604.03118
关键词: 视频生成加速, 分布匹配蒸馏, 自一致性正则, KV缓存感知, 自回归视频生成
核心问题: 将视频扩散模型蒸馏到2-4步推理时,DMD的局部训练信号导致多步去噪更新组合产生轨迹漂移,一致性蒸馏则过于保守导致模糊
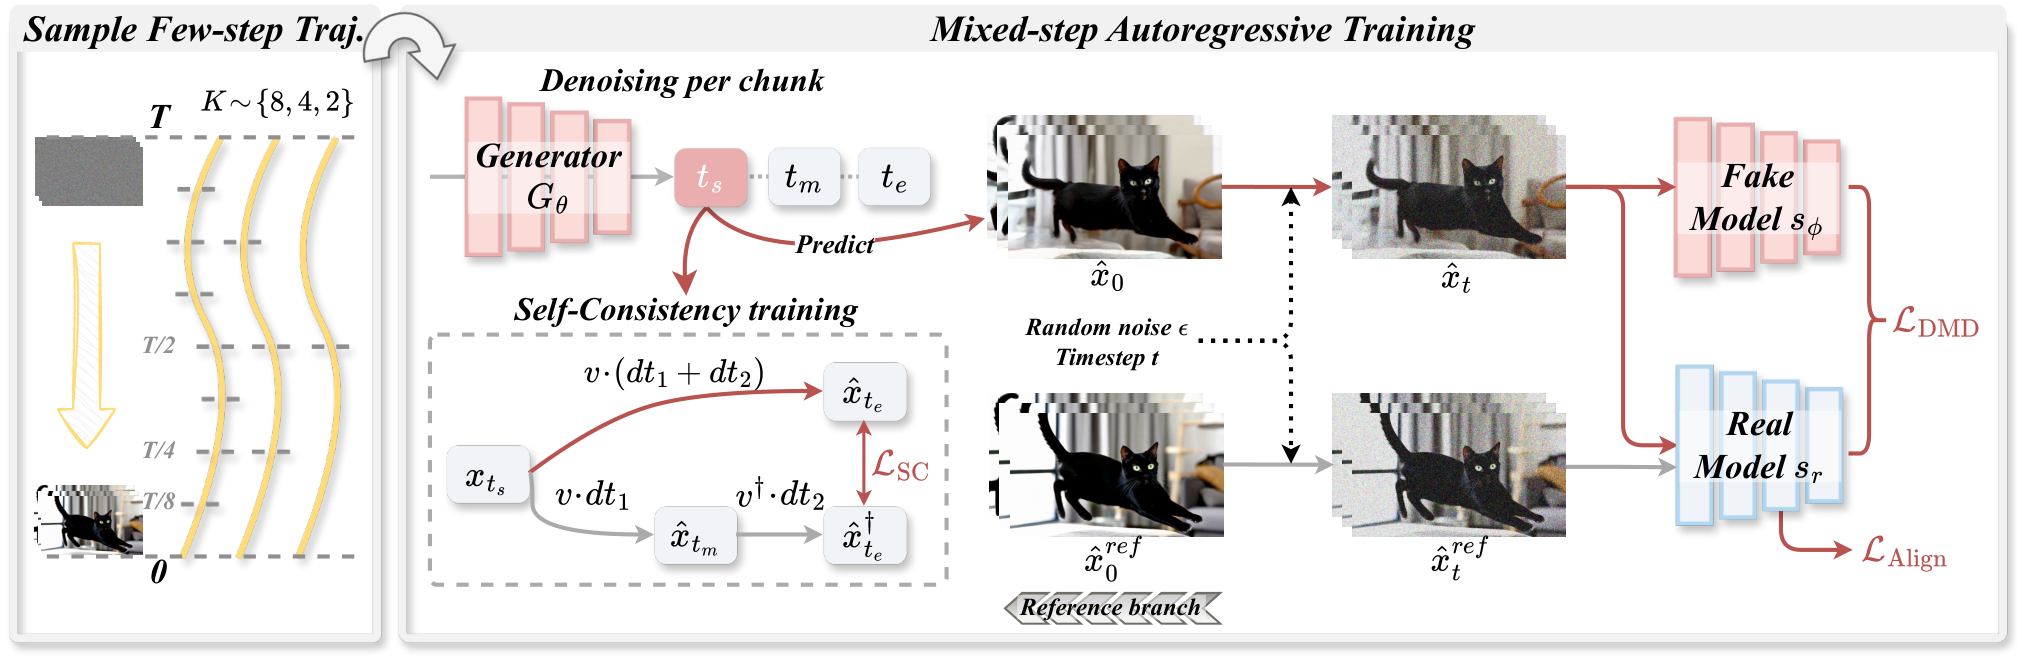
将视频生成模型蒸馏到极低推理步数(2-4步NFEs)对实时部署至关重要但仍极具挑战。轨迹式一致性蒸馏在复杂视频动态下变得保守,导致外观过度平滑和运动微弱。分布匹配蒸馏(DMD)可恢复清晰样本,但其局部训练信号没有显式规范去噪更新如何跨时间步组合,导致多步推理时产生轨迹漂移。Salt提出自一致分布匹配蒸馏(SC-DMD),显式约束连续去噪更新的终点一致组合,结合缓存分布感知训练解决自回归视频生成中的KV缓存质量退化问题。
前序工作及局限:
与前序工作的本质区别: Salt将半群缺陷约束作为DMD框架内的正则化器(而非独立回归目标),既保留DMD的模式寻求分布对齐,又修正多步组合漂移。同时首次引入KV缓存质量参数化条件训练
Salt框架包含两大核心技术创新。(1) 自一致分布匹配蒸馏(SC-DMD):在DMD基础上引入轻量级半群缺陷(Semigroup Defect)正则化器,约束学习到的传输算子在组合时保持终点一致性。具体而言,对任意三元组时间步(ts,tm,te),要求从ts一步跳到te的结果与从ts经tm两步跳到te的结果在终点对齐,DMD负责分布匹配的锐利样本,半群正则修正多步组合漂移。(2) 缓存分布感知训练:针对自回归设定,将KV缓存视为质量参数化条件。采用混合步数滚展策略(K从{2,4,8}中随机采样),让模型训练时接触从高质量到低质量的完整缓存分布。同时引入缓存条件参考对齐损失,通过TRD风格的关系特征空间对齐,将低质量缓存下的输出向高质量参考靠拢。SC-DMD正则化仅在K=8时激活(最长组合链受益最大),对齐损失仅在K为2或4时激活。
SC-DMD概念对比
半群缺陷正则与Shortcut Models、Flow Map Distillation的关系。Salt将半群约束作为DMD框架内正则化器
SC-DMD概念对比
半群缺陷正则与Shortcut Models、Flow Map Distillation的关系。Salt将半群约束作为DMD框架内正则化器
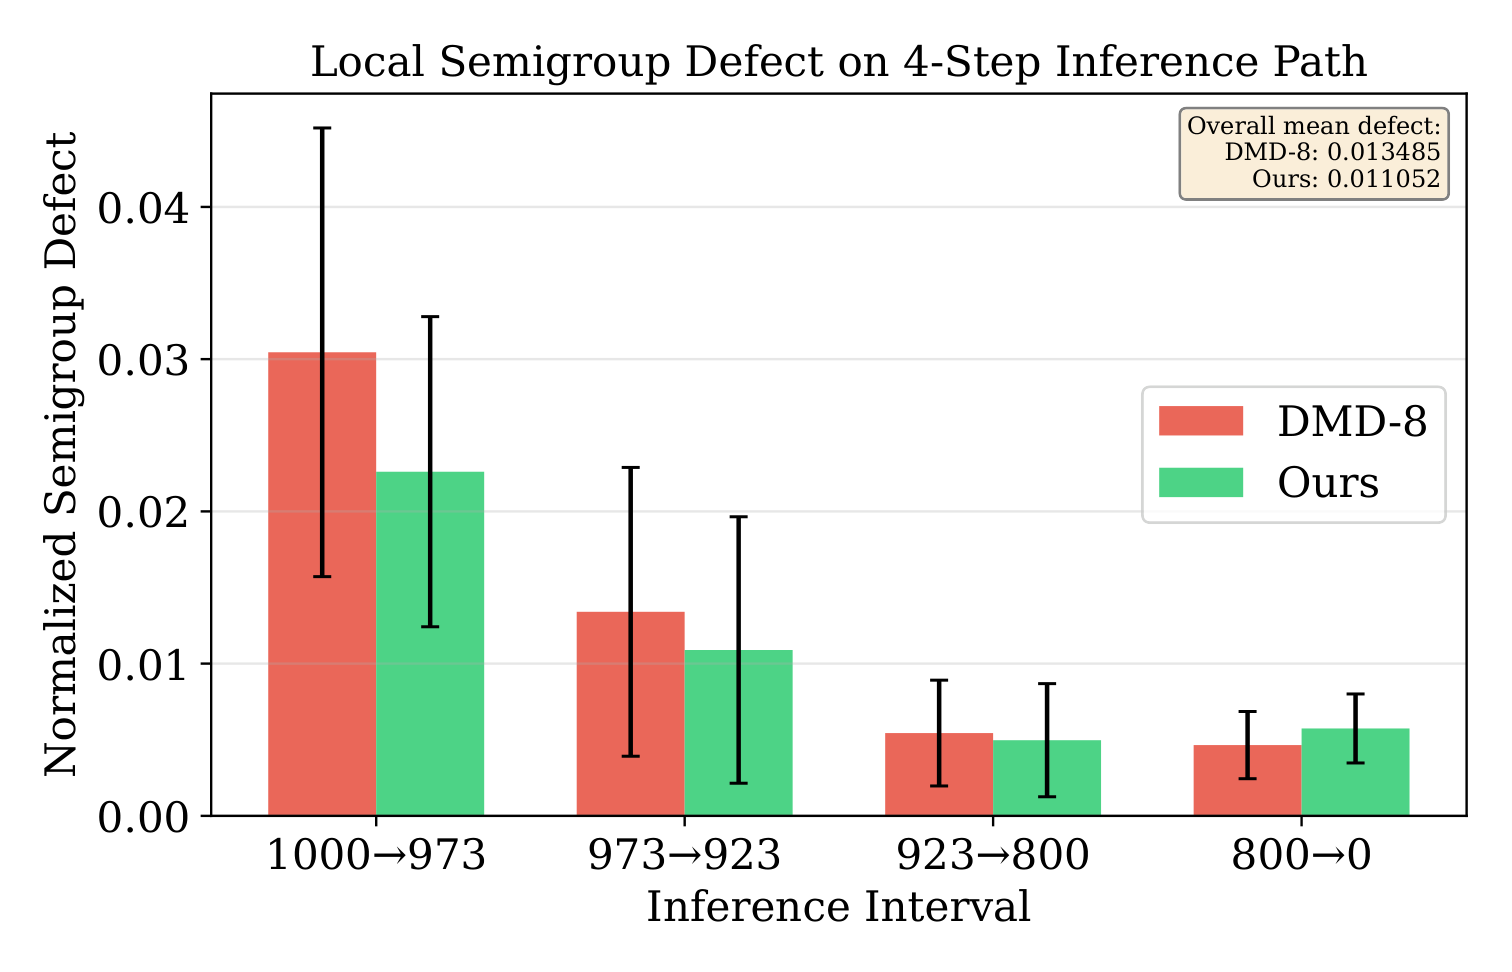
消融实验与半群缺陷分析
不同step数下半群缺陷值变化,SC-DMD有效压制多步推理质量退化
SC-DMD概念对比
半群缺陷正则与Shortcut Models、Flow Map Distillation的关系。Salt将半群约束作为DMD框架内正则化器
消融实验与半群缺陷分析
不同step数下半群缺陷值变化,SC-DMD有效压制多步推理质量退化
视觉效果对比
Salt与DMD基线在不同步数下的视频生成质量对比,展示组合一致性改善
深度点评:
技术演进定位: 视频扩散蒸馏从单步质量(DMD)走向多步一致性(SC-DMD)的关键过渡,自回归实时生成的缓存退化问题的首个系统性解决方案
可能的后续方向:
VOSR: A Vision-Only Generative Model for Image Super-Resolution
关键词: 超分辨率·仅视觉·生成模型·CFG替代·CVPR 2026
贡献: 首个证明无需多模态预训练即可实现高质量生成式超分的框架。视觉语义引导+恢复导向CFG+多步→单步蒸馏,CVPR 2026
效果: 训练成本不到T2I-based方法的十分之一,单步推理即可获得竞争力感知质量,结构保真且减少幻觉
CAMEO: A Conditional and Quality-Aware Multi-Agent Image Editing Orchestrator
关键词: 图像编辑·多智能体·质量感知·闭环反馈·条件编辑
贡献: 多智能体图像编辑协调器,将条件编辑重构为质量感知反馈驱动流程,规划→结构化提示→假设生成→自适应锚定的闭环迭代
效果: 在异常插入和人体姿态切换任务上,平均比SOTA编辑模型持续实现20%+胜率提升
Not All Frames Deserve Full Computation: Accelerating AR Video Generation via Selective Computation and Predictive Extrapolation
关键词: 视频生成加速·免训练·自回归·三模态调度·4.73x加速
贡献: 免训练自回归视频扩散加速框架,三模态调度(缓存/预测/重计算)+基于噪声水平的泰勒外推+选择性活动帧区间计算
效果: MAGI-1和SkyReels-V2上实现高达4.73x加速,质量与原始输出相当,优于所有免训练基线
MMPhysVideo: Scaling Physical Plausibility in Video Generation via Joint Multimodal Modeling
关键词: 视频生成·物理合理性·多模态建模·知识蒸馏·伪RGB
贡献: 首个通过联合多模态建模扩展视频物理合理性的框架,将语义/几何/轨迹转为统一伪RGB格式+双向控制教师架构+蒸馏到单流学生
效果: 无额外推理成本,在各基准上持续提升物理合理性和视觉质量,附带MMPhysPipe数据构建管线
LumaFlux: Lifting 8-Bit Worlds to HDR Reality with Physically-Guided Diffusion Transformers
关键词: HDR重建·DiT·物理引导·逆色调映射·SDR-HDR
贡献: 首个基于DiT的物理+感知引导SDR→HDR重建模型,PGA模块注入亮度/空间/频率线索+PCM层稳定色度纹理+轻量有理二次样条解码器
效果: 以最少额外参数实现卓越亮度重建和感知色彩保真度,在多基准上超越SOTA。首个大规模SDR-HDR语料库
DynFOA: Generating First-Order Ambisonics with Conditional Diffusion for Dynamic 360-Degree Videos
关键词: 空间音频·360度视频·条件扩散·3DGS·Ambisonics
贡献: 集成动态场景重建(3DGS)与条件扩散,从360°视频合成物理一致的一阶Ambisonics空间音频,M2G-360数据集(600片段)
效果: 在空间准确性、声学保真度、分布匹配和感知沉浸体验上持续优于现有方法
Editing on the Generative Manifold: A Theoretical and Empirical Study of Diffusion-Based Image Editing Trade-offs
关键词: 扩散编辑·理论分析·生成流形·多轮编辑·权衡分析
贡献: 首个统一理论框架分析扩散图像编辑的五大核心需求(可控性/忠实度/一致性/局部性/质量),推导引导强度与反转误差的数学界限
效果: 刻画多轮编辑累积效应,对代表性范式进行基准测试,为扩散编辑提供理论指导
GAP-URGENet: A Generative-Predictive Fusion Framework for Universal Speech Enhancement
关键词: 语音增强·生成-预测融合·48kHz·ICASSP 2026·冠军
贡献: 生成-预测融合语音增强框架,生成分支做自监督表示域全栈恢复+预测分支做语谱图增强+后处理融合+带宽扩展到48kHz,ICASSP 2026
效果: URGENT 2026挑战赛客观评估排名第一,盲测阶段顶级表现
ImagenWorld: Stress-Testing Image Generation Models with Explainable Human Evaluation on Open-ended Real-World Tasks
关键词: 图像生成评测·压力测试·可解释评估·ICLR 2026·基准测试
贡献: 3.6K条件集+20K人工细粒度标注的图像生成压力测试基准,6种任务×6种领域,可解释评估模式标记对象级错误,ICLR 2026
效果: 测试14个模型揭示:编辑>生成难度,文本密集域是短板,闭源领先但差距在缩小,VLM指标Kendall准确率0.79
人工智能炼丹师 整理 | 2026-04-07




评论 (0)