搜索到
54
篇与
DiT
的结果
-
 AIGC 每日速读|2026-05-27|美团LongCat-Avatar 1.5开源逼近闭源数… 今日 AIGC 论文速览 今日共 7 篇 · 工业级数字人开源对标闭源 1 篇 · 音视频联合生成评测体系 1 篇 · 视觉生成新范式:层级与通道级 2 篇 · DiT 推理加速与可控编辑 2 篇 · 原生多模态架构路线图 1 篇 重点论文标题列表 LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongAV-Compass:首个分钟级音视频生成评测基准 MRT:20B多层透明图像生成超Qwen CVQ:通道级VQ取代patch挑战传统 RT-Lynx:激活稀疏化让DiT GEMM加速1.55x 今日论文速览 1. LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongCat-Video-Avatar 1.5 Technical Report | 美团 LongCat Team | arXiv:2605.26486 关键词:数字人·美团 LongCat·8 NFE 蒸馏·RLHF·开源对标闭源 前序问题:音频驱动视频生成虽然进展飞快,但要做到「商业级稳定性」仍然难——商用场景下需要的不仅是「唇形对得上」,还要全身时序稳定、长视频身份不漂、多人交互/物体交互不崩,并且部署侧推理 budget 严苛 本文贡献:美团 LongCat-Video-Avatar 1.5:以「系统工程 + 生产就绪」而非架构创新为优先项的开源数字人框架。把 audio encoder 升级到 Whisper Large 并精修训练 recipe,做到准确唇形同步 + 全身时序稳定 + 长视频严格身份一致;通过严格数据清洗 + RLHF 训练,泛化到动漫/动物等风格化域,并原生处理多人交互和物体处理这类真实复杂场景;为工业部署引入 advanced step distillation 把推理压到 8 NFE 实验效果:在 500+ 多样测例 benchmark 上的定量指标 + 严格人评显示 v1.5 在 human-likeness 和专家级质量评估上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越;开源发布拉近了「学术原型」与「商业级部署」的差距 批判点评:美团摆明用「工程优先」的姿态——Whisper Large + 严苛数据 + RLHF + 8 NFE 蒸馏这套组合拳是教科书级的工业打法,公开报告稀缺。但「commercial-grade」更多靠数据规模和清洗,单一架构 trick 不构成壁垒;对标 HeyGen / OmniHuman 1.5 的具体维度需要更详细的 ablation 才能说服业界,且 8 NFE 与 Kling Avatar 2.0 之间的真实人评差距值得追踪 2. LongAV-Compass:首个分钟级音视频生成评测基准 LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV | 北京大学, Kling, 南大, 上交, 港科广州, 上海 AI Lab | arXiv:2605.26244 关键词:音视频生成·minute-scale·评测基准·T2AV/I2AV/V2AV·北大 前序问题:音视频联合生成正在从「短片段」走向「分钟级长内容」,但现有评测协议几乎都还停留在 5-10 秒文本条件生成;很少支持文本/图像/视频三种条件统一评测,更没说清楚长时间下身份一致性、叙事连贯、音画对齐到底怎么退化 本文贡献:LongAV-Compass:首个面向 minute-long 音视频生成的系统化评测基准。284 个精选测例覆盖 T2AV / I2AV / V2AV 三种输入,按应用场景和生成复杂度组织;统一评测框架结合 MLLM 辅助评估和 DINO-v2 / ArcFace / CLIP / ImageBind 等感知指标,覆盖 20+ 细粒度维度——段内质量、跨段一致性、全局叙事连贯、语义对齐、音画同步全都评 实验效果:在 11 个代表性模型上跑 + 人对齐验证,把当前系统在「保持连贯、保持语义对齐、保持时序一致」上的瓶颈量化呈现;为分钟级音视频生成提供了首个诊断式 testbed——音视频联合生成的「评测短板」正式被补上 批判点评:把音视频联合生成的评测从 5-10s 短片推到分钟级是必要补位——评测落后一直是这个赛道的隐形天花板。20+ 细粒度维度 + MLLM 辅助 + 4 大经典感知模型组合非常综合。但 MLLM 评测本身的偏置是隐忧,DINO-v2/ArcFace/CLIP/ImageBind 的权重融合策略需要更多 ablation;分钟级测例 284 个对开源社区评测可行但工业级评测仍偏小 3. MRT:20B多层透明图像生成超Qwen MRT: Masked Region Transformer for Layered Image Generation and Editing at Scale | 微软亚研 MSRA | arXiv:2605.27235 关键词:多层图像生成·20B·masked region·8 步实时·MSRA 前序问题:层级图像生成与编辑是图像生成走向「可复用 / 可重编辑 / 可组合」的关键能力——类比自然语言里的「逐词编辑」——但在大规模上一直是 underexplored 的空白。多层透明生成 + 多任务统一框架既缺数据也缺方法 本文贡献:MRT:20B 参数 masked region diffusion 模型,专为多层透明图像生成与编辑打造,在 10M+ 多语言设计样本上训练,支持多 aspect ratio 与多语言 prompt。两项核心贡献:(i) 把 text-to-layers / image-to-layers / layers-to-layers 三任务统一到「共享 masked region diffusion」框架,靠 selective token masking 灵活切换层级生成与编辑;(ii) overflow-aware canvas layer 处理边界 inconsistency 并支持半透明背景合成,做出可编辑且延伸至画布外的完整图层。配套 diffusion 蒸馏实现 8 步实时多层生成 实验效果:在三项任务上全面超越此前 SOTA 包括商业系统;user-study 显著优于同期 Qwen-Image-Layered 的 image-to-layers 质量,且推理快 10-100×,activation GPU 显存降低 50-90%——为多层透明图像生成立下新基准 批判点评:把多层图像生成做到 20B + 三任务统一 + 8 步实时是非常工业化的工作量;超越 Qwen-Image-Layered 的人评结果是强信号。但 10M+ 设计样本的语义/版权分布未明,多语言/多 ratio 的真实可控性需要更细 ablation;overflow-aware canvas layer 在极端 aspect ratio 下的稳定性也需要追踪 4. CVQ:通道级VQ取代patch挑战传统 Channel-wise Vector Quantization | 上海创新研究院, 西湖大学, 浙大, 复旦 | arXiv:2605.26089 关键词:视觉 tokenization·channel-wise VQ·CAR·next-channel·DPG 86.7 前序问题:传统视觉自回归(VAR)和 VQ-based 文生图都把图像分成 patch、给每个 patch 分配一个离散 token——但这种 patch 视角本质是「把图像当空间网格」,不太符合人类绘画「先勾结构再补细节」的层次过程。codebook 利用率上不去、增大 codebook 后 collapse 也是顽疾 本文贡献:Channel-wise Vector Quantization (CVQ):新视觉 tokenization 范式,离散化对象从 patch 换到 feature map 的每一个 channel——一张图被表示为「不同层级视觉细节的离散等级」而不是「空间 patch 网格」。基于 CVQ 提出 Channel-wise Autoregressive (CAR):next-channel prediction 替代 next-patch prediction,先勾全局结构再渐进精修细粒度属性 实验效果:CVQ 在 16K+ codebook 规模下实现 100% codebook 利用率(无任何 trick),重建质量显著超过传统 VQ;CAR 在文生图上拿到 DPG 86.7 / GenEval 0.79——证明「按 channel 分层渲染」是 patch-based 视觉自回归的现实替代品 批判点评:把 tokenization 从空间 patch 切换到 channel 维度是真正的范式 rethink——「先结构后细节」也与人类作画过程契合。100% codebook 利用率是很硬的数字。但 channel 抽象层次的物理含义不够清晰(哪个 channel 对应「结构」哪个对应「细节」依赖训练涌现),跨分辨率/跨模态时的稳定性需要进一步验证;与 latest DiT 路线的端到端比较略浅 5. RT-Lynx:激活稀疏化让DiT GEMM加速1.55x RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models | 国内系统研究团队 | arXiv:2605.26632 关键词:DiT 加速·激活稀疏化·N:M sparsity·CUDA kernel·1.55x 前序问题:DiT 推理太贵——量化和蒸馏已经被深挖,但能砍掉将近一半 FLOPs 的「半结构化稀疏(N:M sparsity)」一直 underexplored。原因是大家都在做 weight 稀疏化,但对 weight 做 50% 剪枝会拿掉关键模型容量,让生成质量崩坏 本文贡献:RT-Lynx:核心 insight 是「DiT 的激活本身天然稀疏,比 weight 更适合 N:M 半结构化稀疏化」。提出 paradigm shift——从 weight sparsification 转到 activation sparsification;配 error-compensation 缓解精度损失;并实现针对该场景高度优化的 CUDA kernel 实验效果:线性层平均 1.55× speedup,多个扩散模型上保留原生生成质量同时显著加速;为 DiT 部署提供「除量化和蒸馏外的第三条加速路线」 批判点评:把「稀疏化目标」从 weight 切到 activation 是非常对的洞察——activation 在 inference 时本来就动态出现 zero,强制 N:M 模式损失更小。1.55× 加速 + 不掉质量在 DiT 推理优化里属于实打实的硬增量。但 N:M 模式需要硬件配合(Ampere/Hopper 的 sparse tensor core),消费级 GPU 上的实际收益要打折;激活稀疏化对极长 token 序列(高分辨率视频)下的可扩展性需评测 6. ControlLight:Flow Matching做连续强度可控低光增强 ControlLight: Towards Controllable, Consistent, and Generalizable Low-Light Enhancement | 中科院深圳, StepFun | arXiv:2605.25569 关键词:低光增强·flow matching·连续可控·一致性·中科院深圳 前序问题:现有深度学习低光增强方法都在「有限数据集 + 单一增强目标」上训练——既泛化差又不可控。真实场景里同一张暗图,不同用户/不同场景需要不同的增强强度,但现有方法把它当作一个固定函数 fit 本文贡献:ControlLight:「可控 + 一致 + 可泛化」的低光增强框架。先建大规模真实退化图像数据集,对每张图给出「连续光照强度」标签作为监督;引入 misalignment-aware weighted flow matching loss,让模型在不同控制强度下输出仍然保持图像结构一致——用户可以连续滑动「增强强度」拿到不同结果而不撕裂 实验效果:在多个 benchmark 上超过现有低光增强 SOTA,同时具备「连续强度可控」+ 「真实场景泛化」能力,把低光增强从「一锤子函数」改造成「可调节工具」 批判点评:把 flow matching 用到低光增强 + 连续条件标签 + misalignment-aware loss 三件套是非常 clean 的设计——其中「misalignment-aware」直接 attack 不同强度下结构一致的根因。但「连续光照强度标签」如何从真实退化数据获取本身是个隐藏难题;与最近基于 diffusion 的图像 restoration 在极端低光场景的比较需要更全面 7. Native MM Roadmap:原生多模态架构路线图三分类 Toward Native Multimodal Modeling: A Roadmap | 华威大学, Monash, 港理工, 腾讯优图 | arXiv:2605.25343 关键词:原生多模态·NMM·路线图·three-class taxonomy·腾讯优图 前序问题:多模态建模正在从 modality-agnostic 推理走向 world modeling。早期 late-fusion(拼 encoder + frozen LLM + 输出头)已显疲态,最近转向 Native Multimodal Modeling (NMM)——把各模态从根上集成进同一个 transformer 拿到更强性能。但 NMM 的设计空间目前仍未系统化 本文贡献:为社区提供形式化的 NMM 路线图:(1) 形式化定义「架构原生性」,区分 mid-fusion / early-fusion 与非原生范式;(2) 从「输入-输出对偶」角度把现有 native 模型组织成三类——Multi-to-Text(跨模态理解,纯文本输出)/ Multi-to-Target(场景化生成,如图像/音频/视频生成)/ Multi-to-Multi(对称输入输出的统一建模);(3) 全栈式工业视角剖析从架构协调、海量数据 curation、训练 recipe 到推理部署和评测的端到端 pipeline 实验效果:把当前散乱的「统一多模态架构」研究归结成一份可被工程师和研究员同时参考的路线图——理解和生成在「统一 transformer 范式」下无缝共存是 NMM 的目标终态。对走向 GPT-4o / Gemini 1.5 级原生多模态的开源工作给出系统化方法学 批判点评:「形式化 architectural nativity + 输入输出对偶三分类 + 全栈工业视角」三个层次组织得很清晰——是社区急需的概念清理。但综述类天然有「分类强、实证少」的局限,三类边界(特别是 Multi-to-Target 和 Multi-to-Multi)在最新模型上可能交叉;对未来 1-2 年具体技术抉择的指导力度需要在落地 case 中验证 趋势观察 工业级开源数字人 / 视觉基础模型加速对标闭源 — 美团 LongCat-Video-Avatar 1.5 用 Whisper Large + RLHF + 8 NFE 蒸馏的工业打法,在 500+ 测例上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越——昨天百度 ERNIE-Image 是文生图,今天美团 LongCat-Avatar 是数字人——国内大厂正在多个垂类同时按下「开源对标闭源」按钮 音视频联合生成评测从「短片」推到「分钟级」 — LongAV-Compass 提供首个 minute-scale 音视频生成评测基准——284 个测例覆盖 T2AV / I2AV / V2AV、20+ 细粒度维度(段内质量 + 跨段一致 + 全局叙事 + 语义对齐 + 音画同步)。和最近 Baton / SpongeBob / StreamChar 等音视频联合生成模型一起,把「短片评测」时代正式翻篇 视觉生成 tokenization / 架构范式正在被 rethink — MRT 把「图像生成」从单层 RGB 推到「多层透明 + 三任务统一 + 8 步实时」;CVQ 把视觉 tokenization 从 patch-wise 切换到 channel-wise,重提「先结构后细节」的人类作画过程并拿到 100% codebook 利用率与 GenEval 0.79——patch + 单层这两个长期假设都在被挑战 DiT 推理加速的第三条路:从「weight 稀疏」转向「activation 稀疏」 — RT-Lynx 指出 DiT 激活本身就稀疏,对 N:M 半结构化稀疏化远比 weight 鲁棒,配合错误补偿和定制 CUDA kernel 拿到 1.55× 线性层加速且不掉质量——量化、蒸馏之外,「激活稀疏化」正式成为 DiT 部署的第三条加速路线 Native 多模态架构走向系统化,可控生成成为最后一公里 — Toward Native Multimodal Modeling 把原生多模态架构形式化为「Multi-to-Text / Multi-to-Target / Multi-to-Multi」三分类,给出从架构到训练到部署的全栈 roadmap;ControlLight 用 misalignment-aware flow matching 把低光增强做成「连续强度可控」工具——「统一架构 + 可控生成」正在收敛成下一代生成模型的双轨 人工智能炼丹君 整理 | 2026-05-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-26|百度ERNIE-Image开源8B DiT追平闭源 今日 AIGC 论文速览 今日共 11 篇 · 国产开源文生图基础模型 1 篇 · 音视频联合生成与编辑 3 篇 · 视频生成训练范式革新 2 篇 · few-step 蒸馏与自回归视频蒸馏 2 篇 · 推理时自适应与视频编辑 3 篇 重点论文标题列表 ERNIE-Image:百度8B DiT开源逼近闭源SOTA Baton:首引语义蓝图驱动音视频联合生成 ⚡ SpongeBob:首个端到端音视频联合编辑Sync+30% StreamChar:长时流式角色音视频实时生成 PixelWizard:原生2K/4K视频生成10倍加速 今日论文速览 1. ERNIE-Image:百度8B DiT开源逼近闭源SOTA ERNIE-Image Technical Report | 百度 Baidu ERNIE Team | arXiv:2605.25347 关键词:ERNIE-Image·百度·8B DiT·MT-DMD 蒸馏·industrial-grade ⚠️ 前序问题:开源文生图模型与闭源顶级系统在指令跟随、文字渲染、美学质量上仍有明显差距。差距主要来自两件事:预训练数据噪声大且长尾概念覆盖差;后训练人类偏好对齐的稳定性不足,蒸馏期间还会出现 capability drift(蒸馏前能做的事,蒸馏后做不到了) 本文贡献:ERNIE-Image:8B 单流 DiT 架构开源文生图基础模型。预训练用 bottom-up 数据管线(细粒度分类 + 富 caption + 美学评估 + 分层采样)压噪同时保长尾;后训练 top-down 高需求场景 + 多样化 prompt + 稳定化 DPO;ERNIE-Image-Turbo 实现 8-NFE 高效生成,配套 MT-DMD 蒸馏算法缓解 capability drift。配套发布 industrial-grade ERNIE-Image-Aes 美学模型和 ERNIE-Image-Aes-1K benchmark(首个针对真实场景的美学评测基准) 实验效果:开源模型中达到 leading 表现,在指令跟随/文字渲染/美学三项接近顶级闭源商业模型;模型权重和美学评测资源全部开源,覆盖完整工业流水线(包括 Prompt Enhancer 把简短意图扩展为结构化视觉描述) 批判点评:「8B DiT + bottom-up 预训练 + top-down 后训练 + 稳定 DPO + Turbo 蒸馏」是教科书级的工业开源大模型训法,单独哪一项都不算新颖,但全部端到端打通、配套基础设施 + 评测开源是最大贡献。但闭源 SOTA(GPT-Image / Imagen 4 / Midjourney v7)的差距具体几何缺乏精确量化对比,且 industrial-grade aesthetic model 的偏好可能强烈反映中文用户审美,国际场景适用性需观察 2. Baton:首引语义蓝图驱动音视频联合生成 Baton: Explicit Semantic Blueprints for Joint Video-Audio Generation | 复旦大学, 腾讯混元 | arXiv:2605.25195 关键词:音视频联合生成·explicit planning·VA-Planner·腾讯混元·Relative RoPE ⚠️ 前序问题:开源扩散模型做音视频联合生成时,两个模态的去噪轨迹各自为政,导致音画不同步、长时一致性差。根因:现有方法用现成 encoder 的粗粒度 text embedding 引导音/视频去噪——这丢掉了细粒度语义,更关键的是缺少一个跨模态的「长 horizon 共享规划」 本文贡献:提出 Baton:首个引入 explicit semantic planning 的音视频联合生成框架。VA-Planner(带双语义对齐塔的多模态 LLM)让可学习 query 同时 cross-attend 视频和音频特征,吐出一对语义对齐的音/视频 planned token(关键帧级蓝图);这些 plan token 通过 cross-attention 注入扩散 backbone,与粗 text embedding 互补;进一步提出 Relative Semantic RoPE 把 planned token 和 latent 映射到共享时空坐标系,让 latent 准确 attend 到对应语义线索 实验效果:在标准音视频联合生成 benchmark 上定性定量都显著超过基线;首次把「先规划后渲染」的范式从单模态扩散扩展到跨模态联合扩散——和昨天 Bernini「MLLM 规划 + DiT 渲染」是同向延续 批判点评:「explicit semantic planning」做跨模态联合生成是非常对的方向——粗 text embedding 当指挥棒本来就太宽松。VA-Planner + Relative Semantic RoPE 解决了「plan 怎么对齐 latent」的工程关键。但 VA-Planner 多了一次 MLLM 推理,端到端时延和显存对比单 DiT 联合扩散需要进一步说明;planned token 颗粒度是 keyframe-level 而非 frame-level,复杂动作对齐上限仍受限 3. SpongeBob:首个端到端音视频联合编辑Sync+30% SpongeBob: Sync-Aware Harmonious Audio-Visual Generative Editing | 中科大 USTC | arXiv:2605.25193 关键词:音视频联合编辑·端到端·Sync-Aware·Context-Aware·USTC ⚠️ 前序问题:物理世界的视觉和声音本就耦合,但现有视频编辑全部是「视觉编完,再单独配音/换音」的解耦 pipeline,没有双向模态交互。结果是:(i) 音画不同步;(ii) 改动后的画面和保留下来的原音之间出现语义冲突(看到打字键盘却继续是说话声) 本文贡献:SpongeBob:首个端到端音视频联合编辑框架,带双向 cross-modal 交互。Sync-Aware Mechanism 通过双向注意力 + 时序对齐 + 空间约束让视觉编辑跟声音事件对齐;Context-Aware Module 用声/像 context attention 防止编辑后语义冲突;Sync-Preserving Training and Guidance(SPTG)在保持画质的同时强化对齐。配套构建可扩展数据管线 + subject-level 大规模数据集 + SpongeBob-Bench 评测 实验效果:Sync-C(音画同步指标)+30%、Ctx-F1(上下文一致性)+12.5%,显著超越现有 baseline;首次把「音视频编辑」推到 explicit joint 范式,让「改了画也改对应音」成为可能 批判点评:把音视频编辑从「解耦串行」改成「联合并行」是必要的下一步,Sync-Aware + Context-Aware 双模块设计简洁;但训练数据规模和评测集都依赖作者自建,第三方复现成本高;编辑场景的覆盖(替换/插入/删除)和真实创作工作流的对接深度还需后续验证 4. StreamChar:长时流式角色音视频实时生成 StreamChar: Long-Horizon Streaming Character Audio-Video Generation with Decoupled Orchestration | 阿里通义实验室 | arXiv:2605.25659 关键词:流式生成·角色动画·decoupled orchestration·阿里通义·sink-chunk memory ⚠️ 前序问题:实时流式的角色音视频联合生成要同时满足:(1) 说出指定 transcript;(2) 跨 chunk 保持视觉身份;(3) 严格的播放预算(低延迟)。三个目标相互掣肘——逐 chunk 的自回归生成会累积 transcript-audio 错位和视觉漂移;为低延迟而做的 few-step 蒸馏又会牺牲空间多样性和时序质量 本文贡献:StreamChar:把「长 horizon 规划」与「短窗音视频去噪」解耦的流式框架。LLM 编排器(orchestrator)用 transcript 和历史上下文产出帧对齐的音频条件;joint audio-video DiT 做局部双向去噪并带 reference + motion-frame conditioning;两阶段蒸馏先压缩 sampler 再用 online chunk rollout 微调 student;progress-aware pointer 在 rollout 训练时把部分 transcript 与生成音频对齐;sink-chunk memory 提供持久视觉 anchor 缓解长 horizon 漂移 实验效果:把流式 character animation 这个被低延迟严重压制的方向推到「长 horizon + 严格时延 + 身份稳定」可同时满足;解耦式架构让 LLM 做规划、扩散 backbone 做细节生成成为长视频流式生成的可行新范式 批判点评:把「orchestrator vs denoiser」解耦解决了流式 + 长时生成两难,sink-chunk memory + progress pointer 是非常针对性的工程设计。但 LLM orchestrator 引入额外推理路径,对端到端时延的真实贡献需要更细评测;joint audio-video DiT 蒸馏后的 student 与教师模型 audio-visual coherence 的差距上限值得跟踪 5. PixelWizard:原生2K/4K视频生成10倍加速 PixelWizard: Towards Efficient High-Fidelity Video Generation at Ultra-Large Spatial Resolution | 港科大广州, 小米 | arXiv:2605.25801 关键词:高分辨率视频·原生 2K/4K·10× 加速·分层 anchor·小米 ⚠️ 前序问题:高分辨率视频生成有两个相互耦合的瓶颈:(1) token 序列爆炸让优化偏向局部纹理而牺牲全局连贯(结构坍塌);(2) 训练成本巨大、推理延迟严重。简单堆分辨率根本不可持续 本文贡献:PixelWizard 把全局结构建模和细粒度细节合成分层解耦:先建立一个紧凑的时空 anchor 浓缩稠密结构先验,再以此引导高分辨率细节生成,缓解局部优化偏置;引入 Noise-Span Aligned Shortcut Training 让模型可以「大步」遍历生成轨迹(突破推理瓶颈);Exponential Index-Biased Sampling + Adaptive Noise-Span Calibration 把优化与高分辨率网格的偏移噪声 schedule 对齐,实现 robust few-step 推理且无需蒸馏的开销 实验效果:原生 2K/4K 视频生成加速 >10×,同时保证视觉质量;不依赖蒸馏(避免 capability drift),是高分辨率视频生成的「全栈式」效率优化方案 批判点评:分层 anchor + shortcut training 思路很正——直接面对「token 爆炸」根因。10× 加速 + 不蒸馏的组合非常吸引人;但与最新蒸馏路线(如 DMD2/Causal Distill)的端到端对比缺失,结构 anchor 是否能跨场景(人物运动/复杂相机)稳定泛化需要更细评测 6. Paris 2.0:首个去中心化预训练视频生成FVD减半 Paris 2.0: A Decentralized Diffusion Model for Video Generation | Bagel Network | arXiv:2605.26064 关键词:去中心化训练·DDM·视频生成预训练·FVD 2×·Bagel ⚠️ 前序问题:训视频生成模型几乎都要 monolithic GPU 大集群,开源社区无法独立完成时序连贯的视频生成预训练。前作 Paris 1.0 证明了图像生成可以分布式训练(去中心化扩散 DDM),但「时序连贯的视频生成」在 decentralized 训练范式下仍是 open problem 本文贡献:Paris 2.0:首个通过去中心化(decentralized)计算完成预训练的视频生成模型。训练 recipe 基于 Paris 1.0 的开源 DDM 扩展到视频领域,关闭了「分布式训视频」最后一块短板。同 compute budget 下与 monolithic 模型在相同数据上对照评估 实验效果:在 low-resolution 文生视频训练上,相同总算力预算下相比 monolithic baseline,FVD 从 561.04 降到 279.01(~2.0× 提升),CLIP 文本-视频相似度与美学分数双双提升。证明 decentralized 训练不仅可行而且能反超 monolithic——开源社区独立训视频基础模型门槛被显著拉低 批判点评:「分布式 GPU 也能训视频生成」是范式级的工程突破——把视频生成预训练的算力门槛从「必须有大集群」拉到「能聚起多组消费级 GPU」。同算力预算下反超 monolithic 是惊喜数字。但还停留在 low-resolution 段位,高分辨率长视频下分布式通信开销是否仍能 hold 住,是后续最大悬念 7. RTDMD:4步生成同时蒸馏对齐刷新SOTA Reinforcing Few-step Generators via Reward-Tilted Distribution Matching | Sea AI Lab, 港科大 | arXiv:2605.26108 关键词:few-step 扩散·蒸馏·RLHF·GRPO·FLUX.2 ⚠️ 前序问题:few-step 扩散蒸馏已能让图像生成又快又好,但和人类偏好对齐还是难——直接套 RLHF 会破坏蒸馏后的分布稳定性,难以兼得「步数少 + 画质高 + 对齐人类偏好」 本文贡献:RTDMD(Reward-Tilted Distribution Matching Distillation):两阶段统一蒸馏与 RL 对齐。理论上证明 minimizing KL 到「reward-tilted teacher」自然分解为分布匹配 + reward maximization 两项。Stage1:AC-DMD(Ambient-Consistent DMD)做子区间分布匹配 + consistency 正则化,让 fake score 模型追上漂移的 generator;Stage2:混合 policy gradient——GRPO-style estimator 处理随机中间步 + direct reward backprop 处理确定性 final step;进一步用 step-subset GRPO(SubGRPO)降方差 实验效果:在 SD3 / SD3.5 / FLUX.2 上仅 4 步推理就刷新 preference / aesthetic / compositional 三类指标 SOTA,超越此前所有 few-step 文生图方法,代码模型开源 批判点评:把蒸馏和 RL 对齐写成同一个 KL 优化问题在理论上很优雅,工程实现 AC-DMD + 混合 policy gradient + SubGRPO 三件套也都是合理设计;但 GRPO 在 4 步采样下的方差估计仍可能高,跨更多底模(SD3.5 / FLUX 之外)的稳定性需要更多验证 8. AFD:on-policy黑盒蒸馏自回归视频 On-Policy Adversarial Flow Distillation for Autoregressive Video Generation | 新加坡国立大学 NUS | arXiv:2605.26105 关键词:自回归视频·黑盒蒸馏·on-policy·flow-matching·Bradley-Terry ⚠️ 前序问题:自回归视频生成器对流式、长 horizon、交互应用非常有吸引力,但把强黑盒 teacher 蒸馏成 causal student 极其困难:student 必须在自己 rollout 分布下学习,而实际 teacher 通常只暴露 prompt-conditioned 完成的视频,结构/容量/时序设计/采样 schedule 都不同。这让 SFT 是 off-policy 的、score-based 蒸馏不适用、直接对抗模仿对去噪步级 credit assignment 又太稀疏 本文贡献:AFD(Adversarial Flow Distillation):异构黑盒视频蒸馏的 on-policy 框架。同 prompt 同时 query teacher 和 rollout 当前 student;训 prompt-paired Bradley-Terry discriminator 估计 clean-sample 教师-学生差异;把 on-policy advantage 转成 forward-process flow-matching 更新到 student 自己的 noised state 上。这套设计让 student 拿到稠密 velocity-field 监督,且无需 teacher score / latent / 去噪轨迹 / step alignment / reverse-chain RL 实验效果:把「自回归视频生成 + 黑盒强 teacher」蒸馏从死局拉到可行——这恰是流式视频 + 大闭源 teacher 时代的最关键工程问题。on-policy 学习避免分布漂移,flow-matching 转换提供稠密信号,是 RTDMD 在「自回归视频」侧的对偶贡献 批判点评:把「黑盒、异构、自回归视频」三个最难维度同时解决,思路非常对——on-policy + 对抗 + flow-matching 转换是当前最合理的组合。但 Bradley-Terry discriminator 在视频域的样本效率与训练稳定性、以及面对真正巨大闭源 teacher(如商用 Sora / Veo 级别)的 query 成本,是工程落地的真实门槛 9. TT-SAC:talking-head推理时自适应免训练 Test-Time Self-Adaptive Conditioning for Stable Audio-Driven Talking-Head Generation | 格里菲斯大学 Griffith | arXiv:2605.25488 关键词:talking-head·推理时自适应·免训练·feedback loop·身份保持 ⚠️ 前序问题:音频驱动 talking-head(AniTalker / FLOAT / Sonic 等)当前主流是:一张静态参考图条件整段视频生成。但静态身份条件 vs 动态面部运动天然错配,导致 identity drift、时序不一致、感知质量下降 本文贡献:TT-SAC(Test-Time Self-Adaptive Conditioning):完全 parameter-free 的推理时框架,让预训练 talking-head 模型在生成过程中自适应调整 conditioning,不需要重训、不需要梯度、不需要任何额外监督。把 generator 与 encoder 组成 feedback loop:generator 输出再被 encoder 编码,构造与时序动力学对齐的精修 conditioning;单步自适应即近似 self-consistent equilibrium,稳定跨时长的身份与运动 实验效果:把 talking-head 的「静态参考图」假设彻底打破——同一组预训练权重,仅靠推理时 feedback loop 即可显著缓解 identity drift 和时序退化;零训练成本即可升级现有 talking-head 模型,是非常实用的 plug-in 改造 批判点评:把 generator-encoder feedback 当作 implicit fixed-point 迭代是聪明的——既廉价又对预训练模型友好。但 single adaptation step 是否真能稳定逼近 self-consistent equilibrium 取决于具体模型,对发生面部大幅度运动或镜头切换时的鲁棒性需要更细评测;feedback 单步 vs 多步的边际收益曲线也值得展开 10. RVEDiT:MLLM注入Token让DiT分粒度推理编辑 Reasoning to Align: Implicit Reasoning in Diffusion Transformers for Video Editing | 华为 | arXiv:2605.24674 关键词:视频编辑·DiT·MLLM Token·分粒度路由·华为 ⚠️ 前序问题:指令视频编辑需要按自然语言改源视频,同时保留无关内容、保持时序一致。但现有 DiT 编辑器有两个结构性缺陷:(1) 条件信号不分粒度灌入所有 transformer block,单一 token 流既要编码全局意图又要编码细粒度证据;(2) cross-attention 模式只受 pixel-level 重建间接监督,内部推理过程完全不受约束 本文贡献:RVEDiT:implicit Reasoning Video Editing DiT。两个互补组件:(i) Granularity-Routed Token Conditioning——从 MLLM 蒸馏出 learnable editing token 路由到浅层 block,深层 block 留给原生视觉/文本 token,自然形成 coarse-to-fine 编辑过程;(ii) Reference-Anchored Attention Alignment——训练时用参数共享 reference 分支,最大化编辑/参考分支注意力特征的互信息,正则化内部推理但推理时零额外开销 实验效果:在标准指令视频编辑 benchmark 上一致超过 SOTA,对 localized 和 compositional 编辑提升最大;引入 MLLM 推理但部署时单分支,性价比高 批判点评:「分粒度路由 conditioning + reference 互信息对齐」两个手段都直击 DiT 编辑器的结构性病灶,思路非常清晰。但 MLLM 提供的 editing token 是离线蒸馏,可能不能捕捉新颖指令;reference 分支在训练时翻倍显存,长视频上的可扩展性需评测 11. Squeeze-MLLM:MLLM+VAE双条件根治主体生成贴图 Squeezing Capacity from Multimodal Large Language Models for Subject-driven Generation | 多伦多大学 U of T | arXiv:2605.26111 关键词:Subject-driven·MLLM·VAE 身份·DLA·copy-paste ⚠️ 前序问题:subject-driven 生成(保留参考主体身份 + 跟随文字指令)此前主流是 text 和 reference 各编各的——这天然削弱跨模态推理,并导致典型的 copy-paste artifact(参考图被原样贴上去)。最近 MLLM + diffusion 框架改善了指令跟随,但忽略了身份保持 本文贡献:把 diffusion model condition 在 MLLM 上(让 text 和 reference 联合编码),同时用 VAE 做 identity conditioning;新设 Dual Layer Aggregation (DLA) 模块聚合 MLLM 多层级特征做最优 conditioning;用多阶段去噪策略在推理时渐进式平衡 MLLM 提供的语义和 VAE 提供的细节身份 实验效果:把多模态理解和身份保持调和得很好,缓解了 copy-paste 问题,人类偏好评测上 subject-driven 生成超越现有方法;项目页面开放 批判点评:「MLLM 编联合语义 + VAE 守身份细节」的双通道是非常合理的分工——比纯 MLLM/纯 reference encoder 都更接近问题本质。DLA + 多阶段去噪是工程上的细致打磨;但 VAE 通道也可能引入贴图倾向(VAE 重建本身就有 identity 偏置),与最新 IP-Adapter / OmniGen 等的端到端对比是否在所有场景占优需要更细评测 趋势观察 国产开源文生图基础模型加速对标闭源 SOTA — 百度 ERNIE-Image 8B 单流 DiT 系统化打通预训练 bottom-up 数据 + 后训练 top-down + 稳定 DPO + Turbo 蒸馏 + 工业 aesthetic 评测全栈,且模型/数据全部开源——开源阵营在指令跟随/文字渲染/美学三项已逼近 GPT-Image/Imagen/Midjourney 等闭源顶级系统 音视频联合生成进入「规划 + 流式 + 编辑」三角范式 — Baton 用 VA-Planner(多模态 LLM)吐出音/视频共享语义蓝图驱动联合扩散;SpongeBob 通过双向 cross-modal 交互做端到端音视频联合编辑;StreamChar 用 LLM orchestrator 解耦长 horizon 规划与短窗去噪做流式角色音视频——音视频从「各编各的」彻底走向「联合规划 + 联合渲染」 视频生成同时突破两个壁垒:分辨率天花板与训练算力门槛 — PixelWizard 把全局 anchor 与细节合成分层解耦,加上 Noise-Span Aligned Shortcut Training,原生 2K/4K 视频生成提速 10× 且不蒸馏;Paris 2.0 首次完成 decentralized 视频生成预训练,同算力下 FVD 从 561→279(2×)反超 monolithic baseline——视频生成的「分辨率天花板」被工程化突破,「训练必须大集群」被打破 few-step 蒸馏从图像扩散扩展到自回归视频生成 — RTDMD 把蒸馏和 RL 对齐写成同一 KL 优化(4 步刷 SD3/FLUX.2 SOTA);AFD 把 on-policy 对抗 + flow-matching 转换组合用于黑盒异构 teacher 蒸馏 causal 视频 student——证明「步数少 + 画质高 + 对齐人类偏好 + 流式自回归」可以同时拿到,且不依赖白盒 teacher score / 轨迹访问 推理时自适应/编辑成为零训练能力升级标配 — TT-SAC 让 talking-head 模型在推理时通过 generator-encoder feedback loop 自适应 conditioning(免训练、免梯度);RVEDiT 把 MLLM 推理 token 路由到 DiT 浅层 block 形成 coarse-to-fine 编辑;Squeeze-MLLM 用 MLLM+VAE 双通道在推理时渐进平衡语义与身份——「不重训也能拿到新能力」正在成为生成模型的标准升级路径 人工智能炼丹君 整理 | 2026-05-26 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
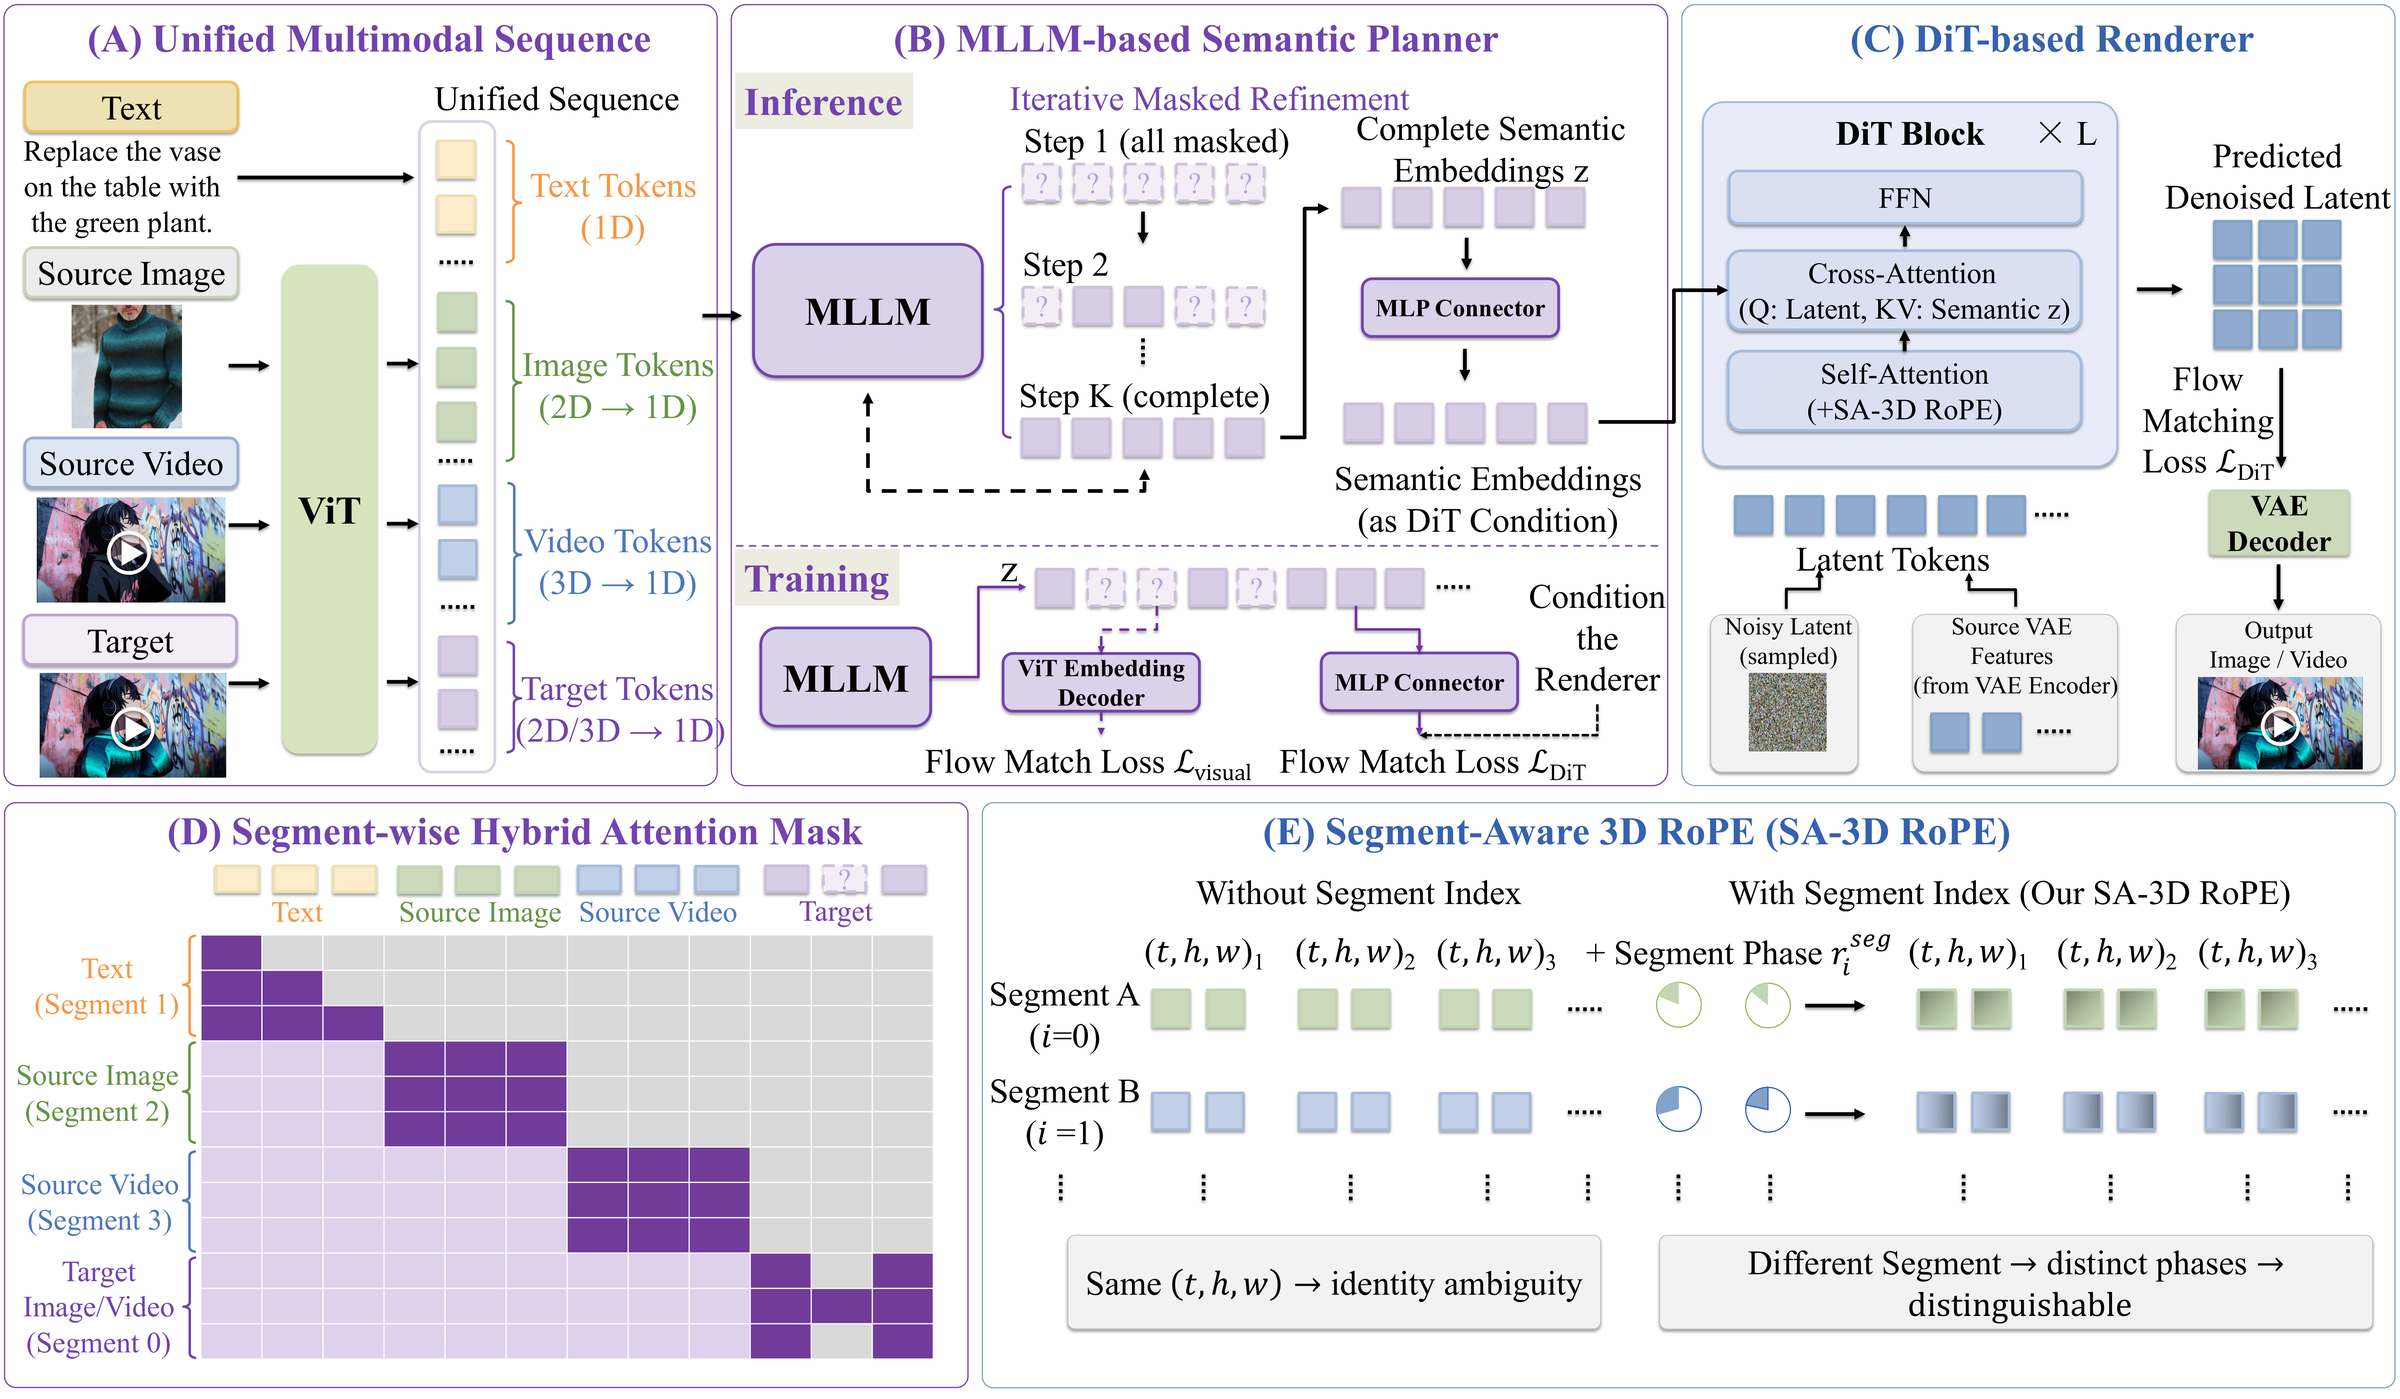
AIGC 每日速读|2026-05-25|字节Bernini让MLLM规划DiT渲染视频 今日 AIGC 论文速览 今日共 11 篇 · 统一视频生成与编辑 2 篇 · Unified Audio 与音乐生成 2 篇 · 文生图基础架构与高清解码 3 篇 · 视频世界模型与可控生成 2 篇 · 高效推理与长上下文 2 篇 重点论文标题列表 Bernini:MLLM做语义规划DiT做像素渲染 StepAudio 2.5:单一音频基础模型三任务全SOTA ⚡ PiD:512潜变量→2048图像 <1秒解码 SCOPE:首个跨游戏FPS世界模型zero-shot迁移 DecQ:8个查询+3.9%算力把RAE重建拉满 今日论文速览 1. Bernini:MLLM做语义规划DiT做像素渲染 Bernini: Latent Semantic Planning for Video Diffusion | 字节跳动 Bernini Team | arXiv:2605.22344 关键词:统一视频生成·MLLM 规划·DiT 渲染·SA-3D RoPE·CoT ⚠️ 前序问题:MLLM 擅长跨模态推理与语义对齐,扩散模型擅长高保真像素合成——但目前两条路线要么混入一个端到端 unified model(损失各自强项),要么靠 adapter 松耦合(语义传递不充分)。视频生成与编辑亟需一种新分工,能把 MLLM 的语义规划能力和 DiT 的像素渲染能力同时榨干 本文贡献:提出 Bernini 统一视频生成与编辑框架:MLLM 规划器直接在 ViT embedding 空间预测目标语义表征(不是文本),DiT 渲染器以这个语义 plan 为主条件,文本特征 + 编辑场景下的源视频 VAE 特征做辅助引导。规划器和渲染器分开训练 + 轻量协同微调,保住各自预训练能力。引入 SA-3D RoPE(Segment-Aware 3D RoPE)处理多视觉输入,并在规划器中引入 CoT reasoning 把「理解」翻译成「生成指令」 实验效果:在多项视频生成与视频编辑 benchmark 上达到 SOTA;编辑任务上 MLLM 的预训练理解力可直接迁移为强泛化能力——挑战性编辑场景下尤其明显 批判点评:「MLLM 当规划器、扩散模型当渲染器」是非常合理的下一代统一架构分工——既避免了端到端 unified model 的能力打架,也比 adapter 路线传递了更丰富的语义。但论文用 ViT embedding 而非文本作为接口让组件互换性变差,规划器换到其他 MLLM 需要重新对齐;SA-3D RoPE 在多视觉输入场景的扩展上限(如 5+ 参考图)未充分测试 2. StepAudio 2.5:单一音频基础模型三任务全SOTA StepAudio 2.5 Technical Report | 阶跃星辰 StepFun | arXiv:2605.23463 关键词:Unified Audio·ASR·TTS·实时对话·RLHF ⚠️ 前序问题:Unified audio-language model 是大趋势,可现实是它们在 ASR/TTS/实时对话三件事上常常打不过专用系统——语义理解、生成合成、低延迟对话天生有结构与目标差异。如何让一个 backbone 同时压过三个专用 SOTA 是开放挑战 本文贡献:StepAudio 2.5 把「模态接口统一」与「目标分化」分两层处理:文本与音频共享多模态表征空间作为底座,任务特化由「数据构造 + 优化目标 + 解码策略」三件事决定。重头戏是把 post-training 从标准 SFT 升级为「任务定制 RLHF」——ASR 用可验证 multi-token decoding 提速、TTS 用 preference-based RLHF + context-rich supervision 保表现力、Realtime 用 generative reward modeling 框架优化人格一致与低延迟 实验效果:在 ASR / TTS / Realtime 三个方向的标准 benchmark 上同时达到 SOTA,证明「单一音频语言基础模型在三个目标上压过专用系统」是可行的——RLHF 是统一 backbone「分化部署」的关键钥匙 批判点评:把「目标分化交给 RLHF」是非常聪明的分工——既保住统一架构的训练效率,又给三个任务留出独立优化空间。但论文的 RLHF 训练成本巨大且对各任务的奖励信号设计依赖深,落地复现门槛高;与 GPT-4o / Gemini 这种闭源多模态对话模型的实时对话直接对比缺失 3. PiD:512潜变量→2048图像 <1秒解码 PiD: Fast and High-Resolution Latent Decoding with Pixel Diffusion | NVIDIA, 多伦多大学, Vector Institute | arXiv:2605.23902 关键词:Pixel Diffusion·高清解码·DMD2 蒸馏·6× 加速·RAE ⚠️ 前序问题:T2I 主流采用「潜空间扩散 + decoder 还原像素」两段式,但 decoder 是重建优化的——只学逆向 encoder,并不主动合成细节。当目标分辨率拉到百万级(megapixel),decoder 的计算变得非常昂贵,画质上限也被牢牢锁死 本文贡献:提出 PiD(Pixel Diffusion Decoder):把「latent → pixel」decoding 改写成「条件像素扩散」,统一了解码与超分两步。直接在高分辨率像素空间去噪,原生支持 4× / 8× 上采样;通过轻量 sigma-aware adapter 把含噪 latent 注入像素扩散 backbone,使 PiD 能在 latent 还没去噪完时提前接手,让上游 latent diffusion 提前停步。再用 DMD2 蒸馏把推理压到 4 步。同时支持普通 VAE latent 和语义 latent(SigLIP/DINOv2,给 RAE 模型用) 实验效果:512×512 latent 解码为 2048×2048 像素在消费级 RTX 5090 上 <1 秒(峰值 13GB),在 GB200 上最快 210ms——比 cascaded diffusion-based super-resolution 快约 6×,视觉保真度也更好。直接把「高清文生图」的推理成本拉到接近实用区间 批判点评:把 decoder 从「重建优化」改为「条件生成优化」是非常正确的方向——这是 RAE 路线之外又一条反思 latent decoding 的工作。<1 秒 2K 解码 + 6× 加速是少有的同时省时又提质的硬数字;但 PiD 与原生 pixel-space 扩散(如 PixArt-Σ pixel)之间的对比仍未完全展开,DMD2 4-step 蒸馏的稳定性如何随分辨率扩展仍需观察 4. SCOPE:首个跨游戏FPS世界模型zero-shot迁移 SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models | 国科大 UCAS-Terminus AI Lab, 新加坡国立 NUS, 浙江大学, 港科大广州 | arXiv:2605.23345 关键词:FPS 世界模型·视频扩散·跨游戏迁移·CrossFPS·per-pixel 条件 ⚠️ 前序问题:FPS(第一人称射击)游戏的可玩世界模型,每一帧都要响应高频重叠的多种操作信号,同时还不能扰动屏幕中无关区域。已有方案要么全图注入动作信号(粒度太粗),要么只在单款游戏上训(无法跨游戏迁移) 本文贡献:观察到 FPS 操作具有「空间选择性」:开火/换弹只影响武器周围的局部 scope,而镜头/移动指令影响全局背景。SCOPE 在预训练视频扩散 transformer 的每个 block 插入条件模块,把特征重塑成 per-pixel 时序序列,每个位置根据本地视觉内容计算自己的动作响应——不依赖任何分割标注就把 in-scope 效果与 out-of-scope 生成分开。同时构建 CrossFPS:首个多游戏 FPS 数据集(7 款游戏、69K 帧对齐 10-DoF 控制信号片段),让模型学到游戏无关的视觉-动作映射 实验效果:训得的世界模型在多个未见场景上 zero-shot 迁移成功,动作响应度强、scope 分离精确,跨游戏泛化效果优——首次让 FPS 世界模型走出「单游戏专门训」的范式 批判点评:「scope 局部 vs 全局」的解构是非常贴近 FPS 物理直觉的观察,per-pixel 时序条件注入比全图条件优雅得多。CrossFPS 数据集让 FPS 世界模型有了 ImageNet 时刻的基础;但 10-DoF 控制信号离真实玩家的复杂连招仍有距离,对长 horizon 一致性(数百帧战斗)效果论文未充分披露 5. DecQ:8个查询+3.9%算力把RAE重建拉满 DecQ: Detail-Condensing Queries for Enhanced Reconstruction and Generation in Representation Autoencoders | 复旦大学, 上海 AI Lab | arXiv:2605.22777 关键词:RAE·DINOv2·细节 Query·重建生成解耦·3.9% 算力 ⚠️ 前序问题:Representation Autoencoder(RAE,把视觉基础模型当 tokenizer encoder)能让 latent diffusion 收敛更快、生成更好——但 VFM 必须冻住,限制了细粒度重建能力。如果反过来微调 VFM 解锁重建,又会破坏预训练语义空间、拖累生成。重建 vs 生成长期是 trade-off 本文贡献:DecQ 思路简单优雅:用一组轻量「detail-condensing queries」通过 condenser 模块从中间层 VFM 特征里抽取细粒度信息,再把这些 query 拼到 decoder 端辅助重建,同时在生成建模阶段与 patch token 一起被预测。深浅两层信息都被聚合,无需碰 VFM 主权重,重建-生成 trade-off 被巧妙绕开 实验效果:DINOv2-based RAE 上仅加 8 个 query 和 3.9% 额外算力,PSNR 从 19.13 dB 提到 22.76 dB(重建端 +3.6dB);生成端比 RAE 收敛快 3.3×,无 guidance FID 1.41、有 guidance FID 1.05——重建与生成同时提升且开销可忽略 批判点评:「不碰冻结 VFM、只加一组 query 当辅助通道」是非常 ROI 高的设计,是「冻结 vs 微调」之外的第三条路。从 PSNR / FID 数字看是确凿的正向贡献;但 8 个 query 是否够撑起更大分辨率(512+)下的细节量级仍待验证,与最新 token-merging / FlexQuery 等类似工作的对比略浅 6. SEGA:DiT训练免微调按频段动态缩放注意力 SEGA: Spectral-Energy Guided Attention for Resolution Extrapolation in Diffusion Transformers | 多伦多大学, Vector Institute | arXiv:2605.22668 关键词:DiT·分辨率外推·RoPE·训练免微调·频段自适应 ⚠️ 前序问题:DiT 在训练分辨率之外生成时画质显著掉,目前 training-free 方案常用 RoPE 外推 + 注意力 scaling 修正,但 scaling 都是一刀切——对 RoPE 各分量(含不同频段)施加同样的缩放,导致「全局结构 vs 细节恢复」此消彼长 本文贡献:提出 SEGA:完全 training-free,根据每个去噪步 latent 的空间-频段结构,动态地对 RoPE 不同分量分别 scaling。低频分量保结构、高频分量恢细节,按内容自适应分配——而不是固定常数 实验效果:多个目标分辨率上一致提升 DiT 高分辨率合成质量,超过现有 training-free 基线;不需要重训,可即插即用 批判点评:「不同频段差别 scaling 而不是常数」是经过谱分析后的小而正确的改进,对 DiT 高清生成是廉价收益。但论文主要在 SD3/FLUX 系列上验证,更激进外推倍率(如 4×)下是否仍稳健没充分展开;与 ScaleCrafter / FreeU 等同类训练免微调方案的端到端定量对比较少 7. Gated DeltaNet-2:线性注意力擦写解耦1.3B全面胜出 Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention | NVIDIA | arXiv:2605.22791 关键词:线性注意力·Gated DeltaNet·擦写解耦·长上下文·NVIDIA ⚠️ 前序问题:线性注意力把无界 softmax cache 压缩成固定 recurrent state,难点不在于「忘掉什么」而在于「怎么编辑这个压缩记忆而不打乱已有联系」。已有 Delta-rule 模型用 scalar gate 同时控制 key 端的擦除和 value 端的写入——一个标量做两件事,能力被绑死 本文贡献:Gated DeltaNet-2(GDN-2)泛化了 Gated DeltaNet 与 KDA:把 erase 与 write 解耦成两个 channel-wise gate(擦除门 b_t / 写入门 w_t);两者塌缩到同一 scalar 时退化为 KDA,再叠加 decay 塌缩则退化为 Gated DeltaNet。配套给出 fast-weight 更新视角、chunkwise WY 算法(channel-wise decay 吸收到非对称 erase 因子)、gate-aware backward——保住了高效并行训练 实验效果:1.3B 参数在 100B FineWeb-Edu tokens 上训完,在语言建模/常识推理/检索上综合超过 Mamba-2 / GDN / KDA / Mamba-3 变体;在 RULER 长上下文 needle-in-a-haystack 多 key retrieval 上优势最大,纯循环与混合架构都强。代码开源 批判点评:「擦除/写入解耦」是 linear attention 设计上一个本应早被做的细节修正——一个 gate 控两件事本来就是工程妥协。GDN-2 是少有「同时改写规则又保住并行训练」的设计;但论文聚焦语言建模,对视觉生成场景(视频扩散 / 多模态 backbone)线性注意力替换的实际收益尚需后续验证,1.3B 规模在 7B+ 是否仍领先 Mamba-3 也是开放问题 8. Geo-Align:首个相机控制视频生成RL几何奖励 Geo-Align: Video Generation Alignment via Metric Geometry Reward | 中科大, 上海 AI Lab, 浙大 | arXiv:2605.23903 关键词:相机控制视频·RL 对齐·metric 3D 奖励·video re-rendering ⚠️ 前序问题:相机控制视频生成(video-to-video re-rendering)此前几乎全靠合成数据上的 SFT,真实多视角同步视频极度稀缺,模型在真实 OOD 视频上对物理尺度与相机轨迹的遵循非常差——「能拍但不像」一直没解决 本文贡献:Geo-Align 首次为相机控制视频再渲染提出 RL 框架:基于预训练模型,用「尺度感知感知奖励」对齐。具体而言引入 metric 3D estimator 从生成视频中抽取精确相机轨迹,对 rotation / translation 偏差显式惩罚;数据 pipeline 精心设计——以真实条件视频 + 合成数据派生的目标相机轨迹训练,消除对 paired data 的依赖 实验效果:相机可控性与视觉保真度同时优于现有 SFT 基线,验证 metric geometry 奖励是补救「合成 → 真实」迁移损耗的有效手段——是 video re-rendering 的下一步 批判点评:把 video re-rendering 从 SFT 推进到 RL + 几何奖励是必然的下一步,metric 3D estimator 当 reward model 思路漂亮;但 metric 3D estimator 本身的精度上限直接决定奖励质量,对动态场景(人物快速运动、遮挡)的估计误差如何不被奖励放大需要后续验证 9. LMDM:消费级笔记本跑实时音乐扩散 Live Music Diffusion Models: Efficient Fine-Tuning and Post-Training of Interactive Diffusion Music Generators | UC San Diego, CMU, Mila, Northeastern | arXiv:2605.22717 关键词:音乐扩散·实时生成·KV Cache·ARC-Forcing·consumer GPU ⚠️ 前序问题:现在最强的「实时流式音乐生成」走的是 discrete-AR(离散自回归)路线,训练和推理都要工业级算力。开源社区强势的音频扩散是双向、非流式的——理论上不能做实时演奏 本文贡献:LMDM 重新审视 block-wise outpainting 扩散管线:识别出诸多推理瓶颈是它比 discrete-AR 慢的根因,提出 block-wise KV Caching 补回;进一步引入 ARC-Forcing post-training,无需 RL 或 reward model 就能稳健做对齐,缓解 error accumulation 实验效果:扩散模型首次在推理复杂度上反超离散 AR 路线,能在消费级游戏本上本地实时跑——支持文条件生成、草图条件音乐合成、jamming;论文还展示了 LMDM 作为「generative delay」在真人音乐家即兴演奏中的真实艺术家-AI 合作 批判点评:把扩散从「非流式」拉到「实时演奏」是开源社区音频生成的关键一步——把 KV Cache 思路从语言模型迁过来很合理。但和 Suno/Udio 这类闭源系统直接对比缺失,对极长(>10 分钟)持续演奏的稳定性论文未深入讨论;ARC-Forcing 替代 RLHF 的 robustness 在不同流派/复杂编曲下的表现仍需更多实验 10. ETCHR:图像编辑器即多模态推理助手 ETCHR: Editing To Clarify and Harness Reasoning | 上海 AI Lab, 港中文 | arXiv:2605.23897 关键词:Think with Images·图像编辑·推理增强·VLM 奖励·MLLM 解耦 ⚠️ 前序问题:MLLM「think with images」范式越来越火,但 toolkit 路线被固定动作束缚,unified 路线产生的中间图常常很噪。如果想用「专用图像编辑器」当 MLLM 的视觉推理助手,会遇到两个 gap:(1) language-side,被动指令跟随的编辑器无法把抽象问题映射成合适的视觉变换;(2) generation-side,推理深度增加时编辑正确性快速退化 本文贡献:ETCHR 提出一个「question-conditioned, reasoning-aware」图像编辑器,与下游 understanding model 完全解耦。两阶段训练:第一阶段 Reasoning Imitation(在编辑轨迹上 SFT),第二阶段 Reasoning Enhancement(用 VLM-derived 奖励同时优化编辑正确性 + 下游推理准确率)。解耦让 ETCHR 可以 plug into 任意开闭源 MLLM 而无需重训 实验效果:覆盖细粒度感知/图表理解/逻辑推理/拼图复原/3D 理解 5 类任务,Pass@1 平均提升:Qwen3-VL-8B +4.82(55.95→60.77)、Gemini-3.1-Flash-Lite +5.47(65.08→70.55)、1T MoE Kimi K2.5 +4.61(76.55→81.16)——证明 reasoning-aware editor 通用有效 批判点评:「编辑器作为 MLLM 的可插拔视觉推理助手」是非常正确的下一步分工,比 toolkit / unified 两条路线都更模块化。但 ETCHR 训练强依赖 VLM-derived rewards,奖励信号的偏差可能复制到编辑器;与最新 unified MLLM(如 GPT-4o Image / Bagel)端到端的 think-with-image 能力对比还需要更全面 11. Swift Sampling:泰勒展开找时序惊奇帧0.02倍开销 Swift Sampling: Selecting Temporal Surprises via Taylor Series | Microsoft Research India | arXiv:2605.22678 关键词:长视频·帧选择·预测编码·Taylor 展开·训练免微调 ⚠️ 前序问题:长视频里大部分帧冗余,关键信息藏在「时序惊奇」——视觉特征偏离了预测轨迹的瞬间。已有 training-free 帧选择要么靠辅助网络(额外算力),要么靠视频特化的超参(不通用) 本文贡献:受脑科学预测编码启发,Swift Sampling 把视频建模成视觉 latent 空间里可微的轨迹,计算 velocity 和 acceleration,用 Taylor 展开预测后续帧的「预期路径」。偏离预期最猛的帧 = 时序惊奇帧 = 应被采样的关键帧。训练免微调、几乎零额外开销 实验效果:比基线只多 0.02× 算力开销(比领先方法的 overhead 还低 30×)。3 个长视频 QA benchmark + 10 个下游任务上一致优于 uniform sampling 与其他 query-agnostic 基线;长视频小预算场景下提升最大(+12.5 分准确率) 批判点评:「预测编码 → Taylor 外推 → 惊奇帧」的链条简洁且物理直觉强,几乎零成本是工程上极少见的免费收益。但 Swift Sampling 是 query-agnostic 的——任务相关的关键帧(需要 query-conditional)仍是它的盲区,未来与 query-aware 方法的组合空间巨大 趋势观察 统一架构出现新分工:MLLM 当语义规划器,扩散/像素模型当渲染器 — Bernini 用 MLLM 在 ViT embedding 空间预测目标语义,DiT 拿这个 plan 当主条件渲染像素;ETCHR 把编辑器训成 MLLM 可插拔的视觉推理助手——「端到端 unified」之外,「语义规划 + 像素渲染」的分工路线正在成型。这条路线把各组件的预训练能力都榨干,比 adapter 更深、比端到端更模块化 像素空间扩散解码器替代传统 VAE:高清/高效解码的新范式 — PiD 把 latent→pixel 改成条件像素扩散,512 latent <1 秒解到 2048 像素(消费级 RTX 5090),比 cascaded SR 快 6× 且画质更好;DecQ 不动 RAE 冻结 VFM 只加 8 个 query + 3.9% 算力就让重建 PSNR +3.6dB、生成收敛快 3.3×——「decoder 该重建还是该生成」的争论开始让位给「decoder 应同时承担解码与上采样」的新范式 Unified Audio 模型靠任务定制 RLHF 同时压过专用系统 — StepAudio 2.5 把 ASR/TTS/Realtime 三件事架在共享 backbone 上,让任务分化交给「数据 + RLHF reward + 解码策略」三件套——ASR 用可验证 multi-token decoding、TTS 用 preference RLHF、Realtime 用 generative reward modeling,最终三项 benchmark 同时 SOTA。证明「unified 不必妥协」的关键钥匙是 RLHF 视频生成对齐从 SFT 走向几何/物理约束的强化学习 — Geo-Align 首次给相机可控视频再渲染加 RL:用 metric 3D estimator 抽取相机轨迹,对 rotation/translation 偏差显式给奖励,不再依赖稀缺的 paired 真实多视角数据。SCOPE 的 per-pixel 时序条件设计也隐含「空间选择性」的物理直觉——视频生成的对齐方式开始引入几何/物理约束 推理期免训练优化在文生图/长视频/长上下文遍地开花 — SEGA 给 DiT 做按频段自适应注意力 scaling 解决高分辨率外推;Swift Sampling 用 Taylor 展开找时序惊奇帧选关键帧(0.02× 开销 +12.5 分);GDN-2 把线性注意力的 erase/write 解耦改善长上下文检索——「免训练 + 信号利用」的范式从图像扩散扩到视频/语言全场景,给落地侧带来快速收益 人工智能炼丹君 整理 | 2026-05-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-21|智能编辑成统一模型通用任务Uni-Edit 今日 AIGC 论文速览 今日共 13 篇 · 统一多模态与图像编辑 2 篇 · 视频生成与编辑 5 篇 · 高效推理与稀疏注意力 3 篇 · 安全与可控生成 2 篇 · 图像复原与评测 2 篇 重点论文标题列表 Uni-Edit:智能编辑成为统一模型唯一训练任务 FullFlow:只训LoRA把T2I升级成双向多模态 ⚡ DVG:时空联合自适应HunyuanVideo提速7倍 BA-Att:块预降采样稀疏注意力提速7倍 FlowLong:滑窗加流形约束推理期出长视频 今日论文速览 1. Uni-Edit:智能编辑成为统一模型唯一训练任务 Uni-Edit: Intelligent Editing Is A General Task For Unified Model Tuning | CUHK MMLab | arXiv:2605.21487 关键词:UMM 统一多模态·智能图像编辑·通用任务·BAGEL·Janus-Pro ⚠️ 前序问题:统一多模态模型(UMM,理解+生成+编辑三件事一起做)当前主要靠混合多任务训练。但任务之间天生冲突,逼出了复杂的多阶段 pipeline、海量数据混合和各种平衡 trick——结果只是性能折中而非真正互相增强 本文贡献:提出 Uni-Edit:智能图像编辑作为 UMM tuning 的「第一个通用任务」。一个任务、一个训练阶段、一个数据集就能同时提升理解/生成/编辑三种能力。为此构建首个自动化可扩展智能编辑数据合成 pipeline:把多样 VQA 数据转化为带嵌入问题和嵌套逻辑的复杂编辑指令,得到 Uni-Edit-148k 数据集(reasoning-intensive 指令 + 高质量编辑图像) 实验效果:BAGEL 与 Janus-Pro 上仅用 Uni-Edit 单任务训练即获得三种能力的全面增强,无需任何辅助操作;模型/数据/代码已开源在 HuggingFace 和 GitHub 批判点评:「编辑作为通用任务」的洞察是范式级——编辑天生需要「理解 + 生成」两件事,这是其作为通用任务的根本理由;但 Uni-Edit-148k 是 VQA 数据合成的,复杂场景下指令质量上限仍受 VQA 数据集决定;BAGEL/Janus-Pro 之外能否泛化到更多 UMM(OmniGen/UniGen)需要后续验证 2. FullFlow:只训LoRA把T2I升级成双向多模态 FullFlow: Upgrading Text-to-Image Flow Matching Models for Bidirectional Vision-Language Generation | ETH Zürich, Google Zurich | arXiv:2605.20316 关键词:统一多模态·LoRA 升级·Rectified Flow·双向生成·参数高效 ⚠️ 前序问题:现代 T2I 扩散模型有强视觉先验,但只暴露在单向 text→image 生成。从 T2I 衍生的统一视觉语言模型要么靠大规模联合预训练,要么大幅重训文本通路——两者都浪费了 T2I backbone 已经学到的强图像先验 本文贡献:提出 FullFlow 参数高效配方:只训 LoRA 适配器和轻量 text head 就把预训练的 rectified-flow T2I 模型升级成双向 vision-language 生成器。图像保持原生连续 flow,文本走离散 insertion 过程;图像/文本独立 timestep 让推理变成「二维生成空间」中的轨迹选择,单 backbone 同时支持 text→image / image→text / 联合采样 / partial-text 预测 实验效果:在 SD3 上同等可训参数和 LoRA rank 下,T2I FID 62.7 → 31.6,I2T CIDEr 2.0 → 99.4(远超之前 SOTA Dual Diffusion);峰值 VRAM 从 ~84GB 降到 ~38GB,吞吐 8×(双 RTX A5000 训 24h,仅训 ~5% backbone 参数);同样配方迁移到 FLUX.1-dev 并支持 partial-text 做下游 VQA 批判点评:5% 参数开销实现双向多模态是非常高 ROI 的工程贡献——把扩散视觉先验「升级 vs 重建」拉到了正确选择;但 image→text CIDEr 99.4 vs Dual Diffusion 2.0 的对比量级悬殊,可能反映 baseline 设置问题;与原生统一模型(BAGEL/Janus)的端到端能力对比缺失 3. DVG:时空联合自适应HunyuanVideo提速7倍 Dynamic Video Generation: Shaping Video Generation Across Time and Space | 上海交大, 华南理工, 清华大学 | arXiv:2605.21042 关键词:视频扩散加速·时空联合·渐进分辨率·HunyuanVideo·近无损 ⚠️ 前序问题:视频扩散每步要处理大量 token,迭代去噪极昂贵。最近渐进分辨率采样在早期阶段降 latent 分辨率取得加速,但 scale 到视频上仍困难——时序维度引入跨视频差异巨大的时空需求,只压一个维度要么加速有限要么质量退化 本文贡献:提出 DVG(Dynamic Video Generation)框架:跨时间和空间联合分配计算,自动选择内容感知(content-aware)的加速策略,无需手工调参或重训。通过学习每个视频的最佳时空降采样模式,实现近无损加速 实验效果:HunyuanVideo / HunyuanVideo-1.5 上达到 7× 加速;与蒸馏组合可达 18× 加速;近无损跨模型跨任务,可作为大规模高效视频生成系统的关键组件——代码开源 批判点评:把渐进分辨率从空间扩到时空联合是合理的下一步,自动 content-aware 策略避免了手工 schedule;但加速倍数高度依赖底模容量与内容多样性,对极端运动场景的 robustness 论文未充分披露;7×→18× 的复合是否保留各自的画质底线需更细粒度评测 4. BA-Att:块预降采样稀疏注意力提速7倍 Efficient Long-Context Modeling in Diffusion Language Models via Block Approximate Sparse Attention | 香港科大, 港大, 浙大, 港中文 | arXiv:2605.19726 关键词:扩散语言模型·稀疏注意力·块降采样·FlashAttention·长上下文 ⚠️ 前序问题:扩散语言模型(DLM)能做全局连贯、双向、可控文本生成,但 scale 到超长序列仍昂贵。现有 block-sparse attention 用固定采样模式(尾部、反斜对角条带)选块——这种 prior-driven 采样会漏关键 token、分布偏移下不稳定 本文贡献:提出 BA-Att 框架:block-wise 预降采样操作在压缩空间识别 informative 区域,避免依赖脆弱的位置先验。理论上定义 oracle post-downsample attention map,形式化前 vs 后降采样方案的近似误差;引入轻量 norm-sorting 模块和协方差补偿修正(用对角 QK 方差近似完整协方差),降复杂度 实验效果:比 FlashAttention 加速最高 6.95×;50% 稀疏度下保持接近 full-attention 性能,跨语言模型/多模态语言模型/视频生成模型一致——证明高效率和强泛化 批判点评:把 sparse attention 的「选块」从 prior-based 升级到 learned downsampled space 是非常正确的方向,6.95× 加速比 FlashAttention 还快是亮眼的工程数字;但 50% 稀疏率下「接近 full」的具体差距需更精细评测;对极长上下文(1M+)的渐近行为仅理论保证而无实测 5. FlowLong:滑窗加流形约束推理期出长视频 FlowLong: Inference-time Long Video Generation via Manifold-constrained Tweedie Matching | KAIST, Amazon | arXiv:2605.20910 关键词:长视频生成·推理期方法·Tweedie matching·滑窗·流形约束 ⚠️ 前序问题:把视频扩散模型生成时长扩到长序列一直没解决:双向模型扩展紧绑架构且长距退化严重,自回归模型有 exposure bias 累积漂移并产生重复运动。现有 training-free 方案没有同时跨这两条路线 本文贡献:提出 architecture-agnostic 推理期长视频生成方法:滑动重叠窗口生成长视频,相邻窗口预测的 clean sample 通过 Tweedie matching 在重叠区强制流形约束 + 时序一致;high-noise 阶段用 stochastic early-phase sampling,每次 Tweedie matching 校正后注入新噪声同步窗口轨迹,再切到 deterministic ODE sampling 保留细节 实验效果:可生成数倍于原生窗口长度的视频,时序一致性和视觉质量超越 training-free 与自回归两类基线;同一思路无微调即可扩展到音视频联合生成、文生 3DGS——证明这套方法是通用的 批判点评:Tweedie matching 在窗口边界做修正是 elegant 的解法,几乎是「无需训练」的最简扩展;但滑窗推理时延比单 pass 显著增加,长视频对内存的累积压力不算小;与原生因果模型(如 Causal Forcing++/Mutual Forcing)相比,缺少同等长度下的直接对比 6. StreamGVE:少步流式生成做训练免视频编辑 StreamGVE: Training-Free Video Editing via Few-Step Streaming Video Generation | UBC ECE | arXiv:2605.21466 关键词:视频编辑·训练免微调·少步流式生成·noise-to-data·双分支 ⚠️ 前序问题:视频编辑方法可行但要花很多昂贵迭代且编辑结果质量勉强。作者把症结归因到「data-to-data」范式——它和现代生成模型(noise-to-data)天生不兼容,绕远路反而拉低了编辑质量 本文贡献:从 noise-to-data 视角重做视频编辑:基于预训练的流式生成模型构建 StreamGVE,保留 few-step 采样并无缝注入源视频条件;引入双分支快速采样(self-attention bridge + cross-attention grounding/boosting)兼顾采样和条件;提出 source-oriented guidance 提目标质量,再加 visual prompting 增强编辑灵活性 实验效果:在多种视频编辑任务上一致超越现有方法,即使在 few-step 设置下也能以最少时间代价完成;方法对不同底模具有鲁棒性和泛化能力 批判点评:把视频编辑「从 data-to-data 转向 noise-to-data」是个范式级洞察,能直接复用流式生成模型的少步能力——很省工;但在风格迁移、物体替换等具体编辑任务上的优势是否一致需要更细分对比;source-oriented guidance 的强度调参成本未明 7. FlowErase-RL:首个GRPO范式的概念擦除框架 FlowErase-RL: Rethinking Concept Erasure as Reward Optimization in Flow Matching Models | 哈工大深圳, 清华深圳, 吉林大学, 鹏城实验室, 清华大学 | arXiv:2605.19739 关键词:Flow Matching·概念擦除·GRPO·安全生成·双路径奖励 ⚠️ 前序问题:Flow Matching 文生图模型质量飞涨同时安全风险也在加剧,要擦除有害/不想要的概念。现有方案要么是推理期干预(效果有限),要么靠 SFT(依赖精对齐数据 + 多概念扩展性差)——擦除问题一直缺少更优范式 本文贡献:首次把概念擦除重新表述为 reward optimization 问题,提出基于 GRPO 的 FlowErase-RL:(1) 双路径动态奖励——CE(Concept Erasure)奖励抑制目标概念,NS(Non-target Space)奖励保住生成质量;(2) 性能驱动的自适应切换策略,无需显式监督就能稳定训练;通用支持裸露/物体/艺术风格三类擦除 实验效果:裸露/物体/艺术风格三类擦除均达 SOTA,图像质量与语义对齐保持很好;对抗攻击鲁棒性强,多概念场景扩展性好——开辟了 Flow Matching 安全可控生成的新范式 批判点评:把擦除从 SFT 转向 RL 是聪明的——擦除本质是分布偏移而非分类,RL 的奖励更贴合;但 GRPO 训练成本不低,CE/NS 双奖励的权重边界对效果影响多大未深入消融;擦除概念之间的相互干扰(擦了概念 A 影响概念 B 的生成)这一长尾问题未充分讨论 8. CPC-VAR:首次给VAR模型做持续多概念个性化 CPC-VAR: Continual Personalized and Compositional Generation in Visual Autoregressive Models | 哈工大深圳, 清华深圳国际研究生院, 鹏城实验室, 华南理工 | arXiv:2605.19750 关键词:持续学习·VAR 个性化·概念神经元·多概念合成·解纠缠 ⚠️ 前序问题:Visual Autoregressive(VAR)做文生图效率高,但现有 VAR 个性化只能静态训单概念——序列学新概念时旧概念会被灾难性遗忘,多概念合成又会出现特征纠缠和属性不一致。这是 VAR 个性化生成的两个老大难 本文贡献:首次系统研究 VAR 持续个性化生成,提出统一框架。两个核心组件:(1) GCNS(Gradient-based Concept Neuron Selection),找到每个概念相关的神经元,只约束跨任务冲突参数,不扩展模型也能抗遗忘;(2) 上下文感知组合策略:多分支特征建模 + 空间条件引导的局部 cross-attention 融合,做精确解纠缠的多概念合成 实验效果:长序列持续个性化场景下显著领先现有 baseline,多概念图像合成上也优于现有方法,证明 VAR 完全有能力做可扩展可控的个性化生成 批判点评:VAR 个性化第一次被系统化研究是好事,神经元级别的 GCNS 设计也比经典扩散模型路线(DreamBooth/LoRA)更经济;但实验是否覆盖到 10+ 概念的真实长尾、跨概念组合的失败模式分析略浅,VAR 底模本身的天花板(vs 扩散模型)没有正面比较 9. DyMoS:一个标量旋钮控 I2V 运动幅度 Rebalancing Reference Frame Dominance to Improve Motion in Image-to-Video Models | 延世大学 Yonsei, GIST, Adobe Research | arXiv:2605.19398 关键词:I2V·运动控制·注意力 rebalance·训练免微调·DyMoS ⚠️ 前序问题:I2V(image-to-video)相比 T2V 生成的视频普遍过于静态。前人方案靠削弱或修改图像条件来增加运动,但要么需要额外训练,要么牺牲了对参考图像的保真度——「动起来 vs 像参考图」是个长期 tradeoff 本文贡献:识别出「reference-frame dominance」是动作抑制的核心机制:非参考帧对参考帧 key token 分配过多 self-attention,导致参考信息被过度跨时传播、压制了帧间动态。提出 DyMoS(Dynamic Motion Slider):训练免微调、模型无关,初始去噪步 rebalance 生成帧到参考帧的注意力路径,输入图和模型权重都不动,只引入一个标量参数连续控制运动强度 实验效果:多个 SOTA I2V backbone 上一致提升运动动态,同时保持视觉质量和对参考图的保真度;提供 user 一个可调的运动旋钮 批判点评:把「动起来 vs 像参考图」从冲突变成可调旋钮是非常实用的工程贡献;但 attention rebalance 的具体公式对不同架构可能需重新调,论文给出的 generality 主要在 SD 系列底模;标量旋钮是否能控制不同方向的运动(横向 vs 纵向)需要更细粒度评测 10. MSAVBench:首个多镜头音视频生成评测基准 MSAVBench: Towards Comprehensive and Reliable Evaluation of Multi-Shot Audio-Video Generation | 复旦大学, 港大, 阿里通义实验室, 浙大, 北大 | arXiv:2605.20183 关键词:多镜头音视频·评测基准·导演级控制·自适应分镜·MSAVBench ⚠️ 前序问题:视频生成正从单镜头扩展到复杂多镜头音视频(MSAV)叙事,但评测仍是基础性挑战——现有 benchmark 范围有限、数据多样性不足、评测流水线僵化,无法系统可靠地评估现代 MSAV 模型 本文贡献:推出 MSAVBench 首个面向多镜头音视频生成的综合评测基准 + 自适应混合评测框架。覆盖视频/音频/镜头/参考四个维度,多种任务设置,最多 15 个镜头,挑战性的非真实场景。评测框架的鲁棒性来自三件事:分镜分割的自适应 self-correction、主观指标的实例级 rubric、复杂判断的工具溯源证据抽取 实验效果:与人类判断的 Spearman 秩相关达 91.5%,对齐度极高;系统评测 19 个 SOTA 闭源/开源模型显示:当前系统在导演级控制和细粒度音视频同步上仍有困难,模块化/agentic 生成 pipeline 是缩小开源-闭源差距的有前途路径;benchmark 数据和评测代码将开源 批判点评:把音视频生成评测从「单镜头质量」推进到「多镜头叙事 + 导演级控制」是必要的下一步;91.5% Spearman 与人类对齐很高,自适应分镜 self-correction 是工程亮点;但 15 个镜头作为基准上限对真正的长视频(>5 分钟、几十个镜头)覆盖度有限;非真实场景的标注成本与一致性如何控制仍是开放问题 11. CogOmniControl:专用CogVLM认知创意意图引导生成 CogOmniControl: Reasoning-Driven Controllable Video Generation via Creative Intent Cognition | 澳门大学 SKL-IOTSC, 腾讯 Online-Video BU | arXiv:2605.19995 关键词:可控视频生成·专业 VLM·创意意图认知·闭环 harness·in-context ⚠️ 前序问题:视频扩散模型对 abstract / 稀疏 / 复杂条件依然脆弱——专业制作工作流(分镜草图、黏土渲染等)下表现差。现有方案要么用 adapter 注入条件,要么把通用 VLM 耦合到扩散 backbone——能力鸿沟仍在,难以输出对齐用户创意意图的视频 本文贡献:提出 CogOmniControl 推理驱动框架:把可控视频生成因式分解为「创意意图认知」+「生成」。专门用真实动漫制作数据训了一个专业版 CogVLM,比通用 VLM 更准确地从稀疏抽象条件中识别用户创意意图,转译成密集 reasoning 输出;CogOmniDiT 通过 in-context generation 统一多种条件,并用 RL 对齐到 CogVLM reasoning 输出。进一步利用 CogVLM 做评测与 Best-of-N 选择,整个框架是闭环 harness 架构。同时发布 CogReasonBench / CogControlBench 来自专业工作流的真实创意意图数据 实验效果:两个 benchmark 上一致超越现有开源模型,在分镜草图、黏土渲染等专业条件下尤其明显——证明专业 VLM 介入的认知能力对可控生成是有效的 批判点评:专业 VLM 当「创意意图认知器」是个新颖思路,引入 reasoning 缓解条件稀疏问题——但训练专业版 VLM 的数据规模有限,跨垂直域(动漫→真人/工业)泛化未验证;闭环 harness 架构推理时延偏高,落地工业流水线存在挑战 12. DiSI:单模型连续滑动失真感知权衡 Disentangling Generation and Regression in Stochastic Interpolants for Controllable Image Restoration | 同济大学, 复旦大学 | arXiv:2605.21381 关键词:图像复原·Stochastic Interpolant·生成-回归解耦·失真感知权衡·像素空间 ⚠️ 前序问题:图像复原(IR)领域生成式(Diffusion/Flow Matching)擅长合成真实纹理但慢且像素保真度差;经典回归式方法单步高效像素准确——两条路线长期不能兼得 本文贡献:提出 DiSI 统一框架:把底层 Stochastic Interpolant 过程显式解耦为独立的生成分量和回归分量。这种解耦让模型在「纯回归 → 全生成」之间连续可控过渡。技术上提供两条具体采样轨迹和统一 sampler 支持任意轨迹的少步推理;网络是像素空间的双分支 U-Net 风格 transformer(专用分支增强条件引导同时保高吞吐) 实验效果:在多种 IR 任务上以高效率取得有竞争力的结果;独有特性:单一模型推理期就能控制失真-感知 tradeoff(distortion-perception trade-off),不再需要训多个模型 批判点评:把 SI 过程拆成生成+回归两个可独立调用的分量,在理论上很优雅,给「失真-感知」连续控制提供了第一种统一手段;但实际 IR 任务中如何选择最佳轨迹(用户需指定 tradeoff?)的 UI/控制接口论文未深入讨论;与最新 OSEDiff/PASD 等方法的端到端对比有所欠缺 13. ABSS:初始几步注意力筛 seed 提画质 Boosting Text-to-Image Diffusion Models via Core Token Attention-Based Seed Selection | Brandeis University | arXiv:2605.19532 关键词:文生图·Seed Selection·Cross-Attention·训练免微调·SD ⚠️ 前序问题:文生图扩散模型的输出对随机 seed 极度敏感——不同 seed 同 prompt 画质和文图对齐差异巨大。但「该用哪个 seed」一直靠盲选,缺乏系统的预选机制 本文贡献:观察到一个关键现象:在前几步去噪过程中,对 prompt 中 core token(content-bearing words)的 cross-attention dynamic 强烈预测最终生成质量。基于此提出 ABSS(Attention-Based Seed Selection),训练免微调即插即用:候选 seed 跑前几步,用对 core token 的 cross-attention 打分排序,只保留 top-k 完成完整生成,不需要固定阈值 实验效果:三个 benchmark 上 Stable Diffusion 各变体的文图对齐和视觉质量一致提升,人工偏好与对齐指标都有改善;可作为现有 seed 优化 pipeline 的轻量预选附加组件叠加额外收益 批判点评:很经济的工程发现:把 seed 筛选问题转换为前几步 attention 信号读取,几乎没有计算开销;但这种基于 attention 的代理指标在跨架构(DiT/MMDiT)的可迁移性需要进一步验证;core token 的提取依赖 prompt parsing 的鲁棒性 趋势观察 「编辑」开始成为统一多模态模型的核心训练任务 — Uni-Edit 把智能编辑提为 UMM 单一通用训练任务,BAGEL/Janus-Pro 上一个数据集就能同时提理解/生成/编辑——「编辑作为通用任务」的认知正在替代「混合多任务训练」的范式。FullFlow 用同样的精简思路(只训 5% 参数)把 T2I 升级成双向多模态,从「重训」走向「升级」 视频生成加速进入「时空联合 + 稀疏注意力」阶段 — DVG 把渐进分辨率从单空间扩到时空联合,HunyuanVideo 上 7× 加速 + 蒸馏达 18×;BA-Att 用块预降采样稀疏注意力比 FlashAttention 还快 6.95×。视频扩散下一阶段的加速重心从单维度优化转向「时空 + 稀疏」组合拳 长视频生成从训练扩展走向「推理期方法」 — FlowLong 用 Tweedie matching 滑窗 training-free 把视频时长扩到数倍——这条 inference-time 路线和 Mutual Forcing/Causal Forcing++ 的训练侧路线形成互补,意味着长视频不一定要重新训模型 I2V 运动控制和文生图 seed 选择都被「单一标量旋钮 + Attention 信号」攻破 — DyMoS 用一个标量参数控 I2V 运动幅度(attention rebalance);ABSS 用初始几步 cross-attention 信号筛 seed——共同点是把「需要训练才能解决」的问题,转化为「读取已有 attention 信号」的免训练方案 概念擦除从 SFT 范式跨入 RL 范式 — FlowErase-RL 首次用 GRPO 做 Flow Matching 概念擦除,CE+NS 双路径动态奖励替代精对齐 SFT 数据——证明在 Flow Matching 时代,「擦除」本质上更适合用 RL 的分布偏移视角而非分类监督视角 人工智能炼丹君 整理 | 2026-05-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
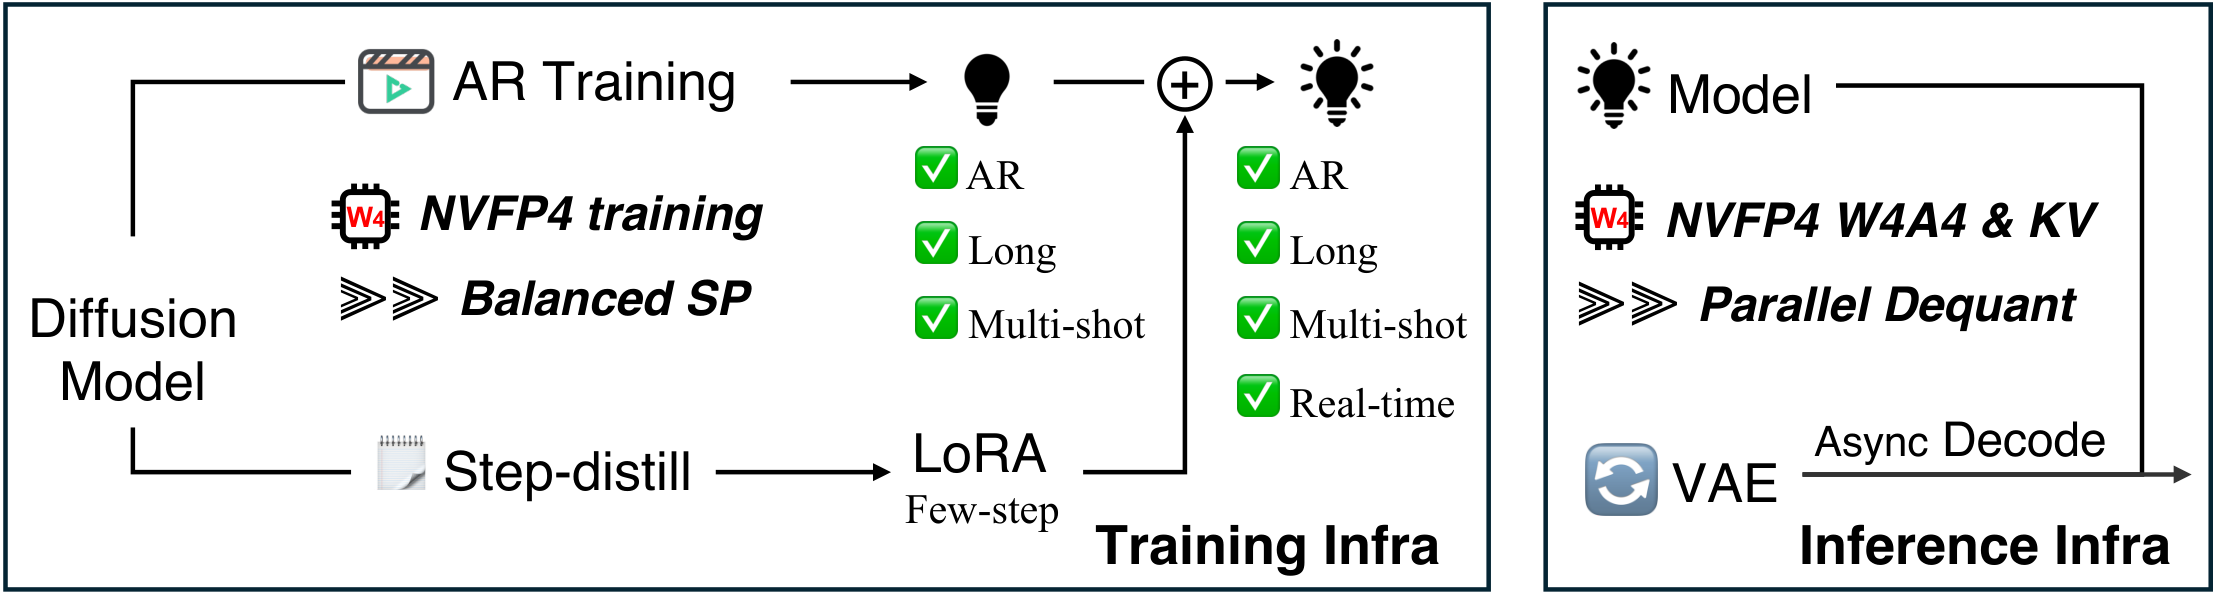
AIGC 每日速读|2026-05-19|长视频生成FP4训推全栈LongLive-2.0 今日 AIGC 论文速览 今日共 13 篇 · 长视频生成与训推优化 2 篇 · 扩散推理加速与量化 4 篇 · 视频编辑与实时特效 2 篇 · 统一多模态生成 1 篇 · 音频生成与综述 2 篇 · 扩散 RL 后训练 2 篇 重点论文标题列表 LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× TACache:Rectified Flow 训练免训练加速 4.14× Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Lance:原生统一图像视频理解生成 MoE 模型 StreamingEffect:单 H200 实时 720p 人像视频特效 今日论文速览 1. LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× LongLive-2.0: An NVFP4 Parallel Infrastructure for Long Video Generation | NVIDIA | arXiv:2605.18739 关键词:长视频生成·NVFP4·序列并行·AR 视频扩散·Song Han 前序问题:长视频生成的训练和推理同时卡在显存和速度上:现有 Self-Forcing 系列依赖 ODE 初始化 + DMD 蒸馏,流程冗长;推理端把 KV cache 与计算精度压不下去,使得分钟级、多镜头、可交互的 AR 视频生成在大模型规模下难以落地 本文贡献:提出 LongLive-2.0:首个 NVFP4 端到端长视频生成训练 + 推理基础设施。(1) 训练侧的 Balanced SP——把 teacher-forcing 布局与序列并行(SP)协同设计,在每个 rank 上配对干净历史 + 噪声目标的时间块,并搭配 SP-aware 分块 VAE 编码;(2) 直接把扩散模型微调成长时多镜头交互式 AR 模型,跳过 ODE 初始化 + DMD 蒸馏;(3) 推理侧 Blackwell 上跑 W4A4 NVFP4,KV cache 也量化到 NVFP4,配合异步流式 VAE 解码 实验效果:训练加速 2.15×、推理加速 1.84×;LongLive-2.0-5B 在保持 benchmark 强表现的同时达到 45.7 FPS 推理;可独立 LoRA 切换为 4 步 / 2 步实时生成模式,是首个面向长视频生成的 NVFP4 训推一体系统 批判点评:把 NVFP4 这种 Blackwell 新精度从推理推到训练全链路是工程级里程碑,5B 跑出 45.7 FPS 把长视频 AR 推到了实时门槛;但 NVFP4 对硬件的强绑定限制了非 Blackwell 集群的复现路径,量化 KV cache 在多镜头切换时的累积误差也值得长期追踪 2. TACache:Rectified Flow 训练免训练加速 4.14× Accelerating Rectified Flow Models via Trajectory-Aware Caching | 上海交大, 军事科学院, 华为 | arXiv:2605.16789 关键词:Rectified Flow·训练-free 加速·缓存·正交分解·扩散推理 前序问题:扩散与 Rectified Flow 模型靠迭代评估速度场出图/出视频,计算昂贵;现有 cache 方法靠跳步加速,但粗略的近似在长跳步区间累积误差大,激进加速下质量明显劣化 本文贡献:提出 TACache(Trajectory-Aware Cache)训练-free 加速框架,遵循「先跳步后补偿」范式:对 RF 轨迹上离散速度加速度做正交分解(平行 + 正交残差),分离每步近似误差的幅值与方向来源;离线阶段用幅值 / 方向累积阈值生成跳步表,在线阶段结合样本历史正交方向重构被跳过的速度,无需额外模型评估 实验效果:在 BAGEL、FLUX.1-dev、Wan2.1-1.3B 上分别实现文生图 4.14×、文生视频 2.11× 加速;在所有 reference-based fidelity 指标上一致优于已有 cache 类方法 批判点评:「先跳步后补偿」+ 速度加速度正交分解,把 cache 类方法从经验调参推到了误差可控的工程范式;但分解效果对模型与数据集分布敏感,离线统计在 prompt 分布漂移时是否仍稳定,还需要更长尾的验证 3. Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Aurora: Unified Video Editing with a Tool-Using Agent | 罗切斯特大学, Adobe | arXiv:2605.18748 关键词:视频编辑·VLM Agent·工具调用·统一扩散·欠规范请求 前序问题:现有统一视频编辑模型把文本、源视频、参考图喂进同一个 DiT 一把搞定替换 / 删除 / 风格 / 参考插入;设计很灵活,但默认用户已提供了 model-ready 的文本、参考图与空间锚定——真实请求里这些往往缺失 本文贡献:提出 Aurora:把工具增强 VLM agent 与统一视频扩散 transformer 配对——agent 把原始用户请求映射成对齐 transformer 条件通道的结构化编辑计划,先解决「文本和视觉欠规范」再生成;用监督数据训练完整编辑规划 + 参考图选取,再用偏好对训练鲁棒工具调用与指令润色;并发布 AgentEdit-Bench 评估「欠规范用户请求」下的 agentic 视频编辑能力 实验效果:在 AgentEdit-Bench 与两个现有视频编辑 benchmark 上,Aurora 显著超越纯指令 baseline;VLM agent 还能迁移到其他冻结的视频编辑模型,作为通用前置规划层 批判点评:把视频编辑里「用户输入欠规范」这一真实痛点显式拆解给 VLM agent 处理,是务实且可迁移的范式;但 agent 错误规划带来的级联编辑错误尚未充分量化,agent + DiT 的端到端延迟也是落地前要解决的关键 4. Lance:原生统一图像视频理解生成 MoE 模型 Lance: Unified Multimodal Modeling by Multi-Task Synergy | 字节跳动 Intelligent Creation Lab | arXiv:2605.18678 关键词:统一多模态·MoE·双流架构·原生训练·图像视频生成 前序问题:统一多模态模型要么靠模型尺寸堆量、要么沿用图文为主的设计,在「图像 + 视频 × 理解 + 生成 + 编辑」的全格子上很难一并打通;理解和生成两条能力路径互相干扰,多模态 token 异质性也让位置编码难以兼顾 本文贡献:提出 Lance:原生轻量级统一多模态模型,从零训练,采用「双流 MoE + 共享交错多模态序列」架构——联合上下文学习同时把理解与生成的能力路径解耦;引入 modality-aware RoPE 缓解异质视觉 token 的相互干扰;训练采用分阶段多任务范式,配合自适应数据调度同时强化语义理解与视觉生成 实验效果:图像和视频生成上大幅超越现有开源统一模型,同时保持强多模态理解能力,证明统一不必靠堆参数,「能力路径解耦」是更可持续的统一范式 批判点评:「统一上下文 + 解耦能力路径」的设计直击当前统一模型最大痛点:什么都做但什么都不极致;不过双流 MoE 的训练稳定性、与闭源旗舰模型的差距,以及在更长视频上的可扩展性仍待时间检验 5. StreamingEffect:单 H200 实时 720p 人像视频特效 StreamingEffect: Real-Time Human-Centric Video Effect Generation | 新加坡国立 Show Lab | arXiv:2605.17019 关键词:视频编辑·实时流式·人像特效·因果蒸馏·VideoEffect-130K 前序问题:电商直播、娱乐、Vlog 等场景需要实时人像视频特效,但缺数据、缺可部署的编辑模型;视频编辑的高效蒸馏几乎没人做,现有加速大多围绕文生视频,无法保住身份、背景与时序一致性 本文贡献:提出 StreamingEffect:上下文式视频编辑架构 + 因果 AR 学生蒸馏,把采样从 50 步压到 4 步;支持关键帧控制——可以在线注入参考特效帧并沿流传播,实现交互式编辑;同时构建 VideoEffect-130K 数据集——70K 特效视频 + 60K 编辑视频、600 类特效,是已知最大的人像视频特效数据集 实验效果:在单张 H200 GPU 上实现实时高质量 720p 视频编辑,数据集和方法共同填补了「人像视频特效实时编辑」的开源生态空白 批判点评:把视频编辑显式当作「实时流式 + 关键帧可控」问题来解,配套 130K 高质量数据是最大的工程贡献;但 600 类特效的覆盖度、4 步学生在长流式生成下身份漂移、以及 H200 之外的部署门槛,是产品化关键考验 6. MeanFlow-LSE:MeanFlow 蒸馏推到 80B 工业级模型 Stabilizing, Scaling & Enhancing MeanFlow for Large-scale Diffusion Distillation | 西电, 腾讯混元 | arXiv:2605.17834 关键词:MeanFlow·扩散蒸馏·大规模训练·HunyuanImage·少步生成 前序问题:MeanFlow 因公式简洁、表现强劲在少步蒸馏受关注,但优化目标不稳定 + 「mean-seeking bias」限制了它在大规模工业模型上的应用,蒸馏到 12B / 80B 级别经常训练崩溃或质量塌陷 本文贡献:(1) 引入 warm-up 技术,用离散解替代原 MeanFlow 微分解,避免 stop-gradient 项含未训好模型导致的训练崩溃;等模型对平均速度场有初步拟合后再切回微分解继续精炼;(2) 引入轨迹分布对齐作为辅助目标,缓解极少步推理下复杂目标分布上的 mean-seeking bias,让学生模型轨迹分布贴近教师 实验效果:在 FLUX.1-dev(12B)上超越现有蒸馏方法;推到 80B 的 SOTA 工业模型 HunyuanImage 3.0,依然展现出鲁棒泛化与强表现,是首次把 MeanFlow 蒸馏验证到 80B 量级 批判点评:warm-up + 轨迹分布对齐两步组合直击 MeanFlow 在大模型上的两大顽疾,工程上意义重大;但 warm-up 阶段 / 切换时机依赖经验设定,对不同 backbone 的迁移性还需更系统消融 7. I2V-Survey:图生视频扩散首份系统综述 Image-to-Video Diffusion: From Foundations to Open Frontiers | 港城大, 格里菲斯大学等 | arXiv:2605.17248 关键词:图生视频·扩散综述·I2V·taxonomy·开放挑战 前序问题:图生视频(I2V)已成为生成模型的核心方向,对内容一致性、身份保留与运动连贯性的要求都比通用视频生成更严;但现有论文大多把 I2V 当作通用视频生成的子话题,缺乏专门的 taxonomy 与系统分析 本文贡献:把扩散 I2V 单独立题,系统梳理任务定义、模型架构、数据集、评测指标,并按架构和训练范式给出 taxonomy;进一步抽取 4 个核心设计——条件编码 / 时序建模 / 噪声先验 / 时空上采样,配合典型应用与开放挑战 实验效果:为 I2V 这一独立子方向提供首份结构化综述,给出可复用的 4 大设计轴和应用-挑战双视角,便于研究者和工程团队系统理解技术路径 批判点评:把 I2V 从「视频生成的角落」抬到独立子方向,「4 个核心设计 + taxonomy」是清晰可用的索引框架;但综述截止时间内未能覆盖最新一波因果 / 实时 I2V,未来需要持续更新追踪 8. WavFlow:原始波形空间直生高保真音频 WavFlow: Audio Generation in Waveform Space | Meta AI, 东北大学 | arXiv:2605.18749 关键词:音频生成·波形空间·Flow Matching·V2A·T2A 前序问题:现代音频生成几乎都依赖潜空间压缩,引入额外复杂度并潜在丢失信息;但波形空间维度极高、能量分布稀疏,让扩散模型直接在波形上建模长期失败 本文贡献:提出 WavFlow:直接在原始波形空间生成高保真音频,无中间表示。通过 waveform patchify 把音频重塑为 2D token grid,引入 amplitude lifting 对齐信号尺度,使 flow matching 中的 x-prediction 优化稳定;并构建自动化数据流水线,整理 500 万视频-文本-音频三元组,从零学习细粒度声学模式 实验效果:在视频转音频 VGGSound 上取得 FD_PaSST 59.98 / IS_PANNs 17.40 / DeSync 0.44;在文生音频 AudioCaps 上 FD_PANNs 10.63 / IS_PANNs 12.62,与已有潜空间方法持平或超越,证明中间压缩并非高质量音频合成的必要条件 批判点评:「不要 latent,直接干波形」是颇有勇气的反潮流路线,patchify + amplitude lifting 是让 flow 在波形上稳的关键工程;但波形 flow matching 的训练成本与采样开销比 latent 方案高得多,工业级落地需要更激进的加速 9. TAPE:时序感知 token 剪枝免训加速视频扩散 Temporal Aware Pruning for Efficient Diffusion-based Video Generation | 匹兹堡大学, IIT, Rutgers, Microsoft AI | arXiv:2605.17837 关键词:视频扩散·token 剪枝·训练-free 加速·时序一致性·ViT 前序问题:视频扩散 ViT 架构出视频质量高,但长时空序列上的注意力计算极贵;已有 token 剪枝多基于 attention、按帧独立操作,难以保住跨帧时序连贯,naive 应用会产生背景不稳、闪烁、画质下降 本文贡献:提出 TAPE 训练-free 时序感知剪枝:(i) 时序平滑对齐相邻帧的 token 重要性,抑制选择抖动;(ii) 在选定层做 token 重选,使剪枝匹配各层的不同语义关注,避免误差在特定区域累积;(iii) 时间步级预算调度——早期噪声重的步骤激进剪、后期保真关键步骤放宽 实验效果:显著提速的同时保持高视觉保真度,超越前期 token reduction 方法;作为 plug-in 训练-free 加速,能直接套到现有视频扩散模型上 批判点评:把 token 剪枝从「每帧独立」拉回「时序感知」是补足视频域专属约束的正确方向,三项设计互相协同;但激进时间步预算调度对极长视频的累积误差、以及 ViT 之外架构的迁移性仍是开放问题 10. SafeDiffusion-R1:在线 GRPO + CLIP 引导奖励安全对齐 SafeDiffusion-R1: Online Reward Steering for Safe Diffusion Post-Training | MBZUAI | arXiv:2605.18719 关键词:扩散安全·在线 RL·GRPO·CLIP 引导·内容审核 前序问题:扩散模型移除预训练中学到的不安全内容,现有方法要么需要昂贵的 unsafe-text 配 safe-image 监督数据,要么走离线 RL / SFT 在合成数据上训,灾难性遗忘严重,生成质量明显劣化,扩展性差 本文贡献:提出在线 RL 框架:在正负 prompt 上跑 GRPO;引入 steering reward 机制利用 CLIP 嵌入空间的固有性质——把文本表示推向正向安全方向、远离负向,无需为每个安全维度单独训 reward 模型;在线策略让模型从包括显式不安全 prompt 在内的多样请求中学习而不灾难性遗忘 实验效果:不当内容下降到 18.07%(vs SD v1.4 的 48.9%),裸露检测 15 vs baseline 646;GenEval 组合生成质量从 42.08% 提升到 47.83%;安全增益泛化到 7 类未见有害 prompt 类别 批判点评:把「安全对齐」从离线 SFT 推到在线 GRPO,叠加 CLIP 嵌入引导避开 reward 模型训练,工程友好且可扩展;但 CLIP 嵌入方向偏向、对抗性提示下 steering 的鲁棒性,仍需对抗压力测试持续追踪 11. CGPO:按 reward 方差自适应难度的文生图 RL Curriculum Group Policy Optimization: Adaptive Sampling for Unleashing the Potential of Text-to-Image Generation | 北邮, 中国电信 TeleAI | arXiv:2605.17807 关键词:文生图·GRPO·课程学习·自适应采样·RL 对齐 前序问题:文生图 RL(特别是 GRPO 系)训练时统一采样策略忽视了样本难度与模型当前能力的匹配,训练效率低,模型常在已掌握或还远不能掌握的 prompt 上空转 本文贡献:提出 CGPO 自适应课程训练框架:每条 prompt 生成一组图像由 reward 模型打分,用组内 reward 方差作为「prompt 不一致性」的在线 proxy——方差高说明模型部分掌握但未稳定,正是最该多采的可学习 prompt,从而提高其采样概率;再用比例公平优化做类别校准,平衡多类别数据集的训练难度 实验效果:在 GenEval、T2I-CompBench++、DPG Bench 上一致提升生成性能,为 GRPO 类文生图 RL 提供可即插即用的课程化增强 批判点评:用 reward 方差当「可学习 prompt」proxy 是优雅且无需额外标注的设计;但 reward 模型本身的偏差会被该 proxy 放大,长期训练下需要监控 reward hacking 12. DiRotQ:PCA 旋转感知 W4A4 DiT 量化 DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers | d-Matrix | arXiv:2605.16732 关键词:DiT·4-bit 量化·PCA 旋转·W4A4·FLUX 前序问题:DiT 出图质量 SOTA 但推理代价高;激进 PTQ 到 4-bit 能省算力却经常严重掉点;已有 smoothing / mixed precision / rotation / low-rank residual 等方法都只能部分缓解,与 FP16/BF16 仍有可见差距 本文贡献:提出 DiRotQ W4A4 PTQ 框架——通过 PCA 找到激活方差主成分所在的低秩子空间,对该子空间用更高精度保留,其余分量量化到 4-bit;推理时用校准得到的正交变换把激活旋转到 PCA 基,逆旋转离线融入权重;再叠加 GPTQ 的权重量化形成完整 W4A4 系统,并给出 Triton kernel 端到端加速 实验效果:在 PixArt-Σ MJHQ-30K 上取得 FID 15.9 / PSNR 19.1 dB,超越 SVDQuant(FID 18.9 / 17.6);12B FLUX.1-dev 在单卡 RTX 4090 上显存降 2.1×,推理比 BF16 加速 2.3×;并首次提出 VLM-as-a-Judge 评测协议 批判点评:把 PCA 子空间高精度保留 + 离线融入权重的设计,把旋转量化做到了 W4A4 的较好均衡,落地友好;但 PCA 校准对长尾 prompt 的覆盖度、VLM-as-a-Judge 与人类偏好的对齐度,是后续要追踪的关键 13. SpectralProgressive:频谱先粗后细动态扩展分辨率 Spectral Progressive Diffusion for Efficient Image and Video Generation | Stanford | arXiv:2605.18736 关键词:频谱扩散·渐进分辨率·训练-free 加速·视频生成·去噪调度 前序问题:扩散模型在频域里隐式自回归生成——低频先出、高频后出;在噪声主导的早期对全分辨率做计算大量冗余,但目前没人把这一观察系统化用于推理加速 本文贡献:提出 Spectral Progressive Diffusion 通用框架——沿去噪轨迹渐进扩展分辨率;设计频谱噪声扩展机制,并从模型自身的功率谱推出最优分辨率调度;支持 training-free 加速和一种新的微调配方,进一步同时改善效率与质量 实验效果:在多个 SOTA 预训练图像和视频生成模型上获得显著加速,且画质保持;为预训练扩散模型提供一条「无需重训」的频谱渐进推理路线 批判点评:把扩散「频谱自回归」的隐式行为显式化为分辨率调度,思路清晰且与 cache 等加速正交;但频谱调度对噪声分布的假设强依赖训练分布,跨数据集与跨模态迁移性需更广验证 趋势观察 NVFP4 把长视频生成训推一体化推到实用门槛 — LongLive-2.0 把 NVFP4 从纯推理量化推到训练 + KV cache + 异步流式 VAE 解码全链路,5B 模型跑出 45.7 FPS——下一代视频生成基础设施开始与 Blackwell 硬件深度协同,长视频 AR 真正走向「可部署的实时」 扩散加速从 cache 推到「频谱 + 时序 + 量化」三路同时压榨 — TACache 从轨迹正交分解给跳步补偿、TAPE 从时序感知做 token 剪枝、SpectralProgressive 从频谱调度动态扩展分辨率、DiRotQ 从 PCA 旋转把 DiT 推到 W4A4——扩散推理优化第一次在「时间步 / 空间 token / 数值精度 / 频谱通道」四个轴上系统并进 视频编辑进入 agent 时代 — Aurora 把模糊用户请求交给 VLM agent 拆解成结构化编辑计划再喂给 DiT;StreamingEffect 配套 130K 数据 + 4 步因果蒸馏直接做实时人像特效——视频编辑从「模型一把吃下所有输入」转向「agent 解码意图 + 模型专注生成」 统一多模态从堆参数走向「能力路径解耦」 — Lance 用「双流 MoE + 共享交错序列」把理解与生成的能力路径显式解耦,配合 modality-aware RoPE 处理 token 异质性;证明轻量原生设计也能在「图像 + 视频 × 理解 + 生成 + 编辑」全格子上同时领先 扩散 RL 对齐从 reward 工程走向 reward 机制 — SafeDiffusion-R1 用 CLIP 嵌入做 steering reward 替代专门 reward 模型;CGPO 把 reward 方差当 prompt 难度 proxy 实现自适应采样——扩散 RL 后训练正在从「堆 reward 模型」转向「挖 reward 信号本身的几何」 人工智能炼丹君 整理 | 2026-05-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
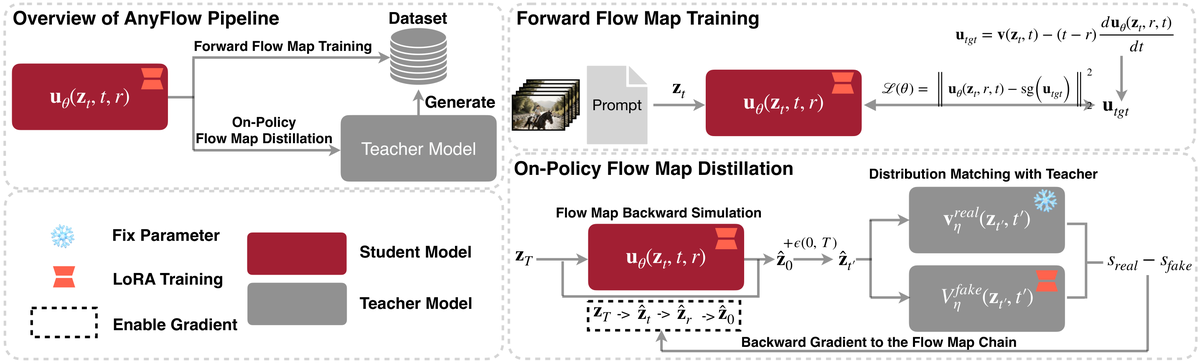
AIGC 每日速读|2026-05-14|视频扩散从少步到任意步AnyFlow 今日 AIGC 论文速览 今日共 6 篇 · 视频扩散与推理加速 2 篇 · 图像生成与表征 2 篇 · 图像编辑与对齐评测 1 篇 · RL 后训练方法论 1 篇 重点论文标题列表 AnyFlow:——首个基于 flow map AsymFlow:rank-asymmetric ⚡ Qwen-Image-VAE-2.0:高压缩 VAE 套件 Edit-Compass:EditReward-Compass Orthrus:双视图框架 今日论文速览 1. AnyFlow:——首个基于 flow map AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation | 新加坡国立大学 Show Lab, MIT, NVIDIA | arXiv:2605.13724 关键词:视频扩散·Flow Map·On-Policy 蒸馏·Any-Step·推理加速 ⚠️ 前序问题:近一年的少步视频生成几乎被一致性蒸馏(Consistency Distillation)统治,4-8 步即可出图,但只要把采样步数从 4 加到 16/32 画质反而塌——CD 用一致性轨迹替换了原始 PF-ODE 轨迹,破坏了 ODE 采样在测试时的可扩展行为,无法服务「任意步数」推理需求 本文贡献:提出 AnyFlow——首个基于 flow map 的任意步数视频扩散蒸馏框架:(1) 把蒸馏目标从端点一致性映射 z_t→z_0 升级为流图过渡 z_t→z_r,让学生学会任意时间区间的跳跃;(2) Flow Map Backward Simulation 把完整 Euler rollout 拆为多段 shortcut,用 on-policy rollout 替代 off-policy 配对蒸馏,缓解少步采样的离散化误差和因果生成的 exposure bias 实验效果:在双向 DiT 与因果两类视频扩散骨干、1.3B 到 14B 全规模区间一致达到或超越 consistency baseline;当步数从 4 提升到 16/32 时性能不再退化、反而单调上升,重新恢复了 ODE 采样的 test-time scaling 优势 批判点评:把蒸馏目标从端点一致性升级到任意区间流图是范式级创新,FMBS 的 on-policy 反向模拟在视频域是首次系统化提出;但论文未公开 VBench/UCF-FVD 等具体数值,复现门槛在 1B-14B 教师 + 大规模 on-policy rollout,数据与算力两端都不低 2. AsymFlow:rank-asymmetric Asymmetric Flow Models | Stanford, ETH | arXiv:2605.12964 关键词:Flow Matching·像素扩散·非对称参数化·FLUX.2·文生图 ⚠️ 前序问题:高维像素空间下做 flow matching 速度预测时,模型必须建模与图像同维的高维噪声,即使数据本身有强低秩结构也只能用满秩参数化硬扛,导致像素扩散与潜空间模型间长期存在显著质量差距 本文贡献:提出 AsymFlow:rank-asymmetric 速度参数化——噪声预测限制在低秩子空间、数据预测保持满维,不改网络结构与训练/采样流程即可解析恢复完整速度;首次给出潜空间预训练→像素空间微调的可行路径,让 FLUX.2 klein 9B 的潜空间先验直接初始化像素生成 实验效果:ImageNet 256×256 取得 1.57 FID,大幅超越同类 DiT/JiT 像素扩散;从 FLUX.2 klein 9B 微调出的像素文生图模型在 HPSv3、DPG-Bench、GenEval 上全面超越其潜空间基模,主观真实感显著提升 批判点评:rank-asymmetric 视角直击像素扩散的本质瓶颈,无侵入式参数化是工程甜点;但低秩子空间的秩选择、与 FLUX.2 这种顶级模型的耦合是否过强、跨数据集泛化能力都还需更大规模验证 3. Qwen-Image-VAE-2.0:高压缩 VAE 套件 Qwen-Image-VAE-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.13565 关键词:图像 VAE·高压缩·文本渲染·扩散兼容·视觉分词器 ⚠️ 前序问题:高压缩比 VAE 在重建保真度和 diffusability 之间长期难以兼得——压得越狠下游 DiT 越难训,文本密集场景(文档、海报)的字符更是首当其冲糊掉 本文贡献:提出 Qwen-Image-VAE-2.0 高压缩 VAE 套件:架构上引入 Global Skip Connections + 扩展潜空间通道;训练上用十亿级图像 + 合成渲染引擎专项强化文本场景;潜空间用增强语义对齐策略让其更适合扩散建模;编解码器采用非对称 + attention-free 主干降低编码开销 实验效果:在公开重建基准上达到 SOTA;提出 OmniDoc-TokenBench 文档专项评测,在高压缩比下兼顾通用与文本场景;下游 DiT 实验显示其 diffusability 显著优于现有高压缩基线,收敛速度明显加快 批判点评:把 VAE 当成独立产品打磨——文档专项 benchmark + 文本渲染合成数据是务实的工程亮点;但相对其他高压缩 VAE 的提升幅度需等论文公开数值后比较,「diffusability」的量化定义仍偏经验 4. Edit-Compass:EditReward-Compass Edit-Compass & EditReward-Compass: A Unified Benchmark for Image Editing and Reward Modeling | 字节跳动 Doubao Team 等 | arXiv:2605.13062 关键词:图像编辑·Reward Model·多维评测·RL 对齐·Benchmark ⚠️ 前序问题:现有图像编辑 benchmark 难度不足、评测维度粗放,已无法区分前沿模型;与此同时图像编辑 RL 越来越依赖 reward model,但 reward model 评测仍停留在脱离实际 RL 场景的设定上,导致编辑模型与 reward model 都缺少可靠裁判 本文贡献:提出 Edit-Compass + EditReward-Compass 统一评测套件:前者含 2,388 条精标实例,覆盖世界知识推理、视觉推理、多图编辑等六级递进任务,采用结构化推理 + 细粒度 rubric 多维评分;后者含 2,251 对偏好对,模拟真实 RL 优化中的 reward 场景 实验效果:为前沿编辑模型提供了能拉开差距的多维难度梯度,配套的 reward model 评测能反映 RL 训练中 reward model 的真实表现,为后续编辑模型与 reward model 的迭代提供统一坐标系 批判点评:把「编辑能力」和「reward model 能力」两条评测线收编进同一套 benchmark 是踏实的基础工作;2,251 对偏好对的标注一致性、reward 评测对真实 RL 收益的预测力,是这类工作走向社区共识的关键门槛 5. Orthrus:双视图框架 Orthrus: Memory-Efficient Parallel Token Generation via Dual-View Diffusion | Adobe Research, University of Oregon | arXiv:2605.12825 关键词:并行解码·扩散语言模型·KV Cache·推理加速·双视图 ⚠️ 前序问题:自回归 LLM 生成保真度高但串行解码慢,扩散语言模型可并行却质量退化、训练贵、收敛缺乏严格保证——视觉/多模态 token 生成场景同样面临「快」与「准」难以兼得 本文贡献:提出 Orthrus 双视图框架:在冻结的 AR LLM 上挂载一个轻量可训练扩散并行视图,两视图共用同一份高保真 KV Cache——AR 头负责 prefill 构建准确表征、扩散头负责并行解码;通过两视图共识机制保证无损推理,把扩散并行解码移植到 Transformer 几乎零侵入 实验效果:在保证完全等价生成(lossless)的前提下,相比纯自回归提供最高 7.8x 加速,KV Cache 内存仅增加 O(1),参数增量极小;为视觉/多模态自回归 token 生成提供直接可用的并行加速路线 批判点评:把扩散当成 AR 的「并行外设」而不是替代品,借共识机制保留 AR 保真度,工程上很优雅;但 7.8x 加速属上限值,真实任务下并行步内的拒绝率与吞吐曲线值得进一步给出,扩散头训练成本也未充分披露 6. Beyond-GRPO:奖励分配原则 Beyond GRPO and On-Policy Distillation: An Empirical Sparse-to-Dense Reward Principle for Language-Model Post-Training | Meta | arXiv:2605.12483 关键词:LLM 后训练·GRPO·On-Policy 蒸馏·奖励密度·稀疏到稠密 ⚠️ 前序问题:在「可验证标注极其稀缺」的后训练场景下,主流做法(在部署模型本身上跑 GRPO)忽视了一个奖励密度原则:稀疏的序列级奖励应该用在能产生有效探索的强模型上、稠密的 token 级奖励才适合把行为压缩进小模型,这一直觉对生成模型的 RL 对齐同样关键 本文贡献:提出 Sparse-to-Dense 奖励分配原则:把宝贵的可验证数据先「上游」给强 teacher 跑 GRPO 做探索,再以稠密蒸馏的形式「下游」灌给小学生,最后在学生侧再补一段稀疏 RL;具体配方为 forward-KL warmup → OPD on-policy → 学生侧 GRPO 的三段桥 实验效果:在 Qwen3-1.7B 学生固定的前提下,先在 8B teacher 上 RL 再蒸馏全面优于直接在学生上 GRPO;学生侧后续 GRPO 把 MATH 从 75.4% 提升到 78.5%、比 replay baseline 高 2.8 分,AIME 端点也最强 批判点评:「奖励密度」的视角让 GRPO 与 OPD 不再对立而成同一光谱的两端,对资源紧张团队的实践指导价值很高;但结论建立在数学这一可验证任务上,对图像/多模态生成等弱验证任务能否平移仍待验证 趋势观察 视频扩散从「少步」走向「任意步」 — AnyFlow 把蒸馏目标从端点一致性升级到任意区间的 flow map,叠加 on-policy 反向模拟,让一个学生模型在 1/4/16/32 步上都呈现良性 scaling——少步视频生成第一次有了真正的「test-time 预算自由度」 像素扩散借势潜空间预训练 — AsymFlow 用 rank-asymmetric 速度参数化把高维噪声预测限制在低秩子空间,并首次跑通了「FLUX.2 klein 9B 潜空间→像素空间」的微调路径——像素扩散与潜空间扩散开始走向「初始化共享、后期分化」的新协作方式 VAE 不再是配角,而是产品 — Qwen-Image-VAE-2.0 把高压缩 VAE 当作独立产品打磨:Global Skip Connections + 扩展通道 + 文档专项 benchmark,承认了「VAE 决定 DiT 上限」的事实,VAE 进入「文本可读、扩散友好、推理便宜」的三维竞赛 编辑模型与 reward model 同台同尺 — Edit-Compass 把「图像编辑能力」和「reward model 能力」并入同一评测套件,并把 reward model 评测从脱节场景改造成贴合 RL 实战的偏好对——前沿编辑模型的 RL 对齐第一次有了配套的统一坐标系 稀疏-稠密奖励分配成为后训练新共识 — Beyond-GRPO 给出一条简单规则:稀缺可验证数据先在强 teacher 上做稀疏 RL,再以稠密蒸馏下沉到小学生,最后学生侧补稀疏 RL;这一原则同样适用于多模态生成模型的 reward 分配,正在成为下一代 alignment pipeline 的骨架 人工智能炼丹君 整理 | 2026-05-14