搜索到
54
篇与
DiT
的结果
-
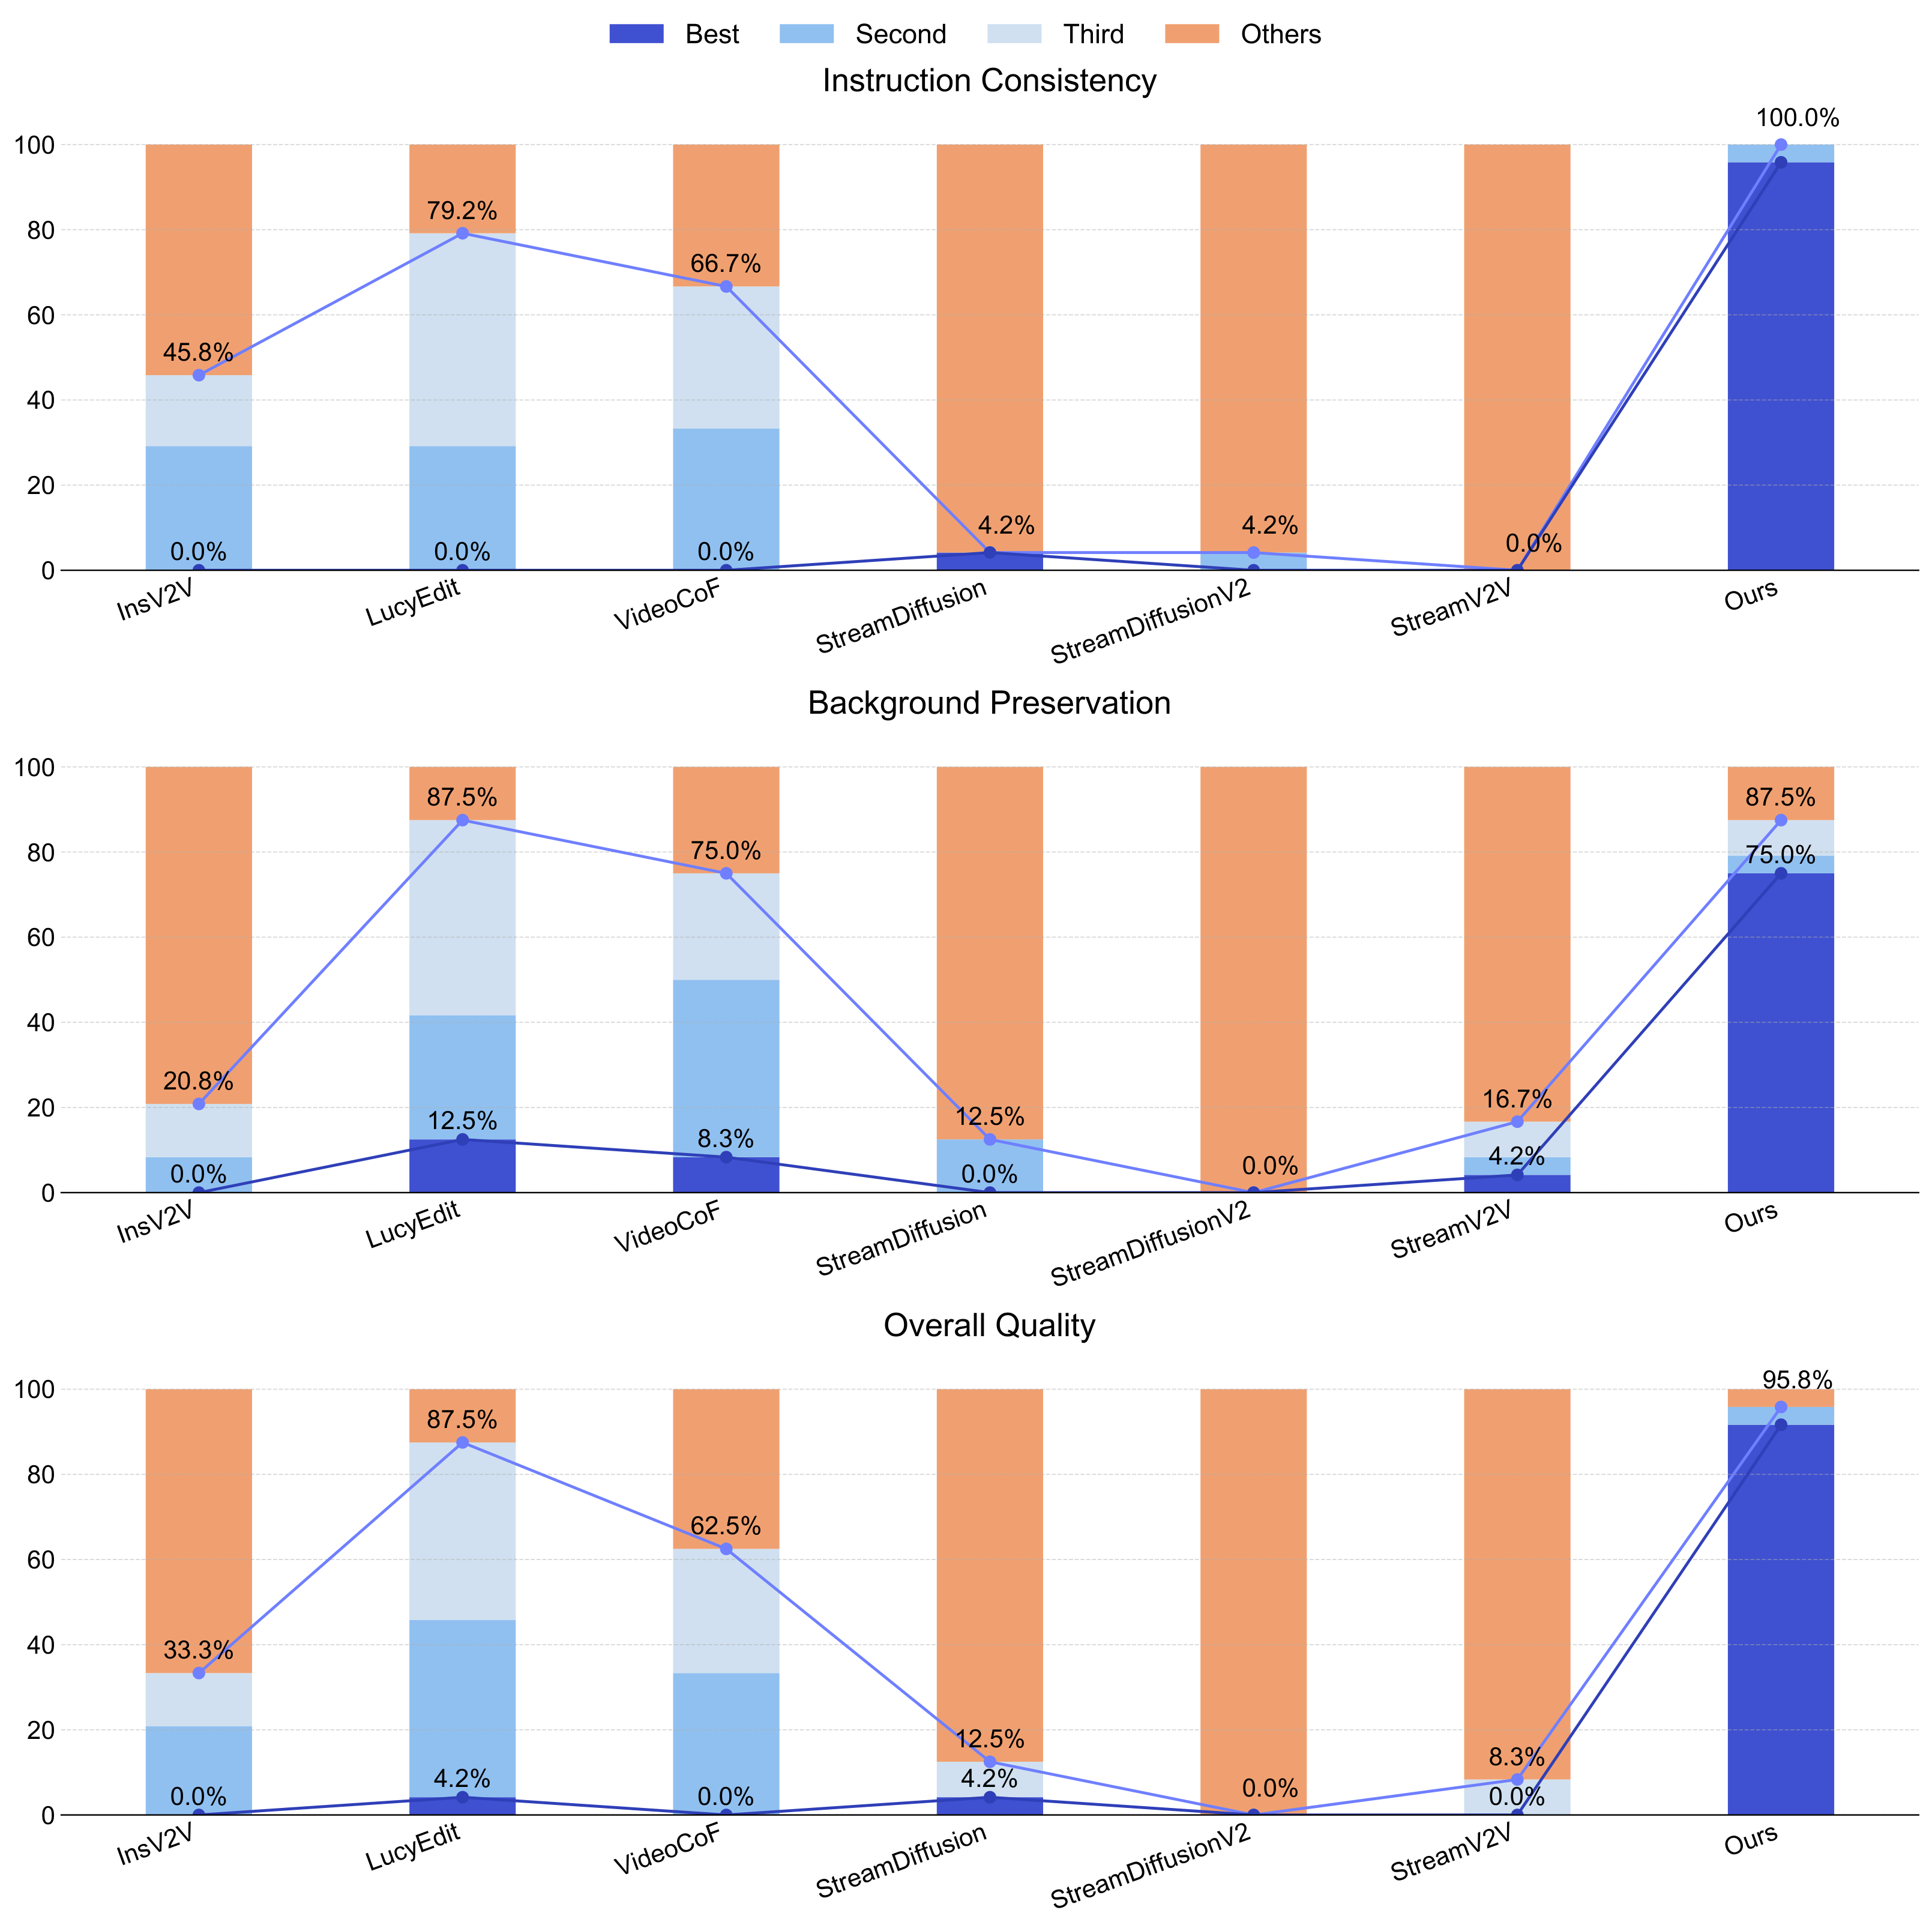
 AIGC 每日速读|2026-08-06|京东22B音画同修让百年老片复活OmniVR 今日 AIGC 论文速览 今日共 10 篇 · 音视频联合生成与修复 2 篇 · 实时与交互视频创作 2 篇 · 多模态Token高效压缩 2 篇 · 生成后训练与条件对齐 2 篇 · 评测与专业可控生成 2 篇 重点论文标题列表 OmniVR(中科大·京东探索研究院):22B让百年老片音画一起复活 JoyAI-Video-Edit(京东Joy Future Academy):16B单卡30FPS实时剪视频 ContextMaster(清华·南京大学·快手可灵·上科大·港科大):固定预算多镜头创作跑16.74FPS OmniPack(西北工业大学·北大·阿里·清华):无训练6.8%算力保住92.9% STEP-OPD(上海交大·阿里):蒸馏学生越过教师得分0.961 今日论文速览 1. OmniVR:22B让百年老片音画一起复活 OmniVR: Joint Video-Audio Conditional Generation for Restoring Degraded Historical Films | 中科大·京东探索研究院 | arXiv:2608.04224 关键词:音视频联合修复,历史影像,LTX-2,多模态DiT,京东 前序问题:历史影像往往同时存在模糊、噪声、闪烁、曝光不足,以及嘶声、削波、掉音和带宽缺失。现有修复器通常把视频与音频拆开处理,不仅留下单模态质量短板,还可能破坏口型、动作和声音之间的同步。 本文贡献:提出首个音视频联合生成式老片修复模型 OmniVR。系统从 22B 参数 LTX-2 音视频骨干出发,把低质音频和视频编码成联合条件,在统一多模态 DiT 中同步去噪;以联合退化管线模拟真实老片损伤,用近零初始化通道拼接与提示词退火把 T2AV 平滑改造成 AV2AV,再以首帧锚定、模态损失重加权和波形监督支持跨 121 帧窗口的长视频修复。 实验效果:在 200 段真实历史片组成的 OmniVRBench 上,真实轨 MUSIQ 达 61.87,显著高于次优 RealBasicVSR 的 52.38;DNSMOS 从退化输入的 2.04 提升至 2.43,FAD 从 15.93 降至 8.32。12 名标注者给出 80.0% 综合偏好。模型输出 1920×1088,作者还报告在独立 RTN 老片基准的六项无参考视觉指标上全部第一。 批判点评:把“修画面”和“修声音”变成一次联合条件生成,方向比串联两个修复器更完整,指标和人评也有说服力。但 22B 骨干以 rank-384 LoRA 在 64 张 H200 上训练约 5 天,成本很高;强生成先验可能补出原片不存在的纹理与颜色,历史档案、司法取证等场景仍需要真实性约束。代码和权重目前只是承诺公开。 2. JoyAI-Video-Edit:16B单卡30FPS实时剪视频 JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion | 京东Joy Future Academy | arXiv:2608.03974 关键词:实时视频编辑,自回归扩散,两步蒸馏,720p,京东 前序问题:直播和视频通话中的编辑必须边接收边输出,不能偷看未来帧,也不能让显存和计算随视频时长不断增长。把离线编辑器简单切成小段会产生边界跳变,自回归地反复使用生成历史又会累积色偏、身份漂移和背景幻觉。 本文贡献:提出 16B 自回归扩散编辑框架:MLLM 条件编码器理解指令和参考,因果 VAE 与分块双向、跨块因果注意力负责流式输出,滑动窗口加首块全局 sink 把历史状态限制在固定预算。Source-Anchored DMD 将多步扩散蒸馏为两步,并用当前源视频块约束教师目标;长程自回归蒸馏则在分段 rollout 上直接学习累积误差。 实验效果:结合两步生成、固定历史 KV 缓存、FP8 量化和优化 VAE 管线,完整系统在单张 NVIDIA B200 上实现端到端 720p 约 30 FPS。自动指标和人评均显著超过现有流式编辑器,在短视频与长视频上可与强离线系统竞争;代码已经公开。 批判点评:这是今日最硬的工业数字:16B 模型把开放式编辑真正推到实时帧率,而且处理时无需预知视频总长度。但单卡指的是昂贵的 B200,30 FPS 不能外推到消费显卡;两步扩散和 FP8 的细节损失、长达数小时的稳定性以及输入输出延迟分布,还需要独立复现。 3. ContextMaster:固定预算多镜头创作跑16.74FPS ContextMaster: Interactive Multi-Shot Video Creation via Fixed-Budget Sparse Context Routing | 清华·南京大学·快手可灵·上科大·港科大 | arXiv:2608.04956 关键词:多镜头视频,交互创作,稀疏路由,上下文缓存,可灵 前序问题:真实视频创作会在多轮中交替生成新镜头、引用人物或场景、编辑已有素材,并持续继承历史。若每个去噪步都密集读取不断增长的上下文,延迟会随会话变长;若只保留短窗口,又会忘掉早期角色与约束。 本文贡献:提出交互式多镜头视频创作 IMVC 与统一模型 ContextMaster。角色感知 RoPE 区分参考图、历史镜头、源视频和待生成目标;可缓存的干净上下文只预填一次,块稀疏路由在固定预算内检索相关历史,ConstraintSink 强制保留参考和逐帧编辑约束。两阶段特权上下文蒸馏先用稠密教师做一致性蒸馏,再用分布匹配修复少步 rollout 的细节。 实验效果:在单张 H200、匹配分辨率与帧数的设置下,五镜头任务平均达到 16.74 FPS;跨镜头一致性由强基线的 0.808 提升到 0.836,并在文本生成、参考生成和视频编辑三类任务中取得最强综合表现。固定 6-FE 读取预算接近质量与速度最佳点。 批判点评:这项工作把多镜头创作从一次性提示升级为有状态工作流,并让每轮上下文读取保持定额,产品形态很清晰。但 16.74 FPS 仍依赖 H200;路由器漏掉关键旧镜头会造成不可逆遗忘,角色一致性也不等于剧情因果一致。训练阶段还使用 64 张 H200,复现门槛不低。 4. OmniPack:无训练6.8%算力保住92.9% OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models | 西北工业大学·北大·阿里·清华 | arXiv:2608.03812 关键词:全模态大模型,Token压缩,免训练,音视频理解,推理加速 前序问题:全模态大模型同时接收长视频与音频时,视觉和声音 token 数远超文本。现有压缩要么在进入 LLM 前过早丢掉分散在长时间轴上的证据,要么进入 LLM 后只听文本指令,没有充分利用已经对齐的音视频交互。 本文贡献:提出免训练两阶段压缩框架 OmniPack。LLM 前按模态重要性、全局覆盖和相似度合并结构冗余,把被删除信息回收到代表 token;多模态充分交互后,再用文本问题引导和音视频协作做第二次语义压缩。不同阶段分别处理“结构重复”和“任务相关性”,无需改权重。 实验效果:在 Qwen2.5-Omni-7B 上仅用原始 16.7% FLOPs 即保留 98.0% 性能;极限设置只用 6.8% FLOPs 仍保留 92.9%。15%/7.5% 两阶段保留率下,FLOPs 降低 10 倍、prefill 加速 4.5 倍,同时保留 95.6% 性能,并跨三种骨干、五项基准保持最佳效率折中。 批判点评:无需训练且跨 Qwen 与 MiniCPM 骨干有效,工程接入成本很低;把“先保全局结构、后按问题精炼”拆开也比统一打分更合理。不过结果主要来自 H20 上的 prefill,端到端对话延迟和 KV 缓存收益未完全等同;极低预算仍损失约 7% 综合性能,稀有短暂事件可能最先被压掉。 5. STEP-OPD:蒸馏学生越过教师得分0.961 STEP-OPD: Rethinking Output Targets and Internal Dynamics in On-Policy Distillation for Diffusion Models | 上海交大·阿里 | arXiv:2608.04887 关键词:扩散蒸馏,On-policy,超越教师,表示对齐,图像生成 前序问题:扩散模型的 on-policy 蒸馏通常只让学生在自己的去噪轨迹上拟合教师速度,理论最优点就是“和教师一样”,无法主动超过教师;只看最终输出还会放任各 Transformer Block 的内部表示以错误方式相互抵消。 本文贡献:提出 STEP-OPD:把任务教师相对共享基础模型的速度差视为能力提升方向,将缩放后的差值继续加到教师目标上,构造“教师之外”的输出外推目标;同时不直接硬对齐隐藏状态,而是匹配相邻 Block 表示变化的方向和幅度,让学生学习能力在网络内部如何逐层形成。 实验效果:在组合对齐、文字渲染与人类偏好三组能力上统一超过标准 DiffusionOPD,并使 GenEval 从 0.927 提升到 0.961;统一学生在三类能力上分别超过对应的单任务教师,证明多教师能力整合不必以教师上限为终点。 批判点评:“教师减基础模型”的差向量能否稳定代表可继续外推的能力,是很有启发性的假设,内部变化对齐也补上了只看终点的盲区。但外推系数依赖任务调参,走得太远可能放大教师偏差;目前只验证图像生成,扩展到视频等更长序列后,中间层监督的显存和计算成本会更突出。 6. TD-V2A:帧间差分让视频配音FAD降至0.53 Visual Representation Matters: Exploiting Temporal Differences in Video-to-Audio Generation | 清华·南洋理工等 | arXiv:2608.04902 关键词:视频配音,帧间差分,音频扩散,时间对齐,视觉表征 前序问题:视频配音区别于看图配音的核心不是多看几张静态图,而是捕捉帧间运动变化。现有方法常外挂音视频对比模型、声学结构预测器或多模态大模型,系统复杂,且可能把真正决定声音时机的低层运动细节压掉。 本文贡献:提出 TD-V2A,直接把相邻帧差分作为额外视觉条件。作者比较像素帧差与编码后特征差,发现编码前差分保留的细粒度运动更有效;训练时以文本到音频预训练、原始视频条件、差分增强条件三阶段持续学习,采样时用退火差分引导在早期先确定全局声音动态,后期逐渐回到原始视觉语义。 实验效果:在约 1.5 万段 VGGSound 测试片上,FAD 达 0.53,优于 MMAudio 的 0.81;IS 达 16.9、ImageBind Score 达 33.8,均明显高于对比方法,时间对齐准确率 89.1。它甚至超过需要额外训练的 CAVP 音视频表示,且没有新增预测网络。 批判点评:把“视频比图片多出来的信息”直接定义为帧差,简单而有效,指标也说明低层运动不应过早被语义编码器抹掉。但逐帧差分对镜头切换、抖动和光照闪烁同样敏感,可能把无关变化误当声源;其时间对齐 89.1 仍略低于专门以对齐目标训练的 Diff-Foley 89.9。 7. CAPE-T2V:训练推理两头对齐提示词 CAPE-T2V: Captioner-Anchored Prompt Enhancement toward Two-Sided Conditioning Alignment in Text-to-Video Generation | 复旦·快手可灵 | arXiv:2608.03046 关键词:文生视频,提示增强,训练推理对齐,Caption,可灵 前序问题:视频 DiT 训练时看到的是详尽视频 caption,线上却由 Prompt Enhancer 把用户短句改写后再喂给模型。即使双方使用同一字段模板,细节选择、组织方式、粒度和措辞仍不同,形成残余 PE-Caption 分布缺口。 本文贡献:提出两步 Captioner-Anchored 对齐:先用外部视频描述器产生统一目标,把简短描述、详细描述和伪用户提示都训练成同一种 Anchored PE 输出;再让这个已经冻结的 PE 重写视频训练 caption 并微调 DiT,部署时仍由同一个 PE 改写用户提示,使训练侧与推理侧真正共享同一文本算子。 实验效果:在 Wan2.2 与 LTX-2.3、StoryEval/VBench-2.0/T2V-CompBench 的六个组合上全部超过只做 schema 对齐的基线。Wan2.2 分别提升 1.6、1.12、0.30 分,LTX-2.3 提升 1.4、0.92、0.65 分;caption 到推理改写的 MMD² 从 0.0764 降至 0.0682。 批判点评:工作指出“字段相同不等于分布相同”,并把 Prompt Enhancer 正式视作生成模型接口,诊断很贴近真实部署。但绝对增益多数只有 0.3–1.6 分,StoryEval 又使用 GPT-5.5 判定;一旦线上 PE 更新,就要重新改写训练 caption 并适配 DiT,维护成本仍然存在。 8. Two-Stage Token Pruning:只留10%视频Token还涨7分 Adaptive Two-Stage Visual Token Pruning for Efficient Inference in Video-Language Models | Amazon | arXiv:2608.03112 关键词:视频语言模型,Token剪枝,免训练,自适应预算,Amazon 前序问题:视频语言模型每帧可产生数百视觉 token,数分钟视频很快进入万 token 区间。现有图像剪枝方法既忽略跨帧重复,又对所有视频使用固定保留率;静态访谈和高速运动显然不该被压成相同预算。 本文贡献:提出完全后处理的两阶段自适应剪枝:先在时间轴选择差异最大的代表帧,再在保留帧内做 token 级裁剪。第二阶段对 token 相关矩阵做特征值分解,用谱衰减速度估计当前视频冗余度,并据此动态决定保留比例,无需训练或微调原模型。 实验效果:在三种 VLM、五项视频基准上持续增益;平均仅保留 10% token 时,VideoDC 准确率达到 76.75%,比同预算 DivPrune 的 68.47% 高 8.28 分,论文摘要按跨设置概括为约 +7%;同时 TFLOPs 降低约 95%,其他问答基准基本保持。 批判点评:把“删哪些帧”和“每帧删多少 token”分开,并让谱结构决定预算,符合视频冗余的实际差异。代价是特征值分解本身有额外开销,当前实验以短视频理解基准为主;突发但关键的一帧或小目标,仍可能在两轮剪枝中被不可逆丢失。 9. OmniEdit-Bench:五赛道揭穿视频编辑假高分 OmniEdit-Bench: A Comprehensive Benchmark for Instruction-based Video Editing | 港大·阿里通义万相·浙大·北大 | arXiv:2608.05049 关键词:视频编辑评测,音频编辑,时间编辑,推理编辑,通义万相 前序问题:很多视频编辑评测沿用图像编辑任务,只看逐帧空间变化;模型即使没有执行指令,只要保留原视频的高画质和一致性,也可能得到高分。音频、时间操作、参考条件和隐式推理因此长期缺席。 本文贡献:构建覆盖空间 240、时间 200、参考 200、音频 100、推理 50 个案例的五赛道基准,并区分显式与隐式指令。评测把质量拆成准确性、保留度、真实感和一致性,再以准确率作为门控缩放后三项,避免“看起来很好但改错了”获得虚高总分。 实验效果:商业与开源模型整体都远未过关:KlingV3-Omni 综合最高也仅 38.3/100,Seedance 2.0 为 37.3;时间赛道最好 Wan2.7-Edit 只有 29.0,推理赛道最好 Seedance 2.0 也只有 29.8。商业模型在空间编辑领先,但优势在音频、时间和推理任务明显收窄。 批判点评:把准确性设为其他质量分的前提,能有效纠正原视频先验造成的假高分;五赛道也比图像式评测更接近真实需求。不过大量评分仍依赖 VLM,门控权重是人为设计;部分商业模型因功能或版权限制没有覆盖全部赛道,横向平均并非完全同条件。 10. CSGen:2.4万样本守住血管道路裂缝 CSGen: A Multi-Domain Curvilinear Structure Generation Model via Hierarchical Multimodal Diffusion | ACM MM 2026·海南大学·广东海洋大学 | arXiv:2608.04655 关键词:可控生成,曲线结构,拓扑保持,专业数据,ACM MM 前序问题:血管、道路、叶脉和裂缝只占图像极少像素,却要求细长分支持续连通。通用扩散模型更擅长生成大物体,普通 MSE 又被背景像素主导,容易把这些稀疏结构画断或偏离控制图。 本文贡献:提出基于 SD3.5 的层次多模态扩散模型 CSGen,并汇集 24678 个样本,覆盖血管、冠脉、混凝土裂缝、叶脉和道路五域及七类标注。分阶段注入 CLIP 拓扑属性与 T5 场景描述,先锁定结构再补环境;稀疏感知损失按等效直径提高细小脆弱分支的权重。 实验效果:相同提示下 FID 达 98.525,优于 SD3.5-ControlNet 的 131.256;完整模型将拓扑 clDice 从基线 0.628 提升到 0.766。合成数据用于下游分割时,道路域 mIoU 最高增加 4.73 分,说明生成结果不只视觉像真,也能补充结构学习。 批判点评:这是 ACM MM 2026 已接收工作,数据、代码和结构指标较完整,说明专业生成不能只看通用审美分。但五个领域仍共享相对简单的二值拓扑先验,跨域统一性有限;合成图提升分割不等于临床或基础设施诊断可靠,专业场景还需真实分布验证。 趋势观察 音视频联合模型开始从内容生成反向进入修复 — OmniVR 直接复用 22B 音视频生成骨干,同时恢复老片画面、声音与同步关系;统一生成先验正在吞并过去彼此独立的增强管线。 视频编辑从固定短片走向实时、有状态和开放时长 — JoyAI 用两步自回归扩散在单 B200 达到 720p 约 30 FPS,ContextMaster 则以固定预算上下文支撑多轮多镜头创作,视频模型正从一次生成器变成持续工作的创作系统。 Token压缩从固定比例升级为内容与问题共同决定 — OmniPack 先保全局音视频结构、再按问题做语义精炼,Amazon 两阶段方案先删重复帧、再按谱冗余决定每帧预算;高效推理正在告别一刀切剪枝。 生成后训练不再满足于复刻教师或单边修补接口 — STEP-OPD 沿教师相对基础模型的能力方向继续外推,CAPE-T2V 则让同一个 Prompt Enhancer 同时定义训练与推理文本分布,优化目标从局部模仿转向端到端系统对齐。 视频能力评测开始补齐时间、声音与隐式推理 — OmniEdit-Bench 的五赛道显示最强商业编辑模型综合仍不足 40 分;TD-V2A 也证明只看语义无法评价配音,时间差分与同步指标将成为音视频系统的基本维度。 人工智能炼丹君 整理 | 2026-08-06 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
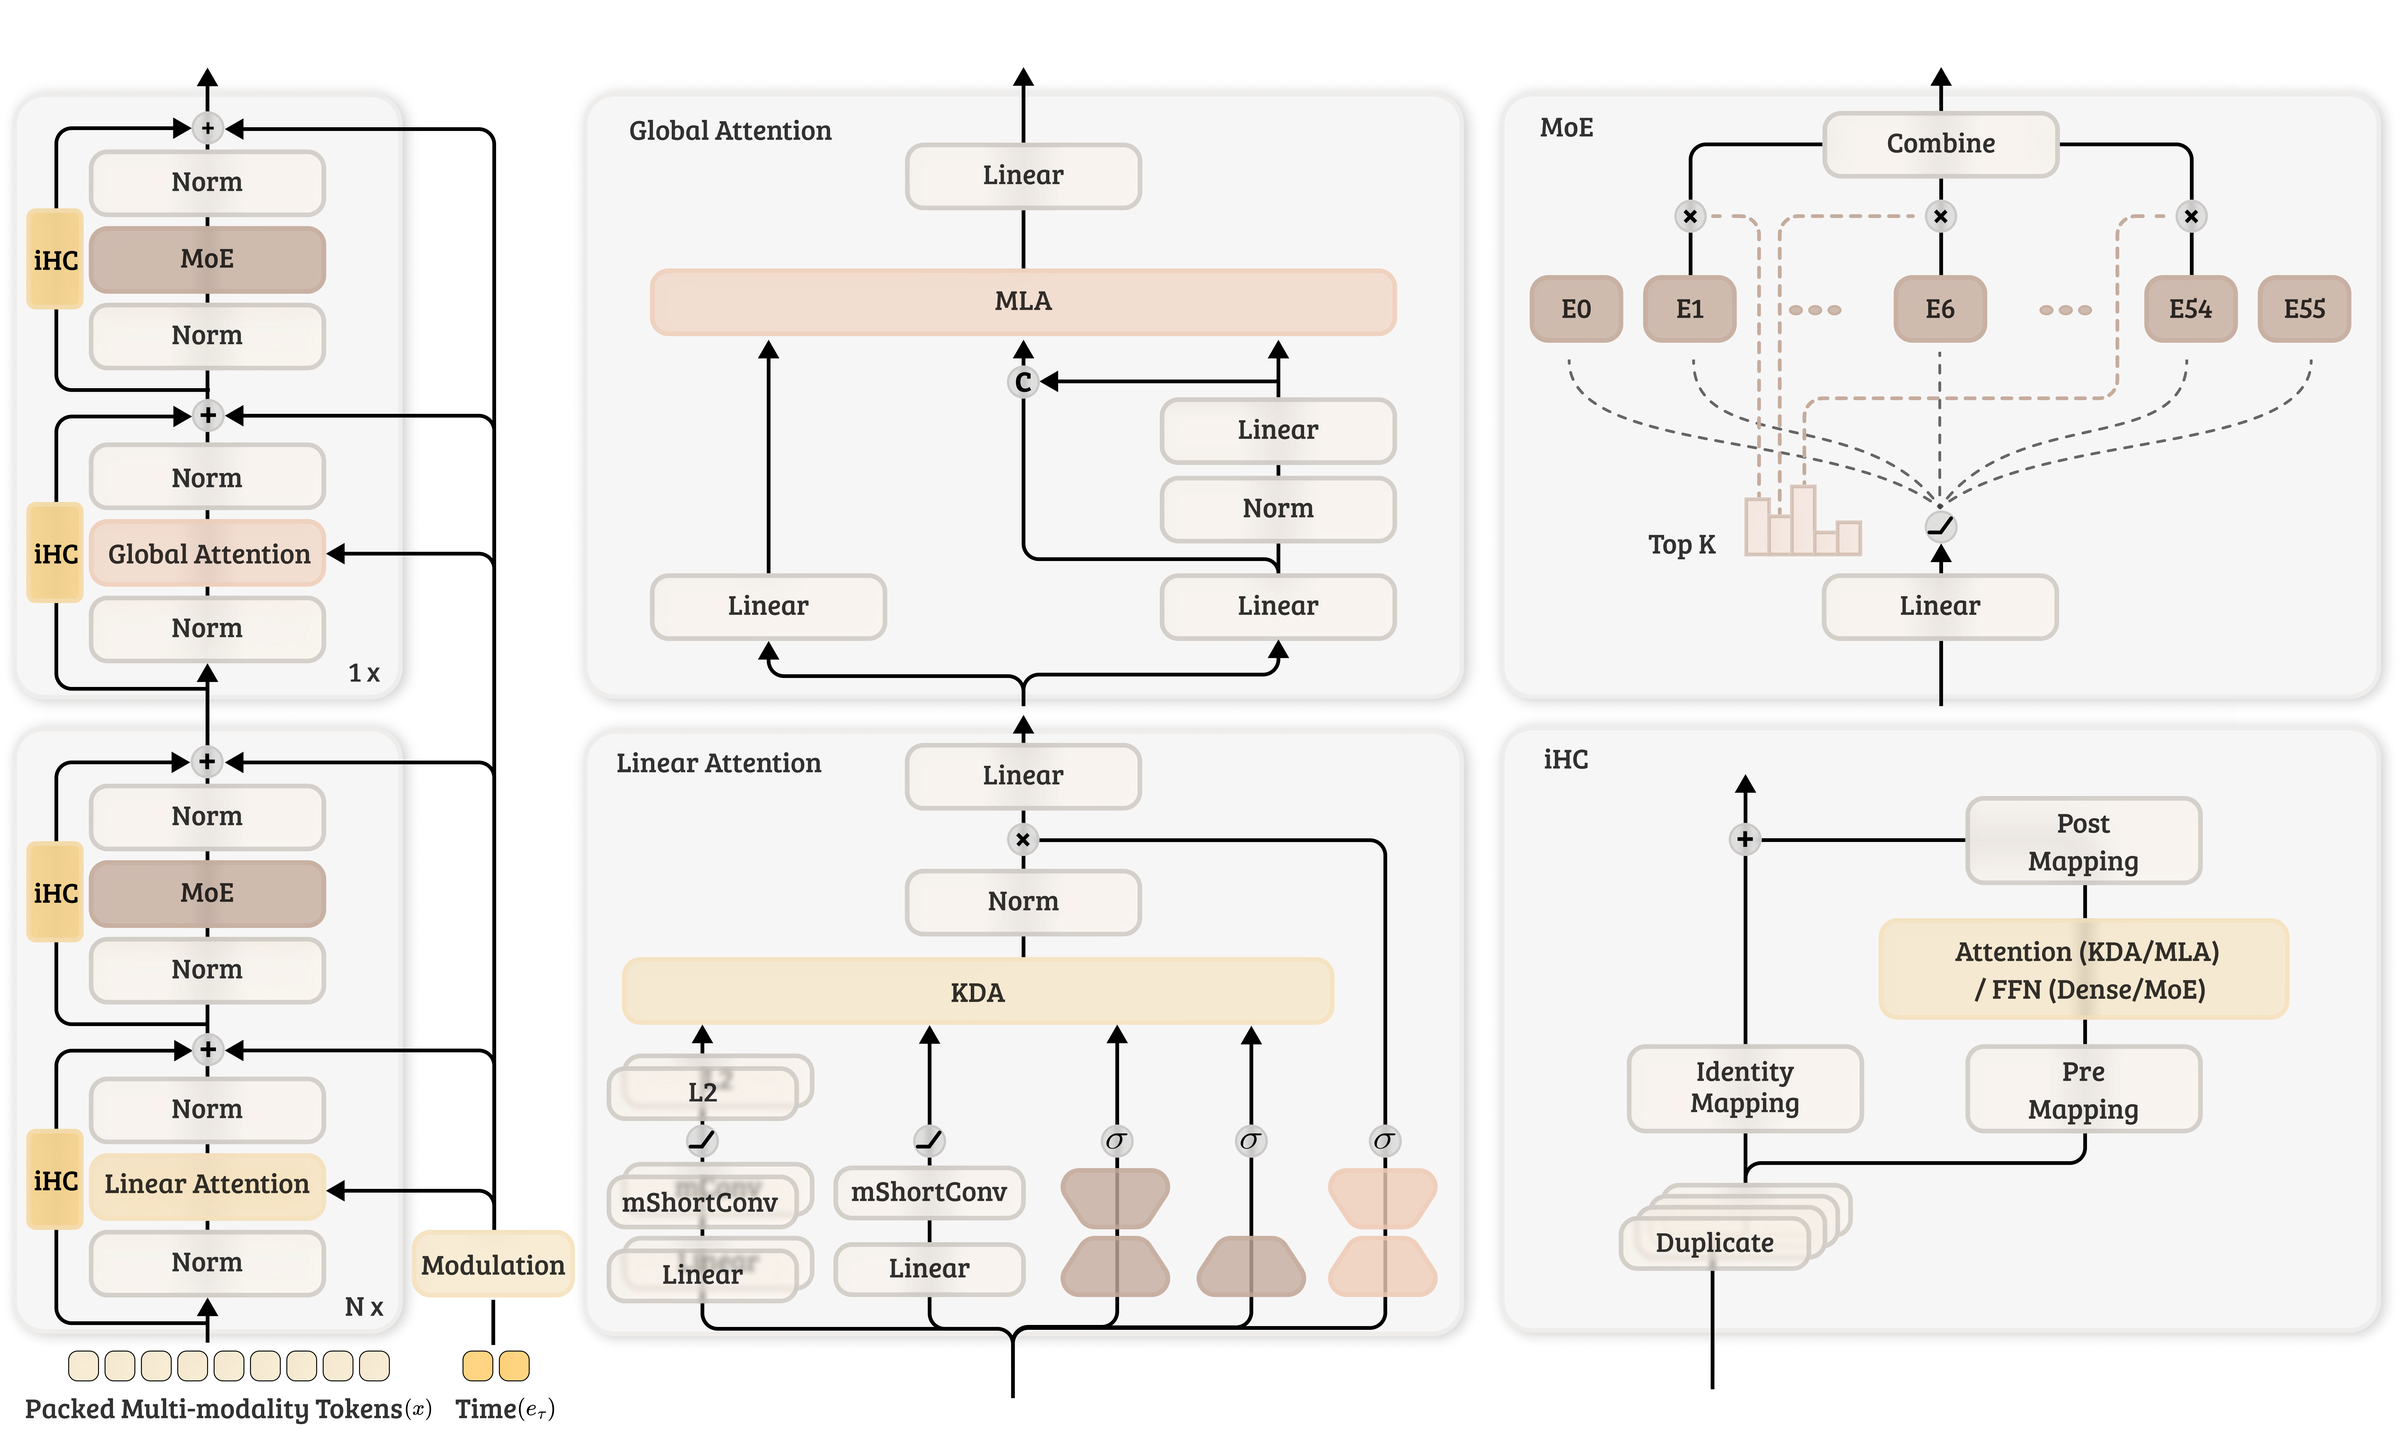
AIGC 每日速读|2026-07-31|Adobe混合DiT算效提升7.3倍Chimera 今日 AIGC 论文速览 今日共 10 篇 · 生成基础范式与高效骨干 2 篇 · 电影叙事与长视频生成 3 篇 · 视频后训练与时间控制 2 篇 · 物理世界建模 2 篇 · 生成式视频编码 1 篇 重点论文标题列表 Chimera(Adobe Research):混合视觉DiT算效提升7.3倍 CineWeaver(上交·中国电信TeleAI):免训练多镜头长视频叙事 XM(UIUC·Harvard):探索成为生成预训练第三轴 cIPO(清华·快手可灵·中山大学):无需标注修复视频时序瑕疵 PhiZero(中科院自动化所):用物理语言显式推演世界 今日论文速览 1. Chimera:混合视觉DiT算效提升7.3倍 Chimera: Designing and Chinchilla-Scaling Hybrid Visual Diffusion Transformers | Adobe Research | arXiv:2607.28611 关键词:视觉DiT,混合注意力,MoE,缩放定律,长视频 前序问题:高分辨率图像、长视频和多模态上下文让视觉生成进入高 token 时代,全注意力 DiT 的二次复杂度愈发不可承受;语言模型中的高效结构又不能直接照搬,因为视觉扩散必须保留时空局部性和跨模态双向交互。 本文贡献:提出混合视觉扩散骨干 Chimera:在统一光栅序列中组合 O(N) 的 Kimi Delta Attention 做长上下文状态跟踪、交错的多头潜注意力做全局交互、模态感知短卷积捕捉局部时空结构,并以稀疏 MoE 扩容量而不显著增加激活计算。进一步提出模块级缩放方法 HeteroP,为异构架构拟合 Chinchilla 式最优模型规模、训练 token 数与图像/视频配比规律,最终训练 11B 参数、每次激活 2B 的模型。 实验效果:稠密骨干相较匹配的全注意力 Wan2.1-2B,预训练计算效率提升 1.7 倍;完整系统提升到 7.3 倍。模型只用 5 秒视频训练,无需长度微调即可零样本生成 30 秒视频,最后 5 秒 FID 仅退化 6.5%。 批判点评:Adobe 将线性状态跟踪、全局注意力、局部卷积和 MoE 组合后,再用专门缩放律调参,避免了“高效模块简单拼装”的常见陷阱,7.3 倍算效与 6 倍时长外推都很亮眼。但系统结构复杂、工程优化依赖强,预训练损失和 FID 并不等价于真实指令遵循与长视频观感;11B/2B 激活规模的复现门槛也不低。 2. CineWeaver:免训练多镜头长视频叙事 CineWeaver: Training-Free Reference-Controllable Multi-Shot Long Video Generation for Cinematic Storytelling | 上交·中国电信TeleAI | arXiv:2607.26529 关键词:多镜头视频,长视频,参考控制,免训练,电影叙事 前序问题:电影级视频生成需要同时满足多镜头切换、人物与场景的逐镜头精细控制,以及跨长时间范围的一致性。现有方法通常针对单项需求定制或重训,难以用一个框架兼顾三者。 本文贡献:提出免训练统一框架 CineWeaver,指出预训练视频扩散模型对时间连续性的结构偏置正是多镜头生成困难的根源。推理时操纵位置编码与注意力模式,主动打破时间连续性以形成清晰转场;设计按镜头路由的参考条件,实现人物和场景的逐镜头控制;再用锚点记忆跨长视频保存全局外观线索。 实验效果:据作者所述,这是首个同时支持长视频、参考可控和多镜头生成且无需重训的统一框架。实验可生成身份一致、全局外观稳定、转场清晰的长时电影级视频。 批判点评:把“视频模型过度追求连续”反过来视为多镜头障碍,并仅在推理期改位置编码与注意力,洞察直接且部署成本低。但免训练控制的上限受基础模型约束,复杂叙事中的因果推进、镜头语言和跨镜头表演一致性仍不能只靠外观锚点解决,长片级验证也有待扩大。 3. XM:探索成为生成预训练第三轴 Explorative Modeling: Unlocking a Third Pretraining Axis and End-to-End Generation | UIUC·Harvard | arXiv:2607.27372 关键词:生成模型,端到端生成,预训练扩展,探索建模,扩散替代 前序问题:生成模型虽然能力强,却仍不像分类模型那样真正端到端:训练时与推理时的采样过程并不一致。现有可扩展方法通过拆分生成过程处理多峰分布,这种分解既阻碍端到端生成,也让生成能力主要只能沿参数量和数据量两个维度扩展。 本文贡献:提出 Explorative Modeling(XM),不再拆分生成过程,而是拆分训练循环:每次探索模型生成与真实数据之间的 K 个候选匹配,只用最佳匹配训练,使预测主动落在具体模式而非平均模糊。由此把“探索量”建立为参数与数据之外的第三条预训练扩展轴;同时提出端到端重建式生成,让训练采样与推理采样保持一致。 实验效果:扩大探索量在图像、视频、语言等连续与离散领域均单调增益,且规模越大收益越高:随数据规模增长,增益从 7% 升至 36%;随模型增大,从 13% 升至 23%。FLOP 效率提升 4.1 倍、样本效率提升 6.2 倍、参数效率提升 47%;ImageNet 无引导生成达到 1.43 FID,并在控制任务上以少 16–256 倍推理步数匹配扩散模型。 批判点评:“探索量成为第三预训练轴”是今天最具范式意义的结论,也给端到端生成提供了不同于扩散/自回归分解的新路径。但 K 候选探索会把部分成本前移到训练阶段,最佳匹配准则也可能偏向易选模式;目前的规模仍不足以证明它能全面替代成熟扩散路线,大规模文本到视频与真实产品中的稳定性尚待验证。 4. cIPO:无需标注修复视频时序瑕疵 Temporal Concentration from Rollout Errors: Implicit Preference Optimization for Text-to-Video Diffusion | 清华·快手可灵·中山大学 | arXiv:2607.28058 关键词:视频扩散,偏好优化,自监督,时序一致性,后训练 前序问题:DPO 等偏好对齐虽能提升视频观感,但运动坍缩、物体闪烁、颜色过饱和往往只短暂出现在少数帧。离线人工偏好昂贵且跟不上模型变化,在线奖励又不稳定;对整段视频均匀监督还会把信用分配给无问题的帧。 本文贡献:提出集中式隐式偏好优化 cIPO,不依赖人工标注或外部奖励模型。对真实视频先加噪再让当前模型迭代重建,把原视频视为偏好样本、带有模型 rollout 错误的重建视为非偏好样本,由去噪过程自动产生贴合当前模型的偏好对;再计算逐帧重建误差,把优化集中到高误差的短时片段。 实验效果:在多个数据集和视频扩散模型上持续提升视频真实性与时间连贯性,尤其能更精准地修复只在少量帧中出现的失败区域,同时省去人工偏好标注和外部奖励模型。 批判点评:可灵团队把模型自己的 rollout 错误变成偏好监督,并按时间集中火力,正面解决视频 DPO 的标注与信用分配瓶颈。不过“真实视频优于重建”主要刻画保真与稳定,不一定等价于用户审美或提示遵循;高误差片段也可能来自困难但合理的运动,需防止优化把动态性一并压平。 5. PhiZero:用物理语言显式推演世界 PhiZero: A World Model Built Around Physical Language | 中科院自动化所 | arXiv:2607.28624 关键词:世界模型,物理语言,显式推理,视频生成,动作仿真 前序问题:现有物理世界模型通常直接在像素空间预测未来视频,世界动力学被隐式藏在高维视觉预测器中,难以解释、组合和显式推理。 本文贡献:提出围绕“物理语言”构建的世界模型 PhiZero:从野外视频中自监督学习描述世界状态转移的紧凑离散表示,并采用先推理、后渲染范式——先把未来演化推断为物理语言序列,再将这些转移渲染成视频,让动力学从像素预测中解耦出来。 实验效果:在生成与理解基准上验证了物理一致世界演化能力,并展示了在写实交互世界建模、细粒度动作条件仿真和零样本运动迁移上的潜力。 批判点评:“物理语言→视频”的显式中间层让世界模型更可解释、可控,也便于组合长期规划,是比纯像素 rollout 更有想象力的路线。但离散语言可能丢掉接触、形变等连续细节,物理语言是否真正学到因果规律而非运动码本仍需更严格反事实测试,渲染器误差也可能掩盖推理质量。 6. Visko Orbis 1.0:4K24FPS实时交互长视频 Visko Orbis 1.0: A Live Model for Real-Time Interactive Long Video Generation | Team Visko | arXiv:2607.26694 关键词:实时视频,长视频,交互生成,4K,流式生成 前序问题:真正的实时视频生成不能只快速吐出短片,还要允许用户在生成过程中随时改变提示,并在持续数十分钟乃至数小时的流式 rollout 中保持主体、场景、风格和颜色稳定。 本文贡献:推出实时交互长视频模型 Visko Orbis 1.0,统一支持文生视频、图生视频、视频续写、多语言提示和生成中切换提示。以有界多尺度记忆跨块保存主体、场景与风格,结合蒸馏后的分块流式生成器、流式视频超分器和优化 GPU 服务引擎。 实验效果:作者报告系统可实时输出 4K、24FPS,并将 rollout 延伸到 1 小时而无明显画质或色偏漂移;在长视频 Arena 中获得最高总体偏好与时间稳定性评分,DOVER 和 VideoAlign 多项指标也领先对比系统。 批判点评:4K/24FPS、实时改提示和小时级生成若能稳定复现,产品信号非常强。但技术报告未在摘要中披露实现该吞吐所需的 GPU 数量、模型规模和端到端延迟,Team Visko 的数据与模型细节也较少;这些亮眼数字应视为作者声明,仍需公开代码或独立测试验证。 7. VideoCoCo:用可执行代码推理物理视频 VideoCoCo: Code-as-CoT for Physically-Consistent Video Generation via an Agentic Dual-Engine System | 港中文·中科大等11机构 | arXiv:2607.27380 关键词:物理视频,代码思维链,Blender,智能体,双引擎 前序问题:文生视频的视觉质量已很高,但文本把完整时空过程压成一句话,模型只能隐式猜测动力学,容易违反物理规律。已有思维链使用的中间计划或视觉状态不可执行、时间又稀疏,无法精确控制全过程。 本文贡献:提出智能体双引擎框架 VideoCoCo,把可执行 Blender 代码作为过程级思维链。编码智能体先把文本写成显式描述场景和时间演化的 Blender 程序,仿真引擎执行后产出确定性时空草图,再由生成式视频引擎通过草图条件编辑渲染成写实视频;并构建 3K 组“草图-指令-目标”数据适配编辑器。 实验效果:相对 OmniWeaving,PhyGenBench 从 0.475 提升到 0.558,VBench-2.0 从 52.18 提升到 77.88,两项均取得最佳平均分,表明可执行代码能充当可控、可检查的物理过程表示。 批判点评:将 Blender 代码变成视频 CoT,把物理推理与写实渲染明确拆开,既可检查又可执行,指标增益也明显。但代码智能体受 Blender 可表达对象和规则限制,真实世界的软体、流体、复杂接触难以准确脚本化;双引擎还会累积代码、仿真和渲染三层误差。 8. ReGenVC:26KB实时生成式视频编码 ReGenVC: End-to-End Real-Time Generative Video Coding at Ultra-Low Bitrate | Intel | arXiv:2607.28144 关键词:生成式编码,超低码率,实时解码,视频压缩,扩散蒸馏 前序问题:传统视频编码在极低码率下会出现严重块效应;生成式编码能借先验保持清晰,却因扩散 Transformer 与 VAE 多步解码过慢,难以用于直播、弱网通话等交互场景。 本文贡献:提出端到端生成式视频编码器 ReGenVC:编码端只发送神经压缩首帧、逐帧姿态关键点和元数据;解码端以参考帧与姿态为条件,用四步蒸馏 DiT 重建视频。系统再结合 8 GPU 统一序列并行、空间切分 VAE 与三级重叠流水线,并以 CPU 承担编码和一次性条件编码,释放 GPU 显存。 实验效果:77 帧人像视频仅约 26KB,而 x264/x265 达到近乎无瑕疵重建需约 250–280KB;同等极低码率下传统编码出现严重块效应,ReGenVC 仍保持清晰。在 8 GPU 节点上达到 24FPS,每 25 帧窗口 972ms;混合 CPU-GPU 部署把单卡峰值显存从 21.1GB 降至约 7.7GB。 批判点评:Intel 把生成先验真正塞进实时编码链路,在弱网人像通信上用约十分之一数据量维持清晰,方向很实用。但“实时”依赖 8 GPU 节点,而内容又集中于说话人视频;生成式重建可能改变细节,新闻、医疗、取证等强调像素真实性的场景还需明确失真边界。 9. FreqForcing:免训练5秒外推到2分钟 FreqForcing: Autoregressive Long Video Generation via Spectral Self-Anchoring | 上海交大 | arXiv:2607.27110 关键词:长视频,自回归扩散,频谱锚定,免训练,时长外推 前序问题:自回归视频扩散可实时流式生成,但自 rollout 误差会长期累积,逐渐表现为色偏、运动停滞直至画面崩溃。作者发现其本质特征是低频能量明显漂移,注意力 sink 只能部分缓解。 本文贡献:提出免训练框架 FreqForcing,以频谱自锚定 SSA 解决长视频误差累积:局部注意力保留当前动态,锚点注意力提供高质量历史参照;在频域中融合局部注意力的高频成分与锚点注意力的低频成分,用低频稳定长期外观,同时避免锚定抹掉高频运动。 实验效果:无需重新训练,即可把仅在 5 秒片段上训练的 Self-Forcing 扩展到 2 分钟,达到 24 倍时长外推;定量与定性表现超过现有免训练方法,并可与代表性训练式方案竞争。 批判点评:把长视频崩坏定位为低频能量漂移,再让锚点只管低频、局部注意力保高频,是很干净的频域解法,24 倍外推也有说服力。但固定锚点可能限制场景长期演化,频率分解无法替代人物关系与叙事状态记忆;两分钟之后是否仍稳定尚未得到证明。 10. TPD:免训练唤醒视频后段事件 TPD: Temporal Prior Decoupling for Text-to-Video Diffusion Models | 马里兰大学 | arXiv:2607.26706 关键词:文生视频,时间先验,反事实引导,免训练,事件控制 前序问题:当提示描述一个持续的早期场景、随后才发生新事件时,视频模型常让早期先验支配整条跨时间注意力轨迹,压制后段事件所需的引导信号。例如沙堡一直存在,浪却没有在后半段将其冲毁。 本文贡献:提出时间先验解耦 TPD。仅以早期场景为条件构造时间反事实,将完整提示与反事实轨迹的差定义为被压制的信号方向;不同于以往投影法删除不想要语义,TPD 在扩散步与视频帧上联合求解帧选择的下界约束,保证被压制信号在应出现的后段帧中贡献,同时不破坏早段连贯。 实验效果:完全运行在标准 classifier-free guidance 采样空间,无需重训、与骨干结构无关。多个文生视频骨干上均发现相同压制现象,TPD 显著提升后段概念实现率,同时保持时间连贯与视觉保真。 批判点评:TPD 把“后段事件没发生”明确解释为早期先验压制,并用下界约束恢复信号,诊断与修复逻辑都很清晰。但它需要能从提示中拆出早期条件,复杂并行事件或语义边界模糊时不易构造反事实;额外条件轨迹也会增加推理成本。 趋势观察 视觉DiT进入混合注意力与专属缩放律时代 — Adobe Chimera 将线性状态、全局注意力、局部卷积与 MoE 协同设计,完整系统算效提升 7.3 倍;高 token 视觉生成不再简单照搬语言模型结构。 生成扩展出现参数和数据之外的第三轴 — XM 把探索量变成第三条预训练扩展轴,FLOP 效率提升 4.1 倍、推理步数减少 16–256 倍,生成模型开始重新思考比扩散分解更端到端的训练范式。 免训练控制正在吞并长视频难题 — CineWeaver 免训练做多镜头长叙事,FreqForcing 把 5 秒模型外推到 2 分钟,TPD 唤醒后段事件;推理期改造正成为低成本增强视频基础模型的主线。 物理视频从隐式像素预测转向显式推理 — PhiZero 用离散物理语言先推理后渲染,VideoCoCo 用可执行 Blender 代码充当视频 CoT,世界动力学开始从黑盒像素 rollout 中被显式抽离。 实时生成从短片扩展到传输与小时级交互 — Visko Orbis 宣称 4K/24FPS 并支持小时级交互长视频,ReGenVC 用约十分之一传统码率实现 24FPS 生成式解码,实时生成正进入流式服务与通信基础设施。 人工智能炼丹君 整理 | 2026-07-31 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
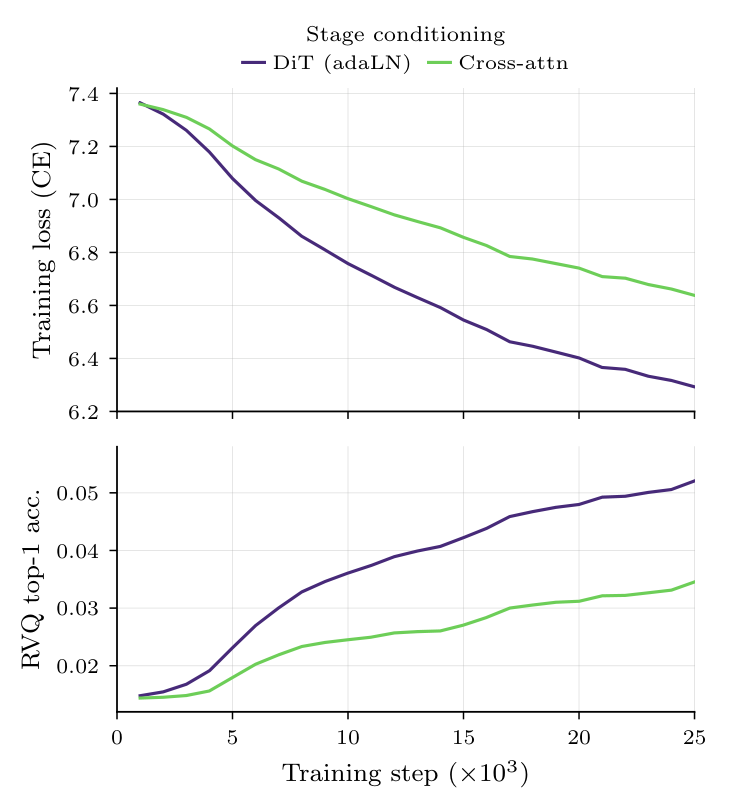
AIGC 每日速读|2026-07-29|Apple端侧Siri语音16倍实时仅21MB 今日 AIGC 论文速览 今日共 10 篇 · 端侧音频与数字人生成 2 篇 · 视觉生成推理加速 2 篇 · 可控视频编辑与专业评测 3 篇 · 全模态表示与扩散蒸馏 2 篇 · 视频模型视觉推理 1 篇 重点论文标题列表 Apple Audio DiT(Apple):端侧Siri语音16倍实时仅21MB Sol-Attn(NVIDIA):在线稀疏注意力让视频快2.3倍 UniGen-AR(CMU·UIUC·Toyota Research):一个自回归模型做15项视觉任务 AptAvatar(阿里淘天):14B数字人两步720P提速60倍 EgoPlay(Snap·KAUST):看到事件发生后才开始编辑视频 今日论文速览 1. Apple Audio DiT:端侧Siri语音16倍实时仅21MB Memory Efficient Audio Synthesis with Decoupled Temporal Depth Diffusion Transformers | Apple | arXiv:2607.23811 关键词:端侧TTS,Siri,音频DiT,RVQ,Apple 前序问题:Siri Expressive Voices要在设备上实时生成可配置、富表现力的语音,但语义音频token转高保真波形的detokenizer受AMX算力和内存严格限制。传统Transformer或GAN随序列长度线性甚至平方增长,难以持续合成长音频。 本文贡献:Apple提出解耦时间与RVQ深度的三组件架构:流式编码器、时间解码器和深度解码器。单个可复用的DiT式深度解码器通过stage conditioning自回归生成全部RVQ层,取代每层一个解码器;因果滑窗注意力配合固定窗口KV缓存,使运行内存不随语音长度增长。 实验效果:部署在Apple Matrix Coprocessor上,每步约10ms、约16倍实时,峰值运行内存仅21MB,端侧资产329MB,可连续合成20到320秒音频。AFM 3 Core Advanced中以10亿参数激活规模运行,相比上一代端侧TTS,整体MOS从3.87升至4.15,对话语音从3.82升至4.24。 批判点评:这是今日最强工业落地:Apple不仅给结构,还给AMX上的时延、内存、资产和MOS,证明十亿级音频生成可真正驻留端侧。代价是方案深度绑定Apple硬件与AFM token体系,16倍实时不能直接外推到通用CPU/GPU;320秒以上稳定性和多语言覆盖也未披露。 2. Sol-Attn:在线稀疏注意力让视频快2.3倍 Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification | NVIDIA | arXiv:2607.24027 关键词:稀疏注意力,视频生成,NVIDIA,免训练,推理加速 前序问题:视频DiT的长token序列让注意力成为推理瓶颈。现有免训练动态稀疏要么固定保留比例、要么按累计概率动态分配,路由预算僵硬或失衡,还要显式生成代理分数图;直接丢掉未选块则在高稀疏率下明显伤质量。 本文贡献:提出免训练Sol-Attn,将动态路由、稀疏计算与近似修正合进同一次online softmax。在线块阈值直接比较代理分数选关键KV块,不物化完整代理图,预算动态且可控;未选块的代理分数被复用来近似其贡献,避免keep-or-drop造成的信息断崖。 实验效果:在保持视觉质量的同时,视频生成端到端提速2.1倍、视频编辑提速2.3倍,并在图像与视频任务上推进免训练稀疏注意力的质量—效率前沿。 批判点评:Sol-Attn的价值不只是稀疏,而是把路由开销和遗漏补偿塞进online softmax一遍完成,NVIDIA背景也意味着内核可落地。但提速依赖模型、序列长度和阈值;代理分数对被丢块的近似在快速运动、小目标或精细文字场景中仍可能失真。 3. UniGen-AR:一个自回归模型做15项视觉任务 UniGen-AR: Unifying Visual Generation with Auto-Regressive Modeling | CMU·UIUC·Toyota Research | arXiv:2607.24157 关键词:统一视觉生成,自回归,VAR,MLLM,VQ-VAE 前序问题:文生图、编辑、修复和传统感知仍由不同模型负责;扩散虽能统一多种图像输出,但迭代采样延迟高,限制统一视觉生成在交互场景落地。 本文贡献:提出UniGen-AR,将通用MLLM与next-scale视觉自回归(VAR)解码器结合。MLLM把自由文本指令和控制信号编码为统一序列,VAR用一套权重和统一提示接口生成图像输出,覆盖四大家族15项以上任务且无需任务专用头。消融指出VQ-VAE码本大小和层级是VAR扩展的关键。 实验效果:相对扩散基线推理延迟最多降低19倍,同时保持或提升输出质量;单模型覆盖文生图、图像编辑、修复、感知等15项以上任务。 批判点评:用VAR替代扩散解码器,把统一视觉生成的效率问题正面解决,19倍延迟优势非常醒目。但自回归速度会受视觉token数量影响,VQ-VAE码本带来的量化误差仍在;15任务统一不等于每项都超过专用SOTA。 4. AptAvatar:14B数字人两步720P提速60倍 AptAvatar: Fast and Vivid Long-Form Audio-Driven Video Generation for Production-Ready Avatars | 阿里淘天 | arXiv:2607.24013 关键词:数字人,音频驱动,两步生成,分布蒸馏,阿里 前序问题:生产级音频驱动数字人既要快,又要保持身份、动作表现力和长视频稳定。现有加速常靠因果注意力、短时间窗、缩小模型或分辨率换速度,在极端两步生成时质量尤其容易塌。 本文贡献:提出14B长视频数字人AptAvatar。端点锚定分布蒸馏在普通DMD外加入Anchor Score Estimator,用冻结四步桥接生成器定义可达到的轨迹端点,指导两步学生;Self-Generated History Replay复用早期checkpoint输出作为分块训练历史,近似推理时自生成上下文而无需昂贵在线rollout。 实验效果:仅2次函数评估即可生成720P长视频数字人,推理提速60倍,同时保持视觉保真、鲜活动作、长时身份一致和文本动作控制。 批判点评:14B、720P、两步和60倍同时成立,说明淘天已瞄准直播与营销生产链。端点锚降低了两步蒸馏难度,但训练依赖四步桥接器和历史checkpoint缓存,流水线并不轻;摘要也未给绝对FPS,生产“实时”仍需硬件数据。 5. EgoPlay:看到事件发生后才开始编辑视频 EgoPlay: Event-Triggered Video Editing for Egocentric Streams | Snap·KAUST | arXiv:2607.24560 关键词:视频编辑,事件触发,第一视角,Snap,流式生成 前序问题:第一视角连续视频需要“当X发生时再做Y”,模型既要识别事件发生与否和时刻,又必须完整保留事件前画面、只改后续。检测器串联编辑器容易误触发并产生误差传递。 本文贡献:提出端到端事件触发V2V编辑器EgoPlay,在一个视频扩散模型中联合学习事件识别、时间克制和像素编辑,支持未发生事件与多事件提示。团队构建10.6万组事件触发片段—提示数据,训练双向编辑器并导出可逐块流式推理的因果版本;评测拆分触发后质量、触发前保持和假触发鲁棒性。 实验效果:相对EgoEdit,编辑质量、视觉质量和背景一致性分别提升17.7%、16.9%、16.4%;相对VLM检测器+编辑器串联基线分别提升15.7%、14.5%、13.5%,GPU内存还不到其一半。 批判点评:EgoPlay把视频编辑从“全片执行指令”升级为事件驱动程序,对AR眼镜和第一视角Agent很关键。风险是模型同时承担检测与生成,触发判断难单独校准;Ego4D里的事件覆盖有限,安全敏感场景不能只依赖生成模型自判。 6. FilmBench:电影学院用专业镜头语言重测视频模型 FilmBench: A Film-Grade Benchmark for Cinematic Video Generation | 阿里·北京电影学院·虎鲸文娱 | arXiv:2607.24241 关键词:视频评测,电影语言,多镜头,阿里,FilmOps 前序问题:多数视频生成基准用网页或LLM提示,并由通用多模态模型打总体画质、文本一致和流畅度,测到的是“像视频”,而非导演真正关心的镜头设计、动态美学和多镜头叙事。 本文贡献:提出电影级T2V/R2V基准FilmBench,与导演、北电教师和制片团队共同设计。1169条提示反推自20类获奖电影片段,其中1056条为多镜头真实shot list;评价体系含3轴、12组件、T2V 35项加R2V 3项子指标,并开放电影语言算子FilmOps和专家级自动评测Agent。 实验效果:评测9个T2V和7个R2V模型,自动评测对人类模型排名的Spearman相关分别达0.95和0.96。现有模型在动态美学上普遍不足,且从单镜头到多镜头性能明显下降,弱模型跌幅更大。 批判点评:FilmBench把视频评测从VBench式通用指标拉到专业电影语言,是生成视频走向影视生产的重要基础设施。但获奖电影反推提示可能偏向成熟电影美学,自动Agent即使排名相关高,也不代表每个镜头级解释都可靠;版权与参考片段可复现性同样重要。 7. OmniVAE:音视频VAE先对齐再联合生成 OmniVAE: An Audio-Video VAE with Cross-Modal Alignment for Joint Generation | 复旦·上海创新院·MOSI·上交 | arXiv:2607.23855 关键词:音视频生成,VAE,跨模态对齐,复旦,全模态 前序问题:联合音视频生成通常分别训练音频VAE和视频VAE,两套潜空间没有细粒度对应,下游生成器不得不从零学习“哪个画面该配哪个声音”,增加同步学习难度。 本文贡献:提出联合训练的OmniVAE。除重建目标外,以片段级音视频对比学习捕获时间—语义对应并对齐潜空间;同时把预训练音频和视频语义编码器特征分别蒸馏进对应潜变量,让两种表示既保留重建能力,又更容易被下游联合生成模型学习。 实验效果:两种对齐目标持续提升潜空间可学习性,使下游文生音视频获得更高生成质量与更准确跨模态同步,验证统一表征应从VAE底座开始。 批判点评:多数工作把同步压力全留给生成DiT,OmniVAE提前在tokenizer阶段对齐,方向很对。但对比目标可能把音画关系压成粗语义相似,口型、碰撞声等毫秒级同步仍需生成器建模;联合VAE也会降低替换单一模态编码器的灵活性。 8. PDM:拆开CFG正负分支修复扩散蒸馏 Rethinking Classifier-Free Guidance in On-Policy Diffusion Distillation | 阿里通义千问 | arXiv:2607.24731 关键词:扩散蒸馏,CFG,在线策略,PDM,视频控制 前序问题:在线策略扩散蒸馏通常直接匹配教师与学生经CFG合成后的速度,但这个总目标无法唯一约束正、负两个分支:两边误差可互相抵消。当教师负分支含学生拿不到的特权信息时,正分支变好反而会伴随负分支恶化。 本文贡献:论文将该失败模式命名为负分支不对称(NBA),并提出分支感知的Positive-Direction Matching(PDM):分别约束正条件预测与CFG条件方向,使监督可识别,不再让合成结果掩盖分支错误。方法用于从稠密到稀疏的视频控制蒸馏。 实验效果:朴素CFG匹配对推理guidance scale高度敏感,PDM在不同引导尺度下实现更稳健、有效的知识迁移,修复教师负分支存在特权条件时的对抗误差动态。 批判点评:它揭示了一个容易被总loss掩盖的蒸馏病灶:CFG结果对了,不代表两个分支学对了。分析价值高于单项榜单。不过当前验证集中在稠密到稀疏视频控制,PDM对文生图少步蒸馏、不同负提示schema的普适性仍需实证。 9. VIPE:先改输入图片再让视频模型推理 Visual Prompt Engineering for Video Models | Google DeepMind | arXiv:2607.25537 关键词:视觉提示工程,视频模型,视觉推理,Google DeepMind,图像编辑 前序问题:视频生成模型正成为视觉推理基础模型,但用户仍主要优化文字提示。对于迷宫、物理轨迹等任务,原始抽象图像可能不符合模型训练分布,仅改文字无法消除视觉输入本身的表达障碍。 本文贡献:提出视觉提示工程VIPE:调用图像编辑模型自动修改任务图像的呈现方式,例如把抽象草图转成写实场景,再交给视频模型推理。它不改目标问题,只优化视觉prompt,使输入更贴近视频模型容易理解和模拟的分布。 实验效果:VIPE在多种任务上提升视频模型视觉推理,效果甚至可超过传统文本提示工程和测试时扩展,且额外计算较低。 批判点评:“不是改问题文字,而是改给模型看的世界”是很有启发的提示工程范式,Google DeepMind视频模型背景也值得关注。但编辑器可能偷偷改变物理条件或答案线索,提升不一定来自更强推理;必须验证语义与几何约束在改图前后严格等价。 10. TriLayer:视频扩散直接生成可编辑RGBA图层 Explicit Layer Modeling for Video Object Insertion and Layer Decomposition | POSTECH | arXiv:2607.25802 关键词:视频编辑,RGBA,图层分解,物体插入,扩散模型 前序问题:多数视频编辑没有显式图层表示,物体插入、复用和后期调整只能隐式推断或逐场景优化。缺少前景RGBA监督,也让阴影、反射等伴随视觉效果难与背景正确合成。 本文贡献:构建TriLayer大规模三元视频数据,逐帧对齐合成画面、背景和含物体外观及视觉效果的前景层。基于此提出双分支DBL-Diffusion,通过共享去噪和跨分支交互联合建模RGB合成与RGBA前景;DBL-Insert生成可后期编辑的插入图层,DBL-Decompose恢复前景与背景。 实验效果:显式图层建模显著提升视频物体插入保真度和图层分解质量,并让生成结果可用于真实合成与灵活后期修改。 批判点评:从最终RGB转向可编辑RGBA资产,是视频生成接入专业后期管线的重要一步。难点在于TriLayer数据如何获得真实透明度和复杂光效监督;半透明、运动模糊、反射及跨层光照很难被单一RGBA层完整表达。 趋势观察 生成模型开始进入端侧十亿参数时代 — Apple在AMX上以21MB峰值内存运行十亿参数激活规模音频生成,达到16倍实时;端侧生成竞争从小模型转向架构与硬件协同。 视觉生成加速分化为稀疏与自回归两条路线 — Sol-Attn用在线稀疏让视频编辑快2.3倍,UniGen-AR以VAR替代扩散让统一视觉任务延迟最多降19倍,计算范式本身成为核心变量。 视频产品同时追求极少步与事件驱动 — AptAvatar把14B数字人压到两步并提速60倍,EgoPlay则只在事件发生后编辑;视频生成正从整段离线采样走向低延迟、条件触发的连续服务。 评测和输出格式开始对接专业生产 — FilmBench用电影学院镜头语言重测模型,TriLayer直接生成RGBA图层;行业关注点从画面像真转向镜头设计、资产复用和后期可编辑性。 统一模型向底层表征与视觉提示延伸 — OmniVAE在VAE阶段对齐音视频,PDM拆解CFG分支监督,VIPE直接优化模型看到的图像;性能提升越来越依赖输入、tokenizer和训练目标的联合设计。 人工智能炼丹君 整理 | 2026-07-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
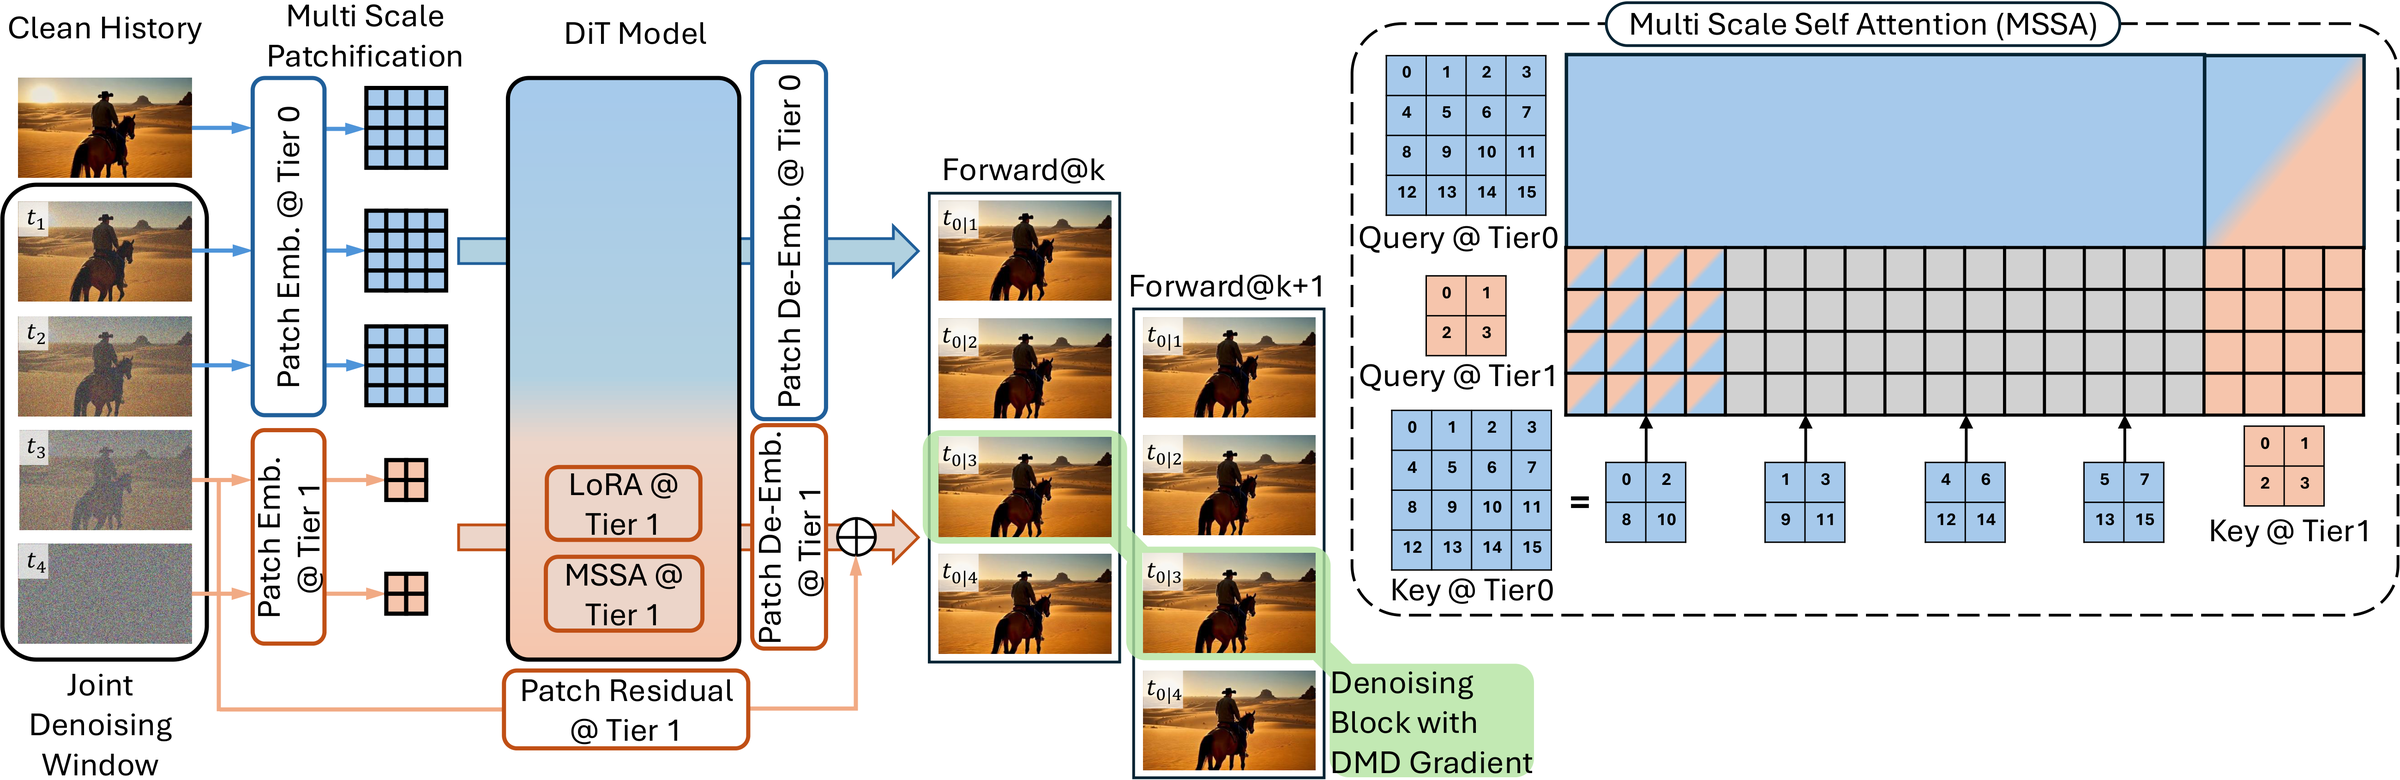
AIGC 每日速读|2026-07-28|Meta单H200实时视频22.84帧MsForcing 今日 AIGC 论文速览 今日共 10 篇 · 实时与长视频生成 2 篇 · 视频测试时扩展与多人物生成 2 篇 · 理解生成统一表征 1 篇 · 可控视频与图像编辑 3 篇 · 生成部署与音频创作 2 篇 重点论文标题列表 Ms. Forcing(Brown·MIT·Meta):单卡实时视频生成22.84帧 Self Gradient Forcing(京东探索研究院):5秒训练窗口外推数分钟 CachedSearch(Google·UT Austin·CU Boulder):63%成本保留94.7%搜索收益 Twins(ICML 2026·腾讯混元·港中文):理解生成共享视觉Token GroupVideo(中科院自动化所·蚂蚁):多人物定制视频不再串脸 今日论文速览 1. Ms. Forcing:单卡实时视频生成22.84帧 Ms. Forcing: Efficient Streaming Video Generation with Multi-Scale Patchification and Attention | Brown·MIT·Meta | arXiv:2607.20940 关键词:流式视频,实时生成,多尺度Patch,滚动扩散,DMD 前序问题:流式视频扩散虽可支持交互式世界模拟,但传统逐帧生成同时嵌套自回归与多步去噪,难以实时。滚动窗口把不同噪声级的连续帧并行去噪,却仍用同样细的空间粒度处理所有状态,浪费大量计算。 本文贡献:提出 Ms. Forcing:多尺度 Patchification(MSP)按噪声级给高噪状态分配更粗 patch,使活动窗口 token 减少45%;多尺度自注意力(MSSA)按查询尺度匹配可见 KV 密度,继续压低注意力成本。固定窗口位置决定全部尺度,计算图保持静态且硬件友好;同噪声级 DMD(H-DMD)则用来自同一源噪声级的干净预测组装训练视频,缩小训练序列与推理滚动的错位。 实验效果:单张 H200 上达到22.84 FPS,比 Rolling Forcing 快39.6%;同时在短视频和长视频设置中显著提升 VBench。 批判点评:这是今日最硬的工业数字:单 H200 首次把流式扩散推到实时帧率,而且不是单纯牺牲质量换速度。关键洞察是高噪帧无需看清每个像素。但22.84 FPS依赖H200与固定窗口配置,分辨率、模型规模和端到端编码开销需一并看;高噪粗粒度也可能损伤快速出现的小物体。 2. Self Gradient Forcing:5秒训练窗口外推数分钟 Self Gradient Forcing: Native Long Video Extrapolation | 京东探索研究院 | arXiv:2607.20368 关键词:长视频,自回归扩散,Self Forcing,KV缓存,梯度训练 前序问题:Self Forcing让模型在自身生成历史上训练,缓解训练看真值、推理看生成结果的暴露偏差;但历史KV缓存只是冻结状态,未来帧损失无法反向教会早期帧“如何写入更有用的记忆”,形成历史上下文梯度缺口。 本文贡献:提出两遍训练的Self Gradient Forcing(SGF),无需穿过完整串行 rollout 反传。第一遍无梯度执行与推理一致的自回归滚动,在抽样退出步记录自生成上下文与噪声潜变量;第二遍并行重算该步的上下文KV和未来对上下文的因果注意力,让未来视频潜变量损失监督历史记忆的写入方式。 实验效果:在逐帧与分块长时实验、不同初始化下,角色身份、背景布局和时间稳定性均强于Self Forcing;仅用5秒训练窗口即可原生外推到数分钟视频。 批判点评:它把长视频问题从“怎样读取历史”推进到“怎样写好历史”,5秒训练到数分钟外推非常抓眼。两遍法避免全序列反传,工程上也现实。不过数分钟不等于全程有意义,身份和背景稳定之外,长期叙事、动作因果与新内容丰富度仍可能衰减。 3. CachedSearch:63%成本保留94.7%搜索收益 CachedSearch: Training-Free Cached Exploration for Test-Time Search in Video Diffusion | Google·UT Austin·CU Boulder | arXiv:2607.23159 关键词:测试时搜索,视频扩散,缓存加速,Best-of-N,免训练 前序问题:测试时best-of-N搜索能让小视频模型接近大模型,却需2到10倍计算,因为所有候选都完整去噪、最后大多被丢弃。缓存可让单次生成快2到3倍,但若近似误差打乱验证器排序,就可能选错赢家。 本文贡献:首次系统研究缓存对视频候选排序的影响,并提出免训练CachedSearch:用激进缓存低成本探索所有种子,仅把缓存阶段的赢家用全计算重生成。缓存与完整生成的每提示中位Spearman相关达0.905,错误主要集中在分数近乎打平的候选,因而影响自限;方案与验证器和搜索算法解耦。 实验效果:N=8时以63%成本保留best-of-N的94.7%收益;同预算可搜索两倍宽度,收益高38%。结论覆盖1.3B到14B、Wan/LTX/CogVideoX/Hunyuan六个模型;叠加中途剪枝可节省3.11倍探索计算并保留88.6%收益。 批判点评:“便宜试遍、只精修赢家”是测试时扩展最直接的降本路线,跨四个模型家族也增强了可信度。但它仍依赖奖励器排序是否符合人类偏好,近似搜索会放大奖励黑客;新架构还需重新校准缓存参数,并非完全零配置。 4. Twins:理解生成共享视觉Token Twins: Learn to Predict Unified Representations with Focal Loss | ICML 2026·腾讯混元·港中文 | arXiv:2607.22531 关键词:统一多模态,视觉Token,ViT,VAE,Flow Matching 前序问题:统一多模态模型常用ViT语义特征做理解、VAE低层潜变量做生成,两套连续表征不一致。直接联合预测时,DiT容易拟合ViT却学不好VAE分布,难以同时满足理解、重建和生成。 本文贡献:提出Twins连续统一表征:在同一token网格按通道拼接SigLIP2 ViT特征与FLUX.2 VAE潜变量,不增加序列长度和注意力成本。团队将失衡归因于频率偏置、内在维度及条件相关/无关不确定性差异,并把Focal Loss思想改造成flow matching焦点回归,重点提升误差大的VAE维度。 实验效果:ImageNet上相对朴素MSE最高改善10.57 gFID,且不使用classifier-free guidance;多模态理解表现保持竞争力,重建保真度也提升。 批判点评:它用最简单的通道拼接绕开两套视觉接口,再用损失重加权处理“语义易学、细节难学”,ICML与混元背景值得关注。但共享token仍是两种预训练特征的并置而非真正涌现的统一空间,推理通道宽度和解码链路成本并未消失。 5. GroupVideo:多人物定制视频不再串脸 GroupVideo: Multi-Identity Customized Text-to-Video Generation | 中科院自动化所·蚂蚁 | arXiv:2607.21027 关键词:视频生成,多人物,身份保持,Video DiT,定制视频 前序问题:身份定制视频大多只支持单人;把多张人脸简单拼接成条件会造成身份混淆,人物表情与动作像把静态脸“贴”到视频上,缺乏自然性。 本文贡献:提出基于Video DiT的GroupVideo。视觉对齐联合编码多张人脸提供稳健身份参考,语义感知器负责提升动作自然度;带空间引导的ID定位模块配合边界框约束与mask正则,将身份信息限制在对应脸部区域,抑制人物间特征串扰。团队还构建2万条高质量多身份视频数据集。 实验效果:在多角色视频中,身份一致性与动作自然度均超过现有方法,并改善多人物同时出现时的身份保真;新增2万条多ID数据为后续研究提供基础。 批判点评:多人物是定制视频迈向真实叙事必须补的一环,显式ID定位比条件拼接更靠谱。局限是训练仍依赖框和mask约束,2万条数据对人物组合、遮挡与长时交互的覆盖有限;多人身份正确也不保证彼此动作逻辑自然。 6. AgentHOI:多Agent先推理再生成人物交互 AgentHOI: Multi-Agent Reasoning for Human-Object-Interaction Video Generation via Implicit Representation Alignment | 腾讯混元·中科院大学 | arXiv:2607.22241 关键词:HOI视频,多Agent,动作规划,腾讯混元,视频扩散 前序问题:人和物体交互视频不仅要让主体动起来,还要理解接触、受力与动作先后。现有方法依赖显式姿态或运动轨迹,扩展到不同物体和复杂指令时成本高、泛化弱。 本文贡献:提出thinking-before-generation的AgentHOI:感知、交互和运动规划多个Agent先把高层文本意图拆成带秒级时间区间的执行计划;再用隐式文本-运动对齐,将文本到动作先验蒸馏进视频扩散模型,使推理时无需额外运动输入。 实验效果:在穿戴、骑乘等高难物体中心场景中,显著提升交互自然度、物体外观保持和复杂文本指令遵循;代码已开源。 批判点评:混元把Agent推理从提示改写推进到动作规划,适合HOI这种先讲逻辑再画运动的任务。但文本计划无法完整表达连续接触力学,Agent链中的错误会被生成模型忠实放大;“自然”仍主要靠视觉评价而非物理正确性。 7. InnoText:一个DiT同时生成编辑中英文字 InnoText: A Unified Model for Visual Text Generation and Editing | 中山大学·京东·中科院 | arXiv:2607.22101 关键词:视觉文字,DiT,图像编辑,中文生成,统一模型 前序问题:视觉文字既要求字形结构规则又要求可读,小字号和中文尤其困难。UNet常生成乱码,现有DiT又多只做生成或编辑单项任务,造成重复训练、风格不一致和跨任务泛化不足。 本文贡献:提出统一DiT框架InnoText,在单模型内同时完成视觉文字生成与编辑。字体大小感知调制(FSAM)适配不同尺度,小字符感知增强专攻细粒度字形,任务特定区域加权损失按生成/编辑区域自适应优化;同时构建覆盖多字体、字号和背景的高质量中英双语数据集。 实验效果:实验显示生成准确率和编辑质量均优于对比方法,可输出更清晰、连贯且与背景融合自然的中英文字图像。 批判点评:把生成与编辑合并对海报、电商和本地化设计很实用,中英双语也比只测拉丁字母更有说服力。但摘要缺少量化幅度,视觉文字真正难点还包括长段排版、罕见字和任意语言,当前双语数据的外推边界待验证。 8. WhereEdit:一步编辑自动找到该改哪里 WhereEdit: Mask-aware Local Latent Editing for One-Step Image Editing | 中科院西安光机所·西交·武大 | arXiv:2607.20883 关键词:一步编辑,局部控制,AutoMask,免训练,图像编辑 前序问题:一步文生图模型让实时编辑成为可能,但现有方法主要靠文字做全局语义搬运,缺少“改哪里”的显式空间控制;即便加入区域约束,目标区修改强度也常不够,背景还容易被连带改变。 本文贡献:提出免训练、免反演的WhereEdit,把一步编辑改写为局部自适应语义运输。AutoMask从模型内部token注意力自动发现相关区域,Amplified Conditional Transport只在局部强化条件变化,同时保护非目标区域与结构一致性;额外区域监督实验进一步验证显式空间推理的价值。 实验效果:PIE-Bench上持续超过现有一步图像编辑方法,在保持一步生成效率的同时取得更高编辑质量;使用真值mask还能继续提升。 批判点评:WhereEdit补上了一步编辑最关键的空间控制,且无需训练和反演,适合交互产品。但AutoMask依赖模型注意力能正确指向目标,抽象属性、多个同类物体和大范围几何变化时容易选错区域;真值mask继续提升也说明自动定位尚未到顶。 9. KroQuant:DiT权重激活都压到4比特 KroQuant: Kronecker-Structured Block Transforms for Efficient Post-Training Quantization of Diffusion Transformers | EPFL·AMD | arXiv:2607.21446 关键词:DiT量化,W4A4,Kronecker变换,AMD,后训练量化 前序问题:DiT做W4A4后训练量化时,线性层输入中的离群激活超出4-bit表示范围,生成质量会严重下降。已有通道缩放损精度,Hadamard变换块大且在线成本高,完整可学习变换又要每层每步执行昂贵矩阵乘。 本文贡献:提出KroQuant,对每32个激活元素应用可学习的Kronecker结构可逆变换,参数不到逐通道缩放一半;块内结构可由tensor core小GEMM执行。离线LoRaQ权重校准再吸收剩余逐权重量化误差,把激活侧变换与权重侧修正结合。 实验效果:MI350 GPU上量化器内核最多比SmoothQuant快14%;PixArt-Σ、SANA、FLUX.1-schnell在W4A4(MXFP4e2)下,比SVDQuant和LoRaQ更接近全精度参考,同时保持或提升图像质量。 批判点评:权重和激活同时4-bit才真正触及DiT部署成本,AMD与EPFL给出的硬件内核数字比只报离线指标更可信。但14%是量化器kernel而非整条生成链路,端到端提速取决于去噪步数和算子占比;Kronecker块大小也可能需按新架构重调。 10. SoundscapeAgent:Agent把声景拆成可编辑时间线 SoundscapeAgent: Agentic Soundscape Construction for Controllable Synthesis and Scalable Audio-Language Supervision | 武汉大学·腾讯混元 | arXiv:2607.21857 关键词:音频生成,创作Agent,声景,腾讯混元,音频语言 前序问题:单次文本到音频把规划、音源选择、时间布局和混音都藏在黑盒里,用户难以控制多事件声景,也无法获得包含事件角色与时间关系的结构化音频语言监督。 本文贡献:提出SoundscapeAgent:LLM Agent把用户意图转成可执行场景计划,通过检索和按需生成获取音频素材,再按可控时间线渲染多事件混音并导出对齐元数据。用户可指定工具并直接编辑计划,实现human-in-the-loop;同一流水线还能规模化生成结构化音频语言训练数据。 实验效果:听测和客观指标显示其生成质量可与文本到音频基线竞争;使用Agent合成数据训练的模型,在下游音频推理上持续超过仅用真实数据的基线。 批判点评:它把“生成一段声音”升级为可检查、可修改的音频工程时间线,既服务创作又反哺理解数据。但检索素材的版权、来源域偏差和混音物理真实性会进入训练集;Agent生成元数据规模大不等于监督准确,仍需质量过滤。 趋势观察 流式视频正式跨过实时帧率门槛 — Ms. Forcing按噪声级动态分配空间精度,单H200达到22.84 FPS;生成加速开始从缓存和蒸馏转向更细的计算粒度调度。 长视频训练开始补上记忆写入梯度 — Self Gradient Forcing让未来损失反向监督历史KV如何写入,仅用5秒窗口外推数分钟,长时一致性从扩展上下文转向优化内部记忆。 测试时扩展进入低成本探索阶段 — CachedSearch证明缓存近似基本保留候选排序,只对赢家全精度重生成,以63%成本拿回94.7%收益,best-of-N正在变得更可部署。 理解生成统一不再只靠共享架构 — Twins直接拼接ViT语义与VAE细节表征,并用焦点回归修复优化失衡;统一模型竞争转向token空间和训练目标的共同设计。 创作Agent从改写提示走向显式规划 — AgentHOI先规划人-物动作,SoundscapeAgent把音源与时间线变成可执行计划;图像、视频、音频生成都在从单次提示走向可检查的中间状态。 人工智能炼丹君 整理 | 2026-07-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
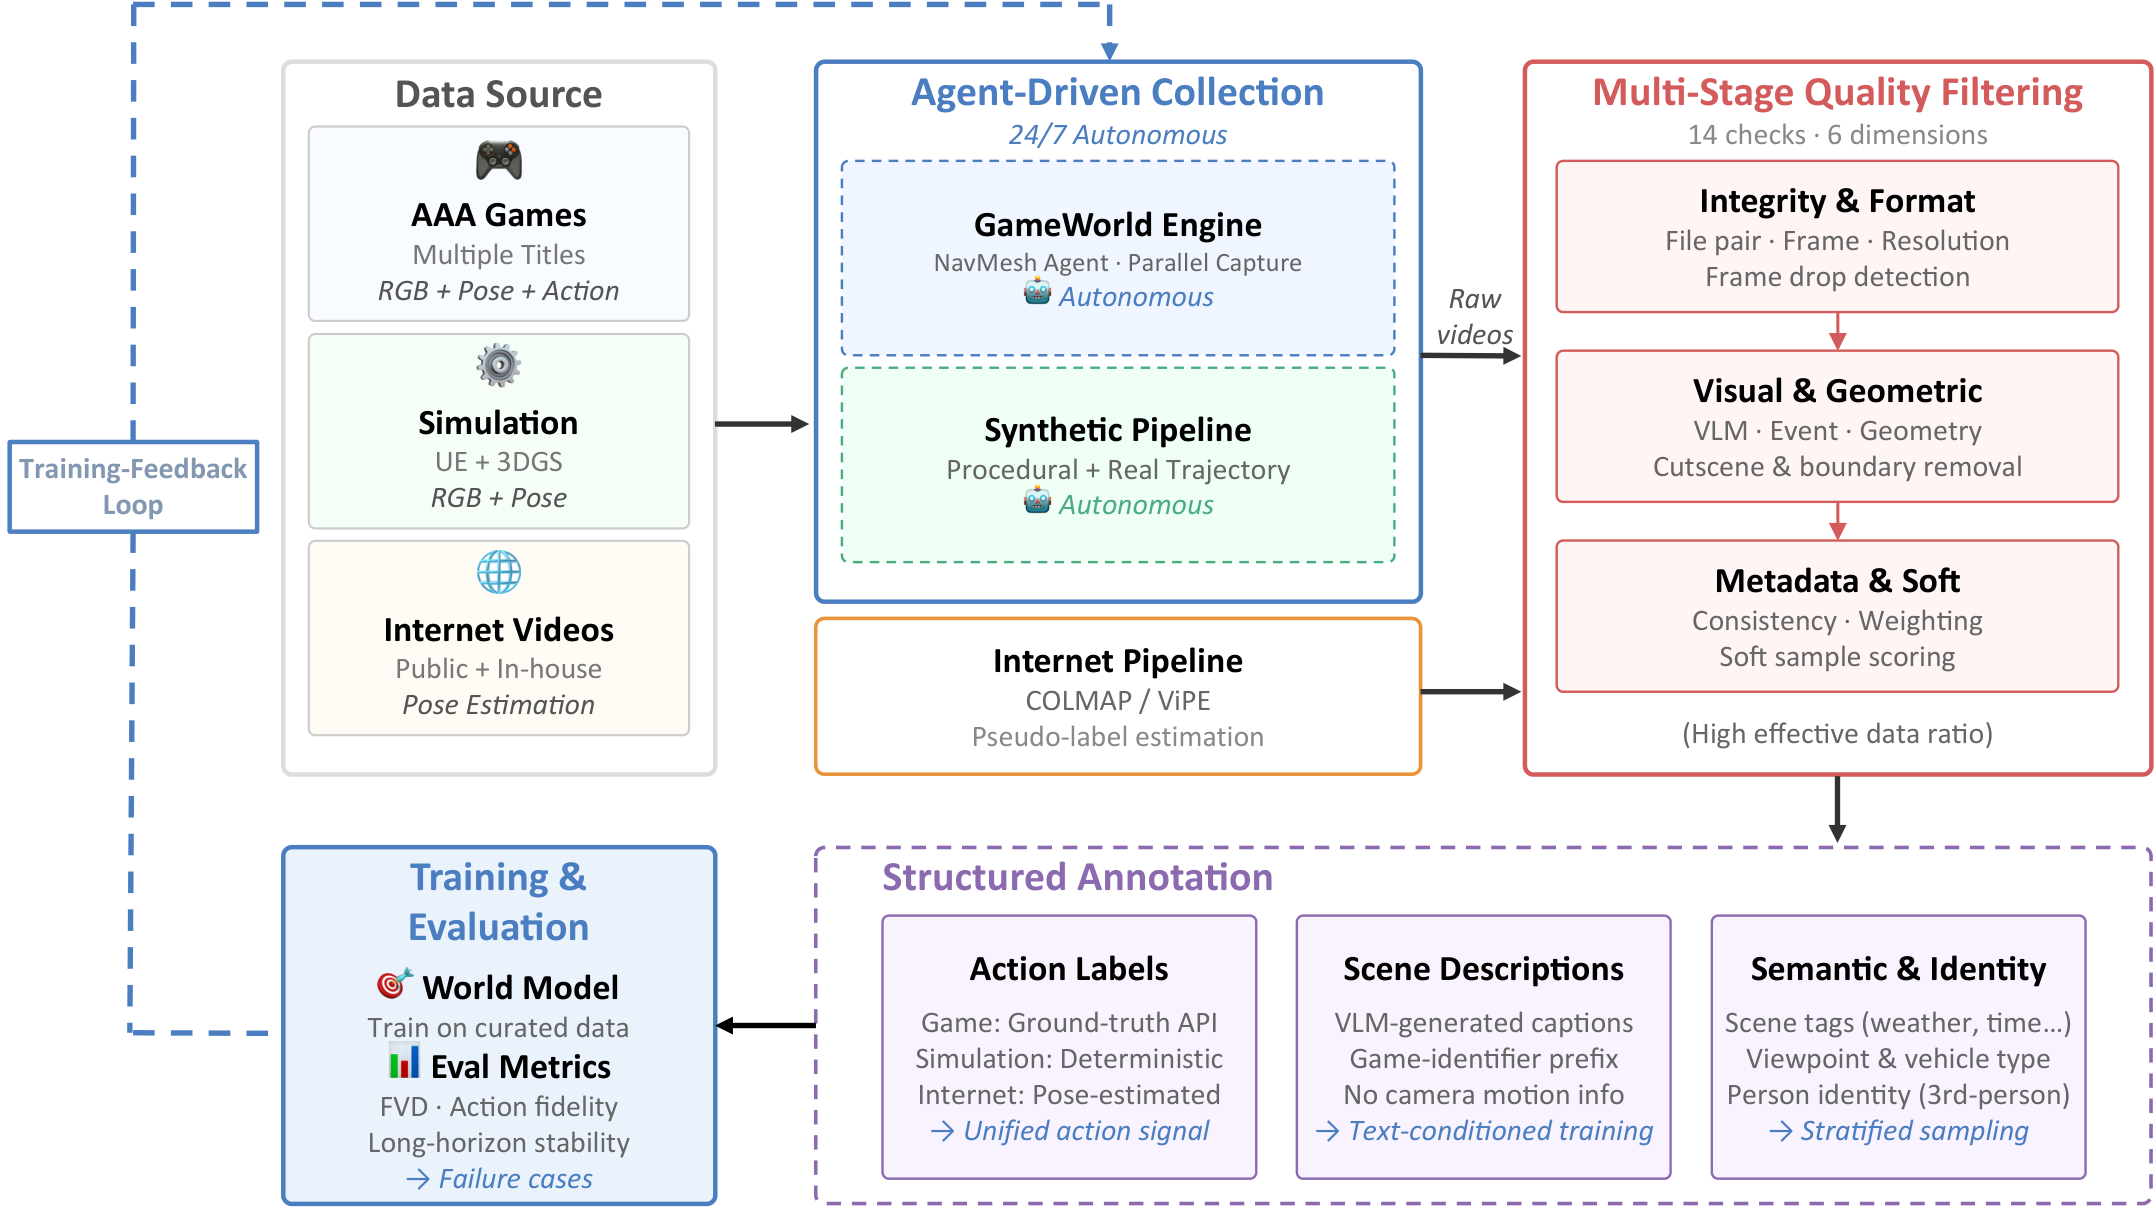
AIGC 每日速读|2026-07-23|阿里高德5090单卡实时世界模型ABot-World-0 今日 AIGC 论文速览 今日共 10 篇 · 交互式世界模型 2 篇 · 高效图像/视频生成与编辑 3 篇 · 可控与电影级视频生成 2 篇 · 生成新用途与安全 2 篇 · 音乐生成 1 篇 重点论文标题列表 ABot-World-0(阿里·高德AMAP):单卡5090实时交互世界模型 AlayaWorld(Alaya Lab):15B交互式长时程世界模型开源 Mage-Flow(Microsoft):微软4B高效图像生成与编辑 OSVE(高丽大学):首个单步视频编辑快155倍 HeadCast(快手可灵):免训练按注意力头加速AR视频 今日论文速览 1. ABot-World-0:单卡5090实时交互世界模型 ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU | 阿里·高德AMAP | arXiv:2607.19191 关键词:世界模型,实时交互,自回归视频,蒸馏,单卡部署 前序问题:交互式视频世界模型要同时具备交互、持久时空一致、稳定长时程生成与高效响应,且此前多依赖重型算力,难在消费级单卡上实时长时程运行。 本文贡献:提出动作条件视频世界模型 ABot-World-0,配套横跨 AAA 游戏/仿真引擎/互联网视频的多源数据基建(WorldExplorer 训练反馈驱动采集 + 14 项确定性质检 + VLM 评估 + 动作/文本同步标注);训练上把双向动作条件教师经 teacher forcing 与 ODE 蒸馏渐进蒸成因果学生,并提 LongForcing 对齐长自 rollout 与扩展时程教师、抑制分布与自回归漂移;原始键盘动作作统一控制接口,参考角色记忆保第三人称身份一致;部署上协同设计流式推理栈(轻量 VAE 解码、高效注意力、内存感知调度、低比特 DiT)。 实验效果:在优化的低比特配置下,单张 NVIDIA RTX 5090 桌面 GPU 上以最高 16FPS 流式生成 720P 视频,动作到首帧延迟 1.2s、峰值显存约 19GiB;在 WorldRoamBench 与长交互 rollout 上展现有竞争力的可控性与连贯的长时程世界演化。 批判点评:把交互式世界模型压进消费级单卡(5090/16FPS/19GiB)是极硬的工程落地,多源数据基建+LongForcing 抑漂移思路完整、阿里高德背景也贴近实景重建。但 16FPS/720P 距真正丝滑仍有距离、低比特下的画质代价、超长时程一致与物理合理性、以及对开放动作的泛化仍需检验。 2. AlayaWorld:15B交互式长时程世界模型开源 AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report | Alaya Lab | arXiv:2607.18367 关键词:世界模型,交互生成,自回归蒸馏,长时程,开源 前序问题:视频世界模型能即时从文本/图像/视频生成可交互环境,但要落地需同时具备交互、持久时空一致、稳定长时程生成与高效响应四大耦合能力。 本文贡献:提出交互式长时程视频世界模型 AlayaWorld:基于 15B 视频扩散 Transformer,在相机轨迹与可切换文本提示下自回归生成短潜块;有界视觉上下文融合持久 sink 帧、压缩时序历史、几何对齐空间记忆与近帧条件;用自 rollout 收集的损坏历史与预测残差训练以降长期漂移;提出离散自回归蒸馏(结合分布匹配蒸馏、self-forcing++、一致性蒸馏)把推理从约 30 步降到每块 4 步。 实验效果:生成 540p/720p、24fps 视频,在 iWorld-Bench 上长时程生成最佳;定位为全栈、开源、长期项目,为交互式视频世界模型研究提供可扩展基座。 批判点评:15B 世界模型+四步蒸馏+全栈开源,对社区推进交互式世界模型很有价值,几何对齐空间记忆+损坏历史训练也对症长程漂移。但 24fps/720p 的实时性、复杂交互下的一致与可控、以及开源基座的训练成本与数据获取门槛,仍是从 demo 到产品要迈的坎。 3. Mage-Flow:微软4B高效图像生成与编辑 Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing | Microsoft | arXiv:2607.19064 关键词:图像生成,图像编辑,原生分辨率,VAE,少步蒸馏 前序问题:大规模视觉生成器越来越强,但训练、微调与部署成本高昂,难以兼顾高分辨率质量与交互级效率。 本文贡献:推出紧凑 4B 生成栈 Mage-Flow:由轻量高保真潜表征分词器 Mage-VAE 与原生分辨率多模态扩散 Transformer(整流流匹配)协同设计。Mage-VAE 用单步扩散式编解码+锚定潜表征正则,在保持强公开 VAE 重建质量的同时把分词成本降一个数量级以上;配合原生分辨率打包与栈级 CUDA 核融合,端到端训练吞吐提升约 2.5 倍。基于此构建 Base/RL 对齐/Turbo 三档、覆盖生成与编辑:Diffusion-NFT 提升指令遵循/文字渲染/美学/编辑保真,配对抗感知引导的少步蒸馏产出 4 步 Turbo。 实验效果:尽管规模紧凑,Mage-Flow 与 Mage-Flow-Edit 在标准生成/编辑基准上具竞争力;Turbo 变体让高分辨率交互实用——单张 A100、1024² 下生成仅 0.59s、编辑仅 1.02s,显存占用小。 批判点评:微软用「分词器-骨干-系统」协同把 4B 小模型的高分辨率生成/编辑做到 0.59s/1.02s,工业化落地感很强、成本友好。但 4B 规模在极致画质/复杂语义/长文本渲染上的天花板、与十亿级大模型的差距,以及 RL 对齐/蒸馏带来的多样性与保真权衡,仍需在更广场景验证。 4. OSVE:首个单步视频编辑快155倍 OSVE: One Step Video Editing with One Step Diffusion Models | 高丽大学 | arXiv:2607.19895 关键词:视频编辑,单步扩散,噪声预测,时序一致,实时 前序问题:扩散模型的文本引导视频编辑因多步采样与反演而慢得不实用。 本文贡献:提出 OSVE,首个成功把单步文生图(T2I)模型适配到高质量视频编辑的框架,攻克反演、可编辑性与时序一致三大难题:训练一个可学习编码器单次前向预测每帧初始噪声以绕开慢速迭代反演,并用结构感知编辑(SAE)损失在结构对齐图对上训练以在编辑中保留源视频几何;提出统一帧编辑(UFE)拼接帧潜表征在单步生成中促成跨帧注意力保时序连贯;对长视频用带锚帧的滑窗保全局一致。 实验效果:编辑质量匹配或超过 SOTA 多步方法,同时快约 155~171 倍,为实用实时视频编辑铺路;代码开源。 批判点评:把单步 T2I 迁到视频编辑、直接预测初始噪声避开反演,155~171 倍提速+结构保持的设计很漂亮,实时编辑价值大。但依赖结构对齐图对训练编码器、单步生成对大幅/复杂编辑的上限、以及长视频滑窗拼接处的一致,仍需更强样例检验。 5. HeadCast:免训练按注意力头加速AR视频 HeadCast: Casting Attention Heads for Efficient Autoregressive Video Generation | 快手可灵 | arXiv:2607.20125 关键词:自回归视频,推理加速,KV缓存,注意力头,免训练 前序问题:自回归(AR)视频扩散是长视频/流式合成的有力范式,但持续增长的 KV cache 让注意力成为主导推理成本(高分辨率下每帧 token 众多);现有缓存淘汰用粗糙启发式致帧间闪烁,或需重训。 本文贡献:提出免训练、即插即用的加速框架 HeadCast:基于「预训练 AR 模型注意力头呈稳定异质行为」的观察,短暖机后在最大噪声步一次性把每个注意力头分为 Sink/Dummy/Spatial/Global 四类,并把单体 KV cache 重构为按头分路径;关键是保留维持长程时序一致的 Global 头。因 Spatial 路径在固定网格上运算,其节省随分辨率增长。 实验效果:在多个 SOTA AR 模型上,720P 加速至多 1.62 倍、1080P 至多 1.95 倍,VBench 质量与全注意力持平且基本无闪烁;代码开源。 批判点评:「按注意力头功能分类+分路径缓存」免训练即插即用、且分辨率越高越省,对长视频/流式生成的推理成本是很实用的解法(可灵背景更贴落地)。但一次性分类的稳健性、四类原型对不同模型的普适、以及在极长序列/更高分辨率下保真与加速的平衡,仍需更多模型验证。 6. ShotPlan:可学习规划token做电影级多镜头 ShotPlan: Cinematic Video Generation with Learnable Planning Token | 中国电信TeleAI·哈工大 | arXiv:2607.17675 关键词:电影级生成,多镜头,规划token,转场,视频扩散 前序问题:现有视频生成在单镜头上效果惊艳,但电影级生成需要连贯叙事与有效多镜头组合、需显式镜头规划,仍受限。 本文贡献:提出 ShotPlan,在视频扩散基座上做显式多镜头电影级生成:引入可学习规划 token 捕捉镜头级转场线索、可与原视频生成 token 无缝融合以控制转场时间戳;规划 token 配分数时间旋转位置编码(FRoPE),使镜头转场可在帧级建模。 实验效果:显著超过现有电影级视频生成方法,提供更灵活的镜头管理与更强的镜头间一致性。 批判点评:用「可学习规划 token+帧级 FRoPE」把多镜头转场显式化,是对电影级叙事生成痛点的对症设计,中国电信 TeleAI 出品。但多镜头的叙事连贯不止转场时机,人物/场景跨镜头一致、复杂运镜与更长叙事的可控性,以及与专业剪辑的差距仍需更多验证。 7. The generator is the tracker:视频生成器即多目标跟踪器 The generator is the tracker: Multi-object tracking by painting persistent identity colours | 康奈尔大学 | arXiv:2607.17120 关键词:多目标跟踪,视频生成,身份一致,重识别,LoRA 前序问题:多目标跟踪(MOT)传统被拆成检测+关联,身份靠轨迹缓存、运动模型、外观嵌入等外部状态维护;能否让视频生成器直接用像素维护这种状态? 本文贡献:微调 22B 文生视频扩散模型(LTX-2.3)配轻量上下文 LoRA,把 RGB 片段翻译成 ID-map 片段——每个人被涂成随时间持久的独特纯色(同色=同身份);长视频以链式窗口生成、每窗以上一窗清理后的尾部为条件,短续训教模型延展给定着色,身份便无需跟踪器/运动模型/重识别模块地沿链流动。 实验效果:DanceTrack 测试榜上达 40.3 HOTA(据称首个上榜且无检测器/无跟踪栈的生成式跟踪器),虽低于专用 SOTA(≥70),但误差画像独特——关联分 AssA 44.1 超原基准全部跟踪器,短板仅在检测;同样生成窗改用经典事后关联得分差一倍(18.2 HOTA);383 个遮挡事件中以 42% 条件率在间隙后重获身份(外观嵌入基线为 0),表明其着色是涌现的重识别信号。 批判点评:「让生成器用像素维护身份」把 MOT 重构为着色生成,关联能力与遮挡重识别的涌现很惊艳、思路极具启发。但 40.3 HOTA 距实用尚远(检测是硬短板)、依赖 22B 大模型链式生成成本高、极密集/快速场景下的可扩展性仍是问题,更像范式验证而非即用方案。 8. Keyframe-Anchored:序列动作视频的身份保持 Keyframe-Anchored Identity Preservation for Sequential-Action Video Generation | 中科大 | arXiv:2607.17985 关键词:身份保持,文生视频,关键帧,序列动作,免训练 前序问题:保身份的文生视频要在整段视频中维持指定主体可识别性;IPVG26 挑战把它从单一整体提示扩展到带时间戳的动作序列——主体须按序完成一串不同动作且身份一致,而端到端生成器随运动累积易外观漂移。 本文贡献:提出免训练三阶段流水线:动作感知提示润色阶段先把输入改写为指定每个动作终态的图像生成提示;保身份生成阶段以参考身份与前一帧联合条件产出关键帧序列,从而解耦时不变外观与时变姿态;身份感知推理增强阶段用多参考引导与身份驱动噪声搜索合成中间片段,双重强化采样期身份保真。 实验效果:在 IPVG26 官方 Track 2 榜排名第三,展现有竞争力的性能与较强通用性。 批判点评:用「关键帧锚定+解耦外观与姿态」免训练做序列动作身份保持,工程组合清晰、竞赛第三也证明有效。但依赖关键帧质量与多阶段拼接,中间片段合成的动作流畅、长序列多动作下的累积漂移,以及免训练相对专门训练方法的天花板仍待观察。 9. BSB:时序一致性越狱商用T2V Between Safe Boundaries: Exploiting Temporal Consistency for Jailbreaking Text-To-Video Generation Models | 中科大 | arXiv:2607.17279 关键词:文生视频,越狱攻击,时序一致性,MCTS,AI安全 前序问题:文生视频(T2V)模型广泛部署,其对越狱攻击的鲁棒性引发担忧;现有方法多从文生图迁移,未利用视频固有的时序一致性、需大量视频查询优化(黑盒不可行)、且对抗提示搜索靠启发式局部信号缺结构化探索。 本文贡献:提出结构化、查询高效的 T2V 越狱框架 BSB:利用时序一致性,把有害意图编码为两个各自无害的「边界状态」之间的转变,攻击那些插值时易在中间帧产生不安全内容的边界状态对;为避免在视频空间直接评估所有候选的高昂开销,BSB 在更廉价的文本代理空间做蒙特卡洛树搜索(MCTS),并用稀疏视频级评估定期校准。 实验效果:在 Veo 3.1、Sora 2、Seedance、Kling v1 等主流商用 T2V 上,BSB 超越所有现有越狱基线,攻击成功率较最强对手平均相对提升 18.6%;揭示时序一致性是被忽视却关键的攻击面。 批判点评:把「时序一致性」从能力变成攻击面、用文本代理空间 MCTS 做查询高效黑盒越狱,视角新颖且对主流商用模型有效,安全警示意义大。但作为攻击方法需警惕滥用、防御侧的对应缓解未深入,攻击在持续迭代的商用安全策略下的长期有效性也存疑。 10. Full-Song:分层自回归+流匹配全曲生成 Pushing the Frontier of Full-Song Generation: Hierarchical Autoregressive Planning Meets Flow-Matching Rendering | 阿里(Token Foundry) | arXiv:2607.20253 关键词:歌曲生成,自回归,流匹配,RVQ,翻唱 前序问题:从歌词、文本描述与音乐属性生成高质量全长歌曲仍具挑战,且需统一支持词到歌、纯器乐、翻唱等多任务。 本文贡献:提出统一歌曲生成框架,支持歌词到歌、器乐生成、翻唱三任务:语义感知分词器把音频编码为 8 码本 RVQ token;hybird-LM 在其上做分层自回归音频 token 建模生成全曲;FullDiT 在连续 VAE 潜空间以码本 token/歌词/文本为条件做全曲流匹配以提升保真;翻唱用旋律模块从参考音频抽取并离散化旋律线索、在保留原旋律的同时引导生成;并探索 DPO/GRPO/OPD 做 hybird-LM 后训练、对 FullDiT 用基于流的 GRPO 提升音乐性与渲染质量。 实验效果:在多语种自动基准与 Artificial Analysis 带人声音乐榜上,框架在所评设置下取得有竞争力的表现。 批判点评:「分层自回归规划+流匹配渲染」的双阶段设计兼顾结构与音质、还统一了词到歌/器乐/翻唱三任务(阿里出品),工程完整。但全曲生成对长程结构、人声吐字与音乐性要求极高,多任务统一下各子任务的上限、翻唱的版权与旋律保真边界,以及主观音乐性的稳定性仍需更多盲测检验。 趋势观察 世界模型冲进消费级实时 — ABot-World-0 单张 RTX5090 跑 720P/16FPS 实时交互世界、AlayaWorld 15B 开源长时程世界模型,交互式世界模型正从云端走向桌面单卡。 高效小模型吃下生成与编辑 — 微软 Mage-Flow 用 4B 栈把 1024² 生成压到 0.59s、编辑 1.02s,'紧凑协同设计'让高分辨率生成编辑走向交互实用。 少步/免训练把视频推向实时 — OSVE 首次让单步 T2I 做视频编辑快 155~171 倍、HeadCast 免训练按注意力头分类加速 AR 视频,效率优化在编辑与长视频两端并进。 视频生成能力外溢到感知与叙事 — '生成器即跟踪器'用视频生成做多目标跟踪、ShotPlan 用规划 token 做多镜头电影级叙事,生成模型的能力正外溢到跟踪、导演等新任务。 生成的可信与安全被正面拷问 — BSB 用时序一致性越狱主流商用 T2V(攻击成功率相对+18.6%),揭示视频生成安全的新攻击面,安全治理需跟上能力跃迁。 人工智能炼丹君 整理 | 2026-07-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-22|华为40万美元逼近闭源Boogu-Image 今日 AIGC 论文速览 今日共 10 篇 · 统一图像生成与编辑 2 篇 · 视频编辑与长视频一致性 5 篇 · 视频插帧与生成效率 1 篇 · 情绪语音生成 1 篇 · 像素扩散技术综述 1 篇 重点论文标题列表 Boogu-Image-0.1(华为香港AI Lab·港大·港科大):40万美元逼近闭源图像模型 D2DF(西交·国家电网AI Lab·浙工大·百度):视频消物一秒只需一步 SlotMem(港大·清华):按角色寻址记住长片人物 ReBind(快手可灵·港科大·南大·北大):显式绑定多参考视频编辑 FlowMimic(字节):图片编辑数据实时变视频 今日论文速览 1. Boogu-Image-0.1:40万美元逼近闭源图像模型 Boogu-Image-0.1: Boosting Open Agentic Multimodal Generation via Understanding under a Minimal Budget | 华为香港AI Lab·港大·港科大 | arXiv:2607.13125 关键词:统一多模态,文生图,图像编辑,Agent推理,开源模型 前序问题:Nano-Banana-Pro、GPT-Image-2 等闭源系统靠模型理解、提示改写与推理时编排形成系统级优势,但内部配方不公开;开源社区如何在有限数据和算力下同时做好文生图、快速推理、指令编辑和中英文字渲染,缺少可复现路线。 本文贡献:发布 Boogu-Image-0.1 开源统一理解生成模型族,含 Base、Turbo、Edit、Edit-Turbo。核心不是只堆生成骨干,而是强化多模态编码器、Agent 式提示重写、数据质量和训练管线,并用 Agentic inference-time scaling 把理解能力转成生成与编辑质量;权重、代码和训练配方均以 Apache 2.0 开源。 实验效果:仅使用 2.0862 亿张去重图像,Base 理论训练成本约 40 万美元;标准基准上持续匹敌或超过其他开源模型,结果逼近领先闭源系统,并覆盖高质量文生图、快速推理、指令编辑和中英文字渲染。 批判点评:「华为团队用 40 万美元把开源模型推近闭源系统」兼具机构信号与成本冲击力,且把系统级配方完整开放,比单点榜单更有价值。但“理论训练成本”未必包含数据、失败实验与基础设施总成本;逼近闭源的结论也依赖所选基准,真实复杂编辑和生产稳定性仍需社区复验。 2. D2DF:视频消物一秒只需一步 From Draft to Draft-Free: One-Step Video Object Removal via Privileged Distillation and Fast Planting | 西交·国家电网AI Lab·浙工大·百度 | arXiv:2607.14976 关键词:视频编辑,物体移除,一步生成,一致性蒸馏,视频修复 前序问题:视频物体移除中,光流/注意力传统方法容易留伪影、结果不自然;扩散方法更真实却需要多步去噪,速度难以实用,而且常依赖外部粗糙移除稿作为输入。 本文贡献:提出 D2DF 三阶段框架:先训练教师把低质移除草稿多步精修成高保真视频;再用先验特权一致性蒸馏(PPCD)将能力压到一步学生;最后以基于时序掩码 Transformer 的自引导快速植入(SGFP),在潜空间自动生成场景一致伪草稿,得到完全不依赖外部草稿的一步模型。 实验效果:有草稿和无草稿两版在多项指标上均达 SOTA,质量与效率超过传统及多步生成方法;单个视频的去噪过程约 1 秒。 批判点评:从“多步精修草稿”蒸馏到“无草稿一步消物”,既解决速度又去掉外部依赖,1 秒数字极具产品价值。但 SGFP 伪草稿的场景推断仍可能在大面积遮挡、复杂动态背景中失真,一步模型的失败可修复性也弱于多步迭代。 3. SlotMem:按角色寻址记住长片人物 SlotMem: Character-Addressable Internal Memory for Narrative Long Video Generation | 港大·清华 | arXiv:2607.15772 关键词:长视频生成,角色一致性,内部记忆,DiT,叙事视频 前序问题:叙事长视频中角色跨场景、隔很久再出现时容易换脸。全局记忆的检索线索并不针对身份,现有角色方法又把身份和姿态、背景等偶然因素混在粗粒度帧级 KV 中,有限容量下还缺少持续更新。 本文贡献:提出可按角色寻址的内部记忆 SlotMem:Character-Semantic Probe 从交叉注意力中定位角色相关 token;Memory Encoder 把 DiT token 压成紧凑的逐角色 slot;Memory Writer 随生成保守更新每个角色的新观察;Character-Wise Cross-Attention 只把对应角色记忆注入同一人物的局部 token。 实验效果:在多个叙事长视频基准上,相比现有方法显著改善跨长时间间隔的角色一致性,同时维持相当的视频总体质量;代码已开源。 批判点评:把“记住整帧”改成“按角色地址读写”,对多角色长片身份漂移非常对症,内存也更省。但角色探针一旦漏检或多人遮挡、换装,错误可能写回并长期污染;如何处理新角色、身份合并与开放世界角色数量仍是难点。 4. ReBind:显式绑定多参考视频编辑 ReBind: Multi-Reference Video Editing via Structured Instructions with Explicit Reference Relationships | 快手可灵·港科大·南大·北大 | arXiv:2607.14681 关键词:视频编辑,多参考,结构化指令,可灵,视觉绑定 前序问题:多参考图条件视频编辑需要明确“哪个参考提供哪个属性”,但自然语言指令通常不写清参考关系,通用 MLLM 也难稳定生成,导致人物、材质、灯光等来源互相串线。 本文贡献:提出 ReBind,以在语义位置嵌入 reference token 的结构化指令作为中间表示,显式绑定视觉属性与来源。ReBind-Instruct 通过两阶段渐进训练学习生成精确参考关系;ReBind-Edit 则轻量适配文生视频模型,按绑定关系协调多个参考源。 实验效果:ReBind-Instruct 的指令质量显著超过通用 MLLM;ReBind-Edit 在参考图条件视频编辑中达到开源方法 SOTA,能更准确组合多视觉来源。 批判点评:把多参考歧义从“模型自己猜”变成结构化显式绑定,是复杂编辑走向可控生产的关键一步,可灵团队也有真实产品场景。但需要专用 MLLM 先生成中间指令,链路更长;参考关系正确不代表遮挡、几何和时间一致性一定正确。 5. FlowMimic:图片编辑数据实时变视频 FlowMimic: Mask-free Visual Editing and Generation with Pixel-pair Warped Flow Field for Online Video Editing Data Generation and Modality Mimicry | 字节 | arXiv:2607.18227 关键词:视频编辑,数据生成,光流,图像视频统一,免Mask 前序问题:视频编辑数据采集依赖人工 mask、I2V/ControlNet 合成和 VLM 过滤,不仅耗时、易引错,任务多样性也远落后图像编辑;推理时还常需外部 MLLM 或显式 mask 才能定位编辑区域。 本文贡献:提出像素对时序扭曲流场,可从图像编辑样本实时生成对应视频编辑样本,并证明仅用这类数据即可学习多层级视频编辑。将图像视作视频特例,以生成/编辑两种 modality mimic loss 让图像与视频能力互相模仿;再加入指代表达分割等感知任务和区域感知潜空间、注意力损失,让模型内化“理解指令—定位区域—只改该处”的能力。 实验效果:无需人工视频 mask 与传统重型合成管线,即可在线扩展多种视频编辑任务;同一模型统一图像/视频生成与编辑,并实现推理期免 mask 的区域感知编辑。 批判点评:把海量图像编辑数据通过流场实时“升格”为视频数据,直击视频编辑数据荒,字节背景也说明工程价值。但扭曲流场能模拟的运动与遮挡仍有限,由图像任务迁移出的时序规律未必覆盖真实长视频和复杂镜头运动。 6. STBridge:让模型说的和画的一致 STBridge: Shared-Target Alignment for Bridging Understanding and Generation in UMMs | 腾讯优图·吉林大学 | arXiv:2607.17140 关键词:统一多模态,理解生成对齐,图像编辑,强化学习,腾讯优图 前序问题:统一多模态模型虽然共用架构,却可能正确描述目标、实际编辑出另一回事;语言输出与视觉输出分居不同空间,在细粒度实体、属性、空间关系和局部细节上尤其缺乏同一目标约束。 本文贡献:提出共享目标对齐 STBridge:在图像编辑中,让目标 caption 表达期望视觉结果、编辑图像实现同一结果,以共同目标状态串起理解和生成。训练采用 align-then-optimize:先监督微调建立共享目标通道,再以序列强化学习优化围绕目标的跨任务协同。 实验效果:在视觉理解、图像生成和图像编辑基准上均持续优于初始化模型;对齐分析确认“模型描述的目标”和“模型生成的结果”之间差距明显缩小。 批判点评:指出“共架构不等于共语义”,并用共享目标把说与画绑在一起,是统一模型后训练的重要方向。但依赖高质量目标 caption 和顺序 RL,目标文本可能成为新的信息瓶颈;复杂视觉变化也未必能被一句 caption 完整表达。 7. TANGO:测试时绕开长视频死路 Test-Time Noise Guided Adaptation for Realistic Autoregressive Video Generation | CERTH·阿姆斯特丹大学 | arXiv:2607.15849 关键词:自回归视频,测试时适配,长视频,噪声引导,FVD 前序问题:自回归视频扩散可生成任意长视频,却会累积误差并逐渐偏离训练条件分布;即使每帧看起来都在真实流形上,某些轨迹也可能走到模型无法继续的“终点”,后续必然崩坏。 本文贡献:提出测试时终点规避 TANGO:假设可良好延续的未来轨迹,其预测噪声应匹配前向加噪的各向同性高斯分布。模型先向前预测一步,用自身充当输出批评器;一旦预测噪声偏离期望分布,就搜索替代轨迹,避免驶入终点,无需重新训练骨干。 实验效果:相对 SOTA,VBench 绝对提升 3.1%,15 秒视频上的平均 FVD 降低 28.3%;代码已开放。 批判点评:让扩散模型用噪声分布自检未来能不能走通,比只把当前帧拉回真实流形更深入,测试时即可插入。但前瞻搜索增加推理开销,各向同性噪声假设未必适合所有内容,且只能绕路、不能补足模型缺失的动态知识。 8. SPEED:一步像素扩散插帧快63% SPEED: One-Step Pixel Diffusion for High-quality Video Frame Interpolation | ACM MM 2026·复旦·B站 | arXiv:2607.15585 关键词:视频插帧,像素扩散,一步生成,4K,ACM MM 前序问题:扩散视频插帧有两大瓶颈:潜空间经 VAE 解码不可避免丢失细节,多步采样又带来高显存与高延迟;尤其 4K 插帧中,精细纹理与效率难兼得。 本文贡献:提出一步像素扩散 SPEED:渐进多阶段架构配动态 patch 缩放,学习多尺度运动、结构和外观;Noise-Update-Only Attention 只更新噪声、保护干净条件帧语义并把计算降近 50%;漂移感知时间步采样与定制目标直接在像素空间预测图像,实现不降质的一步推理。 实验效果:SNU-FILM 上 LPIPS 降低 8.8%,推理加快 63.3%、显存降低 10.6%;在高难 4K 基准上 LPIPS 最多优于先前方法 51.5%,达到 SOTA。 批判点评:一步、像素空间、4K 三个难点同时拿下,复旦+B站且获 ACM MM 2026,数字很硬。但像素扩散训练成本可能转移到离线阶段,动态 patch 与多阶段结构更复杂;插帧 SOTA 不等同于通用视频生成可直接受益。 9. AuEmoChat:离散情绪token让对话更真 AuEmoChat: Authentic Emotion Understanding and Rendering for Conversational Speech Synthesis | ACM MM 2026·内蒙古大学·港中文深圳 | arXiv:2607.15755 关键词:对话语音合成,情绪生成,Flow Matching,Token合并,TTS 前序问题:对话语音合成要理解多轮上下文并表现像人的细腻情绪,但现有方法常把情绪压成七类等有限标签;同时历史中的冗余多模态 token 干扰上下文理解,导致声音情感僵硬或前后不一致。 本文贡献:提出 AuEmoChat:AuEmoCodec 用有限标量量化从大规模情绪语音学习离散真实情绪 token 空间;AuEmoToMe 在保留情绪相关上下文的同时合并冗余多轮 token;自回归文本-语音模型预测目标情绪与语音 token,最后用 Authentic Emotion Flow Matching 联合对话上下文、情绪和声学先验渲染语音。 实验效果:在 NCSSD-EmCap 上超过 SOTA 对话语音合成基线,生成语音的情绪表达更丰富、更真实;代码与语音演示计划开放。 批判点评:从少数人工情绪标签转向数据驱动的离散情绪空间,并同时处理多轮冗余,贴近真实对话产品。但“真实情绪”评价主观且受数据文化偏差影响,离散 token 也可能把连续情绪重新切碎;跨语言、跨说话人泛化仍是关键。 10. Pixel-Space DiT:像素DiT绕开VAE细节瓶颈 Pixel-Space Diffusion Transformers | 北大·Stanford·Cornell·南大 | arXiv:2607.17585 关键词:像素扩散,DiT,VAE,生成综述,统一多模态 前序问题:潜扩散靠 VAE 压缩实现高效高分辨率生成,但固定视觉 tokenizer 会丢纹理和结构细节,重建目标与生成目标分离也限制端到端优化;直接像素扩散则面临高维建模、噪声调度、损失加权和 token 效率难题。 本文贡献:系统综述 Pixel-Space Diffusion Transformer,从模型架构、连续生成机制和统一多模态建模三条线梳理直接在原始像素上扩散的方法,讨论如何去掉 VAE 瓶颈,并让像素、文本与任务条件进入共享 token 空间由同一 Transformer 处理。 实验效果:归纳当前像素 DiT 的代表方法、核心挑战与技术路线,指出其在高保真单阶段生成及理解生成一体化视觉基座上的潜力,并给出未来研究方向。 批判点评:像素空间正在重新成为生成主线,这篇综述适合建立全景认知;但它不是新算法、没有单一实验突破,且像素 DiT 的巨大训练成本与 token 数仍是现实约束,应放在今日列表末尾而非主推。 趋势观察 开源图像模型开始公开系统级配方 — Boogu-Image 不只开权重,还公开强编码器、Agent 提示改写、数据与训练管线,以约 40 万美元理论成本逼近闭源系统,竞争从单模型走向完整生成系统。 视频编辑同时冲刺一步化与免标注数据 — D2DF 把视频消物压到一步约 1 秒,FlowMimic 则把图像编辑样本实时变成视频数据;一个砍推理成本,一个砍数据成本。 长视频从全局缓存转向结构化记忆与自检 — SlotMem 按角色地址读写身份记忆,TANGO 在测试时用预测噪声自检轨迹死路,长视频一致性开始从粗粒度历史帧走向可解释内部状态。 复杂编辑把视觉来源和目标语义显式绑定 — ReBind 用 reference token 绑定多参考来源,STBridge 用共享目标绑定模型说的与画的,可控编辑正在减少让模型自行猜测的隐式接口。 生成底座向像素空间与真实情绪扩展 — SPEED 以一步像素扩散实现 4K 插帧,Pixel-Space DiT 总结绕开 VAE 的技术路线;AuEmoChat 则把生成边界扩到多轮对话中的细腻情绪语音。 人工智能炼丹君 整理 | 2026-07-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-02|快手可灵MemLearner可学习记忆视频世界模型 今日 AIGC 论文速览 今日共 9 篇 · 视频世界模型与人像动画 2 篇 · 图像生成与编辑 3 篇 · 蒸馏加速与模型压缩 2 篇 · 语音合成与生成媒体 2 篇 重点论文标题列表 MemLearner(港大·快手可灵):可学习记忆查询的视频世界模型 WarpI2I(卡内基梅隆):显著区warp保结构做图像翻译 MEPA(西电·华为):VAR配MoE解耦多尺度表征 Cross-Space Distillation(VinAI·罗格斯):跨潜空间蒸馏一步学生 SyncCache(北大·上海AILab·vivo):音频驱动人像动画缓存加速 今日论文速览 1. MemLearner:可学习记忆查询的视频世界模型 MemLearner: Learning to Query Context Memory for Video World Models | 港大·快手可灵 | arXiv:2606.31734 关键词:视频世界模型,记忆,上下文查询,一致性,交互生成 前序问题:视频世界模型据用户动作与历史帧预测未来世界状态,但缺乏记忆导致长时生成场景不一致;此前基于规则的上下文帧检索在遮挡与动态物体场景下泛化差。 本文贡献:提出基于学习的自适应上下文查询 MemLearner:用 query token 桥接上下文与预测 token,直接借视频生成模型自身做上下文查询,复用预训练视觉先验、无需从零训额外模块,并含高效训练/推理策略。收集含遮挡与动态物体的长视频数据集(带相机位姿标注),提出兼用带标注渲染与无标注真实视频的多数据集训练策略。 实验效果:在场景一致性与记忆上显著超过此前视频世界模型,尤其在遮挡与动态挑战场景下优势明显。 批判点评:把「记忆检索」从规则升级为可学习查询、且复用生成模型自身先验,是对世界模型长程一致性痛点的对症之解,有快手可灵背景更接近落地。但仍依赖带位姿标注数据构建、查询机制在超长时程下的累积漂移,以及对开放世界更复杂交互的泛化仍待检验。 2. WarpI2I:显著区warp保结构做图像翻译 WarpI2I: Image Warping for Image-to-Image Translation | 卡内基梅隆 | arXiv:2606.31018 关键词:图像翻译,重打光,显著性,图像warp,扩散模型 前序问题:图像到图像(I2I)翻译在人像重打光、驾驶场景翻译等任务上已见成效,但紧凑型潜在扩散模型(LDM)的编码器把高分辨率输入压到空间下采样的潜空间,常难保细粒度结构。 本文贡献:提出简单的显著性引导 warp-unwarp 框架:编码前把空间表征向显著区域重分配(warp),在不提高潜空间分辨率的前提下更好保留结构细节;warp 后的图像交给原扩散模型处理,再经逆 warp 映回。另配一个基于 outpainting 的高效合成数据生成管线,为图像重打光产出高质量配对数据。方法与模型无关、无需改架构、几乎零额外算力。 实验效果:在人像重打光、驾驶场景重打光与翻译上,结构保持、光照忠实度与画质均提升;逐帧应用即可自然扩展到视频且时序稳定性好。 批判点评:「warp 到显著区再 unwarp」用几乎零成本换取结构保真,即插即用、跨模型通用,工程性价比高。但显著性估计的质量直接决定收益,非均匀形变对非显著区/大范围全局变化可能引入损失,视频靠逐帧应用而非原生时序建模也限制了强运动场景。 3. MEPA:VAR配MoE解耦多尺度表征 MEPA: Multi-Scale Representation Alignment for Visual Autoregressive Modeling with Mixture of Experts | 西电·华为 | arXiv:2607.00371 关键词:视觉自回归,MoE,多尺度,ImageNet,自监督 前序问题:视觉自回归(VAR)开创由粗到细的多尺度自回归生成,但多尺度表征学习存在固有缺陷:低尺度主要捕全局语义、高尺度关注细节,跨尺度共享架构引发优化冲突;且因果自回归下早期尺度的错误语义会传播并显著劣化最终输出。 本文贡献:提出尺度感知 token 路由的 MoE 架构,允许按尺度自适应选专家、解耦各尺度表征学习;并用外部自监督特征增强早期尺度语义建模——非朴素对齐,而是为 VAR 范式设计残差特征聚合方案。 实验效果:ImageNet 256² 上,仅用默认一半训练轮次、更小参数预算即取得优于稠密基线的 FID,训练成本仅微增;随训练轮次增大差距进一步拉开。 批判点评:用 MoE 按尺度分工+自监督特征补早期语义,精准对症 VAR 的跨尺度冲突与误差传播,训练效率提升实在。但 MoE 带来路由与部署复杂度,「一半轮次超稠密」的优势在更大规模/更高分辨率与文生图场景能否延续仍待验证。 4. Cross-Space Distillation:跨潜空间蒸馏一步学生 Cross-Space Distillation: Teaching One-Step Students with Modern Diffusion Teachers | VinAI·罗格斯 | arXiv:2606.32020 关键词:扩散蒸馏,一步生成,跨潜空间,SD1.5,部署 前序问题:现代一步扩散靠基于分布的时间步蒸馏获高质量,却依赖「师生须同一潜空间」这一关键假设,阻止把 SD3.5/Flux 等高容量老师的知识迁到潜分辨率与 VAE 参数化都不同的紧凑学生(如 SD1.5)。 本文贡献:形式化提出 Cross-Space Distillation(师生在潜分辨率与 VAE 空间双双不同),并引入 Bridge——轻量潜空间接口,把学生潜变量映到老师空间而不改学生骨干:以冻结的学生 VAE 解码器作空间先验+紧凑可学习投影器,用潜重建与注意力保真目标训练以稳定对齐老师空间(ECCV 2026)。 实验效果:跨多种现代老师,Bridge 为紧凑一步学生带来显著增益——如把 SD1.5 从 5.4 提升到 9.4 HPSv3,同时保持一步推理、低延迟与广泛生态兼容。 批判点评:打破「师生同空间」限制、用轻量桥接把大老师蒸进小学生,兼顾部署友好与生态兼容,思路清晰、增益明显。但 Bridge 仍需针对师生对训练,跨差异极大的 VAE/分辨率时对齐质量、以及一步学生画质上限能否逼近老师仍是问题。 5. SyncCache:音频驱动人像动画缓存加速 SyncCache: Exploiting Asymmetric Dynamics for Fast Audio-Driven Portrait Animation | 北大·上海AILab·vivo | arXiv:2606.30849 关键词:人像动画,音频驱动,特征缓存,推理加速,唇同步 前序问题:DiT 大幅推进音频驱动人像动画,但算力高、推理延迟大;现有免训练扩散缓存多为文本条件生成设计,忽视人像动画固有的空间与模态不均衡。 本文贡献:提出免训练、面向 DiT 人像动画的缓存加速 SyncCache,显式利用「非对称动态」:音频驱动、集中在人物区域的高频动态比低频视觉背景更难也更关键。用空间非对称探测优先关注动态人区的误差敏感度;用模态解耦缓存跳过重 DiT 块(复用稳定的块间残差)、同时持续重算轻量音频块以保精确唇同步;并把内存自适应缓存选择建模为离线动态规划、无在线开销。 实验效果:在 HunyuanVideo-Avatar 上达 4.12×、Wan-S2V 上 3.75× 加速,视觉近无损且音频对齐精确。 批判点评:抓住「音频高频动态集中在人脸」这一非对称结构做差异化缓存,唇同步与背景分而治之很聪明,加速比可观。但方法针对人像动画定制、跨其他音驱视频任务的通用性有限,缓存比与画质/唇同步的权衡在极端表情/快速语音下仍需验证。 6. AnyBokeh:物理引导任意到任意虚化编辑 AnyBokeh: Physics-Guided Any-to-Any Bokeh Editing with Optical Fingerprint Transfer | 南洋理工 | arXiv:2606.31959 关键词:虚化编辑,景深,物理引导,弥散圆,图像编辑 前序问题:景深控制是摄影基本工具,但单图拍后虚化(bokeh)编辑仍难;现有方法多假设全对焦输入、或先复原全对焦再渲染,会丢弃源图模糊线索并把复原伪影传到最终结果。 本文贡献:提出物理引导的任意到任意虚化编辑 AnyBokeh:不把源模糊当退化去除,而用带符号弥散圆(CoC)图与视差图估计源模糊状态;通过建模「带符号 CoC 与视差差」的线性关系估计源专属「光学指纹」,把源光学特性迁到目标对焦与光圈设置;生成式编辑器以源/目标 CoC 图为条件做相对模糊合成,实现空间自适应的去模糊、保持与散焦渲染。还构建了带精确深度/对焦距离/完整 EXIF 的高保真合成数据集。 实验效果:真实基准上在任意到任意虚化、全对焦到虚化、散焦去模糊上均忠实可控,且免去现有方法常需的全对焦复原与测试时虚化级标定。 批判点评:用「光学指纹+带符号 CoC」把虚化编辑建在物理量上,避开全对焦复原的伪影链,泛化性与可控性都更好。但依赖对 CoC/视差的准确估计,真实复杂场景(多层景深、透明/高光)下物理假设是否成立、合成到真实的域差仍需关注。 7. VitalityCompress:图像到3D扩散模型压缩 Vitality-Aware Compression for Efficient Image-to-Shape Diffusion Transformers | KRAFTON | arXiv:2607.00382 关键词:3D生成,图像到形状,模型压缩,剪枝量化,DiT 前序问题:3D 形状生成进展显著,但大型 DiT 模型在资源受限场景算力过高;其他域的扩散压缩策略难直接迁到 3D,此前 3D 效率工作又多聚焦推理速度而非骨干压缩。 本文贡献:提出首个面向图像到形状(image-to-shape)DiT 的压缩框架:基于「3D DiT 各层对几何合成重要性非均匀」的观察,构建几何感知、以「活力(vitality)」为引导的框架,融合结构化剪枝、自适应量化与定向微调。 实验效果:在多个 SOTA 图像到 3D 模型上实现最高 66% 模型体积缩减,同时保持与全尺寸相当的合成保真度,可作即插即用的高效 3D 生成方案。 批判点评:把「层重要性非均匀」用于几何感知压缩、剪枝+量化+微调三管齐下,填补 3D 骨干压缩空白,通用性不错。但 66% 缩减下几何细节(薄结构/高频表面)的保真边界、量化实际加速高度依赖硬件/kernel,跨更多 3D 表示的迁移仍待看。 8. UniGuidance-FM:统一引导框架加速语音合成 Enhancing Flow Matching with A Unified Guidance Framework for Efficient and Robust Speech Synthesis | 作业帮 | arXiv:2607.00363 关键词:语音合成,流匹配,推理加速,音色泄漏,TTS 前序问题:流匹配(FM)已成语音生成的强范式,但受高推理延迟与音色泄漏制约。 本文贡献:提出统一引导框架,用两条互补策略提升效率与鲁棒:数据侧用异构增强的 Data-guidance 促使模型解耦语言内容与声学残留;模型侧提出增强的 Model-guidance,协同轨迹校正与新颖的内在引导目标,把条件知识蒸进网络权重、拉直推理轨迹,从而免去 Classifier-Free Guidance(CFG)开销。 实验效果:推理提速近 3 倍,同时较 SOTA 基线有效提升说话人相似度(VC 与 TTS 均评)。 批判点评:把「数据解耦+模型内在引导」统一起来同时治延迟与音色泄漏、还省掉 CFG,思路简洁有效、提速实在。但内在引导蒸掉 CFG 后对强可控性/多样性的影响、音色泄漏在跨语言或极端音色下是否彻底解决仍需更多主观评测。 9. Vertigo Vertigo:AI逐场景重构希区柯克名片 Vertigo Vertigo: Reconstructing a Cinematic Ideal through its Predictive AI Double | 伦敦艺术大学 | arXiv:2607.00047 关键词:视频生成,关键帧插值,电影重构,潜先验,生成媒体 前序问题:生成式媒体与经典电影的关系是「范式转变」还是「同一逻辑的加速」?缺乏可量化的探针。 本文贡献:Vertigo Vertigo 用仅 2.78% 原片帧作稀疏关键帧锚点,经大型视频扩散模型做首末帧插值,逐场景重构希区柯克《迷魂记》(1958);把这部「关于强迫性重构人造理想」的电影本身当探针,检验生成系统里编码的经典电影规范(入选 Ars Electronica EXPANDED 2026)。 实验效果:经计算分析与媒体理论学者(Manovich 等)评述,73.1% 的帧可辨认为《迷魂记》的合理再现、仅 3.6% 灾难性失败,表明电影规范被深度压缩进模型潜先验;成片以原片与其「预测影子」的不稳定叠影呈现。 批判点评:把「用 2.78% 帧重构整部经典」做成对生成模型潜先验的文化探针,视角新颖、跨艺术与技术,量化保真数字也有说服力。但本质是艺术/媒体理论作品而非方法创新,'可辨认率'的主观评判、以及结论对不同影片/模型的普适性都有限。 趋势观察 视频世界模型死磕长程一致性 — MemLearner 用可学习记忆查询解决遮挡/动态下的场景漂移,记忆机制成为交互式视频世界模型的核心命题,快手可灵已在推动落地。 用低成本改造换生成保真 — WarpI2I 用显著区 warp 几乎零成本保结构、AnyBokeh 以光学指纹免全对焦复原,'不改架构/不加算力'的即插即用增强成潮流。 加速从缓存到跨空间蒸馏多线并进 — SyncCache 差异化缓存(4.12×)、Cross-Space 把大老师蒸进 SD1.5、UniGuidance-FM 省掉 CFG 提速 3×,效率优化在训练/推理/蒸馏全线展开。 自回归与MoE联手提升生成效率 — MEPA 给 VAR 配尺度感知 MoE,半数训练轮次即超稠密基线,稀疏化正成为提升生成模型训练效率的抓手。 生成扩到3D与文化再创作 — VitalityCompress 压缩图像到 3D 扩散模型(-66%),Vertigo Vertigo 用视频扩散重构经典电影,生成的边界向 3D 与媒体艺术延伸。 人工智能炼丹君 整理 | 2026-07-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-29|清华LiveEdit实时流式视频编辑12.66FPS 今日 AIGC 论文速览 今日共 9 篇 · 视频编辑与生成 3 篇 · 自回归图像生成 2 篇 · 推理加速与压缩 2 篇 · 生成质量与评测 2 篇 重点论文标题列表 LiveEdit(清华·港科大):实时流式视频编辑12.66FPS Causal-rCM(清华·UT Austin·NVIDIA):统一TF+SF自回归扩散蒸馏 PRA(北京大学·深势科技):像素自回归生成新SOTA TMP(腾讯混元):剪枝把80B图像模型塞进4090 LearniBridge(清华(深圳)):可学习特征缓存加速扩散 今日论文速览 1. LiveEdit:实时流式视频编辑12.66FPS LiveEdit: Towards Real-Time Diffusion-Based Streaming Video Editing | 清华·港科大 | arXiv:2606.26740 关键词:视频编辑,流式生成,实时,蒸馏,缓存 前序问题:流式视频编辑落地受两大瓶颈制约:跨时间维持背景与非编辑区稳定,以及实时交互所需的低延迟;而现有流式视频生成方法多为合成设计,因严格保真与区域控制要求无法直接用于编辑。 本文贡献:提出新型流式视频编辑框架,做因果、逐帧编辑且强内容保持、实时响应。核心是三阶段蒸馏管线,把强双向基础模型的编辑能力渐进迁移到高效单向流式编辑器,实现稳定长程编辑而不牺牲画质;并引入面向自回归的 mask cache 跨帧复用区域相关计算,减少冗余、加速推理;还建立了专门的流式视频编辑基准。 实验效果:在流式基线中达到 SOTA 画质,同时把推理速度大幅提升到 12.66 FPS,适配交互与 AR 场景。 批判点评:用「双向→单向」三阶段蒸馏+mask cache 把视频编辑推到实时(12.66FPS),方向价值高、还补齐了流式视频编辑基准空白。但 12.66FPS 距真正流畅交互仍有差距,逐帧因果编辑对快速运动/大幅编辑的长程一致性、以及对复杂编辑指令的上限仍需更多验证。 2. Causal-rCM:统一TF+SF自回归扩散蒸馏 Causal-rCM: A Unified Teacher-Forcing and Self-Forcing Open Recipe for Autoregressive Diffusion Distillation in Streaming Video Generation and Interactive World Models | 清华·UT Austin·NVIDIA | arXiv:2606.25473 关键词:视频生成,自回归扩散,蒸馏,世界模型,一致性模型 前序问题:因果扩散 Transformer 的自回归视频扩散已成实时流式生成与动作可控交互世界模型的主流,但其蒸馏配方缺乏统一、可扩展的开源方案。 本文贡献:把先进蒸馏框架 rCM 扩展到自回归视频扩散,利用前向/反向散度互补——teacher-forcing(TF)对应离线前向散度因果训练、self-forcing(SF)对应在线反向散度精修。贡献含:(1)证明 TF 一致性模型是 SF-DMD 的最佳初始化补充;(2)首次为自回归视频扩散实现连续时间 TF 一致性模型(sCM/MeanFlow),靠自定义 mask FlashAttention-2 JVP kernel 实现,收敛比离散时间快 10×;(3)推出统一可扩展的算法-基建开源配方 Causal-rCM;(4)仅用合成数据训练即在逐帧/分块流式生成上达 SOTA。 实验效果:蒸馏后的 2 步因果 Wan2.1-1.3B 仅 1-2 采样步即得 VBench-T2V 84.63;并应用于全模态世界基础模型 Cosmos 3,实现动作可控的交互世界模型。 批判点评:把 rCM 的「前向×反向散度互补」干净地迁到自回归设定,10× 收敛+全开源配方含金量高,世界模型落地也实在。但收益依赖既有 rCM/DMD 体系与定制 kernel 工程,仅用合成数据训练在真实分布上的泛化、以及 1.3B 规模外的可扩展性仍待看。 3. PRA:像素自回归生成新SOTA Parallel Rollout Approximation for Pixel-Space Autoregressive Image Generation | 北京大学·深势科技 | arXiv:2606.27978 关键词:自回归生成,像素空间,ImageNet,FID,生成理解统一 前序问题:像素空间连续 token 自回归(AR)直接把图像建模为原始像素块序列、免离散分词,但面临耦合难题:高维像素块单步误差大,teacher-forcing 训练又造成训练-推理鸿沟使误差跨步累积;现有 x-prediction、噪声注入只部分缓解,精确 rollout 又因顺序采样太慢不实用。 本文贡献:提出 Parallel Rollout Approximation(PRA):生成低维中间态而非高维像素块,再用像素解码器映回像素 token,保持「像素进-像素出」AR 接口;并通过同一「中间态→像素」路径按位置独立地构造类推理输入,逼近推理时 rollout 的像素反馈接口,同时保留并行 teacher-forcing 训练。 实验效果:ImageNet-1K 256² 类条件生成上,135M 的 PRA-S 取得 FID 2.58,超过此前十亿级像素 AR 的 3.60;511M 的 PRA-L 进一步到 FID 1.94,刷新像素空间 AR 新 SOTA;ImageNet 分类探针准确率也高于其他 AR/扩散基线。 批判点评:用「低维中间态+并行近似 rollout」一招同时治高维误差与训练-推理鸿沟,135M 超十亿参数、FID 1.94 的数字很硬,且指向生成-理解统一。但仍限 ImageNet 类条件、256² 规模,能否迁到大规模文生图与更高分辨率、像素解码器的额外开销如何仍待验证。 4. TMP:剪枝把80B图像模型塞进4090 TMP: Tree-structured Mixed-policy Pruning for Large-scale Image Generation and Editing | 腾讯混元 | arXiv:2606.27089 关键词:模型剪枝,图像生成,MoE,混元,推理降本 前序问题:现代图像生成模型为高保真不断膨胀,参数与算力开销巨大;HunyuanImage-3.0 等开源 SOTA 达 80B、推荐 3×80GB GPU 才能推理,社区难用;而现有结构化剪枝多为 DiT 定制,HunyuanImage-3.0 却是 MoE 解码器 LLM(Hunyuan-A13B),并不适配。 本文贡献:提出首个树形混合策略剪枝框架 TMP,泛化 T2I 与 TI2I 任务、MoE 与 DiT 架构,并可作为步数蒸馏模型的最后一级压缩。 实验效果:把 HunyuanImage-3.0 从 80B 压到 20B(75% 压缩)、生成质量损失有限,并经工程优化让 20B 版在单张 24GB 4090 上可推理(脚本与权重已并入官方开源仓库);还把 Z-Image turbo 从 6B 压到 4B(33%)几乎无损。 批判点评:把 80B 模型塞进单卡 4090 是实打实的工业级降本,覆盖 MoE/DiT 与 T2I/TI2I 也通用,开源落地诚意足。但 75% 剪枝下'有限损失'的主观质量边界、对极端 prompt/细节的退化,以及剪枝叠加步蒸馏后的稳定性仍需更全面评测。 5. LearniBridge:可学习特征缓存加速扩散 LearniBridge: Learnable Calibration of Feature Caching for Diffusion Models Acceleration | 清华(深圳) | arXiv:2606.26778 关键词:特征缓存,扩散加速,DiT,LoRA,低秩 前序问题:DiT 在图像/视频生成上算力开销高,特征缓存靠复用中间表征加速,但现有方法依赖历史特征、在高加速比下误差累积严重。 本文贡献:研究所需特征校正的本质,发现最优校正更新在不同 prompt 间共享一个低秩子空间;据此提出 LearniBridge——可学习的特征缓存校正机制,用轻量 LoRA 更新跨多个时间步桥接,仅需 3-5 个训练样本即可有效校正。 实验效果:图像/视频生成上对 FLUX、HunyuanVideo、WAN2.1 分别达 5.87×、5.75×、4.10× 加速;WAN2.1 在 4.10× 加速下 VBench 较此前 SOTA 提升 1.28%,代码已开源。 批判点评:「校正更新共享低秩子空间」是漂亮的结构性洞察,3-5 样本+LoRA 的轻量校正很实用,加速比与质量提升兼得。但低秩假设在更激进加速比或差异极大的 prompt 分布下是否仍成立、跨架构迁移的稳健性,仍需更广验证(实验用昇腾 910B)。 6. DomainShuttle:开放域主体驱动文生视频 DomainShuttle: Freeform Open Domain Subject-driven Text-to-video Generation | 港科大 | arXiv:2606.26058 关键词:文生视频,主体驱动,跨域生成,RoPE,个性化 前序问题:开放域主体驱动文生视频(S2V)含 in-domain(尽量保主体特征)与 cross-domain(保内在特征但允许无关属性随文本灵活变化)两类;现有方法偏重 in-domain 的主体保真,限制了跨域(新风格/语义组合/域属性)的可编辑与适应性。 本文贡献:提出理想 S2V 应能在不同域间自由「穿梭」,并提出 DomainShuttle:用 Domain-MoT 解耦视频与参考特征、以域感知 AdaLN 做参考图域专属建模;用 Video-Reference DualRoPE 把参考图 token 与视频 token 置于独立 RoPE 空间实现精细主体级空间建模;用 Cross-Pair Consistent Loss 提取不受无关特征影响的内在主体特征。 实验效果:在 in-domain 与 cross-domain 上均显著超过现有方法,跨多样开放域场景兼具高主体保真与生成灵活性。 批判点评:把 S2V 从「死磕保真」重构为「按需在域间穿梭」,DualRoPE 与解耦设计对症跨域编辑痛点。但 in/cross-domain 的平衡靠多模块拼接、复杂度上升,「自由穿梭」的可控边界与对极端跨域(强风格化)的保真衰减仍需看更多样例。 7. Don't Settle:免训练破解流模型多样性坍缩 Don't Settle at the Mode! Mitigating Diversity Collapse in Pretrained Flow Models via Feature Self-Guidance | 印度科学理工·斯坦福 | arXiv:2606.27371 关键词:流模型,多样性坍缩,自引导,免训练,文生图 前序问题:SOTA 流模型按文本/图像生成惊艳图像,但同一条件下多次采样会「多样性坍缩」;现有方法要么靠潜空间引导(效果有限),要么靠样本选择(依赖外部奖励模型、推理开销大)。 本文贡献:提出高效、免训练的自引导机制缓解多样性坍缩、无需额外奖励模型:在批量生成时用「特征自引导」分散流模型内部特征;再用流形正则步把分散特征投影回数据流形,确保多样的同时不偏离输入条件。即插即用,仅增边际推理开销。 实验效果:在多步/少步文生图、深度图到图、参考图生成等多个条件流模型上,多样性显著提升且保真不降,计算开销与 I.I.D. 基线几乎持平(单张 H200 评测)。 批判点评:「特征自引导+流形正则」免训练、免奖励模型地破解多样性坍缩,开销几乎为零、即插即用,很实用。但'分散特征'的强度需与流形约束精细权衡,过度分散可能伤条件对齐;多样性指标(DINO)与人类感知多样性的一致性也值得进一步检验。 8. Safe-AR:自改进码本做AR图像安全 Safe Autoregressive Image Generation with Iterative Self-Improving Codebooks | 牛津大学 | arXiv:2606.27147 关键词:自回归生成,内容安全,码本,统一多模态,自改进 前序问题:自回归统一多模态模型靠顺序预测离散视觉 token(来自码本)生成图像,这种类语言架构擅长文本条件生成,但「以自回归方式生成的图像有多安全」少被研究。 本文贡献:提出迭代自改进码本做安全自回归生成:利用统一多模态模型自身的理解与判断能力、无需人工标注就识别不安全生成图像,并固定码本中的内在表征以消除有害映射。两步法——先用模型识别不安全生成、构造有害/安全图文对建「有害空间」并据此更新码本消除有害输出;再在无害空间内用安全图文对做自适应微调保证质量;两步反复直到无进一步改进。 实验效果:无需任何外部反馈,模型安全性被迭代式提升,同时维持生成质量。 批判点评:「让模型自己判别+修码本」把安全做成无需人工标注的闭环自改进,思路自洽、对统一多模态模型尤其契合。但'用模型判自身不安全'存在盲区(模型识别不到的有害类型无法修复),码本级干预对生成多样性/罕见概念的潜在副作用也需评估。 9. PhyEditBench:物理感知图像编辑基准 PhyEditBench: A Real-World Multi-Stage Benchmark for Physics-Aware Image Editing | 南京大学 | arXiv:2606.26551 关键词:图像编辑,物理推理,评测基准,视频生成,测试时扩展 前序问题:指令式图像编辑虽进步显著,但现有基准缺乏对「基于物理的推理」这一处理真实场景关键能力的全面评估。 本文贡献:提出 PhyEditBench 评估编辑模型的物理理解:按层级分类法设 4 大类 12 子类,含 238 个从真实视频提取以捕捉真实物理动态的高质量高清实例,外加 35 个合成「反物理」实例。并提出免训练基线 PhyWorld,用测试时扩展+潜空间缩减策略。 实验效果:对当前 SOTA 编辑方法的实证分析暴露其物理推理的明显短板;PhyWorld 超过同类模型,表明视频生成过程可有效充当图像编辑的推理机制。 批判点评:把「物理推理」单列为编辑能力维度并配反物理样例,戳中当前编辑模型的真实痛点,PhyWorld「借视频生成做推理」也很有启发。但 238+35 实例规模偏小、层级分类的覆盖与主观性,以及物理正确性评判本身的标准化,都是基准可信度的关键变量。 趋势观察 视频生成/编辑全面冲向实时流式 — LiveEdit 把流式视频编辑推到 12.66FPS,Causal-rCM 用 2 步因果蒸馏达 VBench 84.63,实时交互成为视频 AIGC 的主战场。 蒸馏与缓存成为降本双引擎 — Causal-rCM 统一 TF+SF 蒸馏、LearniBridge 可学习特征缓存(FLUX 5.87×),'更少步+复用计算'是效率竞赛的两条主线。 像素空间自回归逼近扩散画质 — PRA 用并行近似 rollout 把像素 AR 刷到 FID 1.94、135M 超十亿参数,自回归路线在图像生成上持续逼近扩散。 大模型剪枝走向单卡可用 — TMP 把 80B HunyuanImage 压到 20B 并塞进 4090,开源大图像模型的'平民化部署'成为工业重点。 生成的可信度被系统拷问 — PhyEditBench 测物理推理短板、Safe-AR 做码本级安全、Don't Settle 救多样性坍缩,质量/安全/多样性等'软指标'正被正面攻坚。 人工智能炼丹君 整理 | 2026-06-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-22|近两周精选-MaineCoon实时音视频世界模型 今日 AIGC 论文速览 今日共 10 篇 · 音视频与世界模型 2 篇 · 视频生成与编辑 3 篇 · 图像超分与编辑 2 篇 · 人脸修复与动画生成 2 篇 · 生成安全治理 1 篇 重点论文标题列表 MaineCoon(Catnip AI):22B实时音视频社交世界模型 DFD(密歇根·NVIDIA·UIUC):一行代码救回少步视频多样性 UniTemp(威斯康星·Adobe·UCLA):任意时序方向自回归视频生成 teasr(上海交大):免teacher任意步实景超分 AudioWeave(电信TeleAI·中科大):统一音频生成与编辑 今日论文速览 1. MaineCoon:22B实时音视频社交世界模型 MaineCoon: Pursuing A Real-Time Audio-Visual Social World Model | Catnip AI | arXiv:2606.17800 关键词:世界模型,音视频生成,实时自回归,流式生成,社交互动 前序问题:全球视频内容日益在社交平台上被互动式消费,但面向「社交世界」的视频生成模型长期被忽视;既有世界模型擅长模拟物理环境或游戏世界,却与人本社交动态脱节。 本文贡献:首次提出「社交世界模型」定位并造出原型 MaineCoon——首个面向社交互动优化的实时音视频自回归模型,22B 参数,单 GPU 流式生成、亚秒级交互、最高 47.5 FPS。引入自重采样、跨模态表征对齐、域感知偏好优化与强化在线策略蒸馏(ROPD)稳定并加速训练;并设计首个 agentic 流式推理框架,用 agentic 缓存管理与提示规划支持千秒级超长生成、抑制漂移。 实验效果:在高质量、低延迟、长时音视频自回归上刷新 SOTA,单 H100 上每秒生成成本压到 <$0.001 且持续下降,指向 AI-native 社交平台的范式转移。 批判点评:把「世界模型」从物理/游戏拓展到「人本社交动态」,22B 实时音视频+亚秒交互的工程指标极硬,方向极具想象力。但目前仍是原型与 position 论文,长程社交一致性、真实交互可控性与安全治理都待检验,47.5FPS 也依赖 H100 级硬件。 2. DFD:一行代码救回少步视频多样性 Data-Forcing Distillation: Restoring Diversity and Fidelity in Few-Step Video Generation | 密歇根·NVIDIA·UIUC | arXiv:2606.18478 关键词:视频生成,扩散蒸馏,DMD,少步采样,多样性 前序问题:把多步视频扩散蒸馏成少步学生时,DMD/DMD2 因反向 KL 目标出现两大顽疾:样本多样性骤降、输出过饱和而偏离真实视频外观。 本文贡献:提出 Data-Forcing Distillation(DFD):仅需改动一行代码的后训练框架,核心用「教师分数差异」引导学生贴向真实数据分布、把它拉回缺失的模态(mode),从而缓解模式坍缩。 实验效果:在少步视频生成上同时恢复多样性与保真度,去除过饱和、更贴近真实视频外观,且改动极小、收敛快。 批判点评:把少步蒸馏的多样性坍缩精确归因到反向 KL,并用「教师分数差异」一行代码修复,诊断锋利、落地极简。但收益建立在 DMD2 框架之上,'一行代码'表述偏营销,跨更大模型与更极端少步(1-2 步)的稳健性仍需验证。 3. UniTemp:任意时序方向自回归视频生成 UniTemp: Unlocking Video Generation in Any Temporal Order via Bidirectional Distillation | 威斯康星·Adobe·UCLA | arXiv:2606.18702 关键词:视频生成,自回归,双向蒸馏,任意时序,长视频 前序问题:自回归视频扩散在流式长视频上表现强,却被限制为前向时序生成;而真实创作常需灵活方向,如基于未来上下文反向延展、或基于过去+未来做中间插帧。 本文贡献:训练出支持任意时序方向生成的自回归模型 UniTemp,统一前向、后向与中间(inbetween)生成;用双向蒸馏化解被广泛使用的因果 3D VAE 所带来的关键技术障碍。 实验效果:在流式长视频场景把生成从单向扩展为任意时序方向的灵活创作,兼顾前向/后向/插帧三类需求。 批判点评:把「时序方向」从固定前向解放为任意方向,契合真实创作需求,双向蒸馏对付因果 VAE 也有巧思。但任意方向带来的误差累积与跨方向一致性更难控,反向/插帧下的长视频漂移是否同样可控仍待观察。 4. teasr:免teacher任意步实景超分 TEASR: Training-Efficient Any-Step Diffusion Transformer for Real-World Image Super-Resolution | 上海交大 | arXiv:2606.16188 关键词:超分辨率,扩散模型,任意步,训练高效,实景图像 前序问题:扩散模型在真实世界图像超分(Real-ISR)上质量高但采样慢;现有一步蒸馏虽快,却需辅助 teacher 模型、推高训练显存、难扩展到大架构,且固定步数缺乏速度-质量权衡的灵活性。 本文贡献:提出训练高效的「任意步」扩散框架 TEASR:在单一模型内同时支持一步与多步修复、可按需在速度与质量间权衡,且无需 teacher 模型,从而显著降低训练成本并可扩展到大型架构。 实验效果:在真实图像超分上兼顾训练高效、可扩展与「一步/多步」灵活推理,去掉了对 teacher 的依赖。 批判点评:去掉 teacher 依赖+任意步可调,直击一步蒸馏的训练成本与僵化痛点,工程价值高。但 Real-ISR 评测口径多样,'训练高效'相对谁、在多大骨干上仍占优需看完整数字,极端退化下的细节幻觉也是超分通病。 5. AudioWeave:统一音频生成与编辑 Unified Audio Generation and Editing via Joint Condition Modeling and Progressive Training | 电信TeleAI·中科大 | arXiv:2606.16435 关键词:音频生成,音频编辑,文生音,统一建模,渐进训练 前序问题:现有工作把文生音(TTA)与指令式音频编辑等任务当作独立挑战、各用专属架构或模块,缺乏统一建模范式,导致系统搭建开销与复杂度大、可扩展性受限。 本文贡献:提出统一模型 AudioWeave:用联合条件建模+渐进式训练把音频生成与编辑收进单一模型,既覆盖文生音也覆盖基于指令的音频编辑,降低系统复杂度、提升可扩展性。 实验效果:一个模型同时胜任文生音与基于指令的音频编辑,减少维护多套任务专属架构的工程负担。 批判点评:把生成与编辑收进统一条件建模,顺应「大一统」趋势、工程上省事。但统一模型常面临生成与编辑能力的相互妥协,渐进式训练的配比、编辑精度与背景保真能否双赢需看消融与主观评测。 6. PermaVid:编辑后保持一致的视频生成 PermaVid: Consistent Video Generation Across Edits via Disentangled Context Memory | 上海交大·斯坦福·南洋理工·港中文 | arXiv:2606.16449 关键词:视频生成,视频编辑,上下文记忆,一致性,Wan2.1 前序问题:视频生成在编辑(改外观/布局)后需要「持久一致」:后续生成应跨时间、跨视角保持连贯;但现有记忆设计在修改后易过时失效,存储上下文可能失准。 本文贡献:提出 PermaVid(基于 Wan2.1-14B):构建多模态上下文记忆,把空间上下文解耦为「语义外观+几何结构」,并设计编辑感知的记忆更新与检索策略,确保编辑后跨时间、跨视角仍连贯。 实验效果:在编辑操作后维持长程时间与视角一致性,缓解记忆过时导致的崩坏。 批判点评:把记忆解耦成外观/结构并做「编辑感知更新」,对症视频编辑后的一致性塌缩,且基于强骨干 Wan2.1-14B。但解耦记忆+检索更新增加系统复杂度与显存(32×H200 训练),编辑链路变长时的累积误差与检索误命中仍是隐患。 7. TV-Edit:文字+视觉联合指令图像编辑 Text-Vision Co-Instructed Image Editing | 香港理工·OPPO | arXiv:2606.16767 关键词:图像编辑,文本指令,视觉提示,联合建模,FLUX 前序问题:文字指令语义表达强但空间控制粒度粗,拖拽/点选等视觉提示空间精准但语义意图模糊,二者各有短板难以兼得。 本文贡献:提出 Text-Vision Co-Instructed Image Editing(TV-Edit):把文字指令建模为语义意图、把稀疏视觉指令建模为空间引导,二者联合驱动编辑;在 Qwen-Image-Edit 与 FLUX.1 Kontext 双骨干上用少量控制器块实现,验证跨骨干通用性。 实验效果:统一文字与视觉提示之长,实现语义清晰且空间精准的图像编辑,并能在不同编辑骨干上通用。 批判点评:「文+视觉联合指令」补齐了纯文字/纯视觉各自的短板,且证明跨 Qwen/FLUX 骨干通用。但需稀疏视觉标注、用户交互成本上升,联合指令冲突(语义与空间矛盾)时如何取舍、复杂多目标编辑的可扩展性仍待考。 8. RGFVR:参考引导的人脸视频修复 RGFVR: Reference-Guided Face Video Restoration with Flow Matching | 慕尼黑工业大学 | arXiv:2606.16401 关键词:人脸修复,视频修复,身份保持,流匹配,参考引导 前序问题:从退化观测做人脸视频修复需同时恢复视觉保真、时间一致与主体身份;现有方法要么无参考(易丢身份)、要么 subject-specific(难泛化到未见身份)。 本文贡献:提出主体无关、参考引导的身份保持框架 RGFVR:把「感知+描述」双模态身份条件注入预训练 flow-based 文生视频模型(Wan2.1-T2V-1.3B + ArcFace 人脸编码器),两阶段训练、第一阶段仅训身份条件参数。 实验效果:在严重退化下既保身份又保时间一致,并能泛化到未见身份,无需逐人微调。 批判点评:双模态身份条件+参考引导兼顾保真与泛化,避开 subject-specific 的逐人训练。但依赖参考图质量与 ArcFace 身份编码,当参考与目标姿态/表情差异大时身份注入可能反成约束,1.3B 小骨干也限制极端修复上限。 9. SketchKeyAnime:稀疏关键草图生成动画 SketchKeyAnime: Reference-anchored Sparse Key-Sketch Animation Synthesis | 北京邮电大学 | arXiv:2606.19958 关键词:动画生成,视频扩散,关键草图,中间帧,可控生成 前序问题:传统动画依赖手绘关键帧、中间帧与上色;现有动画/视频生成方法多需 RGB 边界帧、密集逐帧条件或完整草图序列,难以适配低成本输入。 本文贡献:提出视频扩散框架 SketchKeyAnime:仅凭「稀疏关键草图」即可生成结构可控、外观一致、时间连贯的动画;含 Sketch Relation Transformer 与 Sketch Resampler 处理稀疏关系,并用 Sketch Cross Attention 与自适应加权损失强化线稿区域。 实验效果:在低成本输入(稀疏关键草图+参考)下产出结构可控、外观一致的动画,贴合真实动画生产流程。 批判点评:把输入门槛降到「稀疏关键草图」很贴合动画产线降本诉求,线稿增强损失也对症。但稀疏输入意味着中间帧靠模型想象,复杂动作/大幅形变的可控性与一致性更难,4×V100 训练规模也限制了分辨率与时长。 10. REINS:训练free做视频扩散安全对齐 Pulling The REINS: Training-Free Safety Alignment of Video Diffusion Models via Representation Steering | UC Riverside·YouTube | arXiv:2606.17257 关键词:视频扩散,安全对齐,表征引导,训练无关,内容安全 前序问题:开源权重视频扩散可生成暴力、虚假等逼真不安全内容;现有防护要么靠昂贵安全微调(损伤通用能力),要么靠外部过滤(易被对抗提示绕过)。 本文贡献:提出训练无关的推理时安全引导 REINS(Representation-space Inference-time Safety steering):发现安全相关结构在隐藏态激活中线性编码,用 SPCA 求出安全方向,并在推理时把模型内部表征朝安全方向引导;1.3B T2V 模型全流程 <24 GPU 小时即可完成。 实验效果:不微调、不损通用能力地把视频扩散在推理时对齐到安全生成,且较难被提示对抗轻易绕过,成本极低。 批判点评:「安全方向线性可引导」既给出可解释结论又落地为零训练方法,成本极低(<24 GPU 时)、不损通用能力,治理价值高。但线性引导对复杂/组合型不安全语义的覆盖有限,强对抗下方向是否仍稳健、引导强度与画质的权衡都需更大规模红队验证。 趋势观察 实时音视频自回归走向社交世界模型 — MaineCoon 22B 单 GPU 47.5FPS、每秒成本<$0.001,把世界模型从物理/游戏推向人本社交互动,瞄准 AI-native 社交平台。 少步/任意步成为视频与超分主线 — DFD 一行代码救回少步视频多样性,teasr 免 teacher 任意步超分,'又快又好且可调'是效率竞赛的新解法。 视频生成解放时序与编辑一致性 — UniTemp 支持任意时序方向生成,PermaVid 用解耦记忆保编辑后一致,视频创作正变得更灵活、更可控。 统一建模继续吞并子任务 — AudioWeave 把音频生成与编辑统进一个模型,TV-Edit 把文字与视觉指令联合,'一个模型多种活'趋势延续。 安全治理走向训练无关与可解释 — REINS 发现安全方向在激活里线性可引导,<24 GPU 时不伤通用能力地对齐,生成安全从'微调/过滤'转向推理时引导。 人工智能炼丹君 整理 | 2026-06-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-02|微软实时流式数字人视频比肩大模型 今日 AIGC 论文速览 今日共 9 篇 · 实时与高效视频生成 2 篇 · 视频与图像编辑 3 篇 · 自回归与多模态生成 2 篇 · 可信与安全生成 2 篇 重点论文标题列表 实时流式数字人(微软研究院):语音驱动实时流式肖像视频 AlbedoEdit(马普所·NVIDIA·UCSB):反照率引导统一视频编辑 MT-EditFlow(Apple·UCLA·UT Austin):RL优化多轮图像编辑 边界保护量化(中科院大学·华为昇腾):Wan2.1视频DiT零损W8A8 RDA(中南大学·牛津·微软):免重训提升AR文字渲染 今日论文速览 1. 实时流式数字人:语音驱动实时流式肖像视频 Real-Time Generation of Streamable Talking Portrait Video with Reference-Guided Deep Compression VAEs | 微软研究院 | arXiv:2606.01620 关键词:数字人,流式生成,因果VAE,Rectified Flow,实时 前序问题:视频扩散模型画质虽好但算力高,难以用于实时交互式数字人场景。 本文贡献:提出面向流式场景的「语音+参考图」驱动数字人视频生成框架:用因果视频 VAE 做深度潜空间压缩,配自回归潜空间去噪生成器。VAE 可接入可变数量参考图作为引导,让网络聚焦动态信息而非静态外观,从而同时提升压缩率与重建质量;并把残差自编码范式扩展到时空因果建模,生成器基于 Rectified Flow Transformer 分块自回归产出视频潜变量。 实验效果:实现高质量数字人视频的实时生成,速度显著快于基线大模型;在真实感、生动性与视频质量上与大模型持平甚至更优。 批判点评:「因果 VAE + 参考图引导 + 分块自回归 RFT」把流式实时数字人做到与大模型同档画质,工程价值很高。但验证集中在语音驱动的正面肖像窄域,缺乏对长时序漂移、侧脸大幅运动、多说话人等极端场景的系统评测,实时性也强依赖特定硬件。 2. AlbedoEdit:反照率引导统一视频编辑 AlbedoEdit: Unified Instance-Level Video Editing with Albedo Guidance | 马普所·NVIDIA·UCSB | arXiv:2606.01362 关键词:视频编辑,反照率,实例级,物体插入,纹理编辑 前序问题:细粒度实例级视频编辑(插入/删除/纹理)要么只有粗语义控制,要么任务专用、难通用。 本文贡献:提出统一视频编辑框架 AlbedoEdit,同时支持物体插入、删除与纹理编辑。核心洞察是本征反照率图不含光照、镜面、阴影与互反射,是指定外观编辑的理想用户接口。基于视频基座模型微调,把源 RGB 视频按用户编辑的首帧反照率翻译为编辑后 RGB 视频;在覆盖三类编辑的配对合成数据集上训练,隐式学会协调编辑内容并模拟高光、软阴影、镜面反射等真实视觉效果。 实验效果:在物体插入、删除、纹理编辑上定性定量均超越 SOTA 视频编辑方法,且单一框架统一支持三类任务。 批判点评:用「反照率」作编辑接口巧妙绕开了光照纠缠,统一三类编辑很优雅。但训练依赖配对合成数据集,真实视频与合成域之间的差距、以及用户能否方便地编辑反照率图(而非直接画 RGB)是落地的现实门槛。 3. MT-EditFlow:RL优化多轮图像编辑 MT-EditFlow: Reinforcement Learning for Multi-Turn Image Editing with Flow Matching | Apple·UCLA·UT Austin | arXiv:2606.01985 关键词:多轮编辑,强化学习,流匹配,GRPO,奖励建模 前序问题:单轮训练的编辑模型在多轮交互编辑中会因「一轮失败毁全程」和误差累积而崩溃。 本文贡献:提出流匹配强化学习框架 MT-EditFlow,把多轮视角与多奖励统一进 GRPO 与 NFT 两类 RL 方法。系统分析轮级聚合打分策略、VLM 推理模式(权衡奖励偏差与方差)、优势融合层级(防奖励黑客),并发现把聚合优势广播到整条编辑轨迹,能弥合局部规划与全局多轮成功之间的鸿沟。 实验效果:在多个基座上显著提升;把 FLUX.1-Kontext-dev 的第 3 轮整体表现提升 6.85 分,超过 Qwen-Image-Edit 等开源 SOTA,并保持高边际成功率、降低暴露偏差。 批判点评:把多轮编辑当作序列决策、用 RL 显式优化轨迹级奖励,方向对路。但奖励信号高度依赖 VLM 打分,VLM 自身偏差会被放大;6.85 分的提升也主要在 turn-3 这一特定设置,更长交互的稳健性仍待验证。 4. 边界保护量化:Wan2.1视频DiT零损W8A8 Boundary-Protection W8A8 HiFloat8 Quantization for Large-Scale Text-to-Video Diffusion Transformers | 中科院大学·华为昇腾 | arXiv:2606.00957 关键词:量化,W8A8,HiFloat8,视频DiT,昇腾NPU 前序问题:视频 DiT 逐块激活分布异质,首尾块统计特性与中间块根本不同,均匀量化失效。 本文贡献:面向 Wan2.1-T2V-14B 在昇腾 910B 上的 W8A8 HiFloat8 量化,对全部 40 个注意力块做逐块激活分析(max-abs、标准差、峰度、99 分位),提出边界保护策略:首 2 块、尾 3 块保留 BF16,其余 35 块用 W8A8 HiF8 量化,兼顾误差遏制与输出保真。 实验效果:PTQ 在 VBench 全部 5 个维度上持平甚至略超 BF16 基线,5-prompt 内无可测精度损失;消融证明须同时保护首尾才有效;量化 35 块省约 12GB 显存,单卡可推理。 批判点评:把「边界块敏感」这一经验观察落到具体保护配置,工程实用且有消融支撑。但评测仅 5 条 prompt、样本量太小,统计说服力有限;QAT 在单卡下反而不如 PTQ,且当前工具链软件量化更慢,硬件原生 HiF8 收益尚未真正兑现。 5. RDA:免重训提升AR文字渲染 Residual Decoder Adapter: ID-Preserving Tokenizer Adaption for Autoregressive Text Rendering | 中南大学·牛津·微软 | arXiv:2606.01911 关键词:自回归生成,文字渲染,Tokenizer,残差适配器,OCR 前序问题:视觉自回归模型文字渲染笔画模糊、字形错乱,根源在 tokenizer 重建细节不足,但重训代价高。 本文贡献:提出 Residual Decoder Adapter(RDA):不改 token 空间、事后升级 tokenizer——引入与原码本共享分布的配对码本,以及在像素空间学习重建图与真值微小残差的并行分支,从而非侵入式增强 tokenizer 且兼容已有 AR 模型,无需重训 tokenizer 与生成模型。 实验效果:大幅提升文字渲染:微调 Janus-Pro 的 OCR 准确率在 TextVisionBlend 从 24.52% 升至 58.26%、StyledTextSynth 从 12.75% 升至 36.81%。 批判点评:「残差适配器」思路精巧,免重训就能补齐文字短板,迁移成本低。但本质是给解码器打补丁、治标性质,token 空间本身的信息瓶颈未动;提升集中在 OCR 类指标,对复杂版式、多语言长文本的泛化仍需更多验证。 6. TFinv:免训练一步扩散反演编辑 Training-free image inversion for one-step diffusion models | 巴塞罗那CVC·MBZUAI·吉大 | arXiv:2606.01380 关键词:图像反演,一步扩散,免训练,图像编辑,PIE-Bench 前序问题:一步扩散模型的真实图像反演与编辑受限于初始潜变量可编辑性与图文 Caption Gap 两大障碍。 本文贡献:提出免训练框架 TFinv:迭代噪声对齐 (iterNA) 缩小初噪与高斯分布的差距、后缀学习 (suffL) 用可学习后缀 token 增强图文对齐,实现精确反演到初噪并便于编辑;并提出基于 mask 的局部编辑以保护背景完整性。 实验效果:在 PIE-Bench 上达到一步扩散编辑 SOTA,效率显著优于多步反演方法。 批判点评:免训练把一步扩散的反演难题拆成「初噪可编辑性 + 图文对齐」两个可操作因子,干净利落。但推理时仍需迭代对齐与后缀学习,并非真正零开销;评测主要在 PIE-Bench,对复杂多物体场景的编辑保真度还需更广验证。 7. ProductWebGen:商品网页生成评测基准 ProductWebGen: Benchmarking Multimodal Product Webpage Generation | 上海交大·快手 | arXiv:2606.01022 关键词:商品网页,多模态生成,统一模型,图像编辑,基准 前序问题:从商品图+指令生成可渲染 HTML 网页需要严格视觉一致与高保真指令遵循,缺乏系统基准。 本文贡献:推出 ProductWebGen 基准:500 个测试样本、13 个品类,每样本含源图、视觉内容指令与网页指令;系统对比两类工作流——编辑式(LLM+图像编辑模型分别生成 HTML 与图)与统一模型式(单 UM 同时生成)。并构建 SFT 数据集 ProductWebGen-1k(1000 组真实商品图+LLM 生成 HTML),在开源 UM BAGEL 上验证有效。 实验效果:编辑式在网页指令遵循与内容吸引力上领先,统一模型式在满足视觉内容指令上更有优势;SFT 数据显著提升 BAGEL 表现。 批判点评:把多模态生成能力落到电商网页这一真实落地场景,任务设计与双工作流对比都很务实。但 500 样本规模偏小、评测多依赖模型/人工主观打分,且「可渲染 HTML」的工程正确性与跨浏览器一致性等硬指标尚未充分覆盖。 8. SafeGen-Bench:图生视频安全性评测基准 SafeGen-Bench: Benchmarking Safety in Image-Conditioned Text-to-Video Generation | 威斯康星·清华·JHU | arXiv:2606.01481 关键词:视频安全,图生视频,红队评测,内容护栏,基准 前序问题:现有视频安全基准只测恶意文本,忽视「安全文本+安全图像」组合仍可能生成有害内容。 本文贡献:推出 SafeGen-Bench 评测条件式 T2V(图生视频)安全性:定义 10 类恶意类别,聚焦时序与行为相关风险,精选多源起始帧配对文本 prompt 模拟真实输入;评测多个条件 T2V 模型,并测试文本/图像护栏的有效性。 实验效果:当前模型难以稳定规避恶意内容,不安全分数最高达 44.5(尤其在追求高质量时);单模态护栏不足以防御,7 类恶意类别下失败率达 80%。 批判点评:点出「安全输入也能合成有害视频」这一被忽视的真实风险并量化护栏失效,警示意义强。但 10 类恶意类别与起始帧选择带主观性,'unsafety score' 的判定依赖评估模型,跨文化/跨场景的有害定义边界也较模糊。 9. KG-FairDiff:知识图谱引导T2I去偏 KG-FairDiff: Knowledge Graph-Guided Prompt Refinement for Demographically Fair Text-to-Image Generation | Sharif·KTH·Vanderbilt | arXiv:2606.01282 关键词:文生图,公平性,去偏,知识图谱,prompt改写 前序问题:文生图系统继承训练数据的人口与文化刻板印象,重训不可行、固定模板又忽视文化语境。 本文贡献:提出模型无关的推理时框架 KG-FairDiff,把公平感知的 prompt 改写形式化为约束优化并做成闭环:约 1200 条文化/偏见三元组的知识图谱检索结构化上下文、LLM 改写器提出修订、验证器只接受能降低基于散度的公平损失且保持语义保真的 prompt;证明改写循环有限步终止,并审计 8 个广泛部署的生成器。 实验效果:在保持 prompt 语义的同时,显著降低性别、种族、年龄及交叉维度的差异,提供无需重训、可直接部署的公平化方案。 批判点评:不碰闭源权重、用推理时 prompt 改写+知识图谱做去偏,部署友好且有终止性证明,务实。但公平损失与目标分布的设定本身带价值判断,1200 条三元组的覆盖与文化偏向也会引入新偏差;强行改写 prompt 可能损害用户原意,'去偏'与'忠实'的取舍仍是开放问题。 趋势观察 实时化成为视频生成主线 — 微软用因果 VAE+分块自回归 RFT 把数字人做到实时流式,边界保护量化让 14B 视频 DiT 单卡零损部署,'又快又省'是今天最强信号。 编辑从单轮走向多轮/实例级 — MT-EditFlow 用 RL 优化多轮编辑轨迹,AlbedoEdit 用反照率统一实例级视频编辑,编辑的可控性与交互性同步进化。 免训练/事后增强降低改造成本 — TFinv 免训练做一步扩散反演,RDA 免重训给 tokenizer 打残差补丁,KG-FairDiff 推理时改写 prompt 去偏——都在追求'不动主模型'。 评测与安全补齐落地短板 — ProductWebGen 补电商网页生成基准,SafeGen-Bench 揭示图生视频的安全盲区,工具与红队评测正追上生成能力。 多极化算力与机构同台 — 微软、马普所、NVIDIA、Apple 与上海交大、中科院大学+华为昇腾、中南大学同日发声,研究力量与算力底座多极化。 人工智能炼丹君 整理 | 2026-06-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-29|生数科技minWM开源实时交互视频世界模型 今日 AIGC 论文速览 今日共 8 篇 · 视频世界模型 3 篇 · 流式视频生成 1 篇 · 音视频联合生成 1 篇 · 可控图像生成与数据 2 篇 · 大模型记忆与微调 1 篇 重点论文标题列表 minWM:实时交互视频世界模型全栈开源 NAVA:原生音视频对齐联合生成6.3B Gamma-World:多智能体生成式世界模型 AdaState:流式视频生成自演化锚点 YoCausal:视频生成因果性认知基准 今日论文速览 1. minWM:实时交互视频世界模型全栈开源 minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models | 生数科技, 清华大学 | arXiv:2605.30263 关键词:视频世界模型·实时交互·自回归蒸馏·开源·生数科技 前序问题:视频扩散基础模型已能高质量出片,但把它变成实时交互视频世界模型仍然难:交互世界模型需要可控、因果、低延迟的 rollout,实践上要打通数据构造、可控微调、自回归训练、少步蒸馏、流式推理整条链路,而开源社区一直缺一套能跑通的端到端 recipe 本文贡献:minWM:全栈开源框架,把现成的双向 T2V/TI2V 视频基础模型转成「相机可控 + 少步自回归」的世界模型。先对双向扩散做相机控制微调,再用 Causal Forcing / Causal Forcing++ 流程(AR diffusion 训练 + causal ODE/consistency 蒸馏 + 非对称 DMD)蒸成少步自回归生成器做低延迟 rollout。框架模块化、架构可扩展:在 Wan2.1-T2V-1.3B(cross-attention 条件注入)和 HY1.5-TI2V-8B(MMDiT)上分别实例化,还能把 HY-WorldPlay 等已有世界模型适配到新数据分布、训练配方与延迟目标 实验效果:不止放出可运行脚本、checkpoint、文档和推理代码,还给出相机轨迹质量、可控性训练步数、最小 batch size 等实战 ablation——是这个方向少见的「能跑起来、可复现、可扩展」的实时交互视频世界模型配方 (github.com/shengshu-ai/minWM) 批判点评:「全栈开源 + 跨两种主流架构(Wan2.1 cross-attn / HY1.5 MMDiT)实例化 + 可适配已有世界模型」三点让它成为这个方向稀缺的工程基建,对想做实时交互视频的团队意义重大。但框架 / recipe 类工作的核心价值在工程完整度而非单点创新;Causal Forcing++ 与非对称 DMD 联训的稳定性、长 rollout 的累积漂移控制还可以披露更多 2. NAVA:原生音视频对齐联合生成6.3B Native Audio-Visual Alignment for Generation | 百度 ERNIE | arXiv:2605.30073 关键词:音视频联合生成·原生对齐·MMDiT·音色可控·百度 前序问题:联合音视频生成要做到时序同步 + 语义连贯,但现有开源方案要么走「双塔 + 后验对齐」(弱化细粒度音视频协同演化),要么走「三模态全统一」(把语义条件和底层同步耦死在一起)——两条路线都有结构性缺陷 本文贡献:NAVA:context-conditioned 的原生音视频对齐框架。先在专用交互空间建立音视频对应关系,再用外部 context 条件化联合去噪。用 Align-then-Fuse MMDiT 架构实例化,从「模态感知的音视频对齐」平滑过渡到「模态共享的联合去噪」;并提出 Timbre-in-Context Conditioning,把参考音色线索关联到对应语音片段,实现可控语音音色 实验效果:在 Verse-Bench 和 Seed-TTS 上配合用户研究表明:仅用 6.3B 参数即取得更优视频质量、精确的音视频同步、有竞争力的音频质量,以及更强的参考音色可控性 批判点评:「先对齐后融合」而非「一上来全统一」的设计直击双塔 / 三模态两条路线的痛点,6.3B 拿下多项指标性价比很高;Timbre-in-Context 把音色可控做进 context 是干净的设计。但「专用交互空间 + 联合去噪」的两阶段是否引入额外训练复杂度、对更长音视频的扩展性仍需观察 3. Gamma-World:多智能体生成式世界模型 Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players | NVIDIA, 清华大学 | arXiv:2605.28816 关键词:多智能体·世界模型·RoPE·稀疏注意力·NVIDIA 前序问题:交互式视频世界模型大多聚焦单 agent(从单一控制信号生成未来观测),但很多生成环境需要多 agent 同时在共享空间行动(多玩家 / 机器人 / 具身体)。扩到多 agent 需要原则性设计:各 agent 独立可控、排列对称、推理高效,同时跨时间和视角保持一致 本文贡献:生成式多智能体世界模型。提出 Simplex Rotary Agent Encoding:3D RoPE 的无参扩展,把 agent 表示成旋转角空间里正单纯形的顶点,给每个 agent 不同相位又保持排列等价——无需学习 per-slot 身份或固定排序即可扩展 agent 身份;提出 Sparse Hub Attention:用可学习 hub token 中介跨 agent 交互,把跨 agent 注意力从二次降到线性。再把全上下文扩散 teacher 蒸成因果 student,带 KV cache 顺序生成时间块,实现 24FPS 的动作响应生成 实验效果:多人虚拟环境实验中,在视频保真度、动作可控性、agent 间一致性上超越 slot-based 和 dense-attention 基线,且无需额外训练即可从 2 玩家泛化到 4 玩家 批判点评:「用正单纯形顶点的旋转相位编码 agent 身份」是极优雅的无参设计——天然排列对称又可扩展;Sparse Hub Attention 把多 agent 注意力线性化是务实工程;从 2 人零样本泛化到 4 人很有说服力。但 hub token 数量与 agent 数的可扩展上限、长时序多 agent 一致性的退化曲线需要更大规模验证 4. AdaState:流式视频生成自演化锚点 AdaState: Self-Evolving Anchors for Streaming Video Generation | 弗吉尼亚理工 Virginia Tech | arXiv:2605.30349 关键词:流式视频生成·自回归扩散·自演化锚点·KV cache·时间相对 前序问题:自回归视频扩散逐块生成、每块条件于已生成内容,但模型结构性地「锚定在第一帧」:首帧 KV 占据注意力 cache 的特权位置、作为整段主场景参考。作为最干净无误差的位置,这个锚点吸走过多注意力,压制视频动态、把场景构图锁死在初始视角,结果是「时间上很浅」的视频——运动、镜头、场景推进都被静态一致性压制 本文贡献:用「自适应 state」替换静态锚点——一个隐 latent,模型每块和内容一起去噪但从不渲染。模型不再参考冻结的首帧,而是每步通过同时关注「前一 state + 当前内容」自己生成场景锚点,产出随生成内容演化的参考。不同于编码绝对时间的标准视频生成,本方法把时间当相对量:每个生成步看到相同的位置结构、state transition 每块都相同。这给生成过程引入了递归——去噪即 transition 函数,KV cache 即载体,无需任何外部模块 实验效果:实验表明自适应 state 大幅改善视频动态,让生成视频内出现更丰富的运动和更自然的场景推进 批判点评:「首帧 KV 锚点偷走注意力 → 视频时间上变浅」的诊断非常精准,用「可去噪但不渲染的隐 state」做自演化锚点是优雅的零外部模块方案,把时间从绝对改成相对的视角很有启发。但「丰富运动」与「时序一致性」本就是 trade-off,自演化锚点会不会牺牲长程一致性需要定量;缺与显式 memory / anchor 方法的正面对比 5. YoCausal:视频生成因果性认知基准 YoCausal: How Far is Video Generation from World Model? A Causality Perspective | 上海 AI Lab, 阳明交大 NYCU | arXiv:2605.30346 关键词:视频生成·世界模型·因果性·评测基准·上海AILab 前序问题:视频扩散模型(VDM)正走向世界模型,关键问题是:它们真懂因果,还是只过拟合统计时序模式?现有基准大多依赖合成数据,受 sim-to-real gap 限制真实世界泛化 本文贡献:YoCausal:受认知科学「违反预期(VoE)」范式启发的两级基准。零成本地把真实世界视频时序反转,作为天然反事实样本,建立可任意扩展的评测协议。Level 1 提出 Reverse Surprise Index (RSI),用去噪 loss 量化「时间箭头」感知;Level 2 提出 Causality Cognition Index (CCI),用 VLM 把数据分层成因果 / 非因果子集,把真正的因果推理从时序偏置中解耦 实验效果:评测 13 个 SOTA VDM 发现:感知到时间箭头并不意味着理解因果,且相对人类级因果认知仍存在显著差距 批判点评:「时序反转真实视频做零成本反事实」是极聪明的基准构造,RSI / CCI 两级指标把「时间感知」与「因果认知」分层解耦的思路很清晰,给「视频生成→世界模型」泼了必要的冷水。但用去噪 loss 衡量「惊讶度」是否完全等价于因果理解仍可争议;VLM 分层本身的可靠性会传导到 CCI 的结论 6. GenClaw:代码驱动的智能体图像生成 GenClaw: Code-Driven Agentic Image Generation | 中山大学 | arXiv:2605.30248 关键词:图像生成·智能体·代码驱动·可控生成·中山大学 前序问题:图像生成已从「文本条件像素合成」走向「具备视觉理解 + 工具调用的多模态 agent」,但现有 agent 仍受制于底层黑盒图像模型——工作流困在「为优化生成反复改 prompt」的循环里,没有直接操控画布的机制。LLM 作为精确视觉构建「画笔」的潜力基本未被开发 本文贡献:GenClaw:代码驱动的智能体图像生成范式,让 agent 像人类艺术家一样创作——先构思、再起草、最后上色。agent 先通过搜索和推理构建概念知识与上下文;再用代码(SVG / HTML / Three.js)渲染可执行的视觉草图;最后用图像生成模型补充纹理、材质、真实感。代码在此作为可控的中间画布,桥接语言推理与像素合成,把程序逻辑与生成模型的视觉表现力无缝整合 实验效果:把图像生成从黑盒范式转成类似真实人类创作的分阶段过程,朝着高度可控、可解释的视觉生成系统迈出一步 批判点评:「代码作中间画布」是把可控性问题转译成「可执行草图」的聪明思路——SVG / HTML / Three.js 草图天然结构化、可精确编辑,比反复改 prompt 强太多;构思-起草-上色的拟人流程也很有叙事性。但代码草图能表达的视觉复杂度有上限(精细写实场景难用 SVG 起草),最终仍依赖底层生成模型的「上色」能力;端到端延迟和失败率需要量化 7. GPIC:28万亿像素许可级图像语料 GPIC: A Giant Permissive Image Corpus for Visual Generation | 斯坦福 李飞飞团队 | arXiv:2605.30341 关键词:图像语料·视觉生成·许可数据集·flow matching·斯坦福 前序问题:研究可扩展的视觉生成方法需要大、可获取、稳定的数据集,但开放且许可清晰的大规模图像语料长期稀缺 本文贡献:GPIC:约 28 万亿像素的巨型许可图像语料。由 SOTA 视觉语言模型为多样互联网图像生成 caption,含 1 亿训练 + 20 万验证 + 100 万测试样本。所有图像均「研究 + 商用」许可宽松,经安全过滤、去重,集中托管于 Hugging Face。提供生成建模的 benchmark 协议,并给出像素空间 flow matching 的参考 baseline 实验效果:数据集、benchmark、模型全部开放(stanford-vision-lab/gpic);为视觉生成提供「大规模 + 许可清晰 + 稳定可复现」的公共底座 批判点评:「许可宽松 + 商用可用 + 安全去重 + 集中托管」直击当前生成数据集的版权 / 可复现痛点——这种基础设施工作对整个社区的长尾价值很高,28 万亿像素 + 完整 benchmark + baseline 让它即插即用。但「VLM 自动 caption」的质量上限会限制可训出的文本对齐能力;与 LAION 类已有大语料的去重重叠和质量差异需要更透明 8. Parametric Memory Law:LoRA参数记忆的幂律定律 How LoRA Remembers? A Parametric Memory Law for LLM Finetuning | 浙江大学, 阿里 | arXiv:2605.30260 关键词:LoRA·参数记忆·幂律·LLM微调·浙大 前序问题:LLM 需持续学习更新知识,LoRA 被广泛用于记忆更新,但现有研究多靠定性下游评测,对「精确参数记忆」的定量容量极限和底层动力学几乎没探索 本文贡献:用 LoRA 作为受控的记忆容量探针,在 latent 空间系统量化精确参数记忆。提出 Parametric Memory Law:把 loss 下降 ΔL 与有效参数量、序列长度联系起来的稳健幂律。token 级细粒度分析揭示确定性相变——证明预测概率 p>0.5 是 greedy decoding 下逐字召回的充分条件。据此提出 MemFT:阈值引导的优化策略,把训练预算动态重分配到次阈值 token 实验效果:实证表明 MemFT 能提升记忆保真度和效率;为「LoRA 到底记住多少、怎么记」给出可量化的定律而非定性结论 (github.com/zjunlp/ParametricMemoryLaw) 批判点评:「用 LoRA 当记忆容量探针 + 找出幂律 + p>0.5 相变的充分条件」是把模糊的「记忆能力」做成可量化科学定律的扎实工作,MemFT 把定律反哺成实际训练策略形成漂亮闭环。但幂律的普适性需要跨更多模型规模 / 任务验证;「逐字召回」的记忆与「泛化知识」的记忆是两回事,定律对后者的适用边界要谨慎 趋势观察 视频生成正在「世界模型化」:从出片段走向实时交互、多智能体、可因果 — minWM 把双向 T2V/TI2V 蒸成相机可控的少步自回归世界模型并全栈开源;Gamma-World 用单纯形旋转编码 + 稀疏 hub 注意力把世界模型从单 agent 扩到多 agent(2→4 人零样本泛化、24FPS);YoCausal 用时序反转真实视频做反事实基准,量出 13 个 SOTA VDM 距离「真懂因果」仍有显著差距——视频生成的下一站从「画面好」转向「能交互、有因果、多主体」 自回归流式视频生成开始解决「时间太浅」的结构病 — AdaState 诊断出首帧 KV 锚点偷走注意力、把场景锁死在初始视角,改用「可去噪但不渲染的自演化隐 state」做相对时间锚点,显著改善运动和场景推进——流式视频生成从「保一致」转向「敢动起来」 音视频联合生成走向「先对齐后融合」的原生范式 — NAVA 指出双塔后验对齐弱化协同、三模态全统一耦合语义与同步两条路都有缺陷,提出 Align-then-Fuse MMDiT 先在交互空间建音视频对应、再 context 条件化联合去噪,6.3B 拿下多项 SOTA + 可控音色——音视频生成的架构共识正在形成 图像生成的可控性升级:代码做中间画布、许可数据做底座 — GenClaw 用 SVG/HTML/Three.js 可执行草图作中间画布,把「反复改 prompt」换成「构思-起草-上色」的拟人可控流程;GPIC 放出 28 万亿像素、研究+商用许可宽松、安全去重的图像语料 + benchmark + flow matching baseline——可控生成的「方法」和「数据底座」被同时推进 大模型记忆与微调走向「可量化定律」 — How LoRA Remembers 用 LoRA 当记忆探针,给出 loss 下降 ΔL 与有效参数 / 序列长度的 Parametric Memory Law,发现 p>0.5 是逐字召回的充分条件,并据此提出阈值引导的 MemFT——把「LoRA 记多少」从定性评测推到可解析的幂律 人工智能炼丹君 整理 | 2026-05-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-28|北大OSP-Next视频生成跨硬件加速 今日 AIGC 论文速览 今日共 11 篇 · 视频生成全栈加速 4 篇 · 视频生成新能力 2 篇 · 音频统一生成 2 篇 · 语音合成与编辑 2 篇 · 扩散模型对齐 1 篇 重点论文标题列表 OSP-Next:稀疏+量化+RL全栈视频生成1.64x PARE:视频DiT结构剪枝+动态路由 ⚡ Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Dasheng AudioGen:首个文生混合音频场景统一模型 今日论文速览 1. OSP-Next:稀疏+量化+RL全栈视频生成1.64x OSP-Next: Efficient High-Quality Video Generation with Sparse Sequence Parallelism, HiF8 Quantization, and Reinforcement Learning | 北大袁粒组, 华为 | arXiv:2605.28691 关键词:视频生成·稀疏注意力·序列并行·HiF8·北大袁粒组 ⚠️ 前序问题:Diffusion Transformer 在视频生成上已经能出好东西,但 full attention 二次开销死死压住效率。前人方案各做一段(稀疏 / 量化 / 蒸馏),缺一套能同时打通通信、计算、精度的端到端方案——尤其在「多卡序列并行」上和「跨国产硬件」上 本文贡献:OSP-Next:把稀疏注意力 + 序列并行 + 量化 + RL 后训练全栈打通的高效 T2V 框架。Skiparse-2D Attention 在空间维做 token-wise + group-wise 稀疏并保留 FlashAttention 兼容;提出 Sparse Sequence Parallelism (SSP) 用一次 All-to-All 切换稀疏模式,相比 Ulysses SP 通信量降低 75%;HiF8 量化支持 8-bit 联合训练 + 稀疏 fine-tune;Mix-GRPO 后训练弥补稀疏模型的质量回退 实验效果:VBench 总分 83.73% 超越 Wan2.1 基线;5 秒 720P/768P 设置下,H200 单 GPU 加速 1.64×,8 GPU 加速 1.52×;OSP-Next-HiF8 仅掉 0.4% 分数即可在国产昇腾 Ascend 950PR 上拿到 1.69× 和 2.27× 加速——是少见的同时验证国际/国产硬件的视频生成加速方案 批判点评:「稀疏注意力 + 序列并行 + 量化 + RL」四件套全栈打通,每一件单独不算新,但 SSP 把通信量直接打掉 75% 是非常硬的工程数字;跨 H200 + 昇腾的双硬件验证为国产硬件视频生成提供了稀缺的实证。但 Skiparse-2D 是 fixed pattern,对极复杂运动场景的可适配性需要看;Mix-GRPO 与 SSP 联训的稳定性细节披露还可以更多 2. PARE:视频DiT结构剪枝+动态路由 PARE: Pruning and Adaptive Routing for Efficient Video Generation | 港中文 CUHK, 上海 AI Lab, 悉尼大学 | arXiv:2605.27336 关键词:视频 DiT·结构剪枝·动态路由·Wan2.1-14B·上海 AI Lab ⚠️ 前序问题:Video DiT 又宽(block 宽)又深(架构深)又要多步采样,部署成本极高。前人通过压宽/压深/压步数减成本,但都 commit 到固定架构——不能针对单个输入或不同去噪阶段动态调整 本文贡献:PARE:把宽度剪枝和深度自适应路由联合做。宽度上观察到 attention head 自然分化为空间 vs 时序角色,设计区分两类的 importance scoring 避免「运动关键的 temporal head」被过早剪掉;深度上训轻量 router 以 denoising timestep + 视觉内容为条件,动态选择每步执行哪些 block——实现「按输入动态计算」而非静态删除。两阶段 progressive pipeline 先用蒸馏修复宽度剪枝的质量损失,再联合优化 student + router 解耦学习目标 实验效果:在 Wan2.1-14B 上对 I2V 和 T2V 都大幅降低每步算力且保住 VBench 各维度质量;与 step 蒸馏天然可组合进一步加速——把「静态剪枝」时代翻篇成「动态路由按需算」 批判点评:「区分空间/时序 head 重要性 + denoising-step 条件的 block router」两个洞察都直击 Video DiT 的结构性冗余。动态路由实现「按输入按 timestep 算」是 efficient video gen 的下一阶段方向。但 router 本身的训练稳定性、推理时的额外 overhead、以及与 OSP-Next 类静态稀疏组合后的边际收益需要更细 ablation 3. Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 Quantized Keys Steal Attention: Bias Correction for KV-Cache Compression in Video Diffusion | 慕尼黑工大 TUM, Tensordyne | arXiv:2605.26266 关键词:视频扩散·KV cache·INT2 量化·Jensen 偏差·长视频 ⚠️ 前序问题:chunk-wise 自回归视频扩散依赖前序 chunk 的 KV cache 避免重复计算,但视频越长 cache 越大,量化 KV 到低 bit 又会显著掉画质。掉画质的根因是什么?以前没人说清楚 本文贡献:首次明确指出根因:softmax 注意力中 exp 的凸性让量化噪声系统性放大「被 cache 的 keys」对注意力的贡献——作者命名为 Jensen bias(量化的 keys 会偷走当前 chunk 的注意力质量)。给出 per-attention-score 的解析修正项,在 expectation 上消除该 bias,只用量化 step size 和 query norm 即可在线算;用二阶 Taylor 近似让额外计算开销可忽略、无需额外显存 实验效果:在 MAGI-1 / SkyReels-V2 / HY-WorldPlay 三个长视频模型上 INT2 量化即可恢复大部分掉的质量、接近 BF16;用 50% 更少显存的 INT2 反而能超过 INT4——长视频 KV cache 压缩拿到新的帕累托前沿 批判点评:把「量化掉画质」从经验问题改写成「Jensen 偏差」这一可解析的统计现象是真正的科学贡献——一行公式校正、零额外显存就拿到 INT2 ≈ BF16 的质量。这种「找根因 + 闭式解」的工作含金量高。但局限在 chunk-wise AR 视频扩散,对非 AR 的全局扩散 KV 压缩不直接适用;与 SmoothQuant 等激活/权重路线的组合策略还可探索 4. SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Timestep-Aware SVDQuant-GPTQ for W4A4 Quantization of Wan2.2-I2V | 华中科技大学 HUST | arXiv:2605.27003 关键词:W4A4 量化·Wan2.2·MoE DiT·SVDQuant·华中科大 ⚠️ 前序问题:把大型视频 DiT 推到 W4A4 量化可以省一大块显存,但两道坎卡死:(1) 稀疏的「大幅激活 outlier」;(2) 不同去噪 timestep 的激活分布漂移很大。这两个问题在 Wan2.2-I2V 双专家 MoE DiT(高噪/低噪两个 expert 量化敏感度完全不同)下被进一步放大——单一全局校准策略根本拿不下 本文贡献:Timestep-Aware SVDQuant-GPTQ:(1) SVDQuant-based 低秩 outlier 补偿处理激活大幅 outlier;(2) GPTQ 重建感知残差权重量化;(3) timestep-bin-wise 逐层激活 clipping-ratio 搜索,对每个 MoE expert 独立完成。三件套合起来就是「按 expert + 按 timestep」精细化校准的 PTQ 框架 实验效果:在 OpenS2V-Eval 上相对 BF16 把峰值 GPU 内存降 59.3%,VBench 平均分仅掉 0.9%,Imaging Quality 仅掉 2.3%——证明「expert + timestep 双感知校准」是 MoE 视频 DiT 量化高保真的必要条件 批判点评:把 MoE DiT 量化从「全局校准」拉到「按 expert + 按 timestep」是正确的颗粒度切分——双专家的量化敏感度本来就不同,强行全局必然掉点。59.3% 内存降 + <1% 质量损是漂亮的工业数字。但 PTQ 路线天然依赖 calibration set 质量,长视频/复杂运动的覆盖度需要追踪;与昨天 RT-Lynx 类激活稀疏的组合潜力值得探索 5. Dasheng AudioGen:首个文生混合音频场景统一模型 Dasheng AudioGen: A Unified Model for Generating Coherent Audio Scenes from Text | 小米, 上海交大 | arXiv:2605.27838 关键词:音频场景生成·multi-view caption·flow matching·小米·DiT ⚠️ 前序问题:音频生成长期被「按域切分」——语音、音乐、音效各有独立模型——做不到从一句描述生成「同时包含人声 + 背景音乐 + 环境音效」的连贯混合音频场景。两大障碍:缺真实混合音频的细粒度监督;声学表示难以同时承载多个并发音频组件 本文贡献:Dasheng AudioGen:首个统一生成混合音频场景的端到端框架。两个核心:(i) structured multi-view captions——把复杂声学场景显式解耦成互补的描述视图,让每个音频层都有细粒度控制;(ii) 高维统一「语义-声学」表示作为共享 latent,注入语义先验加速跨模态训练收敛,同时高维特征空间提供解耦并发声音组件的容量。在此基础上一个简单的 flow-matching DiT 就能跑出端到端高质量音频场景生成 实验效果:在混合音频类别接近真实录音质量,单类型生成(speech/music/SFX)也与专用模型打平——首次把「视觉生成里图文统一」的思路真正落到音频场景上;配套建立音频场景生成的综合评测 pipeline 批判点评:「structured multi-view captions + 高维语义-声学统一 latent」是非常对症的两个设计——把音频域的「描述粒度」和「表示容量」都拉到能容纳混合场景的层次。flow-matching DiT 的工程极简性也很好。但 multi-view caption 的自动构造成本/质量、高维 latent 增加的 DiT 训练开销,以及与商用 ElevenLabs Sound Effect / Stable Audio 2 的端到端对比都需要更细评测 6. HarmoVid:视频肖像重打光和谐化稳定不闪烁 HarmoVid: Relightful Video Portrait Harmonization | Adobe Research, UNC | arXiv:2605.28811 关键词:视频肖像·relight 和谐化·deflicker·alpha mask·Adobe ⚠️ 前序问题:把人物前景视频和谐到目标背景场景(同步阴影、色调、光照强度——relightful harmonization)的硬伤是:视频域没法采集「同一动作不同光照」的成对标注数据。最直接的方案——「按帧调用图像和谐模型」——会带来严重时序抖动(flicker) 本文贡献:HarmoVid 给出整套视频和谐化方案:(i) 全新的 lighting deflickering 模型稳定全局和局部光照 flicker,把「逐帧 image-harmonization」的输出升级成可监督的 paired 视频数据;(ii) 视频扩散模型在 deflickered 真实 + 合成视频上学习;(iii) asymmetric alpha mask conditioning 让模型从真实视频里学到干净的边界 实验效果:在时序连贯、自然度、边界干净度、物理合理光照行为多个维度超越此前所有 image-based 和 video-based 和谐化方法;relighting 表现力也保住——人物视频合成 / 后期合成的标准工业链路被显著升级 批判点评:用「先 deflicker 再训练」绕开「无成对数据」的死结是非常聪明的——deflicker 把单帧图像和谐输出转化成可用监督,是真正的杠杆点。asymmetric alpha mask 也很实用。但 deflicker 模型本身的失败模式(强光/复杂阴影)会传导到下游;与 Adobe 自家的商业级合成工具的真实对比需要更细评测 7. SmartDirector:多关键帧条件电影级视频叙事控制 SmartDirector: Keyframe-Conditioned Cinematic Video Generation with Narrative Pacing Control | 国内视频生成团队 | arXiv:2605.27891 关键词:电影级视频·多关键帧·叙事节奏·两阶段·Director-Gen/SR ⚠️ 前序问题:视频的「叙事质量」决定感知价值,但现有视频生成方法主要靠 text prompt 或首尾帧这类稀疏 condition——对叙事结构和时序节奏的精确控制非常有限,导出不了真正「有 pacing 的电影感视频」 本文贡献:SmartDirector:以多关键帧增强视频生成的叙事能力。支持单镜头、多镜头叙事合成、视频延展三类场景。两阶段:(i) Director-Gen 在低分辨率上以关键帧为条件生成;(ii) Director-SR 利用高分辨率关键帧作为语义锚点把细粒度细节补回来。配套数据管线从电影中精选单镜头/多镜头序列以支撑多关键帧训练 实验效果:在多个评测上大幅超越 SOTA,把视频生成从「按 prompt 出 5 秒片段」升级到「按多关键帧出有节奏的多镜头序列」——电影级视频生成的可控性接近真实创作工作流 批判点评:「多关键帧 + 两阶段先粗后细」直击「电影级叙事控制」的实际痛点——单 prompt / 首尾帧确实远远不够。两阶段把分辨率 vs 叙事控制解耦是合理设计。但「关键帧」的获取成本(人工/AI辅助)和叙事节奏的可量化评测仍是模糊地带;多镜头切换的时空一致性细节需要更深 ablation 8. LoSATok:1280维语义压缩到128维统一audio LoSATok: Low-dimensional Semantic-Acoustic Tokenizer for Cross-Domain Audio Understanding and Generation | 清华深圳, 面壁智能 | arXiv:2605.27840 关键词:audio tokenizer·128 维·语义瓶颈·清华深圳·面壁 ⚠️ 前序问题:音频 tokenizer 是统一「音频理解」和「音频生成」的根基。理解需要高层语义;生成需要语义 + 声学细节。现有统一 tokenizer 在高维连续 latent 里同时编码——这增加了 DiT 生成端的建模负担 本文贡献:LoSATok:观察到 1280 维语义 encoder 特征是可压缩的,引入 Semantic Bottleneck 压到 128 维,并用 time-relation loss 保时序特征一致性;再用「双层级语义监督」同时利用高维/低维语义信号——让 tokenizer 在紧凑 latent 空间里同时承载语义和声学细节 实验效果:在 speech / music / 通用 audio 上 SemBo 保住强低维语义容量,LoSATok 与多个语义表示比较 understanding 性能仍有竞争力;在 DiT 端的 speech / music / audio 生成上一致改进——证明「低维 audio 表示也能同时支撑理解与生成」 批判点评:把「audio 统一 tokenizer」的维度从 1280 砍到 128 是非常硬的容量压缩——若真的不掉理解还能提升生成,那就解掉了「audio 统一表示卡 DiT」的关键梗。time-relation loss + 双层级语义监督是合理工程。但 128 维下声学细节的极限(音乐复杂混音、长 reverb)需要更细测试;与 Dasheng AudioGen 高维路线的端到端比较是行业级议题 9. CosyEdit2:GRPO语音编辑反哺零样本TTS CosyEdit2: Speech-Editing-Oriented Reinforcement Learning Unlocks Better Zero-Shot TTS | 南开大学 | arXiv:2605.25930 关键词:语音编辑·GRPO·zero-shot TTS·南开大学·post-training ⚠️ 前序问题:语音编辑和 zero-shot TTS 同源于「prompt 驱动的语音生成」,但语音编辑对「与周围未编辑内容的局部声学一致性」要求严苛得多。SFT 让 TTS 模型获得编辑能力的路线被卡在「成对编辑数据不完美 + 优化信号粗粒度」 本文贡献:CosyEdit2:建立「先 SFT 初始化 → 再 editing-oriented GRPO 后训练」的两阶段框架。GRPO 阶段在「无目标语音」的数据上做,把语音编辑当作 RL 任务优化,让模型从粗粒度匹配走向精细局部声学一致 实验效果:不仅在语音编辑上显著提升,还反哺 zero-shot TTS 能力——揭示「编辑任务 ↔ 合成任务」之间隐藏的相互增益;GRPO 在 audio 域被验证是有效的 post-training 范式 批判点评:把 GRPO 引入 audio 域、并用「编辑反哺合成」这个新角度证明两个任务的深层互助,是非常聪明的科学故事。无目标语音的 RL 设计也比依赖成对数据更可扩展。但 GRPO 的 reward 设计细节、跨语种/多说话人鲁棒性、以及对 prosody 细节的影响需要更系统评测 10. PilotTTS:高德200K小时开源TTS竞品级 PilotTTS: A Disciplined Modular Recipe for Competitive Speech Synthesis | 高德 AMAP | arXiv:2605.27258 关键词:TTS·200K 小时·开源·Q-Former·高德 AMAP ⚠️ 前序问题:SOTA TTS 系统通常需要数百万小时专有数据 + 多阶段复杂架构——这对资源受限的研究团队是几乎跨不过去的门槛。开源社区想自己训出竞品级 TTS 一直缺成熟 recipe 本文贡献:PilotTTS:高德 AMAP 用「最小化架构 + 严格数据工程」做出竞品级轻量自回归 TTS。仅用 200K 小时数据 + 全开源工具处理。两大贡献:(i) 可复现的多阶段数据处理 pipeline(质量评估 + 标签标注 + 过滤);(ii) Q-Former conditioning 紧凑模型架构,通过 cross-sample paired training 解耦说话人身份与说话风格。统一框架支持 zero-shot voice cloning / 11 类情感合成 / 4 类副语言合成 / 14 种中文方言 实验效果:在 Seed-TTS Eval 上 test-en WER 1.50%(最低)、test-zh CER 0.87%;两个测试集说话人相似度都最高(0.862 / 0.815)——超越使用大得多数据集训出来的系统。完整 data pipeline + 预训练权重 + 代码全开源 (AMAPVOICE/PilotTTS) 批判点评:「200K 小时 + 开源工具 + 极简架构」做出超越百万小时专有数据系统的 TTS——是非常有信号量的开源胜利,对中小团队意义重大。Q-Former 解耦说话人/风格的设计也是 clean。但 PilotTTS 主打数据工程而非架构创新,复现门槛仍在「数据处理 pipeline 的工程细节」;与昨天 LongCat-Avatar 类「audio + 视频联合」的下一步集成是开放问题 11. LAIR:扩散模型从成对偏好升级到列表对齐 Beyond Pairwise Preferences: Listwise Reward-Aware Alignment for Diffusion Models | 斯坦福, 加州理工 Caltech | arXiv:2605.26491 关键词:diffusion 对齐·listwise preference·advantage-weighted·Stanford·Ermon ⚠️ 前序问题:preference optimization 已成 RLHF 之外对齐 T2I 扩散的高效替代,但现有方法基本都把监督降到 binary pairwise——这在「同 prompt 有多张候选 + 有连续 reward 分数」时严重浪费信息(一个 winner-loser 标签远远没用上 reward 分布) 本文贡献:Diffusion LAIR:reward-aware listwise preference optimization。每个 prompt 把候选组的 reward 分数转成中心化 advantage 权重,再优化「advantage-weighted regression」目标——目标定义在 implicit reward(当前模型 vs 固定参考模型的 denoising-loss 改进量)上,配二次惩罚正则隐式 reward 幅度。结果是同时用所有候选而非选 pair,并保持保守。LAIR 目标在 implicit-reward 空间有 bounded closed-form 最优解,把正则强度 → 偏好更新幅度的关系写清楚 实验效果:在 SD1.5 / SDXL 上对 T2I 生成 / 组合生成 / 图像编辑 benchmark 都超越 strong pairwise preference optimization baseline;为 diffusion 对齐提供「更接近 RLHF reward 信息密度但不需在线 RL」的中间路线 批判点评:把 DPO 类 pairwise 升级到 listwise + 给出 closed-form 最优解的清晰表述是教科书级的方法工作——既保留 offline 偏好优化的稳定性,又用上了 reward score 的全部信息。但 listwise 数据采集成本高于 pairwise(要 N 张同 prompt 候选 + reward 分),实际落地的数据可得性是隐藏成本;与 in-context 在线 RL(GRPO 类)的端到端比较略浅 趋势观察 视频生成进入「全栈加速」时代:稀疏 + 量化 + 并行 + 路由 + RL 多管齐下 — OSP-Next 把稀疏注意力 + Sparse Sequence Parallelism(通信 -75%)+ HiF8 量化 + Mix-GRPO 一锅端,跨 H200 / 昇腾双硬件分别 1.64× / 2.27× 加速;PARE 联合宽度剪枝 + 动态深度路由,在 Wan2.1-14B 上按输入按 timestep 动态算;SVDQuant-GPTQ 把 Wan2.2 双专家 MoE DiT 推到 W4A4 显存降 59.3%——视频生成的工业部署正在被「全栈加速」改写 长视频 KV cache 压缩出现「找根因 + 闭式解」类突破 — Quantized Keys Steal Attention 首次把「量化 KV 掉画质」从经验现象写成 Jensen bias(exp 凸性放大 cache key 贡献)的可解析统计现象,一行公式校正零额外显存,让 MAGI-1 / SkyReels-V2 / HY-WorldPlay 在 INT2 上接近 BF16——把 chunk-wise AR 长视频的 KV 压缩从「玄学调参」推到「有理论的工程」 音频生成统一化:从「按域切分」走向「一句描述出混合场景」 — Dasheng AudioGen 是首个能从一句描述同时生成 speech + music + SFX 混合连贯场景的统一模型,关键是 structured multi-view captions + 高维语义-声学统一 latent;LoSATok 反过来把 1280 维语义压到 128 维统一 tokenizer 反哺 DiT 生成;CosyEdit2 在 audio 域用 GRPO 把「编辑」反哺「TTS」——audio 正在重走视觉「统一模型」的同一条路 视频生成的「叙事控制」与「视频后期」继续拓宽到工业链路 — SmartDirector 把视频生成从「按 prompt 出 5 秒片段」升级到「多关键帧 + 两阶段先粗后细」做电影级叙事节奏控制;HarmoVid 用 deflicker 模型破解「视频和谐化无成对数据」的死结,把视频肖像 relight 和谐化做到工业级稳定——视频生成的可控性从「内容」深入到「节奏」和「后期合成」 开源 TTS / 对齐方法补齐 audio + diffusion 的「最后一公里」 — 高德 PilotTTS 用 200K 小时 + 开源工具 + Q-Former 极简架构做出超越百万小时专有系统的开源 TTS(Seed-TTS Eval 第一);Diffusion LAIR 把 T2I 对齐从 pairwise 升级到 listwise,给出 implicit-reward 的 closed-form 最优解——开源社区在 audio 合成 + diffusion 对齐这两个长期被闭源霸占的方向同时迈出了「竞品级 + 理论级」的双台阶 人工智能炼丹君 整理 | 2026-05-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注