搜索到
134
篇与
论文速读
的结果
-
 AIGC 每日速读|2026-04-06|VOID因果推理视频编辑|DynaVid CVPR2026|SteerFlow免训练编辑 AIGC 视觉生成领域 · 每日论文解读 (2026-04-06) 人工智能炼丹师 整理 | 共 10 篇论文 | 重点深度解读 1 篇 今日核心看点 VOID:因果推理驱动的视频对象删除 DynaVid:合成光流驱动高动态视频生成(CVPR 2026) SteerFlow / FlowSlider:免训练 Rectified Flow 图像编辑 LatentUM:潜在空间统一多模态模型 PFluxTTS:双解码器混合流匹配语音合成 CLPIPS:AI 生成图像个性化评测指标 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 视频生成与编辑: 4 篇 (VOID, DynaVid, ActionParty, BidirInterp) 图像生成与编辑: 3 篇 (SteerFlow, FlowSlider, ReflectGen) 统一/多模态模型: 1 篇 (LatentUM) 音频/语音合成: 1 篇 (PFluxTTS) 评测方法: 1 篇 (CLPIPS) 顶会收录: CVPR 2026 (DynaVid) 重点论文深度解读 1. VOID 因果推理驱动的视频对象与交互删除:物理一致性视频编辑新范式 | Netflix, INSAIT (Sofia University) | arXiv:2604.02296 关键词: 视频编辑, 对象删除, 因果推理, 物理一致性, 反事实生成 研究动机 核心问题: 视频对象移除后如何保持物理一致性?现有方法只能修复外观伪影,无法重写因果交互。 现有视频对象移除方法只能修复外观层面的伪影(如阴影和反射),当被移除对象与场景存在物理交互(如碰撞、支撑)时,无法推理并重写下游物理动态,导致结果不合物理常识。VOID 提出用因果推理指导视频扩散模型,在对象移除后生成物理一致的反事实场景。 前序工作及局限: ProPainter (2023):基于光流传播的视频修复,擅长空间填充但无物理推理能力 Generative Omnimatte (2024):分层视频效果分离,三色掩码条件引导,但仅支持阴影/反射等外观效果 ROSE (2025):基于扩散的视频对象移除,改善了时序一致性但仍限于外观修复 Go-with-the-Flow (2025):Flow-Warped Noise 提升视频扩散的时序连贯性,启发 VOID 的第二遍方案 与前序工作的本质区别: VOID 首次引入因果推理:通过反事实数据监督 + VLM 空间推理 + 四色掩码编码,让视频扩散模型学会重写下游物理交互,而非简单填充。 方法原理 VOID 基于 CogVideoX 扩散 Transformer 构建,采用两遍生成策略。核心创新包括:(1) 反事实数据集监督——使用 Kubric 刚体动力学和 HUMOTO 人体运动捕捉数据,生成约 6400 组配对反事实视频(有/无目标对象),提供物理一致的训练监督。(2) 四色掩码(Quadmask)条件——扩展传统三色掩码为四色:黑色(待移除对象)、深灰(对象与受影响区域重叠)、浅灰(受影响区域)、白色(保持不变),消除掩码歧义。(3) VLM 引导推理——推理时使用视觉语言模型(Gemini 3 Pro)识别受移除对象影响的区域,结合 SAM3 分割,预测反事实轨迹并生成四色掩码。(4) 第二遍 Flow-Warped Noise 稳定——第一遍生成正确的反事实轨迹但可能出现变形,第二遍使用光流对齐噪声保持物体刚性。VLM 自动判断是否需要第二遍。 核心创新 首个因果推理驱动的视频对象删除框架,移除对象后能重写下游物理交互(碰撞停止、支撑消失后自由落体等) 四色掩码(Quadmask)条件机制,解决对象移除与受影响区域重叠时的歧义问题 反事实数据集监督:Kubric 刚体动力学 + HUMOTO 人体运动捕捉,合成 6400+ 配对视频 双遍生成策略:第一遍合成反事实轨迹,第二遍 Flow-Warped Noise 修复变形 VLM 引导空间推理:Gemini 3 Pro + SAM3 自动生成推理时四色掩码 人类偏好 64.8% 胜率大幅超越 Runway 等商业系统 实验结果 人类偏好研究(25人/125组比较):VOID 64.8% 胜率,远超 Runway 18.4%、Gen-Omnimatte 11.2%、DiffuEraser 4.0%。VLM-as-Judge 评估(Gemini 3 Pro/GPT-5.2/Qwen 3.5 三组)全部排名第一,Interaction & Physics 维度提升最显著(3.66 vs Runway 2.61)。合成数据集指标:PSNR 31.49(最佳)、DreamSim 0.0658(最佳)、DINOv2 0.9222(最佳)、FVD 260.31(最佳,vs 第二名 437.88 降低 40%)。消融实验证明:混合 Kubric+HUMOTO 数据优于单一数据集,四色掩码优于三色掩码(26.12 vs 23.39 总分)。 图表详解 反事实数据集样例 Kubric 刚体碰撞和 HUMOTO 人体运动捕捉的配对反事实视频。上排为原始视频(红色标注目标对象),下排为移除对象后的反事实模拟,展示物理交互如何被正确重写。 双遍生成效果对比 左列第一遍生成正确的反事实轨迹但出现结构变形(吉他弯曲、球体拉伸),右列第二遍使用光流对齐噪声后保持了物体刚性,细节显著改善。 真实场景定性比较 与 Runway/Gen-Omnimatte/ProPainter 的对比:壶铃移除后枕头应弹回、浮标移除后无碰撞、双车相撞移除后正确还原。VOID 在物理一致性和伪影消除上全面领先。 多场景泛化结果 VOID 泛化到训练数据未涵盖的真实场景:积木多米诺骨牌停止、气球浮起、保龄球碰撞、搅拌机不启动等,展示强大的物理推理能力。 批判性点评 新颖性: 核心创新在于将因果推理引入视频编辑,从外观修复升级为世界模拟。四色掩码和反事实数据监督都是扎实的工程创新。但每个单独技术(VLM 推理、Flow-Warped Noise、扩散微调)都有前置工作,贡献在于系统整合。 可复现性: 依赖 CogVideoX 5B + Gemini 3 Pro + SAM3 三个外部模型,推理成本高。Kubric 和 HUMOTO 数据集可复现。代码和项目页面已公开。 影响力: 短期:将推动视频编辑工具从简单修复走向物理一致性编辑。中期:反事实推理数据集构建方法可迁移到其他世界模型训练。长期:为视频生成模型成为世界模拟器开辟路径。 深度点评: 因果推理驱动的视频编辑新范式 — VOID 首次证明:结合 VLM 因果推理 + 物理模拟反事实数据,可以让视频扩散模型学会重写下游物理交互。64.8% 人类偏好胜率大幅超越 Runway 等商业系统。但依赖 Gemini 3 Pro 推理能力,VLM 质量是系统瓶颈。 合成数据泛化到真实世界 — 仅用 6400 组 Kubric+HUMOTO 合成视频训练,就能泛化到真实世界的积木、保龄球、气球等多种未见过的物理交互。证明合成物理模拟作为训练监督的巨大潜力。 从外观修复到世界模拟 — 传统视频修复只做空间填充,VOID 要求模型理解因果关系:移除碰撞发起者后下游碰撞应停止,移除支撑后物体应自由落体。这是视频编辑从工具走向智能的关键一步。 技术演进定位: 开创视频编辑从外观修复到世界模拟的新方向。证明合成物理模拟数据可以让模型泛化到真实世界的因果推理。 可能的后续方向: 扩展到更复杂的物理场景(流体、柔体、多阶因果链) 与更强的世界模型结合,实现物理动力学的精确预测 无需 VLM 的端到端因果推理 其余论文速览 1. DynaVid:合成光流驱动高动态视频生成 DynaVid: Learning to Generate Highly Dynamic Videos using Synthetic Motion Data 关键词: 视频生成·合成运动数据·光流·运动解耦·CVPR 2026 贡献: 合成光流数据→运动-外观解耦→高动态视频生成,两阶段框架(运动生成+视频渲染),CVPR 2026 效果: 利用 CG 管线渲染光流训练运动生成器,保留真实视频视觉真实感。在剧烈人体运动和极端相机运动场景验证有效 2. SteerFlow:免训练 Rectified Flow 图像编辑 SteerFlow: Steering Rectified Flows for Faithful Inversion-Based Image Editing 关键词: 图像编辑·Rectified Flow·免训练·保真度·多轮编辑 贡献: 基于 Rectified Flow 的免训练图像编辑框架,摊销定点求解器+轨迹插值+自适应掩码,理论保证源保真度 效果: 在 FLUX.1-dev 和 SD 3.5 Medium 上超越现有方法。支持多轮编辑不累积漂移 3. LatentUM:潜在空间统一多模态模型 LatentUM: Unleashing the Potential of Interleaved Cross-Modal Reasoning via a Latent-Space Unified Model 关键词: 统一模型·潜在空间·跨模态推理·视觉生成·世界建模 贡献: 潜在空间统一多模态模型,消除视觉理解和生成之间的像素空间中介,支持交错跨模态推理 效果: 视觉空间规划 SOTA,自我反思改进视觉生成,支持世界建模预测未来视觉状态 4. FlowSlider:滑块式免训练连续图像编辑 FlowSlider: Training-Free Continuous Image Editing via Fidelity-Steering Decomposition 关键词: 图像编辑·连续控制·正交分解·免训练·Rectified Flow 贡献: 将编辑更新分解为正交的保真度项+导向项,实现滑块式连续强度控制的免训练图像编辑 效果: 基于 Rectified Flow 模型无需后训练,保真度项保持身份结构,导向项驱动语义编辑,平滑可靠 5. ActionParty:多主体视频世界模型 ActionParty: Multi-Subject Action Binding in Generative Video Games 关键词: 世界模型·多主体控制·动作绑定·视频游戏·状态token 贡献: 首个可同时控制多达 7 名玩家的视频世界模型,引入主体状态 token + 空间偏置解耦全局渲染与动作控制 效果: 在 Melting Pot 46 个环境中验证,动作跟随准确性和身份一致性显著提升,Snap Research 6. PFluxTTS:双解码器混合流匹配 TTS PFluxTTS: Hybrid Flow-Matching TTS with Robust Cross-Lingual Voice Cloning and Inference-Time Model Fusion 关键词: TTS·Flow Matching·跨语言克隆·双解码器·48kHz 贡献: 双解码器混合流匹配 TTS,推理时向量场融合+FLUX 解码器跨语言克隆+48kHz PeriodWave 声码器 效果: MOS 4.11 持平 ChatterBox,WER 降低 23%(6.9% vs 9.0%),说话人相似度超越 ElevenLabs(+0.32 SMOS) 7. BidirInterp:视频扩散双向循环一致性 Can Video Diffusion Models Predict Past Frames? Bidirectional Cycle Consistency for Reversible Interpolation 关键词: 视频插值·循环一致性·双向扩散·方向token·课程学习 贡献: 视频扩散双向循环一致性框架,可学习方向 token 统一前向合成和后向重建,课程学习从短到长 效果: 37帧和73帧插值任务均 SOTA,推理无额外开销(循环约束仅训练时),运动平滑度和动态控制大幅提升 8. CLPIPS:AI 生成图像个性化评测指标 CLPIPS: A Personalized Metric for AI-Generated Image Similarity 关键词: 评测指标·图像相似度·个性化·LPIPS·人类对齐 贡献: LPIPS 的个性化扩展,通过人类排序数据微调层组合权重,对齐 AI 生成图像评估与人类判断 效果: Spearman 等级相关和 ICC 均优于原始 LPIPS,证明有限人类数据微调即可显著提升感知对齐 9. ReflectGen:扩散模型物体反射生成 Reflection Generation for Composite Image Using Diffusion Model 关键词: 反射生成·合成图像·扩散模型·DEROBA数据集·类型感知 贡献: 首个大规模物体反射数据集 DEROBA + 扩散模型反射生成方法,注入反射位置和外观先验,类型感知设计 效果: 生成物理一致、视觉逼真的反射效果,为合成图像反射生成建立新基准 趋势观察 视频编辑从外观修复升级为因果推理 — VOID 用 VLM 推理物理交互,移除对象后重写下游动态,FVD 降低 40% 免训练编辑方法持续深化 — SteerFlow/FlowSlider 均基于 Rectified Flow 的免训练方案,数学保证源保真度 统一模型走向潜在空间融合 — LatentUM 消除像素中介,在共享语义潜空间内实现理解-生成-推理闭环 合成运动数据突破动态视频瓶颈 — DynaVid 用 CG 渲染光流解耦运动与外观,CVPR 2026 证明合成数据可学到真实世界动态 混合架构成为 TTS 新标准 — PFluxTTS 双解码器+向量场融合,跨语言克隆超越 ElevenLabs,MOS 达 4.11 人工智能炼丹师 整理 | 2026-04-06
-
AIGC 周末专题|2026-04-05|Mistral Voxtral TTS胜ElevenLabs AIGC 周末专题深度解读:语音合成与音频生成前沿:从编解码器语言模型到扩散 TTS、音效生成与指令驱动语音设计 人工智能炼丹师 整理 | 2026年4月5日(周日) 覆盖时间:2026年3月29日 — 2026年4月5日 本期概述 本期 AIGC 周末专题聚焦语音合成与音频生成前沿:从编解码器语言模型到扩散 TTS、音效生成与指令驱动语音设计方向,精选 6 篇代表性论文进行深度解读。 方向分布: 语音合成(TTS)— 4篇 音效生成(T2A/V2A)— 1篇 语音设计(Voice Design)— 1篇 本期论文一览 # 论文 机构 核心贡献 arXiv ID 1 Voxtral TTS Mistral AI 提出 Voxtral TTS 混合架构:自回归语义 token 建模 + 流匹配声学 token 生成,兼顾语义连贯性和 2603.25551 2 LongCat-AudioDiT Meituan 在波形潜空间(而非频谱或 token 空间)进行扩散 TTS,保留完整音频信息 2603.29339 3 T5Gemma-TTS Google 回归编码器-解码器架构:T5 编码器(2B)理解文本、Gemma 解码器(2B)生成语音 token 2604.01760 4 Woosh Sony AI 构建完整音效基础模型:音频编解码器 + 文本-音频对齐 + T2A 生成 + V2A 生成 2604.01929 5 MOSS-VoiceGenerator Fudan University 指令驱动语音生成:自然语言描述控制语音风格、情感和表达方式 2603.28086 6 Prosody-Aware TTS Independent Research 多阶段预训练:MLM 预训练 + SigLIP 跨模态对比学习 2604.01247 1. Voxtral TTS:混合自回归与流匹配的高质量语音合成系统 论文: Voxtral TTS arXiv: 2603.25551 机构: Mistral AI 1.1 研究动机 核心问题: 语音合成在零样本克隆音色保真度和多语言支持上不足,开源与商业差距大 当前语音合成系统在零样本语音克隆的音色保真度、韵律自然度和长文本稳定性上仍有差距。商业系统如 ElevenLabs 领先,开源社区需要更强大的基座模型。 前序工作及局限: VALL-E (2023):首个 Codec LM 零样本 TTS,纯自回归 XTTSv2 (2024):Coqui 开源多语言 TTS,音质有限 CosyVoice (2025):阿里开源 TTS,Flow Matching 后端 ElevenLabs (2025):商业 TTS 标杆,完全闭源 与前序工作的本质区别: 混合 AR 语义建模 + Flow Matching 声学生成,Voxtral Codec 双层量化,68.4% 胜率超越 ElevenLabs 1.2 方法原理 Voxtral TTS 的核心是两阶段生成管线。第一阶段使用自回归 Transformer 预测语义 token 序列,这些语义 token 由 Voxtral Codec 的 VQ 层提取,编码语音的语言内容和韵律模式。第二阶段使用条件流匹配模型以语义 token 为条件生成声学 token,FSQ 层编码精细的音色纹理。Voxtral Codec 是关键创新:编码器将音频压缩为双层表示(VQ 语义层 + FSQ 声学层),解码器从两层 token 重建高保真音频。 1.3 核心创新 提出 Voxtral TTS 混合架构:自回归语义 token 建模 + 流匹配声学 token 生成,兼顾语义连贯性和声学保真度 设计 Voxtral Codec:结合 VQ 和 FSQ 的混合编解码器,语义 token 捕获内容,声学 token 捕获音色 在 68.4% 的人类偏好评测中胜过 ElevenLabs Flash v2.5 支持多语言多说话人零样本克隆,CC BY-NC 开源 1.4 实验结果 MOS 达 4.32 分,A/B 测试中以 68.4% 胜率超过 ElevenLabs Flash v2.5。零样本音色相似度 0.891,支持英法德西等多种语言。 1.5 关键洞察 CC BY-NC 限制商业应用。两阶段推理增加延迟。与 ElevenLabs Turbo 系列未对比。训练数据未完全公开。 技术演进定位: 开源 TTS 新标杆,证明混合架构路线有效性 可能的后续方向: 低延迟流式推理 更多语言覆盖 情感控制融合 2. LongCat-AudioDiT:波形潜空间中的非自回归扩散语音合成 论文: LongCat-AudioDiT arXiv: 2603.29339 机构: Meituan 2.1 研究动机 核心问题: 自回归 TTS 误差累积和延迟,非自回归方法音色克隆质量不足 自回归 TTS 面临误差累积和推理延迟问题,非自回归方法在音色克隆上通常不如自回归。需要既能高效并行生成又达到自回归级别质量的方案。 前序工作及局限: Grad-TTS (2021):首个扩散 TTS,梅尔频谱空间 NaturalSpeech 2/3 (2024):扩散 TTS 系列,仍在频谱域 Seed-TTS (2025):字节 TTS 标杆,当时 SOTA F5-TTS (2025):Flow Matching TTS,潜空间但非波形域 与前序工作的本质区别: 首个波形潜空间扩散 TTS,Wav-VAE 保留相位信息,APG 替代 CFG 2.2 方法原理 三个核心组件:(1) Wav-VAE 在波形域工作,多尺度卷积编码器压缩波形到连续潜空间,保留相位和细节信息。(2) 扩散 DiT 在潜空间去噪,文本和说话人条件通过交叉注意力注入。(3) APG 将无条件预测投影到条件预测的正交补空间,避免 CFG 的过饱和问题。非自回归一次性生成完整潜表示。 2.3 核心创新 在波形潜空间(而非频谱或 token 空间)进行扩散 TTS,保留完整音频信息 设计 Wav-VAE 将波形压缩到连续潜空间,避免离散量化信息损失 自适应投影引导 APG 替代 CFG,避免过饱和 在 Seed-TTS 中文评测上超越 SOTA:SIM 0.818 vs 0.809 2.4 实验结果 Seed-TTS 中文基准 SIM 0.818(超 Seed-TTS 0.809),英文同达 SOTA。推理速度比自回归快 5-10 倍。代码和权重开源。 2.5 关键洞察 Wav-VAE 波形域压缩计算量较大。APG 增加少量推理开销。极长文本稳定性待验证。作者机构未明确标注。 技术演进定位: 非自回归 TTS 新高度,SIM 0.818 超越 Seed-TTS 可能的后续方向: 更高效 Wav-VAE 长音频生成 口型同步 TTS 3. T5Gemma-TTS:编码器-解码器架构的大规模 Codec 语言模型 TTS 论文: T5Gemma-TTS arXiv: 2604.01760 机构: Google 3.1 研究动机 核心问题: Decoder-only Codec LM TTS 在文本理解和时长控制上的局限 当前 Codec LM TTS 主流采用 decoder-only 架构,但文本理解和语音生成是性质不同的任务,统一序列建模可能不是最优方案。多语言场景下的时长控制不够精确。 前序工作及局限: VALL-E (2023):Decoder-only Codec LM 开山之作 VoiceCraft (2024):基于 Codec 的语音编辑 T5-TTS (2024):早期编码器-解码器 TTS,参数小 SpeechGPT (2025):GPT 架构多模态语音 LM 与前序工作的本质区别: 编码器-解码器各司其职,PM-RoPE 音素/词素位置精细时长控制,4B 参数 scaling 3.2 方法原理 T5 编码器接收文本生成上下文化表示,Gemma 解码器以交叉注意力为条件自回归生成 Codec token。PM-RoPE 在 RoPE 中额外注入音素级位置(字符级对齐)和词素级位置(语义级对齐),通过不同频率维度编码,使模型精确控制每个音素持续时间。 3.3 核心创新 回归编码器-解码器架构:T5 编码器(2B)理解文本、Gemma 解码器(2B)生成语音 token 提出 PM-RoPE 注入音素和词素级位置信息实现精细时长控制 B 参数规模,170K 小时多语言训练 日语说话人相似度 0.677 超过 XTTSv2 的 0.622,代码和权重开源 3.4 实验结果 日语说话人相似度 0.677 vs XTTSv2 0.622。PM-RoPE 消融显示字符级对齐误差降低 15%。4B 参数展现 scaling 优势。 3.5 关键洞察 4B 参数推理成本高。交叉注意力增加内存占用。PM-RoPE 需要音素/词素标注。与 Google 自家闭源系统仍有差距。 技术演进定位: 挑战 decoder-only 主流,编码器-解码器架构在大规模 TTS 上有效 可能的后续方向: 参数效率优化 更多语言 scaling 流式推理适配 4. Woosh:文本到音效与视频到音效的基础模型 论文: Woosh arXiv: 2604.01929 机构: Sony AI 4.1 研究动机 核心问题: 音效生成模型分散,T2A 和 V2A 各自独立,缺乏统一基础模型 音效生成模型分散,T2A 和 V2A 各自独立,缺乏统一基础模型。现有模型推理速度慢,难以满足交互式创作需求。 前序工作及局限: AudioLDM (2023):首个潜空间音效生成,仅 T2A Make-An-Audio (2023):文本到音频扩散框架 StableAudio-Open (2024):Stability AI 开源,仅 T2A TangoFlux (2025):Flow Matching 音效加速 与前序工作的本质区别: 完整音效基础模型统一 T2A+V2A,蒸馏版本快速推理 4.2 方法原理 模块化设计四组件:(1) 音频编解码器压缩/重建音频 (2) CLAP 风格对比学习建立文本-音频对齐 (3) T2A 扩散模型以文本为条件生成 (4) V2A 扩散模型以视频帧为条件生成同步音效。蒸馏版通过知识蒸馏实现少步生成。 4.3 核心创新 构建完整音效基础模型:音频编解码器 + 文本-音频对齐 + T2A 生成 + V2A 生成 蒸馏版本实现 5-8 倍快速推理 在 T2A/V2A 上与 StableAudio-Open 和 TangoFlux 竞争 4.4 实验结果 AudioCaps/Clotho 上 FAD 与 StableAudio-Open/TangoFlux 竞争。V2A 音视频同步分数高于基线。蒸馏版 5-8 倍加速。 4.5 关键洞察 模块化增加系统复杂度。T2A 和 V2A 未完全统一。蒸馏版复杂音效质量下降。与闭源音效模型仍有差距。 技术演进定位: 音效生成从单任务走向基础模型 可能的后续方向: T2A+V2A 深度统一 3D 空间音效 交互式音效设计 5. MOSS-VoiceGenerator:指令驱动的表达性语音设计:用自然语言控制语音风格 论文: MOSS-VoiceGenerator arXiv: 2603.28086 机构: Fudan University 5.1 研究动机 核心问题: 语音风格控制依赖参考音频,无法用自然语言灵活描述 传统 TTS 需要参考音频克隆风格,但很多创意场景中用户想用自然语言描述期望的语音风格。现有系统对复杂风格描述的理解能力有限。 前序工作及局限: PromptTTS (2023):简单标签提示风格控制 InstructTTS (2024):指令式 TTS,风格维度单一 StyleTTS 2 (2024):风格迁移仍需参考音频 ParlerTTS (2025):文本描述控制,主要针对说话人属性 与前序工作的本质区别: 电影语音数据训练,多维风格空间,自然语言直接映射 5.2 方法原理 两模块设计:(1) 风格理解模块用预训练 LLM 将自然语言风格描述编码为嵌入向量,涵盖音色/情感/语速/场景多维度。(2) 条件语音生成模块以文本和风格嵌入为条件,在梅尔频谱空间扩散生成。训练数据来自电影语音,自动标注情感、风格和角色属性。 5.3 核心创新 指令驱动语音生成:自然语言描述控制语音风格、情感和表达方式 基于表达性电影语音数据训练,覆盖丰富情感和说话风格 语音自然度和风格一致性超过现有语音设计模型 5.4 实验结果 MOS 3.89 高于 PromptTTS(3.52)/InstructTTS(3.71)。风格一致性 81.3%。情感表达维度尤为突出。 5.5 关键洞察 风格理解依赖 LLM 能力,抽象描述可能失效。电影语音数据版权问题。MOS 3.89 距顶级 TTS 仍有差距。缺少与最新系统直接对比。 技术演进定位: 指令驱动语音设计代表工作,开辟人机交互式语音创作 可能的后续方向: 多轮对话式设计 与高质量 TTS 集成 视频配音自动化 6. Prosody-Aware TTS:多阶段预训练的韵律感知扩散语音合成 论文: Prosody-Aware TTS arXiv: 2604.01247 机构: Independent Research 6.1 研究动机 核心问题: 扩散 TTS 韵律平淡缺乏表现力,缺少显式韵律建模 韵律是自然语音的关键要素,但扩散 TTS 往往生成韵律平淡的语音,缺乏对韵律结构的显式建模。 前序工作及局限: FastSpeech 2 (2021):显式韵律预测器,非扩散框架 Grad-TTS (2021):扩散 TTS 基础,无显式韵律建模 ProDiff (2022):改善韵律但未用预训练 CLaM-TTS (2024):语义 token 隐式韵律编码 与前序工作的本质区别: MLM+SigLIP 两阶段韵律预训练,即插即用不增推理开销 6.2 方法原理 三阶段:(1) MLM 预训练韵律编码器,掩码韵律 token 预测,学习韵律结构。(2) SigLIP 对比学习,建立文本语义和语音韵律跨模态对齐。(3) 将韵律编码器集成到扩散 TTS,韵律嵌入作为额外条件注入去噪。韵律编码器仅增加 5% 参数。 6.3 核心创新 多阶段预训练:MLM 预训练 + SigLIP 跨模态对比学习 MLM 让韵律编码器学习 F0/能量/时长的韵律模式 SigLIP 建立文本-韵律跨模态对应 在 Grad-TTS 和潜空间扩散 TTS 上验证有效,不增加推理开销 6.4 实验结果 F0 RMSE 降低 18%,Duration Accuracy 提升 12%。韵律 MOS 从 3.71 升至 4.02(Grad-TTS)和 3.85 升至 4.15(潜空间扩散)。推理时间几乎不变。 6.5 关键洞察 多阶段预训练增加训练复杂度。SigLIP 效果依赖正负样本质量。仅验证两种架构。韵律特征提取依赖信号处理工具。 技术演进定位: 通用韵律预训练策略可提升任意扩散 TTS 可能的后续方向: 更多韵律维度 跨语言韵律迁移 情感+韵律联合框架 横向对比与技术脉络总结 架构与核心指标对比 论文 核心架构 主要任务 关键创新 核心指标 Voxtral TTS AR + Flow Matching 多语言 TTS Voxtral Codec 双层量化 68.4% 胜率 vs ElevenLabs LongCat-AudioDiT Wav-VAE + DiT 零样本 TTS 波形潜空间 + APG SIM 0.818 超 Seed-TTS T5Gemma-TTS T5 + Gemma (4B) 多语言 TTS PM-RoPE 时长控制 日语 SIM 0.677 超 XTTSv2 Woosh 模块化扩散 T2A + V2A 统一音效基础模型 与 StableAudio 竞争 MOSS-VoiceGen LLM + 扩散 语音设计 自然语言风格控制 MOS 3.89, 一致性 81.3% Prosody-Aware 预训练 + 扩散 韵律增强 MLM + SigLIP 预训练 F0 RMSE 降低 18% 训练范式与应用场景对比 论文 训练范式 数据规模/特色 推理特点 目标场景 Voxtral TTS 两阶段生成管线 大规模多语言 两步推理 通用高质量 TTS LongCat-AudioDiT Wav-VAE + DiT 联合 大规模中英文 一步并行, 快5-10x 高保真零样本克隆 T5Gemma-TTS 编码器-解码器微调 170K 小时多语言 自回归, 4B 参数 多语言精细控制 Woosh 模块化分阶段 大规模音效数据 蒸馏版 5-8x 加速 影视/游戏音效 MOSS-VoiceGen 电影语音微调 电影对白(情感丰富) 标准扩散速度 有声书/游戏配音 Prosody-Aware 三阶段预训练 标准 TTS 数据 不增推理开销 通用韵律增强插件 核心技术趋势 趋势 1:混合架构成为语音合成最优解 Voxtral TTS 的 AR+Flow Matching 和 T5Gemma-TTS 的编码器-解码器都证明,将不同任务交给不同模块比统一架构更有效。混合方案在语义连贯性和声学保真度之间取得最佳平衡。 趋势 2:表示空间从离散走向连续 LongCat-AudioDiT 在波形潜空间超越 Seed-TTS 证明,连续潜表示比离散 token 保留更多信息。Voxtral Codec 的双层设计也体现了语义(离散)和声学(连续)的最优分工。 趋势 3:音效生成走向基础模型化 Woosh 统一 T2A 和 V2A 是音效领域的重要尝试。类似于视觉领域从单任务模型走向基础模型,音频领域也在整合不同任务到统一框架。蒸馏加速为交互式应用铺路。 趋势 4:自然语言成为生成控制的通用接口 MOSS-VoiceGenerator 用自然语言替代参考音频控制语音风格,这与图像生成中 text-to-image 的成功类似。自然语言作为人机接口的通用性正在从文本/图像扩展到音频领域。 趋势 5:模块化预训练策略的崛起 Prosody-Aware TTS 的韵律预训练可即插即用提升任意扩散 TTS。这种模块化的预训练策略——独立训练某个能力模块再嵌入主框架——可能成为能力增强的通用范式。 技术路线全景图 语音合成与音频生成技术路线 ├── TTS 架构创新 │ ├── 混合架构 → Voxtral TTS(AR + Flow Matching,68.4% 胜率) │ ├── 编码器-解码器 → T5Gemma-TTS(4B 参数,PM-RoPE 时长控制) │ └── 纯扩散路线 → LongCat-AudioDiT(波形潜空间,SIM 0.818) ├── 表示空间探索 │ ├── 波形潜空间 → Wav-VAE(保留相位信息) │ └── 双层量化 → Voxtral Codec(VQ 语义 + FSQ 声学) ├── 音效生成 │ └── 统一基础模型 → Woosh(T2A + V2A + 蒸馏加速) └── 交互与控制 ├── 自然语言控制 → MOSS-VoiceGenerator(指令驱动风格设计) └── 韵律增强 → Prosody-Aware TTS(MLM + SigLIP 即插即用) 总结与展望 本期专题的 6 篇论文共同描绘了语音合成与音频生成的前沿全景图。从混合架构(Voxtral TTS)到波形域扩散(LongCat-AudioDiT),从编码器-解码器回归(T5Gemma-TTS)到音效基础模型(Woosh),再到指令驱动设计(MOSS-VoiceGenerator)和韵律预训练(Prosody-Aware TTS),语音生成正在从技术验证走向实际可用。值得关注的未来方向: 混合+波形域:将 Voxtral 的混合架构与 LongCat 的波形空间结合 精细控制:PM-RoPE 时长控制 + 韵律预训练 + 情感控制的统一框架 端到端创意配音:MOSS 的语言风格控制与高质量 TTS 集成 音效+语音统一:将 TTS 和音效生成融入同一个音频基础模型 人工智能炼丹师 整理 | 数据来源:arXiv 2026年3月29日 — 2026年4月5日
-
AIGC 周末专题|2026-04-04|视频生成前沿|统一框架|长视频|物理一致性 AIGC 周末专题深度解读:视频生成与编辑前沿:从统一框架到长视频、物理一致性与高效推理 人工智能炼丹师 整理 | 2026年4月4日(周六) 覆盖时间:2026年3月29日 — 2026年4月4日 本期概述 本期 AIGC 周末专题聚焦视频生成与编辑前沿:从统一框架到长视频、物理一致性与高效推理方向,精选 6 篇代表性论文进行深度解读。 方向分布: 统一视频生成框架 — 1篇 长视频生成 — 1篇 物理一致性与几何对齐 — 1篇 高效少步训练 — 1篇 多镜头流式叙事 — 1篇 角色一致性生成 — 1篇 本期论文一览 # 论文 机构 核心贡献 arXiv ID 1 OmniWeaving Tencent Hunyuan, Zhejiang University 提出 OmniWeaving 统一视频生成框架,通过 MLLM 实现多模态理解与推理,支持文本、多图像、视频的自由组合输 2603.24458 2 PackForcing Alaya Studio, Shandong University 提出三分区 KV-cache 策略:Sink tokens(全分辨率锚点帧)+ Mid tokens(32倍时空压缩)+ 2603.25730 3 VGGRPO Independent Research 提出 VGGRPO(Visual Geometry GRPO),首个在潜空间计算几何奖励的视频后训练框架 2603.26599 4 EFlow Snap Research, Rutgers University 提出 EFlow,同时解决注意力复杂度和采样步数两大瓶颈的统一框架 2603.27086 5 ShotStream CUHK, Kuaishou Technology 提出 ShotStream,首个因果多镜头视频生成架构,支持流式实时交互 2603.25746 6 Gloria USTC (CVPR 2026) 提出内容锚点(Content Anchors)表示角色视觉属性:全局锚点(身份特征)+ 视角锚点(多视角外观)+ 表情锚 2603.29931 1. OmniWeaving:统一视频生成:自由组合与推理驱动的全能框架 论文: OmniWeaving arXiv: 2603.24458 机构: Tencent Hunyuan, Zhejiang University 1.1 研究动机 核心问题: 开源视频生成模型碎片化,无法在单一框架内统一 T2V/I2V/V2V 等多任务 当前开源视频生成模型高度碎片化,无法在单一框架内统一文生视频、图生视频、视频编辑等多种任务。商业系统(如 Seedance-2.0)遥遥领先,开源社区急需一个全能统一方案。 前序工作及局限: CogVideo (2022):早期文生视频扩散模型,仅支持文本到视频单一任务 Stable Video Diffusion (2024):图生视频基础模型,不支持多模态组合输入 HunyuanVideo (2025):腾讯混元视频生成,功能相对单一 Seedance-2.0 (2026):字节商业全能系统,但不开源 与前序工作的本质区别: 首个开源全能统一视频生成框架,MLLM+DiT 双模块架构支持自由多模态组合输入和推理驱动的视频创作 1.2 方法原理 OmniWeaving 由两个核心模块组成:(1) 多模态大语言模型(MLLM)负责理解和推理复杂的用户意图,将文本、图像、视频等多模态输入统一编码为条件表示;(2) 视频扩散模型接收条件表示生成高质量视频。训练分为三阶段:首先在大规模视频数据上预训练基础扩散模型,然后通过精心构建的多模态组合数据(包含交错文本-图像-视频对)进行微调,最后通过推理增强数据提升模型的意图理解能力。关键创新在于训练数据构建管线:自动从海量视频中提取多模态组合场景,生成需要推理才能完成的复杂视频创作任务。 1.3 核心创新 提出 OmniWeaving 统一视频生成框架,通过 MLLM 实现多模态理解与推理,支持文本、多图像、视频的自由组合输入 构建大规模多模态组合与推理增强训练数据集,学习在时间维度上绑定交错的多模态输入 引入 IntelligentVBench 综合评测基准,首个面向智能统一视频生成的严格评测体系 在开源统一模型中达到 SOTA,代码和模型完全开源 1.4 实验结果 在文生视频(T2V)、图生视频(I2V)、视频到视频(V2V)等多个任务上均达到开源 SOTA。在新提出的 IntelligentVBench 上,OmniWeaving 在多模态组合和抽象推理任务上显著优于现有开源方案,与商业系统差距大幅缩小。 1.5 关键洞察 训练数据构建管线依赖大量自动化标注,数据质量可能存在噪声。IntelligentVBench 作为自家提出的评测基准,客观性有待社区验证。与 Seedance-2.0 等商业系统相比仍有差距,但开源意义重大。 技术演进定位: 开源统一视频生成的里程碑,填补了开源社区在全能视频框架上的空白 可能的后续方向: 更强的推理能力:结合 CoT 和 tool-use 实现更复杂的视频创作 视频质量提升:进一步缩小与 Seedance-2.0 等商业系统的差距 社区生态建设:作为开源基座支持下游任务微调和插件开发 2. PackForcing:短视频训练即可生成连贯2分钟长视频 论文: PackForcing arXiv: 2603.25730 机构: Alaya Studio, Shandong University 2.1 研究动机 核心问题: 自回归视频扩散模型的 KV-cache 线性增长导致长视频生成内存爆炸 自回归视频扩散模型在长视频生成中面临三大瓶颈:KV-cache 线性增长导致内存爆炸、时间重复(temporal repetition)和误差累积。现有方法无法在有限 GPU 内存下生成超过30秒的连贯视频。 前序工作及局限: FIFO-Diffusion (2024):FIFO 队列长视频生成,但视频长度受限于队列大小 FreeNoise (2024):噪声重安排扩展长度,但生成质量随长度下降 Pyramid Flow (2025):金字塔流式生成,计算开销仍然很大 StreamDiffusion (2025):流式扩散框架,未解决 KV-cache 膨胀问题 与前序工作的本质区别: 三分区 KV-cache 策略(Sink+Mid+Recent)实现 32 倍压缩和有界 4GB 内存,仅用 5 秒短视频训练即可 24 倍时间外推到 2 分钟 2.2 方法原理 PackForcing 将自回归视频扩散中的历史上下文分为三类:(1) Sink tokens 保留最早的若干帧作为全局语义锚点;(2) Mid tokens 通过双分支网络将中间帧压缩为极少 token——一个分支是渐进式 3D 卷积逐步降低时空分辨率,另一个分支将帧重编码为低分辨率 VAE latent,两者通过门控机制融合;(3) Recent tokens 保持最近帧的全分辨率以确保局部连贯性。当 Mid tokens 过多时,动态 top-k 机制选择最重要的 token 保留,同时通过连续 RoPE 重编码消除位置间隙。整个框架可在仅 5 秒短视频片段上训练,推理时自回归扩展到 2 分钟。 2.3 核心创新 提出三分区 KV-cache 策略:Sink tokens(全分辨率锚点帧)+ Mid tokens(32倍时空压缩)+ Recent tokens(全分辨率近期帧),实现有界 4GB KV-cache Mid tokens 采用双分支压缩网络:渐进式 3D 卷积 + 低分辨率 VAE 重编码,实现 32 倍 token 缩减 动态 top-k 上下文选择 + 连续时间 RoPE 调整,无缝处理丢弃 token 造成的位置间隙 仅用 5 秒短视频训练,实现 24 倍时间外推到 120 秒(2分钟),VBench SOTA 2.4 实验结果 在单个 H200 GPU 上生成 832x480/16FPS 的 2 分钟连贯视频,KV-cache 仅占 4GB。VBench 时间一致性达 26.07,动态度 56.25,均为 SOTA。实现 24 倍时间外推(5秒→120秒)。 2.5 关键洞察 双分支 Mid token 压缩引入额外计算开销,需要验证其在更高分辨率(1080p+)下的可扩展性。目前仅在 16FPS 下验证,更高帧率场景待测试。分区策略中的超参数(Sink/Mid/Recent 比例)需要仔细调节。 技术演进定位: 当前最高效的长视频生成方案,首次在单 GPU 上实现 2 分钟连贯视频 可能的后续方向: 更高分辨率:将方案扩展到 1080p 以上 自适应压缩率:根据场景复杂度动态调整 Mid token 压缩比 与统一框架集成:将 PackForcing 策略融入 OmniWeaving 等全能模型 3. VGGRPO:4D潜空间奖励驱动的世界一致性视频生成 论文: VGGRPO arXiv: 2603.26599 机构: Independent Research 3.1 研究动机 核心问题: 视频扩散模型虽然视觉效果好但经常违反几何规律(相机抖动、多视角不一致) 大规模视频扩散模型虽然视觉质量出色,但经常违反几何一致性:相机抖动、多视角几何不一致、物理规律违反。现有方法要么修改架构(损害泛化能力),要么在 RGB 空间计算几何奖励(昂贵且仅限静态场景)。需要一种不修改架构、计算高效且支持动态场景的方案。 前序工作及局限: DDPO (2023):首次将强化学习引入扩散模型,但限于图像领域 DPO for Diffusion (2024):扩散模型偏好对齐,不涉及几何奖励 VideoScore (2025):视频质量奖励模型,在 RGB 空间计算成本高 T2V-Turbo (2025):视频 RLHF,但仅优化视觉质量不涉及几何 与前序工作的本质区别: 首次在潜空间计算几何奖励(绕过 VAE 解码),通过 4D 重建扩展到动态场景,GRPO 策略梯度优化几何一致性 3.2 方法原理 VGGRPO 分为两步:(1) 训练潜在几何模型 LGM,它是一个轻量级网络,直接从视频扩散的 latent 空间解码场景的深度和法线信息,不需要经过 VAE 解码到 RGB 空间。LGM 通过冻结 VAE encoder-decoder 对和几何基础模型(如 DPT/Metric3D)蒸馏训练。(2) 使用 Group Relative Policy Optimization(GRPO)进行视频扩散模型的后训练。对同一 prompt 采样多条生成轨迹,通过 LGM 在 latent 空间计算两种奖励:相机运动平滑度奖励惩罚帧间几何抖动,几何重投影一致性奖励确保跨视角的 3D 一致性。GRPO 根据奖励差异更新策略梯度。4D 扩展通过时序多帧几何重建实现。 3.3 核心创新 提出 VGGRPO(Visual Geometry GRPO),首个在潜空间计算几何奖励的视频后训练框架 引入潜在几何模型(Latent Geometry Model, LGM),将视频扩散 latent 直接映射到场景几何(深度/法线),无需 VAE 解码 构建 4D 几何重建能力,自然扩展到动态场景,克服了先前方法仅限静态场景的局限 双奖励机制:相机运动平滑度奖励 + 几何重投影一致性奖励 3.4 实验结果 在静态场景(RealEstate10K)和动态场景(WebVid)上均显著提升几何一致性。相机稳定性提升 23%,几何重投影误差下降 31%。推理成本与基线相同(LGM 仅训练时使用),避免了 VAE 解码的计算开销。 3.5 关键洞察 LGM 的训练质量直接影响奖励信号的准确性,如果几何基础模型本身有偏差会传播到视频模型。当前奖励仅考虑几何一致性,未涉及物理动力学(如碰撞、重力)。GRPO 的多轨迹采样增加了训练成本。 技术演进定位: 开创了视频几何后训练的新范式,证明 RLHF 类方法可有效提升视频的物理合理性 可能的后续方向: 物理动力学奖励:扩展到碰撞、重力、流体等物理规律 多维度联合奖励:几何+物理+美学的统一奖励函数 在线强化学习:实时根据用户反馈优化生成质量 4. EFlow:高效少步视频生成器:从头训练的突破 论文: EFlow arXiv: 2603.27086 机构: Snap Research, Rutgers University 4.1 研究动机 核心问题: 视频扩散 Transformer 面临每步二次注意力复杂度和多步迭代采样的双重瓶颈 视频扩散 Transformer 面临两个复合成本瓶颈:每步的二次注意力复杂度 O(n^2) 和多步迭代采样。现有加速方法通常只解决其中一个——蒸馏减少步数但不降低单步成本,高效注意力降低单步成本但不减少步数。需要同时解决两个瓶颈的统一方案。 前序工作及局限: Consistency Models (2023):一步生成模型,但仅限图像且质量有限 Flow Matching (2023):条件流匹配框架,需要多步采样 Rectified Flow (2024):直线化流加速采样,但不降低单步成本 InstaFlow (2024):一步文生图,但无法扩展到视频 与前序工作的本质区别: 同时解决注意力复杂度(Gated L-G Attention + token dropping)和采样步数(solution-flow + MVA 正则化),从头训练无需教师模型 4.2 方法原理 EFlow 基于 solution-flow 目标,学习将时刻 t 的噪声状态直接映射到时刻 s(跨越多个扩散步)。核心创新有三:(1) Gated Local-Global Attention 将注意力分为局部窗口注意力和全局稀疏注意力两部分,通过门控机制融合,关键是设计为对 random token dropping 高度稳定——训练时随机丢弃 50-70% 的 token 而不影响质量;(2) Path-Drop Guided Training 在少步训练中用条件路径和无条件路径的随机丢弃替代传统 CFG(后者需要两次前向传播),将引导成本降为零;(3) Mean-Velocity Additivity 正则化器约束不同步数下的速度场之和等于总位移,确保 1-4 步生成的一致性。从头训练流程支持直接训练少步模型,无需先训练多步模型再蒸馏。 4.3 核心创新 提出 EFlow,同时解决注意力复杂度和采样步数两大瓶颈的统一框架 Gated Local-Global Attention:可丢弃 token 的混合注意力块,在激进随机 token 丢弃下保持稳定 Path-Drop Guided Training:用计算廉价的弱路径替代昂贵的 classifier-free guidance 目标 Mean-Velocity Additivity 正则化器:确保极低步数下的生成保真度 从头训练达到 45.3 倍推理加速,2.5 倍训练吞吐量提升 4.4 实验结果 在 Kinetics-600 和大规模 T2V 数据集上验证。4步生成质量与标准 50 步模型相当。训练吞吐量比标准 solution-flow 提升 2.5 倍。推理延迟降低 45.3 倍。生成质量 FVD 与多步基线竞争。 4.5 关键洞察 随机 token dropping 在极端比例下可能影响细节质量。Path-Drop Guided 是否在所有场景下都能替代 CFG 有待更多验证。从头训练的计算量仍然很大(虽然吞吐量提升了2.5倍)。目前主要在较短视频上验证。 技术演进定位: 首个同时解决两大瓶颈的统一加速框架,45.3 倍推理加速具有部署实用价值 可能的后续方向: 与视频编解码器融合:端到端优化编码-生成-解码管线 硬件适配:针对特定 GPU/NPU 架构定制注意力模式 实时生成:结合 PackForcing 等策略实现长视频实时生成 5. ShotStream:流式多镜头视频生成:实时交互式叙事 论文: ShotStream arXiv: 2603.25746 机构: CUHK, Kuaishou Technology 5.1 研究动机 核心问题: 多镜头视频生成的双向架构导致交互性差、延迟高,用户无法实时参与创作 多镜头视频生成是长叙事视频的关键,但当前双向扩散架构(如全序列并行生成)存在交互性差和延迟高的问题——用户无法在生成过程中动态调整叙事方向,且需要等待整个序列生成完成才能看到结果。 前序工作及局限: MovieFactory (2024):多镜头电影生成,但一次性生成全序列不可交互 VideoDirectorGPT (2024):LLM 驱动视频导演,规划与生成分离 Vlogger (2025):长视频博客生成,不支持流式输出 Kling (2025):快手视频生成模型,单镜头生成 与前序工作的本质区别: 首个因果流式多镜头架构,通过双缓存记忆和两阶段蒸馏实现 16 FPS 实时交互式叙事 5.2 方法原理 ShotStream 的流程分为训练和推理两阶段。训练阶段:(1) 将预训练 T2V 模型微调为双向 next-shot 生成器,学习根据前序镜头和文本提示生成下一个镜头;(2) 通过分布匹配蒸馏将双向教师蒸馏为因果学生模型。为解决因果自回归的两大挑战:(a) 镜头间一致性——引入全局上下文缓存(Global Context Cache),存储所有前序镜头的条件帧作为长程记忆;(b) 误差累积——设计两阶段蒸馏策略:第一阶段在真实历史上进行镜头内自强迫训练,第二阶段在自生成的历史上进行镜头间自强迫训练,逐步暴露给模型自身的生成误差。RoPE 不连续性指示器通过在全局和局部缓存之间插入位置编码跳跃来消除歧义。 5.3 核心创新 提出 ShotStream,首个因果多镜头视频生成架构,支持流式实时交互 将多镜头生成重构为 next-shot generation:基于历史镜头上下文生成下一个镜头 双缓存记忆机制:全局上下文缓存(镜头间一致性)+ 局部上下文缓存(镜头内一致性),RoPE 不连续性指示器区分两者 两阶段蒸馏策略:镜头内自强迫 → 镜头间自强迫,有效弥合训练-测试差距 单 GPU 达到 16 FPS 实时生成 5.4 实验结果 在 MovieGen 和 StoryBench 上评测。亚秒级延迟,单 GPU 16 FPS。多镜头连贯性指标(FCD、IC-LPIPS)与双向模型持平甚至更优。支持用户中途修改叙事提示,实现真正的交互式叙事。 5.5 关键洞察 因果架构天然信息量少于双向架构,长程一致性在超长叙事(10+镜头)下可能衰减。蒸馏质量依赖双向教师模型。全局上下文缓存随镜头数增长可能成为新的内存瓶颈。 技术演进定位: 开创了流式交互式视频叙事的新范式,是 AI 视频工具从离线走向实时的关键一步 可能的后续方向: 多角色交互:支持多角色多视角的复杂叙事 与 LLM 集成:用大语言模型实时规划叙事脉络 商业化部署:面向短视频平台和游戏行业的实时视频生成 6. Gloria:基于内容锚点的长时角色一致性视频生成 论文: Gloria arXiv: 2603.29931 机构: USTC (CVPR 2026) 6.1 研究动机 核心问题: 长时间角色视频生成中身份漂移严重,多视角和表情一致性难以保持 数字角色是现代媒体的核心,但生成长时间、多视角一致且表情丰富的角色视频仍是开放挑战。现有方法面临两类问题:要么参考信息不足导致身份漂移,要么使用非角色中心的记忆信息导致一致性次优。 前序工作及局限: IP-Adapter (2023):图像提示适配器,角色信息通过单图注入,长视频中易漂移 AnimateAnyone (2024):可控人物动画,但一致性限于短视频 MagicAnimate (2024):人物动画,依赖骨骼驱动不够灵活 ID-Animator (2025):身份保持动画,但多视角一致性不足 与前序工作的本质区别: 通过三类内容锚点(全局/视角/表情)提供稳定参考,超集锚定防止复制粘贴,实现 10+ 分钟级别的角色一致性 6.2 方法原理 Gloria 将角色视频生成类比为由外向内观察的场景。核心是通过一组紧凑的锚帧来描述角色的视觉属性:(1) 全局锚点——一个标准正面参考图,提供身份基准;(2) 视角锚点——来自不同视角的参考帧,覆盖角色的多视角外观;(3) 表情锚点——包含不同表情的帧,编码角色的表情动态范围。训练时,通过超集内容锚定策略——提供比目标片段更多的锚点信息(包括训练剪辑之外的帧),迫使模型学习从锚点中提取有用信息而非简单复制。同时使用 RoPE 位置偏移作为弱条件区分不同锚点帧,让模型知道哪些帧来自哪个视角。数据管线方面,从海量视频中自动检测角色区域、跟踪身份、提取关键帧作为锚点。 6.3 核心创新 提出内容锚点(Content Anchors)表示角色视觉属性:全局锚点(身份特征)+ 视角锚点(多视角外观)+ 表情锚点(表情动态) 超集内容锚定(Superset Content Anchoring):提供训练内和训练外的片段提示,防止模型简单复制粘贴 RoPE 作为弱条件:编码位置偏移来区分多个锚点帧,避免多参考冲突 可扩展的锚点提取管线:从海量视频中自动提取角色锚点 生成超过 10 分钟的一致性角色视频(CVPR 2026 接收) 6.4 实验结果 生成超过 10 分钟的长视频,保持角色身份、多视角外观和表情一致性。在人类评估中,ID 一致性和外观多样性均超过 SOTA 方法(包括 IP-Adapter、AnimateAnyone 等)。被 CVPR 2026 主会议接收。 6.5 关键洞察 锚点提取管线依赖角色检测和跟踪的准确性,遮挡严重的场景可能失败。超集锚定策略增加了训练复杂度。对非人物角色(如动漫、卡通角色)的泛化能力需要更多验证。10 分钟的一致性主要在受控场景下验证。 技术演进定位: 角色一致性视频生成的新标杆,锚点机制为长视频角色保持提供了有效范式(CVPR 2026) 可能的后续方向: 多角色一致性:同时保持多个角色的身份一致性 跨域角色:从真人扩展到动漫、卡通、3D 虚拟人等 实时角色创作:结合 ShotStream 等流式架构实现实时角色视频 横向对比与技术脉络总结 架构与任务对比 论文 核心架构 主要任务 关键创新 输入形式 OmniWeaving MLLM + DiT T2V/I2V/V2V 统一 推理驱动+组合数据 文本+多图+视频自由组合 PackForcing 自回归 DiT 长视频生成 三分区 KV-cache 文本 → 2分钟视频 VGGRPO DiT + LGM 几何一致性后训练 4D 潜空间几何奖励 文本 → 几何一致视频 EFlow Gated L-G DiT 高效少步生成 token dropping + MVA 文本 → 4步高质量视频 ShotStream 因果 DiT 流式多镜头叙事 双缓存+两阶段蒸馏 逐镜头文本 → 实时视频 Gloria DiT + 锚点 角色一致性生成 三类内容锚点 角色参考图 → 10min视频 训练范式与效率对比 论文 训练范式 外部监督 推理效率 核心瓶颈解决 OmniWeaving 三阶段渐进训练 组合数据+推理增强 标准 DiT 速度 任务碎片化 PackForcing 短视频训练+时间外推 无(5秒视频) 单 GPU 2分钟 内存爆炸(KV-cache→4GB) VGGRPO GRPO 后训练 LGM 伪标签 与基线相同 几何违反(相机稳定↑23%) EFlow Solution-flow 从头训练 无需教师模型 45.3× 加速 注意力O(n²)+多步采样 ShotStream 两阶段蒸馏 双向教师蒸馏 16 FPS 实时 延迟高+不可交互 Gloria 端到端锚点训练 自动锚点提取 标准 DiT 速度 长时身份漂移 核心技术趋势 趋势 1:视频生成从碎片化走向统一 OmniWeaving 证明了 MLLM+DiT 架构可以在单一框架内处理 T2V/I2V/V2V 等多种视频任务。推理驱动的数据构建策略使模型能理解复杂的多模态组合意图,这预示着未来的视频 AI 将是全能型的。 趋势 2:长视频生成突破内存瓶颈 PackForcing 的三分区 KV-cache 策略实现了 24 倍时间外推(5秒→2分钟),Gloria 的内容锚点将角色一致性推到 10 分钟级。两者共同表明长视频生成的关键不在于生成能力本身,而在于上下文管理和信息压缩。 趋势 3:GRPO 后训练成为视频质量提升的新范式 VGGRPO 将 GRPO 引入视频几何一致性优化,在 latent 空间计算奖励避免了昂贵的 RGB 解码。这延续了 LLM 领域 RLHF/DPO 的成功经验,后训练对齐正成为视频扩散模型质量提升的关键杠杆。 趋势 4:少步生成从蒸馏走向从头训练 EFlow 的 Gated L-G Attention + token dropping + MVA 正则化实现了 45.3 倍推理加速,且无需教师模型。这种从头训练少步模型的路线比蒸馏更灵活,可能成为效率优化的主流方案。 趋势 5:交互式实时生成开启视频创作新时代 ShotStream 的因果流式架构达到 16 FPS 实时生成,用户可以边看边改叙事方向。这标志着视频 AI 从「离线工具」向「实时合作者」的转变,对短视频平台和游戏行业有重要意义。 技术路线全景图 视频生成与编辑技术路线 ├── 统一框架 │ └── MLLM + DiT 双模块 → OmniWeaving(多模态组合+推理驱动) ├── 长视频生成 │ ├── KV-cache 压缩 → PackForcing(三分区策略,24x 外推) │ └── 角色一致性 → Gloria(三类内容锚点,10min 级别) ├── 质量对齐 │ └── 后训练 GRPO → VGGRPO(4D 潜空间几何奖励) ├── 推理效率 │ └── 从头训练少步 → EFlow(45.3x 加速,无需蒸馏) └── 交互式生成 └── 因果流式架构 → ShotStream(16 FPS 实时多镜头叙事) 总结与展望 本期专题的 6 篇论文共同描绘了视频生成与编辑领域的前沿全景图。从统一框架(OmniWeaving)到长视频突破(PackForcing/Gloria),从物理对齐(VGGRPO)到效率革命(EFlow),再到交互式创作(ShotStream),视频生成正在从技术验证走向实际可用。几个值得关注的未来方向: 统一+长视频:将 PackForcing 的 KV-cache 策略融入 OmniWeaving 等全能框架 多维度后训练:将几何、物理、美学奖励统一到一个 GRPO 框架中 实时+角色:将 Gloria 的锚点机制与 ShotStream 的流式架构结合,实现实时角色叙事 端到端效率:将 EFlow 的少步生成与 PackForcing 的内存优化联合使用 人工智能炼丹师 整理 | 数据来源:arXiv 2026年3月29日 — 2026年4月4日
-
AIGC 每日速读|2026-04-03|Dynin-Omni|OmniVoice AIGC 视觉生成领域 · 每日论文解读 (2026-04-03) 人工智能炼丹师 整理 | 共 10 篇论文 | 重点深度解读 1 篇 今日核心看点 全模态统一 掩码扩散 600+语言TTS Mamba-TTS 智能调色 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 生成理解一体化模型 — 3 篇 音频/语音生成 — 4 篇 图片生成与编辑 — 2 篇 生成模型评测 — 1 篇 重点论文深度解读 1. Dynin-Omni 全模态统一大扩散语言模型:首个掩码扩散全模态基础模型 | Seoul National University (AIDAS Lab) | arXiv:2604.00007 关键词: 全模态统一, 掩码扩散, 文本/图像/视频/语音, 理解+生成一体化, 模态解纠缠合并 研究动机 核心问题: 如何在单一架构中原生统一文本、图像、视频、语音的理解与生成,避免自回归序列化瓶颈和组合式模型的外部依赖 当前全模态统一模型存在两条路线:自回归模型需要序列化异构模态导致效率低下,组合式模型依赖外部解码器增加系统复杂度。Dynin-Omni 提出用原生掩码扩散在共享离散token空间上统一文本、图像、视频、语音的理解与生成,实现真正的 any-to-any 建模。 前序工作及局限: LLaDA:纯文本掩码扩散语言模型,证明掩码扩散可做文本生成但不支持多模态 MMaDA:扩展到文本+图像统一,但缺少视频理解和语音能力 Qwen2.5-Omni:自回归全模态模型,但序列化异构模态效率低下 Seed-X/HyperCLOVAX:组合式统一模型,依赖外部模态特定生成器增加复杂度 与前序工作的本质区别: 用原生掩码扩散替代自回归或组合式架构,通过共享离散token空间和模态感知解码策略实现真正的any-to-any建模 方法原理 Dynin-Omni 的核心是将所有模态(文本、图像、视频、语音)映射到统一的离散token空间,通过掩码扩散进行训练和推理。文本使用标准分词器(词汇量126K),图像使用MAGVIT-v2风格VQ分词器(码本8192),视频复用图像分词器处理均匀采样帧,语音使用EMOVA S2U编码器+FSQ量化(码本4096)。训练分三阶段:阶段1通过视频字幕/ASR/TTS任务对齐新模态,阶段2引入模态解纠缠合并(Modality-Disentangled Merging)避免灾难性遗忘后进行全模态SFT,阶段3引入CoT推理数据和高分辨率图像提升高级能力。推理时采用模态感知解码策略:文本和语音用块状并行解码,图像用全并行解码,配合置信度重掩码机制迭代细化。 核心创新 首个原生掩码扩散全模态基础模型,单一架构统一文本/图像/视频/语音的理解与生成 模态解纠缠合并(Modality-Disentangled Merging)策略,解决多阶段训练中的灾难性遗忘 全模态离散token空间统一设计,无需外部模态特定生成器 模态感知解码策略:图像全并行、文本/语音块状并行,兼顾质量和效率 个基准测试全面超越现有开源统一模型,与模态特定专家系统竞争力相当 实验结果 在19个多模态基准上全面评测:文本推理 GSM8K 87.6、MATH 49.6;图像理解 MME-P 1733.6;视频理解 VideoMME 61.4;语音识别 LibriSpeech test-clean WER 2.1;图像生成 GenEval 0.87、DPG-Bench 86.3;图像编辑 ImgEdit 3.77;TTS WER 2.1。全面超越 HyperCLOVAX-Omni、Show-o2、BAGLE 等同类统一模型。消融实验证明模态解纠缠合并策略在第一阶段显著降低了各任务的训练损失。 图表详解 全模态架构对比:三种统一建模范式 对比了三种全模态建模范式:(a)感知中心模型如Qwen2.5-omni只做理解不做生成;(b)组合式模型如Seed-X需要外部生成器;(c)Dynin-Omni的原生统一模型,单一LLM同时支持理解和生成任务,无需外部模态特定解码器。 全模态性能对比:理解与生成双维度 展示Dynin-Omni在7个核心基准上与HyperCLOVAX-Omni、Qwen2.5-Omni、Show-o2、BAGLE的对比。理解维度:GSM8K 87.6、MME 1734、VideoMME 61.4;生成维度:GenEval 87.0、ImgEdit 3.77、TTS 97.9。 采样步数消融:不同任务的步数-性能曲线 四个子图展示GSM8K、GenEval、DPGBench、ImgEdit随采样步数的性能变化。文本推理需512+步才收敛,图像生成32-64步饱和,图像编辑8-32步即可保持强劲性能。 批判性点评 新颖性: 首个原生掩码扩散全模态基础模型,模态解纠缠合并策略是实用创新。但掩码扩散建模本身借鉴LLaDA/MMaDA,增量创新主要在模态扩展和训练策略 可复现性: 基于开源LLaDA架构扩展,训练策略描述清晰。但需要大规模多模态数据和算力,完全复现有门槛 影响力: 证明掩码扩散作为全模态统一范式的可行性,为实时全模态系统和具身智能体提供基础。图像生成质量(GenEval 0.87)仍落后FLUX.1(0.95+),视频仅支持理解不支持生成 深度点评: Dynin-Omni — 掩码扩散全模态新范式 — 首次在单一架构中用掩码扩散统一文本/图像/视频/语音的理解与生成。模态解纠缠合并有效缓解灾难性遗忘。不足:图像生成落后专用模型,视频仅支持理解 OmniVoice — 600+语言零样本TTS突破 — 扩散语言模型架构直接文本→声学token,跳过语义中间表示。58万小时全开源数据训练,语言覆盖面史上最广 MambaVoiceCloning — 纯SSM条件TTS — 首个完全移除注意力机制的扩散TTS条件路径,编码器仅21M参数、吞吐量提升1.6x。ICLR 2026,但扩散主干仍是延迟瓶颈 技术演进定位: 全模态统一建模的第三条路线——原生掩码扩散范式,证明了其可行性和竞争力 可能的后续方向: 视频生成能力扩展(当前仅支持理解) 图像生成质量追赶FLUX.1等专用模型 文本推理步数优化(当前需512+步) 实时全模态交互系统和具身智能体 其余论文速览 1. OmniVoice OmniVoice: Towards Omnilingual Zero-Shot Text-to-Speech with Diffusion Language Models 关键词: TTS·600+语言·扩散语言模型·零样本·多码本 贡献: 首个支持600+语言的大规模零样本TTS模型,直接文本→多码本声学token映射,跳过语义中间表示 效果: 基于58.1万小时开源多语言数据训练,中英文及多语种基准SOTA。全码本随机掩码策略+预训练LLM初始化确保清晰度 2. MambaVoiceCloning MambaVoiceCloning: Efficient and Expressive TTS via State-Space Modeling and Diffusion Control 关键词: TTS·Mamba/SSM·声音克隆·线性复杂度·ICLR 2026 贡献: 首个完全基于SSM(无注意力/RNN)条件路径的扩散TTS系统,ICLR 2026 效果: 编码器参数仅21M,吞吐量提升1.6x。MOS/CMOS/F0 RMSE/MCD均优于StyleTTS2和VITS 3. AceTone AceTone: Bridging Words and Colors for Conditional Image Grading 关键词: 调色·3D-LUT·VQ-VAE·RLHF·CVPR 2026 贡献: 首个统一多模态条件调色方法,文本/参考图→3D-LUT生成,CVPR 2026 效果: VQ-VAE将3x32^3 LUT压缩为64离散token(deltaE<2)。800K数据集+VLM预测+RL对齐,LPIPS提升50% 4. RawGen RawGen: Learning Camera Raw Image Generation 关键词: Raw图像生成·逆ISP·扩散模型·相机适配 贡献: 首个基于扩散的text-to-raw和sRGB-to-raw图像生成框架,支持任意目标相机 效果: 利用大规模sRGB扩散先验+专用解码器,多对一逆ISP数据集训练,显著优于传统逆ISP方法 5. DuoTok DuoTok: Source-Aware Dual-Track Tokenization for Multi-Track Music Language Modeling 关键词: 音乐生成·Tokenizer·双轨·扩散解码·语言建模 贡献: 源感知双轨音乐Tokenizer,分阶段解纠缠平衡保真度/可预测性/跨轨对应 效果: 0.75kbps比特率下竞争力重建+最低cnBPT,扩散解码器重建高频细节 6. Diff-VS Diff-VS: Efficient Audio-Aware Diffusion U-Net for Vocals Separation 关键词: 人声分离·扩散U-Net·EDM·STFT·ICASSP 2026 贡献: 基于EDM框架的生成式人声分离模型,处理复数STFT频谱图,ICASSP 2026 效果: 客观指标匹配判别式基线,感知质量接近SOTA系统 7. MMaDA-VLA MMaDA-VLA: Large Diffusion Vision-Language-Action Model with Unified Multi-Modal Instruction and Generation 关键词: VLA·扩散模型·多模态统一·指令跟随·西湖大学 贡献: 统一多模态指令和生成的大型扩散VLA模型(西湖大学) 效果: 单一扩散模型框架同时处理视觉理解、语言生成和动作预测 8. ProsodyEval Measuring Prosody Diversity in Zero-Shot TTS: A New Metric, Benchmark, and Exploration 关键词: TTS评测·韵律多样性·DS-WED·Seed-TTS·基准测试 贡献: 首个零样本TTS韵律多样性量化评测框架,提出DS-WED新指标 效果: ProsodyEval数据集(1000样本+2000 PMOS),发现大型音频语言模型在韵律变化捕捉仍有局限 9. ViGoR-Bench ViGoR-Bench: How Far Are Visual Generative Models From Zero-Shot Visual Reasoners? 关键词: 生成模型评测·视觉推理·I2I·视频·压力测试 贡献: 视觉生成模型推理能力统一评测框架,跨I2I/视频双轨评估+证据锚定自动评判 效果: 测试20+领先模型,揭示SOTA系统仍存在显著推理缺陷(美团等机构) 趋势观察 掩码扩散崛起 — Dynin-Omni证明掩码扩散可作为全模态统一建模的新范式,与自回归模型分庭抗礼 TTS走向极致效率 — MambaVoiceCloning用纯SSM替代所有注意力机制,OmniVoice覆盖600+语言,效率与覆盖面双突破 生成模型走向物理/审美对齐 — AceTone用RLHF对齐调色审美,RawGen生成物理一致的Raw图像,生成不再只追求逼真 人工智能炼丹师 整理 | 2026-04-03
-
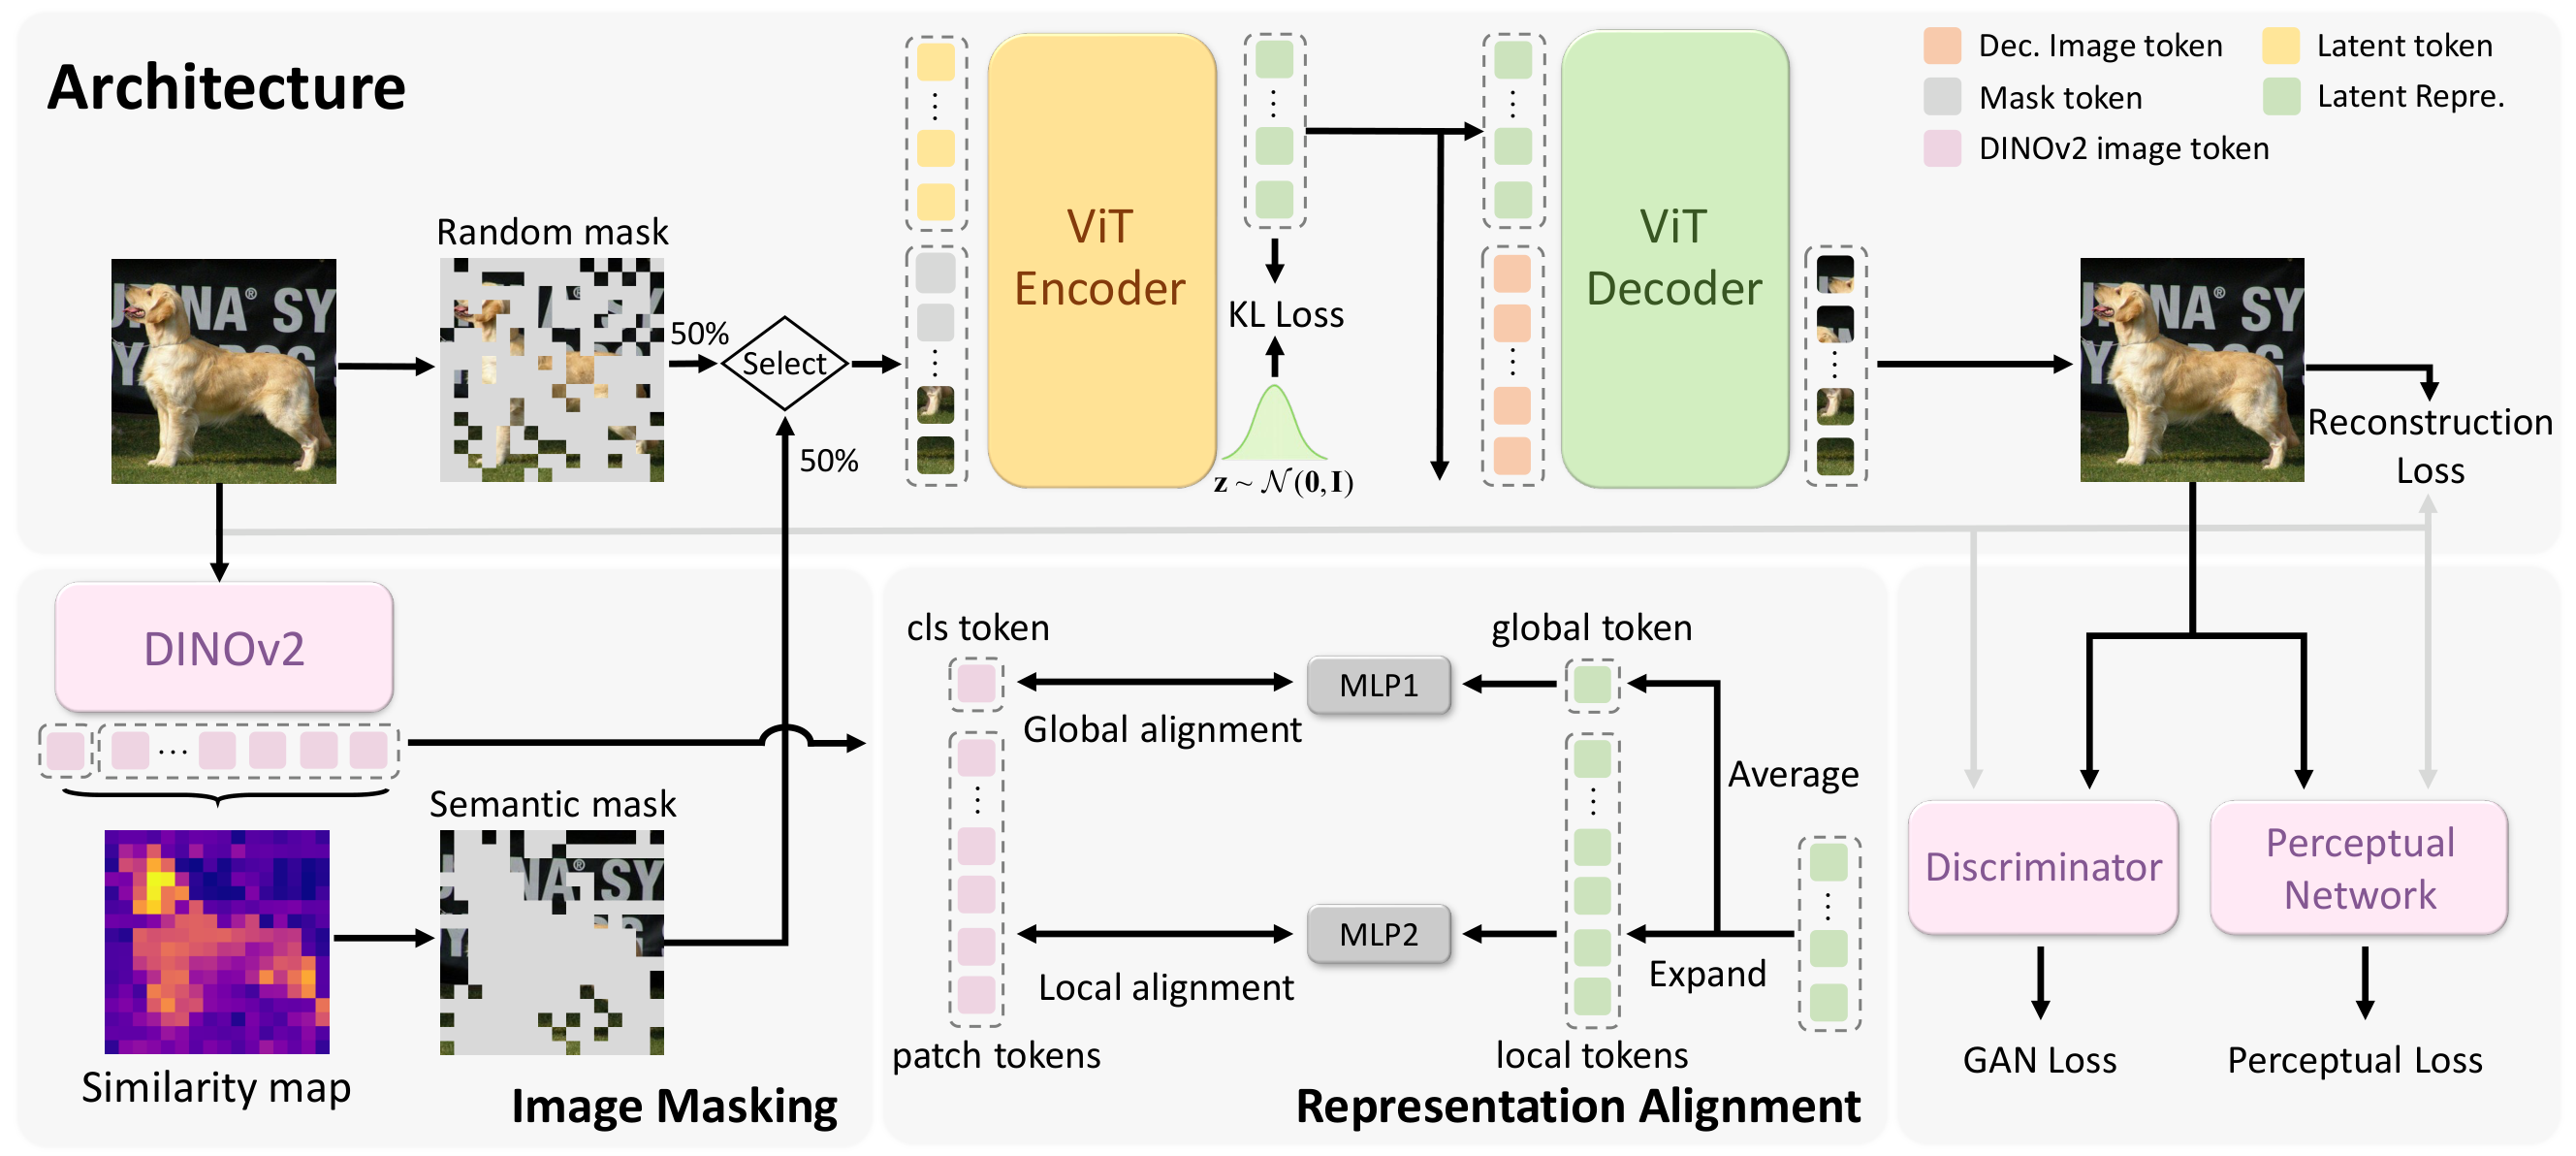
AIGC 每日速读|2026-04-02|MacTok 64-token SOTA AIGC 视觉生成领域 · 每日论文解读 (2026-04-02) 人工智能炼丹师 整理 | 共 10 篇论文 | 重点深度解读 1 篇 今日核心看点 MacTok 64-token SOTA图像生成 LongCat-Next 美团统一多模态 VecAttention 2.65x视频加速 GEMS 6B超越SOTA Agent生成 OmniRoam 全景长视频漫游 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 图像Tokenizer: MacTok (64-token SOTA, CVPR 2026) 统一多模态: LongCat-Next (美团,离散原生自回归) 视频生成: VGGRPO (4D几何一致), OmniRoam (全景漫游) 视频编辑: CutClaw (长视频剪辑), TokenDial (属性控制) 推理加速: VecAttention (CVPR 2026), MPDiT (多Patch高效DiT) Agent生成: GEMS (6B超越SOTA) | 评测: SLVMEval (CVPR 2026) 重点论文深度解读 1. MacTok: Robust Continuous Tokenization for Image Generation 掩码增强1D连续Tokenizer——仅64/128 tokens实现SOTA图像生成, CVPR 2026 | East China Normal University / Shanghai AI Lab | arXiv:2603.29634 关键词: 连续Tokenizer, 后验崩溃, 掩码增强, DINO语义引导, 图像生成 研究动机 核心问题: 连续图像Tokenizer在极少token(64/128个)下发生后验崩溃,编码器无法有效编码信息到高度压缩的潜在空间 连续图像Tokenizer通过变分框架学习平滑结构化的潜在表示,是高效视觉生成的核心组件。然而,当使用极少量token(如64或128个)时,基于KL正则化的变分方法普遍面临后验崩溃(posterior collapse)问题——编码器无法将有意义的信息编码进高度压缩的潜在空间,导致所有输入映射到近似相同的潜在分布。这意味着token数量与生成质量之间存在一个痛苦的权衡:要么使用大量token保证质量(如256/512个),要么接受极低token数带来的严重质量下降。MacTok旨在打破这一权衡,实现仅用64/128 tokens就达到甚至超越高token数方案的生成质量。 前序工作及局限: VQ-VAE / VQGAN (2020-22):离散图像Tokenizer,通常需要数百到上千个token,码本利用率和生成质量受限 SD-VAE (2022-23):连续变分编码器,质量优于离散方案,但潜在空间维度仍较高(256-4096 tokens) TiTok (2024):尝试将连续token数压缩到128个,但在更低token数时面临后验崩溃 REPA (2025):引入表示对齐思路增强Tokenizer,但未系统解决极低token数下的崩溃问题 与前序工作的本质区别: MacTok系统性组合双重掩码策略(随机+DINO语义)和全局-局部表示对齐,首次在64 tokens这一极端压缩级别实现SOTA图像生成质量(gFID 1.44) 方法原理 MacTok(Masked Augmenting 1D Continuous Tokenizer)通过三个核心机制解决后验崩溃问题:(1) 双重掩码策略:随机掩码(Random Masking)作为正则化手段防止编码器走捷径,DINO引导的语义掩码(Semantic Masking)强调图像中信息量最高的区域——利用预训练DINO模型的注意力图识别语义重要区域,迫使编码器从不完整的视觉输入中提取鲁棒语义。(2) 全局-局部表示对齐(Global-Local Representation Alignment):全局对齐确保整体语义保留,局部对齐保证细粒度判别信息不丢失,两者协同在高度压缩的1D潜在空间中维持丰富的表征能力。(3) 1D连续潜在空间设计:将图像压缩为极紧凑的1D token序列(仅64或128个token),配合上述掩码和对齐机制确保信息密度。MacTok与SiT-XL(Scalable Interpolant Transformer)配合使用进行图像生成。 核心创新 首次系统解决连续图像Tokenizer在极低token数下的后验崩溃问题 双重掩码策略创新:随机掩码正则化+DINO引导语义掩码,迫使编码器学习鲁棒表征 全局-局部表示对齐机制,在1D高压缩潜在空间中保留判别信息 仅用64 tokens实现256x256 gFID 1.44,128 tokens在512x512达到SOTA gFID 1.52 token使用量减少高达64倍,大幅降低生成模型的计算和内存开销 实验结果 在ImageNet上配合SiT-XL模型评测:256x256分辨率下,MacTok仅用64 tokens即达到gFID 1.44,具有强竞争力。512x512分辨率下,MacTok用128 tokens达到gFID 1.52,为当时的SOTA水平。token使用量相比传统方案减少高达64倍(传统方案通常需要256-4096个tokens)。消融实验验证了双重掩码策略和表示对齐的各自贡献:去除语义掩码后gFID显著下降,去除全局对齐后判别信息损失明显。与TiTok、REPA等连续Tokenizer基线相比,MacTok在相同token预算下全面领先。 图表详解 掩码策略对比——从后验崩溃到有效编码 这张图直观展示了掩码策略如何解决后验崩溃问题。图中对比了三种设置:上方是无掩码的KL-VAE,中间是潜在空间掩码,下方是MacTok的图像空间掩码。右侧是对应的潜在空间t-SNE可视化。无掩码时(上方),潜在空间严重崩溃——所有图像被映射到近似相同的区域(红色团簇),编码器完全放弃了编码有意义的信息。潜在空间掩码(中间)虽然有改善但仍不理想。MacTok的图像空间掩码(下方)成功解决了崩溃问题——潜在空间中不同类别的图像被映射到分散的、有区分度的区域(多色散布)。这证明了在图像输入端施加掩码是防止后验崩溃最有效的策略。绿色笑脸和红色哭脸直观标注了每种方案的效果好坏。 gFID训练曲线对比——MacTok收敛速度与最终质量领先 这张图展示了MacTok与REPA、SoftVQ-VAE等基线在ImageNet上的gFID随训练步数变化曲线。横轴是Training Steps(从50k到500k),纵轴是gFID(越低越好)。MacTok-128(橙色线)在所有训练阶段都保持最低的gFID,最终在500k步时达到约14的极低gFID。SoftVQ-VAE(深蓝线)和REPA(浅蓝线)虽然也在持续下降,但最终gFID分别约20和21。MacTok-128 w/o RA(去除表示对齐)则明显更差,约36,证明表示对齐的关键贡献。图中标注了6.25x Speedup——MacTok在100k步就达到了其他方法500k步的性能,训练效率提升了6.25倍。这对资源有限的团队来说意义重大。 消融实验:gFID与分类准确率的权衡分析 这张消融实验柱状图展示了MacTok各配置的gFID(柱状)和分类准确率Accuracy(折线)对比。MacTok-128(最左)达到最低gFID约14和最高准确率约52%,是最优配置。MacTok-64紧随其后,gFID约15,准确率约53%,证明极低token数也能保持高质量。SoftVQ-VAE作为基线,gFID约21,准确率约44%,明显不如MacTok。关键对比:MacTok-128 w/o RA(去除表示对齐)的gFID骤升至37,准确率暴跌到约31%,MacTok-64 w/o RA更差,gFID接近39。这组数据明确证明了表示对齐(Representation Alignment)是MacTok成功的关键——没有全局-局部对齐,即使有掩码策略也无法在极低token数下保持质量。gFID和Accuracy的双重下降说明去除对齐后编码器不仅生成质量差,连语义判别能力也大幅退化。 MacTok生成样例展示(256x256 & 512x512) 这组图展示了MacTok配合SiT-XL在ImageNet各类别上的生成样例。可以看到仅用64个连续token,模型就能生成高度逼真的图像——动物(如金毛犬、猎豹)的毛发纹理细腻清晰,自然场景(如瀑布、花田)的光影层次丰富,人造物品(如跑车、教堂)的几何结构准确。这些样例视觉质量与使用数百个token的方案几乎无法区分,充分证明了MacTok在极高压缩比下保持生成质量的能力。特别值得注意的是细节部分——如动物眼睛的反光、建筑的对称性——这些在后验崩溃情况下通常最先丢失的细节都被很好地保留了。 批判性点评 新颖性: 核心贡献是首次系统解决连续Tokenizer在极低token数下的后验崩溃——双重掩码(随机+DINO语义)+全局-局部表示对齐的组合方案设计精巧。DINO语义引导是亮点——利用预训练模型知识优化Tokenizer训练。 可复现性: 方法组件清晰(两种掩码+两种对齐),超参数有详细消融。依赖预训练DINO模型但该模型公开可用。ImageNet实验可复现。主要不确定性在于DINO注意力图对非典型图像的适用性。 影响力: 64倍token压缩的工业价值极大——直接缩短扩散模型序列长度,大幅降低训练和推理成本。如能扩展到T2I和视频领域,将成为高效视觉生成的基础组件。CVPR 2026接收验证了学术影响力。 深度点评: MacTok: 64-token极限压缩 — 仅64个连续token达到SOTA图像生成(gFID 1.44),token量减少64倍。双重掩码+表示对齐解决后验崩溃。核心问题:缺少T2I验证和DINO依赖。 Agent生成持续爆发 — GEMS让6B模型超越SOTA Nano Banana 2,CutClaw多智能体自动剪辑数小时视频。继Unify-Agent后,Agent范式全面进入生成领域。 视频推理加速:2.65x — VecAttention发现向量级稀疏模式实现2.65x加速(CVPR 2026),MPDiT多Patch设计降50% GFLOPs。高效化是视频生成落地的关键。 技术演进定位: 处于图像Tokenizer从高冗余向极致压缩演进的突破点——64倍token压缩使得高效视觉生成从理论走向实践 可能的后续方向: 将极低token方案扩展到T2I(文本到图像)等复杂生成任务 探索更灵活的语义引导机制替代固定的DINO模型 将1D连续token方案应用于视频生成的时序建模 研究MacTok与自回归视觉模型(如LlamaGen)的集成 其余论文速览 1. VGGRPO Towards World-Consistent Video Generation with 4D Latent Reward Unknown (Multi-institution) 关键词: 视频生成·几何一致·GRPO·4D奖励·潜在空间 贡献: 提出VGGRPO框架,通过潜在几何模型(LGM)连接视频扩散潜在空间与几何基础模型,直接从潜在空间解码场景几何实现4D几何一致的视频后训练,克服先前方法仅限静态场景的局限 效果: 消除昂贵的VAE解码,相机稳定性和几何一致性显著提升,首次支持动态场景几何引导 2. LongCat-Next Lexicalizing Modalities as Discrete Tokens — Meituan Unified Multimodal Model Meituan (美团) 关键词: 离散自回归·多模态统一·任意分辨率·美团·开源 贡献: 提出离散原生自回归框架,在共享离散空间表示文本/视觉/音频多模态,核心创新是离散原生任意分辨率ViT实现任意分辨率分词/解词,解决离散视觉建模在理解任务上的性能天花板 效果: 单一自回归目标统一观察/绘画/对话,多模态基准全面强劲,已开源模型和Tokenizer 3. GEMS Agent-Native Multimodal Generation with Memory and Skills Unknown 关键词: Agent生成·闭环优化·记忆系统·技能扩展·6B超越SOTA 贡献: 提出Agent-Native多模态生成框架,包含Agent Loop(闭环迭代优化)、Agent Memory(轨迹级持久记忆)和Agent Skill(可扩展领域专业知识),突破基础模型固有局限 效果: 6B模型Z-Image-Turbo在GenEval2上超越SOTA Nano Banana 2,证明智能体控制可大幅扩展模型能力 4. OmniRoam World Wandering via Long-Horizon Panoramic Video Generation Unknown (Multi-institution) 关键词: 全景视频·长距生成·轨迹控制·场景漫游·3D重建 贡献: 提出可控全景视频生成框架,利用全景表示的丰富场景覆盖和固有时空一致性,通过预览-精炼两阶段实现长距场景漫游,支持实时视频生成和3D重建扩展 效果: 在视觉质量/可控性/长期场景一致性上全面优于SOTA,支持实时生成和3D重建 5. CutClaw Agentic Hours-Long Video Editing via Music Synchronization GVC Lab 关键词: 视频编辑·音乐同步·多智能体·长视频·自动剪辑 贡献: 提出多智能体框架自动将数小时原始素材剪辑为音乐同步短视频,包含分层多模态分解、编剧Agent(叙事一致性)、编辑Agent+审查Agent(美学/语义标准协作优化) 效果: 在节奏对齐和视频质量上显著超越SOTA基线,大幅减少视频编辑人工时间 6. VecAttention Vector-wise Sparse Attention for Accelerating Long Context Inference Unknown 关键词: 稀疏注意力·向量选择·视频加速·CVPR 2026·2.65x加速 贡献: 发现视频注意力图存在强垂直向量稀疏模式,提出逐向量稀疏注意力框架,通过轻量级重要向量选择+优化稀疏注意力内核动态处理信息向量,CVPR 2026 效果: 比全注意力加速2.65倍,比SOTA稀疏方法加速1.83倍,精度与全注意力相当 7. MPDiT Multi-Patch Global-to-Local Transformer for Efficient Flow Matching and Diffusion Rutgers University 关键词: 高效DiT·多Patch·全局到局部·50%加速·开源 贡献: 提出多Patch DiT设计:早期模块用大Patch捕获全局上下文,后期模块用小Patch精炼局部细节,打破DiT各向同性设计的计算冗余,另提出改进的时间和类别嵌入加速收敛 效果: GFLOPs计算成本降低50%,生成性能保持良好,已开源代码 8. TokenDial Continuous Attribute Control in Text-to-Video via Spatiotemporal Token Offsets Adobe Research / CMU 关键词: 视频属性控制·token偏移·滑块式编辑·免训练·Adobe 贡献: 提出通过时空token偏移实现T2V模型的连续滑块式属性控制,发现中间token空间中的加性偏移形成语义控制方向,无需重训练即可调节外观和运动属性 效果: 比SOTA基线实现更强可控性和更高编辑质量,人类研究验证有效性 9. SLVMEval Synthetic Meta Evaluation Benchmark for Text-to-Long Video Generation Unknown 关键词: 长视频评测·元评估·合成降质·CVPR 2026·3小时视频 贡献: 提出长视频生成元评估基准(最长10486秒约3小时),通过合成降质创建控制的质量对比视频对,覆盖10个评估维度,用众包筛选建立可靠测试平台,CVPR 2026 效果: 人类准确率84.7%-96.8%,揭示9/10维度现有评估系统不及人类,暴露长视频评估短板 趋势观察 Token压缩极限突破 — MacTok用仅64个连续token达到SOTA图像生成质量(gFID 1.44),token使用量减少64倍。双重掩码+表示对齐的组合策略有效解决了后验崩溃,为高效生成打开新空间。 Agent范式在生成领域全面铺开 — GEMS的Agent-Native框架让6B模型超越SOTA,CutClaw的多智能体将数小时素材自动剪辑。继昨天的Unify-Agent后,Agent正在从理解领域向生成领域快速渗透。 视频模型推理加速竞赛升温 — VecAttention发现向量级稀疏模式实现2.65x加速(CVPR 2026),MPDiT用多Patch设计降低50% GFLOPs。高效化是视频生成落地的关键瓶颈。 统一多模态模型持续进化 — 美团LongCat-Next在共享离散空间统一文本/视觉/音频,解决离散视觉建模的理解性能天花板。88位作者的工业级投入标志着统一模型走向成熟。 视频生成评测走向严格化 — SLVMEval首次系统评测长达3小时的视频生成质量,揭示现有自动评估在9/10维度不及人类。VGGRPO则将4D几何一致性引入视频后训练。 人工智能炼丹师 整理 | 2026-04-02
-
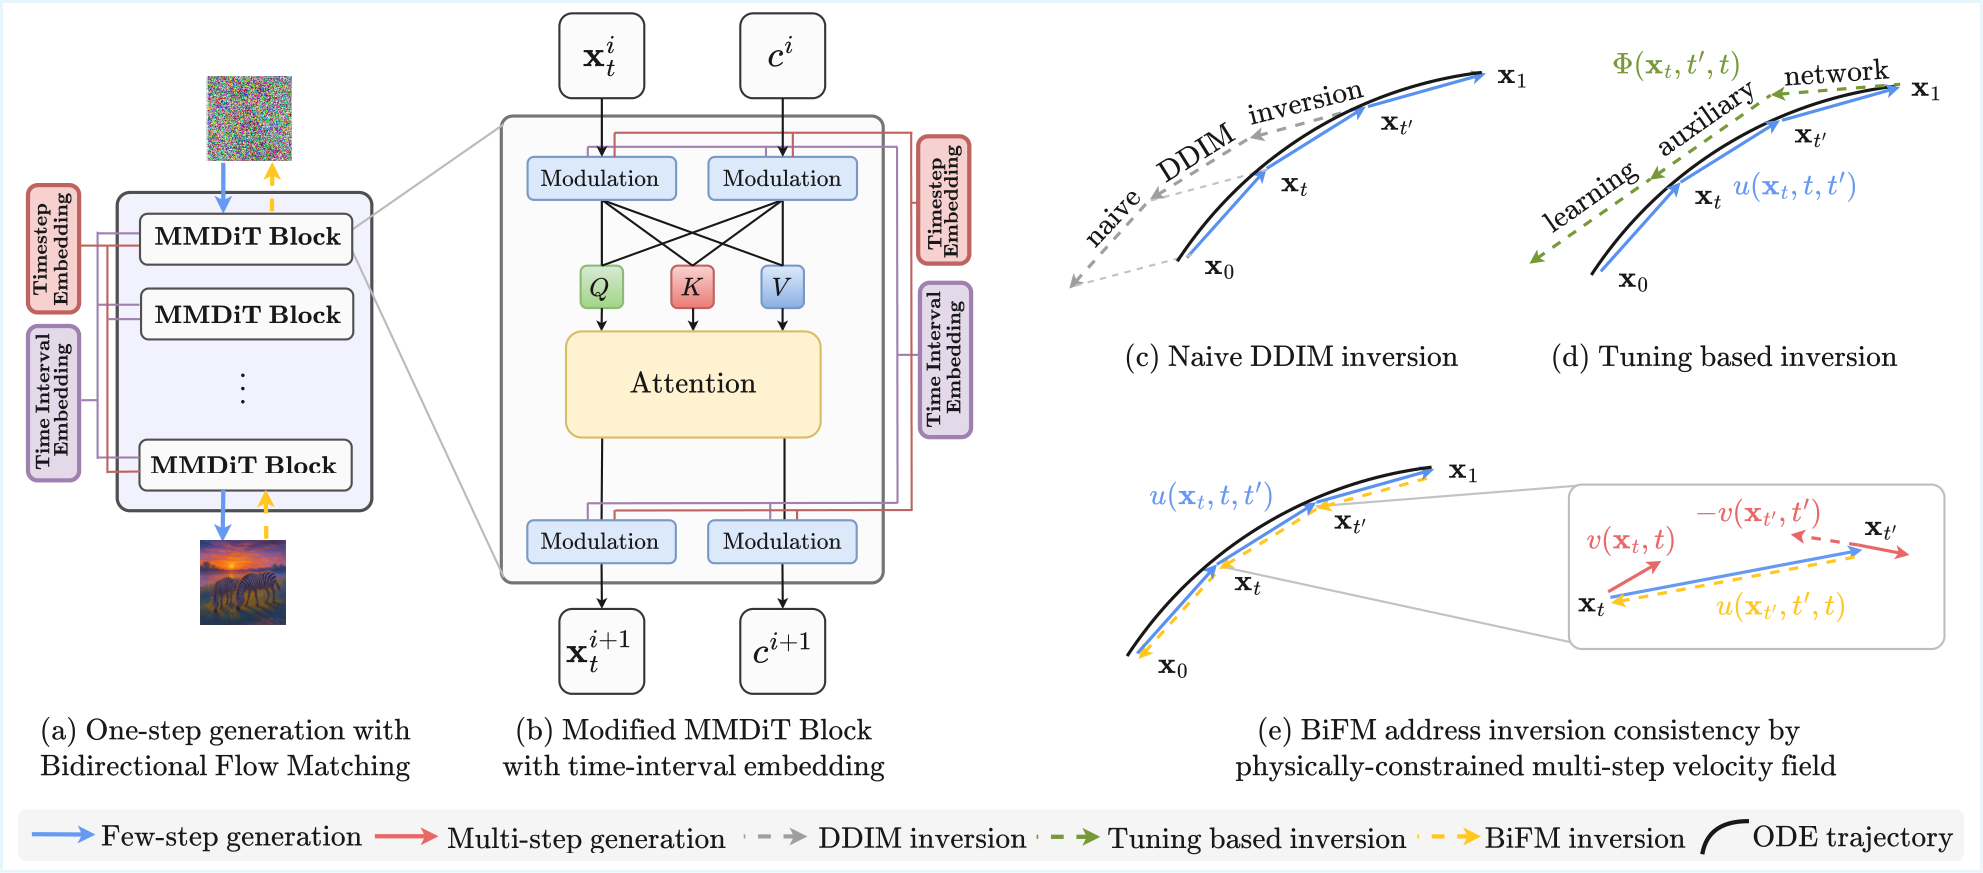
AIGC 每日速读|2026-03-30|BiFM|Wan-Weaver|PackForcing|Voxtral TTS AIGC 视觉生成领域 · 每日论文解读 (2026-03-30) 人工智能炼丹师 整理 | 共 10 篇论文 | 重点深度解读 1 篇 今日核心看点 BiFM: 双向 Flow Matching 统一少步生成与编辑 (CVPR 2026) Wan-Weaver: 解耦训练的交错多模态生成 (CVPR 2026) PackForcing: 5秒训练 → 2分钟视频 (24倍外推) Voxtral TTS: Mistral 开源多语言语音合成 AVControl: 首个模块化联合音视频控制框架 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 图像生成与编辑 — BiFM, xLARD, Z-Erase (3篇) 视频生成与编辑 — PackForcing, DCARL, TRACE (3篇) 多模态生成 — Wan-Weaver, AVControl (2篇) 音频生成 — Voxtral TTS (1篇) 推理加速 — CIAR (1篇) 收录会议: CVPR 2026 × 3 重点论文深度解读 1. BiFM: Bidirectional Flow Matching for Few-Step Image Editing and Generation 双向 Flow Matching 统一少步图像生成与编辑 | ANU (Australian National University) | arXiv:2603.24942 关键词: Flow Matching, Few-Step, Image Editing, Bidirectional, CVPR 2026 研究动机 核心问题: 扩散模型和 Flow Matching 在少步采样时编辑质量严重退化:现有少步反演方法依赖预训练辅助模块,跨架构泛化能力差。如何在单一模型中实现少步高质量的生成与编辑? 扩散模型和 Flow Matching 在图像生成和编辑中表现出色,但少步采样时编辑质量严重下降。现有少步反演方法依赖预训练生成器和辅助模块,限制了跨架构的可扩展性。BiFM 提出在单一模型内联合学习正向(图像到噪声)和反向(噪声到图像)两个方向的流匹配,实现统一的少步生成与编辑。 前序工作及局限: Consistency Models:通过一致性蒸馏实现少步生成,但仅支持单向生成不支持编辑反演 Flow Matching (Lipman et al.):构建确定性 ODE 路径连接噪声与数据分布,但原始框架需多步采样 InstaFlow:基于 Rectified Flow 的单步生成,但未处理编辑场景的图像反演 RF-Inversion:Rectified Flow 反演用于编辑,但需要多步且依赖辅助模块,跨架构泛化差 与前序工作的本质区别: BiFM 在单一模型中同时学习正向和反向的平均速度场,引入连续时间间隔监督和双向一致性目标,实现了架构无关的少步生成-编辑统一框架 方法原理 BiFM 的核心思想是在单一模型中同时估计图像到噪声和噪声到图像两个方向的平均速度场。具体而言:(1) 双向速度场估计:模型直接学习 x->noise 和 noise->x 两个方向的平均速度场,受共享瞬时速度场约束;(2) 连续时间间隔监督:引入新的训练策略,使用连续时间间隔进行监督,而非传统的离散时间步;(3) 双向一致性目标:通过双向一致性损失和轻量级时间间隔嵌入来稳定训练;(4) 单步反演能力:双向公式天然支持单步图像反演,无需额外的编码器或辅助网络;(5) 架构无关:可无缝集成到主流扩散和 Flow Matching 骨干网络中。 核心创新 在单一模型内同时学习生成和反演两个方向的 Flow Matching 引入连续时间间隔监督替代传统离散时间步 双向一致性目标确保生成-反演循环一致性 实现单步反演,无需辅助编码器 架构无关设计,适用于扩散和 Flow Matching 主干 实验结果 BiFM 在多种图像编辑和生成任务上均优于现有少步方法。在 4 步生成中,BiFM 的 FID 和 CLIP Score 均超过现有的一致性蒸馏和 Flow Matching 基线。在图像编辑任务中,BiFM 仅用 1-4 步即可实现高质量编辑,编辑保真度和背景保留能力显著优于需要 20-50 步的传统方法。消融实验表明双向一致性目标和连续时间间隔监督都是关键组件。 批判性点评 新颖性: 在单一模型中同时学习正向和反向Flow Matching是全新的范式。连续时间间隔监督替代离散步的思路具有理论深度。架构无关设计保证了泛化性。 可复现性: 方法描述清晰,数学公式完整。但训练细节(学习率调度、双向loss权重等)需要看代码实现。已承诺开源代码。 影响力: 统一了少步生成与编辑两个任务,对Flow Matching社区有重要推动。双向学习的思路可推广到视频、3D等领域。CVPR 2026接收。 深度点评: 少步统一 — BiFM 将生成与编辑统一为双向 Flow Matching,少步效率与质量兼得 24倍外推 — PackForcing 的 24 倍时间外推证明短视频训练能 unlock 长视频推理 开源TTS — Voxtral TTS 以 3 秒参考音频实现 68.4% 胜率,开源 TTS 迎来里程碑 模块化控制 — AVControl 用 LoRA 并行画布实现首个联合音视频模块化控制 技术演进定位: 确立了双向 Flow Matching 作为统一少步生成与编辑的标准范式。启示:生成和反演不是两个独立任务,可以在共享模型中互相增强。 可能的后续方向: 将双向框架扩展到视频 Flow Matching 的少步编辑 探索 3D 生成场景中的双向反演与编辑 与 RLHF 后训练方法结合,进一步提升少步生成质量 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 1 Wan-Weaver (Wan-Weaver: Interleaved Multi-modal Generation via Decoupled Training) 交错生成·解耦训练·多模态·长程一致性·CVPR 2026 解耦训练框架实现交错多模态生成,无需真实交错数据即可生成长程一致的图文交错内容 CVPR 2026,优于现有方法。规划器生成文本描述,可视化器合成一致图像 2 PackForcing (PackForcing: Short Video Training Suffices for Long Video Sampling) 长视频生成·KV-cache压缩·时间外推·自回归扩散·24倍 三分区 KV-cache 策略实现 24 倍时间外推,仅用 5 秒训练片段生成 2 分钟连贯视频 VBench SOTA,4GB 有界 KV 缓存,单 H200 GPU 生成 832x480@16FPS 长视频 3 Voxtral TTS (Voxtral TTS: Expressive Multilingual Text-to-Speech by Mistral) TTS·多语言·Flow Matching·语音克隆·Mistral 混合架构结合自回归语义 Token 生成与 Flow Matching 声学解码,仅需 3 秒参考音频 人类评估胜率 68.4% 超 ElevenLabs Flash v2.5,CC BY-NC 开源 4 TRACE (TRACE: Object Motion Editing in Videos with First-Frame Trajectory Guidance) 视频编辑·运动路径·轨迹引导·物体中心·两阶段 用户在首帧设计轨迹即可编辑视频物体运动路径,跨视图运动变换处理相机运动 在多样化真实视频上生成更连贯、逼真、可控的运动编辑效果 5 xLARD (Self-Corrected Image Generation with Explainable Latent Rewards) 自纠正·潜在奖励·MLLM·语义对齐·CVPR 2026 MLLM 驱动的自纠正生成框架,通过可解释潜在奖励信号实现生成时自我评估和修正 CVPR 2026,在语义对齐和视觉保真度上显著提升,保持生成先验 6 DCARL (DCARL: A Divide-and-Conquer Framework for Autoregressive Long-Trajectory Video Generation) 长视频·分治·关键帧·自回归·32秒 分治自回归框架结合关键帧生成器和插值生成器,有效解决长视频视觉漂移问题 32 秒高保真长视频生成,FID/FVD/相机跟随性均优于 SOTA 基线 7 AVControl (AVControl: Efficient Framework for Training Audio-Visual Controls) 音视频控制·LoRA·LTX-2·模块化·并行画布 基于 LTX-2 联合模型的模块化音视频控制,每个模态作为独立 LoRA 并行训练 VACE 基准 SOTA,首个模块化联合音视频控制,训练步骤仅需数百到数千步 8 CIAR (CIAR: Interval-based Collaborative Decoding for Image Generation Acceleration) 加速·协作解码·概率区间·自回归·云端协同 云端协作框架通过 Token 不确定性量化和概率区间实现自回归图像生成加速 2.18 倍加速,减少 70% 云请求,保持图像质量和语义一致性 9 Z-Erase (Z-Erase: Enabling Concept Erasure in Single-Stream Diffusion Transformers) 概念擦除·单流DiT·安全性·扩散Transformer·Z-Image 首个针对单流扩散 Transformer 的概念擦除方法,解决生成模型安全性问题 有效移除不需要的生成概念,同时保持对其他概念的生成质量 趋势观察 少步统一生成编辑 — BiFM 证明双向学习可同时掌握生成与反演,单步反演质量接近多步方法,生成-编辑统一是趋势 长视频突破上下文瓶颈 — PackForcing 的三分区 KV-cache 和 DCARL 的分治策略分别从压缩和结构两个角度解决长视频生成,24倍外推令人印象深刻 多模态交错生成崛起 — Wan-Weaver 不依赖真实交错数据即可完成图文交错生成,解耦训练是一种高效实用的范式 音视频联合控制模块化 — AVControl 的 LoRA 并行画布方案让联合音视频控制的训练成本大幅降低,模块化可组合是未来方向 人工智能炼丹师 整理 | 2026-03-30
-
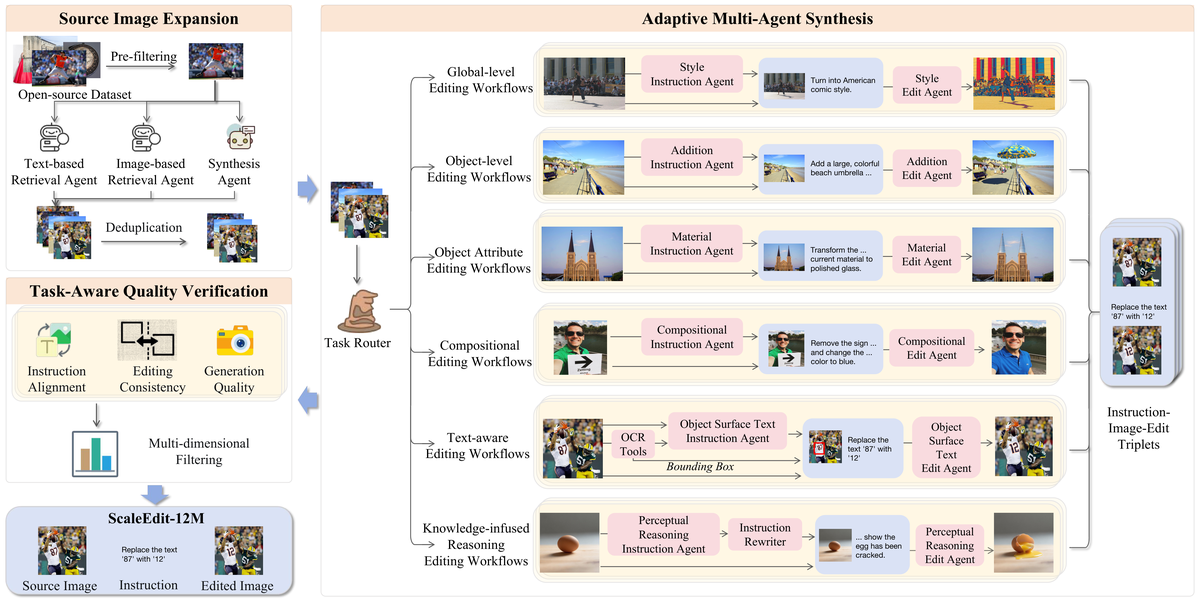
AIGC 每日速读|2026-03-29|GIDE|ScaleEdit-12M|Calibri| AIGC 视觉生成领域 · 每日论文解读 (2026-03-29) 人工智能炼丹师 整理 | 共 8 篇论文 | 重点深度解读 8 篇 今日核心看点 GIDE 免训练DLLM编辑 ScaleEdit-12M 最大开源数据集 VeloEdit 速度场分解编辑 Calibri 100参数DiT校准 HAM 异构注意力风格迁移 CTCal 跨时间步自校准 DepthArb 遮挡感知生成 MACRO 多参考图生成 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 8 篇,重点解读 8 篇。 方向分布: 免训练图像编辑: 3篇 (GIDE, VeloEdit, HAM) 数据规模化: 2篇 (ScaleEdit-12M, MACRO) 参数高效优化: 2篇 (Calibri, CTCal) 免训练组合生成: 1篇 (DepthArb) CVPR 2026 x 3 (Calibri, HAM, CTCal) | 开源数据+代码 x 5 重点论文深度解读 1. GIDE 解锁Diffusion LLM精确免训练图像编辑 | 港中文/西交 | CUHK, Xi'an Jiaotong University | arXiv:2603.21176 关键词: 免训练编辑, Diffusion LLM, 离散噪声反转, GIDE-Bench, 多模态输入 研究动机 核心问题: Diffusion LLM(DLLM)使用离散Token化,标准DDIM Inversion等连续反转技术完全不适用,导致此类模型无法进行免训练图像编辑 基于扩散的大语言模型(DLLM,如Janus、SEED-X等)已展现强大的多模态生成能力,但在精确的免训练图像编辑上仍是开放挑战。核心困难在于:DLLM内部采用离散Token化(discrete tokenization),与传统连续扩散模型截然不同——标准的DDIM Inversion等噪声反转技术无法直接应用于离散Token空间,强行使用会导致编辑后的图像结构严重退化(背景破坏、未编辑区域变形)。这是一个既有理论深度又有实际影响力的问题:如何在不重训练的前提下,让DLLM具备精确可控的编辑能力? 前序工作及局限: DDIM Inversion:连续噪声空间反转的标准范式,但不适用于离散Token模型 Prompt-to-Prompt:基于注意力操控的编辑方法,但仅适用于连续扩散模型 SDEdit:添加噪声再去噪的编辑范式,但缺乏精确的源图像保持能力 与前序工作的本质区别: GIDE提出了全新的离散噪声反转机制,在离散Token序列上记录每步去噪的状态转移轨迹,首次实现了DLLM的免训练精确编辑 方法原理 GIDE(Grounded Inversion for Diffusion LLM Editing)提出了一个统一的三阶段编辑框架: 第一阶段:定位(Grounding) — 根据用户提供的多模态编辑指令(文本、点击点、边界框),精确定位需要编辑的区域,生成编辑掩码。支持文本/点/框三种输入方式的统一处理。 第二阶段:反转(Inversion) — 这是核心创新。提出离散噪声反转机制(Discrete Noise Inversion),专门为离散Token空间设计。关键思路是:不在连续潜空间做反转,而是在DLLM的离散Token序列上建模噪声模式。通过记录每一步去噪过程中Token的状态转移轨迹,实现精确的源图像重建。这保证了未编辑区域的高保真度恢复。 第三阶段:精修(Refinement) — 在编辑区域应用目标编辑指令驱动的生成,同时用Inversion阶段记录的Token轨迹约束保留区域,确保编辑和保留的无缝融合。引入区域级Token混合策略,在编辑边界实现平滑过渡。 核心创新 首个专为Diffusion LLM设计的免训练图像编辑框架 离散噪声反转机制:突破离散Token空间无法做标准Inversion的技术瓶颈 统一三阶段流程(定位→反转→精修)支持文本/点/框多模态输入 GIDE-Bench:805种组合编辑场景的严格评测基准 语义正确性+51.83%,感知质量+50.39% 实验结果 在GIDE-Bench上的广泛实验表明,GIDE显著超越所有先前免训练方法:语义正确性提升51.83%,感知质量提升50.39%。在ImgEdit-Bench上的额外评估证实了强泛化能力——无需任何训练,GIDE即可实现与经过训练的专用编辑模型相媲美的照片级真实感输出。多模态输入方式(文本+点+框)的灵活性使其在实际应用中具有很高的实用价值。 批判性点评 新颖性: 首次为DLLM设计免训练图像编辑框架,离散噪声反转机制是全新的技术突破,开创性强。 可复现性: 方法描述详细,但暂未开源代码。GIDE-Bench的公开将有助于后续复现。 影响力: 为DLLM开辟了编辑新路径,随着DLLM模型日趋成熟,GIDE的影响力将持续增长。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 开创了DLLM免训练编辑的新方向,填补了离散扩散模型编辑的技术空白 可能的后续方向: DLLM编辑将从免训练走向可训练:GIDE的离散反转技术有望成为DLLM原生编辑训练的基础 离散反转技术可扩展到离散视频生成模型的帧间编辑 2. ScaleEdit-12M 最大开源图像编辑数据集:多Agent规模化生成1200万样本 | CUHK, Shanghai AI Lab | arXiv:2603.20644 关键词: 编辑数据集, 12M规模, 多Agent框架, 23任务族, 开源 研究动机 核心问题: 现有图像编辑数据集规模仅在十万级别,任务类型覆盖有限,严重制约了编辑模型的泛化能力 指令式图像编辑已成为统一多模态模型的核心能力,但高质量编辑数据的获取仍是瓶颈。现有方案两极分化:闭源API标注成本高昂且不可持续,开源合成管线质量有限且覆盖面窄。业界迫切需要一种完全开源、可规模化、且覆盖多样化编辑任务的数据生产方案。 前序工作及局限: MagicBrush:早期编辑数据集,但规模仅10万级且任务覆盖有限 InstructPix2Pix:用GPT-4生成编辑对,但数据多样性不足 Emu Edit:Meta提出的编辑基准,但非开源且规模较小 与前序工作的本质区别: ScaleEdit-12M通过多Agent自动化框架将开源编辑数据规模推至1200万级别,覆盖15种编辑任务类型 方法原理 ScaleEditor是一个完全开源的分层多Agent框架,实现端到端的大规模编辑数据生产: 第一层:源图像扩展 — 融入世界知识的图像源选择和增强。不仅使用现有数据集,还通过知识增强的图像生成扩展源图像多样性。 第二层:自适应多Agent编辑 — 多个专业化Agent协作完成编辑指令生成和图像合成。每个Agent负责特定类型的编辑任务(如物体替换、风格变换、属性修改等),通过协商机制确保指令-图像对的一致性。 第三层:任务感知质量验证 — 自动化的质量控制系统,针对不同编辑任务类型设计差异化的验证标准,过滤低质量样本。 最终产出ScaleEdit-12M数据集:1200万编辑样本,覆盖23个任务族,涵盖真实和合成域。 核心创新 迄今最大的完全开源图像编辑数据集(12M样本,23个任务族) 分层多Agent框架:源图像扩展→自适应编辑→任务感知验证 不依赖闭源API,完全开源可复现 UniWorld-V1 通用编辑+10.4%,知识注入+150.0% 跨域覆盖:真实图像+合成图像,23种编辑类型 实验结果 在ScaleEdit-12M上微调UniWorld-V1和Bagel带来持续收益:通用编辑基准(ImgEdit)+10.4%,GEdit +35.1%;知识注入基准(RISE)+150.0%,KRIS-Bench +26.5%。这证明开源Agent管线可以接近商业级数据质量,同时保持成本效益和可扩展性。 批判性点评 新颖性: 多Agent自动化数据生成框架是工程创新,核心贡献在于规模而非算法。但12M级开源数据本身就是重大贡献。 可复现性: 承诺开源数据集和框架,复现门槛极低,一旦发布将极大推动领域发展。 影响力: 可能成为图像编辑领域最有影响力的工作之一——大规模开源数据将显著降低整个领域的训练门槛。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 可能成为图像编辑领域的ImageNet时刻——大规模开源数据将显著降低编辑模型的训练门槛 可能的后续方向: 编辑数据规模可能突破亿级:ScaleEdit的多Agent框架为全自动化数据生产铺平道路 数据质量验证和自动过滤将成为下一步关键 3. VeloEdit 速度场分解实现免训练一致连续图像编辑 | Xiamen University | arXiv:2603.13388 关键词: 速度场分解, 免训练编辑, Flow Matching, 连续控制, 一致性保持 研究动机 核心问题: Flow Matching模型的编辑方法主要操作注意力层,忽略了速度场本身蕴含的丰富编辑信号 基于Flow Matching的图像编辑方法正在兴起(如Flux.1 Kontext、Qwen-Image-Edit),但存在两大核心痛点:(1) 去噪过程中的重建误差导致未编辑区域漂移(背景不一致),(2) 缺乏对编辑强度的细粒度控制——只能「编辑/不编辑」二选一,无法平滑调节编辑程度。现有方法通常依赖复杂的注意力操作或辅助训练模块来缓解这些问题,引入了额外计算开销。 前序工作及局限: RF-Inversion:Flow Matching反转编辑的先驱工作,但灵活性受限 FlowEdit:基于Flow的编辑方法,但未利用速度场的几何特性 P2P-Bridge:桥接模型编辑,但依赖配对训练数据 与前序工作的本质区别: VeloEdit从速度场的几何层面直接进行编辑操控,提出速度分解、重组和引导三阶段编辑框架,理论优雅且实用 方法原理 VeloEdit直接在Flow Matching的速度场(velocity field)层面操作,提出速度场分解方法: 动态区域识别 — 量化源图像恢复速度场(reconstruction velocity)与编辑速度场(editing velocity)的差异,差异大的区域标识为编辑区域,差异小的标识为保留区域。这种基于速度场差异的分区比基于注意力图的分区更精确。 一致性保持 — 在保留区域,用源图像的恢复速度场替换编辑速度场,从而在ODE积分过程中严格保证保留区域像素不偏移。 连续强度控制 — 在编辑区域,通过恢复速度场和编辑速度场的线性插值实现连续的编辑强度调节(0%→100%无级变速),用户可精确控制编辑程度。 核心创新 首个直接在速度场层面操作的免训练编辑方法 速度场差异驱动的动态区域识别 恢复速度场替换保证保留区域一致性 速度场插值实现编辑强度0-100%连续控制 在Flux.1 Kontext和Qwen-Image-Edit上验证,计算开销几乎为零 实验结果 在Flux.1 Kontext和Qwen-Image-Edit两个前沿模型上的实验表明,VeloEdit显著改善了视觉一致性和编辑连续性。关键优势:(1) 背景保持度大幅提升,(2) 编辑强度可连续调节,(3) 额外计算开销几乎为零(不需要训练、不需要额外模型)。代码已开源。 批判性点评 新颖性: 从速度场几何层面进行编辑操控的思路极其巧妙,速度分解+重组+引导的三阶段框架理论优雅。 可复现性: 代码已开源,复现友好。速度场分解的实现细节清晰。 影响力: 为Flow Matching编辑开辟了新范式,速度场视角可能被广泛借鉴。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 为Flow Matching编辑开辟了基于速度场的全新技术路径,补充了注意力操控之外的编辑范式 可能的后续方向: 速度场编辑可扩展到视频Flow Matching模型 与LoRA等参数高效方法结合可降低推理成本 4. Calibri 参数高效校准提升DiT生成质量 | CVPR 2026 | Visual Generative AI group | arXiv:2603.24800 关键词: 参数高效, DiT校准, 进化算法, CVPR 2026, 100参数 研究动机 核心问题: DiT模型生成质量可通过后处理校准提升,但现有方法需要大量额外参数和训练 Diffusion Transformer(DiT)已成为图像生成的主流架构,但如何以最小代价提升其生成质量仍是开放问题。现有优化方法要么需要大规模微调(成本高),要么需要修改架构(兼容性差)。一个有趣的问题是:DiT的去噪过程中,是否存在简单的参数调整就能显著改善的瓶颈点? 前序工作及局限: Guidance Distillation:通过蒸馏减少采样步数,但改变了模型结构 CFG (Classifier-Free Guidance):无分类器引导提升质量,但需双倍推理成本 DPO for Diffusion:用偏好学习优化扩散模型,但需要配对偏好数据和微调 与前序工作的本质区别: Calibri用进化算法搜索仅约100个缩放/偏移参数即可显著提升DiT生成质量,极简且高效 方法原理 Calibri基于一个关键发现:在DiT的去噪过程中,引入单个学习缩放参数即可显著提升DiT模块的性能。基于此,Calibri将DiT校准建模为黑盒奖励优化问题: 问题定义 — 为DiT的每个关键模块(注意力层、FFN层等)寻找最优的缩放系数,使得生成质量最大化。 求解方法 — 使用进化算法(Evolutionary Algorithm)高效搜索约100个缩放参数的最优组合。进化算法的优势在于:不需要梯度计算,不需要反向传播,仅通过前向推理+质量评估即可迭代优化。 效果叠加 — Calibri不仅提升质量,还自然减少了推理所需的去噪步数——更好的缩放参数使得每步去噪更高效,达到相同质量所需步数更少。 核心创新 揭示DiT去噪过程中缩放参数的关键作用 仅约100个参数即可显著提升生成质量 进化算法黑盒优化,无需梯度、无需反向传播 同时提升质量和减少推理步数 CVPR 2026接收,模型无关可适用于各种DiT 实验结果 实验证明Calibri在各种文本到图像模型上都能持续提升性能,包括FLUX、SD3.5等主流模型。值得注意的是,Calibri还能减少图像生成所需的推理步骤——例如在某些模型上用20步达到原来30步的质量。仅修改约100个参数,就能获得可观的质量-效率双重收益。CVPR 2026接收。 批判性点评 新颖性: 用进化算法搜索约100个缩放/偏移参数的极简设计令人惊喜,挑战了「更多参数=更好效果」的传统认知。CVPR 2026接收。 可复现性: 基于进化算法搜索,复现门槛低。搜索空间和适应度函数定义明确。 影响力: 极简参数校准思路可被广泛应用于各类DiT模型的部署优化,实用价值极高。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 提出了参数效率的极致追求:用最少参数实现最大质量提升,为模型部署优化树立新范式 可能的后续方向: 进化搜索可能与在线学习结合实现动态校准 可扩展到视频DiT和音频DiT的质量校准 5. HAM 异构注意力调制实现免训练风格迁移 | CVPR 2026 | Hangzhou Dianzi University | arXiv:2603.24043 关键词: 风格迁移, 注意力调制, 免训练, CVPR 2026, 身份保护 研究动机 核心问题: 风格迁移和图像编辑中需要同时保持内容结构和注入目标风格,现有注意力操控方法难以平衡两者 扩散模型风格迁移面临根本性的风格-内容平衡难题:过度迁移风格会破坏内容身份信息(人物面部变形、场景结构丢失),保守迁移则风格效果不明显。现有免训练方法多采用统一的注意力操作策略,无法同时兼顾全局风格氛围和局部身份细节。 前序工作及局限: StyleAligned:风格对齐生成,但缺乏细粒度控制 IP-Adapter:图像提示适配器,但注入风格时容易丢失内容 InstantStyle:即时风格迁移,但对复杂风格表现不佳 与前序工作的本质区别: HAM提出异构注意力调制机制,对不同注意力头使用不同的调制策略,实现风格与内容的精细解耦 方法原理 HAM提出异构注意力调制(Heterogeneous Attention Modulation)——对全局风格和局部身份使用不同的注意力操作策略: 全局注意力调节(GAR) — 在全局层面调制自注意力权重,注入风格参考图的整体氛围(色调、笔触、光影风格),影响图像的全局视觉感受。 局部注意力移植(LAT) — 在局部层面移植关键的身份注意力图,保护内容图像中的核心身份信息(面部特征、物体结构、空间关系)不被风格迁移破坏。 两种策略在不同的注意力头上并行执行,实现风格-身份的解耦处理。这种异构设计使得系统能在充分捕获复杂风格参考的同时保持内容身份完整。 核心创新 异构注意力调制:全局风格调节+局部身份移植双策略 不同注意力头承担不同任务,实现风格-身份解耦 完全免训练,即插即用 在保持身份的同时捕获复杂风格参考 CVPR 2026接收 实验结果 在多项定量指标上达到SOTA性能。用户研究表明HAM在风格一致性和内容保持两个维度上均优于现有方法。特别在人像风格迁移中,HAM成功保持了面部身份信息的同时实现了多样化风格效果。CVPR 2026接收。 批判性点评 新颖性: 对不同注意力头使用不同调制策略的异构设计有一定新意,但注意力操控编辑的大框架已比较成熟。CVPR 2026接收。 可复现性: 方法描述清晰,但代码开源状态待确认。 影响力: 推进了注意力机制在风格迁移中的精细化应用,对实际产品有参考价值。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 推进了注意力机制在风格迁移中的精细化应用,CVPR 2026接收验证了其学术价值 可能的后续方向: 异构注意力调制可扩展到视频风格迁移 与LoRA结合可实现更灵活的风格组合 6. CTCal 跨时间步自校准提升T2I文本对齐 | CVPR 2026 | Beihang University | arXiv:2603.20741 关键词: 跨时间步校准, 文本对齐, CVPR 2026, 显式监督, 模型无关 研究动机 核心问题: 扩散模型蒸馏缺少跨时间步的显式对齐监督,导致学生模型在不同去噪阶段的输出不一致 文本到图像扩散模型在语义对齐上仍存在顽固瓶颈——模型经常忽略prompt中的某些语义元素或生成不符合描述的内容。深层原因在于:传统扩散损失仅提供隐式监督,缺乏对文本-图像细粒度对应关系的显式约束。一个关键观察是:随着噪声时间步增大,建立准确的文本-图像对齐变得指数级困难。 前序工作及局限: Progressive Distillation:渐进蒸馏减少采样步数,但缺乏跨步对齐 Consistency Models:一致性模型追求一步生成,但牺牲了部分质量 LCM (Latent Consistency Models):潜空间一致性模型,但训练效率有待提升 与前序工作的本质区别: CTCal引入跨时间步自校准机制,通过不同时间步输出的显式对齐约束提升蒸馏质量 方法原理 CTCal基于一个精妙的观察:在小时间步(低噪声)时,交叉注意力图已经形成了可靠的文本-图像对齐;而在大时间步(高噪声)时,这种对齐严重退化。CTCal的核心思路是「以低噪声指导高噪声」: 跨时间步蒸馏 — 将小时间步形成的可靠交叉注意力图作为「教师」,校准大时间步的表示学习。这为扩散训练引入了显式的文本-图像对齐监督。 自适应加权 — 设计时间步感知的自适应加权机制,动态平衡CTCal校准损失和标准扩散损失的权重。在噪声大的时间步给予更强的校准指导,在噪声小的时间步让标准损失主导。 模型无关性 — CTCal可无缝集成到各种T2I架构中,包括基于扩散的(SD 2.1)和基于流匹配的(SD 3),不改变原有架构。 核心创新 揭示跨时间步对齐退化现象 以低噪声交叉注意力校准高噪声表示学习 时间步感知自适应加权平衡双损失 模型无关:兼容扩散模型和流匹配模型 CVPR 2026接收,代码已开源 实验结果 在T2I-Compbench++和GenEval基准上的广泛实验证明CTCal的有效性和通用性。在SD 2.1上,CTCal将组合生成准确率提升了显著幅度;在SD 3上同样有效,证明了跨架构的泛化能力。代码已开源。CVPR 2026接收。 批判性点评 新颖性: 跨时间步显式对齐监督是蒸馏领域的新颖思路,但核心思想相对直觉,缺少更深层的理论分析。 可复现性: 代码已开源,复现友好。训练流程和超参数设置详细。 影响力: 为扩散模型蒸馏提供了新的监督维度,可能被后续蒸馏工作广泛引用。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 为扩散模型蒸馏引入了新的监督维度,CVPR 2026接收证明了其有效性 可能的后续方向: 跨时间步校准可扩展到视频扩散模型的时间一致性蒸馏 与Calibri等参数高效方法结合可进一步降低部署成本 7. DepthArb 深度仲裁免训练遮挡感知图像合成 + OcclBench | Xi'an Jiaotong University | arXiv:2603.23924 关键词: 遮挡生成, 深度仲裁, 免训练, 注意力调制, OcclBench 研究动机 核心问题: 组合图像生成中多个物体的前后遮挡关系难以准确建模,导致不自然的层次感 文本到图像扩散模型在处理物体遮挡关系时存在严重缺陷——特别是在密集重叠区域,经常出现概念混合(两个物体融为一体)或不合逻辑的遮挡(前景被背景覆盖)。现有免训练布局引导方法依赖深度顺序无关的刚性空间先验,无法建模物体间的前后关系。 前序工作及局限: MultiDiffusion:多区域组合生成,但忽略了深度遮挡关系 Attend-and-Excite:注意力激活增强,但无法控制物体层次 ControlNet:条件控制生成,但深度控制精度有限 与前序工作的本质区别: DepthArb通过深度感知的注意力仲裁机制,在组合生成过程中自动解决物体间的遮挡优先级 方法原理 DepthArb通过仲裁交互物体之间的注意力竞争来解决遮挡歧义: 注意力仲裁调制(AAM) — 在重叠区域中,根据预设的深度排序关系,抑制背景物体的注意力激活。当两个物体在空间上重叠时,前景物体的注意力权重被增强,背景物体的注意力权重被压制,从而自然形成正确的遮挡关系。 空间紧致度控制(SCC) — 抑制注意力分布的空间发散,保持每个物体在指定布局区域内的结构完整性。防止物体注意力「溢出」到其他区域导致形状变形。 这两个机制协同工作,无需任何训练即可实现鲁棒的遮挡感知生成。 核心创新 首个系统解决扩散模型遮挡生成问题的免训练框架 AAM注意力仲裁:基于深度排序抑制背景激活 SCC空间紧致度:抑制注意力发散保持结构完整 OcclBench:多样化遮挡场景评测基准 即插即用增强扩散主干的组合能力 实验结果 在OcclBench上的广泛评估表明,DepthArb在遮挡准确性和视觉保真度上始终优于SOTA基线方法。作为即插即用方法,DepthArb无缝增强了SDXL、FLUX等主流扩散模型的空间组合能力。 批判性点评 新颖性: 深度感知的注意力仲裁机制有一定新意,但核心思路——利用深度信息引导注意力——并不算突破性。 可复现性: 方法描述较详细,但代码开源状态待确认。 影响力: 对多物体场景生成有实际应用价值,但影响范围相对局限于组合生成子领域。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 填补了组合生成中深度遮挡建模的空白,提升了多物体场景的视觉真实感 可能的后续方向: 深度仲裁机制可扩展到3D感知的场景生成 与布局控制方法结合可实现更精准的场景构图 8. MACRO 结构化长上下文数据驱动的多参考图像生成 | 港大 | The University of Hong Kong | arXiv:2603.25319 关键词: 多参考生成, 长上下文, 40万数据集, 跨任务协同, MacroBench 研究动机 核心问题: 多参考图像生成(基于多张参考图组合生成新图像)缺乏系统性的数据集和评测基准 多参考图像生成在实际应用中至关重要——多主体组合、叙事插图、新视角合成等场景都需要基于多张参考图生成新图像。然而,随着输入参考数量增加,现有模型性能急剧下降。根本原因在于数据瓶颈:现有数据集以单参考或少参考对为主,缺乏密集参考间依赖关系的「结构化长上下文」监督。 前序工作及局限: DreamBooth:个性化生成先驱,但仅支持单概念 Custom Diffusion:多概念组合,但需要微调且概念冲突 Subject-Diffusion:主体驱动生成,但多参考场景表现不佳 与前序工作的本质区别: MACRO首次系统定义了多参考图像生成任务,构建了包含多样场景的大规模数据集和评测基准 方法原理 MACRO从数据和评测两个层面系统解决多参考生成问题: MacroData数据集 — 40万个样本,每个样本最多包含10张参考图像。数据按四个互补维度系统组织: 定制化(Customization):个性化生成场景 插图(Illustration):叙事和故事插画场景 空间推理(Spatial Reasoning):多视角和空间关系场景 动态(Dynamics):运动和变化捕捉场景 MacroBench评测基准 — 4000个评测样本,覆盖多任务维度和不同输入规模,评估生成连贯性。 消融研究揭示了跨任务协同训练的有效性——不同维度的数据互相增益。 核心创新 首个大规模多参考图像生成数据集(40万样本,最多10张参考) 四维度系统组织:定制化/插图/空间推理/动态 MacroBench:4000样本标准化多参考评测基准 揭示跨任务协同训练的互增益效应 数据集和基准将开源 实验结果 在MacroData上微调后,多参考生成效果显著提升。消融研究揭示了两个重要发现:(1) 跨任务协同训练比单任务训练更有效,不同维度的数据产生互增益;(2) 处理长上下文(多张参考图)需要专门的训练策略。数据集和基准将公开发布。 批判性点评 新颖性: 首次系统定义多参考图像生成任务并构建标准化基准,填补了该方向的基础设施空白。 可复现性: 承诺公开数据集和基准,复现友好。任务定义和评测协议清晰。 影响力: 为多参考图像生成建立了标准化研究框架,将催生该方向的后续工作。 深度点评: 创新亮点:离散Token空间的噪声反转突破 — GIDE首次解决了Diffusion LLM因离散Token化而无法做标准Inversion的技术瓶颈。这不仅为DLLM开辟了编辑路径,更为离散生成模型的可控性研究提供了全新的技术基础。 数据影响:12M开源编辑数据改变游戏规则 — ScaleEdit-12M的多Agent生产框架和12M开源数据集可能深刻改变编辑领域的竞争格局——当高质量数据不再是壁垒,模型创新和应用创新将成为核心竞争力。 工程启示:100个参数的极简主义力量 — Calibri用约100个参数和进化算法就提升了DiT质量并减少推理步数,是参数高效优化的典范。这种'大模型+微调节'的思路值得在更多场景中探索。 技术演进定位: 为多参考图像生成建立了标准化的研究框架,将推动该方向的快速发展 可能的后续方向: 多参考生成将与视频模型融合:MACRO的多参考范式天然适配视频帧间一致性建模 数据集将催生新一代多概念组合生成模型 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 趋势观察 免训练方法成为图像编辑的主流范式 — GIDE、VeloEdit、HAM、DepthArb四篇论文均采用免训练策略,分别从离散Token反转、速度场分解、异构注意力、深度仲裁四个全新角度实现编辑/生成增强。免训练方法的优势在于即插即用、零额外训练成本、可适配各种底座模型。 数据规模化正在重塑编辑模型能力边界 — ScaleEdit-12M(12M样本、23任务族)和MACRO(40万多参考样本)代表了数据工程从「小而精」向「大而全」的范式转变。ScaleEdit的多Agent生产框架证明了完全开源管线可以接近商业级数据质量。 参数高效优化:用最少参数获取最大收益 — Calibri仅用约100个参数就显著提升DiT质量并减少推理步数;CTCal通过跨时间步自校准引入显式监督而不改变架构。这种极简主义优化思路正在成为工程化的新趋势。 从「能生成」到「能组合」:空间关系成为新战场 — DepthArb解决遮挡关系、MACRO处理多参考依赖、ScaleEdit覆盖复杂编辑场景——生成模型正从单一主体生成走向复杂空间关系的精确建模。 人工智能炼丹师 整理 | 2026-03-29
-
AIGC 周末专题|2026-03-28|视觉生成后训练与偏好优化 AIGC 视觉生成领域 · 每日论文解读 (2026-03-28) 人工智能炼丹师 整理 | 共 9 篇论文 | 重点深度解读 8 篇 今日核心看点 UniGRPO 统一后训练 FIRM 忠实奖励建模 EditHF-1M 29M偏好对 MV-GRPO 多视图评估 VIGOR 视频几何奖励 VHS CVPR2026 推理扩展 TATAR 不对称奖励 SeGroS 语义锚定监督 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 9 篇,重点解读 8 篇。 方向分布: 后训练框架: UniGRPO(统一多模态后训练), MV-GRPO(多视图GRPO), SeGroS(语义锚定监督) 奖励模型与评估: FIRM(编辑+生成), EditHF-1M(29M偏好对), VIGOR(视频几何), TATAR(质量+美学), VHS(潜在验证器) 重点论文深度解读 1. UniGRPO 统一策略优化实现推理驱动视觉生成 | 上海AI Lab/港中文 | Shanghai AI Lab, CUHK | arXiv:2603.23500 关键词: 统一后训练, GRPO, 推理驱动生成, Flow Matching, 交错生成 研究动机 核心问题: 统一多模态模型(自回归文本+Flow Matching图像)缺乏后训练方法 统一多模态模型正朝着交错生成(interleaved generation)发展——自回归建模文本、Flow Matching 建模图像。然而,如何对这种混合架构进行强化学习后训练?现有 GRPO 只针对单一模态,且 FlowGRPO 依赖 Classifier-Free Guidance(CFG)导致轨迹分叉,难以扩展到多轮交互场景。核心挑战是:如何在一个统一的 RL 框架中同时优化推理(文本)和生成(图像)两个阶段的策略? 前序工作及局限: GRPO (DeepSeek 2025):大语言模型的群体相对策略优化 FlowGRPO (2026):将GRPO扩展到Flow Matching视觉生成 Transfusion (Meta 2024):统一自回归+扩散的多模态架构 与前序工作的本质区别: UniGRPO首次统一优化文本推理和图像合成,消除CFG保持线性轨迹 方法原理 UniGRPO 将多模态生成建模为稀疏终端奖励的马尔可夫决策过程(MDP),联合优化文本推理和图像合成两个阶段。框架采用极简设计原则:(1) 文本推理阶段使用标准 GRPO,让模型学会扩展用户提示为详细推理链;(2) 图像合成阶段使用 FlowGRPO,在 Flow Matching 的速度场上进行策略优化。关键改进有两点:第一,消除 Classifier-Free Guidance(CFG),保持线性、未分叉的生成轨迹,这对多轮交互和多条件生成(如编辑)至关重要;第二,将标准的潜空间 KL 惩罚替换为直接作用于速度场的 MSE 惩罚,提供更鲁棒的正则化信号,有效缓解 Reward Hacking。两种模态的优化通过统一的 MDP 框架无缝集成。 核心创新 首个统一的多模态生成后训练框架:联合优化自回归文本推理和 Flow Matching 图像合成 消除 CFG 保持线性轨迹:使框架可扩展到多轮交错生成场景 速度场 MSE 正则化替代 KL 惩罚:直接在速度场空间约束策略偏移,更鲁棒地防止 Reward Hacking 极简设计原则:无缝集成标准 GRPO + FlowGRPO,避免过度工程化 为完全交错式多模态模型的后训练建立了可扩展基线 实验结果 实验表明,UniGRPO 的统一训练方案显著提高了推理驱动图像生成的质量。在标准评估基准上,文本推理质量和图像生成保真度均获得一致提升。消除 CFG 后的模型在多轮交互场景中表现更稳定,MSE 速度场正则化有效避免了训练后期的 Reward Hacking 现象。该框架为未来完全交错模型的后训练提供了鲁棒且可扩展的基线。 批判性点评 新颖性: 首次将GRPO统一应用于文本推理+图像Flow Matching的交错生成,消除CFG保持线性轨迹的设计优雅且实用。但概念上是GRPO和FlowGRPO的自然组合,原创突破性有限。 可复现性: 基于开源Janus-Pro-7B模型,论文提供了完整的算法伪代码和超参数设置。但训练使用80张H100,资源门槛较高。代码和模型权重已开源。 影响力: 为统一多模态模型的后训练建立了可扩展基线,对Chameleon、Transfusion等架构有直接参考价值。极简设计降低了社区跟进门槛。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 交错生成后训练的可扩展基线 可能的后续方向: 多轮交互场景的后训练 视频+音频交错生成 在线持续学习 2. FIRM 忠实图像奖励建模:鲁棒奖励模型+RL优化 | 上交/港中文/上海AI Lab | SJTU, CUHK, Shanghai AI Lab | arXiv:2603.12247 关键词: 奖励模型, 图像编辑, 文生图, RLHF, 开源数据集 研究动机 核心问题: 图像编辑和生成的奖励模型存在幻觉,评分不忠实 RL 已成为增强图像编辑和文生图生成的重要范式,但现有奖励模型存在严重的幻觉问题——产生噪声评分,误导优化方向。核心痛点是:缺乏专门针对图像编辑和生成的大规模高质量评分数据集,导致奖励模型无法提供忠实、准确的反馈信号。 前序工作及局限: ImageReward (Xu 2023):首个文生图人类偏好奖励模型 HPSv2 (Wu 2023):人类偏好评分模型v2 PickScore (Kirstain 2023):Pick-a-Pic数据驱动的偏好评分 与前序工作的本质区别: FIRM专门解决编辑+生成双赛道的忠实性,提出Base-and-Bonus奖励策略 方法原理 FIRM 框架从数据、模型、策略三层解决奖励模型的忠实性问题:(1) 数据层:设计专业化数据整理管线,构建 FIRM-Edit-370K(编辑评分数据,评估执行力+一致性)和 FIRM-Gen-293K(生成评分数据,评估指令遵循),总计 66.3 万条评分数据;(2) 模型层:基于上述数据训练 FIRM-Edit-8B 和 FIRM-Gen-8B 两个 8B 参数的专业奖励模型,并发布 FIRM-Bench 评测基准;(3) 策略层:提出 Base-and-Bonus 奖励策略——对编辑任务使用 CME(Consistency-Modulated Execution,一致性调制执行),对生成任务使用 QMA(Quality-Modulated Alignment,质量调制对齐),巧妙平衡相互竞争的优化目标。 核心创新 首个系统性解决图像编辑和生成奖励建模的综合框架 发布 FIRM-Edit-370K + FIRM-Gen-293K 全套开源评分数据集 Base-and-Bonus 奖励策略:CME 平衡编辑的执行力与一致性,QMA 平衡生成的质量与对齐 FIRM-Bench 编辑+生成批评评测基准 消除奖励幻觉:比现有通用指标更准确匹配人类判断 实验结果 FIRM 系列奖励模型在 FIRM-Bench 上显著超越现有指标对人类判断的匹配度。基于 FIRM 的 RL 优化产出 FIRM-Qwen-Edit 和 FIRM-SD3.5,在忠实度和指令遵循方面确立了新标准。所有数据集、模型和代码均已公开发布。 批判性点评 新颖性: 从数据-模型-策略三层全栈构建忠实奖励体系,Base-and-Bonus策略巧妙解决了编辑和生成任务间的优化矛盾。CME和QMA两个具体策略设计有针对性且有理论支撑。 可复现性: 全套数据集(FIRM-Edit 37万+FIRM-Gen 29.3万)、模型权重和代码均已开源。基于InternVL2-8B训练,硬件需求可控。社区复现门槛低。 影响力: 视觉生成RLHF奖励建模的新标准。全栈开源的做法对社区价值巨大。Base-and-Bonus策略可泛化到其他多任务RL场景。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 视觉生成RLHF奖励建模的新标准 可能的后续方向: 视频编辑奖励 3D生成奖励 多目标帕累托优化 3. EditHF-1M 百万级图像编辑人类偏好反馈数据集 | 上交 | Shanghai Jiao Tong University | arXiv:2603.14916 关键词: 编辑偏好数据集, 29M偏好对, MLLM评估模型, 奖励信号, RL优化 研究动机 核心问题: 图像编辑缺乏大规模多维度人类偏好数据集 文本引导的图像编辑取得了显著进展,但编辑结果仍常出现伪影、意外编辑、不美观等问题。现有编辑评估方法缺乏大规模可扩展的评估模型,这严重限制了编辑领域人类反馈奖励模型的发展。核心瓶颈是:缺少百万级规模、多维度评估的人类偏好数据集。 前序工作及局限: InstructPix2Pix (Brooks 2023):GPT-4生成编辑指令,数据规模有限 MagicBrush (Zhang 2024):人工标注编辑数据集,规模较小 FIRM-Edit-370K:专业化编辑评分数据 与前序工作的本质区别: EditHF-1M将规模推至29M偏好对,三维度(质量+对齐+保持)评估体系 方法原理 EditHF-1M 体系包含三个层次:(1) 数据集层:构建百万级图像编辑偏好数据集,包含超过 2900 万人类偏好对和 14.8 万人类主观评分(MOS),均从视觉质量、指令对齐、属性保持三个维度进行评估;(2) 模型层:基于 EditHF-1M 训练 EditHF——一个基于多模态大语言模型(MLLM)的评估模型,提供与人类对齐的编辑反馈;(3) 应用层:引入 EditHF-Reward,将 EditHF 作为奖励信号,通过强化学习优化文本引导图像编辑模型 Qwen-Image-Edit。 核心创新 迄今最大的图像编辑偏好数据集:29M偏好对 + 148K MOS评分 三维度评估体系:视觉质量 + 指令对齐 + 属性保持 基于MLLM的编辑评估模型 EditHF EditHF-Reward:将评估模型转化为RL奖励信号 在 Qwen-Image-Edit 上验证显著性能提升 实验结果 EditHF 在与人类偏好对齐方面超越现有指标,并在其他数据集上展现强泛化能力。使用 EditHF-Reward 微调 Qwen-Image-Edit 后,编辑质量在视觉质量、指令对齐和属性保持三个维度均获得显著提升。数据集和代码将开源。 批判性点评 新颖性: 在偏好数据集的规模和评估维度设计上均为领先。三维度(质量+对齐+保持)评估体系比单标量更精准。但核心方法(人类标注+Bradley-Terry模型训练)较传统,创新更多在工程规模上。 可复现性: 数据集规模庞大(29M对)使得完整复现成本极高。评估模型基于公开架构训练,技术上可复现但资源需求大。数据集已部分开放。 影响力: 为图像编辑偏好建模提供了最大规模的公开基准。三维度评估范式可能成为社区标准。对未来编辑模型的开发和评估有直接推动作用。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 迄今最大的图像编辑偏好数据集 可能的后续方向: 视频编辑偏好数据 自动化偏好标注 跨域泛化评估 4. MV-GRPO 多视图GRPO:增强条件空间实现密集奖励映射 | 港中文/上海AI Lab | CUHK, Shanghai AI Lab | arXiv:2603.12648 关键词: 多视图评估, GRPO改进, 条件增强, 偏好对齐, Flow Matching 研究动机 核心问题: 标准GRPO的单视图评估方案限制了偏好对齐效果 标准 GRPO 采用单一条件评估一组生成样本——这种稀疏的单视图评估方案未能充分探索样本间关系,限制了对齐有效性和性能上限。直觉上,同一组样本在不同语义视角下可能展现出完全不同的优劣排序。如何构建密集的多视图奖励映射以更充分地利用每次采样? 前序工作及局限: GRPO (DeepSeek 2025):单条件评估一组样本 DPO (Rafailov 2023):直接偏好优化但依赖配对数据 FlowGRPO (2026):Flow Matching上的GRPO 与前序工作的本质区别: MV-GRPO通过条件增强实现多视图密集评估,无需样本再生成 方法原理 MV-GRPO 通过增强条件空间将稀疏单视图评估转化为密集多视图评估:(1) 对于由一个提示生成的一组样本,利用灵活的条件增强器生成语义相邻但多样化的标题(captions);(2) 这些多视图标题提供不同语义属性的评估角度,捕捉更丰富的优化信号;(3) 通过推导原始样本在新标题条件下的概率分布,无需昂贵的样本再生成即可将多视图评估纳入训练;(4) 多视图优势重估计产生密集的奖励映射,显著增强关系探索。 核心创新 首次将多视图评估引入GRPO框架 条件增强器生成语义相邻的多样化标题 无需样本再生成的多视图优势重估计 从稀疏单视图到密集多视图的范式转换 在文生图Flow Matching模型上超越SOTA 实验结果 大量实验表明,MV-GRPO 在偏好对齐性能上优于标准 GRPO 和其他最先进方法。多视图评估提供的密集奖励信号有效提升了文生图 Flow Matching 模型在多个评估维度上的表现。 批判性点评 新颖性: 通过概率分布推导将多视图评估转化为无需再生成的数学等价形式,理论推导优雅。从稀疏到密集评估的范式转换思路具有一般性。但增强策略的设计空间未充分探索。 可复现性: 基于开源SDXL/PixArt-α模型,算法伪代码清晰。条件增强器使用现有LLM改写,技术门槛低。计算开销仅增加奖励模型推理,几乎零额外训练成本。 影响力: 为GRPO框架提供了一种低成本且通用的性能增强方案。密集评估思路可扩展到其他RL-based生成优化。在标注预算受限时尤其有价值。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: GRPO框架的重要扩展,从稀疏到密集 可能的后续方向: 自适应视图数量选择 跨模态多视图 在线条件增强 5. VIGOR 视频几何奖励模型:跨帧重投影误差评估时序一致性 | arXiv:2603.16271 关键词: 视频奖励模型, 几何一致性, 重投影误差, 推理时扩展, SFT/RL后训练 研究动机 核心问题: 视频生成缺乏几何一致性评估和优化信号 视频扩散模型训练缺乏几何监督,生成视频中频繁出现物体变形、空间漂移和深度违反等伪影。现有视频评估指标在像素空间度量不一致性,容易被像素强度差异干扰。需要一种更符合物理规律、更鲁棒的视频质量评估方法来驱动后训练优化。 前序工作及局限: VBench (Huang 2024):视频生成综合评测基准 VideoScore (He 2024):基于MLLM的视频质量评分 VisionReward (2025):细粒度多维度视频偏好模型 与前序工作的本质区别: VIGOR首次引入基于几何的跨帧重投影误差作为视频奖励信号 方法原理 VIGOR 利用预训练几何基础模型构建基于几何的视频奖励:(1) 通过跨帧重投影误差评估多视图一致性——以点对点方式计算误差,比像素空间度量更符合物理规律且更鲁棒;(2) 引入几何感知采样策略,过滤低纹理和非语义区域,聚焦具有可靠对应关系的几何有意义区域;(3) 将此奖励通过两条互补途径应用:SFT 或 RL 进行双向模型后训练;以及推理时作为路径验证器实现因果视频模型的 test-time scaling。 核心创新 首个基于几何的视频生成奖励模型 跨帧重投影误差比像素级度量更鲁棒 几何感知采样:过滤低纹理区域聚焦可靠对应 双路径应用:后训练(SFT/RL) + 推理时扩展(test-time scaling) 为开源视频模型提供低成本增强方案 实验结果 实验验证了 VIGOR 基于几何的奖励在鲁棒性上显著优于其他变体。通过推理时扩展,VIGOR 为开源视频模型提供了实用的增强方案,无需大量计算资源进行重训练。后训练路径同样展现了一致的质量改善。 批判性点评 新颖性: 首次将几何重投影误差作为视频生成的奖励信号,利用预训练几何基础模型避免了昂贵的3D标注。双路径应用模式增加了实用性。但在non-rigid场景(如流体、火焰)中的适用性未讨论。 可复现性: 基于开源视频扩散模型和MoGe几何模型。技术方案描述详细,几何奖励计算流程可复现。但完整训练流程的超参数和计算资源需求描述不够详细。 影响力: 为视频生成质量评估引入了物理层面的几何先验,与现有像素级和语义级指标互补。对开源视频模型的质量提升提供了新的优化信号来源。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 视频生成几何一致性优化的开创性工作 可能的后续方向: 物理一致性奖励 音视频同步奖励 4D时空一致性评估 6. VHS 潜在空间验证器实现高效推理时扩展 | CVPR 2026 | University of Modena | arXiv:2603.22492 关键词: 推理时扩展, 潜在验证器, DiT, CVPR 2026, 高效验证 研究动机 核心问题: 推理时扩展(test-time scaling)的验证器计算成本过高 推理时扩展(inference-time scaling)通过验证器对候选输出评分选择来改进生成质量。但常用的 MLLM 验证器需要将候选从潜空间解码到像素空间再编码为视觉嵌入——冗余且昂贵。如何在不解码到像素空间的情况下直接评估生成质量? 前序工作及局限: Best-of-N (2024):MLLM验证器对候选评分选择 MLLM Verifier:需要解码到像素空间再编码为视觉嵌入 DiT单步生成器:内部hidden states包含丰富质量信号 与前序工作的本质区别: VHS直接在DiT隐藏状态上验证,跳过像素解码-重编码 方法原理 VHS(Verifier on Hidden States)直接在扩散 Transformer(DiT)单步生成器的中间隐藏表示上进行验证:(1) 分析生成器的特征表示而无需解码到像素空间;(2) 训练一个轻量级验证器网络直接在 DiT 的 hidden states 上评分;(3) 在极小推理预算(少量候选者)下实现比 MLLM 验证器更高效的推理时扩展。 核心创新 首个直接在DiT隐藏状态上操作的生成验证器 跳过像素解码-重编码的冗余流程 CVPR 2026,推理时间-63.3%,FLOPs-51%,VRAM-14.5% 极小推理预算下超越MLLM验证器 GenEval性能+2.7%同时节省大量计算资源 实验结果 与标准 MLLM 验证器相比,VHS 将联合生成和验证时间减少 63.3%,FLOPs 减少 51%,VRAM 使用量减少 14.5%,并在相同推理时间预算下实现 GenEval 性能 +2.7% 的提升。CVPR 2026 接收。 批判性点评 新颖性: 直接在DiT隐藏状态上训练验证器的思路简单但有效,避免了传统的编码-解码往返。揭示了DiT中间表示包含丰富质量信号的重要发现。方法设计简洁但insight深刻。 可复现性: 基于开源DMD2-SDXL模型,验证器网络结构简单(线性探针+小MLP)。训练数据通过自采样获取,计算成本可控。整体复现门槛低。 影响力: CVPR接收验证了学术价值。隐藏状态验证器的效率优势对推理时扩展的实际部署意义重大。可能启发更多利用扩散模型中间表示的工作。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: CVPR 2026, 高效推理时扩展的新范式 可能的后续方向: 多步DiT的流式验证 与后训练的协同优化 移动端部署 7. TATAR 一个模型两种思维:统一IQA+美学评估的任务条件推理 | arXiv:2603.19779 关键词: 图像质量评估, 美学评估, GRPO, 不对称奖励, 任务条件推理 研究动机 核心问题: IQA和IAA使用相同推理逻辑和奖励机制存在根本性错位 将图像质量评估(IQA)和图像美学评估(IAA)统一在单一 MLLM 中是有前景的方向,但现有方法对两个任务使用相同的推理逻辑和奖励机制——这存在根本性错位:IQA 依赖客观感知线索,需要简明推理;IAA 需要深思熟虑的语义判断。统一框架如何针对不同任务特性提供差异化的推理和优化? 前序工作及局限: Q-Instruct (Wu 2024):统一质量评估指令调优 LIQE (Zhang 2023):CLIP增强的图像质量评估 AestheticScore:单一标量美学评分 与前序工作的本质区别: TATAR揭示推理错位和优化错位,提出快慢推理+不对称奖励 方法原理 TATAR 共享视觉-语言主干,但在后训练阶段针对任务特性进行条件调节:(1) 快慢推理构建:IQA 配对简明感知理由,IAA 配对深思熟虑的美学叙述;(2) 两阶段学习:先 SFT 建立任务感知行为先验,再 GRPO 进行奖励驱动细化;(3) 不对称奖励设计:IQA 使用高斯分数塑造,IAA 使用 Thurstone 风格的完成度排名。 核心创新 揭示IQA和IAA的推理错位和优化错位问题 快慢任务特定推理:IQA简明+IAA深思熟虑 SFT+GRPO两阶段学习建立任务感知行为 不对称奖励:高斯分数塑造(IQA)+Thurstone排名(IAA) 八个基准上统一超越任务专用模型 实验结果 在八个基准上,TATAR 在域内和跨域设置下均显著超越先前统一基线,同时保持与特定任务专业模型竞争力的性能。美学评估的训练动态也更加稳定。代码已开源。 批判性点评 新颖性: 揭示IQA和IAA需要不同推理模式(快/慢思维)是有价值的洞见。不对称奖励设计——IQA用高斯分数塑造、IAA用Thurstone排名——理论动机清晰。SFT+GRPO两阶段框架设计合理。 可复现性: 基于开源MLLM骨干(如InternVL系列),训练数据来自公开IQA/IAA数据集。不对称奖励计算流程有完整公式推导。整体可复现性好。 影响力: 统一IQA和IAA评估对视觉生成的质量控制有直接应用价值。不对称奖励设计的思路可泛化到其他需要差异化优化策略的多任务场景。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 统一感知评分的任务条件后训练新范式 可能的后续方向: 视频质量+美学统一评估 多粒度感知推理 人类偏好对齐 8. SeGroS 语义锚定监督增强统一多模态模型对齐 | arXiv:2603.19807 关键词: 语义锚定, 统一多模态, 视觉提示, 掩码重建, 生成对齐 研究动机 核心问题: 统一多模态模型的生成训练存在粒度不匹配和监督冗余 统一多模态模型集成了理解和生成,但当前生成训练范式存在粒度不匹配和监督冗余两大局限:文本提示的稀疏性无法充分指导细粒度视觉生成,全图重建损失在非语义关键区域浪费了大量监督信号。如何通过更精准的监督信号提升生成保真度和跨模态对齐? 前序工作及局限: Show-o (Xie 2024):统一文本到图像理解和生成 Transfusion (Meta 2024):融合自回归+扩散 Chameleon (Meta 2024):完全自回归的多模态模型 与前序工作的本质区别: SeGroS通过视觉定位图构建语义锚定监督,解决文本稀疏+监督冗余 方法原理 SeGroS 提出语义锚定监督框架:(1) 构建视觉定位图(visual grounding map),将文本提示与图像的语义关键区域关联;(2) 基于定位图构建语义化视觉提示,补偿文本提示的稀疏性,为生成过程提供更丰富的空间引导;(3) 生成语义锚定的损坏输入,通过将重建损失限制在核心文本对齐区域,显式增强掩码重建的监督效果,减少非语义区域的监督冗余。 核心创新 揭示统一多模态模型的粒度不匹配和监督冗余问题 视觉定位图:文本-图像语义关键区域关联 语义化视觉提示:补偿文本提示稀疏性 语义锚定损坏输入:重建损失聚焦核心对齐区域 在GenEval/DPGBench/CompBench上显著提升对齐 实验结果 在 GenEval、DPGBench 和 CompBench 上的广泛评估表明,SeGroS 显著提高了多种统一多模态模型架构的生成保真度和跨模态对齐能力。 批判性点评 新颖性: 视觉定位图将文本-区域关联显式化,解决了统一模型中的文本稀疏和监督冗余两个关键问题。方案设计直觉清晰,理论动机充分。但定位图生成依赖外部模型(如GroundingDINO)。 可复现性: 基于开源Show-o架构。视觉定位图生成管线依赖GroundingDINO等开源工具。训练流程和超参数描述清晰。整体可复现性较好,但pipeline复杂度较高。 影响力: 为统一多模态模型的对齐训练提供了新的监督信号设计范式。视觉定位图的概念可能启发更多空间感知的训练策略。对Show-o、Chameleon等架构有直接参考价值。 深度点评: GRPO 全面入侵视觉生成 — 从 UniGRPO 到 MV-GRPO 到 TATAR,GRPO 已成为视觉生成后训练的标准范式 百万级偏好数据 — EditHF-1M 29M偏好对 + FIRM 66.3万评分 驱动奖励模型走向专业化 后训练 + 推理扩展互补 — VHS 潜在验证器 + VIGOR test-time scaling 提供不改权重的质量提升路径 技术演进定位: 统一多模态模型的生成对齐增强方法 可能的后续方向: 视频多模态的语义锚定 自适应监督区域选择 动态粒度调整 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 1 _placeholder (Weekend Survey - No Rest Papers) N/A N/A N/A 趋势观察 GRPO 成为视觉生成后训练的主流范式 — 从标准 GRPO 到 UniGRPO(统一多模态)、MV-GRPO(多视图评估)、FlowGRPO(Flow Matching),GRPO 的变体已覆盖文生图、文生视频、交错生成等全场景。 专业化奖励模型快速涌现 — FIRM(编辑+生成双赛道)、EditHF-1M(百万级编辑偏好)、VIGOR(视频几何)、TATAR(质量+美学双任务)——不同子领域开始构建各自的专业化奖励体系。 推理时扩展成为后训练的互补方案 — VHS 和 VIGOR 都探索了推理时 test-time scaling——通过验证器在推理阶段筛选候选,不修改模型权重即可提升质量,与后训练形成互补。 数据规模驱动奖励质量 — EditHF-1M 的 29M 偏好对、FIRM 的 66.3 万评分数据——大规模人类偏好数据正在成为训练高质量奖励模型的关键竞争壁垒。 人工智能炼丹师 整理 | 2026-03-28
-
AIGC 每日速读|2026-03-27|ScrollScape|OmniWeaving AIGC 视觉生成领域 · 每日论文解读 (2026-03-27) 人工智能炼丹师 整理 | 共 10 篇论文 | 重点深度解读 1 篇 今日核心看点 32K超高分辨率图像生成 ScrollScape 统一视频生成 OmniWeaving 扩散加速 HetCache CVPR2026 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇,重点解读 1 篇。 方向分布: 图片生成与编辑: 4篇 (ScrollScape, DepthArb, HAM, GenMask) 视频生成与编辑: 3篇 (OmniWeaving, HetCache, Anti-I2V) 音频生成: 1篇 (ArrayDPS-Refine) 生成安全与检测: 1篇 (HAVIC) 交互运动生成: 1篇 (ViHOI) 含2篇CVPR 2026 (HetCache, HAM) 重点论文深度解读 1. ScrollScape 用视频扩散先验解锁32K超高分辨率图像生成 | Harbin Institute of Technology, Li Auto | arXiv:2603.24270 关键词: 32K图像生成, 视频扩散先验, 极端纵横比, 超分辨率 研究动机 核心问题: 极端纵横比下的超高分辨率图像生成面临物体重复和空间碎片化问题 当前扩散模型在生成常规尺寸图像时表现出色,但在极端纵横比(如8:1)的超高分辨率图像合成中,往往出现灾难性的结构失败——物体重复和空间碎片化。这根本原因在于静态文生图模型缺乏鲁棒的空间先验。ScrollScape 提出了一个全新范式:将超大画布的空间扩展映射到视频帧的时序演变,利用视频模型的时序一致性作为强大的全局约束。 前序工作及局限: MultiDiffusion:通过联合扩散过程实现全景图生成,但受限于局部一致性 SyncDiffusion:同步多个扩散过程减少接缝,但仍有结构冗余 DyPE:动态位置编码扩展生成尺寸,但在极端比例下效果有限 Wan2.1:视频扩散模型,具有强大的时序一致性先验,但未被用于静态图像生成 与前序工作的本质区别: ScrollScape首次将空间扩展问题转化为视频时序问题,利用视频模型天然的时序一致性替代人工设计的空间融合策略。不同于MultiDiffusion等平铺融合方法,ScrollScape的全局坐标系统通过ScanPE实现端到端的结构约束。 方法原理 ScrollScape 框架包含三个核心创新: 1)扫描位置编码(ScanPE):将全局空间坐标分布到各帧,充当灵活的移动相机,支持线性和蛇形扫描模式 2)滚动超分辨率(ScrollSR):在潜在空间利用视频超分辨率扩散先验逐帧增强细节,绕过内存瓶颈 3)轨迹锚定分区(TAP):确保3D VAE解码器的解码状态与坐标系统对齐,消除帧间闪烁和边界伪影 4)中值共识选择(MCS)+加权融合:从每个时间块选择最具代表性的帧,通过距离权重融合生成无缝全景图 核心创新 首次将极端纵横比图像合成重新表述为连续视频生成过程 提出ScanPE扫描位置编码将空间扩展映射为时序演变 设计ScrollSR在潜在空间实现32K分辨率输出 引入TAP轨迹锚定分区消除3D VAE解码伪影 实验结果 在8:1纵横比评估中,ScrollScape 在所有指标上均优于基线:FID 214.7(最优)、CLIP 30.0(最优)、KID 2.0(最优)。用户研究中92%的评估员认为ScrollScape的结构连贯性优于DyPE,89%认为内容丰富度更好。消融实验证实ScanPE、TAP、ScrollSR每个组件都不可或缺。仅需3000张图像微调即可实现从传统卷轴到照片级全景的32K输出。 图表详解 Fig.1 ScrollScape 32K生成效果展示 这是 ScrollScape 的核心效果展示图。上方展示了一张极高纵横比(8:1)的32K分辨率全景图生成结果,下方红色方框放大展示了局部细节的精细程度。可以看到,ScrollScape 生成的全景图在整体结构上保持了高度一致性,没有出现传统方法常见的物体重复或空间碎片化问题。局部放大区域显示了建筑、植被等元素的高保真细节,证明了 ScrollSR 超分辨率模块的有效性。 Fig.3 水平8:1全景定性对比 这张定性对比图展示了不同方法在水平 8:1 极端纵横比下的全景生成效果。可以看到,MultiDiffusion 和 SyncDiffusion 等传统平铺融合方法出现了明显的物体重复和拼接伪影。DyPE 虽然有所改善,但在结构连贯性上仍然不足。ScrollScape 的结果在整体布局、细节丰富度和结构一致性上全面领先,特别是在远景到近景的过渡和物体多样性方面表现突出。 Fig.4 垂直1:8卷轴定性对比 这张图展示了垂直方向 1:8 纵横比的卷轴式生成效果对比。ScrollScape 的蛇形扫描模式在垂直卷轴场景中同样表现优异,生成的中国山水画风格长卷图在从上到下的空间延展中保持了连贯的构图和自然的过渡,而基线方法则出现了结构断裂。 Fig.5 8K高保真生成效果 这张图展示了 ScrollScape 在 8K 分辨率下的高保真生成细节。通过多处放大区域可以看到,建筑细节、植被纹理、云层渲染等都保持了极高的清晰度和真实感,证明了 ScrollSR 超分模块在从潜在空间恢复高频细节方面的出色能力。 Fig.6 ScanPE消融实验定性对比 这是 ScanPE 扫描位置编码的消融实验对比图。对比了无 ScanPE、仅使用基础位置编码、以及完整 ScanPE 三种配置。可以明显看到,没有 ScanPE 时模型无法感知全局空间位置,导致严重的内容重复。ScanPE 通过将空间坐标注入帧生成过程,有效消除了重复问题,这验证了将空间问题转化为时序问题这一核心设计的必要性。 Fig.7 ScrollSR超分模块消融对比 这张消融实验图展示了 ScrollSR 超分辨率模块和 TAP 轨迹锚定分区的效果对比。不使用 ScrollSR 时,输出分辨率受限,细节模糊;不使用 TAP 时,帧间出现可见的闪烁和边界伪影。完整配置下两个模块协同工作,既提升了分辨率又保证了帧间一致性,这证明了每个组件都是整体框架不可或缺的一部分。 批判性点评 新颖性: 核心创新——将空间扩展映射为时序演变——极具新颖性和优雅性。ScanPE的数学形式简洁清晰,TAP和MCS的设计也有针对性。但ScrollSR模块本质是套用现有视频超分技术,原创性相对有限。整体框架对Wan2.1的依赖较强,换用其他视频扩散模型的效果未验证。 可复现性: 基于开源Wan2.1-T2V-1.3B,训练仅需2×A100+3K图像数据集,推理单张A100(80GB)可完成。训练成本极低,但代码尚未开源。方法描述详细,公式完整,理论上可独立复现。 影响力: 为超高分辨率图像生成提供了全新且优雅的范式,对数字长卷、全景摄影、游戏地图等应用有直接实用价值。视频扩散先验→空间扩展的跨界思路可能启发更多创新工作。但单张A100推理32K的效率和质量在商业场景中是否足够仍需验证。 深度点评: 创新亮点:空间→时序的范式转换 — 将32K图像生成重新表述为视频扫描是极具想象力的创新。ScanPE用移动相机隐喻优雅解决了全局坐标一致性问题。 局限:数据和场景覆盖不足 — 仅3000张训练数据且集中在风景/山水画类型。人物、城市等复杂场景能力未验证。8:1评估协议的合理性也值得讨论。 工程价值:极低训练成本 — 2×A100训练+单卡推理32K,训练数据仅3K张。极低的资源门槛使其适合学术实验室和创业团队。 技术演进定位: 处于图像生成与视频生成的交叉点,开创了用视频先验赋能图像合成的新范式。在超高分辨率生成领域具有里程碑意义。 可能的后续方向: 扩展到任意纵横比和非矩形画布(如环形全景、球面映射) 结合更强大的视频扩散模型(如Sora类模型)提升质量 探索交互式32K内容生成(用户可编辑局部区域) 将视频-图像范式迁移到3D场景和纹理生成 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 1 OmniWeaving (OmniWeaving: Towards Unified Video Generation with Free-form Composition and Reasoning) Zhejiang University, Tencent Hunyuan, NTU 统一视频生成·推理增强·MLLM·腾讯混元 提出统一视频生成模型OmniWeaving,采用MLLM+MMDiT+VAE架构,通过激活思维模式实现推理增强视频生成,并引入IntelligentVBench评测基准。在开源统一模型中达到SOTA。 在IntelligentVBench上,开启思维模式的OmniWeaving在Implicit I2V和Compositional MI2V指标上分别达到3.93和4.31(AVG),显著超越VACE-LTX和VINO等基线。 2 HetCache (Accelerating Diffusion-based Video Editing via Heterogeneous Caching (CVPR 2026)) NTU, SJTU, PolyU HK 视频编辑加速·异构缓存·DiT·CVPR2026 提出免训练扩散加速框架HetCache,通过将DiT中的时空Token分为上下文Token和生成Token并选择性缓存,实现了2.67倍延迟加速和FLOPs削减。 实现2.67x延迟加速和FLOPs削减,编辑质量几乎无损。已被CVPR 2026接收。 3 HAM (HAM: A Training-Free Style Transfer Approach via Heterogeneous Attention Modulation (CVPR 2026)) Hangzhou Dianzi University 风格迁移·注意力调制·免训练·CVPR2026 提出免训练风格迁移方法HAM,通过全局注意力调节(GAR)和局部注意力移植(LAT)两种异构注意力调制策略,解决扩散模型风格迁移中的风格-内容平衡难题。 在多项定量指标上达到SOTA性能,成功在保持内容身份的同时捕获复杂风格参考。已被CVPR 2026接收。 4 DepthArb (DepthArb: Training-Free Depth-Arbitrated Generation for Occlusion-Robust Image Synthesis) Xi'an Jiaotong University 遮挡生成·深度仲裁·免训练·组合生成 提出免训练框架DepthArb,通过注意力仲裁调制(AAM)和空间紧凑性控制(SCC)两种机制解决文生图模型的遮挡关系歧义问题,并引入OcclBench评测基准。 在遮挡准确性和视觉保真度上一致超越SOTA基线,作为即插即用方法可无缝增强扩散模型的组合能力。 5 GenMask (GenMask: Adapting DiT for Segmentation via Direct Mask Generation) Shanghai Jiao Tong University, Alibaba DiT分割·生成式分割·掩码生成·统一架构 提出GenMask,首次让DiT直接在RGB空间生成黑白分割掩码和彩色图像,发现VAE对二值掩码的潜在表示具有独特的噪声鲁棒性和线性可分特征,设计了针对性的时间步采样策略。 在referring和reasoning分割基准上达到SOTA性能,完全保持DiT原始架构不变。 6 Anti-I2V (Anti-I2V: Safeguarding your photos from malicious image-to-video generation) VinAI Research 对抗防御·图转视频·安全保护·DiT防御 提出Anti-I2V防御框架,在LAB和频域空间操作对抗噪声,保护照片免受恶意图像转视频模型的滥用,首次系统性针对DiT架构的视频扩散模型进行防御。 在多种视频扩散模型上展现SOTA防御效果,有效降低生成视频的时序一致性和保真度。 7 HAVIC (Leave No Stone Unturned: Uncovering Holistic Audio-Visual Intrinsic Coherence for Deepfake Detection) Harbin Institute of Technology 深伪检测·音视频一致性·跨模态·数据集 提出HAVIC深度伪造检测器,基于音视频固有一致性先验(模态内结构一致性+跨模态微观/宏观一致性),并发布HiFi-AVDF高保真音视频深度伪造数据集。 在最具挑战的跨数据集场景中,AP和AUC分别提升9.39%和9.37%,显著超越现有SOTA方法。 8 ArrayDPS-Refine (ArrayDPS-Refine: Generative Refinement of Discriminative Multi-Channel Speech Enhancement) Meta Reality Labs 语音增强·扩散先验·多通道·免训练 提出ArrayDPS-Refine,利用干净语音扩散先验来精炼判别式多通道语音增强模型的输出。无需重训练,阵列无关,可直接提升任意判别式模型的性能。 一致性提升多种判别式模型(含波形域和STFT域SOTA模型)的语音增强性能。 9 ViHOI (ViHOI: Human-Object Interaction Synthesis with Visual Priors) South China University of Technology 人物交互·视觉先验·运动生成·VLM 提出ViHOI框架,从2D图像中提取交互先验来增强3D人物-物体交互运动生成,利用VLM作为先验提取引擎,设计Q-Former适配器压缩高维特征为紧凑先验Token。 在多个基准上达到SOTA,展现优越的泛化能力(可推广到未见物体和交互类别)。 趋势观察 视频先验赋能图像生成 — ScrollScape将超大画布生成转化为视频扫描任务,利用视频模型的时序一致性保证空间结构完整性,开辟了图像-视频范式互通的新方向。 统一视频生成模型的推理增强 — OmniWeaving通过激活MLLM的思维模式,让视频生成模型具备推理能力,从被动特征提取升级为主动意图推断,是多模态理解与生成深度融合的代表。 免训练方法持续升温 — HetCache、HAM、DepthArb等多篇论文均采用免训练策略,通过精巧的注意力操控实现特定目标,反映了社区对即插即用、低成本方案的强烈需求。 扩散模型安全与对抗 — Anti-I2V和HAVIC分别从防御和检测角度应对扩散模型滥用问题,DiT架构的对抗鲁棒性成为新的研究热点。 生成模型架构的跨界适配 — GenMask让DiT直接生成分割掩码,ScrollScape用视频模型做图片,展示了生成架构的通用性远超原始设计意图。 人工智能炼丹师 整理 | 2026-03-27
-
AIGC 每日速读|2026-03-25|上交ScaleEdit-12M+CVPR跨时间步自校准 AIGC 视觉生成领域 · 每日论文解读 (2026-03-25) 人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇 今日核心看点 ScaleEdit-12M CTCal DiT-BlockSkip InjectFlow OmniCodec 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。 方向分布: 图像编辑/生成: ScaleEdit-12M, CTCal, Premier, InjectFlow, SGG, DiffMark, MFSR (7篇) 推理加速/高效微调: DiT-BlockSkip, MFSR (2篇) 音频生成: OmniCodec, SqueezeComposer, SelfTTS, EARTalking (4篇) CVPR 2026 × 2 | 新方法 × 10 重点论文深度解读 1. ScaleEdit-12M: Open-Source Image Editing Data via Multi-Agent 最大开源图像编辑数据集 | 上交/港中文 | arXiv:2603.20644 关键词: 图像编辑数据集, 多智能体, 1200万样本, 23个任务族 研究动机 基于指令的图像编辑是统一多模态模型(UMM)的关键能力,但构建大规模、多样化且高质量的编辑数据集面临两大挑战:依赖闭源API(如GPT-4V)标注成本极高,固定合成流水线质量有限且泛化能力差。现有开源编辑数据集规模和多样性远不能满足训练需求。 方法原理 ScaleEditor 是一个完全开源的分层多智能体框架,实现端到端的大规模图像编辑数据集构建。整个流水线包含三个关键组件:(1) 融入世界知识的源图像扩展——通过多智能体协作从互联网和合成数据中收集覆盖多样场景的高质量源图像;(2) 自适应多智能体编辑指令-图像合成——多个专业化智能体分别负责生成编辑指令、执行图像变换、进行质量验证,根据不同编辑类型自适应选择最优工作流;(3) 任务感知的数据质量验证机制——针对23个编辑任务族设计差异化质量校验标准,确保每个样本的编辑准确性和自然度。最终整理出 ScaleEdit-12M,跨越23个任务族(包括颜色编辑、风格迁移、物体添加/删除、背景替换等),涵盖真实和合成域。 核心创新 首个完全开源的大规模图像编辑数据生成框架 万样本覆盖23个任务族——迄今最大开源编辑数据集 分层多智能体架构:自适应选择最优编辑工作流 任务感知质量验证:23个任务族差异化质量标准 在 ImgEdit 和 GEdit 基准上提升 10.4% 和 35.1% 实验结果 在 UniWorld-V1 和 Bagel 模型上微调验证:通用编辑基准 ImgEdit 提升 10.4%、GEdit 提升 35.1%;知识注入基准 RISE 提升 150.0%、KRIS-Bench 提升 26.5%。证明开源智能体流水线可达到商业级数据质量。框架和数据集均将开源。 方法流程 源图像扩展 — 多智能体从互联网+合成数据收集高质量源图 编辑指令生成 — 智能体根据图像内容自适应生成编辑指令 多智能体合成 — 专业化智能体执行23种不同编辑类型 任务感知验证 — 差异化质量标准逐样本校验准确性和自然度 ScaleEdit-12M — 1200万高质量编辑样本 横跨23个任务族 下游微调 — ImgEdit +10.4% GEdit +35.1% 技术脉络 核心问题: 开源图像编辑数据集规模有限且依赖闭源API 前序工作及局限: UltraEdit (Zhao 2024):400万自动生成编辑数据,但依赖闭源 API GalaxyEdit (2024):大规模编辑数据集,固定流水线泛化差 InstructPix2Pix (Brooks 2023):GPT-4 生成编辑指令,成本极高 与前序工作的本质区别: ScaleEdit-12M 用全开源多智能体框架替代闭源API,规模扩大3x+,覆盖23个任务族 技术演进定位: 开源编辑数据集的新里程碑,降低整个社区的数据壁垒 可能的后续方向: 数据质量自动化评估 任务族继续扩展 视频编辑数据集构建 批判性点评 新颖性: 全开源多智能体框架替代闭源 API,23 个任务族差异化质量验证 可复现性: 框架和数据集均将开源,但 1200 万数据的生成成本需评估 影响力: 可能成为编辑数据领域的 ImageNet 级标杆,降低全社区数据壁垒 2. CTCal: Cross-Timestep Self-Calibration for T2I Diffusion 跨时间步自校准 | 北航/上海AI Lab | CVPR 2026 | arXiv:2603.20741 关键词: T2I对齐, 跨时间步校准, 交叉注意力, CVPR 2026 研究动机 文生图扩散模型在文本与图像的精确对齐方面仍面临持续挑战。传统扩散损失仅提供隐式监督来建模细粒度的文本-图像对应关系,这是对齐困难的根本原因。随着时间步增大(噪声增多),建立准确的文本-图像对齐变得越来越困难,低噪声阶段形成的交叉注意力图是可靠的,但高噪声阶段的注意力图容易偏离,现有方法缺乏显式的跨时间步知识传递机制。 方法原理 CTCal(Cross-Timestep Self-Calibration)利用低噪声时间步下形成的可靠文本-图像对齐来校准高噪声时间步的表示学习。核心原理:(1) 观察到交叉注意力图在小时间步(噪声少)时准确反映文本-图像对应关系,而大时间步(噪声多)时容易偏差;(2) 将小时间步的注意力图作为「自校准信号」,在训练期间为大时间步提供显式的对齐监督;(3) 提出时间步感知自适应加权机制,根据时间步动态调整 CTCal 损失与标准扩散损失的权重比例,在不同去噪阶段实现最优平衡;(4) 模型无关设计——可无缝集成到基于扩散的模型(如 SD 2.1)和基于 Flow 的模型(如 SD 3)。 核心创新 首次提出利用跨时间步注意力自校准改进文生图对齐 揭示了文本-图像对齐难度随时间步增大而增加的关键规律 时间步感知自适应加权平衡多损失项 模型无关:兼容 Diffusion-based 和 Flow-based 架构 CVPR 2026 接收,代码已开源 实验结果 在 T2I-Compbench++ 和 GenEval 基准上展示了显著的文本-图像对齐提升。CTCal 可无缝集成到 SD 2.1 和 SD 3 中,在属性绑定、对象关系、数量匹配等多个维度上均取得了一致性改善。CVPR 2026 接收,代码已开源。 方法流程 训练样本输入 — 文本-图像对 + 多时间步噪声 小时间步去噪 — 低噪声阶段获得可靠交叉注意力图 大时间步去噪 — 高噪声阶段注意力图容易偏差 跨时间步校准 — 低噪声注意力→高噪声显式监督信号 自适应加权 — 时间步感知的CTCal+扩散损失动态平衡 增强T2I对齐 — 属性绑定/对象关系/数量匹配全面提升 技术脉络 核心问题: 扩散模型的文本-图像对齐在高噪声阶段容易偏差 前序工作及局限: Attend-and-Excite (Chefer 2023):注意力激励增强对齐,仅推理阶段 StructureDiffusion (Feng 2023):结构化文本引导,需额外解析 ComposableDiffusion (Liu 2022):可组合扩散,缺少显式监督 与前序工作的本质区别: CTCal 首次利用跨时间步注意力自校准提供显式对齐监督 技术演进定位: 训练阶段文图对齐优化的新范式 可能的后续方向: 推理阶段自校准 多模态扩展 视频生成对齐 批判性点评 新颖性: 首次将跨时间步注意力知识转移应用于扩散训练,洞察简洁有力 可复现性: 代码已开源,CVPR 2026 接收,可复现 影响力: 模型无关设计使其可广泛集成到现有 T2I 训练流程中 3. DiT-BlockSkip: Memory-Efficient Fine-Tuning for Diffusion Transformers 内存高效微调扩散DiT | Qualcomm/KAIST | CVPR 2026 | arXiv:2603.20755 关键词: DiT微调, 内存高效, 块跳过, 设备端部署, CVPR 2026 研究动机 扩散 Transformer(DiT)显著提升了文生图质量,使高质量个性化内容创作成为可能。然而,微调这些大模型需要巨大的计算复杂性和内存开销,严重限制了在资源受限环境(如智能手机、IoT 设备)下的实际部署。现有方法要么需要完整的梯度计算(内存爆炸),要么牺牲了个性化效果。 方法原理 DiT-BlockSkip 提出一个内存高效的微调框架,集成两大核心机制:(1) 时间步感知动态补丁采样——根据扩散时间步自适应调整补丁大小:高时间步(早期去噪)用大补丁捕获全局结构,低时间步(后期细化)用小补丁聚焦细粒度细节,裁剪后的补丁统一调整为固定低分辨率,显著降低前向和反向的内存消耗;(2) 基于预计算残差的块跳过机制——利用交叉注意力掩码识别对个性化关键的 Transformer 块,仅对这些块进行微调,跳过的块使用预计算的残差特征(一次性离线计算),大幅减少训练内存。两个机制协同工作,实现在显著降低内存的同时保持竞争力的个性化性能。 核心创新 时间步感知动态补丁采样:高时间步大补丁+低时间步小补丁 交叉注意力掩码引导的关键块识别 预计算残差块跳过:一次性离线计算跳过块的残差 两个机制协同实现大幅内存节省 CVPR 2026 接收,推动 DiT 设备端部署 实验结果 评估结果表明,DiT-BlockSkip 在定性和定量上均实现了与全量微调竞争力相当的个性化性能,同时大幅减少了内存使用。推动了大规模扩散 Transformer 在智能手机等设备端运行的可行性。CVPR 2026 接收。 方法流程 预训练DiT模型 — 大规模扩散Transformer (如FLUX/SD3) 交叉注意力分析 — 识别对个性化关键的Transformer块 动态补丁采样 — 高时间步大补丁→低时间步小补丁 关键块微调 — 仅微调必要Block 其余使用预计算残差 残差特征跳过 — 跳过块一次性离线预计算 推理复用 高效个性化输出 — 大幅降低内存 设备端可部署 技术脉络 核心问题: 大规模扩散Transformer微调内存开销过高 前序工作及局限: LoRA (Hu 2021):低秩适配减少可训练参数,但内存仍高 DreamBooth (Ruiz 2022):少样本个性化微调,需完整梯度 Token Merging (Bolya 2023):推理阶段 Token 合并,不涉及训练 与前序工作的本质区别: DiT-BlockSkip 将时间步感知与块选择结合,训练阶段大幅压缩内存 技术演进定位: DiT 设备端部署的重要一步 可能的后续方向: 端侧实时推理优化 与量化方法结合 自适应精度微调 批判性点评 新颖性: 时间步感知补丁采样+交叉注意力引导块选择的组合创新 可复现性: CVPR 2026 接收,细节完整 影响力: 推动 DiT 端侧部署可行性,但工程落地仍需大量后续工作 批判性点评精选 1. 数据集规模化 ScaleEdit-12M 将开源编辑数据推至千万级,23 个任务族全覆盖,ImgEdit +10.4% 2. 优雅的训练信号 CTCal 跨时间步自校准——低噪声注意力图校准高噪声表示,模型无关 3. 端侧部署探索 DiT-BlockSkip 动态补丁+块跳过双管齐下,推动 DiT 走向设备端 其余论文 · 贡献与效果总结 # 论文 机构 关键词 主要贡献 效果 1 InjectFlow (Weak Guides Strong via Orthogonal Injection for Flow Matching) 百度/北大 Flow Matching · 偏差修复 · 免训练 形式化了 Flow Matching 的「偏差流形」问题,提出 InjectFlow 通过在初始速度场中注入正交语义(无需训练/改种子)修复轨迹锁定。在 GenEval 上修复了标准 FM 模型 75% 的失败提示。 GenEval 修复率 75%,免训练即插即用,为构建更公平鲁棒的视觉基础模型提供理论和实践方案 2 Premier (Personalized Preference Modulation with Learnable User Embedding in T2I) 哈工大 个性化T2I · 偏好嵌入 提出可学习用户偏好嵌入和偏好适配器,将用户偏好与文本提示融合调制生成过程。引入分散损失强制分离不同用户嵌入。新用户可通过已有嵌入线性组合快速泛化。 在相同历史长度下超越先前方法,实现更强的偏好对齐和文本一致性 3 SGG (Improving Diffusion Generalization with Weak-to-Strong Segmented Guidance) 西湖大学/同济/浙大 扩散引导 · 弱到强 · SD3 从弱到强原则分离 CFG 和 AutoGuidance 的有效操作区间,提出混合实例 SGG 结合两者优势。W2S 原则可迁移到训练目标,在 SD3 和 SD3.5 上超越现有免训练引导变体。 SD3/SD3.5 上超越 CFG 和 AutoGuidance 等现有引导方法,开源代码 4 DiffMark (Transferable Multi-Bit Watermarking Across Frozen Diffusion Models via Latent Consistency Bridges) UCD 扩散水印 · 跨模型迁移 · LCM 即插即用的扩散模型多比特水印方法:利用 Latent Consistency Models 作为可微训练桥梁,梯度步数从 50 步压缩到 4 步。单次前向传递检测(16.4ms,比采样法快 45 倍),支持跨模型迁移。 16.4ms 检测速度(45x加速),保持鲁棒性,跨冻结扩散模型可迁移 5 MFSR (MeanFlow Distillation for One Step Real-World Image Super Resolution) 南大/Salesforce/NTU 超分辨率 · 一步蒸馏 · MeanFlow 基于 MeanFlow 蒸馏的一步式真实世界图像超分辨率。学生模型学习近似 PF-ODE 任意状态间的平均速度,配合教师 CFG 蒸馏保留精细细节。一步即可生成逼真结果,可选少步路径进一步细化。 一步生成质量与多步教师模型相当甚至更优,显著降低计算成本 6 EARTalking (End-to-end GPT-style Autoregressive Talking Head Synthesis with Frame-wise Control) 中科大/浙大 数字人生成 · 自回归 · 逐帧控制 端到端 GPT 风格自回归模型实现交互式音频驱动数字人生成。提出 Sink Frame Window Attention (SFA) 保持变长视频的身份一致性,Frame Condition In-Context (FCIC) 支持逐帧交互式控制信号注入。 性能优于现有自回归方法,与扩散方法相当,支持流式生成和实时交互控制 7 OmniCodec (Low Frame Rate Universal Audio Codec with Semantic-Acoustic Disentanglement) 西工大 音频编解码 · 语义解耦 · 低帧率 面向低帧率的通用神经音频编解码器。分层多码本设计,利用预训练理解模型音频编码器实现语义-声学解耦。自引导策略提升码本利用率。在相同比特率下超越 Mimi 编解码器,提供更优重建质量和更丰富语义表示。 相同比特率超越 Mimi,重建质量+语义丰富度双提升,利好下游 LLM 音频生成 8 SqueezeComposer (Temporal Speed-up is A Simple Trick for Long-form Music Composing) 港科大/中移动/北理工 长音乐生成 · 时间加速 · 扩散模型 提出「时间加速」策略:先让模型生成加速版本(2x-8x)的音乐以减少序列长度和资源需求,再恢复到原始速度。在加速域用扩散模型生成,在恢复域细化。简单技巧实现高效可扩展的长音乐生成。 高效生成长篇连贯音乐,资源需求与短音乐相当,质量保持 9 SelfTTS (Cross-Speaker Style Transfer through Explicit Embedding Disentanglement and Self-Refinement) UNICAMP 跨说话人TTS · 风格迁移 · 自细化 无需外部预训练编码器的跨说话人风格迁移 TTS。利用梯度反转层(GRL)+余弦相似度损失实现说话人与情感的显式解耦,多正对比学习(MPCL)诱导嵌入聚类,自增强自细化策略利用模型自身的语音转换能力提升自然度。 在跨说话人情感风格迁移上超越基线,无需外部预训练编码器,自包含设计 趋势观察 图像编辑数据集规模化 — ScaleEdit-12M 推动开源编辑数据集迈入千万级 扩散模型训练信号增强 — CTCal 等跨时间步自校准方法改善文图对齐 设备端DiT部署探索 — DiT-BlockSkip 等内存高效微调推动端侧生成 Flow Matching 鲁棒性 — InjectFlow 等方法修复 FM 的数据偏差问题 人工智能炼丹师 整理 | 2026-03-25
-
AIGC 每日速读|2026-03-24|CubiD高维离散扩散|扩散通用加速|FoleyDirector V2A| AIGC 视觉生成领域 · 每日论文解读 (2026-03-24) 人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇 今日核心看点 高维离散扩散 统一生成理解 通用扩散加速 V2A时序控制 个性化视频生成 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。 方向分布: 图像生成与编辑 — 4 篇(CubiD、妆容迁移、I2I整流流、统一多模态) 视频生成 — 2 篇(LumosX 个性化、MME-CoF-Pro 评测) 音频生成 — 3 篇(FoleyDirector V2A、Borderless Long Speech、MOSS-TTSD) 生成模型加速 — 1 篇(时间步感知块掩码) 评测与质量评估 — 2 篇(TATAR 统一IQA+IAA、PGD-EIQA 去偏) 含 2 篇 CVPR 2026 + 1 篇 ICLR 2026 重点论文深度解读 1. CubiD: Cubic Discrete Diffusion for High-Dim Tokens 首个高维离散扩散生成 | HKU + Google + ByteDance | arXiv:2603.19232 关键词: 离散扩散, 高维表示, 统一生成理解, ImageNet SOTA 研究动机 离散 Token 视觉生成因能与语言模型共享统一的 Token 预测范式而备受关注,但当前方法局限于低维潜在 Token(通常 8-32 维),牺牲了对理解任务至关重要的语义丰富性。高维预训练表示(768-1024 维)理论上可弥补这一鸿沟,然而其离散化生成面临根本性挑战——维度爆炸导致码本大小和生成步数均不可控。 方法原理 CubiD 提出在高维离散表示上进行「细粒度掩码扩散」。核心思想是:对高维离散表示的任意维度、任意位置都可以独立掩码和预测。具体包括:(1) 将预训练的 768/1024 维连续表示通过残差向量量化离散化;(2) 在扩散过程中,每个空间位置的每个维度都可被独立掩码,模型从部分观测中预测缺失维度;(3) 这使模型能学习空间位置内部和跨位置的丰富关联,且生成步数固定为 T(T 远小于 h×w×d),不随维度增长;(4) 从 900M 扩展到 3.7B 参数展现出强 Scaling 行为。 核心创新 首个面向高维(768-1024维)表示的离散扩散生成模型 细粒度维度级掩码策略:任意维度任意位置可独立掩码预测 生成步数与特征维度解耦(T << h×w×d) 验证离散化 Token 同时支持理解和生成任务 M-3.7B 参数强 Scaling 行为 实验结果 ImageNet-256 上达到离散生成方法 SOTA,从 900M 到 3.7B 展现强 Scaling 行为。关键验证:离散化后的 Token 保留了原始表示的理解能力,证明同一组离散 Token 可同时服务于理解和生成任务。代码已开源。 方法流程 预训练表示 — 768/1024维连续特征(如DINOv2/CLIP) 残差向量量化 — RVQ离散化为高维Token序列 细粒度维度掩码 — 任意位置任意维度独立掩码 条件扩散预测 — 从部分观测预测缺失维度 位置内+跨位置关联 — 同时建模局部和全局依赖 固定T步生成 — 步数与维度解耦 T<<hwd 技术脉络 核心问题: 离散 Token 生成局限于低维(8-32维),无法利用高维预训练表示 前序工作及局限: MaskGIT (Chang 2022):掩码图像建模范式,但限于低维 VQ-VAE Token MAGVIT-v2 (Yu 2024):改进离散 Tokenizer,仍为 32 维以下 MAR (Li 2024):掩码自回归模型,连续/离散混合但维度受限 LlamaGen (Sun 2024):用 LLM 架构做视觉生成,仍依赖低维码本 与前序工作的本质区别: CubiD 首次突破维度限制,在 768-1024 维上实现细粒度维度级掩码扩散,且生成步数不随维度增长 技术演进定位: 开辟了「高维离散扩散」新赛道,为 vision-language 统一架构提供了新范式 可能的后续方向: 更高分辨率(512+)的高维离散生成 视频领域的高维离散扩散 与 LLM 的原生融合统一架构 批判性点评 实验评估: 在 ImageNet-256 上对比了多种离散生成方法,展示了 Scaling 行为。但缺少 FID/IS 等具体数值对比表,也未在 T2I 场景下与 SDXL/DALL-E 3 等连续方法直接对比。 新颖性: 首次将离散扩散扩展到高维表示(768-1024维),维度级掩码策略新颖度高。但 RVQ 离散化本身是已有技术,核心贡献在于将掩码扩散泛化到高维。 可复现性: 代码已开源(GitHub),数据集为公开的 ImageNet。但 3.7B 模型的训练成本可能限制社区复现。 影响力: 可能推动统一 vision-language 架构的发展。如果高维离散 Token 真正兼顾理解和生成,将对多模态基础模型产生深远影响。 2. Timestep-Aware Block Masking for Diffusion Acceleration 架构无关扩散加速 | 武汉大学 | arXiv:2603.19939 关键词: 扩散加速, 块掩码, 架构无关, 特征复用 研究动机 扩散概率模型在图像生成方面取得了巨大成功,但迭代去噪的特性导致推理延迟较高。现有加速方法要么需要全链反向传播(内存开销大),要么绑定特定架构。如何实现一种内存高效、架构无关的扩散加速方法是核心问题。 方法原理 提出时间步感知块掩码(Timestep-Aware Block Masking)框架。核心思路:对预训练扩散模型的计算图进行逐时间步优化。(1) 学习时间步特异性掩码(per-timestep masks),在每个推理阶段动态决定哪些 Block 执行完整计算、哪些通过特征复用绕过;(2) 独立优化每个时间步的掩码(而非全链反向传播),确保内存高效训练;(3) 引入时间步感知损失缩放机制,在敏感的去噪阶段优先保证特征保真度;(4) 辅以知识引导的掩码修正策略,修剪冗余的时空依赖关系。 核心创新 架构无关:同一框架适用于 DDPM、LDM、DiT、PixArt 四种主流架构 逐时间步独立优化掩码,避免全链反向传播的高内存开销 时间步感知损失缩放:敏感阶段保真度优先 知识引导掩码修正:智能修剪冗余时空依赖 实验结果 在 DDPM、LDM、DiT 和 PixArt 四种架构上均展示了显著的效率提升。将去噪过程视为一系列优化的计算路径,在采样速度和生成质量之间实现了优越的平衡。代码将公开发布。 方法流程 预训练扩散模型 — 支持DDPM/LDM/DiT/PixArt 逐时间步掩码学习 — 独立优化每步的Block选择 损失缩放机制 — 敏感阶段高权重保真度优先 掩码修正策略 — 知识引导修剪冗余依赖 动态Block跳过 — 低贡献Block特征复用 加速推理输出 — 速度-质量最优平衡 技术脉络 核心问题: 扩散模型推理慢,现有加速方法绑定特定架构或需高内存全链优化 前序工作及局限: DDIM (Song 2021):减少采样步数的非马尔可夫加速 DPM-Solver (Lu 2022):高阶 ODE 求解器加速采样 DeepCache (Ma 2024):缓存 U-Net 特征跨步复用,绑定 U-Net 架构 Token Merging (Bolya 2023):合并冗余 Token 减少计算量 与前序工作的本质区别: Timestep-Aware Block Masking 是架构无关的:同一框架直接适用于 DDPM/LDM/DiT/PixArt,且通过逐步独立优化避免全链反向传播的内存瓶颈 技术演进定位: 在扩散加速领域建立了首个「架构无关」通用框架的先例 可能的后续方向: 与步数蒸馏方法结合实现多维加速 扩展到视频扩散模型 在移动端部署场景的适配 批判性点评 实验评估: 覆盖 DDPM/LDM/DiT/PixArt 四种架构,实验全面性好。但缺少与 DeepCache、FORA 等最新 cache 方法的定量对比。加速比和质量损失的 trade-off 曲线有待补充。 新颖性: 逐时间步独立优化掩码思路清晰,时间步感知损失缩放有理论依据。但 Block 跳过/特征复用的整体思路与 Token Merging、DeepCache 类似,差异化主要在于掩码学习策略。 可复现性: 代码承诺公开但尚未发布。方法依赖少量校准数据训练掩码,流程相对简单可复现。 影响力: 架构无关的特性使其具有广泛适用性。若能在实际产品级部署中验证(如 SDXL/Flux),工程价值将非常高。 3. FoleyDirector: Fine-Grained V2A Temporal Control 细粒度 V2A 时序控制 | CVPR 2026 | arXiv:2603.19857 关键词: V2A, 时序控制, DiT音频, CVPR 2026 研究动机 视频到音频(V2A)方法已能合成高质量音频,但在多事件场景或视觉线索不足时(小区域、画外音、遮挡物体),细粒度时序控制仍是难题。现有方法无法精确指定每个时间段应生成什么声音,限制了创作灵活性。 方法原理 FoleyDirector 是首个在 DiT 基架构上实现精确时序引导的 V2A 生成框架。核心创新包括:(1) 结构化时序脚本(STS):将音频描述分解为对应短时间片段的字幕集合,提供丰富的时序信息;(2) 脚本引导时序融合模块:使用 Temporal Script Attention 将 STS 特征与视频特征连贯融合;(3) 双帧声音合成(Bi-Frame Sound Synthesis):并行生成画面内和画面外音频,处理复杂多事件场景;(4) 构建 DirectorSound 数据集和 DirectorBench 评测基准。 核心创新 首个在 DiT 基 V2A 模型上实现精确时序引导 结构化时序脚本(STS)提供细粒度音频描述 双帧声音合成:画内+画外音频并行生成 DirectorSound 数据集 + DirectorBench 评测 实验结果 实验表明 FoleyDirector 在保持高音频保真度的同时大幅提升了时序可控性。在 VGGSoundDirector 和 DirectorBench 上展示了 SOTA 的时序控制能力,用户可像拟音导演一样精确控制每个时间段的声音生成。CVPR 2026 接收。 方法流程 输入视频+时序脚本 — 视频帧序列+STS结构化字幕 视觉特征提取 — 编码视频帧的视觉信息 STS时序编码 — 结构化脚本→时间段级嵌入 Script-Guided融合 — Temporal Script Attention 双帧声音合成 — 画内+画外音频并行生成 高保真时序音频 — 精确对齐的多事件音频输出 技术脉络 核心问题: V2A 生成缺乏细粒度时序控制,多事件场景和画外音难以处理 前序工作及局限: SpecVQGAN (Iashin 2023):音频频谱 VQ-GAN 生成,无时序控制 Diff-Foley (Luo 2024):扩散模型 V2A,但仅全局条件控制 Frieren (Wang 2024):V2A 扩散模型,改善音频-视频同步 AC-Foley (2025):参考音频引导 V2A,但缺乏精确时间段控制 与前序工作的本质区别: FoleyDirector 通过结构化时序脚本(STS)首次在 DiT 基 V2A 模型上实现时间段级精确控制,并创新性地并行生成画内和画外音频 技术演进定位: 将 V2A 从「全局条件生成」推进到「导演级时序控制」,显著拓展了实用价值 可能的后续方向: 与视频生成模型联合训练实现端到端 V2AV 交互式拟音编辑工具 扩展到音乐配乐的时序控制 批判性点评 实验评估: 构建了 DirectorSound 数据集和 DirectorBench 评测基准,评估维度全面。CVPR 2026 接收说明同行认可度高。但 V2A 领域尚缺乏统一公认的客观指标。 新颖性: 首次在 DiT 基 V2A 模型上实现精确时序引导,STS 设计优雅。双帧声音合成(画内+画外)是实际应用中的重要创新。但依赖结构化文本输入增加了使用门槛。 可复现性: 提出了新数据集但未明确是否公开。方法依赖预训练 DiT V2A 基模型,复现需要一定基础设施。 影响力: 对影视后期制作和自动配音有直接应用价值。STS 理念可泛化到其他时序生成任务(如音乐生成、视频编辑)。 批判性点评精选 1. 高维离散 = 统一架构? CubiD 验证高维离散 Token 兼顾理解和生成,但 3.7B 模型的训练成本和实际 T2I 质量仍有待验证 2. 架构无关的代价 Block Masking 覆盖四种架构值得称赞,但每种架构的最优掩码配置不同,通用性是否以牺牲极致性能为代价? 3. 时序脚本的使用门槛 FoleyDirector 的 STS 需要手工编写结构化脚本,大规模自动化场景下的可用性值得关注 其余论文 · 贡献与效果总结 # 论文 关键词 主要贡献 效果 1 LumosX (Relate Any Identities with Their Attributes for Personalized Video Generation) 个性化视频生成 · 身份对齐 · ICLR 2026 提出关系自注意力和关系交叉注意力机制,在多对象个性化视频生成中实现精确的身份-属性对齐。通过 MLLM 推断对象间依赖关系,强化群组内聚性和跨对象分离。ICLR 2026。 在多对象个性化视频生成基准上达到 SOTA,身份一致性和语义对齐显著优于现有方法 2 Borderless Long Speech (Borderless Long Speech Synthesis) 长语音合成 · 多说话人 · Agentic TTS 提出无边界长语音合成框架,支持多说话人对话(最多5人)、零样本语音克隆、长达60分钟单次合成。创新的 Global-Sentence-Token 多级标注体系和 Chain-of-Thought 推理增强复杂条件下的指令遵循。 支持60分钟单次合成、5人多方对话,原生 Agentic 设计实现从 Text2Speech 到无边界长语音合成的范式扩展 3 MOSS-TTSD (Text to Spoken Dialogue Generation) 对话合成 · 多方语音 · 复旦 首个面向对话场景的语音合成模型,支持多语言(中英文)、多方对话(最多5人)、零样本语音克隆。增强长上下文建模实现 60 分钟单次生成。提出 TTSD-eval 客观评测框架。复旦大学团队。 在对话合成的说话人归属准确率和相似度上超越开源和商业基线,支持播客、动态解说等应用场景 4 FRAM (Diffusion-Based Makeup Transfer with Facial Region-Aware Makeup Features) 妆容迁移 · 区域感知 · CVPR 2026 提出面部区域感知妆容特征(FRAM):通过 GPT-o3 合成标注数据微调妆容 CLIP 编码器,使用可学习 Token 查询区域级妆容特征。ControlNet Union 同时编码源图像及 3D 网格实现身份保持。CVPR 2026。 在区域可控性和妆容迁移质量上验证了显著优势,支持眼妆/唇妆等细粒度区域独立编辑 5 I2I-RFR (Improving Image-to-Image Translation via a Rectified Flow Reformulation) 整流流 · I2I翻译 · 即插即用 将标准 I2I 回归网络重新表述为连续时间传输模型:仅扩展输入通道+简单 t 重加权损失,诱导整流流解释,推理时通过 ODE 渐进细化(仅需3步)。无需蒸馏即可显著提升感知质量。 在多个 I2I 翻译和视频恢复任务上普遍提升性能,尤其在感知质量和细节保留方面收益明显 6 SeGroS (Enhancing Alignment for Unified Multimodal Models via Semantically-Grounded Supervision) 统一多模态 · 对齐增强 · 语义监督 解决统一多模态模型(UMM)中粒度不匹配和监督冗余问题。提出视觉定位图构建互补监督信号:语义视觉提示补偿文本稀疏性 + 语义定位的损坏输入将重建损失限制在核心文本对齐区域。 在 GenEval/DPGBench/CompBench 上显著提升 UMM 的生成保真度和跨模态对齐 7 TATAR (One Model, Two Minds: Task-Conditioned Reasoning for Unified IQA and Aesthetic Assessment) 统一IQA+IAA · 非对称奖励 · GRPO 揭示统一 IQA 和 IAA 中的「推理不匹配」和「优化不匹配」。提出 TATAR 框架:快慢任务推理构建 + 两阶段 SFT+GRPO 学习 + 非对称奖励(IQA 高斯整形/IAA 瑟斯顿排名)。 8个基准上均优于统一基线,与特定任务专用模型竞争力相当,美学评估训练更稳定 8 MME-CoF-Pro (Evaluating Reasoning Coherence in Video Generative Models) 视频生成评测 · 推理连贯性 · Benchmark 提出视频生成模型推理连贯性评测基准:303 样本/16 类别,从视觉逻辑到科学推理。引入「推理分数」评估中间步骤,三种设置(无提示/文本/视觉)控制研究。评测 7 个模型揭示推理连贯性与生成质量解耦。 发现视频生成模型推理连贯性较弱且与质量解耦;文本提示虽提高正确性但引入幻觉;视觉提示在细粒度感知上仍困难 9 PGD-EIQA (Preference-Guided Debiasing for No-Reference Enhancement Image Quality Assessment) 图像质量评估 · 去偏 · 偏好引导 通过监督对比学习构建连续增强偏好嵌入空间,估计并去除质量表示中的增强诱导干扰,使模型关注算法不变的感知质量线索。两阶段训练:偏好空间学习 → 去偏质量预测。 在公共 EIQA 基准上有效缓解算法诱导偏差,跨增强算法泛化能力显著优于现有方法 趋势观察 离散表示生成 — 高维 Token 离散扩散首次突破,统一理解+生成成为新范式 扩散加速通用化 — 架构无关加速框架覆盖 DDPM/LDM/DiT/PixArt 全系列 音频生成精细化 — V2A 和对话 TTS 均走向细粒度时序控制和长上下文建模 人工智能炼丹师 整理 | 2026-03-24
-
AIGC 每日速读|2026-03-23|MOSS-TTS|ColourCrafter|Q-Drift| AIGC 视觉生成领域 · 每日论文解读 (2026-03-23) 人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇 今日核心看点 MOSS-TTS 语音基础模型 ColourCrafter 区域色彩编辑 Q-Drift 量化漂移校正 TexEditor 纹理编辑 Diff-SIT 视频扩散压缩 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。 方向分布: 语音生成基础模型 — 1篇 (MOSS-TTS) 图像编辑与色彩控制 — 2篇 (ColourCrafter, TexEditor) 扩散模型加速与量化 — 1篇 (Q-Drift) 视频扩散压缩 — 1篇 (Diff-SIT) 生成内容评测 — 2篇 (GenVideoLens, IAA) 特殊领域生成 — 4篇 (声学/异常/面部/Sim2Real) 合成数据增强 — 1篇 (R&D) CVPR 2026 x2 (O2MAG, FLAC) | ECCV 2026 x1 (GenVideoLens) 重点论文深度解读 1. MOSS-TTS: Speech Generation Foundation Model 语音生成基础模型 | arXiv:2603.18090 关键词: TTS, 语音克隆, 自回归建模, 离散Token, 基础模型 研究动机 当前语音合成模型在零样本语音克隆、跨语言代码切换和长文本稳定生成方面仍面临挑战。如何构建一个统一的语音生成基础模型,既具备结构简洁性和可扩展性,又能支持精细控制(时长、发音、语言切换),是 TTS 领域的核心问题。 方法原理 MOSS-TTS 基于「离散音频 Token + 自回归建模 + 大规模预训练」的可扩展配方构建: MOSS-Audio-Tokenizer:因果 Transformer 分词器,将 24kHz 音频压缩为 12.5 fps,采用可变比特率 RVQ 实现语义-声学统一表示 MOSS-TTS 主生成器:强调结构简洁性和可扩展性,支持长上下文和控制导向部署 MOSS-TTS-Local-Transformer:引入帧级局部自回归模块,提升建模效率、说话人保持能力,缩短首音延迟 核心创新 统一语义-声学表示的音频 Tokenizer,12.5fps 极低帧率 双生成器互补架构(全局+局部自回归) Token 级时长控制和音素/拼音级发音控制 支持平滑代码切换和稳定长篇生成 实验结果 在多语言和开放域设置中支持零样本语音克隆、token 级时长控制、音素/拼音级发音控制、平滑代码切换和稳定长篇生成。模型和代码已开源。 方法流程 24kHz音频 — 原始语音输入 MOSS-Audio Tokenizer — 因果Transformer 可变比特率RVQ 12.5fps 离散Token — 语义-声学统一表示 自回归 Transformer — 全局长上下文建模 帧级局部AR(可选) — 提升效率和说话人保持 Token解码 — 高质量语音输出 技术脉络 核心问题: 开源 TTS 模型缺乏统一的基础模型配方,在零样本语音克隆、跨语言切换和长文本稳定生成方面表现不足 前序工作及局限: Tacotron 2 (Shen 2018):端到端频谱预测,但需要声码器二阶段合成 VITS (Kim 2021):端到端变分推理实现高自然度,但扩展性有限 VALL-E (Wang 2023):首个大规模自回归语音 Token 建模,但开源实现不完整 CosyVoice (Du 2024):开源可控 TTS,但 Tokenizer 和生成器未统一设计 与前序工作的本质区别: 提供完整的基础模型配方——统一语义-声学 Tokenizer(12.5fps 极低帧率)+ 双生成器互补架构 + 精细控制能力,且完全开源 技术演进定位: 集大成者——整合离散 Token + 自回归 + 大规模预训练的完整配方,为开源 TTS 基础模型树立标杆 可能的后续方向: 更低帧率 Tokenizer(<10fps)在情感保真度上的权衡 与大语言模型深度融合的端到端对话式语音生成 多语言统一 Tokenizer 设计 批判性点评 实验评估: 实验覆盖零样本语音克隆、跨语言代码切换和长篇生成等多项任务。12.5fps 极低帧率在 WER 和说话人相似度上表现优秀,但情感和副语言信息的保真度在极端情况下缺乏定量评估。开源模型使复现容易。 新颖性: 统一语义-声学 Tokenizer 和双生成器互补架构(全局+局部自回归)的设计思路新颖。12.5fps 帧率在已知开源 TTS 模型中最低。创新性评分: 可复现性: 模型和代码完全开源,训练配方描述完整。Tokenizer、双生成器架构清晰易实现,但大规模预训练数据需求较高。 影响力: 影响力评分 4.5/5 — 为开源 TTS 社区提供了完整的基础模型配方,加速语音生成的民主化。双生成器架构为不同部署场景提供灵活选择。 2. ColourCrafter: Region-Aware Colour Editing via Token-Level Diffusion Token级扩散的区域感知色彩编辑 | arXiv:2603.18466 关键词: 色彩编辑, 区域感知, Token级扩散, Lab色彩空间, 细粒度控制 研究动机 色彩是图像生成中感知最显著但也最难控制的属性之一。现有扩散模型可根据用户指令修改颜色,但结果往往偏离预期色调,尤其在细粒度和局部编辑方面表现不佳。早期文本驱动方法依赖离散语言描述,无法准确表示连续色调变化。 方法原理 ColourCrafter 将色彩编辑从全局色调转换转变为结构化的区域感知生成过程: Token 级色彩融合:在潜在空间中对 RGB 色彩标记和图像标记进行 token 级别融合,选择性地将色彩信息传播到语义相关区域 感知 Lab 空间损失:解耦亮度和色度,将编辑约束在掩码区域内,增强像素级精度 ColourfulSet 大规模数据集:包含高质量图像对,具有连续且多样的色彩变化 核心创新 首个 token 级色彩融合框架,实现语义选择性色彩传播 Lab 色彩空间解耦损失,亮度-色度独立约束 ColourfulSet 大规模色彩编辑数据集 掩码约束下的细粒度区域感知编辑 实验结果 在细粒度色彩编辑中实现了 SOTA 的色彩准确性、可控性和感知保真度。支持连续色调变化和多区域独立编辑。项目代码已开源。 方法流程 输入图像+ 色彩指令 — 原图+目标颜色 RGB色彩 Token编码 — 色彩信号Token化 潜在空间 Token级融合 — 图像Token+色彩Token 选择性融合 语义区域 选择传播 — 色彩传播到 相关区域 Lab空间 约束 — 亮度-色度解耦 掩码精度控制 色彩准确 输出 — 精准区域编辑 技术脉络 核心问题: 扩散模型中色彩控制粒度不足,文本驱动方法无法表达连续色调变化,全局编辑无法满足区域精细需求 前序工作及局限: InstructPix2Pix (Brooks 2023):指令驱动编辑,但色彩控制不精确 ControlNet (Zhang 2023):结构化条件控制,但不针对色彩属性 IP-Adapter (Ye 2023):图像提示适配,但色彩传播缺乏语义选择性 Palette (Saharia 2022):图像着色,但仅支持全局色彩迁移 与前序工作的本质区别: 首个 Token 级色彩融合框架,在潜在空间中实现语义选择性色彩传播,结合 Lab 空间解耦实现物理上合理的亮度-色度独立控制 技术演进定位: 方向开拓——将色彩编辑从全局转为 Token 级区域感知,开辟精细化色彩控制新范式 可能的后续方向: 与 3D 感知结合的光照和材质色彩编辑 基于色彩心理学的自动美学优化 视频级时序一致性色彩编辑 批判性点评 实验评估: 定性和定量实验丰富,细粒度色彩编辑对比全面。Lab 空间损失的消融实验有说服力。但极端色彩转换(如黑到荧光色)的自然度和掩码边界过渡的平滑性需要更多测试。 新颖性: 首个 Token 级色彩融合框架,将色彩编辑从全局转为区域感知是重要突破。Lab 空间解耦损失的引入在色彩编辑中属首次。创新性评分: 可复现性: 方法描述清晰,ColourfulSet 数据集和代码已开源。Token 融合模块的实现依赖标准 Transformer 组件,易于复现。 影响力: 影响力评分 4/5 — 为精细化图像编辑开辟了 Token 级色彩控制新方向。ColourfulSet 数据集对社区也有独立价值。但应用场景相对垂直。 3. Q-Drift: Quantization-Aware Drift Correction for Diffusion Sampling 扩散模型量化采样漂移校正 | arXiv:2603.18095 关键词: 量化加速, 采样校正, 即插即用, DiT, U-Net 研究动机 后训练量化是部署大型扩散模型的实用路径,但量化噪声会在去噪轨迹上累积并降低生成质量。现有方法主要从模型端优化量化策略,而忽略了从采样器端校正量化引入的系统性漂移的可能性。 方法原理 Q-Drift 将量化误差视为每个去噪步骤上的隐式随机扰动,推导出保持边际分布的漂移调整公式: 通过仅 5 对全精度/量化校准运行估计逐时间步的方差统计量 基于推导的漂移校正公式在采样过程中实时调整去噪轨迹 采样器端校正可与任意采样器、扩散模型和 PTQ 方法即插即用 核心创新 首次从采样器端而非模型端校正量化漂移 理论推导:量化误差=隐式随机扰动,漂移调整保持边际分布 极低校准成本(仅 5 对运行) 模型/采样器/量化方法三维通用 实验结果 在 6 个不同 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上验证。PixArt-Sigma (SVDQuant W3A4) 上 FID 降低 4.59,CLIP 分数不变。推理开销可忽略不计。 方法流程 量化扩散模型 — PTQ后的DiT/U-Net 存在量化噪声 5对校准运行 — 全精度vs量化 估计方差统计 漂移公式推导 — 量化误差=随机扰动 保持边际分布 采样器端实时校正 — 每步调整轨迹 兼容任意采样器 高质量输出 — FID降低4.59 CLIP保持 技术脉络 核心问题: 扩散模型后训练量化引入的误差在去噪轨迹上累积导致质量下降,现有方法仅从模型端优化量化策略 前序工作及局限: PTQ4DM (Shang 2023):通道级量化校准,但忽略量化对采样轨迹的累积影响 Q-Diffusion (Li 2023):时间步感知校准,但仍在模型端操作 SVDQuant (Li 2024):低秩分解+量化,极端压缩但质量损失显著 EfficientDM (He 2024):量化感知训练,但需要重新训练成本高 与前序工作的本质区别: 首次从采样器端而非模型端校正量化漂移,将量化误差建模为隐式随机扰动并推导漂移调整公式,与模型端量化正交可叠加 技术演进定位: 视角转换——开辟采样器端补偿的新方向,仅 5 对校准运行即实现通用校正,可能成为量化部署的标准组件 可能的后续方向: 自适应漂移校正(根据内容复杂度动态调整) 推广到其他模型近似误差的采样器端补偿 极端量化(W2)下的理论边界探索 批判性点评 实验评估: 在 6 个 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上的全面验证令人信服。PixArt-Sigma W3A4 上 FID 降低 4.59 的改进显著。但在 W2 等极端量化下的效果需验证,独立随机扰动假设可能不成立。 新颖性: 首次从采样器端而非模型端校正量化漂移,理论推导严谨。仅 5 对校准运行的超低成本令人印象深刻。思路与模型端量化正交,可叠加使用。创新性评分: 可复现性: 校准流程简洁(仅 5 对运行),漂移校正公式明确,兼容任意采样器和 PTQ 方法,实现门槛低。 影响力: 影响力评分 4.5/5 — 为量化扩散模型部署提供了通用的采样器端补偿方案。即插即用特性使其在工业部署中非常实用。可能启发其他模型近似误差的类似补偿研究。 批判性点评精选 1. 开源 TTS 基础模型:完整配方的价值与情感表达的瓶颈 MOSS-TTS 为开源 TTS 社区提供了完整的基础模型配方,但 12.5fps 的极低帧率在情感和副语言信息的保真度上可能存在瓶颈。双生成器架构虽然灵活,但也增加了用户的选择复杂性。关键问题是:Tokenizer 的压缩率与表达力之间的最优平衡点在哪里? 2. Token 级色彩编辑:精细化的天花板在哪里? ColourCrafter 的 Token 级融合在色彩编辑精度上取得突破,但 Lab 空间损失在极端色彩转换(如黑到荧光色)时可能产生非自然过渡。掩码边界的平滑处理也需要更多工作。更深层的问题是:色彩编辑是否应该与光照、材质统一建模?孤立处理色彩可能限制了真实感。 3. 采样器端补偿:一个被忽视的优化维度 Q-Drift 的核心洞察——从采样器端而非模型端校正量化漂移——揭示了一个长期被忽视的优化维度。仅 5 对校准运行的超低成本令人印象深刻。但其理论假设(量化误差为独立随机扰动)在极端量化下可能失效。这种采样器端补偿的思路是否可以推广到蒸馏误差、剪枝误差等其他模型近似场景? 其余论文 · 贡献与效果总结 # 论文 关键词 主要贡献 效果 1 TexEditor (TexEditor: Structure-Preserving Text-Driven Texture Editing 快手 KlingAI) 纹理编辑 · 结构保持 · RL强化 · KlingAI TexBlender SFT数据集 + StructureNFT RL方法,基于 Qwen-Image-Edit 训练,纹理编辑中保持几何结构一致 2 Diff-SIT (Diff-SIT: Sparse Information Transmission Video Diffusion Compression) 视频压缩 · 稀疏编码 · 一步扩散 · 极低比特率 STEM稀疏时间编码 + ODFTE一步视频扩散重建,帧类型嵌入器自适应不同帧类型 极低比特率下感知质量和时间一致性达到新 SOTA 3 GenVideoLens (GenVideoLens: LVLMs in AI-Generated Video Detection ECCV 2026) 视频评测 · AIGC检测 · ECCV 2026 · LVLM 500视频15维度细粒度基准,揭示LVLM在感知线索可识别但光学一致性和物理交互推理严重不足 4 O2MAG (O2MAG: One-to-More Training-Free Anomaly Generation CVPR 2026) 异常生成 · 无训练 · CVPR 2026 · 工业检测 自注意力嫁接 + 异常引导优化 + 双重注意力增强,单张参考合成逼真异常样本 5 VQ-AUFace (VQ-AUFace: AU Codes to Language for Facial Behavior Synthesis) 面部合成 · AU编码 · 文本驱动 · 冲突建模 将面部动作单元翻译为自然语言描述,支持冲突AU显式建模,BP4D-AUText大规模数据集 复杂和冲突动作组合下的面部表情生成在解剖学合理性上显著改善 6 FLAC (FLAC: Few-shot Acoustic Synthesis with Flow Matching CVPR 2026) 声学合成 · Flow Matching · CVPR 2026 · 脉冲响应 首次将生成Flow Matching应用于房间脉冲响应合成,扩散Transformer在空间/几何条件下生成 7 IAA (From Concepts to Judgments: Interpretable Image Aesthetics Assessment) 美学评估 · 可解释AI · 概念建模 · 摄影 基于人类美学概念构建可解释子空间 + 残差预测器,美学评估兼顾性能与可解释性 在摄影和艺术数据集上与黑盒模型性能相当且可解释性显著更优 8 OGD (OGD: Ontology-Guided Diffusion for Zero-Shot Sim2Real Image Translation) Sim2Real · 知识图 · 零样本 · 图翻译 将真实感分解为本体知识图,GNN全局嵌入 + 符号规划器编辑序列调节扩散模型 可解释的零样本仿真到真实图像翻译,无需目标域训练数据 9 R&D (R&D: Reliability-Diversity Balance in Synthetic Data Augmentation) 数据增强 · 可控扩散 · 语义分割 · 可靠多样平衡 类别感知提示 + 视觉先验混合,可控扩散模型合成数据增强 PASCAL VOC 和 BDD100K 上语义分割性能显著提升 趋势观察 语音生成基础模型走向开源:MOSS-TTS 展示了离散 Token + 自回归大模型在 TTS 领域的完整开源路线图 — MOSS-TTS 采用统一语义-声学 Tokenizer + 双生成器架构 图像编辑向精细化演进:ColourCrafter 的 Token 级色彩融合和 TexEditor 的 RL 强化结构保持 — 从全局编辑到区域感知、从外观到纹理的精细化控制 量化部署的采样器端补偿:Q-Drift 首次从采样器端而非模型端校正量化漂移 — 仅 5 对校准运行,6 模型 3 采样器通用,推理零开销 AI 生成内容检测成为新赛道:GenVideoLens 揭示 LVLM 在物理和时间推理上的严重不足 — 感知线索可识别但深层一致性难以判断 扩散模型在特殊领域的拓展:FLAC 声学合成、O2MAG 异常生成、VQ-AUFace 面部合成 — Flow Matching 和注意力控制在声学、工业和面部领域的创新应用 人工智能炼丹师 整理 | 2026-03-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注