


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 4 篇 · 物理常识与可控视频生成 2 篇 · 世界模型与实时交互 1 篇 · 高效音频生成 1 篇
NEWTON: Agentic Planning for Physically Grounded Video Generation | 浙江大学, 香港理工大学, IROOTECH/三一集团 | arXiv:2605.18396
关键词:视频生成·物理常识·Agentic Planning·VideoPhy-2·Flow-GRPO
前序问题:视频生成模型画面好看但系统性违反物理常识——VideoPhy-2 上最强模型 joint accuracy 仅 32.6%。论文把根源诊断为「条件规约瓶颈」:文本 prompt 是物理世界的有损压缩,遗漏了真正决定动力学的参数(速度/质量/碰撞角度),单纯堆模型容量补不回来从未被指定的信息
本文贡献:提出 NEWTON 框架:把视频生成「降级」为 agent 工具箱中的一个动作,由可学习的 planner 编排关键帧生成、科学计算、prompt 改写等物理感知工具构造丰富条件,再用 verifier 闭环迭代;planner 是唯一可训练组件,在多轮真实交互中用 Flow-GRPO 在线优化。提出物理条件需满足的三条性质:sufficiency / dynamism / verifiability

实验效果:VideoPhy-2 上 joint accuracy 显著提升:LTX-Video 21.4% → 29.7%(+8.3pp),Veo-3.1 30.7% → 37.4%(+6.7pp),关键是不修改任何视频生成器底模,只改 planner
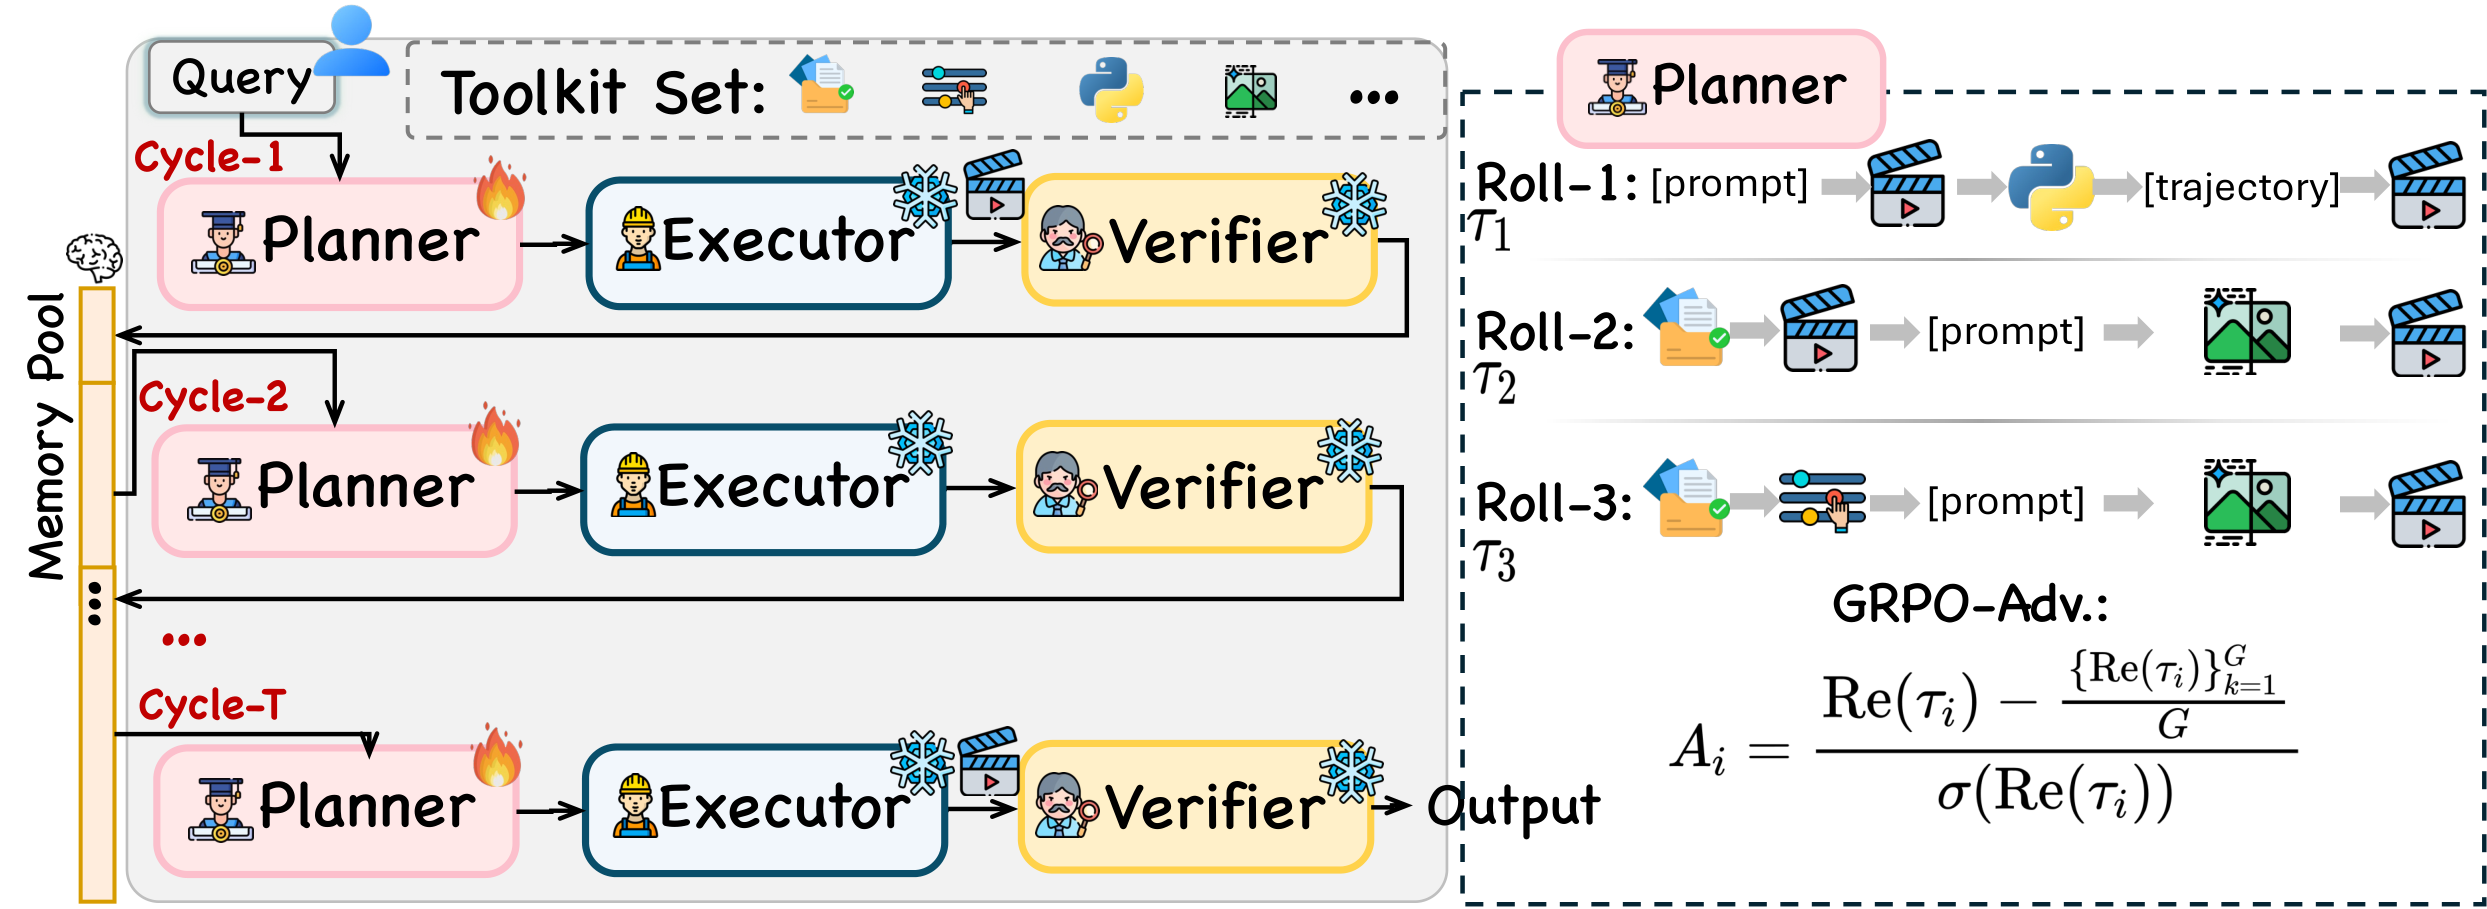
批判点评:把视频生成嵌入 agent loop 是个聪明的 reframe——既然底模拿不到完整物理参数就别强求底模,把信息构造交给可推理的 planner;但 Flow-GRPO 的训练成本不低,物理工具链对生成时延的影响论文未充分披露,verifier 能否在更多元物理现象上稳定收敛仍待验证
Advancing Narrative Long Video Generation via Training-Free Identity-Aware Memory | 浙江大学, 腾讯优图, 华中科大, 上海交大 | arXiv:2605.18733
关键词:长视频生成·身份记忆·训练免微调·叙事生成·NarraStream-Bench
前序问题:自回归长视频生成在视觉保真度和交互上进步快,但长序列里身份漂移、角色重复、属性丢失的问题严重;现有方案要么用预定义策略压缩历史帧,要么靠粗糙的隐式注意力检索关键帧,对「带角色切换的演化型 prompt」都处理不好
本文贡献:提出 IAMFlow 训练免微调身份感知记忆框架:用 LLM 从每个 prompt 抽实体并赋予全局唯一 ID,建立身份记忆;用 VLM 异步从渲染帧验证并修正属性,把隐式相似度匹配换成显式实体追踪。配套异步视觉验证 + 自适应 prompt 切换 + 模型量化的推理加速流水线,并发布 NarraStream-Bench 长叙事流式视频评测基准(324 个多 prompt 脚本)
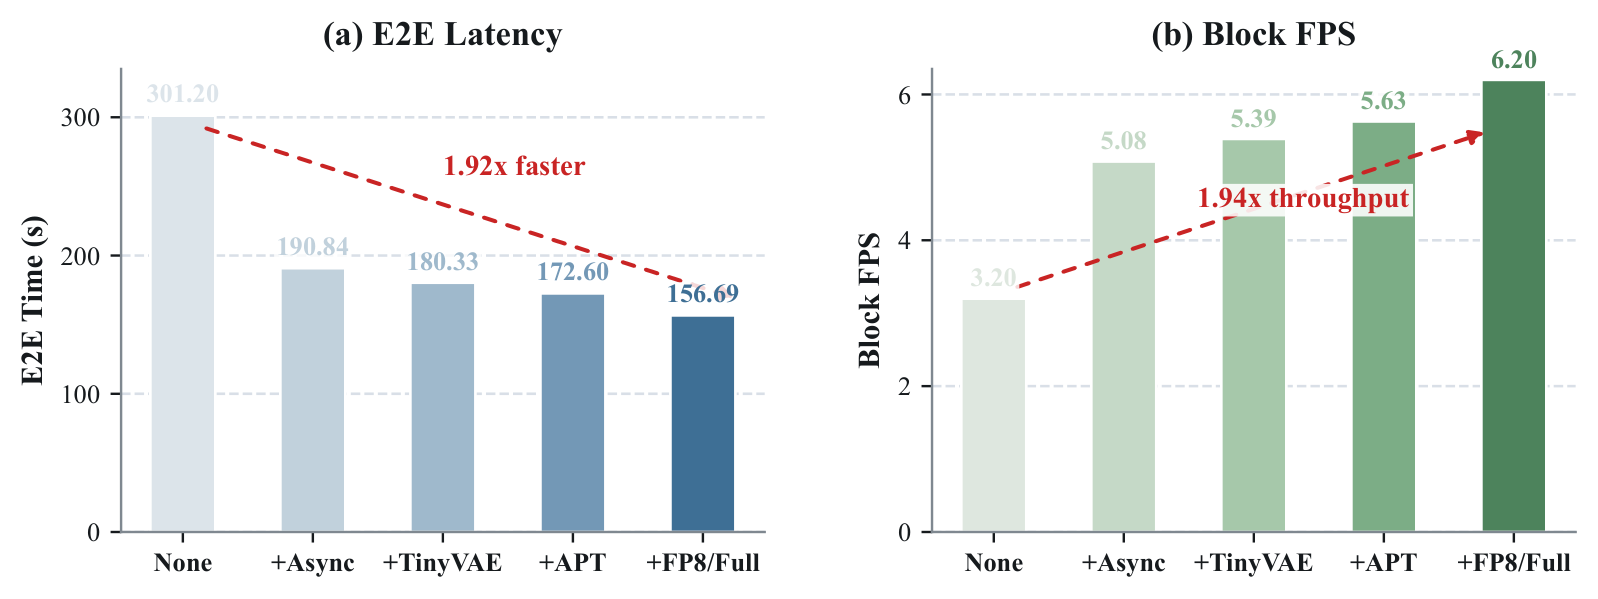
实验效果:NarraStream-Bench 上整体最佳,比最强 baseline 高 2.56 分;60 秒多 prompt 生成相比最高效 baseline 还有 1.39× 加速,做到「质量更好且更快」
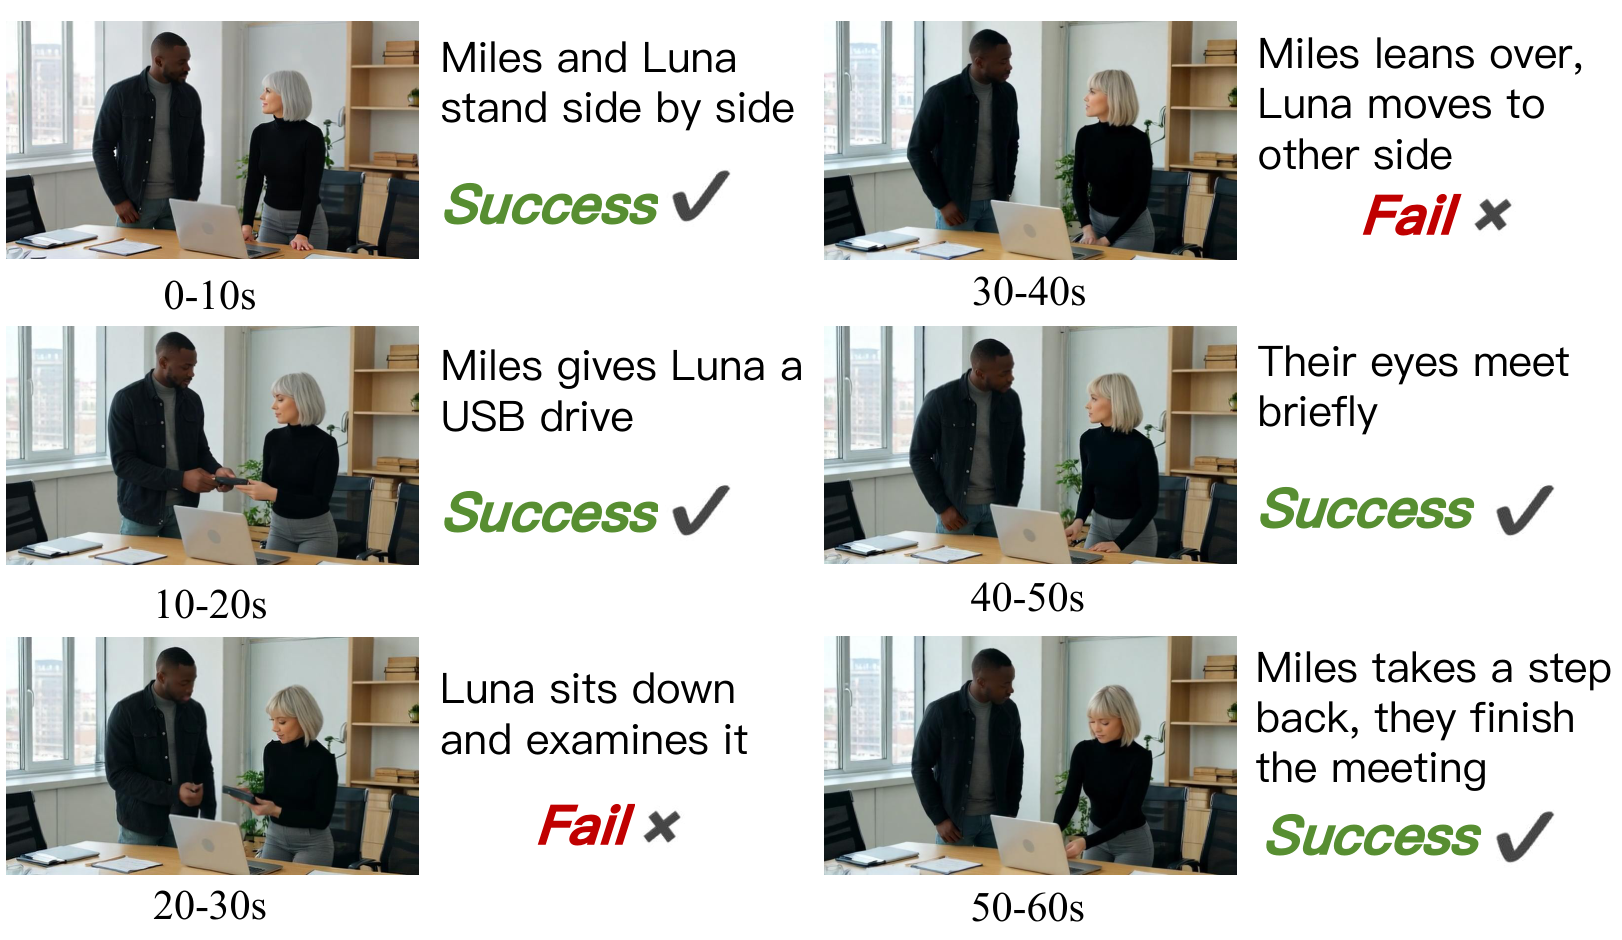
批判点评:把身份当作显式可寻址符号、用 VLM 异步验证属性,是把 agentic memory 思想正式带进长视频生成的工作;但训练免微调依赖 LLM/VLM 的稳定性和延迟,多角色密集交互场景下全局 ID 解析是否还稳健仍是开放问题;NarraStream-Bench 的 324 个脚本规模偏小,对极端长视频(>3 分钟)的覆盖度有限
Stable Audio 3: Fast Latent Diffusion for Variable-Length Audio Generation | Stability AI | arXiv:2605.17991
关键词:音频生成·latent diffusion·变长生成·对抗后训练·消费级开源
Incantation: Natural Language as the Action Interface for Multi-Entity Video World Models | 上海交大, NVIDIA Research, USTC, UCAS, NUS, UWaterloo, HKUST, HKU, 紫光研究院 | arXiv:2605.18601
关键词:视频世界模型·自然语言动作接口·实时流式·Self-Forcing·跨游戏泛化
前序问题:当前交互式视频世界模型画质好但缺多实体细粒度控制和跨实体/跨世界泛化——根因在「动作接口」:标准控制协议(动画 ID、设备输入、场景级 caption)在设计期就把动作语义绑死到具体实体或引擎上,无法跨游戏迁移
本文贡献:首次把自然语言作为视频世界模型的动作接口:每 0.25 秒(1 个 latent frame)一条自然语言条件,原生支持同时多实体控制和跨实体概念迁移;架构是预训练双向视频底模 + frame-local text cross-attention;通过 ODE-initialized Self-Forcing 蒸馏 + RoPE-decoupled 滑窗 KV-cache 实现实时长 horizon 流式生成;同款架构和训练配方迁移到《拳皇》只需换 per-entity 动作词表
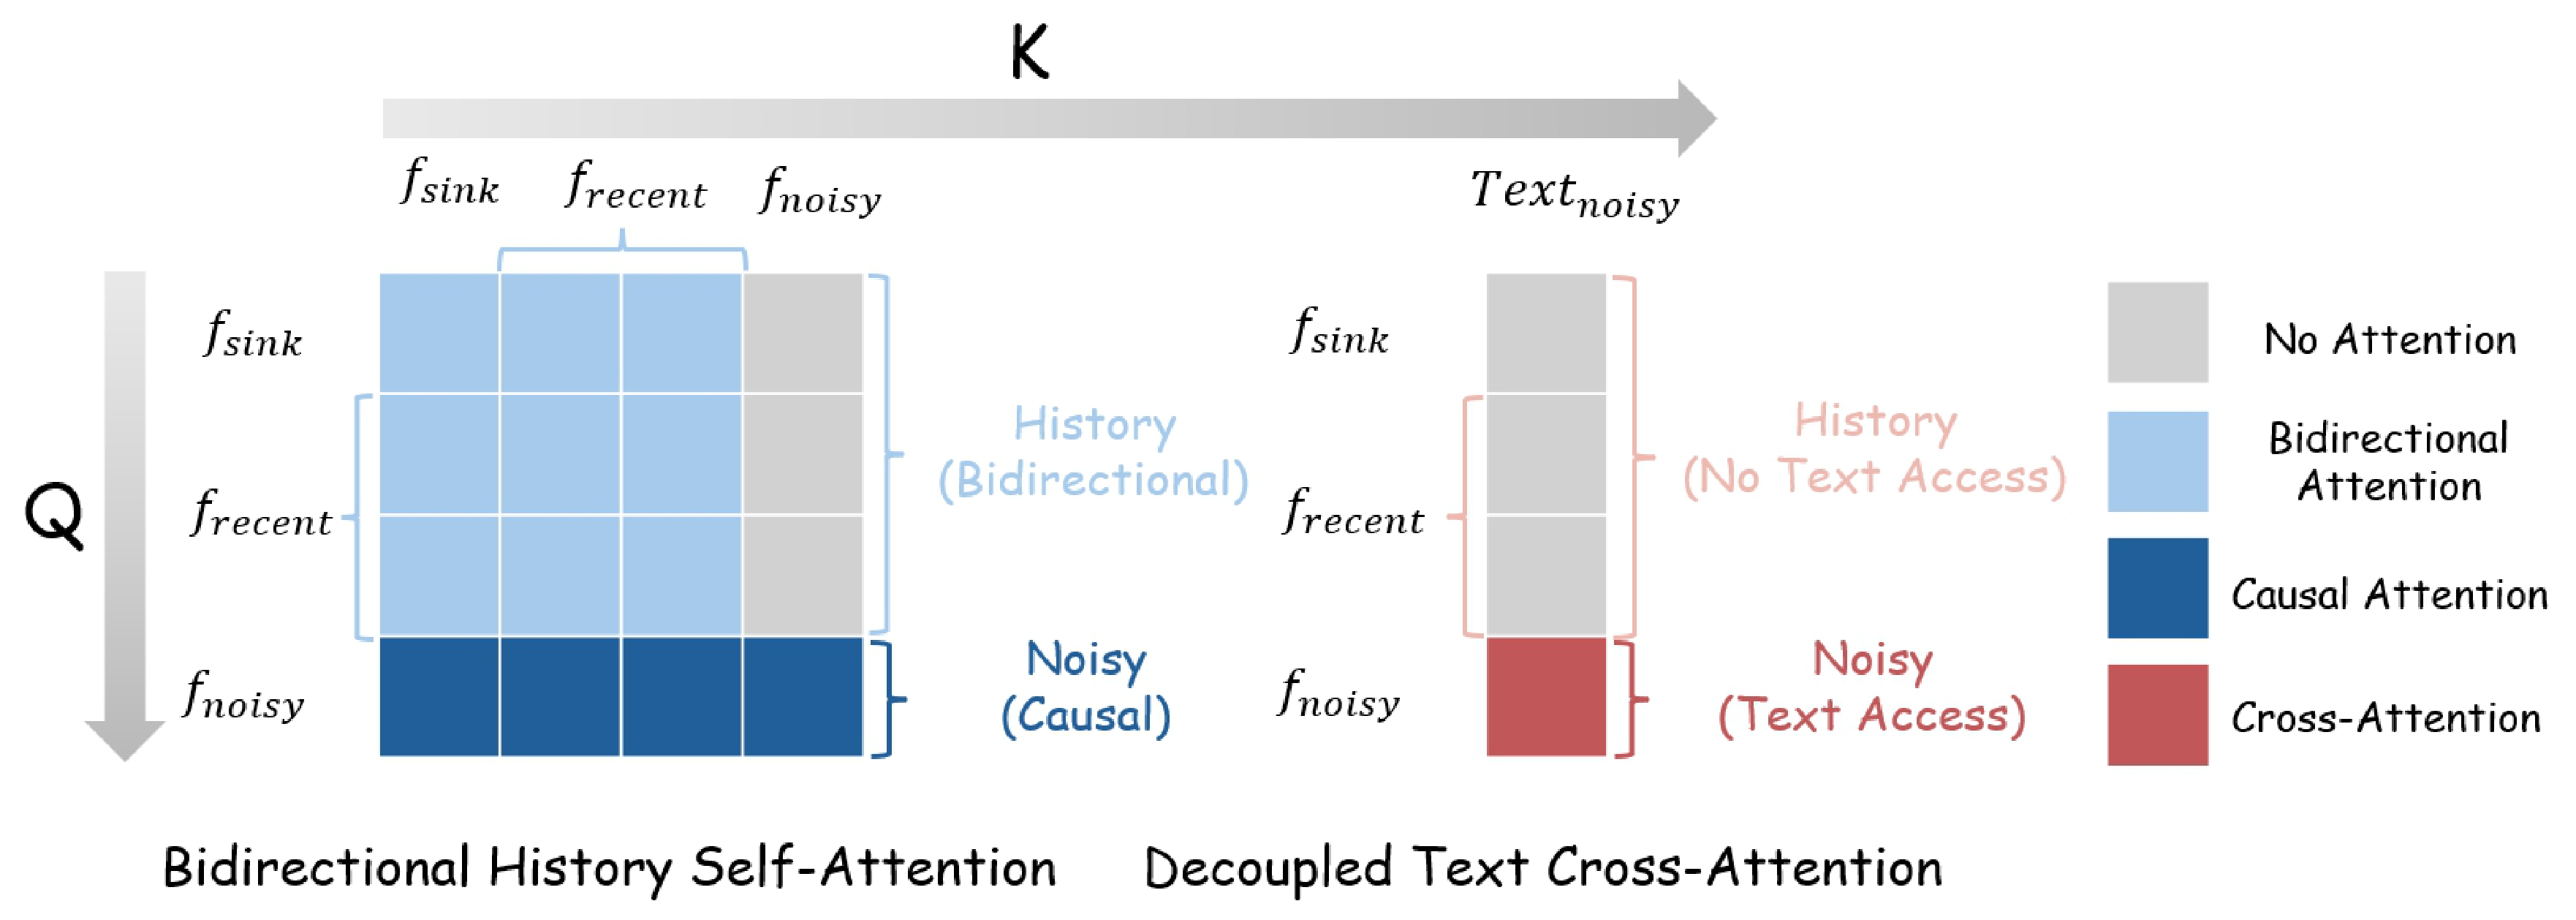
实验效果:跨实体迁移成功率 89% vs Action-Index baseline 43%;out-of-vocabulary prompts 90% vs 0%;2 步学生模型在 480p 上稳定 19.7 FPS,2 小时长 rollout 不发散,FVD 维持稳定;同时发布 Elden Ring 玩家-Boss 战斗剪辑数据集预览

批判点评:把世界模型的动作接口从「枚举 ID」升级到「自由语言」是非常正确的方向,跨实体 89% vs 43% 的提升清晰证明了价值;但训练数据是手工标注的游戏片段(Elden Ring/KOF),真实世界视频里语言 → 物理动作的映射可能远比游戏复杂;Self-Forcing 蒸馏依赖双向教师的瓶颈仍未解(参考 Mutual Forcing 路线的下一步演化方向)
人工智能炼丹君 整理 | 2026-05-20
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)