


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日 arXiv cs.CV 视觉生成相关论文共 10 篇。
方向分布:
Awaking Spatial Intelligence in Unified Multimodal Understanding and Generation | JoyAI | 2605.04128
关键词: 统一多模态模型·MLLM+MMDiT·空间智能·文生图·指令编辑·新视角推理
前序工作问题: 现有统一多模态模型仅追求功能整合(理解+生成),但在空间感知、几何推理和可控编辑方面能力不足,理解与生成之间缺乏双向增强的闭环
贡献: 提出 JoyAI-Image,将空间增强 MLLM 与 MMDiT 通过共享多模态接口耦合,结合统一指令微调、长文本渲染监督、空间编辑信号和新视角辅助推理,实现理解↔生成双向增强
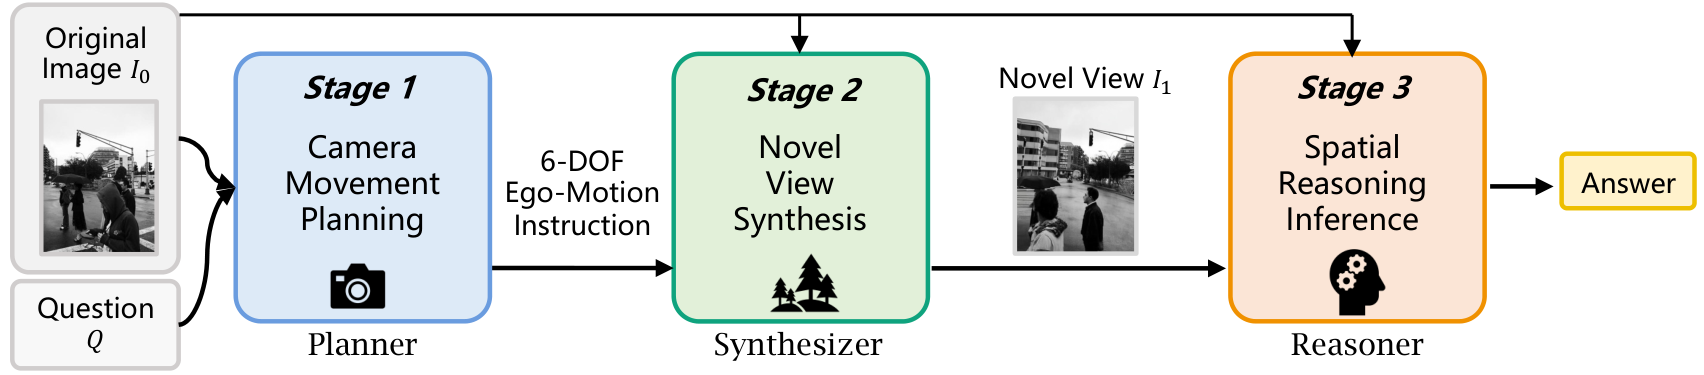
效果: 在理解、生成、长文本渲染和编辑四大基准上均达 SOTA 或高度竞争,展示了统一模型通向空间智能和世界模型的可行路径
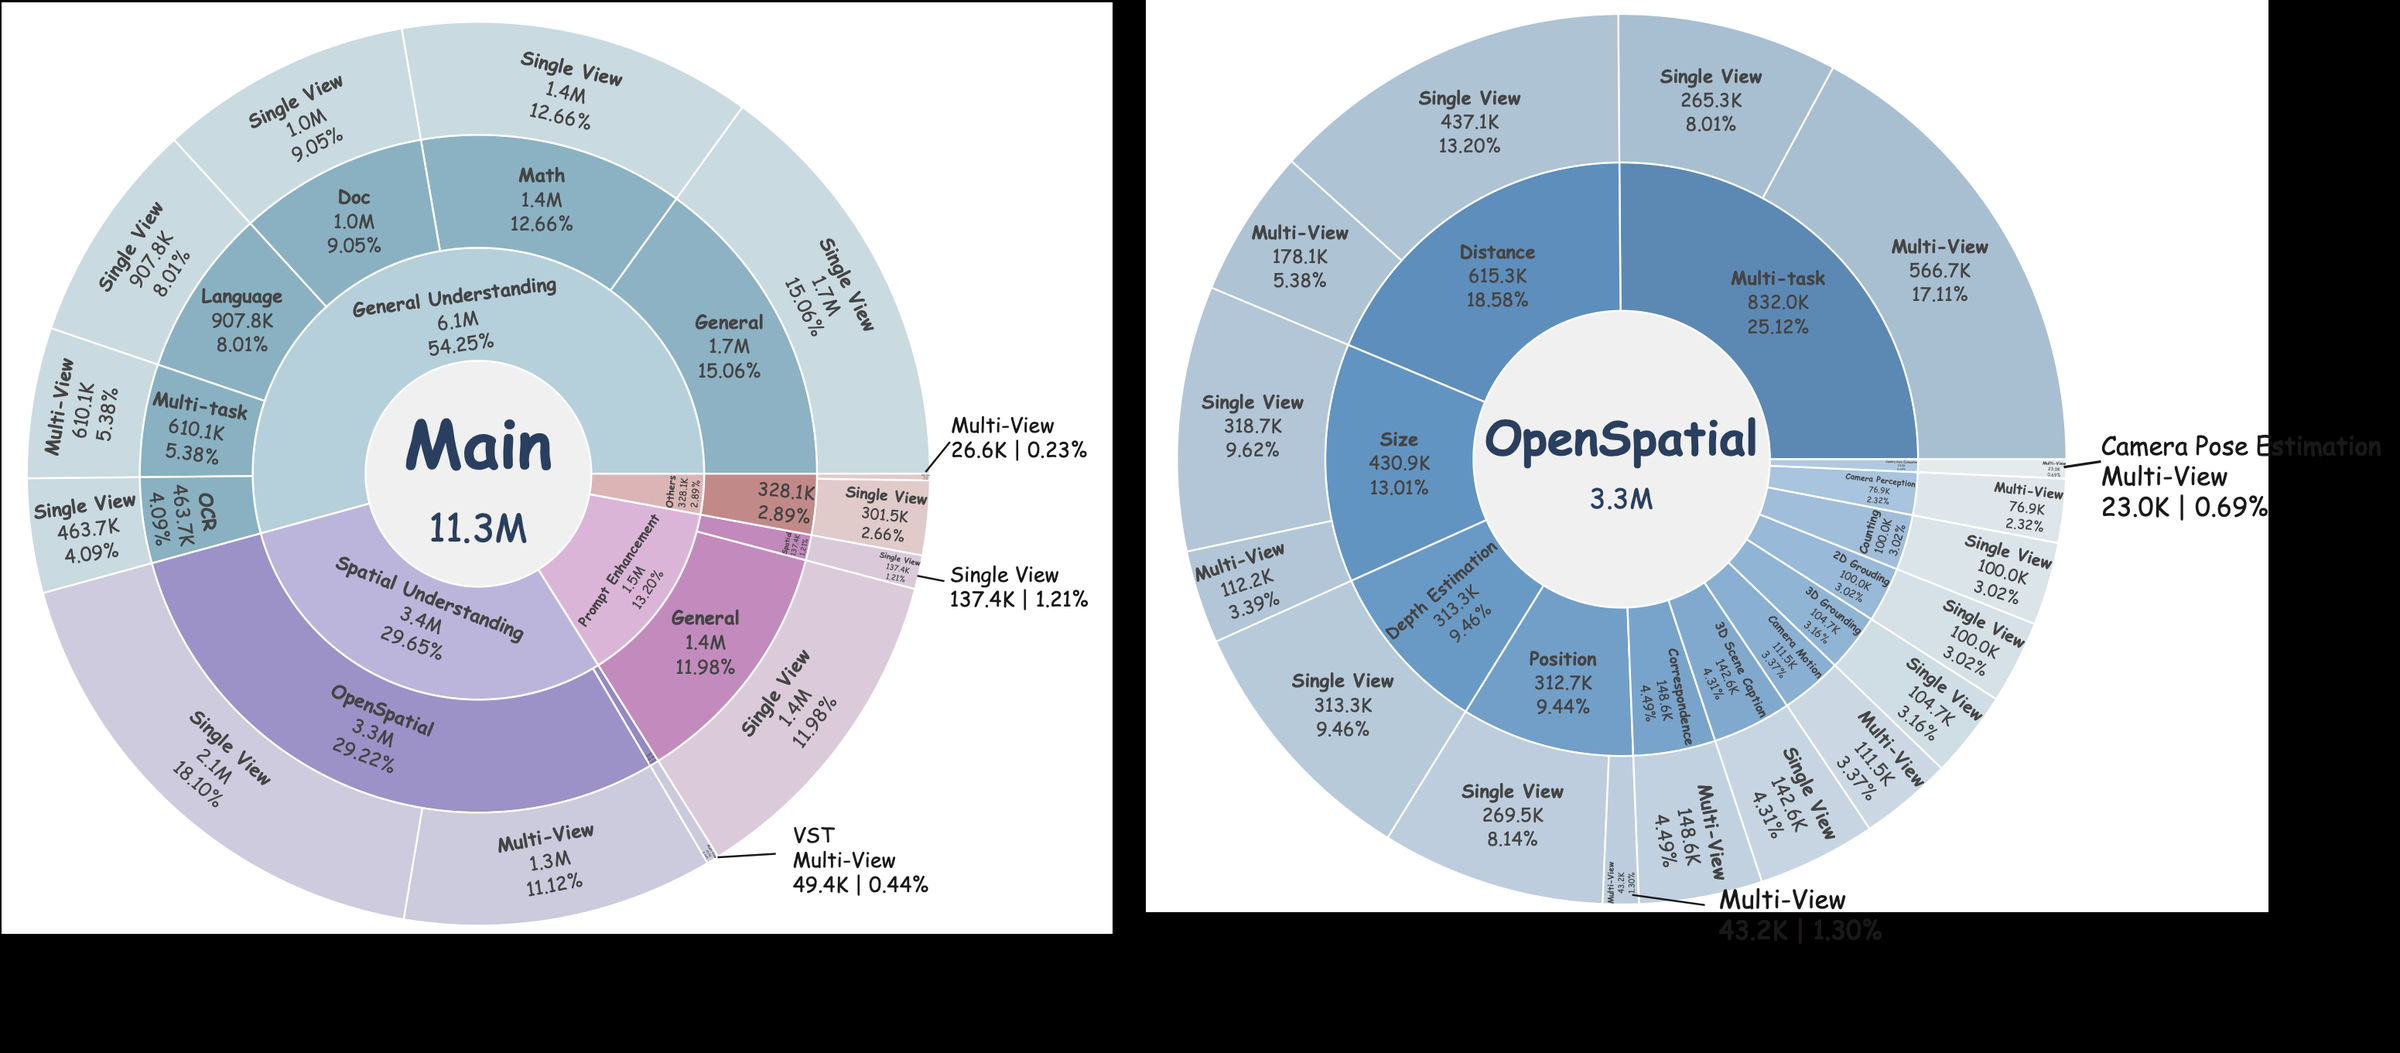
批判点评: 论文未公开模型权重和训练数据细节,且作者机构信息模糊;空间智能的评估维度仍有限,缺少与 GPT-4o 等商业模型在编辑任务上的系统对比
D-OPSD: On-Policy Self-Distillation for Continuously Tuning Step-Distilled Diffusion Models | Tongyi-MAI (Alibaba) | 2605.05204
关键词: 少步蒸馏·on-policy自蒸馏·LLM/VLM编码器·持续微调·概念学习
前序工作问题: Z-Image-Turbo、FLUX.2-klein 等少步蒸馏模型在传统 SFT 微调后会丧失少步推理能力,导致质量严重退化
贡献: 发现 LLM/VLM 编码器的 in-context 能力可被扩散模型继承,据此设计 on-policy 自蒸馏:同一模型分别以纯文本和多模态条件扮演学生/教师,在模型自身轨迹上最小化分布差异,实现概念/风格学习且保持少步能力

效果: 在 Z-Image-Turbo 和 FLUX.2-klein 上验证,微调后保持原始少步推理速度的同时成功学习新概念和风格

批判点评: 仅验证了图像生成,能否扩展到视频蒸馏模型未知;自蒸馏的教师信号质量依赖参考图像质量,在困难概念上的鲁棒性有待验证
Stream-T1: Test-Time Scaling for Streaming Video Generation | USTC / FrameX-AI | 2605.04461
关键词: 测试时缩放·流式视频生成·噪声传播·奖励剪枝·记忆沉降
前序工作问题: 基于扩散模型的测试时缩放(TTS)方法候选探索成本巨大且缺乏时序引导,在视频生成中难以规模化应用
贡献: 提出 Stream-T1,首个面向流式视频生成的综合 TTS 框架,包含三个模块:噪声传播(利用历史高质量噪声引导当前生成)、奖励剪枝(短期美学+滑动窗口长期一致性)、记忆沉降(奖励驱动的 KV-cache 动态路由)

效果: 在 5 秒和 30 秒视频基准上显著提升时序一致性、运动平滑度和帧级视觉质量,配合 Stream-R1 构成完整流式生成体系

批判点评: TTS 天然增加推理时间,三个模块叠加后的实际延迟开销未量化;奖励模型本身的偏差可能导致错误剪枝
Lightning Unified Video Editing via In-Context Sparse Attention | ICML 2026 | 2605.04569
关键词: 视频编辑·稀疏注意力·ICL·170万数据集·注意力延迟60%削减
前序工作问题: 基于上下文学习(ICL)的视频编辑方法因二次注意力成本产生严重计算瓶颈,限制了实际部署
贡献: 提出 ISA(In-context Sparse Attention),首个面向 ICL 视频编辑的近无损稀疏框架:上下文 token 裁剪 + Query 锐度驱动的动态分组(高误差走全注意力、低误差走零阶泰勒近似),并构建 170 万高质量编辑数据集训练 LIVEditor
效果: 注意力模块延迟削减约 60%,同时在 EditVerseBench、IVE-Bench、VIE-Bench 三个基准上超越 SOTA,ICML 2026 接收
批判点评: 稀疏注意力的误差阈值需手动调节,不同编辑类型的最优配置可能不同;170 万数据集的构建细节和质量保证流程未充分披露
PhysForge: Generating Physics-Grounded 3D Assets for Interactive Virtual World | HKU MMLab | 2605.05163
关键词: 3D资产生成·物理蓝图·运动学注入·15万资产数据集·ICML 2026
前序工作问题: 现有3D生成方法聚焦静态几何,忽略了交互虚拟世界所需的材质、功能、运动学等物理属性,生成的资产无法直接用于仿真
贡献: 提出 PhysForge 两阶段解耦框架:(1) VLM 物理架构师规划分层物理蓝图(材质→功能→运动学);(2) 物理驱动扩散模型通过 KineVoxel Injection 同时合成高保真几何与精确运动学参数。配套 PhysDB 15万资产四级物理标注数据集
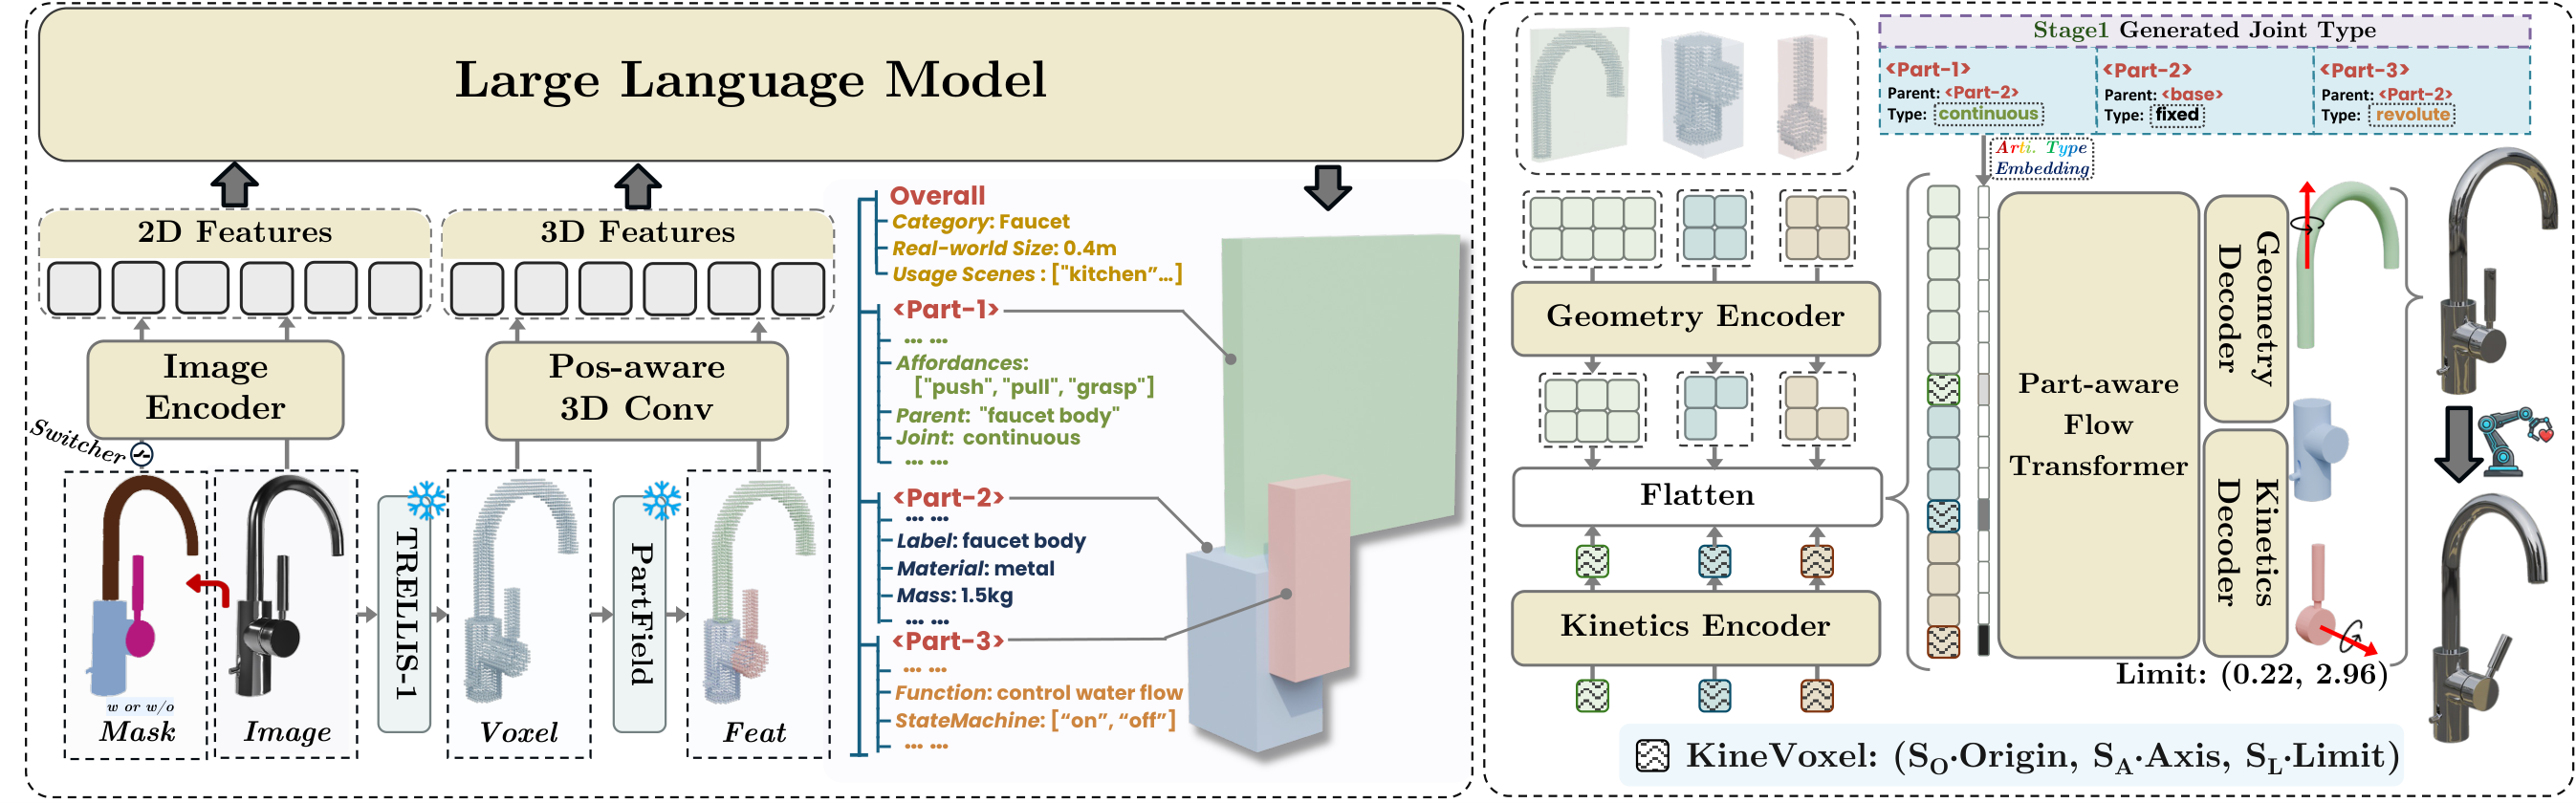
效果: 生成的资产可直接用于物理仿真,功能合理性和几何质量均优于现有方法,ICML 2026 接收

批判点评: 15 万数据集的标注质量和覆盖范围未详述;VLM 物理蓝图的错误传播到下游生成的容错机制不明确
Structured 3D Latents Are Surprisingly Powerful: Unleashing Generalizable Style with 2D Diffusion | N/A | 2605.04412
关键词: 3D风格迁移·结构化3D潜空间·2D扩散引导·OOD风格·即插即用
前序工作问题: 现有3D风格化方法依赖训练分布内的风格图像,面对分布外(OOD)风格时性能严重退化甚至失败
贡献: 提出 DiLAST,利用预训练2D扩散模型作为风格先验教师,通过扩散引导对齐渲染视图与目标风格,优化结构化3D潜空间表示,发现潜空间本身表达力极强但被低估
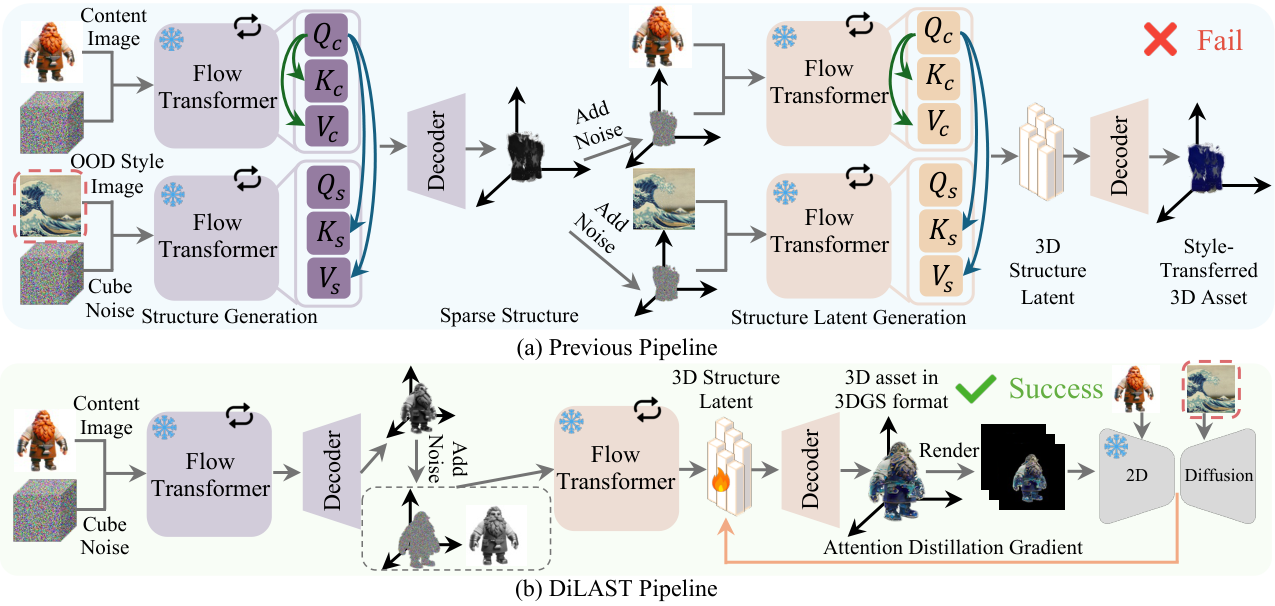
效果: 在多种数据和多个3D生成骨干上验证有效,即插即用地实现多样OOD风格迁移
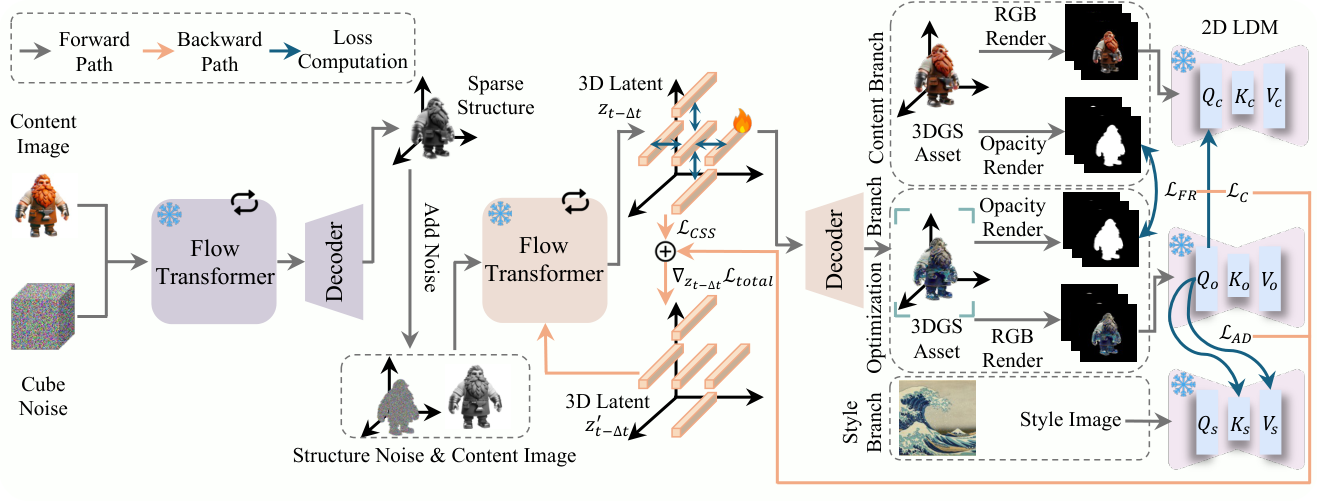
批判点评: 需要逐样本优化,速度较慢;风格一致性在复杂拓扑结构上是否稳定未充分验证
StableI2I: Spotting Unintended Changes in Image-to-Image Transition | N/A | 2605.04453
关键词: I2I评估·内容保真·前后一致性·无参考评测·MLLM基准
前序工作问题: 现有 I2I 评估主要关注指令遵循和感知质量,忽略了输出是否保持输入的语义对应和空间结构,导致"改了不该改的地方"难以被检测
贡献: 提出 StableI2I 统一动态评估框架,无需参考图像即可评估内容保真和前后一致性;构建 StableI2I-Bench 系统评估 MLLM 在保真与一致性判断上的准确度
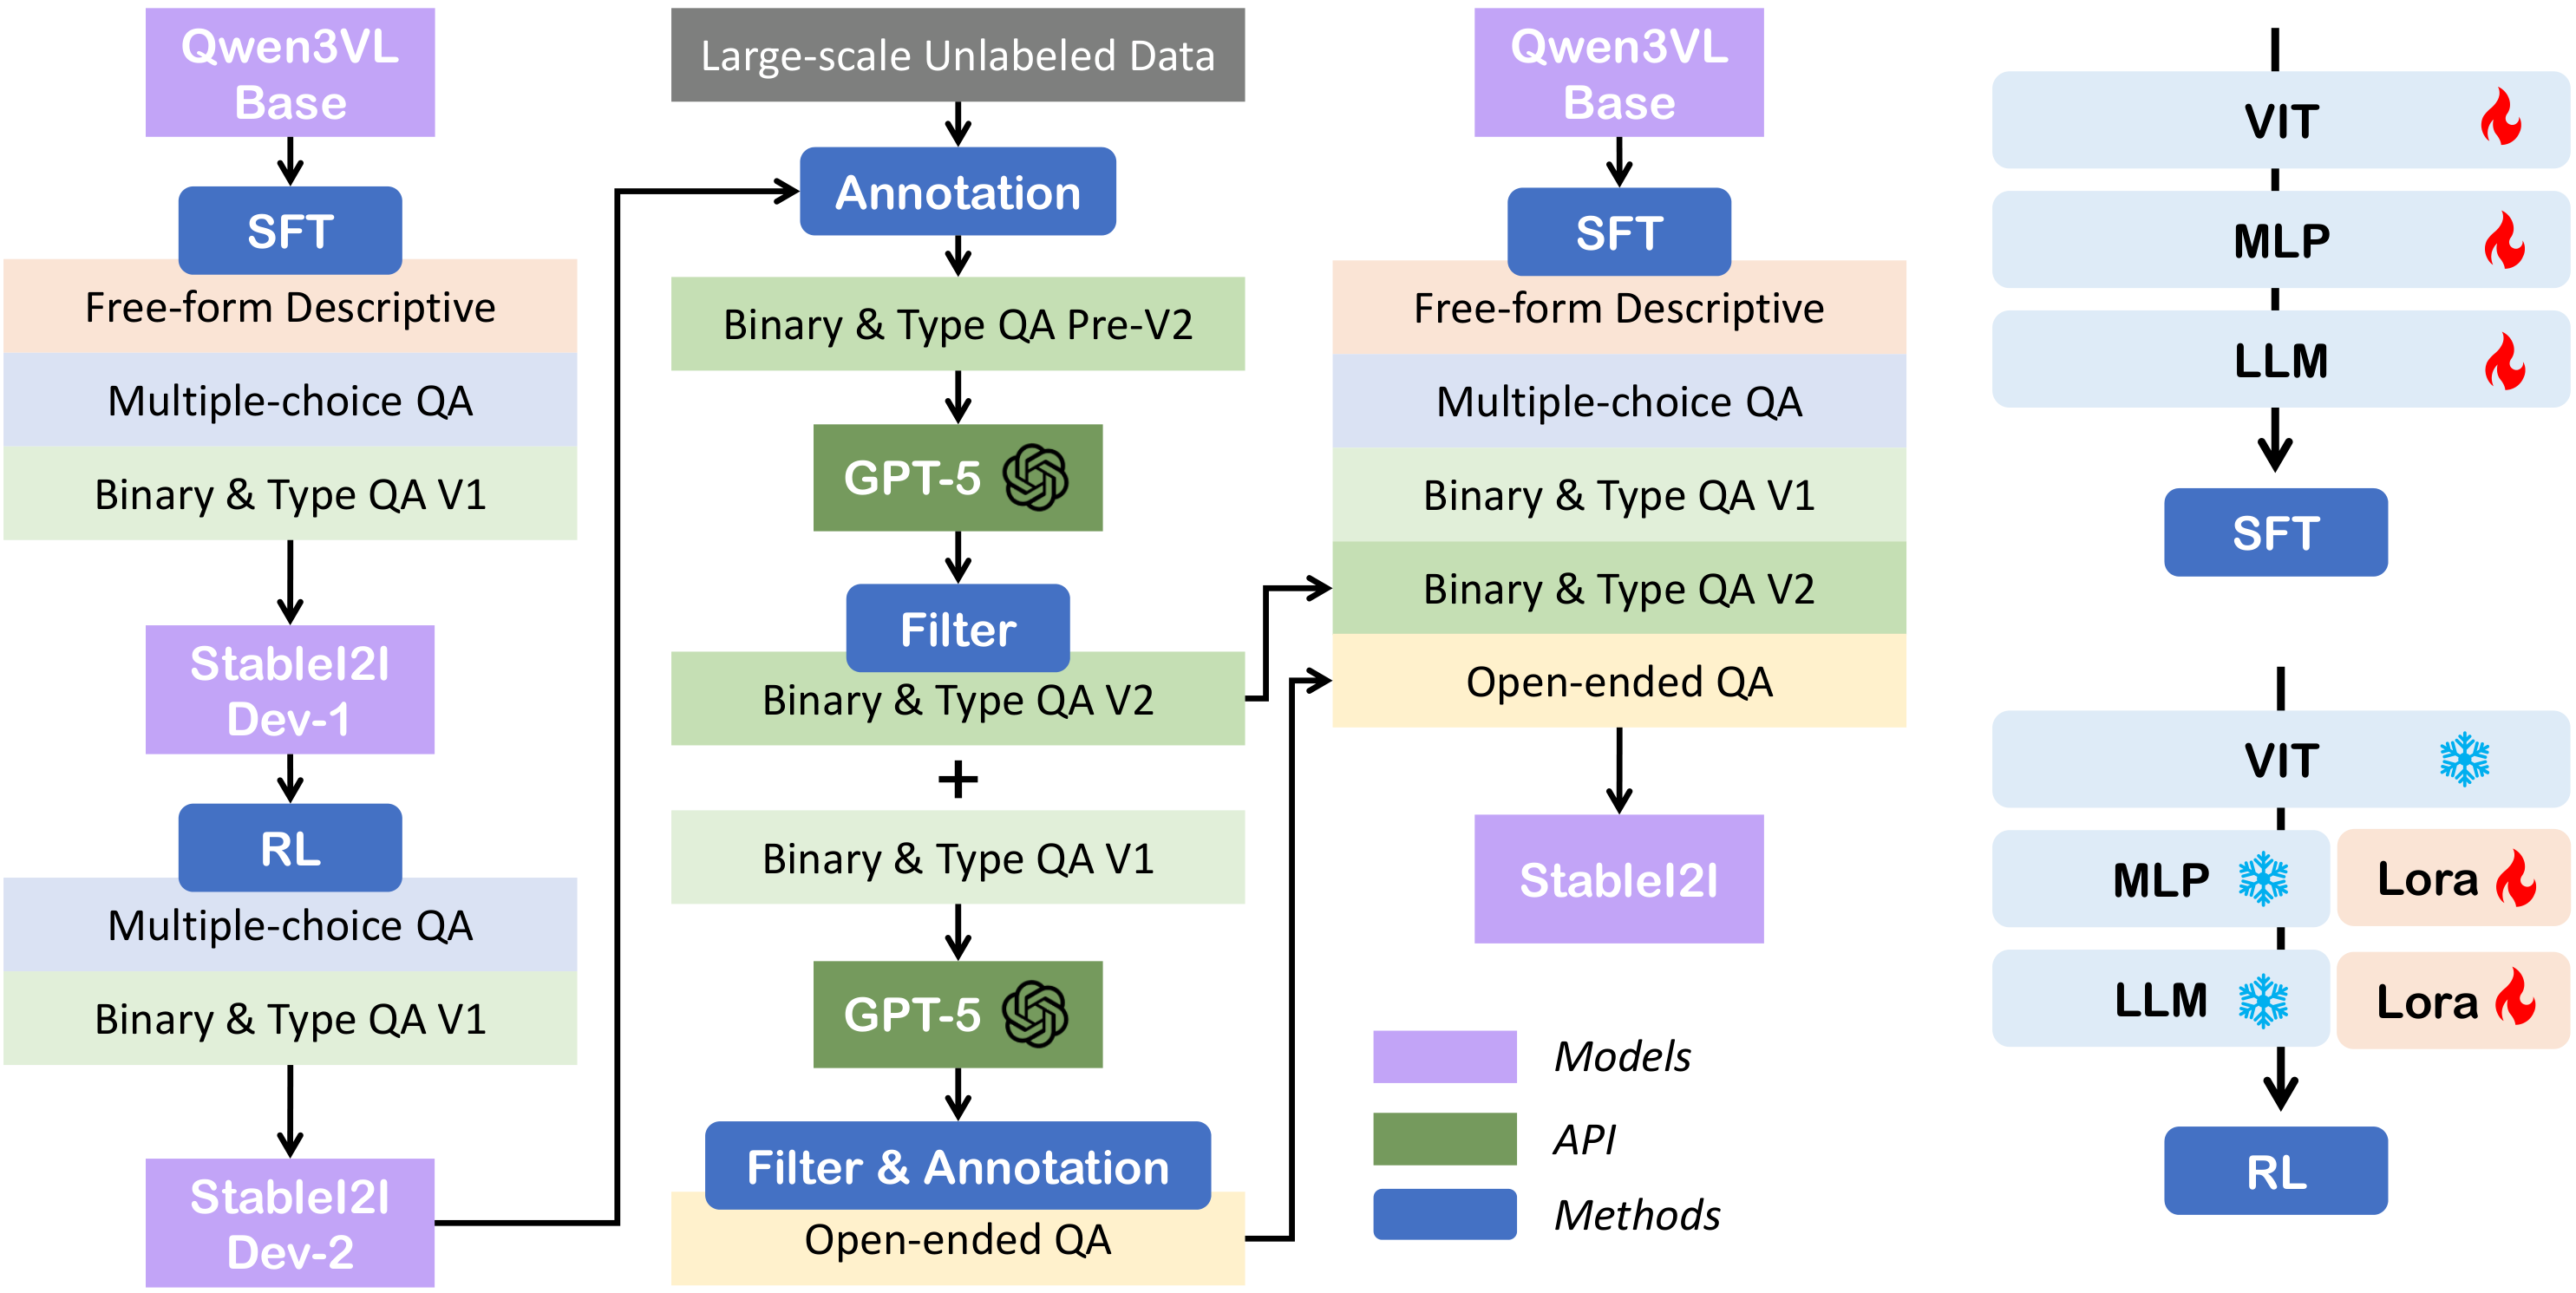
效果: 与人类主观判断高度相关,可作为 I2I 系统的标准化诊断工具

批判点评: 评测指标的鲁棒性仅在有限模型集上验证;"不该改的地方"的定义本身带有主观性,边界案例处理不够充分
Open-Source Image Editing Models Are Zero-Shot Vision Learners | N/A | 2605.04566
关键词: 图像编辑模型·零样本·深度估计·法线估计·语义分割·涌现能力
前序工作问题: 生成模型具有零样本视觉理解能力的证据集中在闭源模型,开源图像编辑模型是否也具备这种涌现能力尚未系统验证
贡献: 系统评估 Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit 三个开源编辑模型在深度估计、法线估计和语义分割上的零样本表现,验证编辑预训练本身催生视觉理解能力
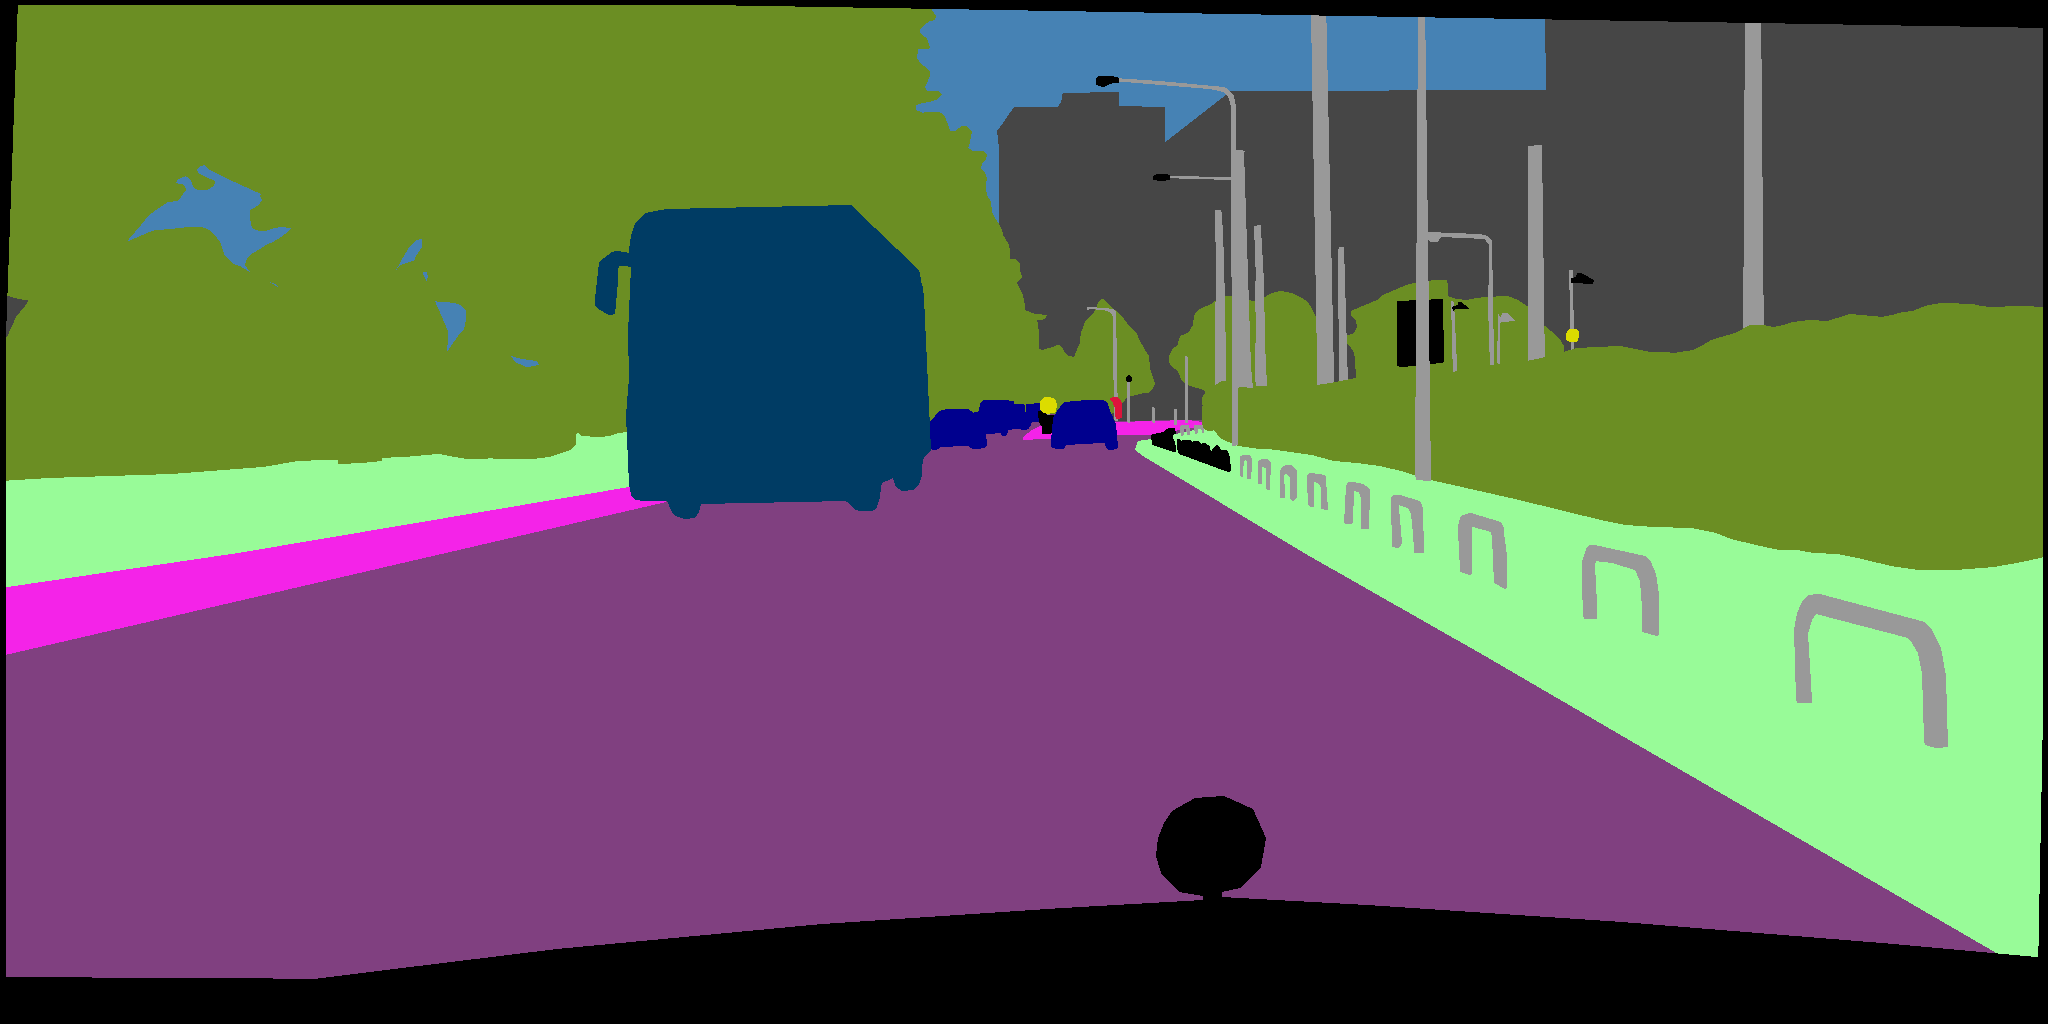
效果: FireRed 法线估计 17.69° 超越微调的 Marigold(20.86°)并匹配 Vision Banana(17.78°);Qwen 在 DIODE 深度达 δ₁=0.868
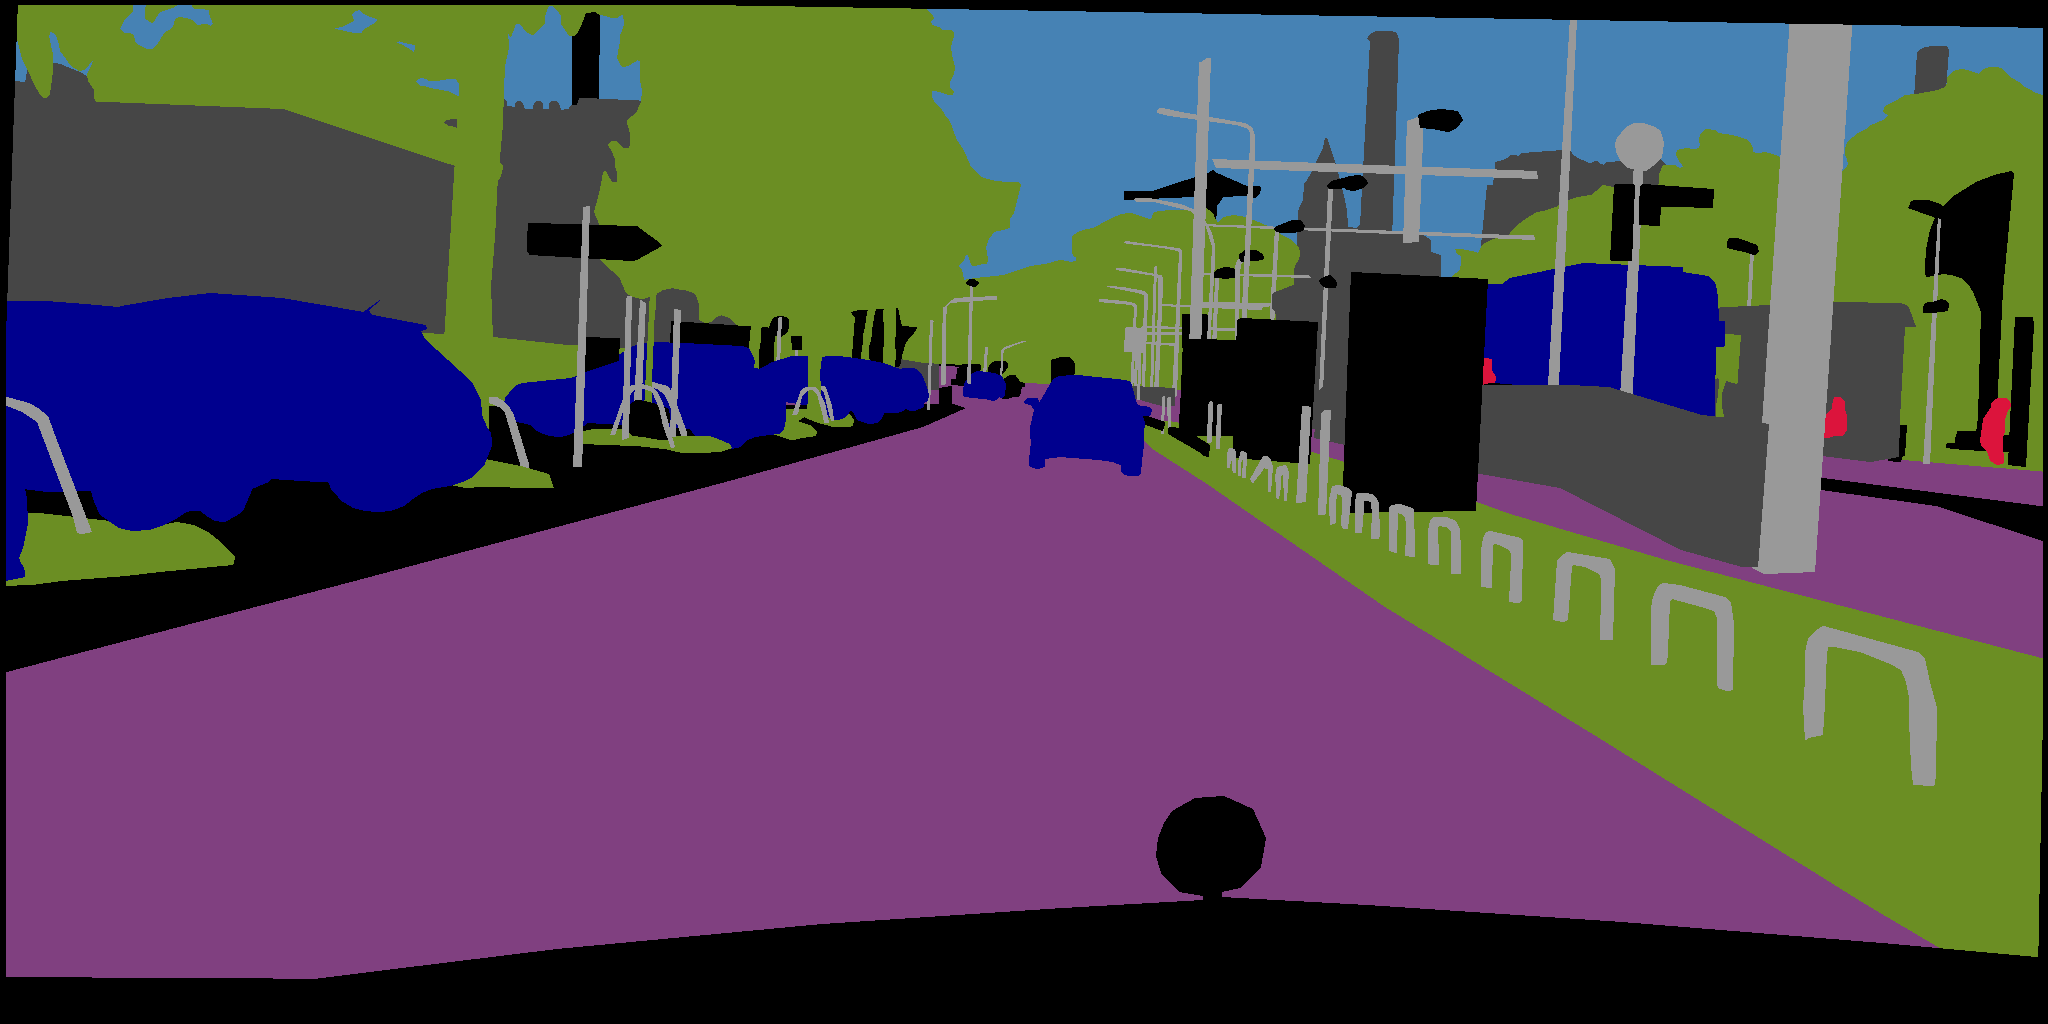
批判点评: 仅测试三个模型,样本量有限;编辑预训练数据的分布偏差可能导致某些任务表现虚高而非真正涌现
Detecting Deepfakes via Hamiltonian Dynamics | NUS | 2605.04405
关键词: Deepfake检测·哈密顿动力学·势能面·稳定性分析·跨数据集迁移
前序工作问题: Deepfake 检测器需要针对每种新生成技术反复校准,难以泛化,根本原因是依赖静态模式匹配而非捕获真实/伪造图像的本质差异
贡献: 提出 HAAD,从物理动力学角度出发:将图像潜空间建模为势能面,真实图像对应低能稳定盆地、生成图像对应高能不稳定状态,通过哈密顿轨迹的 action 和能量耗散两个统计量区分真伪
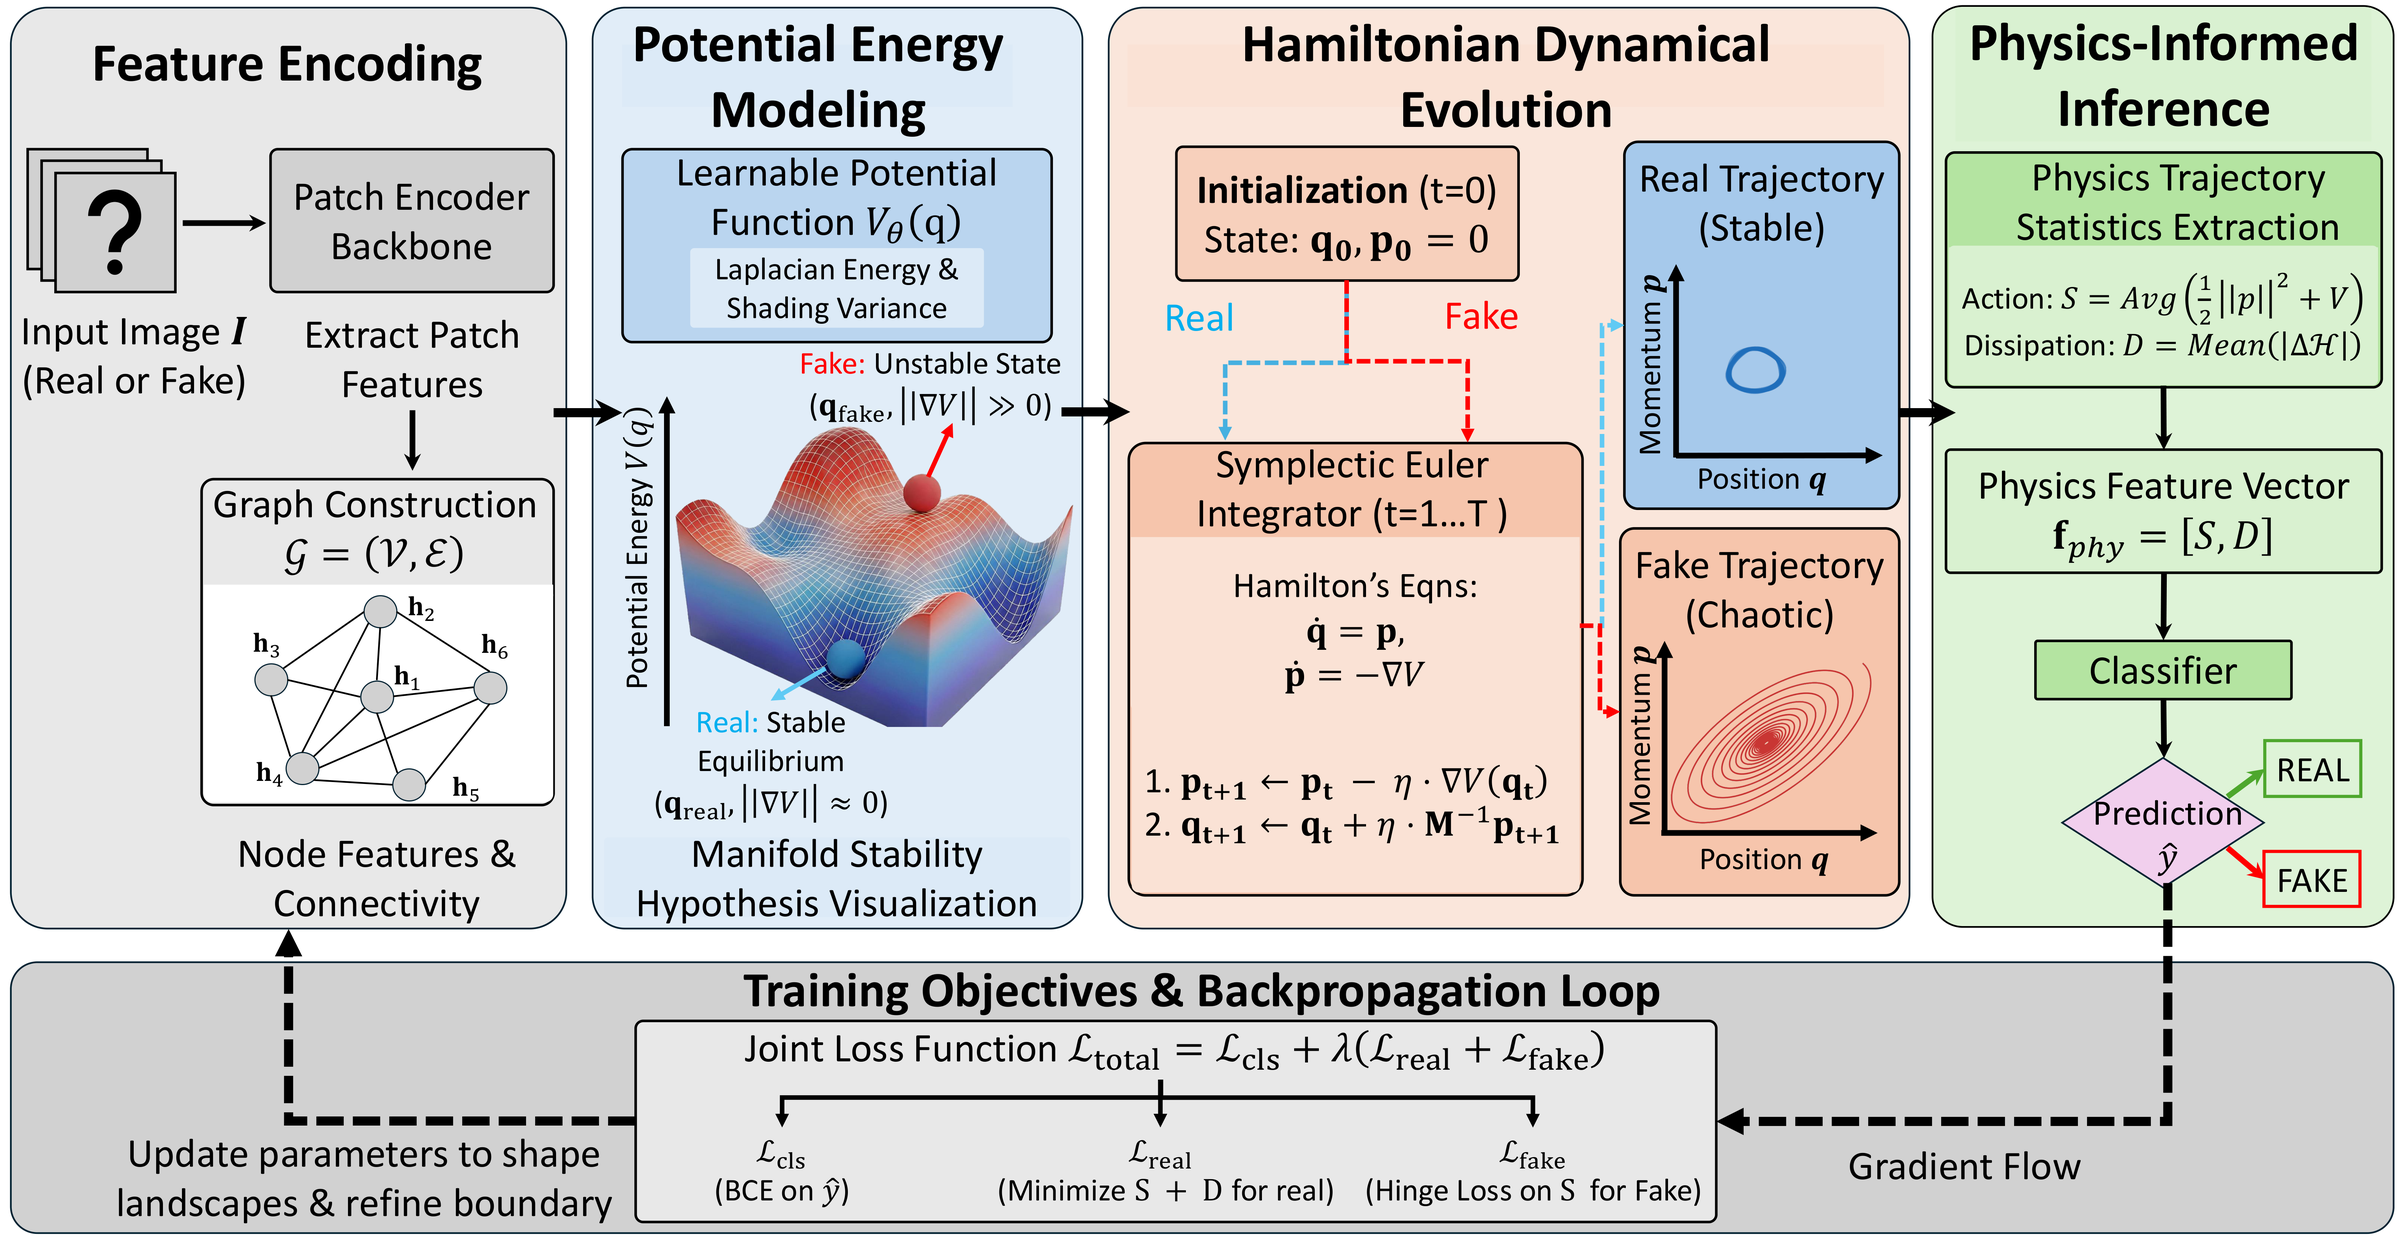
效果: 在跨数据集迁移基准上超越 SOTA 基线,无需针对新生成器重训练
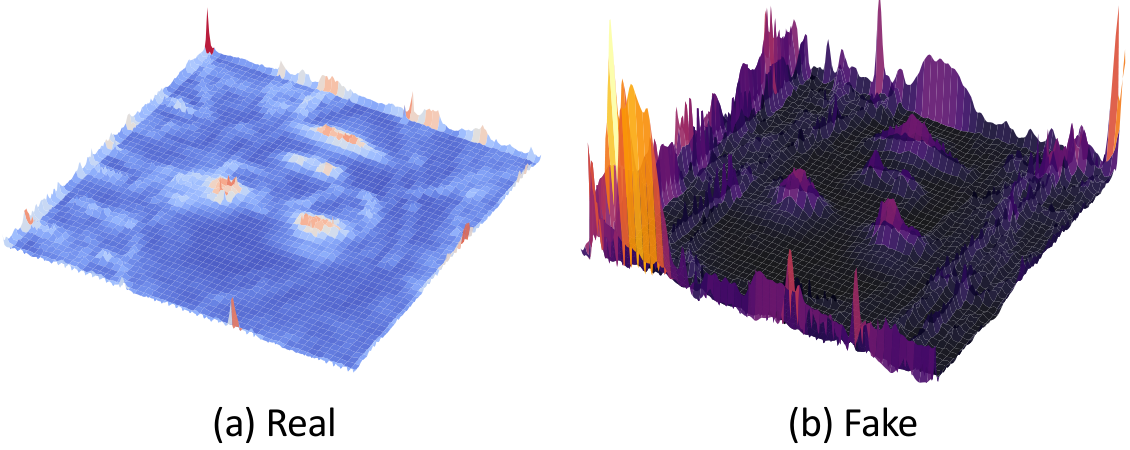
批判点评: 物理类比的假设过强——高质量生成模型可能也会逼近稳定均衡;计算轨迹的额外开销可能限制实时部署
From Diffusion to Rectified Flow: Rethinking Text-Based Segmentation | ICMR 2026 | 2605.04590
关键词: 文本分割·整流流·零样本·单步推理·无架构修改
前序工作问题: 将扩散模型用作文本分割的特征提取器会继承其生成噪声-去噪的固有性质,这对判别性分割任务有害,且需要优化时间步
贡献: 提出 RLFSeg,用 Rectified Flow 替代扩散过程,在潜空间中学习从图像到分割掩码的直接映射,引入标签细化和自适应单步采样策略,零修改模型结构
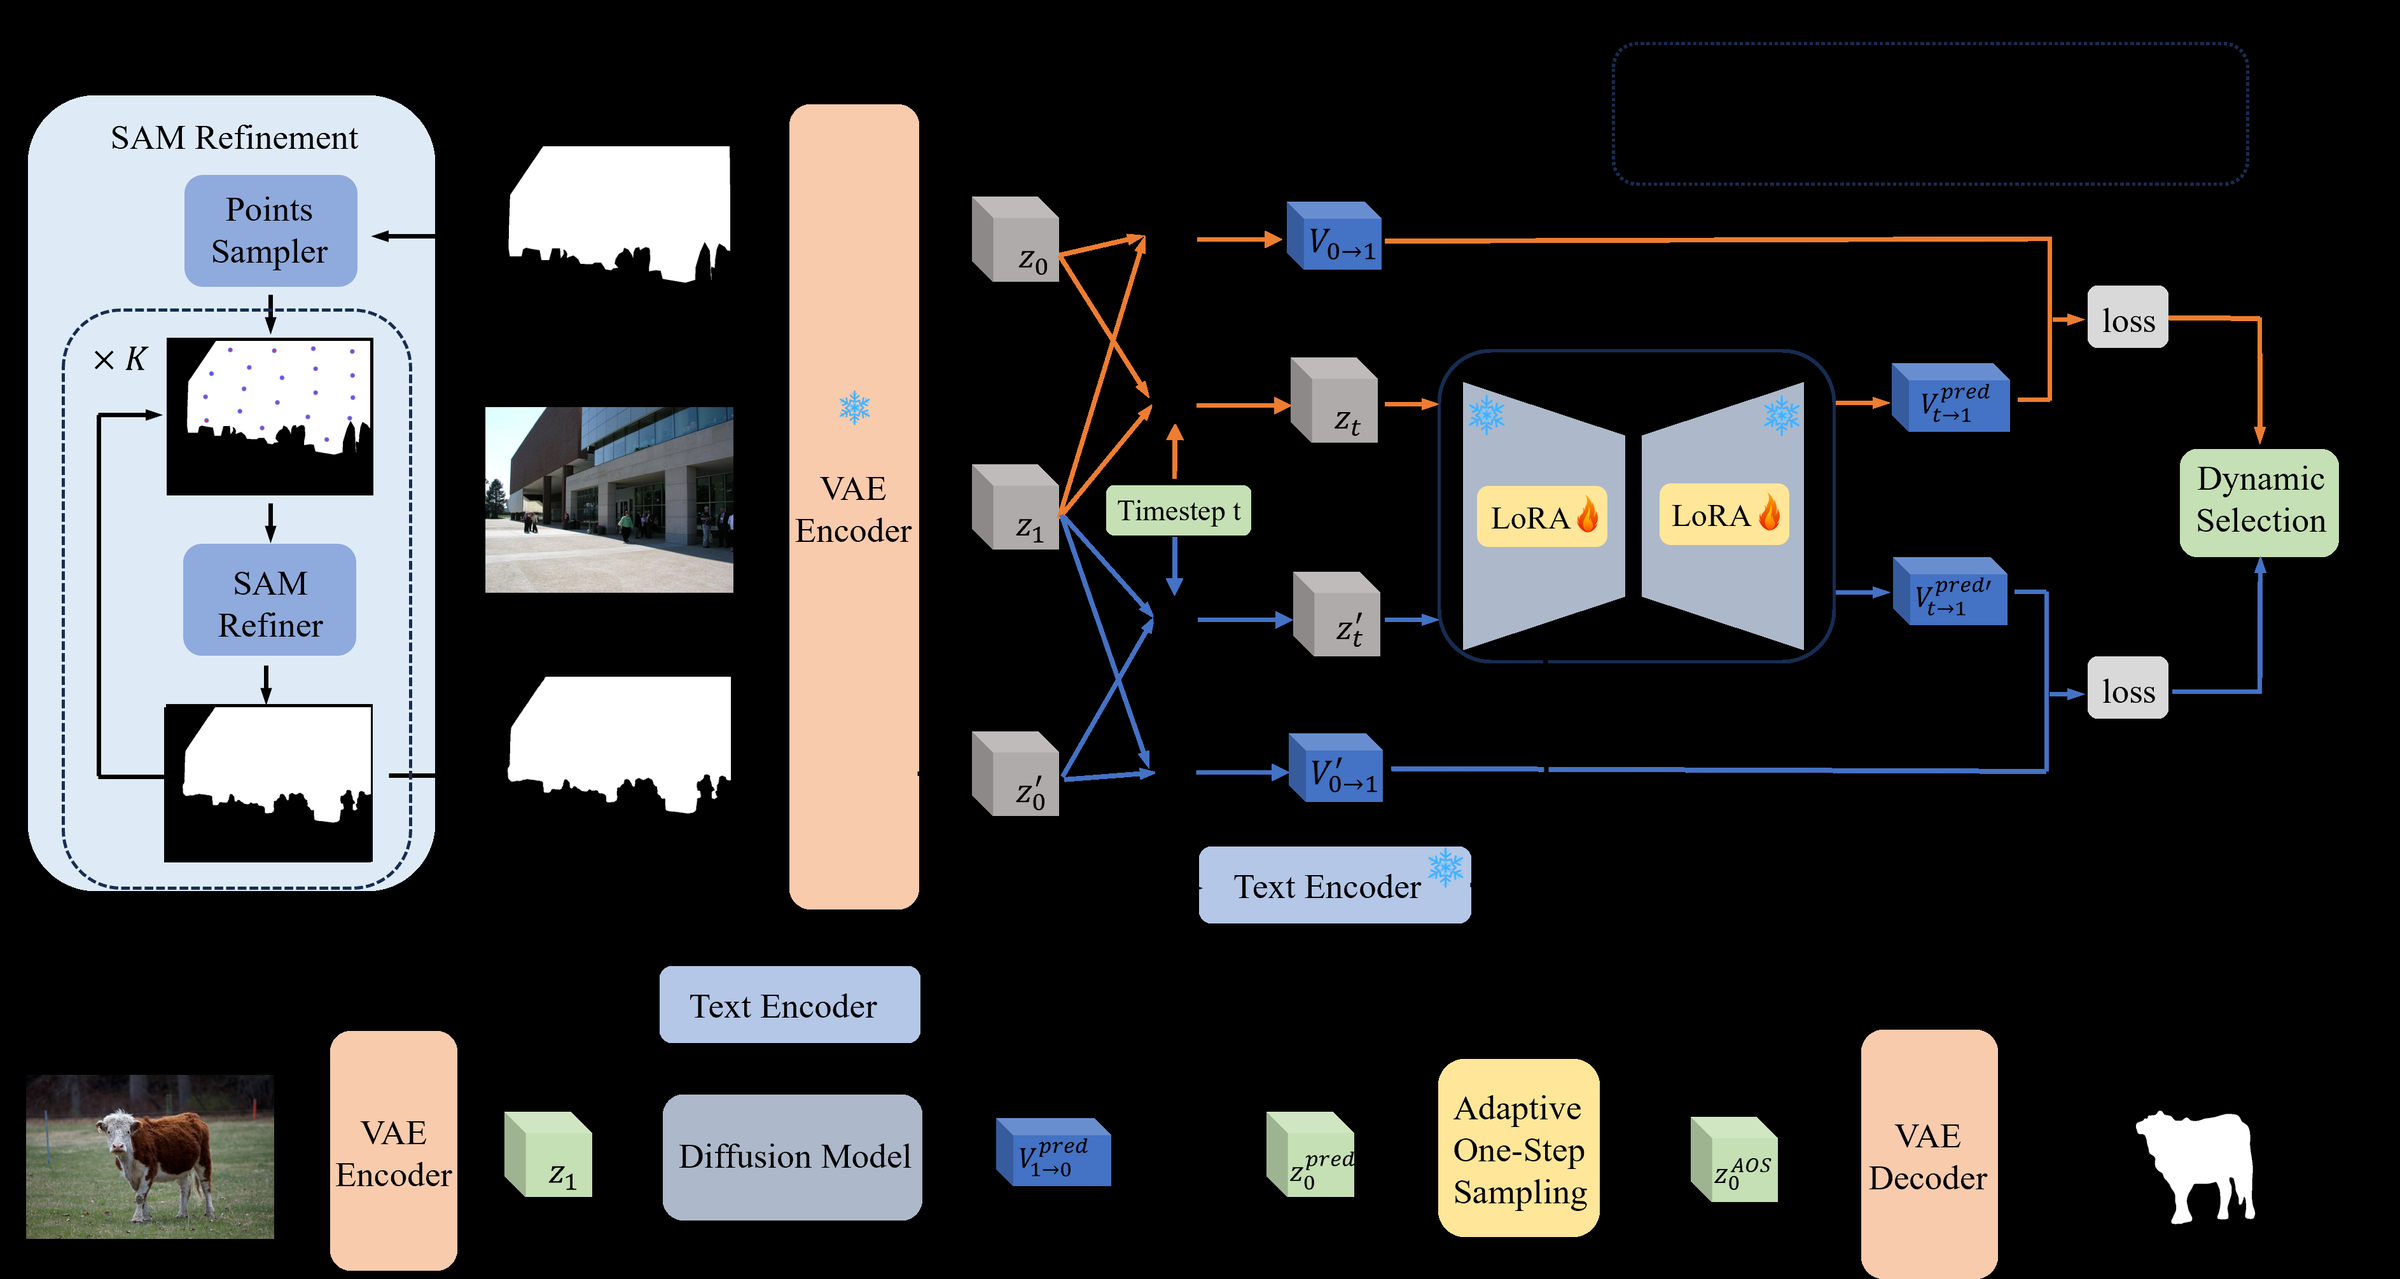
效果: 在零样本场景下显著优于之前的扩散方法,单步推理即可达到高精度,ICMR 2026 接收
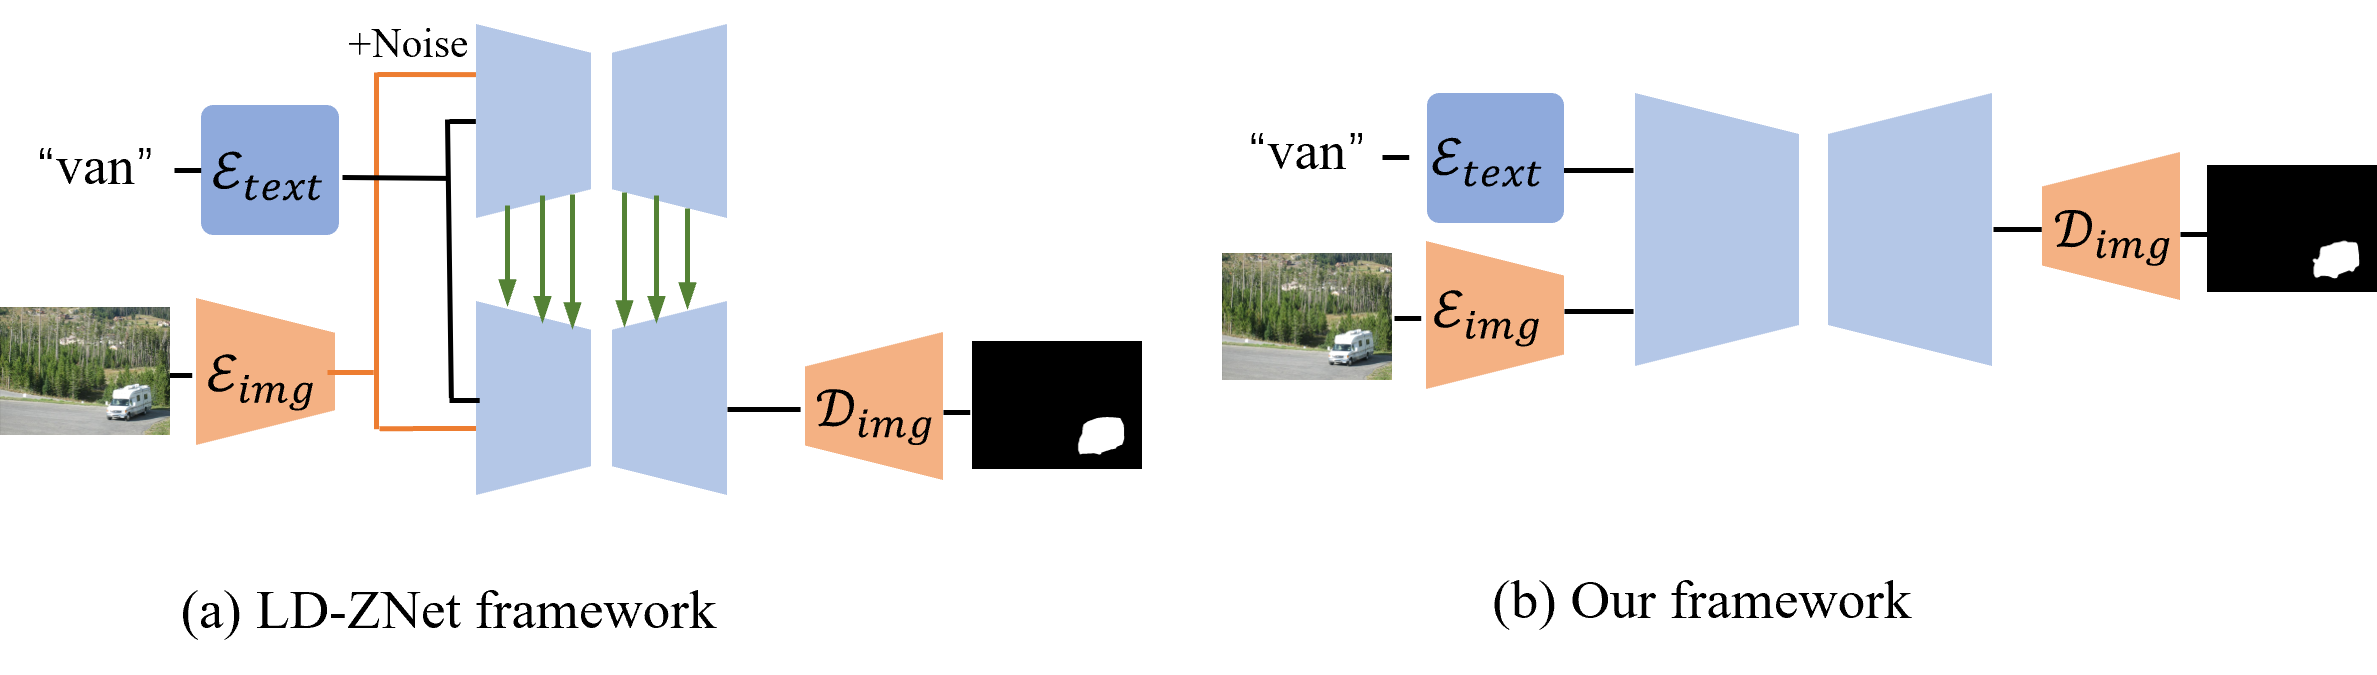
批判点评: 仅在文本分割任务验证,能否推广到其他像素级任务未知;Rectified Flow 的训练稳定性在大规模数据上的表现有待验证
人工智能炼丹君 整理 | 2026-05-08




评论 (0)