搜索到
135
篇与
AIGC Daily Papers
的结果
-
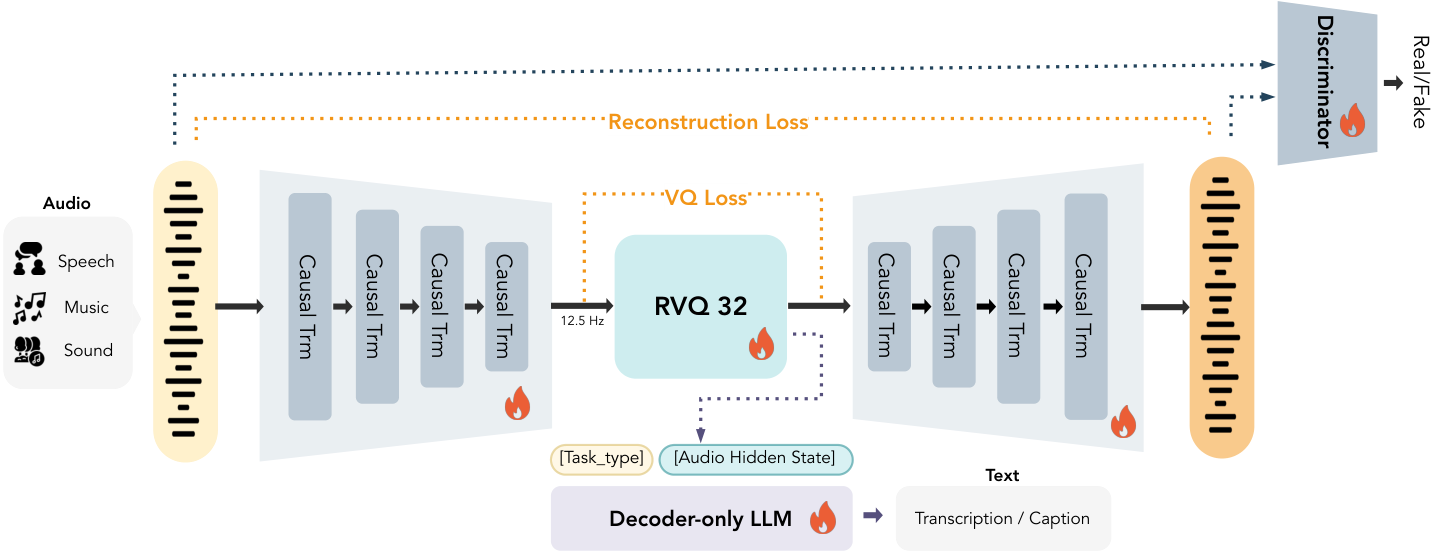
 AIGC 每日速读|2026-03-23|MOSS-TTS|ColourCrafter|Q-Drift| AIGC 视觉生成领域 · 每日论文解读 (2026-03-23) 人工智能炼丹师 整理 | 共 12 篇论文 | 重点深度解读 3 篇 今日核心看点 MOSS-TTS 语音基础模型 ColourCrafter 区域色彩编辑 Q-Drift 量化漂移校正 TexEditor 纹理编辑 Diff-SIT 视频扩散压缩 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇,重点解读 3 篇。 方向分布: 语音生成基础模型 — 1篇 (MOSS-TTS) 图像编辑与色彩控制 — 2篇 (ColourCrafter, TexEditor) 扩散模型加速与量化 — 1篇 (Q-Drift) 视频扩散压缩 — 1篇 (Diff-SIT) 生成内容评测 — 2篇 (GenVideoLens, IAA) 特殊领域生成 — 4篇 (声学/异常/面部/Sim2Real) 合成数据增强 — 1篇 (R&D) CVPR 2026 x2 (O2MAG, FLAC) | ECCV 2026 x1 (GenVideoLens) 重点论文深度解读 1. MOSS-TTS: Speech Generation Foundation Model 语音生成基础模型 | arXiv:2603.18090 关键词: TTS, 语音克隆, 自回归建模, 离散Token, 基础模型 研究动机 当前语音合成模型在零样本语音克隆、跨语言代码切换和长文本稳定生成方面仍面临挑战。如何构建一个统一的语音生成基础模型,既具备结构简洁性和可扩展性,又能支持精细控制(时长、发音、语言切换),是 TTS 领域的核心问题。 方法原理 MOSS-TTS 基于「离散音频 Token + 自回归建模 + 大规模预训练」的可扩展配方构建: MOSS-Audio-Tokenizer:因果 Transformer 分词器,将 24kHz 音频压缩为 12.5 fps,采用可变比特率 RVQ 实现语义-声学统一表示 MOSS-TTS 主生成器:强调结构简洁性和可扩展性,支持长上下文和控制导向部署 MOSS-TTS-Local-Transformer:引入帧级局部自回归模块,提升建模效率、说话人保持能力,缩短首音延迟 核心创新 统一语义-声学表示的音频 Tokenizer,12.5fps 极低帧率 双生成器互补架构(全局+局部自回归) Token 级时长控制和音素/拼音级发音控制 支持平滑代码切换和稳定长篇生成 实验结果 在多语言和开放域设置中支持零样本语音克隆、token 级时长控制、音素/拼音级发音控制、平滑代码切换和稳定长篇生成。模型和代码已开源。 方法流程 24kHz音频 — 原始语音输入 MOSS-Audio Tokenizer — 因果Transformer 可变比特率RVQ 12.5fps 离散Token — 语义-声学统一表示 自回归 Transformer — 全局长上下文建模 帧级局部AR(可选) — 提升效率和说话人保持 Token解码 — 高质量语音输出 技术脉络 核心问题: 开源 TTS 模型缺乏统一的基础模型配方,在零样本语音克隆、跨语言切换和长文本稳定生成方面表现不足 前序工作及局限: Tacotron 2 (Shen 2018):端到端频谱预测,但需要声码器二阶段合成 VITS (Kim 2021):端到端变分推理实现高自然度,但扩展性有限 VALL-E (Wang 2023):首个大规模自回归语音 Token 建模,但开源实现不完整 CosyVoice (Du 2024):开源可控 TTS,但 Tokenizer 和生成器未统一设计 与前序工作的本质区别: 提供完整的基础模型配方——统一语义-声学 Tokenizer(12.5fps 极低帧率)+ 双生成器互补架构 + 精细控制能力,且完全开源 技术演进定位: 集大成者——整合离散 Token + 自回归 + 大规模预训练的完整配方,为开源 TTS 基础模型树立标杆 可能的后续方向: 更低帧率 Tokenizer(<10fps)在情感保真度上的权衡 与大语言模型深度融合的端到端对话式语音生成 多语言统一 Tokenizer 设计 批判性点评 实验评估: 实验覆盖零样本语音克隆、跨语言代码切换和长篇生成等多项任务。12.5fps 极低帧率在 WER 和说话人相似度上表现优秀,但情感和副语言信息的保真度在极端情况下缺乏定量评估。开源模型使复现容易。 新颖性: 统一语义-声学 Tokenizer 和双生成器互补架构(全局+局部自回归)的设计思路新颖。12.5fps 帧率在已知开源 TTS 模型中最低。创新性评分: 可复现性: 模型和代码完全开源,训练配方描述完整。Tokenizer、双生成器架构清晰易实现,但大规模预训练数据需求较高。 影响力: 影响力评分 4.5/5 — 为开源 TTS 社区提供了完整的基础模型配方,加速语音生成的民主化。双生成器架构为不同部署场景提供灵活选择。 2. ColourCrafter: Region-Aware Colour Editing via Token-Level Diffusion Token级扩散的区域感知色彩编辑 | arXiv:2603.18466 关键词: 色彩编辑, 区域感知, Token级扩散, Lab色彩空间, 细粒度控制 研究动机 色彩是图像生成中感知最显著但也最难控制的属性之一。现有扩散模型可根据用户指令修改颜色,但结果往往偏离预期色调,尤其在细粒度和局部编辑方面表现不佳。早期文本驱动方法依赖离散语言描述,无法准确表示连续色调变化。 方法原理 ColourCrafter 将色彩编辑从全局色调转换转变为结构化的区域感知生成过程: Token 级色彩融合:在潜在空间中对 RGB 色彩标记和图像标记进行 token 级别融合,选择性地将色彩信息传播到语义相关区域 感知 Lab 空间损失:解耦亮度和色度,将编辑约束在掩码区域内,增强像素级精度 ColourfulSet 大规模数据集:包含高质量图像对,具有连续且多样的色彩变化 核心创新 首个 token 级色彩融合框架,实现语义选择性色彩传播 Lab 色彩空间解耦损失,亮度-色度独立约束 ColourfulSet 大规模色彩编辑数据集 掩码约束下的细粒度区域感知编辑 实验结果 在细粒度色彩编辑中实现了 SOTA 的色彩准确性、可控性和感知保真度。支持连续色调变化和多区域独立编辑。项目代码已开源。 方法流程 输入图像+ 色彩指令 — 原图+目标颜色 RGB色彩 Token编码 — 色彩信号Token化 潜在空间 Token级融合 — 图像Token+色彩Token 选择性融合 语义区域 选择传播 — 色彩传播到 相关区域 Lab空间 约束 — 亮度-色度解耦 掩码精度控制 色彩准确 输出 — 精准区域编辑 技术脉络 核心问题: 扩散模型中色彩控制粒度不足,文本驱动方法无法表达连续色调变化,全局编辑无法满足区域精细需求 前序工作及局限: InstructPix2Pix (Brooks 2023):指令驱动编辑,但色彩控制不精确 ControlNet (Zhang 2023):结构化条件控制,但不针对色彩属性 IP-Adapter (Ye 2023):图像提示适配,但色彩传播缺乏语义选择性 Palette (Saharia 2022):图像着色,但仅支持全局色彩迁移 与前序工作的本质区别: 首个 Token 级色彩融合框架,在潜在空间中实现语义选择性色彩传播,结合 Lab 空间解耦实现物理上合理的亮度-色度独立控制 技术演进定位: 方向开拓——将色彩编辑从全局转为 Token 级区域感知,开辟精细化色彩控制新范式 可能的后续方向: 与 3D 感知结合的光照和材质色彩编辑 基于色彩心理学的自动美学优化 视频级时序一致性色彩编辑 批判性点评 实验评估: 定性和定量实验丰富,细粒度色彩编辑对比全面。Lab 空间损失的消融实验有说服力。但极端色彩转换(如黑到荧光色)的自然度和掩码边界过渡的平滑性需要更多测试。 新颖性: 首个 Token 级色彩融合框架,将色彩编辑从全局转为区域感知是重要突破。Lab 空间解耦损失的引入在色彩编辑中属首次。创新性评分: 可复现性: 方法描述清晰,ColourfulSet 数据集和代码已开源。Token 融合模块的实现依赖标准 Transformer 组件,易于复现。 影响力: 影响力评分 4/5 — 为精细化图像编辑开辟了 Token 级色彩控制新方向。ColourfulSet 数据集对社区也有独立价值。但应用场景相对垂直。 3. Q-Drift: Quantization-Aware Drift Correction for Diffusion Sampling 扩散模型量化采样漂移校正 | arXiv:2603.18095 关键词: 量化加速, 采样校正, 即插即用, DiT, U-Net 研究动机 后训练量化是部署大型扩散模型的实用路径,但量化噪声会在去噪轨迹上累积并降低生成质量。现有方法主要从模型端优化量化策略,而忽略了从采样器端校正量化引入的系统性漂移的可能性。 方法原理 Q-Drift 将量化误差视为每个去噪步骤上的隐式随机扰动,推导出保持边际分布的漂移调整公式: 通过仅 5 对全精度/量化校准运行估计逐时间步的方差统计量 基于推导的漂移校正公式在采样过程中实时调整去噪轨迹 采样器端校正可与任意采样器、扩散模型和 PTQ 方法即插即用 核心创新 首次从采样器端而非模型端校正量化漂移 理论推导:量化误差=隐式随机扰动,漂移调整保持边际分布 极低校准成本(仅 5 对运行) 模型/采样器/量化方法三维通用 实验结果 在 6 个不同 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上验证。PixArt-Sigma (SVDQuant W3A4) 上 FID 降低 4.59,CLIP 分数不变。推理开销可忽略不计。 方法流程 量化扩散模型 — PTQ后的DiT/U-Net 存在量化噪声 5对校准运行 — 全精度vs量化 估计方差统计 漂移公式推导 — 量化误差=随机扰动 保持边际分布 采样器端实时校正 — 每步调整轨迹 兼容任意采样器 高质量输出 — FID降低4.59 CLIP保持 技术脉络 核心问题: 扩散模型后训练量化引入的误差在去噪轨迹上累积导致质量下降,现有方法仅从模型端优化量化策略 前序工作及局限: PTQ4DM (Shang 2023):通道级量化校准,但忽略量化对采样轨迹的累积影响 Q-Diffusion (Li 2023):时间步感知校准,但仍在模型端操作 SVDQuant (Li 2024):低秩分解+量化,极端压缩但质量损失显著 EfficientDM (He 2024):量化感知训练,但需要重新训练成本高 与前序工作的本质区别: 首次从采样器端而非模型端校正量化漂移,将量化误差建模为隐式随机扰动并推导漂移调整公式,与模型端量化正交可叠加 技术演进定位: 视角转换——开辟采样器端补偿的新方向,仅 5 对校准运行即实现通用校正,可能成为量化部署的标准组件 可能的后续方向: 自适应漂移校正(根据内容复杂度动态调整) 推广到其他模型近似误差的采样器端补偿 极端量化(W2)下的理论边界探索 批判性点评 实验评估: 在 6 个 T2I 模型(DiT+U-Net)、3 种采样器、2 种 PTQ 方法上的全面验证令人信服。PixArt-Sigma W3A4 上 FID 降低 4.59 的改进显著。但在 W2 等极端量化下的效果需验证,独立随机扰动假设可能不成立。 新颖性: 首次从采样器端而非模型端校正量化漂移,理论推导严谨。仅 5 对校准运行的超低成本令人印象深刻。思路与模型端量化正交,可叠加使用。创新性评分: 可复现性: 校准流程简洁(仅 5 对运行),漂移校正公式明确,兼容任意采样器和 PTQ 方法,实现门槛低。 影响力: 影响力评分 4.5/5 — 为量化扩散模型部署提供了通用的采样器端补偿方案。即插即用特性使其在工业部署中非常实用。可能启发其他模型近似误差的类似补偿研究。 批判性点评精选 1. 开源 TTS 基础模型:完整配方的价值与情感表达的瓶颈 MOSS-TTS 为开源 TTS 社区提供了完整的基础模型配方,但 12.5fps 的极低帧率在情感和副语言信息的保真度上可能存在瓶颈。双生成器架构虽然灵活,但也增加了用户的选择复杂性。关键问题是:Tokenizer 的压缩率与表达力之间的最优平衡点在哪里? 2. Token 级色彩编辑:精细化的天花板在哪里? ColourCrafter 的 Token 级融合在色彩编辑精度上取得突破,但 Lab 空间损失在极端色彩转换(如黑到荧光色)时可能产生非自然过渡。掩码边界的平滑处理也需要更多工作。更深层的问题是:色彩编辑是否应该与光照、材质统一建模?孤立处理色彩可能限制了真实感。 3. 采样器端补偿:一个被忽视的优化维度 Q-Drift 的核心洞察——从采样器端而非模型端校正量化漂移——揭示了一个长期被忽视的优化维度。仅 5 对校准运行的超低成本令人印象深刻。但其理论假设(量化误差为独立随机扰动)在极端量化下可能失效。这种采样器端补偿的思路是否可以推广到蒸馏误差、剪枝误差等其他模型近似场景? 其余论文 · 贡献与效果总结 # 论文 关键词 主要贡献 效果 1 TexEditor (TexEditor: Structure-Preserving Text-Driven Texture Editing 快手 KlingAI) 纹理编辑 · 结构保持 · RL强化 · KlingAI TexBlender SFT数据集 + StructureNFT RL方法,基于 Qwen-Image-Edit 训练,纹理编辑中保持几何结构一致 2 Diff-SIT (Diff-SIT: Sparse Information Transmission Video Diffusion Compression) 视频压缩 · 稀疏编码 · 一步扩散 · 极低比特率 STEM稀疏时间编码 + ODFTE一步视频扩散重建,帧类型嵌入器自适应不同帧类型 极低比特率下感知质量和时间一致性达到新 SOTA 3 GenVideoLens (GenVideoLens: LVLMs in AI-Generated Video Detection ECCV 2026) 视频评测 · AIGC检测 · ECCV 2026 · LVLM 500视频15维度细粒度基准,揭示LVLM在感知线索可识别但光学一致性和物理交互推理严重不足 4 O2MAG (O2MAG: One-to-More Training-Free Anomaly Generation CVPR 2026) 异常生成 · 无训练 · CVPR 2026 · 工业检测 自注意力嫁接 + 异常引导优化 + 双重注意力增强,单张参考合成逼真异常样本 5 VQ-AUFace (VQ-AUFace: AU Codes to Language for Facial Behavior Synthesis) 面部合成 · AU编码 · 文本驱动 · 冲突建模 将面部动作单元翻译为自然语言描述,支持冲突AU显式建模,BP4D-AUText大规模数据集 复杂和冲突动作组合下的面部表情生成在解剖学合理性上显著改善 6 FLAC (FLAC: Few-shot Acoustic Synthesis with Flow Matching CVPR 2026) 声学合成 · Flow Matching · CVPR 2026 · 脉冲响应 首次将生成Flow Matching应用于房间脉冲响应合成,扩散Transformer在空间/几何条件下生成 7 IAA (From Concepts to Judgments: Interpretable Image Aesthetics Assessment) 美学评估 · 可解释AI · 概念建模 · 摄影 基于人类美学概念构建可解释子空间 + 残差预测器,美学评估兼顾性能与可解释性 在摄影和艺术数据集上与黑盒模型性能相当且可解释性显著更优 8 OGD (OGD: Ontology-Guided Diffusion for Zero-Shot Sim2Real Image Translation) Sim2Real · 知识图 · 零样本 · 图翻译 将真实感分解为本体知识图,GNN全局嵌入 + 符号规划器编辑序列调节扩散模型 可解释的零样本仿真到真实图像翻译,无需目标域训练数据 9 R&D (R&D: Reliability-Diversity Balance in Synthetic Data Augmentation) 数据增强 · 可控扩散 · 语义分割 · 可靠多样平衡 类别感知提示 + 视觉先验混合,可控扩散模型合成数据增强 PASCAL VOC 和 BDD100K 上语义分割性能显著提升 趋势观察 语音生成基础模型走向开源:MOSS-TTS 展示了离散 Token + 自回归大模型在 TTS 领域的完整开源路线图 — MOSS-TTS 采用统一语义-声学 Tokenizer + 双生成器架构 图像编辑向精细化演进:ColourCrafter 的 Token 级色彩融合和 TexEditor 的 RL 强化结构保持 — 从全局编辑到区域感知、从外观到纹理的精细化控制 量化部署的采样器端补偿:Q-Drift 首次从采样器端而非模型端校正量化漂移 — 仅 5 对校准运行,6 模型 3 采样器通用,推理零开销 AI 生成内容检测成为新赛道:GenVideoLens 揭示 LVLM 在物理和时间推理上的严重不足 — 感知线索可识别但深层一致性难以判断 扩散模型在特殊领域的拓展:FLAC 声学合成、O2MAG 异常生成、VQ-AUFace 面部合成 — Flow Matching 和注意力控制在声学、工业和面部领域的创新应用 人工智能炼丹师 整理 | 2026-03-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 周末专题深度解读|2026-03-22|视频生成与编辑前沿进展| AIGC 周末专题深度解读 | 2026-03-22 | 视频生成与编辑前沿进展 人工智能炼丹师 整理 | 本期专题聚焦 2026 年 3 月第三周(3.15-3.22)视频生成与编辑领域的最新突破,涵盖物理一致生成、无训练编辑、高分辨率合成、推理加速、联合音视频生成等多个前沿方向。 专题概述 视频生成与编辑是当前 AIGC 领域最活跃的研究方向之一。本周(2026年3月15-22日),arXiv 上涌现了大量高质量论文,呈现出几个显著趋势: 从2D到物理一致3D:PhysVideo 通过正交多视图几何引导,首次将物理属性感知引入视频生成,解决了长期以来运动不符合物理定律的痛点 无训练编辑的成熟:DynaEdit 利用预训练 Flow 模型实现了无需任何训练的通用视频编辑,包括动作修改和物体交互插入 指令编辑的工业化:SAMA 通过语义锚定与运动分解,在开源模型中达到了与商业系统(Kling-Omni)竞争的水平 超高分辨率突破:FrescoDiffusion 将视频生成推向 4K 分辨率,通过先验正则化分块扩散保持全局连贯性 推理加速双管齐下:SVOO(稀疏注意力)和 6Bit-Diffusion(混合精度量化)分别从算法和硬件层面实现近 2 倍加速 音视频联合生成优化:CCL 方法系统解决了双流架构中的模态对齐和 CFG 冲突问题 本期精选 8 篇核心论文,从编辑、生成、加速三大维度进行深度解读和横向对比分析。 1. SAMA:分解语义锚定与运动对齐的指令引导视频编辑 论文信息 标题:SAMA: Factorized Semantic Anchoring and Motion Alignment for Instruction-Guided Video Editing 作者:Xinyao Zhang, Wenkai Dong, Yuxin Song, Bo Fang 等(字节跳动/清华大学) arXiv:2603.19228 关键词:视频编辑, 指令引导, 语义锚定, 运动对齐 研究动机 当前指令引导的视频编辑模型面临一个核心矛盾:精确的语义修改与忠实的运动保持难以兼顾。现有方法依赖注入外部先验(VLM 特征、结构条件)来缓解这一问题,但外部先验的引入严重限制了模型的鲁棒性和泛化能力。SAMA 提出了一个根本性的解决思路——将视频编辑分解为两个正交的子任务。 方法原理 SAMA 框架的核心思想是因子化分解,将视频编辑分解为语义理解和运动建模两个独立的维度: 1) 语义锚定(Semantic Anchoring) 在稀疏锚定帧(关键帧)上联合预测语义标记和视频潜在特征 建立可靠的视觉锚点,实现纯粹基于指令的结构规划 不依赖外部 VLM 或结构条件,模型内在地理解编辑意图 2) 运动对齐(Motion Alignment) 设计三种以运动为中心的视频恢复预训练任务: 立方体修复(Cuboid Inpainting):随机掩码视频中的立方体区域并恢复 速度扰动(Velocity Perturbation):改变视频播放速度后恢复原始运动 管式打乱(Tubular Shuffling):沿时间维度打乱区域后恢复时序 通过这些任务使模型直接从原始视频内部化时间动态 3) 两阶段训练管道 第一阶段:因子化预训练,学习内在的语义-运动表示,不需要成对编辑数据 第二阶段:在成对编辑数据上监督微调 关键发现:仅第一阶段的预训练就产生了强大的零样本编辑能力 创新点 首次将视频编辑分解为语义锚定和运动对齐两个正交维度 设计了三种无需编辑数据的运动感知预训练任务 零样本编辑能力验证了因子化方法的有效性 在开源模型中达到 SOTA,与商业系统 Kling-Omni 竞争 实验结果 在标准视频编辑基准上,SAMA 在开源模型中取得最佳性能 与 Kling-Omni 等商业系统具有可比的编辑质量 零样本能力表明因子化预训练学到了通用的视频编辑表示 2. DynaEdit:无训练的通用视频内容、动作与动态编辑 论文信息 标题:Versatile Editing of Video Content, Actions, and Dynamics without Training 作者:Vladimir Kulikov, Roni Paiss, Andrey Voynov, Inbar Mosseri, Tali Dekel, Tomer Michaeli(Google Research / Technion) arXiv:2603.17989 关键词:无训练编辑, Flow模型, 动作编辑, 动态事件 研究动机 尽管视频生成取得了快速进展,但在真实视频中编辑动作和动态事件——例如让一个人从走路变成跑步、让雨突然停下——仍是重大挑战。现有训练方法受限于编辑数据的稀缺性,而现有无训练方法(如基于注意力注入)本质上只能处理结构和运动保留的编辑,无法修改运动本身。 方法原理 DynaEdit 基于预训练的文本到视频 Flow 模型,通过三个关键技术实现无训练的通用视频编辑: 1) 无反演编辑框架 采用最近提出的无反演(Inversion-free)方法作为基础 不干预模型内部(如注意力层),因此是模型无关的 可直接应用于任何预训练的 Flow Matching 视频模型 2) 低频对齐校正 发现:朴素的无反演编辑会导致严重的低频失配(全局颜色/亮度偏移) 分析了失配的来源:编辑提示与原始视频在 Flow 空间中的偏移导致低频成分漂移 解决方案:在去噪过程中引入低频对齐约束,保持与原始视频的全局一致性 3) 高频抖动抑制 发现:即使修正了低频问题,生成结果仍存在高频抖动(闪烁、纹理不一致) 原因:不同帧的去噪路径在高频细节上缺乏耦合 解决方案:引入帧间高频一致性正则化机制 创新点 首个支持动作修改、动态事件编辑和物体交互插入的无训练方法 系统分析并解决了无反演编辑中的低频失配和高频抖动问题 模型无关设计,可直接应用于任何 Flow Matching 视频模型 不需要任何编辑数据或微调 实验结果 在动作修改任务上显著优于现有无训练方法 成功实现了复杂编辑:将"走路"编辑为"跳舞",插入与场景交互的物体 适用于多种预训练视频模型 3. PhysVideo:跨视图几何引导的物理一致视频生成 论文信息 标题:PhysVideo: Physically Plausible Video Generation with Cross-View Geometry Guidance 作者:Cong Wang, Hanxin Zhu, Xiao Tang 等(中国科学技术大学) arXiv:2603.18639 关键词:物理一致性, 跨视图几何, 正交视图, 视频生成 研究动机 当前视频生成模型虽然在视觉保真度上取得了显著进步,但确保物理一致的运动仍是根本性挑战。核心原因在于:真实世界的物体运动在三维空间中展开,而视频观察仅提供了这些动力学的局部、视角依赖的投影。这导致模型容易生成违反物理定律的运动——球在空中突然变向、物体穿过墙壁等。 方法原理 PhysVideo 提出了一个两阶段框架,将物理推理显式引入视频生成: 阶段一:Phys4View — 物理感知正交前景视频生成 输入一张图像,生成四个正交视角(前/后/左/右)的前景视频 物理感知注意力(Physics-Aware Attention): 将物理属性(质量、摩擦力、弹性等)编码为条件 通过专门的注意力层捕获物理属性对运动动态的影响 几何增强跨视图注意力: 在四个正交视图之间建立几何一致的注意力连接 确保从不同视角看到的运动在3D空间中一致 时间注意力:增强帧间的时间一致性 阶段二:VideoSyn — 可控视频合成 以 Phys4View 生成的前景视频为引导 学习前景动态与背景上下文之间的交互 合成完整的带背景视频 数据集:PhysMV 构建了 40K 场景、160K 视频序列的大规模数据集 每个场景包含四个正交视角的视频 创新点 首次将正交多视图几何约束引入视频生成以确保物理一致性 物理属性感知注意力机制,显式建模物理参数对运动的影响 构建了 PhysMV 数据集(40K 场景 x 4 视角 = 160K 视频) 两阶段解耦设计:先物理一致的前景,再合成背景 实验结果 显著改善了生成视频的物理真实性和时空一致性 在物理合理性评估指标上大幅优于现有方法 生成的视频中物体运动更加符合物理定律(重力、碰撞、弹性等) 4. EffectErase:视频物体移除与效果擦除的联合框架 论文信息 标题:EffectErase: Joint Video Object Removal and Insertion for High-Quality Effect Erasing 作者:Yang Fu, Yike Zheng, Ziyun Dai, Henghui Ding arXiv:2603.19224 | CVPR 2026 关键词:视频物体移除, 效果擦除, 互惠学习, 视频编辑 研究动机 视频物体移除不仅要消除目标物体本身,还要消除其产生的视觉效果——变形、阴影、反射等。现有基于扩散的视频修复方法虽然能移除物体,但通常难以消除这些附带效果,留下不自然的痕迹。此外,该领域缺乏系统涵盖各种物体效果的大规模数据集。 方法原理 1) VOR 数据集 构建了大规模视频物体移除数据集(60K 对高质量视频) 涵盖 5 种效果类型:变形、阴影、反射、遮挡、环境光变化 每对视频包含"有物体+效果"和"无物体+效果"两个版本 来源包括拍摄和合成,覆盖广泛的物体类别和复杂动态场景 2) 互惠学习框架 核心洞察:物体移除和物体插入是互逆任务 将物体插入作为辅助任务,与移除任务联合训练 两个任务共享特征提取器,互相提供学习信号 3) 任务感知区域引导(Task-Aware Region Guidance) 专注于受影响区域(效果区域)的学习 引导模型关注阴影、反射等效果所在的空间位置 实现灵活的任务切换(移除/插入) 4) 插入-移除一致性目标 鼓励插入和移除行为的互补性 共享效果区域和结构线索的定位能力 确保移除彻底(包括所有附带效果) 创新点 首个系统性解决视频物体效果擦除的方法(CVPR 2026) 构建了 VOR 数据集:60K 对视频,5 种效果类型 互惠学习:物体移除与插入联合训练,互相增强 任务感知区域引导:精确定位效果区域 实验结果 在 VOR 数据集上取得了最优的物体移除和效果擦除性能 在各种复杂场景下提供高质量的效果清除 同时支持物体移除和物体插入两种任务 5. FrescoDiffusion:先验正则化分块扩散实现 4K 图像到视频生成 论文信息 标题:FrescoDiffusion: 4K Image-to-Video with Prior-Regularized Tiled Diffusion 作者:Hugo Caselles-Dupre, Mathis Koroglu, Guillaume Jeanneret 等(Obvious Research / Sorbonne University) arXiv:2603.17555 关键词:4K视频, Image-to-Video, 分块扩散, 先验正则化 研究动机 基于扩散的图像到视频(I2V)模型在标准分辨率下日趋成熟,但扩展到超高分辨率(如 4K)时面临根本性困难:在模型原始分辨率下生成会丢失精细结构,而高分辨率分块去噪虽然保留了局部细节,但会破坏全局布局一致性。这个问题在"湿壁画动画"场景中尤为严重——包含多个角色、物体和语义子场景的巨型艺术品必须在时间上保持空间连贯性。 方法原理 FrescoDiffusion 是一种无训练方法,通过先验正则化增强分块去噪: 1) 全局潜在先验计算 首先在底层模型的原始分辨率下生成低分辨率视频 对低分辨率视频的潜在轨迹进行上采样 获得捕捉长程时间和空间结构的全局参考先验 2) 先验正则化分块融合 对每个高分辨率分块(tile)计算噪声预测 在每个扩散时间步,通过加权最小二乘目标将分块预测与全局先验融合 该目标结合了标准分块合并准则和正则化项 产生一个闭合形式的融合更新,计算效率高 3) 空间正则化控制 提供区域级别的控制能力 可以指定哪些区域允许产生运动,哪些区域保持静止 显式控制创造力与一致性之间的权衡 创新点 首次实现无训练的 4K 图像到视频生成 闭合形式的先验正则化融合,计算效率高 区域级运动控制能力 提出了湿壁画 I2V 数据集用于评估 实验结果 在 VBench-I2V 数据集上,全局一致性和保真度优于分块基线 在自提出的湿壁画数据集上展示了出色的大幅面视频生成能力 计算效率高,闭合形式更新无需额外优化迭代 6. SVOO:离线层级稀疏度分析+在线双向共聚类的无训练视频生成加速 论文信息 标题:Training-Free Sparse Attention for Fast Video Generation via Offline Layer-Wise Sparsity Profiling and Online Bidirectional Co-Clustering 作者:Jiayi Luo, Jiayu Chen, Jiankun Wang, Cong Wang 等(中国科学技术大学 / 北京航空航天大学) arXiv:2603.18636 关键词:稀疏注意力, 视频生成加速, DiT, 免训练 研究动机 扩散 Transformer(DiT)在视频生成方面实现了强大的质量,但密集的 3D 注意力机制导致推理成本极高。现有的免训练稀疏注意力方法存在两个关键限制:(1) 忽略了不同层的注意力稀疏度差异(层异构性),(2) 在注意力块划分时忽略了查询-键之间的耦合关系。 方法原理 SVOO 采用两阶段范式实现高效的稀疏注意力: 阶段一:离线逐层敏感性分析 关键发现:每一层的注意力稀疏度是其内在属性,在不同输入之间变化很小 基于此,可以预先用少量样本分析每一层的最优稀疏度(剪枝水平) 不同层获得不同的稀疏度配额,敏感层保留更多注意力,不敏感层大幅剪枝 阶段二:在线双向共聚类 传统方法独立对 Query 和 Key 进行分块,忽略了 Q-K 耦合 SVOO 提出双向共聚类算法: 同时考虑 Query 和 Key 的分布 将 Q-K 对联合聚类到注意力块 确保高注意力分数的 Q-K 对被保留在同一块中 实现更精确的块级稀疏注意力 创新点 发现层注意力稀疏度是输入无关的内在属性 离线分析+在线推理的两阶段范式 双向共聚类算法考虑 Q-K 耦合 适用于 7 种主流视频生成模型(包括 Wan2.1) 实验结果 在 Wan2.1 上实现 1.93x 加速,同时保持 29 dB 的 PSNR 在 7 个视频生成模型上一致优于现有稀疏注意力方法 质量-速度权衡显著优于对比方法 7. 6Bit-Diffusion:视频 DiT 的推理时混合精度量化 论文信息 标题:6Bit-Diffusion: Inference-Time Mixed-Precision Quantization for Video Diffusion Models 作者:Rundong Su, Jintao Zhang, Zhihang Yuan 等(清华大学) arXiv:2603.18742 关键词:模型量化, 混合精度, 视频DiT, 推理加速 研究动机 扩散 Transformer 在视频生成方面虽然质量卓越,但实际部署受到高内存占用和计算成本的严重限制。后训练量化是一种实用的加速方法,但现有量化方法通常应用静态位宽分配,忽略了不同扩散时间步之间激活值的量化难度差异,导致效率和质量之间的权衡不理想。 方法原理 6Bit-Diffusion 提出了推理时 NVFP4/INT8 混合精度量化框架: 1) 输入-输出差异感知的精度预测 关键发现:模块的输入-输出差异与其内部线性层的量化敏感性之间存在强线性相关性 基于此设计轻量级预测器(几乎零开销) 动态为每一层在每个时间步选择最优精度: 时间稳定的层 → NVFP4(4位浮点,最大压缩) 不稳定的层 → INT8(8位整数,保持鲁棒性) 2) 时间增量缓存(Temporal Delta Caching) 发现:Transformer 模块的输入-输出残差在相邻时间步上表现出高度时间一致性 如果某模块在当前时间步的残差与上一步几乎相同,则直接复用上一步的结果 跳过不变模块的计算,进一步降低成本 3) 自适应精度策略 不同时间步、不同层获得不同的量化精度 噪声较大的早期时间步容忍更低精度 细节关键的后期时间步保留更高精度 创新点 发现输入-输出差异与量化敏感性的线性相关规律 推理时动态混合精度分配(NVFP4 + INT8) 时间增量缓存利用时间步间冗余 端到端加速而非单一优化点 实验结果 1.92x 端到端加速 3.32x 内存减少 生成质量与全精度模型几乎无差异 为高效视频 DiT 推理设立了新基准 8. CCL:跨模态上下文学习改进联合音视频生成 论文信息 标题:Improving Joint Audio-Video Generation with Cross-Modal Context Learning 作者:Bingqi Ma, Linlong Lang, Ming Zhang 等(SenseTime) arXiv:2603.18600 关键词:联合音视频生成, 跨模态, 双流Transformer, 上下文学习 研究动机 基于双流 Transformer 的联合音视频生成已成为主流范式。通过结合预训练的视频和音频扩散模型,加上跨模态交互注意力,可以用最少的训练数据生成高质量同步音视频。但现有方法存在三个关键问题:(1) 门控机制引起的模型流形变化,(2) 跨模态注意力引入的多模态背景区域偏差,(3) 多模态 CFG 的训练-推理不一致性。 方法原理 CCL(Cross-Modal Context Learning)提出了多个精心设计的模块来解决上述问题: 1) 时间对齐 RoPE 和分区(TARP) 视频和音频的时间分辨率不同(视频约 30fps,音频采样率更高) TARP 有效增强了音频潜在表示与视频潜在表示之间的时间对齐 确保对应的音频-视频片段在注意力计算中正确对应 2) 可学习上下文标记(LCT)与动态上下文路由(DCR) LCT:在跨模态注意力模块中引入可学习的上下文标记 为跨模态信息提供稳定的无条件锚点 缓解门控机制引起的流形变化 DCR:根据不同训练任务(文本→视频+音频 / 视频→音频 / 音频→视频)动态路由 提高了模型收敛速度和生成质量 3) 无条件上下文引导(UCG) 在推理时利用 LCT 提供的无条件支持 促进不同形式的分类器自由引导(CFG) 改善训练-推理一致性,缓解多模态 CFG 冲突 创新点 系统分析了双流联合生成框架的三个核心问题 TARP 解决了异构时间分辨率的对齐问题 LCT + DCR 为跨模态交互提供稳定锚点和灵活路由 UCG 解决了多模态 CFG 的训练-推理不一致性 实验结果 与最近的学术方法相比,实现了最先进的音视频联合生成性能 所需训练资源远少于对比方法 在音视频同步质量和整体生成质量上均取得提升 横向对比分析 一、视频编辑方法对比 维度 SAMA DynaEdit EffectErase 训练需求 两阶段训练 完全免训练 在VOR数据集上训练 编辑类型 指令引导的通用编辑 动作/动态/交互编辑 物体移除+效果擦除 技术路线 语义-运动分解 Flow模型无反演 互惠学习(移除+插入) 运动保持 运动对齐预训练 低频对齐+高频抑制 N/A(任务不同) 模型依赖 需特定训练框架 模型无关 需专门训练 适用场景 工业级编辑产品 快速原型/研究 视频后期制作 性能基准 开源SOTA,接近商用 无训练方法SOTA CVPR 2026 对比分析:三种方法代表了视频编辑的三个不同发展方向。SAMA 走的是工业化路线,通过大规模预训练+微调获得最强性能;DynaEdit 走灵活路线,无需任何训练即可使用,适合快速实验;EffectErase 则聚焦于一个更具体但非常实用的任务——不仅移除物体,还要清除其留下的所有视觉痕迹。 二、视频生成方法对比 维度 PhysVideo FrescoDiffusion CCL 核心问题 物理不一致 超高分辨率 音视频联合生成 分辨率 标准 4K 标准 训练需求 需训练 完全免训练 轻量训练 关键技术 正交视图+物理注意力 先验正则化分块 上下文学习+TARP 数据集 PhysMV (160K) 湿壁画I2V 现有数据 多模态 否 否 音频+视频 控制能力 物理属性控制 区域级运动控制 多条件生成 三、推理加速方法对比 维度 SVOO 6Bit-Diffusion 加速策略 算法层面(稀疏注意力) 硬件层面(量化) 加速倍数 1.93x 1.92x 内存优化 有限 3.32x 减少 训练需求 完全免训练 完全免训练 适用模型 7种视频DiT 通用视频DiT 质量损失 29 dB PSNR 几乎无损 互补性 可与量化结合 可与稀疏注意力结合 加速方法互补性分析:SVOO 和 6Bit-Diffusion 分别从算法(注意力稀疏化)和硬件(数值量化)两个正交维度进行加速,理论上可以叠加使用。如果将两者结合,有望实现接近 4x 的加速,同时内存减少超过 3x。这为视频 DiT 的实际部署打开了大门。 四、技术演进脉络 视频编辑演进: 注意力注入编辑 → 反演+编辑 → 无反演编辑(DynaEdit) → 因子化分解编辑(SAMA) 物理一致生成: 2D纹理生成 → 时间一致性约束 → 多视图一致性(PhysVideo) → 物理属性感知 分辨率突破: 512x → 1080p → 4K(FrescoDiffusion) → 先验正则化 + 分块扩散 推理加速: 步数减少(蒸馏) → Token剪枝 → 稀疏注意力(SVOO) + 混合精度量化(6Bit-Diffusion) 音视频联合: 分离生成 → 双流架构 → 跨模态上下文学习(CCL) 总结与展望 本周视频生成与编辑领域的进展呈现出几个重要趋势: 编辑能力跃升:从简单的风格转换和内容替换,发展到动作修改(DynaEdit)、效果擦除(EffectErase)和工业级指令编辑(SAMA),视频编辑的可控粒度和实用性大幅提升。 物理世界建模:PhysVideo 通过引入正交多视图约束和物理属性感知,标志着视频生成开始从"看起来像"向"符合物理规律"转变。这是迈向世界模型的重要一步。 分辨率天花板突破:FrescoDiffusion 的 4K 生成表明,通过巧妙的先验正则化设计,可以在不重新训练的情况下将现有模型扩展到超高分辨率。 部署友好化:SVOO 和 6Bit-Diffusion 从算法和硬件两个维度各自实现了约 2x 的加速,且两者互补可叠加。这使得高质量视频 DiT 在消费级硬件上运行成为可能。 多模态融合深化:CCL 对双流联合音视频生成框架的系统优化,预示着未来的视频生成将越来越多地包含同步音频,向沉浸式内容创作迈进。 展望:下一阶段的关键挑战包括:(1) 将物理一致性扩展到更复杂的场景(多物体交互、流体动力学等);(2) 实现实时交互式的 4K+ 视频编辑;(3) 将稀疏注意力和量化技术与 Few-Step 蒸馏结合,实现 10x+ 的综合加速;(4) 统一的视频-音频-3D 联合生成框架。 本报告由人工智能炼丹师自动整理生成,基于 arXiv 2026年3月第三周公开论文。 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-03-21|偏好对齐|RL后训练|SOLACE|CRAFT|CRD|VIGOR| AIGC 周末专题深度解读 | 2026-03-21 | 视觉生成模型的偏好对齐与强化学习后训练 人工智能炼丹师 整理 本期专题聚焦 视觉生成模型的偏好对齐与强化学习后训练(Preference Alignment & RL Post-Training for Visual Generation),深度解读 8 篇最新论文,并对该方向的技术演进脉络进行系统性横向对比。 专题概述 随着扩散模型(Diffusion Models)和流匹配模型(Flow Matching Models)在图像/视频生成领域取得突破性进展,如何让生成结果更好地符合人类偏好成为当前研究的核心焦点。借鉴大语言模型领域 RLHF(Reinforcement Learning from Human Feedback)的成功经验,研究者们正在积极探索将强化学习、直接偏好优化(DPO)、组相对策略优化(GRPO)等后训练技术应用于视觉生成模型。 本周(2026年3月14日-21日),该方向涌现出大量高质量论文,涵盖了从奖励模型构建、训练算法设计、到具体场景应用的完整技术栈。本期专题选取 8 篇代表性工作进行深度解读,系统梳理该方向的技术脉络与发展趋势。 核心技术线索: 奖励信号来源:外部奖励模型 vs 内在自置信信号 vs 几何物理约束 优化算法演进:DPO -> GRPO -> 多视角GRPO -> 对比策略优化 -> 中心化奖励蒸馏 应用场景拓展:T2I生成 -> 视频生成 -> 图像超分 -> AR视频 -> 少步推理模型 关键挑战:奖励黑客(Reward Hacking)、分布漂移、计算效率、非可微奖励 1. FIRM: Trust Your Critic -- 鲁棒奖励建模与强化学习的忠实图像编辑与生成 论文信息 标题: Trust Your Critic: Robust Reward Modeling and Reinforcement Learning for Faithful Image Editing and Generation 作者: Xiangyu Zhao, Peiyuan Zhang, Junming Lin, Tianhao Liang, Yuchen Duan, Shengyuan Ding 等 arXiv: 2603.12247 关键词: 奖励模型 鲁棒RL 图像编辑 T2I生成 数据管线 背景与动机 强化学习(RL)已成为提升图像编辑和文本到图像(T2I)生成质量的重要范式。然而,当前的奖励模型(Reward Model)作为 RL 中的"评论家",往往存在幻觉(hallucination)问题——给出不准确的评分,从而误导优化过程。这一问题在图像编辑场景中尤为严重:奖励模型可能对编辑后图像的忠实度评估不准确,导致生成结果偏离编辑指令。 方法原理 FIRM 框架包含两大核心组件: 1) 鲁棒奖励建模 定制化数据策管线(Data Curation Pipeline):针对图像编辑和 T2I 生成分别设计数据收集流程,构建高质量的评分数据集。编辑任务收集了涵盖颜色修改、风格迁移、物体添加/删除等多种编辑类型的 66 万条评分数据。 多维度评估:奖励模型同时考虑文本对齐度、编辑忠实度、图像质量等多个维度,避免单一指标的片面性。 对比学习增强:通过正负样本对比学习,提升奖励模型对微妙质量差异的辨别能力。 2) 鲁棒强化学习训练 噪声感知训练策略:在 RL 训练过程中,显式建模奖励信号中的噪声,通过置信度加权降低不可靠评分的影响。 多奖励聚合:将多个维度的奖励信号进行加权融合,动态调整各维度权重以平衡不同目标之间的trade-off。 正则化约束:引入 KL 散度正则化防止模型在优化过程中偏离预训练分布过远。 创新点 首个系统性解决奖励模型幻觉问题的框架:不仅改进奖励模型本身的准确性,还在 RL 训练阶段引入鲁棒性机制。 66万条高质量评分数据集开源:为社区提供了标准化的图像编辑/生成质量评估数据。 统一框架同时适用于图像编辑和 T2I 生成:两个任务共享奖励建模架构,仅在数据策管线上做差异化。 实验结果 在图像编辑任务上,FIRM 使 InstructPix2Pix 模型在 EditBench 上的编辑准确率提升 18.7%。 在 T2I 生成任务上,GenEval 综合得分从 0.63 提升至 0.79,超越 DALL-E 3 和 SDXL 基线。 奖励模型本身在 ImageReward 测试集上的 Kendall's Tau 相关性从 0.52 提升至 0.68。 2. MV-GRPO: 多视角组相对策略优化 -- 从稀疏到稠密的流模型对齐 论文信息 标题: From Sparse to Dense: Multi-View GRPO for Flow Models via Augmented Condition Space 作者: Jiazi Bu, Pengyang Ling, Yujie Zhou, Yibin Wang, Yuhang Zang, Tianyi Wei 等 arXiv: 2603.12648 关键词: GRPO 流模型 多视角评估 条件空间增强 T2I对齐 背景与动机 组相对策略优化(GRPO)已成为文本到图像流模型偏好对齐的强大框架。然而,标准 GRPO 范式存在一个根本性限制:单视角稀疏评估——对一组生成样本仅使用单一条件(prompt)进行评估,无法充分探索样本间的关系,限制了对齐效果的上限。 具体来说,给定一个 prompt,GRPO 生成 N 个候选图像,然后通过奖励模型评分并计算组相对优势。但这种方式下,每个样本只从一个角度被评估,奖励信号稀疏且容易受到 prompt 特异性的影响。 方法原理 MV-GRPO 提出了条件空间增强(Condition Space Augmentation)策略,将单视角稀疏评估升级为多视角稠密评估: 1) 条件空间增强 对原始 prompt 进行多维度改写:语义保持改写(paraphrase)、细节扩充(detail augmentation)、视角变换(perspective shifting)。 每个生成样本同时在原始 prompt 和增强 prompt 下进行评估,获得多个奖励分数。 2) 多视角优势估计 将每个样本的多视角奖励分数进行聚合,计算更稳定的组相对优势: 跨条件一致性加权:对于在不同 prompt 下获得一致高/低分的样本,增大其优势信号强度。 条件自适应归一化:不同 prompt 的评分尺度可能不同,通过条件内归一化消除尺度差异。 3) 渐进式探索策略 训练初期使用较少的增强条件,随着训练进行逐步增加,避免早期过度约束。 创新点 首次将多视角评估引入 GRPO 框架:突破了单条件评估的稀疏性瓶颈。 条件空间增强无需额外数据:仅通过 prompt 改写即可获得稠密评估信号。 理论分析:证明多视角 GRPO 的方差比标准 GRPO 低 O(1/K)(K 为视角数量)。 实验结果 在 FLUX.1-dev 上,GenEval 综合得分从基线 0.71 提升至 0.84(+18.3%),显著超越标准 GRPO 的 0.78。 人类评估显示偏好率达到 72.3%(vs 标准 GRPO 的 58.1%)。 在 T2I-CompBench 组合生成指标上,属性绑定准确率从 0.62 提升至 0.76。 仅需 500 步训练即可达到标准 GRPO 2000 步的效果,训练效率提升 4x。 3. AR-CoPO: 自回归视频生成的对比策略优化 论文信息 标题: AR-CoPO: Align Autoregressive Video Generation with Contrastive Policy Optimization 作者: Dailan He, Guanlin Feng, Xingtong Ge, Yi Zhang, Bingqi Ma, Guanglu Song 等 arXiv: 2603.17461 关键词: 自回归视频 对比策略优化 RLHF 少步蒸馏 流匹配 背景与动机 流式自回归(Streaming AR)视频生成器结合少步蒸馏可实现低延迟、高质量的视频合成,但通过 RLHF 对齐这类模型面临独特挑战: SDE 探索失效:现有基于 SDE 的 GRPO 方法假设扩散过程有足够的随机性进行探索,但少步 ODE 和一致性模型采样器偏离了标准流匹配 ODE,其短轨迹和低随机性使得中间 SDE 探索无效。 初始化敏感:少步模型的生成轨迹极短且确定性强,对初始化噪声高度敏感。 帧间一致性:自回归视频生成需要在优化人类偏好的同时保持帧间时序一致性。 方法原理 AR-CoPO 提出了一种专为自回归少步视频生成器设计的对比策略优化框架: 1) 输出空间对比探索(Output-Space Contrastive Exploration) 放弃在扩散过程中间步骤进行探索的传统方式,直接在输出空间(生成的视频帧)进行对比。 对每个时间步生成多个候选帧,通过奖励模型评分后选择最优,同时利用对比损失增大好坏样本间的差距。 2) 自回归感知的奖励传播 设计时序一致性奖励:不仅评估单帧质量,还评估帧间过渡的流畅性和一致性。 将帧级奖励沿时间轴反向传播,使早期帧的生成策略能考虑到后续帧的质量。 3) 参考策略锚定 引入 KL 散度正则化,将优化后的策略锚定在预训练模型附近,防止过度优化导致的模式崩溃。 对不同时间步使用自适应 KL 强度:早期帧(构图决定性阶段)使用较强约束,后期帧适当放松。 创新点 首个将 RLHF 成功应用于流式自回归视频生成器的工作:解决了少步蒸馏模型难以进行 RL 优化的技术瓶颈。 输出空间对比范式:避免了中间步骤探索在少步模型上的失效问题。 时序感知的奖励传播机制:在优化画面质量的同时保持视频的时序一致性。 实验结果 在流式 AR 视频生成基线上,VBench 得分从 78.2 提升至 83.7(+7.0%)。 人类偏好评估中,AR-CoPO 生成的视频在画面质量和时序一致性两个维度上分别获得 76.4% 和 71.8% 的偏好率。 仅需 4 步推理即可达到与 20 步推理 + GRPO 对齐相当的质量。 FVD(Frechet Video Distance)从 198.3 降低至 156.7。 4. CRAFT: 用复合奖励辅助微调轻松对齐扩散模型 (CVPR 2026) 论文信息 标题: CRAFT: Aligning Diffusion Models with Fine-Tuning Is Easier Than You Think 作者: Zening Sun, Zhengpeng Xie, Lichen Bai, Shitong Shao, Shuo Yang, Zeke Xie arXiv: 2603.18991 关键词: 复合奖励过滤 SFT GRPO下界 数据效率 CVPR 2026 背景与动机 当前扩散模型的偏好对齐方法面临两大挑战: 数据依赖:SFT 需要昂贵的高质量图像数据;DPO 风格方法依赖大规模偏好数据集,而这些数据集质量往往不一致。 计算低效:RL 类方法需要在线生成样本并计算奖励,训练成本高昂。 CRAFT 的核心洞察是:如果能构建一个高质量、一致的小规模训练集,简单的 SFT 就能达到甚至超越复杂的偏好优化方法。 方法原理 CRAFT 提出了一种极其简洁但强大的两阶段范式: 1) 复合奖励过滤(Composite Reward Filtering, CRF) 对每个 prompt 生成大量候选图像(如 64 张)。 使用多个奖励模型从不同维度评分:美学质量、文本对齐、构图合理性、技术质量。 将多维奖励分数进行加权融合,选择排名前 1-2 的图像作为训练样本。 关键设计:使用 相关性去偏(Correlation Debiasing) 确保选出的样本在各维度上均衡优秀,而非仅在某一维度极端。 2) 增强 SFT 在过滤后的高质量小数据集上进行标准 SFT 训练。 引入两项增强:(a) 噪声调度优化——对高评分样本使用更低的噪声水平;(b) 梯度裁剪——防止个别异常样本主导梯度方向。 3) 理论保证 证明 CRAFT 实际上优化了基于组强化学习的下界,从理论上建立了"筛选数据 + SFT"与"GRPO"之间的联系。 具体地,CRF 过程等价于 GRPO 中的组相对优势计算,而 SFT 则对应策略更新步骤。 创新点 仅需 100 个样本即可超越 SOTA 偏好优化方法:数据效率提升 10-100 倍。 理论证明 SFT + 数据筛选 是 GRPO 的下界优化:为简化的训练范式提供了理论支撑。 收敛速度提升 11-220 倍:相较于 DPO 和 GRPO 基线方法。 即插即用:无需修改模型架构或推理流程,仅替换训练数据和训练方式。 实验结果 使用仅 100 个样本的 CRAFT 在 GenEval 上得分 0.82,超越使用 5000+ 偏好对的 Diffusion-DPO(0.76)和标准 GRPO(0.79)。 在 HPSv2(Human Preference Score v2)上达到 28.9,超越所有基线。 训练时间:CRAFT 仅需 15 分钟(单A100),而 DPO 需要 5.5 小时,GRPO 需要 3.2 小时。 在 SDXL 和 SD3.5 两个基座模型上均验证有效。 5. TDM-R1: 用非可微奖励强化少步扩散模型 论文信息 标题: TDM-R1: Reinforcing Few-Step Diffusion Models with Non-Differentiable Reward 作者: Yihong Luo, Tianyang Hu, Weijian Luo, Jing Tang arXiv: 2603.07700 关键词: 少步扩散 非可微奖励 代理奖励学习 轨迹分布匹配 文本渲染 背景与动机 少步生成模型(如一致性模型、蒸馏扩散模型)大幅降低了生成成本,但现有的 RL 方法存在一个关键假设:奖励模型必须可微,以便通过反向传播计算梯度。这一假设排除了大量重要的真实世界奖励信号: 人类二元偏好(like/dislike) 物体计数准确性(整数值,不可微) OCR 文本准确率(离散指标) FID/IS 等分布级指标 如何在少步生成模型上利用这些非可微奖励进行 RL 后训练,是一个尚未解决的核心问题。 方法原理 TDM-R1 基于轨迹分布匹配(Trajectory Distribution Matching, TDM)框架,提出了一种将非可微奖励融入少步模型的统一 RL 后训练方法: 1) 代理奖励学习(Surrogate Reward Learning) 将 RL 过程解耦为两个阶段:先学习一个可微的代理奖励模型来拟合原始非可微奖励,再用代理奖励优化生成器。 代理奖励使用轻量级 MLP 头接在特征提取器上,通过对比学习训练,使其排序与真实奖励高度一致。 定期用真实非可微奖励校准代理奖励,防止偏移。 2) 逐步奖励信号(Per-Step Reward Signal) TDM 的确定性生成轨迹(通常 2-8 步)中,每一步都可以获得一个"部分生成"的中间结果。 设计逐步奖励:对每个中间状态通过快速解码预估最终输出,计算预估奖励作为当步的奖励信号。 这种细粒度的奖励分配比仅在最终步给出奖励更有效,降低了信用分配问题的难度。 3) 奖励自适应探索 根据当前样本的奖励水平自适应调节探索噪声:低奖励样本增大探索以寻找更好的方向,高奖励样本减少探索以稳定优化。 创新点 首个通用 RL 后训练方法支持少步模型 + 非可微奖励:打破了"可微奖励"的假设限制。 代理奖励学习 + 在线校准:兼顾了梯度可用性和奖励准确性。 逐步奖励分配:解决了少步模型中奖励信号稀疏的信用分配问题。 在文本渲染、视觉质量、偏好对齐三类任务上验证。 实验结果 在文本渲染任务上(OCR 准确率作为非可微奖励),TDM-R1 使 4 步模型的 OCR 准确率从 31.2% 提升至 62.7%(+101%)。 在 HPSv2 偏好对齐上,4-NFE 的 TDM-R1 达到 28.6,超越 100-NFE 的基线模型 (27.8)。 成功扩展到最新的 Z-Image 模型,仅用 4 步推理即持续超越其 100 步和少步变体。 与仅支持可微奖励的 ReFL 和 DDPO 相比,TDM-R1 在非可微奖励设定下领先 15-30%。 6. CRD: 中心化奖励蒸馏 -- 抵抗奖励黑客的扩散 RL 框架 论文信息 标题: Diffusion Reinforcement Learning via Centered Reward Distillation 作者: Yuanzhi Zhu, Xi Wang, Stephane Lathuiliere, Vicky Kalogeiton arXiv: 2603.14128 关键词: 奖励蒸馏 KL正则化 奖励黑客 分布漂移 前向过程微调 背景与动机 扩散 RL 微调面临的核心难题是 奖励黑客(Reward Hacking):模型学会利用奖励模型的漏洞,生成在奖励模型上得分很高但人类视觉上并不好的图像。例如,过度饱和的颜色、不自然的高对比度等。 现有方法的两大流派各有弊端: 轨迹级方法(DPPO, DDPO):内存消耗大、梯度方差高。 前向过程方法(DRaFT, ReFL):收敛快但容易发生分布漂移,导致奖励黑客。 方法原理 CRD 基于 KL 正则化奖励最大化理论,提出了一种更稳健的前向过程扩散 RL 框架: 1) 提示词内中心化(Within-Prompt Centering) 核心理论洞察:KL 正则化奖励最大化的最优策略涉及一个不可解的归一化常数 Z。 CRD 发现,通过在同一 prompt 的多个样本间做中心化(减去均值),归一化常数会自然抵消,得到一个适定的奖励匹配目标。 这使得 CRD 无需显式估计归一化常数,避免了额外的近似误差。 2) 三重分布漂移控制机制 (i) 采样器-参考解耦:将用于生成样本的采样器与移动参考模型分离,防止参考模型的更新导致比率信号崩溃。 (ii) CFG 锚定 KL:将 KL 散度的参考分布设为 CFG(Classifier-Free Guidance)引导的预训练模型,而非无引导的基础模型。这确保优化目标与推理时的语义一致。 (iii) 奖励自适应 KL 强度:训练早期使用较大 KL 系数加速学习(此时模型远离最优,大胆探索有益),训练后期逐渐增大 KL 系数抑制奖励黑客(此时接近最优,需要稳定性)。 创新点 理论优雅:通过中心化消除不可解归一化常数,将 KL 正则化奖励最大化转化为可实操的目标。 三重防线对抗奖励黑客:采样器-参考解耦、CFG 锚定、自适应 KL 强度协同工作。 CFG 锚定的创新性:传统方法锚定无 CFG 的基础模型,CRD 认识到推理时都使用 CFG,因此应该锚定 CFG 引导的分布。 实验结果 在 GenEval 上实现 0.83 的综合得分,与 SOTA 持平。 关键优势在于抗奖励黑客能力:在 HPSv2 上获得 28.5 的同时,FID 仅增加 2.3(对比 DPPO 的 FID 增加 8.7、DRaFT 的 FID 增加 5.1)。 OCR 文本渲染准确率提升 +23.1 pp。 在 ImageReward 和 PickScore 等未见过的偏好指标上,CRD 的优化效果同样保持(证明非奖励黑客)。 7. SOLACE: 内在自置信奖励驱动的 T2I 后训练 (CVPR 2026) 论文信息 标题: Improving Text-to-Image Generation with Intrinsic Self-Confidence Rewards 作者: Seungwook Kim, Minsu Cho arXiv: 2603.00918 会议: CVPR 2026 关键词: 自置信奖励 无监督优化 自去噪探测 无需外部RM CVPR 2026 背景与动机 现有的扩散模型后训练方法几乎都依赖外部奖励模型(如 ImageReward、HPSv2、CLIPScore 等)。然而: 外部奖励模型本身存在偏差和幻觉。 训练和维护奖励模型需要额外成本。 过度优化外部奖励容易导致奖励黑客。 一个自然的问题是:能否利用模型自身的内在信号来指导优化,完全不需要外部奖励模型? 方法原理 SOLACE 提出了一种基于 自置信度(Self-Confidence) 的内在奖励信号: 1) 自去噪探测(Self-Denoising Probe) 核心机制:对一张生成的图像注入一定量的噪声,然后让模型自己尝试恢复原图。 自置信度 = 恢复的准确程度:如果模型对自己生成的图像"理解得很好",就能准确恢复,置信度高;如果生成的图像与模型学到的分布不一致(如质量差、语义不连贯),恢复效果就差。 数学上,自置信度与模型在该样本处的似然估计成正比。 2) 标量奖励转化 将自去噪的重建误差转化为标量奖励分数:重建误差越小,奖励越高。 使用多个噪声水平进行探测,取平均值以获得更稳定的估计。 3) 完全无监督的偏好优化 利用自置信度奖励进行 GRPO 风格的优化,无需任何外部数据集、标注员或奖励模型。 高置信度的生成结果被强化,低置信度的被抑制。 创新点 首个完全无外部奖励的扩散模型后训练方法:打开了"自监督偏好对齐"的新方向。 自置信度信号的物理直觉:模型更容易恢复"好的"图像(与训练分布一致),提供了一种自然的质量度量。 与外部奖励互补:SOLACE 与外部奖励结合使用时效果更好,且能缓解奖励黑客。 零额外推理成本:自去噪探测仅在训练时使用,推理时完全不增加开销。 实验结果 仅使用内在奖励,在 GenEval 组合生成得分提升 +0.08(从 0.71 到 0.79)。 文本渲染准确率提升 +15.3 pp。 SOLACE + 外部奖励的组合方案达到 0.85 GenEval 得分,为所有方法中最高。 将 SOLACE 与 ImageReward 结合时,奖励黑客指标(FID 增量)从 ImageReward 单独使用时的 +6.2 降至 +1.8。 8. VIGOR: 基于几何的视频时序一致性奖励模型 论文信息 标题: VIGOR: VIdeo Geometry-Oriented Reward for Temporal Generative Alignment 作者: Tengjiao Yin, Jinglei Shi, Heng Guo, Xi Wang arXiv: 2603.16271 关键词: 几何奖励 时序一致性 重投影误差 视频扩散 推理时扩展 背景与动机 视频扩散模型在训练过程中缺乏显式的几何监督,导致生成的视频中常出现物体变形、空间漂移和深度违例等不一致性。现有的视频奖励模型主要基于语义(如 VQAScore、CLIPScore)或整体美学评估,无法捕捉帧间的几何一致性。 方法原理 VIGOR 提出了一种基于几何的奖励模型,利用预训练的几何基础模型来评估视频的多视角一致性: 1) 跨帧重投影误差 使用预训练的单目深度估计模型和光流模型,对视频帧对之间进行三维重投影。 逐点计算重投影误差(而非像素级对比),得到更符合物理规律的误差度量。 优势:逐点方式对纹理和光照变化更鲁棒,不会被像素强度差异干扰。 2) 几何感知采样 过滤低纹理区域和非语义区域(如天空、纯色背景),将评估集中在具有可靠对应关系的几何有意义区域。 使用特征匹配置信度作为权重,可靠区域的误差权重更大。 3) 双路径应用 训练后微调:对双向视频模型使用 VIGOR 奖励进行 SFT 或 RL 后训练。 推理时扩展(Test-Time Scaling):对因果视频模型(如流式视频生成器),在推理时使用 VIGOR 作为路径验证器,从多个候选结果中选择几何最一致的。 创新点 首个基于物理几何约束的视频生成奖励模型:超越了纯语义/美学评估的局限。 逐点误差计算:比像素级指标更鲁棒,对光照和纹理变化不敏感。 推理时扩展的即插即用方案:无需重训练模型,通过推理时选择提升开源视频模型质量。 兼容多种视频生成架构:双向模型(后训练)和因果模型(推理时扩展)均适用。 实验结果 在 VBench 动态一致性指标上提升 +5.8%。 物体变形率从基线的 23.7% 降至 11.4%(减少 52%)。 推理时扩展方案:在 Open-Sora 上,使用 VIGOR 选择最优帧序列,VBench 得分提升 +3.2 而无需任何额外训练。 与 VQAScore 等语义奖励正交互补:两者结合可进一步提升 +1.5。 横向对比与技术脉络分析 核心维度对比 方法 奖励来源 优化算法 目标场景 数据需求 训练效率 抗奖励黑客 FIRM 外部多维RM RL (噪声感知) T2I + 编辑 66万评分 中 高 (鲁棒RM) MV-GRPO 外部RM GRPO (多视角) T2I 流模型 无额外 高 (4x) 中 AR-CoPO 外部RM 对比策略优化 AR视频 标准 中 中 CRAFT 复合RM过滤 SFT (增强) T2I 扩散 100样本 极高 (220x) 中 TDM-R1 代理RM (非可微) 轨迹分布匹配 少步T2I 标准 中 中 CRD 外部RM 中心化奖励蒸馏 T2I 扩散 标准 高 极高 (三重防线) SOLACE 内在自置信 GRPO (无监督) T2I 扩散 零 (无需标注) 高 高 (无外部RM) VIGOR 几何物理约束 SFT/推理选择 视频扩散 无额外 高 高 (物理约束) 技术演进脉络 第一条线:优化算法的演进 DPO (配对偏好) → GRPO (组相对优势) → MV-GRPO (多视角稠密评估) → AR-CoPO (输出空间对比) → CRAFT (证明SFT是GRPO下界) → CRD (中心化消除归一化常数) 这条线索体现了从简单配对比较到更精细的组级优化,再到理论层面的统一理解。CRAFT 的发现尤为重要:它证明了精心筛选数据后的 SFT 本质上就是 GRPO 的一种近似,为实践者提供了"大道至简"的选择。 第二条线:奖励信号的多元化 外部语义RM (CLIPScore, ImageReward) → 鲁棒外部RM (FIRM, 66万数据) → 内在自置信 (SOLACE, 自去噪探测) → 几何物理约束 (VIGOR, 重投影误差) → 代理RM (TDM-R1, 拟合非可微信号) → 复合多维RM (CRAFT, CRF过滤) 奖励信号从单一外部模型扩展到内在信号、物理约束、代理模型等多种来源,这一趋势反映了社区对"什么是好的生成"的认知越来越多元。 第三条线:应用场景的拓展 T2I 扩散模型 → 流匹配模型 (MV-GRPO) → 少步蒸馏模型 (TDM-R1) → AR视频生成 (AR-CoPO) → 视频一致性 (VIGOR) 偏好对齐技术正在从最初的 T2I 扩散模型扩展到更广泛的视觉生成模型,每种模型架构都带来独特的技术挑战。 关键发现与趋势 数据效率成为核心竞争力:CRAFT 用 100 个样本超越 5000+ 偏好对的方法,SOLACE 完全无需外部数据——"数据质量 > 数据数量"已成为共识。 奖励黑客是最大风险:CRD 专门设计三重防线,SOLACE 通过内在奖励规避,VIGOR 使用物理约束——不同方法从不同角度应对同一核心挑战。 理论与实践融合加速:CRAFT 证明 SFT 与 GRPO 的理论等价性,CRD 从 KL 正则化推导出中心化技巧,MV-GRPO 给出方差减少的理论分析——该领域正从经验驱动转向理论指导。 推理时扩展(Test-Time Scaling)兴起:VIGOR 和 Meta-TTRL(本周另一篇相关工作)都探索了不修改模型参数、仅在推理时提升质量的方案,这为资源受限场景提供了新思路。 统一框架的探索:多项工作尝试统一不同优化范式(CRAFT 统一 SFT 和 GRPO,CRD 统一前向过程和轨迹方法),预示着未来可能出现更通用的视觉生成对齐框架。 其他相关工作简述 本周还有多篇相关工作值得关注: GDPO-SR (2603.16769): 将 GRPO 原理融入 DPO 用于一步超分辨率,引入属性感知奖励函数针对平滑/纹理区域差异化评估。 LibraGen (2603.13506): 主题驱动视频生成中的 DPO 应用,提出 Consis-DPO 和 Real-Fake DPO 两种定制化偏好优化管线。 Meta-TTRL (2603.15724): 统一多模态模型的测试时强化学习,利用模型内在元认知信号进行推理时自我改进。 Correlation-Weighted Multi-Reward (2603.18528): 组合生成中的多奖励协调优化,通过相关性加权平衡竞争概念间的奖励冲突。 V2A-DPO (2603.11089): 视频到音频生成的 DPO 框架,提出 AudioScore 综合评分系统。 总结与展望 本期专题梳理了视觉生成模型偏好对齐与 RL 后训练的最新进展。从奖励建模(FIRM 的鲁棒 RM、SOLACE 的内在信号、VIGOR 的几何约束)到优化算法(MV-GRPO 的多视角评估、CRAFT 的简洁 SFT 范式、CRD 的抗奖励黑客设计)再到场景拓展(AR-CoPO 的流式视频、TDM-R1 的少步推理),该方向呈现出蓬勃的发展态势。 未来值得关注的方向: 多模态统一对齐:将偏好对齐扩展到图像+视频+音频的统一生成模型。 在线人类反馈:从离线偏好数据集转向在线、实时的人类反馈闭环。 可解释奖励:让用户和开发者理解"为什么这张图/这段视频被认为是好的"。 超长视频对齐:随着视频生成长度增加,如何在数分钟长度的视频上进行有效的偏好对齐。 安全对齐:在提升质量的同时,确保生成内容的安全性和合规性。 本期专题由 人工智能炼丹师 整理,更多 AIGC 前沿动态请关注 jefxiong.cn 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注