搜索到
119
篇与
论文速读
的结果
-
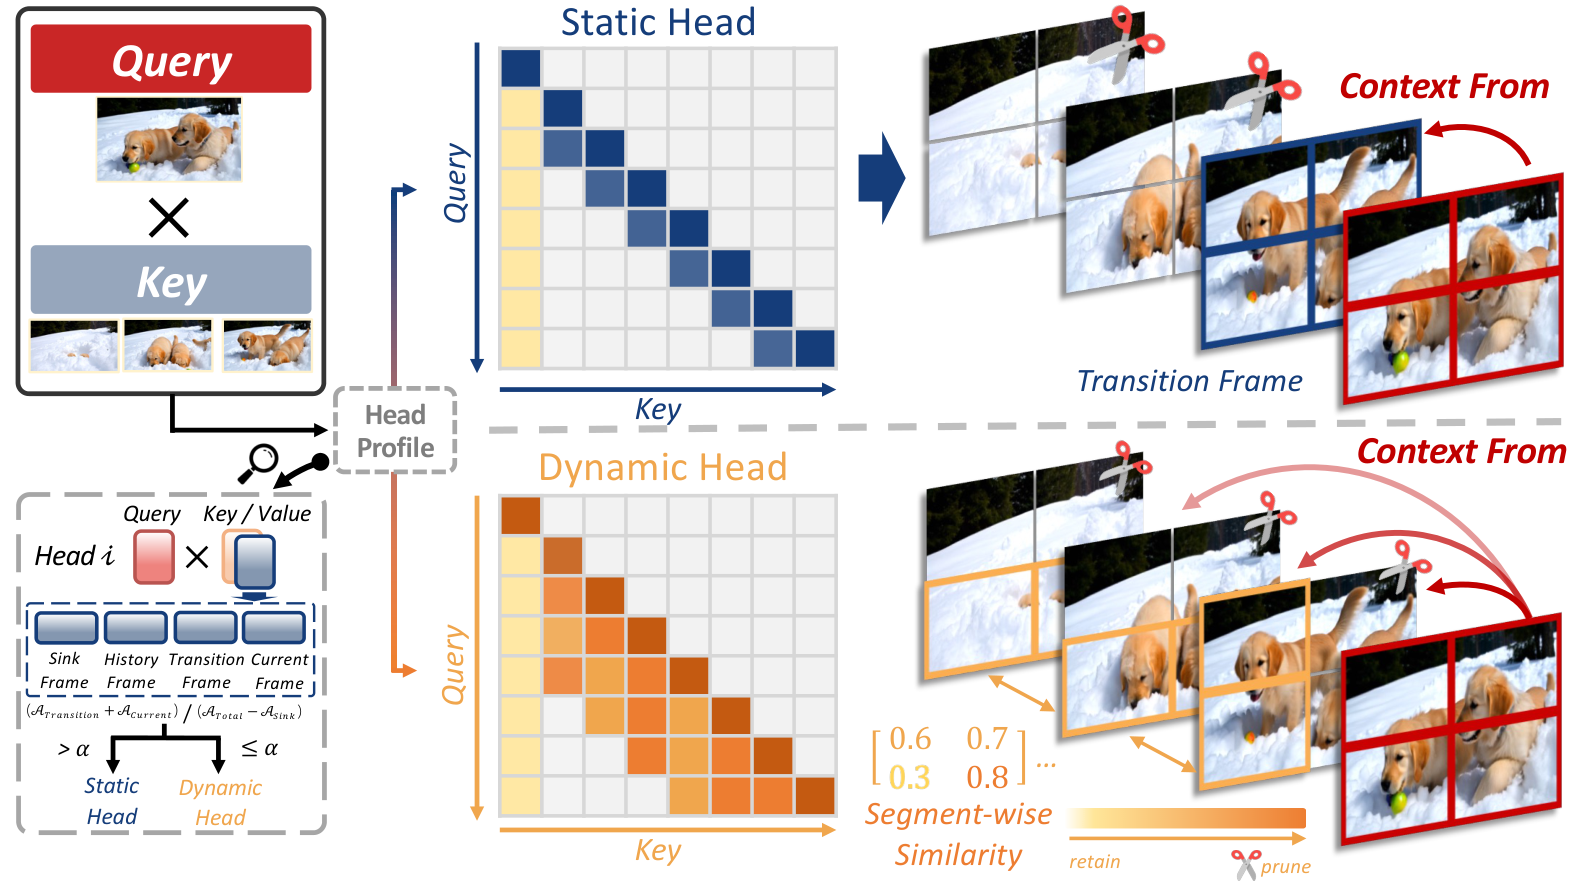
 AIGC 每日速读|2026-05-12|Forcing-KV 视频扩散2.82倍加速突破实时 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与加速 4 篇 · 图像生成与超分 2 篇 · 生成对齐与评估 2 篇 · 视频理解 1 篇 · 语音合成 1 篇 重点论文标题列表 Forcing-KV:混合 KV cache 压缩策略 TIE:一种即插即用的区间感知 RoPE SWIFT:无训练框架 Unison:统一框架 Auto-Rubric as Reward:将 VLM 内隐偏好知识外化为 今日论文速览 1. Forcing-KV:混合 KV cache 压缩策略 Forcing-KV: Hybrid KV Cache Compression for Efficient Autoregressive Video Diffusion Models | Nvidia, MIT, ETH Zurich, ZJU | arXiv:2605.09681 关键词:KV Cache压缩·自回归视频扩散·注意力头特化·流式视频生成·推理加速 前序问题:自回归视频扩散模型(如 Self Forcing)实现了流式长视频生成,但历史帧的 KV cache 冗余导致注意力复杂度爆炸和显存瓶颈,严重限制可扩展性 本文贡献:提出 Forcing-KV 混合 KV cache 压缩策略:发现注意力头具有稳定的功能特化(静态头负责跨 chunk 过渡和帧内保真,动态头负责帧间运动与一致性),对静态头执行结构化剪枝,对动态头执行基于片段相似度的动态剪枝 实验效果:单卡 H200 达到 29+ FPS 并减少 30% cache 显存;在 LongLive 和 Self Forcing 上分别获得 1.35x 和 1.50x 加速(480P),1080P 场景加速比达 2.82x 批判点评:注意力头功能特化的发现颇具洞察,但实验仅在两个 AR 视频扩散模型上验证,是否推广到 CogVideoX 等非 AR 架构有待检验;静态/动态头的划分策略对新架构是否仍然成立存疑 2. TIE:一种即插即用的区间感知 RoPE TIE: Time Interval Encoding for Video Generation over Events | University of Science and Technology of China, Fudan University | arXiv:2605.10543 关键词:时间区间编码·多事件视频生成·RoPE·DiT·时间控制 前序问题:现有视频生成器将时间表征为离散点(点式位置编码),无法表示时间区间和重叠事件——68% 的通用视频片段和 99% 的机器人/游戏片段包含事件重叠,但多事件生成器仍假设单一活跃 prompt 本文贡献:提出 Time Interval Encoding (TIE),一种即插即用的区间感知 RoPE 泛化方案,将时间区间提升为 DiT 交叉注意力的一等原语;基于时间可积性和持续时间不变性两个原则推导出高效闭式 sinc 解 实验效果:在 OmniEvents 数据集上将人工验证的时间约束满足率从 77.34% 提升至 96.03%,时间边界误差从 0.261s 降至 0.073s,同时保持视觉质量不损 批判点评:理论推导优雅(sinc 解的闭式形式),但区间编码的假设依赖均匀核,非均匀时间分布场景的鲁棒性需进一步验证;数据集规模和事件复杂度有限 3. SWIFT:无训练框架 SWIFT: Prompt-Adaptive Memory for Efficient Interactive Long Video Generation | University of Science and Technology of China, Fudan University, Georgia Institute of Technology | arXiv:2605.09442 关键词:长视频生成·语义切换·无训练·自适应记忆·流式推理 前序问题:流式长视频生成中的连续语义切换需要自适应记忆保持视觉连贯性,但现有方法在 prompt 边界重建缓存导致冗余计算,固定显存预算无法灵活适配语义变化 本文贡献:提出 SWIFT(Semantic Windowing and Injection for Flexible Transitions)无训练框架:引入语义注入缓存增强而非重建记忆,逐头语义注入使每个注意力头按视频状态对齐度接收更新,自适应动态窗口按 prompt 阶段分配时间记忆 实验效果:在保持生成质量的同时,单卡 H100 上达到 22.6 FPS,为多 prompt 长视频生成建立了显著更高效的方案 批判点评:无训练方案的通用性令人印象深刻,但逐头注入的语义对齐度计算本身可能引入延迟;仅在因果视频扩散模型上验证,对双向注意力架构的适用性存疑 4. Unison:统一框架 Unison: Harmonizing Motion, Speech, and Sound for Human-Centric Audio-Video Generation | Wuhan University, Westlake University | arXiv:2605.08729 关键词:音视频生成·多模态协调·语音合成·音效生成·人物视频 前序问题:人物视频中的动作、语音和音效具有异质时序特征,联合生成时各模态难以保持一致对齐,导致运动-语音-环境音之间出现明显不匹配 本文贡献:提出 Unison 统一框架:音频流内通过语义引导的协调策略解耦语音与音效生成(双向音频交叉注意力+语义条件门控),跨模态通过双向交叉模态 forcing 策略让更干净的模态引导更噪声的模态,配合渐进稳定策略 实验效果:在音频感知质量和跨模态同步性两方面均达到 SOTA,有效缓解了语音主导问题并增强了声学清晰度 批判点评:多模态协调机制设计精巧,但「更干净模态引导更噪声模态」的假设在实际复杂场景中不一定成立;人物视频数据集的多样性可能限制泛化能力 5. Auto-Rubric as Reward:将 VLM 内隐偏好知识外化为 Auto-Rubric as Reward: From Implicit Preferences to Explicit Multimodal Generative Criteria | Nanyang Technological University, Ant Group, MMLab, CUHK | arXiv:2605.08354 关键词:奖励建模·RLHF·评分准则·文生图对齐·可解释AI 前序问题:多模态生成模型的 RLHF 对齐将人类多维判断压缩为标量/成对标签,丢失了组合结构化偏好,导致奖励 hacking 和不可解释性 本文贡献:提出 Auto-Rubric as Reward (ARR):将 VLM 内隐偏好知识外化为 prompt 特定的评分准则(rubric),将整体意图分解为独立可验证的质量维度;进一步提出 Rubric Policy Optimization (RPO) 将多维评估蒸馏为稳健的二元奖励 实验效果:在文生图和图片编辑基准上超越成对奖励模型和 VLM 裁判,证明瓶颈不在知识缺失而在缺乏分解接口 批判点评:将隐式偏好显式化为 rubric 的思路新颖且可解释性强,但 rubric 生成依赖 VLM 质量——若 VLM 本身存在偏见则 rubric 会继承;RPO 的二元奖励简化是否在高维偏好空间中信息损失过大值得探讨 6. SMFSR:保持噪声起始点 Noise-Started One-Step Real-World Super-Resolution via LR-Conditioned SplitMeanFlow and GAN Refinement | Nanjing University of Science and Technology, ETH Zurich | arXiv:2605.09328 关键词:真实超分·单步推理·流匹配蒸馏·GAN精炼·噪声起始 前序问题:扩散模型真实超分面临效率-质量权衡:多步方法质量好但慢,单步方法用直接 LR→HR 映射替代噪声起始过程从而削弱随机性,限制了真实纹理合成能力 本文贡献:提出 SMFSR:保持噪声起始点+学习以 LR 为条件的直接噪声到 HR 映射;Interval Splitting Consistency 将多步轨迹蒸馏为单步平均速度预测;GAN 精炼阶段(DINOv3 判别器+变分分数蒸馏)补偿渐进精炼的缺失 实验效果:在单步扩散超分方法中达到 SOTA 感知质量,保持快速单步推理的同时实现逼真的纹理细节合成 批判点评:噪声起始+单步映射的设计巧妙地兼顾了多样性和效率,但 GAN 精炼阶段引入的额外训练成本和模式坍塌风险未充分讨论;DINOv3 判别器的选择缺乏消融对比 7. ExtraVAR:无训练策略 ExtraVAR: Stage-Aware RoPE Remapping for Resolution Extrapolation in Visual Autoregressive Models | Tsinghua University | arXiv:2605.10045 关键词:视觉自回归·分辨率外推·RoPE重映射·无训练·注意力校准 前序问题:Visual Autoregressive(VAR)模型训练分辨率固定,直接外推到更高分辨率会出现三种失败模式:全局重复、局部重复和细节退化——根因是频段-阶段错配 本文贡献:提出 Stage-Aware RoPE Remapping 无训练策略:为每个频段分配阶段特定的重映射规则,联合抑制三种失败模式;进一步提出 Entropy-Driven Adaptive Attention Calibration,通过分辨率无关的归一化熵量化注意力分散度并生成逐头缩放因子 实验效果:在结构连贯性和细节保真度上一致优于现有分辨率外推方法,无需额外训练即可在 VAR 模型上实现高分辨率图像生成 批判点评:对 VAR 生成过程中频段-阶段关系的分析深入且自洽,但无训练方法的质量上限受限于原始模型的表征能力;熵驱动校准的闭式解依赖于注意力分布的特定假设 8. OZ-TAL:在线零样本时序动作定位 OZ-TAL: Online Zero-Shot Temporal Action Localization | Harbin Institute of Technology | arXiv:2605.09976 关键词:零样本·在线动作定位·视觉语言模型·无训练·时序定位 前序问题:在线时序动作定位方法通常在特定领域训练,面对未见动作时泛化能力有限,无法适应开放世界中任意视频流的实时动作检测 本文贡献:提出在线零样本时序动作定位(OZ-TAL)新任务和无训练框架:利用现成视觉语言模型(VLM),引入额外机制增强视觉表征并缓解 VLM 固有偏差,在流式视频中检测从未见过的动作 实验效果:在 THUMOS14 和 ActivityNet-1.3 上建立 OZ-TAL 基准,在离线和在线零样本设置下均大幅超越现有 SOTA 批判点评:零样本+在线检测的问题设定有实际价值,但无训练框架对 VLM 能力高度依赖——VLM 的时序理解弱点可能成为瓶颈;基准设置仍较为受限 9. WorldReasonBench:将视频生成评估重构为世界状态预测任务 WorldReasonBench: Human-Aligned Stress Testing of Video Generators as Future World-State Predictors | University of Waterloo, MBZUAI | arXiv:2605.10434 关键词:视频生成评估·世界模型·推理基准·状态预测·奖励模型 前序问题:视频生成器被视为「世界模拟器」,但缺乏直接测试模型能否推理世界状态演化的基准——视频可以视觉逼真但物理/因果/信息一致性完全错误 本文贡献:提出 WorldReasonBench:将视频生成评估重构为世界状态预测任务(初始状态+动作→未来视频),包含 436 个结构化测试用例覆盖 4 个推理维度和 22 个子类别;提出双重评估方法论(过程感知推理验证+多维质量评估)和 WorldRewardBench(~6K 专家标注偏好对) 实验效果:揭示当前视频生成器在视觉逼真与世界推理之间存在持续鸿沟:视频可以看起来令人信服但在动力学、因果性或信息保存方面失败 批判点评:评估框架设计系统全面,但 436 个测试用例的规模可能不足以覆盖开放世界的复杂性;「世界推理」的定义边界模糊——部分子类别更接近常识推理而非物理模拟 10. GibbsTTS:动力学最优调度器 Kinetic-Optimal Scheduling with Moment Correction for Metric-Induced Discrete Flow Matching in Zero-Shot Text-to-Speech | The University of Tokyo | arXiv:2605.09386 关键词:零样本TTS·离散流匹配·动力学最优调度·CTMC·语音合成 前序问题:度量诱导离散流匹配(MI-DFM)利用 token-latent 几何进行离散生成,但受限于启发式调度器需要超参搜索和一阶 CTMC 求解器的有限步路径跟踪误差 本文贡献:推导出动力学最优调度器(训练无关,以恒定 Fisher-Rao 速度遍历概率路径),并引入有限步矩校正调整跳转概率同时保持跳转目标分布不变;构建 GibbsTTS 零样本语音合成系统 实验效果:在统一架构和大规模数据集的控制对比中,GibbsTTS 达到最佳客观自然度且在主观评估中优于掩码离散生成基线;说话人相似度在四个测试集中三个排第一 批判点评:动力学最优调度的理论推导严谨(Fisher-Rao 恒速)且无需额外训练,但 codec-based TTS 的 token 离散化本身引入的信息损失是否被该方法放大未讨论 趋势观察 KV Cache 压缩从 LLM 迁移到视频扩散 — Forcing-KV 证明了注意力头功能特化在视频扩散中同样成立,混合剪枝策略为 AR 视频模型开辟了 1080P 实时生成的路径。LLM 加速技巧向视觉生成的系统性迁移正成为趋势。 时间控制从离散点走向连续区间 — TIE 将 RoPE 从时间点泛化到时间区间,使多事件重叠可被直接表示。这标志着视频生成对时间维度的建模精度正从帧级跃迁到事件级。 无训练方法的崛起与边界 — SWIFT、ExtraVAR 和 OZ-TAL 均采用无训练范式,通过精巧的注意力操作或外部 VLM 实现新能力。无训练方法的共同局限在于受限于基础模型的表征天花板。 奖励建模从隐式走向可解释分解 — ARR 将 RLHF 的黑盒偏好分解为可验证的 rubric 维度,WorldReasonBench 将视频评估分解为 22 个推理子类别——结构化、可解释的评估正在替代标量评分。 单步生成的效率-质量帕累托前沿推进 — SMFSR 通过保持噪声起始+流匹配蒸馏+GAN 精炼,在单步推理中逼近多步质量。单步生成方法正在系统性地补全其相对于多步方法的各项短板。 人工智能炼丹君 整理 | 2026-05-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
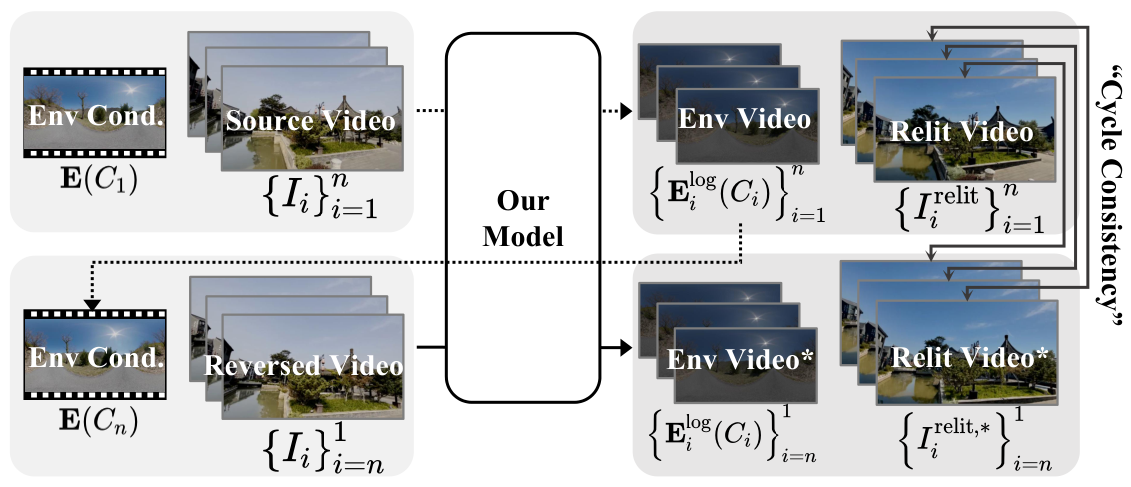
AIGC 每日速读|2026-05-11|Cola DLM 扩散语言模型挑战自回归范式 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与渲染 3 篇 · 扩散模型对齐与RL 2 篇 · 推理加速与蒸馏 2 篇 · 评测基准与奖励模型 2 篇 · 医学视频编辑 1 篇 重点论文标题列表 Relit-LiVE:无需相机位姿的物理一致视频重光照 MARBLE:多维奖励平衡的扩散模型强化学习 HSA:异构步数分配加速DiT视频生成 VURB:视频理解奖励模型的鲁棒基准 ReasonEdit:可解释图像编辑评估 今日论文速览 1. Relit-LiVE:无需相机位姿的物理一致视频重光照 Relit-LiVE: Relight Video by Jointly Learning Environment Video | ETH | arXiv:2605.06658 关键词:视频重光照 · 视频扩散 · 环境贴图预测 · 内在分解 · 神经渲染 前序问题:现有视频重光照范式依赖精确的内在分解(albedo/normal/shading),但真实视频的内在分解高度不可靠,导致重光照结果出现外观失真、材质破损和时序伪影累积 本文贡献:提出 Relit-LiVE,通过引入原始参考图像恢复内在分解中丢失的关键场景线索,并首创环境视频预测公式,在单次扩散过程中同时生成重光照视频和逐帧环境贴图 实验效果:在合成和真实场景基准上均一致优于SOTA视频重光照和神经渲染方法,支持场景级渲染、材质编辑、物体插入和流式视频重光照等下游应用 批判点评:联合预测环境贴图的方式优雅地避开了内在分解的瓶颈,但环境视频预测本身的精度上限取决于扩散模型的几何理解能力;流式重光照的实时性指标未详细报告 2. MARBLE:多维奖励平衡的扩散模型强化学习 MARBLE: Multi-Aspect Reward Balance for Diffusion RL | ETH | arXiv:2605.06507 关键词:扩散模型RL · 多奖励对齐 · 梯度平衡 · 二次规划 · RLHF 前序问题:扩散模型多奖励对齐中,加权求和方案因样本级别不匹配导致梯度互相稀释——大多数 rollout 仅对特定奖励维度有信息量,对其他维度无关,加权聚合丢失了这种差异性 本文贡献:提出 MARBLE 梯度空间优化框架,为每个奖励维度维护独立优势估计器并计算逐奖励策略梯度,通过求解二次规划问题将多维梯度协调为单一更新方向,无需人工调权重 实验效果:在 SD3.5 Medium + 5 个奖励维度上同时提升全部指标,将加权求和方案中最差维度的梯度余弦从80%批次为负扭转为持续正值,训练速度保持基线的 0.97 倍 批判点评:QP 求解将多奖励冲突显式化处理是优雅的,但 5 维奖励的结论能否推广到更多维度(如10+)需验证;EMA 平滑引入的额外超参数可能增加调优成本 3. HSA:异构步数分配加速DiT视频生成 Not All Tokens Need 40 Steps: Heterogeneous Step Allocation in Diffusion Transformers for Efficient Video Generation | Johns Hopkins University | arXiv:2605.06892 关键词:DiT加速 · 异构步数分配 · KV-cache · 视频生成 · 无训练推理 前序问题:DiT 视频生成标准推理对每个 token 均匀施加相同去噪步数,但人类视觉忽略大量冗余运动,均匀分配造成巨大计算浪费 本文贡献:提出 HSA(Heterogeneous Step Allocation),基于 token 速度动态为不同时空 token 分配不同去噪步数,通过 KV-cache 同步机制和缓存 Euler 更新实现无训练推理加速 实验效果:在 Wan-2 和 LTX-2 模型的 T2V/I2V 任务上显著优于现有缓存方法,在 50% 和 25% 计算预算下仍保持结构完整性和生成质量,无需离线 profiling 批判点评:基于速度动态的 token 重要性判断简单高效,但速度指标能否准确捕获所有视觉显著性值得商榷;在极端加速(如 25% 预算)下的长视频质量退化模式需要更多分析 4. VURB:视频理解奖励模型的鲁棒基准 Video Understanding Reward Modeling: A Robust Benchmark and Performant Reward Models | PKU / ByteDance | arXiv:2605.07872 关键词:视频奖励模型 · 偏好学习 · CoT推理 · 视频理解 · 基准测试 前序问题:多模态奖励模型在文本和图像领域进展迅速,但视频理解方向的奖励建模严重受限于缺乏鲁棒的评测基准和高质量偏好数据 本文贡献:提出 VURB 基准(2,100 偏好对 + 长链推理痕迹)和 VUP-35K 全自动偏好数据集,训练出 VideoDRM(判别式)和 VideoGRM(生成式)两种视频奖励模型 实验效果:两种奖励模型在 VURB 和 VideoRewardBench 上均达到 SOTA,VUP-35K 数据同时提升奖励性能和模型推理能力,best-of-N 测试时缩放显著增益 批判点评:统一框架覆盖了基准设计、数据构建和模型训练,但 VURB 偏好对数量(2,100)相对有限;VUP-35K 全自动构建的偏好质量上限取决于标注模型的视频理解能力 5. ReasonEdit:可解释图像编辑评估 ReasonEdit: Towards Interpretable Image Editing Evaluation via Reinforcement Learning | SJTU / UESTC | arXiv:2605.07477 关键词:图像编辑评估 · CoT推理 · 奖励模型 · GRPO · 可解释AI 前序问题:现有文本引导图像编辑(TIE)评估方法大多依赖标量分数缺乏可解释性,主要原因是缺少高质量的 TIE 解释数据集和有效的奖励模型来训练可解释评估器 本文贡献:构建 ReasonEdit-22K 数据集(22K 编辑图 + 113K CoT 样本 + 1.3M 人类判断),提出 RE-Reward 奖励模型和基于 GRPO 训练的可解释评估模型 ReasonEdit 实验效果:在多个公开基准上与人类偏好对齐度优于现有方法,能生成高质量可解释评估文本,实现更透明可信的图像编辑评估 批判点评:首个将 CoT 推理与奖励模型结合到图像编辑评估的工作,数据规模可观(1.3M 人类判断);但可解释性的评估本身就是主观的,"逻辑性/准确性/有用性"三维度的标注一致性需关注 6. CDM:连续时间分布匹配蒸馏 Continuous-Time Distribution Matching for Few-Step Diffusion Distillation | Alibaba / Nankai | arXiv:2605.06376 关键词:蒸馏加速 · 分布匹配 · 连续时间 · Flow Matching · 少步生成 前序问题:DMD 蒸馏在稀疏离散时间步上做分布匹配,加上反向 KL 散度的模式寻求特性,容易产生视觉伪影和过度平滑输出,通常需要 GAN 或奖励模型等复杂辅助模块来恢复保真度 本文贡献:将 DMD 框架从离散锚定首次迁移到连续优化,提出动态连续调度(任意轨迹点分布匹配)和连续时间对齐目标(主动偏离轨迹匹配),无需 GAN 或奖励模型等复杂辅助模块 实验效果:在 SD3-Medium 和 Longcat-Image 上展示了高度竞争力的少步生成视觉保真度,代码已开源 批判点评:连续时间优化思路自然且优雅,有效弥补了 DMD 离散锚定的根本缺陷;但连续调度增加了采样复杂度,实际训练时间和显存开销的对比数据不够充分 7. CASCADE:上下文感知的推测解码加速图像生成 CASCADE: Context-Aware Relaxation for Speculative Image Decoding | UIUC / Qualcomm | arXiv:2605.07230 关键词:自回归图像生成 · 推测解码 · 树搜索 · 接受放松 · 推理加速 前序问题:自回归图像生成计算密集且缓慢,现有推测解码在图像域无法实现文本域那样的效率提升,核心瓶颈是目标模型在图像生成时不确定性高导致草稿 token 拒绝率高 本文贡献:发现目标模型在树状推测解码中的语义可互换性和收敛性两个冗余模式,利用隐状态冗余实现有原则的接受放松策略,并将冗余信号注入草稿模型训练提升独立性能 实验效果:在多个文生图模型和草稿架构上实现最高 3.6 倍加速,保持图像质量和文本-提示忠实度,达到基于草稿的推测解码 SOTA 批判点评:从冗余模式出发设计接受放松策略的思路新颖,3.6x 加速在实用中很有价值;但放松策略的质量保证依赖于冗余模式假设的普适性,在风格差异大的生成任务中可能失效 8. Flow-OPD:在策略蒸馏统一Flow Matching对齐 Flow-OPD: On-Policy Distillation for Flow Matching Models | USTC / UCLA / CUHK / Xiaohongshu | arXiv:2605.08063 关键词:Flow Matching · 在策略蒸馏 · GRPO · 多任务对齐 · 文生图 前序问题:现有 Flow Matching 文生图模型在多任务对齐时面临两大瓶颈:标量奖励导致的奖励稀疏性和异构目标联合优化的梯度干扰,引发"跷跷板效应"和奖励黑客 本文贡献:提出 Flow-OPD,首个将在策略蒸馏集成到 Flow Matching 的统一后训练框架:先通过单奖励 GRPO 培养领域专家教师,再通过冷启动+三步编排将异质专长蒸馏到单一学生模型 实验效果:基于 SD3.5 Medium,GenEval 从 63 提升至 92,OCR 准确率从 59 提升至 94,比 vanilla GRPO 总体提升约 10 分,并展现出"超越教师"效应 批判点评:OPD 从 LLM 社区引入扩散模型是很好的跨界迁移,GenEval +29 的提升显著;但两阶段训练(先训专家再蒸馏)的总计算成本较高,MAR 正则化引入的额外教师也增加了复杂度 9. Diffusion-APO:轨迹感知视频扩散偏好对齐 Diffusion-APO: Trajectory-Aware Direct Preference Alignment for Video Diffusion Transformers | Kuaishou | arXiv:2605.07503 关键词:视频扩散 · 偏好对齐 · 轨迹感知 · RLHF · DPO 前序问题:大规模视频扩散模型与人类意图对齐需要弥合训练噪声分布与推理轨迹之间的固有差异,现有 DPO 和 GRPO 方案受限于有偏奖励模型或次优时间步采样 本文贡献:提出 Diffusion-APO 轨迹感知算法,通过同步训练噪声与推理去噪路径最大化梯度信号效能,配合在线排名/半在线锚定/离线精细化/蒸馏漂移校正的统一模块化 RLHF 框架 实验效果:在视觉质量和指令跟随上一致优于标准基线,同时在模型加速过程中有效保持生成保真度,提供了可扩展的端到端视频扩散对齐方案 批判点评:轨迹感知的梯度信号同步是一个被忽视但重要的问题,模块化 RLHF 框架提供了灵活的多阶段对齐能力;但没有依赖标量奖励模型这一点需要更多消融验证其优势来源 10. OphEdit:无训练的眼科手术视频文本引导编辑 OphEdit: Training-Free Text-Guided Editing of Ophthalmic Surgical Videos | IIST India | arXiv:2605.07695 关键词:手术视频编辑 · 无训练 · ODE反演 · CFG注入 · 眼科AI 前序问题:高保真手术视频生成对医学训练和AI开发至关重要,但将生成模型适配为精确视频编辑面临严峻挑战——手术属性修改(器械-组织交互、手术阶段变换)需满足严格的解剖和时序约束 本文贡献:提出 OphEdit,利用二阶 ODE 反演捕获注意力值张量,在去噪阶段选择性注入 CFG 条件分支,在保持眼部解剖几何的同时实现文本驱动的手术语义修改 实验效果:临床评估显示在器械替换、手术阶段变换等复杂转换中,结构保真度和时序一致性优于自然域视频编辑器,为首个眼科手术域的无训练视频编辑应用 批判点评:首次将无训练视频编辑应用于眼科手术域是一个有价值的交叉创新;但眼科手术的解剖结构相对规整,是否能推广到更复杂的手术场景(如腹腔镜/心脏外科)需验证 趋势观察 视频重光照告别内在分解 — Relit-LiVE 跳过不可靠的内在分解,直接引入参考图像+环境视频联合预测,重新定义了视频重光照的范式 多奖励对齐进入梯度空间 — MARBLE 和 Flow-OPD 不约而同地在梯度层面解决多奖励冲突,标志着扩散模型 RLHF 从标量聚合向精细化梯度调控演进 推理加速的「不均匀」哲学 — HSA 和 CASCADE 都挑战了「均匀对待所有 token/步数」的默认假设,用异构分配和冗余利用实现更聪明的计算资源调度 蒸馏从离散走向连续 — CDM 将 DMD 从固定离散锚点迁移到连续轨迹优化,消除了离散化带来的视觉伪影,是蒸馏范式的重要理论推进 AI评测走向可解释 — ReasonEdit 和 VURB 推动评测从不透明的标量分数走向 CoT 推理和长链偏好标注,让评估本身变得可审计 人工智能炼丹君 整理 | 2026-05-11
-
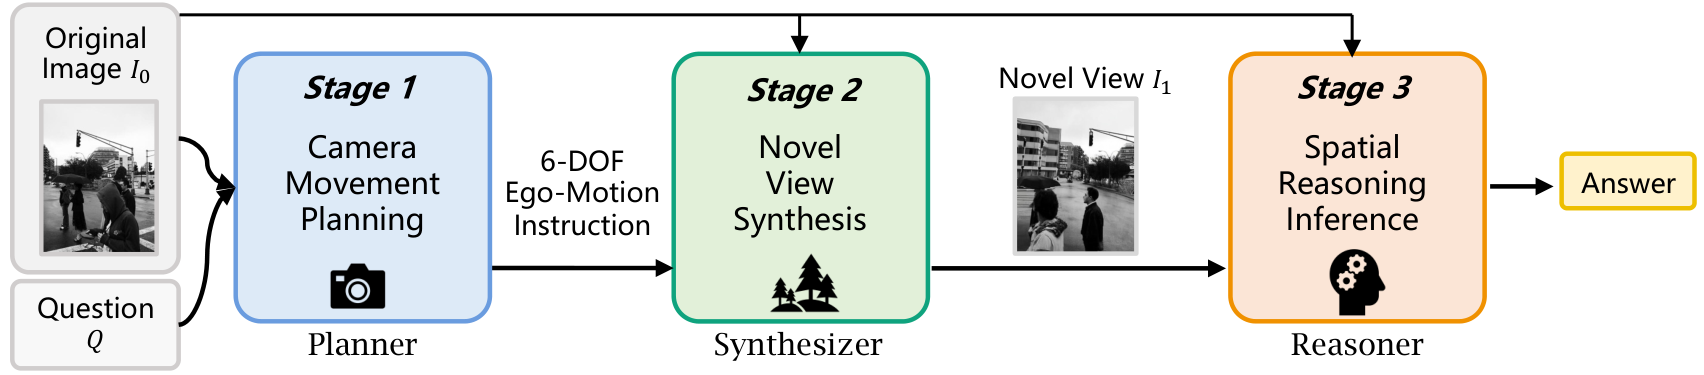
AIGC每日速读|2026-05-08|JoyAI统一模型唤醒空间智能,通义D-OPSD破解少步… 今日核心看点 JoyAI-Image D-OPSD Stream-T1 LIVEditor PhysForge 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 统一多模态生成与理解 2 篇 (JoyAI-Image, Open-Source Editors) 扩散模型微调与蒸馏 1 篇 (D-OPSD) 视频生成与编辑加速 2 篇 (Stream-T1, LIVEditor) 3D生成与风格迁移 2 篇 (PhysForge, DiLAST) 生成内容检测与评测 3 篇 (HAAD, StableI2I, RLFSeg) 今日论文速览 1. JoyAI-Image:唤醒空间智能的统一多模态理解与生成模型 Awaking Spatial Intelligence in Unified Multimodal Understanding and Generation | JoyAI | 2605.04128 关键词: 统一多模态模型·MLLM+MMDiT·空间智能·文生图·指令编辑·新视角推理 前序工作问题: 现有统一多模态模型仅追求功能整合(理解+生成),但在空间感知、几何推理和可控编辑方面能力不足,理解与生成之间缺乏双向增强的闭环 贡献: 提出 JoyAI-Image,将空间增强 MLLM 与 MMDiT 通过共享多模态接口耦合,结合统一指令微调、长文本渲染监督、空间编辑信号和新视角辅助推理,实现理解↔生成双向增强 效果: 在理解、生成、长文本渲染和编辑四大基准上均达 SOTA 或高度竞争,展示了统一模型通向空间智能和世界模型的可行路径 批判点评: 论文未公开模型权重和训练数据细节,且作者机构信息模糊;空间智能的评估维度仍有限,缺少与 GPT-4o 等商业模型在编辑任务上的系统对比 2. D-OPSD:让少步蒸馏扩散模型持续微调不掉速 D-OPSD: On-Policy Self-Distillation for Continuously Tuning Step-Distilled Diffusion Models | Tongyi-MAI (Alibaba) | 2605.05204 关键词: 少步蒸馏·on-policy自蒸馏·LLM/VLM编码器·持续微调·概念学习 前序工作问题: Z-Image-Turbo、FLUX.2-klein 等少步蒸馏模型在传统 SFT 微调后会丧失少步推理能力,导致质量严重退化 贡献: 发现 LLM/VLM 编码器的 in-context 能力可被扩散模型继承,据此设计 on-policy 自蒸馏:同一模型分别以纯文本和多模态条件扮演学生/教师,在模型自身轨迹上最小化分布差异,实现概念/风格学习且保持少步能力 效果: 在 Z-Image-Turbo 和 FLUX.2-klein 上验证,微调后保持原始少步推理速度的同时成功学习新概念和风格 批判点评: 仅验证了图像生成,能否扩展到视频蒸馏模型未知;自蒸馏的教师信号质量依赖参考图像质量,在困难概念上的鲁棒性有待验证 3. Stream-T1:流式视频生成的测试时缩放框架 Stream-T1: Test-Time Scaling for Streaming Video Generation | USTC / FrameX-AI | 2605.04461 关键词: 测试时缩放·流式视频生成·噪声传播·奖励剪枝·记忆沉降 前序工作问题: 基于扩散模型的测试时缩放(TTS)方法候选探索成本巨大且缺乏时序引导,在视频生成中难以规模化应用 贡献: 提出 Stream-T1,首个面向流式视频生成的综合 TTS 框架,包含三个模块:噪声传播(利用历史高质量噪声引导当前生成)、奖励剪枝(短期美学+滑动窗口长期一致性)、记忆沉降(奖励驱动的 KV-cache 动态路由) 效果: 在 5 秒和 30 秒视频基准上显著提升时序一致性、运动平滑度和帧级视觉质量,配合 Stream-R1 构成完整流式生成体系 批判点评: TTS 天然增加推理时间,三个模块叠加后的实际延迟开销未量化;奖励模型本身的偏差可能导致错误剪枝 4. LIVEditor:稀疏注意力加速统一视频编辑 Lightning Unified Video Editing via In-Context Sparse Attention | ICML 2026 | 2605.04569 关键词: 视频编辑·稀疏注意力·ICL·170万数据集·注意力延迟60%削减 前序工作问题: 基于上下文学习(ICL)的视频编辑方法因二次注意力成本产生严重计算瓶颈,限制了实际部署 贡献: 提出 ISA(In-context Sparse Attention),首个面向 ICL 视频编辑的近无损稀疏框架:上下文 token 裁剪 + Query 锐度驱动的动态分组(高误差走全注意力、低误差走零阶泰勒近似),并构建 170 万高质量编辑数据集训练 LIVEditor 效果: 注意力模块延迟削减约 60%,同时在 EditVerseBench、IVE-Bench、VIE-Bench 三个基准上超越 SOTA,ICML 2026 接收 批判点评: 稀疏注意力的误差阈值需手动调节,不同编辑类型的最优配置可能不同;170 万数据集的构建细节和质量保证流程未充分披露 5. PhysForge:物理驱动的交互式3D资产生成 PhysForge: Generating Physics-Grounded 3D Assets for Interactive Virtual World | HKU MMLab | 2605.05163 关键词: 3D资产生成·物理蓝图·运动学注入·15万资产数据集·ICML 2026 前序工作问题: 现有3D生成方法聚焦静态几何,忽略了交互虚拟世界所需的材质、功能、运动学等物理属性,生成的资产无法直接用于仿真 贡献: 提出 PhysForge 两阶段解耦框架:(1) VLM 物理架构师规划分层物理蓝图(材质→功能→运动学);(2) 物理驱动扩散模型通过 KineVoxel Injection 同时合成高保真几何与精确运动学参数。配套 PhysDB 15万资产四级物理标注数据集 效果: 生成的资产可直接用于物理仿真,功能合理性和几何质量均优于现有方法,ICML 2026 接收 批判点评: 15 万数据集的标注质量和覆盖范围未详述;VLM 物理蓝图的错误传播到下游生成的容错机制不明确 6. DiLAST:2D扩散引导唤醒3D潜空间风格迁移 Structured 3D Latents Are Surprisingly Powerful: Unleashing Generalizable Style with 2D Diffusion | N/A | 2605.04412 关键词: 3D风格迁移·结构化3D潜空间·2D扩散引导·OOD风格·即插即用 前序工作问题: 现有3D风格化方法依赖训练分布内的风格图像,面对分布外(OOD)风格时性能严重退化甚至失败 贡献: 提出 DiLAST,利用预训练2D扩散模型作为风格先验教师,通过扩散引导对齐渲染视图与目标风格,优化结构化3D潜空间表示,发现潜空间本身表达力极强但被低估 效果: 在多种数据和多个3D生成骨干上验证有效,即插即用地实现多样OOD风格迁移 批判点评: 需要逐样本优化,速度较慢;风格一致性在复杂拓扑结构上是否稳定未充分验证 7. StableI2I:I2I任务的内容保真与一致性统一评估框架 StableI2I: Spotting Unintended Changes in Image-to-Image Transition | N/A | 2605.04453 关键词: I2I评估·内容保真·前后一致性·无参考评测·MLLM基准 前序工作问题: 现有 I2I 评估主要关注指令遵循和感知质量,忽略了输出是否保持输入的语义对应和空间结构,导致"改了不该改的地方"难以被检测 贡献: 提出 StableI2I 统一动态评估框架,无需参考图像即可评估内容保真和前后一致性;构建 StableI2I-Bench 系统评估 MLLM 在保真与一致性判断上的准确度 效果: 与人类主观判断高度相关,可作为 I2I 系统的标准化诊断工具 批判点评: 评测指标的鲁棒性仅在有限模型集上验证;"不该改的地方"的定义本身带有主观性,边界案例处理不够充分 8. Open-Source Editors:开源图像编辑模型是零样本视觉学习器 Open-Source Image Editing Models Are Zero-Shot Vision Learners | N/A | 2605.04566 关键词: 图像编辑模型·零样本·深度估计·法线估计·语义分割·涌现能力 前序工作问题: 生成模型具有零样本视觉理解能力的证据集中在闭源模型,开源图像编辑模型是否也具备这种涌现能力尚未系统验证 贡献: 系统评估 Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit 三个开源编辑模型在深度估计、法线估计和语义分割上的零样本表现,验证编辑预训练本身催生视觉理解能力 效果: FireRed 法线估计 17.69° 超越微调的 Marigold(20.86°)并匹配 Vision Banana(17.78°);Qwen 在 DIODE 深度达 δ₁=0.868 批判点评: 仅测试三个模型,样本量有限;编辑预训练数据的分布偏差可能导致某些任务表现虚高而非真正涌现 9. HAAD:用哈密顿动力学检测AI生成图像 Detecting Deepfakes via Hamiltonian Dynamics | NUS | 2605.04405 关键词: Deepfake检测·哈密顿动力学·势能面·稳定性分析·跨数据集迁移 前序工作问题: Deepfake 检测器需要针对每种新生成技术反复校准,难以泛化,根本原因是依赖静态模式匹配而非捕获真实/伪造图像的本质差异 贡献: 提出 HAAD,从物理动力学角度出发:将图像潜空间建模为势能面,真实图像对应低能稳定盆地、生成图像对应高能不稳定状态,通过哈密顿轨迹的 action 和能量耗散两个统计量区分真伪 效果: 在跨数据集迁移基准上超越 SOTA 基线,无需针对新生成器重训练 批判点评: 物理类比的假设过强——高质量生成模型可能也会逼近稳定均衡;计算轨迹的额外开销可能限制实时部署 10. RLFSeg:整流流替代扩散实现零样本文本分割 From Diffusion to Rectified Flow: Rethinking Text-Based Segmentation | ICMR 2026 | 2605.04590 关键词: 文本分割·整流流·零样本·单步推理·无架构修改 前序工作问题: 将扩散模型用作文本分割的特征提取器会继承其生成噪声-去噪的固有性质,这对判别性分割任务有害,且需要优化时间步 贡献: 提出 RLFSeg,用 Rectified Flow 替代扩散过程,在潜空间中学习从图像到分割掩码的直接映射,引入标签细化和自适应单步采样策略,零修改模型结构 效果: 在零样本场景下显著优于之前的扩散方法,单步推理即可达到高精度,ICMR 2026 接收 批判点评: 仅在文本分割任务验证,能否推广到其他像素级任务未知;Rectified Flow 的训练稳定性在大规模数据上的表现有待验证 趋势观察 统一生成-理解模型走向空间智能 — JoyAI-Image 将空间理解、文生图、编辑融为一体并加入新视角推理,标志着统一模型从'能做'走向'做好'的拐点 少步蒸馏模型的微调困境被破解 — D-OPSD 利用 LLM/VLM encoder 的 in-context 能力实现 on-policy 自蒸馏,让 Z-Image-Turbo 等模型微调不掉速,打开了个性化少步模型的大门 视频编辑从'能改'走向'秒改' — LIVEditor 通过 ISA 稀疏注意力将上下文冗余裁剪 60%,同时刷新三个编辑基准,ICML'26 认可说明效率与质量可以兼得 人工智能炼丹君 整理 | 2026-05-08
-
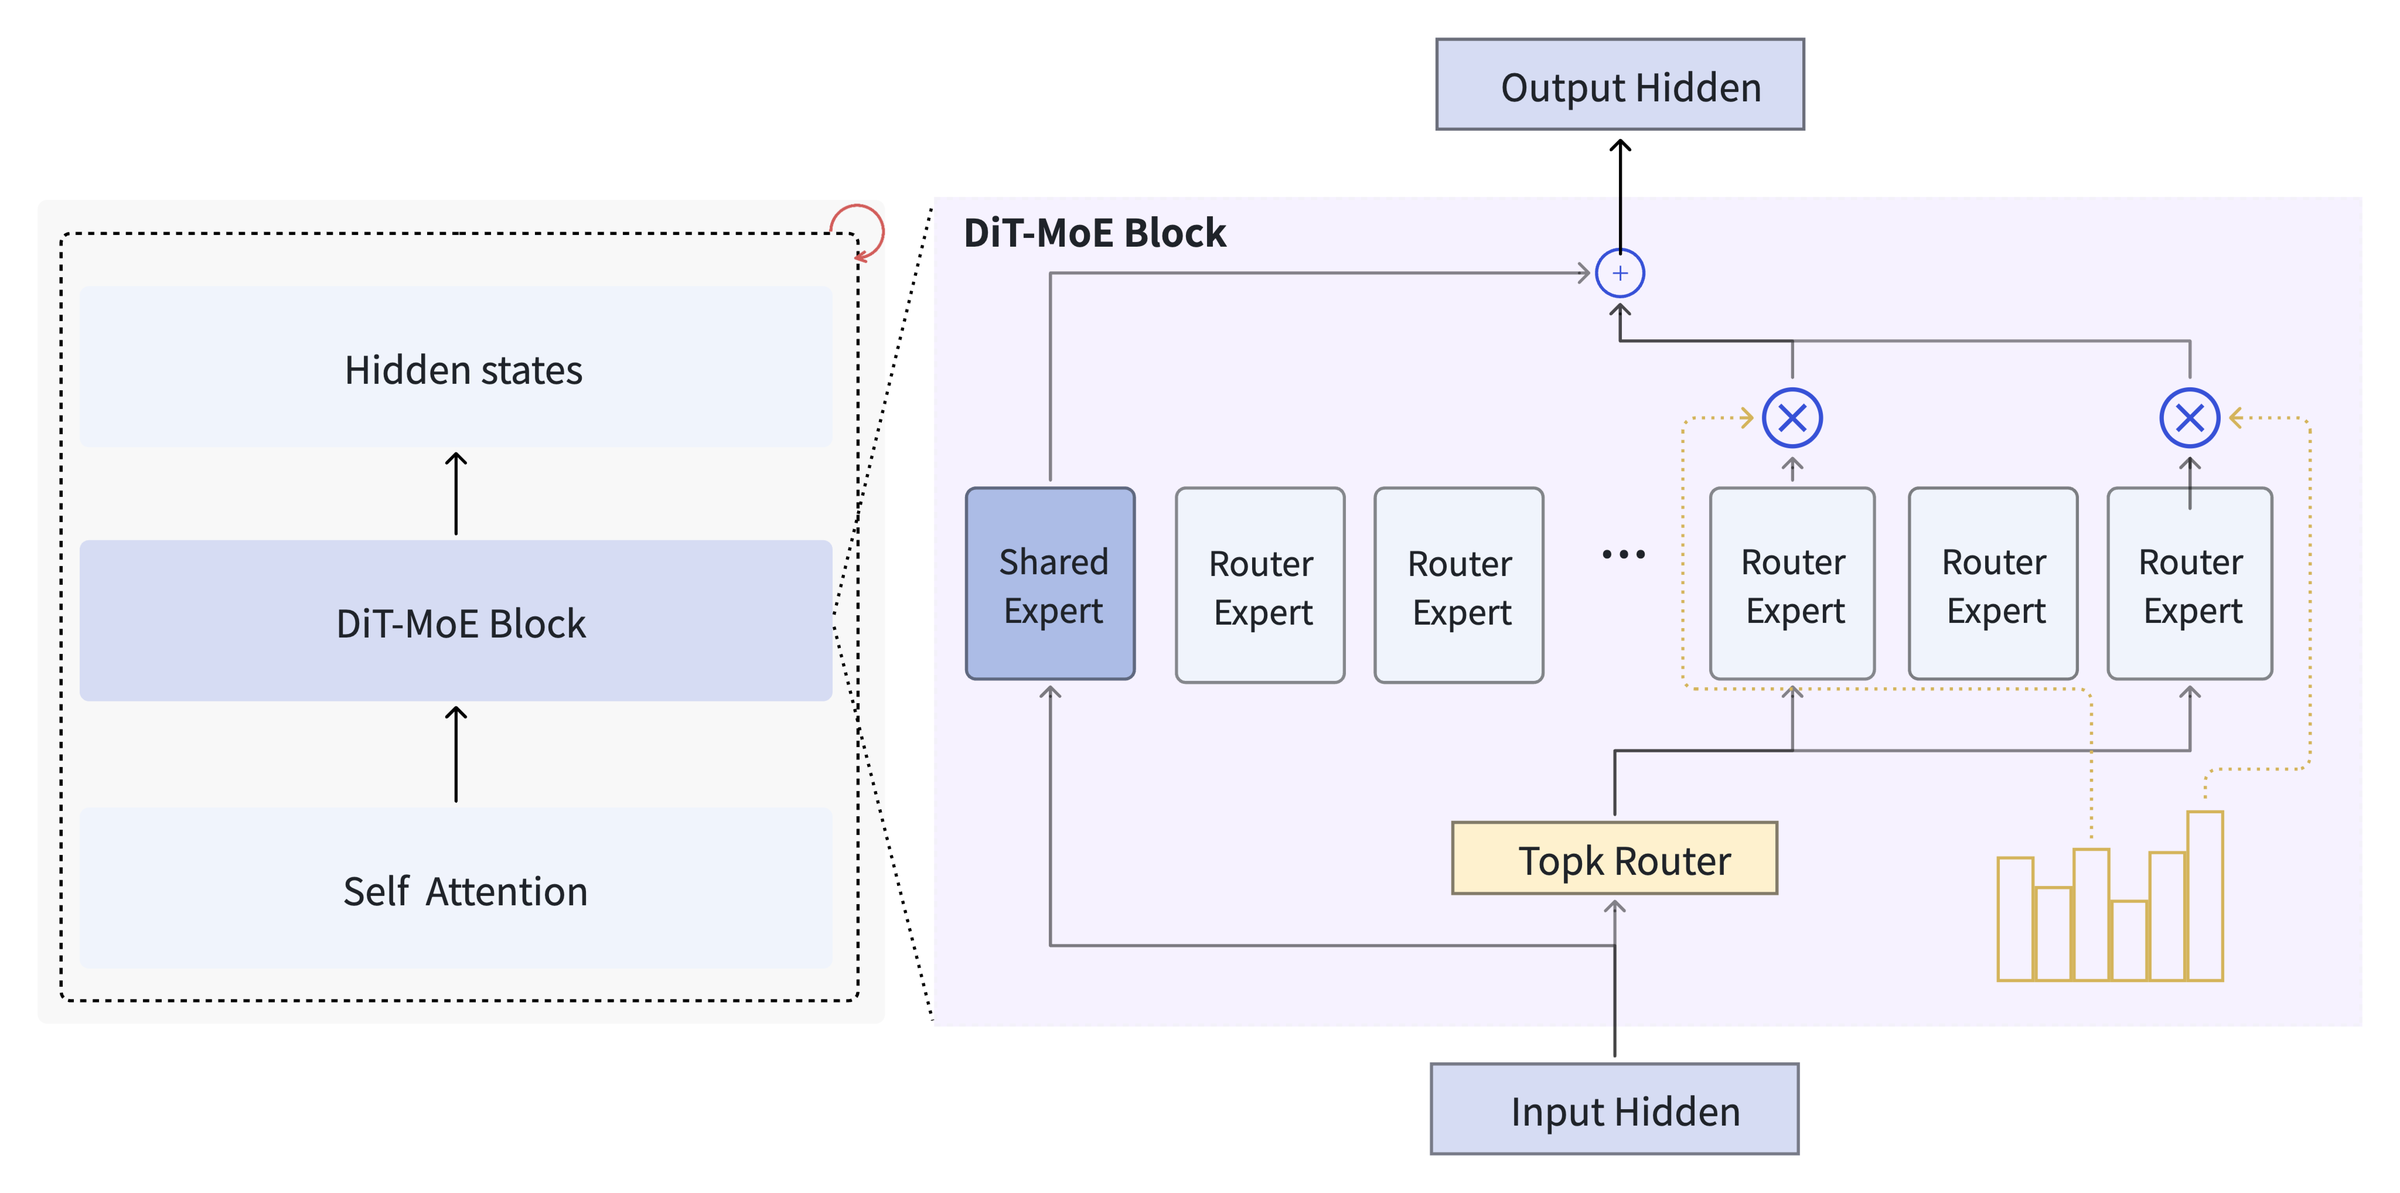
AIGC每日速读|2026-05-06|DiT-MoE统一多模态模型25B仅激活3B,运动感知缓… 今日核心看点 DiT-MoE统一多模态25B(Mamoda2.5) 运动感知缓存加速6.28x(MotionCache) 线性化SD3.5仅1h微调(T5) 64层RVQ音乐生成(Khala) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 统一多模态生成 1 篇 (Mamoda2.5) 视频/图像生成加速 3 篇 (MotionCache, SD3.5-T5, TOC-SR) 音乐生成 1 篇 (Khala) 评测基准 2 篇 (BRITE, Pixel Perfect) 图像编辑与数据集 1 篇 (ScribbleEdit) 3D/人体生成 2 篇 (BlenderRAG, HumanSplatHMR) 今日论文速览 1. Mamoda2.5: Enhancing Unified Multimodal Model with DiT-MoE Mamoda2.5:DiT-MoE统一多模态模型,25B参数仅激活3B,视频编辑加速95.9x | Unknown (Industry) | arXiv:2605.02641 关键词: 统一多模态·DiT-MoE·AR-Diffusion·视频生成·蒸馏加速 前序工作问题: 多模态理解与生成模型通常分离训练,缺乏统一框架;视频编辑推理速度慢难以部署 贡献: 提出统一AR-Diffusion框架,为Diffusion Transformer配备细粒度MoE(128专家Top-8路由),25B参数仅激活3B;联合少步蒸馏与强化学习将30步压缩为4步 效果: VBench 2.0视频生成顶尖,视频编辑创新高;匹敌Kling O1等闭源模型;编辑推理加速95.9x,广告场景成功率98% 批判点评: 128专家路由的负载均衡和专家坍缩问题未详细分析;仅激活3B参数是否在复杂多模态推理任务上存在能力天花板待验证 2. MotionCache: Motion-Aware Caching for Efficient Autoregressive Video Generation MotionCache:运动感知缓存加速自回归视频生成6.28x | Xiamen University | arXiv:2605.01725 关键词: 视频生成加速·运动感知·缓存复用·SkyReels-V2·MAGI-1 前序工作问题: 自回归视频生成因逐步去噪计算量巨大难以部署;现有缓存策略采用粗粒度块级跳步,忽略像素级运动动态 贡献: 形式化证明缓存误差与残差不稳定性的关联,提出利用帧间差分作为像素级运动代理的粗到细策略:预热阶段建立语义连贯,随后按运动权重动态调整每Token更新频率 效果: SkyReels-V2加速6.28x(VBench仅降1%),MAGI-1加速1.64x(VBench仅降0.01%),代码已开源 批判点评: 帧间差分作为运动代理过于简单,无法区分相机运动与物体运动;预热阶段长度为超参数,对不同内容敏感 3. SD3.5-T5: Linearizing Vision Transformer with Test-Time Training 用TTT线性化SD3.5:1小时微调实现1.47x推理加速 | Tsinghua University / ICML 2026 | arXiv:2605.02772 关键词: 线性注意力·TTT·SD3.5·推理加速·权重迁移 前序工作问题: Softmax注意力二次复杂度限制高分辨率生成效率;从头训练线性注意力模型成本过高 贡献: 发现TTT的两层动态公式与Softmax注意力结构对齐,可直接继承预训练权重;引入Key实例归一化和轻量局部性增强模块保持表征一致性 效果: 4xH20 GPU仅1小时微调,文生图质量与原模型可比;1K分辨率1.32x加速,2K分辨率1.47x加速(ICML 2026) 批判点评: 1.47x加速幅度相比FlashAttention等工程优化的叠加优势有限;TTT的额外在线学习开销在批处理场景的表现未报告 4. Khala: Scaling Acoustic Token Language Models Toward High-Fidelity Music Generation Khala:64层RVQ统一声学Token语言建模,无需语义Token阶段 | Tsinghua University | arXiv:2605.01790 关键词: 音乐生成·声学Token·RVQ·语言建模·粗到细 前序工作问题: 现有音乐生成将语义Token与声学Token分离为异构表示空间,系统复杂且信息传递断裂 贡献: 证明文本-声学对齐可在纯声学Token语言建模中涌现无需语义Token阶段;设计64层RVQ统一表示,两阶段粗到细框架固定62步推理,混合注意力训练 效果: 高保真音乐生成,文本-人声对齐自然涌现;超分辨率模型从骨干迁移学习显著提升收敛和质量 批判点评: 64层RVQ的编码复杂度和码本利用率未详细分析;固定62步推理对不同长度音乐的效率适配性待验证 5. BRITE: A Benchmark for Reliable and Interpretable T2V Evaluation on Implausible Scenarios BRITE:首个含音视频对齐的T2V评测基准,实测Sora 2/Veo 3.1/Gen4.5 | Unknown | arXiv:2605.00873 关键词: T2V评测·不合理场景·音视频对齐·人工循环·QA可解释 前序工作问题: 现有T2V评测忽视不合理场景和音视频对齐维度;全自动MLLM评测易受幻觉和歧义影响 贡献: 统一不合理场景提示、细粒度音视频一致性评估和QA式可解释评测三大组件;人工循环协议保障可靠性 效果: 实测Sora 2/Veo 3.1/Runway Gen4.5/Pixverse V5.5/Qwen3Max五大模型,发现物体-动作绑定和音视频同步存在显著性能缺口 批判点评: 仅评测5个模型样本量有限,结论的统计显著性和可推广性存疑;人工循环协议扩展成本高 6. TOC-SR: Task-Optimal Compact Diffusion for Image Super Resolution TOC-SR:贝叶斯优化发现紧凑扩散架构,6.6x参数压缩单步超分 | Unknown (Industry) | arXiv:2605.02767 关键词: 图像超分·紧凑扩散·贝叶斯优化·蒸馏·单步推理 前序工作问题: 扩散超分模型因大参数量和多步采样难以在边缘设备部署 贡献: 从16通道隐扩散模型出发,通过特征级生成蒸馏构建高效替代块,用epsilon约束贝叶斯优化搜索最优紧凑架构,再将多步过程蒸馏为单步生成器 效果: 参数量压缩6.6x,计算量减少2.8x,单步推理保持强重建质量 批判点评: NAS搜索成本本身较高,一次性投入是否划算取决于部署规模;蒸馏后模型在困难退化场景的鲁棒性未评估 7. ScribbleEdit: Synthetic Data for Image Editing with Scribbles and Text ScribbleEdit:涂鸦+文本联合编辑大规模合成数据集 | UC Berkeley | arXiv:2605.01135 关键词: 图像编辑·涂鸦输入·合成数据·空间对齐·多模态控制 前序工作问题: 用户难以同时传达精确空间布局和语义细节;缺乏涂鸦-文本联合编辑的专用训练数据 贡献: 设计自动生成管线:通过修复生成源-目标图像对,配对人工涂鸦和VLM生成的文本指令,构建大规模合成数据集 效果: 微调后模型在空间对齐和语义一致性上显著提升,扩散和自回归两类模型均受益 批判点评: 合成涂鸦与真实用户涂鸦分布差异可能导致域迁移问题;VLM生成的文本指令质量依赖VLM能力上限 8. BlenderRAG: High-Fidelity 3D Object Generation via Retrieval-Augmented Code Synthesis BlenderRAG:检索增强代码合成生成高保真3D对象 | University of Bologna | arXiv:2605.00632 关键词: 3D生成·RAG·Blender代码·LLM·检索增强 前序工作问题: LLM直接生成3D建模代码编译成功率低且几何一致性差,无需微调的3D生成方案匮乏 贡献: 构建500例专家验证的多模态数据集(50类别),RAG检索语义相似示例辅助LLM生成可执行Blender代码,无需微调或特殊硬件 效果: 编译成功率从40.8%提升至70%(+29.2%),CLIP语义对齐从0.41提升至0.77,跨4个LLM一致有效 批判点评: 500例数据集规模有限,复杂场景和组合对象的覆盖度不足;代码生成方式难以表达光滑曲面等连续几何 9. HumanSplatHMR: Closing the Loop Between Human Mesh Recovery and Gaussian Splatting Avatar HumanSplatHMR:闭环联合优化人体Mesh恢复与高斯泼溅化身 | University of Michigan | arXiv:2605.02784 关键词: 人体重建·高斯泼溅·Mesh恢复·闭环优化·新视角合成 前序工作问题: 现有方法将姿态估计与外观重建解耦,姿态误差累积到渲染中无法修正 贡献: 通过可微渲染闭环,将光度/分割/深度损失反向传播到姿态参数和全局位置,实现姿态-外观联合优化 效果: 全局3D姿态恢复精度和新视角渲染质量均超越解耦基线,无需动捕设备即可从视频重建高质量化身 批判点评: 闭环优化增加训练时间;对遮挡严重或极端姿态的鲁棒性未充分验证 10. Pixel Perfect: Relational Image Quality Assessment with Spatially-Aware Distortions Pixel Perfect:自监督关系型IQA,无需人工标注的空间感知质量评估 | Unknown | arXiv:2605.02863 关键词: 图像质量评估·自监督·关系型·空间感知·对比学习 前序工作问题: 传统IQA依赖MOS人工标注,成本高且无法提供可解释的局部反馈 贡献: 从绝对质量预测转向关系型方向性评估;自监督合成失真引擎生成训练数据;反对称目标训练失真预测网络输出空间感知解耦图;对比学习训练评分网络 效果: 完全无需人工标注,提供失真类型/强度/方向的空间感知映射,可针对性优化图像处理算法 批判点评: 合成失真与真实世界失真分布差距可能影响泛化;关系型评估难以与传统MOS指标直接对比 趋势观察 MoE+蒸馏成为统一多模态模型标配 — Mamoda2.5 用128专家Top-8路由实现25B参数仅激活3B,再通过蒸馏+RL将30步压缩为4步,95.9x加速;统一模型正在从'大而全'走向'大而高效' 推理加速从粗粒度跳步走向精细化自适应 — MotionCache 按像素运动强度分配去噪资源实现6.28x加速,SD3.5-T5 用线性注意力替代Softmax实现1.47x加速,加速策略日趋精细和理论化 人工智能炼丹君 整理 | 2026-05-06
-
AIGC论文速读|2026-05-05|纯视觉流统一生成颠覆文本管线,1D-Token端到端FI… 今日核心看点 纯视觉流统一生成(FlowInOne) 端到端自回归FID 1.48(1D-Token) 隐空间压缩加速视频(LC-VAE) 两步跳跃Flow对齐(LeapAlign) 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 统一多模态生成 2 篇 (FlowInOne, UniVidX) 自回归图像生成与预训练 2 篇 (1D-Tokenizer, GenLIP) 推理加速 2 篇 (LC-VAE, DepthVAR) 后训练对齐 2 篇 (LeapAlign, PostTrain) 音视频生成与评测 2 篇 (Talker-T2AV, MOSAIC) 今日论文速览 1. FlowInOne: Unifying Multimodal Generation as Image-In, Image-Out Flow Matching FlowInOne:纯视觉流统一多模态生成,消除跨模态对齐瓶颈 | Microsoft Research Asia | arXiv:2604.06757 关键词: 统一生成·流匹配·视觉提示·Image-In-Out·VisPrompt-5M 前序工作问题: 多模态生成长期被文本管线主导,语言驱动视觉但无法在视觉空间内推理创作,跨模态对齐与任务特定分支增加系统复杂度 贡献: 将所有模态(文本、布局、编辑指令)统一编码为视觉提示,用单一流匹配模型实现 Image-In Image-Out 管线,消除噪声调度和跨模态对齐,配套 VisPrompt-5M 数据集与 VP-Bench 基准 效果: 在文生图、布局引导编辑、视觉指令跟随等任务上全面超越开源模型和商业系统,建立视觉原生统一生成新范式 批判点评: 纯视觉流假设对高度抽象语义(如否定逻辑、数量推理)的编码能力有限;5M 数据集构建成本高且任务覆盖均匀性待验证 2. UniVidX: A Unified Multimodal Framework for Versatile Video Generation via Diffusion Priors UniVidX:统一多模态视频生成框架,不足千条视频实现全向条件生成 | NJU / SIGGRAPH 2026 | arXiv:2605.00658 关键词: 视频生成·统一框架·随机掩码·门控LoRA·跨模态注意力 前序工作问题: 现有方法为每种模态组合训练独立模型,固定输入输出映射且忽略跨模态关联 贡献: 提出随机条件掩码 SCM、解耦门控 LoRA DGL 和跨模态自注意力 CMSA 三大设计,用不到 1000 条视频训练出支持 RGB/内秉图/RGBA 分层的全向条件生成 效果: 在深度/法线/反照率估计和视频分层任务上达到 SOTA,成功泛化到野外场景,被 SIGGRAPH 2026 接收 批判点评: 训练数据仅千条视频,复杂动态场景的泛化鲁棒性存疑;多模态同时生成的质量-一致性权衡未深入分析 3. End-to-End Autoregressive Image Generation with 1D Semantic Tokenizer 端到端训练 1D 语义 Tokenizer,FID 1.48 刷新自回归生图 SOTA | ByteDance Seed / ICML 2026 Spotlight | arXiv:2605.00503 关键词: 自回归生图·1D Tokenizer·端到端·视觉基础模型·FID 1.48 前序工作问题: 两阶段方法先训 Tokenizer 再训生成器,生成信号无法反馈到 Tokenizer,重建与生成目标脱节 贡献: 设计端到端管线联合优化 Tokenizer 与生成器,利用视觉基础模型提升 1D Tokenizer 语义表达能力,实现重建-生成信号直通 效果: ImageNet 256x256 无 guidance 达到 FID 1.48(SOTA),被 ICML 2026 选为 Spotlight 批判点评: 端到端训练需同步两个大模型,显存和训练稳定性要求高;仅在 ImageNet class-conditional 验证,开放域文生图能力未展示 4. GenLIP: Generative Language-Image Pre-training for Vision Transformers GenLIP:ViT直接预测语言Token,极简生成式视觉预训练 | ByteDance | arXiv:2605.00809 关键词: 视觉预训练·生成式·ViT·语言建模·多模态 前序工作问题: 现有视觉预训练依赖对比学习的大批量构建或额外文本解码器,架构复杂且难以扩展 贡献: 让 ViT 用标准语言建模目标直接从视觉 Token 预测语言 Token,单一 Transformer 联合建模视觉与文本,无需对比批构建或额外解码器 效果: 在 8B 样本上训练即达到或超越强对比基线,多模态基准全面竞争力;续训多分辨率后在 OCR 和图表理解上进一步提升 批判点评: 生成式预训练对负样本信息的利用不如对比学习充分;8B 训练数据仍是较大规模,小数据场景表现未报告 5. LC-VAE: Latent-Compressed Variational Autoencoder for Video Diffusion Models LC-VAE:高频裁剪代替通道压缩,解锁视频扩散生成质量 | CVPR 2026 Findings | arXiv:2604.16479 关键词: 视频VAE·隐空间压缩·高频裁剪·扩散收敛·通道冗余 前序工作问题: 视频 VAE 需大量隐通道保证重建质量,但过多通道反而阻碍扩散模型收敛并恶化生成性能 贡献: 提出隐空间高频分量移除策略替代直接减通道,在保持等效压缩比的前提下保留重建保真度,同时释放扩散模型收敛潜力 效果: 同等压缩比下视频重建质量超越强基线,扩散模型训练收敛更快且生成质量更高,被 CVPR 2026 接收 批判点评: 高频裁剪阈值的选取对不同视频类型(快速运动 vs 静态)敏感性未深入分析;仅在特定模型架构上验证 6. DepthVAR: Depth Adaptive Efficient Visual Autoregressive Modeling DepthVAR:按 Token 自适应分配计算深度,VAR 加速 2.3-3.1x | CVPR 2026 Findings | arXiv:2604.17286 关键词: VAR加速·自适应深度·免训练·循环调度·图像生成 前序工作问题: VAR 对每个位置施加固定计算深度,存在显著深度冗余;现有频率图 Token 剪枝方法采用二值硬剪枝,无法提升质量 贡献: 提出从剪枝整个 Token 转向按 Token 自适应分配深度的范式,设计循环旋转调度器与动态推理流程,按处理深度比例混合输出编码 效果: 免训练实现 2.3x-3.1x 加速,质量损失极小且优于硬剪枝方案,被 CVPR 2026 Findings 接收 批判点评: 调度策略为启发式循环旋转,最优深度分配应可学习化;仅验证 VAR 架构,DiT 等其他范式适用性未探索 7. LeapAlign: Post-Training Flow Matching Models at Any Generation Step LeapAlign:两步跳跃轨迹实现 Flow Matching 任意步对齐 | ANU / ByteDance Seed / CVPR 2026 | arXiv:2604.15311 关键词: 后训练·Flow Matching·奖励对齐·梯度稳定·Flux 前序工作问题: Flow Matching 长轨迹反传导致显存爆炸和梯度爆炸,且难以更新决定全局结构的早期步 贡献: 将长轨迹压缩为两步跳跃,每跳跨越多个 ODE 采样步一步预测未来隐变量;随机化起止时间步实现任意步更新,高权重分配给与长路径一致的轨迹 效果: 在 Flux 模型上全面超越 GRPO 和直接梯度方法,图像质量和文图对齐均达 SOTA,被 CVPR 2026 接收 批判点评: 两步跳跃近似引入轨迹偏差,对高步数采样的兼容性需进一步分析;仅在 Flux 单模型验证 8. A Systematic Post-Train Framework for Video Generation 视频生成系统化后训练:SFT+GRPO+提示增强四阶段管线 | Microsoft / HKU | arXiv:2604.25427 关键词: 后训练·视频扩散·GRPO·SFT·提示增强 前序工作问题: 视频扩散模型预训练性能与部署需求间存在巨大差距:提示敏感性高、时间不连贯、推理成本大 贡献: 提出四阶段后训练框架:SFT 转化为指令跟随策略→视频 GRPO 强化感知质量→提示增强器提升输入→推理优化降成本,形成统一可复制管线 效果: RLHF 阶段 GSB 指标提升 31%,提示增强再提 20%,视觉质量与动作连贯性显著增强同时保持语义对齐 批判点评: 文本对齐改善有限暴露当前文本-视频奖励模型瓶颈;四阶段训练流程复杂度高,各阶段超参互相耦合 9. Talker-T2AV: Joint Talking Audio-Video Generation with Autoregressive Diffusion Talker-T2AV:自回归扩散联合生成语音与肖像视频 | Unknown | arXiv:2604.23586 关键词: 音视频联合生成·自回归扩散·解耦解码·唇同步·肖像 前序工作问题: 现有联合音视频生成模型在全层级通过密集注意力耦合模态,高层语义与低层渲染纠缠导致效率低下且质量受限 贡献: 提出高层跨模态建模在共享骨干、低层精化在模态专属解码器的解耦架构;统一 Patch 级 Token 空间下自回归语言模型联合推理音视频,再由轻量 DiT 头解码为帧级隐变量 效果: 唇同步精度、视频质量、音频质量全面超越双分支基线,跨模态一致性强于级联管线 批判点评: 仅在说话人肖像场景验证,开放域音视频生成能力未测试;Patch 级 Token 量化损失对音质影响未量化 10. When Do Diffusion Models Learn to Generate Multiple Objects? 扩散模型何时学会多对象生成?MOSAIC 框架揭示数据本质 | ICML 2026 | arXiv:2605.00273 关键词: 多对象生成·组合泛化·数据分析·MOSAIC·扩散模型 前序工作问题: 文生图扩散模型在多对象生成上表现不可靠,失败根因不明确:是数据不足还是模型能力限制 贡献: 引入 MOSAIC 可控数据集生成框架,从概念泛化和组合泛化两个维度系统研究数据量与多对象生成能力的关系 效果: 发现场景复杂度比概念不均衡更关键,计数在低数据区极难学习,组合泛化随留出比例增加急剧退化;揭示需要更强归纳偏置 批判点评: 使用合成数据框架研究结论的真实世界迁移性有限;未提出具体解决方案仅停留在诊断层面 趋势观察 统一范式从文本主导走向视觉主导 — FlowInOne 将所有模态编码为视觉提示实现 Image-In Image-Out,UniVidX 用随机条件掩码实现全向生成,统一模型正式进入视觉原生时代 VAE隐空间优化成为视频生成新瓶颈 — LC-VAE 发现过多隐通道反而阻碍扩散收敛,通过高频裁剪代替通道压缩解锁生成质量;DepthVAR 从Token深度冗余切入加速,压缩思路多元化 人工智能炼丹君 整理 | 2026-05-05
-
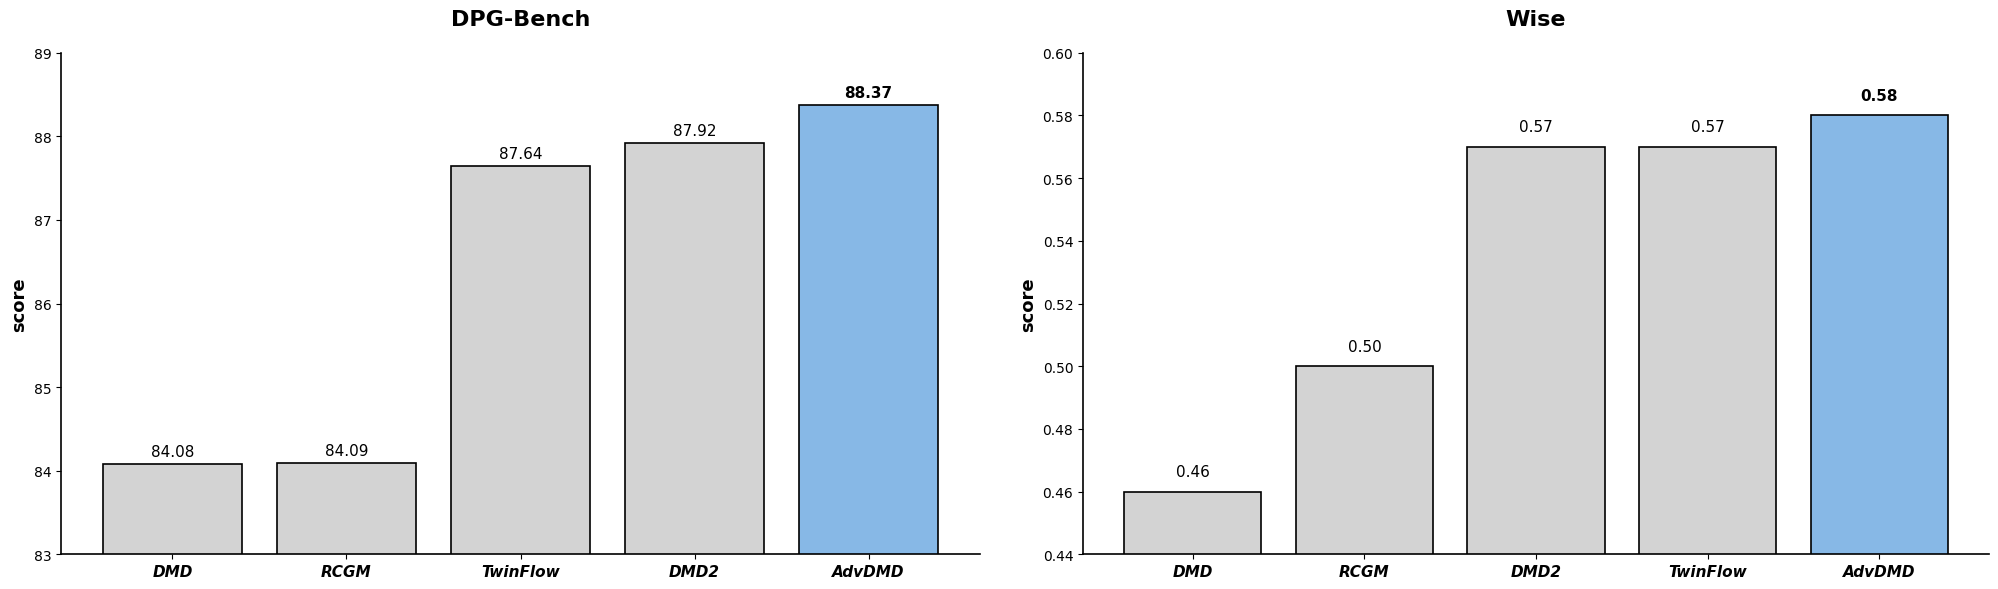
AIGC论文速读|20260504|4步打败40步!AdvDMD蒸馏加速刷新SD3.5 今日核心看点 AdvDMD 4步超40步蒸馏 Edit-R1 验证器奖励模型 PhyCo 物理可控视频 AesRM 美学奖励模型 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 推理加速与蒸馏 2 篇 (AdvDMD, YOSE) 奖励模型与强化学习 2 篇 (Edit-R1, AesRM) 视频生成与编辑 3 篇 (PhyCo, TAVR, ExoActor) 训练方法与评估 2 篇 (RFL, Visual Gen Survey) 多模态一体化 1 篇 (Nemotron 3) 今日论文速览 1. AdvDMD: Adversarial Reward Meets DMD for Few-Step Generation AdvDMD:对抗奖励融合蒸馏实现高质量少步生成 | Unknown | arXiv:2604.28126 关键词: 蒸馏加速·DMD·对抗奖励·少步生成·SD3.5 前序工作问题: 扩散模型蒸馏加速方法将 DMD 与 RL 简单拼接,两种优化目标相互干扰导致训练不稳定且加速倍率有限 贡献: 将 DMD2 的对抗判别器直接复用为 RL 奖励模型,通过统一 SDE 反向模拟对中间态和终态联合监督,实现 DMD 与 RL 的无缝融合 效果: 4 步 AdvDMD 在 SD3.5 上 DPG-Bench 超越原模型 40 步表现;2 步版本在 Qwen-Image 上超越 TwinFlow 批判点评: 对抗判别器随蒸馏模型在线更新增加训练复杂度;在极端 1 步生成场景下质量衰减幅度未报告 2. Edit-R1: Leveraging Verifier-Based RL in Image Editing Edit-R1:验证器驱动强化学习提升图像编辑 | ByteDance Seed | arXiv:2604.27505 关键词: 图像编辑·奖励模型·CoT验证器·GRPO·FLUX 前序工作问题: 图像编辑缺乏可靠通用奖励模型,现有模型仅给整体评分无法逐条验证编辑指令是否满足 贡献: 提出推理奖励模型 RRM,通过 CoT 将指令拆分为独立原则逐条验证并聚合为细粒度可解释奖励,用 GCPO+GRPO 两阶段训练 效果: Edit-RRM 超越 Seed-1.5-VL/1.6-VL 等强 VLM 作为编辑奖励模型;3B→7B 清晰涨点;赋能 FLUX.1-kontext 编辑器 批判点评: CoT 推理链增加奖励计算成本,实际部署中每次编辑需额外 VLM 推理;仅在 FLUX 上验证泛化性有限 3. AesRM: Improving Video Aesthetics with Expert-Level Feedback AesRM:专家级美学反馈提升视频生成质量 | Unknown | arXiv:2604.28078 关键词: 视频美学·奖励模型·分层评测·CoT推理·Wan2.2 前序工作问题: 视频生成评估过度关注保真度而忽视电影级美学(构图、光影、色彩和谐),缺乏系统化美学评价体系 贡献: 构建 3 维 15 细项美学评分体系与约 2500 对专家标注数据集 AesVideo-Bench,训练 AesRM-Base 和 AesRM-CoT 两版奖励模型 效果: 在多个美学基准上超越基线,位置偏差更低更鲁棒;成功对齐 Wan2.2 视频生成模型的美学输出 批判点评: 2500 视频对规模偏小可能限制泛化;美学本质上主观性强,专家标注的跨文化一致性未讨论 4. Representation Fréchet Loss for Visual Generation RFL:表征空间 Fréchet 距离作为训练损失提升生成质量 | Unknown | arXiv:2604.28190 关键词: FD损失·表征空间·一步生成·蒸馏替代·ImageNet 前序工作问题: Fréchet 距离一直仅用于评估而非训练,因为其需要大规模样本估计群体统计量与小批量梯度计算矛盾 贡献: 解耦 FD 估计所需群体规模(50k)与梯度计算批量(1024),提出 FD-loss 使 Fréchet 距离可直接作为训练目标 效果: ImageNet 256x256 上一步生成器达 0.72 FID;无需教师蒸馏或对抗训练即可将多步模型转化为强一步生成器 批判点评: FD-loss 对表征空间选择敏感,不同表征可能导致矛盾优化方向;维护 50k 统计量的内存开销在高分辨率场景未讨论 5. YOSE: Essential Token Selection for DiT-based Video Object Removal YOSE:按需选择关键 Token 加速 DiT 视频去物 | CVPR 2026 | arXiv:2604.27322 关键词: 视频去物·Token选择·DiT加速·掩码感知·线性缩放 前序工作问题: DiT 视频去物方法对全时空 Token 密集计算,即使仅小区域需修复也需处理完整 Token 空间,推理极慢(约 10 FPS) 贡献: 提出批量变长索引 BVI 按掩码自适应选择关键 Token,配合 DiffSim 模块为未掩码 Token 模拟扩散注意力影响 效果: 70% 场景实现 2.5 倍加速,推理时间与掩码区域大小近似线性缩放,生成质量保持可比 批判点评: 加速比强依赖掩码面积,大面积去物场景加速有限;DiffSim 的近似可能在复杂运动区域引入伪影 6. PhyCo: Learning Controllable Physical Priors for Generative Motion PhyCo:学习可控物理先验实现物理真实视频生成 | CMU / NEC Labs / UCSD | CVPR 2026 | arXiv:2604.28169 关键词: 物理先验·可控生成·摩擦力·弹性·视频扩散 前序工作问题: 视频扩散模型擅长外观合成但物理一致性差:物体漂移、碰撞无回弹、材料响应不真实 贡献: 从简单模拟(滑块/弹球)中学习连续可解释的物理先验(摩擦/弹性/形变/力),推理时无需物理引擎即可注入视频扩散 效果: 实现连续可控的物理参数调节,生成物理真实的碰撞回弹和材料变形效果,CVPR 2026 收录 批判点评: 训练仅用简单几何体模拟数据,对复杂真实场景(如流体、布料)的泛化能力存疑;推理时物理参数需手动指定 7. Visual Generation in the New Era: From Atomic Mapping to Agentic World Modeling 视觉生成新纪元:从原子映射到智能体世界建模(综述) | Multi-institution (27 authors) | arXiv:2604.28185 关键词: 综述·五级分类·Flow Matching·后训练·奖励模型·世界模型 前序工作问题: 视觉生成模型在空间推理、状态持续、长期一致性和因果理解上仍有系统性缺陷,但缺乏统一评价框架 贡献: 提出五级渐进式分类体系(原子→条件→上下文→智能体→世界建模),系统梳理流匹配、统一模型、后训练、奖励建模等技术驱动力 效果: HF Daily Papers 82 票热度最高,提供能力导向的视角理解和推进下一代智能视觉生成系统 批判点评: 27 人综述难免覆盖面广但深度不足;五级分类边界模糊(如 Level 3 与 Level 4 区分标准主观) 8. TAVR: Generate Your Talking Avatar from Video Reference TAVR:从跨场景视频参考生成高保真说话头像 | HeyGen Research | arXiv:2604.27918 关键词: 说话头·跨场景·视频参考·Token选择·身份强化学习 前序工作问题: 现有说话头生成方法依赖同场景静态图参考,跨场景视频参考时身份保持和背景适应能力差 贡献: 提出视频参考范式 TAVR,含 Token 选择处理长时上下文、三阶段训练(同场景预训练→跨场景微调→身份 RL),构建 158 对跨场景评测基准 效果: 量化和定性评估均超越现有基线,已部署于 HeyGen Avatar-V 产品上线 批判点评: 强依赖参考视频质量和时长;身份 RL 奖励可能过拟合特定人脸特征分布,非正面角度效果存疑 9. Nemotron 3 Nano Omni: Efficient Open Multimodal Intelligence Nemotron 3 Nano Omni:NVIDIA 高效开源全模态模型 | NVIDIA | arXiv:2604.24954 关键词: 多模态·音频视觉文本·文档理解·Agent·开源 前序工作问题: 智能体系统需分别调用视觉、语音和语言模型,模型间数据传递耗时且丢失跨模态上下文 贡献: 首次原生支持音频+文本+图像+视频四模态输入,在文档理解、长音视频理解和 Agent 计算机操控上刷新效率基准 效果: 在 6 项权威榜单名列前茅;较前代在所有模态上准确率一致提升;已被 Foxconn 等企业采用 批判点评: 仅支持理解而无生成能力,不属于生成-理解统一模型;Nano 级别参数量在复杂推理场景可能受限 10. ExoActor: Exocentric Video Generation as Humanoid Control ExoActor:第三人称视频生成驱动通用人形机器人控制 | BAAI | arXiv:2604.27711 关键词: 人形控制·视频生成·第三人称·交互动力学·零样本泛化 前序工作问题: 人形机器人需同时建模空间上下文、时序动力学、动作和任务意图的交互,现有方法难以大规模获取多样化数据 贡献: 复用大规模视频生成模型作为交互动力学的统一接口,两阶段流程:先生成第三人称执行视频,再通过运动估计转为可执行动作 效果: 无需额外真实数据即可泛化到新场景,展示视频生成模型在机器人领域的全新应用范式 批判点评: 两阶段流程中运动估计误差会逐级累积;视频生成的物理真实性不足可能导致不可执行的动作序列 趋势观察 奖励模型正成为视觉生成标配 — 从 Edit-R1 到 AesRM,RL 驱动的奖励模型正覆盖图像编辑和视频美学两大场景,验证器范式取代简单打分 蒸馏与 Token 选择加速双管齐下 — AdvDMD 4 步超 40 步原模,YOSE 按掩码比例线性缩放,加速方法从模型级延伸到 Token 级 人工智能炼丹君 整理 | 2026-05-04
-
AIGC 周末专题|2026-05-02|13.7-18.6x注意力加速,稀疏注意力撕开视频Di… AIGC 周末专题深度解读:稀疏注意力在视频生成中的应用:从免训练加速到可训练融合 人工智能炼丹君 整理 | 2026年5月2日(周六) 覆盖时间:2025年5月 — 2026年4月 本期概述 本期 AIGC 周末专题聚焦稀疏注意力在视频生成中的应用:从免训练加速到可训练融合方向,精选 10 篇代表性论文进行深度解读。 方向分布: 稀疏+线性融合 3篇 3 篇 (SLA, SLA2, SALAD) 免训练稀疏注意力 3篇 3 篇 (SVG-EAR, CalibAtt, AdaSpa) 结构化/Pattern稀疏 2篇 2 篇 (Sparse-vDiT, VMonarch) 可训练/AR稀疏 2篇 2 篇 (VSA, Light Forcing) 其余工作 14篇 1 篇 (SVG/SVG2/STA/BSA/NABLA/SSTA/TempCache/SODA/EasyCache/FasterCache/FastLightGen/FrameDiT/DiagDist/Survey) 含 ICLR 2026 Oral × 1, ICLR 2026 × 1, NeurIPS 2025 × 1, AAAI 2026 × 1, ICCV 2025 × 1 技术路线与时间线 基础探索(2024.06 — 2025.02) 描述:Sparse Attention 从 LLM 领域迁移到视频 DiT,研究者发现 3D 全注意力中天然存在的稀疏性。 关键节点: 2024.06–2025.02:LLM 稀疏注意力技术向视频扩散模型迁移 免训练加速(2025.02 — 2025.05) 描述:Sparse VideoGen 系列开创免训练框架,系统性利用 3D 全注意力天然稀疏性。 关键节点: 2025.02:SVG:首个免训练稀疏注意力加速框架 2025.05:SVG2:语义聚类驱动稀疏模式发现 可训练突破(2025.05 — 2025.09) 描述:VSA 首次证明可训练稀疏注意力可在预训练阶段全程替代全注意力。 关键节点: 2025.05:VSA(NeurIPS 2025):训练+推理全程稀疏 融合范式确立(2025.09 — 2026.01) 描述:SLA(ICLR 2026 Oral)确立稀疏+线性融合范式,SALAD 和 VMonarch 从不同角度验证。 关键节点: 2025.09:SLA(ICLR 2026 Oral):13.7x 注意力加速 2026.01:SALAD:2000 样本微调达 90% 稀疏度 2026.01:VMonarch:Monarch 矩阵 17.5x FLOPs 减少 极致推进(2026.01 — 2026.04) 描述:SLA2 将加速比推向 18.6x,SVG-EAR 刷新免训练帕累托前沿,Light Forcing 开辟 AR 方向。 关键节点: 2026.02:SLA2:可学习路由 + QAT,18.6x 加速 2026.02:Light Forcing:首个 AR 视频扩散稀疏注意力 2026.03:SVG-EAR:误差感知路由,1.93x 免训练加速 2026.02:AdaSpa(ICCV 2025):LSE 缓存搜索 1. SLA:稀疏-线性注意力融合——自定义GPU Kernel实现13.7倍注意力加速(ICLR 2026 Oral) 论文: SLA arXiv: 2509.24006 机构: 清华大学, UC Berkeley 1.1 研究动机 核心问题: 视频DiT中全注意力O(N²)复杂度导致推理延迟极高 注意力权重可分为两部分:少量大权重(高秩)和大量小权重(低秩)。这天然暗示:对大权重用稀疏注意力(O(N²)但只算少量),对小权重用线性注意力(O(N))。现有方法要么纯稀疏(丢失低秩信息)要么纯线性(无法捕捉局部关键依赖),SLA首次将两者系统融合。 前序工作及局限: 稀疏注意力(Top-K/局部窗口):丢失信息或不灵活 线性注意力(Linear Transformer):表达能力不足 与前序工作的本质区别: SLA首次系统性融合稀疏+线性注意力,通过三级分类+自定义GPU kernel实现最优分配 1.2 方法原理 SLA的核心设计:\n\n(1) 三级分类:将注意力权重按大小分为Critical(精确计算)、Marginal(线性注意力近似)、Negligible(跳过)三个级别。\n\n(2) 融合GPU Kernel:将稀疏注意力和线性注意力的前向/反向计算融合到单个自定义GPU kernel中,消除额外显存开销和kernel launch延迟。\n\n(3) 轻量微调:仅需少量步即可在目标视频DiT模型上完成适配。 1.3 核心创新 首次系统性融合稀疏注意力与线性注意力\n提出三级权重分类:Critical(O(N²)精确)+Marginal(O(N)线性)+Negligible(跳过)\n实现自定义GPU kernel支持前向+反向传播融合计算\n95%注意力计算减少,13.7倍注意力加速,2.2倍端到端加速\nICLR 2026 Oral——学术最高认可 1.4 实验结果 注意力计算减少95%(20倍)\n注意力加速13.7倍\n端到端加速2.2倍(Wan 2.1-1.3B)\n生成质量无损(VBench指标保持)\nICLR 2026 Oral接收 1.5 关键洞察 优势:ICLR 2026 Oral验证了方法的学术价值;自定义kernel可直接工业落地;2.2x E2E加速是质量无损方法的最优数字。局限:目前仅在1.3B模型上验证,14B+模型效果未知;kernel需针对不同硬件调优。 技术演进定位: 稀疏-线性融合范式的奠基工作(ICLR 2026 Oral) 可能的后续方向: 更大模型验证(14B+) 与蒸馏/缓存叠加 2. SLA2:可学习路由+量化感知训练——97%稀疏度实现18.6倍注意力加速 论文: SLA2 arXiv: 2602.12675 机构: 清华大学, UC Berkeley 2.1 研究动机 核心问题: SLA固定分类边界无法适应动态变化,且未利用量化压缩空间 SLA采用固定的三级分类边界,无法适应不同层/头/时间步的动态变化。SLA2提出:能否让模型自己学习最优的稀疏-线性分配比例?同时,SLA未利用量化技术进一步压缩计算,存在额外压缩空间。 前序工作及局限: SLA:固定三级分类,ICLR 2026 Oral 量化感知训练(QAT):LLM领域成熟技术 与前序工作的本质区别: SLA2引入可学习路由器实现层级自适应+QAT进一步压缩,将加速比从13.7x提升到18.6x 2.2 方法原理 SLA2的核心改进:\n\n(1) 可学习路由器:每层每头配备轻量路由网络,动态预测每个注意力块应使用稀疏、线性还是跳过策略。\n\n(2) 改进注意力公式:重新设计稀疏+线性混合公式,更好地贴合原始SLA的分解动机,减少近似误差。\n\n(3) 量化感知训练(QAT):联合训练路由器和量化参数,在INT4/INT8精度下保持质量。 2.3 核心创新 突破SLA固定分类上限,引入可学习路由器动态调节稀疏/线性比例\n提出贴合原始分解动机的改进注意力公式\n量化感知训练(QAT)进一步压缩推理成本\n97%注意力稀疏度,18.6倍注意力加速\n质量保持与全注意力几乎无差距 2.4 实验结果 97%注意力稀疏度(仅3%计算量)\n18.6倍注意力加速\n视频生成质量与全注意力几乎无差距\n支持INT4量化进一步压缩 2.5 关键洞察 优势:在SLA基础上进一步将加速比提升35%,可学习路由实现层级自适应。局限:需要训练路由器(非免训练);QAT引入额外训练复杂性。 技术演进定位: SLA范式的极致推进 可能的后续方向: 与稀疏+蒸馏联合优化 消费级设备部署 3. SVG-EAR:误差感知路由+无参数线性补偿——免训练1.93倍端到端加速 论文: SVG-EAR arXiv: 2603.08982 机构: UC Berkeley 3.1 研究动机 核心问题: 免训练稀疏注意力丢弃块后信息损失且传统路由不精确 现有稀疏注意力面临两难:直接丢弃被跳过块会丢失信息;用学习型预测器近似又引入训练开销和分布偏移。SVG-EAR提出关键洞察:经过语义聚类后,同一块内的key/value具有高度相似性,可用少量聚类质心准确概括。 前序工作及局限: Sparse VideoGen/SVG2:在线稀疏模式识别 CalibAtt:离线校准静态模式 与前序工作的本质区别: SVG-EAR用聚类质心无参数恢复被跳过块+误差感知路由替代传统注意力分数路由 3.2 方法原理 SVG-EAR的核心设计:\n\n(1) 聚类质心补偿:对被跳过的注意力块,用key/value的聚类质心做线性(O(N))近似,恢复其对输出的贡献。\n\n(2) 误差感知路由:不按注意力分数选择块,而是用轻量探测器估计每个块的补偿误差,选择'误差-成本比'最高的块做精确计算。\n\n(3) 理论保证:提供注意力重建误差与聚类质量之间的理论上界。 3.3 核心创新 颠覆传统'高注意力分数=重要'的假设,改为'高近似误差=需要精确计算'\n无参数线性补偿:用聚类质心O(N)恢复被跳过块的贡献\n误差感知路由:选择误差-成本比最高的块做精确计算\n提供注意力重建误差的理论上界 3.4 实验结果 Wan 2.2:1.77x端到端加速,PSNR 29.759\nHunyuanVideo:1.93x端到端加速,PSNR 31.043\n显著优于Sparse VideoGen2和CalibAtt\n完全免训练 3.5 关键洞察 优势:免训练、有理论保证、误差感知路由思路优雅。局限:聚类质心计算本身有开销;PSNR不是视频生成的最佳指标;加速上限受限于免训练范式。 技术演进定位: 免训练稀疏注意力的帕累托前沿 可能的后续方向: 与可训练方法结合 聚类效率优化 4. VSA:端到端可训练稀疏注意力——从预训练阶段替换全注意力(NeurIPS 2025) 论文: VSA arXiv: 2505.13389 机构: UC Berkeley, FastVideo 4.1 研究动机 核心问题: 稀疏注意力仅用于推理,训练仍需全注意力导致训练-推理不一致 现有稀疏注意力主要用于推理加速,训练仍需全注意力。这导致训练-推理不一致和训练成本居高不下。VSA提出核心问题:能否设计一种从训练到推理全程使用的稀疏注意力,彻底替代全注意力? 前序工作及局限: 所有推理时稀疏方法:训练仍用全注意力 FlashAttention:全注意力的高效实现 与前序工作的本质区别: VSA首次证明可训练稀疏注意力可从预训练阶段全程替代全注意力 4.2 方法原理 VSA采用层次化两阶段设计:\n\n(1) 粗粒度阶段:将token序列划分为3D cubes并池化为粗粒度表示,用低成本全注意力预测每个cube的重要性分数,选出关键token区域。\n\n(2) 细粒度阶段:仅在预测的关键区域执行token级精确注意力,形成块稀疏计算模式。\n\n(3) 硬件对齐:cube大小和块大小均对齐GPU的执行粒度,最大化并行效率。 4.3 核心创新 首个在预训练阶段就替换全注意力的可训练稀疏注意力\n层次化设计:粗粒度cube池化预测关键token+细粒度块稀疏注意力\n硬件对齐:所有操作均对齐GPU warp/SM执行模式\n训练和推理双加速——不仅加速推理,还加速训练\n建立可训练稀疏注意力作为全注意力实用替代的里程碑 4.4 实验结果 训练和推理同时加速\n在视频生成质量上与全注意力基线持平\n显著降低训练GPU小时数\n建立可训练稀疏注意力作为全注意力的实用替代\nNeurIPS 2025接收 4.5 关键洞察 优势:训练+推理双加速是独特卖点;硬件对齐设计实用性强;NeurIPS 2025验证了学术质量。局限:粗粒度预测可能丢失细粒度关键信息;需要从头预训练或大量微调。 技术演进定位: 训练范式变革的先驱(NeurIPS 2025) 可能的后续方向: 更大规模模型验证 社区标准化 5. Sparse-vDiT:三模式稀疏Pattern识别+定制Kernel——视频DiT注意力图的系统性利用(AAAI 2026) 论文: Sparse-vDiT arXiv: 2506.03065 机构: 多机构合作 5.1 研究动机 核心问题: 统一稀疏策略未充分利用视频DiT注意力图的结构特征 此前的稀疏注意力方法大多采用统一的稀疏策略(如Top-K或块级稀疏),未充分利用视频DiT注意力图的结构特征。Sparse-vDiT通过详细分析注意力图,发现三种反复出现的稀疏模式,并为每种模式定制高效计算方案。 前序工作及局限: 通用稀疏注意力:统一Top-K或块级策略 FlashAttention:稠密注意力优化 与前序工作的本质区别: Sparse-vDiT系统识别三种稀疏Pattern并为每种设计专用kernel 5.2 方法原理 Sparse-vDiT的核心设计:\n\n(1) 稀疏模式识别:通过统计分析发现视频DiT注意力图中三种主导模式——对角线(diagonal)反映时间邻近性、多对角线(multi-diagonal)反映空间局部性、竖条纹(vertical-stripe)反映全局anchor token。\n\n(2) Pattern-Optimized Sparse Kernels:为每种模式设计专用的CUDA kernel,将稠密注意力替换为结构化稀疏计算。\n\n(3) 自适应模式选择:根据每层每头的注意力分布自动选择最匹配的稀疏模式。 5.3 核心创新 系统性识别视频DiT注意力图中的三种稀疏模式:对角线、多对角线、竖条纹\n为每种模式设计定制的高效计算kernel\n同时减少理论FLOPs和实际推理延迟\n即插即用框架,适配多种视频DiT模型\nAAAI 2026接收 5.4 实验结果 理论FLOPs大幅减少\n实际推理速度显著提升\n视觉质量保持\n适配HunyuanVideo等主流模型\nAAAI 2026接收 5.5 关键洞察 优势:对注意力图的结构化分析深入,三种模式的识别有启发性;定制kernel实现到位。局限:固定的三种模式可能无法覆盖所有场景;模式选择的开销需考虑。 技术演进定位: Pattern-aware稀疏注意力的开拓者(AAAI 2026) 可能的后续方向: 更多Pattern发现 自动Pattern选择 6. SALAD:门控线性注意力并行分支——仅2000样本微调实现90%稀疏度 论文: SALAD arXiv: 2601.16515 机构: 清华大学, 腾讯 6.1 研究动机 核心问题: 免训练稀疏度受限于50-70%,而训练型方法计算成本高 免训练稀疏注意力受限于有限的稀疏度(通常50-70%),突破稀疏度上限需要训练。但训练型方法通常需要大量数据和计算。SALAD提出:能否用极轻量的微调达到极高稀疏度? 前序工作及局限: 免训练稀疏方法:稀疏度上限有限 SLA:需要较多微调步数 与前序工作的本质区别: SALAD用极轻量微调(2000样本)在稀疏注意力旁添加线性分支达到90%稀疏度 6.2 方法原理 SALAD的核心设计:\n\n(1) 双分支并行:在原始稀疏注意力旁边添加一个轻量线性注意力分支,线性分支负责捕捉被稀疏注意力丢弃的低秩信息。\n\n(2) 输入依赖门控:用可学习门控机制根据输入内容动态调节两个分支的贡献权重。\n\n(3) 极轻量微调:仅新增线性注意力层和门控网络的参数,用2000个视频样本1600步即可完成训练。 6.3 核心创新 在稀疏注意力旁添加轻量线性注意力并行分支\n输入依赖门控机制动态平衡两分支贡献\n极轻量微调:仅需2000个视频样本和1600步训练\n90%稀疏度下质量与全注意力基线相当\n1.72x推理加速 6.4 实验结果 90%稀疏度,1.72x推理加速\n生成质量与全注意力基线相当\n仅需2000样本微调\n适配多种视频DiT模型 6.5 关键洞察 优势:微调效率极高(2000样本),工程门槛低;门控机制优雅。局限:1.72x加速低于SLA的2.2x;线性注意力的表达能力有限。 技术演进定位: 工程门槛最低的稀疏-线性融合方案 可能的后续方向: 门控机制改进 与VSA思路融合 7. VMonarch:Monarch矩阵结构化注意力——17.5倍FLOPs减少的数学最优解 论文: VMonarch arXiv: 2601.22275 机构: 南京大学, 腾讯 7.1 研究动机 核心问题: 现有稀疏方法缺乏数学最优性保证 视频DiT的注意力模式天然具有高度稀疏的时空结构,但现有稀疏方法(Top-K/局部窗口)要么不灵活要么丢失全局信息。VMonarch发现Monarch矩阵——一类具有灵活稀疏性的结构化矩阵——可以优雅地表示这些模式。 前序工作及局限: Monarch Mixer(2023):结构化矩阵在Mixer中的应用 Monarch in LLM:LLM注意力压缩 与前序工作的本质区别: VMonarch首次将Monarch矩阵引入视频DiT,提供时空注意力的数学最优分解 7.2 方法原理 VMonarch的核心设计:\n\n(1) 时空Monarch分解:将全注意力矩阵分解为帧内(空间)和帧间(时间)两组Monarch因子,分别捕捉空间和时间相关性。\n\n(2) 交替最小化:通过交替优化两组因子来逼近原始全注意力,配合重计算策略解决收敛不稳定问题。\n\n(3) 在线熵算法:融入FlashAttention的在线计算范式,使Monarch矩阵更新在长序列上高效可行。 7.3 核心创新 首次将Monarch矩阵引入视频DiT注意力\n时空Monarch分解:帧内(空间)+帧间(时间)两组结构化因子\n交替最小化+重计算策略解决不稳定问题\n在线熵算法融入FlashAttention支持长序列\n17.5倍FLOPs减少,5倍以上注意力加速 7.4 实验结果 注意力FLOPs减少17.5倍\n注意力计算加速5倍以上\n90%稀疏度下超越所有SOTA稀疏注意力方法\n轻量微调后VBench质量与全注意力相当 7.5 关键洞察 优势:数学上最优雅的方案;FlashAttention兼容;理论深度最强。局限:交替最小化收敛依赖初始化;实际wall-clock加速(5x)远小于理论FLOPs减少(17.5x),存在实现瓶颈。 技术演进定位: 理论深度最强的结构化注意力方案 可能的后续方向: 工程优化缩小理论-实际差距 与FlashAttention深度融合 8. Light Forcing:首个面向自回归视频扩散的稀疏注意力——Chunk-Aware Growth机制 论文: Light Forcing arXiv: 2602.04789 机构: 多机构合作 8.1 研究动机 核心问题: 现有稀疏注意力面向双向扩散模型,忽视自回归视频生成的因果特性 现有稀疏注意力主要面向双向扩散模型(如Wan/HunyuanVideo),而自回归视频扩散模型(如GameGen/Oasis/CogVideoX-AR)的因果结构与双向模型截然不同。Light Forcing首次为AR视频扩散定制稀疏注意力方案。 前序工作及局限: 双向扩散稀疏方法:SVG/CalibAtt/SLA等 AR视频扩散模型:CogVideoX-AR/GameGen 与前序工作的本质区别: Light Forcing首次为AR视频扩散定制Chunk-Aware Growth稀疏注意力 8.2 方法原理 Light Forcing的核心设计:\n\n(1) AR注意力模式分析:发现AR视频扩散中注意力呈现因果增长的独特模式——新生成帧主要关注临近帧和关键锚帧。\n\n(2) Chunk-Aware Growth机制:将视频序列划分为因果chunk,稀疏注意力范围随chunk增长动态扩展,保持对历史的选择性回顾。\n\n(3) 锚帧保留策略:自动识别并保留关键参考帧的全注意力计算,确保长程一致性。 8.3 核心创新 首个专门面向自回归(AR)视频生成模型的稀疏注意力\n提出Chunk-Aware Growth机制适应AR生成的因果增长特性\n发现AR视频扩散中独特的注意力稀疏模式\n兼顾质量提升和效率加速\n开源代码和模型 8.4 实验结果 AR视频生成质量提升(质量和效率双赢)\n推理速度显著加速\n长视频生成的一致性提升\n代码开源 8.5 关键洞察 优势:AR视频生成方向的首个稀疏注意力方案,填补空白;Chunk-Aware Growth设计与AR范式天然匹配。局限:AR视频生成模型本身尚未成为主流;方法可推广性受限于AR架构。 技术演进定位: AR视频生成稀疏加速的开创者 可能的后续方向: AR范式普及后的标准化 与KV缓存压缩联合 9. CalibAtt:离线校准+在线高效推理——跨输入稳定的块级稀疏模式 论文: CalibAtt arXiv: 2603.05503 机构: 以色列理工 9.1 研究动机 核心问题: 免训练方法需要在线动态判断token重要性,开销大 已有稀疏注意力方法要么需要训练,要么在线动态判断token重要性(开销大)。CalibAtt发现核心洞察:稀疏模式在不同输入上惊人地稳定,可以离线一次校准、在线直接复用。 前序工作及局限: Sparse VideoGen:在线3%样本分析 动态稀疏方法:运行时判断开销 与前序工作的本质区别: CalibAtt发现稀疏模式跨输入稳定,可离线固定复用 9.2 方法原理 CalibAtt采用两阶段策略:\n\n(1) 离线校准阶段:在少量参考视频上运行全注意力,统计每一层、每个头、每个扩散时间步的块级稀疏模式和重复模式。\n\n(2) 模式编译:将稳定的稀疏模式编译为优化的注意力操作(类似JIT编译)。\n\n(3) 在线推理:只计算被选中的输入相关连接,以硬件友好方式跳过未选中连接。 9.3 核心创新 发现关键洞察:大量token-to-token连接在不同输入上一致地产生可忽略的注意力分数\n离线校准+在线推理两阶段策略\n层-头-时间步三维稀疏模式校准\n块级粒度兼顾精度和硬件效率\n完全免训练,1.58x端到端加速 9.4 实验结果 Wan 2.1 14B、Mochi 1及其蒸馏版本上实现1.58x端到端加速\n视频生成质量和文本-视频对齐度优于已有免训练方法\n支持多种分辨率\n完全免训练 9.5 关键洞察 优势:完全免训练、直接即插即用;离线校准成本低;硬件友好。局限:1.58x加速比在近期方法中不突出;对新架构需重新校准;块级粒度可能丢失细粒度信息。 技术演进定位: 离线校准范式的开创者 可能的后续方向: 模式自动更新 新架构快速适配 10. AdaSpa:动态模式+在线精确搜索——面向长视频的自适应稀疏注意力(ICCV 2025) 论文: AdaSpa arXiv: 2502.21079 机构: 字节跳动, 北京大学 10.1 研究动机 核心问题: 动态模式和在线搜索难以兼顾,现有方法牺牲其一 现有免训练稀疏方法要么用固定模式(无法适应动态变化),要么在线搜索开销大。AdaSpa提出:能否将动态模式与在线精确搜索结合,实现既准确又高效的自适应稀疏注意力? 前序工作及局限: 固定模式方法:CalibAtt等,无法动态适应 在线搜索方法:开销大 与前序工作的本质区别: AdaSpa利用FlashAttention的LSE副产品零开销实现在线精确搜索 10.2 方法原理 AdaSpa的核心设计:\n\n(1) 块化模式(Blockified Pattern):将注意力矩阵划分为层次化block结构,高效表示DiT中的多尺度稀疏性。\n\n(2) LSE缓存搜索:利用FlashAttention计算过程中的LogSumExp副产品作为block重要性信号,零额外开销精确定位关键token区域。\n\n(3) 自适应稀疏决策:根据每步动态计算的重要性信号决定哪些block需要精确计算,实现自适应稀疏。 10.3 核心创新 首个结合动态模式和在线精确搜索的稀疏注意力方法\n块化模式(Blockified Pattern)高效表示DiT的层次稀疏性\nLSE(LogSumExp)缓存搜索实现精确重要token定位\n免训练、免数据、即插即用\n面向长视频生成加速\nICCV 2025接收 10.4 实验结果 长视频生成速度显著提升\n视觉质量与原始模型几乎相同\n免训练、免数据\nICCV 2025接收\n适配OpenSora等模型 10.5 关键洞察 优势:LSE缓存搜索零开销,设计极其优雅;免训练免数据实用性最强。局限:依赖FlashAttention实现,对其他注意力实现不通用。 技术演进定位: 免训练免数据方案的最优解(ICCV 2025) 可能的后续方向: 推广到更多注意力实现 与缓存方法叠加 其余论文速览 1. Sparse VideoGen Sparse VideoGen: Accelerating Video Diffusion Transformers with Inherent Sparsity | UC Berkeley | arXiv:2502.01776 关键词: 免训练, 空间/时间稀疏, 3D全注意力, 系列开山作 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 首个系统性利用3D全注意力天然稀疏性的免训练加速框架,在线3%样本分析识别空间/时间稀疏模式 效果: 在Wan/HunyuanVideo/Mochi上实现高效免训练加速,开创Sparse VideoGen系列 2. Sparse VideoGen2 Sparse VideoGen2: Accelerate Video Generation with Sparse Attention via Semantic-Aware Clustering | UC Berkeley | arXiv:2505.18875 关键词: 语义聚类, K-Means, 空间/时间稀疏, SVG系列第二代 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 基于K-Means语义聚类的稀疏注意力加速,自动发现空间和时间两种稀疏模式并分别优化 效果: 在SVG基础上进一步提升加速比,聚类质量直接影响加速效果 3. TempCache Fast Autoregressive Video Diffusion and World Models with Temporal Cache Compression and Sparse Attention | 多机构合作 | arXiv:2602.01801 关键词: KV缓存压缩, 自回归, 世界模型, AnnCA 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 面向自回归视频扩散的时间KV缓存压缩+稀疏注意力联合加速,AnnCA近似近邻注意力 效果: 长视频流式生成效率大幅提升,支持视频世界模型 4. SODA SODA: Sensitivity-Oriented Dynamic Acceleration for Diffusion Transformer | 多机构合作 | arXiv:2603.07057 关键词: 敏感度建模, 动态规划, 缓存+剪枝, 统一框架 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 敏感度导向的缓存+剪枝统一框架,通过动态规划求解最优缓存时间点 效果: 在DiT-XL/PixArt-α/OpenSora上实现SOTA保真度-加速比权衡 5. EasyCache Less is Enough: Training-Free Video Diffusion Acceleration via Adaptive Caching | 多机构合作 | arXiv:2507.03065 关键词: 免训练, 自适应缓存, 可叠加, 3x加速 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 无需训练的自适应缓存加速,运行时自适应决策何时复用何时重算,与SVG稀疏注意力可叠加 效果: SVG+EasyCache在HunyuanVideo上实现3x以上加速 6. FasterCache FasterCache: Training-Free Video Diffusion Model Acceleration with High Quality | 多机构合作 | ICLR 2026 关键词: 免训练缓存, 时间步复用, ICLR 2026, 全自注意力 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 免训练视频扩散缓存加速,利用全自注意力层的时间步相关性进行特征复用 效果: 在CogVideoX/Vchitect 2.0/Mochi上实现高质量免训练加速 7. FastLightGen FastLightGen: Fast and Light Video Generation with Fewer Steps and Parameters | 香港科技大学(广州) | arXiv:2603.01685 关键词: 步数蒸馏, 参数剪枝, 联合压缩, 35x加速 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 步数+参数同时压缩的三阶段协同蒸馏管线,将13B模型压缩至30%参数4步推理 效果: 35x加速HunyuanVideo/WanX,5秒视频数秒内生成 8. FrameDiT FrameDiT: Frame-level Matrix Attention for Video Diffusion Transformers | 多机构合作 | arXiv:2603.10200 关键词: 帧级注意力, 矩阵注意力, 结构化, 需训练 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 帧级矩阵注意力替代token级全注意力,粒度介于Full 3D和Local Factorized之间 效果: 效率与Local Factorized Attention相当,多个视频生成benchmark达到SOTA 9. CausVid From Slow Bidirectional to Fast Autoregressive Video Diffusion Models | Nvidia, Technion | arXiv:2412.07772 关键词: 非对称蒸馏, CVPR 2025, 自回归, 实时生成, 9.4 FPS 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 将双向扩散模型蒸馏为因果自回归生成器,DMD视频蒸馏50步→4步,非对称蒸馏用双向教师监督因果学生 效果: 9.4 FPS实时生成,VBench-Long 84.27,CVPR 2025接收 10. STA Fast Video Generation with Sliding Tile Attention | UC Berkeley (Hao AI Lab) | arXiv:2502.04507 关键词: 滑动窗口, Tile级, 硬件友好, ICML 2025, 免训练 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 提出Tile级滑动窗口注意力替代Token级,利用视频DiT注意力在3D时空局部窗口内集中的特性,硬件友好设计 效果: 注意力加速2.8-17x(vs FlashAttention-2),端到端1.36-3.53x加速,ICML 2025接收 11. BSA Bidirectional Sparse Attention for Faster Video Diffusion Training | UC Berkeley (Hao AI Lab) | arXiv:2509.01085 关键词: 训练加速, 双向稀疏, Query+KV稀疏, 动态阈值, 20x FLOPs 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 首个同时动态稀疏化Query和KV对的训练加速方法,通过语义相似性选择Query+动态阈值保留关键KV块 效果: 训练FLOPs减少20x,注意力训练加速17.79x,生成质量与全注意力持平或超越 12. NABLA ∇NABLA: Neighborhood Adaptive Block-Level Attention | AI Forever | arXiv:2507.13546 关键词: 块级注意力, CDF二值化, Flex Attention, 训练+推理, 开源权重 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 自适应块级注意力:下采样Q/K后在压缩空间计算注意力,CDF二值化生成稀疏mask,集成PyTorch Flex Attention无需自定义CUDA 效果: 训练和推理加速最高2.7x,可与STA叠加使用,Wan 2.1预微调权重已开源 13. SSTA (HunyuanVideo 1.5) HunyuanVideo 1.5 Technical Report — Selective and Sliding Tile Attention | 腾讯混元 | arXiv:2511.18870 关键词: SSTA, 选择性注意力, 滑动Tile, 工业级, 消费级GPU, 开源 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 提出SSTA(Selective and Sliding Tile Attention):识别并剪除冗余时空KV块,仅对高信息区域执行全注意力,集成于8.3B参数的工业级视频生成模型 效果: 10秒720p视频端到端1.87x加速(vs FlashAttention-3),消费级GPU可运行,开源模型权重 14. Awesome-Video-Attention Awesome-Video-Attention: A Curated Survey of Efficient Video Attention Methods | UC Berkeley (Hao AI Lab) | GitHub (hao-ai-lab) 关键词: 综述, 社区资源, 全技术栈, 持续更新 前序工作问题: 统一多模态生成与理解长期面临模态表示、训练目标和推理范式不一致的问题。 贡献: 视频注意力加速方法的系统性综述列表,涵盖稀疏化/量化/缓存等全部技术路线 效果: 社区标准参考,持续更新,按时间逆序排列 横向对比与技术脉络总结 横向对比:稀疏注意力在视频生成中的技术路线对比 论文 方法类别 是否需要训练 注意力加速 端到端加速 测试模型 质量保持 SLA 稀疏+线性融合 轻量微调 13.7x 2.2x Wan 2.1 1.3B SLA2 稀疏+线性+量化 可学习路由 18.6x - 视频DiT SVG-EAR 稀疏+线性补偿 免训练 - 1.93x Wan 2.2 / HunyuanVideo VSA 可训练稀疏 预训练替换 训练+推理 - 视频DiT Sparse-vDiT Pattern定制kernel 免训练 显著 显著 HunyuanVideo SALAD 稀疏+线性门控 2000样本微调 - 1.72x 视频DiT VMonarch 结构化Monarch 轻量微调 5x - VBench Light Forcing AR稀疏 免训练 显著 - AR视频DiT CalibAtt 离线校准稀疏 免训练 - 1.58x Wan 2.1 14B / Mochi AdaSpa 自适应稀疏 免训练免数据 显著 显著 OpenSora 核心技术趋势 从免训练到可训练,从推理到全程 稀疏注意力的演进路线清晰:免训练方法(CalibAtt/SVG-EAR)天花板约2x,轻量微调(SALAD/SLA)突破至2-5x,全程可训练(VSA)则实现训练+推理双加速。三条路线并行发展,适用于不同部署场景。 稀疏+线性融合成为最优范式 SLA(ICLR 2026 Oral)确立了'大权重用稀疏、小权重用线性'的分工模式。SLA2通过可学习路由将其推向极致(18.6x)。SALAD用门控机制轻量化实现同一思路。这一范式的优势在于理论完备且工程可落地。 注意力图的结构化利用 从统一稀疏策略到结构化利用:Sparse-vDiT识别三种Pattern、VMonarch用Monarch矩阵表示时空结构、CalibAtt发现跨输入稳定性。理解注意力图的内在结构是设计更好稀疏方案的关键。 自回归视频扩散带来新挑战 Light Forcing和TempCache分别面向AR视频扩散设计稀疏注意力和缓存压缩。随着AR范式(CogVideoX-AR/GameGen)兴起,因果注意力的稀疏化将成为新研究热点。 多方法叠加实现极致加速 EasyCache+SVG可叠加达3x+;SLA+步数蒸馏理论可达5-10x无损加速;稀疏注意力+量化(SLA2 QAT)+缓存三者联合将推动视频生成走向消费级设备实时部署。 人工智能炼丹君 整理 | 数据来源:arXiv 2025年5月 — 2026年4月
-
AIGC 每日速读|2026-05-01|20秒训练7x加速DiT,SAMG零开销解锁空间自适应… 今日核心看点 ViPO 偏好优化 SAMG 自适应引导 L2P 推理加速 SpatialFusion 3D感知 Z² 零开销采样 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 推理加速与采样优化 3 篇 (L2P, Z²-Sampling, IDaS-SR) 引导策略与偏好对齐 3 篇 (SAMG, ViPO, ACPO) 统一生成架构与可控性 2 篇 (SpatialFusion, Diffusion Templates) 生成式超分辨率 2 篇 (MetaSR, IDaS-SR) 视觉推理与规划评测 1 篇 (EAR) 今日论文速览 1. ViPO: Visual Preference Optimization at Scale ViPO:大规模视觉偏好优化 | ICLR 2026 | arXiv:2604.24953 关键词: 偏好优化·扩散模型·DPO·大规模数据集·图像视频生成 前序工作问题: 开源偏好数据集存在冲突模式和噪声,直接优化难以学习有效偏好,阻碍视觉生成模型的大规模偏好对齐 贡献: 提出 Poly-DPO 算法通过多项式项动态调节模型置信度适应不同数据分布,构建含 100 万图像对和 30 万视频对的大规模偏好数据集 效果: 在 Pick-a-Pic V2 上 GenEval 指标超 Diffusion-DPO 6.87 分(SD1.5)和 2.32 分(SDXL),训练模型远超现有开源偏好数据集 批判点评: 数据集构建依赖 SOTA 模型生成偏好对,可能引入模型自身偏差;Poly-DPO 在高质量数据上退化为标准 DPO,额外复杂度的实际收益有限 2. SpatialFusion: Endowing Unified Image Generation with Intrinsic 3D Geometric Awareness SpatialFusion:赋予统一图像生成内在3D几何感知 | Zhejiang University | arXiv:2604.26341 关键词: 3D感知·统一生成·MoT架构·深度图·空间推理 前序工作问题: 统一图像生成模型在空间感知任务上表现受限,缺乏内在空间理解和生成时的显式几何引导 贡献: 提出 MoT 架构并行空间 Transformer 提取度量深度图作为几何支架,通过深度适配器注入扩散骨干实现空间一致生成 效果: 在空间感知基准上显著超越 GPT-4o 等领先模型,同时在 T2I 和图像编辑上实现泛化性能提升,推理开销可忽略 批判点评: 依赖额外深度 Transformer 分支增加参数量;空间感知仅覆盖单目深度,对遮挡和多视角一致性的处理能力未验证 3. Delta Score Matters! Spatial Adaptive Multi Guidance in Diffusion Models SAMG:空间自适应多引导打破细节-伪影困境 | Unknown | arXiv:2604.26503 关键词: CFG改进·空间自适应·微分几何·零开销·图像视频扩散 前序工作问题: 标准 CFG 使用全局均匀标量引导,陷入'细节-伪影困境':低引导丢失语义细节,高引导导致结构退化和色彩过饱和 贡献: 从微分几何角度揭示 CFG 本质是切向线性外推在弯曲流形上引入正交偏差,提出 SAMG 逐点动态计算引导能量实现空间自适应 效果: 跨 SD1.5/SDXL/SD3.5/CogVideoX/ModelScope 五种架构验证,零计算开销下同时提升语义对齐、结构完整性和时序平滑度 批判点评: 理论分析基于 Tweedie 公式的局部近似,对高阶流形曲率的建模精度不明;逐点计算在极高分辨率下的内存开销未讨论 4. Beyond Fixed Formulas: Data-Driven Linear Predictor for Efficient Diffusion Models L2P:可学习线性预测器加速 DiT 推理 | CVPR 2026 | arXiv:2604.26365 关键词: 推理加速·特征缓存·可学习权重·DiT·FLUX 前序工作问题: DiT 特征缓存加速方法依赖手工固定预测公式,在激进跳步策略下性能严重退化 贡献: 提出 L2P 用可学习的逐时间步权重替代固定系数,仅需单 GPU 约 20 秒训练即可从历史轨迹精确重建当前特征 效果: FLUX.1-dev 上实现 4.55 倍 FLOPs 降低和 4.15 倍延迟加速,Qwen-Image 上 7.18 倍加速仍保持高视觉保真度 批判点评: 线性预测器表达能力有限,对复杂非线性特征变化的建模可能存在天花板;泛化到不同提示分布的鲁棒性未充分验证 5. Diffusion Templates: A Unified Plugin Framework for Controllable Diffusion Diffusion Templates:统一插件框架实现可控扩散模组化 | Unknown | arXiv:2604.24351 关键词: 可控生成·插件框架·模块化·KV-Cache·LoRA·开源 前序工作问题: 可控扩散方法各自独立开发,训练管线、参数格式和运行时钩子互不兼容,难以跨任务复用和组合多种控制 贡献: 提出系统级统一接口框架,解耦基础模型推理与可控能力注入,通过 Template Model/Cache/Pipeline 三组件支持异构能力载体 效果: 构建覆盖结构控制、亮度/色彩调整、编辑、超分、锐化、美学对齐、内容参考、局部修复、年龄控制等 11+ 任务的模型动物园 批判点评: 框架抽象层可能引入额外推理延迟;不同 Template 组合时的冲突解决策略未深入讨论 6. Z²-Sampling: Zero-Cost Zigzag Trajectories for Semantic Alignment in Diffusion Models Z²-Sampling:零开销锯齿采样破 Pareto 前沿 | Unknown | arXiv:2604.23536 关键词: 采样加速·锯齿轨迹·代数消元·CFG增强·零额外NFE 前序工作问题: 显式锯齿采样(Z-Sampling)通过多步前向-后向遍历探测流形曲率提升语义对齐,但三倍化 NFE 开销且引入离流形截断误差 贡献: 证明显式锯齿序列拓扑可约,提出隐式 Z-Sampling 通过算子对偶代数消元中间态,结合时序语义代理实现零开销 效果: 恢复标准 2-NFE 基线同时保留语义探索增益,跨 UNet/DiT 架构和图像/视频模态验证,与 AYS/Diffusion-DPO 正交兼容 批判点评: 代数消元依赖特定 ODE 求解器的时序相干性假设,对自适应步长调度器的兼容性需进一步验证 7. Bridging Restoration and Generation Manifolds in One-Step Diffusion for Real-World Super-Resolution IDaS-SR:一步扩散桥接修复与生成流形 | Unknown | arXiv:2604.24136 关键词: 真实超分·一步推理·流形桥接·感知-失真平衡·噪声估计 前序工作问题: 单步蒸馏加速方法面临刚性时间步初始化、分布轨迹错配和脆弱随机调制导致的感知-失真权衡困境 贡献: 提出 MINE 预测退化感知时间步和反演噪声锚定低质量潜变量,CHARIOT 连续生成导向机制显式导航感知-失真边界 效果: 一步推理下超越 SOTA 方法,从严格结构修复器到精细纹理幻觉器的无缝过渡 批判点评: 退化感知依赖预训练的退化分类器,对未见退化类型的泛化能力存疑;一步推理的质量上界仍受限于蒸馏教师 8. ACPO: Anchor-Constrained Perceptual Optimization for Diffusion Models with No-Reference Quality Guidance ACPO:锚点约束感知优化提升扩散模型主观质量 | Unknown | arXiv:2604.26348 关键词: 感知质量·无参考IQA·锚点正则化·微调稳定性·分布漂移 前序工作问题: 扩散模型训练以像素级全参考损失为主,忽略主观视觉感知质量;直接优化无参考 IQA 信号导致训练不稳定和分布漂移 贡献: 提出锚点约束优化框架,通过 NR-IQA 模型引导感知优化同时用锚点正则化在噪声预测层面保持与基础模型一致性 效果: 有效平衡感知质量提升与生成保真度/多样性保持,避免微调过程中的训练不稳定 批判点评: NR-IQA 模型自身的偏差可能被放大注入生成模型;锚点强度的最优选择缺乏自适应机制 9. MetaSR: Content-Adaptive Metadata Orchestration for Generative Super-Resolution MetaSR:内容自适应元数据编排生成式超分辨率 | Northwestern University | arXiv:2604.26244 关键词: 生成式超分·元数据引导·DiT·一步蒸馏·码率优化 前序工作问题: 现有元数据引导超分方法使用固定调节设计,在内容和退化多样性高的真实场景中次优,传输预算受限时尤甚 贡献: 提出基于 DiT 的框架智能选择并注入任务相关元数据引导超分,利用 VAE 和 Transformer 融合异构元数据并实现一步推理蒸馏 效果: 跨多种内容桶和退化模式超越参考方案最高 1.0dB PSNR,匹配质量下节省 50% 传输码率 批判点评: 元数据选择策略的计算开销和在线部署延迟未量化;实验未覆盖极端退化(如严重压缩伪影)场景 10. Probing Visual Planning in Image Editing Models EAR:编辑即推理探测图像编辑模型视觉规划能力 | Unknown | arXiv:2604.22868 关键词: 视觉规划·编辑即推理·抽象谜题·迷宫·评测基准 前序工作问题: 视觉规划是人类智能关键能力,但机器学习中多以语言为中心解决;纯视觉方法因逐步生成范式计算效率低下 贡献: 提出 EAR 编辑即推理范式将视觉规划重构为单步图像变换,引入 AMAZE 抽象迷宫数据集自动评估 AR 和扩散模型的像素保真度与逻辑有效性 效果: 微调后模型可泛化到更大规模和域外几何,但最佳模型仍无法匹配人类零样本效率,揭示神经视觉推理差距 批判点评: 抽象迷宫任务与真实图像编辑场景差异大,结论迁移性存疑;评估仅覆盖路径规划类任务,对创意编辑推理无覆盖 趋势观察 扩散模型推理加速持续白热化 — L2P(20秒训练7x加速)、Z²-Sampling(零开销语义增强)、IDaS-SR(一步超分) 三篇工作从不同角度逼近效率极限 CFG 引导范式迎来几何重构 — SAMG 和 Z²-Sampling 不约而同从微分几何视角重新理解 CFG,推动引导策略从粗暴标量走向精细空间自适应 人工智能炼丹君 整理 | 2026-05-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-04-30|V-GRPO让RL对齐提速3倍,64token暴力生图 今日核心看点 RL对齐扩散 1D AR生成 视频后训练 音频RLHF 组合式文生图 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 10 篇。 方向分布: 扩散模型 RL 对齐与加速 2 篇 (V-GRPO, Mutual Forcing) 视频生成后训练与叙事 2 篇 (Systematic Post-Train, Co-Director) 图像生成与编辑 4 篇 (VibeToken, RvR, Golden RPG, ResetEdit) 音频与音乐生成 2 篇 (Step-Audio-R1.5, SymphonyGen) 今日论文速览 1. V-GRPO:RL对齐扩散模型原来这么简单,文生图SOTA提速3倍 V-GRPO: Online Reinforcement Learning for Denoising Generative Models Is Easier than You Think | 2604.23380 关键词: 强化学习·扩散模型·ELBO·GRPO·文生图对齐 前序工作问题: 用策略梯度在线 RL 对齐扩散生成模型面临似然不可解难题,现有 MDP 轨迹方法稳定但低效,ELBO 代理方法在视觉生成上表现不佳 贡献: 提出 V-GRPO,将 ELBO 代理与 GRPO 算法融合,通过降低代理方差和控制梯度步长使 ELBO 路线首次超越 MDP 方法,实现稳定高效的扩散模型 RL 对齐 效果: 在文生图合成中达到 SOTA 性能,相比 MixGRPO 提速 2 倍,相比 DiffusionNFT 提速 3 倍,且实现简单、与预训练目标自然对齐 批判点评: ELBO 代理的方差控制依赖精心调参,泛化到不同扩散架构的鲁棒性待验证;仅在文生图场景评估,对视频生成等其他扩散任务的迁移能力未知;与 DPO 等离线方法的对比缺少公平条件分析 2. VibeToken:1D Tokenizer让AR图像生成效率暴增63倍(CVPR 2026) VibeToken: Scaling 1D Image Tokenizers and Autoregressive Models for Dynamic Resolution Generations | 2604.24885 关键词: 图像Tokenizer·自回归生成·动态分辨率·1D序列·CVPR 2026 前序工作问题: 固定分辨率 AR 模型的推理 FLOPs 随分辨率二次增长(LlamaGen 在 1024×1024 需 11T FLOPs),且无法泛化到任意宽高比 贡献: 提出 VibeToken,基于 1D Transformer 的分辨率无关图像 Tokenizer,将图像编码为 32-256 个用户可控 token,实现动态分辨率自回归生成;VibeToken-Gen 仅用 64 token 即可合成 1024×1024 图像 效果: 64 token 生成 1024×1024 图像达 3.94 gFID(对比 SOTA 扩散模型 1024 token / 5.87 gFID),推理 FLOPs 仅 179G,比 LlamaGen 高效 63.4 倍且与分辨率无关 批判点评: 极端压缩(32 token 编码一张图)可能丢失高频细节;1D tokenizer 对空间结构的建模能力不如 2D 方案;CVPR 接收但 gFID 指标与最新扩散模型仍有差距 3. Mutual Forcing:4步搞定音视频角色生成,无需教师模型 Mutual Forcing: Dual-Mode Self-Evolution for Fast Autoregressive Audio-Video Character Generation | 2604.25819 关键词: 音视频生成·自回归·自蒸馏·少步生成·双模式协同 前序工作问题: 现有流式蒸馏管线需先训练双向教师模型再多阶段蒸馏为因果生成器,流程复杂、训练开销大,且受限于固定教师质量 贡献: 提出 Mutual Forcing 框架,在原生自回归模型上集成少步和多步两种生成模式共享参数,多步模式通过自蒸馏提升少步模式质量,少步模式在训练时生成历史上下文改善训练-推理一致性,两模式互相强化 效果: 仅用 4-8 步即可匹配或超越需要约 50 步采样的强基线,无需额外双向教师模型,支持更灵活的训练序列长度 批判点评: 双模式共享参数可能导致两种模式互相干扰而非完全互补;4-8 步生成在高质量要求场景下是否真正匹配全步效果需更多定量验证;仅在角色动画场景验证,泛化到通用音视频的能力待考 4. 视频生成后训练蓝图:SFT→RLHF→提示增强→推理优化四步走 A Systematic Post-Train Framework for Video Generation | 2604.25427 关键词: 视频生成·后训练·RLHF·GRPO·SFT·推理优化 前序工作问题: 大规模视频扩散模型预训练后仍存在提示敏感、时序不一致和推理成本过高等问题,导致与实际部署需求之间有巨大差距 贡献: 提出系统化后训练框架,分四阶段逐步对齐:SFT 稳定指令跟随 → RLHF(视频专用 GRPO)增强感知质量和时序一致性 → 提示增强精炼用户输入 → 推理优化压缩采样成本 效果: 统一管线有效抑制常见伪影,显著提升可控性和视觉美学,同时满足严格的采样成本约束,提供可复制的生产级后训练蓝图 批判点评: 四阶段串联管线的调参和维护成本极高;GRPO 在视频维度的奖励设计细节不够充分;缺少与 InstructVideo、VideoDirectorGPT 等已有后训练方法的直接对比 5. RvR:统一多模态模型的图像精修应该「再生」而非「编辑」 Refinement via Regeneration: Enlarging Modification Space Boosts Image Refinement in Unified Multimodal Models | 2604.25636 关键词: 统一多模态·图像精修·条件再生成·语义对齐·修改空间 前序工作问题: 统一多模态模型的精修方法沿用编辑范式(RvE),编辑指令对齐描述粗糙且像素级保留过度限制修改空间,导致精修不完整 贡献: 提出 Refinement via Regeneration (RvR) 框架,将精修重定义为基于目标提示和初始图像语义 token 的条件再生成,突破编辑范式的修改空间限制实现更完整的语义对齐 效果: Geneval 从 0.78 提升至 0.91,DPGBench 从 84.02 到 87.21,UniGenBench++ 从 61.53 到 77.41,全面提升文图对齐质量 批判点评: 再生成策略可能导致图像风格和低级纹理的不一致;对已经高度对齐的初始图像反而可能引入不必要的变化;语义 token 的压缩程度对再生成质量的影响未充分消融 6. Step-Audio-R1.5:用RLHF突破音频推理的「可验证奖励陷阱」 Step-Audio-R1.5 Technical Report | 2604.25719 关键词: 音频推理·RLHF·可验证奖励陷阱·韵律自然度·沉浸对话 前序工作问题: 大型音频语言模型通过 RLVR 优化在基准测试上取得高分,但系统性地退化对话的韵律自然度、情感连续性和用户沉浸感,变成机械的「答题机器」 贡献: 揭示「可验证奖励陷阱」——RLVR 将丰富连续的听觉语境压缩为离散可验证标签的根本矛盾;引入 Step-Audio-R1.5,开创性地在音频推理中使用 RLHF 替代 RLVR,从机械客观验证转向感官共情 效果: Step-Audio-R1.5 在保持分析推理能力的同时深刻改善交互体验,重新定义深度沉浸式长轮对话的边界 批判点评: RLHF 的人类偏好数据收集成本极高且主观性强;「可验证奖励陷阱」的论述虽有洞察但定量证据不足;对非对话场景(如音频分类、音频检索)的影响未讨论 7. Co-Director:多智能体协作驱动视频叙事创作 Co-Director: Agentic Generative Video Storytelling | 2604.24842 关键词: 视频叙事·多智能体·分层优化·多臂赌博机·身份一致性 前序工作问题: 扩散模型能生成高保真视频片段但难以构成连贯叙事,现有智能体管线因独立手工提示而导致语义漂移和级联失败 贡献: 提出 Co-Director 分层多智能体框架,将视频叙事形式化为全局优化问题:多臂赌博机全局探索有前景的创意方向,局部多模态自精炼循环抑制身份漂移确保序列级一致性 效果: 在 GenAD-Bench(400 场景个性化广告数据集)上显著超越 SOTA 基线,可无缝泛化到更广泛的电影叙事 批判点评: 多臂赌博机的探索-利用权衡在创意领域的适用性存疑;400 场景集中在广告领域,对长篇叙事的验证不足;多智能体协调的计算开销和延迟缺乏量化分析 8. Golden RPG:区域感知噪声让组合式文生图更精准 Golden RPG: Confidence-Adaptive Region-Aware Noise for Compositional Text-to-Image Generation | 2604.25314 关键词: 组合式文生图·区域感知·噪声预测·FiLM·置信度自适应 前序工作问题: 扩散模型的 golden noise 预测本质上是全局的,同一网络用单一文本嵌入概括多区域提示,在描述空间分离实体时成为瓶颈 贡献: 提出 Golden RPG,在冻结 NPNet 上增加两个可训练模块:逐区域 FiLM 适配器按子提示重塑预测噪声、Region Cross-Attention 让不同空间位置关注不同子提示 token;置信度自适应融合头动态决定区域信号覆盖全局信号的强度 效果: 在 RPG 基准和 T2I-CompBench 四类多区域评测上均取得最高 Cross-Region-Coherence 分数,用户研究中约 67% 偏好率超越最强基线,仅增加约 2M 参数和 0.6s 推理开销 批判点评: 依赖冻结的 NPNet 基座,其固有局限传导到区域预测;FiLM 适配器的区域分解假设子提示完全独立,忽略跨区域交互;仅在 SDXL 上验证,对其他扩散架构的迁移性未知 9. ResetEdit:给生成图预埋「回溯锚点」实现精确重编辑 ResetEdit: Precise Text-guided Editing of Generated Image via Resettable Starting Latent | 2604.25128 关键词: 图像编辑·扩散反演·可重置隐变量·主动嵌入·VAE补偿 前序工作问题: 现有反演方法(如 DDIM 反演)产生的起始隐变量质量差,导致编辑保真度和结构一致性受损;理想的编辑锚点是生成时的原始隐变量,但为每张图存储该隐变量不现实 贡献: 提出 ResetEdit 主动扩散编辑框架,在生成过程中将干净隐变量与扩散隐变量的差异信息嵌入扩散轨迹,反演时提取该信息重建近似真实起始状态的可重置隐变量;轻量隐变量优化模块补偿 VAE 不对称导致的重建偏差 效果: 基于 Stable Diffusion 无缝集成现有免微调编辑方法,在可控性和视觉保真度上持续超越 SOTA 基线 批判点评: 需要在生成阶段预埋信息,无法用于已有的外部图像编辑;嵌入的差异信息可能影响原始生成质量;对高步数扩散过程的信息保持能力未分析 10. SymphonyGen:3D分层管弦乐生成,GRPO+不协和感知采样 SymphonyGen: 3D Hierarchical Orchestral Generation with Controllable Harmony Skeleton | 2604.25498 关键词: 音乐生成·交响乐·3D分层·GRPO·不协和感知采样 前序工作问题: 交响音乐生成需同时管理高层结构形式和密集多轨编配,现有符号模型面临「复杂度-控制失衡」,扩展瓶颈限制长期精细可控性 贡献: 提出 SymphonyGen 3D 分层框架,级联解码器将 Bar-Track-Event 三轴解耦提升计算效率;引入 beat-quantized 多声部和声骨架实现轮廓控制;GRPO 跨模态音频感知奖励对齐符号输出与现代声学期望;不协和感知采样算法抑制推理时的意外调性冲突 效果: 客观评估证明 RL 和不协和感知采样有效提升和声清洁度同时保持旋律表达力,主观评估在音乐性和偏好度上超越基线 批判点评: 3D 分层解码器的三轴解耦假设 Bar/Track/Event 独立性,可能丢失跨轴依赖;GRPO 奖励基于音频渲染,符号到音频的转换引入额外噪声;训练数据以西方古典/电影音乐为主,对其他音乐体系的泛化有限 趋势观察 GRPO 成为生成模型标配优化器 — V-GRPO、Systematic Post-Train、SymphonyGen 三篇独立工作不约而同选择 GRPO 作为 RL 对齐核心,标志着 GRPO 从 LLM 走向多模态生成的全面渗透 生成模型从预训练转向后训练精细化 — Systematic Post-Train 的四阶段蓝图和 Step-Audio-R1.5 对 RLHF 的引入,说明业界已从追求更大预训练模型转向挖掘后训练阶段的对齐潜力 人工智能炼丹君 整理 | 2026-04-30
-
AIGC 每日速读|2026-04-28|20FPS实时数字人Hallo-Live 今日核心看点 Hallo-Live 20FPS实时 Z²零成本采样 REDEdit无掩码编辑 V-GRPO偏好对齐 EAD-Net情感Talking Head 今日概览 共 10 篇 | 覆盖 4 个方向 | 含 Fudan / ETH / MIT / Baidu 等机构 方向 篇数 代表论文 视频/数字人 5 Hallo-Live(实时流式)、Talker-T2AV、EAD-Net、BurstGP、MotionHiFlow 采样优化 2 Z2-Sampling(零成本锯齿)、Oracle Noise(球面对齐) 图片编辑 2 REDEdit(无掩码局部编辑)、Geometry-Conditioned Diffusion 模型对齐 1 V-GRPO(在线RL偏好对齐) 今日论文速览 1. Hallo-Live:提出 Hallo-Live 框架 Hallo-Live: Real-Time Streaming Joint Audio-Video Avatar Generation with Asynchronous Dual-Stream and Human-Centric Preference Distillation | Shanghai Innovation Institute, Fudan University, University of Science and Technology of China, Nanjing University, Baidu 关键词: 实时生成, 音视频数字人, 双流扩散, 偏好蒸馏 前序工作问题: 现有音视频扩散模型推理速度太慢,无法满足实时交互式数字人生成的需求,激进加速后质量严重退化。 贡献: 提出 Hallo-Live 框架,通过异步双流扩散架构(视频流与音频流独立去噪 + Future-Expanding Attention)和以人为本偏好蒸馏(HP-DMD),实现首个实时流式联合音视频数字人生成。 效果: 在两块 H200 GPU 上达到 20.38 FPS、0.94 秒延迟,较教师模型吞吐量提升 16 倍、延迟降低 99.3 倍。VideoAlign 整体分数和 Sync 分数均超越教师模型。 批判点评: 双H200的硬件门槛不低,20FPS实时性令人印象深刻但工程复杂度高,偏好蒸馏的泛化性有待更多场景验证 2. BurstGP:提出 BurstGP BurstGP: Enhancing Raw Burst Image Super Resolution with Generative Priors | ETH 关键词: 突发超分, 扩散先验, 退化感知 前序工作问题: 传统 Burst 超分方法在复杂纹理上过度平滑,难以从多帧低分辨率图像重建精细视觉细节。 贡献: 提出 BurstGP,利用预训练视频扩散模型的生成先验来增强多帧突发(Burst)图像超分辨率,解决传统方法在复杂纹理上过度平滑的问题。 效果: 引入退化感知条件机制控制细节合成力度,以及鲁棒的 sRGB-to-lRGB 反转模块以利用视频先验。在感知指标(MUSIQ、LPIPS)上达到 SOTA,纹理恢复和结构细节显著提升。 批判点评: 视频扩散先验用于Burst超分思路新颖,但退化感知机制的鲁棒性在极端退化场景下可能受限 3. $Z^2$-Sampling:理论证明 Z-Sampling 的显式锯齿轨迹可拓扑约简 $Z^2$-Sampling: Zero-Cost Zigzag Trajectories for Semantic Alignment in Diffusion Models | MIT, ETH 关键词: 采样优化, CFG增强, 零成本 前序工作问题: 标准 CFG 仅利用瞬时梯度,忽略历史去噪轨迹中的语义对齐信息,限制了扩散模型的生成质量。 贡献: 理论证明 Z-Sampling 的显式锯齿轨迹可拓扑约简,提出 Z²-Sampling(零成本锯齿采样),在不增加 NFE 开销的情况下显著提升扩散模型的语义对齐质量。 效果: 利用概率流 ODE 的时间连续性,将隐式代数坍缩与动态缓存结合,零额外计算成本实现与 Z-Sampling 相当的语义对齐提升,消除离流形评估误差。 批判点评: 零成本提升语义对齐的理论贡献扎实,但实际增益幅度需看具体任务和模型架构 4. Oracle Noise:提出 Oracle Noise 方法 Oracle Noise: Faster Semantic Spherical Alignment for Interpretable Latent Optimization | MIT, ETH 关键词: 噪声优化, 球面对齐, 语义增强 前序工作问题: 文生图扩散模型在复杂文本提示下语义对齐不精确,传统初始噪声优化方法会破坏高斯先验导致伪影。 贡献: 提出 Oracle Noise 方法,通过球面对齐优化初始噪声来提升文生图模型的语义对齐,避免传统欧几里得梯度上升破坏高斯先验导致的伪影。 效果: 在球面流形上进行约束优化,保持噪声的高斯分布性质,消除颜色过饱和等伪影,实现更快速的语义对齐收敛。 批判点评: 球面约束优化思路优雅,2秒预算内的收敛速度是亮点,但对高分辨率生成的扩展性存疑 5. Talker-T2AV:提出 Talker-T2AV Talker-T2AV: Joint Talking Audio-Video Generation with Autoregressive Diffusion Modeling 关键词: Talking Head, 自回归扩散, 音视频联合 前序工作问题: 现有联合音视频生成模型在整个去噪过程中耦合模态,无法有效解耦语义关联与底层渲染。 贡献: 提出 Talker-T2AV,采用自回归扩散建模实现联合说话音视频生成,将语义关联与底层渲染解耦。 效果: 高层语义跨模态关联,低层音频信号和视觉纹理独立渲染,减少不必要的纠缠,提升说话头像合成中的音画质量和唇形同步精度。 批判点评: 语义-渲染解耦设计合理,但双头架构的训练稳定性和音视频同步精度需更大规模验证 6. MotionHiFlow:提出 MotionHiFlow MotionHiFlow: Text-to-motion via hierarchical flow matching | MIT 关键词: 动作生成, 分层流匹配, 文本驱动 前序工作问题: 文本驱动动作生成在复杂动作的层级理解和精细细节保真方面仍有不足,单一层次建模难以兼顾语义对齐与物理合理性。 贡献: 提出 MotionHiFlow,一种用于文本驱动动作生成的分层 Flow Matching 框架,模拟人类认知中对复杂动作的层级理解。 效果: 在多个时间尺度上逐层生成动作,从粗粒度语义到细粒度细节,提升语义对齐和时间连贯性,生成更自然的 3D 人体运动。 批判点评: 分层Flow Matching概念清晰,跨尺度过渡机制是关键创新,但3D动作的物理合理性评估不够充分 7. EAD-Net:提出 EAD-Net EAD-Net: Emotion-Aware Talking Head Generation with Spatial Refinement and Temporal Coherence | MIT, ETH 关键词: 情感驱动, Talking Head, 时间连贯 前序工作问题: 情感说话头像生成依赖简单情感标签语义不足,且引入情感表达往往导致唇形同步质量退化。 贡献: 提出 EAD-Net,情感感知的说话头像生成方法,解决简单情感标签语义不足和唇形同步退化问题。 效果: 引入高层语义情感信息增强表情表达力,同时通过空间精化和时间连贯性模块平衡计算效率与全局运动感知,减轻长视频中的闪烁伪影。 批判点评: 情感标签→LLM文本描述的升级方向正确,但STDA的计算开销可能限制长视频实用性 8. V-GRPO:提出 V-GRPO V-GRPO: Online Reinforcement Learning for Denoising Generative Models Is Easier than You Think | MIT, ETH 关键词: GRPO, 偏好对齐, 在线RL 前序工作问题: 将去噪生成模型与人类偏好对齐仍面临方差大、训练不稳定等挑战,现有策略梯度方法效率有限。 贡献: 提出 V-GRPO,用在线强化学习对齐去噪生成模型与人类偏好,基于 ELBO 似然代理实现高效稳定的策略优化。 效果: 关键发现:ELBO 似然代理在足够的 KL 正则化下效果与精确似然相当。V-GRPO 在视觉生成任务上优于 MDP 轨迹优化方法,训练更高效。 批判点评: ELBO代理+GRPO的组合简洁高效,2-3倍加速实用价值高,但奖励模型的质量仍是瓶颈 9. Geometry-Conditioned:将遮挡感知数据增强重新定义为几何条件生成建模任务 Geometry-Conditioned Diffusion for Occlusion-Robust In-Bed Pose Estimation | MIT, ETH 关键词: 姿态估计, 遮挡鲁棒, 条件扩散 前序工作问题: 毯子遮挡下的床上人体姿态估计缺乏可靠标注数据,现有多模态方法成本高且适应性差。 贡献: 将遮挡感知数据增强重新定义为几何条件生成建模任务,提出姿态条件扩散模型用于被毯子遮挡的床上姿态估计。 效果: 系统比较确定性遮罩、非配对翻译、配对扩散翻译和姿态条件生成四种方案,实现不依赖多模态传感器的鲁棒遮挡姿态估计。 批判点评: 从骨架直接生成遮挡图像消除了配对数据依赖,但应用场景较窄,泛化到其他遮挡类型需验证 10. Edit Where You Mean:提出 REDEdit Edit Where You Mean: Region-Aware Adapter Injection for Mask-Free Local Image Editing 关键词: 局部编辑, 无掩码, DiT适配器 前序工作问题: 大型 DiT 模型的联合注意力架构缺乏显式空间控制,局部编辑指令会不可避免地泄漏到无关区域。 贡献: 提出 REDEdit,指令与区域感知的适配器框架,让冻结的 DiT 变成精确的局部编辑器,无需修改骨干网络权重。 效果: 通过 Block Adapter 在每个 Transformer 块注入结构化条件流,将「编辑什么」与「在哪编辑」分离,解决 DiT 局部编辑泄漏到无关区域的问题,无需掩码输入。 批判点评: Block Adapter免训练骨干的设计实用性强,MaskPredictor自动定位编辑区域是亮点,但复杂多区域编辑场景未充分探索 趋势观察 实时流式生成 — 数字人生成从离线走向实时流式,Hallo-Live 以 20.38 FPS 展示了扩散模型实时音视频生成的可行性,Future-Expanding Attention 和偏好蒸馏是关键使能技术。 采样效率理论突破 — Z²-Sampling 从拓扑学角度证明显式锯齿轨迹可约简,Oracle Noise 引入球面约束优化,两者都在不增加或减少计算开销的前提下提升语义对齐。 音视频联合建模深化 — Talker-T2AV 和 EAD-Net 分别从自回归解耦和情感感知角度推进 Talking Head 技术,语义-渲染分离成为新范式。 扩散后训练对齐 — V-GRPO 证明基于 ELBO 的在线 RL 可有效对齐去噪生成模型,为扩散模型的 RLHF 提供了简洁高效的新路径。 精准可控编辑 — REDEdit 解决了 DiT 架构下局部编辑泄漏的痛点,Block Adapter 实现指令与空间的分离,无掩码精准编辑。 人工智能炼丹君 整理 | 2026-04-28
-
AIGC 每日速读|2026-04-27|多目标Pareto后训练ParetoSlider 今日核心看点 NVIDIA ParetoSlider 多目标Pareto后训练 扩散蒸馏嵌入损失 训练成本大降 快手Kling UniSonate 统一音频生成 VAR蒸馏一步超分 10倍加速 FlowAnchor 免反转视频编辑 今日概览 今日 arXiv cs.CV 视觉生成相关论文共 12 篇。 方向分布: 图像生成与编辑 — 5 篇(Pareto多目标后训练、扩散蒸馏加速、VAR超分蒸馏、HDR线性图像生成、人脸属性编辑) 视频生成与编辑 — 4 篇(Flow-based视频编辑、稀疏注意力实时生成、注意力操控、知识驱动广告视频) 音频生成 — 1 篇(统一语音/音乐/音效生成,快手Kling团队) 生成理解一体化 — 1 篇(精确视频描述语言+Wan微调,CMU/Stanford) 生成模型推理加速 — 1 篇(VAR风格迁移自回归建模) 源自 arXiv 4月25日 141 篇候选 + HF Daily Papers,经多维评分排序精选 今日论文速览 1. ParetoSlider:提出多目标RL框架训练单个扩散模型逼近整个Pareto前沿 ParetoSlider: Diffusion Models Post-Training for Continuous Reward Control | Tel Aviv University / NVIDIA | arXiv:2604.20816 关键词: 多目标RL·Pareto前沿·扩散后训练·推理时控制 前序工作问题: RL后训练只能优化单一标量奖励,无法在推理时动态控制文本对齐度、美学、真实感等多个冲突目标间的权衡 贡献: 提出多目标RL框架训练单个扩散模型逼近整个Pareto前沿,通过偏好权重条件化+多目标GRPO实现推理时Slider实时调控 效果: 在SD3.5/FluxKontext/LTX-2三个骨干上单模型匹配或超越多个独立训练的基线,权衡导航平滑连续 批判点评: Pareto前沿维度灾难:目标数超过3-4个时近似质量可能下降,reward model覆盖度有限 2. EmbedDist:提出嵌入损失替代传统蒸馏目标 Efficient Diffusion Distillation via Embedding Loss | Unknown | arXiv:2604.22379 关键词: 扩散蒸馏·嵌入损失·少步生成·训练效率 前序工作问题: 扩散蒸馏训练成本极高:回归损失需预生成大量教师样本,对抗损失训练不稳定且资源消耗大 贡献: 提出嵌入损失替代传统蒸馏目标,用预训练视觉编码器(DINO/CLIP)将师生输出映射到嵌入空间计算相似度,兼具稳定性和感知质量 效果: 训练效率相比对抗蒸馏提升数倍,生成质量保持或提升,即插即用适配多种蒸馏框架 批判点评: 嵌入损失上限受预训练编码器表达能力制约,与对抗损失的最优组合尚未探索 3. UniSonate:首个单模型统一三大音频任务 UniSonate: A Unified Model for Speech, Music, and Sound Effect Generation with Text Instructions | Tianjin University / Kling Team, Kuaishou / Chinese Academy of Sciences | arXiv:2604.22209 关键词: 统一音频生成·TTS·音乐生成·音效生成·快手Kling 前序工作问题: 音频生成被割裂为TTS、文生音乐、文生音效三个独立领域,结构化语义与非结构化声学纹理的统一面临根本挑战 贡献: 首个单模型统一三大音频任务,设计层次化token(语义+声学)+两阶段生成(语言模型+扩散),文本指令统一接口 效果: 单模型在语音/音乐/音效上接近专用模型性能,支持跨模态组合生成(如带背景音乐的语音) 批判点评: 系统复杂度高(多编码器+LM+扩散),复现门槛大,与专用SOTA的性能差距需详细量化 4. FlowAnchor:提出FlowAnchor训练免费框架 FlowAnchor: Stabilizing the Editing Signal for Inversion-Free Video Editing | Unknown | arXiv:2604.22586 关键词: 视频编辑·Flow-based·免反转·训练免费 前序工作问题: 免反转的flow-based视频编辑方法在多物体场景下信号不稳定,常出现失败 贡献: 提出FlowAnchor训练免费框架,通过锚定编辑信号稳定采样轨迹,实现高效结构保持的视频编辑 效果: 在多物体场景的视频编辑任务中显著提升稳定性和结构保真度 批判点评: 锚定策略的通用性需在更多编辑场景验证,对大幅度语义变化的支持可能有限 5. Sparse Forcing:提出Sparse Forcing范式 Sparse Forcing: Native Trainable Sparse Attention for Real-time Autoregressive Diffusion Video Generation | Unknown | arXiv:2604.21221 关键词: 稀疏注意力·视频扩散·自回归·实时生成 前序工作问题: 自回归视频扩散模型的注意力计算量随序列增长爆炸,无法实时生成长视频 贡献: 提出Sparse Forcing范式,利用注意力集中于显著视觉块的观察设计原生可训练稀疏注意力,同时提升生成质量和降低延迟 效果: 长视频生成质量提升的同时解码延迟显著降低,向实时自回归视频生成迈进 批判点评: 稀疏模式的选择依赖场景特性,对快速运动或场景切换的鲁棒性待验证 6. VARestorer:提出蒸馏框架将预训练文生图VAR模型转化为一步超分模型 VARestorer: One-Step VAR Distillation for Real-World Image Super-Resolution | Tsinghua University | arXiv:2604.21450 关键词: VAR蒸馏·图像超分·一步推理·参数高效 前序工作问题: 视觉自回归模型(VAR)的逐尺度预测机制在超分任务中因因果注意力限制无法利用全局低质量上下文,导致输出模糊,且多步迭代引发误差累积 贡献: 提出蒸馏框架将预训练文生图VAR模型转化为一步超分模型,引入金字塔图像条件+跨尺度注意力实现双向尺度交互,仅微调1.2%参数 效果: DIV2K上MUSIQ 72.32、CLIPIQA 0.7669达SOTA,推理速度提升10倍 批判点评: 蒸馏依赖教师模型质量,对极端退化场景(如严重压缩伪影)的泛化能力待验证 7. Linear Image Gen:首次提出文本到线性图像生成任务 Linear Image Generation by Synthesizing Exposure Brackets | Adobe Research / NTU | arXiv:2604.21008 关键词: 线性图像·曝光包围·HDR生成·DiT流匹配 前序工作问题: 现有生成模型只能合成经色调映射的显示参考图像,丢失场景真实辐照信息,限制后期编辑空间 贡献: 首次提出文本到线性图像生成任务,将线性图像表示为曝光包围序列,设计DiT流匹配架构生成多曝光bracket保留完整动态范围 效果: 生成高质量场景参考线性图像,支持文本引导编辑和ControlNet结构条件生成等下游应用 批判点评: 曝光包围表示增加推理开销,线性图像评估标准尚未建立,实用性需更多专业摄影师反馈验证 8. CHAI:定义结构化视频描述规范(数百个视觉原语) Building a Precise Video Language with Human-AI Oversight | CMU / Stanford | arXiv:2604.21718 关键词: 视频描述·CHAI框架·人机协同·Wan微调 前序工作问题: 现有视频语言模型缺乏精确描述运动、空间和摄像机动态的能力,标注数据质量参差不齐 贡献: 定义结构化视频描述规范(数百个视觉原语),提出CHAI人机协同框架让专家对模型预标注进行批判修正,支持SFT/DPO/推理时Scaling 效果: 在适度人工监督下开源模型超越Gemini-3.1-Pro;微调Wan实现400词长提示的精准视频生成控制 批判点评: 专家监督仍需大量人力投入,视觉原语定义的通用性和可扩展性有待社区验证 9. StyleVAR:基于VAR框架将风格迁移建模为条件离散序列生成 StyleVAR: Controllable Image Style Transfer via Visual Autoregressive Modeling | Unknown | arXiv:2604.21052 关键词: VAR框架·风格迁移·离散序列·VQ-VAE 前序工作问题: 现有风格迁移方法在内容保持与风格一致性之间难以平衡,基于扩散的方法推理慢 贡献: 基于VAR框架将风格迁移建模为条件离散序列生成,用VQ-VAE分解多尺度表示,Transformer自回归建模风格和内容条件下的目标token分布 效果: 在内容保持和风格一致性两方面取得良好平衡,推理速度优于扩散方法 批判点评: VQ-VAE的离散化可能导致细节损失,对抽象艺术风格的迁移效果待验证 10. AttentionBender:基于Network Bending设计工具 AttentionBender: Manipulating Cross-Attention in Video Diffusion Transformers | University of the Arts London | arXiv:2604.20936 关键词: 注意力操控·视频DiT·创意工具·可解释AI 前序工作问题: 视频生成模型只能通过提示词控制,艺术家无法直观理解和操控模型内部机制以突破默认生成倾向 贡献: 基于Network Bending设计工具,对视频DiT的交叉注意力图施加2D变换(旋转/缩放/平移),4500+视频实验验证操控效果 效果: 揭示交叉注意力高度纠缠特性,产生超越模型学习表征空间的新颖glitch美学效果 批判点评: 操控效果高度非线性且难以预测,作为实用工具的可控性和易用性较弱 11. KD-CVG:构建广告创意知识库(ACKB) KD-CVG: A Knowledge-Driven Approach for Creative Video Generation | Xi'an Jiaotong University / ByteDance | arXiv:2604.21362 关键词: 创意视频·广告生成·知识图谱·语义对齐 前序工作问题: T2V模型在广告创意视频生成中存在语义对齐模糊和运动适应性不足两大问题 贡献: 构建广告创意知识库(ACKB),提出语义感知检索(SAR)+多模态知识参考(MKR)两阶段方法,用图注意力网络和RL反馈增强卖点-视频关联理解 效果: 在语义对齐和运动适应性指标上超越现有方法,代码和数据集将开源 批判点评: 知识库构建成本高且依赖特定广告领域,泛化到其他创意场景需额外适配 12. AttDiff-GAN:提出混合Diffusion-GAN框架 AttDiff-GAN: A Hybrid Diffusion-GAN Framework for Facial Attribute Editing | Unknown | arXiv:2604.21289 关键词: 人脸编辑·扩散GAN混合·属性解耦·高保真 前序工作问题: GAN方法可控性好但风格码与属性语义对齐弱,扩散方法图像真实但编辑精度受噪声纠缠限制 贡献: 提出混合Diffusion-GAN框架,融合GAN的可控性和扩散模型的高真实度,实现精确人脸属性编辑 效果: 在属性编辑精度和图像保真度上超越纯GAN和纯扩散基线 批判点评: 人脸属性编辑场景较窄,对非人脸图像编辑的泛化性未知 趋势观察 多目标优化进入扩散后训练 — ParetoSlider证明单模型可逼近整个Pareto前沿,推理时实时调控多个冲突目标的权衡,标志着扩散模型后训练从单目标RLHF进化到多目标连续控制 扩散蒸馏降本增效竞争激烈 — EmbedDist用嵌入损失替代传统回归/对抗损失,大幅降低蒸馏训练成本,表明高效蒸馏仍是加速扩散推理的活跃战场 音频生成走向统一大模型 — UniSonate首次在单模型中统一TTS、音乐和音效生成,层次化token设计优雅统一结构化与非结构化音频,预示音频领域的GPT时刻 视觉自回归模型多点开花 — VARestorer将VAR用于超分恢复,StyleVAR将VAR用于风格迁移,VAR框架正从纯生成扩展到更广泛的视觉任务 稀疏注意力助推实时视频生成 — Sparse Forcing利用注意力集中性设计原生稀疏机制,在保持质量的同时降低延迟,为实时自回归视频生成铺路 人工智能炼丹君 整理 | 2026-04-27
-
AIGC周末专题|2026-04-26|统一多模态生成大爆发:Omni五模态SOTA碾压Qwen 技术路线与时间线 离散 token 统一探索(2024.05 — 2024.12) 描述:Chameleon、Emu3、Show-o 等工作证明文本、图像、视频可以进入同一 token/Transformer 框架。 关键节点: 2024.05:Chameleon:mixed-modal early-fusion 2024.08:Show-o:自回归 + 离散扩散统一 2024.09:Emu3:next-token prediction 统一视觉生成理解 双编码器与混合目标稳定化(2025.01 — 2025.06) 描述:Janus-Pro、Transfusion、Show-o2 等工作开始稳定统一图文生成质量,并探索视频扩展。 关键节点: 2025.01:Janus-Pro:理解/生成编码解耦 + scaling 2025.05:BAGEL:交错多模态预训练基座 2025.06:Show-o2:自回归 + Flow Matching 扩散式统一模型升温(2026.01 — 2026.03) 描述:AR-Omni、LLaDA-o 等从自回归和扩散两端推进 any-to-any 与 omni diffusion。 关键节点: 2026.01:AR-Omni:统一自回归 any-to-any 生成 2026.03:LLaDA-o:Mixture of Diffusion + 长度自适应 近期大爆发(2026.04) 描述:Qwen3.5-Omni、LLaDA2.0-Uni、Vision Banana、Uni-ViGU、Omni 等集中出现,统一模型成为主线。 关键节点: 2026.04.09:Uni-ViGU:视频生成器基座统一理解生成 2026.04.17:Qwen3.5-Omni:千亿级全模态系统 2026.04.22:Vision Banana:生成器成为通用视觉学习器 2026.04.23:Omni:上下文展开统一多模态推理 1. Omni (Context Unrolling):原生多模态统一模型——上下文展开让生成与理解互相增强 论文: Omni (Context Unrolling) arXiv: 2604.21921 机构: 字节跳动 / BAGEL 团队 1.1 研究动机 核心问题: 统一多模态模型常被做成“理解模型+生成头”或“生成模型+理解头”,但这种拼接式统一缺乏推理过程中的跨模态中间状态。 统一多模态模型常被做成“理解模型+生成头”或“生成模型+理解头”,但这种拼接式统一缺乏推理过程中的跨模态中间状态。模型看似统一,实际仍很难让文本、图像、视频线索在生成前反复互相补充。 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: Omni (Context Unrolling) 的关键区别在于:提出上下文展开(Context Unrolling):把跨模态中间表征作为原子操作写回共享上下文。 1.2 方法原理 方法框架图 Omni 的核心是上下文展开:模型把任务分成描述、局部视觉展开、编辑、视频预测等原子操作,每一步输出都重新写回共享上下文,再基于更丰富的上下文生成最终答案。相比一次性条件生成,它更像一个多模态工作区:先把输入转换成可复用中间表征,再逐步调用不同模态能力。架构上沿用 BAGEL 系列 MoE 统一骨干,以较小活跃参数承载生成与理解。 1.3 核心创新 提出上下文展开(Context Unrolling):把跨模态中间表征作为原子操作写回共享上下文 在统一模型内部显式进行跨模态组合推理,而不是简单共享任务头 图像生成 GenEval2=54.12、DPG Bench=88.55,视频编辑 FiVE=72.41 以较小活跃参数覆盖文本、图像、视频等生成与理解任务 1.4 实验结果 实验结果 图像生成 GenEval2=54.12,DPG Bench=88.55;视频编辑 FiVE=72.41,显著高于 Wan-Edit;视频生成 VBench 语义分 84.29;多项视觉理解任务也达到强基线水平。最重要的不是单项 SOTA,而是它展示了统一模型可以通过“中间推理状态”同时提升生成和理解。 1.5 关键洞察 优势:上下文展开是很强的范式信号,让统一模型从多任务容器走向组合式推理系统。局限:仍依赖高质量多模态训练数据,视频分辨率和长时序能力距离专用模型还有差距。 技术演进定位: Omni (Context Unrolling) 位于统一多模态生成路线中的“统一多模态”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 2. LLaDA2.0-Uni:离散扩散 LLM 统一多模态理解与生成——扩散路线正面挑战自回归 论文: LLaDA2.0-Uni arXiv: 2604.20796 机构: Inclusion AI / Westlake University / Zhejiang University 2.1 研究动机 核心问题: 自回归模型擅长文本推理,但图像生成往往依赖连续扩散;把二者硬接在一起会造成训练目标割裂。 自回归模型擅长文本推理,但图像生成往往依赖连续扩散;把二者硬接在一起会造成训练目标割裂。LLaDA2.0-Uni 要回答的问题是:离散扩散语言模型能否成为统一多模态生成和理解的新底座? 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: LLaDA2.0-Uni 的关键区别在于:基于离散扩散大语言模型构建统一多模态理解与生成框架。 2.2 方法原理 方法框架图 方法上,它把视觉信息先通过 SigLIP-VQ 转为语义离散 token,再用离散扩散 LLM 的块级 mask/denoise 过程同时建模文本与视觉序列。MoE 主干承载多模态 token,生成时通过少步蒸馏降低迭代成本;理解时则利用双向上下文优势处理图文推理。关键在于:图像不再只是扩散头的连续 latent,而是进入语言模型式的离散生成过程。 2.3 核心创新 基于离散扩散大语言模型构建统一多模态理解与生成框架 使用 SigLIP-VQ 语义离散视觉分词器,把图像纳入块级掩码扩散 MoE 主干同时处理文本与视觉 token,支持交错生成、编辑和理解 通过前缀感知优化与少步蒸馏提高扩散式解码效率 2.4 实验结果 实验结果 在多模态理解上接近专用 VLM,图像生成和编辑表现强,支持交错文本-图像生成。其重要性在于证明“扩散 LLM”不是只适合文本,也可以成为统一多模态生成的核心范式。 2.5 关键洞察 优势:主题贴合度极高,代表扩散式统一模型路线。局限:离散视觉量化会损失细粒度纹理;扩散式多步生成的交互延迟仍需和自回归模型继续比较。 技术演进定位: LLaDA2.0-Uni 位于统一多模态生成路线中的“离散扩散”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 3. Qwen3.5-Omni:千亿级全模态模型——文本、图像、视频、音频理解与语音生成的一体化工程样板 论文: Qwen3.5-Omni arXiv: 2604.15804 机构: Alibaba / Qwen Team 3.1 研究动机 核心问题: 统一多模态不只是图文生成,还包括音频、语音、视频和长上下文交互。 统一多模态不只是图文生成,还包括音频、语音、视频和长上下文交互。Qwen3.5-Omni 的意义在于把“全模态”做成大规模工程系统,回答大厂路线如何把理解和生成能力产品化。 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: Qwen3.5-Omni 的关键区别在于:千亿级全模态模型,支持文本、图像、视频、音频的统一理解。 3.2 方法原理 方法框架图 技术报告围绕大规模全模态训练展开:文本、视觉、音频和视频输入被统一到长上下文模型中,语音生成通过 ARIA 动态对齐文本 token 与语音单元,缓解流式对话语音的稳定性和韵律问题。它更偏工程规模化:依靠大模型容量、长上下文和海量音视频数据,让模型具备跨模态理解、对话、语音生成和多语言能力。 3.3 核心创新 千亿级全模态模型,支持文本、图像、视频、音频的统一理解 K 长上下文与大规模音视频数据训练,覆盖 215 个音频/音视频任务 提出 ARIA 语音合成技术,动态对齐文本与语音单元 展示 Audio-Visual Vibe Coding 等跨模态交互能力 3.4 实验结果 实验结果 在 215 个音频和音视频任务上达到 SOTA 或强竞争表现,支持 10 种语言理解与生成,并出现音视频指令直接生成代码等能力。它代表统一多模态从论文 demo 走向系统级产品的路线。 3.5 关键洞察 优势:规模、模态覆盖和工程完整性强,是近期全模态方向绕不开的基准。局限:更多是技术报告与系统工程,生成细节和训练数据配方透明度有限;图像/视频生成本身不是全部重点。 技术演进定位: Qwen3.5-Omni 位于统一多模态生成路线中的“全模态”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 4. Vision Banana:Google 证明“图像生成器也是通用视觉学习器”——生成即理解路线的强证据 论文: Vision Banana arXiv: 2604.20329 机构: Google DeepMind 4.1 研究动机 核心问题: 过去很多人怀疑图像生成模型只是学会了像素分布,并不一定具备真正视觉理解。 过去很多人怀疑图像生成模型只是学会了像素分布,并不一定具备真正视觉理解。Vision Banana 把问题反过来:如果把分割、深度、关键点等视觉任务都变成“生成一张答案图”,生成器能否成为通用视觉模型? 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: Vision Banana 的关键区别在于:把视觉任务输出统一参数化为 RGB 图像,让生成器直接执行感知任务。 4.2 方法原理 方法框架图 它将各类视觉任务的输出统一成 RGB 图像或可视化结果,让一个图像生成器在指令条件下直接生成任务答案。这样做绕开了为不同任务设计专用头的问题,把视觉理解也表述成生成。模型从强生成基座出发,通过多任务指令微调学习“看懂并画出答案”。 4.3 核心创新 把视觉任务输出统一参数化为 RGB 图像,让生成器直接执行感知任务 基于强图像生成器指令微调,得到通用视觉学习器 在分割、深度、视觉定位等任务上展现强泛化,同时保持生成能力 为“生成预训练是否学到视觉理解”提供直接证据 4.4 实验结果 实验结果 报告显示模型在多个 2D 感知任务上达到强结果,并且不牺牲原有图像生成能力。它的重要性不在于替代所有视觉专家,而在于证明生成模型内部表征可以迁移到通用视觉理解。 4.5 关键洞察 优势:范式意义强,是生成→理解路线的重要证据。局限:依赖未完全开源的强基座,部分需要精确数值输出的任务不适合 RGB 参数化。 技术演进定位: Vision Banana 位于统一多模态生成路线中的“生成即理解”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 5. Uni-ViGU:以视频生成器为基座统一理解与生成——生成中心路线的低成本验证 论文: Uni-ViGU arXiv: 2604.08121 机构: 上海人工智能科学研究院 / 复旦大学 5.1 研究动机 核心问题: 视频生成 token 数远大于文本理解。 视频生成 token 数远大于文本理解。与其在理解模型上外接昂贵的视频生成模块,不如从视频生成器出发,把理解能力补进去。Uni-ViGU 正是这条“生成中心”路线的代表。 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: Uni-ViGU 的关键区别在于:逆转主流范式:以 WAN2.1 视频生成器为基座扩展理解能力。 5.2 方法原理 方法框架图 模型基于 WAN2.1 视频生成器扩展。视频 latent 使用连续流匹配,文本嵌入使用离散流匹配,二者通过共享自注意力耦合;FFN 按模态分支,视频分支保留预训练权重,文本分支新初始化。训练分两阶段:先做提示词回忆保持生成器知识,再用详细 caption 训练视频理解。 5.3 核心创新 逆转主流范式:以 WAN2.1 视频生成器为基座扩展理解能力 统一流匹配:连续流匹配处理视频,离散流匹配处理文本 模态驱动 MoE:共享注意力保留跨模态对齐,分离 FFN 适配不同模态 块 H800 一周训练,验证生成器作为统一基座的可行性 5.4 实验结果 实验结果 在小规模训练预算下同时获得视频生成与理解能力,展示了生成器基座迁移到统一模型的可行性。它和 Vision Banana 一起构成“生成器即理解器”的路线。 5.5 关键洞察 优势:思路清晰、成本低、主题贴合。局限:公开量化结果不足,仍是路线验证而非大规模 SOTA 系统。 技术演进定位: Uni-ViGU 位于统一多模态生成路线中的“视频生成器”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 6. LLaDA-o:长度自适应 Omni Diffusion——文本离散扩散与图像连续扩散的混合专家统一 论文: LLaDA-o arXiv: 2603.01068 机构: Gaoling School of AI / Renmin University 等 6.1 研究动机 核心问题: 文本和图像天然偏好不同扩散动态:文本适合离散 mask denoising,图像适合连续 latent diffusion。 文本和图像天然偏好不同扩散动态:文本适合离散 mask denoising,图像适合连续 latent diffusion。LLaDA-o 试图解决“统一扩散模型是否必须用同一种扩散过程”的问题。 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: LLaDA-o 的关键区别在于:提出 Mixture of Diffusion(MoD):文本理解用离散 masked diffusion,视觉生成用连续扩散。 6.2 方法原理 方法框架图 它采用 Mixture of Diffusion:理解专家处理文本与视觉编码 token 的离散掩码扩散,生成专家处理图像 latent 的连续扩散;二者共享注意力骨干以交换跨模态信息。长度自适应训练让模型在理解任务中不被固定输出长度限制,同时推理时可调节置信阈值,在速度和准确率之间权衡。 6.3 核心创新 提出 Mixture of Diffusion(MoD):文本理解用离散 masked diffusion,视觉生成用连续扩散 共享高效注意力骨干,减少固定条件下的冗余计算 数据中心的长度自适应策略,无需改架构即可支持灵活长度输出 DPG-Bench=87.04,成为 omni-diffusion 路线的重要强基线 6.4 实验结果 实验结果 在多模态理解中达到 omni-diffusion 强结果;文生图 DPG-Bench=87.04,超过多种统一模型;MathVista 推理中相较 LLaDA-V 获得约 5.9x 吞吐提升。 6.5 关键洞察 优势:很好地解释了“统一”不等于“同构”,用混合扩散解决模态差异。局限:总体语言能力仍受 LLaDA 语基座限制;与 BAGEL 等自回归强模型相比仍有差距。 技术演进定位: LLaDA-o 位于统一多模态生成路线中的“Omni Diffusion”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 7. AR-Omni:统一自回归 Any-to-Any 生成——文本、图像、语音流式输出的单解码器路线 论文: AR-Omni arXiv: 2601.17761 机构: 未披露 7.1 研究动机 核心问题: 扩散路线在图像质量上强,但自回归模型在交互、流式和工具生态上更成熟。 扩散路线在图像质量上强,但自回归模型在交互、流式和工具生态上更成熟。AR-Omni 的核心问题是:能否用单一自回归解码器完成任意模态到任意模态的生成? 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: AR-Omni 的关键区别在于:单一 Transformer Decoder 统一自回归文本、图像和流式语音生成。 7.2 方法原理 方法框架图 方法将文本、图像和语音 token 放进统一自回归序列。训练中用任务感知损失重加权解决不同模态 token 数和梯度规模差异;视觉生成则加入 token-level perceptual alignment,让离散视觉 token 更贴近感知质量;语音分支强调流式实时生成。 7.3 核心创新 单一 Transformer Decoder 统一自回归文本、图像和流式语音生成 任务感知 loss reweighting 缓解多模态训练不平衡 token-level perceptual alignment 提升视觉保真度 语音生成达到 0.88 RTF,展示 any-to-any 自回归路线潜力 7.4 实验结果 实验结果 模型支持文本/图像/语音的统一自回归生成,语音生成 RTF=0.88,说明自回归统一模型可以保留交互实时性。它是扩散统一路线的重要对照组。 7.5 关键洞察 优势:范式清晰,any-to-any 与实时语音对话契合应用。局限:图像质量通常受离散 token 表示限制;公开细节和大规模对比仍需补充。 技术演进定位: AR-Omni 位于统一多模态生成路线中的“自回归”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 8. BAGEL:开源统一多模态预训练基座——大规模交错数据涌现复杂生成与理解能力 论文: BAGEL arXiv: 2505.14683 机构: 开源社区 / 多机构 8.1 研究动机 核心问题: 统一多模态模型能否靠大规模交错预训练自然涌现生成与理解能力?BAGEL 的价值在于提供了一个开放统一基座,让研究者能观察 scaling、数据混合和模态交错带来的能力迁移。 统一多模态模型能否靠大规模交错预训练自然涌现生成与理解能力?BAGEL 的价值在于提供了一个开放统一基座,让研究者能观察 scaling、数据混合和模态交错带来的能力迁移。 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: BAGEL 的关键区别在于:Decoder-only 统一模型,在交错文本、图像、视频和网页数据上大规模预训练。 8.2 方法原理 方法框架图 BAGEL 采用 decoder-only 统一建模,将文本、图像、视频等数据组织为交错序列进行预训练。模型学习的不只是单向文生图,而是多轮图文上下文中的理解、编辑和生成。相比“理解模型+扩散头”,它更强调单一序列建模和统一上下文。 8.3 核心创新 Decoder-only 统一模型,在交错文本、图像、视频和网页数据上大规模预训练 展示自由图像编辑、未来帧预测、图文推理等涌现能力 为 Omni 的上下文展开和统一 MoE 路线提供重要基座 开源属性让其成为统一多模态研究的公共参考点 8.4 实验结果 实验结果 在图像生成、自由编辑、复杂多模态推理和部分视频相关任务中表现强,成为后续 Omni 等工作的技术基础。其影响力来自“开放统一基座”而非单一 benchmark。 8.5 关键洞察 优势:开源和基座意义强,是路线图中不可缺的中间层。局限:训练成本高,模型能力强依赖数据规模;部分 3D/空间能力不是本期重点。 技术演进定位: BAGEL 位于统一多模态生成路线中的“开源基座”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 9. MMCORE:轻量连接统一框架——用 VLM 表征桥接扩散生成,不必从头训练统一巨模型 论文: MMCORE arXiv: 2604.19902 机构: ByteDance 9.1 研究动机 核心问题: 并不是所有团队都有资源训练 Qwen/Omni 级别的统一巨模型。 并不是所有团队都有资源训练 Qwen/Omni 级别的统一巨模型。MMCORE 代表更实用的路线:能否通过轻量连接,把现有强 VLM 和扩散生成器组合成统一生成系统? 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: MMCORE 的关键区别在于:提出 MultiModal COnnection with Representation Aligned Latent Embeddings。 9.2 方法原理 方法框架图 MMCORE 使用可学习查询 token 从 VLM 中抽取语义视觉嵌入,并对齐到扩散模型可用的 latent 条件空间。这样 VLM 负责理解、推理和定位,扩散模型负责高保真像素合成。相比深度融合,它训练成本更低,也更容易接入已有生成器。 9.3 核心创新 提出 MultiModal COnnection with Representation Aligned Latent Embeddings 用预训练 VLM 预测语义视觉嵌入,再作为扩散模型条件 无需从头训练深度融合架构,即可把 VLM 推理能力迁移到视觉生成 在文生图、交错生成和多图编辑中提升复杂语义控制 9.4 实验结果 实验结果 在文生图、交错图像生成、单图/多图编辑等任务上相对基线提升,尤其适合需要复杂语义条件和多图上下文的场景。它是“组合式统一”路线的代表。 9.5 关键洞察 优势:工程实用性强,能复用已有 VLM 和扩散模型。局限:连接带宽有限,复杂像素级约束和长序列一致性仍可能不足;不是原生统一。 技术演进定位: MMCORE 位于统一多模态生成路线中的“轻量统一”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 10. Show-o2:原生统一模型的二代改进——自回归 + Flow Matching 支持图像与视频扩展 论文: Show-o2 arXiv: 2506.15564 机构: 多机构合作 10.1 研究动机 核心问题: 早期统一模型大多停留在图文任务。 早期统一模型大多停留在图文任务。Show-o2 的问题意识是:如何让统一模型从图像扩展到视频,同时不完全放弃自回归文本建模的优势? 前序工作及局限: Chameleon / Emu3 / Show-o:早期统一 token 或混合目标模型证明方向可行,但生成质量、模态覆盖和中间推理仍有限 Janus / Transfusion / BAGEL:通过双编码器、混合目标或交错预训练提升稳定性,但统一方式仍各有取舍 与前序工作的本质区别: Show-o2 的关键区别在于:在 Show-o 基础上改进原生统一多模态模型。 10.2 方法原理 方法框架图 Show-o2 将自回归 token 建模和 Flow Matching 结合,在统一 Transformer 中处理不同模态。图像/视频被映射到适合生成的 latent 空间,时空融合模块帮助视频扩展;文本仍保留自回归序列建模。它代表“混合生成目标”的统一路线。 10.3 核心创新 在 Show-o 基础上改进原生统一多模态模型 结合自回归建模与 Flow Matching,兼顾文本/图像/视频生成 引入 3D causal VAE 空间与双路径时空融合,提升视频扩展性 在统一图像生成、理解和视频生成上形成较完整桥梁 10.4 实验结果 实验结果 相较 Show-o,Show-o2 在统一生成质量和视频扩展上更完整,并成为后续 LLaDA-o、Omni 等论文常用比较对象之一。 10.5 关键洞察 优势:承上启下,连接早期统一图文模型和后续视频/扩散统一模型。局限:相较 2026 年最新模型,指标和规模已不是最强,但路线价值仍高。 技术演进定位: Show-o2 位于统一多模态生成路线中的“Show-o2”分支。 可能的后续方向: 后续关键在于更大规模可复现训练、跨模态中间推理、更低延迟生成以及真实应用场景中的稳定性验证。 其余论文速览 路线奠基(2024.05 — 2025.01) 1. Chameleon:早期用统一 token 序列建模文本和图像 Chameleon: Mixed-Modal Early-Fusion Foundation Models | arXiv:2405.09818 关键词: 混合模态·早期融合·统一token 前序工作问题: 多模态模型长期将理解和生成分离成独立系统,缺乏统一的 token 表示和 early-fusion 训练方案。 贡献: 早期用统一 token 序列建模文本和图像,证明 early-fusion mixed-modal 模型可行。 效果: 在混合模态对话和图像生成任务上验证了统一 token 框架的可行性,为后续 Emu3、Show-o 等工作奠定基础。 批判点评: 生成质量和训练稳定性有限,但奠定离散 token 统一路线。 2. Emu3:用 next-token prediction 统一文本、图像和视频生成/理解 Emu3: Next-Token Prediction is All You Need | arXiv:2409.18869 关键词: 自回归·next-token·统一视觉生成 前序工作问题: 视觉生成和理解使用不同的建模范式(扩散 vs 判别),难以在单一自回归框架中统一。 贡献: 用 next-token prediction 统一文本、图像和视频生成/理解,是自回归统一路线的重要代表。 效果: 在图像生成、视频生成和视觉理解上均展现竞争力,证明纯自回归路线可覆盖多模态全栈。 批判点评: 离散视觉 token 对细节保真有压力,视频长时序仍受限。 3. Show-o:把自回归与离散扩散放进单一 Transformer Show-o: One Single Transformer to Unify Multimodal Understanding and Generation | arXiv:2408.12528 关键词: 单Transformer·自回归+扩散·图文统一 前序工作问题: 自回归擅长文本但图像生成质量有限,扩散擅长图像但不适合文本——两种目标难以在单一模型中共存。 贡献: 把自回归与离散扩散放进单一 Transformer,支持 VQA、文生图、编辑和交错生成。 效果: 首次在单一 Transformer 中同时实现理解和生成,VQA 和文生图均达到可用水平。 批判点评: 早期模型规模和生成质量有限,但提出了很关键的混合目标思路。 4. Transfusion:同一模型中结合 next-token 文本预测和图像扩散 Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model | arXiv:2408.11039 关键词: next-token·diffusion·混合目标 前序工作问题: 纯自回归的图像生成质量不如连续扩散,但两种训练目标如何在同一模型中兼容缺乏验证。 贡献: 同一模型中结合 next-token 文本预测和图像扩散,为混合目标统一训练提供早期证据。 效果: 在图文理解和生成任务上同时表现合理,验证了 Transfusion 混合目标架构的收敛性和兼容性。 批判点评: 主要覆盖图文,离全模态和视频统一仍远。 5. Janus-Pro:理解/生成解耦编码器与数据扩展 Janus-Pro: Unified Multimodal Understanding and Generation with Data and Model Scaling | arXiv:2501.17811 关键词: 双编码器·图文统一·数据扩展 前序工作问题: 统一模型中理解和生成共享同一视觉编码器容易导致能力冲突,生成质量上不去。 贡献: 通过理解/生成解耦编码器与数据扩展提升统一图文模型质量。 效果: 在图像生成和视觉理解上均有明显提升,验证了解耦编码器 + 数据 scaling 的有效性。 批判点评: 双编码器设计更稳,但原生统一程度弱于单工作区模型。 路线深化(2025.10 — 2026.03) 6. LightBagel:轻量双融合框架连接理解和生成模型 LightBagel: A Light-weighted Double Fusion Framework | arXiv:2510.22946 关键词: 轻量融合·低成本·统一模型 前序工作问题: 深度融合的统一模型训练成本极高,中小团队难以复现或迭代。 贡献: 用轻量双融合框架连接理解和生成模型,代表低成本统一模型方向。 效果: 在复用现有 VLM 和生成器的前提下,以较低训练成本实现统一模型的基础能力。 批判点评: 组合式架构依赖外部专家,统一性不如原生模型。 7. DREAM:视觉理解与文生图的联合优化框架 DREAM: Where Visual Understanding Meets Text-to-Image Generation | arXiv:2603.02667 | MIT + Amazon 关键词: 联合训练·Masking Warmup·语义对齐解码 前序工作问题: 对比学习(低掩码率)和生成训练(高掩码率)的训练目标直接冲突,联合训练不稳定。 贡献: 提出 Masking Warmup + Semantically Aligned Decoding,在 CC12M 上同时提升判别与生成性能,证明二者存在协同效应而非零和竞争。 效果: ImageNet 线性探测 72.7%(+1.1%),FID 4.25(-6.2%),文本-图像保真度提升 6.3%,无需外部重排序器。 批判点评: 仅在 CC12M 上验证,规模扩大后协同效应是否更强仍待验证,但训练策略设计(先学"看"再学"画")具有启发性。 8. Omni-Diffusion:首个全离散掩码扩散 any-to-any 统一模型 Omni-Diffusion: Unified Multimodal Understanding and Generation with Masked Discrete Diffusion | arXiv:2603.06577 | 腾讯 + 中科院自动化所 关键词: 离散扩散·any-to-any·并行生成 前序工作问题: 统一多模态模型几乎都基于自回归架构,存在逐 token 生成慢、错误累积等固有局限。 贡献: 首个完全基于掩码离散扩散模型的 any-to-any 多模态语言模型,文本/图像/语音全部编码为离散 token 后统一建模联合分布,证明离散扩散可替代自回归成为统一模型骨干。 效果: 在理解任务上与现有多模态系统持平或超越,图像生成质量突出,支持并行解码。 批判点评: 打破"统一多模态 = 自回归"定式,但整体规模和精细生成质量仍有空间。 9. InternVL-U:4B 参数挑战 14B+ 统一模型 InternVL-U: Democratizing Unified Multimodal Models | arXiv:2603.09877 | 上海 AI Lab + 商汤 关键词: 小模型·CoT增强生成·模块化 前序工作问题: 现有统一模型需要 10B+ 参数才能在理解和生成上都取得不错效果,中小规模模型往往顾此失彼。 贡献: 仅 4B 参数,通过解耦视觉表征 + CoT 推理增强生成 + 三阶段渐进训练,在生成和编辑任务上超越 BAGEL(14B)等大 3 倍以上的模型,证明"小而精"路线可行。 效果: 4B 模型在生成/编辑上超越 14B 基线,同时保持与同尺寸纯理解模型相当的多模态推理能力。 批判点评: 精心的架构设计和数据工程弥补参数量不足,但模型能力天花板仍受参数限制。 10. UniCom:压缩连续语义表征的统一多模态建模 UniCom: Unified Multimodal Modeling via Compressed Continuous Semantic Representations | arXiv:2603.10702 | 阿里达摩院 关键词: 压缩连续表征·通道压缩·Transfusion 前序工作问题: 离散 token(VQ-VAE)信息损失大导致理解弱,连续表征(CLIP)维度高难以建模生成,缺乏兼顾两端的折中方案。 贡献: 发现通道压缩优于空间下采样,用基于注意力的语义压缩器将 CLIP 特征压缩为紧凑表征,同时服务理解和生成;验证 Transfusion 架构收敛更快且一致性更好。 效果: 在统一模型中实现最先进的生成性能,图像编辑可控性优于离散 token 方案。 批判点评: 为"离散 vs 连续"之争提供折中方案,压缩后的连续表征可能是未来主流选择。 11. UniLongGen:长序列交错生成的主动遗忘策略 How Long Can Unified Multimodal Models Generate Images Reliably? | arXiv:2603.07540 | Adobe + 香港理工 关键词: 长序列生成·主动遗忘·视觉污染 前序工作问题: 统一模型在长序列交错生成(交替文本和图像)中,随序列增长生成质量急剧崩溃,原因不明。 贡献: 发现长序列中质量崩溃并非由 token 总数引起,而是累积图像事件数导致的视觉污染;提出无训练的注意力感知上下文清理策略,通过"主动遗忘"低相关历史图像显著提升长期保真度。 效果: 长期保真度和一致性显著优于所有基线方法,同时减少内存占用和提升推理速度。 批判点评: 揭示了反直觉事实——"记住所有东西"反而有害,但策略依赖注意力权重质量。 12. UniG2U-Bench:生成增强理解的首个系统性评测 UniG2U-Bench: Do Unified Models Advance Multimodal Understanding? | arXiv:2603.03241 | 多机构联合 关键词: G2U评测·7种机制·30子任务 前序工作问题: 统一模型声称"生成能力可以增强理解",但缺乏系统性评测来验证这一承诺在多大程度上成立。 贡献: 首个系统性评测"生成是否增强理解"的基准,覆盖心理旋转、视觉类比、反事实推理等 7 种机制 30 个子任务;关键发现:G2U 效应仅在特定场景(多步推理、视觉错觉)下成立,并非万能药。 效果: 对 30+ 个模型的评估表明,统一模型通常不如其基础 VLM,但在空间推理和多步推理场景下生成确实能增强理解。 批判点评: 给出清醒结论,为后续统一模型设计提供明确优化方向。 扩展总结:从 0315 到 0426——统一多模态模型六周演进 本期主题与 2026 年 3 月 15 日专题 同属"统一多模态模型"方向。六周内该领域经历了从路线探索到大规模爆发的加速演进,以下是核心变化: 六周关键变化 维度 0315 期状态 0426 期进展 架构主线 自回归为主,离散扩散刚起步(Omni-Diffusion) 扩散与自回归双线并行:LLaDA2.0-Uni、LLaDA-o 代表扩散主线,AR-Omni 代表自回归对照 规模 4B–14B 参数探索(InternVL-U、BAGEL) 千亿级系统(Qwen3.5-Omni)+ 中等规模(Omni MoE)并存 范式创新 联合训练(DREAM) 上下文展开(Omni Context Unrolling)、生成器即理解器(Vision Banana) 模态覆盖 图文为主,语音初步涉及 全模态(文本/图像/视频/音频/3D)成为标配 工程化 偏学术验证 Qwen3.5-Omni 代表产品级全模态系统 四大技术趋势(综合两期) 原生统一正在取代拼接式统一:从 Show-o/Janus 到 BAGEL 再到 Omni,统一模型越来越强调共享工作区和中间推理,而不是简单外接生成头。Omni 的上下文展开让统一模型从多任务容器走向组合式推理系统。 扩散语言模型成为自回归之外的第二条主线:从 Omni-Diffusion 首次验证到 LLaDA2.0-Uni / LLaDA-o 的系统化推进,离散扩散可以同时承担理解和生成。混合扩散(MoD)进一步说明"统一"不等于"同构"。 生成器即理解器成为新共识:Vision Banana 和 Uni-ViGU 从图像和视频两端证明,强生成器内部已学习可迁移视觉表征,未来生成模型可能反哺理解,甚至成为视觉预训练的新范式。 工程化全模态与开源基座并行推进:Qwen3.5-Omni 代表大厂规模化系统,BAGEL/MMCORE/LightBagel/InternVL-U 则代表可复现和低成本路线,两条线共同推动统一模型走向实用。 人工智能炼丹君 整理 | 数据来源:arXiv 2026年1月 — 2026年4月(重点覆盖近4个月 arXiv 热门统一多模态模型) 扩展参考:2026年3月15日专题——统一多模态模型:生成与理解的大一统之路